Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM对齐微调-OAPL

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(OAPL)LLMs Can Learn to Reason Via Off-Policy RL, 20260222 & 20260227, Cornell University & Databricks & Harvard
    • 作者的前一篇论文:(A*-PO,A*PO)Accelerating rl for llm reasoning with optimal advantage regression, 20250527, Harvard
      • 是这篇文章思想来源,但是 A*PO 中是基于 \(\pi_\text{ref}\) 的采样样本来估计 \(V^{\star}\) 的,策略的更新则是 On-policy 的
      • 根源是两者的推导目标不一致:
        • A*PO 目标中的 KL 散度约束是当前策略与 \(\pi_\text{ref}\)(参考策略) 的 KL 散度
        • 本文 OAPL 目标中的 KL 散度约束是当前策略与 \(\pi_\text{vllm}\)(采样策略)的 KL 散度

Paper Summary

  • 整体说明:
    • 严格来说,本文是第一篇直视 LLM 中 Off-policy 方法的论文(忽略 PPO 中可能存在的微小 Off-policy 更新)
    • 本文提出的 OAPL(Optimal Advantage-based Policy Optimization with Lagged Inference policy)方法完全接受了 Off-policy 训练,无需任何重要性加权比率
    • 亮点:
      • 在代码生成实验中,策略滞后(Off-policy 程度)可能高达 400 次梯度更新 ,而无需任何重要性采样
      • 稳定地改进了 Pass@k 测试时扩展指标
    • 本文证明了一个简单的 off-policy RL 方法可以比用于 LLM 后训练的 on-policy RL 方法 GRPO 更有效
      • 需要确认的点:是否是因为 \(\pi_\text{ref}\) 被不断向前更新导致的?
    • 使用 Off-policy 方法,本文可以实现完全异步训练,并允许算法重用先前采样的数据,带来极高的样本效率
    • 实验用的模型较小(数学仅 4B,代码仅 14B),在更大的模型上是否有提升还需要进一步验证
    • 本文的最核心思路理解:
      • OAPL 的梯度推动策略 \(\pi\) 向着 使对数比值 \(\beta \ln(\pi/\pi_{\mathrm{vllm} })\) 逼近最优优势函数 \(A^{*}\) 的方向更新
        • 这是一种 回归到最优策略 的过程(其中最优策略由带 KL 正则化的最大化奖励目标定义)
      • 由于 \(A^{*}\) 是通过 \(\pi_{\mathrm{vllm} }\) 采样估计的,因此这个更新是 完全 off-policy 的,不需要重要性采样,也不需要 on-policy 数据
  • 背景 & 问题提出
    • LLM 的 RL 方法常使用 On-policy 算法(例如 PPO 或 GRPO)
    • 分布式训练架构带来的策略滞后以及训练策略与推理策略之间的差异导致数据在设计上就是 Off-policy 的,这破坏了 On-policy 假设
      • 理解:实际上这些 Off-policy 本身是可以解决的,只是说需要一些时间成本
  • 之前工作的解法:
    • 核心思路主要集中于使这些 Off-policy 数据看起来更符合 On-policy 数据
    • 方案一:通过重要性采样
    • 方案二:通过显式修改 Inference Engine 来更紧密地对齐训练策略和推理策略
  • 本文接受了 Off-policy 特性,并提出了一种新颖的、不需要这些修改的 Off-policy 强化学习算法 OAPL :
    • 基于最优优势的带滞后推理策略策略优化(Optimal Advantage-based Policy Optimization with Lagged Inference policy, OAPL)
  • OAPL 在竞赛数学基准测试上优于使用重要性采样的 GRPO
    • 在 LiveCodeBench 上匹配公开可用的代码模型 DeepCoder 的性能
    • 而且:训练中使用的生成次数减少了 3 倍
      • 如果能严格说明不是学习率导致,那么这个算是非常大的提升了(当前 LLM RL 训练的耗时大头基本都在 Rollout 上)
  • 实验证明,经 OAPL 训练的模型在 Pass@k 指标下具有改进的测试时扩展能力
  • 即使训练策略和推理策略之间的滞后超过 400 个梯度步 (比先前方法的 Off-policy 程度高 100 倍),OAPL 也能实现高效、有效的后训练
    • 注:之前一般异步不会超过 10,大部分时候是 4 以内

Introduction and Discussion

  • 自 DeepSeek-R1 以来,研究主要集中于改进 GRPO 的训练稳定性 , 训练稳定性 难以实现的一个核心原因是:
    • 现代的 RL 后训练基础设施通常并非真正的 On-policy
    • 特别是, Trainer (例如 HuggingFace 模型)和 Inference Engine (例如 vLLM 模型)可能对相同的序列产生不同的对数概率,即使两个模型具有相同的权重
      • 这种不匹配可能源于 Trainer 和 Inference Engine 内核实现的差异(2025),或者源于异步训练流程,其中 Inference Engine 可能包含一个较旧版本的 Trainer 权重 (2025)
  • 这种对数概率的差异使得实际的策略梯度训练有效地变成了 Off-policy 的:
    • 即用于优化当前策略的数据并非由该策略生成
  • 而经典的策略梯度方法(REINFORCE 等),以及现代的策略优化方法如 GRPO、PPO ,都是在 On-policy 的假设下工作的:
    • 即假定数据由待优化的当前策略生成
  • 大多数对 GRPO 的改进都集中在尽管 Trainer 和 Inference Engine 之间存在差距,也要使其尽可能地保持 On-policy
    • 通常有两个工作系列来解决这个问题:
      • (1)引入额外的重要性权重 (2025)
      • (2)通过修改 Inference Engine 来缩小 Trainer 和 Inference Engine 之间的差距 (2025)
  • 作者认为两者都不是理想
    • 第一种方法(IS):向 GRPO 目标添加重要性权重会给强化学习损失函数引入额外的方差
    • 第二种方法:会使 Inference Engine 变慢,并且在异步强化学习训练中并不能完全消除 Inference Engine 和 Trainer 之间的差距(这里的差距来源于异步训练时,参数本身不是完全对齐的)
  • 本文要解决的核心问题:On-policy 算法对于强化学习后训练是必要的吗?能否开发出简单且可扩展的 Off-policy 强化学习算法?
    • 作者观点:保持 On-policy 对于强化学习后训练并非必要
    • 作者提出了提出了一种易于实现且有效的 Off-policy 后训练算法:
      • 基于最优优势的带滞后推理策略策略优化,缩写为 OAPL
      • 将 Trainer 和 Inference Engine 策略之间的不匹配视为一个 KL 正则化的强化学习问题,其中 KL 项明确地防止训练策略偏离推理策略太远
        • 利用 KL 正则化强化学习的闭式解,推导出一个平方回归目标 ,该目标在来自滞后推理策略的 Rollout 上进行训练,从而消除了对 On-policy 采样的需求
  • OAPL 在一个迭代过程中使用上述推导目标,以很大的间隔同步 Trainer 和推理策略,从而实现比其他方法显著更 Off-policy 的训练
    • 亮点:OAPL 完全接受了 Off-policy 训练,无需任何重要性加权比率
  • 注:作者的观点与经典的强化学习结果一致,即 On-policy 学习对于强化学习后训练并非必要
    • 在经典的强化学习结果中,诸如 PPO 和 REINFORCE 之类的 On-policy 策略梯度方法在传统的机器人控制和视频游戏基准测试上通常不如 DDPG 和 SAC 等 Off-policy 算法高效 (2015; 2018)
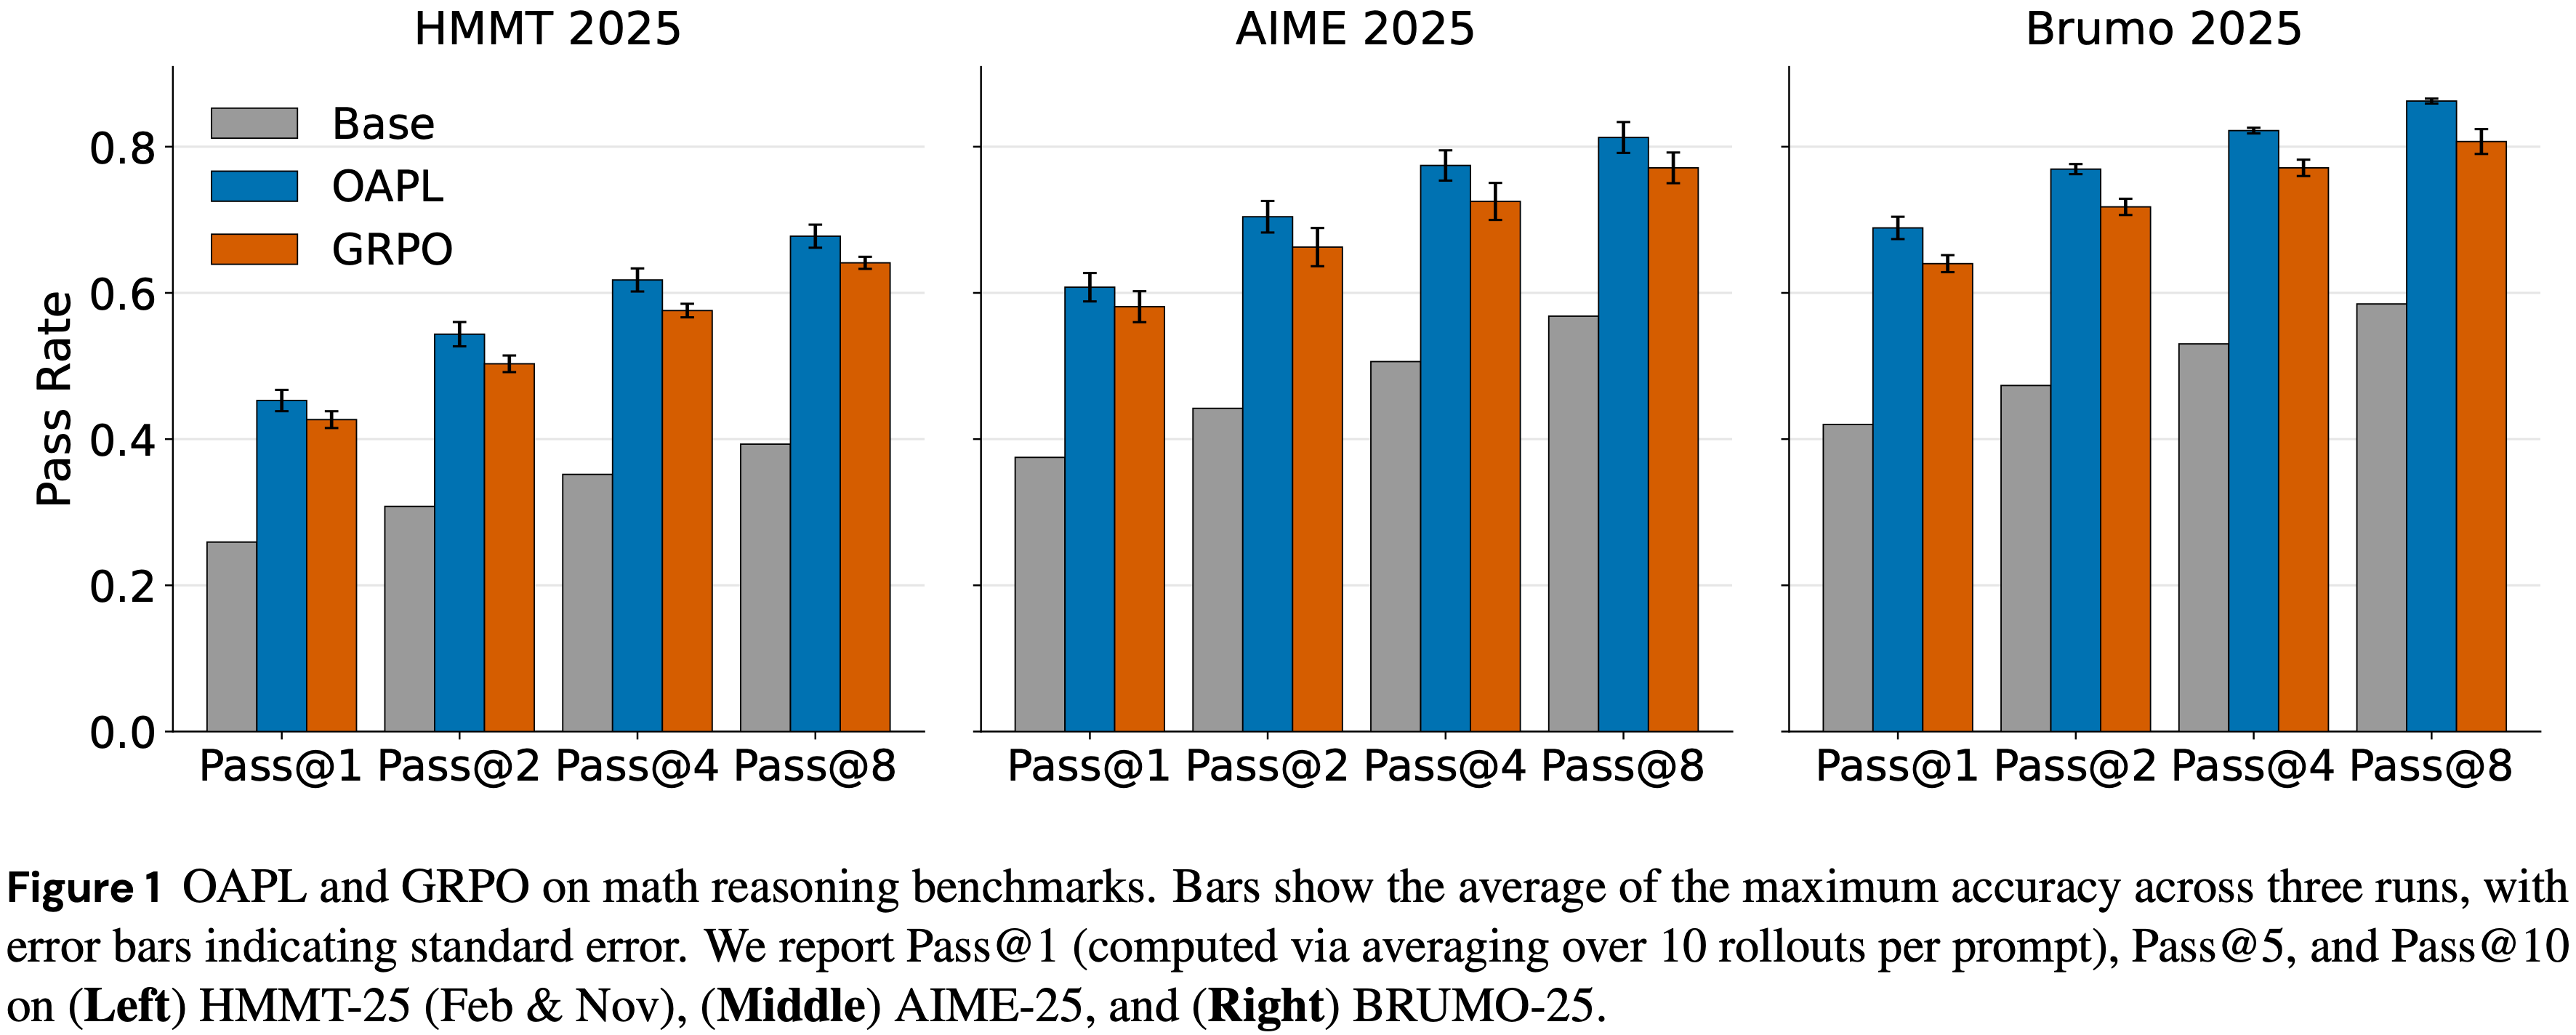
  • 实验表明,OAPL 在多个 Pass@k 指标上可以在三个数学竞赛基准测试(AIME 25,HMMT 25 Feb 和 Nov,BRUMO 25)上胜过基于 GRPO 的基线(见图 1)
    • 在 LiveCodeBench v5 上,在各种 Pass@k 指标上,作者的方法可以匹配或胜过 DeepCoder (2025a)
      • DeepCoder 是通过 GRPO 并辅以额外的启发式方法(包括 clip-high、超长过滤等)训练的,同时训练使用的生成次数大约是其三分之一
  • 作者还观察到 OAPL 不仅仅是进行基模型分布锐化
    • OAPL 不会导致熵崩溃,并且稳定地改进了 Pass@k 测试时扩展指标,其中 k 的范围从 1 到 256
  • In Summary,作者证明了保持 On-policy 并非必要,接受 Off-policy 学习可以实现对推理型 LLMs 稳定、有效且高效的训练

Background

  • 现代强化学习后训练中,通常有两种类型的策略: Trainer \(\pi\) 和 Inference Engine \(\pi_{\text{vllm} }\)
    • Trainer \(\pi\) 用于根据生成的序列计算梯度更新
    • Inference Engine \(\pi_{\text{vllm} }\) 用于快速生成
  • 即使当 \(\pi\) 和 \(\pi_{\text{vllm} }\) 共享相同的权重,对于相同的 Token 序列,它们也可能输出不同的对数概率
    • 这种来自 \(\pi\) 和 \(\pi_{\text{vllm} }\) 的对数概率的固有差异,破坏了基于策略梯度的方法的 On-policy 假设
    • Liu 等人 (2025b) 测量了 Inference Engine 和 Trainer 之间的 KL 散度,并发现该散度的突然增加导致了 GRPO 训练的不稳定性和策略崩溃
    • Inference Engine 和 Trainer 之间的差距在异步强化学习训练框架中可能会进一步扩大
      • 比如:\(\pi_{\text{vllm} }\) 可能落后 Trainer \(\pi\) 多个梯度步
  • 处理 LLM 后训练中 Off-policy Rollout 的一种常见方法(Baseline)是标准的重要性采样
    • IS 在 Token-level 应用 (2025),也可以在 Sequence-level 应用 (2025a)
    • 给定从 \(\pi_{\text{vllm} }(\cdot |x)\) 采样的任意前缀 \(x\) 和下一个动作 \(a\),重要性采样计算似然比:
      $$\frac{\pi(a|x)}{\pi_{\text{vllm} }(a|x)}$$
    • 用它对 GRPO 损失函数进行重新加权,然后在一个批次样本上取平均
    • 这些似然比旨在纠正因动作 \(a\) 由 \(\pi_{\text{vllm} }\) 而非 \(\pi\) 生成所导致的不匹配
  • 可以将 GRPO 表述为一个带有重要性权重的损失函数:
    $$\mathbb{E}_{\{y_i\}_{i = 1}^c\sim \pi_{\text{vllm} }(\cdot |x)}\left[\frac{1}{G}\sum_{y\in \mathcal{G} }\frac{1}{|y|}\sum_{t = 1}^{|y|}\frac{\pi_{\text{old} }(y_t|x,y_{< t})}{\pi_{\text{vllm} }(y_t|x,y_{< t})}\cdot \min \{r_tA_t,\text{clip}(r_t,1 - \epsilon ,1 + \epsilon)A_t\} \right]$$
    • \(\pi_{\text{old} }\) 是 Trainer 前一次迭代的版本
    • \(r_t = \frac{\pi(y_t|x,y_{< t})}{\pi_{\text{old} }(y_t|x,y_{< t})}\) 是 PPO 风格的似然比
    • \(A_t\) 是归一化的优势
  • Fu 等人 (2025) 为其异步强化学习训练框架引入了上面这个损失函数
    • 在该框架中,数据生成策略 \(\pi_{\text{vllm} }\) 可能落后于当前的训练策略 \(\pi\)
    • 额外的 Token-level 比率 \(\frac{\pi_{\text{old} }(y_t|x,y_{< t})}{\pi_{\text{vllm} }(y_t|x,y_{< t})}\) 对从 \(\pi_{\text{vllm} }\) 采样的 Token \(y_t\) 进行重新加权,就好像它们是由 \(\pi_{\text{old} }\) 生成的一样
    • 但当行为策略和目标策略差异很大时,重要性采样可能变得不可靠,这促使先前的大量工作致力于方差缩减技术 (2016; 2015; 2013)
  • 根据实验,先前的工作尝试了许多额外的启发式方法
    • 例如裁剪重要性采样比率 :明确从 GRPO 目标中删除那些重要性采样比率过大或过小的 Token,或者丢弃那些过于 Off-policy 的整个 Rollout
    • 虽然这些启发式方法专门针对 GRPO 训练并经过测试,使 GRPO 训练稳定,但它们越来越偏离经典策略梯度理论背后的原理
    • 由于这些启发式方法是专门为 GRPO 损失函数设计并在其下测试的,目前尚不清楚它们如何在非常具体的 GRPO 损失函数之外推广
      • 其实其他的任何 On-policy 方法都可以使用 IS 方法进行修正 Off-policy 问题吧!
  • 这项工作没有专注于修改 GRPO 的损失,而是走了一条不同的路线,设计了一个新的、能够自然处理 Off-policy 数据的强化学习训练目标

Method: OAPL

  • 基于最优优势的带滞后推理策略策略优化(OAPL)是一个 Principled Off-policy 目标,即使在显著的策略滞后下也能保持稳定
    • 先前的方法:需要定制 Inference Engine 或用额外比率、裁剪算子或删除陈旧 Token/序列来增强 GRPO 及其 变体
    • 本文:接受强化学习后训练的 Off-policy 性质,并设计了一个简单、完全 Off-policy 的强化学习算法

Off-policy Loss Function

  • 本文的 Off-policy 策略优化目标,其动机源于 KL 正则化的强化学习形式,考虑以下目标:
    $$\max_{\pi}\mathbb{E}_{x,y\sim \pi (\cdot |x)}r(x,y) - \beta \text{KL}(\pi ||\pi_{\text{vllm} }) \tag {1}$$
    • 该目标旨在最大化奖励 \(r\),同时最小化与推理策略 \(\pi_{\text{vllm} }\) 的 KL 散度
    • 注意:一般的目标下,这里是 \(\pi_{\text{ref}}\),比如 (A*-PO,A*PO)Accelerating rl for llm reasoning with optimal advantage regression, 20250527, Harvard 中
  • 上述 KL 正则化强化学习问题的最优策略 \(\pi^{\star}\) 和最优值函数 \(V^{\star}\) 具有以下闭式表达式:
    $$\pi^{\star}(y|x)\propto \pi_{\text{vllm} }(y|x)\exp (r(x,y) / \beta),$$ $$V^{\star}(x) = \beta \ln \mathbb{E}_{y\sim \pi_{\text{vllm} }(\cdot |x)}\exp (r(x,y) / \beta).$$
    • \(\pi^{\star}\) 的详细证明可见本人之前的博客:RL——CQL 的附录部分,DPO 论文(NLP——LLM对齐微调-DPO)中也有类似需要证明的式子
    • \(V^{\star}(x)\) 的详细证明见本文附录: 最优优势 \(A^{\star}\) 的推导部分
  • \(\pi^{\star}\) 和 \(V^{\star}\) 之间的关系可表示表示如下:
    $$\beta \ln \frac{\pi^{\star}(y|x)}{\pi_{\text{vllm} }(y|x)} = \underbrace{r(x,y) - V^{\star}(x)}_{\text{optimal advantage } A^{\star}}, \quad \forall x,y.$$
  • 特别说明:定义 \(V^{\star}\) 的期望是在采样策略 \(\pi_{\text{vllm} }\) 下取的,而不是 \(\pi^{\star}\)
    • 因此,给定 \(x\) 和一组从 \(\pi_{\text{vllm} }(\cdot |x)\) 采样的 \(G\) 个 Rollouts \(\{y_1,\ldots ,y_G\}\),Brantley 等人 (2025) 提出通过以下方式估计 \(V^{\star}\):
      $$\hat{V}^{\star}(x) = \beta \ln \frac{1}{G}\sum_{i = 1}^{G}\exp (r(x,y_i) / \beta) \tag {2}$$
      • 注:这与 (A*-PO,A*PO)Accelerating rl for llm reasoning with optimal advantage regression, 20250527, Harvard 中的 \(V^{\star}\) 是不同的
  • 在采样分布 \(\pi_{\text{vllm} }\) 的温和假设下,估计量 \(\hat{V}^{\star}\) 可以是准确的
    • 特别是,对于二元奖励,如果 \(\pi_{\text{vllm} }\) 有非零概率解决 \(x\),那么随着 \(G\) 的增加,\(\hat{V}^{\star}(x)\) 收敛到 \(V^{\star}(x)\) (2025; 2025)
    • 这里 \(\beta\) 的作用是平滑:
      • 当 \(\beta \rightarrow 0\) 时,我们有
        $$\hat{V}^{\star}(x) = \max_{i}r(x,y_{i})$$
      • 当 \(\beta \rightarrow \infty\) 时,\(\hat{V}^{\star}(x)\) 成为平均值
        $$\hat{V}^{\star}(x) = \sum_{i}r(x,y_{i}) / G$$
        • 这是当前推理策略 \(\pi_{\text{vllm} }\) 平均奖励的无偏估计
  • 给定 \(\hat{V}^{\star}\),可以将最优优势 \(A^{\star}(x,y)\) 估计为
    $$r(x,y) - \hat{V}^{\star}(x)$$
  • 作者采用 Brantley 等人 (2025) 的 \(A^{\star}\)-PO 目标,并定义以下策略优化目标:
    $$\min_{\pi}\sum_{x}\sum_{i = 1}^{G}\left(\beta \ln \frac{\pi(y_{i}|x)}{\pi_{\text{vllm} }(y_{i}|x)} -(r(x,y_{i}) - \hat{V}^{\star}(x))\right)^{2} \tag {3}$$
    • 上述目标对应的损失函数和梯度 在 (A*-PO,A*PO)Accelerating rl for llm reasoning with optimal advantage regression, 20250527, Harvard 附录 F 中同一批作者已经给出,上述公式的目标对应的损失函数为:
      $$
      \mathcal{l}(\theta) = \sum_{x}\sum_{i = 1}^{G}\left(\beta \ln \frac{\pi_\theta(y_{i}|x)}{\pi_{\text{vllm} }(y_{i}|x)} -(r(x,y_{i}) - \hat{V}^{\star}(x))\right)^{2}
      $$
      • 论文中的梯度不太好理解,本文附录中我给出了这个损失函数梯度和方向的分析
  • 当 \(\hat{V}^{\star} = V^{\star}\) 时,无论 \(y\) 的采样分布如何(例如,它适用于从 \(\pi_{\text{vllm} }\) 抽取的 Rollouts),公式 3 都由 KL 正则化的最优策略 \(\pi^{\star}\) 最小化
  • 虽然作者的损失函数的动机来自 \(A^{\star}\)-PO,但 \(A^{\star}\)-PO 被设计为一种 On-policy 算法,即它在从 \(\pi\) 生成的 On-policy 数据集下制定上述优化
    • 作者反而依赖该目标的唯一最小化器,并直接使用来自 Inference Engine 的 Off-policy 数据和对数概率
  • 正如原始 \(A^{\star}\)-PO 论文所提出的
    • 从 Rollouts 组中估计 \(\hat{V}^{\star}\) 能够避免做额外的假设
    • 例如 \(V^{\star}\) 由一个常数逼近 (2024),不用神经网络建模 \(V^{\star}\)(这可能在计算上很昂贵)

OAPL: The Off-policy RL Algorithm

  • 作者将公式 3 转换为一个带有滞后 Inference Engine 的实用后训练流程
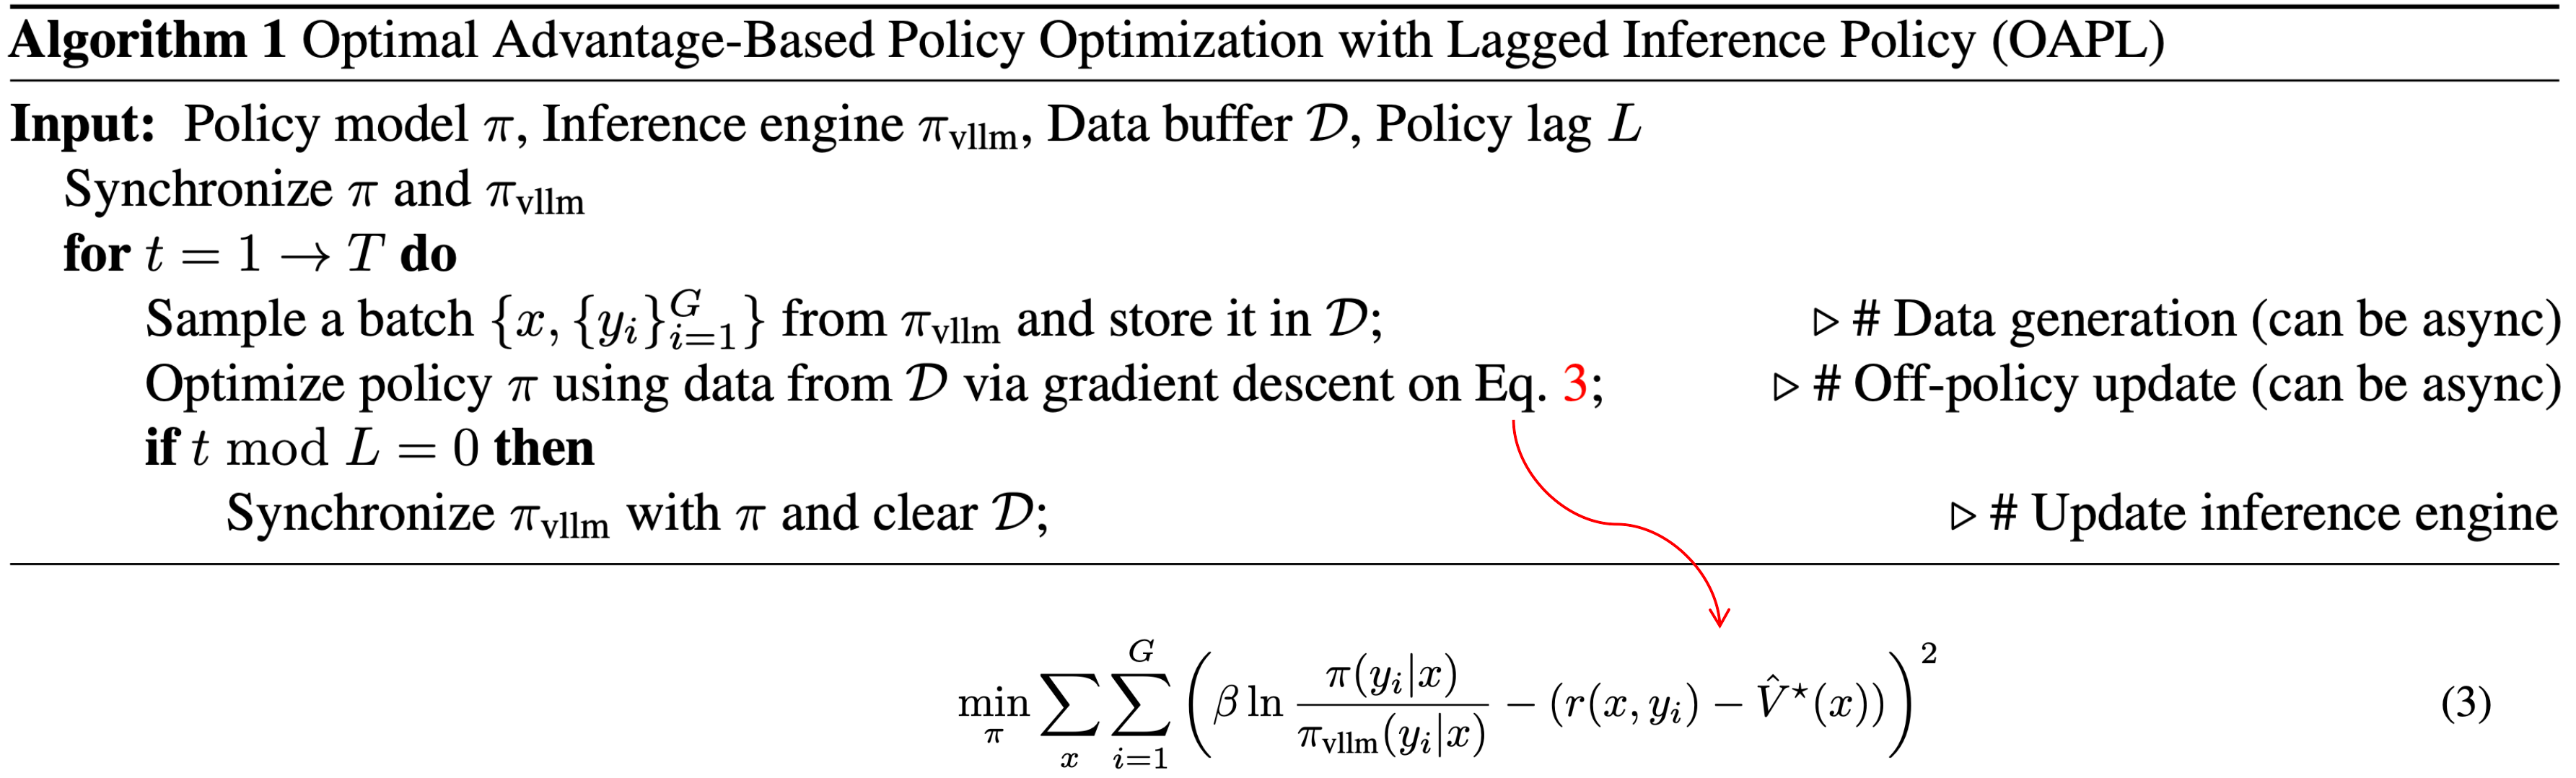
  • 这产生了基于最优优势的带滞后推理策略策略优化(算法 1),缩写为 OAPL
    • Step1: 同步 \(\pi\) 和 \(\pi_{\text{vllm} }\),使它们共享相同的权重
    • Step2: 开始迭代:
      • 使用 \(\pi_{\text{vllm} }\) 的 Inference Engine 开始异步生成数据,并将其添加到缓冲区 \(\mathcal{D}\) 中
      • Trainer 通过最小化公式 3 来更新策略 \(\pi\),使用从 \(\mathcal{D}\) 中采样的数据
        • 注:公式中的 \(\hat{V}^{\star}(x)\) 可通过公式 2 直接计算得到(每次采样后可直接得到,不需要建模为神经网络更新)
      • 每隔 \(L\) 次 Trainer 迭代(\(L\) 是一个超参数),算法同步 \(\pi\) 和 \(\pi_{\text{vllm} }\) 的权重
  • 在同步的间隔上,算法以 Off-policy 方式运行:
    • \(\pi_{\text{vllm} }\) 既生成数据,又在公式 3 中充当 KL 参考
    • 由于其完全的 Off-policy 性质,OAPL 可以在 \(\pi\) 和 \(\pi_{\text{vllm} }\) 的两次同步步骤之间完全异步运行
  • 每当我们将 \(\pi_{\text{vllm} }\) 与 \(\pi\) 同步时,我们会清除缓冲区 \(\mathcal{D}\)
    • 以确保 \(\mathcal{D}\) 仅包含来自单个 \(\pi_{\text{vllm} }\) 的数据
    • 这是为了确保估计量 \(\bar{V}^{\star}\) 进而优势始终仅使用来自一个采样分布 \(\pi_{\text{vllm} }\) 的数据进行计算
    • 由于 OAPL 不依赖于重要性比率或裁剪操作,因此得到的更新简化为一个简单的最小二乘回归损失 ,即使在显著的策略滞后下也能保持稳定
Comparison to GRPO
  • GRPO 使用裁剪算子作用于 \(\frac{\pi(y|x)}{\pi_{\text{old} }(y|x)}\) 以防止 \(\pi\) 偏离 \(\pi_{\text{old} }\) 太远
    • 只是遵循了 PPO 的原始设计
    • 其中 \(\pi_{\text{old} }\) 是前一次迭代的 Trainer
  • 这个动机是保守策略迭代 (2002),但裁剪并不总是能有效地防止 \(\pi\) 偏离 \(\pi_{\text{old} }\)
    • 当从 \(\pi = \pi_{\text{old} }\) 开始时,使用 GRPO 损失的第一次梯度更新的计算不会引起任何裁剪
      • 如果第一个梯度很大,一步梯度下降就可能已经使 \(\pi\) 远离 \(\pi_{\text{old} }\),并且裁剪算子无法将 \(\pi\) 拉回到 \(\pi_{\text{old} }\)
      • 这是 PPO/GRPO 损失函数的一个已知问题 (2020)
      • 理解:其实每一步都会发生类似问题,不在于第一步,也不是因为第一步无裁剪,理论上,每一步都会有概率超过裁剪
  • OAPL 将 KL 正则化纳入优化目标,直接针对 \(\pi_{\text{vllm} }\),完全摒弃了 \(\pi_{\text{old} }\) 的概念,并直接使用来自采样分布 \(\pi_{\text{vllm} }\) 的对数概率
    • 在每次迭代中,OAPL 直接鼓励 Trainer \(\pi\) 在优化奖励的同时保持接近 \(\pi_{\text{vllm} }\)
    • 这种设计,加上 \(\pi_{\text{vllm} }\) 不频繁的更新,可以在训练期间防止策略的熵崩溃,从而带来比 GRPO 更好的测试时扩展能力
Comparison to \(A^{\star}\text{PO}\)
  • \(A^{\star}\text{PO}\) 最初被设计为一种 On-policy 强化学习算法,它使用损失函数中的 \(\ln \frac{\pi(y|x)}{\pi_{\text{ref} }(y|x)}\) 来估计在固定参考策略 \(\pi_{\text{ref} }\) 下定义的 \(V^{\star}\)
    • \(A^{\star}\text{PO}\) 在训练期间从不更新 \(\pi_{\text{ref} }\)
  • OAPL 以 Off-policy 方式运行,定期更新 Inference Engine \(\pi_{\text{vllm} }\),并且始终直接在损失函数中使用来自 \(\pi_{\text{vllm} }\) 的对数概率

Related Work

Off-policy RL Post-Training Approaches

  • 处理强化学习后训练中 Off-policy 采样的方法大致可以分为两类:一类避免重要性采样,另一类应用重要性采样或其相关变体
  • 避免重要性采样的方法示例包括:
    • Melo 等人 (2025) 估计 Fisher 信息用于 Token 掩码
    • Arnal 等人 (2025) 为其目标函数添加偏差以获得性能改进保证
  • OAPL 类似地避免了重要性采样带来的额外方差,但在保持无偏的同时不需要额外的估计过程
  • 这一类中与作者工作最相关的是使用平方回归损失进行 On-policy 或 Off-policy 训练的方法,例如 REBEL (2024a)、REFUEL (2024b)、AGRO (2025) 或 Kimi K2 (2025a)
    • 这些方法不像 OAPL 那样估计 \(V^{\star}\),而是用类似于 RLOO 估计器 (2019) 的组相对基线进行方差缩减
  • 依赖重要性采样,或仅依赖重要性比率 \(\frac{\pi(y|x)}{\pi_{\text{vllm} }(y|x)}\) 的方法,在具体如何应用它方面有所不同
    • 例如,DeepSeek-v3.2 (2025a) 删除那些在 \(\pi\) 下似然较低的 Rollouts
    • Zhao 等人 (2025) 和 Zheng 等人 (2025b) 删除那些 Token-level 比率过大或过小的 Token
    • Roux 等人 (2025) 和 Su 等人 (2026) 构建目标函数来限制具有大重要性比率的 Token 的梯度
  • 通过避免重要性采样,OAPL 避免了删除可能对学习有用的样本或 Token,并且不会因向比率或梯度添加裁剪而引入偏差或额外的调优成本

Off-Policy RL in Asynchronous Settings

  • 关于异步和大规模强化学习训练的工作也处理了 Off-policy 采样
  • 例如,最近关于扩展基于人类反馈的强化学习系统的工作 (2025; 2025) 为此使用了截断的重要性采样
  • 在语言模型领域之外,扩展策略梯度算法和利用 Off-policy 数据的方法也使用某种形式的(通常是截断的)重要性采样 (2018; 2016; 2017; 2015),或者约束其数据生成以避免收集过于 Off-policy 的数据 (2019)
  • 其他方法通过学习 Q 函数完全避免重要性采样 (2018; 2015, 2016)
  • OAPL 同样不需要重要性采样,并且实际上可以理解为一种值学习方法
    • OAPL 使用 \(\ln \frac{\pi}{\pi_{\text{vllm} } }\) 作为函数逼近器来直接估计最优优势 \(A^{\star}\)

Experimental Setup

  • 在竞赛数学问题求解和代码生成上评估 OAPL,重点关注异步训练期间的稳定性以及通过 Pass@k 衡量的性能
  • 对于竞赛数学和代码生成两种设置,与 Brantley 等人 (2025) 的做法一致,作者在公式 2 和公式 3 中分别使用两个不同的 beta(\(\beta_{1}\) 和 \(\beta_{2}\)),而不是单一的 \(\beta\)
    • 这为选择超参数提供了额外的自由度
  • 关于实验的训练设置和超参数的更多细节可以在附录 A 中找到

Math Experimental Setup

  • 数学实验使用 Deepscaler (2025b) 作为作者的训练数据集,并使用 AIME 25、HMMT 25(02 月和 11 月)和 BRUMO 25 作为作者的评估集
  • 将 OAPL 与 GRPO 进行比较,后者增加了考虑 Inference Engine 和 Trainer 之间对数概率差异的重要性采样 (2025)
  • 对于这两种方法,作者都实现了异步优化,即着 Inference Engine 可以在作者优化 Trainer 的同时生成数据
  • 对于 OAPL,作者设置 \(L = 50\),即作者每 50 次迭代同步一次 Inference Engine 和 Trainer
  • 对于 GRPO,作者使用错位一步的异步训练
    • Trainer 使用的训练数据可能来自比 Trainer 自身最多老 1 次迭代的推理策略
  • 使用 Qwen3-4B-Thinking-2507 作为作者的基础模型,两种方法的最大生成长度均为 16384 个 token

Code Generation Experimental Setup

  • 代码生成实验使用一个高度 off-policy 的两阶段训练过程来复现 DeepCoder (2025a) 的性能
    • DeepCoder 是一个公开可用的、通过 GRPO 并辅以几个额外启发式方法训练的代码模型
  • 从基础模型 DeepSeek-R1-Distill-Qwen-14B 开始,为 DeepCoder 训练数据集中的每个 Prompt 生成一个包含 8 个 Response 的离线数据集
  • 为了将训练集中在可解的问题上,额外过滤掉了模型没有生成任何正确 Response 的所有 Prompt
  • 使用 OAPL 在这个数据集上训练基础模型 1 个 epoch,期间不同步 Trainer 和 Inference Engine
    • 使用得到的模型,从一个随机抽取的 4000 个 Prompt 的子集(由于资源限制)生成一个新的离线数据集,并在这个数据集上继续训练额外的 4 个 epoch
    • 这相当于运行 OAPL,其中 \(L\) 设置为 1 个 epoch(大约 400 次梯度更新),总迭代次数 \(T = 2\)
    • 两轮训练的最大生成长度均为 32K 个 token
  • 对于评估,遵循 DeepCoder 的 LiveCodeBench (2024) 设置,使用相同的 279 个 LiveCodeBench 问题子集,并以最大生成长度 64K 进行评估
    • 本文评估了 OAPL 第二轮训练中每个 epoch 的所有四个检查点,并报告表现最佳的检查点的结果

Experimental Results

  • 作者从三个方面评估 OAPL:在标准推理基准上的最终准确率、异步 Rollout 下的训练动态和稳定性,以及通过 Pass@k 衡量的测试时扩展性
  • 作者首先研究竞赛数学,在那里作者可以跟踪学习曲线和训练过程中的熵,然后转向代码生成,在那里作者评估极端策略滞后下的鲁棒性,并与经过 GRPO 训练的 DeepCoder 模型进行比较

Results on Competition Math

Performance on benchmarks
  • 图 1 表明,在三个基准测试的所有 Pass@k(针对不同的 \(k\))上,OAPL 都优于 GRPO 基线
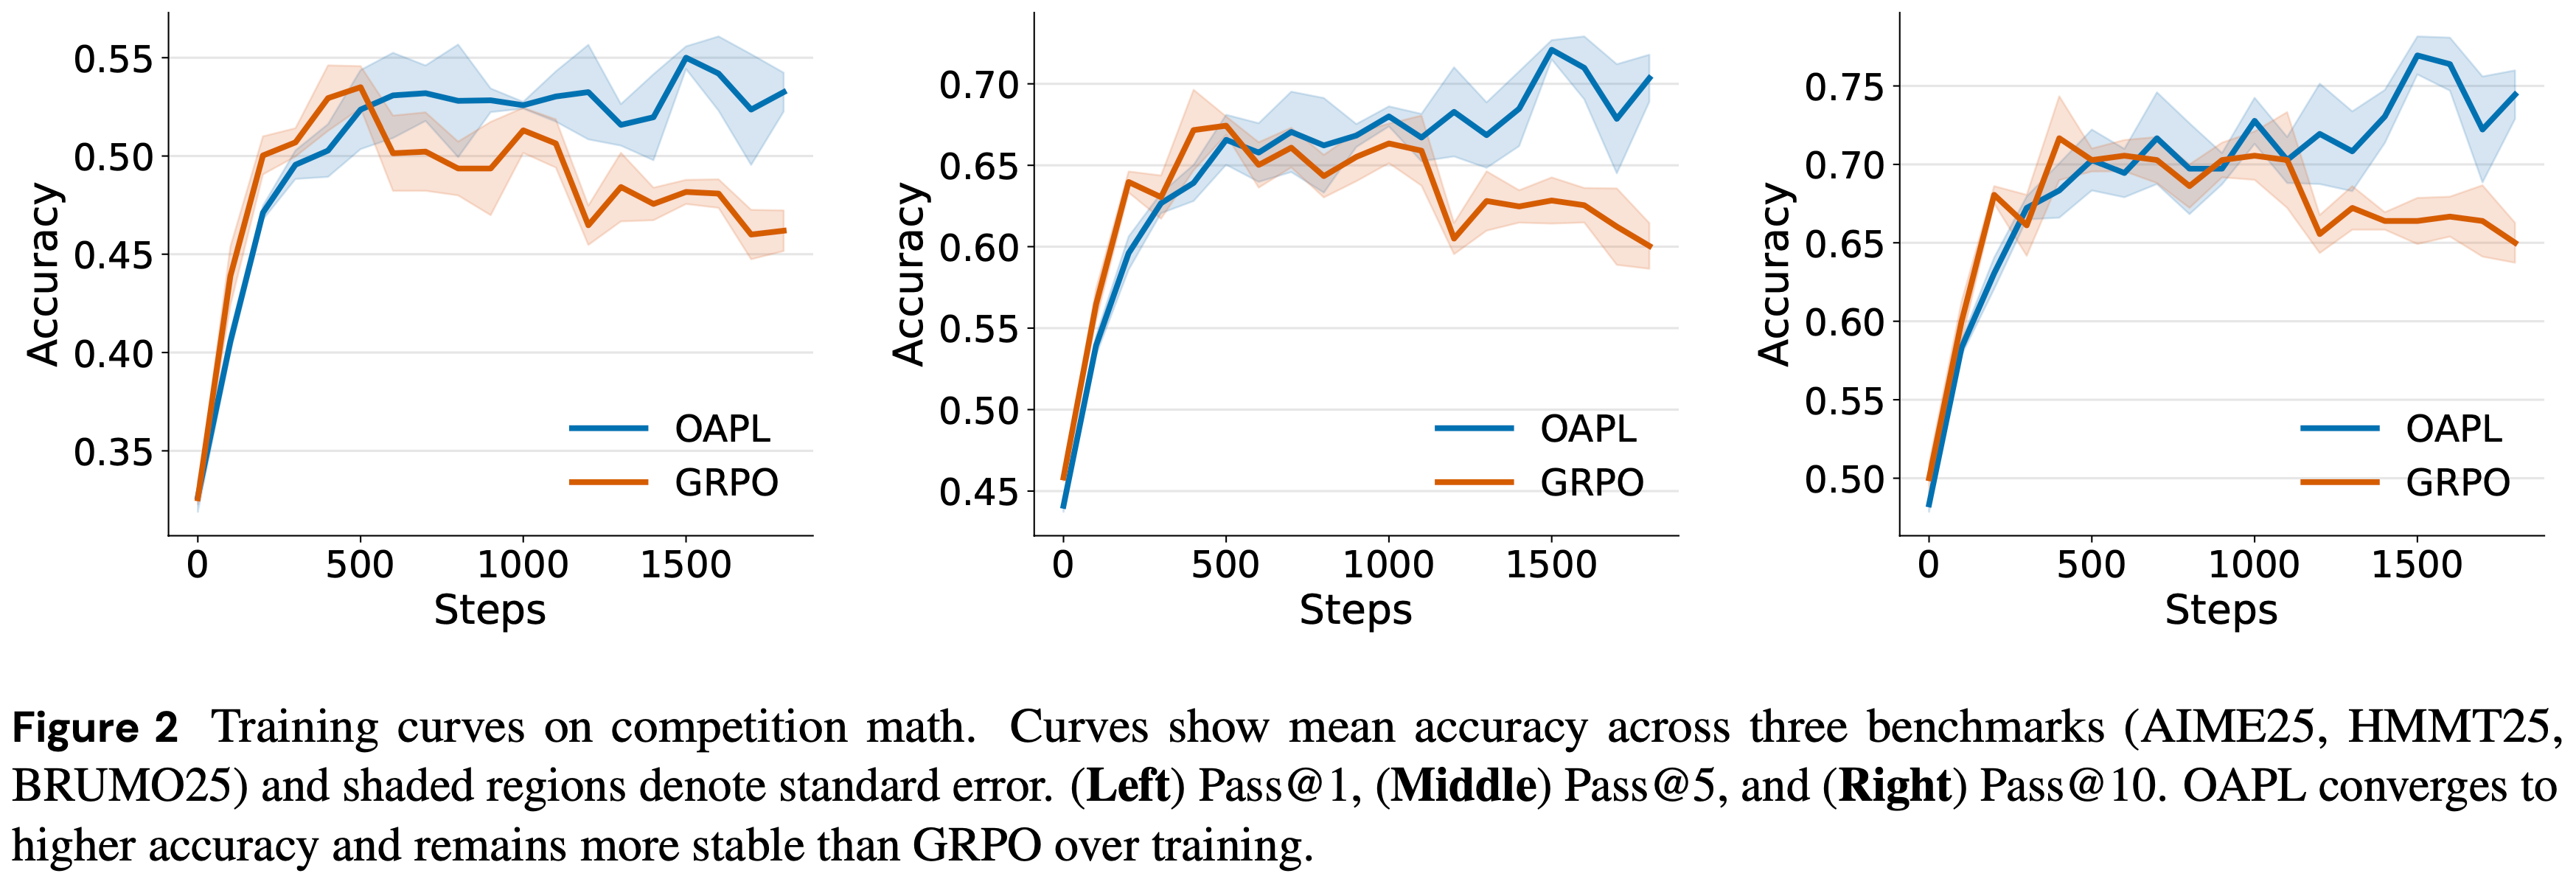
  • 图 2 展示了在三个基准测试上的平均训练过程性能
  • 总体来说 OAPL 比 GRPO 学习得更稳定且性能更优
    • 还观察到,对于 GRPO 和 OAPL,在 Pass@1 奖励(即仅结果奖励)上进行训练可以提高 \(k > 1\) 时的 Pass@k。包括作者将要展示的代码生成实验,作者通常没有观察到 RL 不能提高 \(k > 1\) 时 Pass@k 的现象
Entropy behavior
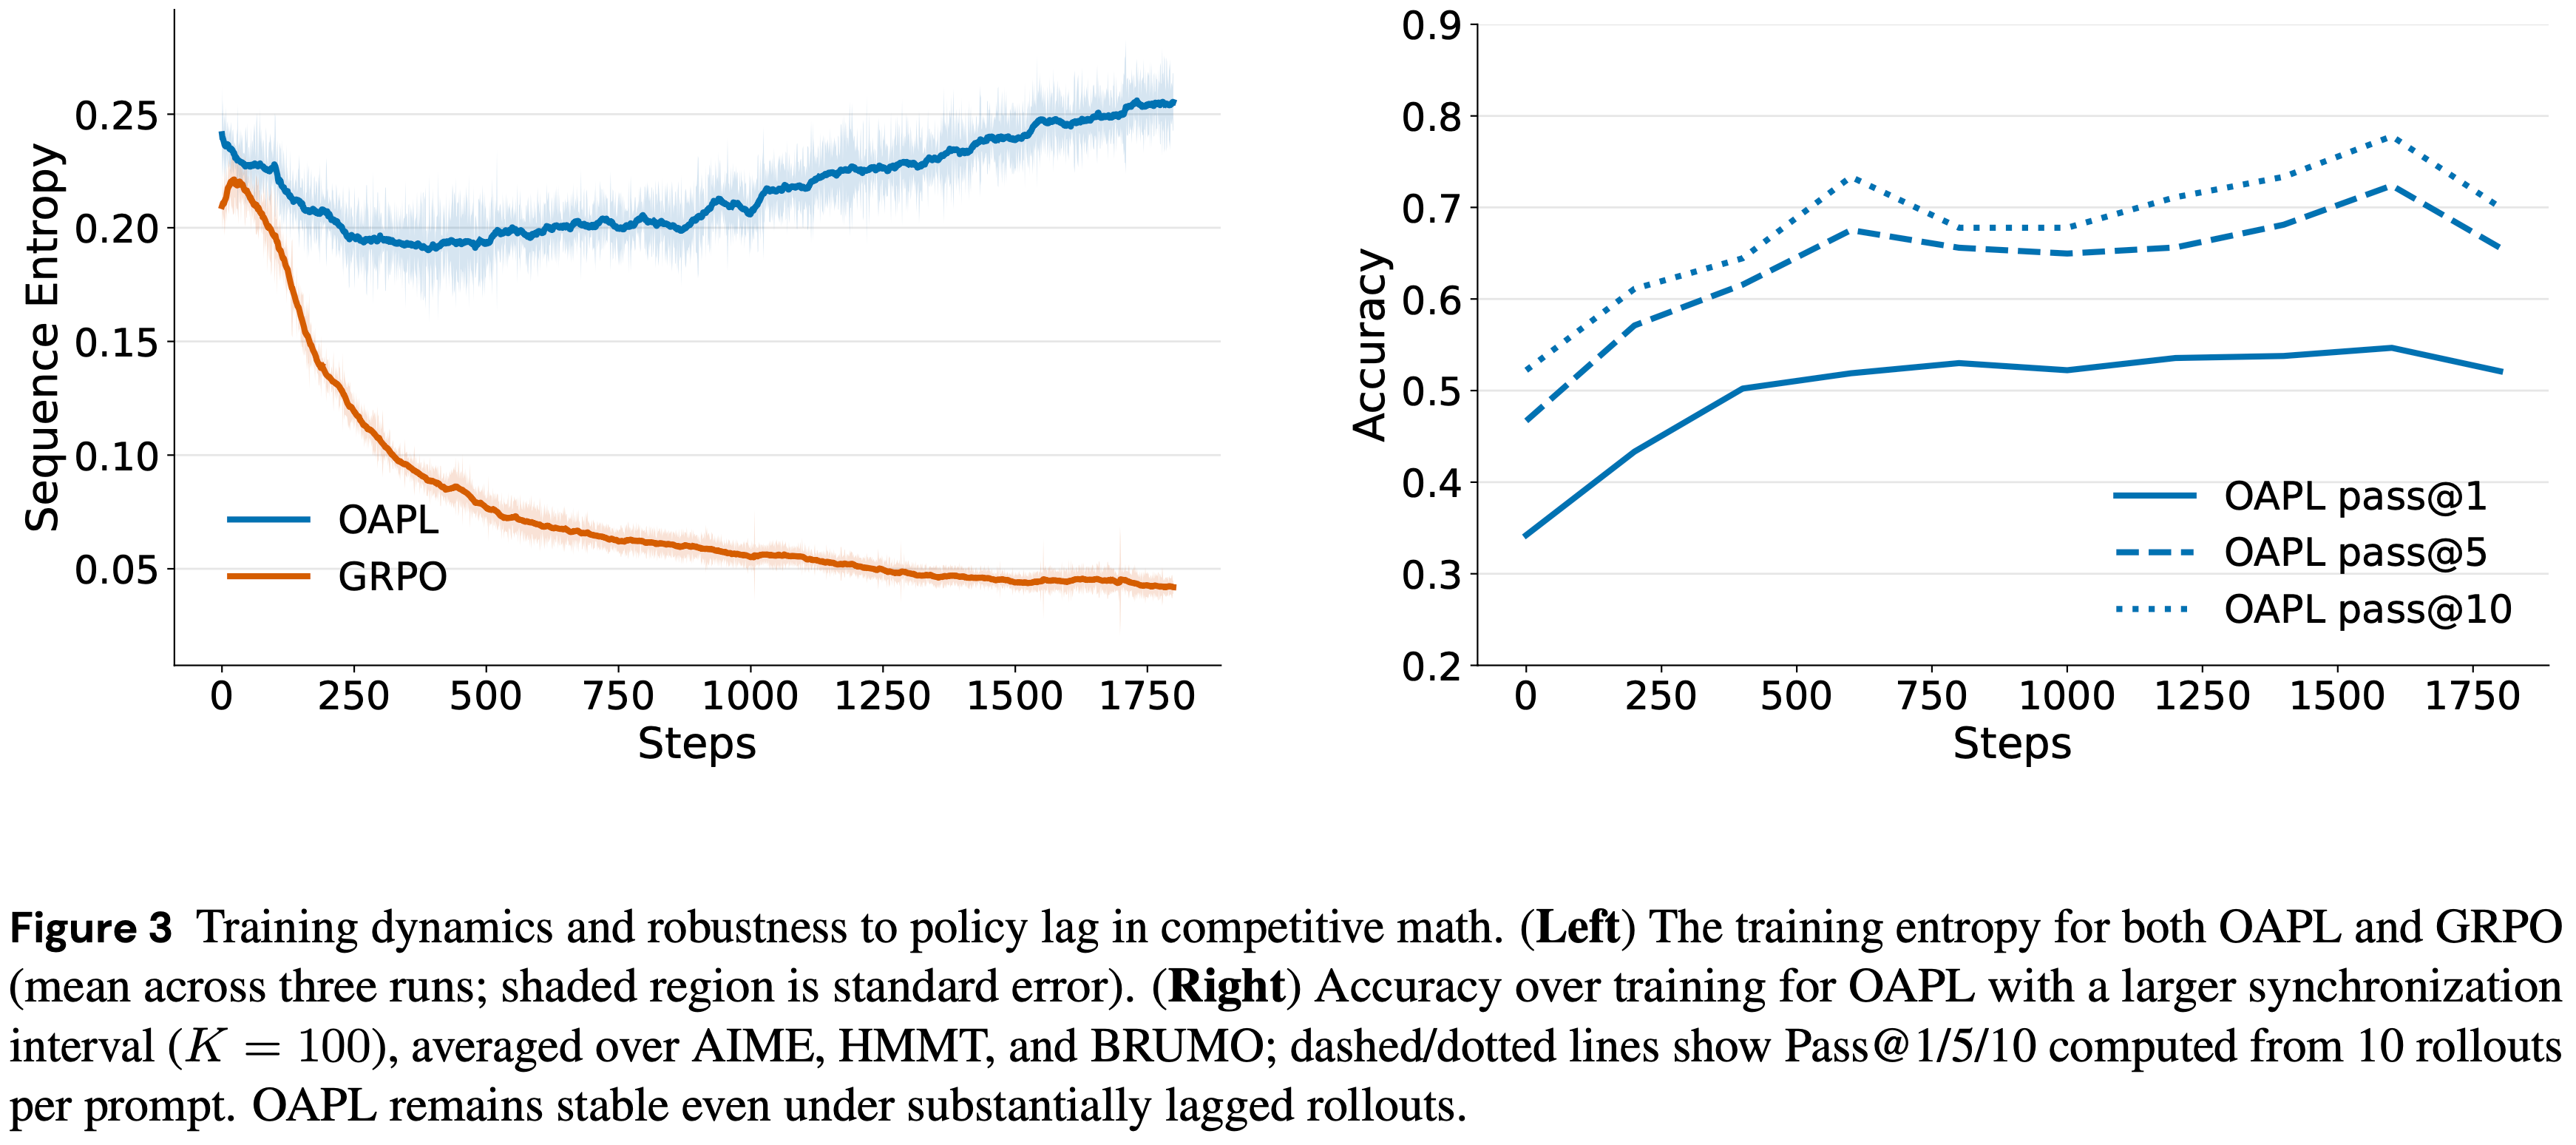
  • 图 3(左)显示了训练过程中序列熵的变化
  • 观察到 OAPL 的熵没有崩溃,而 GRPO 的熵崩溃了
  • 在使用 OAPL 训练时观察到的熵增加,有助于 OAPL 在图 2 中的 Pass@5 和 Pass@10 指标上优于 GRPO
  • 作者相信这种行为是由于 Inference Engine 和 Trainer 之间的不同步同步以及 Trainer 对 Inference Engine 的显式 KL 正则化所致
  • 注意,在作者的实验中,GRPO 和 OAPL 都不包含对 \(\pi_{\text{ref} }\) 的固定 KL 正则化
    • 这是因为 OAPL 和 GRPO 基线的目标都只是找到优化奖励的策略
Scaling k in Pass@k
  • OAPL 中更高的熵是否会导致 Pass@k 下更好的扩展行为?
    • 作者为每种方法选择最佳检查点(基于三个基准的平均 Pass@1),并随着 \(k\) 的增加评估 Pass@k
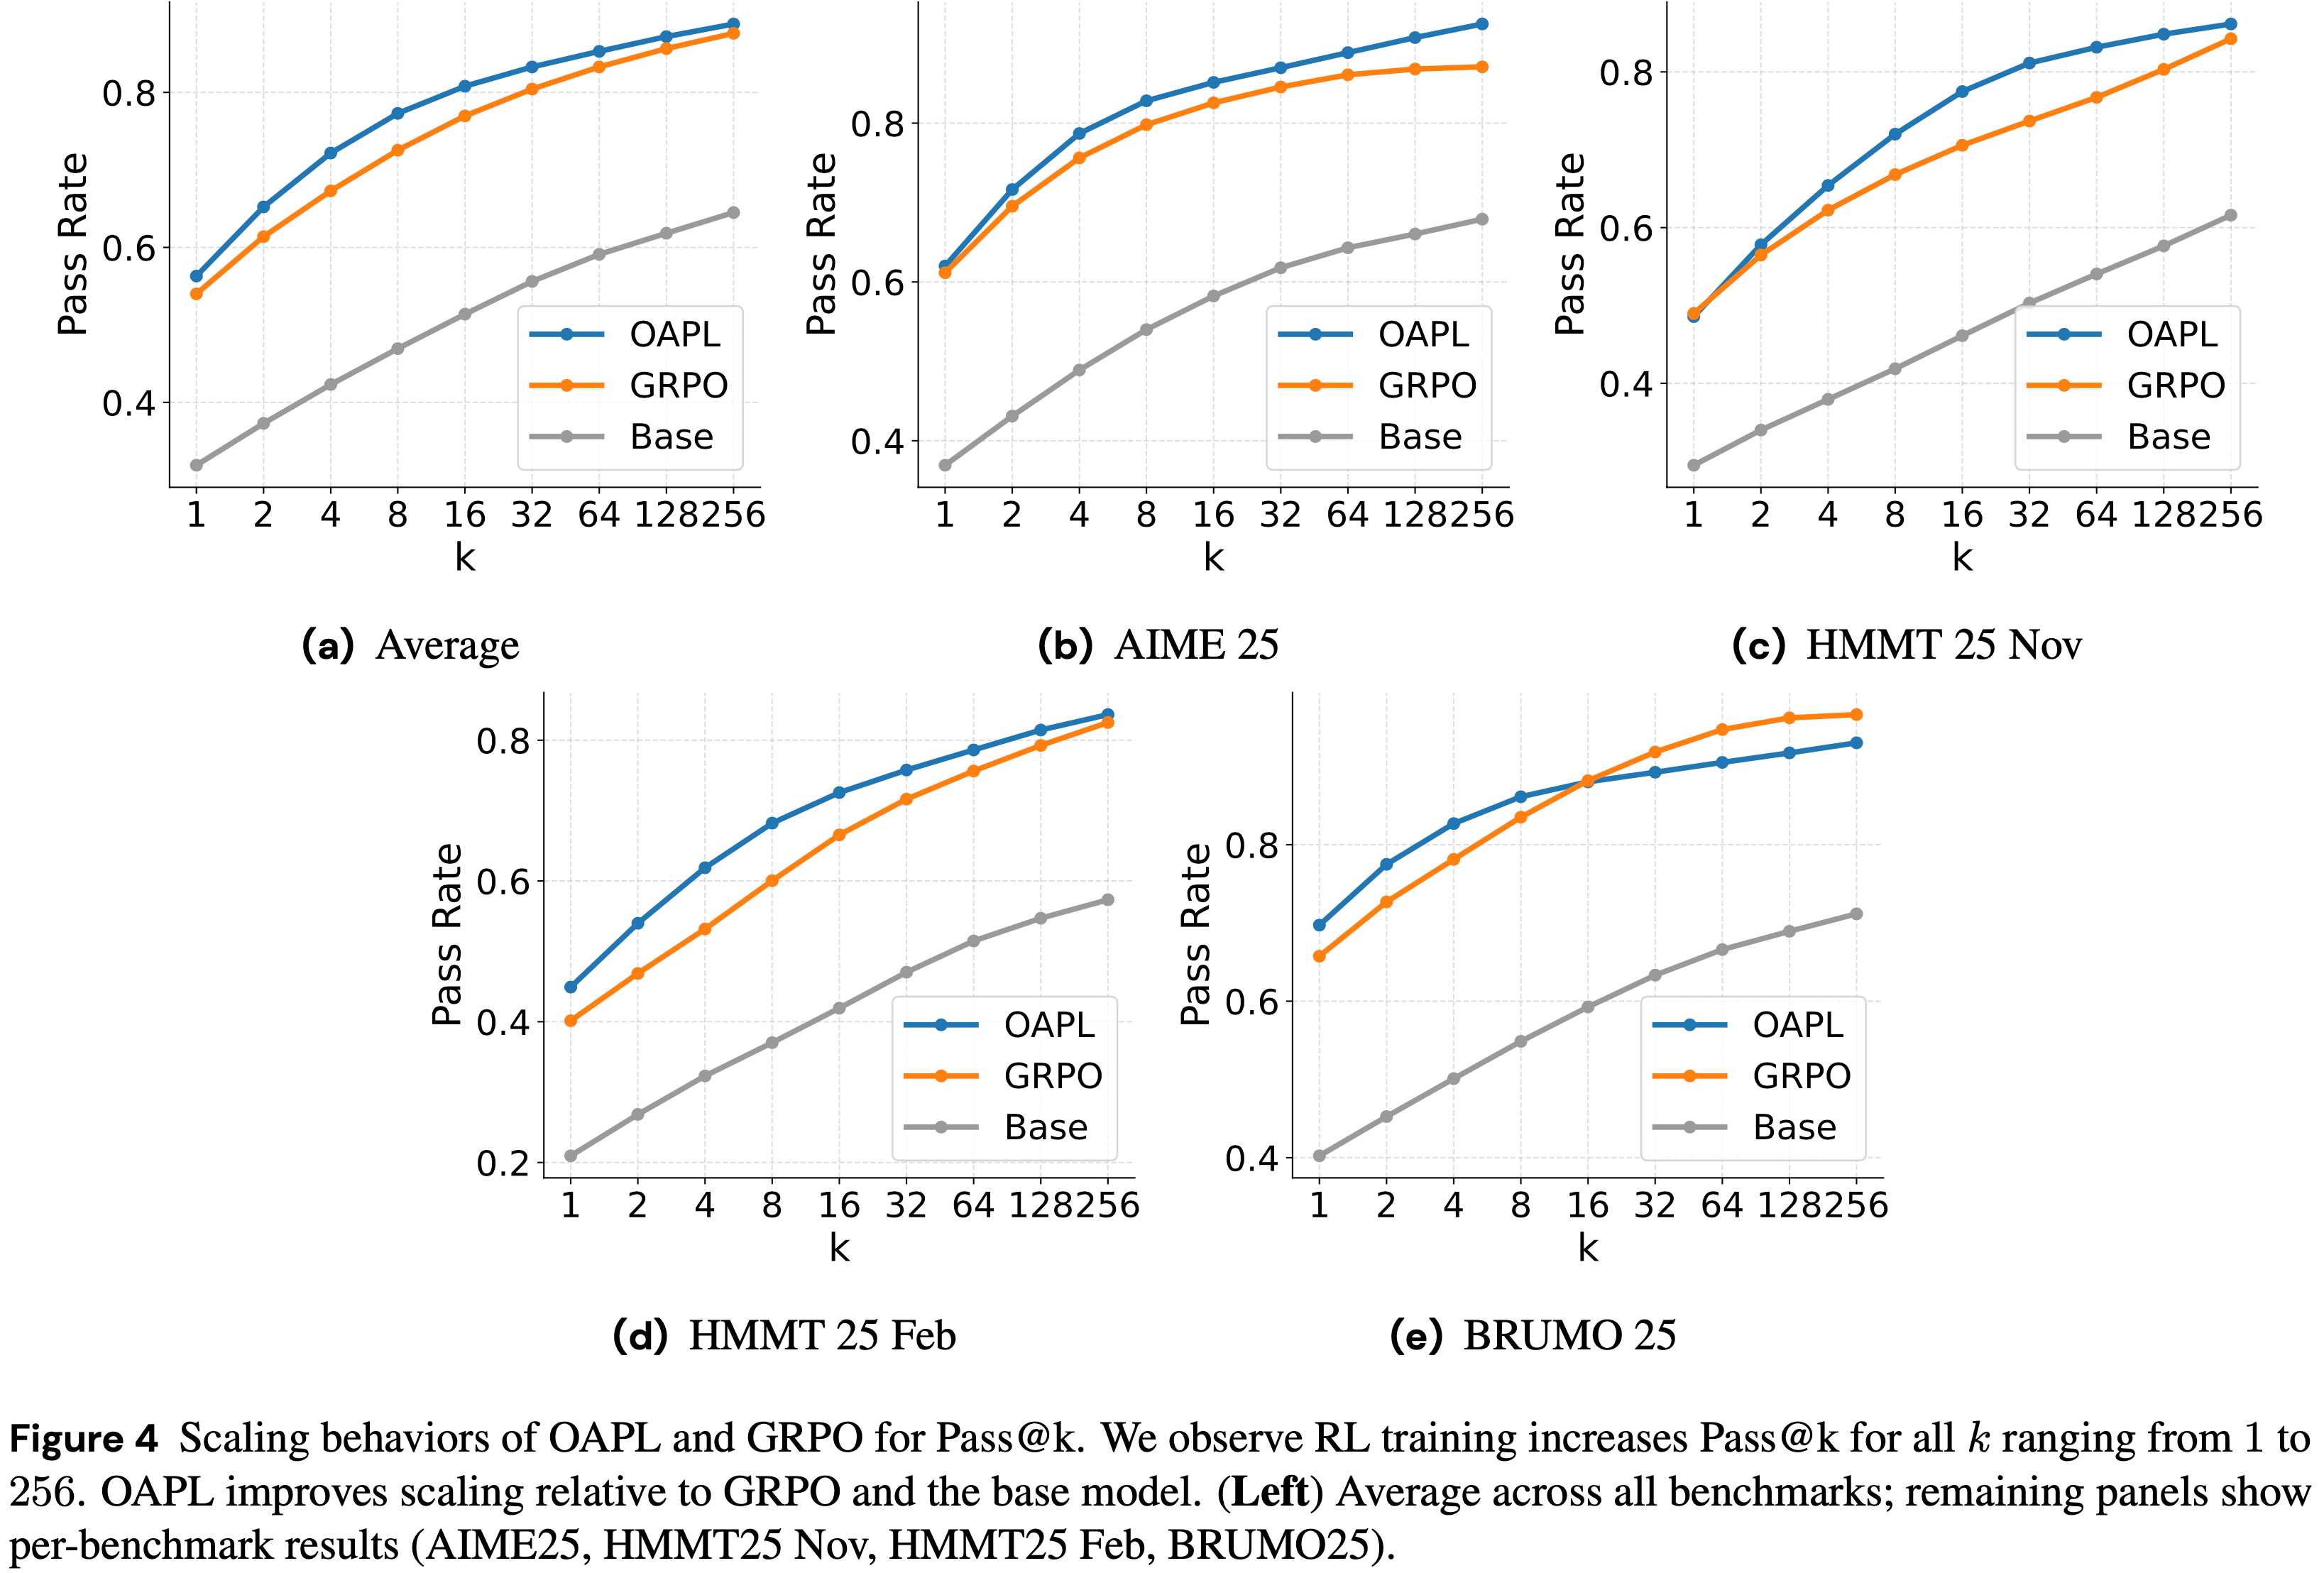
  • 图 4 表明
    • \(OAPL\) 平均而言(左图)比 GRPO 扩展得更好,并且在除 BRUMO 之外的每个基准上都是如此,在 BRUMO 上两种方法在 \(k = 64\) 时都已经达到了 \(90\) 以上的准确率
    • 特别是,对于 HMMT Nov 2025,OAPL 和 GRPO 之间存在很大差距
    • 有趣的是,RL 训练(OAPL 和 GRPO)在广泛的 \(k\) 范围内提高了 Pass@k
      • 与基础模型相比(例如,在 HMMT 25 Nov 上,OAPL 和基础模型之间的差距实际上随着 \(k\) 的增加而增加)
      • 这与许多先前的工作(例如 (2025))形成鲜明对比,后者认为 RL 只会锐化基础模型分布,从它不能提高大 \(k\) 时的 Pass@k 这个意义上说
Training stability with large policy lags
  • 当 Inference Engine 策略显著落后于 Trainer 时,OAPL 还能稳定学习吗?
    • 作者进一步评估了 \(L = 100\) 的 OAPL,即作者每 100 次迭代才同步 \(\pi_{\text{vlmm} }\) 和 \(\pi\)
  • 如图 3(右)所示,OAPL 继续稳定学习,这证明了 OAPL 对训练数据中不同程度的 off-policyness 的鲁棒性

Results on Code Generation

  • 使用第 5.2 节中描述的两阶段离线 Rollout 程序评估 OAPL 在极端 off-policyness 下是否仍然有效,并在 LiveCodeBench 上与 DeepCoder (2025a) 进行比较
Pass@k performance
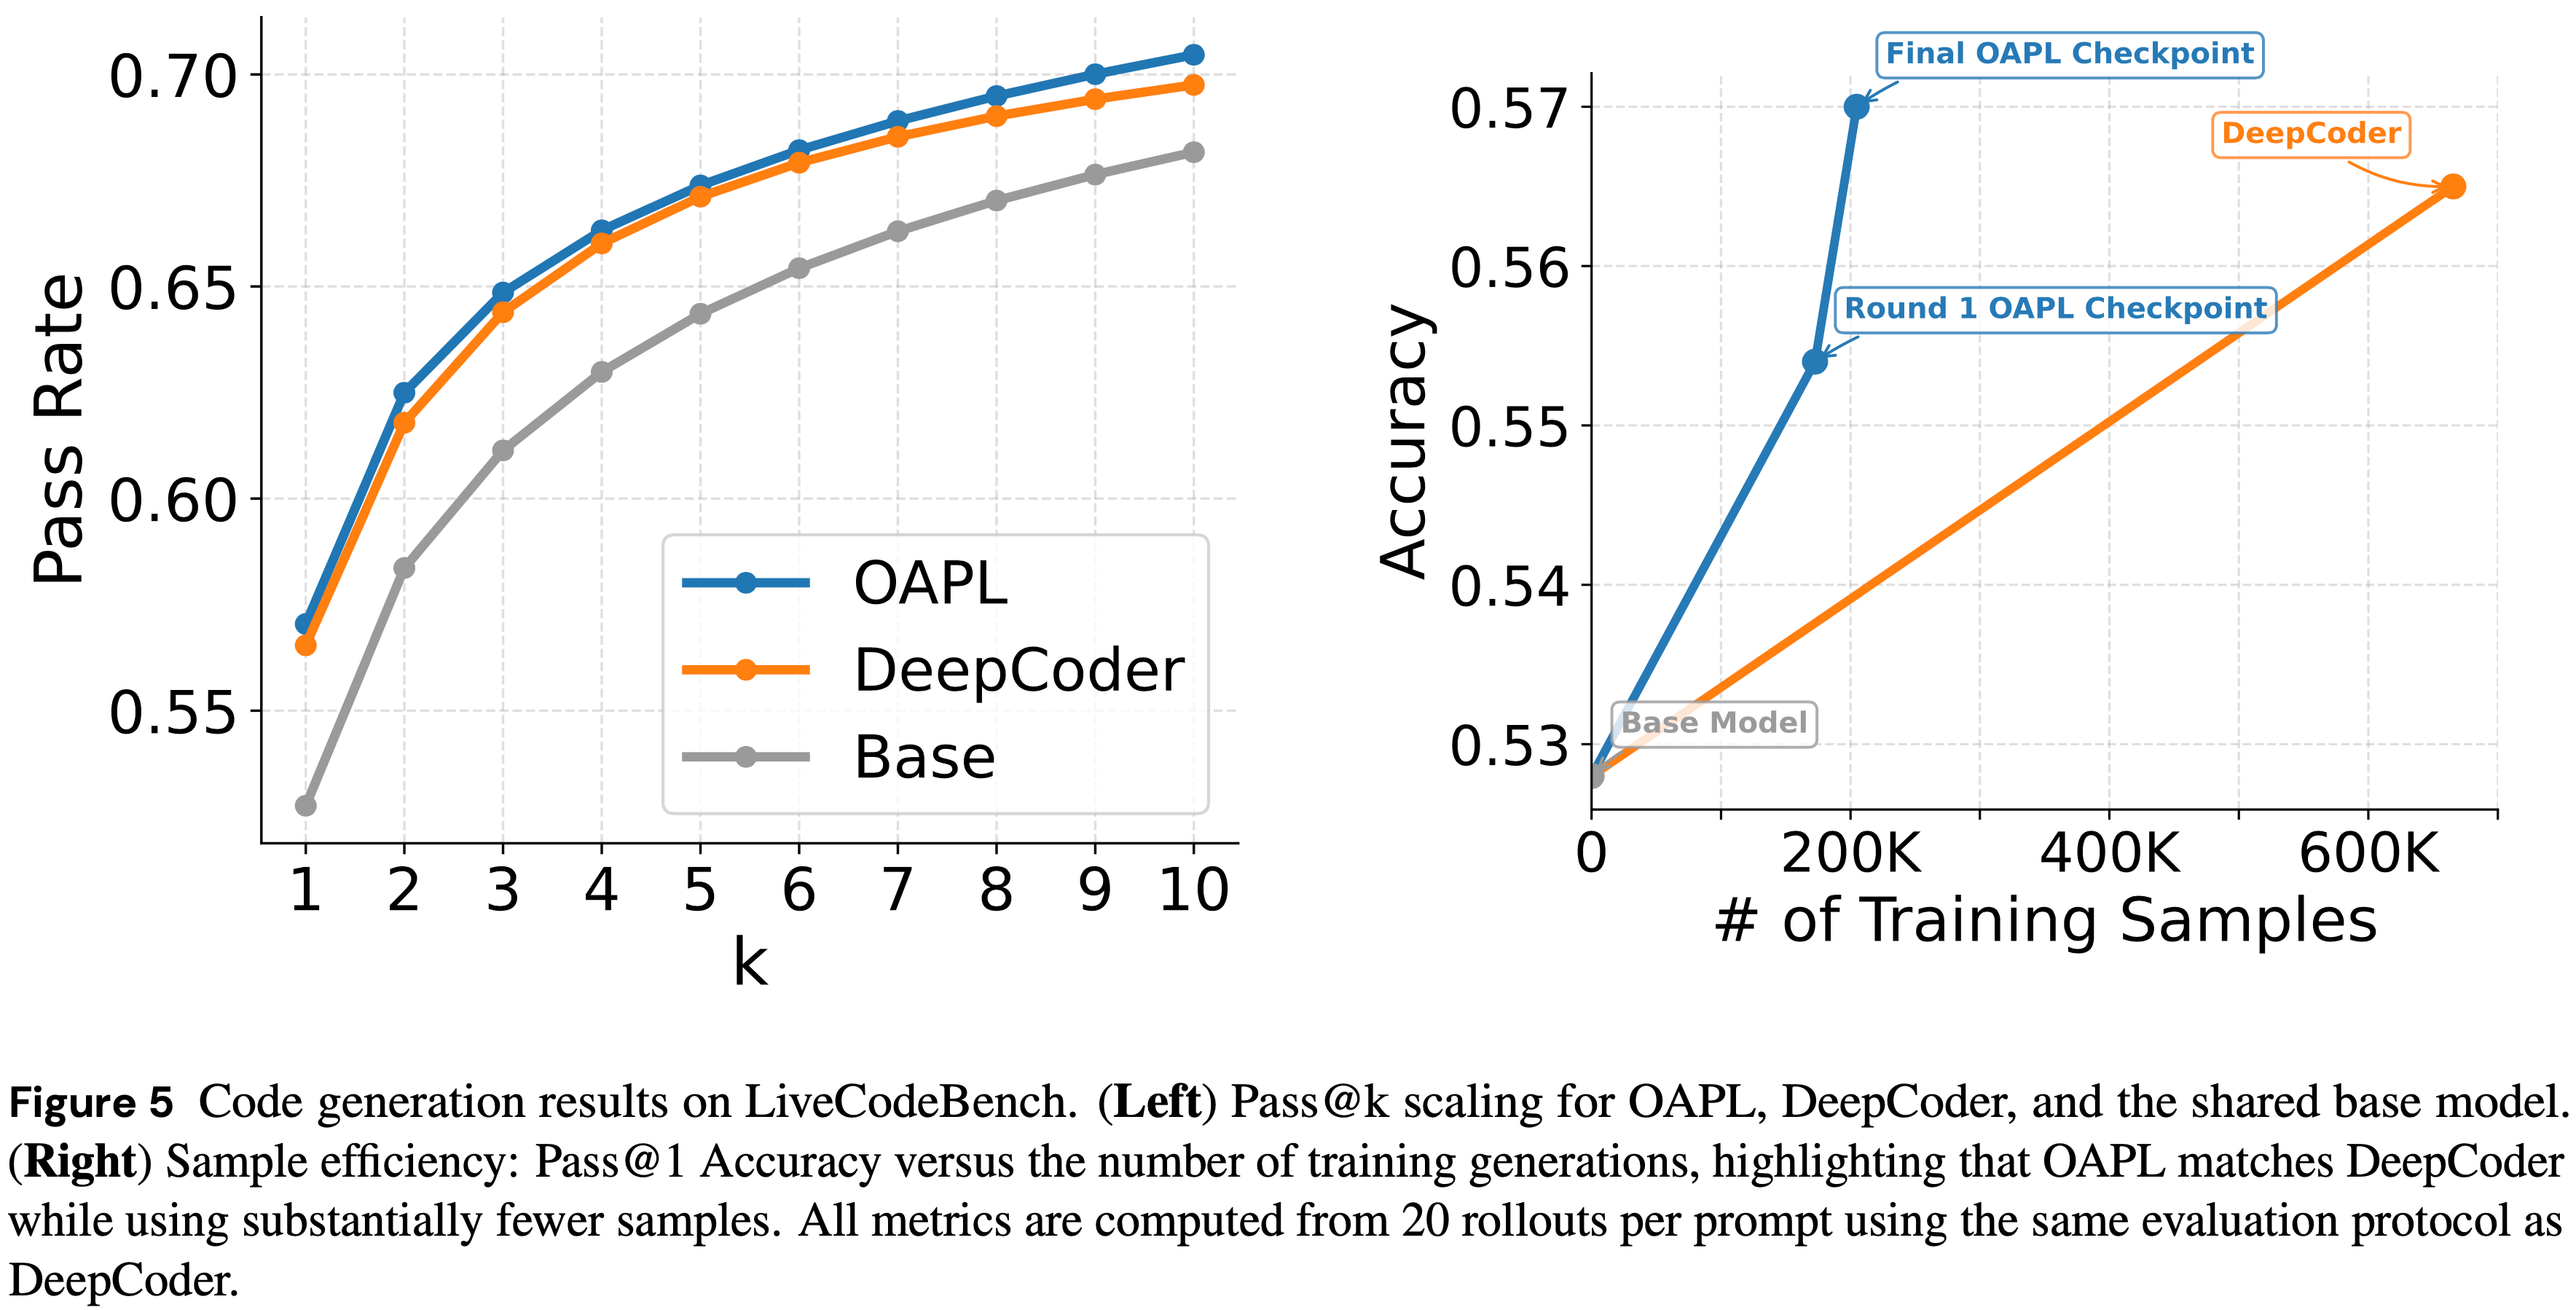
  • 图 5(左)显示了 DeepCoder、作者的 OAPL 训练复现模型以及两者使用的基础模型 (Deepseek-R1-Distill-Qwen-14B) 在 LiveCodeBench 上的 Pass@k 性能
  • 对于所有模型,Pass@k 随着 \(k\) 的增加而增加
  • 在整个 \(k\) 范围内,OAPL 训练的模型与 DeepCoder 性能相当或略优
  • 与基础模型的扩展曲线相比,再次看到 RL 训练(OAPL 和用于 DeepCoder 的 GRPO 变体)提高了大 \(k\) 下的 pass@k
Sample efficiency
  • 使用 OAPL 训练也比原始的 DeepCoder 训练流程具有显著的样本效率
  • 图 5(右)显示了 OAPL 和 DeepCoder 的 Pass@1 性能随总训练样本数的变化
  • DeepCoder 在训练中使用了大约 65 万个样本
    • 相比之下,使用 OAPL 训练只需要 \(\sim 20\) 万个样本
  • 这表示所需的样本数量减少了大约 3 倍,同时达到相同或更好的性能
  • 这种比较确实略微夸大了 DeepCoder 的实际总计算成本,因为他们训练的第一部分(160 步)限制在 16K 长度的生成,之后才切换到 32K
  • 但即使作者将 16K 生成计为“半个”样本以进行更公平的核算,总数也大约是 58 万个样本,OAPL 仍然提供了显著的样本效率提升

附录 A:Experimental Details

A.1 Math Training Hyperparameters

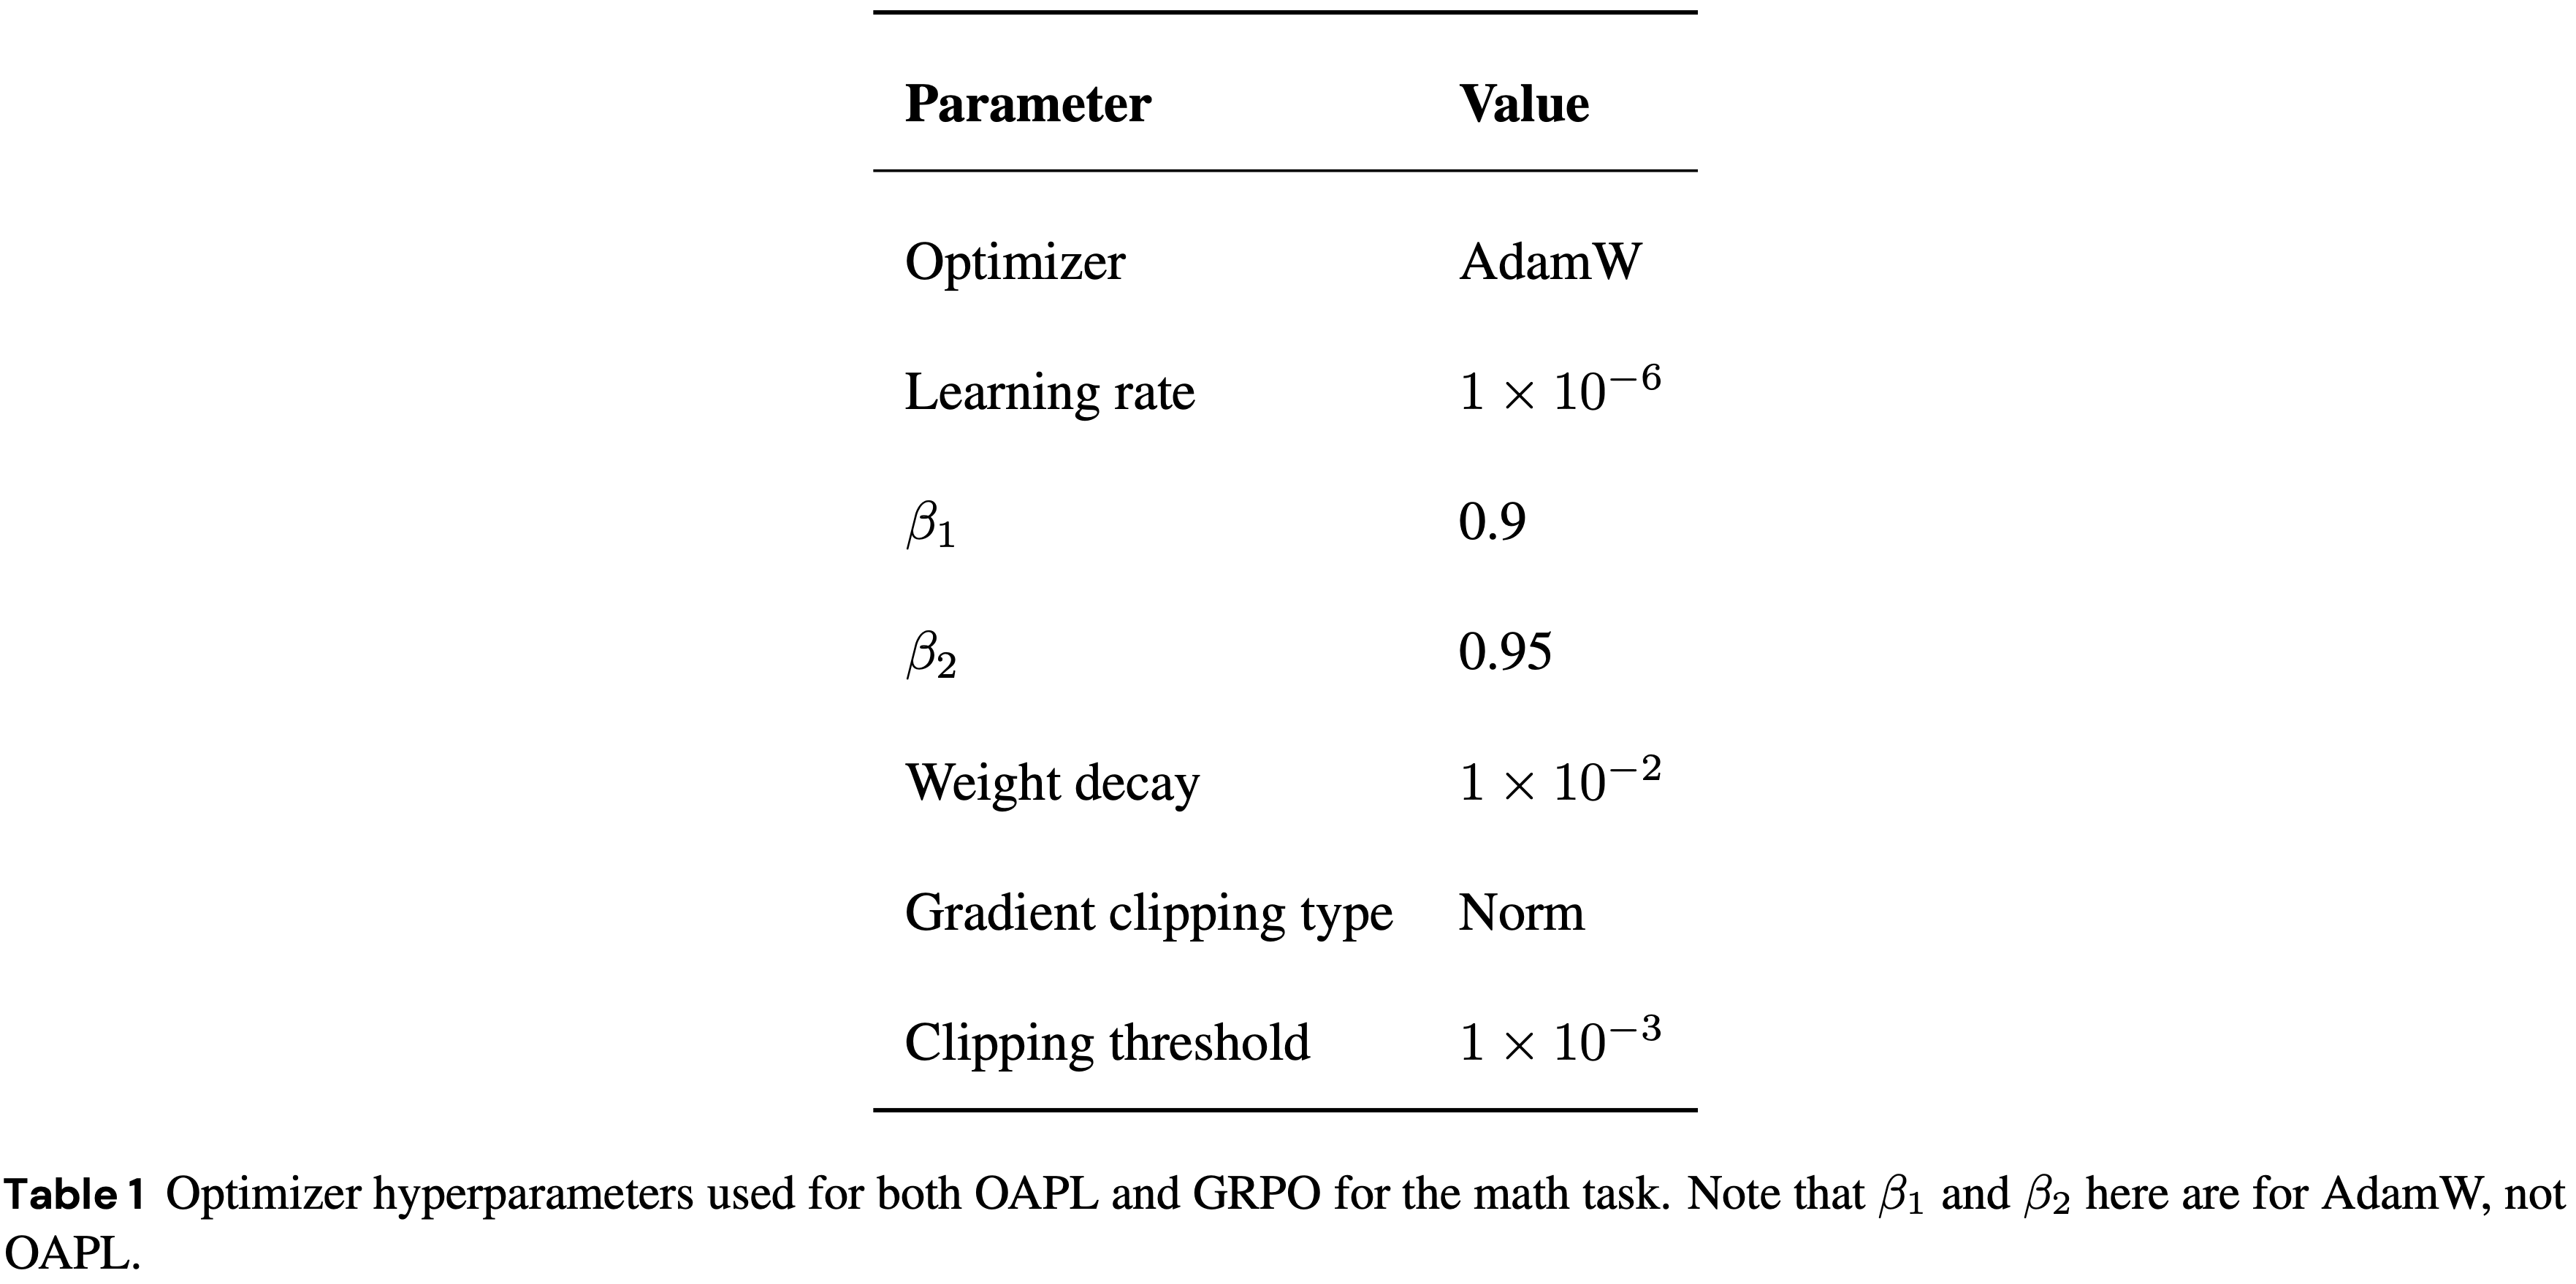
  • 表 1 显示了两种方法使用的优化器超参数
    • 作者没有针对数学任务调整优化器
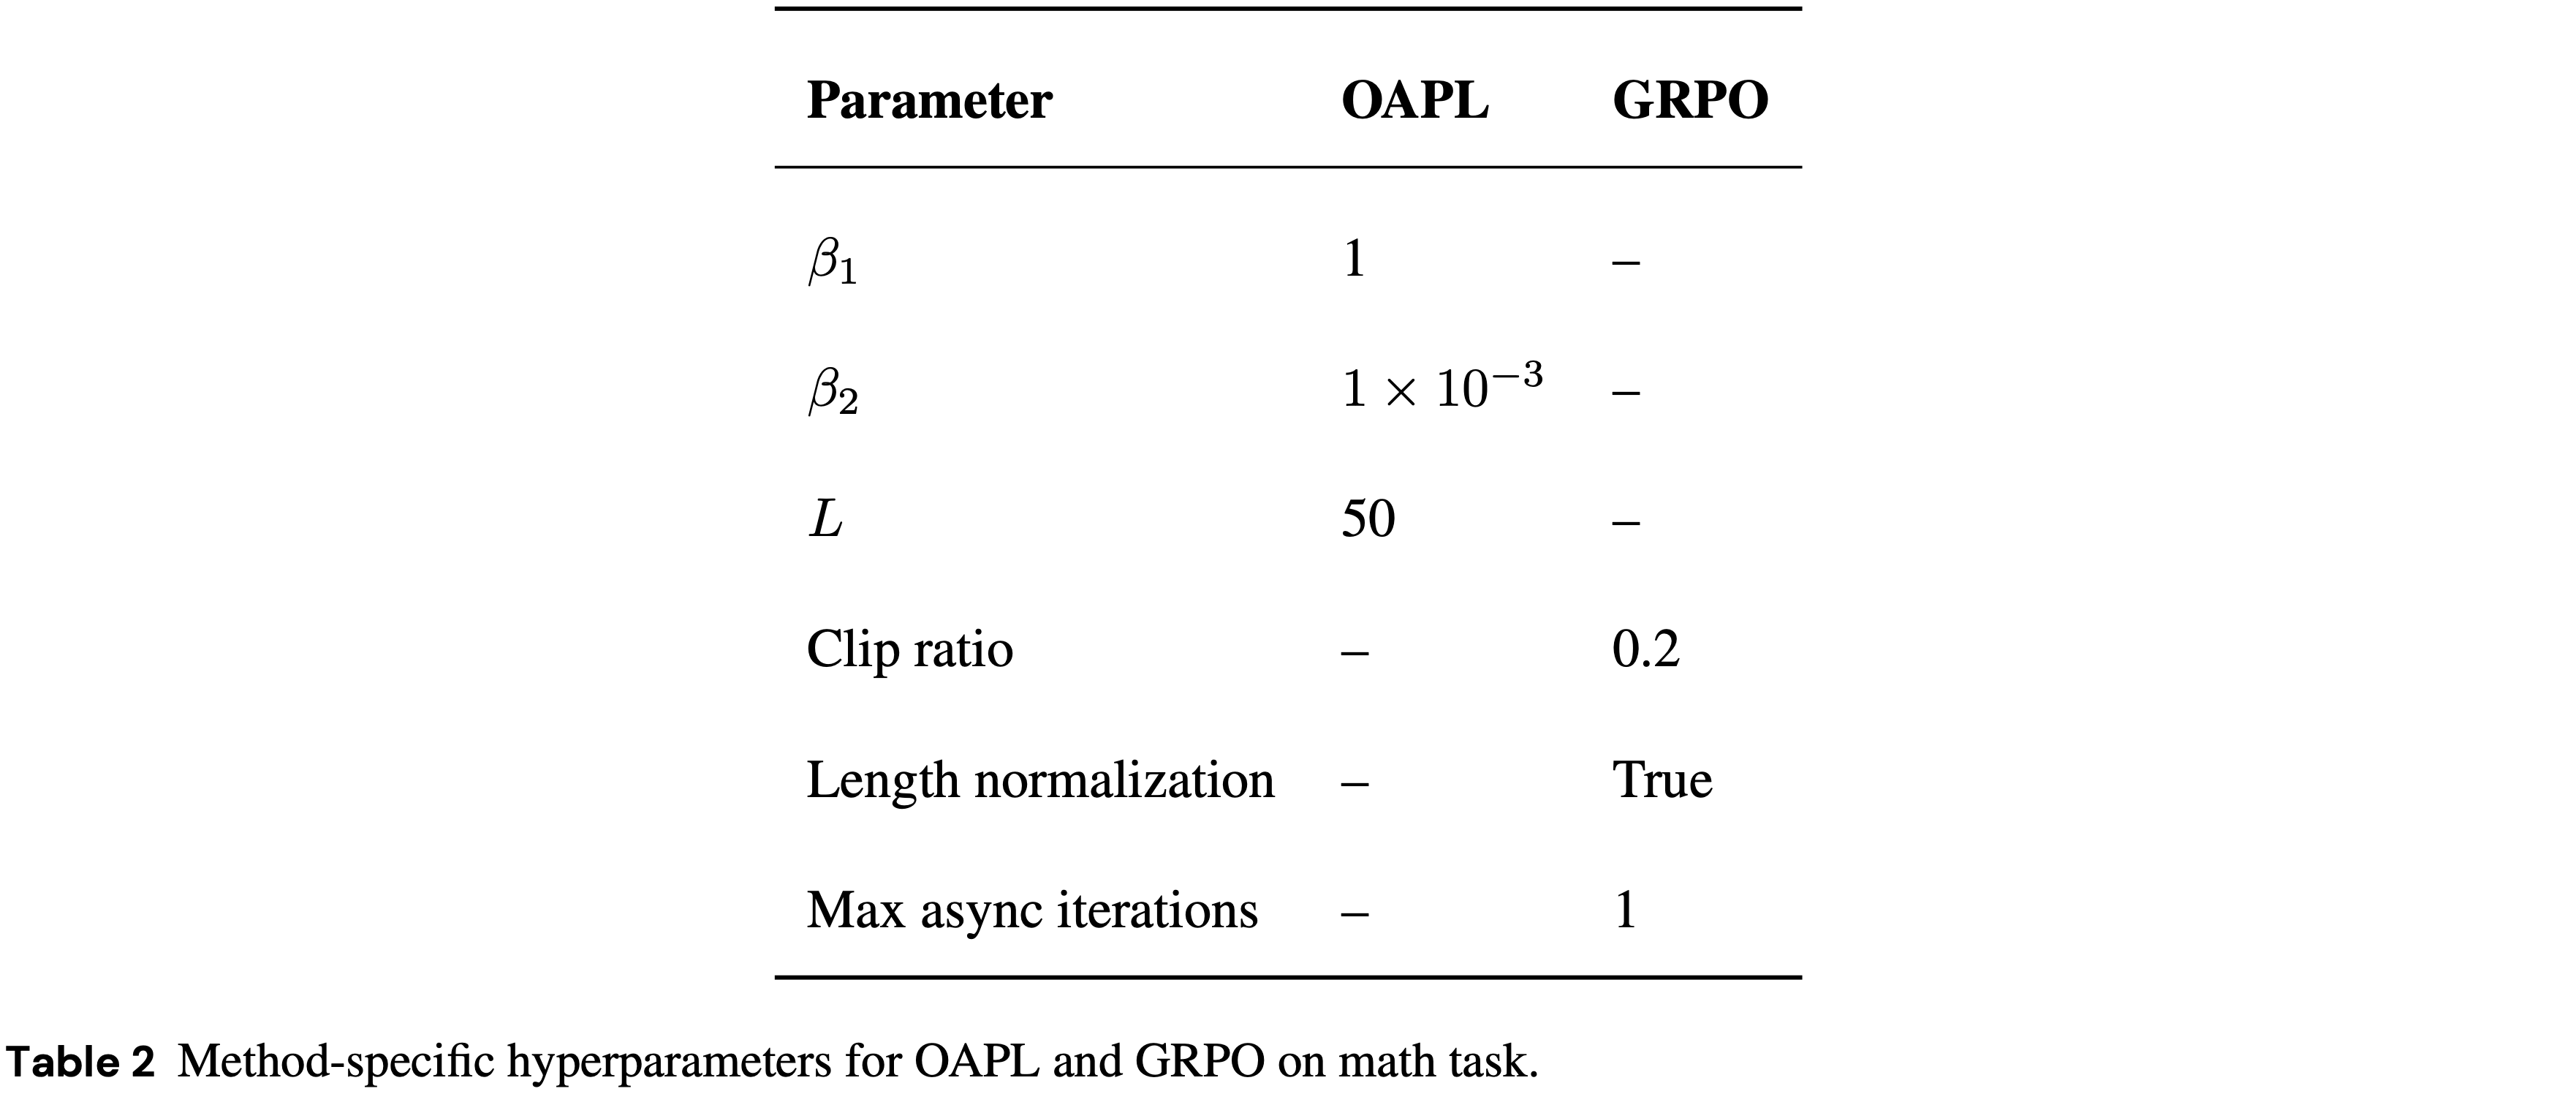
  • 表 2 显示了特定于方法的超参数
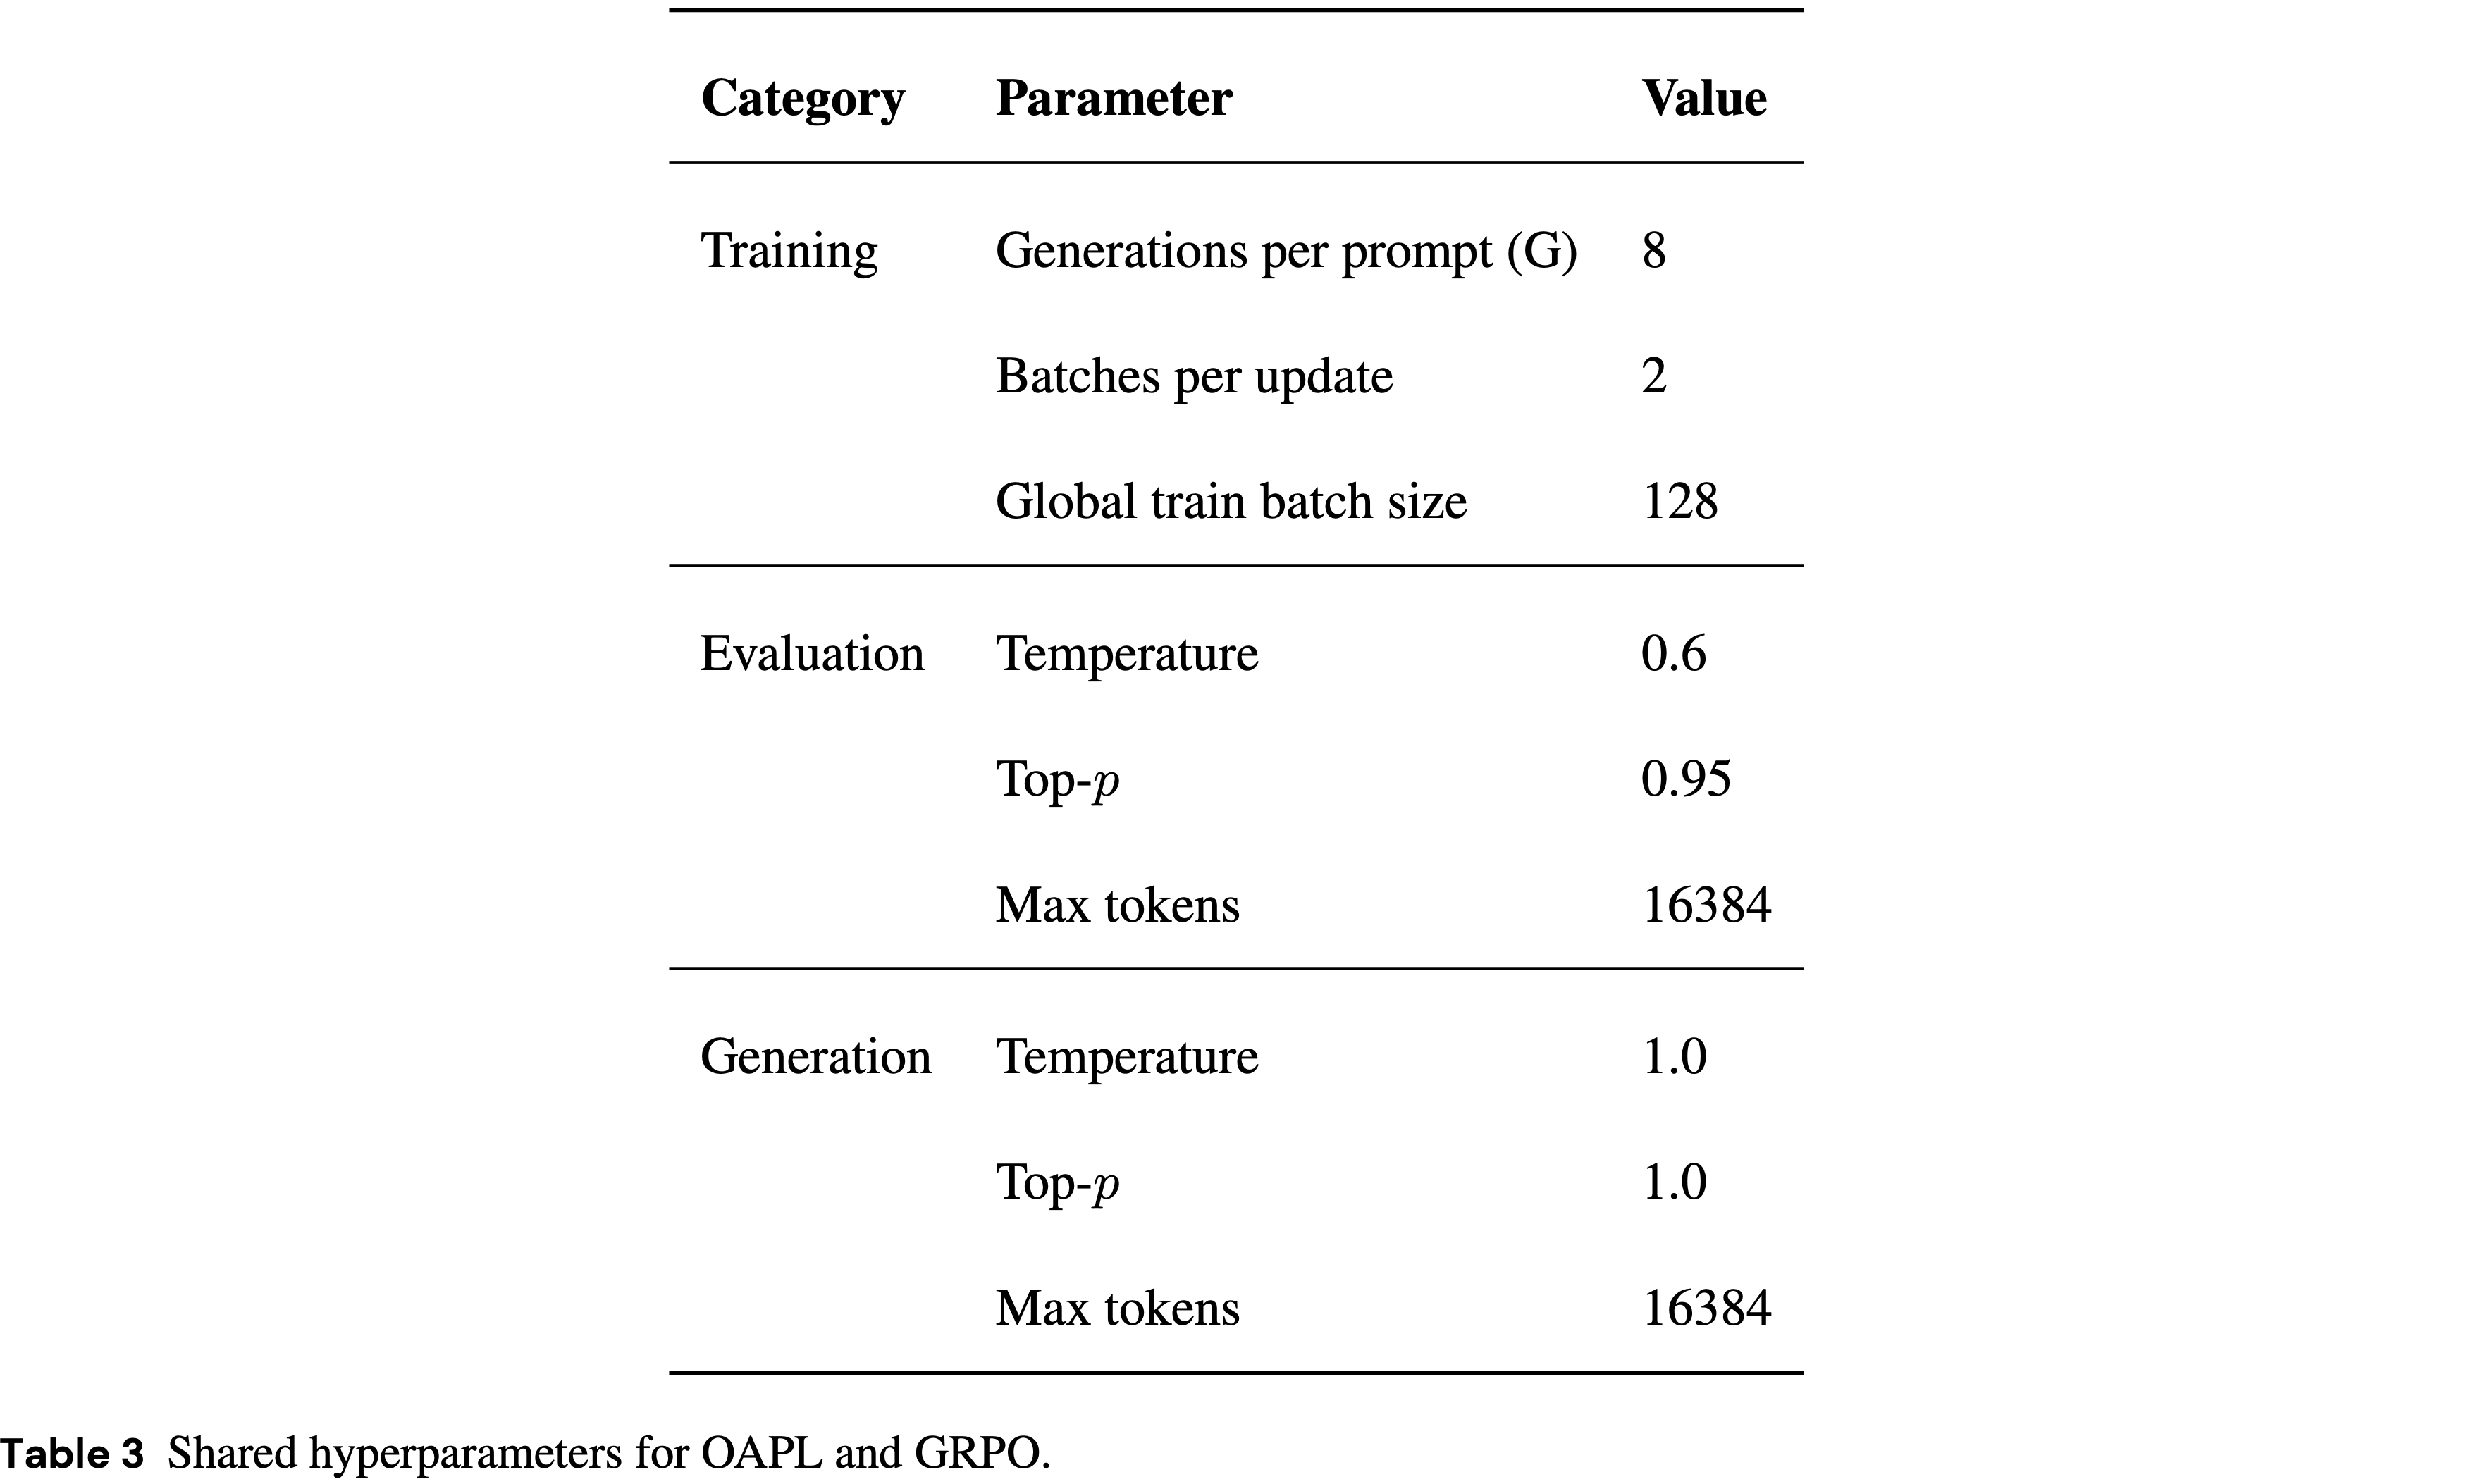
  • 表 3 显示了两种方法共享的超参数
  • 对于 OAPL,作者对 \(\beta_{1} = \{1,5\}\) 和 \(\beta_{2} = \{1e - 2,1e - 3\}\) 进行了超参数搜索
    • 可以观察到 \(\{\beta_{1} = 1,\beta_{2} = 1e - 3\}\) 给出了最佳的整体性能(平均而言),并报告使用这些值时的性能

Code Generation Training Hyperparameters

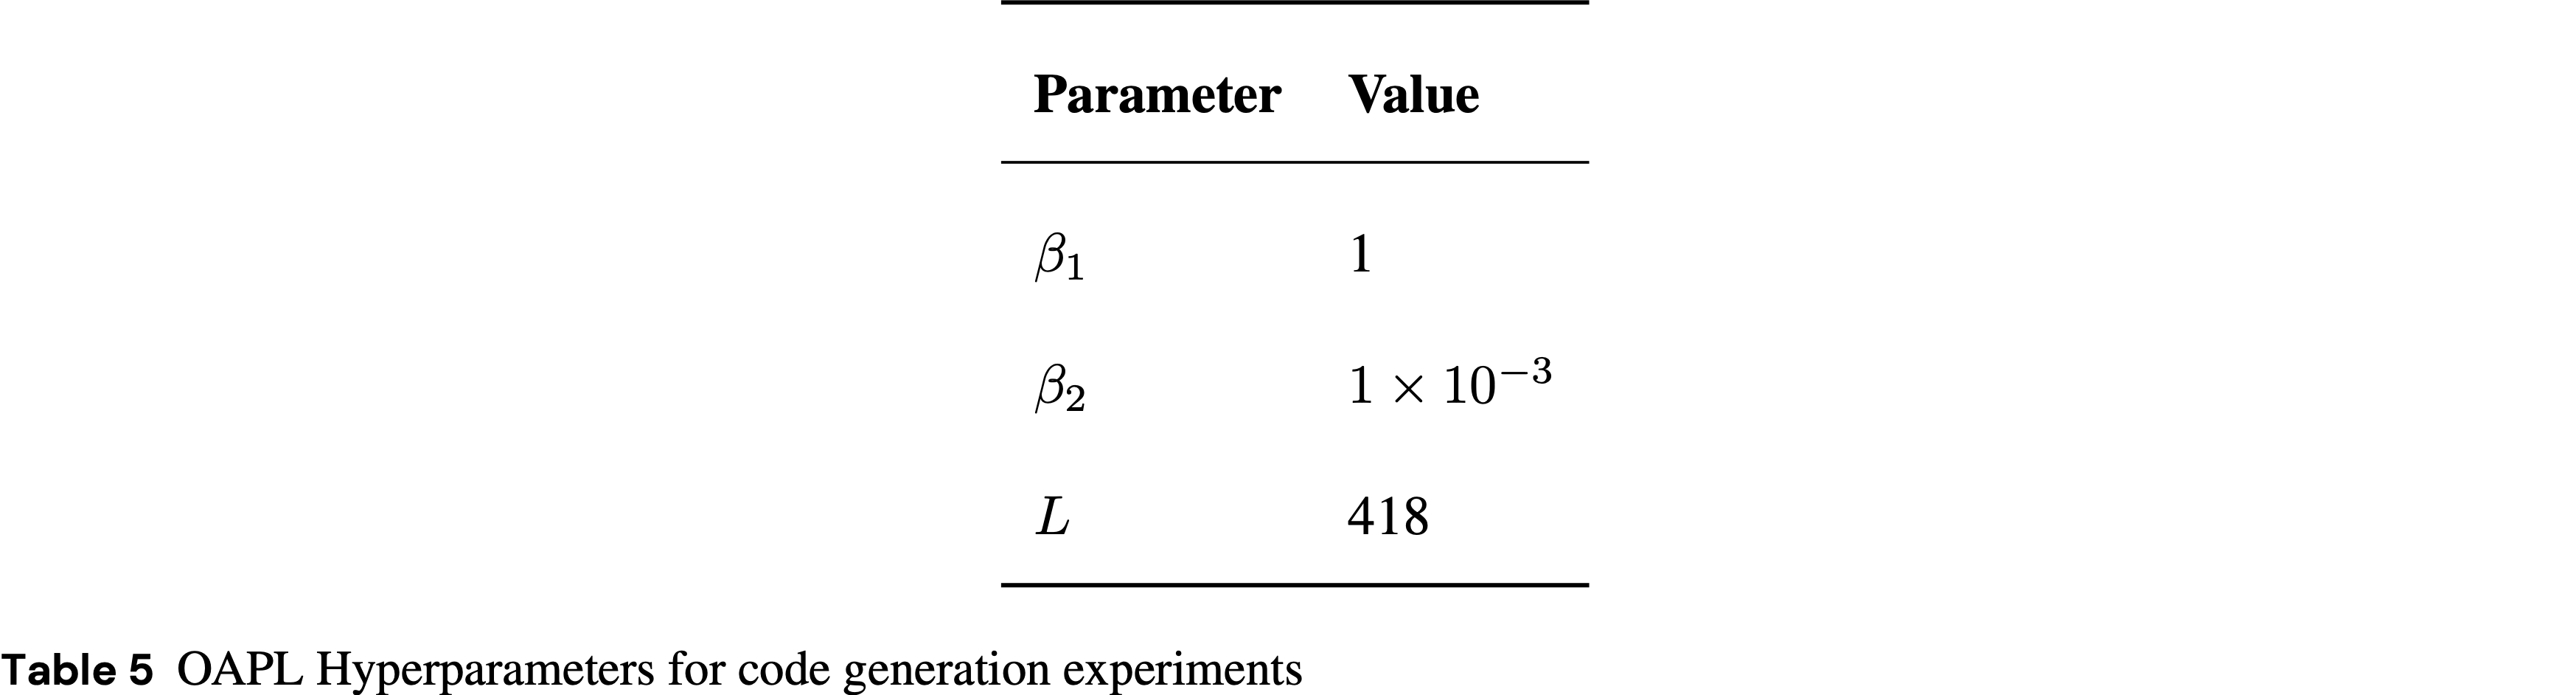
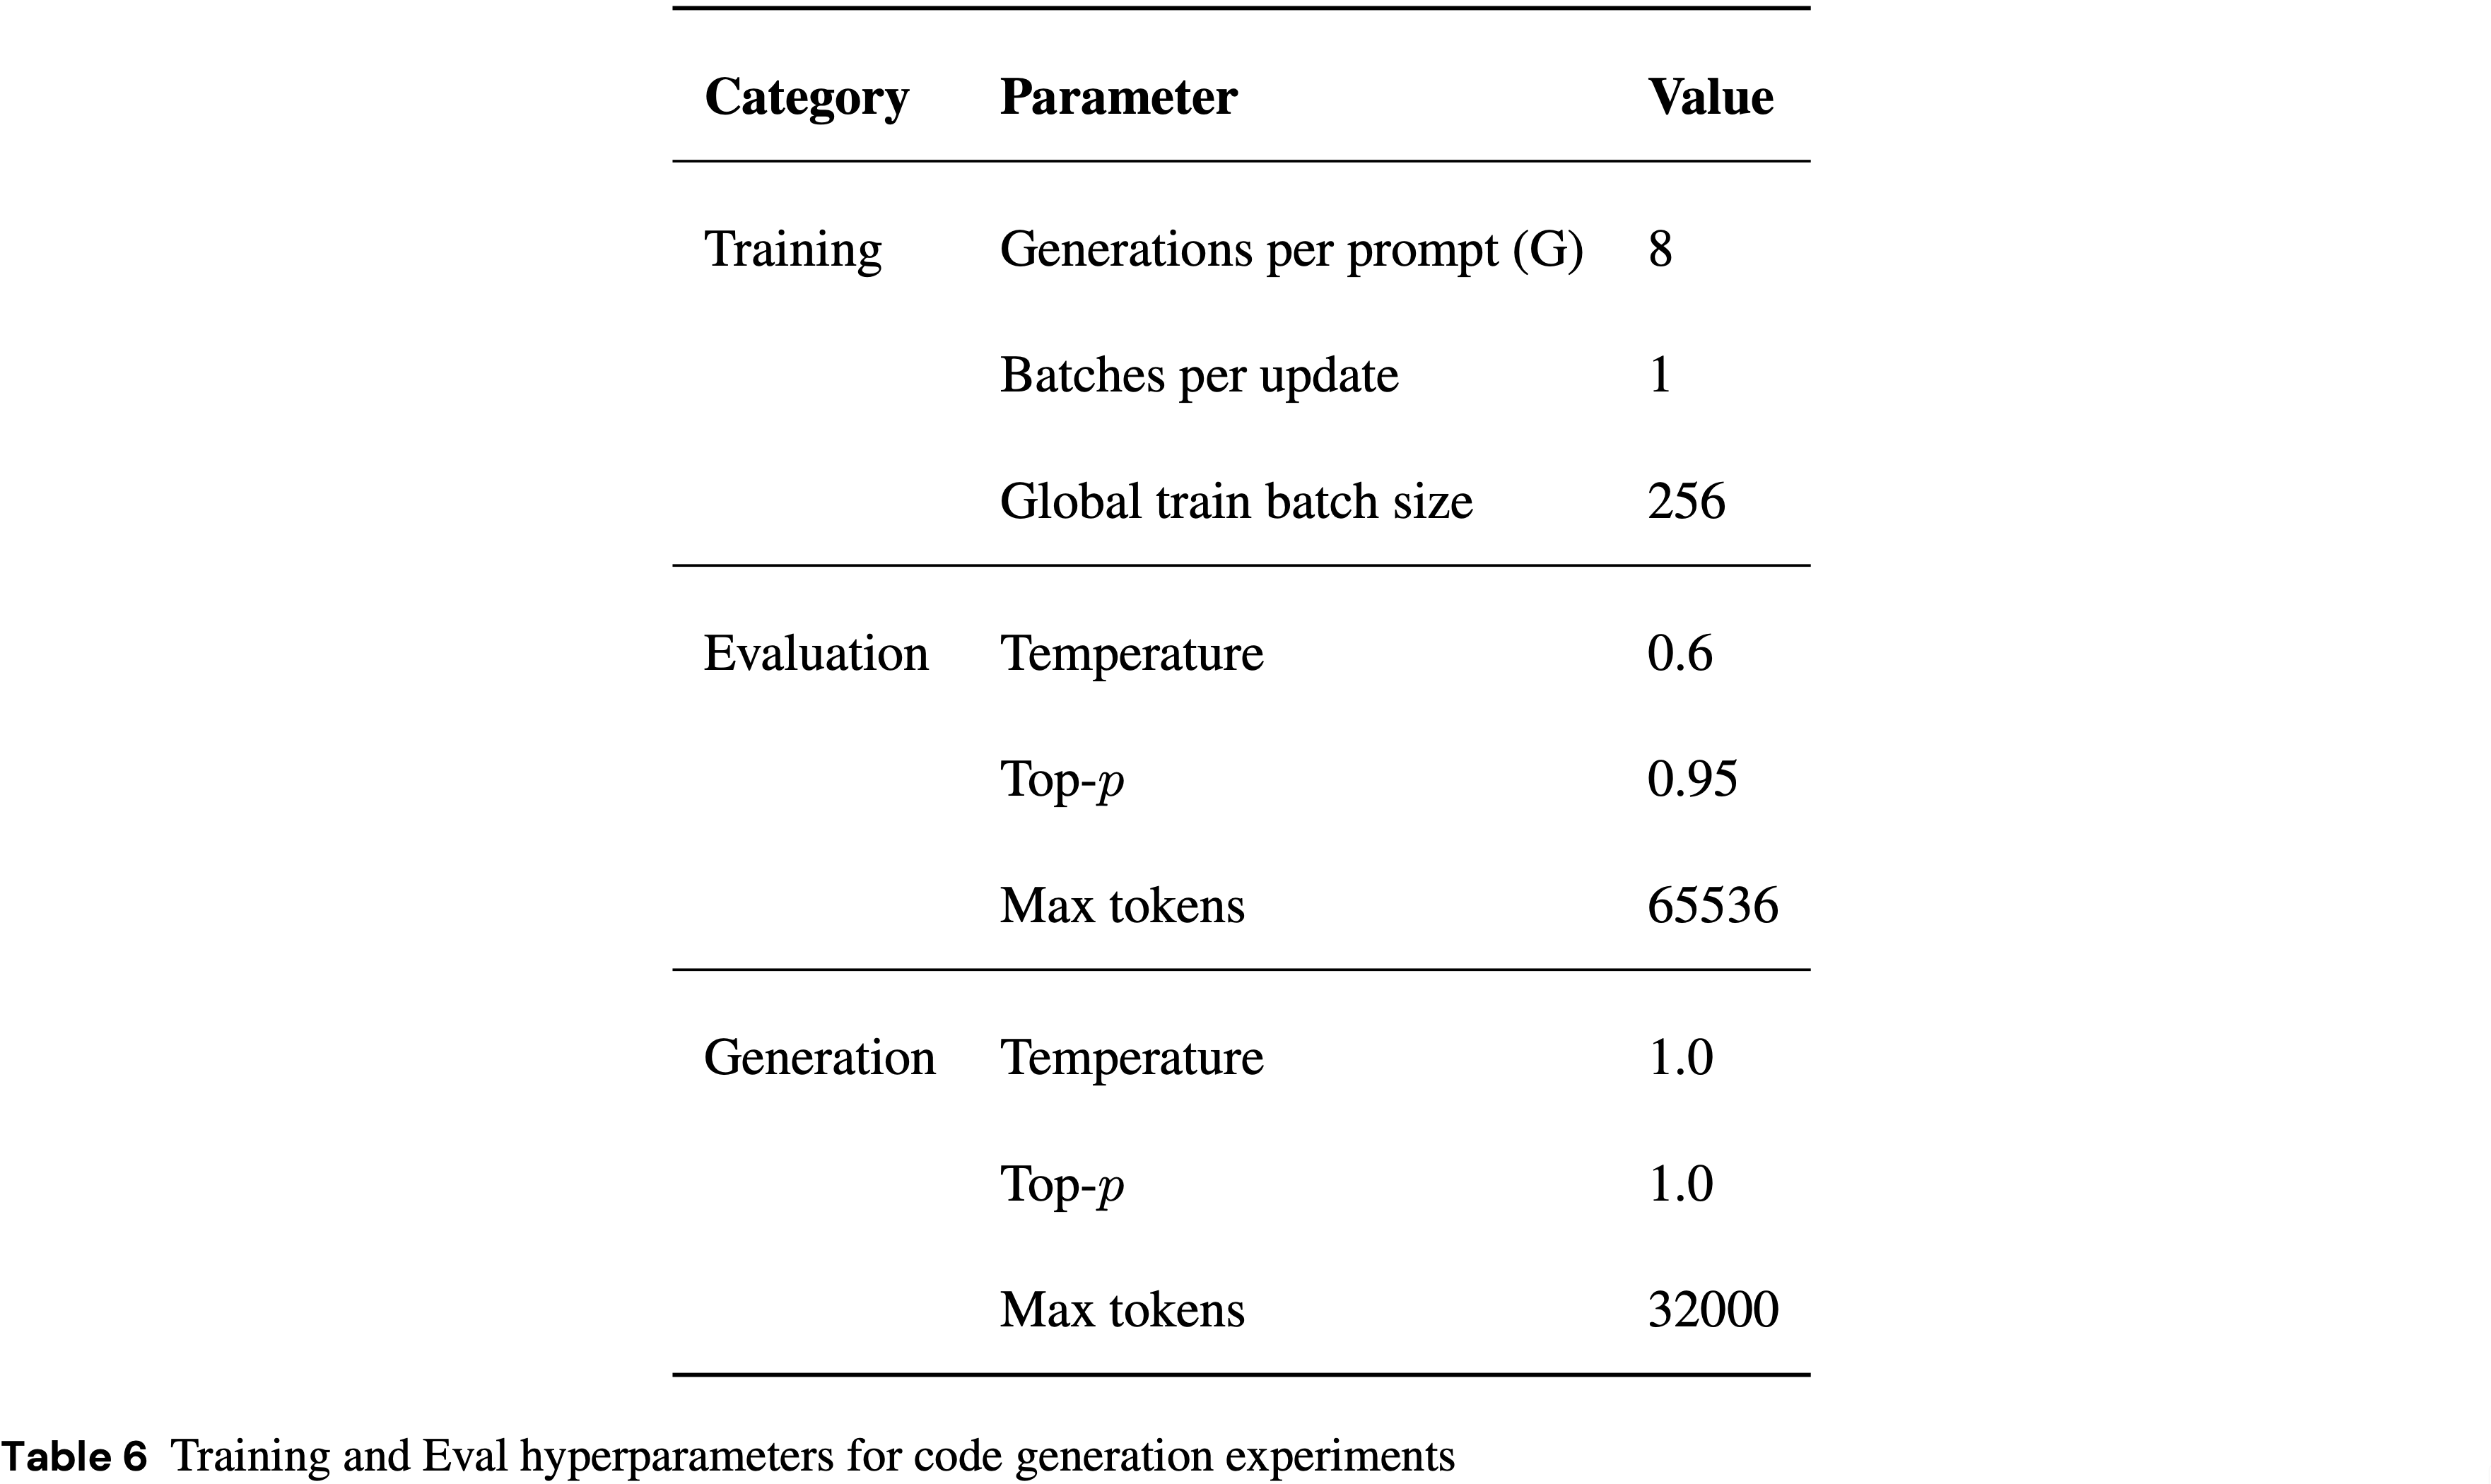
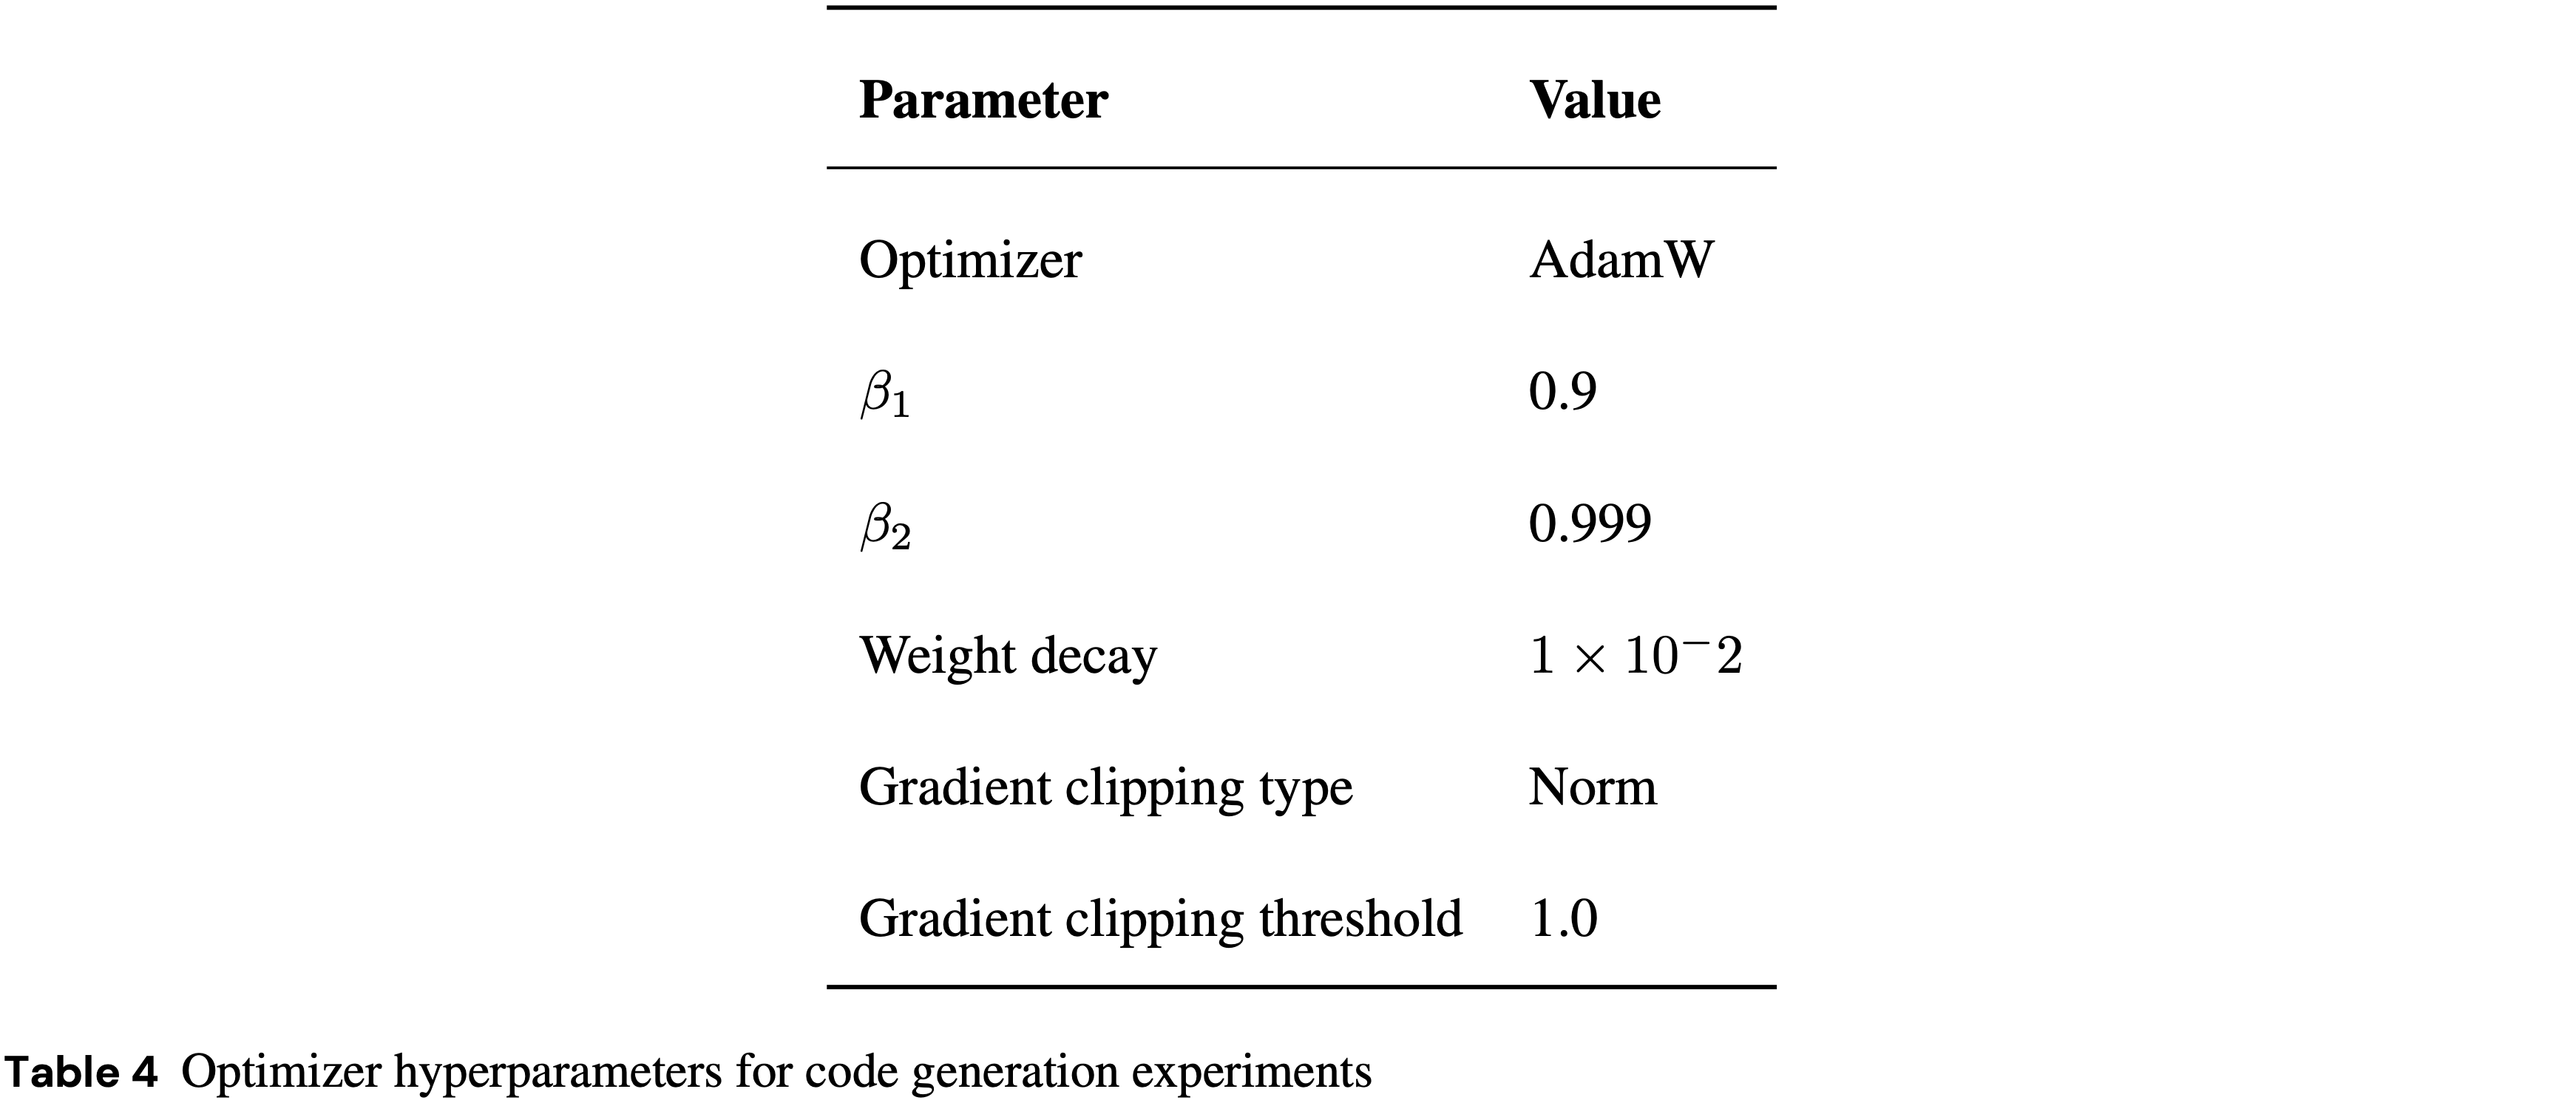
  • 表 4、5 和 6 分别显示了作者的代码生成实验的优化器、OAPL 特定和训练超参数
    • 由于运行的计算成本,作者没有进行超参数搜索来选择超参数,而是根据在其他实验中发现有效的默认值,为 OAPL 选择了 \(\beta_{1}, \beta_{2}\)
附录:公式 1 到 \(V^{\star}\) 的证明

证明目标

  • 在 KL 正则化 RL 的框架下,下面目标函数
    $$
    \max_{\pi} \mathbb{E}_{x, y \sim \pi(\cdot|x)} \left[ r(x, y) \right] - \beta , \text{KL}(\pi | \pi_{\mathrm{vllm} })
    $$
  • 的最优值函数 \(V^{\star}(x)\) 具有以下封闭形式:
    $$
    V^{\star}(x) = \beta \ln \mathbb{E}_{y \sim \pi_{\mathrm{vllm} }(\cdot|x)} \exp\left( \frac{r(x, y)}{\beta} \right)
    $$

证明

先求解最优策略的表达式
  • 本节证明亦可参考 RL——CQL 的附录部分
  • 给定 \(x\),作者考虑以下优化问题:
    $$
    \max_{\pi(\cdot|x)} \mathbb{E}_{y \sim \pi(\cdot|x)} \left[ r(x, y) \right] - \beta , \text{KL}(\pi(\cdot|x) | \pi_{\mathrm{vllm} }(\cdot|x))
    $$
  • KL 散度的定义:
    $$
    \text{KL}(\pi | \pi_{\mathrm{vllm} }) = \mathbb{E}_{y \sim \pi} \left[ \ln \frac{\pi(y|x)}{\pi_{\mathrm{vllm} }(y|x)} \right]
    $$
  • 因此目标函数可写为:
    $$
    \mathcal{L}(\pi) = \mathbb{E}_{y \sim \pi} \left[ r(x, y) - \beta \ln \frac{\pi(y|x)}{\pi_{\mathrm{vllm} }(y|x)} \right]
    $$
  • 可以用拉格朗日乘子法求解带归一化约束 \(\sum_y \pi(y|x) = 1\) 的优化问题,写出拉格朗日函数:
    $$
    \mathcal{L} = \sum_y \pi(y|x) \left[ r(x, y) - \beta \ln \frac{\pi(y|x)}{\pi_{\mathrm{vllm} }(y|x)} \right] + \lambda \left( 1 - \sum_y \pi(y|x) \right)
    $$
  • 对 \(\pi(y|x)\) 求导并令其为零(注意 \(\ln \pi\) 的导数):
    $$
    \frac{\partial}{\partial \pi(y|x)} \left[ \pi(y|x) \left( r(x, y) - \beta \ln \pi(y|x) + \beta \ln \pi_{\mathrm{vllm} }(y|x) \right) \right] - \lambda = 0
    $$
  • 展开得:
    $$
    r(x, y) - \beta \ln \pi(y|x) - \beta + \beta \ln \pi_{\mathrm{vllm} }(y|x) - \lambda = 0
    $$
  • 整理有:
    $$
    - \beta \ln \pi(y|x) + \beta \ln \pi_{\mathrm{vllm} }(y|x) + r(x, y) - \beta - \lambda = 0
    $$
  • 即:
    $$
    \ln \frac{\pi(y|x)}{\pi_{\mathrm{vllm} }(y|x)} = \frac{r(x, y) - \beta - \lambda}{\beta}
    $$
  • 令 \(Z = e^{(\beta + \lambda)/\beta}\),则:
    $$
    \pi(y|x) = \frac{1}{Z} \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)
    $$
  • 由归一化条件 \(\sum_y \pi(y|x) = 1\),得:
    $$
    Z = \sum_y \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)
    $$
  • 因此最优策略为:
    $$
    \pi^{\star}(y|x) = \frac{\pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)}{\sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right)}
    $$
最优值函数 \(V^{\star}(x)\)
  • 将 \(\pi^{\star}\) 代入原目标函数:
    $$
    V^{\star}(x) = \mathbb{E}_{y \sim \pi^{\star} } \left[ r(x, y) - \beta \ln \frac{\pi^{\star}(y|x)}{\pi_{\mathrm{vllm} }(y|x)} \right]
    $$
  • 由 \(\pi^{\star}\) 的表达式:
    $$
    \ln \frac{\pi^{\star}(y|x)}{\pi_{\mathrm{vllm} }(y|x)} = \frac{r(x, y)}{\beta} - \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right)
    $$
  • 代入得:
    $$
    \begin{align}
    V^{\star}(x) &= \mathbb{E}_{y \sim \pi^{\star} } \left[ r(x, y) - \beta \left( \frac{r(x, y)}{\beta} - \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) e^{r(x, y’)/\beta} \right) \right] \\
    &= \mathbb{E}_{y \sim \pi^{\star} } \left[ r(x, y) - r(x, y) + \beta \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) e^{r(x, y’)/\beta} \right] \\
    &= \beta \ln \sum_{y} \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)
    \end{align}
    $$
  • 即,最终得到:
    $$ V^{\star}(x) = \beta \ln \sum_{y} \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right) $$
  • 证毕

附录:最优优势 \(A^{\star}\) 的推导

  • 副标题:公式 \(\pi^{\star}\) 和 \(V^{\star}\) 的关系推导

证明目标

  • 本节的证明目标是:
    $$\beta \ln \frac{\pi^{\star}(y|x)}{\pi_{\text{vllm} }(y|x)} = \underbrace{r(x,y) - V^{\star}(x)}_{\text{optimal advantage } A^{\star}}, \quad \forall x,y.$$

证明过程

  • 由之前的推导已知:
    $$
    \begin{align}
    \pi^{\star}(y|x) &= \frac{\pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)}{\sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right)} \\
    V^{\star}(x) &= \beta \ln \sum_{y} \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right)
    \end{align}
    $$
  • 对 \(\pi^{\star}(y|x)\) 取对数:
    $$
    \ln \pi^{\star}(y|x) = \ln \pi_{\mathrm{vllm} }(y|x) + \frac{r(x, y)}{\beta} - \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right).
    $$
  • 整理对齐待证明式子:
    $$
    \ln \pi^{\star}(y|x) - \ln \pi_{\mathrm{vllm} }(y|x) = \frac{r(x, y)}{\beta} - \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right).
    $$
  • 两边乘以 \(\beta\):
    $$
    \beta \ln \frac{\pi^{\star}(y|x)}{\pi_{\mathrm{vllm} }(y|x)} = r(x, y) - \beta \ln \sum_{y’} \pi_{\mathrm{vllm} }(y’|x) \exp\left( \frac{r(x, y’)}{\beta} \right).
    $$
  • 由 \(V^{\star}(x)\) 的定义:
    $$
    V^{\star}(x) = \beta \ln \sum_{y} \pi_{\mathrm{vllm} }(y|x) \exp\left( \frac{r(x, y)}{\beta} \right),
    $$
  • 代入得:
    $$
    \beta \ln \frac{\pi^{\star}(y|x)}{\pi_{\mathrm{vllm} }(y|x)} = r(x, y) - V^{\star}(x).
    $$
  • 这是本文最优优势 \(A^{\star}(x, y)\) 的定义,证毕

附录:OAPL 策略更新损失函数的梯度推导及分析

  • 回顾论文中的公式 (3) 如下:
    $$
    \min_{\pi} \sum_{x} \sum_{i=1}^{G} \left( \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} - \big( r(x, y_i) - \hat{V}^{*}(x) \big) \right)^2
    $$
    • \(\pi\) 是当前要优化的策略(trainer policy)
    • \(\pi_{\mathrm{vllm} }\) 是固定的推理策略(inference engine policy)
    • \(\beta > 0\) 是正则化系数
    • \(r(x, y_i)\) 是奖励
    • \(\hat{V}^{*}(x)\) 是通过组内样本估计的最优值函数
    • \(A^{*}(x, y_i) = r(x, y_i) - \hat{V}^{*}(x)\) 是估计的最优优势函数

OAPL 目标对 \(\pi\) 的梯度推导

  • 首先,上述目标对应的损失函数为:
    $$
    L = \sum_{x} \sum_{i=1}^{G} \left( \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} - A^{*}(x, y_i) \right)^2
    $$
  • 为简化分析,令:
    $$
    u_i = \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} - A^{*}(x, y_i)
    $$
  • 于是有:
    $$
    \frac{\partial L}{\partial \ln \pi(y_i | x)} = 2 u_i \cdot \beta
    $$
    • 注:对 \(\pi(y | x)\) 求梯度,本来考虑的是对某个具体的 token 序列 \(y\) 对应的 logits 的梯度,但为了清晰,我们直接先对 \(\ln \pi(y|x)\) 求导(这样已经足够分析梯度的含义了)
  • 因此有:
    $$
    \frac{\partial L}{\partial \pi(y_i | x)} = \frac{\partial L}{\partial \ln \pi(y_i | x)} \cdot \frac{\partial \ln \pi(y_i | x)}{\partial \pi(y_i | x)} = 2 \beta u_i \cdot \frac{1}{\pi(y_i | x)}
    $$
  • 故,原始损失函数的梯度为:
    $$
    \nabla_{\pi(y_i | x)} L = 2\beta \left( \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} - A^{*}(x, y_i) \right) \cdot \frac{1}{\pi(y_i | x)}
    $$

OAPL 梯度方向分析

  • 这里本文关注的是 梯度下降 更新规则:
    $$
    \pi_{\text{new} }(y|x) = \pi_{\text{old} }(y|x) - \eta \nabla_{\pi} L
    $$
  • 当 \(u_i > 0\) 时
    $$
    \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} > A^{*}(x, y_i)
    $$
    • 左边是当前的策略 \(\pi\) 相对于 \(\pi_{\mathrm{vllm} }\) 的对数比值,乘以 \(\beta\)
    • 右边是估计的最优优势函数
    • 如果 \(u_i > 0\),说明 当前策略 \(\pi\) 对 \(y_i\) 的偏好程度(相对于 \(\pi_{\mathrm{vllm} }\))已经超过了最优优势所指示的合理程度
    • 此时梯度为正,更新时会 降低 \(\pi(y_i|x)\) 的概率
  • 当 \(u_i < 0\) 时
    $$
    \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} < A^{*}(x, y_i)
    $$
    • 说明 当前策略 \(\pi\) 对 \(y_i\) 的偏好程度低于最优优势所指示的合理程度
    • 此时梯度为负,更新时会 增加 \(\pi(y_i|x)\) 的概率
  • 当 \(u_i = 0\) 时
    $$
    \beta \ln \frac{\pi(y_i | x)}{\pi_{\mathrm{vllm} }(y_i | x)} = A^{*}(x, y_i)
    $$
    • 此时梯度为零,\(\pi(y_i|x)\) 已经达到最优

整体理解

  • OAPL 梯度更新方向实际上是在做 一种隐式的策略调整 :
    • 目标是最小化 \(\beta \ln(\pi/\pi_{\mathrm{vllm} })\) 与 \(A^{*}\) 之间的平方误差
    • 换句话说,它希望 当前策略 \(\pi\) 对某个序列的偏好程度(相对于 \(\pi_{\mathrm{vllm} }\))与最优优势函数的值匹配
    • 如果 \(\pi\) 对某个高优势序列的偏好不足(\(u_i < 0\)),就增加它的概率;
    • 如果 \(\pi\) 对某个低优势序列的偏好过高(\(u_i > 0\)),就降低它的概率;
    • 同时,这种调整受 \(\beta\) 控制,\(\beta\) 越大,越强调保持与 \(\pi_{\mathrm{vllm} }\) 接近

NLP——LLM对齐微调-VeRL-rollout_corr解读

注:本文包含 AI 辅助创作

  • 参考链接:
    • github.com/verl-project/verl/blob/main/docs/algo/rollout_corr.md
    • 其他相关文件:(Mathematical Formulations of Rollout Correction Methods in verl)github.com/verl-project/verl/blob/main/docs/algo/rollout_corr_math.md
    • 最新论文:Trust Region Masking for Long-Horizon LLM Reinforcement Learning, 20251228-20260626

整体说明

  • “Rollout Correction” 包含两种可同时存在的修正组件:
    • 重要性采样(IS,Importance Sampling)权重,修正 off-policy 偏差
    • 拒绝采样(RS,Rejection Sampling),过滤异常样本
  • 内部变量 rollout_is_weights 特指 IS 权重组件
  • Rollout Correction(Rollout 校正)提供了一个统一的框架,用于处理 RL 训练中的一般 off-policy 问题
    • 任何数据收集分布与训练分布不同的场景都可以从这些方法中受益

常见的 off-policy 场景:

  • 1)策略不匹配(实现差异)
    • 不同精度:FP8 vs FP16 vs BF16 vs FP32
    • 不同后端:vLLM vs SGLang vs FSDP vs Megatron
    • 即使权重相同,不同实现也会有差异
  • 2)时间滞后(模型陈旧性)
    • Rollout 使用较旧的 checkpoint,而训练已经推进
    • 具有陈旧参数的异步 Rollout 工作器
    • 常见于分布式/异步 RL 系统
  • 3)回放缓冲区(Replay Buffers)
    • 在来自更早迭代的历史轨迹上训练
    • 来自不同策略版本的经验回放
    • 数据增强或重采样策略
  • 4)Off-Policy 算法
    • 来自专家演示的行为克隆
    • DAPO(来自辅助策略的数据)
    • 任何使用来自不同策略轨迹的算法
  • 5)数据质量过滤
    • 收集数据的重新加权或过滤
    • 具有修改分布的偏好学习
    • 具有分布偏移的课程学习
  • 这些 off-policy 差距可能导致训练不稳定和策略崩溃
  • Rollout Correction(Rollout 校正)使用重要性采样(IS)权重和拒绝采样(RS)来校正数据收集与训练之间的任何分布偏移

关于常见实现错误的重要说明:

  • 许多 LLM-RL 实现错误地应用 PPO,忽略实际的 Rollout 策略 \(\pi_{\text{rollout}}\),并假设训练参考策略 \(\pi_{\text{old}}\) 是行为策略
  • 当 \(\pi_{\text{rollout}}\) ≠ \(\pi_{\text{old}}\) 时(由于 LLM-RL 中 Rollout 与训练之间的精度/后端差异,这很典型),这在数学上是不正确的
  • 这不是 PPO 的错
    • PPO 本身在数学上是正确的,问题在于 naive 实现中错误地假设 \(\pi_{\text{old}}\) = \(\pi_{\text{rollout}}\)
  • 这个导致 RL 训练崩溃的关键实现错误在博客文章 “When Speed Kills Stability: Demystifying RL Collapse from the Training-Inference Mismatch” 中被指出,并推动了本 Rollout 校正框架的开发

数学上正确的方法

  • Decoupled 模式(Decoupled mode) :三种策略(\(\pi_{\text{rollout}}\)、\(\pi_{\text{old}}\)、\(\pi_\theta\)),使用从 \(\pi_{\text{rollout}}\) 到 \(\pi_{\text{old}}\) 的 IS 校正
  • ** Bypass Mode (Bypass mode)** :两种策略(\(\pi_{\text{rollout}}\) = \(\pi_{\text{old}}\)、\(\pi_\theta\)),使用实际 Rollout 策略作为 PPO 锚点
  • Bypass + 策略梯度模式(Bypass + Policy Gradient mode) :两种策略(\(\pi_{\text{rollout}}\)、\(\pi_\theta\)),使用 IS/RS 校正且不进行 PPO 裁剪
  • 详见 rollout_corr_math.md 文件

关键设计原则:IS 权重与拒绝采样的分离

  • 实现清晰地将两种正交机制分开
  • 机制1 IS 权重(rollout_is_weights):用于梯度校正的连续重加权
    • 策略比率:\(\pi_{\text{old}}\)/\(\pi_{\text{rollout}}\)(Decoupled 模式)或 \(\pi_\theta\)/\(\pi_{\text{rollout}}\)( Bypass Mode )
    • 安全有界 :被限制在 [exp(-20), exp(20)] ≈ [2e-9, 5e8] 以防止溢出
      • Token 级:对每个 token 的比率施加界限
      • 序列级:对比率乘积施加界限(广播到所有 token)
    • 截断 :通过 .clamp(max=rollout_is_threshold) 进行上限截断(TIS:截断重要性采样,Truncated Importance Sampling)
    • 在填充位置置零 :乘以 response_mask 以将填充位置置零
    • 用于加权策略梯度(方差降低)
  • 机制2 拒绝采样(modified_response_mask):用于排除异常值的二值过滤
    • 创建二值掩码:1 = 保留,0 = 拒绝
    • 拒绝 IS 比率落在 [lower_threshold, upper_threshold] 之外的 token/序列
    • 修改 response_mask 以从训练中排除被拒绝的样本
  • 这种分离确保:
    • ✅ IS 权重提供连续重加权(降低方差)
    • ✅ 拒绝采样提供硬过滤(移除极端异常值)
    • ✅ 两种机制可以独立或同时启用
    • ✅ 安全界限在所有情况下防止数值溢出

Quark Start:使用经过验证的预设(Verified Presets)

  • 现在提供类型化配置,以及针对常见场景经过验证的预设
    • 这些预设已在各种模型和训练场景下经过数万 GPU 小时的验证

Python API

  • Python API 调用可以快速获取这些 config:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    from verl.trainer.config.algorithm import RolloutCorrectionConfig

    # === Decoupled PPO 模式(3 种策略:\\(\pi_{\text{rollout}}\\)、\\(\pi_{\text{old}}\\)、\\(\pi_\theta\\))===
    # IS 权重校正 \\(\pi_{\text{old}}\\) 与 \\(\pi_{\text{rollout}}\\) 之间的差距
    config = RolloutCorrectionConfig.decoupled_token_is() # Token-TIS
    config = RolloutCorrectionConfig.decoupled_seq_is() # Seq-TIS
    config = RolloutCorrectionConfig.decoupled_seq_is_rs() # Seq-MIS
    config = RolloutCorrectionConfig.decoupled_geo_rs() # Geo-RS(比率模式)
    config = RolloutCorrectionConfig.decoupled_geo_rs_token_tis() # Geo-RS + Token-TIS

    # === K3 KL 估计器预设(对于小 KL 更稳定)===
    config = RolloutCorrectionConfig.decoupled_k3_rs() # K3-RS 仅
    config = RolloutCorrectionConfig.decoupled_k3_rs_token_tis() # K3-RS + Token-TIS

    # === Bypass PPO 模式(2 种策略:\\(\pi_{\text{rollout}}\\) = \\(\pi_{\text{old}}\\)、\\(\pi_\theta\\))- 快速 ===
    # PPO 比率处理 IS,因此不需要显式 IS 权重
    config = RolloutCorrectionConfig.bypass_ppo_clip() # PPO-clip 仅
    config = RolloutCorrectionConfig.bypass_ppo_clip_geo_rs() # PPO-clip + Geo-RS
    config = RolloutCorrectionConfig.bypass_ppo_clip_k3_rs() # PPO-clip + K3-RS

    # === Bypass PG 模式(2 种策略,无 PPO 裁剪)- 快速 ===
    # IS 权重在损失函数中即时计算为 \\(\pi_\theta\\) / \\(\pi_{\text{rollout}}\\)
    config = RolloutCorrectionConfig.bypass_pg_is() # Seq-TIS + PG
    config = RolloutCorrectionConfig.bypass_pg_geo_rs() # Geo-RS + PG
    config = RolloutCorrectionConfig.bypass_pg_geo_rs_token_tis() # Geo-RS + Token-TIS + PG

    # === 其他 ===
    config = RolloutCorrectionConfig.disabled() # 仅指标(不进行校正)

YAML 配置(高级)

  • 用于高级定制或基于 YAML 的配置:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    algorithm:
    rollout_correction:
    rollout_is: token # IS 权重:"token"、"sequence" 或 null
    rollout_is_threshold: 2.0 # TIS 上限,或用于 IcePop 的 "0.5_5.0"
    rollout_is_batch_normalize: false # 批归一化 IS 权重使均值为 1.0
    rollout_rs: null # 拒绝采样:逗号分隔的规范选项(例如 "token_k1,seq_max_k2")
    rollout_rs_threshold: null # 阈值规格:float 或 "lower_upper" 字符串
    bypass_mode: false # 跳过 old_log_prob 计算(设置 \\(\pi_{\text{old}}\\) = \\(\pi_{\text{rollout}}\\))
    loss_type: ppo_clip # Bypass Mode 中的损失类型:"ppo_clip"(默认)或 "reinforce"

    # 必需:启用 log prob 计算
    actor_rollout_ref:
    rollout:
    calculate_log_probs: true
  • 注:使用 YAML 配置的时候可以参考 Python API 的内容来配置,确保自己的配置和官方一致


Configuration Parameters

  • 所有参数都在 algorithm.rollout_correction 下:

rollout_is(str 或 null)

  • 重要性采样权重聚合级别:
    • null = 不计算 IS 权重(仅指标模式)
    • "token":每个 Token 的 IS 权重
      • Decoupled 模式 :\(\rho_t\) = \(\pi_{\text{old}}(t)\)/\(\pi_{\text{rollout}}(t)\)
      • Bypass/纯 IS 模式 :\(\rho_t\) = \(\pi_\theta(t)\)/\(\pi_{\text{rollout}}(t)\)
      • 每个 Token 独立截断
      • 典型阈值:1.5 - 5.0
    • "sequence":每个序列的权重 \(\rho_\text{seq} = \prod_t \rho_t\)
      • 在序列上进行乘法聚合
      • 典型阈值:2.0 - 10.0
  • 所有 IS 权重都被安全限制在 [exp(-20), exp(20)] ≈ [2e-9, 5e8] 范围内

rollout_is_threshold(str 或 float)

  • IS 加权的阈值,默认值:2.0
  • 单个 float 或类 float 字符串:通过 .clamp(max=rollout_is_threshold) 进行 TIS
  • 诸如 "0.5_5.0" 的 "lower_upper" 字符串:IcePop,将 [lower, upper] 外的权重置零
  • 应用于 IS 权重以降低方差
  • 与拒绝采样分开(由 rollout_rs 参数控制)
  • 与 rollout_rs 不同,IcePop 不修改 response_mask;它只改变 IS 系数

rollout_is_batch_normalize(bool)

  • 对 IS 权重应用批归一化,默认值:False
    • True:在每个批次内将 IS 权重归一化为均值 = 1.0
      • Token 级 IS :在所有 token 权重上归一化,即除以 Token 粒度的均值(保证优化后的均值为 1)
      • 序列级 IS :在序列均值上归一化(每个序列一个权重),即除以 Sequence 粒度的均值(保证归一化后的均值为 1)
      • 注:不论哪种情况,被除以的那个数字都是 weights_mean,并被上报为 rollout_is_batch_norm_factor 指标
    • False:使用原始(截断的)IS 权重
  • 通过确保每批平均权重为 1.0 来降低方差
  • 在截断之后应用,以保留截断语义
  • 仅影响最终生效的 IS 权重值,不影响拒绝采样
    • 特别说明:也不会影响 rollout_is_mean 和 rollout_is_seq_mean 等上报指标
    • 打开 rollout_is_batch_normalize,可以看到 rollout_is_batch_norm_factor 指标(这个指标是归一化时除以的那个均值 weights_mean)
    • 补充:rollout_is_batch_norm_factor 与 rollout_is_seq_mean 的关系
      • 在 sequence 粒度的 TIS 校准中,当前上报方式下两者值相等,但 202603 之前(202511 版本)中,两者有差异,当时上报的 rollout_is_seq_mean 等指标是在截断 rollout_is_weights = rollout_is_weights.clamp(max=rollout_is_threshold) 之前上报的
      • token 粒度的 TIS 校准 rollout_is_batch_norm_factor 与 rollout_is_mean 的关系 也类似

rollout_rs(str 或 null)

  • 拒绝采样聚合模式,提供逗号分隔的字符串(空格可选),使用 rollout_corr_helper 中实现的规范选项:
    • token_k1:Token 级拒绝,使用 -log r 界限(比率阈值以 lower_upper 提供),示例:"0.6_1.4"
    • token_k2:Token 级拒绝,使用 0.5 * (log r)^2(仅上限)
    • token_k3:Token 级拒绝,使用 exp(log r) - 1 - log r(仅上限)
    • seq_sum_k1:序列级拒绝,使用 -log r 之和(比率界限)
    • seq_sum_k2:序列级拒绝,使用 0.5 * (log r)^2 之和(仅上限)
    • seq_sum_k3:序列级拒绝,使用 exp(log r) - 1 - log r 之和(仅上限)
    • seq_mean_k1:序列级拒绝,使用 -log r 的均值(比率界限)
    • seq_mean_k2:序列级拒绝,使用 0.5 * (log r)^2 的均值(仅上限)
    • seq_mean_k3:序列级拒绝,使用 exp(log r) - 1 - log r 的均值(仅上限)
    • seq_max_k2:序列级拒绝,使用 0.5 * (log r)^2 的最大值(仅上限)
    • seq_max_k3:序列级拒绝,使用 exp(log r) - 1 - log r 的最大值(仅上限)

rollout_rs_threshold(str、float 或 null)

  • rollout_rs_threshold 是拒绝采样的阈值
  • 为每个选项提供一个 entry ,用逗号分隔,单个 entry 会广播到所有 option
    • 注:这里这么说是因为 rollout_rs 是可以同时配置多个的 rollout_rs="token_k1,seq_max_k2" 这样,此时 rollout_rs_threshold 可以使用单个值来自动广播,也可以按照逗号分别配置阈值
  • 不同模式的阈值说明:
    • k1 KL 模式(*k1) :使用 "lower_upper" 字符串(例如 "0.7_1.3")
      • 理解:这里的 k1 KL 模式包括 token_k1、seq_sum_k1、seq_mean_k1 等,这些是双侧比率限制(因为 k1 是可能为负值的),阈值要写成 包含 “lower_upper” 的字符串
      • 注:如果只写一个 float 则意味着只是上界(此时的下限默认为其倒数)
    • k2/k3 KL 模式(*k2/*k3) :提供正的上限(float 或数字字符串)
      • 理解:包括 token_k2、seq_max_k2、seq_mean_k3 等,这些是单侧散度限制(因为 k2 和 k3 是非负的),只需要提供一个正的上界
  • 阈值设置为 null 时,表示完全禁用阈值
    • 注意:仅当 rollout_rs 为 null (即不启用任何拒绝采样)时才合法
  • 使用注意:在训练时,使用 RS 有可能导致 assert response_mask.any(), "Expected at least one valid token in response mask"
    • 这里 Rollout Correction 的 off-policy 指标统计是在 micro_batch 维度,所以 micro_batch 上的所有样本都被 Mask 时,则会直接报错
      • 注:类似 Megatron 中将 mini-batch 拆为多个 micro-batch,verl 也会将 mini-batch 拆为多个 micro-batch
        • verl 中策略:
          • 打开 use_dynamic_bsz=True 时使用 rearrange_micro_batches 函数来拆分 micro-batches
            • 这里的目标是让每个 GPU 单次的 Token 数量小于等于 ppo_max_token_len_per_gpu,所以 micro-batch 数量也是不确定的(平均队列越短,得到的 micro-batch 数量越小)
            • 极端情况下一个 micro-batch 中的真实样本数可能非常小(如果序列长度跟 ppo_max_token_len_per_gpu 时,甚至只包含一个样本,此时这个样本被 mask 就意味着出问题)
            • 注:rearrange_micro_batches 函数拆分 micro-batches 时只按照索引拆,仍然是多上,packing 发生在 forward_fn 内部,对我们是透明的
          • 否则 use_dynamic_bsz=False 时使用固定条数作为一个 micro-batches
            • 此时的配置为 ppo_micro_batch_size_per_gpu
        • 不论怎样,micro-batches 都会小于 mini-batch 数
    • 补充指标计算位置:
      指标组 产生函数 调用位置 输入规模
      rollout_is_*(含 rollout_is_seq_min/max) compute_rollout_correction_weights → compute_is_metrics 仅 ray_trainer.py(driver 侧) 完整 512 条
      kl / log_ppl_* / chi2 compute_rollout_corr_metrics_from_logprobs megatron_actor.py、dp_actor.py 单个 micro-batch
      • 上诉问题一般发生在 compute_rollout_corr_metrics_from_logprobs 中
      • 注:其实这种方式下 compute_rollout_corr_metrics_from_logprobs 中上报的 sequence 粒度的指标似乎都不是真实 Sequence 粒度的了(待确认)

Understanding the Framework: Components and Combinations

  • Rollout 校正框架构建自正交组件 ,可以灵活组合

Key Components

  • 1) Operating Mode
    • Decoupled :三种策略(\(\pi_{\text{rollout}}\)、\(\pi_{\text{old}}\)、\(\pi_\theta\)),单独计算 \(\pi_{\text{old}}\)
    • Bypass :两种策略(\(\pi_{\text{rollout}}\) = \(\pi_{\text{old}}\)、\(\pi_\theta\)),跳过 \(\pi_{\text{old}}\) 计算
  • 2) Loss Function( Bypass Mode 下,由 loss_type 控制)
    • PPO-clip(loss_type="ppo_clip",默认):PPO 裁剪目标(IS 由比率处理)
    • REINFORCE(loss_type="reinforce"):带显式 IS 权重的策略梯度(无裁剪)
  • 3) IS/RS Aggregation Level
    • Token :每个 Token 的 IS 权重/拒绝
    • Sequence :序列级 IS 权重/拒绝

Preset Configuration Guide

  • 本节给的每个 Preset 都是针对常见场景优化的特定组件组合

Understanding the Presets

Available Preset Methods
  • 所有提前配置好的方法示例:
    预设方法 估计器 模式 IS 级别 RS 级别 属性
    Decoupled PPO Mode(3 种策略:\(\pi_{\text{rollout}}\)、\(\pi_{\text{old}}\)、\(\pi_\theta\))
    decoupled_token_is() Token-TIS Decoupled token - Token 级 IS 权重
    decoupled_seq_is() Seq-TIS Decoupled sequence - 序列级 IS 权重
    decoupled_seq_is_rs() Seq-MIS Decoupled sequence sequence 序列 IS + seq_sum_k1 RS
    decoupled_geo_rs() Geo-RS Decoupled - sequence 几何 RS(seq_mean_k1)
    decoupled_geo_rs_token_tis() Geo-RS-Token-TIS Decoupled token sequence 几何 RS + token IS
    K3 KL Estimator(对小 KL 值更稳定)
    decoupled_k3_rs() K3-RS Decoupled - sequence seq_mean_k3 RS
    decoupled_k3_rs_token_tis() K3-RS-Token-TIS Decoupled token sequence seq_mean_k3 RS + token IS
    Bypass PPO-clip Mode(2 种策略;比率处理 IS,RS 掩码排除异常值)
    bypass_ppo_clip() - Bypass(PPO-clip) - - 仅 PPO-clip
    bypass_ppo_clip_geo_rs() Geo-RS Bypass(PPO-clip) - sequence PPO-clip + Geo-RS
    bypass_ppo_clip_k3_rs() K3-RS Bypass(PPO-clip) - sequence PPO-clip + K3-RS
    Bypass REINFORCE Mode(2 种策略;显式 IS 权重,无 PPO 裁剪)
    bypass_pg_is() Seq-TIS Bypass(REINFORCE) sequence - 带显式 IS 的 REINFORCE
    bypass_pg_geo_rs() Geo-RS Bypass(REINFORCE) - sequence REINFORCE + Geo-RS
    bypass_pg_geo_rs_token_tis() Geo-RS-Token-TIS Bypass(REINFORCE) token sequence REINFORCE + Geo-RS + token IS
    Other
    disabled() - - - - 仅指标,不校正
  • 使用注意:
    • Bypass Mode设置 \(\pi_{\text{old}} = \pi_{\text{rollout}}\),并使用 loss_type 选择损失函数:
      • "ppo_clip"(默认):PPO 裁剪目标,其中比率 = \(\pi_\theta / \pi_{\text{rollout}}\) 已经处理了 IS
      • "reinforce":带显式 IS 权重的 REINFORCE,IS 权重为 \(\pi_\theta / \pi_{\text{rollout}}\)
    • 两种损失类型都受益于拒绝采样(RS),它掩码掉分布外的样本
    • 所有估计器(Token-TIS、Seq-TIS、Seq-MIS、Geo-RS 等)都与Decoupled 模式和 Bypass Mode 兼容
其他可行组合(需手动配置)
  • 没有预设方法但受可行的其他组合:
    • Token IS + Token RS:Token 级 IS 权重 + Token 级 RS 掩码
    • 纯 Token RS:仅 Token 级 RS,无 IS 权重
    • 纯序列 RS:仅序列级 RS,无 IS 权重
  • 说明:
    • 任何聚合级别(token/sequence)都可在 Decoupled 或 Bypass Mode 下工作
    • 实现完全支持所有组合
    • 拒绝采样独立于 IS 加权
    • 纯 RS(bypass_pg_rs)使用 Bypass + 几何 RS,loss_type="reinforce"(无 IS 权重)

Decoupled 模式 + Token 级重要性采样(decoupled_token_is)

  • 参数配置:

    1
    config = RolloutCorrectionConfig.decoupled_token_is(threshold=2.0)
  • 基本组件

    • 运行模式 :Decoupled(3 种策略)
    • 损失 :带裁剪的 PPO(仅用于第二次漂移校正)
    • IS 聚合 :Token 级
    • RS :无(可单独添加)
  • 等效 YAML:

    1
    2
    3
    4
    5
    6
    algorithm:
    rollout_correction:
    rollout_is: token
    rollout_is_threshold: 2.0
    rollout_rs: null
    bypass_mode: false # Decoupled 模式
  • 特点:

    • 每个 Token 独立截断
    • 方差低于序列级(比率乘积被逐项限制)
    • 典型阈值:1.5 - 5.0

Decoupled 模式 + 序列级重要性采样(decoupled_seq_is)

  • 也称为:Seq-TIS(序列级截断重要性采样,Sequence-Level Truncated IS)

  • 参数配置:

    1
    config = RolloutCorrectionConfig.decoupled_seq_is(threshold=2.0)
  • 基本组件:

    • 运行模式 :Decoupled(3 种策略)
    • 损失 :带裁剪的 PPO(仅用于第二次漂移校正)
    • IS 聚合 :序列级(Seq-TIS)
    • RS :无(可单独添加)
  • 等效 YAML:

    1
    2
    3
    4
    5
    6
    algorithm:
    rollout_correction:
    rollout_is: sequence
    rollout_is_threshold: 2.0
    rollout_rs: null
    bypass_mode: false # Decoupled 模式
  • 特点:

    • 在序列上进行乘法聚合
    • 对异常值比 Token 级更敏感
    • 典型阈值:2.0 - 10.0(高于 Token 级)

Decoupled 模式 + 序列级 IS + 拒绝采样(decoupled_seq_is_rs)

  • 也称为:Seq-MIS(序列级掩码 IS,Sequence-Level Masked IS)

  • 参数配置:

    1
    config = RolloutCorrectionConfig.decoupled_seq_is_rs(is_threshold=2.0, rs_threshold="0.5_2.0")
  • 基本组件:

    • 运行模式 :Decoupled(3 种策略)
    • 损失 :带裁剪的 PPO(仅用于第二次漂移校正)
    • IS 聚合 :序列级(Seq-TIS)
    • RS :序列级拒绝(Seq-MIS)
  • 等效 YAML:

    1
    2
    3
    4
    5
    6
    7
    algorithm:
    rollout_correction:
    rollout_is: sequence
    rollout_is_threshold: 2.0
    rollout_rs: seq_sum_k1
    rollout_rs_threshold: 0.5_2.0
    bypass_mode: false # Decoupled 模式
  • 特点:

    • 双重机制:IS 重加权(Seq-TIS)+ 拒绝过滤(Seq-MIS)
    • 有效样本量较低(拒绝异常值)
    • 适用于严重的 off-policy 差距或当分布尾部是“有毒的”(垃圾/对抗样本)时
  • 何时使用 Seq-MIS 而非 Seq-TIS:

    • Seq-TIS(仅裁剪) :最大化信息效率;从所有样本中提取信号
      • 当数据干净且不匹配适中时使用
    • Seq-MIS(拒绝) :最大化安全性;充当硬信任区域过滤器
      • 当不匹配严重或高权重样本很可能是垃圾而非信号时使用

Bypass Mode + PPO-clip(bypass_ppo_clip)

  • 参数配置:

    1
    config = RolloutCorrectionConfig.bypass_ppo_clip()
  • 基本组件:

    • 运行模式 :Bypass(2 种策略:\(\pi_{\text{rollout}}\) = \(\pi_{\text{old}}\)、\(\pi_\theta\))
    • 损失 :PPO-clip(IS 由比率处理,无显式 IS 权重)
    • IS 聚合 :无(PPO 比率处理)
    • RS :无
  • 等效 YAML:

    1
    2
    3
    4
    5
    rollout_correction:
    rollout_is: null
    rollout_rs: null
    bypass_mode: true
    loss_type: ppo_clip
  • 特点:

    • Bypass Mode 下的 PPO 裁剪目标
    • PPO 比率 = \(\pi_\theta / \pi_{\text{rollout}}\) 已经处理了 IS(不需要显式 IS 权重)
    • 跳过 actor.compute_log_prob() 前向传播(2 种策略而非 3 种)
    • 无拒绝采样——使用 bypass_ppo_clip_geo_rs() 添加 RS
  • 配置要求:

    • 需要设置 actor_rollout_ref.rollout.calculate_log_probs: true
  • Bypass Mode 的额外要求:

    • 设置 actor_rollout_ref.actor.use_rollout_log_probs: true
    • 设置 actor_rollout_ref.actor.policy_loss.loss_mode: bypass_mode
    • 通过 actor_rollout_ref.actor.policy_loss.rollout_correction 设置 Rollout 校正配置为上诉 Yaml 配置

带 IS 的 REINFORCE(bypass_pg_is)

  • 参数配置:

    1
    config = RolloutCorrectionConfig.bypass_pg_is(threshold=2.0)
  • 基本组件:

    • 运行模式 :Bypass(2 种策略:\(\pi_{\text{rollout}}\)、\(\pi_\theta\))
    • 损失 :REINFORCE(带显式 IS 权重的策略梯度,无 PPO 裁剪)
    • IS 聚合 :序列级
    • RS :无
  • 等效 YAML:

    1
    2
    3
    4
    5
    6
    rollout_correction:
    rollout_is: sequence
    rollout_is_threshold: 2.0
    rollout_rs: null
    bypass_mode: true
    loss_type: reinforce # 带显式 IS 权重的 REINFORCE
  • 特点:

    • 带显式 IS 权重的 REINFORCE 损失(无 PPO 裁剪)
    • 单次前向传播(跳过 old_log_prob 计算)
    • IS 权重在损失函数中即时计算
  • 问题:为什么 这里要将 Bypass Mode + PPO-clip 模式 和 带 IS 的 REINFORCE 模式 分开写?

    • 因为两者在 VeRL 中需要的配置不同
      • Bypass Mode + PPO-clip 模式配置 rollout_is=null
      • 带 IS 的 REINFORCE 模式配置 rollout_is=sequence/token
    • PPO-clip 中天然就有 IS 和 Clip 了,可以通过 PPO 的 IS(\(r_t\theta\)) 直接校准两种不同
      $$
      r_t(\theta) = \frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\text{rollout} }(a_t \mid s_t)}
      $$
    • 带 IS 的 REINFORCE 中将 IS 视为了 Rollout 修正 的这个角色的比值(\(\rho_t\theta\)),所以需要设置 rollout_is=sequence/token(打开 rollout_correction)
      • 若为 Token 粒度
        $$
        \rho_t(\theta) = \frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\text{rollout} }(a_t \mid s_t)}
        $$
      • 若为 Sequence 粒度
        $$
        w_{\text{seq} }(\theta) = \rho(\theta) = \frac{\pi_{\theta}(y \mid x)}{\pi_{\text{rollout} }(y \mid x)} = \prod_{t=1}^{T} \frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\text{rollout} }(a_t \mid s_t)}
        $$

补充:额外有用的配置(未作为预设公开)

  • 这些配置可用 ,但还没有便捷的预设方法

Token IS + Token RS(token_is_rs)

  • Token 级 IS 权重加上 Token 级 RS 掩码

    1
    2
    3
    4
    5
    6
    config = RolloutCorrectionConfig(
    rollout_is="token",
    rollout_is_threshold=2.0,
    rollout_rs="token_k1",
    rollout_rs_threshold=2.0,
    )
  • 特点: 每个 Token 的 IS 权重 + 每个 Token 的 RS 掩码

纯 Token RS(token_rs)

  • 仅 Token 级 RS,无 IS 权重

    1
    2
    3
    4
    5
    config = RolloutCorrectionConfig(
    rollout_is=None,
    rollout_rs="token_k1",
    rollout_rs_threshold=2.0,
    )
  • 特点:Token 级 RS 掩码,无 IS 重加权

纯序列 RS(seq_rs)

  • 仅序列级 RS,无 IS 权重

    1
    2
    3
    4
    5
    config = RolloutCorrectionConfig(
    rollout_is=None,
    rollout_rs="seq_sum_k1",
    rollout_rs_threshold="0.5_2.0",
    )
  • 特点:序列级 RS 掩码,无 IS 重加权

总结:IS 权重的处理方式

  • IS 权重(rollout_is_weights)经过固定的处理流水线:
  • 阶段 1:安全界限(防止溢出)
    • Token 级:每个 Token 的 exp(clamp(log_ratio, -20, 20)) → 将每个 token 限制在 [2e-9, 5e8]
    • 序列级:exp(clamp(sum(log_ratio), -20, 20)) → 将乘积限制在 [2e-9, 5e8],广播到所有 token
  • 阶段 2:截断(降低方差)
    • .clamp(max=rollout_is_threshold) → 将权重上限截断(TIS:截断重要性采样)
    • 无下限截断(对小权重保持无偏性)
  • 阶段 3:填充位置置零(正确聚合)
    • weights * response_mask → 将填充位置置零
  • 阶段 4:可选的批归一化
    • 如果 rollout_is_batch_normalize=True:将权重归一化到批次内均值为 1.0
    • 在截断之后应用,以保留截断语义
  • 拒绝采样(独立机制)
    • 拒绝采样通过 compute_rollout_rejection_mask() 修改 response_mask(而非权重):
      • 独立计算安全有界的比率
      • 创建二值掩码:落在 [lower_threshold, upper_threshold] 之外的 token/序列 → 0(拒绝)
      • 修改后的掩码用于损失聚合

Operation Modes

  • 该框架提供两种运行模式 来计算 \(\pi_{\text{old}}\),可与不同的损失函数结合

Operating Modes and Configuration

  • Operating Modes 配置情况:
    配置 bypass_mode loss_type 运行模式 损失函数 描述
    Decoupled false N/A Decoupled PPO 通过 actor.compute_log_prob() 单独计算 old_log_prob
    Bypass + PPO-clip true "ppo_clip"(默认) Bypass PPO-clip PPO 裁剪目标(IS 由比率处理)
    Bypass + REINFORCE true "reinforce" Bypass REINFORCE 带显式 IS 权重的策略梯度(无 PPO 裁剪)

Operating Mode Details

Decoupled Mode,三种策略
  • 策略设置:
    • \(\pi_{\text{rollout}}\):行为策略(数据收集)
    • \(\pi_{\text{old}}\):近端策略(在训练 epoch 开始时通过 actor.compute_log_prob() 计算)
    • \(\pi_\theta\):当前策略(正在更新)
  • 参数配置: bypass_mode = false
  • 特点:
    • ✅ 实现批次大小不变性
    • ✅ 分别校正漂移 1(rollout→old)和漂移 2(old→current)
    • ✅ 高效利用陈旧数据
    • ❌ 需要额外的前向传播(actor.compute_log_prob())
Bypass Mode,两种策略
  • 策略设置:
    • \(\pi_{\text{rollout}}\):行为策略(数据收集)
    • \(\pi_{\text{old}}\) = \(\pi_{\text{rollout}}\):近端策略等于行为策略
    • \(\pi_\theta\):当前策略(正在更新)
  • 参数配置: bypass_mode = true
  • 属性:
    • ✅ 跳过 actor.compute_log_prob() 调用(更快)
    • ✅ 通过 IS/RS 处理 off-policy 校正(当使用带 IS/RS 的策略梯度时)
    • ✅ 使用两种策略而非三种(\(\pi_{\text{rollout}}\) = \(\pi_{\text{old}}\))
    • ⚠️ 不将近端策略与行为策略分离(不同于 Decoupled 模式)

IS/RS 聚合级别(正交于运行模式)

  • 聚合级别可以独立于 运行模式选择,任何聚合级别都可以在 Decoupled 或 Bypass Mode 下工作
    rollout_is rollout_rs 行为
    null null 禁用 :不计算、无指标、无拒绝
    null "token_k1"、"seq_sum_k1"、"seq_mean_k1"、"seq_max_k2" 等 仅拒绝 :计算指标、不进行权重校正、进行拒绝采样
    "token" 或 "sequence" null 仅 IS 权重 :启用权重校正、不进行拒绝采样
    "token" 或 "sequence" "token_k1"、"seq_sum_k1"、"seq_mean_k1"、"seq_max_k2" 等 完整校正 :同时启用权重校正和拒绝采样

Key Insights

  • ✅ 任何 IS/RS 聚合级别(token/sequence/geometric)都可以在Decoupled或Bypass模式下使用
  • ✅ 您可以单独使用拒绝采样而不进行 IS 权重校正(rollout_is=null, rollout_rs="token_k1")
  • ✅ 您可以单独使用 IS 权重而不进行异常值拒绝(rollout_is="token", rollout_rs=null)
  • ✅ 您可以同时使用两者(rollout_is="token", rollout_rs="token_k1")
  • ✅ 您可以仅监控指标而不进行任何校正,方法是同时将两者设置为 null,但仍提供 rollout_log_probs

Example Workflow

推荐: Bypass Mode
  • 该工作流为高效而使用 Bypass Mode

  • 1) 从仅指标开始 ,以了解 off-policy 差距:

    1
    2
    3
    4
    5
    rollout_correction:
    rollout_is: null
    rollout_rs: null
    bypass_mode: true # Bypass Mode (推荐)
    loss_type: ppo_clip # 默认:PPO 裁剪目标
    • 监控 rollout_corr/kl、rollout_corr/log_ppl_abs_diff、rollout_corr/chi2_token 以评估 off-policy 差距
    • 注意:off-policy 指标是无条件计算的,不管是否打开 rollout_correction 都会被计算
      • 关闭 Bypass Mode 模式下,ritio = old_log_prob/rollout_log_prob :
        • old_log_prob = log_prob
        • rollout_log_prob = rollout_log_prob
  • 2) 如果看到高异常值比例,则启用拒绝采样 :

    1
    2
    3
    4
    5
    6
    rollout_correction:
    rollout_is: null
    rollout_rs: sequence # 或 "geometric" 以获得更高敏感性
    rollout_rs_threshold: 2.0
    bypass_mode: true # Bypass Mode
    loss_type: ppo_clip # 或 "reinforce" 以使用显式 IS 权重
    • 这将从训练中排除异常值,而不修改梯度
  • 3) 一旦对指标满意,启用完整的 IS 校正(配合 REINFORCE 损失):

    1
    2
    3
    4
    5
    6
    7
    rollout_correction:
    rollout_is: sequence # 推荐:无偏,适用于大多数情况(
    rollout_is_threshold: 2.0
    rollout_rs: sequence # 或 "geometric" 以进行更激进的过滤
    rollout_rs_threshold: 2.0
    bypass_mode: true # Bypass Mode
    loss_type: reinforce # 带显式 IS 权重的 REINFORCE
    • 理解(个人经验):虽然 sequence-level MIS 是无偏的,但亲测当 micro-batch 过小时,容易报错
      • rollout_corr_helper.py 本身会 assert 一个 micro-batch 内部的 Token 不能全被 Mask
      • 解法1:
        • Mask 时将 Advantage 置为 0 而不是使用 response_mask
      • 解法2:
        • 使用 Token 粒度的 Mask,然后保留 Sequence 粒度的 IS
  • Bypass Mode 的优点:

    • ✅ 跳过昂贵的 actor.compute_log_prob() 前向传播(更快)
    • ✅ loss_type 控制损失函数:”ppo_clip”(默认)或 “reinforce”
    • ✅ PPO-clip:IS 由比率处理(无显式权重),应用 RS 掩码
    • ✅ REINFORCE:显式 IS 权重即时计算(\(\pi_\theta\) / \(\pi_{\text{rollout}}\))
    • ✅ 两种损失类型都与所有 IS/RS 组合兼容

Usage

Basic Setup

  • 配置:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    algorithm:
    rollout_correction:
    rollout_is: token # 在 Token 级启用 IS 权重
    rollout_is_threshold: 2.0 # IS 权重的阈值
    rollout_rs: null # 不进行拒绝采样

    actor_rollout_ref:
    rollout:
    calculate_log_probs: true # 必需!

Bypass Mode 的额外配置

  • 设置 actor_rollout_ref.actor.use_rollout_log_probs: true
  • 设置 actor_rollout_ref.actor.policy_loss.loss_mode: bypass_mode
  • 通过 actor_rollout_ref.actor.policy_loss.rollout_correction 设置 Rollout 校正配置

Metrics

  • 所有指标在日志中都以 rollout_corr/ 为前缀
    • 例如,rollout_is_mean 在日志中显示为 rollout_corr/rollout_is_mean
  • 这些指标涵盖:
    • 诊断指标 :KL 散度、困惑度差异(衡量 off-policy 差距)
    • 校正统计量 :IS 权重、拒绝率(衡量所施加的校正)
Core IS Weight Metrics
  • rollout_is_mean :所有有效 token 上的平均重要性采样权重
    • Token 粒度的 IS 时,这个指标一般为 1 左右(看着上报甚至四舍五入后一直是 1)
      • 注意:等于 1 而不是小于 1 的原因是跟之前我们所熟悉的 KL 散度不一样
        • KL 的结论针对 log ratio,不是 ratio
          • \(q\):rollout 策略
          • \(p\):训练引擎重算 old_log_probs 对应的策略
          • \(r=p/q\)
        • 对于固定上下文,在支持集覆盖、概率计算正确的条件下:
          $$
          \mathbb E_{a\sim q}[r]=\sum_a q(a)\frac{p(a)}{q(a)}=\sum_a p(a)=1.
          $$
        • 而 KL 对应的是:
          $$
          \mathbb E_q[\log r]=-D_{\text{KL} }(q\Vert p)\le 0.
          $$
        • 所以:
          $$
          \begin{align}
          \underbrace{\mathbb E_q[r]&=1}_{\text{算术平均} }\\
          \underbrace{\exp(\mathbb E_q[\log r])&\le 1}_{\text{几何平均} }
          \end{align}
          $$
    • Sequence 粒度 IS 时,每个 Token 的权重相等,计算平均后一般不是 1(长序列的 IS 小于1)
  • rollout_is_std :IS 权重的标准差
    • 值越高表示 IS 权重方差越大
  • rollout_is_min :观察到的最小 IS 权重
    • 显示最被低估的 token/序列
    • 对于 sequence/geometric:从未裁剪的对数空间比率计算(真实最小值)
    • 对于 token:从安全有界的权重计算
  • rollout_is_max :观察到的最大 IS 权重
    • 显示最被高估的 token/序列
    • 对于 sequence/geometric:从未裁剪的对数空间比率计算(安全界限之前的真实最大值)
    • 对于 token:从安全有界的权重计算(阈值裁剪之前)
    • 与 rollout_is_threshold 比较以查看截断影响
Effective Sample Size
  • rollout_is_eff_sample_size :IS 加权后的有效样本量
    • 公式 :1 / mean(weights^2),其中权重已归一化
      • 注:这个是可以推导出来的,详情见:NLP——LLM-RL训练指标记录
    • 范围 :0.0 到 1.0(占原始批次的分数)
    • 值越低表示权重集中在更少的样本上
Threshold Exceedance Metrics
  • rollout_is_ratio_fraction_high :超过上限阈值的权重比例
    • 显示截断/掩码在高端的发生频率
    • 对于 sequence/geometric:从未裁剪的对数空间比率计算(真实超出)
    • 对于 token:从安全有界的权重计算(阈值裁剪之前)
  • rollout_is_ratio_fraction_low :低于下限阈值(1/upper_threshold)的权重比例
    • 显示有多少权重低于倒数阈值的诊断指标
    • 对于 sequence/geometric:从未裁剪的对数空间比率计算(真实超出)
    • 对于 token:从安全有界的权重计算(截断之前)
序列级指标(用于序列聚合)
  • rollout_is_seq_mean :序列级的平均 IS 权重
    • 现在 seq 内部对所有 Token 的 IS(这个 IS 的粒度可能是 sequence 或者 Token) 平均,然后再对 batch 内部对 seq 平均
    • Token 粒度的 IS 时,这个指标和 rollout_is_mean 一般都是 1
    • Sequence 粒度的 IS 时,这个指标可能较小,且和 rollout_is_mean 可能不一致
  • rollout_is_seq_std :序列级 IS 权重的标准差
  • rollout_is_seq_min :最小序列级 IS 权重
  • rollout_is_seq_max :最大序列级 IS 权重
  • rollout_is_seq_max_deviation :序列级与 1.0 的最大绝对偏差
    • 显示最坏情况序列的 off-policy 差距
  • rollout_is_seq_fraction_high :超过上限阈值的序列比例
  • rollout_is_seq_fraction_low :低于下限阈值的序列比例
补充:rollout_is_seq_mean 和 rollout_is_mean 指标计算细节
  • rollout_is=token 下,rollout_is_seq_mean 和 rollout_is_mean 都接近 \(1\)
    • 名字中的 seq 不代表“把整条序列的 token ratio 相乘
    • 设第 \(i\) 条序列有 \(L_i\) 个有效 token,token ratio 为 \(r_{it}\),代码先求每条序列的算术均值:
      $$
      a_i=\frac{1}{L_i}\sum_t r_{it}.
      $$
    • 然后两个指标分别是:
      $$
      \begin{align}
      \texttt{rollout_is_mean}&=\frac{\sum_i L_i a_i}{\sum_i L_i} \\
      \texttt{rollout_is_seq_mean}&=\frac1N\sum_i a_i
      \end{align}
      $$
    • 即:
      • mean:所有有效 token 等权,长序列贡献更多;
      • seq_mean:先在序列内平均,再让各序列等权
    • 当各序列内部的 token ratio 均值都接近 \(1\) 时,两个指标自然都接近 \(1\)
  • 换成 rollout_is=sequence 后, seq_mean 一般比 mean 大,甚至大一个数量级
    • sequence 模式改变了权重本身,此时每条序列计算一个权重:
      $$
      w_i=\exp\left(\sum_t\log r_{it}\right),
      $$
    • 实现上会先将上述 log-ratio 总和 clamp 到 \([-20,20]\),再取指数,并将 \(w_i\) 广播到该序列的所有有效 token
    • 因此,两个指标变为:
      $$
      \begin{align}
      \texttt{rollout_is_mean}&=\frac{\sum_i L_iw_i}{\sum_i L_i} \\
      \texttt{rollout_is_seq_mean}&=\frac1N\sum_i w_i
      \end{align}
      $$
      • 它们仍是同一批权重的不同加权平均,不是两种不同的修正比例
    • 当长序列权重更小时,token 加权均值就更低
      • 补充:为什么长轨迹容易出现小权重?
        • 因为 sequence IS 累积的是 log ratio 的总和,没有除以长度 :
          $$
          \log w_i=L_i\cdot\overline{\log r}_i.
          $$
        • 例如,一条轨迹的平均 log ratio 仅为 \(-0.001\)(对应 ratio 微小于 1):
          • \(1,000\) 个 token:\(w=e^{-1}\approx0.368\);
          • \(10,000\) 个 token:\(w=e^{-10}\approx0.0000454\)
拒绝采样指标(当启用 rollout_rs 时)
  • rollout_rs_masked_fraction :通过拒绝采样被拒绝的 token 比例
    • 重要 :拒绝采样修改 response_mask(将被拒绝的 token 设为 0)
    • 与 IS 权重分开 :IS 权重仍然被截断;拒绝是独立的过滤步骤
    • 仅在启用 rollout_rs 时存在(token/sequence/geometric)
  • rollout_rs_seq_masked_fraction :至少有一个被拒绝 token 的序列比例
    • 显示拒绝采样对序列级的影响
    • Token 级 RS:如果 ANY token 在 [lower, upper] 之外,则序列被拒绝
    • 序列级 RS:整个序列根据序列级比率被拒绝或接受
    • 几何 RS:整个序列根据几何均值被拒绝或接受
Off-Policy 诊断指标(训练策略 vs Rollout 策略)
  • 关于术语的说明: 这些指标使用 “training” 指代训练参考策略,“rollout” 指代 \(\pi_{\text{rollout}}\)(用于数据收集的行为策略)
  • Decoupled 模式 :“training” = \(\pi_{\text{old}}\)(在训练 epoch 开始时计算)
  • Bypass/纯 IS 模式 :“training” = \(\pi_\theta\)(当前正在训练的策略)
  • 在 Bypass/纯 IS 模式下,指标直接衡量 \(\pi_\theta\) 与 \(\pi_{\text{rollout}}\) 之间的漂移
  • training_ppl :训练参考策略的困惑度(Decoupled 模式下为 \(\pi_{\text{old}}\),Bypass/纯 IS 模式下为 \(\pi_\theta\))
    • 公式 :exp(-mean(log_probs))
    • 值越低表示模型置信度越高
  • rollout_ppl :Rollout 策略 \(\pi_{\text{rollout}}\) 的困惑度(例如 vLLM BF16)
  • ppl_ratio :训练 PPL 与 Rollout PPL 的比率
    • 公式 :exp(mean(log(training_ppl / rollout_ppl)))
    • 含义 :> 1.0 表示训练不如 Rollout 自信
  • training_log_ppl :训练策略的对数困惑度
    • 有助于识别趋势(线性尺度)
  • rollout_log_ppl :Rollout 策略的对数困惑度
  • log_ppl_diff :对数困惑度差异的均值
    • 公式 :mean(log_ppl_rollout - log_ppl_training)
    • 符号指示哪个策略更自信
  • log_ppl_abs_diff :对数困惑度绝对差异的均值
    • off-policy 差距的大小,与方向无关
  • log_ppl_diff_max :序列间最大的对数困惑度差异
    • 识别最坏情况序列
  • log_ppl_diff_min :序列间最小的对数困惑度差异
  • kl :KL 散度 KL(\(\pi_{\text{rollout}}\) || \(\pi_\text{training}\))
    • 公式 :mean(log_prob_rollout - log_prob_training)
    • 注意 :可以为负(Rollout 不太自信)
  • k3_kl :K3 散度(在期望上等于 KL(\(\pi_{\text{rollout}}\) || \(\pi_\text{training}\)))
    • 公式 :mean(exp(log_ratio) - log_ratio - 1)
    • 比直接 KL 更稳定(每个 token 非负)
    • 总是 >= 0
  • chi2_token :Token 级的卡方散度
    • 公式 :mean(ratio²) - 1,其中 ratio = \(\pi_\text{training}\)/\(\pi_{\text{rollout}}\)
    • 衡量 IS 权重分布的二阶矩
    • 总是非负
    • 理解;这个指标相对 kl 等的好处是,对训推不一致的感受更加敏感,往往在 kl 等变化比较平缓时,chi2_token 已经波动较大了
  • chi2_seq :序列级的卡方散度
    • 公式 :mean((∏_t ratio_t)²) - 1
    • IS 权重的序列级二阶矩
    • 比 Token 级卡方更敏感
    • 理解:这个指标比 chi2_token 更敏感,特别在模型的输出长度方差较大时,常样本带来的波动会在这里很敏感的体现出来
示例:在代码中访问指标
  • 代码示例(详情见原文,这里只保留核心阈值思路):
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    from verl.trainer.ppo.rollout_corr_helper import compute_rollout_correction_and_rejection_mask

    weights_proto, modified_response_mask, metrics = compute_rollout_correction_and_rejection_mask(
    old_log_prob=training_log_probs,
    rollout_log_prob=rollout_log_probs,
    response_mask=response_mask,
    rollout_is="token",
    rollout_is_threshold=2.0,
    rollout_rs="token_k1",
    rollout_rs_threshold="0.5_2.0",
    )

    is_weights = weights_proto.batch["rollout_is_weights"]

    if metrics['rollout_corr/rollout_is_mean'] < 0.5 or metrics['rollout_corr/rollout_is_mean'] > 2.0:
    # IS 在 [0.5, 2.0] 之外,异常告警

    if metrics['rollout_corr/rollout_is_eff_sample_size'] < 0.3:
    # 有效样本低于 在 0.3,异常告警
示例:基于指标的条件告警
  • 一些告警条件示例:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    def check_rollout_correction_health(metrics, config):
    """检查 Rollout Correction 指标是否表明训练健康"""
    warnings = []

    # 检查平均 IS 权重
    mean_weight = metrics['rollout_corr/rollout_is_mean']
    if mean_weight < 0.5 or mean_weight > 2.0:
    warnings.append(f"平均 IS 权重 {mean_weight:.3f} 远离 1.0")

    # 检查有效样本量
    ess = metrics['rollout_corr/rollout_is_eff_sample_size']
    if ess < 0.3:
    warnings.append(f"有效样本量 {ess:.3f} 过低")

    # 检查标准差
    std = metrics['rollout_corr/rollout_is_std']
    if std > 1.0:
    warnings.append(f"IS 权重标准差 {std:.3f} 过高")

    # 检查 KL 散度
    kl = metrics['rollout_corr/kl']
    if abs(kl) > 0.1:
    warnings.append(f"KL 散度 {kl:.3f} 表明存在显著 off-policy 差距")

    # 检查卡方散度
    if 'rollout_corr/chi2_token' in metrics:
    chi2_token = metrics['rollout_corr/chi2_token']
    if chi2_token > 1.0:
    warnings.append(f"卡方散度(token){chi2_token:.3f} 表明存在严重分布偏移")

    if warnings:
    print("Rollout Correction 健康警告:")
    for warning in warnings:
    print(f" - {warning}")
    return False
    else:
    print("Rollout Correction 指标看起来健康")
    return True

    _,_, metrics = compute_rollout_correction_and_rejection_mask(...)
    is_healthy = check_rollout_correction_health(metrics, config)

    if not is_healthy:
    print("考虑:")
    print(" - 收紧 rollout_is_threshold")
    print(" - 切换到几何聚合级别")
    print(" - 检查 Rollout 和训练策略是否差异过大")

Running Examples

  • 从基本的 Token 级截断配置开始:

    1
    bash examples/rollout_correction/run_qwen2_5_7b_fsdp.sh
  • 在调整参数之前监控指标 1-2 个 epoch


Configuration Examples

  • 示例 1:仅 IS 权重(Token 级)

    1
    2
    3
    4
    5
    algorithm:
    rollout_correction:
    rollout_is: token
    rollout_is_threshold: 2.0
    rollout_rs: null # 不进行拒绝采样
  • 示例 2:仅拒绝采样(无 IS 权重)

    1
    2
    3
    4
    5
    algorithm:
    rollout_correction:
    rollout_is: null # 无 IS 权重
    rollout_rs: token_k1
    rollout_rs_threshold: "0.5_2.0"
  • 示例 3:同时使用 IS 和 RS(Token RS)

    1
    2
    3
    4
    5
    6
    algorithm:
    rollout_correction:
    rollout_is: token
    rollout_is_threshold: 2.0
    rollout_rs: token_k1
    rollout_rs_threshold: "0.5_2.0"
  • 示例 5: Bypass Mode + PPO-clip(默认)

    1
    2
    3
    4
    5
    6
    7
    8
    algorithm:
    rollout_correction:
    rollout_is: token
    rollout_is_threshold: 2.0
    rollout_rs: token_k1
    rollout_rs_threshold: "0.5_2.0"
    bypass_mode: true # 跳过 old_log_prob 计算
    loss_type: ppo_clip # PPO 裁剪目标(默认)
  • 示例 6: Bypass Mode + REINFORCE,无 PPO 裁剪,纯策略梯度 + IS 校正

    1
    2
    3
    4
    5
    6
    rollout_correction:
    rollout_is: sequence # 损失中的显式 IS 校正
    rollout_is_threshold: 2.0
    rollout_rs: null # 可选:可以添加拒绝采样
    bypass_mode: true
    loss_type: reinforce # 带显式 IS 权重的 REINFORCE
  • 示例 7: Bypass Mode + PPO-clip + 拒绝采样,PPO 裁剪 + 拒绝采样,IS 由 PPO 比率处理(无显式 IS 权重)

    1
    2
    3
    4
    5
    6
    7
    rollout_correction:
    rollout_is: sequence # 为指标计算
    rollout_is_threshold: 2.0
    rollout_rs: seq_max_k2 # 序列最大 χ²/2 守卫
    rollout_rs_threshold: 2.5
    bypass_mode: true
    loss_type: ppo_clip # PPO 裁剪目标(IS 由比率处理)
    • 问题:这里不担心 PPO Clip 和 rollout_is 两次校准重复了吗?
    • 回答:不用担心,源码如下:
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14
      15
      16
      17
      18
      19
      20
      21
      22
      23
      24
      25
      26
      27
      28
      # Dispatch to appropriate loss function based on loss_type
      if loss_type == "reinforce":
      # REINFORCE: Apply IS weights explicitly
      pg_loss, pg_metrics = compute_policy_loss_reinforce(
      rollout_log_prob=rollout_log_prob,
      log_prob=log_prob,
      advantages=advantages,
      response_mask=effective_mask,
      loss_agg_mode=loss_agg_mode,
      config=config,
      # 下面这一行是核心,REINFORCE 没有 ppo_clip,需要加入 computed_is_weights 作为训推不一致的校正
      rollout_is_weights=computed_is_weights,
      )

      elif loss_type == "ppo_clip":
      # PPO-clip: The ratio π_current/π_old = π_current/π_rollout already handles IS
      # DO NOT apply IS weights - would be double-counting!
      # The clipping mechanism constrains the effective IS ratio
      pg_loss, pg_metrics = compute_policy_loss_vanilla( # type: ignore[call-arg]
      old_log_prob=rollout_log_prob, # = old_log_prob in bypass mode
      log_prob=log_prob,
      advantages=advantages,
      response_mask=effective_mask,
      loss_agg_mode=loss_agg_mode,
      config=config,
      # 下面这一行是核心,保证即使 computed_is_weights 在之前有值(有时会为了上报指标而打开 rollout_is),也不影响 Loss 计算
      rollout_is_weights=None, # Explicitly None - no IS weights for PPO-clip
      )

Troubleshooting

问题:IS 权重分布范围过大

  • 问题表现: rollout_is_std > 1.0,rollout_is_eff_sample_size < 0.3
  • 解决方案:
    • 1)从 sequence 切换到 geometric 级别
    • 2)收紧阈值
    • 3)验证 Rollout 和训练差异是否过大

问题:平均 IS 权重远离 1.0

  • 问题表现:rollout_is_mean < 0.5 或 > 2.0
  • 解决方案:
    • 1)确认已设置 calculate_log_probs=True
    • 2)检查 rollout_log_probs 是否正确传递
    • 3)检查是否存在系统性分布偏移

调试:可视化指标

  • 示例:绘制 IS 权重分布
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    import matplotlib.pyplot as plt
    import numpy as np

    def plot_is_metrics(metrics_history):
    """绘制随训练步数变化的 Rollout IS 指标"""
    fig, axes = plt.subplots(2, 3, figsize=(15, 10))

    # 图 1:平均 IS 权重随时间变化
    axes[0, 0].plot(metrics_history['rollout_corr/rollout_is_mean'])
    axes[0, 0].axhline(y=1.0, color='r', linestyle='--', label='理想值')
    axes[0, 0].set_title('平均 IS 权重')
    axes[0, 0].set_xlabel('步数')
    axes[0, 0].legend()

    # 图 2:有效样本量
    axes[0, 1].plot(metrics_history['rollout_corr/rollout_is_eff_sample_size'])
    axes[0, 1].axhline(y=0.5, color='g', linestyle='--', label='良好')
    axes[0, 1].axhline(y=0.3, color='r', linestyle='--', label='警告')
    axes[0, 1].set_title('有效样本量')
    axes[0, 1].set_xlabel('步数')
    axes[0, 1].legend()

    # 图 3:KL 散度随时间变化
    axes[1, 0].plot(metrics_history['rollout_corr/kl'], label='KL')
    axes[1, 0].plot(metrics_history['rollout_corr/k3_kl'], label='K3 KL')
    axes[1, 0].axhline(y=0, color='g', linestyle='--', alpha=0.3)
    axes[1, 0].set_title('KL 散度')
    axes[1, 0].set_xlabel('步数')
    axes[1, 0].legend()

    # 图 4:PPL 比率随时间变化
    axes[1, 1].plot(metrics_history['rollout_corr/ppl_ratio'])
    axes[1, 1].axhline(y=1.0, color='r', linestyle='--', label='理想值')
    axes[1, 1].set_title('PPL 比率(训练/Rollout)')
    axes[1, 1].set_xlabel('步数')
    axes[1, 1].legend()

    # 图 5:卡方散度
    if 'rollout_corr/chi2_token' in metrics_history:
    axes[1, 2].plot(metrics_history['rollout_corr/chi2_token'], label='Token 级')
    if 'rollout_corr/chi2_seq' in metrics_history:
    axes[1, 2].plot(metrics_history['rollout_corr/chi2_seq'], label='序列级')
    axes[1, 2].axhline(y=1.0, color='r', linestyle='--', label='警告')
    axes[1, 2].set_title('卡方散度')
    axes[1, 2].set_xlabel('步数')
    axes[1, 2].legend()
    else:
    axes[1, 2].axis('off')

    plt.tight_layout()
    plt.savefig('rollout_is_metrics.png', dpi=150)
    print("已将图表保存为 rollout_is_metrics.png")

补充:其他事项

Performance Impact

  • 内存开销 :约为模型内存的 1%
  • 计算开销 :取决于级别,约为 1-3%
  • 训练稳定性 :当存在 off-policy 差距时显著提高

Testing

  • 运行测试套件以验证一切正常:

    1
    2
    3
    4
    5
    # 基本单元测试
    python tests/trainer/ppo/test_rollout_corr.py

    # 集成测试(如果 pytest 可用)
    pytest tests/trainer/ppo/test_rollout_corr_integration.py -v
  • 预期输出:所有测试通过

1…192021…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4