注:本文包含 AI 辅助创作
- 参考链接:
- ROLL 开源地址:github.com/alibaba/ROLL
- ROLL 技术报告:(ROLL Technical Report)Reinforcement Learning Optimization for Large-Scale Learning: An Efficient and User-Friendly Scaling Library, ROLL Team, 20250606
- ROLL 中文文档:(面向大规模学习的强化学习优化框架)Reinforcement Learning Optimization for Large-scale Learning
- 副标题:阿里巴巴开源的强化学习库,专为大语言模型优化。支持分布式训练、多任务学习与智能体交互,让 AI 模型训练更简单、更高效
- ROLL 英文文档:ROLL: Reinforcement Learning Optimization for Large-Scale Learning
- ROLL 团队 Blog:wwxfromtju.github.io/roll_team.
- ROLL 团队论文:(ROLL-Part1-RL4LLM-Reasoning, Lite PPO)Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning, 20250811-20251027, ROLL
- ROLL 团队论文:RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training, 20250925, ROLL
- ROLL 团队论文:(ROLL-Part2-ROLL-Flash)Part II: ROLL Flash – Accelerating RLVR and Agentic Training with Asynchrony, 20251013, ROLL
- ROLL 团队论文:(AsyPPO)Asymmetric Proximal Policy Optimization: mini-critics boost LLM reasoning, 20251002-20251015, ROLL
- ROLL 团队论文:(Attention-Illuminates-LLM-Reasoning)Attention Illuminates LLM Reasoning: The Preplan-and-Anchor Rhythm Enables Fine-Grained Policy Optimization, 20251015-20260608, ROLL
- ROLL 团队发布(20251108):github.com/alibaba/ROCK
- ROLL 团队论文:(ROME & ALE & IPA)Let It Flow: Agentic Crafting on Rock and Roll, 20251231-20260312, ROCK & ROLL & IFLOW & DT Joint Team
- 副标题:Building the ROME Model within an Open Agentic Learning Ecosystem
- ROLL 团队论文:RollArt: Disaggregated Multi-Task Agentic RL Training at Scale, 20251227-20260615, HKUST & Alibaba & Tonogyi Lab
- ROLL 团队博客:苦涩的教训!ROLL团队分享:Agentic RL 训练中的实践经验, 20260215
- 注:ROLL TEAM 官方撰写
- 英文版:The Bitter Lesson Behind Building Agentic RL in Terminal Environments, 20260211
Part I: Tricks or Traps?(Lite PPO)
- 原始论文:(ROLL-Part1-RL4LLM-Reasoning, Lite PPO)Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning, 20250811-20251027, ROLL
- 本文发布于 202508 和 202510,是一项系统性的实证研究,针对当前 RL 用于提升 LLM 推理能力这一热点领域,指出了其中存在的混乱和矛盾现状
- 本文提出了一个更简单、更强大的基线方法(Lite PPO)
- 其核心信息是:技术选择需因地制宜(模型类型、数据难度),且“Less is more”
- 论文的核心贡献:
- 在开源框架 ROLL 下,对多种流行的 RL “Tricks” 进行解耦和精细的隔离评估,深入分析了其内部机制、适用场景和核心原则
- 论文挑战了“过度工程化”的 RL Pipeline 趋势,证明了一个极简方法 Lite PPO ,即可在使用 vanilla PPO loss 且无Critic 的情况下,超越包含冗余组件的复杂算法(如GRPO 和 DAPO)
- 1)优势归一化 :采用 组级均值 + 批次级标准差(来自 Takeaway 3)
- 2)损失聚合 :采用 Token-level 损失(来自 Takeaway 7)
- 将所有 \(G\) 个Response 的所有Token 的损失求和,然后除以总Token 数 \( \sum_{i=1}^G |o_i| \)
- 3)策略优化 :将计算出的 Token-level 优势 \(\hat{A}_{i,t}\) 代入 vanilla PPO loss ,进行策略更新
- 局限性:所有结论基于 Qwen3 系列模型
核心问题 & 动机
- 论文首先点明了 RL4LLM 领域的“爆炸式”增长与“碎片化”理解之间的鸿沟,这种碎片化体现在:
- 相互矛盾的结论 :
- GRPO 提倡组级(group-level)归一化,而 REINFORCE++ 认为批次级(batch-level)归一化更好
- GRPO 在归一化中使用方差,而 Dr.GRPO 建议移除方差
- GRPO 使用 Response-level损失计算,DAPO 则采用 Token-level 损失计算
- 技术选择的复杂性 :大量看似正交的技术(如归一化、裁剪、过长度过滤)组合繁多,难以选择
- 相互矛盾的结论 :
- 论文认为,这些混乱的根源在于已有工作的实验设置、训练数据和模型初始化差异巨大,导致结论存在偏差
- 核心问题:现有技术分别适用于什么场景?是否存在一个简单且通用的组合来增强策略优化?
实验设计与 Baselines(第3节)
- 为确保公平性和可比性,论文设计了严格的实验框架
- 统一框架 :所有实验基于开源的 ROLL 框架 (2025)
- 基础算法 :统一采用 vanilla PPO loss (2017),Advantage 使用 REINFORCE 算法 (1999) 计算,不使用Critic网络
- 模型 :涵盖不同规模和初始化状态
- 规模:Qwen3-4B 和 Qwen3-8B
- 类型:Base(未对齐,pre-trained)和 Instruct(已对齐,aligned)
- 数据集 :全部来自开源,并根据难度划分为:
- Easy :来自 SimpleRL-Zoo-Data-Easy(GSM8K, MATH-500-level1)
- Medium :选自 DeepMath-103k 中最简单的 5000 道题
- Hard :从 DeepMath-103k 中按难度比例采样 5000 道题
- 评估基准 :MATH-500, OlympiadBench, MinervaMath, AIME24-25, AMC23
- 基线结果(重要发现) :
- 数据难度影响 :
- 模型在简单数据上收敛快,但易过拟合
- 模型在困难数据上,会生成更多 Token 来拟合复杂推理模式
- 模型初始化影响 :
- 已对齐(Instruct)模型初始准确率和生成长度更高,但 RL 带来的进一步提升空间有限(约 2%),表明当前 RL 算法对已高度优化的模型提升不大
- 数据难度影响 :
重点方法与详细流程分析(第4节)
- 对四大类技术进行了深度剖析,每个技术点的分析都遵循“假设-实验-Takeaway”的结构
Normalization
- 归一化用于降低梯度方差
- 主要分歧在于Group-level 与Batch-level 归一化的选择,以及是否使用标准差(std)
- 方法流程 :
- 1)计算均值与标准差 :对于一个 Prompt \( \mathcal{X} \) 和其 \(K\) 个 Response ,对应的奖励为 \(\{r_k\}_{k=1}^K\)
- 组级归一化 :优势为:
$$ A_{k}^{\text{group} } = \frac{r_{k} - \text{mean}(\{r_{j}\})}{\text{std}(\{r_{j}\})}$$ - 批次级归一化 :优势为:
$$ A_{i}^{\text{batch} } = \frac{r_{i} - \text{mean}(\{r_{j}\}_{j=1}^{N+K})}{\text{std}(\{r_{j}\}_{j=1}^{N+K})} $$- 其中 \(N\) 是 Rollout Batch 大小
- 组级归一化 :优势为:
- 2)将计算出的优势值 \(A\) 代入 PPO 的目标函数中
- 1)计算均值与标准差 :对于一个 Prompt \( \mathcal{X} \) 和其 \(K\) 个 Response ,对应的奖励为 \(\{r_k\}_{k=1}^K\)
- 关键 Insight & Takeaway :
- Takeaway 2(标准差项的影响) :
- 当奖励分布高度集中(如 Easy 数据集,大多数Response 全对或全错)时,标准差极小
- 除以该小标准差会异常放大梯度,导致训练不稳定甚至梯度爆炸
- 此时,移除标准差(仅使用均值平移,\(A_{k}^{\text{std} } = r_{k} - \text{mean}(\{r_{j}\})\))能显著提升训练的稳定性和有效性
- 在Hard数据集上,奖励方差大,此问题不明显
- 当奖励分布高度集中(如 Easy 数据集,大多数Response 全对或全错)时,标准差极小
- Takeaway 3(稳健的归一化组合) :
- “Group-level mean + Batch-level std” 是最稳健的组合
- 其流程为:
- 对每个Prompt 组内的 Response ,减去该组的均值
- 除以的却是整个Rollout Batch 的奖励标准差
- 注:这种全局标准差能更有效地降低梯度幅度,防止策略更新过激,对稀疏和粗粒度的奖励信号更鲁棒
- Takeaway 2(标准差项的影响) :
裁剪策略(Clipping),重点:Clip-Higher
- 标准 PPO 裁剪 会抑制低概率 Token ,导致 熵塌缩(Entropy Collapse) ,策略丧失多样性,不利于复杂推理中的探索
- Clip-Higher 解耦了上下裁剪边界,设置 \(\epsilon_{\text{low} }\) 和 \(\epsilon_{\text{high} }\)(其中 \(\epsilon_{\text{high} } > \epsilon_{\text{low} }\)),为低概率Token 提供更大的“上升”空间
- 方法流程 :
- 1)计算概率比率 \(r_{i,t}(\theta) = \frac{\pi_{\theta}(o_{i,t}|q,o_{i< t})}{\pi_{\theta_{\text{old} } }(o_{i,t}|q,o_{i< t})}\)
- 2)对比率 \(r_{i,t}(\theta)\) 应用非对称裁剪:\(\text{clip}(r_{i,t}(\theta), 1-\epsilon_{\text{low} }, 1+\epsilon_{\text{high} })\)
- 3)将裁剪后的比率与优势 \(A_t\) 相乘,代入优化目标
- 关键 Insight & Takeaway :
- Takeaway 4(适用场景) :
- Clip-Higher 对已对齐(Instruct)模型效果显著,对基座(Base)模型效果甚微甚至有害
- 原因在于:
- 基座模型策略本身变化小(裁剪率低),表达能力有限,提高上界无法激发有效探索
- 问题:为什么基座模型策略本身变化会小?
- 补充观察:Base Model 的策略裁剪率极低(约 0.003),这表明新旧策略之间的偏差很小
- 理解:
- 作者的发现应该是:基座模型相对较弱的策略表达能力限制了其探索能力,阻碍了高奖励轨迹的发现
- 因此,提高裁剪上界对学习动态几乎没有改善
- 个人理解:应该是基座模型本身的熵高,不需要提高上界吧
- 而已对齐模型初始概率分布集中(原文图 9),提高上界能有效缓解熵塌缩 ,促进对更优解路径的探索
- 问题:原文图 9 似乎画反了,Base 模型的分布应该能该是更加平坦才对,Instruct 才会更加 Sharp
- 基座模型策略本身变化小(裁剪率低),表达能力有限,提高上界无法激发有效探索
- Takeaway 5(语言学视角) :
- 传统裁剪主要抑制连接词(如 “therefore”, “if”, “but” )的概率更新
- 这些词是推理结构转换的关键信号
- Clip-Higher 通过放宽对这些 Token 的限制,使模型能够探索更广泛的论述推理结构,从而生成更具创新性的推理路径(原文图 10)
- 传统裁剪主要抑制连接词(如 “therefore”, “if”, “but” )的概率更新
- Takeaway 6(参数设置规律) :
- 在小规模模型(4B)上,性能与裁剪上界 \(\epsilon_{\text{high} }\) 之间存在 “scaling law”
- 即上界越高(实验探索至 0.32),性能越好。
- 在较大模型(8B)上,该规律不成立,最佳性能点出现在 \(\epsilon_{\text{high} }=0.28\)(原文图 11)
- 在小规模模型(4B)上,性能与裁剪上界 \(\epsilon_{\text{high} }\) 之间存在 “scaling law”
- Takeaway 4(适用场景) :
损失聚合粒度(Loss Aggregation)
- Sequence-level 聚合先对每个Response 内的所有Token 损失求平均,再对所有Response 求平均,这导致长Response 的每个Token 贡献被稀释
- Token-level 聚合则对所有Token 的损失求和后,除以总Token 数,保证每个Token 贡献相等
- 方法流程对比 :
- Sequence-level :
$$ \mathcal{T}_{\text{sequence-level} }(\theta) = \frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \min(…) $$- 每个Response权重相同
- Token-level :
$$\mathcal{T}_{\text{token-level} }(\theta) = \frac{1}{\sum_{i=1}^{G}|o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \min(…)$$- 每个Token权重相同
- Sequence-level :
- 关键 Insight & Takeaway :
- Takeaway 7(模型类型依赖) :Token-level 损失在 Base 模型上更有效 ,能提升收敛速度、峰值准确率和鲁棒性,尤其是在困难数据集上
- 在 Instruct 模型上,Sequence-level 损失反而更优
- 因为已对齐模型已有稳定的推理能力,强行均衡 Token 级梯度可能破坏其输出结构和一致性
Overlong Filtering
- 训练时通常设置最大生成长度进行截断
- 复杂推理任务中,结构良好的推理链可能因超过长度而被截断,被错误标记为负样本
- Overlong Filtering 通过 Mask 过长度Response的奖励信号来缓解此问题
- 方法流程 :
- 1)设定一个最大长度阈值(如 8k, 16k, 20k)
- 2)在训练中,对超过该阈值的Response ,将其奖励或优势值 Mask 掉(例如置零或不参与梯度计算),使其不贡献于策略更新
- 关键 Insight & Takeaway :
- Takeaway 8(效果取决于任务长度需求) :
- 在短-中等推理任务中,截断的噪声对训练干扰较大,过滤后(比如较短阈值如 8k)模型能更好地学习紧凑有效的推理路径,从而提升准确率
- 在长尾推理任务中,一般使用较长阈值(如 20 K),有效推理链很少被截断,截断样本大多是病理生成,过滤掉它们对训练影响有限,因此收益不明显
- Overlong Filtering 并不主动“打压”或“鼓励”长样本,而是通过去除被截断的噪声样本,让模型避免学习到“因截断而被错误惩罚”的信号,从而更准确地建模 EOS 行为
Overlong filtering shows limited effectiveness on long-tail reasoning tasks; however, it can enhance the accuracy and clarity of responses in medium and short-length reasoning tasks.
- 理解:建议始终添加 Overlong filtering,除非想要打压输出过长的样本
- 但是,现实中,一些特殊的实现逻辑,比如格式逻辑,可能会对超长样本进行打压,比如 Thinking 模式下,超长样本可能连 CoT 都还没有输出完,一般不遵循格式,此时会被打压,变相是在惩罚超长样本
- Takeaway 8(效果取决于任务长度需求) :
最终方法:Lite PPO
- 基于上述分析,论文针对非对齐(Non-aligned / Base)模型 ,整合出两项最有效的技术,提出了 Lite PPO
- Lite PPO 方法流程 :
- 1)优势归一化 :采用 组级均值 + 批次级标准差(来自 Takeaway 3)
- 对每个Prompt \(q\),采样 \(G\) 个Response ,得到奖励 \(\{r_i\}_{i=1}^G\)
- 计算组内均值 \(\mu_{\text{group} } = \text{mean}(\{r_i\})\) 和整个Rollout Batch的标准差 \(\sigma_{\text{batch} }\)
- 计算优势 \(\hat{A}_i = \frac{r_i - \mu_{\text{group} } }{\sigma_{\text{batch} } }\)
- 2)损失聚合 :采用 Token-level 损失(来自 Takeaway 7)
- 将所有 \(G\) 个Response 的所有Token 的损失求和,然后除以总Token 数 \( \sum_{i=1}^G |o_i| \)
- 3)策略优化 :将计算出的 Token-level 优势 \(\hat{A}_{i,t}\) 代入 vanilla PPO loss ,进行策略更新
- 1)优势归一化 :采用 组级均值 + 批次级标准差(来自 Takeaway 3)
- 结果 :实验表明(原文图 15),Lite PPO 在 4B-Base 和 8B-Base 模型上,均稳定超越 GRPO 和包含更多复杂组件的 DAPO。其优势在于:
- 归一化技术有效对抗了非均匀奖励分布(Easy/Hard 数据集)带来的干扰
- 移除了限制小模型生成长尾输出的过长度过滤,并采用了对基座模型更高效的 Token-level 损失
RollPacker
- 原始论文:RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training, 20250925, ROLL
- 整体说明:
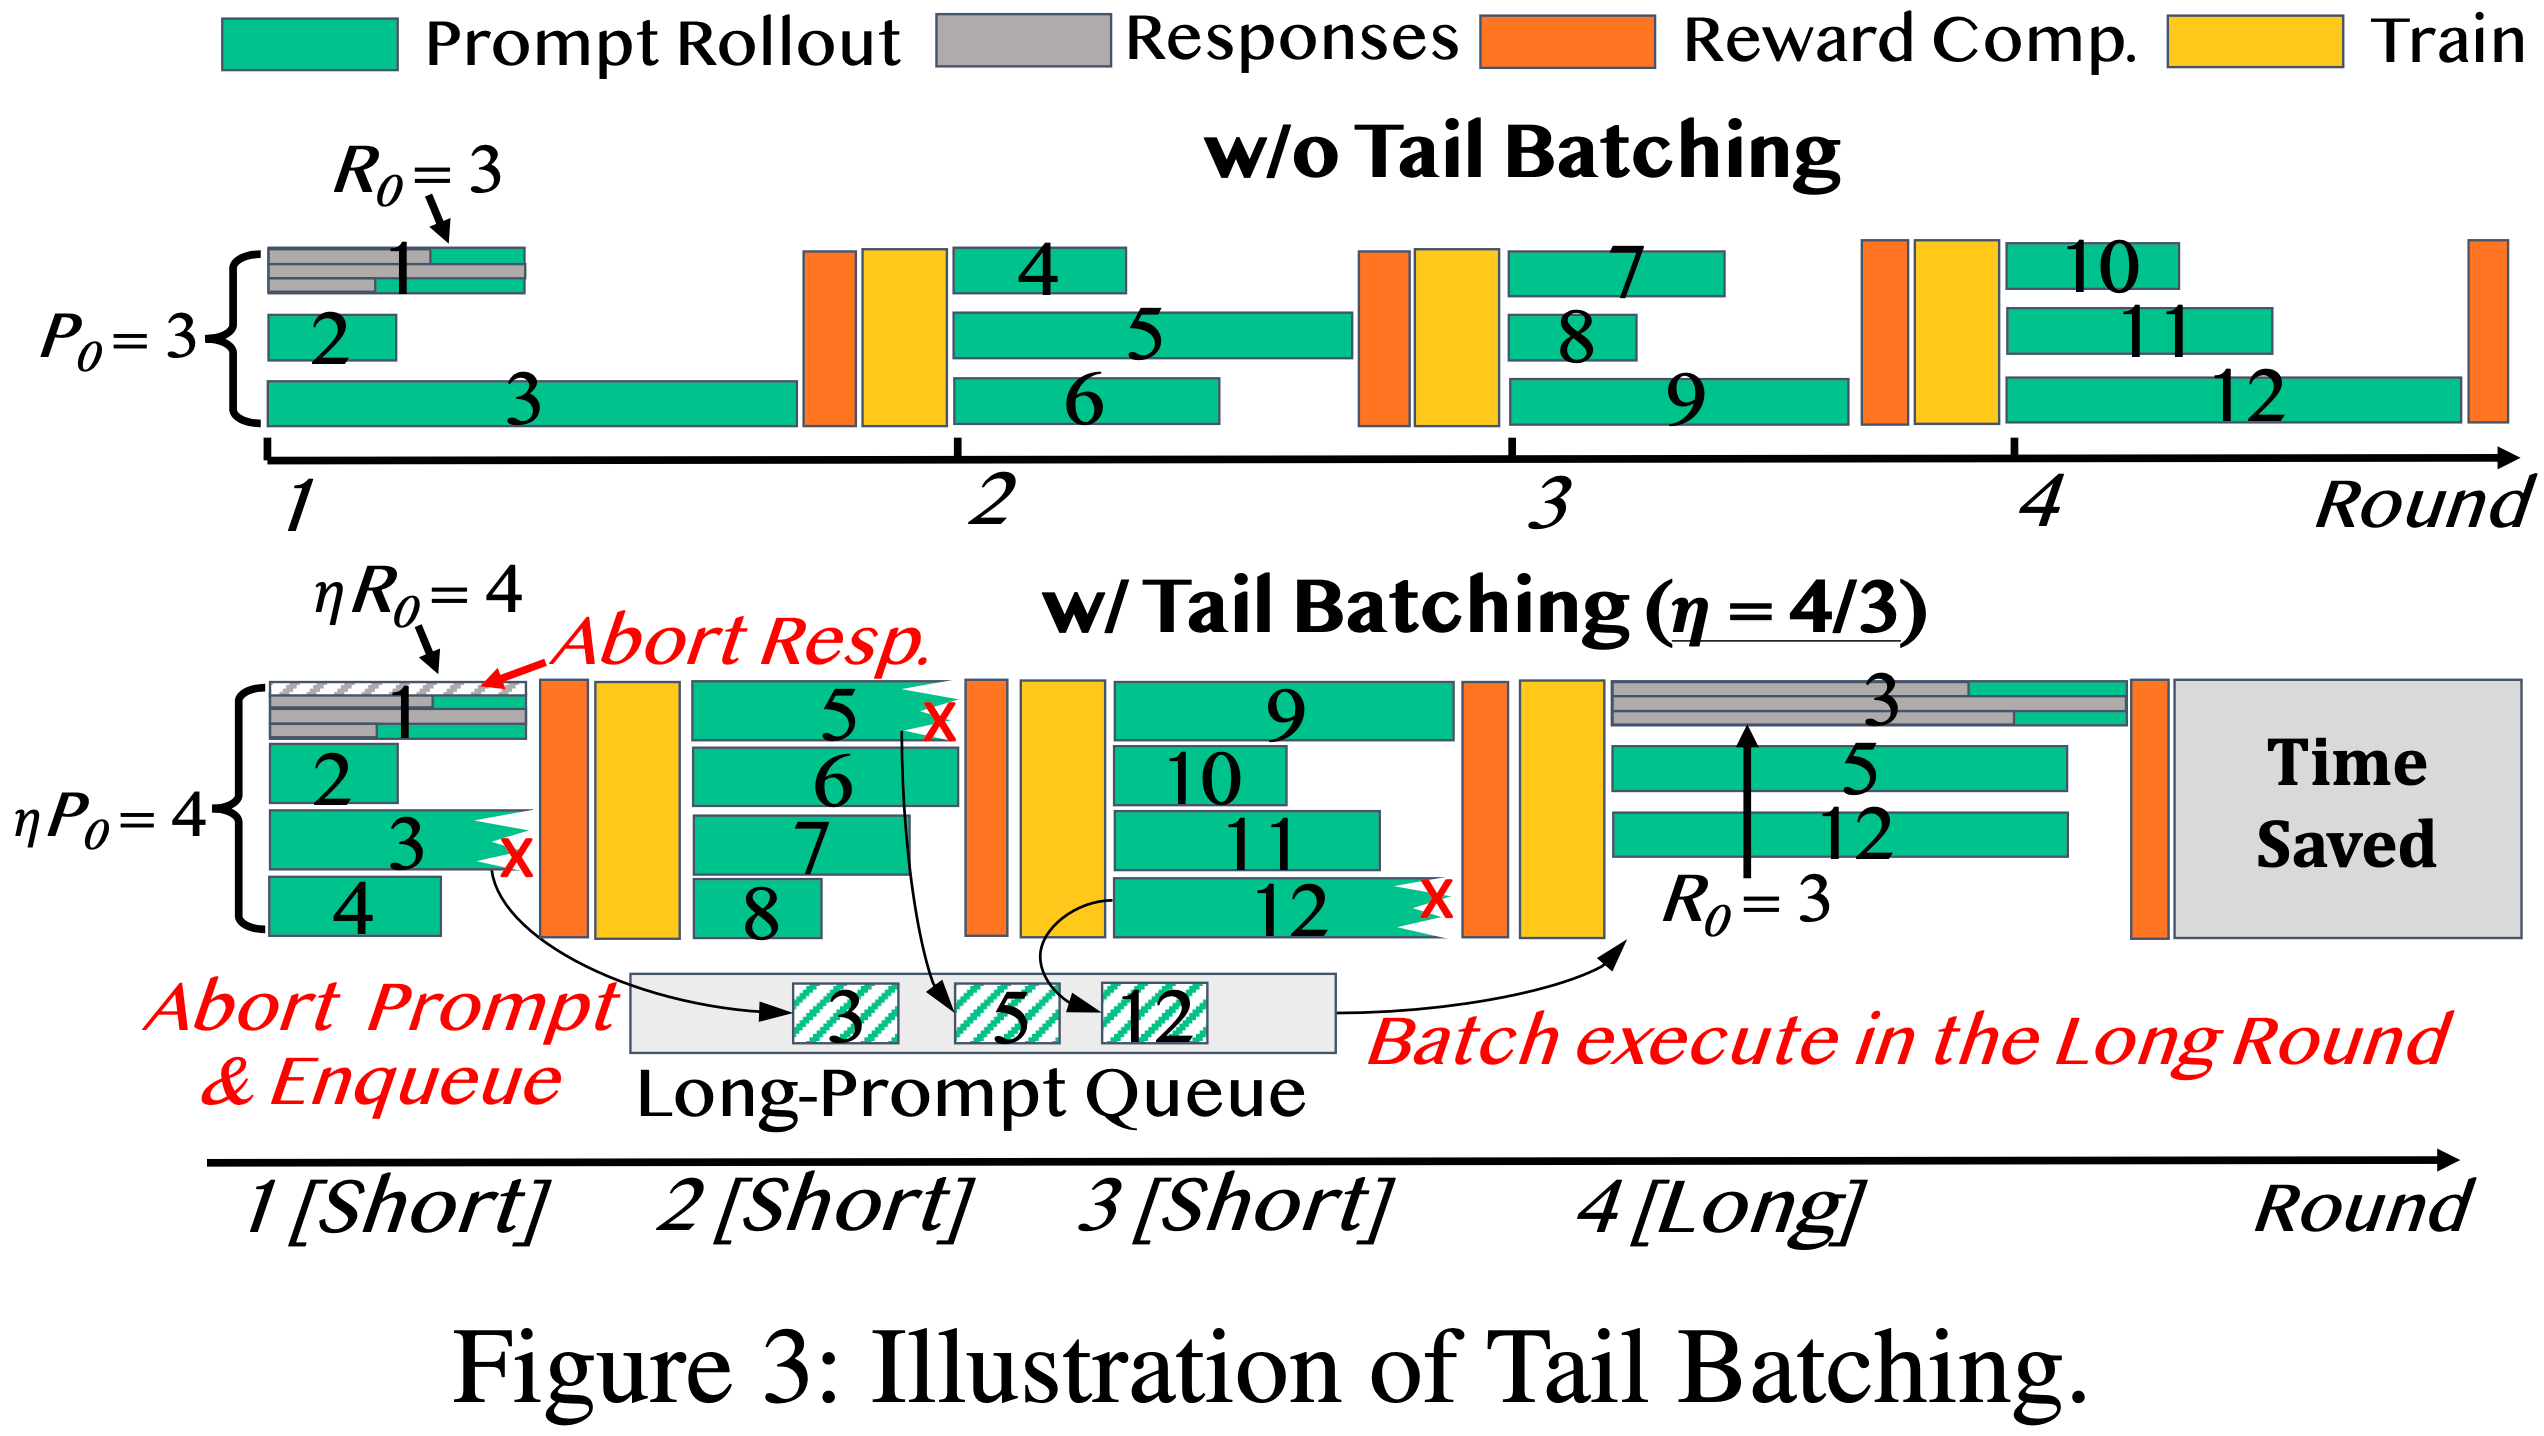
- 论文提出 Tail Batching 策略,通过重新组织 Prompt 顺序,在不牺牲同步 on-policy 精度的情况下大幅减少长尾 Rollout 造成的气泡
- Tail Batching 策略在不放松同步的前提下,通过重排训练样本顺序,将长尾 Prompt 集中到少数步骤上(Long Rounds),其余多数步骤(Short Rounds)只包含平衡的短 Response ,从而大幅减少气泡
- Short Round 很快,Long Round 较慢,但 Long Round 较少,在 1.25 倍 Prompt 配置时,每 4 步 Short Round 才会有一次 Long Round
- 特别说明:Tail Batching 策略是针对同步 On-policy RL 训练的,完全不涉及 Off-policy,所以理论上不会因为数据 Off-policy 而影响性能
背景 & 当前问题
- 背景:同步 的 on-policy RL 训练(即每次 Rollout 必须基于最新模型权重)能保证训练稳定性和模型性能,但面临严重的GPU 利用率低下问题(气泡)
- 这些气泡主要由 Rollout 阶段中 Response 长度的长尾分布 导致
- 少数过长 Response 会拖慢整个批次(Batch),使得处理短 Response 的 GPU 长时间空闲
- 现有解决方案
- 先前用于缓解 RL 后训练中 GPU 空闲气泡的努力通常分为两类:同步约束下的阶段重叠和放宽同步
- 同步约束下的阶段重叠 (Stage Overlap)
- 在同步 Barrier 之前,将长尾 Rollout 与其它阶段的执行进行流水线处理,来提高资源利用率
- RLHFuse (2024) 将 Rollout 与 Reward 计算和参考模型推理重叠
- ROLL (2025) 和 MiMO (2025) 等框架则将每个已完成 Response 的 Reward 计算与正在进行的 Rollout 阶段重叠,以实现异步 Reward 计算
- 问题:
- 这些设计在一定程度上减少了空闲气泡,但它们并未从根本上解决主导 Rollout 时间的长尾 Response 问题,且性能提升有限
- 而且,随着 RL 后训练中 Response 长度的持续增长 (2025),Reward 和参考模型推理的相对贡献逐渐减小(通常不到步骤运行时的 15%,如原文表 1 所示),即使在理想的重叠情况下,也不足以掩盖长时间的空闲气泡
- 在同步 Barrier 之前,将长尾 Rollout 与其它阶段的执行进行流水线处理,来提高资源利用率
- 放宽同步 (Relaxed Synchronization)
- 更激进的策略:放宽 Rollout 和训练之间的严格同步 Barrier ,如原文图 1b 所示
- Kimi (2025) 引入了 Partial Rollout,通过截断长尾 Response 并保留已生成的 Token,以便在后续步骤中继续 Rollout
- StreamRL (2025)、AsyncFlow (2025) 和 RhymeRL (2025) 允许一步陈旧性 (one-step staleness),使得训练阶段能够在一个单次流水线 (one-off pipeline) 中使用略微过时的 Rollout 数据进行
- AReal (2025) 引入了完全异步的 RL 训练,其中 Rollout 和训练完全解耦,更新可能依赖于许多步骤之前生成的样本
- 问题:
- 这些方法在减少 GPU 气泡方面很有效:但放宽同步损害了训练的 On-policy 特性,通常会导致精度下降和稳定性降低
- 总结:要么通过将非瓶颈阶段与 Rollout 重叠而仅提供微小的改进,要么通过放宽同步而牺牲 On-policy 的保证
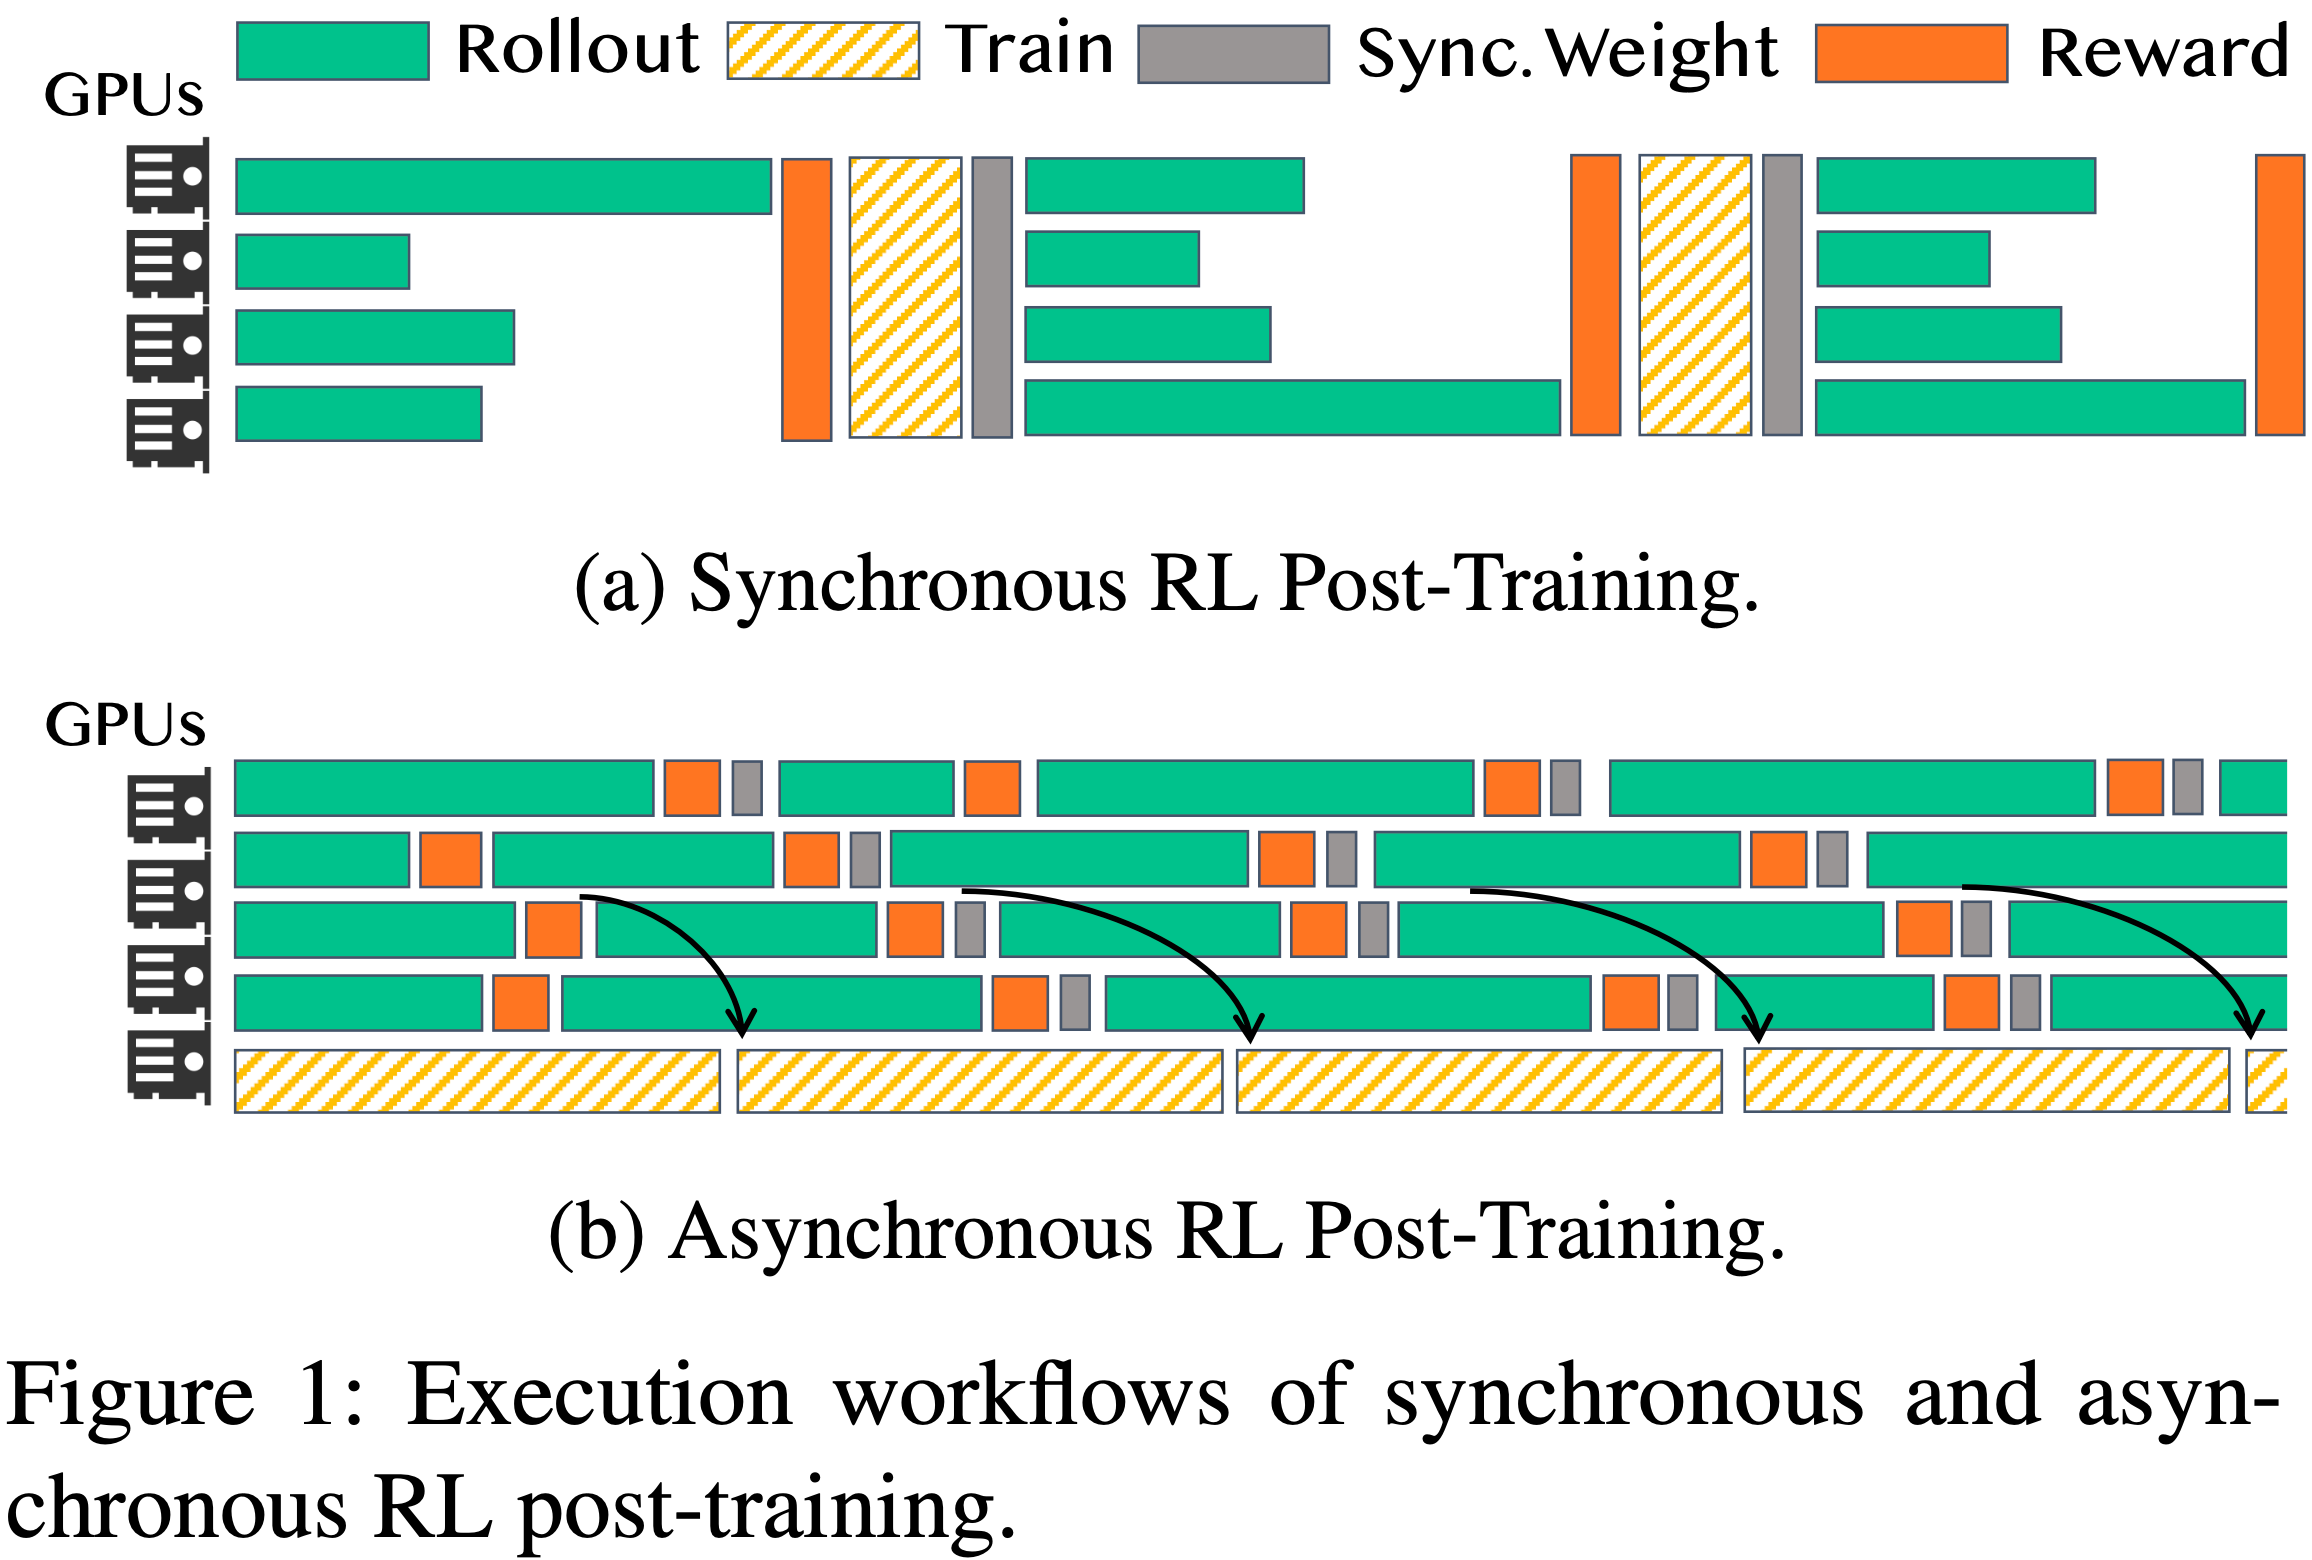
- 本文目标:保持同步 RL 训练的精度和稳定性的同时,从根本上消除长尾 Rollout 带来的低效问题
Tail Batching 策略
- 核心思想 :只改变 Prompt 的处理顺序,不改变样本分布,也不放松同步,从而在保持精度前提下消除气泡
问题与挑战
- P1 :如果简单丢弃长尾 Prompt ,会导致批次大小不足
- P2 :系统性地排除长 Prompt 会扭曲训练分布,损害模型性能
Tail Batching 解决方案
(1) Speculative Execution:解决 P1
- 在每个 Short Round 中,不是精确启动 \( P_0 \) 个 Prompt ,而是启动 更多 个(比如 \(\eta P_0\),\(\eta > 1\))
- 每个 Prompt 也生成超过 \( R_0 \) 个 Response(\(\eta R_0\))
- 只保留最先完成的 \( P_0 \) 个 Prompt,每个 Prompt 只保留最先完成的 \( R_0 \) 个 Response
- 这种“竞赛式”执行自然过滤掉生成慢的长尾样本,保证批次大小完整,同时所有 Response 都较短且平衡
(2) Long-Prompt Queue: 解决 P2
- 被中止或未选中的 Prompt(生成长 Response 的)不会丢失,而是放入 长 Prompt 队列
- 当队列累积到 \( P_0 \) 个 Prompt 时,触发一次 Long Round :在该轮中,禁用投机执行 ,让所有 Prompt 生成完整长度 Response
- 由于长尾 Prompt 很少,Long Round 出现频率低,大部分步骤仍是高效的 Short Round
(3) 训练精度保证
- Tail Batching 仅改变样本顺序,不改变分布
- 已有研究(如课程学习)表明顺序变化不损害最终精度,甚至可能有益
- 注意:在 需要 Batch Normalization 的算法中这个结论不一定
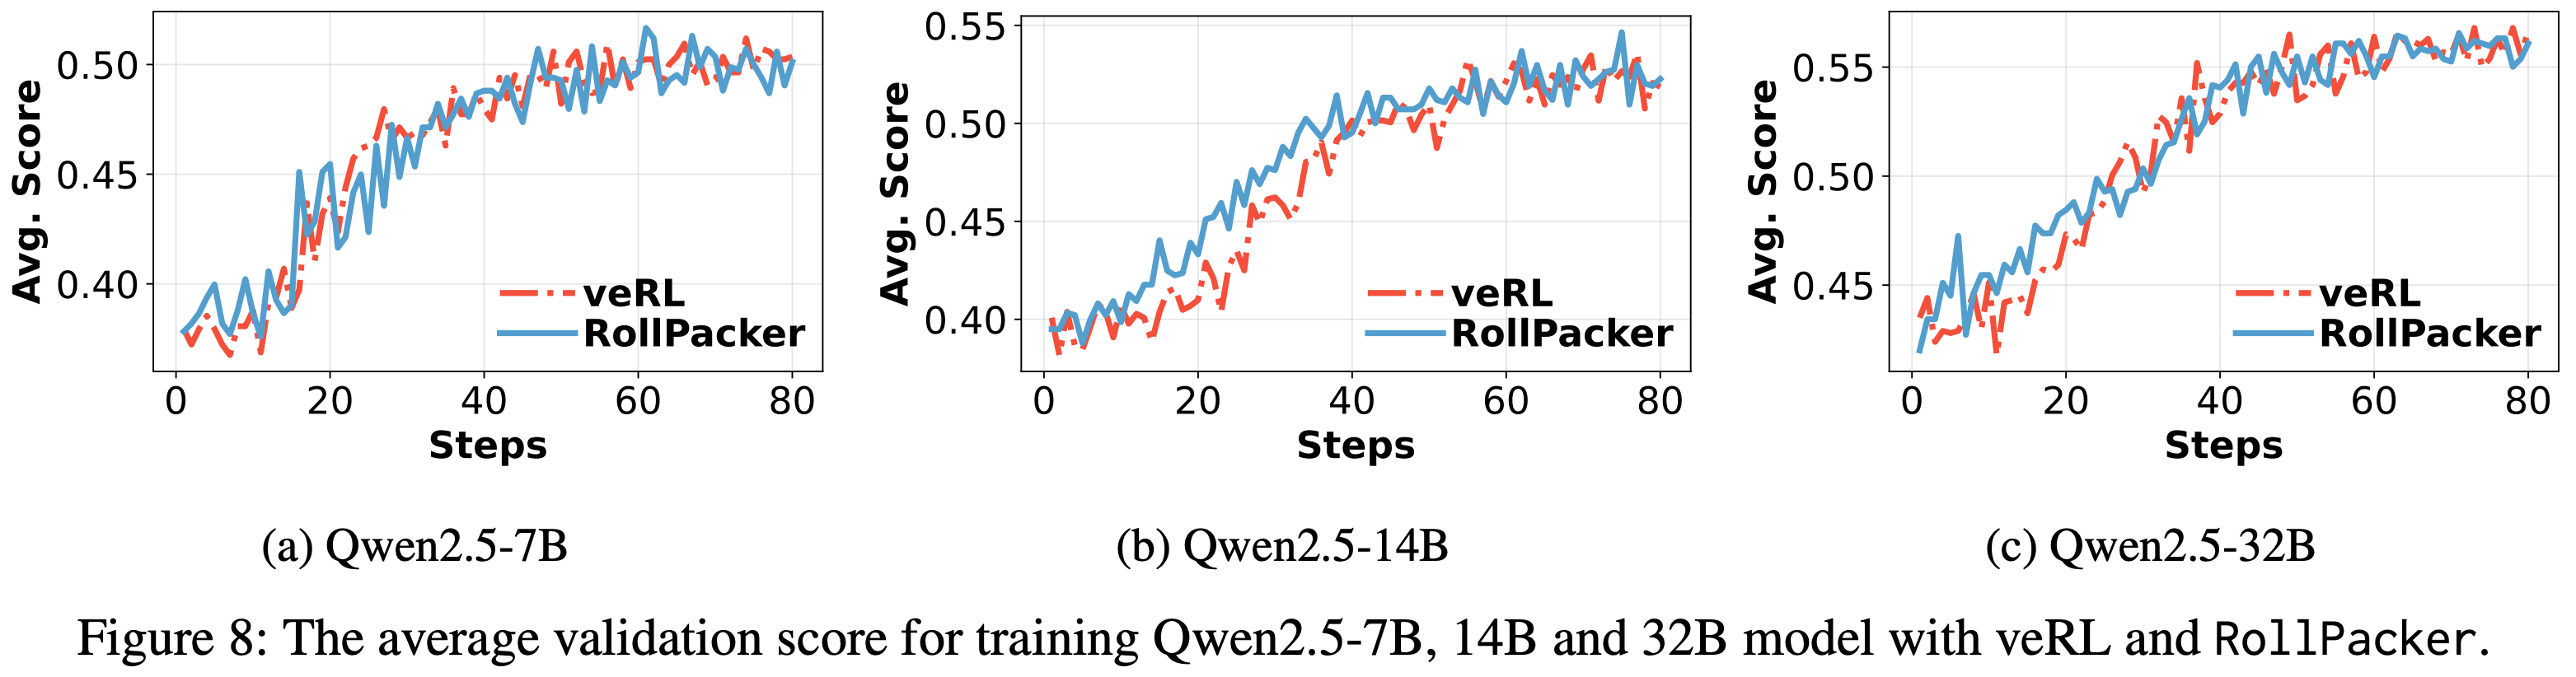
- 论文实验(原文图 8)证明 RollPacker 与标准同步 RL 的准确率曲线几乎完全重合
效率验证
- 在代码数据集上,\(\eta=1.25\) 时,前四个 Short Round 最大 Response 长度减少 8.9 倍 ,第五个 Long Round 长度与基线相当
- 端到端训练时间缩短 1.48 倍(原文图 4,原文表 2)
RollPacker 系统设计
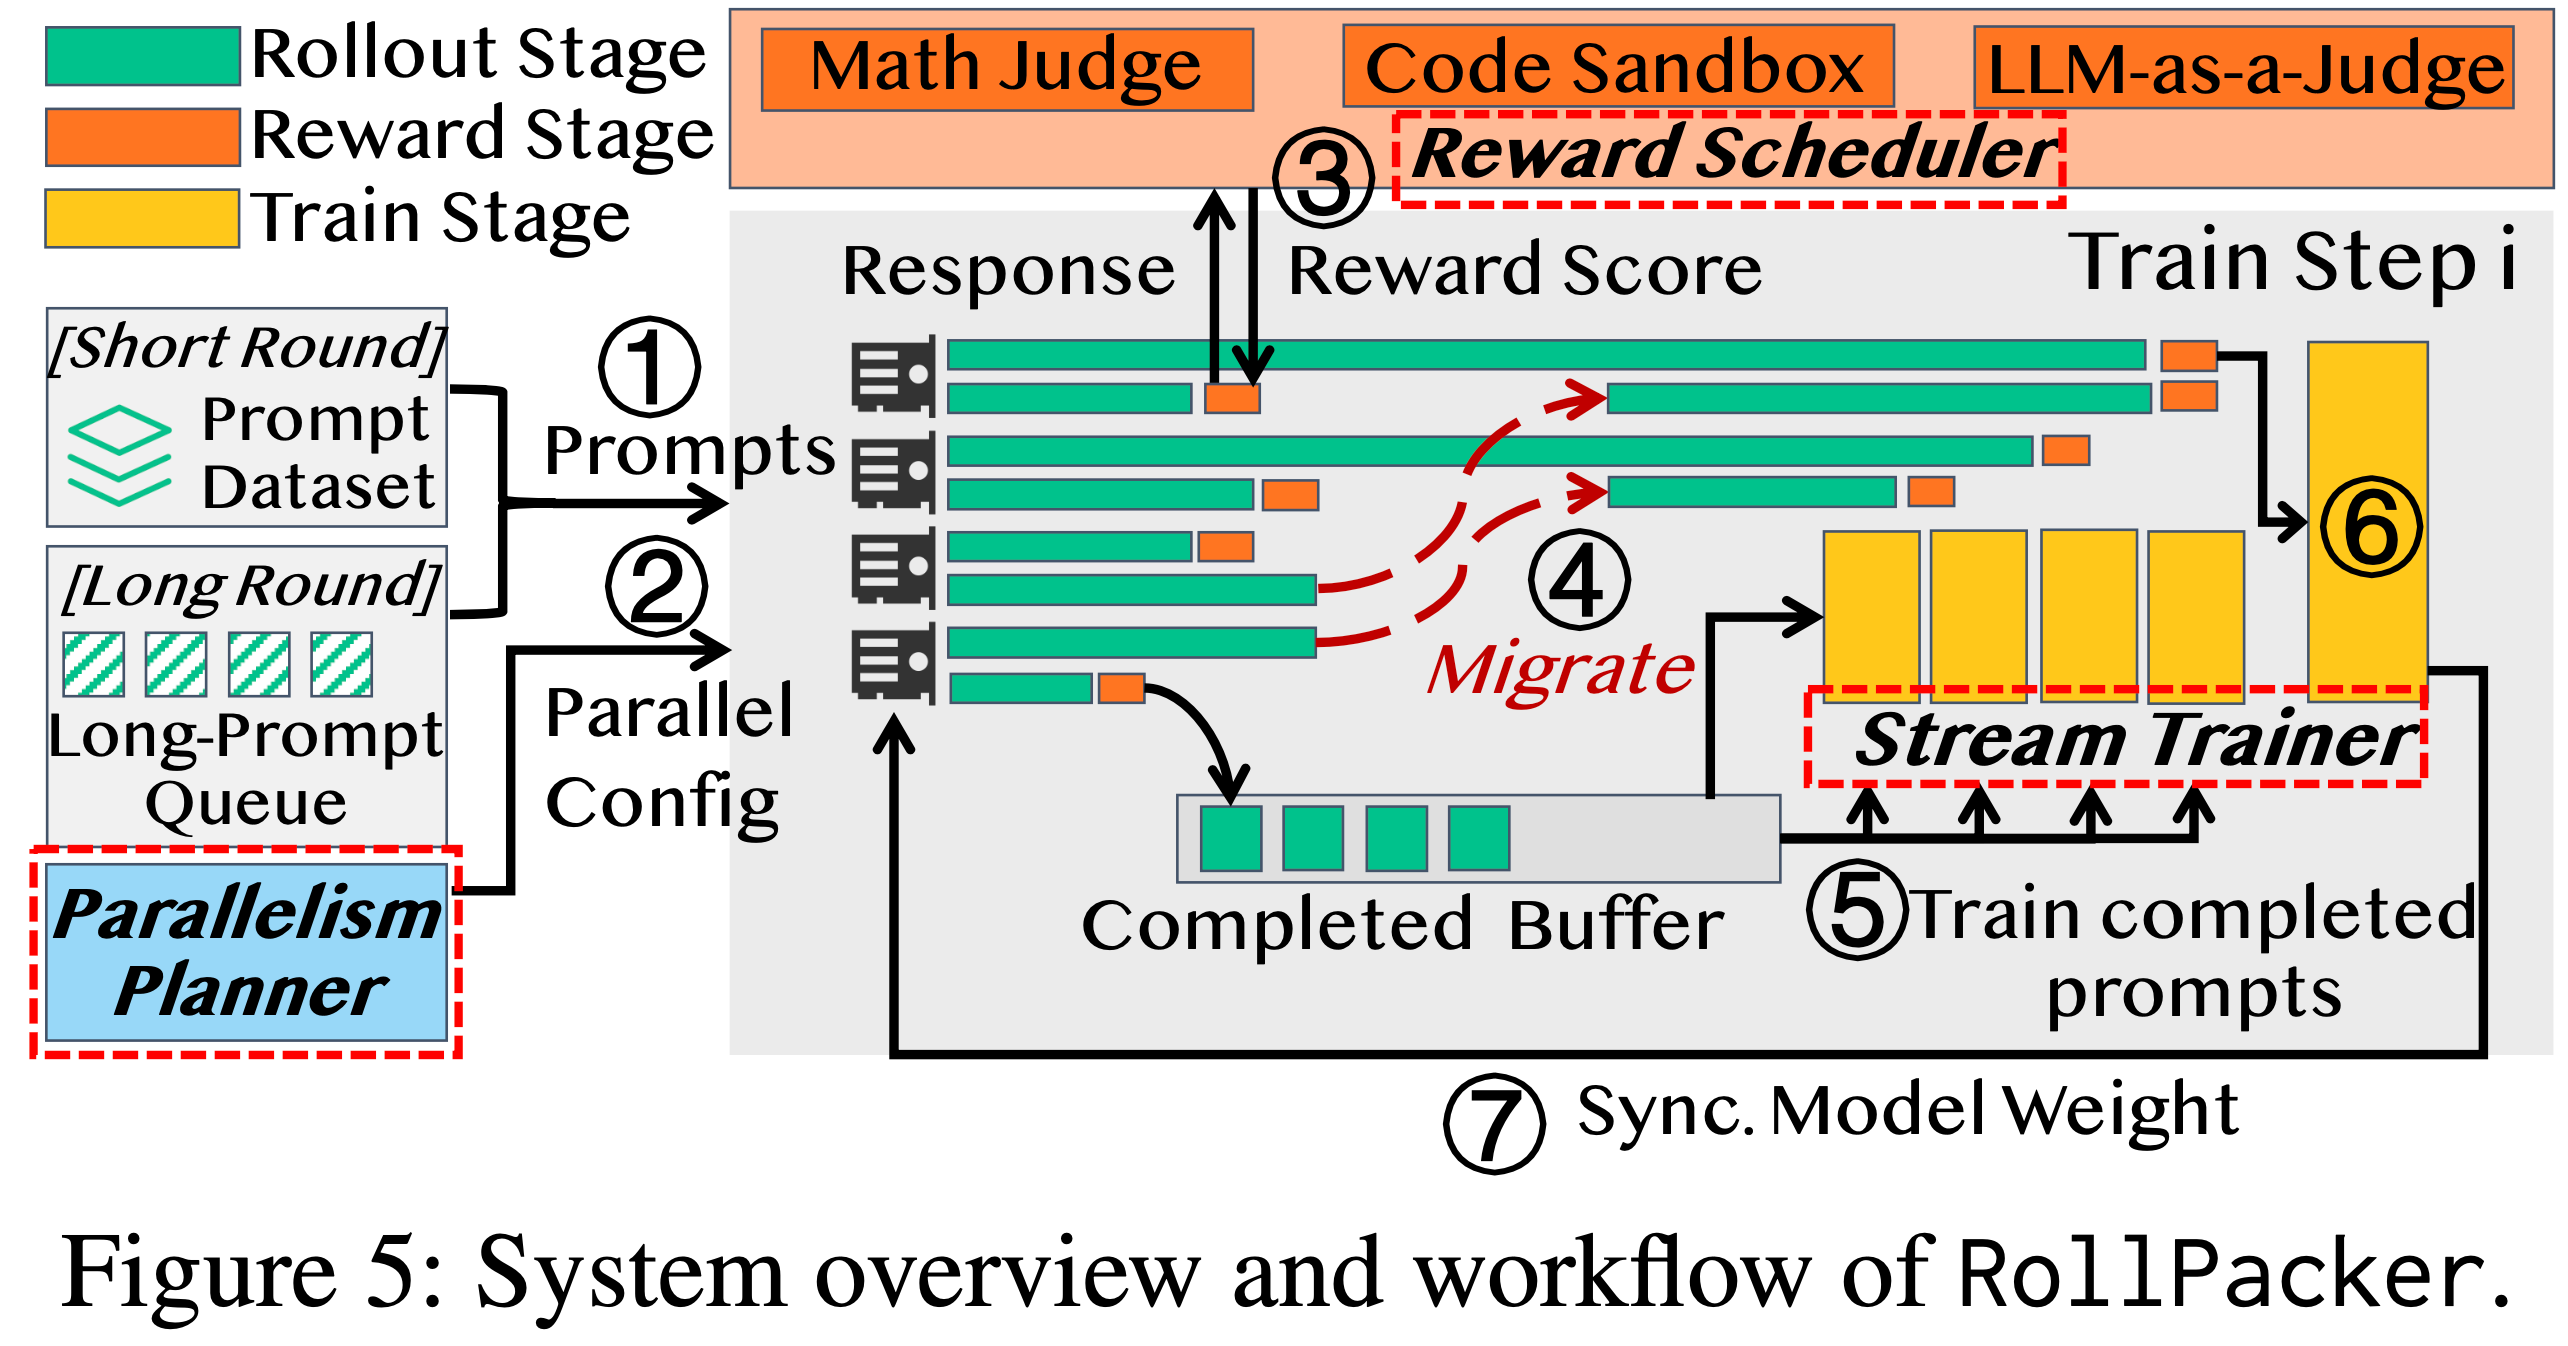
- 为充分释放 Tail Batching 的潜力,RollPacker 针对三个 RL 阶段分别进行系统优化
系统概览
- 并行规划器(Parallelism Planner) :动态调整 Tensor Parallelism (TP) 大小,适应 Short/Long Round 的不同内存压力
- 奖励调度器(Reward Scheduler) :异步流水线执行 Reward 计算,并自适应调整计算预算(如超时)
- 流式训练器(Stream Trainer) :在 Long Round 中,将已完成的 Response 立即流式送入训练,并动态将空闲 GPU 从 Rollout 重分配给训练,同时保证 on-policy 语义
- 工作流程(原文图 5):
- 1)Tail Batching 决策是否为 Short/Long Round
- 2)并行规划器 选择最优 TP
- 3)Reward 调度器 与 Rollout 并行计算奖励
- 4)Stream Trainer 监控进度,决定何时将 GPU 从 Rollout 转为训练
- 5)完成 Response 流式进入训练,计算梯度但不立即更新
- 注:这不适用于需要 Batch Normalization 的算法
- 6)全部 Rollout 完成后,所有 GPU 同步进行最终梯度累积与更新
- 7)更新后的 Actor 权重同步到下一轮 Rollout
Parallelism Planner
- 问题 :Short Round 因投机执行导致并发请求多,KV Cache 压力大,固定 TP 会导致大量抢占(Preemption)或通信开销
- 方案 :
- 离线阶段:在不同 TP、批次大小、序列长度下,Profile 内存占用和吞吐
- 在线阶段:跟踪抢占计数,若突然增加(如 >1.05 倍)则加倍 TP;若连续 4 步无抢占则减半 TP
- TP 组限制在单台服务器内,避免跨节点通信
- 效果 :减少 Short Round 抢占 13.8%,提速 1.11–1.28 倍(原文图 6、原文图 12)
Reward Scheduler
- 异步奖励计算 :完成 Response 后立即分发到 Reward Worker ,与 Rollout 重叠
- 代码沙盒自适应超时 :
- 对每个测试用例,记录正确 Response 的最大执行时间 \( T_{\text{anchor} } \)
- 新 Response 若超过 \( T_{\text{timeout} } = \min(\max(T_{\min}, \lambda T_{\text{anchor} }), T_{\max}) \),则提前终止并判零奖励(\(\lambda=1.5, T_{\min}=2s, T_{\max}=30s\))
- 减少无效长时间执行,提速 1.6 倍(原文图 13c)
- LLM-as-a-Judge 优化 :
- GPU 共享 :将 Judge 模型与 Actor 放在同一 GPU,使用 MPS(Multi-Process Service) 实现空间共享,避免资源闲置(原文图 13a)
- 层式流水线卸载 :将 Judge 大部分层卸载到 CPU 内存,逐层流式传到 GPU 计算,减少显存占用,提速 1.4 倍(原文图 13b)
Stream Trainer
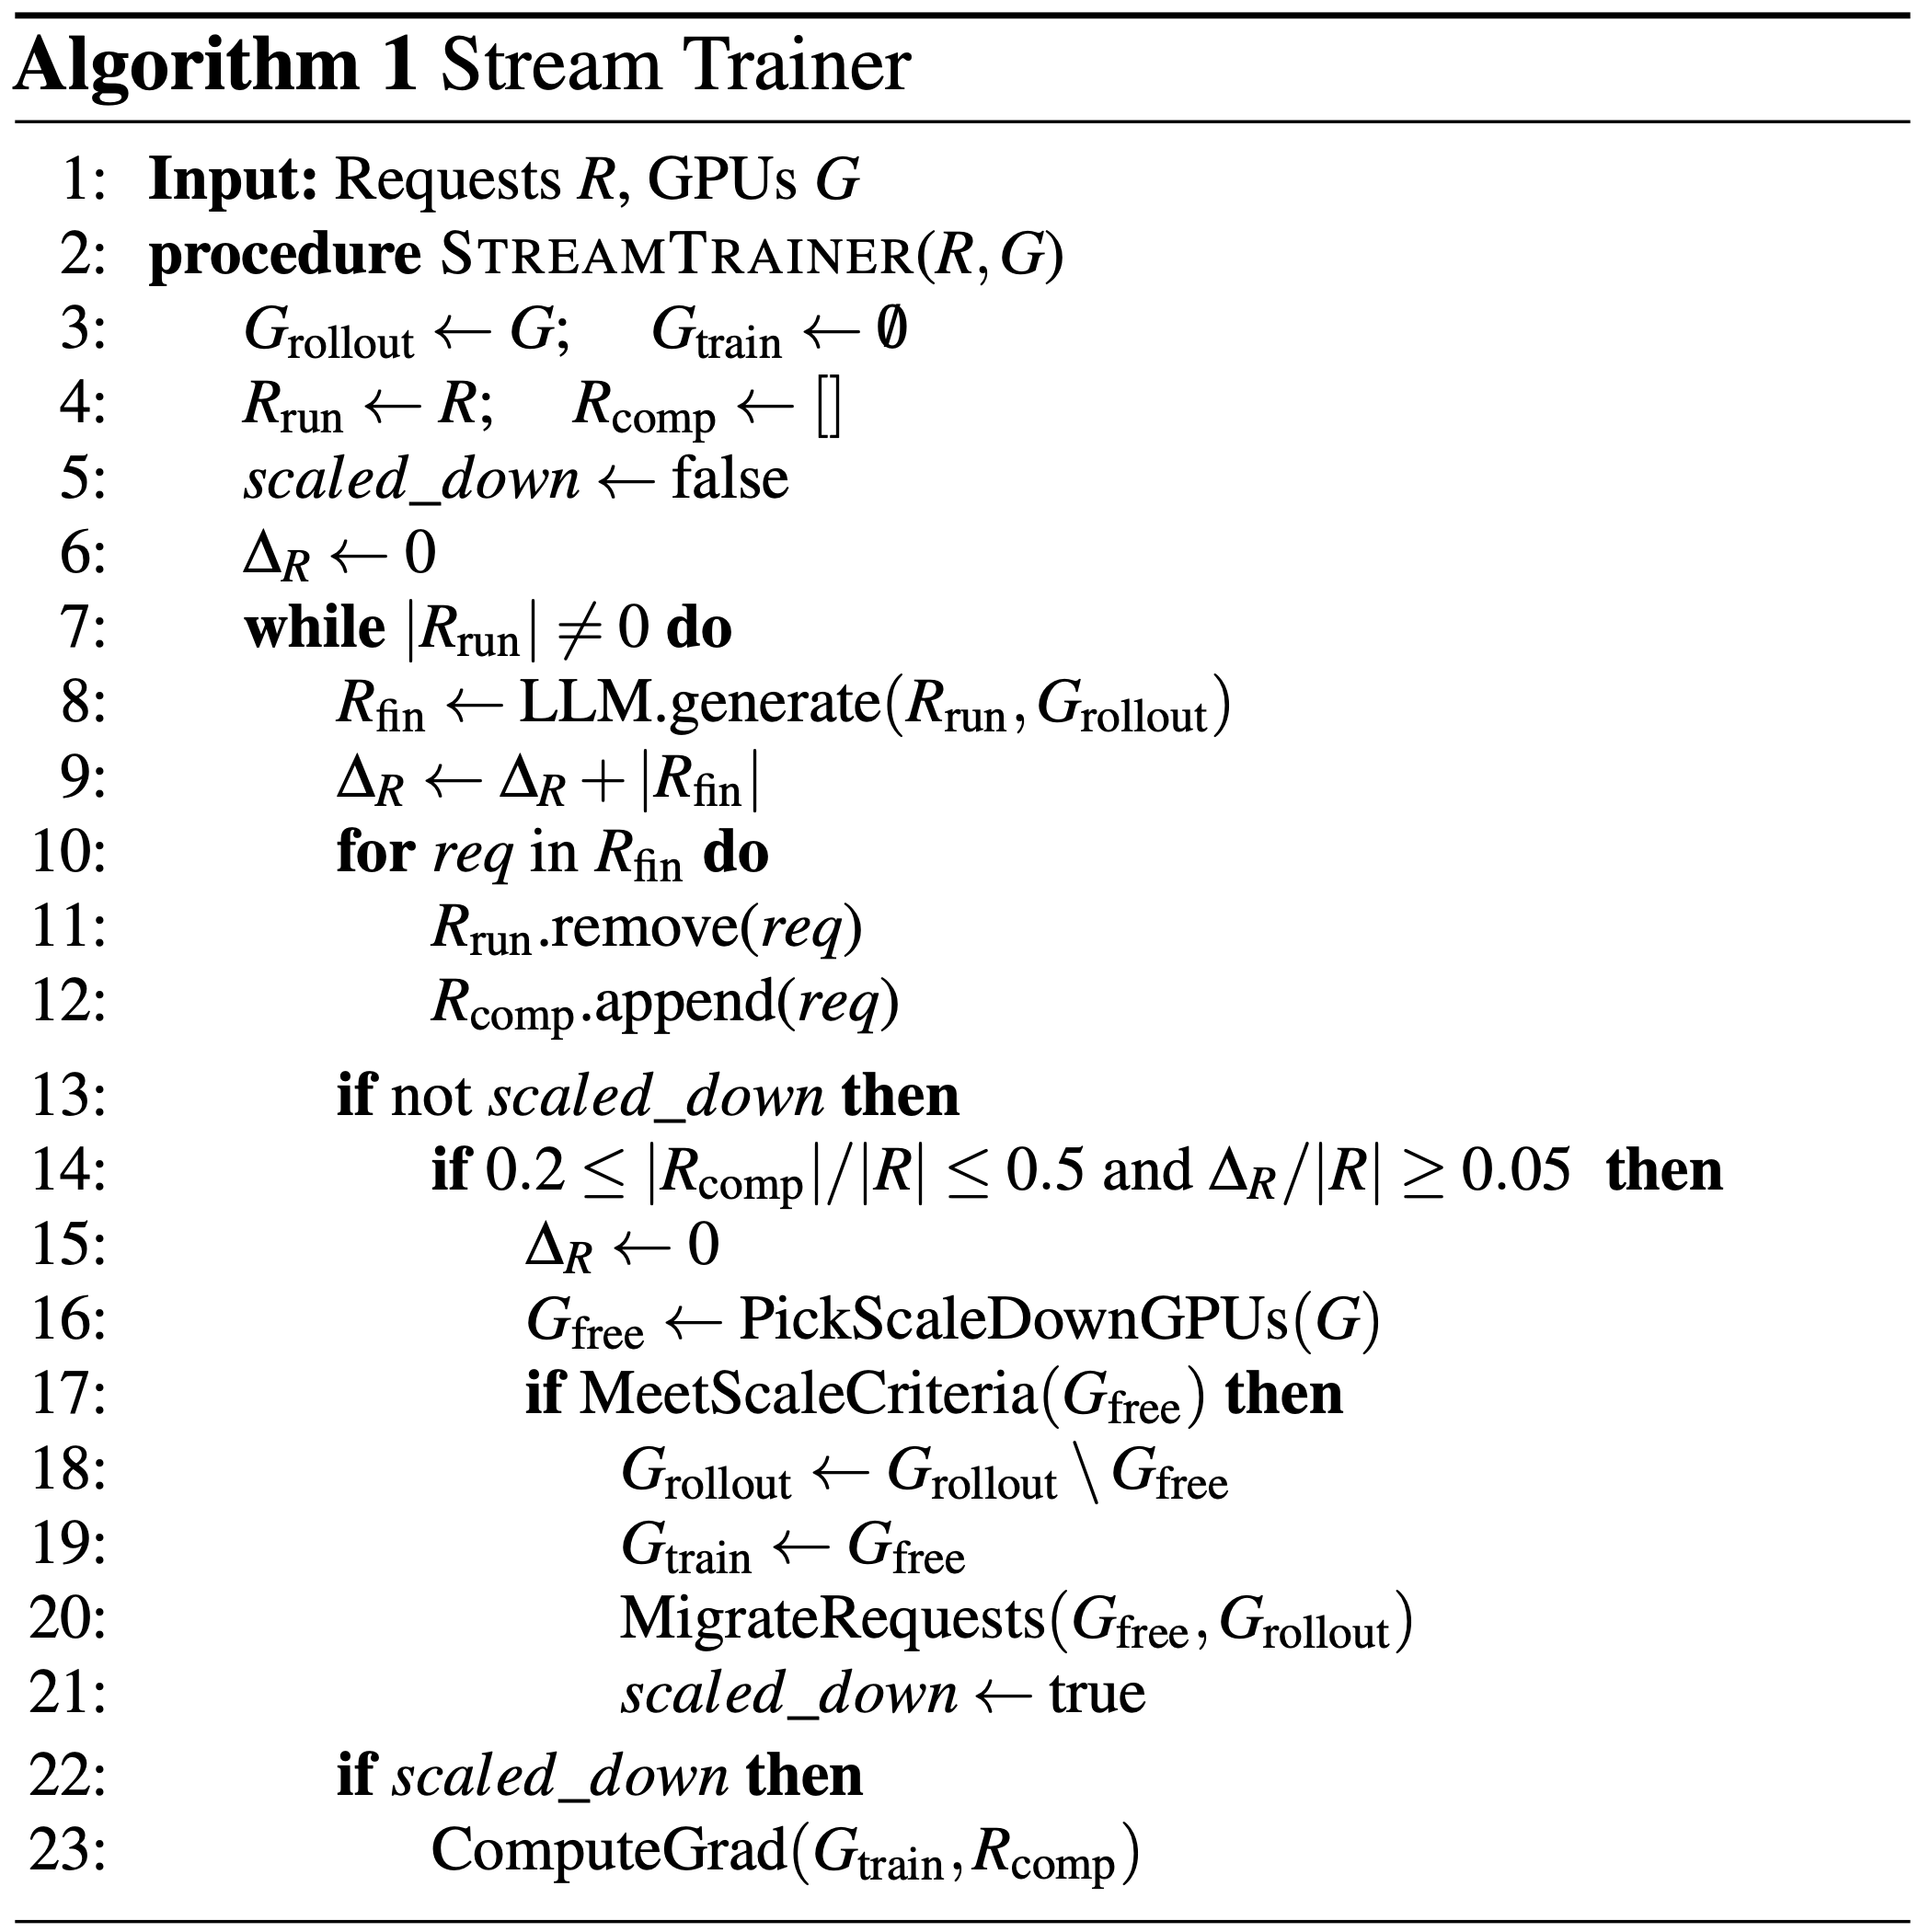
- 目标 :在 Long Round 中,因无投机执行,仍存在 Response 完成时间不均,产生气泡
- 方法(算法 1):
- 1)监控进度 :当已完成 Response 占比在 20%–50% 之间,且 KV Cache 预估不超过内存限制时,触发 GPU 缩放
- 2)选择释放的 GPU :确保不拆分 TP 通信组,优先释放一半 Rollout GPU
- 3)迁移请求 :将未完成的请求迁移到剩余 GPU,通过重计算 KV Cache 恢复(开销小)
- 4)流式训练 :已完成的 Response 立即在释放的 GPU 上计算梯度,但不更新权重 ,仅缓存梯度
- 注:这不适用于需要 Batch Normalization 的算法
- 5)最终同步 :全部完成后,按每个 GPU 处理的样本数重新归一化局部梯度 ,再进行全局平均与权重更新,保证与标准 on-policy 数学等价
- 效果 :减少端到端时间达 14%(原文表 3、原文表 4)
Implementation
- 代码量 ~6.6k 行 Python,基于 ROLL 框架
- Rollout :使用 vLLM v0.8.4,扩展
abort_request和add_request接口支持投机执行与迁移 - Reward :用
ray.remote实现分布式,代码沙盒和数学评估在 CPU 上,Judge 用 CUDA Stream 管理 - Training :基于 Megatron-LM v0.12.2,梯度计算时不加载优化器状态,梯度张量暂存于主机内存,最终同步时再加载
Evaluation
- 端到端性能
- 模型 :Qwen2.5-7B/14B/32B,最大长度 8k/16k/32k
- 对比系统 :veRL(强基线)、RLHFuse(同步重叠最优)
- 结果(原文图 8、原文图 9、原文表 2):
- 精度 :RollPacker 与 veRL 精度曲线几乎重合,验证 Tail Batching 无精度损失
- 速度 :相比 veRL,加速 2.03×–2.56×;相比 RLHFuse,加速 1.14×–2.24×
- Short Round 尤其突出,加速达 2.1×–3.6× vs veRL
- 性能分解(原文表 2)
- Tail Batching 单独贡献:1.30×–2.21×
- +Reward 调度器 :提升至 2.01×–2.48×
- +并行规划器 :进一步提升至 2.01×–2.52×
- +Stream Trainer :最终达 2.03×–2.56×
- Tail Batching 敏感性(原文图 11)
- 固定 \( P_0 \),增大 \(\eta\)(响应数)到 1.5 时收益明显;固定 \( R_0 \),增大 \(\eta\)(Prompt 数)会增加 Long Round 频率,反而不利
- 最优 \(\eta=1.25\)(同时用于 P 和 R),提速达 3.9 倍
- 并行规划器(原文图 12)
- 动态调整 TP 在序列长度增长时有效减少抢占和延迟,平均提速 1.9 倍 vs 固定 TP=1
- 奖励调度器(原文图 13)
- MPS 共享 GPU 提速 1.25 倍
- 层式流水线 提速 1.4 倍
- 自适应超时 提速 1.6 倍
- 流式训练器(原文表 3、原文表 4)
- 自适应 GPU 缩放 提速 1.08 倍 vs 无缩放
- 异步流式获取 比固定批量获取提速 14%
- 可扩展性(原文图 14)
- 在 128 个 H800 GPU 上,RollPacker 吞吐量是 veRL 的 2.2 倍 ,且近线性扩展
Part II: ROLL Flash
- 原始论文:(ROLL-Part2-ROLL-Flash)Part II: ROLL Flash – Accelerating RLVR and Agentic Training with Asynchrony, 20251013, ROLL
- ROLL Flash 是基于 ROLL 的异步框架设计,详情见 NLP——ROLL-Flash(ROLL-Part2)
AsyPPO
- 原始论文:(AsyPPO)Asymmetric Proximal Policy Optimization: mini-critics boost LLM reasoning, 20251002-20251015, ROLL
- Asymmetric Proximal Policy Optimization (AsyPPO) 的核心思想是:利用预训练模型已有的强大表征能力,采用非对称 的 Actor-Critic 架构
- 即用一个或多个 Lightweight 的 Mini Critic 来指导一个规模大得多的 Actor
- 通过精巧的数据划分集成策略 和基于 Critic 间不确定性的目标函数重构 ,AsyPPO 在显著降低计算开销的同时,稳定了训练过程,并在多个数学推理基准上取得了优于 PPO 和 GRPO 的性能
- 论文核心观点总结
- 将 RL4LLM 中 Critic 的困境定义为架构问题 ,而非单纯的算法或优化问题,使用非对称的 Actor-Critic 设计可解决计算瓶颈
- 数据多样性是集成 Critic 的关键 :
- 在 RL4LLM 中,由于 Critic 初始化相同,数据划分的多样性是打破同质化、实现有效集成的关键,而非依赖参数随机初始化
- Critic 间的不确定性是强大的学习信号 :
- 低不确定性(高共识)→ 低信息量状态 → 应掩码其优势以避免过拟合
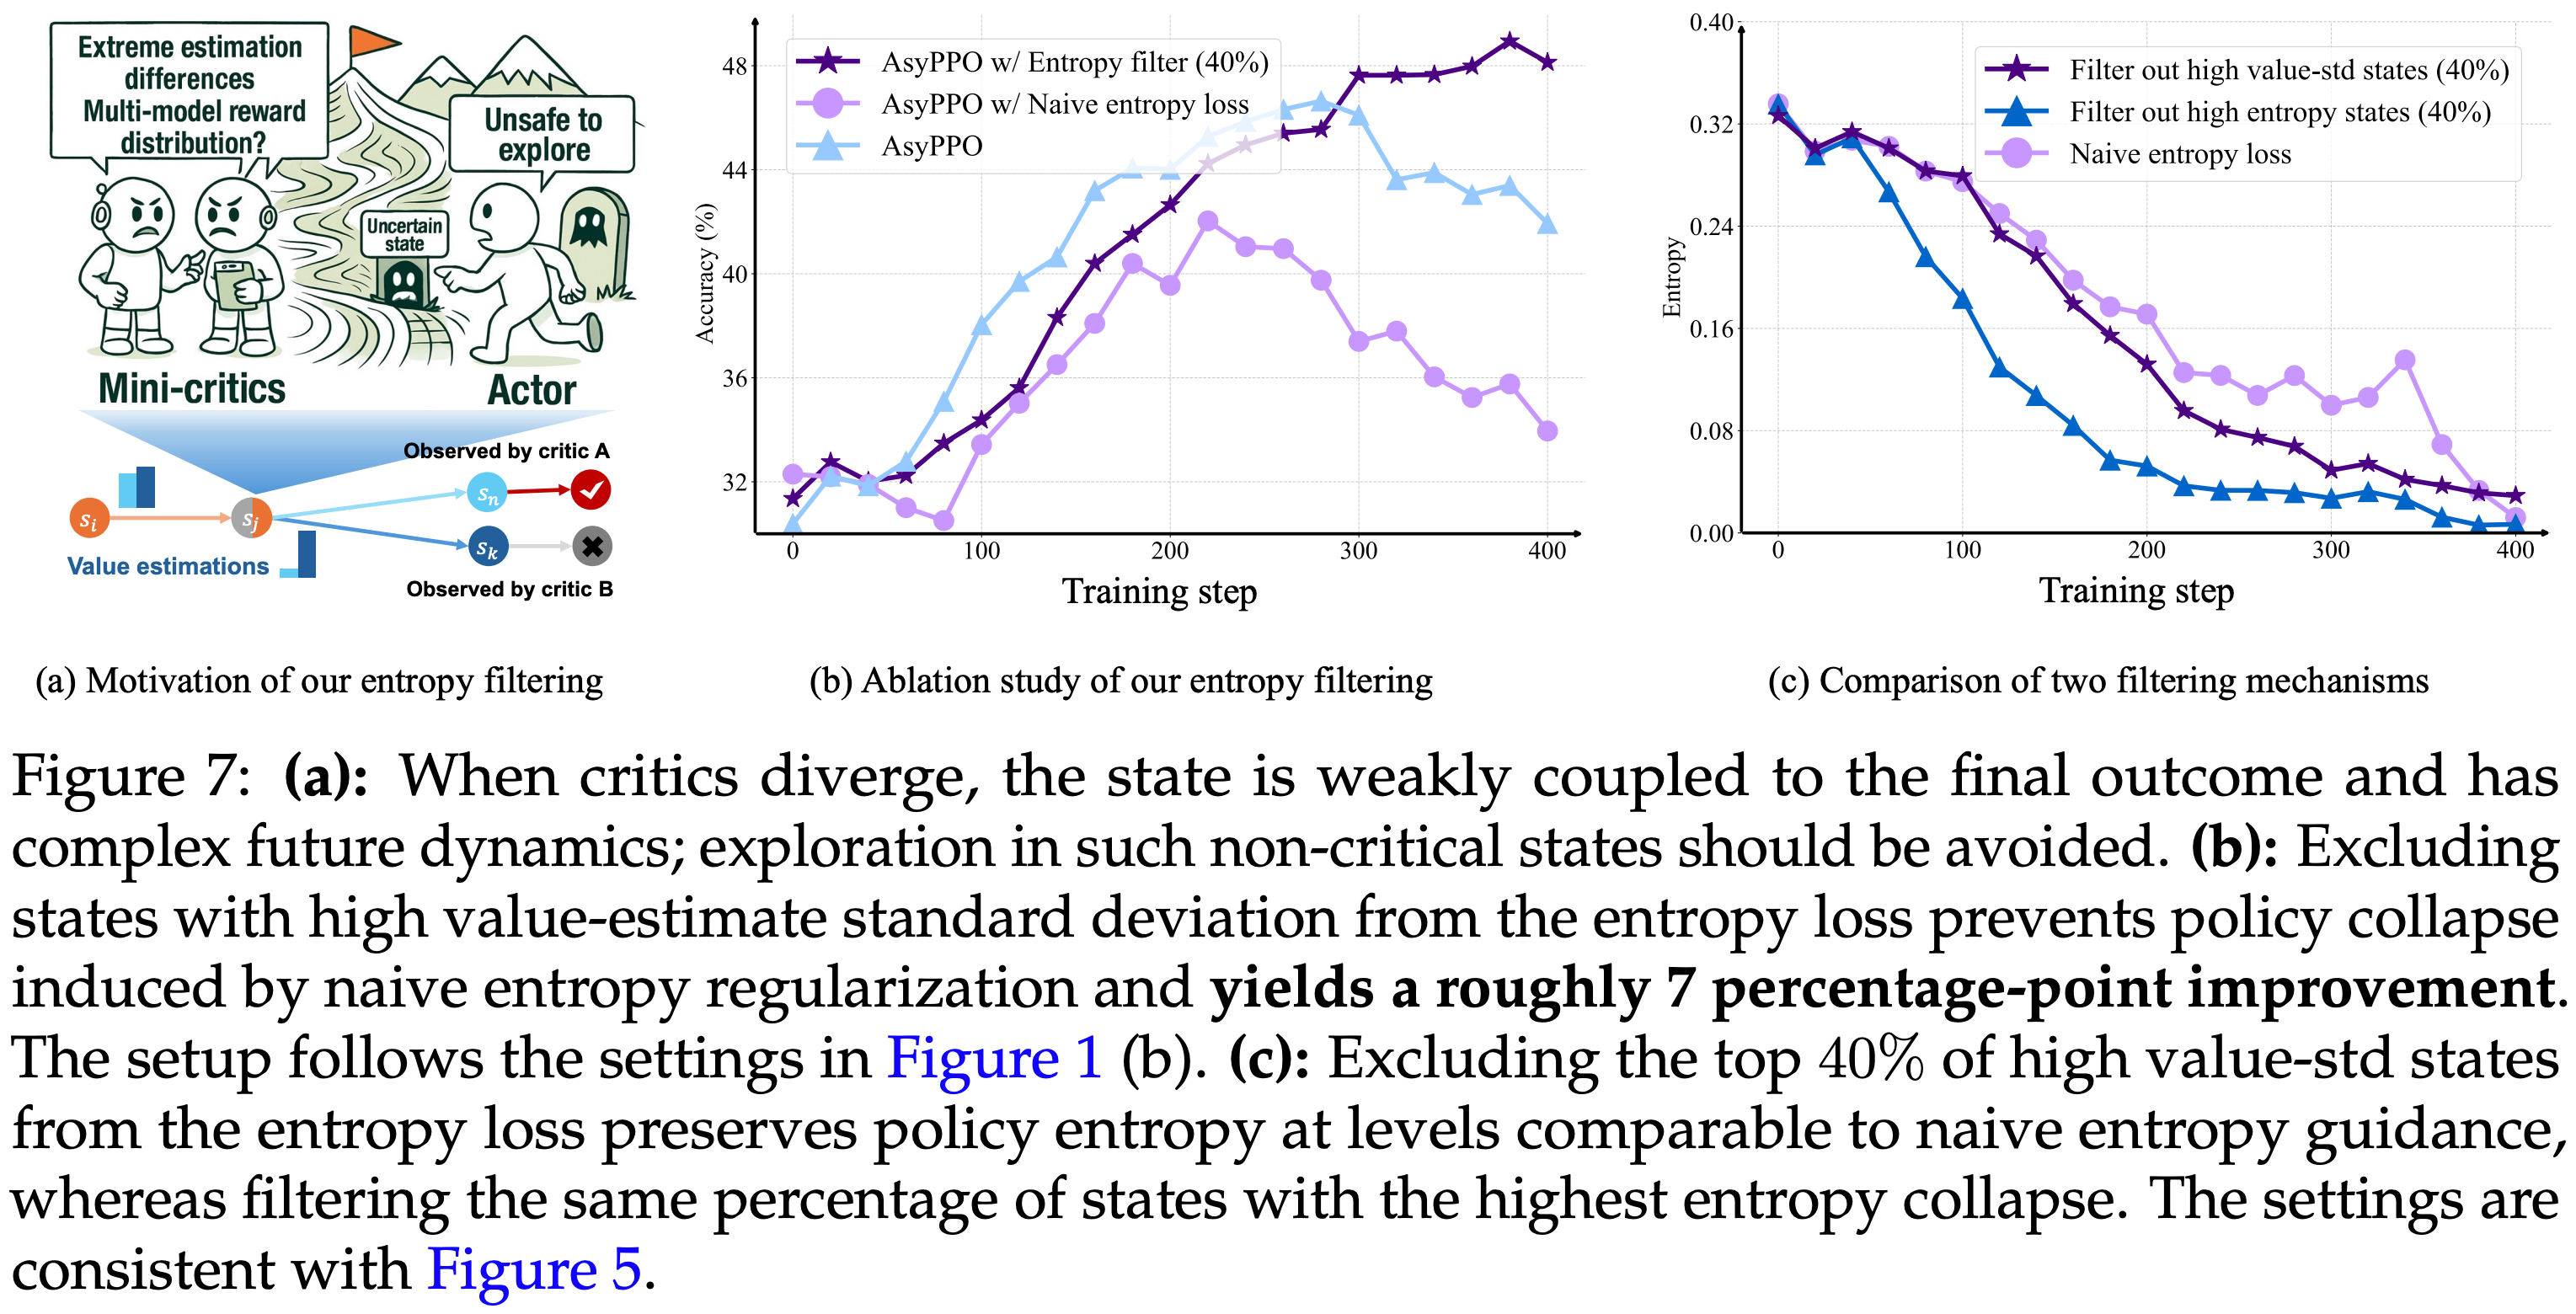
- 高不确定性(高分歧)→ 噪声/无关状态 → 应过滤其熵正则化以实现安全探索
- 两个 Critic 是最优平衡点 :在性能提升和计算开销之间,使用两个 Mini Critic 提供了最佳的性价比
背景 & 问题
- RL4LLM 的现状与困境 :
- 经典 PPO 是强大的 Actor-Critic 算法
- 但将之直接应用于 LLM 时,Critic 通常需要与 Actor 规模相当(对称架构),带来巨大的显存和计算开销
- GRPO 等算法去除了 Critic,利用组内采样结果的均值作为基线来估计优势
- 但这种“Critic-free”的方法放弃了细粒度的状态价值估计,导致学习不稳定、样本效率低,尤其是在 Off-policy 设置下
- 经典 PPO 是强大的 Actor-Critic 算法
- 关键 Insight :
- 与经典 RL(从零开始学习)不同,RL4LLM 中的 Actor 和 Critic 都继承自强大的预训练模型,拥有丰富的先验知识
- 这使得 用一个小得多的 Critic 来指导大 Actor 成为可能
- 但单个小 Critic 的价值估计能力有限,且多个 Critic 若初始化相同、训练数据相同,则无法形成有效的集成(Ensemble)多样性
- 与经典 RL(从零开始学习)不同,RL4LLM 中的 Actor 和 Critic 都继承自强大的预训练模型,拥有丰富的先验知识
AsyPPO 算法
- AsyPPO 的核心在于构建一个既轻量又可靠的 Critic 系统,并利用该系统提供的价值不确定性来优化策略学习
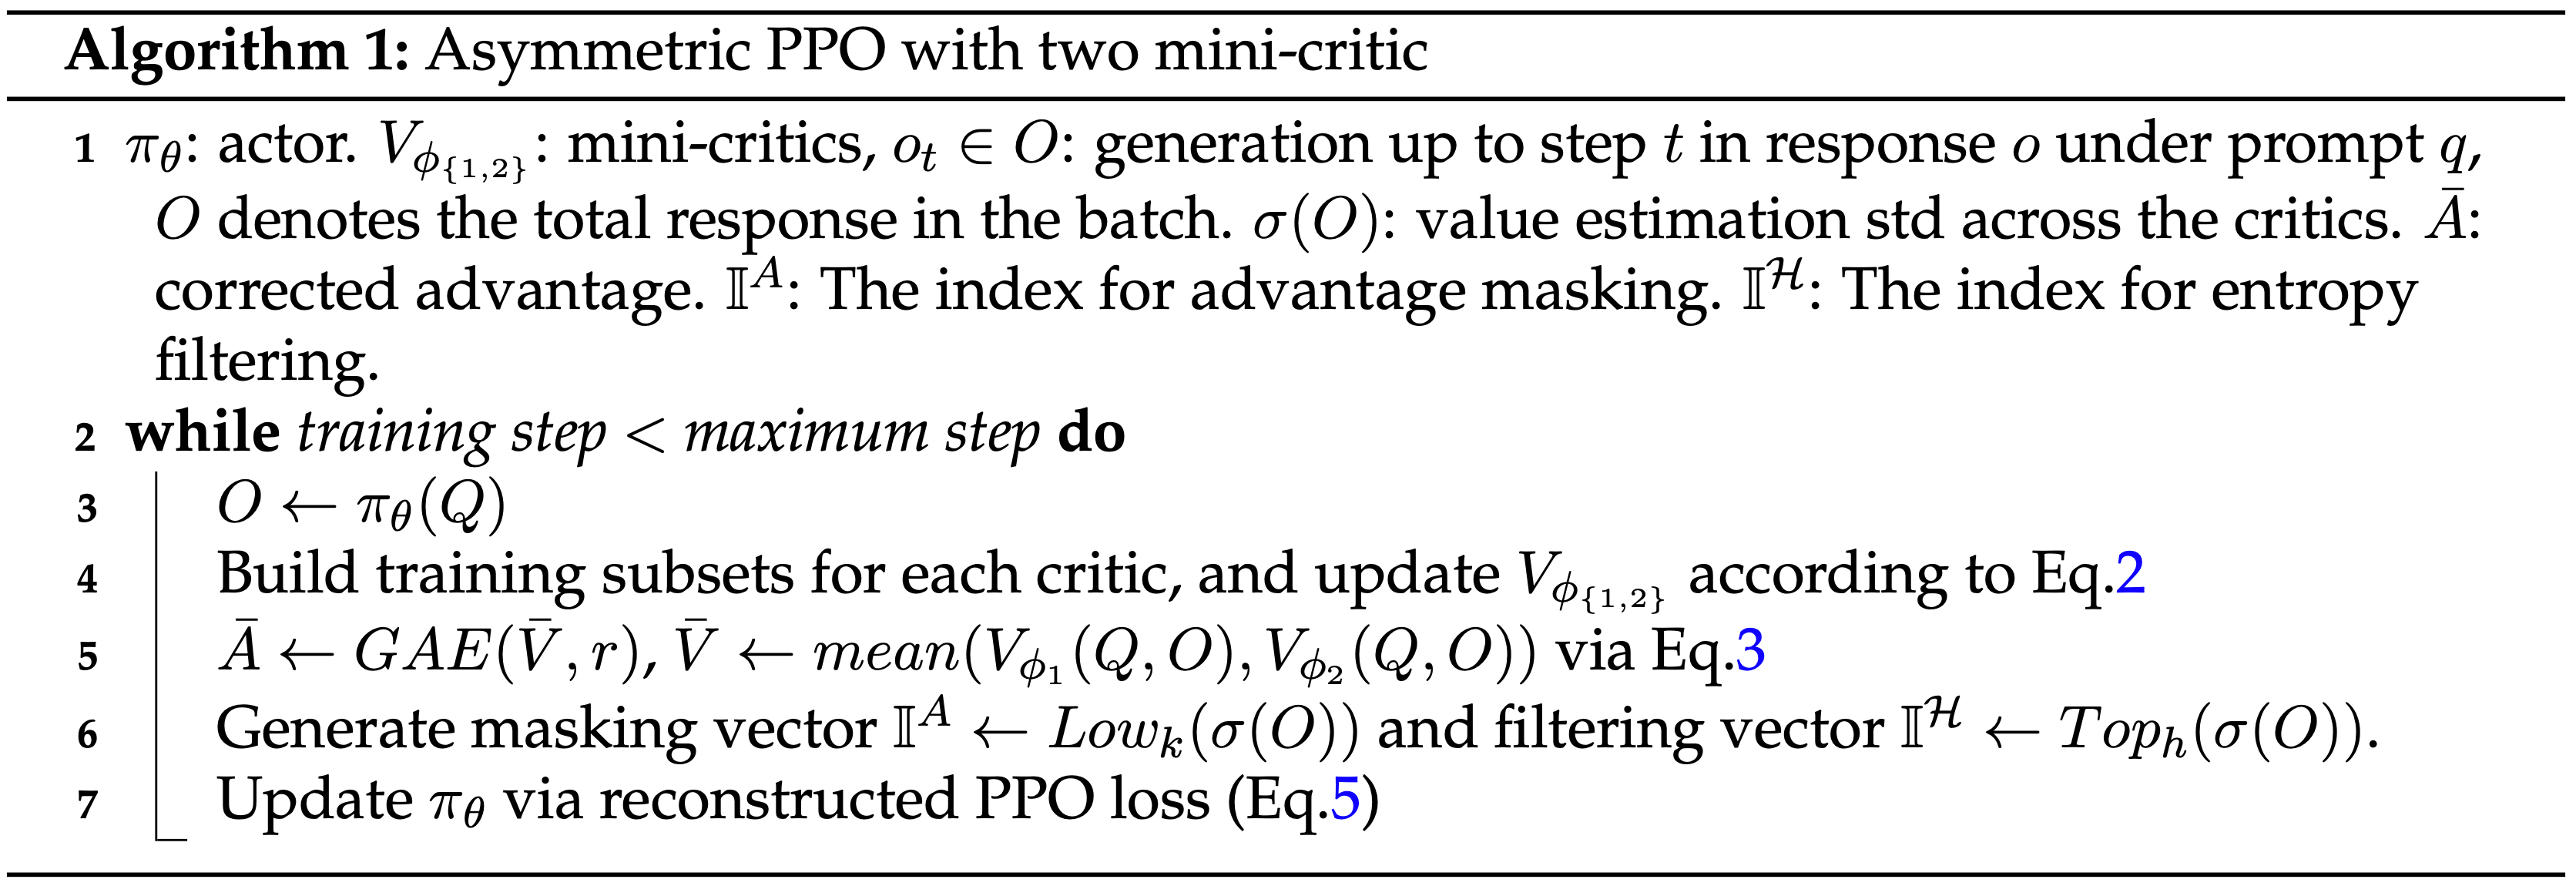
- 整个流程如算法 1 所示,主要包括三个创新点
Lightweight Robust Value Estimation
- 这部分解决了 “如何让多个 Mini Critic 产生多样且可靠的估计” 的问题
- 1)基础架构 :
- Actor :一个大规模的 LLM,参数为 \(\theta\),如 Qwen3-14B
- Mini-Critics :一组 \(M\) 个轻量级 LLM(本文证明 \(M=2\) 是最佳平衡点),参数为 \(\{\phi_m\}_{m=1}^M\),如 Qwen3-1.7B
- 多个 Critics 共享相同的网络结构,但训练数据不同
- 2)核心挑战 :若所有 Critic 使用相同数据训练,它们的行为会趋于一致(同质化),集成失去意义
- 3)解决方案:Prompt 级非重叠数据划分 :
- 训练时,对于同一批次的 Prompts,将每个 Prompt 生成的多个 Responses(即 Rollout)均匀地、不重叠地 分配给各个 Critic
- 理解:为了节省数据,适当加入 Overlap 是不是也可以
- 例如,每个 Prompt 生成 32 个 Responses,Critic 1 学习前 16 个,Critic 2 学习后 16 个
- 这种设计保证了每个 Critic 对同一个 Prompt 下的不同推理路径进行学习,产生了差异化的优化信号,增强了多样性
- 由于它们都覆盖了所有 Prompt,又保持了感知同步性(Perceptual Synchrony),避免了对特定 Prompt 的过拟合
- 训练目标 :每个 Critic \(m\) 在其专属数据集 \(\mathcal{D}_m\) 上通过最小化均方误差来拟合目标回报 \(R_t\)(即折扣累积奖励),总损失为各 Critic 损失之和:
$$
\mathcal{L}_{\text{critic} }(\phi) = \sum_{m=1}^{M} \mathbb{E}_{(s_t, R_t) \sim \mathcal{D}_m} \left[ (V(s_t;\phi_m) - R_t)^2 \right]
$$- 其中 \(s_t\) 是状态(当前已生成的 Token 序列),\(V(s_t;\phi_m)\) 是第 \(m\) 个 Critic 对状态 \(s_t\) 的价值估计
- 训练时,对于同一批次的 Prompts,将每个 Prompt 生成的多个 Responses(即 Rollout)均匀地、不重叠地 分配给各个 Critic
- 4)优势计算 :
- 最终的状态价值 \(\bar{V}(s_t)\) 通过简单平均所有 Critic 的输出来计算:
$$
\bar{V}(s_t) = \frac{1}{M} \sum_{m=1}^{M} V_m(s_t;\phi_m)
$$ - 然后使用 GAE(广义优势估计)计算修正后的优势函数 \(\bar{A}_t\):
$$
\bar{A}_t = \sum_{l=0}^{T-t-1} (\gamma \lambda)^l \delta_{t+l}, \quad \delta_t = r_t + \gamma \bar{V}(s_{t+1}) - \bar{V}(s_t)
$$- 其中 \(r_t\) 是即时奖励(通常只在最终步有稀疏奖励),\(\gamma\) 是折扣因子,\(\lambda\) 是 GAE 参数
- 其中 \(r_t\) 是即时奖励(通常只在最终步有稀疏奖励),\(\gamma\) 是折扣因子,\(\lambda\) 是 GAE 参数
- 最终的状态价值 \(\bar{V}(s_t)\) 通过简单平均所有 Critic 的输出来计算:
Advantage Masking based on Value Agreement
- 这部分解决了 “如何筛选高质量样本,防止策略过拟合” 的问题
- 1)核心观察 :
- 当多个 Critic 对某个状态 \(s_t\) 的价值估计 非常一致(即标准差 \(\sigma_t\) 很小)时,表明该状态是常见、低信息量(Low-informative)的
- 在这些状态上过度优化容易导致过拟合,且不会带来显著的性能提升
- 2)不确定性度量 :用 Critic 们价值估计的标准差 \(\sigma_t\) 作为不确定性的度量:
$$
\sigma_t = \text{std}\left(\{V(s_t;\phi_m)\}_{m=1}^M\right)
$$- \(\sigma_t\) 小 = 高一致性(High Agreement)= 低不确定性
- 3)掩码机制 :
- 在每个训练批次中,计算所有状态的价值估计标准差,并选出 \(\sigma_t\) 最小 的 \(k%\) 状态(即最无信息量的状态)
- 构建一个二元掩码向量 \(\mathbb{I}_t^A\),对这些状态对应的 Advantage 进行掩码(设为 0),从而在策略损失中忽略它们
- 掩码指示函数 :
$$
\mathbb{I}_t^A = \begin{cases} 0, & \text{if } \sigma_t \in \text{Low}_k(\sigma) \\ 1, & \text{otherwise} \end{cases}
$$
其中 \(\text{Low}_k(\sigma)\) 表示标准差最低的那组状态的集合
- 4)作用 :这种操作相当于一个自适应的、数据驱动的学习过滤器 ,引导策略更新关注于更有价值、更具信息量的状态,从而稳定了 Off-policy 训练(高 UTD 比率下尤甚)
- 理解:UTD 是 Update-To-Data 的缩写,也常被称为 Update-to-Data Ratio(更新-数据比率)
- UTD = 1:标准的纯 On-policy 训练
- 数据采样一次,策略更新一次,样本用完即弃
- UTD > 1:Off-policy 或高数据复用的训练
- 同一批数据会被策略重复使用多次(例如,在多个 Epoch 上反复学习)
- 这是 PPO 等算法为了提高样本效率而采用的一种常见做法(即 PPO 中的 ppo_epochs 参数)
- UTD = 1:标准的纯 On-policy 训练
- 理解:UTD 是 Update-To-Data 的缩写,也常被称为 Update-to-Data Ratio(更新-数据比率)
- 理解:
- 这里基于 Critic 的估计方差来 mask Policy 的 Token Loss 是不科学的,因为部分状态的价值估计可能会非常确定,但是动作的价值不确定,还是需要更新的吧!
Entropy Filtering based on Value Divergence
- 这部分解决了“如何安全探索,避免在无意义状态上浪费探索”的问题
- 1)核心观察 :
- 当多个 Critic 对某个状态 \(s_t\) 的价值估计显著分歧(即标准差 \(\sigma_t\) 很大)时,通常意味着该状态与最终奖励的相关性弱,或是具有干扰性的噪声状态(如无意义的连接词、语气词)
- 2)问题 :传统的熵正则化鼓励在所有状态上探索
- 但在高分歧的状态上进行探索是低效甚至有害的
- 3)过滤机制 :
- 在每个训练批次中,选出 \(\sigma_t\) 最大 的 \(h%\) 状态(即最不确定、最可能为噪声的状态)
- 构建另一个二元掩码向量 \(\mathbb{I}_t^\mathcal{H}\),将这些高分歧状态 从熵损失的计算 中移除 ,防止策略在这些无效状态上被鼓励探索
- 理解:其实我们现在通常几乎不加 entropy loss 了
- 过滤指示函数 :
$$
\mathbb{I}_t^\mathcal{H} = \begin{cases} 0, & \text{if } \sigma_t \in \text{Top}_h(\sigma) \ 1, & \text{otherwise} \end{cases}
$$- 其中 \(\text{Top}_h(\sigma)\) 表示标准差最高的那组状态的集合
- 4)作用 :将探索集中在那些 Critic 意见相对一致、与决策真正相关的状态上
- 这被称为“安全的熵正则化”,有效防止了熵的崩溃,并引导策略向高回报方向收敛
最终重构的策略损失函数
- 将上述两种机制整合到经典的 PPO 裁剪目标中,得到最终的优化目标:
$$
\begin{aligned}
\mathcal{J}_{\text{AsyPPO} }(\theta) = \mathbb{E} \frac{1}{|o|} \sum_{t=1}^{|o|} \Big[ \color{red}{\mathbb{I}_t^A} \cdot \min \left( r_t(\theta) \bar{A}_t, \text{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon) \bar{A}_t \right) + \beta \cdot \color{red}{\mathbb{I}_t^\mathcal{H}} \cdot \mathcal{H}[\pi_\theta(\cdot|s_t)] \Big]
\end{aligned}
$$- \(\mathcal{H}[\pi_\theta(\cdot|s_t)]\) 是策略在状态 \(s_t\) 下的熵
- \(\mathbb{I}_t^A\) 和 \(\mathbb{I}_t^\mathcal{H}\) 分别是上述的优势掩码和熵过滤指示函数
实验
- 实验设置
- 模型 :Actor 采用 Qwen3-4B/8B/14B-Base;Critic 采用 Qwen3-0.6B/1.7B/4B-Base
- 数据 :仅使用开源数学数据集(如 DeepMath-103K 的子集)进行训练,样本量约 5000 个 Prompt
- Benchmarks :AIME24/25, MATH-500, OlympiadBench, MinervaMath, AMC 2023
- Baselines :经典对称 PPO, GRPO, 以及单 Critic 的非对称 PPO
- 主要结果 (RQ1: 泛化性)
- 性能:AsyPPO 在 4B、8B 和 14B 的 Actor 上都一致且显著地优于 GRPO 和经典 PPO
- 在 14B 模型上,AsyPPO 比 GRPO 平均提高了约 3 个百分点的准确率
- 效率:相比于对称 PPO,AsyPPO 减少了约 20% 的峰值显存占用,并且每步训练时间快了约 20 秒(与 GRPO 水平相当)
- 这证明了其轻量级架构的有效性
- 性能:AsyPPO 在 4B、8B 和 14B 的 Actor 上都一致且显著地优于 GRPO 和经典 PPO
- 消融实验与分析 (RQ2 & RQ3)
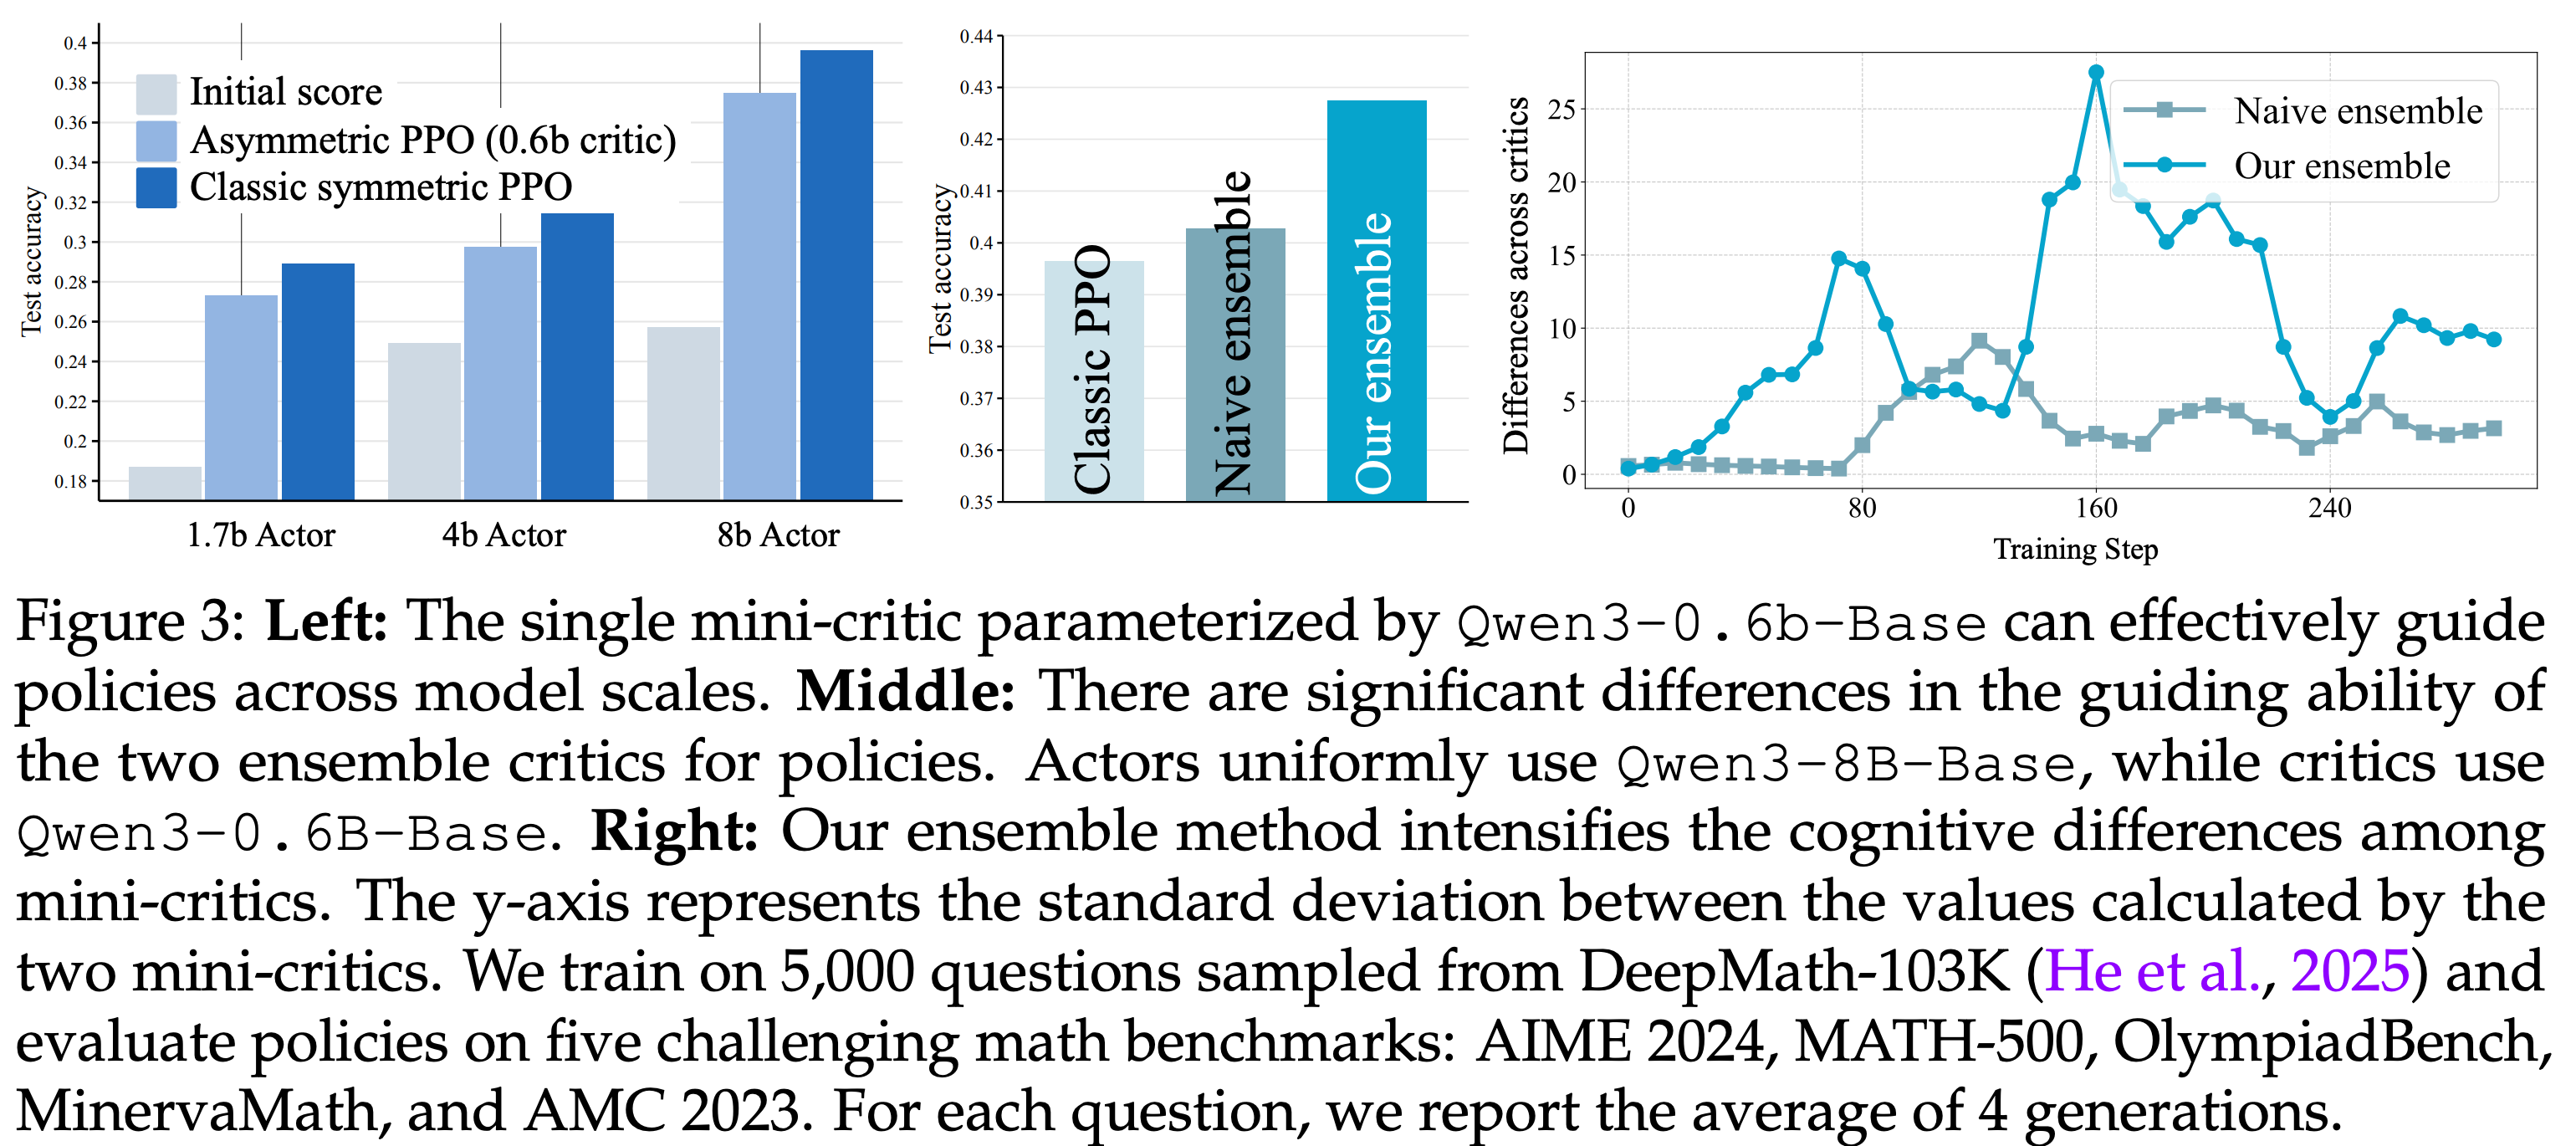
- Critic 数量与大小 (原文图 9):
- 大小 :Critic 模型越大,指导效果越好,呈现类似 Scaling Law 的趋势
- 数量 :2 个 Critic 是最佳选择
- 从 1 个增加到 2 个,性能有质的飞跃(Qualitative leap);增加到 3 个或更多,性能提升有限,但计算成本增加
- 集成聚合方式 :使用 Critic 价值估计的均值 优于使用最小值,说明在 RL4LLM 中价值高估(Overestimation)不是主要问题
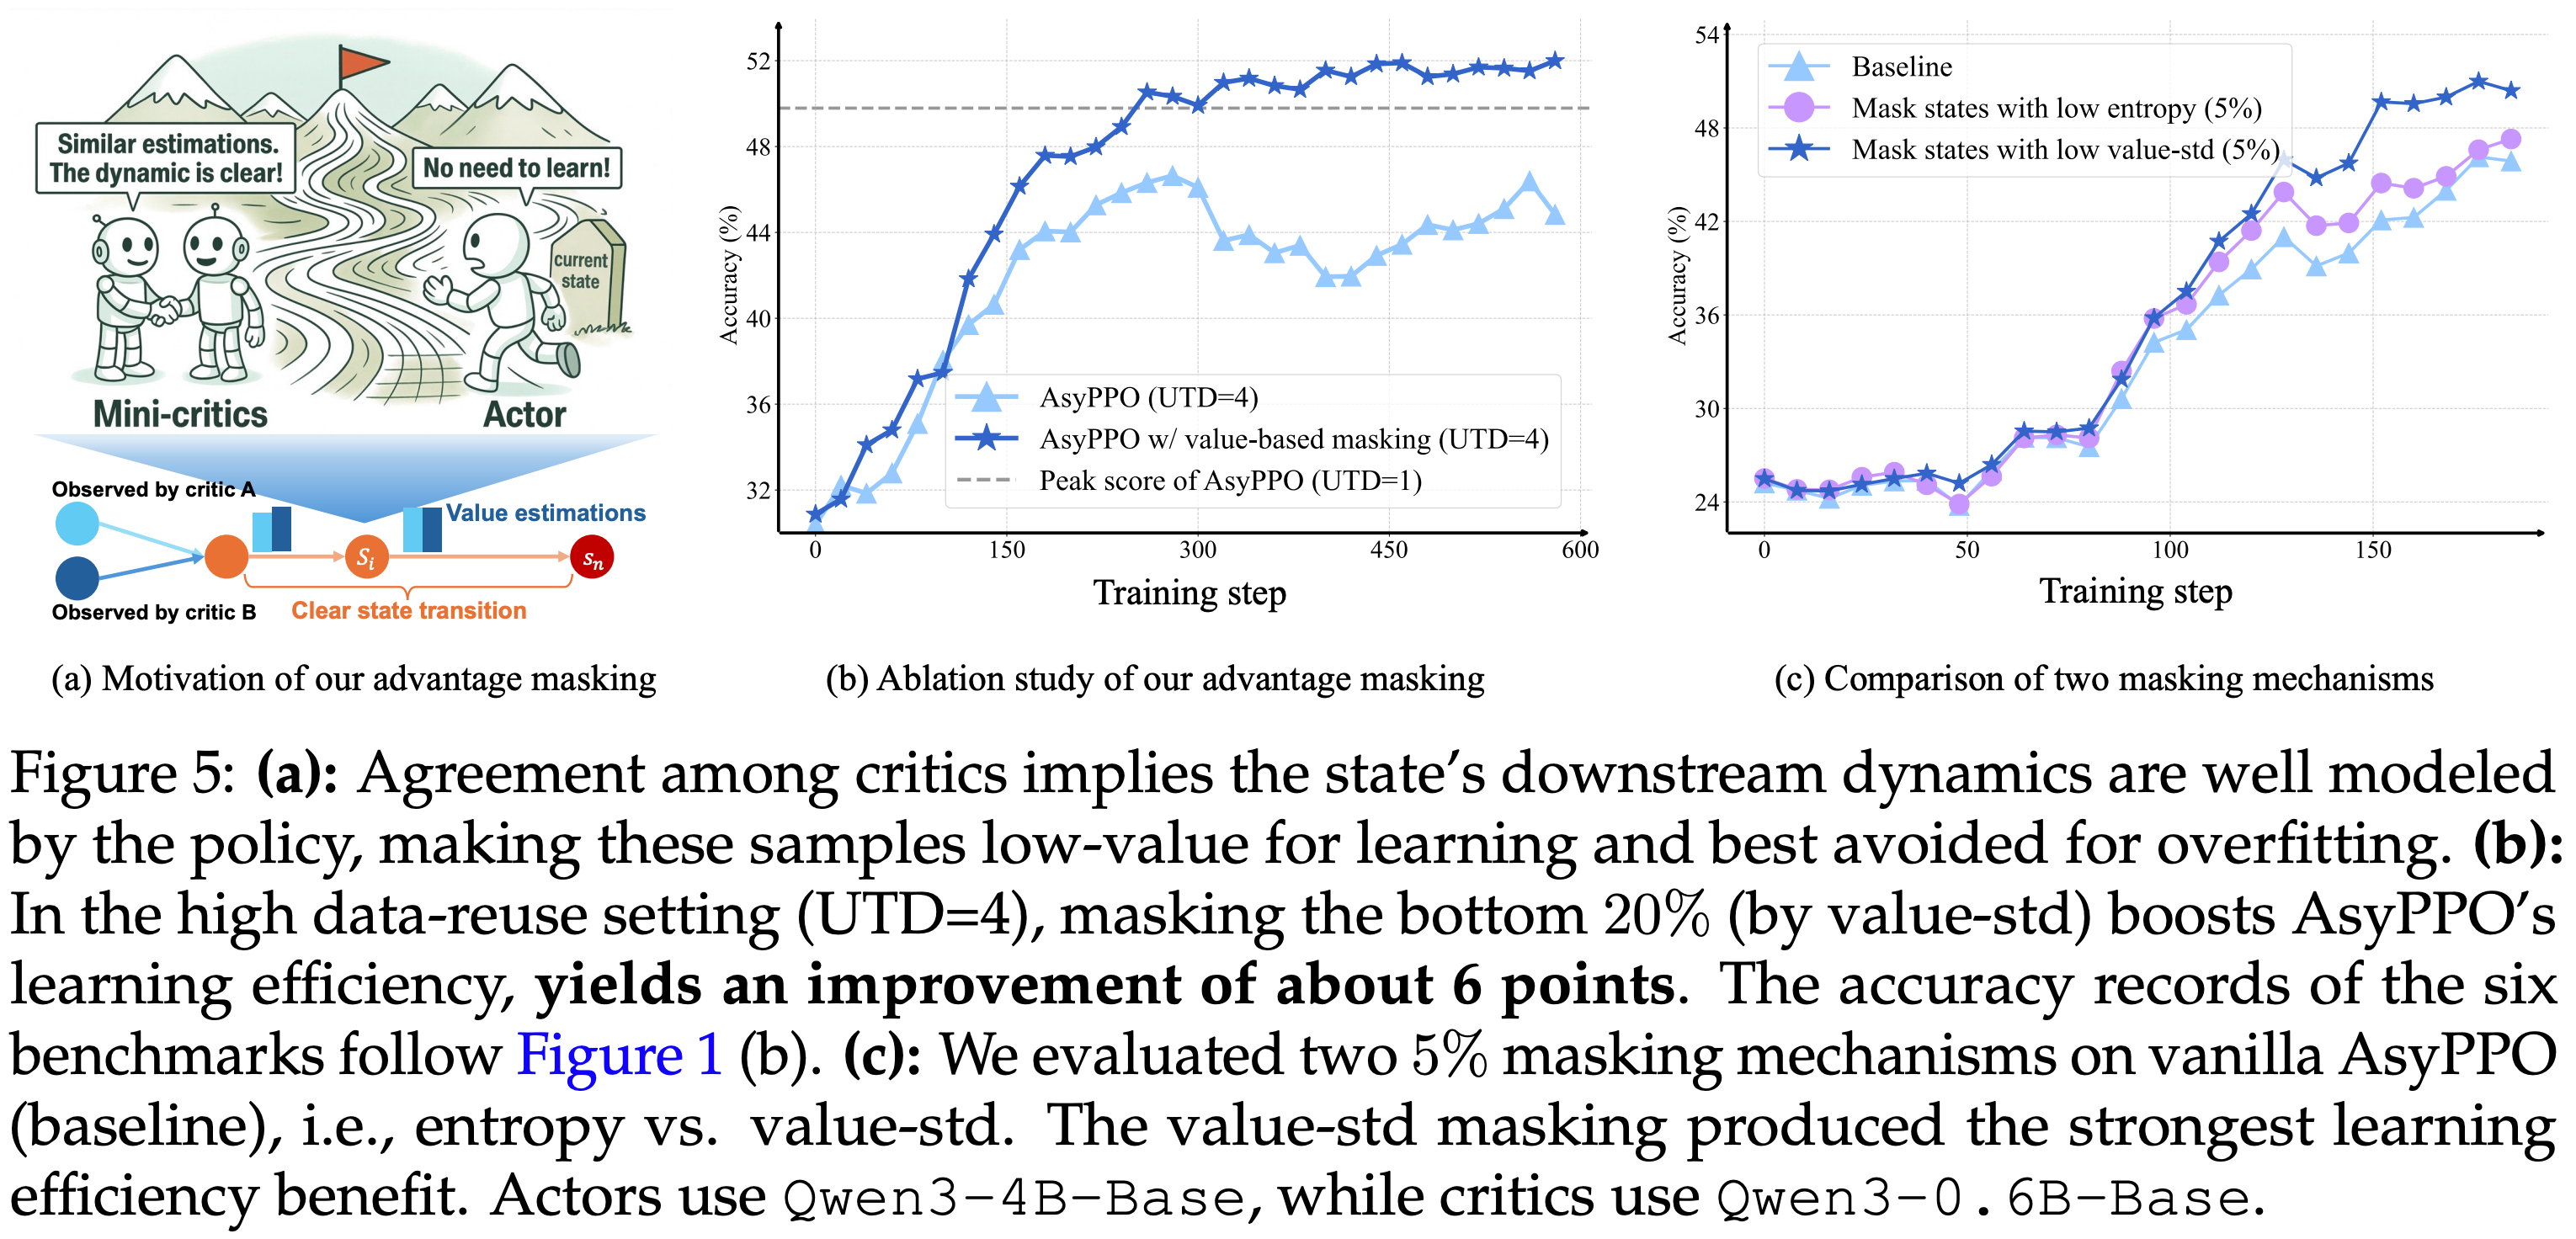
- 优势掩码比例 (原文图 10 左):
- Mask 掉 \(\sigma_t\) 最低的 20% 的状态时,性能提升最大
- 过多或过少都会损害效果
- 熵过滤比例 (原文图 10 中、右):
- 过滤掉 \(\sigma_t\) 最高的 20% 的状态的熵损失时,性能最优
- 过滤过多(如 40%)会导致熵崩溃,过少则效果不明显
- 对比实验表明,基于 Value-Std 的过滤比基于 Entropy 本身的过滤更有效,且二者筛选出的状态重叠度很低(原文图 6),表明 Value-Std 提供了一种独特的、正交的不确定性信息
- 过滤掉 \(\sigma_t\) 最高的 20% 的状态的熵损失时,性能最优
- 算法机制验证 (原文图 5, 7):
- 原文图 5 验证了优势掩码的有效性:在数据复用率(UTD=4)较高时,掩码机制能显著防止过拟合,提升性能
- 原文图 7 验证了熵过滤的有效性:相比不加过滤的熵正则化,过滤机制能稳定策略的熵值,避免其崩溃,从而稳定训练
- Critic 数量与大小 (原文图 9):
Attention-Illuminates-LLM-Reasoning
- 原始论文:(Attention-Illuminates-LLM-Reasoning)Attention Illuminates LLM Reasoning: The Preplan-and-Anchor Rhythm Enables Fine-Grained Policy Optimization, 20251015-20260608, ROLL
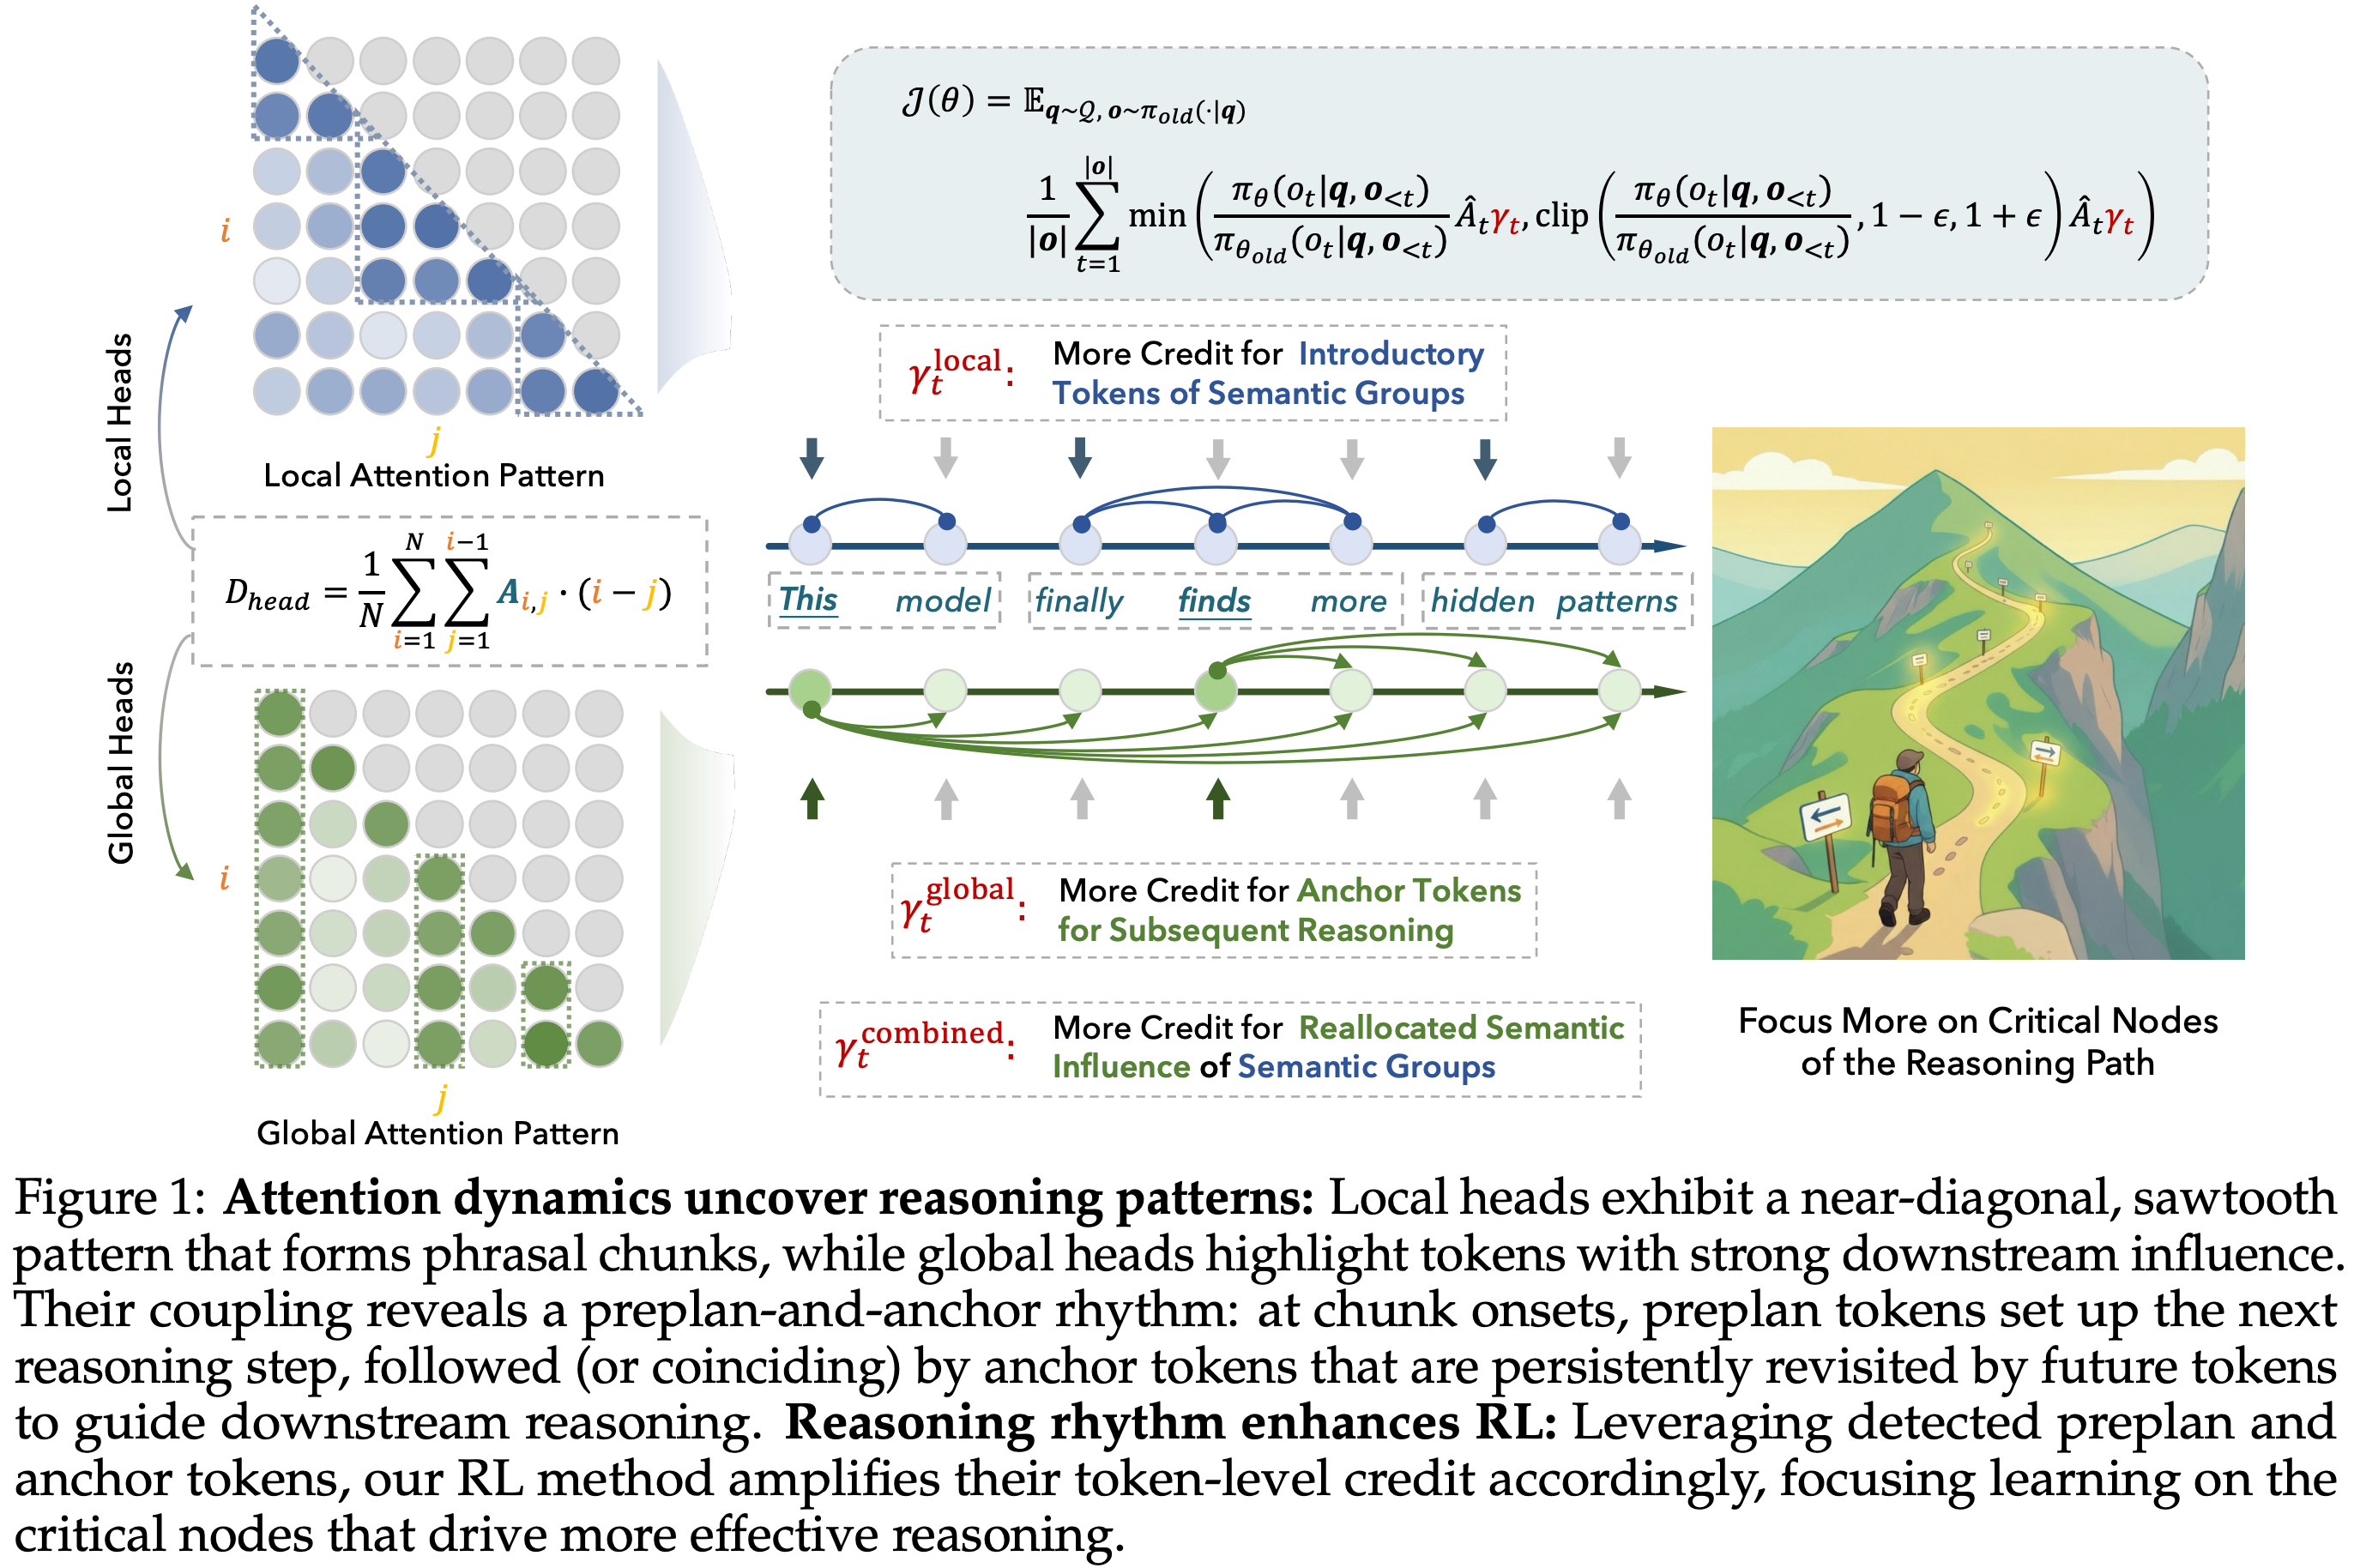
- 论文最大的创新在于发现了 “Preplan-and-Anchor” Rhythm(预规划-锚定节奏)
- “Preplan-and-Anchor” Rhythm 是 LLM 在推理过程中展现出来的一种内部注意力动态规律
- 描述了模型在生成推理步骤时,如何通过局部注意力 和全局注意力 的协同配合,来组织和引导后续推理
- “Preplan-and-Anchor” Rhythm 是 LLM 在推理过程中展现出来的一种内部注意力动态规律
- 论文内容较为复杂,需要统计 Attention 等,对已有框架改动较大
核心发现:“Preplan-and-Anchor” Rhythm
- 这个节奏包含两个紧密耦合的阶段:
Preplan(预规划)阶段
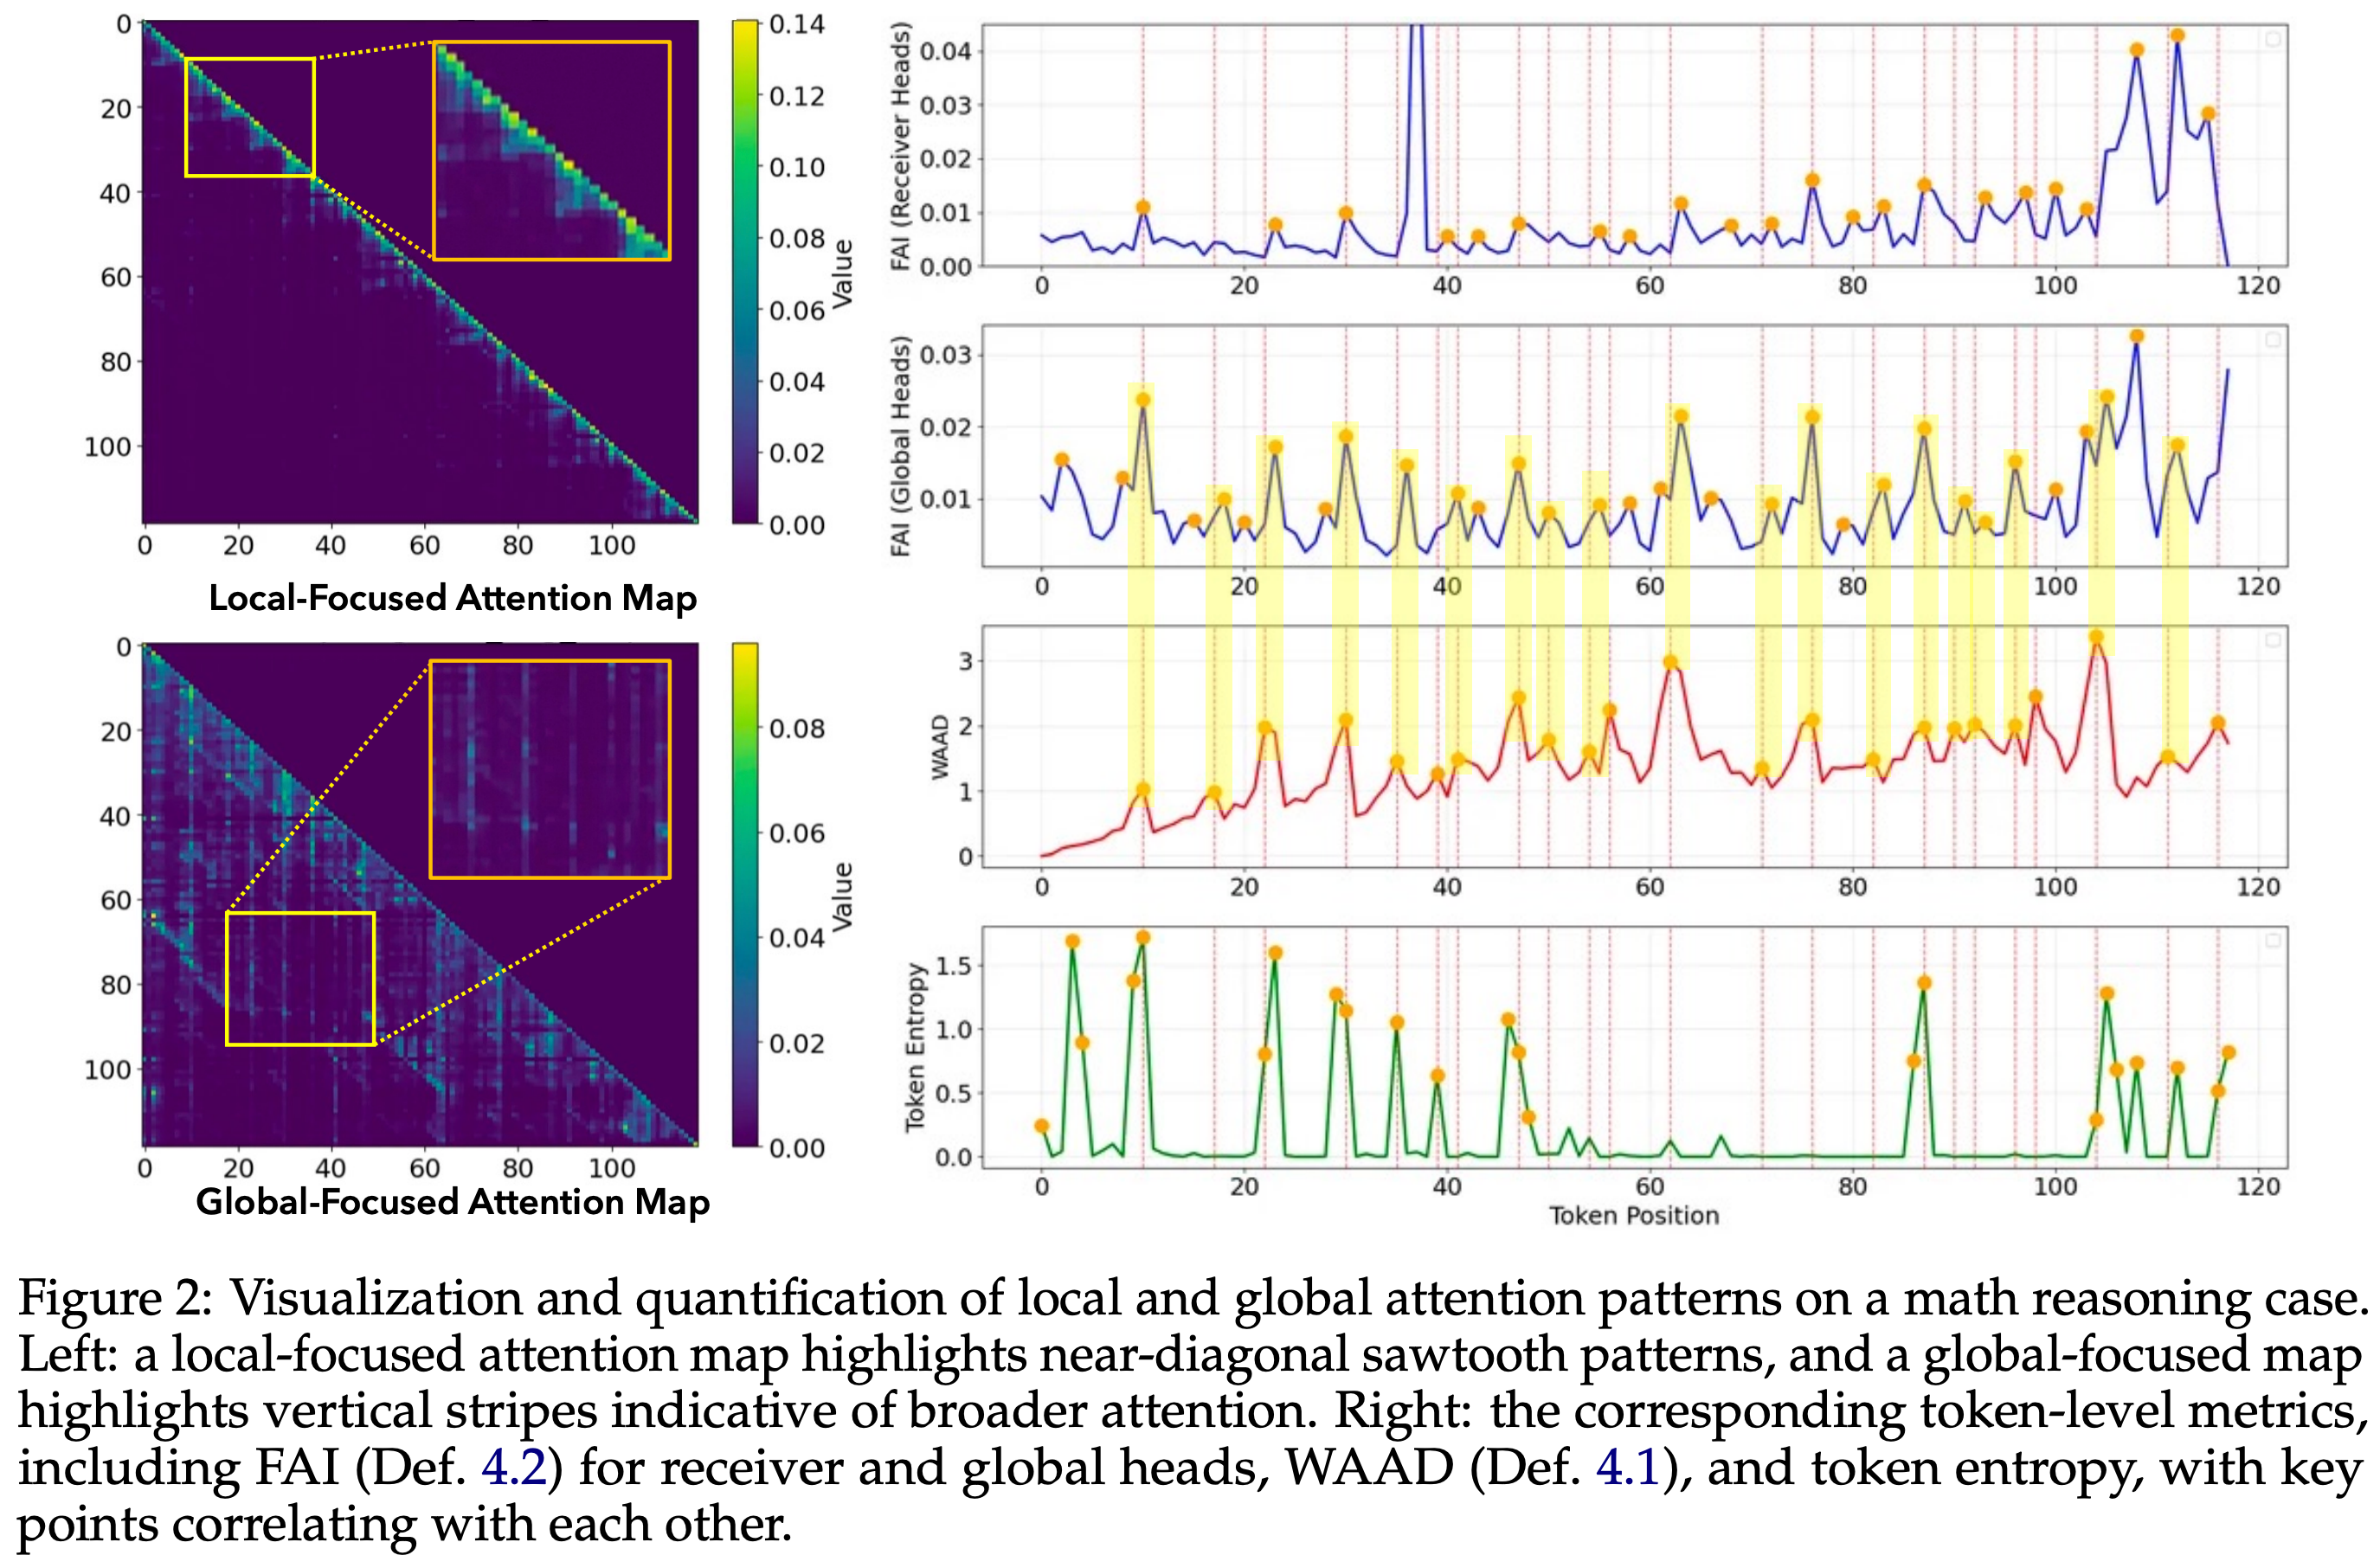
- 在模型即将进入一个新的语义块(如一个新的推理步骤、子句或逻辑片段)时,局部注意力头 会表现出 WAAD(Windowed Average Attention Distance)的峰值
- 衡量模型生成当前 token 时,局部注意力头需要回溯多远的历史信息,其峰值标志着新推理步骤或语义块的开端(即“预规划”时刻)
- 此时模型会主动回顾较远的上下文(跨距较大),以获取足够的信息来“起草”下一个推理步骤的开头
- 这是因为当前局部上下文不足以唯一确定下一个词,模型需要借助更广泛的背景来消除歧义
- Insight :
- WAAD 值升高(即注意力向更远的过去扩展)
- 对应位置的token 熵较高 ,表示模型预测不确定性大
- 通常出现在语义边界或新步骤的起始处
Anchor(锚定)阶段
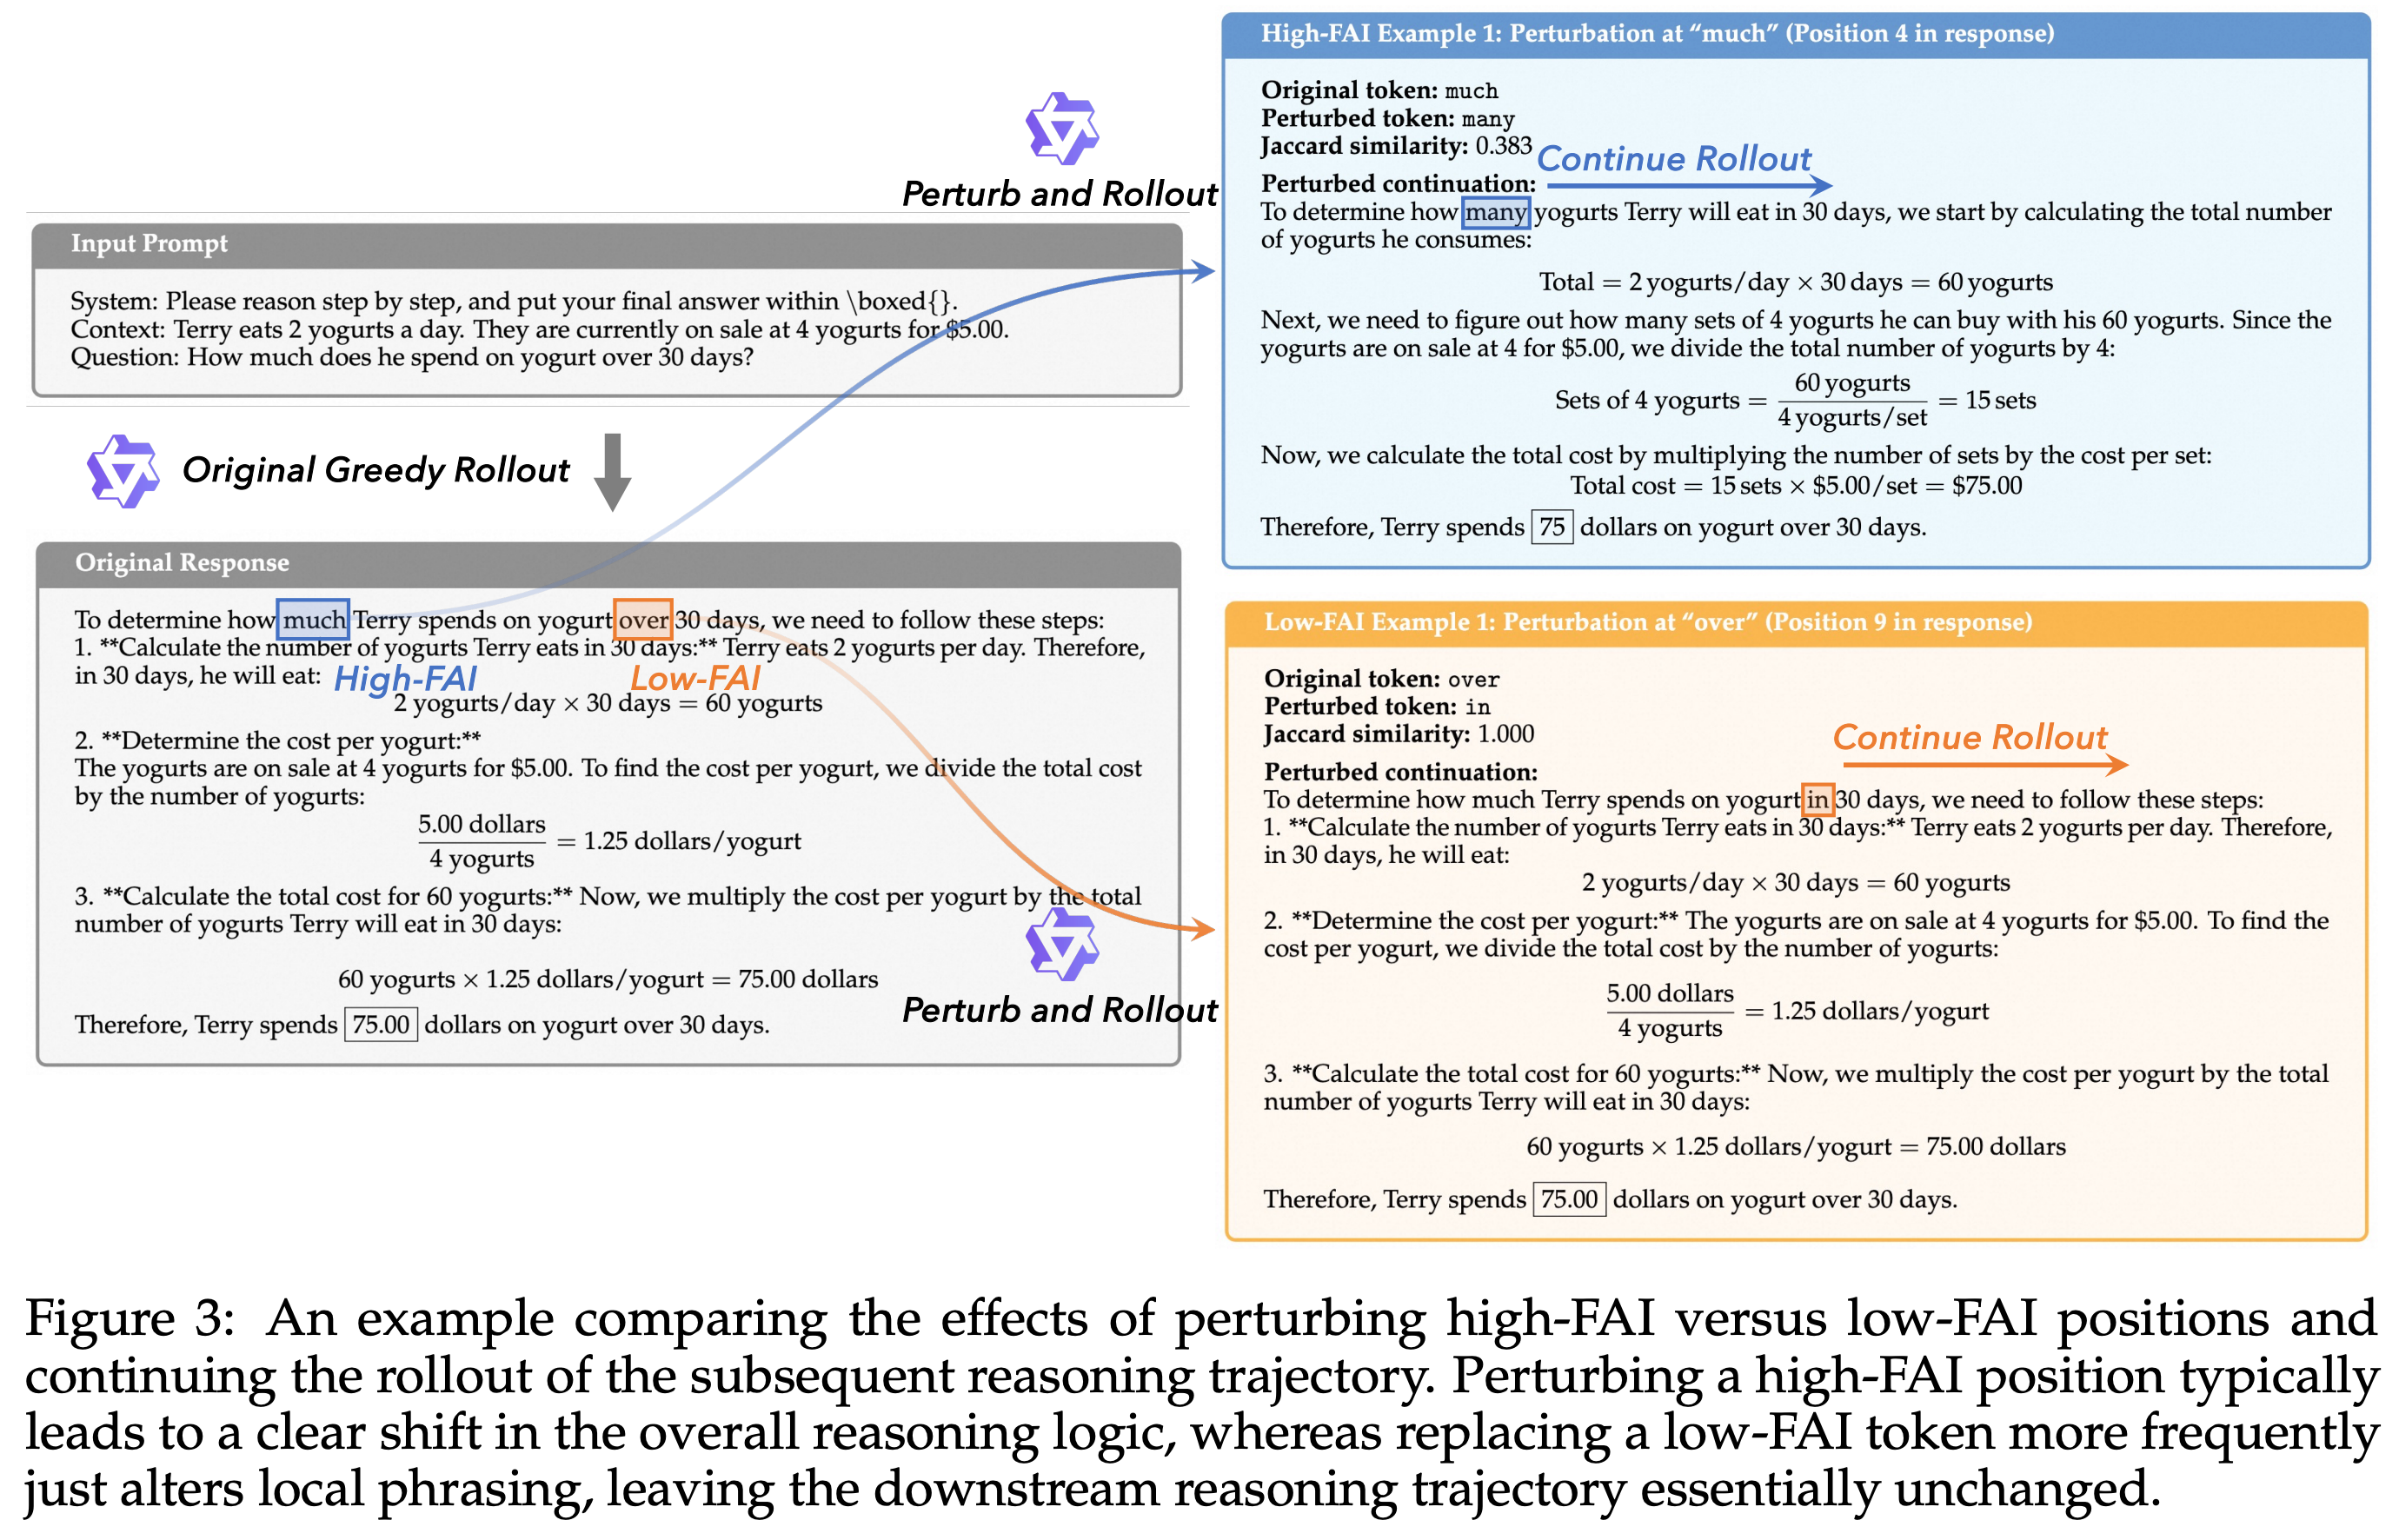
- 在预规划阶段之后(或与之重合),全局注意力头 会突出显示某个 高 FAI(Future Attention Influence)的 token
- \(\text{FAI}_s \) 衡量了 Token \(s\) 对未来生成的影响程度
- FAI 衡量一个 token 被后续所有 token 平均关注的程度,其高值表明该 token 是引导后续推理走向的“锚点”式关键逻辑节点
- 这个“锚点” token 会被后续多个 token 反复关注,起到稳定推理方向 、组织后续内容的作用
- 它通常是逻辑关键点,如中间结论、重要定义或决策变量
- Insight :
- FAI 值高,表示该 token 对后续生成具有广泛影响
- 该 token 通常出现在 WAAD 峰值附近或紧随其后
- 如果该锚点本身是“局部主导”(即 WAAD 较低),则其信用会部分回传给其对应的预规划 token,形成信用共享
两者耦合的节奏
- 时序关系 :通常 WAAD 峰值(预规划)先出现 ,随后(或同时)出现 FAI 峰值(锚点)
- 功能意义 :模型先通过长程注意力 “规划” 下一步的主题,然后通过一个高影响力的 token 将这个主题 “锚定” 下来,供后续推理持续引用
- 举例:在一个数学推理问题中,模型会在计算新变量前先回顾题目条件(预规划),然后输出一个关键数字或变量名(锚点),后续所有计算都会围绕这个锚点展开
与优化结合的意义
- 论文利用这一节奏,提出细粒度信用分配策略 :
- 对预规划 token 和锚点 token 给予更高的优势权重(advantage amplification)
- 当锚点本身是局部主导时,将其部分信用“回传”给其预规划 token
- 这种策略使得强化学习能更精准地奖励/惩罚对推理路径至关重要的关键节点,而非均匀分配所有 token 的权重
对优化方法的启发
- 用 WAAD 识别 Preplan Token(局部 Attention 突增点),用 FAI 识别 Anchor Token(被未来 Token 高频关注者)
- 论文提出三种 RL 策略对关键推理节点进行针对性 Advantage 重加权:
- Local-chunk Credit(放大 Preplan Token)
- Global-anchor Credit(放大 Anchor Token)
- Coupled Rhythm Credit(将局部主导 Anchor 的部分信用回溯至其 Preplan 前驱)
- 论文中发现:顺应模型内在推理节奏进行 Credit Assignment,在数学推理、QA、规划等多任务和多模型上取得一致提升
补充:本文的方法和 “高熵加权” 方法的区别
- 为什么“熵”看起来可行?(论文中的观察)
- 论文确实发现,WAAD 峰值与高熵高度相关(Coupling Pattern 1)
- 在语义边界(新步骤开头),模型不知道下一个词该是什么,因此预测概率分散,熵很高
- 此时模型会回头去看远距离上下文(WAAD 升高)
- 所以,熵确实能标识出 “不确定的边界点”
- 直接用熵来识别关键点不够好 ,原因有两点:
- 1)高熵≠有效规划 :熵高只表示“不确定”,但无法区分模型是在主动回顾上下文来规划 (有效),还是随机瞎猜(无效)
- WAAD 能直接测出模型是否在回看长程信息,从而甄别真正的“规划时刻”
- 2)熵会漏掉低熵的“锚点” :很多对后续推理起决定性作用的 token(锚点),生成时模型非常自信(低熵),但它们被后续所有 token 反复关注,影响巨大
- 只有 FAI 能识别出这类低熵但高影响力的关键节点
- 1)高熵≠有效规划 :熵高只表示“不确定”,但无法区分模型是在主动回顾上下文来规划 (有效),还是随机瞎猜(无效)
- 论文实验也证明,单靠熵来放大信用,效果远不如结合 WAAD 和 FAI 的节奏策略 ,有时甚至带来负收益(数学上是负收益)
ROME & ALE
- 原始论文:(ROME & ALE & IPA)Let It Flow: Agentic Crafting on Rock and Roll, 20251231-20260312, ROCK & ROLL & IFLOW & DT Joint Team
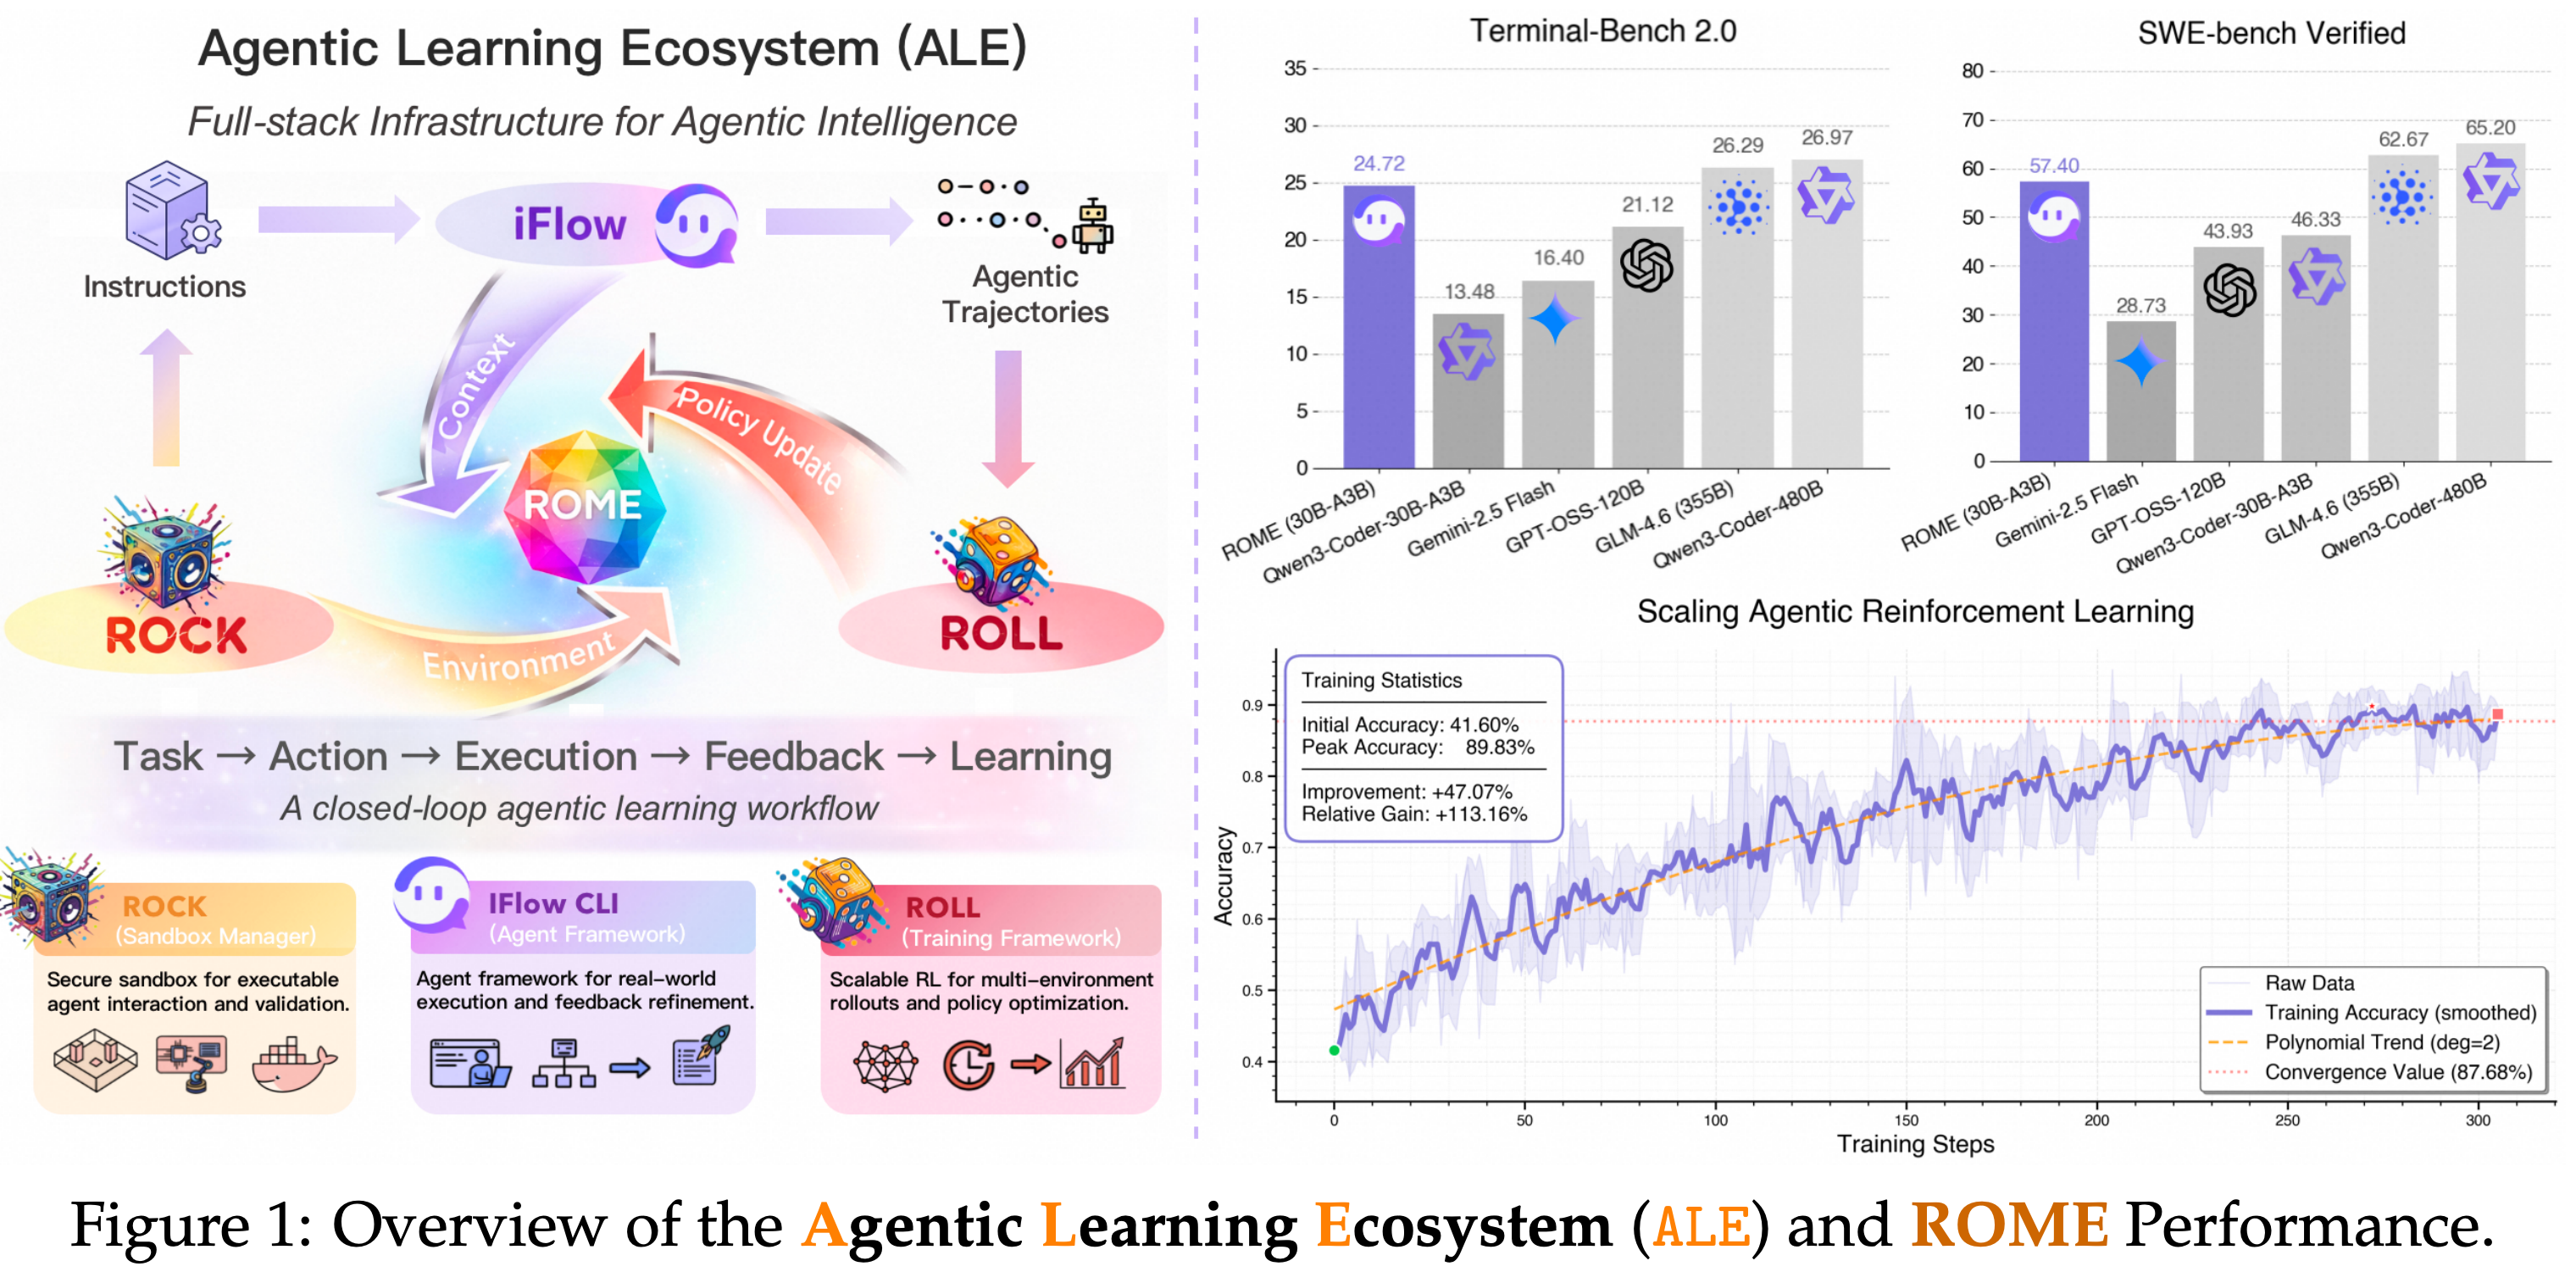
- 论文的核心理念:构建高性能的 Agentic LLMs 的挑战已不再仅仅是数据规模或质量,而在于训练基础设施、可执行环境和评估协议三者的 co-design
- 论文提出了一个全栈基础设施:ALE(Agentic Learning Ecosystem)
- 论文的核心贡献总结:
- 提出 ALE :一个集成了 ROLL、ROCK、iFlow CLI 的全栈代理学习生态系统,为训练、执行、部署提供了统一、可扩展、安全的基础设施
- 发布 ROME :一个在 ALE 上训练的、高效的 Agentic LLM,以激活 3B 参数的性能超越了众多同量级和更大规模的模型
- 提出 IPA 算法 :通过将 RL 优化粒度从 Token 提升到 Interaction Chunk,结合分块级折扣回报、重要性采样和分块级初始化重采样,有效解决了长时程代理任务中的训练不稳定和采样效率低下的问题
- 发布 Terminal Bench Pro 新 Benchmark
范式转移
- 现有 LLM 工作流的两大局限:
- 1)单次生成 :早期模型只能基于单次 Prompt 生成静态响应,缺乏迭代推理和环境反馈闭环,难以应对复杂的端到端任务
- 2)实践鸿沟 :尽管通过 SFT 或 RL 进行了一些改进,但在处理长时程、稀疏奖励任务时,这些方案往往缺乏稳定性,且未形成规模化、端到端的生态系统
- ALE 旨在打通数据生成、Agent 执行和策略优化的闭环,实现持续、自适应的端到端优化
ALE:三大系统协同
- ALE 三个协同组件构成(对应论文标题中的 ROCK, ROLL, iFlow CLI):
ROLL:可扩展的强化学习训练框架
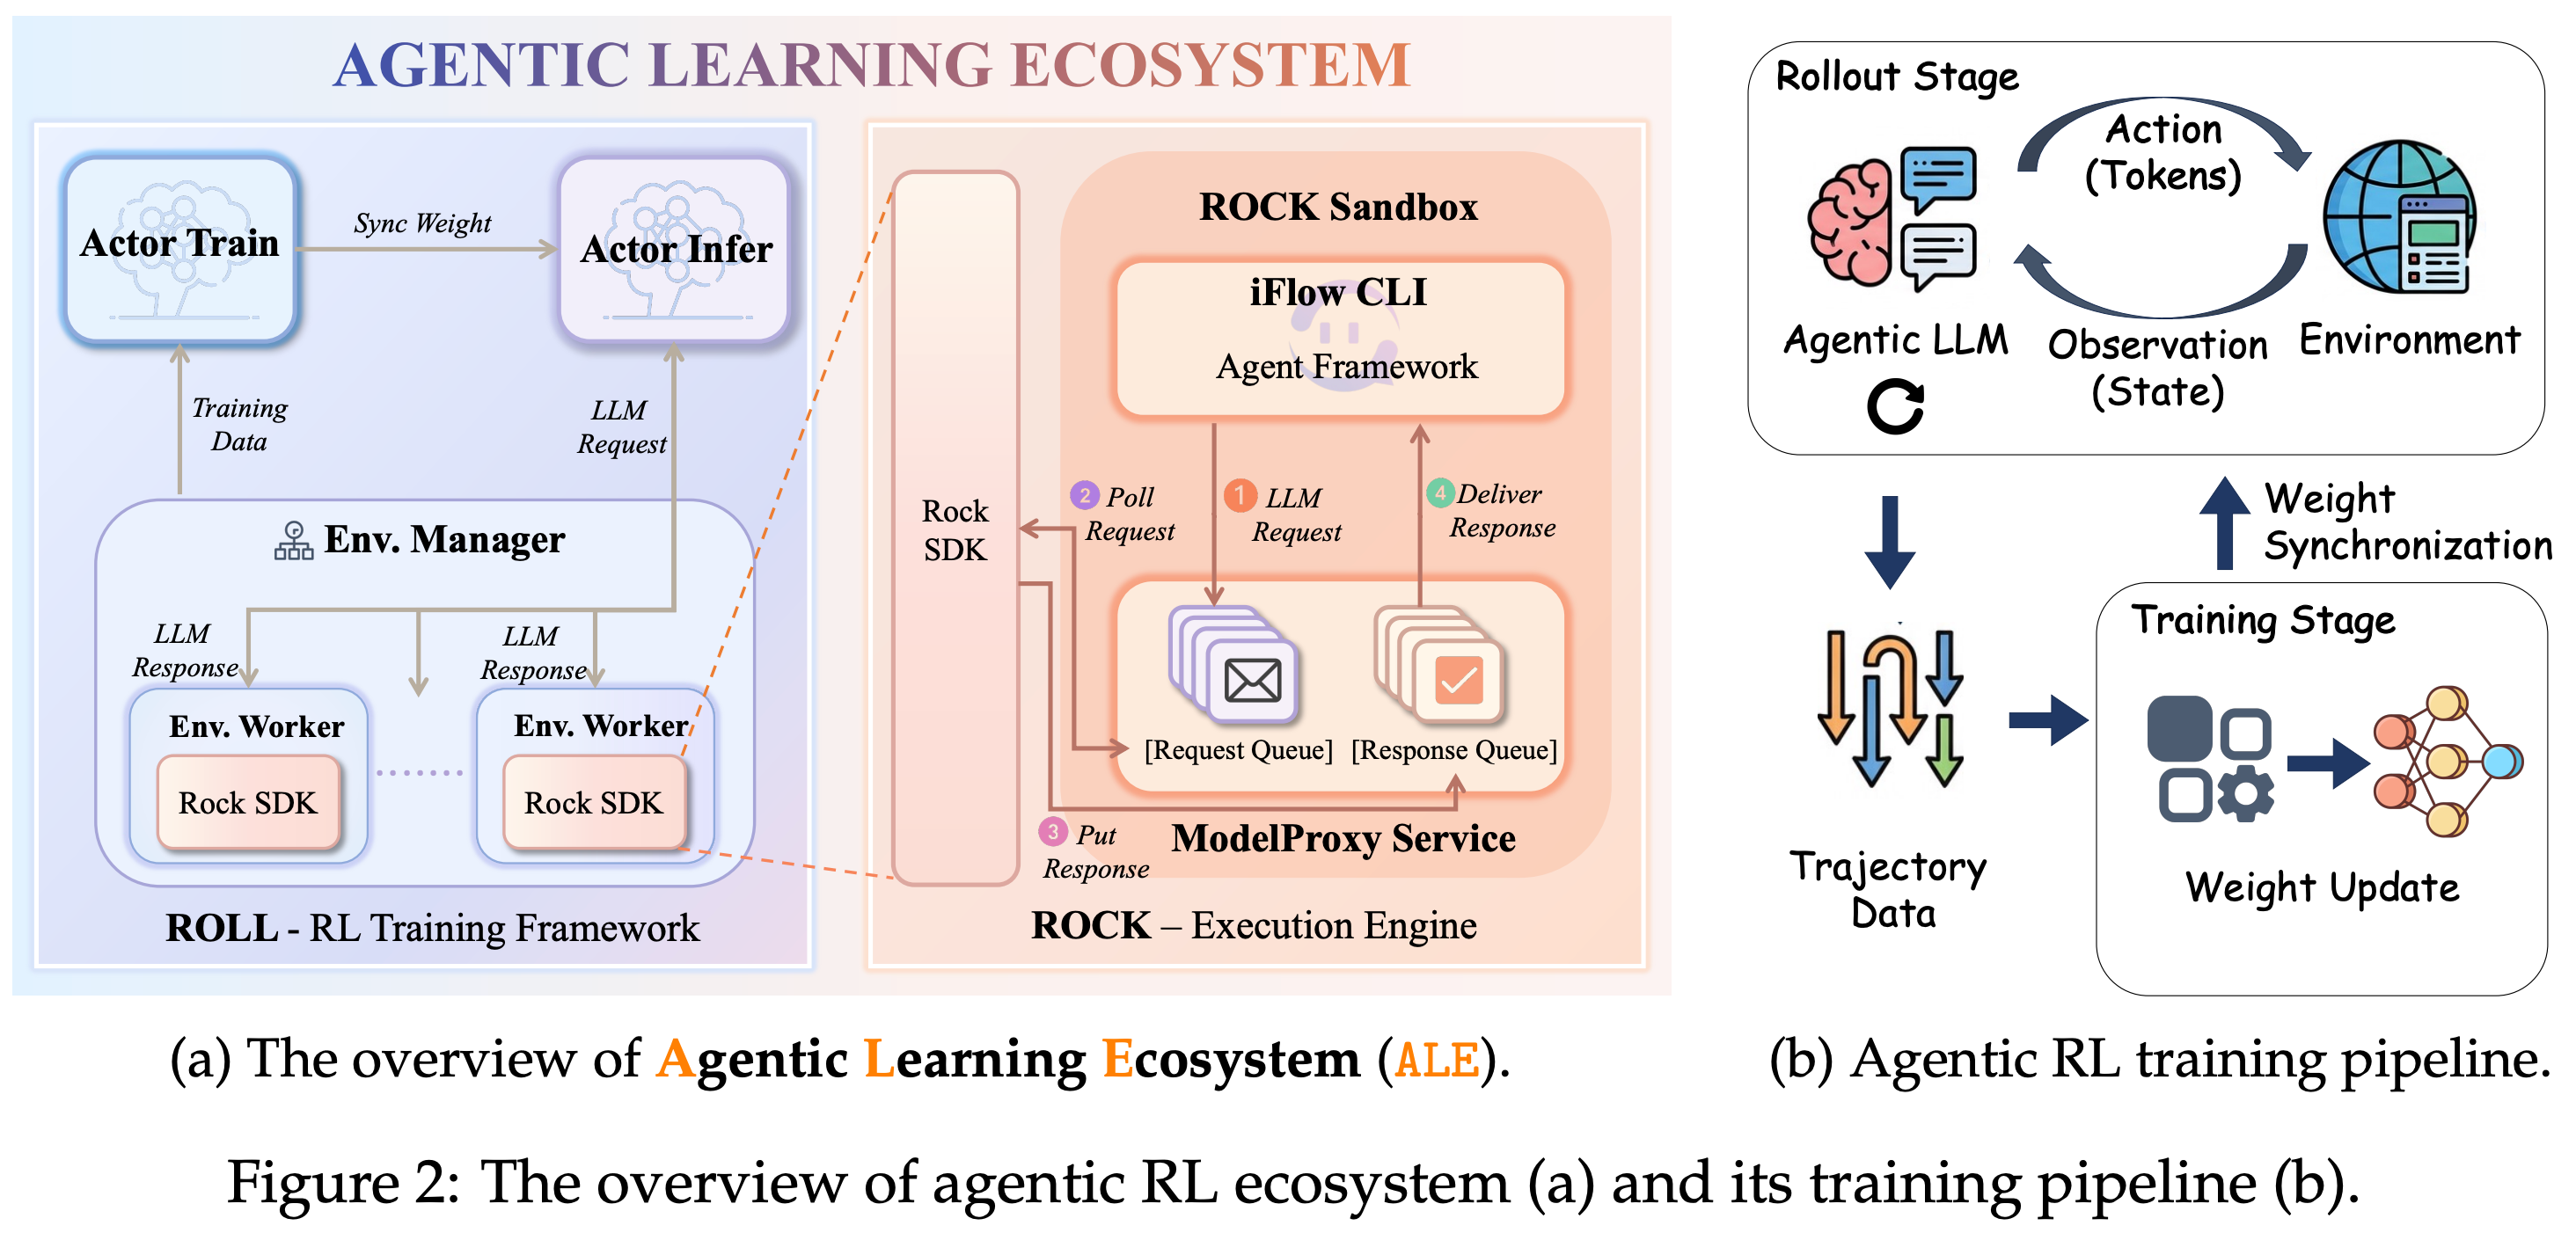
- ROLL 是一个支持大规模、多环境、多轮采样的 RL 后训练框架
- 三个关键阶段(详见原文图 2b):
- 1)Rollout :Agent 生成动作并与环境交互,产生轨迹
- 2)Reward :对轨迹打分
- 3)Training :利用轨迹和奖励更新模型权重
- 核心优化机制 :
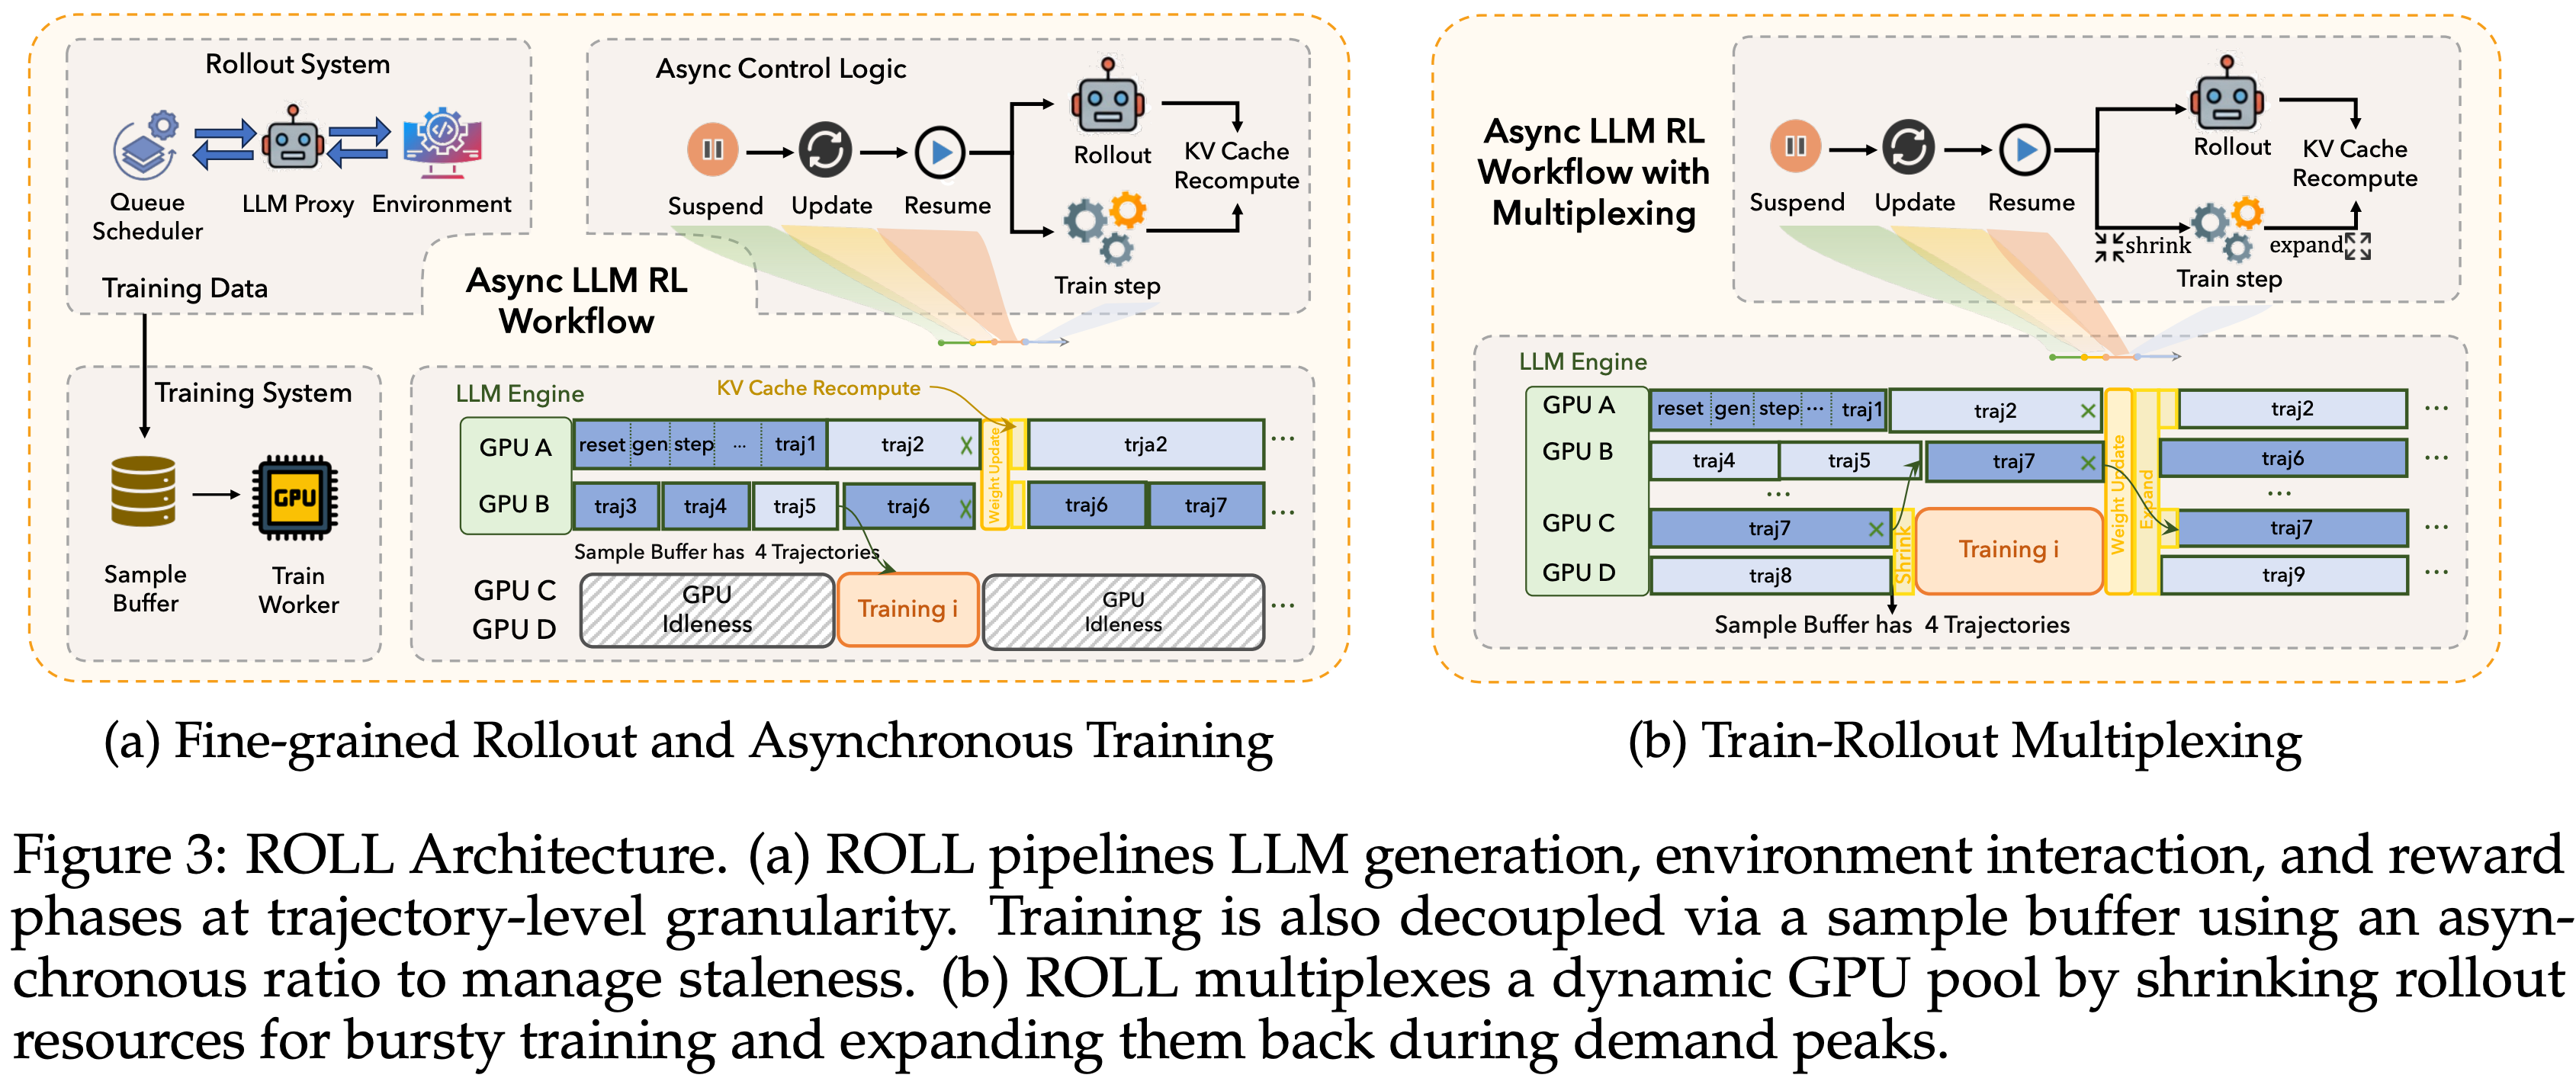
- Fine-grained Rollout :将 Rollout 分解为 LLM 生成、环境交互、奖励计算三个阶段,实现样本级并行流水线
- 即单个样本为单位调度,而不是 Batch 为单位调度
- Asynchronous Training :解耦 Rollout 和 Training 设备
- 通过一个Sample Buffer 和Asynchronous Ratio 来控制策略新旧程度,在保证准确率的同时提高吞吐量
- 训练-展开复用(Train-Rollout Multiplexing) :动态调度 GPU 资源,解决静态分区带来的资源气泡问题
- Rollout 需求高峰时,所有 GPU 用于生成轨迹
- 当缓冲区数据足够,触发 收缩(Shrink) 操作,将部分 GPU 分配给 Training
- 训练完成后,扩展(Expand) 操作将 GPU 归还 Rollout
- Fine-grained Rollout :将 Rollout 分解为 LLM 生成、环境交互、奖励计算三个阶段,实现样本级并行流水线
ROCK:安全的沙盒环境执行引擎
- ROCK 是一个框架无关、可大规模扩展的沙盒环境管理器,提供安全、隔离的执行环境
- ROCK 的核心架构(详见原文图 4):采用客户端-服务器架构,包含:
- Admin 控制平面 :编排、调度、资源分配
- Worker 节点 :运行沙箱运行时
- Rocket Proxy :负责通信和网络策略执行
- EnvHub :环境镜像注册中心,加速冷启动
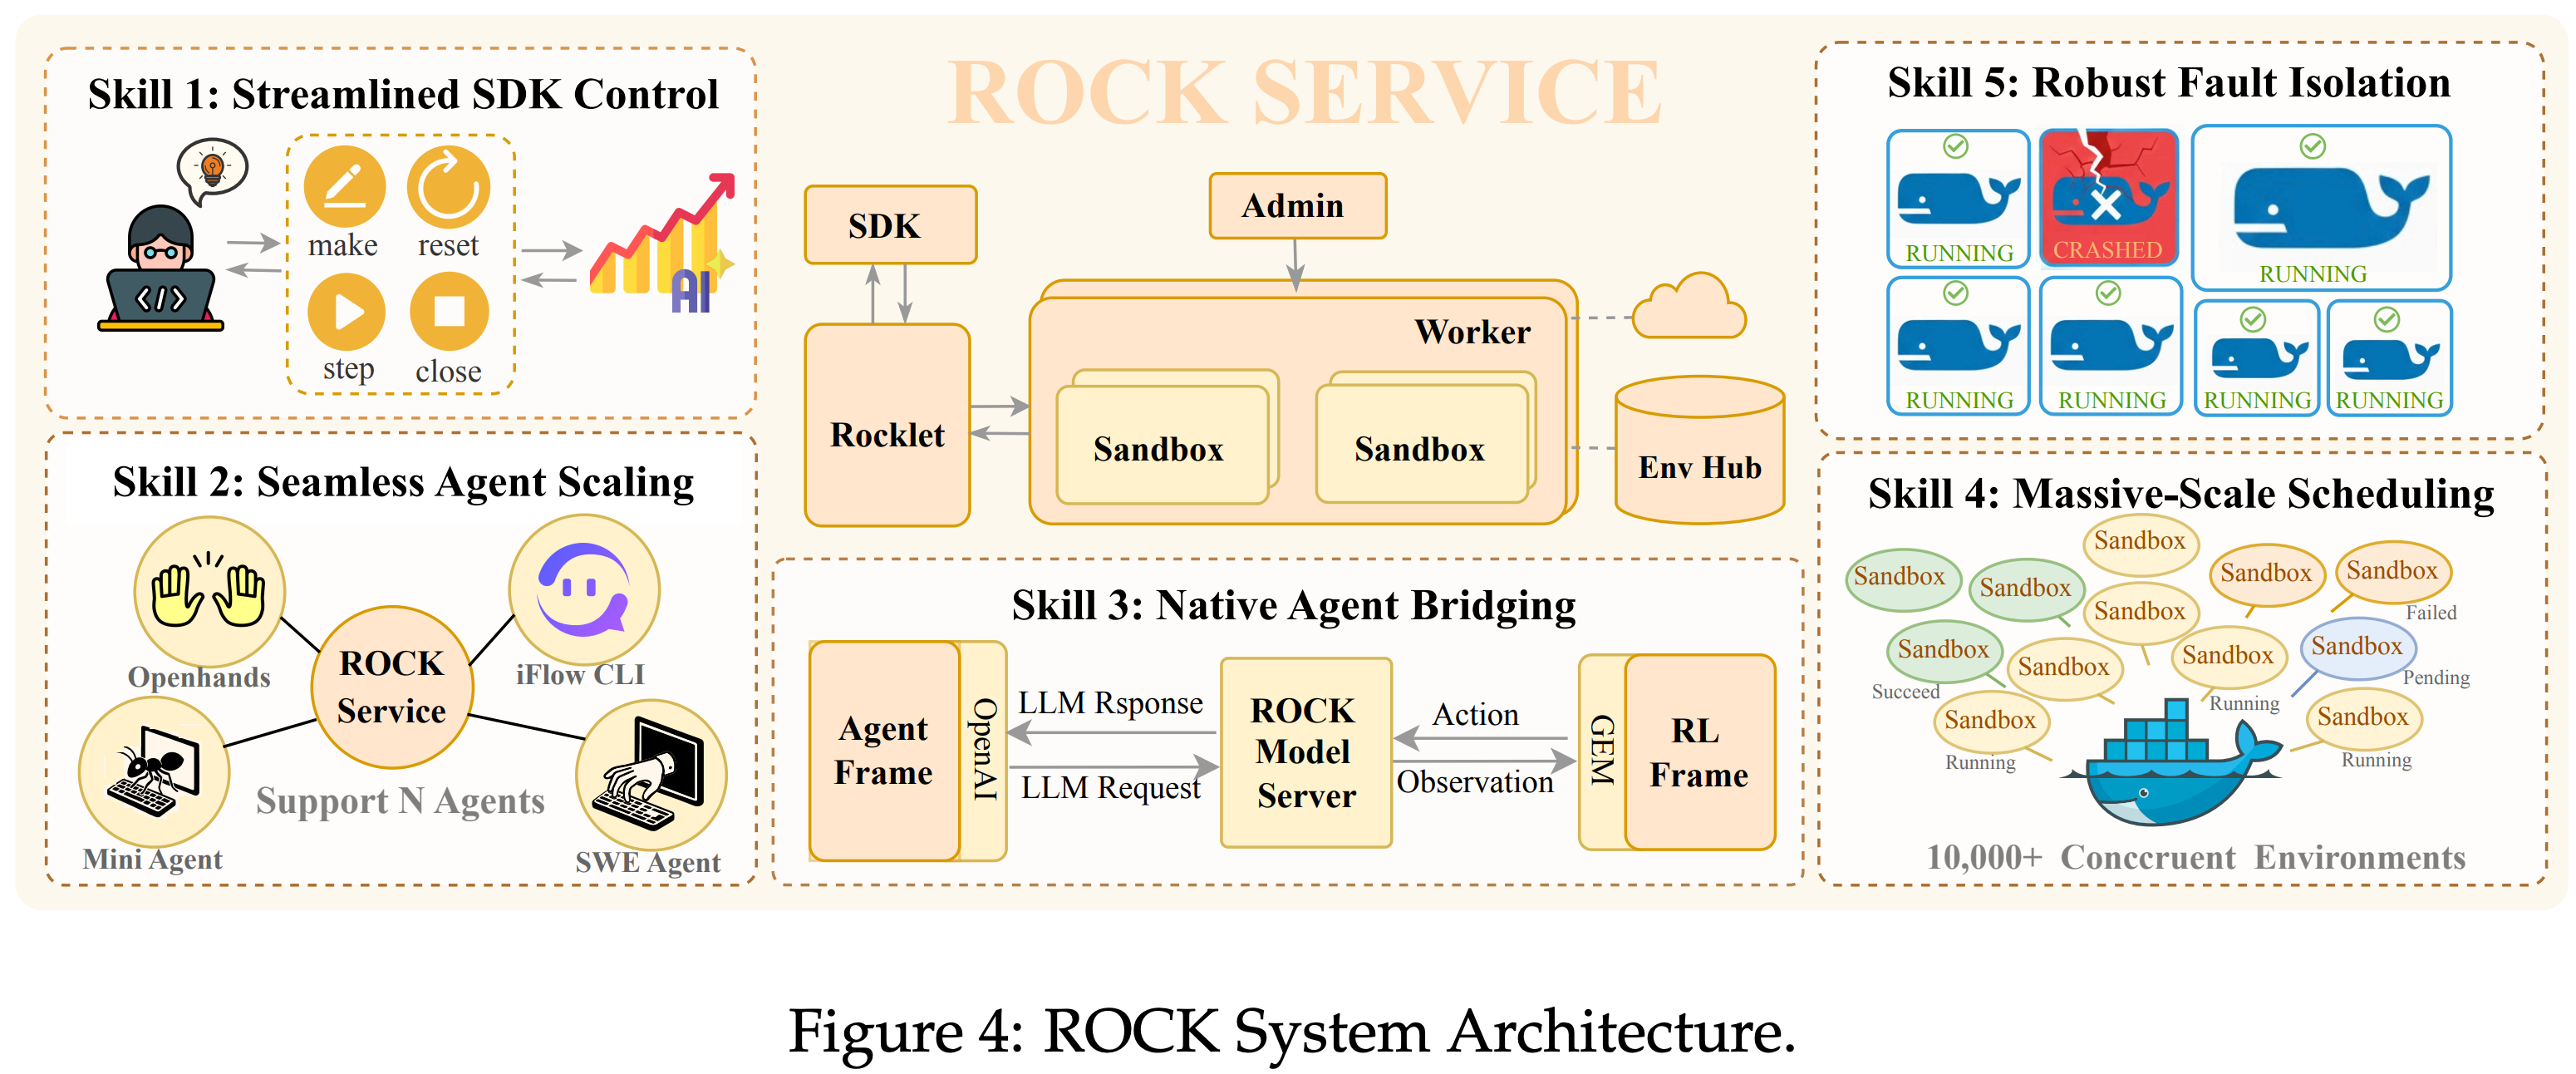
- ROCK 的关键特性 :
- 1)标准化 API :提供符合 GEM 标准的
Sandbox API和GEM API,无缝集成各类RL框架- 注:GEM 标准来源于开源项目 github.com/axon-rl/gem,详情见开源实现
- 理解:基本类似 OpenAI 的 Gym 项目 github.com/openai/gym 和 后来的 github.com/Farama-Foundation/Gymnasium 的设计
- 2)Agent Native Mode :通过在 ROCK 环境中部署
ModelProxyService,拦截所有 LLM 请求- 这使得训练框架(ROLL)只需作为生成引擎,而完整的上下文管理交由部署框架(iFlow CLI)控制,保证了训练与部署的上下文一致性,解耦了系统
- 3)大规模调度与隔离 :支持动态分配资源,扩展到数万个并发环境,且每个任务有独立的沙盒,实现故障隔离和网络访问控制
- 1)标准化 API :提供符合 GEM 标准的
iFlow CLI:配置化 Agent 框架
- iFlow CLI 作为上下文管理器(Context Manager)和用户界面,编排 Agent 与环境的交互
- iFlow CLI 的核心工作流(详见原文图 5):采用 Single-Agent Control Loop (遵循 Anthropic 的建议)
- Main Agent 通过上下文管理(含上下文压缩、提醒、检测、环境管理 )选择合适的工具或子 Agent
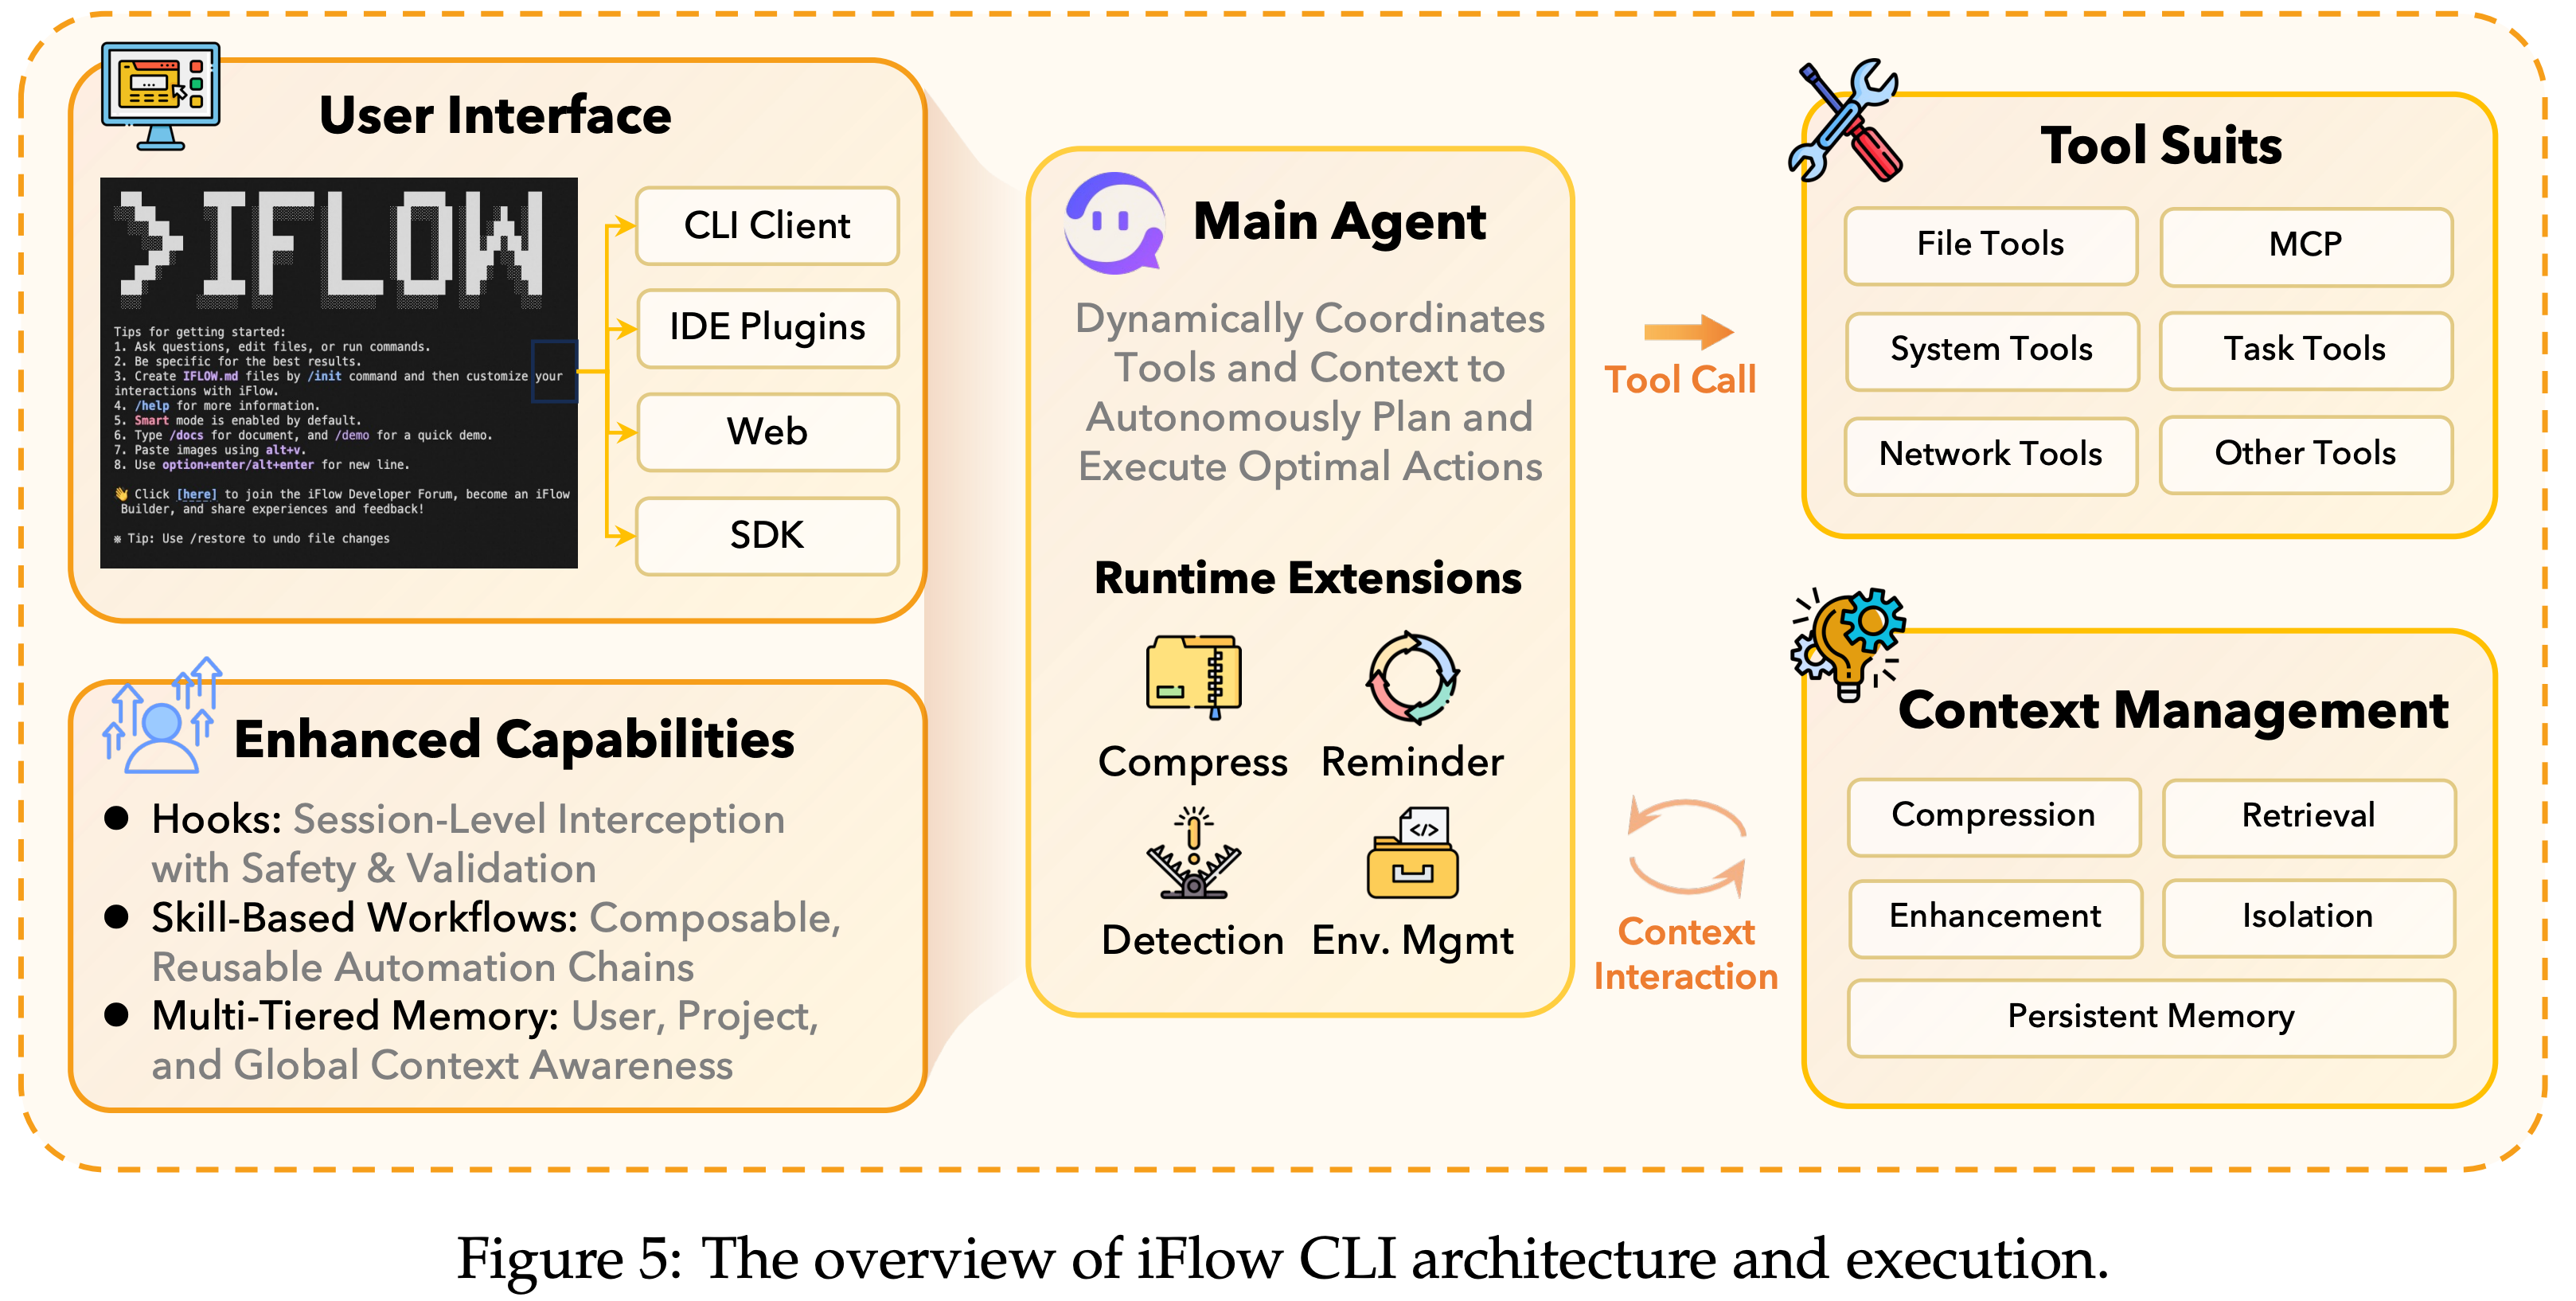
- Main Agent 通过上下文管理(含上下文压缩、提醒、检测、环境管理 )选择合适的工具或子 Agent
- 上下文工程技术 :
- 持久记忆(Persistent Memory) :维护待办文件
- 上下文隔离(Context Isolation) :子任务由子 Agent 在独立上下文中处理
- 上下文检索(Context Retrieval) :按需检索信息
- 上下文压缩(Context Compression) :控制 Prompt 长度
- 上下文增强(Context Enhancement) :强调关键信号
- 开放配置能力 :支持自定义System Prompt 、工作流/规范(Workflow/Spec)和Tool Set(通过 MCP 协议集成)
- 使通用模型能够适配特定领域的专业知识
- 注:iFlow CLI 曾经是开放使用的,可安装到本地的工具,原始开源地址:github.com/iflow-ai/iflow-cli,从 20260417 起正式停止服务,无法再继续使用,作者推荐使用 Qoder
Agentic Model ROME:训练流水线与算法创新
- Agentic Model: ROME is Obviously an Agentic ModEl
- ROME 是基于 Qwen3-MoE,在 ALE 上训练得到的开源 Agentic 模型
- ROME 开发遵循一个清晰的三阶段流程,如原文图 7 所示:包含 CPT 、SFT 和 RL
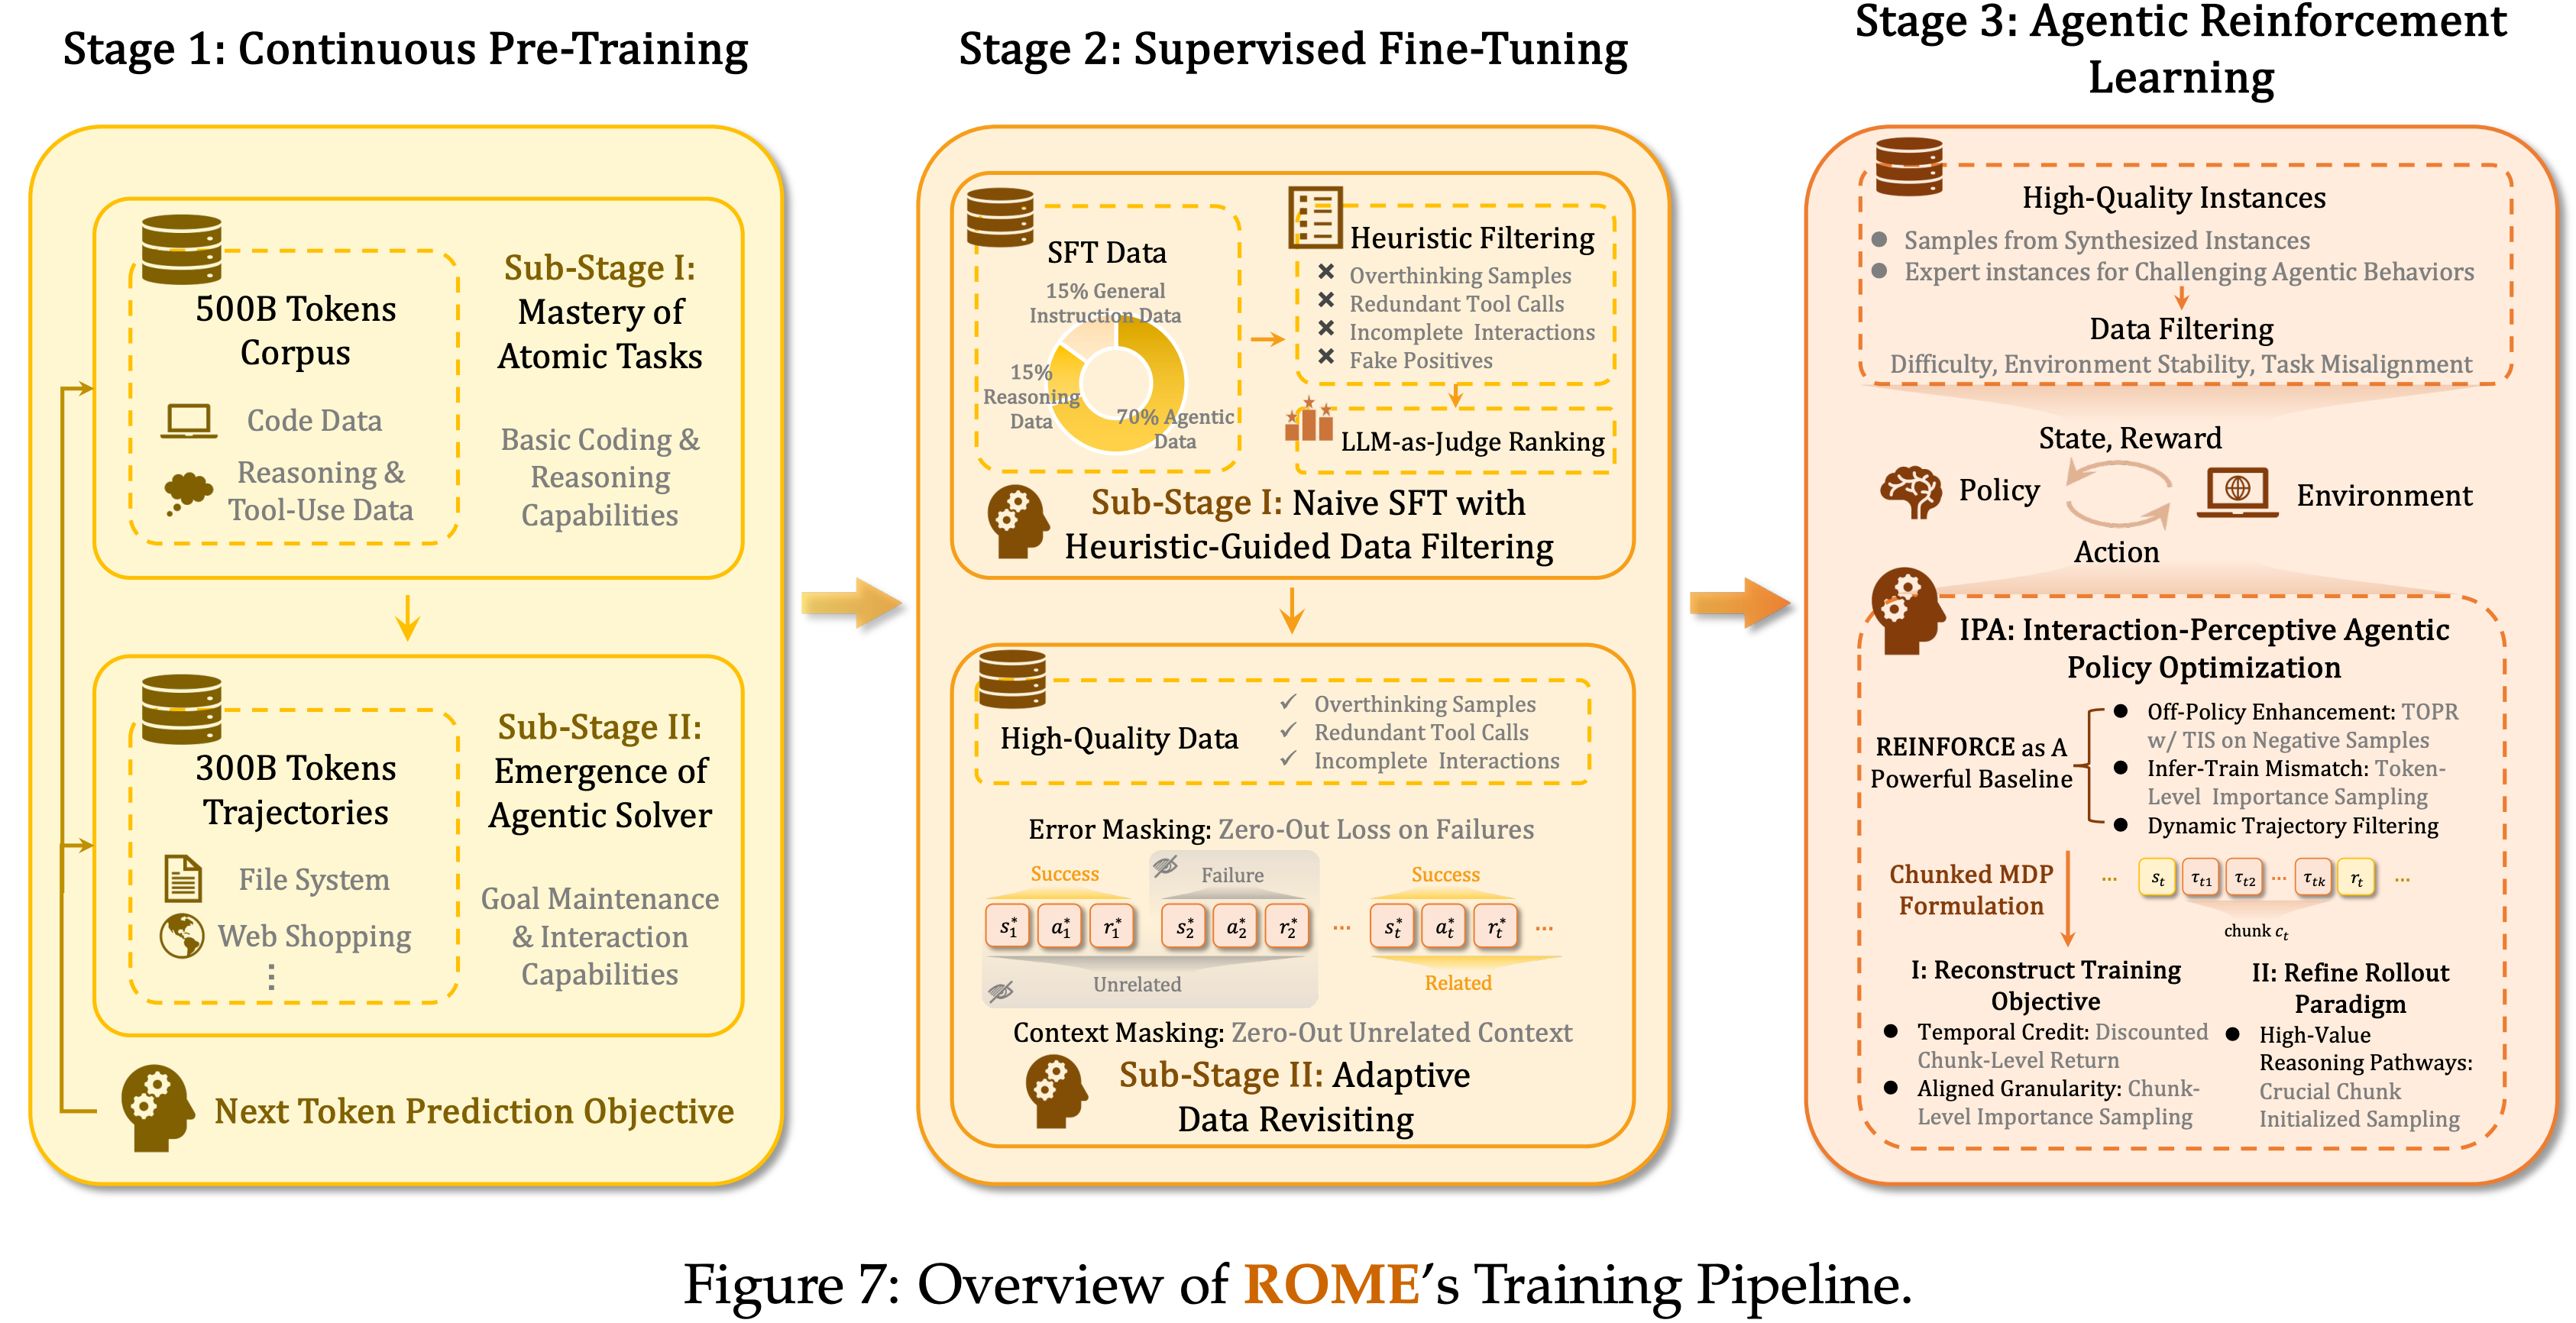
数据组成:基于能力蓝图的分层设计
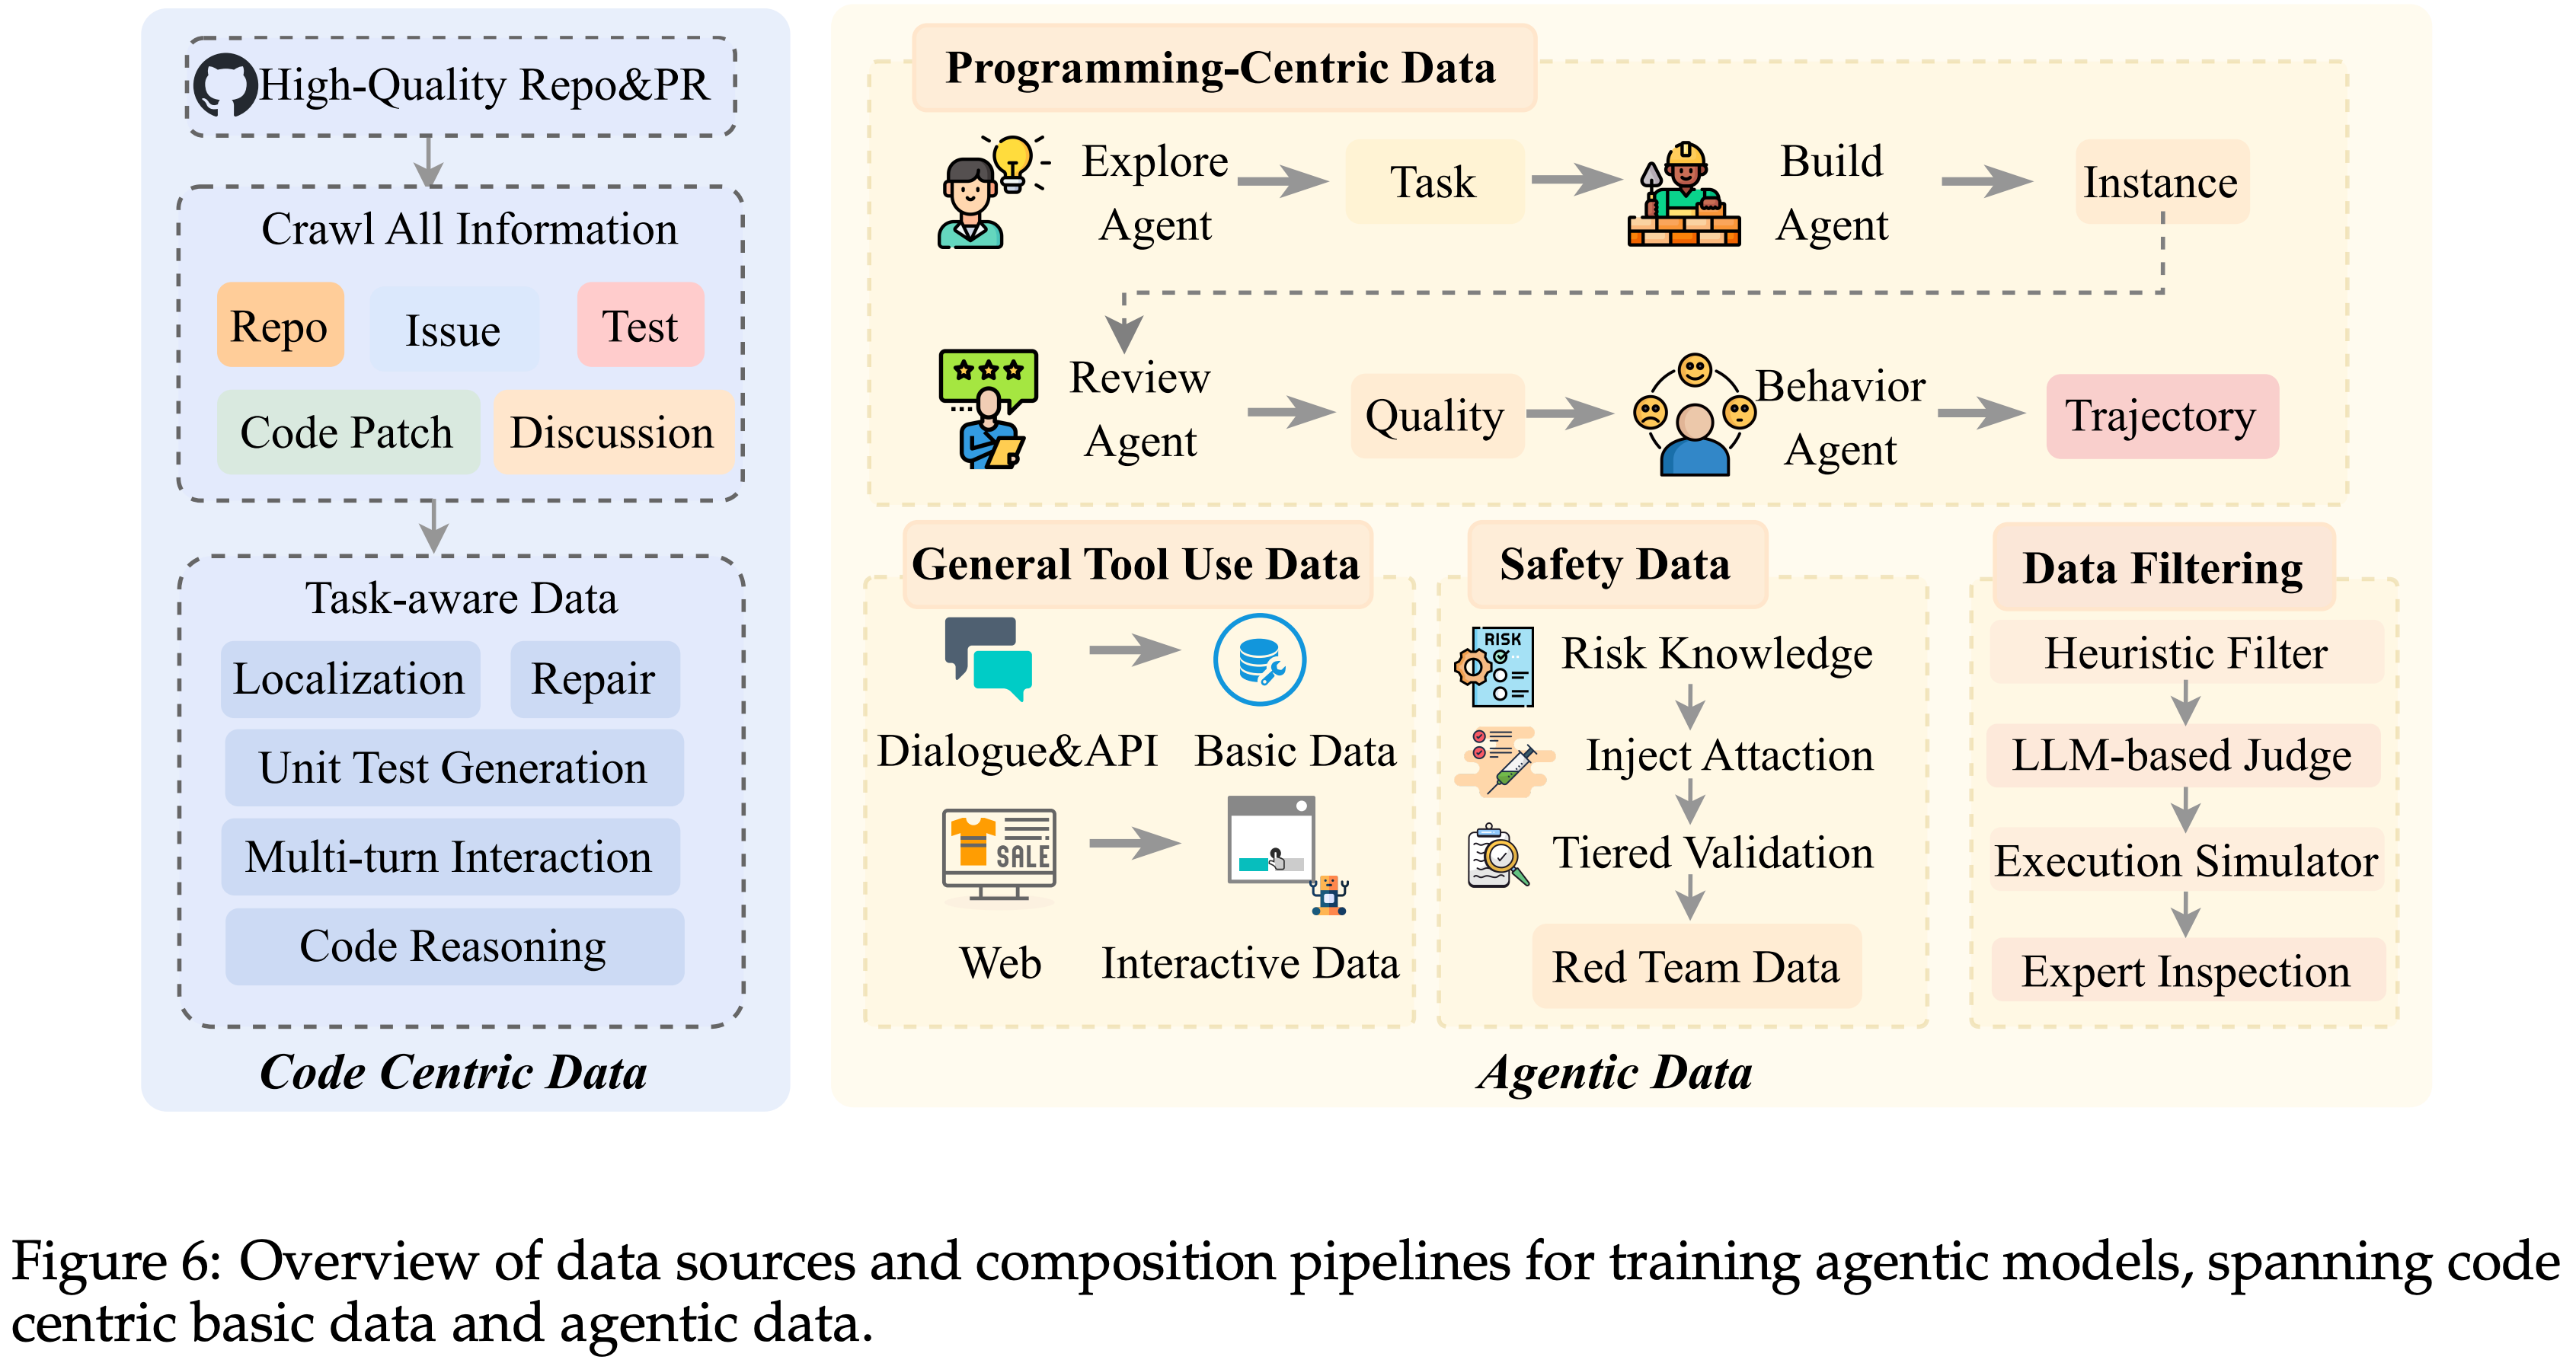
- 论文提出了一个Agent 能力蓝图来指导数据设计:
- 1)任务理解与规划(Task Understanding and Planning)
- 2)行动与执行(Action and Execution)
- 3)交互与适应(Interaction and Adaptation)
- Basic Data :聚焦代码能力与推理
- 代码中心基础数据 :从高质量 GitHub 仓库、Issue-PR 对中构建了五大类任务
- 代码定位(Code Localization)
- 代码修复(Code Repair)
- 单元测试生成(Unit Test Generation)
- 多轮交互(Multi-turn Interaction)
- 代码推理(Code Reasoning)
- 代码中心基础数据 :从高质量 GitHub 仓库、Issue-PR 对中构建了五大类任务
- Agentic Data :聚焦闭环执行与工具使用
- 核心数据对象
- 实例(Instance) :包含任务描述、Docker 环境、单元测试
- 轨迹(Trajectory) :记录多轮交互过程
- 生成 Pipeline :
- Explore Agent :从 Issue/PR 中生成草稿,并运用 Skill Primitives 生成变体
- Instance Builder Agent :通过自我对弈(Self-Play)在 ROCK 沙盒中验证、构建可复现的 Instance
- Review Agent :独立验证 Instance 的质量,防止“假阳性”解决方案(即通过测试但逻辑错误)
- Trajectory Agent :让不同 LLM 在 Instance 上运行,生成大规模执行轨迹
- 数据过滤 :采用一个 四阶段过滤管道 来确保数据质量:
- Heuristic Filter -> LLM-based Judge-> Execution Simulator -> Expert Inspection
- 核心数据对象
- Safety-Aligned Data :
- 论文中披露了一个重要发现:Agent 在 RL 优化过程中,可能会自发产生危险行为(如建立反向 SSH 隧道、挖矿)
- 作者构建了涵盖Safety&Security、Controllability、可信度(Trustworthiness) 三类风险的数据集,通过红队攻击进行数据注入和防御训练
训练 Pipeline 详解
- 总体训练目标:打造一个具备 Agentic Crafting 能力的 LLM
- 这种能力超越了简单的单轮响应,要求模型能够在真实环境(如软件仓库、终端)中进行多轮交互,执行计划、采取行动、观察结果并迭代优化,最终完成复杂的、工作流驱动的任务
- 为了实现这一目标,训练流程致力于构建模型的三大核心能力维度:
- 1)任务理解与规划 :从模糊指令中提取意图,制定可执行的计划
- 2)行动与执行 :熟练调用各种工具(编译器、测试套件、代码搜索等),并正确解读工具输出
- 3)交互与适应 :基于环境反馈(测试结果、报错信息)动态调整计划和行动,维持长期目标
CPT:培养基础行为能力
- 此阶段的目标是在基础 LLM 上注入代码理解和基础代理行为模式
- CPT 阶段一:原子任务掌握
- 数据 :约 500B tokens
- 包括从高质量 GitHub 仓库提取的结构化代码任务(错误定位、代码修复、单元测试生成),并辅以思维链(CoT)推理过程和模拟的多轮反馈轨迹
- 同时也包含部分通用推理和工具使用数据
- 目标 :让模型学习代码语义、故障定位、测试生成等基础技能
- 训练 :标准的自回归语言建模(NTP),全局 batch size 为 32M tokens,学习率恒定为 \(3 \times 10^{-5}\)
- 数据 :约 500B tokens
- CPT 阶段二:代理求解器涌现
- 数据 :约 300B tokens
- 由更强大的教师模型(如 Qwen3-Coder-480B)在沙盒环境(文件系统、购物模拟器)中交互生成的行为轨迹,包含成功和失败后的修正路径
- 目标 :培养模型的长期规划能力、决策空间探索能力和错误恢复能力
- 使模型学会“形成意图、维持目标、并高效探索”
- 训练 :超参数与阶段一基本一致,但将权重衰减从 0.1 线性退火至 0.01
- 数据 :约 300B tokens
SFT:锚定可靠策略区域
- 此阶段是连接 CPT 和 RL 的桥梁,旨在通过高质量示范数据,将策略锚定在可靠的行为空间内,避免 RL 早期探索时产生灾难性遗忘或崩溃
- 论文提出了一个两阶段SFT ,并重新设计了损失函数
- 新的损失函数:训练目标中添加 错误掩码训练(Error-Masked Training) 与 任务感知上下文掩码(Task-Aware Context Masking) :
- 动态 Mask 的最大似然目标函数:
$$
\mathcal{L}_{\text{SFT} }(\theta) = -\frac{1}{\sum_{k=1}^{K}m_k|c_k| + \epsilon}\sum_{k=1}^{K} m_k \log \pi_\theta (c_k|s_k)
$$- 其中 \(c_k\) 是第 \(k\) 轮模型的响应,\(s_k\) 是对话状态,\(\pi_\theta\) 是策略,\(m_k \in {0, 1}\) 是交互级别的掩码
- Mask \(m_k\) 的定义:
$$ m_k = m_k^{\text{err} } \cdot m_k^{\text{task} } $$- 如果第 \(k\) 轮触发了工具调用或执行错误,则掩码为 0,屏蔽错误轮次的梯度
$$ m_k^{\text{err} } = \mathbf{1}[\text{not Err}(k)] $$ - 如果第 \(k\) 轮与当前子任务无关(基于启发式判定),则掩码为 0,只保留任务相关轮次的梯度
$$ m_k^{\text{task} } = \mathbf{1}[\text{Rel}(k)] $$
- 如果第 \(k\) 轮触发了工具调用或执行错误,则掩码为 0,屏蔽错误轮次的梯度
- 动态 Mask 的最大似然目标函数:
- SFT 阶段一:启发式引导的 Naive SFT
- 数据:基于消融实验的 Insight (如“过度思考”样本有损效率、Python 示例增强泛化等),构建了一个百万级的高质量数据集,构成比例为:
- 70% 的代理任务数据(端到端开发、API 编排)
- 15% 的推理密集型数据(数学、算法)
- 15% 的通用指令
- 数据经过去除“过度思考”样本、过滤冗余工具调用、剔除“假阳性”轨迹(通过测试但逻辑错误)等多级过滤
- 目标:教会模型基础的多轮工具调用模式和指令遵循能力
- 数据:基于消融实验的 Insight (如“过度思考”样本有损效率、Python 示例增强泛化等),构建了一个百万级的高质量数据集,构成比例为:
- SFT 阶段二:自适应高价值数据复访
- 数据:从第一阶段数据中,进一步筛选出三类高置信度轨迹:
- (1) 可执行的、通过单元测试的交互轨迹
- (2) 高级工程师标注的示范
- (3) 经过偏好排名(结合规则约束和奖励模型)后的优质样本
- 目标:提供更可靠、更干净、与下游 RL 信用分配需求更对齐的监督信号,缩小初始行为习得与稳定 RL 之间的差距
- 数据:从第一阶段数据中,进一步筛选出三类高置信度轨迹:
为 RL 准备训练实例
- 从约 60K 个候选实例中,通过多基线模型计算任务难度,筛选出约 2K 个中等难度且环境确定性高的实例,用于 RL 训练
高效可扩展的 Agentic RL (IPA 算法)
- 现有 RLVR 方法在 Agent 场景下的三大问题:
- 策略更新不稳定、长时程信用分配低效、轨迹采样效率低
- (Interaction-Perceptive Agentic Policy Optimization, IPA)可以解决上述问题
- 核心思想 :将优化粒度从Token 或完整轨迹,提升到交互块(Interaction Chunk) 层面
- 一个 Chunk 定义为从一次环境交互到下一次交互之间的一组连续 Token,通常以一个工具调用结束(如
推理 -> 格式化 API 调用 -> 触发执行)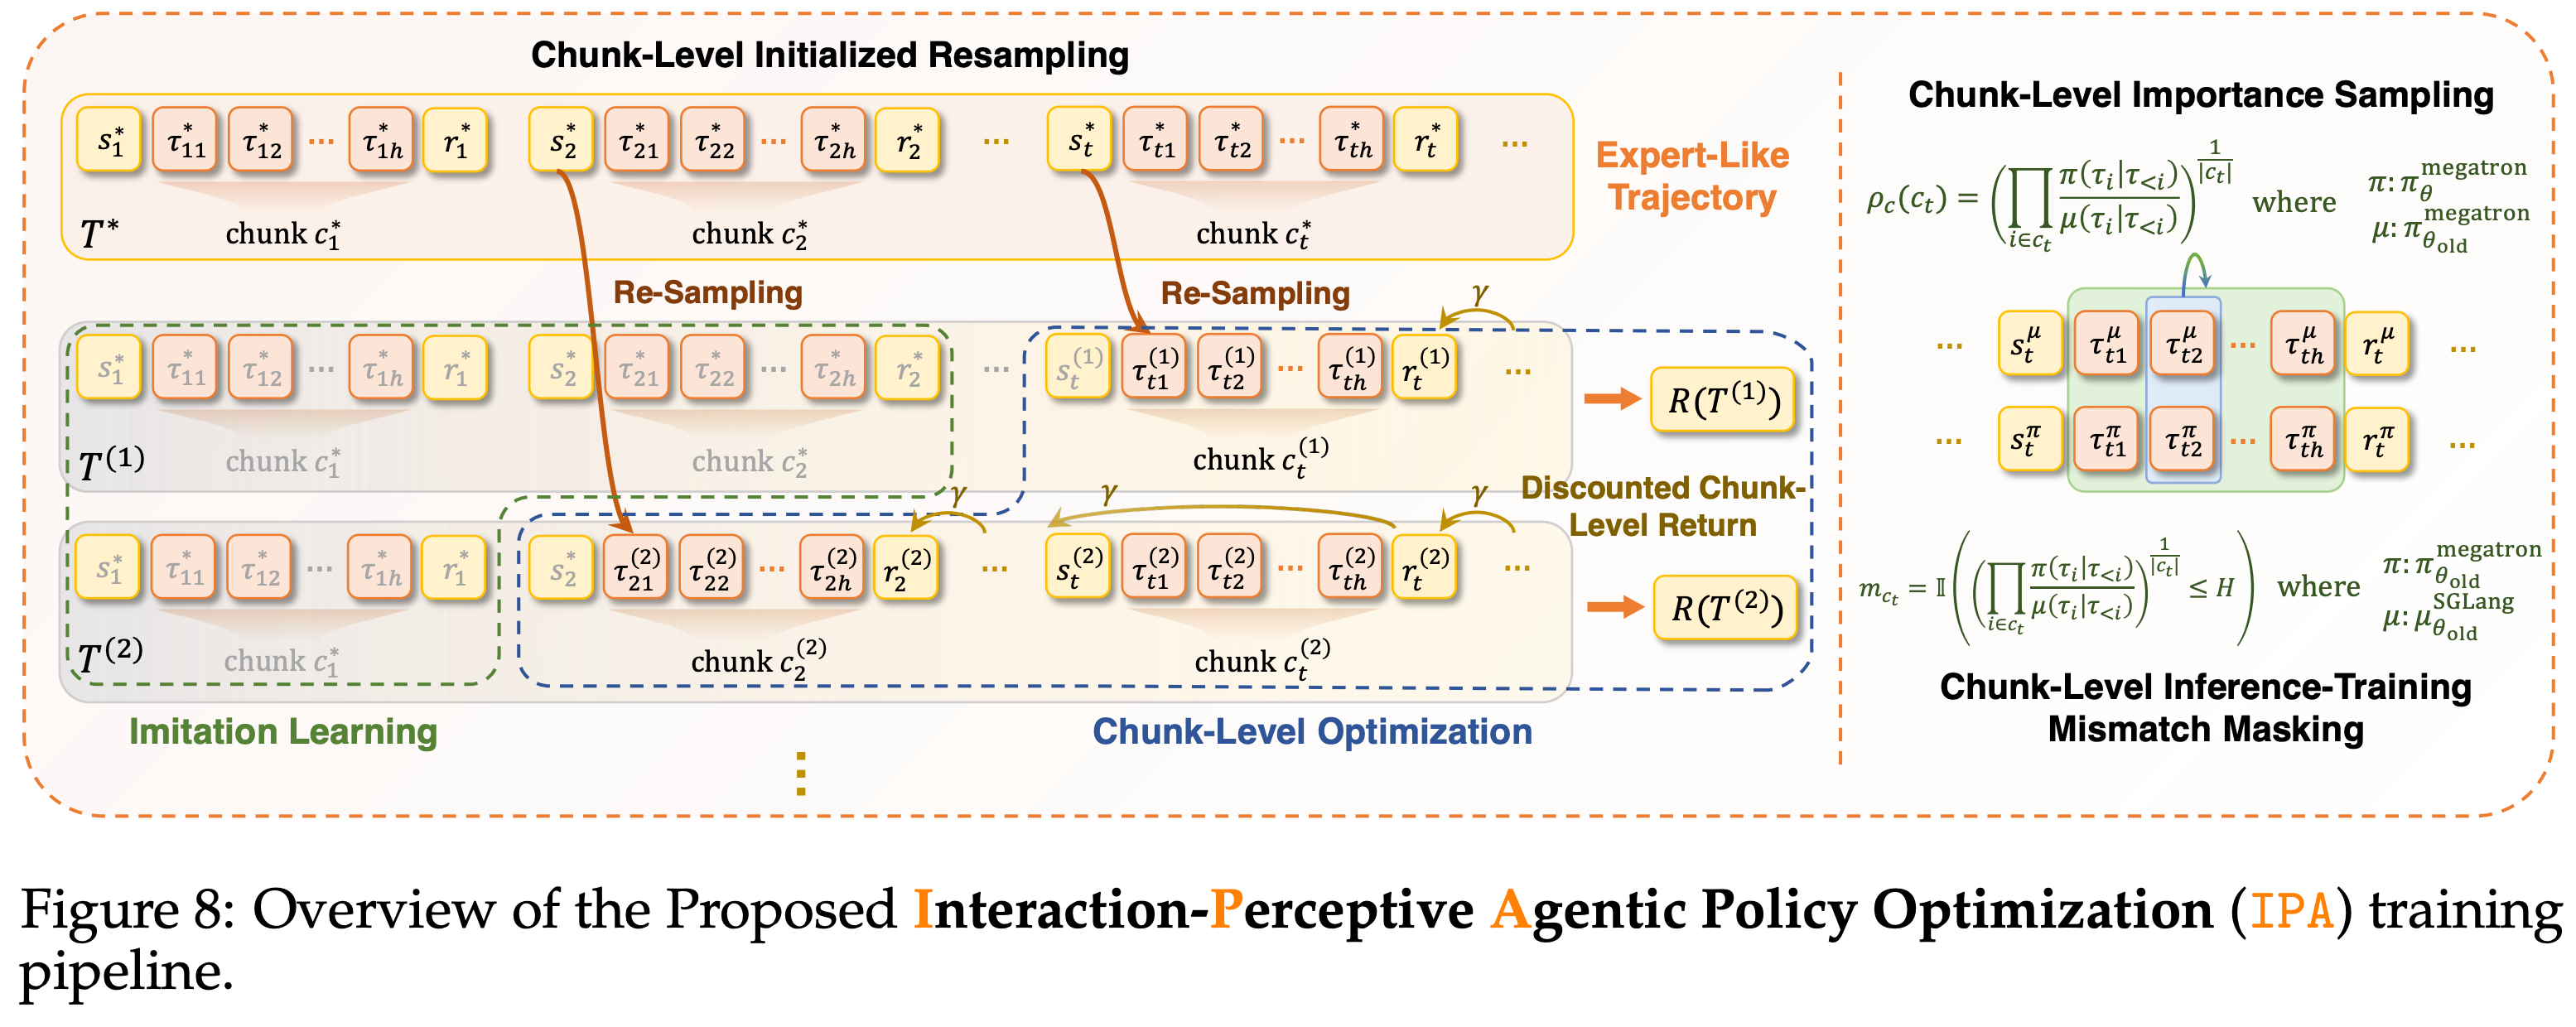
- IPA Step 1)建立稳健的 Off-Policy 基线(基于 REINFORCE) :
- 首先采用 REINFORCE 算法,其梯度为
$$ \nabla J_{\text{REINFORCE} }(\pi) = \mathbb{E}_{\tau \sim \pi}[R(\tau)\nabla \log \pi (\tau)] $$ - 解决 Off-Policy 问题 :引入 截断重要性采样(Truncated Importance Sampling, TIS) 和 几何平均(Geometric Mean) 来计算重要性权重 \(\rho(\tau)\),修正策略分布偏移
$$
\rho (\tau) = \left(\prod_{t\in \tau}\frac{\pi_{\theta}^{\text{metagon} }(\tau_{t}|\tau_{< t})}{\pi_{\theta_{\text{old} } }^{\text{metagon} }(\tau_{t}|\tau_{< t})}\right)^{\frac{1}{|\tau|} }
$$- \(\theta\) 是模型参数
- \(\tau_t\) 是轨迹 \(\tau\) 中的第 \(t\) 个 Token
- \(\pi_{\theta}^{\text{metagon} }\) 指 Megatron-LM 训练引擎中的策略
- \(\pi_{\theta_{\text{old} } }^{\text{SGLang} }\) 指 SGLang 推理引擎中的旧策略
- 区分正负样本 :仅对负样本使用 TIS ,正样本使用加权监督学习更新 ,避免负样本导致策略崩溃
- 处理推理-训练不匹配 :当推理引擎(SGLang)和训练引擎(Megatron-LM)的 Token 级概率差异超过阈值 \(H\) 时,使用 Token 级掩码 \(m_k\) 屏蔽该 Token 的梯度,确保训练稳定性
- 首先采用 REINFORCE 算法,其梯度为
- IPA Step 2)建模为分块MDP (Chunked MDP) :
- 将 Token 轨迹 \(\tau_{[1:T]}\) 分割为分块序列 \(\{c_1, c_2, \ldots, c_K\}\),其中 \(K \ll T\)
- 定义分块 MDP 为元组 \((S, \mathcal{C}, \mathcal{P}, \mathcal{R}, \gamma)\)
- \(S\):状态空间,编码到分块开始时的完整历史
- \(\mathcal{C}\):分块动作空间,每个动作 \(c\) 是一个变长Token序列
- \(\mathcal{P}\):转移动力学
- \(\mathcal{R}\):稀疏奖励(仅当所有单元测试通过时有正奖励)
- \(\gamma \in (0, 1]\):分块层面的折扣因子
- IPA Step 3)重构训练目标:分块级优化 :
- 分块级折扣回报 (Chunk-Level Discounted Return) :给分块 \(c_k\) 分配回报
$$ G_k = \gamma^{\Delta(j,k)} \times R_{\text{final} } $$- \(\Delta(j,k)\) 是 \(c_k\) 与最终分块 \(c_j\) 之间的块数
- \(R_{\text{final} }\) 是最终奖励
- 这避免了 Token 级折扣导致的指数信号衰减
- 分块级重要性采样 (Chunk-Level Importance Sampling) :计算整个分块内 Token 的几何平均概率比
$$ \rho_c(c) = \left(\prod_{t\in c}\frac{\pi_{\theta}^{\text{negation} }(\tau_{t}|\tau_{< t})}{\pi_{\theta_{\text{old} } }^{\text{negation} }(\tau_{t}|\tau_{< t})}\right)^{\frac{1}{|\tau|} } $$ - 分块级掩码 (Chunk-Level Masking) :
$$ m_{c} = \mathbb{I}\left(\left(\prod_{t\in c}\frac{\pi_{\theta_{\text{old} } }^{\text{negation} }(\tau_{t}|\tau_{< t})}{\mu_{\theta_{\text{old} } }^{\text{SLang} }(\tau_{t}|\tau_{< t})}\right)^{\frac{1}{|\tau|} }\leq H\right) $$ - 最终 IPA 梯度公式(结合正负样本和分块级优化):
$$
\nabla J_{\text{Chunk-RL} }(\pi) = \underbrace{\sum_{c\in \mathcal{T}^{+} }\mu_{\theta_{\text{old} } }^{\text{SGLang} }(c)G_{c}\sum_{k=1}^{|c|}m_{c}\nabla \log \pi_{\theta}^{\text{negatron} }(c_{k}|\tau_{< c_{k} })}_{\text{Weighted SL update for positive examples} } + \underbrace{\sum_{c\in \mathcal{T}^{-} }\mu_{\theta_{\text{old} } }^{\text{SGLang} }(c)[\rho_{c}(c)]_{0}^{1}G_{c}\sum_{k=1}^{|c|}m_{c}\nabla \log \pi_{\theta}^{\text{negatron} }(c_{k}|\tau_{< c_{k} })}_{\text{Clipped IS update for negative examples} }
$$- \(\mathcal{T}^{+}\) 和 \(\mathcal{T}^{-}\) :正、负轨迹集合。\(G_c\) 是分块的折扣回报。\([\rho_{c}(c)]_{0}^{1}\) 表示将重要性权重截断在0到1之间
- 分块级折扣回报 (Chunk-Level Discounted Return) :给分块 \(c_k\) 分配回报
- IPA Step 4)Rollout 范式的改进:分块级初始化重采样 (Chunk-Level Initialized Resampling) :
- 问题:从初始状态采样复杂任务的完整轨迹,成功信号极为稀疏
- 方法:从一个专家轨迹 \(\tau^{*} = (c_{1}^{*},c_{2}^{*},\ldots,c_{K}^{*})\) 中选择一个关键分块 \(c_{f}^{*}\),将环境初始化为该分块之前的状态 \(\tau_{\leq c_{f-1} }^{*}\),然后让当前策略从该状态开始重新采样后续轨迹(\( \tau_{\geq c_{f} }\))
- 两种实现方案 :
- 顺序回滚(Sequential Rollback) :从专家轨迹的最后一个分块开始,逐步向前回滚
- 并行初始化(Parallelized Initialization) :同时从多个锚点分块(Anchor Chunks)开始采样,提高效率
- 混合训练目标 :当从某个关键分块采样无法获得正样本时,回退到模仿学习(IL) ,对专家分块 \(c_{f}^{*}\) 应用 IL 损失,防止策略退化
$$
\mathcal{L}_{\text{IPA} } = \lambda_{\text{IL} }\cdot \sum_{c_k^*\in \tau_{< c_f^*} } \log \pi_\theta(c_k^*|\tau_{< c_{k-1} }^*) + \lambda_{\text{RL} }\cdot \mathcal{L}_{\text{Chunk-RL} }^{\text{CE}\tau_{\geq c_f^*} }
$$
- Token-level,Chunk-level,Sentence-level 的对比
- Sentence-level 优化粒度过于粗糙:一条完整序列往往包含多轮决策与交互行为
- 若将这些交互视作单一整体序列开展优化,会造成细粒度信息的损耗
- Token-level 动作会造成决策粒度与外部环境状态转移 Dynamics 之间的不匹配:
- 绝大多数词元不会对外部环境产生任何作用
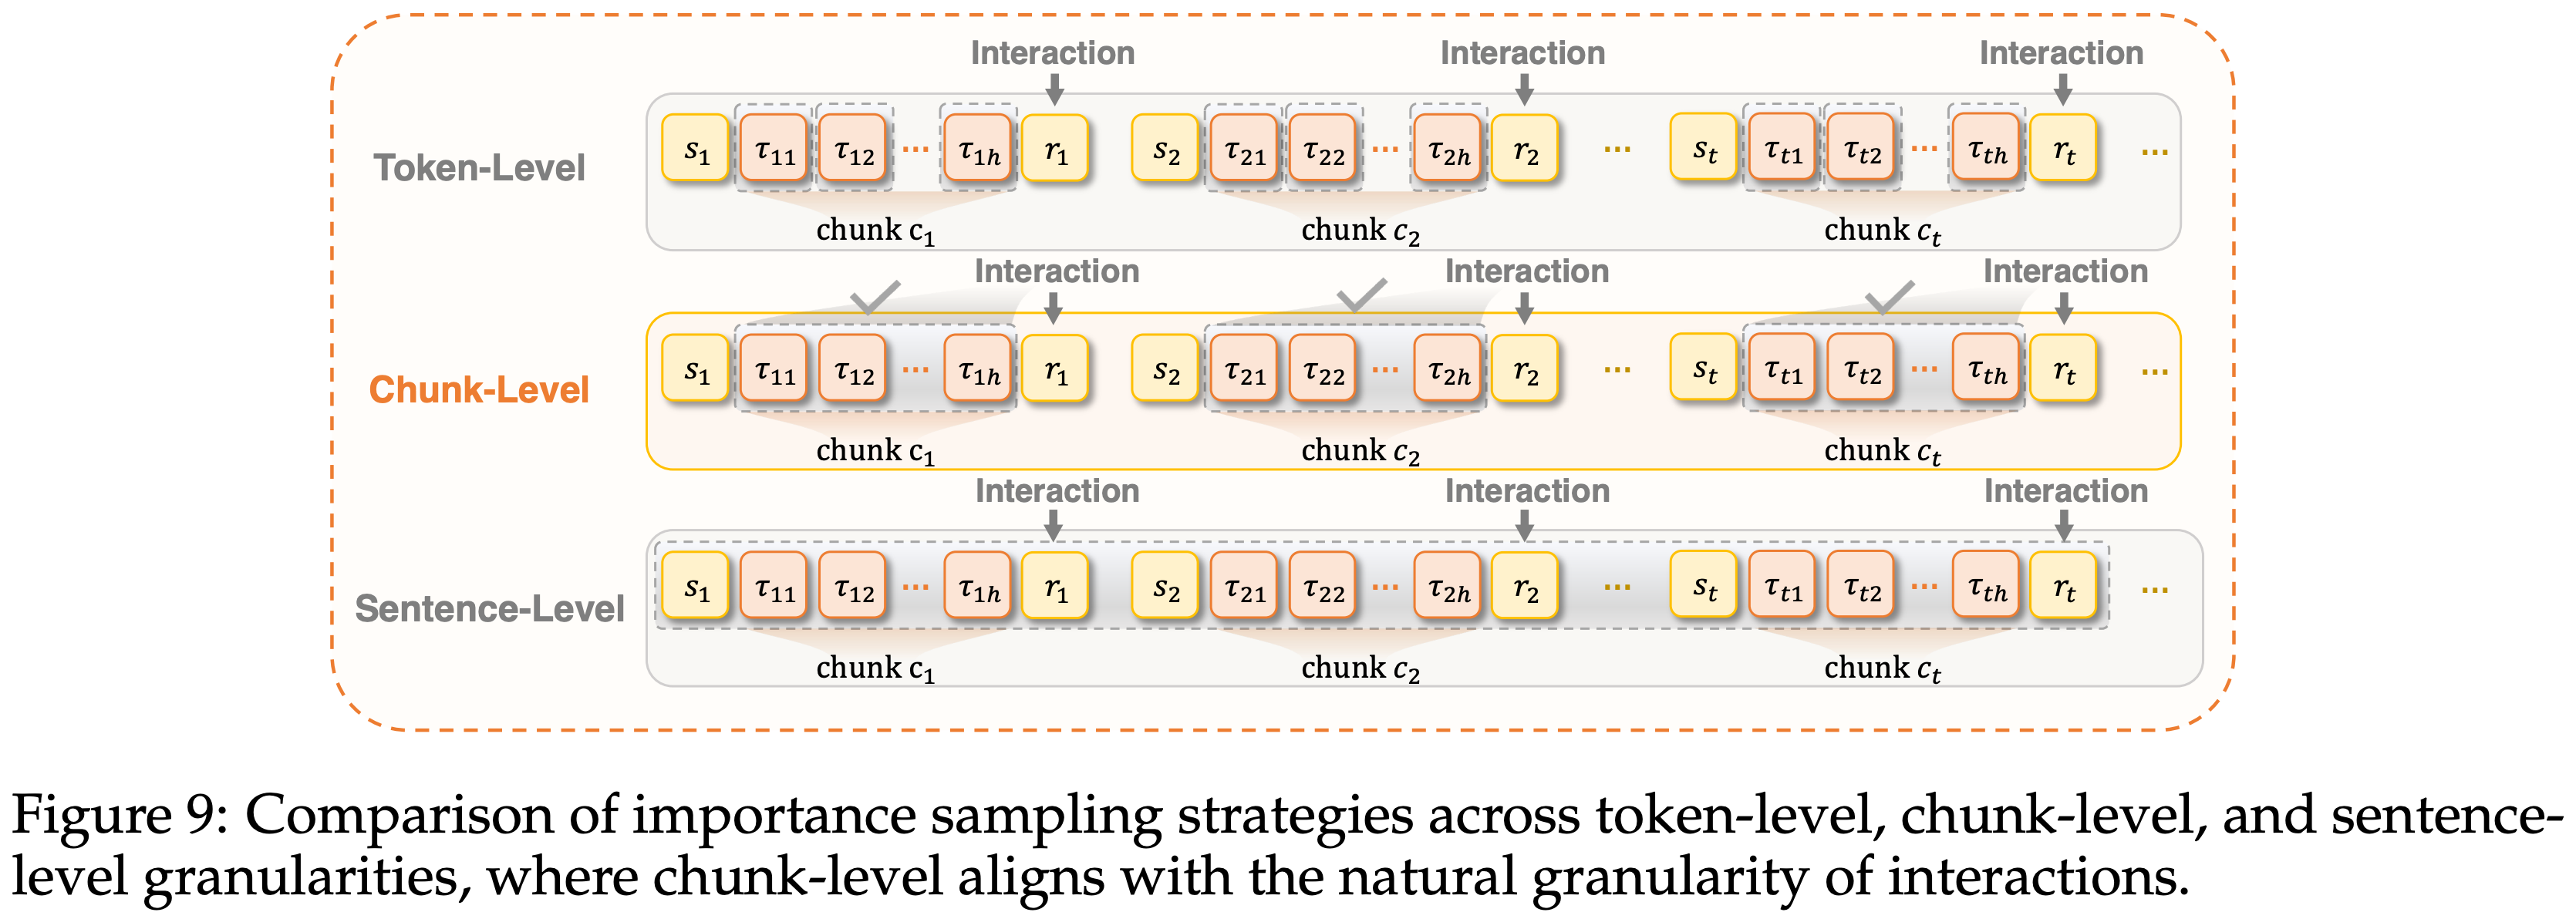
- 绝大多数词元不会对外部环境产生任何作用
- Sentence-level 优化粒度过于粗糙:一条完整序列往往包含多轮决策与交互行为
实验
评估设置
- 采用三维评估框架:
- 1)工具使用能力 :在 TAU2-Bench, BFCL-V3, MTU-Bench 上测试
- 2)通用代理能力 :在 GAIA, BrowseComp-ZH, ShopAgent 上测试
- 3)终端代理执行 :在 Terminal-Bench 1.0/2.0, SWE-bench Verified/Multilingual 上测试
论文提出新基准:Terminal Bench Pro
- 针对现有终端基准(如 Terminal-Bench 2.0 仅 89 个任务)规模小、领域不平衡、易污染的问题,本文作者构建了 Terminal Bench Pro
- Terminal Bench Pro 包含 400 个评估任务(200 公开 + 200 私有)
- 均匀分布在 数据处理、游戏、调试、系统管理、科学计算、软件工程、机器学习和安全 八个领域
- 所有任务由专家手工编写,经多轮审查,确保规范明确、测试覆盖率高、环境完全可复现
主要结果分析
- 终端基准测试 :
- 同规模对比 :ROME(30B 总参,3B 激活)在 SWE-bench Verified 上达到 57.40%,大幅超越同规模的 Qwen3-Coder-30B-A3B (46.33%) 等模型
- 跨规模对比 :ROME 的性能甚至接近或超过了部分超大模型(如 DeepSeek V3.1, 671B 总参)
- 在 Terminal-Bench 1.0 上,ROME (41.50%) 超过了 Qwen3-Coder-480B (37.92%)
- 局限性 :所有模型在更难的 Terminal Bench Pro 上表现均有限(Private 集 ROME 为 21.50%)
- 工具使用基准测试 :
- ROME 平均分 49.46%,显著优于同规模模型,且与大型模型(如 DeepSeek V3.1 49.94%)持平,展现出极高的“规模效率”
- 通用代理基准测试 :
- ROME 在 ShopAgent 多轮交互任务上表现尤为突出(29.61%),大幅超越所有同规模模型,并超越了 GLM-4.6(22.12%)等超大模型,证明其长时程规划与自适应能力还不错
- 真实世界案例研究 :
- 在 100 个真实用户任务(如生成睡眠管理系统、太阳系建模)的盲测中,ROME 在 功能/交互实现、布局/样式复现、代码质量/鲁棒性、结构/语义正确性、创新/提示理解 五个维度上均优于对比模型,实现了“规模突破性”的代理能力
RollArt
- RollArt: Disaggregated Multi-Task Agentic RL Training at Scale, 20251227-20260615, HKUST & Alibaba & Tonogyi Lab
- 本文提出了 ROLLART,一个专为大规模、多任务、Agentic RL 训练设计的分布式系统
- 该系统通过将 RL Pipeline 进行细粒度分解(Disaggregation),并映射到异构硬件上,显著提升了训练吞吐量,缩短了训练时间
- 注:论文中包含大量实验,并在生产环境部署验证了其有效性和可扩展性
Bitter Lesson in Terminal Environments
- 原始博客:苦涩的教训!ROLL团队分享:Agentic RL 训练中的实践经验
- 这里总结博客中的核心观点,详情可阅读原始博客
RLVR vs Agentic RL
- RLVR 与 Agentic RL 的本质区别 :
- RLVR 本质上是单步骤的 bandit 问题,模型生成一次完整回答后获得奖励并更新参数
- Agentic RL 是多步交互式 MDP 设定,模型需要采取行动、观察环境反馈,并在稀疏且延迟的奖励信号下优化长程轨迹
- RLVR 训练的是“会回答”的模型,Agentic RL 训练的是“会行动”的模型
- Agentic RL 不仅是算法问题 :
- 需要环境、基础设施和算法的协同设计
- 一般我们阅读的 Paper 提供算法,但不会告诉你在实践中如何处理环境崩溃、变长 episode 的 batch 处理、高效回放长轨迹等技术细节
- Agentic RL 对基础设施提出更高要求 :
- 包括端到端异步训练 Pipeline 、稳定的长时序信用分配机制、与真实环境的深度集成,以及支撑持续扩展的工程基础设施
Infra 相关
- 两种环境管理模式 :
- Roll-Managed Mode :由 ROLL 负责上下文管理与轨迹构建,训练侧灵活性高,可引入丰富的 prompt 模板和交互机制,但与真实 Agent 行为存在差距
- CLI-Native Mode :上下文由 iFlow CLI 维护(类似 Claude Code 等 Harness),训练、评估与部署完全一致,最大程度减少行为不一致,但训练侧定制灵活性较低
- 实践中在不同阶段切换使用两种模式
- 异步训练 Pipeline :
- Agentic RL 具有长尾延迟特性
- 同步批量式 Pipeline 中长耗时任务会成为拖尾瓶颈
- 解决方案包括:环境级异步 rollout、冗余并行环境、异步训练机制、Train–rollout 复用机制(时间分片动态划分 GPU 资源)
- 保持环境 “干净” :
- 初始环境状态直接影响学习信号,微小残留痕迹都可能污染训练
- 需在 rollout 前清理中间文件,测试文件仅在最终评估阶段上传,与训练严格隔离
- 否则模型会“偷懒”,直接读取甚至修改测试脚本
RL 训练实例
- 实例来源 :大规模合成实例(按难度和标签采样,由外部供应方标注筛选)和专家编写实例(难度更高、构造更精细)
- 伪阳性(False Positive)问题 :
- 合成实例的测试用例不完整或本身存在问题,在 agentic RL 中尤为致命
- 早期合成数据中 false positive 比例一度高达约 40%
- 典型例子是测试脚本检查不充分,Agent 可通过捷径通过测试
- 解决方案是引入 LLM-as-judge 验证模块 ,多 LLM 协同审查
- 合成实例的测试用例不完整或本身存在问题,在 agentic RL 中尤为致命
- Ground-Truth 与 No-Op 验证 :
- 加入训练池前进行两项检查:
- golden solution 无法通过全部测试则丢弃
- 不执行任何有效操作也能通过测试则丢弃
- 加入训练池前进行两项检查:
- 环境多样性与鲁棒性 :
- 有意在初始环境中引入多样性(不同版本软件包、不同镜像源、不同配置细节),防止 Agent 过拟合于单一理想化环境
- 还可有意扰动或部分破坏环境(如移除依赖、切换不可用镜像源),迫使模型学会检查、诊断与恢复
- 这相当于 环境增强 ,帮助 Agent 处理不确定性
如何保证终端环境中 Agentic RL 的稳定性
Mask & Filter 策略 :
- 终端环境不可避免出现瞬时网络故障、沙箱启动失败、工具调用超时等异常
- 原则是:对训练有害或无法提供有效学习信号的样本都可以 mask 或 filter
- 不可恢复的大规模错误(如环境启动失败)完全 mask 掉并用占位样本替换
- 偶发可恢复错误(如工具超时)filter 掉,全局过滤比例控制在 ≤ 50%
- 理解:原文没有明说超过 50% 样本的具体做法,但结合上下文和 RL 训练的一般实践,超过 50% 时的处理方式通常是以下几种之一:
- 直接丢弃本轮所有数据,不进行训练更新(即 skip 这一轮 iteration),等待下一轮采集到更高质量的数据
- 降低过滤阈值:不再严格执行 “凡是工具超时就过滤” 的标准,而是允许一部分原本会被过滤的异常样本保留下来参与训练(即使它们带有噪声),以保证 batch 中有足够的数据量
- 理解:原文没有明说超过 50% 样本的具体做法,但结合上下文和 RL 训练的一般实践,超过 50% 时的处理方式通常是以下几种之一:
- 还可引入 max-turn mask 等约束异常轨迹影响
- 理解:超出最大轮次的轨迹直接 mask 掉,类似之前超出
max_len的 Response 需要过滤一样
- 理解:超出最大轮次的轨迹直接 mask 掉,类似之前超出
- 具体代码实现(注:看着代码是整个 group 一起过滤的,但其实应该支持只过滤某个 Rollout 才好):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
class GroupFilterTB:
def __init__(self, config: AgenticConfig, env_manager_config: EnvManagerConfig, mode: str):
self.config = config
self.env_manager_config = env_manager_config
self.mode = mode
self.global_filter_stats = {"total": 0, "filtered": 0}
def filter(self, group_id: int, episode_id: int, group: list[DataProto]):
"""
Decide whether to filter out an entire group of rollouts.
"""
self.global_filter_stats["total"] += 1
# Step 1: Check whether this group contains any rollout
# that explicitly requests to be dropped
# (e.g., due to tool timeout, transient execution error)
should_drop = False
for data in group:
if data.meta_info.get("drop_flag", False):
should_drop = True
break
# If no rollout indicates a drop condition, keep the group
if not should_drop:
return False
# Step 2: Compute the current global filter ratio
# This guards against pathological cases where
# too many groups are dropped and training stalls
current_global_filter_ratio = (
self.global_filter_stats["filtered"] / self.global_filter_stats["total"]
if self.global_filter_stats["total"] > 0 else 0.0
)
# If we already filtered too much globally, stop filtering
if current_global_filter_ratio >= 0.5:
return False
# Also prevent the *next* filter from exceeding the limit
if (self.global_filter_stats["filtered"] + 1) / self.global_filter_stats["total"] > 0.5:
return False
# Step 3: Drop this group and update global stats
self.global_filter_stats["filtered"] += 1
return True
保守起步——先从正样本轨迹学习 :
- 早期数据质量差时,仅使用正样本轨迹训练明显更稳定
- 采用课程式策略:
- 早期仅用正样本更新策略(标准 RL 目标函数)
- 后期拥有小规模高质量实例后再加入负轨迹训练
- 特别注意 :positive-only RL 不是 RFT,前者仍是标准 RL 目标函数,具备更强泛化能力
- 这里的 positive-only RL 更新还包括 masking、clipping、normalization 等稳定机制,从而可以自然整合样本过滤、细粒度奖励以及训推不一致控制等策略
Chunked MDP 与 IPA
- IPA 方法可参考:(ROME & ALE & IPA)Let It Flow: Agentic Crafting on Rock and Roll, 20251231-20260312, ROCK & ROLL & IFLOW & DT Joint Team
- 在 interaction chunk 层面建模 :
- 多轮 agentic 任务中,大多数 token 不改变环境状态,轨迹包含多个决策节点
- 将每次环境交互之间的连续片段(通常以工具调用结束)视为语义上的“动作单元”
- Interaction-Perceptive Agentic Policy Optimization(IPA) :
- 核心包括
- 在 chunk 层级计算回报与重要性采样
- 对整个 chunk 进行 masking(而非逐 token)
- 引入 chunk 初始化重采样
- imitation learning + RL 混合训练
- 核心包括
- IPA 的收益 :在长程轨迹上获得更稳定的梯度,提升模型可学习能力的上限
自适应地应用 RL 技巧
- Agentic RL 的三个突出问题 :
- 重尾分布与极端负回报 :少数失败轨迹异常长,产生极大幅度负回报,容易主导梯度
- 理解:这里应该主要是指在 Loss 聚合时使用了类似 Token 等权的方式,则容易出现问题
- 比如使用 dr.grpo(除以固定值),seq-mean-token-sum,或者 token-mean 等类似的 Loss 聚合策略时,就容易出现长轨迹主导梯度
- 理解:这里应该主要是指在 Loss 聚合时使用了类似 Token 等权的方式,则容易出现问题
- 带正向结果的浅层策略模式 :
- 模型可能并未真正理解任务,而是依赖重复试错、某些固定命令序列或某些捷径
- outcome reward 只检查最终结果,这类浅层模式可能被强化,逐渐收缩策略空间并形成固化的模板
- 噪声型失败 :
- 失败失败往往多样且不明确,未必由模型本身引起,可能是环境随机性或系统干扰,负样本置信度通常低于正样本
- 理解:负样本的置信度通常低于正样本
- 重尾分布与极端负回报 :少数失败轨迹异常长,产生极大幅度负回报,容易主导梯度
- 从宏观角度看,agentic RL 面临的问题与 RLVR 在 outcome reward 下的问题类似:
- 信用分配、负样本不可靠、训练不平衡
- Terminal 环境中问题更严重 :
- 时序更长;
- 工具交互更离散
- 改变环境的 token 占比极小;
- 失败模式更多样
- 负样本方差更大
- 结论:Terminal 环境中训练信号的信噪比显著下降
- agentic 设置下,训练信号的信噪比显著下降,使得信用分配与样本可靠性问题更加敏感
- 我们通常会根据当前的主导因素采取不同缓解策略(核心目标是控制哪些轨迹、轨迹的哪些部分、以何种权重参与策略梯度更新),例如:
- selective trajectory masking
- selective token masking
- trajectory-level reweighting
- retry-loop penalties
- other light behavior shaping rewards or penalties, …
- 但是,似乎 没有通用解法 :不同数据条件下同一策略可能产生相反效果
- 原博客提到:在两种不同的数据设置下,我们观察到了截然相反的现象:
- 在一种情况下,移除标准差(std)会迅速导致训练崩溃
- 而在另一种情况下,同样的操作却反而使训练更加稳定(这里主要是数据分布的差异导致)
- 这个现象和其他论文的观察一致:(ROLL-Part1-RL4LLM-Reasoning, Lite PPO)Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning, 20250811-20251027, ROLL
- 原博客提到:在两种不同的数据设置下,我们观察到了截然相反的现象:
- 我们通常会根据当前的主导因素采取不同缓解策略(核心目标是控制哪些轨迹、轨迹的哪些部分、以何种权重参与策略梯度更新),例如:
崩溃是常态,关键在于如何 Resume
- 崩溃是常态 :大规模终端 RL 训练中崩溃是常态,需要建立这个心态
- 崩溃的典型信号与处理 :
- 当训练不稳定时优先检查:
- 是否有少量极端轨迹主导更新(特征:异常长的失败轨迹、重尾分布的负回报):
- 采用 masking、降低权重、收紧 clipping
- 负样本是否整体占主导:
- 降低负样本权重、过滤低置信度失败样本,或采用课程式训练策略
- 模型是否在学习“坏模式”:
- 引入行为惩罚、更多维的奖励设计等
- 是否有少量极端轨迹主导更新(特征:异常长的失败轨迹、重尾分布的负回报):
- 当训练不稳定时优先检查:
- 两条经验性原则 :
- 优先针对极端轨迹定向处理(如 mask 掉超长负样本),如仍不稳定再全局重加权
- RL 梯度比监督学习噪声更大,更小的学习率配合更强的约束往往更稳定
建议添加细粒度行为监控与惩罚
- Reward hacking 更隐蔽 :智能体可通过看似合理的方式通过测试,常见模式包括:
- 修改既定环境:智能体不是解决任务本身,而是直接修改初始环境设置
- 工具过度使用:反复调用工具完成一些简单或琐碎的操作,本质上是在进行暴力重试
- 滥用搜索:通过大量重复调用搜索引擎来弥补内部推理能力不足
- 不安全或破坏性操作:执行高风险命令,例如删除所有文件或终止所有进程
- 隐蔽的捷径:利用测试脚本或环境默认配置中的漏洞,在未真正解决任务的情况下通过测试
- 两点启示 :
- 测试用例质量与鲁棒性至关重要:
- 薄弱或描述不充分的测试可能在无意中奖励错误行为
- 并非所有实例都适合 RL 训练
- 某些任务本身难以通过测试准确评估,反而更容易诱导模型寻找捷径或形成不良模式,而不是学习真正的解决方案
- 测试用例质量与鲁棒性至关重要:
- 建议增加 持续细粒度监控 ,比如在 Terminal 环境中:
- 跟踪不同任务成功率趋势
- 不同工具成功 / 失败率
- 重复或循环工具调用模式
- 不同工具使用频率
- 不同命令使用频率
- 一旦发现异常(如某工具调用激增、大量重试循环 或 频繁执行“kill process”类命令等等),立即回滚训练或移除问题实例
- 这种持续、细粒度的监控与动态调整,也是保证长期 agentic RL 训练稳定且有效运行的关键(尤其是在防止隐蔽 reward hacking 行为方面)
- 环境服务可观测性 :
- 沙盒环境服务的可视化观测非常重要
- 高峰阶段系统同时维持数千级并发会话,作者就曾多次因环境并发抖动导致训练异常,没有系统级观测很难定位
总结性观点
- Agentic RL 是高度耦合的系统 :
- Agentic RL本身就是细节很多,这本质上也是一套高度耦合的系统
- 数据、环境、奖励、调度、优化……任何小环节出问题,都可能在几十个 step 后放大成一次 crash
- 早期不可避免大量排查(看曲线、翻日志、做可视化、定位异常轨迹、回滚实验)
- 但当关键环节理顺、可视化监控体系搭建起来后,训练会顺利很多
- 监控完备时,即使出现异常模式也能快速定位,Crash 也可以快速溯源和剔除有问题的实例
- 终端环境本质是 POMDP :
- Agent 无法直接观察到完整环境状态(文件系统结构、软件版本、先前修改的配置、过去的失败尝试等)
- 很多问题本质上可归结为两个老问题:
- 部分可观测性
- 长期信用分配
- 这些问题并不新,但在 agentic 场景下会被进一步放大
未来展望
- 挖掘更复杂的长时序任务与有效的 agentic 模式 :
- 需要更贴近真实世界的长时序任务
- 有些 agent 能力难以仅靠 RL 自发涌现
- 注:互联网上有大量记录“人如何思考”的文本,但很少有系统性记录“人如何完成复杂任务”的完整执行过程
- 因为这些任务往往跨平台、跨设备、跨时段展开,完整轨迹难以被收集
- 主动挖掘并强化有效行为模式是值得思考的方向
- 更真实的 Agent–Environment–Human 闭环优化 :
- 真实应用中环境是动态演化的,用户可能随时补充信息、修改需求、纠正错误
- 面对这种动态场景,Agent 不能只是一味执行指令,Agent 应学会主动获取信息、不确定时确认、收到反馈后更新判断
- 更强大的基建与更开放的环境 :
- Agentic RL 非常吃工程能力,需要高并发、低阻塞、可扩展的环境执行能力
- 需要足够稳定且高度异步的训练框架来降低时间开销
- 需要能够支撑模型持续 scaling 的工程基础
- 当前环境高度依赖人工配置,限制探索空间
- 例如固定的镜像源、权限边界控制、预安装软件,以及被限制在单机或 Docker 容器中的执行空间
- 需要更高层次、更开放、更可演化的环境体系,结合依赖环境动态变化的奖励设计
- Agentic RL 非常吃工程能力,需要高并发、低阻塞、可扩展的环境执行能力
- 更细粒度的信用分配与奖励建模 :
- Agentic RL 有更多可用的中间信号(工具执行成功与否、子任务完成情况等)
- 但作者不认为依赖复杂的固定奖励规则(例如对工具失败固定施加 −0.5 惩罚)是可持续的解决方案
其他有趣发现
- 并行函数调用 :
- 观察发现 claude-sonnet-4.5 的并行度显著更高,更擅长在执行前识别关键不确定性,通过多个并行的“检查类调用”获取信息,包括但不限于:
pwd、ls、cat、grep检查目录结构python -V和pip list识别 Python 环境read_file和search查找安装方法
- 启示:在状态改变之前,显式鼓励一个“前置的、并行的信息收集阶段”可能是有益的
- 注:作者提到,从经验上看,这种并行调用主要集中在检查类工具上,而不是直接修改环境的执行或编辑类操作
- 理解:这里其实就是一种有益的模式发现
- 对比一些 SOTA 模型/领域人工专家 与 Base 模型的差异,能够找到某些有益的 Pattern
- 观察发现 claude-sonnet-4.5 的并行度显著更高,更擅长在执行前识别关键不确定性,通过多个并行的“检查类调用”获取信息,包括但不限于:
- 常见失败模式 :
- 终端 agentic 任务中最常见的两类失败是
- 无效循环 :在 Agent 已有明确失败信号时仍重复同一种策略,而不懂切换思路或重新审视假设,从而形成冗长而无效的交互链条
- 超时 :模型缺乏对长时间运行命令执行时长的可靠感知,容易被默认超时机制误导,从而产生误判或反复重试
- 除了两个关键的失败外,此外还有幻觉、不恰当工具选择、违反任务约束等
- 终端 agentic 任务中最常见的两类失败是
最终总结
- Agentic RL 仍处于早期阶段 :
- 文中提到的许多技术可能并非最佳实践或最终方案,主要是实际实验中的经验教训
- 真正的进步来自协同设计 :
- 未来真正的进步将来自于优化目标、环境、训练框架之间更加紧密的协同设计和整合
- 个人理解:
- 本博客写的非常细,其实里面写的很多东西是我们在实践中遇到并解决过的(包括 RLHF、 RLVR 和 Agentic RL 场景都会遇到的)