注:本文包含 AI 辅助创作
Paper Summary
- 整体总结:
- RLAnything 是一个针对任意 LLM 或 Agentic 场景都可以做 RL 训练的框架
- RLAnything 使用整合的监督训练策略,并通过一致性反馈改进奖励模型,在整个训练过程中提供更强、更可靠的信号
- RLAnything 包含了 策略 和 奖励模型 的同时学习
- 奖励模型的训练是通过奖励信号学习的
- 整合了 Step-wise 和 Outcome 的反馈信号
- 号称通过本文方法优化 的奖励模型信号 优于 人工标注的结果信号(注:这一点其实存疑)
- 本文还会动态调整训练环境:
- 本文证明了一个结论:对于任何目标策略来说,过于简单或者过于复杂的环境都不适合做这个策略的 RL 训练
- In Summary,RLAnything 使环境、策略和奖励模型能够相互提供反馈,从而增强学习信号并改进整个系统
- 具体描述:
- RLAnything 通过 Closed-loop Optimization 动态地优化环境 、策略 和奖励模型 ,放大学习信号并增强整个 RL 系统在任意 LLM 或智能体场景下的能力
- 本文包含多个 Features,实验对各种做了详细的 Ablation
- OSWorld 上, Qwen3-VL-8B-Thinking 的性能提升了 \(9.1%\)
- AlfWorld 和 LiveBench 上,分别将 Qwen2.5-7B-Instruct 的性能提升了 \(18.7%\) 和 \(11.9%\)
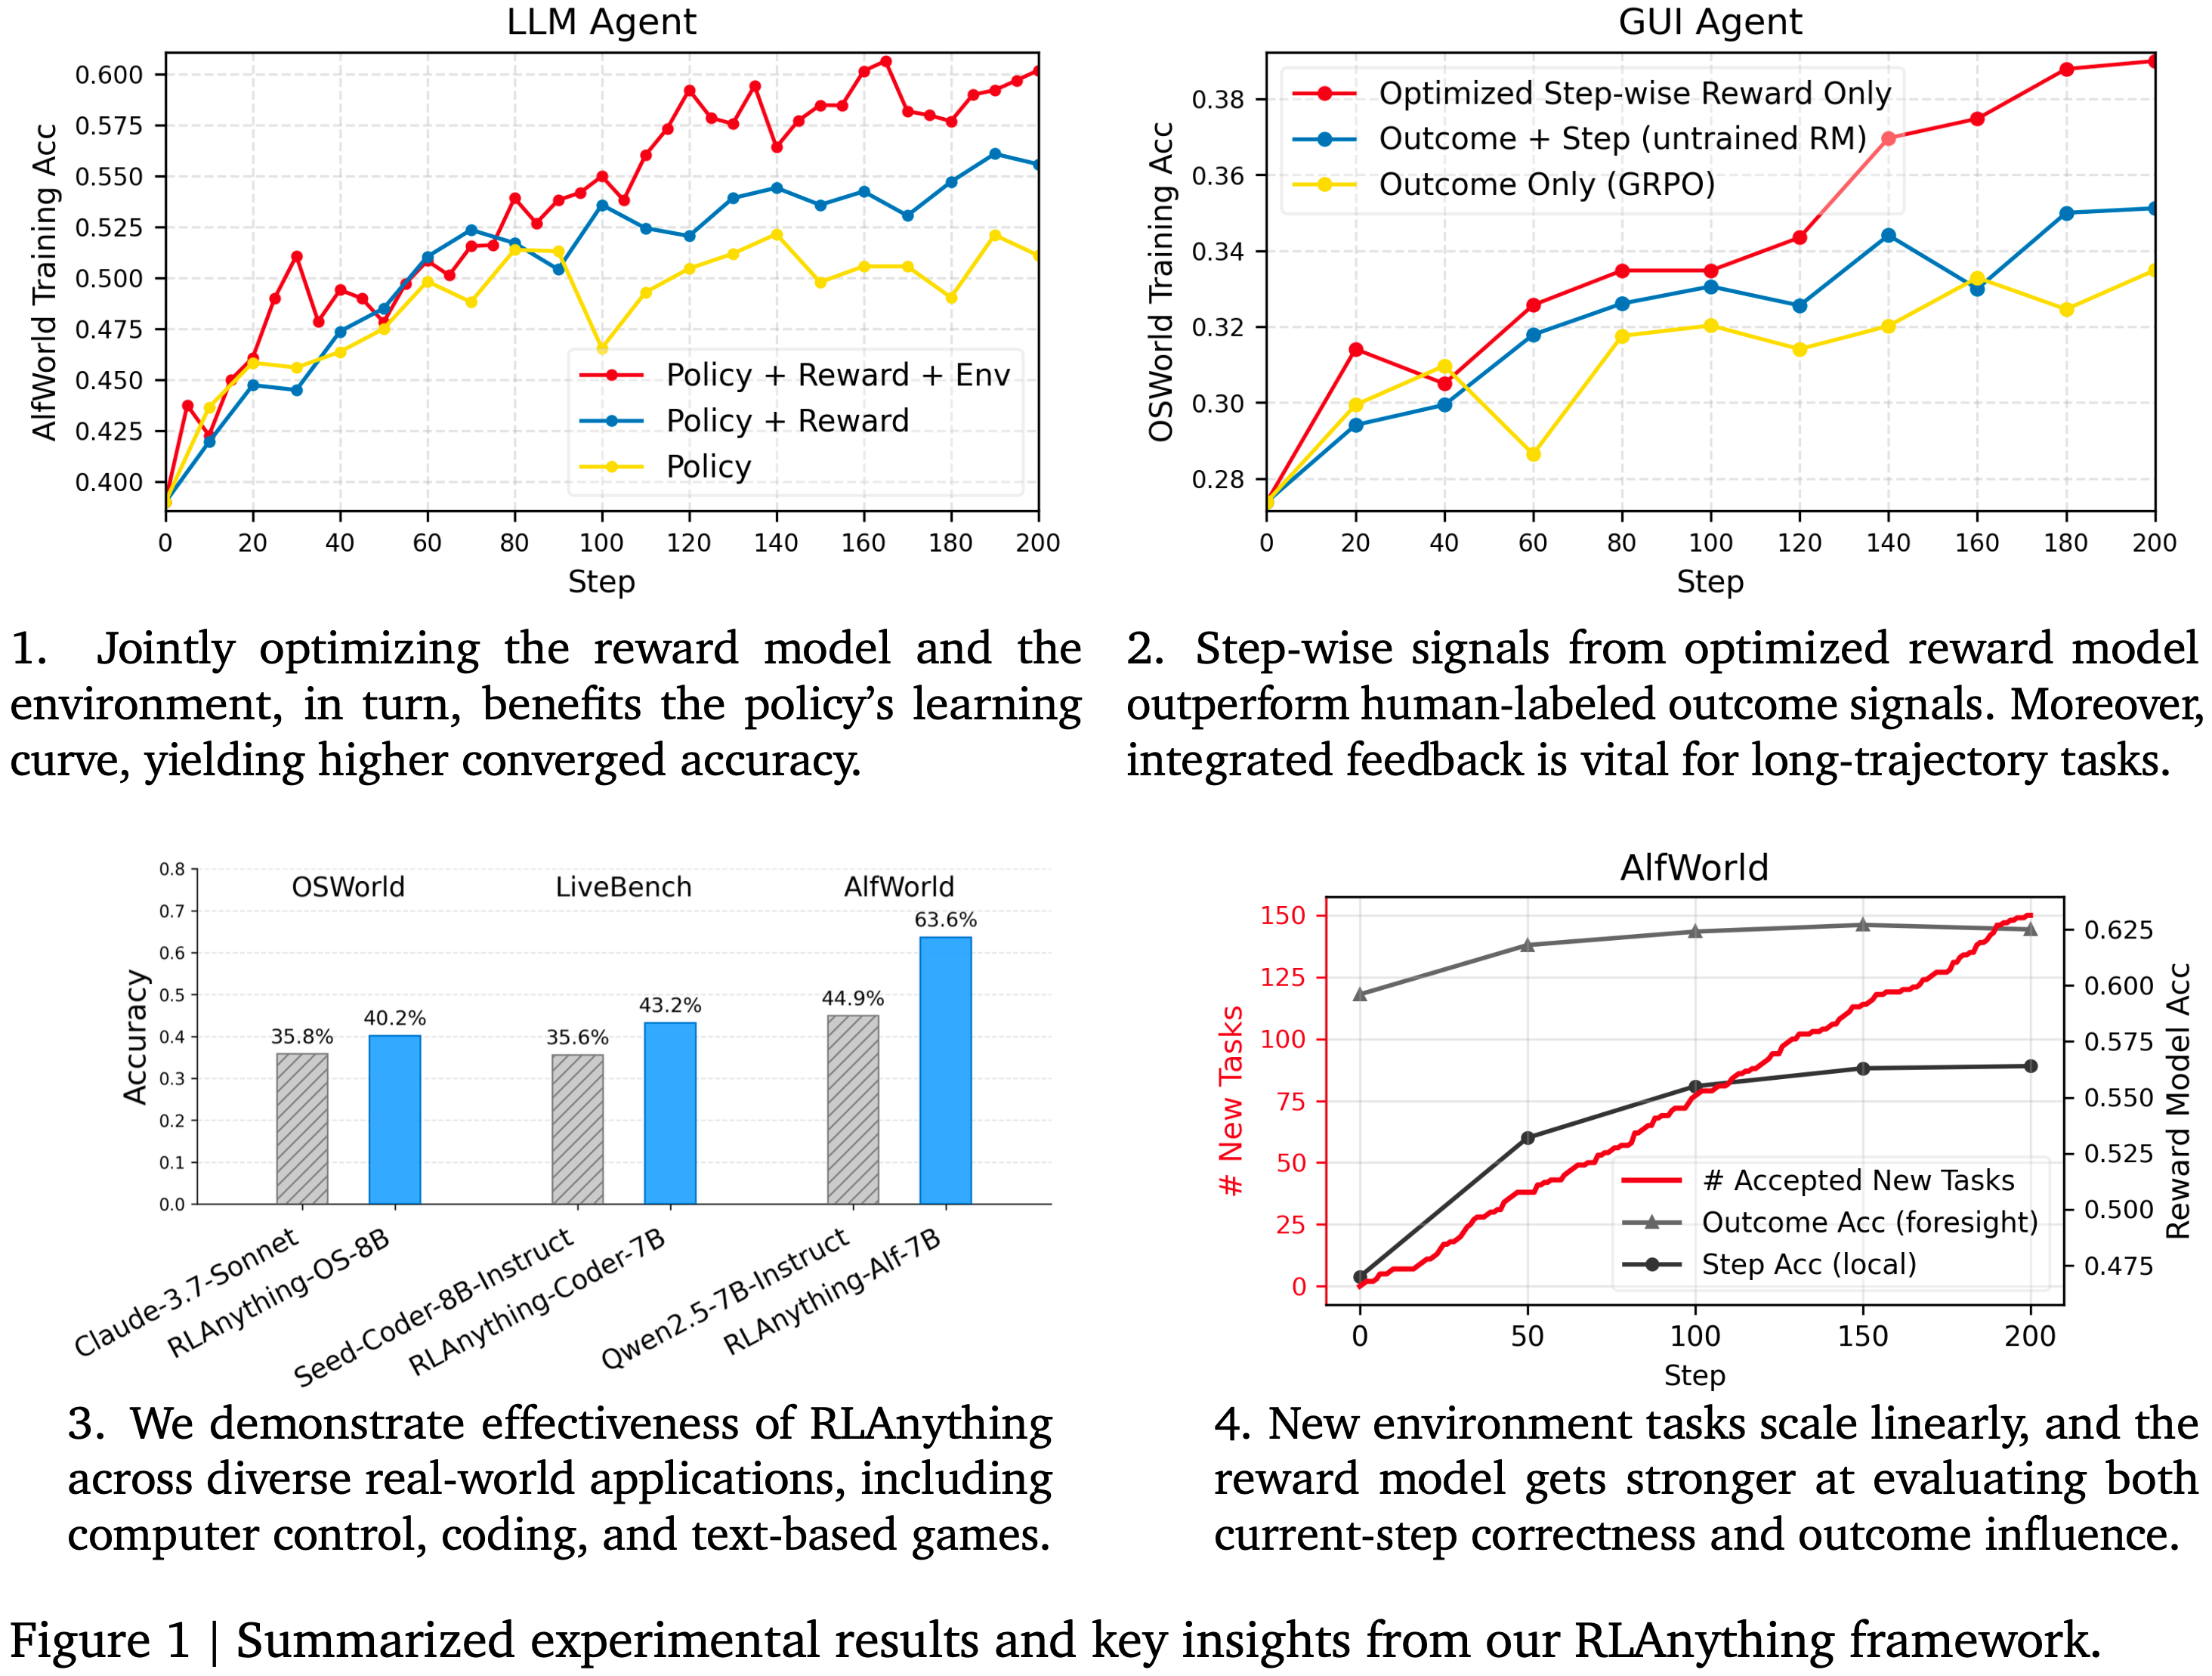
- 图 1:RLAnything 框架的总结性实验结果和关键 Insight
- 1)联合优化奖励模型和环境,反过来有益于策略的学习曲线,从而获得更高的收敛精度
- 2)来自优化后奖励模型的 Step-wise 信号优于人工标注的结果信号
- 此外,还可以观察到整合后的反馈对于长轨迹任务至关重要
- 3)RLAnything 在多种现实应用中的验证
- 4)新的环境任务呈线性扩展,奖励模型在评估当前步骤的正确性和对结果的影响方面都变得更强大
Introduction and Discussion
- 背景:
- RLVR 效果不错,但在策略与环境进行长轨迹的迭代交互时,仅靠二元结果奖励提供的监督是不足的 (2023; 2025; 2024)
- Step-wise 信号通常由生成式奖励模型提供,这些模型通过利用语言模型的推理能力,往往优于基于标量的模型 (2025; 2024)
- 但训练这些模型通常需要收集高质量的、特定于任务的监督数据 (2025; 2025)
- 结论:需要一个更自动化方法和可扩展的监督
- 环境的质量对于扩展强化学习也很重要
- 举例1:将任务难度与模型当前能力对齐已知能改善训练动态 (2025; 2025)
- 在 RLVR 中,在优化过程中调整任务难度可以改善策略训练 (2025)
- 举例2:在现实世界的环境中,探索的范围很大程度上由任务定义
- 例如用于 GUI 智能体的计算机 (2025a; 2024) 或用于机器人的物理世界 (2013),
- 通过增加任务多样性来扩展环境可以进一步促进策略在更广泛场景下的泛化能力 (2025; 2025; 2020; 2025; 2026; 2021)
- 举例1:将任务难度与模型当前能力对齐已知能改善训练动态 (2025; 2025)
- 核心问题提出:是否存在一个可以联合优化环境、策略和奖励模型的 RL 系统,能用于放大学习信号并强化整个系统?
- RLAnything 就是这样一个动态的 RL 框架,可以在闭环系统中 Forge 环境、策略和奖励模型
- 每个组件持续接收来自其他组件的反馈,在各种复杂的 LLM 或智能体场景中放大学习信号
- 策略训练:使用整合后的反馈进行训练
- 该反馈结合了可验证的结果奖励和奖励模型提供的 Step-wise 信号
- 奖励模型训练:通过基于结果和自洽性(self-consistency)的一致性反馈进行联合优化
- 这样可产生可靠的 Step-wise 监督,这反过来又改善了策略学习
- 奖励模型训练改进:
- 基于理论结果分析得到结论:平衡任务难度不仅有益于策略训练,也有益于 RL 系统中的奖励模型训练
- 环境任务调整:
- 基于来自策略和奖励模型的 Critic 反馈来调整环境任务,实现精确和自动的任务调整
- 将奖励模型总结出的、捕捉策略失败原因的信息输入到一个语言模型中,以扰动任务,为如何修改任务提供具体指导
- RLAnything 是通用的,在多种场景中进行了验证:
- Compute use (2024)
- Text-based Interactive Games (2018; 2020)
- Coding LLM 场景
- 主要贡献总结:
- (个人补充)作者通过大量实验观察到了一些关键 Insight
- 作者提出了动态 RL 系统 RLAnything,通过闭环优化 Forge 环境、策略和奖励模型,以放大学习信号并强化整个系统
- 作者多个场景(Compute-use Agent、Text-based LLM 智能体和 Coding LLM)实验中,展示了每个添加的动态组件都持续地有益于整个系统,并提升了 OOD 性能
- 实验指标显著提升:
- 在 OSWorld 上,Qwen3-VL-8B-Thinking 的性能提升了 \(9.1%\)
- 在 AlfWorld 和 LiveBench 上,Qwen2.5-7B-Instruct 的性能分别提升了 \(18.7%\) 和 \(11.9%\)
- 展示了广泛的适用性: Optimized RM 信号优于依赖人工标注的结果信号,使得从经验中主动学习(active learning)和环境扩展成为可能
RLAnything
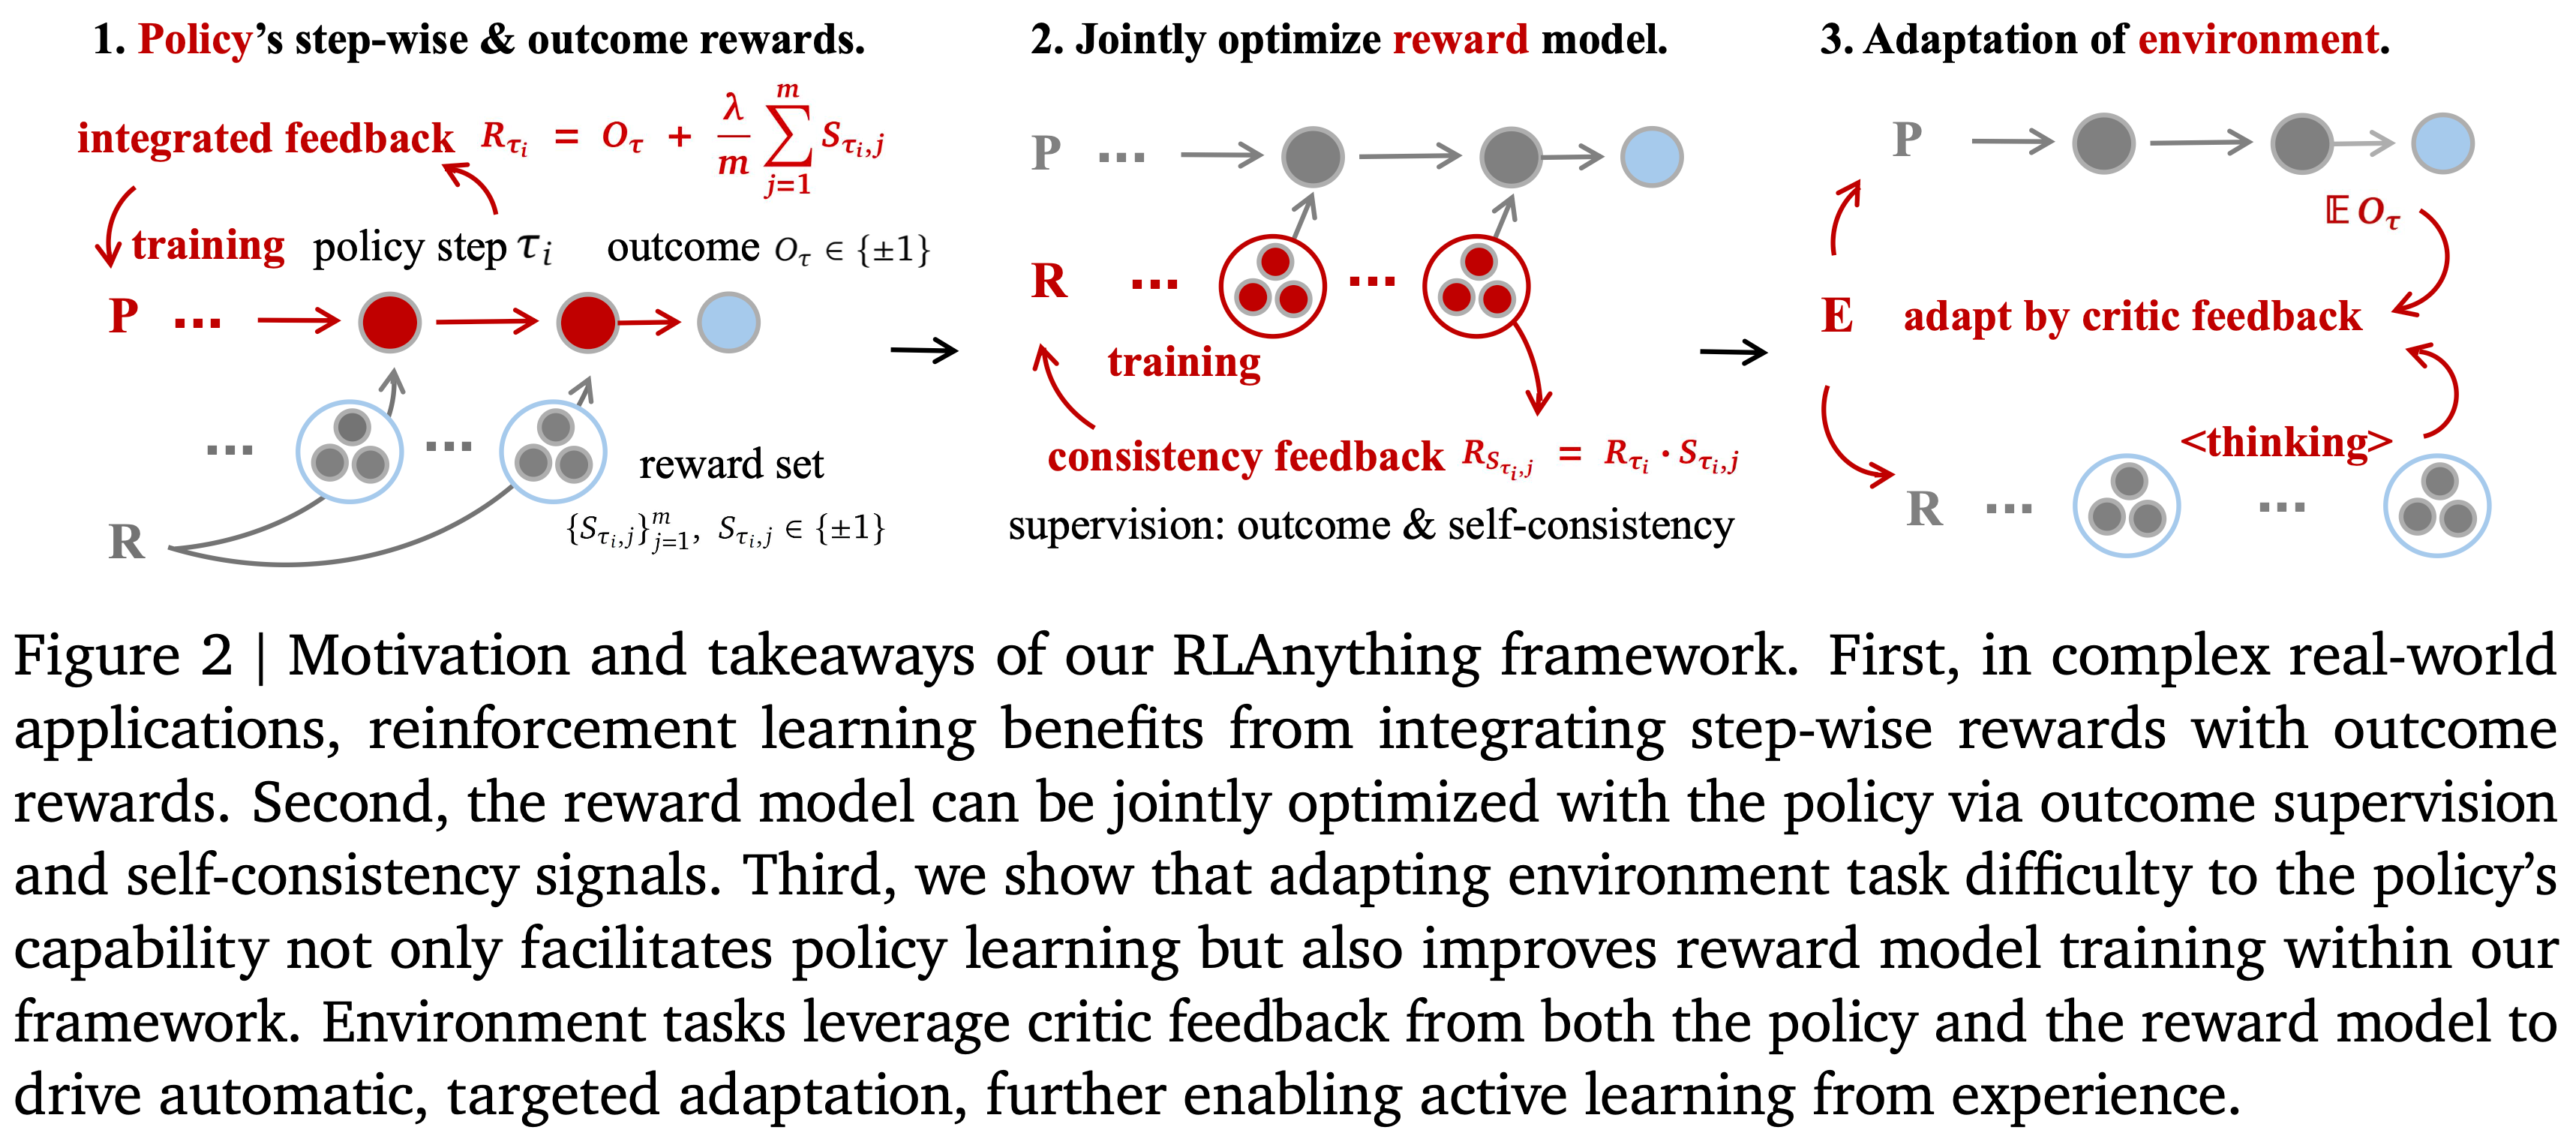
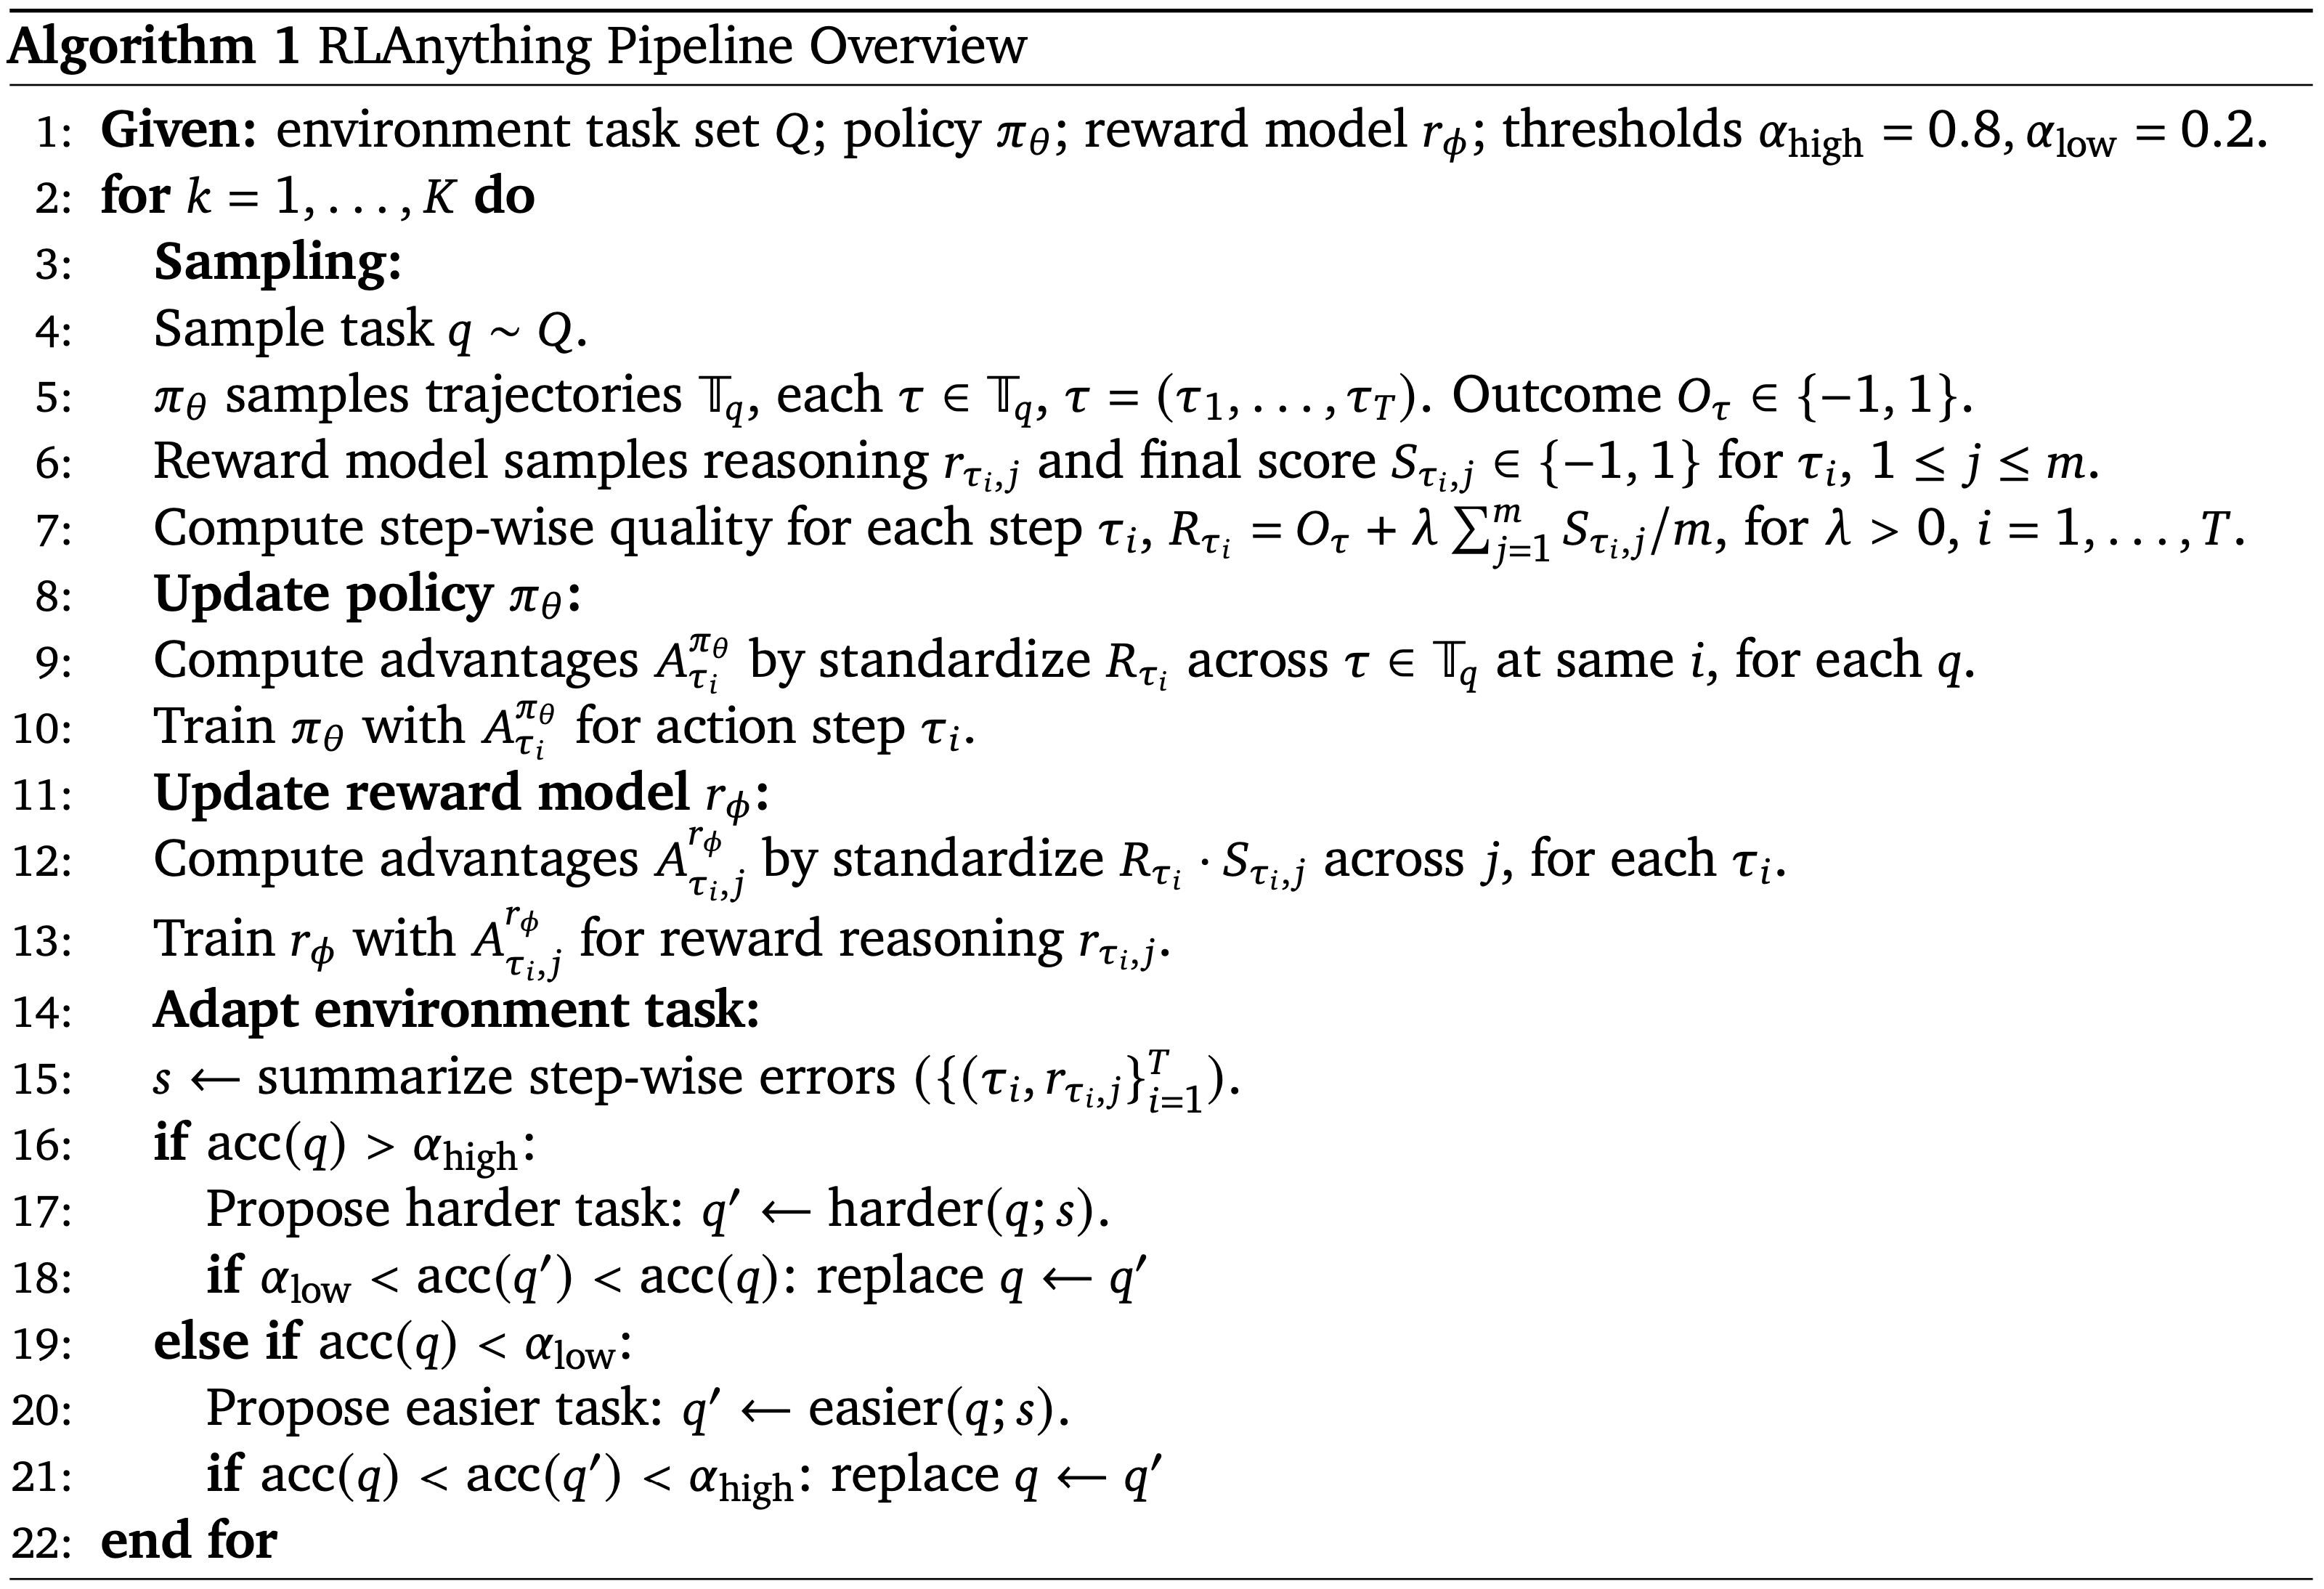
- RLAnything(参见算法 1)将策略模型、奖励模型和环境紧密结合,以实现联合优化
- 具体方法:
- 使用整合后的反馈(第 2.1 节中的公式 1)来训练策略
- 反馈结合了来自奖励模型的 Step-wise 信号和 Trajectory-level 的结果信号
- 通过将策略的轨迹视为环境任务,并通过公式 2 分配一致性反馈来训练奖励模型
- 作者在第 2.3 节中证明,这个目标也能提高奖励模型预测最终结果的准确性
- 随着奖励模型变得更准确,它反过来为策略提供了更强、更具信息量的学习信号
- 调整环境任务的难度不仅有益于策略训练,也有益于奖励模型训练
- 使用整合后的反馈(第 2.1 节中的公式 1)来训练策略
- 为了实现自动化和有针对性的调整,具体的任务修改由从奖励模型的评估响应中总结出的 Critic 反馈来指导(第 2.4 节)
Integration Feedback for Policy
- 给定一个任务 \(q \in Q\) 和一个策略 \(\pi\),采样一个轨迹 \(\tau \sim \pi(\cdot | q)\) 并获得一个最终结果奖励
$$ O_{\tau} \in \{- 1, 1\} $$ - 对于第 \(i\) 步 \(\tau_{i}\),独立用奖励模型进行 \(m\) 次打分 ,得到
$$S_{\tau_{i,j} } \in \{- 1, 1\}$$- 其中 \(j = 1, \ldots , m\),这里的 \(-1\) 表示未向最终目标推进或是一个 Step-wise 错误
- 本文将步骤奖励定义为:
$$R_{\tau_i} = O_{\tau} + \frac{\lambda}{m}\sum_{j = 1}^{m}S_{\tau_{i,j} } \tag {1}$$- 该公式将结果信号与细致的 Step-wise 反馈结合起来
- 默认情况下设 \(\lambda = 1\)
- 理解:当前设置下, Step-wise 的反馈奖励 和 Outcome 奖励各占一半融合(注,Step-wise 是 \(m\) 次采样得到的)
- 通过在相同步骤索引 \(i\) 上的轨迹集合(即 \(\{R_{\tau_i}: \tau \sim \pi(\cdot | q)\}\))中对奖励进行标准化来计算优势(advantages)
- 补充理解:这也是后来在 OpenClaw-RL 中使用的 Step-level 归一化方法(可能存在归一化时状态不一致的问题,理论上最优的归一化方式是在相同的 状态下才可以)
- 注意:这里起始的状态是相同的(即 \(q\) 相同),但中间步骤的状态会不同
- 若果 \(q\) 不同是不行的,状态差异太大了
Consistency Feedback for Reward Model
- 对于轨迹的第 \(i\) 步 \(\tau_{i}\),奖励模型 \(r_{\phi}\) 的第 \(j\) 次打分(总共 \(m\) 次)为 Step-wise 标签 \(S_{\tau_{i,j} }\),并接收以下奖励信号:
$$R_{\tau_{i,j} } = R_{\tau_{i} }\cdot S_{\tau_{i,j} } \tag {2}$$- 注:前一节中可以知道:
- \(R_{\tau_i} = O_{\tau} + \frac{\lambda}{m}\sum_{j = 1}^{m}S_{\tau_{i,j} }\) 是包含了 Step-wise 和 Outcome 的融合奖励
- \(S_{\tau_{i,j} } \in \{- 1, 1\}\) 是 Step \(i\) 下,奖励模型第 \(j\) 次打分得到的结果
- \(R_{\tau_{i} }\in [- 1,1]\) ,反映了步骤 \(\tau_{i}\) 的整体质量
- \(R_{\tau_{i} }< 0\) 表示质量差
- \(R_{\tau_{i} } > 0\) 表示质量好
- \(R_{\tau_{i} }\) 的值越接近 0,表示对该步骤的不确定性越大(可能好也可能坏,不好区分)
- 这个 Step-wise 信号与第 \(j\) 次评估之间的一致性由 \(R_{\tau_{i} }\cdot S_{\tau_{i,j} }\) 捕获,本文将其用作该评估的监督信号
- 问题:这里的表述不太清晰,如何理解这里的一致性?
- 注:前一节中可以知道:
- 在策略优化过程中,策略的轨迹也充当奖励模型的训练环境(即 RM 也是动态更新优化的)
- Refined 奖励模型为策略提供更强的奖励信号,并为指导环境任务调整提供更准确的反馈,这反过来又促进了策略和奖励模型的训练
Adaptation of Environment Benefits Both Policy and Reward Models,环境调整有益于策略和奖励模型
- (本节中作者证明了优化上一节的这个目标可以提高奖励模型预测未来结果的准确性,并且本文的环境调整进一步促进了这种优化)
- 本节目标:证明 对于任何目标策略来说,过于简单或者过于复杂的环境都不适合做这个策略的 RL 训练
- 奖励模型信号的质量不仅取决于单个步骤的逻辑正确性,还取决于它预测该步骤未来影响的能力
- 本文希望优化以下奖励精度:
$$\mathcal{A} = P(S_{\tau_{i}^{+} } > S_{\tau_{i}^{-} }|O_{\tau^{+} } = 1,O_{\tau^{-} } = -1),$$- 其中 \(S_{\tau_{i} } = \frac{\sum_{j = 1}^{m} S_{\tau_{i,j} }}{m}\) 是由 \(r_{\phi}\) 分配的平均过程奖励
- 理解:这个指标 \(\mathcal{A} > 0\) 的本质是:最终成功的轨迹的 Step-wise 奖励 大于 最终失败的轨迹的 Step-wise 奖励(这里使用概率来表达)
- 定理 1 证明了这个奖励精度可以转化为一个可以通过本文的奖励设计来近似的目标:
$$\mu \triangleq p_{+} + p_{- }$$- 其中 \(p_{+} = P(S_{\tau_{i}^{+},j} = 1)\) 和 \(p_{- } = P(S_{\tau_{i}^{-},j} = -1)\)
- 注:这个精度是用于衡量环境是否合适的(不同策略下,需要用不同的环境训练,即最适配策略优化的环境应该是在训练过程中动态变化的)
- Theorem 1
- 当 \(m \rightarrow \infty\) 时,当且仅当 \(\mu > 1\) ,有 \(\mathcal{A} \rightarrow 1\)
- 当 \(\mu > 1\) 时,\(\mathcal{A} \geq 1 - e^{- m(\mu - 1)^{2} / 4}\)
- 目标 \(\mu = p_{+} + p_{- }\) 表明,用于估计 \(p_{+}\) 和 \(p_{- }\) 的采样密度应该平衡,而不是严重偏向某一侧;
- 否则,估计器可能被单一类别主导,导致评估偏差
- 然而,当由策略轨迹诱导的奖励模型训练环境在任务难度上不平衡时,这种平衡就可能被打破
- Theorem 2
- 目标如下:
$$\mathbb{E}_{\tau \sim \pi_{\theta}(\cdot |q)}\mathbb{E}_{S_{\tau_{i,j} }\sim r_{\phi}(\cdot |\tau_{i})}[R_{S_{\tau_{i,j} } }] = 4\mathbb{E}_{q\sim Q}[\langle p_{+},f_{+}\rangle + \langle p_{-},f_{-}\rangle ] + C,$$- \(f_{+} \geq 0\) 和 \(f_{- } \geq 0\) 是 \(\tau\) 的重要性权重函数
- \(\langle \cdot , \cdot \rangle\) 表示在 \(\tau \sim \pi_{\theta}(\cdot | q)\) 上的 \(L^{2}\) 内积
- 问题:如何理解这里的内积含义?【这里写的晦涩难懂,符号也不太清晰,后续可以回来重新看看】
- \(C\) 是与 \(\phi\) 无关的常数,且 \(| \cdot |\) 是 \(L^{2}\) 范数
- 上式左边 :
- 是奖励模型的 RL 目标
- 上式右边 :
- 【来自原文的奇怪描述】当 \(\lambda = 1\) 时,有右边的式子:
- 理解:这里的 \(\lambda\) 是公式 1 中提到的 Step-wise 奖励与 Outcome-wise 奖励的加权系数
- 当 \(P(O_{\tau} = - 1 | q, \pi_{\theta}) \rightarrow 1\):重要性权重的范数比 \(\frac{| f_{+} |}{| f_{- } |} \rightarrow 0\)
- 当 \(P(O_{\tau} = 1 | q, \pi_{\theta}) \rightarrow 1\):\(\frac{| f_{+} |}{| f_{- } |} \rightarrow \infty\)
- 目标如下:
- 这证明:
- 当一个任务 \(q\) 对于策略模型来说过于困难(即 \(P(O_{\tau} = - 1 | q, \pi_{\theta}) \rightarrow 1\))或过于容易(即 \(P(O_{\tau} = 1 | q, \pi_{\theta}) \rightarrow 1\))时
- \(p_{+}\) 和 \(p_{- }\) 之间的重要性采样变得极度不平衡,违反了定理 1 中建立的奖励精度目标 \(p_{+} + p_{- }\)
- 基于这一 Insight,在本文的奖励系统中, 调节任务 \(q\) 的难度不仅可以促进策略训练,还可以改善过程奖励模型的训练
- 当一个任务 \(q\) 对于策略模型来说过于困难(即 \(P(O_{\tau} = - 1 | q, \pi_{\theta}) \rightarrow 1\))或过于容易(即 \(P(O_{\tau} = 1 | q, \pi_{\theta}) \rightarrow 1\))时
Critic Feedback for Environment Tasks
- 本文使用策略的 Rollout 准确率来估计任务难度
- 当准确率落在预设的阈值(\(\alpha_{\mathrm{low} }\) 和 \(\alpha_{\mathrm{high} }\))之外时
- 会 Prompt 一个语言模型来修改任务,使其更难或更容易,同时保留原始任务的本质(参见附录 C.7 中的提示词)
- 具体的修改由从奖励模型 \(r_{\tau_{i,j} }\) 总结出的评估痕迹(evaluative traces)来指导,这些痕迹是在获得 \(S_{\tau_{i,j} }\) 时生成的
- 当准确率落在预设的阈值(\(\alpha_{\mathrm{low} }\) 和 \(\alpha_{\mathrm{high} }\))之外时
- 本文只总结那些表现出潜在失败的步骤 \(\tau_{i}\),即对于某些 \(j\) 满足 \(S_{\tau_{i,j} } = - 1\) 的步骤,以捕获策略可能的错误模式(附录 C.6)
- 因此,任务调整依赖于准确的 Critic 反馈,并反过来产生更有效的调整,使策略和奖励模型都受益
- 作者还对修改后的任务实施质量控制
- 如果目标是使原始任务 \(q\) 更难,仅在 满足下面准确率 时接受修改后的任务 \(q^{\prime}\)
$$ \alpha_{\mathrm{low} }< \mathrm{acc}(q^{\prime})< \mathrm{acc}(q) $$ - 如果目标是使其更容易,仅在 满足下面准确率 时接受 \(q^{\prime}\)
$$ \mathrm{acc}(q)< \mathrm{acc}(q^{\prime})< \alpha_{\mathrm{high} } $$ - 这有助于确保新任务的有效性和调整的有效性(算法 1)
- 如果目标是使原始任务 \(q\) 更难,仅在 满足下面准确率 时接受修改后的任务 \(q^{\prime}\)
- 然后将原始任务替换为任务集 \(Q\) 中被接受的任务 \(q^{\prime}\)
Experiments
- 本节重点关注两种现实世界的智能体设置:
- Compute use 代理和基于文本的交互式游戏,其中大型语言模型既用作策略也用作奖励模型,并且作者执行自动环境适应
- 此外,还验证了 RLAnything 框架在 RLVR 编码任务上的有效性
- 注:该任务中没有可用的交互环境
Experiment Settings
Models and Optimizations
- 对于 OSWorld (2024) 上的 GUI 代理
- 使用 Qwen3-VL-8B-Thinking 作为策略和奖励模型
- 将评估的最大交互步数设置为 50,将 RL Rollout 的最大步数设置为 30
- 在每个 RL 步骤中,采样 12 个任务,每个任务有 8 个独立的 Rollout 轨迹
- 对于奖励模型,对每个策略 Response 执行 3 次评估
- 使用 Qwen3-4B (2025) 进行任务适应
- 对于 AlfWorld (2018; 2020) 上的 LLM 代理
- 使用 Qwen2.5-7B-Instruct 作为策略模型
- 使用 Qwen2.5-14B-Instruct 作为奖励模型 (2024a)
- 使用 Qwen3-4B (2025) 进行任务适应
- 将评估的最大步数设置为 60,将 RL Rollout 的最大步数设置为 40
- 在每个 RL 步骤中,采样 16 个任务,每个任务有 8 个独立的 Rollout
- 对于 Coding LLM
- 使用与 AlfWorld 设置中相同的模型组合
- 在每个 RL 步骤中,采样 64 个任务,每个任务有 32 个独立的代码解决方案生成和 32 个独立的单元测试生成
Training and Evaluation Datasets
- 在每个设置中,使用单独的训练和测试数据集
- 对于 GUI 代理,划分 OSWorld-verified 数据集,使得训练集排除 “Multiple Apps” 和 “Chrome” 任务类别,将其视为最终评估中的 OOD 任务
- 在 230 个域内任务和 139 个 OOD 任务上进行评估
- 对于 AlfWorld,遵循官方设置:
- 任务被划分为 3.5k 个训练任务、140 个域内评估任务和 134 个 OOD 评估任务
- 对于 Coding LLM ,使用 LiveCodeBench-V2 (2024)、CodeContests (2022) 和 LiveBench (2024) 进行评估,并使用 CodeContests (2022) 进行训练
- Specificlly 对于 CodeContests,提取难度级别 \(\le 2\) 的任务,并将其随机划分为包含 4.5k 个样本的训练集和包含 200 个样本的评估集
Reward Modeling
- 对于奖励建模,使用 LLM 作为生成式奖励模型:
- Prompt LLM 评估每个步骤的质量及其对最终结果的潜在影响,然后在推理后输出 1 或 -1(附录 C.5)
- 对于 GUI 代理,提供先前操作的摘要、最近的两张图像以及要评估的这两张图像之间的操作作为上下文
- 对于 AlfWorld,总结了先前的操作及其观察到的结果
- 在 Coding-LLM 设置中,使用单元测试生成器作为奖励模型,其中每个新生成的测试评估代码的一个方面
- 在本文所有的实验中,奖励模型为每个策略步骤生成 3 个独立的评估(即 \(m = 3\))
Environment Task Adaptation
- 在环境适应之前
- 首先总结奖励模型的输出,这些输出针对被标记为潜在错误的步骤,定义为至少有一个最终得分为 -1 的步骤(附录 C.6)
- 然后将此 Critic 反馈输入到语言模型中,以根据目标扰动重写任务,使其更容易或更难(附录 C.7)
- 在 Coding-LLM 设置中,Critic 反馈仅仅是代码在生成的单元测试上的评估结果
- 在 AlfWorld 设置中,环境模型使用 Critic 反馈和对当前环境的结构化摘要(包括对象位置和属性)重写任务
- 在编码设置中,环境模型生成一个新任务以及相应的单元测试
- 在 GUI 设置中,除了使用 Critic 反馈添加或移除提示来调整难度外,适应不同的目标需要创建新的验证文件
- 本文为 230 个训练任务中的 47 个预先创建了额外的扰动版本(附录 C.8)
- 每个扰动版本都包含其对应的评估器和验证器文件
- 这些任务被包含在本文实验中所有训练设置中,以确保公平比较
Results and Insights
RLAnything Facilitates Policy Training,RLAnything 能促进策略训练
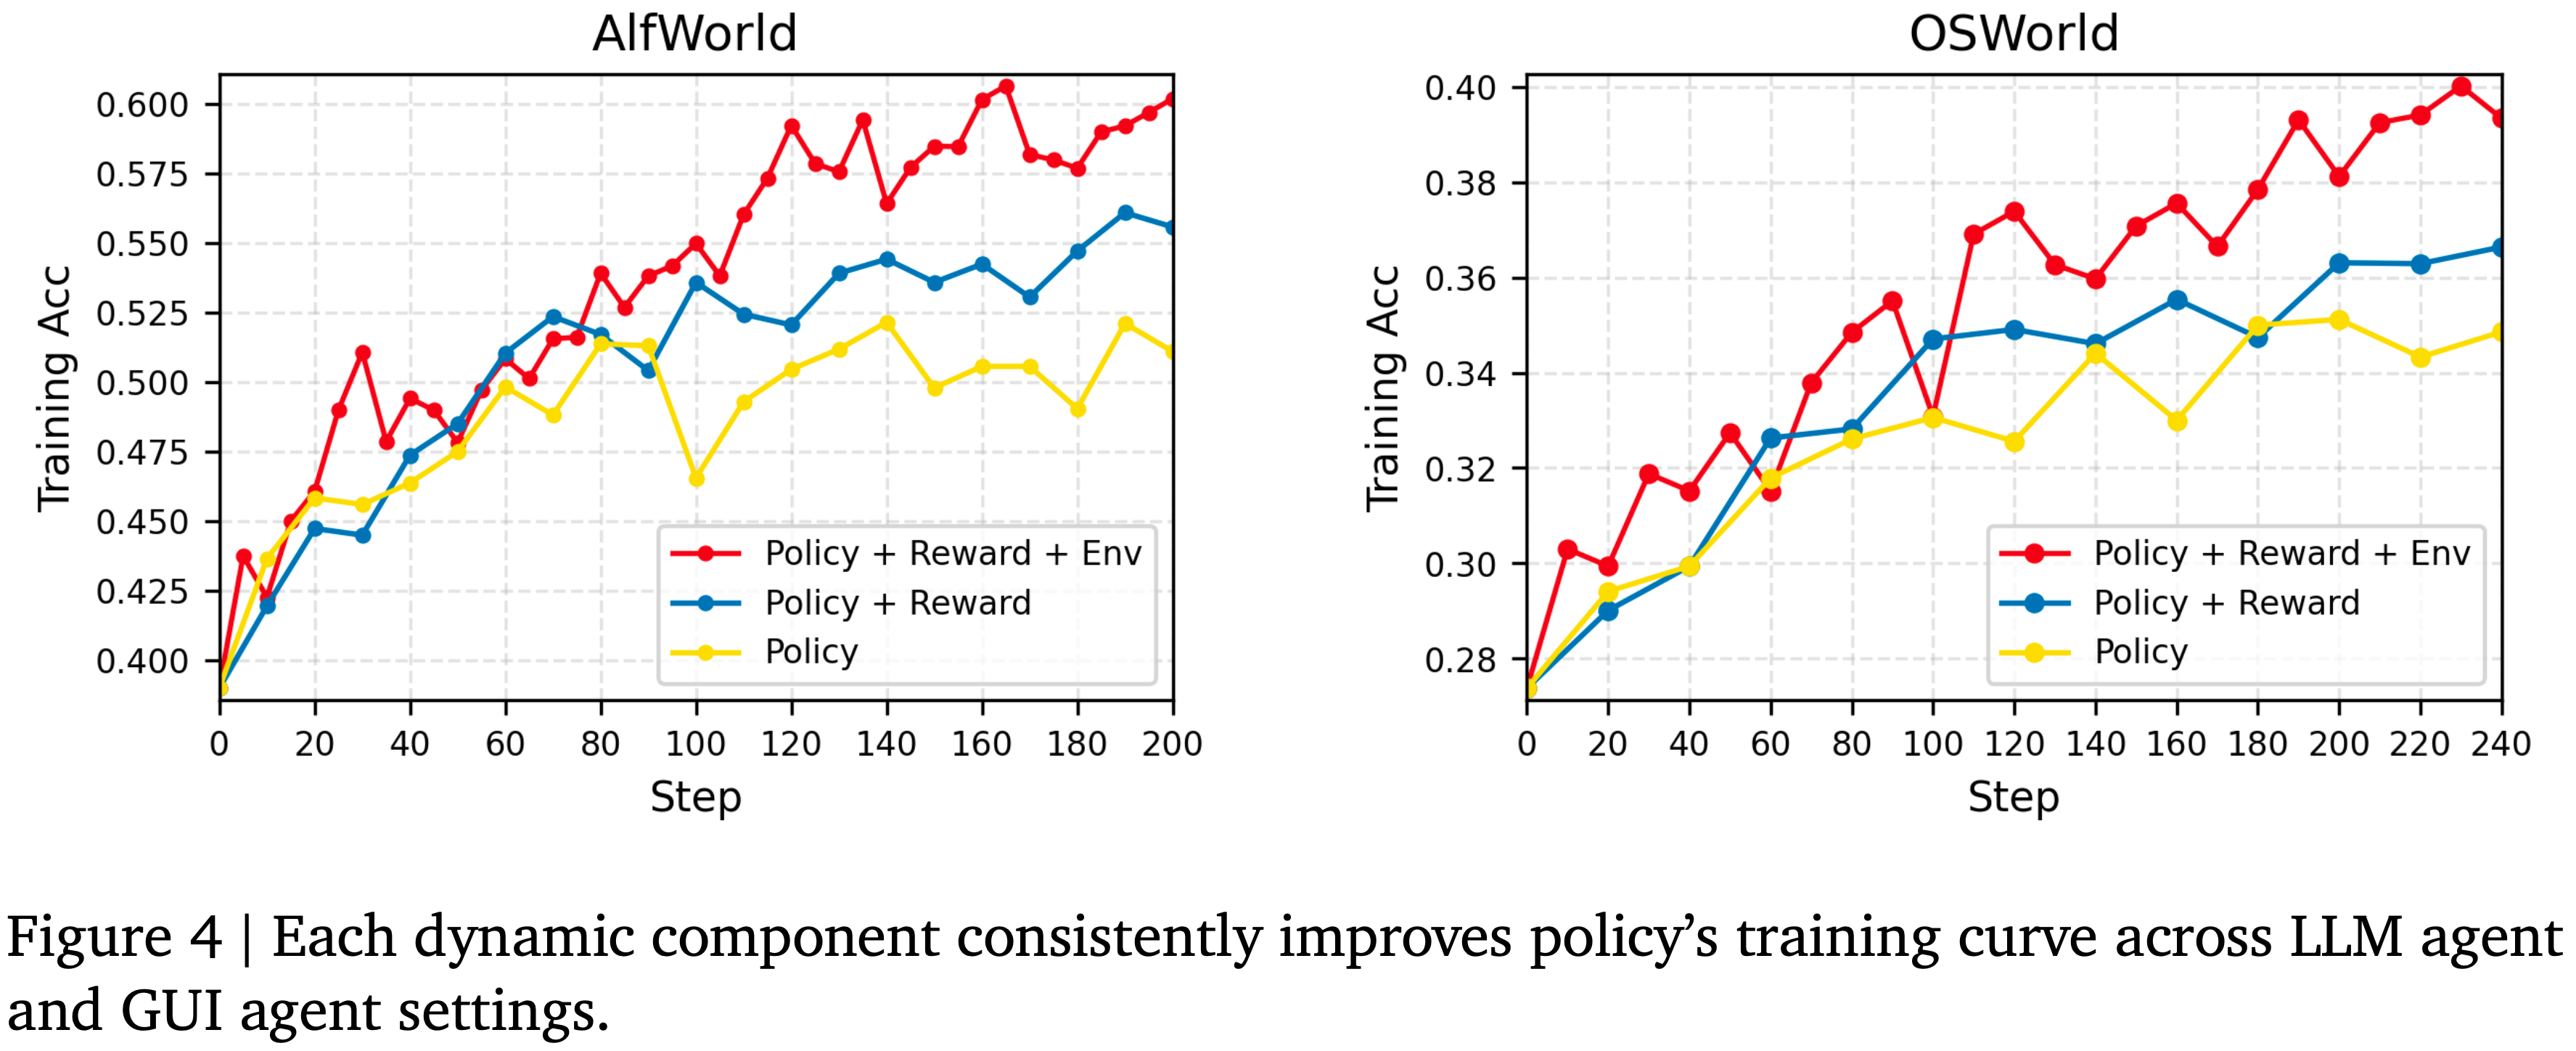
- 图 4 中报告了三个训练曲线,其中每个方法都添加了一个额外的动态组件
- 图 4 展示了每个动态组件都能持续改进策略优化
- 图 4 展示了每个动态组件都能持续改进策略优化
- 对于曲线上的中间评估,将 OSWorld 的最大交互步数设置为 30,将 AlfWorld 的最大交互步数设置为 60
- 可以发现,使奖励模型和环境都保持动态能产生更强的优化和更高的收敛点
- 具体来说,联合优化奖励模型改善了监督信号,这反过来又有利于策略训练
- 此外,环境适应不仅有利于策略,也有利于奖励模型(第 3.2.2 节),从而为策略训练带来三倍的增益
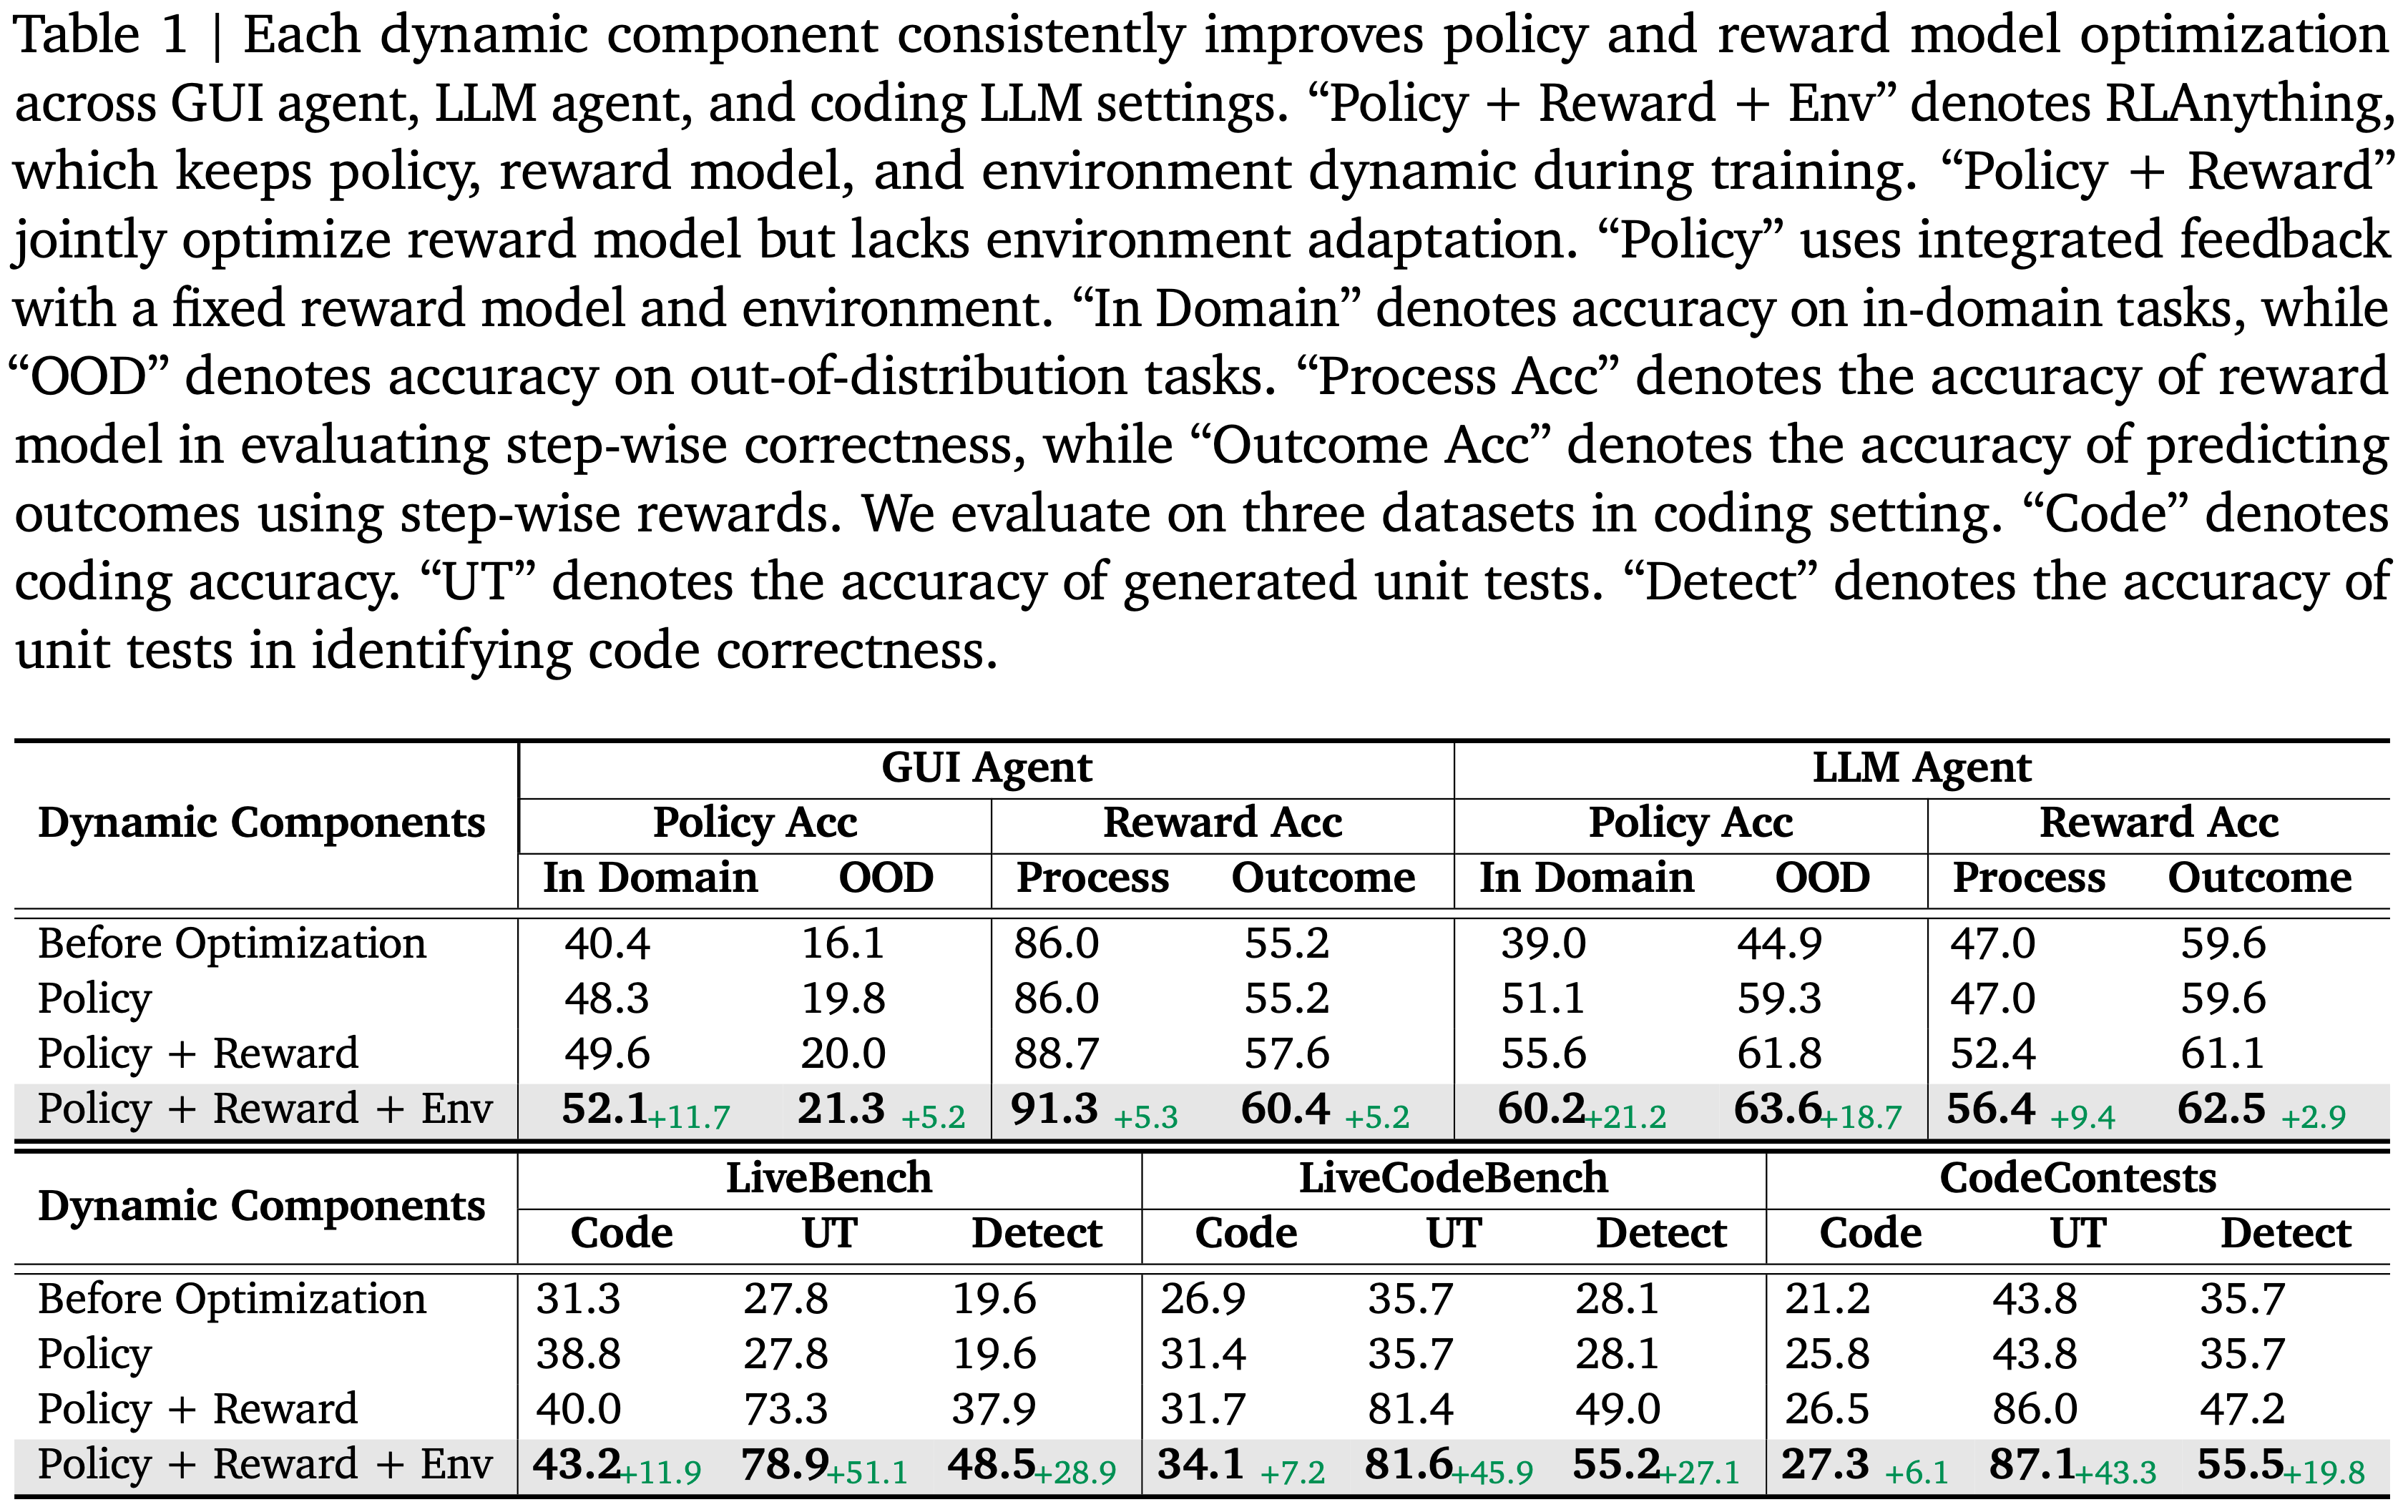
- 表 1 中报告了域内和 OOD 任务的最终评估结果
- 在 OOD 任务上的显著改进突显了作者优化框架更强的泛化能力
RLAnything Produces a Stronger Reward Model,产生更强的奖励模型
- 从表 1 中可得出两个结论
- 第一,本文的奖励设计(公式 2)有效地改进了奖励模型
- 第二,适应环境任务进一步促进了奖励模型的训练,支持了本文的理论结果
- 为了评估奖励模型的改进,本文考虑两个方面:
- (i) 其评估步骤质量的能力(过程准确性)
- (ii) 其预测步骤对最终结果影响的能力(结果准确性)
- 标签来源:
- 结果准确性的真实标签来自可验证的结果
- 步骤质量标签是通过对提示评估步骤质量的更强推理模型进行多数投票获得的
- 详情见附录 C.2
- 从表 1 中,可以发现这两个准确性指标在所有设置优化后都有所提高,并且环境适应进一步提升了它们
- 此外,本文还使用不同的监督模型进行了消融研究,结果见附录 B.1,显示了类似的结果
Adaptation of Environments Enables Active Learning from Experience,环境 Adaptation 允许从经验中 主动学习
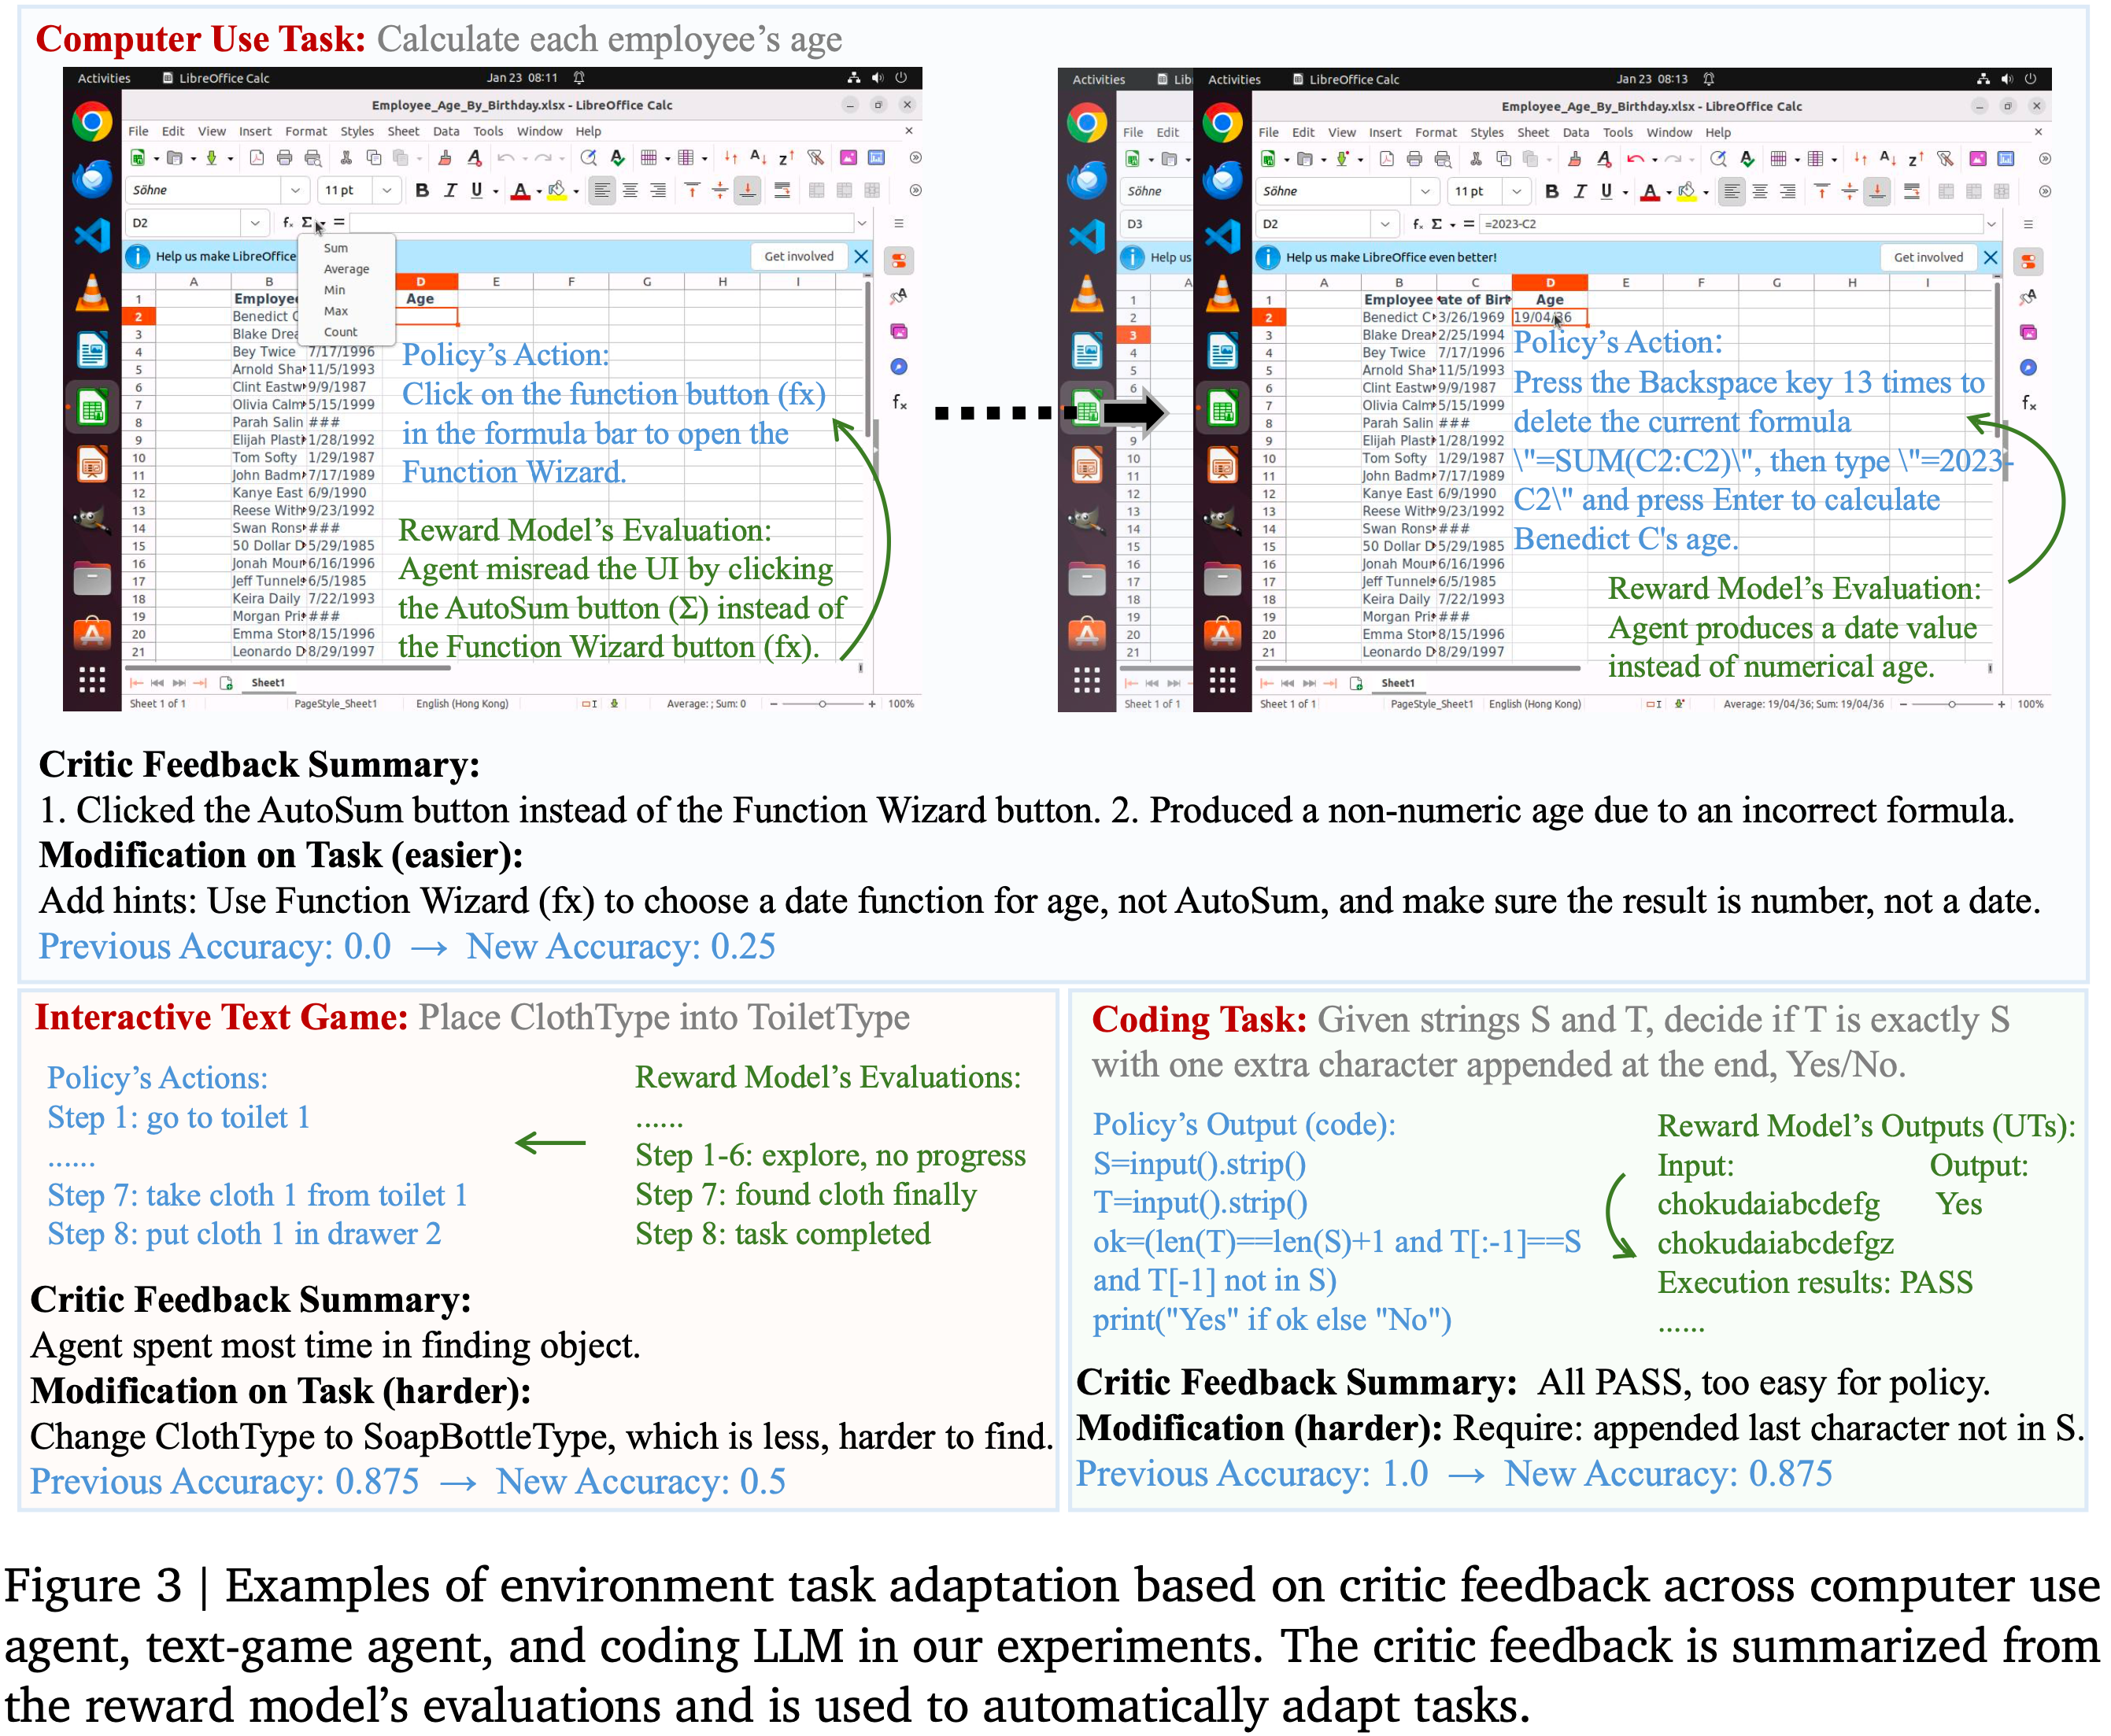
- 作者的环境适应是自动化的,并明确由奖励模型的 Critic 反馈指导,该反馈诊断策略在给定任务上可能出现的错误
- 本节提供示例,展示这种有针对性的适应如何促进更主动的策略学习
- 在图 3 的示例中
- GUI 代理在独立的 Rollout 中未能获得任何成功的轨迹
- 奖励模型指出了策略在此任务上犯的两个具体错误,其输出作为重写任务的诊断反馈
- 修改后的提示添加了有针对性的提示,使策略能够实现成功的 Rollout 并更有效地学习,而不是依赖随机探索
- 注:任务也可以向相反方向调整,以鼓励更具挑战性的探索
- 在交互式文本游戏示例中,策略在所有轨迹中都成功了,但花费了大部分步骤来搜索对象
- 模型通过用出现频率较低的目标对象替换当前对象来增加难度
- 参见附录 B.2 中的其他示例
- GUI 代理在独立的 Rollout 中未能获得任何成功的轨迹
State-of-the-Art Performance of the Optimized Multimodal GUI Agent,优化后的多模态 GUI Agent 到达 SOTA 性能
- 本文进一步扩展了 GUI 代理的 RLAnything 优化(图 8,左),并将其与开源基线进行比较,包括 UI-TARS1.5-7B (2025)、OpenCUA-7B (2025b) 和 Qwen3-VL-8B-Thinking (2025)
- 注:图 8 左给出的是训练 ACC 曲线,可以看到训练过程中 ACC 指标是一直在涨的
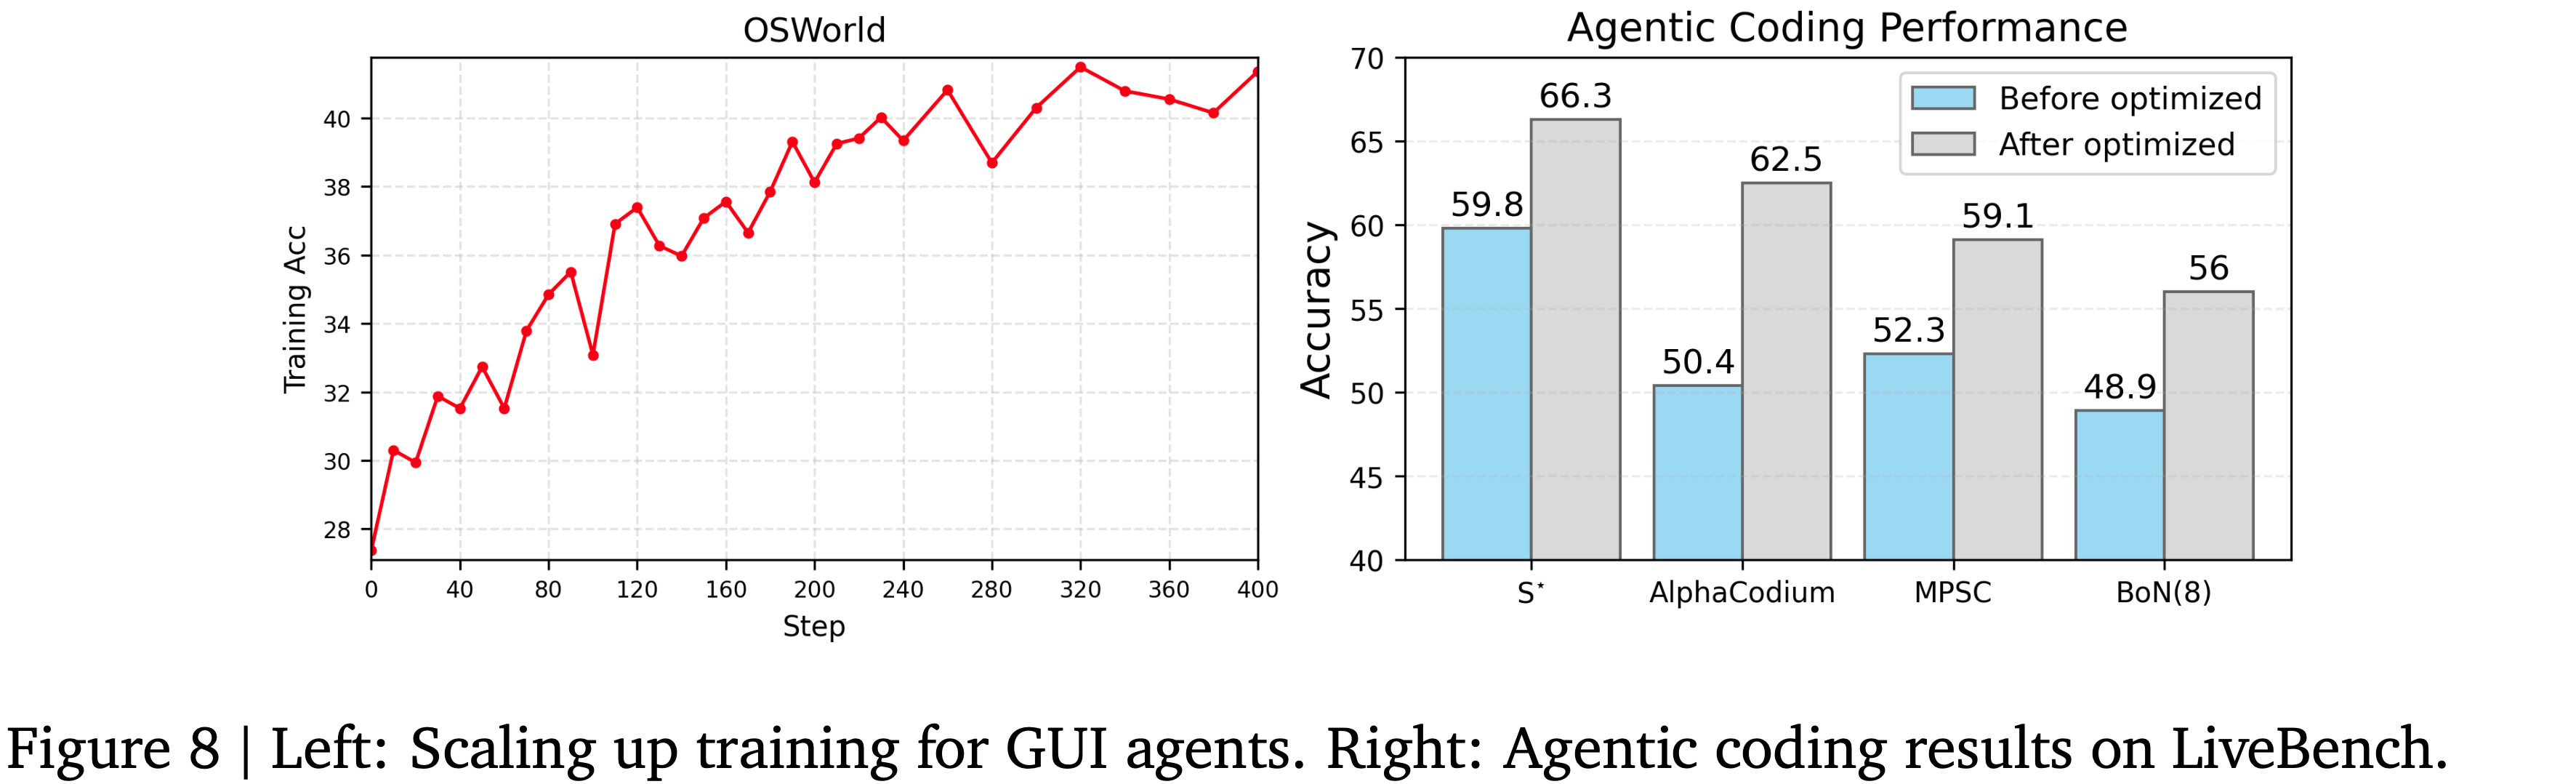
- 注:图 8 左给出的是训练 ACC 曲线,可以看到训练过程中 ACC 指标是一直在涨的
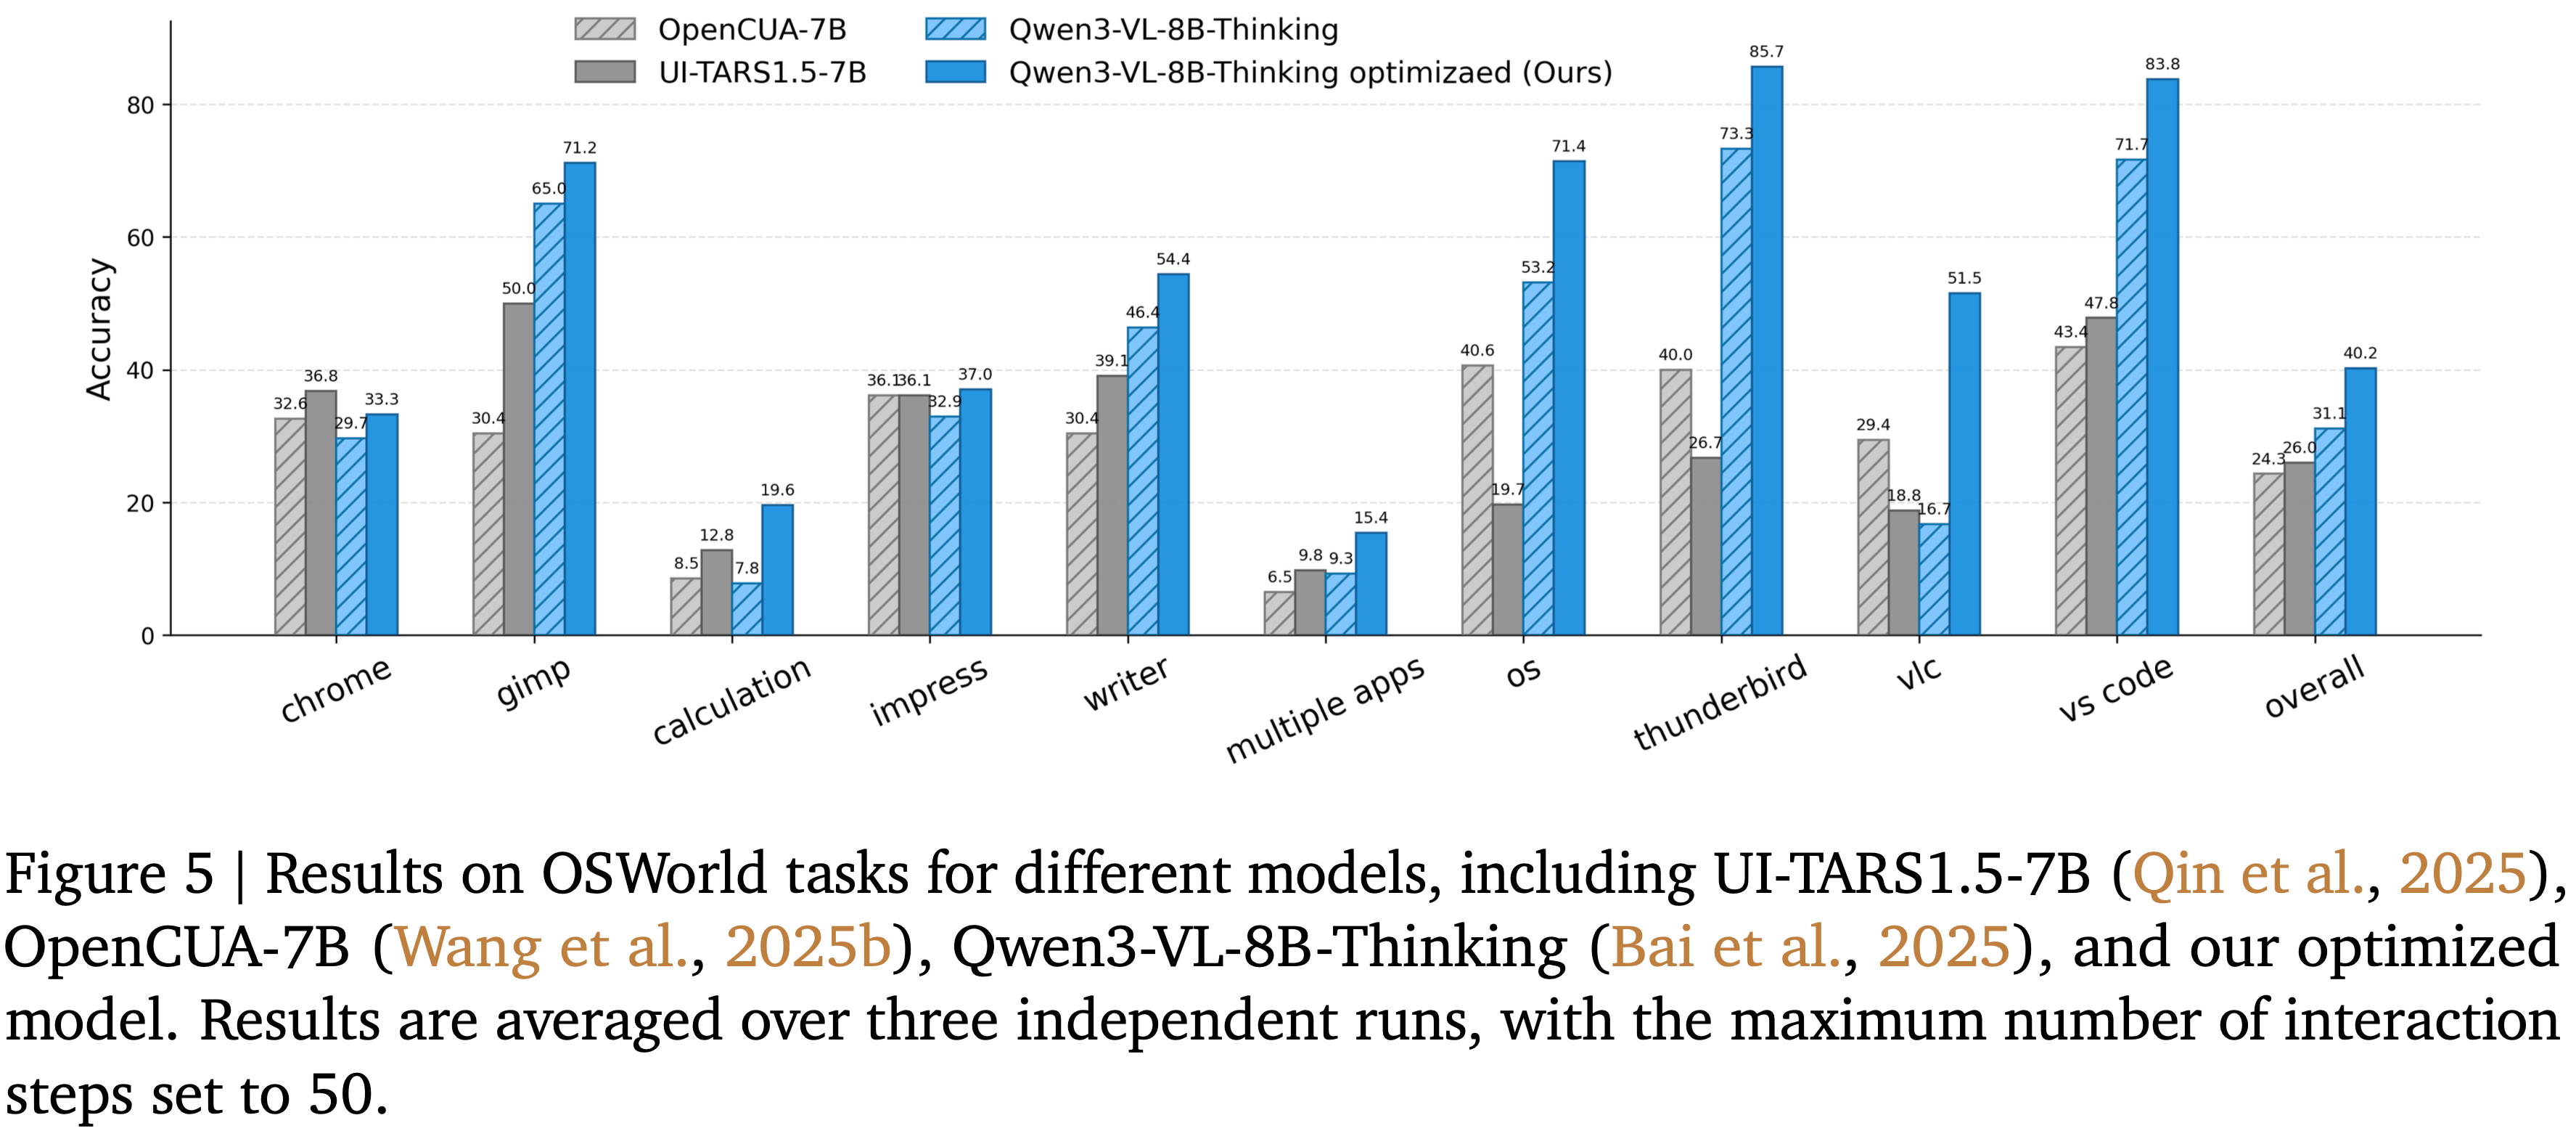
- 如图 5 所示,优化后的模型在所有 OSWorld 任务类别中都取得了显著性能,突显了作者优化框架的有效性
- 优化后的模型在 OSWorld 上的准确率提高了 9.1%
- 在分布外任务上,模型也提高了 5.2%
Advantages of Integrating Step-wise and Outcome Rewards for Policy Training,整合 Step-wise 和 Outcome 奖励
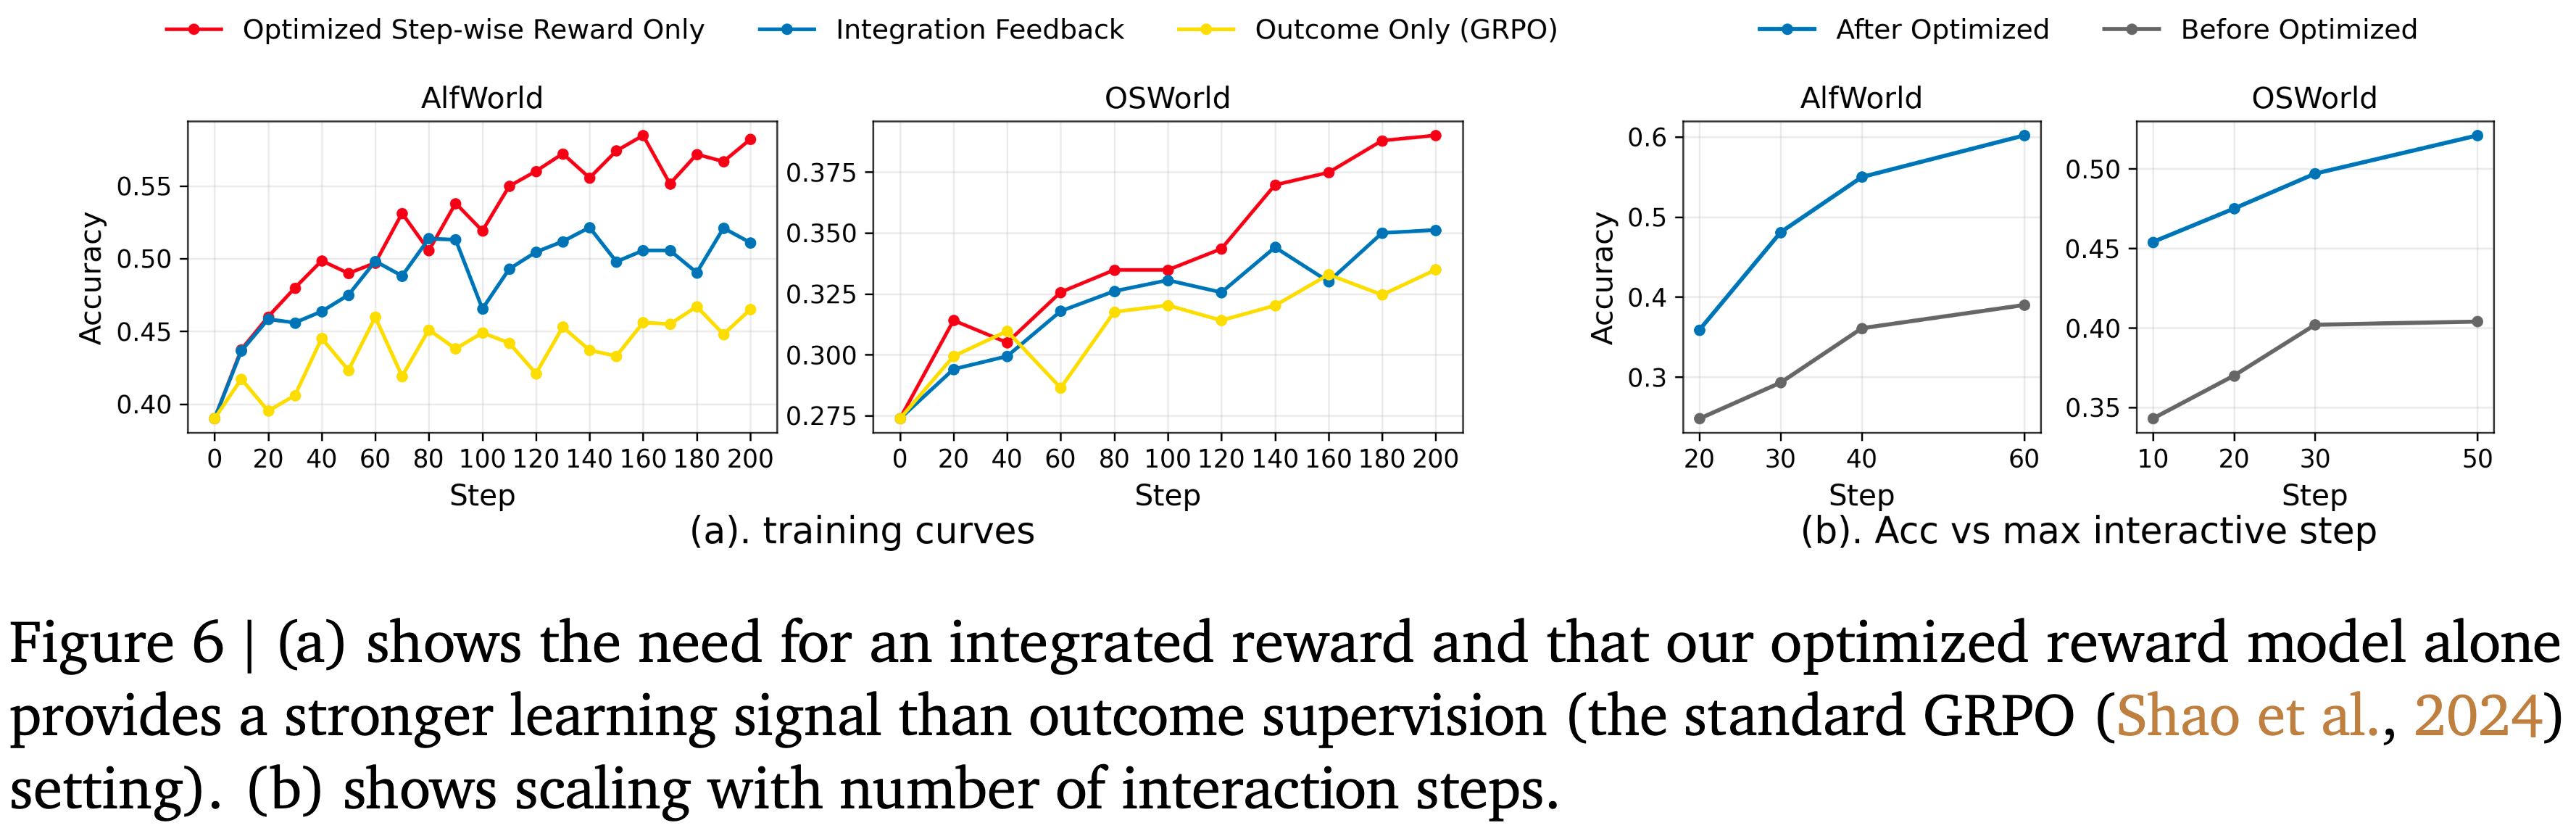
- 在复杂的现实世界环境中,策略必须与环境交互,在长轨迹上进行充分探索(见图 6(b)), Outcome Reward 过于稀疏,无法提供有效的训练信号
- 将常用的 Outcome-only Reward 与本文的整合奖励设计(公式 1)在 LLM 代理和 GUI 代理设置的 RL 训练曲线(图 6(a))上进行了比较
- 问题:这里最优的方案是 Optimized Step-wise Reward Only,但是没有非常明确给出这个奖励的定义,是 Step-wise 标准化以后得到的奖励吗?
- 结果突显了整合奖励的必要性,它将细微的逐步信号与可验证的最终结果的忠实监督相结合
Optimized Reward Model Supervision Outperforms Human-Labeled Outcome Supervision,Optimized RM 超过人工打标的 Outcome 监督
- 在 Compute use 任务等复杂的现实世界环境中,定义可验证的结果通常需要人工努力
- 特别是,GUI 评估器通常实现为人工编写的评估脚本,这限制了用于探索和训练的环境扩展
- 本文提议仅使用 Optimized RM 提供的逐步信号,该模型可以评估当前操作及其未来影响
- 具体来说,仅使用本文的 Optimized RM 进行逐步监督来训练策略,而不使用来自评估器脚本的任何 Outcome Reward
- 令人惊讶的是,这种设置甚至优于使用可验证 Outcome Reward 的训练(见图 6(a)),展示了本文的框架在改进奖励模型方面的有效性,以及其在计算机等现实世界环境中实现大规模、自我进化代理的潜力
Also Works for Single-Turn Coding Tasks,单轮 Coding 任务也 Work
- 除了交互式设置外,RLAnything 也适用于 RLVR 风格的编码任务:
- 策略奖励是代码在单元测试上的通过率
- 按如下方式为每个生成的单元测试分配奖励
- 如果一个生成的代码通过了数据集提供的所有真实单元测试,作者将其标记为真实代码
- 如果一个生成的单元测试在所有真实代码上都能通过,将其标记为真实单元测试
- 一个真实单元测试获得的奖励等于它导致失败的非真实代码的数量
- 否则,它获得的奖励等于它错误地让其通过的非真实代码的数量的负数
- 本文附录 A.2 中展示了这与本文通用框架的等价性
- 为了评估奖励模型,本文作者测量了生成的单元测试的正确性及其在检测代码正确性方面的准确性(附录 C.2)
- 总体而言,表 1 显示,通过联合单元测试训练和环境适应,编码性能和单元测试生成质量都得到了提高
Trade-off Between Outcome and Self-consistency Supervision in Optimization
- 在整合奖励设计 \(R_{\tau_i}\) 中,来自最终结果 \(O_{\tau}\) 的监督与聚合的逐步信号 \(\lambda \sum_{j = 1}^{m}S_{\tau_{i,j} } / m\) 由超参数 \(\lambda\) 平衡
- 除了对策略的影响外,\(\lambda\) 也影响奖励模型的监督:
- 较大的 \(\lambda\) 更强调 Step-wise 质量,而较少强调预测结果影响
- 本文在 AlfWorld 设置中对 \(\lambda\) 进行了消融研究,进行了 100 个 RL 训练步骤,评估了策略和奖励模型
- 为了研究对奖励模型的影响,本文在 \(R_{\tau_i}\) 中固定 \(\lambda = 1\),并在 \(R_{\tau_i}\) 中改变 \(\lambda\)
- 为了研究对策略的影响,本文在 \(R_{\tau_i}\) 中固定 \(\lambda = 1\),并在 \(R_{\tau_i}\) 中改变 \(\lambda\)
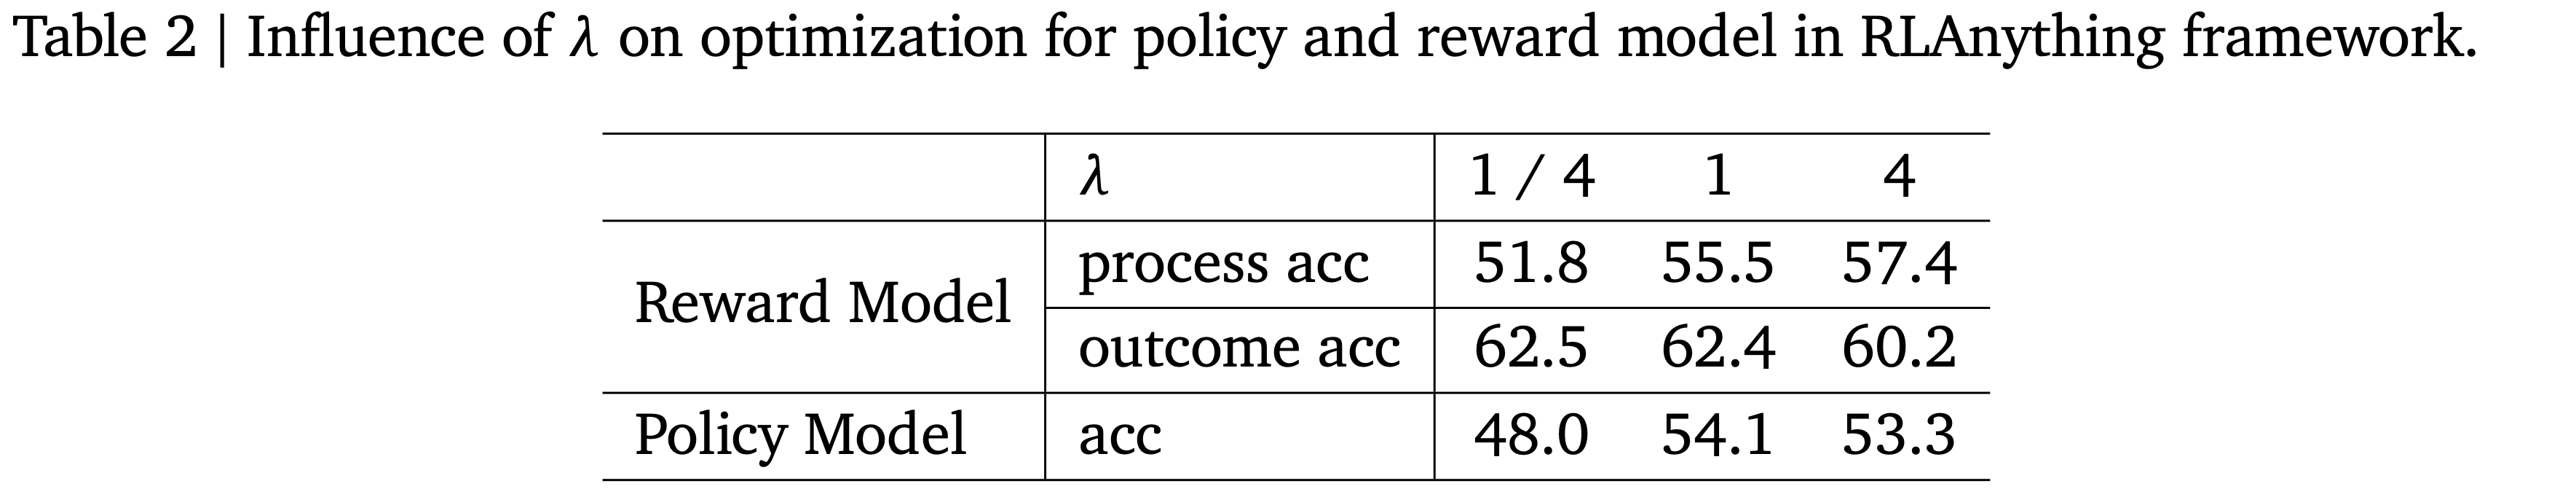
- 如表 2 所示,\(\lambda\) 确实在基于结果和基于自洽性的监督之间进行了权衡,策略优化在 \(\lambda = 1\) 时表现最佳,这是本文默认使用的
- 报告的数字是训练曲线上最后三次评估的平均值,每次评估都是三次独立运行的平均值
- 本文附录 A.2 中讨论了 \(\lambda\) 如何影响理论结果
Dynamics of Accepted New Tasks
- 本节分析了优化过程中接受的任务(见图 7(a))
- 1)接受的任务数量随训练步数近似线性增长,表明了环境扩展的潜力
- 2)本文使用 策略在这些接受任务上的准确率 来表征任务难度
- 由于初始样本有限,准确率早期有所波动,但很快稳定在中等水平
- 也就是说训练过程中,任务难度始终保持在中间水位
- 收敛值低于 0.5,因为原始任务对策略来说大多具有挑战性
- 由于初始样本有限,准确率早期有所波动,但很快稳定在中等水平
- 3)本文使用更强的推理模型(GUI 设置使用 Qwen3-VL-32B-Thinking,AlfWorld 和编码设置使用 Qwen3-32B)评估接受任务的质量,每个任务运行 16 次独立试验,并报告至少一次成功运行的比率
- 得到的至少一次通过率分别为 96.0%、96.7% 和 94.2%
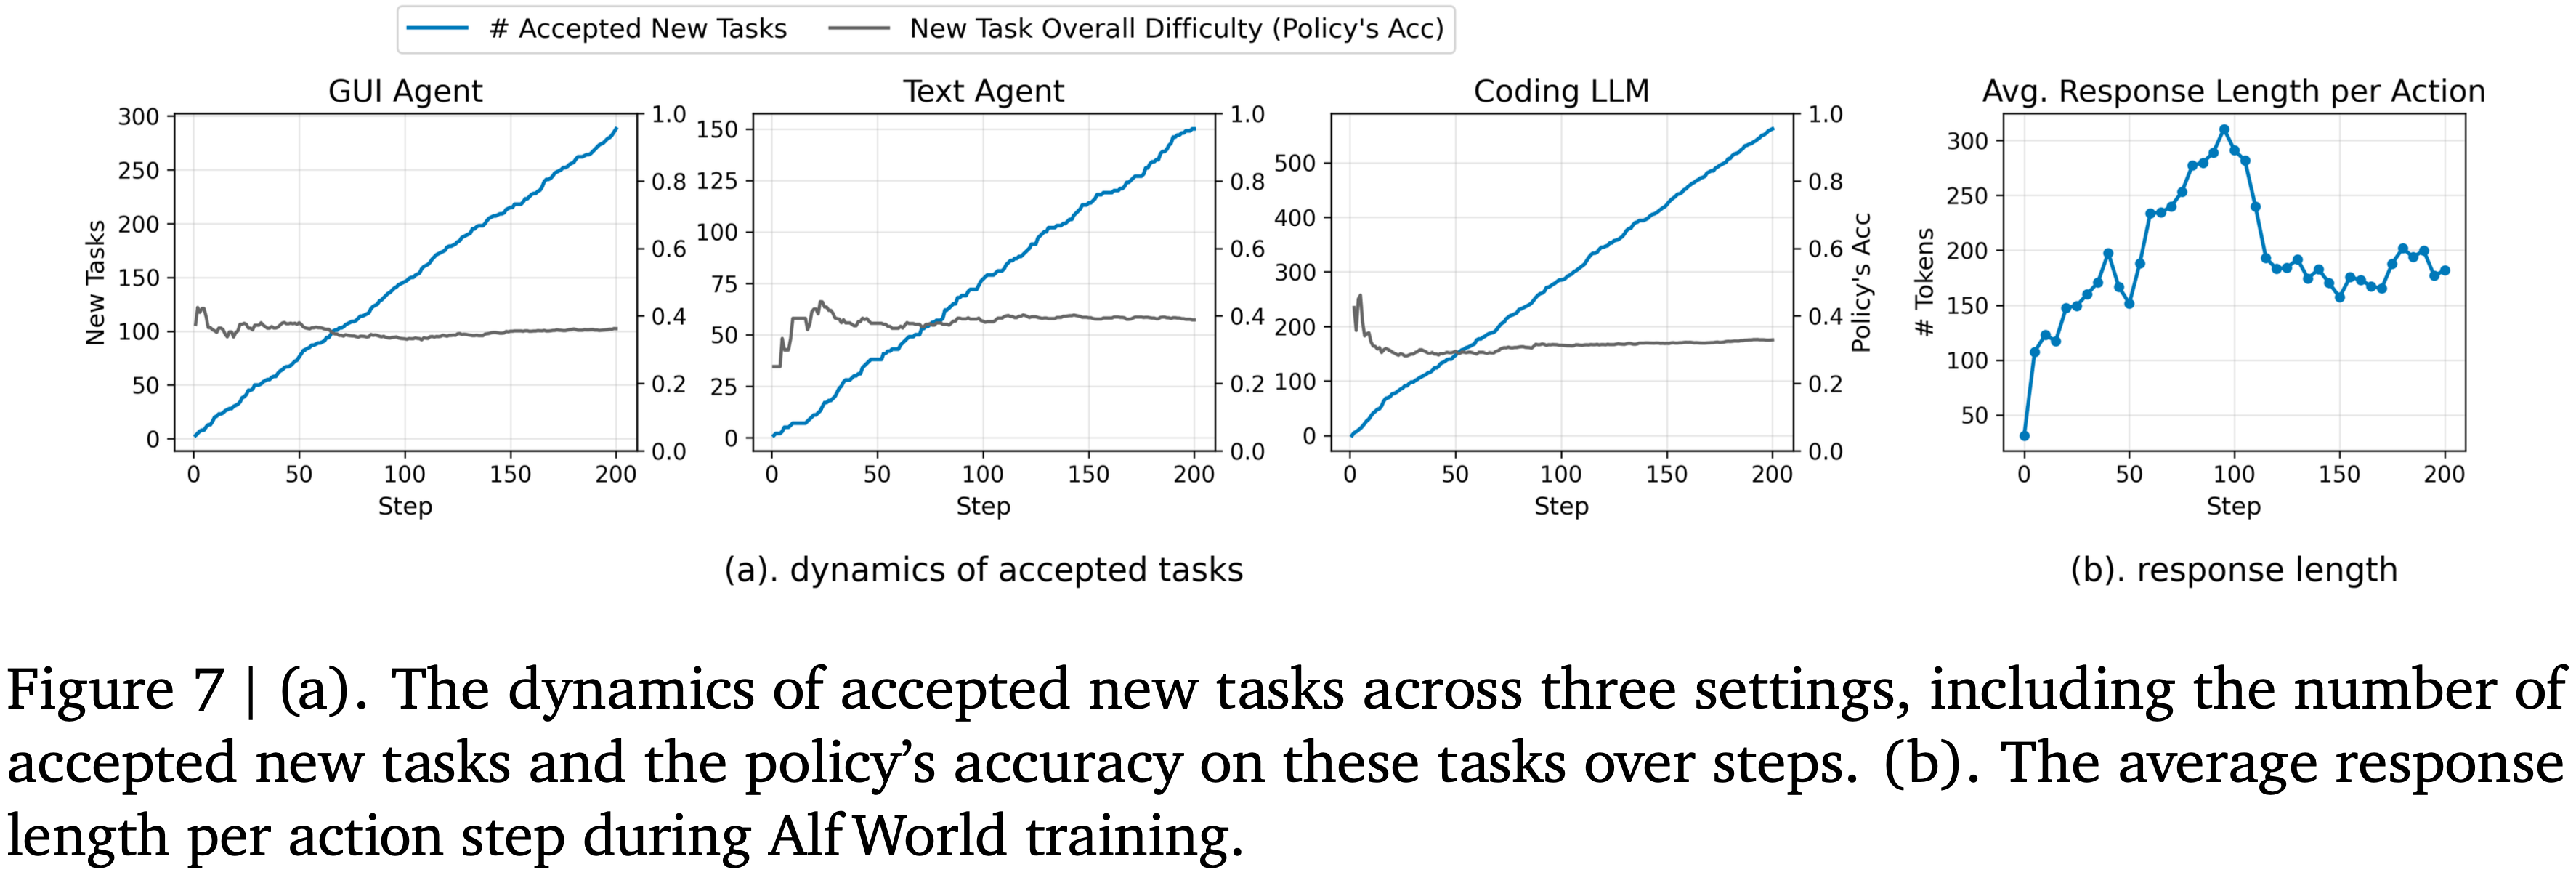
- 这些结果证明了作者接受机制在过滤错误合成任务方面的有效性
Application on Agentic Coding
- 本文在多种代理编码方法下评估了优化后的编码模型,包括 MPSC (2024)、AlphaCodium (2024)、\(S^{\star}\) (2025a) 和 Best of N 方法(附录 C.3)
- 从图 8(右)中,可以发现优化后的模型显著提高了各种方法下的代理编码性能
Response Length on AlfWorld
- 作者还研究了 AlfWorld 设置中的响应长度和推理模式(图 7(b))
- 优化前,策略模型 (Qwen2.5-7B-Instruct) 在采取行动前通常无法产生足够的推理
- 优化后,其思维链长度迅速增加,到训练结束时,响应变得更加稳定和高效,同时仍保持足够的推理能力
Related Works
Reinforcement Learning of Large Language Models
- RL 已被用于增强语言模型的推理能力,并已应用于包括编码任务 和 RAG 任务 等场景
- 随着 Agentic AI 的广泛采用,RL 也已扩展到多轮设置,策略模型在长轨迹上与环境交互
- 但奖励稀疏性 (2023; 2024) 和现有环境的有限规模 仍然是关键挑战
Reward Modeling and Environments
- RM(尤其是 GRM),在使 RL 变得实用方面发挥着重要作用
- RLVR Setting 中,单一的 Outcome Reward 可以联合优化奖励模型和策略,但由于缺乏逐步监督,这并不能直接扩展到多轮设置
- 环境质量对于有效的 RL 也至关重要 (2024; 2022; 2023)
- 先前的工作表明,调整任务难度可以改善策略训练 (2025; 2025),这激发了生成或修改任务以增强学习信号的方法 (2025b; 2025a; 2025; 2024)
- 例如,Zeng 等人 (2025) 构建了一个 RLVR 引擎,其中每个任务都有多个难度级别
- Xue 等人 (2026) 通过可验证的自动化任务合成扩展了这一方向
- 但这些系统缺乏长时程交互任务所需的逐步信号
- 相比之下,本文作者证明了环境、策略和奖励模型的耦合优化能为整个系统产生更强的信号
附录 A:Proof of Theorems
- 详情暂见原文(待补充)
- 包含对 Theorem 1 和 Theorem 2 的证明
附录 B:Additional Experimental Results
B.1. Ablation Studies on Using Different Models for Reward Model Evaluation,不同模型进行奖励模型评估的消融研究
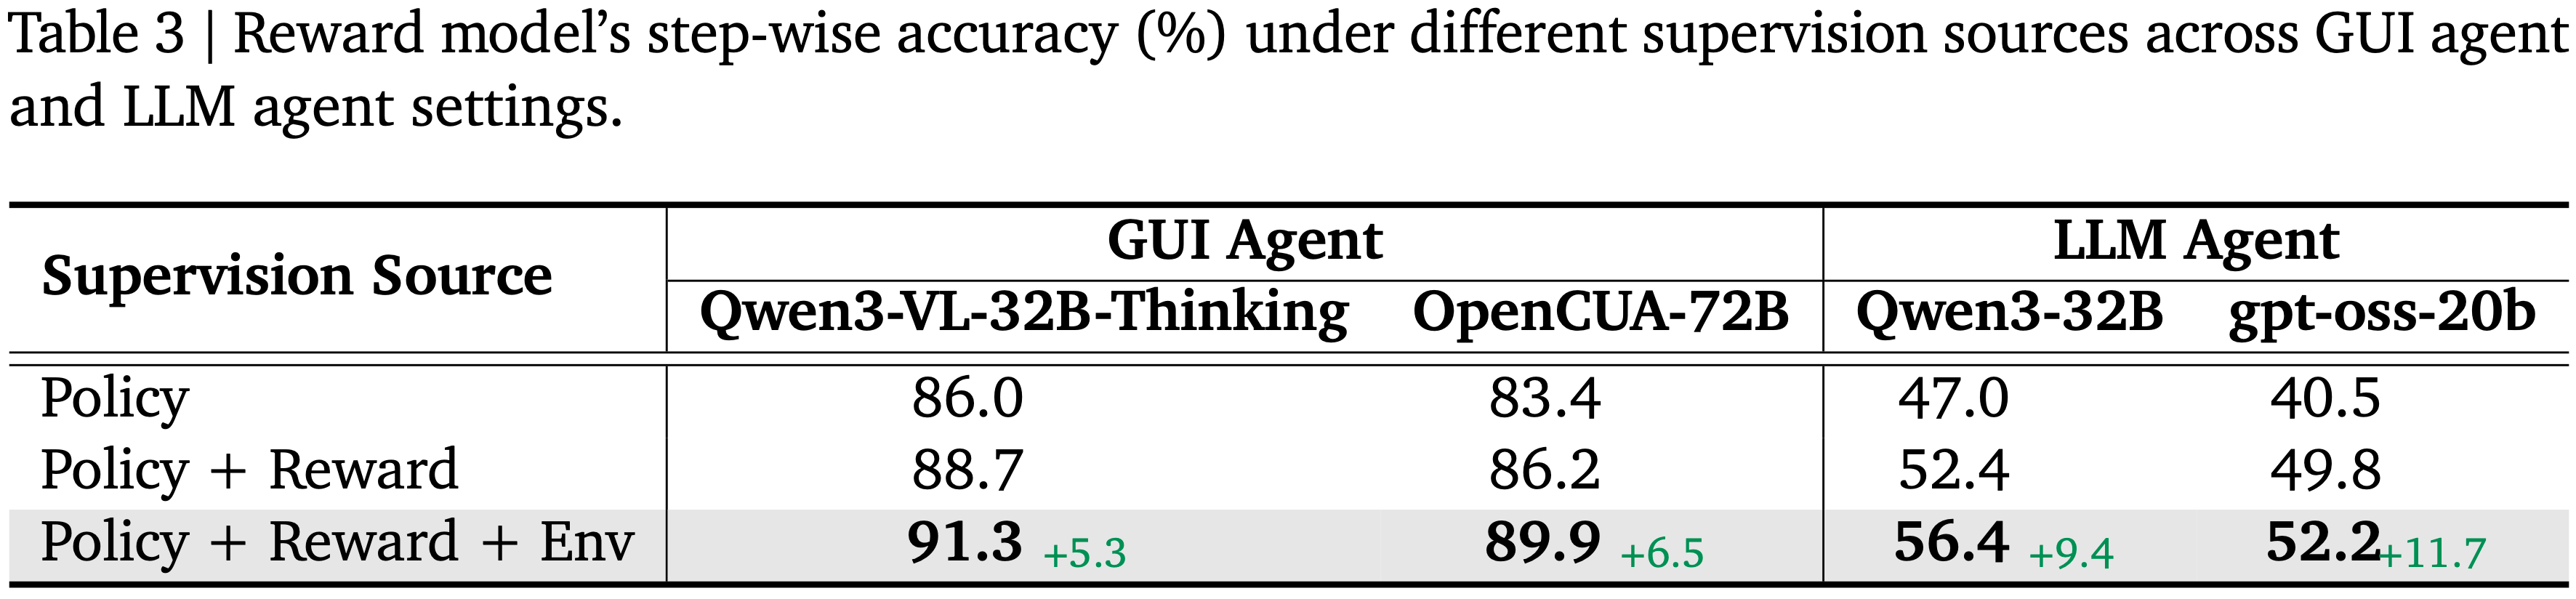
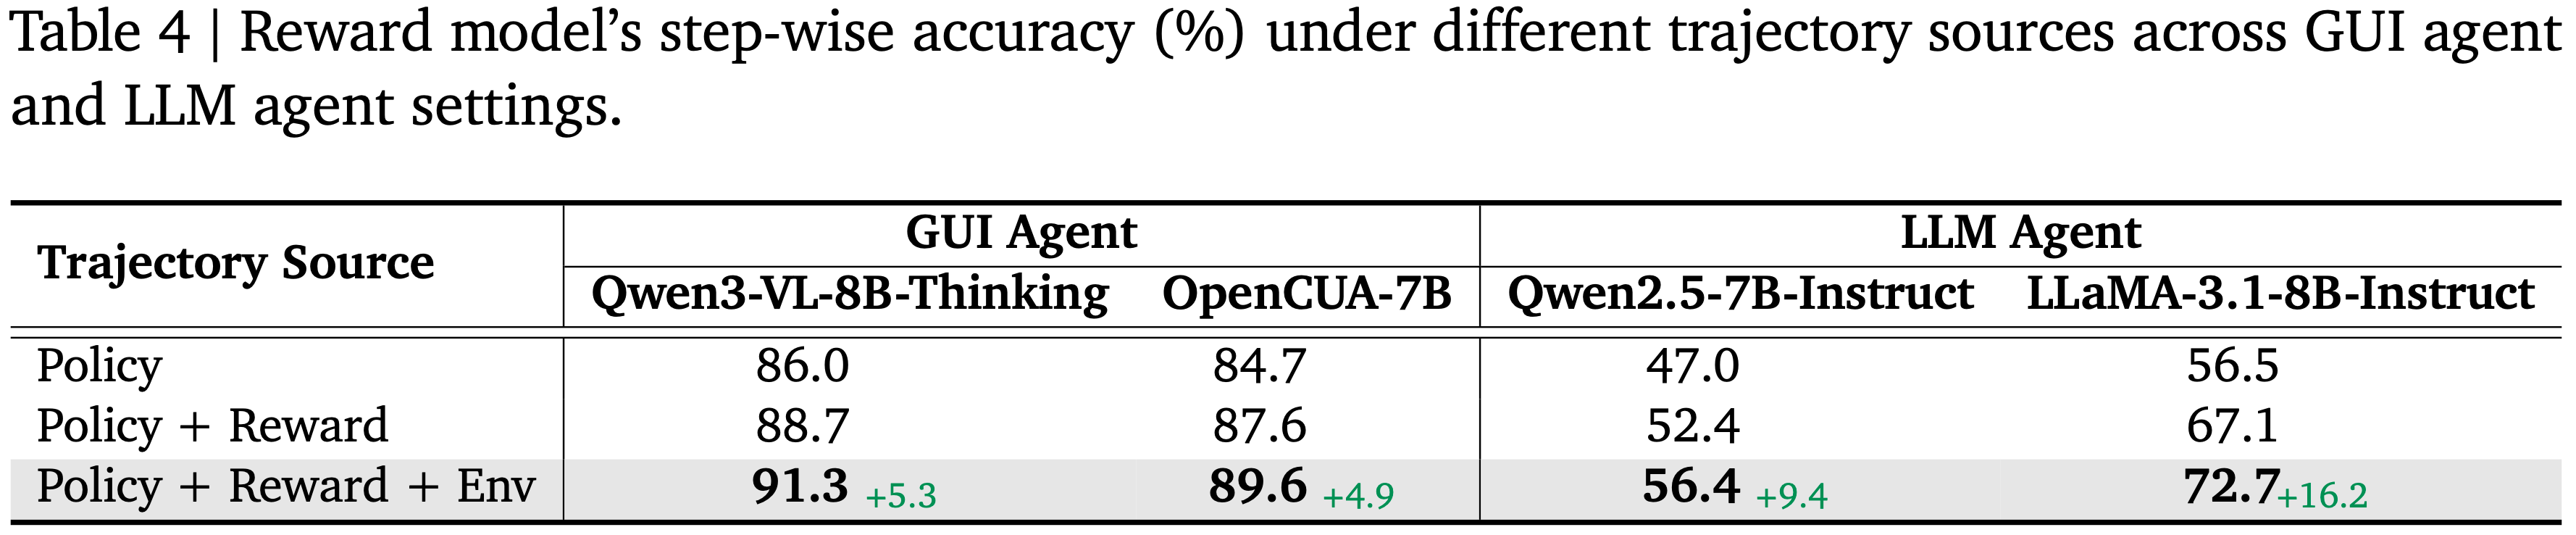
- 本节展示了使用不同的监督模型来评估分配步骤奖励的准确性会得出相同的结论
- 在附录 C.2 中提供了这种评估方法的细节
- 在 GUI 设置中使用 OpenCUA-72B,在 LLM 智能体设置中使用 gpt-oss-20b (OpenAI, 2025) 进行了消融研究
- 此外,本文作者还改变了用于生成奖励模型评估的轨迹的模型:
- 在 GUI 设置中使用 OpenCUA-7B,在 LLM 智能体设置中使用 LLaMA-3.1-8B-Instruct (2024)
- 结果(表 3 和表 4)与表 1 中的主要结果一致,验证了本文使用 LLM-as-a-judge 进行评估的方法
B.2. Examples of Environment Adaptation,Environment Adaptation 的示例和分析
下面的 GUI 智能体示例说明了环境模型如何使用总结的错误模式向任务 Prompt 中添加 Tips,从而使策略更容易完成任务
- 策略在此任务上的准确率从 0 提高到 0.125
原始任务对于策略来说太难了,没有产生任何成功的轨迹,因此无法从成功案例中获得训练信号
添加 Tips 简化任务后,策略偶尔会成功,提供学习信号,使其能够逐渐解决任务
GUI Task Adaptation Example 1 (Target: Easier)
1
2
3
4**template**: Using the Pivot Table feature, summarize the total revenue for each promotion type in a new sheet (’Sheet2’), with the promotion names as the column headers.
**old task prompt**: Summarize the total revenue for each promotion type in a new sheet (Sheet2) with the promotion names as the column headers using the Pivot Table feature.
**new task prompt**: Using the Pivot Table feature, summarize the total revenue for each promotion type in a new sheet (’Sheet2’), with the promotion names as column headers. Ensure ’Promotion’ is in Column Fields and use ’Insert’, ’PivotTable’ for correct setup. Verify field names to avoid confusion between ’Date’ and ’Promotion’.
**policy accuracy change**: 0 → 0.125 (easier for the policy)- 中文版:
1
2
3
4
* **模板** : 使用数据透视表功能,在一个新工作表('Sheet2')中汇总每种促销类型的总收入,促销名称作为列标题
* **旧任务提示** : 使用数据透视表功能,在一个新工作表(Sheet2)中汇总每种促销类型的总收入,促销名称作为列标题
* **新任务提示** : 使用数据透视表功能,在一个新工作表('Sheet2')中汇总每种促销类型的总收入,促销名称作为列标题。确保将“促销”放在列字段中,并使用“插入”、“数据透视表”进行正确设置。验证字段名称以避免“日期”和“促销”混淆
* **策略准确率变化** : \\(0 \rightarrow 0.125\\) (对策略来说更容易)
- 中文版:
下面的示例展示了 GUI 任务对策略模型来说太容易的情况,因此扰动通过切换到更具挑战性的任务模板使任务更难
GUI Task Adaptation Example 2 (Target: Harder)
1
2
3
4
5
6
**template candidates**:
• template1: Copy the “Revenue” column along with the header to a new sheet named “Sheet2”.
• template2: Copy the “Revenue” column along with the header to a new sheet named “Sheet2”. Then rename this “Revenue” column in “Sheet2” to “Profit”.
**old task prompt**: Copy the “Revenue” column along with the header to a new sheet named “Sheet2”.
**new task prompt**: Copy the “Revenue” column along with the header to a new sheet named “Sheet2”. Then rename this “Revenue” column in “Sheet2” to “Profit”.
**policy accuracy change**: 1.0 → 0.625 (harder for the policy)- 中文版:
1
2
3
4
5
6
* **模板候选** :
- 模板 1: 将“收入”列及其标题复制到名为“Sheet2”的新工作表中
- 模板 2: 将“收入”列及其标题复制到名为“Sheet2”的新工作表中,然后将“Sheet2”中的此“收入”列重命名为“利润”
* **旧任务提示** : 将“收入”列及其标题复制到名为“Sheet2”的新工作表中
* **新任务提示** : 将“收入”列及其标题复制到名为“Sheet2”的新工作表中,然后将“Sheet2”中的此“收入”列重命名为“利润”
* **策略准确率变化** : \\(1.0 \rightarrow 0.625\\) (对策略来说更难)
- 中文版:
以下两个示例通过改变涉及的对象数量来调整任务难度
ALFWorld Task Adaptation Example 1 (Target: Easier)
- 英文版见原论文
- 中文版:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
* **任务** : 修改目标词元 (对象类型,容器类型) 以使任务更容易,同时保留原始目标框架
* **响应** : 我需要找到一对满足约束且更有可能在当前状态下成功完成的对象和容器类型。查看“可清洁”列表,许多对象都是可清洁的。“可容纳”列表显示,许多容器可以容纳许多对象
原始目标是清洁马铃薯类型并将其放入微波炉类型。虽然有效,但成功可能性较低,因为:
1. 马铃薯类型只有 2 个实例 (potato1, potato2)
2. 微波炉类型只能容纳某些对象 (AppleType, BowlType, BreadType, CupType, EggType, MugType, PlateType, PotatoType, TomatoType)
3. 智能体在 loc32,这可能不在微波炉附近
一个更好的选择是具有更多实例的对象和可以容纳它的容器。查看“可清洁”列表,“CupType”有 3 个实例 (cup1, cup2, cup3),并且可以放置在包括微波炉类型在内的许多容器中
目标“清洁 CupType 然后放入 MicrowaveType”将:
- 由于实例更多,更有可能成功
- 有效,因为 CupType 是可清洁的,并且 MicrowaveType 可以容纳它
- 遵循清洁对象并将其放入容器中的框架
**最终答案**
CupType, MicrowaveType
* **策略准确率变化** : 0.125 \\(\rightarrow\\) 0.5
ALFWorld Task Adaptation Example 2 (Target: Harder)
- 英文版见原轮文
- 中文版:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
* **任务** : 修改目标词元 (对象类型,容器类型) 以使任务更难,同时保留原始目标框架
* **响应** : 让我分析创建更难目标的要求
原始目标是将 RemoteControlType 放入 ArmChairType。这是可行的,因为 (ArmChairType, RemoteControlType) 在 canContain 列表中
为了使其更难,我需要:
1. 选择实例更少的对象类型
2. 选择可以容纳它但实例更少的容器类型
3. 确保该对是有效的 (满足 canContain)
查看对象类型:
- WatchType 有 3 个实例 (watch1, watch2, watch3)
- KeyChainType 有 3 个实例 (keychain1, keychain2, keychain3)
- CreditCardType 有 1 个实例 (creditcard1)
查看容器类型:
- ArmChairType 有 2 个实例 (armchair1, armchair2)
- CoffeeTableType 有 2 个实例 (coffeetable1, coffeetable2)
- DiningTableType 有 1 个实例 (diningtable1)
- SofaType 有 1 个实例 (sofa1)
对 (KeyChainType, ArmChairType) 是有效的 (在 canContain 中),并且:
- KeyChainType 有 3 个实例
- ArmChairType 有 2 个实例
这是一个有效的对,但它并不比原始目标更难
让作者试试 (CreditCardType, ArmChairType):
- CreditCardType 有 1 个实例
- ArmChairType 有 2 个实例
- (ArmChairType, CreditCardType) 在 canContain 中
这对是有效的,并且实例更少,使其更难
所以更难的目标将是:
**最终答案**
CreditCardType, ArmChairType
* **策略准确率变化** : 1.0 \\(\rightarrow\\) 0.25
附录 C:Experimental Details
C.1. Models and Settings
- 对于应用于 OSWorld (2024) 的 GUI 智能体
- 本文在实验中使用了 Qwen3-VL-8B-Thinking (2025)、UI-TARS1.5-7B (2025) 和 OpenCUA-7B (2025b)
- 在最终评估中,本文将最大步数设置为 50,温度设置为 0,并报告 3 次独立运行的平均准确率
- 在 RL 优化期间,将最大步数设置为 30,并对策略模型使用温度 1.0,对过程奖励模型使用温度 0.8
- 对于策略模型,在每个 RL 步骤中,作者采样 12 个任务,每个任务有 8 条独立的 Rollout 轨迹
- 上下文管理遵循标准的 OSWorld 流程 (2024),包括最近的三张图像 ,并将所有先前的操作总结为上下文
- 当使用 OpenCUA 时,将其 CoT 级别设置为 2,遵循其默认设置
- 对于奖励模型,使用 Qwen3-VL-8B-Thinking 作为基座模型,并对每个策略 Response 进行 3 次评估
- 奖励上下文通过总结所有先前的操作、包含最近的两张图像以及这两张图像之间作者要求奖励模型评估的操作来构建
- 本文使用 Qwen3-4B (2025) 来调整任务
- 在优化期间,本文将执行后等待时间(截图前)设置为 0 以保持训练效率,而在评估期间则设置为 5 秒
- 本文使用 12 个节点进行训练
- 对于应用于 AlfWorld (2018; 2020) 的 LLM 智能体
- 使用 Qwen2.5-7B-Instruct 作为策略模型,Qwen2.5-14B-Instruct 作为奖励模型 (2024a),并使用 Qwen3-4B (2025) 来调整任务
- 在最终评估中,本文将最大步数设置为 60,温度设置为 0.8,并报告 3 次独立运行的平均准确率
- 在 RL 优化期间,本文将最大步数设置为 40,并对策略模型和过程奖励模型使用温度 0.8
- 在每个 RL 步骤中,采样 16 个任务,每个任务有 8 条独立的 Rollout
- 通过总结所有先前的操作及其相应的观察,并包含最近要选择的动作来构建策略模型上下文
- 使用 8 个节点进行训练
- 对于 Coding LLM ,使用与上述 LLM 智能体设置中相同的模型组合
- 在每个 RL 步骤中,采样 64 个任务,每个任务有 32 次独立的代码解决方案生成和 32 次独立的单元测试生成
- 使用 4 个节点进行训练
- 在所有 RL 训练过程中
- 在策略目标中使用以下标准超参数:裁剪阈值 \(\epsilon = 0.2\) (2017),KL 散度权重 \(\beta = 0.01\) ,学习率为 \(1 \times 10^{-6}\)
- 使用 k3 KL 估计器,并使用 AdamW (2017) 进行优化
- 为 GUI 智能体训练 240 步,为 LLM 智能体训练 200 步,为 Coding LLM 训练 300 步,以获得表 1 中报告的最终模型
C.2. Evaluation for Reward Models
- 对于 OSWorld 和 AlfWorld 设置,本文评估了 Step-level 质量(过程准确率)和预测某一步骤对最终结果影响的能力(结果准确率)
- 对于结果准确率,其 Ground Truth 标签就是可验证的结果
- 对于过程准确率,标签由一个 比所使用的奖励模型更强的推理模型提供(这不够准确吧?)
- 在 OSWorld 设置中
- 使用 Qwen3-VL-32B-Thinking 对每个策略 Response 提供八次独立的评估,使用的 Prompt 见 C.5 节,并将多数投票结果(1 或 \(-1\))作为 Ground Truth 标签
- 策略 Response 由 Qwen3-VL-8B-Thinking 在 OSWorld 的多个应用任务上生成:
- 对于每个任务,策略采样 16 条独立的 Rollout,每个任务产生 16 条轨迹
- 在 AlfWorld 设置中
- 使用 Qwen3-32B 进行评估,并使用 Qwen2.5-7B-Instruct 在 AlfWorld OOD 评估集(第 3.1.2 节)上生成轨迹,使用与 OSWorld 设置相同的协议和超参数
- 在编码 Setting 中
- 使用 Qwen2.5-7B-Instruct 作为策略模型,为评估数据集(LiveCodeBench、CodeContests 或 LiveBench)中的每个任务生成 16 个独立的代码解决方案,并使用 Qwen2.5-14B-Instruct 作为奖励模型,为每个任务生成 32 个独立的单元测试
- 如果一个生成的解决方案通过了所有数据集提供的单元测试,则被标记为 Ground Truth 正确
- 如果一个生成的单元测试通过了所有 Ground Truth 正确的解决方案,则该单元测试是正确的
- 如果它是正确的,并且能拒绝所有非 Ground Truth 的解决方案(即导致它们失败),那么它是完美的
- 本文使用正确率和完美率来评估奖励模型,其中完美率对应表 1 中报告的检测准确率
C.3. Agentic Coding Applications
- 在多种智能体编码方法下评估优化后的编码模型,包括 MPSC (2024)、AlphaCodium (2024) 和 \(S^{\star}\) (2025a)
- 在 MPSC 中
- 为每个任务生成 8 个代码、单元测试和规范样本
- 一个规范是一对函数(前置条件和后置条件),它定义了程序的有效输入空间和预期的输入输出行为,作为其预期功能的形式化描述
- 然后遵循迭代优化过程计算一致性分数,用于识别最佳的代码解决方案
- 在 AlphaCodium 中
- 为每个任务使用对公开测试的推理生成 8 个代码解决方案,以及 8 个对应的单元测试
- 每个解决方案根据在公开测试上的执行结果进行两次优化迭代,然后根据在生成的单元测试上的执行结果再进行两次迭代
- 具体来说,每个优化步骤都以单元测试、当前代码和执行日志为条件,并决定是否以及如何更新解决方案
- 在 \(S^{\star}\) 中
- 生成 8 个代码解决方案,并应用四轮使用公开测试的自调试,以获得 8 个优化版本
- 由于调试依赖于 Ground Truth 单元测试的执行结果,本文直接在测试失败时提示模型修改代码
- 最终的解决方案使用它们的成对比较方法选择,以生成的单元测试作为评估信号
- 本文作者还考虑了最简单的测试时扩展方法,即最佳 N 选一
- 具体来说,独立生成 8 个代码和 8 个单元测试,并选择通过最多生成单元测试的代码作为最终解决方案
C.4. Policy Prompt Templates
在 RL 采样和最终评估中都使用这些模板进行上下文管理
对于 OpenCUA 和 UI-TARS,遵循标准的 OSWorld 流程,该流程总结先前的操作,同时保留最近的三张图像作为上下文
GUI Agent Prompt Templates (Qwen3-VL-8B-Thinking)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
**Tool-Calling; System Prompt**
’’’<|im_start|>system
# Tools
You may call one or more functions to assist with the user query.
You are provided with function signatures within <tools></tools> XML tags:
<tools>
{{tools_def}}
</tools>
For each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:
<tool_call>
{"name": <function-name>, "arguments": <args-json-object>}
</tool_call>
# Response format
Response format for every step:
1) Action: a short imperative describing what to do in the UI.
2) A single <tool_call>...</tool_call> block containing only the JSON:
{"name": <function-name>, "arguments": <args-json-object>}.
Rules:
- Output exactly in the order: Action, <tool_call>.
- Be brief: one sentence for Action.
- Do not output anything else outside those parts.
- If finishing, use action=terminate in the tool call.
<|im_end|>
’’’
Message Construction
# We construct a multimodal message list as follows:
# 1) A system message containing the tool-calling specification and the tool schema.
# 2) For historical context, we keep:
# - All past actions as a text-only history (Step 1: ..., Step 2: ..., ...).
# - At most the most recent 3 screenshots (image-only history).
# 3) For each retained past step i:
# - Append a user message with the screenshot i.
# - Append an assistant message with the model’s response at step i (Action + < tool_call>).
# 4) For the current step:
# - Append a user message containing the current screenshot + the instruction prompt
# (which includes the instruction and the full action history).
# Variables used in the paper template:
# - tools_def: JSON string of tool definitions (i.e., json.dumps(tools_def))
# - step_index: current step id (0-based)
# - screenshots[i]: base64-encoded PNG screenshot at step i (string without the data: prefix)
# - responses[i]: assistant response text at step i (Action + <tool_call>)
# - actions: list of action strings taken so far (for the text-only action history)
# - instruction: the current task instruction (string)
messages = [{"role": "system", "content": [{"type": "text", "text": "system_prompt"}]}]
# Keep at most the last 3 screenshots
start_i = max(0, step_index - 3 + 1)
for i in range(start_i, step_index):
# 历史截图 i
img_url_i = f"data:image/png;base64,{screenshots[i]}"
messages.append({"role": "user", "content": [{"type": "image_url", "image_url": {"url": img_url_i} }]})
# 历史助手响应 i (Action + <tool_call>)
messages.append({"role": "assistant", "content": [{"type": "text", "text": responses[i]}]})
# Text-only full action history
previous_actions_str = "None" if len(actions) == 0 else "\n".join([f"Step {k+1}: {a}" for k, a in enumerate(actions)])
instruction_prompt = f"""
请根据UI截图、指令和之前的操作,生成下一步
指令:{instruction}
之前的操作:{previous_actions_str}
"""
# Current screenshot + instruction prompt
curr_img_url = f"data:image/png;base64,{screenshots[step_index]}"
messages.append(
{"role": "user", "content": [
{"type": "image_url", "image_url": {"url": curr_img_url} },
{"type": "text", "text": instruction_prompt},
]}
)LLM Agent Prompt Templates (ALFWorld)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
**Guide Prompt)**
guide = {
"You are playing a text game. Your objective is to complete the task as soon as possible.\n"
"Below is your trajectory so far and current candidate actions.\n"
"You need to think step by step then put the integer (the index of your chosen action) in \\boxed{}. \n"
}
**Trajectory Rendering; summarized history**
# The trajectory is summarized into alternating observation/action lines
def_render_traj(traj):
lines = []
for t in traj:
if "obs" in t and t["obs"] is not None:
lines.append(f"observation: {t['obs']}")
if t.get("act") is not None:
lines.append(f"you took action: {t['act']}")
return "\n".join(lines)
trajectory_history =_render_traj(traj)
**Full Prompt Template**
'''<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
{ {guide} }<|im_start|>system
You need to think step by step then choose one action by number:<|action_options|><|im_end|>
<|im_start|>assistant
'''
{ {trajectory_history} }
You need to think step by step then choose one action by number: { {action_options} }<|im_end|>
<|im_start|>assistant
'''
** Coding LLM Prompt 模板**
```python
'''<|im_start|>system
You are a helpful assistant that helps the user solve programming problems.<|im_end|>
<|im_start|>user
You need to think first then write a Python script.
You should use input() to read input and print() to produce output in your script.
This is the problem:
<|prom|><|prom|><|prom|><|prom|><|prom|><|prom|>
You should put your code in "python ".
<|im_end|>
<|im_start|>assistant
'''
C.5. Process Reward Model Prompt Templates,PRM Prompt 模板
对于 GUI 智能体 Setting
- 本文使用 Qwen3-VL-8B-Thinking 作为过程奖励模型来评估每个策略 Response
- 奖励模型上下文由以下部分组成
- 所有先前操作的摘要
- 最近的两张图像
- 评估的这两张图像之间的操作
对于 AlfWorld 设置
- 本文提供策略 Prompt 和 Response,并要求 LLM 评判该 Response
在这两种 Setting 中,Prompt 旨在评估 Step-level 质量以及该步骤对最终结果的潜在影响
最终输出的奖励只能是 1 或 -1
- 对于 Coding LLM 设置,提示 LLM 生成单元测试
- 这些单元测试的质量可作为对生成代码某些方面的评估信号,并可用作过程奖励的一种特殊形式
GUI Agent Rewarding Prompt Templates
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
# We build reward_messages as a multimodal user content list.
# The reward prompt includes:
# - A text-only prefix containing "Previous Actions" (older action history).
# - A short window of recent steps: for each step i in the window,
# (a) the environment screenshot at step i,
# (b) the agent action taken at step i.
# - The current observation screenshot (the state after the most recent action).
# - A strict evaluation instruction describing the agent objective and the most recent response.
# Variables used in the paper template:
# - step_index: current step id (0-based, the "most recent step" is step_index)
# - actions[i]: action text taken at step i
# - instruction: task instruction / objective string
# - response: the agent’s most recent response (reasoning + action/tool call)
# - reward_messages: chat message list for the reward model
# - reward_user_content: multimodal user content list (text/image blocks)
reward_user_content = []
# 最多为奖励上下文保留最近 2 步(不包括当前 Observation)
rstart_i = max(0, step_index - 2 + 1)
# (1) 之前的操作:rstart_i 之前的所有操作
prev_lines = []
for i in range(rstart_i):
prev_lines.append(f"Step {i+1}: {actions[i]}")
previous_reward_actions_str = "\n".join(prev_lines) if prev_lines else "None"
reward_user_content.append({"type": "text", "text": f"Previous Actions:\n{previous_reward_actions_str}"})
# (2) 最近的步骤窗口:对于 [rstart_i, step_index) 范围内的每个步骤 i
for i in range(rstart_i, step_index):
reward_user_content.append({"type": "text", "text": "Image of environment:\n"})
reward_user_content.append({"type": "image", "image": "image"})
reward_user_content.append({"type": "text", "text": f"\nAction of agent:\nStep {i+1}:\n{actions[i]}\n"})
# (3) 当前观察图像(执行最近操作后)
reward_user_content.append({"type": "text", "text": "Agent's current observation:\n"})
reward_user_content.append({"type": "image", "image": "image"})
# (4) 评估指令(目标 + 最近响应)
REWARD_INSTRUCTION_TEMPLATE = r"""
You are a strict evaluator to evaluate the most recent step of the agent in the following.
Objective of Agent: {instruction}
Agent's most recent step (reasoning + action): {response}
"""
reward_user_content.append({
"type": "text",
"text": "\n" + REWARD_INSTRUCTION_TEMPLATE.format(instruction=instruction, response=response)
})
reward_messages.append({"role": "user", "content": reward_user_content})在评估奖励模型预测的 Step-level 质量时,使用以下奖励指令模板并要求 Qwen3-VL-32B-Thinking 提供标签:
REWARD_INSTRUCTION_TEMPLATE for evaluating reward model’s step-wise accuracy (OSWorld)
1
2
3
4
5
6
7
REWARD_INSTRUCTION_TEMPLATE = r"""
You are a strict evaluator to evaluate the most recent step of the agent in the following. Focus on the quality of this step.
Objective of Agent: {instruction}
Agent's most recent step (reasoning + action): {response}
"""- 问题:这里不应该是一个 Meta Evaluator 吗?
LLM Agent Rewarding Prompt Templates (ALFWorld)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
'''<|im_start|>system
You are a helpful assistant.
<|im_end|>
<|im_start|>user
You are a judge for an agent acting in a text-based environment.
Evaluate ONE step using:
- the agent's prompt (observation + candidate actions),
- its response (reasoning + chosen index), and
- the environment's next observation after executing that action.
Scoring (binary):
Score 1 if ALL are true:
(a) The selected action is appropriate for the current observation and task goal (it reasonably explores, progresses or completes the task);
(b) The reasoning is present, relevant, and not self-contradictory (no hallucinated objects/locations);
(c) The chosen index exists in the candidate list, and the resulting next observation is consistent with the described action.
Otherwise score -1. Cases include: no reasoning provided; index out of range; clearly irrelevant; undoes progress; self-contradictory/hallucinated reasoning; or next observation contradicts the action.
Important: think first then put the final score in \\boxed{}.
Agent's prompt:
{ {policy_prompt} }
Agent's response:
{ {policy_response} }
Next observation after this action:
{ {next_obs} }
<|im_end|>
<|im_start|>assistant
'''在评估奖励模型预测的 Step-level 质量(AlfWorld Setting)时,使用以下奖励指令模板并要求 Qwen3-32B 提供标签:
Prompt Template for evaluating reward model’s step-wise accuracy (Alf World)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
'''<|im_start|>system
You are a helpful assistant.
<|im_end|>
<|im_start|>user
You are a judge for an agent acting in a text-based environment.
Evaluate ONE step using:
- the agent's prompt (observation + candidate actions),
- its response (reasoning + chosen index), and
- the environment's next observation after executing that action.
Scoring (binary):
Score 1 if ALL are true:
(a) The selected action is appropriate for the current observation;
(b) The reasoning is present, relevant, and not self-contradictory (no hallucinated objects/locations);
(c) The chosen index exists in the candidate list, and the resulting next observation is consistent with the described action.
Otherwise score -1. Cases include: no reasoning provided; index out of range; clearly irrelevant; undoes progress; self-contradictory/hallucinated reasoning; or next observation contradicts the action.
Important: think first then put the final score in \\boxed{}.
Agent's prompt:
{ {policy_prompt} }
Agent's response:
{ {policy_response} }
Next observation after this action:
{ {next_obs} }
<|im_end|>
<|im_start|>assistant
'''Coding LLM Reward Prompt Template
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
REWARD_TEST_PROMPT = r"""<|im_start|>system
You are a rigorous unit-test designer for coding problems.
You must produce exactly ONE new test example that is correct and discriminative.
<|im_end|>
<|im_start|>user
You need to provide a new test example. A good test example should be completely
- accurate and conform to the problem's format requirements, while also
- possessing enough discriminative power to distinguish correct code from
- incorrect code.
Before providing a test example, you must think carefully and reason step by step to
- derive an input and output you are very confident are correct. For example,
- start by designing an input you can reliably handle, then compute the output
- step by step. If you're unsure about the output, revise or re-design the input
- to ensure accuracy. Directly providing input/output pairs without this
- process is discouraged, as it often results in low accuracy.
Finally, after completing these previous thinking and derivation steps (you should
- not write the final test example unless you have gone through these steps very
- thoroughly), you MUST put your final test example in the following format:
**Test Input:**
'''
<put the EXACT stdin content here>
'''
**Test Output:**
'''
<put the EXACT stdout content here>
'''
**Explanation:** <brief explanation here>
IMPORTANT:
- Output must contain exactly one **Test Input:** block and one **Test Output:** block.
- Use triple backticks exactly as shown.
- The test must be self-contained and match the problem format.
Problem: { {problem} }
<|im_end|>
<|im_start|>assistant
"""
C.6. Error Pattern Summarization and Prompt Templates,错误 Pattern 总结
通过总结过程奖励模型输出的思考部分来识别策略可能出错的地方
对于每个任务,获得几个句子来描述策略在解决任务时所犯的错误
对于 GUI 智能体
- 首先通过聚合至少一个评估分数为 \(-1\)(表示潜在错误)的步骤上的独立评估来进行 Step-level 总结,生成 Step-level 摘要
- 然后进行 Trajectory-level 总结:
- 对于每条轨迹,使用 Step-level 摘要作为上下文,并要求模型总结整个轨迹中发生的错误
- 对于每个任务的每条策略轨迹,获得一个关于策略错误模式的简洁摘要
对于 AlfWorld 上的 LLM 智能体
- 直接使用完整轨迹(智能体的操作和相应的观察),并突出显示所有评估分数均为 \(-1\) 的步骤作为总结上下文
- 由于这里的上下文短得多且直接,本文未使用 GUI 智能体设置中采用的两阶段 Step-level 后接 Trajectory-level 总结
本文为 OSWorld 设置使用 Qwen3-VL-8B-Thinking,为 AlfWorld 设置使用 Qwen3-4B
- 对于 Coding Thinking,诊断信息包括生成的代码未能通过的单元测试
OSWorld (GUI Agent) Error Summarization Prompt Templates
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
**Step-wise Summarization (OSWorld GUI)**
STEP_ERROR_SUMMARY_PROMPT = (
"you are analyzing one step in a trajectory for an OSWorld/desktop task.\n\n"
f"step_index: {step_index}\n\n"
"You are given:\n"
"- reward_model_responses (multiple candidates)\n"
"- extracted_reward aligned with responses (+1/-1/0)\n\n"
"Task:\n"
"Write ONE high-density summary (<= 2 sentences) explaining why this step was judged negative.\n"
"Be specific about the failure mode (e.g., wrong assumption, misread UI, inconsistent with instruction, hallucinated value, skipped constraint).\n\n"
"Rules:\n"
"- Do NOT repeat the prompt verbatim.\n"
"- Final answer MUST be in \\boxed{...} ONLY.\n\n"
"reward_model_responses:\n"
f"{json.dumps(reward_model_responses, ensure_ascii=False)}\n\n"
"extracted_reward:\n"
f"{json.dumps(extracted_reward, ensure_ascii=False)}\n"
)
**Trajectory-wise Summarization (OSWorld GUI)**
TRAJECTORY_ERROR_SUMMARY_PROMPT = (
"You are given step-level error summaries for ONE trajectory.\n\n"
"Task:\n"
"Produce ONE trajectory-level error summary (<= 2 sentences) capturing the main recurring failure modes.\n\n"
"CRITICAL anti-redundancy rule:\n"
"- Do NOT repeat the same error across different steps.\n"
"- If multiple steps share the same failure type, mention it ONCE and, if helpful, note it as recurring.\n"
"- Keep language concise but high information density.\n\n"
"- Do reasoning first, then put Final Answer in \\boxed{...} ONLY.\n\n"
"step_error_summaries (JSON):\n"
f"{json.dumps(step_summaries, ensure_ascii=False)}\n"
)Alf World (LLM Agent) Error Summarization Prompt Template
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
ALFWORLD_ERROR_SUMMARY_PROMPT = (
"<|im_start|>You are a helpful assistant. <|im_end|>\n"
"<|im_start|>user\n"
"You are analyzing a failed rollout of a policy in a text-based environment.\n"
f"The rollout did NOT finish the task within {max_steps} interaction steps.\n"
f"Task (natural language): {task}\n\n"
"Full trajectory (observation/action sequence):\n"
f"{traj_text}\n\n"
f"Some steps that are marked by reward model to be highly possible incorrect: {steps_information}\n\n"
"In at most TWO sentences, explain the most likely reasons the policy failed to finish in time.\n"
"Be concrete (e.g., wrong exploration, looping, wrong target/location, inconsistent reasoning, hallucination, etc.).\n"
"Put the final \\(<= 2\\) sentence summary in \\boxed{ and output NOTHING else.\n"
"<|im_end|>\n"
"<|im_start|>assistant"
)
C.7. Environment Modification and Prompt Templates,环境修改和 Prompt 模板
为了获得能更好地匹配策略当前能力的新任务 ,同时保留原始任务的本质 (以防止任务集偏离原始分布太远)
本文设计以下 Prompt 模板供推理模型使用,以基于关于策略准确率及其在每个任务上具体错误的总结信息来调整任务
对于 GUI 智能体
- 为每个任务提供一组任务模板 :原始任务始终包含在内,偶尔会添加新的但高度相关的模板
- 为 230 个训练任务中的 47 个预先创建了额外的任务模板,总共得到 295 个任务模板(示例见附录 C.8)
- 在本文的消融研究中,所有这些任务都包含在训练集中
- 本文提供策略在原始任务上可能出错的位置的信息,并要求模型(如果适用)选择一个新任务模板,并根据该模板编写一个新的任务 Prompt
- 当目标是让任务更容易时,模型可以根据总结的错误模式在 Prompt 中添加 Tips,从而对策略难以处理的任务实现更主动的调整
- 当目标是让任务更难时,模型可以移除此类 Tips 并使指令更模糊
- 任务模板的选择也可以取决于目标难度和扰动类型
对于 AlfWorld 上的 LLM 智能体
- 本文向模型提供策略在任务上的表现,以及基本环境信息(例如,环境包含哪些对象、它们的属性以及它们的位置),以帮助模型决定如何修改任务
- 例如:
- 如果子类别“拾取和放置”中的原始任务对于策略来说太难,因为它找不到目标对象,则环境模型将目标替换为更容易找到的对象
- 如果任务对策略来说太容易,环境模型会使目标对象更难找到
GUI Agent Task-Difficulty Adaptation Prompt Template (OSWorld)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
# Variables:
# - goal: str, target difficulty direction, e.g., "easier" or "harder"
# - current_task_json: str, JSON string of the current task object
# - task_template_json: str, JSON string of a mapping evaluator_name -> canonical instruction
# - traj_summaries_json: str, JSON string of OPTIONAL historical trajectory-level error summaries
# (each trajectory_summary is already deduplicated across steps)
SYSTEM_PROMPT = """<|im_start|>You are a helpful assistant. <|im_end|>
<|im_start|>user
You will help me adjust the difficulty of an OSWorld/desktop task.
You are given:
(1) current_task (JSON)
(2) task_template: a JSON object mapping evaluator_name -> a canonical instruction for that evaluator.
(3) previous_rollout_trajectory_summaries: OPTIONAL historical error analyses from earlier rollouts.
- A task may have multiple trajectories (runs).
- Each trajectory_summary is already deduplicated across steps (no repeated same error across steps).
Goal: make the task {{goal}}.
Rules:
- You MAY switch to a different evaluator from task_template (by changing the key), OR keep the same evaluator.
- You MAY rewrite the instruction to increase/decrease hint strength (add hints to make easier, remove hints to make harder).
- The instruction can NOT be too long.
- You MUST NOT change the essential task meaning compared to the chosen evaluator’s template. Do NOT invent a new task.
- Do NOT invent new evaluator names. The output key must be one of the keys in task_template.
- You SHOULD use previous_rollout_trajectory_summaries to guide how you adjust difficulty:
- If goal is EASIER: add minimal, targeted clarifying hints addressing recurring failure modes.
- If goal is HARDER: remove such hints, but still keep the same essential task and stay within the chosen evaluator template.
- Output MUST be valid JSON ONLY (no markdown, no extra text).
- Output format MUST be the new current_task JSON object with EXACTLY ONE key:
{"evaluatorX": "your rewritten instruction"}
- If you accidentally output other text, ensure the FINAL output segment is the JSON object.
current_task:
{{current_task_json}}
task_template:
{{task_template_json}}
previous_rollout_trajectory_summaries:
{{traj_summaries_json}}
<|im_end|>
<|im_start|>assistant
"""Alf World (LLM Agent) Task-Difficulty Adaptation Prompt Template
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
**Environment Summary from INIT**
# summarize_init_english(problem_text) 返回:
# (1) summary_text: 一个人类可读的 INIT 事实的英文摘要,包括:
# - 对象/容器类型 -> 具体实例
# - 位置
# - cancontain(type -> type) 约束
# - 按谓词名称分组的其他实例化谓词
# (2) S: 一个结构化的已解析事实字典,用于下游约束,包括:
# - obj2type, rec2type
# - otype2obj, rtype2recs
# - cancontain
# - caps (能力集,如 pickable/toggleable/cleanable/hearable/coolable/sliceable)
summary_text, S = summarize_init_english(problem_text)
**Prompt Construction (environment info + failure summaries + goal editing instruction)**
prompt_text = (
"|<im_start|>You are a helpful assistant. <|im_end|>\n"
"<|im_start|>user\n"
"Review the following details about an interactive environment. A related task will follow.\n"
+ summary_text
)
prompt_text += "\n\n--\n"
fails = item.get("failed_rollout_summaries", [])
if fails:
prompt_text += "### Failure summaries from recent rollouts (failed rollouts only)\n"
for rec in sorted(fails, key=lambda x: int(x.get("rollout_idx", 0))):
rj = rec.get("rollout_idx", 0)
ss = str(rec.get("summary", "").strip())
prompt_text += f"- Rollout {rj}: {ss}\n"
prompt_text += "\n"
prompt_text += f"### Your job is to propose a new goal that makes the task \*\*{goal.upper()}\*\*.\n"
prompt_text += f"- The parent rollout accuracy (prev_acc) is {acc_before}.\n"
prompt_text += "- The new goal must be different from the original and follow the instructions.\n"
prompt_text += "- The overall framework of the goal cannot be changed; you may only modify two tokens within this framework.\n"
prompt_text += "Represent the new goal by outputting two tokens, placed inside \n boxed{ and separated by a comma, e.g., \\boxed{TOKEN_A,TOKEN_B}.\n"
prompt_text += "You need to think step by step then provide final result in \\boxed {}. \n"
prompt_text += "\n" + goal_brief_and_instruction(
task, goal_obj_types, goal_rec_types, S, direction=goal, prev_acc=acc_before
)
prompt_text += "\n<|im_end|>\n<|im_start|>assistant"
**Task-Specific Editing Rubric (goal_brief_and_instruction)**
def goal_brief_and_instruction(task, goal_obj_types, goal_rec_types, S, direction: Optional[str] = None, prev_acc: Optional[float] = None):
lines = []
if direction in ("harder", "easier"):
lines.append(f"### Difficulty goal: \*{direction.upper()}\* (prev_acc={prev_acc})")
if direction == "harder":
lines.append("- Prefer types with \*fewer\* available instances (rarer) while keeping constraints satisfied.")
lines.append("- Prefer combinations likely requiring more search/steps, but still solvable in this environment.")
else:
lines.append("- Prefer types with \*more\* available instances (more common) while keeping constraints satisfied.")
lines.append("- Prefer combinations likely easier to find/complete, but still valid.")
if task == "pick_and_place_simple":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_rec_types[0] if goal_rec_types else "<?>")
lines.append("\*Overall Framework\*: place an object type into/on a receptacle type.")
lines.append(f"\*Original goal\*: place an object of type \*\*[g[0]]\* into/on a receptacle of type \*\*{g[1]}\*.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("\*Design instructions\*: Output exactly \*two tokens\* - < OBJ_TYPE> <REC_TYPE>.")
lines.append("- Constraints: pair must satisfy 'canContain(REC_TYPE, OBJ_TYPE)'.")
elif task == "look_at_obj_in_light":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_obj_types[1] if len(goal_obj_types) > 1 else "<?>")
lines.append("\*Overall Framework\*: a light object type is present at the agent's location; the agent \*holds\* an object type.")
lines.append(f"\*Original goal (Example)\*: a \*toggleable and toggled\* light object of type \*{g[0]}\* is present; agent \*holds\* type \*{g[1]}\*.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("\*Design instructions\*: Output exactly \*two tokens\* - < LIGHT_OBJ_TYPE> <HOLD_OBJ_TYPE>'.")
lines.append("- Constraints: LIGHT must have 'toggleable'; HOLD should have a 'pickupable' instance in INIT.")
elif task == "pick_clean_then_place_in_recep":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_rec_types[0] if goal_rec_types else "<?>")
lines.append("**Overall Framework** : **clean** an object type and place it into/on a receptacle type.")
lines.append(f"**Original goal** : clean type **{g[0]}** then place into/on type **{g[1]}**.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("- Constraints: OBJ must be cleanable; canContain(REC,OBJ).")
elif task == "pick_heat_then_place_in_recep":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_rec_types[0] if goal_rec_types else "<?>")
lines.append("**Overall Framework** : **heat** an object type and place it into/on a receptacle type.")
lines.append(f"**Original goal** : heat type **{g[0]}** then place into/on type **{g[1]}**.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("- Constraints: OBJ must be heatable; canContain(REC,OBJ).")
elif task == "pick_cool_then_place_in_recep":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_rec_types[0] if goal_rec_types else "<?>")
lines.append("**Overall Framework** : **cool** an object type and place it into/on a receptacle type.")
lines.append(f"**Original goal** : cool type **{g[0]}** then place into/on type **{g[1]}**.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("- Constraints: OBJ must be coolable; canContain(REC,OBJ).")
elif task == "pick_two_obj_and_place":
g = (goal_obj_types[0] if goal_obj_types else "<?>", goal_rec_types[0] if goal_rec_types else "<?>")
lines.append("**Overall Framework** : place **two distinct objects** (same type) into/on a receptacle type.")
lines.append(f"**Original goal** : place two objects of type **{g[0]}** into/on type **{g[1]}**.")
lines.append(f"The final output example is \\boxed{ {g[0]}, {g[1]} }")
lines.append("- Constraints: >=2 instances of OBJ_TYPE; canContain(REC,OBJ).")
else:
lines.append("**Original goal** : (unknown task type).")
return "\n".join(lines)
C.8. Examples of Task Templates in GUI data
- 正如附录 C.7 中讨论的,本文在 GUI 训练数据中为某些任务添加了新的任务模板
- 本文提供的示例如下,每个任务模板都配有一个评估器及其对应的可验证结果文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
TASK_TEMPLATE_EXAMPLES = r"
Example 1:
"task_template":{
"evaluator1": "Work out the monthly total sales in a new row called 'Total', and then create a line chart to show the results (with Months on the x-axis).",
"evaluator2": "Work out the monthly total sales in a new row called 'Total'.",
"evaluator3": "Work out January's total sales in a new row called 'Total'.",
"evaluator4": "Work out the monthly total sales in a new row called 'Total', and then create a line chart to show the results (with Months on the x-axis, for January, February, and March only)."
}
Example 2:
"task_template":{
"evaluator1": "Fill all blank cells in B1:E30 with the value from the cell directly above. Finish the task and do not modify irrelevant regions, even if they are blank.",
"evaluator2": "Fill all blank cells in B1:B30 with the value from the cell directly above. Finish the task and do not modify irrelevant regions, even if they are blank.",
"evaluator3": "Fill all blank cells in E1:E30 with the value from the cell directly above. Finish the task and do not modify irrelevant regions, even if they are blank.",
"evaluator4": "Fill all blank cells in E1:E24 with the value from the cell directly above. Finish the task and do not modify irrelevant regions, even if they are blank."
}
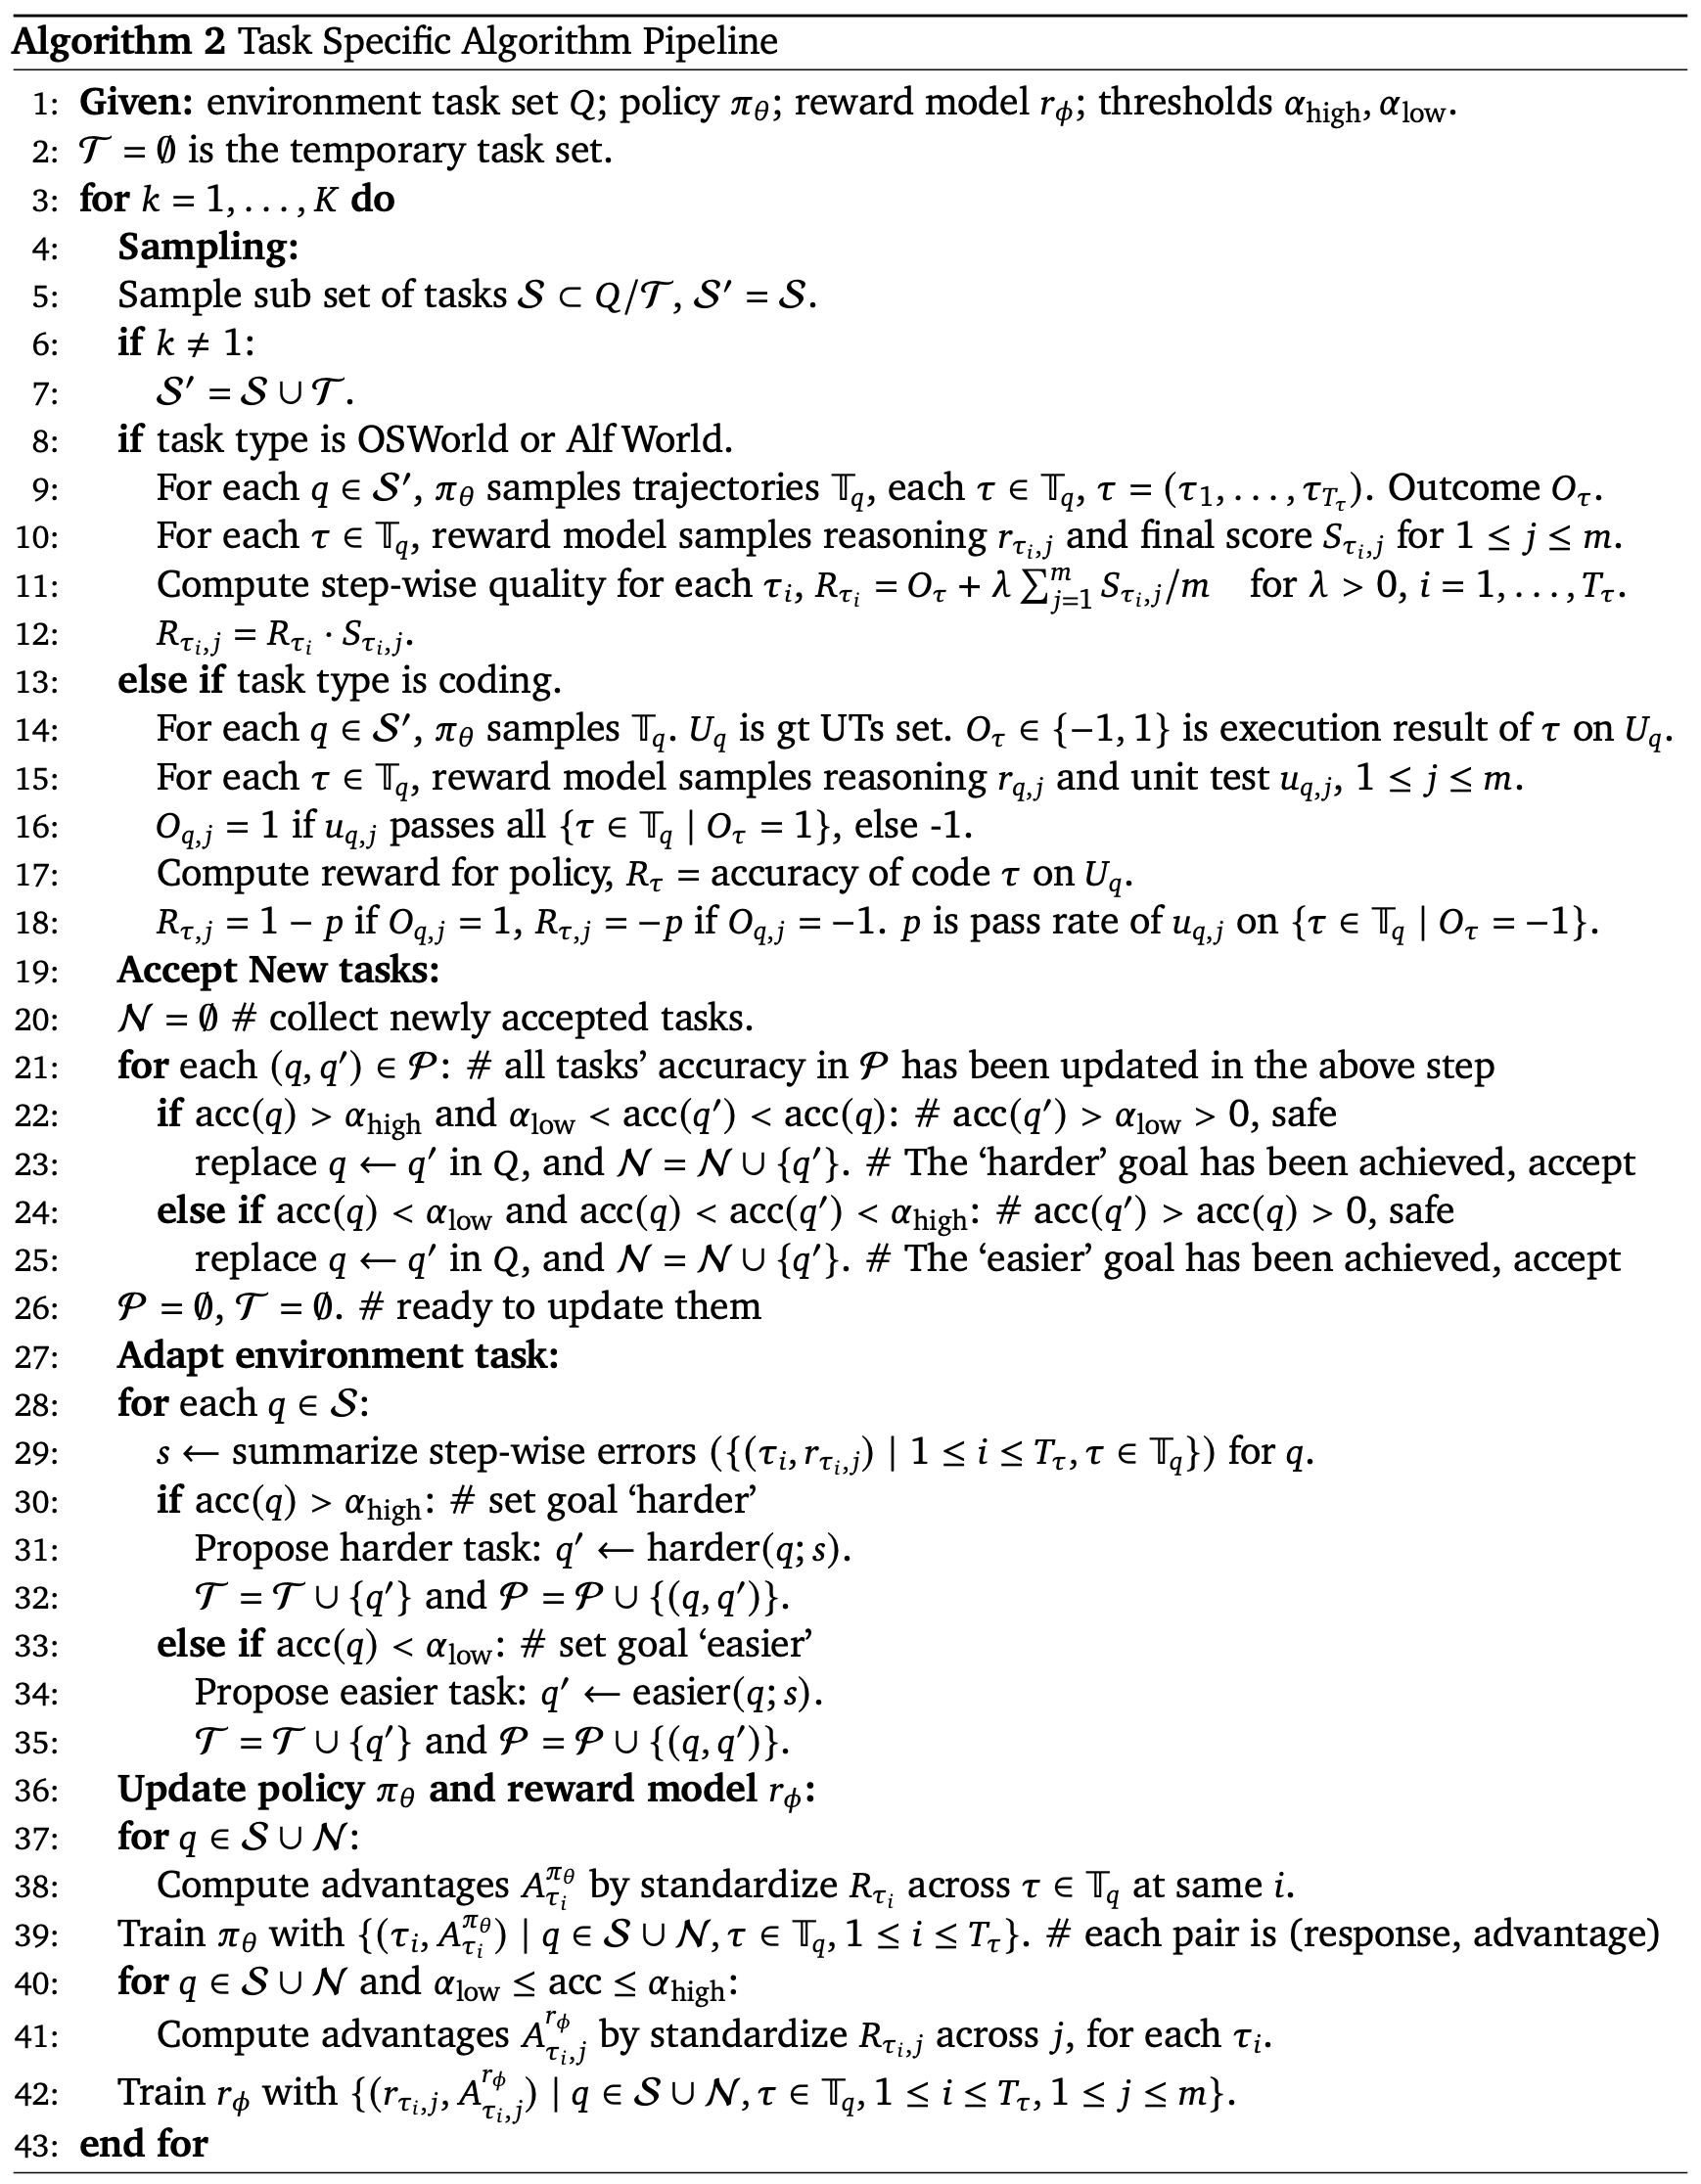
C.9. Task Specific Algorithm
- Algorithm2: