Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——Why-Self-Distillation-Fails-in-Reasoning

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(Why-Self-Distillation-Fails-in-Reasoning)Why Does Self-Distillation (Sometimes) Degrade the Reasoning Capability of LLMs?, Microsoft, 20260325

Paper Summary

  • 整体总结:
    • 本文从信息论的视角看 Self-Distillation
    • 分析表名:Self-Distillation 的有效性 取决于信息如何提供给模型 ,以及模型如何将不确定性纳入其推理过程
    • Self-Distillation 通过鼓励模型产生更高置信度的答案 来重塑模型的推理行为
      • 这种效应能够实现更紧凑的推理,并在任务覆盖有限时快速提高领域内性能
      • 当任务覆盖范围广时,它会变得不那么有效,甚至可能损害 OOD 性能
  • 背景 & 问题提出:
    • 背景:Self-Distillation 是 LLM 的一种有效的后训练范式
      • 特点:通常在缩短推理轨迹的同时提升性能
    • 问题提出:
      • 在数学推理中,Self-Distillation 会减少响应长度,同时降低性能
    • 本文将这种性能下降归因于 Epistemic Verbalization (epistemic verbalization) 的抑制
      • 即对模型在推理过程中表达不确定性的行为的抑制
  • 实验 Insight:
    • 让 Teacher 依赖于丰富的信息会抑制不确定性表达
      • 这能够在有限的任务覆盖度下实现快速的领域内优化,但会损害 OOD 性能
      • 因为未见过的(unseen)问题往往受益于表达不确定性并进行相应调整
    • 在 Qwen3-8B、DeepSeek-Distill-Qwen-7B 和 Olmo3-7B-Instruct 上,性能下降高达 40%
  • 结论:暴露适当水平的不确定性对于稳健的推理至关重要 ,并强调了优化推理行为的重要性 ,而不仅仅是强化正确的答案轨迹

Introduction and Discussion

  • Self-Distillation 的定义:
    • (2022) 使用同一模型的两个实例:
      • 实例1:依赖于真实解决方案作为 Teacher
      • 实例2:无法访问解决方案的实例
    • Teacher 为 无法访问解决方案的实例 生成的响应提供信息丰富的奖励信号
  • Self-Distillation 与 RLVR 等后训练方法相结合,可以实现高效的性能提升 (2025; 2026;)
    • 在诸如代理环境 (agentic environments) 和科学推理等领域显示出尤为显著的改进,特别是在 In-domain 评估 Setting 下
    • 先前工作的实验观察:性能随着响应长度的减少而提高,这表明 Self-Distillation 促进了更简洁和有效的推理
  • 问题提出:
    • Self-Distillation 方法应用于数学推理任务时,发生了显著不同的现象
    • 图 1 比较了代表性 Self-Distillation 算法 SDPO 在化学领域 (a) 和数学领域 (b) 的效果
      • 在化学领域,与 GRPO 相比, Self-Distillation 显著减少了响应长度,同时快速提高了性能
      • 在数学领域,尽管响应长度随着训练进行而持续减少,但性能却显著下降,这与之前的发现相反
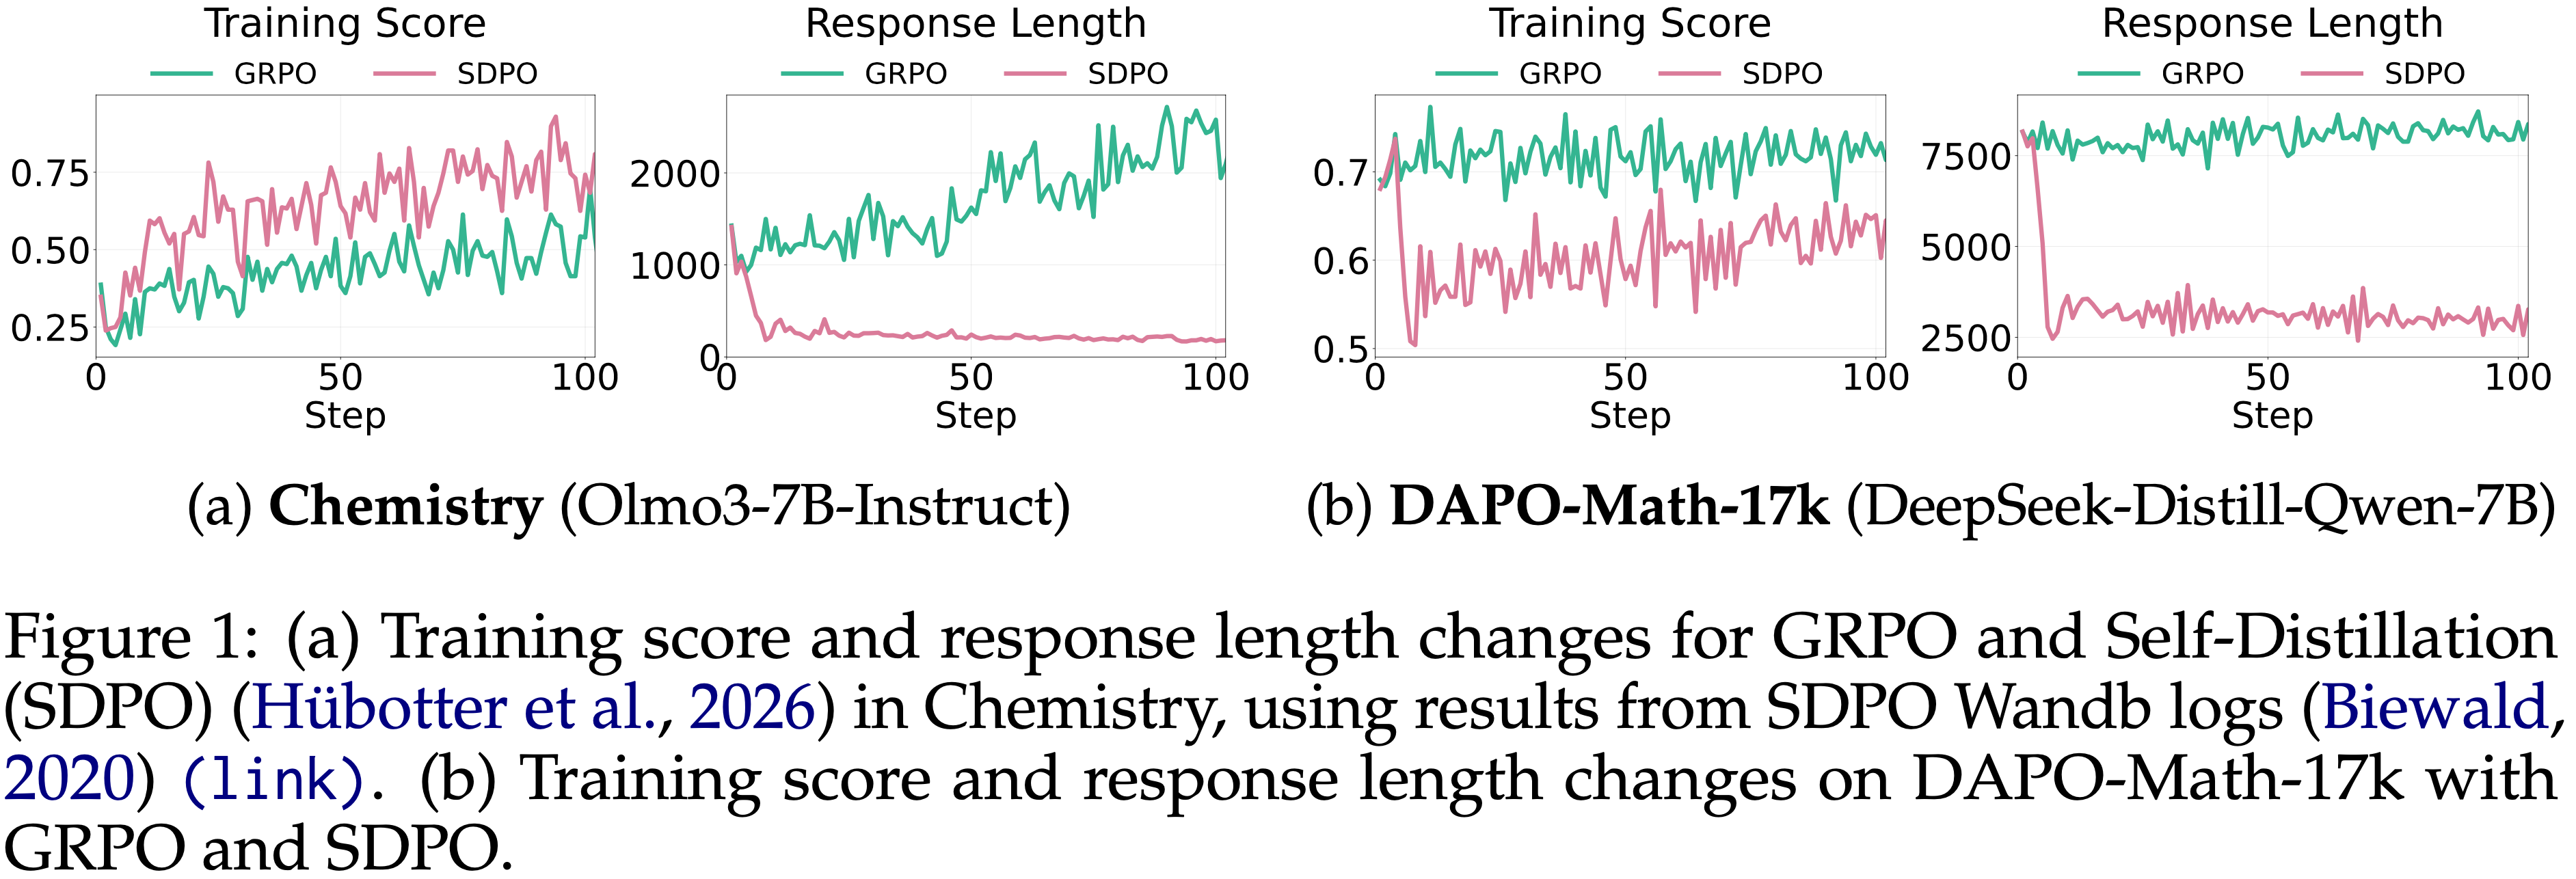
    • 这引出了一个问题:“为什么即使模型被训练成朝着正确答案移动,性能有时反而会下降?”

      ”Why does performance sometimes degrade despite the model being trained to move toward the correct answer?”

  • 本文分析结论:
    • 提供给 Teacher 的上下文信息越丰富,其生成的推理就越简洁和自信,不确定性表达显著减少,尤其是在数学推理中,性能会下降
    • 作者将这种影响归因于 Epistemic Verbalization (2026) 的抑制
      • 即对 模型明确地表达并将不确定性纳入其推理过程 的能力的抑制
      • 理解:本文的 Epistemic Verbalization 含义可以理解为是不确定性 Token
    • 像 DeepSeek-R1 (2025b) 这样强大的推理模型经常使用像“Wait”或“Hmm”这样的 Token 来表达不确定性
      • 这些表达可能不会直接推进推理,但移除它们会丢弃推理路径可能有缺陷的重要信号,导致显著的性能下降 (2026)
  • Self-Distillation 何时以及为何会抑制 Epistemic Verbalization ?
    • 本文确定了两个关键因素: 信息丰富度 和 任务覆盖度
    • 信息丰富度:
      • 当 Teacher 依赖于更丰富的信息(如正确的解决方案)时,它产生的推理轨迹几乎不表达不确定性
        • 从而鼓励学生模型 (student) 模仿一种自信的推理风格,这种风格预设了在推理时无法获得的信息
    • 任务覆盖度:
      • 任务覆盖度有限时,这种压缩使得能够快速进行领域内优化
      • 随着覆盖度的增加,训练中对 Epistemic Verbalization 的消除会干扰跨多样化任务的优化,从而在更具挑战性或之前未见过的(unseen)问题上降低性能
  • 结果表明:
    • 即使训练目标忠实地引导模型走向正确的推理轨迹,所产生的推理风格也可能会悄然转变,从而损害泛化能力
      • 标准目标不会惩罚对 Epistemic Verbalization 的抑制,但会对 OOD 性能产生负面影响
    • 这表明:
      • 后训练目标不仅要考虑答案的正确性 ,还要考虑激发和保留具有不确定性意识的推理行为

Preliminaries

Self-Distillation

  • 定义:
    • \(x\in \mathcal{X}\) 表示一个输入
    • \(y = (y_{1},\ldots ,y_{T})\) 表示由语言模型 \(\pi_{\theta}\) 生成的一个序列
  • 该模型定义了一个自回归分布
    $$ \pi_{\theta}(y|x) = \prod_{t = 1}^{T}\pi_{\theta}(y_{t}\mid x,y_{< t})$$
  • 在 Self-Distillation 中,同一个模型在不同的条件上下文下既充当学生又充当教师
    • 学生首先生成一个序列 \(y\sim \pi_{\theta}(\cdot \mid x)\)
    • 教师策略是通过让模型依赖于一个更丰富的上下文 \(c\) 来获得的,该上下文提供了关于输入的额外信息(例如,解决方案、环境反馈或其他辅助信号):
      $$ \pi_{\theta}^{T}(\cdot \mid x,c) = \pi_{\theta}(\cdot \mid x,c) $$
  • 训练过程最小化学生和教师下一个 Token 分布之间的散度:
    $$\mathcal{L}_{\text{SD} }(\theta) = \sum_{t}\text{KL}(\pi_{\theta}(\cdot \mid x,y_{< t})\parallel \text{stopgrad}(\pi_{\theta}(\cdot \mid x,c,y_{< t}))) \tag {1}$$
    • 这个目标鼓励学生匹配教师在更丰富上下文下的预测,使模型能够通过提炼训练时可用的信息来改进,而无需外部教师
    • 理解:
      • 这里主要强调目标,通过对上述目标求导可证明,上述目标的梯度本质等价于 On-Policy Distillation(RL)形式
        • 但在实现时 RL 仅针对当前采样到的 Token 进行更新,OPD 则会针对每个 Token 位置上,全词表上(或 Student Top-\(K\) 的)候选 Token 进行更新
      • 也就是说,这个目标可以被解释为 密集奖励策略梯度 :
        $$
        r_n = \log p_T(\hat{y}_n) - \log p_S(\hat{y}_n)
        $$
        • 简单理解:将原始目标设置为 KL 散度,然后按照当前策略采样并展开成对数相减形式即可看到 Thinking Machines 的 OPD 博客中给出的形式
        • 详细证明见 (SDPO)Reinforcement Learning via Self-Distillation, 20260128 & 20260216, ETH Zurich & Max Planck Institute for Intelligent Systems & MIT & Stanford 的附录 B.1 部分(本人解读博客:NLP——LLM对齐微调-SDPO)

Key Characteristics of Math Reasoning

  • 在 LLM 中,数学推理可以被视为一种自我贝叶斯推理 (self-Bayesian reasoning)
    • 其中每一步都仅基于问题和之前生成的 Token 进行生成,模型迭代地更新其对中间假设的信念(belief) (2026)
  • 数学推理涵盖了算术、代数、几何、文字题和逻辑模式识别等多种任务,使得评估基准常常因组合和推理深度的变化而相对于训练数据属于 OOD
  • 关于任务覆盖度、其对性能的影响以及这如何将数学与其他领域区分开来的更深入讨论,请参见第 6 节
  • 在这个过程中,对 \(y\) 的语言化不确定性(称为 Epistemic Verbalization (epistemic verbalization) (2026))可以作为一种信息丰富的信号,而不仅仅是风格上的冗余
    • 如图 2(a) 所示,没有这种信号的推理可能导致模型过早地固守错误的假设,且纠正机会有限,而 Epistemic Verbalization 则有助于维持替代假设并支持逐步减少不确定性
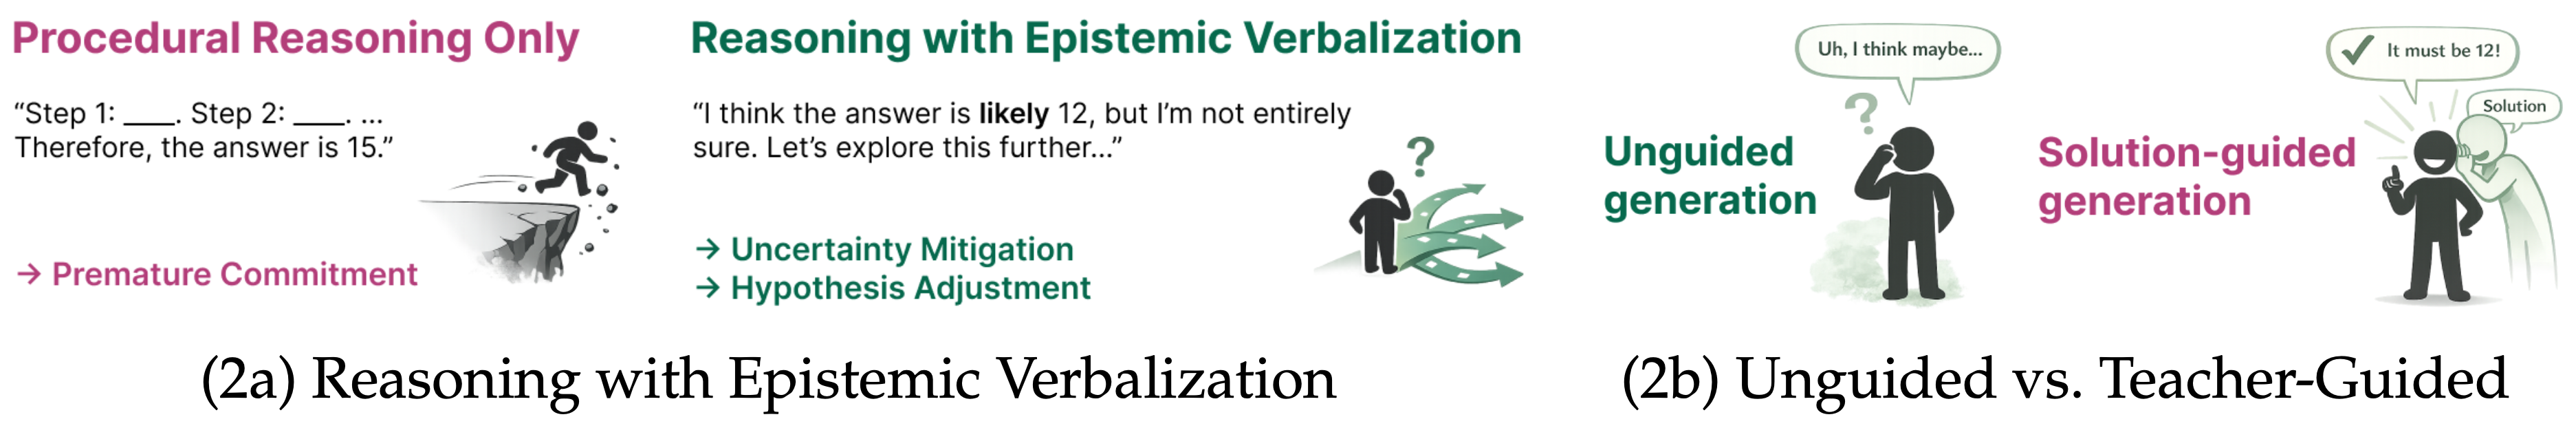
  • 在 Self-Distillation 中, Teacher 可以访问更丰富的上下文 \(c\),使其能够生成带有强提示和最小化不确定性表达的推理轨迹
    • 这会带来更简洁的响应 ,但可能会阻碍学生模型执行具有不确定性意识的推理的能力
    • 因此,激进的长度约束和过度自信的推理风格 有可能不仅消除了不必要的冗长内容 ,也消除了有价值的认知信号 (尤其是在参数知识有限的小模型中 )
  • 关键的挑战是:
    • 过滤掉非信息性内容,同时保留能够实现迭代信念修正的认知表达 ,而不是盲目地压缩推理过程

LLM Reasoning Behavior Under Richer Information,更丰富信息下的 LLM 推理行为

  • 为了形式化条件上下文的信息量,本文将 \(c\) 提供的关于目标序列 \(y\) 的信息定义为条件互信息
    $$I(y;c\mid x) = H(y\mid x) - H(y\mid x,c), \tag {2}$$
    • 条件互信息 \(I(y;c\mid x)\) 捕捉了在给定额外上下文 \(c\) 后,关于 \(y\) 的不确定性的减少量
  • 使用 DAPO-Math-17k 数据集 (2025) 和 DeepSeek-R1-Distill-Qwen-7B (2025b) 基础模型
    • 选择 100 个问题,在这些问题上,基础模型在 8 次 Rollout 中的准确率介于 0.125 和 0.5 之间
  • 定义:
    • \(s\) 表示完整解决方案(包括在 <think> 标签中的思维链)
    • \(s_{\text{th} }\) 表示移除了 <think> 内容的解决方案
    • \(\tilde{y}\) 表示之前在全解决方案指导下生成的响应
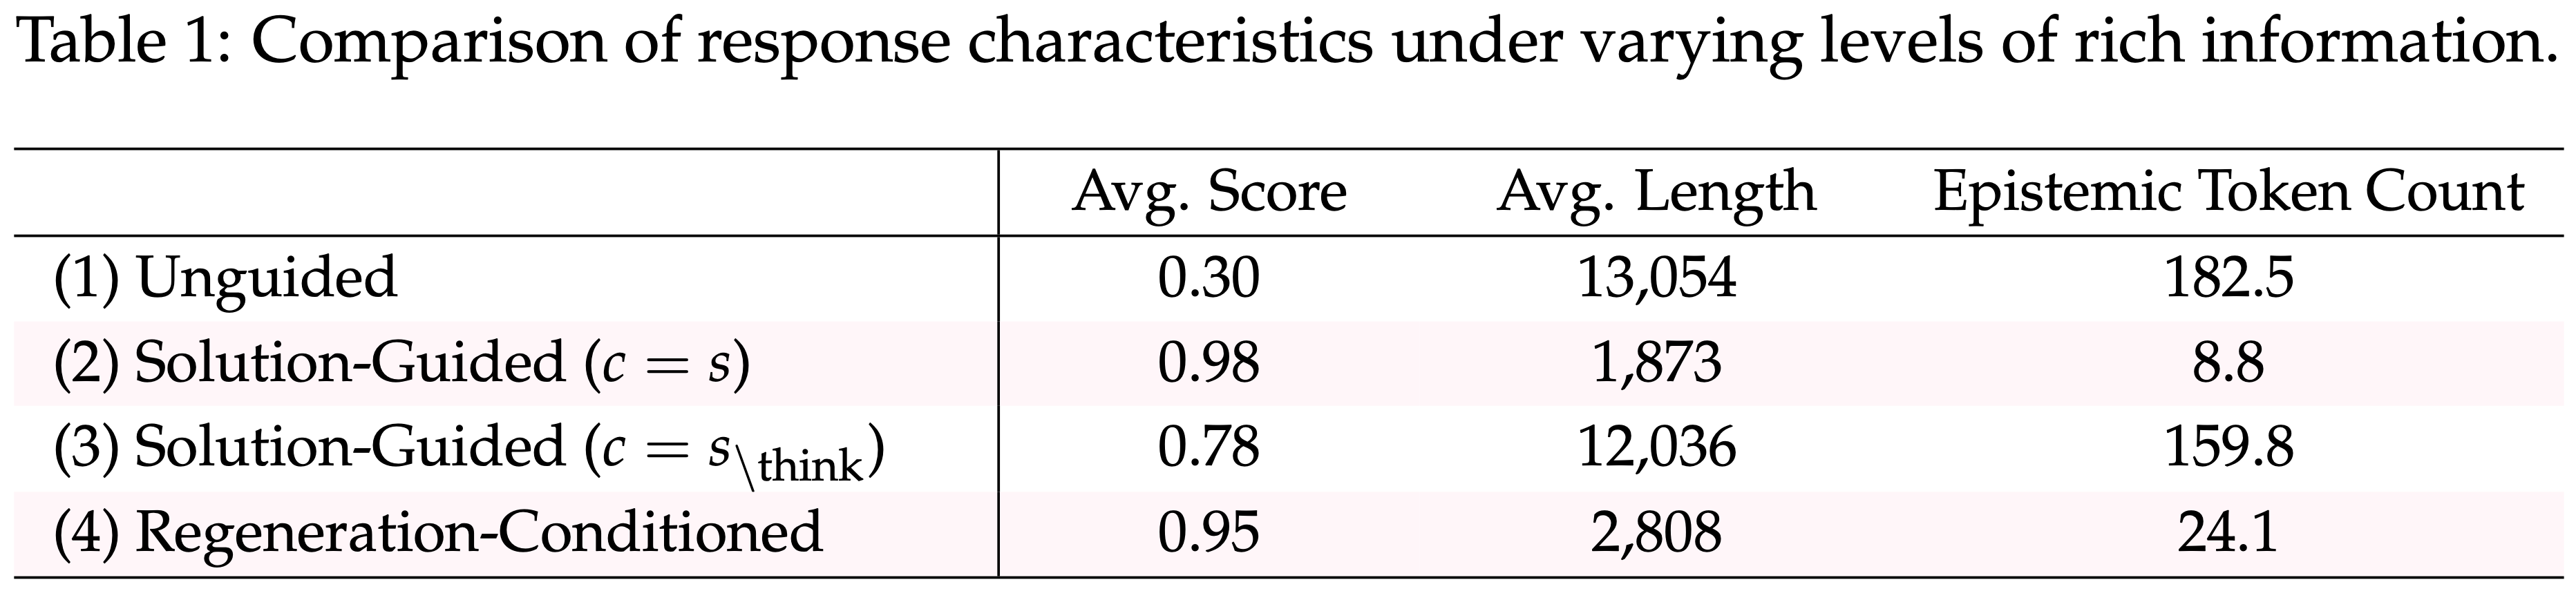
  • 本文比较了模型在四种条件信息递增的生成设置下的响应:
    • (1) 无引导生成 (Unguided generation):
      $$ c = \emptyset $$
      • 此时 \(I(y;c\mid x) = 0\)
    • (2) 解决方案引导生成 (Solution-guided generation):
      $$ c = s $$
      • 提供最大引导,并产生最大的 \(I(y;c\mid x)\)
    • (3) 解决方案引导生成(无 think 内容)(Solution-guided generation (without think contents)):
      $$c = s_{\text{\think} }$$
      • 由于 \(s_{\text{\think} }\) 是 \(s\) 的一个严格信息子集,于是有
        $$ I(y;s_{\text{\think} }\mid x)\leq I(y;s\mid x) $$
    • (4) 重生成条件生成 (Regeneration-conditioned generation):
      $$ c = \tilde{y} $$
      • 其中 \(\tilde{y}\) 是在设置 (2) 下生成的,于是有:
        $$ I(y;\tilde{y}\mid x)\leq I(y;s\mid x) $$
        • 理解:文章中没有非常明确这里的 \(\tilde{y}\) 具体是如何生成的,但这里应该是基于 Setting 2 中的完整方案,再让模型重新生成一次得到的结果,目前推测这个结果应该是也包含 Thinking 信息的
  • 这些设置引出了以下关于条件互信息的排序:
    $$\underbrace{I(y;c\mid x)}_{(1)} = 0< \underbrace{I(y;s_{\text{\think} }\mid x)}_{(3)}\leq \underbrace{I(y;\tilde{y}\mid x)}_{(4)}\leq \underbrace{I(y;s\mid x)}_{(2)} \tag {3}$$

Prompts

  • Prompts 用于无引导和解决方案引导设置的提示词如下

  • 对于重生成,本文使用了与 Hübottter 等 (2026) 相同的提示词

    • Prompt for unguided generation:

      1
      2
      {question}
      Please reason step by step, and put your final answer within \boxed{}.
    • Regeneration prompt (followed the prompt in Hübottter et al. (2026))

      1
      2
      3
      4
      {question}
      Please reason step by step, and put your final answer within \boxed{}.
      Correctsolution: {previously correct solution}
      Correctly solve the original question.
      • 理解:Regeneration 时,给出标准答案,再让模型解决问题

      Epistemic tokens, Epistemic Token

  • Following Kim 等 (2026),本文作者定义了一组 10 个认知性标记(Epistemic Markers)作为不确定性外化可能发生区域的实用指标:
    $$ \mathcal{T} = \{\text{wait, hmm, perhaps, maybe, actually, alternatively, seems, might, likely, check}\} $$

  • 本文测量一个响应 \(y\) 的 Epistemic Token 数量为
    $$ E(y) = \sum_{t \in \mathcal{T} } \text{count}(t, y) $$

Results

  • 分析不同形式的解决方案引导如何影响模型的推理行为
    • 比较四种设置下的平均响应长度 \(\mathbb{E}[L(y)]\)、模型分数和 Epistemic Token 数量 \(\mathbb{E}[E(y)]\)
  • 如表 1 所示,这两个量都随着 \(I(y; c \mid x)\) 的增加而单调递减:
    $$\mathbb{E}[L(y)]\Big|_{(1)} > \mathbb{E}[L(y)]\Big|_{(3)} > \mathbb{E}[L(y)]\Big|_{(4)} > \mathbb{E}[L(y)]\Big|_{(2)}, \tag {4}$$
    • 并且对于 \(\mathbb{E}[E(y)]\) 也是如此
    • 证实了更丰富的条件信息会导致更简洁和自信的推理
  • 无引导生成 \((c = \emptyset)\) 产生了明显更长的响应和最高的 Epistemic Token 数量
  • 当在 (2) 中提供完整解决方案 \(s\) 时,模型以高置信度遵循给定的推理轨迹,其简洁输出可以看作是 \(s\) 中基本推理的压缩表示
  • 在 (3) 中,移除 <think> 部分仅保留 \(s_{\backslash \text{\think} }\) (13,054 个响应 Token 中的 640 个)
    • \(\mathbb{E}[L(y)]\) 和 \(\mathbb{E}[E(y)]\) 都再次向无引导水平增加,反映了显著的信息损失
  • (4) 依赖于重生成的响应 \(\tilde{y}\),产生了中间值(低于 (3) 但高于 (2))
    • 表明 \(\tilde{y}\) 保留了完整解决方案的大部分信息结构
  • 详细的每个 Token 的分解见附录 A.1.1
Takeaway 1: Information Richness and Epistemic Verbalization
  • 随着条件上下文 \(c\) 变得越来越信息丰富且直接有用,LLM 生成的答案更加自信,并且认知性不确定性表达更少

Supervised Finetuning with Self-Distillation,使用 Self-Distillation 进行 SFT

  • 问题提出:在高 \(I(y; c \mid x)\) 下对 Epistemic Verbalization 的抑制仅仅是风格上的变化,还是对推理能力有切实的影响
  • 为了验证这一点,本文使用 DeepSeek-R1-Distill-Qwen-7B (2025a) 在两个数据集上进行了 Off-policy Self-Distillation(即 SFT)
    • 每个数据集包含 800 个正确响应:
      • \(\mathcal{D}_{\text{ug} }\):无引导响应 \((c = \emptyset)\),具有高 \(\mathbb{E}[E(y)]\) 和 \(\mathbb{E}[L(y)] \approx 12k\) Token
      • \(\mathcal{D}_{\text{sg} }\):解决方案引导响应 \((c = s)\),具有低 \(\mathbb{E}[E(y)]\) 和 \(\mathbb{E}[L(y)] \approx 2k\) Token
  • 两个数据集都由完全正确的轨迹组成;关键区别在于训练信号的认知密度
    • 本文在多个数学基准上评估了得到的检查点(每个数据集的示例在作者的博客:Why Does Self-Distillation (Sometimes) Degrade the Reasoning Capability of LLMs? 中展示)
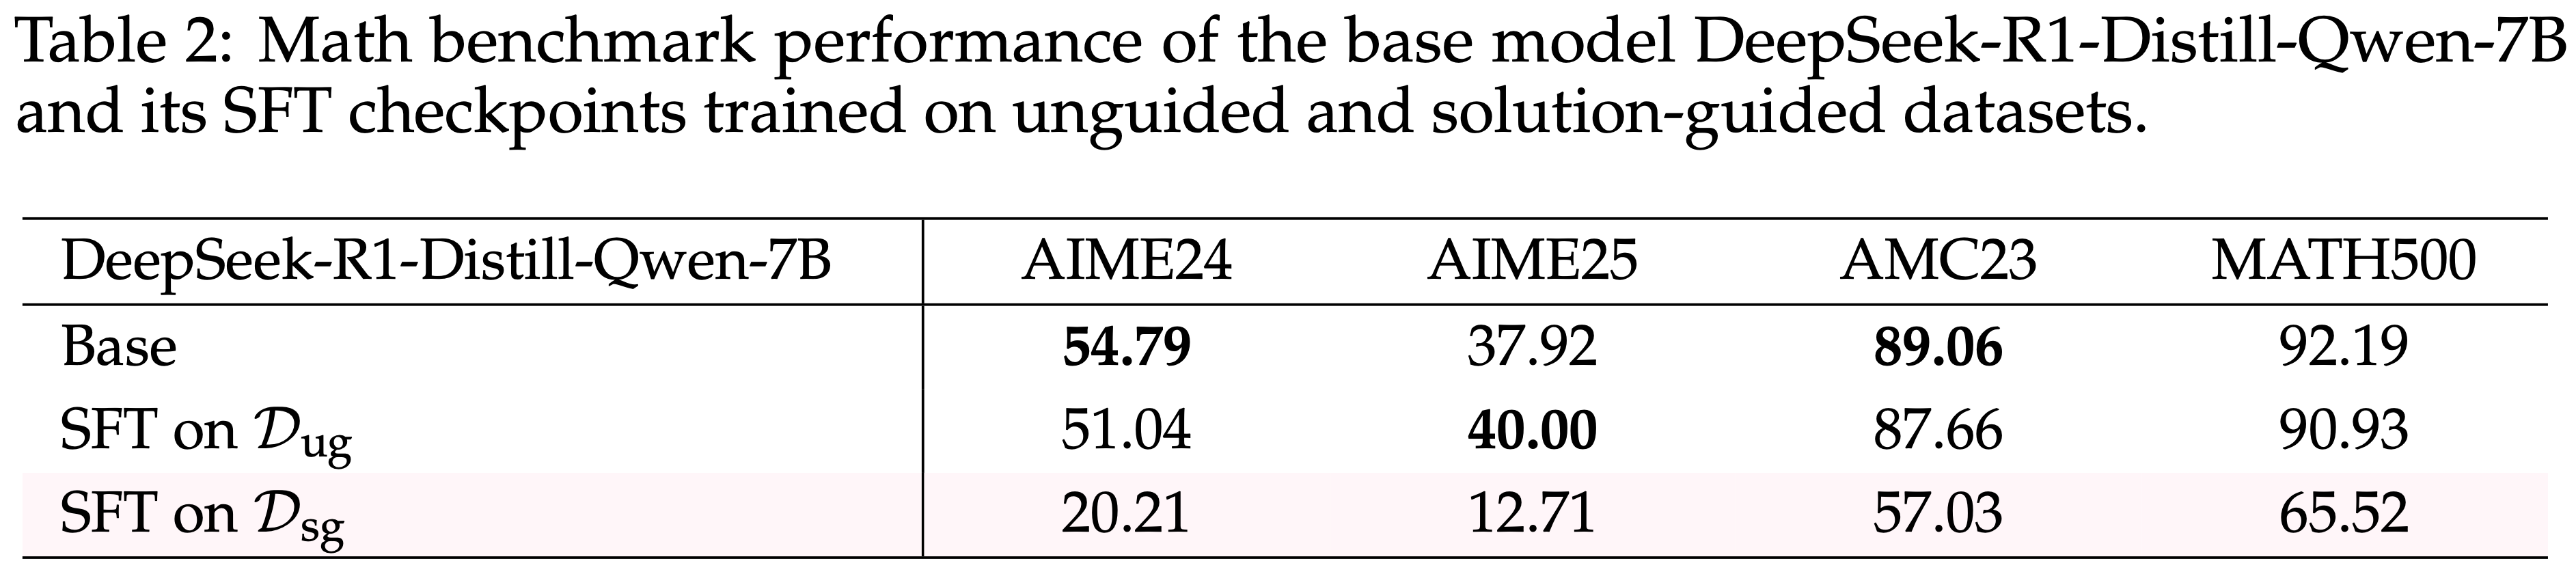
  • 如表 2 所示,数据集由正确答案组成
    • 在 \(\mathcal{D}_{\text{sg} }\) 上训练导致了所有基准上的显著性能下降
    • 在 \(\mathcal{D}_{\text{ug} }\) 上训练则没有产生显著的性能变化
    • 这种不对称性产生的原因是
      • 解决方案引导的响应之所以简洁,正是因为外部上下文 \(s\) 的存在
      • 在没有 \(s\) 的情况下将它们用作 SFT 目标,迫使模型模仿一种预设了推理时无法获得的信息的推理风格,从而有效地抑制了支持自主探索和错误修正的 Epistemic Token
    • 这些结果与 Kim 等 (2026) 一致,该研究表明抑制 Epistemic Verbalization 会显著降低推理性能

Epistemic Suppression and Reasoning Performance

  • 即使在正确的轨迹上进行训练,过度抑制 Epistemic Verbalization 也可能严重损害推理性能

On-Policy Self-Distillation

  • On-Policy Self-Distillation (2026;) 中,模型从自教师提供的奖励信号中学习,该教师可以访问正确的解决方案,并基于当前策略的响应
  • 具体做法:
    • 在 DAPO-Math-17k 数据集 (2025) 上,使用 Qwen3-8B (2025) 和 DeepSeek-R1-Distill-Qwen-7B (2025b) 作为基础模型,比较了 GRPO 和基于 Self-Distillation 的强化学习 (Reinforcement Learning via Self-Distillation, SDPO) (Hü2026)
      • 关于 Olmo-3-7B-Instruct (2025) 的附加结果见附录 D.2
    • 对于每个模型,跟踪训练得分和响应长度,以及在两个标准数学基准 AIME24 和 AMC23 上的 OOD 性能
      • 将教师策略固定为初始策略,而不是使用移动目标 ,因为这能获得更好的性能 (关于比较见第 5.4 节)
  • On-Policy Self-Distillation 的行为取决于两个因素:
    • (i) 基础模型已经表现出的认知口头化程度
    • (ii) 条件上下文 \(c\) 的丰富程度
  • 为了厘清这些因素,本文在两种设置下比较了 GRPO 和 SDPO:
    • \(c = s\)(完整解决方案)
    • \(c = s_{\text{\think} }\)(去除 <think> 内容的解决方案)

DeepSeek-R1-Distill-Qwen-7B

  • DeepSeek-R1-Distill-Qwen-7B 是一个代表性的高推理能力模型
    • DeepSeek-R1-Distill-Qwen-7B 以其在 <think> 标签内生成大量 Epistemic Verbalization 和产生长响应而闻名,实现了强大的推理性能
Training Performance
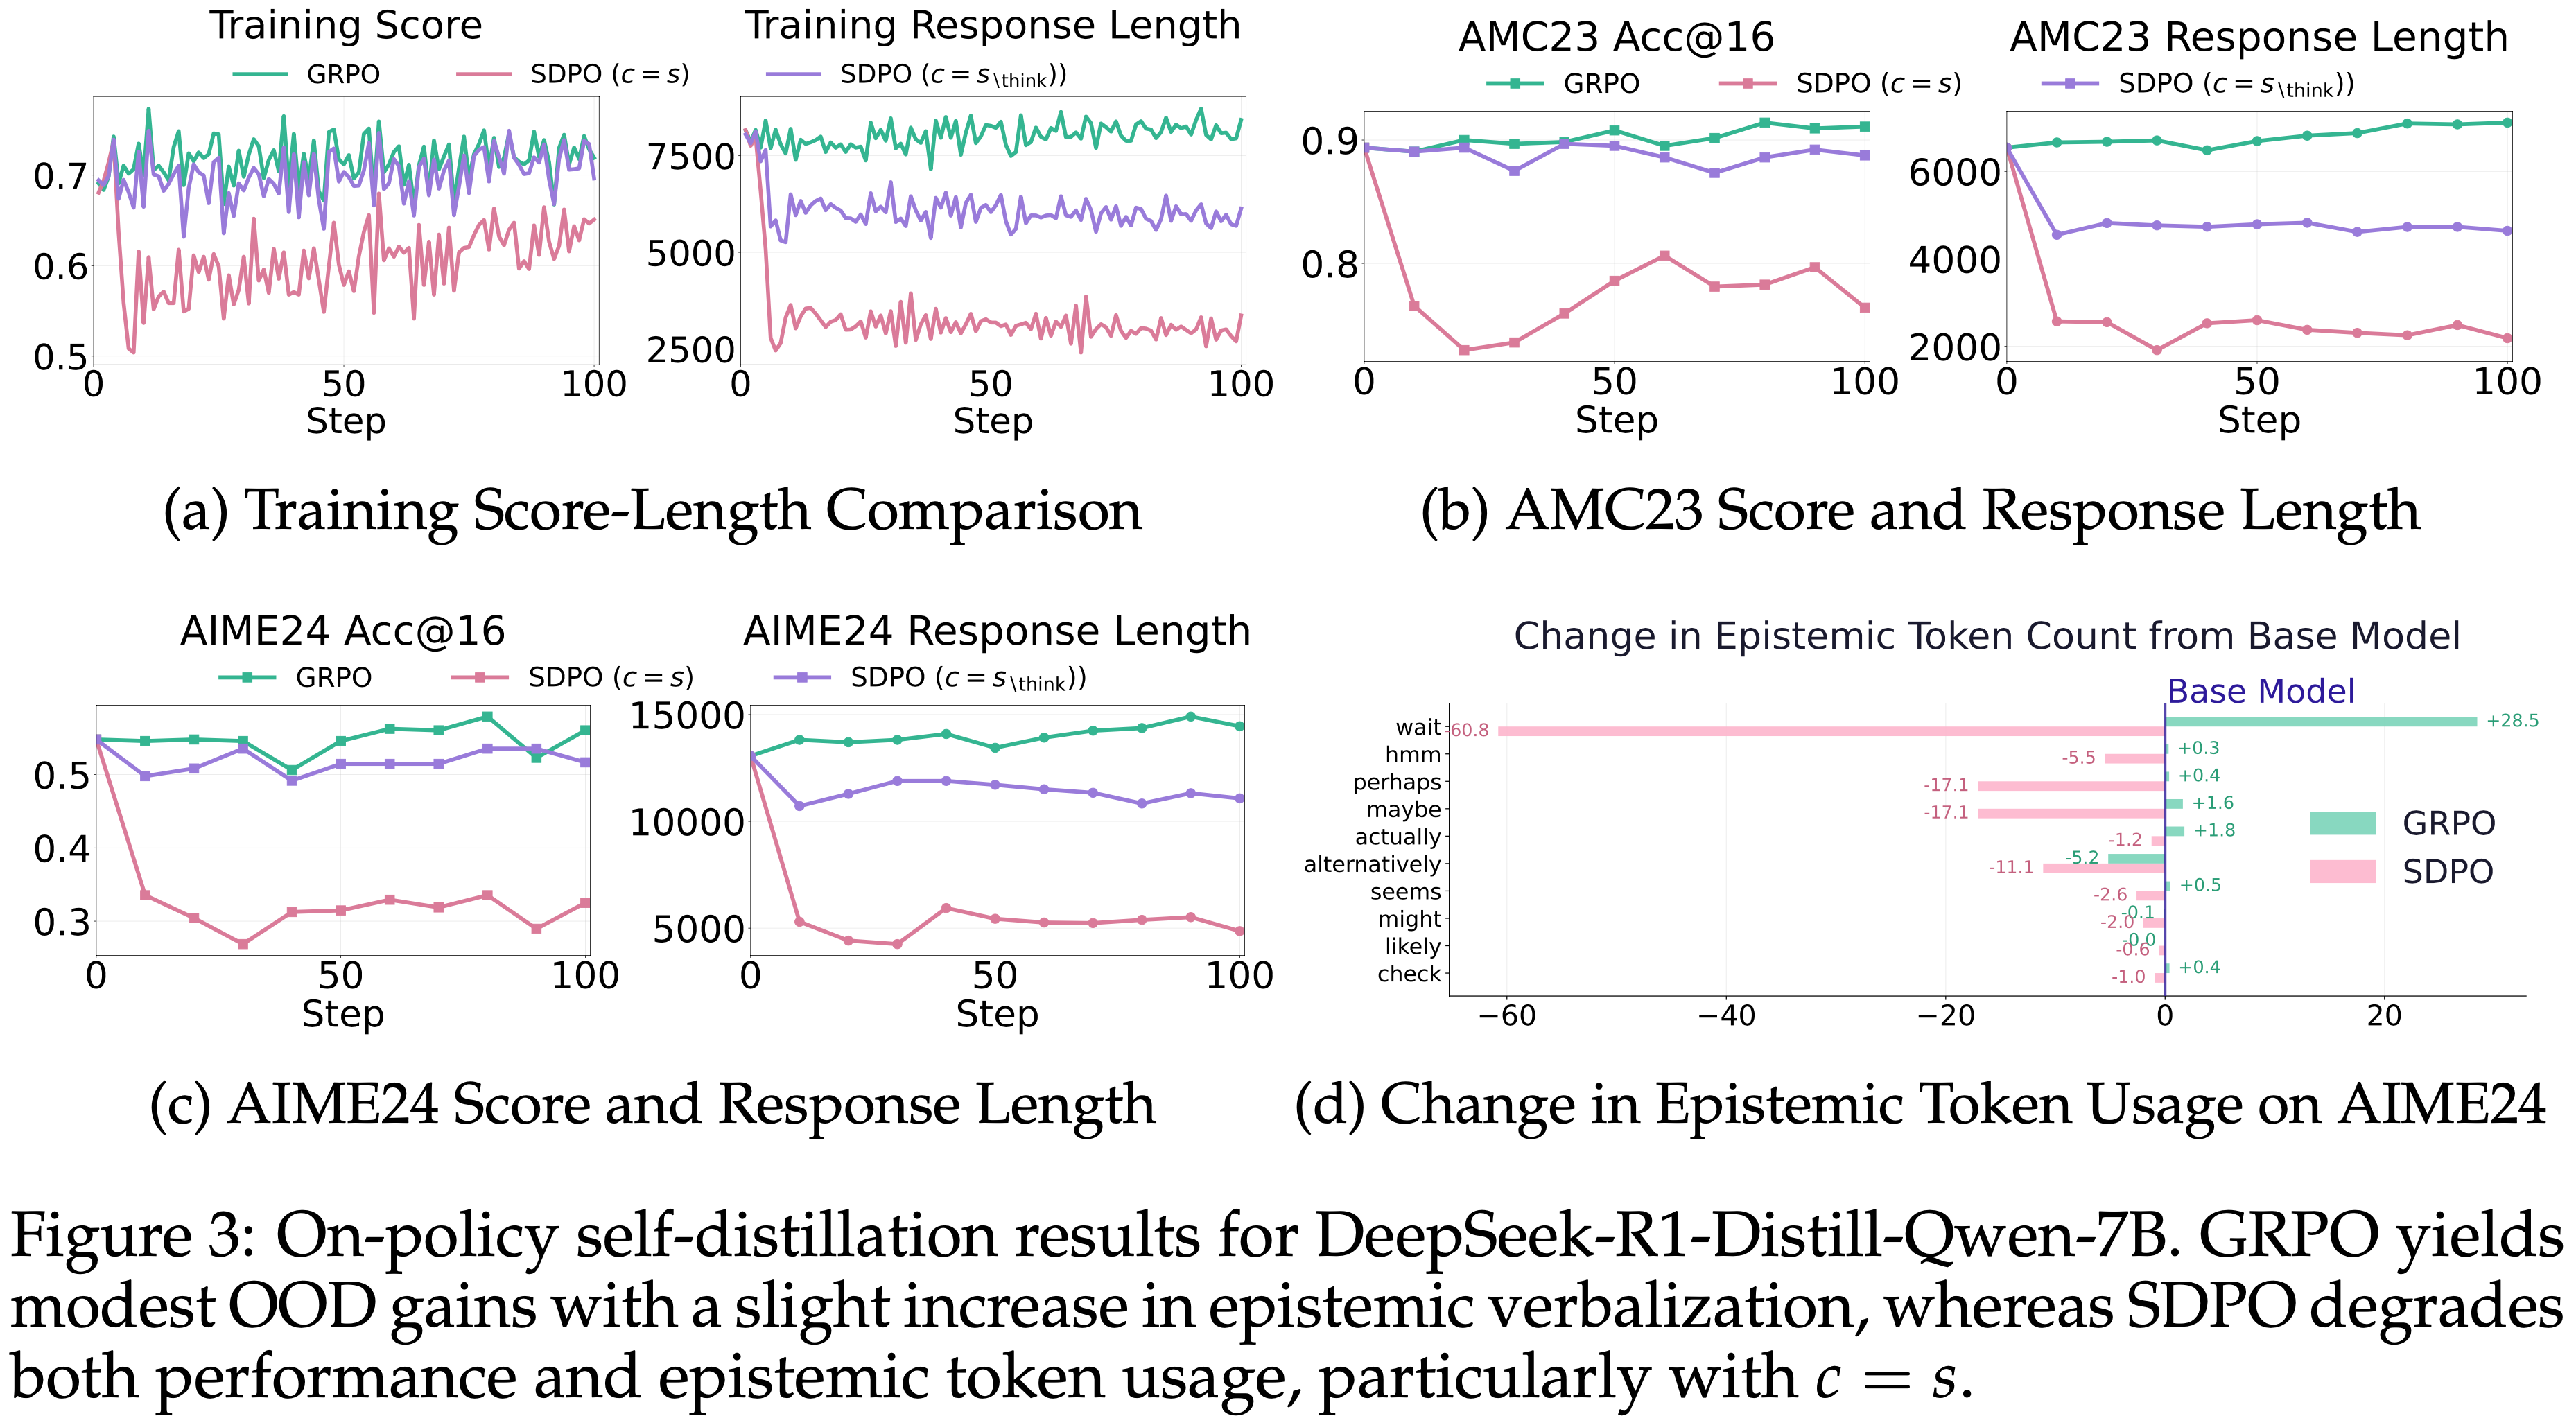
  • 如图 4a 所示
    • GRPO 训练略微增加了 \(\mathbb{E}[L(y)]\),同时得分略有提高
    • 采用 \(c = s\) 的 SDPO
      • \(\mathbb{E}[L(y)]\) 和得分都出现急剧的初始下降,然后性能逐渐恢复
      • 但在整个训练过程中仍低于 GRPO
    • 采用 \(c = s_{\text{\think} }\) 的 SDPO
      • \(\mathbb{E}[L(y)]\) 的下降幅度减弱,得分轨迹接近 GRPO
      • 这与第 3 节讨论的 \(I(y; c \mid x)\) 与认知抑制之间的关系一致
OOD Evaluation - AIME24, AMC23
  • 与训练趋势一致:
    • GRPO 在两个 OOD 基准测试上都取得了适度的提升(图 3b 和 3c),同时 \(\mathbb{E}[L(y)]\) 略有增加
      • AIME24: \(54.7 \rightarrow 56.0\)
      • AMC23: \(89.3 \rightarrow 91.1\)
    • 采用 \(c = s\) 的 SDPO 显著降低了性能
      • AIME24 上约 \(40%\)
      • AMC23 上约 \(15%\)
    • 采用 \(c = s_{\backslash \text{\think} }\) 的 SDPO 缓解了性能下降
      • 但性能仍低于基础模型
Reasoning Pattern
  • 图 3d 展示了训练后模型的 Epistemic Token 计数
  • GRPO 增加了 \(\mathbb{E}[E(y)]\),而 SDPO 则更激进地抑制了它,这与作者在整个分析中观察到的认知抑制与性能下降之间的相关性一致
    • 回顾 \(\mathbb{E}[E(y)]\) 是 Epistemic Token Count

Qwen3-8B (Thinking Mode: ON)

  • 启用思考模式后,Qwen3-8B 最初生成的响应非常长,甚至比 DeepSeek-R1-Distill-Qwen-7B 还要长,同时伴随着大量的 Epistemic Token
  • 详情见附录 A.1.2 所示
Training Performance
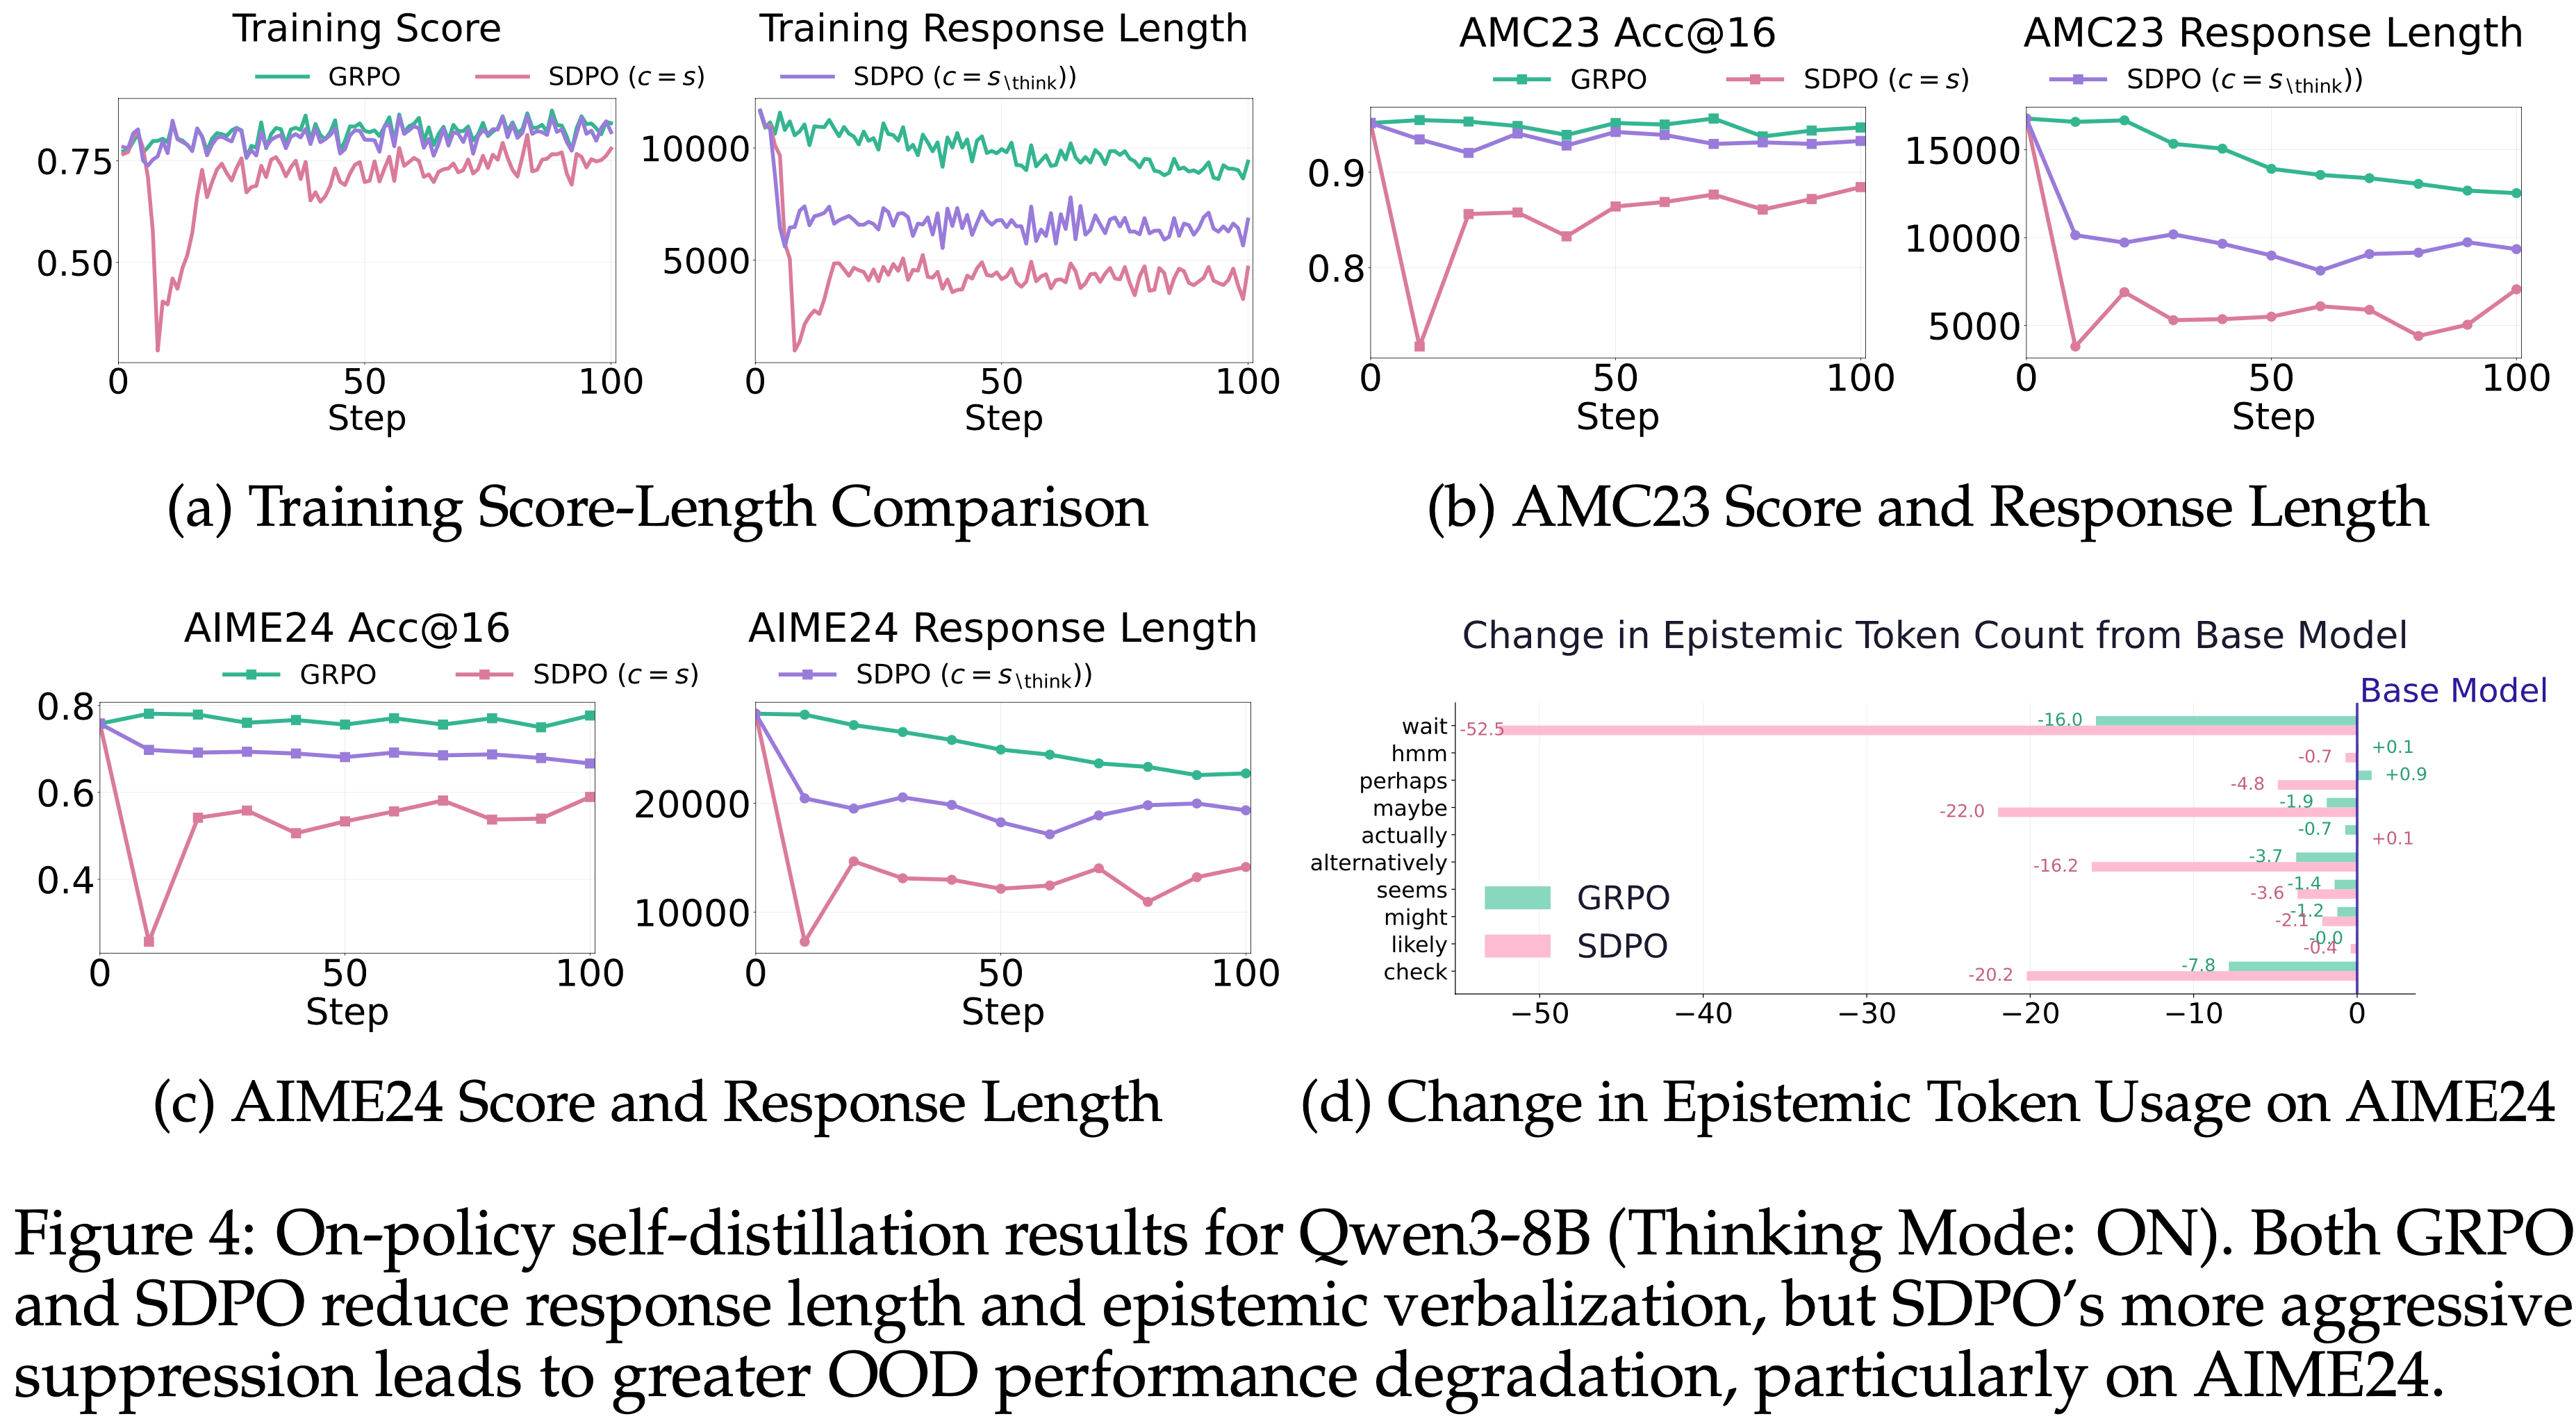
  • 如图 4a 所示
    • 在 GRPO 和 SDPO 下,\(\mathbb{E}[L(y)]\) 均有所下降
      • 其中 SDPO 表现出更大的下降幅度和相应的更大性能下降
        • Notably,\(\mathbb{E}[L(y)]\) 首先急剧下降,然后略有上升
        • 由于教师策略被固定为参考策略,将响应缩短约 \(900\) 个 Token 会降低 \(c\) 的信息量,即减小 \(I(y; c \mid x)\)
          • 随着上下文信息量减少,模型通过增加 Epistemic Verbalization 来补偿,导致长度部分恢复
          • 问题:这里的教师策略是参考策略的话,训练过程中教师策略应该是不变的,这时候为什么 \(c\) 的信息量会减小?大约减少 900 个 Token 的数字是从哪里看出来的(图 4 中给出的长度降幅都远远高于 900 个 Token)?
OOD Evaluation - AIME24, AMC23
  • 这种差距在 OOD 基准测试上变得更加明显:
    • GRPO 在 \(\mathbb{E}[L(y)]\) 逐渐下降的同时保持了基本稳定的性能
    • SDPO 则降至基础模型以下,尤其是在 \(c = s\) 的情况下
  • GRPO 和采用 \(c = s_{\backslash \text{\think} }\) 的 SDPO 达到了相当的训练性能
    • 但它们的 OOD 结果却出现分歧,尤其是在更具挑战性的 AIME24 上(AIME23 上还好)
    • 采用 \(c = s_{\backslash \text{\think} }\) 的 SDPO 随着训练的进行表现出逐渐的性能下降
Reasoning Pattern
  • GRPO 和 SDPO 两种方法相对于基础模型都降低了 \(\mathbb{E}[E(y)]\),但 SDPO 更为激进
  • 这表明 Qwen3-8B 最初产生的 Epistemic Verbalization 比必要的更多
  • 虽然两种方法都减轻了这种冗余,但过于激进的抑制可能会移除携带有用推理信息的认知信号

Qwen3-8B (Thinking Mode: OFF)

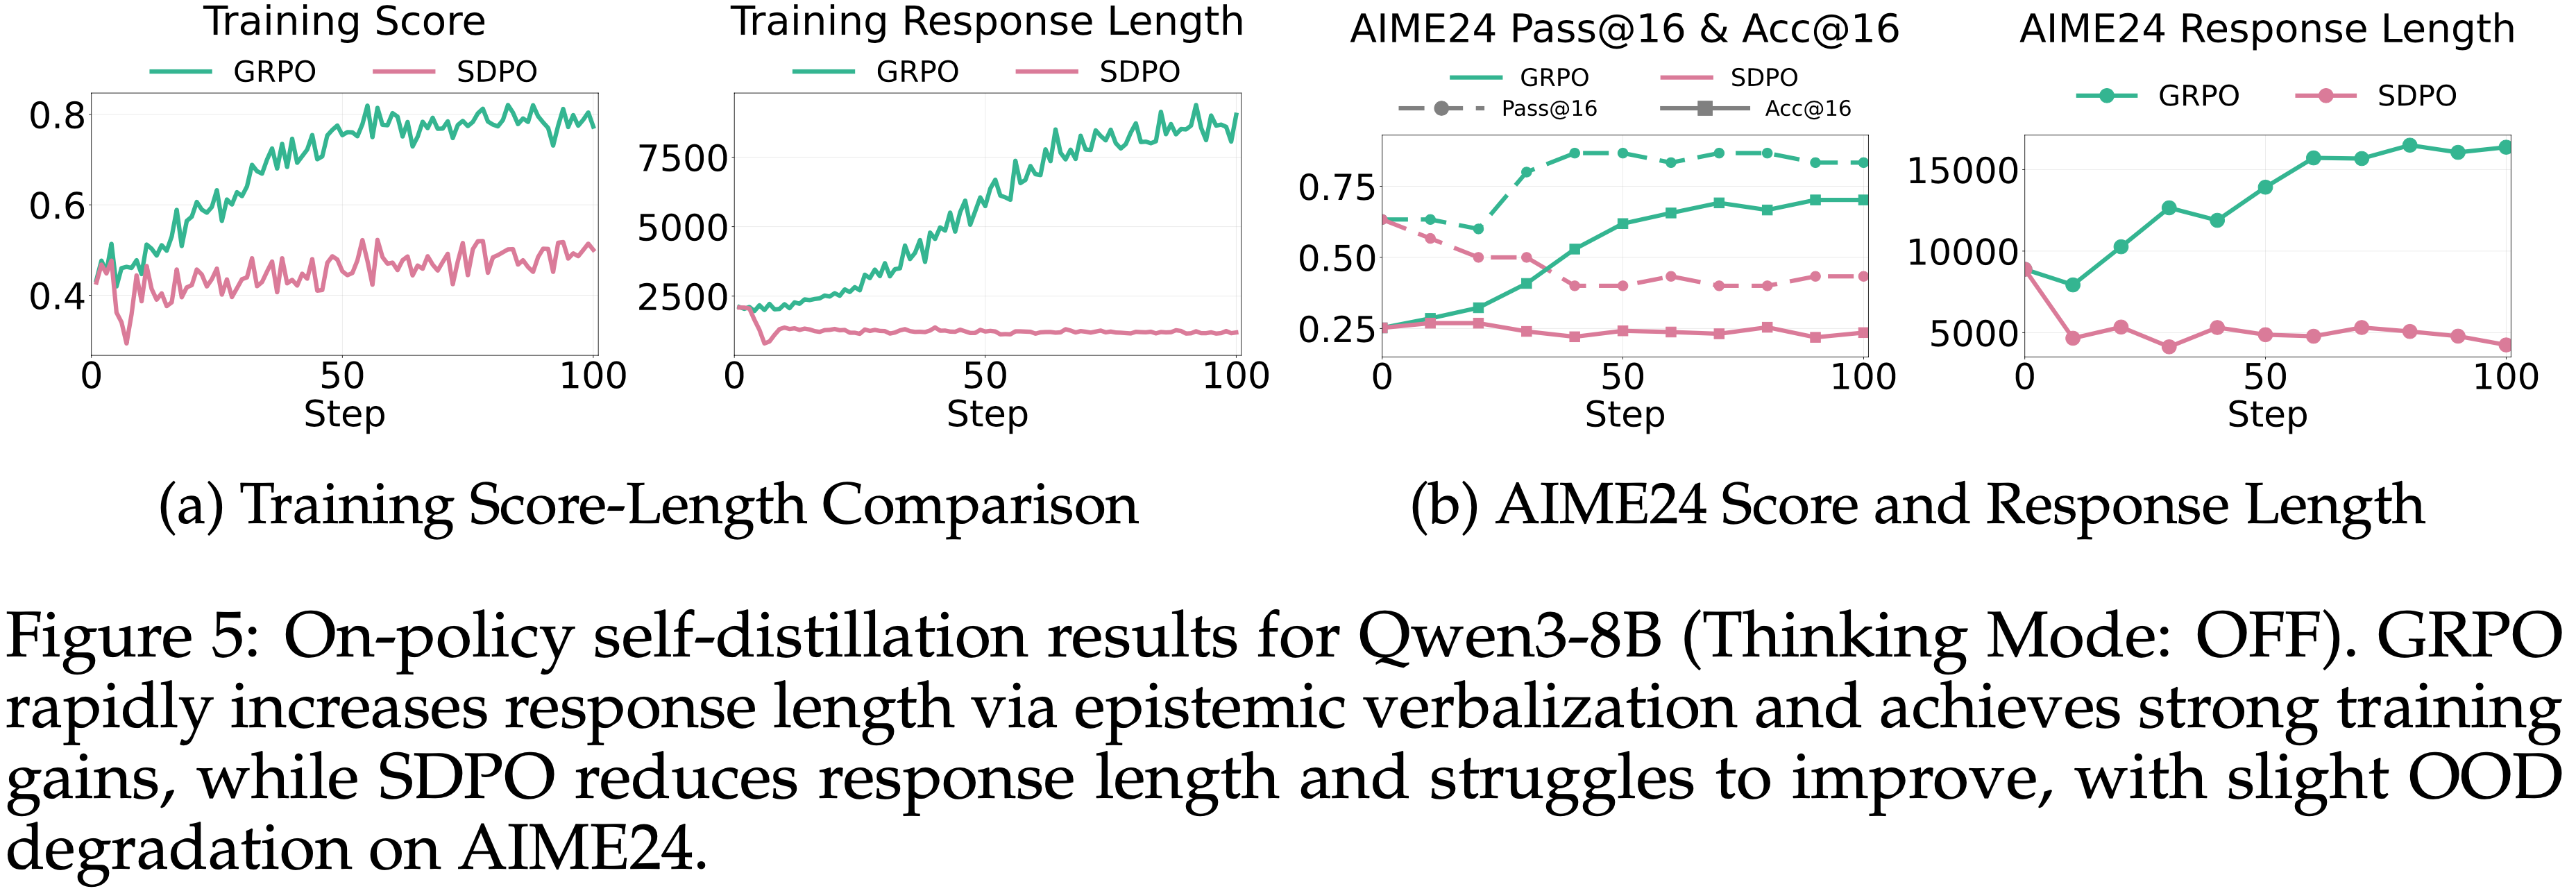
  • 当 Qwen3-8B 在不使用思考模式的情况下使用时,<think> 标签不存在,只比较 \(c = s\)
    • Qwen3-8B 最初产生的响应要短得多,并且表现出显著降低的性能
    • GRPO 通过促进 Epistemic Verbalization (如附录 D.1 所示)迅速增加了 \(\mathbb{E}[L(y)]\),快速达到了高训练得分
    • SDPO 减少了 \(\mathbb{E}[L(y)]\) 并且改进速度慢得多
      • 如图 5b 所示,训练得分略有增加,但 AIME24 上的测试性能略有下降 \((0.25 \rightarrow 0.23)\)
      • 这进一步说明了 Self-Distillation 下认知抑制的代价
Takeaway 3: Epistemic Verbalization Changes and Performance in On-Policy Self-Distillation
  • 随着教师上下文 \(c\) 变得信息更丰富, On-Policy Self-Distillation 会减少 Epistemic Verbalization 并缩短响应
  • 这种效应因基础模型最初表达的不确定性水平而异
    • 理解(初始模型的长度和 Epistemic Verbalization 等决定了使用 不同算法训练时观察到的 现象):
      • 如原始 Qwen3-8B (Thinking Mode: ON) 生成的响应非常长,且包含大量的 Epistemic Token
        • 此时训练 GRPO/SDPO 都会缩短长度,且 GRPO 和 采用 \(c = s_{\backslash \text{\think} }\) 的 SDPO 的分数差不多
      • Qwen3-8B (Thinking Mode: OFF) 则回答很短
        • 此时训练 GRPO 会提升长度,而 采用 \(c = s_{\backslash \text{\think} }\) 的 SDPO 则会降低长度

Ablation Study: Fixed vs. Moving Target Teacher,固定 Teacher 模型 or 滑动 Teacher 模型

  • 在朴素的 On-Policy Self-Distillation 中,教师和学生共享一个持续更新的策略
    • 此时教师是一个移动目标,可能引入训练不稳定性 (2026; 2026)
  • 为了缓解这个问题,SDPO 使用 EMA 平滑的教师(EMA 率:0.05)
    • 进一步的实验发现,将 EMA 率设置为 0.0(即固定教师为初始策略)能获得更好的性能(注:第 5 节遵循此设置)
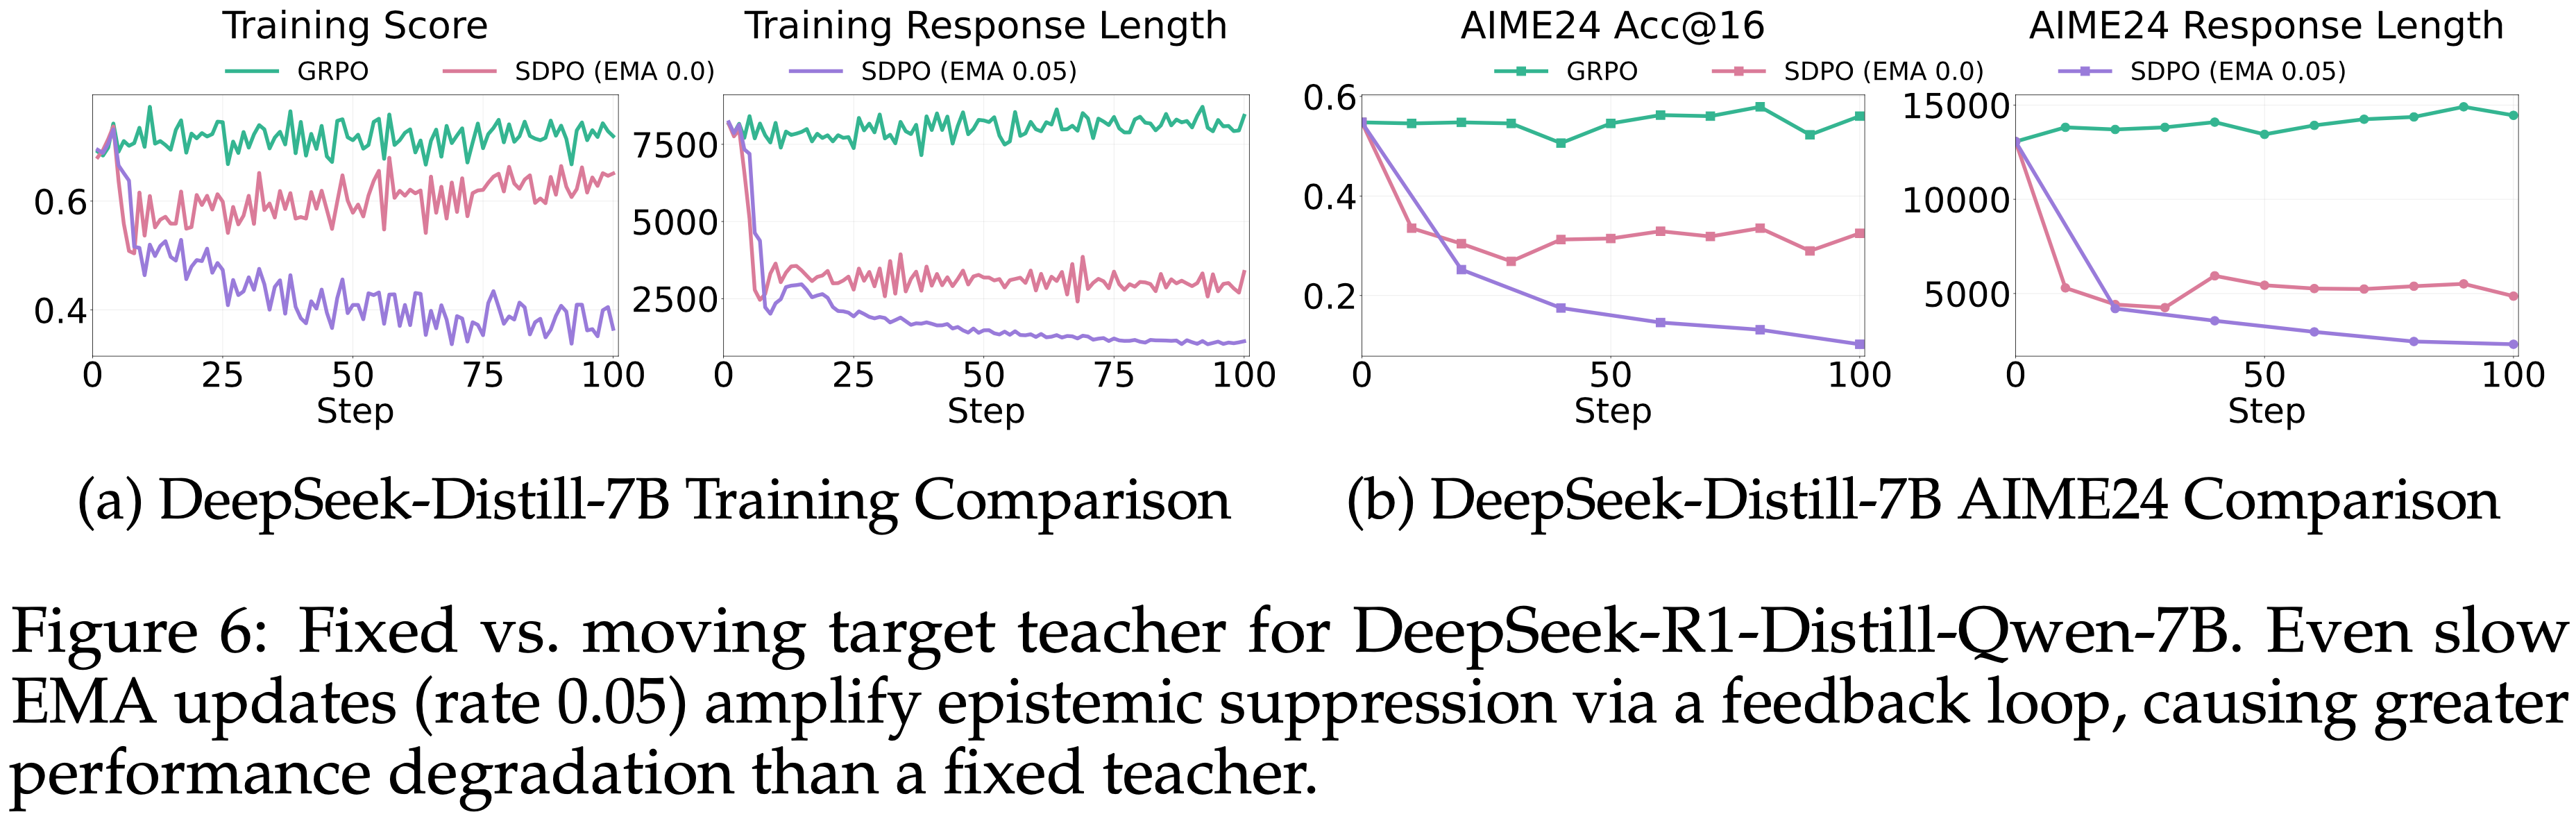
  • 图 6: DeepSeek-R1-Distill-Qwen-7B 的固定教师与移动目标教师对比
    • 即使缓慢的 EMA 更新(率 0.05)也会通过反馈循环放大认知抑制,导致比固定教师更严重的性能下降
  • 图 6a 显示了在训练期间更新教师时的额外比较结果
    • 即使是缓慢的更新(例如,率 0.05)也会导致响应长度更急剧的减少,从而导致更大的性能下降
    • 这可以解释为 Self-Distillation 中的一个反馈循环:
      • 模型被训练产生越来越自信的输出,当使用同一个模型的 checkpoint 作为教师时,它会产生更自信的响应 ,从而在迭代中放大这种效应
        • 个人理解1:这个理解应该不对,个人理解应该是这样的:
          • 模型训练过程中本来就是越来越自信的,这个现象其实说明收敛快,并不一定是坏事
        • 个人理解2:从另一个视角看,持续变化的 Teacher 会导致目标(Teacher)一直在变化,不利于模型(Student)收敛,这类似 DQN 中最早面临的问题(使用的 Target Q 可缓解这个问题),所以 OPSD 中 实验发现这一设置有助于稳定训练
        • 个人理解3:使用初始的策略作为 Teacher,能隐式起到正则化作用,防止模型过度偏离初始策略 (观点来自 OPSD 中)
    • 问题(推测):如果 Teacher 不随着 Student 策略变化,那么 Teacher 的上限太明显了
      • 建议考虑以一定的间隔或较小的 EMA 更新参数(比如间隔 100 步或 EMA 系数=0.01 等),类似 DQN 中 Target Q 的实现,这样才能打开 Teacher 的上限
      • 但需要特别注意训练稳定性以及对原始策略的偏离程度(比如加一个 KL 散度来缓解,或者第一步更新前的策略给与固定高权重?)
  • 关于学习率和 top-k logits 的进一步消融研究见附录 E

Relationship Between Task Coverage, Epistemic Verbalization and Generalization Ability,任务覆盖 & Epistemic Verbalization 与泛化能力的关系

  • 上述分析可知,不论 Off-policy 还是 On-policy Setting
    • Self-Distillation 都会一致地产生更自信的响应,并降低了 \(\mathbb{E}[E(y)]\)
      • 问题:Off-policy 的 Self-Distillation 是什么?
      • 回答:是第 4 节开头提到的 SFT,在 SFT 上,也观察到了类似 \(\mathbb{E}[E(y)]\) 降低的现象
    • 这与 Hübottter 等 (2026) 的发现一致,该报告指出 SDPO 学会了简洁地推理:
      • 在科学问答(化学、物理、生物学和材料科学)(2024)、工具使用 (2023) 和 LiveCodeBench v6 (2025) 上,SDPO 在产生更短输出、更少认知标记的同时,实现了比 GRPO 更高的准确率
  • 在这些领域中, Self-Distillation 抑制了 Epistemic Verbalization ,同时提高了性能
  • 关键问题提出:为什么相同的机制在数学聚焦 Setting 中会导致性能下降?
    • 本文作者推测答案在于训练分布和评估分布之间任务覆盖的差异

Comparison of Task Coverage

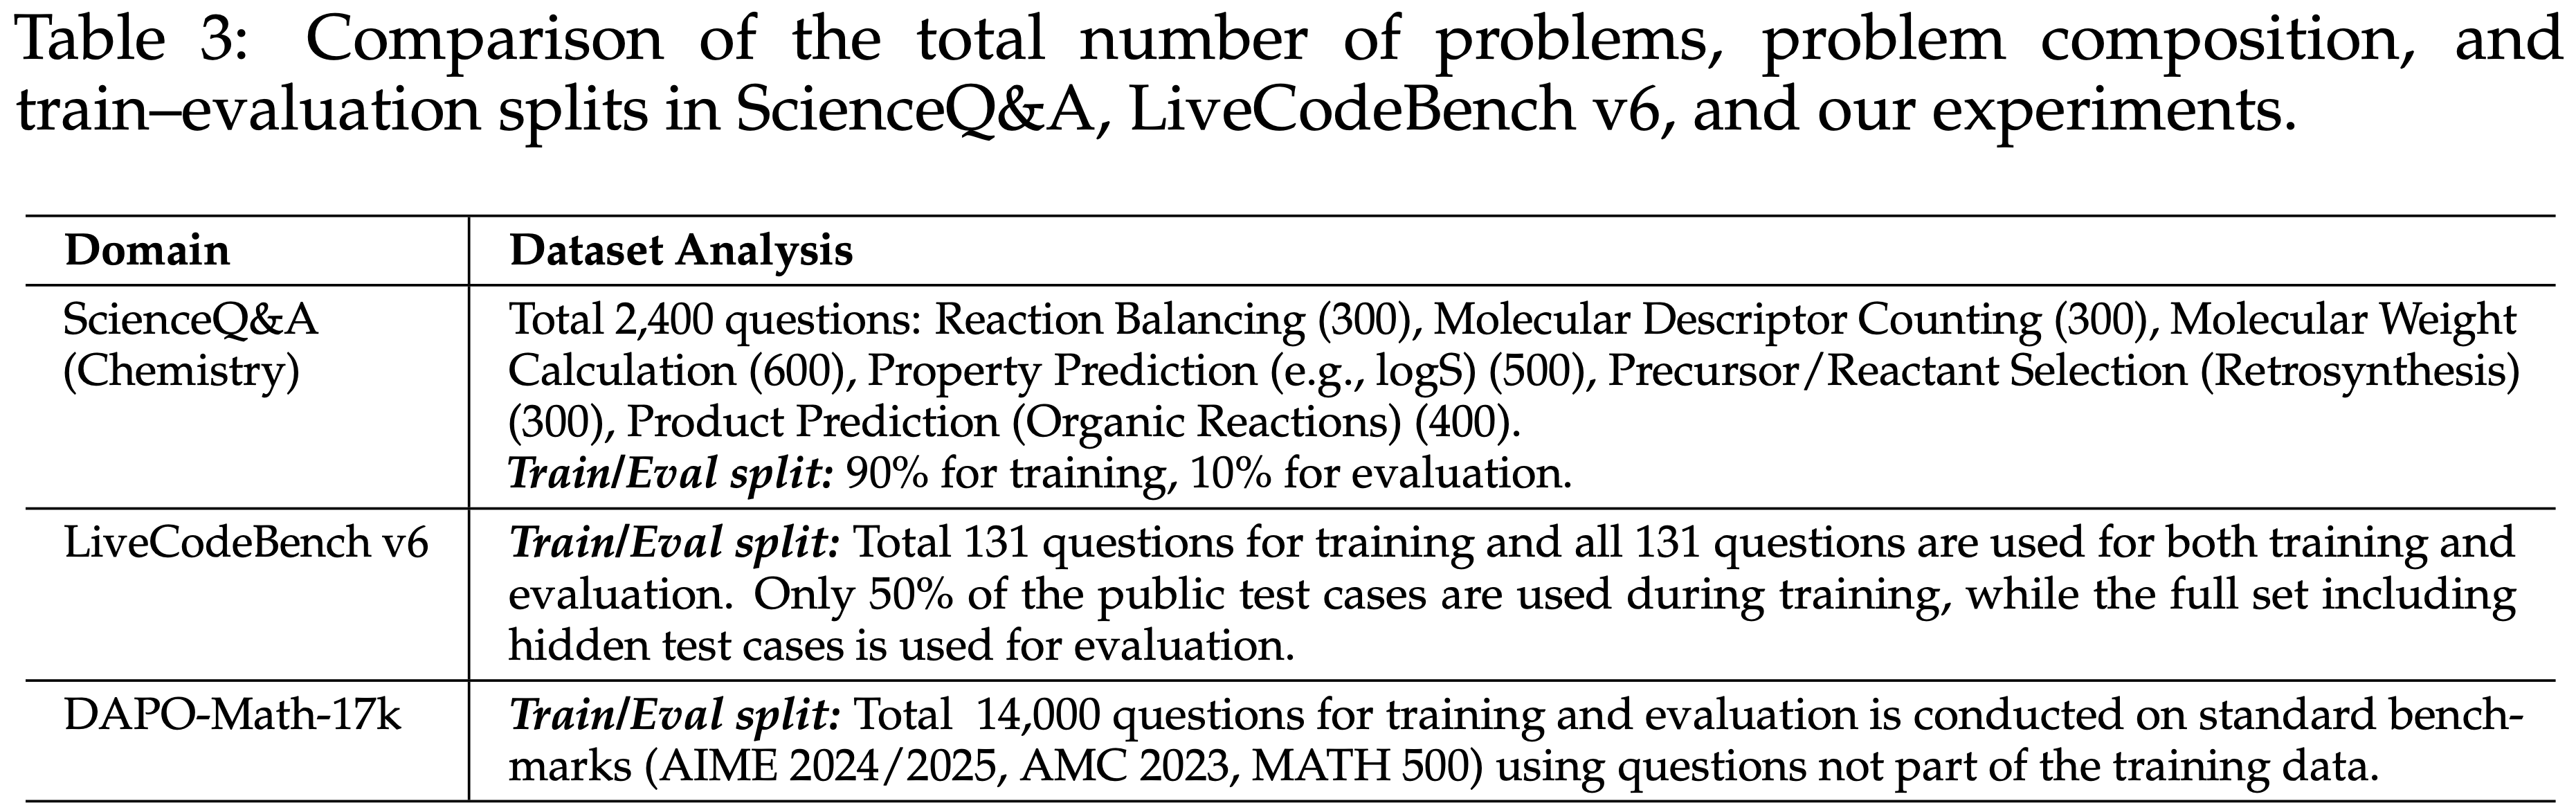
  • 为了验证这个 hypothesis,作者比较了 SDPO 优于 GRPO 的设置与本文实验设置的数据集特征
  • 如表 3 所示
    • 化学数据集虽然规模庞大,但仅来自六种主要问题类型
      • 这些类型主要在表面细节上有所不同,而非底层结构
    • LiveCodeBench v6 包含多样化的问题,但总共只有 131 个
      • 在训练期间使用相同的训练/评估划分进行重复暴露
    • DAPO-Math-17k 让模型接触到 14,000 个不同的问题
      • 由于重复采样,在 100 步中抽取到 25,600 个样本中的 78%
        • 问题:如何理解这里的 重复采样和 78%?
      • 涵盖了广泛且不重叠的问题类型,并且评估是在未见过的的问题类型上进行的

Relationship Between Task Coverage and Learning Performance

  • 为了进一步研究任务覆盖与泛化之间的相互作用,本文改变了来自 DAPO-Math-17k 的训练问题数量
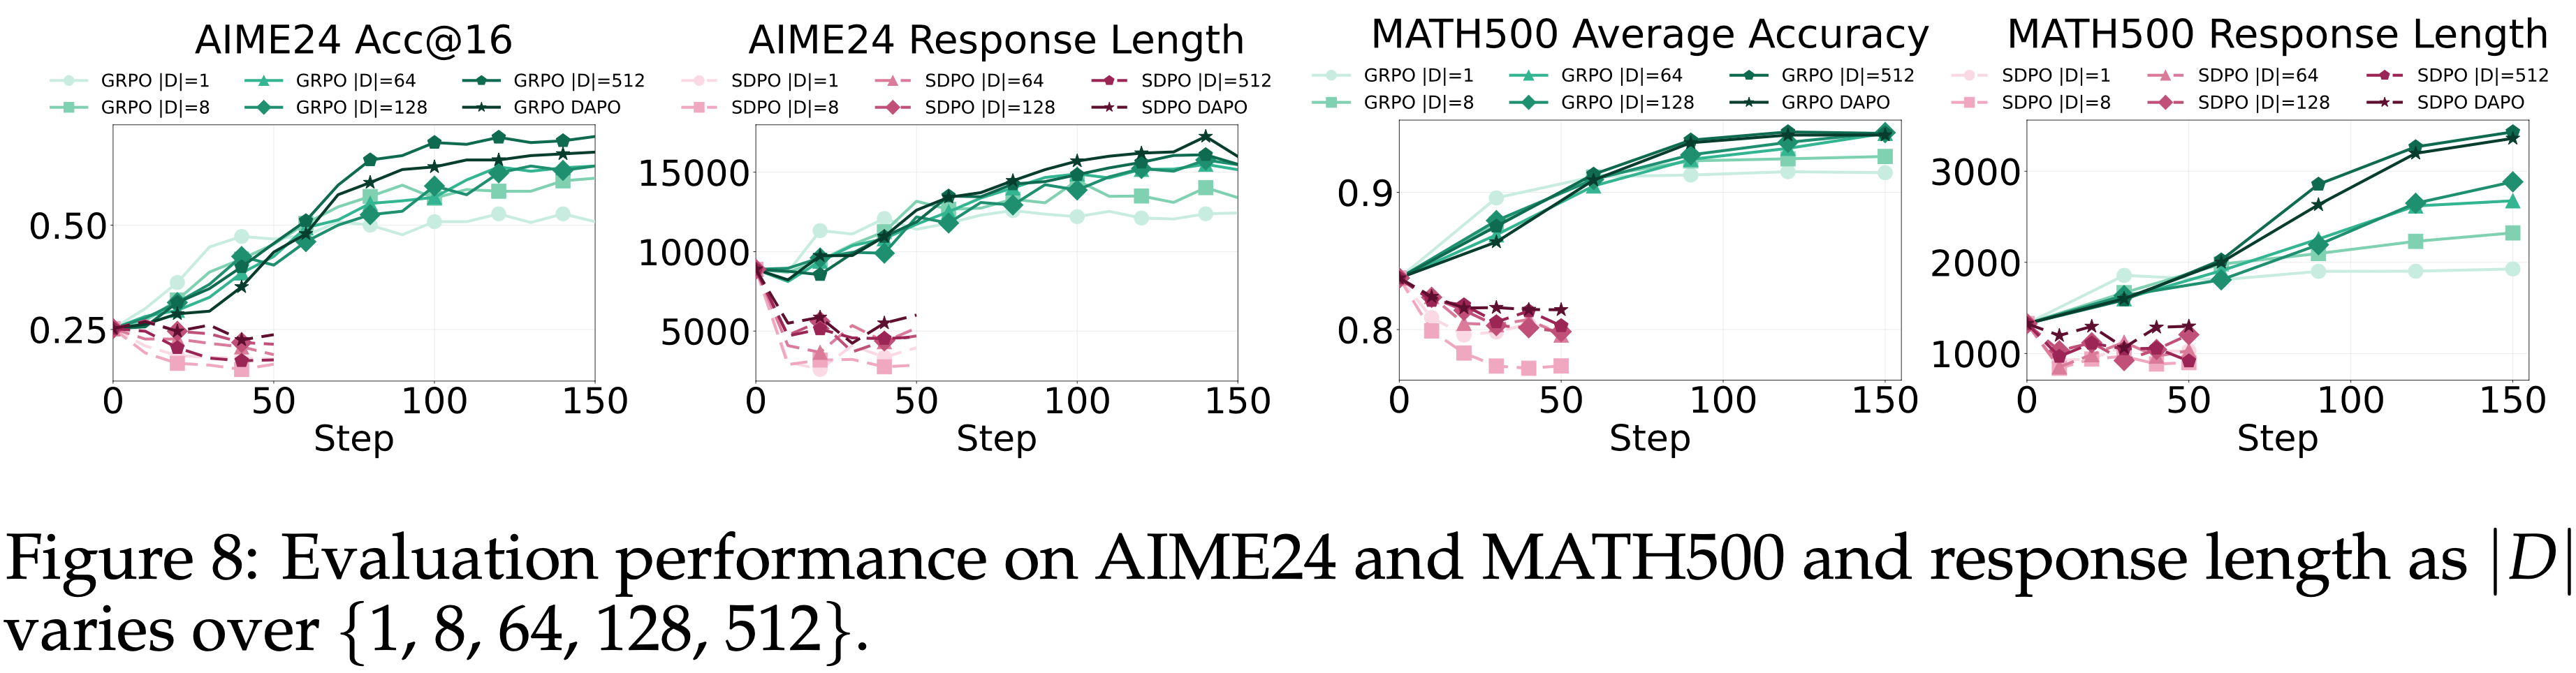
    $$|\mathcal{D}| \in \{1, 8, 64, 128, 512\}$$
    • 并使用 GRPO 和 SDPO 进行训练
  • 所有实验均使用 Qwen3-8B(Thinking Mode OFF)
Training Logs
  • GRPO 和 SDPO 随着 \(|\mathcal{D}|\) 的变化展现出不同的训练动态
    • SDPO
      • 当 \(|\mathcal{D}|\leq 128\) 时 ,SDPO 在减少 \(\mathbb{E}[L(y)]\) 的同时快速达到高分
        • 表明在小型任务集上 SDPO 具有更高的训练效率
      • 当 \(|\mathcal{D}| = 512\) 时 ,相对于 GRPO,\(\mathbb{E}[L(y)]\) 的进一步减少开始损害训练得分 ,(图 7 左数第三个图))
    • GRPO 的 \(\mathbb{E}[L(y)]\) 则随着 \(|\mathcal{D}|\) 的增加而逐渐增加
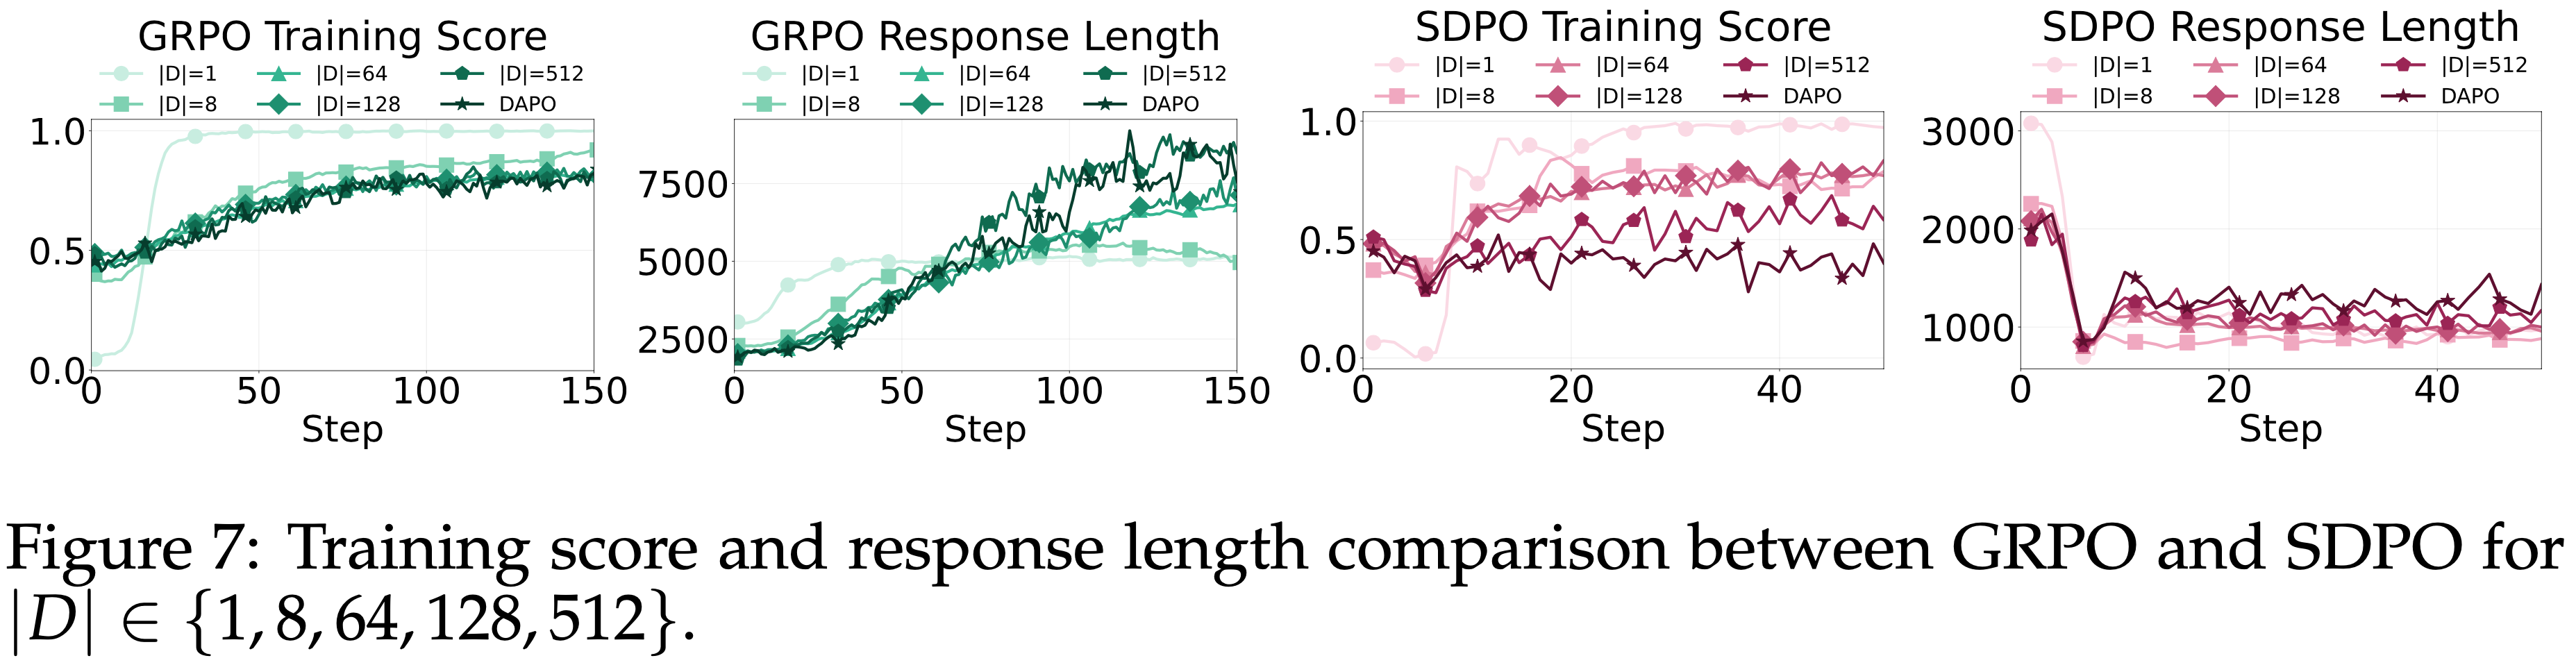
  • 这种差异可以通过任务覆盖来解释
    • 随着 \(|\mathcal{D}|\) 的增长,模型必须适应更广泛的推理模式
    • GRPO 通过增加 \(\mathbb{E}[E(y)]\) 来解决这个问题,使模型能够表达更大的不确定性并相应地调整其推理
    • SDPO 则鼓励自信、简洁的响应——这在任务覆盖较小时有效,但当问题集变得更大、更多样化时则会受限
OOD Evaluation - AIME24, MATH500
  • GRPO 和 SDPO 之间的区别在 OOD 基准测试(图 8)上变得更加明显
    • 在 GRPO 下,性能随 \(|\mathcal{D}|\) 的增大而稳定提升:
      • \(|\mathcal{D}| = 1\) 时收敛迅速但很快停止改进
      • 较大的 \(|\mathcal{D}|\) 则产生逐渐更高的最终得分
      • 伴随着 \(\mathbb{E}[L(y)]\) 的增加
    • 在 SDPO 下:
      • 较小的 \(|\mathcal{D}|\) 导致更严重的 OOD 性能下降
      • 即使在最大的 \(|\mathcal{D}|\)(DAPO Setting)下,SDPO 的性能仍然低于基础模型
        • 理解:图中的 SDPO DAPO 实验组即全量数据的场景
  • 示例推理模式见附录 A.2
Takeaway 4: Epistemic Verbalization Depends on Task Generalization
  • Epistemic Verbalization 的价值随泛化需求的增加而增加:
    • 对于熟悉、重复的任务(小 \(|\mathcal{D}|\)),Epistemic Verbalization 在很大程度上是多余的,可以为了效率而移除
    • 随着任务多样性的增长,Epistemic Verbalization 变得越来越重要

附录 A:Additional Analysis of Epistemic Tokens Count

A.1 LLM Reasoning Behavior Under Richer Information,更丰富信息下的 LLM 推理行为

A.1.1 Per-Token Analysis of Epistemic Verbalization,Epistemic Verbalization 的逐 Token 分析
  • 在第 3 节的表 1 中,本文比较了每个 Response 中十个 Epistemic Token 的平均数量
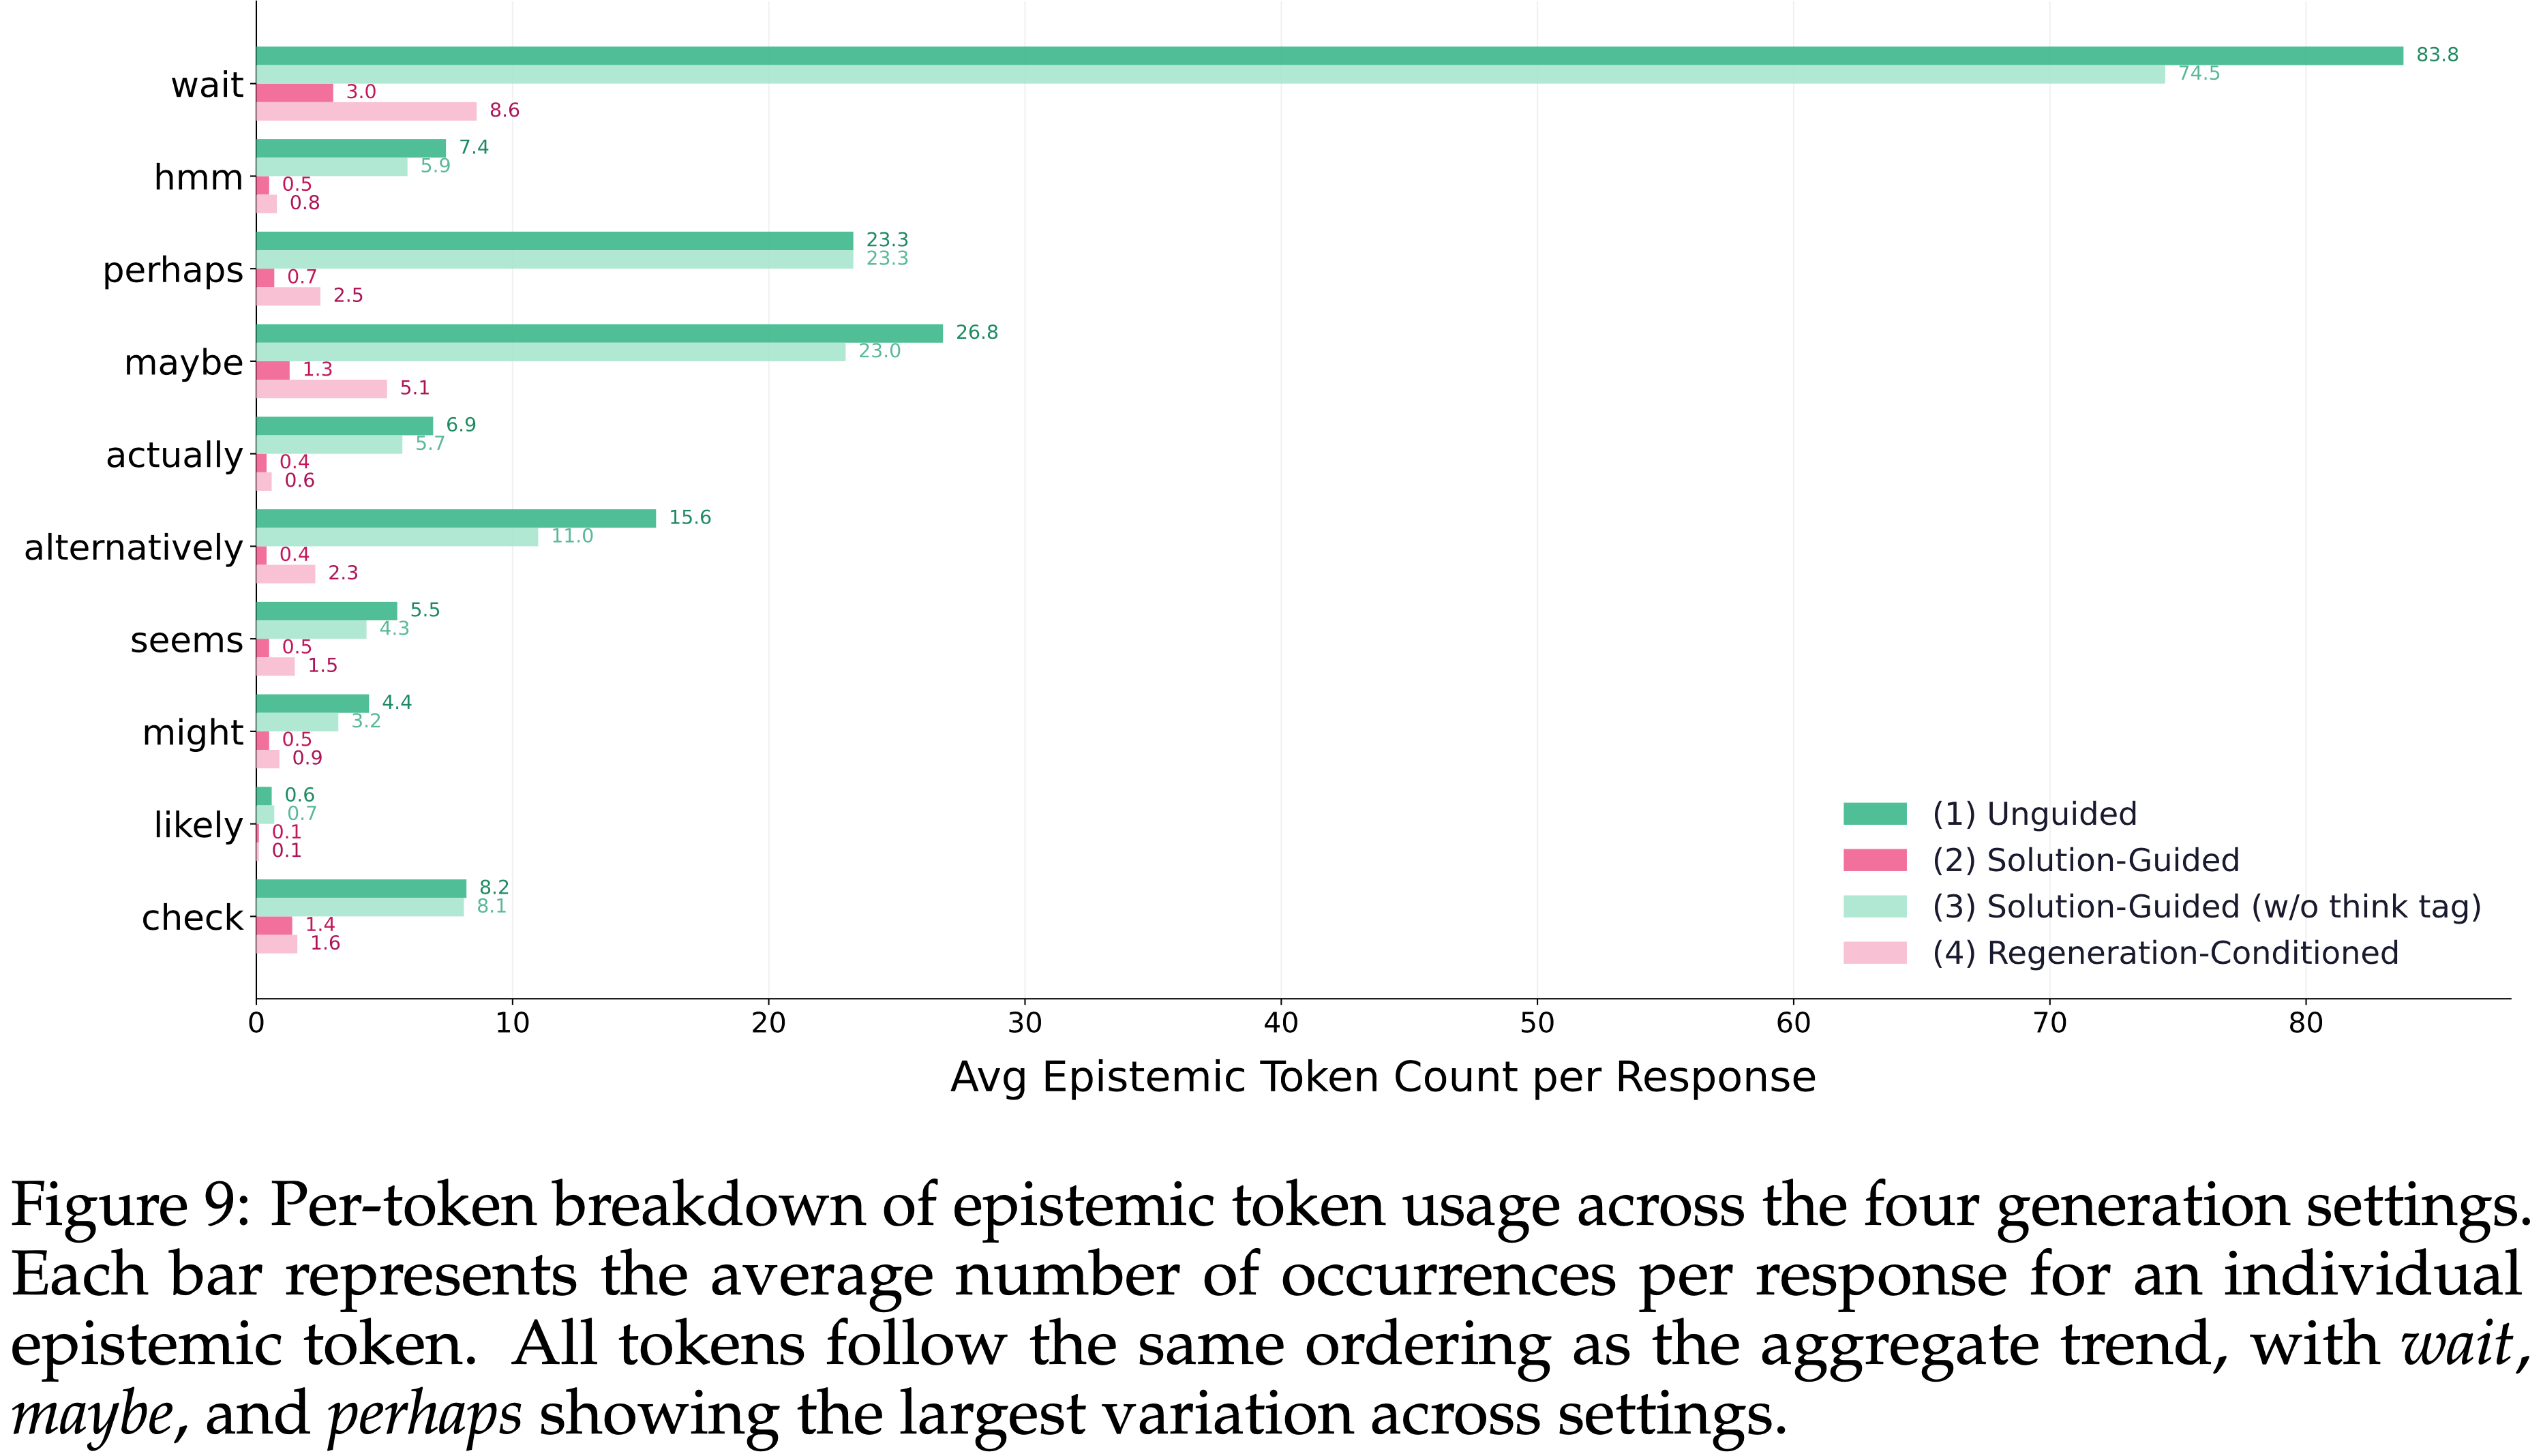
  • 图 9 进一步扩展了这一分析,展示了在不同程度的条件信息下,每个单独 Token 的平均每 Response 计数如何变化
    • 当检查每个 Token 的计数时,所有 Token 都表现出一致的趋势:
      $$
      \mathbb{E}[E(y)]\bigg|_{(1)} > \mathbb{E}[E(y)]\bigg|_{(3)} > \mathbb{E}[E(y)]\bigg|_{(4)} > \mathbb{E}[E(y)]\bigg|_{(2)},
      $$
      • 其中像 wait、maybe 和 perhaps 这样的 Token 尤其突出
  • 图 9: 四种生成设置下 Epistemic Token 使用情况的逐 Token 细分
    • 每个条形图表示每个 Response 中单个 Epistemic Token 的平均出现次数
    • 所有 Token 都遵循与总体趋势相同的顺序,其中 wait、maybe 和 perhaps 在不同设置下表现出最大的变化
A.1.2 Comparison of Epistemic Token Usage Across Models,不同模型间 Epistemic Token 使用情况的比较
  • 继第 3 节中对 DeepSeek-R1-Distill-Qwen-7B (DeepSeek-Distill-7B) 的分析之后
    • 这里进一步比较了三种设置下的 Epistemic Token 使用情况:
      • DeepSeek-Distill-7B
      • 启用思考模式的 Qwen3-8B
      • 禁用思考模式的 Qwen3-8B
  • 如图 10 所示
    • DeepSeek-Distill-7B 和启用思考模式的 Qwen3-8B 产生的 Epistemic Token 数量都远多于禁用思考模式的 Qwen3-8B
    • 虽然这两个启用思考的模型在表达不确定性方面有相似的趋势,但它们在偏好的 Epistemic Token 上有所不同
      • 例如:
        • DeepSeek-Distill-7B 经常使用 wait,并且使用 perhaps 和 maybe 的频率相当
        • Qwen3-8B 使用 perhaps 相对较少,更倾向于使用 maybe
        • Qwen3-8B 使用 alternatively 和 check 的频率远高于 DeepSeek-Distill-7B,并且总体上在其推理中嵌入了更多的不确定性
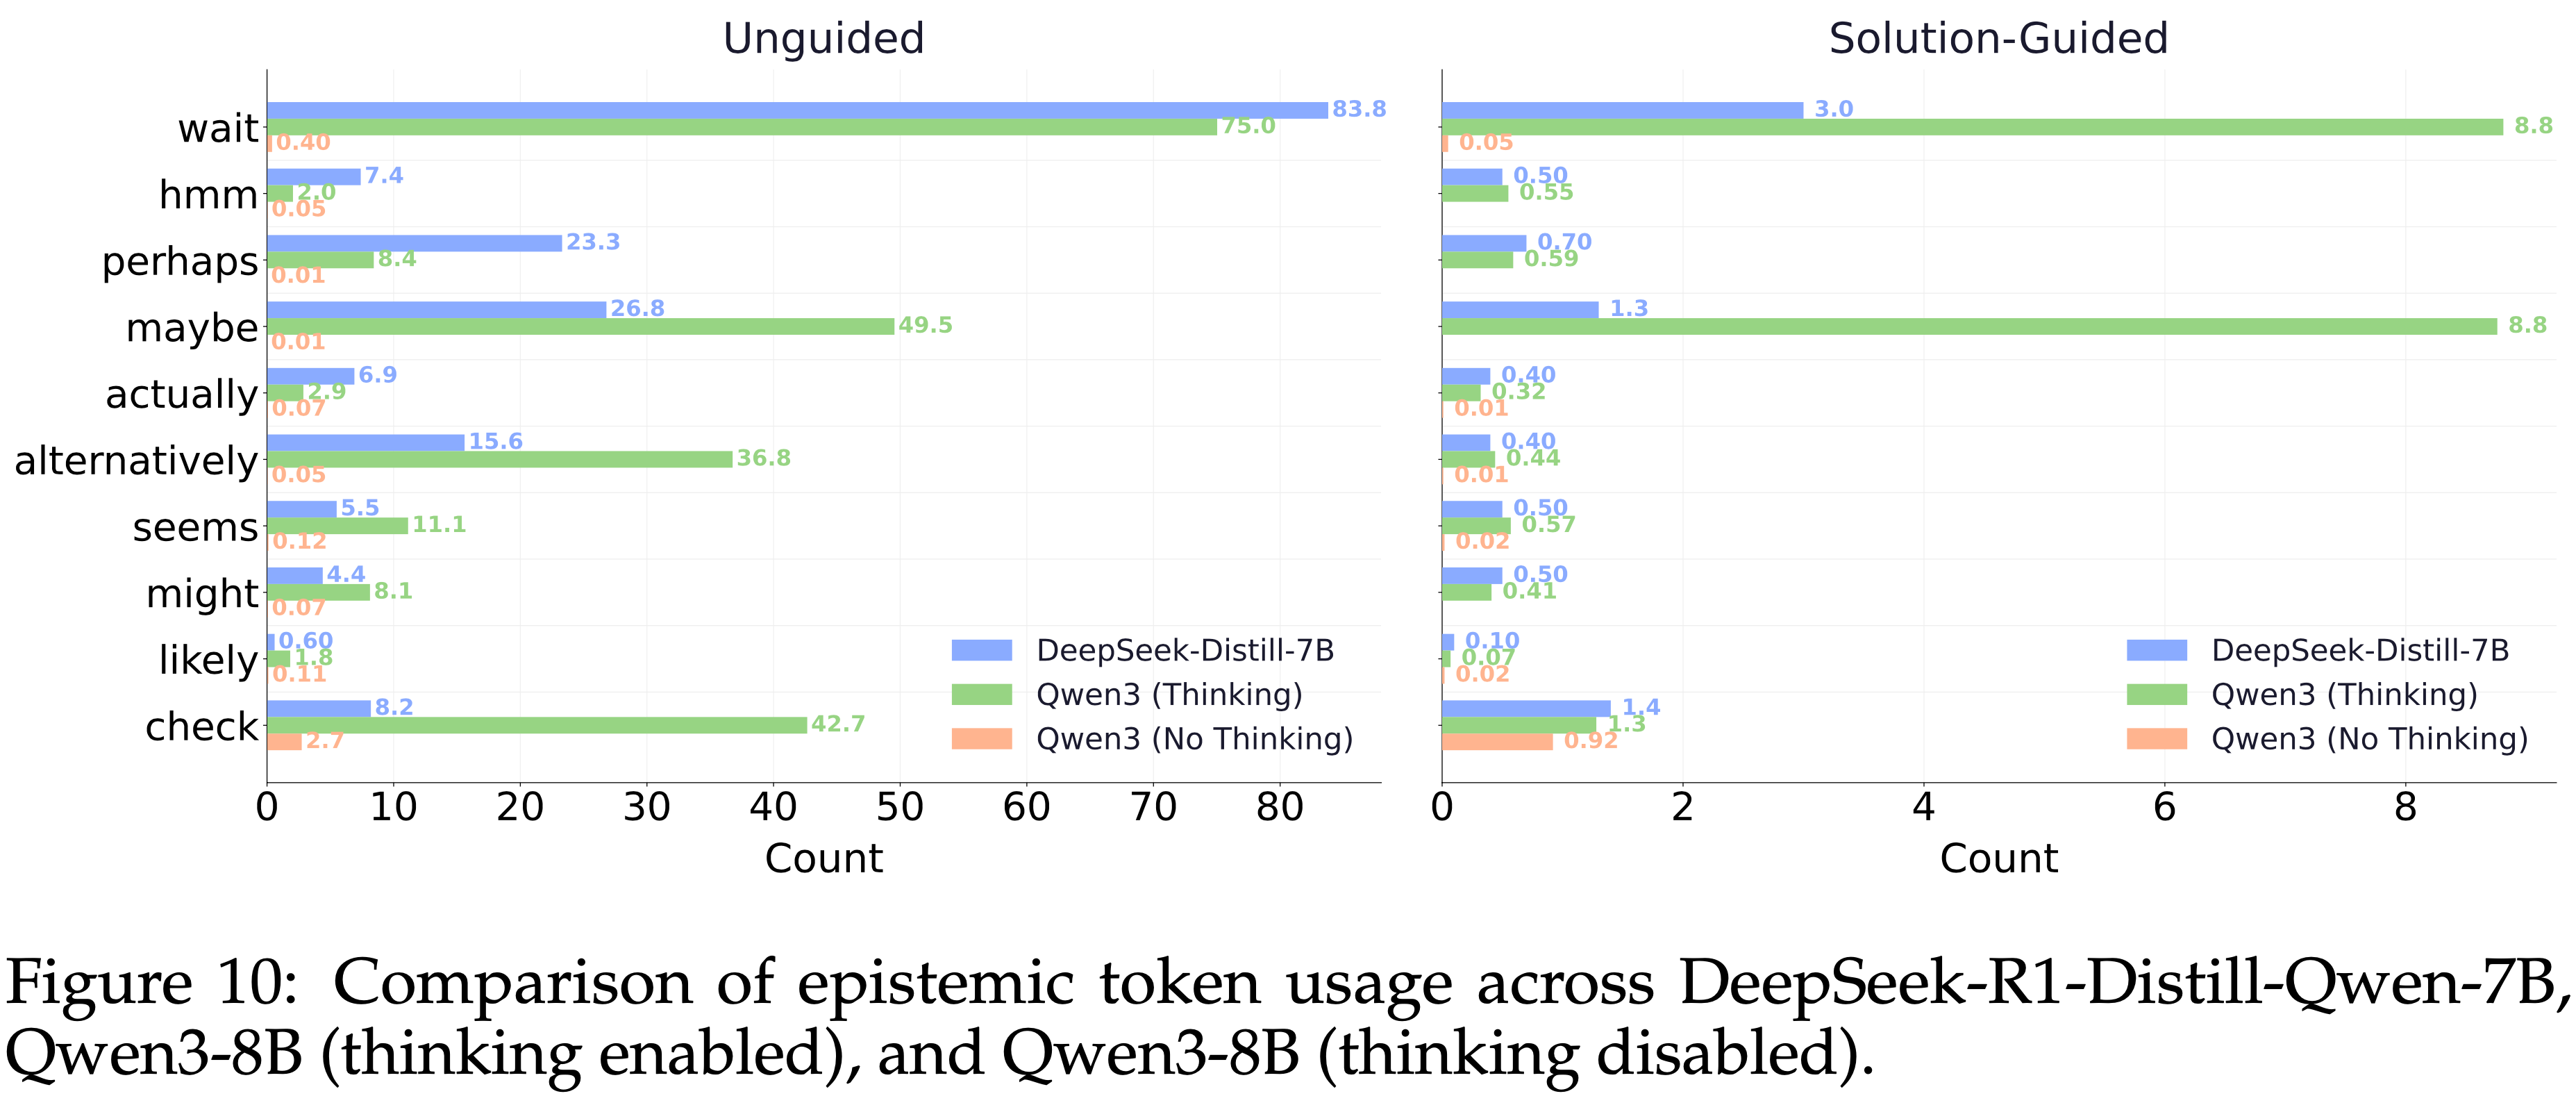
  • Extending 第 3 节的讨论,还可观察到
    • 在 Solution-Guided 生成下,Qwen3-8B 生成的 Epistemic Token 远少于 Unguided 生成
    • 在所有三种设置中 Epistemic Token 数量从大到小依次为:
      • 启用思考模式的 Qwen3-8B 产生的 Epistemic Token 最多
      • 其次是 DeepSeek-Distill-7B
      • 最后是禁用思考模式的 Qwen3-8B
Relationship Between Task Coverage and Learning Performance, 任务覆盖与学习性能之间的关系
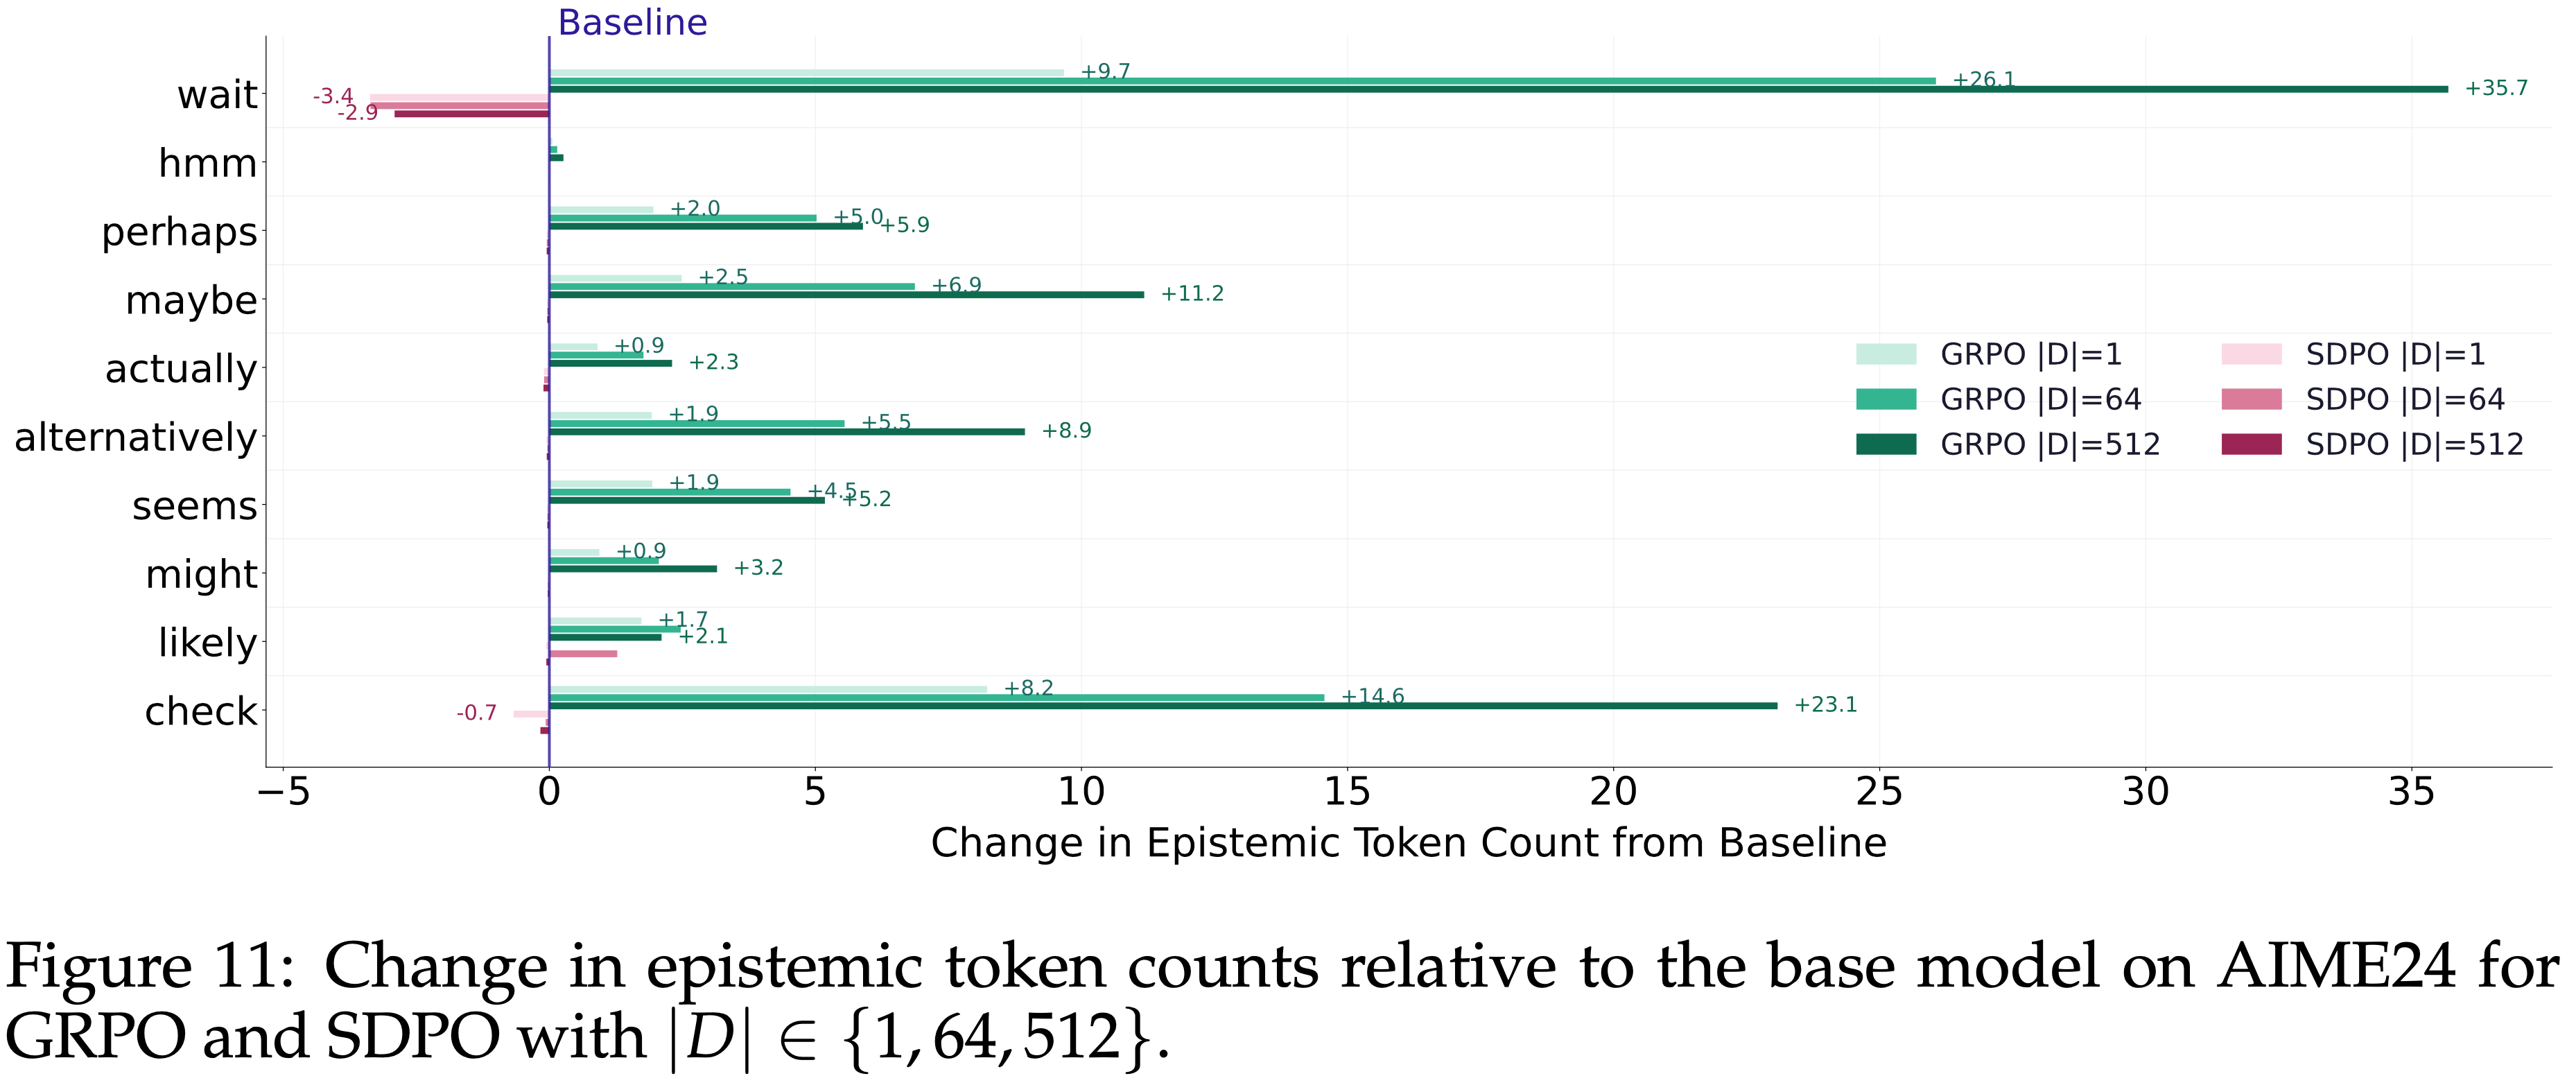
  • 为了对第 6.2 节图 8 中的结果进行更深入的分析,本文比较了六种训练配置下 AIME24 上相对于基础模型的 Epistemic Token 计数的变化:
    • 交叉供 6 种:GRPO 和 SDPO,每种配置下 \(|D| \in \{1, 64, 512\}\)
  • 图 11 显示
    • GRPO:Epistemic Token 使用量 在增加
      • \(|D|\) 越大,Epistemic Token 使用量增加越多
    • SDPO:Epistemic Token 使用量 在减少
      • \(|D|\) 越大,Epistemic Token 使用量减少越少
  • 问题:相对之前的 图 3 ,为什么 图 11 这里 SDPO Epistemic Token 使用量减少的幅度这么小?

附录 B:Experimental Details

Training

  • 对于 GRPO 和 SDPO 训练

    • 本文在 SDPO 实现 github.com/lasgroup/SDPO 的基础上进行了构建,并额外加入了 DAPO-Math-17k 数据集
  • 原始的 DAPO-Math-17k 数据集使用以下 Prompt 格式:

    1
    Solve the following math problem step by step. The last line of your response should be of the form Answer: $Answer (without quotes) where $Answer is the answer to the problem. \n\n{question}\nRemember to put your answer on its own line after "Answer:".
  • 本文将其替换为更简单的格式(因为观察到这种格式能持续获得更高的评估性能):

    1
    {question}\nPlease reason step by step, and put your final answer within \boxed{boxed}.
  • 对于奖励验证,使用了 vert 框架中的评分函数,该函数从 \boxed{} 表达式中提取答案,并通过精确匹配和数学等价性检查(使用 math-verify,改编自 EleutherAI 的 lmevaluation-harness (2024))来验证其正确性

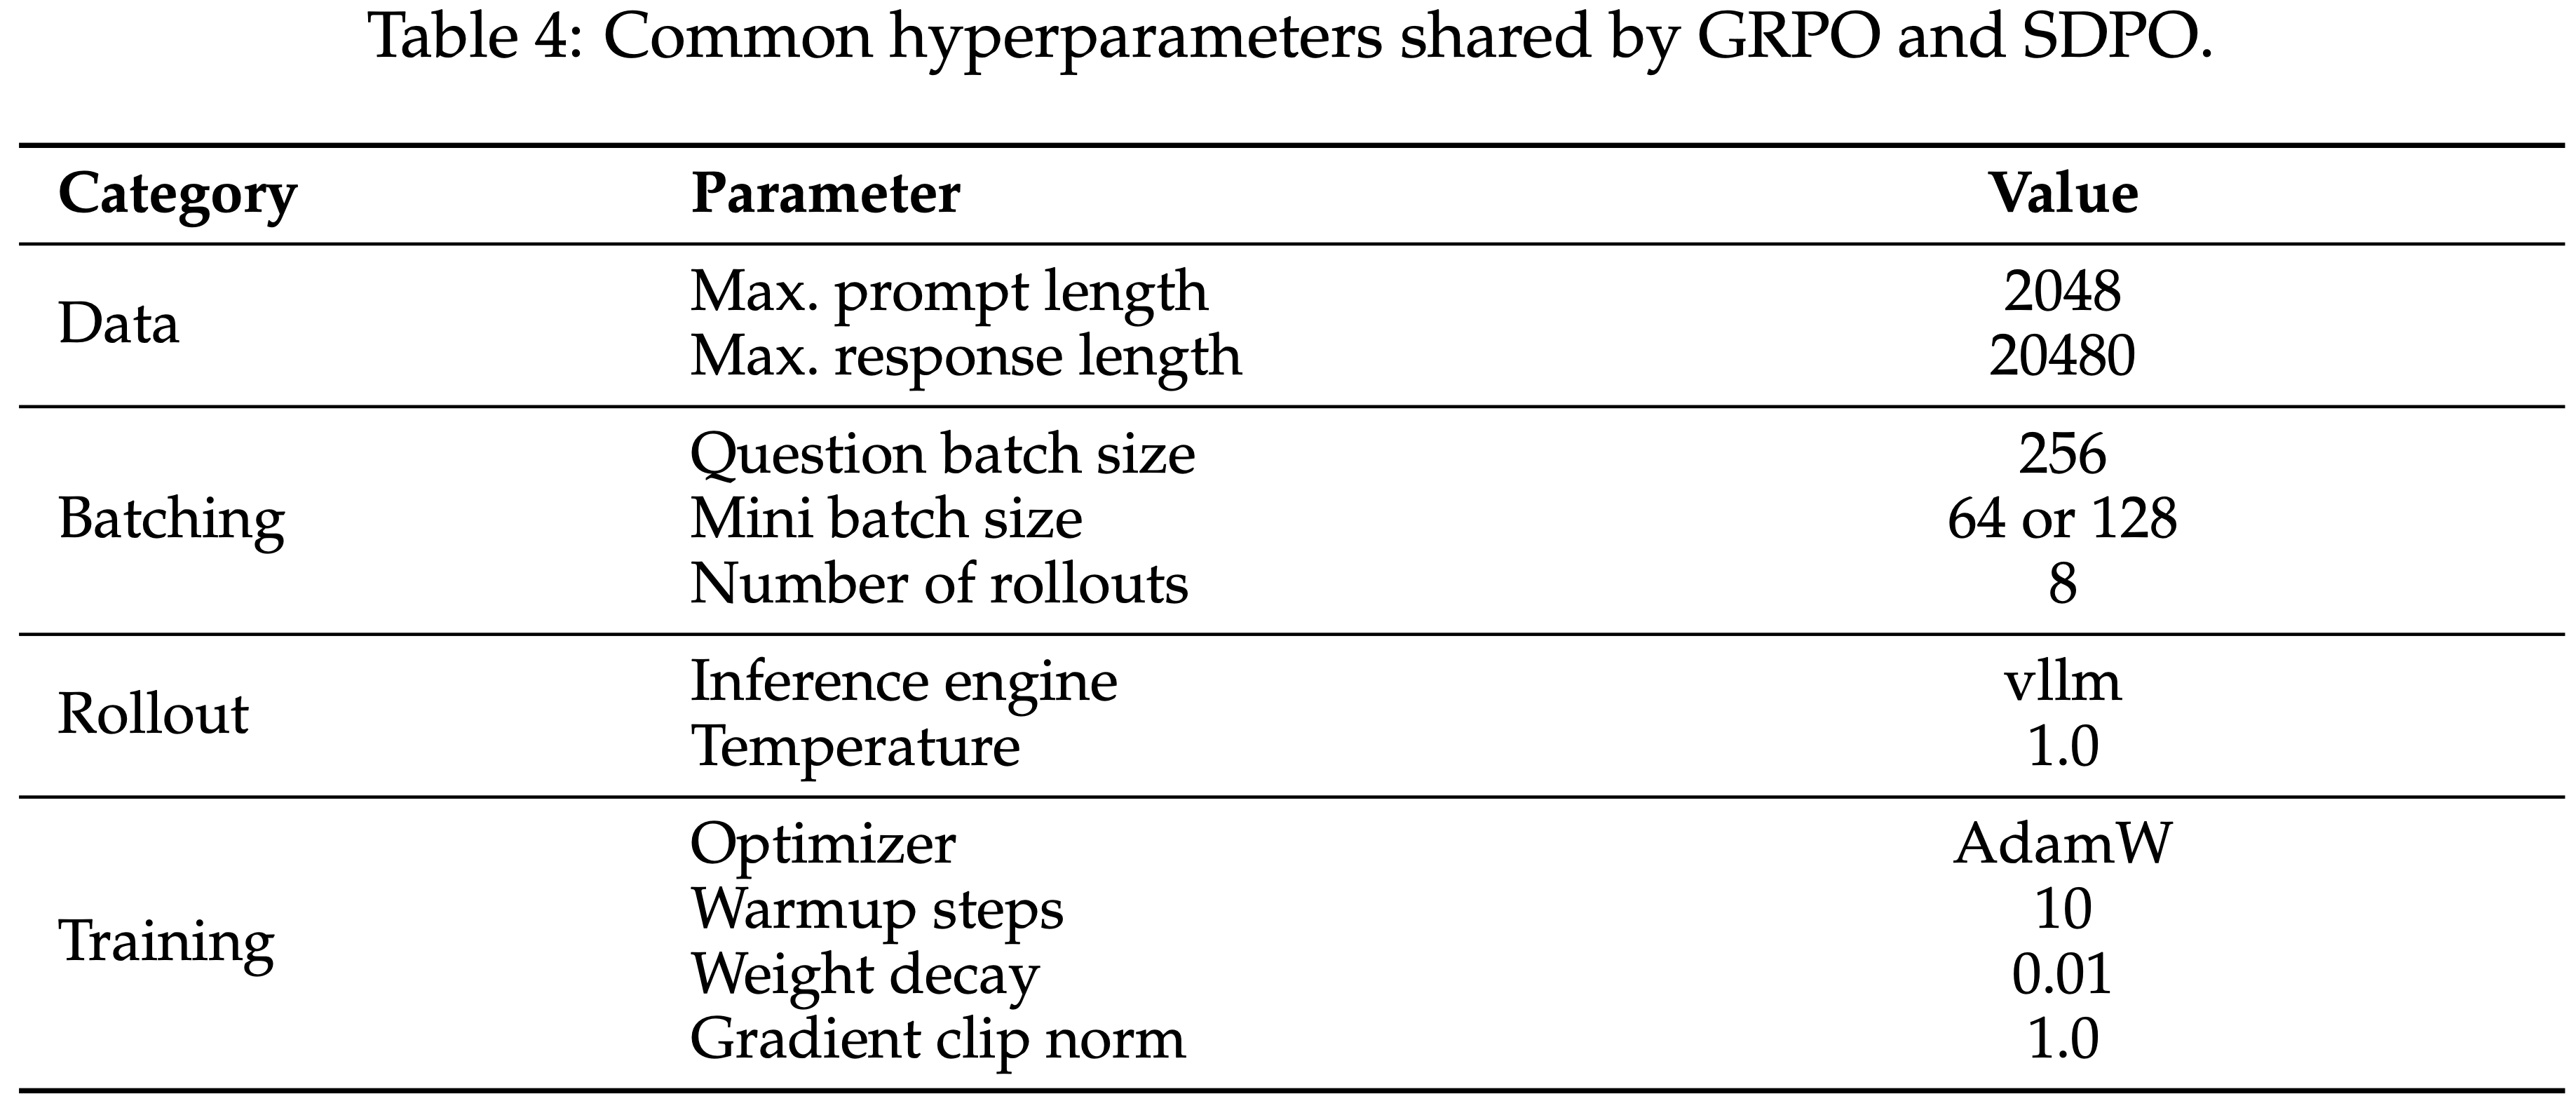
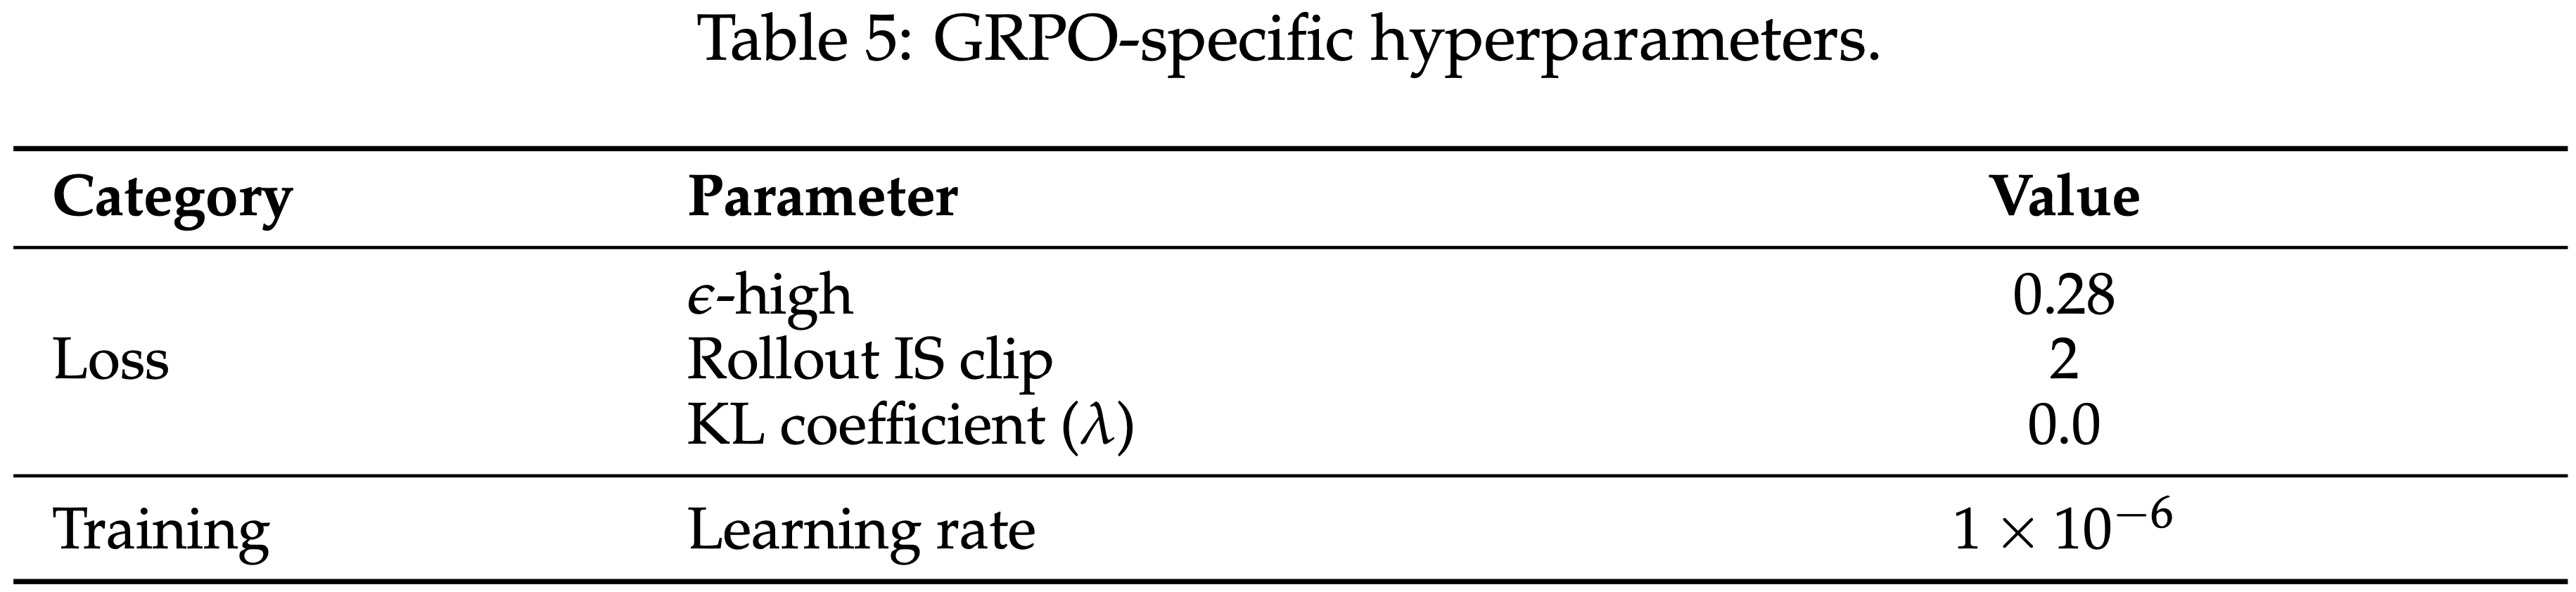
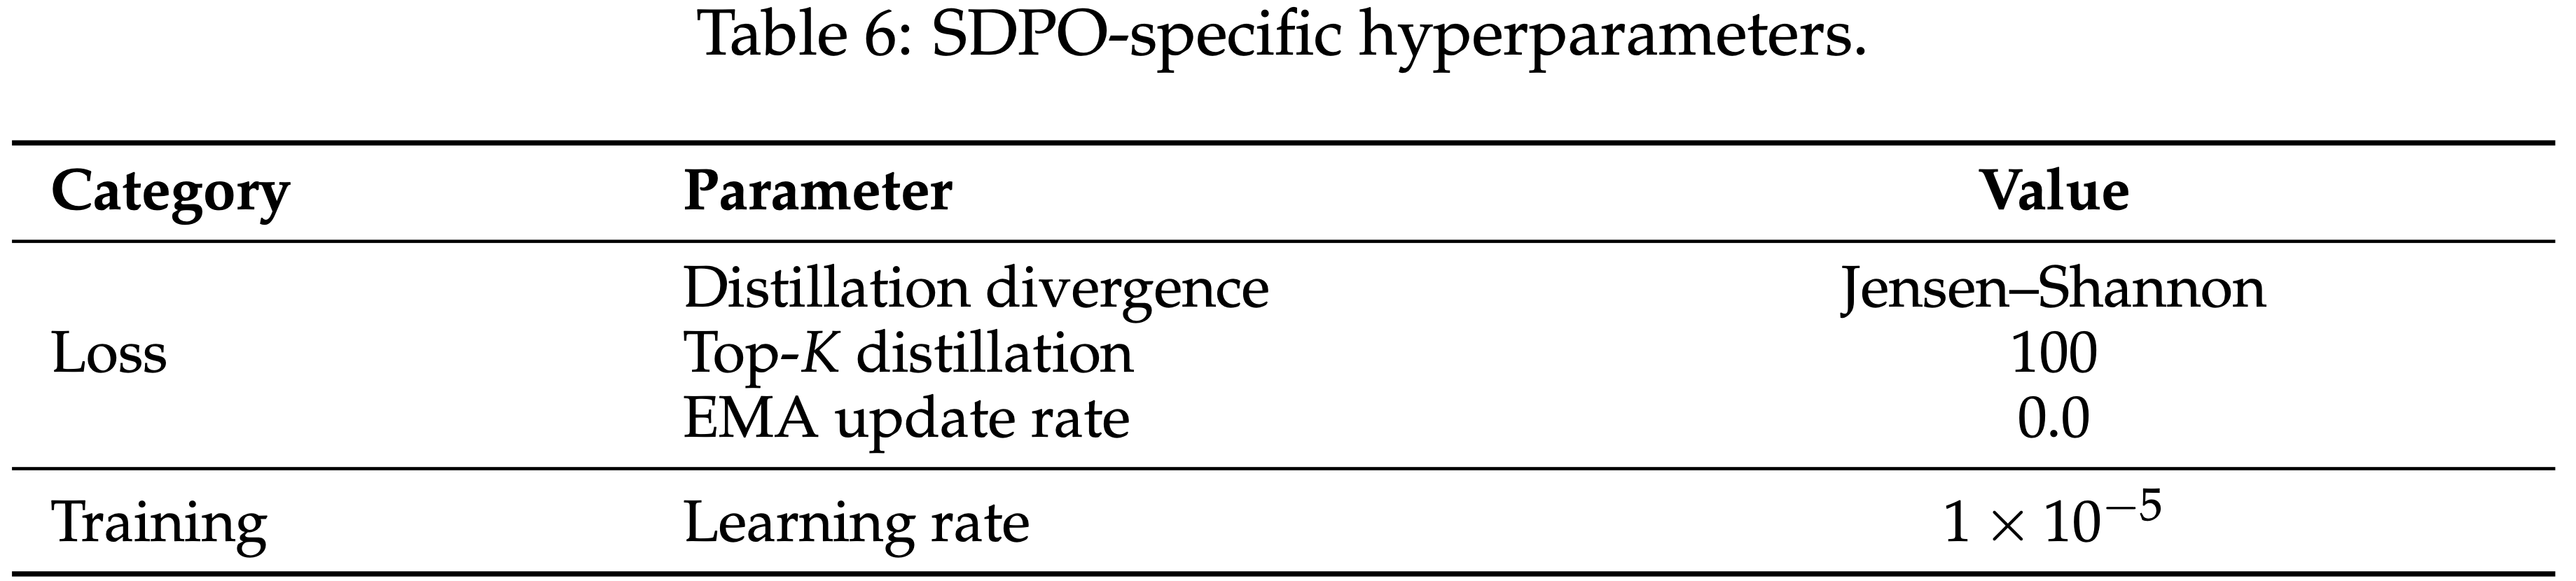
  • GRPO 和 SDPO 训练的超参数列在表 4、5 和 6 中

    • 对于图 8 中关于任务覆盖与学习性能之间关系的实验,由于使用了更小的训练问题集,本文将问题批次大小减少到了 64
  • 表 4: GRPO 和 SDPO 共享的通用超参数

  • 表 5: GRPO 特定超参数

  • 表 6: SDPO 特定超参数,从表 6 的超参数可以看出,训练时:

    • 训练的损失是 Jensen-Shannon 距离,且仅使用了 Top-100 Token 计算距离
    • 同时 EMA 为 0 表示 Teacher 模型固定不动

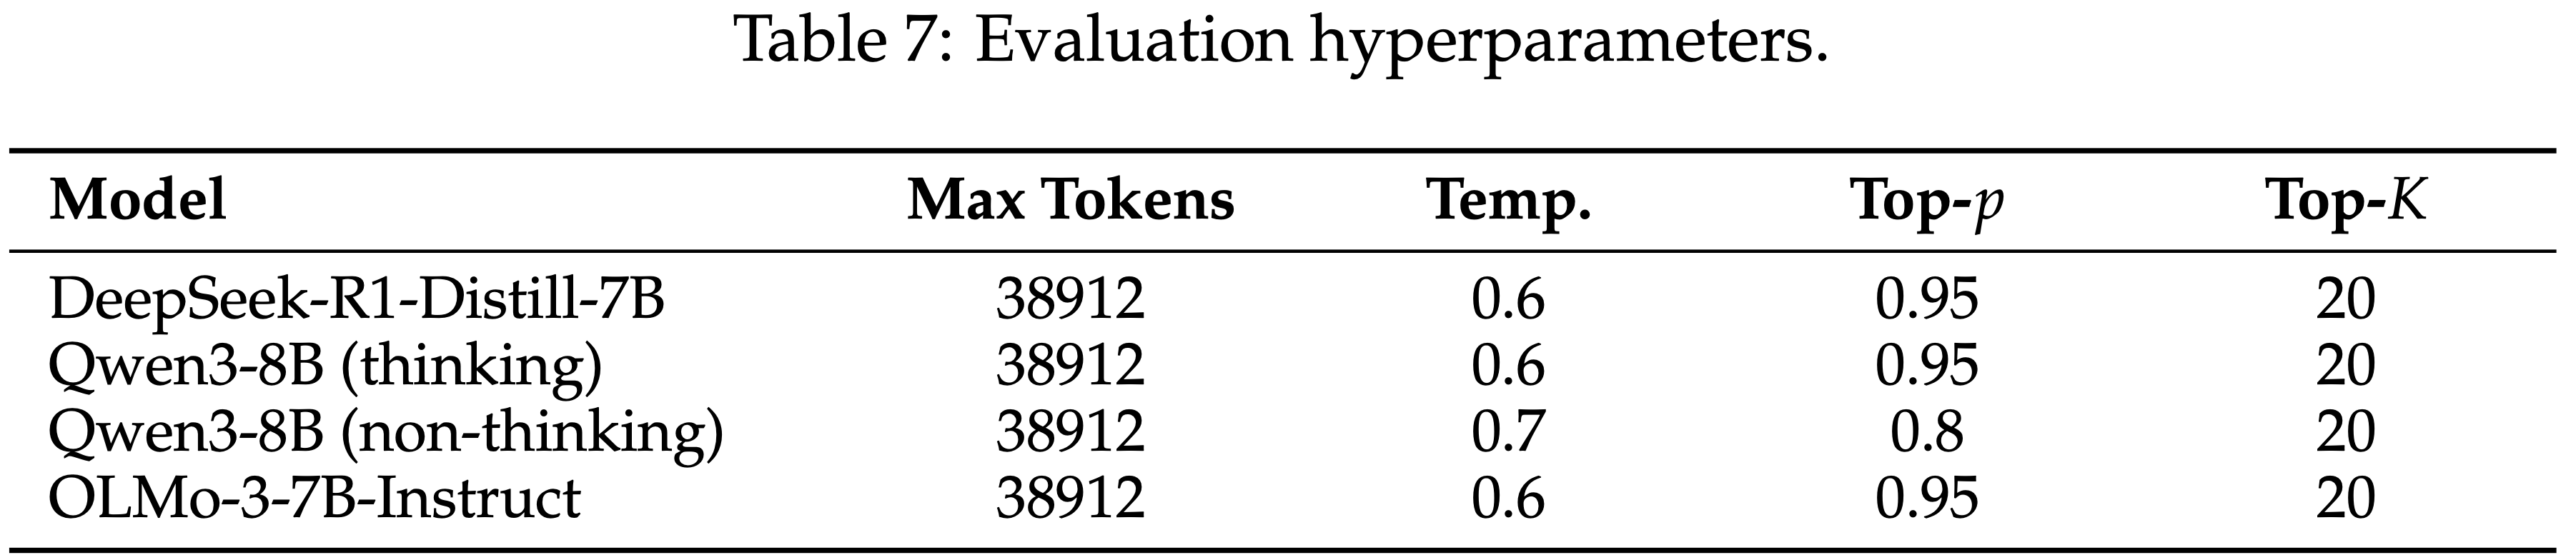
Evaluation

  • 使用表 7 中列出的超参数评估所有模型,这些设置遵循了每个模型官方文档中的推荐设置
Chat Templates for Different Model Series

  • 这里总结了几种开源权重语言模型家族使用的 Chat Template 格式

    • 每个模型系列使用不同的特殊 Token 和结构来区分用户和 Assistant 的对话轮次
    • 在整个过程中,本文使用相同的数学问题作为示例 Prompt
  • DeepSeek-R1-Distill-7B

    1
    2
    <begin_of_sentence></User>Find the largest possible real part of [(75 + 117)z + \text{frac}(96 + 144i)(z)] where z is a complex number with |z| = 4 
    Please reason step by step, and put your final answer within \boxed{}.<|Assistant|><think>
  • Qwen3-8B (Thinking Mode: ON)

    1
    2
    3
    4
    <|im_start|>user 
    Find the largest possible real part of [((75 + 117)z + \text{frac}(96 + 144i)(z)] where $z$ is a complex number with $|z| = 4$
    Please reason step by step, and put your final answer within \boxed{}.<|im_end|>
    <|im_start|>assistant
  • Qwen3-8B (Thinking Mode: OFF)

    1
    2
    3
    4
    5
    6
    <|im_start|>user 
    Find the largest possible real part of [((75 + 117)z + \text{frac}(96 + 144i)(z)] where $z$ is a complex number with $|z| = 4$
    Please reason step by step, and put your final answer within \boxed{}.<|im_end|>
    <|im_start|>assistant
    <think>
    </think>
    • 注:这是 Qwen3 的创新设计,使用 <think>\n</think> 来表示这里没有任何思考内容
  • OLMo-3-7B-Instruct

    1
    2
    3
    4
    5
    6
    <|im_start|>system
    You are a helpful function-calling AI assistant. You do not currently have access to any functions.<functions></functions><|im_end|>
    <|im_start|>user
    Find the largest possible real part of \[((75 + 117)z + \text{frac}(96 + 144i)(z)\] where $z$ is a complex number with $|z| = 4$
    Please reason step by step, and put your final answer within \\boxed{}.<|im_end|>
    <|im_start|>assistant

附录 C:Comparison with OPSD

  • 最近,OPSD (2026) 展示了通过 Self-Distillation 在数学推理中的性能提升,特别是在 Qwen3 系列上
  • 差异一:模型 Setting 差异
    • 本文的 Setting :学生和教师都启用或都禁用 思考模式
    • OPSD 的 Setting :采用了一种混合配置,其中 学生禁用思考模式 ,教师启用思考模式
    • 正如本文的实验也证实的那样
      • 启用思考模式会产生更长且带有更多 Epistemic Token 的 Response,这使得这种混合设置的功能更类似于传统的教师-学生蒸馏,尽管使用的是同一个底层模型
      • 注:这种配置本质上仅限于像 Qwen3 这样支持切换思考模式的模型家族,其他的模型并不支持(其实已经不能算是同一个模型了)
  • 差异二:训练 Token 差异
    • (为了训练效率)OPSD 并不在整个学生 Response 上进行训练
      • OPSD 只关注一个前缀(默认为 1024 个 Token)
      • 注:OPSD 中(附录 B 中),不是只关注 1024 的前缀,而是在生成时就特意只生成了 1024 个
        • 理解:传统的 RL 中不能这样做(这是 OPD 专有的优点)
          • 在 OPD 场景中,不需要 Rollout 结束就可以有奖励(来源于 Teacher)
          • 在传统 RL 场景,一般是需要 Rollout 结束才能得到 Reward 反馈的
    • 本文使用的 SDPO 则是所有 Response 上都训练的
  • 差异三:微调方式
    • 本文 SDPO:基于 verl (2024) 执行全量微调
    • OPSD:使用基于 trl (2020) 的 LoRA 微调
  • 差异四:其他超参数差异
    • 本文 SDPO:Batch Size 256,学习率 1e-5
    • OPSD:Batch Size 32,学习率 1e-6
    • OPSD 有更高的训练效率(BS 更小),但每一步的参数更新更小
      • 注:学习率本该是全量微调上更小的,这里更多是与 BS 有关
  • 图 12: Qwen3-1.7B 中 OPSD 混合蒸馏与本文同质 Chat Template 设置的训练动态
    • (a) 在混合(Hybrid)设置下
      • 启用思考的教师最初提高了学生性能,但随着时间的推移收益发生逆转
      • 同质设置显示出持续下降的趋势
    • (b) 同质(Homogeneous)设置中的 Response 长度和 Epistemic Token 使用情况
  • 在 Qwen3-1.7B 的混合设置和前缀学习下,如图 12a(橙色线)所示
    • 观察到一个有趣的训练动态:
      • 在早期阶段,启用思考的教师驱动学生生成更长的 Response,并提高了性能,展示了混合蒸馏在训练早期的有效性
      • 但随着训练的进行,Response 长度逐渐减少,同时伴随着性能的相应下降
    • 在本文的同质设置(如图 12b 所示,学生和教师都启用了思考模式)下,性能持续下降
      • Response 长度和 Epistemic Token 计数也稳步下降,这与本文之前的分析一致
  • 问题遗留:
    • 这种针对 Qwen3 系列的混合蒸馏设置代表了一个有趣的研究方向,具有其独特的训练动态
      • 例如,为什么性能会先提升后下降,以及这是否源于推理行为的变化或 Chat Template 的不匹配
    • 深入探究这个现象超出了本工作的范围,留待未来探索

附录 D:More On-Policy Self-Distillation Results

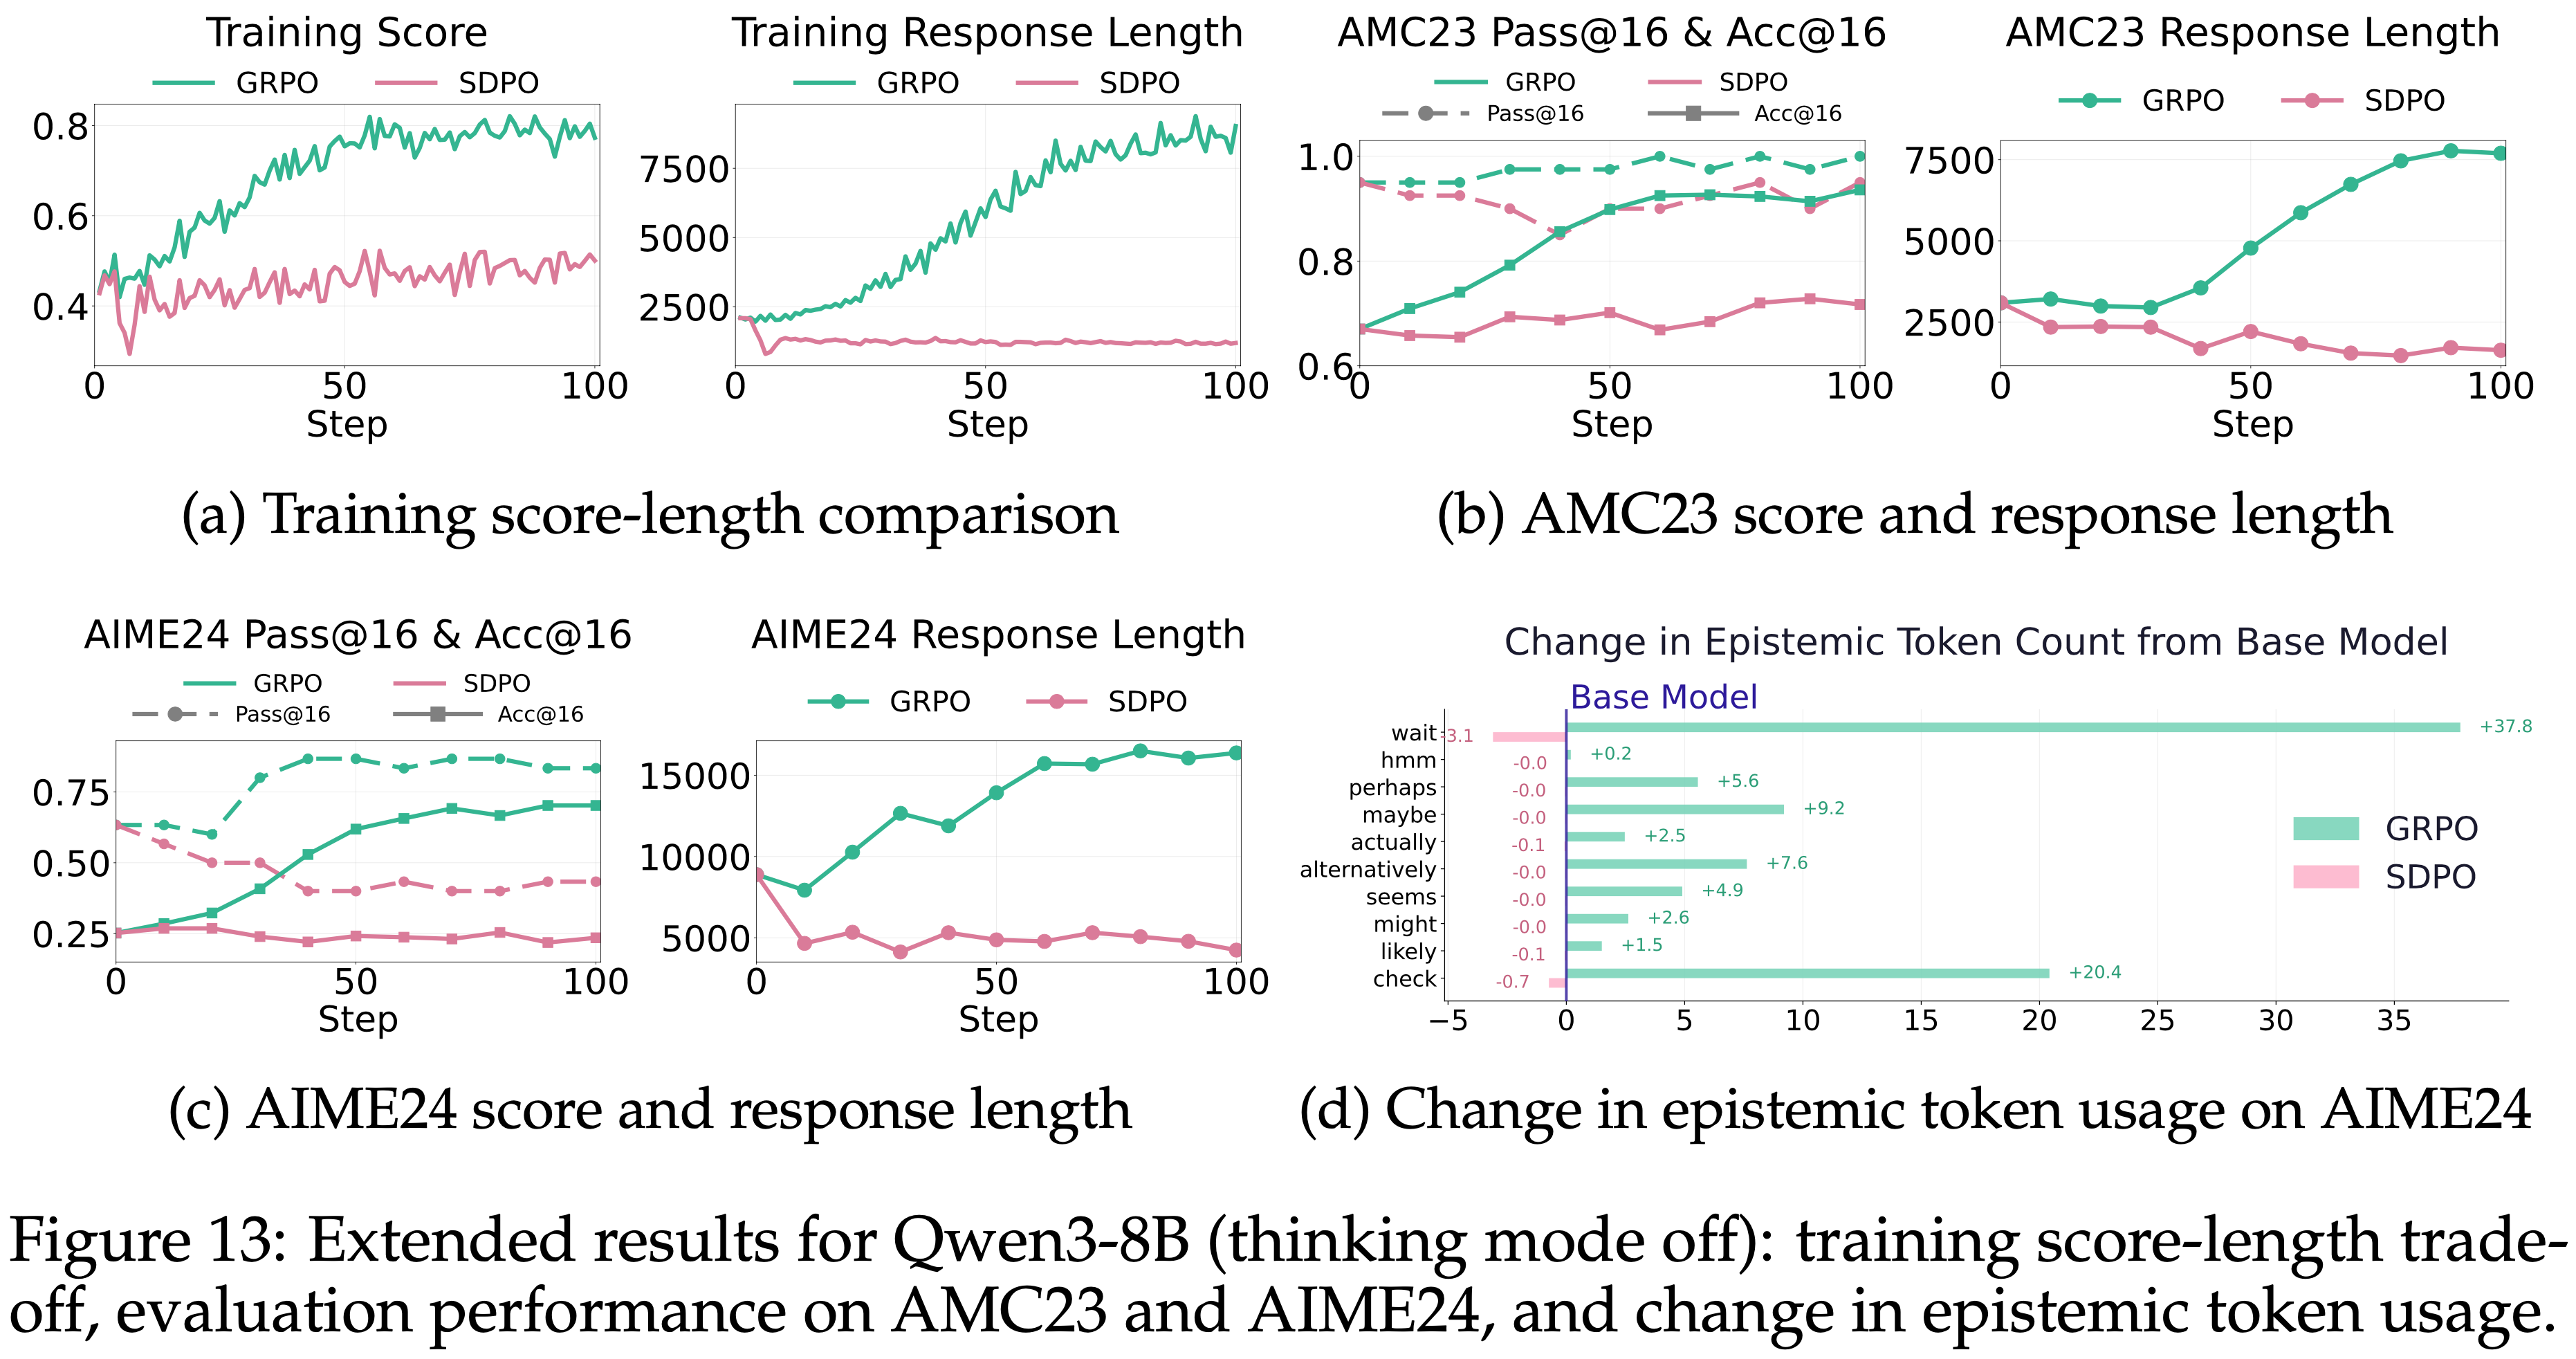
D.1 Qwen3-8B (Thinking Mode: OFF)

  • 作为第 5.3 节图 5 的扩展,本节额外比较了 AMC23 的评估分数和 AIME24 上 Epistemic Token 使用量的变化
  • 如图 13 所示
    • GRPO 显著增加了 Response 长度,并在两个基准测试上都带来了显著的性能提升
    • SDPO 表现出不同的趋势:
      • 在 AMC23 上,acc@16 从 0.67 增加到 0.73,同时 Response 长度减少约一半
      • 在 AIME24 上,acc@16 从 0.25 略微下降到 0.23,pass@16 下降更显著
    • 在 AMC23 上,SDPO 以更短的 Response 实现了约 6 个百分点的提升,而 GRPO 则以更长的 Response 为代价获得了约 36 个百分点的更大提升
      • 在保持合理 Response 长度的同时实现大的性能提升仍然是一个开放的挑战
D.2 Olmo-3-7B-Instruct

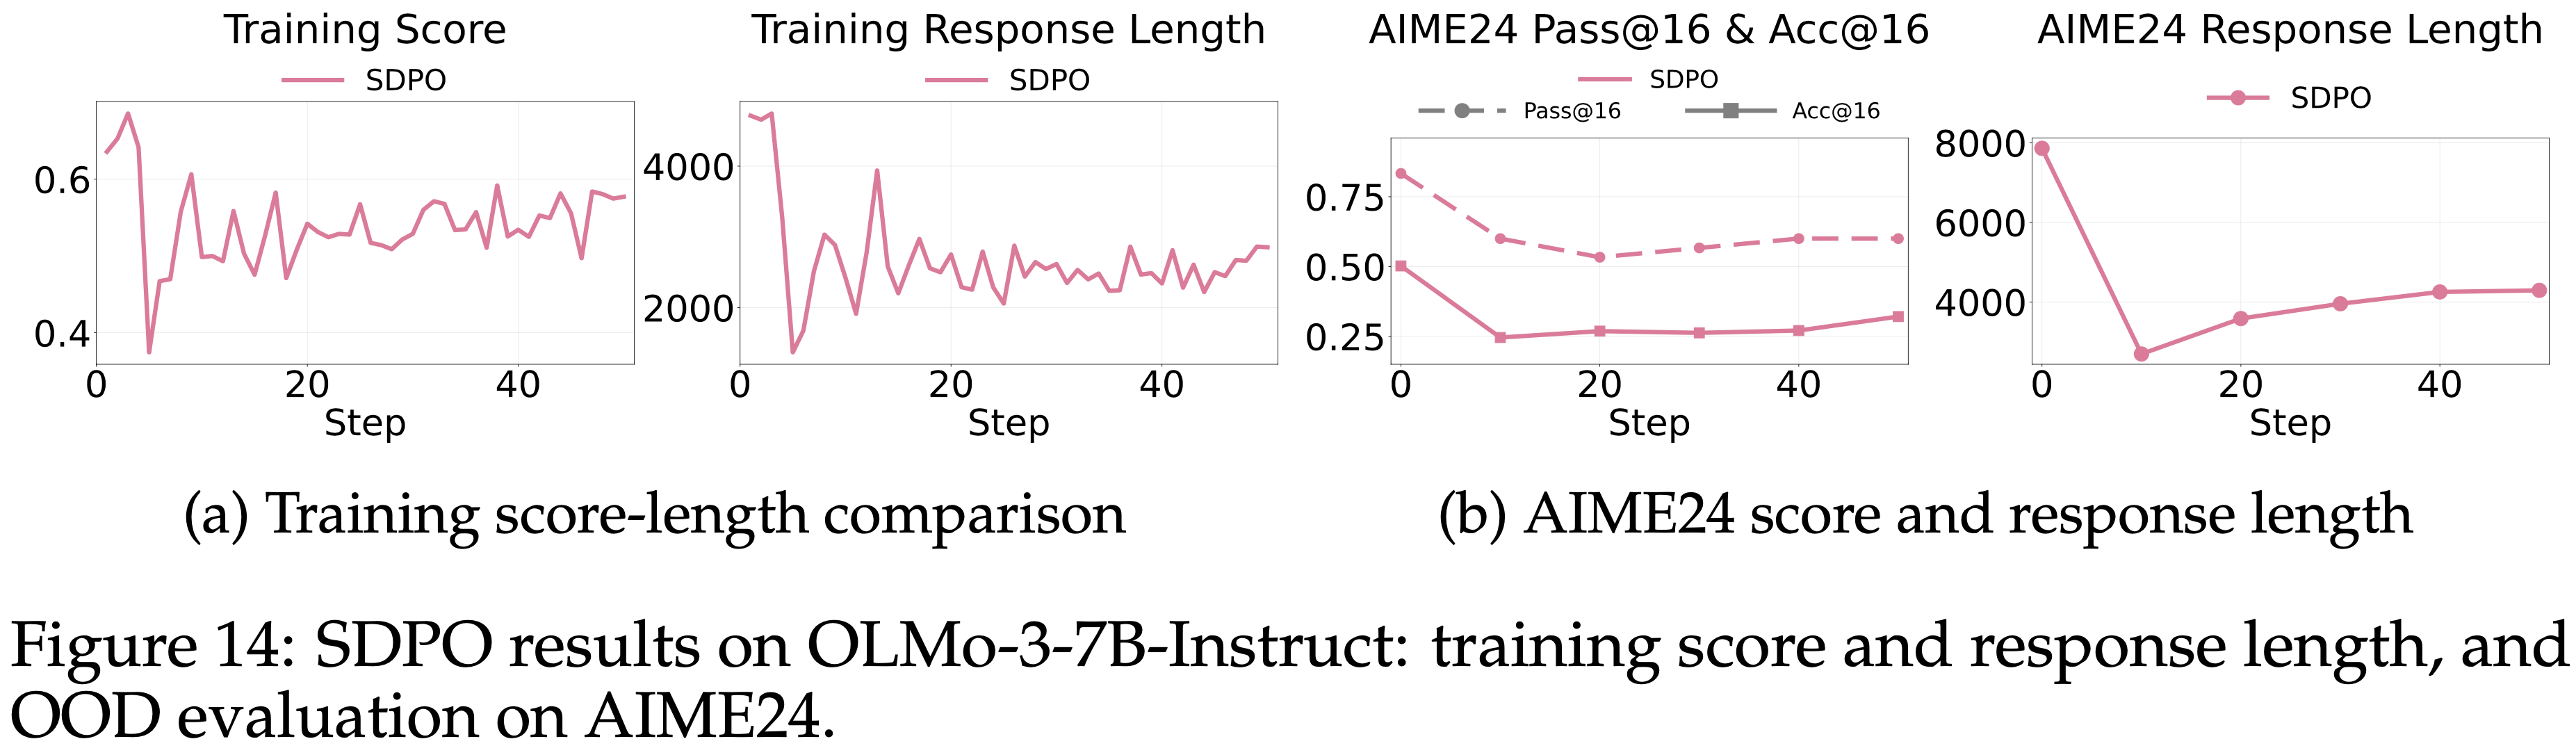
  • 除了 DeepSeek-R1-Distill-Qwen-7B 和 Qwen3-8B,本文进一步在另一个模型家族 OLMo-3-7B-Instruct 上评估了 On-Policy Self-Distillation
  • 如图 14 所示,与本文之前的分析一致,SDPO 也降低该模型上的推理性能,OOD 评估分数降至基础模型之下
    • 证实了作者的发现并非模型依赖的,反映了跨不同模型家族的推理行为的稳健特征

D.3 Pass@16 Score

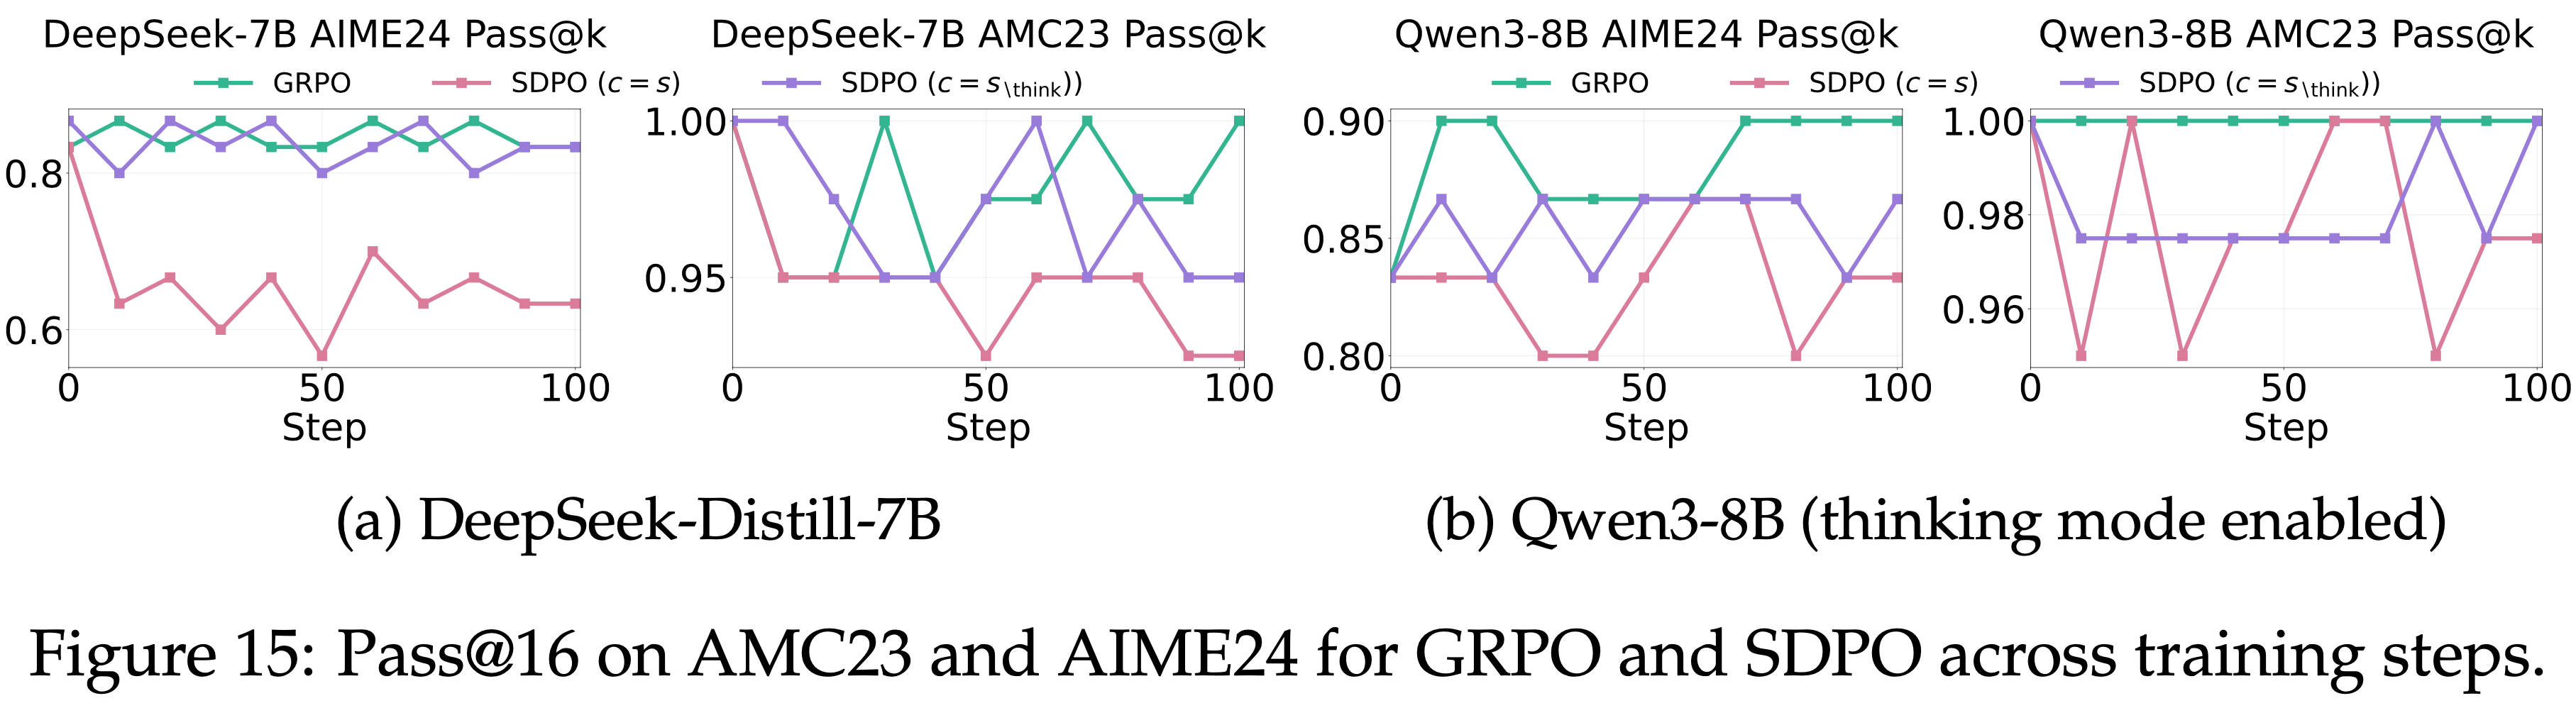
  • 除了图 3b、3c、4b 和 4c 中显示的 DeepSeek-Distill-7B 和 Qwen3-8B(thinking mode enabled)的 acc@16 分数外
    • 本文还在图 15 中报告了 pass@16 分数
  • GRPO 和 SDPO 在 pass@16 上的差距:
    • DeepSeek-Distill-7B 大于 Qwen3-8B
    • 并且在更难的基准测试(AIME24)上比 AMC23 上更为明显
  • 问题:如何理解 GRPO 和 SDPO 在 pass@16 上的差距,DeepSeek-Distill-7B 大于 Qwen3-8B 这件事情?
    • 简单理解:
      • 模型方面,一个理解是 DeepSeek-Distill-7B 的不确定性更低一些,长度更短一些,受 SDPO 的影响也更小?
      • 难度方面,一方面是越难的题目可能对 Epistemic Token 的数量要求就更高些,另一方面也可能更多是 OOD 导致的?

附录 E:More Ablation Study

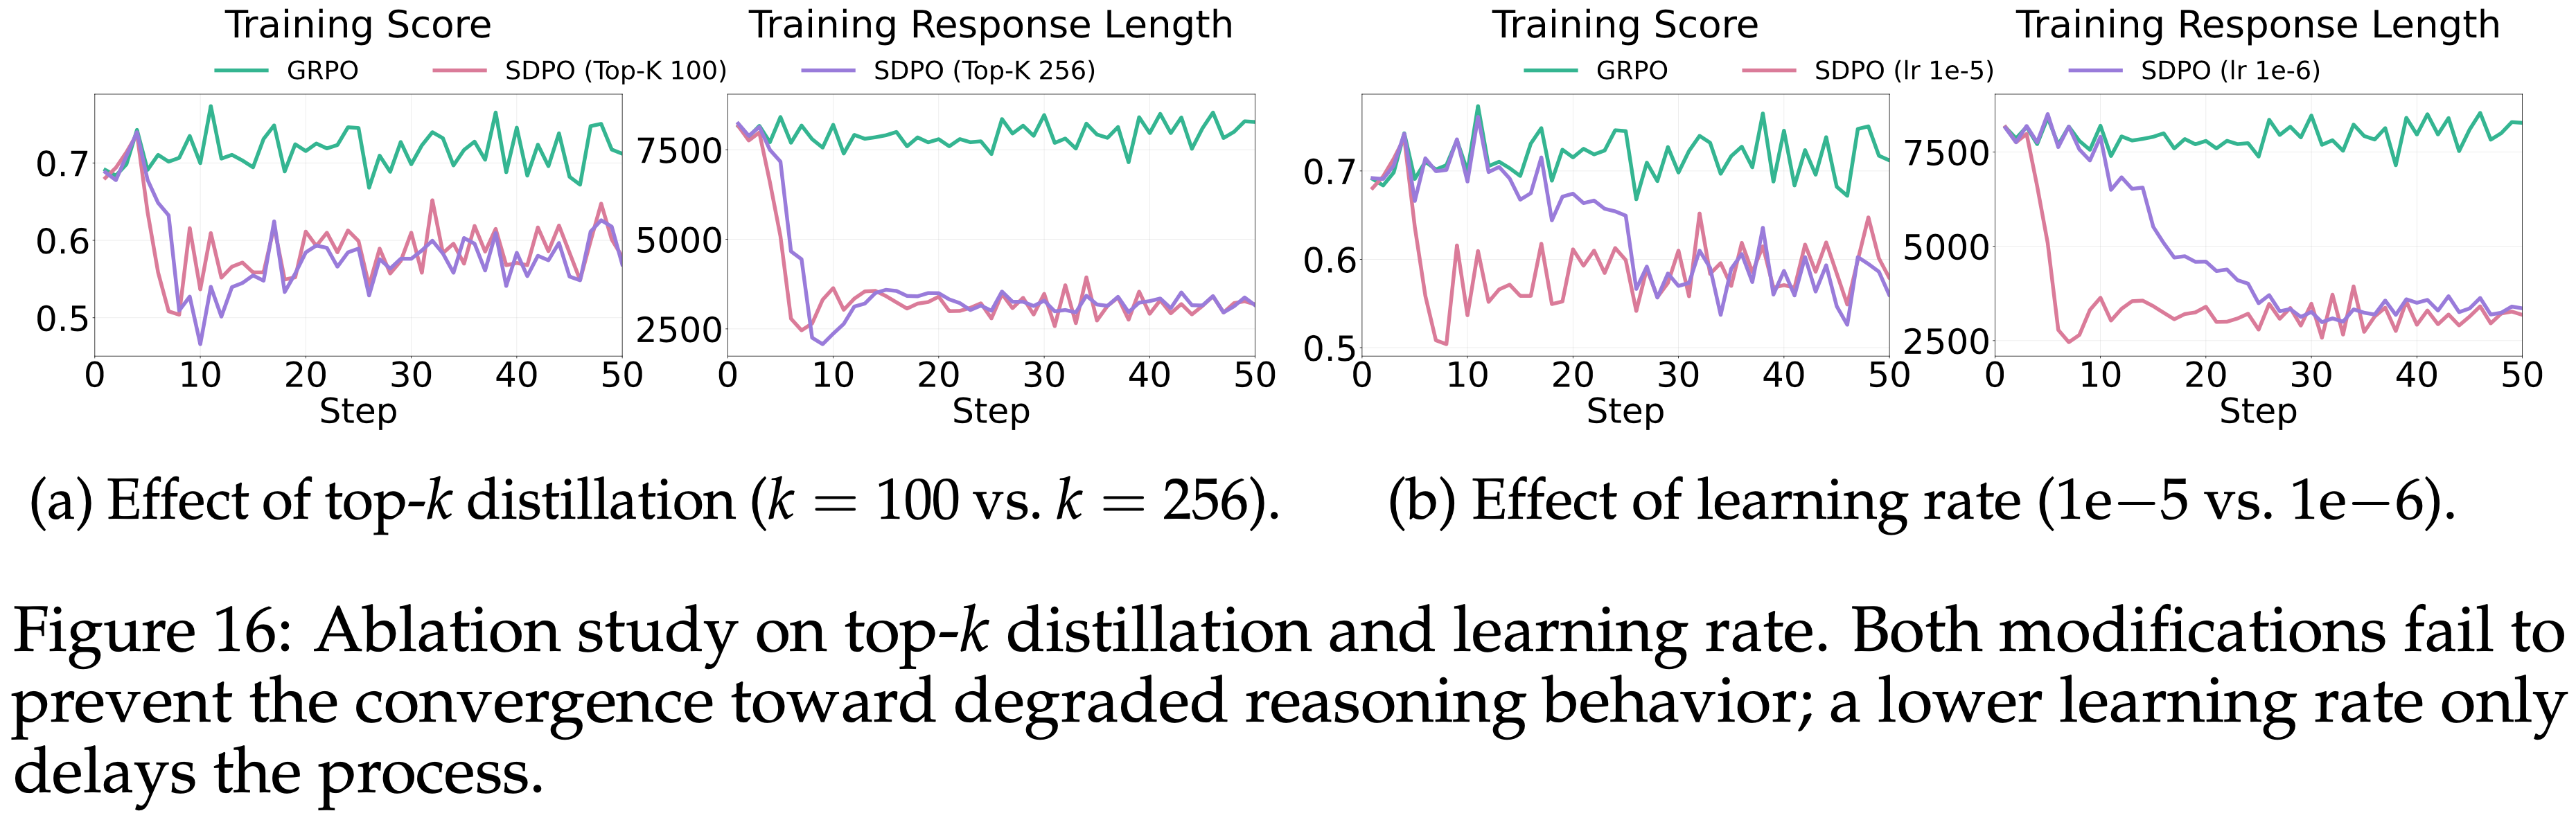
  • 为了检查各种训练超参数对 Self-Distillation 行为的影响,本文通过改变 top-\(k\) 蒸馏参数和学习率进行了额外的实验
    • 问题:这里的 top-\(k\) 参数是什么?
  • 如图 16a 所示
    • 将 top-\(k\) 从 100 增加到 256 在训练动态或最终性能上没有产生显著差异
  • 如图 16b 所示
    • 将学习率从 1e-5 降低到 1e-6 仅仅是减缓了性能下降的速度
  • 模型最终收敛到相同的推理行为

NLP——技术报告解读-Nemotron-Cascade-2

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(Nemotron-Cascade-2 Technical Report) Nemotron-Cascade 2: Post-Training LLMs with Cascade RL and Multi-Domain On-Policy Distillation, 20260319-20260322, NVIDIA
    • HuggingFace: huggingface.co/nvidia/Nemotron-Cascade-2-30B-A3B
    • 补充前一篇文章:(Nemotron-Cascade Technical Report) Nemotron-Cascade: Scaling Cascaded Reinforcement Learning for General-Purpose Reasoning Models, 20251215-20260327, NVIDIA

Paper Summary

  • 整体介绍
    • 本文包含了非常详细的训练细节,值得一读
    • 英伟达开源了 Nemotron-Cascade-2-30B-A3B(基于 Nemotron-3-Nano-30B-A3B-Base 进行后训练得到)
    • 主推核心能力:Reasoning 和 Agentic 能力,小尺寸但其数学和编码 Reasoning 性能接近前沿的开放模型
    • 是继 DeepSeek-V3.2-Speciale-671B-A37B 之后,第二个在 2025 年国际数学奥林匹克竞赛 (IMO)、国际信息学奥林匹克竞赛 (IOI) 和 ICPC 世界总决赛中达到金牌水平的开源权重 LLM
      • 特点:显著更高的智能密度,参数减少了 20 倍
    • 与 Nemotron-Cascade 1 相比,关键的技术进步如下
      • 在经过精心策划的数据集上进行 SFT 之后,大幅扩展了 Cascade RL,使其覆盖更广泛的 Reasoning 和 Agentic 领域
      • 在整个 Cascade RL 过程中为每个领域引入了来自最强中间教师模型的 MOPD (Multi-Domain On-Policy Distillation)
        • 有效地恢复基准测试的退化,持续保持强大的性能提升
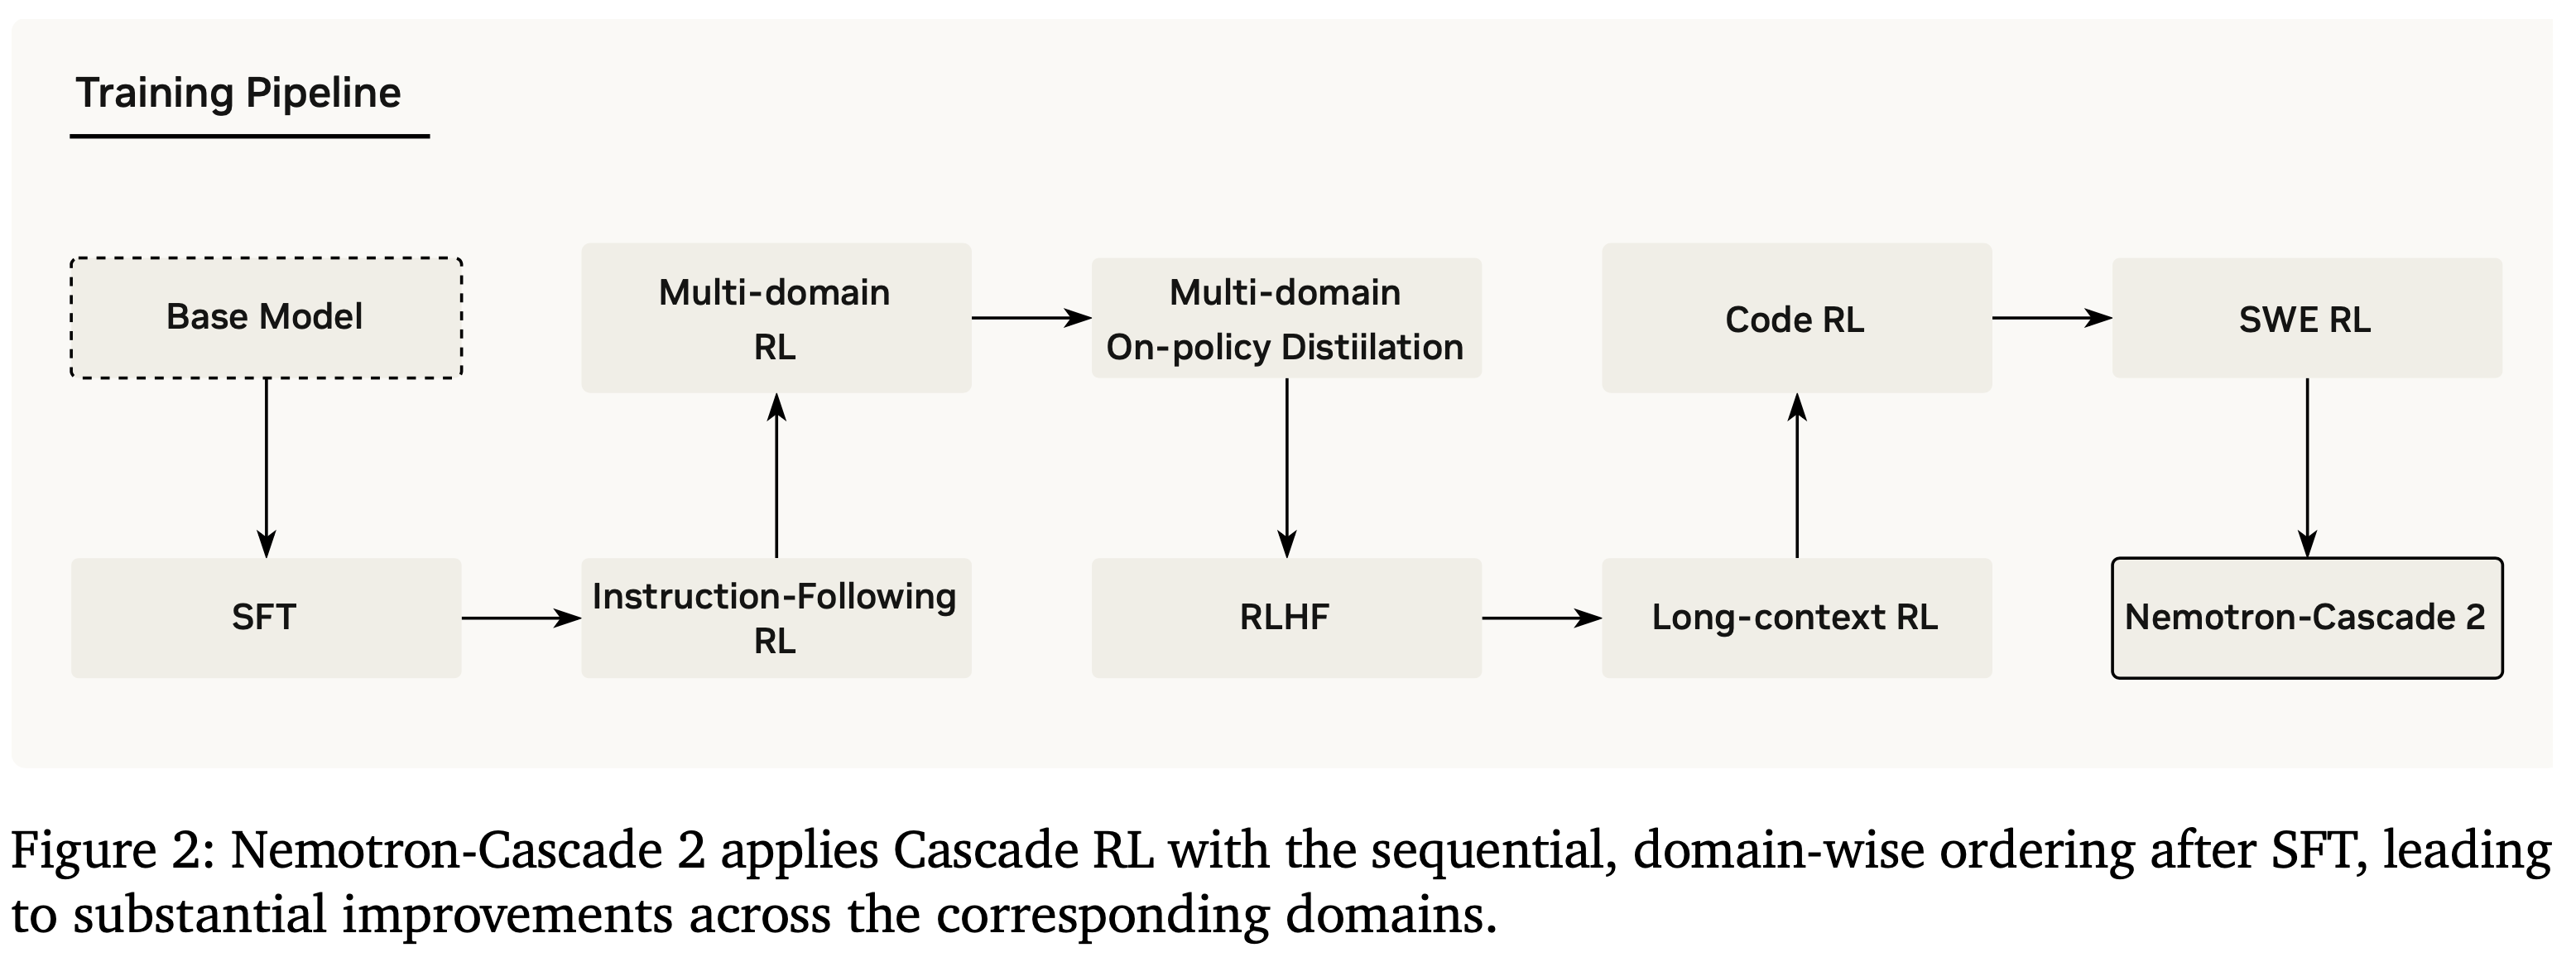
    • Nemotron-Cascade-2 训练流程:SFT -> IF-RL -> Multi-domain RL -> MOPD -> RLHF -> Long-context RL -> Code RL -> SWE RL
      • PS:Nemotron-Cascade 训练流程是 SFT -> RLHF -> IF RL -> Math RL -> Code RL -> SWE RL
  • 注:本文还发布了训练数据(在 HuggingFace 上均可下载)
    • Nemotron-Cascade-2-SFT-Data:用于 Nemotron-Cascade-2 的 SFT 数据集
    • Nemotron-Cascade-2-RL-Data:用于 Nemotron-Cascade-2 的 RL 数据集

Introduction and Discussion

  • Reasoning 和 Agentic 任务上,RL 的主要挑战在于成功整合更广泛的 RL 环境和非常多样化的 Reasoning 与 Agentic 任务
  • 扩展 RL 以涵盖多方面的现实世界应用,需要能够处理各种奖励信号 和复杂环境反馈 , 且不破坏训练过程 的鲁棒框架
  • 本文作者之前的工作 Nemotron-Cascade 1 (2025) 引入了 Cascade RL
    • Cascade RL 是一个跨专业任务领域协调顺序的、领域特定的 RL 训练的框架
      • Cascade RL 的多个阶段:SFT -> RLHF -> IF RL -> Math RL -> Code RL -> SWE RL
    • Cascade RL 显著简化了与多领域 RL 相关的工程复杂性,同时在广泛的基准测试上实现了最先进的性能
    • Cascade RL 的优势有三点
      • 第一:特定领域的 RL 阶段对灾难性遗忘具有显著的抵抗力
        • Cascade RL 很少会降低在早期领域获得的基准性能,甚至可能提高它
      • 第二:Cascade RL 允许为每个特定领域精心定制 RL 超参数和训练课程
        • 从而实现优化的学习动态和改进的最终性能
      • 第三:每个 RL 阶段内的任务同质性也带来算力节省
        • 因为在一个领域内,Response 长度和验证挂钟时间比在联合训练的多个领域中更一致
  • 本文介绍了 Nemotron-Cascade 2,与其前身类似,Nemotron-Cascade 2 进一步在高优先级领域上扩展了 Cascade RL,以保留领域特定训练的好处,能够将关键领域的 Reasoning 性能极限推向最先进水平
  • 本文将 On-Policy Distillation (2026; 2026) 融入到 Cascade RL 训练阶段
    • 通过在 Cascade RL 期间从每个特定领域内表现最佳的中间教师模型中蒸馏知识,这种机制有效地恢复了在日益复杂的 RL 环境中训练时可能发生的任何基准测试性能退化
    • 将多领域 RL 集成到 Cascade RL 中,用于具有相似 Response 格式和可比验证成本的任务组,允许它们联合训练,以扩展到更多的 RL 环境,并在跨任务干扰最小时提高训练效率
  • 本文的 Nemotron-Cascade-2-30B-A3B 在数学和编码 Reasoning 方面实现了突破性的性能
    • 仅 30B 的 MoE 模型,但在 2025 年国际数学奥林匹克竞赛 (IMO) 和国际信息学奥林匹克竞赛 (IOI) 中都获得了金牌成绩,同时在广泛的基准测试中提供了最佳性能,包括 Alignment、Instruction-Following、Long Context(例如,1M 上下文窗口)和 Agentic 任务
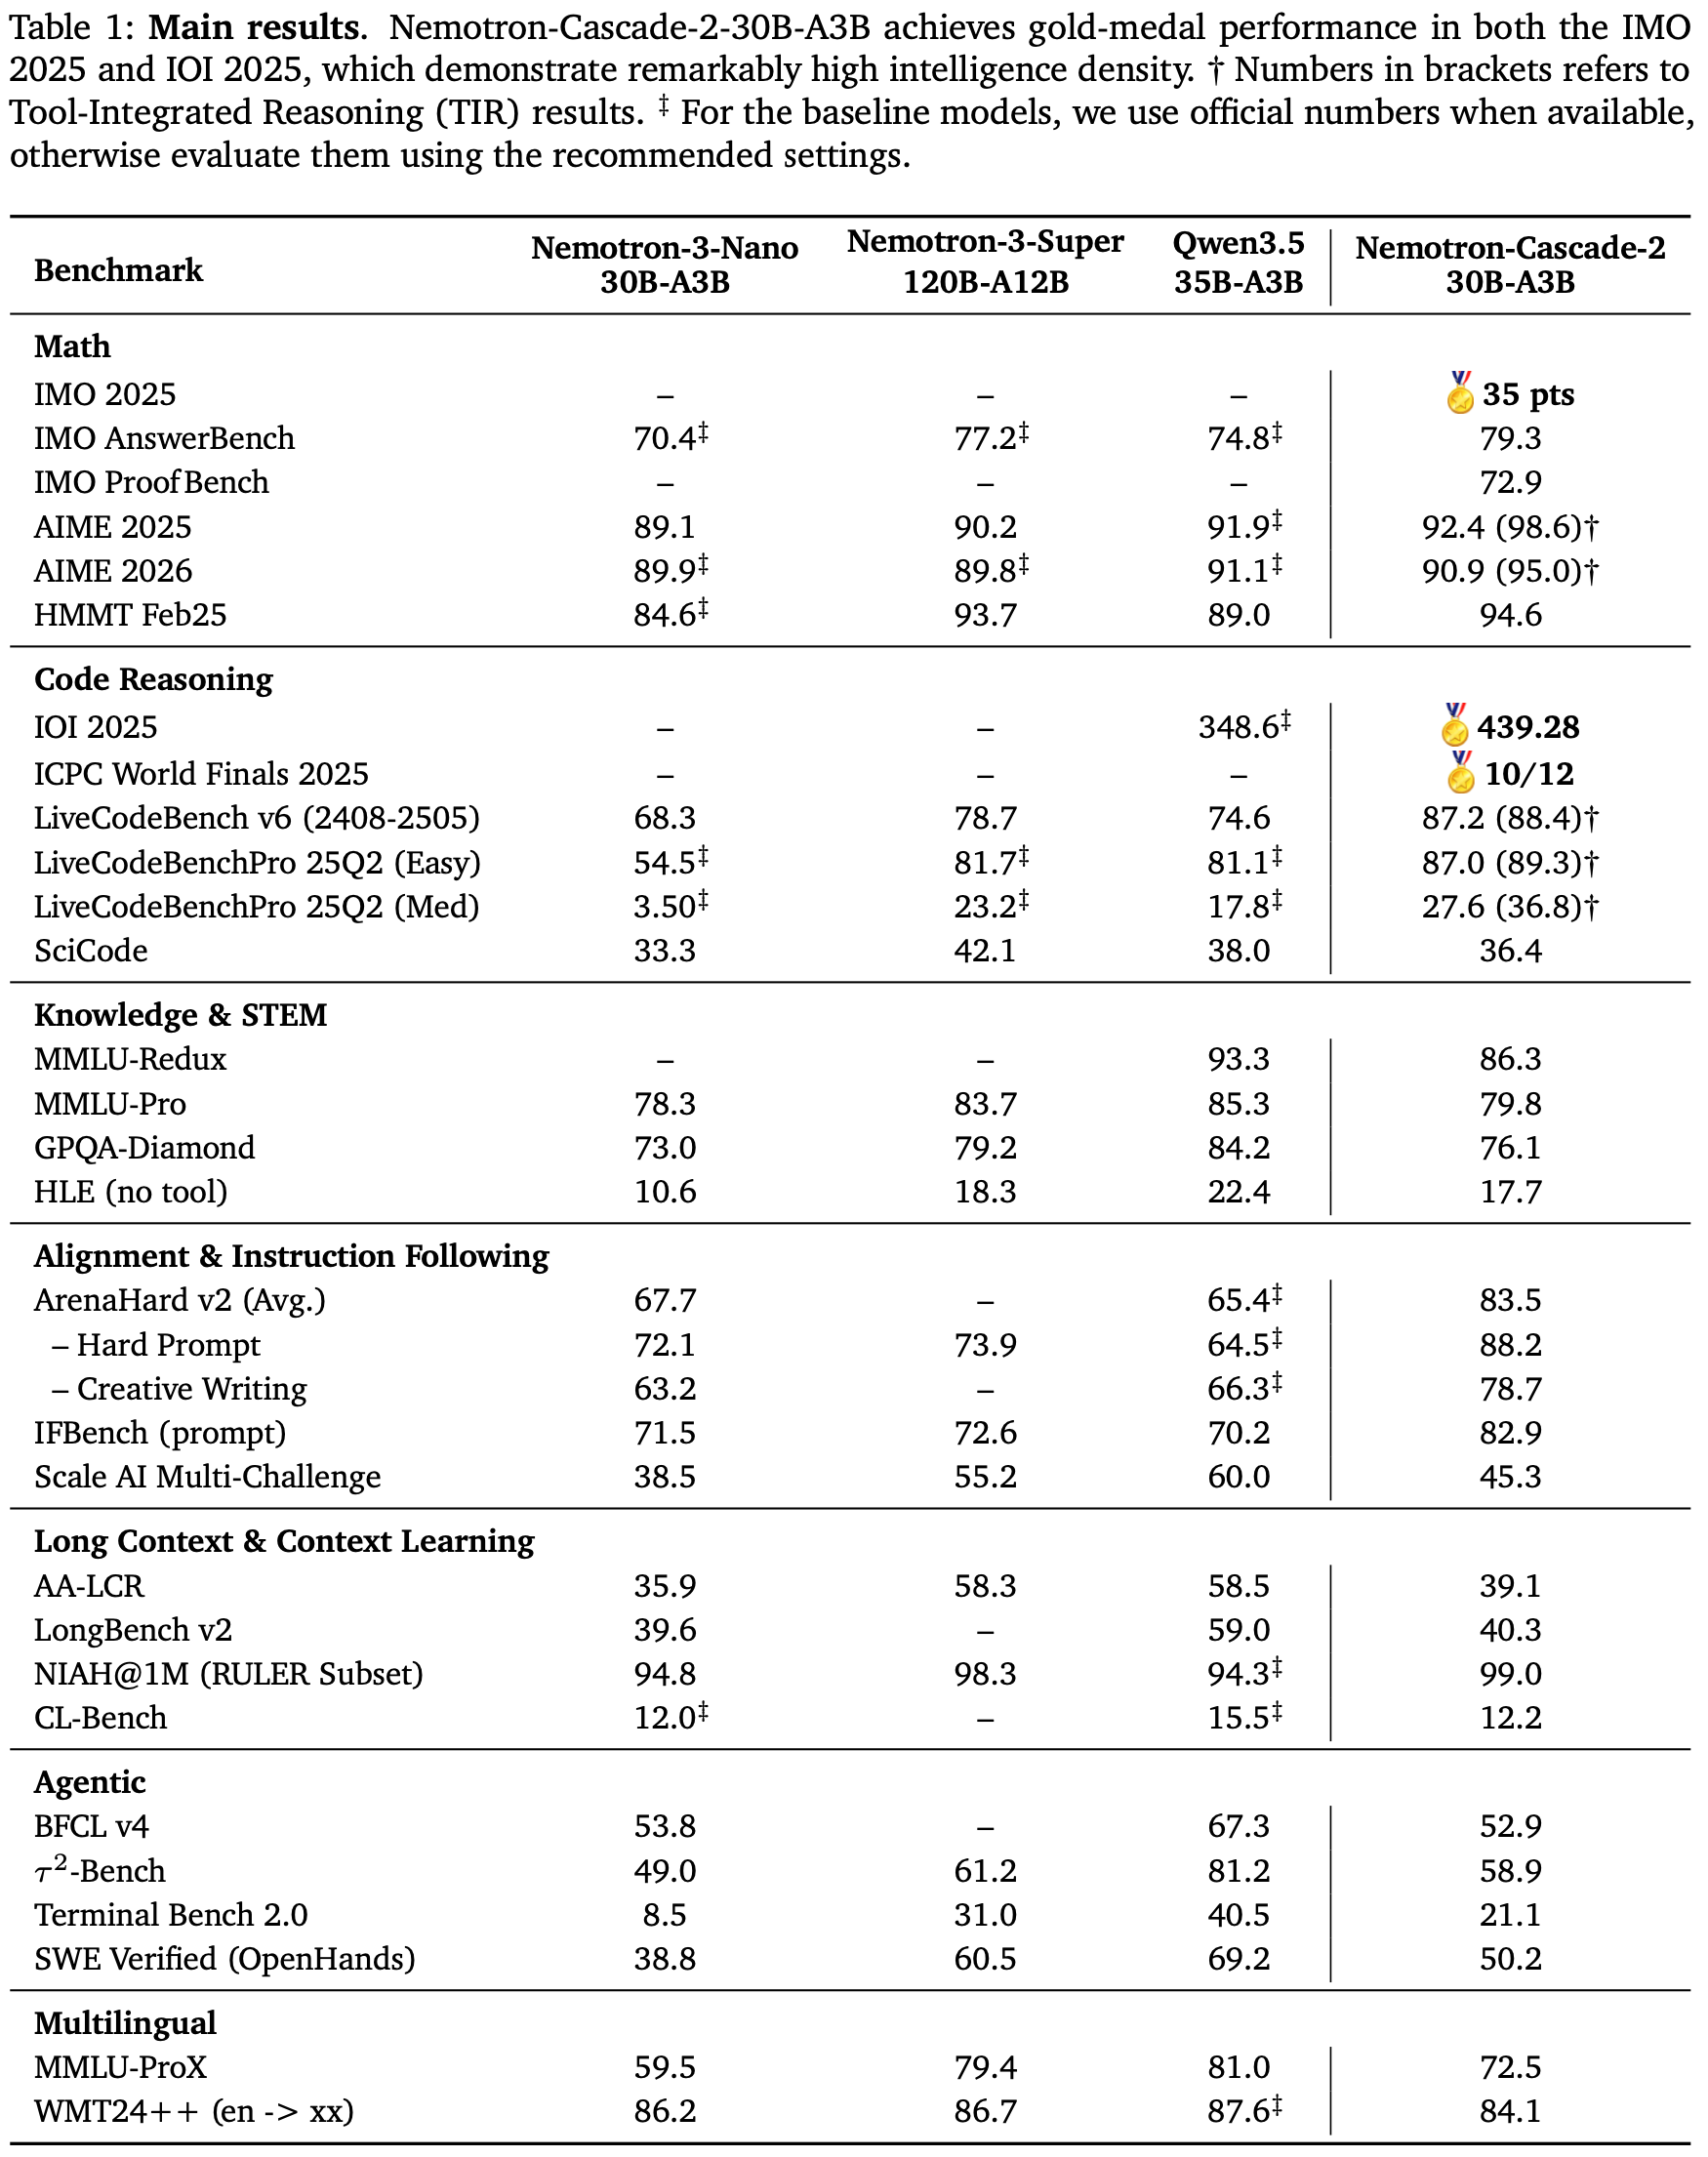
    • 完整结果见表 1
  • 注:本文完全开源了模型权重、训练数据和方法细节,使研究社区能够复现、分析和扩展所提出的 Cascade RL 训练范式
    • 这一点特别重要,文章中包含许多训练细节和超参数等

Main Results

  • 在涵盖数学和编码 Reasoning 、知识与 STEM、 Alignment 与 指令跟随 、长上下文理解与上下文学习 (In-Context Learning)、多语言能力和 Agentic 任务的全面基准套件上评估了 Nemotron-Cascade 2
  • 主要结果显示在表 1 中,基准测试和详细的评估设置见附录 A
  • 表 1:主要结果
    • Nemotron-Cascade-2-30B-A3B 在 IMO 2025 和 IOI 2025 中均实现了金牌性能,展示了显著的高智能密度
    • 方括号中的数字指的是工具集成推理 (Tool-Integrated Reasoning, TIR) 结果
    • 对于基线模型,使用可用的官方数值,否则使用推荐的设置进行评估
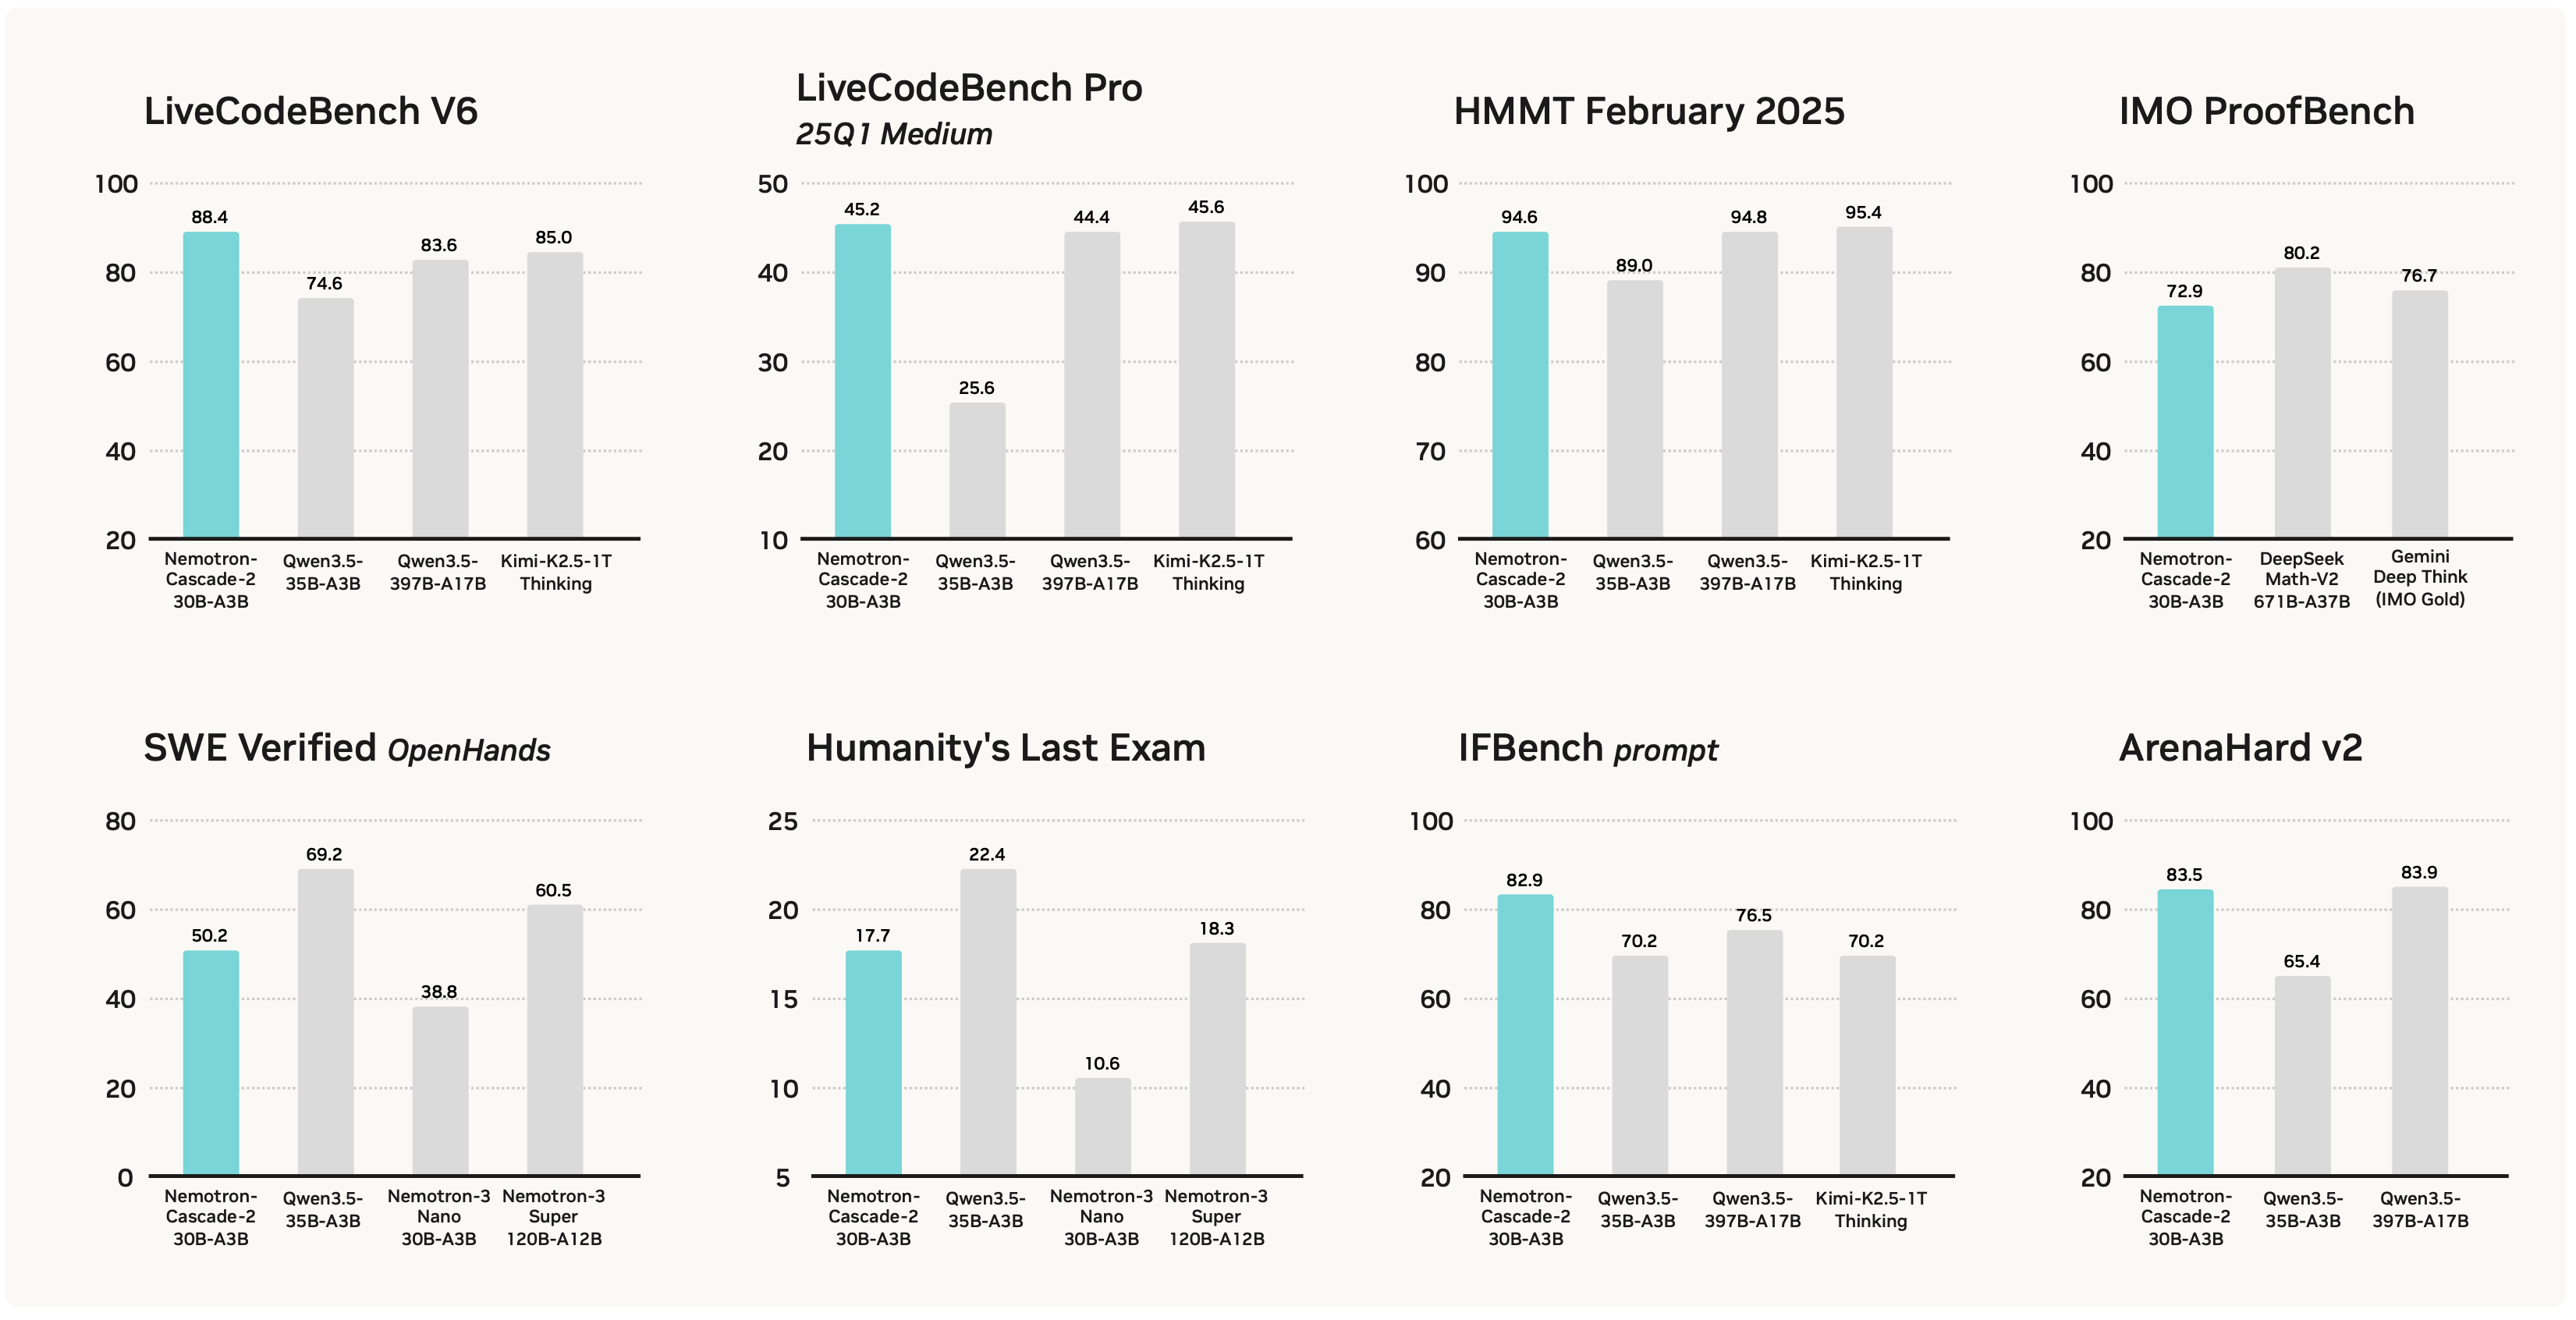
  • 从表 1 可以看出,Nemotron-Cascade-2-30B-A3B 不仅优于最新发布的 Qwen3.5-35B-A3B (2026-02-24) (Qwen Team, 2026),也优于更大的 Nemotron-3-Super-120B-A12B (2026-03-11) (2025),并在数学、代码 Reasoning 、通用 Alignment 和 指令跟随 的基准测试中实现了同类最佳性能
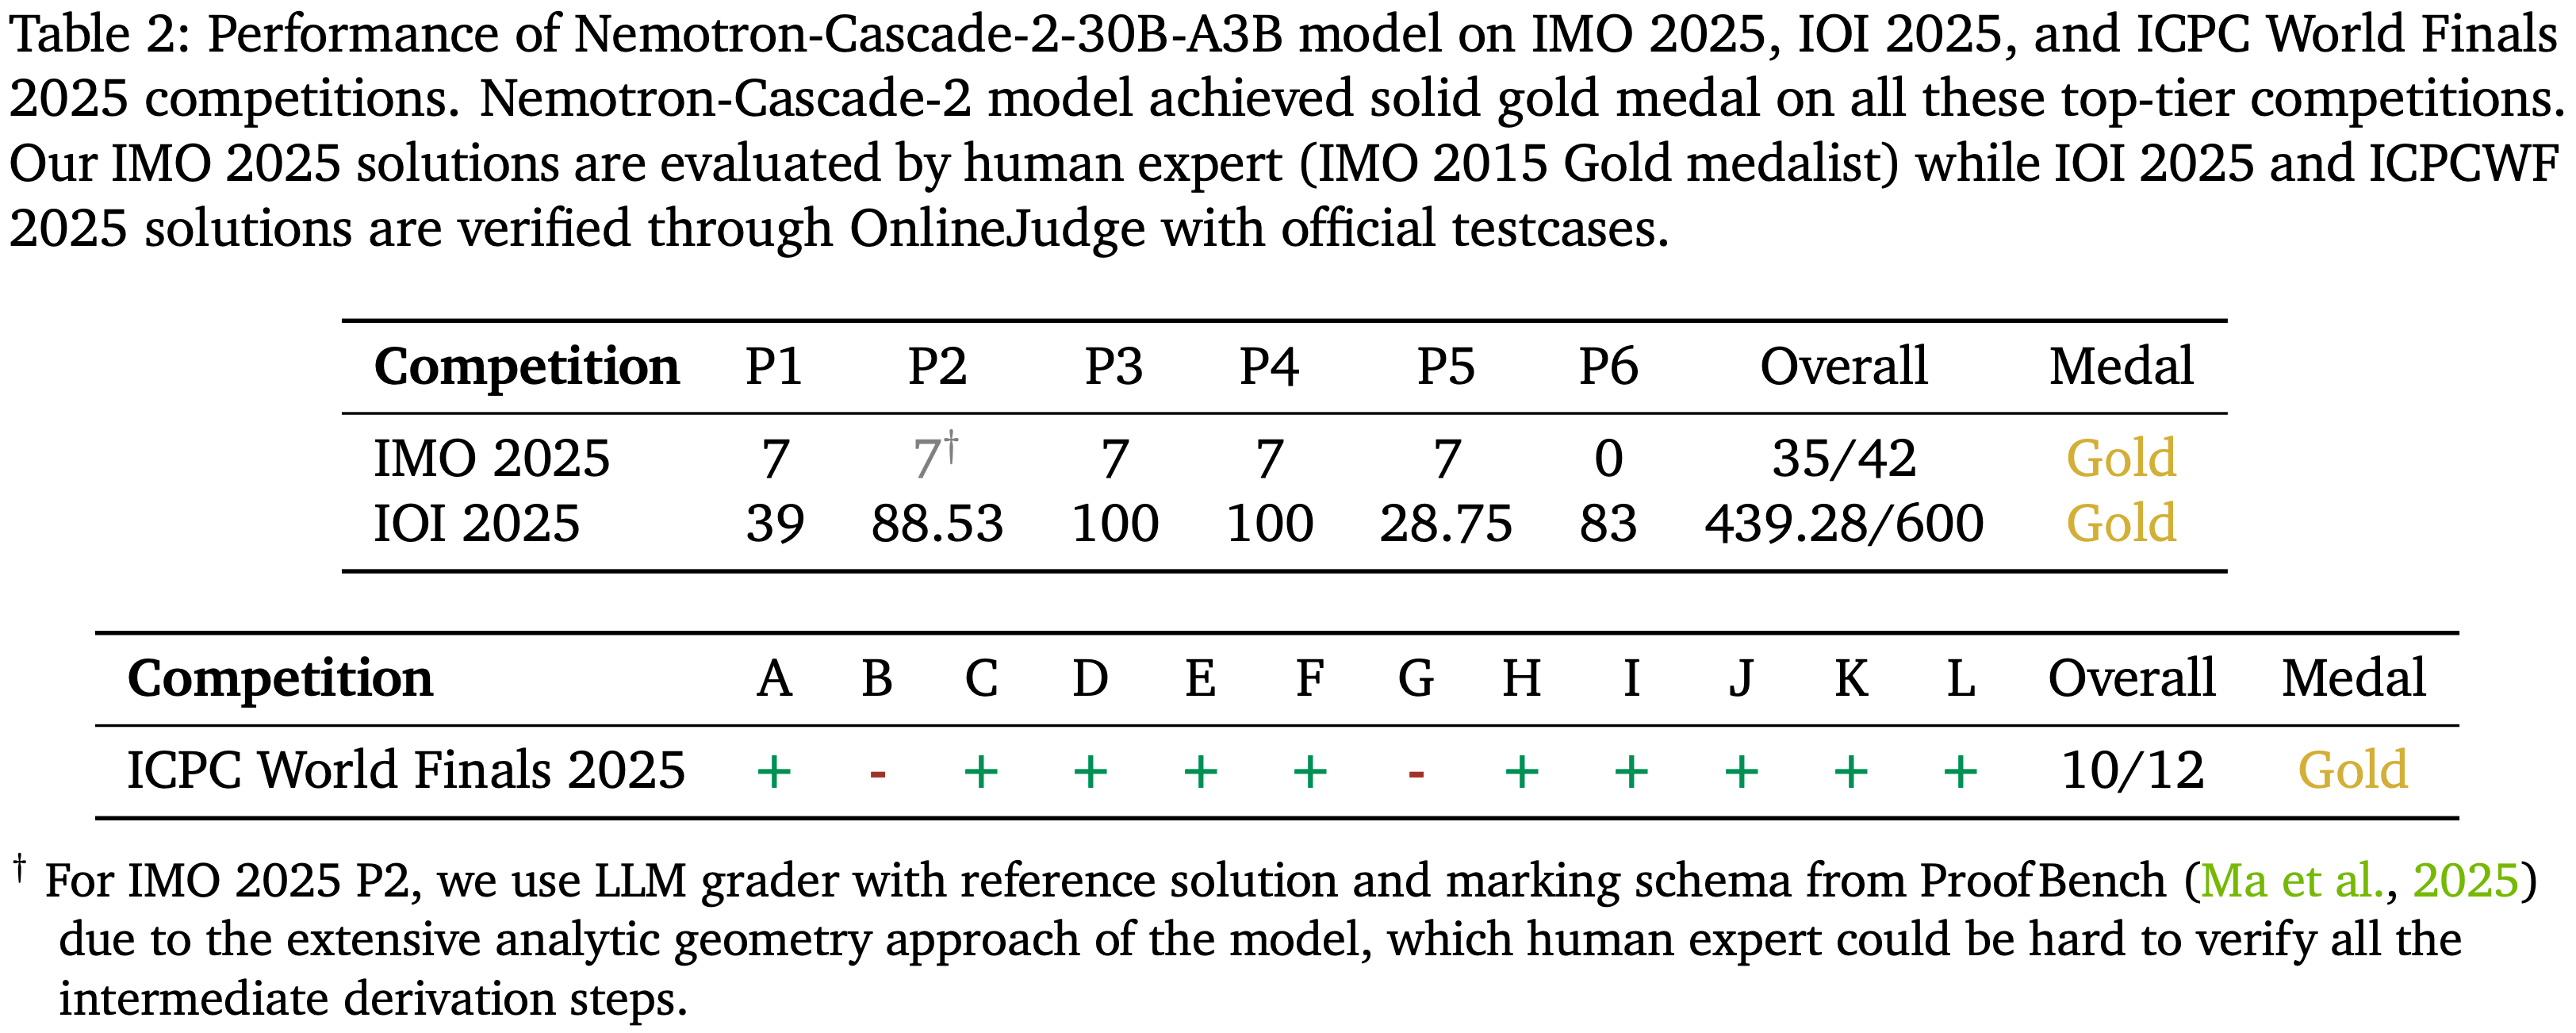
  • 表 2:
    • 对于 IMO 2025 P2,由于模型采用了广泛的分析几何方法,人类专家可能难以验证所有中间推导步骤
      • 本文使用来自 ProofBench (2025) 的参考解决方案和评分方案的 LLM 评分器
  • 特别说明:Nemotron-Cascade 2(30B 的 MoE 模型)在 IMO 2025、IOI 2025 和 ICPC World Finals 2025 上取得了金牌性能
    • 这一结果以前被认为只有前沿的专有模型 (Gemini Team, 2025)(即 Gemini Deep Think)和前沿规模的开源模型 (2025)(即 DeepSeek-V3.2-Speciale-671B-A37B)才能达到
    • 本文模型的详细性能在表 2 中报告
    • 对于 IMO 2025,模型生成的解决方案以及人类专家的评审和分数见附录 E
  • Nemotron-Cascade-2-30B-A3B 在几乎所有基准测试上也优于 Nemotron-3-Nano-30B-A3B
    • 注:这两个模型都是从相同的预训练模型 Nemotron-3-Nano-30B-A3B-Base (NVIIDA, 2025) 进行后训练的
    • 这一结果进一步证明了本文的 Cascade RL 加 MOPD 训练流程的有效性
  • 注:Nemotron-Cascade-2-30B-A3B 在知识密集型和 Agentic 基准测试上表现不如 Qwen3.5-35B-A3B
    • 未来工作重点:进行更强的知识密集型预训练和 Agentic RL

SFT

  • 本节描述 SFT 训练框架和数据管理过程,这是作者后训练流程的第一阶段。此阶段为模型配备了基础能力,包括 Reasoning 、对话能力、 指令跟随 以及 Agentic 和软件工程技能

Training Framework

Overview
  • 本文的 SFT 数据涵盖包括
    • 数学、编码、科学、工具使用、Agentic 任务和软件工程
    • 通用领域:如多轮对话、知识密集型问答、创意写作、角色扮演、安全性和 指令跟随
  • 本文将所有 SFT 样本打包进长达 256K Token 的序列中,并在单个阶段训练模型
    • 经验发现:SFT 模型在大约 1.5 个 Epoch 后达到最佳性能
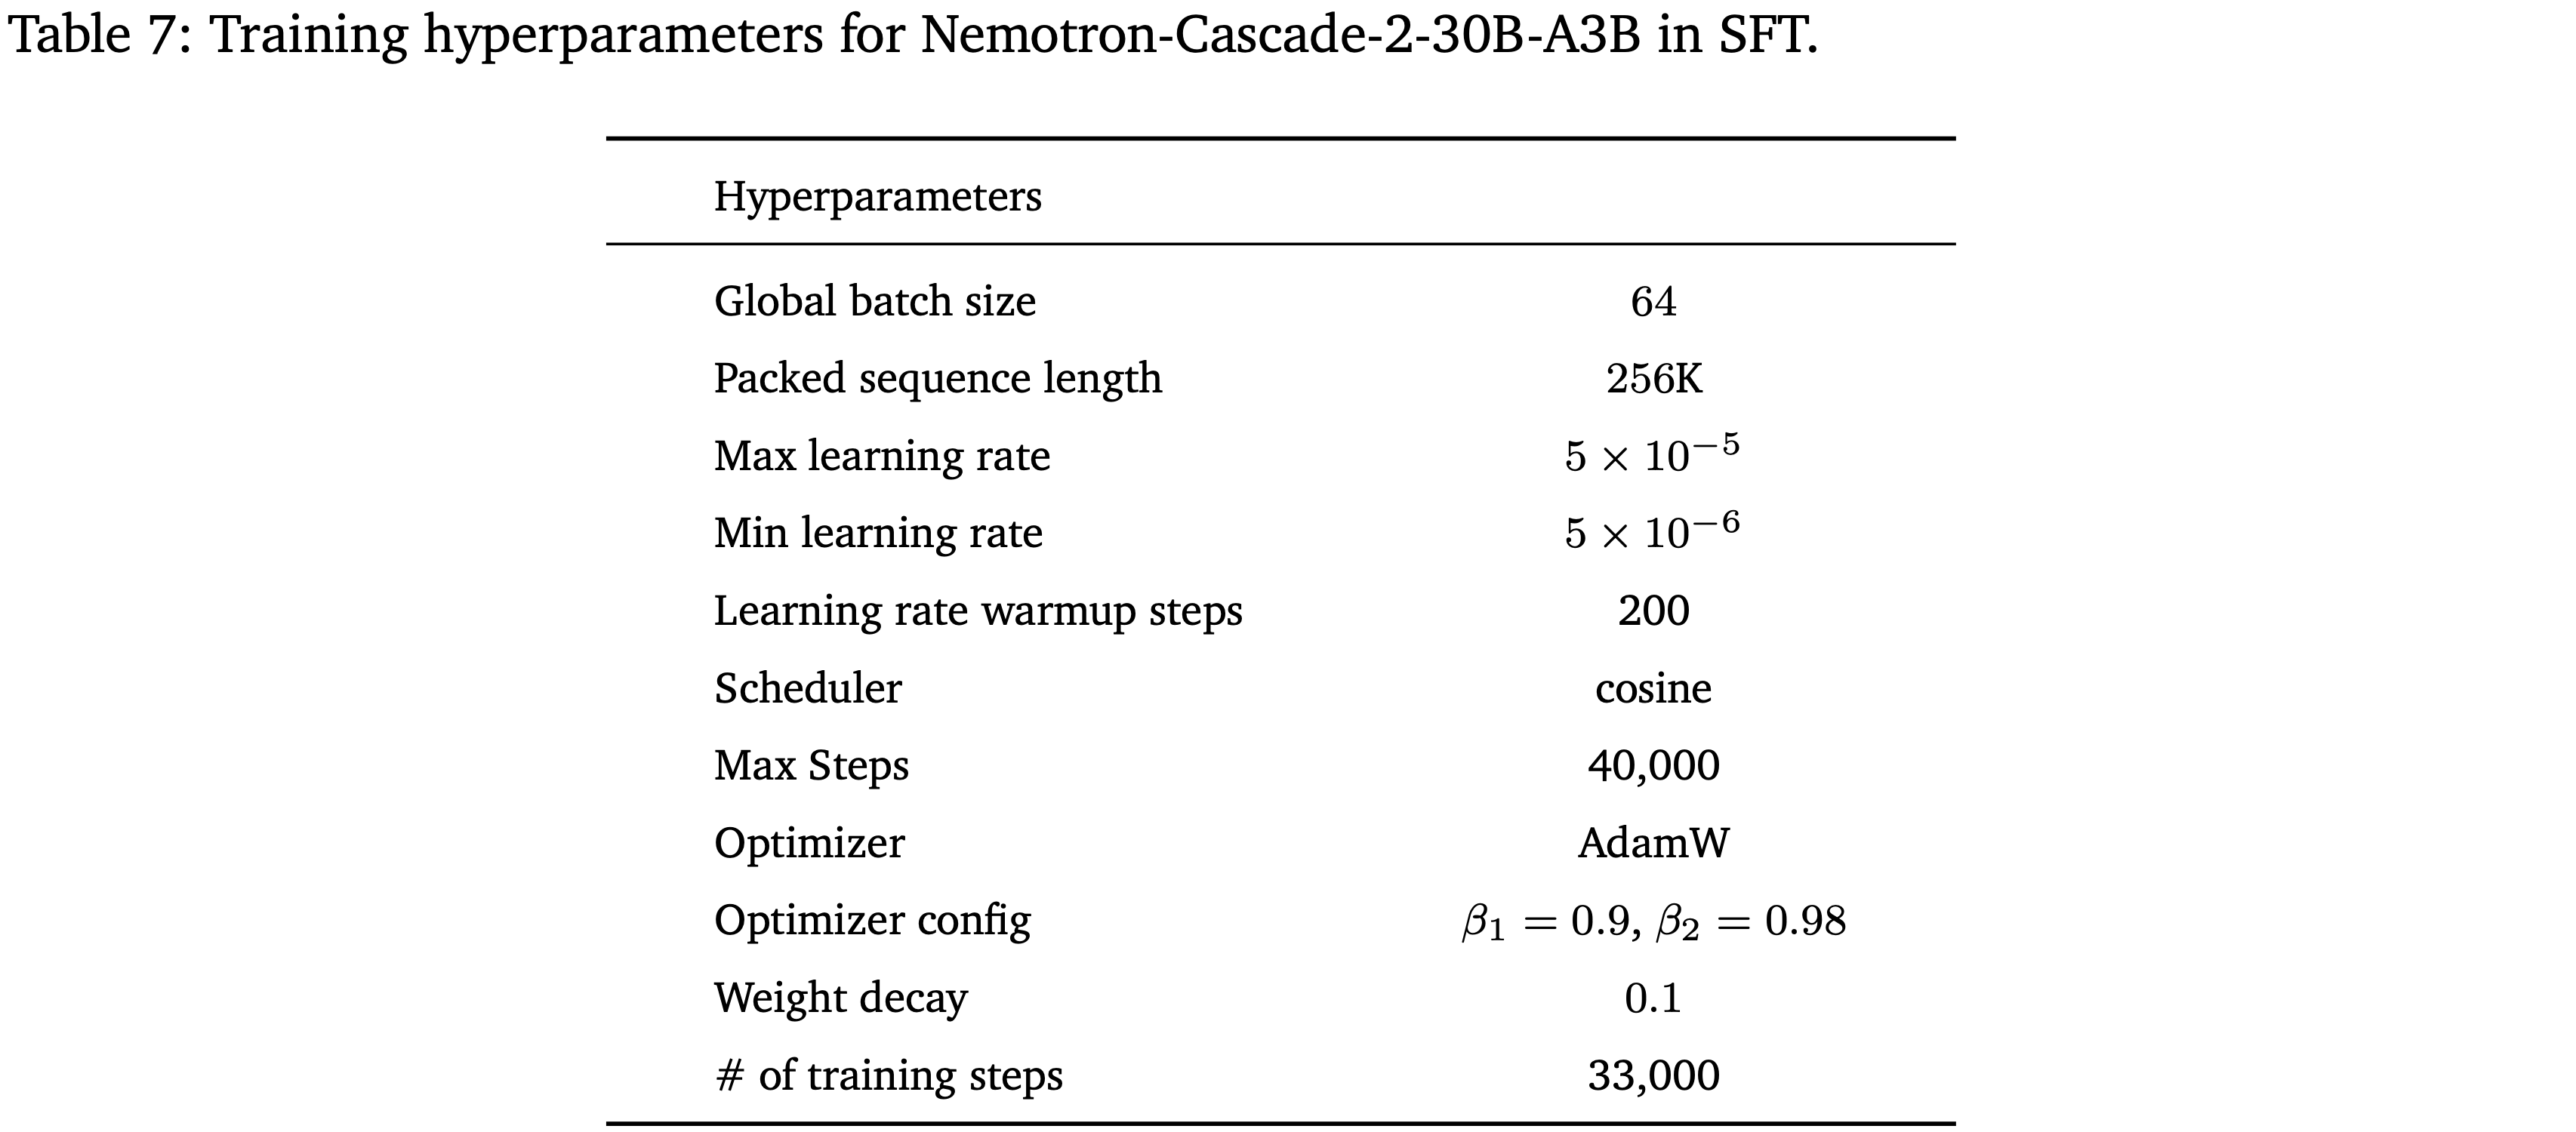
    • SFT 训练超参数见附录 B(表 7)
Chat Template
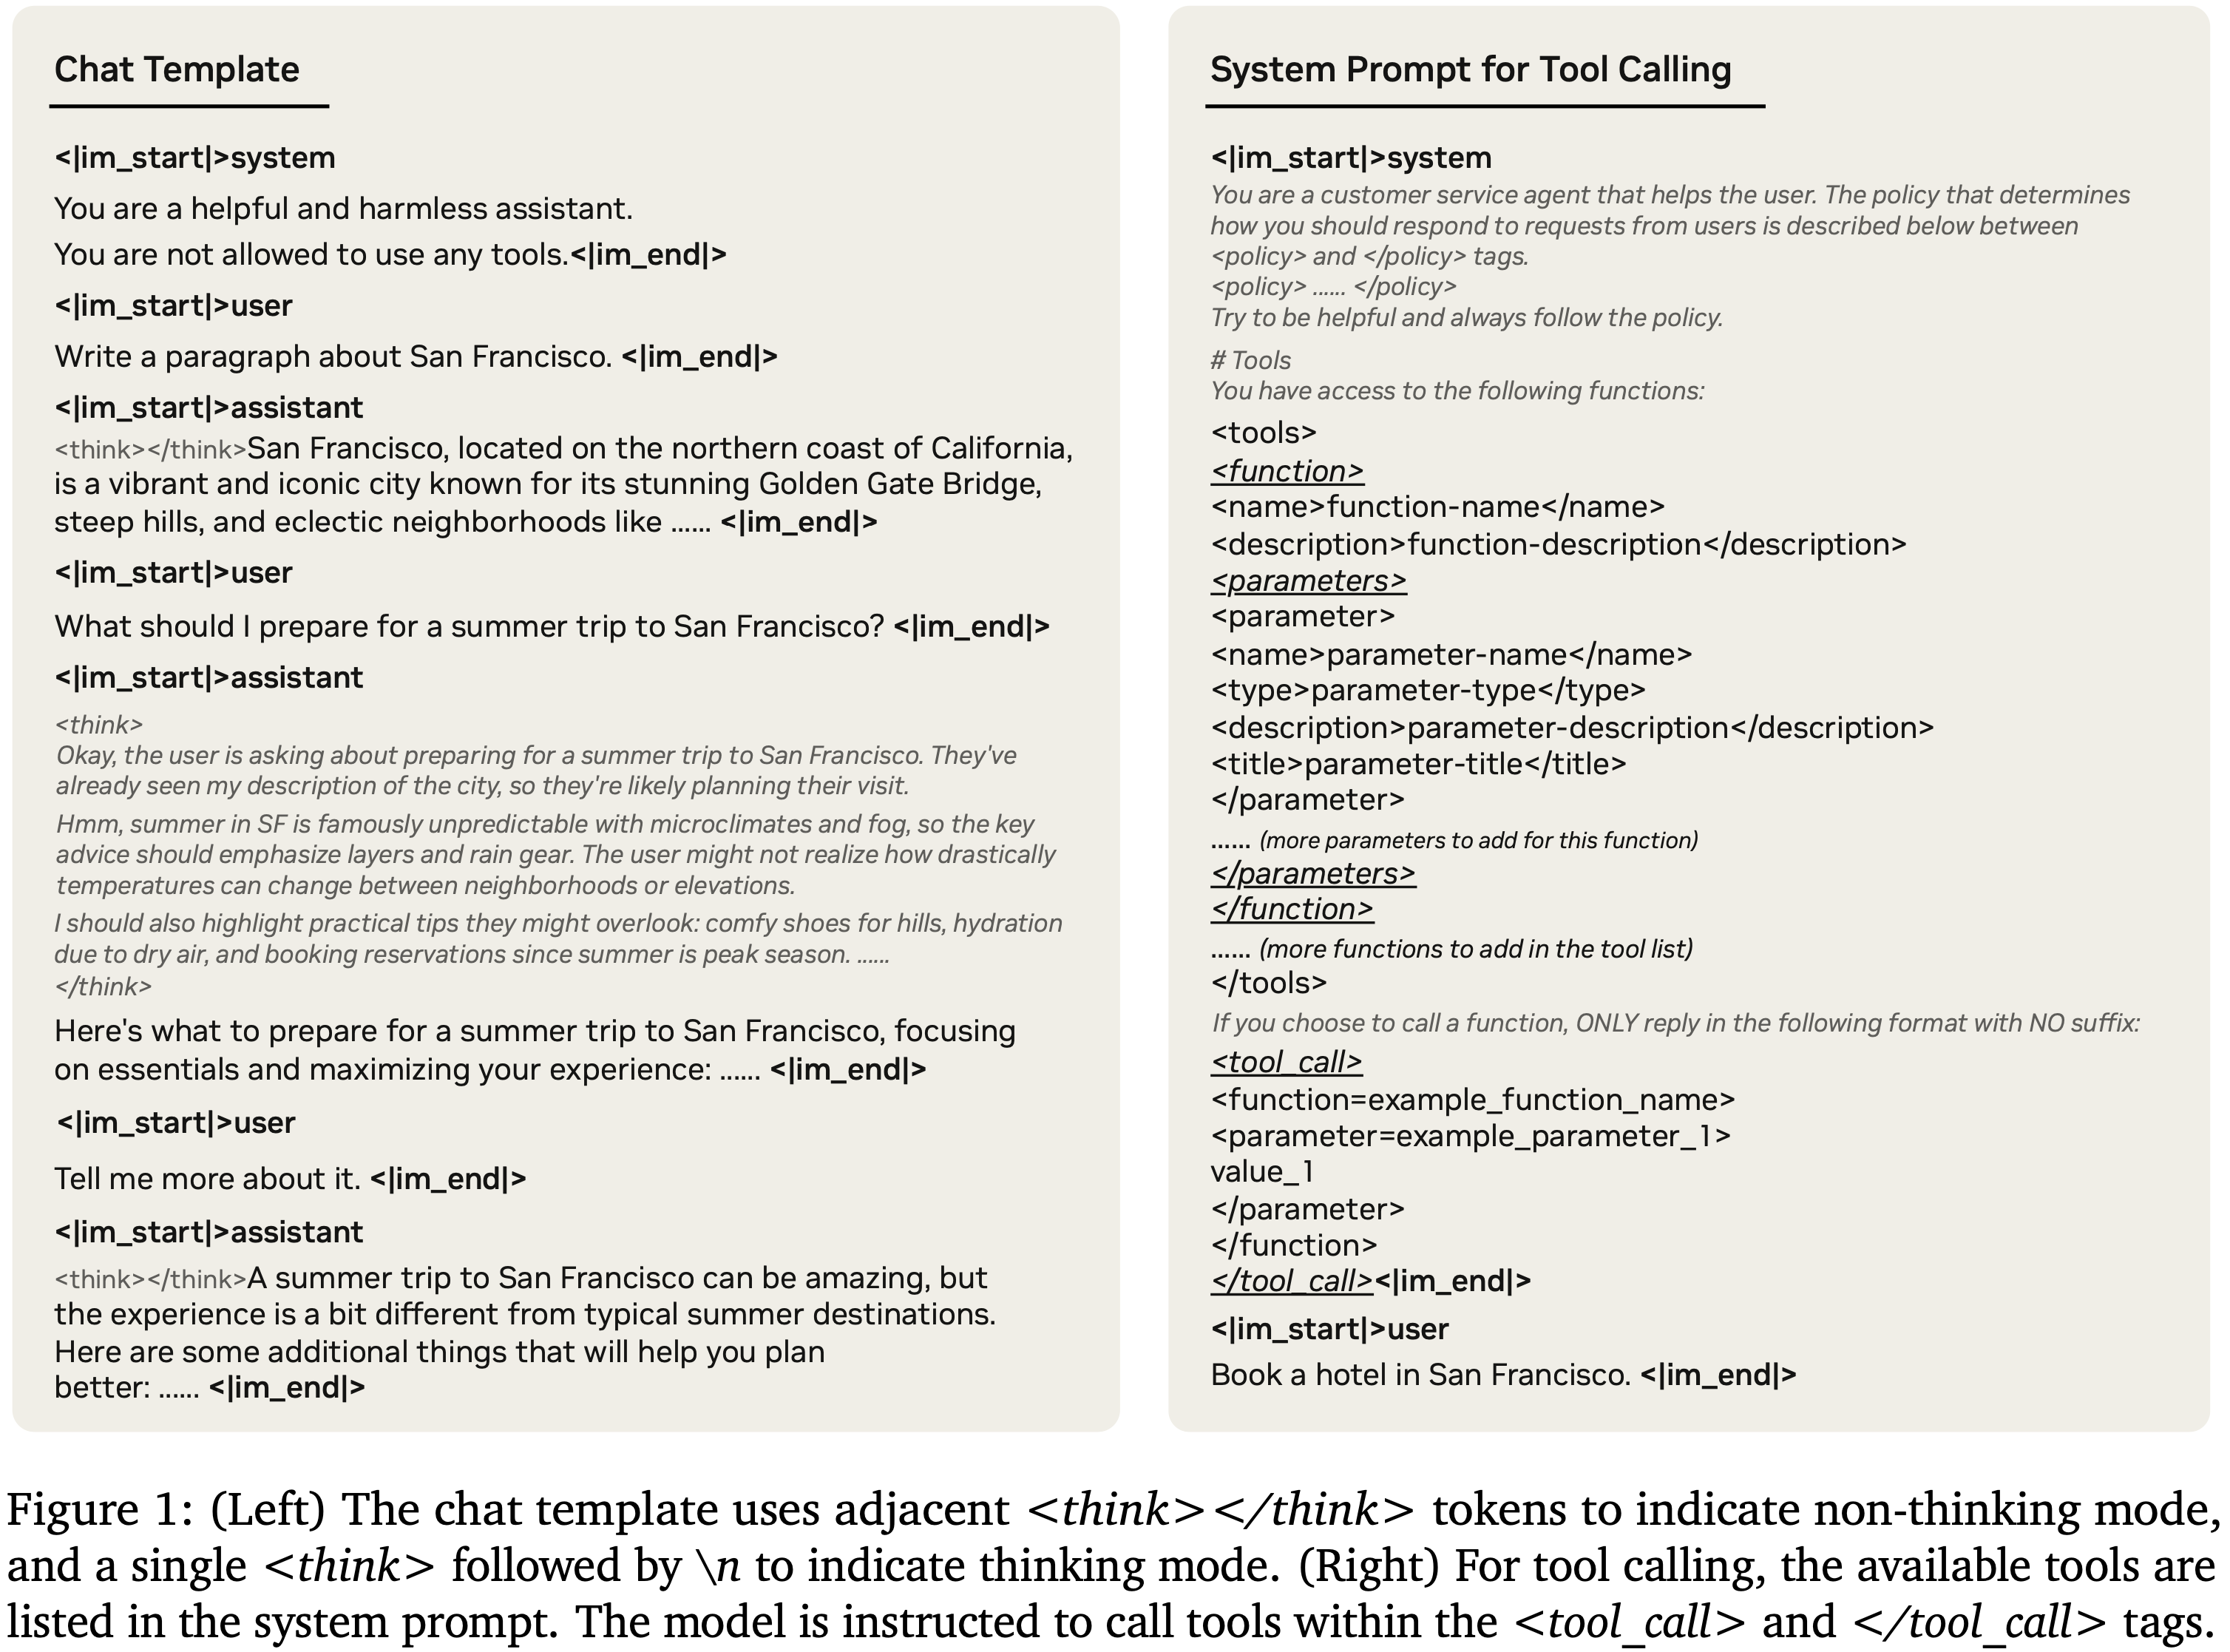
  • 聊天模板如图 1 所示
    • 与 Nemotron-Cascade (2025) (解读见:NLP——技术报告解读-Nemotron-Cascade)相比,聊天模板有两个变化
      • 第一:为了简化,移除了 /think 和 /no_think 标签
      • 第二:预先添加一个空的 <think></think> 块以激活非思考模式
    • 对于工具调用任务,在系统 Prompt 中的 <tools> 和 </tools> 标签内指定所有可用工具

SFT Data Curation

Math
  • 非证明数学 Prompt 主要来源于 Nemotron-Cascade (2025) 和 Nemotron-Math-v2 (2025)
    • 从中收集了 1.8M 个工具调用(即 Python)样本和 190 万个非工具样本
    • 其 Response 分别由 DeepSeek-V3.2 和 DeepSeek-V3.2-Speciale (2025) 生成
  • 从 Nemotron-3-Nano (2025) 的生成-选择类别中收集了 676K 个样本
    • 其 Response 由 GPT-OSS-120B (2025) 生成
    • 竞赛数学 SFT 包括 1.8M 个工具调用样本和 2.6M 个不使用工具的样本
  • 对于数学自然语言证明,从 Nemotron-Math-Proofs-v1 (2025) 的 AOPS 分割中收集了 98K 个数学证明问题
    • 为每个问题生成多个样本以涵盖两种能力:
      • 证明生成 (410K ) 和证明验证 (400K )
      • 使用 DeepSeek-V3.2-Speciale (2025),总共产生 816K 个样本
Code Reasoning
  • 基于 Nemotron-Cascade 1 (2025),从几个开源数据集中管理了大约 165K 个 Unique 编码 Prompt
    • 包括 OpenCode-Stage2 (2024)、OpenCodeReasoning (2025) 和 HardTests (2025)
    • 这些 Prompt 最初来源于竞争性编程平台,如 Codeforces、AtCoder、AIZU 和 CodeChef
    • 为鼓励 Prompt 多样性并减少 SFT 训练集中的冗余,使用两种方法应用了严格的去重:
      • (1) 样本 I/O 指纹识别
      • (2) 基于 n-gram 的文本分析
      • 以上过程移除了大约 24.2% 的自我重复编码 Prompt
  • 选择 GPT-OSS-120B (2025) 作为本文 SFT 教师模型
    • 因为它具有强大的代码 Reasoning 能力
  • 对于每个具有可验证测试用例的编码 Prompt,对教师的 Reasoning 轨迹应用正确性过滤,只保留那些生成正确代码的轨迹
    • 对于没有可验证测试用例的 Prompt,通常选择更长的 Reasoning 轨迹,假设它们反映了更彻底的问题分析
  • 此流程最终产生了一个数据集,包含 1.9M 条 Python Reasoning 轨迹、1M 条 C++14 Reasoning 轨迹和 1.3M 条用于竞争性编程的 Python 工具调用 Reasoning 轨迹
Scientific Coding
  • 本文进一步收集了跨越生物学、材料科学、物理学、化学和数学领域的科学研究编码 Prompt
  • 对这些 Prompt 的 Response 由 GPT-OSS-120B (2025) 生成,总共产生 1.1M 个 SFT 样本
Science
  • 收集的科学 Prompt 跨越物理、化学和生物学
  • 使用了来自 Nemotron-Cascade (2025) 的 1.4M 个科学 SFT 样本,以及来自 Nemotron-3-Nano (2025) 的另外 1.3M 个样本
    • 两个数据集中的 Response 均由 GPT-OSS-120B (2025) 生成
Long Context
  • 采用来自 Nemotron-3-Nano (2025) 的 160K 条长上下文 SFT 数据,其平均序列长度为 128K Token
  • 此外还从 ChatQA-2 (2024) 收集了另外 74K 条长上下文 SFT,其平均长度为 29K Token
General Chat
  • 从 Nemotron-Cascade 1 (2025) 获取 Prompt,并构建了 4.9M 个 Reasoning-on 和 372K 个 Reasoning-off 的样本
    • Reasoning-on 样本的 Response 由 GPT-OSS-120B (2025) 生成
    • Reasoning-off 样本中:
      • 300K 个 Response 取自数据集本身内的高质量注释短答案
      • 另外 330K 个由 DeepSeek-V3-0324 (2024) 生成以提高 Response 质量
  • 为了增强多轮对话能力,使用两个 GPT-OSS-120B (2025) 实例在角色扮演设置中合成了大约 700K 个多轮对话样本,其中一个实例扮演用户,另一个扮演助手
    • 用户端模型可以随时终止对话以防止重复交流
  • 本文还从 Nemotron-3-Nano (2025) 中引入了 4.6M 个 Reasoning-on 聊天样本,其 Prompt 来源于 LMSYS (2023) 和 WildChat (2024)
    • Response 由 GPT-OSS-120B (2025)、Qwen3-235B-A22B-Thinking-2507 和 Qwen3-235B-A22B-Instruct-2507 (2025) 生成
    • 问题:是一个 Prompt 生成多个模型的 Response,同时使用吗?
Instruction Following
  • 从 Nemotron-Cascade 1 (2025) 获取 Prompt
    • 使用 GPT-OSS-120B (2025) 生成了大约 230K 个 Reasoning-on Response
    • 使用 DeepSeek-V3-0324 (2024) 生成了 64K 个 Reasoning-off Response
  • 此外从 Nemotron-3-Nano (2025) 引入了 497K 个 指令跟随 样本,包括 457K 个 Reasoning-on 和 40K 个 Reasoning-off Response
    • 这些 Response 由 GPT-OSS-120B (2025)、Qwen3-235B-A22B-Thinking-2507 和 Qwen3-235B-A22B-Instruct-2507 (2025) 生成
Safety
  • 从 Nemotron-3-Nano (2025) 收集了 4000 个安全性 SFT 样本,以使模型在遇到不安全输入时能够表现出适当的拒绝行为
  • SFT Prompt 主要来源于 Nemotron Content Safety v2 (2025)、Gretel Safety Alignment v1 (2024)、Harmful Tasks (2024) 和 Red-Team-2K (2024)
Conversational Agent
  • 除了用于数学和代码 Reasoning 的 Python 工具使用数据外,还在多轮对话设置中收集了工具使用样本
    • 其中多个工具可用,助手必须确定调用哪些工具以及如何有效地使用它们
  • 本文从 Nemotron3-Nano (2025) 收集了 822K 个对话式工具使用样本
    • 其 Response 由 Qwen3-235B-A22B-Thinking-2507、Qwen3-32B、Qwen3-235B-A22B-Instruct-2507 (2025) 和 GPT-OSS-120B (2025) 生成
Software Engineering Agent
  • 使用各种 Agentic Scaffold(包括 OpenHands (2025)、SWE-Agent (2024)、Mini-SWE-Agent 以及 Wei 等 (2025) 提出的无 Agent Scaffold)来管理软件工程数据,以增强模型的 Agentic 软件工程能力
    • 第一:利用来自 Nemotron 3 Nano (2025) 和 Super (2025) 的数据
      • 这些数据包括使用 Qwen3-Coder-480B-A35B-Instruct (2025) 生成的 SWE Agentic 轨迹
      • 问题实例来自 SWE-Gym (Pan*2025)、SWE-rebench (2025) 和 R2E-Subset (2025)
    • 第二:采用来自 Nemotron-Cascade 1 (2025) 的 SWE 无 Agent 数据,其中包括三个主要任务:
      • (1) 错误代码定位
      • (2) 代码修复
      • (3) 测试用例生成
    • 遵循 Wang 等 (2025) 中既定的程序,使用 DeepSeek-V3.2 (2025) 重构了代码修复数据
  • 本文初步研究表明,整合 SWE 无 Agent 数据可以提高模型在 SWE Agentic 任务上的有效性
    • 例如
      • 仅在 Agentic 数据上进行微调,在 SWE-bench Verified 上使用 OpenHands 的 Pass@1 为 48.9,Pass@4 为 62.8
      • 在 Agentic 和无 Agent 数据组合上进行微调则分别将性能提高到 Pass@1 的 49.9 和 Pass@4 的 65.2
    • 基于这一观察,本文将 125K 个 Agentic 样本和 389K 个无 Agent 样本组合起来,作为 SWE 任务的 SFT 数据
    • 本文的模型在 SWE Agentic 数据上以非思考模式 训练,在 SWE 无 Agent 数据上以思考模式 训练
Terminal Agent
  • 为增强终端使用的 Agentic 能力,本文采用 Terminal-Task-Gen 方法 (2026) 来管理作者的训练任务
  • 该框架包括
    • (1) 将静态数据转换为交互式终端格式的数据集适配器
    • (2) 从不同的种子 Prompt 和一个结构化的终端技能分类法中生成的合成任务
  • 使用这个框架,总共 curate 了 490K 个样本
    • 首先从现有的高质量来源 (2025) 适配了 162K 个数学、32K 个代码和 32K 个 SWE 特定样本,这建立了广泛的基础覆盖
    • 为了进一步提高针对性技能的完善,合成了 120K 个基于种子和 140K 个基于技能的任务
    • 对于轨迹构建,利用上述任务,并采用 DeepSeek-V3.2 作为核心引擎 ,通过在隔离的 Docker 环境中的执行-反馈循环来生成逐步的解决方案轨迹
    • 注:Terminus 2 Agent 框架 (2026) 作为底层的 Scaffold 和工具使用协议,使模型能够与终端交互并完成复杂任务

Cascade RL and Multi-Domain On-Policy Distillation,Cascade RL 和 MOPD

  • 遵循与 Nemotron-Cascade 1 (2025) 类似的方法,本文 Cascade RL 作为后训练流程
  • 特别地,在 Cascade RL 流程中集成了多领域 On-Policy 蒸馏 (Multi-Domain On-Policy Distillation,简称 MOPD)

Training Framework

  • 图 2 中展示了训练过程
    • 第一步:从 IF-RL (§4.2) 开始 Cascade RL 流程
      • 建立基础的指令遵循能力
    • 第二步:进行多领域 RL (§4.3)
      • 增强模型的工具调用能力、STEM 推理能力和 Response 格式遵循能力
    • 第三步:过渡到 MOPD (§4.4)
      • 将专门领域的专业知识统一到一个连贯的 Policy 中,以缓解性能下降
    • 第四步;使用 RLHF (§4.5) 进行人类对齐
    • 第五步:使用长上下文 RL (§4.6) 增强对长输入序列的推理能力
    • 第六步:使用 Code RL (§4.7) 处理竞争性编程问题
    • 第七步:使用 SWE RL (§4.8) 掌握 Agentic 软件交互
What determines the ordering of Cascade RL,Cascade RL 的顺序
  • Cascade RL 流程中各阶段的最优顺序并非一个通用常数
    • 它是模型潜在行为和学习轨迹的动态函数
  • 与原始的 Nemotron Cascade (2025) 相比
    • 当前的工作 Nemotron-Cascade 2 在 SFT 数据质量上引入了显著改进,并大幅扩展了 RL 环境和任务的复杂性
    • 这些进步从根本上改变了模型的行为动态,这使得需要采用不同的顺序,以更好地适应 LLM 不断发展的能力
Rule of thumb: Mitigating Inter-Domain Interference,经验法则:减少域内干扰
  • 这种顺序的基本原理主要是为了缓解模型与日益多样化的环境交互时可能发生的灾难性遗忘
  • Cascade RL 提供了一个精细的视角,通过它可以观察特定领域如何竞争或冲突
    • 例如 IF-RL 中严格的指令遵循与 RLHF 中的人类偏好对齐
    • 本文核心设计原则是确定一个能最小化领域间负面干扰的顺序,同时彻底优化最高优先级的领域
  • 通过识别哪些任务是基础先验,哪些是专门的细化,我们可以减轻领域间干扰
Scaling via Multi-Domain Integration,通过多领域集成扩展
  • 遵循这一原则,当特定领域被发现与整体性能不冲突或有益时,Cascade RL 流程可以包含多领域 RL 阶段
  • 这种集成方法在 RL 环境和数据集复杂性增加时尤其有效,同时确保模型在 §4.3 中详述的各种基准测试中保持广泛的性能
Stabilization through On-policy Distillation,通过 OPD 稳定
  • 发现:MOPD (§4.4) 在此顺序中充当了一个关键的稳定点
    • MOPD 能够有效地恢复在 Cascade RL 早期、更专业化的阶段可能出现的基准性能下降,从而产生更平衡、更稳健的最终 Policy 模型
RL Training Configuration
  • 在整个 Cascade RL 过程中,遵循 Nemotron Cascade (2025) 的做法
    • 使用具有严格 On-Policy 训练的 GRPO 算法 (2024)
    • 采用 On-Policy 训练以提高稳定性和准确性
  • 使用 Nemo-RL 代码库 (NVIDIA, 2025) 进行训练
    • 注:之前 Cascade RL 使用的是 VeRL
  • 在每次迭代中,从当前 Policy \(\pi_{\theta}\) 生成一组 \(G\) 个 Rollout,然后执行一次梯度更新
    • 这确保了用于数据收集的 Policy 始终与被更新的 Policy 匹配,使得重要性采样比率恰好为 1
    • 这种 On-Policy 设置有助于稳定的 RL 训练并减轻熵崩溃
  • 本文完全移除了 KL 散度项,这将 GRPO 目标简化为标准的 REINFORCE 目标 (1992),该目标具有组归一化奖励和 Token-level 损失 (2025):
    $$\mathcal{J}_{\text{GRPO} }(\theta) = \mathbb{E}_{(q,a)\sim \mathcal{D},\{o_i\}_{i = 1}^G\sim \pi_\theta (\cdot |q)}\left[\frac{1}{\sum_{i = 1}^G|o_i|}\sum_{i = 1}^G\sum_{t = 1}^{|o_i|}\hat{A}_{i,t}\right],\quad \text{ where }\hat{A}_{i,t} = \frac{r_i - \text{mean}(\{r_i\}_{i = 1}^G)}{\text{std}(\{r_i\}_{i = 1}^G)} \text{ for all } t \tag {1}$$
    • \(\{r_i\}_{i = 1}^G\) 表示分配给从数据集 \(\mathcal{D}\) 中抽取的给定问题 \(q\) 的采样 Response \(\{o_i\}_{i = 1}^G\) 的一组 \(\mathbf{G}\) 奖励
      • 对于 RLVR,根据真实答案 \(a\) 进行验证
      • 对于 RLHF,\(r_i\) 是来自生成式奖励模型 (generative reward model) 的,针对 Response \(o_i\) 和问题 \(q\) 的聚合奖励分数
      • 不同领域的奖励函数细节将在相应的小节中提供
    • 理解:上面是目标有点问题,应该还需要加个概率分布函数
      $$
      \mathcal{J}_{\text{GRPO} }(\theta) = \mathbb{E}_{(q,a) \sim \mathcal{D}, \{o_i\}_{i=1}^{G} \sim \pi_{\theta}(\cdot|q)} \left[ \frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \hat{A}_{i,t} \color{red}{\cdot \pi_\theta(o_{i,t}|q,o_{i, < t})} \right], \quad \text{Where } \hat{A}_{i,t} = \frac{r_i - \text{mean}(\{r_i\}_{i=1}^{G})}{\text{std}(\{r_i\}_{i=1}^{G})} \text{ for all } t,
      $$
      • 因为梯度应该是:
        $$
        \nabla \mathcal{J}_{\text{GRPO} }(\theta) = \mathbb{E}_{(q,a) \sim \mathcal{D}, \{o_i\}_{i=1}^{G} \sim \pi_{\theta}(\cdot|q)} \left[ \frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \hat{A}_{i,t} \color{red}{\nabla \pi_\theta(o_{i,t}|q,o_{i, < t})} \right], \quad \text{Where } \hat{A}_{i,t} = \frac{r_i - \text{mean}(\{r_i\}_{i=1}^{G})}{\text{std}(\{r_i\}_{i=1}^{G})} \text{ for all } t,
        $$

IF-RL:Instruction-Following Reinforcement Learning

  • Cascade RL 第一阶段是 IF-RL 方法
  • 本文证明了应用可验证的 IF-RL 能显著提高指令遵循能力,在 IFBench (2025) 上达到了 \(83.13%\) 的最先进准确率
Dataset
  • 使用与 NVIDIA Nano-v3 后训练 (2025) 相同的指令遵循训练数据
    • 该数据集中的指令设计为客观可验证的,例如,要求 Response 字数少于 200 字
    • 这使得该数据集非常适合训练和评估模型在严格遵循指令方面的能力
  • 鉴于数据的基线质量很高,数据整理过程主要解决某些指令类型(例如,count_increment_word)中关键字参数的格式不一致问题
Training recipe
  • 遵循 (2025) 的方法,应用了动态过滤 (dynamic filtering) (2025)
  • 该技术会过滤掉那些所有 Rollout 都完全正确或完全错误的样本
  • 通过确保批次中的每个 Prompt 都能提供有效的梯度,动态过滤稳定了 IF-RL 训练并提高了模型性能的上限
  • 过长的 IF-RL 训练可能导致 Token 使用过多,这对于满足一般聊天领域的特定约束通常是不必要的
    • 为了缓解这个问题,应用 Oerlong penalty,即对那些未能在最大序列长度内完成生成的样本给予零奖励
  • 与 Nemotron Cascade (2025) 的不同点
    • 本文将 IF-RL 作为 Cascade RL 训练的第一阶段,主要有两个原因:
      • (i) IF-RL 可能会对人类对齐能力(例如,ArenaHard)产生负面影响,而后续基于生成式奖励模型的 RLHF 对指令遵循分数的影响可以忽略不计
        • 通过优先考虑指令遵循,可以专注于最大化指令遵循性能,然后利用后续阶段来恢复和完善人类偏好对齐
      • (ii) 早期的 IF-RL 阶段会产生一个具有卓越指令遵循能力的模型,该模型可作为后续多领域 On-Policy 蒸馏的强大教师
    • 与 Nemotron Cascade (2025) 的另一个不同之处:
      • IF-RL 完全在“思考模式 (thinking mode)”下训练,没有结合奖励模型
        • 理解:不训练 Non-thinking 模式,且仅使用 RLVR 奖励
      • 由于后续的 RL 阶段会恢复 IF-RL 期间引入的人类偏好对齐的任何退化,我们可以完全专注于最大化指令遵循,而无需承担辅助奖励模型的计算开销
  • 超参数:
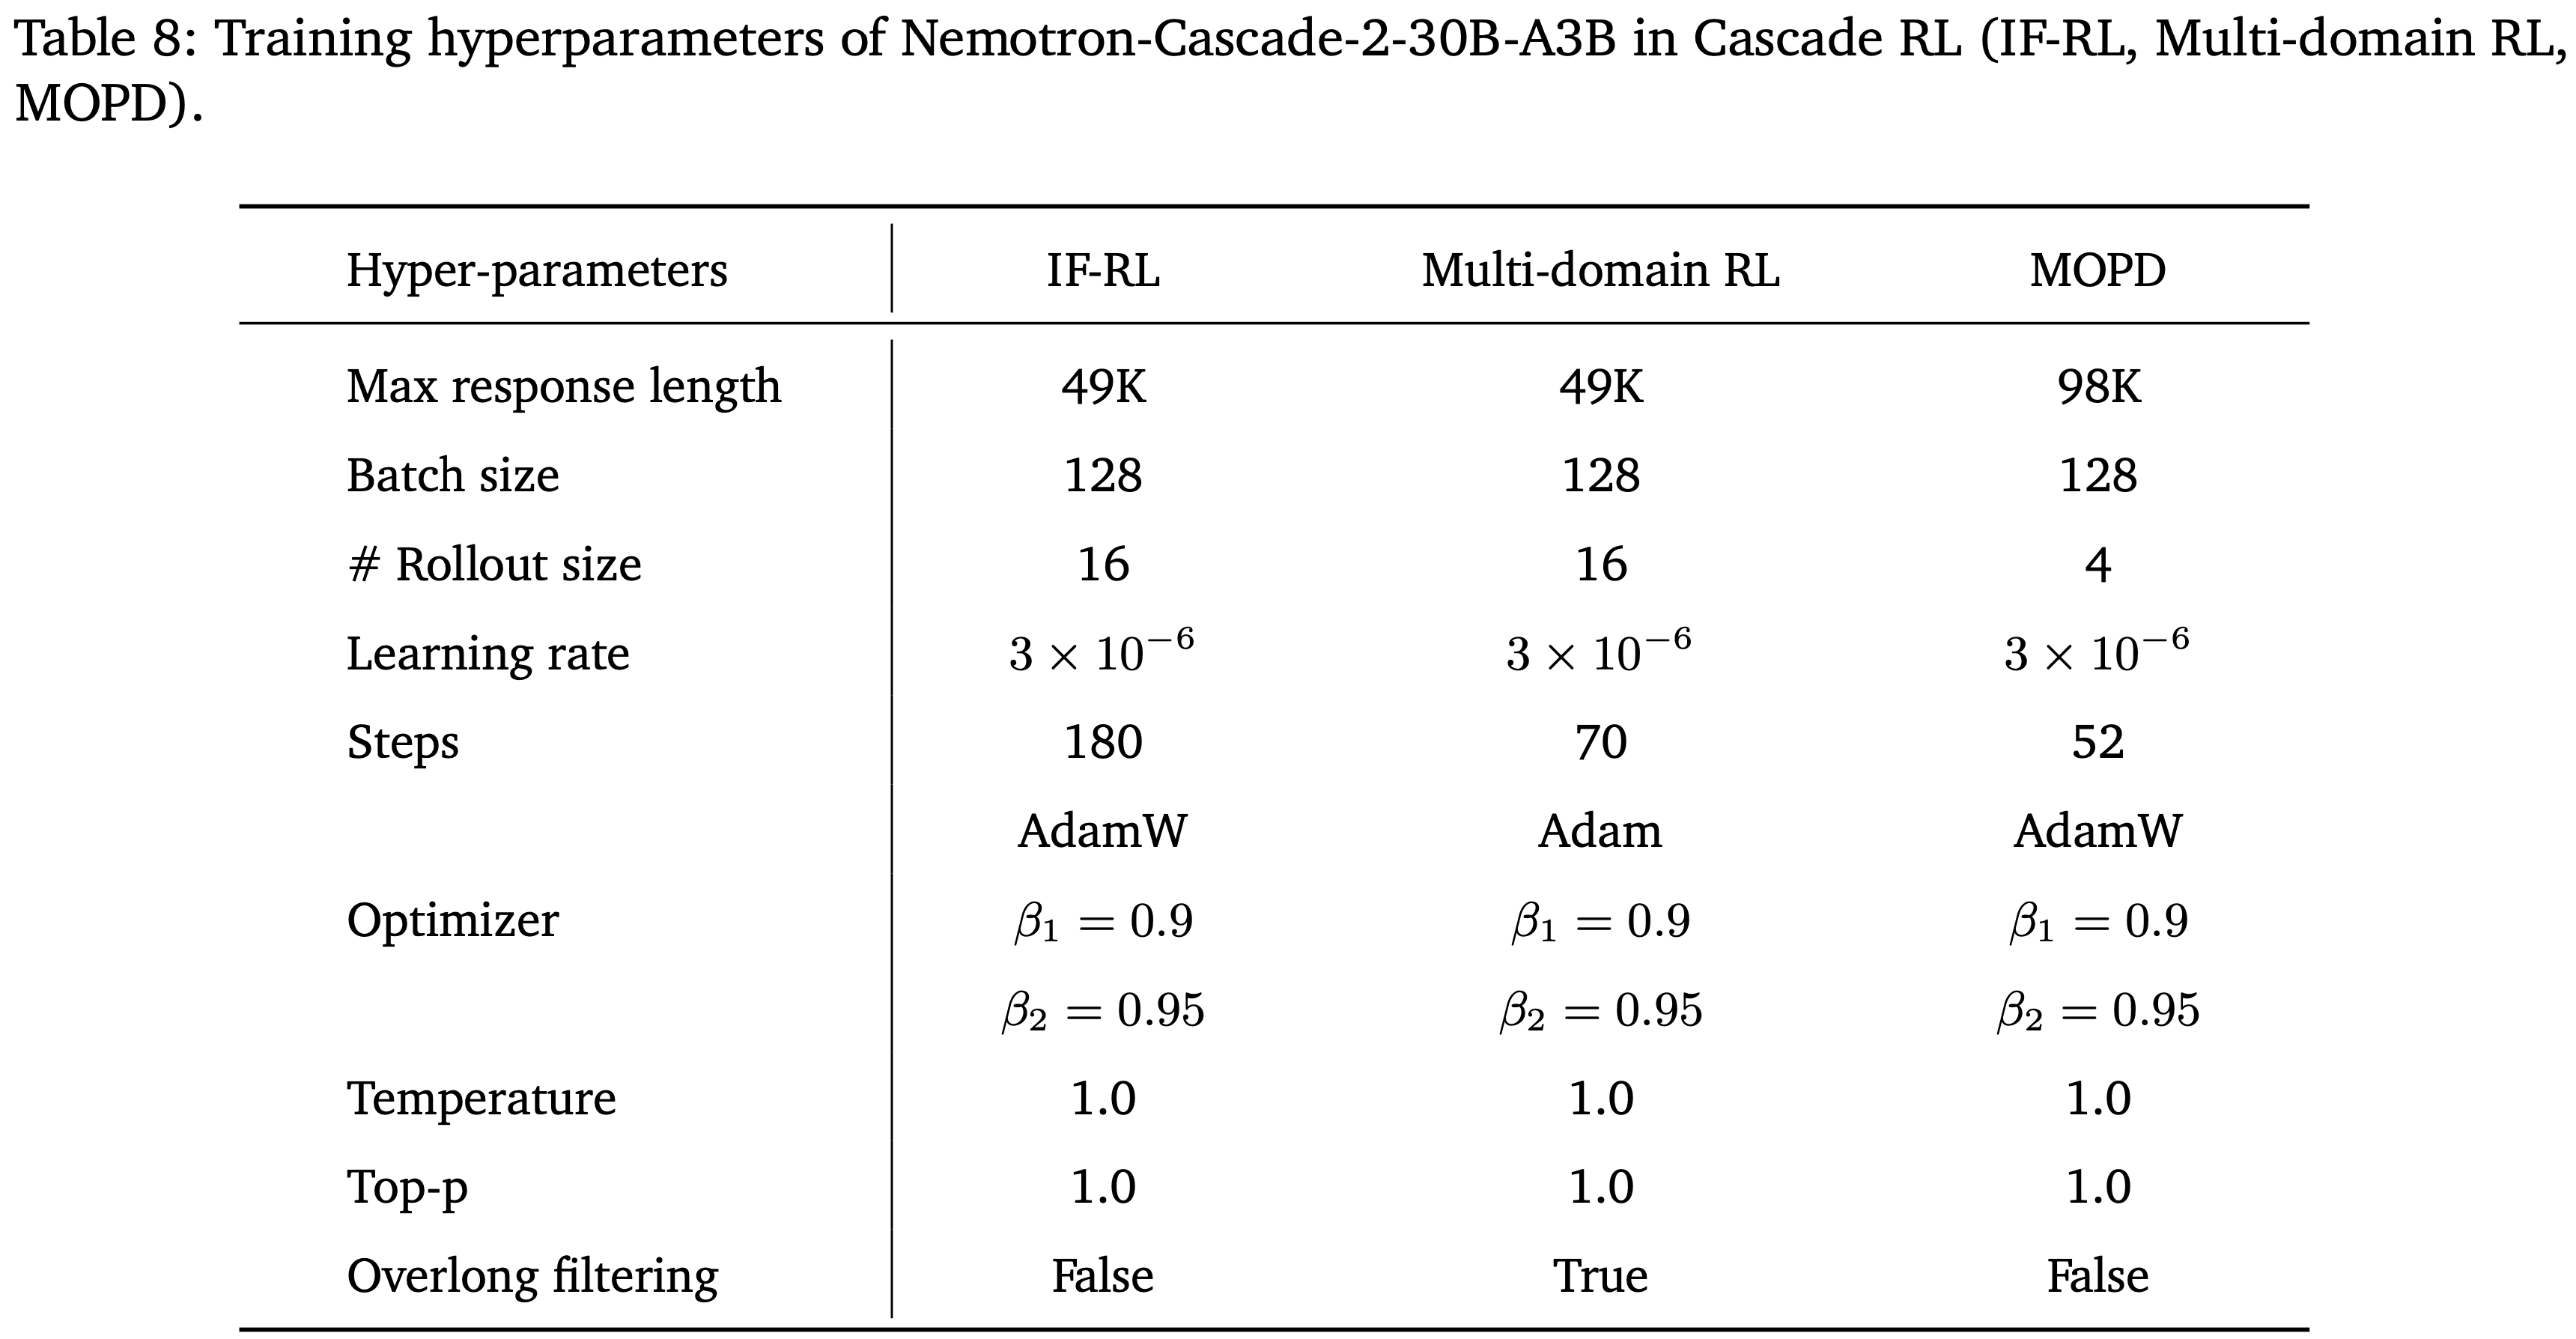
    • 使用 128 的 Batch Size ,每个 Prompt 采样 16 个 Response,温度为 1.0,Top-p 为 1.0
    • 采用 AdamW 优化器,学习率为 3e-6,并将熵损失系数和 KL 损失系数均设为 0
    • 带有动态过滤的 IF-RL 大约需要 180 步
  • 完整的超参数集见附录 B(表 8)

Multi-domain RL

  • 在 IF-RL 之后,进行了另一阶段的多领域 RL,涵盖了三种能力:
    • STEM 领域的多项选择问答 (multiple-choice question answering,简称 MCQA)
    • Agentic 工具调用
    • 指令遵循的结构化输出
  • 数据集取自 NVIDIA Nano-v3 RL 训练混合物 (2025)
    • 数据混合比例大约为:
      • \(55%\) 的 MCQA
      • \(30%\) 的使用 Workplace Assistant 设置的 Agentic 工具调用 (2025)
      • \(15%\) 的结构化输出
  • 本文将这些领域组合成一个单一的多领域 RL 阶段,主要有两个原因
    • 第一:在混合领域上训练时,没有观察到评估基准上的性能下降
      • 模型在包括 MMLU-Pro、\(\tau^2\)-Bench 和 IF-Bench 的基准测试中表现出持续改进
    • 第二:这些数据集的 Response 长度和验证时间相似,这最大限度地减少了因等待更长的生成或较慢的环境验证而导致的训练效率低下
  • 超参数:
    • 使用 128 的 Batch Size ,每个 Prompt 采样 16 个 Response,温度为 1.0,Top-p 为 1.0(见附录 B)
    • 采用 AdamW 优化器,学习率为 \(3 \times 10^{-6}\),并将熵损失系数和 KL 损失系数均设为 0
    • 此多领域 RL 阶段运行大约 70 个训练步
  • 其他超参数与 IF-RL 一致,详情见附录 B(表 8)

MOPD:Multi-domain On-Policy Distillation

  • 虽然精心设计的 Cascade RL 与任意顺序的普通顺序 RL 相比,大大减少了灾难性遗忘
    • 但随着训练环境数量的增加,它并不能完全消除能力漂移(Capability Drift)
  • 实践观察:整个训练过程中跟踪的不同基准类别存在明显波动,且主要的权衡因阶段而异
    • 例如:
      • 某些 RLVR 训练通常会降低模型熵并缩短推理轨迹,因此可能对数学推理性能产生负面影响
      • 以 RLHF 为导向的优化可能会部分地与指令遵循行为进行权衡
    • 这些观察结果促使我们在 Cascade RL 流程中增加一个额外的训练阶段来重新平衡能力
      • 本文采用 MOPD (2024; 2024; 2025; 2026; 2025; 2026) 作为补充的后训练阶段
  • 在本文 Setting 中,MOPD 由于三个原因而特别有吸引力
    • 第一:教师 Checkpoint 可以直接从 Cascade RL 流程中选择,为每个基准类别选择最强的验证 Checkpoint,这使得组装一个能力多样的教师池变得容易,而无需引入外部模型系列
    • 第二:由于这些教师都源自相同的 SFT 初始化,它们与 Student 共享相同的 Tokenizer 和词汇表,从而减少了分布偏移并避免了额外的对齐问题
    • 第三,MOPD 提供了密集的 Token-level 训练优势,与稀疏的 Outcome Reward 相比尤其有用
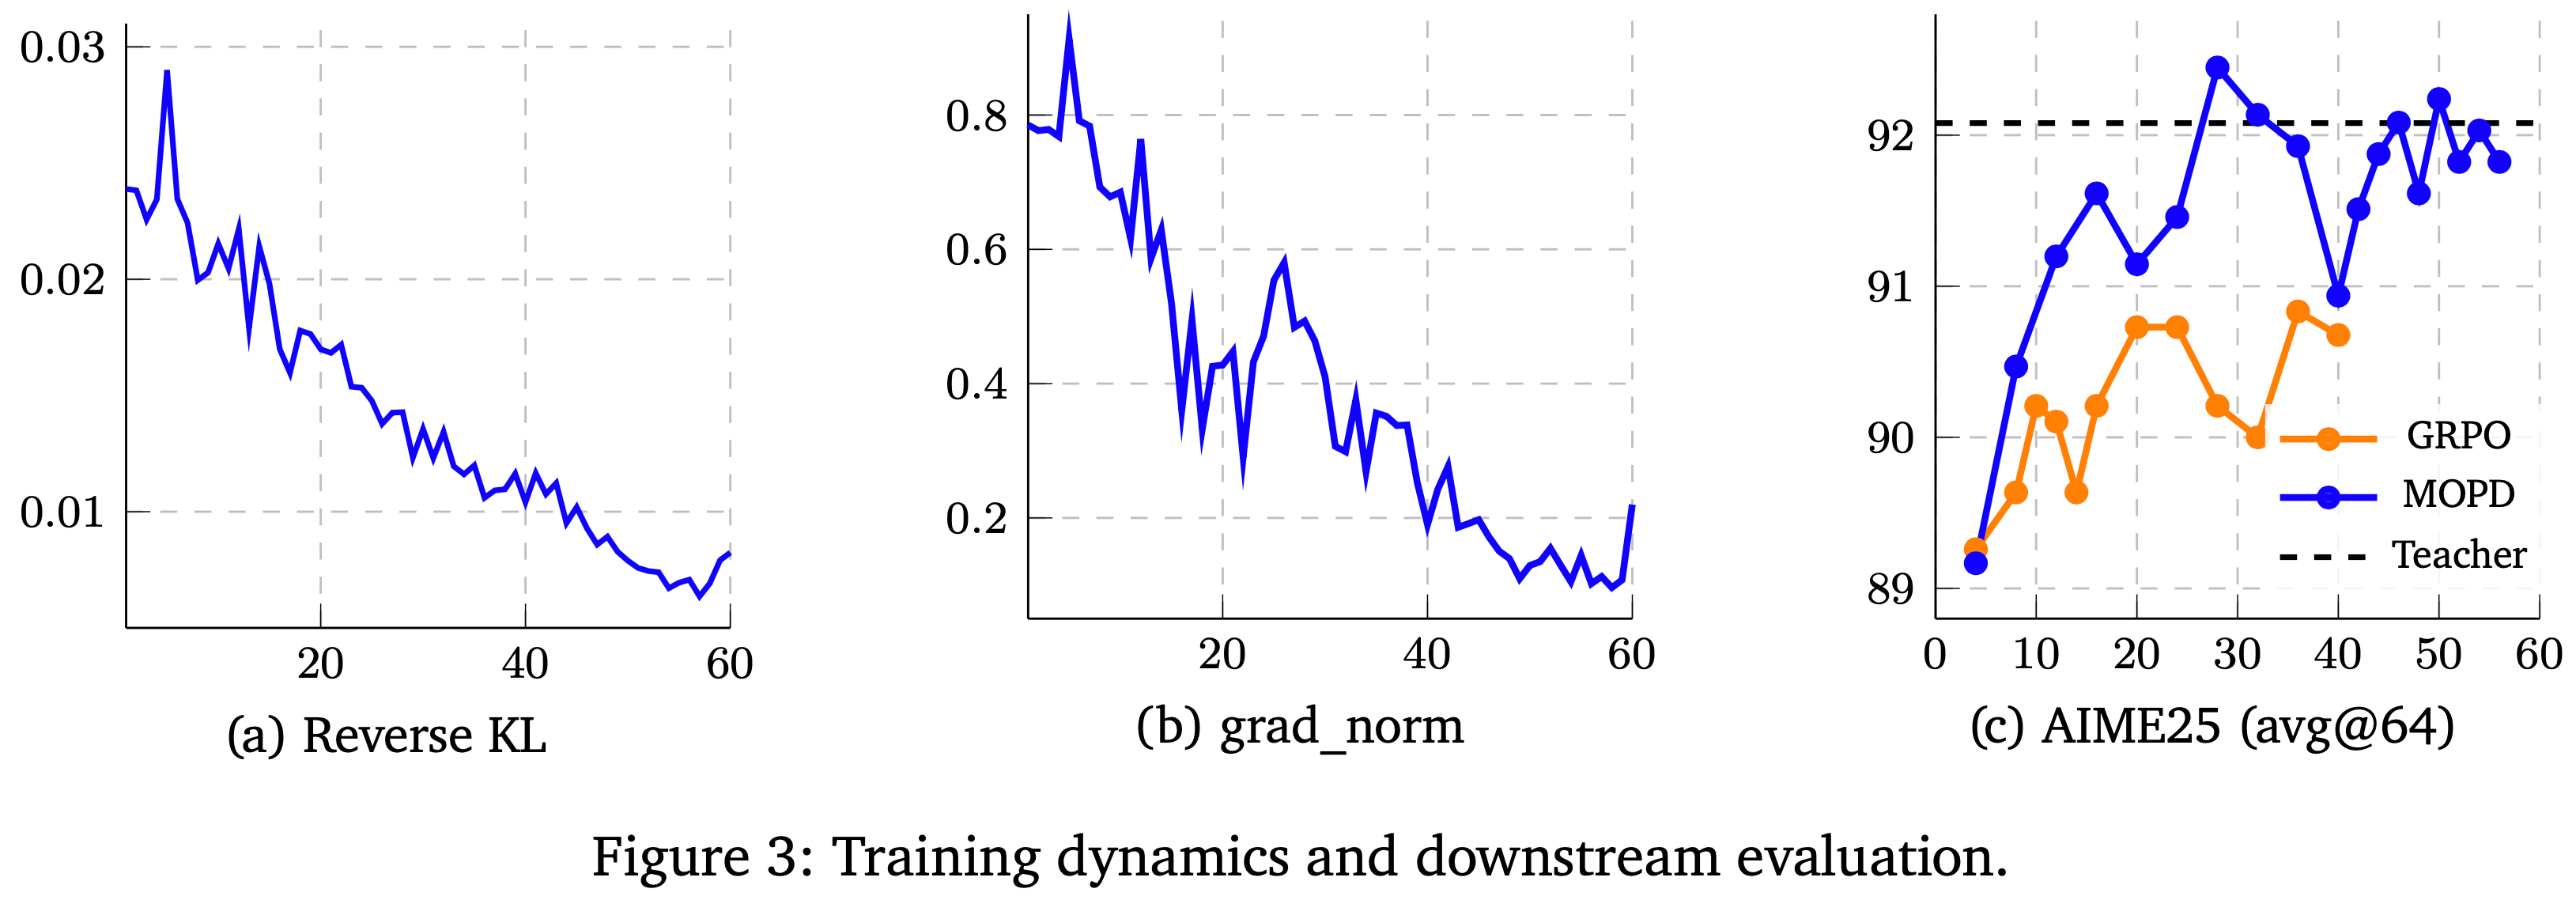
      • 在图 3(c) 中,本文展示了其与 GRPO 相比的训练效率优势
MOPD objective
  • 令 \(\pi^{\text{inf} }\) 表示用于推理引擎中 Response 生成的 Student Policy
  • 令 \(\pi^{\text{train} }\) 表示由训练引擎优化的 Student Policy
  • 对于每个 Prompt \(x\)
    • 采样一个 Response
      $$ y = (y_1, \ldots , y_T) \sim \pi^{\text{inf} }(\cdot |x) $$
    • 为该训练示例选择一个领域教师 \(\pi^{\text{domain}_i}\)
      • 其中领域 \(i\) 表示与所选教师关联的能力领域(理解:根据提前约定的样本领域选择教师)
    • 将 \(s_t = (x,y_{< t})\) 写为时间步 \(t\) 的解码状态,使用 Reverse-KL 定义 Token-level 蒸馏优势 (distillation advantage) 为
      $$a_t^{\text{MOPD} } = \log \pi^{\text{domain}_i}(y_t |s_t) - \log \pi^{\text{train} }(y_t |s_t) \tag {2}$$
      • 当领域教师分配给采样 Token 的概率高于当前训练 Policy 时,此项为正
        • 因此在训练期间作为密集的 Token-level 蒸馏优势收敛到 0(教师和学生概率相同时优势为 0)
      • 对数概率差仅在 Student 采样的 Token 上计算,而不是在整个词汇表上计算
  • 由于 Response 是在 \(\pi^{\text{inf} }\) 下采样但在 \(\pi^{\text{train} }\) 下优化,应用截断重要性权重 (truncated importance weighting) 来解决训练-推理不匹配问题:
    $$r_t = \frac{\pi^{\text{train} }(y_t |s_t)}{\pi^{\text{train} }(y_t |s_t)},\quad w_t = \text{sg}[r_t]\mathbf{1}[\epsilon_{\text{low} }\leq r_t\leq \epsilon_{\text{high} }] \tag {3}$$
    • 其中 \(\text{sg}[\cdot ]\) 表示停止梯度 (stop-gradient)
    • 理解:当训推不一致差异过大时,即 \(r_t\) 不在指定范围内,则将权重置为 0(即 Mask 掉这个 Token)
  • 最终的优化代理目标为:
    $$\mathcal{L}_{\text{MOPD} } = -\mathbb{E}_{x\sim \mathcal{D},y\sim \pi^{\text{inf} }(\cdot |x)}\left[\frac{1}{|\mathcal{V}(y)|}\sum_{t\in \mathcal{V}(y)}w_t \cdot \text{sg}[a_t^{\text{MOPD} }]\log \pi^{\text{train} }(y_t |s_t)\right] \tag {4}$$
    • 其中 \(\mathcal{V}(y)\) 是由 Token 掩码保留的有效 Response Token 的集合
Hyperparameters(Of MOPD)
  • Unless otherwise specified
    • 本文使用 4 的 Rollout 大小和每次更新 128 个 Prompt,得到 512 个 Response 的有效 Batch Size
    • 后来实验发现使用 512 个 Prompt 和 1 的 Rollout 大小产生的优化略稳定,同时产生相似的最终结果
  • 本文使用 \(2 \times 10^{-6}\) 的学习率,并在前 30 个优化步中进行线性预热
    • 从 \(2 \times 10^{-7}\) 开始
  • 训练通常在 40-50 个优化步内收敛(图 3(a))(吐槽:也没多训练一会儿,目前根本没看到收敛!)
  • 发现:预热阶段对稳定性很重要
    • 梯度范数在训练开始时显著较大,并在预热阶段后迅速减小(图 3(b))
  • 对于截断重要性权重
    • 设置 \(\epsilon_{\text{low} } = 0.5\) 和 \(\epsilon_{\text{high} } = 2.0\)
  • 主要实验使用了三个领域教师,分别对应数学、RLHF 和多领域
    • 数学教师是初始的 SFT Checkpoint,在精心整理的 SFT 数据集下训练,SFT 后的模型已经表现出强大的数学推理能力
    • RLHF 教师是一个通过 RLHF 从初始 SFT Checkpoint 优化的 Checkpoint
    • 多领域教师是从先前 IF-RL + 多领域 RL 阶段之后的 Checkpoint 中选择的
      • 理解:刚开始训练时,也就是说多领域教师与 MOPD 训练的目标策略是同一个模型,但也可能 多领域教师模型是之前步骤的最优 Checkpoint
  • 数据采样方式:
    • 相应地从 RL 训练数据池(RLHF、IF-RL 和多领域)以及 AceReason-Math (2025) 中对数学 Prompt 进行采样
    • 问题:数据采样的百分比是?
Training efficiency advantage,训练效率优势
  • MOPD 提供了密集的 Token-level 蒸馏优势(而 GRPO 依赖于稀疏的序列级别 Outcome Reward,该 Reward 在所有生成的 Token 之间共享)
    • MOPD 在实践中更具样本效率和步效率
  • 从相同的初始 Checkpoint 开始,MOPD 能够在更少的优化步内持续达到更强的性能
  • 在 AIME25 上(图 3(c))
    • 在仅数学训练下
      • GRPO 在 25 步后从 89.9 提升到 91.0,而 MOPD 在 30 步内达到 92.0 并恢复到教师级别的性能
      • 问题:89.9 到 91 分,怎么感觉像是波动
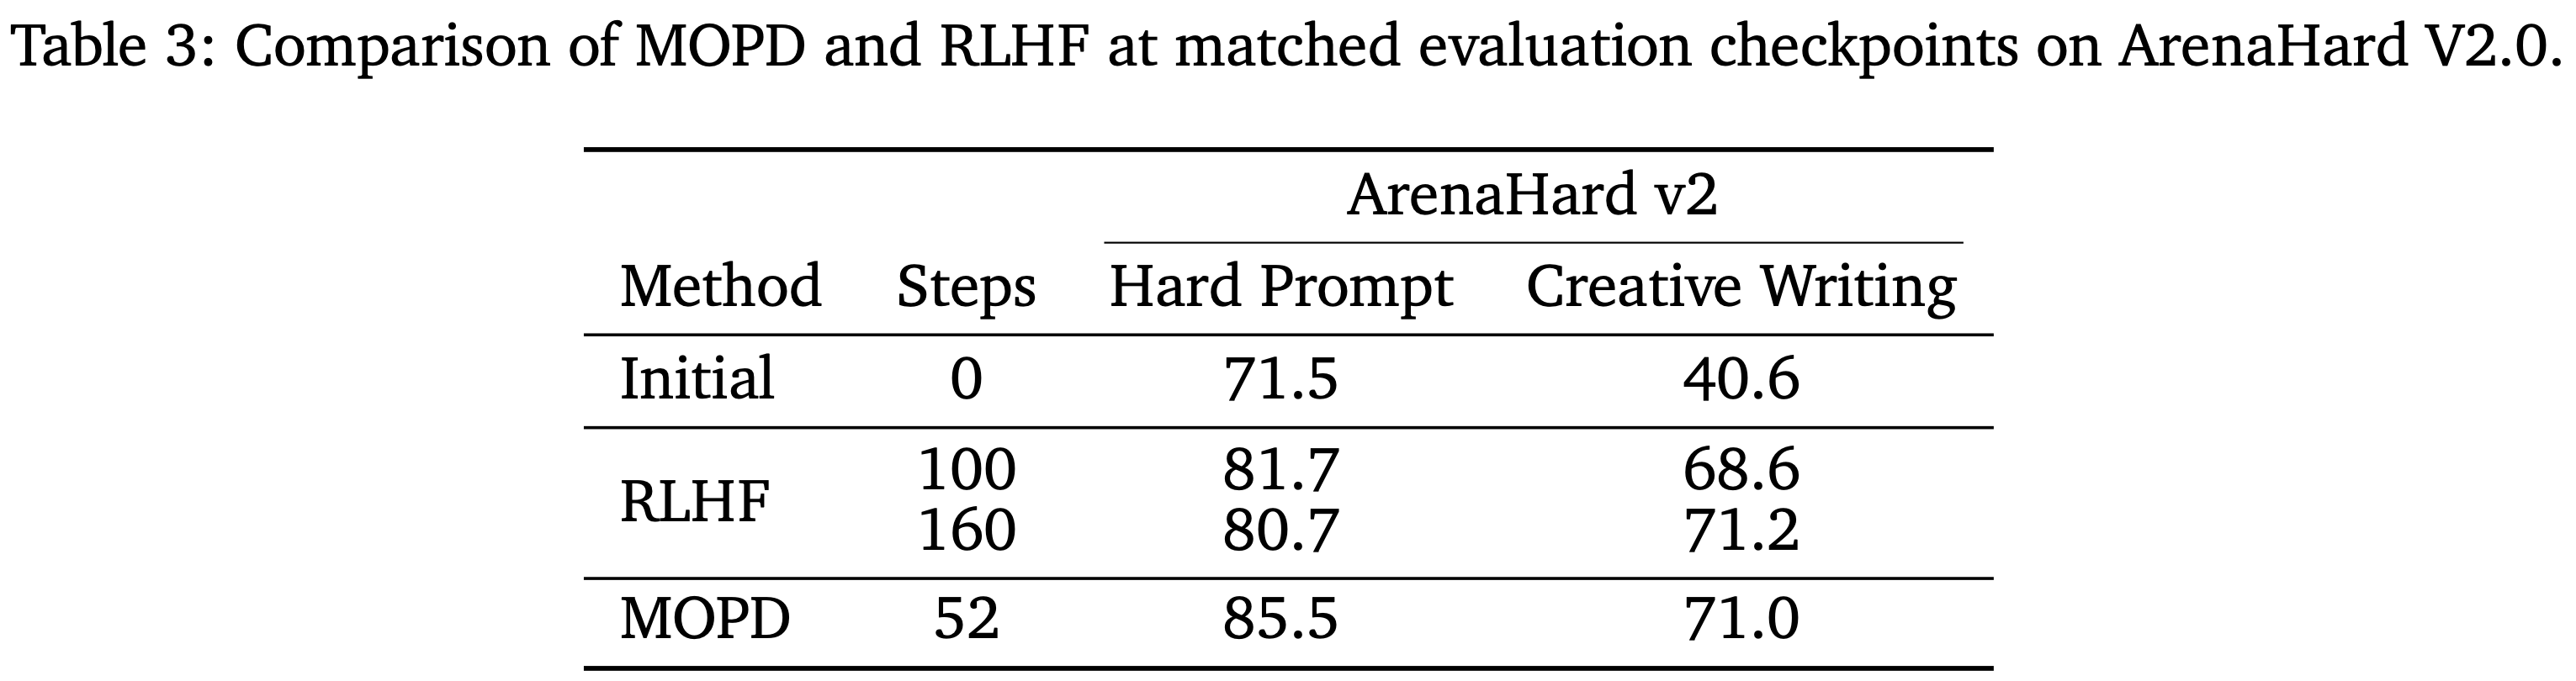
    • 在 ArenaHard v2 上也出现了类似的趋势(表 3)
      • 在 52 步后,MOPD 将 Hard Prompt 从 71.5 提升到 85.5,将 Creative Writing 从 40.6 提升到 71.0
      • RLHF 训练则需要 160 步才能达到 Hard Prompt 的 80.7 和 Creative Writing 的 71.2
    • 以上这些结果表明,On-Policy 蒸馏中的密集 Token-level 优势带来更快的训练收敛

RLHF:Reinforcement Learning from Human Feedback

  • 在 MOPD 的基础上,RLHF 方法侧重于人类偏好学习
    • 此过程进一步增强了创造性写作以及在编码和数学中不可验证的问题解决能力(通过 ArenaHard v2 (2024) 衡量),同时保持其他领域的性能不下降
Dataset
  • 采用了来自 NVIDIA Nano-v3 (2025) 的 RLHF 训练数据集
    • 其中包括 HelpSteer3 (2025)、arena-human-preference-140k 数据集 (2024) 的一个商业友好子集,以及一个合成的安全混合集 (2025)
  • 遵循 NVIDIA Nano-v3 (2025) 的做法,利用 Qwen3-235B-A22B-Thinking-2507 (2025) 作为生成式奖励模型 (generative reward model,简称 GenRM)
    • 该模型通过 HelpSteer3 框架 (2025) 进行训练
  • GenRM 的输入输出:
    • 给定对话历史、用户请求和两个候选 Response,GenRM 首先推理每个 Response 的优缺点,然后生成各自的帮助性分数和最终的比较排名
Training recipe
  • 遵循与 NVIDIA Nano-v3 (2025) 相似的训练方案,使用 GenRM 进行 RLHF
    • 理解:看起来这里不再使用 BT RM 了
  • 为确保训练信号的质量,采用 Pair-wise comparisons 来比较每个 Prompt 的所有 Rollout 对
  • 以与 NVIDIA Nano-v3 RLHF 训练相同的方式聚合奖励分数,并应用相同的长度归一化奖励调整 (length-normalized reward adjustment) 和基于质量的门控简洁奖励 (quality-gated conciseness bonus) (2025)
    • 这些机制鼓励更短的 Response 而不牺牲质量,从而有效缓解推理 Token 使用量的快速增长
  • 与 Nemotron Cascade (2025) 不同,仅在思考模式下训练 RLHF
    • 虽然同时结合思考模式和非思考模式可以提高训练收敛性并在评估基准上带来微小提升,但指令遵循性能显著下降(由此产生的下降幅度足够大,以至于早期 RLVR 阶段获得的收益无法完全恢复)
Hyper-parameters
  • 使用 128 的 Batch Size ,每个 Prompt 生成 16 个 Rollout,温度为 1.0,Top-p 值为 1.0
  • 使用 16K 的最大 Response 长度,不应用过长过滤
  • 采用 AdamW 优化器,学习率为 \(3\times 10^{-6}\)
  • 将熵损失系数设为 0,KL 损失系数设为 0.03,以保持模型在其他领域的能力
  • 训练大约需要 30 步
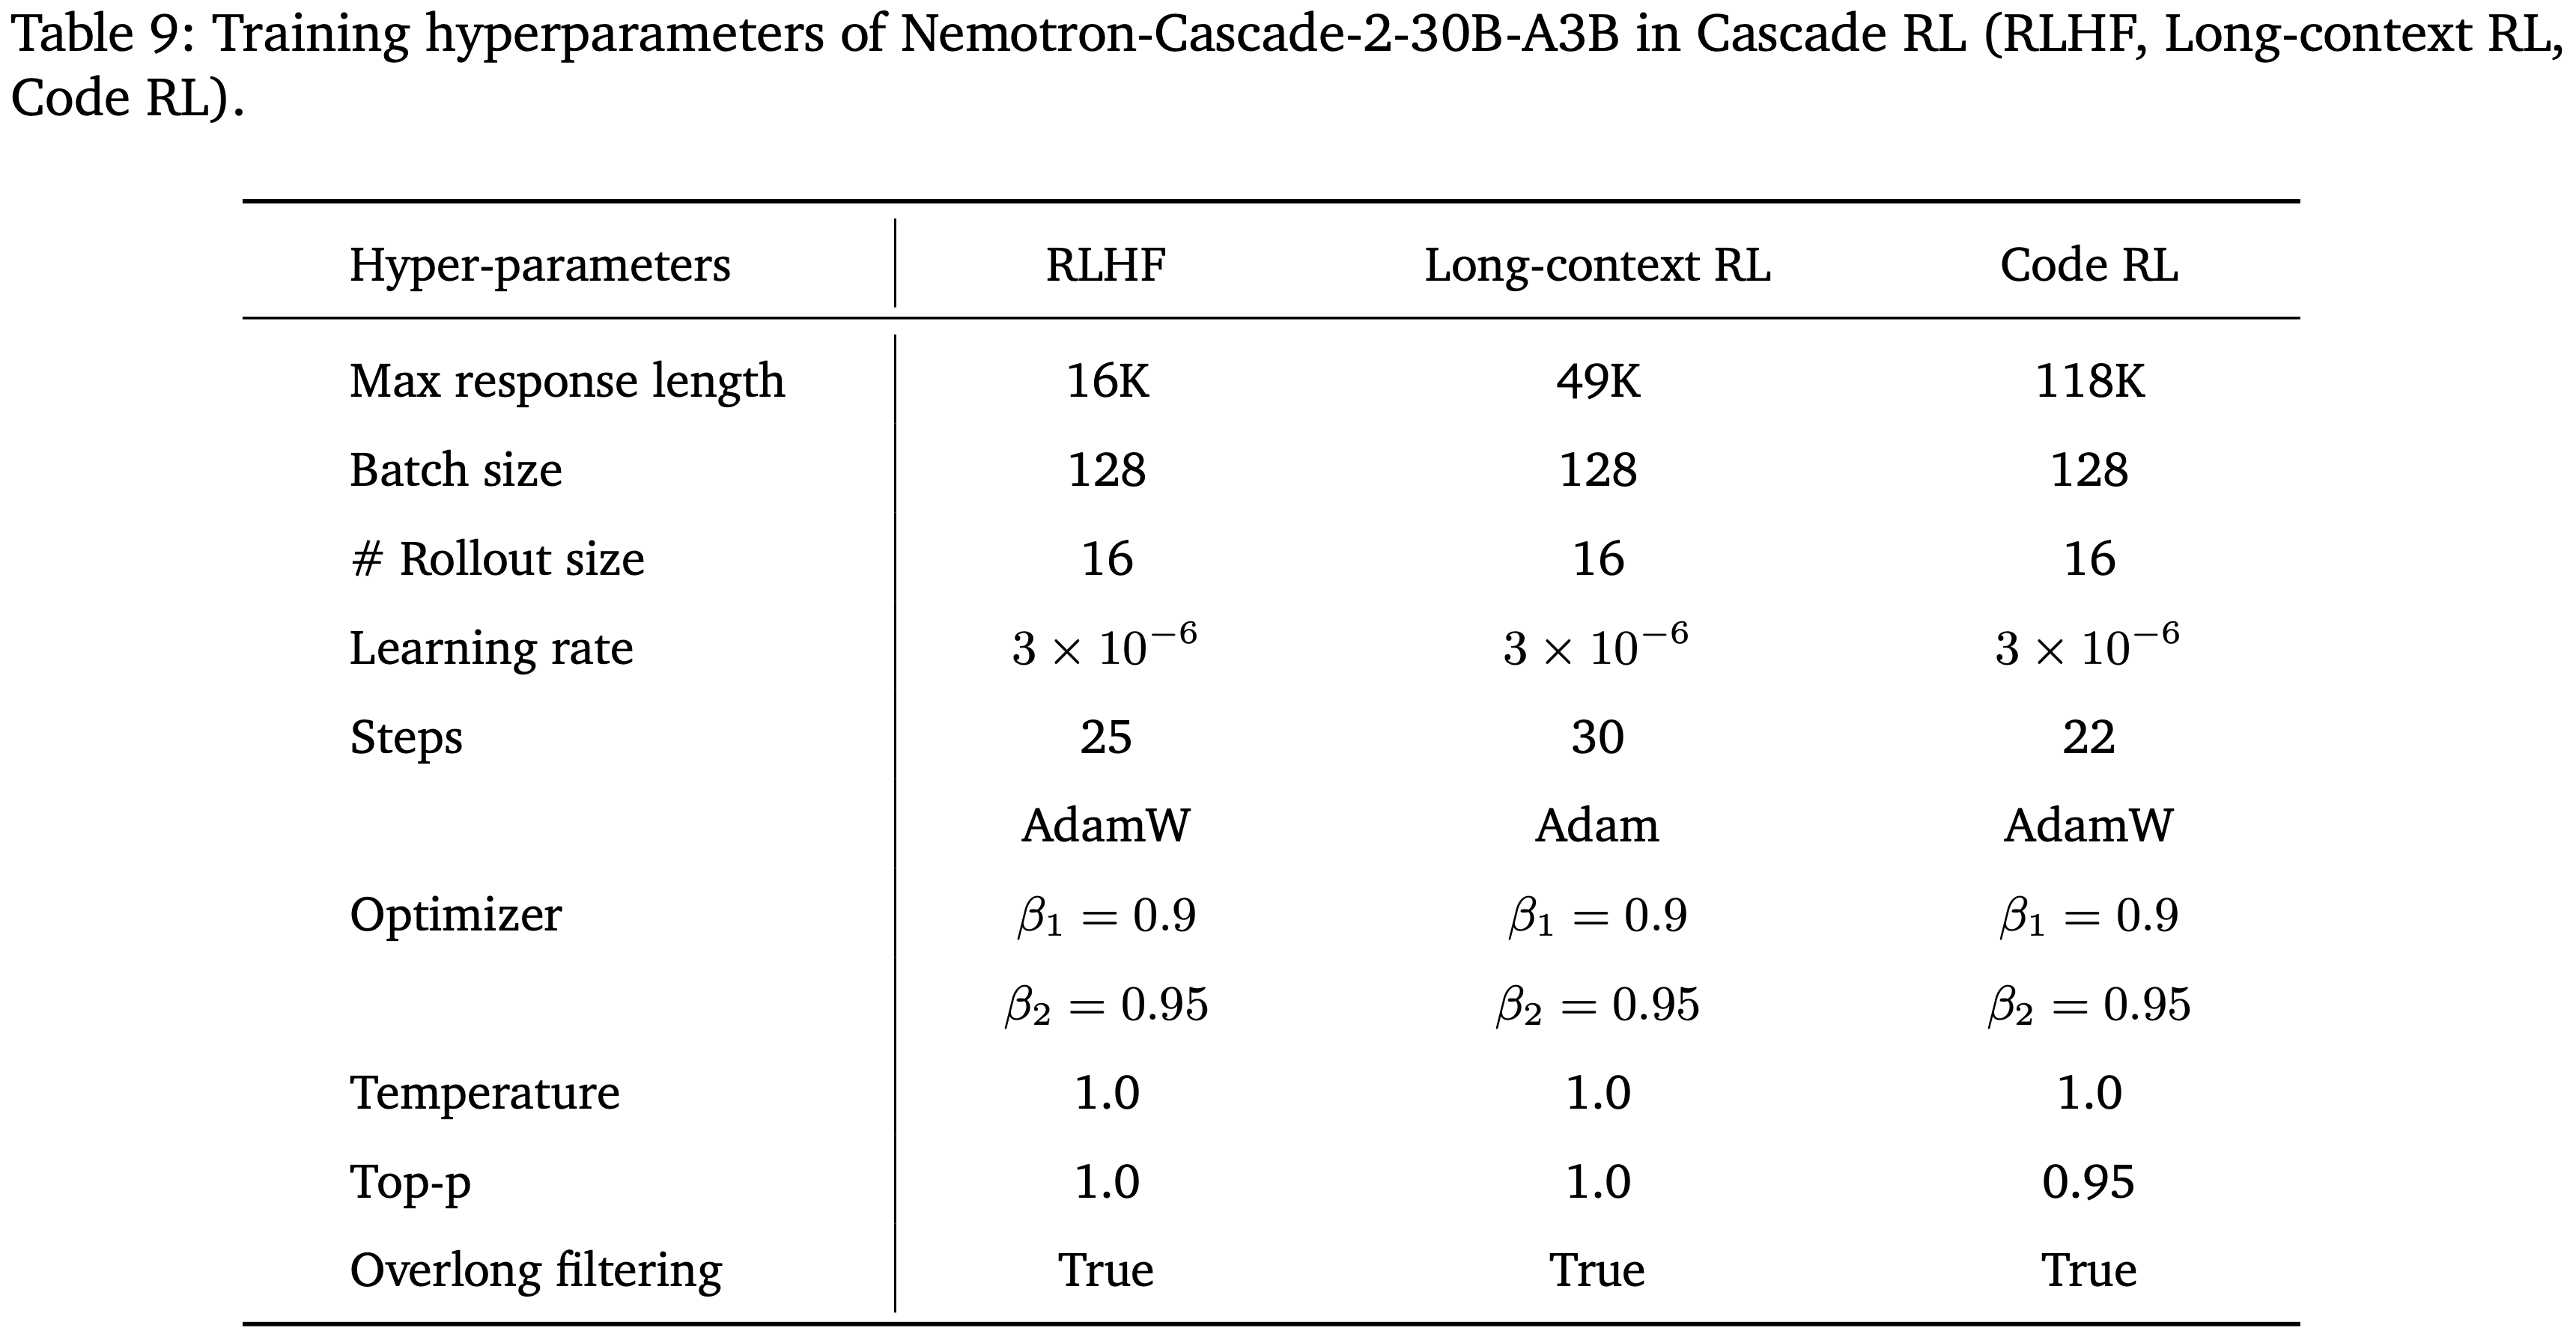
  • 更多参数见 表 9

Long-context RL

  • 在 RLHF 之后进行一个阶段的长上下文 RL,以进一步增强模型的长上下文理解和推理能力
  • 使用 NVIDIA Nano-v3 RL 数据混合集 (2025),但此阶段仅限于长上下文数据集
  • 在本文实验中,在长上下文 RL 期间纳入其他领域会对不相关的基准测试产生负面影响,这证明了这种特定领域训练设置的合理性
  • 采用 Nemo-Gym RL 环境 (NVIDIA, 2025),并使用 Qwen3-235B-A22B-Instruct-2507 作为 LLM Judge 来评估模型在问答任务上的 Rollout
    • 在训练期间,输入序列限制为 32K Token,最大序列长度设置为 49K Token,不应用过长过滤
  • 使用 128 的 Batch Size 进行训练,每个 Prompt 生成 16 个 Rollout,温度为 1.0,Top-p 为 1.0
  • 使用 AdamW 优化器,学习率为 \(3\times 10^{-6}\),同时熵和 KL 损失系数均设为零
  • 训练大约运行 30 步
    • 因为观察到在此之后生成的 Token 数量会迅速增加
  • 其他更多超参与 RLHF 相同,详情见表 9

Code RL

Data Curation
  • 从 Nemotron-Cascade 编码语料库 (2025) 构建了 Code RL 训练集
    • 其中包含来自现代竞争性编程平台(如 AtCoder、Codeforces 和 AIZU)的编码 Prompt,这些 Prompt 带有用于奖励验证的可靠测试用例
  • 为了提高训练效率和加强深度推理,积极过滤掉那些 GPT-OSS-120B 在全部 8 次 Rollout 中都能正确解决的 Prompt ,最终得到一个仅包含 3.5K 个样本的紧凑集合
    • 问题:为什么不使用自己当前的模型来 Rollout?万一 GPT-OSS-120B 能解决但当前不能解决的题目被过滤掉呢?
  • 发现:高难度的 Prompt 与强大的测试用例相结合,对于进一步提升模型性能至关重要
Training Details
  • 使用 128 的 Batch Size 和 AdamW 优化器进行 Code RL,学习率为 \(3\times 10^{-6}\)
  • 与 Nemotron-Cascade 相比,
    • 将 RL 期间的最大 Response 长度增加到 118K Token,并将每个样本的 Rollout 数量增加到 16,这使得 Policy 能够更好地捕捉那些需要长推理轨迹的极难问题上的稀疏奖励信号
    • 采用严格的二元奖励函数来避免潜在的 Reward hacking,并保持整个训练过程的 On-Policy 性质以保持稳定性
    • 为了支持由此产生的每个 RL 步 \(128\times 16 = 2,048\) 次代码执行的验证吞吐量,部署了一个异步奖励验证服务器,该服务器在 384 个 CPU 核心上,每批次完成时间为 427.2 秒
  • 其他更多超参与 RLHF 相同,详情见表 9

SWE RL:Software Engineering Reinforcement Learning

Agentless RL
Training Details and Hyperparameters
  • 为了增强模型的代码修复能力,本文采用与 Wang 等 (2025) 相同的数据源进行无智能体代码修复强化学习训练
    • 由于大多数实例不提供可执行的 Docker 环境,本文采用 GPT-OSS-120B 作为奖励模型来评估模型生成的代码修复质量
  • 遵循 Wang 等 (2025) 的方法
    • 对于每个实例:使用 Golden localization 和排名前 5 的检索定位来构建 Prompt,并过滤掉相对容易的样本
  • 进行无智能体 SWE RL 时
    • Batch Size 为 \(128\times 16 = 2,048\)(128 个 Prompt,每个 Prompt 有 16 个 Rollout),最大序列长度为 98,304
    • 使用 AdamW 优化器,学习率为 \(3\times 10^{-6}\)
    • 以温度 1.0 和 Top-p 1.0 采样 Response
  • 在训练期间,Mask 那些没有一个 Rollout 获得大于 0.5 奖励的 Prompt 的损失
    • 本文观察到这些困难的 Prompt 会降低无智能体 SWE RL 训练的稳定性和有效性
    • 本文的无智能体 RL 训练通常在 40-50 步内收敛
Can Agentless RL Training Helps Agentic Tasks?
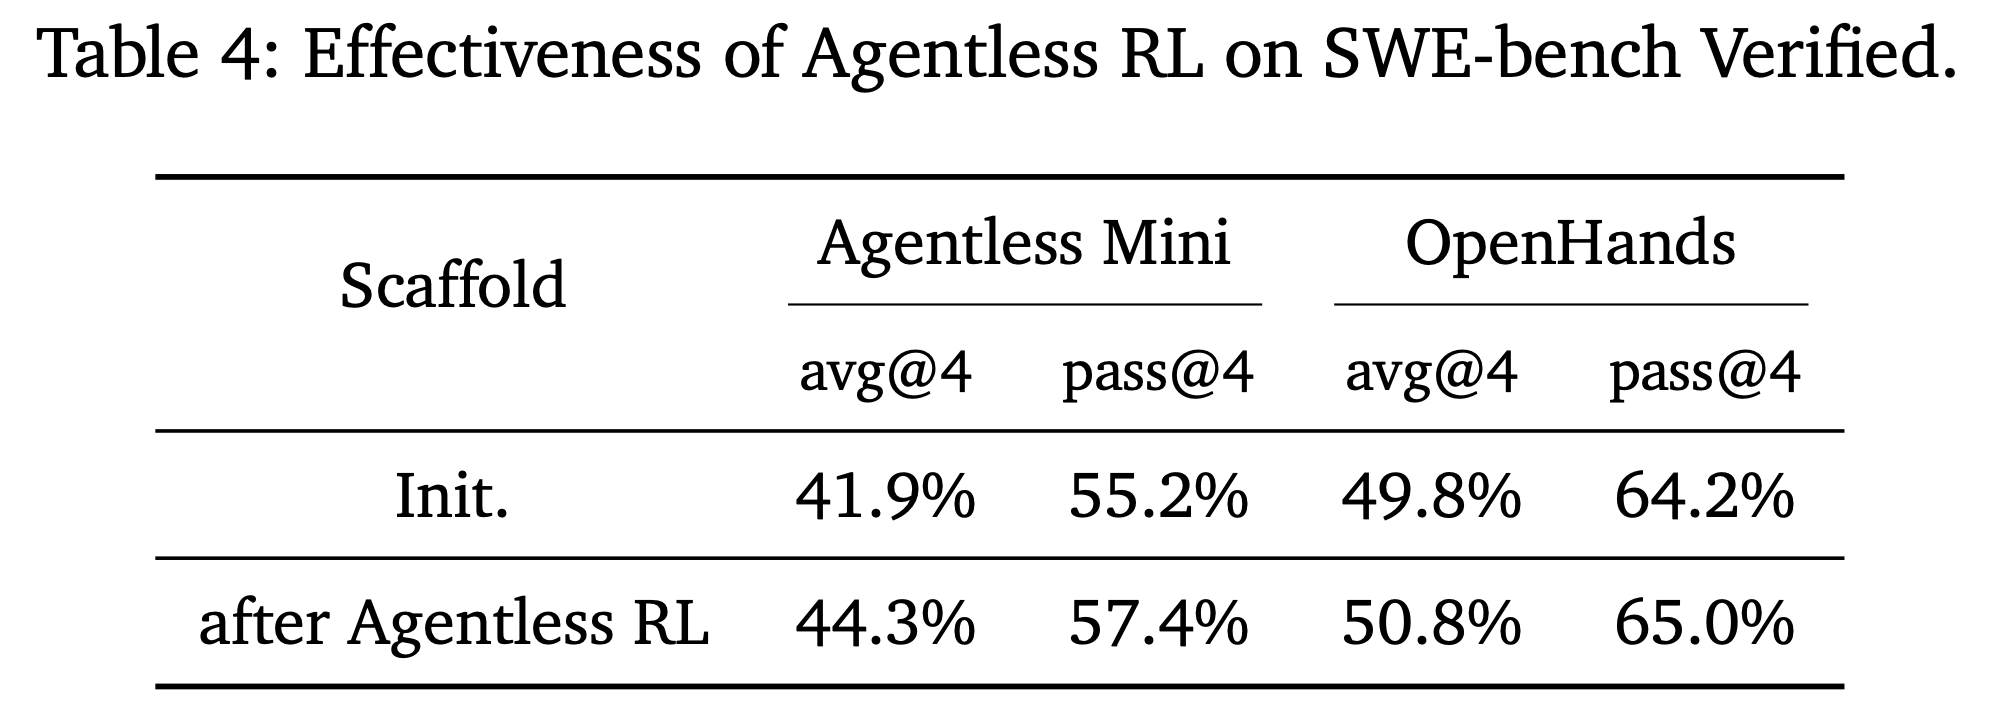
  • 表 4 显示,无智能体 RL 训练不仅提高了模型在无智能体框架内的性能,还增强了模型在 Agentic 设置中解决 SWE 任务的能力
  • 对于无智能体 Mini 评估,采用了一个代码 Embedding 模型 NV-Embed-Code (2025) 来检索 5 个候选文件,这些文件的代码内容在语义上与问题上下文相似
  • 这一结果表明,仅提高模型的代码修复能力就可以泛化到不同的 Scaffold 上,这与 Yang 等 (2026) 的观察结果一致
Execution-based RL for Agentic SWE Scaffold,面向 Agentic SWE Scaffold 的基于执行的 RL
  • 现代软件工程 Agent 依赖于协调仓库交互、工具调用、代码编辑和测试执行的 Scaffolding 框架
    • 训练 Agent 在这些环境中有效运作,不仅需要优化单个模型输出,还需要优化整个问题解决轨迹
  • 为了解决这个问题,本文直接在 Agentic SWE Scaffold 中应用 RLVR,从而实现完整 Agent 工作流的端到端优化
    • 本文训练环境集成了已建立的 OpenHands 框架 (2025),该框架提供了结构化的工具使用、仓库交互和迭代 Patch 生成
  • 本文在完全可执行的软件环境中使用基于执行的强化学习来训练 Agent,其中每个 Episode 对应于解决来自 SWE-bench 等基准测试的一个软件问题实例
    • Agent 在一个仪器化的仓库内操作,该仓库公开了用于文件检查、搜索、代码编辑和测试执行的工具
    • Agent 生成的候选 Patch 在环境内执行,该环境从编译结果和单元测试结果中返回可验证的信号,从而无需人工注释即可实现自动奖励计算
    • 通过 OpenHands Scaffolding 框架,Agent 迭代地定位缺陷、提出 Patch,并通过测试执行对其进行验证
    • 环境反馈:包括编译错误、失败的测试或成功的测试通过,提供了直接反映功能正确性的确定性奖励
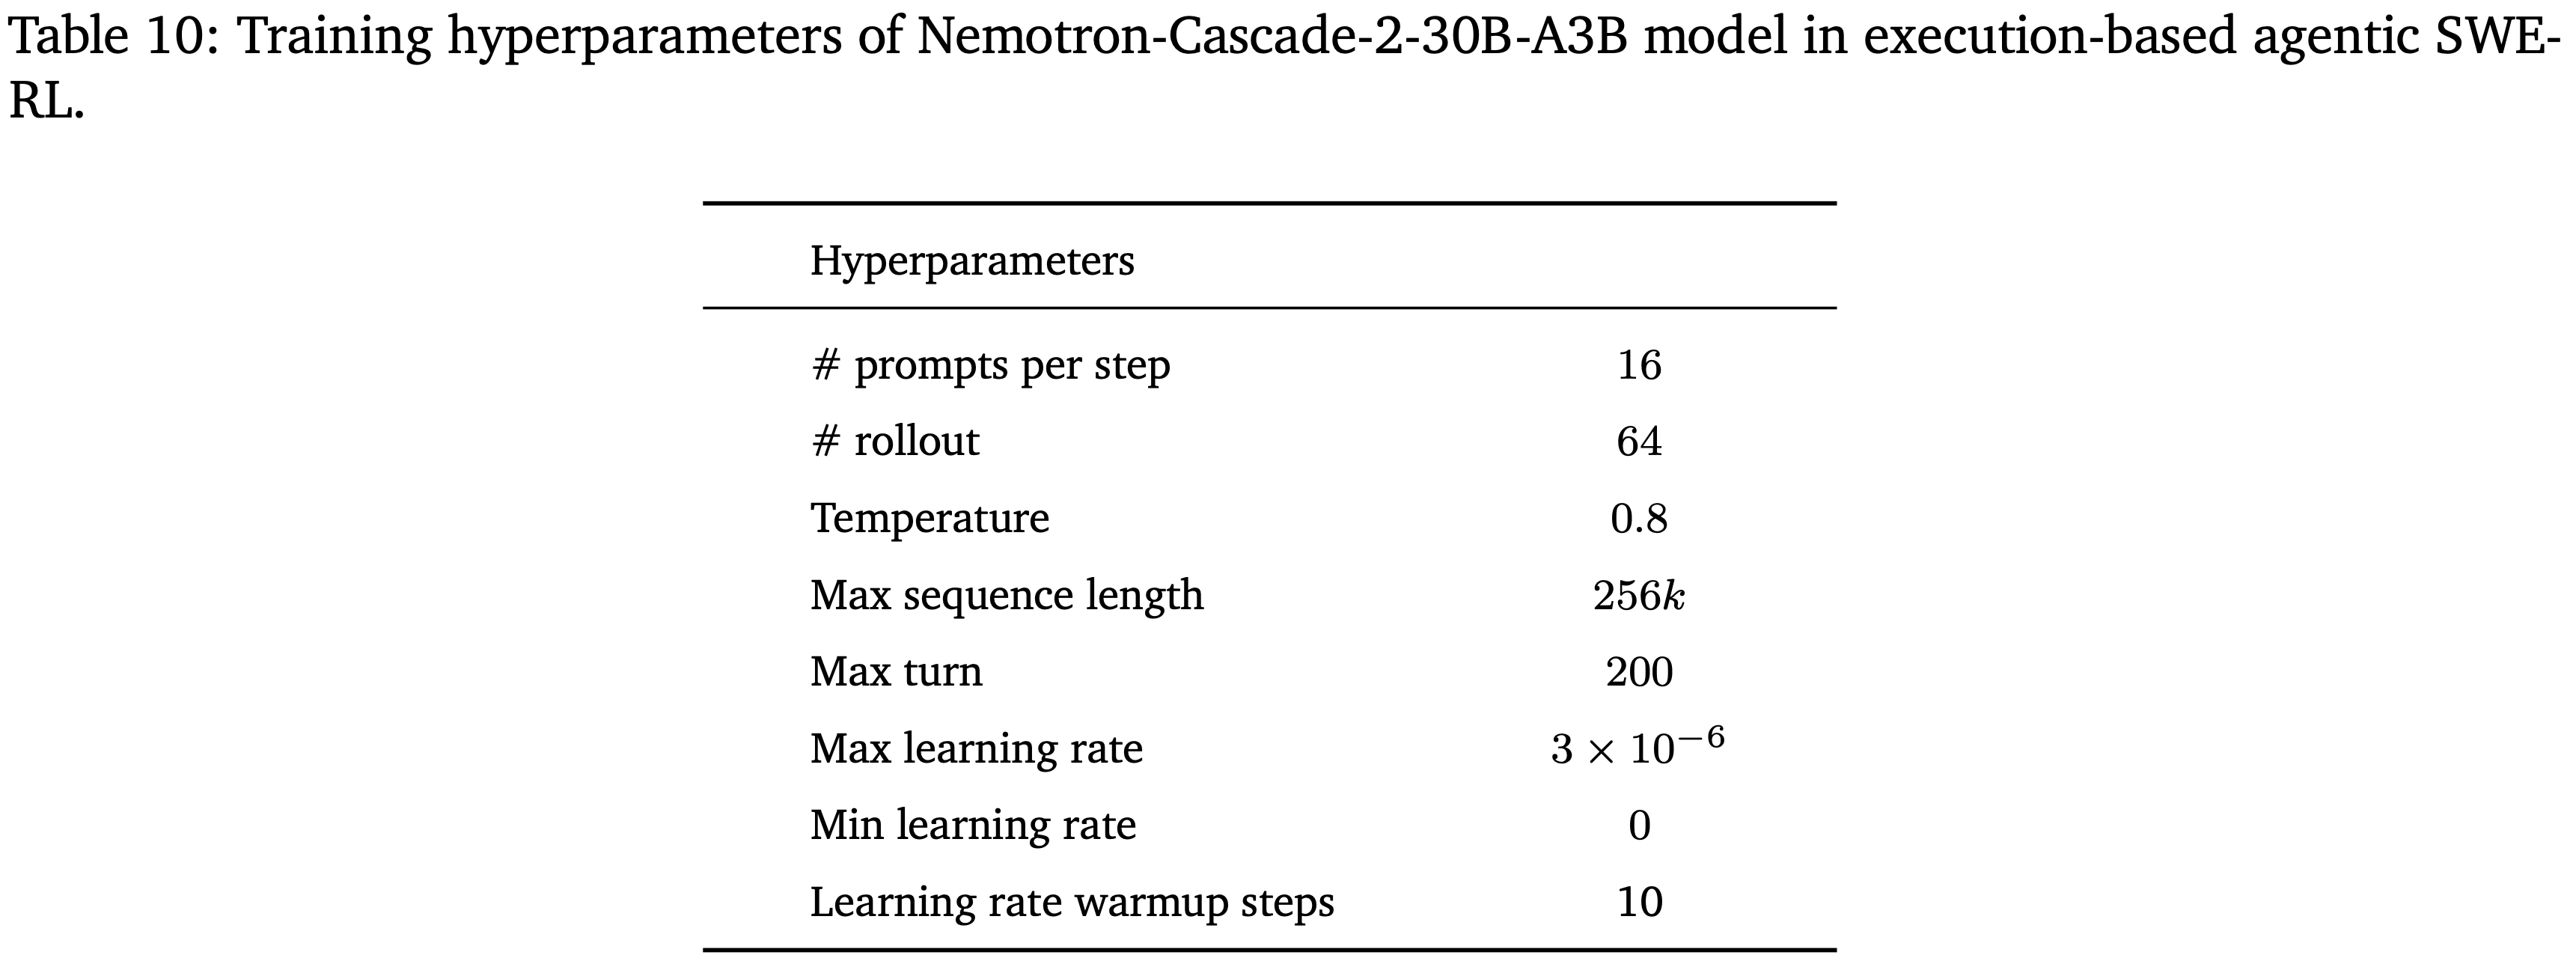
  • 进行基于执行的 Agentic 强化学习时的超参
    • Batch Size 为 1024,对应于 16 个 Prompt,每个 Prompt 有 64 个 Rollout
    • 最大上下文长度设置为 256K Token,Agent 最多允许 200 个交互轮次(在 Agentic 编码问题解决期间提供更大的推理 Token 预算)
  • 训练数据来自 SWE-Gym (Pan*2025) 和 R2E-Subset (2025)
    • 使用中间模型为每个实例生成 16 个 Rollout,并使用验证流程进行评估
    • 所有 Rollout 都通过验证(100% 准确率)的实例(表明问题过于简单)将从数据集中移除
    • 对于没有 Rollout 通过验证(0% 准确率)的实例(表明问题极其困难),随机丢弃 90% 的此类案例,以减少它们在训练数据中的比例
  • 更多超参数见附录 B(表 10)

IMO:International Mathematical Olympiad

IMO 2025

  • 在表 2 中,本文使用一个自我改进的测试时扩展框架 (2025) 在 IMO 2025 问题集上评估了 Nemotron-Cascade-2-30B-A3B
    • 在该框架中,模型迭代生成候选解决方案,对其进行验证,并根据其自身的反馈进行细化
  • 尽管其规模相对较小(30B-A3B),该模型仍成功解决了前五个问题
  • 本文在附录 E 中提供了完整的模型解决方案,以及人类专家的评论
    • 这些结果尤其令人鼓舞,因为它们表明,当与有效的推理时扩展相结合时,一个相对紧凑的模型也能产生强大的奥林匹克级数学推理能力
  • 仍有几个有希望的改进方向:
    • 专家评审表明,一些证明比必要的要长,包括多余的中间步骤或定义,偶尔会暴露中间推理的痕迹,并且有时包含轻微的排版问题
    • 对于问题 2,该模型采用了解析解策略,类似于 OpenAI 的方法,而不是像 Gemini Deep Think (IMO Gold) 使用的那种更具几何性的方法

IMO-ProofBench

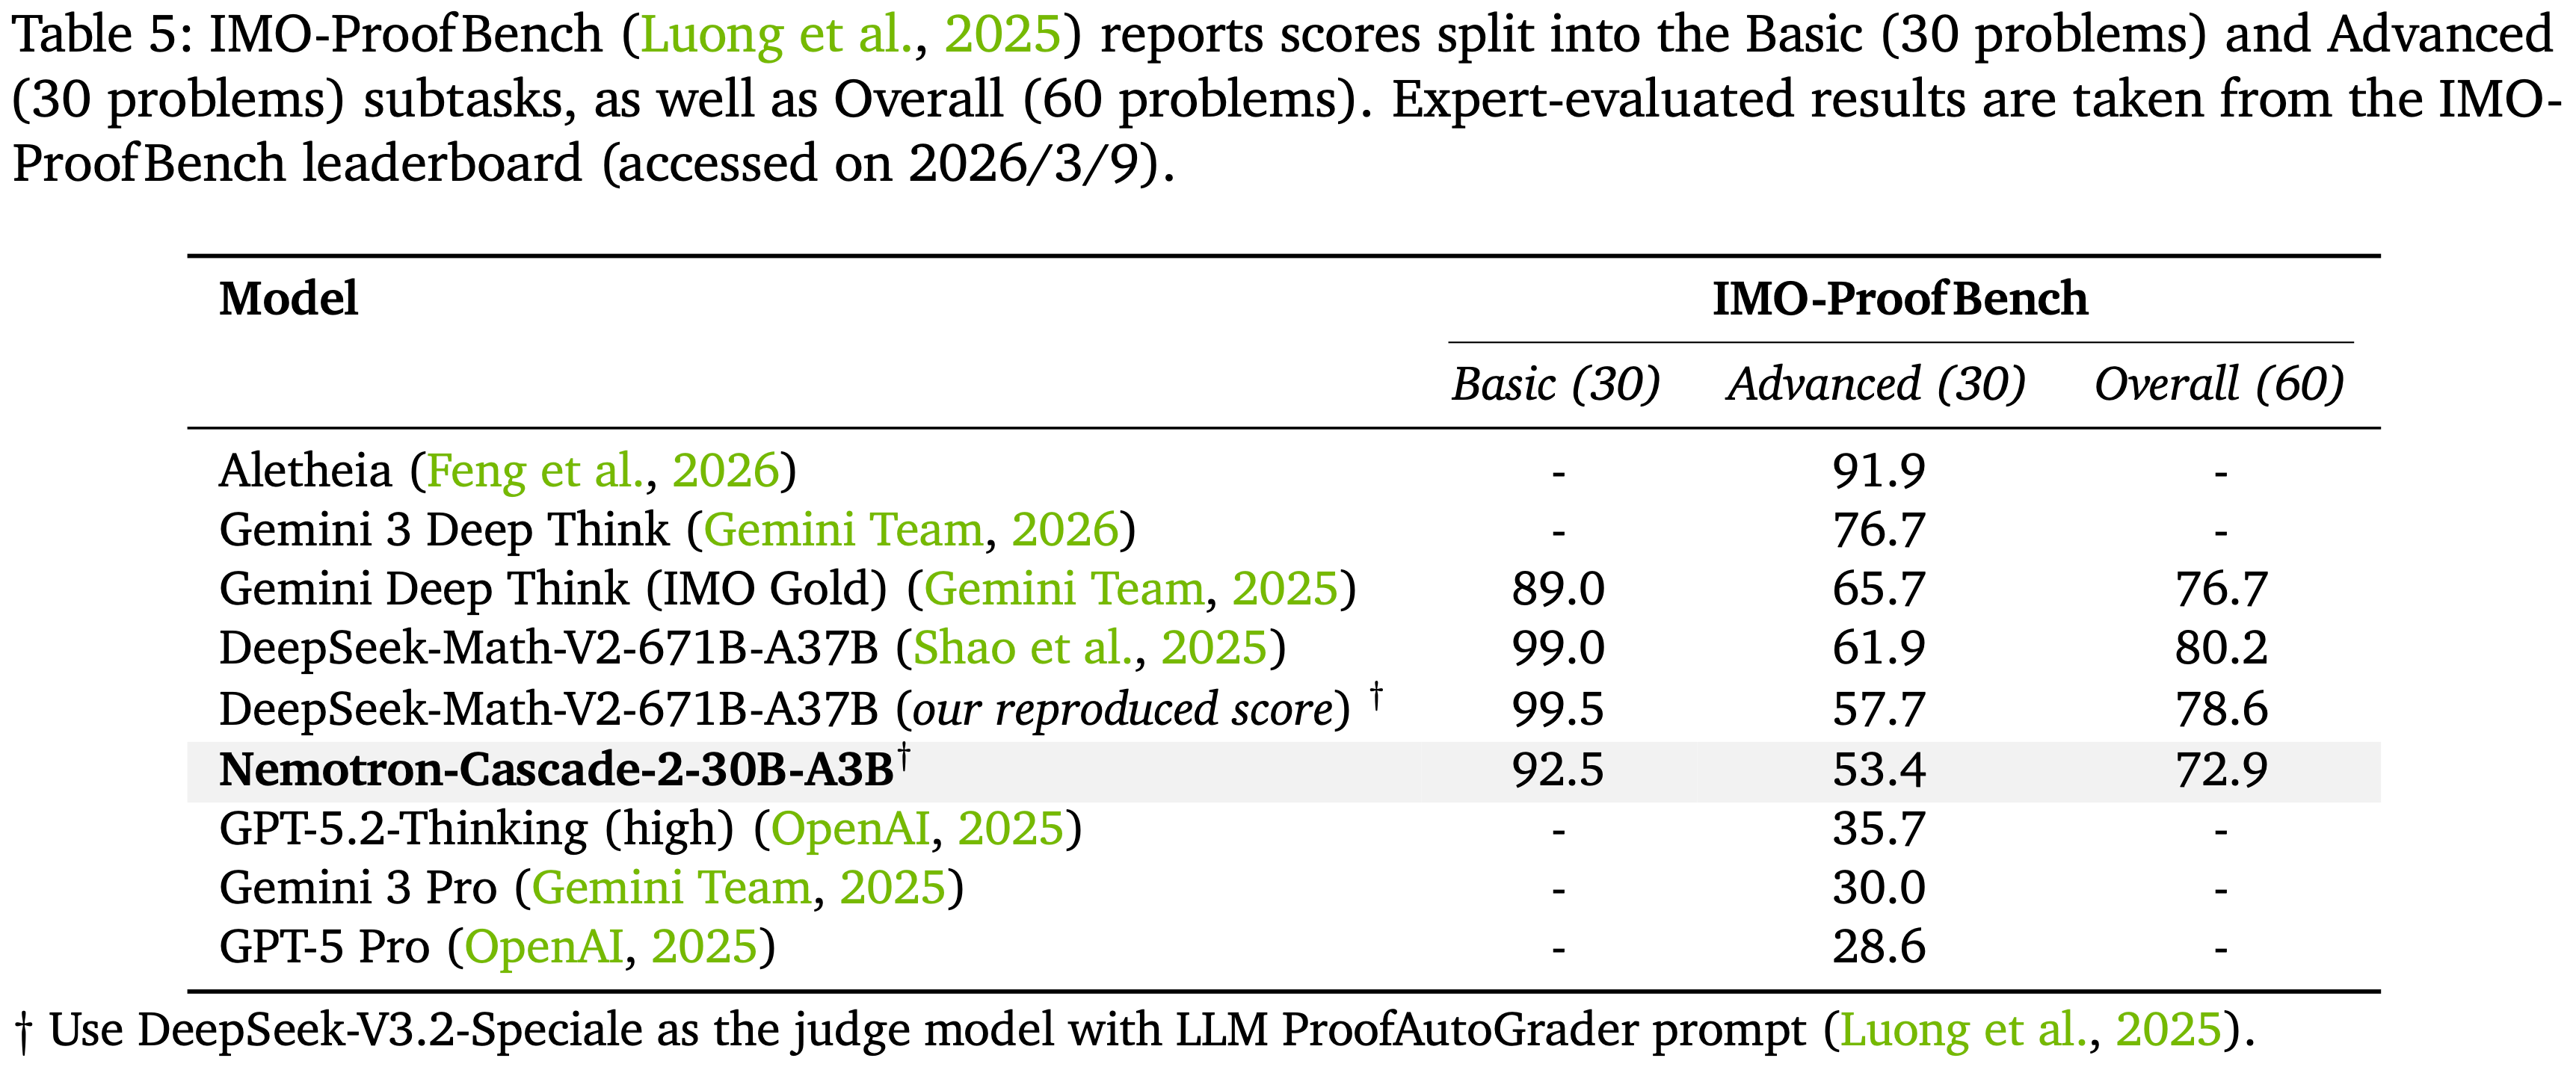
  • 如表 5 所示,Nemotron-Cascade-2-30B-A3B 在使用生成-验证-细化测试时扩展的情况下,在 IMO-ProofBench 上达到了 72.9 分
    • 其使用的激活参数少了 \(10\times\),但与 DeepSeek-Math-V2-671B-A37B 的差距在 8 分以内
  • 在 Basic 分集上达到 \(90+\) 分,并超过了 QED-Nano-4B (54.0) (LM-2026) 18 分
    • 由于评判模型不同,后者不能直接比较
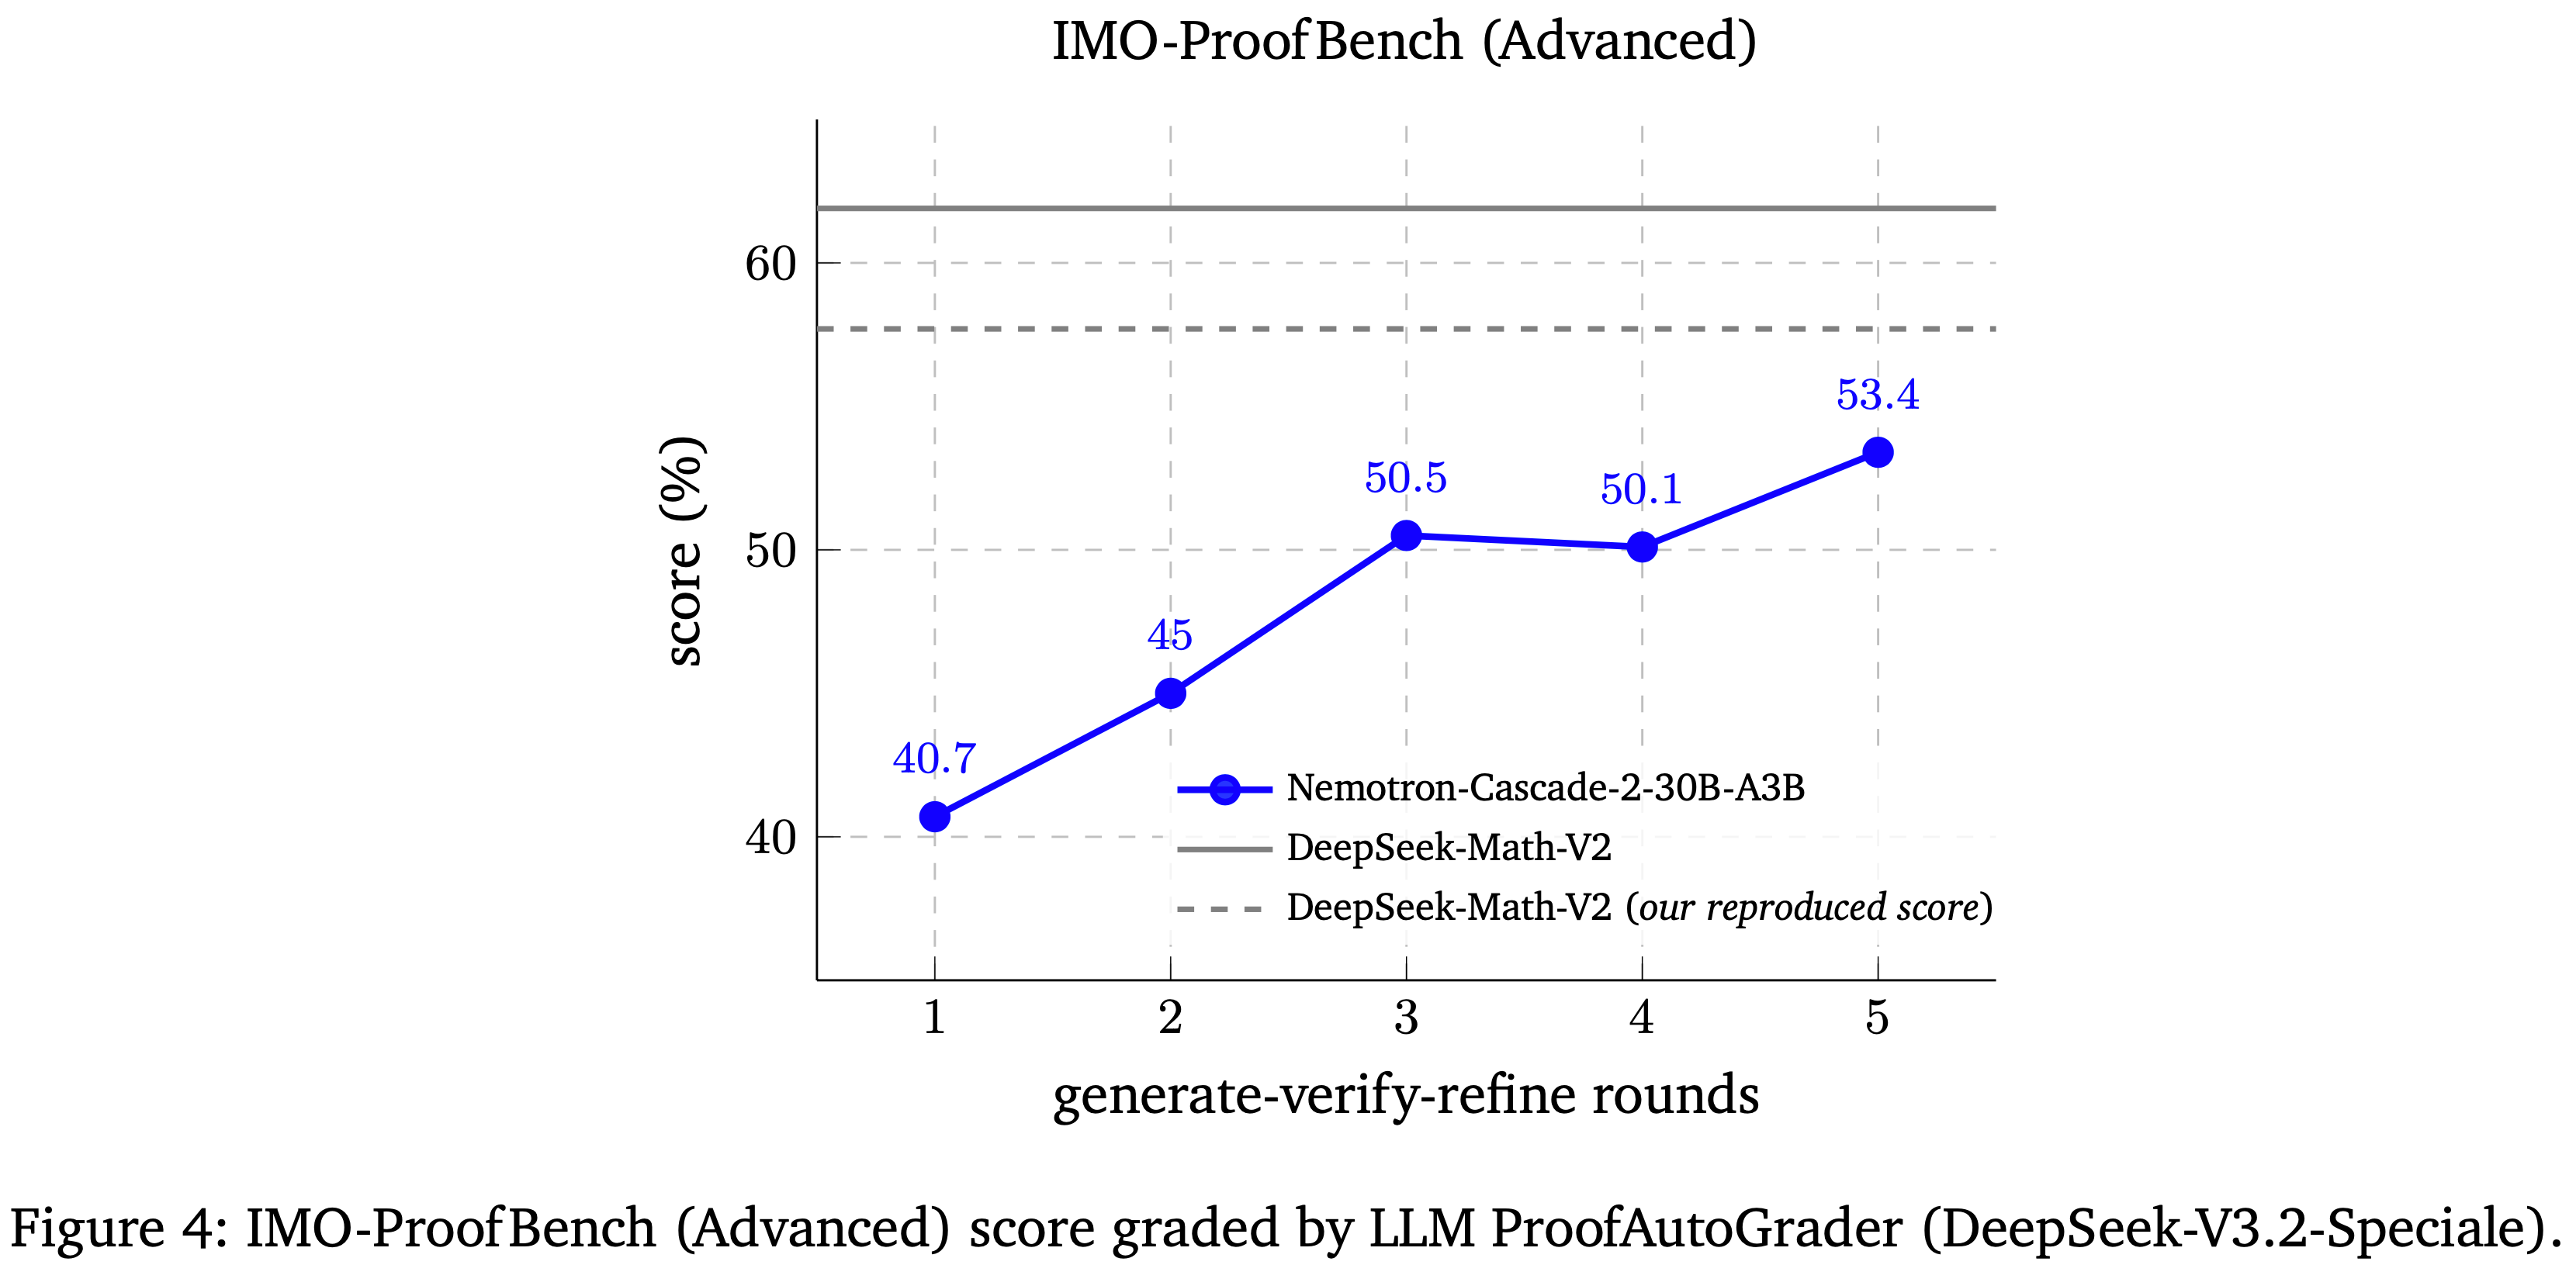
  • 在本文 LLM 评判设置下重新评估提供的 DeepSeek-Math-V2 证明,得到的分数与报告的人类评分相差 4 分以内
    • 这表明本文协议没有实质性地高估性能(更多细节见附录 A.1.2)
  • 图 4 展示了增加测试时计算量可以提高 Nemotron-Cascade-2-30B-A3B 在 IMO-ProofBench (Advanced) 上的表现,将其分数从第 1 轮的 40.7 提升到第 5 轮的 53.4,并在相同评判下缩小了与 DeepSeek-Math-V2 的差距

Competitive Coding

IOI 2025 and ICPC World Finals 2025

  • 对于 IOI 2025,采用了 Nemotron-Cascade (2025) 的 IOI 测试时扩展流程,该流程可视为一个多轮生成-选择-提交框架,利用了模型在 IOI 官方规则下的推理能力
    • 每个子任务最多分配 50 轮
      • 在每一轮中,提示模型生成 40 个候选解决方案,并结合了
        • (1) 来自前几轮的带有官方评判结果的提交历史
        • (2) 来自同一主任务中高分或完全解决的子任务的共享见解
      • 完整的聊天模板见附录 C.1
    • 使用这种方法,在问题 3 和 4 上获得了满分,在至多 \(40 \times 50 = 2000\) 次模型生成内获得了 439.28 分的金牌分数,而在 5000 次生成内可获得 507.66 分
    • 在需要设计和优化启发式算法的问题 2 上,本文流程仅在 5 轮内(至多 200 次模型生成)就获得了超过 86 分,证明了自我优化和跨子任务见解的有效性
  • 对于 ICPC 世界总决赛 2025
    • 为每个问题生成最多 1000 个解决方案,并在初步筛选后提交给官方评估
    • 本文成功解决了 12 个问题中的 10 个,获得了 #4 金牌名次,其中 8 个问题(除问题 A 和 I 外)仅在 100 次提交内就得到解决

Competitive Coding Benchmark Results

  • 在各种竞争性编码基准上评估了 Nemotron-Cascade-2-30B-A3B 模型
    • 包括 LiveCodeBench v6 (2024) 和 LiveCodeBench Pro (2025) 的 25Q1 和 25Q2 分集
  • 还通过在 2501 至 2507 年间举办的 40 场 Div.1/Div.2 Codeforces 轮次中的模拟参与来估算 Codeforces ELO 分数
    • 在 128K token 的思考预算、1.0 的采样温度和 0.95 的 top_p 下报告作者的 avg@8 结果
  • 对于工具集成推理 (Tool-Integrated Reasoning, TIR) 结果,允许模型调用最多 100 次有状态的 Python 执行器
    • 对于基线模型评估,遵循其推荐的推理配置,确保至少 128K token 到最多 256K token 的思考预算
    • 更多评估细节可以在附录 A 和附录 D 中找到
  • 如表 6 所示
    • Nemotron-Cascade-2-30B-A3B 在 Pass@1 准确率和 ELO 评分方面取得了卓越的成绩
      • 即使与总参数超过 100B 的前沿开源模型(如 Nemotron-3-Super-120B-A12B、GPT-OSS-120B 和 Qwen-3.5-122B-A10B)相比也是如此
    • 通过工具集成推理 (TIR),模型的性能可以进一步提高,尤其是在难题上,并匹配了总参数超过 300B 的最强开源模型,如 Kimi-K2.5-1T-Thinking、Qwen-3.5-397B-A17B 和 DeepSeek-v3.2-Speciale,这些模型要么缺乏对深度推理的 TIR 支持,要么在使用 Python TIR 时表现不佳
    • Nemotron-Cascade-2-30B-A3B 在 8 次尝试内在 LiveCodeBench Pro 的困难分集上实现了高于 0% 的准确率
      • 展示了在即使对人类来说也极其困难的问题上的强大推理能力

附录 A:Benchmarks and Evaluation Setups

A.1. Math

A.1.1. Non-proof Math
  • 详情见原文
A.1.2. Math Proof
  • 详情见原文

A.2. Code Reasoning

  • 详情见原文

A.3. Knowledge and STEM

  • 对于在 thinking 模式下评估 MMLU-Redux、MMLU-Pro、GPQA-Diamond 和 HLE 的 Nemotron-Cascade-2-30B-A3B
    • 使用温度 1.0,top-p 值 0.95,以及 128K Token 的 thinking 预算(最大 Response 长度)
  • 对于 HLE,使用默认的系统 Prompt
    • 在每个问题后附加“请将最终答案放在 \boxed{} 中”
    • 使用 GPT-OSS-120B 作为 LLM Judge
    • 使用附录 C.2 中的 Prompt 进行答案提取和正确性验证
  • 与官方的 HLE Response 格式(要求解释、答案和置信度分数)相比,此框式答案 Prompt 通过更好地与作者的数学 SFT 数据中使用的答案格式对齐,将准确率提高了 6-7 分,主要是在数学子集上

A.4. Alignment and Instruction-Following

  • 在非 thinking 模式下评估 IFEval
  • 在 thinking 模式下评估 IFBench 和 ArenaHard 的 Nemotron-Cascade 模型
  • 使用温度 0.6,top-p 值 0.95,以及最大 Response 长度 32K Token
  • 对于基线模型,尽可能使用官方报告的结果;如果没有这样的结果,将使用其推荐的推理配置或与作者的设置相同的设置进行评估

A.5. Long Context and Context Learning

  • 对于长上下文和上下文学习任务,本文包括:
  • AA-LCR (2025) 包含 100 个具有挑战性的基于文本的问题,需要对多个长的现实世界文档(包括公司报告、政府咨询、法律文件和学术论文)进行推理
    • 每个样本包含一个平均约 100K Token 的文档集
    • 这些问题的设计使得答案无法直接从文档中检索,而是需要跨多个信息源进行推理
    • 本文报告 thinking 模式下的 pass@1 准确率,平均 16 次生成 (avg@16)
  • LongBench v2 (2025) 包含 503 个具有挑战性的多项选择题,上下文长度范围从 8K 到 2M 个词
    • 该基准涵盖六个任务类别:单文档 QA、多文档 QA、长上下文学习、长对话历史理解、代码库理解和长结构化数据理解
    • 这些问题设计得很难;即使是配备文档搜索工具的人类专家也可能需要大量时间才能正确回答
    • 本文在 thinking 模式下评估模型,并报告平均四次生成 (avg@4) 的 pass@1 准确率
  • NIAH@1M (Ruler 子集) 指的是来自 RULER 基准 (2024) 的“大海捞针”(NIAH) 任务
  • NIAH 测试 (Kamradt, 2023) 评估 LLM 检索嵌入在长干扰文本(“大海”)中的特定信息(“针”)的长上下文能力
  • RULER 基准定义了此任务的四个变体:单针 (Single NIAH)、多键针 (Multi-keys NIAH)、多值针 (Multi-values NIAH) 和多查询针 (Multi-queries NIAH)
    • 遵循 Blakeman 等人 (2025),本文使用 1M Token 上下文设置评估每个类别的 100 个实例
      • 模型在 Reasoning-off 模式下评估,报告单次生成 (avg@1) 的 pass@1 准确率
  • CL-Bench (2026) 评估 LLM 从提供的上下文中学习并将获得的知识应用于解决任务的能力,这一过程称为上下文学习
    • 该基准包含 1,899 个测试样本,涵盖 500 个复杂上下文和 31,607 个验证 rubrics,全部由经验丰富的领域专家开发
    • 完成这些任务所需的知识大部分超出了现有模型在预训练期间通常学习的内容,要求模型直接从提供的上下文中学习
    • 模型在 thinking 模式下评估,报告单次生成 (avg@1) 的 pass@1 准确率

A.6. Agentic Tasks

  • BFCL v4 (2025) 为 LLM 提供了一个全面的 Agentic 评估框架,涵盖诸如网络搜索、内存读写以及跨多种编程语言的函数调用等任务
    • 遵循官方的 BFCL v4 评估协议,并报告跨 Agentic、多轮 (multi-turn)、实时 (live) 和非实时 (non-live) 类别的分数
    • 模型在 thinking 模式下评估,报告基于单次生成 (avg@1) 的 pass@1 准确率
  • SWE-bench Verified (OpenAI, 2024) 是来自 SWE-bench (2023) 原始测试集的一个子集,包含 500 个经人工标注员验证为无问题的样本
    • 在非 thinking 模式下评估模型,并报告 pass@1 准确率,每个 Prompt 平均 4 次生成 (avg@4)
  • \(\tau^2\)-Bench (2025) 在具有明确策略、工具使用和共享世界状态更新的环境中评估多轮客户服务 Agent
    • 在三个官方子集上评估:航空 (airline,50 个示例)、零售 (retail,114 个示例) 和电信 (telecom,114 个示例)
    • 为了将标准误差控制在 1.5 以内,在航空子集上报告 avg@16,在零售和电信子集上报告 avg@8
  • Terminal Bench 2.0 (2026) 用于评估基于终端的环境中的 Agent,包含 89 个人工验证的任务,涵盖科学计算、机器学习和系统管理等专业领域
    • 超越简单的代码生成,该基准专注于端到端的工作流,要求 Agent 展示在整体操作(如模型训练、系统配置和软件调试)中的熟练程度,而不仅仅是生成孤立的函数
    • 本文使用默认的 Terminus-2 框架 (scaffolding) 评估模型,报告 avg@5 任务成功率
  • 更多细节见原文

A.7. Multilingual

  • MMLU-ProX (2025) 将具有挑战性的 MMLU-Pro 基准扩展到包括 29 种语言
    • 遵循 Blakeman 等人 (2025),选择六种语言进行评估:英语 (en)、德语 (de)、西班牙语 (es)、法语 (fr)、意大利语 (it) 和日语 (ja)
    • 模型在 thinking 模式下评估,报告单次生成 (avg@1) 的 pass@1 准确率
  • WMT24++ (2025) 将 WMT24 机器翻译基准扩展到覆盖 55 种语言
    • 遵循 Blakeman 等人 (2025),作者在五个翻译对上进行评估:英语到德语 (en \(\rightarrow\) de)、英语到西班牙语 (en \(\rightarrow\) es)、英语到法语 (en \(\rightarrow\) fr)、英语到意大利语 (en \(\rightarrow\) it) 和英语到日语 (en \(\rightarrow\) ja)
    • 使用 XCOMET-XXL (2024) 作为评估指标来评估翻译质量
    • 模型在 thinking 模式下评估,报告单次生成 (avg@1) 的 pass@1 准确率

附录 B:Training Hyperparameters

  • 表 7、8、9、10 中列出了 Nemotron-Cascade-2-30B-A3B 在所有阶段的训练超参数

附录 C:Prompt Templates

C.1. Prompt Templates for Test-Time Scaling on IOI 2025

  • 详情见原文

C.2. HLE Judge Prompt

  • 英文原文

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    Judge whether the following [response] to [question] is correct or not based on the precise and unambiguous [correct_answer] below.
    [question]: {question}
    [response]: {response}
    Your judgement must be in the format and criteria specified below:
    extracted_final_answer: The final exact answer extracted from the [response]. Put the extracted answer as ’None’ if there is no exact, final answer to extract from the response.
    [correct_answer]: {correct_answer}
    reasoning: Explain why the extracted_final_answer is correct or incorrect based on [correct_answer], focusing only on if there are meaningful differences between [correct_answer] and the extracted_final_answer.
    Do not comment on any background to the problem, do not attempt to solve the problem, do not argue for any answer different than [correct_answer], focus only on whether the answers match.
    correct: Answer ’yes’ if extracted_final_answer matches the [correct_answer] given above, or is within a small margin of error for numerical problems. Answer ’no’ otherwise, i.e. if there if there is any inconsistency, ambiguity, non-equivalency, or if the extracted answer is incorrect.
    confidence: The extracted confidence score between 0|%| and 100|%| from [response]. Put 100 if there is no confidence score available.
    • 中文版:
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      根据下面精确且明确的 [correct_answer],判断以下对 [question] 的 [response] 是否正确
      [question]: \\{question\\}
      [response]: \\{response\\}

      你的判断必须符合以下指定格式和标准:
      extracted_final_answer: 从 [response] 中提取的最终确切答案。如果 response 中没有要提取的确切最终答案,则将提取的答案设为 'None'
      [correct_answer]: \\{correct_answer\\}

      reasoning: 基于 [correct_answer] 解释 extracted_final_answer 正确或错误的原因,仅关注 [correct_answer] 和提取出的最终答案之间是否存在有意义的差异。不要评论问题的任何背景,不要试图解决问题,不要为除 [correct_answer] 之外的任何答案辩护,只关注答案是否匹配
      correct: 如果 extracted_final_answer 与上面给出的 [correct_answer] 匹配,或者对于数值问题在小的误差范围内,则回答 'yes'。否则,即如果存在任何不一致、歧义、不等价,或者提取的答案不正确,则回答 'no'
      confidence: 从 [response] 中提取的置信度分数,介于 \\(0\%\\) 和 \\(100\%\\) 之间。如果没有可用的置信度分数,则填入 100
1…131415…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4