Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——EcomGPT-CT

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:EcomGPT-CT: Continual Pre-training of E-commerce Large Language Models with Semi-structured Data, arXiv 202312, THU, Alibaba

Paper Summary

  • 整体内容总结:
    • 本论文对 LLM 的领域特定 CPT 进行了广泛研究,重点关注电子商务领域
    • 本文实验表明,通过结合通用语料和领域特定语料进行有针对性的 CPT,可以有效地将 LLM 适配到特定领域
    • CPT 在不牺牲模型在广泛 NLP 应用中能力的前提下,提升了模型在电子商务任务上的性能
    • 论文设计的数据混合策略被证明在增强模型从不同数据源吸收和整合知识的能力方面是有效的,从而在领域特定任务上实现了性能提升
  • 背景:
    • LLM 在大量语料上预训练后,已在各种 NLP 任务中展现出卓越性能,但将这些模型应用于特定领域仍面临重大挑战
    • 例如缺乏领域知识、利用领域知识的能力有限,以及对领域特定数据格式的适应性不足
  • 本文方案介绍:
    • 考虑到从头训练 LLM 的极高成本和特定领域标注数据的稀缺性,本研究以电商领域为例,专注于 LLM 的领域特定持续预训练(domain-specific continual pre-training)
    • 论文探索了使用未标注的通用语料和电商语料对 LLM 进行持续预训练(CPT)的影响
    • 论文设计了一种混合不同数据源的策略,以更好地利用电商半结构化数据
    • 论文构建了多个任务来评估 LLM 在电商领域的少样本上下文学习(ICL)能力及其在指令微调后的零样本性能
  • 实验结果表明,电商 LLM 的 CPT 以及论文设计的数据混合策略均具有显著效果

Introduction and Discussion

  • LLM 通过预训练数十亿文本标记,能够掌握广泛的世界知识和人类语言规则(2023)。因此,LLM 在各类 NLP 任务中表现优异(2020; 2022; 2023b)
  • 然而,现有的 LLM 并不完美,将其应用于特定领域仍存在重大挑战:
    • (1)LLM 缺乏必要的领域特定知识,或难以利用相关知识解决实际任务(2023a;2023)
    • (2)LLM 难以适应特定领域的独特文本格式或数据分布,因此无法满足领域应用的需求(2023a;2023b)
  • 考虑到:
    • 训练 LLM 需要大量硬件资源和长时间训练,从头预训练一个领域特定的 LLM 在实际中并不可行
    • 特定领域的标注数据通常稀缺且成本高昂,而未标注数据则更为丰富且易于获取
  • 因此:本研究以电商领域为例,探索通过 CPT 使 LLM 适应特定领域的方法
  • 已有充分证据表明,特定领域的 CPT 能够显著提升掩码语言模型(MLM,例如 BERT(2019)、RoBERTa(2019))在相应领域下游任务中的表现(2020; 2020;2022;)
  • 在 LLM 时代,受限于数据和计算资源:
    • 大多数领域适应研究通过指令微调或提示工程实现(2023;)
    • 仅有少数研究尝试通过 CPT 将领域知识注入模型(2023a; 2023),且缺乏从实际应用角度对 LLM 领域特定 CPT 的深入分析
  • 论文工作内容如下:
    • 基于 BLOOM(2022)等一系列多语言自回归模型,构建了电商领域的 EcomGPT-CT 模型
    • 探索了在难以获取完整原始预训练数据的情况下,使用通用和电商未标注语料对 LLM 进行 CPT 的影响
      • 论文关注模型在解决实际电商任务中的表现,并分析训练过程中的性能变化
    • 提出了一种混合不同数据源的策略,以有效利用电商领域丰富的半结构化数据,从而提升预训练数据的规模和多样性

Related Work

Large Language Models

  • 近年来,LLM 领域发展迅速,当前主流的 LLM 主要基于 Transformer 模块,并在海量文本数据上预训练
  • 自 GPT-2(2019)和 T5(2020)证明各种 NLP 任务可以统一为文本生成范式后,主流 LLM 均采用仅解码器的自回归架构
  • 近期,遵循 scaling law(2020),不同参数规模的 LLM 被构建并发布,包括 GPT-3(2020)、Chinchilla(2022)、BLOOM(2022)、PaLM(2022)、Llama(2023)、Baichuan(2023a)
  • 受LLM卓越性能的激励,研究者致力于构建领域适应的 LLM 以解决特定领域任务,比如:
    • 生物医学领域的 Med-PaLM(2023)和 ChatDoctor(2023)
    • 数学领域的 Minerva(2022)
    • 金融领域的 BloombergGPT(2023)和 FinGPT(2023b)
    • 以及法律领域的 ChatLaw(2023)

Continual Pre-training

  • CPT 是指:在通用预训练和下游任务微调两个阶段之间增加的额外预训练阶段
    • CPT 采用与通用预训练相同的训练目标 ,但通常使用特定领域或任务的未标注语料 ,旨在实现领域适应或任务适应
  • 对于 BERT(2019)和 RoBERTa(2019)等掩码语言模型预训练模型,领域自适应或任务自适应的 CPT 能够引导模型与相应领域或任务的数据分布对齐,从而有效提升模型在相关下游任务中的表现(2020;2022)
  • 对于当前主流的自回归 LLM ,关于 CPT 过程的研究(2023)或 CPT 在构建领域特定 LLM 中的应用(2023a)仍然有限
    • 目前缺乏对** CPT 如何影响 LLM 解决领域特定任务效果的详细分析,也缺乏关于如何提升 LLM CPT 效果策略**的研究

Domain-specific Continual Pre-training

Training Task

  • CPT (Continual Pre-training)无缝连接了通用预训练(General Pre-training)和SFT阶段,从而提升模型在特定领域或任务中的性能,如图 1 所示
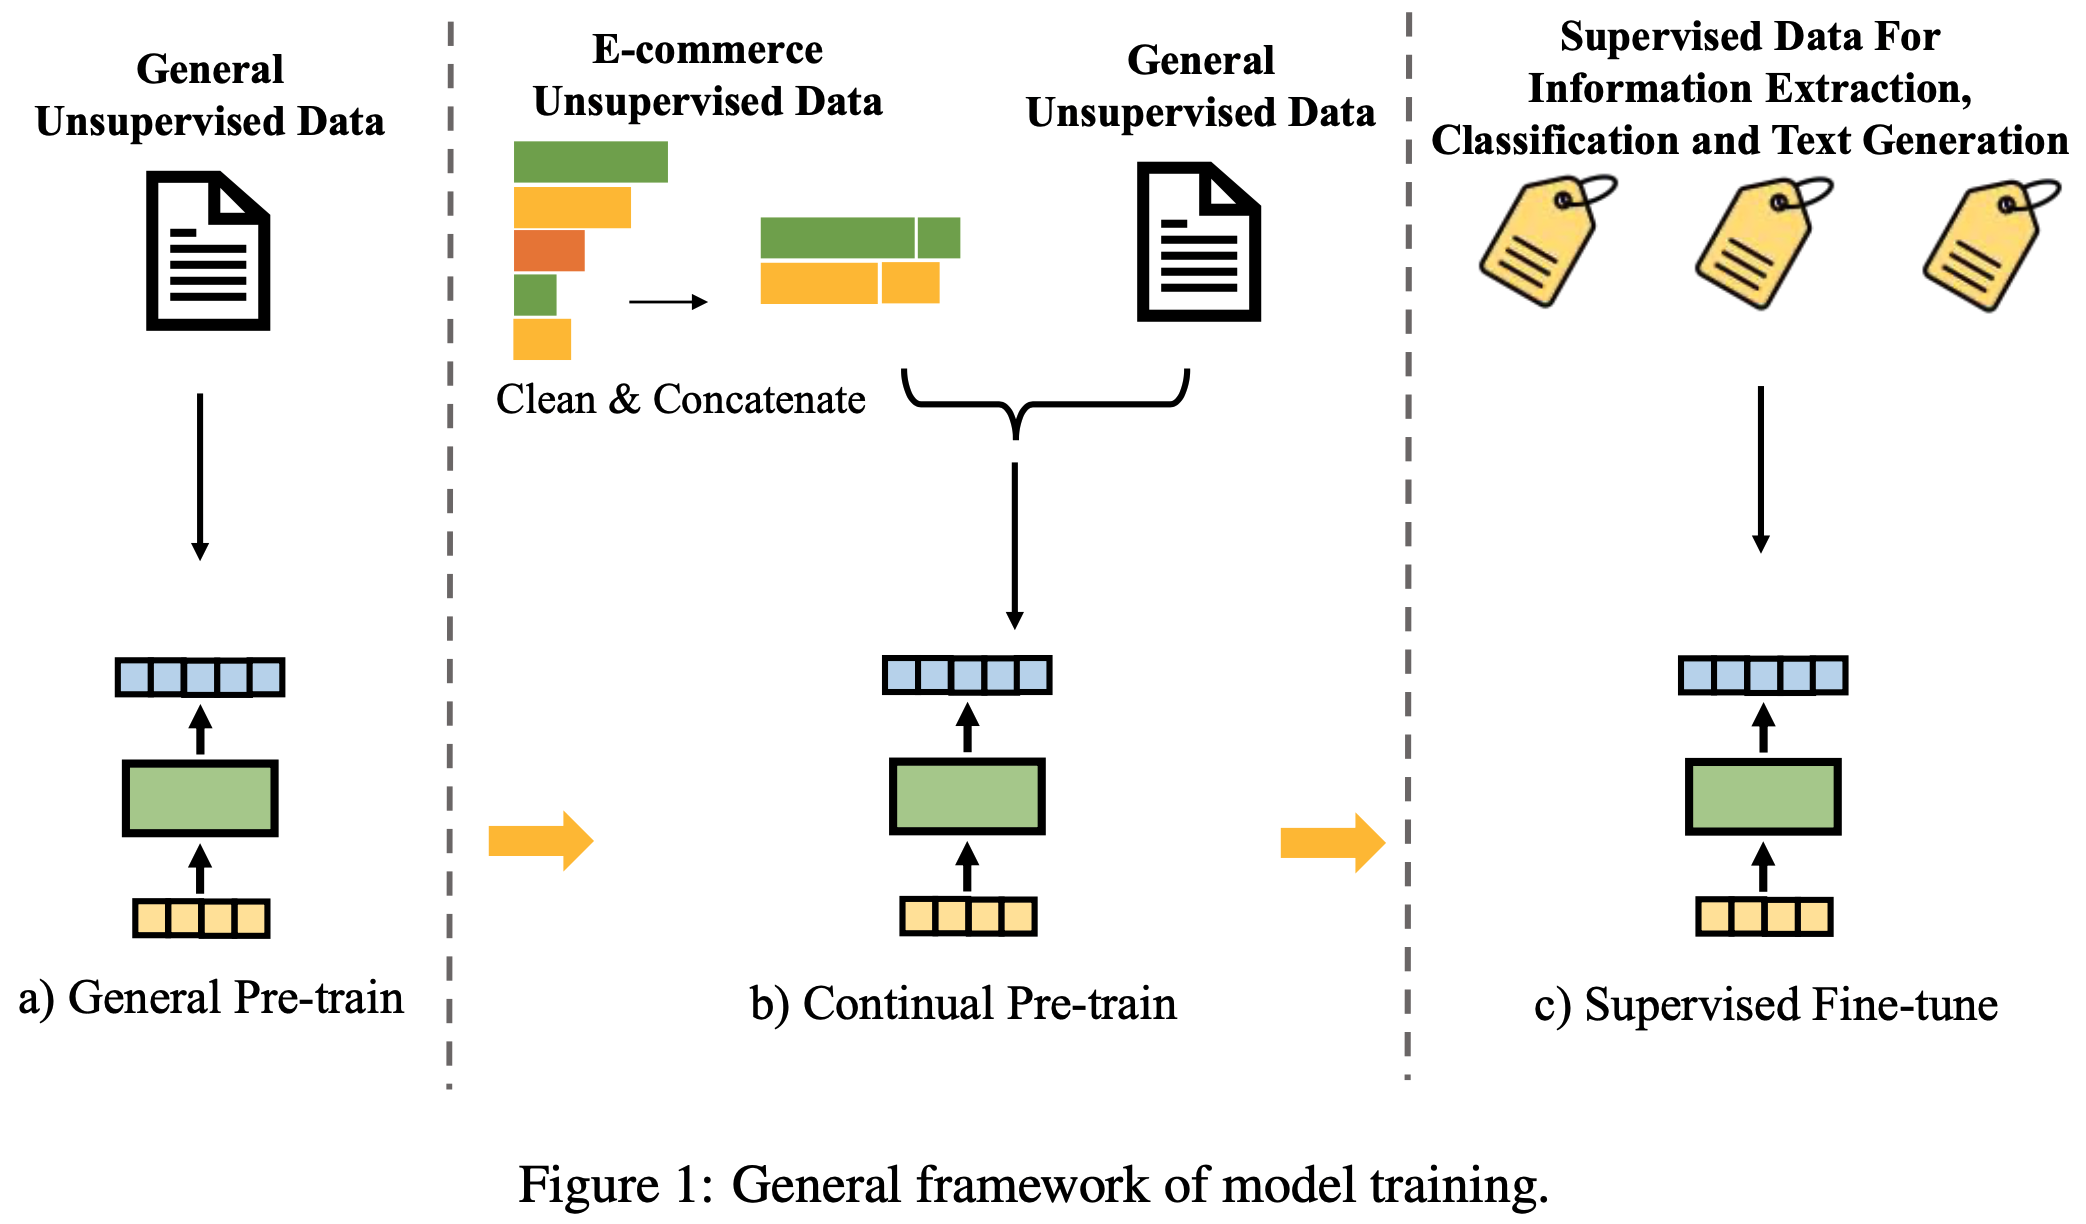
  • CPT 采用与通用预训练相同的目标函数,但专注于特定领域或任务的未标注语料
  • 论文中,论文使用仅包含解码器的 Transformer 模型(Decoder-only Transformer Models),这是当前主流LLM 的架构。预训练的目标是下一词预测任务(Next Token Prediction)或自回归语言建模(Auto-regressive Language Modeling):
    $$
    \max_{\theta}\sum_{i=1}^{N}\log P(y_{i}|y_{ < i};\theta),
    $$
    • 其中,\(\theta\) 是模型参数,\(y\) 是训练文本序列

Dataset Construction

  • 论文通过 CPT 提升 LLM 在电子商务(E-commerce)领域的性能
  • 论文整理了大量的电子商务数据,用于向 LLM 注入领域特定知识,并帮助模型适应电子商务领域独特的文本格式
  • 为了保留 LLM 的世界知识和泛化能力,论文还将通用文本数据纳入训练数据集中
  • 电子商务语料(E-commerce Corpora) :论文从亚马逊(Amazon)和淘宝(Taobao)收集了大量产品的标题、属性、描述和评论
    • 此外,还利用了淘宝“逛逛”频道的文章 ,这些文章介绍了产品特性、分享了用户体验并展示了品牌故事
  • 通用语料(General Corpora) :为了构建通用语料,论文从 WuDaoCorpora (2021) 和 RefinedWeb (2023) 中采样文本
    • 这两个数据集分别包含从网页中收集的 72B 中文 Characters 和 600B 英文 Tokens
  • 数据预处理(Data Pre-processing) :为了确保预训练数据的质量,论文实现了一个全面的流水线
    • 包含数据重构、过滤和去重过程
    • 对于半结构化产品数据,论文首先按产品 ID 将标题、属性、描述和评论分组
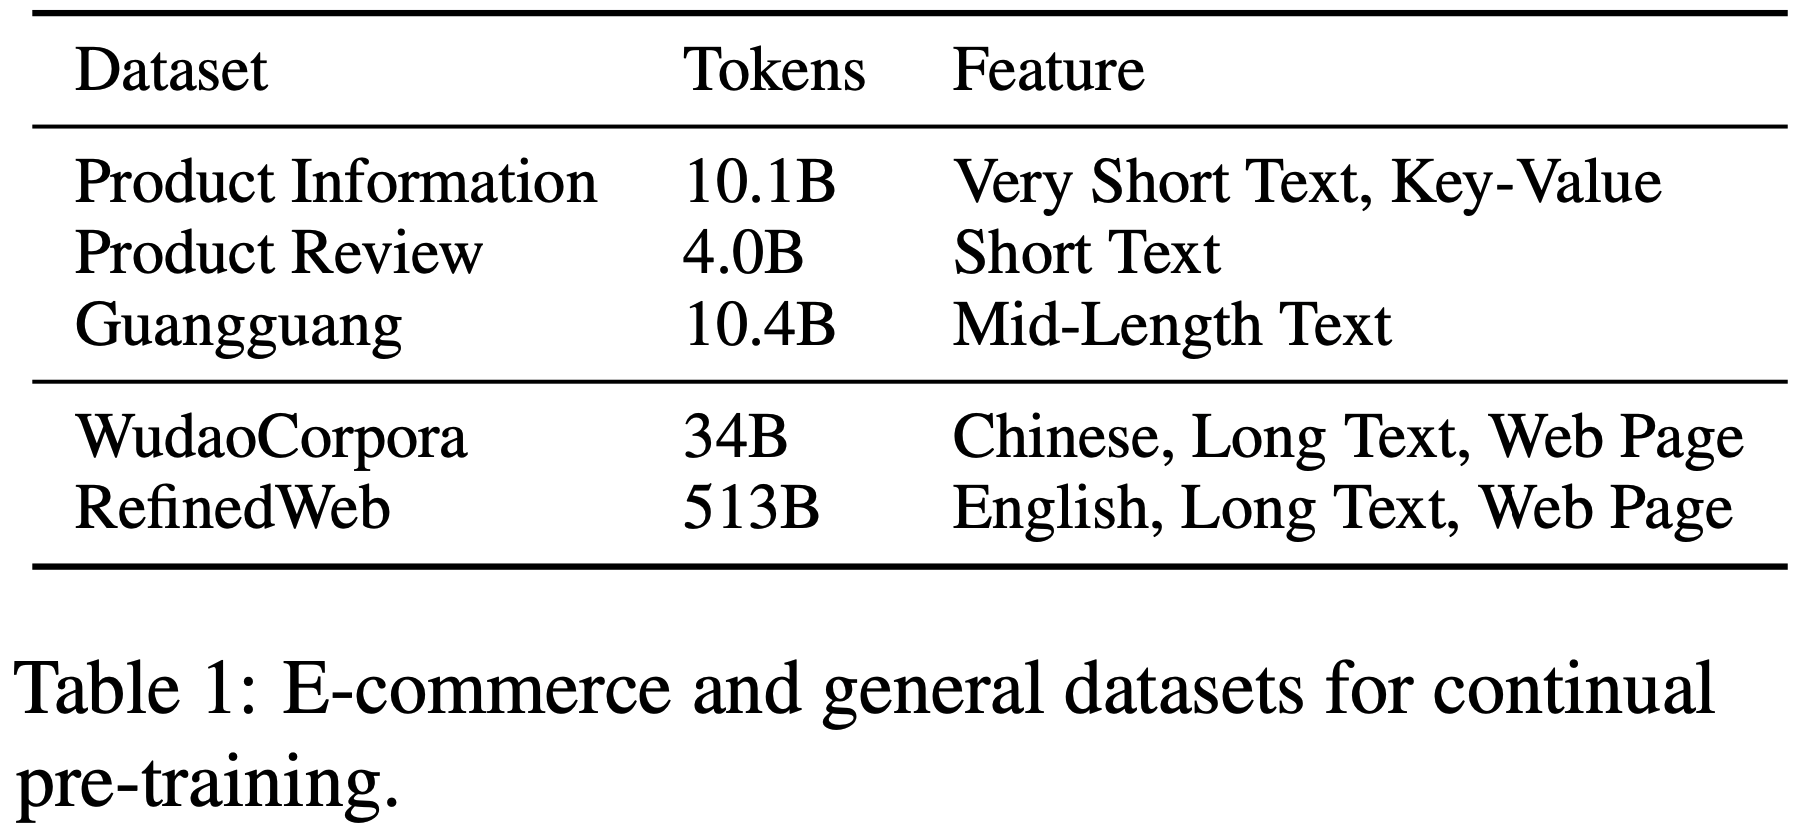
  • 表1 展示了处理后的电子商务和通用数据集的统计信息,论文观察到,收集的数据集中不同数据源的 Token 数量存在显著差异
    • 经过过滤和处理的电子商务数据包含约 20B Tokens,不到通用领域网页数据 Token 数量的 5%
    • 在通用数据中,中文数据的数量远少于英文数据
  • 考虑到领域特定 CPT 的目标是提升模型在解决领域特定任务时的性能,同时不损害其泛化能力,因此在训练样本中保持通用数据和领域特定数据的 Token 数量平衡至关重要
    • 但由于硬件限制,论文无法对不同类型数据的比例进行详细实验
    • 经过初步探索,论文将通用数据与领域特定数据的 Token 数量比例设定为 2:1 ,并将通用数据中的中英文数据比例设定为 1:1
Dataset Mixing Strategy

  • 通常,用于LLM 预训练的数据来自网页上的长文本,例如 CommonCrawl 和 Wikipedia
  • 但在某些特定领域(包括电子商务领域),大量文本数据以半结构化格式存储在表格或数据库中
    • 这些半结构化文本数据在形式上与常规文本数据存在显著差异
  • 尽管如此,作者相信将这些数据适当地纳入 CPT 中,可以进一步提升LLM 的领域特定性能
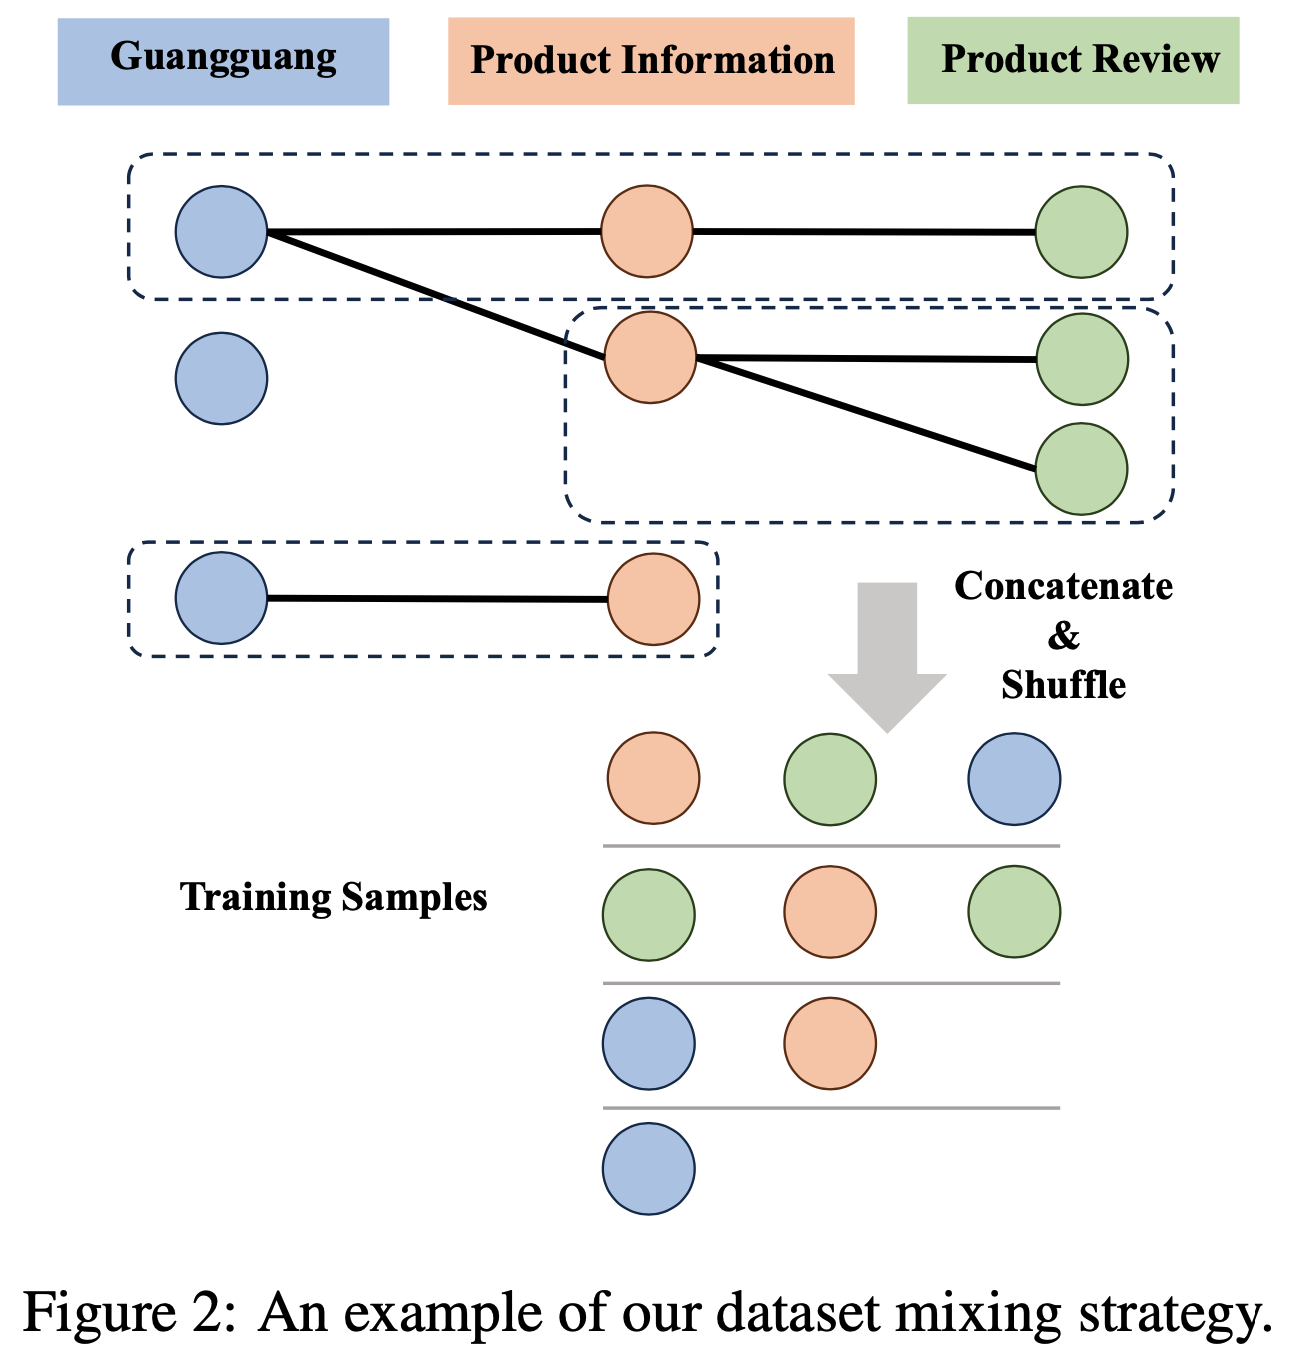
  • 为了有效地将这些丰富的半结构化数据转化为模型训练所需的文本序列,论文设计了一种跨不同数据源的数据集混合策略。论文的数据混合策略包含以下步骤:
    • 1)节点构造 :从不同数据源收集半结构化数据,每个数据源代表一组节点,每个节点对应一个数据条目(即一行或一个对象)
    • 2)边构造 :在跨两个数据源相关联的节点之间建立边,构建表示数据关系的异构图(Heterogeneous Graph)
      • 在论文的实验中,所有数据均与电子商务产品相关,因此论文使用产品 ID 作为唯一标识符,连接与同一产品相关的所有节点
    • 3)簇选择并移除 :基于预定义的簇大小范围,迭代地从图中选择连通的簇,并遵循尽可能覆盖更多数据源的规则
      • 选择簇后,从图中移除所有对应节点以避免冗余
    • 4)簇内节点拼接 :在每个选定的簇内随机排列所有节点,提取每个节点中的可用文本,并将它们拼接成一个训练样本
  • 图2 展示了一个示例:
    • 作者认为,这种数据混合策略建立了来自不同数据源文本之间的联系
    • 与从每个数据源独立采样文本的策略相比,论文的策略增强了单个样本中文本的多样性,从而更有效地训练 LLM
  • 问题:论文的数据混合策略有经过实验验证吗?
    • 后面实验部分有实验,证明了这种做法是有效的

Training Setup

  • 作者选择 BLOOM(2022)作为 EcomGPT-CT 的骨干模型(backbone),原因如下:
    • (1) BLOOM 是一个支持中英文的多语言预训练模型;
    • (2) BLOOM 未经过任何Post-training,这确保了在 CPT 后评估我们基准测试性能变化的可靠性
  • 作者分别在参数规模为 3B 和 7.1B 的 BLOOM 模型上进行了实验
  • 受限于硬件配额,论文的每项实验均在 2-4 块 NVIDIA Tesla A100 80GB GPU 上完成,这为计算资源有限的应用场景提供了有价值的参考(有趣的表达)
  • 论文采用了 Huggingface 的 Transformers(2019)和 DeepSpeed(2020)框架
    • Transformers 提供了模型实现和基础的训练流程
    • DeepSpeed 则通过 ZeRO 优化器(2020)对训练状态(如模型参数、梯度和优化器状态)进行分片,从而优化 GPU 内存消耗
    • 论文使用了 ZeRO stage 2 并启用了 offload 功能,这意味着优化器状态和梯度会被分片,且训练状态可以在主机和设备之间交换
  • 训练过程采用 bfloat16 混合精度(2019)进行,以提高训练效率并避免数值下溢或溢出问题
  • 实验中使用的超参数如表2 所示(部分超参数是基于 BLOOM 原始预训练设置而确定的)
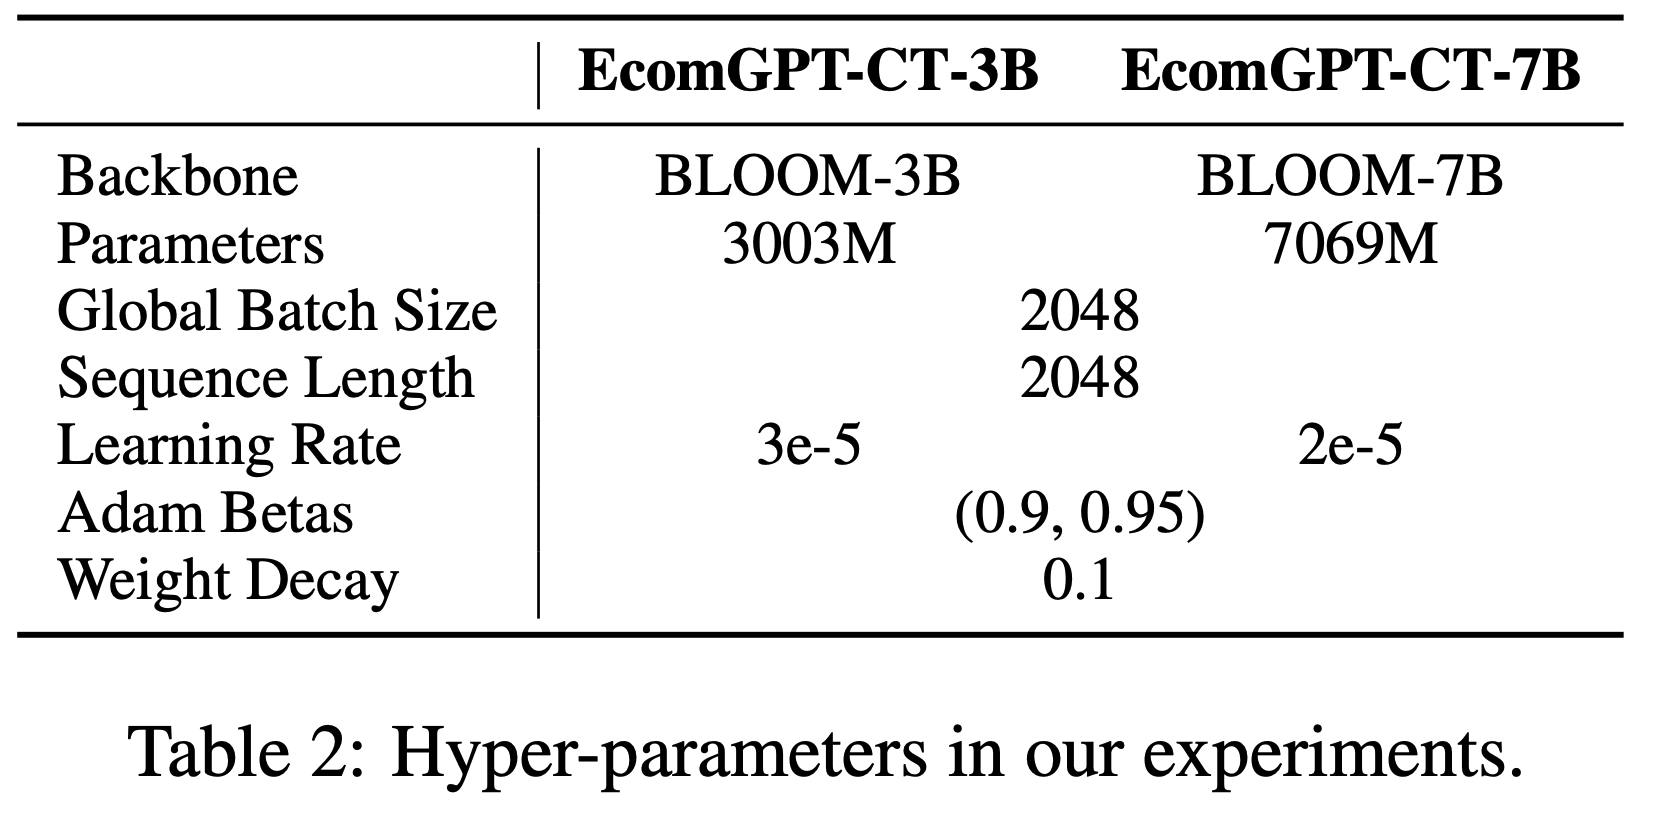
  • 超参数分析:小模型使用更大的学习率

Experiments

Evaluation Benchmarks

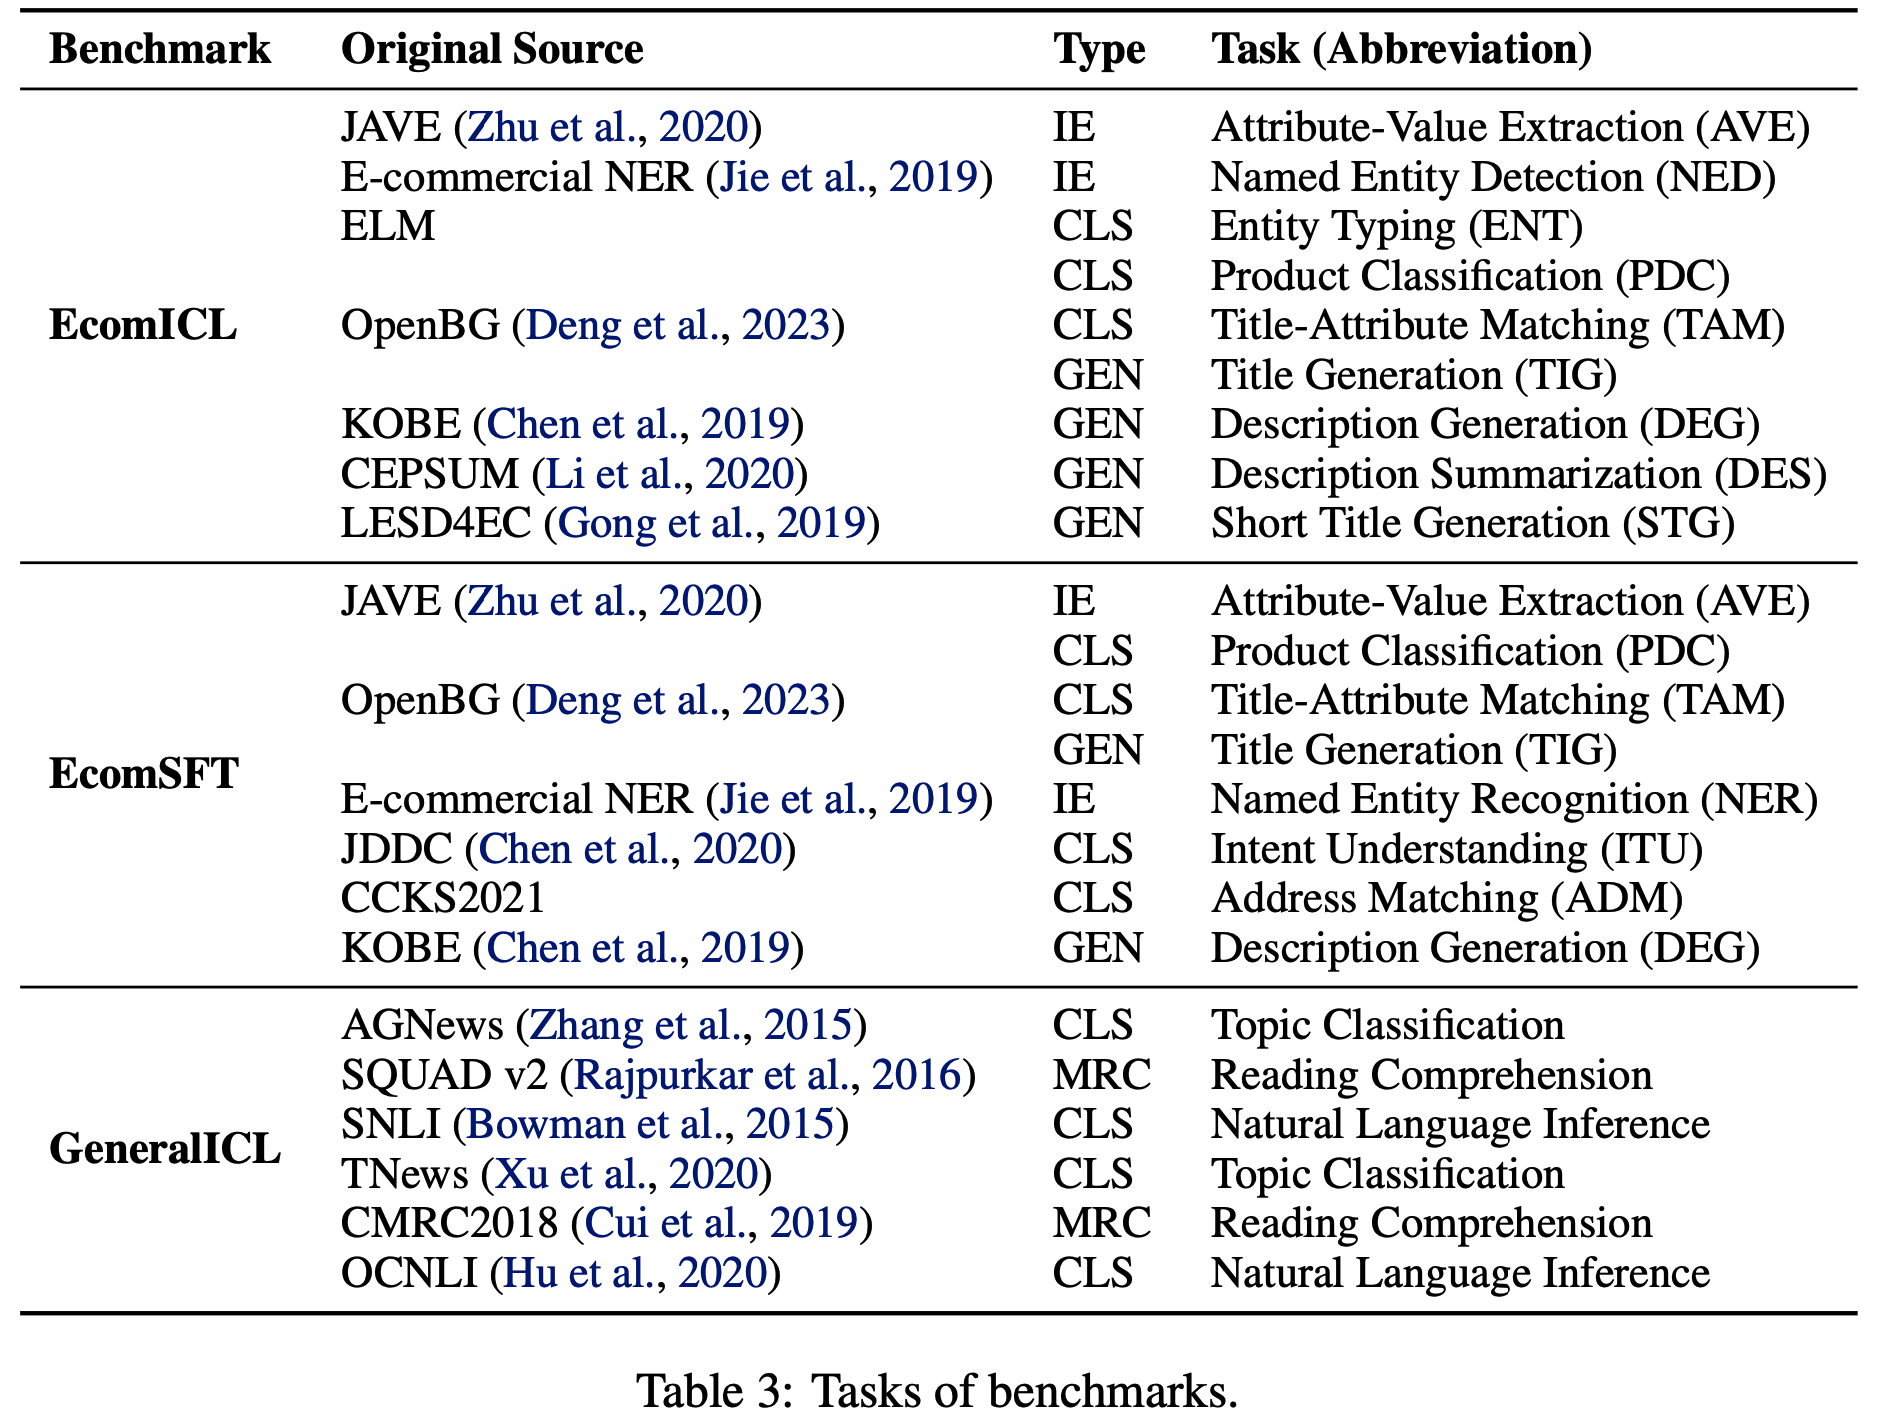
  • 为了从解决实际问题的角度评估基础 LLM 在电子商务领域的性能,论文基于 EcomInstruct(2023a)构建了两个基准,如表3 所示:
    • (1) EcomICL :论文选择了 9 项任务,涵盖文本分类(text classification, CLS)、文本生成(text generation, GEN)和信息抽取(information extraction, IE)等多种类型
      • 每个数据实例被处理为标准格式,并提供多个相同格式的示例作为演示,以评估 LLM 的少样本上下文学习(Few-shot ICL)性能
    • (2) EcomSFT :论文使用 EcomInstruct 的训练数据对基础 LLM 进行 SFT(然后进一步评估)
      • 选择了 8 项任务进行评估,包括 4 项训练集内任务和 4 项训练集外任务,旨在评估 SFT 后模型的指令遵循性能
  • 为了评估基础 LLM 在 CPT 后是否仍能解决通用自然语言处理(NLP)任务,论文分别从中文和英文 NLP 基准中选择了 3 项任务
    • 以 Few-shot ICL(GeneralICL)的形式进行评估
    • 对于每项任务,论文在实验中随机选取最多 1000 个数据实例
  • 对于自回归 LLM ,每项任务都被视为文本生成任务。因此,我们可以使用文本生成的自动评估指标来评估模型在不同任务上的性能
    • 根据先前的工作(2022;2022),论文使用 ROUGE-L(2004)作为评估指标
    • 对于分类任务,论文报告准确率指标;
    • 对于两项 IE 任务,论文还使用了精确率、召回率和 F1 值指标

补充:论文相关的评估指标汇总

  • 表3 列出了所有评估指标
  • AVE :属性-值提取(Attribute-Value Extraction,AVE) :从商品信息中提取属性和对应的值,如商品“颜色:红色”
  • NED :命名实体检测(Named Entity Detection,NED) :识别文本中的特定实体,如品牌名、商品名等
  • ENT :实体类型分类(Entity Typing,ENT) :对文本中的实体进行分类,如“苹果”是水果还是品牌
  • PDC :产品分类(Product Classification,PDC) :将商品归类到预定义的类别中,如“手机”属于“电子产品”
  • TAM :标题-属性匹配(Title-Attribute Matching,TAM) :判断商品标题是否与其属性描述一致
  • TIG :标题生成(Title Generation,TIG) :根据商品信息生成简洁且吸引人的标题(问题:如何评估简洁和吸引人?)
  • DEG :描述生成(Description Generation,DEG) :基于商品属性生成详细的描述文本
  • DES :描述摘要(Description Summarization,DES) :将商品的长描述压缩成简短的摘要
  • STG :短标题生成(Short Title Generation,STG) :生成更简短的标题(问题:用于移动端展示?)
  • NER :命名实体识别(Named Entity Recognition,NER) :识别并分类文本中的命名实体,如人名、地名等
    • 注:NER = NED + 实体分类,部分文献中也会混用两者,但实际上强调 NED 时,是不用对实体进行分类的
    • 输入句子 :"马云在杭州创立了阿里巴巴。"
    • NED输出 :[马云] 在 [杭州] 创立了 [阿里巴巴]
    • NER输出 :[马云]PER 在 [杭州]LOC 创立了 [阿里巴巴]ORG
  • ITD :意图理解(Intent Understanding,ITD) :分析用户查询的意图,如“购买”或“咨询”
  • ADM :地址匹配(Address Matching,ADM) :验证或匹配用户输入的地址信息
  • AGNews :主题分类(Topic Classification) :将新闻文本分类到预定义的主题类别
  • SQUAD v2 :阅读理解(Machine Reading Comprehension,MRC) :阅读理解任务,根据文章回答问题
  • SNLI :自然语言推理(Natural Language Inference) :判断两个句子之间的逻辑关系(蕴含、矛盾或中立)
  • TNews :主题分类(Topic Classification) :中文新闻文本的主题分类任务
  • CMRC2018 :阅读理解(Machine Reading Comprehension,MRC) :中文阅读理解任务,根据文章回答问题
  • OCNLI :自然语言推理(Natural Language Inference) :中文自然语言推理任务,判断句子间的关系

Results on Domain-specific Tasks

  • 表4 展示了 BLOOM-3B 和 BLOOM-3B-7B 模型在不同 CPT 设置下对多种电子商务 Few-shot ICL(EcomICL)任务的评估结果
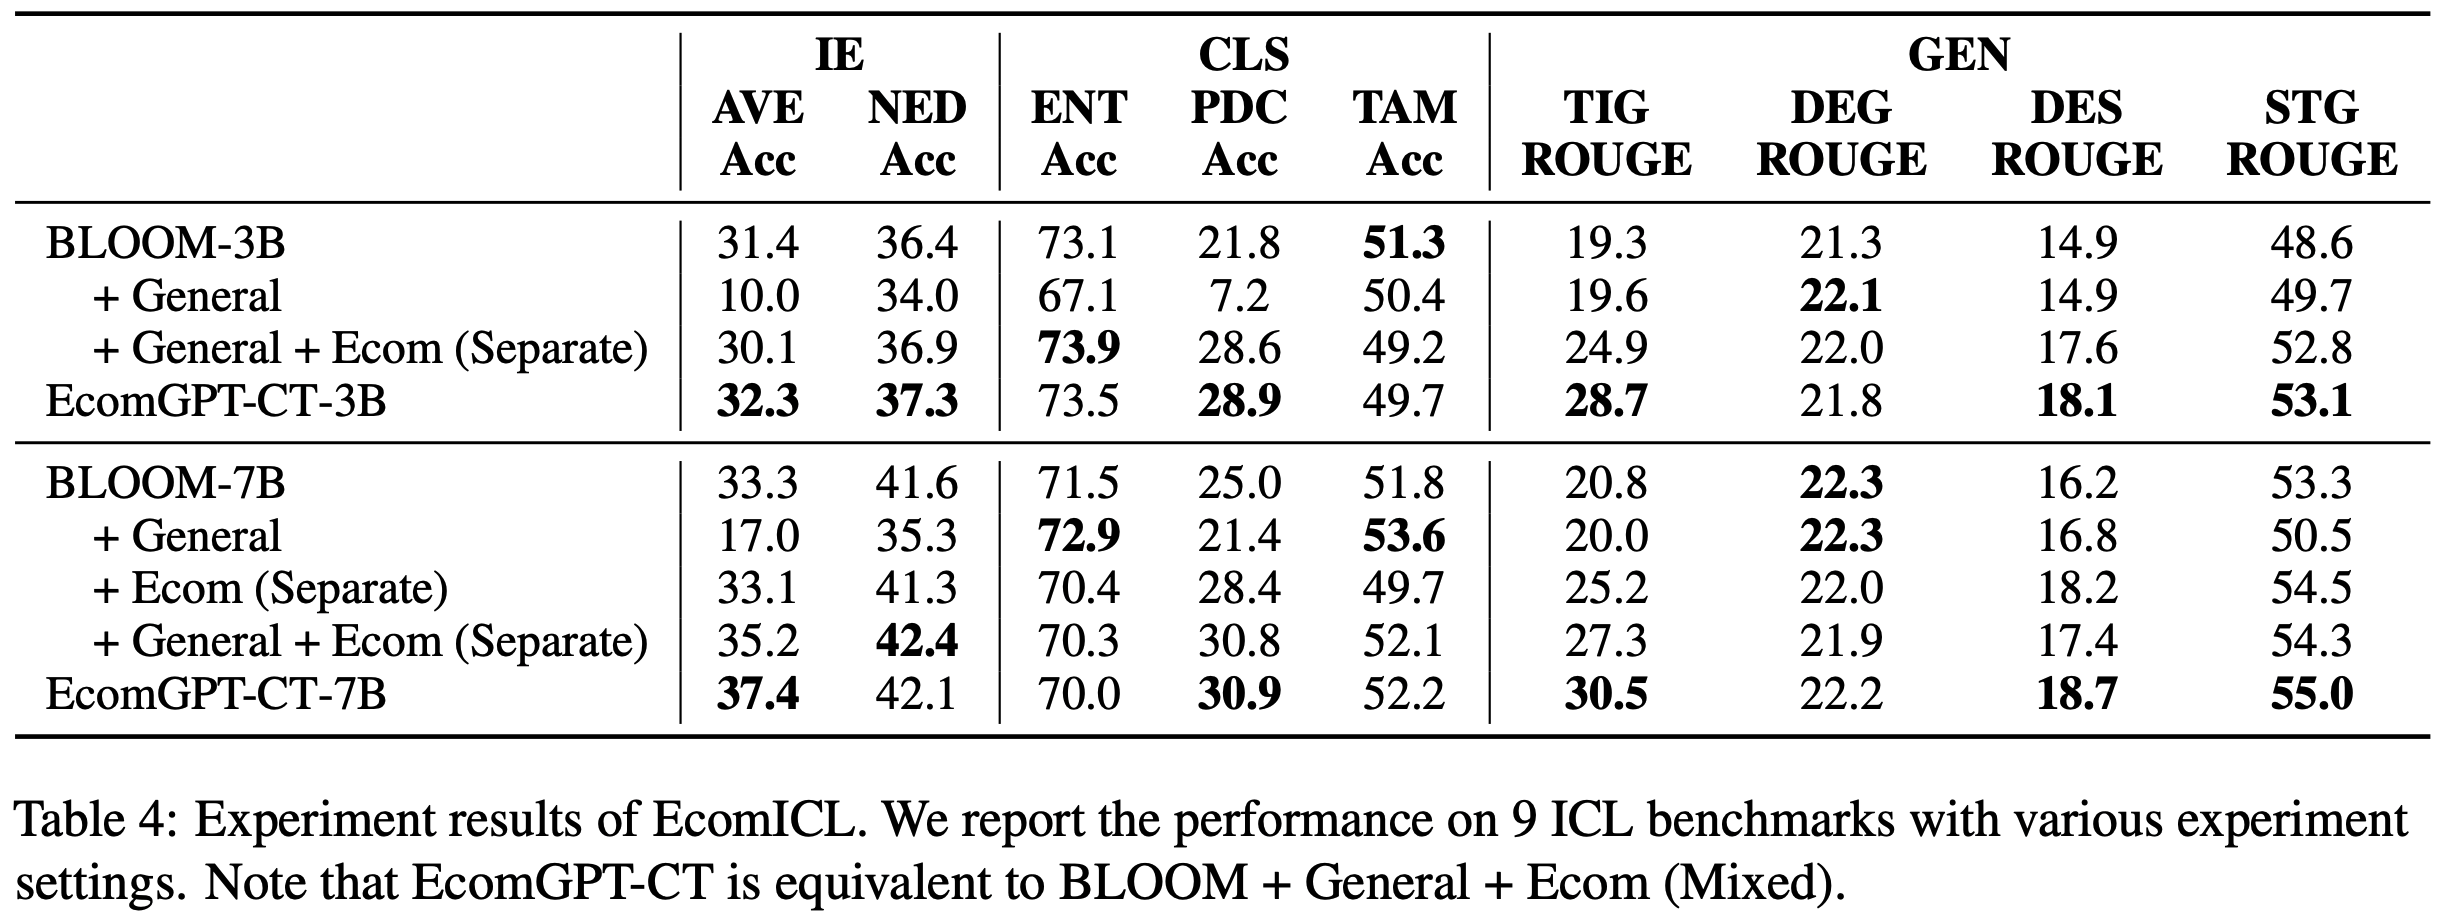
  • Few-shot ICL 评估直接反映了 LLM 在无需额外微调的情况下解决领域特定任务的能力。实验结果表明:
    • (1) 从训练数据的角度来看:
      • 使用电子商务数据进行 CPT 有效提升了 3B 和 7B 模型在部分电子商务任务上的 ICL 性能
      • 仅使用通用数据训练模型会导致几乎所有任务的性能显著下降
      • 混合领域特定数据和通用数据进行训练能带来更一致的性能提升
      • 这些结果说明:在 CPT 中同时纳入领域特定语料和通用语料是必要的
        • 因为领域特定数据有助于模型适应领域特定知识和数据格式 ,而通用数据则帮助模型避免遗忘世界知识并保持泛化能力
    • (2) 从数据混合的角度来看:
      • 论文设计的将不同来源数据整合到同一上下文中的策略(表4 中不带 Separate 的行),在大多数任务上实现了更大的性能提升或更小的性能下降,优于从不同数据源独立采样的结果(表4 中带 Separate 的行)
      • 在属性-值抽取(Attribute-Value Extraction, AVE)和标题生成(Title Generation, TIG)任务中观察到显著改进
      • 这表明论文的数据混合策略在建立不同数据源之间的关联以及将电子商务数据中的领域特定知识注入模型方面是有效的
    • (3) 领域特定 CPT 对模型性能的影响因任务类型而异
      • 对于 高度依赖领域知识 或 数据格式与通用文本差异较大 的任务, CPT 显著提升了模型在这些任务上的性能
        • 高度依赖领域知识的任务:例如产品分类(Product Classification, PDC)和标题生成(Title Generation, TIG)
        • 数据格式与通用文本差异较大的任务:例如描述摘要(Description Summary, DES)和短标题生成(Short Title Generation, STG)
      • 对于需要一定领域知识但形式与通用 NLP 任务差异较小的任务,领域特定 CPT 仅带来边际性能提升
        • 需要一定领域知识但形式与通用 NLP 任务差异较小的任务:例如属性-值抽取(Attribute-Value Extraction, AVE)和命名实体检测(Named Entity Detection,NED)
      • 对于缺乏领域特异性 或本身难以通过 Few-shot ICL 解决的任务, CPT 未能带来有效收益
        • 缺乏领域特异性的任务:例如实体分类(Entity Typing,ENT)
        • 本身难以通过 Few-shot ICL 解决的任务:例如标题-属性匹配(Title-Attribute Matching,TAM)
CPT 对 SFT 的影响如何?
  • 论文还对采用不同配置训练的模型进行了 SFT(注:SFT 时使用相同的 EcomInstruct 训练数据集)
    • 随后,论文评估了 SFT 后模型在各项任务上的性能
    • 指令微调后的模型可以更方便地用于解决实际场景中的 NLP 问题
    • 因此,相关基准上的实验结果间接反映了 CPT 对 LLM 领域特定性能的影响
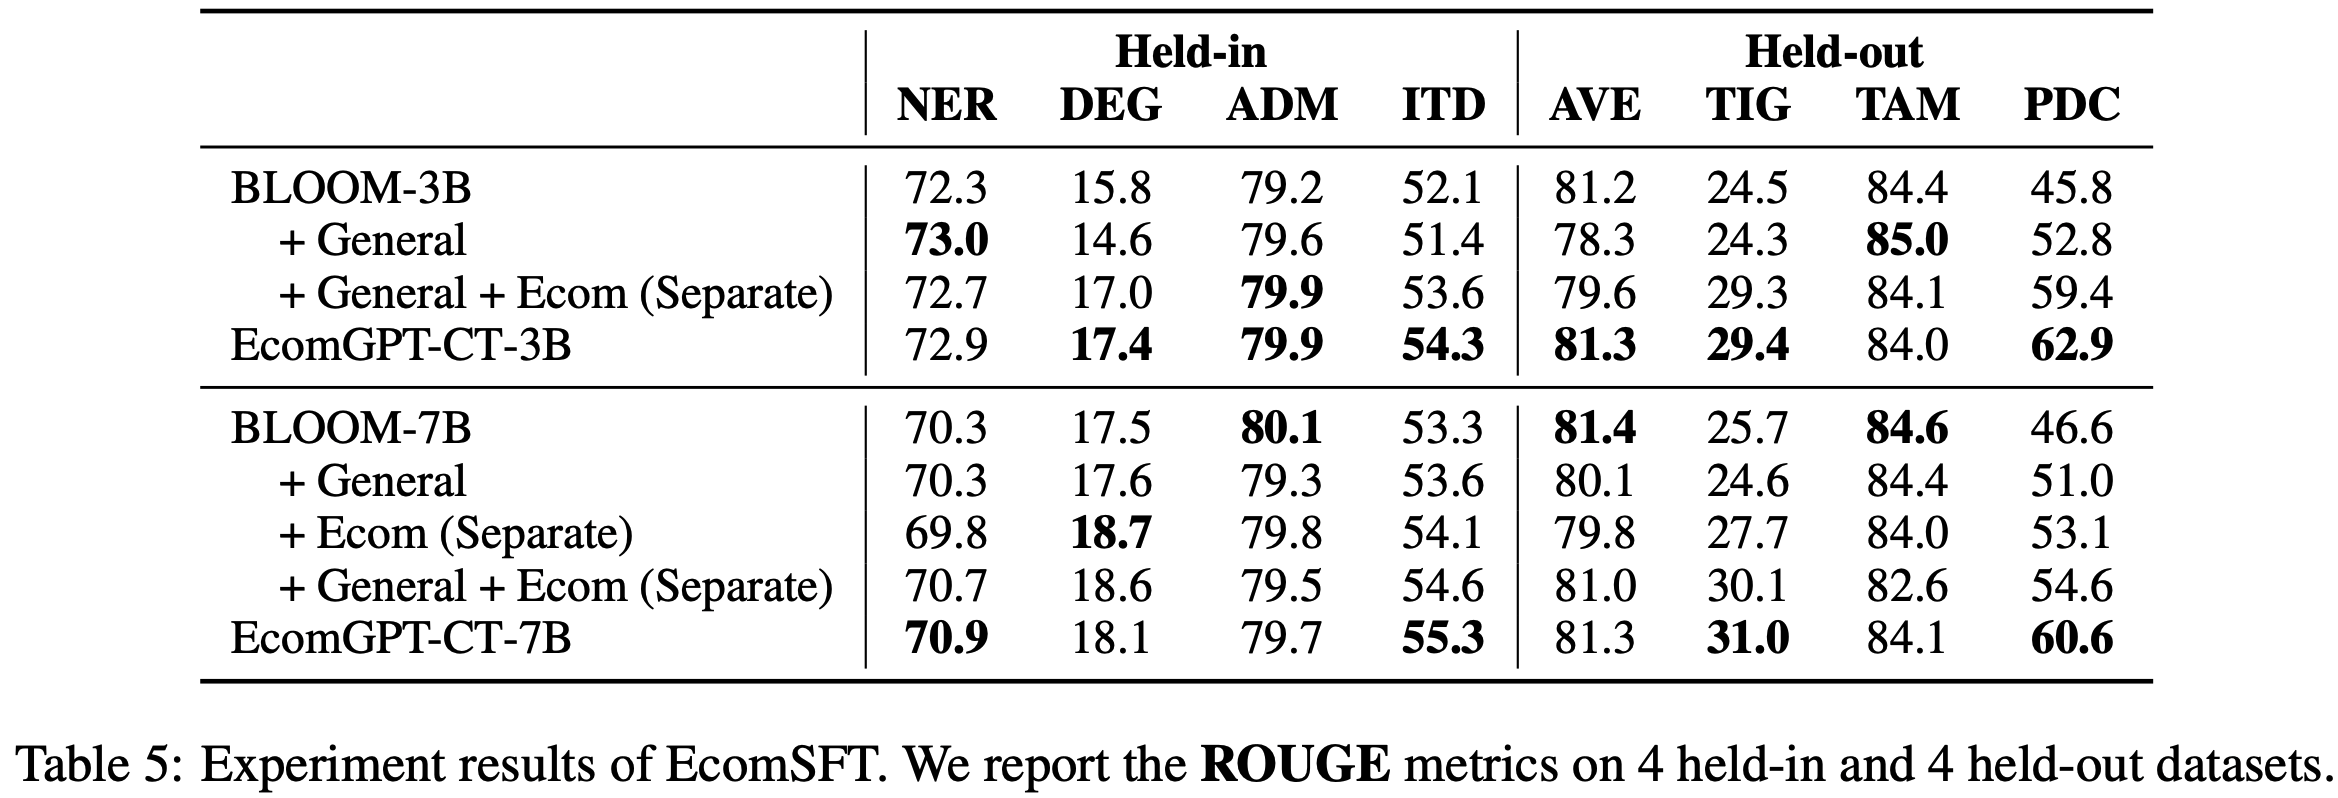
  • 表5 展示了进行了 SFT的相关实验结果,从中论文观察到以下现象:
    • (1) 使用领域特定数据进行 CPT 有效提升了模型在大多数基准上的性能 ,而将通用预训练数据与领域特定数据结合进一步增强了模型性能(与 Few-shot ICL 评估结果类似)
      • 在 CPT 过程中,论文设计的数据混合策略 ,在提升模型 SFT 后的性能方面比从不同来源独立采样领域特定数据更有效
    • (2) CPT 对 SFT 后领域性能的影响因任务类型而异
      • 与 EcomICL 的发现类似, CPT 为需要领域知识 或 涉及特定数据格式的任务带来了显著增益,而对其他任务的增益较小
        • 例如标题生成(Title Generation, TIG)、产品分类(Product Classification, PDC)、意图检测(Intent Detection, ITD)
    • (3) CPT 对训练集内(held-in)和训练集外(held-out)任务均表现出整体性能提升,其中训练集外任务的提升更为明显
      • 这一结果符合直觉,因为 SFT 直接训练了模型解决某些特定任务的能力,从而减轻了 CPT 的影响
      • 在此过程中,训练集内(held-in)任务的相关数据被包含在训练集中,使得这些任务更容易受到 SFT 的影响
Results on General Tasks

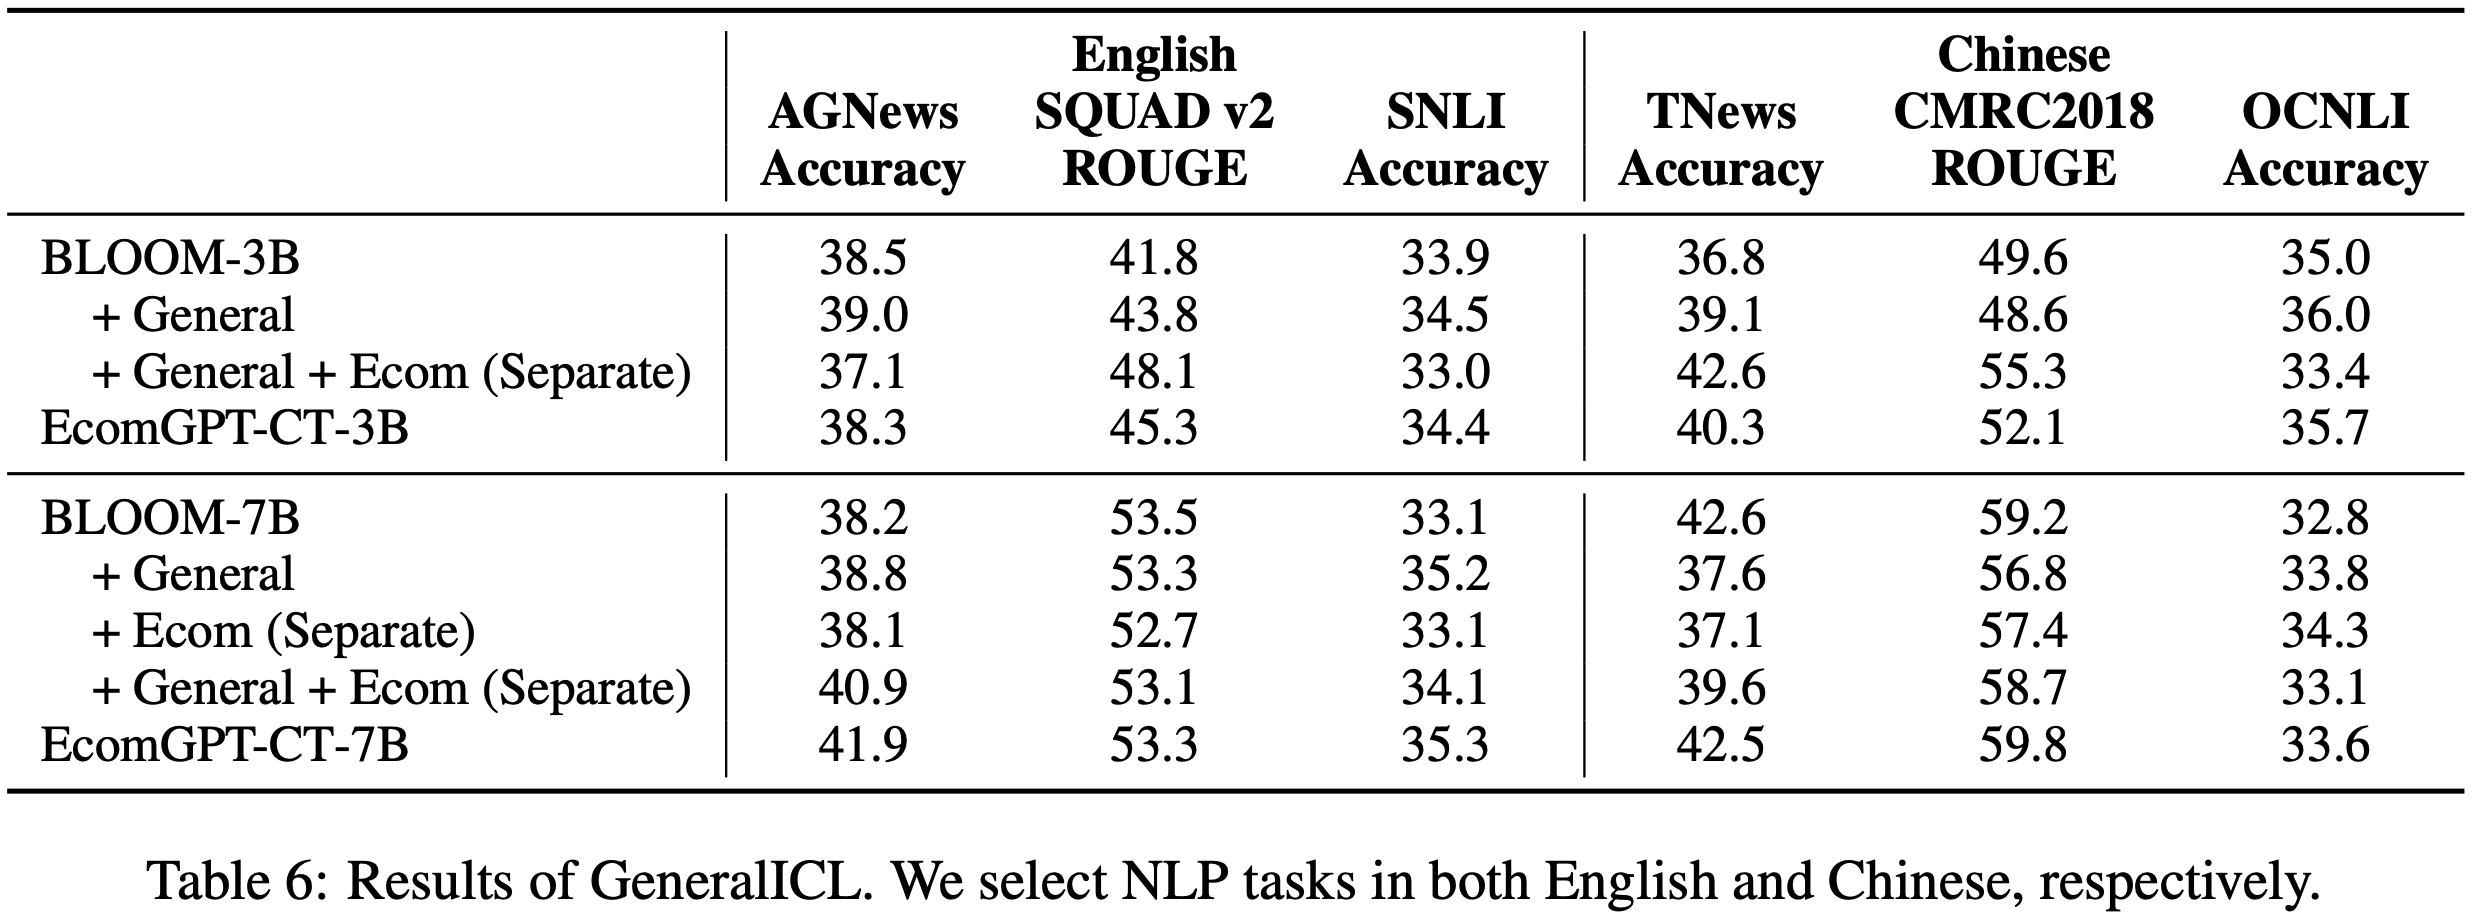
  • 除了领域特定基准外,论文还评估了 LLM 在几项中英文通用 NLP 任务上的 Few-shot ICL 性能
  • 表6 提供了关于 CPT 对 LLM 通用能力影响的 insight
  • 实验结果表明:
    • 从解决实际问题的角度来看,使用通用数据和领域特定数据混合 CPT 模型对模型解决主题分类(Topic Classification)、机器阅读理解(Machine Reading Comprehension)、自然语言推理(Natural Language Inference)等经典 NLP 任务的 Few-shot ICL 能力影响较小
      • AGNews :主题分类(Topic Classification)
      • SQUAD v2 :阅读理解(Machine Reading Comprehension,MRC)
      • SNLI :自然语言推理(Natural Language Inference)
      • TNews :主题分类(Topic Classification)
      • CMRC2018 :阅读理解(Machine Reading Comprehension,MRC)
      • OCNLI :自然语言推理(Natural Language Inference)
    • 然而,由于论文的领域特定数据主要是中文,仅使用领域特定数据进行 CPT 会导致模型在中文基准上的性能下降
      • 这验证了在领域特定预训练中纳入通用数据以保持模型通用 NLP 能力的重要性
    • 需要注意的是,在本实验中,论文并未评估模型的复杂推理或知识保留能力,因此无法得出领域特定预训练是否会损害模型这些能力的结论

Performance Variation during Training

  • 论文还评估了 CPT 过程中多个模型检查点在领域特定和通用 ICL 基准上的性能,以分析 LLM 在训练过程中的性能变化。图 3(a) 和 3(b) 展示了部分代表性任务上各模型检查点的性能
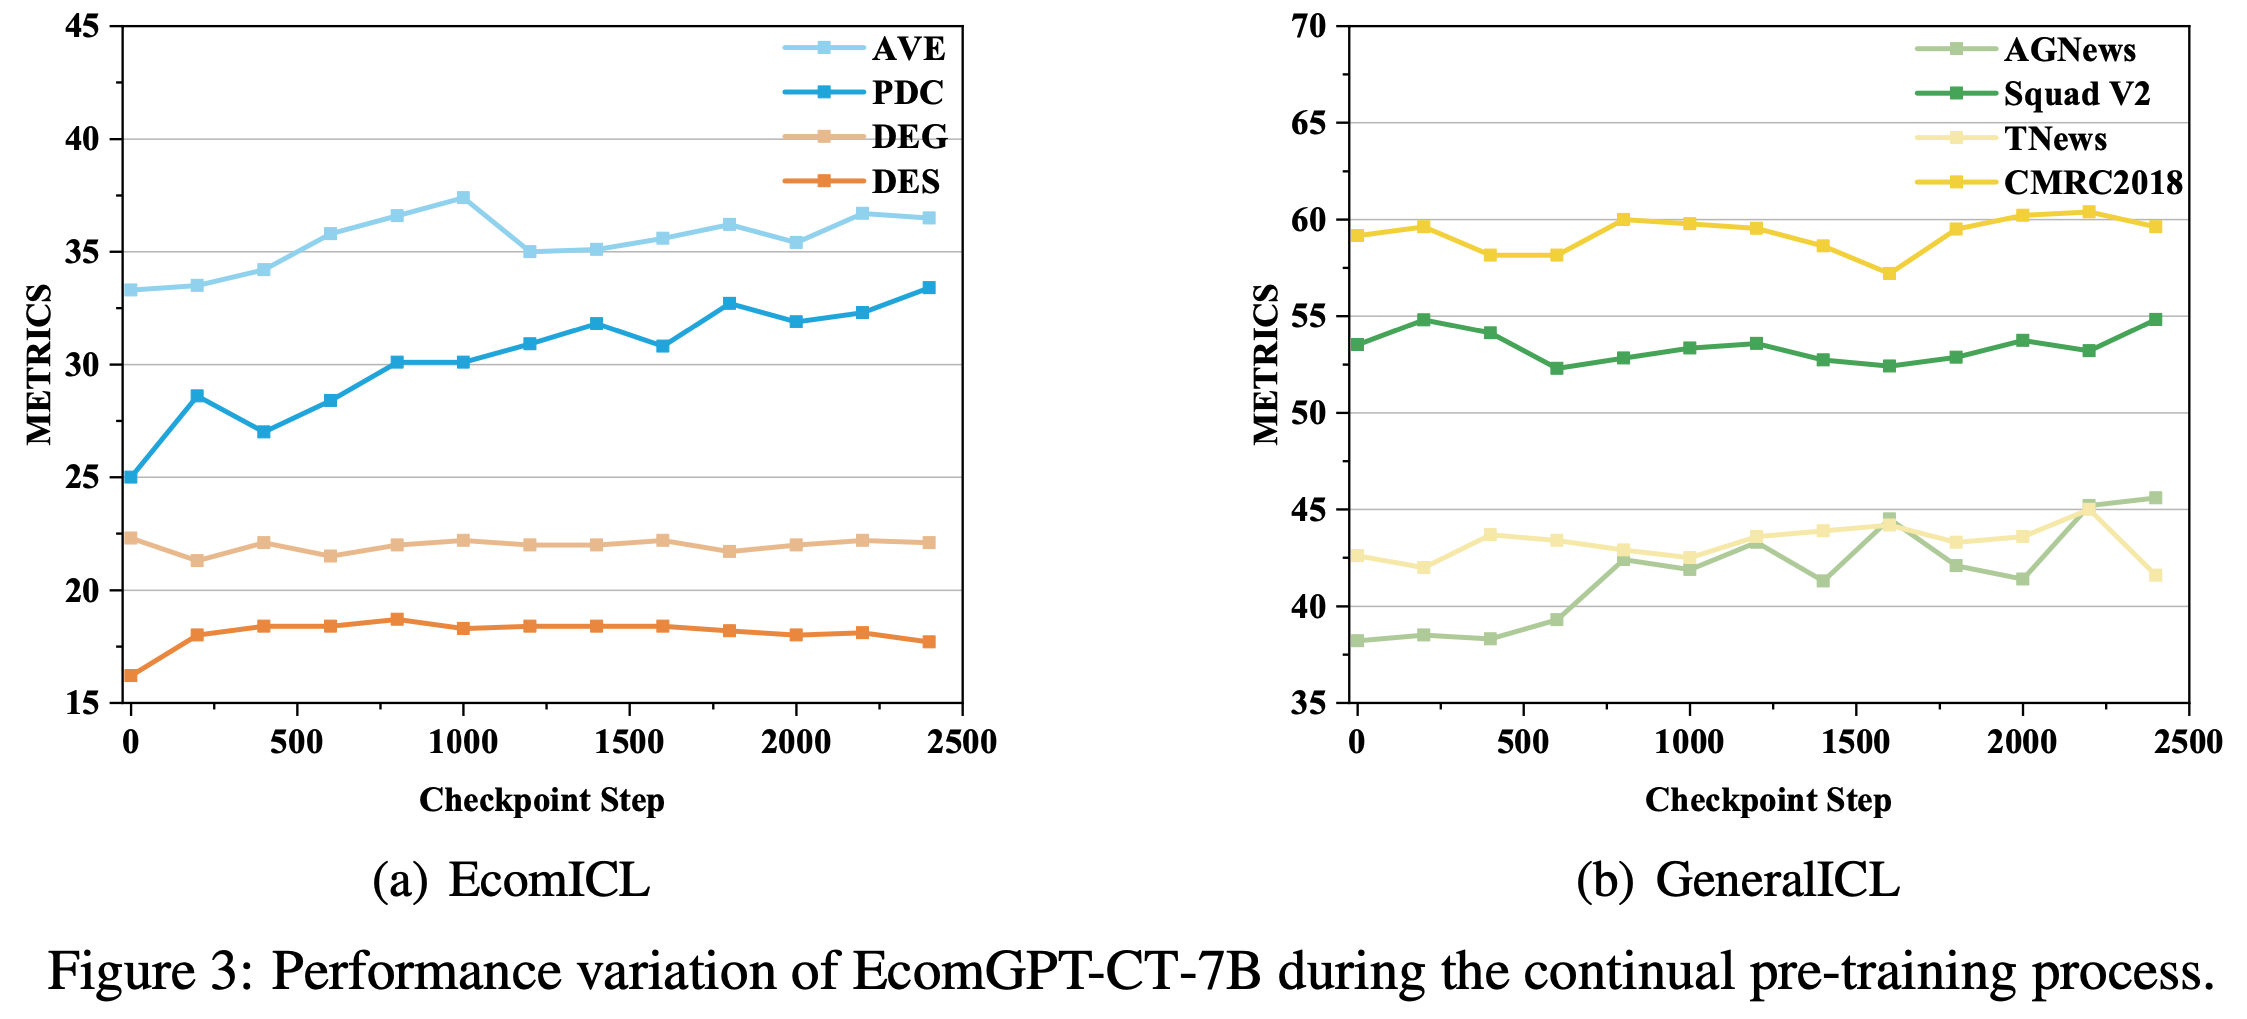
  • 从 EcomICL 中四项任务的性能变化中观察到三种不同的趋势:
    • (1) 在某些任务(例如产品分类(PDC))中,模型的性能稳步提升
    • (2) 在另一些任务(例如描述生成(DEG))中,模型性能保持相对稳定
    • (3) 在某些任务(例如属性-值抽取(AVE)和描述摘要(DES))中,模型的性能最初提升,但在达到转折点后不再显著变化
  • 对于 GeneralICL 中的四项典型任务
    • 可以明显看出模型的性能在训练过程中波动
    • 然而,在观察到的时间范围内,指标并未显著偏离 CPT 前的初始值
    • 这一结果进一步强调,选择合适的数据进行 CPT 可以有效保持模型的通用 NLP 能力
RS——COBRA

Cascaded Organized Bi-Represented generAtive retrieval, COBR

  • 参考链接:
    • (COBRA)Sparse Meets Dense: Unified Generative Recommendations with Cascaded Sparse-Dense Representations, 202503, Baidu

整体思路

  • 现有召回方案的问题 :生成模型能够直接从用户交互序列中预测 item ID,但现有方法难以达到 sequential Dense 召回技术的建模精度(原因是量化、序列建模等阶段的分离导致严重的信息损失),整合生成式与 Dense 召回方法仍是一个关键挑战
  • 论文提出一种生成式召回方法COBRA(Cascaded Organized Bi-Represented generAtive retrieval):
    • 核心亮点 :通过级联过程(Cascading Process)创新性地整合 Sparse 语义 ID 与 Dense 向量,提升召回准确性和多样性
    • 具体思路 :交替生成 Sparse 语义 ID 与 Dense 向量这两种表示,先生成 Sparse ID ,再将其作为条件辅助生成 Dense 向量(Sparse ID 是 Dense 向量的生成条件)
      • 训练时 :端到端训练实现了 Dense Representation 的动态优化,同时捕捉 user-item 交互中的语义信息与协同信号
      • 推理时 :COBRA 采用 Coarse-to-Fine的策略,首先生成 Sparse ID,再通过生成模型将其细化为 Dense 向量
    • 论文还提出了 BeamFusion 方法,结合 Beam Search 与最近邻分数(Nearest Neighbor Scores)以提升推理灵活性与推荐多样性
  • 实验 :离线+在线实验

一些讨论

  • 序列推荐(Sequential Recommendation)方法,利用用户交互的时序特性提升推荐性能。SASRec 和 BERT4Rec 等模型证明了序列模型在捕捉用户行为模式上的有效性
  • 生成模型可直接基于用户行为序列预测目标 item(与传统序列推荐方法不同)
    • 生成模型能处理复杂的 user-item 交互,并具备推理和小样本学习(few-shot learning)等新兴能力,显著提升推荐准确性与多样性
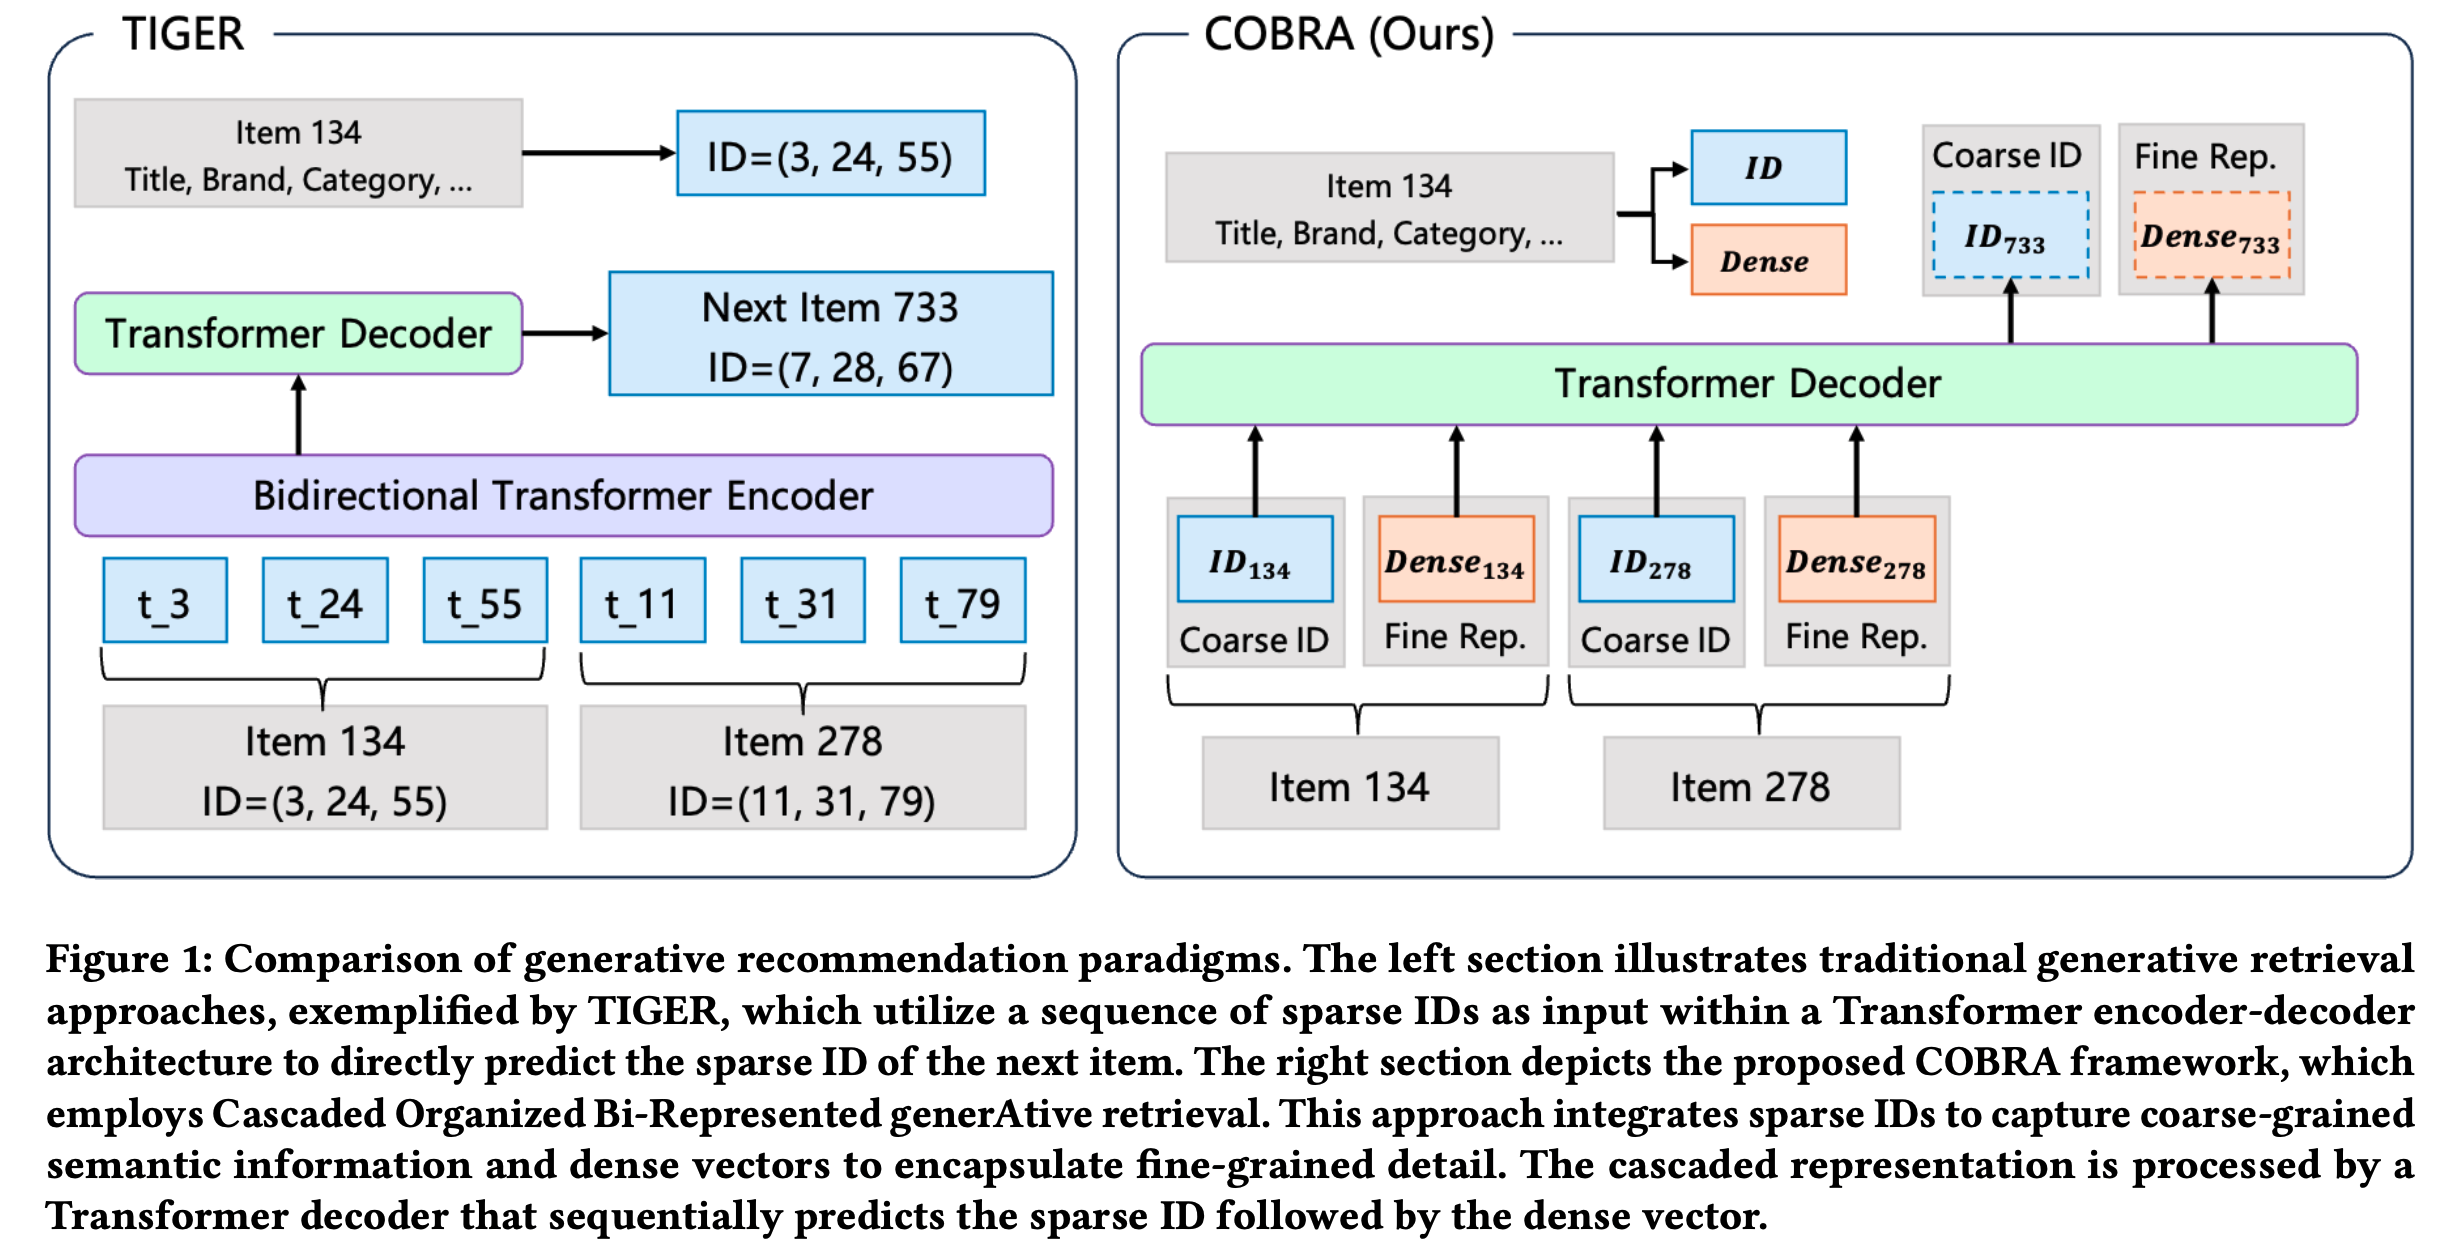
    • TIGER 是生成式推荐领域的开创性工作。如图1(左下)所示,TIGER利用残差量化变分自 Encoder (RQ-VAE)将 item 内容特征编码为分层语义 ID,使模型能在语义相似 item 间共享知识和 Embedding(不是独立的 item Embedding)
    • 除 TIGER 外,其他方法也探索了生成模型与推荐系统的融合
      • LC-Rec 通过一系列对齐任务将语义与协同信息结合;
      • ColaRec 从预训练推荐模型中获得(deriving)生成式标识符,整合协同过滤信号与内容信息;
      • IDGenRec 利用大语言模型生成独特、简洁且语义丰富的文本标识符,在零样本(zero-shot)场景中展现出强大潜力
  • 现有生成式推荐方法的挑战 :(相比序列 Dense 召回方法的挑战)
    • 问题 :序列 Dense 召回方法依赖每个 item 的 Dense 嵌入,具有高准确性和鲁棒性,但需要大量存储和计算资源;生成式方法高效,却常难以建模细粒度相似性
      • 理解:细粒度相似性指的是一些 item 的统计信息相似,但是 ID 完全不想关?
    • 解决思路 :为有效结合两种召回范式的优势,论文提出 COBRA(协同生成式与 Dense 召回的框架),图1(右)展示了 COBRA 中级联 Sparse-Dense Representation 的结构
      • 该方法通过交替生成 Sparse ID 与 Dense 向量的级联生成式召回框架,缓解了基于 ID 方法固有的信息损失
    • 具体实现 :COBRA 的输入是由用户交互历史中 item 的 Sparse ID 和 Dense 向量组成的级联表示(Cascaded Representations)序列
      • 训练时,Dense Representation 通过端到端的对比学习目标进行学习
        • 先生成 Sparse ID 再生成 Dense Representation ,降低了 Dense Representation 的学习难度并促进两种表示间的相互学习
      • 推理时,COBRA 采用 Coarse-to-Fine 生成过程:
        • 先生成 Sparse ID 以捕获 item 的高层类别特征 ,随后将该 ID 追加至输入序列并反馈至模型中以预测捕捉细粒度细节的 Dense 向量 ,从而实现更精准的个性化推荐
      • 此外,为确保灵活推理,论文引入 BeamFusion 采样技术,结合 Beam Search 与最近邻分数,确保召回 item 的多样性可控
        • 与仅依赖 Sparse ID 的 TIGER 不同,COBRA 同时利用了 Sparse 与 Dense Representation 的优势
  • 论文的主要贡献如下:
    • 提出 COBRA 框架 :交替生成 Sparse 语义 ID 与 Dense 向量,将 Dense Representation 融入 ID 序列,补充了基于 ID 方法的信息损失;以 Sparse ID 为条件生成 Dense 向量,降低了 Dense Representation 的学习难度
    • 端到端训练的可学习 Dense Representation :COBRA 利用原始 item 数据作为输入,通过端到端训练生成 Dense Representation。不同于静态嵌入,COBRA 的 Dense 向量是动态学习的,能捕捉语义信息与细粒度细节
    • Coarse-to-Fine 生成过程 :推理时,COBRA 先生成 Sparse ID,再将其反馈至模型生成优化的 Dense Representation,提升向量的细粒度。此外,论文提出 BeamFusion 以实现灵活多样的推荐
    • 实验 :离线+在线

相关工作(直译)

  • 序列 Dense 推荐 :序列 Dense 推荐系统利用用户交互序列学习用户与 item 的 Dense Representation [8, 15, 21],捕捉长期偏好与短期动态[25, 51, 22, 10]
    • 早期模型如 GRU4Rec[14]使用循环神经网络(RNN)[49]捕捉用户行为的时间依赖性
    • Caser[39]将序列视为“图像”,应用卷积神经网络(CNN)[36]提取空间特征
    • Transformer 相关模型如 SASRec[18]和 BERT4Rec[37]显著推动了该领域发展,这些模型采用自注意力机制捕捉复杂用户行为,其中 SASRec 专注于自回归任务,BERT4Rec侧重双向上下文建模
    • PinnerFormer[30]和 FDSA[52]等更先进的模型通过利用 Transformer 进行长期行为建模与特征整合,进一步提升了用户表示
    • ZESRec[8]、UniSRec[15]和 RecFormer[21]等近期工作通过融合文本特征和对比学习技术,强调了跨领域可迁移性,RecFormer 尤其通过双向 Transformer 统一了语言理解与序列推荐
  • 生成式推荐 :生成模型在各领域的普及推动了推荐系统从判别式向生成式模型的范式转变[17, 44, 26, 27, 42, 46]。生成模型直接生成 item 标识符而非计算每个 item 的排序分数[11, 34, 38, 54]
    • P5[11]将多种推荐任务转化为自然语言序列,通过独特训练目标和提示为推荐补全提供通用框架
    • TIGER[33]首创将生成式召回应用于推荐,利用残差量化自 Encoder 创建语义丰富的索引标识符,随后由基于Transformer的模型从用户历史中生成 item 标识符
    • LC-Rec[53]通过额外对齐任务将语义标识符与协同过滤技术结合以增强效果
    • IDGenRec[38]将生成式系统与大语言模型结合,生成独特且语义 Dense 的文本标识符,在零样本场景中表现优异
    • SEATER[34]通过平衡的k叉树结构索引保持语义一致性,并结合对比与多任务学习优化
    • ColaRec[45]对齐基于内容的语义空间与协同交互空间以提升推荐效果
    • 以上现有的生成式方法仍面临挑战,例如:
      • 基于离散 ID 的方法:可能缺乏细粒度细节并存在信息损失 ,限制其准确捕捉用户偏好的能力[48]
      • 依赖自然语言的方法:可能难以将语言表达与推荐任务需求对齐 ,导致性能欠佳[25]
    • 为解决以上这些问题,LIGER[48]提出结合生成式与 Dense 召回优势的混合模型,同时生成 Sparse ID 与 Dense Representation ,将其视为同一对象粒度的互补表示
      • 该混合方法在一定程度上缩小了生成式与 Dense 召回间的差距;
      • 但 LIGER 的 ID 与 Dense Representation 共享相同粒度,且 Dense Representation 是预训练且固定的。因此,如何更灵活地结合生成式与 Dense 召回仍是待探索的开放问题

COBRA框架方法

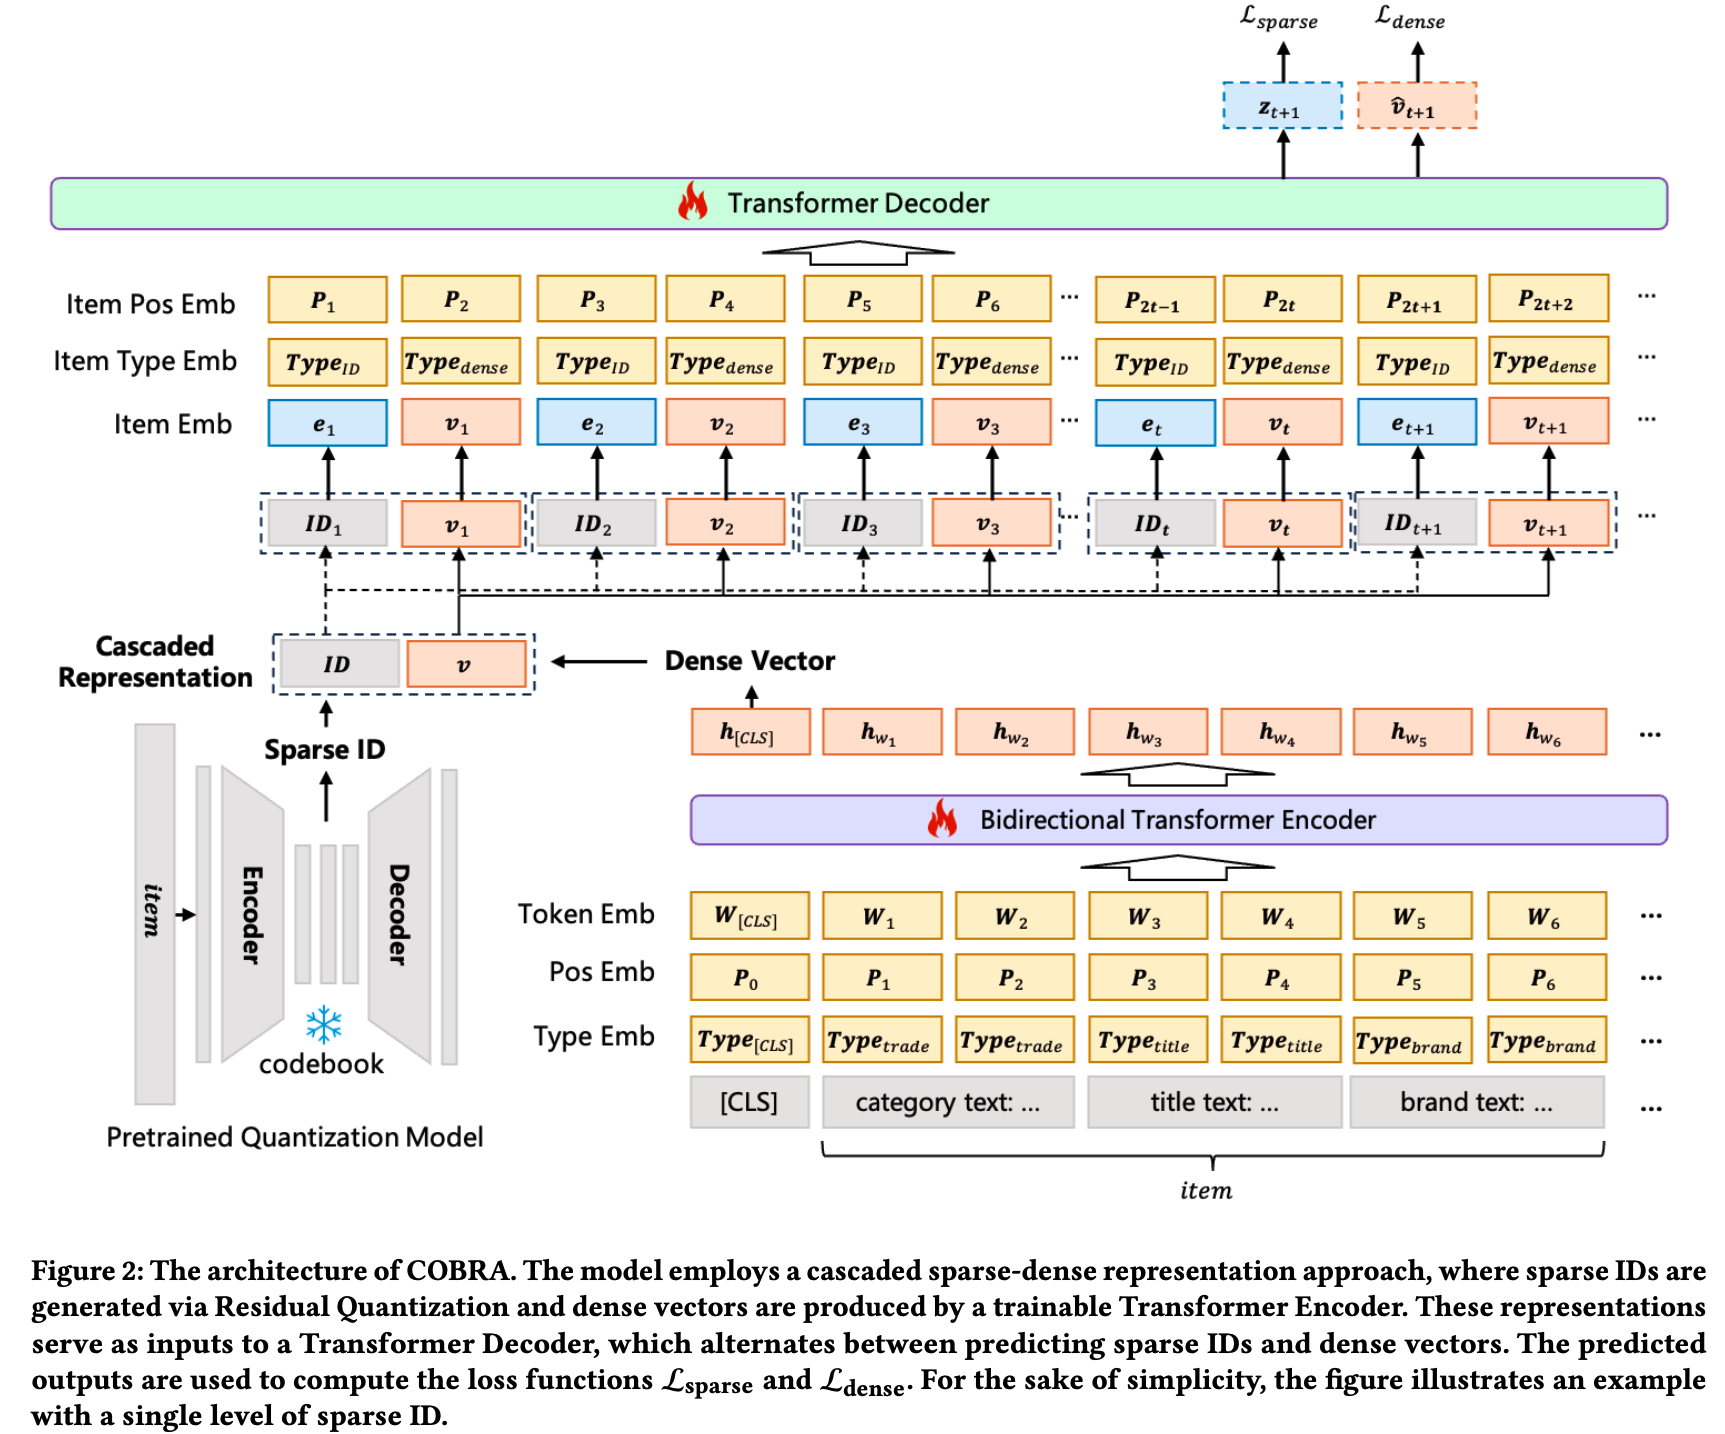
  • 本节介绍 COBRA(Cascaded Organized Bi-Represented generAtive Retrieval)框架,该框架通过级联 Sparse-Dense Representation 和 Coarse-to-Fine 生成过程提升推荐性能。图2展示了 COBRA 的整体框架

Sparse-Dense Representation

Sparse 表示
  • COBRA 使用残差量化变分自 Encoder (RQ-VAE)生成 Sparse ID,灵感来源于 TIGER[33]的方法。对于每个 item ,提取其属性生成文本描述,将其嵌入 Dense 向量空间并量化生成 Sparse ID。这些 ID 捕捉 item 的类别本质,为后续处理奠定基础
  • 注:为简洁起见 ,后续方法描述假设 Sparse ID 仅包含单层,但该方法可轻松扩展至多层场景
Dense Representation
  • 端到端可训练的 **Dense Encoder ** :用于对 item 文本内容进行编码(可捕捉细粒度的属性信息)
    • 每个 item 的属性被展平为文本句子,前缀为 [CLS] token,并输入基于 Bidirectional Transformer 的文本 Encoder Encoder
    • Dense Representation \(\mathbf{v}_{t}\) 从 [CLS] token 对应的输出中提取,捕捉 item 文本内容的细粒度细节
  • 如图2下半部分所示,论文加入位置 Embedding 和类型 Embedding 以建模序列中 token 的位置和上下文。这些 Embeddings 以加法方式与 token Embedding 结合,增强模型区分不同 token 及其在序列中位置的能力
    • 注:文中未指明类型(type) Embedding是什么
Cascaded Representation
  • 思路 :Cascaded Representation(级联表示)将 Sparse ID 和 Dense 向量整合到统一的生成模型中
  • 具体方案 :对于每个 item,论文将其 Sparse ID \( ID_{t}\) 和 Dense 向量 \(\mathbf{v}_{t}\) 组合为级联表示 \(( ID_{t},\mathbf{v}_{t})\)
    • 该方法结合两种表示的优势,提供更全面的 item 表征:Sparse ID 通过离散约束提供稳定的类别基础,而 Dense 向量保持连续特征分辨率,确保模型同时捕捉高层语义和细粒度细节

序列建模(Sequential Modeling)

概率分解(Probabilistic Decomposition)
  • 思路 :目标 item 的概率分布建模分为两个阶段,利用 Sparse 和 Dense Representation 的互补优势
  • 具体方案 :COBRA 不直接基于历史交互序列 \(S_{1:t}\) 预测 next item \(s_{t+1}\),而是分别预测 Sparse ID \( ID_{t+1}\) 和 Dense 向量 \(\mathbf{v}_{t+1}\):
    $$P( ID_{t+1},\mathbf{v}_{t+1}|S_{1:t})=P( ID_{t+1}|S_{1:t})P(\mathbf{v}_{t+1}| ID_{t+1},S_{1:t})$$
    • \(P( ID_{t+1}|S_{1:t})\) 表示基于历史序列 \(S_{1:t}\) 生成 Sparse ID \( ID_{t+1}\)的概率,捕捉下一个 item 的类别本质;
    • \(P(\mathbf{v}_{t+1}| ID_{t+1},S_{1:t})\) 表示在给定 Sparse ID \( ID_{t+1}\) 和历史序列 \(S_{1:t}\) 下生成 Dense 向量 \(\mathbf{v}_{t+1}\) 的概率,捕捉下一个 item 的细粒度细节
    • 这种分解使 COBRA 能够同时利用 Sparse ID 提供的类别信息和 Dense 向量捕捉的细粒度细节
    • 注:论文中未明确,但根据上下文信息可以推测 \(s_{t}\) 的定义为 \(s_{t} = ( ID_{t},\mathbf{v}_{t})\)
统一生成模型的序列建模(Sequential Modeling with a Unified Generative Model)
  • 使用基于 Transformer 架构的统一生成模型做序列建模,有效捕捉 user-item 交互中的序列依赖关系:
    • Transformer 接收级联表示的输入序列,每个 item 由其 Sparse ID 和 Dense 向量表示
  • Sparse ID 嵌入 :Sparse ID \( ID_{t}\)通过嵌入层转换为 Dense 向量空间:\(\boldsymbol{e}_{t}=\textbf{Embed}( ID_{t})\)。该 Embedding \(\boldsymbol{e}_{t}\) 与 Dense 向量 \(\mathbf{v}_{t}\) 拼接形成模型在每一步的输入:
    $$\mathbf{h}_{t}=[\boldsymbol{e}_{t};\mathbf{v}_{t}]$$
  • Transformer建模 :论文的Transformer Decoder 模型包含多层,每层具有自注意力机制和前馈网络
    • 如图2上半部分所示, Decoder 的输入序列由级联表示组成
    • 为增强序列和上下文信息建模,这些表示加入了 item 位置和类型 Embedding
    • 为简洁起见,后续数学公式聚焦于级联序列表示,省略位置和类型嵌入的显式 token
    • Decoder 处理这一增强的输入,生成用于预测后续 Sparse ID 和 Dense 向量的上下文表示
  • Sparse ID 预测 :给定历史交互序列\(S_{1:t}\),为预测 Sparse ID \( ID_{t+1}\),Transformer的输入序列为:
    $$S_{1:t}=[\mathbf{h}_{1},\mathbf{h}_{2},\ldots,\mathbf{h}_{t}]=[\boldsymbol{e}_{1},\mathbf{v}_{1},\boldsymbol{e}_{2},\mathbf{v}_{2},\ldots,\boldsymbol{e}_{t},\mathbf{v}_{t}]$$
    • 其中每个 \(\mathbf{h}_{i}\) 是第 \(i\) 个 item 的 Sparse ID 嵌入和 Dense 向量的拼接
    • Transformer 处理该序列生成上下文表示,随后用于预测下一个 Sparse ID 和 Dense 向量。Transformer Decoder 处理序列 \(S_{1:t}\),生成向量序列\(\mathbf{y}_{t}=\textbf{TransformerDecoder}(S_{1:t})\)。Sparse ID 预测的logits通过下式得到:
      $$\mathbf{z}_{t+1}=\textbf{SparseHead}(\mathbf{y}_{t})$$
      • 其中 \(\mathbf{z}_{t+1}\) 表示预测 Sparse ID \( ID_{t+1}\) 的logits
  • Dense 向量预测 :为预测 Dense 向量\(\mathbf{v}_{t+1}\),Transformer的输入序列为:
    $$\tilde{S}_{1:t}=[S_{1:t},\boldsymbol{e}_{t+1}]=[\boldsymbol{e}_{1},\mathbf{v}_{1},\boldsymbol{e}_{2},\mathbf{v}_{2},\ldots,\boldsymbol{e}_{t},\mathbf{v}_{t},\boldsymbol{e}_{t+1}]$$
    • Transformer Decoder 处理\(\tilde{S}_{1:t}\),输出预测的 Dense 向量:
      $$\hat{\mathbf{v} }_{t+1}=\textbf{TransformerDecoder}(\tilde{S}_{1:t})$$

端到端训练(End-to-End Training)

  • 在 COBRA 中,端到端训练过程旨在联合优化 Sparse 和 Dense Representation 预测。训练过程由组合损失函数控制,该函数结合了 Sparse ID 预测损失和 Dense 向量预测损
  • Sparse ID 预测损失 \(\mathcal{L}_{\textrm{Sparse} }\) 确保模型能够基于历史序列 \(S_{1:t}\) 熟练预测下一个 Sparse ID:
    $$\mathcal{L}_{\textrm{Sparse} }=-\sum_{t=1}^{T-1}\log\left(\frac{\exp(\mathbf{z}_{t+1}^{ ID_{t+1} })}{\sum_{j=1}^{C}\exp(\mathbf{z}_{t+1}^{j})}\right)$$
    • \(T\) 是历史序列的长度
    • \( ID_{t+1}\) 是时间步 \(t+1\) 交互 item 对应的 Sparse ID
    • \(\mathbf{z}_{t+1}^{ ID_{t+1} }\) 表示 Transformer Decoder 在时间步 \(t+1\) 生成的真实 Sparse ID \( ID_{t+1}\)的预测 logit
    • \(C\) 表示所有 Sparse ID 的集合
    • 注:Sparse ID 预测损失本质是个交叉熵损失函数
  • Dense 向量预测损失 \(\mathcal{L}_{\textrm{Dense} }\) 聚焦于优化 Dense 向量,使其能够区分相似和不相似的 item,损失定义为:
    $$\mathcal{L}_{\textrm{Dense} }=-\sum_{t=1}^{T-1}\log\frac{\exp(\cos(\hat{\mathbf{v} }_{t+1}\cdot\mathbf{v}_{t+1}))}{\sum_{item_{j}\in\textrm{Batch} }\exp(\cos(\hat{\mathbf{v} }_{t+1},\mathbf{v}_{item_{j} }))}$$
    • \(\hat{\mathbf{v} }_{t}\) 是预测的 Dense 向量
    • \(\mathbf{v}_{t}\) 是正样本的真实 Dense 向量
    • \(\mathbf{v}_{j}\) 表示批次内 item 的 Dense 向量
    • \(\cos(\hat{\mathbf{v} }_{t+1}\cdot\mathbf{v}_{t+1})\) 表示预测和真实 Dense 向量之间的余弦相似度,较高的余弦相似度表明向量在方向上更相似,这对于准确的 Dense 向量预测是理想的
    • Dense 向量由端到端可训练的 Encoder Encoder生成,该 Encoder 在训练过程中优化,确保 Dense 向量动态调整并适应推荐任务的特定需求
    • 注:Dense 向量预测损失本质是个 InfoNCE
  • 总体损失函数为:
    $$\mathcal{L}=\mathcal{L}_{\textrm{Sparse} }+\mathcal{L}_{\textrm{Dense} }$$
  • 双目标损失函数实现了平衡的优化过程,模型在 Sparse ID 的引导下动态优化 Dense 向量。这种端到端训练方法同时捕捉高层语义和特征级信息,联合优化 Sparse 和 Dense Representation 以获得卓越性能
  • 问题:图2中的 上层 Bidirectional Transformer 和 (Casual) Transformer Decoder 是同时训练的吗?
    • 看起来是的,这也是论文所说的端到端训练

Coarse-to-Fine Generation

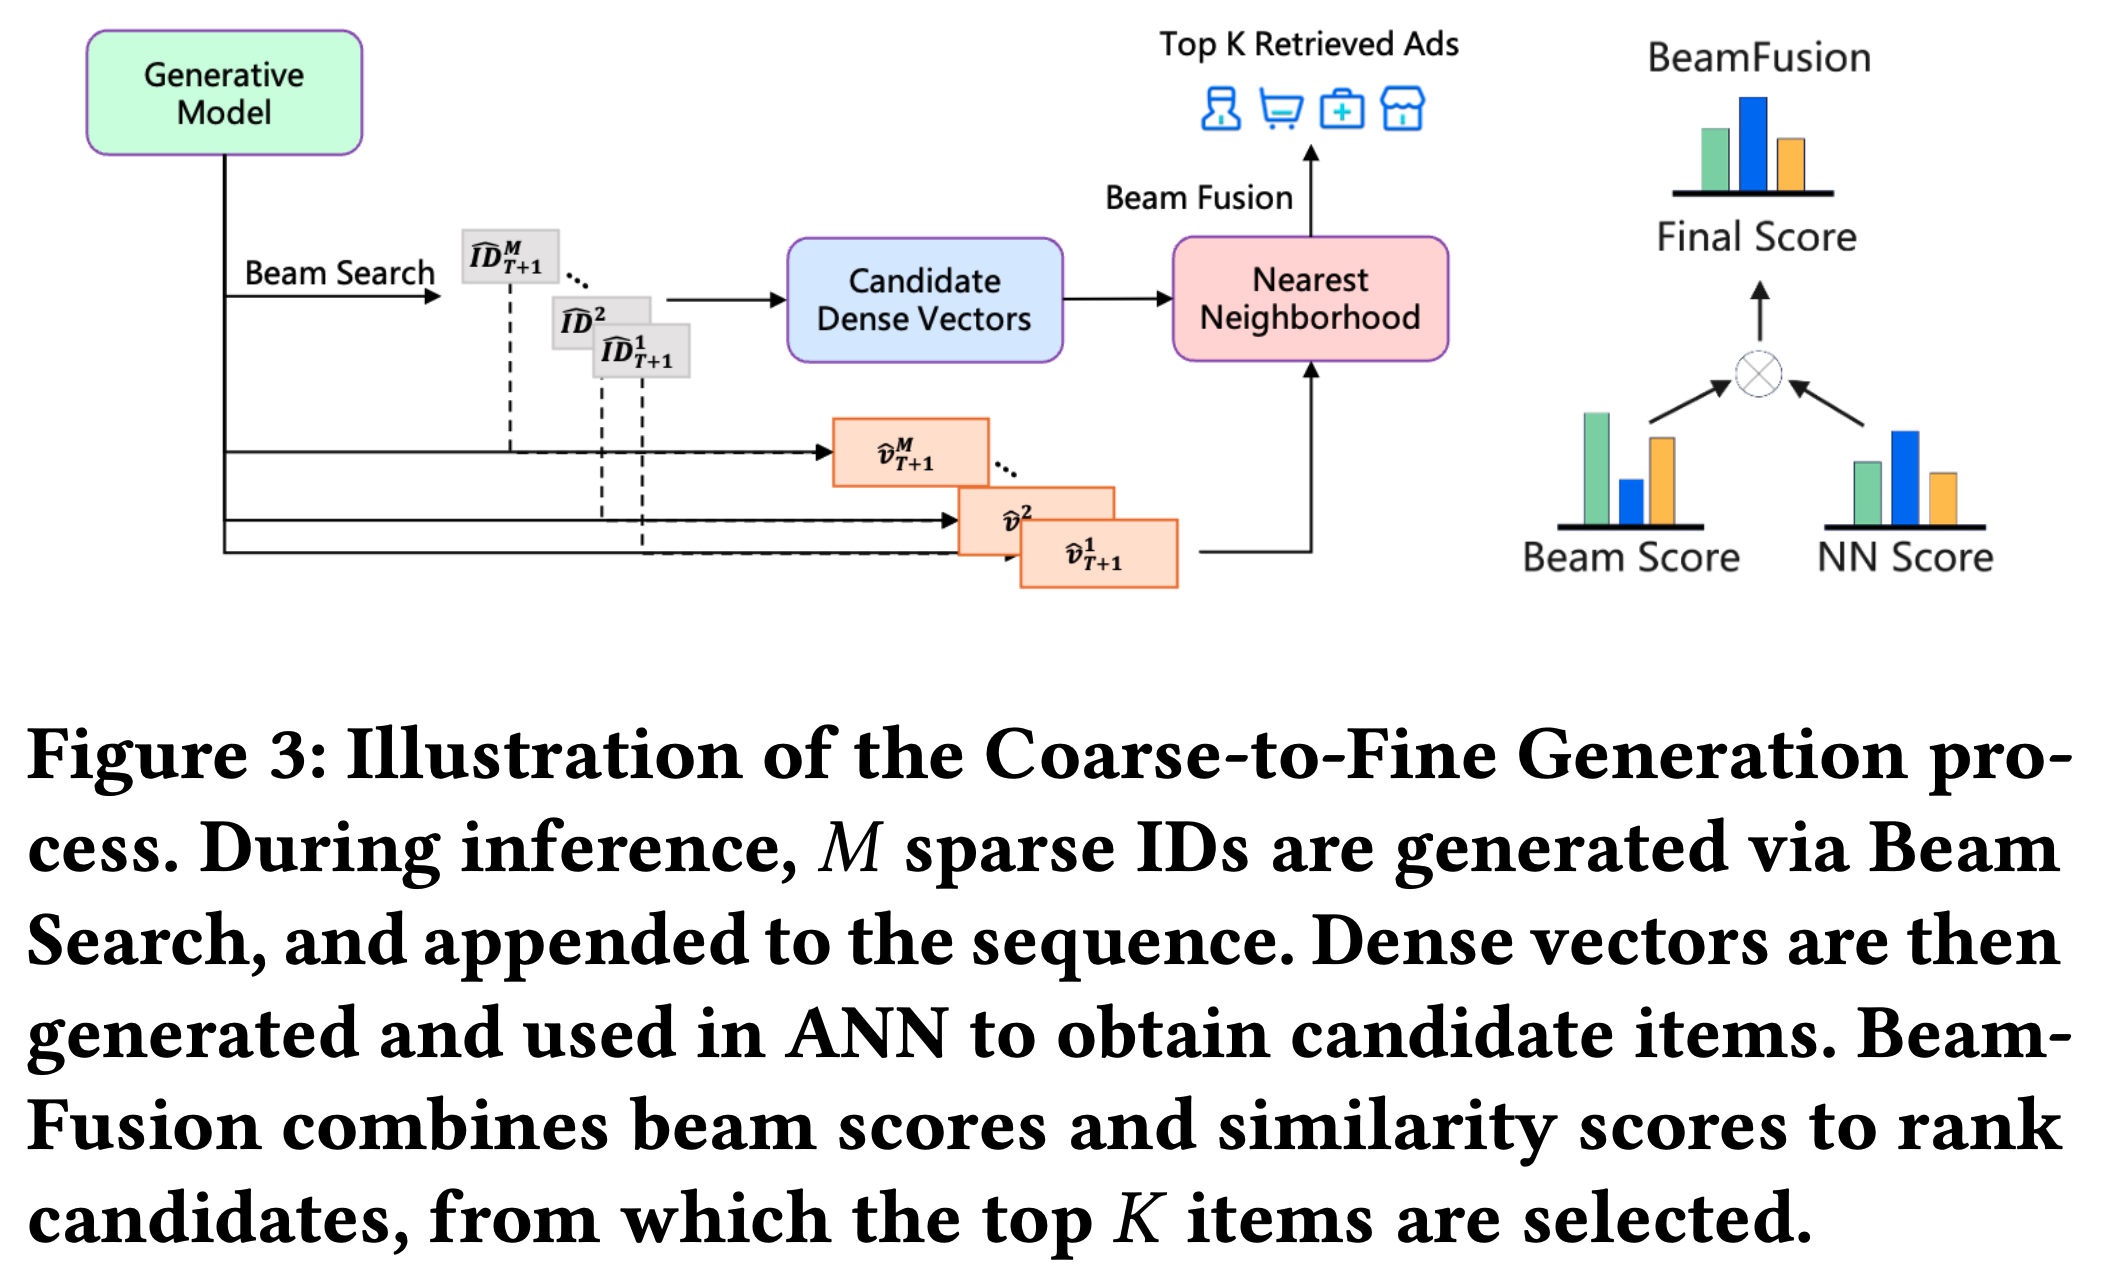
  • 在推理阶段,COBRA 实现 Coarse-to-Fine 生成过程,依次生成 Sparse ID 并级联优化 Dense 向量(如图3所示)
  • COBRA 中的 Coarse-to-Fine 生成过程旨在捕捉 user-item 交互的类别本质和细粒度细节。该过程包含两个主要阶段:
  • Sparse ID 生成 :给定用户序列 \(S_{1:T}\),论文利用 Transformer Decoder 建模的 ID 概率分布 \(\hat{\textit{ ID } }_{T+1}\sim P(t_{T+1}|S_{1:T})\),并采用 Beam Search 算法得到前 \(M\) 个 ID:
    $$\{\hat{\textsf{ ID } }^{k}_{T+1}\}_{k=1}^{M}=\textrm{BeamSearch}(\textbf{TransformerDecoder}(\textrm{S}_{1:T}),M)$$
    • \(k\in\{1,2,\ldots,M\}\)
    • 每个生成的 ID 关联一个 Beam 分数 \(\phi_{\hat{\textsf{ ID } }^{k}_{T+1} }\)
  • Dense 向量精细化(Dense Vector Refinement) :每个生成的 Sparse ID \(\hat{\textsf{ ID } }^{k}_{T+1}\) 随后转换为嵌入并追加到先前的级联序列嵌入 \(\textrm{S}_{1:T}\) 中,然后生成对应的 Dense 向量 \(\mathbf{\hat{v}}^{k}_{T+1}\):
    $$\mathbf{\hat{v}}^{k}_{T+1}=\textbf{TransformerDecoder}(\{\textrm{S}_{1:T},\textbf{Embed}(\hat{\textsf{ ID } }^{k}_{T+1})\})$$
  • ANN 搜索候选 item :对每一个 Sparse ID \(\hat{\textsf{ ID } }^{k}_{T+1}\),论文使用近似最近邻(ANN)搜索检索前 \(N\) 个候选 item :
    $$\mathcal{A}_{k}=\textrm{ANN}(\hat{\textsf{ ID } }^{k}_{T+1},C(\hat{\textsf{ ID } }^{k}_{T+1}),N)$$
    • \(C(\hat{\textsf{ ID } }^{k}_{T+1})\) 是与 Sparse ID \(\hat{\textsf{ ID } }^{k}_{T+1}\) 关联的候选 item 集合
    • \(N\) 表示要召回的 top item 数量
    • 理解:这里的 ANN 搜索是为 Beam Search 生成的每一个 \(k\),即 Sparse ID \(\hat{\textsf{ ID } }^{k}_{T+1}\) 都生成一个候选集合 \(\mathbf{\hat{v}}^{k}_{T+1}\)
    • 注:这里原论文未给出 ANN 的具体方法(是否与 Dense 向量 \(\mathbf{\hat{v}}^{k}_{T+1}\) 有关还未知)
  • BeamFusion 机制合并结果 :为实现精度和多样性的平衡,论文为每个 Sparse ID 对应的 item 设计全局可比分数。该分数能反映不同 Sparse ID 之间的差异以及同一 Sparse ID 下 item 间的细粒度差异。为此,论文提出 BeamFusion 机制:
    $$\Phi^{(\mathbf{\hat{v}}^{k}_{T+1},\hat{\textsf{ ID } }^{k}_{T+1},\mathbf{a})}=\textrm{Softmax}(\tau\phi_{\hat{\textsf{ ID } }^{k}_{T+1} })\times\textrm{Softmax}(\psi\cos(\mathbf{\hat{v}}^{k}_{T+1},\mathbf{a}))$$
    • \(\mathbf{a}\) 表示候选 item(理解:文章未明确说明,但通过上下文可推测:\(\mathbf{a} \in \mathcal{A}_{k}\))
    • \(\tau\) 和 \(\psi\) 是系数
    • \(\phi_{\hat{\textsf{ ID } }^{k}_{T+1} }\)表示 Beam Search 过程中获得的 Beam 分数
  • 最后,基于 BeamFusion 分数对所有候选 item 排序 ,并选择前 \(K\) 个 item 作为最终推荐:
    $$\mathcal{R}=\textrm{TopK}\left(\bigcup_{k=1}^{M}\mathcal{A}_{k},\Phi,K\right)$$
    • \(\mathcal{R}\) 表示最终推荐集合
    • TopK 表示选择具有最高 BeamFusion 分数的前 \(K\) 个 item 的操作

相关实验(离线+在线)

  • 数据:公开数据集 + 工业数据集
  • 指标:重点关注 COBRA 在提升推荐准确性和多样性方面的能力
  • 实验方式:离线 + 在线

公开数据集实验

数据集与评估指标
  • 采用 Amazon 产品评论数据集[13,29](注:该数据集是推荐任务的经典基准)
  • 该数据集包含从 1996年5月 至 2014年9月 收集的产品评论及相关元数据。论文选取了三个特定子集:”Beauty”、”Sports and Outdoors”和”Toys and Games”
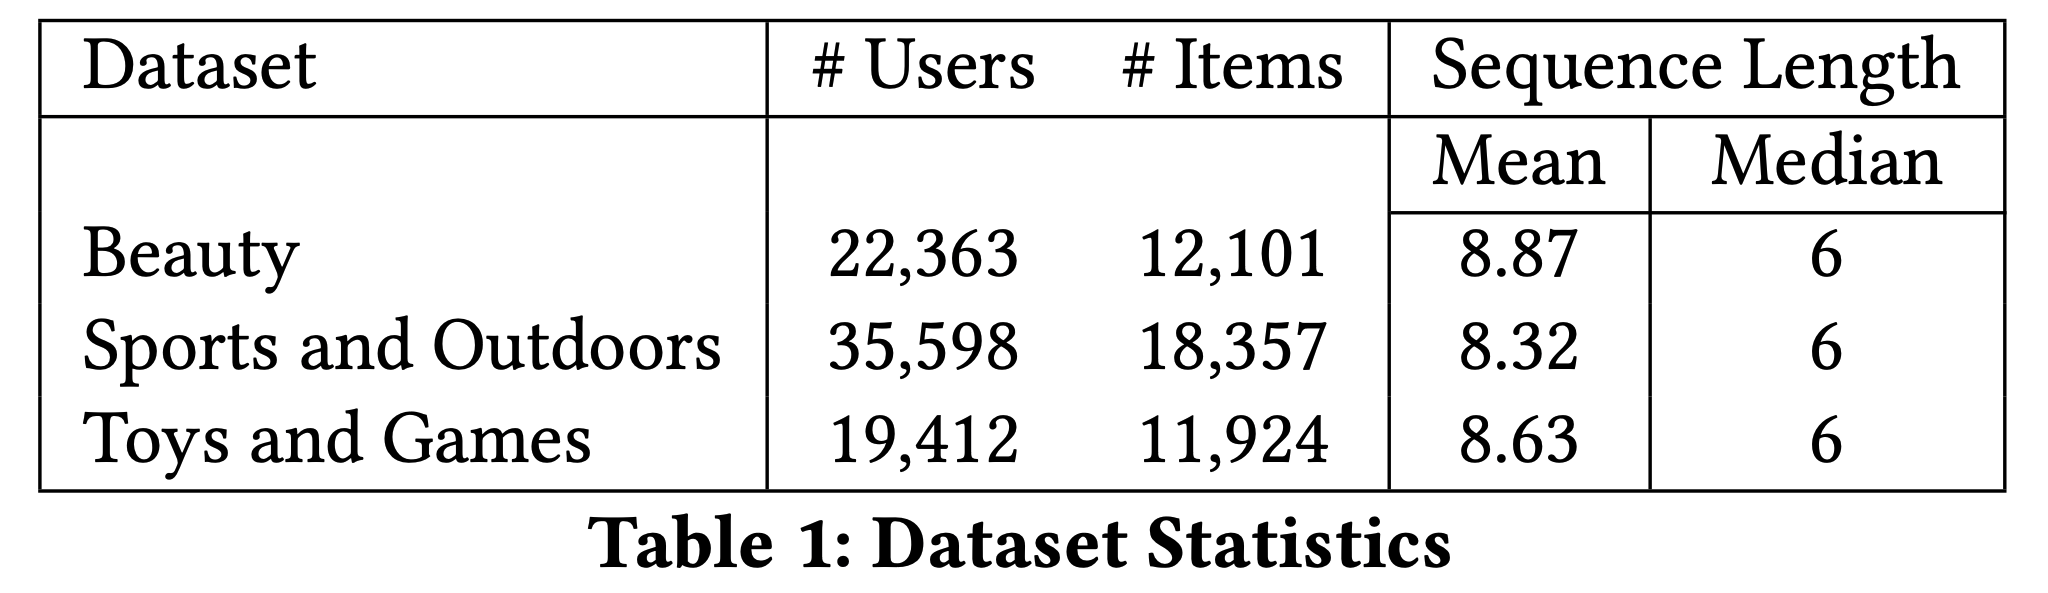
  • 对于每个子集,论文利用标题、价格、类别和描述等属性构建 item 嵌入。为确保数据质量,论文应用了5-core过滤处理,剔除了交互次数少于5次的 item 和用户。数据集统计信息详见表1
  • 为评估推荐准确性和排序质量,论文采用 Recall@K(准确性)和 NDCG@K(排序质量)指标,其中 \(K=5\) 和 \(K=10\)
基线方法
  • 为全面评估 COBRA 的性能,论文将其与以下 SOTA 推荐方法进行比较(这些方法代表了多种推荐技术,包括序列 Dense 推荐和生成式推荐):
    • P5[11]:将推荐任务转化为自然语言序列
    • Caser[39]:使用卷积层捕捉序列模式
    • HGN[28]:通过分层门控网络建模用户长短期兴趣
    • GRU4Rec[14]:利用门控循环单元建模用户行为
    • SASRec[18]:基于 Transformer 的模型,用于捕捉长期依赖关系
    • FDSA[52]:自注意力模型,用于 item 特征转移
    • BERT4Rec[37]:结合双向自注意力与掩码目标函数
    • S³-Rec[55]:通过对比学习提升推荐效果
    • TIGER[33] :使用 RQ-VAE 编码 item 内容特征,并利用 Transformer 进行生成式召回
实现细节
  • 论文采用与 TIGER 类似的语义 ID 生成方法,但与其配置不同,论文使用 3 层语义 ID 结构,每层对应 Codebook 大小为32
  • 这些语义 ID 通过 T5 模型生成
    • 理解:这里原文表达有误,应该是需要从 item 文本描述中提取 Embedding,再进入 RQ-VAE 编码为离散 Code(也就是语义 ID),TIGER 中也使用了 Sentence-T5 作为第一步的文本编码器的
  • COBRA 采用轻量级架构实现,包含 1 层 Encoder 和 2 层 Decoder
结果
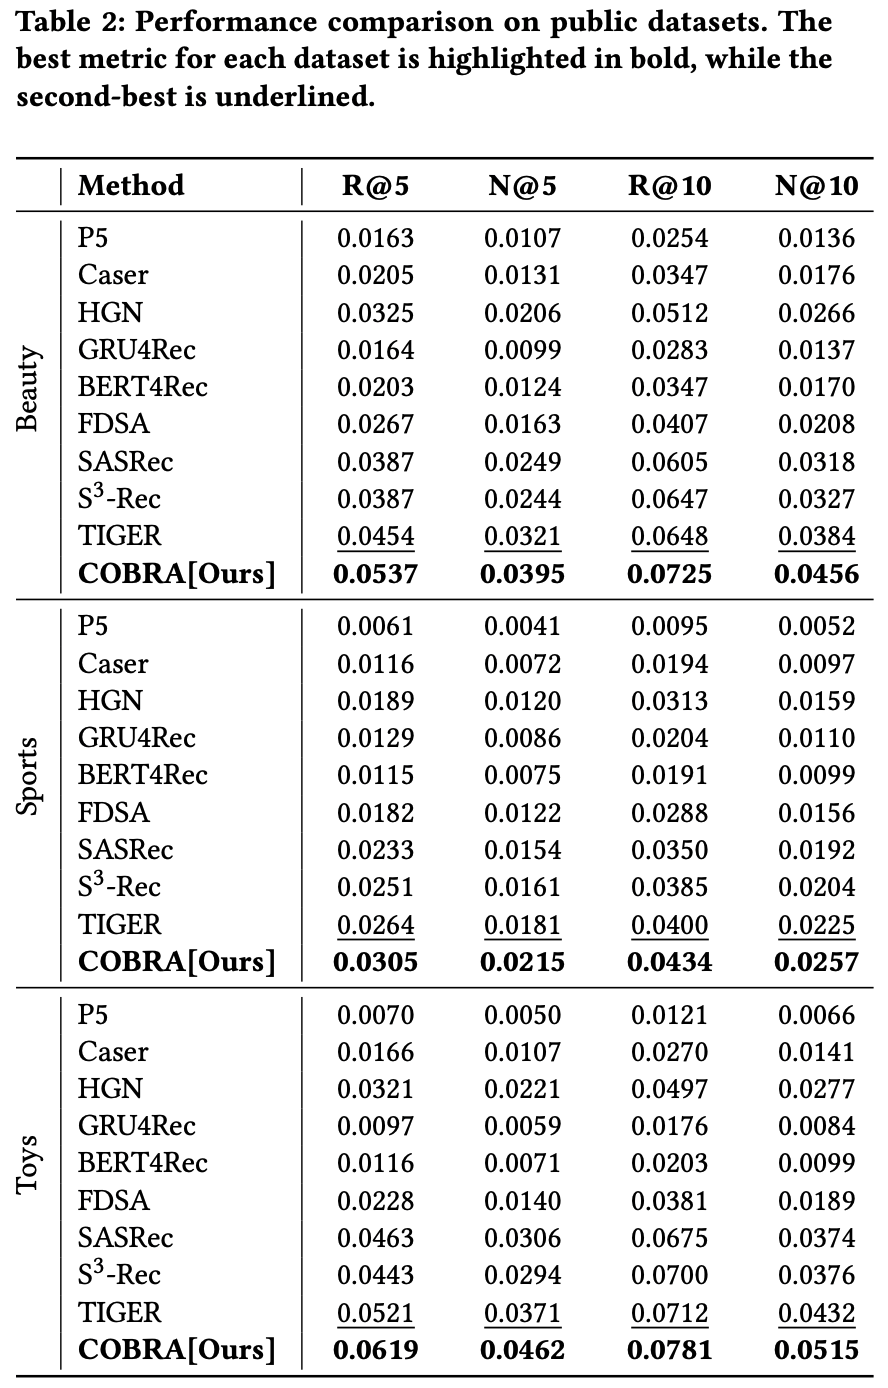
  • 如表2所示,COBRA 在各项指标上均超越所有基线模型

工业规模实验(Industrial-scale Experiments)

数据集与评估指标
  • 在百度工业数据集上进行实验,该数据集源自百度广告平台的用户交互日志,涵盖列表页、双栏和短视频等多种推荐场景
  • 数据集包含500万用户和200万广告,全面反映了真实世界的用户行为和广告内容
  • 广告和广告主通过标题、行业标签、品牌和活动文本等属性表示,这些属性被处理并编码为两层 Sparse ID 和 Dense 向量,捕捉粗粒度和细粒度语义信息。这种双重表示使 COBRA 能够有效建模用户偏好和 item 特征
  • 数据集分为两部分: \(D_{\text{train} }\) 和 \(D_{\text{test} }\)
    • 训练集 \(D_{\text{train} }\) 包含前60天的用户交互日志,覆盖该期间的推荐内容交互
    • 测试集 \(D_{\text{test} }\) 构建自 \(D_{\text{train} }\) 之后一天的日志,作为评估模型性能的基准
    • 离线评估采用 Recall@K 指标,测试 \(K \in \{50,100,200,500,800\}\),该指标衡量模型在不同阈值下准确召回推荐内容的能力
基线方法
  • 论文将 COBRA 与其变体进行比较:
    • COBRA w/o ID :移除 Sparse ID,仅依赖 Dense 向量。该变体类似于 RecFormer[21],使用轻量级 Transformer 进行序列建模
    • COBRA w/o Dense :移除 Dense 向量,仅使用 Sparse ID。由于 ID 的粗粒度特性,该变体采用类似 TIGER[33]的生成式召回方法,利用语义 ID 进行召回
    • COBRA w/o BeamFusion :移除 BeamFusion 模块,使用 top-1 Sparse ID 和最近邻召回获取 top-\(k\) 结果
实现细节
  • COBRA 基于 Transformer 架构实现
  • Encoder 将广告文本处理为序列,随后由 Sparse ID 头部预测2层语义 ID,配置为 \(32 \times 32\)
  • 变体 COBRA w/o Dense 采用 3 层语义 ID ( \(256 \times 256 \times 256\) ),以更细粒度地建模广告
结果
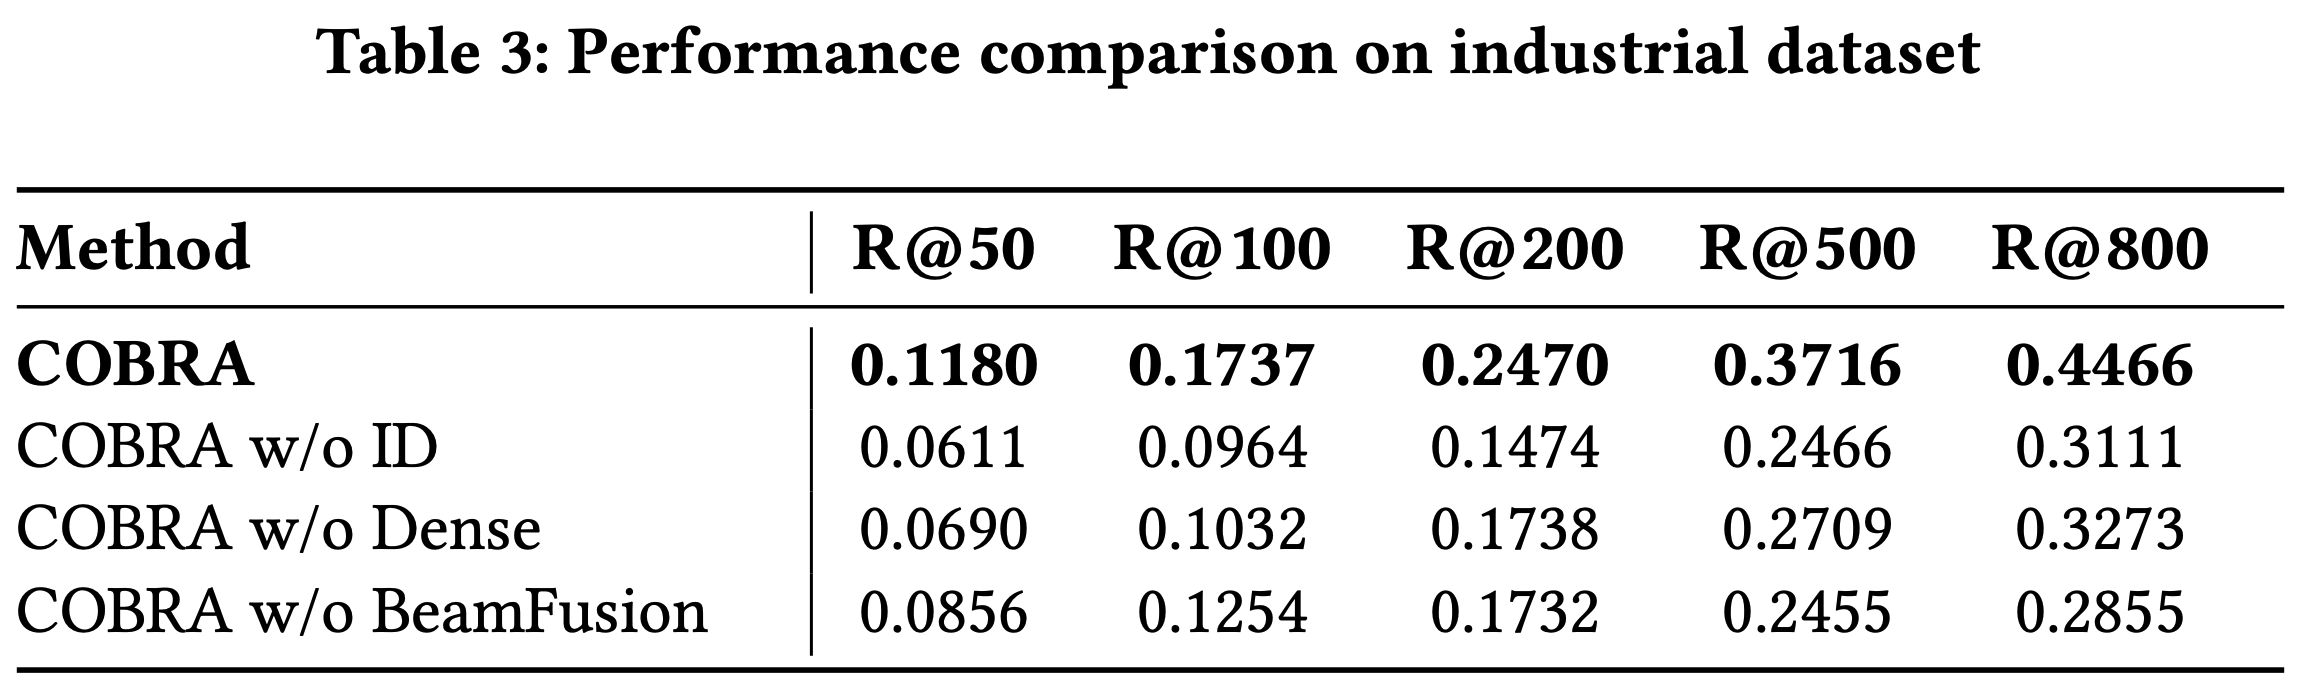
  • 如表3所示,COBRA 在所有评估指标上均优于其变体
  • 值得注意的是,在较小的 \(K\) 值时,缺少 Dense 或 Sparse 表示会导致更明显的性能下降,这凸显了级联表示对于实现粒度和精度的重要性。相反,随着召回规模 \(K\) 的增加,BeamFusion 的性能优势愈发明显,证明了其在工业召回系统中的有效性
  • 结果进一步凸显了特定组件的贡献:
    • 移除 Sparse ID(COBRA w/o ID)导致召回率下降 26.7%至41.5%,表明语义分类的关键作用
    • 移除 3 层语义 ID(COBRA w/o Dense)导致性能下降 30.3%至48.3%,说明细粒度建模的重要性
    • 移除 BeamFusion 导致召回率下降 27.5%至36.1%,强调了其在 Sparse ID 内部和 Sparse ID 之间的信息整合的重要性

进一步分析

表示学习分析
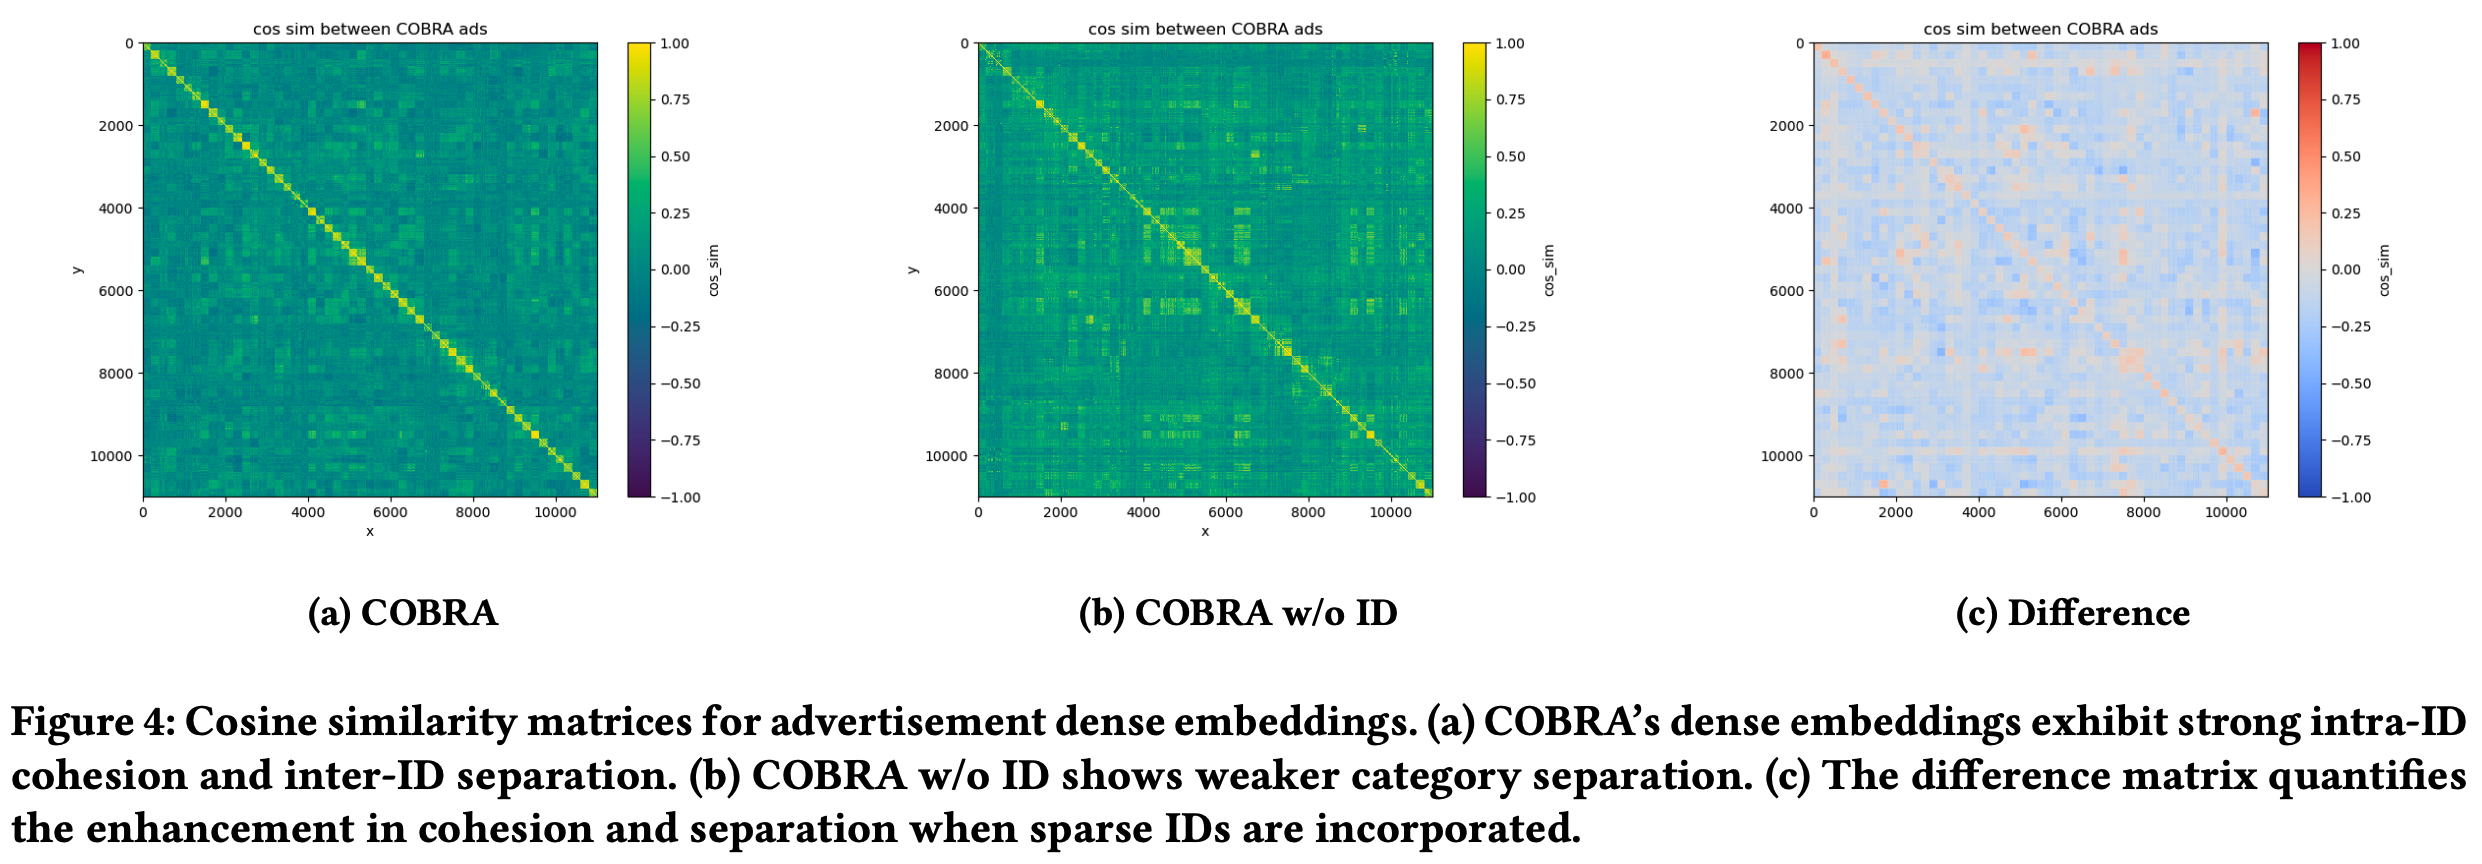
  • 为评估 COBRA 模型的表示学习能力,论文构建了广告 Dense 嵌入的相似度矩阵,如图4所示
  • 图4相关结论:
    • 图4a:COBRA 模型展现出显著的 ID 内凝聚性(intra-ID cohesion) 和 ID 间分离性(inter-ID separation) ,表明其 Dense 嵌入能够有效捕捉 item 细节特征,同时保持类别内的语义一致性
    • 图4b:无 Sparse ID 的模型变体显示出较弱的类别分离性,凸显了 Sparse ID 在保持语义结构中的重要性
    • 图4c:差异矩阵定量验证了 Sparse ID 对增强内聚性和分离性的作用
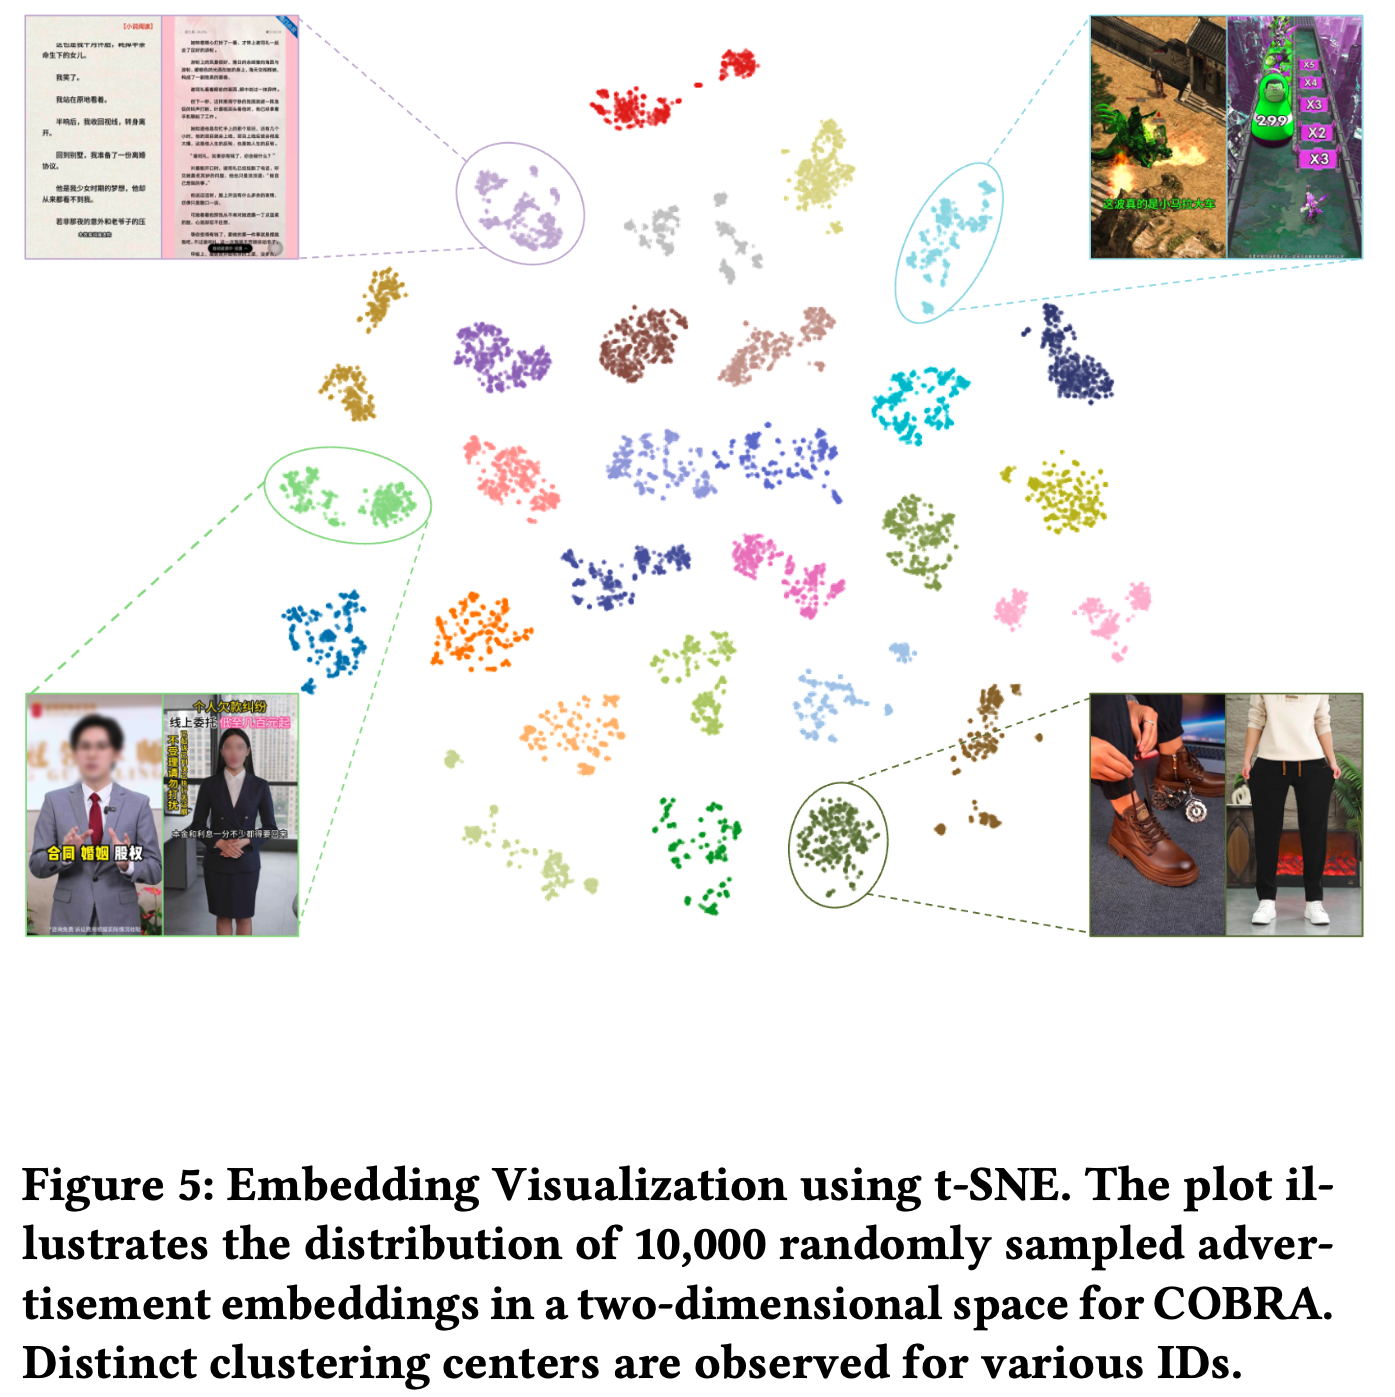
  • 通过 t-SNE 将广告嵌入分布可视化,进一步验证 COBRA 嵌入的效果。随机采样 10,000 个广告后,可观察到不同类别的明显聚类中心。图5显示广告按类别有效聚类,表明类别内的强内聚性。紫色、青色、浅绿色和深绿色聚类分别主要对应小说、游戏、法律服务和服装类广告,表明广告表示有效捕捉了语义信息
召回-多样性平衡
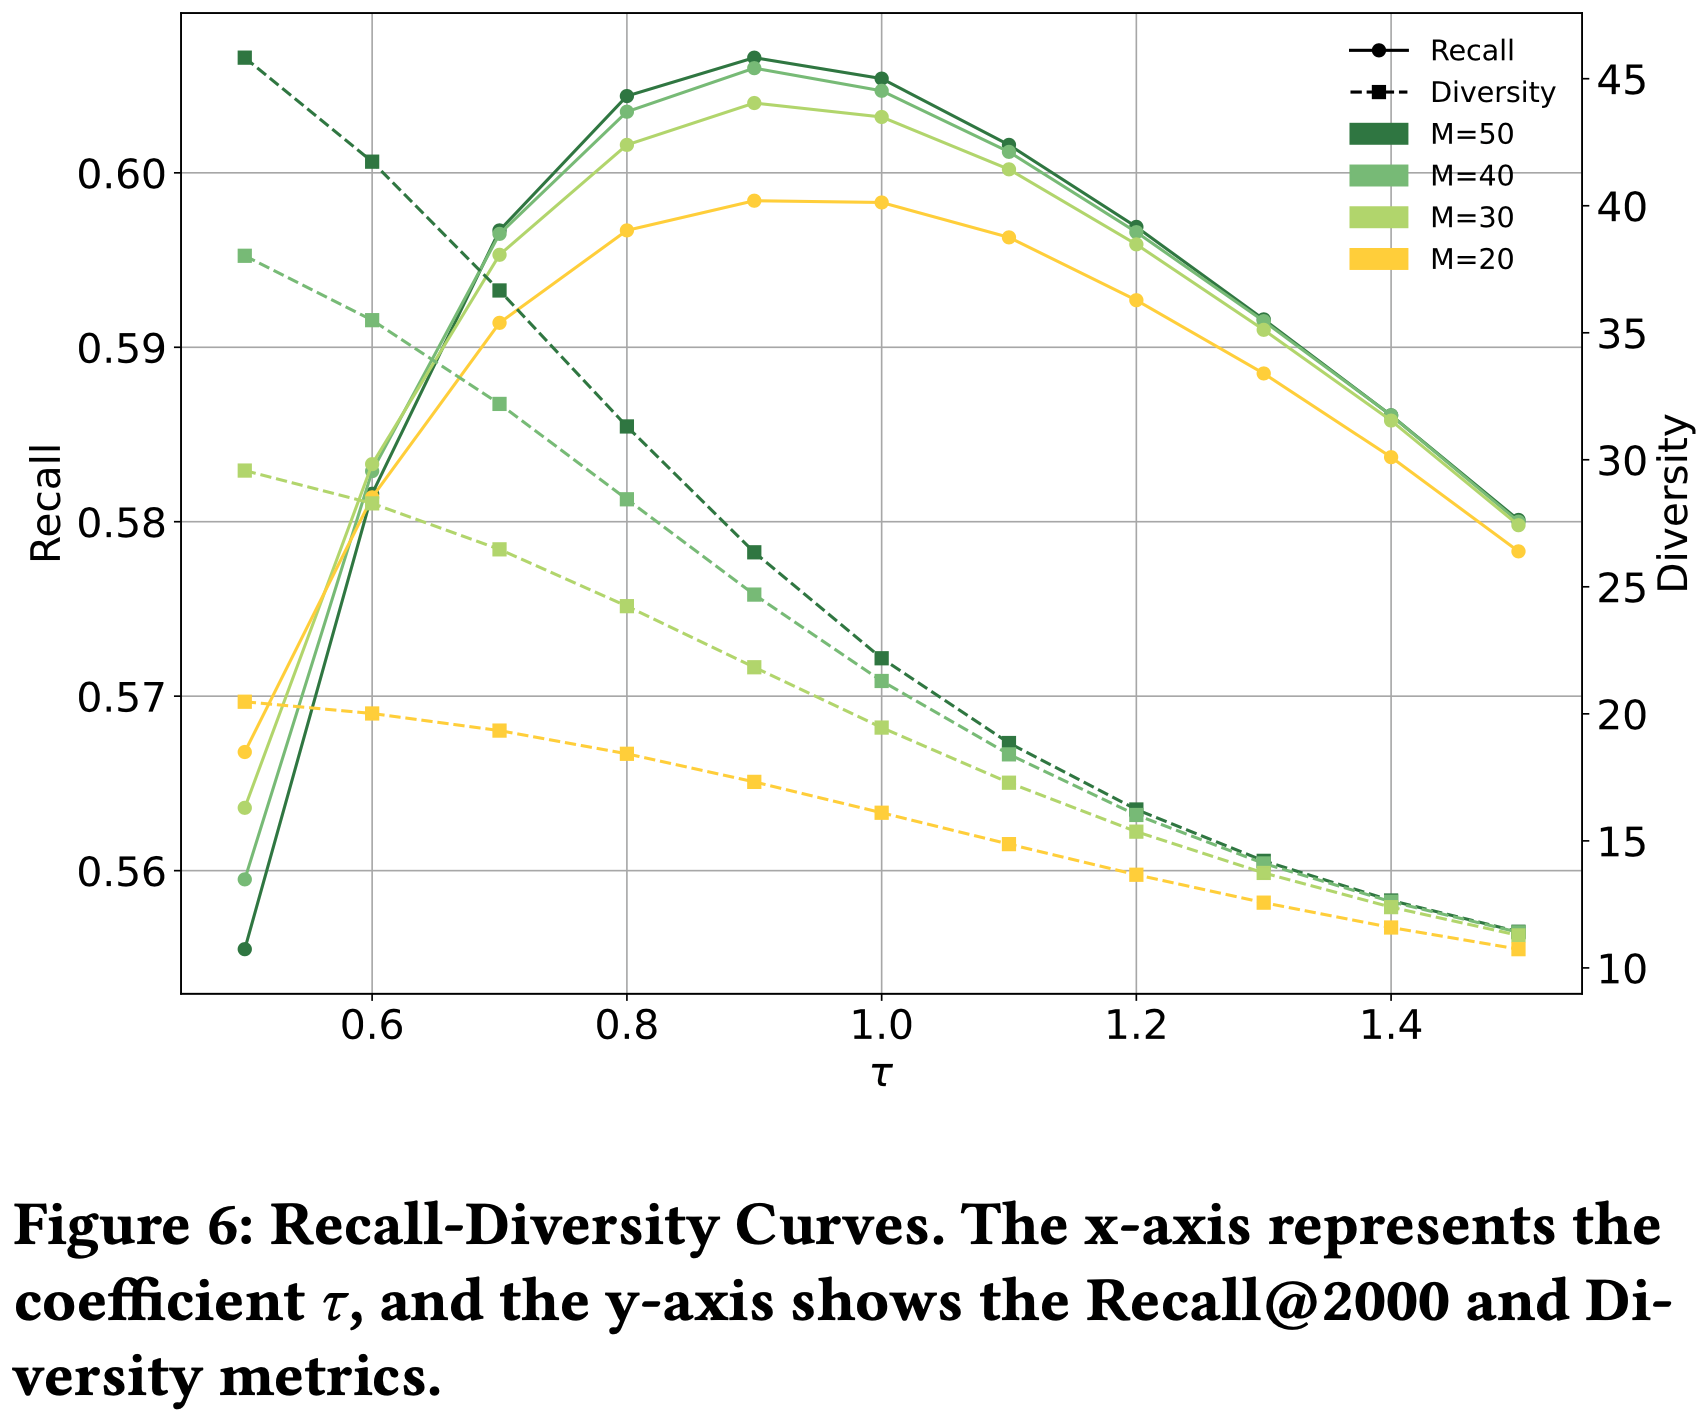
  • 在推荐系统的召回阶段,平衡准确性和多样性是一项挑战,为分析 COBRA 的这种权衡,论文研究了召回-多样性曲线(recall-diversity curves)
    • 该曲线描述了在固定 \(\phi=16\) 时,Recall@2000 和多样性指标如何随 BeamFusion 机制中的系数 \(\tau\) 变化
    • 如图6所示,增加 \(\tau\) 通常会导致多样性下降
  • COBRA 在 \(\tau=0.9\) 和 \(\phi=16\) 时达到召回与多样性的最佳平衡,此时模型在保持高准确性的同时确保推荐 item 覆盖足够多样的集合
    • 多样性指标定义 :召回 item 中不同 ID 的数量,反映模型避免冗余和为用户提供更广泛选择的能力
    • 通过精细控制 \(\tau\) 和 \(\phi\),实现业务目标

在线结果

  • 论文于 2025年1月 在百度工业数据集上进行了在线A/B测试
  • 测试覆盖 10% 的用户流量 ,确保统计显著性(ensuring statistical significance)
  • 主要评估指标 :转化率(用户参与度)和用户平均收入(ARPU,经济价值)
  • 在论文策略覆盖的领域中,COBRA 实现 转化率+3.60%,ARPU+4.15%
1…535455…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4