Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——ScaleRL

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(ScaleRL)The Art of Scaling Reinforcement Learning Compute for LLMs, Meta, 20251015
    • 代码地址:github.com/OpenLMLab/MOSS-RLHF

Paper Summary

  • 核心总结(本文的核心贡献是 Meta 团队丰富的认知):
    • 论文缩放方法论的一个重要见解是:可以系统地使用较小规模的消融来预测更大规模的性能,这使论文能够创建最终的可扩展 Recipe
    • 根据论文的消融实验, Off-policy 算法、损失函数和模型精度是最重要的决策
      • 其他每个决策单独影响不大,但正如论文从留一法实验中看到的,当它们全部组合时,仍然具有一些累积影响(在效率方面)
    • 渐近性能与效率 (Asymptotic performance vs. efficiency)
      • 论文发现更好的选项同时提高了效率和渐近性能,但情况并非总是如此(例如,对于 FP32,图 4(b)),当从基线方法开始进行”正向”消融时,论文首先且最主要地选择渐近性能
      • 当从 ScaleRL Recipe 进行”反向”留一法消融时,论文发现每个决策对渐近性能的影响非常小,但算法的每个组件似乎都有助于提高效率
        • 这表明变化的累积效应是相当鲁棒的
    • Generalization:虽然对泛化的全面描述超出了论文工作的范围,但论文确实观察到分布内验证与下游泛化性能之间的相关性
      • 有一些算法选择似乎更有助于泛化,作者指出了:
        • 更大的批次大小(章节 A.14)
        • 减少截断(章节 A.15)
        • 更长的生成长度(第 5 节,图 9)
        • 更大的模型规模(第 5 节,图 1)
    • 多任务强化学习 (Multi-task RL)
  • 背景 & 问题:
    • RL 已成为训练 LLMs 的核心技术,然而 RL 领域缺乏与预训练阶段相当的预测性 Scaling 方法论
    • 计算预算迅速增长,但对于如何评估算法改进以 Scaling RL 计算,目前尚无原则性的理解(principled understanding)
  • 论文工作:
    • 论文进行了首次大规模系统性研究,总计超过 400,000 GPU hous ,定义了一个原则性框架,用于分析和预测 LLM 中的 RL Scaling
  • 论文为 RL 训练拟合了 S 形计算-性能曲线(sigmoidal compute-performance curves),并广泛消融了一系列常见的设计选择,以分析它们对渐近性能和计算效率的影响
  • 论文观察到:
    • (1) 并非所有 Recipe (recipes)都能产生相似的渐近性能;
    • (2) 诸如损失聚合、归一化、课程学习以及 Off-policy 算法等细节主要调节计算效率,而不会显著改变渐近性能;

      Details such as loss aggregation, normalization, curriculum, and off-policy algorithm primarily modulate compute efficiency without materially shifting the asymptote

    • (3) 稳定、可扩展的 Recipe 遵循可预测的 Scaling 轨迹,使得能够从小规模运行中进行外推
  • 结合这些见解,论文提出了一个最佳实践(best-practice) Recipe ScaleRL ,并通过成功地将单个 RL 运行扩展到 100,000 GPU hous 并预测其验证性能,证明了其有效性
  • 论文的工作既提供了一个用于分析 RL Scaling 的科学框架,也提供了一个实用的 Recipe ,使 RL 训练更接近预训练中长期实现的预测性
Introduction and Discussion

  • Scaling RL 计算正成为推进 LLMs 发展的关键范式
    • 预训练奠定了模型的基础;但随后的 RL 训练阶段释放了当今许多最重要的 LLM 能力,从 test-time thinking (OpenAI, 2024; DeepSeek, 2025) 到智能体能力 (Kimi, 2025a)
    • 例如 Deepseek-RL-Zero 使用了 100,000 H800 GPU hous 进行 RL 训练,占其预训练计算的 3.75% (DeepSeek, 2025)
    • RL 计算的这种急剧增长在前沿 LLM 的各代产品中被放大,从 o1 到 o3 增加了超过 \(10\times\) (OpenAI, 2025),从 Grok-3 到 Grok-4 也有类似的飞跃 (xAI Team, 2025)
  • 尽管用于 LLM 的 RL 计算已经大规模扩展,但我们对如何扩展 RL 的理解并未跟上;其方法论仍然更像艺术而非科学
    • 最近的 RL 突破主要由针对新颖算法的孤立研究 (例如,DAPO, (2025)) 和特定模型的训练报告所驱动,例如 MiniMax 等 (2025) 和 Magistral (2025)
    • 且这些研究提供了针对特定背景的临时解决方案,但并未说明如何开发能够随计算规模扩展的 RL 方法
  • 这种 Scaling 方法论的缺乏阻碍了研究进展:
    • 由于没有可靠的方法先验地识别有前景的 RL 候选方案,进展与大规模实验绑定,这使得大多数学术界团体被边缘化
  • 这项工作通过借鉴预训练中成熟的概念 Scaling Laws ,为 RL Scaling 的科学奠定了基础
    • 虽然预训练已经收敛到能够可预测地随计算规模扩展的算法 Recipe (2020; 2022; Owen, 2024),但 RL 领域缺乏明确的标准
    • RL 从业者面临着令人眼花缭乱的设计选择,使得如何扩展以及扩展什么这些基本问题悬而未决
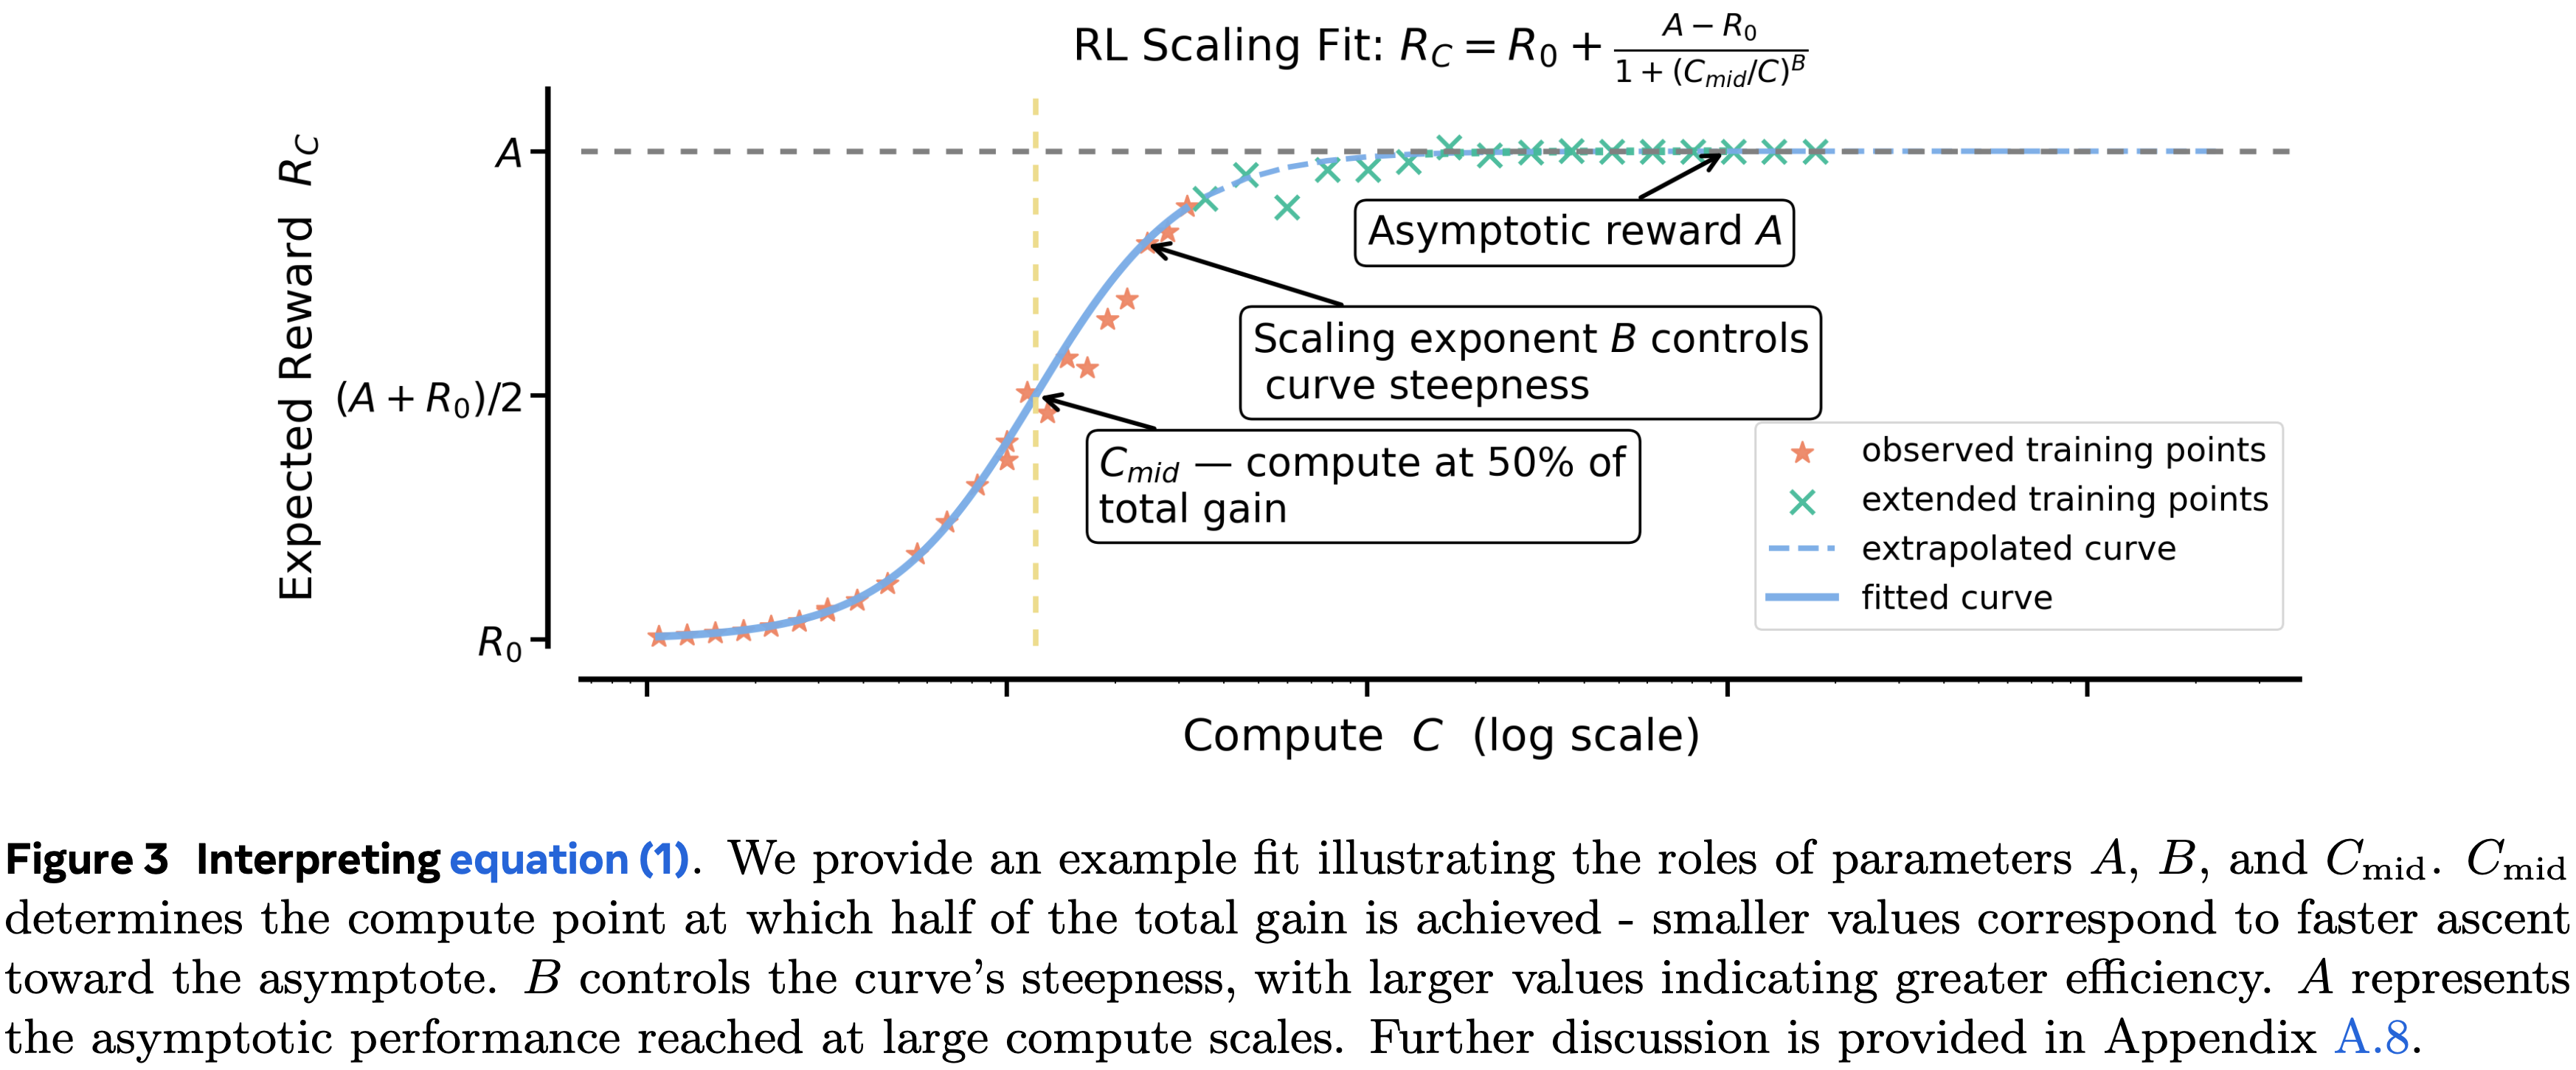
    • 为了解决这些问题,论文建立了一个使用类 S 形饱和曲线来预测 RL 性能的框架,该曲线描述了在同分布验证集上的期望奖励 (\(R_{C}\)) 与训练计算量 (\(C\)) 之间的关系:
      $$\boxed{ \overbrace{R_{C}-R_{0} }^{ \text{Reward Gain} } = \overbrace {(A-R_{0})}^{ \text{Asymptotic Reward Gain} } \times \frac{1}{\underbrace{1+(C_{\rm mid}/C)^{B} }_{ \text{Compute Efficiency} } } } \quad \quad \text{(fixed model and traning data)} \tag{1}$$
    • \(0\leq A\leq 1\) 代表渐近通过率
    • \(B>0\) 是决定计算效率的缩放指数
    • \(C_{\rm mid}\) 设定了 RL 性能曲线的中点
    • 注:\((A-R_{0})\) 可以理解为 渐近的奖励增益(Asymptotic Reward Gain), \(A\) 为渐近奖励(Asymptotic Reward)
    • 理解:
      • \(A-R_0\) 是表示一个系数,越大时,整体收益 \(R_C\) 越大
      • \(C\) 是一个越大,\(C_{\rm mid}/C\) 变小,\(1+(C_{\rm mid}/C)^B\) 变小,\(\frac{1}{1+(C_{\rm mid}/C)^B}\) 变大,整体曲线如图 3 所示
  • 图 3 提供了这些参数的示意图解释
  • 公式 (1) 中的框架使研究人员能够从低计算量运行外推性能到高计算预算,从而能够在无需承担将每个实验都运行到其计算极限的成本的情况下,评估 RL 方法的可扩展性
  • 在这个框架的指导下,论文开发了 ScaleRL ,这是一个能够可预测地随计算规模扩展的 RL Recipe
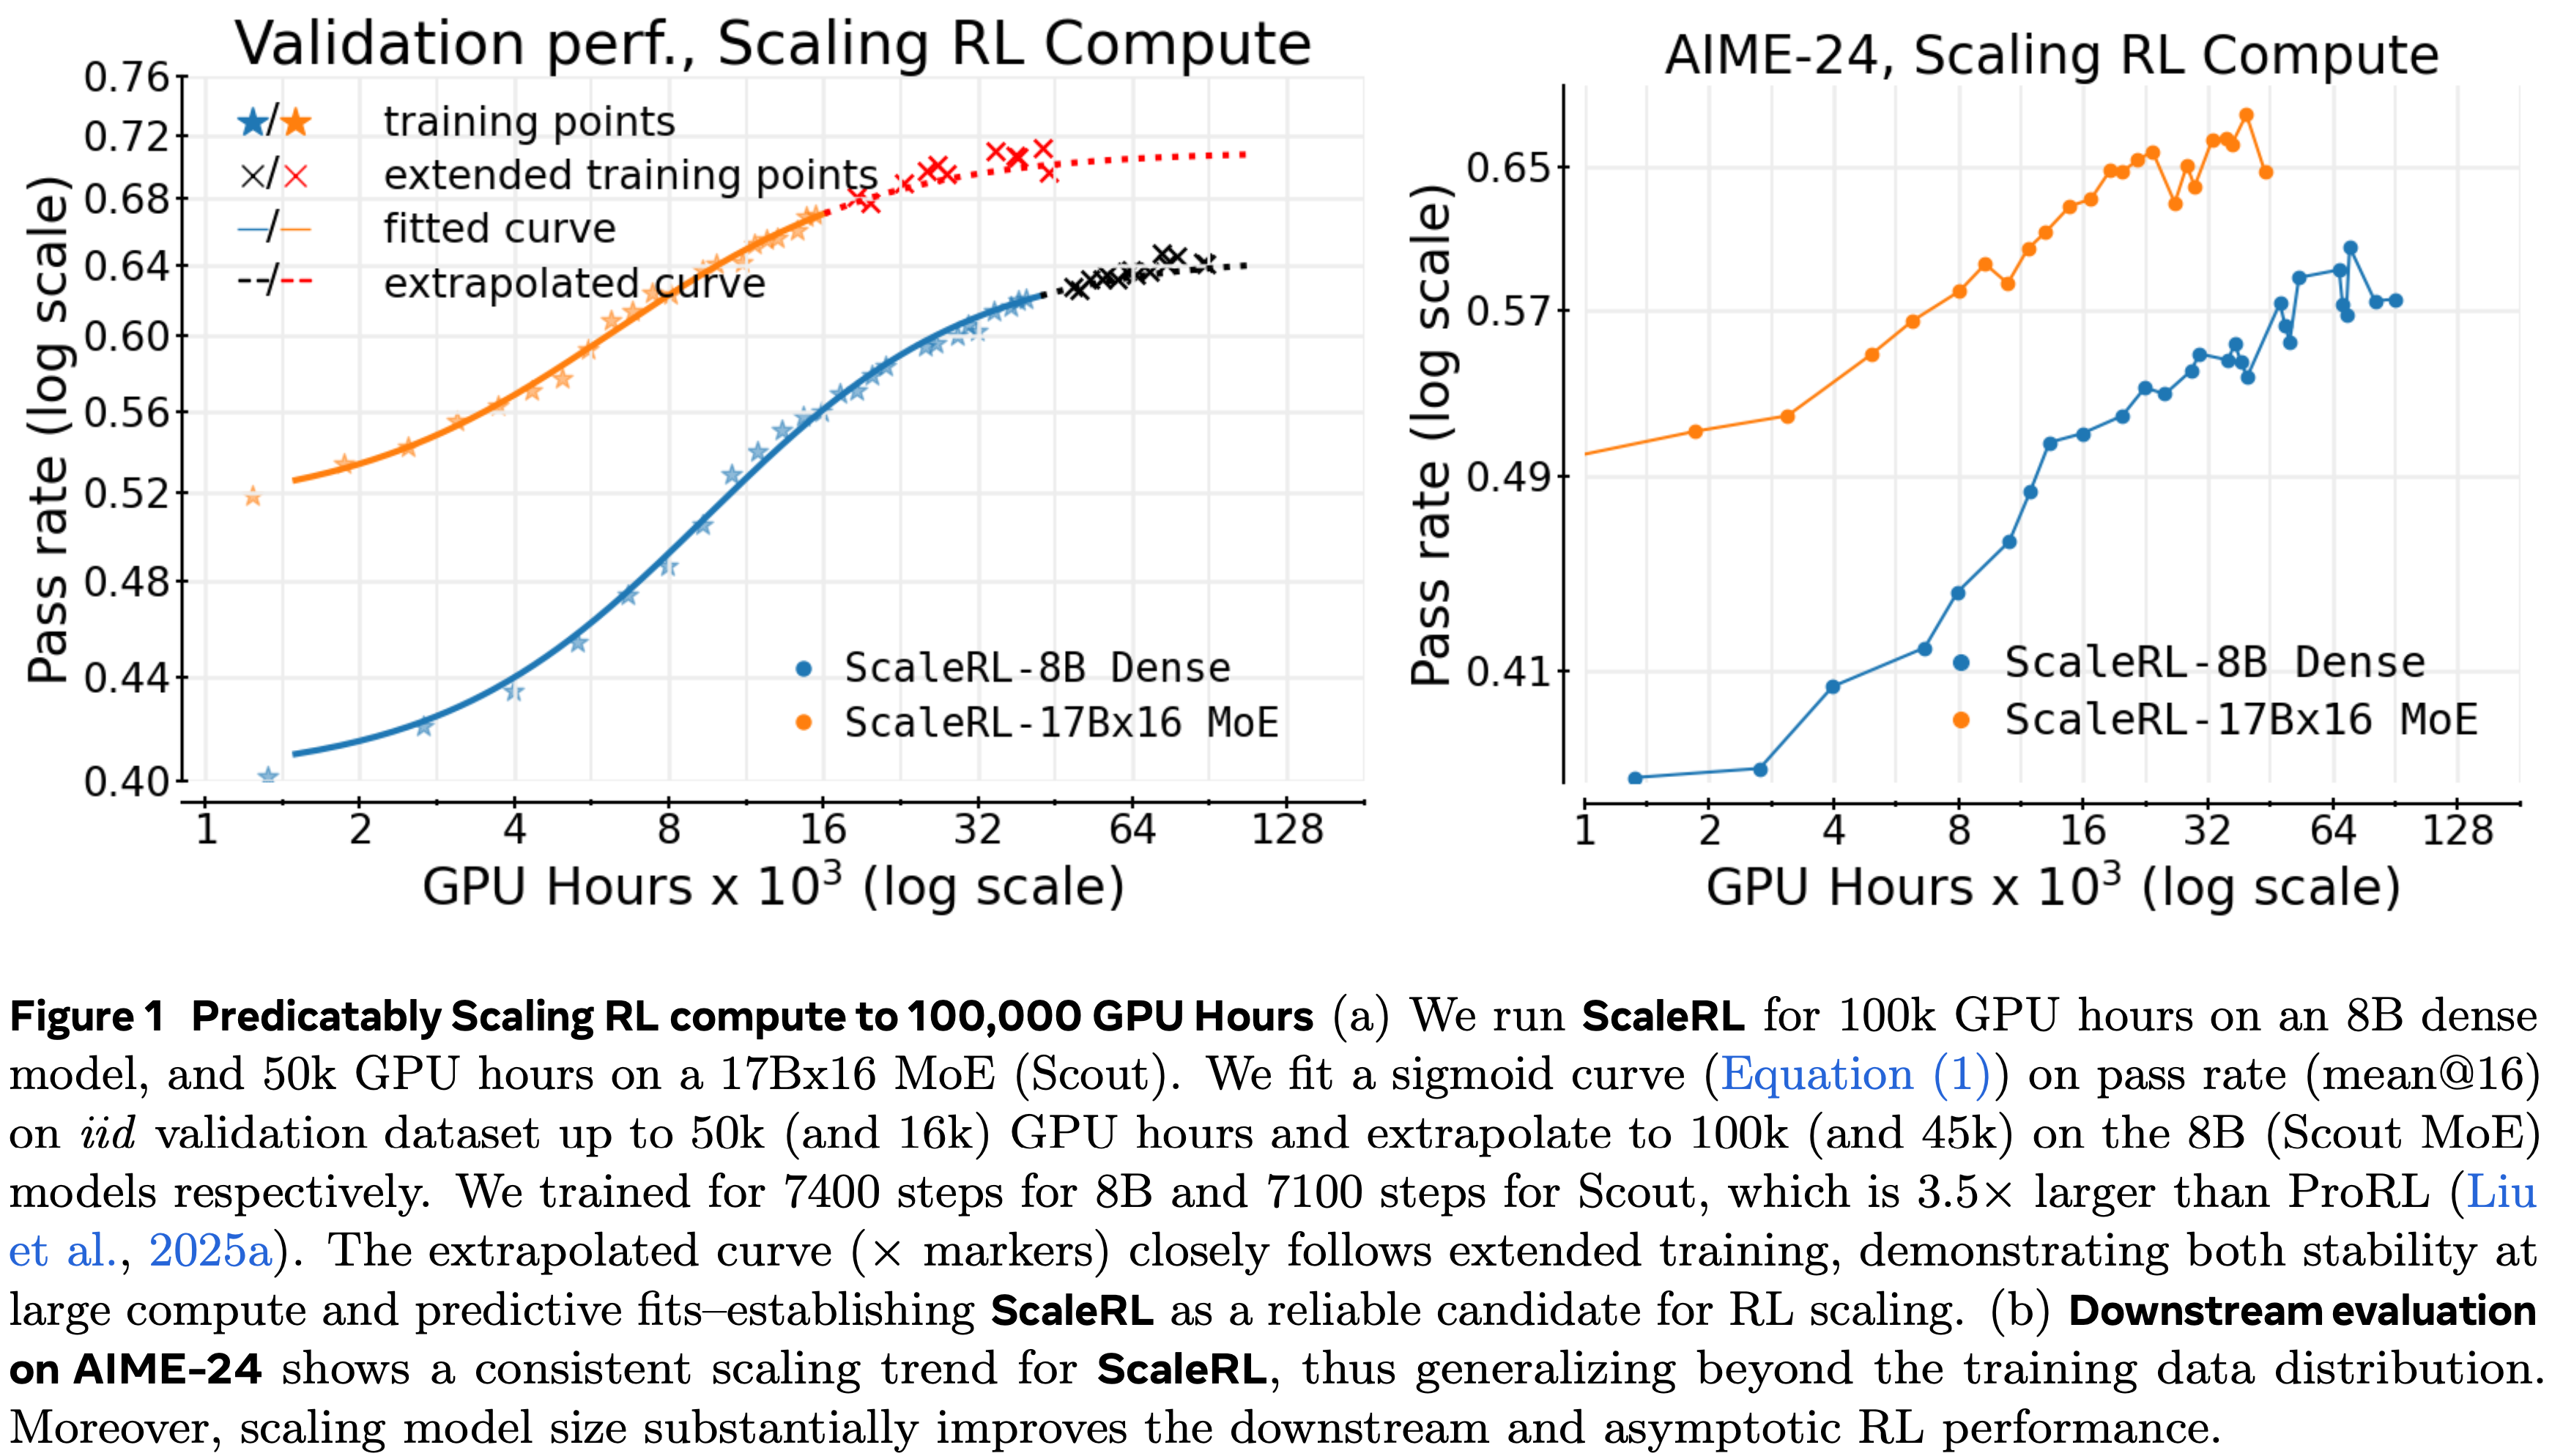
    • 在一个大规模的100,000 GPU hous 训练运行中,论文展示了 ScaleRL 的性能与论文的框架预测的扩展曲线紧密匹配(图 1)
    • 仅从训练的初始阶段外推的扩展曲线与最终观察到的性能紧密匹配,证实了论文的框架在极端计算规模下的预测能力
  • ScaleRL 的设计基于一项全面的 RL Scaling 实证研究,该研究跨越了超过 400,000 GPU hous(在 Nvidia GB200 GPU 上)
  • 这项研究在 8B 模型参数规模上探索了众多设计选择,其中单个运行使用高达 16,000 GPU hous,使其比在论文最大训练运行规模上进行实验便宜 6 倍
  • 这项调查得出了三个关键原则:
    • RL 性能上限并非普适(RL Performance Ceilings are Not Universal) :当我们为不同方法扩展训练计算量时,它们会遇到不同的可达到性能上限 (\(A\))
      • 这个限制可以通过诸如损失类型和批次大小等选择来改变
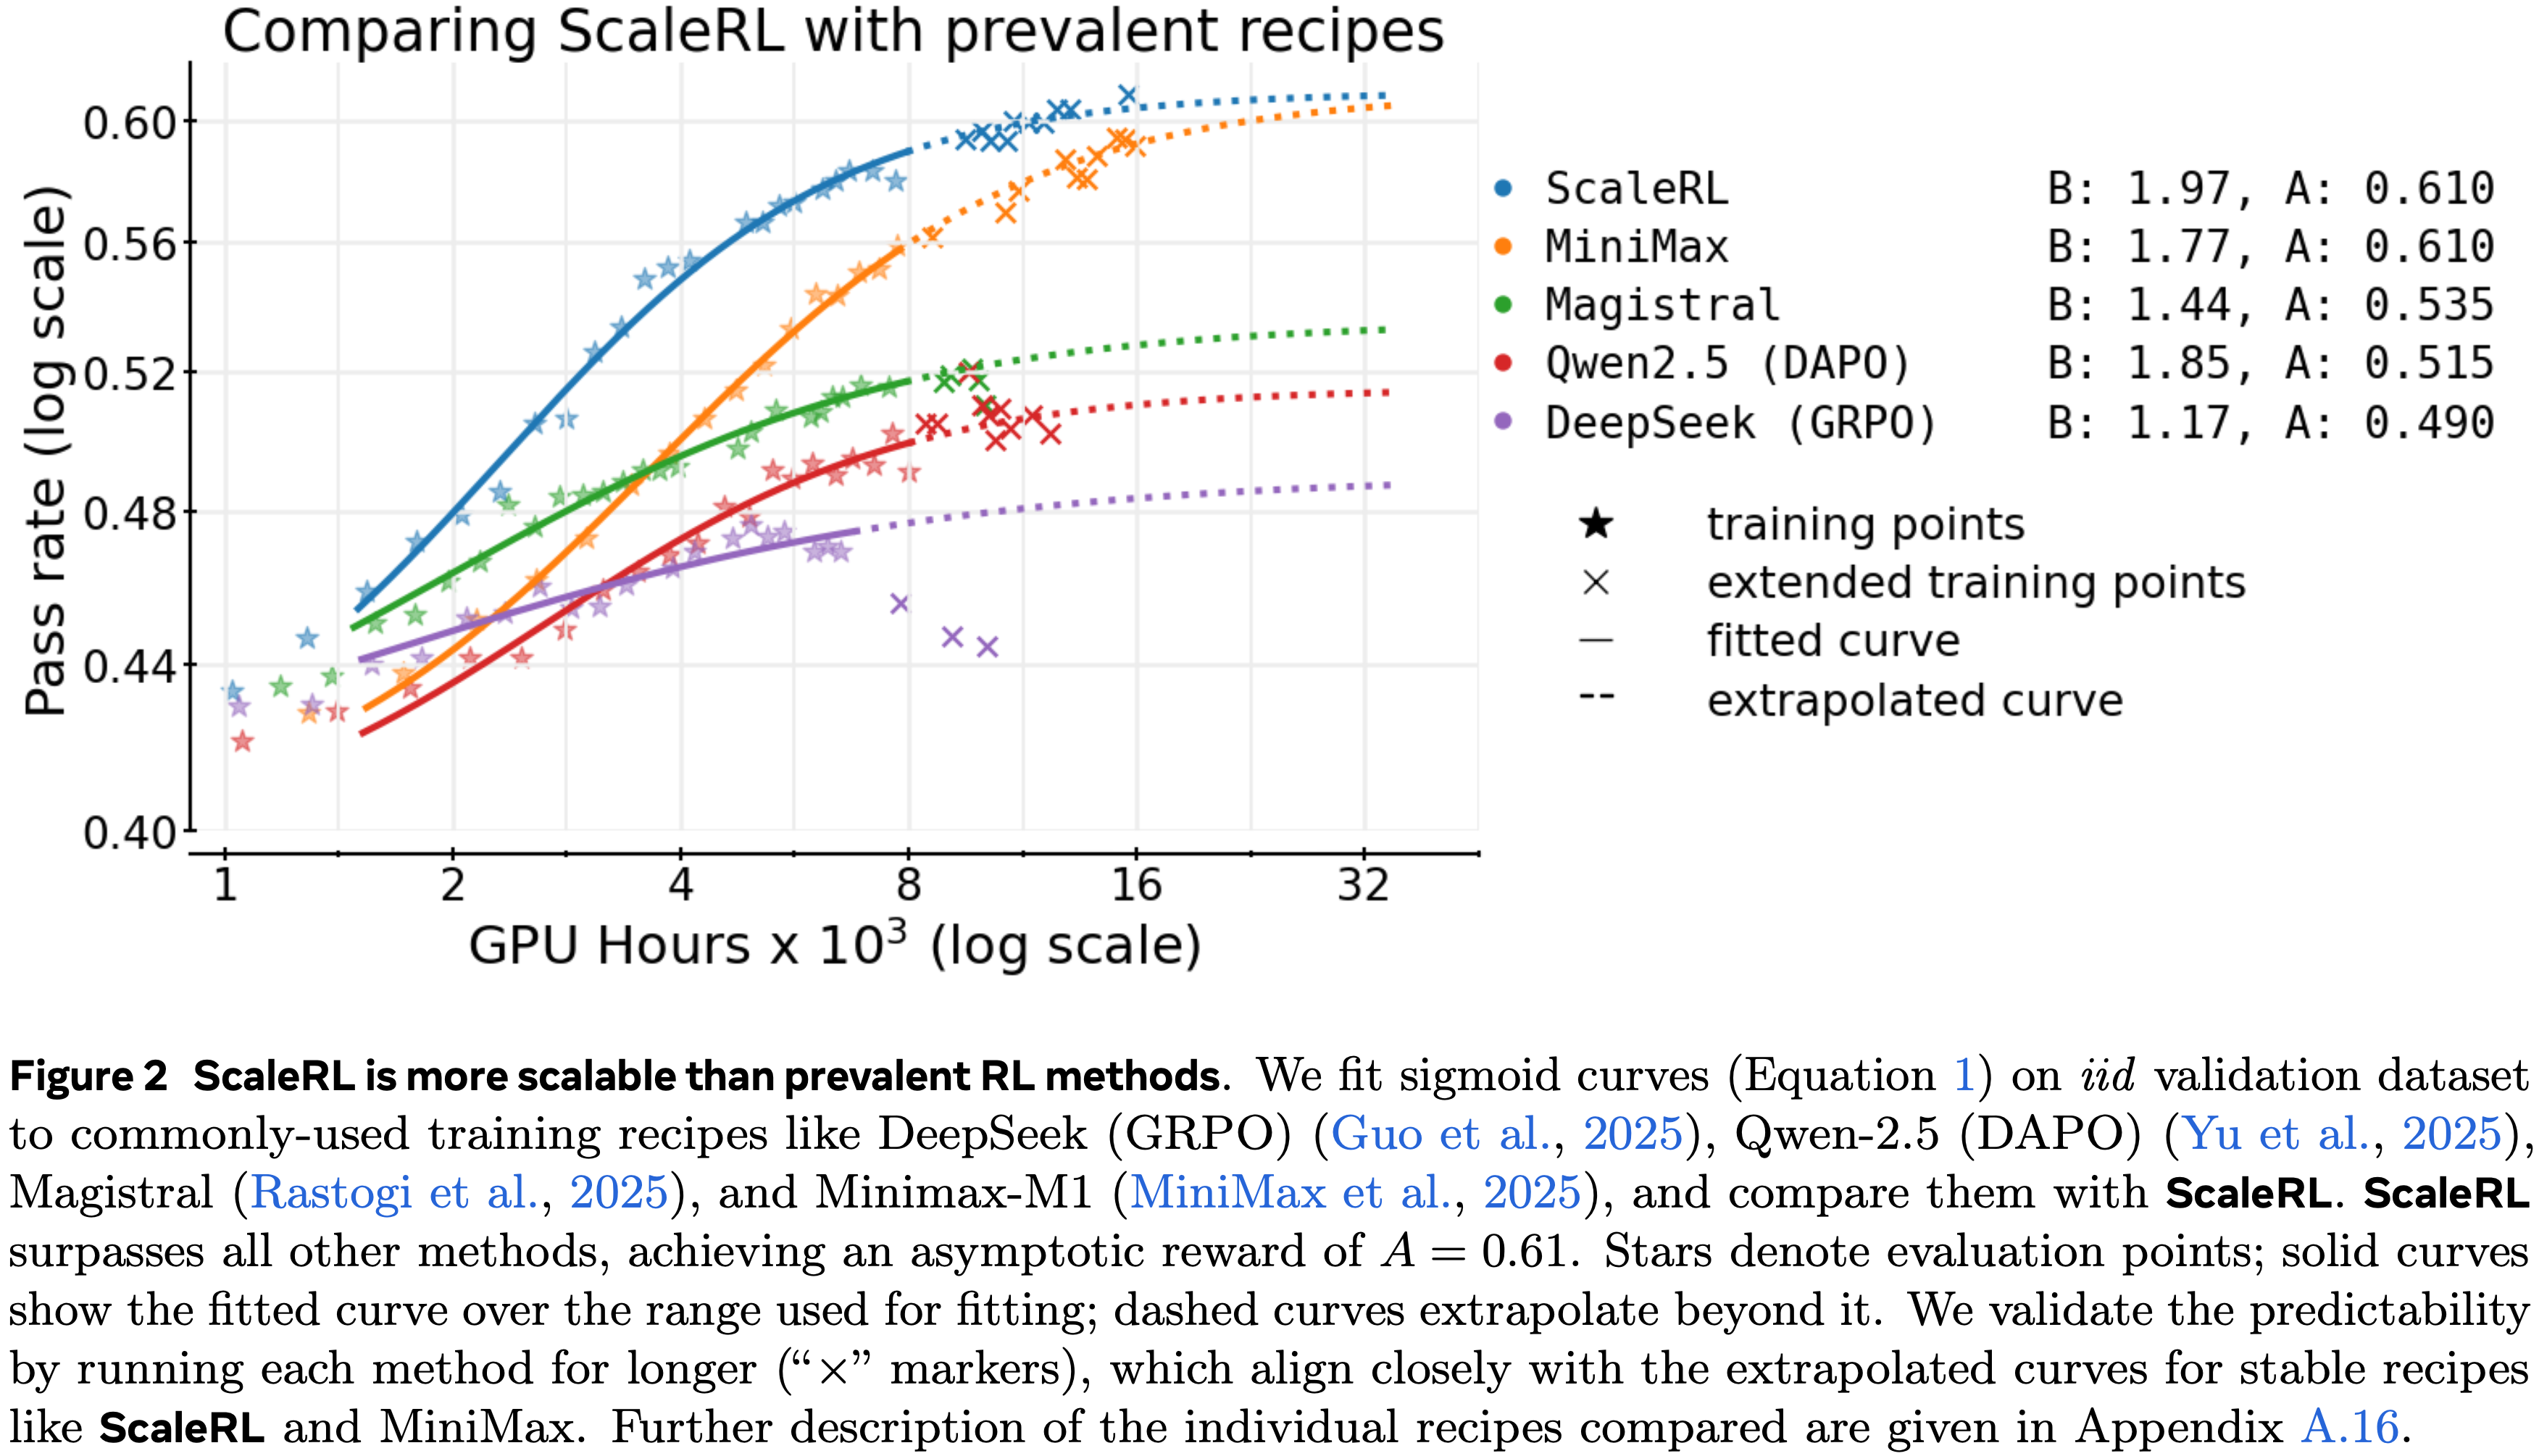
    • 拥抱苦涩教训(Embracing the Bitter Lesson) :在小计算预算下表现优越的方法,在外推到大规模计算区域时可能更差(图 2)
      • 仍然可以通过使用论文的框架(公式 (1))从早期训练动态中估计缩放参数 (\(A\), \(B\)) 来识别可扩展的方法
    • 重新评估常见智慧 :通常被认为能提高峰值性能的干预措施(例如,损失聚合、数据课程、长度惩罚、优势归一化)主要调整计算效率 (\(B\)),而不会显著改变性能上限
  • 基于这些见解,ScaleRL 通过整合现有方法而非发明新方法来实现可预测的扩展
    • 具体来说,ScaleRL 结合了异步 Pipeline-RL 设置(第 3.1 节)、强制长度中断、截断重要性采样 RL 损失 (CISPO from MiniMax-M1)、提示级损失平均、批次级优势归一化、logits 处的 FP32 精度、零方差过滤和 No-Positive-Resampling
    • 以上每个组件的贡献都在消耗 16,000 GPU hous 每次运行的留一法消融实验中得到了验证
    • ScaleRL 实现可预测地扩展,且建立了新的SOTA(图 2)
      • 与已建立的 RL Recipe 相比,它实现了更高的渐近性能和计算效率
    • ScaleRL 在跨多个训练轴增加计算量时保持了可预测的扩展性(第 5 节)
      • 包括 \(2.5\times\) 更大的批次大小、长达 32,768 个 Token 的生成长度、使用数学和代码的多任务 RL 以及更大的混合专家模型 (Llama-4 17B\(\times\)16);
      • 其益处持续迁移到下游任务
  • 总的来说,这项工作建立了一种严谨的方法论,用于成本效益地预测新 RL 算法的可扩展性

Preliminaries & Setup

  • 论文使用 LLM 进行强化学习,其中提示 \(x\) 从数据分布 \(D\) 中采样
  • 论文的设置遵循在 GPU 上的 Generator-Trainer 分离:
    • Generator GPU 使用优化的推理内核进行高通量 rollout 生成
    • Trainer GPU(其余的 GPU)运行训练后端 (FSDP) 并更新参数
  • 论文分别用 \(\pi^{\theta}_{\text{gen} }\) 和 \(\pi^{\theta}_{\text{train} }\) 表示 Generator 和训练后端上具有参数 \(\theta\) 的模型
  • 对于每个提示, Generator GPU 上的旧策略 \(\pi^{\theta_\text{old} }_\text{gen}\) 产生候选补全,然后被分配标量奖励
  • 策略优化通过最大化一个裁剪的 Surrogate Objective 进行,对 \(x\sim D\) 和来自 \(\pi^{\theta_\text{old} }_\text{gen}\) 的 rollout 取期望

Training Regimen(安排,规划)

  • 所有实验均在用于推理的 RL 领域进行,其中模型产生一个用特殊 Token(<think> … **</think>**)包围的思考轨迹和一个最终解决方案
  • 除非另有说明,训练使用 16,384 个 Token 的序列长度:
    • 12,288 用于思考,2,048 用于解决方案,另外 2,048 用于输入提示
  • 论文采用 12,288 的思考预算以加快迭代速度,并在第 5 节展示 ScaleRL 外推在使用更大思考预算 (32,768) 进行训练时仍保持预测性
  • 对于数学 RL 实验,论文使用 Polaris-53K 数据集 (2025),批次大小为 768(48 个提示,每个提示 16 次生成)
  • 在论文的设置中,扩展 RL 计算对应于在训练提示上运行多个周期
  • 关于训练的更多细节,包括 SFT 和超参数,见附录 A.3

Base RL Algorithm

  • 作为论文在第 3 节的起点,论文从一个“基础”算法开始
    • 该算法类似于没有 KL 正则化项的 GRPO (2024),与大规模训练报告一致 (Magistral, 2025; MiniMax, 2025)
    • 论文包含了非对称 DAPO 裁剪 (2025),它作为避免熵崩溃和保持输出多样性的默认方法被广泛采用
  • 对于给定的提示 \(x\),旧策略 \(\pi_{\text{gen} }(\theta_{\text{old} })\) 生成 \(G\) 个候选补全 \(\{y_{i}\}_{i=1}^{G}\),每个被分配一个标量奖励 \(r_{i}\)。论文计算优势 \(\hat{A}_{i}\) 并使用组归一化优势:
    $$\hat{A}_{i}=r_{i}-\text{mean}(\{r_{j}\}_{j=1}^{G}),\quad\hat{A}_{i}^{G}=\hat{A}_ {i}/(\text{std}(\{r_{j}\}_{j=1}^{G})+\epsilon).$$
    • 每个长度为 \(|y_{i}|\) 的补全 \(y_{i}\) 在 Token-level 的重要性采样 (IS) 比率 \(\rho_{i,t}(\theta)\) 上做出贡献,具有非对称的上限和下限裁剪阈值,类似于 DAPO (2025):
      $$\rho_{i,t}(\theta):=\frac{\pi^{\theta}_\text{train}(y_{i,t}\mid x,y_{i,<t})}{\pi^{ \theta_{\text{old} } }_\text{gen }(y_{i,t}\mid x,y_{i,<t})}=\frac{\pi^ {\theta}_\text{train}(y_{i,t})}{\pi^{\theta_{\text{old} } }_\text{gen }(y_{ i,t})};\quad\text{clip}_{\text{asym} }(\rho,\epsilon^{-},\epsilon^{+}):=\text{ clip}(\rho,1-\epsilon^{-},1+\epsilon^{+}). \tag{2}$$
    • 论文在 Sample-level 聚合损失,即在跨样本平均之前,先平均每个样本的 Token 损失
    • Surrogate Objective 为:
      $$\mathcal{J}(\theta)=\mathbb{E}_{x\sim D,\atop\{y_{i}\}_{i=1}^{G}\sim\pi^{ \theta_{\text{old} } }_\text{gen }(\cdot|x)}\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1 }{|y_{i}|}\sum_{t=1}^{|y_{i}|}\min\Bigl{(}\rho_{i,t}(\theta)\hat{A}_{i}^{G}, \text{clip}_{\text{asym} }(\rho_{i,t}(\theta),\epsilon^{-},\epsilon^{+})\hat{A}_ {i}^{G}\Bigr{)}\right]. \tag{3}$$
  • 控制生成长度 (Controlling Generation Lengths)
    • 为了防止训练过程中推理输出长度爆炸性增长,这有害于训练稳定性和效率,论文使用中断 (GLM-V Team, 2025; 2025),通过附加一个思考结束短语(例如,“</think>”)来强制停止过长的生成,示意 LLM 终止其推理并产生最终答案
    • 论文将在后面的第 4 节重新讨论这个选择,并将其与惩罚长生成的长度惩罚进行比较 (2025; Kimi Team, 2025b)

Predictive compute-scaling and fitting curves

  • 与通常使用幂律拟合预测曲线的预训练不同,论文使用 S 形函数(公式 (1))来模拟通过率与 \(\log(compute)\) 的关系
    • 论文这样做是因为论文经验发现 S 形拟合比幂律拟合更鲁棒和稳定,论文将在附录 A.4 中进一步讨论
    • 论文的选择与先前使用类 S 形幂律来捕捉有界指标(如准确率)的工作一致 (2024; 2022)
  • 与预训练研究类似 (2025b; 2025),论文发现排除非常早期的低计算区域(low-compute regime)会产生更稳定的拟合,之后训练遵循可预测的轨迹
    • 除非另有说明,论文所有的缩放拟合都在约 1.5k GPU hous 之后开始
    • 拟合过程的进一步细节在附录 A.5 中提供,论文曲线拟合的鲁棒性在附录 A.7 中讨论
    • 问题:这里是指拟合 S 形曲线时,排除早期的训练结果,理解是因为此时模型没有得到良好的训练,不排除会受波动影响较大
  • 解释缩放曲线 (Interpreting scaling curves)
    • 直观地说,S 形曲线捕捉了饱和回报:
      • 在低计算区域增长缓慢,在高效缩放的中段急剧加速,然后在计算量高时饱和
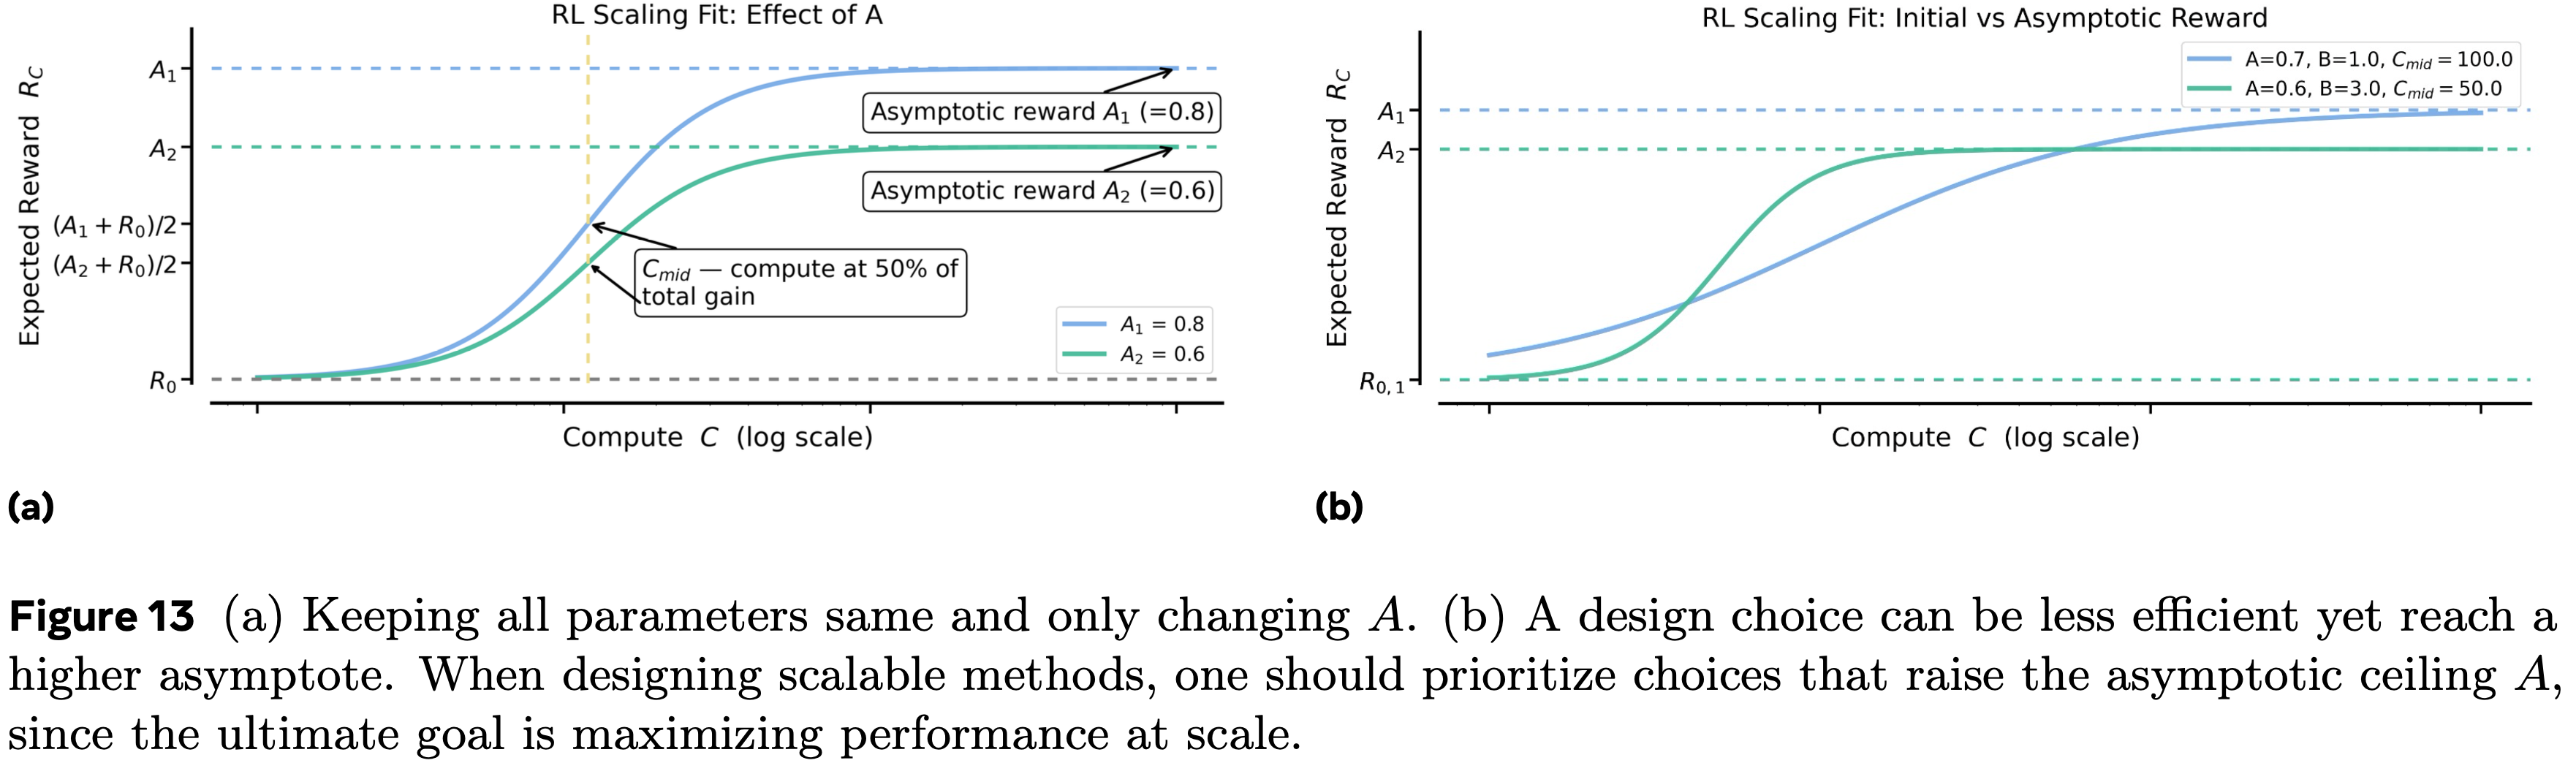
    • 论文还在图 3 中提供了 S 形曲线参数 \(A,B,\text{ 和 }C_{mid}\) 的示意图解释
      • 可以看到,\(B,C_{\text{mid} }\) 主要影响运行的效率,\(A\) 表示在大型计算规模下的渐近性能
    • 关于这些参数的进一步讨论在附录 A.8 中提供
  • 在留出验证集上的缩放曲线 (Scaling curve on held-out validation)
    • 与预训练实践一致 (2022; 2025),论文在同分布验证数据上测量预测性能
    • 由于训练运行跨越多个 Epochs,论文从 Polaris-53k 数据集中随机留出 \(1,000\) 个提示用于验证,并使用其余部分进行训练
    • 缩放曲线拟合在验证点上,这些点每 100 个训练步骤测量一次平均通过率,在 \(1,000\) 个留出提示上每个提示有 16 次生成

An Empirical Study of RL Scaling

  • 论文使用一个 8B 参数的稠密模型在可验证的数学问题上进行 RL 实验
  • 使用第 2 节中描述的设置,论文研究了几个设计轴在其可预测的计算缩放行为方面,即渐近性能 (asymptotic performance, \(A\)) 和计算效率 (compute efficiency, \(B\)),如图 3 所示
  • 论文将实验结构分为三个阶段
    • 首先,在 3.5k 到 4k GPU hous 的基线之上消融设计选择,因为一些实验选择在此规模之外会变得不稳定(附录 A.15)
      • 每当一个设计改变被证明是稳定的,论文就将其训练更长时间
    • 然后,将最佳选择组合成 ScaleRL ,并在第 4 节进行 16k GPU hous 的留一法 (LOO) 实验
      • 在这里,论文通过在前 8k GPU hous 上拟合并外推运行的剩余部分来评估可预测性
    • 最后,为了证明使用 ScaleRL 的可预测缩放,论文在第 5 节还考虑了具有更大批次大小、混合专家模型、多任务(数学和代码)和更长序列长度的训练设置

Asynchronous RL Setup

  • 论文首先研究异步 Off-policy RL 设置 (2024) 的选择,因为它控制着训练稳定性和效率,通常独立于所有其他设计选择
  • 论文考虑两种 Off-policy 学习方法:PPO-off-policy-\(k\) 和 PipelineRL-\(k\)
  • PPO-off-policy-\(k\) 是异步 RL 的默认方法,先前已被 Qwen3 (2025) 和 ProRL (2025a) 使用
    • 在这种设置中,旧策略 \(\pi_{\theta^{\text{old} }_{\text{gen} } }^{op}\) 为一批 \(B\) 个提示生成推理轨迹
    • 每次梯度更新处理一个包含 \(\hat{B}\) 个提示的小批次,导致每个批次有 \(k=B/\hat{B}\) 次梯度更新
    • 在论文的实验中,论文固定 \(\hat{B}=48\) 个提示(每个提示 16 次生成),并通过设置 \(B=k\times 48\) 来改变 \(k\in \{1,8\}\)
  • PipelineRL-\(k\) 是来自 Piche 等 (2025) 的一种新方法,并被 Magistral (2025) 使用
    • 在 PipelineRL-\(k\) 中, Generator 以流式方式持续产生推理轨迹
    • 每当 Trainer 完成一次策略更新时,新参数立即推送到 Generator , Generator 继续使用更新后的权重但使用来自旧策略的陈旧 KV 缓存进行生成
    • 一旦生成完整的轨迹批次,它就被传递给 Trainer 进行下一次更新
    • 在论文的设置中,论文引入了一个参数 \(k\):如果 Trainer 比 Generator 提前 \(k\) 步,它们就会等待
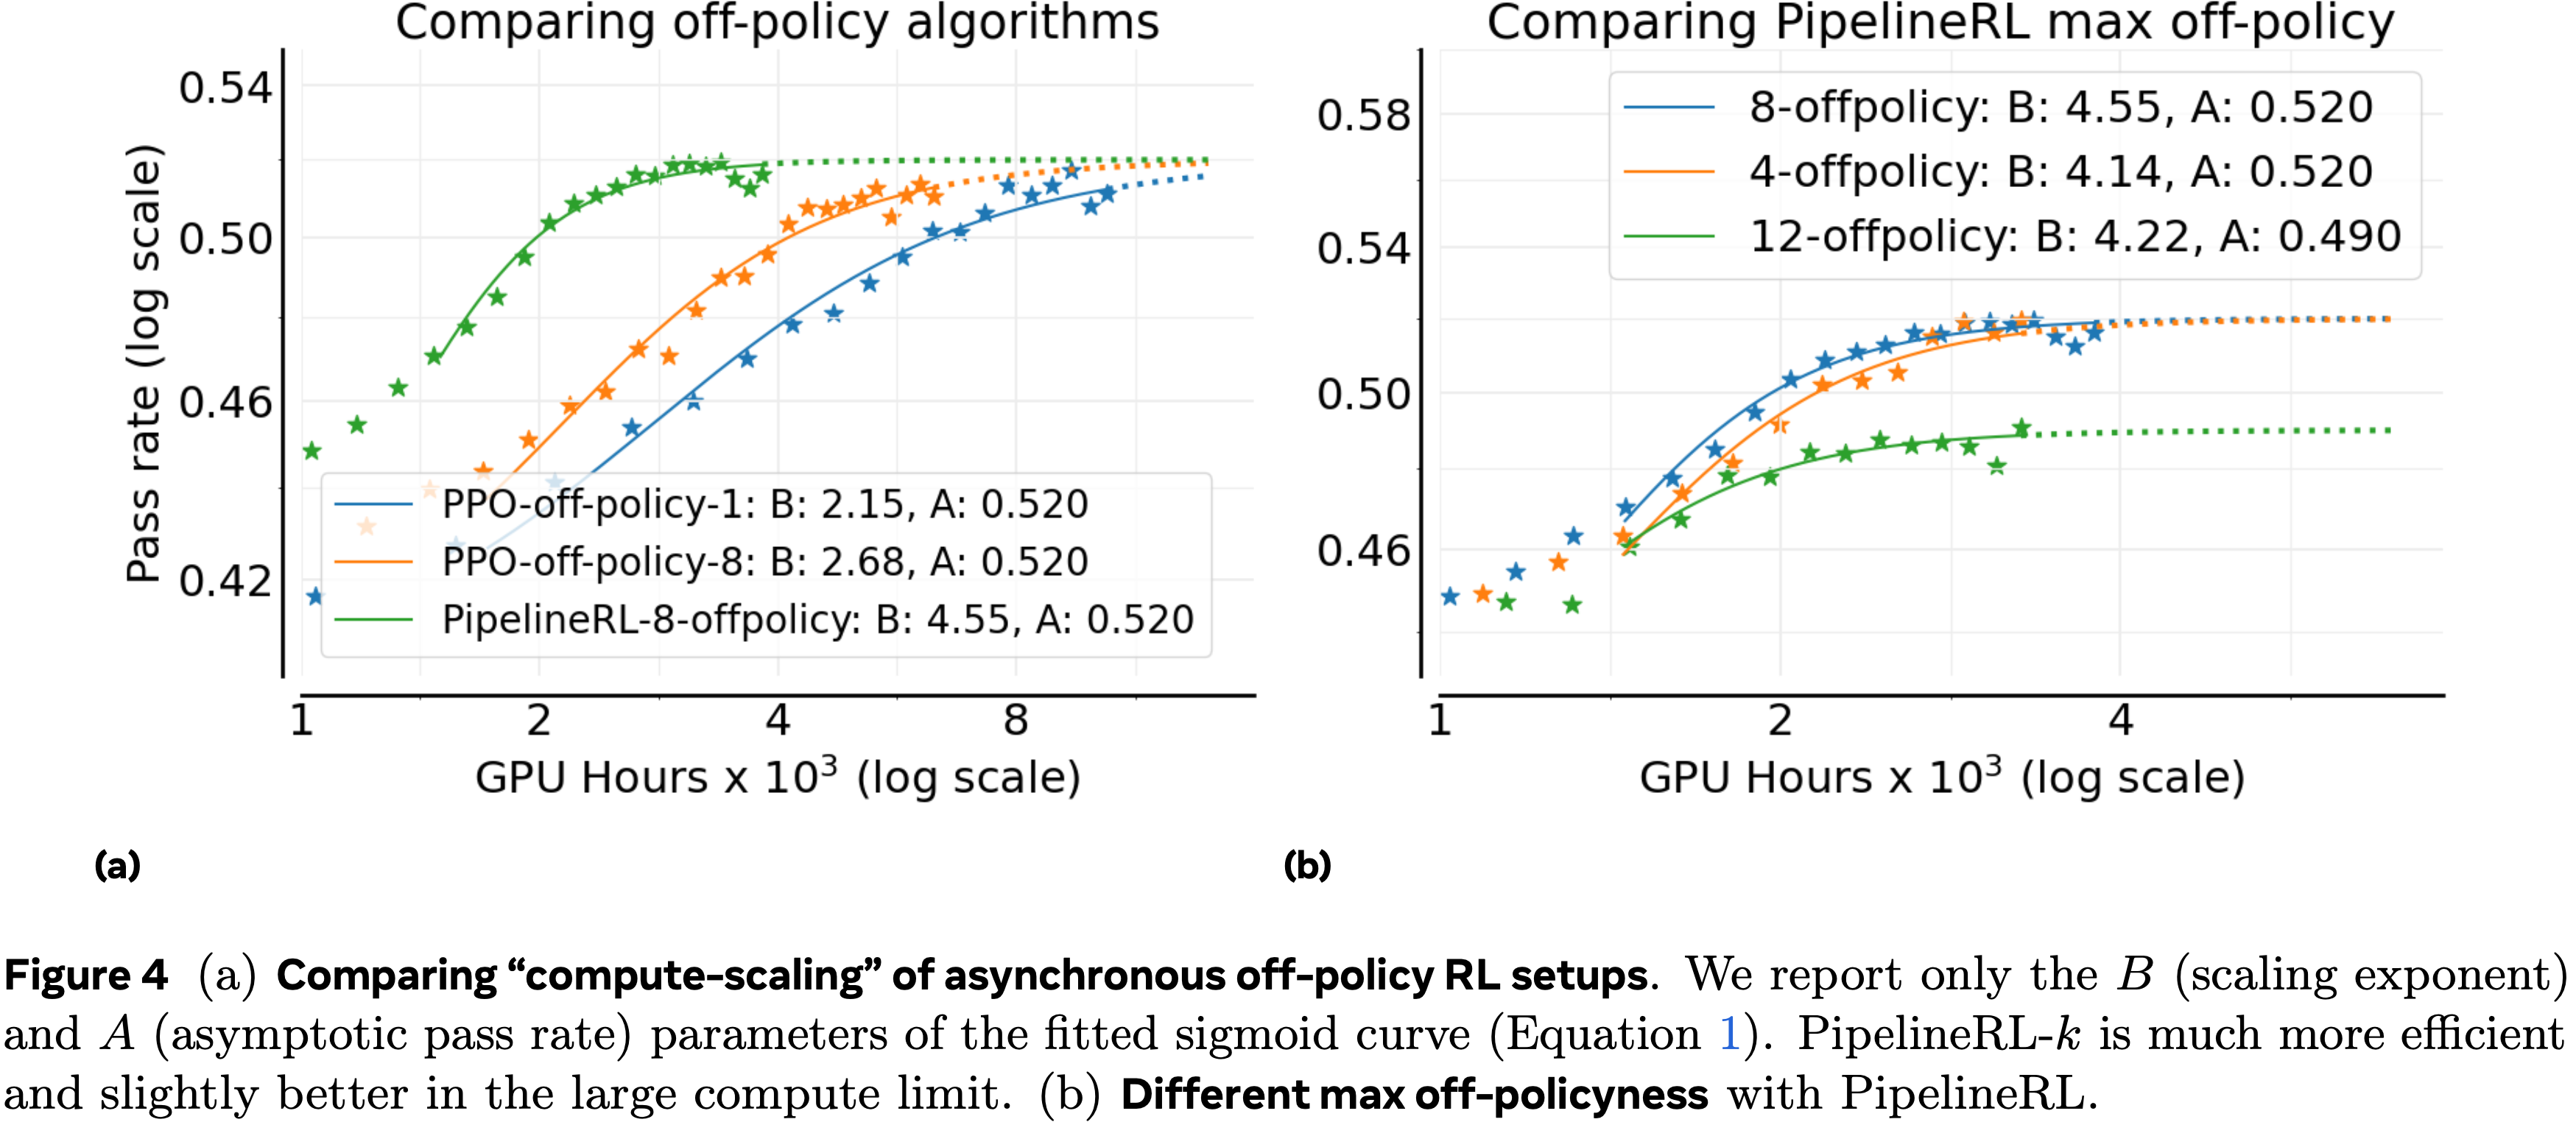
  • 论文在图 4(a) 中比较了这些方法
    • PipelineRL 和 PPO-off-policy 实现了相似的渐近性能 \(A\),但 PipelineRL 显著提高了计算效率 \(B\);从而更快地达到上限 \(A\)
      • 因为 PipelineRL 减少了训练过程中的空闲时间
    • 这种选择以更少的 Token 产生可靠的收益,使得在较低计算预算下进行更大范围的扫描成为可能
    • 论文还改变了 PipelineRL 的最大 Off-policy 程度,并发现 \(k=8\) 是最优的,如图 4(b) 所示,论文将在附录 A.11 中进一步讨论
Algorithmic Choices

  • 基于以上结果,论文采用 PipelineRL-8 作为论文更新后的基线。然后论文研究了六个额外的算法轴:
    • (a) 损失聚合, loss aggregation
    • (b) 优势归一化,advantage normalization
    • (c) 精度修正,precision fixes
    • (d) 数据课程,data curriculum
    • (e) 批次定义,batch definition
    • (f) 损失类型,loss type
  • 在第 4 节,论文将最佳选项组合成一个统一的 Recipe ,称为 ScaleRL (Scale-able RL),并在 16,000 GPU hous 的更大规模上进行留一法实验

Loss type

  • 论文将非对称 DAPO 损失(公式 8)与两个最近提出的替代方案进行比较:GSPO (Qwen, 2025a) 和 CISPO (MiniMax, 2025; 2025)
  • GSPO 在序列级别应用重要性采样,而不是 GRPO 的 Token-level 公式。具体来说,GSPO 将 Token-level 的 IS 比率(公式 2)改变为序列级别的比率:
    $$ \rho_{i}(\theta)=\frac{ {\pi_\text{train}(y_{i}|x,\theta)} }{ {\pi_{gen}(y_{i}|x,\theta_{\text{old} })} }$$
  • CISPO 简单地将截断 IS 与普通策略梯度 (Ionides, 2008) 结合起来,其中 \(\mathbf{sg}\) 是停止梯度函数:
    $$\mathcal{J}_{\text{CISPO} }(\theta)=\underset{\begin{subarray}{c}x\sim D,\ (y_{t})_{t=1}^{G}\sim\pi_{gen}(\cdot|x,\theta_{\text{old} })\end{subarray} }{\mathbb {E} }\left[\frac{1}{T}\sum_{t=1}^{G}\sum_{t=1}^{\lvert y_{t}\rvert}\mathbf{sg}(\min(\rho_{i,t},\epsilon_{\max}))\hat{A}_{i}\log \left(\pi_\text{train}(y_{i,t}|x,y_{i<t},\theta)\right)\right] \tag{4}$$
  • 图 5(a) 显示 GSPO 和 CISPO 都显著优于 DAPO,大幅提高了渐近通过率 \(A\)
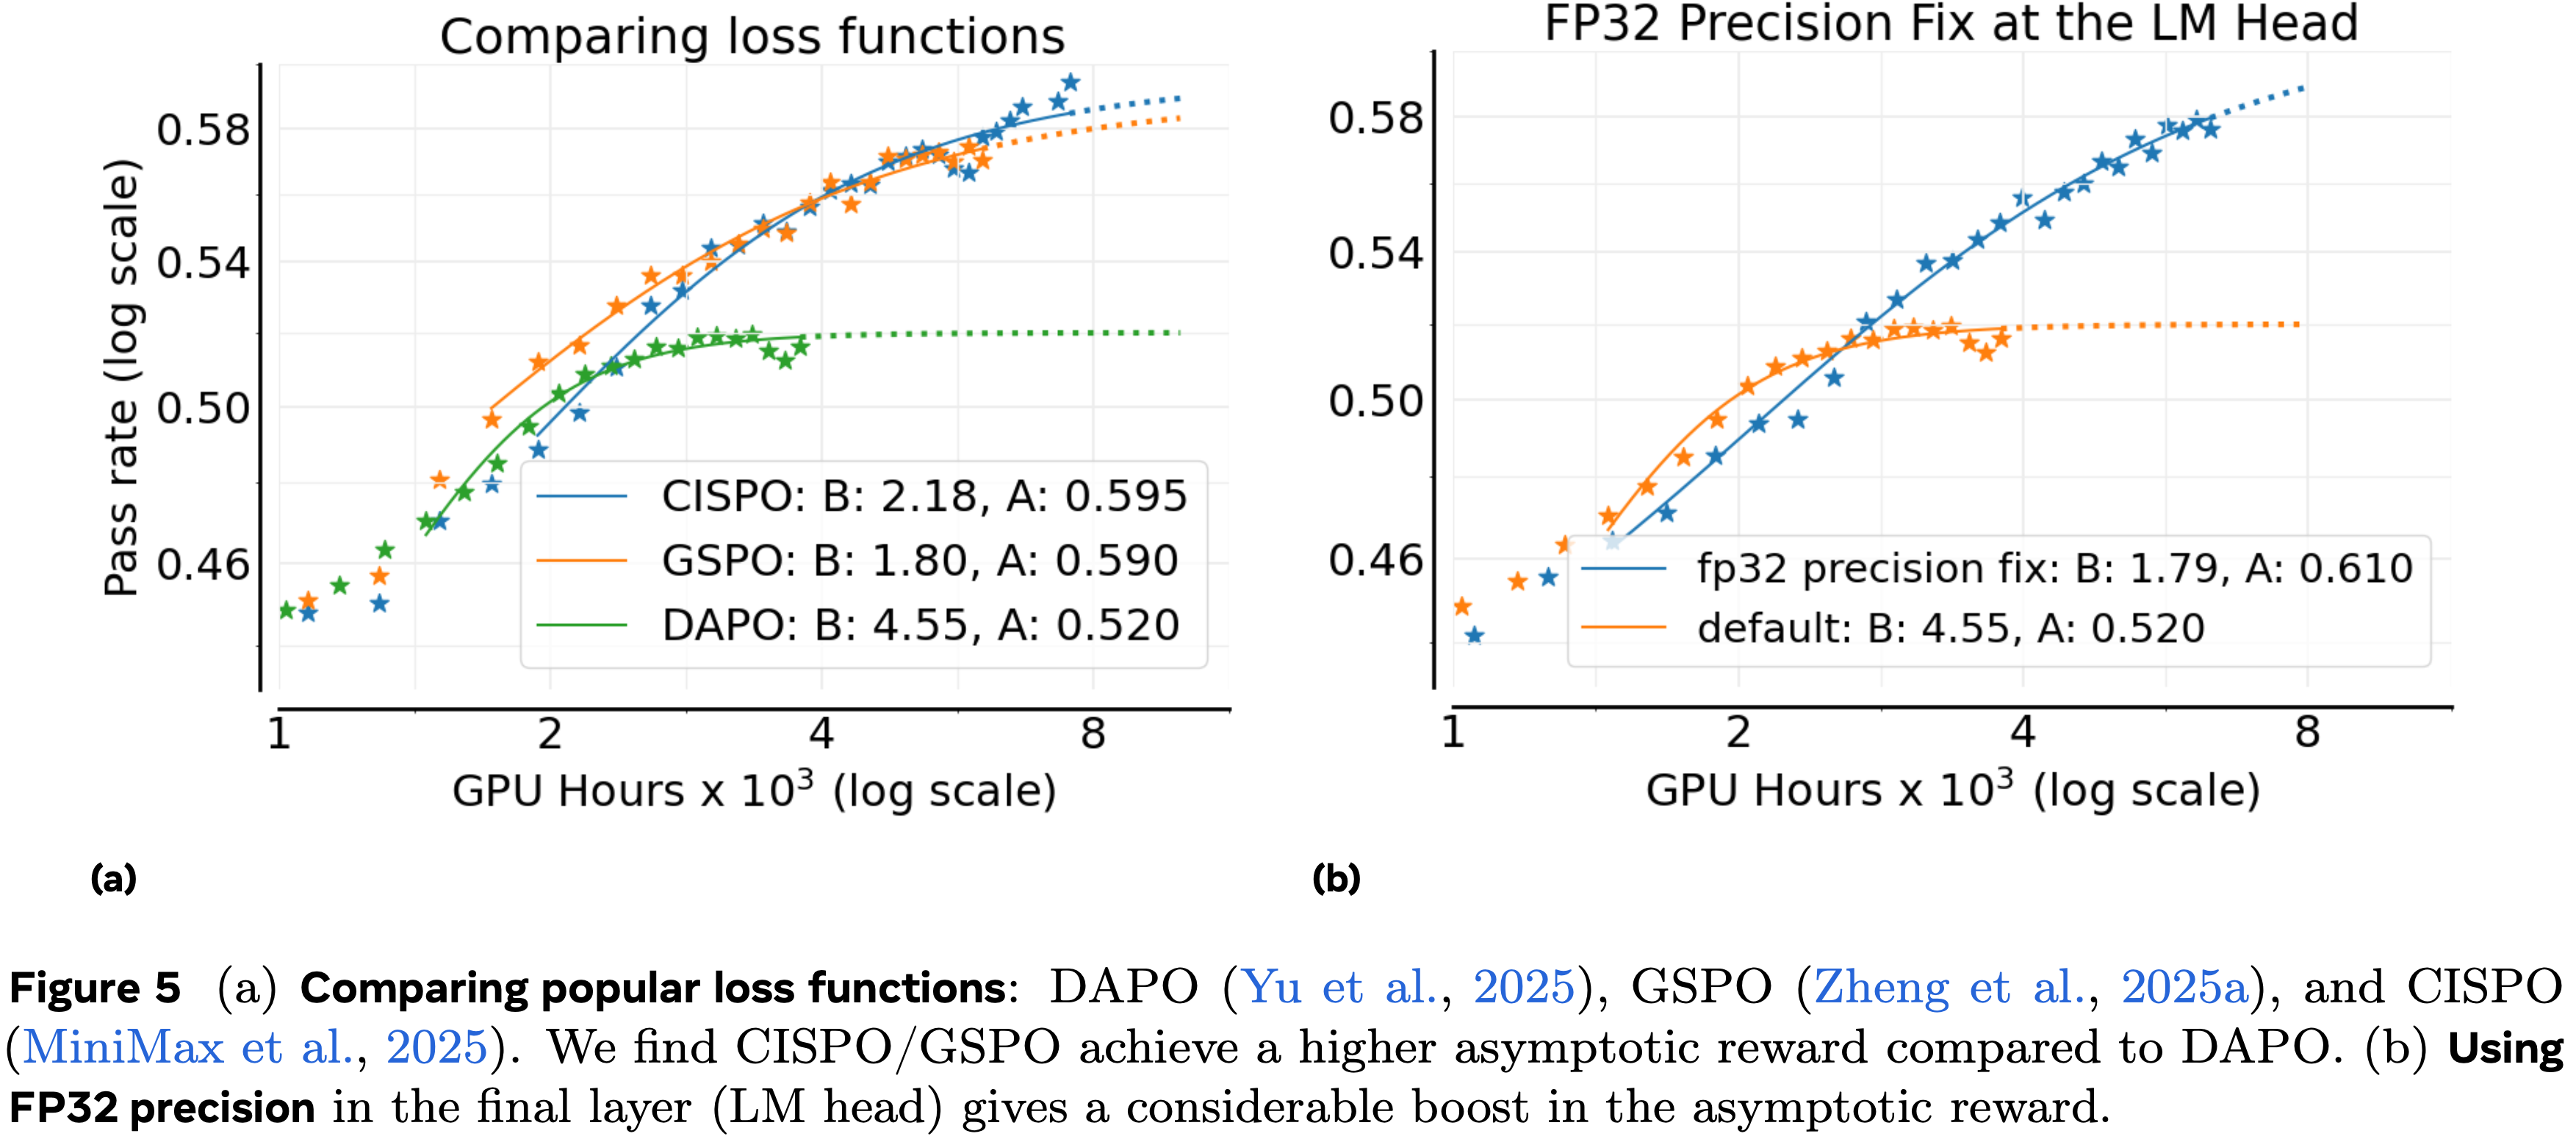
  • CISPO 表现出延长的近线性奖励增长,并且在训练后期略优于 GSPO,因此论文选择 CISPO 作为论文的最佳损失类型
  • 关于 Off-policy 损失类型及其超参数鲁棒性的进一步讨论在第 4 节和附录 A.17 中详述

FP32 Precision for LLM logits

  • Generator 和 Trainer 依赖不同的内核进行推理和训练,导致它们的 Token 概率存在小的数值不匹配 (ThinkingMachine Defeating nondeterminism in LLM inference, 2025)
    • RL 训练对此类差异高度敏感,因为它们直接影响 Surrogate Objective 中的 IS 比率
  • MiniMax (2025) 发现这些不匹配在语言模型头(language model head)尤其明显,并通过在 Generator 和 Trainer 的 Head 使用 FP32 计算来缓解这个问题
    • 如图 5(b) 所示,精度修正将渐近性能 \(A\) 从 \(0.52\) 显著提高到 \(0.61\)
    • 鉴于这个明显的好处,论文将 FP32 精度修正包含在论文的 ScaleRL Recipe 中

Loss Aggregation

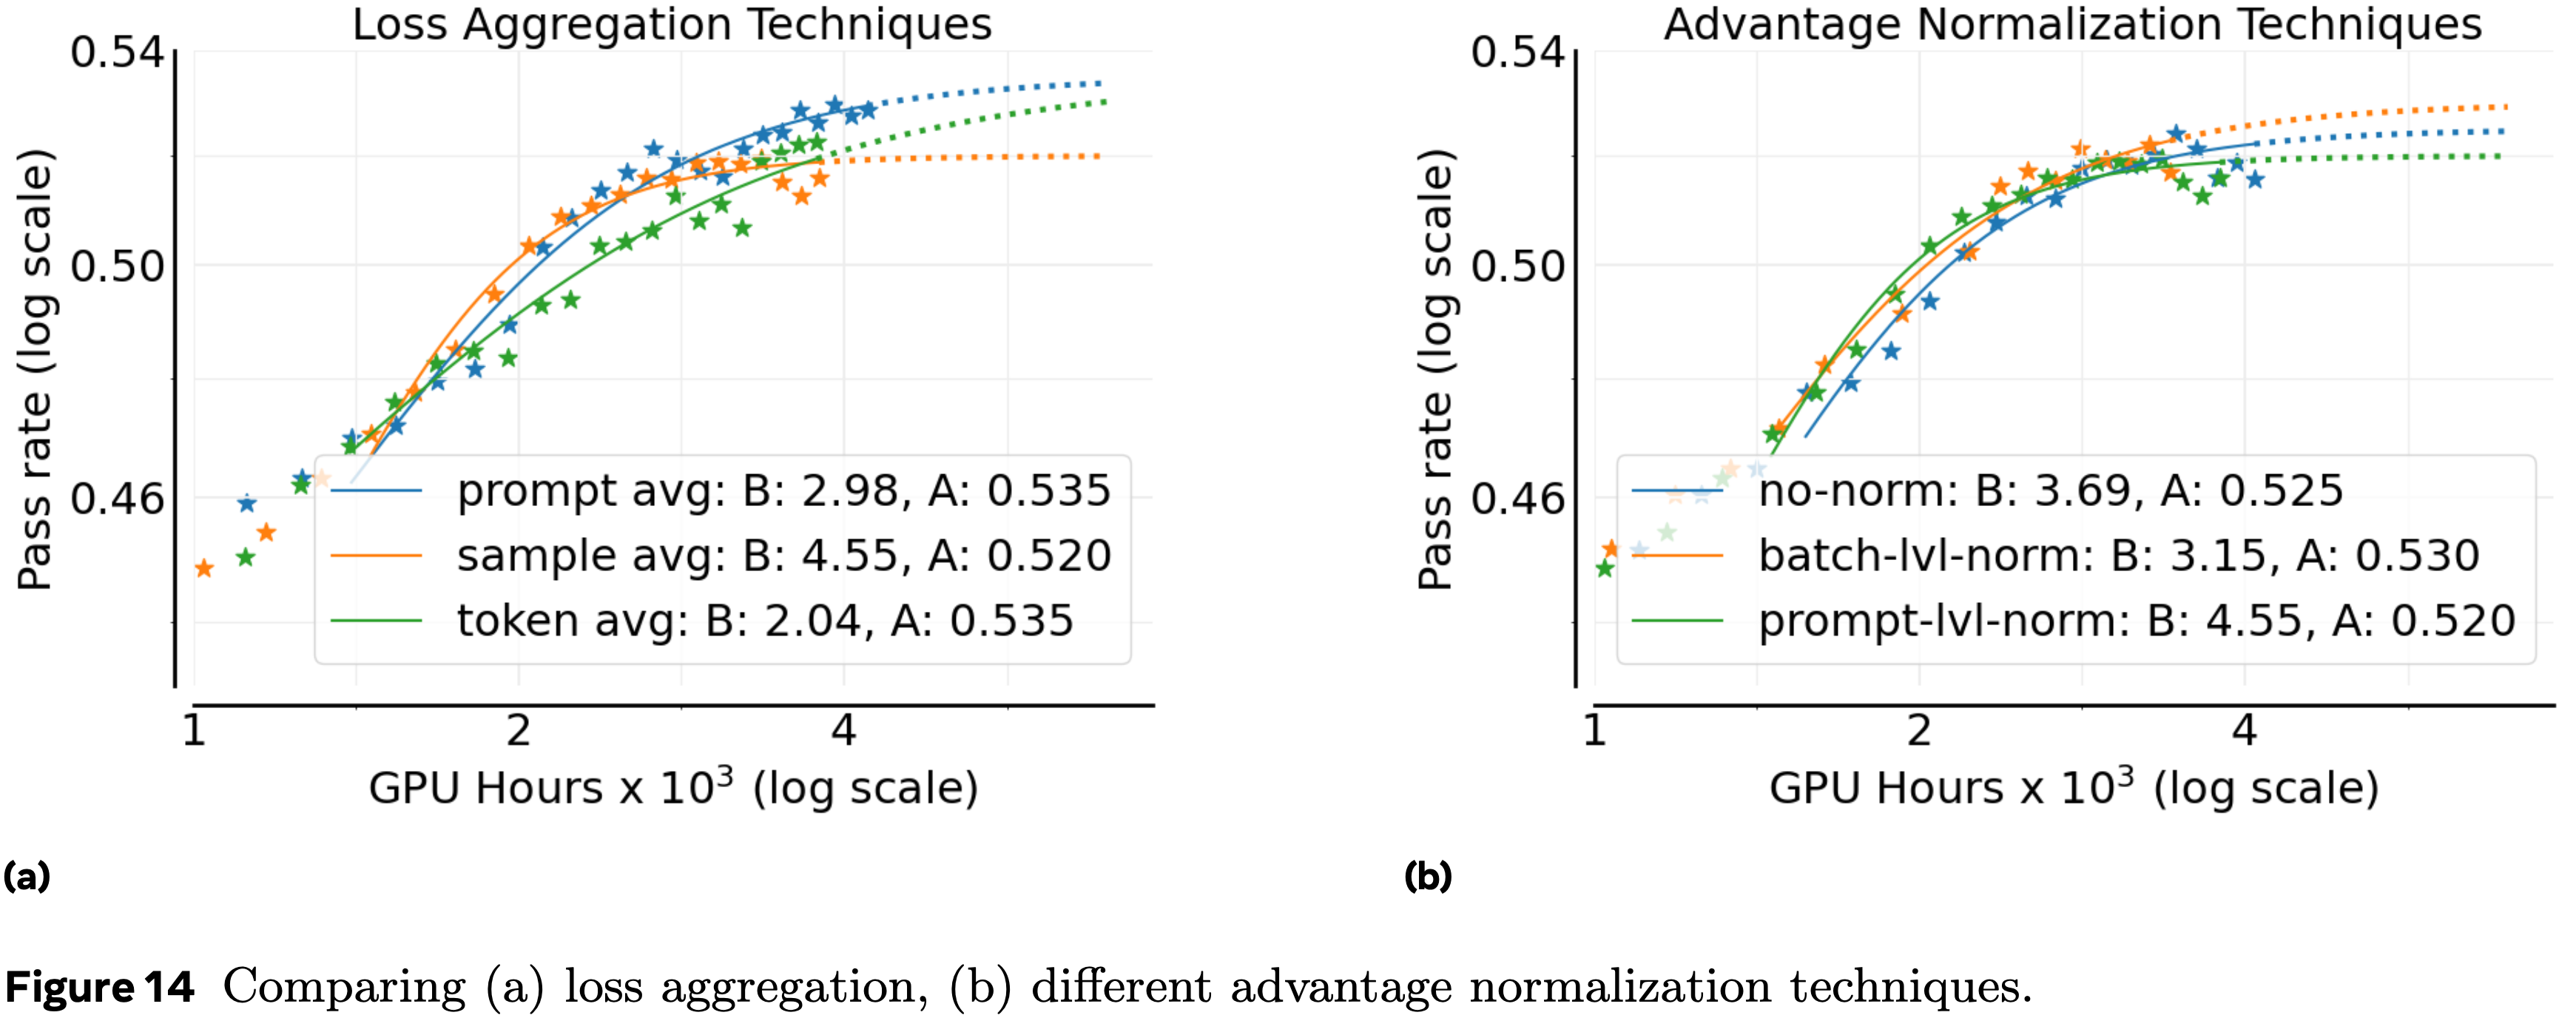
  • 论文评估了三种聚合 RL 损失的策略:
    • (a) 样本平均(Sample average) ,每个 rollout 贡献相等(如 GRPO,附录 A.2)
    • (b) 提示平均(Prompt average) ,每个提示贡献相等(如 DAPO,附录 A.2)
    • (c) Token 平均(Token average) ,批次中的所有 Token 损失直接平均,没有中间分组
  • 比较结果见附录 A.9(图 14(a))
  • 论文发现 Prompt average 实现了最高的渐近性能,因此在 ScaleRL 中使用此选择

Advantage Normalization

  • 论文比较了三种优势归一化的变体:
    • (a) 提示级别(Prompt level) ,优势通过同一提示的 rollout 奖励的标准差进行归一化(如 GRPO,附录 A.2)
    • (b) 批次级别(Batch level) ,优势通过批次中所有生成的标准差进行归一化,如 Reinforce++ (2025a); Magistral (2025) 所用
    • (c) 无归一化(No normalization) ,优势计算为原始奖励减去提示生成的平均奖励,没有方差缩放(如 Dr. GRPO (2025c) 所提出)
  • 比较图见附录 A.9(图 14(b)),观察到所有三种方法产生相似的性能
  • 因此论文采用 Batch level 归一化,因为它在理论上合理且略好
  • 这个选择在第 4 节的更大规模留一法实验中也得到了进一步证实

Zero-Variance Filtering

  • 在每个批次中,一些提示在其所有生成中产生相同的奖励
    • 这些“零方差”提示具有零优势,因此贡献零策略梯度
    • 默认基线在损失计算中包含这些提示,但尚不清楚是否应将它们包含在有效批次中
  • 为了测试这一点,论文将默认设置与有效批次(effective batch)方法进行比较
    • 在 effective batch approach 中,只有具有非零方差的提示被包含在损失计算中(如 Seed (2025) 所做)
  • 请注意:零方差过滤不同于 DAPO (2025) 中的动态采样
    • 零方差过滤仅仅是丢弃 Prompt ,而 DAPO 是重新采样更多提示直到批次满员(until the batch is full)
    • 论文在图 6(a) 中显示使用有效批次在渐近性能上表现更好;论文将其纳入论文的 ScaleRL Recipe
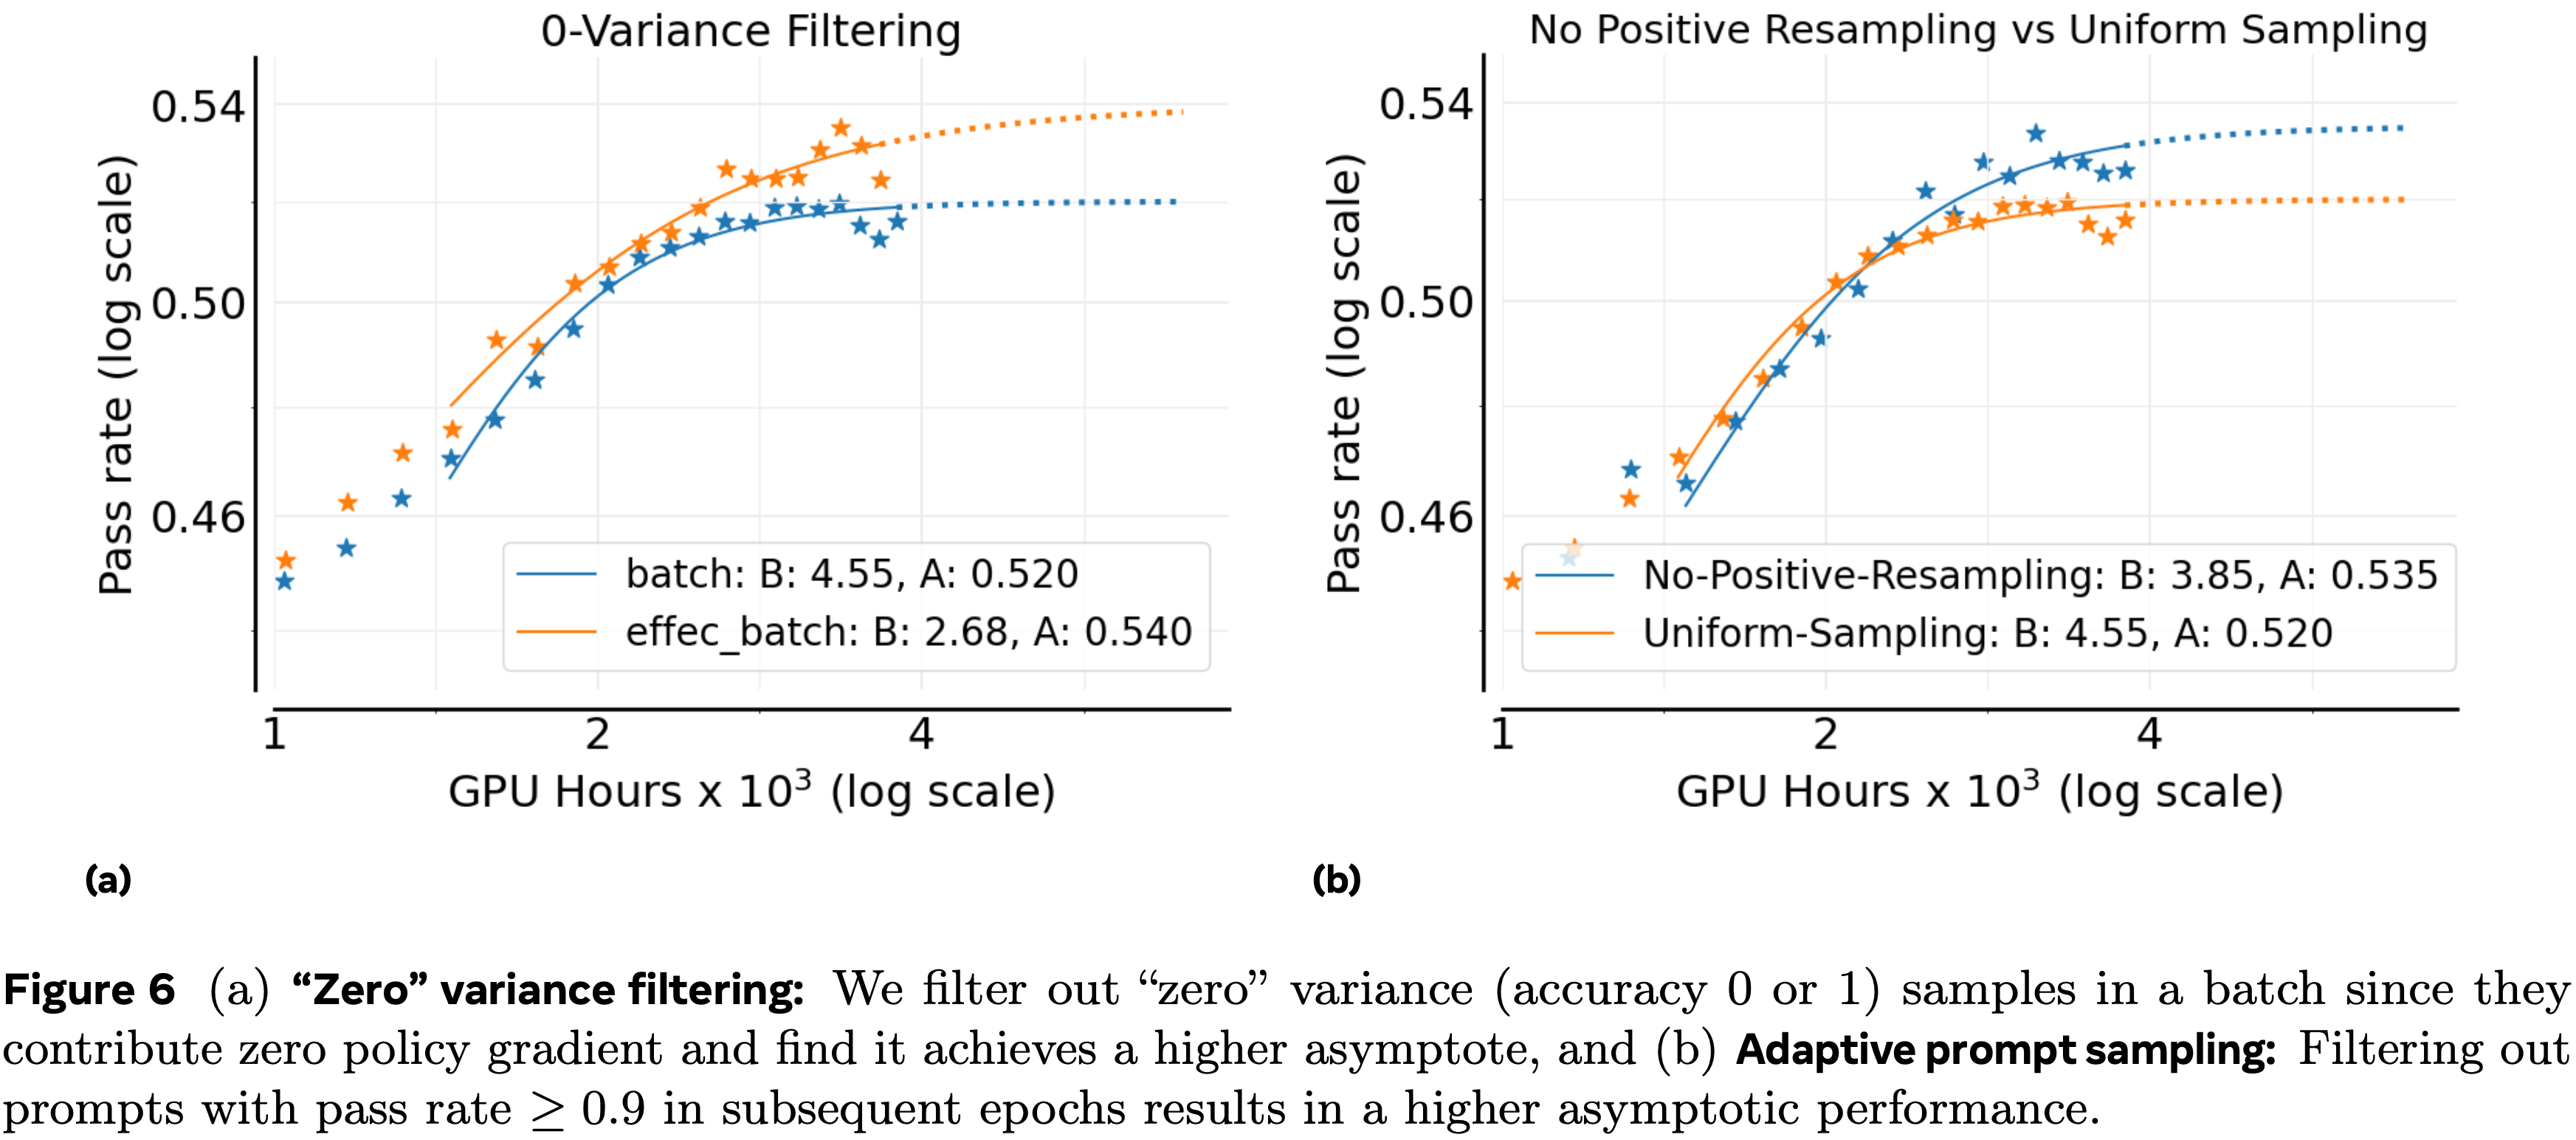
Adaptive Prompt Filtering

  • 已经提出了许多用于 RL 训练的数据课程策略以提高样本效率 (2025; 2025b; 2025b)
  • 这里论文评估一个简单的变体,由 (2025) 引入,其关键观察是
    • 一旦一个提示对策略变得过于简单,它通常会持续保持简单
    • 由于这样的提示消耗一些计算但不再贡献有用的梯度信号(第 3.2 节),最好将它们从未来的训练中排除
  • 论文通过维护一个通过率历史记录并永久移除任何通过率 \(\geq 0.9\) 的提示在后续周期中来实现这一点(论文称之为 No-Positive-Resampling)
  • 在图 6(b) 中,论文将此课程与默认设置(所有提示在整个训练过程中均匀重新采样)进行比较
    • 论文看到课程提高了可扩展性和渐近奖励 \(A\)

ScaleRL: 有效且可预测地扩展强化学习计算 (ScaleRL: Scaling RL Compute Effectively & Predictably)

  • 根据上述研究的设计维度,论文将性能最佳的设置整合到一个单一的 Recipe 中,论文称之为 ScaleRL (Scale-able RL)
  • ScaleRL 是一种异步强化学习 Recipe ,它使用下面的配置:
    • 具有 8 步 Off-policy 性的 PipelineRL
    • 基于中断的长度控制进行截断(interruption-based length control for truncation)
      • 注:后文有提到,对于强制中断,论文使用思考结束短语:”Okay, time is up. Let me stop thinking and formulate a final answer now. </think>“
    • FP32 计算用于逻辑单元
    • 优化 \(\mathcal{J}_{\texttt{ScaleRL} }(\theta)\) 损失
  • \(\mathcal{J}_{\texttt{ScaleRL} }(\theta)\) 损失结合了:
    • Prompt-level 损失聚合
    • Batch-level 优势归一化
      • 注意:是按照批次做 Advantage 归一化的,不是 GRPO 方法,而是类似 REINFORCE++ 方法
      • 补充:REINFORCE++ 的方法:
        • 记录历史平均奖励作为基线,判断模型是否在进步
        • 使用历史奖励的均值和方差做归一化,类似 Batch Normalization)
    • 截断重要性采样(truncated importance-sampling)REINFORCE 损失 (CISPO)
    • 零方差过滤(zero-variance filtering)
    • 无正例重采样(no-positive resampling)
      $$\begin{split}\mathcal{J}_{\texttt{ScaleRL} }(\theta)=& \underset{x\sim D,\atop\{y_{i}\}_{i=1}^{G},\sim\pi^{data}_{g\in h}( \cdot|x)}{\mathbb{E} }\left[\frac{1}{\sum_{g=1}^{G}|y_{g}|}\sum_{i=1}^{G}\sum_{t=1 }^{|y_{i}|}\mathsf{sg}(\min(\rho_{i,t},\epsilon))\hat{A}^{\text{norm} }_{i}\log \pi^{ {\theta} }_\text{train}(y_{i,t})\right],\\ \rho_{i,t}=&\frac{\pi^{ {\theta} }_\text{train}(y_{i,t})}{\pi^{ {\theta}_{add} }_{g\in h}(y_{i,t})},\hat{A}^{\text{norm} }_{i}=\hat{A}_{i}/\hat{A}_{\text{std} },0<\text{mean}(\{r_{j}\}_{j=1}^{G})<1,\text{pass_rate} (x)<0.9,\end{split}$$
    • 其中 \(\mathsf{sg}\) 是停止梯度函数
    • \(\hat{A}_{\text{std} }\) 是一个批次中所有优势 \(\hat{A}_{i}\) 的标准差
    • pass_rate\((x)\) 表示提示 \(x\) 的历史通过率

留一法消融实验 (Leave-One-Out (LOO) Ablations)

  • 为了验证这些选择在组合后仍然是最优的,论文进行了留一法 (LOO) 实验:
    • 从 ScaleRL 开始,论文每次将一个维度恢复到其在第 2 节中的基线对应项
    • 这确保了每个设计决策即使在其他所有决策都存在的情况下也能做出积极贡献
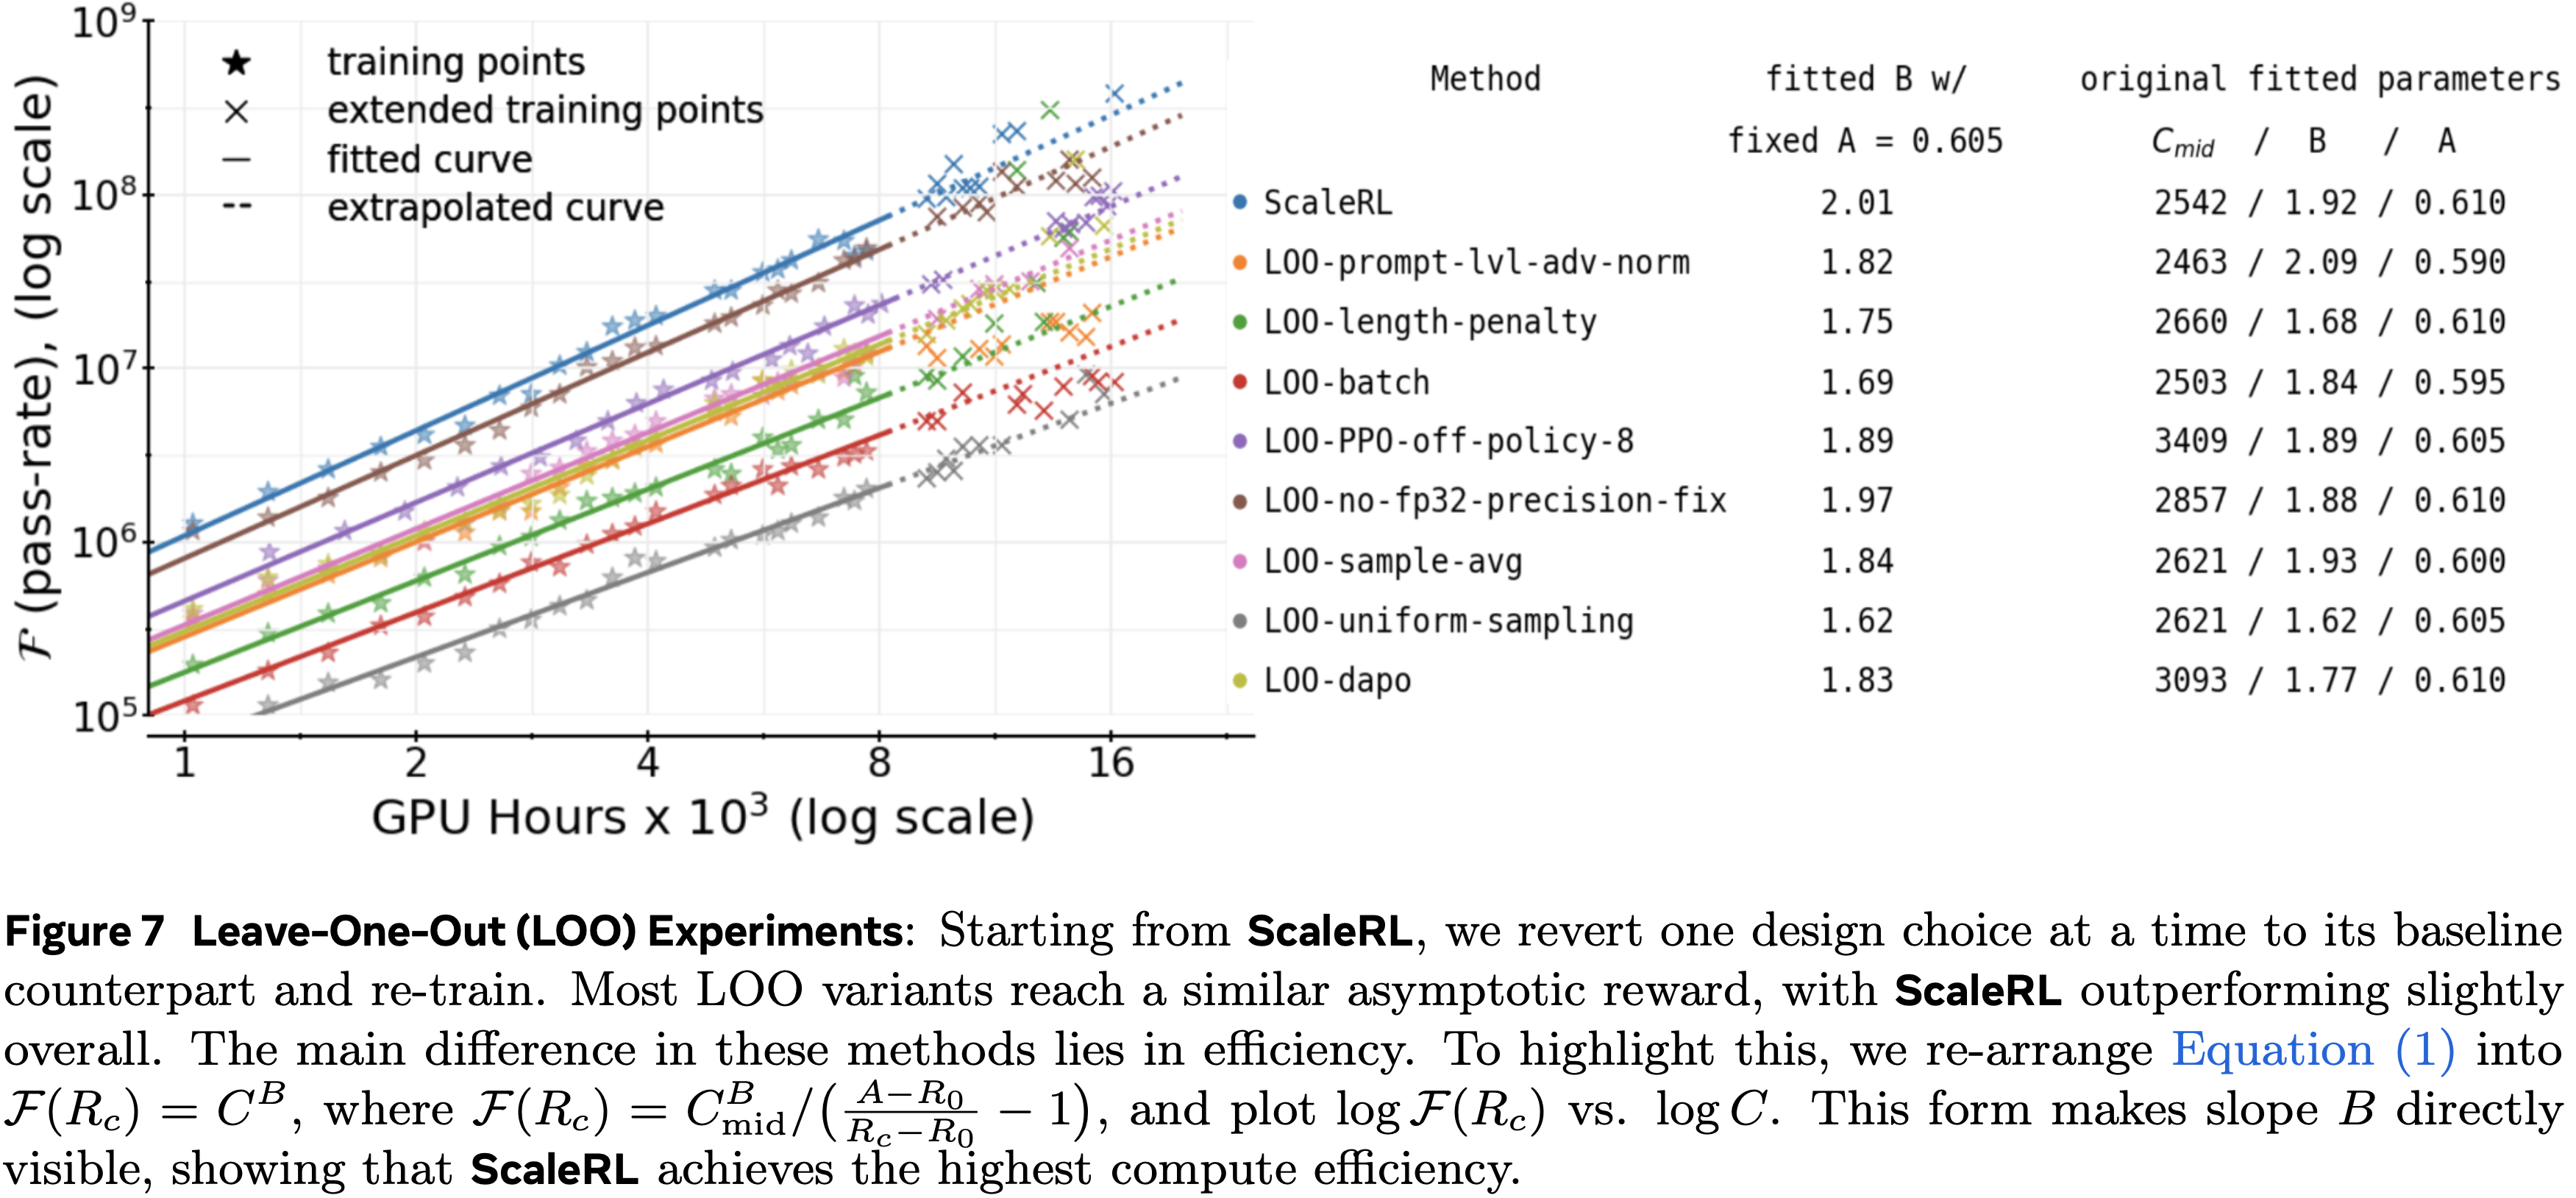
  • 图 7 报告了这些实验,每个实验扩展到 16k GPU hous
  • 在所有维度上,ScaleRL 始终是最有效的配置,在渐近奖励或计算效率上略微优于 LOO 变体(参见图 7 表格的最后一列)
    • 由于大多数 LOO 变体达到相似的渐近通过率,论文将 sigmoid 拟合转换为幂律拟合,以通过斜率 \(B\) 突出效率差异(细节见图 7)
    • 具体来说,论文平均所有运行的渐近奖励 \(A\),用这个固定的 \(A\) 重新拟合曲线,然后在图 7 中比较斜率(衡量效率)
    • 相应的未转换的通过率与计算曲线在附录 A.2 中提供

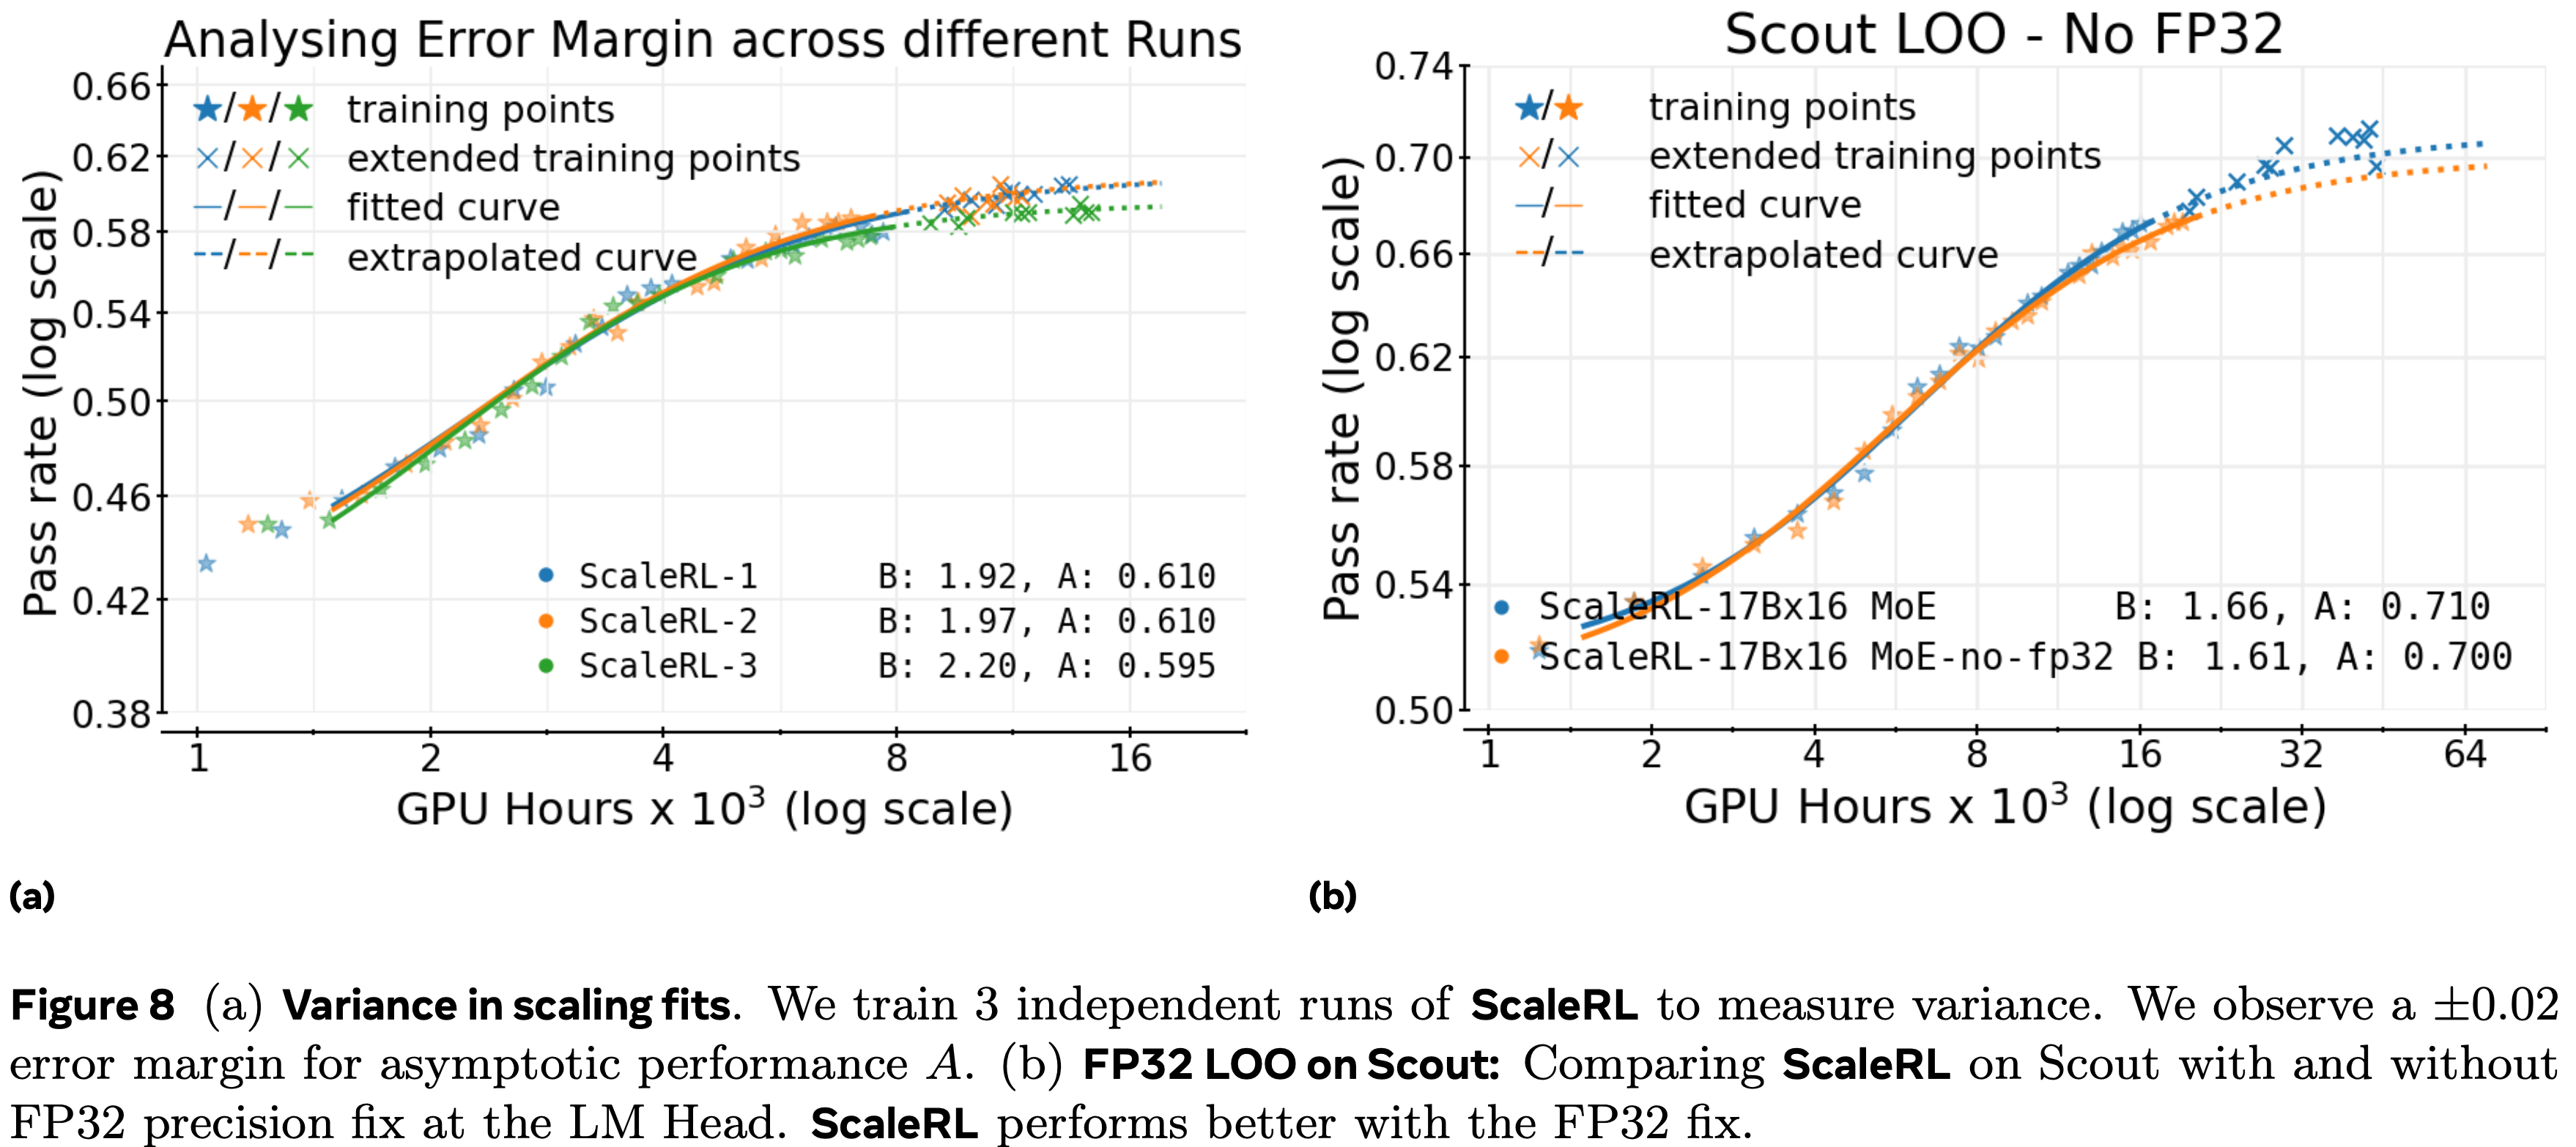
Error margin(误差范围)in fitting scaling curves

  • 由于强化学习训练已知具有高方差 (2021),论文使用三个独立的 ScaleRL 运行(图 8a)来估计拟合缩放系数的变异性
    • 观察到的渐近奖励和效率参数的方差作为论文的经验误差范围,用于确定两个不同运行的计算效率或渐近性能的变化是否具有统计意义 (2024)
Extrapolating Scaling Curves

  • 在论文所有的 LOO 实验以及独立的 ScaleRL 运行中,论文拟合了高达 8000 GPU hous 的 sigmoid 曲线,并外推到 16000 GPU hous ,观察到预测曲线与训练点和扩展点都紧密对齐
    • 这证明了 ScaleRL 和其他稳定、可扩展的 Recipe 在大规模强化学习训练下的稳定性和可预测性

Are the design choices worth it?

  • 在第 3.2 节中,某些设计选择改变了渐近性能,例如损失类型(图 5a)和 FP32 精度(图 5b)
  • 但在论文使用 ScaleRL 的 LOO 实验中(图 7),这些组件单独来看似乎不那么关键(图中最后一列)
  • 这就提出了一个问题:某些设计选择是否可以安全地保留其”默认”值
    • 作者认为上述问题的答案是否定的
    • 即使一个选择在组合 Recipe 中显得多余,它仍然可以提供稳定性或鲁棒性,这在其他情况下可能变得至关重要
      • 问题:如何理解显得多余又能提供稳定性或鲁棒性,是指不使用这些指标时,不同随机种子下表现差异大吗?还是说在不同的 模型规模或者数据集上表现差异大?
    • 例如,虽然 FP32 精度修复在使用 ScaleRL 训练的密集 8B 模型上差异不大(图 7),但它在 GRPO/DAPO 风格的损失中通过减轻数值不稳定性带来了巨大收益
      • 这表明它的好处超出了论文研究的特定 ScaleRL 配置
      • 为了进一步测试这一点,论文在 Scout 17Bx16 MoE 上进行了留一法实验,观察到 FP32 精度提高了整体可扩展性(图 8b)
    • 损失类型也出现了类似的情况
      • 在图 7 中,恢复到 DAPO 在 ScaleRL 内产生了与 CISPO 相似的渐近性能
      • 但如论文在附录 A.17 中讨论的那样,CISPO 对 IS 裁剪参数 \(\epsilon_{\text{max} }\) 的选择明显更鲁棒,降低了训练对超参数调整的敏感性
      • 而且它在 LOO 实验中比 DAPO 更高效(\(B=2.01\) 对比 \(B=1.77\))
      • 这证明了即使一个经过仔细调整的 DAPO 变体在渐近性能上可能相似,也倾向于选择 CISPO 是合理的
  • 总之,即使个别设计选择在组合 Recipe 中显得多余,它们通常也能以跨模型和设置泛化的方式增强训练稳定性、鲁棒性或效率
    • ScaleRL 保留这些组件不仅仅是为了在特定配置中获得边际收益,而是因为它们解决了在强化学习体系中反复出现的不稳定性和方差来源
  • 注:本节的主要目标是说明,很多改进点看似在论文特定场景下没有收益,但在更通用的其他场景(随机种子,数据集,模型等)下,可能会有收益,为了保证方法的稳定性,建议加上一些确定性的改进点

Predictable Scaling Returns Across RL Compute Axes(跨强化学习计算轴的可预测缩放回报)

  • 给定固定或增长的计算预算,哪个缩放旋钮(上下文长度、批次大小、每个提示的生成次数和模型大小)能带来最可靠的性能增益,并且论文多早可以预测到这种回报?
  • 论文通过以下方式回答这个问题:
    • (i) 在每种设置的训练早期(精确地说,是目标预算的一半)拟合方程 (1) 中的饱和幂律;
    • (ii) 外推到目标预算;
    • (iii) 扩展训练以验证预测
  • 在下面所有的轴线上,论文观察到清晰、可预测的拟合,其外推曲线与扩展轨迹对齐,反映了论文在 100,000 GPU hous 运行(图 1)和图 2 中的跨 Recipe 比较中看到的行为

模型规模(Model scale (MoE))

  • ScaleRL 在更大模型上是否仍然保持可预测性和稳定性?(注:即论文的 Scaling Law 是否能泛化到其他模型上)
  • 使用 ScaleRL 训练 17B\(\times\)16 Llama-4 Scout MoE 表现出与 8B 模型相同的可预测缩放行为 ,具有低截断率且没有不稳定性问题(附录 A.15, A.17)
    • 图 1 显示了训练曲线
  • 扩展点与拟合曲线对齐,支持了论文 Recipe 对模型规模的不变性
  • 更大的 17B\(\times\)16 MoE 表现出比 8B 密集模型高得多的渐近强化学习性能,仅使用其 1/6 的强化学习训练计算量就超越了 8B 的性能

Generation length(context budget,即上下文预算)

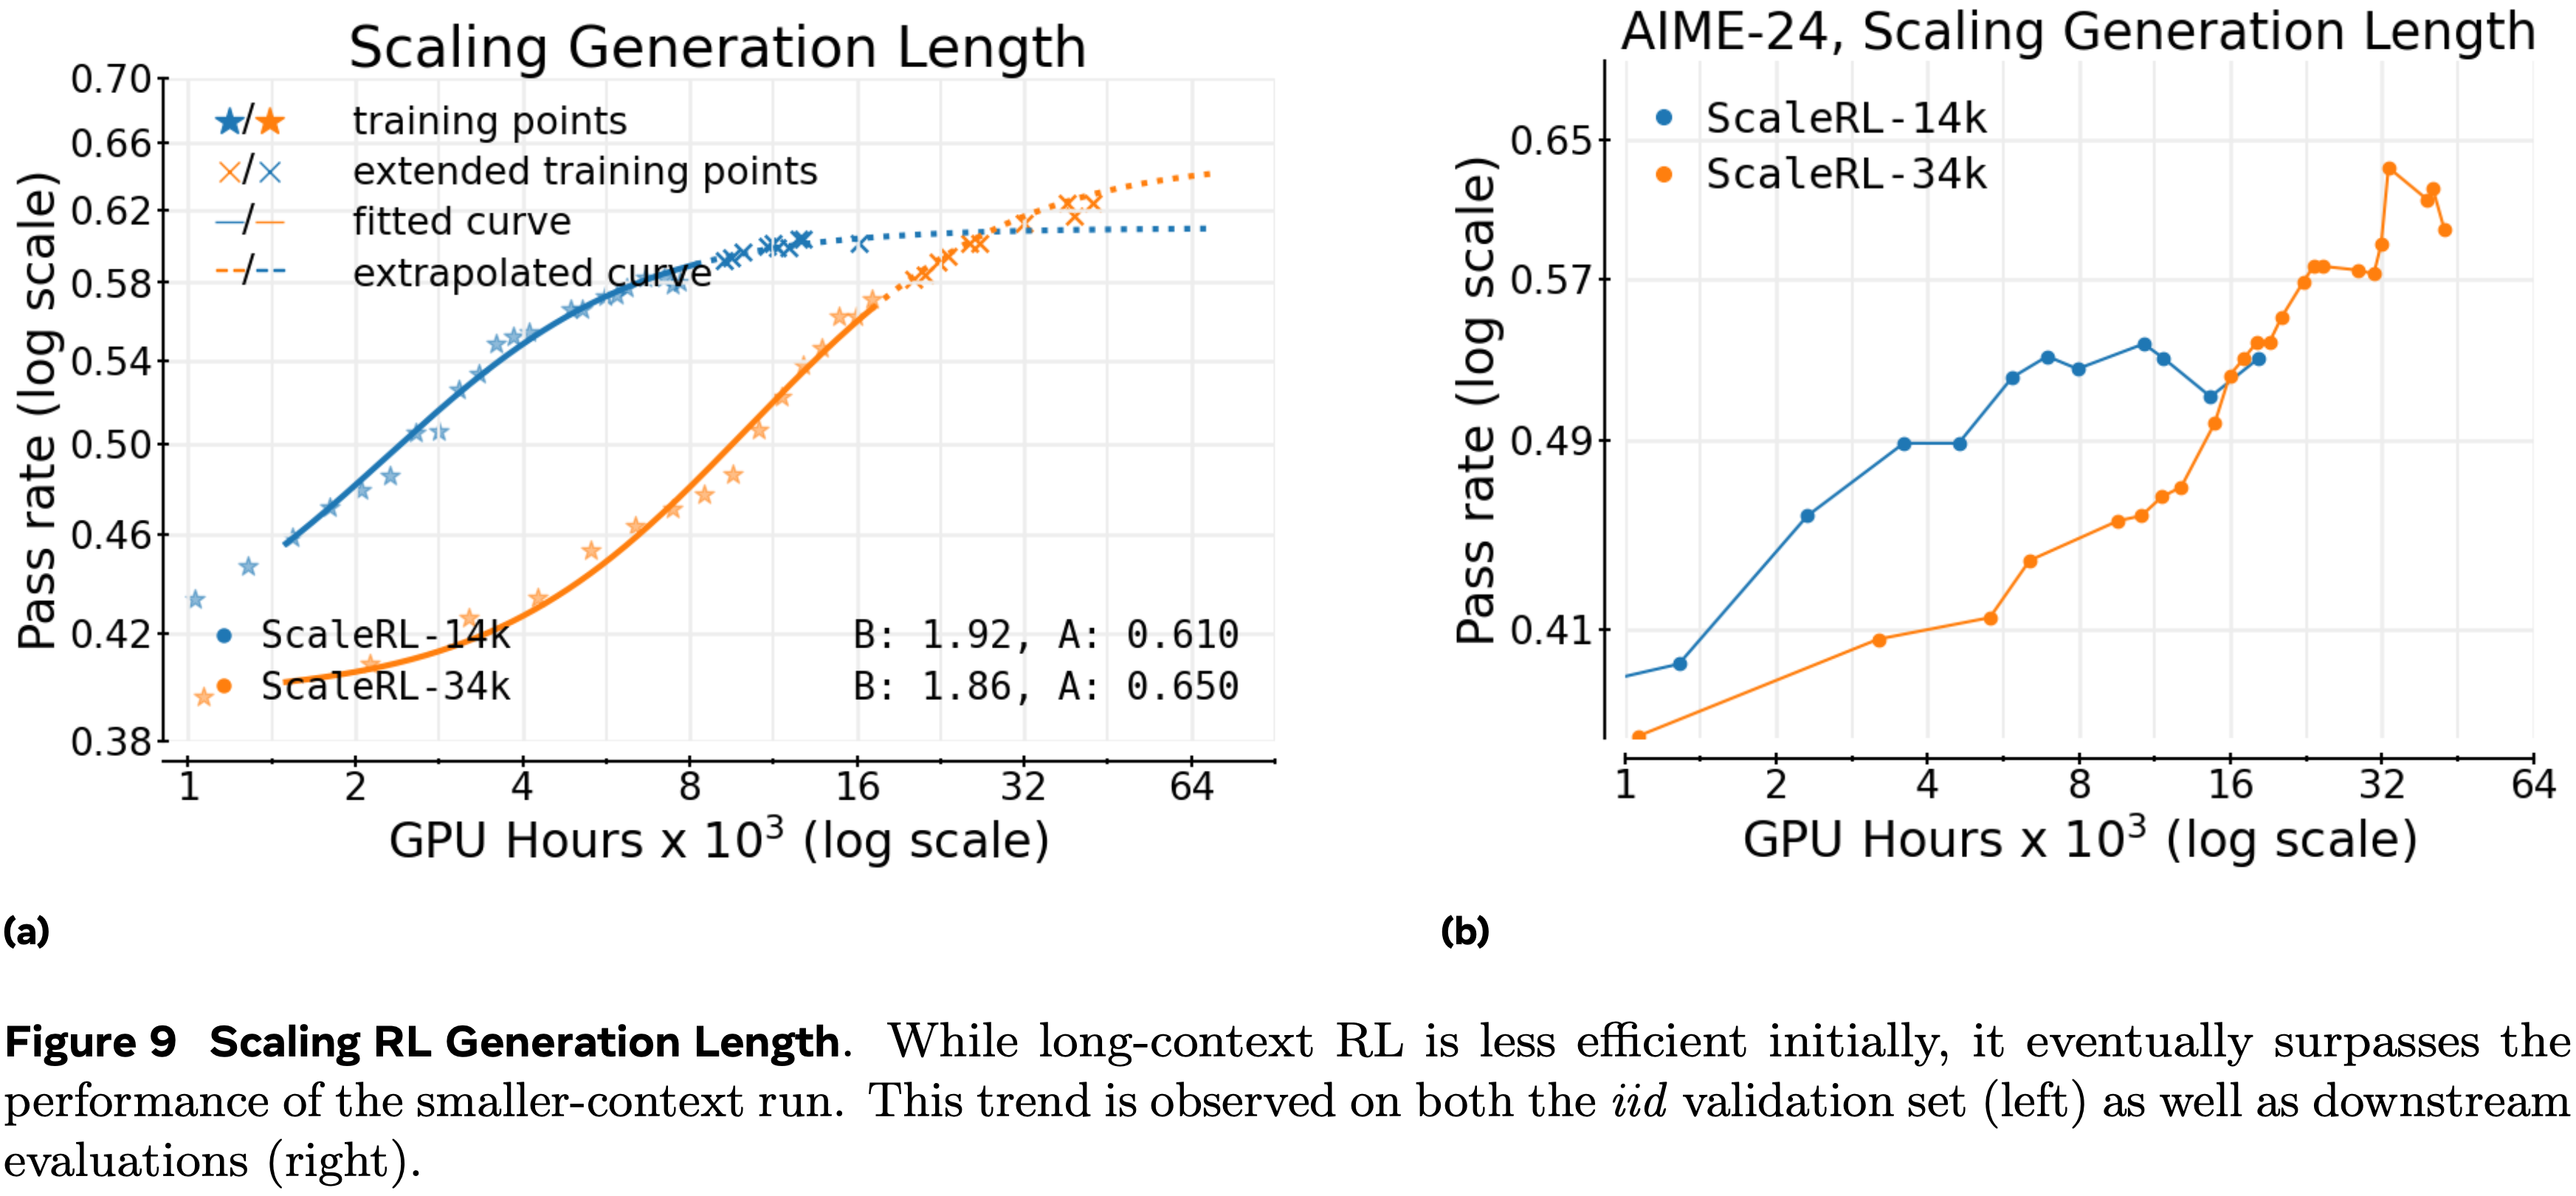
  • 将生成长度从 14k 增加到 32k 个 Token 会减缓早期进展(更低的 \(B\) 和更高的 \(C_{mid}\)),但会持续提升了拟合的渐近线 (A)
    • 提供足够的计算量后,可以产生更高的最终性能(图 9)
  • 这验证了长上下文强化学习是一个提升性能上限的旋钮,而不仅仅是效率权衡
  • 从拟合中做出的外推正确地预测了当训练扩展时更高的 32k Token 轨迹

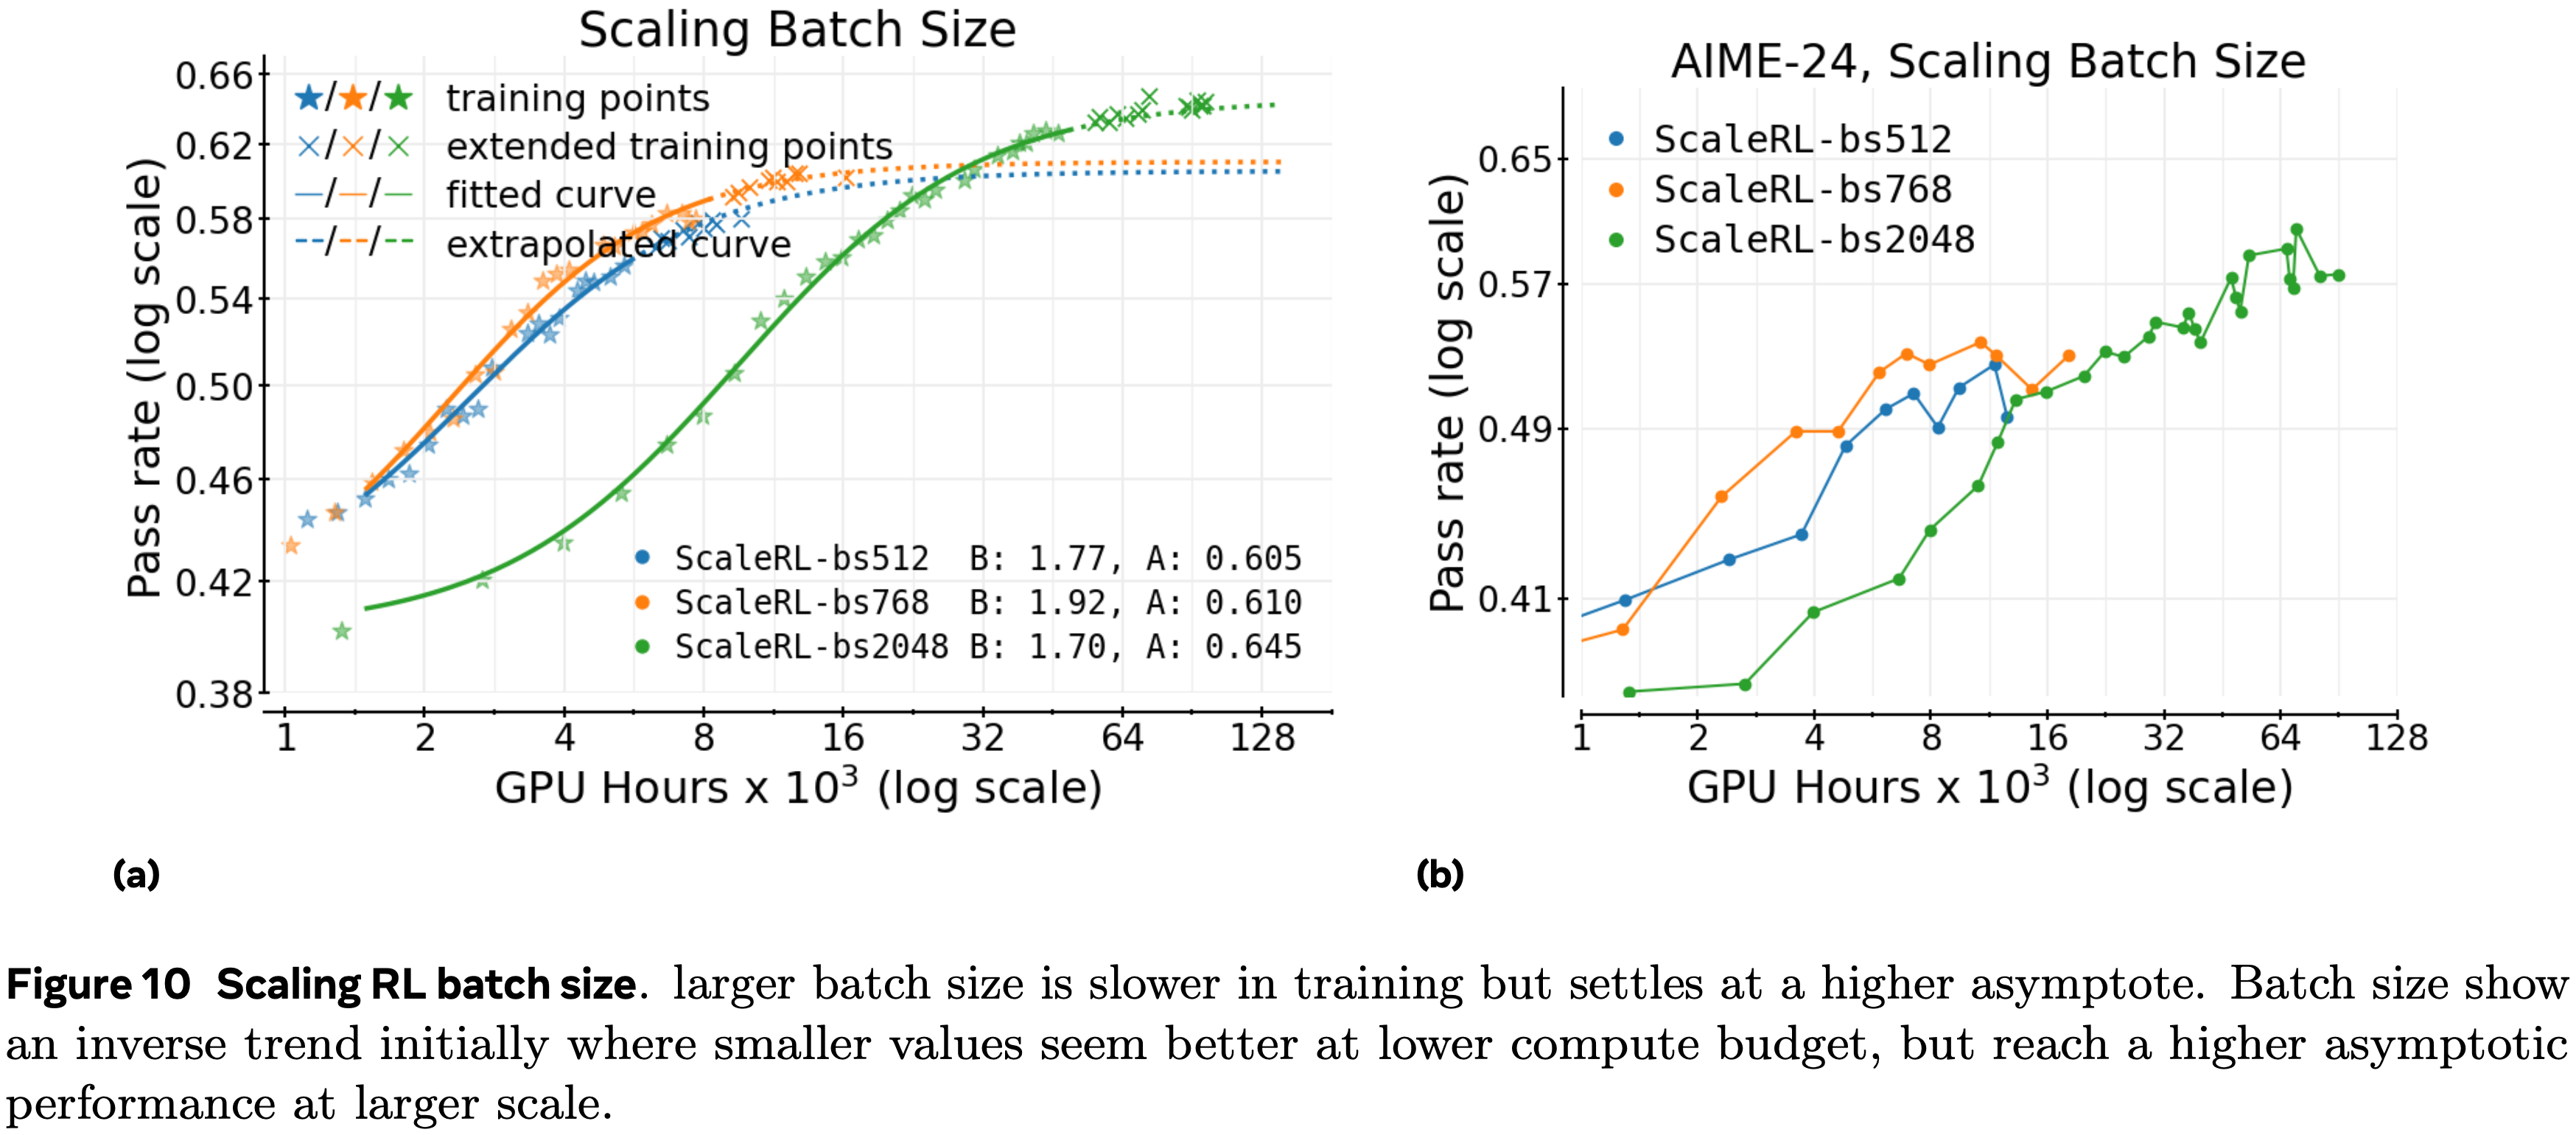
Global batch size(prompts,即提示数)

  • 较小的批次运行在下游基准测试中显示出早期停滞(即使分布内验证性能持续提高)
  • 较大的批次可靠地改善了渐近线,并避免了论文在较小批次运行中观察到的下游停滞
  • 图 10a 在中尺度上显示了相同的定性模式:
    • 小批次可能在早期表现更好,但随着计算量的增长会被超越
    • 在论文图 1 中最大的数学运行中,将批次大小增加到 2048 个提示既稳定了训练,又产生了一个可以从高达 50k GPU hous 外推到最终 100k 点的拟合
每个提示的生成次数(固定总批次)(Generations per prompt (fixed total batch))

  • 对于固定的总批次,是分配更多提示还是每个提示分配更多生成次数更好?
    • 扫描每个提示的生成次数 8,16,24,32 并调整提示数以保持总批次固定,得到的拟合缩放曲线基本不变(附录 A.13)
    • 这表明在中等批次下,这种分配对于 A 和 B 都是次要选择
  • 在更大批次(例如,2k+)下可能会出现更明显的差异,论文将其留待未来工作

Related Work

  • 论文在本节中详细介绍了与论文研究最相关的两项工作
  • ProRL (2025a) 证明,在大型语言模型上进行长时间的强化学习微调(约 2000 个优化步骤,批次大小 64),使用混合推理任务进行 16K GPU hous ,可以发现超越模型基础能力的新解决方案策略
    • 这种更长的训练方案在 1.5B 模型上带来了显著收益,在某些基准测试中媲美更大模型的性能
    • ProRL 的贡献在于特定的稳定性启发式方法(KL 正则化、策略重置、熵控制等),以实现 1.5B 模型的高性能
  • Alibaba Group 等 (2025c), Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning 提供了一个互补的视角
    • 在 Qwen-3 4B/8B (2025) 上的一致条件下消融了各种设计选择,并提出了一种极简组合 LitePPO
      • LitePPO 在较小规模的模型和计算量上优于更复杂的方法,如 GRPO (2024) 和 DAPO (2025)
    • 这产生了有价值的算法见解,但重点是比较实证发现,而不是缩放行为
  • 这些工作都没有研究这些方法的”缩放(scaling)”特性
    • 事实上,主要的比较是在下游评估上进行的,这可能不是研究可预测缩放的正确指标
    • 正如在预训练和论文这里的工作中所做的那样,论文研究分布内留出验证集上的性能
  • 与上述提到的相关工作相比,论文的工作开发并验证了一个具有预测拟合的计算-性能框架,同时在更大的计算预算(例如,比 ProRL 大 6 倍)和模型规模上运行
  • 论文的研究结果产生了一个近乎 SOTA 强化学习 Recipe ,可以可预测地扩展到超过 100,000 GPU hous 而没有任何稳定性问题
  • 其余相关工作推迟到附录 A.1

Discussion & Conclusion

  • 在这项工作中,论文研究了用于大型语言模型强化学习的各种技术的缩放特性,以寻求一个可预测、可扩展的 Recipe
  • 基于此使命,论文推导出一种为验证集准确率拟合预测性缩放曲线的方法,使论文能够量化强化学习方法的渐近性能和计算效率
  • 使用这种方法论,论文的主要贡献是仔细进行了一系列消融实验,涉及构成强化学习 Recipe 的若干算法选项
    • 对于每次消融,论文尽可能选择具有更高渐近性能的选项,否则选择效率更高的选项
  • 结合这些选择产生了 ScaleRL Recipe ,它在论文的实验中比所有现有 Recipe 缩放得更好
  • 以下几点观察值得注意:
    • 计算缩放外推 (Compute scaling extrapolation)
      • 论文缩放方法论的一个重要见解是,我们可以系统地使用较小规模的消融来预测更大规模的性能
      • 这使论文能够创建最终的可扩展 Recipe
    • 最重要的决策 (Most important decisions)
      • 根据论文的消融实验, Off-policy 算法、损失函数和模型精度是最重要的决策
      • 其他每个决策单独影响不大,但正如论文从留一法实验中看到的,当它们全部组合时,仍然具有一些累积影响(在效率方面)
    • 渐近性能与效率 (Asymptotic performance vs. efficiency)
      • 对于论文许多消融实验,论文发现更好的选项同时提高了效率和渐近性能,但情况并非总是如此(例如,对于 FP32,图 4(b))
        • 当从基线方法开始进行”正向”消融时,论文首先且最主要地选择渐近性能
      • 有趣的是,当从 ScaleRL Recipe 进行”反向”留一法消融时,论文发现每个决策对渐近性能的影响非常小,但算法的每个组件似乎都有助于提高效率
        • 这表明变化的累积效应是相当鲁棒的
    • 泛化 (Generalization)
      • 虽然论文报告了下游评估的迁移情况,但论文的主要重点是研究预测性缩放,这是通过在训练提示的留出数据集上的分布内性能曲线来表征的 (2022;2025)
        • 这仍然留下了大型语言模型从训练分布到留出测试集的泛化能力如何的问题
      • 虽然对泛化的全面描述超出了论文工作的范围,但论文确实观察到分布内验证与下游泛化性能之间的相关性
      • 但有一些算法选择似乎更有助于泛化,论文在此想指出,包括:
        • 更大的批次大小(章节 A.14)
        • 减少截断(章节 A.15)
        • 更长的生成长度(第 5 节,图 9)
        • 更大的模型规模(第 5 节,图 1)
    • 多任务强化学习 (Multi-task RL)
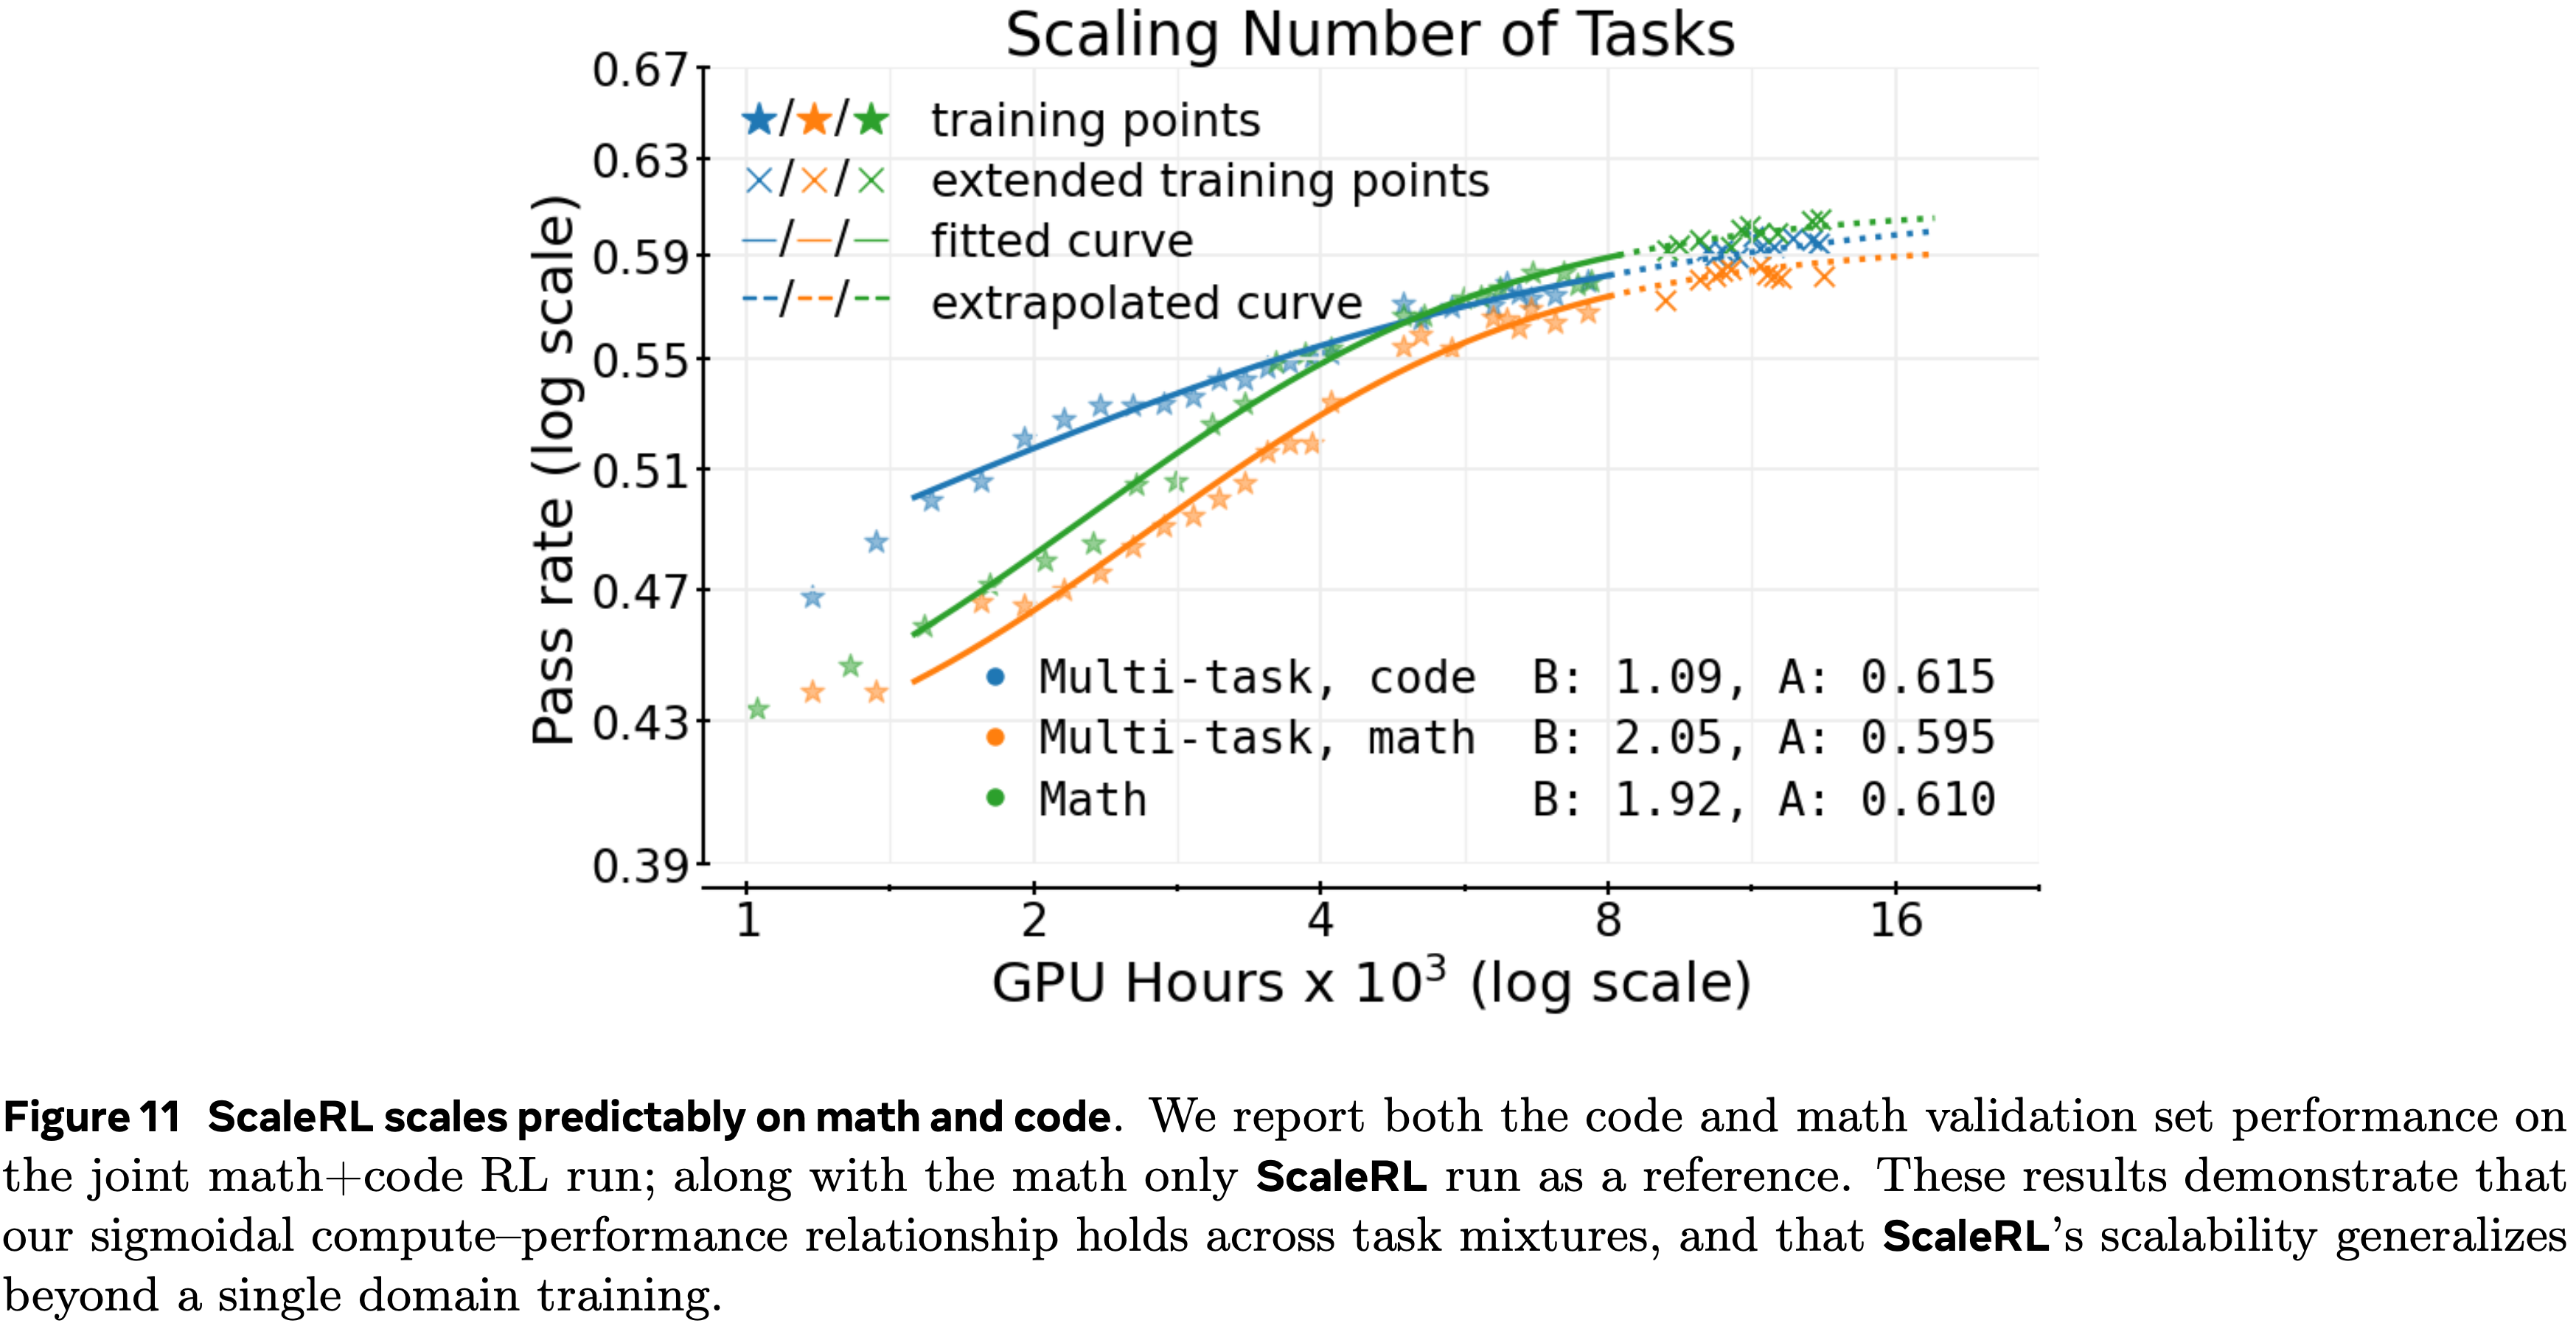
      • 虽然论文的实验主要集中在数学领域,但论文也在多任务强化学习训练下评估了 ScaleRL
      • 如图 11 所示,在数学和代码上联合训练为每个领域产生了清晰、平行的幂律趋势,扩展的运行保持与外推曲线对齐
      • 虽然论文的初步结果是有希望的,但彻底研究具有不同训练数据混合的多任务强化学习的计算缩放可预测性将是很有趣的
Future work

  • 一个自然的下一步是为强化学习在预训练计算、模型大小和强化学习训练数据方面推导预测性的”Scaling Laws”
  • 未来的研究还可以包括其他强化学习计算缩放的轴(Axes),例如结合结构化或密集奖励 (2025b;2024) 和更计算密集的生成验证器 (2025a),以找到强化学习训练的最佳计算分配
  • 最后,这里介绍的方法论框架可以应用于研究其他后训练机制的缩放行为,包括多轮强化学习、智能体交互和长形式推理
  • 强化学习中有许多设计选择,因此作者认为论文的 ScaleRL Recipe 并非故事的终点
    • 作者希望论文对可扩展强化学习的关注以及预测可扩展性的方法能够激励未来的工作,进一步推动大型语言模型强化学习的前沿
    • 为了使未来的研究能够拟合计算-性能强化学习缩放曲线,论文在 www.devvrit.com/scalerl_curve_fitting 发布了一个最小代码库

附录 A:Appendix

A.1 Extended Related Work

  • 近期涌现的一波工作将强化学习应用于提升大语言模型的推理能力;这些工作通常能在具有挑战性的任务上取得 SOTA 结果 (2024; 2025; 2025; 2025)
    • OpenAI 的 o1 系列模型证实了大规模强化学习能显著增强长程推理能力,但并未发布这些模型训练方式的任何细节
    • Deepseek R1(以及 R1-Zero)(2025) 提供了首个关于主要通过强化学习训练高性能长思维链模型的全面研究,记录了在扩展强化学习下不依赖奖励模型 (2023) 或蒙特卡洛树搜索 (2024) 而出现的涌现行为
  • 这波推理发展浪潮中最早被广泛引用的 RLVR(可验证奖励)算法是 GRPO
    • GRPO 是一种无评论员、分组相对的策略梯度方法,采用 PPO 风格的裁剪,用分组基线替代学习的价值基线,以降低计算成本并稳定长思维链的信用分配
    • 虽然 GRPO 催化了快速进展,但后续工作记录了其局限性( Token-Level 裁剪、模型崩溃风险)并推动了不同分组或序列级别的变体 (2025; 2025; 2025; 2025)
  • DAPO 提出了解耦裁剪和动态采样策略优化
    • DAPO 在 GRPO 目标中解耦了 \(\epsilon_{\text{low} }\) 和 \(\epsilon_{\text{high} }\) 裁剪,并对 \(\epsilon_{\text{high} }\) 进行 Clip-Higher操作以避免熵崩溃
    • DAPO 在给定批次中对提示进行动态采样,以避免方差(或优势)为零的样本,这些样本对策略梯度没有贡献
    • DAPO 采用 Token-Level 损失聚合(注:GRPO 使用样本级损失平均)
    • 通过以上这些修改,DAPO 能够在避免强化学习训练中熵崩溃的同时超越原始 GRPO 基线
  • 与此同时提出的 VAPO 是一种专为长思维链设计的价值增强型 PPO,具有强大的稳定性,并优于像 GRPO 和 DAPO 这样的无价值基线
    • VAPO 结合了价值预训练和来自 VC-PPO (2025) 的解耦广义优势估计、来自 DAPO 的损失目标修改,并提出了长度自适应的 GAE,从而形成了一个开放的 Recipe VAPO,该 Recipe 已被用于训练 Seed1.5-thinking (2025) 中的大型混合专家模型
    • 类似地,其他技术报告如 Magistral (2025)、Kimi-k1.5 (2025)、Minimax-01 (2025) 详细介绍了他们强化学习训练 Recipe 的各种细节,但并未分享关于其设计选择为何优于基线的广泛实验

A.2 面向大语言模型的强化学习:GRPO 和 DAPO (RL for LLMs: GRPO and DAPO)

GRPO (2024)
  • GRPO 将 PPO (2017) 应用于具有可验证奖励的大语言模型微调
  • 对于给定的提示 \(x\),旧策略 \(\pi_{\text{gen} }(\theta_{\text{old} })\) 生成 \(G\) 个候选补全 \(\{y_i\}_{i=1}^G\),每个补全被分配一个标量奖励 \(r_i\)
  • 为了强调组内的相对质量,奖励被归一化为
    $$
    \hat{A}_i=\frac{r_i-\text{mean}(\{r_j\}_{j=1}^G)}{\text{std}(\{r_j\}_{j=1}^G)+\epsilon}.
    $$
  • 每个长度为 \(|y_i|\) 的补全 \(y_i\) 通过比率在 Token-level 上做出贡献
    $$
    \rho_{i,t}(\theta)=\frac{\pi_\text{train}(y_{i,t} \mid x,y_{i,<t},\theta)}{\pi_{gen}(y_{i,t} \mid x,y_{i,<t},\theta_{\text{old} })}.
    $$
  • GRPO 目标在补全和 Token 之间进行平均:
    $$
    \mathcal{J}_{\text{GRPO} }(\theta)=\mathbb{E}_{x\sim D,\atop\{y_i\}_{i=1}^G,\sim\pi_{\text{gen}(\cdot \mid x,\theta_{\text{old} })} }\left[\frac{1}{G}\sum_{i=1}^G\frac{1}{|y_i|}\sum_{t=1}^{|y_i|}\min\Big(\rho_{i,t}(\theta)\hat{A}_i,\ \operatorname{clip}(\rho_{i,t}(\theta),1\pm\epsilon)\hat{A}_i\Big)\right].
    $$
  • GRPO 像 PPO 一样保留了 Token-level 的策略比率,同时使用序列级别、分组归一化的优势来在稀疏奖励下稳定学习
DAPO
  • DAPO (2025) 通过两个关键修改扩展了 GRPO
  • 第一个改进点:用 非对称裁剪 替代了对称裁剪,对向上和向下的偏差使用不同的阈值:
    $$ \text{clip}_{\text{asym} }(\rho,a)=\text{clip}(\rho,,1-\epsilon^{-},1+\epsilon^{+})$$
    • 其中 \(\epsilon^{-}\) 和 \(\epsilon^{+}\) 是超参数
  • 第二个改进点:DAPO 将聚合方案更改为在 提示级别 操作
    • 对于给定的提示 \(x\sim D\),旧策略产生 \(G\) 个补全 \(\{y_i\}_{i=1}^G\),其优势为 \(\{\hat{A}_i\}\)(公式 (5))
    • 令 \(T=\sum_{i=1}^G|y_i|\) 表示所有补全的总 Token 数
    • Token-level 比率如公式 (2) 所示
  • DAPO 代理目标为
    $$
    \mathcal{J}_{\text{DAPO} }(\theta)=\mathbb{E}_{x\sim D,\atop\{y_i\}_{i=1}^G\sim\pi_{\text{gen}(-|x,\theta_{\text{old} })} }\left[\frac{1}{T}\sum_{i=1}^G\sum_{t=1}^{|y_i|}\min\Bigl(\rho_{i,t}(\theta)\hat{A}_i,\ \text{clip}_{\text{asym} }(\rho_{i,t}(\theta))\hat{A}_i\Bigr)\right].
    $$
  • 这种提示级别的归一化确保每个 Token 对提示的损失贡献相等,无论其采样补全的数量或长度如何
  • DAPO 还引入了在训练期间动态丢弃批次中方差为零的提示,并用更多提示填充批次直到批次满员(论文在此跳过该更改,因为其效果类似于拥有更大的批次大小)

A.3 Training Setup

  • 数据集
    • 对于小规模监督微调,论文使用精心策划的推理轨迹数据混合
    • 论文通过移除琐碎的提示、丢弃超过 12\(k\) 个 Token 的解决方案轨迹,并使用 AIME 2024/2025 和 MATH-500 (2021) 基准进行去污染来过滤此数据集
    • 对于强化学习阶段,论文在大多数运行中使用 Polaris-53K 数据集 (2025);
    • 对于同时包含数学和代码的运行,使用 Deepcoder 数据集 (2025)
  • 监督微调
    • 论文使用 2M Token 的批次大小、最大序列长度 12288 和学习率 \(3\times 10^{-5}\),在 32 个 H100 GPU 节点上使用 AdamW 优化器 (2019) 运行监督微调,总共大约 4 个轮次和 32B Token
  • 强化学习
    • 论文在强化学习训练期间分配 14k 的生成预算,其中 12k Token 分配给中间推理(“思考”),随后 2k Token 用于最终解决方案和答案
    • 论文在每个批次中采样 48 个提示,每个提示有 16 个生成(即每个梯度更新步骤的总批次大小为 768 个回复)
    • 奖励分别给予正确和错误的轨迹 \(\pm 1\)
    • 使用恒定学习率 \(5\times 10^{-7}\)
    • AdamW 优化器 (2019),其中 \(\epsilon=10^{-15}\),权重衰减为 0.01(AdamW 中的默认值)
      • 注:较低的 \(\epsilon\) 是为了避免梯度裁剪(epsilon 下溢)(2023)
    • 100 步的线性预热
  • 数学问题评估:
    • 论文使用自动化检查器,如 Sympy (2017) 或 Math-Verify 来评估数学问题在剥离思考轨迹(\(<\)think\(>\)\(\cdots\)\(<\)/think\(>\))后最终答案的正确性
  • 代码问题:
    • 对于涉及单元测试和期望输出的代码问题,论文使用自定义代码执行环境
  • 硬件:
    • 论文使用 80 个 Nvidia GB200 GPU 进行单次运行
      • 3.5-4K GPU hous(用于在第 3.2 节中建立不同的设计选择)
      • 16K GPU hous 用于留一法实验(第 4 节)
      • 30k-100K GPU hous 用于论文更大规模的运行(第 5 节)
    • 论文在 GPU 之间采用 Generator-Trainer 分离
      • 对于 80 个 GPU 的实验,论文将其中的 64 个设置为 Generator ,负责使用优化的推理代码库生成推理轨迹
      • 其余的 16 个 GPU 作为 Trainer ,接收生成的轨迹,执行策略更新,并定期将更新后的参数广播回 Generator

A.4 拟合什么曲线? (What curve to fit?)

  • 预训练曲线通常使用幂律方程进行拟合 (2025; 2020; 2025)
  • 在论文的情况下,这将性能建模为 \(R_C=A-D/C^B, C\geq C_0\),其中 \(D\) 是常数,\(C_0\) 标志着超出该阈值后定律成立的计算量阈值
    • 直观地说,这意味着计算的每次倍增都会带来性能的恒定比例增益
  • 但对于强化学习后训练,论文发现 S 形曲线(公式 (1))更合适,原因如下
    • 首先,对于有界指标,如准确率或奖励,S 形曲线提供了更好的预测拟合 (2024; 2022);论文观察到同样的情况,能够准确外推到更高的计算量(图 1)
    • 其次,幂律在低计算量时是无界的,并且通常只在超过阈值 \(C_0\) 后才进行拟合
      • 在强化学习中,总训练步数要少得多(例如,图 1 中只有约 75 个评估点可供拟合),丢弃早期点会进一步减少本已有限的拟合数据
    • 第三,根据经验,S 形拟合比幂律拟合更加稳健和稳定
      • 具体来说,考虑图 1 中所示的在 8B 稠密模型上进行的 100k GPU hous 运行
        • 当论文在 1.5k-50k GPU hous 之间拟合幂律曲线时,它预测的渐近性能为 \(A=1.0\),这显然是错误的(实际曲线在 0.65 附近饱和)
        • 相比之下,S 形拟合给出了 \(A=0.645\) 的准确预测
      • 此外,幂律拟合对所选拟合区间高度敏感:
        • 在 (5\(\text{k}\),50\(\text{k}\)) GPU hous 上拟合则得到 \(A=0.74\),而 S 形拟合仍然稳健,并且仍然预测 \(A=0.645\)
      • 幂律模型只有在专门在高计算量区间(例如,30k-60k GPU hous )拟合时才能恢复正确的渐近线
        • 但论文的目标是从低计算量区间预测大规模性能,而在这些区间无法获得如此长的运行
  • 考虑到这些因素,论文在整个分析中使用 S 形形式
    • S 形曲线捕捉了收益递减规律,即在低计算量区间增长缓慢,在高效缩放的中等区间急剧加速,然后在计算量高时饱和,接近有限的性能上限
  • 需要注意的一点是,在高计算量区间,S 形曲线的行为与幂律相同
    • 具体来说,我们可以对 S 形曲线进行以下近似:
      $$
      \begin{align}
      R_C &=R_0+\frac{A-R_0}{1+(C_{mid}/C)^B} \quad \text{(来自公式 (1) 的 S 形曲线)} \\
      \implies R_C &\approx R_0+(A-R_0)\left(1-\frac{C^{B}_{mid} }{C^{B} }\right) \quad \text{(对于 \(C>>C_{mid}\), 高计算量区间(high compute regime))} \\
      &=A-\frac{(A-R_0)C^{B}_{mid} }{C^{B} } \\
      &=A-\frac{D}{C^{B} }
      \end{align}
      $$
    • 其中 \(D=(A-R_0)C^{B}_{mid}\)
    • 这与本节开头提到的幂律形式相同

A.5 Fitting scaling curves

  • 论文将公式 (1) 中的 S 形定律方程拟合到论文留出验证集上的平均奖励
    • 包含从 Polaris-53k (2025) 数学数据集中留出的 1,000 个提示,每 100 个训练步骤进行一次评估,每次在留出的 1,000 个提示上采样 16 个生成
  • 直接拟合所有三个参数 \(\{A,B,C_{mid}\}\) 具有挑战性
    • 所以论文执行网格搜索,遍历 \(A\in\{0.450,0.455,0.460,\ldots,0.800\}\) 和 \(C_{mid}\in[100,40000]\)(搜索 100 个线性分隔的值),并对每个候选的 \(A,C_{mid}\) 拟合 \(B\)
      • 在此网格上最佳拟合(通过残差平方和衡量)作为最终曲线
    • 论文使用 SciPy 的 curve_fit 和默认初始化;改变初始化策略产生了相同的结果
    • 为了使未来的研究能够拟合计算性能强化学习缩放曲线,论文在 www.dewrit.com/scalerl_curve_fitting 发布了一个最小的代码库
  • 为了估计论文拟合的误差范围,论文训练了三个独立的 ScaleRL 运行,批次大小为 768,生成长度为 14k(如第 4 节所用),如图 8a 所示
    • \(A\) 的拟合值最多变化 \(\pm 0.015\),表明在渐近性能估计上 0.02 是一个合理的误差范围
    • 估计拟合值 \(B\) 的误差范围很困难,因为具有不同 \(A\) 值的不同算法可能对 \(B\) 有不同的误差范围
    • 为了比较算法的目的,我们可以安全地推断,如果两种方法达到相似的 \(A\) 值(在 0.02 范围内),那么当使用 \(A\) 值的平均值重新拟合时,具有较高 \(B\) 值的方法在可扩展效率方面至少同样好

A.6 Comparing algorithms

  • 与大规模预训练中的观察一致,损失在初始急剧下降后进入可预测的幂律衰减阶段 (2025),论文在强化学习中也观察到类似的两阶段行为
  • 平均奖励在约第一个 epoch(约 1k 步,或对于大多数运行约 1.5k GPU hous )期间快速、几乎线性地增加,之后曲线遵循 S 形定律行为(见图 15 查看“S 形”曲线)
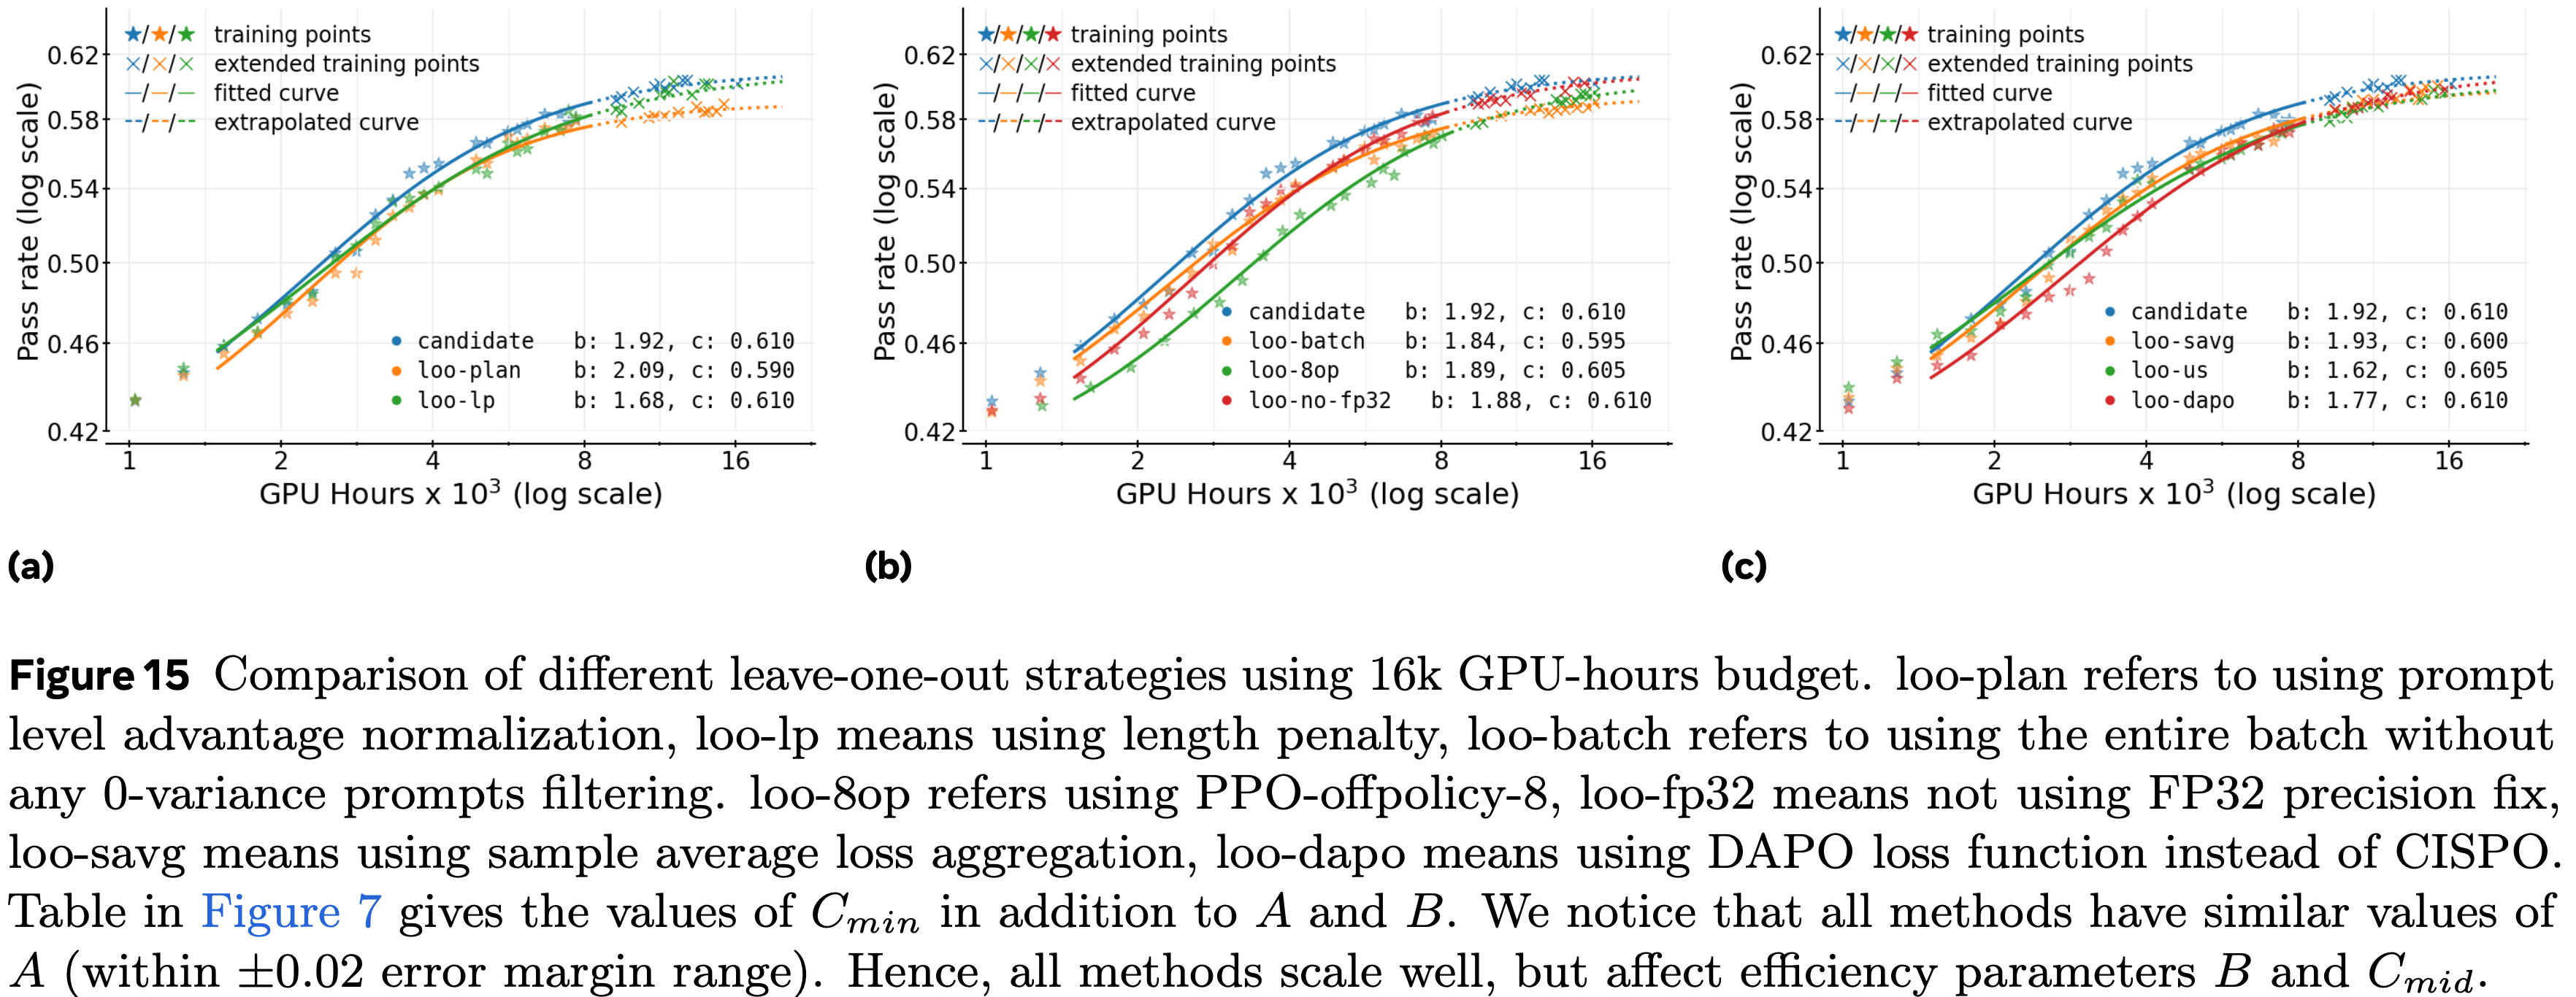
  • 论文的 S 形定律拟合应用于训练曲线的后一部分
  • 与预训练不同,论文的主要目标不是预测固定 Recipe 的性能,而是识别哪些算法和设计选择能够可靠地扩展,并设计出具有可预测性的算法
  • 实现高度稳健的拟合通常需要具有数百或数千个评估点的非常大的运行,这在论文的设置中是不切实际的,原因有两个
    • 第一个原因:在此规模上运行所有消融实验在计算上是不可行的
    • 第二个原因:论文比较的许多强化学习算法本身无法扩展到如此极端的预算:它们通常更早饱和,甚至由于不稳定性而在计算量增加时性能下降
      • 例如,论文的基线方法(第 3.2 节)在超过约 3500 GPU hous 后变得不稳定,因为过长的生成截断超过了生成的 10%,降低了有效批次大小
      • 关于此点的更多讨论见第 A.15 节
  • 当论文在第 3.2 节中跨不同轴进行消融时,论文发现了能在更高计算量下提高稳定性的设计选择
    • 一些消融变体可以进一步扩展,例如,DAPO 中 \(\epsilon=0.26\) 的情况下约 5k GPU hous ,使用 FP32 精度修复(第 3.2 节)的情况下约 6k GPU hous ,以及 CISPO 的情况下约 7k GPU hous
    • 结合论文最佳的设计选择是一个稳定且可扩展的 Recipe ,这使论文能够以每次运行约 1600 GPU hous 的预算进行留一法实验
      问题:怎么还变少了?

A.7 Robustness of fits

  • 对于稳定且可扩展的实验,包括从第 4 节开始的所有运行,改变拟合区间(例如,包含或排除初始 1.5k GPU hous 范围)会产生类似的可预测结果
    • 例如,在 8B 稠密模型上的 100k GPU hous 运行中,在 (1.5\(\text{k}\),50\(\text{k}\)) 上拟合得到 \(B=1.70\),\(A=0.645\),而 (0,100\(\text{k}\)) 得到 \(B=1.56\),\(A=0.655\),(0,50\(\text{k}\)) 得到 \(B=1.7,A=0.645\),以及 (5\(\text{k}\),50\(\text{k}\)) 得到 \(B=1.67\),\(A=0.645\)。在这些区间内,参数值保持在预期误差范围内(第 7 节)
  • 此外,论文跳过低计算量区间,因为早期训练阶段,尤其是在第 3.2 节中不太稳定的设置中,常常由于短暂的不稳定性而过早达到平台期或偏离 S 形趋势(见附录 A.6, A.15)
    • 排除此区域可以使拟合专注于中高计算量范围,在该范围内饱和行为更清晰、更一致
  • 1.5k GPU hous 阈值是根据经验选择的启发式方法:
    • 它大约对应于第 3.2 节中大多数实验的一个 epoch
    • 较大的截止值减少了拟合点的数量,而较小的截止值常常引入噪声
    • 论文发现 1.5k GPU hous 能在拟合稳定性和样本覆盖率之间提供最佳平衡,这与在预训练缩放分析和拟合中跳过低 FLOPs 区间的做法一致 (2025)

A.8 Interpreting Sigmoidal Curves

  • 图 3 展示了一个示例拟合,说明了参数 \(A\)、\(B\) 和 \(C_{\text{mid} }\) 的影响
  • 通过额外的图示扩展了这一点:图 12a、图 12b 和图 13a 分别改变了 \(B\)、\(C_{\text{mid} }\) 和 \(A\),同时保持其他参数不变
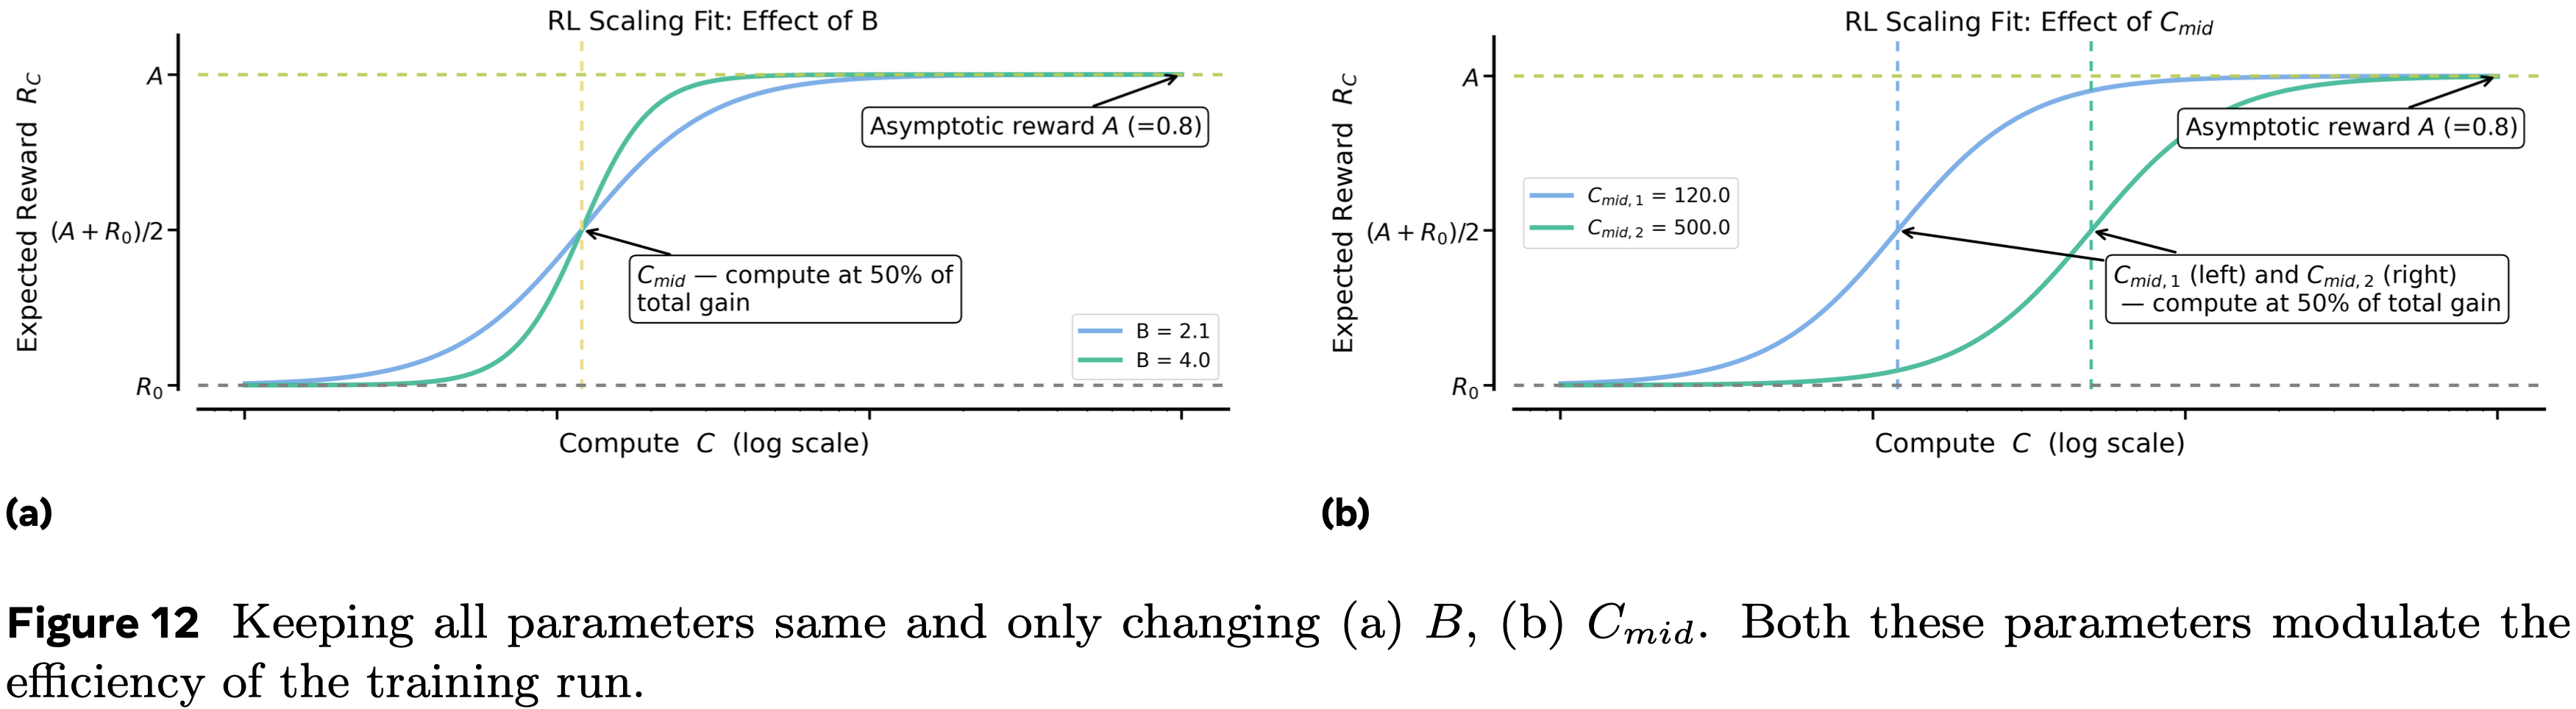
  • \(B\) 和 \(C_{\text{mid} }\) 主要影响缩放的效率 ,而 \(A\) 决定了在大计算量下可实现的渐近性能
  • 在图 13b 中,论文看到一个两个运行的案例,其中一个效率高得多,因此显示出初期有希望的收益,但收敛到较低的渐近线,而另一个进展较慢,但由于更高的 \(A\) 最终超过了前者
  • 在实践中,缩放策略应优先考虑提高渐近上限 \(A\) 的设计选择,然后才优化效率参数,如 \(B\) 或 \(C_{\text{mid} }\)

A.9 Forward and LOO Ablations

  • 论文在图 14a-14b 中展示了第 3.2 节的额外结果
  • 图 15 中绘制了第 4 节中关于通过率与计算量的留一法实验

A.10 Controlling generation length

  • 推理强化学习中一个常见的担忧是控制爆炸性增长的生成长度,这会损害训练效率和稳定性(附录 A.15)
  • 论文考虑两种方法:
    • (a) 中断(Interruptions),用于像 GLM-4.1V (2025) 和 Qwen3 (2025) 这样的工作;
    • (b) 长度惩罚(Length penalties),用于像 DAPO (2025)、Kimi (2025)、Magistral (2025) 和 Minimax-M1 (2025) 这样的工作
中断,Interruptions
  • 通过附加一个标记性短语(例如“Okay, time is up. Let me stop thinking and formulate a final answer \(<\)/think\(>\)”)来强制停止生成,指示模型终止其推理并产生最终答案
  • 在论文的设置中,中断 Token 被随机放置在 \([10k,12k]\) Token 长度之间,以诱导对不同生成长度的泛化
Length penalties
  • 用于重塑奖励
  • 遵循 DAPO (2025),论文使用容忍区间 \(L_{\text{cache} }\) 来惩罚过长的补全:
    $$
    R_{\text{length} }(y)=clip\left(\frac{L_{\max}-|y|}{L_{\text{cache} } }-1,-1,0\right)
    $$
  • 此惩罚仅添加到正确的轨迹上,以阻止过长的生成
    • 在长度惩罚实验中,论文设置 \(L_{\max}=14\text{k}\) 个 Token 和 \(L_{\text{cache} }=2\text{k}\) 个 Token
  • 在第 4 节中,论文在 16\(\text{k}\) GPU hous 的规模上比较了长度惩罚和中断
  • 在论文的最终 ScaleRL Recipe 中用长度惩罚替换中断不能提高性能

A.11 PipelineRL

  • 使用基线设置,论文在 PipelineRL 中消融了 Off-policy 参数(图 4(b))
  • Off-policy 度为 4 和 8 的表现同样好,论文在第 3.1 节更新基线时采用 8 作为默认设置
    • 为什么 8 比 1 效果好?是因为横坐标不是 step,而是 GPU 时间吗?
  • 为什么 PipelineRL 始终优于经典的 PPO-off-policy 方法(第 3.1 节和 第 4 节)?
    • 论文将其归因于其与 On-policy 训练更紧密的对齐
    • 在 PPO-off-policy 中,生成和训练交替进行:
      • Trainer 严格处理与所选参数 \(k\) 一样 Off-policy 的批次,基于过时的 Rollout 更新进行更新
      • PipelineRL 以流式方式运行:
        • 一旦批次可用,它就传递给 Trainer ;
        • 同样,一旦模型更新就绪,它就立即共享回 Generator ,Generator 立即使用它(包括在部分生成的轨迹的延续中)
      • 这种紧密的反馈循环使训练更接近 On-policy 状态,减少了 Generator 和 Trainer 分布之间的不匹配
  • 重要的是,这种区别影响了缩放曲线的渐近性能 \(c\),而不仅仅是效率指数 \(b\)
    • 很少有轴能以这种方式移动渐近线,使得 Off-policy 算法的选择成为强化学习后训练中最关键的设计决策之一

A.12 熵曲线:缩放批次大小 (Entropy Curves: Scaling Batch Size)

  • 论文在整个训练过程中跟踪了留出验证集上的熵
    • 在所有实验中(包括批次大小、任务数量、生成长度和模型规模的变体)论文观察到熵总体一致下降
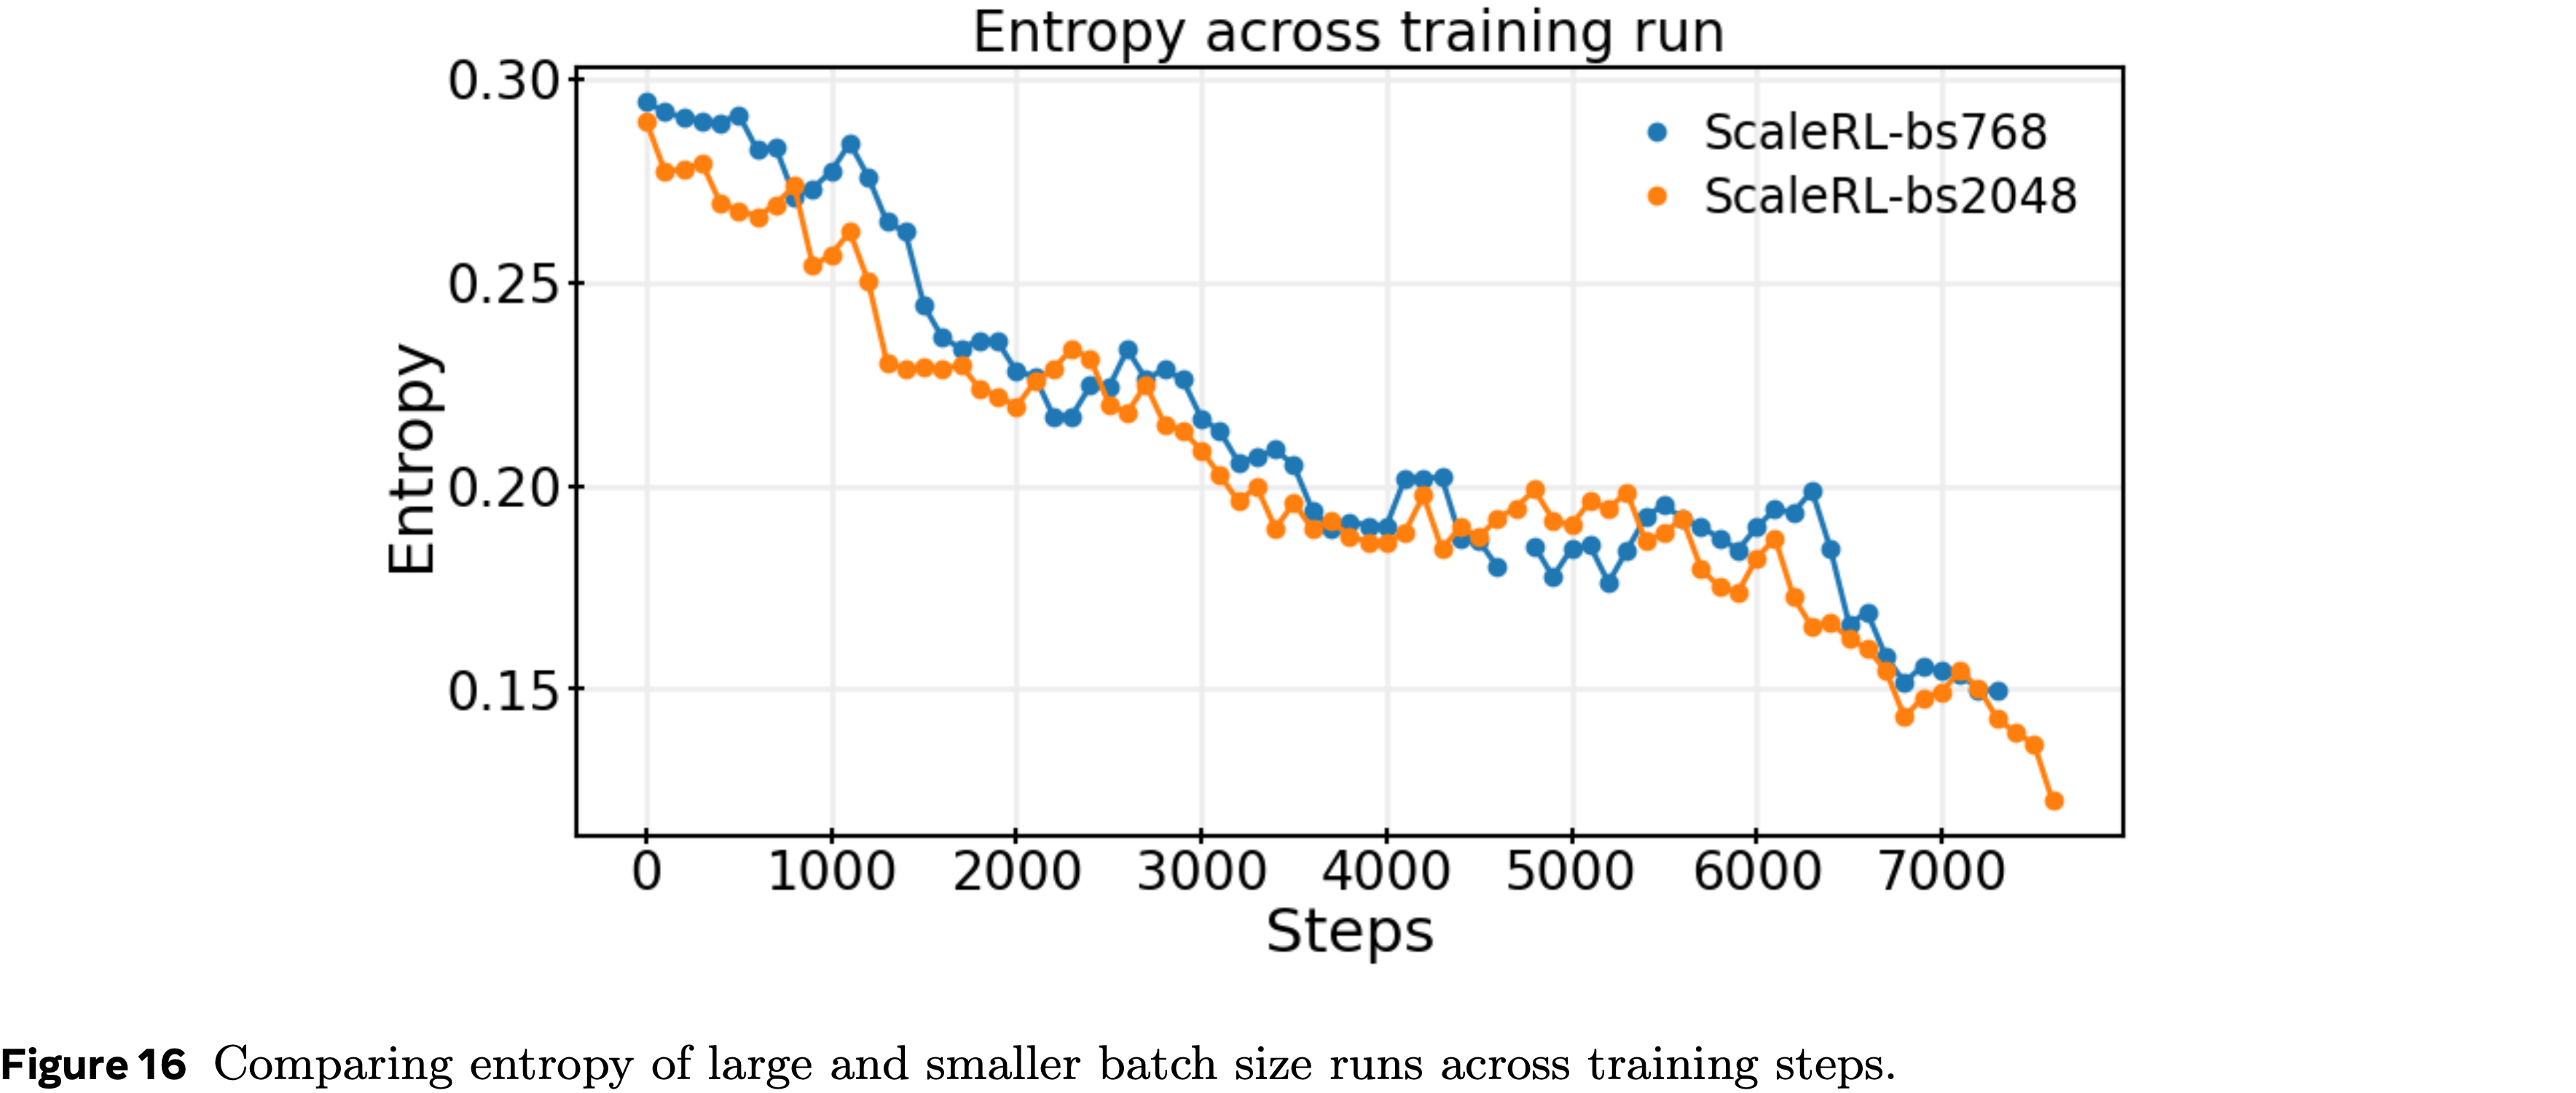
  • 一个有趣的发现是,熵可能并不总是能提供对性能的预测性洞察,正如最近一些工作如 (2025) 所提出的那样
    • 在第本节中,论文绘制了批次大小为 768 和 2048 的 ScaleRL 运行的熵
      • 2048 批次大小的运行在每个阶段都实现了更强的下游性能(图 10b),但两个运行在每一步都遵循几乎相同的熵轨迹(第 A.12 节)
        • 这突出了一个重要点,尽管熵有时被用作探索的代理指标,但仅仅保持较高的熵并不能转化为更好的泛化
      • 相反,较大的批次每一步减少了有效探索,类似于较小的批次,但仍然产生了显著更好的性能——强调了批次大小是一个重要的决定性因素
  • 总的来说,论文的发现表明,虽然熵在训练期间持续下降,但它不一定是下游性能的可靠预测指标
    • 这一观察结果强化了在旨在提高训练分布以及下游任务分布性能时,除了熵动态之外,还需要关注算法和缩放选择(例如,批次大小、 Off-policy 方法)的必要性

A.13 Scaling on multiple axes

  • 在图 17 中提供了剩余的不同轴缩放的图表(问题:如何理解这里的轴?是指不同的维度的超参)
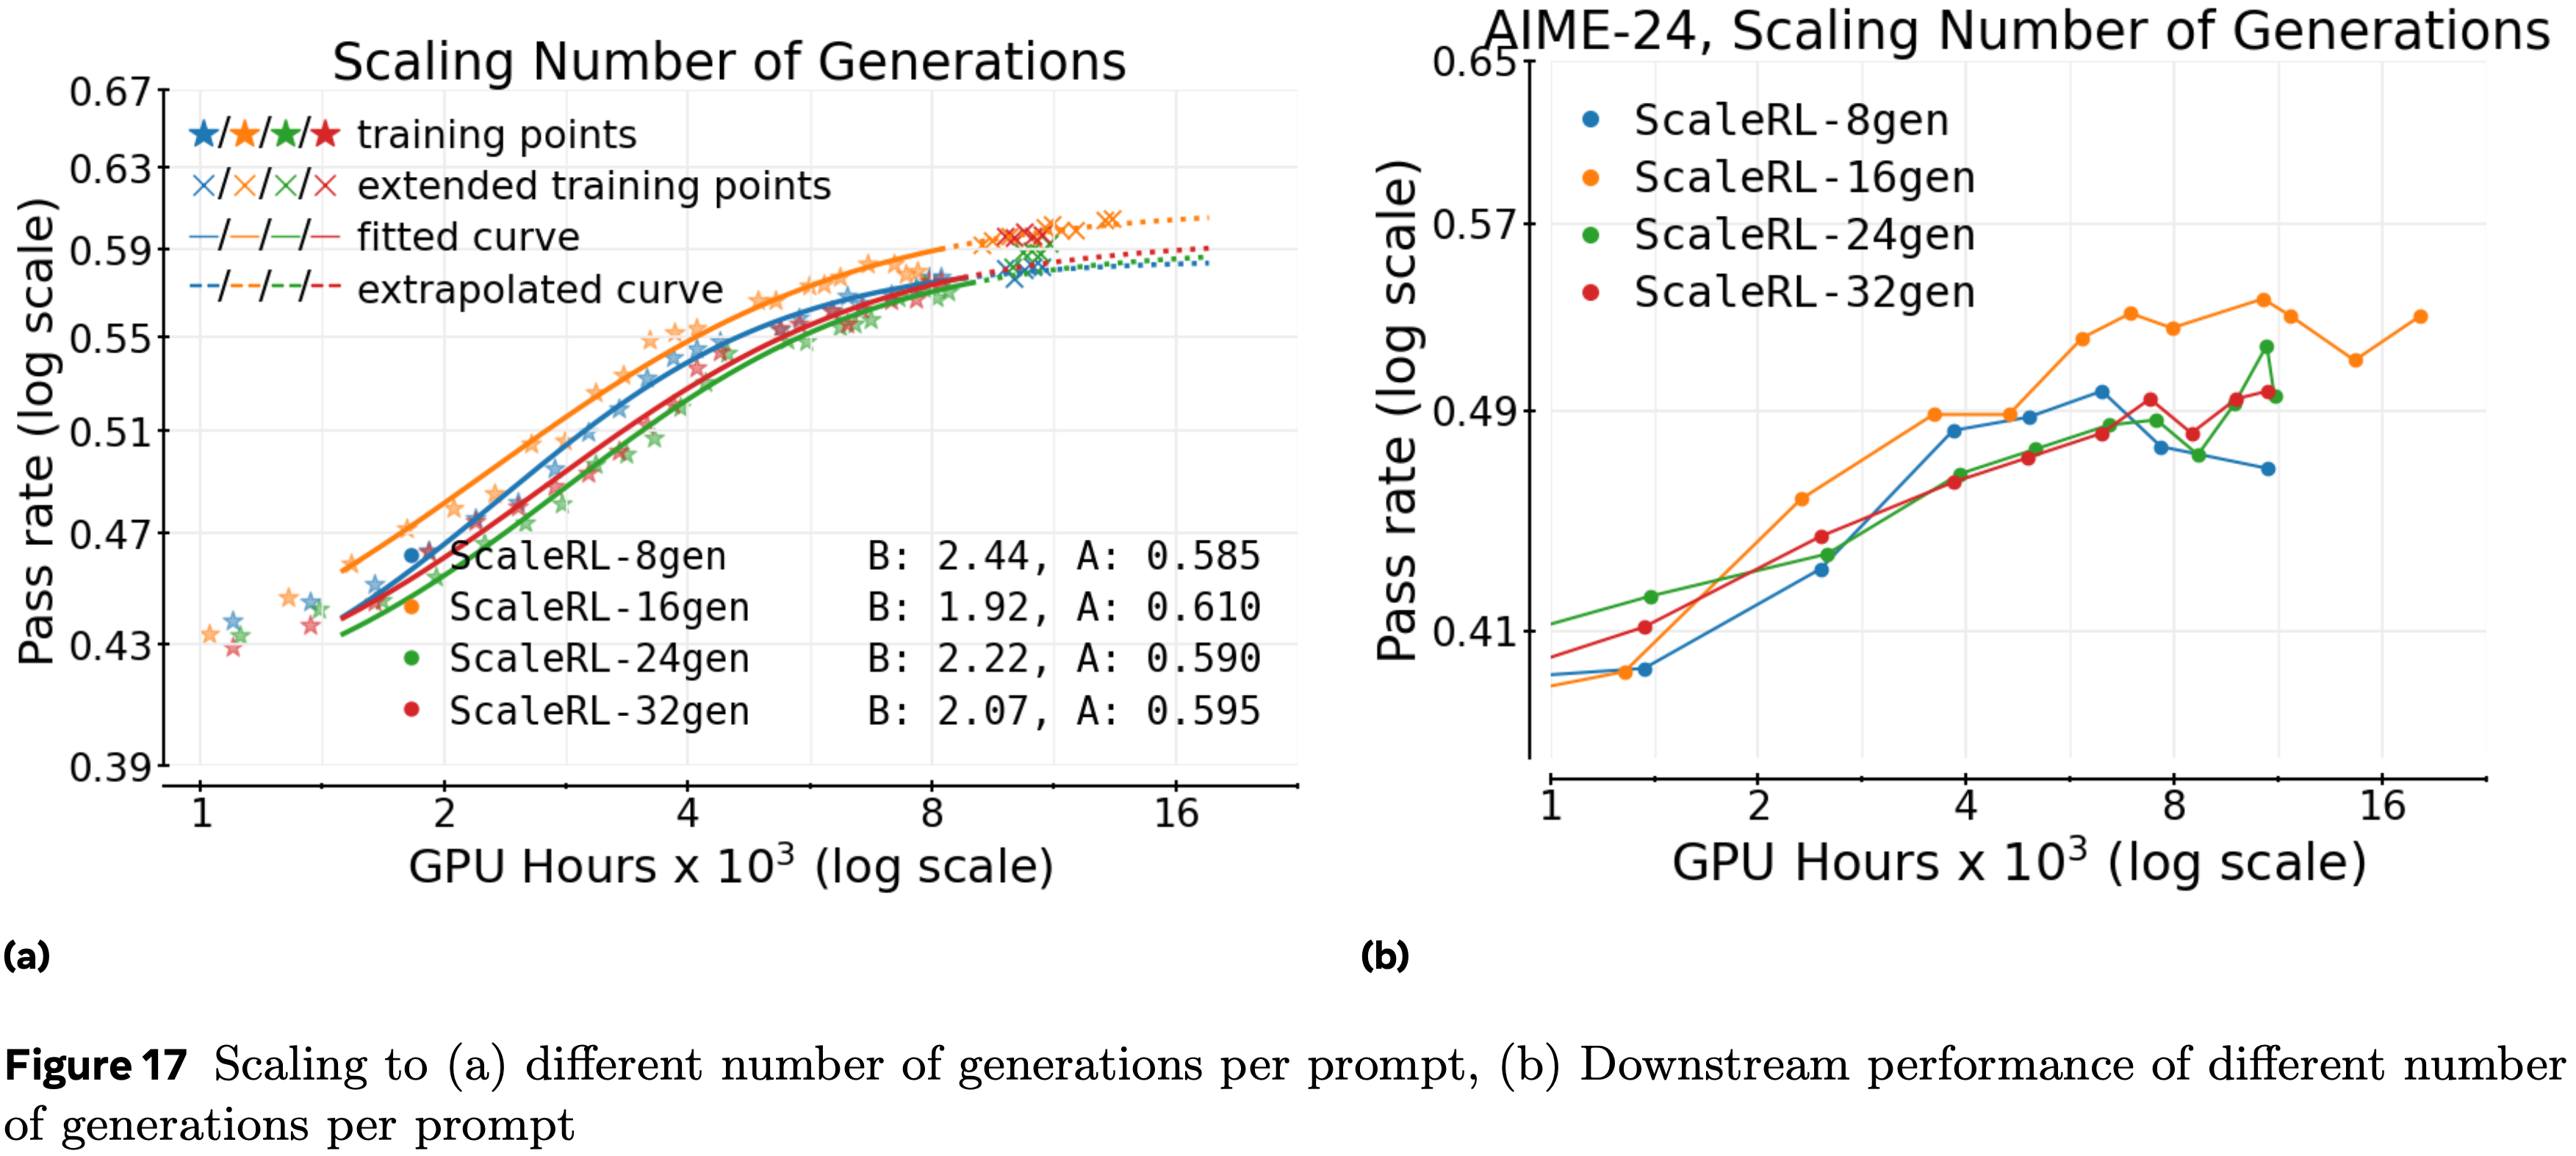
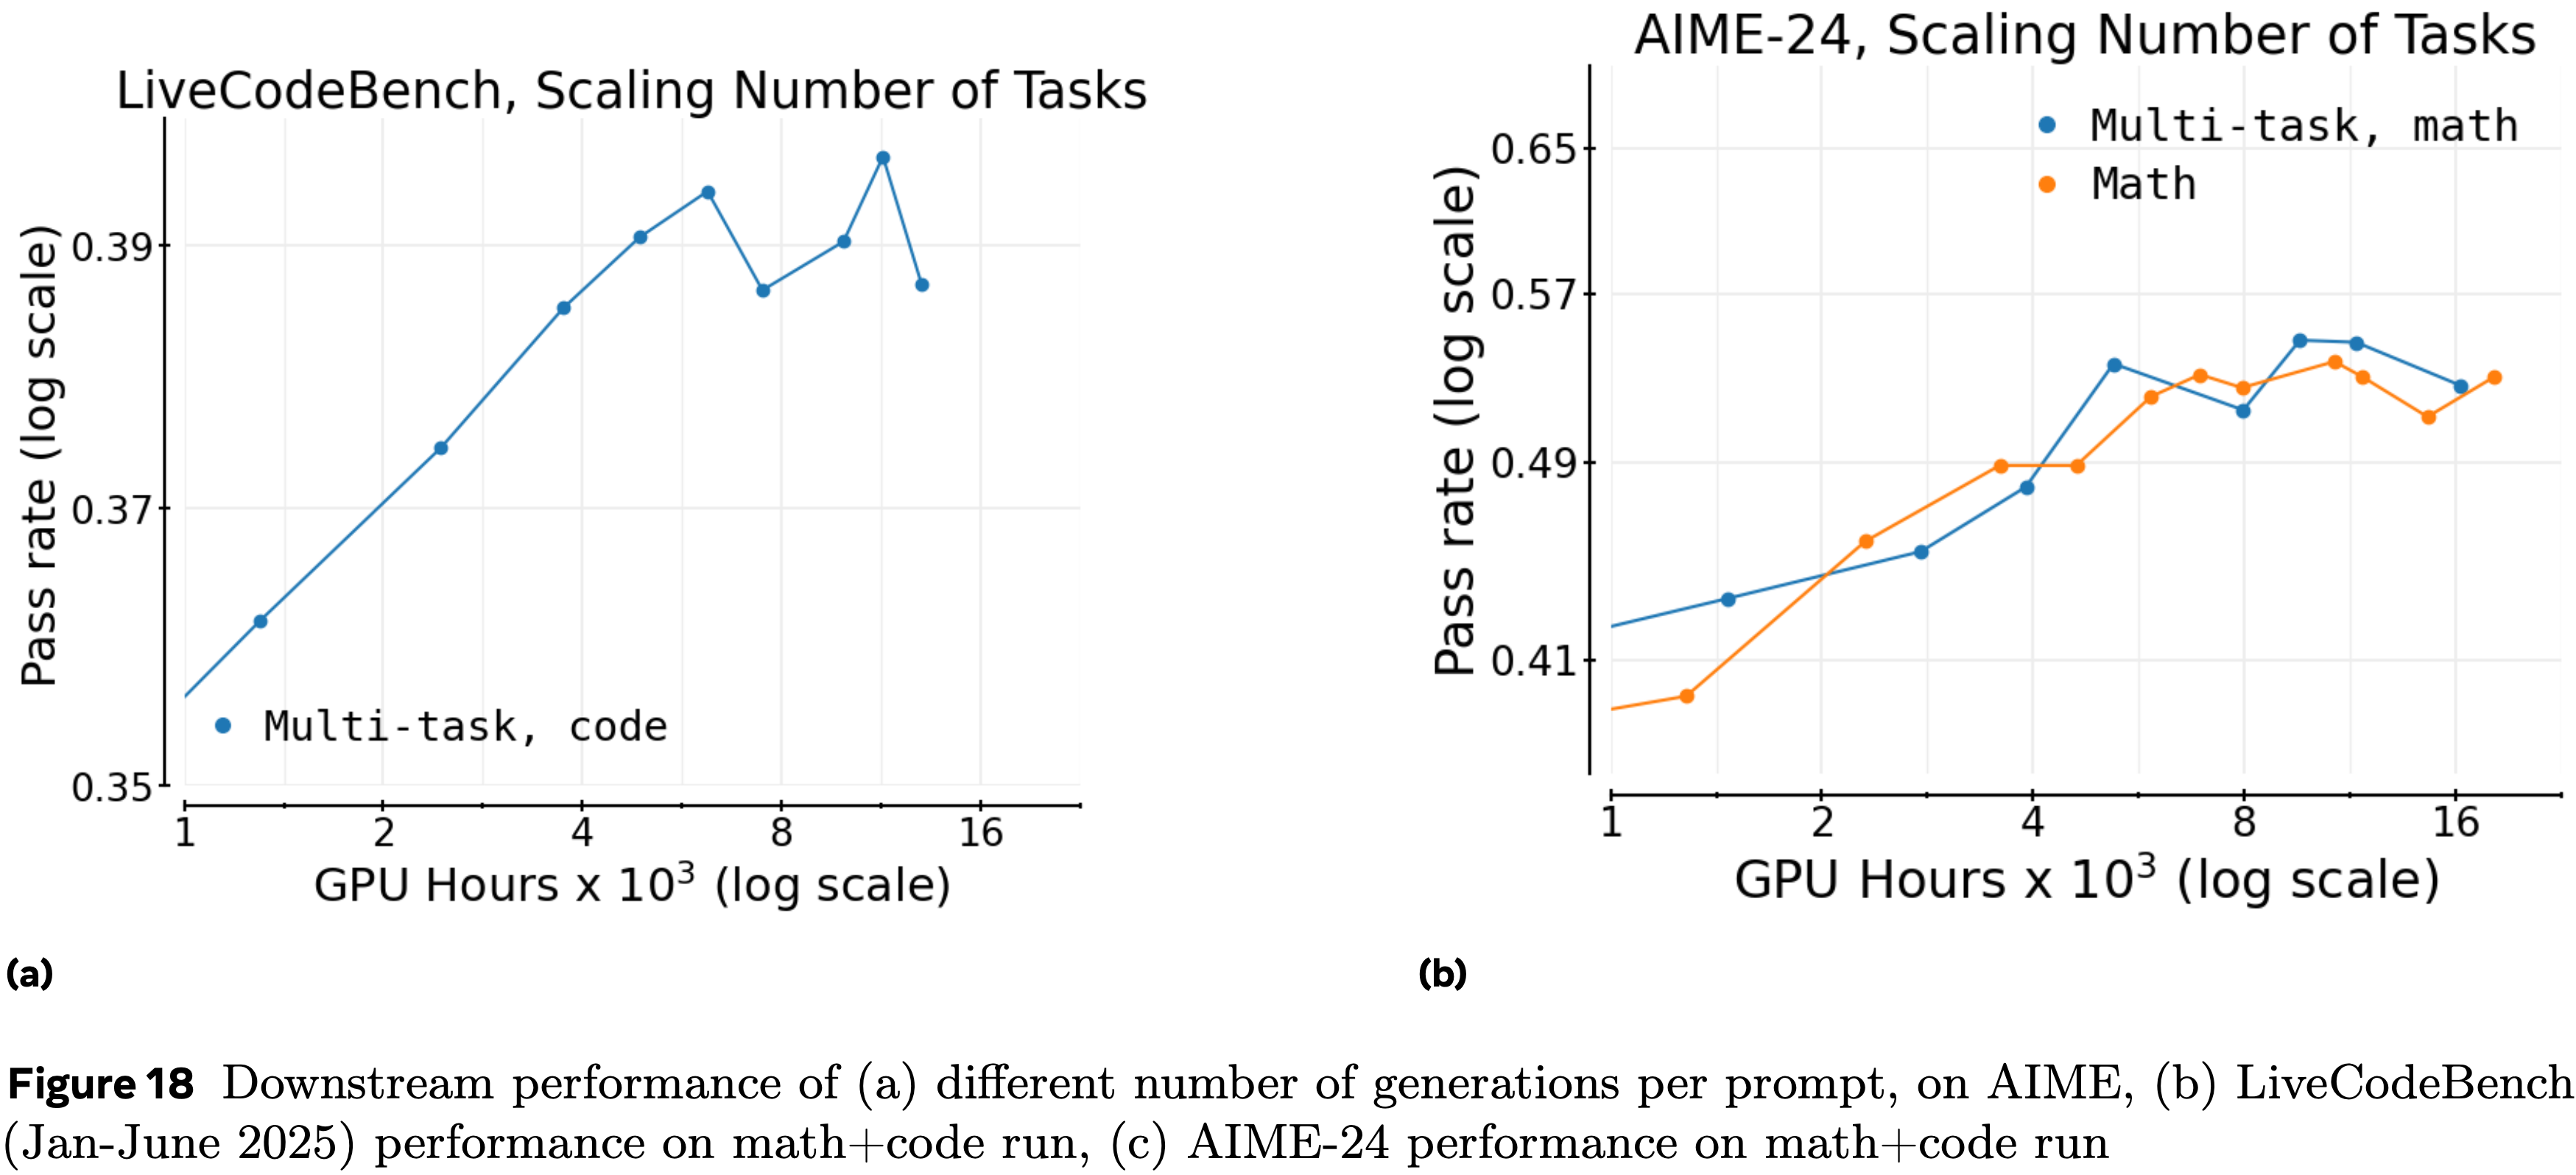
  • 在图 18 中提供了相应的下游评估
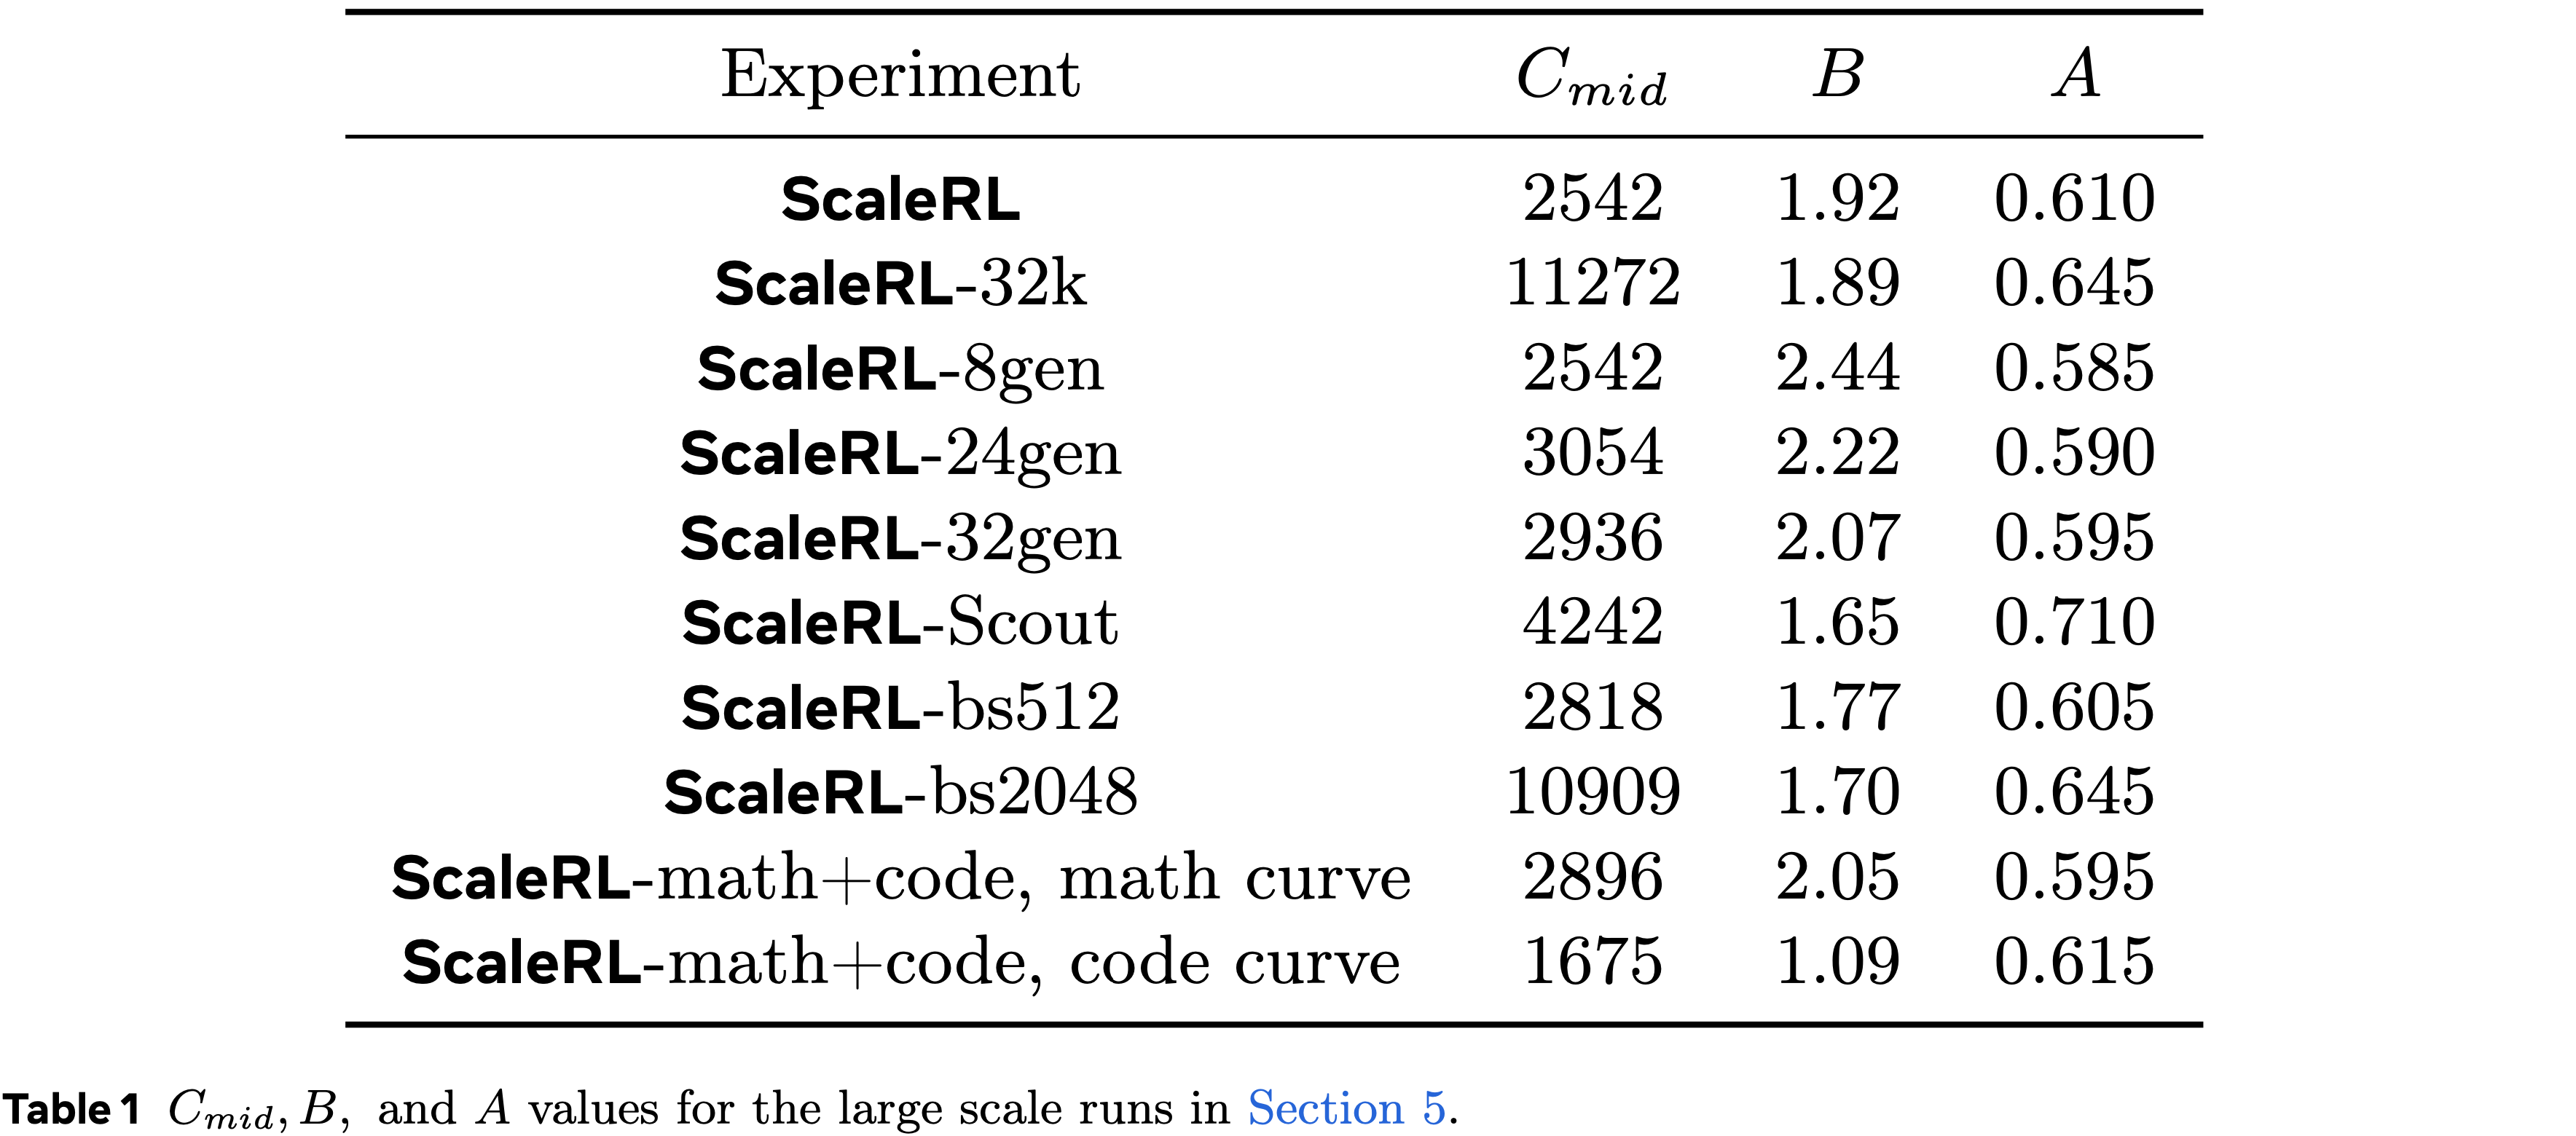
  • 论文还在表 1 中提供了 \(A,B,C_{mid}\) 的值

A.14 Downstream performance

  • 在图 1、9、10b 和 18 中报告了一组具有代表性的下游评估曲线
  • 这些包括具有批次大小 \(\{512,768,2048\}\) 的 ScaleRL 运行、具有 32k 生成长度的长上下文训练运行、大模型(Scout)训练运行、多任务运行(数学 + 代码)以及不同每个提示生成数量(固定批次大小)的运行
  • 对于每种设置,论文绘制了性能与计算量的关系
  • 结论:对于像更大批次大小、更长生成长度和更大模型大小这样的实验,下游性能更好(与验证集曲线的顺序相似)

A.15 Truncations and training instabilities

  • 在论文的所有实验中,论文发现训练不稳定性通常与截断有关
    • 随着生成长度的增加,许多强化学习运行表现出波动的截断率,有时在训练过程中增加
  • 在批次大小 768 的情况下,论文观察到 10-15% 范围内的截断通常会破坏训练稳定性 ,性能下降且无干预就无法恢复
    • 例子包括图 2 中扩展的 GRPO 运行,其中不稳定性与上升的截断率相关,以及第 3.2 节中使用的更新基线
  • 相比之下,ScaleRL 运行更加稳定
    • 在 8B 模型上,超过 90% 的训练时间内截断率保持在 5% 以下
    • 在批次大小 2048 时,截断率略高,偶尔接近约 7%
      • 这种增加主要归因于训练期间观察到的更长的平均生成长度,这自然增加了超过预算的机会
      • 但,即使排除截断样本后,有效批次仍然很大,训练稳定性得以保持
    • 直观地说,更大的生成长度预算应有助于减少截断
    • 使用 34k 生成长度(批次 768)进行训练保持稳定(截断率短暂飙升至约 4%,但迅速降至 2% 以下)
  • 更大的模型更稳健
    • 在 Scout 运行中,截断率始终低于 2%,并且在 > 90% 的训练步数中低于 1%
    • 这可能反映了更大模型调节生成长度的固有能力以及它们更强的指令遵循能力,这使得中断信号更有效
  • 总结:论文建议实践者密切监控截断率
  • 论文的发现表明,高截断率是不稳定性的可靠警告信号 ,而更大的模型、更高的生成预算和谨慎的设计选择(如在 ScaleRL 中)可以显著降低这种风险

A.16 Comparing Prevalent Methods

  • 在图 2 中,论文将一些流行的训练 Recipe 与 ScaleRL 进行了比较,论文在此简要描述这些现有 Recipe
DeepSeek (GRPO)
  • 这个 Recipe 主要遵循 DeepSeek (2025) 的工作
  • 论文使用 GRPO 作为损失函数(第 A.2 节),其中 \(\epsilon_{min}=\epsilon_{max}=0.2\),样本平均损失聚合,以及 PPO-offpolicy-8 算法
  • 训练在 6k GPU hous 后由于截断(第 A.15 节)变得不稳定
Qwen2.5 (DAPO)
  • 这个 Recipe 遵循 DAPO (2025),包括 DAPO 损失函数(附录 A.2),其中 \(\epsilon_{min}=0.2,\epsilon_{max}=0.26\)(附录 A.17.1)
    • 这个 Recipe 使用 PPO-offpolicy-8 和提示平均损失聚合
    • 与原始 DAPO 论文 (2025) 的唯一区别是关于动态填充批次
      • DAPO 丢弃方差为零的提示,并采样更多提示直到批次满员
      • 在论文的代码库中,这效率不高
        • 因为对于 PPO-offpolicy 算法,Generator 会预先决定每个 Generator 将为 #prompts/#generators 生成 Rollout
        • 如果某个特定的 Generator 有更多方差为零的提示 ,它会采样更多的提示来完成其 #prompts/#generators 的份额
        • 这可能导致其他 Generator 停滞和整体速度减慢
      • 为了解决这个问题,论文保持一个更大的批次大小 1280(80 个提示,每个 16 个生成),并从批次中丢弃方差为零的提示
      • 论文注意到,丢弃后,有效批次仍然大于 768,即论文用于 ScaleRL 的大小
Magistral
  • 这指的是 (2025) 中使用的 Recipe
  • 这个 Recipe 包括与 DAPO 类似的 Recipe ,主要区别在于使用 PipelineRL 作为 Off-policy 算法
MiniMax
  • 这指的是 (2025) 中使用的 Recipe
  • 这个 Recipe 使用 CISPO 损失、LM 头部的 FP32 精度修复、PPO-offpolicy 算法和提示平均
  • 与 DAPO 类似,它也丢弃方差为零的提示,因此论文也给它一个更大的批次大小 1280

A.17 Loss Type - Stability and Robustness

  • GRPO/DAPO 风格的损失对裁剪比率超参数 \(\epsilon_{\text{max} }\) 的选择高度敏感;CISPO 和 GSPO 显示出远更强的稳健性
    • 例如,在附录 A.17.2 中,将 CISPO 的 \(\epsilon_{\text{max} }\) 在 \(\{4,5,8\}\) 之间变化,性能没有显著差异
  • 对于 GSPO ,原始论文 (2025) 中使用的 \(10^{-4}\) 裁剪尺度在论文的设置中效果不佳
    • 论文在更广泛的尺度上进行了消融,发现确定了正确的数量级(例如,\(4\times 10^{-3}\) 及更高)以后,性能就稳定了,并且对细粒度的变化(例如,\(\{4\times 10^{-3},5\times 10^{-3}\}\))基本不敏感
A.17.1 DAPO clipping ratios
  • 在本节中,论文分析了 DAPO 损失函数(公式 (8))中裁剪阈值 \(\epsilon_{\text{max} }\) 的作用
  • \(\epsilon_{max}\) 的超参数敏感性已在先前工作中观察到
    • 例如,GRPO 通常设置 \(\epsilon_{\text{max} }=0.2\),而 DAPO 使用 \(0.28\)
  • 除了调整敏感性之外,论文发现 \(\epsilon_{\text{max} }\) 直接改变了算法的缩放行为
    • 随着 \(\epsilon_{\text{max} }\) 增加,终端奖励 \(A\) 增加,直到达到一个最佳范围,之后 \(A\) 再次下降
  • 这是一个显著的效果:与许多仅改变收敛速度的超参数不同,\(\epsilon_{\text{max} }\) 控制着渐近误差本身
A.17.2 CISPO Clipping Ratios
  • 论文消融了 CISPO 的较高裁剪比率,将较低裁剪比率固定为 \(0\)(图 19b)
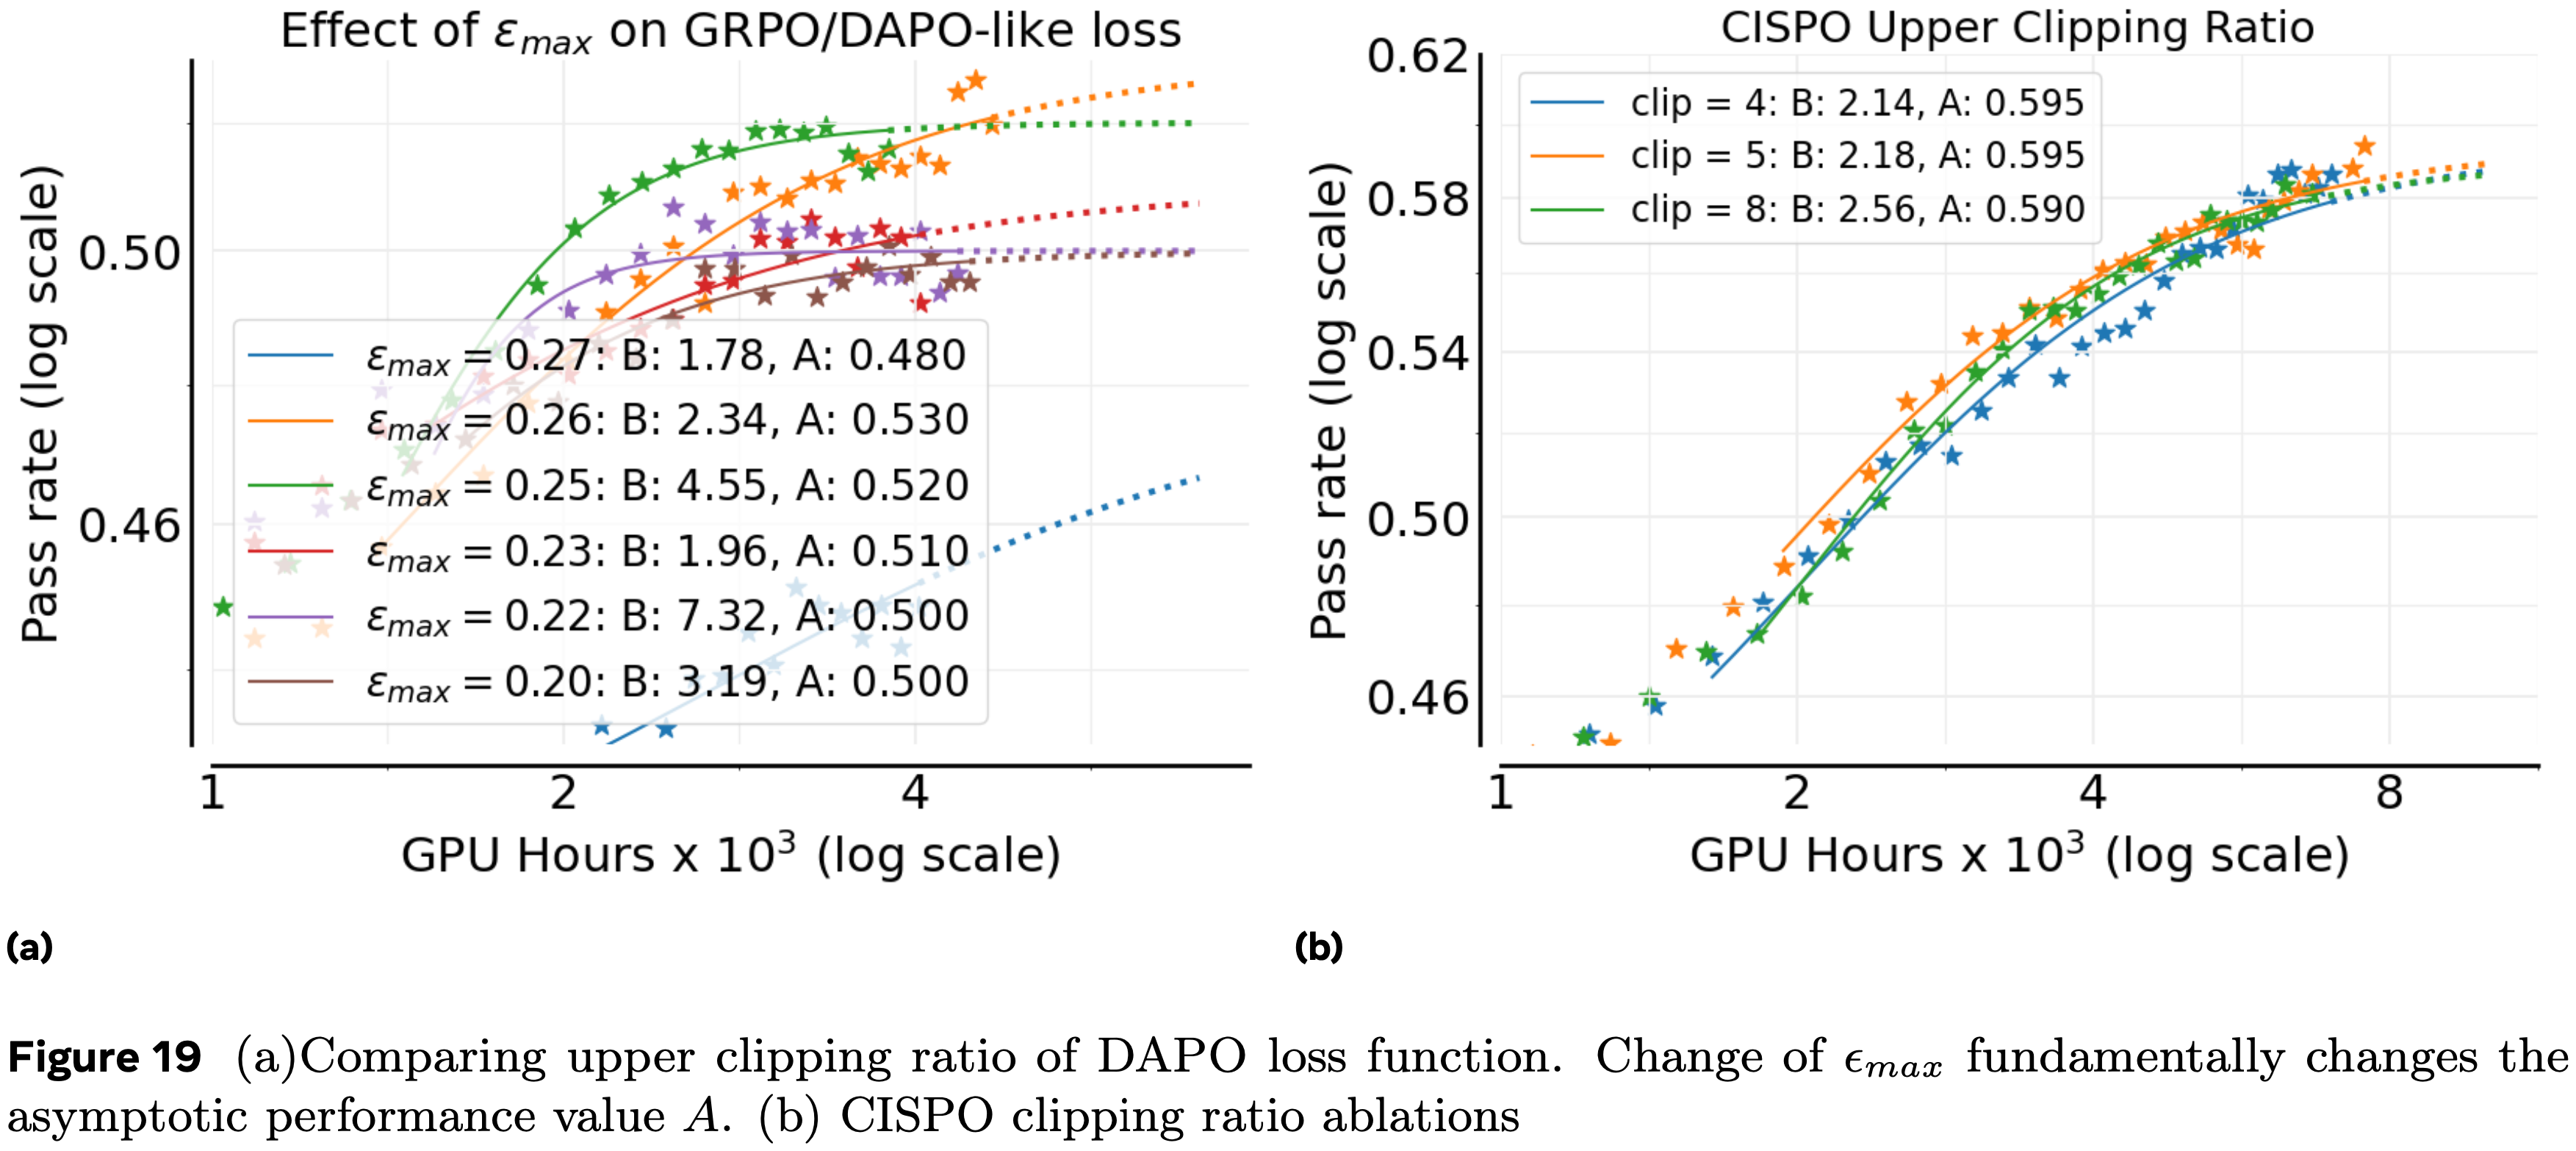
  • 在很宽的值范围内,论文发现性能差异很小,表明 CISPO 对这个超参数基本不敏感
  • 这种稳健性反映了论文对 GSPO 的发现(第 A.17.3 节),并且与 DAPO/GRPO 风格的目标形成对比,后者对裁剪阈值的精确选择高度敏感
  • 这种在超参数变化下的稳定性使 CISPO 成为大规模训练中默认使用的有力候选者
A.17.3 GSPO ablations
  • 论文消融了 GSPO 中使用的裁剪比率尺度,如图 20a 所示
  • GSPO 论文 (2025) 中给出的默认 \(10^{-4}\) 尺度对论文的 8B 模型缩放效果不是最好
  • \(10^{-3}\) 尺度的表现与其他替代方案一样好,或者更好(图 20a)
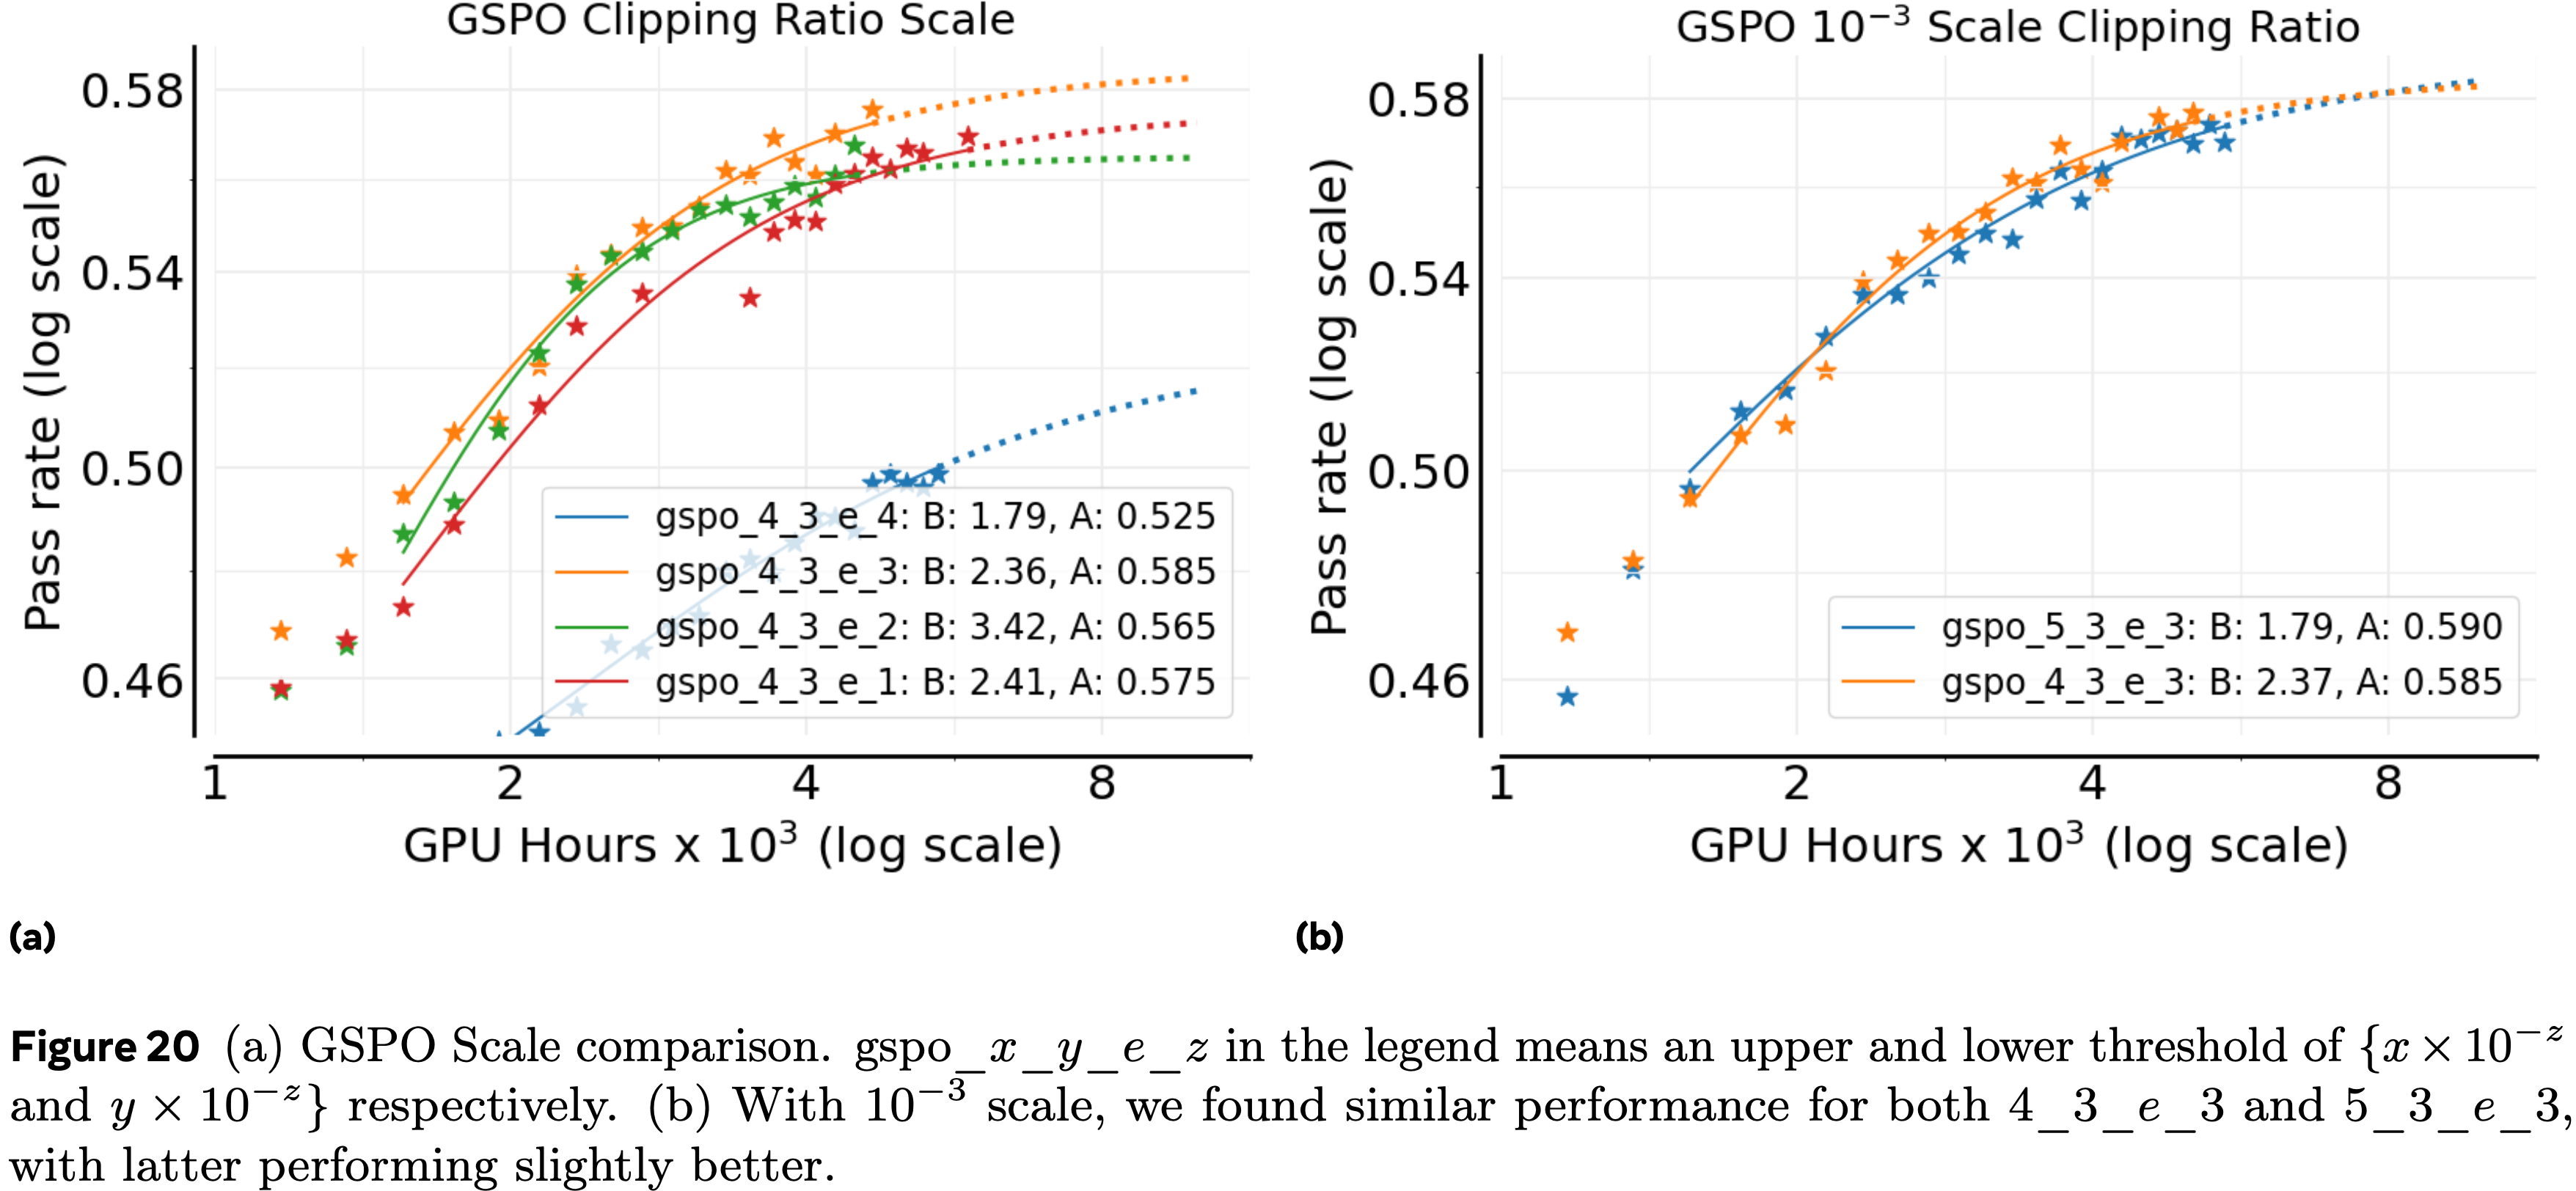
  • 给定这个尺度,论文进一步将上裁剪比率在 \(\{4\times 10^{-3},5\times 10^{-3}\}\) 之间变化,并发现 \(\{5\times 10^{-3}\}\) 产生了稍好的拟合(图 20b)
  • GSPO 对裁剪比率的选择相当稳健
    • 确定了正确的尺度以后,大多数附近的值甚至更大的尺度表现相似
    • 这种稳健性与 DAPO 风格的损失形成鲜明对比,后者对上裁剪比率的精确值高度敏感,如第 3.2 节所述
A.17.4 GSPO vs CISPO
  • 尽管具有超参数稳健性,但论文遇到了 GSPO 的稳定性问题
    • 在多次情况下,GSPO 运行在训练中期发散,导致性能突然下降
    • 对于 8B 模型,从稳定检查点重新启动可以恢复,但此策略在更大的模型(如 Scout)上失败,尽管重复重置到稳定检查点,不稳定性仍然存在
    • 虽然论文尽最大努力检查了任何实现错误,但论文没有发现
  • 总的来说,虽然所有三种损失系列在调整好的设置下都可以具有竞争力,但 CISPO 在稳定性和对超参数的稳健性方面提供了最佳平衡 ,使其成为论文推荐的选择
NLP——技术报告解读-DeepSeek-V3.2

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文(已过期):DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek, 20251202
    • 原始论文(arXiv):DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek, 20251202
    • 参考博客:DeepSeek-V3.2 技术报告深度解析:架构演进、RL 扩展与 Agent 合成数据
    • 对 Unbiased KL Estimate 的理解:DeepSeek-V3.2中无偏 KL估计(Unbiased KL Estimate)的一些想法 - Keith Jiang的文章 - 知乎

Paper Summary

  • DeepSeek-V3.2:在高效计算与卓越推理和智能体性能之间取得平衡的模型
  • DeepSeek-V3.2 关键技术:
    • (1) DeepSeek 稀疏注意力 (DeepSeek Sparse Attention, DSA): 论文引入了 DSA,这是一种高效的注意力机制,能在保持长上下文场景下模型性能的同时,显著降低计算复杂度
    • (2) 可扩展的强化学习框架 (Scalable Reinforcement Learning Framework): 通过实施一个鲁棒的强化学习协议并扩展后训练计算量,DeepSeek-V3.2 的性能与 GPT-5 相当
      • DeepSeek-V3.2-Speciale(DeepSeek-V3.2 的高计算量变体) 超越了 GPT-5,并且其推理能力与 Gemini-3.0-Pro 持平,在 2025 年国际数学奥林匹克 (International Mathematical Olympiad, IMO) 和国际信息学奥林匹克 (International Olympiad in Informatics, IOI) 中均取得了金牌表现
    • (3) 大规模智能体任务合成流程 (Large-Scale Agentic Task Synthesis Pipeline): 为了将推理能力整合到工具使用场景中,论文开发了一种新颖的合成流程,系统地大规模生成训练数据。这种方法促进了可扩展的智能体后训练,在复杂、交互式环境中显著提升了模型的泛化能力和遵循指令的鲁棒性
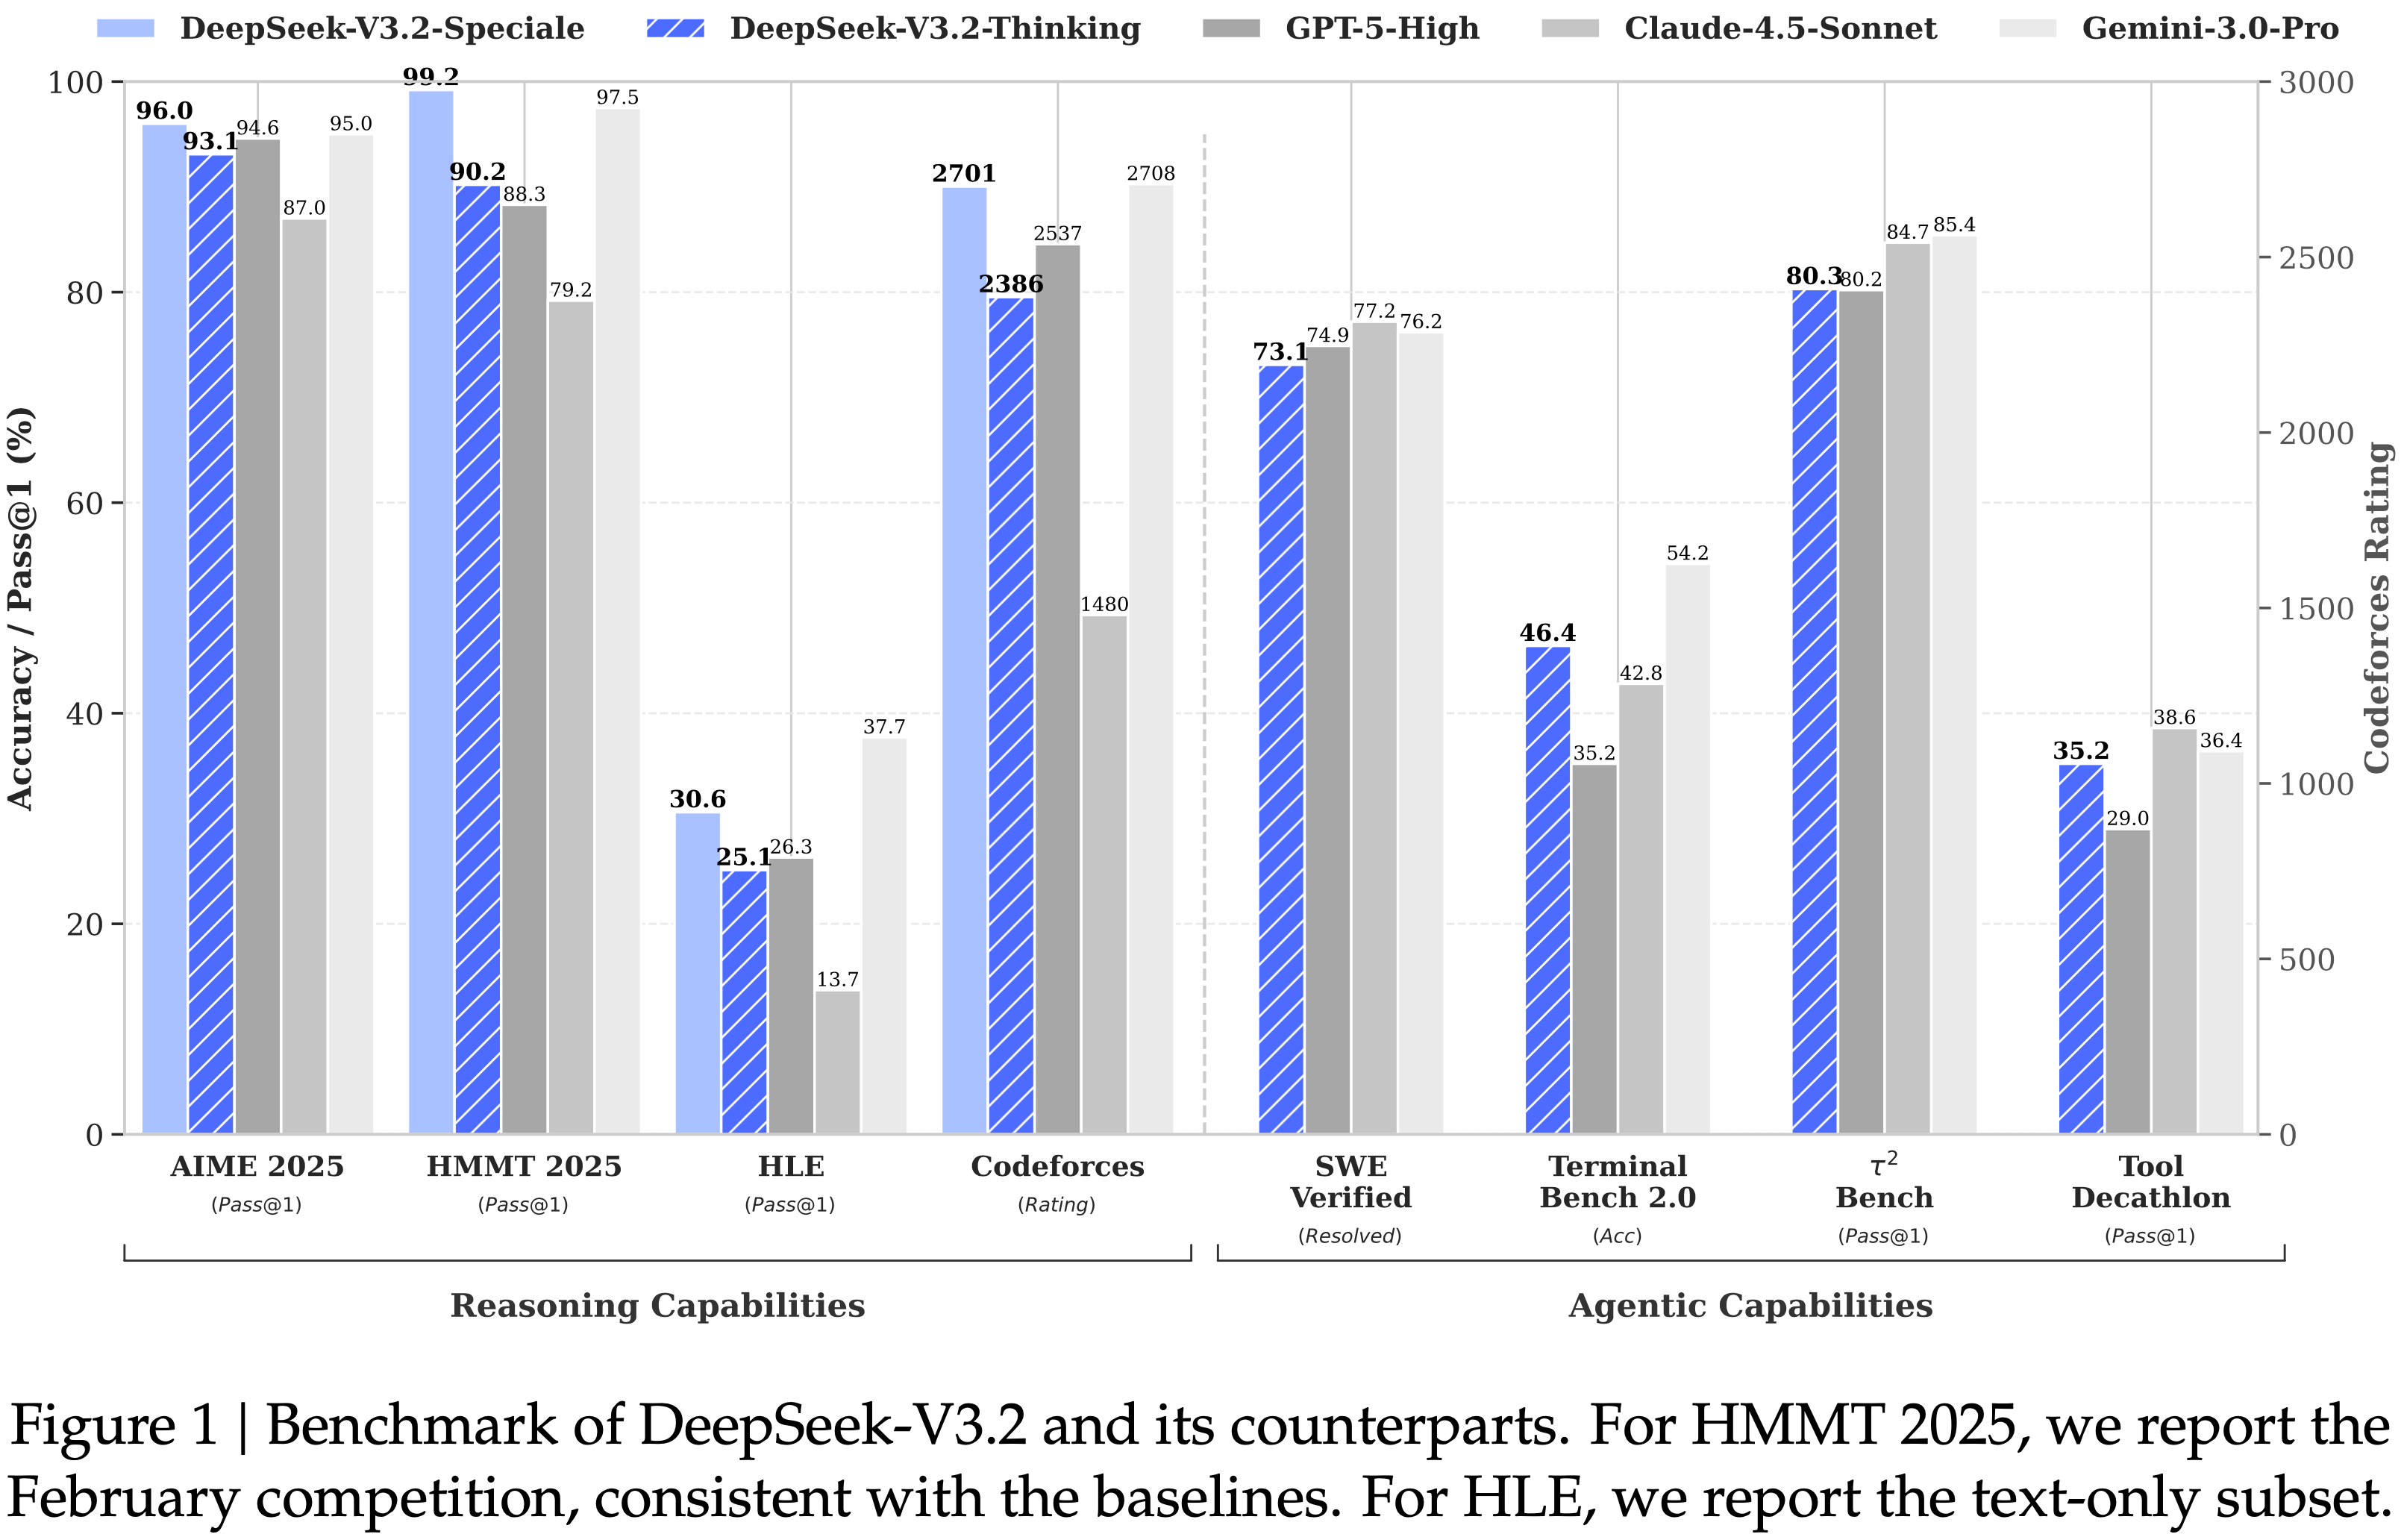
  • 图 1:DeepSeek-V3.2 及其同类模型的基准测试
    • 对于 HMMT 2025,论文报告的是二月份的比赛结果,与基线一致
    • 对于 HLE,论文报告的是纯文本子集

Introduction and Discussion

  • 推理模型的发布标志着 LLM 演进中的一个关键转折点,在可验证领域的整体性能的显著飞跃
  • 自这一里程碑以来,LLM 的能力迅速发展;但在过去几个月中出现了明显的分化
    • 虽然开源社区持续取得进展,但闭源专有模型 (Anthropic; DeepMind; OpenAI, 2025) 的性能提升轨迹以明显更快的速度在加速
    • 闭源和开源模型之间的性能差距不仅没有缩小,反而似乎在扩大,专有系统在复杂任务中表现出日益卓越的能力
  • 作者分析确定了限制开源模型在复杂任务中能力的三个关键不足
    • 在架构上,主要依赖普通注意力 (vanilla attention) (2017) 机制严重限制了长序列的效率
      • 这种低效性对可扩展部署和有效后训练都构成了重大障碍
    • 在资源分配方面,开源模型在后训练阶段的计算投入不足,限制了其在困难任务上的表现
    • 在 AI 智能体 (AI agents) 的背景下,与专有模型相比,开源模型在泛化能力和指令遵循能力方面表现出明显的滞后 (EvalSys, 2025; 2025; 2025),这阻碍了其在实际部署中的有效性
  • 为了解决这些关键限制,论文做了如下改进:
    • 第一:引入 DSA,一种旨在显著降低计算复杂度的高效注意力机制
      • 该架构有效解决了效率瓶颈,即使在长上下文场景下也能保持模型性能
    • 第二:开发了一种稳定且可扩展的 RL 协议,允许在后训练阶段进行显著的计算扩展
      • 该框架分配的后训练计算预算超过了预训练成本的 \(10%\),从而解锁了高级能力
    • 第三,提出了一种新颖的流程,以促进工具使用场景中可泛化的推理
      • 首先,实施一个冷启动 (cold-start) 阶段,利用 DeepSeek-V3 (DeepSeek-AI, 2024) 的方法论将推理和工具使用统一在单个轨迹内
      • 随后,论文推进到大规模智能体任务合成,生成了超过 1,800 个不同的环境和 85,000 个复杂的 Prompt
      • 这种广泛的合成数据驱动了 RL 过程,显著增强了模型在智能体上下文中的泛化能力和指令遵循能力
  • 小结:
    • DeepSeek-V3.2 在多个推理基准测试中与 Kimi-k2-thinking 和 GPT-5 取得了相近的性能
    • DeepSeek-V3.2 显著提升了开源模型的智能体能力,在之前工作(EvalSys,2025; 2025; 2025)引入的长尾智能体任务上表现出卓越的熟练度
    • DeepSeek-V3.2 成为智能体场景中一个极具成本效益的替代方案,在显著降低成本的同时,大大缩小了开源模型与前沿专有模型之间的性能差距
    • 特别地:为了推动开源模型在推理领域的前沿,论文放宽了长度约束以开发 DeepSeek-V3.2-Speciale
      • DeepSeek-V3.2-Speciale 达到了与领先闭源系统 Gemini-3.0-Pro (DeepMind) 相当的性能
      • 在 IOI 2025、ICPC World Final 2025、IMO 2025 和 CMO 2025 中均表现出金牌水平的性能
    • 注:论文评估了 CMO 2025 的英文版。IMO 2025 和 CMO 2025 的问题以及推理代码可在 github.com/deepseek-ai/DeepSeek-Math-V2 找到

DeepSeek-V3.2 Architecture

DeepSeek Sparse Attention

  • DeepSeek-V3.2 的架构与 DeepSeek-V3.2-Exp 完全相同
  • 与 DeepSeek-V3.1 的最后一个版本 DeepSeek-V3.1-Terminus 相比,DeepSeek-V3.2 唯一的架构修改是通过持续训练(Continuous Training)引入了 DeepSeek 稀疏注意力 (DeepSeek Sparse Attention, DSA)
  • DSA 原型 (Prototype of DSA)
    • DSA 的原型主要由两个部分组成:一个 Lightning Indexer 和一个细粒度 Token 选择机制 (fine-grained token selection mechanism)
  • Lightning Indexer
    • 计算查询 Token \(\mathbf{h}_{t}\in\mathbb{R}^{d}\) 与前一个 Token \(\mathbf{h}_{s}\in\mathbb{R}^{d}\) 之间的索引分数 \(I_{t,s}\),确定哪些 Token 将被查询 Token 选择:
      $$I_{t,s}=\sum_{j=1}^{H^{l} }w_{t,j}^{I}\cdot\text{ReLU}\left(\mathbf{q}_{t,j}^{I} \cdot\mathbf{k}_{s}^{I}\right), \tag{1}$$
      • \(H^{l}\) 表示 Indexer 头 (indexer heads) 的数量;
      • \(\mathbf{q}_{t,j}^{I}\in\mathbb{R}^{d^{l} }\) 和 \(w_{t,j}^{I}\in\mathbb{R}\) 来源于查询 Token \(\mathbf{h}_{t}\);
      • \(\mathbf{k}_{s}^{I}\in\mathbb{R}^{d^{l} }\) 来源于前一个 Token \(\mathbf{h}_{s}\)
    • 出于吞吐量考虑,论文选择 ReLU 作为激活函数
    • 鉴于 Lightning Indexer 具有少量头部并且可以在 FPS 中实现,其计算效率非常显著
  • 细粒度 Token 选择机制 (fine-grained token selection mechanism)
    • 给定每个查询 Token \(\mathbf{h}_{t}\) 的索引分数 \(\{I_{t,s}\}\),fine-grained token selection mechanism 仅检索与最高 k 个索引分数对应的键值条目 \(\{\mathbf{c}_{s}\}\)
    • 然后,通过在查询 Token \(\mathbf{h}_{t}\) 和稀疏选择的键值条目 \(\{\mathbf{c}_{s}\}\) 之间应用注意力机制来计算注意力输出 \(\mathbf{u}_{t}\):
      $$\mathbf{u}_{t}=\text{Attn}(\mathbf{h}_{t},\left\{\mathbf{c}_{s}\mid I_{t,s}\in \text{Top-k}(I_{t,:})\right\}). \tag{2}$$
  • 在 MLA 下实例化 DSA (Instantiate DSA Under MLA)
    • 出于从 DeepSeek-V3.1-Terminus 进行持续训练的考虑,论文为 DeepSeek-V3.2 基于 MLA (DeepSeek-AI, 2024) 实例化了 DSA
    • 在 kernel 层面,为了提高计算效率,每个键值条目必须在多个查询之间共享 (2025)
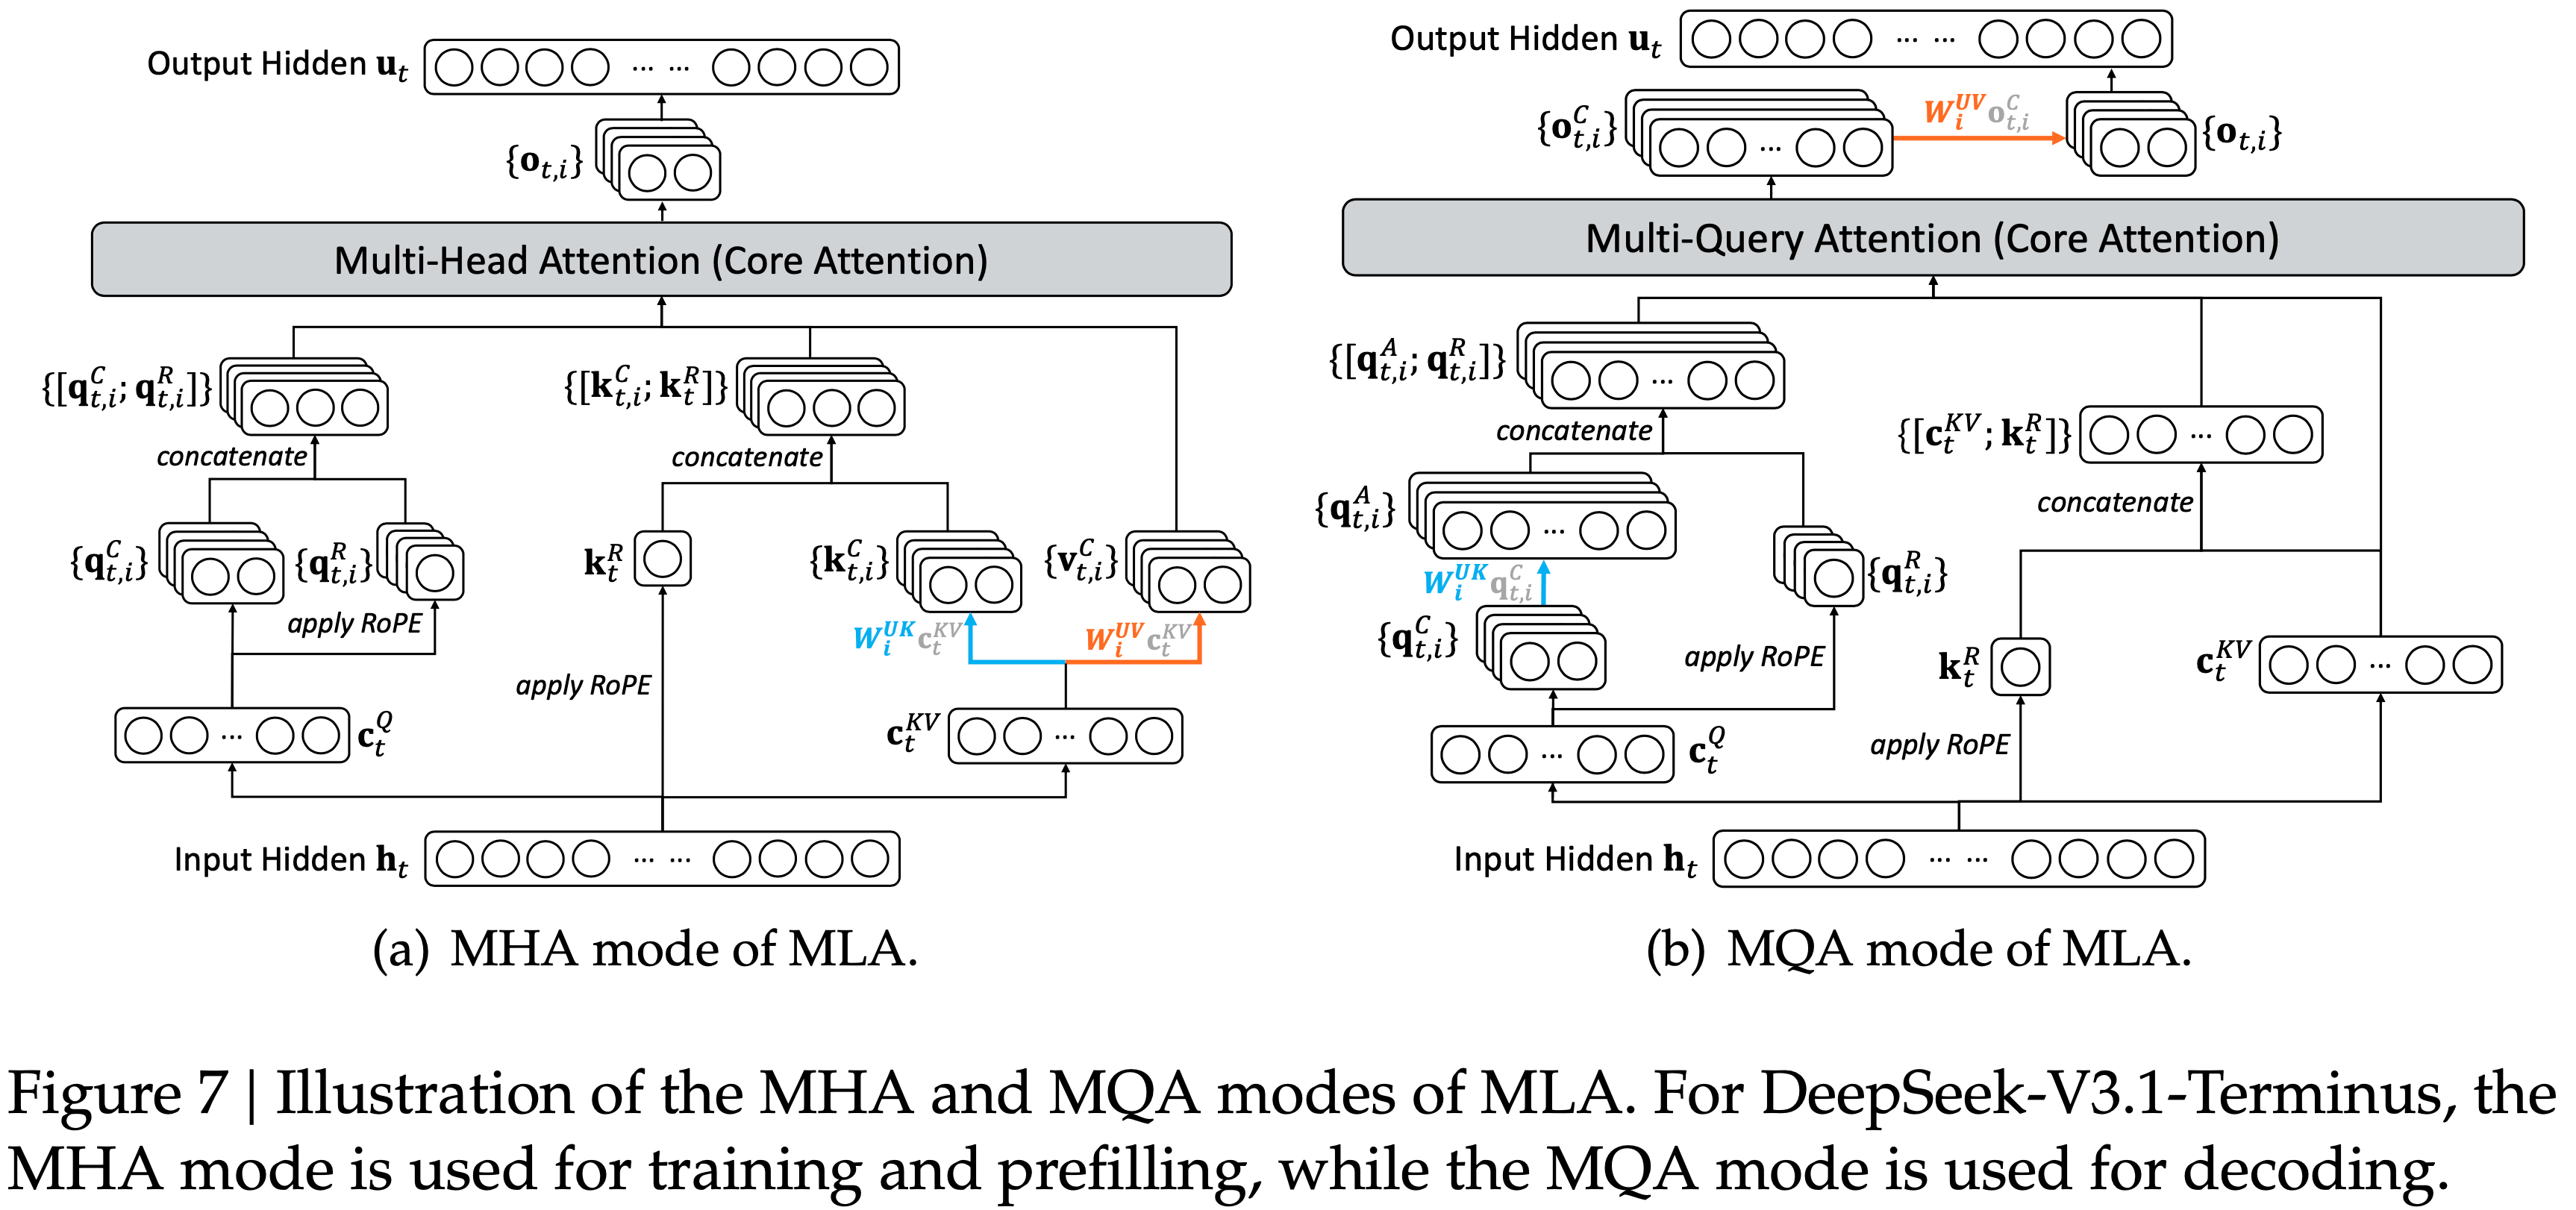
    • 基于 MLA1 的 MQA (Multi-Query Attention) 模式 (Shazeer, 2019) 实现了 DSA,其中每个潜在向量 (MLA 的键值条目) 将在查询 Token 的所有查询头之间共享
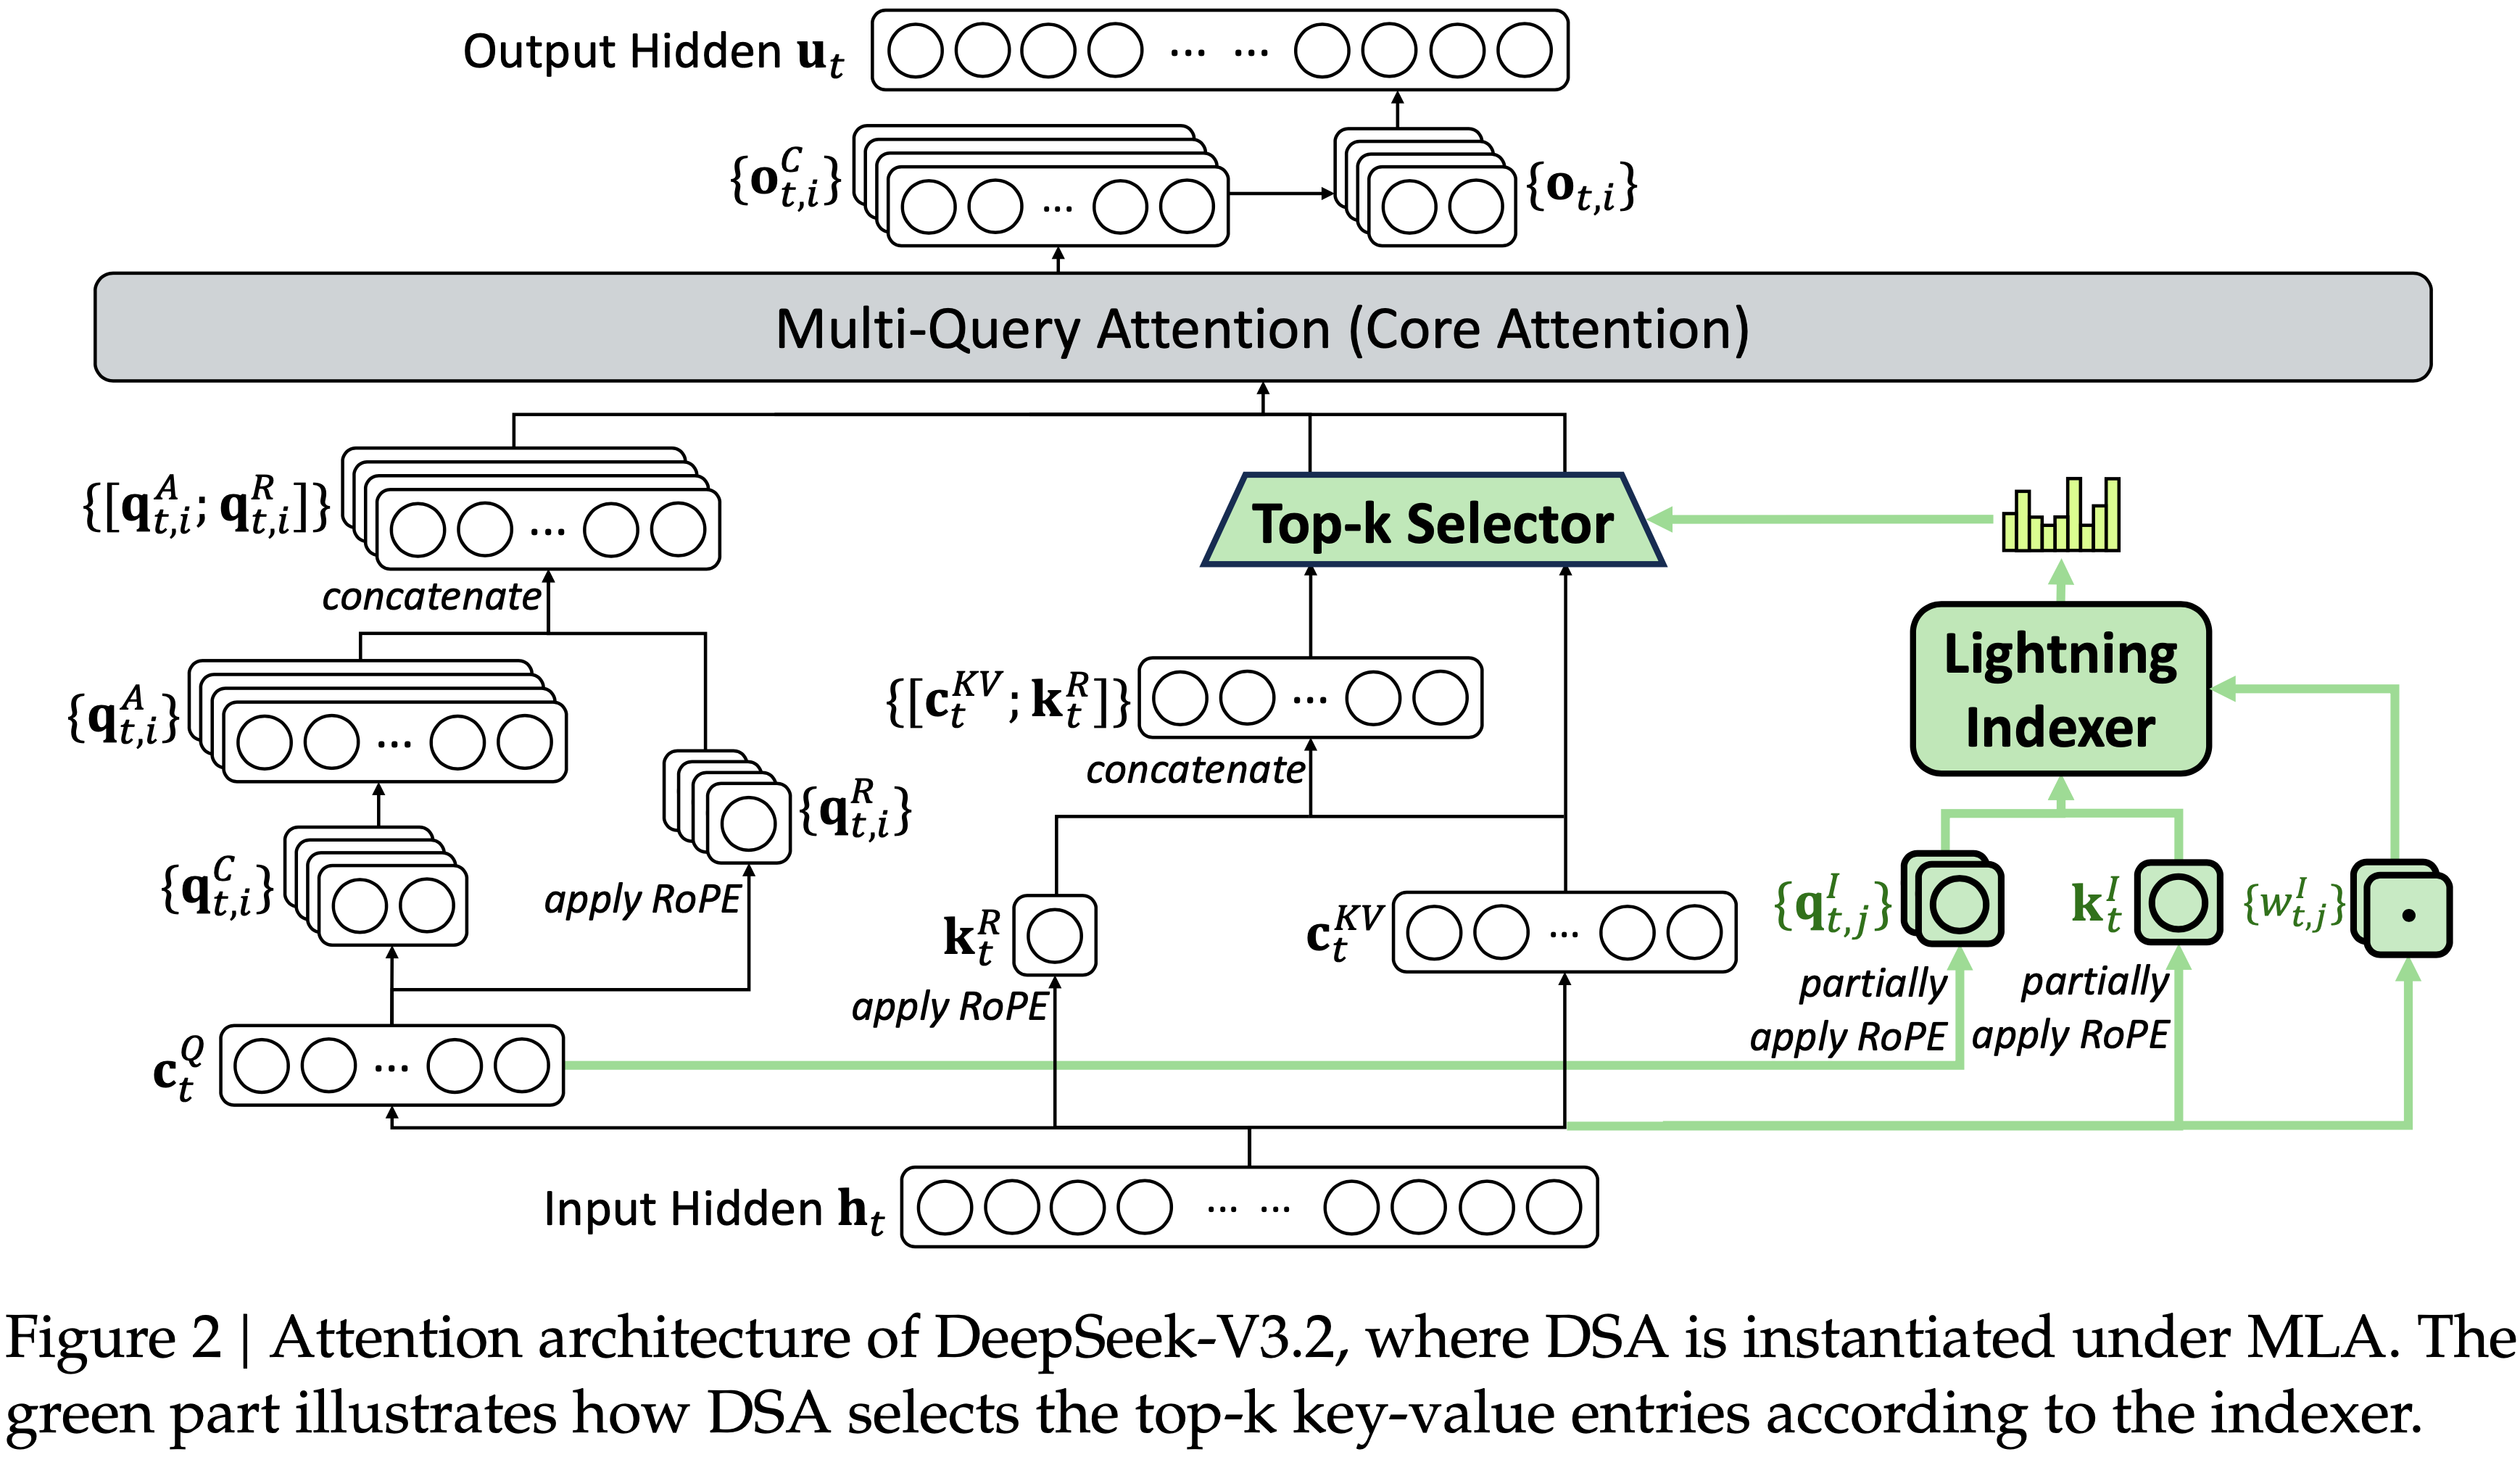
    • 基于 MLA 的 DSA 架构如图 2 所示
    • 详情见:DeepSeek-V3.2 的开源实现以明确指定细节 和 论文附录
Continued Pre-Training
  • 从一个上下文长度已扩展到 128K 的 DeepSeek-V3.1-Terminus base checkpoint 开始,进行持续预训练,随后进行后训练(最终得到 DeepSeek-V3.2)
  • DeepSeek-V3.2 的持续预训练包括两个训练阶段
    • 对于这两个阶段,训练数据的分布与用于 DeepSeek-V3.1-Terminus 的 128K 长上下文扩展数据完全一致
  • 密集预热阶段 (Dense Warm-up Stage) : 使用一个简短的预热阶段来初始化 Lightning Indexer (预热)
    • 在此阶段,论文保持密集注意力,并冻结除 Lightning Indexer 外的所有模型参数
    • 为了使 Indexer 输出与主要注意力分布对齐,对于第 \(t\) 个查询 Token
      • 先通过对所有注意力头求和来聚合主要注意力分数
      • 然后,沿序列维度对该和进行 L1 归一化以产生目标分布 \(p_{t,:}\in\mathbb{R}^{t}\)
    • 基于 \(p_{t,:}\),论文将 KL 散度损失设置为 Indexer 的训练目标:
      $$\mathcal{L}^{l}=\sum_{t}\mathbf{D}_{\text{KL} }\big{(}p_{t,:}\big{|}\text{Softmax }(I_{t,:})\big{)}. \tag{3}$$
    • 对于预热,使用 \(10^{-3}\) 的学习率
    • 只对 Indexer 训练 \(1000\) 步,每步包含 \(16\) 个 128K Token 的序列,总计 2.1B Token
  • 稀疏训练阶段 (Sparse Training Stage) : Indexer 预热之后,引入细粒度 Token 选择机制,并优化所有模型参数以使模型适应 DSA 的稀疏模式
    • 在此阶段,论文仍然保持 Indexer 输出与主要注意力分布的对齐,但仅考虑被选择的 Token 集合 \(\mathcal{S}_{t}=\{s|I_{t,s}\in\text{Top-k}(I_{t,:})\}\):
      $$\mathcal{L}^{l}=\sum_{t}\mathbf{D}_{\text{KL} }\big{(}p_{t,\mathcal{S}_{t} }\big{|}\text{Softmax}(I_{t,\mathcal{S}_{t} })\big{)}. \tag{4}$$
  • 特别注意:作者将 Indexer 输入从计算图中分离 (detach) 出来进行单独优化
    • Indexer 的训练信号仅来自 \(\mathcal{L}^{l}\),而主要模型的优化仅根据语言建模损失进行
    • 在这个稀疏训练阶段,论文使用 \(7.3\times 10^{-6}\) 的学习率,并为每个查询 Token 选择 \(2048\) 个键值 Token
    • 对主要模型和 Indexer 都训练了 \(15000\) 步,每步包含 \(480\) 个 128K Token 的序列,总计 9437 亿 Token
  • 图 2: DeepSeek-V3.2 的注意力架构,其中 DSA 在 MLA 下实例化
    • 绿色部分说明了 DSA 如何根据 Indexer 选择 top-k 的键值条目

Post-Training

  • 持续预训练(continued pre-training)后再执行后训练
  • DeepSeek-V3.2 的后训练也采用与稀疏持续预训练阶段相同的方式使用稀疏注意力
  • DeepSeek-V3.2 保持与 DeepSeek-V3.2-Exp 相同的后训练流程,其中包括专家蒸馏和混合强化学习训练
  • 专家蒸馏(Specialist Distillation)
    • 对于每项任务,首先开发一个专门针对该特定领域的专用模型
      • 所有专家模型都从同一个预训练的 DeepSeek-V3.2 基础 Checkpoint 进行微调
    • 除了写作任务和通用问答外,论文的框架还涵盖六个专业领域:
      • 数学、编程、通用逻辑推理、通用智能体任务、智能体编码和智能体搜索
      • 所有这些领域都同时支持 Thinking 模式和非 Thinking 模式
    • 每个专家都通过大规模 RL 计算进行训练
    • 使用不同的模型来生成长链 Thinking 推理( Thinking 模式)和直接响应生成(非 Thinking 模式)的训练数据
      • 专家模型用来为最终 Checkpoint 生成特定领域的数据
      • 实验结果表明,在蒸馏数据上训练的模型达到的性能水平仅略低于领域特定专家,并且通过后续的 RL 训练可以有效地消除性能差距
  • 混合 RL 训练(Mixed RL Training)
    • 对于 DeepSeek-V3.2,论文仍然采用 GRPO (DeepSeek-AI, 2025; 2024) 作为 RL 训练算法
    • 与 DeepSeek-V3.2-Exp 一样,将推理、智能体和对齐训练合并到一个 RL 阶段
    • 这种方法有效地平衡了不同领域的性能,同时避免了通常与多阶段训练范式相关的灾难性遗忘问题
    • 对于推理和智能体任务,论文采用基于规则的结果奖励、长度惩罚和语言一致性奖励
    • 对于通用任务,论文采用生成式奖励模型,其中每个 Prompt 都有其自己的评估准则(Rubrics RM?)

      For general tasks, we employ a generative reward model where each prompt has its own rubrics for evaluation

  • DeepSeek-V3.2 与 DeepSeek-V3.2-Speciale
    • DeepSeek-V3.2 整合了从专家蒸馏出的推理、智能体和对齐数据,并经过数千步的持续 RL 训练以到达最终 Checkpoint
    • 为了研究扩展 Thinking 的潜力,开发了一个实验性变体,DeepSeek-V3.2-Speciale
      • 该模型仅在 RL 期间长度惩罚降低的情况下,专门在推理数据上进行训练
      • 作者还整合了来自 DeepSeekMath-V2 (2025) 的数据集和奖励方法,以增强数学证明方面的能力
  • 作者重点强调:在第 3.1 节中介绍如何创建一个稳定的方案来扩大 RL 计算规模,以及在第 3.2 节中介绍如何将 Thinking 整合到智能体任务中的努力
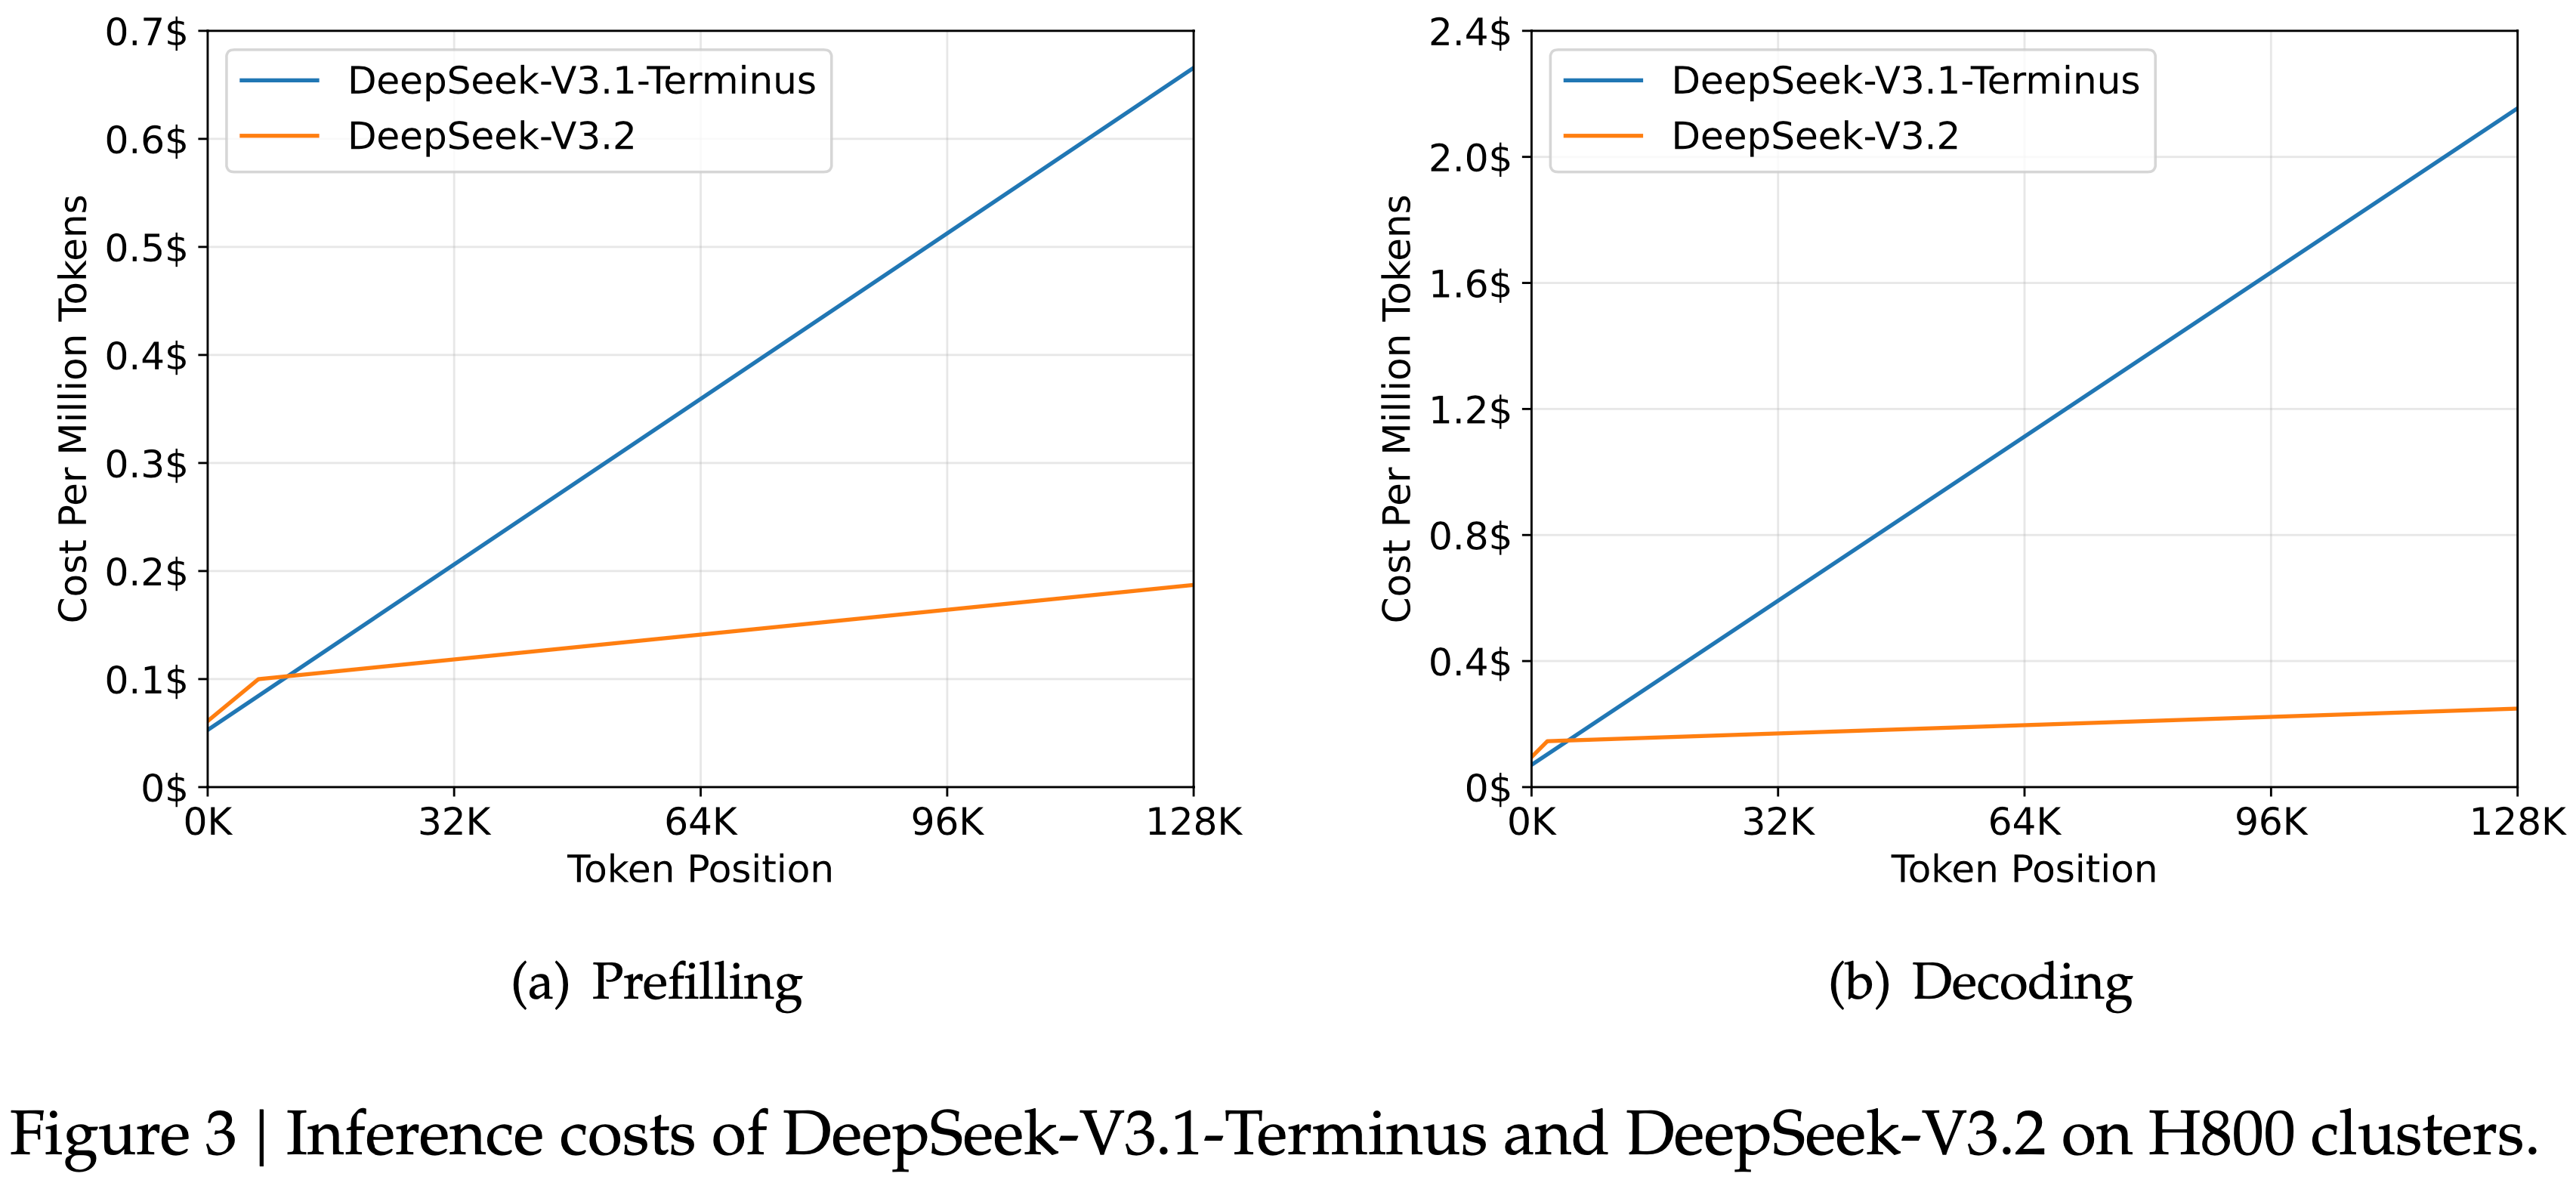
  • 图 3:DeepSeek-V3.1-Terminus 和 DeepSeek-V3.2 在 H800 集群上的推理成本

Scaling GRPO

  • 首先回顾 GRPO 的目标
  • GRPO 通过最大化以下关于从旧策略 \(\pi_{\text{old} }\) 采样得到的一组响应 \(\{o_{1},\cdots,o_{G}\}\) 的目标函数来优化策略模型 \(\pi_{\theta}\),给定每个问题 \(q\):
    $$
    \mathcal{J}_{\text{GRPO} }(\theta) =\mathbb{E}_{q\sim P(Q),\{o_i\}_{i=1}^{G}\sim\pi_{\text{old} }(\cdot|q)}\Bigg[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}
    \min \left(r_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\right)\hat{A}_{i,t}\right)-\beta\mathbb{D}_{\text{KL} }\left(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\right)\Bigg],
    $$
    • \(r_{i,t}(\theta)\) 是当前策略与旧策略之间的重要性采样比率:
      $$
      r_{i,t}(\theta)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}
      $$
    • \(\varepsilon\) 和 \(\beta\) 是分别控制剪切范围和 KL 惩罚强度的超参数
    • \(\hat{A}_{i,t}\) 是 \(o_{i,t}\) 的优势,通过对组内的结果奖励进行归一化来估计
      • 使用一组奖励模型为组中的每个输出 \(o_i\) 评一个结果奖励 \(R_i\),分别得到 \(G\) 个奖励 \(R=\{R_1,\cdots,R_G\}\)
      • \(o_{i,t}\) 的优势通过从输出 \(o_i\) 的奖励中减去组的平均奖励来计算,即
        $$ \hat{A}_{i,t}=R_i-\text{mean}(R)$$
        • 特别注意:这里作者没有除以分母!
  • 论文接下来介绍了基于 GRPO 算法的额外更新策略,这些策略可以稳定 RL 的扩展
无偏 KL 估计(Unbiased KL Estimate):有趣的做法
  • 给定 \(o_{i,t}\) 是从旧策略 \(\pi_{\text{old} }(\cdot|q,o_{i,< t})\) 中采样的,这里校正 k3 估计器 (Schulman, 2020) 以使用当前策略 \(\pi_{\theta}\) 和旧策略 \(\pi_{\text{old} }\) 之间的重要性采样比率来获得无偏 KL 估计
    $$
    \mathbb{D}_{\text{KL} }\big(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\big)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}\left(\frac{\pi_{\text{ref} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-\log\frac{\pi_{\text{ref} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-1\right).
    $$
  • 作为此调整的直接结果,该 KL 估计器的梯度变得无偏,从而消除了系统性估计误差,促进了稳定的收敛
  • 这与原始的 k3 估计器形成鲜明对比,特别是当采样到的 Token 在当前策略下的概率远低于参考策略时,即 \(\pi_{\theta}\ll\pi_{\text{ref} }\)
    • 在这种情况下,k3 估计器的梯度会分配不成比例的大且无界的权重来最大化这些 Token 的似然,从而导致噪声梯度更新,这些更新累积起来会降低后续迭代中的样本质量并导致不稳定的训练动态
  • 在实践中,论文发现不同领域受益于不同强度的 KL 正则化
  • 对于某些领域,例如数学 ,应用相对较弱的 KL 惩罚甚至完全省略它都可以获得改进的性能
  • 详细推到证明见附录
Off-Policy Sequence Masking
  • 为了提高 RL 系统的效率,通常生成大量的 rollout 数据,随后将其分割成多个小批次用于若干次梯度更新步骤
    • 但这种做法本质上引入了离策略行为
  • 此外,用于高效数据生成的推理框架通常经过高度优化,其实现细节可能与训练框架不同
    • 这种训练-推理的不一致性进一步加剧了离策略的程度
  • 为了稳定训练并提高对离策略更新的容忍度,论文掩码那些引入显著策略分歧的负序列,其衡量标准是数据采样策略 \(\pi_{\text{old} }\) 与当前策略 \(\pi_{\theta}\) 之间的 KL 散度
  • 论文在 GRPO 损失中引入一个二元掩码 \(M\):
    $$
    \mathcal{J}_{\text{GRPO} }(\theta)=\mathbb{E}_{q\sim P(Q),\{o_i\}_{i=1}^{G}\sim\pi_{\text{old} }(\cdot|q)}\Bigg[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}
    \min \left(r_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\right)\hat{A}_{i,t}\right)M_{i,t}-\beta\mathbb{D}_{\text{KL} }\left(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\right)\Bigg],
    $$
  • 其中
    $$
    M_{i,t}=\begin{cases}
    0 & \hat{A}_{i,t}<0,\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\log\frac{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}>\delta\
    1 & \text{otherwise},
    \end{cases}
    $$
  • \(\delta\) 是一个控制策略分歧阈值的超参数
  • 注意:这里的 \(\pi_{\text{old} }\) 表示推理框架直接返回的采样概率,因此旧策略与当前策略之间的 KL 散度考虑了上述两种离策略来源
  • 同样值得注意的是,论文只掩码具有负优势的序列
  • 直观地说,模型从自身错误中学习受益最大,而高度离策略的负样本可能是有害的,可能误导或破坏优化过程的稳定性
  • 论文通过经验观察到,这种离策略序列掩码操作改善了在某些原本会表现出不稳定性的训练场景中的稳定性
  • 理解:
    • 这个做法很常见,主要是当 \(A < 0\) 时,原始 PPO 的 Clip 机制无法限制 \(\frac{\pi_\theta}{\pi_{\theta_\text{old}}}\) 很大的情况
Keep Routing
  • MoE 模型通过在推理期间仅激活专家模块的子集来提高计算效率
  • 但推理和训练框架之间的差异,加上策略更新,可能导致即使对于相同的输入,在推理和训练期间也产生不一致的专家路由
    • 这种不一致性会引起活跃参数子空间的突然变化,从而破坏优化的稳定性并加剧离策略问题
  • 缓解这个问题的方案:
    • 作者保留了在推理框架中采样期间使用的专家路由路径 ,并在训练期间强制执行相同的路由路径 ,确保优化相同的专家参数
    • 作者发现这种保持路由操作对于 MoE 模型的 RL 训练稳定性至关重要,并且自 DeepSeek-V3-0324 以来已在论文 RL 训练流程中采用
Keep Sampling Mask(解决因 top-p 和 top-k 等导致的训推不一致问题)
  • Top-p 和 top-k 采样是广泛使用的采样策略,用于提高 LLM 生成的响应质量
  • 在 RL 训练中采用这些策略也是有益的,因为它避免了采样极低概率的 Token
    • 理解1:这就避免了使用这些 Token 用作优化目标,而这部分 Token 的重要性权重往往可能较大(波动较大)?
    • 理解2:这还可以使得模型发布以后的 Inference 参数和训练参数(top-p, top-k 等能对齐),理论上可以保证模型训练的目标就是最优化真实场景的 Inference 策略
      • 注:平时训练时,RL 优化目标其实和真实目标有点对不齐(但影响应该还好)
  • 这种截断保持了样本质量,但它引入了 \(\pi_{\text{old} }\) 和 \(\pi_{\theta}\) 之间动作空间的不匹配
    • 这违反了重要性采样的原则并使训练不稳定
  • 解决这个问题的方案:
    • top-k:在从 \(\pi_{\text{old} }\) 采样期间保留截断掩码,并在训练期间将它们应用于 \(\pi_{\theta}\)
      • 确保两种策略共享相同的动作子空间
    • top-p:将 top-p 采样与保持采样掩码策略结合使用:
      • 可以有效保持 RL 训练期间的语言一致性
    • 理解:mask 的方式是(top-k 和 top-p 的 mask 方式都是 mask 词表中被 top-k 和 top-p drop 掉的部分):
      • 在推理时记录采样时(计算 Softmax 前)被 drop 掉的 token
      • 在训练引擎上,计算概率时 mask 掉这部分 token(mask 方式也是在计算 Softmax 前进行 mask,将 atten_score 置为 负无穷)
      • 虽然 mask 掉了这些 Token,但是这些 Token 的概率依然会因为整体参数的更新而变化的
    • 更多详情见本文附录

Thinking in Tool-Use

Thinking Context Management
  • DeepSeek-R1 已经证明,融入 Thinking 过程可以显著增强模型解决复杂问题的能力
    • 基于这一见解,作者的目标是将 Thinking 能力整合到工具调用场景中
  • 作者观察到,复制 DeepSeek-R1 的策略会导致显著的 Token 效率低下
    • 注:DeepSeek-R1 的策略是在第二轮消息到达时丢弃推理内容
    • 这种方法迫使模型在每次后续工具调用时为整个问题冗余地重新推理
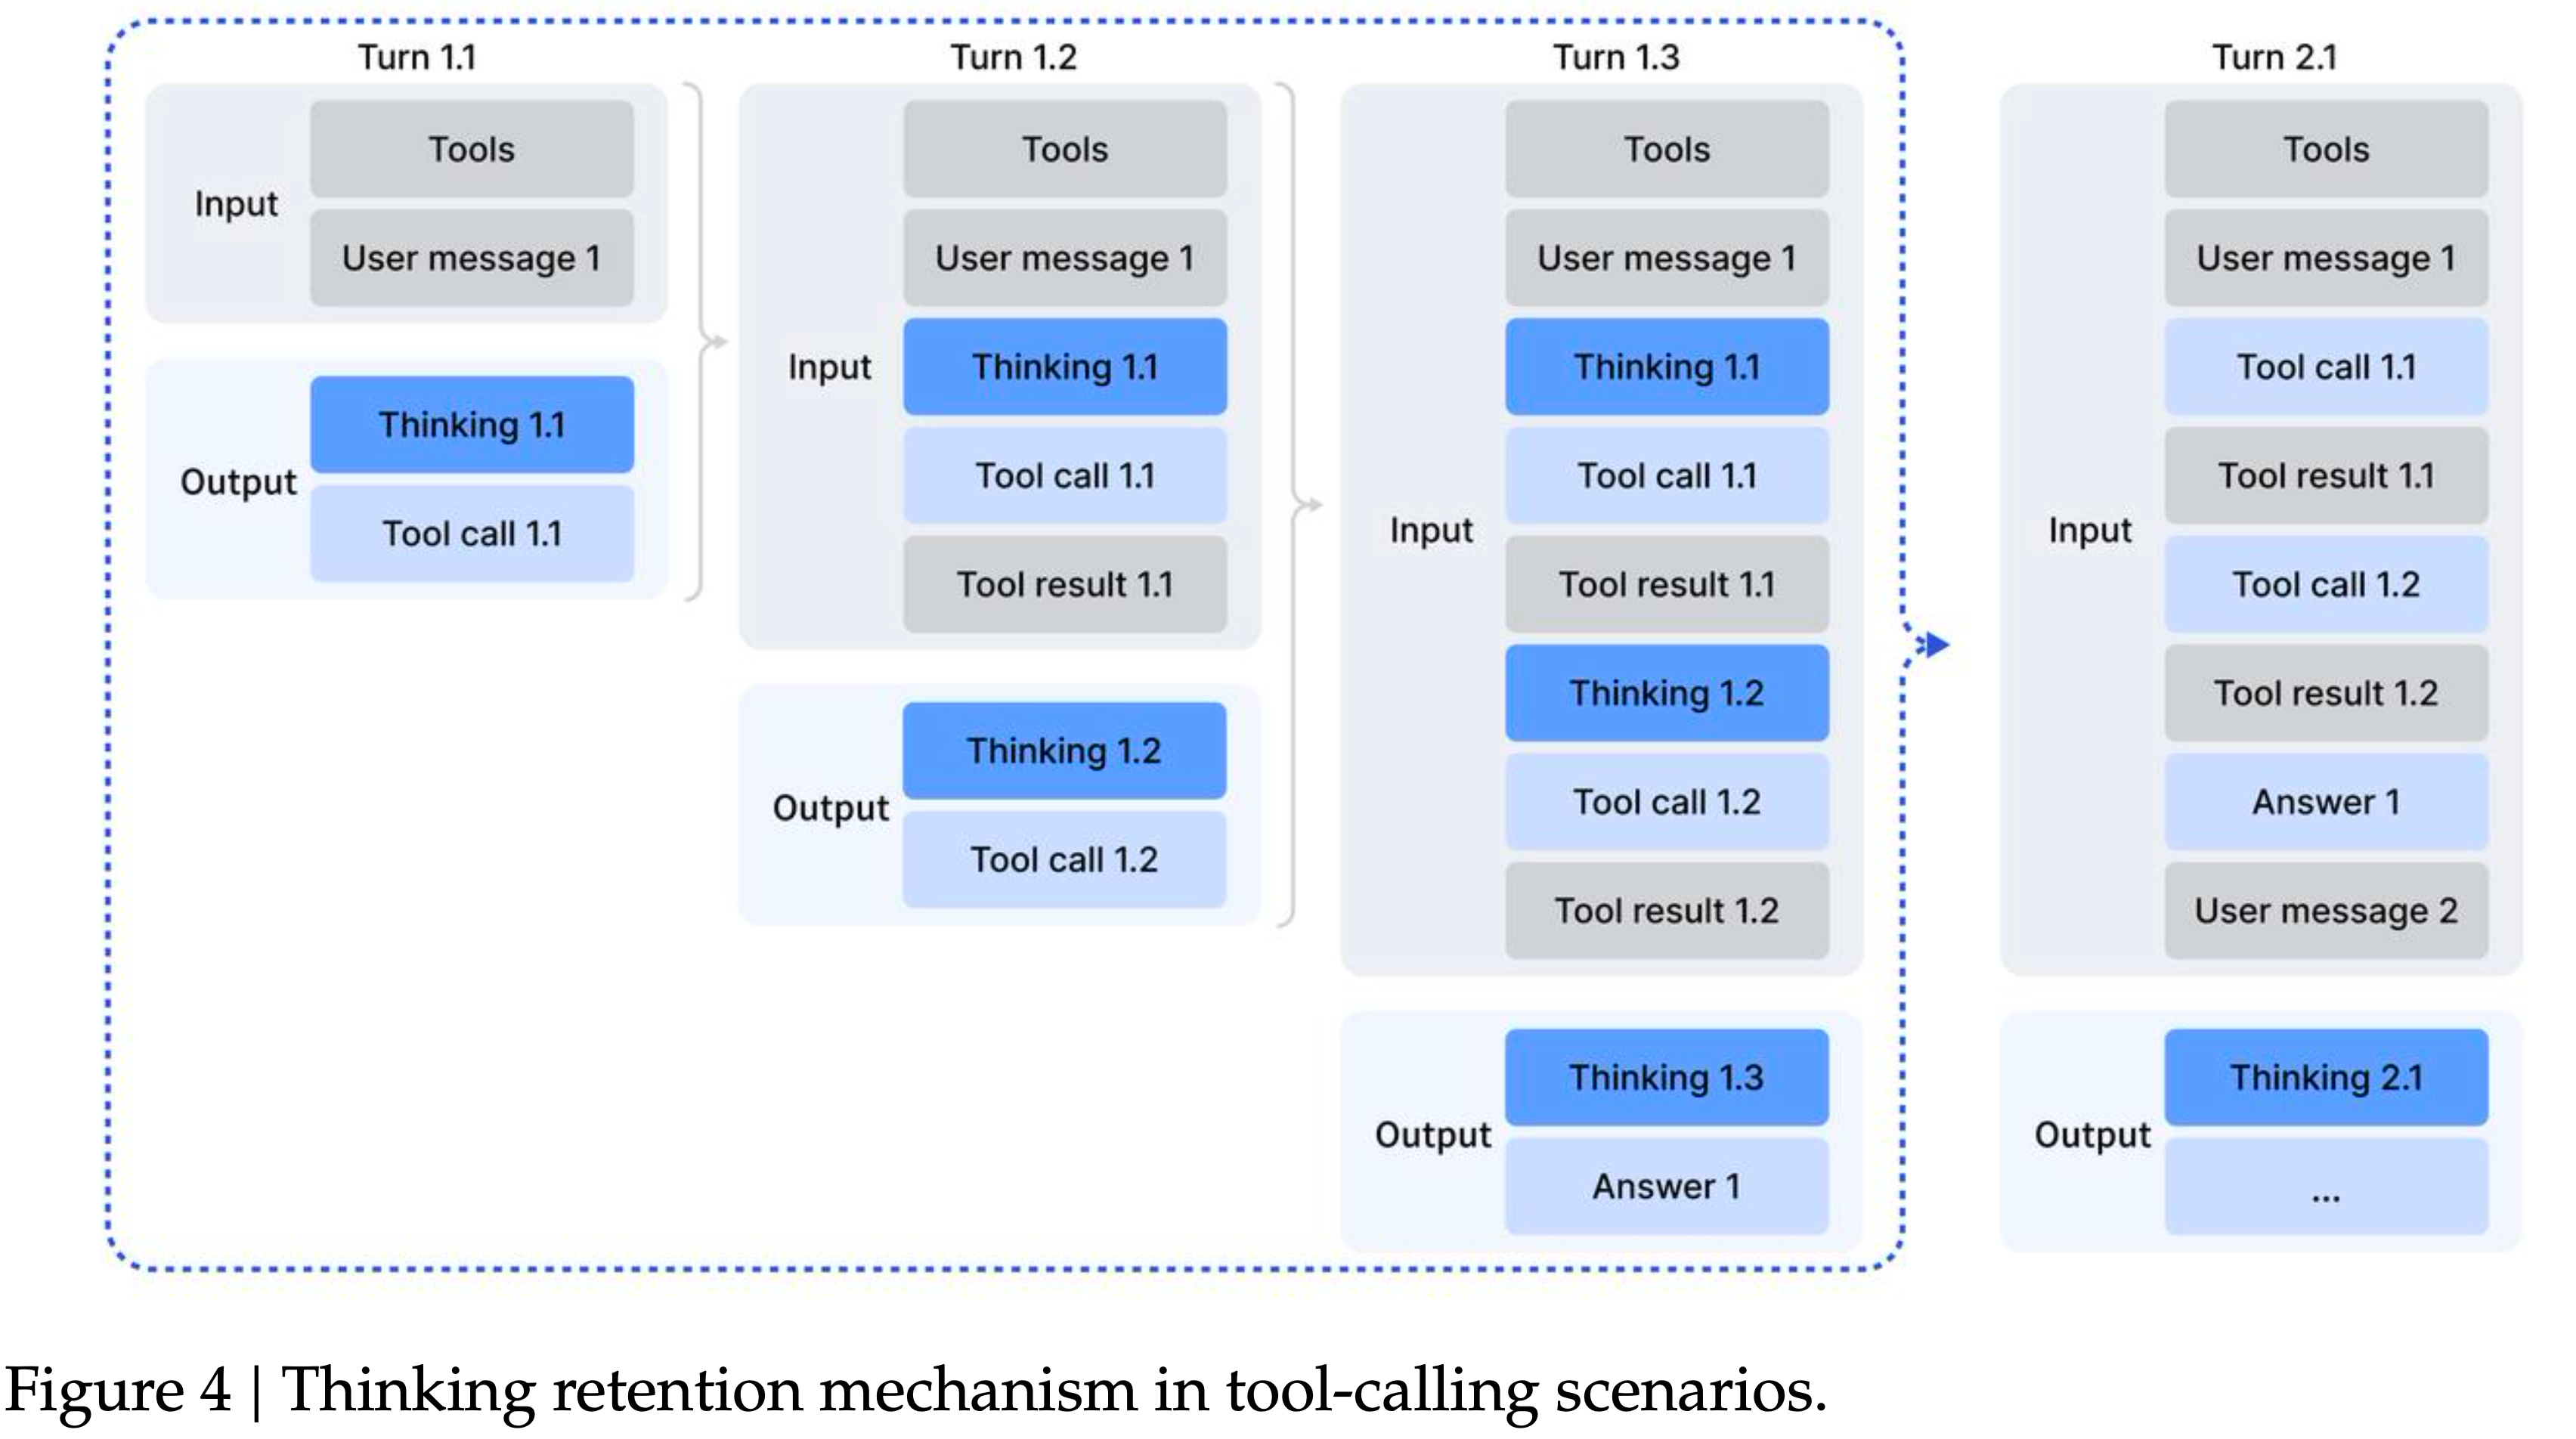
  • 为了缓解这个问题,作者开发了如图 4 所示的、为工具调用场景严格定制的上下文管理:
    • 仅当对话中引入新的用户消息时,才会丢弃历史推理内容
      • 如果仅追加与工具相关的消息(例如,工具输出),则推理内容在整个交互过程中保留
    • 当推理痕迹被移除时,工具调用及其结果的历史记录仍保留在上下文中
  • 特别需要注意:某些智能体框架,例如 Roo Code 或 Terminus,通过用户消息模拟工具交互
    • 由于上述上下文管理规则,这些框架可能无法完全受益于论文增强的推理持久性
    • 因此,作者建议在此类架构中使用非 Thinking 模型以获得最佳性能
  • 图 4:工具调用场景中的 Thinking 保留机制
Cold-Start
  • 鉴于已有推理数据(非智能体)和非推理智能体数据的可用性,整合这两种能力的一个直接策略是通过精心设计的 Prompting
  • 论文假设模型具备足够的能力来准确遵循明确的指令,从而能够在推理过程中无缝整合工具执行
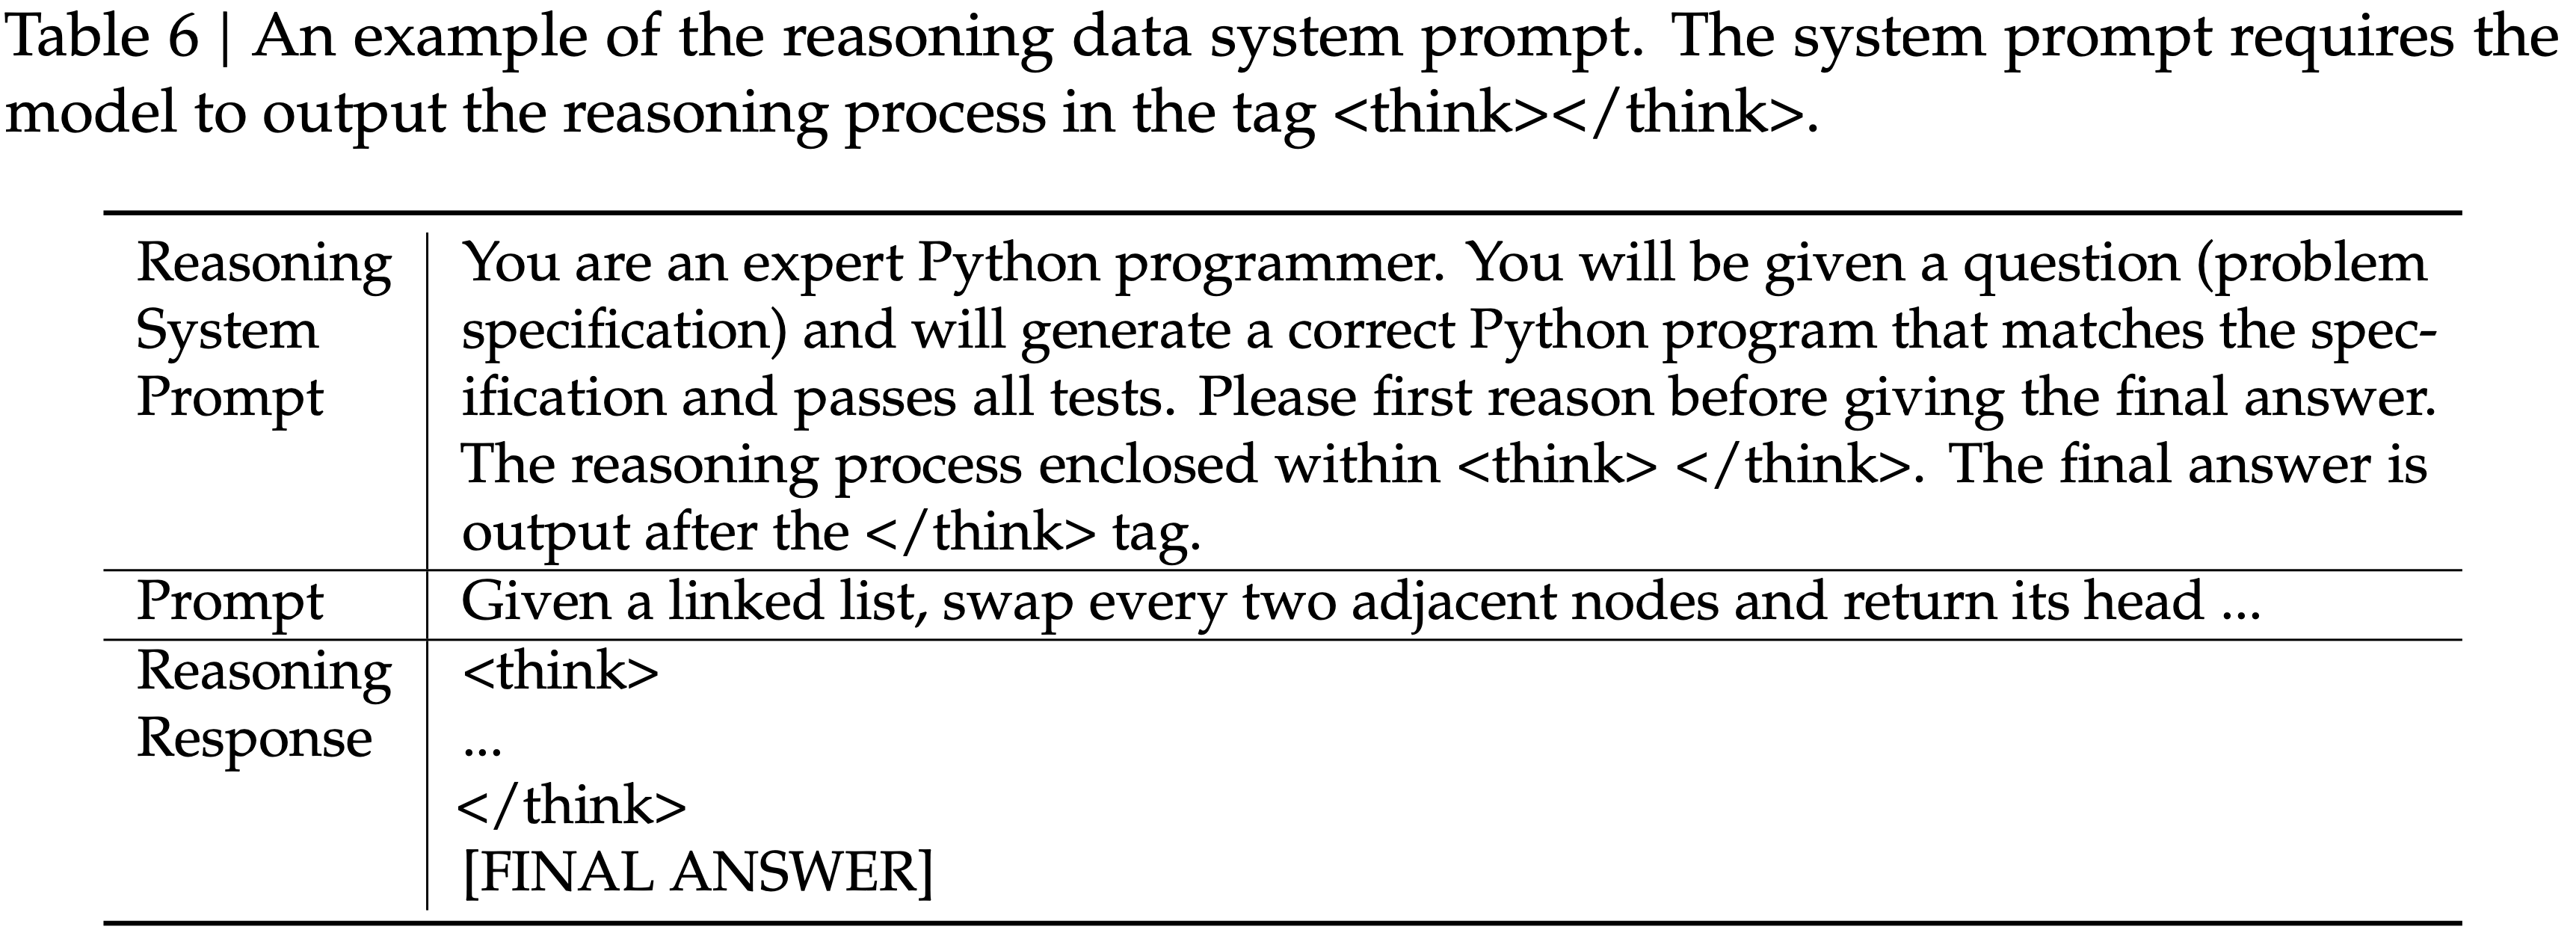
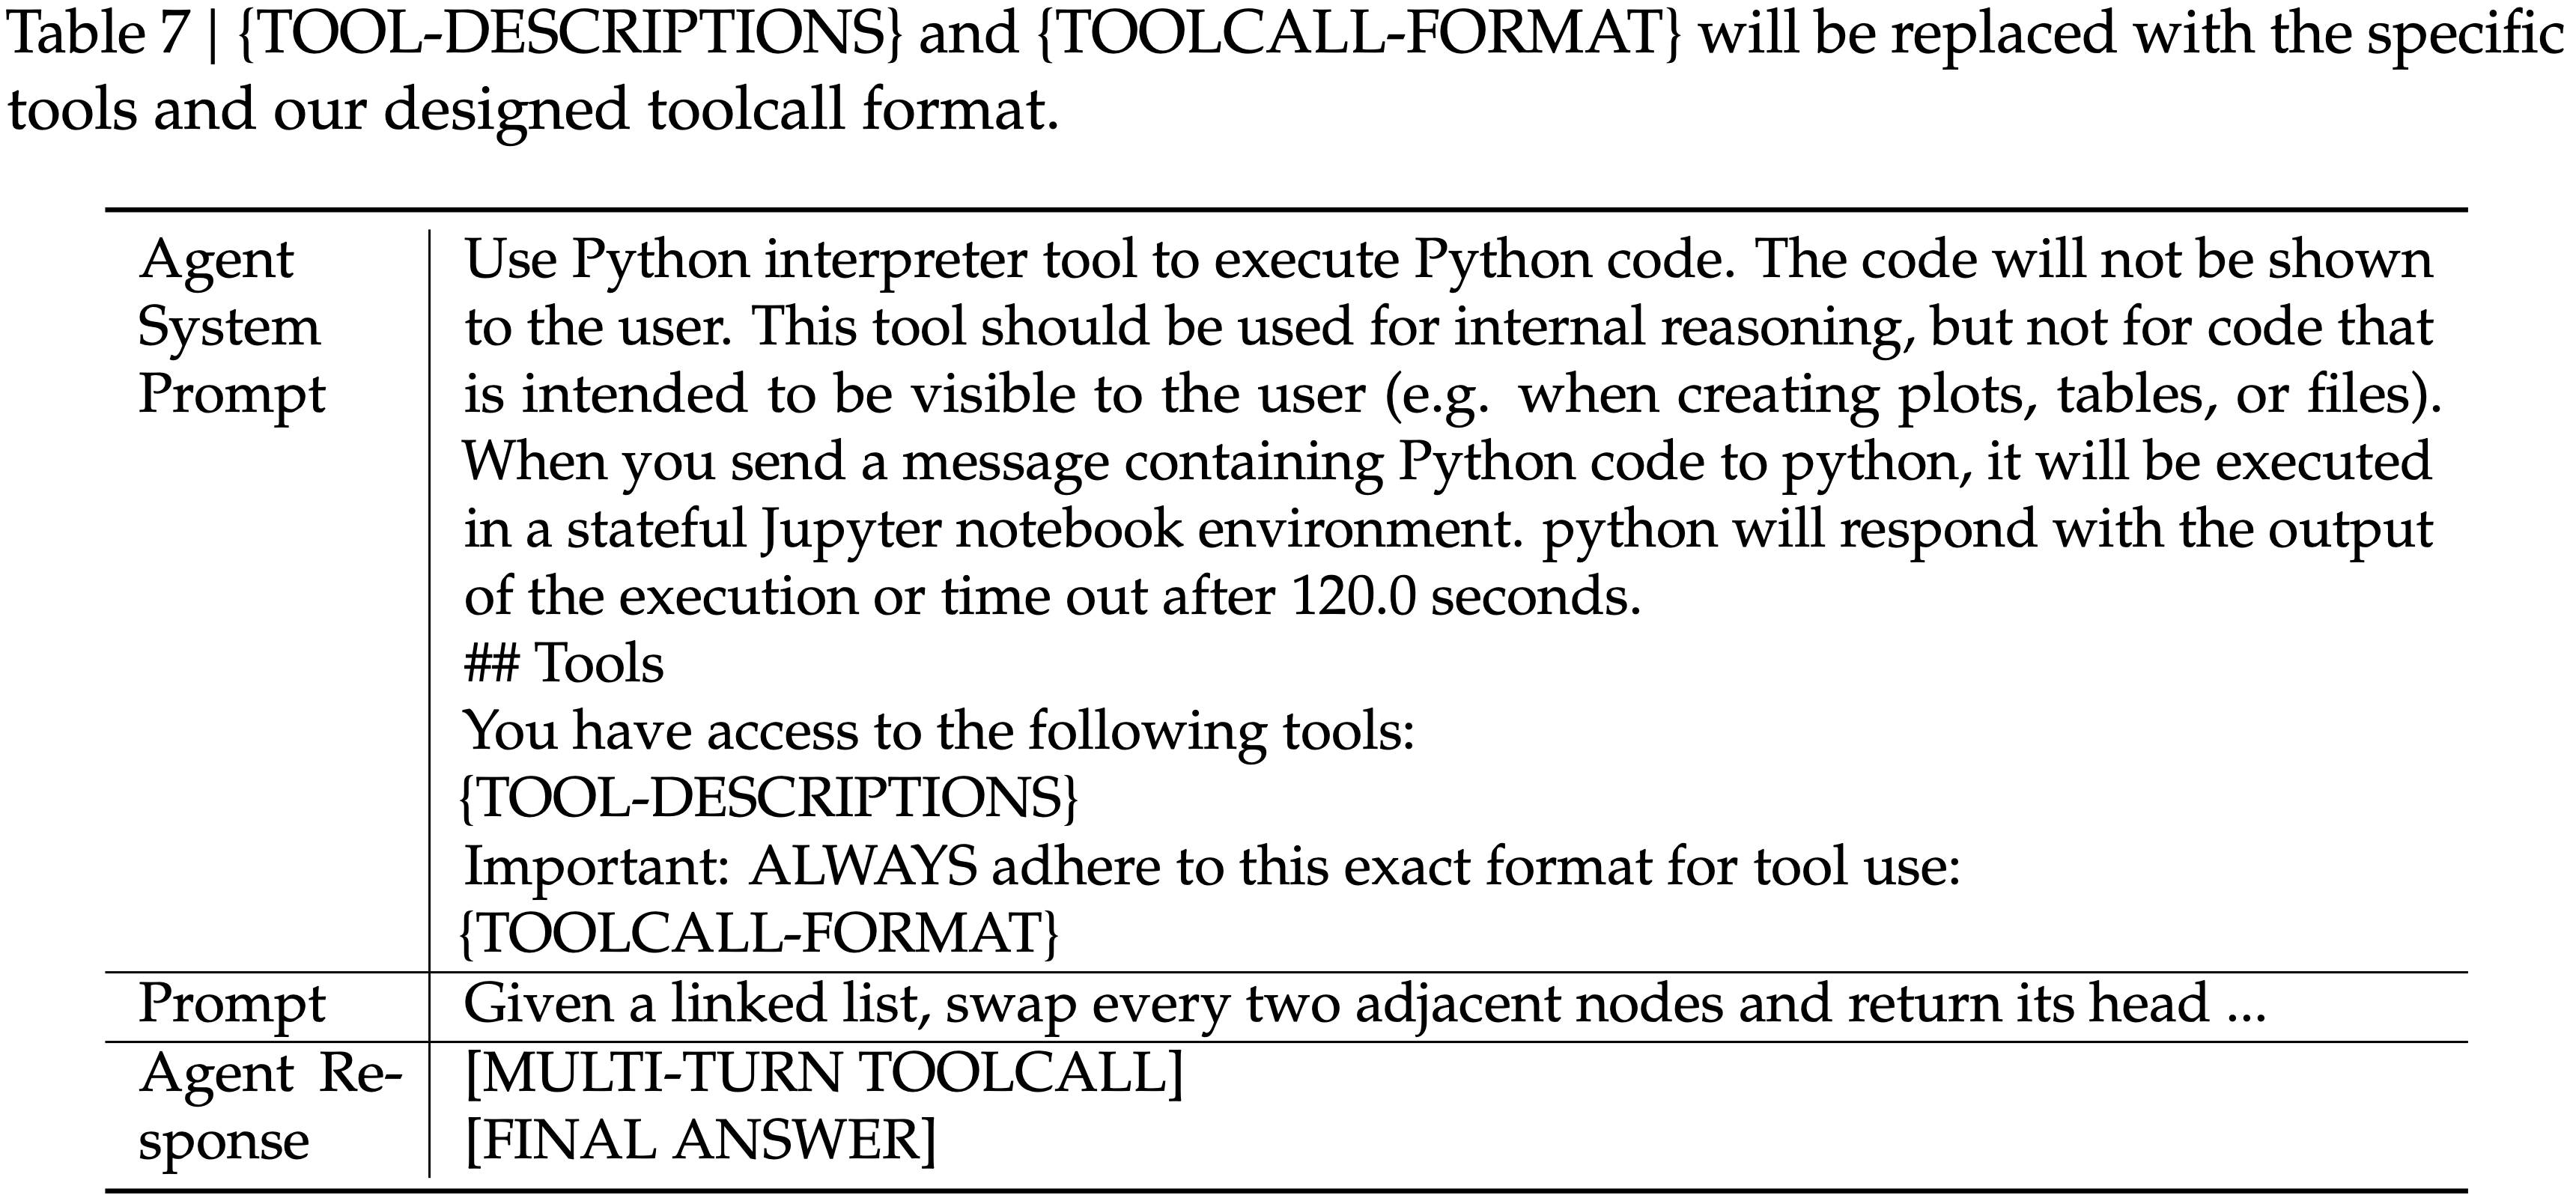
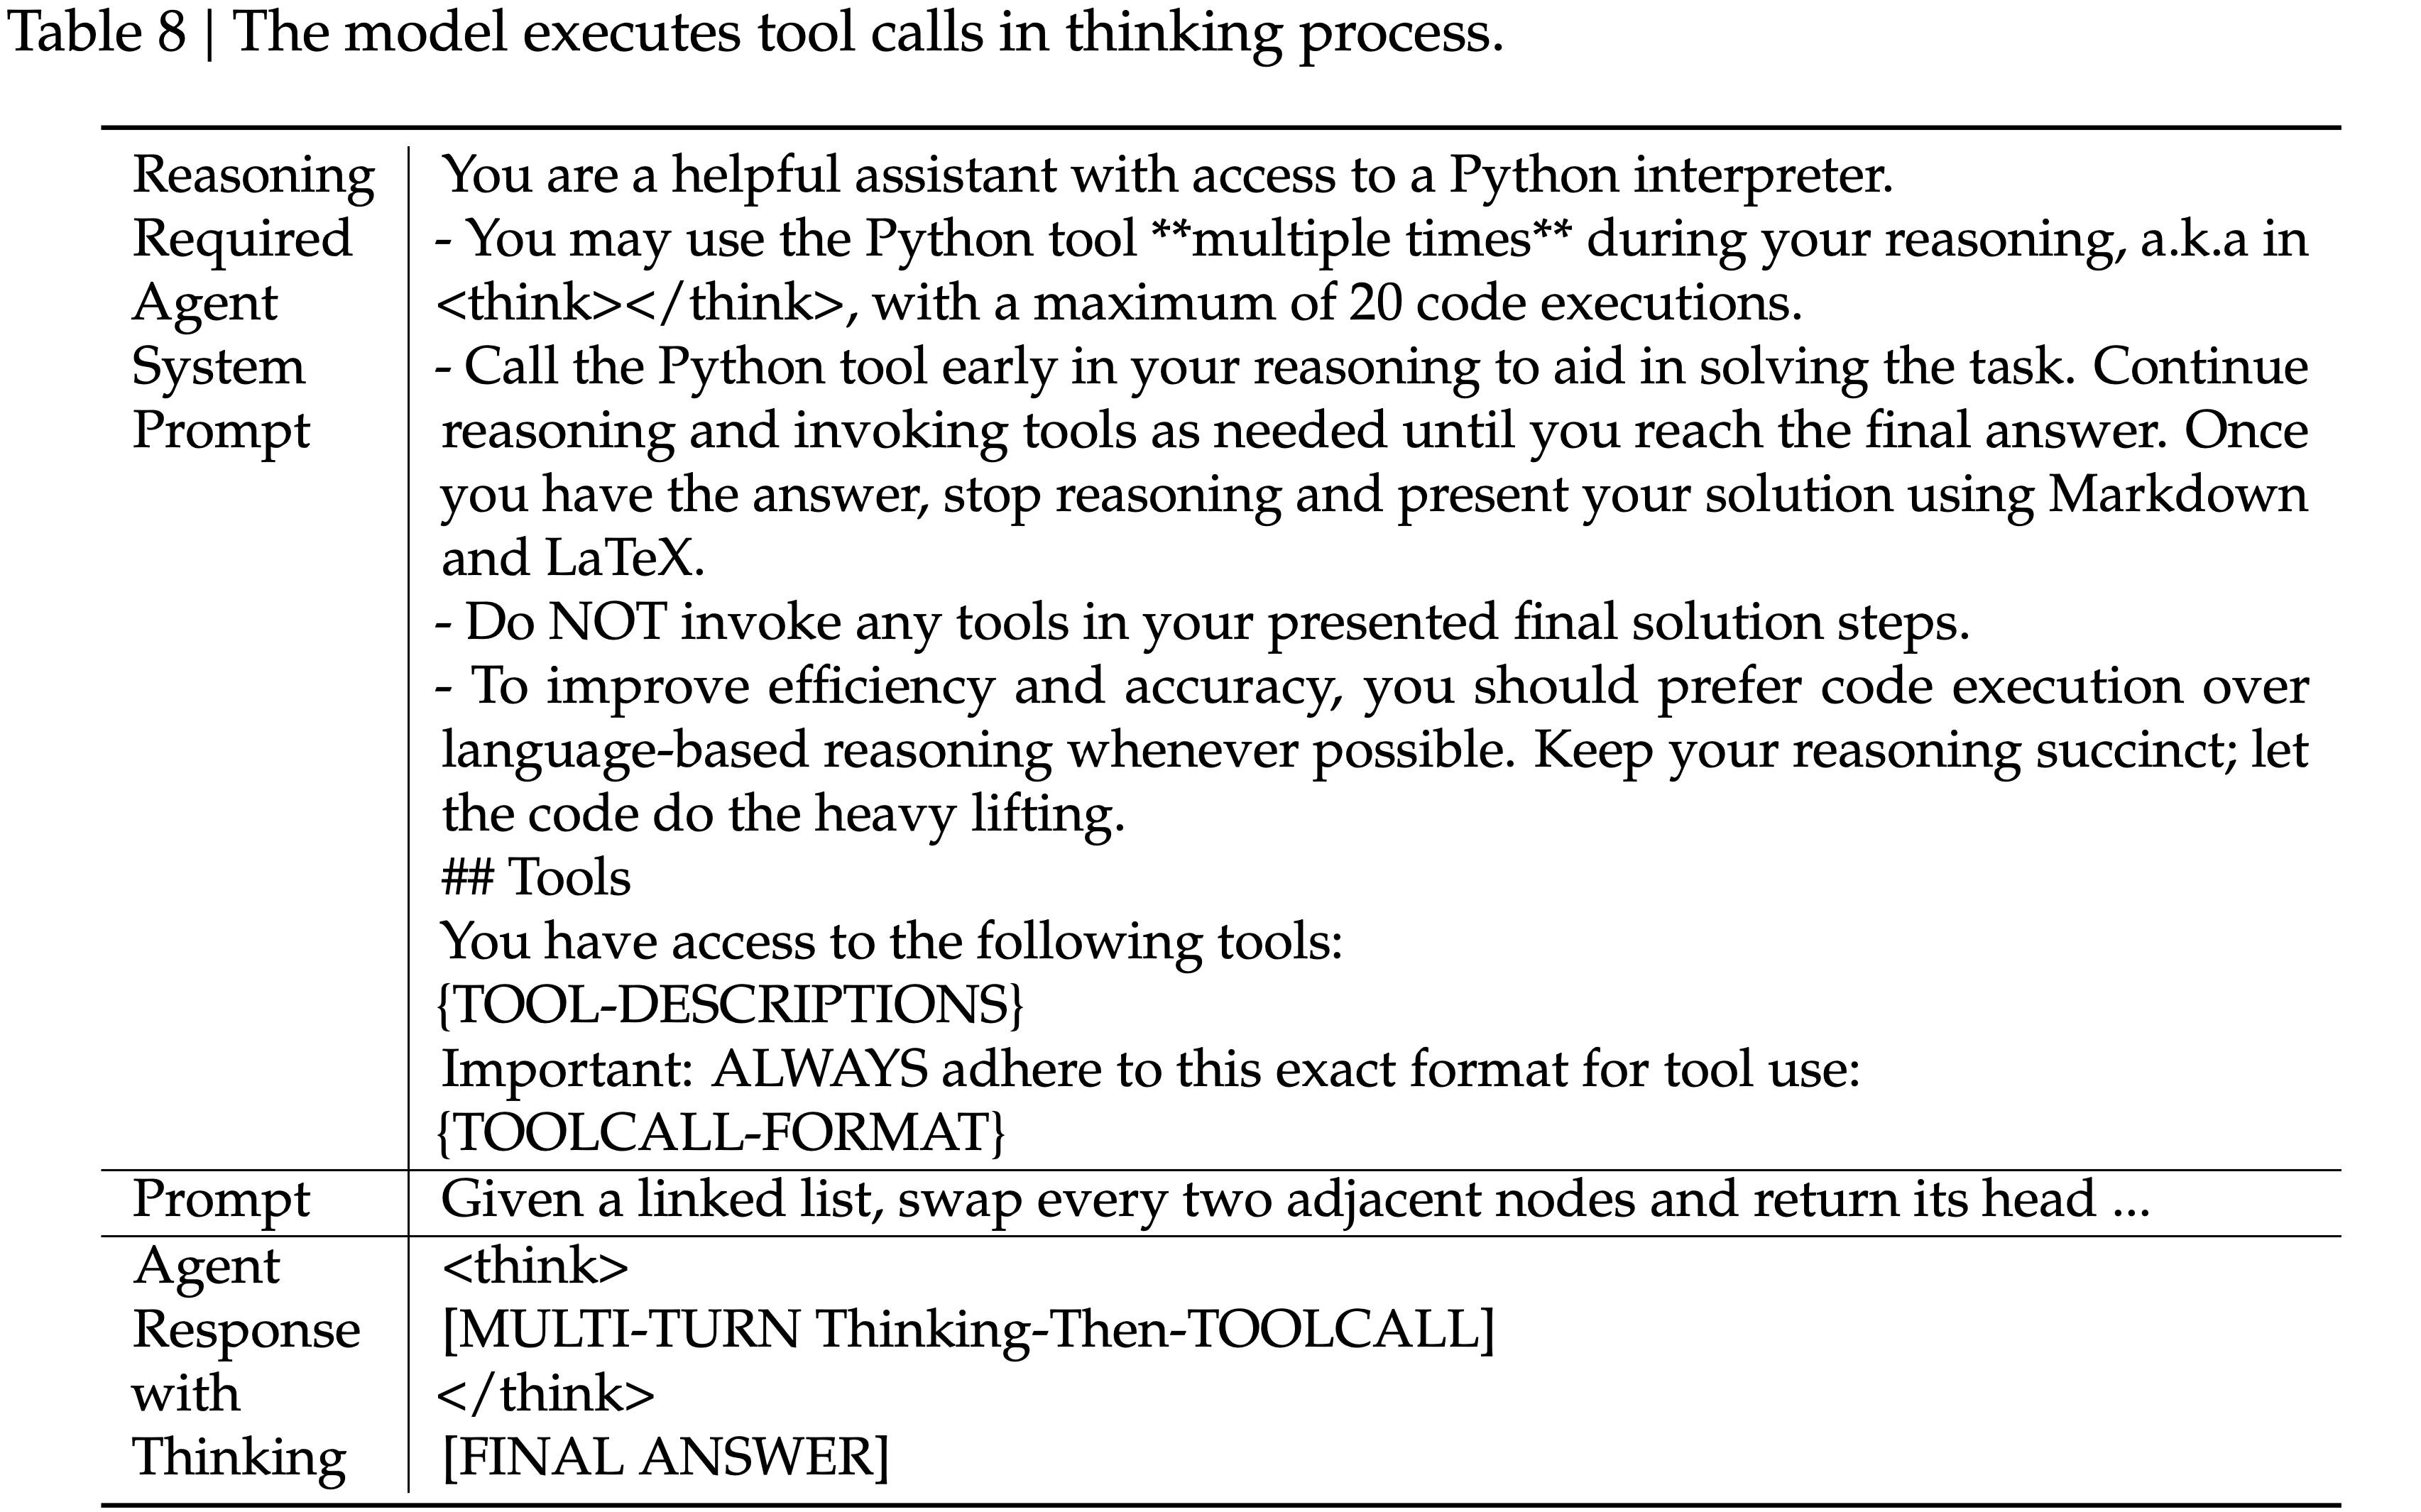
  • 为了演示冷启动机制的运作(operation),论文选择性地采样训练数据,如附录表 6-8 所示
    • 需要注意的是,不同的任务 Prompt 与不同的系统 Prompt 相关联
  • 表 6-8 展示了一个对应于竞赛编程(competitive programming) Prompt 的示例
    • 表 6 展示了论文推理数据的一个示例,其中使用系统 Prompt 明确要求模型在最终答案之前进行推理,并使用特殊标签 <think></think> 来标记推理路径
    • 表 7 展示了非推理智能体数据的 Prompt ,其中系统 Prompt 包含工具调用的指导
    • 表 8 展示了论文设计的系统 Prompt ,用于指导模型在其推理过程中整合多个工具调用
  • 通过这种方式,尽管工具使用模式中的推理可能缺乏鲁棒性 ,但模型偶尔能够生成期望的轨迹 ,从而为后续的强化学习阶段提供基础
Large-Scale Agentic Tasks
  • 多样化的 RL 任务对于增强模型的鲁棒性至关重要
  • 对于搜索、代码工程和代码解释等任务,论文使用现实世界的工具,包括实际的网络搜索 API、编码工具和 Jupyter Notebooks
    • 虽然这些 RL 环境是真实的,但所使用的 Prompt 要么从互联网来源提取,要么是合成生成的,而不是从真实的用户交互中获取
  • 对于其他任务,环境和 Prompt 都是合成的
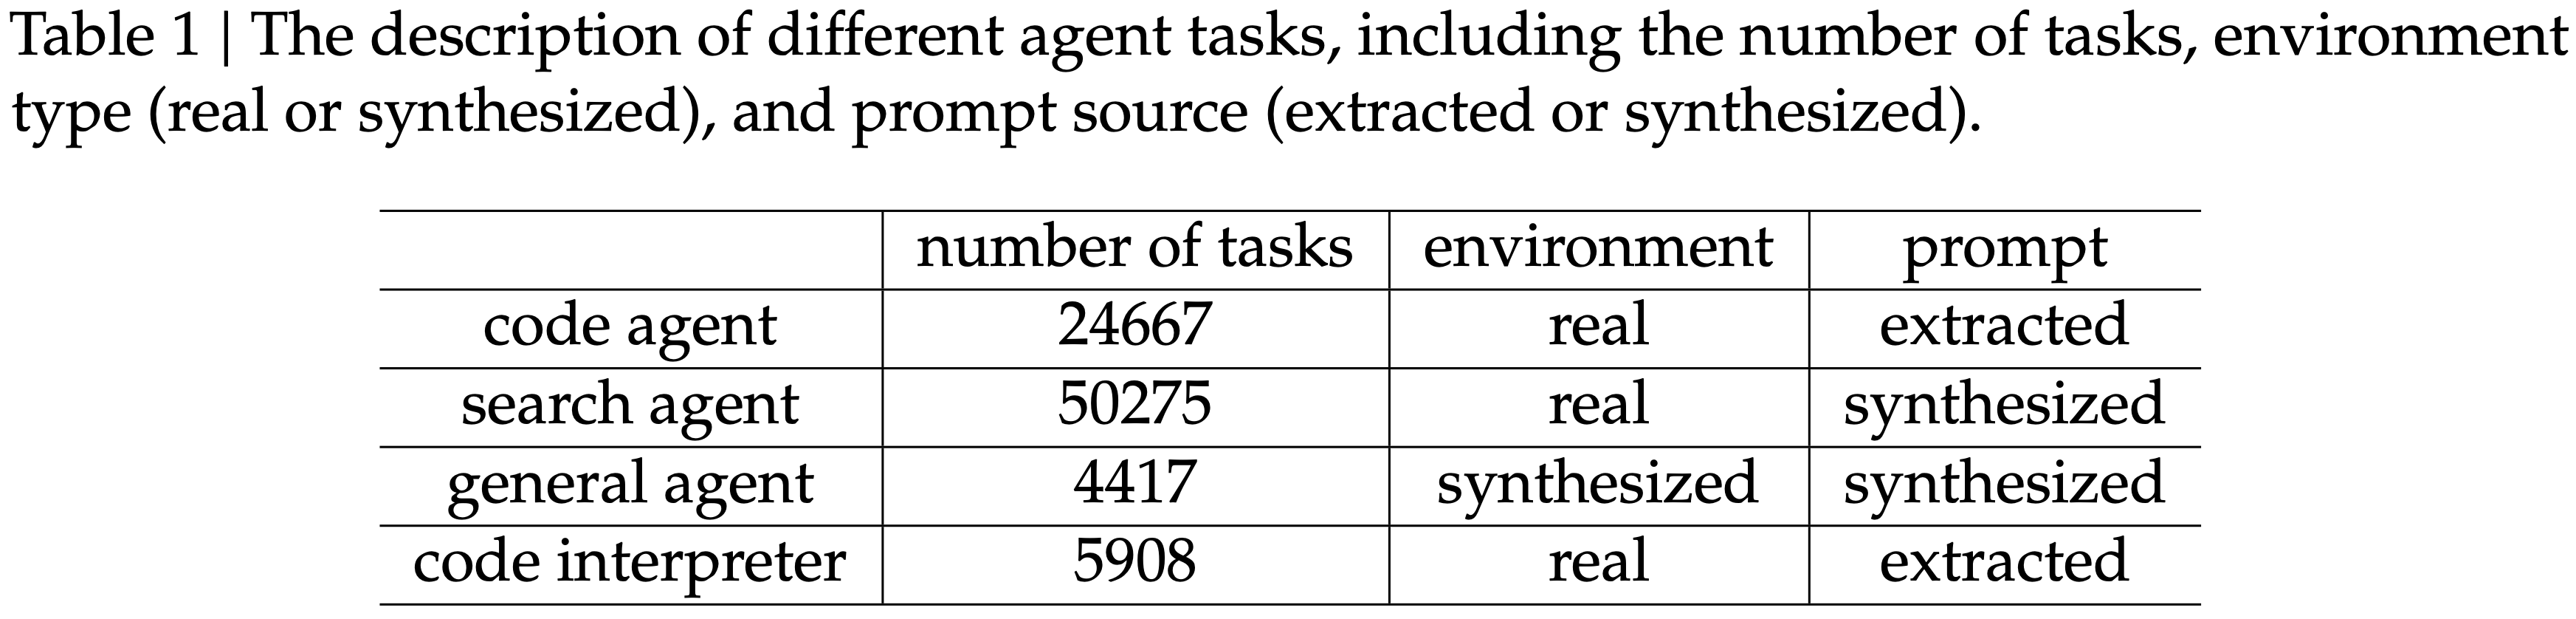
  • 论文使用的智能体任务如表 1 所述
    • 表 1:不同智能体任务的描述,包括任务数量、环境类型(真实或合成)和 Prompt 来源(提取或合成)
Search Agent
  • 论文采用基于 DeepSeek-V3.2 的多智能体管道来生成多样化、高质量的训练数据
    • 从大规模网络语料库中跨不同领域采样信息丰富的长尾实体
    • (一个)问题构建智能体 使用可配置深度和广度参数的搜索工具探索每个实体,将发现的信息整合成问答对
    • 具有异构配置(不同 Checkpoint 、系统 Prompt 等)的 (多个)答案生成智能体 为每个提出的 QA 对生成不同的候选响应
    • 具有搜索能力的 一个验证智能体 通过多次轮询验证所有答案,只保留真实答案正确且所有候选答案均可验证为错误的样本
    • 这些数据涵盖多种语言、领域和难度级别
  • 为了补充这些可验证的样本并更好地反映现实世界的使用情况
    • 第一:用来自现有有帮助 RL 数据集的过滤实例来增强数据集,对于这些数据集,搜索工具提供了 measurable benefits
    • 第二:开发跨多个质量维度的详细评估准则(rubrics),并采用生成式奖励模型根据这些准则对响应进行评分
    • 这种混合方法使得能够同时针对事实可靠性和实际帮助性进行优化
Code Agent
  • 论文通过从 GitHub 挖掘数百万个 issue-Pull Request (PR) pairs,为软件问题解决构建了大规模、可执行的环境
  • 该数据集使用启发式规则和 LLM-based 判断进行了严格过滤,以确保高质量,要求每个条目包含合理的问题描述、相关的 Gold Patch 以及用于验证的测试补丁
  • 论文使用由 DeepSeek-V3.2 驱动的自动化环境设置智能体来为这些 pairs 构建可执行环境
    • 该智能体处理包安装、依赖项解决和测试执行
    • 测试结果以标准的 JUnit 格式输出,确保跨编程语言和测试框架的一致解析
  • 只有当应用 Gold Patch 后,满足下面的条件,才认为环境成功构建
    • non-zero count of false-to-positive(F2P)test cases(表明问题已修复)
      • 即 F2P 数量不为 0:即至少存在一个测试用例曾经失败的,使用 Gold Patch 后成功了
    • zero count of pass-to-fail(P2F)test cases(表明没有 regressions)
      • P2F 数量为 0:即没有测试用例曾经成功,使用 Gold Patch 后,失败了
  • 使用此管道,论文成功构建了数万个可重现的问题解决环境,涵盖多种编程语言,包括 Python、Java、JavaScript、TypeScript、C、C++、Go 和 PHP
Code Interpreter Agent
  • 利用 Jupyter Notebook 作为代码解释器来解决复杂的推理任务
  • 作者策划了一组涵盖数学、逻辑和数据科学的多样化问题,每个问题都需要模型利用代码执行能力来得出 Solution
通用智能体(General Agent)【这里的流程还需要再明确】
  • 为了在 RL 中扩大智能体环境和任务规模,作者用了一个自动环境合成智能体,它合成了 1827 个面向任务的环境

    • 这些任务难以解决但易于验证
    • 合成工作流程主要包括环境和工具集构建、任务合成以及 Solution 生成
  • 具体来说,工作流程如下

    • 1)给定一个任务类别(例如,规划旅行行程)和一个配备 bash 和搜索工具的沙盒,智能体首先使用这些工具从互联网生成或检索相关数据,并将它们存储在沙盒数据库中
    • 2)智能体合成一组特定于任务的工具 ,每个工具都实现为一个函数
    • 3)为了创建既具有挑战性又可自动验证的任务 ,智能体做如下工作:
      • 首先:基于当前数据库 propose 一个简单任务,同时抽取这个任务的 Python 实现 Solution Function 和 Verification function
        • 对 Solution function 的要求:
          • 第一:这里的 Solution function 仅限于调用工具函数或执行逻辑计算,不能调用其他函数或直接访问数据库 ,确保只能通过工具接口(interface)解决问题
          • 第二:这个 Solution function 产生的结果必须由 Verification function 验证
        • 如果以上 Solution function 验证未通过,智能体将修改 Solution function 或 Verification function ,直到它产生的 Solution function 输出通过 Verification function 验证
      • 然后:智能体迭代地增加任务难度 ,并更新相应的 Solution function 和 Verification function
        • 在此迭代过程中,如果当前工具集不足以解决任务,智能体将扩展工具集
          • 问题:扩展的依据是什么?何时扩展?
      • 问题:是针对同一个问题,逐步提升任务难度?还是针对不同难度的问题,先解决简单问题,再解决复杂问题?
  • 遵循此工作流程,获得了数千个 <环境, 工具, 任务, 验证器>(<environment, tools, task, verifier>) 元组

    • 理解:这里的 <environment, tools, task, verifier> 是匹配对齐的,在这个环境 envirnoment 下,用这些工具 tools 能解决的任务 task 和 可以验证该 任务是否成功的验证器 verifier
  • 然后使用 DeepSeek-V3.2 在该数据集上执行 RL,并仅保留 pass@100 非 0 的实例,最终得到 1827 个环境及其相应的任务(共 4417 个)

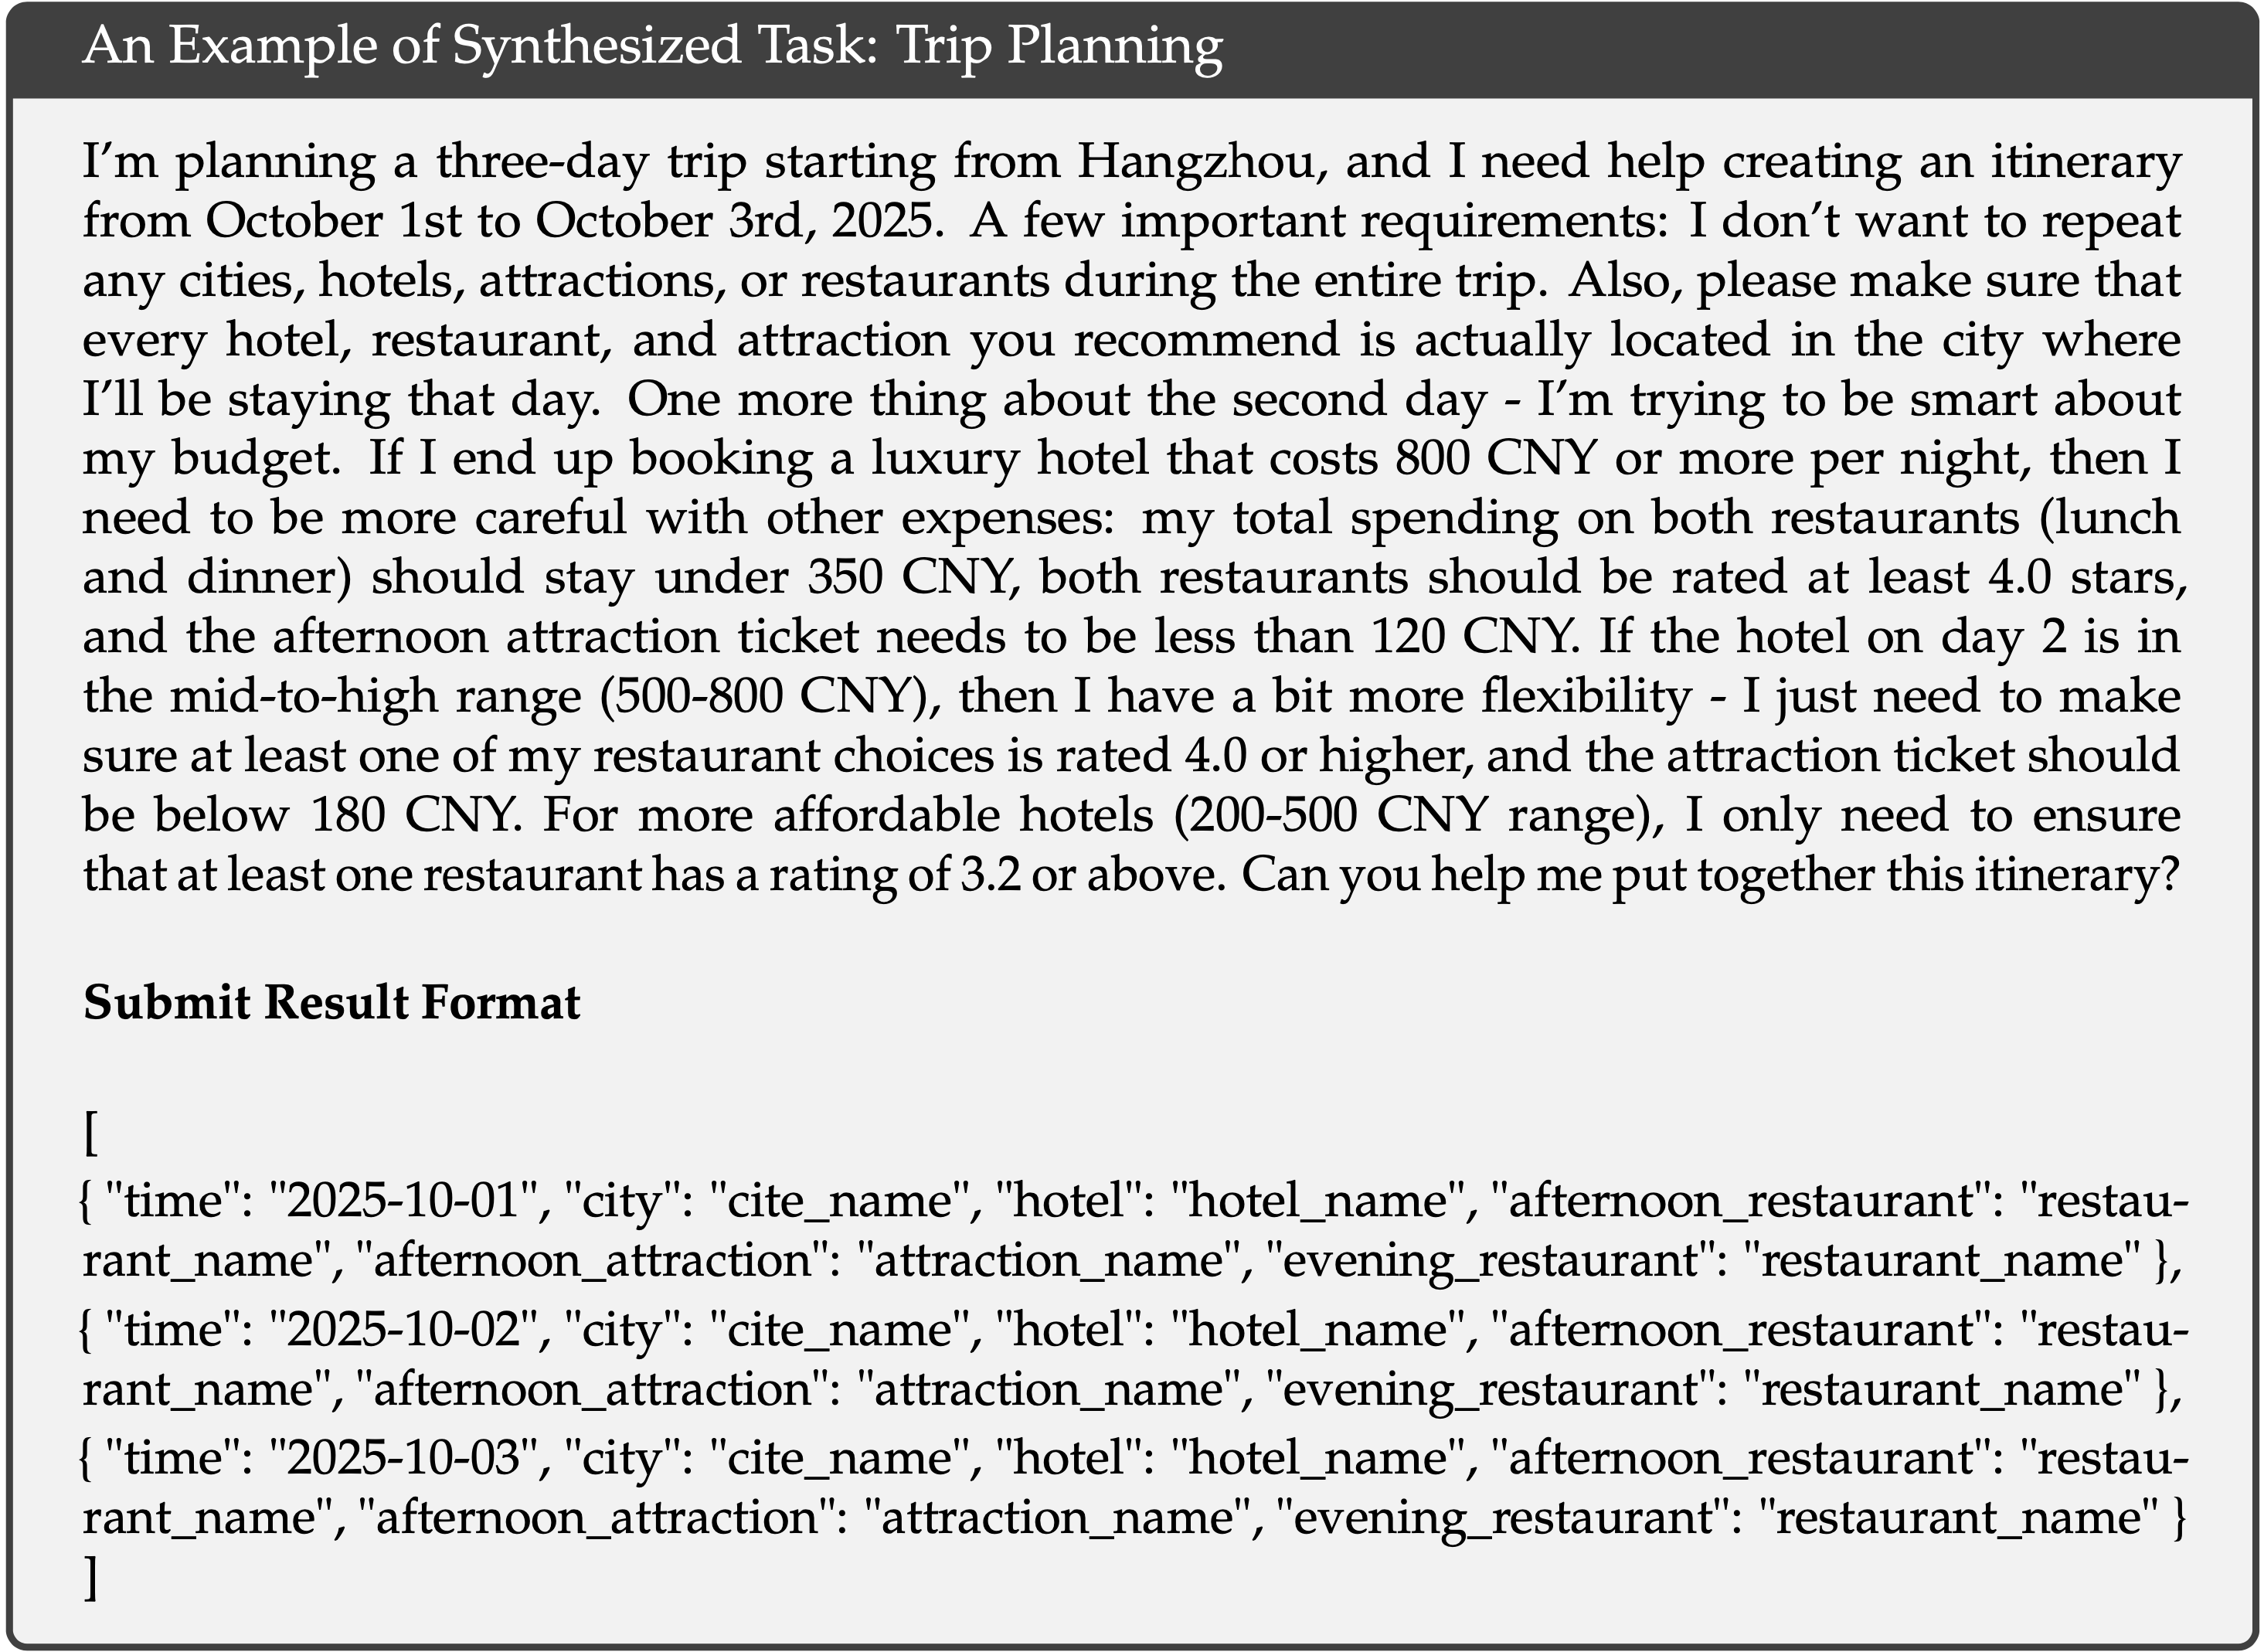
  • 下面展示了一个合成的行程规划示例

  • 示例说明:此示例强调,虽然为满足所有约束的行程计划搜索大型组合空间具有挑战性,但检查给定的候选 Solution 是否满足这些约束则相对简单

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    **合成任务示例:行程规划(An Example of Synthesized Task: Trip Planning)**
    我正在计划从杭州开始的三天旅行,需要帮助创建 2025 年 10 月 1 日至 10 月 3 日的行程。
    一些重要要求:在整个旅行中,我不想重复任何城市、酒店、景点或餐厅。
    另外,请确保你推荐的每家酒店、餐厅和景点实际上都位于我当天将要入住的城市。
    关于第二天还有一件事——我正在试图精明地控制预算。如果我最终预订了每晚 800 元人民币或更贵的豪华酒店,那么我需要更加谨慎地控制其他开支:
    我在两家餐厅(午餐和晚餐)的总消费应保持在 350 元人民币以下,两家餐厅的评分至少应为 4.0 星,并且下午景点的门票需要低于 120 元人民币。
    如果第 2 天的酒店属于中高端范围(500-800 元人民币),那么我有更多的灵活性——我只需要确保我选择的至少一家餐厅评分在 4.0 或更高,并且景点门票应低于 180 元人民币。
    对于更经济实惠的酒店(200-500 元人民币范围),我只需要确保至少一家餐厅的评分在 3.2 或以上。你能帮我制定这个行程吗?

    **提交结果格式(Submit Result Format)**
    ```json
    [
    {"time": "2025-10-01", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"},
    {"time": "2025-10-02", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"},
    {"time": "2025-10-03", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"}
    ]

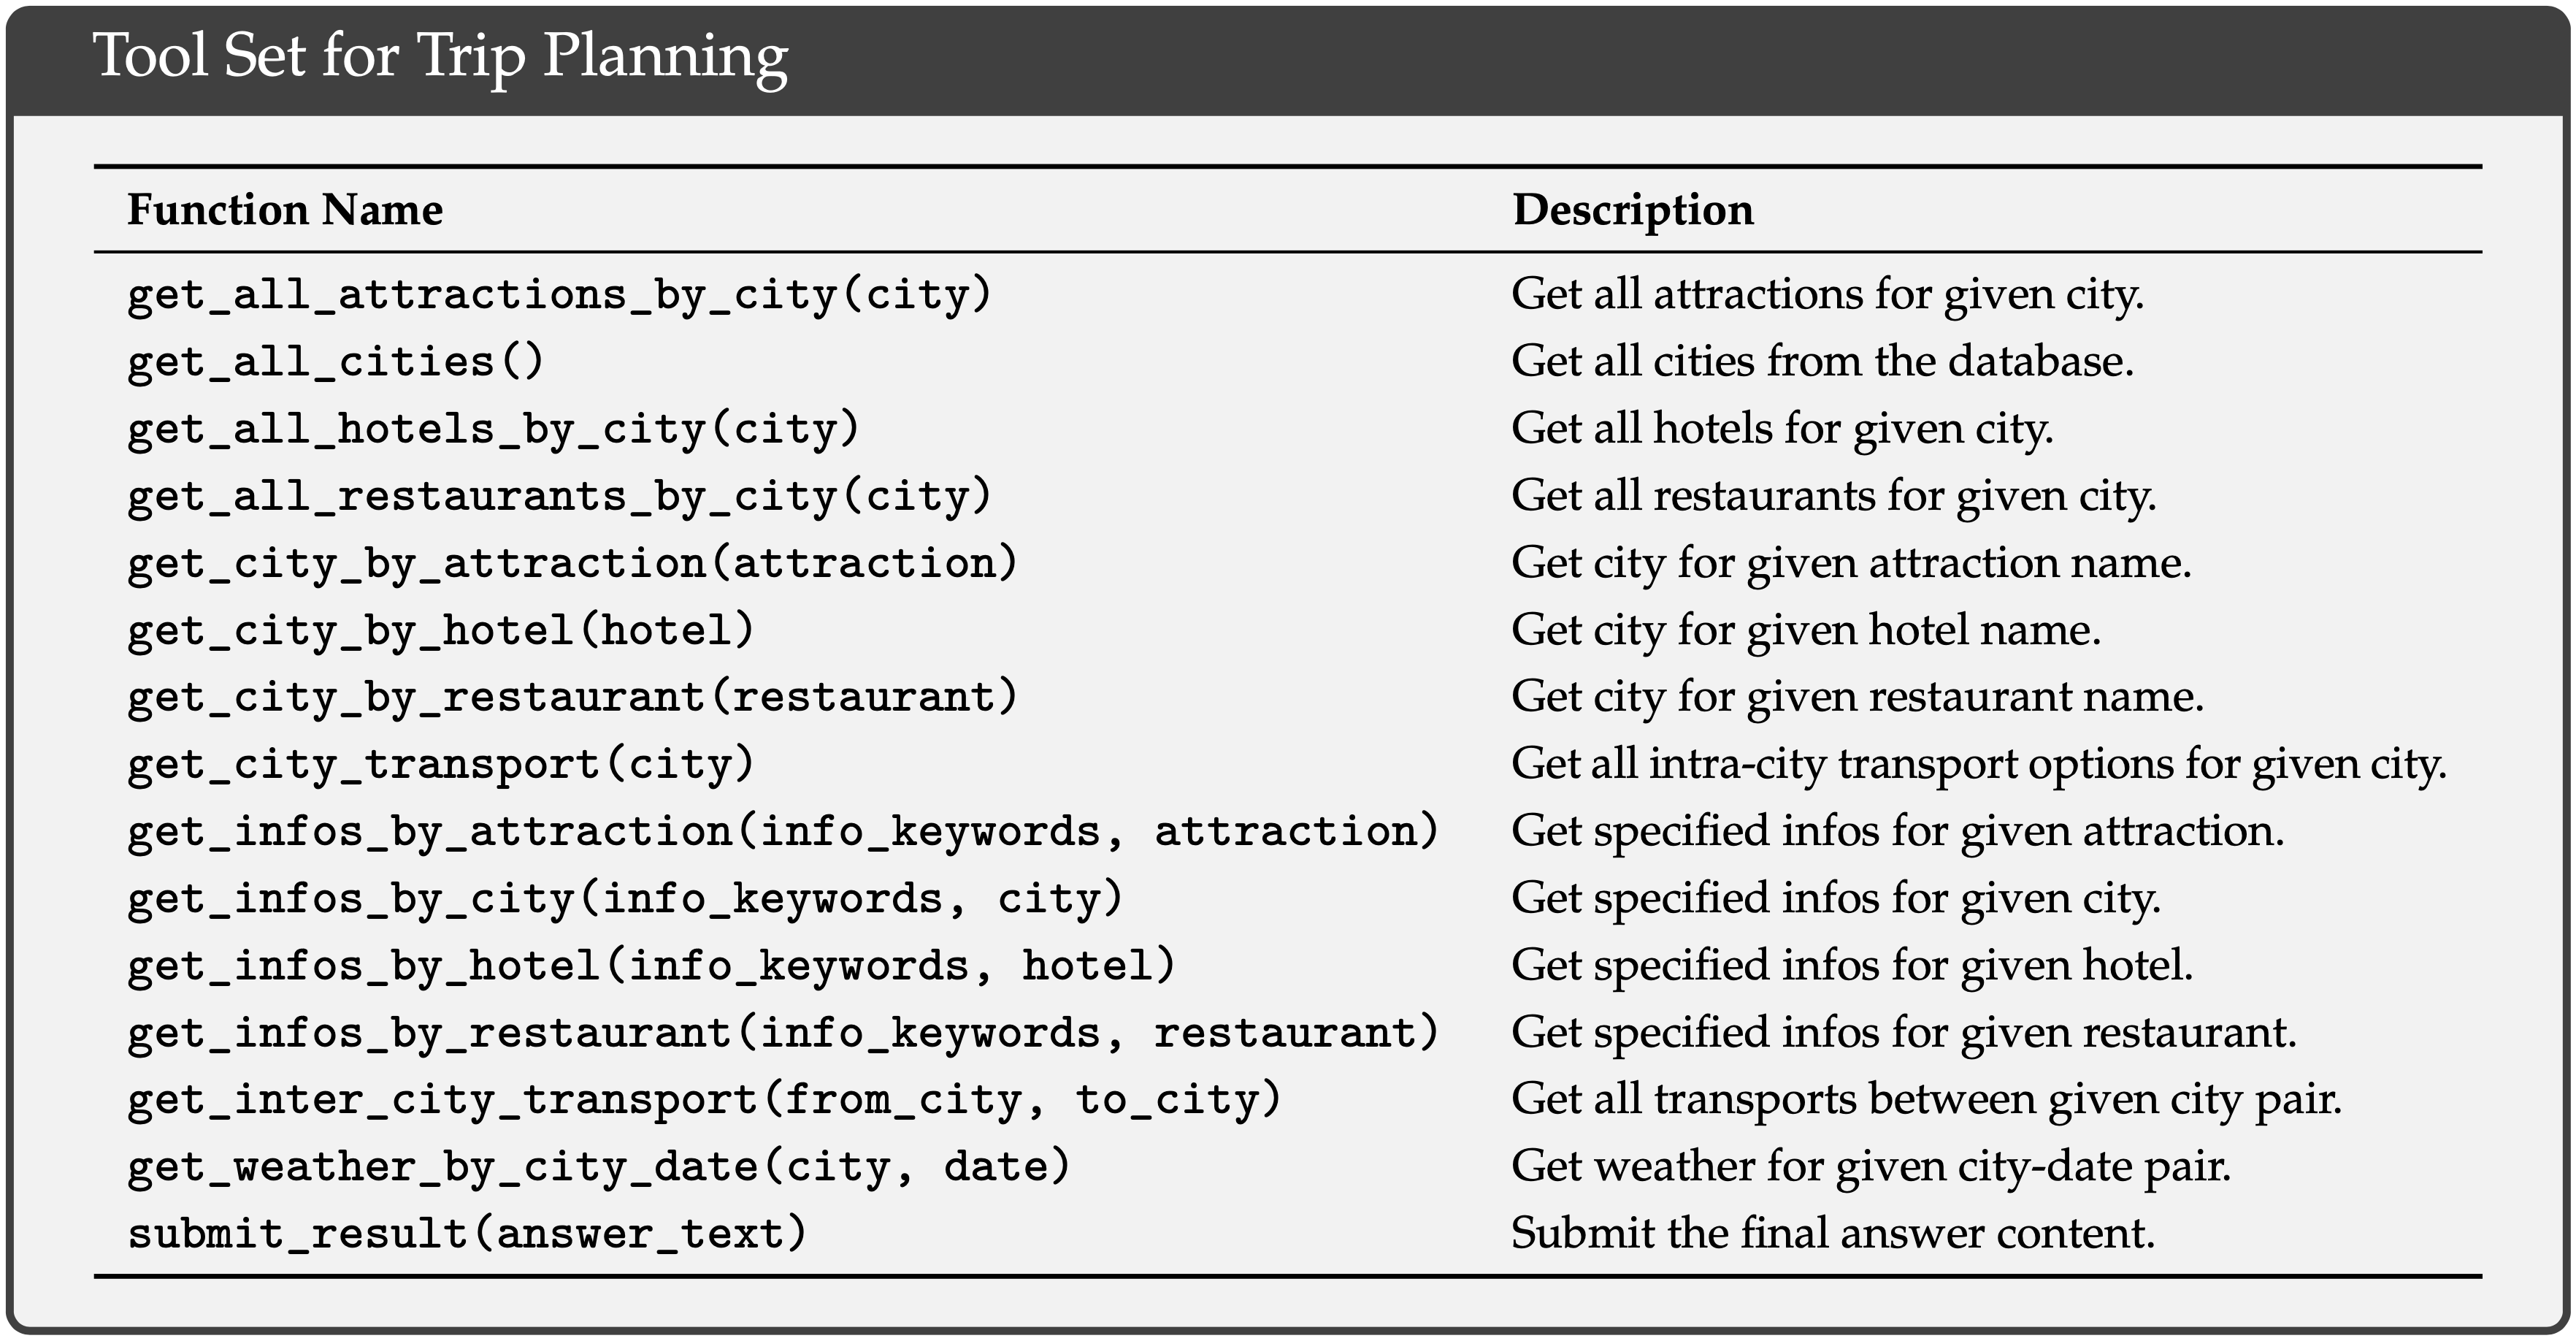
    行程规划工具集(Tool Set for Trip Planning)

    函数名称 描述
    get_all_attractions_by_city(city) 获取给定城市的所有景点
    get_all_cities() 从数据库获取所有城市
    get_all_hotels_by_city(city) 获取给定城市的所有酒店
    get_all_restaurants_by_city(city) 获取给定城市的所有餐厅
    get_city_by_attraction(attraction) 获取给定景点名称的城市
    get_city_by_hotel(hotel) 获取给定酒店名称的城市
    get_city_by_restaurant(restaurant) 获取给定餐厅名称的城市
    get_city_transport(city) 获取给定城市的所有市内交通选项
    get_infos_by_attraction(info_keywords, attraction) 获取给定景点的指定信息
    get_infos_by_city(info_keywords, city) 获取给定城市的指定信息
    get_infos_by_hotel(info_keywords, hotel) 获取给定酒店的指定信息
    get_infos_by_restaurant(info_keywords, restaurant) 获取给定餐厅的指定信息
    get_inter_city_transport(from_city, to_city) 获取给定城市对之间的所有交通方式
    get_weather_by_city_date(city, date) 获取给定城市-日期对的天气
    submit_result(answer_text) 提交最终答案内容


Evaluation

Main Results

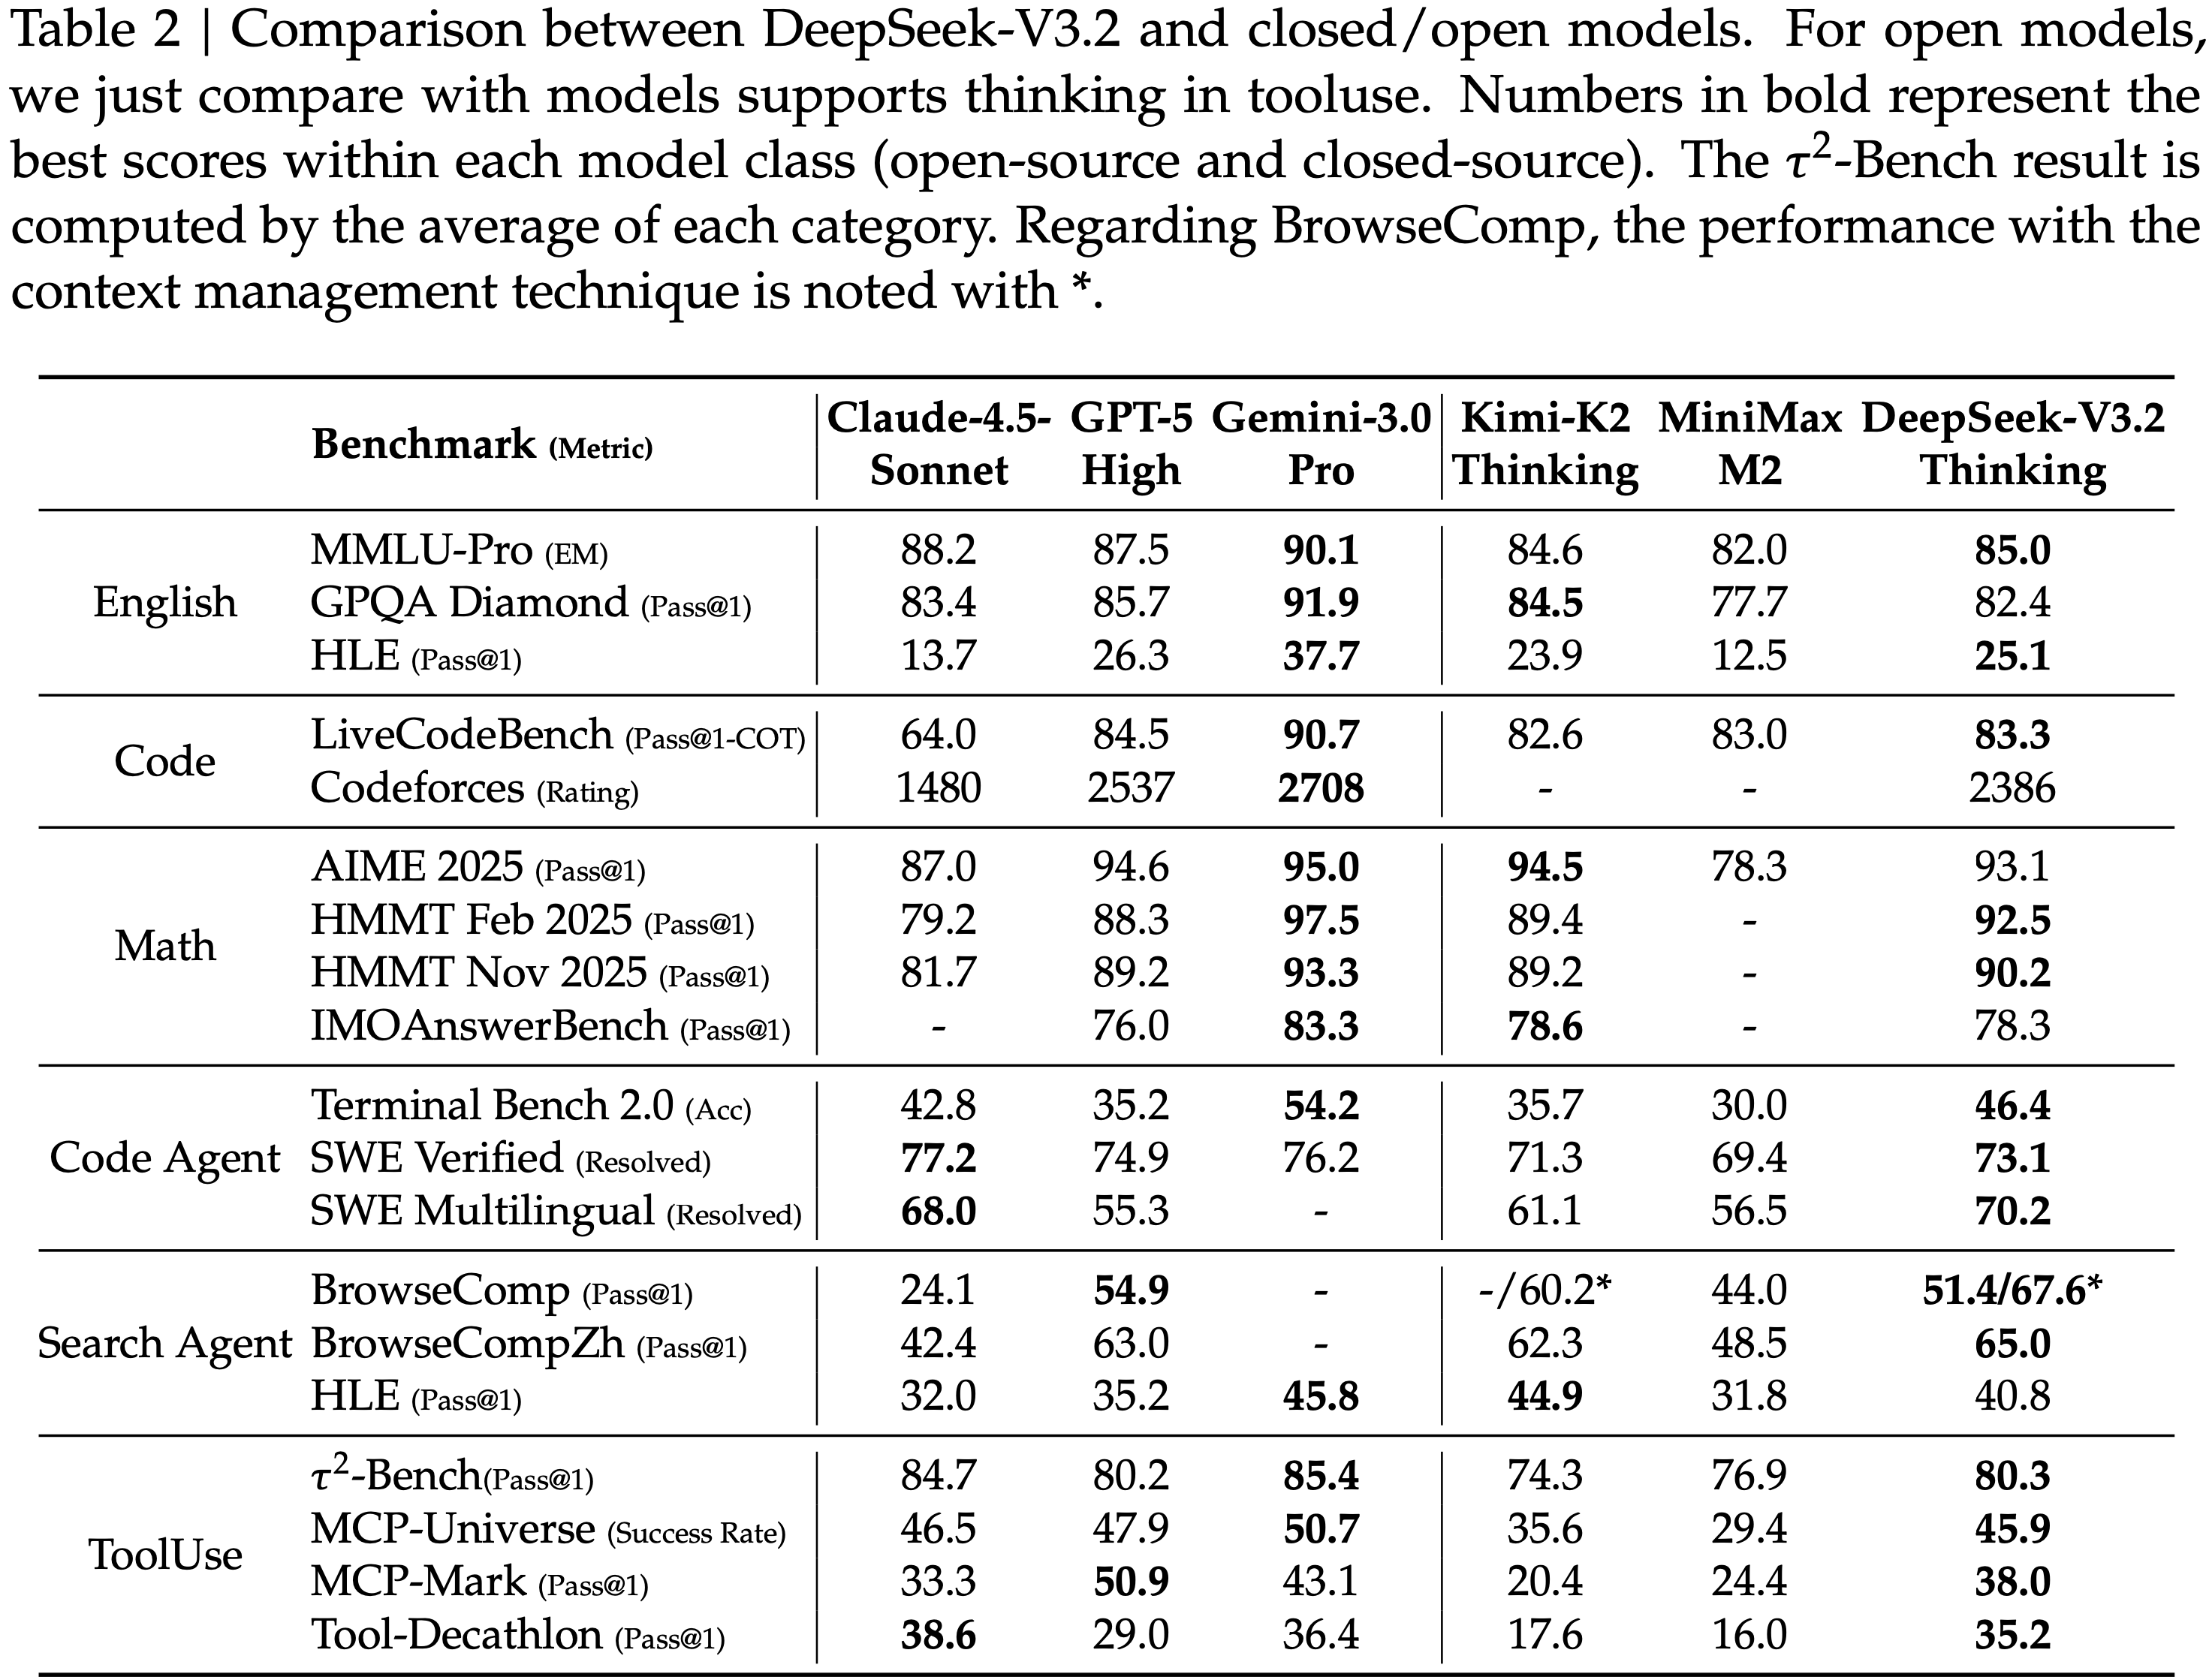
  • 作者在多个 Benchmark 上进行了评估,包括:
    • MMLU-Pro (2024)
    • GPQA Diamond (2023)
    • Human Last Exam (HLE) Text-only (2025)
    • LiveCodeBench (2024.08-2025.04)
    • Codeforces
    • Aider-Polyglot
    • AIME 2025
    • HMMT Feb 2025
    • HMMT Nov 2025 (2025)
    • IMOAnswerBench (2025)
    • Terminal Bench 2.0
    • SWE-Verified (OpenAI, 2024b)
    • SWE Multilingual (2025)
    • BrowseComp (2025)
    • BrowseCompZh (2025)
    • \(\tau^{2}\)-bench (2025)
    • MCP-Universe (2025)
    • MCP-Mark (EvalSys, 2025)
    • Tool-Decathlon (2025)
  • 评估说明及结果:
    • 工具使用基准使用标准函数调用格式进行评估,其中模型配置为思考模式
    • MCP-Universe (2025) 和 MCP-Mark (EvalSys, 2025),使用内部环境评估所有模型
      • 因为搜索和 playwright 环境可能与官方设置略有不同
    • 论文中,将温度设置为 1.0,上下文窗口设置为 128K tokens
    • 对于数学相关任务,如 AIME, HMMT, IMOAnswerBench 和 HLE(理解:其实 HLE 中不全是数学):
      • 论文使用以下模板进行评估:"{question}\n Please reason step by step, and put your final answer within \boxed{}"
        • 理解:这是一个业内目前常用的 Thinking 模板
      • 注:对于 HLE,论文还使用官方模板评估了 DeepSeek-V3.2-Thinking,得分为 23.9
  • 在推理任务上(reasoning tasks):
    • DeepSeek-V3.2 与 GPT-5-high 表现相当,略逊于 Gemini-3.0-Pro
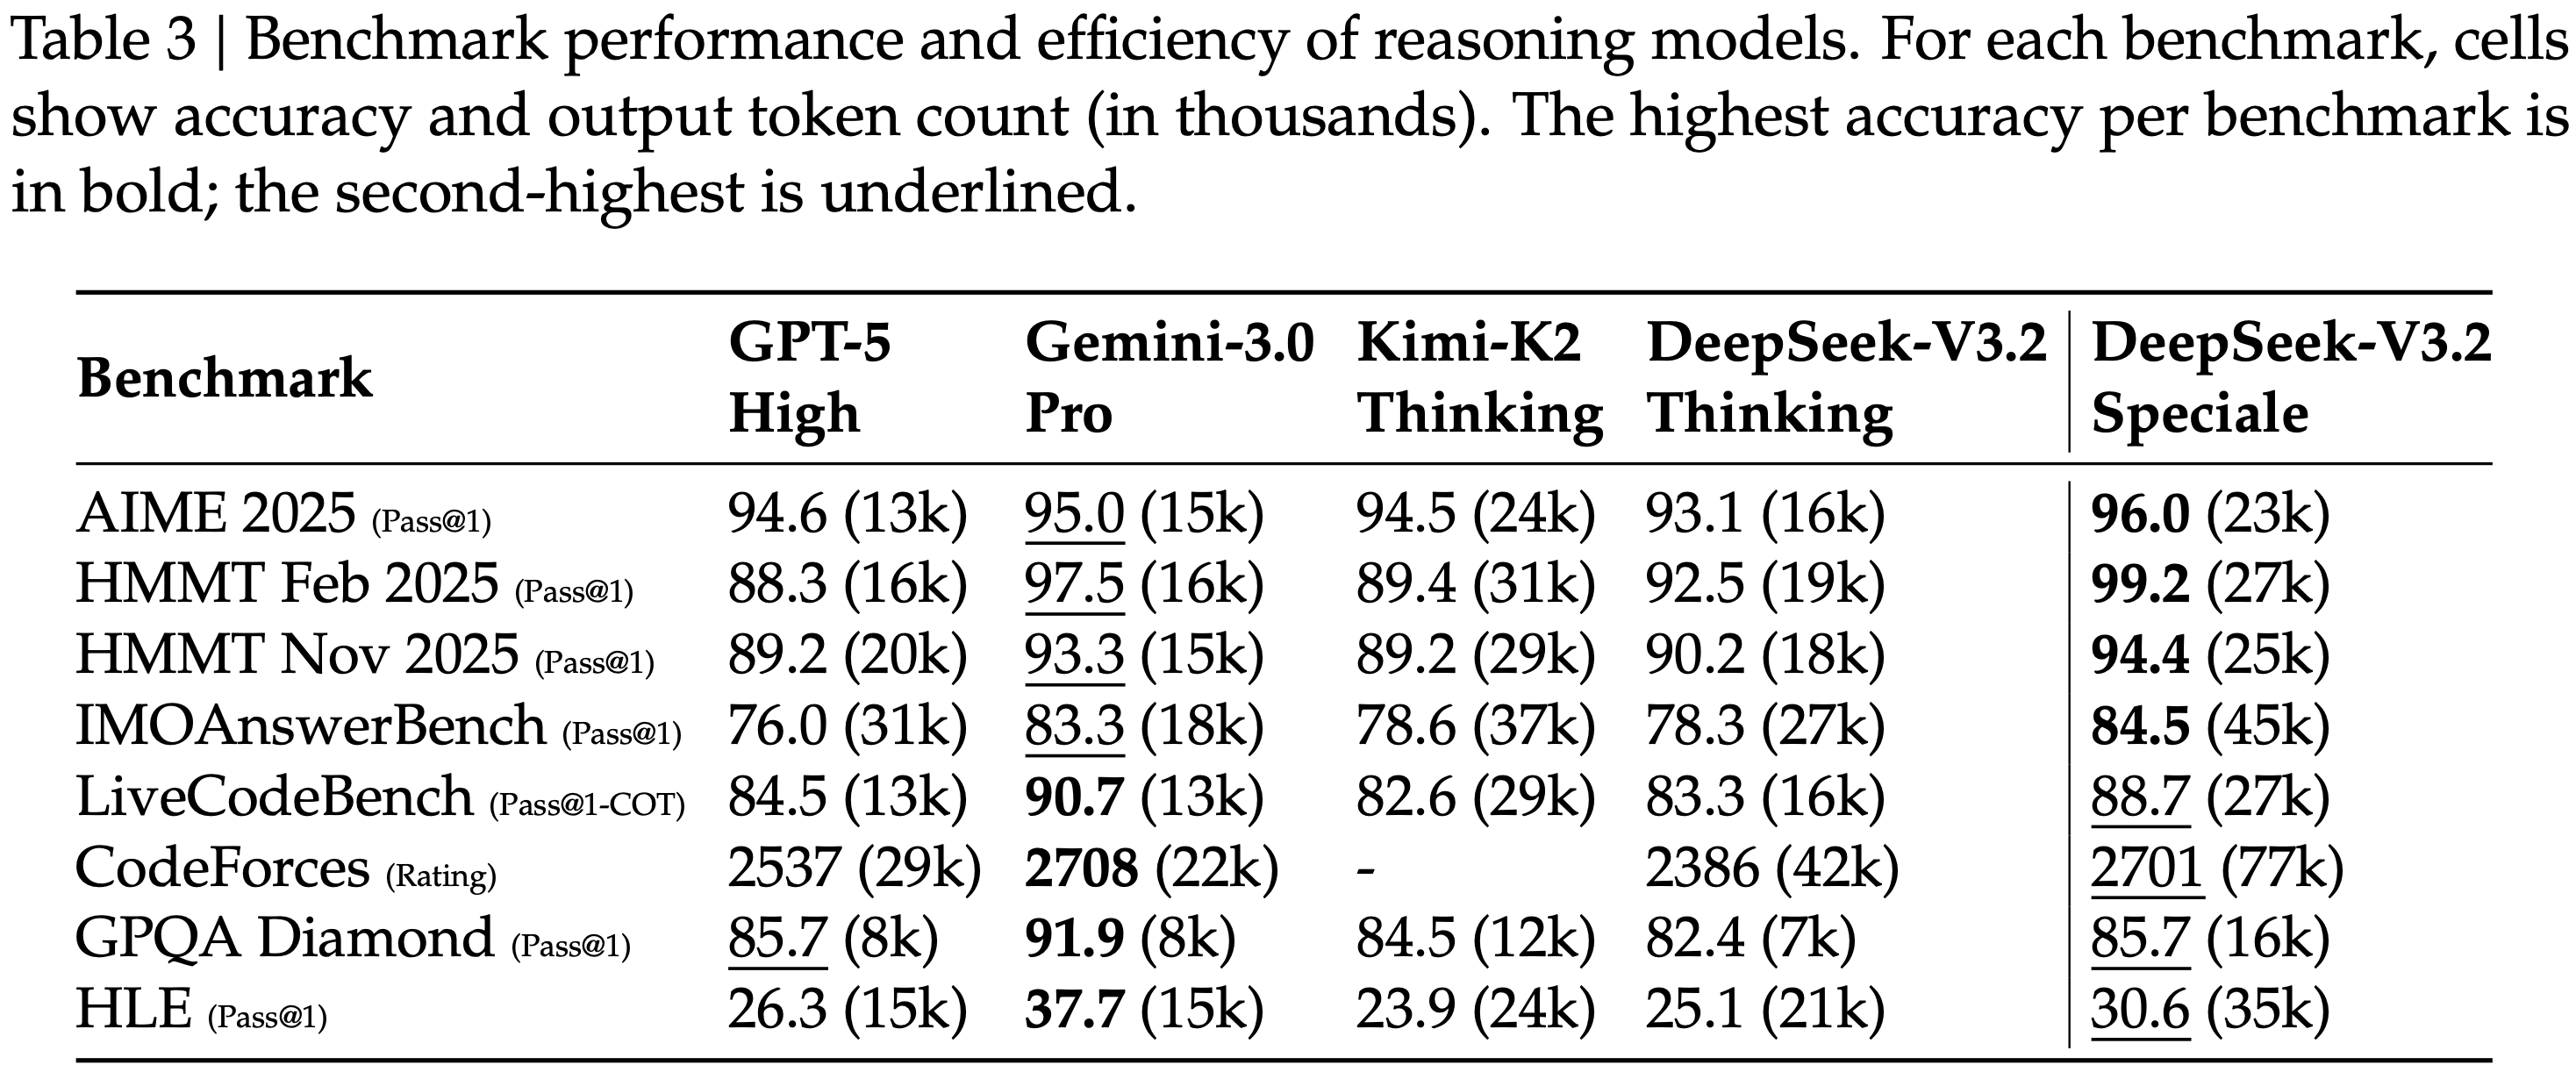
    • 与 K2-Thinking 相比,DeepSeek-V3.2 以显著更少的输出 token 获得了相似的分数,如表 3 所示
    • 这些性能提升可归因于分配给 RL 训练的计算资源增加
      • 在最近几个月,作者观察到性能的持续改进与 RL 训练预算的延长相关,该预算已超过预训练成本的 \(10%\)
      • 作者假设额外的计算预算分配可以进一步增强推理能力
      • 论文呈现的 DeepSeek-V3.2 性能受到长度约束奖励模型的限制;在移除该限制后,论文观察到模型性能的进一步提升,详见第 4.2 节
  • 在代码智能体任务中(code agent evaluations):
    • DeepSeek-V3.2 在 SWE-bench Verified 和 Terminal Bench 2.0 上均显著优于开源 LLM
      • 展示了 DeepSeek-V3.2 在现实世界编码工作流程中的潜力
    • 关于 Terminal Bench 2.0 的特别说明
      • (如前所述)作者为 “思考模式(thinking mode)” 设计的上下文管理策略目前与 Terminus 不兼容;
      • 因此,报告的 46.4 分是使用 Claude Code 框架实现的
      • 作者也使用 Terminus 在非思考模式(non-thinking mode)下评估了 DeepSeek-V3.2,得分为 39.3
    • 对于 SWE-bench Verified,主要得分是使用 DeepSeek 的内部框架获得的
      • 在其他设置(包括 Claude Code 和 RooCode 框架,以及非思考模式)下的鲁棒性测试产生了一致的结果,范围在 72 到 74 之间
  • 对于搜索智能体评估(search agent evaluation)
    • 论文使用标准的商业搜索 API 评估论文的模型
    • 由于 DeepSeek-V3.2 最大仅支持 128K 的上下文长度,大约 \(20%\) 以上的测试用例超过此限制
      • 为了解决这个问题,作者采用了一种上下文管理方法来获得最终分数
      • 注:不使用上下文管理的分数是 51.4
    • 更多细节在第 4.4 节提供
  • 在工具使用基准上(tool-use benchmarks):
    • DeepSeek-V3.2 显著缩小了 open-source 与 closed-source LLM 之间的性能差距,但仍低于 frontier 模型
    • 对于 \(\tau^{2}\)-bench
      • 作者使用模型本身作为 User Agent,获得的最终类别分数为 63.8 (Airline), 81.1 (Retail), and 96.2 (Telecom)
    • 对于 MCP 基准
      • 作者使用函数调用格式,并将工具输出放在标记为 ‘tool’ 角色的消息中,而不是 ‘user’ 角色
      • 在论文的测试中,作者观察到 DeepSeek-V3.2 经常进行冗余的自我验证,生成了过长的轨迹
        • 这种倾向通常导致上下文长度超过 128K 的限制,特别是在诸如 MCP-Mark GitHub 和 Playwright 评估等任务中
          • 因此,这种现象阻碍了 DeepSeek-V3.2 的最终性能
        • 但集成上下文管理策略可以进一步提高性能
          • 论文将此确定为未来工作的方向和对用户的实用考虑
        • 即使 DeepSeek-V3.2 存在此问题,它仍然显著优于现有的开源模型
      • Notably,由于这些基准中使用的环境和工具集在 RL 训练期间未遇到过 ,观察到的改进证明了 DeepSeek-V3.2 将其推理策略泛化到领域外智能体场景的能力
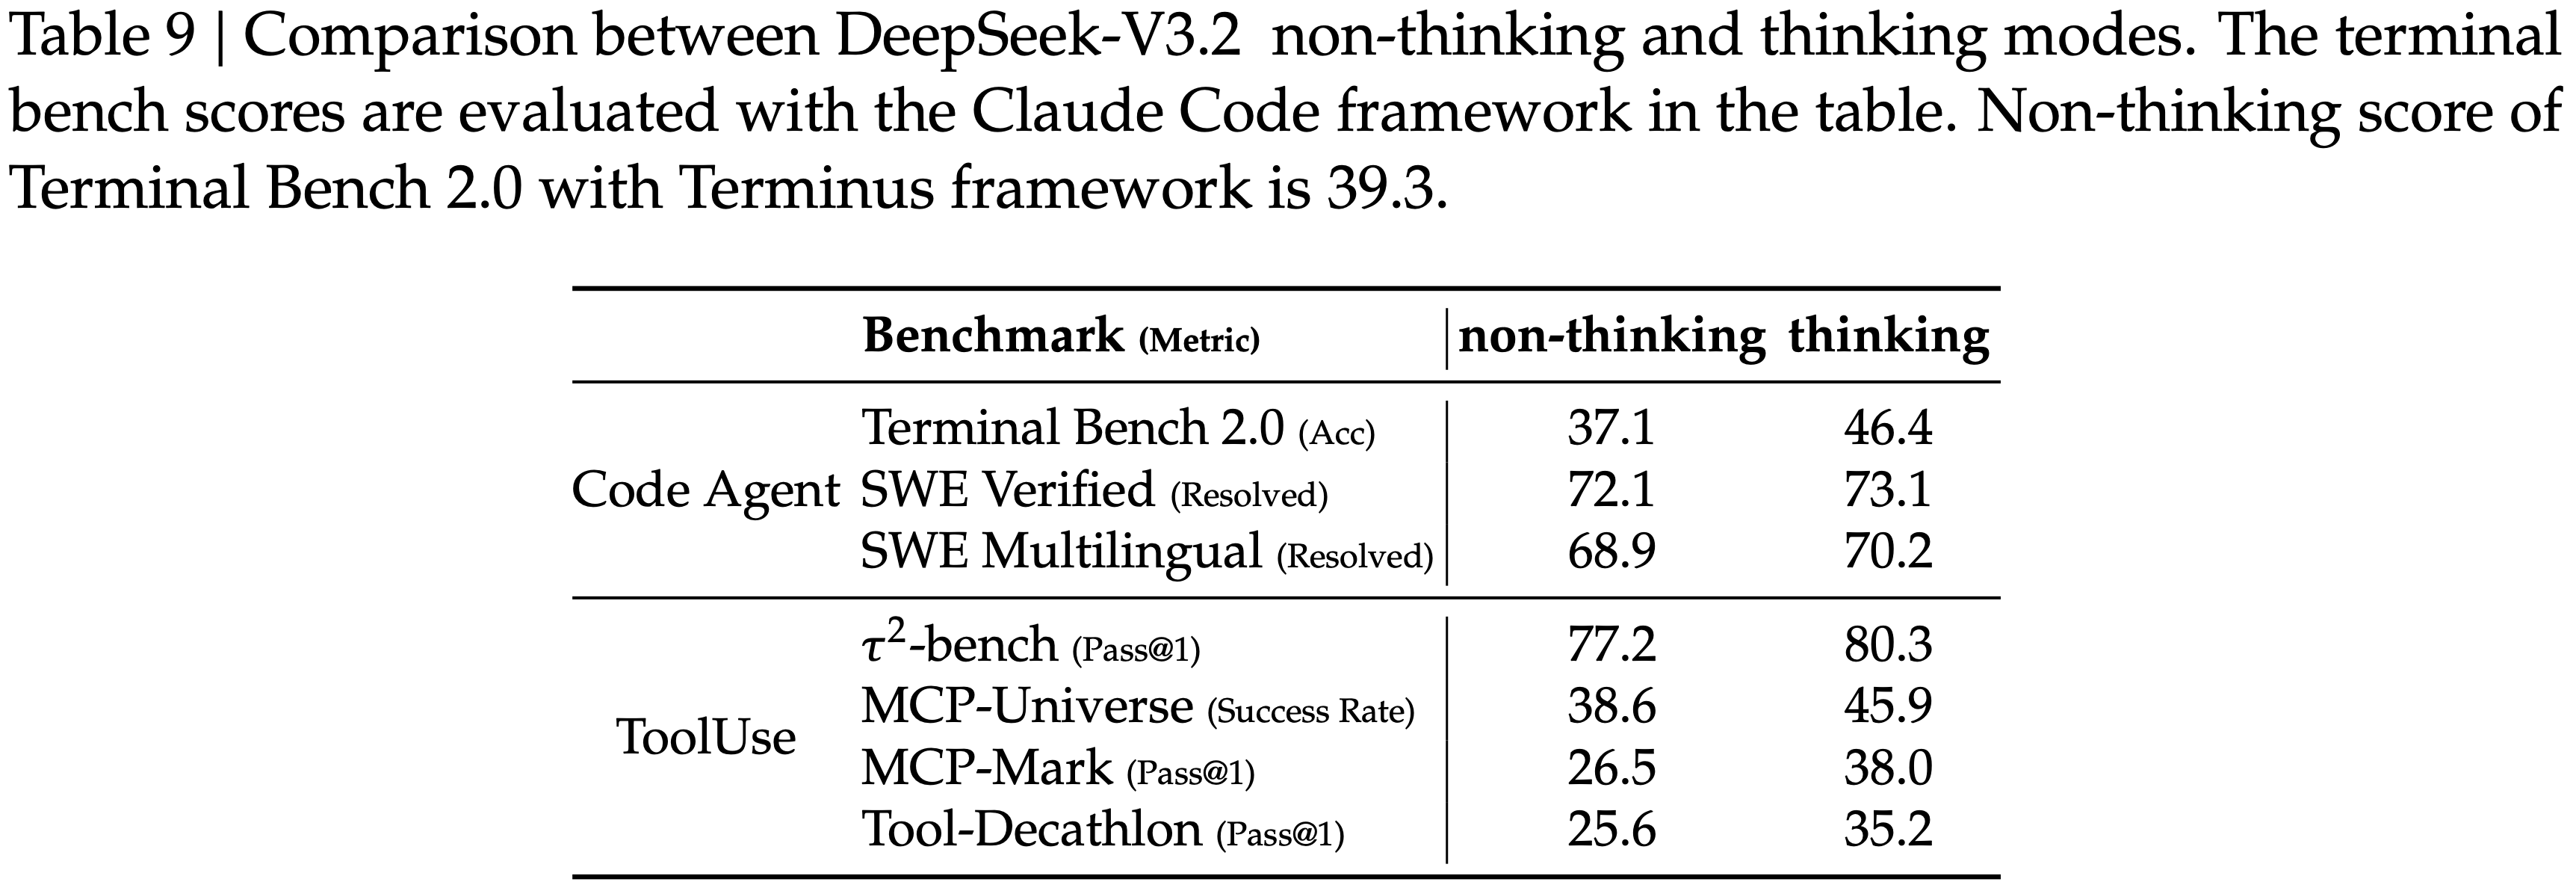
        • 非思考模型在智能体场景中的评估见附录表 9

Results of DeepSeek-V3.2-Speciale

  • 表 3 表明,DeepSeek-V3.2-Speciale 通过利用增加的推理 token 获得了卓越的性能,在多个基准上超越了 SOTA Gemini-3.0-Pro
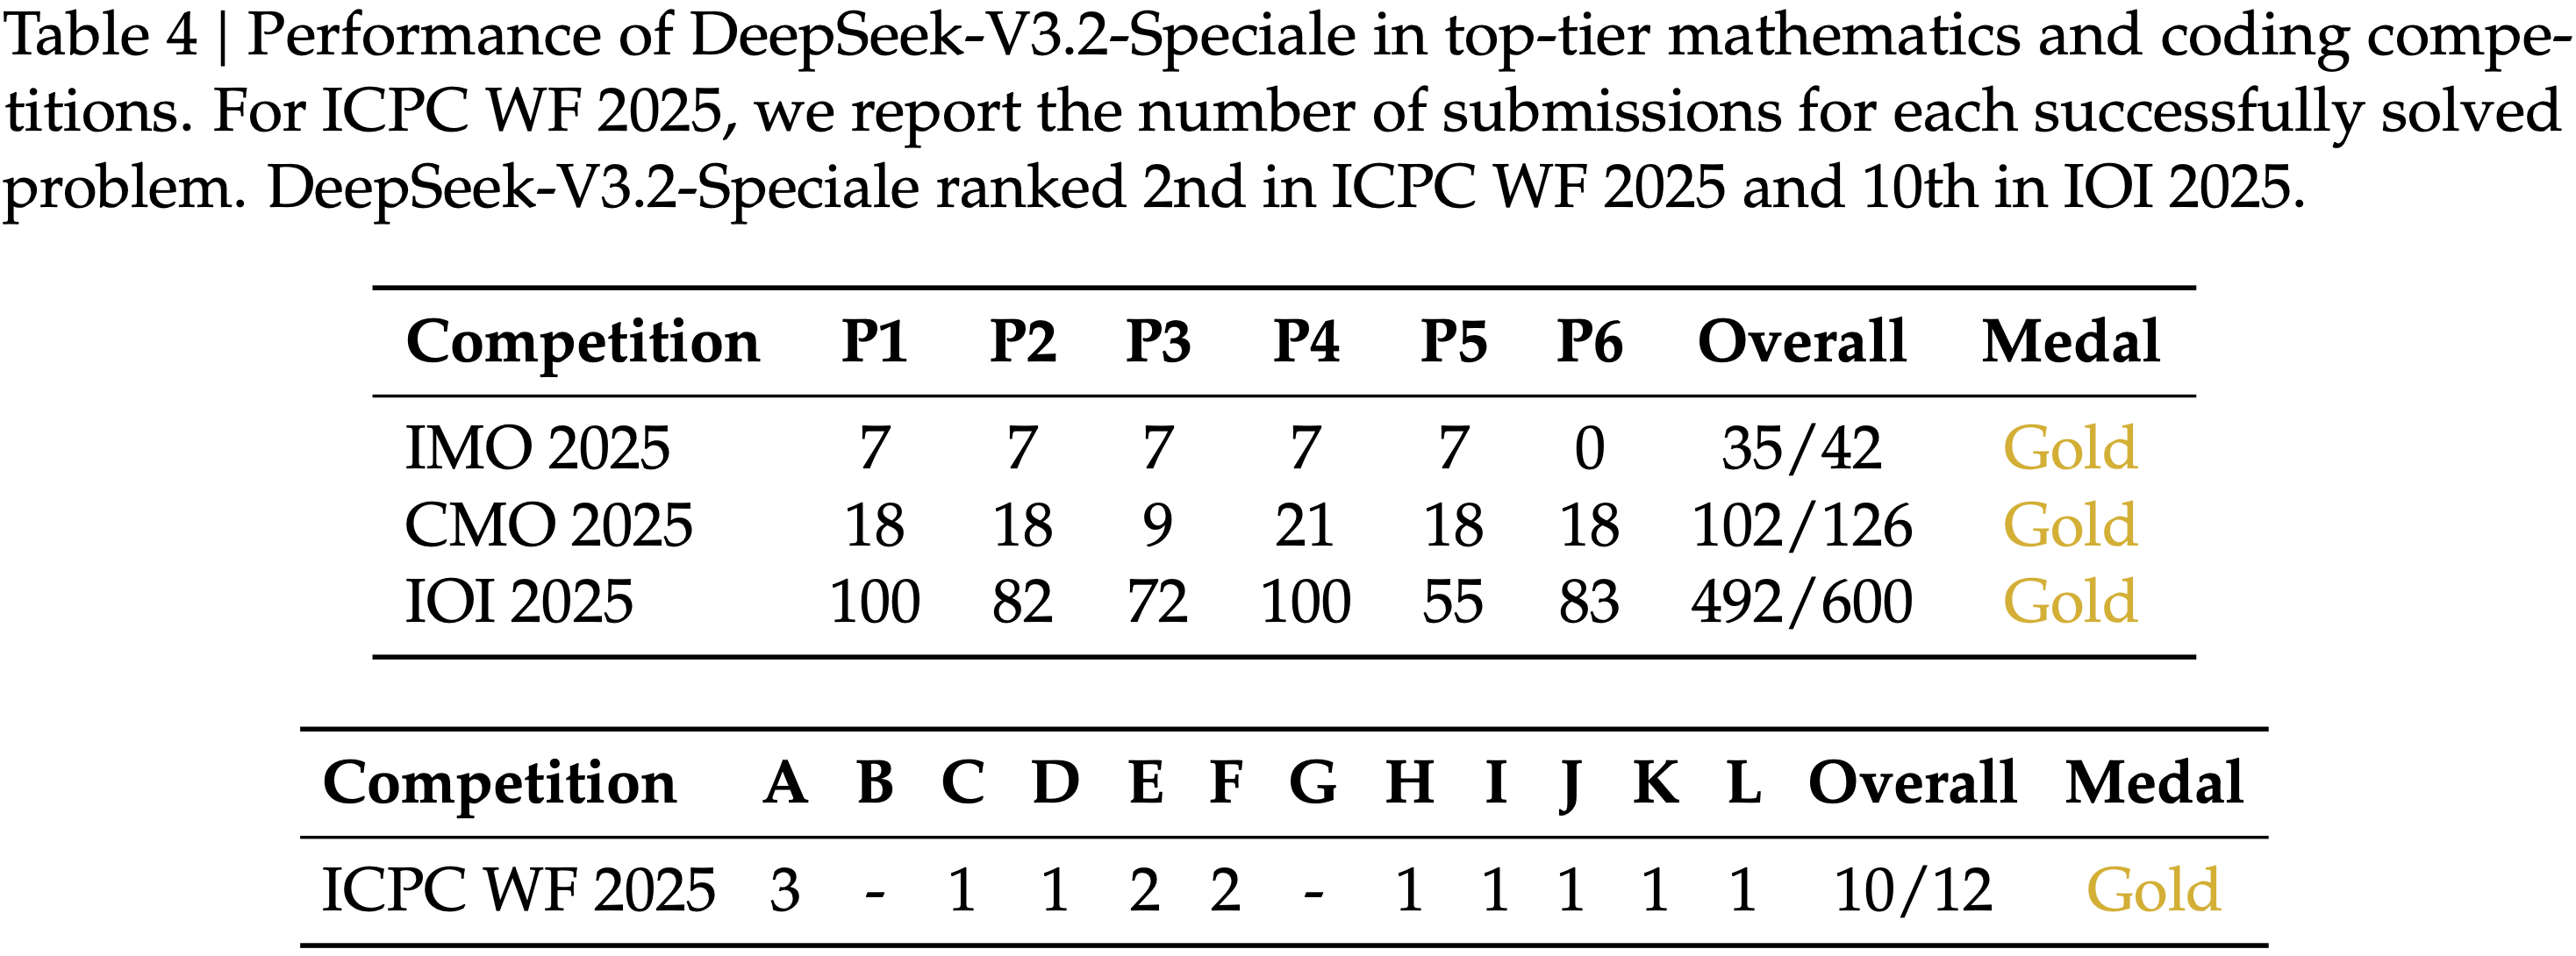
  • Remarkably,如表 4 所示
    • DeepSeek-V3.2-Speciale 这个通用模型在 2025 年国际信息学奥林匹克竞赛(IOI)和 ICPC 世界总决赛(ICPC WF)中达到了金牌级别的性能,而无需针对性的训练
    • Furthermore,通过结合 Shao 等人 (2025) 的技术,DeepSeek-V3.2-Speciale 模型在复杂的证明任务中表现出色,达到了 2025 年国际数学奥林匹克竞赛(IMO)和中国数学奥林匹克竞赛(CMO)的金牌门槛\(^5\)
    • 详细的评估协议在附录 D 中提供
  • However,DeepSeek-V3.2-Speciale 的 token 效率仍然显著低于 Gemini-3.0-Pro
    • 为了降低部署成本和延迟,作者在官方 DeepSeek-V3.2 的训练中施加了更严格的 token 约束,旨在优化性能与成本之间的权衡
    • 作者认为 token 效率仍然是未来研究的一个关键领域

Synthesis Agentic Tasks

  • 在本节中,作者进行消融实验来研究合成智能体任务的效果
  • 论文关注两个问题
    • 第一:合成任务对强化学习来说是否足够具有挑战性?
    • 第二:这些合成任务的泛化能力如何,即它们能否迁移到不同的下游任务或现实世界环境?
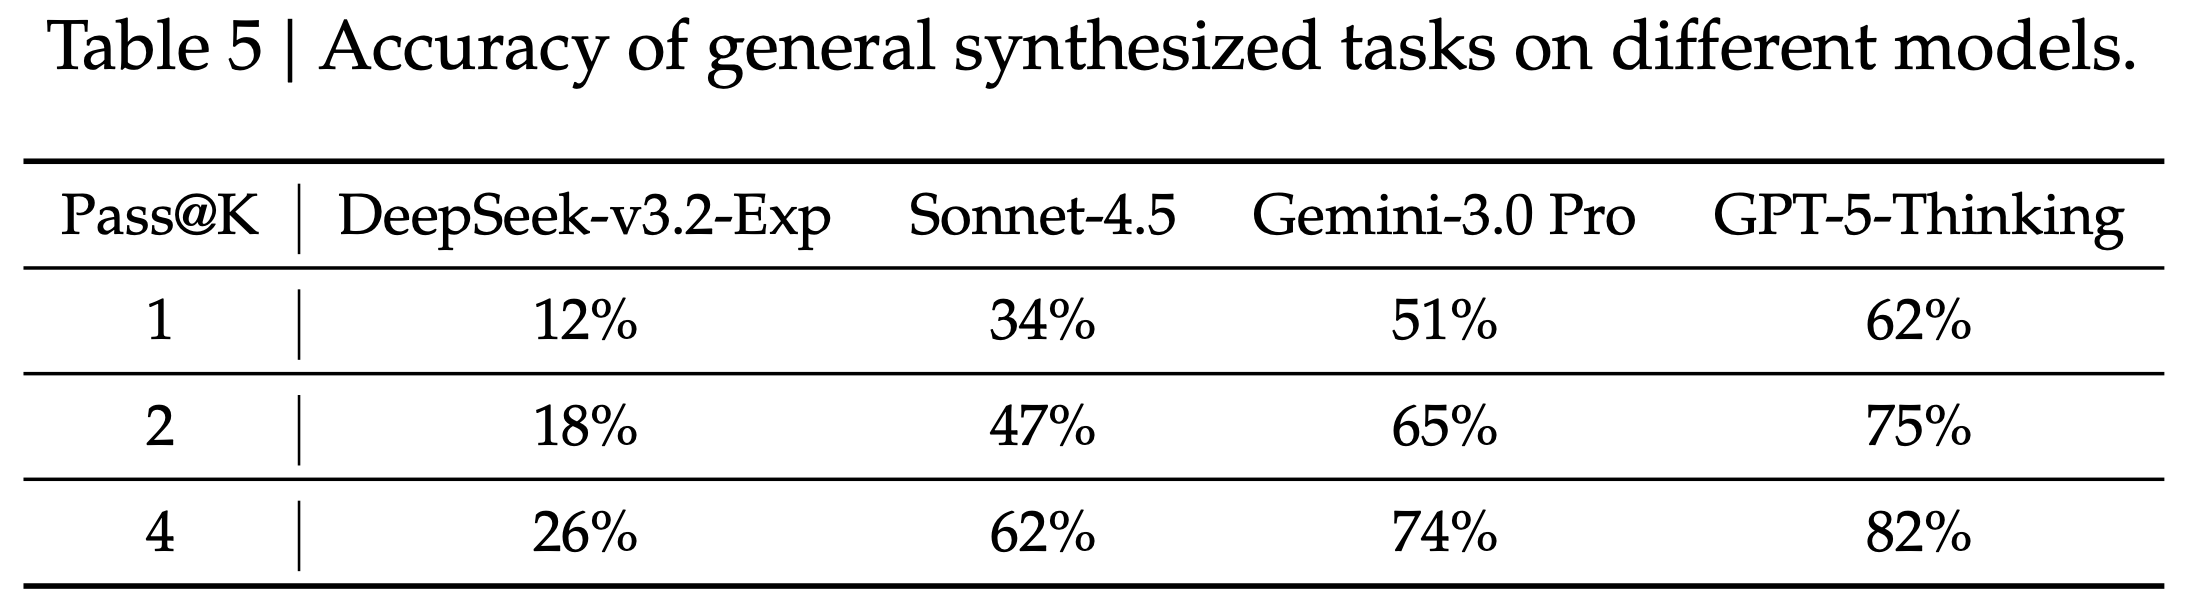
  • 为了回答第一个问题,作者从通用合成智能体任务中随机抽取 50 个实例,并评估用于合成的模型和 frontier closed-source LLM
  • 如表 5 所示,DeepSeek-V3.2-Exp 的准确率仅为 12%,而 frontier closed-source 模型的准确率最多为 62%
    • 这些结果表明,合成数据包含了对 DeepSeek-V3.2-Exp 和 frontier closed-source 模型都具有挑战性的智能体任务
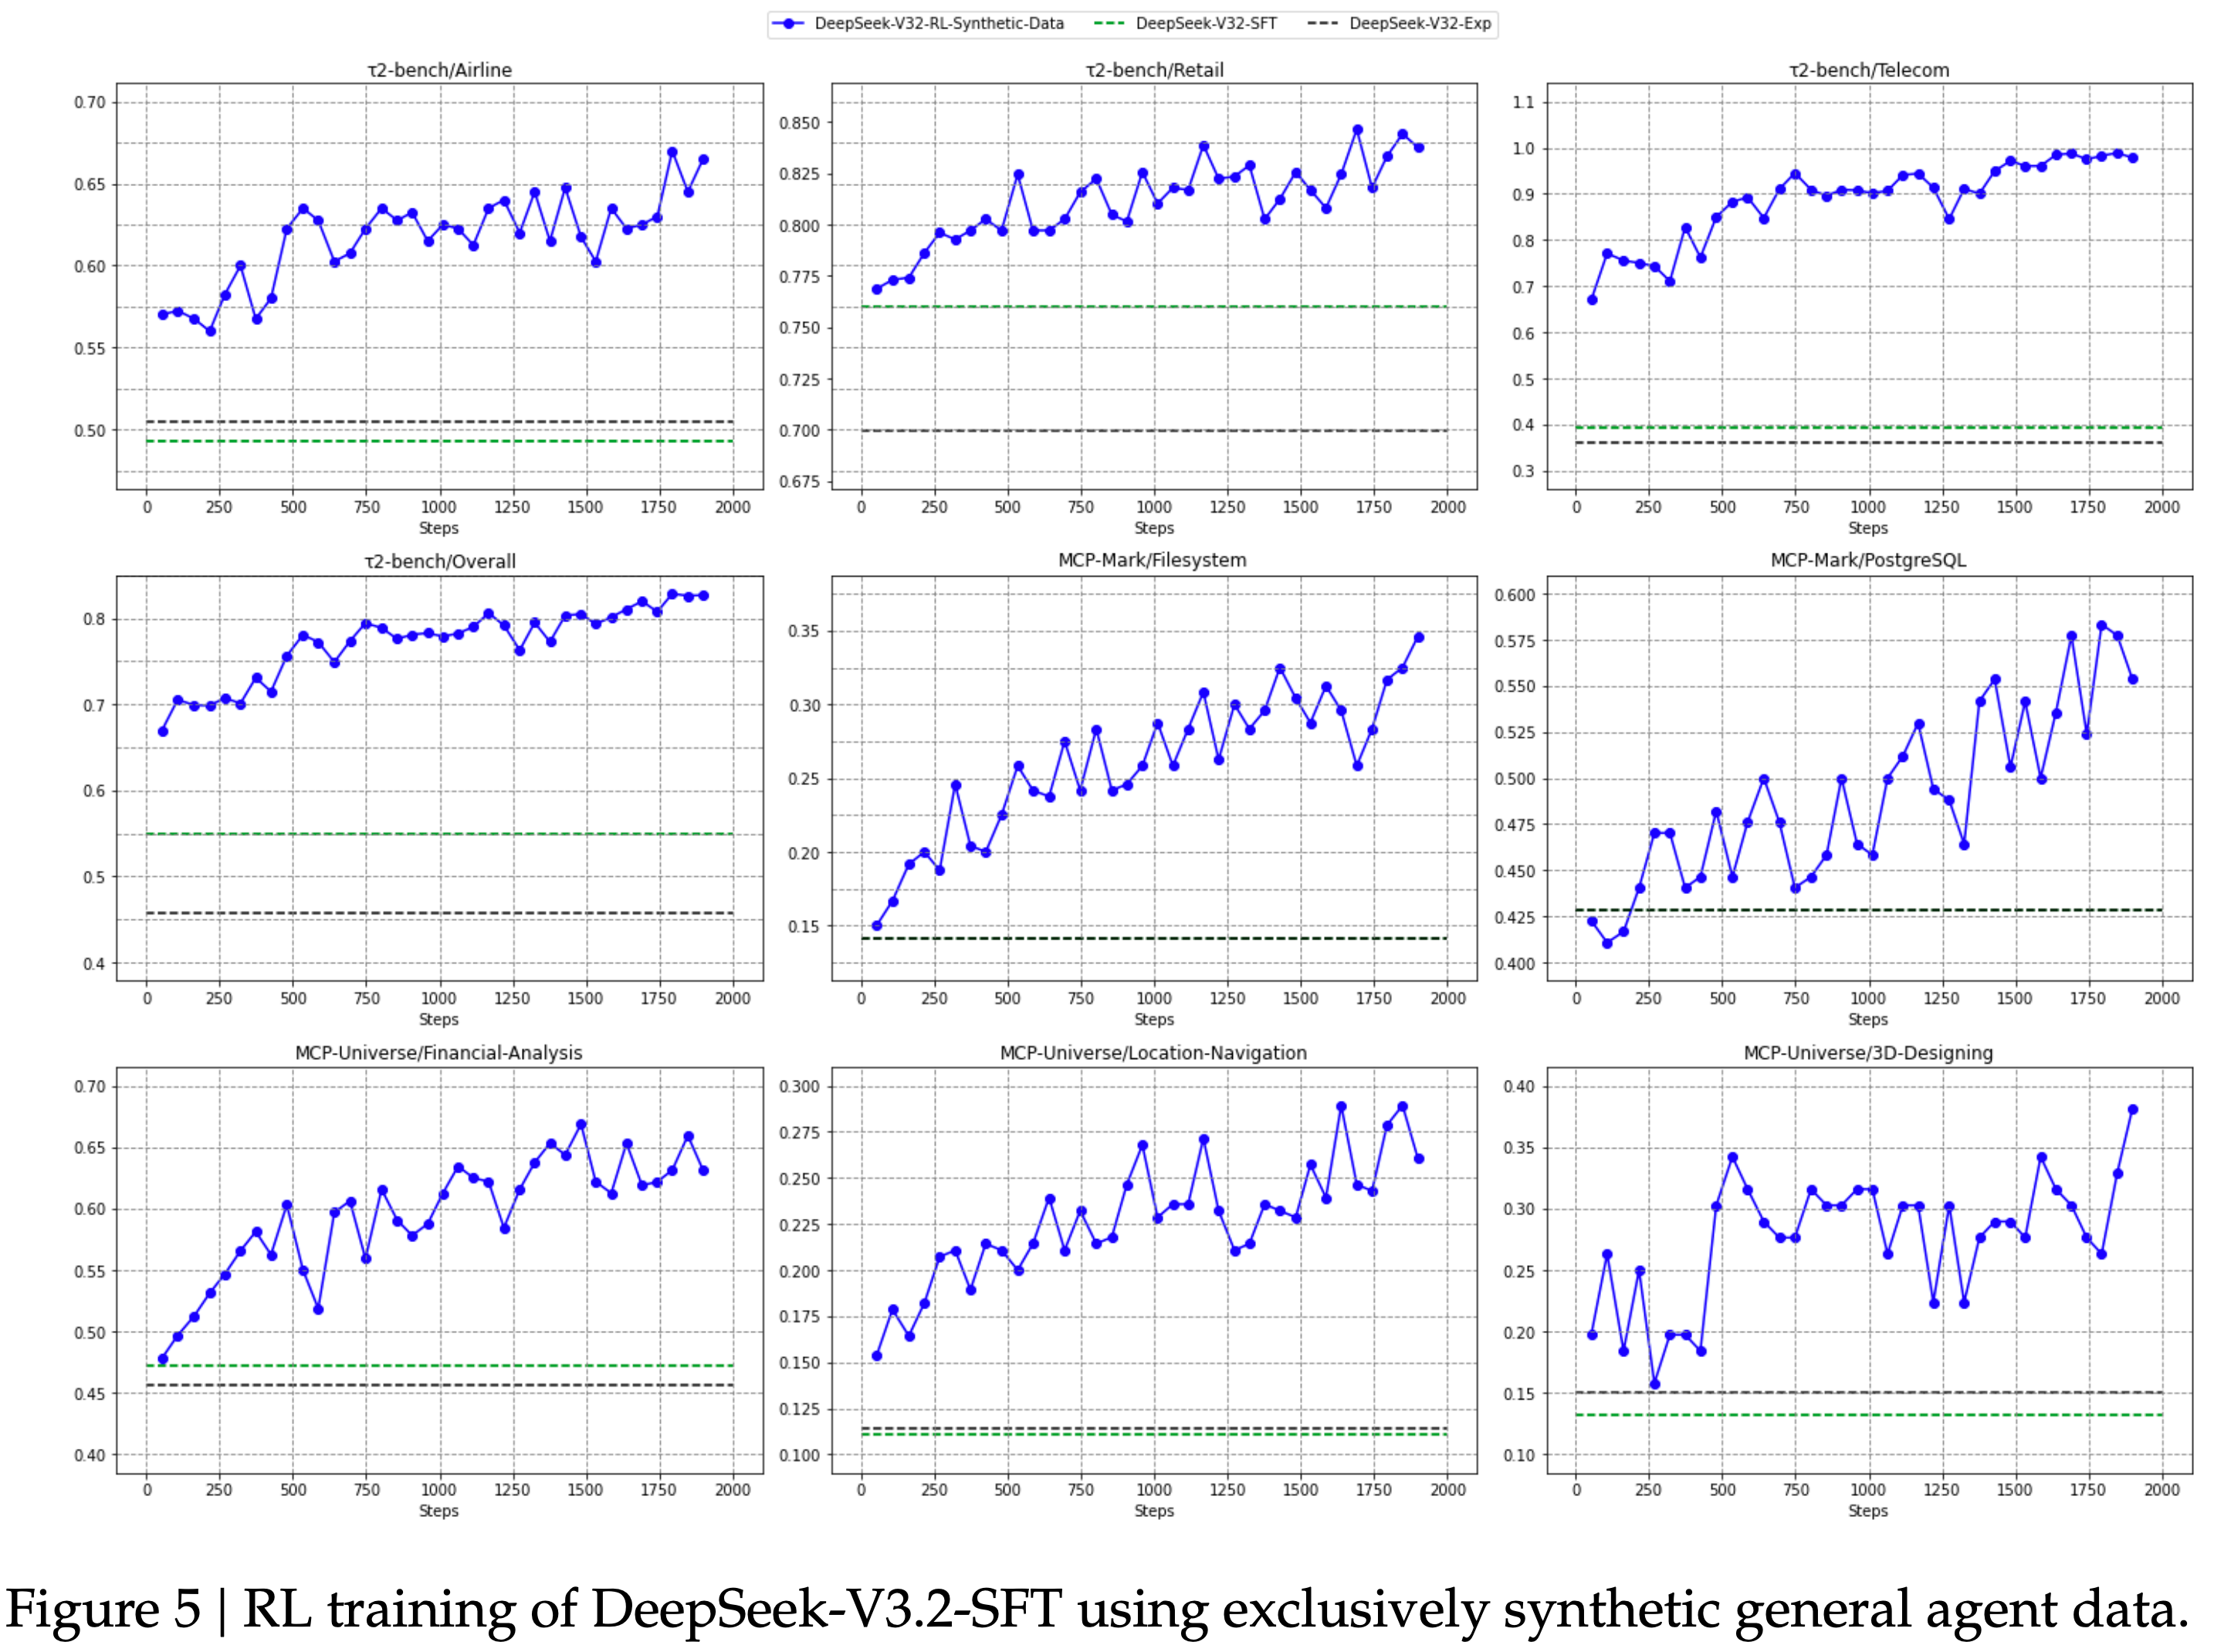
  • 为了研究合成数据上的 RL 能否泛化到不同的任务或现实世界环境
    • 作者对 DeepSeek-V3.2 的 SFT Checkpoint(记为 DeepSeek-V3.2-SFT)应用 RL
  • 为了排除长 Thinking 链和其他 RL 数据的影响
    • 作者仅在非思考模式下对合成智能体任务进行 RL
  • 作者将上述模型与 DeepSeek-V3.2-SFT 和 DeepSeek-V3.2-Exp 进行比较
    • 其中 DeepSeek-V3.2-Exp 仅在搜索和代码环境中进行了 RL 训练(即不包含 合成数据)
    • DeepSeek-V3.2-SFT 则未经过任何 RL 训练
  • 如图 5 所示,在合成数据上进行大规模 RL 在 Tau2Bench、MCP-Mark 和 MCP-Universe 基准上相比 DeepSeek-V3.2-SFT 带来了显著的改进
    • 相比之下,将 RL 限制在代码和搜索场景并未改善这些基准上的性能,进一步凸显了合成数据的潜力

Context Management of Search Agent

  • 即使使用扩展的上下文窗口(如 128k),智能体工作流,特别是在基于搜索的场景中,也经常会遇到最大长度限制,从而过早地截断推理过程
    • 这个瓶颈抑制了测试时计算潜力的充分发挥
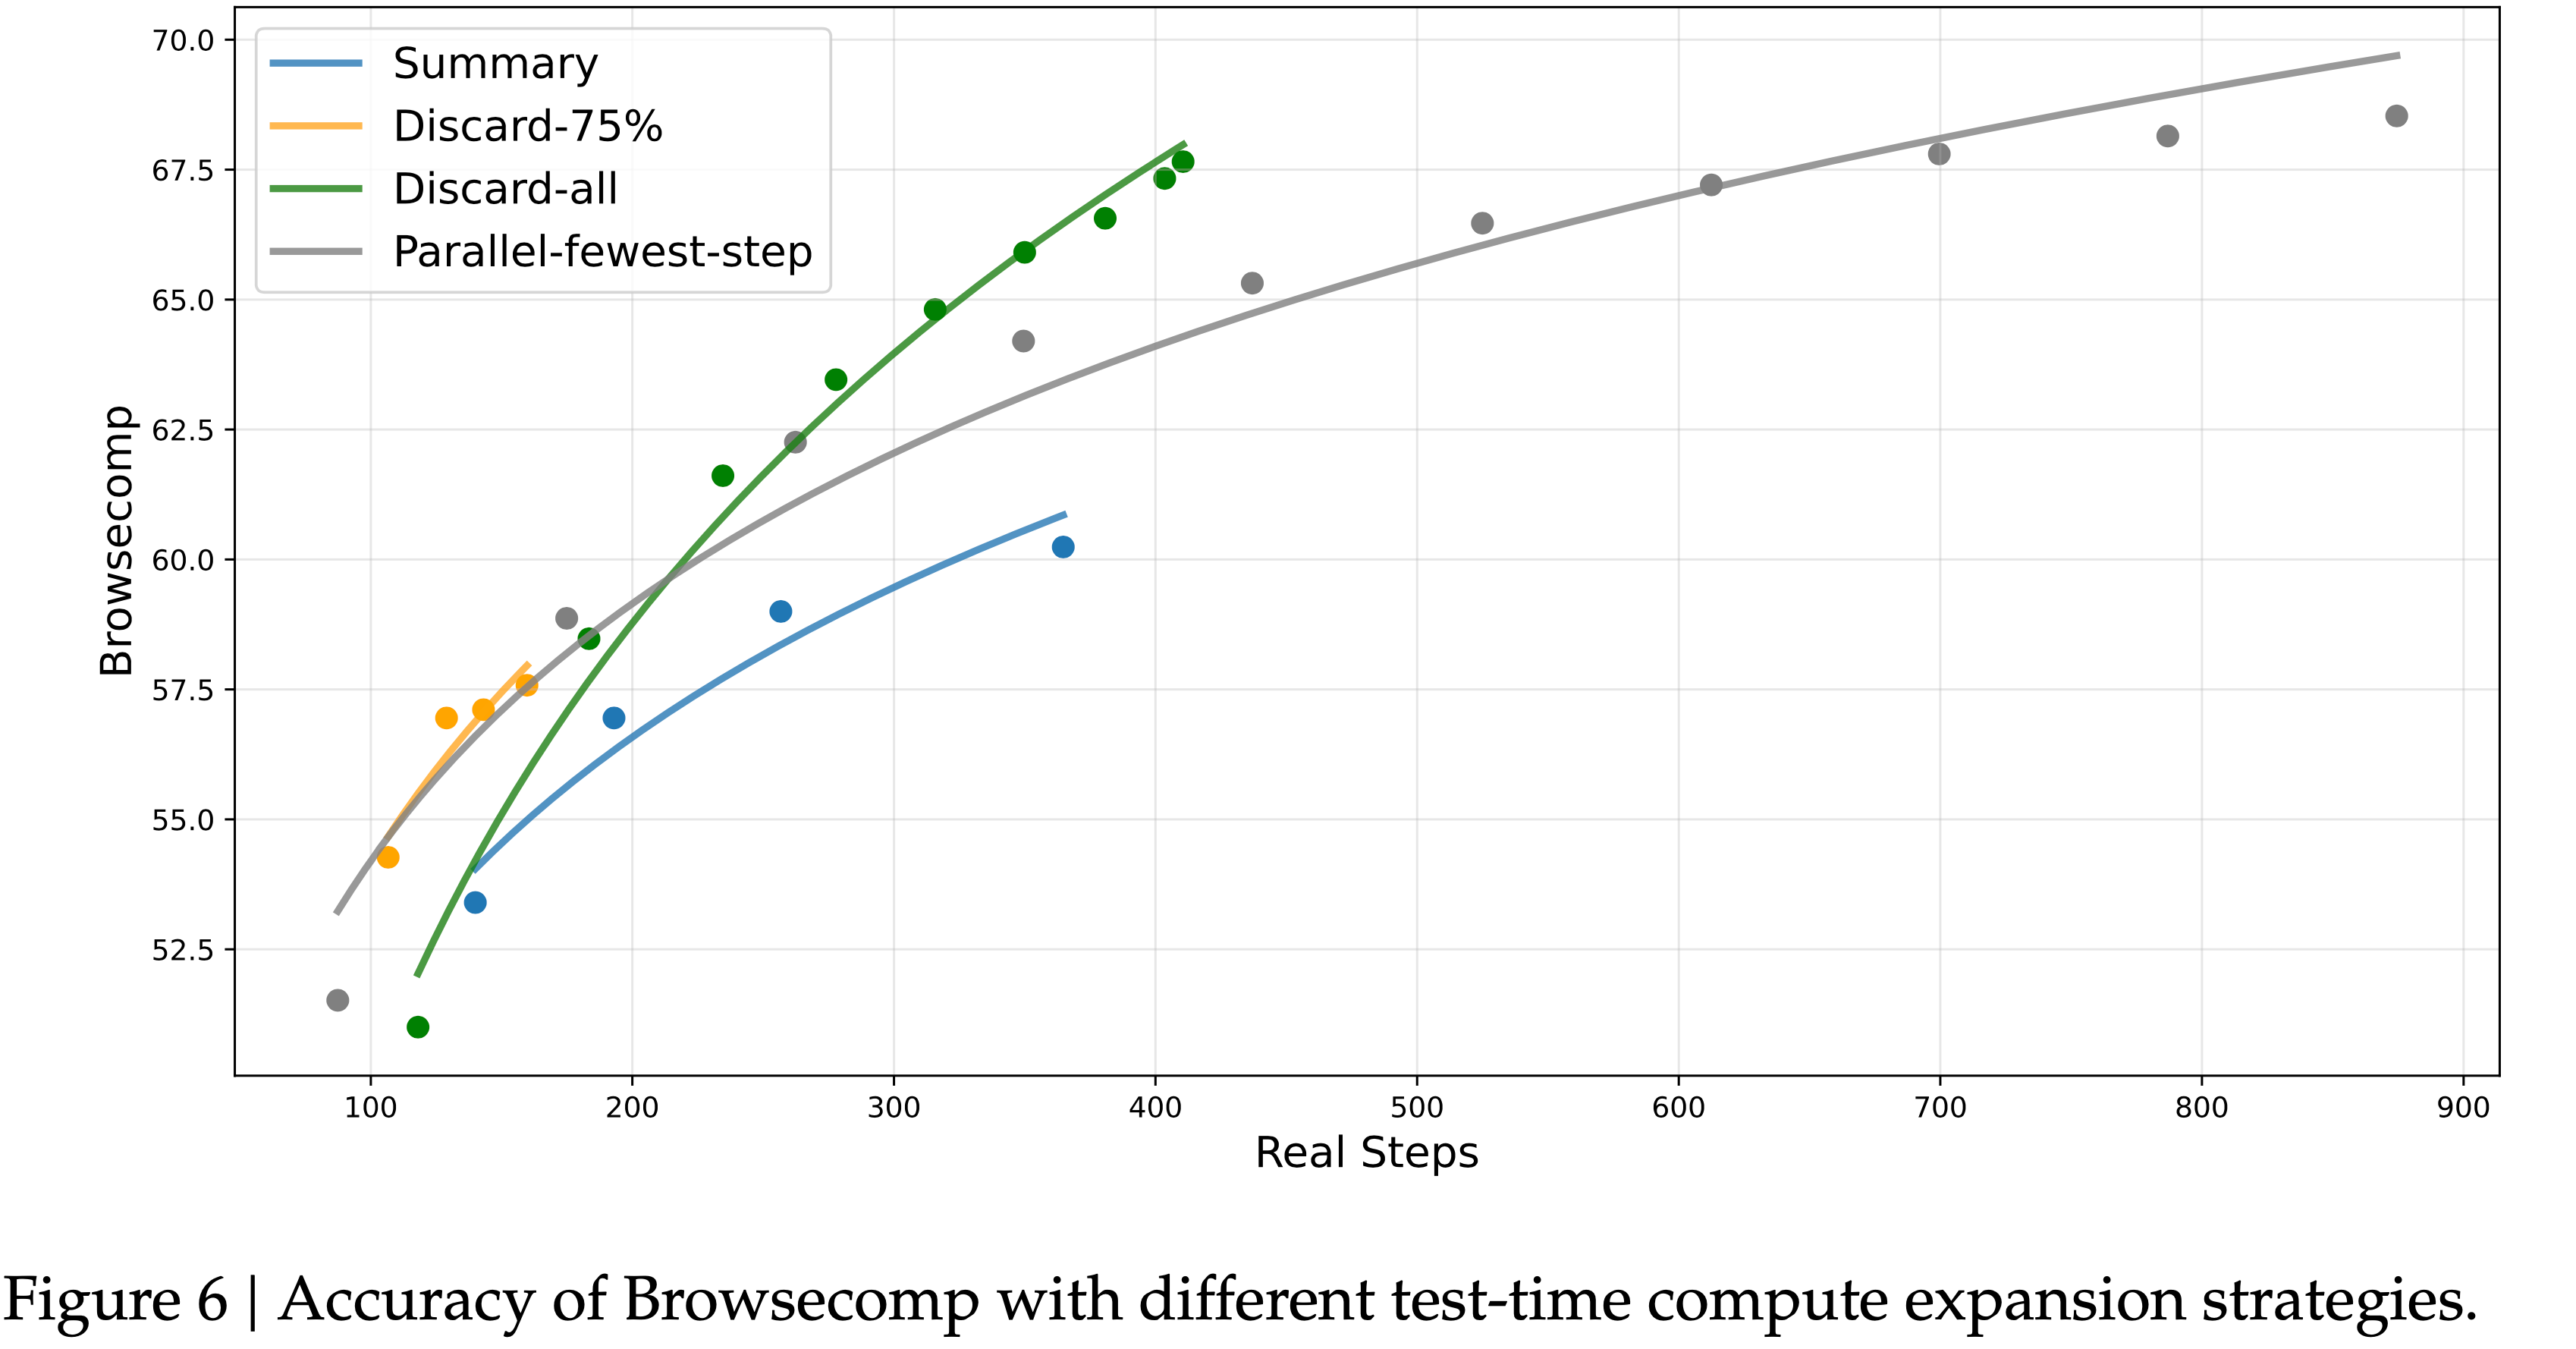
  • 为了解决这个问题,当 token 使用量超过上下文窗口长度的 80% 时,作者引入了上下文管理,采用简单的策略在测试时扩展 token 预算
  • 这些策略包括:
    • (1) 总结 (Summary) :总结溢出的轨迹并重新启动 rollout;
    • (2) 丢弃-75% (Discard-75%) :丢弃轨迹中前 75% 的工具调用历史以释放空间;
    • (3) 全部丢弃 (Discard-all) :通过丢弃之前所有工具调用历史来重置上下文(类似于新的上下文工具 Anthropic (2025a))
  • 为了比较,论文还实现了一个并行扩展基线:
    • 并行最少步骤 (Parallel-fewest-step) :采样 N 个独立的轨迹并选择步骤最少的轨迹
  • 论文在 BrowseComp 基准 (2025) 上评估这些策略
  • 如图 6 所示:
    • 在不同的计算预算下,上下文管理通过允许模型扩展测试时计算、提供更多空间来执行额外的执行步骤,从而带来显著的性能提升
    • Summary 将平均步骤从 140 扩展到 364,将性能从 53.4 提高到 60.2;但其整体效率相对较低
    • 尽管 Discard-all 很简单,但它在效率和可扩展性方面都表现良好,达到了 67.6 分,与并行扩展相当,同时使用的步骤显著更少
  • In summary:
    • 测试时计算可以通过上下文管理串行扩展,也可以并行扩展,两者都能有效扩展模型的问题解决能力
    • 但不同的策略表现出不同的效率和可扩展性
      • Thus,在对模型性能进行基准测试时,考虑实际的计算成本至关重要
      • Meanwhile,寻找串行和并行扩展的最佳组合以最大化效率和可扩展性,仍然是未来工作的一个关键方向

Conclusion, Limitation, and Future Work

  • 论文介绍了 DeepSeek-V3.2,有效弥合计算效率与高级推理能力之间差距
  • DeepSeek-V3.2 使用 DSA 解决了关键的计算复杂性,同时没有牺牲长上下文性能
  • (通过增加计算预算)DeepSeek-V3.2 在推理基准上实现了与 GPT-5 相当的性能
  • 论文的大规模智能体任务合成 Pipeline 的集成显著提高了工具使用熟练度,为具有开放 LLM 的鲁棒和可泛化的人工智能智能体开启了新的可能性
  • 高计算变体 DeepSeek-V3.2-Speciale,通过在 IMO 和 IOI 中获得的金牌成就得到了验证,为开放 LLM 树立了一个里程碑
  • 尽管取得了这些成就,与诸如 Gemini-3.0-Pro 这样的 frontier closed-source 模型相比,作者承认存在某些局限性
    • 第一:由于总训练 FLOPs 较少,DeepSeek-V3.2 的世界知识的广度仍然落后于领先的专有模型
      • 论文计划在未来的迭代中通过扩大预训练计算来解决这一知识差距
    • 第二:token 效率仍然是一个挑战;
      • DeepSeek-V3.2 通常需要更长的生成轨迹(即更多 token)来匹配像 Gemini-3.0-Pro 这样的模型的输出质量
      • 未来的工作将侧重于优化模型推理链的智能密度以提高效率
    • 第三,解决复杂任务的能力仍然不如前沿模型,作者将进一步改进论文的基础模型和后训练方案

附录 A: MLA 的 MHA 与 MQA 模式

  • 图 7:MLA 的 MHA 和 MQA 模式示意图
    • 对于 DeepSeek-V3.1-Terminus,训练和前填充时使用 MHA 模式,解码时使用 MQA 模式
    • 图 7 展示了 MLA 的两个方面(MHA 和 MQA 模式)以及它们之间的转换

附录 B:冷启动模板

  • 表 6: 推理数据系统 Prompt 示例。系统 Prompt 要求模型在 <think></think> 标签中输出推理过程
  • 表 7:[工具描述] 和 [工具调用格式] 将被替换为具体的工具和论文设计的工具调用格式
  • 表 8:模型在 Thinking 过程中执行工具调用

附录 C:non-thinking mode DeepSeek-V3.2 智能体能力评估

  • 表 9:DeepSeek-V3.2 非思考模式与思考模式对比
    • 表中的终端测试台分数使用 Claude Code 框架评估
    • 使用 Terminus 框架的非思考模式终端测试台 2.0 分数为 39.3
  • 非思考模式的性能略逊于思考模式,但仍然具有竞争力

附录 D:IOI、ICPC 世界总决赛、IMO 及 CMO 的评估方法

  • 对于所有竞赛:
    • 模型的最大生成长度设置为 128k
    • 不使用任何工具或互联网访问,测试严格遵守竞赛的时间和尝试限制
  • 对于 IOI 评估
    • 作者根据官方竞赛规则设计了提交策略,规则允许每道题最多提交 50 次,并根据在所有子任务中获得的最高分对每次提交进行评分
    • 具体来说:
      • 首先为每道题采样 500 个候选 Solution,然后应用一个多阶段过滤流程
      • 在初始阶段,剔除未能通过提供的样例测试用例或超出长度限制的无效提交
      • 随后,使用 DeepSeek-V3.2-Exp 模型来识别并剔除那些模型明确表示无法或拒绝解决问题的样本
      • 从剩余的有效候选方案中,论文选择具有最长 Thinking 轨迹的 50 个样本进行最终提交
  • 对于 ICPC 评估
    • 作者采用了相同的过滤方法,但初始采样规模较小
    • 论文为每道题生成 32 个候选 Solution ,并应用相同的过滤标准来选择提交
  • 在 IMO 和 CMO 任务中
    • 作者采用 generate-verify-refine 的循环
    • 模型迭代地改进其 Solution ,直到获得完美的自我评估或达到最大修订上限,此过程与 Shao 等人 (2025) 的方法相同

附录:Unbiased KL Estimate 的推导

  • 部分推导逻辑也可以参考博客:DeepSeek-V3.2中无偏 KL估计(Unbiased KL Estimate)的一些想法 - Keith Jiang的文章 - 知乎
  • 本节核心目标是说明为何 DeepSeek-V3.2 在策略梯度中将 KL 散度项乘以重要性权重(importance weight),从而实现对 KL 梯度的无偏估计
    • 注1:在绝对的 On-policy 的更新中,其实 \(\pi_\theta = \pi_{\theta_\text{old}}\),这个重要性权重值为 1,加不加都行
    • 注2:本节中主要是针对 Off-policy 更新的步骤中,需要对 GRPO 的 KL 散度添加重要性权重校准

Background :带 KL 约束的强化学习目标

  • 考虑 LLM 强化学习中的一般目标函数:
    $$
    J_{\text{RL} }(\theta; x) = \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ r(x, y) \right] - \beta \cdot D_{\mathrm{KL} }\left[ \pi_\theta(\cdot|x) \parallel \pi_{\theta_0}(\cdot|x) \right]
    $$
  • 其中:
    • \(x\) 是输入(如 prompt)
    • \(y = (y_1, \dots, y_T)\) 是模型生成的 token 序列
    • \(r(x, y)\) 是 reward
    • \(\pi_{\theta_0}\) 是参考策略(通常为初始策略或 SFT 模型)
    • \(\beta\) 是 KL 正则化系数

自回归模型下的 KL 散度展开

  • 由于语言模型是自回归的,有:
    $$
    \pi_\theta(y|x) = \prod_{t=1}^T \pi_\theta(y_t|x, y_{ < t})
    $$
  • 因此 KL 散度可写为:
    $$
    \begin{align}
    D_{\mathrm{KL} }[\pi_\theta(y|x) \parallel \pi_{\theta_0}(y|x)]
    &= \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ \sum_{t=1}^T \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] \\
    &= \sum_{t=1}^T \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right]
    \end{align}
    $$
    • 注:上式最后一步通过 交换期望与求和顺序 得到
  • 接下来我们先关注第 \(t\) 项
    • 注意到内部只依赖于 \(y_{\le t}\),而期望是对整个序列 \(y\) 的,所以可以利用全概率公式(联合概率密度分解成 \(< t\) 的部分和 \(t\) 本身),于是可以将期望分解为:
      $$
      \mathbb{E}_{y \sim \pi_\theta(\cdot|x)}\left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right]
      = \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ \mathbb{E}_{y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] \right]
      $$
    • 上面中括号里面的内容可以转换成 KL 散度的形式:
      $$
      \mathbb{E}_{y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] = D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big)
      $$
    • 于是第 \(t\) 项变为:
      $$
      \text{Term}_t = \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right]
      $$
  • 最终得到:
    $$
    \begin{align}
    D_{\mathrm{KL} }[\pi_\theta(y|x) \parallel \pi_{\theta_0}(y|x)]
    &= \sum_{t=1}^T \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right] \\
    &= \mathbb{E}_{y_{ < t} \sim \color{red}{\pi_\theta}(\cdot|x)} \left[ \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right]
    \end{align}
    $$
    • 注:上面最后一步是交换期望与求和顺序得到的

将 KL 项放入采样期望内(关键步骤)

  • 回顾原 RL 目标为:
    $$
    J_{\text{RL} }(\theta;x) = \mathbb{E}_{y\sim\pi_\theta}[r(x,y)] - \beta \cdot \mathbb{E}_{y\sim\pi_\theta} \left[ \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right]
    $$
    • 注:这里对 \( D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big)\) 求期望的做法已经在前面推导过
  • 将奖励和 KL 散度合并为单个期望得到最原始的 RL 目标应该是:
    $$
    J_{\text{RL} }(\theta;x) = \mathbb{E}_{y\sim\pi_\theta} \left[ r(x,y) - \beta \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right]
    $$
  • 在实际训练中(如 PPO、GRPO),我们无法直接从当前策略 \(\pi_\theta\) 采样(因为参数正在更新),而是从旧策略 \(\pi_{\theta_{\text{old} } }\) 采样轨迹 \(\{o_i\}_{i=1}^G\)
    • 此时,目标函数一般需通过重要性采样重写,对于任意函数 \(f(y)\),有重要性采样如下:
      $$
      \mathbb{E}_{y \sim \pi_\theta(\cdot|x)}[f(y)]
      = \mathbb{E}_{y \sim \pi_{\theta_{\text{old} } }(\cdot|x)} \left[ \frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} f(y) \right]
      $$
  • 现在用 \(\pi_{\theta_{\text{old} } }\) 采样,对 \(J_{\text{RL} }(\theta;x)\) 中的期望估计应用重要性采样有:
    $$
    \begin{align}
    J_{\text{RL} }(\theta;x)
    &= \mathbb{E}_{y\sim\pi_{\theta_{\text{old} } } } \left[ \frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} \left( r(x,y) - \beta \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right) \right]
    \end{align}
    $$
    • 特别注意:这里的 KL 本身依赖于 \(\pi_\theta\)(这一点容易遗忘),重要性权重也依赖 \(\pi_\theta\)
    • 这一步在这里看起来推导很顺利,但是其实非常关键,这里直接回答了之前的一些问题,有了这一步之后,如博客 The critical implementation detail of KL loss in GRPO, Hongyu Zang 中提出的问题就不存在了
  • 至此,可以看出:
    • 当 \(y \sim \pi_{\theta_\text{old}}\) 采样时,重要性权重需要同时对奖励 \(r(x,y)\) 和 KL 散度 \(\sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big)\) 进行修正才对
    • 注:之前的实现一般仅对奖励使用重要性权重修正, 而忽略了 KL 散度

Token-level 分别加权的讨论

  • 上述的结果还是按照序列粒度评估的,实际上单独考虑 KL 散度时(不考虑奖励时),其实可以按照 Token-level 来考量
  • 对自回归模型,重要性权重可分解为 token-level 的形式:
    $$
    \frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} = \prod_{t=1}^T \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_{\text{old} } }(y_t|x, y_{ < t})}
    $$
    • 注意:这里是序列级别加权的,即整个序列看成是一个整体,即 期望里面的 KL 散度先算出来,再统一乘以外面的 Sequence-level 重要性权重
  • 在 RLHF 中, PPO/GRPO 实践时,常采用 token-level importance weight,即 每一步单独加权(而非整句相同重要性权重)
    • 注:数学上,其实这里的 Token-level 重要性权重本是不能拆开的,必须乘起来才能做到在数学上等价于序列级别的奖励和 KL 整体目标
    • 这种从 Sequence-level 到 Token-level 的转换,是为了降低方差,同时 Token-level 的方式可以看做 Sequence-level 重要性采样的一阶近似,更多讨论见论文和本人其他讨论博客:(GSPO)Group Sequence Policy Optimization, 20250728, Qwen(本人解读博客:NLP——LLM对齐微调-GSPO) 和 (MiniRL)Stabilizing Reinforcement Learning with LLMs: Formulation and Practices, 20251201, Qwen(本人解读博客:NLP——LLM对齐微调-MiniRL

补充分析:k3 估计下的 Token-Level 无偏 KL 估计(DeepSeek-V3.2 的做法)

  • 跟上述讨论一样,DeepSeek-V3.2 将 KL 项按照 token 分解,并对每个 token 的 KL 分别使用对应的重要性权重
  • 回忆 k3 估计(一种 KL 的无偏估计器):
    $$
    \begin{align}
    D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }] &\approx \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - 1 \\
    &= \text{k3}
    \end{align}
    $$
    • 补充 k3 本身的性质:对以上 k3 估计求 \(a \sim \pi_\theta\) 下的期望,满足
      $$ \mathbb{E}_{a \sim \pi_\theta}[\text{k3}] = D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }]$$
  • 但在 GRPO 中,样本是从 \(\pi_{\theta_{\text{old} } }\) 采的,所以要估计(使用重要性采样):
    $$
    \mathbb{E}_{a \sim \pi_\theta} [\text{k3}] = \mathbb{E}_{a \sim \pi_{\theta_{\text{old} } } } \left[ \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \text{k3} \right]
    $$
    • 注:若直接用 \(\pi_{\theta_{\text{old} } }\) 采样而不加权,则估计有偏;
  • 真正的无偏估计应为:
    $$
    \begin{align}
    \widehat{D}_{\mathrm{KL} }^{\text{unbiased} }
    &= \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \left( \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - 1 \right) \\
    &= \frac{\pi_{\text{ref} }(a)}{\pi_{\theta_{\text{old} } }(a)} - \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)}
    \end{align}
    $$
  • DeepSeek 论文中公式与上面等价(DeepSeek 中直接使用了 Token-level 的加权形式),其形式保留原始 k3 形式并乘以重要性权重:
    $$
    D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }]
    \approx \frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})} \left(\frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - \log \frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - 1 \right)
    $$
    • 这就是 DeepSeek-V3.2 文章中提到的 Unbiased KL Estimate
    • 这里的约等于应该是有两层含义:
      • k3 估计是无偏的,但是仍然是一种估计,而不是等于
      • Sequence-level 重要性加权 KL 到 Token-level 重要性加权 KL 的近似
个人思考:无偏性反向证明
  • 上面是正向推导形式,为了方便理解,我们其实也可以反向证明无偏性
  • 记重要性权重为:
    $$
    r_{i,t} = \frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})}
    $$
  • 则有:
    $$
    \mathcal{L}_{\text{KL} }^{\text{unbiased} }
    = r_{i,t} \left( \frac{\pi_{\text{ref} } }{\pi_\theta} - \log \frac{\pi_{\text{ref} } }{\pi_\theta} - 1 \right)
    $$
  • 其期望满足(下面第一步的转换是将期望概率乘进去消掉重要性权重的分母,然后将分子作为概率提出来作为期望):
    $$
    \begin{align}
    \mathbb{E}_{o_{i,t} \sim \pi_{\theta_{\text{old} } } } \left[ \mathcal{L}_{\text{KL} }^{\text{unbiased} } \right]
    &= \mathbb{E}_{o_{i,t} \sim \pi_\theta} \left[ \frac{\pi_{\text{ref} } }{\pi_\theta} - \log \frac{\pi_{\text{ref} } }{\pi_\theta} - 1 \right] \\
    &= \mathbb{E}_{o_{i,t} \sim \pi_\theta} \left[ \text{k3} \right] \\
    &= D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }] \\
    \end{align}
    $$
    • 因此,DeepSeek-V3.2 文章中提到的 Unbiased KL Estimate 估计形式是无偏的

一些思考

  • DeepSeek-V3.2 的 Unbiased KL Estimate 的核心思想是:
    • 将 KL 散度项视为 reward 的一部分,并对其应用与 policy gradient 相同的重要性采样权重,从而保证 KL 梯度的无偏性
  • 最终,在 GRPO 目标函数中,KL 项变为:
    $$
    -\beta \cdot \frac{1}{G} \sum_{i=1}^G \frac{1}{ o_i } \sum_{t=1}^{ o_i }
    \underbrace{\color{red}{\frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})}} \left(\frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - \log \frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - 1\right)}_{\text{Unbiased KL Estimate} }
    $$
    • 注:这里新添加的 \(\color{red}{\frac{\pi_\theta(o_{i,t} | q, o_{i,< t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,< t})}}\) 本身就是 PPO 重要性采样的 ratio,所以这里计算时可以复用这个系数 ratio
    • 这使得整个目标函数的梯度在使用旧策略采样时仍保持对真实 KL 的无偏估计,提升了训练稳定性与效果
    • 注:再次强调,在绝对的 On-policy 的更新中,其实 \(\pi_\theta = \pi_{\theta_\text{old}}\),这个重要性权重可以忽略,类似说明其他博客也有提到
    • 这种做法比之前的一些丢弃 KL 散度的方法更好,但是否比改变形式的方法更好?
  • 理解:其实除了 k3 外,如果使用 k2 也会出现类似的问题,也需要类似修正
  • 其他补充:其实之前的博客也讨论过类似的问题:The critical implementation detail of KL loss in GRPO, Hongyu Zang
    • 博客中还提出了一些解决方案,其中一个方案(方案三)就跟 DeepSeek-V3.2 的方案思想类似
      • 博客中的方案三也是对 KL 散度使用 \(\frac{\pi_{\theta}}{\pi_{\theta_\text{old}}}\) 来进行修正
      • 但博客中提到的方案三是直接将 KL 添加到 Reward 中(类似传统 RLHF 中的做法一样),而 DeepSeek-V3.2 的 Unbiased KL Estimate 仍然是独立的一个 KL Loss
      • 博客相当于 DeepSeek-V3.2 工作的一半,提出了本文前面 “将 KL 项放入采样期望内” 的这一步,没有进一步推导回到独立的 KL Loss
      • 特别说明:如果进一步推导可以发现,在 GRPO 中,使用 kl in reward 是不合适的,因为这会导致 kl(本身的方差就大)会影响真实的 ORM 信号,比如因为正确样本中某个 Token 的 kl 过大,而打压正确样本,这个可能不是我们想要的(最好是整体样本鼓励,但打压某个 kl 较大的 Token 会更合适)

附录:LLM RL 训练中 top-p 导致的训推不一致修复讨论

  • top-k/top-p 采样在 RL 训练中虽能提升生成质量、避免采样到极低概率 token,但会导致旧策略与新策略的动作空间不一致,违反了重要性采样的基本原则,从而引发训练不稳定

实际 serving top-p=0.95 的场景下各种分布定义

  • 设温度缩放后的完整 softmax 分布为:
    $$
    \begin{align}
    \pi_\theta(a\mid h) &= \pi_\theta(\cdot\mid h)_a \\
    &=\text{softmax}(z_\theta(h)/T)_a \\
    &=\frac{ \exp(z_\theta(h,a)/T) }{ \sum_{v\in V} \exp(z_\theta(h,v)/T)}
    \end{align}
    $$
    • \(\theta\) 表示模型参数
    • \(h\) 表示当前上下文(前缀)
    • \(T\):温度参数
    • \(z_\theta(h)\):模型在给定上下文 \(h\) 下,对下一个 token 输出的未归一化 logits 向量
      • \(z_\theta(h)\) 是一个向量,每个分量对应词表中的一个 token,维度等于词表大小 \(|V|\), 可以写成:
        $$
        z_\theta(h)\in\mathbb R^{|V|}
        $$
    • \(z_\theta(h,a)\) 表示 logits 向量 \(z_\theta(h)\) 中,token \(a\) 对应的那个标量 logit 值
    • \(_a\) 表示取这个概率向量中 对应 token \(a\) 的那个分量
    • \(V\) 是整个词表
  • top-p=0.95 保留集合为 \(S_\theta(h)\)(在 LLM 中,也将 top-p 时生效的集合称为核,英文名为 nucleus),则保留概率质量为:
    $$
    Z_\theta(h)=\sum_{a\in S_\theta(h)}\pi_\theta(a\mid h)
    $$
  • top-p=0.95 下的实际 serving 采样分布为:
    $$
    q_\theta(a\mid h)
    =\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
    $$

serving top-p=0.95 的场景,仅将 rollout 的 top-p 从 1.0 改为 0.95 会发生什么

  • 设定:对于 serving top-p=0.95 的场景

  • 若仅修改 rollout 的 top-p 为 0.95,而其他部分保持不变,会产生许多不一致性

  • 结论:只把 rollout 的 top-p 从 1 改成 0.95,其他地方都不动,不一定会立刻训崩,但这是明确的“有偏训练”,不是正确对齐

    • 短期小规模实验可能看起来正常
    • 长期或大规模训练有很大风险,不建议用
  • PPO ratio 也会错位,当前实际 ratio 是:
    $$
    r_t=\frac{\pi_{\text{new} }(a_t\mid h_t)}{\pi_{\text{old} }(a_t\mid h_t)}
    $$

  • 因为数据来自 \(q_{\text{old} }\),要正确做 off-policy 修正,至少应该包含 \(q_{\text{old} }\),例如目标为 \(\pi\) 时需要类似:
    $$
    \frac{\pi_{\text{new} }(a_t\mid h_t)}{q_{\text{old} }(a_t\mid h_t)}
    $$

  • 如果目标就是 serving 的 \(q\),则应该直接对 \(q\) 求梯度,而不是对 \(\pi\) 求梯度

不一致分析 1:轨迹采样与 actor 更新的错位(天然就需要 IS 修正)
  • 轨迹样本来自 \(q_{\text{rollout} }\)(这是经过 top-p 生效的分布),实际 rollout 采样分布 与 线上 serving 分布对齐,在不考虑其他硬件和引擎误差的情况下,有:
    $$
    q_{\text{rollout} } = q_\theta(a\mid h)
    =\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
    $$
  • actor 更新仍然用完整词表上的 \(\log \pi_\theta(a_t\mid h_t)\) 计算 logprob 并反向传播(不是 \(\log q_\theta(a_t\mid h_t)\))
    • 也就是说真实被优化的 actor 的目标分布仍是完整分布 \(\pi_\theta\),而不是经过 top-p 修正的 实际 \(q_\theta\)
  • 问题:这会天然导致采样分布 old 策略分布之间有一个误差,需要经过 off-policy IS 修正(且因为支撑集缺失,这本质是不可能从IS 来完整修复的)
不一致分析 2:现有 IS 修正看不到 top-p 截断差异(来自框架的问题)
  • 注:这发生在 VeRL 的官方实现中,也存在于一般的推理框架中(返回的概率是 top-p 剩下前的概率而不是生效后重新归一化的真实采样概率)
  • 采样使用了 top-p=0.95 后,Megatron actor 也仍然按完整分布 \(\pi_\theta\) 算 logprob,于是:
    • 1)行为策略是 \(q_{\text{old} }\)
    • 2)训练侧 old/current 概率是 \(\pi_{\text{old} }\)、\(\pi_{\text{new} }\)
    • 3)TIS rollout correction 里的 IS 权重近似是类似:
      $$
      w_t=frac{\pi_{\text{old} }(a_t\mid h_t)}{\pi_{\text{rollout} }(a_t\mid h_t)}
      $$
      • 但当前 VeRL 中,这里的 \(\pi_{\text{rollout} }\) 记录的仍是截断前的 \(\pi\)(未经过 top-p 修正的原始概率分布),不是实际采样概率 \(q\)
      • 它看不到 top-p 截断带来的分布差异 ,也不会自动修正,即使看到 rollout_corr/kl 接近零,也不能证明 top-p 下训推一致
      • 分母是 \(\pi_{\text{rollout} }\)(未经过 top-p 修正的原始概率分布),不是实际采样概率 \(q_{\text{rollout} }\)
        • 从 IS 的定义可以知道,只有在分母为 实际采样概率 \(q_{\text{rollout} }\) 时才能倍准确修正
  • 若针对当前的配置使用 Token-level TIS(假设上界为 2),则 rollout correction 实际计算的是:
    $$
    w_t=\min\left(2,\frac{\pi_{\text{old} }(a_t\mid h_t)}{\pi_{\text{rollout} }(a_t\mid h_t)}\right)
    $$
  • top-p 导致的分布差异 没有进入 IS 权重 ,也没有进入任何指标
    • 即使 rollout_corr/kl 接近零,也只能说明截断前的 \(\pi\) 很接近,不能说明实际采样分布 \(q\) 与 actor 训练分布一致
不一致分析 3:梯度层面的缺失(优化目标不一致)
  • 我们的优化目标应该是基于 serving 截断分布目标,这样才能跟线上 serving 策略对齐:
    $$
    J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
    $$
  • 其中 \(q_\theta\) 分布为:
    $$
    q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
    $$
  • 若仅针对支撑集上的 Token 来看 有:
    $$
    q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)}{Z_\theta(h)}
    $$
  • 仅针对支撑集上的 Token 来看 ,对 serving 分布 \(q_\theta\) 求对数概率:
    $$\log q_\theta(a\mid h)=\log \pi_\theta(a\mid h)-\log Z_\theta(h)$$
  • 因此 仅针对支撑集上的 Token 来看 正确梯度是:
    $$\nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)$$
  • 问题总结:
    • 即使仅考虑 仅针对支撑集上的 Token 来看 ,当前 actor 也只计算了 \(\nabla_\theta \log \pi_\theta(a\mid h)\),缺少 \(-\nabla_\theta \log Z_\theta(h)\)
    • 并且 \(Z_\theta(h)\) 必须参与反向传播:不能把保存下来的 \(\log Z\) 当常量减掉,那样只修正了概率数值,没有补上缺失的梯度
不一致分析 4:支持集问题
  • 回顾重要性采样公式为:
    $$
    \mathbb E_{\color{blue}{a\sim \pi}}[f(a)]=\mathbb E_{\color{red}{a\sim q}}\left[\frac{\pi(a)}{q(a)} f(a)\right]
    $$
  • 但它有一个前提条件:目标分布 \(\pi\) 必须绝对连续于行为分布 \(q\),即:
    $$
    \pi(a)>0 \quad \Rightarrow \quad q(a)>0
    $$
  • 如果存在某个动作 \(a\) 满足 \(\pi(a)>0\) 且 \(q(a)=0\),则 \(\frac{\pi(a)}{q(a)}\) 没有定义,且该动作永远不会被 \(q\) 采样到,样本中根本没有这个动作
    • 理解:重要性采样的公式没有错,但是由于行为策略采样到这个动作的概率为 0,导致 IS 比值为无穷大,无穷大是没有意义的
  • 因此重要性采样无法等于
    $$\mathbb E_{\color{blue}{a\sim \pi}}[f(a)]$$
    • 重要性采样只能在保留集合内重加权:
      $$
      \mathbb E_{\color{red}{a\sim q}}\left[\frac{\pi(a)}{q(a)}f(a)\right]=\sum_{\color{red}{a\in S}}\pi(a)f(a)
      $$
    • 它无法恢复 \(\sum_{a\notin S}\pi(a)f(a)\),即尾部贡献缺失
  • top-p 截断正是这种情况:完整分布 \(\pi_\theta\) 在整个词表上都有正概率,但 rollout 截断分布 \(q_\theta\) 只在 \(S_\theta(h)\) 内为正:
    • 对于被截掉的尾部动作 \(a\notin S_\theta(h)\),有 \(q_\theta(a\mid h)=0\) 但 \(\pi_\theta(a\mid h)>0\)
    • 即使在保留集合上使用正确的重要性权重,也只能得到 \(\sum_{a\in S}\pi(a)f(a)\),尾部贡献 \(\sum_{a\notin S}\pi(a)f(a)\) 仍然缺失
    • 如果试图从 \(q_\theta\) 采样却想恢复完整分布 \(\pi_\theta\) 的目标 \(J_\pi\),尾部动作永远采不到
不一致分析总结
  • 若只修改 Rollout 的 top-p=0.95,那么当前的优化目标既不是 \(J_\pi\) 也不是 \(J_q\)
    • 基于完整分布的目标 \(J_\pi\) 是:
      $$
      J_\pi(\theta)=\mathbb E_{\tau\sim\pi_\theta}[R(\tau)]
      $$
    • 基于 serving 截断分布目标 \(J_q\) 是:
      $$
      J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
      $$
    • 只改 rollout top-p=0.95 时的目标:
      • 不是 \(J_\pi\) 的严格无偏梯度
        • 样本来自 \(q\) 而非 \(\pi\)
        • Rollout 返回的概率是 top-p 生效前的 \(\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]\),无法被 当前的 IS 准确修正
        • 即使返回了 top-p 生效后的概率,支撑集也存在问题,没法被 IS 方式修正
      • 不是 \(J_q\) 的严格无偏梯度:
        • actor 没有对 \(q_\theta\) 求梯度,缺少 \(-\nabla_\theta \log Z_\theta\) 这一项,所以也不是 \(J_q\) 的严格无偏梯度
  • 进一步理解:只改 rollout top-p=0.95 后的目标是一个 “混合目标” 的有偏近似
    • 只改 rollout top-p=0.95 后的更新期望大致是:
      $$
      \mathbb E_{\color{red}{a\sim q}}\left[A(h,a)\nabla_\theta \log \pi_\theta(a\mid h)\right]
      $$
    • 但我们可能想要的是:
      $$
      \mathbb E_{\color{blue}{a\sim \pi}}\left[A(h,a)\nabla_\theta \log \pi_\theta(a\mid h)\right]
      $$
    • 或者:
      $$
      \mathbb E_{\color{red}{a\sim q}}\left[A(h,a)\nabla_\theta \log q_\theta(a\mid h)\right]
      $$
    • 这三个不是一回事

补充:如果 rollout 同时返回 top-p 后的真实分布会怎样?

  • 只让 SGLang 返回 top-p 实际采样分布 \(q\) 的 logprob,其他都不改,仍然不是正确对齐
  • 这一步主要修正了 rollout correction 的分母,但 actor 侧仍然在对完整分布 \(\pi\) 求梯度
  • 问题一:训练目标 \(\pi\) 跟 serving 目标 \(q\) 仍然没有对齐
    • 我们真正想要的是对 serving 策略 \(q\) 求梯度:
      $$
      \nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)
      $$
    • 但 actor 侧没有改,仍然只计算:
      $$
      \nabla_\theta \log \pi_\theta(a\mid h)
      $$
    • 它缺少第二项:
      $$
      -\nabla_\theta \log Z_\theta(h)
      $$
    • 即使 SGLang 返回了正确的 \(\log q\),actor 的梯度目标仍然是 \(\pi\),不是 \(q\)
  • 问题二:即使是想要使用 \(J_\pi\) 作为目标,支持集的缺失也会导致无法用 \(q\) 的采样分布来修正分布 \(\pi\)
    • 这在保留集合 \(S\) 内,确实是正确的从 \(q_{\text{old} }\) 到 \(\pi_{\text{new} }\) 的重要性权重
    • 所以 对于 \(S\) 内的样本 Token ,这一步修正是对的,但是无法对支持集外的 Token 分布进行修正
  • 总结:如果 rollout 同时返回 top-p 后的真实分布,优化的目标仍然是个混合目标(四不像)
    • 对完整 \(\pi\) 目标:\(S\) 内修正正确,尾部缺失
    • 对 serving \(q\) 目标:仍然缺少 top-p 归一化项的梯度

DeepSeek-V3.2 的解决方案

  • DeepSeek-V3.2 使用 Keep Sampling Mask 策略来解决这个问题,但是目标策略变成了一个混合策略
Keep Sampling Mask
  • DeepSeek-V3.2 的解决方案是:在从 \(\pi_{\text{old} }\) 采样时保留由 top-p/top-k 截断产生的掩码,并在训练过程中将该掩码应用于 \(\pi_\theta\),确保两个策略共享完全相同的动作子空间
  • 设 rollout 时的旧策略参数为 \(\theta_{\text{old} }\),其 top-p 保留集合为:
    $$
    S_{\text{old} }(h)=S_{\theta_{\text{old} } }(h)
    $$
  • Keep Sampling Mask 的做法是:训练时不再重新计算当前策略的 top-p 集合 \(S_\theta(h)\),沿用 rollout 时的集合 \(S_{\text{old} }\),只在这个集合内重新归一化:
    $$
    \tilde q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_{\text{old} }(h)]}{\sum_{v\in S_{\text{old} }(h)}\pi_\theta(v\mid h)}
    $$
  • 这样支持集固定,重要性采样可行:
    $$
    \frac{\tilde q_\theta(a\mid h)}{q_{\text{old} }(a\mid h)}
    $$
  • 注意:此时也不能实现最准确的 优化目标 \(J_q\) ,因为强行将支持集固定为 Rollout 时的 top-p 集合后,后续的目标策略已经不是当前真实的目标策略了,本质是一个混合策略(类似 R2 或者 R3 的实现带来的后果)
    • 当然,Pure On-policy 下,且不考虑不同引擎带来的不一致性(认为不同引擎的 top-p 集合是一致的),则这种做法是能准确实现 优化目标 \(J_q\) 的
  • 注:在 DeepSeek-V3.2 的 TR 中指出,将 top-p 采样与 Keep Sampling Mask 策略相结合,能够在 RL 训练过程中有效保持语言一致性
  • 注意:论文中没有明确指出,但是在一次 Rollout 多次 gradient update 的场景中,Keep Sampling Mask 应该是用于同时保证三个策略 \(\mu, \pi_\text{old}, \pi_\theta\) 的支持集相同,都是 Rollout 时的支持集

补充:数学上无偏解决 top-p 训推不一致的方法(个人思考,暂时只是粗糙想法)

  • 终极目标:如果最终 serving 固定 top-p=0.95,直接优化 \(J_q\) 才是最直接的目标对齐
方法 A:Pure On-policy,且不考虑训推引擎差异,直接对目标策略求导(仅特定情况下可用)
  • 直接优化 \(J_q\) 时 ,此时的的动作空间就是 top-p 截断后的 动作空间 集合(支持集,即 top-p 的核分布动作空间)
  • Pure On-policy,不考虑训推引擎差异,于是有 行为策略和训练策略的 动作空间 集合一致
    • 注:必须要满足 动作空间 集合在 \(q_\text{rollout}, \pi_\text{old}, \pi_\theta\) 策略下 完全一致才行
      • 若 动作空间 集合不一致的话, IS 是无法准确修正 支撑集不一致的分布的
  • 于是,在 动作空间 集合不发生变化的局部区域内,优化的准确分布为:
    $$ q_\theta(a\mid h) = \frac{\pi_\theta(a\mid h)}{Z_\theta(h)} $$
    • 直接对这个分布求梯度为:
      $$
      \nabla_\theta\log q_\theta(a\mid h)=\nabla_\theta\log\pi_\theta(a\mid h)-\nabla_\theta\log Z_\theta(h)
      $$
  • 采样使用上诉分布,即令:
    $$ q_\text{rollout} = q_\theta(a\mid h) $$
  • 在基于 \(q_\text{rollout}\) 采样到的样本 \(B\) 上,不考虑训练和推理引擎带来的不一致 的情况下,针对 \(J_q\) 目标的一个无偏的 on-policy 梯度估计是 :
    $$
    \hat g=\frac1B\sum_{i=1}^{B}\sum_t\bigl(R_i-b(h_{i,t})\bigr)\nabla_\theta\log q_\theta(a_{i,t}\mid h_{i,t})
    $$
    • 这个无偏梯度就是直接针对 top-p 后的分布 \(q_\theta\) 求导得到的
方法 B:Pure On-policy,独立辅助 token 无偏估计归一化梯度(称为 Aux-Token 法)
  • 如果 serving 固定用 top-p=0.95,那么真正部署的分布是:
    $$
    q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
    $$
    • 其中:
      $$
      \begin{align}
      \pi_\theta(a\mid h)&=\text{softmax}(z_\theta(h)/T)_a \\
      Z_\theta(h)&=\sum_{a\in S_\theta(h)}\pi_\theta(a\mid h)
      \end{align}
      $$
      • \(S_\theta(h)\) 是 top-p 保留集合,也就是 nucleus
  • 我们的终极目标是想优化:
    $$
    J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
    $$
  • 根据策略梯度定理,最终的梯度表达式为下面的形式(详情见:RL——策略梯度法推导):
    $$
    \nabla_\theta J_q(\theta)=\mathbb E_{\tau\sim q_\theta}
    \left[R(\tau)\sum_t\nabla_\theta \log q_\theta(a_t\mid h_t)\right]
    $$
    • 注:如果加上 baseline,就是 advantage 乘上 \(\nabla_\theta \log q_\theta\):
      $$
      \nabla_\theta J_q(\theta)=\mathbb E_{\tau\sim q_\theta}\left[\sum_tA(h_t,a_t)\nabla_\theta \log q_\theta(a_t\mid h_t)\right]
      $$
  • 根据上面的推导,梯度 \(\nabla_\theta \log q_\theta(a_t\mid h_t)\) 部分等于:
    $$
    \nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)
    $$
    • 注:第二项 \(-\nabla_\theta \log Z_\theta(h)\) 本质是一个期望,\(Z_\theta(h)\) 依赖动态的 动作空间 集合
      $$
      \nabla_\theta \log Z_\theta(h)=\mathbb E_{u\sim q_\theta(\cdot\mid h)}\left[\nabla_\theta \log \pi_\theta(u\mid h)\right]
      $$
    • 从期望的定义可以知道,我们可以得到:
      • 1)从当前的 top-p 分布 \(q_\theta(\cdot\mid h)\) 里随机抽一个 token \(u\)
      • 2)算 \(\nabla_\theta \log \pi_\theta(u\mid h)\)
      • 3)1 和 2 抽很多次取平均,就得到 \(\nabla_\theta \log Z_\theta(h)\)
      • 在接受单个样本替代期望造成的方差时,可以用一次采样替代
  • 在每个真实生成位置 \(t\),已经有真实动作:
    $$
    a_t\sim q_\theta(\cdot\mid h_t)
    $$
  • 额外采样动作(核心):如果额外再从同一个 top-p 分布独立抽一个辅助 token:
    $$
    u_t\sim q_\theta(\cdot\mid h_t)
    $$
    • 要求:
      • \(u_t\) 与 \(a_t\) 在给定 \(h_t\) 下独立
      • \(u_t\) 不进入上下文
      • \(u_t\) 不执行工具
      • \(u_t\) 不参与奖励
      • \(u_t\) 只用来构造梯度估计
  • 定义单步估计量:
    $$
    \hat s_t=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log \pi_\theta(u_t\mid h_t)
    $$
  • 它的条件期望是:
    $$
    \mathbb E_{u_t \sim q_\theta(\cdot\mid h_t)}\left[\hat s_t\mid h_t,a_t\right]=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\mathbb E_{u_t}\left[\nabla_\theta \log \pi_\theta(u_t\mid h_t)\right]
    $$
    • 注意:因为 \(u_t, a_t\) 是相互独立的,所以这里第一项的期望就是他自身 \(\nabla_\theta \log \pi_\theta(a_t\mid h_t)\)
  • 由于:
    $$
    \mathbb E_{u_t}\left[\nabla_\theta \log \pi_\theta(u_t\mid h_t)\right]=\nabla_\theta \log Z_\theta(h_t)
    $$
  • 所以:
    $$
    \mathbb E_{u_t}[\hat s_t\mid h_t,a_t]=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log Z_\theta(h_t)=\nabla_\theta \log q_\theta(a_t\mid h_t)
    $$
    • 固定真实动作 \(a_t\),只对辅助 token \(u_t\) 求期望,\(\hat s_t\) 正好等于我们想要的 top-p 梯度
  • 注意:进一步来看,还可以进一步将 \(\hat s_t\) 化简为 logits 差分的形式,即
    $$
    \begin{align}
    \hat s_t&=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log \pi_\theta(u_t\mid h_t) \\
    &=\frac{1}{T}\nabla_\theta\left[z_\theta(h_t,a_t)-z_\theta(h_t,u_t)\right]
    \end{align}
    $$
    • 证明:其中全词表 softmax 的归一化项 \(\nabla_\theta \Omega_\theta(h_t)\) 在相减时抵消,所以最终只剩下两个 logits 的差分
      • 根据 \(\pi_\theta(a\mid h)\) 中 softmax 的定义有:
        $$
        \log \pi_\theta(a\mid h) = \frac{z_\theta(h,a)}{T} - \Omega_\theta(h)
        $$
        • 其中:
          $$ \Omega_\theta(h)=\log\sum_{v\in V}\exp\left(\frac{z_\theta(h,v)}{T}\right) $$
      • 于是有:
        $$
        \begin{align}
        \hat s_t
        &= \nabla_\theta \log \pi_\theta(a_t\mid h_t)- \nabla_\theta \log \pi_\theta(u_t\mid h_t) \\
        &= \left(\frac{1}{T}\nabla_\theta z_\theta(h_t,a_t)-\nabla_\theta \Omega_\theta(h_t)\right)-\left(\frac{1}{T}\nabla_\theta z_\theta(h_t,u_t)-\nabla_\theta \Omega_\theta(h_t)\right) \\
        &= \frac{1}{T}\nabla_\theta z_\theta(h_t,a_t)- \nabla_\theta \Omega_\theta(h_t)- \frac{1}{T}\nabla_\theta z_\theta(h_t,u_t)+ \nabla_\theta \Omega_\theta(h_t)\\
        &= \frac{1}{T}\nabla_\theta z_\theta(h_t,a_t) - \frac{1}{T}\nabla_\theta z_\theta(h_t,u_t) \\
        &= \frac{1}{T}\nabla_\theta\left[z_\theta(h_t,a_t)-z_\theta(h_t,u_t)\right]
        \end{align}
        $$
Aux-Token 法 的代码 实现方式
  • 1)Sampler 侧 :rollout 时,除了返回真实 token \(a_t\),还要从同一个 top-p 分布独立采一个辅助 token \(u_t\)
  • 2)轨迹字段 :每条轨迹保存每个位置的辅助 token ID \(u_t\)
  • 3)Actor loss :不再只算 \(\log \pi_\theta(a_t\mid h_t)\),而是计算 logits 差分:
    $$
    z_\theta(h_t,a_t)-z_\theta(h_t,u_t)
    $$
    • 这里是可以证明的,
  • 对应的局部 surrogate 是:
    $$
    L=-\frac1B\sum_{i,t} A(h_{i,t}, a_{i,t})\frac{z_\theta(h_{i,t},a_{i,t})-z_\theta(h_{i,t},u_{i,t})}{T}
    $$
    • 其中 \(A(h_{i,t}, a_{i,t})\) 是 advantage,不反传梯度
Aux-Token 法 的一个极简例子
  • 假设词表只有两个 token:A 和 B,当前 top-p 分布:
    $$
    q(A)=0.9,\qquad q(B)=0.1
    $$
  • 真实动作是 \(a=A\),advantage 是 \(A(h,A)=1\)
  • 辅助 token \(u\) 从同一个分布抽:
    • 以 \(0.9\) 的概率抽到 \(u=A\),此时 \(\hat s=0\);
    • 以 \(0.1\) 的概率抽到 \(u=B\),此时:
      $$
      \hat s=\nabla\log\pi(A)-\nabla\log\pi(B)
      $$
  • 所以:
    $$
    \mathbb E_u[\hat s\mid a=A]=0.9\cdot 0+0.1\cdot\bigl(\nabla\log\pi(A)-\nabla\log\pi(B)\bigr)
    $$
Aux-Token 法 的优点与缺点
  • Aux-Token 法 的优点
    • 不需要显式计算 动作空间 集合 \(S_\theta(h)\)
    • 不需要显式保存或求导 \(\log Z_\theta(h)\)
    • 对辅助 token 求期望后,梯度估计无偏(注意:Aux-Token 方法是真实无偏的(吐槽:但方差大),目标也没有经过修改,也不用 IS 来修正,而 DeepSeek-V3.2 是经过修改的)
  • Aux-Token 法 的缺点
    • 辅助 token 是随机采样,基于单个 Token 估计期望,会增加梯度方差
    • 当真实 token 概率很高时,\(u_t=a_t\) 很常见,很多 \(\hat s_t=0\),信号稀疏
    • 改动成本高:
      • 需要修改 sampler
      • 除了主轨迹外,需要增加一个额外 Token
      • 需要修改 actor loss,对所有算法都有入侵
    • 要求真正 on-policy 的采样和概率定义一致
    • 不能修正引擎数值带来的差异(因为没有 IS 来修正)
      • 也不能修正 PPO clipping、IS 截断等其他近似
      • 如果想要修正类似方法,需要单独使用 IS 修正

补充:平时应该用什么方式解决 top-p

  • 方案一(策略混杂,但目前较好方案,对 Infra 要求高):
    • 像 DeepSeek 一样,使用 Keep Sampling Mask 策略,成本高,但理论上可行
  • 方案二(训练目标与最终目标不一致,但训推一致,训练稳定):
    • 训练目标设定为 top-p 等于 1 的策略,采样时也使用 top-p 等于 1 的策略,从而无需修正
      • 训练以后再测试 top-p=0.95 和 top-p=1.0 谁更好就用谁
    • 注意:这种方法下,对于 top-p=0.95 和 top-p=1 差异很大的场景则很难训练(因为两者采样到的样本特点不同),RL 可能需要修复很多 top-p=0.95 上不存在 但 top-p=1 上存在的问题,基础分数就低了一大截
      • 一般越小的模型,熵越高,越需要类似的 top-p=0.95 这样的修正(有时候还会叠加 temperature=0.6)
  • 方案三(训推不一致):
    • 采样时也使用 top-p 等于 0.95 的策略,不修改任何地方
    • 由于返回的概率是 top-p 生效前的分布,所以不会被 IS 修正(风险很高,理论上训练过程中可能随时崩溃)
    • 训练目标是个四不像,既不是 \(J_\pi\),也不是 \(J_q\)
  • 方案四(训推不一致):
    • 采样时也使用 top-p 等于 0.95 的策略,同时返回的概率也使用 top-p 生效后的
    • 由于返回的概率是 top-p 生效后的分布,所以可以被 IS 部分修正
      • 支持集与 \(\pi\) 不同,所以无法修正为 \(J_\pi\)
    • 风险:由于训练策略为修改,IS 总是会偏小
    • 训练目标仍然是个四不像,既不是 \(J_\pi\),也不是 \(J_q\)
      • 考虑到支持集仅是 Rollout 时, top-p 上的动作空间,所以修正后的策略也是个四不像
  • 方案五(训推不一致):
    • 采样时也使用 top-p 等于 0.95 的策略,同时返回的概率也使用 top-p 生效后的,再将策略 \(\pi_\theta\) 也改成 top-p 生效后的目标
    • 由于返回的概率是 top-p 生效后的分布,所以可以被 IS 部分修正
      • 支持集与修正后的 \(\pi\) (即策略 \(q\))不同,所以无法准确修正为 \(J_q\),仅完成部分修正
    • 训练目标是个有点偏差的 \(J_q\)
      • 偏差来源于支持集不同
  • 更多方案?
1…184185186…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4