注:本文包含 AI 辅助创作
- 参考链接:
- 原始论文(已过期):DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek, 20251202
- 原始论文(arXiv):DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, DeepSeek, 20251202
- 参考博客:DeepSeek-V3.2 技术报告深度解析:架构演进、RL 扩展与 Agent 合成数据
- 对 Unbiased KL Estimate 的理解:DeepSeek-V3.2中无偏 KL估计(Unbiased KL Estimate)的一些想法 - Keith Jiang的文章 - 知乎
Paper Summary
- DeepSeek-V3.2:在高效计算与卓越推理和智能体性能之间取得平衡的模型
- DeepSeek-V3.2 关键技术:
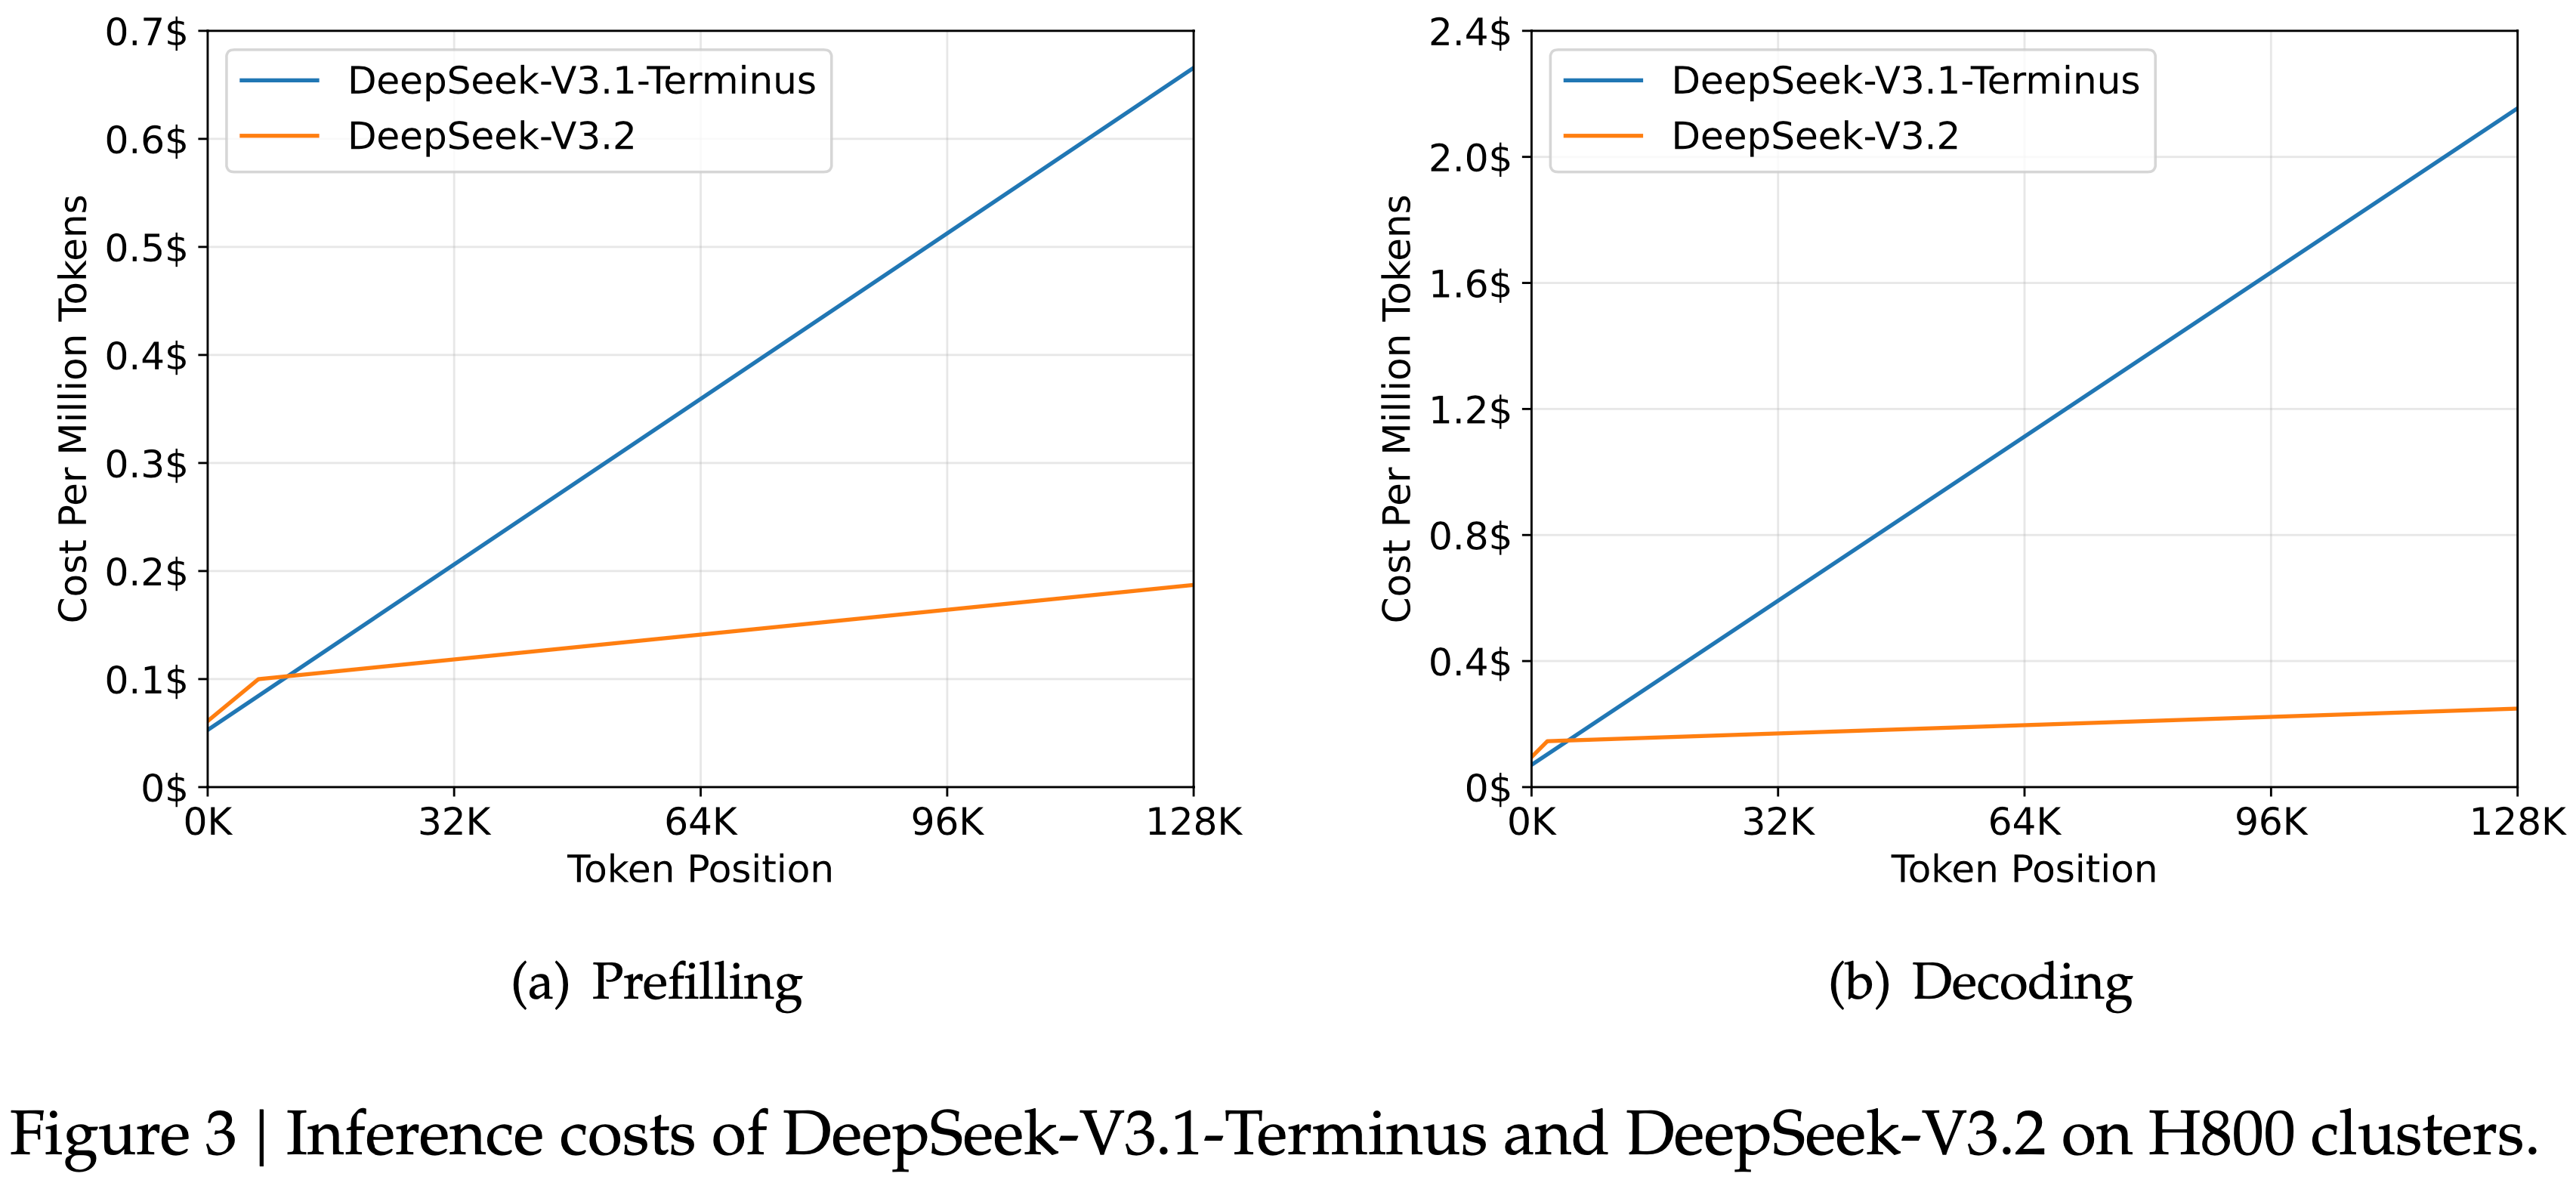
- (1) DeepSeek 稀疏注意力 (DeepSeek Sparse Attention, DSA): 论文引入了 DSA,这是一种高效的注意力机制,能在保持长上下文场景下模型性能的同时,显著降低计算复杂度
- (2) 可扩展的强化学习框架 (Scalable Reinforcement Learning Framework): 通过实施一个鲁棒的强化学习协议并扩展后训练计算量,DeepSeek-V3.2 的性能与 GPT-5 相当
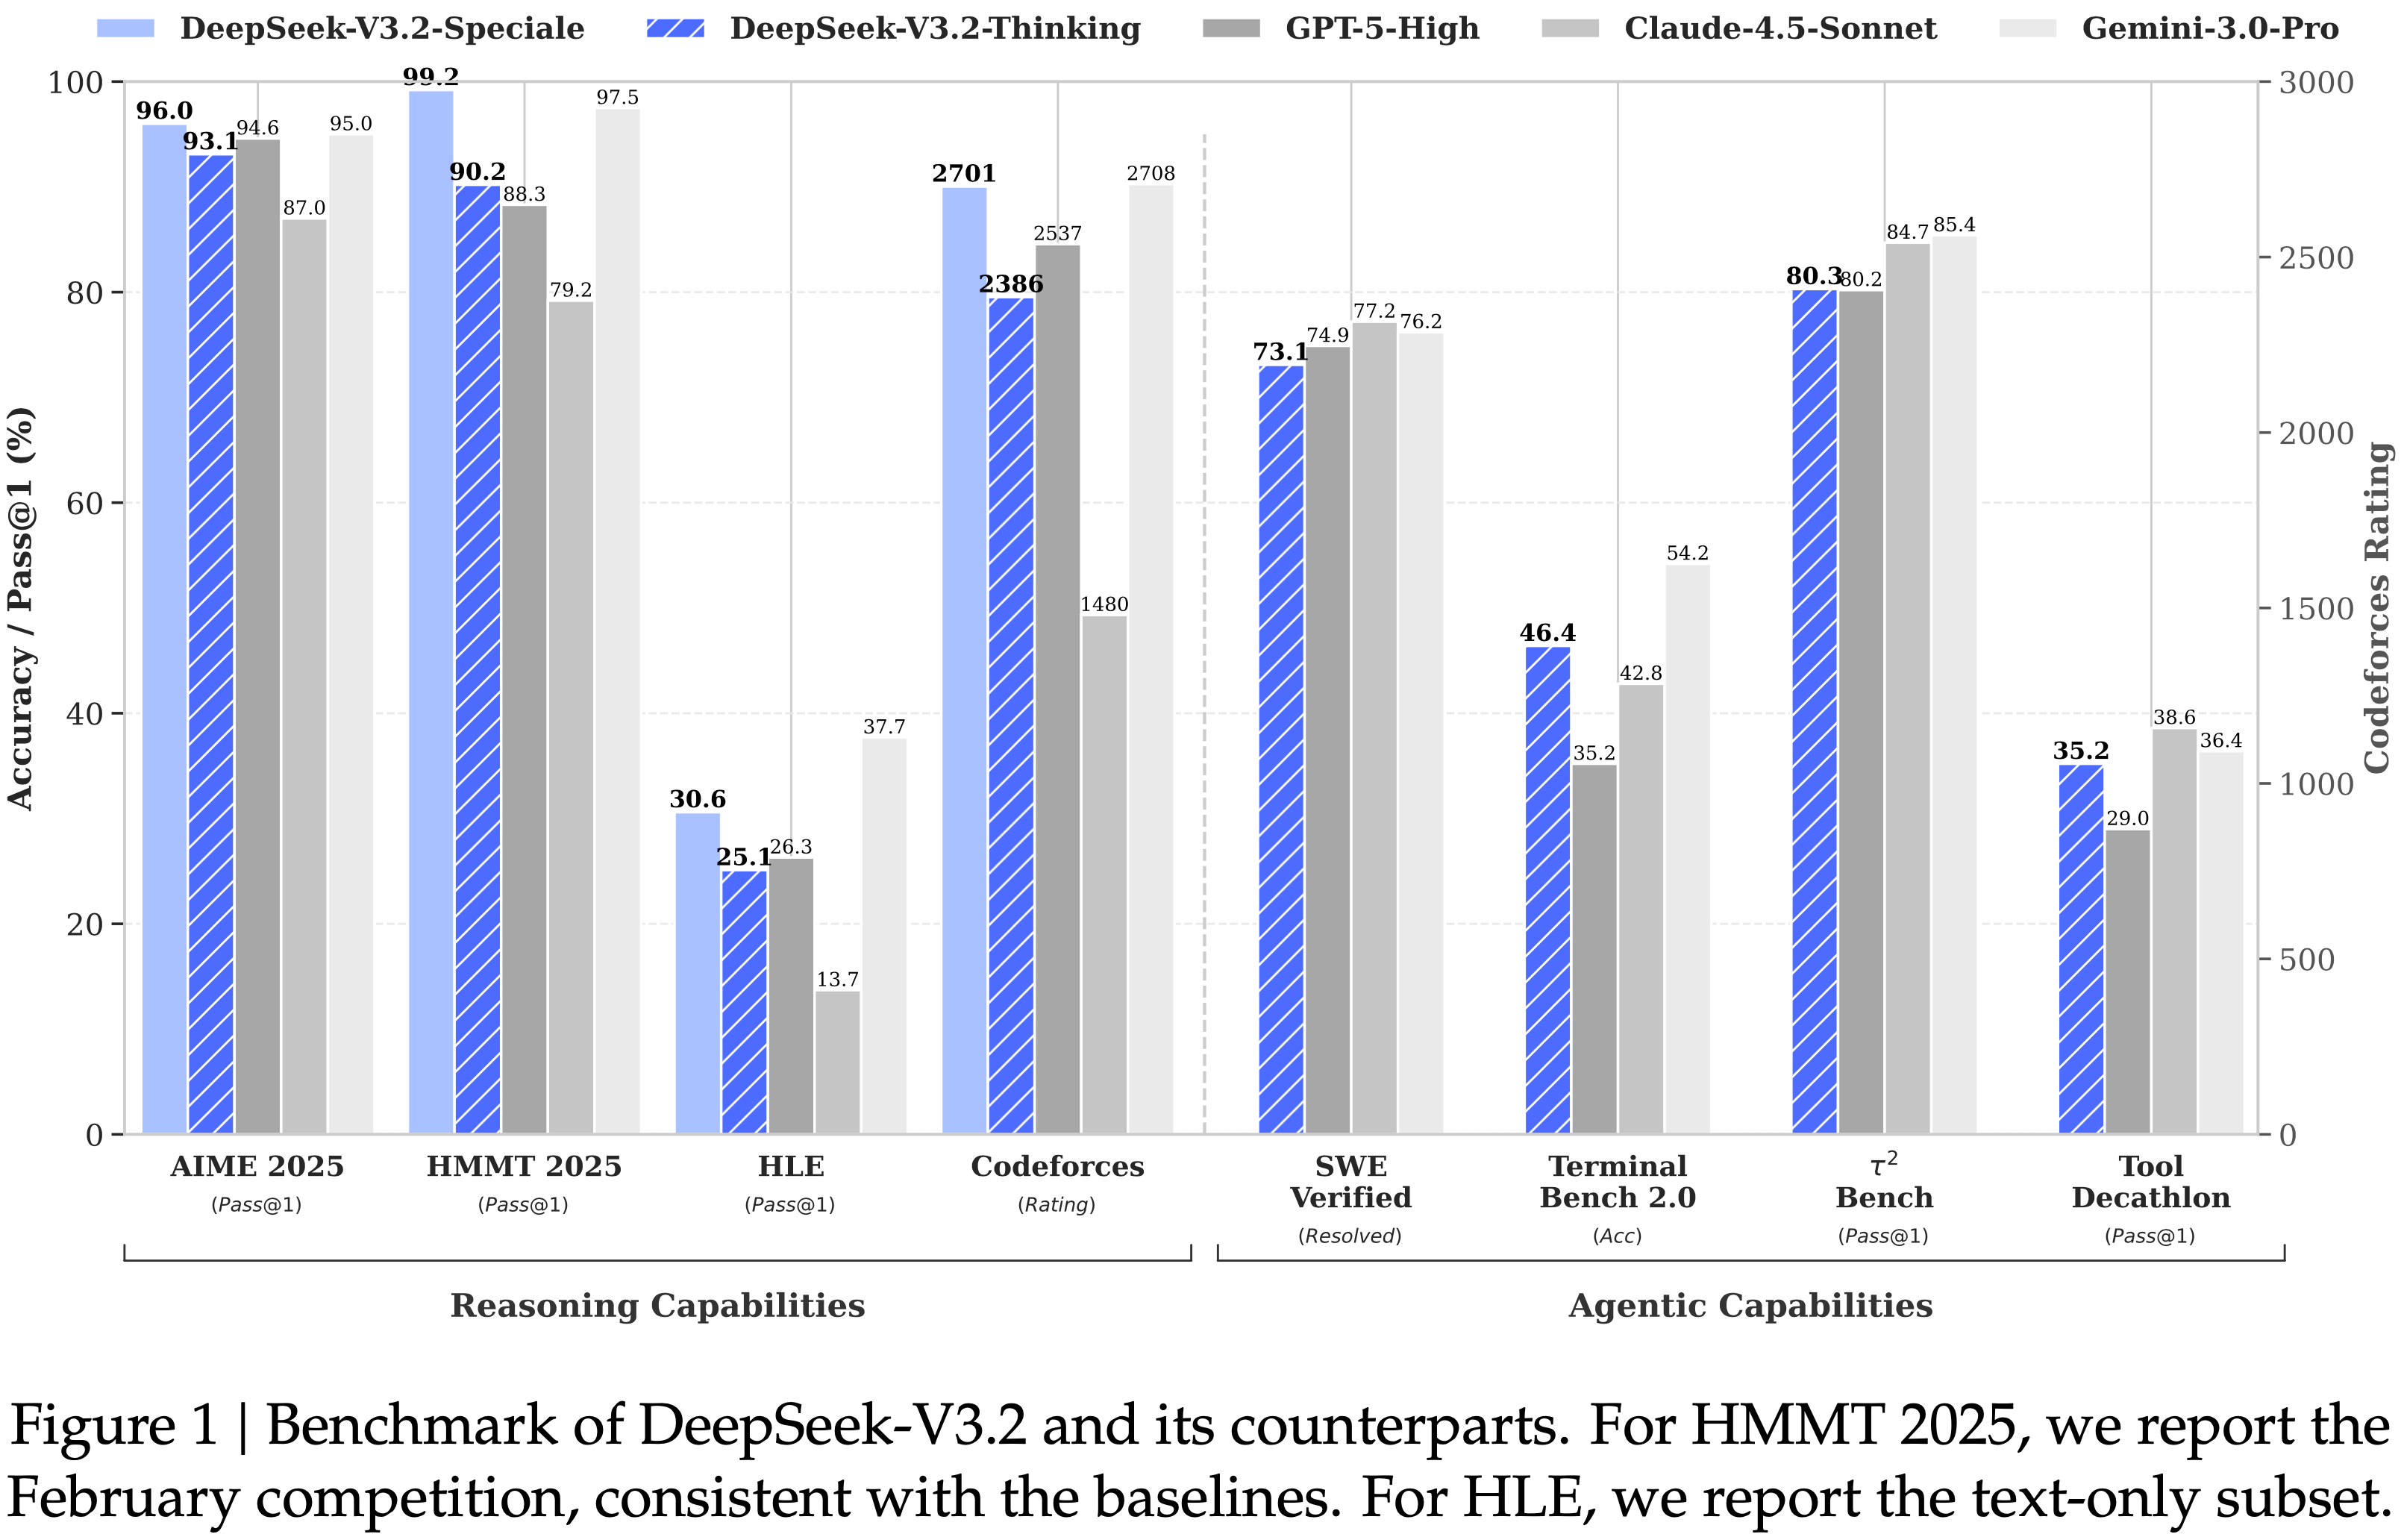
- DeepSeek-V3.2-Speciale(DeepSeek-V3.2 的高计算量变体) 超越了 GPT-5,并且其推理能力与 Gemini-3.0-Pro 持平,在 2025 年国际数学奥林匹克 (International Mathematical Olympiad, IMO) 和国际信息学奥林匹克 (International Olympiad in Informatics, IOI) 中均取得了金牌表现
- (3) 大规模智能体任务合成流程 (Large-Scale Agentic Task Synthesis Pipeline): 为了将推理能力整合到工具使用场景中,论文开发了一种新颖的合成流程,系统地大规模生成训练数据。这种方法促进了可扩展的智能体后训练,在复杂、交互式环境中显著提升了模型的泛化能力和遵循指令的鲁棒性
- 图 1:DeepSeek-V3.2 及其同类模型的基准测试
- 对于 HMMT 2025,论文报告的是二月份的比赛结果,与基线一致
- 对于 HLE,论文报告的是纯文本子集
Introduction and Discussion
- 推理模型的发布标志着 LLM 演进中的一个关键转折点,在可验证领域的整体性能的显著飞跃
- 自这一里程碑以来,LLM 的能力迅速发展;但在过去几个月中出现了明显的分化
- 虽然开源社区持续取得进展,但闭源专有模型 (Anthropic; DeepMind; OpenAI, 2025) 的性能提升轨迹以明显更快的速度在加速
- 闭源和开源模型之间的性能差距不仅没有缩小,反而似乎在扩大,专有系统在复杂任务中表现出日益卓越的能力
- 作者分析确定了限制开源模型在复杂任务中能力的三个关键不足
- 在架构上,主要依赖普通注意力 (vanilla attention) (2017) 机制严重限制了长序列的效率
- 这种低效性对可扩展部署和有效后训练都构成了重大障碍
- 在资源分配方面,开源模型在后训练阶段的计算投入不足,限制了其在困难任务上的表现
- 在 AI 智能体 (AI agents) 的背景下,与专有模型相比,开源模型在泛化能力和指令遵循能力方面表现出明显的滞后 (EvalSys, 2025; 2025; 2025),这阻碍了其在实际部署中的有效性
- 在架构上,主要依赖普通注意力 (vanilla attention) (2017) 机制严重限制了长序列的效率
- 为了解决这些关键限制,论文做了如下改进:
- 第一:引入 DSA,一种旨在显著降低计算复杂度的高效注意力机制
- 该架构有效解决了效率瓶颈,即使在长上下文场景下也能保持模型性能
- 第二:开发了一种稳定且可扩展的 RL 协议,允许在后训练阶段进行显著的计算扩展
- 该框架分配的后训练计算预算超过了预训练成本的 \(10%\),从而解锁了高级能力
- 第三,提出了一种新颖的流程,以促进工具使用场景中可泛化的推理
- 首先,实施一个冷启动 (cold-start) 阶段,利用 DeepSeek-V3 (DeepSeek-AI, 2024) 的方法论将推理和工具使用统一在单个轨迹内
- 随后,论文推进到大规模智能体任务合成,生成了超过 1,800 个不同的环境和 85,000 个复杂的 Prompt
- 这种广泛的合成数据驱动了 RL 过程,显著增强了模型在智能体上下文中的泛化能力和指令遵循能力
- 第一:引入 DSA,一种旨在显著降低计算复杂度的高效注意力机制
- 小结:
- DeepSeek-V3.2 在多个推理基准测试中与 Kimi-k2-thinking 和 GPT-5 取得了相近的性能
- DeepSeek-V3.2 显著提升了开源模型的智能体能力,在之前工作(EvalSys,2025; 2025; 2025)引入的长尾智能体任务上表现出卓越的熟练度
- DeepSeek-V3.2 成为智能体场景中一个极具成本效益的替代方案,在显著降低成本的同时,大大缩小了开源模型与前沿专有模型之间的性能差距
- 特别地:为了推动开源模型在推理领域的前沿,论文放宽了长度约束以开发 DeepSeek-V3.2-Speciale
- DeepSeek-V3.2-Speciale 达到了与领先闭源系统 Gemini-3.0-Pro (DeepMind) 相当的性能
- 在 IOI 2025、ICPC World Final 2025、IMO 2025 和 CMO 2025 中均表现出金牌水平的性能
- 注:论文评估了 CMO 2025 的英文版。IMO 2025 和 CMO 2025 的问题以及推理代码可在 github.com/deepseek-ai/DeepSeek-Math-V2 找到
DeepSeek-V3.2 Architecture
DeepSeek Sparse Attention
- DeepSeek-V3.2 的架构与 DeepSeek-V3.2-Exp 完全相同
- 与 DeepSeek-V3.1 的最后一个版本 DeepSeek-V3.1-Terminus 相比,DeepSeek-V3.2 唯一的架构修改是通过持续训练(Continuous Training)引入了 DeepSeek 稀疏注意力 (DeepSeek Sparse Attention, DSA)
- DSA 原型 (Prototype of DSA)
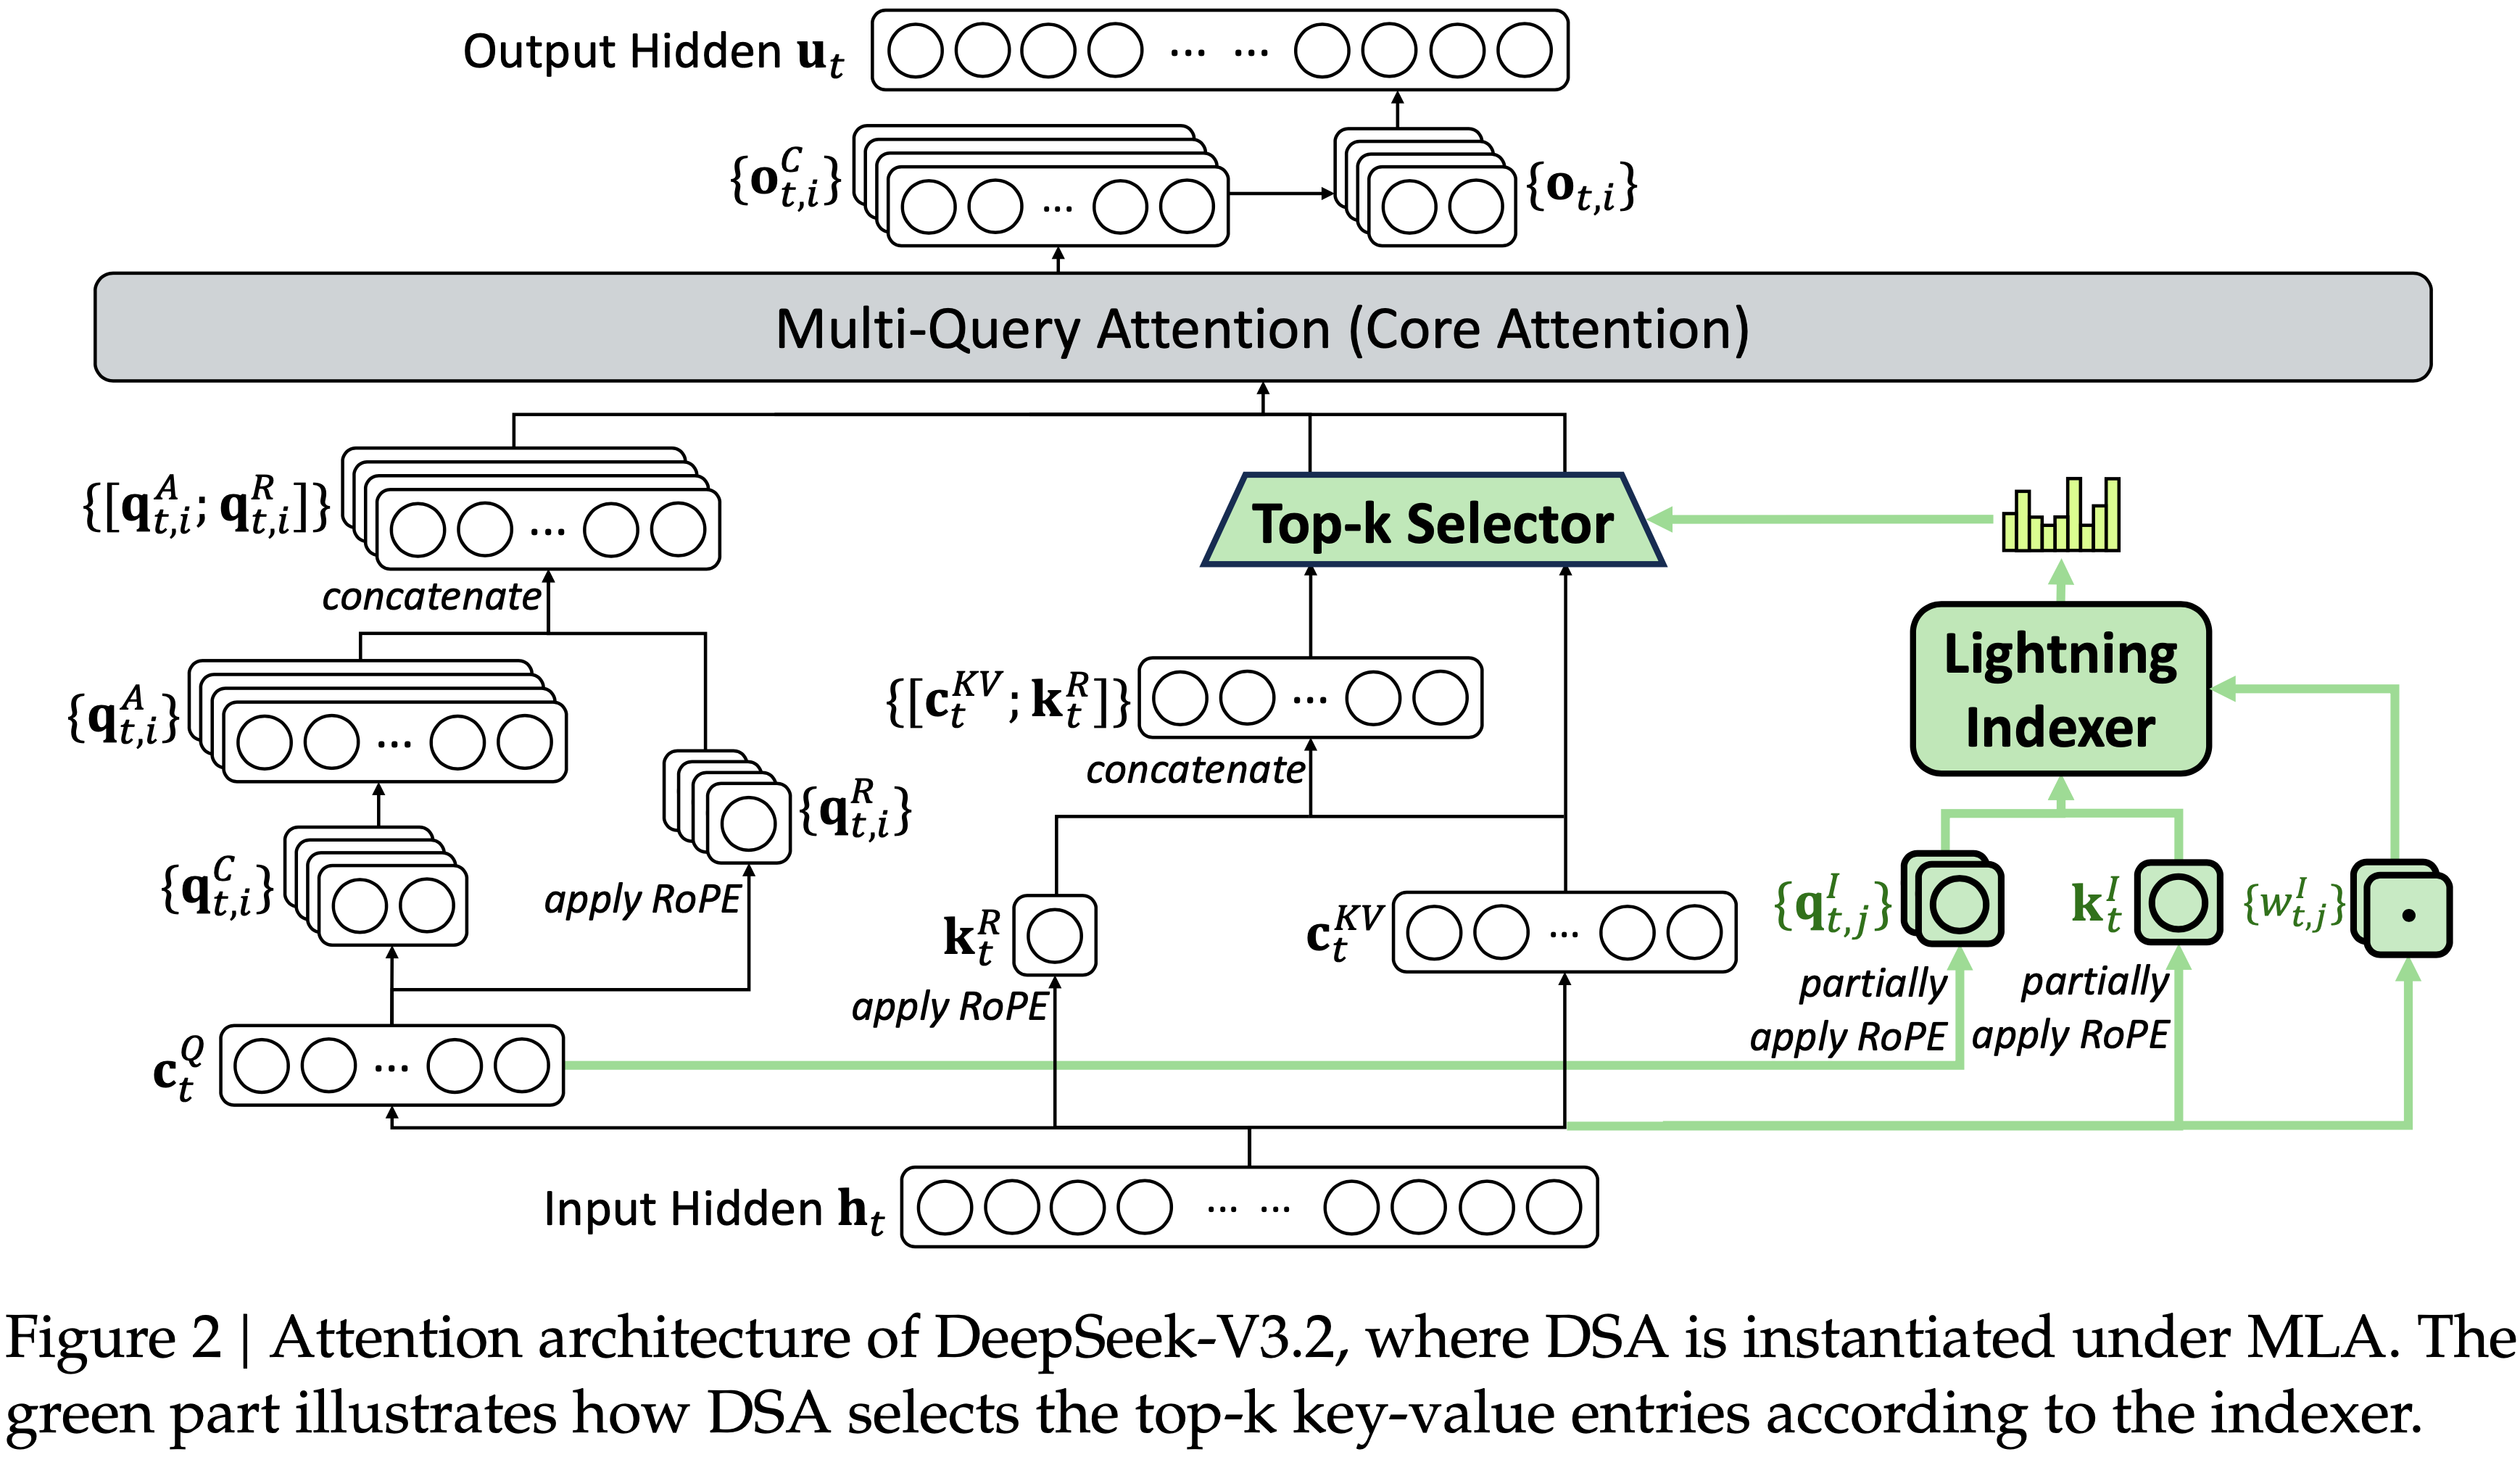
- DSA 的原型主要由两个部分组成:一个 Lightning Indexer 和一个细粒度 Token 选择机制 (fine-grained token selection mechanism)
- Lightning Indexer
- 计算查询 Token \(\mathbf{h}_{t}\in\mathbb{R}^{d}\) 与前一个 Token \(\mathbf{h}_{s}\in\mathbb{R}^{d}\) 之间的索引分数 \(I_{t,s}\),确定哪些 Token 将被查询 Token 选择:
$$I_{t,s}=\sum_{j=1}^{H^{l} }w_{t,j}^{I}\cdot\text{ReLU}\left(\mathbf{q}_{t,j}^{I} \cdot\mathbf{k}_{s}^{I}\right), \tag{1}$$- \(H^{l}\) 表示 Indexer 头 (indexer heads) 的数量;
- \(\mathbf{q}_{t,j}^{I}\in\mathbb{R}^{d^{l} }\) 和 \(w_{t,j}^{I}\in\mathbb{R}\) 来源于查询 Token \(\mathbf{h}_{t}\);
- \(\mathbf{k}_{s}^{I}\in\mathbb{R}^{d^{l} }\) 来源于前一个 Token \(\mathbf{h}_{s}\)
- 出于吞吐量考虑,论文选择 ReLU 作为激活函数
- 鉴于 Lightning Indexer 具有少量头部并且可以在 FPS 中实现,其计算效率非常显著
- 计算查询 Token \(\mathbf{h}_{t}\in\mathbb{R}^{d}\) 与前一个 Token \(\mathbf{h}_{s}\in\mathbb{R}^{d}\) 之间的索引分数 \(I_{t,s}\),确定哪些 Token 将被查询 Token 选择:
- 细粒度 Token 选择机制 (fine-grained token selection mechanism)
- 给定每个查询 Token \(\mathbf{h}_{t}\) 的索引分数 \(\{I_{t,s}\}\),fine-grained token selection mechanism 仅检索与最高 k 个索引分数对应的键值条目 \(\{\mathbf{c}_{s}\}\)
- 然后,通过在查询 Token \(\mathbf{h}_{t}\) 和稀疏选择的键值条目 \(\{\mathbf{c}_{s}\}\) 之间应用注意力机制来计算注意力输出 \(\mathbf{u}_{t}\):
$$\mathbf{u}_{t}=\text{Attn}(\mathbf{h}_{t},\left\{\mathbf{c}_{s}\mid I_{t,s}\in \text{Top-k}(I_{t,:})\right\}). \tag{2}$$
- 在 MLA 下实例化 DSA (Instantiate DSA Under MLA)
- 出于从 DeepSeek-V3.1-Terminus 进行持续训练的考虑,论文为 DeepSeek-V3.2 基于 MLA (DeepSeek-AI, 2024) 实例化了 DSA
- 在 kernel 层面,为了提高计算效率,每个键值条目必须在多个查询之间共享 (2025)
- 基于 MLA1 的 MQA (Multi-Query Attention) 模式 (Shazeer, 2019) 实现了 DSA,其中每个潜在向量 (MLA 的键值条目) 将在查询 Token 的所有查询头之间共享
- 基于 MLA 的 DSA 架构如图 2 所示
- 详情见:DeepSeek-V3.2 的开源实现以明确指定细节 和 论文附录
Continued Pre-Training
- 从一个上下文长度已扩展到 128K 的 DeepSeek-V3.1-Terminus base checkpoint 开始,进行持续预训练,随后进行后训练(最终得到 DeepSeek-V3.2)
- DeepSeek-V3.2 的持续预训练包括两个训练阶段
- 对于这两个阶段,训练数据的分布与用于 DeepSeek-V3.1-Terminus 的 128K 长上下文扩展数据完全一致
- 密集预热阶段 (Dense Warm-up Stage) : 使用一个简短的预热阶段来初始化 Lightning Indexer (预热)
- 在此阶段,论文保持密集注意力,并冻结除 Lightning Indexer 外的所有模型参数
- 为了使 Indexer 输出与主要注意力分布对齐,对于第 \(t\) 个查询 Token
- 先通过对所有注意力头求和来聚合主要注意力分数
- 然后,沿序列维度对该和进行 L1 归一化以产生目标分布 \(p_{t,:}\in\mathbb{R}^{t}\)
- 基于 \(p_{t,:}\),论文将 KL 散度损失设置为 Indexer 的训练目标:
$$\mathcal{L}^{l}=\sum_{t}\mathbf{D}_{\text{KL} }\big{(}p_{t,:}\big{|}\text{Softmax }(I_{t,:})\big{)}. \tag{3}$$ - 对于预热,使用 \(10^{-3}\) 的学习率
- 只对 Indexer 训练 \(1000\) 步,每步包含 \(16\) 个 128K Token 的序列,总计 2.1B Token
- 稀疏训练阶段 (Sparse Training Stage) : Indexer 预热之后,引入细粒度 Token 选择机制,并优化所有模型参数以使模型适应 DSA 的稀疏模式
- 在此阶段,论文仍然保持 Indexer 输出与主要注意力分布的对齐,但仅考虑被选择的 Token 集合 \(\mathcal{S}_{t}=\{s|I_{t,s}\in\text{Top-k}(I_{t,:})\}\):
$$\mathcal{L}^{l}=\sum_{t}\mathbf{D}_{\text{KL} }\big{(}p_{t,\mathcal{S}_{t} }\big{|}\text{Softmax}(I_{t,\mathcal{S}_{t} })\big{)}. \tag{4}$$
- 在此阶段,论文仍然保持 Indexer 输出与主要注意力分布的对齐,但仅考虑被选择的 Token 集合 \(\mathcal{S}_{t}=\{s|I_{t,s}\in\text{Top-k}(I_{t,:})\}\):
- 特别注意:作者将 Indexer 输入从计算图中分离 (detach) 出来进行单独优化
- Indexer 的训练信号仅来自 \(\mathcal{L}^{l}\),而主要模型的优化仅根据语言建模损失进行
- 在这个稀疏训练阶段,论文使用 \(7.3\times 10^{-6}\) 的学习率,并为每个查询 Token 选择 \(2048\) 个键值 Token
- 对主要模型和 Indexer 都训练了 \(15000\) 步,每步包含 \(480\) 个 128K Token 的序列,总计 9437 亿 Token
- 图 2: DeepSeek-V3.2 的注意力架构,其中 DSA 在 MLA 下实例化
- 绿色部分说明了 DSA 如何根据 Indexer 选择 top-k 的键值条目
- 绿色部分说明了 DSA 如何根据 Indexer 选择 top-k 的键值条目
Post-Training
- 持续预训练(continued pre-training)后再执行后训练
- DeepSeek-V3.2 的后训练也采用与稀疏持续预训练阶段相同的方式使用稀疏注意力
- DeepSeek-V3.2 保持与 DeepSeek-V3.2-Exp 相同的后训练流程,其中包括专家蒸馏和混合强化学习训练
- 专家蒸馏(Specialist Distillation)
- 对于每项任务,首先开发一个专门针对该特定领域的专用模型
- 所有专家模型都从同一个预训练的 DeepSeek-V3.2 基础 Checkpoint 进行微调
- 除了写作任务和通用问答外,论文的框架还涵盖六个专业领域:
- 数学、编程、通用逻辑推理、通用智能体任务、智能体编码和智能体搜索
- 所有这些领域都同时支持 Thinking 模式和非 Thinking 模式
- 每个专家都通过大规模 RL 计算进行训练
- 使用不同的模型来生成长链 Thinking 推理( Thinking 模式)和直接响应生成(非 Thinking 模式)的训练数据
- 专家模型用来为最终 Checkpoint 生成特定领域的数据
- 实验结果表明,在蒸馏数据上训练的模型达到的性能水平仅略低于领域特定专家,并且通过后续的 RL 训练可以有效地消除性能差距
- 对于每项任务,首先开发一个专门针对该特定领域的专用模型
- 混合 RL 训练(Mixed RL Training)
- 对于 DeepSeek-V3.2,论文仍然采用 GRPO (DeepSeek-AI, 2025; 2024) 作为 RL 训练算法
- 与 DeepSeek-V3.2-Exp 一样,将推理、智能体和对齐训练合并到一个 RL 阶段
- 这种方法有效地平衡了不同领域的性能,同时避免了通常与多阶段训练范式相关的灾难性遗忘问题
- 对于推理和智能体任务,论文采用基于规则的结果奖励、长度惩罚和语言一致性奖励
- 对于通用任务,论文采用生成式奖励模型,其中每个 Prompt 都有其自己的评估准则(Rubrics RM?)
For general tasks, we employ a generative reward model where each prompt has its own rubrics for evaluation
- DeepSeek-V3.2 与 DeepSeek-V3.2-Speciale
- DeepSeek-V3.2 整合了从专家蒸馏出的推理、智能体和对齐数据,并经过数千步的持续 RL 训练以到达最终 Checkpoint
- 为了研究扩展 Thinking 的潜力,开发了一个实验性变体,DeepSeek-V3.2-Speciale
- 该模型仅在 RL 期间长度惩罚降低的情况下,专门在推理数据上进行训练
- 作者还整合了来自 DeepSeekMath-V2 (2025) 的数据集和奖励方法,以增强数学证明方面的能力
- 作者重点强调:在第 3.1 节中介绍如何创建一个稳定的方案来扩大 RL 计算规模,以及在第 3.2 节中介绍如何将 Thinking 整合到智能体任务中的努力
- 图 3:DeepSeek-V3.1-Terminus 和 DeepSeek-V3.2 在 H800 集群上的推理成本
Scaling GRPO
- 首先回顾 GRPO 的目标
- GRPO 通过最大化以下关于从旧策略 \(\pi_{\text{old} }\) 采样得到的一组响应 \(\{o_{1},\cdots,o_{G}\}\) 的目标函数来优化策略模型 \(\pi_{\theta}\),给定每个问题 \(q\):
$$
\mathcal{J}_{\text{GRPO} }(\theta) =\mathbb{E}_{q\sim P(Q),\{o_i\}_{i=1}^{G}\sim\pi_{\text{old} }(\cdot|q)}\Bigg[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}
\min \left(r_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\right)\hat{A}_{i,t}\right)-\beta\mathbb{D}_{\text{KL} }\left(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\right)\Bigg],
$$- \(r_{i,t}(\theta)\) 是当前策略与旧策略之间的重要性采样比率:
$$
r_{i,t}(\theta)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}
$$ - \(\varepsilon\) 和 \(\beta\) 是分别控制剪切范围和 KL 惩罚强度的超参数
- \(\hat{A}_{i,t}\) 是 \(o_{i,t}\) 的优势,通过对组内的结果奖励进行归一化来估计
- 使用一组奖励模型为组中的每个输出 \(o_i\) 评一个结果奖励 \(R_i\),分别得到 \(G\) 个奖励 \(R=\{R_1,\cdots,R_G\}\)
- \(o_{i,t}\) 的优势通过从输出 \(o_i\) 的奖励中减去组的平均奖励来计算,即
$$ \hat{A}_{i,t}=R_i-\text{mean}(R)$$- 特别注意:这里作者没有除以分母!
- \(r_{i,t}(\theta)\) 是当前策略与旧策略之间的重要性采样比率:
- 论文接下来介绍了基于 GRPO 算法的额外更新策略,这些策略可以稳定 RL 的扩展
无偏 KL 估计(Unbiased KL Estimate):有趣的做法
- 给定 \(o_{i,t}\) 是从旧策略 \(\pi_{\text{old} }(\cdot|q,o_{i,< t})\) 中采样的,这里校正 k3 估计器 (Schulman, 2020) 以使用当前策略 \(\pi_{\theta}\) 和旧策略 \(\pi_{\text{old} }\) 之间的重要性采样比率来获得无偏 KL 估计
$$
\mathbb{D}_{\text{KL} }\big(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\big)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}\left(\frac{\pi_{\text{ref} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-\log\frac{\pi_{\text{ref} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-1\right).
$$ - 作为此调整的直接结果,该 KL 估计器的梯度变得无偏,从而消除了系统性估计误差,促进了稳定的收敛
- 这与原始的 k3 估计器形成鲜明对比,特别是当采样到的 Token 在当前策略下的概率远低于参考策略时,即 \(\pi_{\theta}\ll\pi_{\text{ref} }\)
- 在这种情况下,k3 估计器的梯度会分配不成比例的大且无界的权重来最大化这些 Token 的似然,从而导致噪声梯度更新,这些更新累积起来会降低后续迭代中的样本质量并导致不稳定的训练动态
- 在实践中,论文发现不同领域受益于不同强度的 KL 正则化
- 对于某些领域,例如数学 ,应用相对较弱的 KL 惩罚甚至完全省略它都可以获得改进的性能
- 详细推到证明见附录
Off-Policy Sequence Masking
- 为了提高 RL 系统的效率,通常生成大量的 rollout 数据,随后将其分割成多个小批次用于若干次梯度更新步骤
- 但这种做法本质上引入了离策略行为
- 此外,用于高效数据生成的推理框架通常经过高度优化,其实现细节可能与训练框架不同
- 这种训练-推理的不一致性进一步加剧了离策略的程度
- 为了稳定训练并提高对离策略更新的容忍度,论文掩码那些引入显著策略分歧的负序列,其衡量标准是数据采样策略 \(\pi_{\text{old} }\) 与当前策略 \(\pi_{\theta}\) 之间的 KL 散度
- 论文在 GRPO 损失中引入一个二元掩码 \(M\):
$$
\mathcal{J}_{\text{GRPO} }(\theta)=\mathbb{E}_{q\sim P(Q),\{o_i\}_{i=1}^{G}\sim\pi_{\text{old} }(\cdot|q)}\Bigg[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}
\min \left(r_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\right)\hat{A}_{i,t}\right)M_{i,t}-\beta\mathbb{D}_{\text{KL} }\left(\pi_{\theta}(o_{i,t})\parallel\pi_{\text{ref} }(o_{i,t})\right)\Bigg],
$$ - 其中
$$
M_{i,t}=\begin{cases}
0 & \hat{A}_{i,t}<0,\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\log\frac{\pi_{\text{old} }(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}>\delta\
1 & \text{otherwise},
\end{cases}
$$ - \(\delta\) 是一个控制策略分歧阈值的超参数
- 注意:这里的 \(\pi_{\text{old} }\) 表示推理框架直接返回的采样概率,因此旧策略与当前策略之间的 KL 散度考虑了上述两种离策略来源
- 同样值得注意的是,论文只掩码具有负优势的序列
- 直观地说,模型从自身错误中学习受益最大,而高度离策略的负样本可能是有害的,可能误导或破坏优化过程的稳定性
- 论文通过经验观察到,这种离策略序列掩码操作改善了在某些原本会表现出不稳定性的训练场景中的稳定性
- 理解:
- 这个做法很常见,主要是当 \(A < 0\) 时,原始 PPO 的 Clip 机制无法限制 \(\frac{\pi_\theta}{\pi_{\theta_\text{old}}}\) 很大的情况
Keep Routing
- MoE 模型通过在推理期间仅激活专家模块的子集来提高计算效率
- 但推理和训练框架之间的差异,加上策略更新,可能导致即使对于相同的输入,在推理和训练期间也产生不一致的专家路由
- 这种不一致性会引起活跃参数子空间的突然变化,从而破坏优化的稳定性并加剧离策略问题
- 缓解这个问题的方案:
- 作者保留了在推理框架中采样期间使用的专家路由路径 ,并在训练期间强制执行相同的路由路径 ,确保优化相同的专家参数
- 作者发现这种保持路由操作对于 MoE 模型的 RL 训练稳定性至关重要,并且自 DeepSeek-V3-0324 以来已在论文 RL 训练流程中采用
Keep Sampling Mask(解决因 top-p 和 top-k 等导致的训推不一致问题)
- Top-p 和 top-k 采样是广泛使用的采样策略,用于提高 LLM 生成的响应质量
- 在 RL 训练中采用这些策略也是有益的,因为它避免了采样极低概率的 Token
- 理解1:这就避免了使用这些 Token 用作优化目标,而这部分 Token 的重要性权重往往可能较大(波动较大)?
- 理解2:这还可以使得模型发布以后的 Inference 参数和训练参数(top-p, top-k 等能对齐),理论上可以保证模型训练的目标就是最优化真实场景的 Inference 策略
- 注:平时训练时,RL 优化目标其实和真实目标有点对不齐(但影响应该还好)
- 这种截断保持了样本质量,但它引入了 \(\pi_{\text{old} }\) 和 \(\pi_{\theta}\) 之间动作空间的不匹配
- 这违反了重要性采样的原则并使训练不稳定
- 解决这个问题的方案:
- top-k:在从 \(\pi_{\text{old} }\) 采样期间保留截断掩码,并在训练期间将它们应用于 \(\pi_{\theta}\)
- 确保两种策略共享相同的动作子空间
- top-p:将 top-p 采样与保持采样掩码策略结合使用:
- 可以有效保持 RL 训练期间的语言一致性
- 理解:mask 的方式是(top-k 和 top-p 的 mask 方式都是 mask 词表中被 top-k 和 top-p drop 掉的部分):
- 在推理时记录采样时(计算 Softmax 前)被 drop 掉的 token
- 在训练引擎上,计算概率时 mask 掉这部分 token(mask 方式也是在计算 Softmax 前进行 mask,将 atten_score 置为 负无穷)
- 虽然 mask 掉了这些 Token,但是这些 Token 的概率依然会因为整体参数的更新而变化的
- 更多详情见本文附录
- top-k:在从 \(\pi_{\text{old} }\) 采样期间保留截断掩码,并在训练期间将它们应用于 \(\pi_{\theta}\)
Thinking in Tool-Use
Thinking Context Management
- DeepSeek-R1 已经证明,融入 Thinking 过程可以显著增强模型解决复杂问题的能力
- 基于这一见解,作者的目标是将 Thinking 能力整合到工具调用场景中
- 作者观察到,复制 DeepSeek-R1 的策略会导致显著的 Token 效率低下
- 注:DeepSeek-R1 的策略是在第二轮消息到达时丢弃推理内容
- 这种方法迫使模型在每次后续工具调用时为整个问题冗余地重新推理
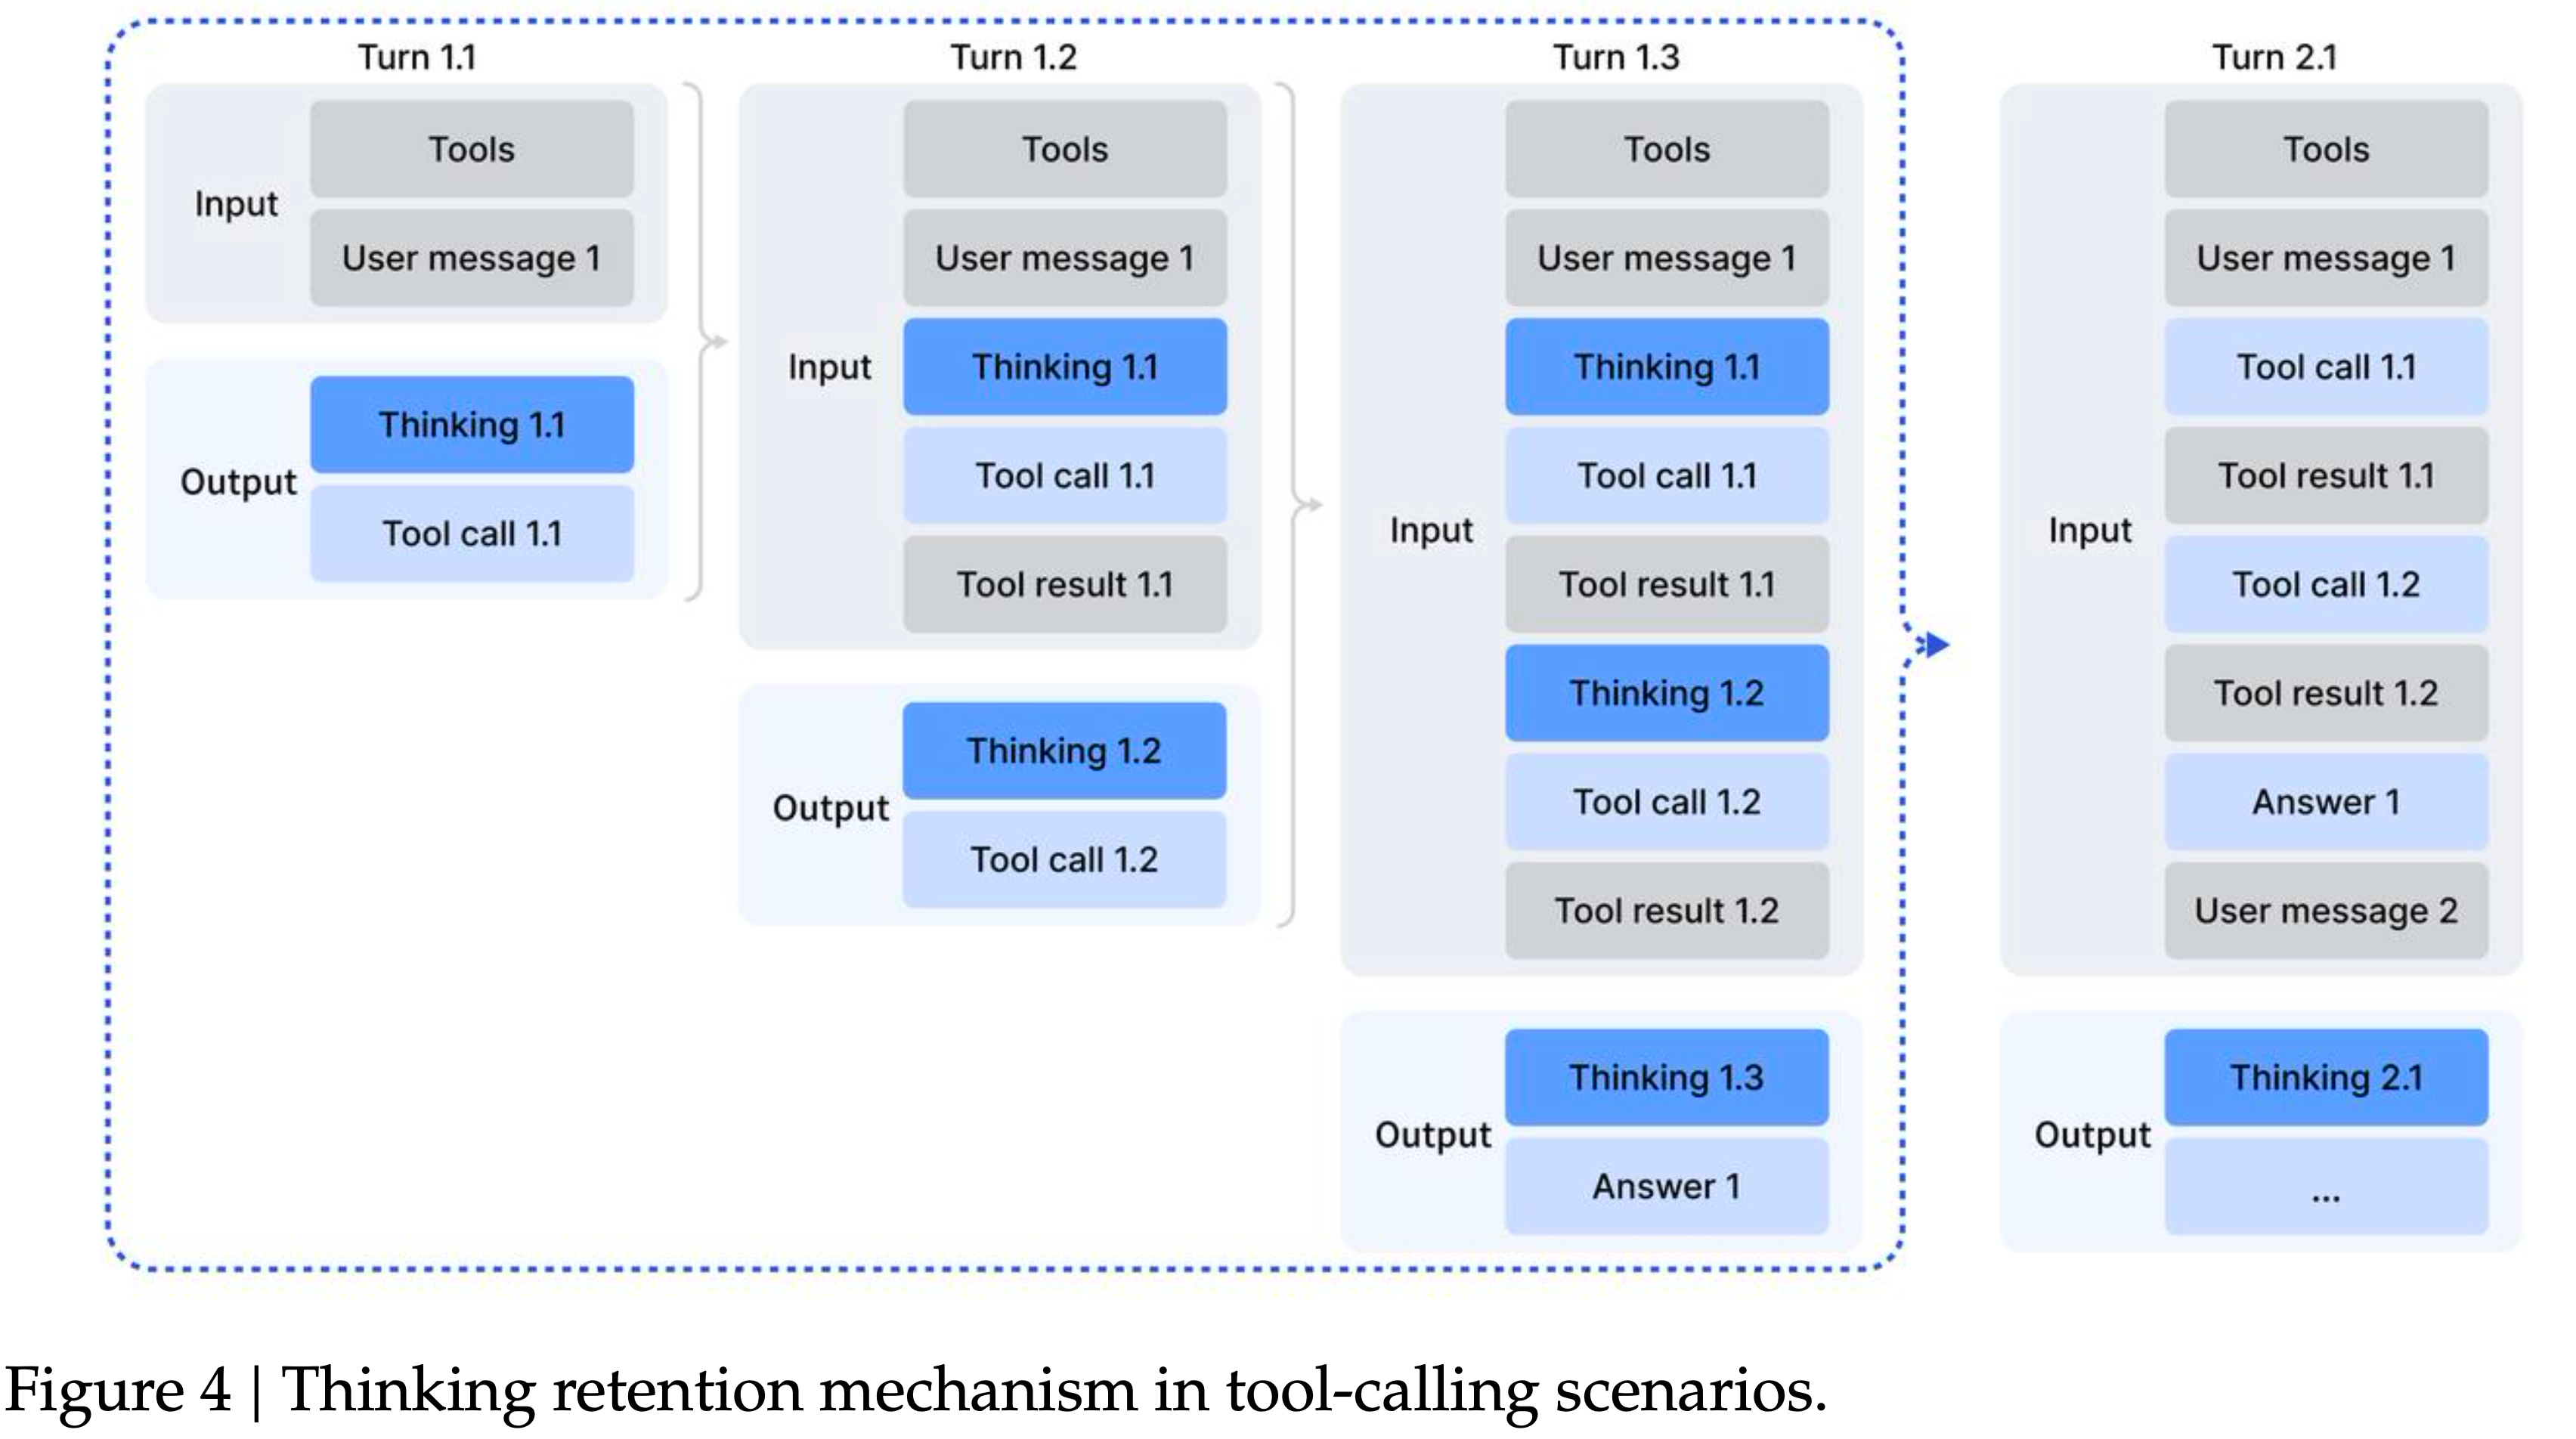
- 为了缓解这个问题,作者开发了如图 4 所示的、为工具调用场景严格定制的上下文管理:
- 仅当对话中引入新的用户消息时,才会丢弃历史推理内容
- 如果仅追加与工具相关的消息(例如,工具输出),则推理内容在整个交互过程中保留
- 当推理痕迹被移除时,工具调用及其结果的历史记录仍保留在上下文中
- 仅当对话中引入新的用户消息时,才会丢弃历史推理内容
- 特别需要注意:某些智能体框架,例如 Roo Code 或 Terminus,通过用户消息模拟工具交互
- 由于上述上下文管理规则,这些框架可能无法完全受益于论文增强的推理持久性
- 因此,作者建议在此类架构中使用非 Thinking 模型以获得最佳性能
- 图 4:工具调用场景中的 Thinking 保留机制
Cold-Start
- 鉴于已有推理数据(非智能体)和非推理智能体数据的可用性,整合这两种能力的一个直接策略是通过精心设计的 Prompting
- 论文假设模型具备足够的能力来准确遵循明确的指令,从而能够在推理过程中无缝整合工具执行
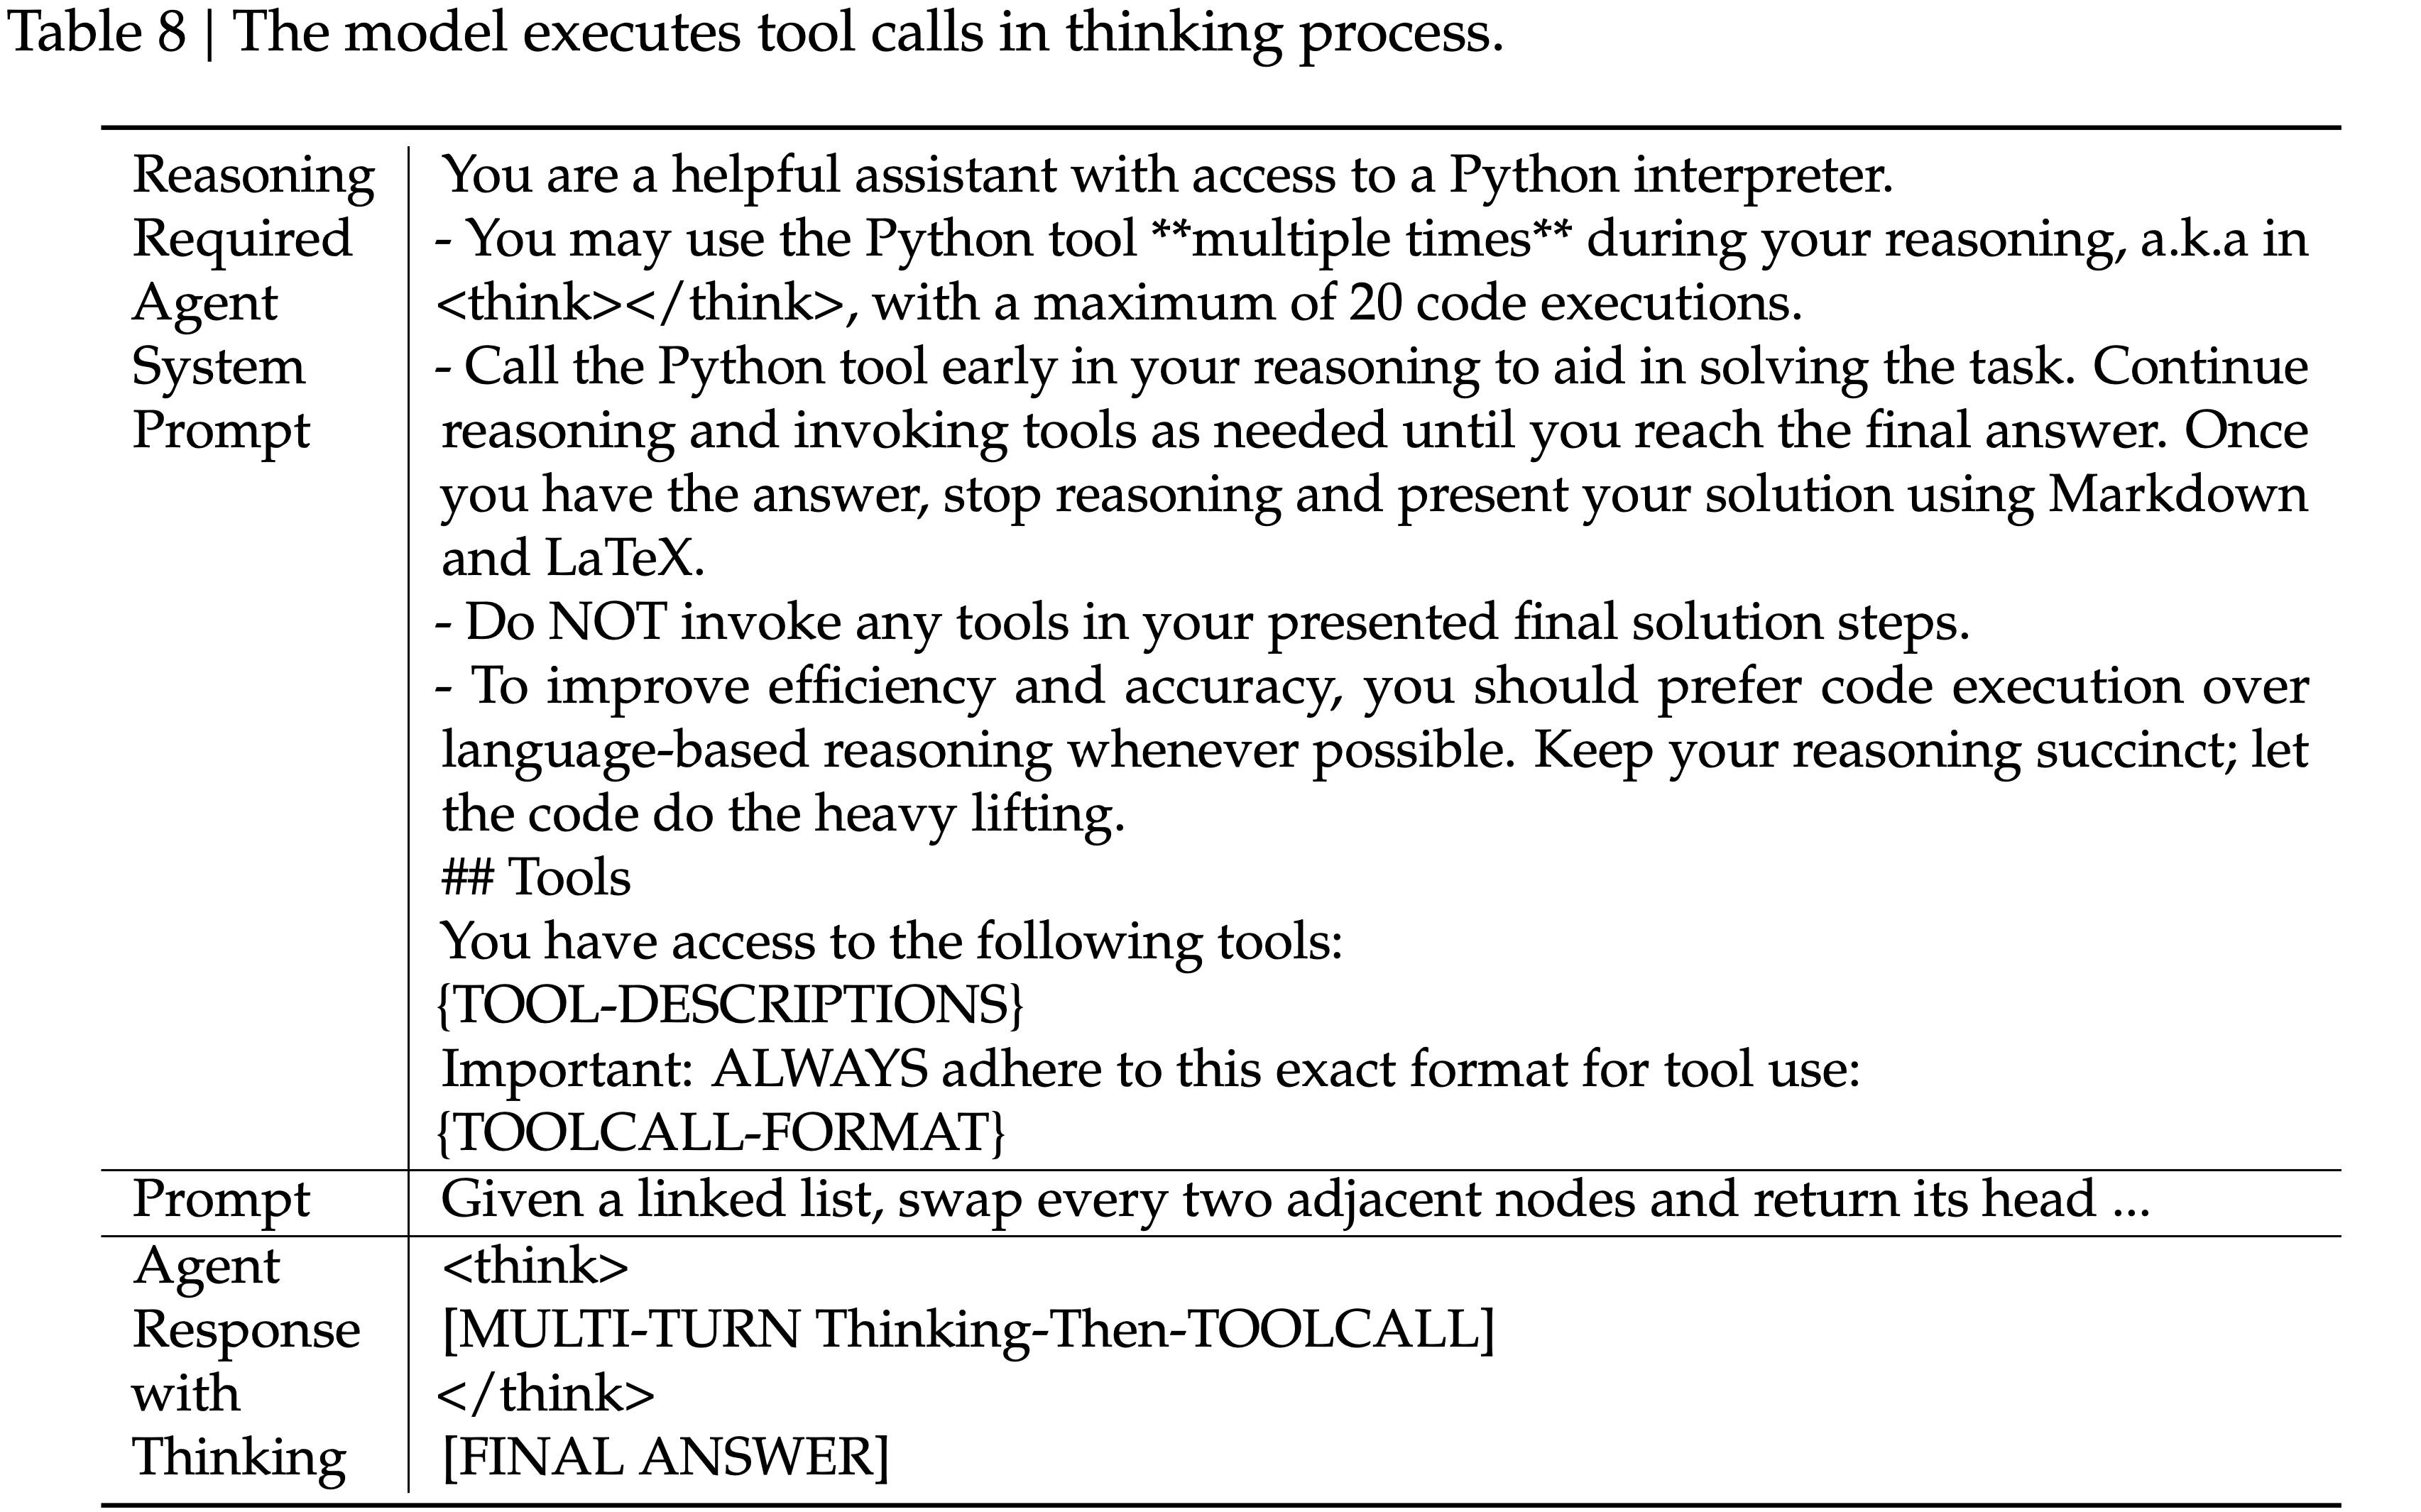
- 为了演示冷启动机制的运作(operation),论文选择性地采样训练数据,如附录表 6-8 所示
- 需要注意的是,不同的任务 Prompt 与不同的系统 Prompt 相关联
- 表 6-8 展示了一个对应于竞赛编程(competitive programming) Prompt 的示例
- 表 6 展示了论文推理数据的一个示例,其中使用系统 Prompt 明确要求模型在最终答案之前进行推理,并使用特殊标签
<think></think>来标记推理路径 - 表 7 展示了非推理智能体数据的 Prompt ,其中系统 Prompt 包含工具调用的指导
- 表 8 展示了论文设计的系统 Prompt ,用于指导模型在其推理过程中整合多个工具调用
- 表 6 展示了论文推理数据的一个示例,其中使用系统 Prompt 明确要求模型在最终答案之前进行推理,并使用特殊标签
- 通过这种方式,尽管工具使用模式中的推理可能缺乏鲁棒性 ,但模型偶尔能够生成期望的轨迹 ,从而为后续的强化学习阶段提供基础
Large-Scale Agentic Tasks
- 多样化的 RL 任务对于增强模型的鲁棒性至关重要
- 对于搜索、代码工程和代码解释等任务,论文使用现实世界的工具,包括实际的网络搜索 API、编码工具和 Jupyter Notebooks
- 虽然这些 RL 环境是真实的,但所使用的 Prompt 要么从互联网来源提取,要么是合成生成的,而不是从真实的用户交互中获取
- 对于其他任务,环境和 Prompt 都是合成的
- 论文使用的智能体任务如表 1 所述
- 表 1:不同智能体任务的描述,包括任务数量、环境类型(真实或合成)和 Prompt 来源(提取或合成)
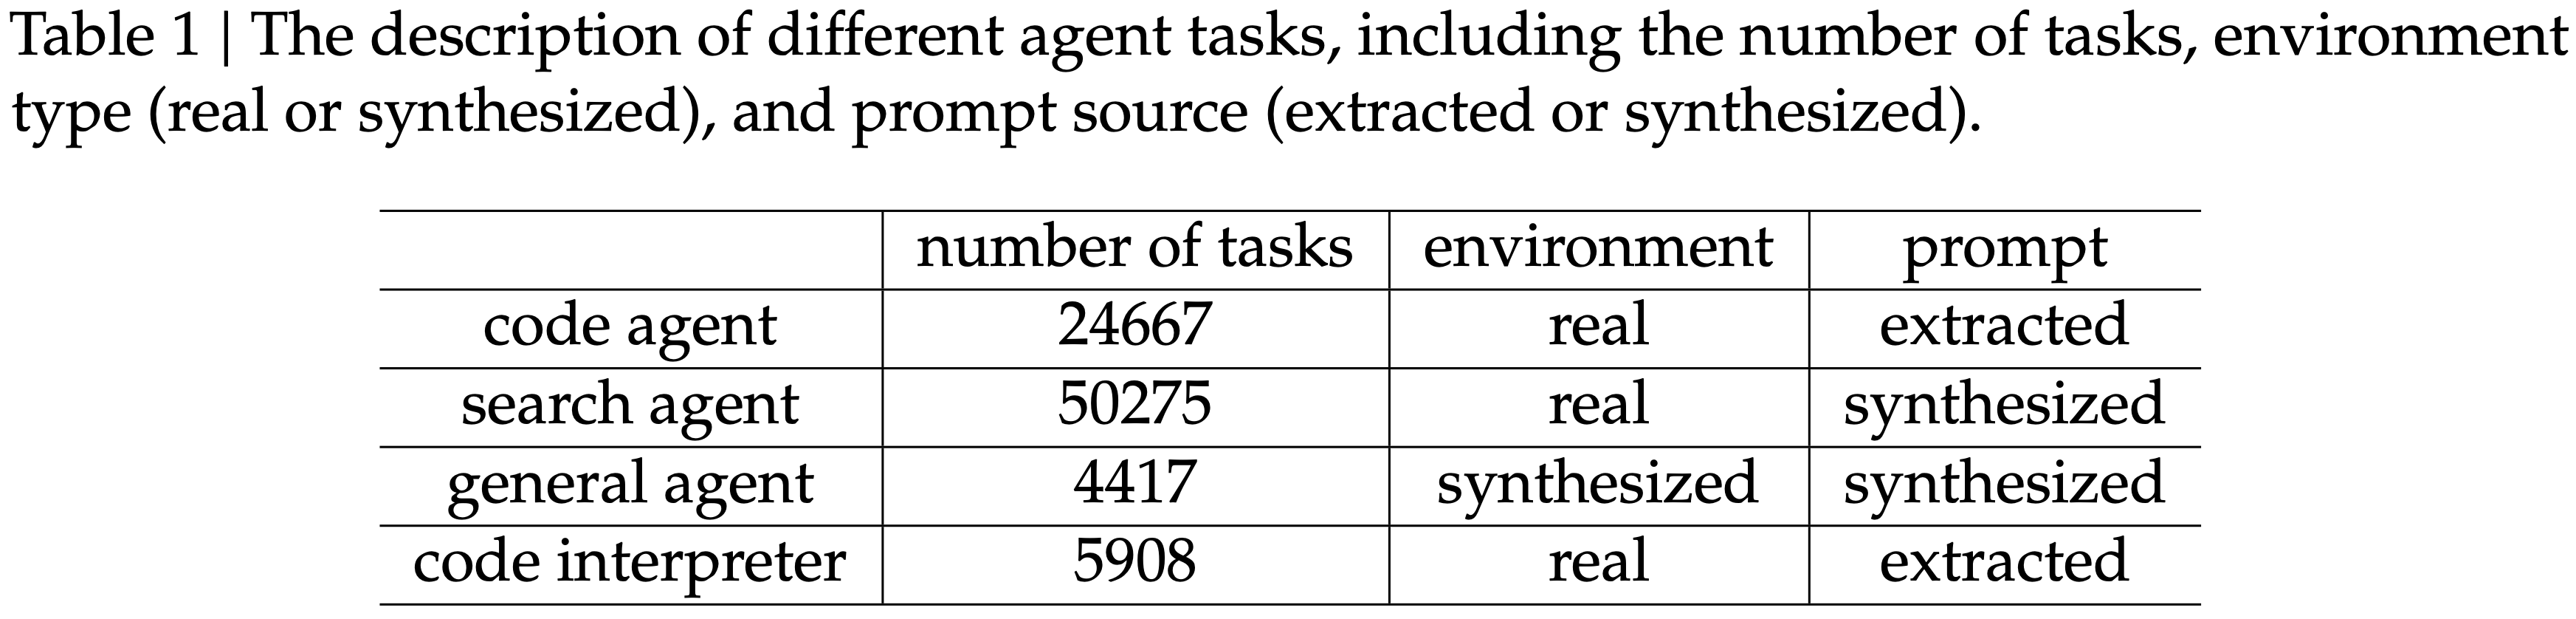
- 表 1:不同智能体任务的描述,包括任务数量、环境类型(真实或合成)和 Prompt 来源(提取或合成)
Search Agent
- 论文采用基于 DeepSeek-V3.2 的多智能体管道来生成多样化、高质量的训练数据
- 从大规模网络语料库中跨不同领域采样信息丰富的长尾实体
- (一个)问题构建智能体 使用可配置深度和广度参数的搜索工具探索每个实体,将发现的信息整合成问答对
- 具有异构配置(不同 Checkpoint 、系统 Prompt 等)的 (多个)答案生成智能体 为每个提出的 QA 对生成不同的候选响应
- 具有搜索能力的 一个验证智能体 通过多次轮询验证所有答案,只保留真实答案正确且所有候选答案均可验证为错误的样本
- 这些数据涵盖多种语言、领域和难度级别
- 为了补充这些可验证的样本并更好地反映现实世界的使用情况
- 第一:用来自现有有帮助 RL 数据集的过滤实例来增强数据集,对于这些数据集,搜索工具提供了 measurable benefits
- 第二:开发跨多个质量维度的详细评估准则(rubrics),并采用生成式奖励模型根据这些准则对响应进行评分
- 这种混合方法使得能够同时针对事实可靠性和实际帮助性进行优化
Code Agent
- 论文通过从 GitHub 挖掘数百万个 issue-Pull Request (PR) pairs,为软件问题解决构建了大规模、可执行的环境
- 该数据集使用启发式规则和 LLM-based 判断进行了严格过滤,以确保高质量,要求每个条目包含合理的问题描述、相关的 Gold Patch 以及用于验证的测试补丁
- 论文使用由 DeepSeek-V3.2 驱动的自动化环境设置智能体来为这些 pairs 构建可执行环境
- 该智能体处理包安装、依赖项解决和测试执行
- 测试结果以标准的 JUnit 格式输出,确保跨编程语言和测试框架的一致解析
- 只有当应用 Gold Patch 后,满足下面的条件,才认为环境成功构建
- non-zero count of false-to-positive(F2P)test cases(表明问题已修复)
- 即 F2P 数量不为 0:即至少存在一个测试用例曾经失败的,使用 Gold Patch 后成功了
- zero count of pass-to-fail(P2F)test cases(表明没有 regressions)
- P2F 数量为 0:即没有测试用例曾经成功,使用 Gold Patch 后,失败了
- non-zero count of false-to-positive(F2P)test cases(表明问题已修复)
- 使用此管道,论文成功构建了数万个可重现的问题解决环境,涵盖多种编程语言,包括 Python、Java、JavaScript、TypeScript、C、C++、Go 和 PHP
Code Interpreter Agent
- 利用 Jupyter Notebook 作为代码解释器来解决复杂的推理任务
- 作者策划了一组涵盖数学、逻辑和数据科学的多样化问题,每个问题都需要模型利用代码执行能力来得出 Solution
通用智能体(General Agent)【这里的流程还需要再明确】
为了在 RL 中扩大智能体环境和任务规模,作者用了一个自动环境合成智能体,它合成了 1827 个面向任务的环境
- 这些任务难以解决但易于验证
- 合成工作流程主要包括环境和工具集构建、任务合成以及 Solution 生成
具体来说,工作流程如下
- 1)给定一个任务类别(例如,规划旅行行程)和一个配备 bash 和搜索工具的沙盒,智能体首先使用这些工具从互联网生成或检索相关数据,并将它们存储在沙盒数据库中
- 2)智能体合成一组特定于任务的工具 ,每个工具都实现为一个函数
- 3)为了创建既具有挑战性又可自动验证的任务 ,智能体做如下工作:
- 首先:基于当前数据库 propose 一个简单任务,同时抽取这个任务的 Python 实现 Solution Function 和 Verification function
- 对 Solution function 的要求:
- 第一:这里的 Solution function 仅限于调用工具函数或执行逻辑计算,不能调用其他函数或直接访问数据库 ,确保只能通过工具接口(interface)解决问题
- 第二:这个 Solution function 产生的结果必须由 Verification function 验证
- 如果以上 Solution function 验证未通过,智能体将修改 Solution function 或 Verification function ,直到它产生的 Solution function 输出通过 Verification function 验证
- 对 Solution function 的要求:
- 然后:智能体迭代地增加任务难度 ,并更新相应的 Solution function 和 Verification function
- 在此迭代过程中,如果当前工具集不足以解决任务,智能体将扩展工具集
- 问题:扩展的依据是什么?何时扩展?
- 在此迭代过程中,如果当前工具集不足以解决任务,智能体将扩展工具集
- 问题:是针对同一个问题,逐步提升任务难度?还是针对不同难度的问题,先解决简单问题,再解决复杂问题?
- 首先:基于当前数据库 propose 一个简单任务,同时抽取这个任务的 Python 实现 Solution Function 和 Verification function
遵循此工作流程,获得了数千个
<环境, 工具, 任务, 验证器>(<environment, tools, task, verifier>) 元组- 理解:这里的
<environment, tools, task, verifier>是匹配对齐的,在这个环境envirnoment下,用这些工具tools能解决的任务task和 可以验证该 任务是否成功的验证器verifier
- 理解:这里的
然后使用 DeepSeek-V3.2 在该数据集上执行 RL,并仅保留
pass@100非 0 的实例,最终得到 1827 个环境及其相应的任务(共 4417 个)下面展示了一个合成的行程规划示例
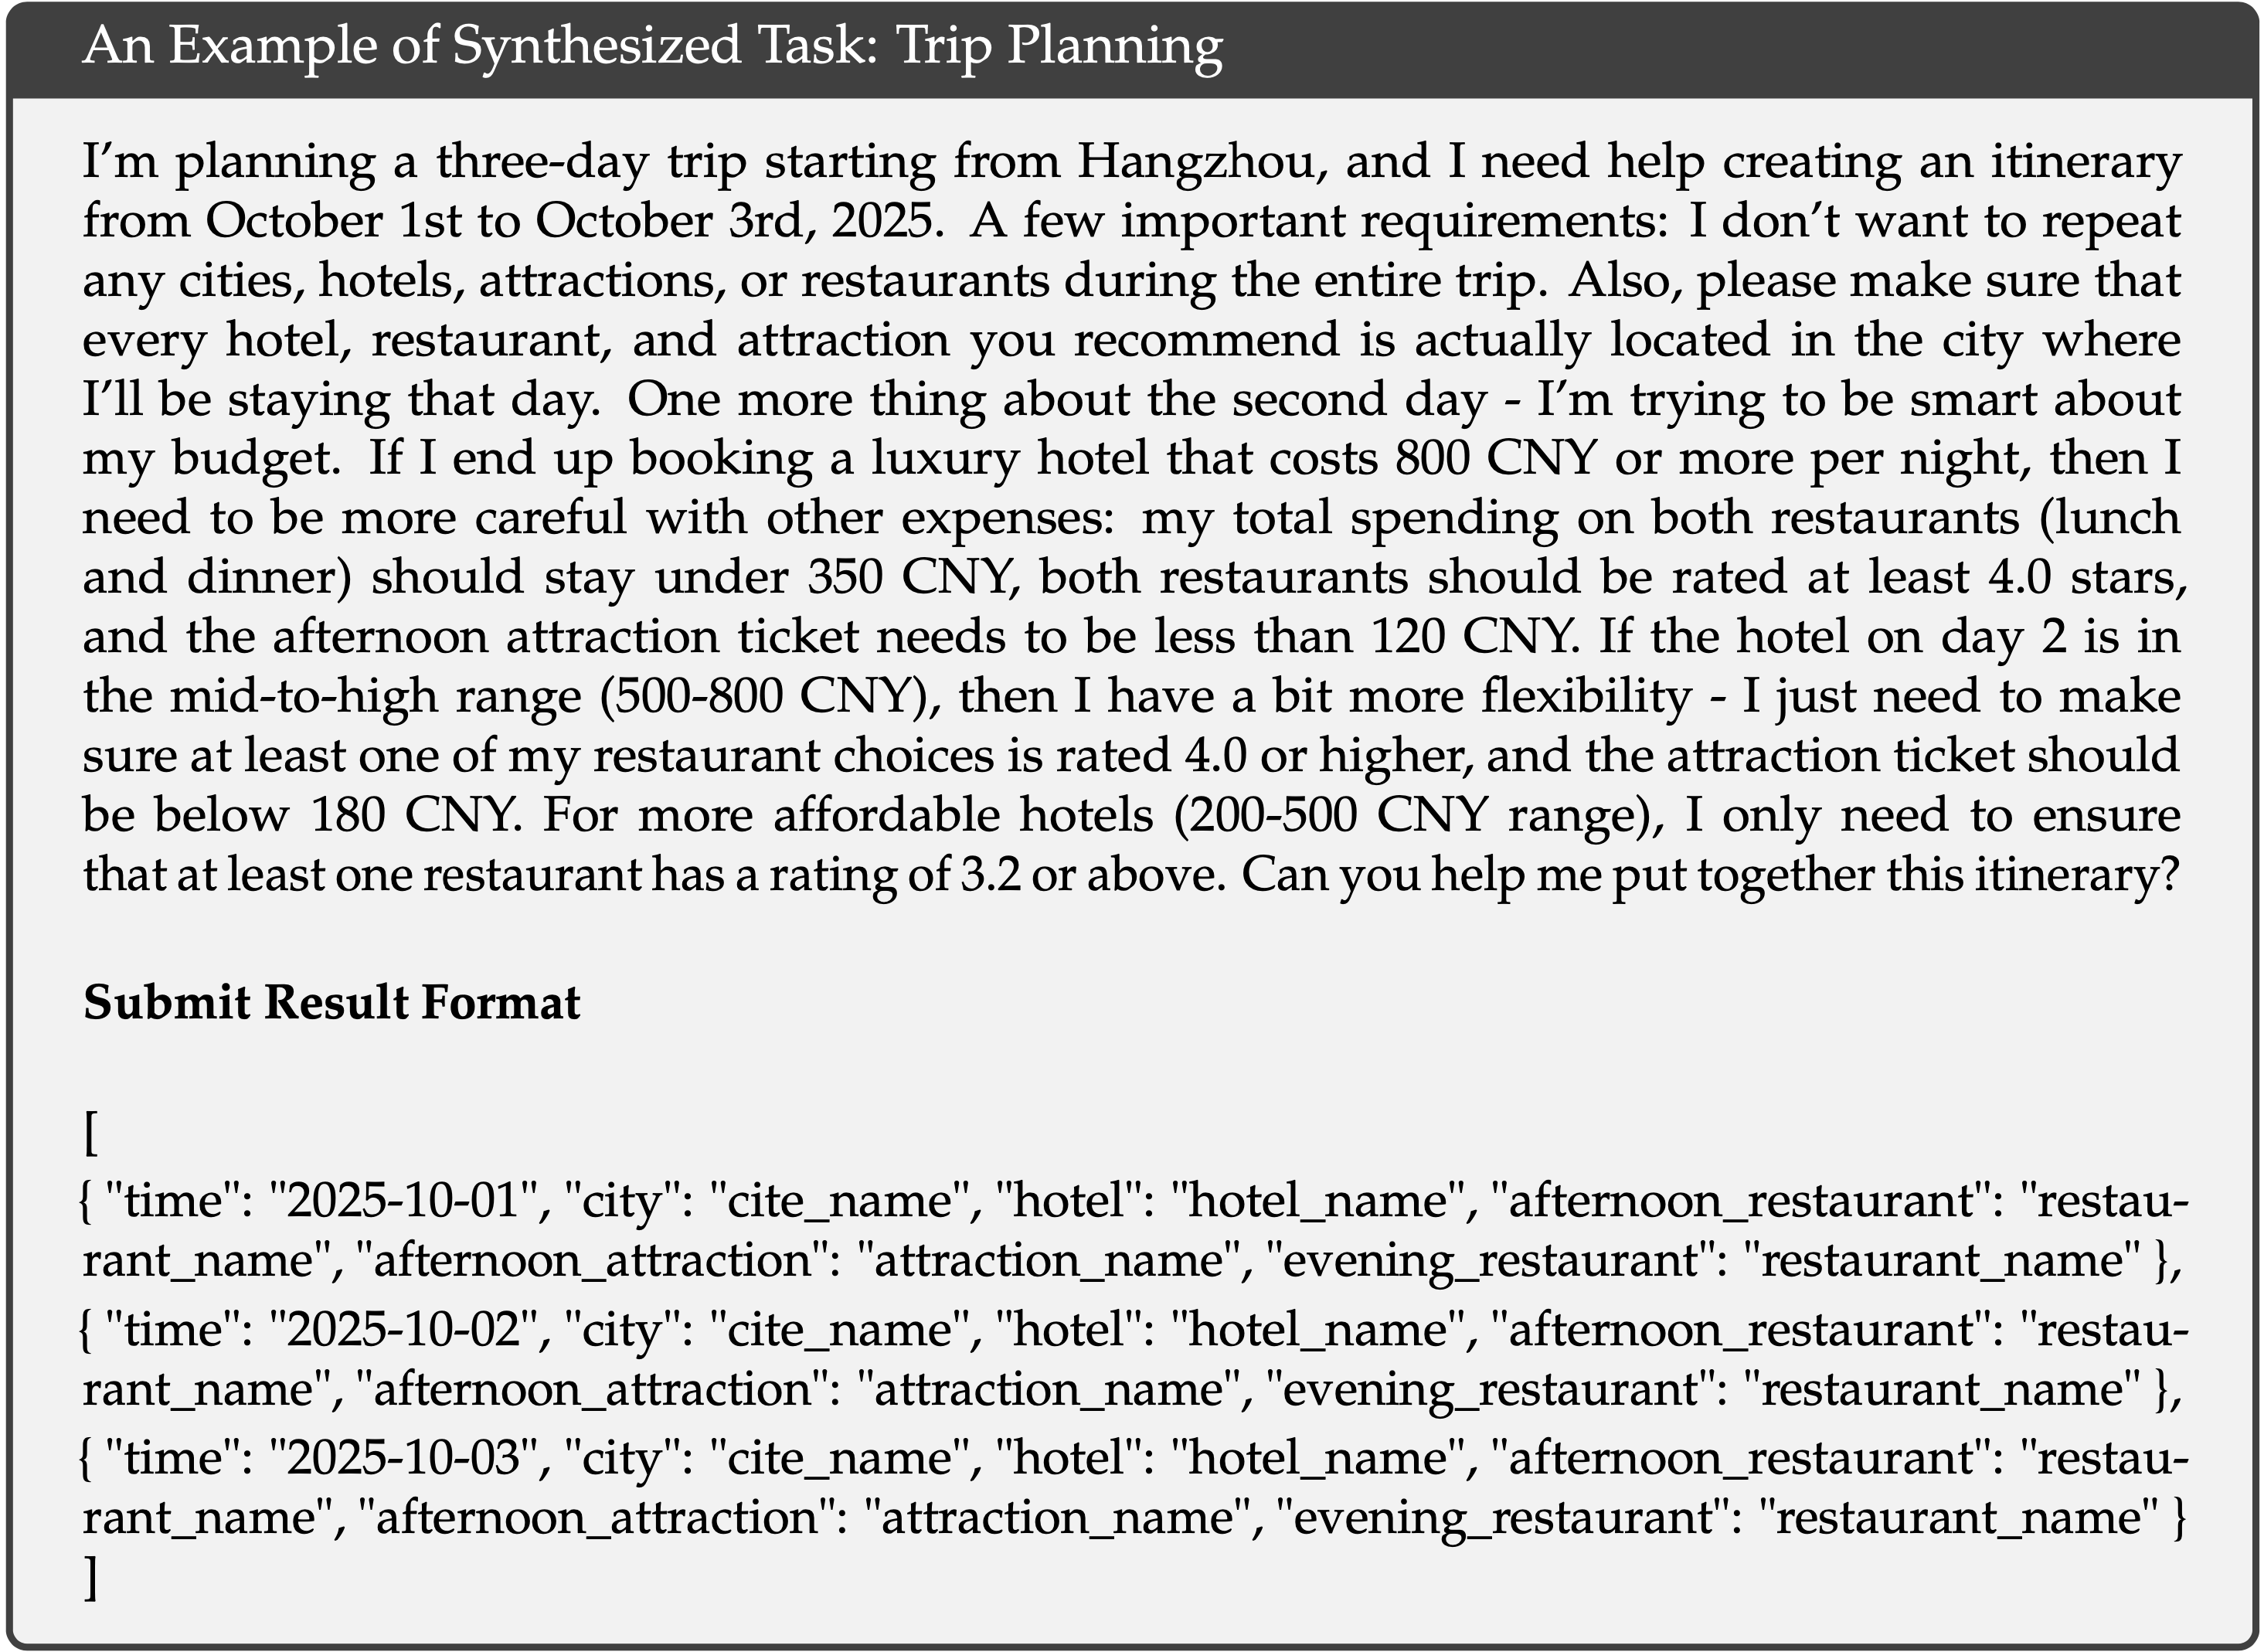
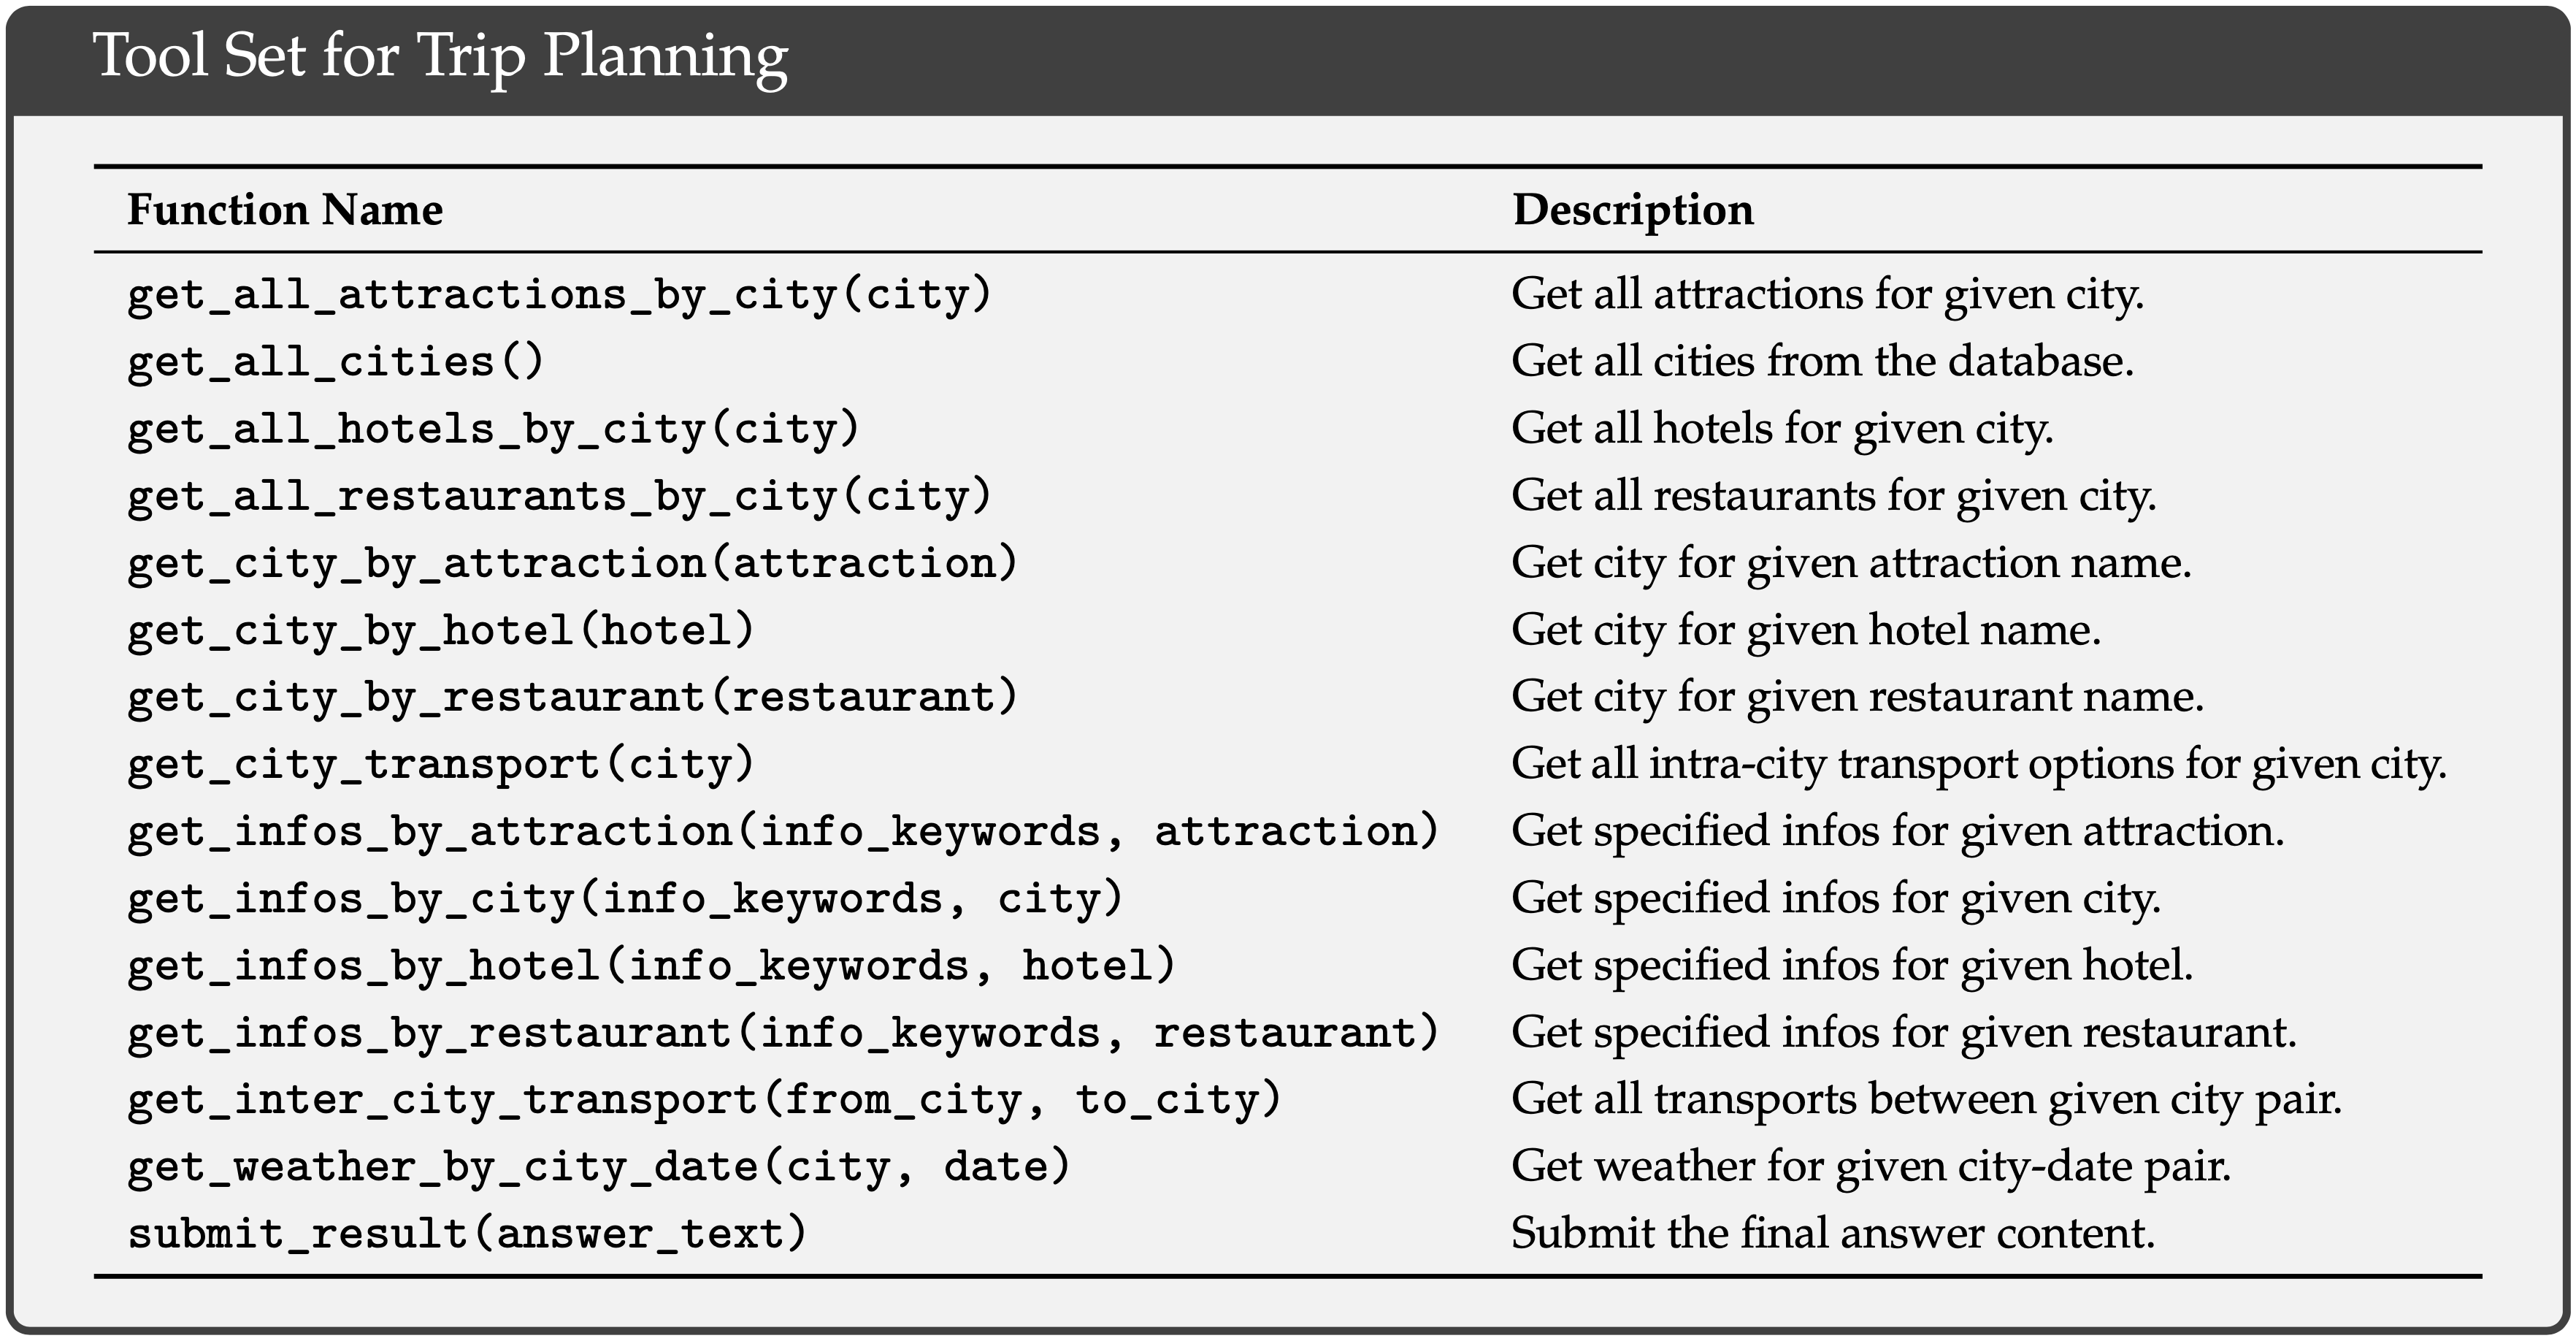
示例说明:此示例强调,虽然为满足所有约束的行程计划搜索大型组合空间具有挑战性,但检查给定的候选 Solution 是否满足这些约束则相对简单
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
**合成任务示例:行程规划(An Example of Synthesized Task: Trip Planning)**
我正在计划从杭州开始的三天旅行,需要帮助创建 2025 年 10 月 1 日至 10 月 3 日的行程。
一些重要要求:在整个旅行中,我不想重复任何城市、酒店、景点或餐厅。
另外,请确保你推荐的每家酒店、餐厅和景点实际上都位于我当天将要入住的城市。
关于第二天还有一件事——我正在试图精明地控制预算。如果我最终预订了每晚 800 元人民币或更贵的豪华酒店,那么我需要更加谨慎地控制其他开支:
我在两家餐厅(午餐和晚餐)的总消费应保持在 350 元人民币以下,两家餐厅的评分至少应为 4.0 星,并且下午景点的门票需要低于 120 元人民币。
如果第 2 天的酒店属于中高端范围(500-800 元人民币),那么我有更多的灵活性——我只需要确保我选择的至少一家餐厅评分在 4.0 或更高,并且景点门票应低于 180 元人民币。
对于更经济实惠的酒店(200-500 元人民币范围),我只需要确保至少一家餐厅的评分在 3.2 或以上。你能帮我制定这个行程吗?
**提交结果格式(Submit Result Format)**
```json
[
{"time": "2025-10-01", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"},
{"time": "2025-10-02", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"},
{"time": "2025-10-03", "city": "city_name", "hotel": "hotel_name", "afternoon_restaurant": "restaurant_name", "afternoon_attraction": "attraction_name", "evening_restaurant": "restaurant_name"}
]行程规划工具集(Tool Set for Trip Planning)
函数名称 描述 get_all_attractions_by_city(city)获取给定城市的所有景点 get_all_cities()从数据库获取所有城市 get_all_hotels_by_city(city)获取给定城市的所有酒店 get_all_restaurants_by_city(city)获取给定城市的所有餐厅 get_city_by_attraction(attraction)获取给定景点名称的城市 get_city_by_hotel(hotel)获取给定酒店名称的城市 get_city_by_restaurant(restaurant)获取给定餐厅名称的城市 get_city_transport(city)获取给定城市的所有市内交通选项 get_infos_by_attraction(info_keywords, attraction)获取给定景点的指定信息 get_infos_by_city(info_keywords, city)获取给定城市的指定信息 get_infos_by_hotel(info_keywords, hotel)获取给定酒店的指定信息 get_infos_by_restaurant(info_keywords, restaurant)获取给定餐厅的指定信息 get_inter_city_transport(from_city, to_city)获取给定城市对之间的所有交通方式 get_weather_by_city_date(city, date)获取给定城市-日期对的天气 submit_result(answer_text)提交最终答案内容
Evaluation
Main Results
- 作者在多个 Benchmark 上进行了评估,包括:
- MMLU-Pro (2024)
- GPQA Diamond (2023)
- Human Last Exam (HLE) Text-only (2025)
- LiveCodeBench (2024.08-2025.04)
- Codeforces
- Aider-Polyglot
- AIME 2025
- HMMT Feb 2025
- HMMT Nov 2025 (2025)
- IMOAnswerBench (2025)
- Terminal Bench 2.0
- SWE-Verified (OpenAI, 2024b)
- SWE Multilingual (2025)
- BrowseComp (2025)
- BrowseCompZh (2025)
- \(\tau^{2}\)-bench (2025)
- MCP-Universe (2025)
- MCP-Mark (EvalSys, 2025)
- Tool-Decathlon (2025)
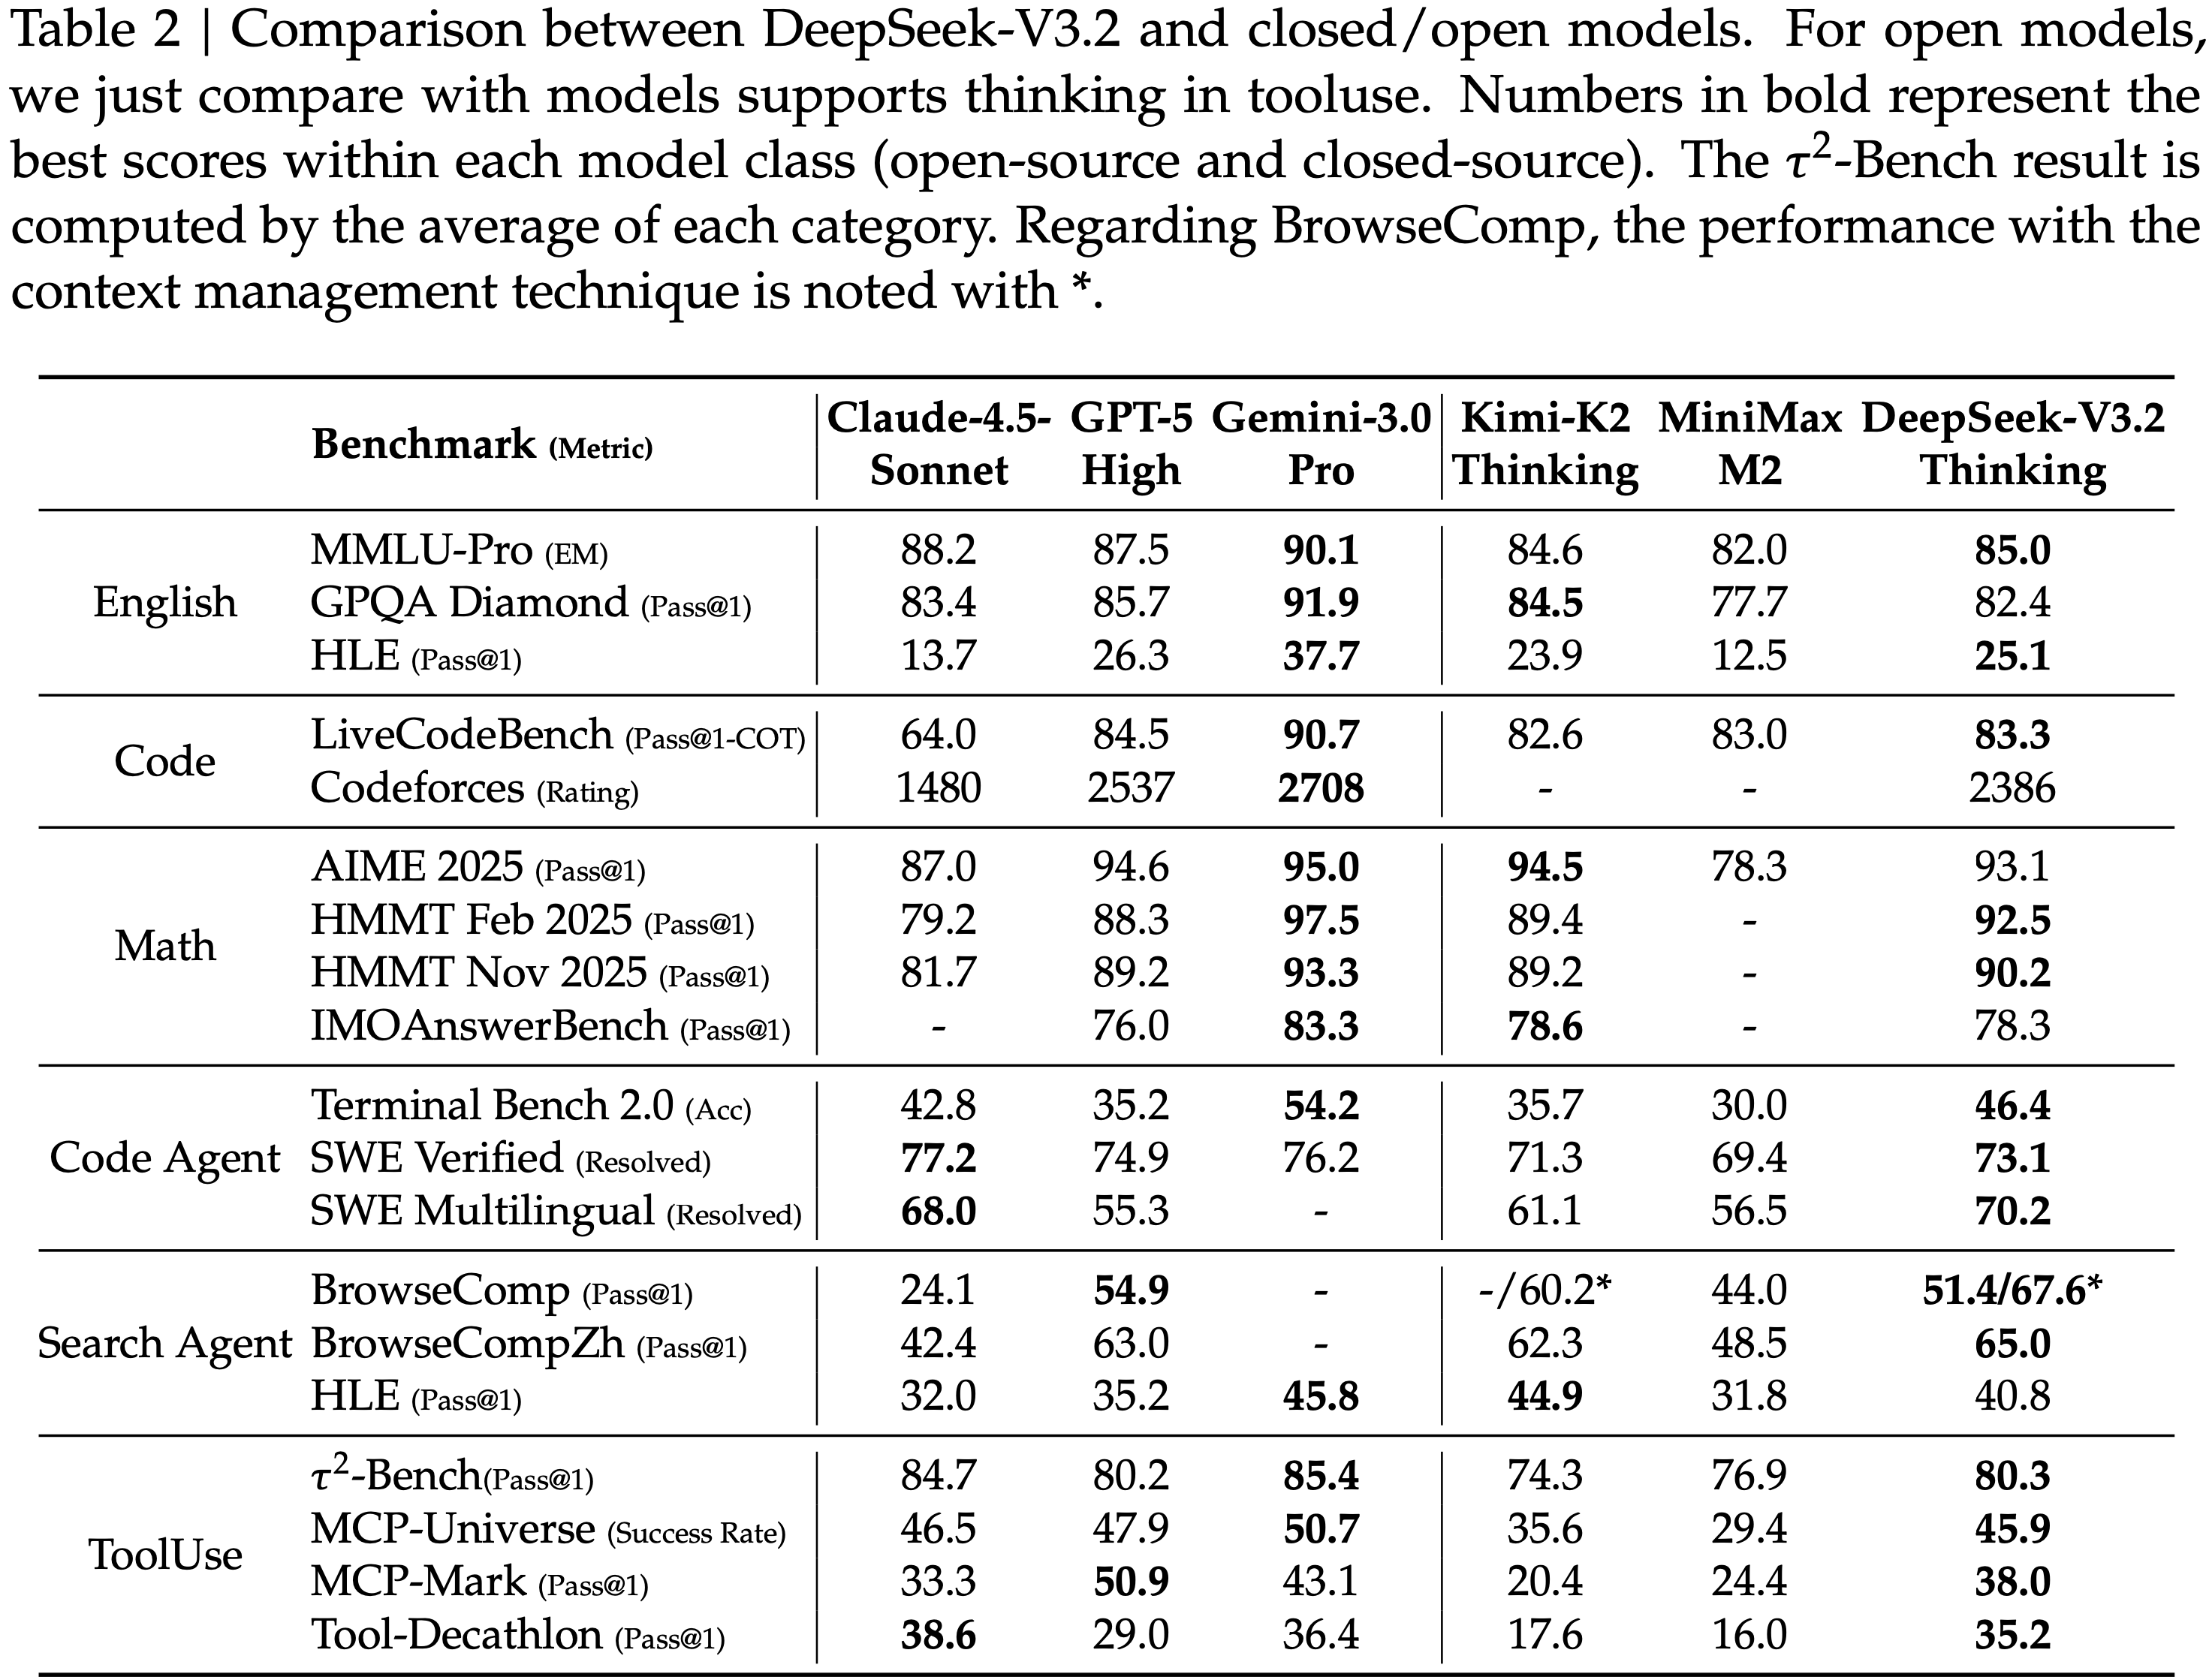
- 评估说明及结果:
- 工具使用基准使用标准函数调用格式进行评估,其中模型配置为思考模式
- MCP-Universe (2025) 和 MCP-Mark (EvalSys, 2025),使用内部环境评估所有模型
- 因为搜索和 playwright 环境可能与官方设置略有不同
- 论文中,将温度设置为 1.0,上下文窗口设置为 128K tokens
- 对于数学相关任务,如 AIME, HMMT, IMOAnswerBench 和 HLE(理解:其实 HLE 中不全是数学):
- 论文使用以下模板进行评估:
"{question}\n Please reason step by step, and put your final answer within \boxed{}"- 理解:这是一个业内目前常用的 Thinking 模板
- 注:对于 HLE,论文还使用官方模板评估了 DeepSeek-V3.2-Thinking,得分为 23.9
- 论文使用以下模板进行评估:
- 在推理任务上(reasoning tasks):
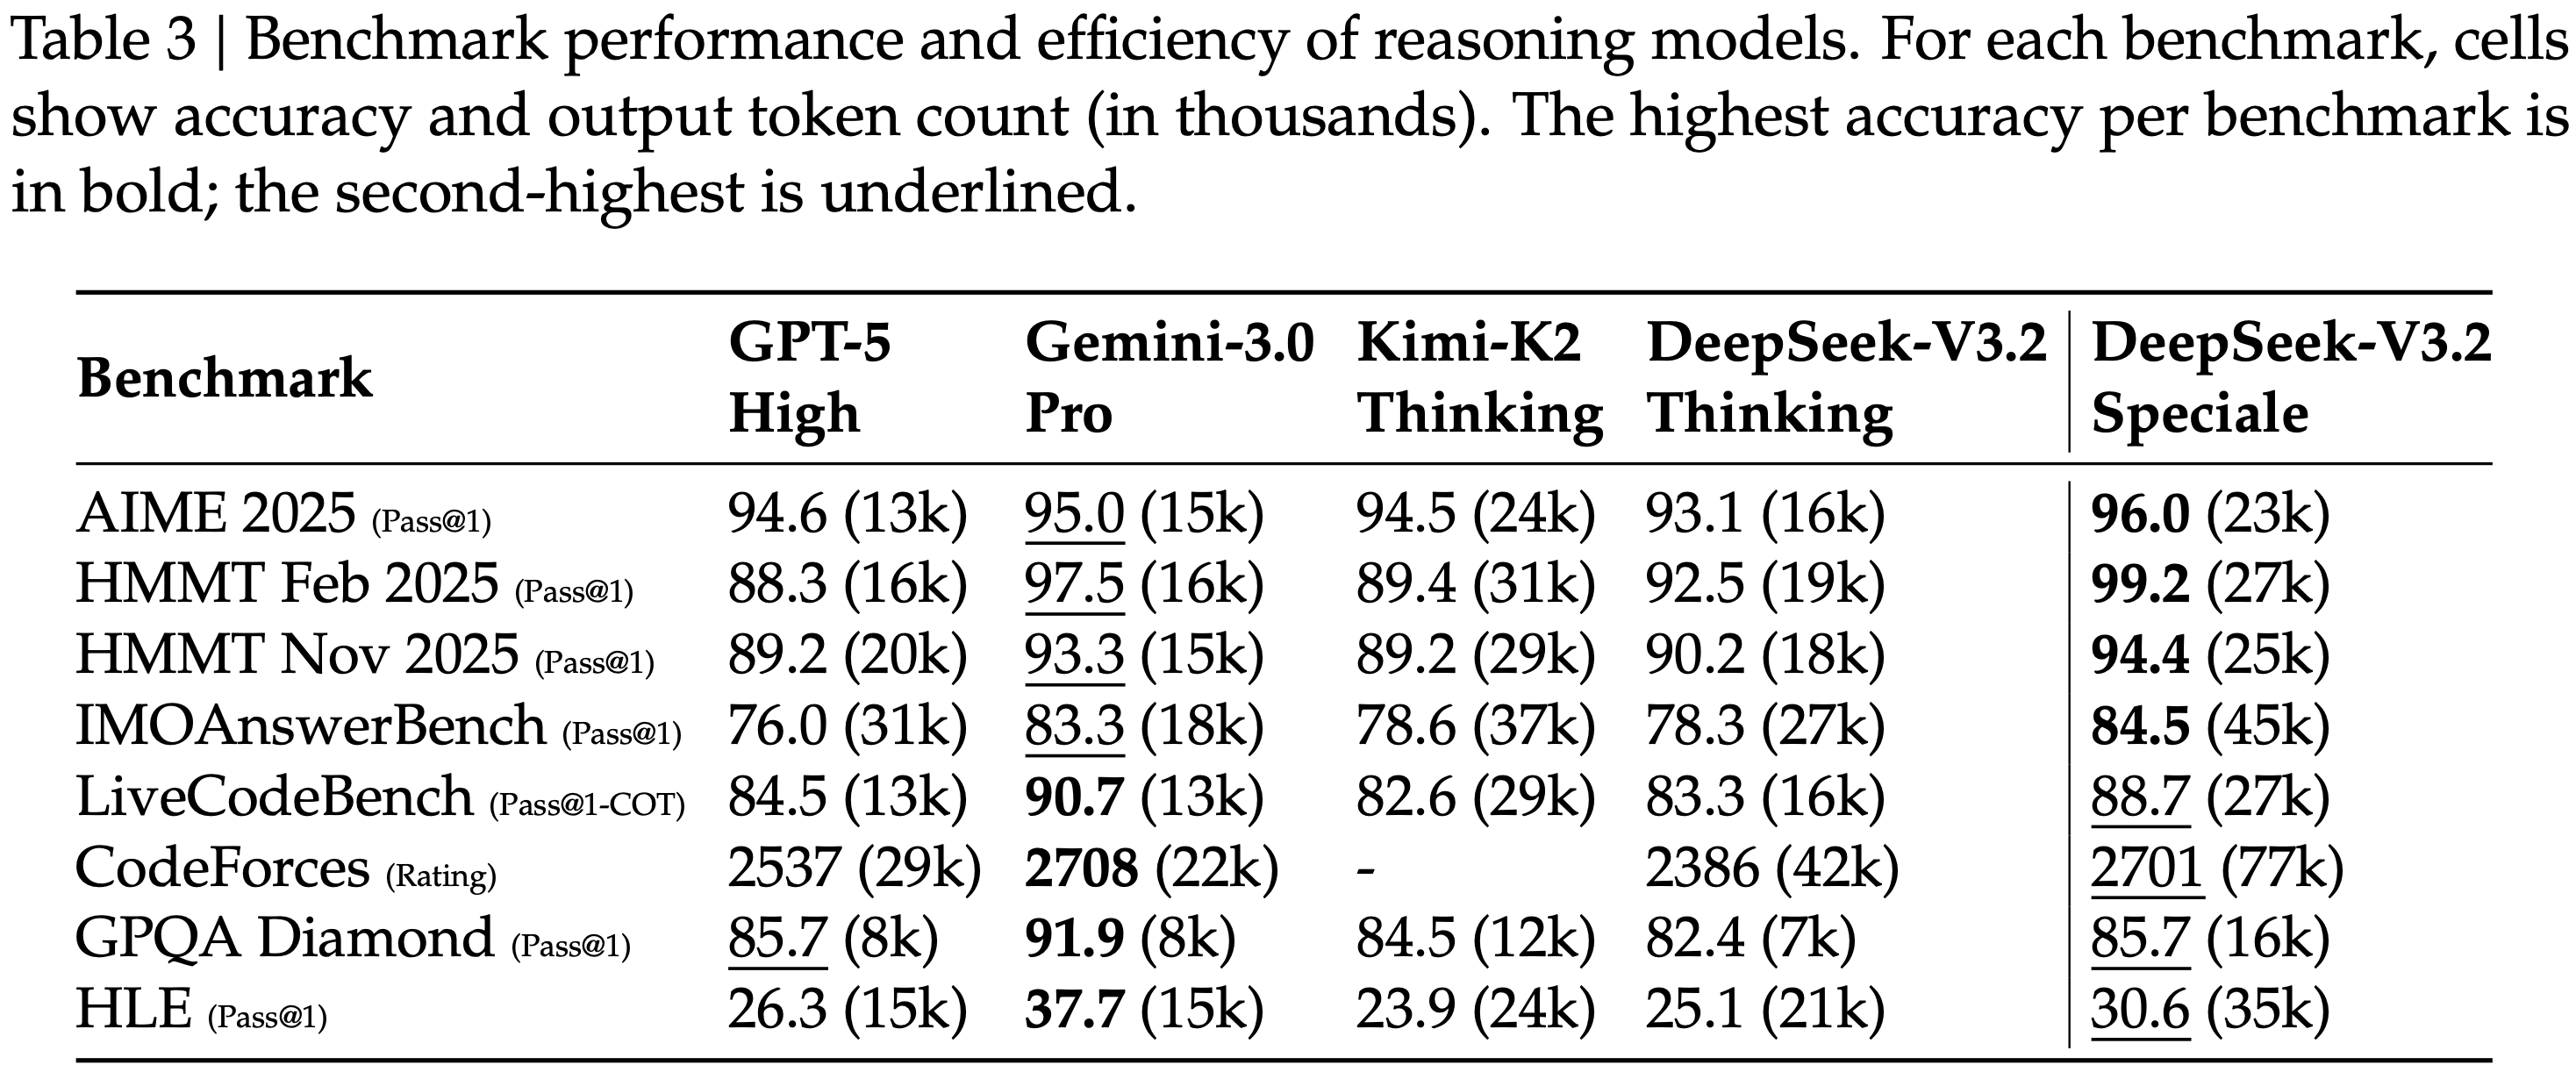
- DeepSeek-V3.2 与 GPT-5-high 表现相当,略逊于 Gemini-3.0-Pro
- 与 K2-Thinking 相比,DeepSeek-V3.2 以显著更少的输出 token 获得了相似的分数,如表 3 所示
- 这些性能提升可归因于分配给 RL 训练的计算资源增加
- 在最近几个月,作者观察到性能的持续改进与 RL 训练预算的延长相关,该预算已超过预训练成本的 \(10%\)
- 作者假设额外的计算预算分配可以进一步增强推理能力
- 论文呈现的 DeepSeek-V3.2 性能受到长度约束奖励模型的限制;在移除该限制后,论文观察到模型性能的进一步提升,详见第 4.2 节
- 在代码智能体任务中(code agent evaluations):
- DeepSeek-V3.2 在 SWE-bench Verified 和 Terminal Bench 2.0 上均显著优于开源 LLM
- 展示了 DeepSeek-V3.2 在现实世界编码工作流程中的潜力
- 关于 Terminal Bench 2.0 的特别说明
- (如前所述)作者为 “思考模式(thinking mode)” 设计的上下文管理策略目前与 Terminus 不兼容;
- 因此,报告的 46.4 分是使用 Claude Code 框架实现的
- 作者也使用 Terminus 在非思考模式(non-thinking mode)下评估了 DeepSeek-V3.2,得分为 39.3
- 对于 SWE-bench Verified,主要得分是使用 DeepSeek 的内部框架获得的
- 在其他设置(包括 Claude Code 和 RooCode 框架,以及非思考模式)下的鲁棒性测试产生了一致的结果,范围在 72 到 74 之间
- DeepSeek-V3.2 在 SWE-bench Verified 和 Terminal Bench 2.0 上均显著优于开源 LLM
- 对于搜索智能体评估(search agent evaluation)
- 论文使用标准的商业搜索 API 评估论文的模型
- 由于 DeepSeek-V3.2 最大仅支持 128K 的上下文长度,大约 \(20%\) 以上的测试用例超过此限制
- 为了解决这个问题,作者采用了一种上下文管理方法来获得最终分数
- 注:不使用上下文管理的分数是 51.4
- 更多细节在第 4.4 节提供
- 在工具使用基准上(tool-use benchmarks):
- DeepSeek-V3.2 显著缩小了 open-source 与 closed-source LLM 之间的性能差距,但仍低于 frontier 模型
- 对于 \(\tau^{2}\)-bench
- 作者使用模型本身作为 User Agent,获得的最终类别分数为 63.8 (Airline), 81.1 (Retail), and 96.2 (Telecom)
- 对于 MCP 基准
- 作者使用函数调用格式,并将工具输出放在标记为 ‘tool’ 角色的消息中,而不是 ‘user’ 角色
- 在论文的测试中,作者观察到 DeepSeek-V3.2 经常进行冗余的自我验证,生成了过长的轨迹
- 这种倾向通常导致上下文长度超过 128K 的限制,特别是在诸如 MCP-Mark GitHub 和 Playwright 评估等任务中
- 因此,这种现象阻碍了 DeepSeek-V3.2 的最终性能
- 但集成上下文管理策略可以进一步提高性能
- 论文将此确定为未来工作的方向和对用户的实用考虑
- 即使 DeepSeek-V3.2 存在此问题,它仍然显著优于现有的开源模型
- 这种倾向通常导致上下文长度超过 128K 的限制,特别是在诸如 MCP-Mark GitHub 和 Playwright 评估等任务中
- Notably,由于这些基准中使用的环境和工具集在 RL 训练期间未遇到过 ,观察到的改进证明了 DeepSeek-V3.2 将其推理策略泛化到领域外智能体场景的能力
- 非思考模型在智能体场景中的评估见附录表 9
Results of DeepSeek-V3.2-Speciale
- 表 3 表明,DeepSeek-V3.2-Speciale 通过利用增加的推理 token 获得了卓越的性能,在多个基准上超越了 SOTA Gemini-3.0-Pro
- Remarkably,如表 4 所示
- DeepSeek-V3.2-Speciale 这个通用模型在 2025 年国际信息学奥林匹克竞赛(IOI)和 ICPC 世界总决赛(ICPC WF)中达到了金牌级别的性能,而无需针对性的训练
- Furthermore,通过结合 Shao 等人 (2025) 的技术,DeepSeek-V3.2-Speciale 模型在复杂的证明任务中表现出色,达到了 2025 年国际数学奥林匹克竞赛(IMO)和中国数学奥林匹克竞赛(CMO)的金牌门槛\(^5\)
- 详细的评估协议在附录 D 中提供
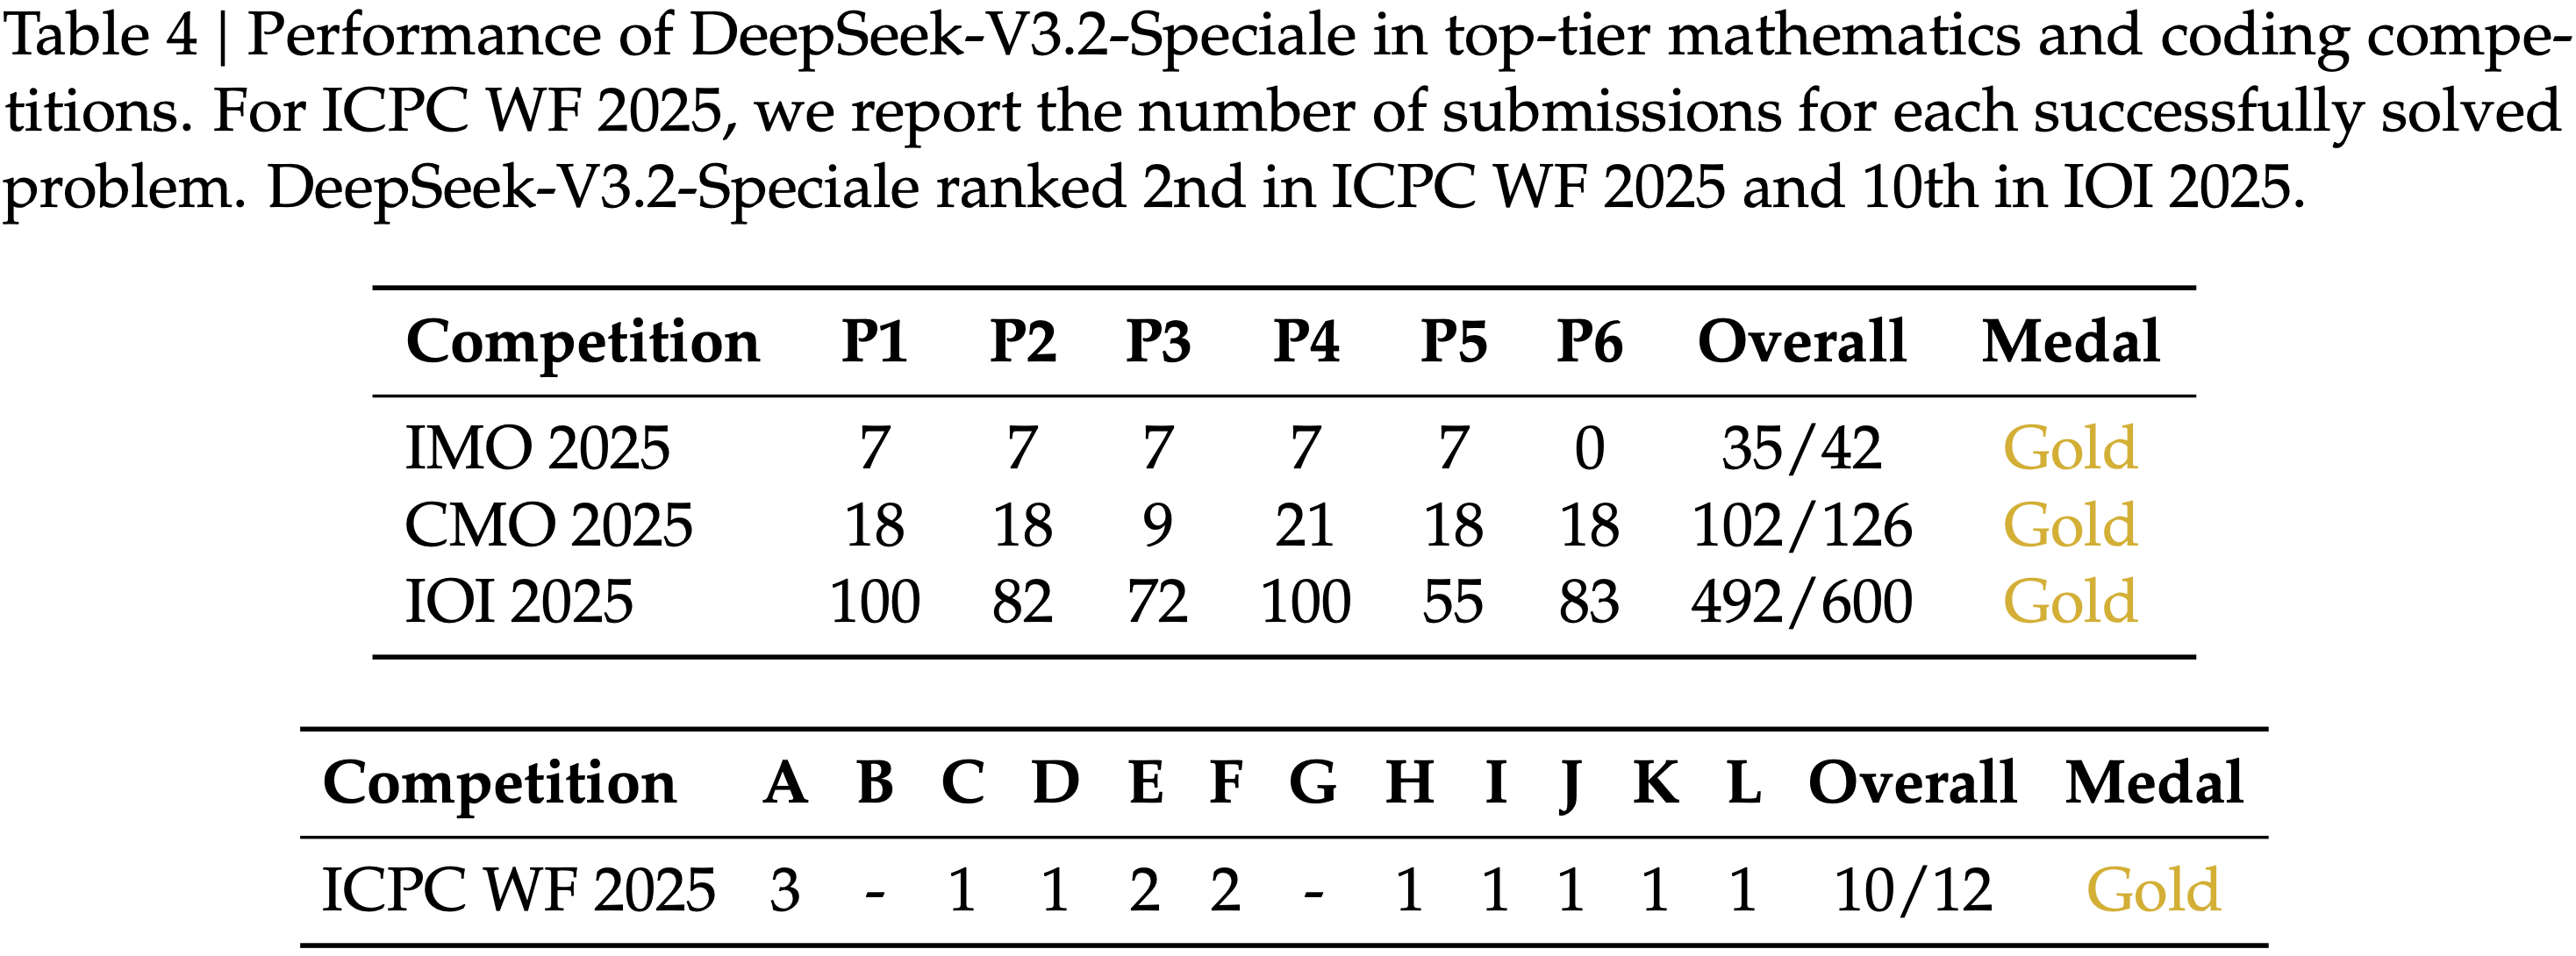
- However,DeepSeek-V3.2-Speciale 的 token 效率仍然显著低于 Gemini-3.0-Pro
- 为了降低部署成本和延迟,作者在官方 DeepSeek-V3.2 的训练中施加了更严格的 token 约束,旨在优化性能与成本之间的权衡
- 作者认为 token 效率仍然是未来研究的一个关键领域
Synthesis Agentic Tasks
- 在本节中,作者进行消融实验来研究合成智能体任务的效果
- 论文关注两个问题
- 第一:合成任务对强化学习来说是否足够具有挑战性?
- 第二:这些合成任务的泛化能力如何,即它们能否迁移到不同的下游任务或现实世界环境?
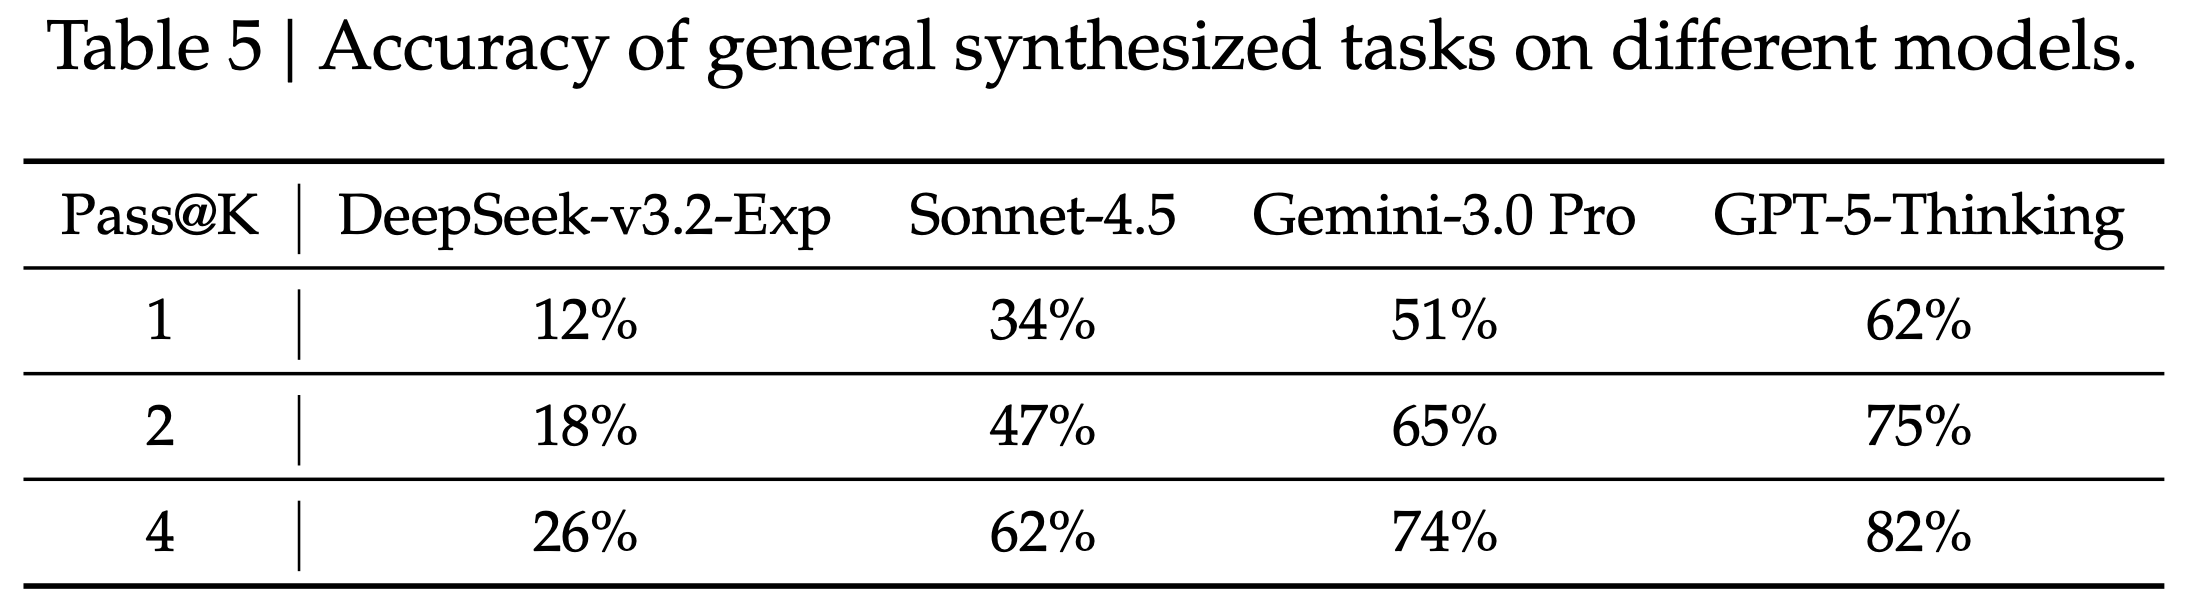
- 为了回答第一个问题,作者从通用合成智能体任务中随机抽取 50 个实例,并评估用于合成的模型和 frontier closed-source LLM
- 如表 5 所示,DeepSeek-V3.2-Exp 的准确率仅为 12%,而 frontier closed-source 模型的准确率最多为 62%
- 这些结果表明,合成数据包含了对 DeepSeek-V3.2-Exp 和 frontier closed-source 模型都具有挑战性的智能体任务
- 这些结果表明,合成数据包含了对 DeepSeek-V3.2-Exp 和 frontier closed-source 模型都具有挑战性的智能体任务
- 为了研究合成数据上的 RL 能否泛化到不同的任务或现实世界环境
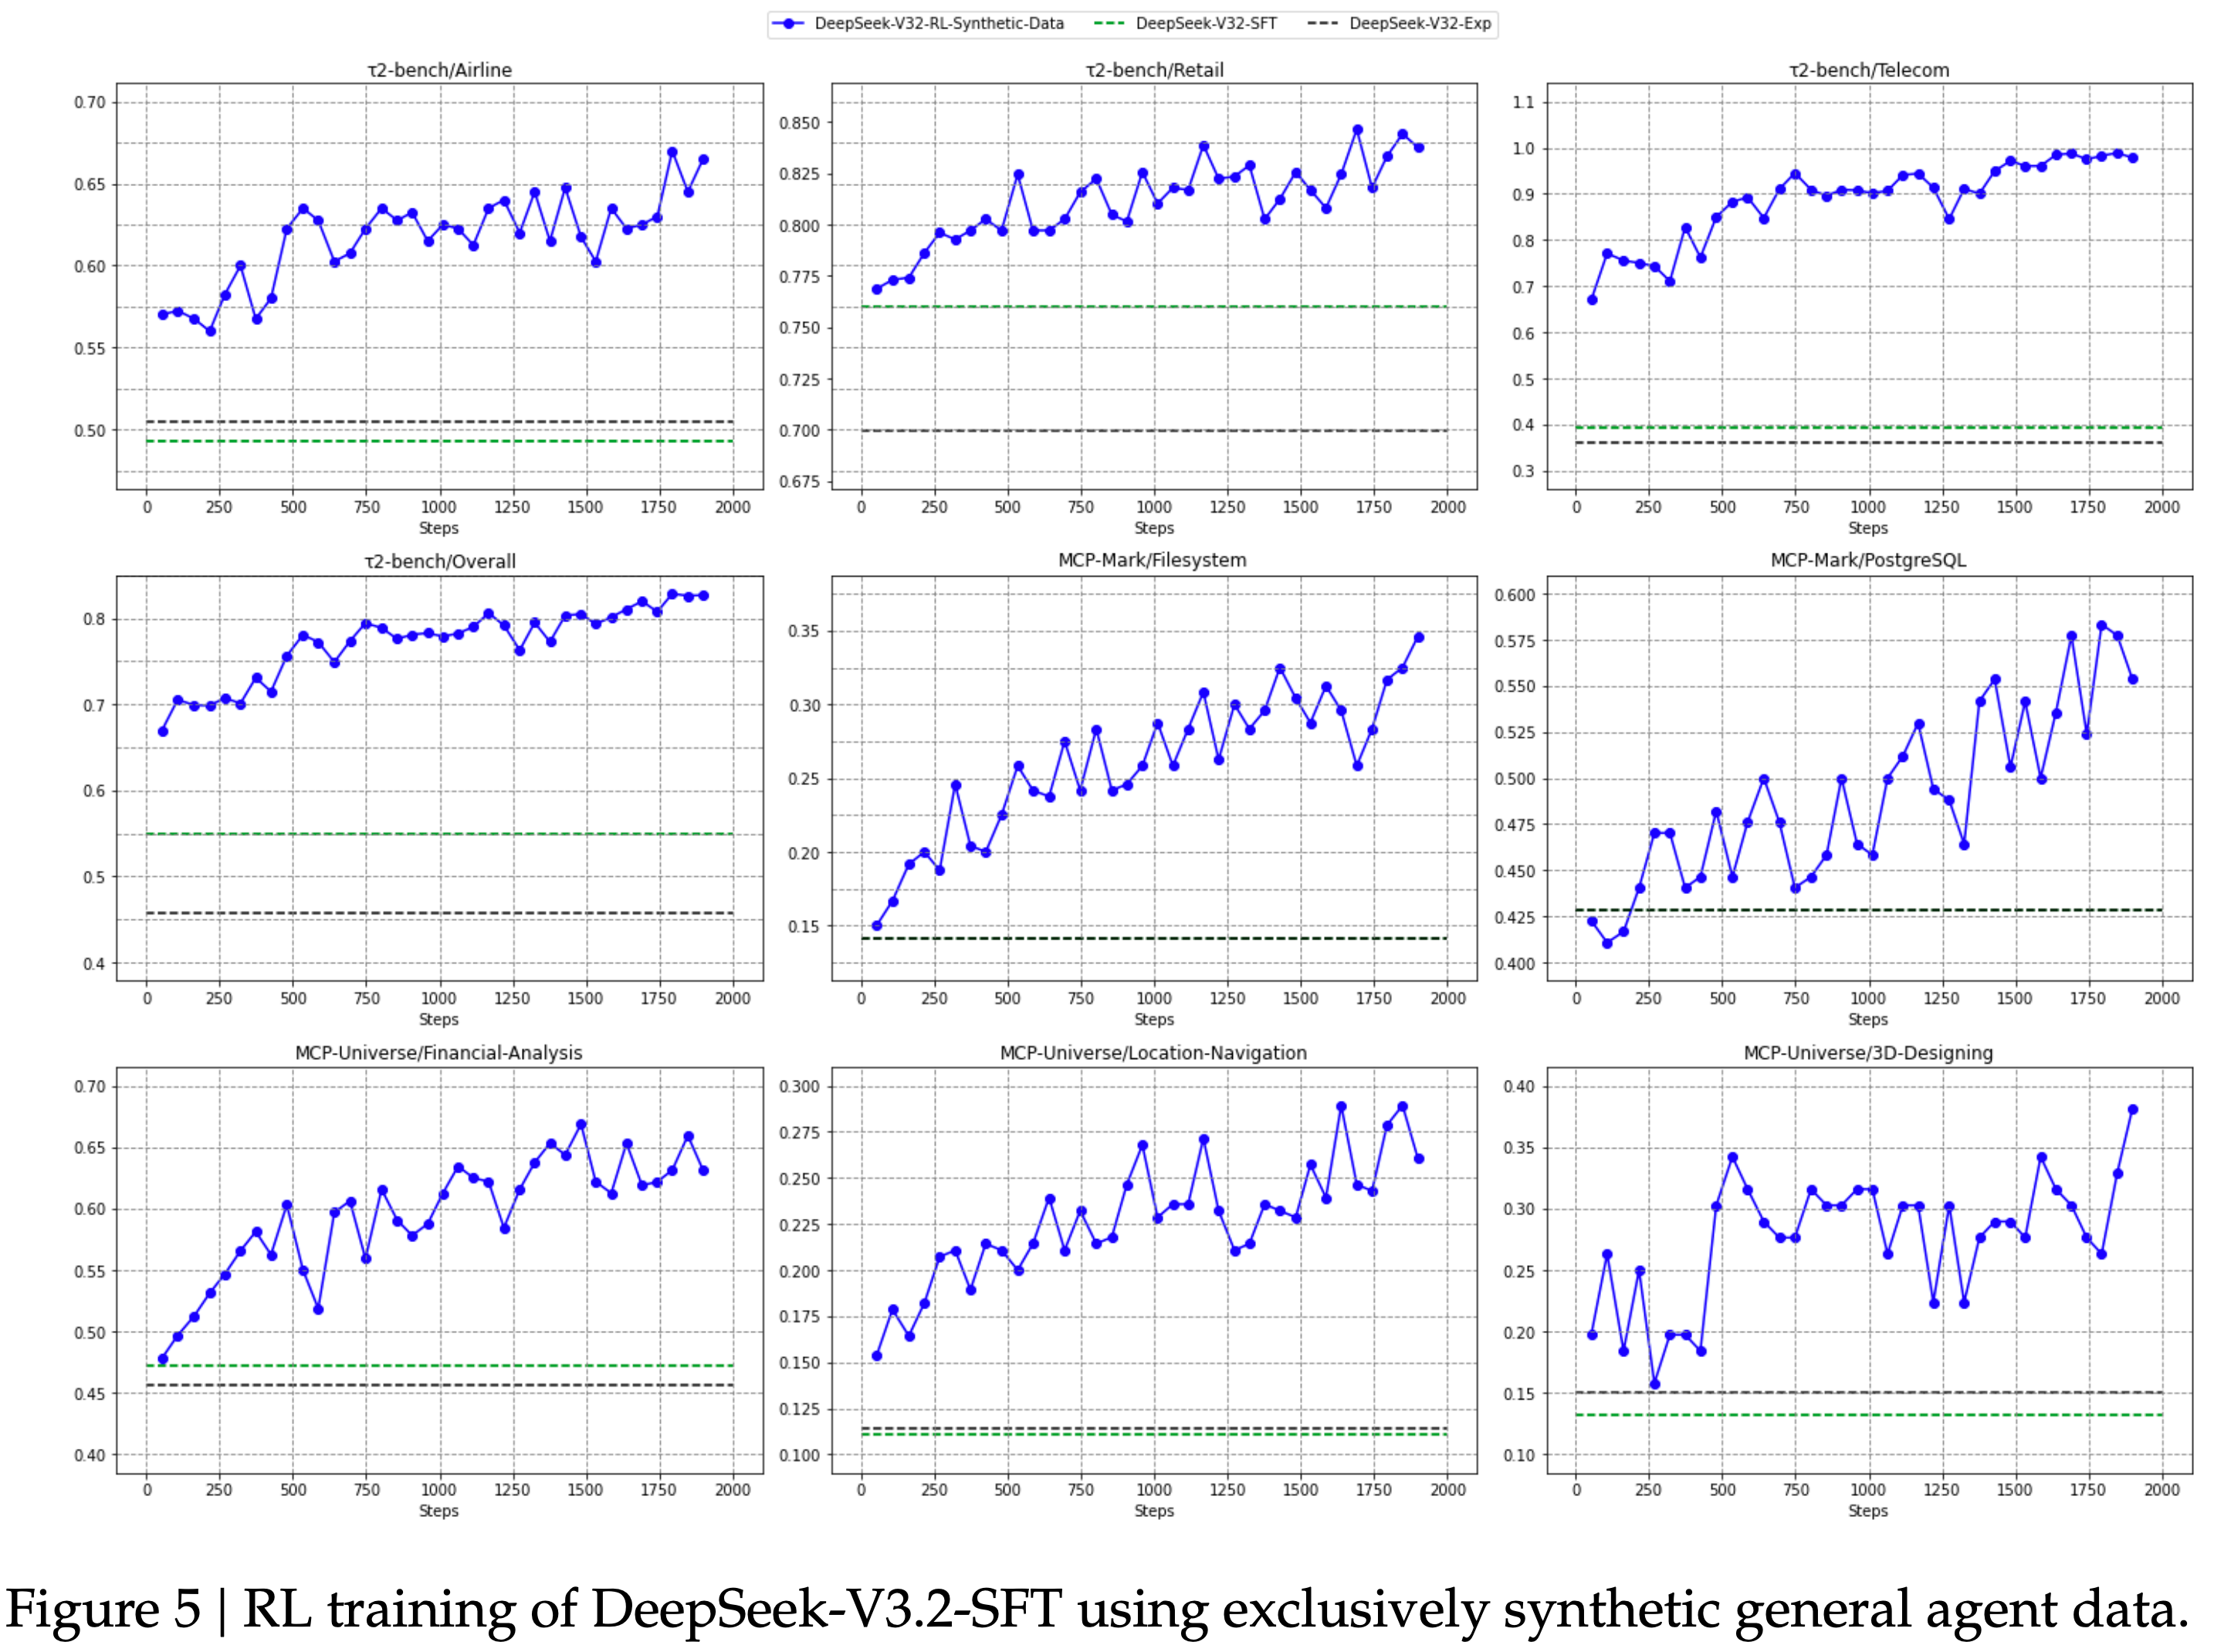
- 作者对 DeepSeek-V3.2 的 SFT Checkpoint(记为 DeepSeek-V3.2-SFT)应用 RL
- 为了排除长 Thinking 链和其他 RL 数据的影响
- 作者仅在非思考模式下对合成智能体任务进行 RL
- 作者将上述模型与 DeepSeek-V3.2-SFT 和 DeepSeek-V3.2-Exp 进行比较
- 其中 DeepSeek-V3.2-Exp 仅在搜索和代码环境中进行了 RL 训练(即不包含 合成数据)
- DeepSeek-V3.2-SFT 则未经过任何 RL 训练
- 如图 5 所示,在合成数据上进行大规模 RL 在 Tau2Bench、MCP-Mark 和 MCP-Universe 基准上相比 DeepSeek-V3.2-SFT 带来了显著的改进
- 相比之下,将 RL 限制在代码和搜索场景并未改善这些基准上的性能,进一步凸显了合成数据的潜力
- 相比之下,将 RL 限制在代码和搜索场景并未改善这些基准上的性能,进一步凸显了合成数据的潜力
Context Management of Search Agent
- 即使使用扩展的上下文窗口(如 128k),智能体工作流,特别是在基于搜索的场景中,也经常会遇到最大长度限制,从而过早地截断推理过程
- 这个瓶颈抑制了测试时计算潜力的充分发挥
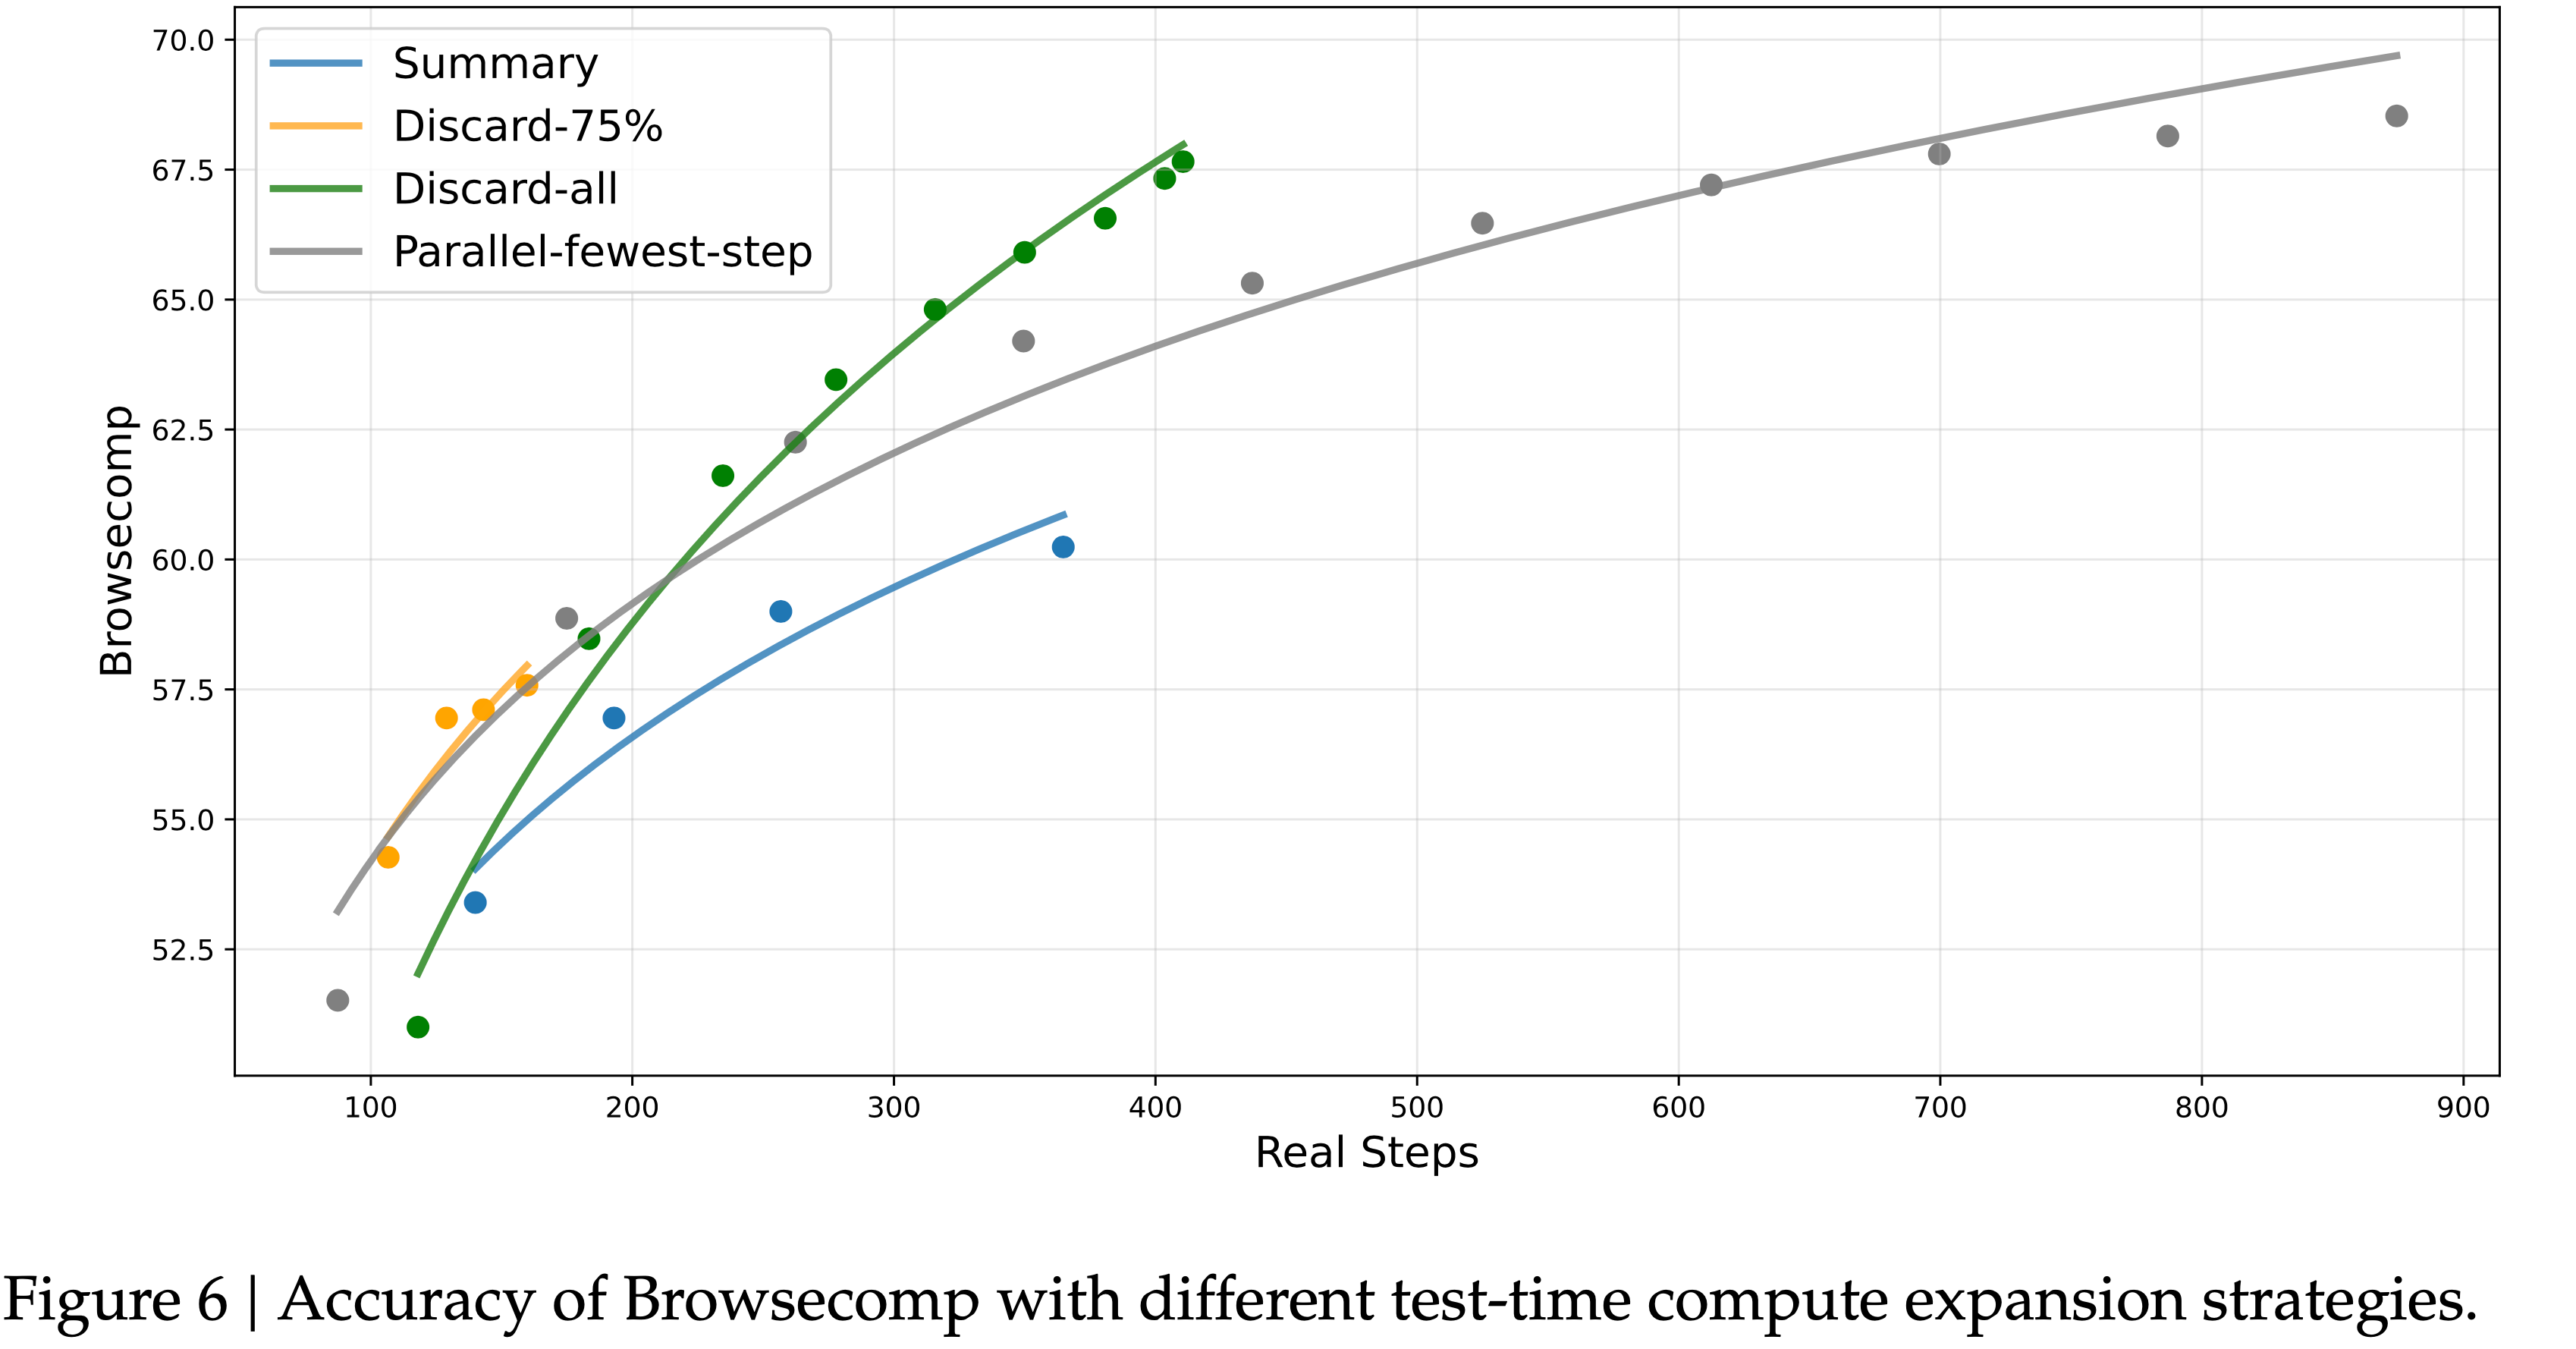
- 为了解决这个问题,当 token 使用量超过上下文窗口长度的 80% 时,作者引入了上下文管理,采用简单的策略在测试时扩展 token 预算
- 这些策略包括:
- (1) 总结 (Summary) :总结溢出的轨迹并重新启动 rollout;
- (2) 丢弃-75% (Discard-75%) :丢弃轨迹中前 75% 的工具调用历史以释放空间;
- (3) 全部丢弃 (Discard-all) :通过丢弃之前所有工具调用历史来重置上下文(类似于新的上下文工具 Anthropic (2025a))
- 为了比较,论文还实现了一个并行扩展基线:
- 并行最少步骤 (Parallel-fewest-step) :采样 N 个独立的轨迹并选择步骤最少的轨迹
- 论文在 BrowseComp 基准 (2025) 上评估这些策略
- 如图 6 所示:
- 在不同的计算预算下,上下文管理通过允许模型扩展测试时计算、提供更多空间来执行额外的执行步骤,从而带来显著的性能提升
- Summary 将平均步骤从 140 扩展到 364,将性能从 53.4 提高到 60.2;但其整体效率相对较低
- 尽管 Discard-all 很简单,但它在效率和可扩展性方面都表现良好,达到了 67.6 分,与并行扩展相当,同时使用的步骤显著更少
- In summary:
- 测试时计算可以通过上下文管理串行扩展,也可以并行扩展,两者都能有效扩展模型的问题解决能力
- 但不同的策略表现出不同的效率和可扩展性
- Thus,在对模型性能进行基准测试时,考虑实际的计算成本至关重要
- Meanwhile,寻找串行和并行扩展的最佳组合以最大化效率和可扩展性,仍然是未来工作的一个关键方向
Conclusion, Limitation, and Future Work
- 论文介绍了 DeepSeek-V3.2,有效弥合计算效率与高级推理能力之间差距
- DeepSeek-V3.2 使用 DSA 解决了关键的计算复杂性,同时没有牺牲长上下文性能
- (通过增加计算预算)DeepSeek-V3.2 在推理基准上实现了与 GPT-5 相当的性能
- 论文的大规模智能体任务合成 Pipeline 的集成显著提高了工具使用熟练度,为具有开放 LLM 的鲁棒和可泛化的人工智能智能体开启了新的可能性
- 高计算变体 DeepSeek-V3.2-Speciale,通过在 IMO 和 IOI 中获得的金牌成就得到了验证,为开放 LLM 树立了一个里程碑
- 尽管取得了这些成就,与诸如 Gemini-3.0-Pro 这样的 frontier closed-source 模型相比,作者承认存在某些局限性
- 第一:由于总训练 FLOPs 较少,DeepSeek-V3.2 的世界知识的广度仍然落后于领先的专有模型
- 论文计划在未来的迭代中通过扩大预训练计算来解决这一知识差距
- 第二:token 效率仍然是一个挑战;
- DeepSeek-V3.2 通常需要更长的生成轨迹(即更多 token)来匹配像 Gemini-3.0-Pro 这样的模型的输出质量
- 未来的工作将侧重于优化模型推理链的智能密度以提高效率
- 第三,解决复杂任务的能力仍然不如前沿模型,作者将进一步改进论文的基础模型和后训练方案
- 第一:由于总训练 FLOPs 较少,DeepSeek-V3.2 的世界知识的广度仍然落后于领先的专有模型
附录 A: MLA 的 MHA 与 MQA 模式
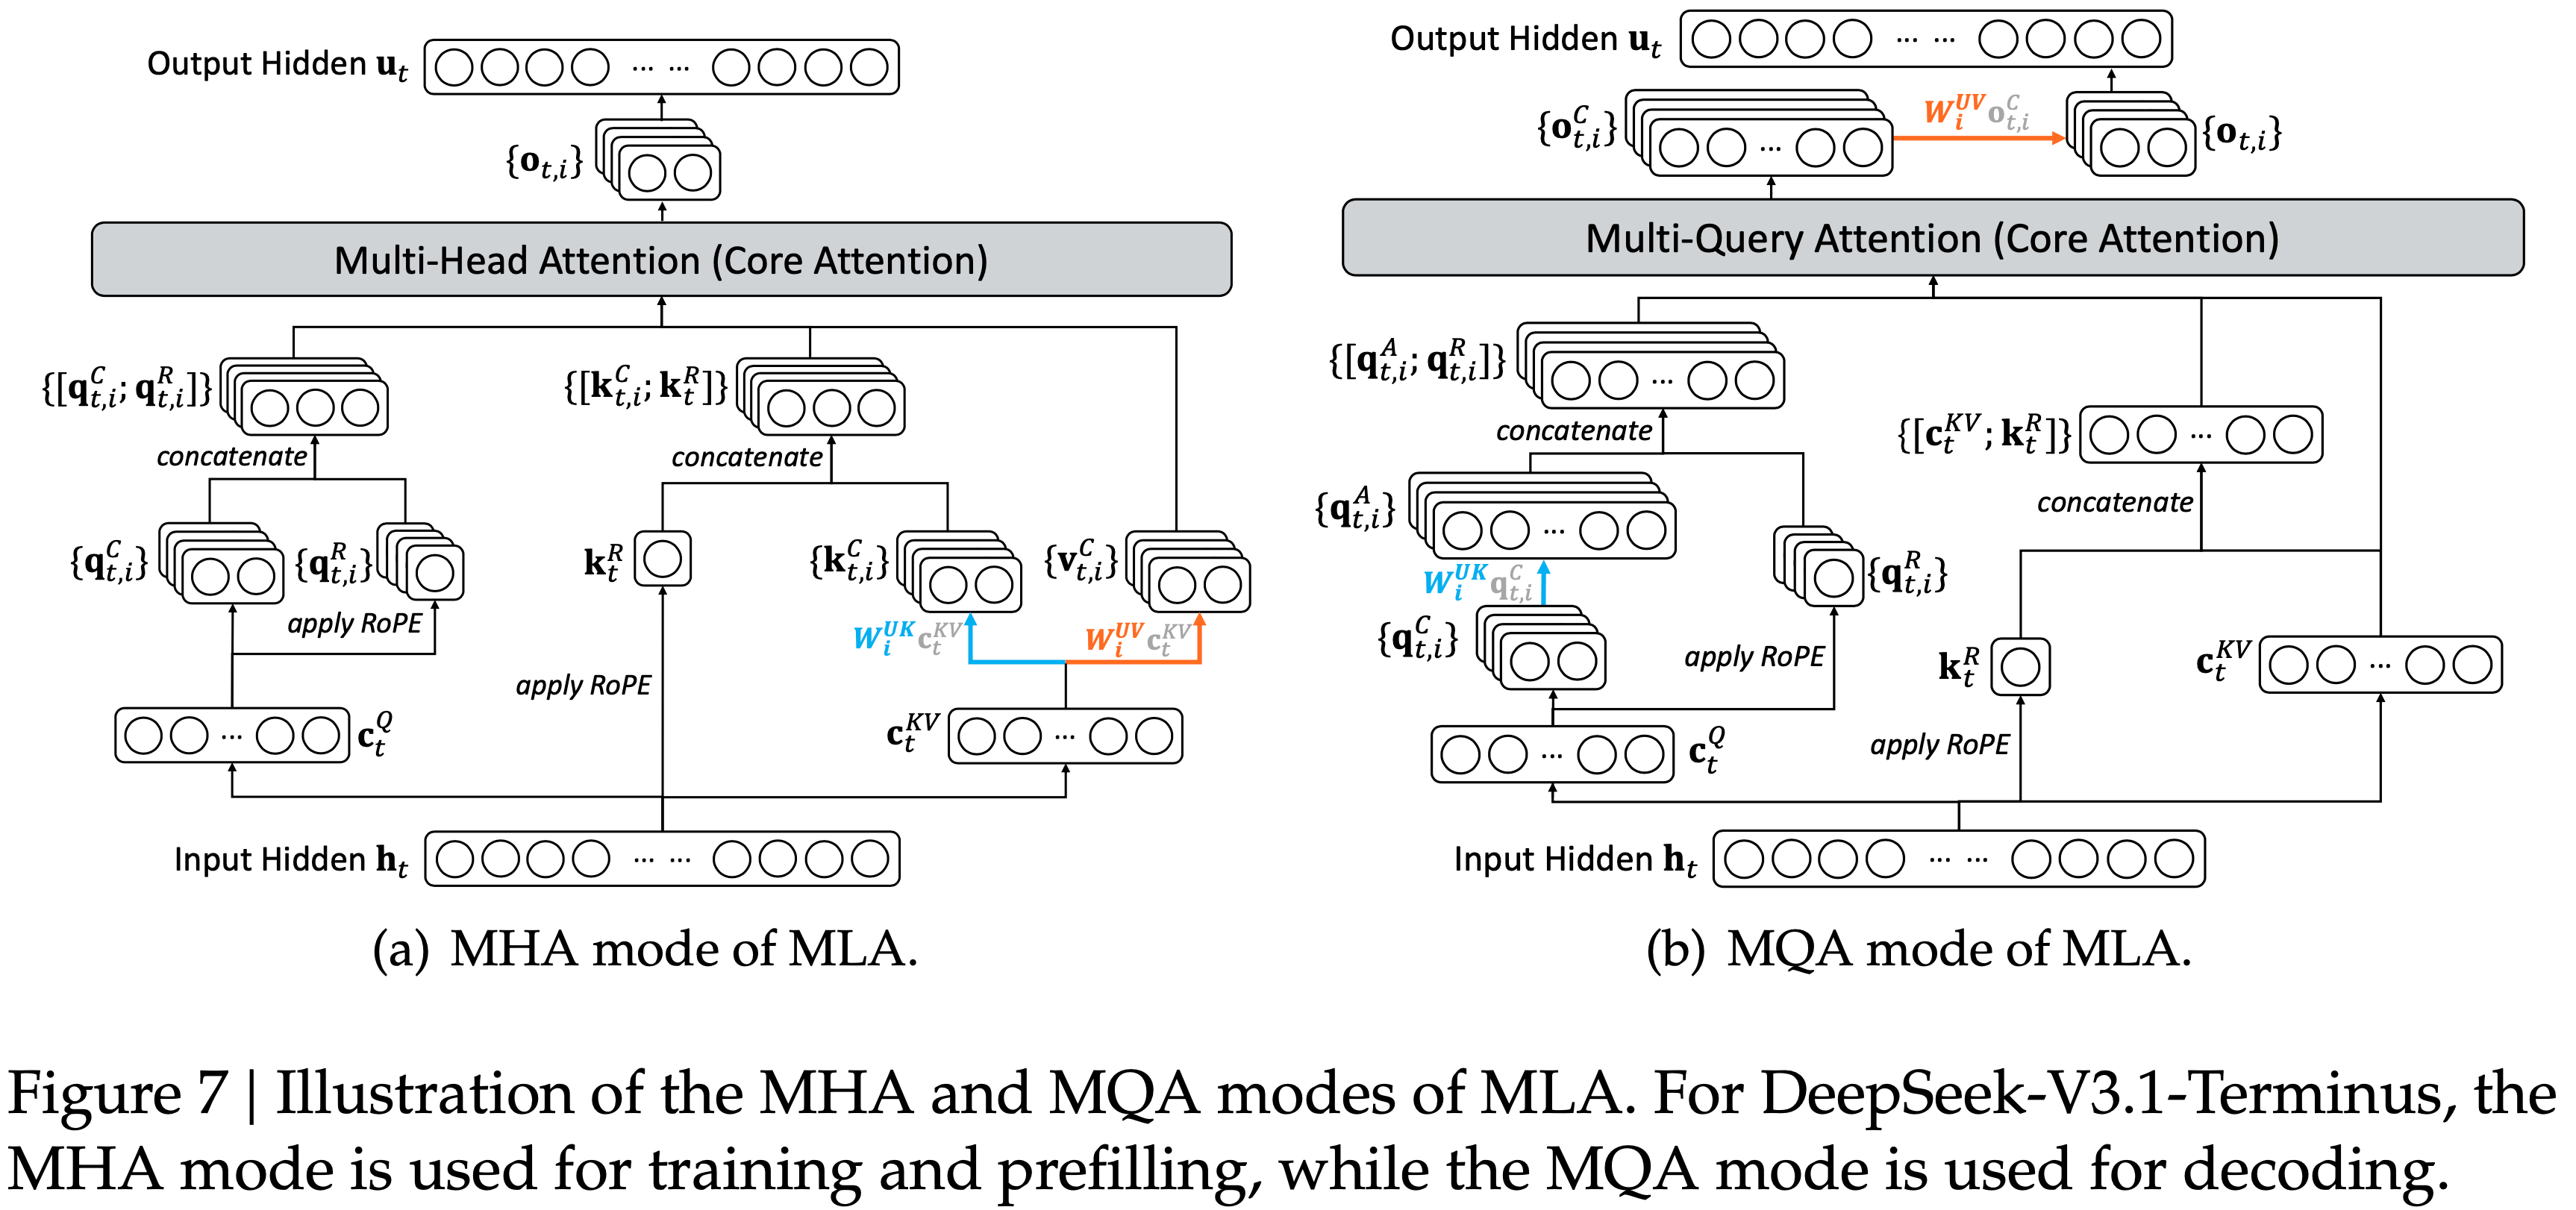
- 图 7:MLA 的 MHA 和 MQA 模式示意图
- 对于 DeepSeek-V3.1-Terminus,训练和前填充时使用 MHA 模式,解码时使用 MQA 模式
- 图 7 展示了 MLA 的两个方面(MHA 和 MQA 模式)以及它们之间的转换
附录 B:冷启动模板
- 表 6: 推理数据系统 Prompt 示例。系统 Prompt 要求模型在
<think></think>标签中输出推理过程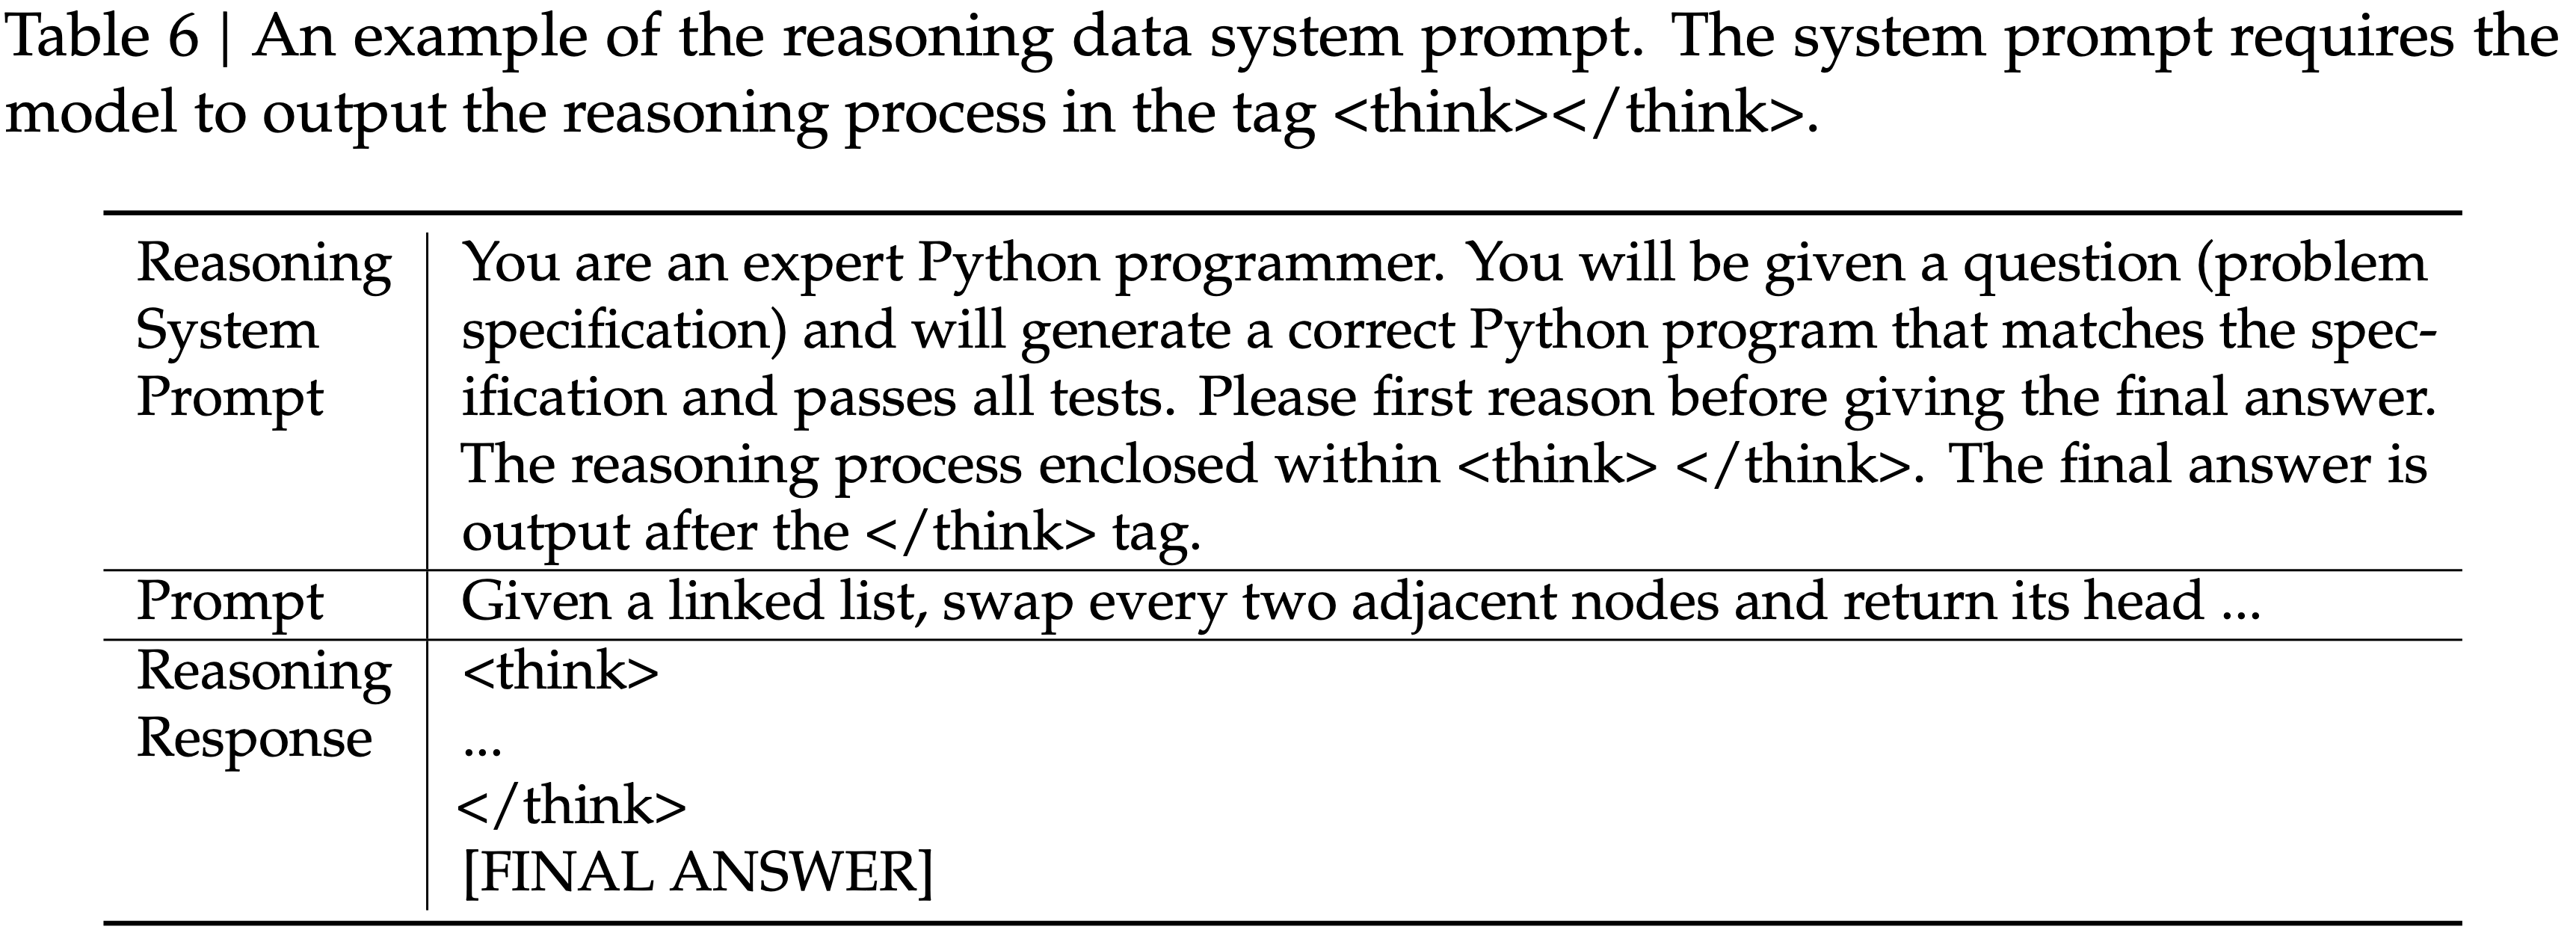
- 表 7:
[工具描述]和[工具调用格式]将被替换为具体的工具和论文设计的工具调用格式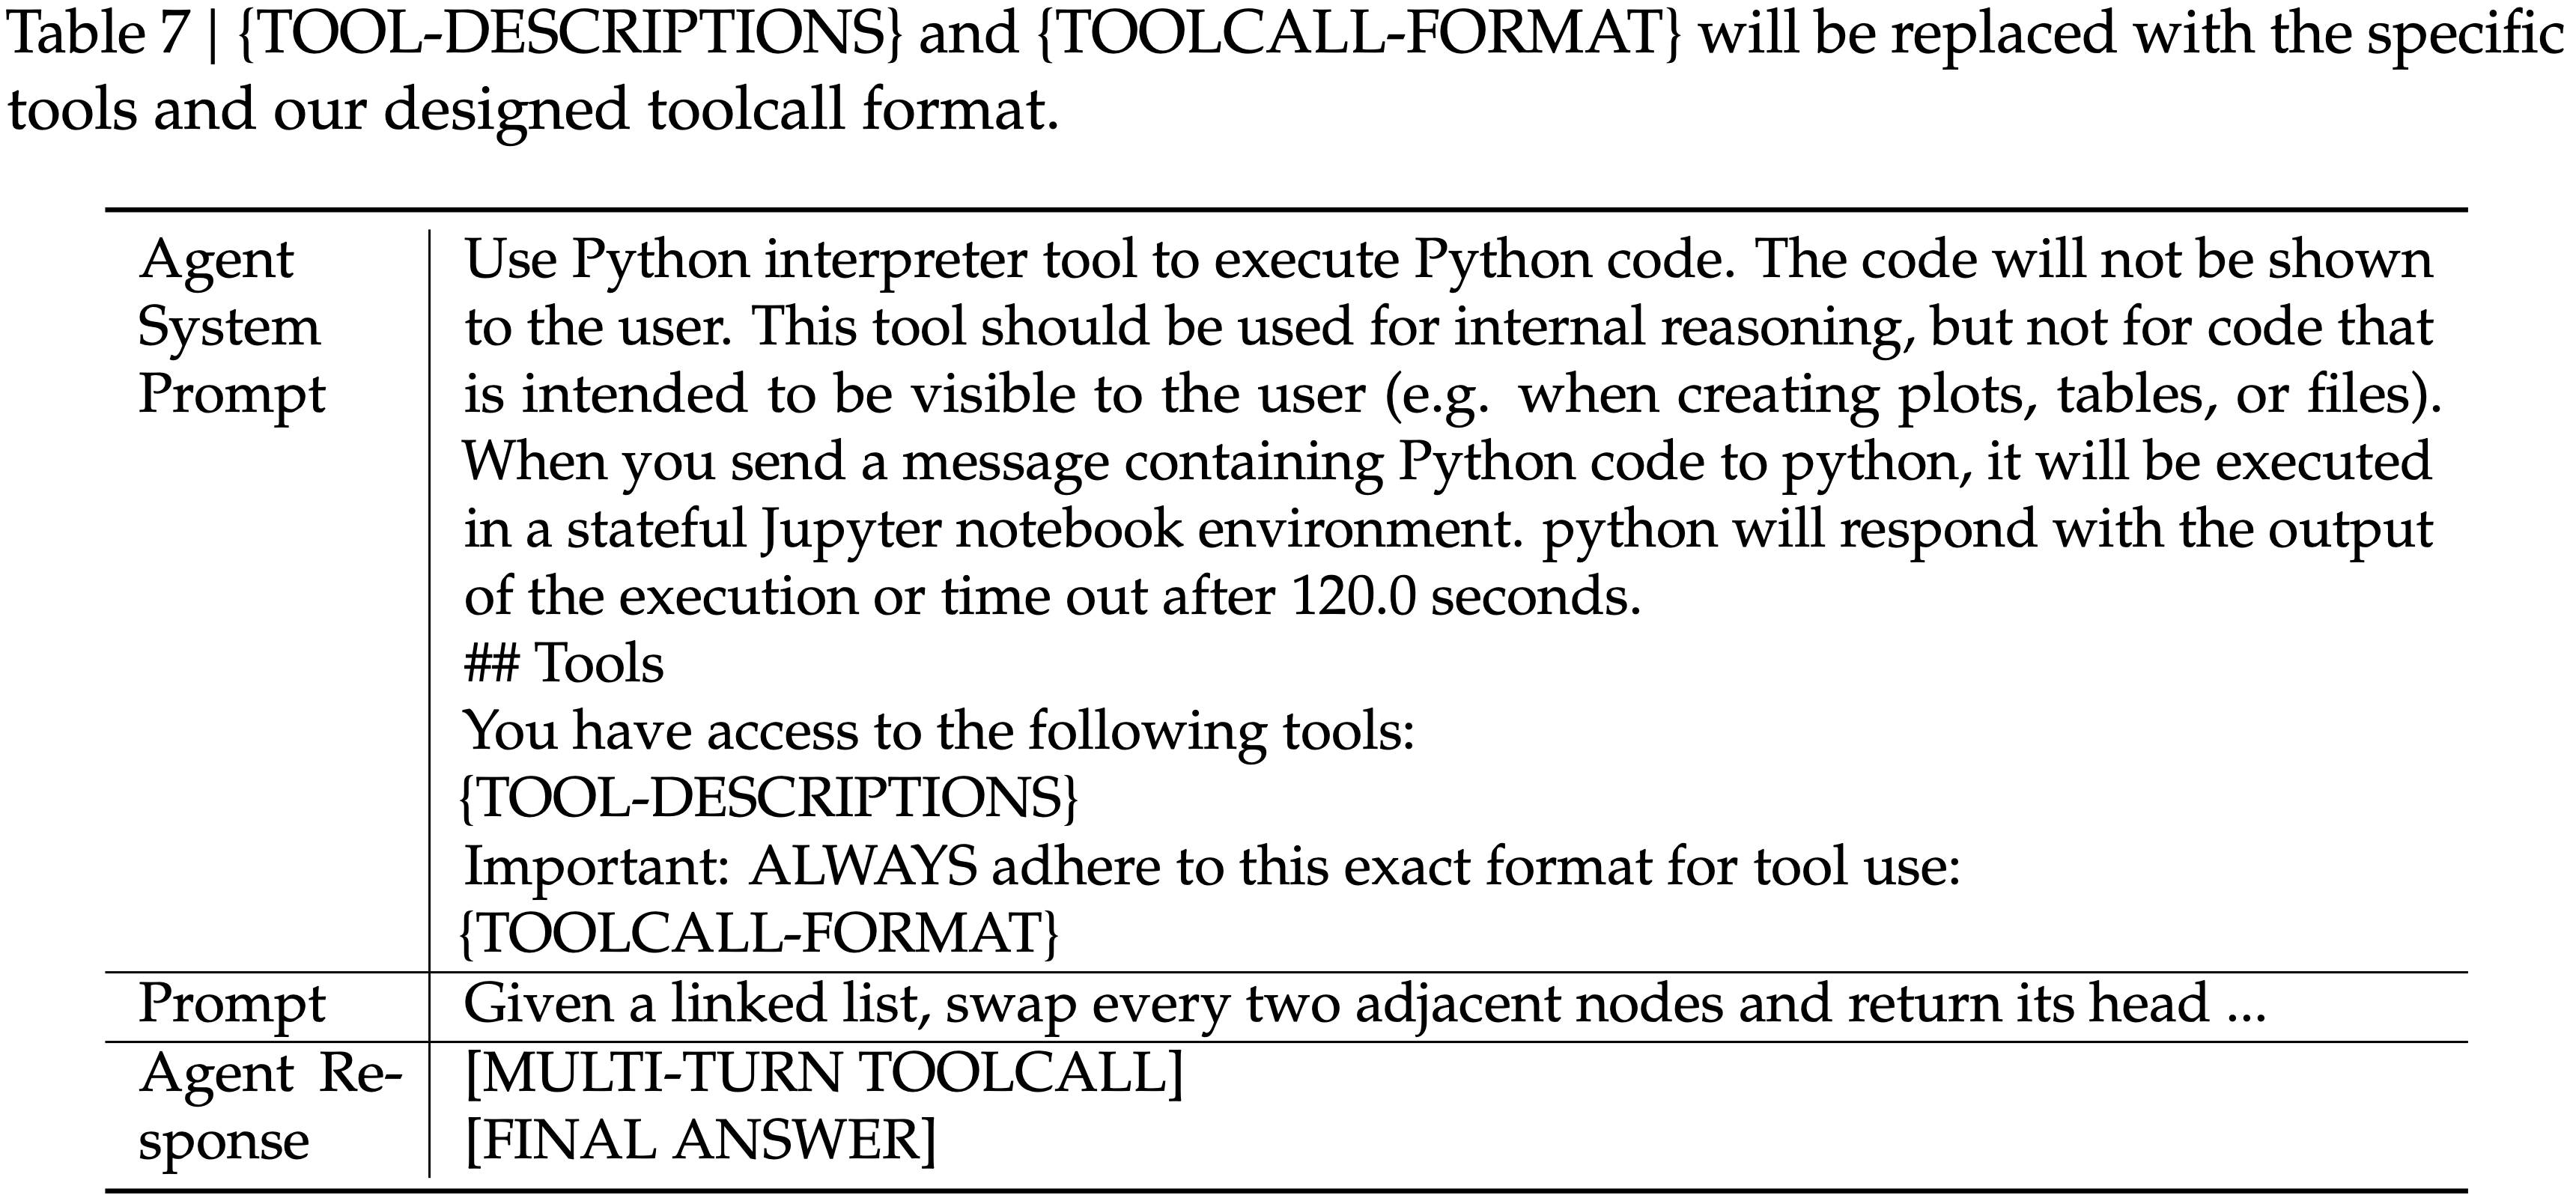
- 表 8:模型在 Thinking 过程中执行工具调用
附录 C:non-thinking mode DeepSeek-V3.2 智能体能力评估
- 表 9:DeepSeek-V3.2 非思考模式与思考模式对比
- 表中的终端测试台分数使用 Claude Code 框架评估
- 使用 Terminus 框架的非思考模式终端测试台 2.0 分数为 39.3
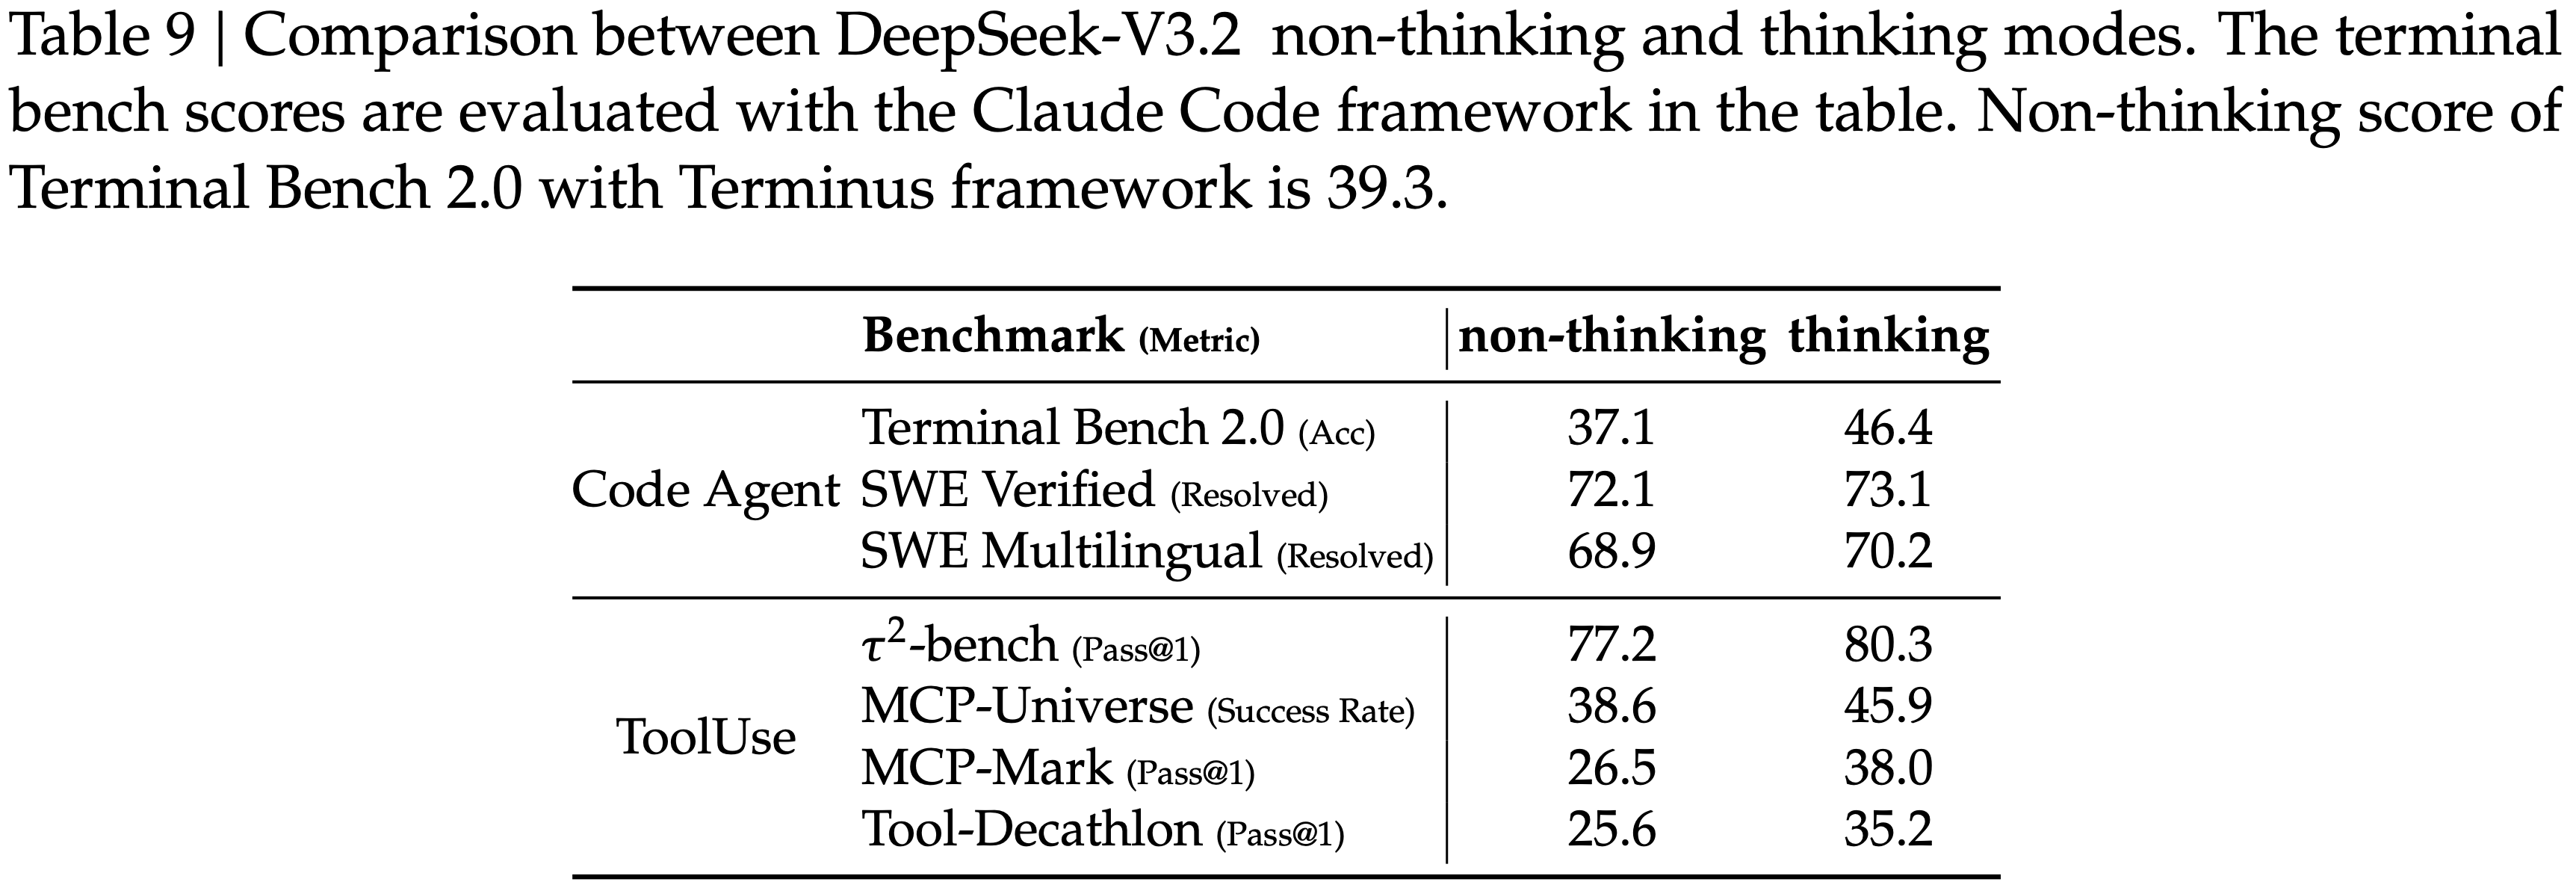
- 非思考模式的性能略逊于思考模式,但仍然具有竞争力
附录 D:IOI、ICPC 世界总决赛、IMO 及 CMO 的评估方法
- 对于所有竞赛:
- 模型的最大生成长度设置为 128k
- 不使用任何工具或互联网访问,测试严格遵守竞赛的时间和尝试限制
- 对于 IOI 评估
- 作者根据官方竞赛规则设计了提交策略,规则允许每道题最多提交 50 次,并根据在所有子任务中获得的最高分对每次提交进行评分
- 具体来说:
- 首先为每道题采样 500 个候选 Solution,然后应用一个多阶段过滤流程
- 在初始阶段,剔除未能通过提供的样例测试用例或超出长度限制的无效提交
- 随后,使用 DeepSeek-V3.2-Exp 模型来识别并剔除那些模型明确表示无法或拒绝解决问题的样本
- 从剩余的有效候选方案中,论文选择具有最长 Thinking 轨迹的 50 个样本进行最终提交
- 对于 ICPC 评估
- 作者采用了相同的过滤方法,但初始采样规模较小
- 论文为每道题生成 32 个候选 Solution ,并应用相同的过滤标准来选择提交
- 在 IMO 和 CMO 任务中
- 作者采用 generate-verify-refine 的循环
- 模型迭代地改进其 Solution ,直到获得完美的自我评估或达到最大修订上限,此过程与 Shao 等人 (2025) 的方法相同
附录:Unbiased KL Estimate 的推导
- 部分推导逻辑也可以参考博客:DeepSeek-V3.2中无偏 KL估计(Unbiased KL Estimate)的一些想法 - Keith Jiang的文章 - 知乎
- 本节核心目标是说明为何 DeepSeek-V3.2 在策略梯度中将 KL 散度项乘以重要性权重(importance weight),从而实现对 KL 梯度的无偏估计
- 注1:在绝对的 On-policy 的更新中,其实 \(\pi_\theta = \pi_{\theta_\text{old}}\),这个重要性权重值为 1,加不加都行
- 注2:本节中主要是针对 Off-policy 更新的步骤中,需要对 GRPO 的 KL 散度添加重要性权重校准
Background :带 KL 约束的强化学习目标
- 考虑 LLM 强化学习中的一般目标函数:
$$
J_{\text{RL} }(\theta; x) = \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ r(x, y) \right] - \beta \cdot D_{\mathrm{KL} }\left[ \pi_\theta(\cdot|x) \parallel \pi_{\theta_0}(\cdot|x) \right]
$$ - 其中:
- \(x\) 是输入(如 prompt)
- \(y = (y_1, \dots, y_T)\) 是模型生成的 token 序列
- \(r(x, y)\) 是 reward
- \(\pi_{\theta_0}\) 是参考策略(通常为初始策略或 SFT 模型)
- \(\beta\) 是 KL 正则化系数
自回归模型下的 KL 散度展开
- 由于语言模型是自回归的,有:
$$
\pi_\theta(y|x) = \prod_{t=1}^T \pi_\theta(y_t|x, y_{ < t})
$$ - 因此 KL 散度可写为:
$$
\begin{align}
D_{\mathrm{KL} }[\pi_\theta(y|x) \parallel \pi_{\theta_0}(y|x)]
&= \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ \sum_{t=1}^T \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] \\
&= \sum_{t=1}^T \mathbb{E}_{y \sim \pi_\theta(\cdot|x)} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right]
\end{align}
$$- 注:上式最后一步通过 交换期望与求和顺序 得到
- 接下来我们先关注第 \(t\) 项
- 注意到内部只依赖于 \(y_{\le t}\),而期望是对整个序列 \(y\) 的,所以可以利用全概率公式(联合概率密度分解成 \(< t\) 的部分和 \(t\) 本身),于是可以将期望分解为:
$$
\mathbb{E}_{y \sim \pi_\theta(\cdot|x)}\left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right]
= \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ \mathbb{E}_{y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] \right]
$$ - 上面中括号里面的内容可以转换成 KL 散度的形式:
$$
\mathbb{E}_{y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \left[ \log \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_0}(y_t|x, y_{ < t})} \right] = D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big)
$$ - 于是第 \(t\) 项变为:
$$
\text{Term}_t = \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right]
$$
- 注意到内部只依赖于 \(y_{\le t}\),而期望是对整个序列 \(y\) 的,所以可以利用全概率公式(联合概率密度分解成 \(< t\) 的部分和 \(t\) 本身),于是可以将期望分解为:
- 最终得到:
$$
\begin{align}
D_{\mathrm{KL} }[\pi_\theta(y|x) \parallel \pi_{\theta_0}(y|x)]
&= \sum_{t=1}^T \mathbb{E}_{y_{ < t} \sim \pi_\theta(\cdot|x)} \left[ D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right] \\
&= \mathbb{E}_{y_{ < t} \sim \color{red}{\pi_\theta}(\cdot|x)} \left[ \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\theta_0}(\cdot|x, y_{ < t}) \big) \right]
\end{align}
$$- 注:上面最后一步是交换期望与求和顺序得到的
将 KL 项放入采样期望内(关键步骤)
- 回顾原 RL 目标为:
$$
J_{\text{RL} }(\theta;x) = \mathbb{E}_{y\sim\pi_\theta}[r(x,y)] - \beta \cdot \mathbb{E}_{y\sim\pi_\theta} \left[ \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right]
$$- 注:这里对 \( D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big)\) 求期望的做法已经在前面推导过
- 将奖励和 KL 散度合并为单个期望得到最原始的 RL 目标应该是:
$$
J_{\text{RL} }(\theta;x) = \mathbb{E}_{y\sim\pi_\theta} \left[ r(x,y) - \beta \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right]
$$ - 在实际训练中(如 PPO、GRPO),我们无法直接从当前策略 \(\pi_\theta\) 采样(因为参数正在更新),而是从旧策略 \(\pi_{\theta_{\text{old} } }\) 采样轨迹 \(\{o_i\}_{i=1}^G\)
- 此时,目标函数一般需通过重要性采样重写,对于任意函数 \(f(y)\),有重要性采样如下:
$$
\mathbb{E}_{y \sim \pi_\theta(\cdot|x)}[f(y)]
= \mathbb{E}_{y \sim \pi_{\theta_{\text{old} } }(\cdot|x)} \left[ \frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} f(y) \right]
$$
- 此时,目标函数一般需通过重要性采样重写,对于任意函数 \(f(y)\),有重要性采样如下:
- 现在用 \(\pi_{\theta_{\text{old} } }\) 采样,对 \(J_{\text{RL} }(\theta;x)\) 中的期望估计应用重要性采样有:
$$
\begin{align}
J_{\text{RL} }(\theta;x)
&= \mathbb{E}_{y\sim\pi_{\theta_{\text{old} } } } \left[ \frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} \left( r(x,y) - \beta \sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big) \right) \right]
\end{align}
$$- 特别注意:这里的 KL 本身依赖于 \(\pi_\theta\)(这一点容易遗忘),重要性权重也依赖 \(\pi_\theta\)
- 这一步在这里看起来推导很顺利,但是其实非常关键,这里直接回答了之前的一些问题,有了这一步之后,如博客 The critical implementation detail of KL loss in GRPO, Hongyu Zang 中提出的问题就不存在了
- 至此,可以看出:
- 当 \(y \sim \pi_{\theta_\text{old}}\) 采样时,重要性权重需要同时对奖励 \(r(x,y)\) 和 KL 散度 \(\sum_{t=1}^T D_{\mathrm{KL} }\big( \pi_\theta(\cdot|x, y_{ < t}) \parallel \pi_{\text{ref} }(\cdot|x, y_{ < t}) \big)\) 进行修正才对
- 注:之前的实现一般仅对奖励使用重要性权重修正, 而忽略了 KL 散度
Token-level 分别加权的讨论
- 上述的结果还是按照序列粒度评估的,实际上单独考虑 KL 散度时(不考虑奖励时),其实可以按照 Token-level 来考量
- 对自回归模型,重要性权重可分解为 token-level 的形式:
$$
\frac{\pi_\theta(y|x)}{\pi_{\theta_{\text{old} } }(y|x)} = \prod_{t=1}^T \frac{\pi_\theta(y_t|x, y_{ < t})}{\pi_{\theta_{\text{old} } }(y_t|x, y_{ < t})}
$$- 注意:这里是序列级别加权的,即整个序列看成是一个整体,即 期望里面的 KL 散度先算出来,再统一乘以外面的 Sequence-level 重要性权重
- 在 RLHF 中, PPO/GRPO 实践时,常采用 token-level importance weight,即 每一步单独加权(而非整句相同重要性权重)
- 注:数学上,其实这里的 Token-level 重要性权重本是不能拆开的,必须乘起来才能做到在数学上等价于序列级别的奖励和 KL 整体目标
- 这种从 Sequence-level 到 Token-level 的转换,是为了降低方差,同时 Token-level 的方式可以看做 Sequence-level 重要性采样的一阶近似,更多讨论见论文和本人其他讨论博客:(GSPO)Group Sequence Policy Optimization, 20250728, Qwen(本人解读博客:NLP——LLM对齐微调-GSPO) 和 (MiniRL)Stabilizing Reinforcement Learning with LLMs: Formulation and Practices, 20251201, Qwen(本人解读博客:NLP——LLM对齐微调-MiniRL
补充分析:k3 估计下的 Token-Level 无偏 KL 估计(DeepSeek-V3.2 的做法)
- 跟上述讨论一样,DeepSeek-V3.2 将 KL 项按照 token 分解,并对每个 token 的 KL 分别使用对应的重要性权重
- 回忆 k3 估计(一种 KL 的无偏估计器):
$$
\begin{align}
D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }] &\approx \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - 1 \\
&= \text{k3}
\end{align}
$$- 补充 k3 本身的性质:对以上 k3 估计求 \(a \sim \pi_\theta\) 下的期望,满足
$$ \mathbb{E}_{a \sim \pi_\theta}[\text{k3}] = D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }]$$
- 补充 k3 本身的性质:对以上 k3 估计求 \(a \sim \pi_\theta\) 下的期望,满足
- 但在 GRPO 中,样本是从 \(\pi_{\theta_{\text{old} } }\) 采的,所以要估计(使用重要性采样):
$$
\mathbb{E}_{a \sim \pi_\theta} [\text{k3}] = \mathbb{E}_{a \sim \pi_{\theta_{\text{old} } } } \left[ \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \text{k3} \right]
$$- 注:若直接用 \(\pi_{\theta_{\text{old} } }\) 采样而不加权,则估计有偏;
- 真正的无偏估计应为:
$$
\begin{align}
\widehat{D}_{\mathrm{KL} }^{\text{unbiased} }
&= \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \left( \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - 1 \right) \\
&= \frac{\pi_{\text{ref} }(a)}{\pi_{\theta_{\text{old} } }(a)} - \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)} \log \frac{\pi_{\text{ref} }(a)}{\pi_\theta(a)} - \frac{\pi_\theta(a)}{\pi_{\theta_{\text{old} } }(a)}
\end{align}
$$ - DeepSeek 论文中公式与上面等价(DeepSeek 中直接使用了 Token-level 的加权形式),其形式保留原始 k3 形式并乘以重要性权重:
$$
D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }]
\approx \frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})} \left(\frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - \log \frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - 1 \right)
$$- 这就是 DeepSeek-V3.2 文章中提到的 Unbiased KL Estimate
- 这里的约等于应该是有两层含义:
- k3 估计是无偏的,但是仍然是一种估计,而不是等于
- Sequence-level 重要性加权 KL 到 Token-level 重要性加权 KL 的近似
个人思考:无偏性反向证明
- 上面是正向推导形式,为了方便理解,我们其实也可以反向证明无偏性
- 记重要性权重为:
$$
r_{i,t} = \frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})}
$$ - 则有:
$$
\mathcal{L}_{\text{KL} }^{\text{unbiased} }
= r_{i,t} \left( \frac{\pi_{\text{ref} } }{\pi_\theta} - \log \frac{\pi_{\text{ref} } }{\pi_\theta} - 1 \right)
$$ - 其期望满足(下面第一步的转换是将期望概率乘进去消掉重要性权重的分母,然后将分子作为概率提出来作为期望):
$$
\begin{align}
\mathbb{E}_{o_{i,t} \sim \pi_{\theta_{\text{old} } } } \left[ \mathcal{L}_{\text{KL} }^{\text{unbiased} } \right]
&= \mathbb{E}_{o_{i,t} \sim \pi_\theta} \left[ \frac{\pi_{\text{ref} } }{\pi_\theta} - \log \frac{\pi_{\text{ref} } }{\pi_\theta} - 1 \right] \\
&= \mathbb{E}_{o_{i,t} \sim \pi_\theta} \left[ \text{k3} \right] \\
&= D_{\mathrm{KL} }[\pi_\theta \parallel \pi_{\text{ref} }] \\
\end{align}
$$- 因此,DeepSeek-V3.2 文章中提到的 Unbiased KL Estimate 估计形式是无偏的
一些思考
- DeepSeek-V3.2 的 Unbiased KL Estimate 的核心思想是:
- 将 KL 散度项视为 reward 的一部分,并对其应用与 policy gradient 相同的重要性采样权重,从而保证 KL 梯度的无偏性
- 最终,在 GRPO 目标函数中,KL 项变为:
$$
-\beta \cdot \frac{1}{G} \sum_{i=1}^G \frac{1}{ o_i } \sum_{t=1}^{ o_i }
\underbrace{\color{red}{\frac{\pi_\theta(o_{i,t} | q, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,<t})}} \left(\frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - \log \frac{\pi_{\text{ref} }(o_{i,t} | q, o_{i,<t})}{\pi_\theta(o_{i,t} | q, o_{i,<t})} - 1\right)}_{\text{Unbiased KL Estimate} }
$$- 注:这里新添加的 \(\color{red}{\frac{\pi_\theta(o_{i,t} | q, o_{i,< t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,< t})}}\) 本身就是 PPO 重要性采样的 ratio,所以这里计算时可以复用这个系数 ratio
- 这使得整个目标函数的梯度在使用旧策略采样时仍保持对真实 KL 的无偏估计,提升了训练稳定性与效果
- 注:再次强调,在绝对的 On-policy 的更新中,其实 \(\pi_\theta = \pi_{\theta_\text{old}}\),这个重要性权重可以忽略,类似说明其他博客也有提到
- 这种做法比之前的一些丢弃 KL 散度的方法更好,但是否比改变形式的方法更好?
- 理解:其实除了 k3 外,如果使用 k2 也会出现类似的问题,也需要类似修正
- 其他补充:其实之前的博客也讨论过类似的问题:The critical implementation detail of KL loss in GRPO, Hongyu Zang
- 博客中还提出了一些解决方案,其中一个方案(方案三)就跟 DeepSeek-V3.2 的方案思想类似
- 博客中的方案三也是对 KL 散度使用 \(\frac{\pi_{\theta}}{\pi_{\theta_\text{old}}}\) 来进行修正
- 但博客中提到的方案三是直接将 KL 添加到 Reward 中(类似传统 RLHF 中的做法一样),而 DeepSeek-V3.2 的 Unbiased KL Estimate 仍然是独立的一个 KL Loss
- 博客相当于 DeepSeek-V3.2 工作的一半,提出了本文前面 “将 KL 项放入采样期望内” 的这一步,没有进一步推导回到独立的 KL Loss
- 特别说明:如果进一步推导可以发现,在 GRPO 中,使用 kl in reward 是不合适的,因为这会导致 kl(本身的方差就大)会影响真实的 ORM 信号,比如因为正确样本中某个 Token 的 kl 过大,而打压正确样本,这个可能不是我们想要的(最好是整体样本鼓励,但打压某个 kl 较大的 Token 会更合适)
- 博客中还提出了一些解决方案,其中一个方案(方案三)就跟 DeepSeek-V3.2 的方案思想类似
附录:LLM RL 训练中 top-p 导致的训推不一致修复讨论
- top-k/top-p 采样在 RL 训练中虽能提升生成质量、避免采样到极低概率 token,但会导致旧策略与新策略的动作空间不一致,违反了重要性采样的基本原则,从而引发训练不稳定
实际 serving top-p=0.95 的场景下各种分布定义
- 设温度缩放后的完整 softmax 分布为:
$$
\begin{align}
\pi_\theta(a\mid h) &= \pi_\theta(\cdot\mid h)_a \\
&=\text{softmax}(z_\theta(h)/T)_a \\
&=\frac{ \exp(z_\theta(h,a)/T) }{ \sum_{v\in V} \exp(z_\theta(h,v)/T)}
\end{align}
$$- \(\theta\) 表示模型参数
- \(h\) 表示当前上下文(前缀)
- \(T\):温度参数
- \(z_\theta(h)\):模型在给定上下文 \(h\) 下,对下一个 token 输出的未归一化 logits 向量
- \(z_\theta(h)\) 是一个向量,每个分量对应词表中的一个 token,维度等于词表大小 \(|V|\), 可以写成:
$$
z_\theta(h)\in\mathbb R^{|V|}
$$
- \(z_\theta(h)\) 是一个向量,每个分量对应词表中的一个 token,维度等于词表大小 \(|V|\), 可以写成:
- \(z_\theta(h,a)\) 表示 logits 向量 \(z_\theta(h)\) 中,token \(a\) 对应的那个标量 logit 值
- \(_a\) 表示取这个概率向量中 对应 token \(a\) 的那个分量
- \(V\) 是整个词表
top-p=0.95保留集合为 \(S_\theta(h)\)(在 LLM 中,也将 top-p 时生效的集合称为核,英文名为 nucleus),则保留概率质量为:
$$
Z_\theta(h)=\sum_{a\in S_\theta(h)}\pi_\theta(a\mid h)
$$top-p=0.95下的实际 serving 采样分布为:
$$
q_\theta(a\mid h)
=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
$$
serving top-p=0.95 的场景,仅将 rollout 的 top-p 从 1.0 改为 0.95 会发生什么
设定:对于
serving top-p=0.95的场景若仅修改 rollout 的 top-p 为 0.95,而其他部分保持不变,会产生许多不一致性
结论:只把 rollout 的 top-p 从 1 改成 0.95,其他地方都不动,不一定会立刻训崩,但这是明确的“有偏训练”,不是正确对齐
- 短期小规模实验可能看起来正常
- 长期或大规模训练有很大风险,不建议用
PPO ratio 也会错位,当前实际 ratio 是:
$$
r_t=\frac{\pi_{\text{new} }(a_t\mid h_t)}{\pi_{\text{old} }(a_t\mid h_t)}
$$因为数据来自 \(q_{\text{old} }\),要正确做 off-policy 修正,至少应该包含 \(q_{\text{old} }\),例如目标为 \(\pi\) 时需要类似:
$$
\frac{\pi_{\text{new} }(a_t\mid h_t)}{q_{\text{old} }(a_t\mid h_t)}
$$如果目标就是 serving 的 \(q\),则应该直接对 \(q\) 求梯度,而不是对 \(\pi\) 求梯度
不一致分析 1:轨迹采样与 actor 更新的错位(天然就需要 IS 修正)
- 轨迹样本来自 \(q_{\text{rollout} }\)(这是经过 top-p 生效的分布),实际 rollout 采样分布 与 线上 serving 分布对齐,在不考虑其他硬件和引擎误差的情况下,有:
$$
q_{\text{rollout} } = q_\theta(a\mid h)
=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
$$ - actor 更新仍然用完整词表上的 \(\log \pi_\theta(a_t\mid h_t)\) 计算 logprob 并反向传播(不是 \(\log q_\theta(a_t\mid h_t)\))
- 也就是说真实被优化的 actor 的目标分布仍是完整分布 \(\pi_\theta\),而不是经过 top-p 修正的 实际 \(q_\theta\)
- 问题:这会天然导致采样分布 old 策略分布之间有一个误差,需要经过 off-policy IS 修正(且因为支撑集缺失,这本质是不可能从IS 来完整修复的)
不一致分析 2:现有 IS 修正看不到 top-p 截断差异(来自框架的问题)
- 注:这发生在 VeRL 的官方实现中,也存在于一般的推理框架中(返回的概率是 top-p 剩下前的概率而不是生效后重新归一化的真实采样概率)
- 采样使用了
top-p=0.95后,Megatron actor 也仍然按完整分布 \(\pi_\theta\) 算 logprob,于是:- 1)行为策略是 \(q_{\text{old} }\)
- 2)训练侧 old/current 概率是 \(\pi_{\text{old} }\)、\(\pi_{\text{new} }\)
- 3)TIS rollout correction 里的 IS 权重近似是类似:
$$
w_t=frac{\pi_{\text{old} }(a_t\mid h_t)}{\pi_{\text{rollout} }(a_t\mid h_t)}
$$- 但当前 VeRL 中,这里的 \(\pi_{\text{rollout} }\) 记录的仍是截断前的 \(\pi\)(未经过 top-p 修正的原始概率分布),不是实际采样概率 \(q\)
- 它看不到 top-p 截断带来的分布差异 ,也不会自动修正,即使看到
rollout_corr/kl接近零,也不能证明 top-p 下训推一致 - 分母是 \(\pi_{\text{rollout} }\)(未经过 top-p 修正的原始概率分布),不是实际采样概率 \(q_{\text{rollout} }\)
- 从 IS 的定义可以知道,只有在分母为 实际采样概率 \(q_{\text{rollout} }\) 时才能倍准确修正
- 若针对当前的配置使用 Token-level TIS(假设上界为 2),则 rollout correction 实际计算的是:
$$
w_t=\min\left(2,\frac{\pi_{\text{old} }(a_t\mid h_t)}{\pi_{\text{rollout} }(a_t\mid h_t)}\right)
$$ - top-p 导致的分布差异 没有进入 IS 权重 ,也没有进入任何指标
- 即使
rollout_corr/kl接近零,也只能说明截断前的 \(\pi\) 很接近,不能说明实际采样分布 \(q\) 与 actor 训练分布一致
- 即使
不一致分析 3:梯度层面的缺失(优化目标不一致)
- 我们的优化目标应该是基于 serving 截断分布目标,这样才能跟线上 serving 策略对齐:
$$
J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
$$ - 其中 \(q_\theta\) 分布为:
$$
q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
$$ - 若仅针对支撑集上的 Token 来看 有:
$$
q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)}{Z_\theta(h)}
$$ - 仅针对支撑集上的 Token 来看 ,对 serving 分布 \(q_\theta\) 求对数概率:
$$\log q_\theta(a\mid h)=\log \pi_\theta(a\mid h)-\log Z_\theta(h)$$ - 因此 仅针对支撑集上的 Token 来看 正确梯度是:
$$\nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)$$ - 问题总结:
- 即使仅考虑 仅针对支撑集上的 Token 来看 ,当前 actor 也只计算了 \(\nabla_\theta \log \pi_\theta(a\mid h)\),缺少 \(-\nabla_\theta \log Z_\theta(h)\)
- 并且 \(Z_\theta(h)\) 必须参与反向传播:不能把保存下来的 \(\log Z\) 当常量减掉,那样只修正了概率数值,没有补上缺失的梯度
不一致分析 4:支持集问题
- 回顾重要性采样公式为:
$$
\mathbb E_{\color{blue}{a\sim \pi}}[f(a)]=\mathbb E_{\color{red}{a\sim q}}\left[\frac{\pi(a)}{q(a)} f(a)\right]
$$ - 但它有一个前提条件:目标分布 \(\pi\) 必须绝对连续于行为分布 \(q\),即:
$$
\pi(a)>0 \quad \Rightarrow \quad q(a)>0
$$ - 如果存在某个动作 \(a\) 满足 \(\pi(a)>0\) 且 \(q(a)=0\),则 \(\frac{\pi(a)}{q(a)}\) 没有定义,且该动作永远不会被 \(q\) 采样到,样本中根本没有这个动作
- 理解:重要性采样的公式没有错,但是由于行为策略采样到这个动作的概率为 0,导致 IS 比值为无穷大,无穷大是没有意义的
- 因此重要性采样无法等于
$$\mathbb E_{\color{blue}{a\sim \pi}}[f(a)]$$- 重要性采样只能在保留集合内重加权:
$$
\mathbb E_{\color{red}{a\sim q}}\left[\frac{\pi(a)}{q(a)}f(a)\right]=\sum_{\color{red}{a\in S}}\pi(a)f(a)
$$ - 它无法恢复 \(\sum_{a\notin S}\pi(a)f(a)\),即尾部贡献缺失
- 重要性采样只能在保留集合内重加权:
- top-p 截断正是这种情况:完整分布 \(\pi_\theta\) 在整个词表上都有正概率,但 rollout 截断分布 \(q_\theta\) 只在 \(S_\theta(h)\) 内为正:
- 对于被截掉的尾部动作 \(a\notin S_\theta(h)\),有 \(q_\theta(a\mid h)=0\) 但 \(\pi_\theta(a\mid h)>0\)
- 即使在保留集合上使用正确的重要性权重,也只能得到 \(\sum_{a\in S}\pi(a)f(a)\),尾部贡献 \(\sum_{a\notin S}\pi(a)f(a)\) 仍然缺失
- 如果试图从 \(q_\theta\) 采样却想恢复完整分布 \(\pi_\theta\) 的目标 \(J_\pi\),尾部动作永远采不到
不一致分析总结
- 若只修改 Rollout 的
top-p=0.95,那么当前的优化目标既不是 \(J_\pi\) 也不是 \(J_q\)- 基于完整分布的目标 \(J_\pi\) 是:
$$
J_\pi(\theta)=\mathbb E_{\tau\sim\pi_\theta}[R(\tau)]
$$ - 基于 serving 截断分布目标 \(J_q\) 是:
$$
J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
$$ - 只改 rollout
top-p=0.95时的目标:- 不是 \(J_\pi\) 的严格无偏梯度
- 样本来自 \(q\) 而非 \(\pi\)
- Rollout 返回的概率是 top-p 生效前的 \(\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]\),无法被 当前的 IS 准确修正
- 即使返回了 top-p 生效后的概率,支撑集也存在问题,没法被 IS 方式修正
- 不是 \(J_q\) 的严格无偏梯度:
- actor 没有对 \(q_\theta\) 求梯度,缺少 \(-\nabla_\theta \log Z_\theta\) 这一项,所以也不是 \(J_q\) 的严格无偏梯度
- 不是 \(J_\pi\) 的严格无偏梯度
- 基于完整分布的目标 \(J_\pi\) 是:
- 进一步理解:只改 rollout
top-p=0.95后的目标是一个 “混合目标” 的有偏近似- 只改 rollout
top-p=0.95后的更新期望大致是:
$$
\mathbb E_{\color{red}{a\sim q}}\left[A(h,a)\nabla_\theta \log \pi_\theta(a\mid h)\right]
$$ - 但我们可能想要的是:
$$
\mathbb E_{\color{blue}{a\sim \pi}}\left[A(h,a)\nabla_\theta \log \pi_\theta(a\mid h)\right]
$$ - 或者:
$$
\mathbb E_{\color{red}{a\sim q}}\left[A(h,a)\nabla_\theta \log q_\theta(a\mid h)\right]
$$ - 这三个不是一回事
- 只改 rollout
补充:如果 rollout 同时返回 top-p 后的真实分布会怎样?
- 只让 SGLang 返回 top-p 实际采样分布 \(q\) 的 logprob,其他都不改,仍然不是正确对齐
- 这一步主要修正了 rollout correction 的分母,但 actor 侧仍然在对完整分布 \(\pi\) 求梯度
- 问题一:训练目标 \(\pi\) 跟 serving 目标 \(q\) 仍然没有对齐
- 我们真正想要的是对 serving 策略 \(q\) 求梯度:
$$
\nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)
$$ - 但 actor 侧没有改,仍然只计算:
$$
\nabla_\theta \log \pi_\theta(a\mid h)
$$ - 它缺少第二项:
$$
-\nabla_\theta \log Z_\theta(h)
$$ - 即使 SGLang 返回了正确的 \(\log q\),actor 的梯度目标仍然是 \(\pi\),不是 \(q\)
- 我们真正想要的是对 serving 策略 \(q\) 求梯度:
- 问题二:即使是想要使用 \(J_\pi\) 作为目标,支持集的缺失也会导致无法用 \(q\) 的采样分布来修正分布 \(\pi\)
- 这在保留集合 \(S\) 内,确实是正确的从 \(q_{\text{old} }\) 到 \(\pi_{\text{new} }\) 的重要性权重
- 所以 对于 \(S\) 内的样本 Token ,这一步修正是对的,但是无法对支持集外的 Token 分布进行修正
- 总结:如果 rollout 同时返回 top-p 后的真实分布,优化的目标仍然是个混合目标(四不像)
- 对完整 \(\pi\) 目标:\(S\) 内修正正确,尾部缺失
- 对 serving \(q\) 目标:仍然缺少 top-p 归一化项的梯度
DeepSeek-V3.2 的解决方案
- DeepSeek-V3.2 使用 Keep Sampling Mask 策略来解决这个问题,但是目标策略变成了一个混合策略
Keep Sampling Mask
- DeepSeek-V3.2 的解决方案是:在从 \(\pi_{\text{old} }\) 采样时保留由 top-p/top-k 截断产生的掩码,并在训练过程中将该掩码应用于 \(\pi_\theta\),确保两个策略共享完全相同的动作子空间
- 设 rollout 时的旧策略参数为 \(\theta_{\text{old} }\),其 top-p 保留集合为:
$$
S_{\text{old} }(h)=S_{\theta_{\text{old} } }(h)
$$ - Keep Sampling Mask 的做法是:训练时不再重新计算当前策略的 top-p 集合 \(S_\theta(h)\),沿用 rollout 时的集合 \(S_{\text{old} }\),只在这个集合内重新归一化:
$$
\tilde q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_{\text{old} }(h)]}{\sum_{v\in S_{\text{old} }(h)}\pi_\theta(v\mid h)}
$$ - 这样支持集固定,重要性采样可行:
$$
\frac{\tilde q_\theta(a\mid h)}{q_{\text{old} }(a\mid h)}
$$ - 注意:此时也不能实现最准确的 优化目标 \(J_q\) ,因为强行将支持集固定为 Rollout 时的 top-p 集合后,后续的目标策略已经不是当前真实的目标策略了,本质是一个混合策略(类似 R2 或者 R3 的实现带来的后果)
- 当然,Pure On-policy 下,且不考虑不同引擎带来的不一致性(认为不同引擎的 top-p 集合是一致的),则这种做法是能准确实现 优化目标 \(J_q\) 的
- 注:在 DeepSeek-V3.2 的 TR 中指出,将 top-p 采样与 Keep Sampling Mask 策略相结合,能够在 RL 训练过程中有效保持语言一致性
- 注意:论文中没有明确指出,但是在一次 Rollout 多次 gradient update 的场景中,Keep Sampling Mask 应该是用于同时保证三个策略 \(\mu, \pi_\text{old}, \pi_\theta\) 的支持集相同,都是 Rollout 时的支持集
补充:数学上无偏解决 top-p 训推不一致的方法(个人思考,暂时只是粗糙想法)
- 终极目标:如果最终 serving 固定
top-p=0.95,直接优化 \(J_q\) 才是最直接的目标对齐
方法 A:Pure On-policy,且不考虑训推引擎差异,直接对目标策略求导(仅特定情况下可用)
- 直接优化 \(J_q\) 时 ,此时的的动作空间就是 top-p 截断后的 动作空间 集合(支持集,即 top-p 的核分布动作空间)
- Pure On-policy,不考虑训推引擎差异,于是有 行为策略和训练策略的 动作空间 集合一致
- 注:必须要满足 动作空间 集合在 \(q_\text{rollout}, \pi_\text{old}, \pi_\theta\) 策略下 完全一致才行
- 若 动作空间 集合不一致的话, IS 是无法准确修正 支撑集不一致的分布的
- 注:必须要满足 动作空间 集合在 \(q_\text{rollout}, \pi_\text{old}, \pi_\theta\) 策略下 完全一致才行
- 于是,在 动作空间 集合不发生变化的局部区域内,优化的准确分布为:
$$ q_\theta(a\mid h) = \frac{\pi_\theta(a\mid h)}{Z_\theta(h)} $$- 直接对这个分布求梯度为:
$$
\nabla_\theta\log q_\theta(a\mid h)=\nabla_\theta\log\pi_\theta(a\mid h)-\nabla_\theta\log Z_\theta(h)
$$
- 直接对这个分布求梯度为:
- 采样使用上诉分布,即令:
$$ q_\text{rollout} = q_\theta(a\mid h) $$ - 在基于 \(q_\text{rollout}\) 采样到的样本 \(B\) 上,不考虑训练和推理引擎带来的不一致 的情况下,针对 \(J_q\) 目标的一个无偏的 on-policy 梯度估计是 :
$$
\hat g=\frac1B\sum_{i=1}^{B}\sum_t\bigl(R_i-b(h_{i,t})\bigr)\nabla_\theta\log q_\theta(a_{i,t}\mid h_{i,t})
$$- 这个无偏梯度就是直接针对 top-p 后的分布 \(q_\theta\) 求导得到的
方法 B:Pure On-policy,独立辅助 token 无偏估计归一化梯度(称为 Aux-Token 法)
- 如果 serving 固定用 top-p=0.95,那么真正部署的分布是:
$$
q_\theta(a\mid h)=\frac{\pi_\theta(a\mid h)\mathbf 1[a\in S_\theta(h)]}{Z_\theta(h)}
$$- 其中:
$$
\begin{align}
\pi_\theta(a\mid h)&=\text{softmax}(z_\theta(h)/T)_a \\
Z_\theta(h)&=\sum_{a\in S_\theta(h)}\pi_\theta(a\mid h)
\end{align}
$$- \(S_\theta(h)\) 是 top-p 保留集合,也就是 nucleus
- 其中:
- 我们的终极目标是想优化:
$$
J_q(\theta)=\mathbb E_{\tau\sim q_\theta}[R(\tau)]
$$ - 根据策略梯度定理,最终的梯度表达式为下面的形式(详情见:RL——策略梯度法推导):
$$
\nabla_\theta J_q(\theta)=\mathbb E_{\tau\sim q_\theta}
\left[R(\tau)\sum_t\nabla_\theta \log q_\theta(a_t\mid h_t)\right]
$$- 注:如果加上 baseline,就是 advantage 乘上 \(\nabla_\theta \log q_\theta\):
$$
\nabla_\theta J_q(\theta)=\mathbb E_{\tau\sim q_\theta}\left[\sum_tA(h_t,a_t)\nabla_\theta \log q_\theta(a_t\mid h_t)\right]
$$
- 注:如果加上 baseline,就是 advantage 乘上 \(\nabla_\theta \log q_\theta\):
- 根据上面的推导,梯度 \(\nabla_\theta \log q_\theta(a_t\mid h_t)\) 部分等于:
$$
\nabla_\theta \log q_\theta(a\mid h)=\nabla_\theta \log \pi_\theta(a\mid h)-\nabla_\theta \log Z_\theta(h)
$$- 注:第二项 \(-\nabla_\theta \log Z_\theta(h)\) 本质是一个期望,\(Z_\theta(h)\) 依赖动态的 动作空间 集合
$$
\nabla_\theta \log Z_\theta(h)=\mathbb E_{u\sim q_\theta(\cdot\mid h)}\left[\nabla_\theta \log \pi_\theta(u\mid h)\right]
$$ - 从期望的定义可以知道,我们可以得到:
- 1)从当前的 top-p 分布 \(q_\theta(\cdot\mid h)\) 里随机抽一个 token \(u\)
- 2)算 \(\nabla_\theta \log \pi_\theta(u\mid h)\)
- 3)1 和 2 抽很多次取平均,就得到 \(\nabla_\theta \log Z_\theta(h)\)
- 在接受单个样本替代期望造成的方差时,可以用一次采样替代
- 注:第二项 \(-\nabla_\theta \log Z_\theta(h)\) 本质是一个期望,\(Z_\theta(h)\) 依赖动态的 动作空间 集合
- 在每个真实生成位置 \(t\),已经有真实动作:
$$
a_t\sim q_\theta(\cdot\mid h_t)
$$ - 额外采样动作(核心):如果额外再从同一个 top-p 分布独立抽一个辅助 token:
$$
u_t\sim q_\theta(\cdot\mid h_t)
$$- 要求:
- \(u_t\) 与 \(a_t\) 在给定 \(h_t\) 下独立
- \(u_t\) 不进入上下文
- \(u_t\) 不执行工具
- \(u_t\) 不参与奖励
- \(u_t\) 只用来构造梯度估计
- 要求:
- 定义单步估计量:
$$
\hat s_t=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log \pi_\theta(u_t\mid h_t)
$$ - 它的条件期望是:
$$
\mathbb E_{u_t \sim q_\theta(\cdot\mid h_t)}\left[\hat s_t\mid h_t,a_t\right]=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\mathbb E_{u_t}\left[\nabla_\theta \log \pi_\theta(u_t\mid h_t)\right]
$$- 注意:因为 \(u_t, a_t\) 是相互独立的,所以这里第一项的期望就是他自身 \(\nabla_\theta \log \pi_\theta(a_t\mid h_t)\)
- 由于:
$$
\mathbb E_{u_t}\left[\nabla_\theta \log \pi_\theta(u_t\mid h_t)\right]=\nabla_\theta \log Z_\theta(h_t)
$$ - 所以:
$$
\mathbb E_{u_t}[\hat s_t\mid h_t,a_t]=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log Z_\theta(h_t)=\nabla_\theta \log q_\theta(a_t\mid h_t)
$$- 固定真实动作 \(a_t\),只对辅助 token \(u_t\) 求期望,\(\hat s_t\) 正好等于我们想要的 top-p 梯度
- 注意:进一步来看,还可以进一步将 \(\hat s_t\) 化简为 logits 差分的形式,即
$$
\begin{align}
\hat s_t&=\nabla_\theta \log \pi_\theta(a_t\mid h_t)-\nabla_\theta \log \pi_\theta(u_t\mid h_t) \\
&=\frac{1}{T}\nabla_\theta\left[z_\theta(h_t,a_t)-z_\theta(h_t,u_t)\right]
\end{align}
$$- 证明:其中全词表 softmax 的归一化项 \(\nabla_\theta \Omega_\theta(h_t)\) 在相减时抵消,所以最终只剩下两个 logits 的差分
- 根据 \(\pi_\theta(a\mid h)\) 中 softmax 的定义有:
$$
\log \pi_\theta(a\mid h) = \frac{z_\theta(h,a)}{T} - \Omega_\theta(h)
$$- 其中:
$$ \Omega_\theta(h)=\log\sum_{v\in V}\exp\left(\frac{z_\theta(h,v)}{T}\right) $$
- 其中:
- 于是有:
$$
\begin{align}
\hat s_t
&= \nabla_\theta \log \pi_\theta(a_t\mid h_t)- \nabla_\theta \log \pi_\theta(u_t\mid h_t) \\
&= \left(\frac{1}{T}\nabla_\theta z_\theta(h_t,a_t)-\nabla_\theta \Omega_\theta(h_t)\right)-\left(\frac{1}{T}\nabla_\theta z_\theta(h_t,u_t)-\nabla_\theta \Omega_\theta(h_t)\right) \\
&= \frac{1}{T}\nabla_\theta z_\theta(h_t,a_t)- \nabla_\theta \Omega_\theta(h_t)- \frac{1}{T}\nabla_\theta z_\theta(h_t,u_t)+ \nabla_\theta \Omega_\theta(h_t)\\
&= \frac{1}{T}\nabla_\theta z_\theta(h_t,a_t) - \frac{1}{T}\nabla_\theta z_\theta(h_t,u_t) \\
&= \frac{1}{T}\nabla_\theta\left[z_\theta(h_t,a_t)-z_\theta(h_t,u_t)\right]
\end{align}
$$
- 根据 \(\pi_\theta(a\mid h)\) 中 softmax 的定义有:
- 证明:其中全词表 softmax 的归一化项 \(\nabla_\theta \Omega_\theta(h_t)\) 在相减时抵消,所以最终只剩下两个 logits 的差分
Aux-Token 法 的代码 实现方式
- 1)Sampler 侧 :rollout 时,除了返回真实 token \(a_t\),还要从同一个 top-p 分布独立采一个辅助 token \(u_t\)
- 2)轨迹字段 :每条轨迹保存每个位置的辅助 token ID \(u_t\)
- 3)Actor loss :不再只算 \(\log \pi_\theta(a_t\mid h_t)\),而是计算 logits 差分:
$$
z_\theta(h_t,a_t)-z_\theta(h_t,u_t)
$$- 这里是可以证明的,
- 对应的局部 surrogate 是:
$$
L=-\frac1B\sum_{i,t} A(h_{i,t}, a_{i,t})\frac{z_\theta(h_{i,t},a_{i,t})-z_\theta(h_{i,t},u_{i,t})}{T}
$$- 其中 \(A(h_{i,t}, a_{i,t})\) 是 advantage,不反传梯度
Aux-Token 法 的一个极简例子
- 假设词表只有两个 token:A 和 B,当前 top-p 分布:
$$
q(A)=0.9,\qquad q(B)=0.1
$$ - 真实动作是 \(a=A\),advantage 是 \(A(h,A)=1\)
- 辅助 token \(u\) 从同一个分布抽:
- 以 \(0.9\) 的概率抽到 \(u=A\),此时 \(\hat s=0\);
- 以 \(0.1\) 的概率抽到 \(u=B\),此时:
$$
\hat s=\nabla\log\pi(A)-\nabla\log\pi(B)
$$
- 所以:
$$
\mathbb E_u[\hat s\mid a=A]=0.9\cdot 0+0.1\cdot\bigl(\nabla\log\pi(A)-\nabla\log\pi(B)\bigr)
$$
Aux-Token 法 的优点与缺点
- Aux-Token 法 的优点
- 不需要显式计算 动作空间 集合 \(S_\theta(h)\)
- 不需要显式保存或求导 \(\log Z_\theta(h)\)
- 对辅助 token 求期望后,梯度估计无偏(注意:Aux-Token 方法是真实无偏的(吐槽:但方差大),目标也没有经过修改,也不用 IS 来修正,而 DeepSeek-V3.2 是经过修改的)
- Aux-Token 法 的缺点
- 辅助 token 是随机采样,基于单个 Token 估计期望,会增加梯度方差
- 当真实 token 概率很高时,\(u_t=a_t\) 很常见,很多 \(\hat s_t=0\),信号稀疏
- 改动成本高:
- 需要修改 sampler
- 除了主轨迹外,需要增加一个额外 Token
- 需要修改 actor loss,对所有算法都有入侵
- 要求真正 on-policy 的采样和概率定义一致
- 不能修正引擎数值带来的差异(因为没有 IS 来修正)
- 也不能修正 PPO clipping、IS 截断等其他近似
- 如果想要修正类似方法,需要单独使用 IS 修正
补充:平时应该用什么方式解决 top-p
- 方案一(策略混杂,但目前较好方案,对 Infra 要求高):
- 像 DeepSeek 一样,使用 Keep Sampling Mask 策略,成本高,但理论上可行
- 方案二(训练目标与最终目标不一致,但训推一致,训练稳定):
- 训练目标设定为 top-p 等于 1 的策略,采样时也使用 top-p 等于 1 的策略,从而无需修正
- 训练以后再测试 top-p=0.95 和 top-p=1.0 谁更好就用谁
- 注意:这种方法下,对于 top-p=0.95 和 top-p=1 差异很大的场景则很难训练(因为两者采样到的样本特点不同),RL 可能需要修复很多 top-p=0.95 上不存在 但 top-p=1 上存在的问题,基础分数就低了一大截
- 一般越小的模型,熵越高,越需要类似的
top-p=0.95这样的修正(有时候还会叠加temperature=0.6)
- 一般越小的模型,熵越高,越需要类似的
- 训练目标设定为 top-p 等于 1 的策略,采样时也使用 top-p 等于 1 的策略,从而无需修正
- 方案三(训推不一致):
- 采样时也使用 top-p 等于 0.95 的策略,不修改任何地方
- 由于返回的概率是 top-p 生效前的分布,所以不会被 IS 修正(风险很高,理论上训练过程中可能随时崩溃)
- 训练目标是个四不像,既不是 \(J_\pi\),也不是 \(J_q\)
- 方案四(训推不一致):
- 采样时也使用 top-p 等于 0.95 的策略,同时返回的概率也使用 top-p 生效后的
- 由于返回的概率是 top-p 生效后的分布,所以可以被 IS 部分修正
- 支持集与 \(\pi\) 不同,所以无法修正为 \(J_\pi\)
- 风险:由于训练策略为修改,IS 总是会偏小
- 训练目标仍然是个四不像,既不是 \(J_\pi\),也不是 \(J_q\)
- 考虑到支持集仅是 Rollout 时, top-p 上的动作空间,所以修正后的策略也是个四不像
- 方案五(训推不一致):
- 采样时也使用 top-p 等于 0.95 的策略,同时返回的概率也使用 top-p 生效后的,再将策略 \(\pi_\theta\) 也改成 top-p 生效后的目标
- 由于返回的概率是 top-p 生效后的分布,所以可以被 IS 部分修正
- 支持集与修正后的 \(\pi\) (即策略 \(q\))不同,所以无法准确修正为 \(J_q\),仅完成部分修正
- 训练目标是个有点偏差的 \(J_q\)
- 偏差来源于支持集不同
- 更多方案?