Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——Agent-Learning-via-Early-Experience

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:Agent Learning via Early Experience, arXiv 202451009, Meta

Paper Summary

  • 论文核心介绍了通过 Early Experience 范式来训练 Agent 的策略
    • 提出 Early Experience 作为一种可扩展的、无奖励的范式,在强化学习环境完全准备好之前推进语言智能体
    • 通过将智能体自身的动作和结果状态转换为监督,而无需外部奖励信号,论文在八个多样化的环境中取得了一致的增益,涵盖了具身导航、科学实验、长程规划、多轮工具使用和网络导航
    • 在此范式下提出的两种方法:隐式世界建模 (implicit world modeling) 和自反思 (self-reflection)
      • 这两种方法可以改善领域内的有效性和领域外的鲁棒性(in-domain effectiveness and out-of-domain robustness),并且在用于热启动(warm-start)强化学习时保持了其优势
      • 在即将到来的经验时代 (era of experience) 中,作者将 Early Experience 定位为构建更强语言智能体的实用和通用基础(practical and general foundation)
  • 思考:
    • 论文所谓的隐式世界建模和自反思,侧重于短程轨迹,将这些扩展到解决没有显式奖励的长程信用分配仍然是一个开放的挑战
    • 未来的工作将探索(来自原文)
      • 方向一:将 Early Experience 与更丰富的自监督目标相结合 ,利用跨环境迁移,并在持续学习设置中将其与基于奖励的微调相集成
      • 方向二:研究除了论文提出的两种方法之外的其他 Early Experience 实例
      • 论文也希望将该范式扩展到大规模、真实世界的部署中,在那里交互数据被有机地收集并可以驱动策略的持续改进
  • 问题提出:语言智能体的一个长期目标是通过自身经验进行学习和改进,最终在复杂的现实世界任务中超越人类
    • 但在许多环境中,使用经验数据通过强化学习来训练智能体仍然很困难
    • 这些环境要么缺乏可验证的奖励(例如网站),要么需要低效的 Long-horizon 展开(例如多轮工具使用)
  • 目前大多数智能体依赖于在专家数据上进行监督微调,这种方法难以扩展且泛化能力差
    • 这种局限性源于专家 Demonstrations 的本质:只捕捉了狭窄范围的场景,并且让智能体接触到的环境多样性有限
  • 论文通过一种论文称之为 Early Experience 的中间范式来解决这个局限性:
    • 由智能体自身行动产生的交互数据,其中产生的未来状态作为监督信号 ,无需奖励信号
  • 在这个范式中,论文研究了使用这种数据的两种策略:
    • (1) 隐式世界建模(Implicit World Modeling) ,它使用收集到的状态来使策略基于环境动态;
    • (2) Self-Reflection ,智能体从其次优行动中学习以改进推理和决策制定
  • 论文在八个不同的环境和多个模型系列中进行评估
  • 论文的方法持续提高了有效性和领域外泛化能力,突显了 Early Experience 的价值
  • 在具有可验证奖励的环境中,论文的结果提供了有希望的信号,表明 Early Experience 为后续的强化学习奠定了坚实的基础,将其定位为模仿学习和完全由经验驱动的智能体(fully experience-driven agents)之间的实用桥梁
  • 问题:为什么不试试 IWM 和 Self-Reflection 同时生效的策略?

Introduction and Discussion

  • 自主智能体(Autonomous agents) (1995; 1997) 长期以来一直是人工智能的核心目标,旨在无需人工干预的情况下,在复杂环境中感知、行动和学习以完成目标
  • 随着语言智能体 (2024;) 的出现,这一愿景正变得越来越现实,这些智能体构建在大语言模型 (2024) 之上
    • 凭借从大规模预训练中获得的知识以及语言接口的灵活性,语言智能体现在被应用于广泛的环境中
    • 它们可以浏览网站和移动应用程序 (2023; 2024;),控制各种工具 (2024),并辅助科学研究 (2025;),显示出作为下一代智能系统基础的强大潜力
  • 构建此类语言智能体 ,一个有前途的解决方案是强化学习 ,即通过优化环境返回的期望累积奖励来训练智能体
    • 这种范式使得像 AlphaGo (2016) 这样的传统智能体在具有明确定义环境和奖励结构的领域(如 Atari 游戏 (2013) 和围棋游戏)中实现了超人的性能,呼应了语言智能体新兴的 经验时代 (2025) 的愿景
    • 但将强化学习应用于现实世界的语言智能体目前仍然极具挑战性
      • 许多感兴趣的环境缺乏可验证或密集的奖励信号 ,特别是在开放式设置中,比如网站,平台不暴露真实反馈
        • 例如,一个表单可能看起来提交成功,但智能体没有收到任何关于每条信息是否填写正确的指示
      • 此外,多轮工具使用环境中的任务通常涉及长的交互序列 (2025),结果延迟或模糊 ,使得信用分配和训练低效且不稳定
  • 作为一种变通方法,目前大多数语言智能体转而使用监督微调 (2023; 2025;) 在专家策划的数据上进行训练
    • 这种范式通过学习人类 Demonstrations 来规避对奖励信号的需求,智能体使用静态数据集将状态映射到行动
    • 虽然监督微调训练起来简单高效,但它有其固有的局限性
      • 在此范式下的智能体在训练期间不与环境交互;它不观察自身行动的结果
      • 这限制了它从失败中学习、改进其决策制定或泛化到未见情况的能力 (2025)
    • 此外,这种方法假设数据是专家或接近最优的,然而扩展高质量的人类 Demonstrations 既昂贵又难以持续
    • 更关键的是,它将智能体锁定在一个被动的角色中,受限于其训练数据的想象力和覆盖范围,而不是主动地从自身经验中学习
  • 鉴于这些局限性以及前述可靠奖励信号通常不可用,我们遇到了一个问题:如何训练智能体从其自身经验中成长 ,无需任何外部奖励信号呢?
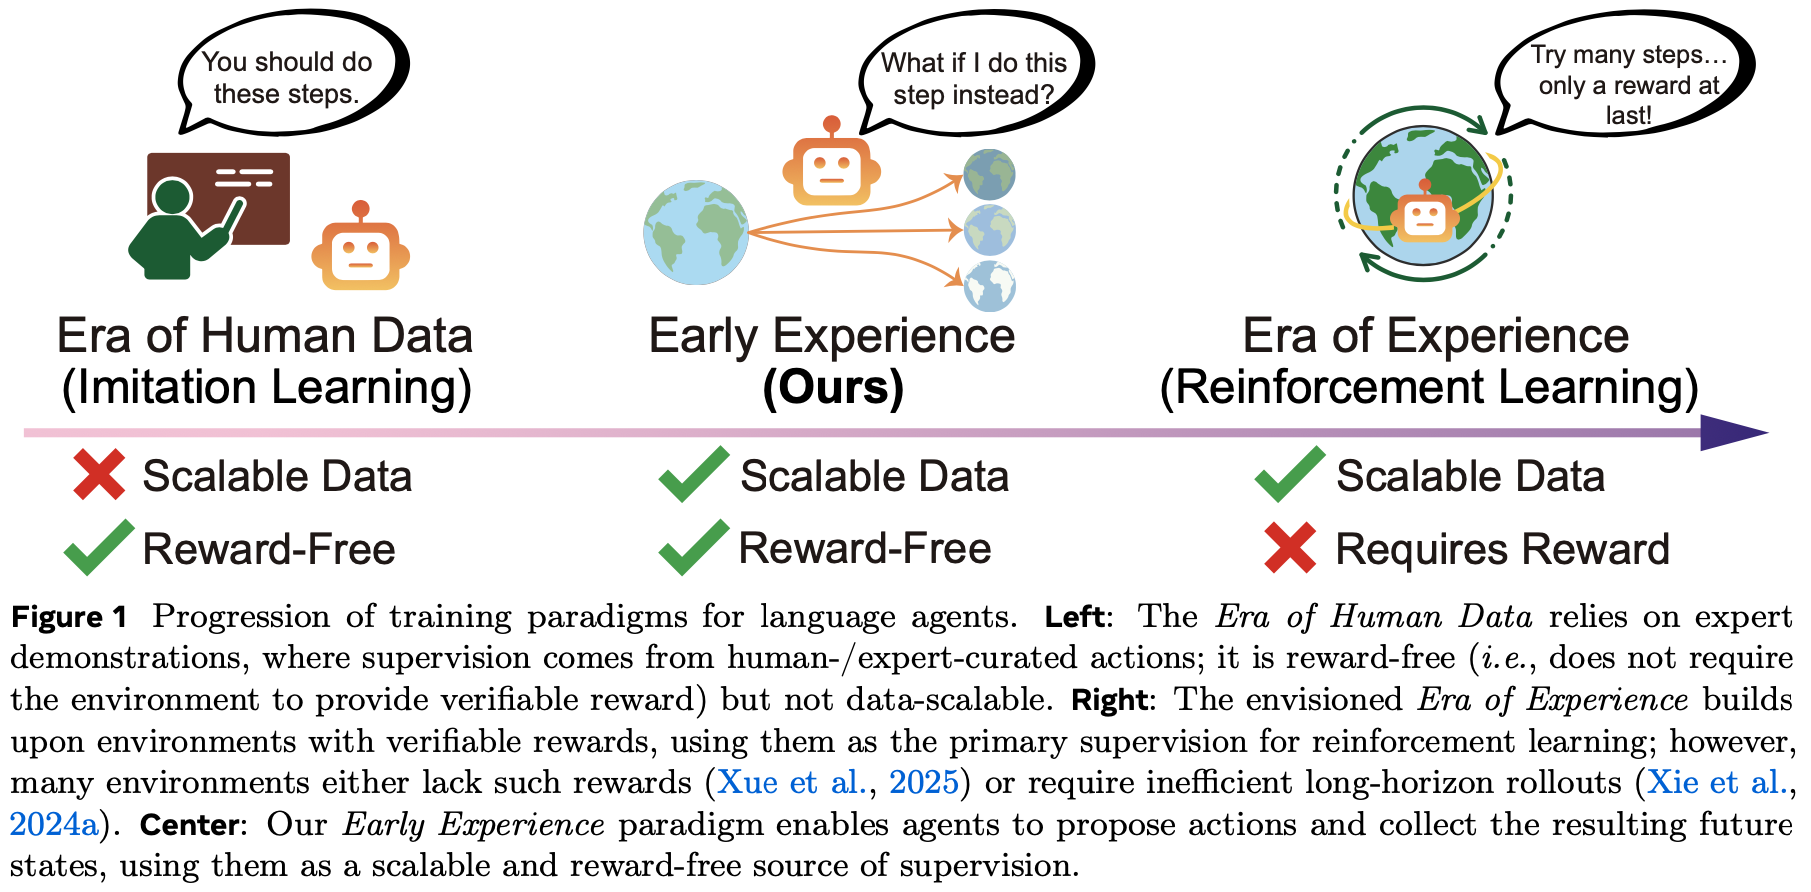
  • 受这些局限性启发,论文引入了 Early Experience 范式,作为模仿学习和强化学习之间的中间地带,如图 1 所示
    • 在这种设置中,智能体不仅从人类策划的数据中学习,还从其自身在环境中提出的行动所驱动的未来状态中学习
    • 这些未来状态是智能体自身的经验,并且可以转化为监督信号,使其能够直接从其行动的后果中成长,而无需依赖外部奖励信号
  • 论文探索了两种将这些未来状态转化为监督的策略:
    • (1) 隐式世界建模 :使用收集到的未来状态来帮助智能体建立对环境动态的内部表征,使其通过预测未来状态来更好地理解环境
    • (2) Self-Reflection :引导智能体将其行为与专家 Demonstrations 进行比较,识别次优决策,并提取经验教训以改进未来的决策制定
  • 这两种策略共享相同的原则:在缺乏外部奖励的情况下,智能体自身的行动及其产生的未来状态仍然可以构成经验,作为直接的监督来源
    • 通过将由其自身行动产生的未来状态转化为学习信号,语言智能体可以在不依赖额外人类数据或外部奖励的情况下持续改进
  • 论文在八个不同的环境中全面评估 Early Experience,涵盖具身导航、网络导航、多轮工具使用、 Long-horizon 规划和多领域 API 任务,并使用多种基础架构
    • 在所有设置中,两种方法都一致地优于纯模仿学习基线,在成功率上平均绝对增益为 +9.6 ,在领域外泛化上平均绝对增益为 +9.4
    • 此外,在具有可验证奖励的环境中,使用 Early Experience 方法训练的检查点初始化强化学习,与标准的模仿学习热启动相比,能带来显著更强的性能,最终成功率提高了 +6.4
    • 这表明 Early Experience 阶段带来的性能增益可以延续到强化学习后最终模型的性能上
  • 除了这些经验性收益之外,论文的分析表明, Early Experience 实现了仅通过模仿学习无法获得的能力
    • 它能有效扩展,仅用一半甚至更少的专家数据就能达到相当或更优的性能
    • 该范式可无缝应用于更大的模型,在不同规模上保持其有效性
  • 这些结果表明, Early Experience 不仅仅是模仿学习的替代品,而且是通向强化学习的一个实用且可扩展的桥梁,既带来了有效性的即时收益,也为 经验时代(era of experience) 的训练机制带来了长期益处
  • 论文的贡献总结如下:
    • (1) 论文倡导并将 Early Experience 范式形式化,作为构建自主语言智能体的模仿学习和强化学习之间的一个实用且可扩展的桥梁
      • 它使智能体能够将其自身经验转化为学习信号,而无需依赖外部奖励,并且可以无缝集成到现有的训练流程中
    • (2) 论文在此范式下提出并系统研究了两种训练策略:
      • 隐式世界建模,通过直接从收集的经验中建模环境动态来增强决策制定;
      • Self-Reflection ,从智能体自身行动中提炼细粒度的经验教训
    • (3) 论文在八个不同的环境和多个模型系列中进行了全面评估
      • 论文的方法持续提高了任务有效性、领域外泛化能力和下游强化学习性能,在多个基准测试中取得了 SOTA 结果,并通过详细分析提供了可行的见解

Preliminaries

  • 论文将语言智能体决策制定问题形式化为马尔可夫决策过程 (MDP, 1957),这为论文的 Early Experience 范式提供了数学基础
  • 论文考虑一个由下面元组 定义的 MDP
    $$ \mathcal{M}=(\mathcal{S},\mathcal{A},T,R,\gamma,\rho_{0})$$
    • 其中 \(\mathcal{S}\) 表示状态空间,\(\mathcal{A}\) 表示行动空间
    • 状态转移函数 \(T\colon \mathcal{S}\times \mathcal{A}\to \Delta(\mathcal{S})\) 支配状态动态,其中 \(\Delta(\mathcal{S})\) 表示 \(\mathcal{S}\) 上的概率单纯形
    • 奖励函数 \(R\colon \mathcal{S}\times \mathcal{A}\to \mathbb{R}\) 在可用时提供反馈信号,尽管在许多现实世界设置中,此函数在训练期间可能未知或不可验证
    • \(\gamma\in [0,1]\) 是折扣因子,\(\rho_{0}\in \Delta(\mathcal{S})\) 指定了初始状态分布
  • 在语言智能体环境中:
    • 状态 \(s\in \mathcal{S}\) 编码智能体可访问的环境配置,例如网页内容、工具输出或文本环境描述
      • 理解:还包括了之前的 所有 Prompt 吧
    • 行动 \(a\in \mathcal{A}\) 对应于离散选择,例如点击元素、调用工具或生成文本响应
    • 智能体维护一个由 \(\theta\) 参数化的策略,将状态映射到行动分布 (1992):
      $$ \pi_{\theta}\colon \mathcal{S}\to \Delta(\mathcal{A}) $$

Learning without Rewards

  • 现实世界语言智能体环境中的一个关键挑战是缺乏可靠的奖励信号
    • 许多环境要么完全缺乏可验证的奖励,要么仅在长的交互序列之后提供稀疏、延迟的反馈
  • 这促使论文从替代的监督源中学习
  • 给定一个专家 Demonstrations 数据集
    $$ \mathcal{D}_{\text{expert} }=\{(s_{i},a_{i})\}_{i=1}^{N}$$
    • 其中 \(a_{i}\) 表示在状态 \(s_{i}\) 下的专家行动
  • 模仿学习 (1991; 1996; 2017) 旨在最小化监督学习损失:
    $$ \mathcal{L}_{\text{IL} }(\theta)=-\sum_{i=1}^{N}\log \pi_{\theta}(a_{i} \mid s_{i}). $$
  • 然而,这种方法会遭受分布偏移并且缺乏对行动后果的认知
  • 分布偏移的发生是因为智能体学习到的策略 \(\pi_{\theta}\) 在部署时不可避免地会偏离专家策略,导致训练数据未覆盖的状态,其中错误会复合 (2011)
  • 智能体缺乏对行动后果的认知,因为它从未观察到当其采取非专家行动时会发生什么;它只看到专家状态-行动对,而没有体验替代选择的后果
  • 这限制了其从错误中恢复或推理某些行动为何失败的能力 (2010)

Early Experience

  • 论文引入了 Early Experience 范式,在这种范式中,语言智能体通过与环境进行无奖励但信息丰富的未来状态交互来改进
  • 为了建立直观理解,考虑一个学习在网络上预订航班的语言智能体
    • 在传统的模仿学习中,它只看到成功预订的专家演示
    • 而有了 Early Experience ,智能体还会探索当它点击不同的按钮或错误填写表格时会发生什么,观察错误消息、页面变化和其他结果
      • 这些观察结果成为了没有显式奖励的学习信号
    • 从专家轨迹开始,智能体在每个访问状态提出自己的动作,通过探索(Thrun, 1992)收集额外的环境反馈

Notation for Early Experience

  • 对于专家数据集 \(\mathcal{D}_{\text{expert} }=\{(s_{i},a_{i})\}_{i=1}^{N}\) 中的每个专家状态 \(s_{i}\),论文定义一个候选动作集 \(\mathcal{A}_{i}=\{a_{i}^{1},a_{i}^{2},\ldots,a_{i}^{K}\}\),其中论文从初始策略 \(\pi_{\theta}(\cdot \mid s_{i})\) 中采样 \(K\) 个 alternative 动作
    • 论文在分析中也包括专家动作 \(a_{i}\)
  • 对于专家动作 \(a_{i}\),执行它会跳转到下一个状态 \(s_{i+1}\)
    • 对于每个 alternative 动作\(a_{i}^{j}\in \mathcal{A}_{i}\) ,在环境中执行它会从转移函数 \(T(s_{i},a_{i}^{j})\) 中采样得到一个下一个状态 \(s_{i}^{j}\)
    • 这些下一个状态捕捉了在状态 \(s_{i}\) 采取动作 \(a_{i}^{j}\) 的直接后果,反映了环境中的变化,例如更新的 DOM 结构、新的工具输出、错误消息或任务进展
  • 论文将这些交互收集到一个 rollout 数据集中:
    $$\mathcal{D}_{\text{rollout} }=\{(s_{i},a_{i}^{j},s_{i}^{j})\mid i\in[N],j\in[K]\},$$
    • 其中每个三元组表示一个状态、在该状态采取的一个 alternative 动作以及产生的下一个状态
    • 所有 alternative 动作 \(a_{i}^{j}\) 都与专家动作 \(a_{i}\) 不同 ,允许智能体从其自身提出的动作中体验多样化的状态转移
      • 这个 rollout 数据集 \(\mathcal{D}_{\text{rollout} }\) 提供了丰富的监督信号,而不需要显式的奖励
    • 下一个状态 \(\{s_{i}^{j}\mid j\in[K]\}\) 通过环境响应编码了关于动作质量的隐式反馈,使智能体能够从专家和非专家行为的后果中学习
  • 图 2:两种 Early Experience 方法的概述
    • 隐式世界建模(左)用 alternative 动作和预测的下一个状态增强专家轨迹,在部署前训练策略以内化转移动态
    • Self-Reflection(右)用自我生成的解释 \(c_{1}\) 增强专家动作,训练策略对其自身决策进行推理和修正
    • 两种方法都使用初始策略(LLM)提出的 alternative 动作
    • alternative 动作的数量(\(K\))是一个超参数;为简洁起见,图中仅展示了一个
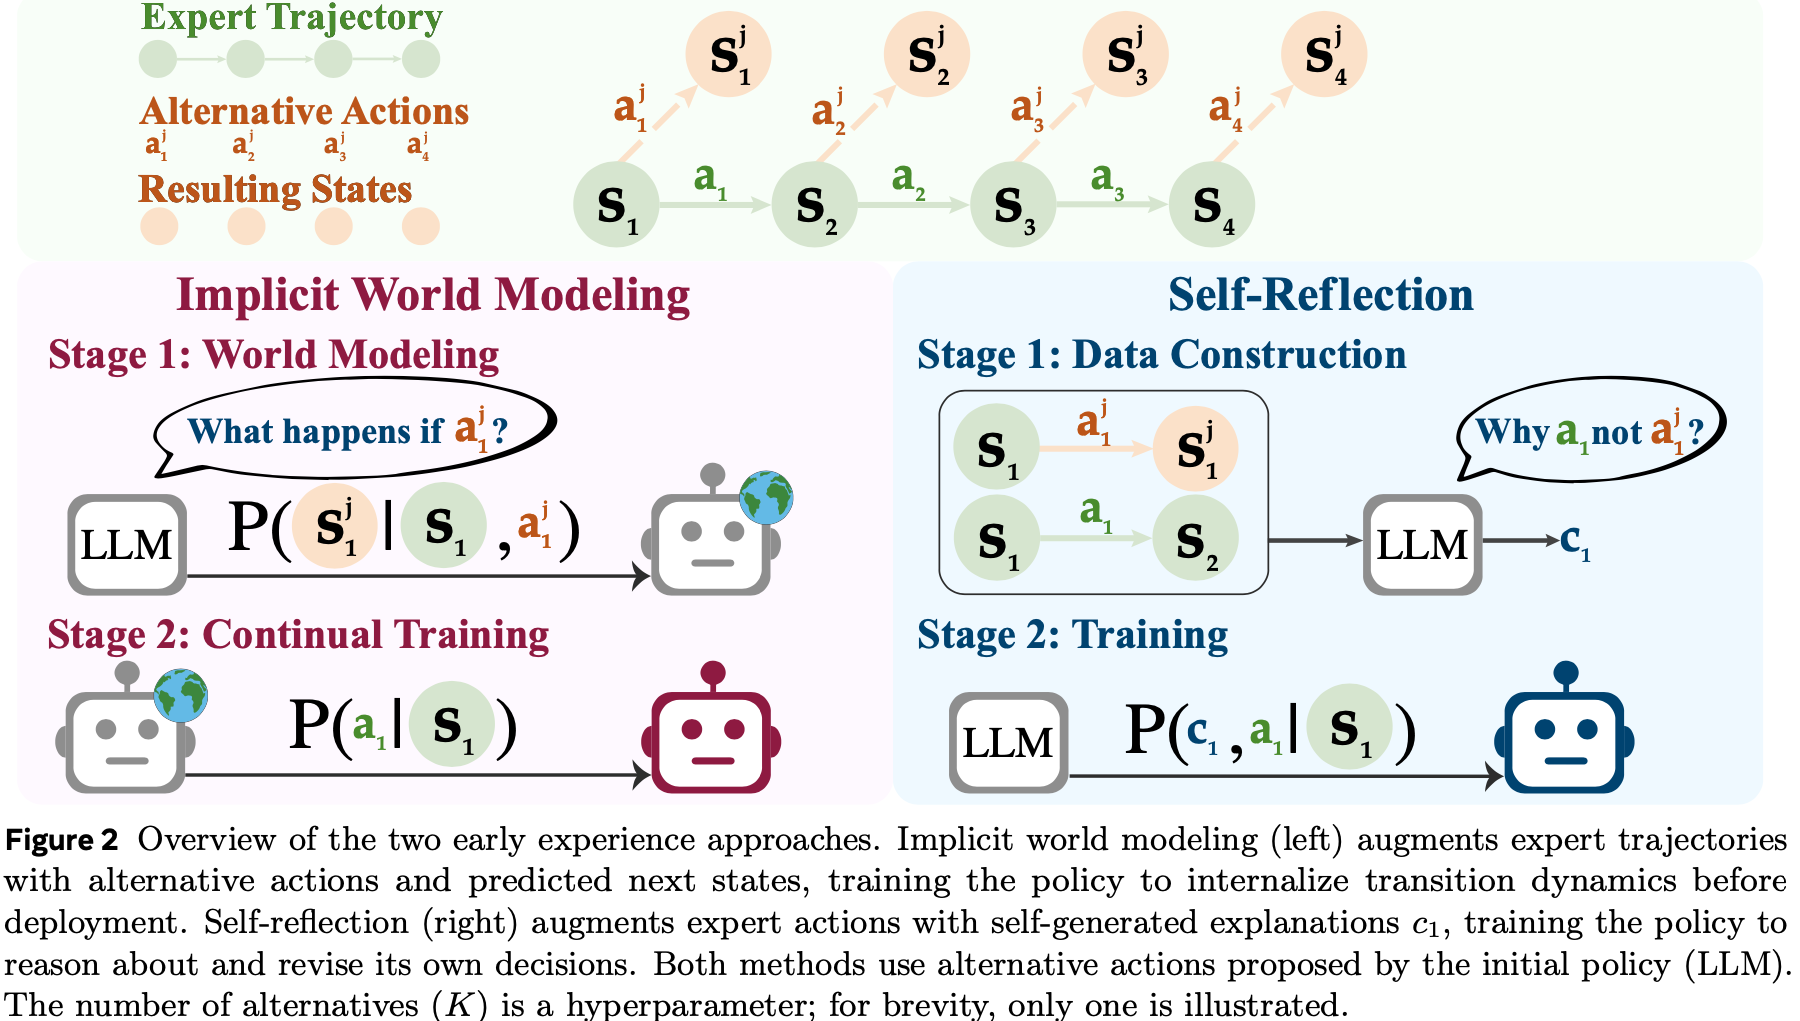
  • 基于第 3 节的符号,论文利用专家数据集 \(\mathcal{D}_{\text{expert} }=\{(s_{i},a_{i})\}_{i=1}^{N}\) 和 rollout 数据集 \(\mathcal{D}_{\text{rollout} }=\{(s_{i},a_{i}^{j},s_{i}^{j})\mid i\in[N],j\in[K]\}\) 来在同一 Early Experience 原则下开发两种不同的训练方法
    • 关键的洞见是,由非专家动作产生的下一个状态 \(s_{i}^{j}\) 提供了有价值的监督信号,而无需显式奖励
    • 论文现在描述论文的两种 Early Experience 方法如何利用这个数据集

Implicit World Modeling

  • 论文将世界建模制定为一个辅助预测任务 ,帮助智能体从其自身的 Early Experience 中内化环境动态
  • 在论文的设定中,状态完全用自然语言表示,这允许论文将下一个状态(Next-State)预测建模为一个标准的 Next-Token 预测目标
  • 受先前将 LLM 训练为世界模型(2025)的工作启发,论文使用 rollout 集 \(\mathcal{D}_{\text{rollout} }\) 中的下一个状态作为语言智能体策略 \(\pi_{\theta}\) 的直接训练信号
    • 例如,在网络上预订航班时,模型可能预测输入无效日期后的页面状态,从作为下一个状态自然语言表示的文本错误消息中学习
    • 这种设计移除了对单独模块的需求,并自然地契合了 LLM 微调范式
  • 对于每个 rollout 三元组 \((s_{i},a_{i}^{j},s_{i}^{j})\in \mathcal{D}_{\text{rollout} }\),论文构建一个预测任务,其中模型以状态-动作对 \((s_{i},a_{i}^{j})\) 作为输入,并学习预测产生的下一个状态 \(s_{i}^{j}\)
    • 论文将训练目标定义为一个 Next-Token 预测损失:
      $$\mathcal{L}_{\text{IWM} }=-\sum_{(s_{i},a_{i}^{j},s_{i}^{j})\in \mathcal{D}_{\text{rollout} } }\log p_{\theta}(s_{i}^{j}\mid s_{i},a_{i}^{j}),$$
    • 其中 \(p_{\theta}\) 表示语言模型的输出分布
    • 注意,论文对状态预测(在世界建模期间)和动作预测(在策略执行期间)使用相同的模型参数 \(\theta\),允许策略直接内化环境动态
  • 这个训练目标鼓励模型捕捉环境行为中的规律性,包括常见的转移、副作用和无效动作结果
    • 与用于规划的推理时世界模型不同,论文的 隐式 (implicit) 表述将预测信号直接集成到策略学习中,作为监督学习或下游优化之前的轻量级预热
    • 它将智能体暴露于多样化的非专家行为中,提高了对分布偏移的鲁棒性,并减少了对脆弱专家轨迹的依赖
    • 在实践中, rollout 数据通常比 \(\mathcal{D}_{\text{expert} }\) 大一个数量级
    • 论文采用一个两阶段流程 :
      • 首先用 \(\mathcal{L}_{\text{IWM} }\) 训练以内化粗略动态
      • 然后在 \(\mathcal{D}_{\text{expert} }\) 上微调(即 \(\mathcal{L}_{\text{IL} }\))

Self-Reflection

  • 论文将 Self-Reflection 制定为一种机制,使智能体能够从其自身的探索性结果中学习

  • 智能体不仅仅依赖专家状态-动作对 ,而是在每个状态将专家动作与其策略中采样的 alternative 动作进行比较 ,利用产生的下一个状态生成自然语言解释 ,说明为什么专家选择更好

    • 这些解释比单独的专家动作提供了更丰富、可转移的监督,利用了 LLM 在处理语言方面的优势,以内化能够跨任务泛化的决策原则
  • 具体来说

    • 对于每个专家状态 \(s_{i}\),论文首先执行专家动作 \(a_{i}\) 以获得专家下一个状态 \(s_{i+1}\)
    • 对于每个 alternative 动作 \(a_{i}^{j}\)(其中 \(j\in\{1,…,K\}\))
      • 论文先获得相应的下一个状态 \(s_{i}^{j}\)
      • 然后提示一个语言模型生成一个思维链 \(c_{i}^{j}\) ,根据其结果状态 \(s_{i+1}\) 和 \(s_{i}^{j}\) 之间的差异,解释为什么专家动作 \(a_{i}\) 优于 alternative 动作\(a_{i}^{j}\)
      • 这个提示旨在引发自然语言推理,突出 \(a_{i}^{j}\) 中潜在的局限性或低效性,并以观察到的实际状态转移为基础
    • 产生的三元组 \((s_{i},a_{i}^{j},c_{i}^{j})\) 被收集到一个数据集 \(\mathcal{D}_{\text{refl} }\) 中
    • 然后论文训练智能体在给定状态 \(s_{i}\) 的条件下 ,联合预测思维链和专家动作 ,使用在连接的目标序列 \(c_{i}^{j}\circ a_{i}\) 上的 Next-Token 预测损失:
      $${\cal L}_{\rm SR}=-\sum_{(s_{i},a^{j}_{i},c^{j}_{i})\in{\cal D}_{\rm refl} }\log p_{\theta}(c^{j}_{i},a_{i}\mid s_{i}),$$
    • 其中 \(p_{\theta}\) 表示语言模型的输出分布,与智能体的策略 \(\pi_{\theta}\) 对齐
  • 在实践中,论文将 Self-Reflection 数据 \({\cal D}_{\rm refl}\) 与专家数据集 \({\cal D}_{\rm expert}\) 混合 ,并使用标准的 Next-Token 预测损失来训练模型

    • 思维链推理仅为 Self-Reflection 训练数据生成 ,并且只要专家轨迹提供了原始的思维链推理,论文就在所有使用 \({\cal D}_{\rm expert}\) 训练的模型中保留它
    • 这种联合训练设置平衡了来自演示的 grounded 决策和来自探索性结果的对比性洞见
      • 理解:即专家决策和自己的探索性决策之间的对比性不同

        This joint training setup balances grounded decision-making from demonstrations with contrastive insights from exploratory outcomes.

  • 从这两个来源学习鼓励模型超越死记硬背的模仿,并发展出更可泛化的决策标准 ,举个例子来说:

    • 在 WebShop 中,当专家动作是“点击 15 美元的蓝色衬衫”时,一个 alternative 动作可能是“点击 30 美元的红色衬衫”
    • 生成的反思可能是:“虽然红色衬衫符合颜色偏好,但它超过了查询中指定的 20 美元预算限制。蓝色衬衫既满足了风格要求,也符合预算限制。”
    • 这教会了模型优先考虑约束条件,这是一个可以超越这个特定项目的经验教训。论文在下面展示了跨环境使用的提示模板
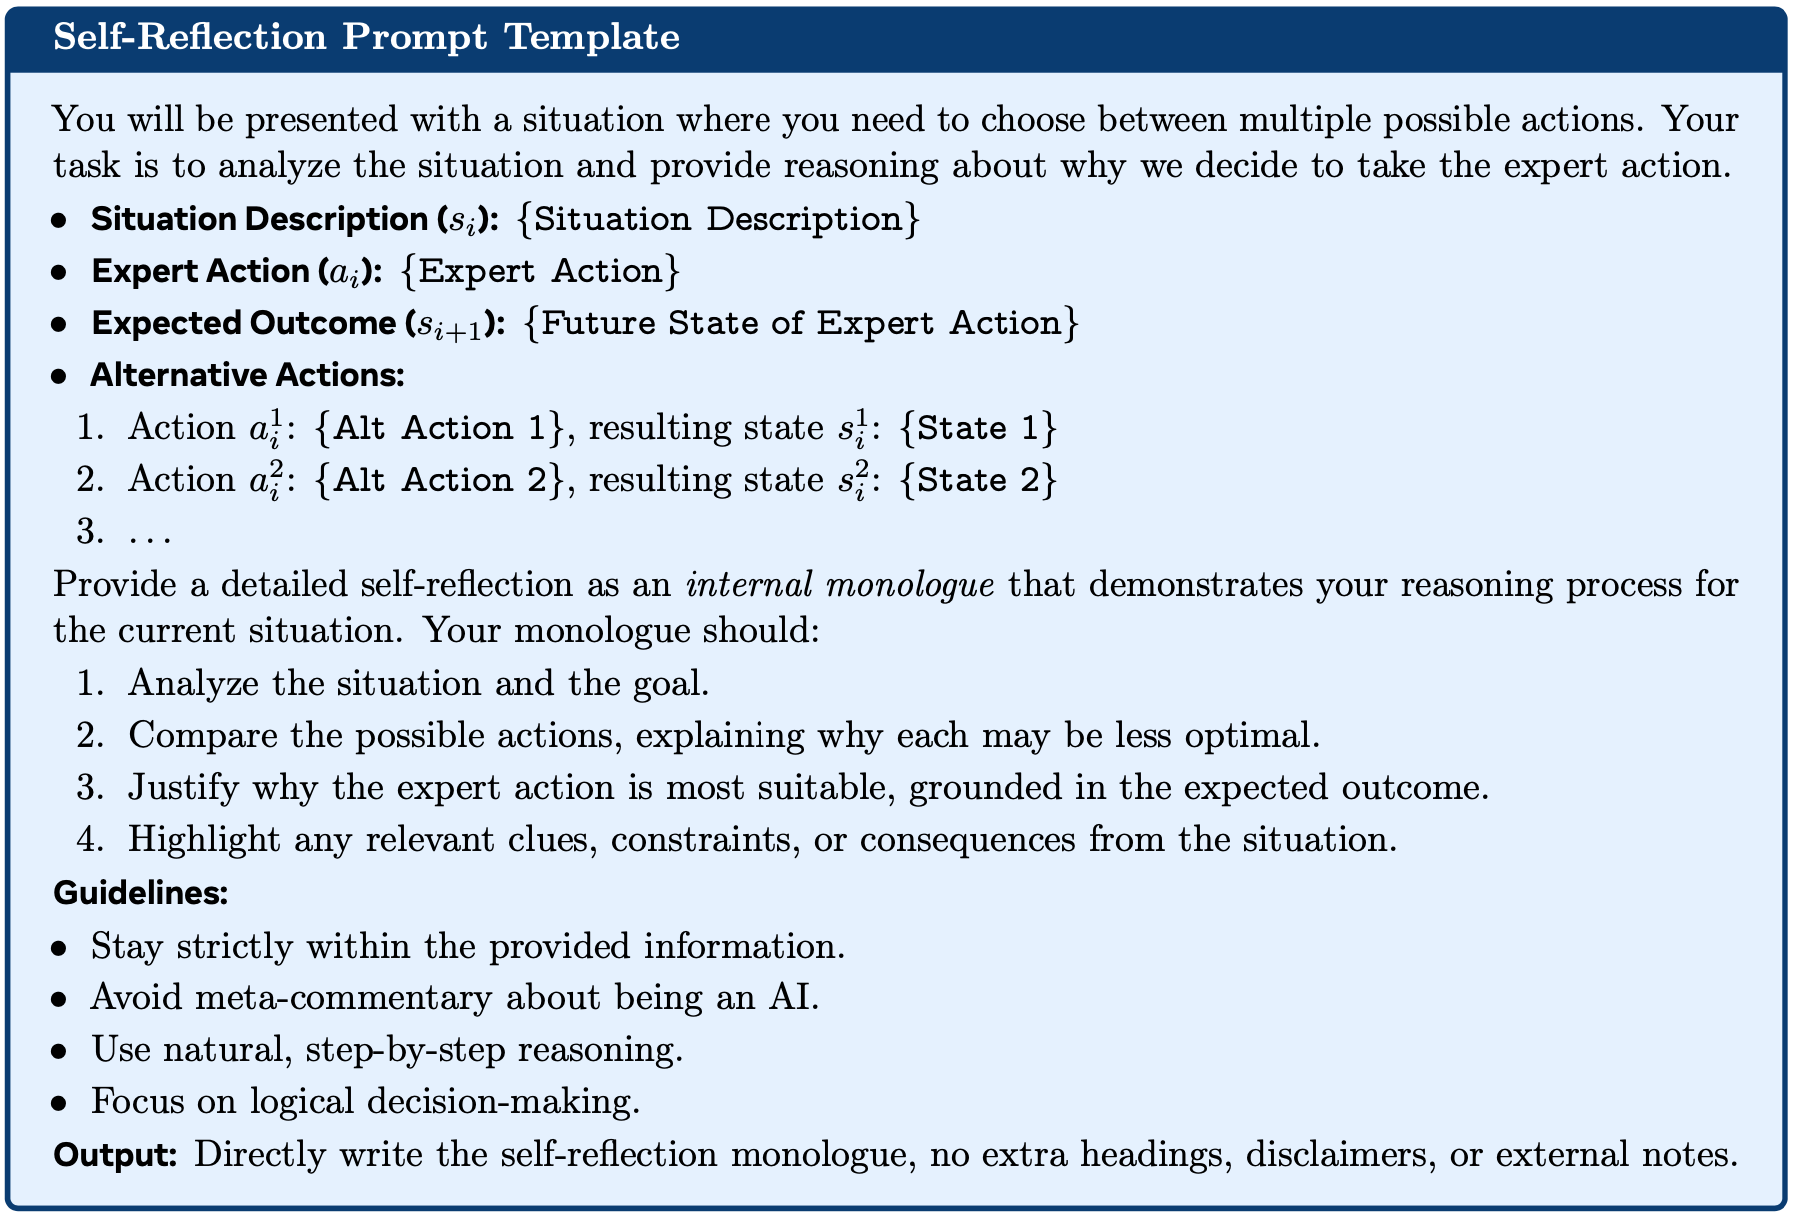
  • Self-Reflection 提示模板 (Self-Reflection Prompt Template)

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    你将看到一个需要你在多个可能动作之间进行选择的情境。你的任务是分析该情境,并提供关于论文为何决定采取专家动作的推理

    * **情境描述 (\\(s_{i}\\)):** {Situation Description}
    * **专家动作 (\\(a_{i}\\)):** {Expert Action}
    * **预期结果 (\\(s_{i+1}\\)):** {Future State of Expert Action}
    * ** alternative 动作(alternative 动作Actions):**
    1. 动作 \\(a^{1}\_{i}\\): {Alt Action 1}, 结果状态 \\(s^{1}\_{i}\\): {State 1}
    2. 动作 \\(a^{2}\_{i}\\): {Alt Action 2}, 结果状态 \\(s^{2}\_{i}\\): {State 2}
    3. ...
    提供一个详细的 **Self-Reflection** (self-reflection),作为你对此情境推理过程的 **内心独白** (internal monologue)。你的独白应该:
    1. 分析情境和目标
    2. 比较可能的动作,解释为什么每个可能不那么优化
    3. 证明为什么专家动作最合适,以预期结果为基础
    4. 突出情境中任何相关的线索、约束或后果

    **指南 (Guidelines):**
    * 严格保持在提供的信息范围内
    * 避免关于自己是 AI 的元评论
    * 使用自然的、逐步的推理
    * 专注于逻辑决策

    **输出 (Output):** 直接写出 Self-Reflection 独白,不要额外的标题、免责声明或外部注释
  • 隐式世界建模和 Self-Reflection 都遵循相同的原则 :

    • 将智能体自身的动作和产生的未来状态转化为可扩展的监督,从而实现更可泛化的 语言智能体 策略

Experiments

  • 论文通过在此范式中提出的两种方法,在一套多样化的语言智能体环境中评估 Early Experience 范式,测试其有效性(第 5.2 节)、领域外泛化能力(第 5.3 节)以及与事后强化学习的兼容性(第 5.4 节)
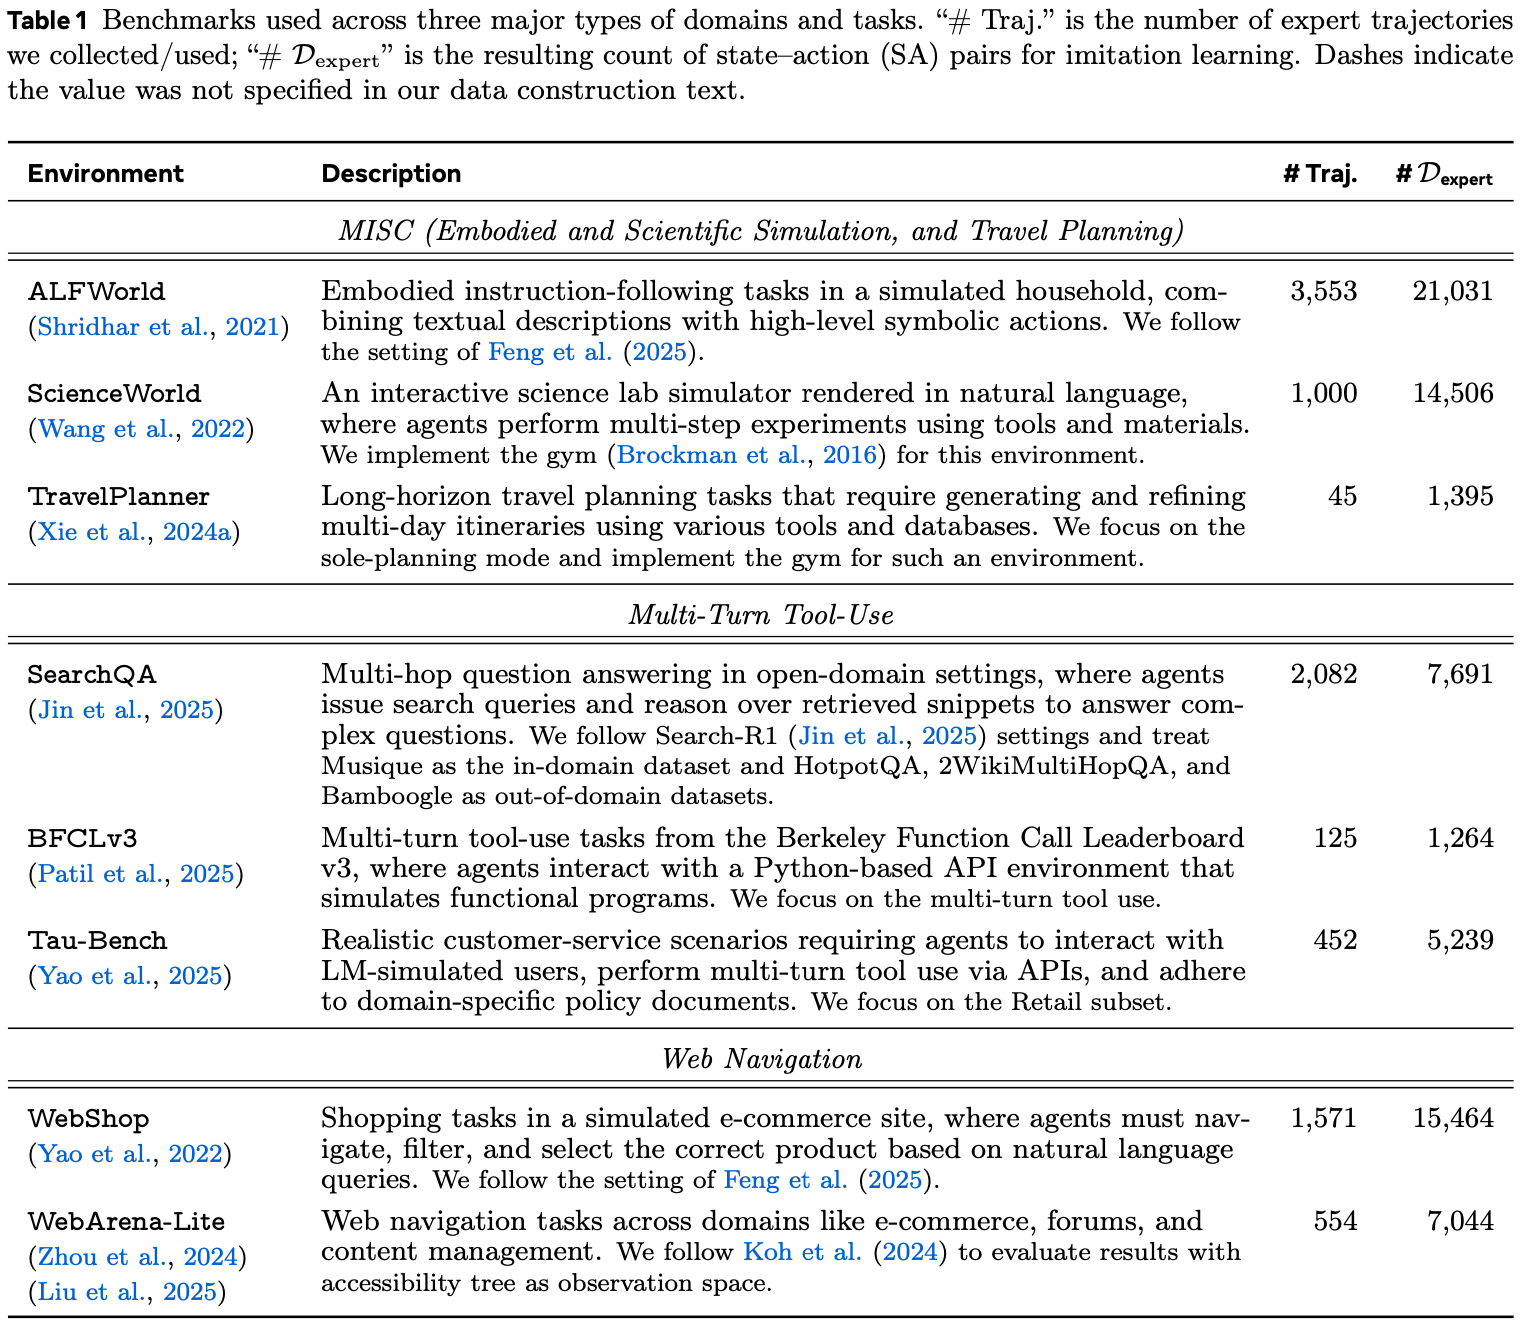
  • 表 1:跨三个主要领域和任务类型使用的基准
    • “# Traj.” 是论文收集/使用的专家轨迹数量;
    • “# \(\mathcal{D}_{\text{expert} }\)” 是用于模仿学习的状态-动作(SA)对的结果计数
    • 破折号表示该值在论文的数据构建文本中未指定

Experiment Setup

  • 环境 (Environments)
    • 论文在八个语言智能体环境上进行实验,涵盖了广泛的领域和任务格式,包括多轮工具使用 (2025; 2025; 2025)、网络导航 (2022; 2024)、具身模拟 (2021)、科学模拟 (2022) 和 Long-horizon 规划 (2024a)
    • 这些基准的详细信息列于表 1,更多细节可在附录 B 中找到
  • 模型和专家轨迹 (Models and Expert Trajectories)
    • 论文使用来自两个模型系列的三个经过指令调优的模型来评估 Early Experience :
      • Llama-3.2-3B、Qwen-2.5-7B 和 Llama-3.1-8B
    • 无论是否使用 Early Experience 增强,每个模型都在固定数量的专家演示上进行训练
    • 这些演示来自跨环境的不同来源
    • 更多细节在附录 B 中提供
  • 训练和评估 (Training and Evaluation)
    • 论文在所有设置中使用一致的提示格式和解码策略
    • 由于环境在数据大小和视野上有所不同,论文做了以下工作:
      • 首先为每个环境探索模仿学习基线的优化步数 ,并选择在验证集上具有最低训练损失和最佳性能的检查点
      • 然后固定这个步数预算 ,并在论文的方法中保持不变地使用它以确保公平比较
        • 对于隐式世界建模 ,论文从 WM 目标的一个 Epoch 开始 ,然后继续进行监督更新 ,使得总更新次数等于模仿预算 ,没有额外的步骤
        • 对于 Self-Reflection ,论文训练与模仿学习相同数量的 Epoch
        • 所有实验在训练和评估时最多使用 8 个 H100 GPU
    • 在评估方面,论文报告每个基准的主要原生指标,并遵循其官方验证器。完整的评估结果请参考附录 B

Effectiveness

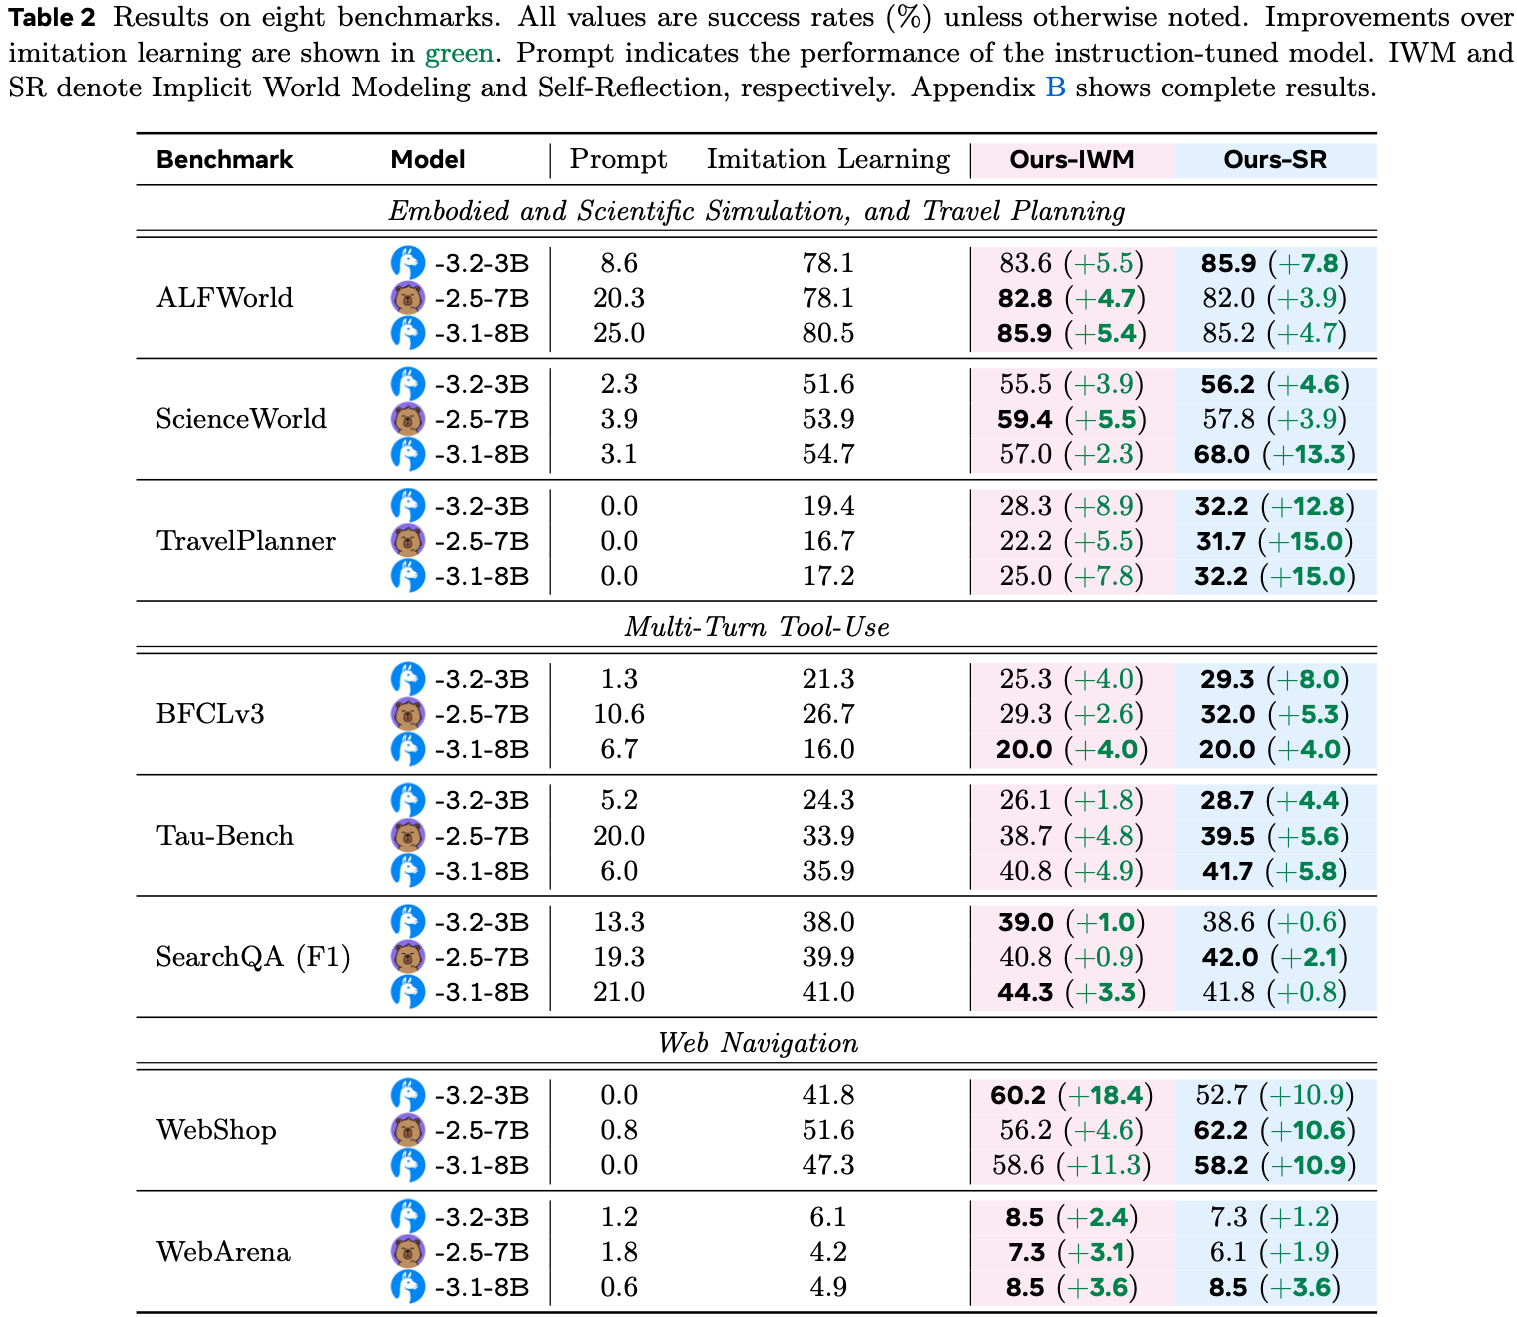
  • 表2,八个基准的结果
    • 除非另有说明,所有值均为成功率(%)
    • 相对于模仿学习的改进以绿色显示
    • Prompt 表示指令调优模型的性能
    • IWM 和 SR 分别表示隐式世界建模和 Self-Reflection
    • 附录 B 显示了完整结果
  • 论文在跨越多轮工具使用、网络导航等的八个环境中进行评估(表 2)
    • 所有模型都使用相同的提示格式和解码策略为每个环境进行训练
  • 总体收益 (Overall Gains)
    • Early Experience 在几乎所有设置和两种模型大小下都优于模仿学习
    • 隐式世界建模 (IWM) 在结构化模拟器和事务性站点中产生稳定收益(ALFWorld/ScienceWorld +2.3 到 +5.5;WebShop +11.3 到 +18.4)
    • Self-Reflection (SR) 在任务需要多步推理和约束满足时带来最大的提升(TravelPlanner +12.8 到 +15.0;ScienceWorld +13.3;BFCLv3 在 3B 模型上 +8.0)
    • 即使在最具挑战性的设置中,收益也是一致的,尽管绝对值较小(WebArena +1.2 到 +3.6;SearchQA +0.6 到 +3.3)
  • 动作空间视角 (Action-Space Perspective)
    • 在论文的八个环境中,动作空间分为三种情况
      • 封闭且有限的动作集(例如,用于具身导航的 ALFWorld ,用于科学程序的 ScienceWorld ,以及用于行程规划的 TravelPlanner)从一开始就呈现一个小的、固定的允许动作列表
        • 在这里,IWM 帮助策略内化转移规律,而 SR 为 Long-horizon 计划增加了有针对性的修正(例如,在 TravelPlanner 上的巨大 SR 收益)
      • 结构化但大的动作集(例如,用于终端任务的 BFCLv3 和用于多域 API 的 Tau-Bench)需要从许多带有参数的类型化工具中选择并正确排序它们
        • 在这种情况下, Early Experience 减少了工具的误用并改善了排序;
        • 当策略错误主要是逻辑性错误时,SR 通常更有帮助
      • 开放动作集(例如,具有自由形式搜索查询的 SearchQA,具有细粒度网页元素交互的 WebArena)允许大量可能的动作,通常是组合性质的
        • 这些是最困难的机制;尽管如此, Early Experience 仍然通过将探索性 rollout 转化为密集的训练信号而产生了可靠的收益,而不需要奖励
  • 观察空间视角 (Observation-Space Perspective)
    • 论文的基准涵盖了广泛的观察复杂性
      • 在低端,ALFWorld 提供场景的简短、干净的文本描述;ScienceWorld 产生正在进行的实验的程序性读数
      • 中等范围的设置,如 BFCLv3 和 Tau-Bench,返回结构化的 API 模式和工具输出,必须正确解析和排序
      • 在高端,WebArena 将嘈杂的、细粒度的网页状态呈现为可访问性树,需要对数百个类似 DOM 的元素进行推理
      • 论文在附录 B 中提供了每个环境的示例
    • 在状态转移一致且可预测的设置中(例如,WebShop),IWM 通过帮助智能体内化环境动态和改进下一个状态预测而表现出色
    • 当失败主要源于推理错误或需要修复 Long-horizon 计划时(例如,TravelPlanner, ScienceWorld),SR 通过明确地将动作与专家轨迹进行比较而带来更大的收益
    • 总的来说,无论环境的观察多么简单或复杂, Early Experience 方法都持续地将智能体自身的动作和结果状态转化为有效的监督信号,从而在没有奖励的情况下改进策略学习
  • Takeaway
    • Early Experience 可靠地将智能体自身的动作和结果状态转化为超越专家演示的可扩展监督
    • 在此范式下的两种方法都在动作空间和观察复杂性截然不同的环境中加强了策略
    • 这些效应在三个模型大小和三个环境家族中均成立,证明了论文 Early Experience 范式的强大可泛化可行性

Out-Of-Domain Generalization

  • 为了评估训练策略在领域内性能之外的鲁棒性,论文在具有 领域外(out-of-domain,OOD)splits 的环境中探索 Early Experience ,使用与第 5.2 节评估相同的检查点
  • 在设置方面,对于 ALFWorld 和 SearchQA,论文遵循其原始工作中定义的 OOD splits
  • 对于 BFCLv3:
    • 领域内设置是多轮 base;
    • OOD 设置是对多轮 missing function、missing argument 和long context 进行平均
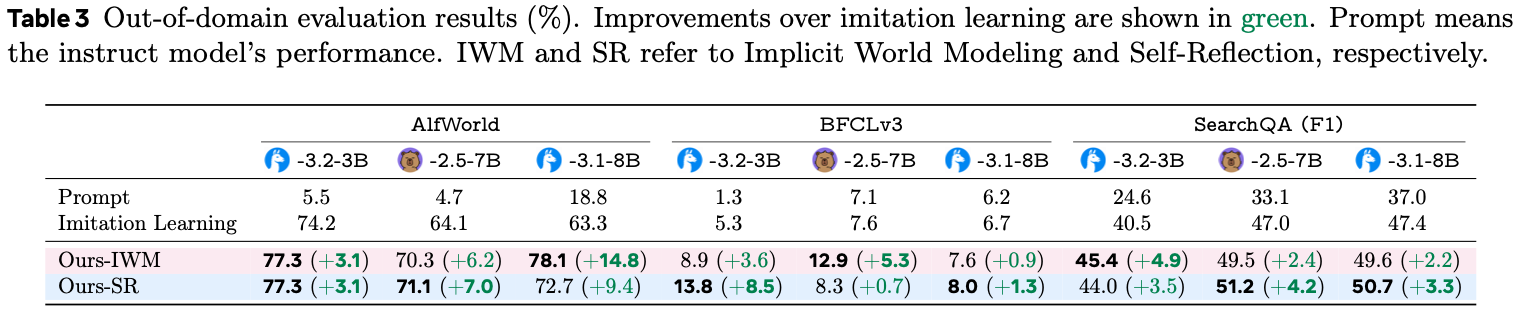
  • 论文训练模型的结果如表 3 所示,从中我们可以得出以下观察结果
    • OOD 分数在所有任务中相对于领域内都有所下降,但 Early Experience 持续恢复了差距的很大一部分
    • 在几种情况下,相对收益大于领域内收益(例如,SearchQA),这表明将自身的 rollout 转化为监督可以使策略为演示未覆盖的状态做好准备
    • 方法上的模式反映了领域内趋势:
      • IWM 在动态稳定的地方帮助最大(例如,ALFWorld);
      • SR 在分布偏移改变工具可用性或参数时最强(例如,BFCLv3);
      • IWM 和 SR 都在检索偏移下(例如,SearchQA)对所有模型大小都有帮助
  • 表 3:领域外评估结果(%);相对于模仿学习的改进以绿色显示;Prompt 表示指令模型的性能;IWM 和 SR 分别指隐式世界建模和 Self-Reflection
  • Takeaway
    • Early Experience 在多样化的 OOD 机制下提高了鲁棒性:
      • IWM 在动态稳定时表现出色,SR 在偏移影响工具可用性、参数或检索分布时表现出色
    • 在几个基准测试中(例如,ALFWorld, SearchQA),OOD 收益达到或超过领域内收益,这强化了智能体自身的经验提供了超越专家演示的监督

Reinforcement Learning Following Early Experience

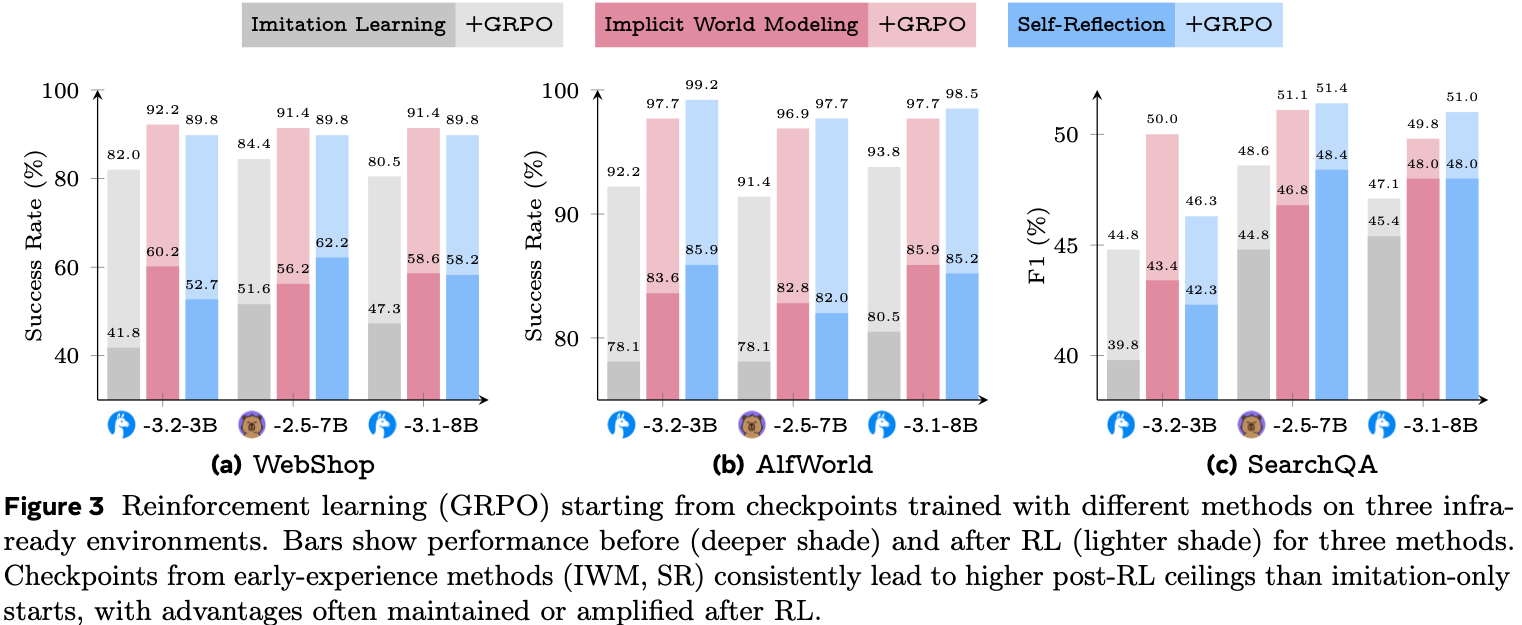
  • 为了评估一旦环境提供可验证奖励(“经验时代”的决定性条件)时 Early Experience 的影响,论文在第 5.2 节训练的模型后附加了一个强化学习阶段
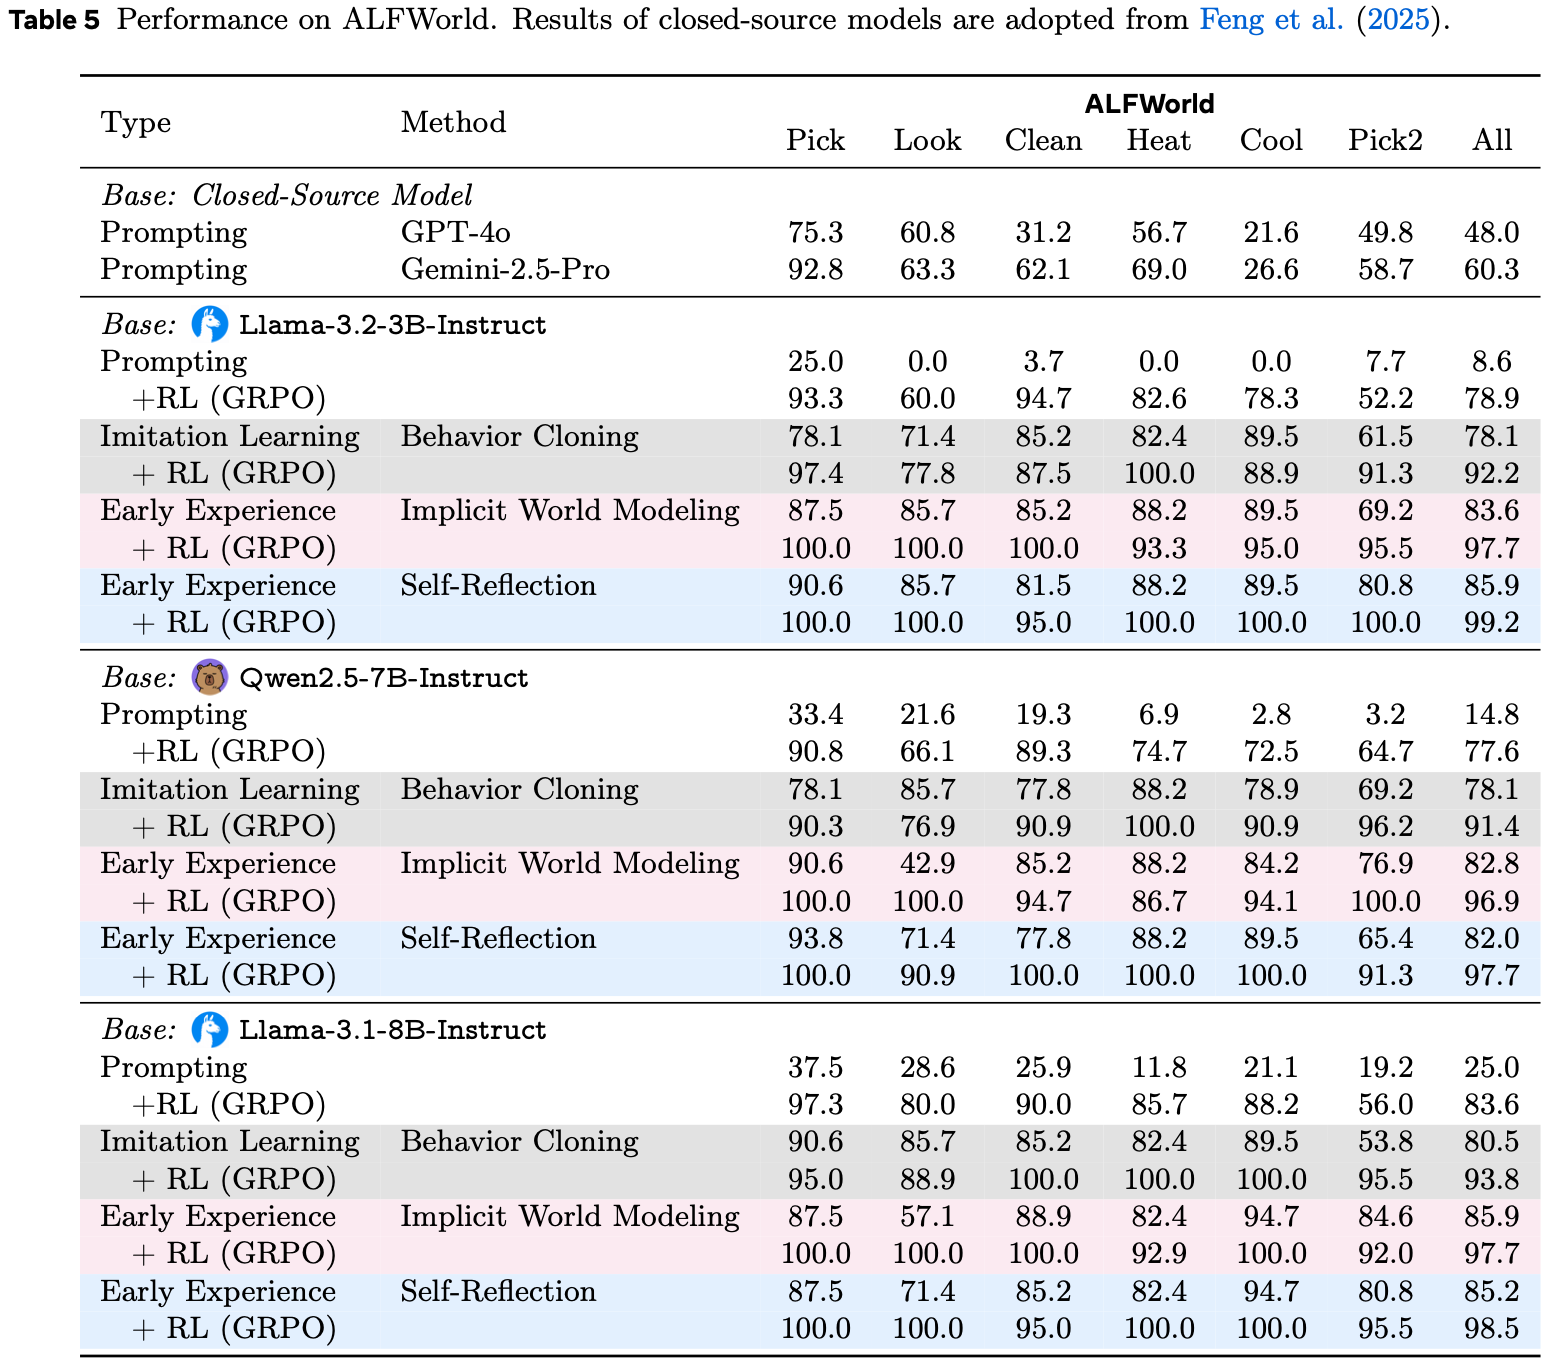
  • 论文专注于三个有奖励可用的基准:WebShop、ALFWorld 和 SearchQA,并采用广泛使用的 GRPO 算法 (2024)
    • 其超参数和训练步数与既定方案 (2025; 2025) 相同
    • 不同运行(runs)之间唯一变化的因素是初始化 :模仿学习 (IL)、隐式世界建模 (IWM) 或 Self-Reflection (SR)
  • 图 3 的结果显示了一个清晰的模式:
    • 从 Early Experience 开始总是能产生更高的 RL 后性能上限
      • 在某些情况下,性能差距在 RL 训练期间增大(例如,ALFWorld);
      • 在其他情况下,差距缩小但从未逆转
    • 即使应用相同步数的奖励优化,IL 起点也很少能达到 Early Experience 起点的最终性能
    • 为了完善实验(completeness),论文还直接从原始预训练模型运行 GRPO,没有任何监督阶段
      • 这在所有任务中表现最差,并显示出不稳定的训练动态,突显了强初始化的必要性
    • 带有详细指标的完整结果可以在附录 B 中找到
  • Takeaway
    • Early Experience 充当了人类数据时代和经验时代之间的 中期训练桥梁 (mid-training bridge)
    • Early Experience 产生的策略在没有奖励的情况下已经表现强劲,并且放大了后续 RL 的收益
    • 在相同的 RL 方案下,Early Experience 起点实现了更高的最终性能
    • 这些结果表明,一旦 RL 基础设施在新的环境中可用,Early Experience 可以立即解锁进一步的收益,而无需从头开始重新训练

Discussion

Comparison to Baselines

  • 论文将 Early Experience 与两种替代方案进行比较,这些方案在不执行 alternative 动作 或 观察动作引发的状态的情况下注入 额外的监督或推理信号
    • 理解:讨论这里是想介绍两种相似的方案,作为 Early Experience 的补充比较
  • 这使论文能够测试论文的增益是否可以通过简单地扩展推理时间或在训练期间添加未经实际验证的推理来匹配
    • (I) 长思维链 (Long CoT) (test-time scaling)
      • 受测试时扩展 (2024) 的启发,论文的目标是帮助特定模型在推理时进行更广泛的推理
        • 这些特定模型包括:在专家轨迹上训练的、通常缺乏推理过程的指令微调模型和纯模仿模型
      • 提示基线使用现成的指令微调模型和先前工作中的官方提示,这些提示通常产生短思维链 (2022)
      • 论文的长思维链变体通过在 Training splits 上进行更重的提示搜索,当存在标记推理结束的分隔符 Token(例如 </think>)时,截断它以鼓励继续生成,来强制在动作生成之前进行更长的推理
        • 问题:这样也可以吗?如果人家已经不想思考了,模型会输出什么奇怪的东西呢?比如很可能重复输出吧?
      • 论文报告每个环境上的最佳结果
    • (II) STaR 风格数据 (STaR-style data) (reasoning without alternative actions or resulting states,没有 alternative 动作或结果状态的推理)
      • 遵循 STaR (2022):
        • 让模型为每个状态下的专家动作生成一个原理,并仅保留预测动作与专家动作匹配的情况
        • 然后在(状态,原理,动作)元组((state, rationale, action) tuples)上进行微调,如公式 \(\ref{eq:self_refl}\) 所示
      • 注意:没有使用 alternative 动作及其结果状态(因为这些原理在实际结果中仍然是未经实际验证的)
      • 其他超参数:
        • 搜索用于原理合成的提示词变体并保留最强的配置
        • 优化步骤的数量与论文的自反思方法相同
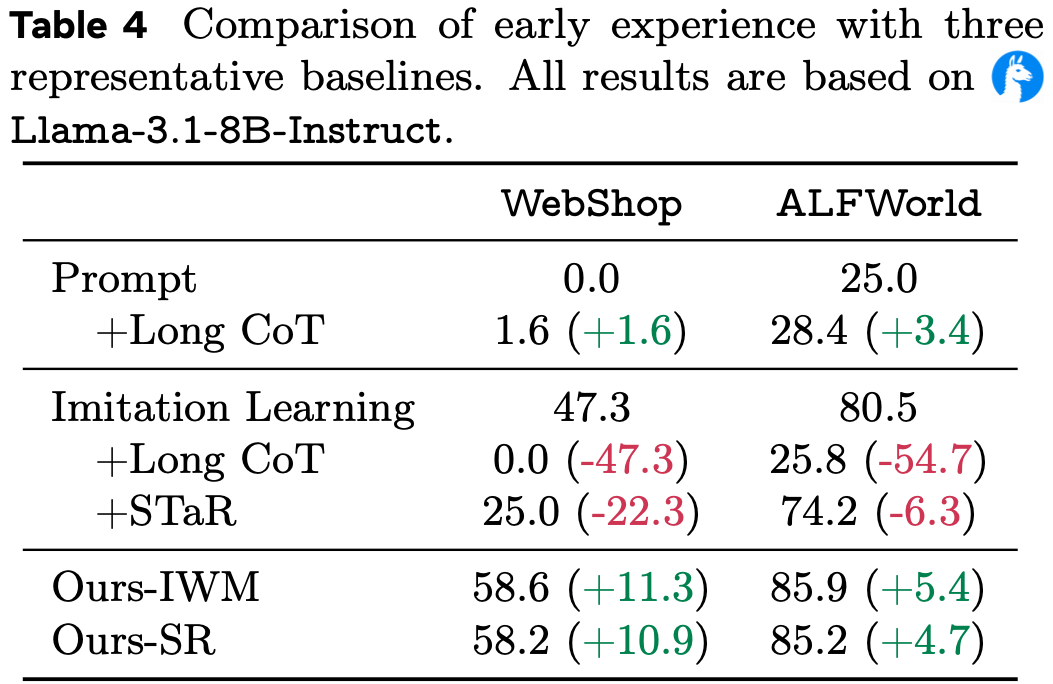
  • 表 4 显示,两种 Early Experience 方法在任务和模型大小上都实现了最大的增益
    • 对于长思维链 ,更重的提示搜索和推理长度控制可以适度地改善经过模仿训练的提示基线 ,但在更困难的设置中,增益迅速消失
    • 一旦仅在缺乏固有原理的专家轨迹上进行微调,模型就失去了维持连贯长形式推理的能力,因此尽管在思维-动作边界处进行了截断,扩展的思维链常常漂移或崩溃为无效/偏离策略的动作
    • 对于 STaR 风格数据,生成的动作与专家动作之间的匹配率很低,留下的可用训练数据很少
    • 保留的原理是未经实际验证的,从未在环境中测试过,并且经常幻觉工具或事实,因此对它们进行微调甚至可能降低性能
    • 相比之下, Early Experience 直接将策略自身的非专家 rollout 转换为来自观察到的下一状态的经实际验证的监督,产生了这些替代方案无法匹配的稳健改进
Impact of Amount of Human Data

  • 为了检查性能如何随专家监督的数量而变化,论文在保持总训练预算固定的情况下,改变用于启动 Early Experience 的 Demonstrations 数量
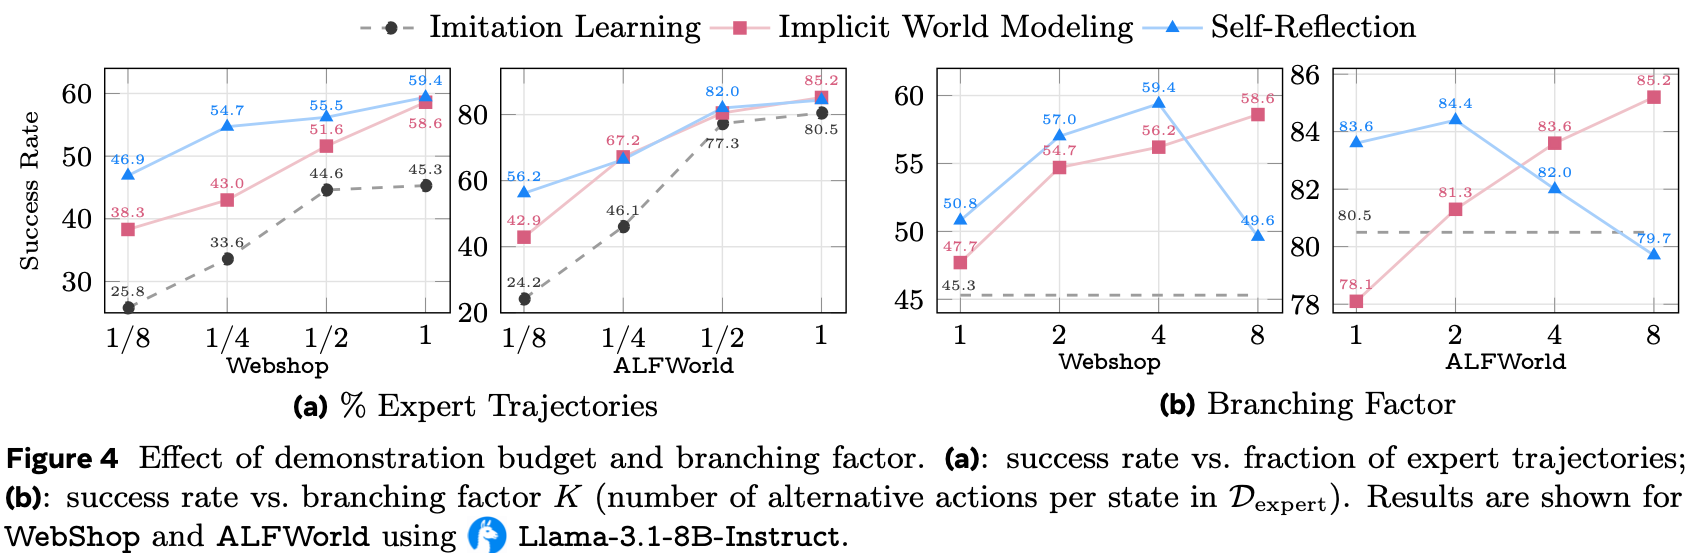
  • 图 4 (a) 显示,在每个数据水平上, Early Experience 都保持对模仿学习的一致领先
    • 在 WebShop 上,仅使用 \(1/8\) 的 Demonstrations 就已经超过了在全量数据集上训练的模仿学习;
    • 在 ALFWorld 上,使用 \(1/2\) 的 Demonstrations 也保持了同样的优势
  • IWM 和 SR 都随着更多专家数据而改进,但相对于模仿学习的优势仍然很大,这强调了 Early Experience 提供了超越仅靠 Demonstrations 所能提供的额外监督信号
Impact of Branching Factor

  • 为了研究分支因子对论文方法的影响,论文还对分支因子 \(K\)(在生成 Early Experience 时每个专家状态 roll out 的 alternative 动作数量)进行了消融
  • 图 4 (b) 显示,随着 \(K\) 的增加,IWM 稳步改进,这与学习更丰富的转移规律相一致
  • SR 在中小 \(K\) 值时改进,并且在非常大的 \(K\) 值时可能非单调:
    • 比较许多 alternative 动作偶尔会包括其他导致成功的动作,减少了与专家的对比,并且当前模型在单个上下文中推理许多 alternative 动作和结果的能力有限
  • 总的来说,两种变体在大部分时间都有所改进,IWM 倾向于更大的 \(K\),而 SR 在适中的 \(K\)(例如 2–4)下效果最好

Model Scaling

  • 论文研究了 Early Experience 的益处是否随着模型缩放而持续
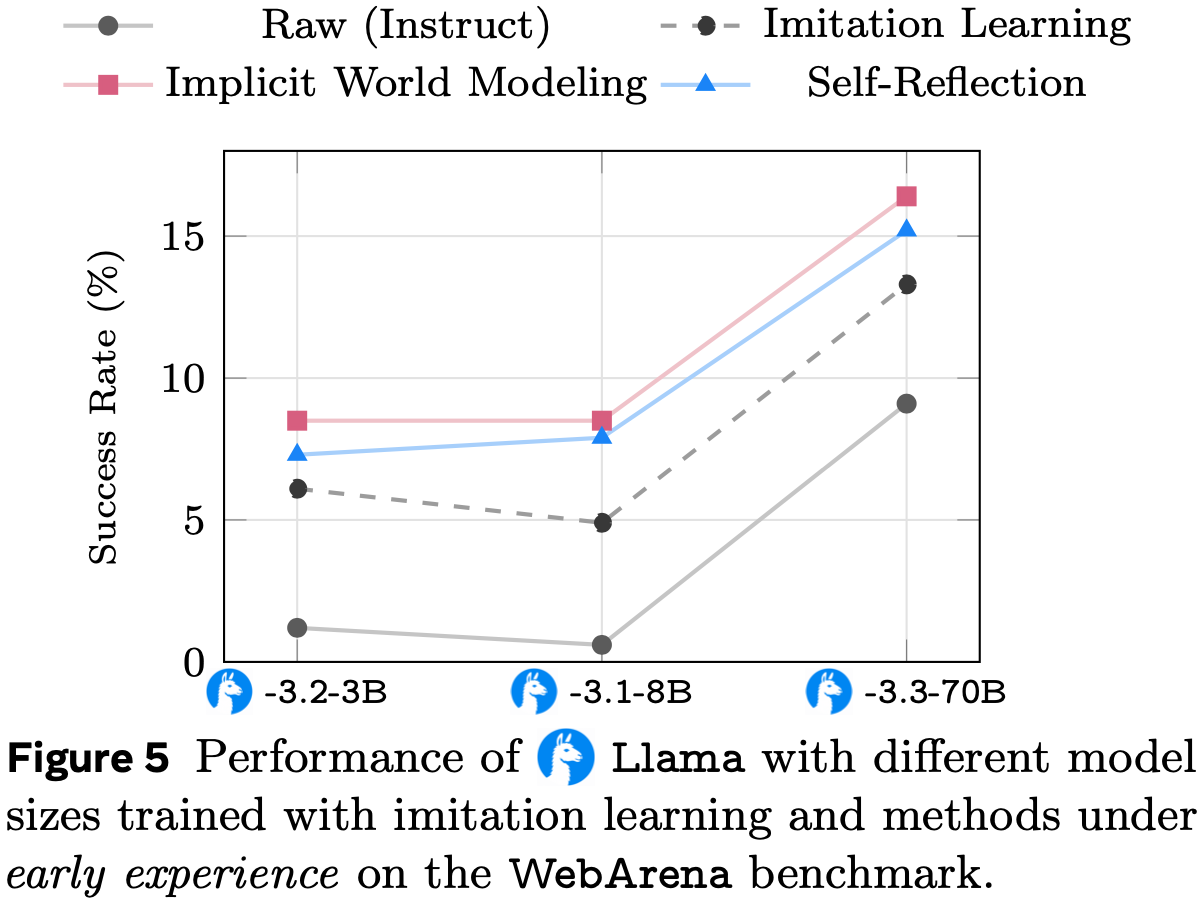
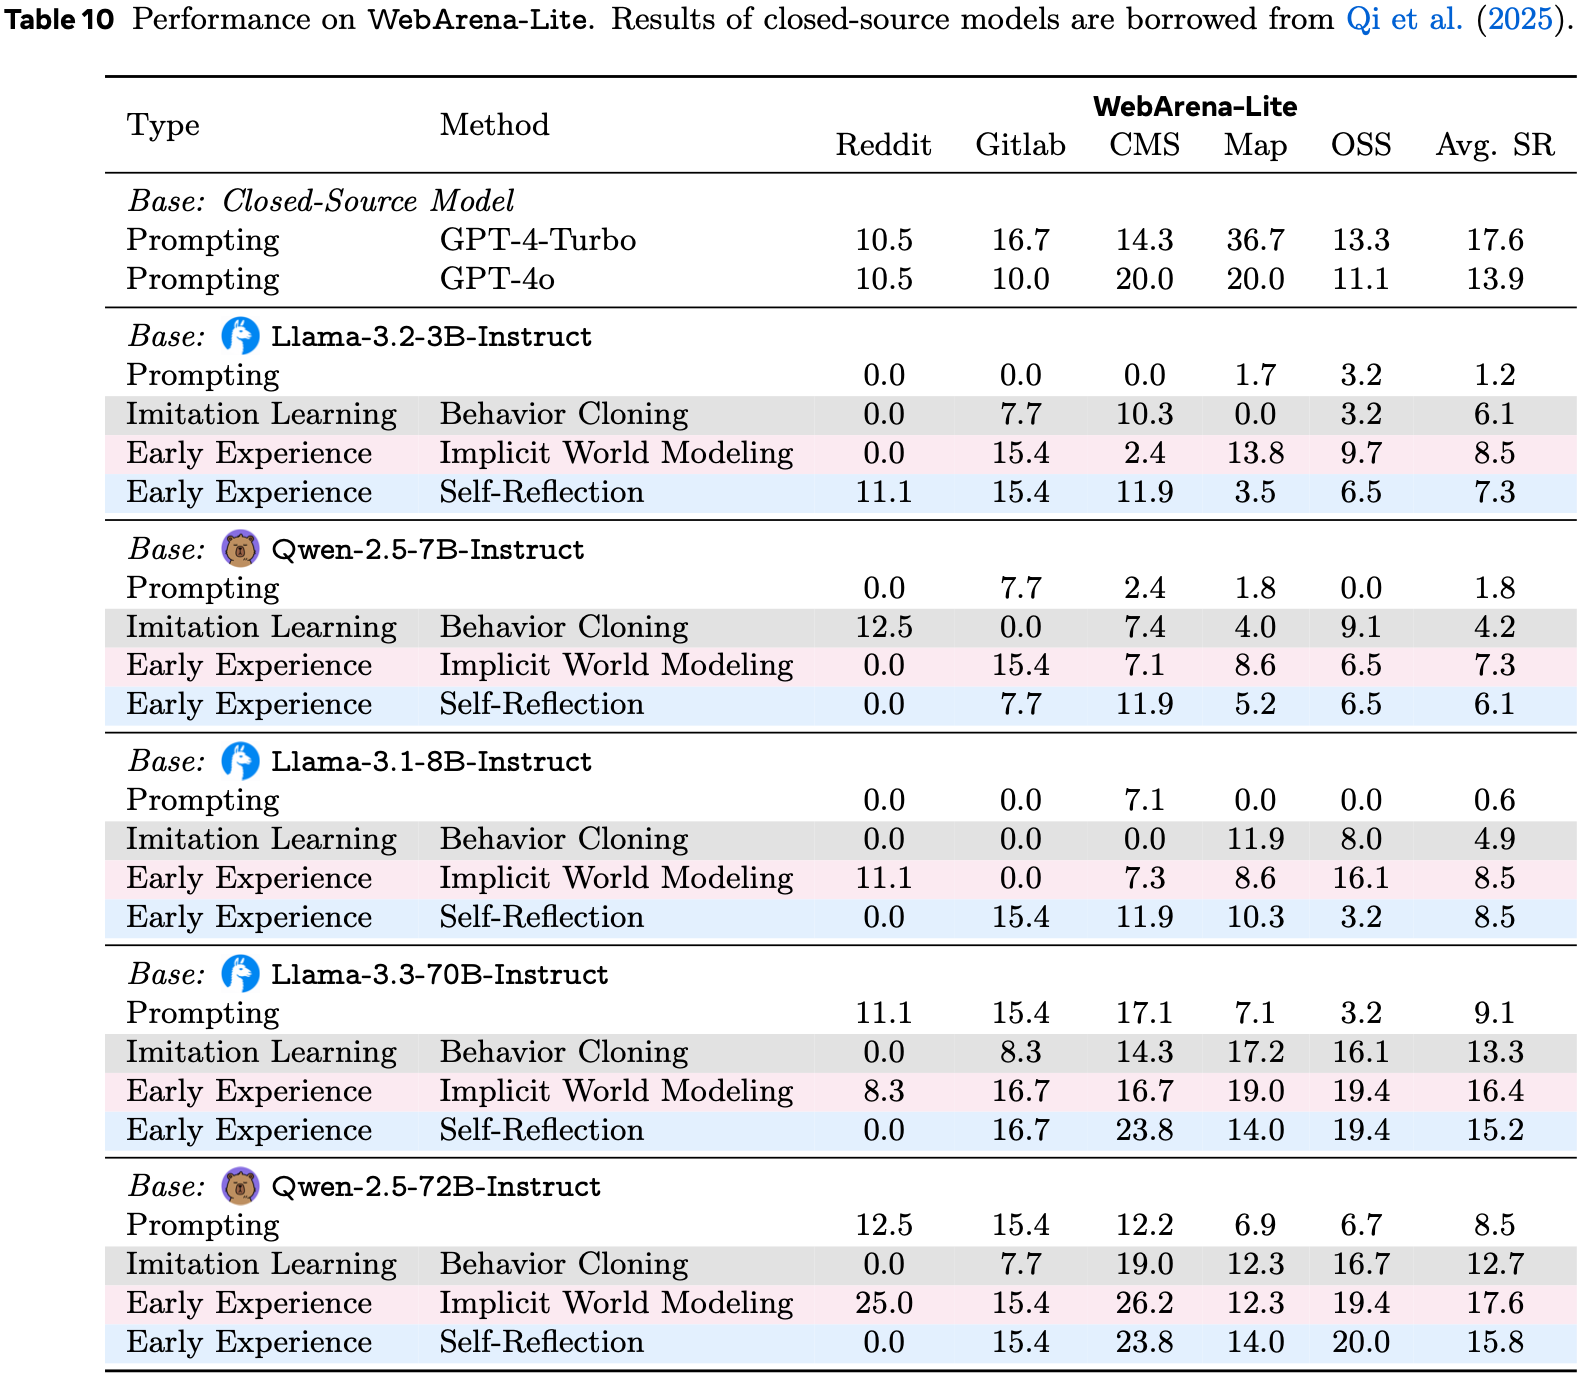
  • 在 WebArena 上,论文比较了 \(\bigcirc\) Llama-3.2-3B、\(\bigcirc\) Llama-3.1-8B 和 \(\bigcirc\) Llama-3.3-70B
  • 由于计算资源有限,70B 模型的微调对所有方法都使用参数高效的 LoRA (2022),保持相同的秩和更新步数;对于 IWM,在第二阶段继续使用相同的适配器,使得总可调参数和计算量与模仿学习相匹配
    • 问题:Meta 缺少计算资源?
  • 图 5 显示, Early Experience 在每个规模上都优于模仿学习,即使对于 70B 模型,差距仍然存在
    • 绝对性能随规模提升,而 Early Experience 检查点 consistently 占据顶部曲线,表明其提供的监督是对模型规模的补充而非替代
    • 即使仅使用 LoRA 更新,IWM 和 SR 都带来了稳定的增益,证明该方法在受限计算预算下仍然有效
    • 论文在附录 B 的表 10 中观察到 Qwen 模型的类似趋势

补充:Related Work

Training Paradigms for Language Agents

  • SFT
    • 大多数语言智能体 (2022; 2023; 2024; 2025) 使用监督微调在专家轨迹上进行训练,在强化学习文献中也称为模仿学习或行为克隆,特别是在复杂设置中,例如网络 (2024) 或操作系统 (2024)
    • 这些轨迹可能是人工标注的 (2022; 2023),也可能是由遵循精心设计的人类工作流程的更强语言模型合成的 (2024; 2025)
    • 尽管合成 Demonstrations 增加了覆盖范围,但它们只提供了增量收益,因为底层的监督信号仍然是静态的
    • 监督微调提供了密集的、无奖励的监督信号,但仍然受限于高质量 Demonstrations 的成本 (2025),并且当智能体面对新状态时显得脆弱 (2025; 2023)
  • RL
    • 强化学习通过试错来训练智能体,优化长期奖励 (1998)
    • 尽管它在控制、棋盘游戏和 Atari (2013; 2016; 2020; 2020) 中取得了令人印象深刻的结果,但在语言智能体设置中有效应用强化学习仍然很困难 (2025;)
    • 当前的研究仍处于探索阶段:
      • 许多研究依赖于由更大的教师模型产生的近似奖励 (2025;),或者依赖于精心策划的奖励函数 (2025) 和手动调整的训练方案 (2025) 来保持稳定性
    • 支持的基础设施也尚未成熟;
      • 大多数现实世界的语言智能体环境缺乏可靠的模拟器、标准的重置机制和可扩展的评估平台 (2025;),使得语言智能体的大规模强化学习训练成本高昂且脆弱
    • 总之,这些局限性表明,语言智能体的可扩展强化学习尚未成熟,这促使需要一个范式来桥接当前基于模仿的训练和未来完全由经验驱动的学习

Supervision from Exploration

  • 强化学习中的传统探索-利用策略收集轨迹,随后通过奖励反馈进行优化
  • 诸如 Hindsight Experience Replay (2017) 之类的方法通过将已实现的结果改造为目标来稠密化稀疏奖励,但仍然需要许多语言智能体环境中不可用的可验证奖励函数
  • 论文的设置以不同的方式使用探索:交互轨迹成为直接的监督信号,完全消除了对奖励或手动重新标注的需求

World Models

  • 传统上的世界模型 (1991; 2018; 2020, 2021) 是指:在观察到的状态转移上进行训练,以预测未来状态和奖励,允许基于模型的强化学习减少样本复杂度并支持推测性规划
  • 最近的工作通过使用大语言模型作为世界模型 (2025; 2023) 将此思想扩展到语言智能体 ,这通过语言介导的模拟提高了下游性能
    • 尽管不同时代的世界模型具有不同的状态表征,但这些系统中的大多数仍然将世界模型视为一个 独立的 模拟器,呼应了经典的控制流程
    • 相比之下,论文将交互轨迹本身视为智能体策略的辅助预测任务,在精神上类似于中期训练 (2025)
    • 通过训练策略来预测其自身的未来状态,模型内化了粗略的环境动态,而无需独立的模拟器
    • 这种 隐式(implicit) 世界模型将智能体锚定在其操作上下文中,提供了轻量级的热身以便更快地适应,并避免了显式模拟器所需的规划开销

Self-Reflection

  • Self-Reflection (2023;) 最初是作为一种提示技术引入的,允许大语言模型通过多轮自我对话 (2024) 或精心设计的提示词变体 (2023) 来修改其答案 ,而无需更新模型参数
  • 后续工作在有奖励的轨迹上总结经验教训(例如,短期情景记忆 (2025))到提示中,以指导未来的推理
    • 但后来的研究 (2024; 2023) 表明,这类推理时方法在无法获得外部反馈(例如奖励)时常常失败
  • 另一条研究线使用大语言模型为正确答案生成原理,将这些原理视为训练目标以引导推理 (2022; 2023)
    • 论文将这种反思的观点扩展到 缺乏显式奖励(explicit rewards are absent) 的智能体设置中
    • 论文的方法训练智能体反思其自身的次优行动及由此产生的轨迹,然后使用反思出的原理作为训练信号来改进决策制定

附录 B:Implementation details

  • 在本节中,论文为每个环境提供实现细节
  • 对于每个环境,论文呈现包含所有可用指标的表格
  • 此外,论文还展示了由 Llama-3.1-8B 合成的具体训练示例(例如,用于 Self-Reflection 的数据)

B.1 ALFWorld

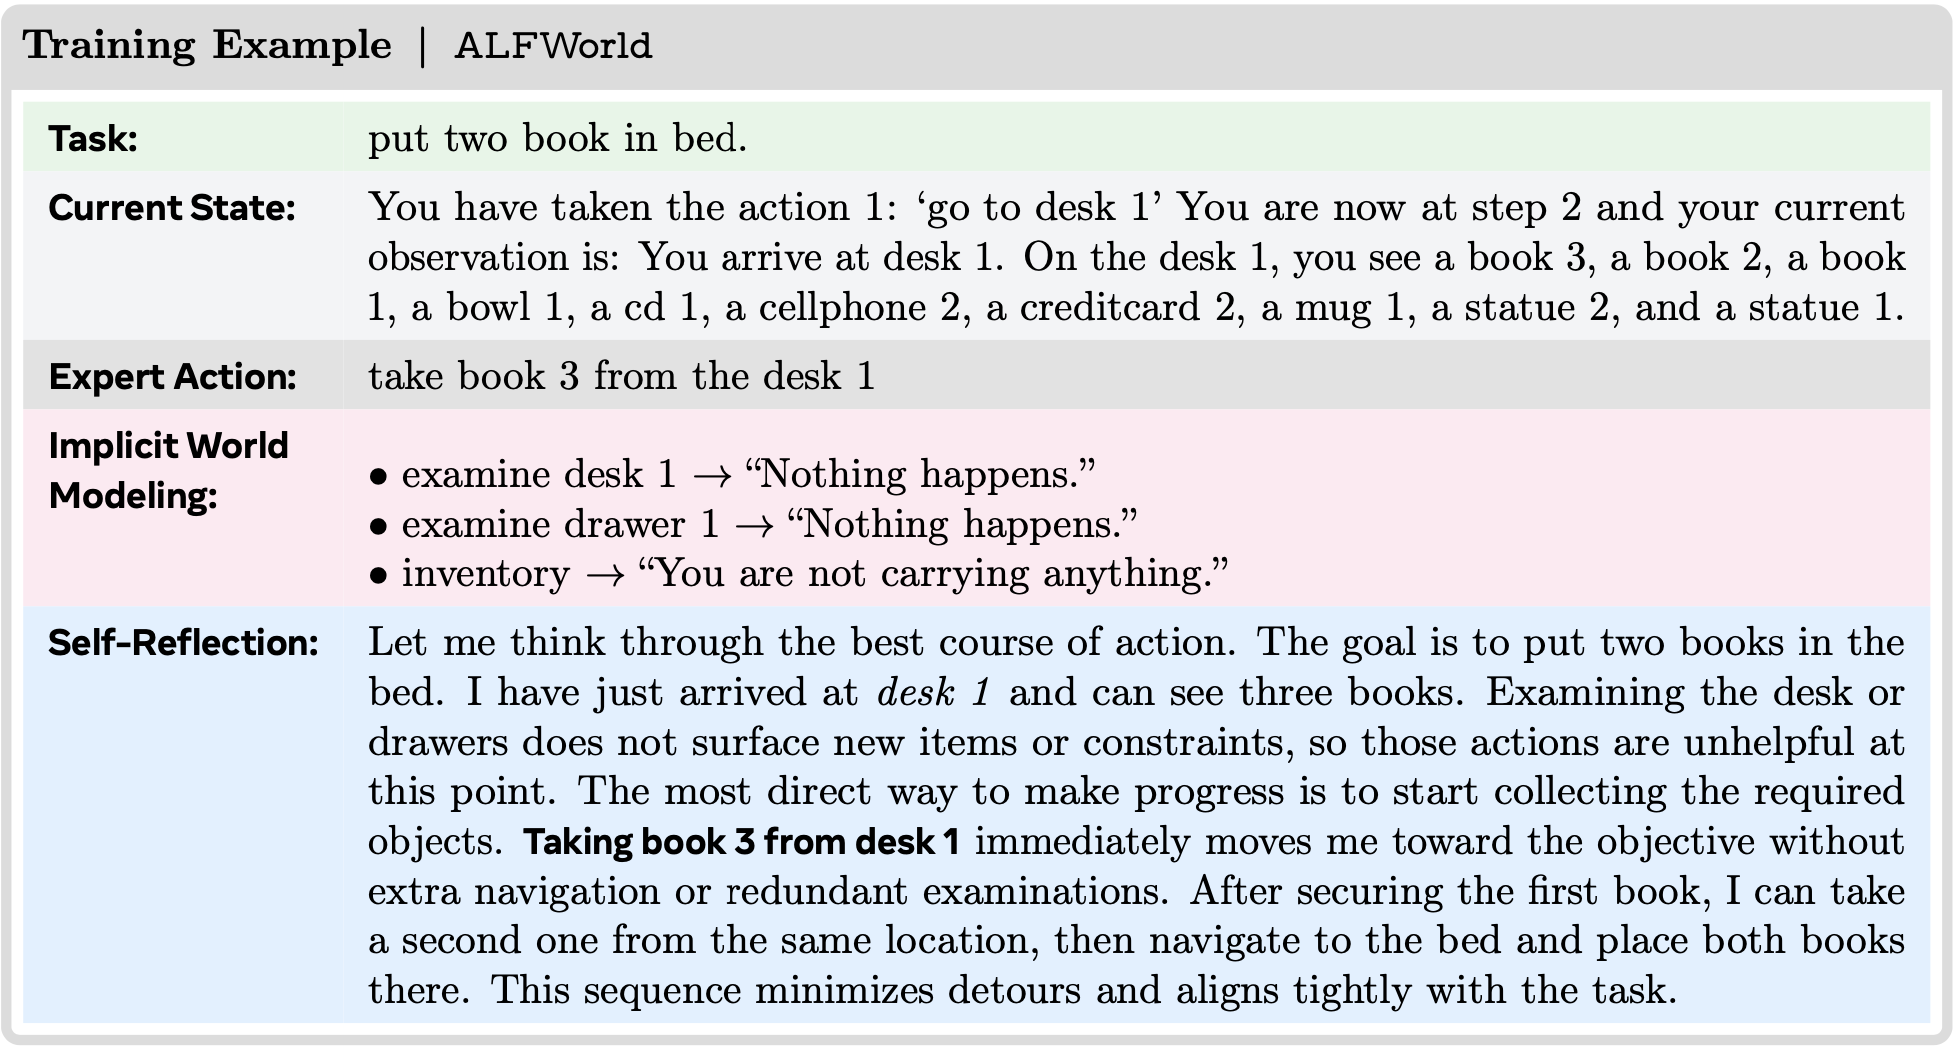
  • 论文遵循 ALFWorld (2021) 的默认 split,使用 Verl-Agent (2025) 框架下的 TextWorld (2019) 设置
    • 论文从 ALFWorld 的专家轨迹中提取了 21,031 个状态-动作对来构成 \(\mathcal{D}_{\text{expert} }\)
    • 鉴于数据集中任务可解性的完整性,这些专家轨迹是最优的
  • 对于隐式世界建模,论文使用 \(\mathcal{D}_{\text{rollout} }\) 来增强 \(\mathcal{D}_{\text{expert} }\)
    • 在每个状态,论文从可行动作列表中(排除专家动作)均匀地、无放回地采样 8 个非专家动作
    • 包含专家动作,总计为隐式世界建模产生 \(21,031 \times 9 = 189,279\) 个三元组
  • 对于 Self-Reflection ,论文通过提示模型解释其自身决策来构建数据
    • 对于每个状态,论文使用相同的策略模型(温度设为 1.0)来提出最多 3 个 alternative 动作
      • 对提出的动作进行规范化处理,并仅保留唯一动作
    • 如果提出的动作不在该状态的可行动作空间内,将其丢弃,并改为从剩余未选中的可行动作中均匀随机采样
    • 最终的提示要求模型根据当前状态和可用工具,证明为什么专家动作优于采样得到的 alternative 动作
  • 在训练期间,论文使用批大小为 16,学习率为 \(1\mathrm{e}{-5}\),并使用 LlamaFactory (2024b) 训练 2 个 Epoch
    • 对于强化学习训练,论文采用 Verl-Agent 中的默认超参数 ,并在其论文(理解:应该是 ALFWorld 论文)报告的相同 split 上进行评估
    • 对于评估,论文将最大提示长度设置为 4096,最大响应长度设置为 1024,温度设置为 0.4
  • 完整结果见表 5

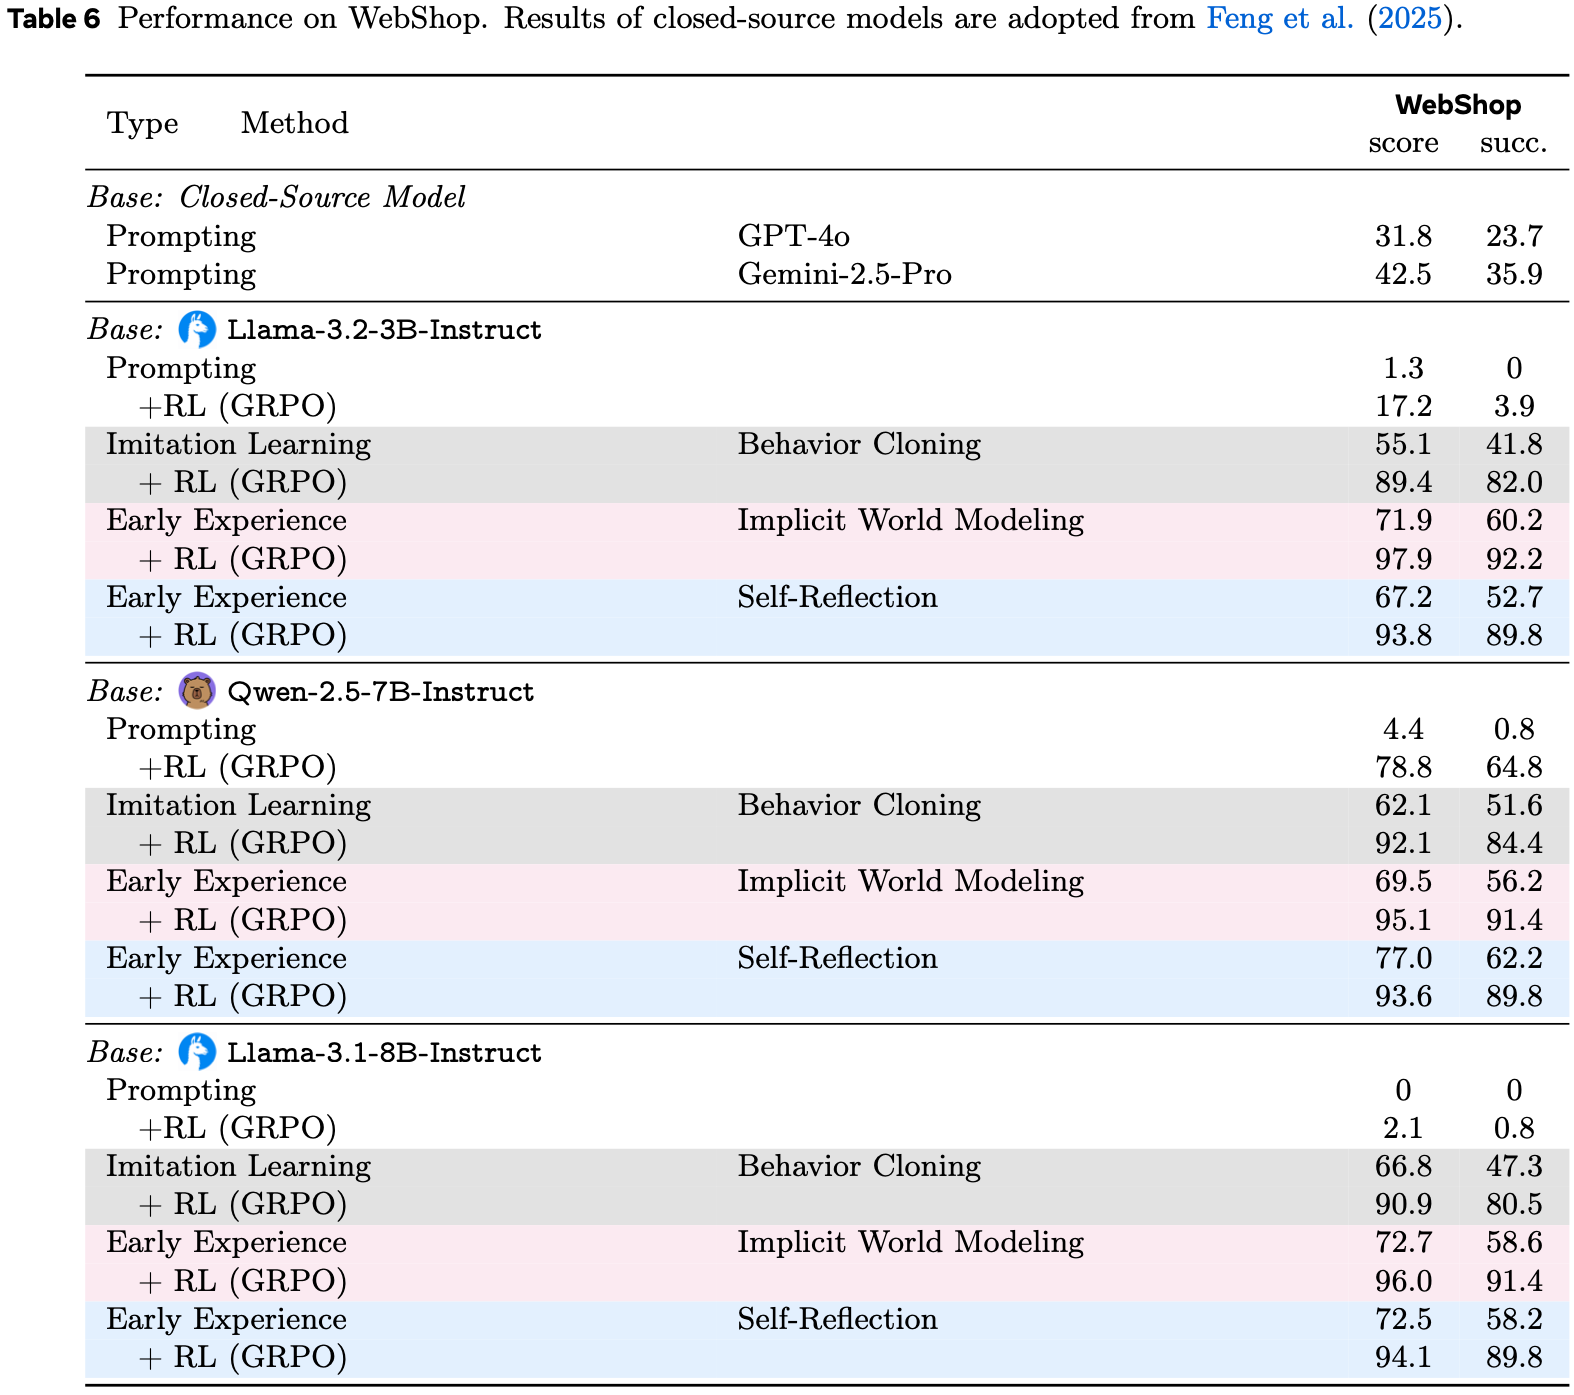
B.2 WebShop

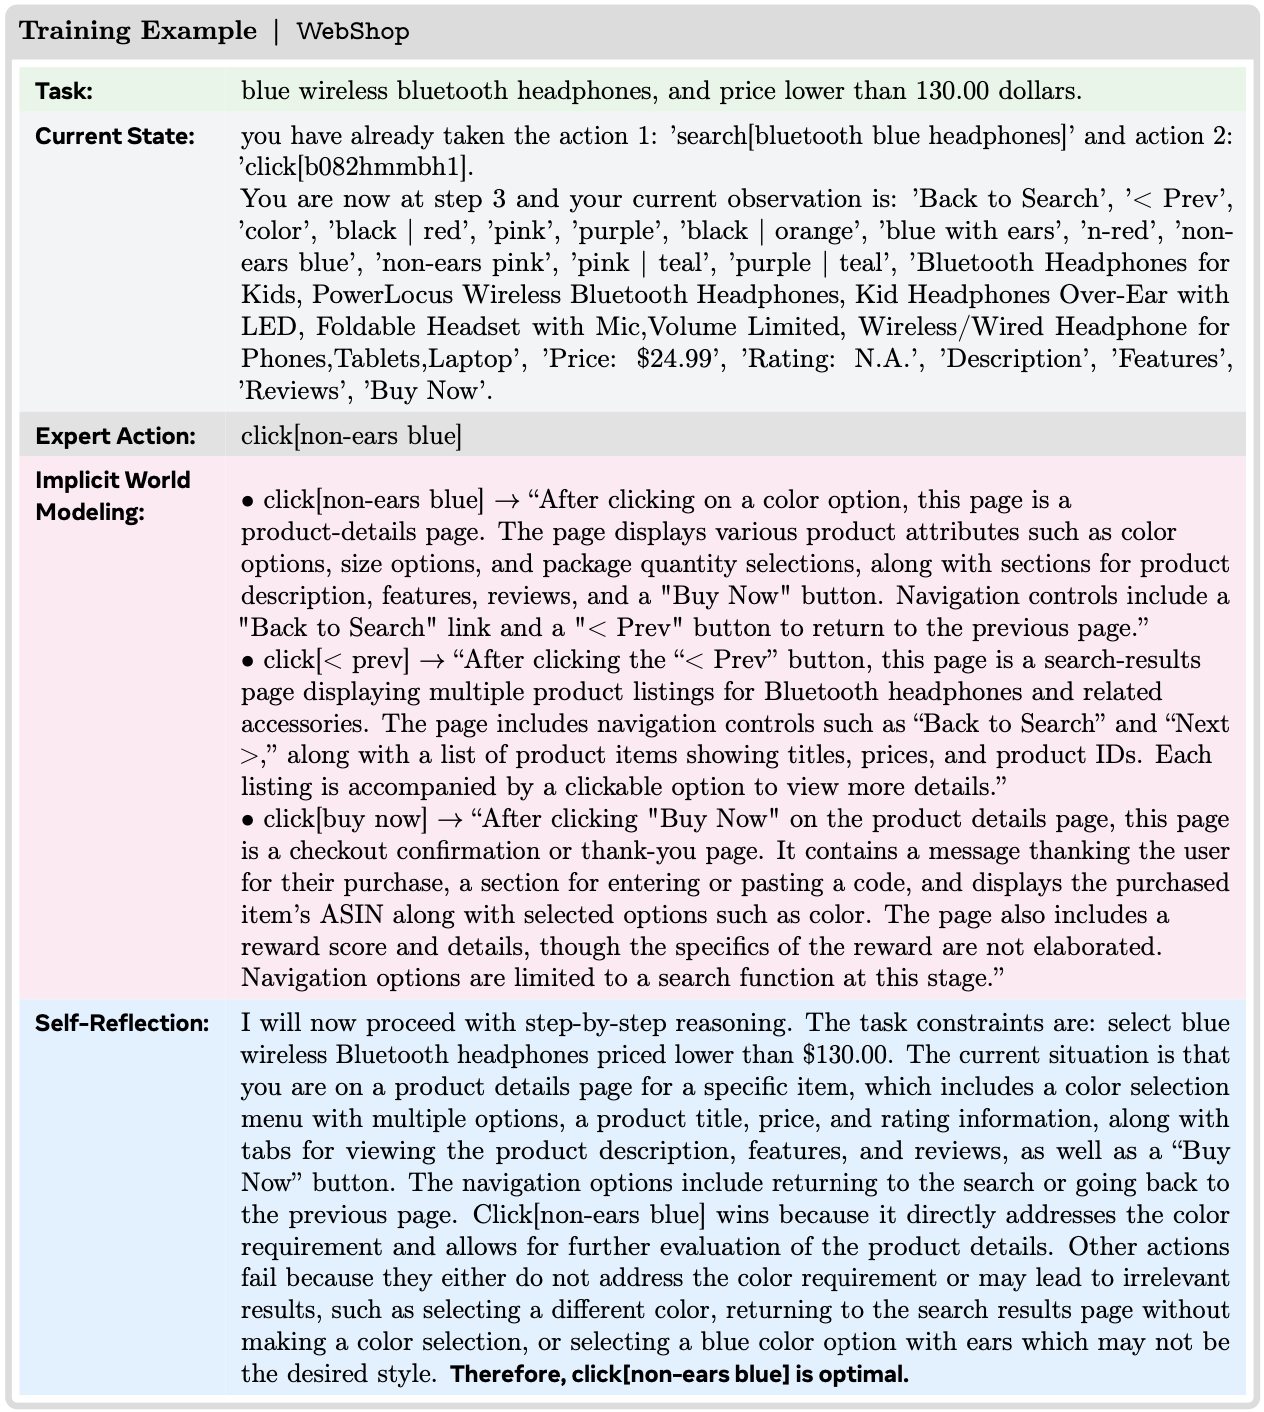
  • 根据 WebShop (2022) 官方发布的人类演示数据,论文提取了 1,571 条人类轨迹,并将其转换为 Verl-Agent (2025) 格式,得到了 15,464 个状态-动作对,构成了用于模仿学习的 \(\mathcal{D}_{\text{expert} }\)
  • 对于隐式世界建模,数据包含两个部分
    • 第一部分直接来源于 \(\mathcal{D}_{\text{expert} }\),通过将每个步骤重新格式化为世界建模格式,其中输入包含历史上下文和当前步骤采取的动作,目标是执行该动作后下一个状态的离线文本摘要(平均长度 345 个字符)
    • 第二部分是通过用非专家动作增强每个专家状态获得的:
      • 让相同的策略在温度 {0.5, 0.8, 0.9} 下提出动作,并额外为每个状态均匀随机采样最多五个可行动作
      • 然后将增强的样本转换为与第一部分相同的世界建模格式:
        • 对于每个非专家动作,论文在 WebShop 环境中执行它以获得后续观察结果,并推导出下一个状态的离线文本摘要
      • 所有候选动作都经过规范化和去重处理
      • 将这些与专家动作合并后,论文得到了 122,954 个三元组用于隐式世界建模
  • 对于 Self-Reflection ,论文构建的提示包括专家动作以及 3 个 alternative 动作 ,并要求模型根据当前状态和可行动作证明为什么专家动作更优
    • 由于原始专家轨迹中的某些动作是次优的 ,论文应用了一个简单的质量过滤器 ,仅保留那些任务能在少于 15 步内完成的轨迹中的动作 ,从而得到了 6,235 个反思示例
      • 问题:仅保留那些任务能在少于 15 步内完成的轨迹中的动作 与 某些动作是次优的 有什么关系?
    • 对于每个这样的状态,alternative 动作的抽取方式与世界建模中相同,即混合模型提出的动作(使用上述温度)和均匀采样的可行动作;
    • 经过规范化和去重后,论文保留 3 个不同的 alternative 动作
    • 论文有意保留多样化的 alternative 动作集合,包括可行但无帮助的动作、空响应以及偶尔的无效动作,以帮助模型学习更清晰的决策边界
  • 在训练期间,论文使用批大小为 4,学习率为 \(1\mathrm{e}{-5}\),并使用 LlamaFactory (2024b) 进行训练
    • 对于强化学习训练,论文采用 Verl-Agent 中的默认超参数,并在其论文报告的相同 split 上进行评估
  • 完整结果见表 6

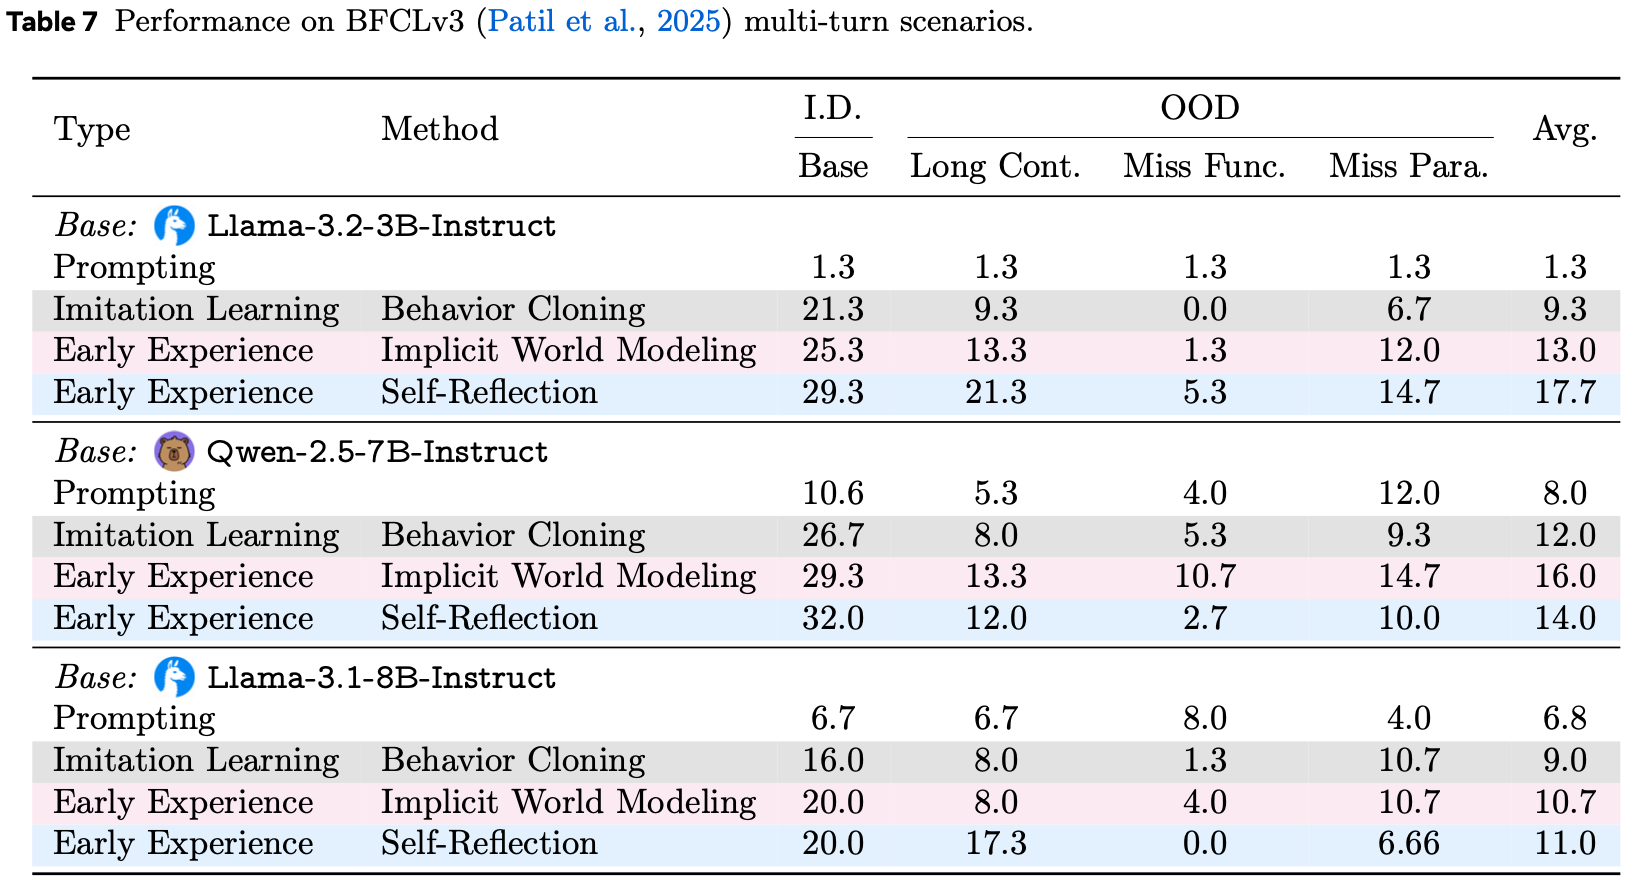
B.3 BFCLv3

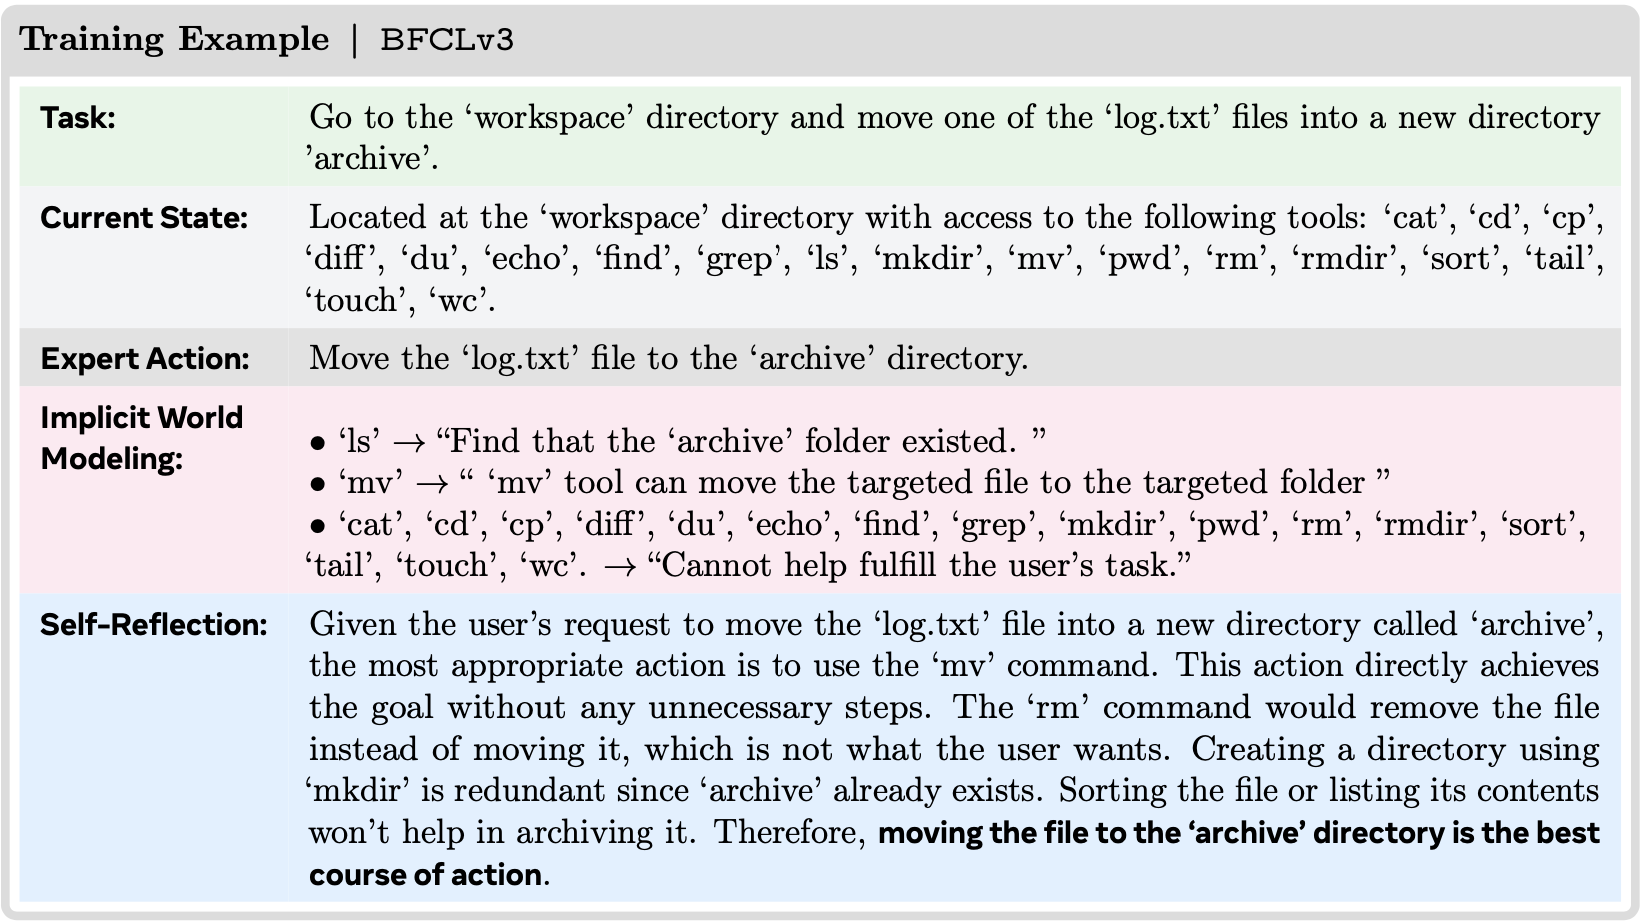
  • 论文遵循 BFCLv3 (2025) 基准测试的默认多轮函数调用 split ,该 split 将任务分类为Base、Long-Context、Miss Function 和Miss Parameters
    • Base 包含基础但多样的多轮交互 ,其中所有必要信息 ,包括用户请求、先前轮次的执行结果和探索性函数输出,都可用于完成任务而无歧义
    • Long-Context 通过引入大量无关数据(例如,数百个文件或数千条记录)来评估模型在冗长、信息密集的环境中保持准确性的能力 ,从而测试其在认知负荷下提取基本细节的能力
    • Miss Function 评估模型能否识别出没有可用函数可以满足用户请求的情况;
      • 当该问题被识别出来时,将在后续轮次中提供缺失的函数 ,并要求模型适应新可用的能力(理解:即函数)
    • Miss Parameters 检查模型是否能够检测到用户请求中缺少基本参数且无法从系统状态推断的情况,提示其请求澄清而不是做出无根据的假设
  • 由于默认的 BFCLv3 基准测试不提供训练集 split ,为了构建训练集,论文专门使用Base 类别中的样本
    • 论文随机选择其中 75% 的样本(125 条轨迹)作为用于模仿学习的专家轨迹 \(\mathcal{D}_{\text{expert} }\)
      • 每条轨迹包含多个步骤和交互,论文将其进一步拆分为单独的步骤以提高训练效率
  • 对于隐式世界建模,数据包含两个部分
    • 第一部分直接来源于 \(\mathcal{D}_{\text{expert} }\),通过将每条轨迹重新格式化为世界建模格式,其中给定历史上下文和上一步的动作,模型预测下一个状态
      • 这产生了 1,264 个训练样本
    • 第二部分是通过增强生成的:
      • 对于专家轨迹中的每个状态,论文让目标模型除了专家动作外再采样 10 个 alternative 动作 ,按照与 ALFWorld 相同的过程 ,产生了 11,904 个样本
  • 对于 Self-Reflection,论文通过提示模型解释其决策来构建训练数据,强调在当前状态下,包括先前定义的工具集在内,为什么专家动作优于其他可用动作
    • 在过滤掉一小部分生成的结论动作与专家动作不匹配的低质量样本后,论文获得了 1,200 个训练样本
  • 论文使用 LlamaFactory (2024b),以批大小 16、学习率 \(1\mathrm{e}{-5}\) 进行训练
    • 为了推理效率,论文采用 vLLM 基础设施
  • 完整结果见表 7

B.4 Tau-Bench

  • 论文使用 Tau-Bench 中的零售任务(retail task)进行实验,在 Tau-Bench 中,零售任务分为训练集和评估集,分别包含 495 和 115 个任务
  • 论文采用一个高性能的指令调优 LLaMA 系列模型在训练集上收集专家轨迹
    • 对于每个任务,推理温度设置为 1.0,并生成四条轨迹
      • 选择最终奖励为 1 的轨迹作为专家轨迹;
      • 如果存在多条这样的轨迹,则随机选择一条;
      • 如果没有轨迹达到奖励 1,则丢弃该任务
    • 此过程为 452 个任务生成了专家轨迹,总共得到 5,239 个(观察,动作)(〈observation, action〉)对
  • 对于世界模型数据,论文使用目标模型为专家轨迹中的每个观察提出五个动作候选
    • 为了避免重复的工具调用并促进探索 ,论文从每个专家观察对应的工具集中移除专家动作中使用的工具,允许模型从剩余工具中进行选择
    • 然后,在环境中执行所选动作以获得下一个观察
      • 每个生成的(专家观察,动作,下一个观察)三元组都包含在世界模型的训练数据集中
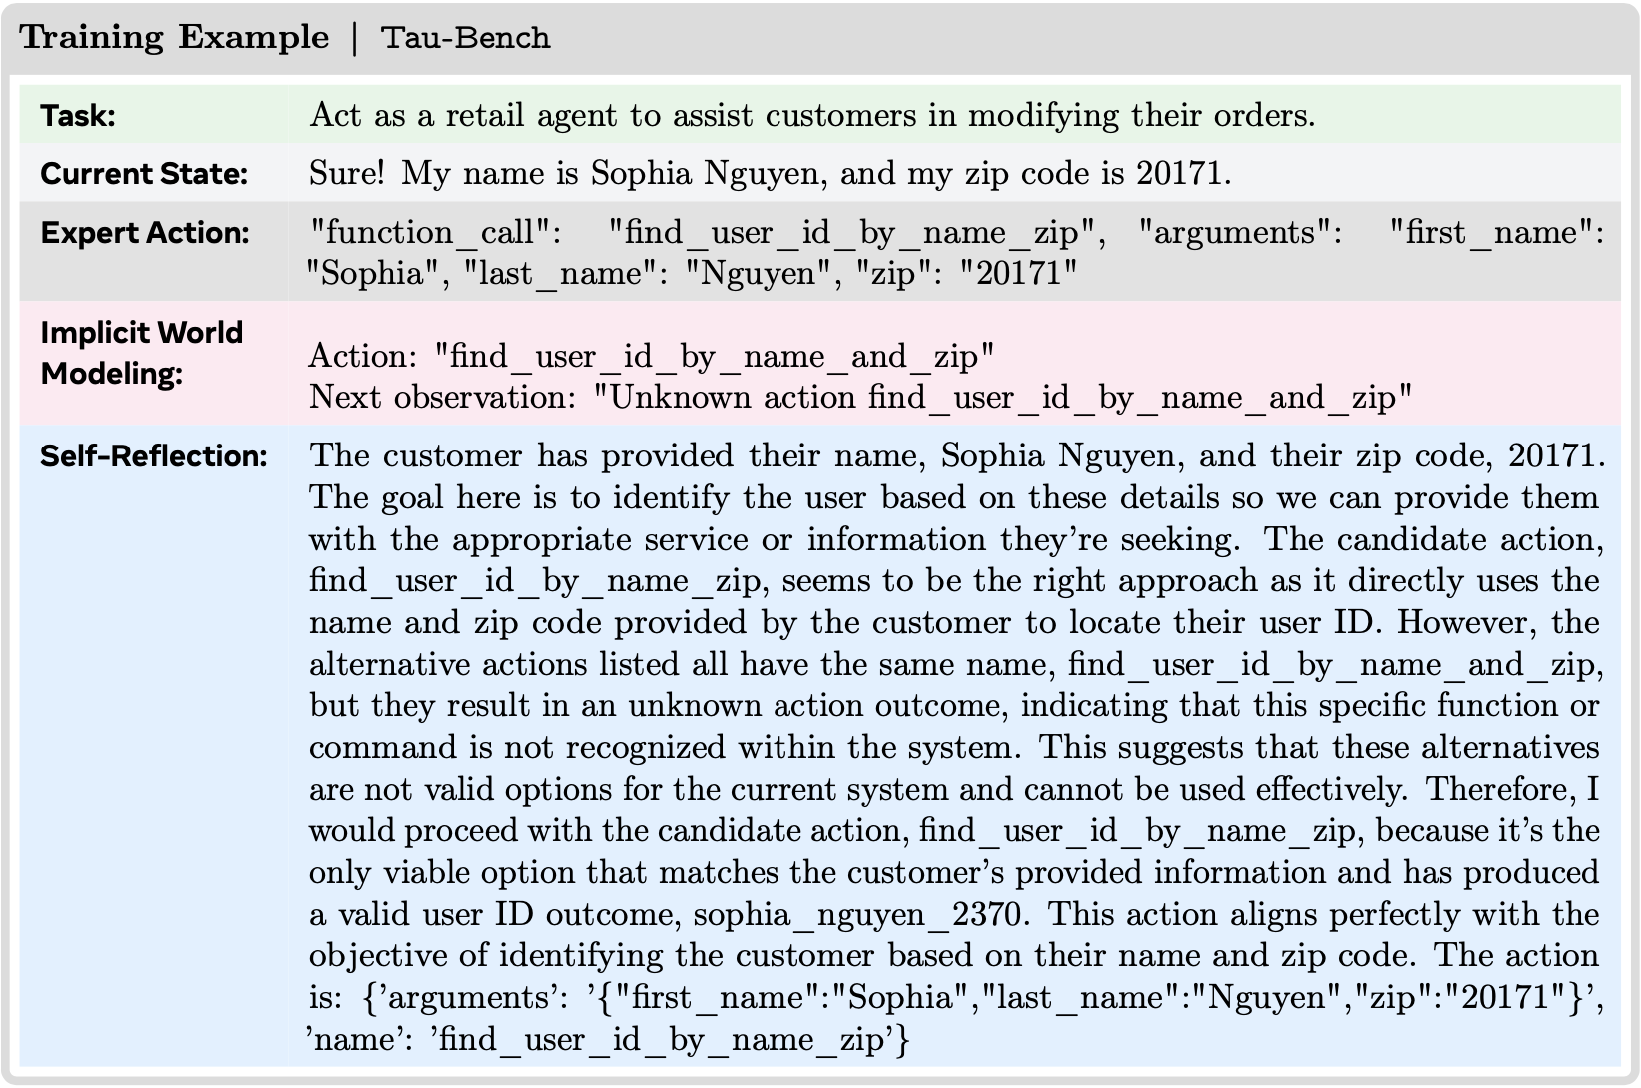
  • 对于 Self-Reflection 数据,对于每个(专家观察,专家动作)对,论文从相应的五个世界模型数据点中选择三个 alternative 动作,并将其呈现给模型本身进行反思,提示其解释选择专家动作背后的原理
    • 论文过滤掉一小部分低质量的反思样本,最终得到总共 5,233 个训练实例
  • 论文采用 LLamaFactory (2024b) 作为训练代码库
    • 对于模仿学习,论文以 1e-5 的学习率训练 6 个 Epoch
    • 对于隐式世界模型学习,论文以 5e-6 的学习率训练 1 个 Epoch
    • 对于 Self-Reflection ,论文以 1e-5 的学习率进行 6 个 Epoch 的 SFT
    • 在所有训练配置中,批大小固定为 16
  • 由于 Tau-Bench 不包含更细粒度的指标,论文在表 2 中报告了完整表格
B.5 SearchQA

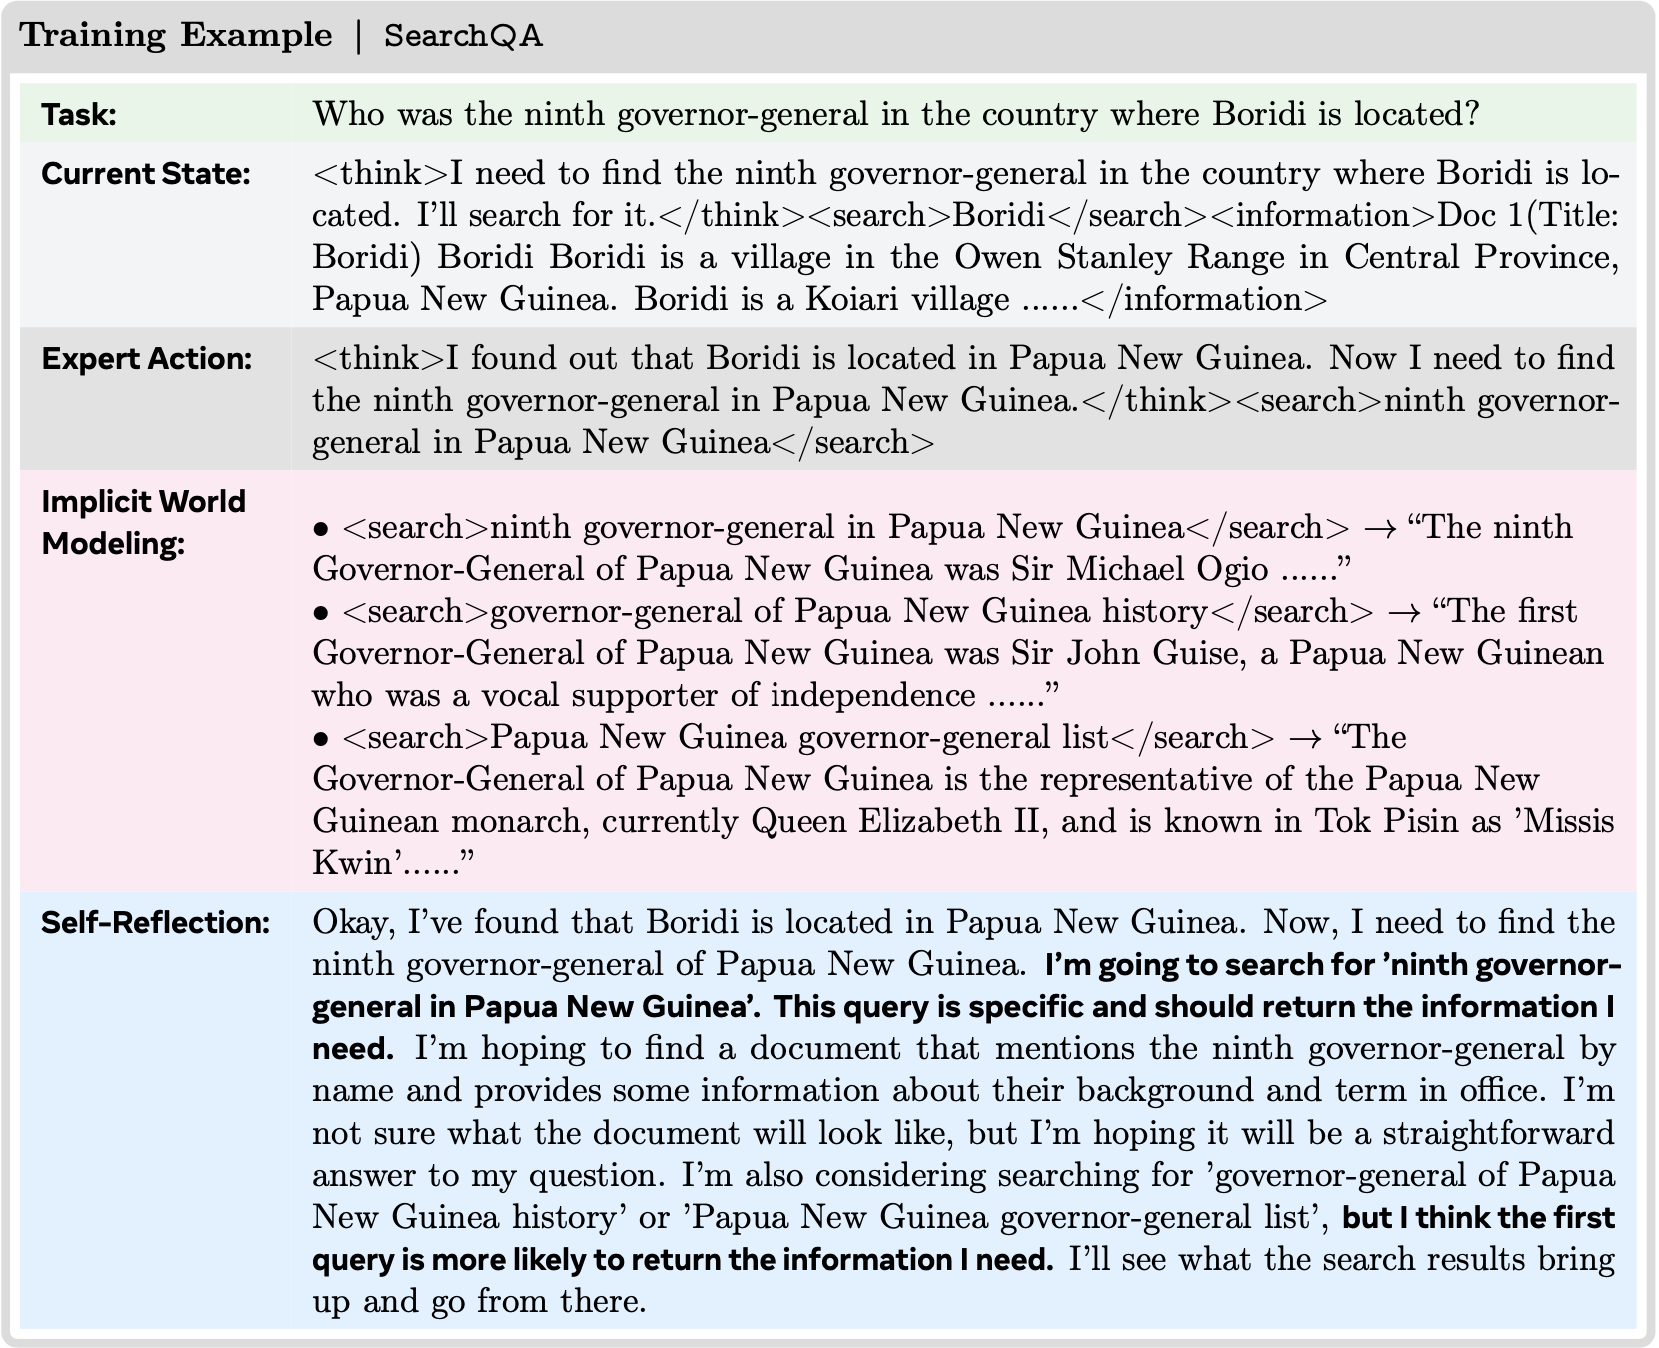
  • 专家轨迹收集 论文从 MuSiQue 训练数据集中选择了所有的 3 跳和 4 跳任务,以及随机抽样的 1,438 个 2 跳任务,以适应需要多步推理来解决复杂问题的场景
    • 最终,论文总共有 7,000 个任务
    • 由于训练数据缺乏细粒度的推理轨迹,例如 Jin 等人 (2025) 所使用的思考-搜索-答案结构,论文使用 Search-R1 模型来生成专家数据
      • 具体来说,论文将温度设置为 1.0,并为每个任务生成 5 条轨迹,仅保留最终答案与真实答案匹配的轨迹
      • 为了减少冗余,论文每个任务最多保留 2 条正确轨迹。此过程产生了 2,082 条轨迹,包含总共 7,691 个状态-动作对用于模仿学习
  • 世界建模数据构建 与 Jin 等人 (2025) 的观察一致,论文发现直接预测检索到的文档内容会产生次优性能,因为许多 Token 与搜索查询不直接相关
    • 为了解决这个问题,论文首先指导模型总结检索到的文档,然后让模型预测这些摘要而不是全文
    • 对于专家轨迹中的每个状态,论文让模型在温度为 1.0 的情况下生成 30 个 alternative 动作,使其能够从自身的 Early Experience 中实质性地内化环境动态
    • 如果生成的动作无效,即查询没有包含在 \(<\)search\(><\)/search\(>\) 标签内,论文返回反馈:”格式错误!如果需要外部知识,你必须将搜索查询包含在 \(<\)search\(><\)/search\(>\) 标签内。”
  • Self-Reflection 数据构建 为了构建 Self-Reflection 训练数据集,论文为每个状态随机采样 2 个 alternative 动作
    • 对于每个实例,提示模型基于当前状态、专家动作、 alternative 动作以及与这些动作相关的检索文档,生成解释为什么专家动作优于 alternative 动作的细粒度推理
    • 此过程产生了 7,691 个包含详细推理过程的训练数据
  • 训练细节 论文采用 LLamaFactory (2024b) 作为代码库,并使用 ZeRO-3 在 4 个 H100 GPU 上进行全参数调优
    • 对于模仿学习和 Self-Reflection ,论文以 \(1\times 10^{-5}\) 的学习率、8192 个 Token 的上下文窗口、每个 GPU 批大小为 2 进行 3 个 Epoch 的训练,同时将梯度累积步数设置为 16
    • 对于隐式世界模型学习,论文利用来自专家轨迹的世界模型数据,使其与模仿学习数据集达到 1:1 的比例,并在相同设置下进行训练
    • 对于强化学习,论文采用 Search-R1 代码库并在 8 个 H100 GPU 上进行训练
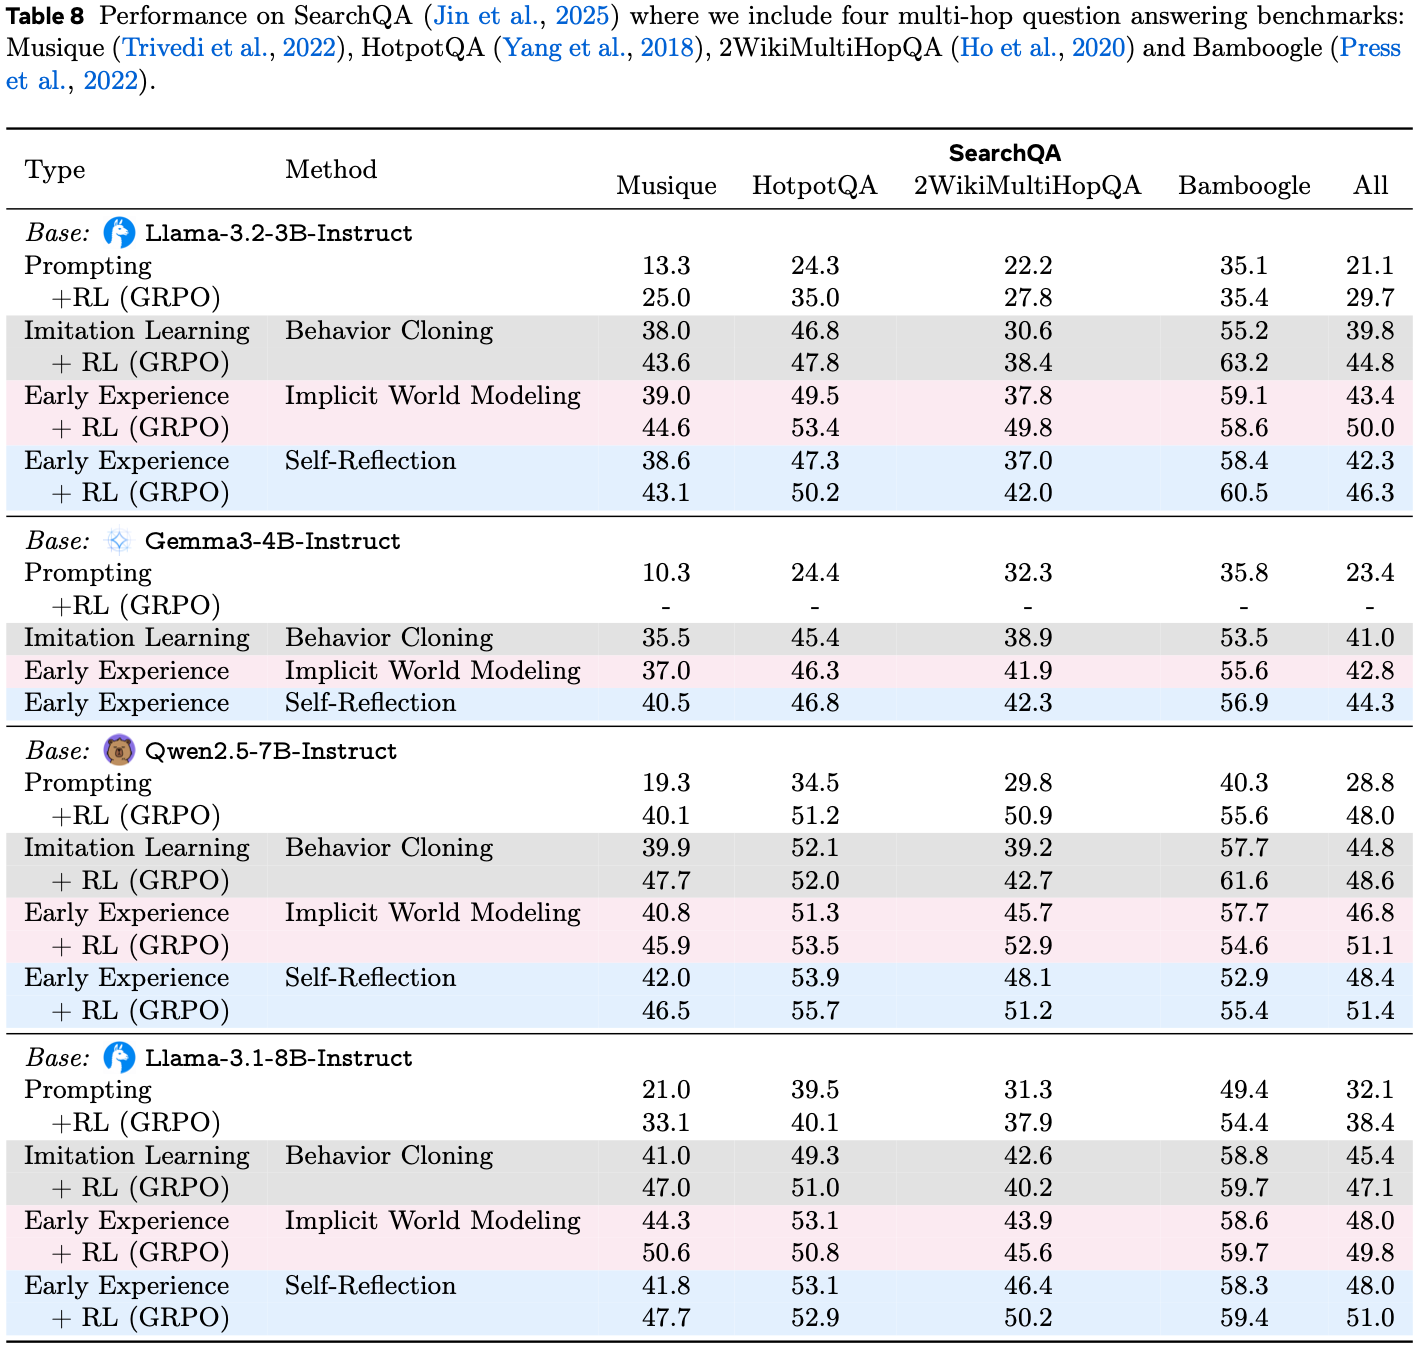
      • 所有设置与 Jin 等人 (2025) 保持一致,除了论文使用 F1 分数作为奖励,将最大检索交互次数设置为 6,配置上下文窗口为 12,280 个 Token ,并指定最大输出长度为 2,048 个 Token
      • 对于训练数据,论文使用 MuSiQue 数据集中的所有训练任务
  • 完整结果见表 8

B.6 ScienceWorld

  • 论文遵循 ScienceWorld (2022) 的默认 split ,使用 Verl-Agent (2025) 框架下的 AgentGym (2024) 设置
    • 从 ScienceWorld 的专家轨迹中,论文提取了 14,506 个状态-动作对来构成 \(\mathcal{D}_{\text{expert} }\)
    • 鉴于数据集中任务可解性的完整性,这些专家轨迹是最优的
  • 对于隐式世界建模,论文使用 \(\mathcal{D}_{\text{tollout} }\) 来增强 \(\mathcal{D}_{\text{expert} }\)
    • 在每个状态,论文从可行动作列表中(排除专家动作)均匀地、无放回地采样 3 个非专家动作,并包含专家动作用于隐式世界建模
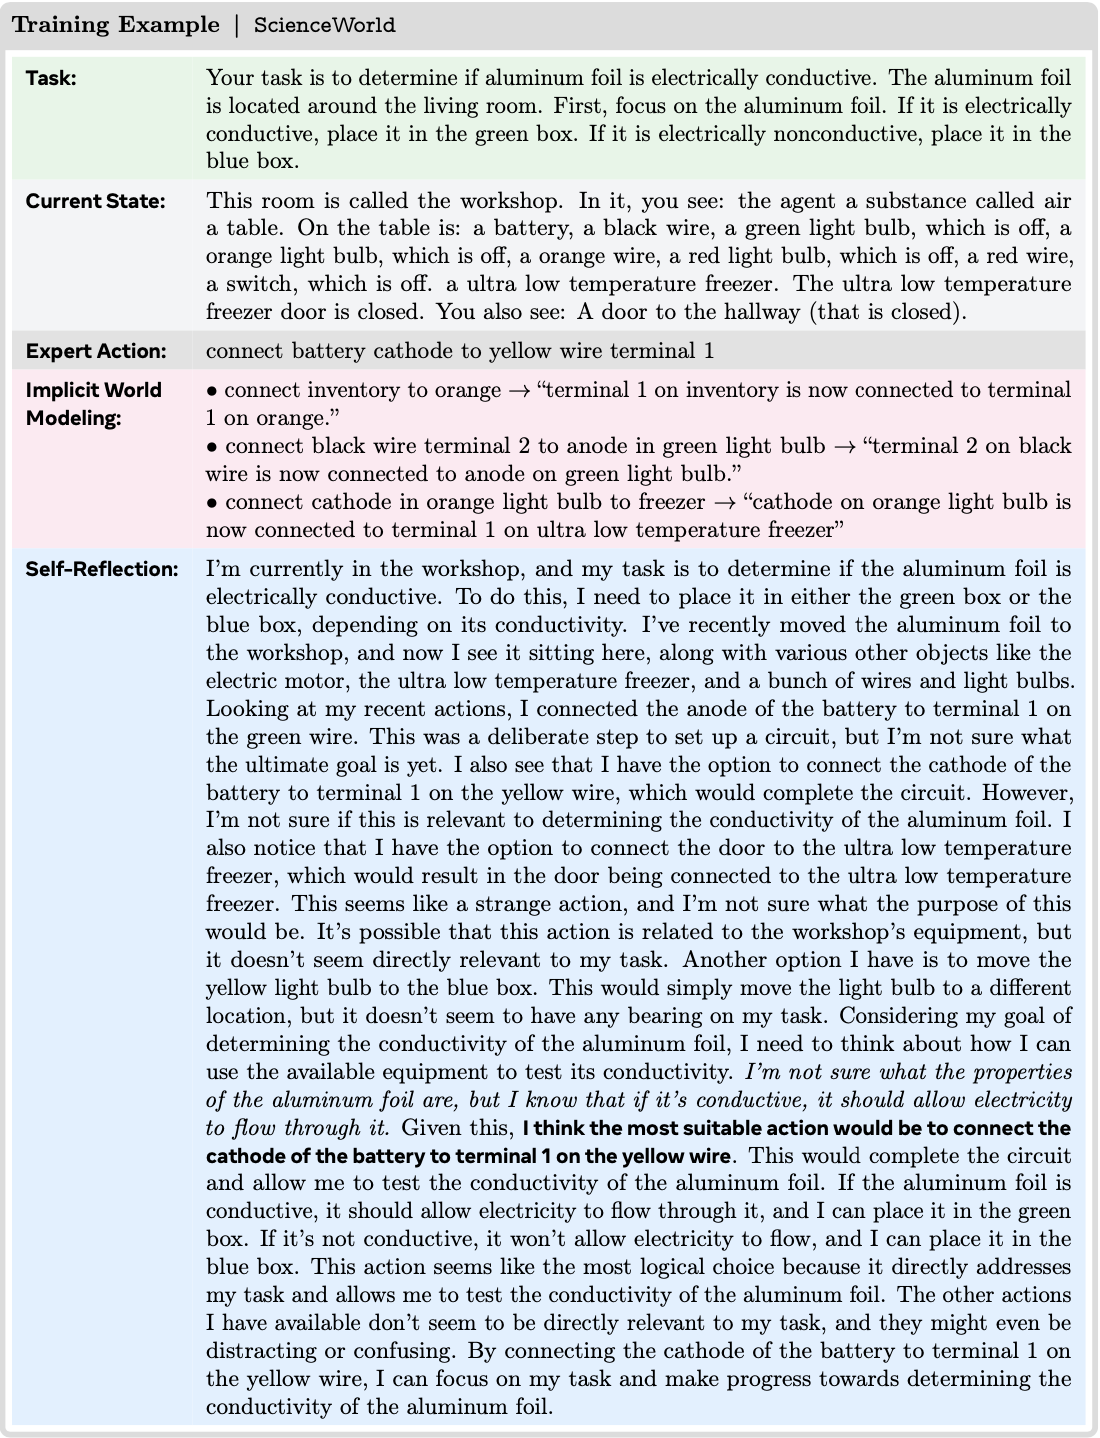
  • 对于 Self-Reflection ,论文通过提示模型解释其自身决策来构建数据
    • 对于每个状态,论文使用相同的策略模型(温度设为 1.0)来提出最多 3 个 alternative 动作(对于 Llama-3.1-8B-Instruct 则为 2 个 alternative 动作)
    • 论文对提出的动作进行规范化处理,并仅保留唯一的动作
      • 如果提出的动作不在该状态的可行动作空间内,论文将其丢弃,并改为从剩余未选中的可行动作中均匀随机采样
    • 最终的提示要求模型根据当前状态和可用工具,证明为什么专家动作优于采样得到的 alternative 动作
  • 对于所有的训练和评估,论文使用 one-shot example
    • 在训练期间,论文使用批大小为 32,学习率为 \(5\mathrm{e}{-6}\),并使用 LlamaFactory (2024b) 训练 1 个 Epoch
    • 对于评估,论文将最大提示长度设置为 4096,最大响应长度设置为 1024,温度设置为 0.4
  • 由于 ScienceWorld 不包含更细粒度的指标,论文在表 2 中报告了完整表格
B.7 TravelPlanner

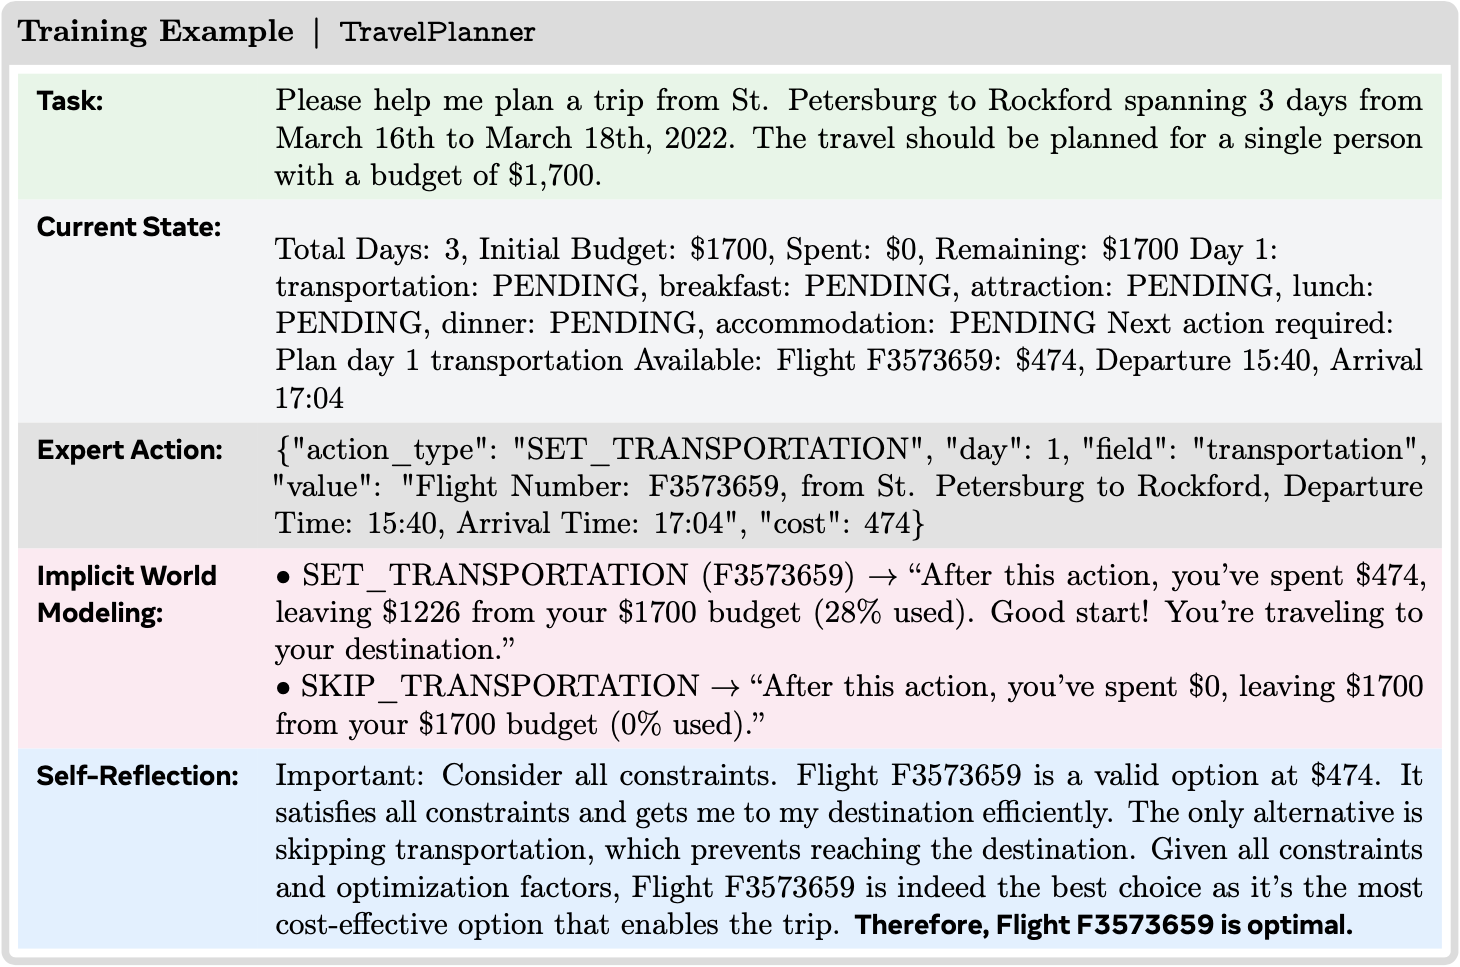
  • 论文将 TravelPlanner (2024a) 基准测试适配为一个基于 gym 的环境 ,用于训练语言智能体
    • 原始基准测试包含 1,225 个查询,分为训练集(45 个查询)、验证集(180 个查询)和测试集
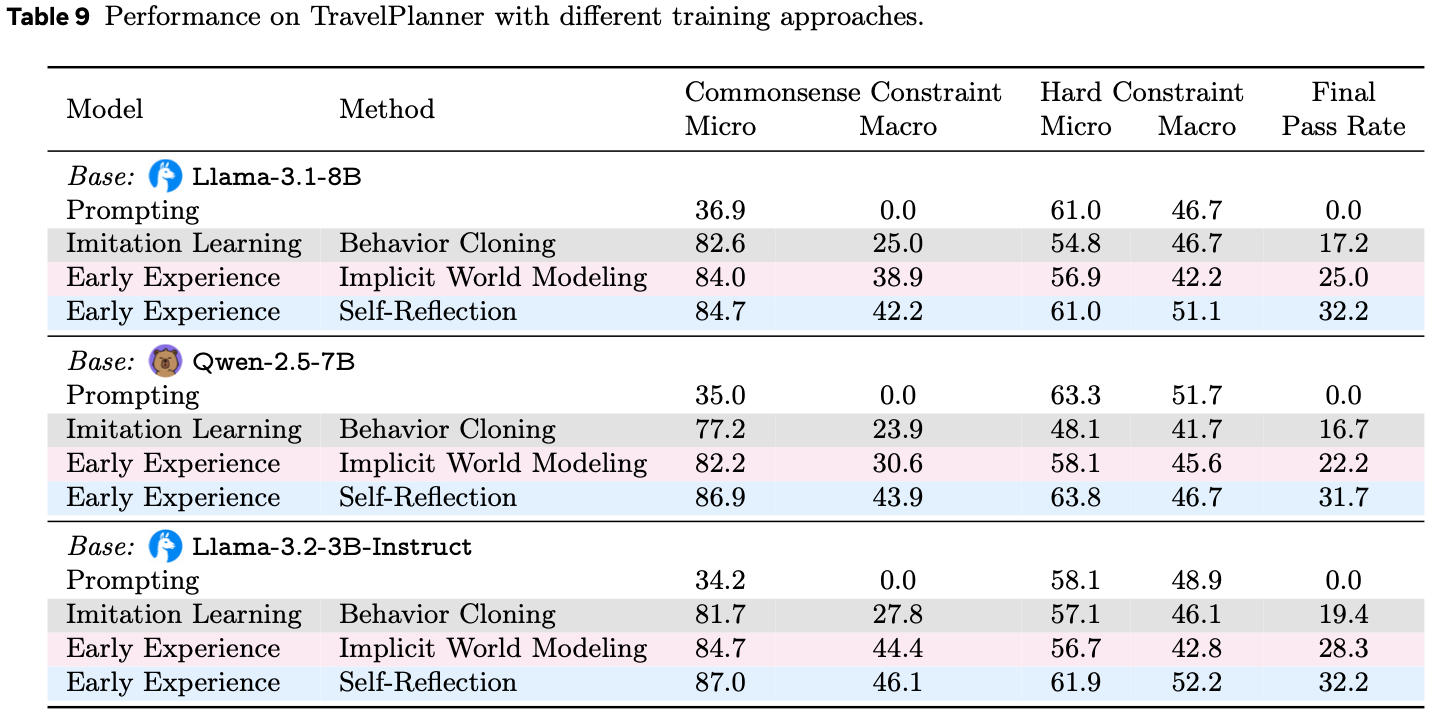
    • 论文使用涵盖不同难度级别(基于旅行持续时间:3、5 或 7 天)和约束复杂性(简单、中等、困难)的多样化规划场景的 45 个训练轨迹
      • 简单 查询主要是针对单人的预算约束
      • 中等 查询引入了额外的约束,如美食类型、房间类型或房间规则,旅行者人数在 2 到 8 人之间变化
      • 困难 查询包括交通偏好以及所有中等级别的约束,包含三个随机选择的困难约束。论文在包含 180 个查询的验证集上进行评估
  • 环境实现 论文将 TravelPlanner 实现为一个具有离散动作空间和字典观察空间的 gym 环境
    • 状态表示包括以结构化文本格式格式化的当前规划进度:
      • 查询描述、预算跟踪(初始/已花费/剩余)以及每天显示交通、餐饮、景点和住宿字段的当前计划状态
    • 动作是 JSON 对象,包含动作类型(例如,SET TRANSPORTATION, SET MEAL, SET ACCOMMODATION)、天数、字段名称、选定值和成本等字段
      • 动作空间根据参考信息中的可用数据动态生成所有有效动作,包括城市间的航班、具有美食类型和价格的餐厅、景点以及具有房间规则和最低住宿夜数要求的住宿
    • 环境实时跟踪预算支出,验证约束条件,并通过状态机维护规划进度,该状态机按顺序推进每个字段
  • 专家轨迹收集 论文使用训练集中的 45 条带标注轨迹作为专家演示 \(\mathcal{D}_{\text{expert} }\)
    • 每条轨迹包含一个完整的多日旅行计划,其中包含交通、住宿、餐饮和景点的真实动作
    • 论文使用 SFTConverter 将这些轨迹分解为 1,395 个独立的状态-动作对,该转换器将专家计划条目映射到有效的 gym 动作,同时处理城市名称变化并根据环境约束进行验证
  • 隐式世界建模 对于世界建模数据,论文生成两种类型的训练样本
    • 首先,将专家轨迹重新格式化为状态转换格式 ,模型学习在给定当前状态和动作的情况下预测下一个状态
    • 其次,论文通过执行专家轨迹中每个状态下所有可用的有效动作(而不仅仅是采样)来执行 exhaustive augmentation,收集全面的状态转换以最大化环境动态的覆盖范围
      • 理解:这里的 exhaustive augmentation 指 穷尽式数据增强,访问了所有的有效动作
    • 此过程生成了超过 70,000 个状态转换样本,为学习环境动态(包括预算更新、约束评估和计划进展)提供了丰富的监督信息
  • Self-Reflection 论文通过提示 Llama-3.1-8B-Instruct 生成思维链推理来解释为什么专家动作优于 alternative 动作,从而构建 Self-Reflection 数据
    • 对于 1,395 个状态-动作对中的每一个,论文探索最多 30 个替代的有效动作,并生成考虑多个约束的推理:预算限制、住宿的最低住宿夜数、餐厅多样性要求以及往返完成情况
    • 推理生成使用温度 0.9 和 8 路张量并行性来产生自然的解释,同时保持逻辑一致性
    • 论文不应用额外的过滤,因为推理生成过程已经验证了约束满足情况
    • 问题:这里为什么要使用 Llama-3.1-8B-Instruct 而不是目标模型?
  • 训练细节 论文使用 LlamaFactory ,在 8 个 H100 GPU 上使用 DeepSpeed ZeRO-3 进行全参数微调来训练模型
    • 对于模仿学习和隐式世界建模,论文以 \(1\mathrm{e}{-5}\) 的学习率和余弦调度器训练 5 个 Epoch
    • 对于 Self-Reflection ,论文将最大生成长度扩展到 8K Token 以容纳详细的推理
    • 所有模型使用 32K 上下文窗口,每个 GPU 批大小为 16
    • 对于评估,论文使用 vLLM,在 8 个 GPU 上进行张量并行,并使用贪婪解码以确保可重现性
  • 完整结果见表 9

B.8 WebArena

  • 鉴于 WebArena (2024) 中的完整评估集冗长且包含许多类似任务
    • 论文遵循先前的工作 (2024; 2025a) ,在 WebArena-Lite (2024) 上评估论文训练好的智能体,这是一个从原始的 812 个任务中手动挑选出的更高效、更平衡的 165 个高质量、具有挑战性的任务的子集
    • WebArena 中剩余的 647 个任务(不包括评估集中的任务)用于智能体训练
  • 为了获取 WebArena 中的专家演示,论文从公开的 WebArena 排行榜上表现最佳的智能体中提取成功的轨迹
    • 具体来说,论文选择那些在其观察中包含可访问性树信息的智能体,例如 IBM CUGA (2025), ScribeAgent (2024), Learn-by-Interact (2025) 和 AgentOccam (2024)
    • 在过滤掉不成功的轨迹后,论文获得了 554 条成功的轨迹和 7,044 个状态-动作对,构成了 \(\mathcal{D}_{\text{expert} }\)
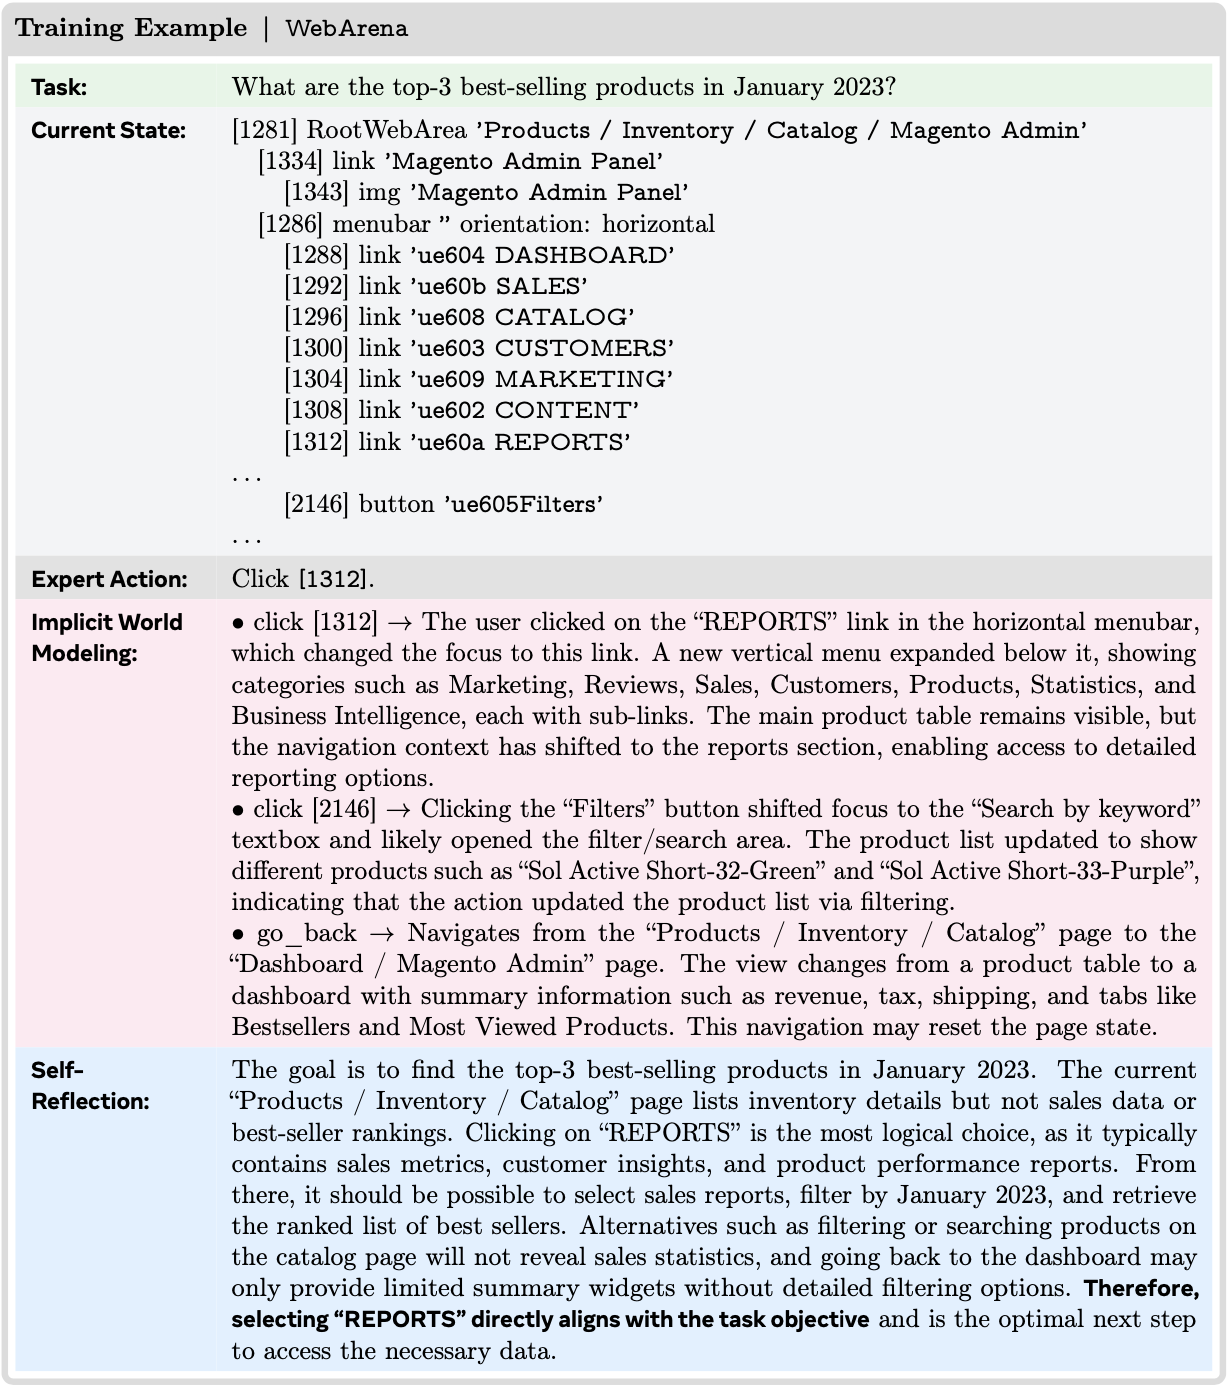
  • 对于隐式世界建模 ,为了从专家轨迹中分支出来进行隐式世界建模 ,论文增强 \(\mathcal{D}_{\text{expert} }\) 以形成 \(\mathcal{D}_{\text{rollout} }\)
    • 对于 \(\mathcal{D}_{\text{expert} }\) 中的每个状态,论文让目标模型(待训练)使用自由形式生成提出 5 个非专家动作,排除任何与专家动作相同的动作
    • 对于每个 resulting next state,论文应用一个额外的处理步骤:使用相同的模型,论文生成下一个状态观察的简洁摘要,该摘要以任务为条件,替换原始观察以减少噪声并强调与任务相关的信息。然后,论文将专家动作与采样的动作一起包含进来,创建形式为(当前状态,动作,摘要化的下一个状态)的三元组,最终为每个模型总共产生 \(7,044 \times 6 = 42,264\) 个三元组
  • 对于 Self-Reflection ,论文通过提示模型解释在当前状态下为什么专家动作优于采样的 alternative 动作来构建 \(\mathcal{D}_{\text{SR} }\)
    • 论文使用来自 \(\mathcal{D}_{\text{rollout} }\) 的相同 5 个 alternative 动作,规范化动作字符串以避免重复,并用随机采样的有效动作替换任何无效动作(例如,引用不存在的 UI 元素)
    • 最终的提示词包括当前状态、可行动作和专家动作,并要求模型在任务进度、约束满足和效率方面证明专家选择的最优性
    • 论文过滤掉那些解释错误地支持非专家动作的低质量生成内容,留下 3,190 个高质量的 Self-Reflection 示例
  • 所有模型均以 1e-5 的学习率和余弦调度器训练 2 个 Epoch
  • 论文在 WebArena-Lite 上的完整数据报告在表 10 中
NLP——EvoCUA

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:EvoCUA Technical Report, Meituan, 20260122
    • Github:github.com/meituan/EvoCUA
    • Huggingface:huggingface.co/meituan/EvoCUA-32B-20260105
    • OSWorld:os-world.github.io/
    • 原作者解读:美团EvoCUA技术报告解读

Paper Summary

  • 对论文的评价和关键认知:
    • 论文是研究生同学的作品,实现了 CUA 方向的开源 SOTA,有非常丰富的数据生产经验和 Sense,值得深读
    • 虽然没有使用太多 PPO 等高大上的技术,但从文章里面可以看到作者的工作逻辑是非常严谨的,也做的非常深入,靠的是比较全面的调研、深入思考和工程实践能力拿到的最终效果,值得参考
    • 论文的核心认知:
      • 先对模型注入广泛的原子能力,再通过后续的训练将原子能力串起来,思路与之前的 \(f(g(x))\) 论文类似
      • 数据的质量需要高度保证(去噪非常重要),高质量的数据对应高质量的模型,理解:Garbage in,Garbage out
      • 根据数据的深入分析,构建时识别第一个分叉点,目标是构造 <chosen,rejected> 对用于标准的 DPO 训练,分为两方面构建损失:
        • 范式1:
          • Rejected:旧的错误步骤
          • Chosen:新合成的正确步骤,针对步骤 \(t^*\) 动作纠正,用最优的 Chosen 响应 \((z_{w},a_{w})\) 替换 Rejected 的错误 \((z_{l},a_{l})\)
        • 范式2:
          • Rejected:之前盲目继续的样本
          • Chosen:反思样本,针对步骤 \(t^* + 1\),对错误步骤进行改进(其他更优模型或高温),而不是盲目继续(之前的轨迹会盲目继续)
            • 这里相当于让模型开始反思,从错误中反思重新开始的方式,最终模型能学会思考
      • RFT 和 DPO 数据要使用 On-policy 的
    • 论文整体再次体现了数据为王的思路
  • 问题提出:
    • 原生计算机使用智能体 (Native Computer-use Agents,CUA) 的发展代表了多模态 AI 领域的重大飞跃
    • 但其潜力目前受限于静态数据扩展的约束
  • 现有范式主要依赖于对静态数据集的被动模仿,难以捕捉长时程计算机任务中固有的复杂因果动态
  • 论文介绍了 EvoCUA,一个原生计算机使用智能体模型
    • 与静态模仿不同,EvoCUA 将数据生成和策略优化整合到一个自我维持的演进循环中
    • 为了缓解数据稀缺问题,论文开发了一个可验证的合成引擎,能够自主生成多样化的任务并附带可执行的验证器
    • 为了实现大规模经验获取,论文设计了一个可扩展的基础设施,能够编排数以万计的异步沙箱 Rollout
    • 基于这些海量轨迹,论文提出了一种迭代演进学习策略,以有效地将这些经验内化
      • 该机制通过识别能力边界来动态调控策略更新,即强化成功的例程,同时通过错误分析和自我纠正将失败轨迹转化为丰富的监督信号
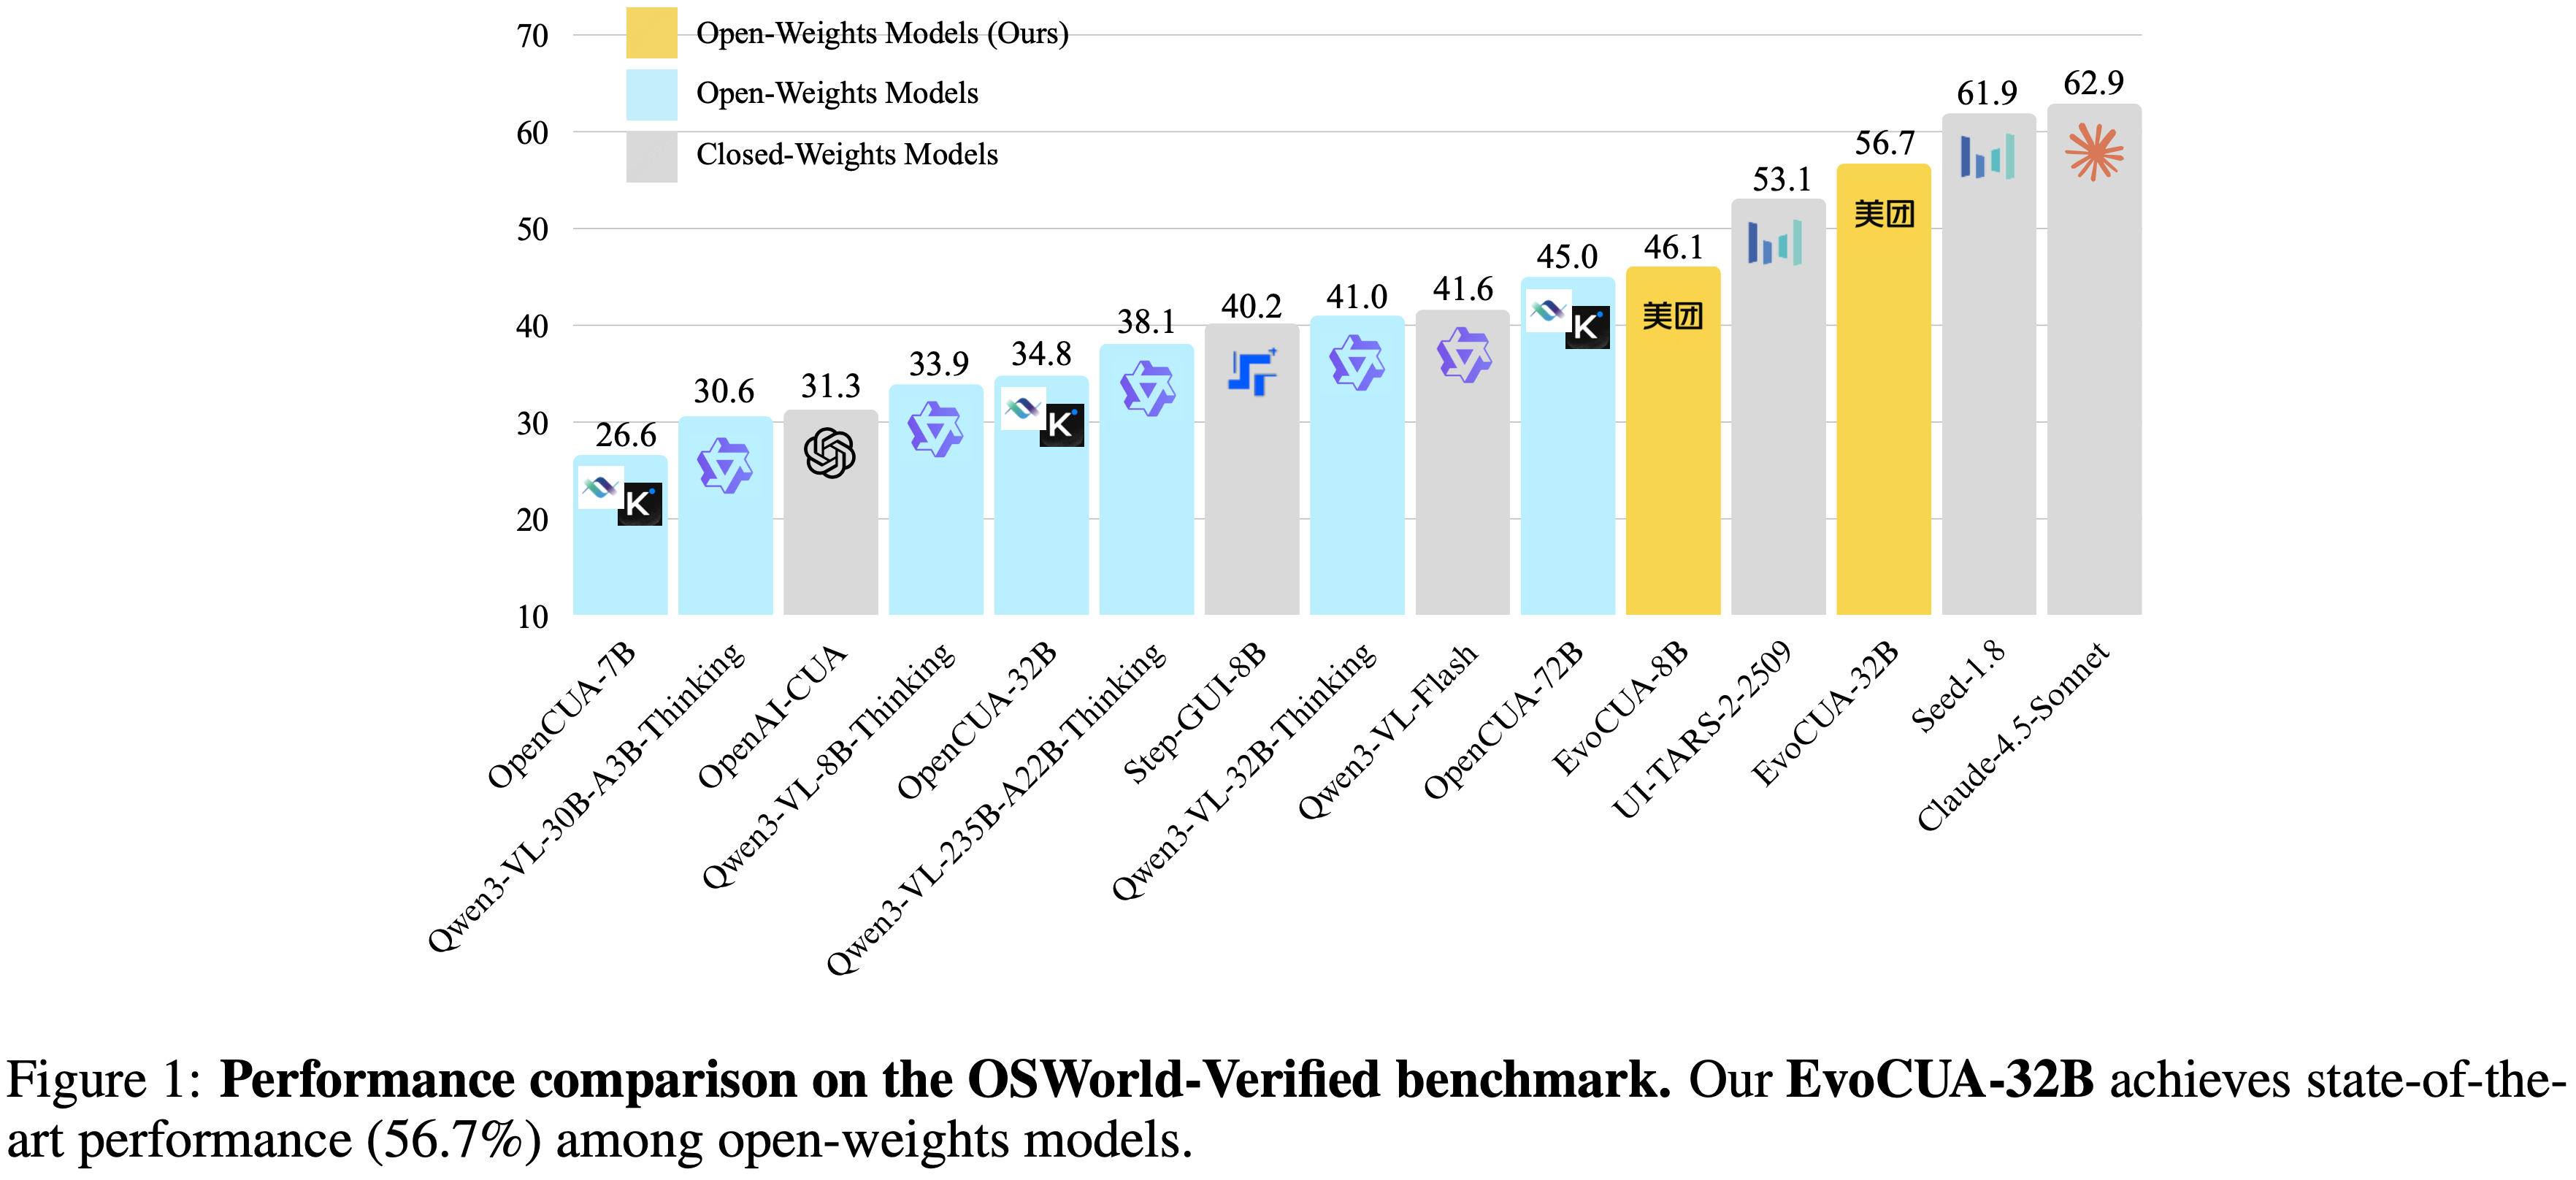
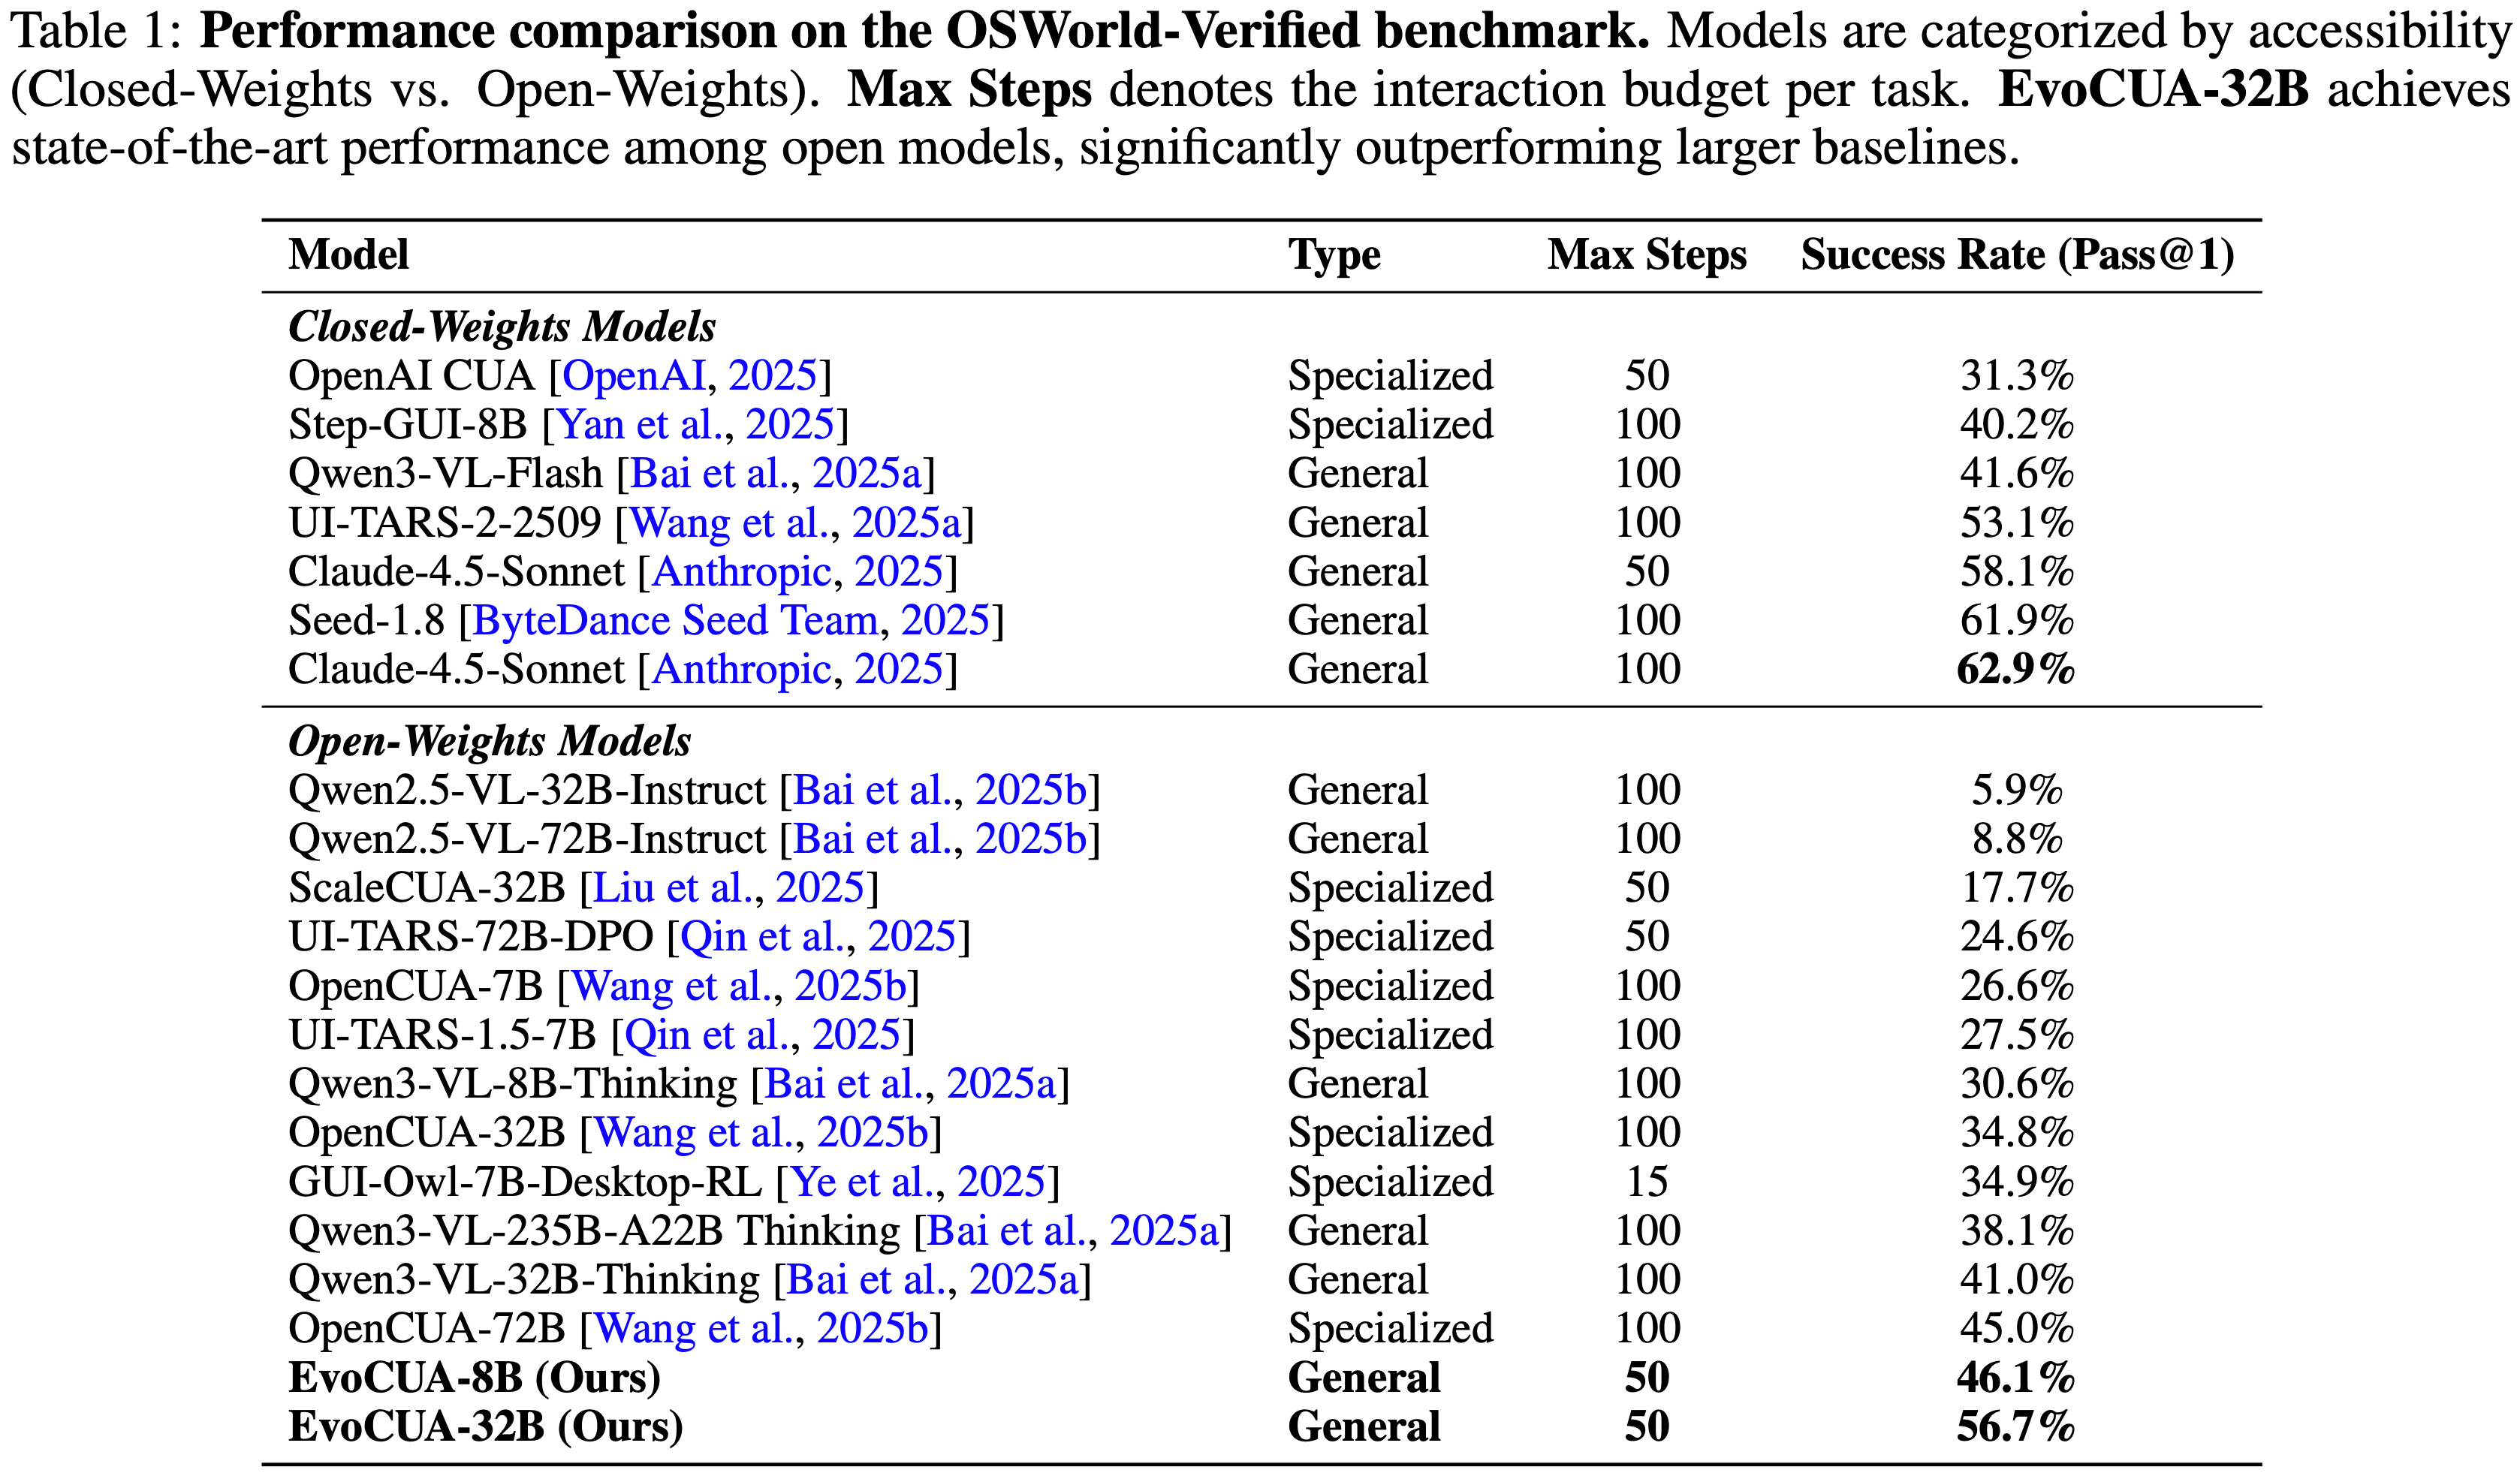
    • 在 OSWorld 基准测试上的实证评估表明,EvoCUA 取得了 \(56.7%\) 的成功率,建立了新的开源 state-of-the-art
  • EvoCUA 显著优于先前最好的开源模型 OpenCUA-72B (\(45.0%\)),并超越了领先的闭源权重模型,如 UI-TARS-2 (\(53.1%\))
  • 论文的结果强调了该方法的泛化能力:
    • 通过从经验中学习驱动的演进范式,在不同规模的基座模型上都能带来持续的性能提升,为推进原生智能体能力建立了一条稳健且可扩展的路径

Introduction and Discussion

  • 能够掌握图形用户界面 (GUIs) 的通才(generalist)智能体的开发,代表了通向人工通用智能的关键里程碑
    • 与专用工具不同,这些智能体必须感知复杂的视觉上下文,并在异构应用程序中执行长时程工作流,有效地模拟人机交互
  • 最近的原生视觉语言模型 (VLMs) 已成功地将感知和动作集成到端到端架构中 (2025a, 2025),但实现人类水平的可靠性仍然是一个重大挑战
    • 尽管 UI-TARS-2 (2025a) 和 OpenCUA (2025b) 等 SOTA 模型的,已经建立了基础架构,但进一步的进展越来越受到一个关键瓶颈的限制:依赖静态数据集进行扩展的收益递减
  • 现有的扩展定律主要局限于对固定的、非交互式数据集的被动模仿,无法捕捉现实世界计算机使用中固有的因果反馈
    • 克服这一限制需要一个范式转变,即从通过静态轨迹进行数据扩展,转变为通过大规模交互式 Rollout 进行经验扩展
    • 动态经验比静态文本提供了更丰富的监督信号,包含了环境反馈以及来自成功和失败的关键 Insight
  • However,将原始交互转化为自我改进的学习循环存在三个主要挑战:
    • 1)可验证的数据合成(Verifiable data synthesis) :
      • 仅仅合成文本 Query 通常会导致幻觉,智能体会为不可行的任务生成看似合理的计划
      • 因此,需要一个稳健的框架来确保生成的 Query 严格基于可解决的状态,符合可验证奖励的原则
    • 2)可扩展的交互基础设施(Scalable interaction infrastructure) :
      • 高吞吐量的经验生产需要一个统一系统,将大规模环境模拟与高性能强化学习相结合,以支持持续、异步的交互
    • 3)高效的训练方案(Efficient training recipe) :
      • 给定一个大规模的交互空间,无限制的探索在计算上是不可行的
      • 有效的学习需要一种遵循策略的方法,模仿人类学习动态:巩固已掌握的例程(routines),同时集中关注智能体在成功和失败之间摇摆的边界任务
  • 为了解决这些问题,本报告介绍了 EvoCUA ,一个原生计算机使用智能体,它通过从经验中学习驱动的演进范式应对这些挑战
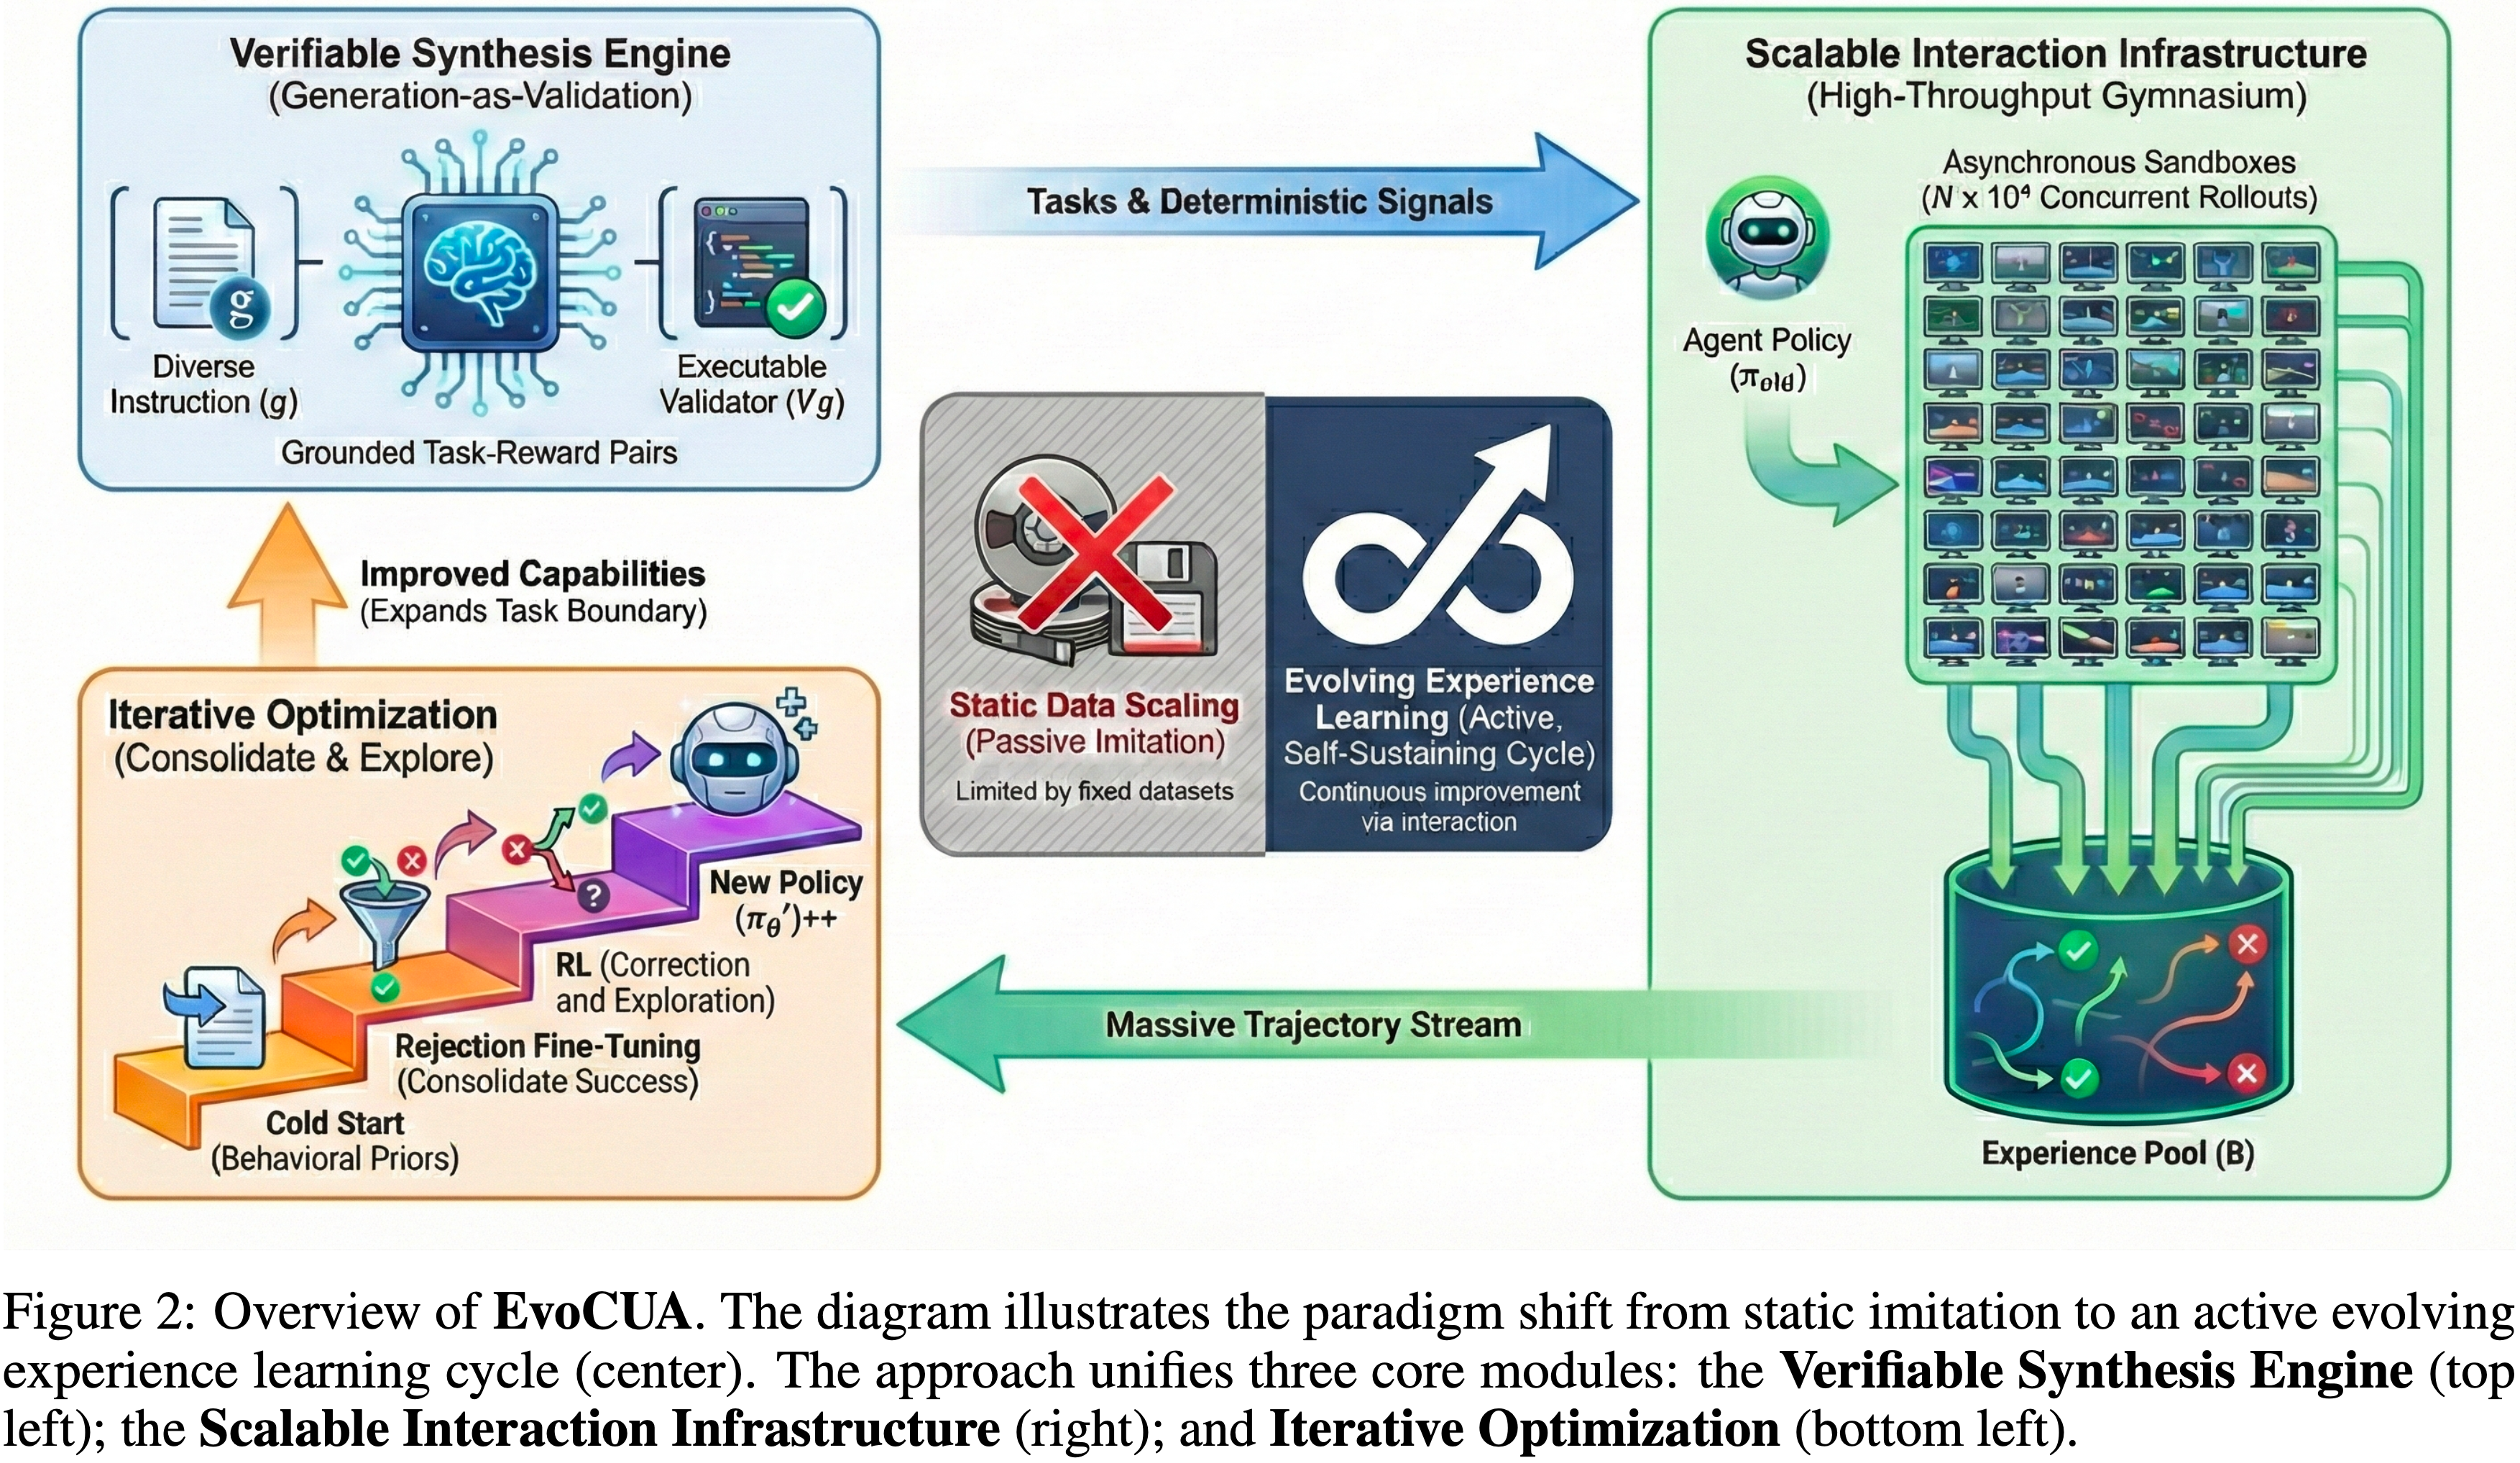
    • 如图 2 所示,通过将可验证合成、高吞吐量基础设施和演进优化相统一,EvoCUA 建立了一个自我维持的循环,持续将合成计算转化为高质量的智能体能力
  • 论文的核心贡献有三方面:
    • 可验证合成引擎 (Verifiable Synthesis Engine)
      • 为了克服数据瓶颈同时确保严格的环境基础,论文首先提出了一个合成引擎,能够 自主生成多样化任务及其可执行验证器(executable validators)
      • 超越纯文本生成,论文分析原子能力以合成自包含的任务定义
      • 这种“生成即验证(Generation-as-Validation)”的方法消除了自然语言奖励的模糊性,为智能体提供精确的、确定性的监督信号
    • 可扩展交互基础设施 (Scalable Interaction Infrastructure)
      • 为了支持所需的大规模经验扩展,论文构建了一个高性能基础设施,集成了大规模沙箱环境
      • 这个系统不仅仅是轨迹生成,它充当一个动态训练场,提供策略优化所必需的实时反馈和状态转换
      • 通过架构一个完全异步的 Rollout 机制,论文将模拟与模型更新解耦,使系统能够编排数万个并发的交互会话
    • 通过从经验中学习的演进范式 (Evolving Paradigm via Learning from Experience)
      • 论文引入了一个以从经验中学习为中心的迭代训练范式,以确保效率
      • 该过程始于一个注重多样性的冷启动,以 建立稳健的先验
      • 随后,通过持续的环境探索,模型对比成功与失败的轨迹,以巩固有效模式并纠正错误
      • 这个动态反馈循环将累积的经验转化为模型参数,产生一个精确而稳健的执行策略
  • 实证评估表明,EvoCUA 在 OSWorld 基准测试上 (2024) 取得了 state-of-the-art 成功率 \(56.7%\),显著超越了之前的开源 SOTA,OpenCUA-72B (45.0%) (2025b),并超过了领先的闭源模型 UI-TARS-2 (53.1%) (2025a)
    • 此外,演进式经验学习范式被证明是一条可泛化的路径,在不同大小的多个基座模型上带来了一致的增益

Preliminaries

  • 在介绍论文的 EvoCUA 之前,论文在下文中提供 CUA 的基本任务定义
  • 形式上,CUA 可以看作是一个具有显式推理的部分可观测马尔可夫决策过程 (POMDP) (1998),它通过可验证任务合成和策略优化的协同演进循环进行优化

POMDP

  • 给定一个自然语言指令 \(g\),交互过程被建模为一个元组 \((S, A, \mathcal{Z}, \mathcal{O}, \mathcal{P}, \mathcal{R}_{syn})\)
    • 其中 \(S\), \(A\), \(Z\), \(\mathcal{O}\), \(\mathcal{P}\), 和 \(\mathcal{R}_{syn}\) 分别表示状态空间、动作空间、思维空间、观测、转移核和奖励函数
  • 细节如下所示:
    • 状态空间 \((S)\) (State Space) :
      • 环境被建模为具有底层计算机系统状态 \(s_t \in S\),包括应用程序状态、系统配置和隐式的系统级上下文
        • 智能体无法直接观测到这个状态,智能体感知到从该状态渲染出的视觉观测(对应于时间 \(t\) 的屏幕图像)
          $$ I_t \triangleq \mathrm{Render}(s_t) \in \mathbb{R}^{H \times W \times 3} $$
          • \(H\), \(W\) 分别表示屏幕截图的高度和宽度
          • 渲染的屏幕截图 \(I_t\) 是智能体观察环境的唯一感知接口
    • 观测 \((O)\) (Observation) :
      • 在步骤 \(t\),智能体接收原始视觉观测 \(o_t \in \mathcal{O}\),其中
        $$ o_t \triangleq I_t \in \mathbb{R}^{H \times W \times 3} $$
      • 为了解决部分可观测性,论文定义了交互历史
        $$h_t = \{g, o_0, z_0, a_0, \ldots , o_{t-1}, z_{t-1}, a_{t-1}\}$$
        • 它作为智能体决策过程的条件上下文
      • 在实际实现中,为了防止上下文窗口溢出,论文遵循 (2025b, 2025a) 执行上下文工程策略
      • 论文将视觉历史限制为最近的五张屏幕截图,并使用结构化的内心独白和动作表示来压缩文本历史,以平衡性能和 token 效率
    • 动作空间 \((A)\) (Action Space) :
      • 论文定义了一个统一的原生动作空间 \(A\),它包含基于坐标的鼠标事件 \(A_{\mathrm{mouse} }\)、键盘输入 \(A_{\mathrm{keyboard} }\) 以及用于管理任务执行流的特殊控制 \(A_{\mathrm{control} }\) 原语
      • 形式上,论文定义
        $$A = A_{\mathrm{mouse} } \cup A_{\mathrm{keyboard} } \cup A_{\mathrm{control} }$$
    • 思维空间 \((Z)\) (Thought Space) :
      • 论文将推理过程显式地建模为内部思维空间 \(Z\)
      • 在每个步骤 \(t\),智能体在执行动作之前生成一个自然语言推理痕迹(Reasoning Trace) \(z_t \in Z\)
      • 它作为智能体内部的中间认知状态,用于将后续的物理动作基于当前的视觉上下文
    • 策略 \((\pi_\theta)\) (Policy) :
      • 智能体遵循一个参数化的策略
        $$ \pi_\theta (z_t, a_t \mid h_t, o_t)$$
        • 该策略控制推理和动作选择
      • 在每个步骤 \(t\),策略首先生成一个基于当前交互上下文的推理痕迹 \(z_t\),随后基于生成的推理选择一个可执行动作 \(a_t\)
      • 这种顺序生成确保动作执行以显式推理为条件
    • 转移 \((\mathcal{P})\) (Transition) :
      • 环境状态根据状态转移核 \(\mathcal{P}(s_{t + 1} \mid s_t, a_t)\) 演化,它捕捉底层计算机系统响应执行的物理动作 \(a_t\) 的 Dynamics
      • 给定更新后的状态 \(s_{t + 1}\),后续的视觉观测被渲染为 \(I_{t + 1} = \text{Render}(s_{t + 1})\)
    • 可验证奖励 \((\mathcal{R}_{syn})\) (Verifiable Reward (Rsyn)) :
      • 监督通过可验证合成机制基于执行正确性建立
      • 对于 给定的指令 \(g\) ,合成引擎提供一个 可执行的验证器(validator) \(V_g\) ,用于评估任务目标是否满足
        • 注意:每个指令都有不同的 Validator
      • 论文基于终止环境状态定义一个稀疏的、二元的、指令条件的奖励:
        $$ \mathcal{R}_{syn}(s_T; g) \triangleq \mathbb{I}[V_g(s_T) = \text{True}]$$
        • 其中 \(s_T\) 表示 Episode 终止时的环境状态
      • 这种奖励公式提供了结果级别的监督,无需中间标注

Objective

  • 论文不将训练数据视为静态数据集,而是将其概念化为一个动态分布,该分布根据当前策略快照 \(\pi_{\mathrm{old} }\) 进行自适应参数化
  • 优化目标 \(J(\theta)\) 被制定为最大化在:由合成引擎 \(\mathcal{T}_{syn}\) 编排的耦合课程上的验证率
Theoretical Objective
  • 形式上,论文的目标是最大化在一个任务分布上的期望成功率,该分布根据当前策略的能力 \((\pi_{\mathrm{old} })\) 自适应地演进:
    $$J(\theta) = \mathbb{E}_{(g,V_g)\sim \mathcal{T}_{\pi_{\mathrm{old} } }(\cdot |\pi_{\mathrm{old} })}\left[\mathbb{E}_{\tau \sim \pi_\theta (\cdot |g)}[\mathcal{R}_{syn}(s_T;g)]\right],$$
    • 其中 \(\mathcal{T}_{syn}(\cdot |\pi_{\mathrm{old} })\) 表示合成引擎的分布,它根据智能体的性能动态调整任务复杂性和多样性
    • 论文使用 \(\tau \sim \pi_{\theta}(\cdot |g)\) 表示在指令 \(g\) 下在环境 Dynamics \(\mathcal{P}\) 中执行策略 \(\pi_{\theta}\) 所诱导出的轨迹
    • 理解:这里的 \(s_T\) 是 轨迹 \(\tau\) 中的最后一个状态(终止状态)
Empirical Approximation
  • 由于上述期望没有闭式解,论文通过大规模蒙特卡洛估计进行经验近似
  • 可扩展的交互基础设施维护一个临时的经验池 \(\mathcal{B}\),它聚合了高吞吐量的新鲜交互轨迹流:
    $$\mathcal{B} = \{(\tau ,V_g)\mid \tau \sim \pi_{\mathrm{old} }(\cdot |g),(g,V_g)\sim \mathcal{T}_{syn}\} ,$$
    • 其中 \(\pi_{\mathrm{old} }\) 表示驱动成千上万个异步沙箱的策略快照
    • 通过使用从 \(\mathcal{B}\) 中采样的批次持续更新 \(\theta\),论文有效地闭合了可验证合成、大规模执行和策略优化之间的循环
  • 注意:上面的公式表示了经验包括了 轨迹 \(\tau\) 和验证器 \(\V_g\)

Verifiable Synthesis Engine

  • 本节介绍一个可验证合成引擎,它专注于克服固有的局限性
    • 例如 Reward Hacking ,以及缺乏精确的训练信号
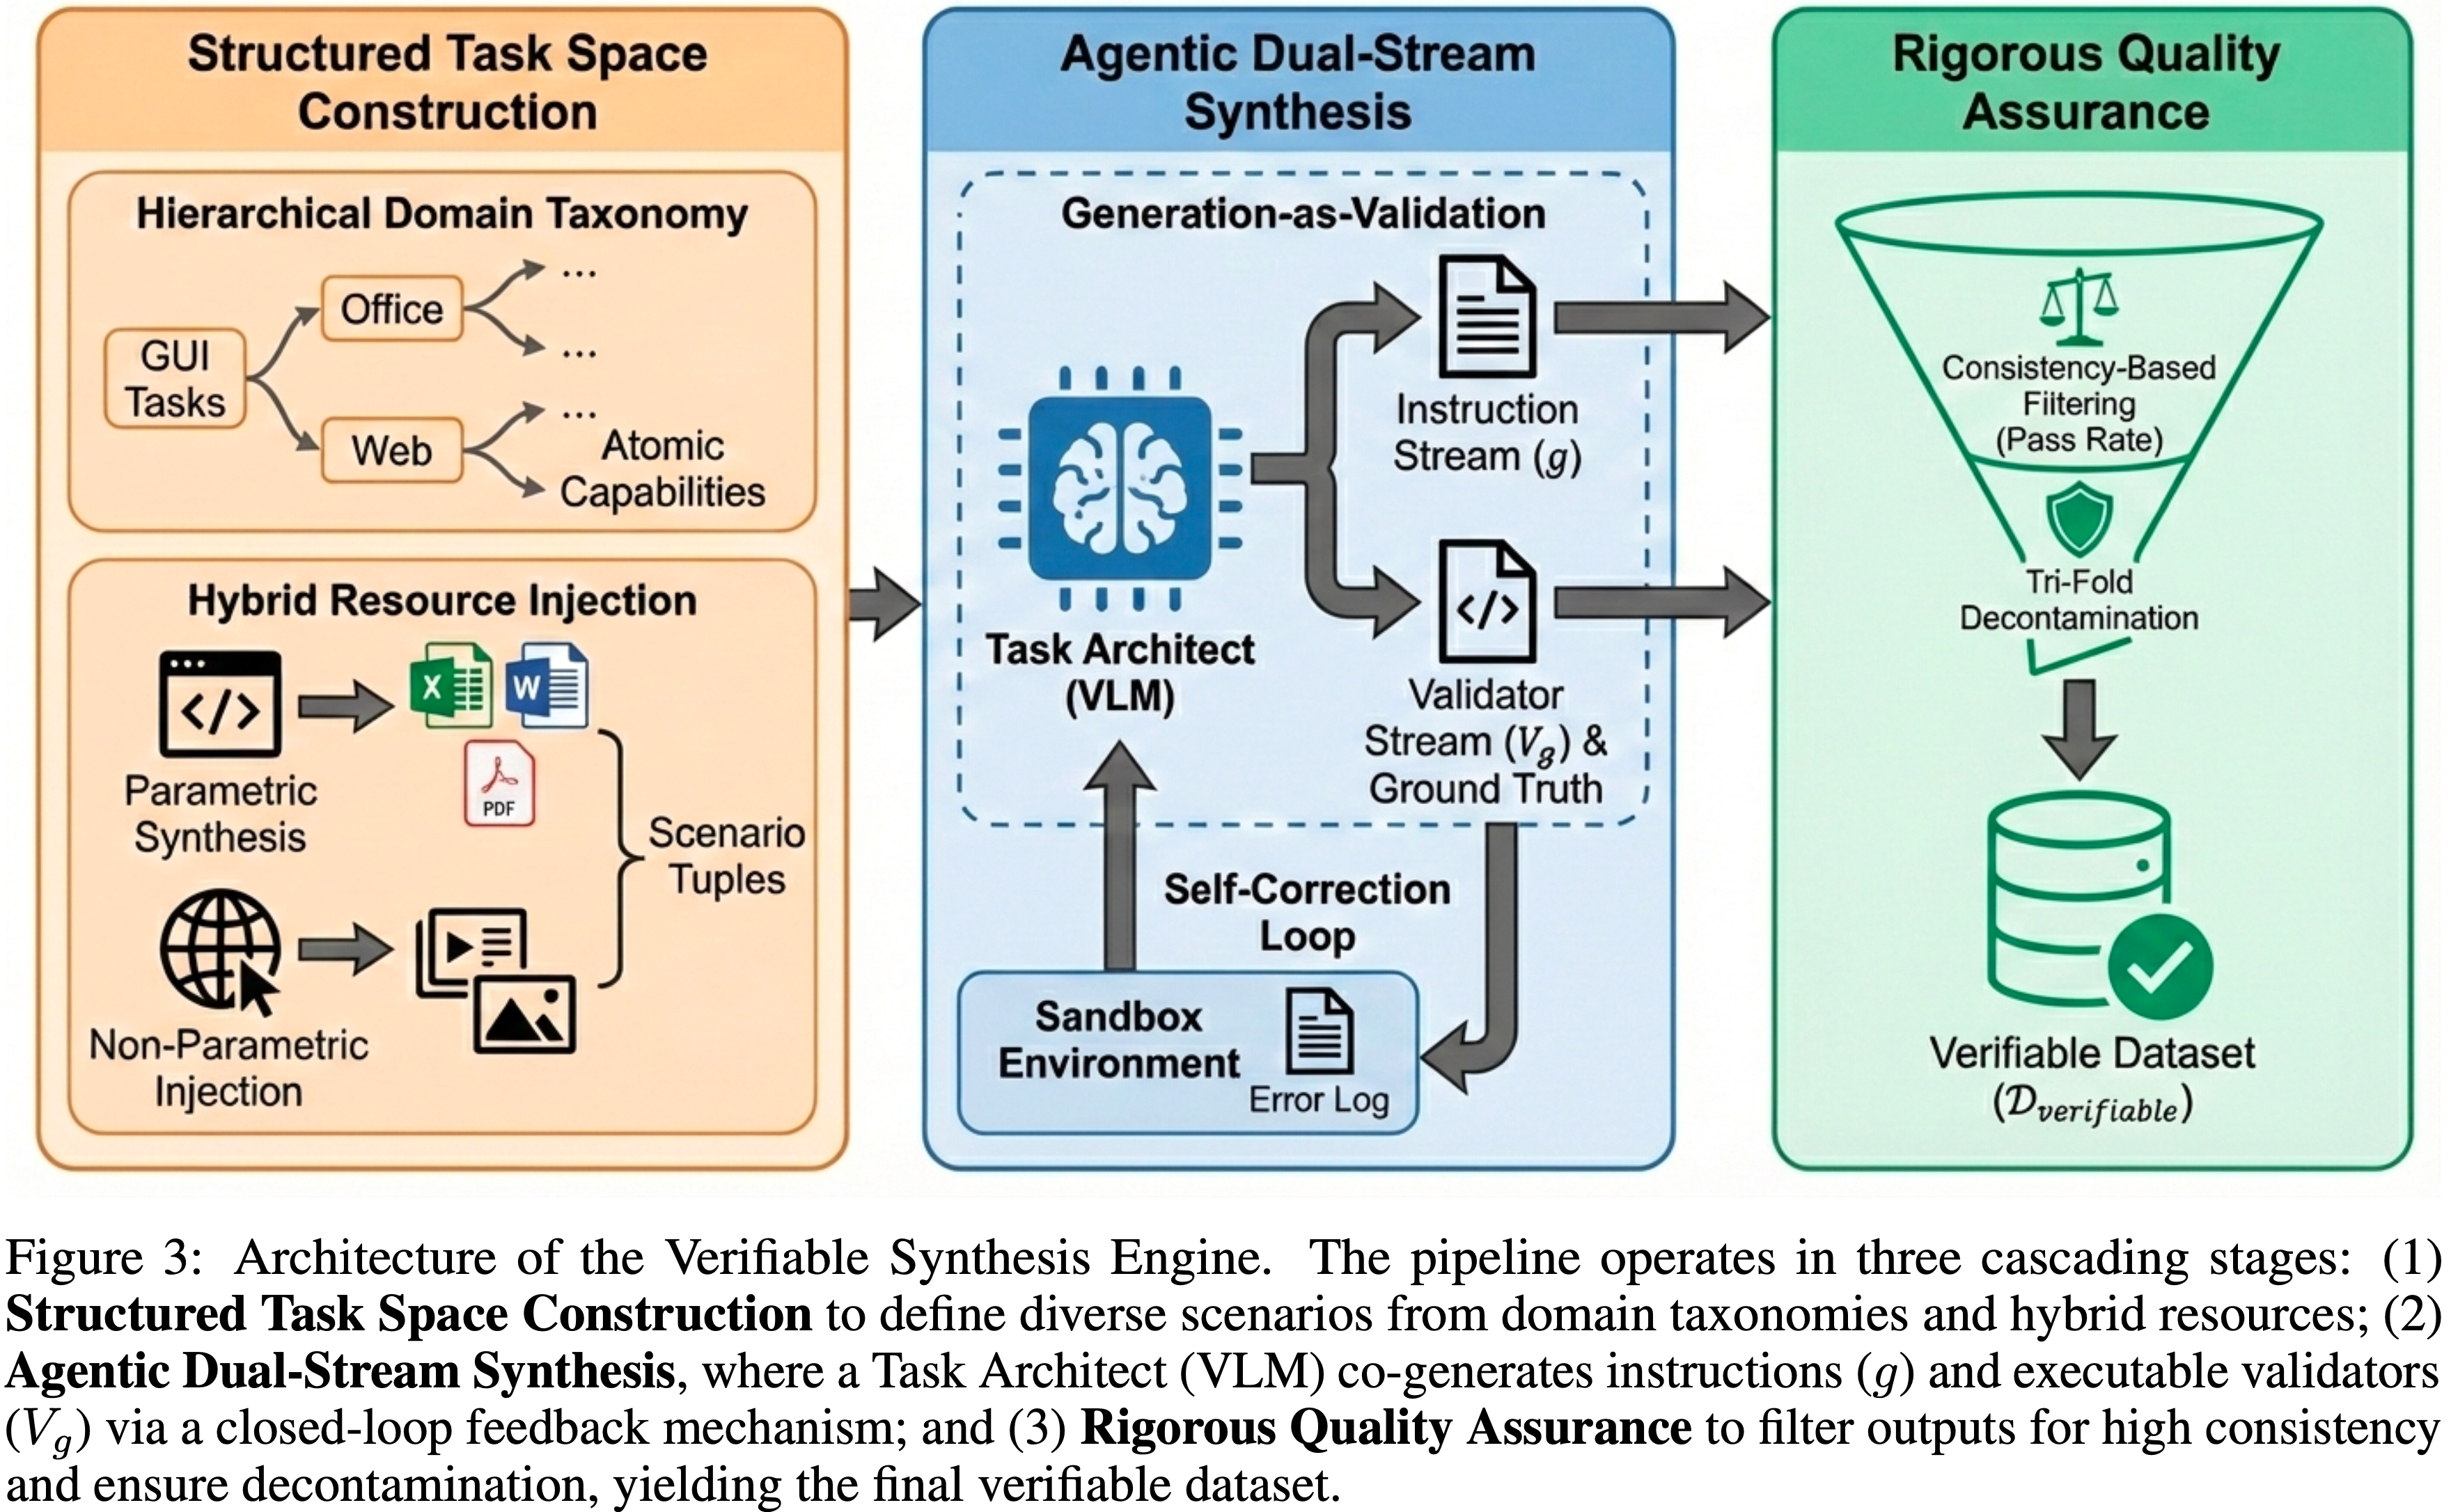
  • 与被动数据收集不同,基于该引擎,我们可以实现在“Generation-as-Validation”范式上的操作,如图 3 所示
  • 形式上,给定一个合成指令 \(g\),引擎必须共同生成一个确定性的、可执行的验证器 \(V_g\)
    • 这确保了奖励信号 \(\mathcal{R}_{syn}(s_T; g)\) 源自对最终环境状态的严格验证,从而绕过了语义匹配的模糊性
  • 该架构组织成三个级联模块:结构化任务空间构建、智能体双流合成和严格的质量保证

Structured Task Space Construction

  • 为确保合成分布 \(\mathcal{T}_{syn}\) 捕捉真实世界计算机使用的复杂性,论文首先建立一个分解为域和资源的结构化任务空间
Hierarchical Domain Taxonomy
  • 作者认为原子能力本质上是可转移的,并能组合形成复杂任务
    • 在此原则指导下,论文系统地分类核心桌面应用程序(例如,Web 浏览器、Excel、Word),并将用户行为分解为原子能力
    • 这种正交分解使智能体能够通过原始技能的重组泛化到多样化的场景
    • 例如,Excel 中的财务分析任务被分解为子技能,如公式操作、数据排序和图表生成
  • 利用分层域分类法,论文合成了涵盖多样化用户角色 (2024) 的广泛任务场景,以确保数据多样性
  • 合成的场景范围从教育工作者设计讲座幻灯片到算法工程师进行技术文献调研
Hybrid Resource Injection
  • 为了弥合模拟与现实的差距,论文对环境的初始状态实施了一种混合策略:
    • 参数化合成 (Parametric synthesis) :
      • 对于结构化数据(例如,产品销售数据),论文利用基于代码的生成器,通过参数化变量(如名称、价格和日期)来批量生成文档(Word, Excel, PDF)
      • 这确保了数值和布局的高度可变性
    • 非参数化注入 (Non-parametric injection) :
      • 为了减轻合成模板的单调性,论文注入公共互联网数据(例如,图像、音频、复杂幻灯片)
      • 这迫使智能体处理真实世界文件中固有的视觉噪声和结构多样性

Agentic Dual-Stream Synthesis(双流合成)

  • 核心合成过程被建模为一个基于 ReAct 的智能体工作流 (2022)
  • 给定一个采样的场景元组(角色,能力,资源),一个基座 VLM 作为任务架构师(Architect)执行双流生成:
    • 1)指令流 (g) (Instruction stream) :架构师基于特定的资源上下文制定一个自然语言 Query ,确保用户意图清晰且可实现
    • 2)验证器流 \((V_{g})\) (Validator stream) :同时,架构师生成真值 (GT) 以及相应的可执行评估器代码
      • 这段代码定义了任务的精确成功条件 (2025)
  • 为了确保可执行性,论文强制执行一个闭环反馈机制
    • 生成的代码立即在一个真实的沙箱环境中执行
    • 执行结果(包括成功运行的输出文件,以及失败执行(例如,语法错误、API 不匹配)产生的错误消息)被反馈给模型,用于评估 GT 文件和评估器的质量
    • 这个过程迭代多轮,直到执行成功并通过质量检查
    • 为了进一步增强稳定性,论文将频繁使用的验证逻辑抽象成一个标准化工具库
    • 最后,有效的元组被格式化为一个标准化的 JSON 结构,与 OSWorld 等现有基准测试兼容

Rigorous Quality Assurance

  • 最后阶段通过一个严格的协议过滤原始合成的配对 \(\{(g, V_g)\}\),以消除误报(幻觉的成功)、漏报和数据泄露
Consistency-based filtering
  • 论文部署一个参考计算机使用智能体,在合成任务上执行沙箱 Rollout
  • 论文对数据纳入设定了高标准
    • 首先,由于参数配置异常等问题而无法完成 Rollout 的任务,会将错误消息返回给基于 ReAct 的智能体工作流进行修改
    • 其次,对于成功 Rollout 的任务,论文使用奖励模型和评估器计算通过率
      • 在论文的分层域分类法组织下,论文对 奖励模型和评估器 这两个来源通过率存在显著差异的任务进行人工抽查
      • 对于人工检查发现评估器明显失败导致误报或漏报的情况,论文优化基于 ReAct 的智能体工作流以缓解这些问题
    • 最后,论文保留那些通过沙箱 Rollout、奖励模型和人工检查交叉验证的任务
Tri-fold decontamination:三重去污染
  • 合成数据生成有效地缓解了高质量轨迹的稀缺性,但它引入了数据泄漏的风险,因为强大的模型可能会无意中从其庞大的预训练语料库中复制基准测试内容
  • 为了防止指标虚高并确保论文实验洞察的有效性,论文执行了严格的去污染:
    • (1) 语义去污染,使用 LLM-based 过滤移除与基准测试 Query 语义等效的指令;
    • (2) 配置去污染,修剪在某些域内具有相同应用程序初始化设置的任务;
    • (3) 评估器去污染,验证生成的执行成功条件和真值文件与现有评估脚本没有重叠
  • 通过这条流水线,论文已成功将可验证训练数据扩展到 数万个实例 ,有效打破了人工数据整理的瓶颈

Scalable Interaction Infrastructure

  • 从静态数据扩展到演进式经验学习,需要对基础设施能力进行根本性转变
  • 论文的主动学习范式与被动训练流程不同,需要一个高吞吐量的“健身房(gymnasium)”,能够大规模地持续生成多样化、交互式的反馈
  • 为了应对大规模强化学习中固有的异构性、高并发性和严格会话隔离等挑战,论文开发了一个统一的环境沙箱平台
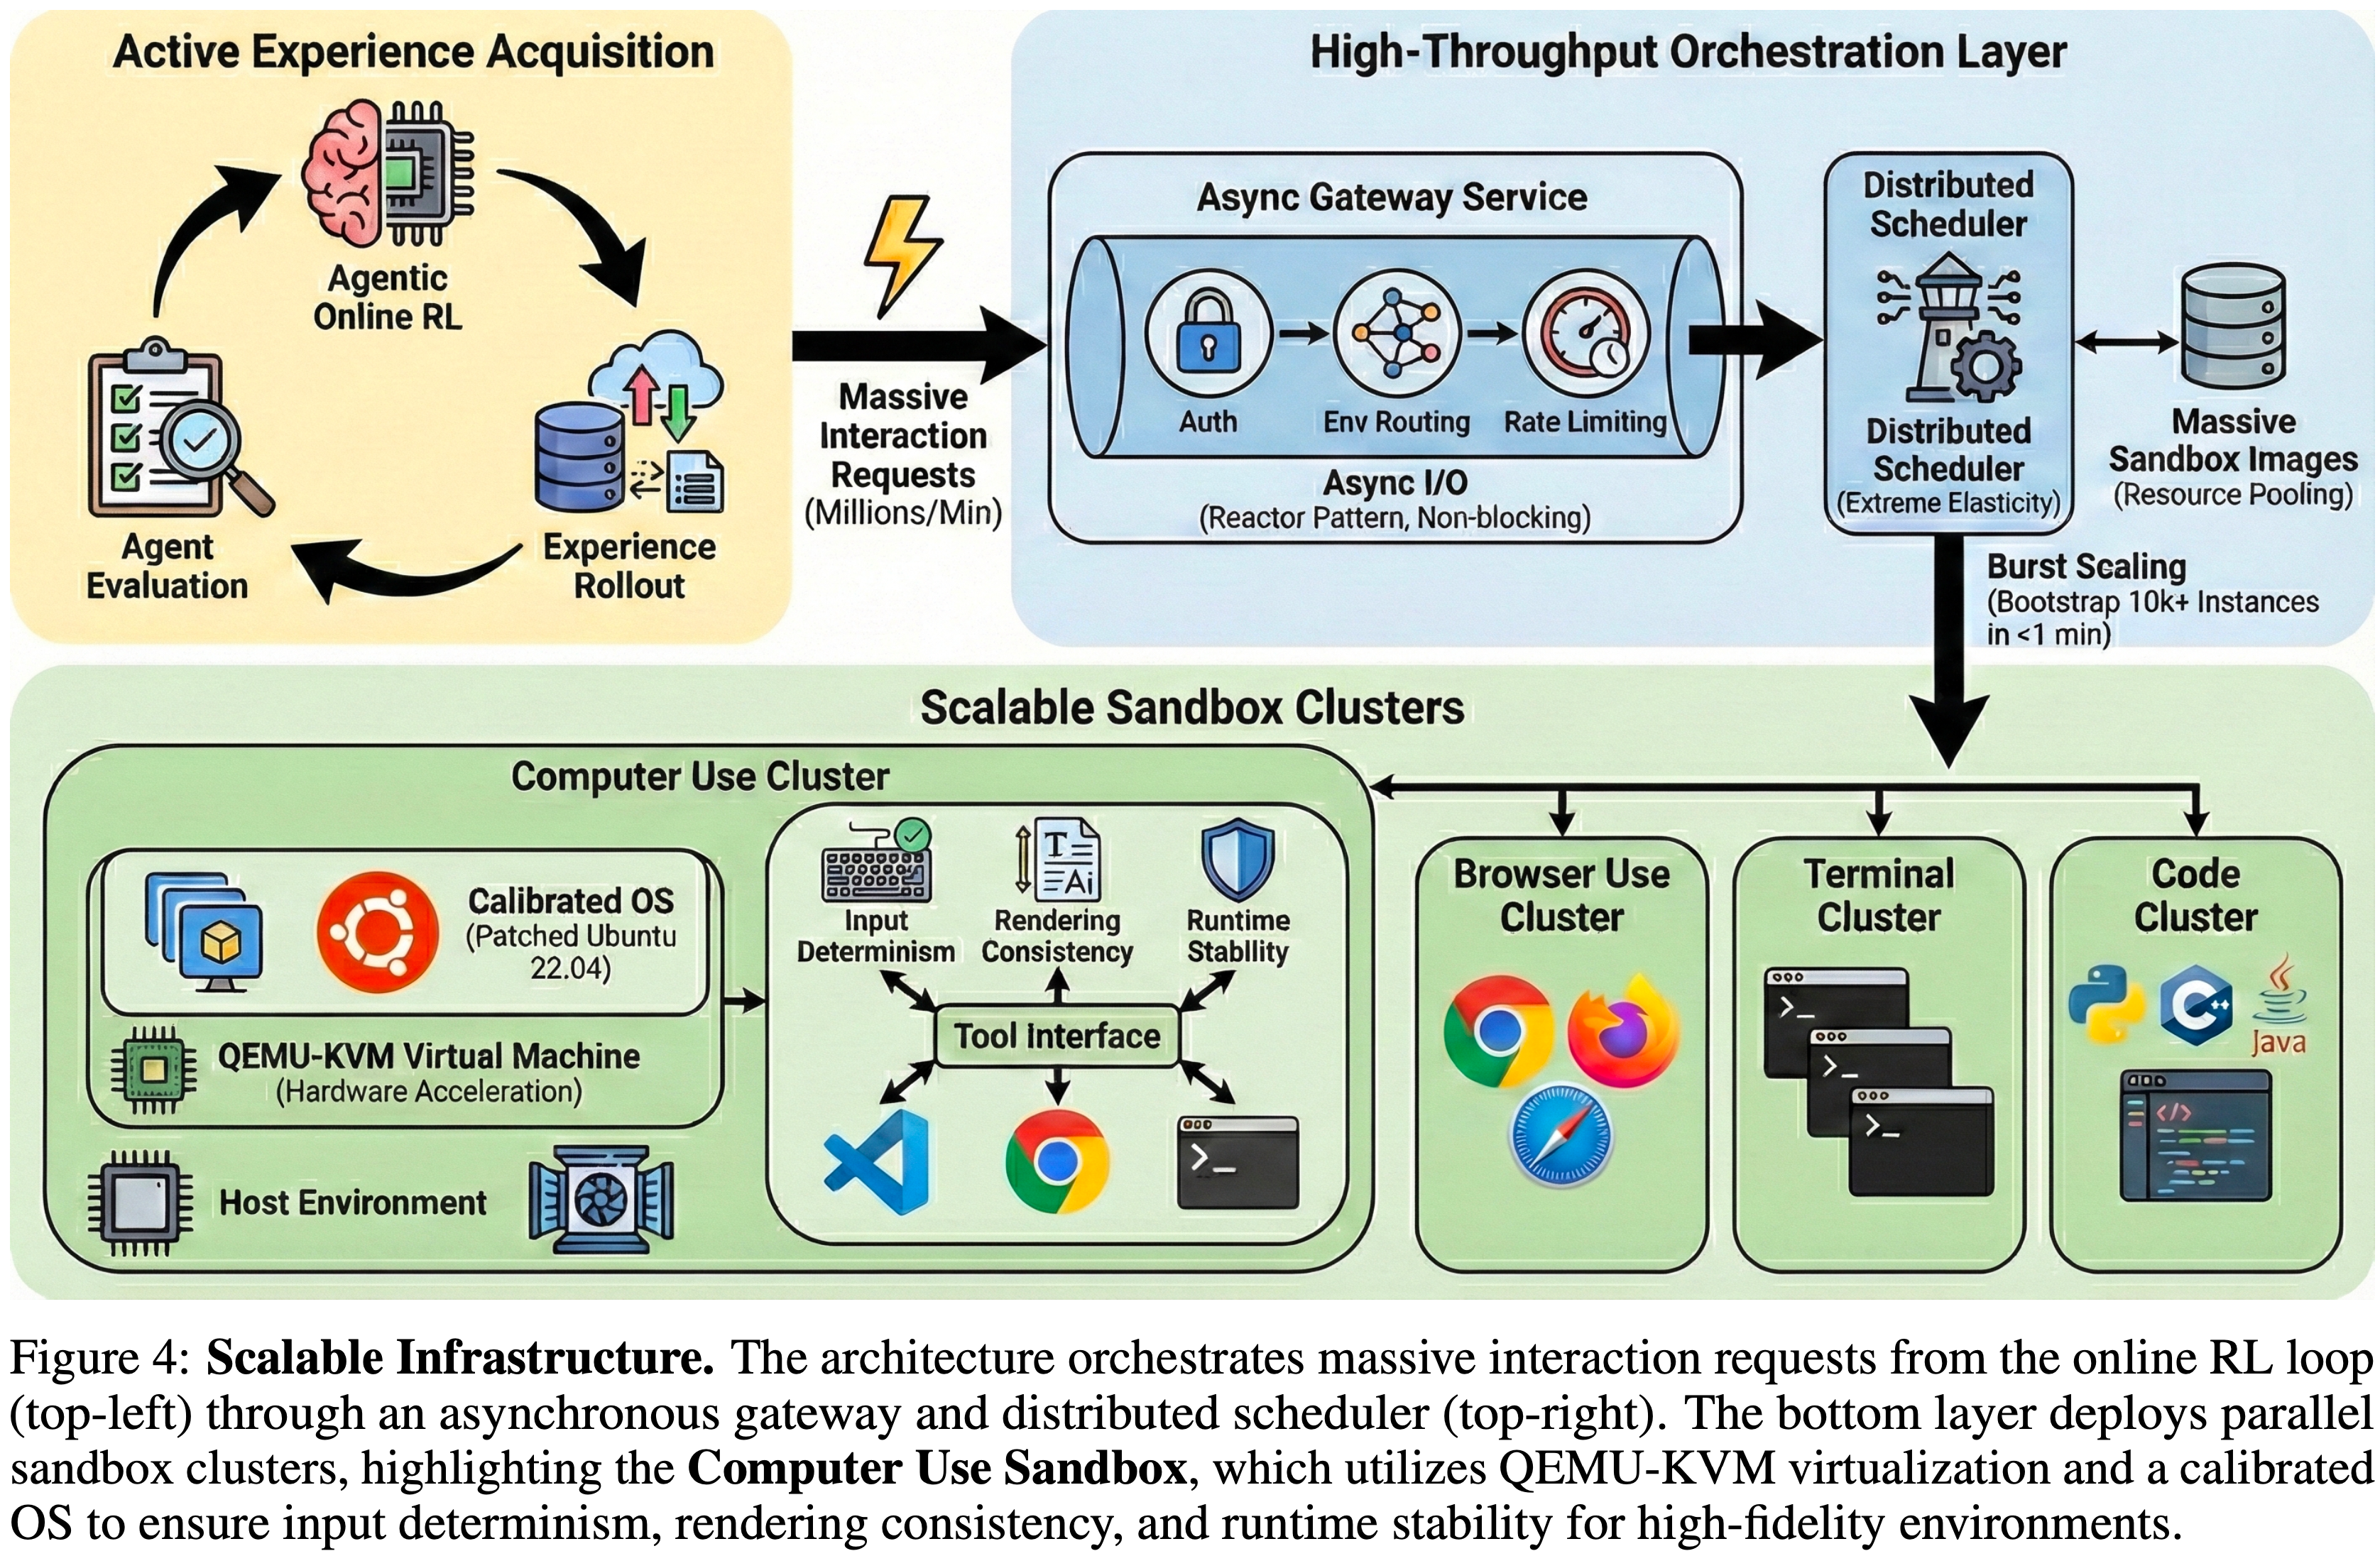
  • 如图 4 所示,该平台是 EvoCUA 的基石,每天编排数十万个沙箱会话,处理数百万个交互请求,并保持工业级的稳定性

Architecture and Abstractions

  • 为了管理多样化交互任务的复杂性,该平台围绕两个核心抽象进行架构:Tools 和 Clusters
  • Tools:
    • 一个工具封装了模拟环境的不可变定义,包括版本控制的系统镜像和暴露的交互 API
    • 该平台目前支持数百种不同的环境类型,从通用基准测试到专门的智能体环境
    • 这种设计将环境迭代与实验解耦,确保了向后兼容性和可复现性
  • 集群 (动态扩展单元) (Clusters (Dynamic Scaling Units))
    • 集群代表工具的运行时实例,是环境扩展的基本单位
    • 通过指定工具类型和配置资源配额,用户可以为不同的工作负载即时提供定制化的环境服务
    • 这种抽象允许基础设施动态扩展环境实例(从少量调试会话到数万个并发训练节点)而不会产生资源争用或交叉污染

High-Throughput Orchestration(编排)

  • 支持大规模探索的能力取决于论文的微服务架构的效率,该架构专门设计用于消除 I/O 瓶颈并实现快速的环境扩展
    • 基于反应器模式,基础设施依赖于一个异步网关服务以实现非阻塞 I/O
    • 该服务实现了每分钟数十万请求量级的路由吞吐量
  • 通过将控制平面(生命周期管理)与数据平面(环境交互)解耦,网关防止了长时间运行的环境执行阻塞关键的路由逻辑
    • 与网关相辅相成,分布式调度器专为极致的弹性而设计,负责管理海量沙箱镜像的生命周期
    • 利用分布式分片和资源池化,调度器实现了高效的节点调度
    • 更重要的是,它支持突发扩展能力,能在一分钟内启动数万个沙箱实例
  • 这种快速实例化确保了环境扩展严格匹配 On-Policy 强化学习的训练需求,最大限度地减少了策略更新与经验收集之间的延迟
  • 最终,这个弹性的 Scheduling backbone 使基础设施能够稳定地维持超过 10 万个并发沙箱

High-Fidelity Environment Instantiation(高保真环境实例化)

  • 为了支持计算机使用任务的严格要求,论文实现了一个混合虚拟化架构,将 QEMU-KVM 虚拟机封装在 Docker 容器内
Hybrid virtualization,混合虚拟化
  • 虽然 Docker 提供了与论文的编排层的兼容性,但内部执行依赖于带有 KVM 硬件加速的 QEMU
  • 论文构建了一个定制的 QEMU 启动序列,明确禁用了非必需的外围设备,同时优化了 I/O 性能
  • 这种嵌套设计确保了严格的内核级隔离(当智能体执行任意代码时,这对安全性至关重要),同时为 GUI 渲染和 I/O 操作保持了近乎原生的性能
Deterministic environment calibration(校准)
  • 论文基于 Ubuntu 22.04 构建了一个定制的操作系统镜像,以解决模拟环境与现实部署之间的差距,并实现了特定的内核和用户空间补丁:
    • 输入确定性 (HID补丁) (Input determinism (HID patching)) :
      • 标准虚拟化通常存在键位映射冲突
      • 论文在 xkb 内核级别校准了人机接口设备映射
      • 具体来说,论文修改了 /usr/share/x11/xkb/symbols/pc 的定义,以解决符号冲突(例如,US布局中的 < 与 > 的shift状态错误),确保智能体的符号意图与最终实现的字符输入严格匹配
    • 渲染一致性 (Rendering consistency) :
      • 为了防止办公软件中的布局偏移误导视觉智能体,论文将一套全面的专有字体直接注入到系统字体缓存(fc-cache)中
      • 这保证了文档的渲染效果与其原生版本完全相同
    • 运行时稳定性 (Runtime stability) :
      • 镜像通过系统级代理配置进行了加固,以解决网络不稳定的问题,并预安装了xsel和qpdf等依赖项,以消除剪贴板操作和PDF处理过程中的常见运行时错误

Evolving Paradigm via Learning from Experience

  • 为了弥合原子模仿与通用问题解决之间的鸿沟,论文提出了通过从经验中学习的演进范式
  • 该范式从静态数据扩展转向动态能力演进循环
  • 该过程被构建为三个递进阶段:有监督的冷启动以建立行为先验,拒采样微调以通过自适应扩展巩固成功经验,以及强化学习以纠正失败并通过交互探索复杂动态

Cold-Start

  • 为了使用强大的行为先验初始化策略 \(\pi_{\mathrm{init} }\) ,论文构建了一个数据集 \(\mathcal{D}_{\mathrm{prior} }\) ,其中包含展示精确执行和连贯推理的轨迹
  • 论文首先形式化地定义了统一动作和思考空间,以确立智能体的结构边界,随后利用这些定义来合成并格式化基于现实环境的交互数据
Unifying the Action Space(A)
  • 论文实现了语义动作映射 (Semantic Action Mapping),以构建一个统一动作空间
    $$ \mathcal{A} = \mathcal{A}_{\mathrm{mouse} } \cup \mathcal{A}_{\mathrm{keyboard} } \cup \mathcal{A}_{\mathrm{control} }$$
    • 如附录 A 所示
  • 论文将原始事件流分为两个主要部分:
    • 物理交互 (\(\mathcal{A}_{\mathrm{mouse} } \cup \mathcal{A}_{\mathrm{keyboard} }\)) (Physical Interaction) :
      • 这部分包括基于坐标的鼠标事件和键盘输入
      • 为了支持复杂的多步骤操作,论文实现了一个状态化交互机制 (Stateful Interaction mechanism)
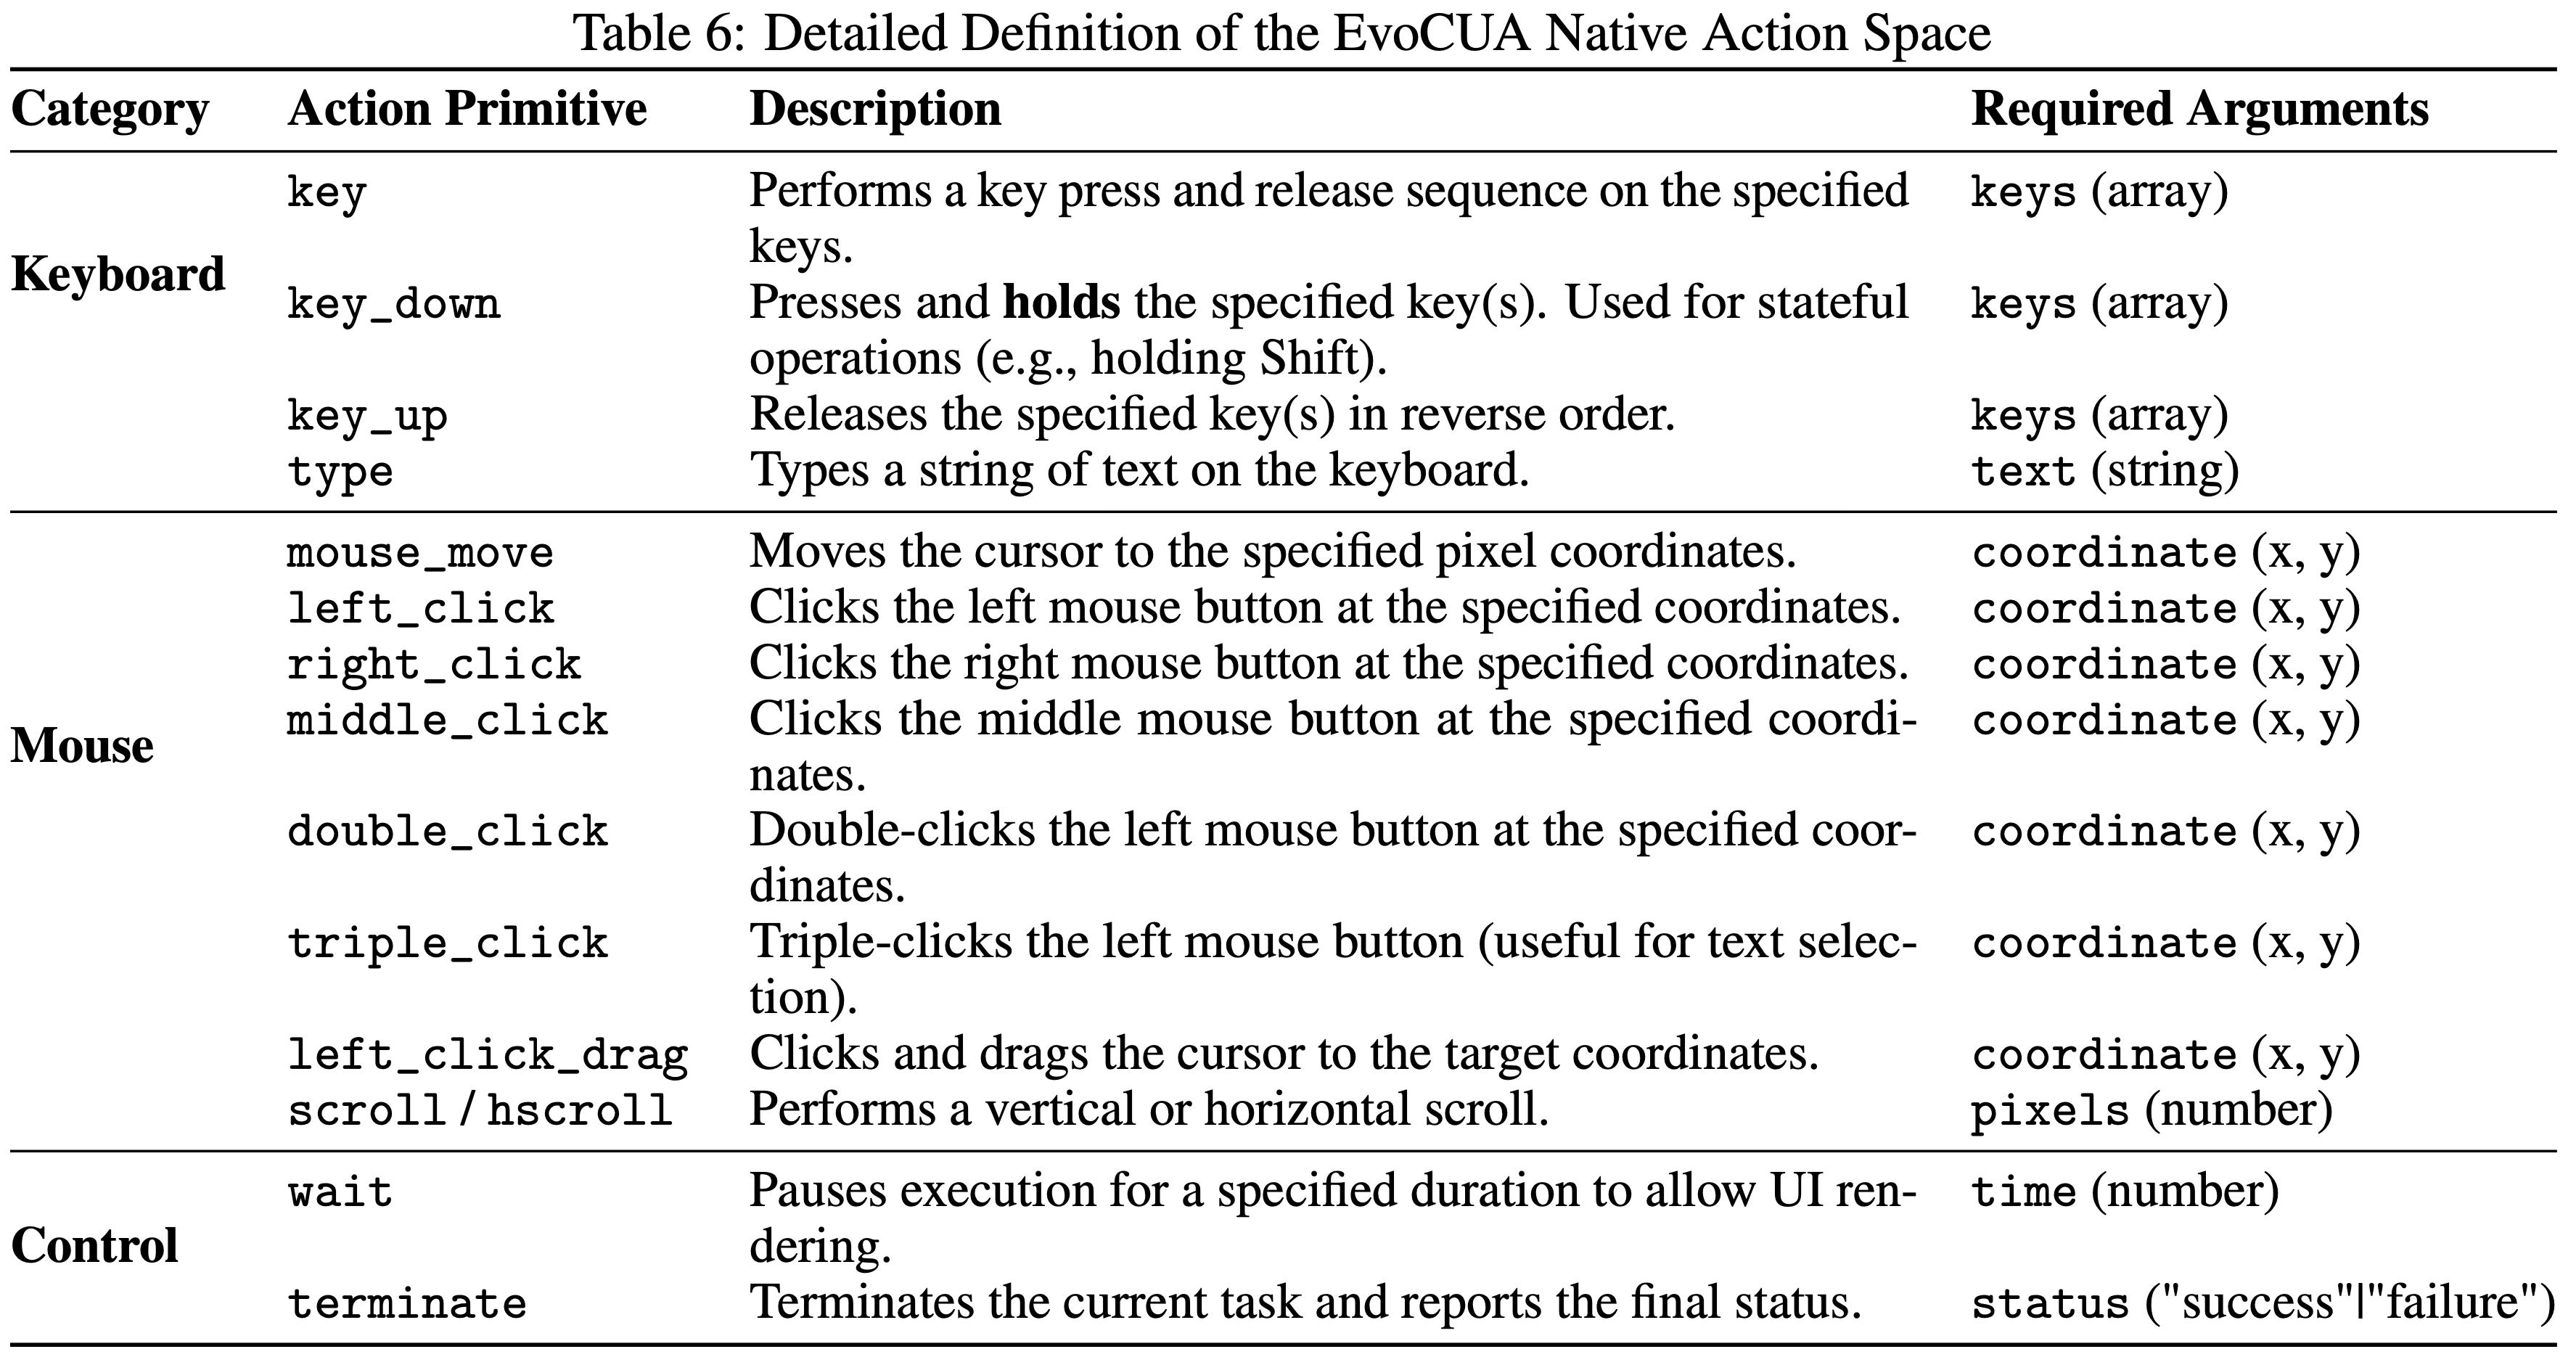
      • 通过将离散的按键操作分解为 key_down 和 key_up 事件,策略可以维护复杂任务所需的活动状态(例如,按住 Shift 键进行多选)
    • 控制原语 (\(\mathcal{A}_{\mathrm{control} }\)) (Control Primitives) :
      • 论文引入了元动作来管理与物理 I/O 不同的执行流程
      • 具体来说,wait 原语允许智能体处理异步UI渲染,而 terminate 作为正式信号来结束任务
Structuring the Thought Space(Z)
  • 为了实现可解释和稳健的决策,论文为潜在思考空间 \(Z\) 定义了一个推理模式 (Reasoning Schema)
  • 该模式强加了一种结构化格式,以确保推理过程与执行逻辑严格一致:
    • 目标澄清 (\(z_{0}\)) (Goal Clarification) :
      • 在初始步骤 (\(t = 0\)),要求智能体明确转述用户的目标
      • 这澄清了模糊的指令,并为后续规划过程奠定了基础
    • 观察一致性 (\(z_{\mathrm{obs} }\)) (Observation Consistency) :
      • 为了最小化幻觉 (hallucination),推理轨迹必须包含关键视觉元素的简洁摘要
      • 论文 强制要求此文本摘要与实际观察到的状态之间存在严格的语义一致性
    • 自我验证 (\(z_{\mathrm{check} }\)) (Self-Verification) :
      • 在发出最终终止信号之前,提示智能体执行辅助交互步骤(例如,检查文件状态),以视觉方式确认执行结果与用户指令相符
    • 反思与纠正 (\(z_{\mathrm{reflect} }\)) (Reflection and Correction) :
      • 论文利用失败的 Rollout 进行错误纠正。在识别出失败轨迹中的关键错误步骤后,论文将环境恢复到错误发生前的状态
      • 为了考虑沙箱的非确定性,论文严格筛选恢复的环境与原始轨迹之间的状态一致性
      • 从这个有效的恢复状态出发,论文使用高温采样来诱导自我纠正,生成成功的补救路径
    • 推理增强终止 (\(z_{T}\)) (Reasoning-Augmented Termination) :
      • 为了防止模型对终止标签过拟合,终止动作必须严格以前面的推理轨迹为条件
      • 该轨迹要求智能体明确综合视觉证据来证明任务完成,确保决策基于逻辑而非记忆的模式
  • 基于这些形式化的定义,论文通过在模块化框架内利用基础视觉语言模型(例如,Qwen3-VL、OpenCUA)来合成先验数据集 \(\mathcal{D}_{\mathrm{prior} }\)
    • 至关重要的是,为了确保推理与动作之间的一致性,论文采用了一种事后推理生成策略 (Hindsight Reasoning Generation strategy)
    • 将真实执行路径视为已知的未来信息,论文事后生成解释所观察动作的推理轨迹 \(z_{t}\) ,从而用连贯的认知链来增强物理轨迹
Training Details
  • 对于模型训练,论文将这些多轮轨迹分解为单轮样本
  • 为了平衡信息密度与内存限制,输入上下文仅为最近五个步骤保留完整的多模态细节(截图、推理和动作),而较早的历史信息则被压缩为纯文本的语义动作
    • 训练损失仅针对当前步骤的推理和动作进行计算
  • 最后,为了保留通用的基础能力,论文融入了多样化的通用数据混合,涵盖 STEM、OCR、视觉基础理解和基于文本的推理
    • 这些通用数据的数量与分解后的单轮轨迹样本规模保持平衡
Qualitative Analysis
  • 论文合成了符合此模式的轨迹数据
  • 经过冷启动训练后,定性分析证实智能体有效地掌握了原子能力,如附录 D 所示
    • 但在复杂场景中仍存在关键的稳健性差距
  • 虽然智能体可以执行标准的长流程工作流,但在边界案例中表现出脆弱性
  • 为了应对这些限制,论文进入下一阶段:内化可扩展、高质量的经验

Rejection Sampling Fine-Tuning(RFT)

  • 拒采样微调 (Rejection Sampling Fine-Tuning (RFT)) (2024) 的目标是通过仅从高质量、成功的执行中学习,来巩固智能体解决任务的能力
  • 这个过程包括两个关键组成部分:通过动态计算高效生成成功轨迹,以及对它们进行去噪以最大化信噪比
Dynamic Compute Budgeting
  • 为了在计算限制下优化高质量经验的生成,论文提出了动态计算预算
    • 该机制不是均匀分配 Rollout 资源,而是根据智能体当前对每个特定任务的熟练程度来调整探索预算
  • 论文建立一个层次化的预算谱(hierarchical budget spectrum)
    $$ \mathcal{K} = \{k_{1},\ldots ,k_{n}\}$$
    • 并配以递减的成功率阈值
      $$ \Lambda = \{\tau_{1},\ldots ,\tau_{n}\}$$
      • 理解:过滤用的成功率阈值为什么是逐步递减的,是因为这里的成功率是跟前面的预算一一对齐的,推测预算是逐步减少的,故而对应的成功率也会逐渐减小
    • 对于从合成引擎 \(\mathcal{T}_{\mathrm{syn} }\) 抽取的给定任务 Query \(g\) ,系统识别满足充分条件的最优 Rollout 预算 \(K^{*}\) :
      $$K^{*} = k_{i^{*} }\quad \mathrm{where}\quad i^{*} = \min \{i\mid \mathrm{SR}(k_{i})\geq \tau_{i}\} \tag{1}$$
      • \(\mathrm{SR}(k_{i})\) 表示使用预算 \(k_{i}\) 观察到的通过率
    • 该策略有效地剪除了高效解决的任务,并将计算能力集中在边界 Query 上,即策略表现出高方差的任务
Step-Level Denoising
  • 虽然成功的 Rollout 展示了模型的能力,但它们通常包含显著的噪音
  • 论文使用一个评估模型 (judge model) 来分析轨迹并屏蔽冗余步骤
  • 这种过滤对于不可行的任务尤其重要;
    • 对于这些任务,论文移除所有中间动作,并严格保留推理轨迹和最终的终止失败动作
    • 这个过程将原始数据精炼为高质量监督信号,然后将其汇总到经验池 \(B\) 中
  • 通过这个生成和过滤流程,论文将高保真经验池 \(B\) 扩展到数万条轨迹
  • 论文将这些特定领域的经验与平衡的通用多模态数据语料库交错混合,以防止灾难性遗忘

Reinforcement Learning

  • 虽然 RFT 巩固了智能体能做什么 ,但它 并不显式地纠正其错误
  • 为了扩展能力边界,论文采用 RL 从失败中学习,并通过在线交互进行探索
  • 由于状态不对齐,标准的轨迹级偏好优化不适合长流程任务
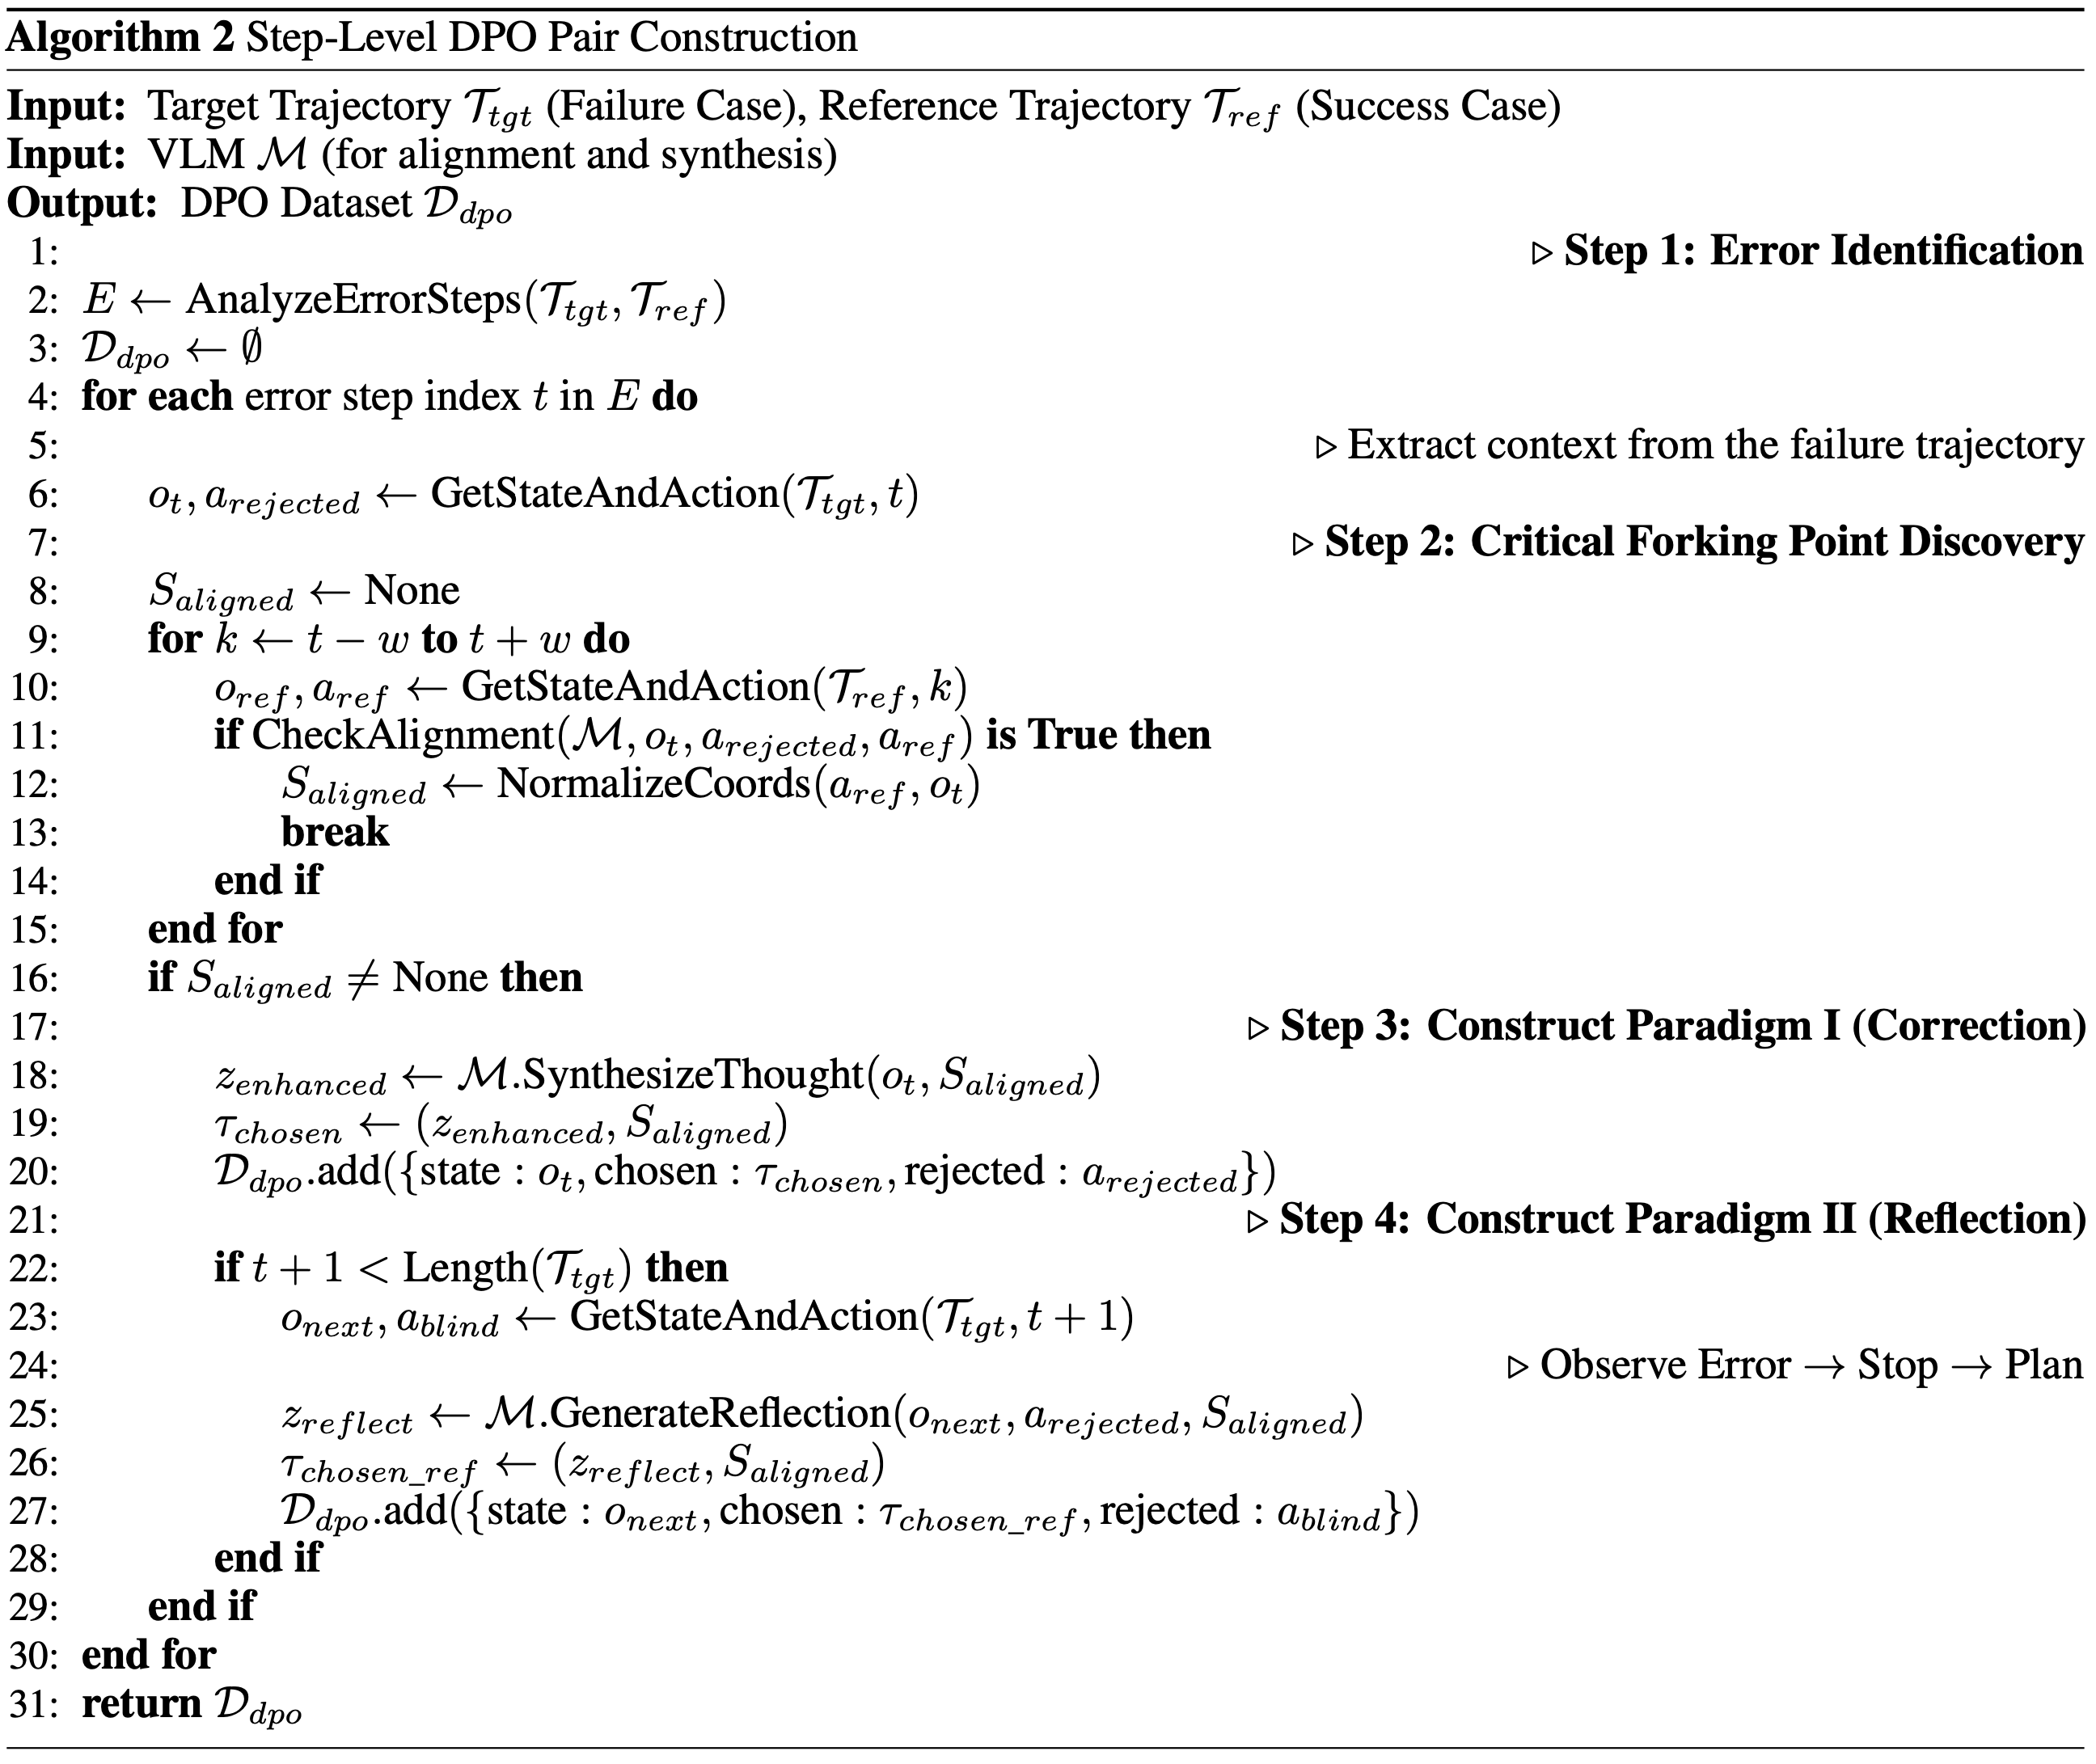
  • 论文转而提出了一种步骤级直接偏好优化策略 (Step-Level Direct Preference Optimization strategy) (2024),该策略针对图5所示的关键分叉点 (Critical Forking Points)
Causal Deviation Discovery,因果偏差发现
  • 给定一个失败的 Rollout \(\tau^{- }\) 和一个成功的参考轨迹 \(\tau^{+}\) (从相同或语义等价的任务中检索),论文采用参考引导诊断机制 (Reference-Guided Diagnosis mechanism)
  • 论文将 关键偏差步骤 \(t^{*}\) 识别为第一个时间戳 ,在该时间戳处,尽管环境状态在功能上保持等效,但智能体的动作偏离了参考
  • 这隔离了导致智能体离开最优解流形的特定响应 \((z_{t^{*} }^{- },a_{t^{*} }^{- })\)
  • 注意:这里只是识别到了关键错误步骤
Structured Preference Construction
  • 识别出关键错误 \((z_{l},a_{l}) = (z_{l}^{*},a_{l}^{*})\) 后,论文构建偏好对以提供全面的监督
  • 范式1:动作纠正 (在步骤 \(t^*\)) (Paradigm I: Action Correction (At Step \(t^*\)))
    • 目标是用最优的 Chosen 响应 \((z_{w},a_{w})\) 替换 Rejected 的错误 \((z_{l},a_{l})\)
    • 论文通过基于窗口的参考对齐(通过 VLM 语义匹配从 \(\tau^+\) 迁移思考和动作)或基于视觉的合成(当不存在对齐时,通过通用模型合成新的轨迹)来获得 \((z_{w},a_{w})\)
  • 范式2:反思与恢复 (在步骤 \(t^* +1\)) (Paradigm II: Reflection and Recovery (At Step \(t^* +1\)))
    • 为了提高稳健性,论文处理错误发生后的立即状态 \((t^* +1)\)
    • 论文将智能体的盲目继续视为 Rejected 样本
    • 对于 Chosen 样本 ,论文合成一个反思轨迹 (Reflection Trace)
    • 智能体被训练为停止并生成一个推理链,而不是盲目行动
      • 该推理链:(1) 观察意外的屏幕状态 并 (2) 制定补救计划
  • 理解:
    • 范式1:
      • Rejected:旧的错误步骤
      • Chosen:新合成的正确步骤,针对步骤 \(t^*\) 动作纠正,用最优的 Chosen 响应 \((z_{w},a_{w})\) 替换 Rejected 的错误 \((z_{l},a_{l})\)
    • 范式2:
      • Rejected:之前盲目继续的样本
      • Chosen:反思样本,针对步骤 \(t^* + 1\),对错误步骤进行改进(其他更优模型或高温),而不是盲目继续(之前的轨迹会盲目继续)
        • 这里相当于让模型开始反思,从错误中反思重新开始的方式,最终模型能学会思考
Optimization Objective
  • 论文使用直接偏好优化 (Direct Preference Optimization (DPO)) 来优化策略 \(\pi_{\theta}\)
  • 与论文策略根据历史 \(h_{t}\) 和观察 \(o_{t}\) 生成推理轨迹 \(z\) 和动作 \(a\) 的公式一致,损失函数定义为:
    $$\mathcal{I}(\theta) = -\mathbb{E}_{(h_t,a_t,(z,a)_w,(z,a)_l)\sim \mathcal{D} }\left[\log \sigma \left(\beta \log \frac{\pi_{\theta}(z_w,a_w|h_t,a_t)}{\pi_{\mathrm{ref} }(z_w,a_w|h_t,a_t)} -\beta \log \frac{\pi_{\theta}(z_l,a_l|h_t,a_t)}{\pi_{\mathrm{ref} }(z_l,a_l|h_t,a_t)}\right)\right]. \tag{2}$$
  • 通过使用这些结构化偏好迭代更新策略,EvoCUA 不断扩展其能力边界,有效地将短暂的交互经验转化为稳健的模型参数
  • 总之,演进式经验学习范式为增强智能体可靠性建立了一个严格的循环
  • 通过协同结合拒采样微调来巩固基本执行模式,以及强化学习来纠正复杂、长尾场景中的错误,EvoCUA 迭代地将可扩展的合成经验转化为策略参数
  • 这种双重机制确保智能体不仅在标准任务上稳定性能,而且在边界条件下显著提高了稳健性和泛化能力,从而实现更稳定和通用的计算机使用能力

Evaluation

  • 本节对 EvoCUA 进行全面实证评估
  • 论文的分析聚焦于三个关键维度:
    • (1) 在线智能体能力 (Online Agentic Capability),评估在真实环境中的长程交互;
    • (2) 离线定位 (Offline Grounding),评估细粒度的 UI 元素理解;
    • (3) 通用 VLM 能力 (General VLM Capabilities),确保保留通用的多模态推理能力

Experimental Setup

  • 为了超越静态模仿,论文采用统一的训练流程,该流程始于一个轻量级的冷启动 (cold start) 阶段,使用约 1k 条高质量轨迹来建立完整的动作空间和结构化的推理模式
  • 随后,模型进入一个结合经验生成与策略优化的持续迭代优化循环
    • 在这个演化阶段,论文通过从大规模拒绝采样中收集成功轨迹、应用步级降噪,同时通过从错误中提取的偏好学习和在真实环境中的在线探索来混合优化策略,逐步扩展训练分布
    • 整个过程由一个 pass@k 引导的动态计算策略驱动,该策略自动将计算资源集中在更难的问题上,并为表现不佳的领域合成补充数据,确保跨迭代的持续能力增长
  • 论文通过在 Qwen3-VL-Thinking (2025a) (8B, 32B) 和 OpenCUA (2025b) (7B, 32B, 72B) 基础模型上进行后训练,在不同规模上验证了论文的方法

Main Results

Online Agent Evaluation
  • 论文在 OSWorld 基准测试上评估 EvoCUA,该基准是开放式计算机使用任务的代表性测试平台
  • 如表 1 总结所示,论文的结果突显了所提出方法的有效性:
  • ** SOTA 开放权重性能 (State-of-the-Art Open-Weights Performance)**
    • 论文的主要模型 EvoCUA-32B,基于 Qwen3-VL-32B-Thinking (2025a) 主干微调,达到了 \(56.7%\) 的成功率
    • 这一性能在所有评估的开放权重模型中位列第一
  • 显著改进与效率 (Significant Improvements & Efficiency)
    • EvoCUA-32B 相比之前的开源最先进模型 OpenCUA-72B (45.0%) 取得了 \(+11.7%\) 的绝对提升,相比其基础模型提升了 \(+15.1%\)
    • 值得注意的是,这些结果是在严格的 50 步限制下实现的,而基线模型通常需要 100 步预算才能达到峰值性能,这表明论文模型具有更优的执行精度
  • 与闭源权重前沿模型竞争 (Competitive with Closed-Weights Frontiers)
    • EvoCUA-32B 有效地缩小了与闭源权重模型的差距
    • 最显著的是,它以 \(+3.6%\) 的优势超过了强大的闭源权重基线 UI-TARS-2-2509 (53.1%)
    • 在相同的步数限制下,EvoCUA-32B 与行业领先的 Claude-4.5-Sonnet (58.1%) 之间的性能差距缩小到仅 \(1.4%\)
  • 扩展效率与训练优势 (Scaling Efficiency & Training Superiority)
    • 论文方法的有效性延伸到了更小的模型规模
    • EvoCUA-8B 达到了 \(46.1%\) 的成功率,超越了像 OpenCUA-72B 这样的专用 72B 参数模型
    • 与 Step-GUI-8B (2025) 的直接对比尤其具有启发性:
      • 尽管两个模型都从相同的 Qwen3-VL-8B 主干初始化,但 EvoCUA-8B 取得了 \(+5.9%\) 的更高成功率 (46.1% 对比 40.2%)
      • 这严格隔离了论文演化经验学习范式的贡献,确认了论文的数据合成和 RL 策略从相同的基础架构中释放了显著更大的潜力
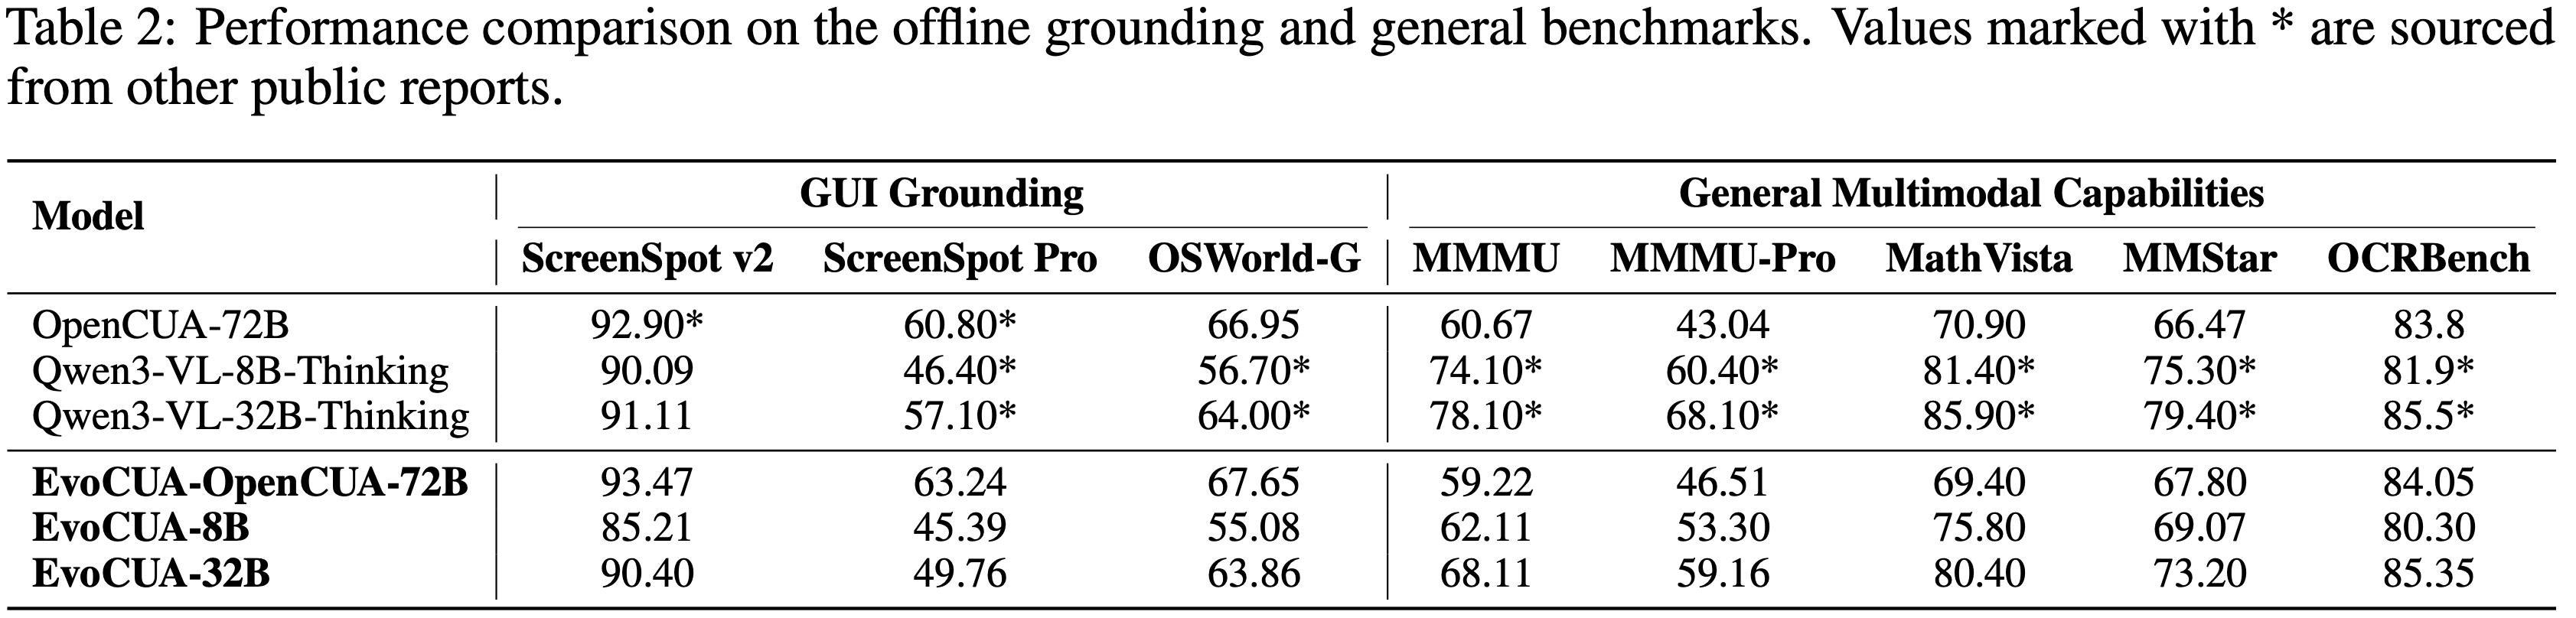
Offline Grounding(定位)and General Capabilities
  • 论文评估 EvoCUA 在两个关键维度的性能:
    • 细粒度 GUI 定位 (ScreenSpot-v2 (2024), ScreenSpot-Pro (2025), OSWorld-G (2025))
    • 通用多模态鲁棒性 (MMMU (2024), MMMU-Pro (2025), MathVista (2024), MMStar (2024), OCRBench (2024))
  • 表 2 总结了不同模型规模和主干的结果
Analysis
  • 论文观察到根据使用的基础模型的不同而有不同的行为
  • 对于 OpenCUA-72B 主干,论文的后训练策略在定位和通用基准测试中都保持了性能持平或略有提升(例如,保持 MMMU 分数同时提升 OSWorld-G)
    • 这种稳定性证实,当数据分布一致时,论文的训练方法能有效保留基础模型的知识
  • 与 Qwen3-VL-32B-Thinking 基线相比,EvoCUA-32B 变体在特定指标上表现出性能下降,尤其是在 ScreenSpot-Pro 和 MMMU 上
    • 论文将这种性能下降主要归因于数据分布和模式的差异
    • 由于时间限制,用于微调 EvoCUA 的通用数据集直接采用了来自 OpenCUA-72B 变体实验的数据集
    • 然而,这个数据集是“非思考型”的,与 Qwen3-VL-32B-Thinking 模型的“思考型”分布存在显著不匹配
  • 论文进一步分析了 Qwen3-VL-32B-Thinking 和 EvoCUA 在通用基准测试上的输出长度
    • 结果显示,与 Qwen3-VL-32B-Thinking 相比,EvoCUA 的 Token 数量显著减少 (2,514 vs 3,620),同时输出风格也发生了转变
Conclusion
  • 在 OpenCUA 主干上的一致性能验证了论文训练策略的有效性
  • 在基于 Qwen3-VL-Thinking 的变体中观察到的性能下降主要归因于通用数据分布和模式的转变
  • 未来版本的 EvoCUA 模型将纳入升级的基于“思考”的通用数据集
  • 这种对齐有望解决当前的差异,并进一步提高模型的泛化性能

Ablation Study

  • 为了严格验证 EvoCUA 中每个组件的贡献,论文进行了广泛的消融研究
  • 论文使用了两个不同的基础模型,Qwen3-VL-32B-Thinking 和 OpenCUA-72B,以证明论文特定模块的效力以及演化经验学习范式的普适性
Component Analysis on EvoCUA-32B
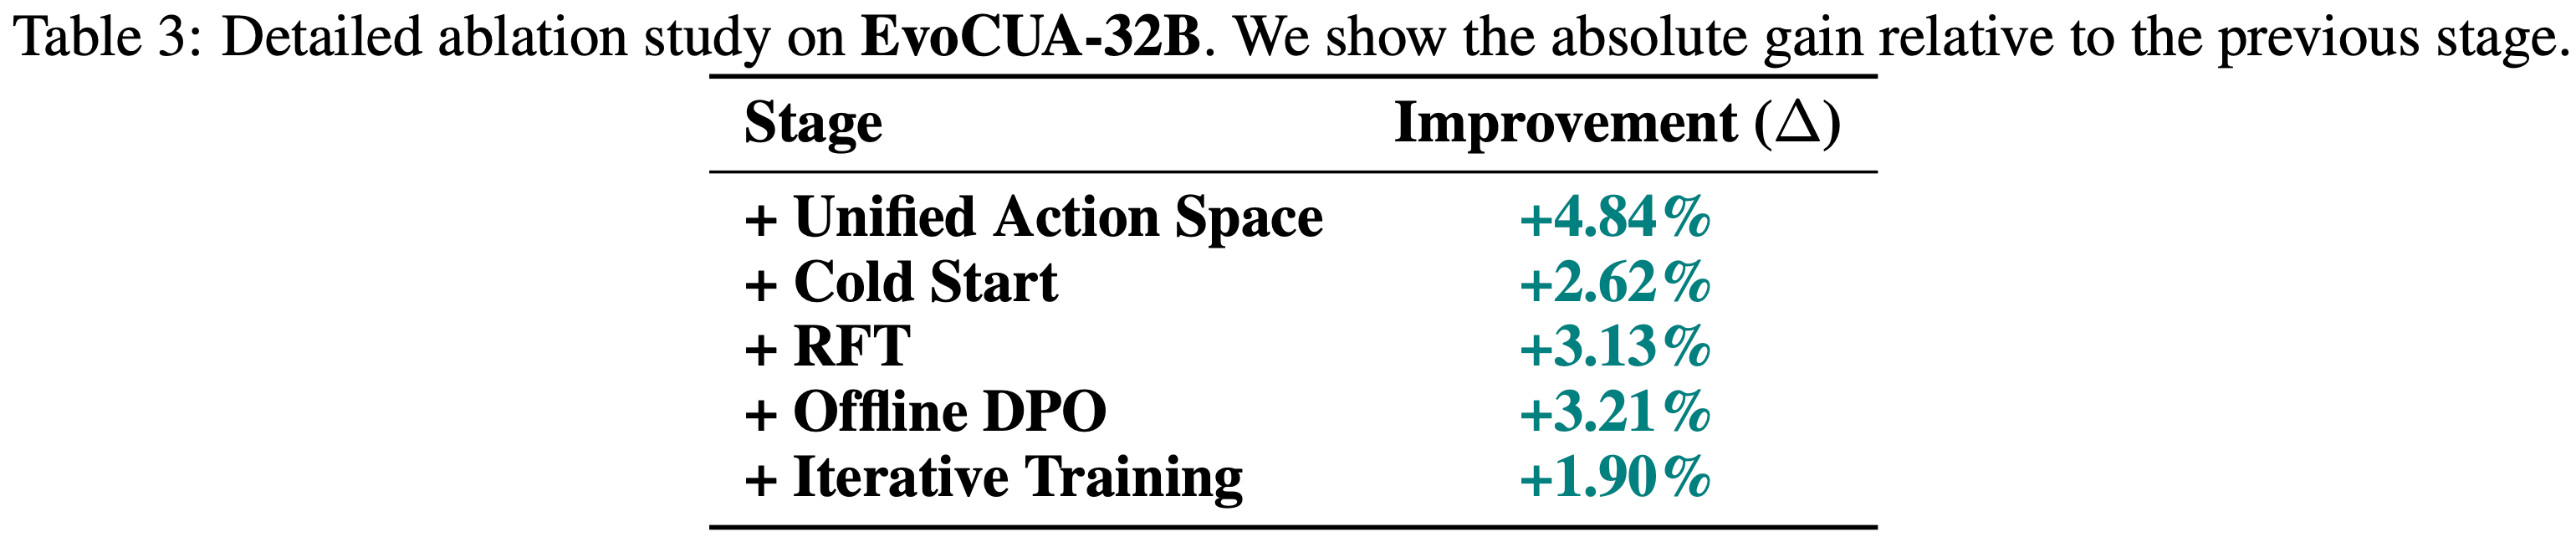
  • 论文采用 Qwen3-VL-32B-Thinking 作为基础检查点,以剖析来自统一动作空间、冷启动、拒绝微调和 RL 的累积收益
  • 如表 3 所示,演化循环的每个阶段都带来了显著的单调改进
  • 统一动作空间与冷启动的影响 (Impact of Action Space & Cold Start)
    • 论文首先通过受控单变量实验量化了统一动作空间的影响,将标准的 SFT 基线与一个包含论文精确定义动作的 SFT 变体进行比较
      • 统一动作空间的明确表述提供了 +4.84% 的基础增益
    • 通过进一步在合成的高质量轨迹上进行冷启动训练来注入行为先验,论文观察到额外的 \(+2.62%\) 增益
      • 这验证了用结构化动作模式和连贯推理模式为基础模型奠定基础是进行有效大规模经验学习的前提
  • 演化学习的效力 (Efficacy of Evolutionary Learning (RFT & DPO))
    • 过渡到主动学习阶段,拒绝微调通过巩固成功经验将性能显著提升了 \(+3.13%\)
    • 随后,通过 DPO 明确解决失败模式,论文实现了 \(+3.21%\) 的显著改进,突显了学习“不应该做什么”与学习成功惯例同等重要
    • Crucially,对整个演化循环执行额外的迭代(再叠加一轮 RFT 和 DPO)带来了进一步的 \(+1.90%\) 增益
      • 这种持续收益证实了论文范式的自我维持特性,模型通过递归合成和纠正迭代地精炼其能力边界
Generalizability on OpenCUA-72B
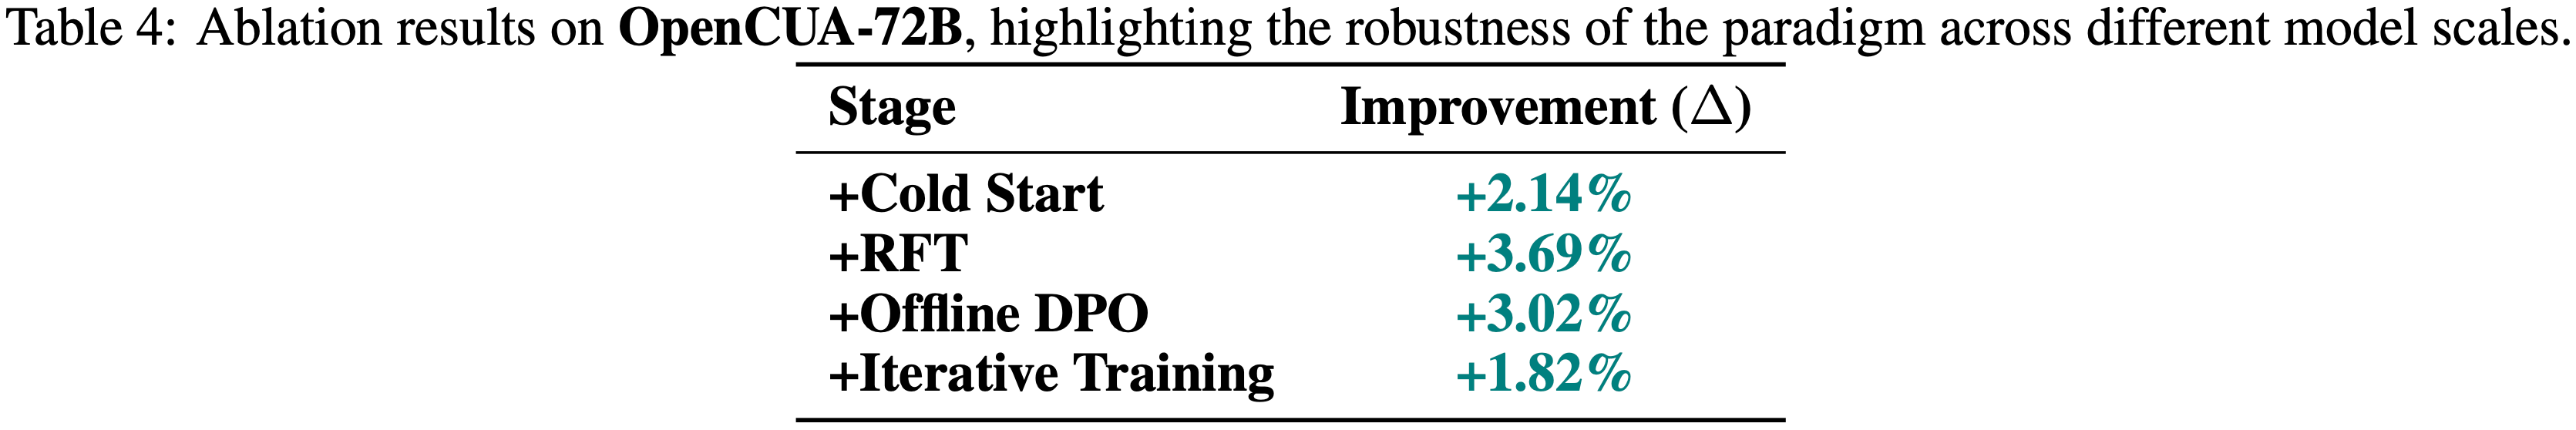
  • 为了验证论文方法的普适性,论文将相同的范式应用于更大的 OpenCUA-72B 模型
  • 如表 4 详述,演化经验学习范式在不同模型规模上带来了一致的增益
  • OpenCUA-72B 上的结果与论文在 Qwen3-VL 上的发现相呼应,DPO \((+3.02%)\) 和 RFT \((+3.69%)\) 贡献显著
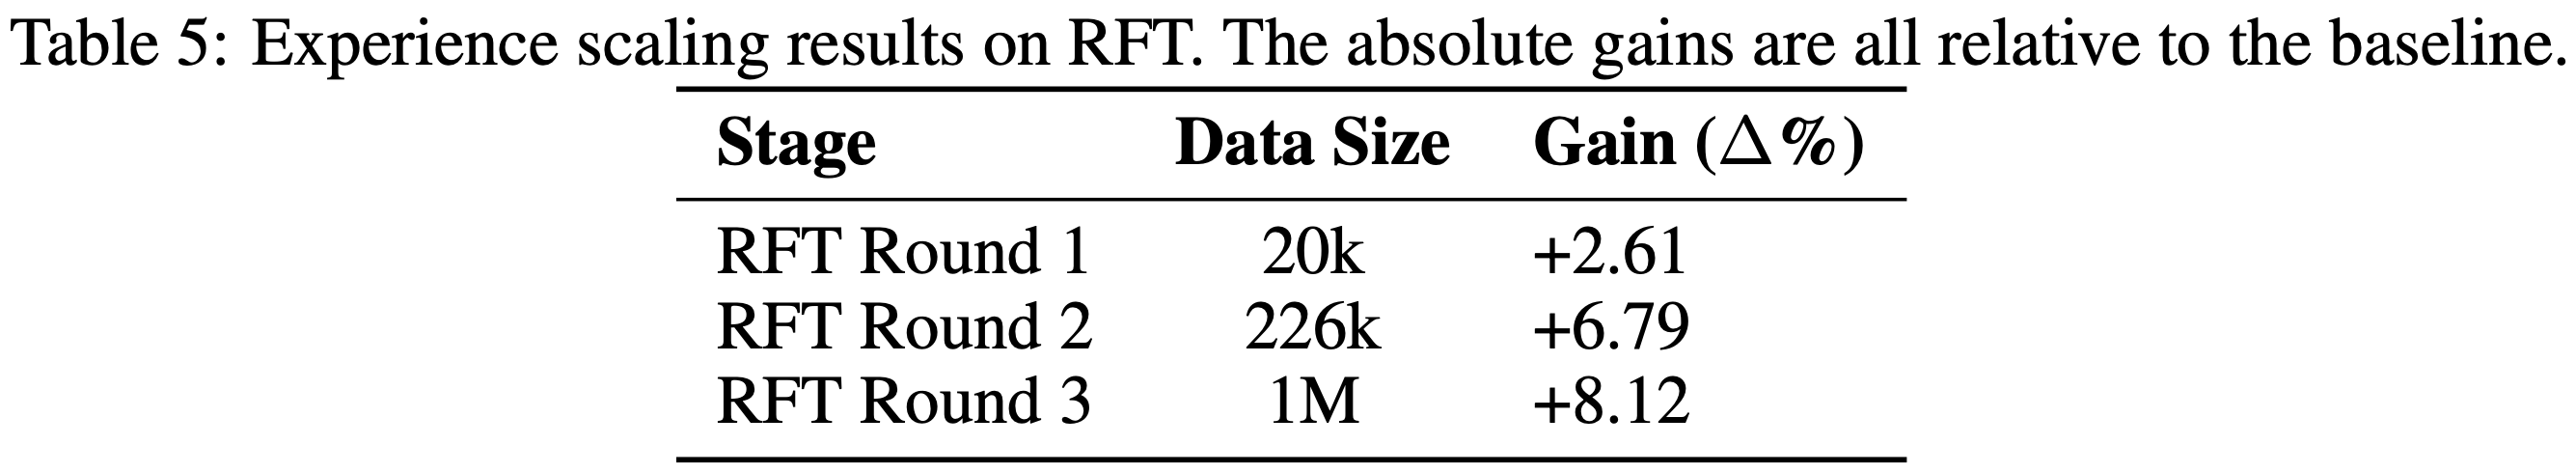
  • 有趣的是,论文观察到纯 RFT(叠加 3 轮,没有明确的冷启动)实现了 \(+8.12%\) 的显著增益,如表 5 所示
    • 这表明,对于一个足够强大的基础模型,仅凭合成引擎和可扩展的交互基础设施就可以驱动巨大的能力改进,甚至无需显式注入先验
  • 此外,OpenCUA-72B 采用了标准的 pyautogui 格式
    • 这个动作空间本身支持有状态操作(例如 shift+click)并且没有明显的功能缺陷

Scaling Analysis

  • 论文通过分析在不同 Pass@k 值、最大推理步数和数据量下的性能增益 \((\Delta %)\) 来研究 EvoCUA 的可扩展性
Scaling with Pass@k
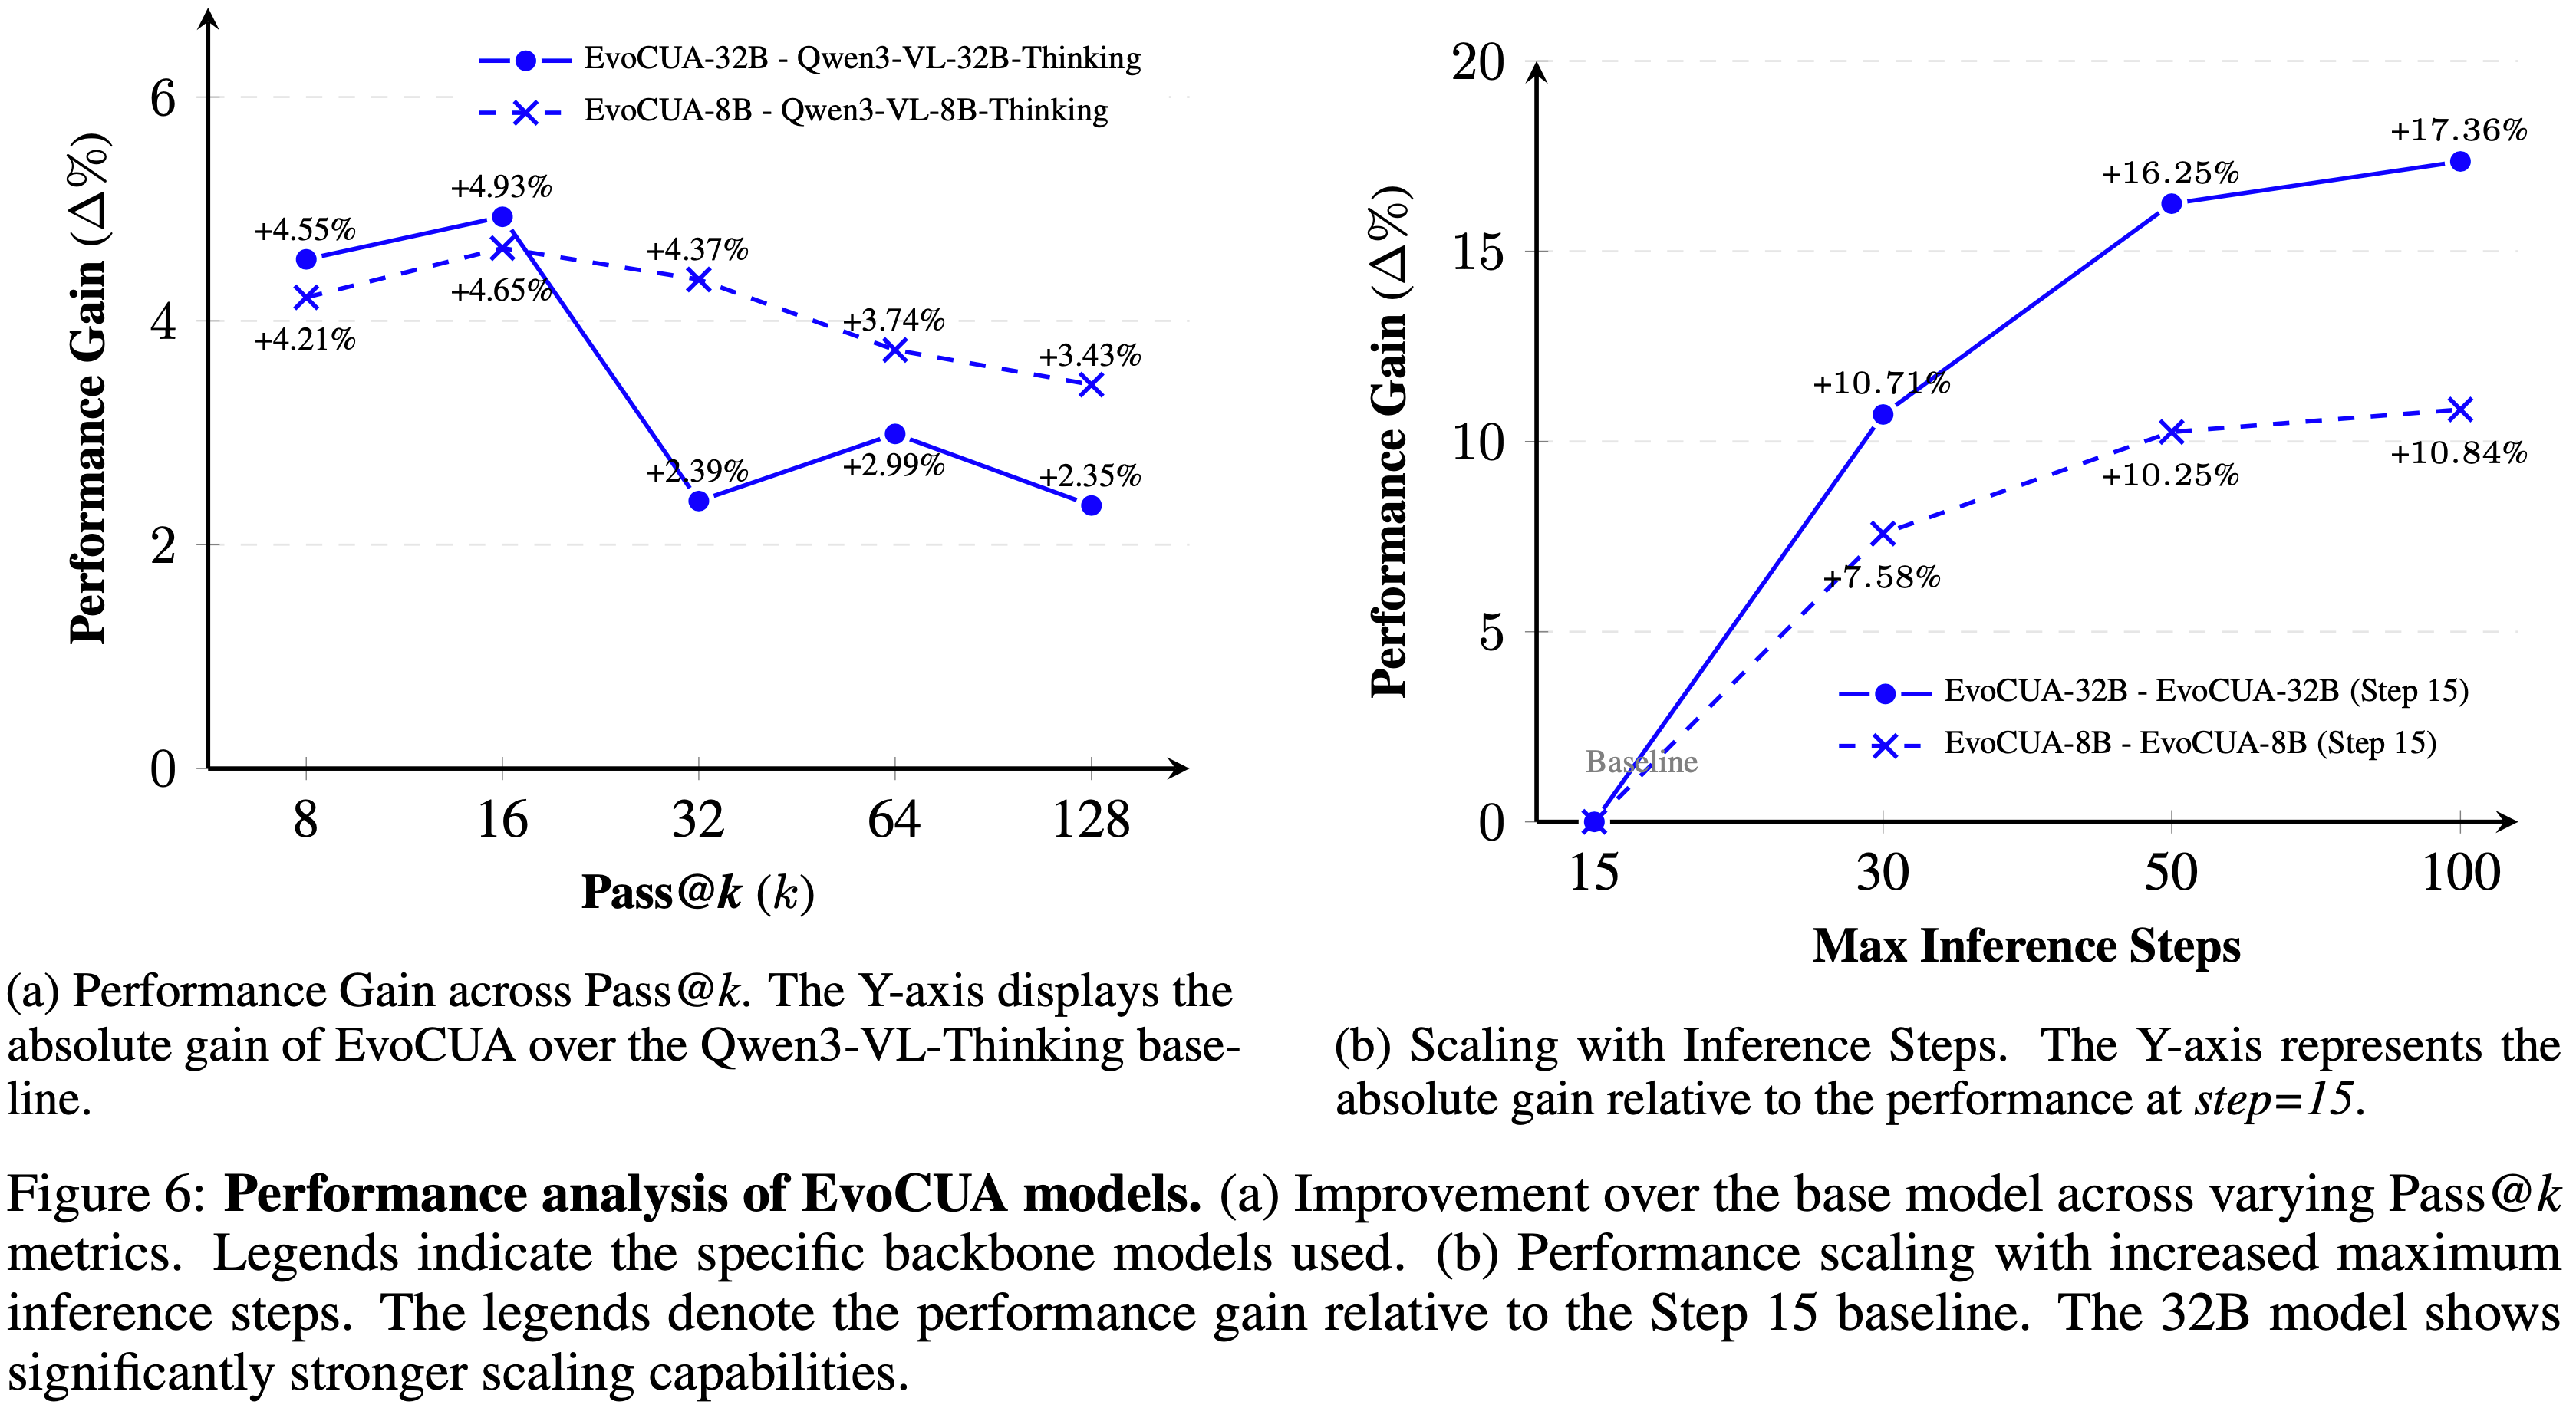
  • 在图 6a 中,在所有 Pass@k 指标上,EvoCUA 相对于基础模型 (Qwen3-VL-Thinking) 保持了稳定的性能领先
    • 如图 6a 所示,32B 模型保持了正向增益,在 \(k = 16\) 时达到峰值 \(+4.93%\),即使是在更高的 \(k\) 值时也保持显著优势
    • 这种持续的性能差距表明,论文优化动作空间和推理先验的训练策略从根本上提升了模型的性能上限
Scaling with Max Steps
  • 在图 6b 中,论文观察到随着最大步数限制的增加,性能稳步提升
    • 将推理能力从 15 步增加到 50 步带来了一致的增益,32B 模型相比基线提升了 \(+16.25%\)
    • 超过 50 步后,改进速度放缓,这主要是由于当前训练分布中超过 50 步的轨迹稀缺
Experience Scaling
  • 论文在 RFT 上进行了经验扩展实验
  • 具体来说,论文在 OpenCUA-72B 模型的一个早期迭代上进行了消融研究,省略了冷启动和 DPO 阶段,以专注于多轮 RFT
  • 如表 5 所示,相对于基线的性能增益如下:
    • Round 1:在 2 万样本上独立训练,带来 +2.61 个百分点的增益
    • Round 2:在 22.6 万样本上迭代训练,从第一轮的检查点初始化,将增益提高到 +6.79 个百分点
    • Round 3:在三轮 RFT 迭代聚合的 100 万样本上训练 OpenCUA-72B 基础模型,实现了 +8.12 个百分点的改进
  • 论文的分析突显了数据规模、 Off-Policy 分布和信噪比之间的关键权衡
    • 随着模型能力随规模提升,对噪声的容忍度降低,这为现有的迭代方法创造了瓶颈
    • 但至关重要的是,作者仍然相信只要数据质量、策略对齐和信噪比得到有效优化,进一步的扩展是可以持续的
Environmental Uncertainty and Evaluation
  • 区分 Pass@k 在智能体任务与标准 LLM 基准测试中的作用至关重要
    • 在传统文本生成中,“环境”(即提示)是静态且确定性的;
      • 此时,Pass@k 仅衡量模型内部能力的多样性
    • GUI 环境中引入了固有的环境随机性
      • 系统延迟、网络波动和细微渲染变化等因素意味着相同的动作序列可能产生不同的状态转换
  • 因此,在这种背景下,Pass@k 具有双重目的:
    • 它不仅评估模型的生成多样性,还评估其对抗环境噪声的鲁棒性
  • 论文观察到,即使采用确定性采样(temperature=0),由于这些系统扰动,成功率也会表现出方差
    • 这一发现突显了纯数据扩展的一个关键局限性
    • 为了实现人类级别的可靠性,未来的研究必须优先考虑环境扩展,扩展环境多样性和建模动态不确定性,以确保在现实世界系统中的鲁棒性

Discussions

  • 基于总计超过 100 万加速器小时的上千次独立实验,论文将关于原生计算机使用智能体训练动态的观察归纳为四个关键维度
  • 维度1:经验的双重性 (The Dual Nature of Experiences) :论文的分析表明,成功和失败轨迹的信噪比存在根本性差异,需要不同的处理策略
    • 成功轨迹 (Success trajectories) :由模型生成的轨迹代表已知知识,其特点是噪声低但信息增益有限
      • 虽然最终结果正确,但步级冗余构成了主要的噪声源
      • 如果不积极过滤这些低效步骤,模型会变得脆弱,导致诸如动作别名(对单一状态输出冲突动作)和循环重复(无休止点击相同坐标)等现象
        • 因此,有效过滤是多轮拒绝采样微调的前提
    • 失败轨迹 (Failure trajectories) :相反,失败轨迹是高噪声但高信息的
      • 它们描绘了模型的能力边界,并包含了当前策略无法处理的边界情况
      • 虽然原始失败数据噪声太大无法直接学习,但识别关键错误步骤可以用于构建偏好对
      • 这将失败的尝试转化为用于边界对齐的高价值来源
  • 维度2:基础约束与初始化 (Foundational Constraints and Initialization) :初始化阶段极大地影响了智能体的潜在性能
    • 动作空间的完备性 (Completeness of action space) :动作空间的全面定义是前提
      • 缺少高效操作(例如,三连击、基于 Shift 的快捷键)会导致特定任务(例如复杂的电子表格编辑)实际上无法解决
      • 与正确的初始定义相比,事后添加动作空间是低效的
    • 以模式为中心的冷启动 (Pattern-centric cold start) :冷启动阶段应优先考虑模式多样性而非数据量
      • 论文观察到,轻量级的冷启动足以建立潜在的对齐(奠定动作空间并稳定输出格式)
      • 重度的冷启动通常会产生较高的监督指标,但会创建一个后期更难精炼的检查点
      • 轻量级初始化,随后进行严格的拒绝采样和偏好优化,始终能产生更优的最终性能
  • 维度3:迭代优化的动态 (Dynamics of Iterative Optimization) :计算机使用任务本质上是长程的,通常需要数十次交互回合,为此进行优化需要严格遵守特定的动态属性
    • On-Policy 的必然性 (The on-policy imperative) :论文强调在迭代学习期间使用严格 On-Policy 数据的必要性
      • 作者推测 Off-Policy 数据会扰乱监督期间建立的优化向量的主方向
      • 一旦模型的权重由于分布偏移而偏离最优流形,恢复正确的优化路径在计算上是不可行的
    • 终止的不对称性 (Termination asymmetry) :终止动作的分布是最关键的控制变量
      • 论文观察到一个明显的不对称性:模型在识别失败方面收敛迅速,而识别成功则需要精心校准的正样本密度
      • 成功信号的过度集中会导致过早终止,而不足则阻止智能体停止
    • 自我纠正与未来潜力 (Self-correction and future potential) :为了减轻长程任务中的错误累积,论文利用专注于状态检查和反思的偏好优化
      • 通过针对智能体未能感知错误的步骤,论文增强了鲁棒性
      • 这些改进表明,逻辑上的演进是过渡到在线强化学习,其中先进的信用分配机制可以进一步优化复杂多步环境中的性能
  • 维度4:可视化驱动的诊断与迭代 (Visualization-Driven Diagnosis and Iteration) :作者认为,在长程任务中实现 SOTA 性能需要的不仅仅是算法新颖性;它需要一个透明的调试基础设施
    • 论文开发了一套全面的轨迹分析和可视化工具套件,作为论文演化循环的“眼睛”
    • 这些工具在三个关键阶段发挥了关键作用:
      • 合成的质量保证 (Quality Assurance for Synthesis) :它们使论文能够将合成样本与其真实状态一起可视化,从而能够在论文的合成引擎中的“幻觉验证器”或可执行逻辑错误污染训练池之前快速识别它们
      • 冷启动数据构建 (Cold-Start Data Construction) :通过可视化对比不同基础模型的轨迹特征,论文识别出更优的推理模式和动作序列
        • 这指导了论文高质量冷启动数据集的整理,确保智能体学习鲁棒的行为先验而非嘈杂的模仿
      • 用于精炼的失败分析 (Failure Analysis for Refinement) :论文的 Pass@k 差异分析工具聚合了同一 Query 的成功和失败轨迹
        • 这种细粒度的比较帮助论文精确识别特定的失败模(例如坐标漂移或推理-动作错位),直接指导论文步级策略优化的设计以纠正这些特定弱点

Future Work on Online Agentic RL

  • RLVR (2025) 已成为提升模型可靠性、泛化性和性能的关键框架
  • 在此基础上,论文未来的工作旨在探索基于 GUI 的智能体任务中的在线智能体强化学习
  • 受限于时间,论文尚未进行足够的模型训练和全面的基准评估
  • 因此,本节的后续部分将首先深入分析训练-推理差异问题,然后讨论推进这项工作的未来研究方向

(Training-Inference Discrepancy in Trajectory-Level Training)

  • 诸如 GRPO (2024) 等算法已被证明在广泛的推理任务上有效
  • 这些算法为单个 Query 收集一组轨迹,计算轨迹组内的优势函数,并以轨迹粒度进行训练
    • 但轨迹级训练会在 GUI 任务中引起训练-推理差异
  • 在 Rollout 阶段,GUI 模型并不保留所有完整的上下文信息,而只保留最近步骤的完整信息(包括截图、推理和动作),而更早的历史信息被压缩为纯文本语义动作
    • 如果直接使用最终步骤的轨迹进行训练,模型将无法学习中间步骤的监督信号
Step-Level Policy Optimization
  • 为了解决轨迹级训练中的训练-推理差异,论文提出一种简单而有效的策略优化算法,即步级策略优化 (Step-Level Policy Optimization, STEPO)
  • 对于一个长度为 \(T\) 的轨迹 \(\tau\),每一步 \(t\in \{1,2,\ldots ,T\}\) 包含 \(K_{t}\) 个 Token
    • 论文将步骤 \(t\) 中的第 \(k\) 个 Token 表示为 \(x_{t,k}\) \((k\in \{1,2,\dots,K_t\})\),步骤 \(t\) 的完整 Token 序列表示为 \(x_{t} = (x_{t,1},x_{t,2},\ldots ,x_{t,K_{t} })\)
    • 对于轨迹集合 \(\mathcal{T} = \{\tau_{1},\tau_{2},\ldots ,\tau_{n}\}\),第 \(i\) 个轨迹中步骤 \(t\) 的位置 \(k\) 的 Token 表示为 \(x_{i,t,k}\)
  • 对于每个问题 \(q\),类似于 GRPO,STEPO 从策略 \(\pi_{\theta_{\mathrm{old} } }\) 采样一组轨迹 \(G\):\(\{\tau_{1},\tau_{2},\ldots ,\tau_{n}\}\),并计算轨迹组内的优势:
    $$\hat{A}_i = \frac{R_i - \mathrm{mean}(\{R_j\}_{j = 1}^G)}{\mathrm{std}(\{R_j\}_{j = 1}^G)} \tag{3}$$
    • 其中 \(R_{i}\) 表示轨迹 \(\tau_{i}\) 的奖励
  • 随后,将每个轨迹 \(\tau_{i}\) 对应的优势值 \(\hat{A}_{i}\) 均匀分配给该轨迹包含的所有步骤,即:
    $$\hat{A}_{i,t} = \frac{\hat{A}_i}{ T_i}, \quad t\in \{1,2,\ldots ,T_i\} , \tag{4}$$
    • 其中 \(T_{i}\) 表示轨迹 \(\tau_{i}\) 包含的步骤数
    • 同一步骤内的所有 Token 共享该步骤对应的优势值 \(\hat{A}_{i,t}\)
    • 在此基础上,论文使用所有步级样本进行模型训练
  • STEPO 算法的优化目标可表示为:
    $$\begin{array}{rl} {\mathcal{I}_{\mathrm{STEPO} }(\theta) = \mathbb{E}_{[q\sim P(Q),\{\tau_i\}_{i = 1}^G\sim \pi_{\theta_{\mathrm{old} } }(\mathcal{T}|q)]}} {\frac{1}{G}\sum_{i = 1}^{G}\sum_{t = 1}^{T_i}\frac{1}{K_t}\sum_{k = 1}^{K_t}\{\min [r_{i,t,k}(\theta)\hat{A}_{i,t},\mathrm{clip}(r_{i,t,k},1 - \epsilon_{\mathrm{low} },1 + \epsilon_{\mathrm{high} })\hat{A}_{i,t}] - \beta \mathbb{D}_{KL}(\pi_{\theta}| \pi_{\mathrm{ref} })\} ,} \end{array} \tag{5}$$
    • \(r_{i,t,k}(\theta)\) 表示重要性采样比率:
      $$r_{i,t,k}(\theta) = \frac{\pi_{\theta}(\tau_{i,t,k}|q,\tau_{i,t,k})}{\pi_{\theta_{\mathrm{old} } }(\tau_{i,t,k}|q,\tau_{i,t,k})}, \tag{6}$$
    • \(\epsilon\) 表示剪裁参数
    • \(\mathbb{D}_{KL}\) 表示 KL 惩罚项
    • \(\beta\) 控制 KL 散度正则化强度
  • 通过将轨迹的优势值均匀分配给其包含的所有步骤,该策略实现了两个核心优化效果:
    • 首先,它驱使高优势值轨迹以更少的步骤完成任务,从而减少冗余的执行步骤;
    • 其次,它促使低优势值轨迹扩展探索步骤数,从而提高任务完成率。通过步级策略优化机制,STEPO 可以有效规避训练-推理差异问题
Experiments and Analysis
  • 为了阐明训练-推理差异的影响并验证 STEPO 的有效性,论文在 OpenCUA-32B 模型上进行了在线 RL 训练
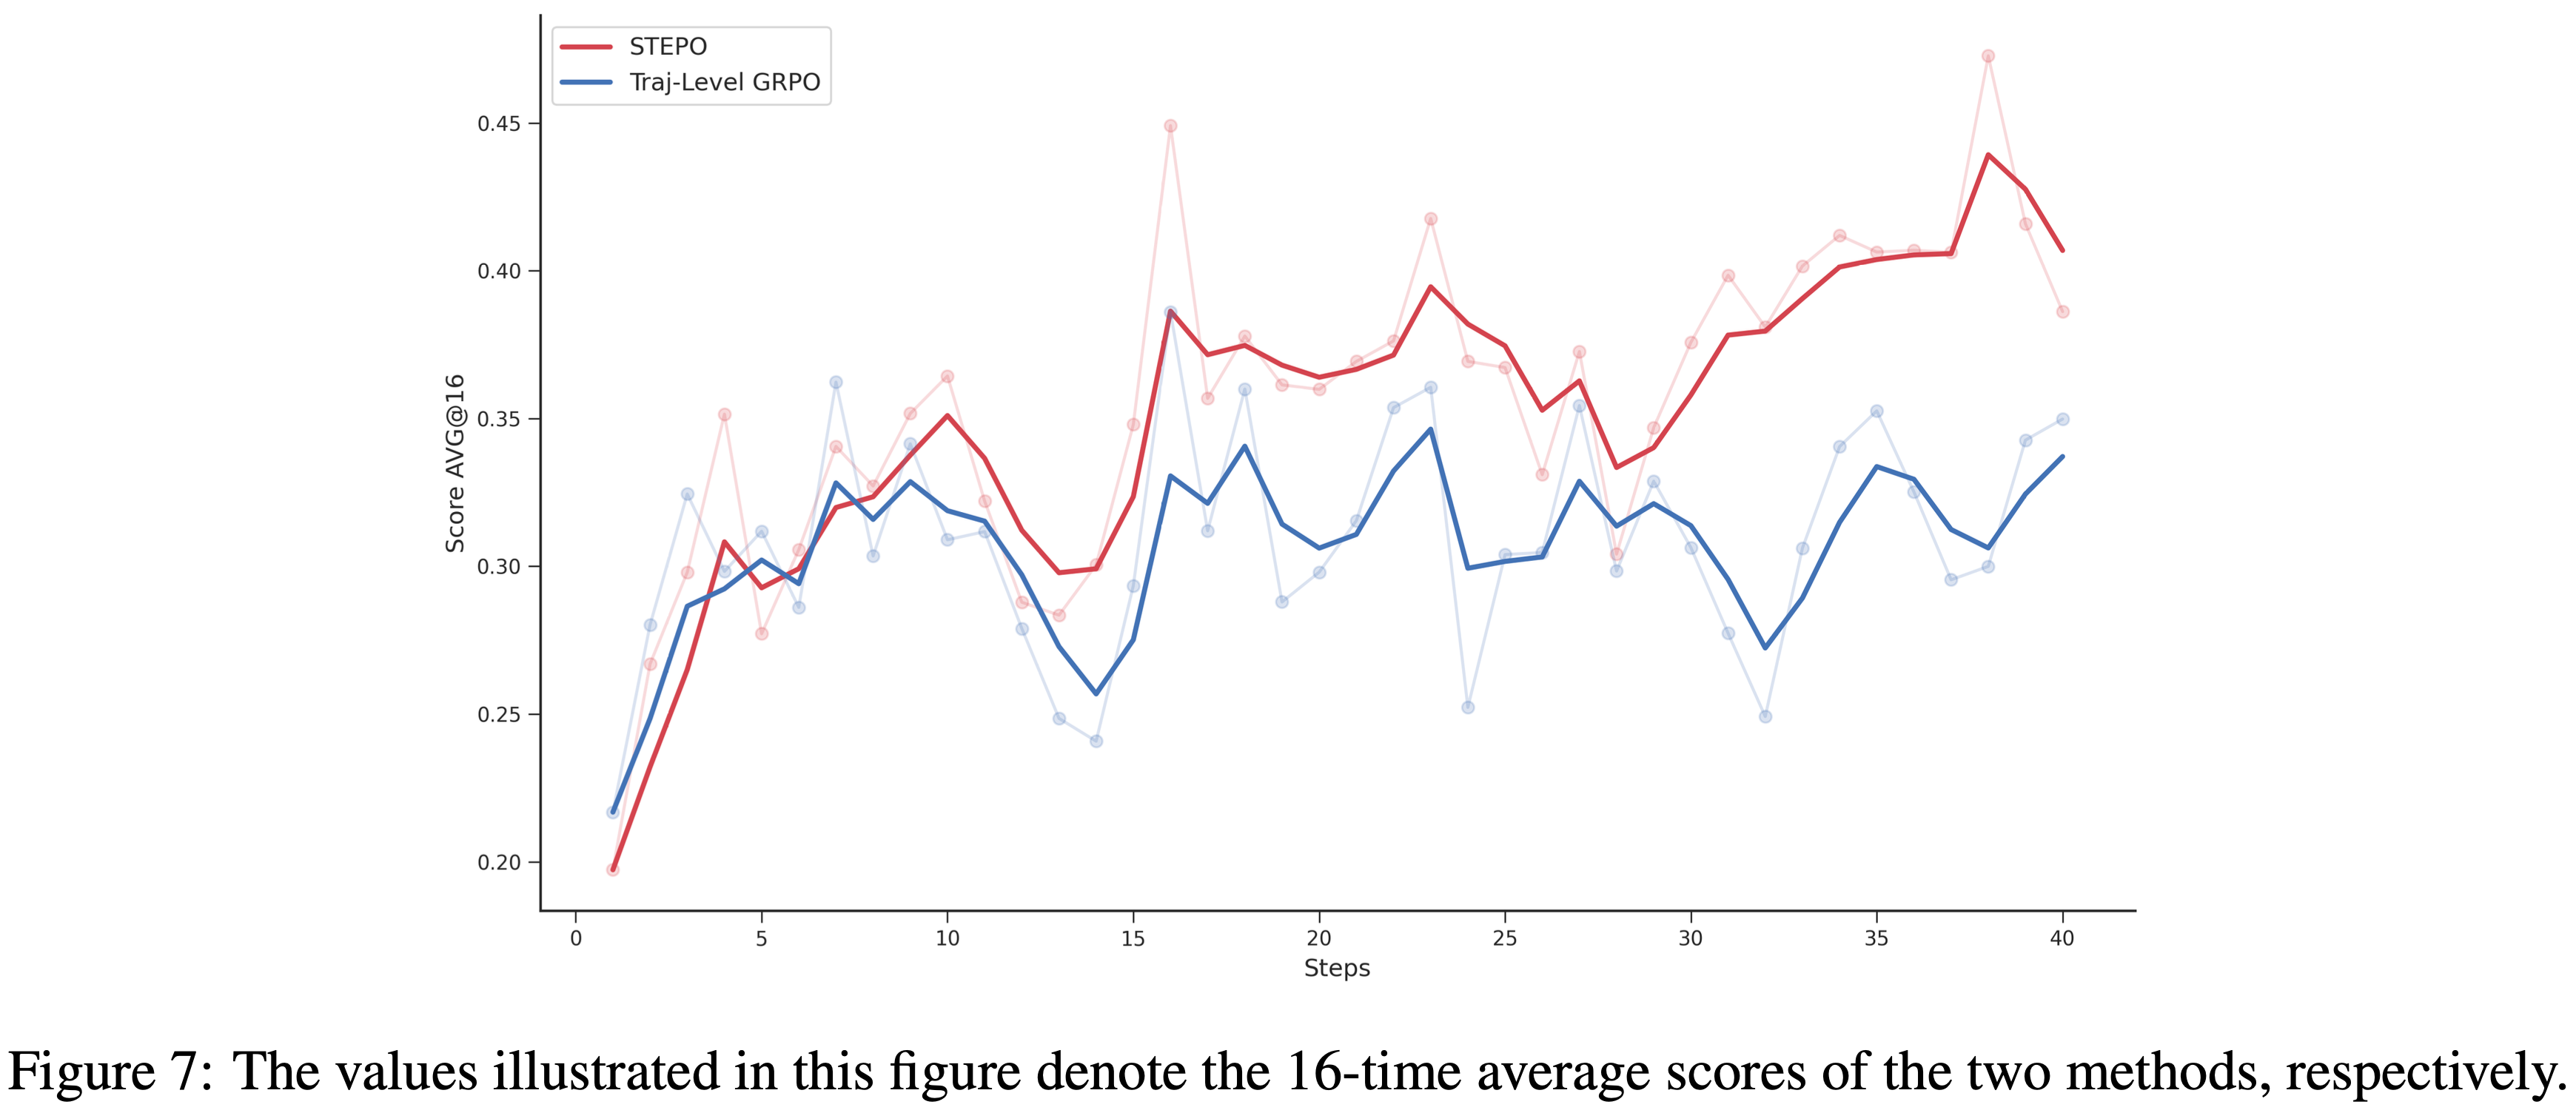
  • 如图 7 所示,STEPO 的训练性能显著优于使用最终轨迹训练的 GRPO,这充分证实了 STEPO 的有效性
  • 然而,STEPO 存在训练成本高的问题,因为策略模型的更新次数显著倍增
  • 因此,论文猜测步级训练的要求可能在不同的训练阶段并不一致,仅训练特定的关键步骤也可能达到与训练所有步骤相当的性能
    • 未来,论文将探索扩大在线 RL 规模以及开发更有效的 RL 训练方案等方向

Related Work

Foundation VLMs and Computer Use Capabilities

  • 大型视觉语言模型的格局已迅速发展以支持复杂的智能体任务
  • 专有的前沿模型,最著名的是 Claude 4.5 Sonnet (2025) 和 Seed 1.8 (2025),设定了行业标准,在零样本指令跟随和长程规划方面展示了人类级别的熟练度
  • 在开放权重领域,Qwen3-VL (2025a) 已成为一个强大的主干,引入了下一代动态分辨率和增强的 OCR 能力
  • EvoCUA 直接建立在 Qwen3-VL 架构之上,通过专门的演化后训练课程对其进行增强,以超越通用预训练的限制

Generalist GUI Agents and Benchmarks

  • 为了评估在线智能体性能,OSWorld (2024) 和 OSWorld 是主要的测试平台
  • OpenCUA (2025b) 凭借 AgentNet 数据集建立了一个关键的基础,而 SOTA 工作如 UI-TARS-2 (2025a) 和 Step-GUI (2025) 分别利用了多轮 RL 和逐步视觉推理
  • 与这些重度依赖演示的方法不同,EvoCUA 利用自主合成的、可验证的经验来降低标注成本,同时在 OSWorld 排行榜上实现了更优的性能

Visual Grounding and Action Execution

  • 精确的 GUI 定位是原生计算机使用的基石
  • 早期的方法如 Aguvis (2024) 奠定了基础,而最近的模型如 ShowUI (2025) 和 UGround (2024) 专门针对高分辨率布局优化了视觉-语言-动作架构
  • EvoCUA 从这些专门用于定位的架构中汲取见解,以在高层次规划优化之前建立鲁棒的执行原语

From Imitation to Learning from Experience

  • 训练范式正在从行为克隆 (Behavior Cloning, BC) 向强化学习转变
  • 标准算法如 PPO (2017) 已被 UI-TARS-2 (2025a) 成功适配于多轮 GUI 交互,但最近的研究专注于激励推理能力
    • 这一转变由 DeepSeek-R1 (2025) 和 DeepSeekMath (2024) 开创,它们引入了 RLVR 范式
    • 他们证明了 RL 可以在没有密集过程监督的情况下隐式验证复杂的推理链
  • Feng 等人 (2025) 提出了组内优化 (Group-in-Group optimization) 以稳定此类训练
  • Zhang 等人 (2025) 探索了通过无奖励的“早期经验”进行学习
  • EvoCUA 通过一个可验证的合成引擎解决了数据稀缺瓶颈,从而推进了这一方向,该引擎自主产生可扩展的、基于真实值验证的合成数据
  • 这一基础实现了论文通过经验学习的演化范式,这是一个自我维持的循环,通过在大规模可验证合成轨迹上进行拒绝采样和偏好学习,迭代地增强智能体能力

Conclusion

  • 论文提出了一个通过经验学习的演化范式开发的原生计算机使用智能体 EvoCUA,详尽展示了将合成计算转化为高质量训练信号的有效性
    • 可验证的合成
    • 可扩展的交互基础设施相结合
  • 在 OSWorld 基准测试上,EvoCUA 达到了 \(56.7%\) 的成功率
  • 注:当前的开源模型与领先的闭源权重系统或人类级别的可靠性之间仍然存在性能差距
    • 这种差异突显了仅从合成痕迹进行离线学习的局限性
  • 为了解决这个问题,作者的中心对在线强化学习上
    • 目前作者已经在初步尝试,作者初步调查确定了主动环境交互是进一步改进的关键驱动力,奖励累积的持续上升趋势证明了这一点
    • 未来的作者的工作将侧重于系统地扩展这个在线演化边界,旨在弥合剩余的差距,实现完全自主的计算机使用能力

附录 A:A Unified Action Space

  • 下表详细说明了在 EvoCUA 中实现的统一原生行动空间 \(\mathcal{A}\)
  • Agent 通过调用 computer_use 函数并指定特定的行动及其相应参数来与环境交互

附录 B:Cold Start: Hindsight Reasoning Generation(事后推理生成)

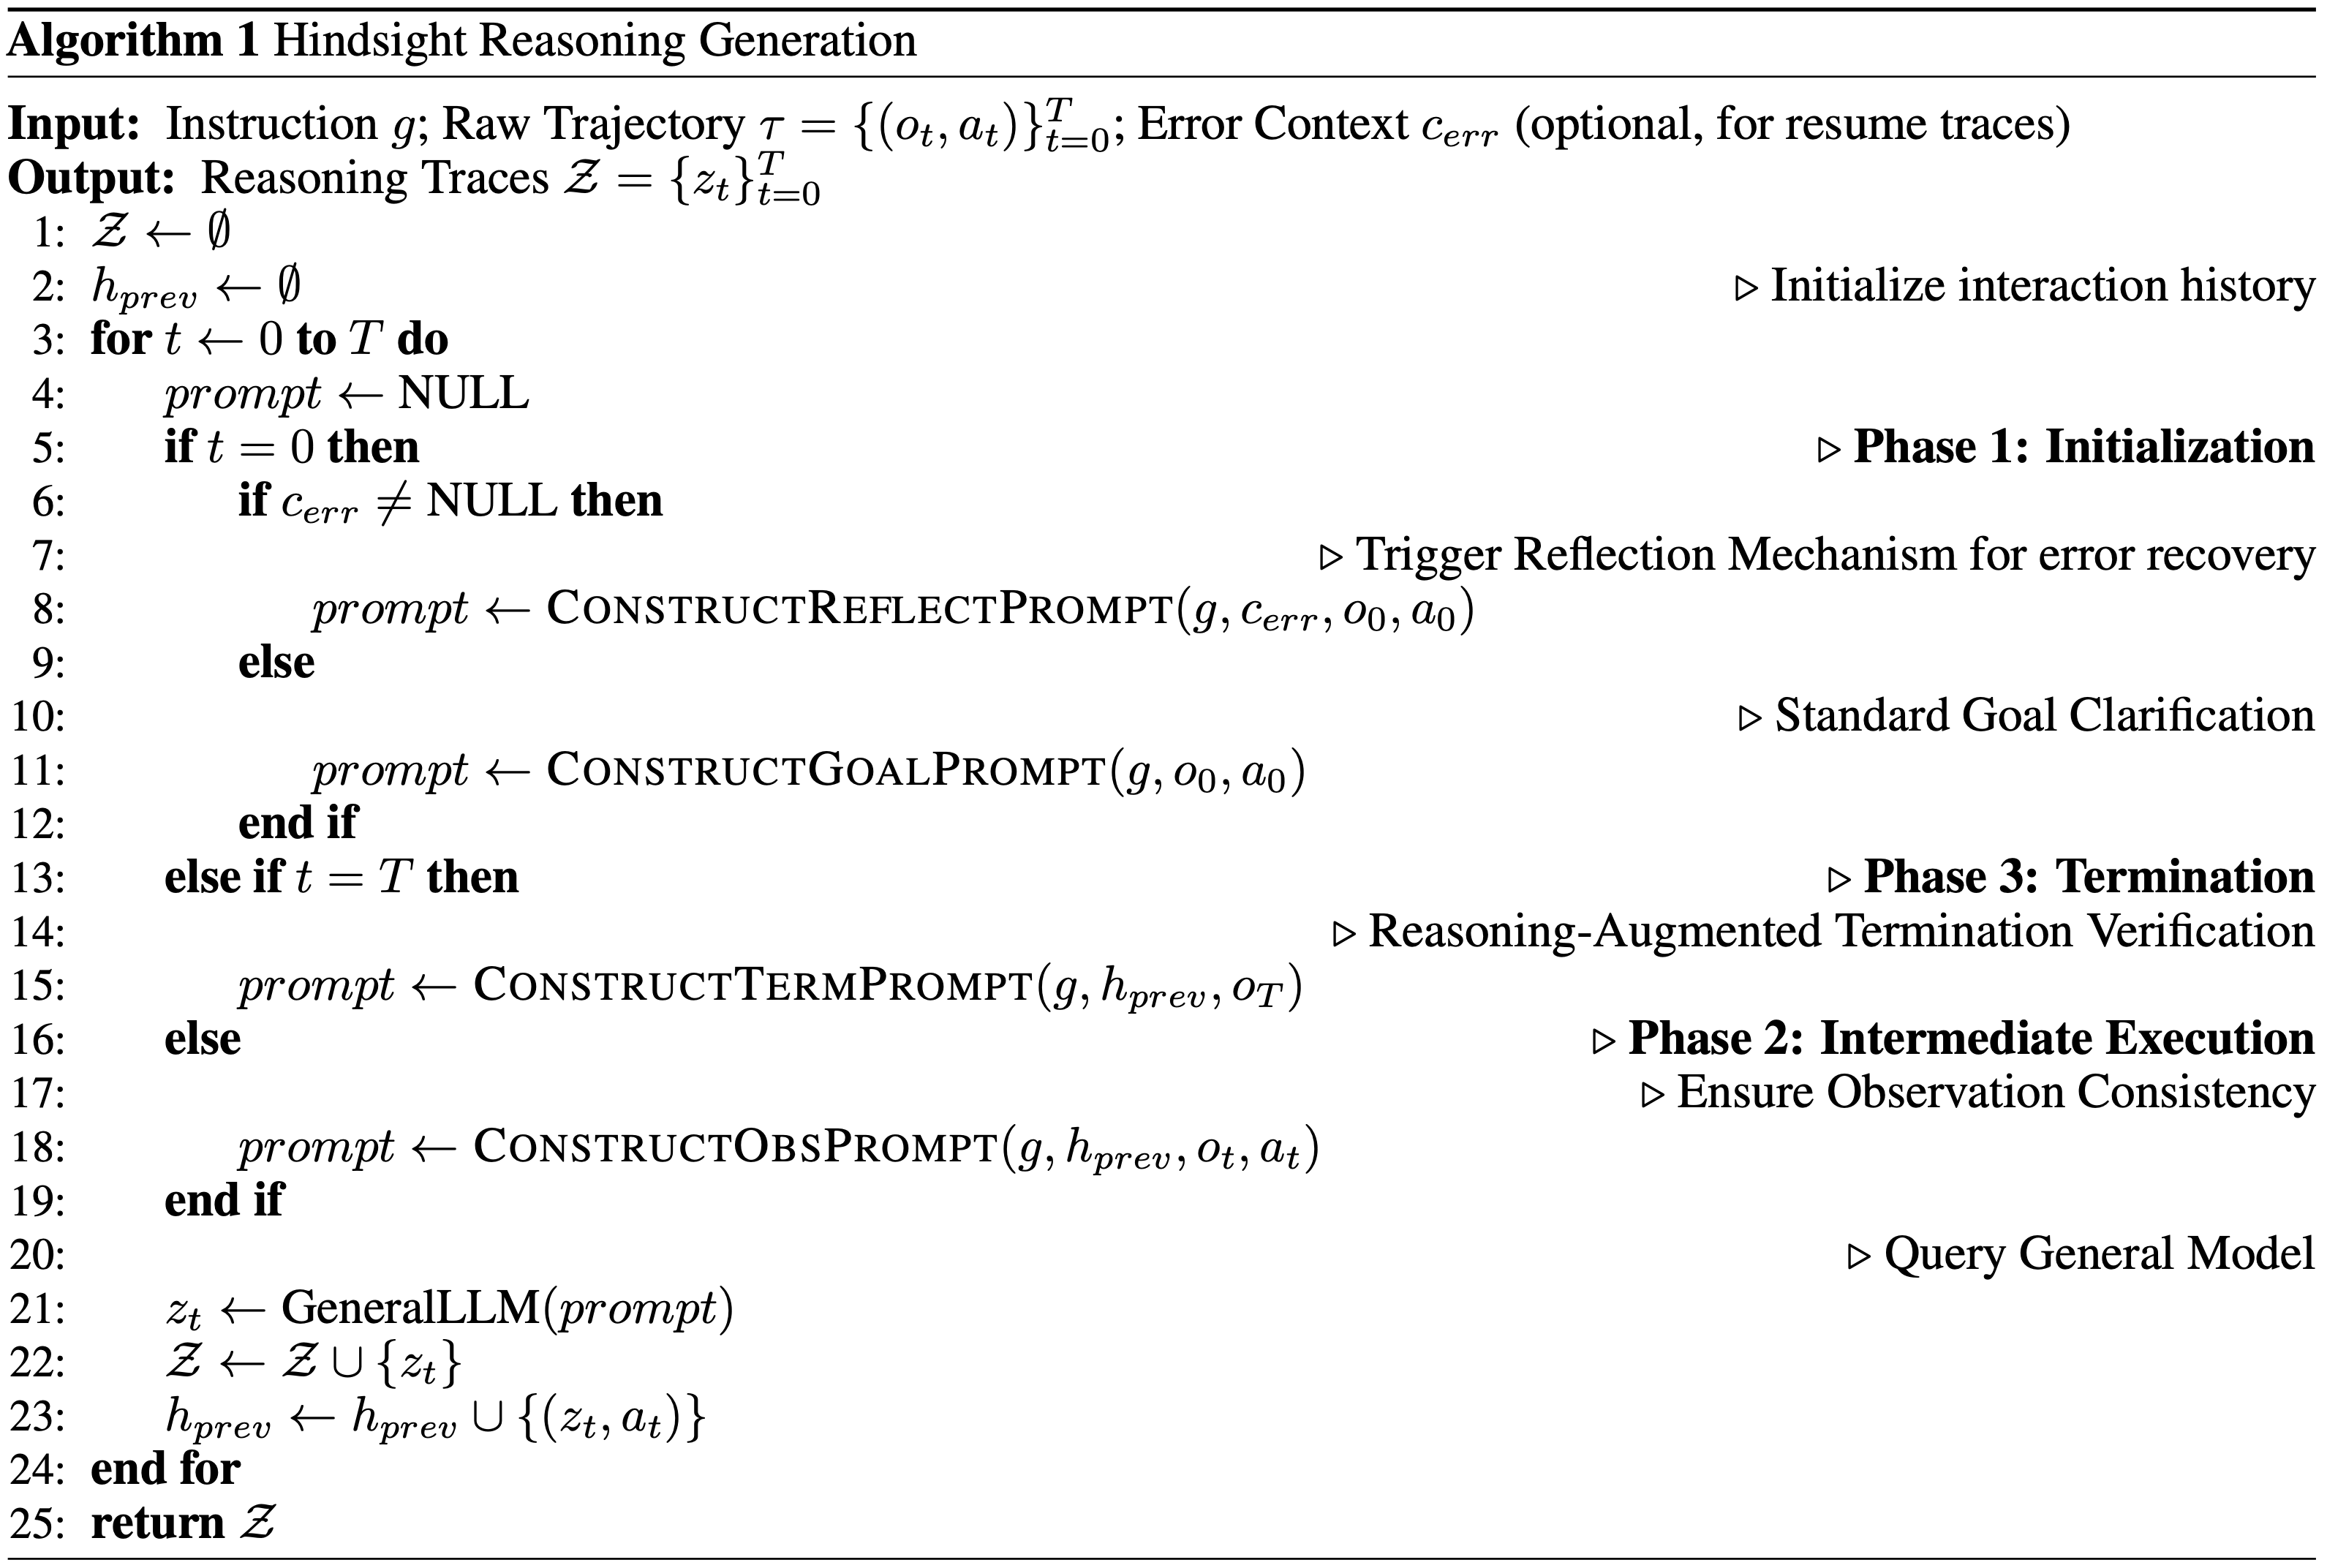
  • 为了为监督式冷启动阶段构建高质量数据,论文将原始的物理交互轨迹转化为增强了明确认知链的训练样本
  • 论文采用事后推理生成 (Hindsight Reasoning Generation) 策略来实现这一点
    • 通过将真实执行路径视为已知的未来信息,论文利用一个通用模型来回溯性地生成解释所观察行动的推理轨迹 \((z_{t})\),从而在认知和执行之间建立因果对齐
  • 生成过程由一系列强制执行论文思维空间 \((Z)\) 中所定义结构模式的、上下文感知的提示模板驱动
  • 根据执行阶段的不同,生成逻辑调整如下:
    • 1)目标澄清 \((z_{0})\) 在轨迹的初始步骤 \((t = 0)\),推理生成的重点是解决歧义并建立全局计划
      • 上下文 (Context) :为通用模型提供用户指令、初始屏幕截图和第一个可执行代码块
      • 生成逻辑 (Generation Logic) :论文使用一个强制要求第一人称视角的特定模板。模型必须明确陈述当前环境状态、澄清任务目标、并阐述一个高层次计划(例如,“我需要打开浏览器来搜索…”),然后证明所采取的具体行动是合理的。这确保了后续的物理执行基于清晰的意图
    • 2)观察一致性 \((z_{obs})\) 对于中间步骤,目标是保持视觉观察和推理轨迹之间的语义一致性
      • 上下文 (Context) :模型分析从前一个状态到当前状态的转换
      • 生成逻辑 (Generation Logic) :提示指令模型识别环境中“发生了什么变化”,并解释“为什么需要这个行动”来推进工作流
      • 语义抽象 (Semantic Abstraction) :为了防止过拟合于特定的屏幕分辨率,提示明确限制生成内容,避免提及原始像素坐标
        • 相反,引导模型从语义上描述目标 UI 元素(例如,“点击‘文件’菜单”而非“点击 (100, 200)”),确保推理对不同布局变化保持鲁棒性
    • 3)反思与纠正 \((z_{reflect})\) 对于涉及错误恢复(“恢复”轨迹)的轨迹,论文实现了一个专门的反思机制 (Reflection Mechanism)
      • 上下文 (Context) :当处理从失败中恢复的轨迹片段时,合成引擎将特定的 analysis_reason(先前失败的根本原因)注入到提示上下文中
      • 生成逻辑 (Generation Logic) :模型被强制要求以专用的标头开始思维轨迹:“反思:”
        • 它必须回顾性地分析失败原因(例如,“反思:我意识到我之前点击图标的尝试失败了,因为…”)
      • 自我纠正 (Self-Correction) :在反思之后,模型必须自然地过渡到一个纠正后的计划(例如,“现在我将尝试一种不同的方法…”),从而有效地将自我纠正的逻辑内化到训练数据中
    • 4)推理增强的终止 \((z_{T})\) 为了缓解过早或延迟停止的问题,终止行动基于严格的视觉验证过程
      • 上下文 (Context) :生成在轨迹的最后一步触发
      • 生成逻辑 (Generation Logic) :要求通用模型根据初始指令评估最终屏幕截图
        • 它必须在发出最终终止信号之前,生成一个提供任务完成(或失败)视觉证据的推理轨迹
        • 这确保了 Agent 的终止决策是基于逻辑验证,而不是记忆的轨迹长度
  • Algorithm 1:

附录 C:Algorithm for DPO

  • 在本节中,论文介绍步骤级直接偏好优化 (Step-Level Direct Preference Optimization, DPO) 的算法实现
  • 该方法侧重于两个核心过程:关键错误识别和偏好对构建
  • 算法 2 详细说明了论文如何从失败轨迹中识别关键分岔点 (Critical Forking Points) ,并为行动纠正和反思两者构建配对数据

附录 D:Trajectory Analysis and Visualization

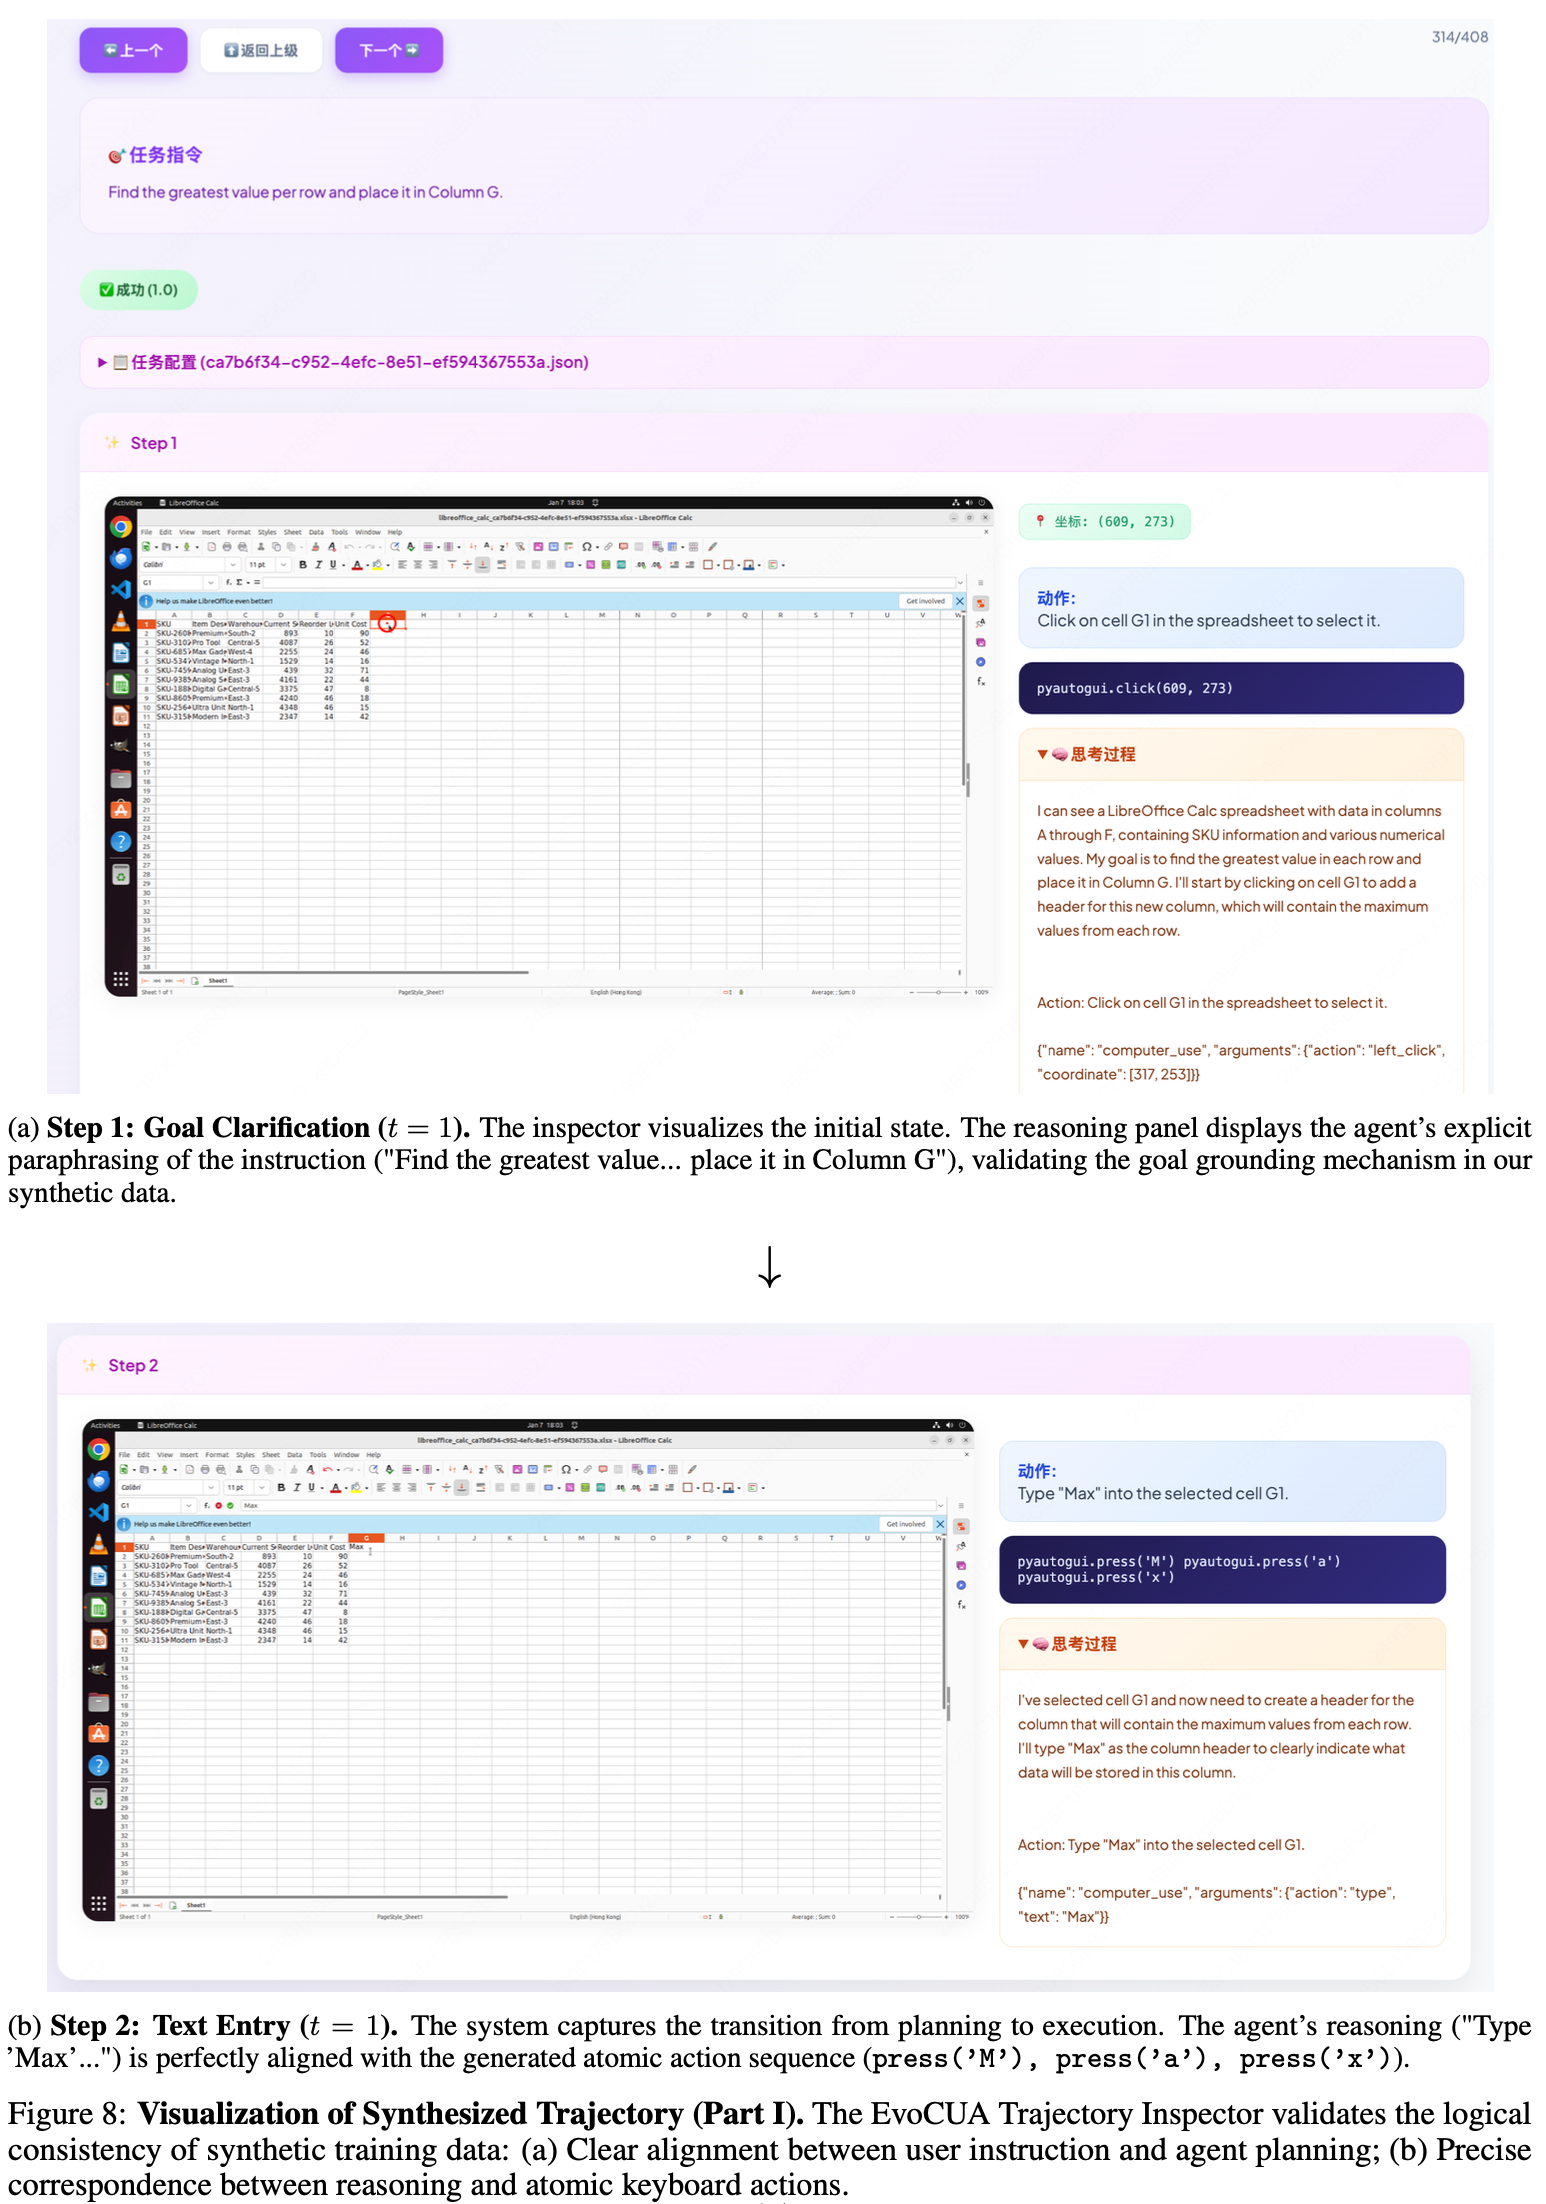
  • 为了实现 Agent 行为的细粒度诊断并严格验证论文合成生成的经验质量,论文开发了 EvoCUA 轨迹检查器 (EvoCUA Trajectory Inspector)
    • 该可视化系统允许论文逐帧检查 Agent 的视觉观察 \((o_{t})\)、内部推理轨迹 \((z_{t})\) 和可执行代码行动 \((a_{t})\) 之间的对齐情况
  • 论文使用一个来自电子表格领域的代表性合成任务来说明该系统的实用性:“找到每行的最大值并将其放置在 G 列中” 这个长视程任务是一个验证论文合成引擎逻辑一致性的严格测试平台
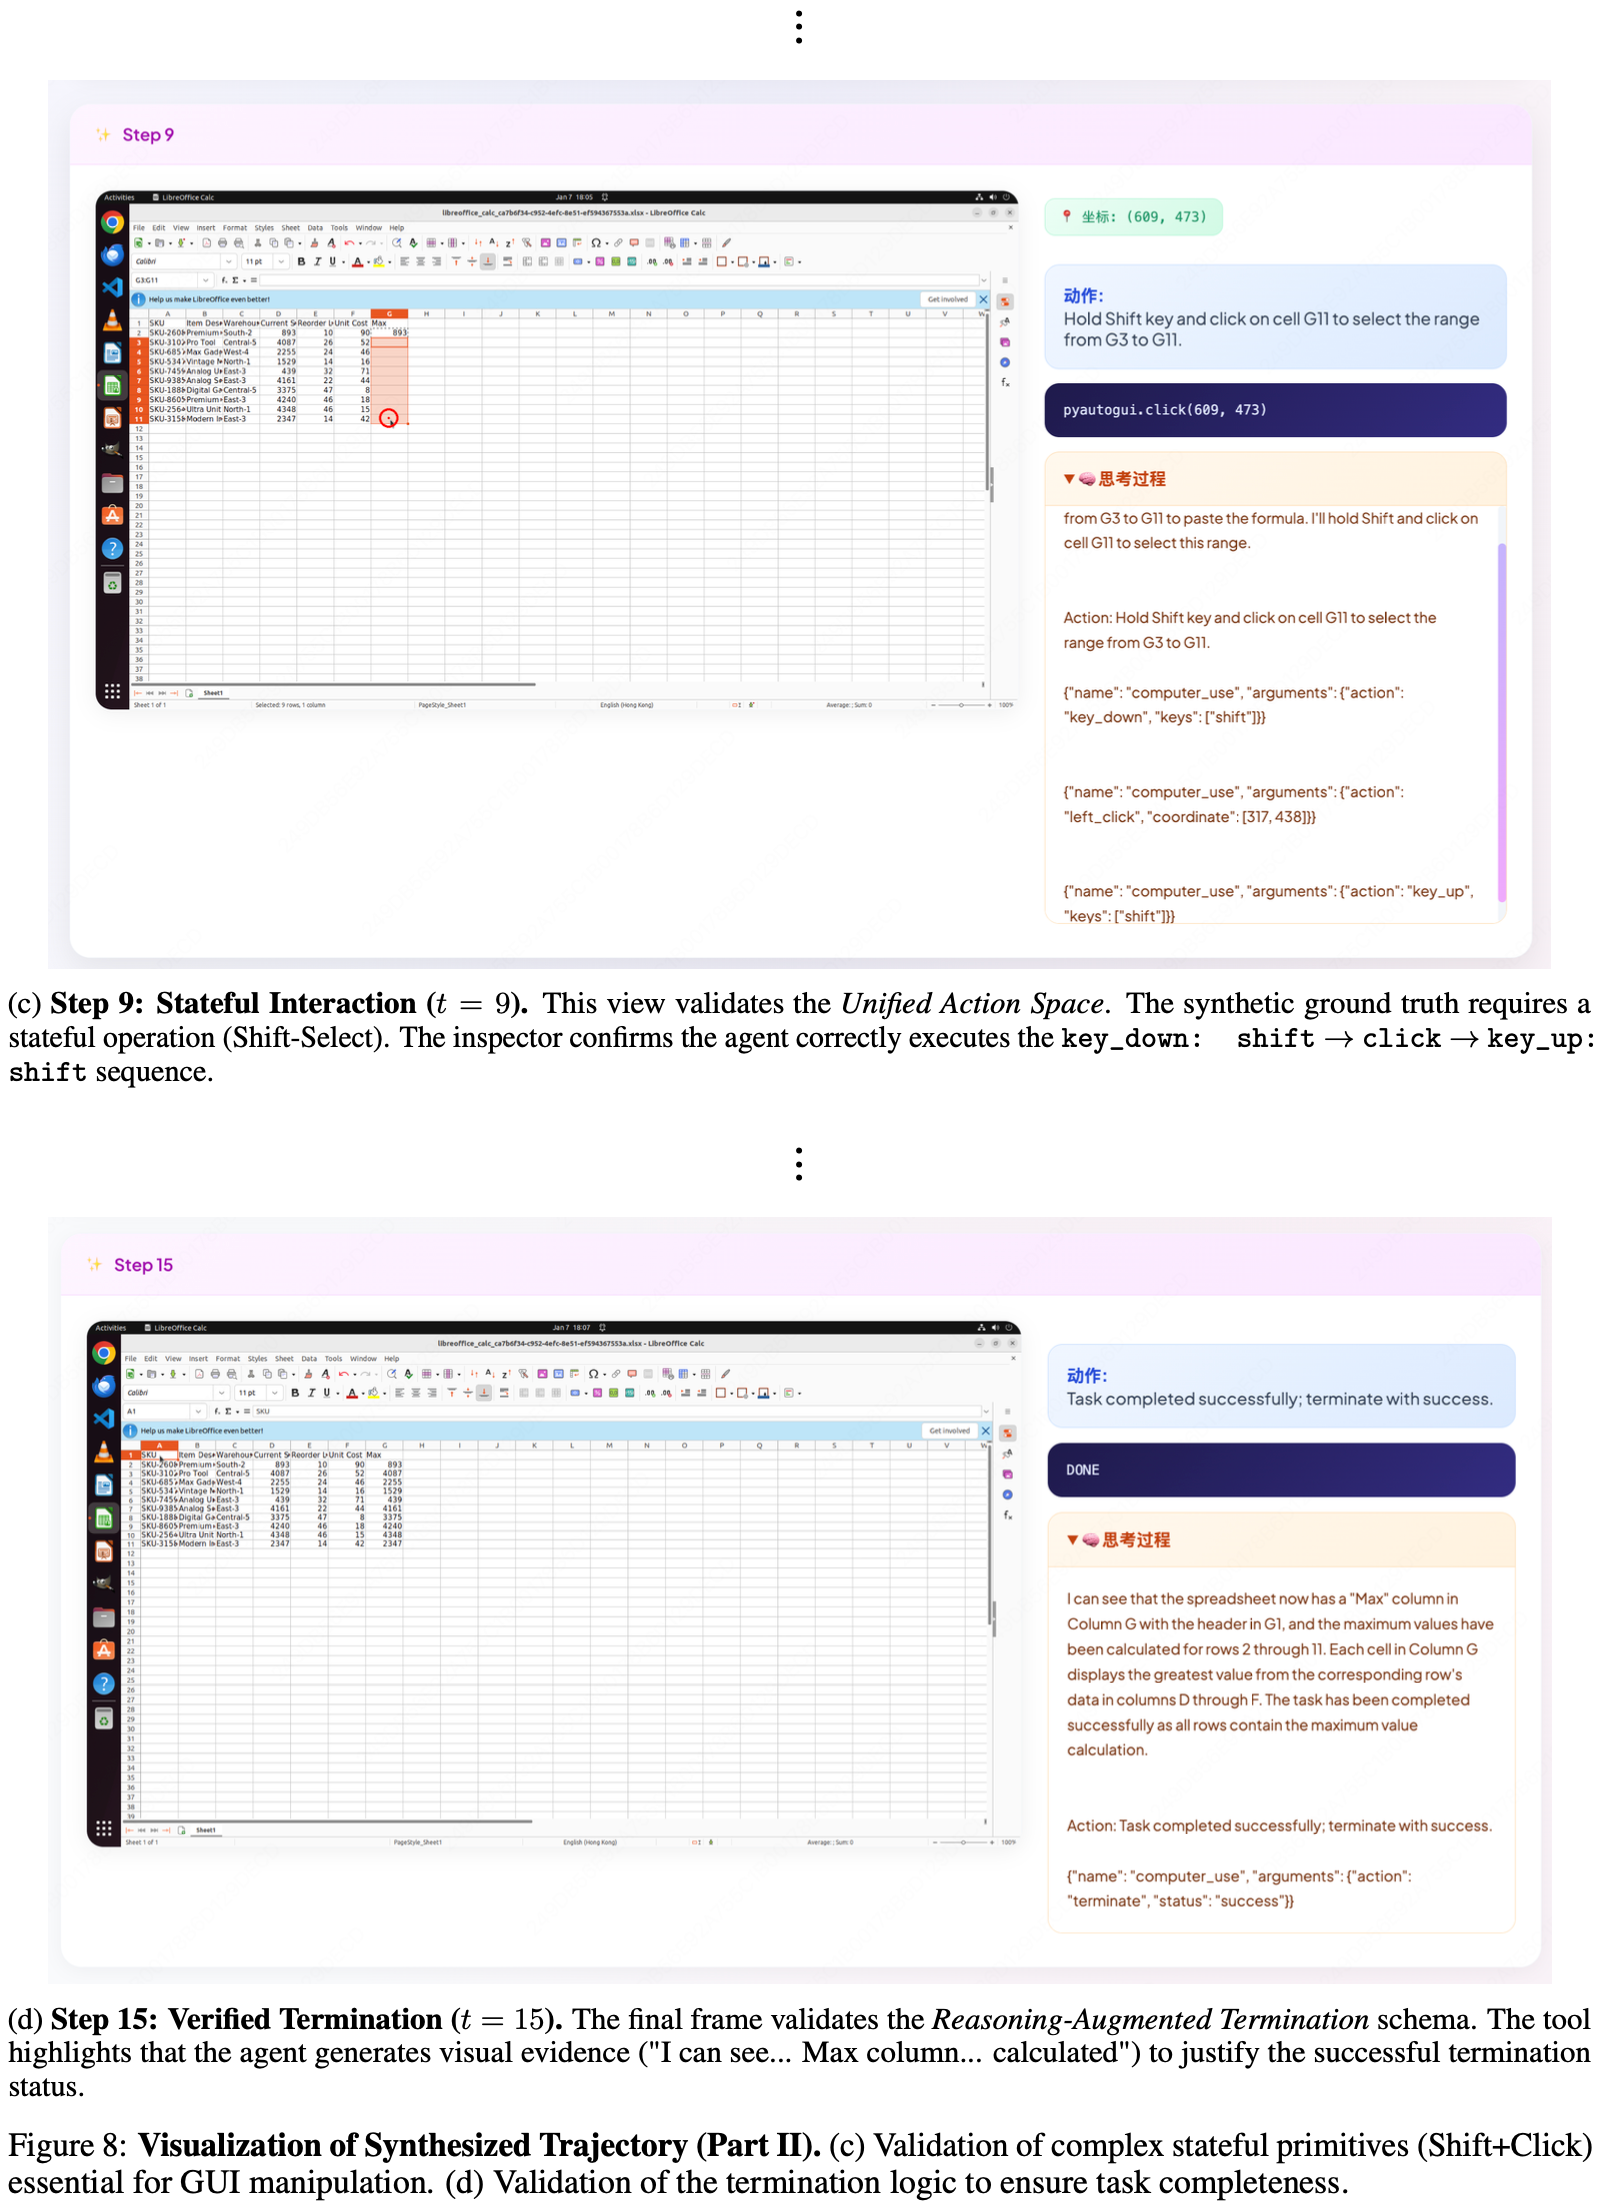
  • 图 8 展示了这些关键时间戳的可视化
  • 解读:
    • 步骤 9(\(t=9\)):有状态交互
      • 此视图验证了统一行动空间 (Unified Action Space)
      • 合成真实情况需要一个有状态操作(Shift-选择)
      • 检查器确认 Agent 正确执行了 key_down: shift \(\rightarrow\) click \(\rightarrow\) key_up: shift 序列
    • 步骤 15(\(t=15\)):已验证的终止
      • 最后一帧验证了推理增强的终止模式 (Reasoning-Augmented Termination schema)
      • 工具突出显示 Agent 生成了视觉证据(“我可以看到… 最大值列… 已计算”)来证明成功的终止状态是合理的

EvoCUA-1.5 技术报告解读

  • 原始论文:EvoCUA-1.5: Online Reinforcement Learning for Multi-turn Computer-Use Agents, 20260707, Meituan
    • 英文博客:EvoCUA-1.5: Online RL for Multi-turn Computer Use Agents
    • 中文博客:EvoCUA-1.5: Computer Use Agent在线强化学习
  • 整体总结:
    • EvoCUA-1.5 主要是在 EvoCUA 的基础上进行 Online RL 训练,博客内容也在描述 RL 的具体设计

样本组织方式

  • 基于滑动窗口,窗口内完整保留多模态数据,窗口外只保留历史动作
    • 理解:窗口外丢弃观测(图片)和思考(CoT)

Advantage 的设计

  • 每个轨迹的所有 Step 共享相等的 Advantage,但按照 Step 进行归一化

RL 数据的选择

  • 本节内容内容主要来自中文博客原文
  • 为了保证数据质量,从三方面进行监控:
    • 1)原子能力覆盖度:数据集需要涵盖所有原子能力,保证每个任务的基础能力均能得到训练。
    • 2)原子能力数据量:每个原子能力需要有一定关联的数据量,并且数据量和模型本身能力相关。
    • 3)Pass Rate:使用模型 rollout 一遍数据,限定 pass rate 在一定范围内保留,以提供RL 训练过程中有效的监督信号。
  • EvoCUA 通过沙盒可行性验证和基于 Model Judge 的轨迹分析,对合成任务进行系统性的质量控制与校准,确保任务具备以下特征:
    • (1) 明确的初始状态和成功条件,避免奖励模糊性,防止训练过程中出现假阳现象带偏模型
    • (2) 充分的原子能力覆盖度和数据量,保证各方面能力得到充足训练
    • (3) 高信噪比和适中的难度梯度,既不过于简单(无法提供学习信号)也不过于困难(导致探索效率低下)
    • (4) 跨domain的原子能力组合,促进知识的可迁移性
  • 这种精心筛选的数据使得 online RL 中的每一次策略更新都能获得高信噪比(SNR)的梯度信号
  • 文章中对高信噪比任务的认知:
    • 从轨迹视角,Pass Rate 在两边的任务信号较弱,Pass Rate 为 0.5 左右的任务信号最高
    • 从 Step 视角,高SNR样本不是一整条长轨迹,而是轨迹中的某一个具体的局部片段
      • 定义:将同一个任务的多条成功轨迹和失败轨迹对齐后,模型做出第一个导致结局反转的决策动作(即成功轨迹选A,失败轨迹在同一状态下选B的那一帧)
      • 为什么这种 Step 片段信噪比高:因为这一帧直接建立了“特定状态 + 特定动作 = 最终成败”的强因果链条
        • 在此之前的状态是铺垫(噪声多),在此之后的状态是连锁反应(因果稀释)
        • 只有这个分岔点周围的观测-动作对,信号最纯粹
    • 信号强度与当前模型的能力相关
    • 总结:“当前模型成败各半的边界任务中,那个直接导致结局分叉的、且没有任何多余废动作的具体决策步骤”
  • 个人理解:
    • 噪音是不可避免的,比如环境的随机性、奖励模型的随机性、一些工具调用的随机错误等
      • 噪音是可以减少的,比如使用较为准确且确定的奖励模型,保证工具调用错误率等
    • 信号的可以选择加强的:
      • 轨迹上选择非全对或全错的
      • Step 上选择核心发生错误的交叉点

RL 训练流程 DTAC

  • Dynamic Tri-Adaptive Curriculum(DTAC),一种面向 CUA online RL 的动态三重自适应课程学习策略
  • DTAC 由三个互补的采样通道组成:
    • Variance-Adaptive Sampling(VAS) 根据样本的 pass rate 方差动态估计其训练价值,使模型优先学习当前最具区分度、正负反馈较均衡的任务
    • Difficulty-Adaptive Positive Replay(AdaPR) 针对仍具有正向学习信号的困难任务进行额外重放,避免模型在高难任务上探索不足
    • Infeasibility-Controlled Sampling(ICS) 为 infeasible 任务建立独立采样通道,防止其被普通困难任务机制过度重放,同时维持模型对不可行任务的识别与处理能力

其他认知

  • PRM 可能能够加快模型收敛,但可能会导致模型 PRM 涨,而 ORM 降低,最终指标也会降低
    • 理解:PRM 很难做到准确,做不好就容易出现 Reward Hacking
      • RL 的训练过程学习能力很强,很容易 Hacking
  • 对未来的思考:
    • 扩展环境和任务
    • 结合 CLI 场景,GUI 与 CLI 结合
    • 优化 Context Management 策略(当前是简单的滑动窗口)
    • Infra 优化
    • 多轮场景 Credit Assignment
    • 更好的 benchmark
1…183184185…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4