Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM对齐微调-Self-Rewarding-RubricRL

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(Self-Rewarding-RubricRL) Self-Rewarding Rubric-Based Reinforcement Learning for Open-Ended Reasoning, 20250919, Ant Group

Paper Summary

  • 整体说明:
    • 论文介绍了一种轻量级的训练范式 用于开放域推理的 Rubric-based RL Self-rewarding 强化学习(Self-Rewarding Rubric-Based Reinforcement Learning for Open-Ended Reasoning) ,在基于 Rubric 验证的奖励下,用策略模型本身替代了单独的奖励模型
      • 这种方法在降低训练成本的同时,提升了在困难任务上的性能
    • 核心创新点:自己作为自己的 Grader,不断“互相”进化(循环进化)
    • 注意:这项工作的实验仅限于医疗领域的 HealthBench
      • 作者相信该方法对其他开放域任务也会有效,未来的工作应探索更广泛的领域
    • 阅读问题:
      • 在数据分析阶段,全文包含了许多图片和文字描述不一致的情况!深究下去比较浪费时间,不建议深究,仅关注论文的核心贡献是 Self-Rewarding 即可
  • 背景 & 问题:
    • 开放式评估对于在现实世界场景中部署大语言模型至关重要
    • 在研究 HealthBench 时,作者观察到使用模型自身作为 Grader 并生成 Rubric-based 奖励信号,能显著提高推理性能(训练后的模型也会成为更强的 Grader )
  • Motivated by this,论文提出了 Self-Rewarding Rubric-Based Reinforcement Learning for Open-Ended Reasoning
    • 一个轻量级框架,能够实现更快、更高效的资源利用训练,同时超越 Baseline 方法
    • 在 Qwen3-32B 模型上,仅使用 4000 个样本的 HealthBench Easy 子集进行训练,就足以获得一个在 HealthBench Hard 上性能超过 GPT-5 的模型
    • 加入少量由教师(Teacher)评分的数据可以进一步提升能力较弱模型的性能

Introduction and Discussion

  • 随着 OpenAI o1 (2024) 的发布和 DeepSeek R1 (2025) 的开源,基于 RLVR 的推理模型已迅速成为社区关注的焦点,为大型语言模型引入了第二个可扩展性维度
  • 早期的研究主要集中在提升数学和编码能力,而最近的开源模型如 Kimi K2 (2025) 和 GLM-4.5 (2025) 则将注意力转向训练智能体能力
    • 与开放式(Open-Ended)推理相比,这些场景下的奖励信号相对明确
  • 在实际应用中,用户通过多轮对话与模型交互,并提出开放式问题,这与基准测试类型的任务有很大不同
    • 因此,用于评估和强化学习的可靠奖励信号要难以获取得多
  • 这一挑战在医疗保健领域(healthcare domain)尤为突出(Particularly pronounced) ,因为用户期望获得值得信赖且可靠的回答
    • 为解决此问题,OpenAI 引入了一个名为 HealthBench (2025) 的开源基准
      • HealthBench 是一个基于对话的开放式评估基准,旨在评估语言模型在医学领域的能力
      • HealthBench 采用 LLM-as-a-Judge (2023) 框架,并使用基于详细 Rubric 的评分系统,针对特定任务的标准来评估模型性能
  • 为应对这一挑战,论文专注于 HealthBench 基准测试,并提出Self-rewarding Rubric-based 的开放式推理强化学习 ,
    • 该方法直接利用 Rubric-based 评估信号进行训练,并整合了模型的自我评分(self-grading)
  • 论文的方法显著降低了资源消耗,提高了训练效率,同时提升了性能

Background and Preliminary Experiments

Background on Open-Ended Evaluation

  • 自从将 RLVR 引入训练以来,LLMs 在具有客观可验证事实依据的任务上取得了显著进步,例如:
    • 数学领域的 AIME 和 FrontierMath (2025);
    • 编码领域的 SWE-bench (2024) 和 Aider Polyglot (2025);
    • 用于指令遵循或工具使用的 BrowseComp (2025) 和 Tau2-bench (2025)
    • 这展示了强大的推理时 Scaling 能力(inference-time scaling capabilities.)
    • 这些进步主要归因于在强化训练期间,此类任务中存在定义明确的奖励信号
  • By Contrast,针对大语言模型的开放式评估基准相对较少
    • 代表性的例子包括 LMSYS Chatbot Arena (2023)、 MT-Bench (2023) 和 AlpacaEval (2023),但这些基准通常依赖于 LLMs 或人类专家作为 Grader ,这带来了潜在的偏见和可扩展性问题
  • HealthBench 是一个医学领域的开放式评估基准,包含 5000 个对话实例,其模型回答根据 Task-specific Rubric 进行评估,论文主要关注 HealthBench ,原因如下:
    • HealthBench 的基准数据由具有临床实践经验的医师标注,确保了正确性和领域专业知识,因此与 LMSYS Chatbot Arena (2025) 相比减少了偏见
    • HealthBench 包含一个由 1000 个问题组成的 HealthBench Hard 子集,前沿模型在该子集上的得分尚未超过 50% ,这使其适合研究开放式回答中的推理
    • HealthBench 提供了一个元评估(在论文中称为 HealthBench Meta ),该评估使用宏观 F1 分数来量化 LLM Grader 与人类医师之间的差异

Meta Evaluation of Open-Source Models on HealthBench

  • HealthBench 依赖闭源模型 GPT-4.1 进行评分,这对评估的可重复性和训练的可行性提出了挑战
    • 因此,论文使用不同规模的开源模型进行 HealthBench 评估
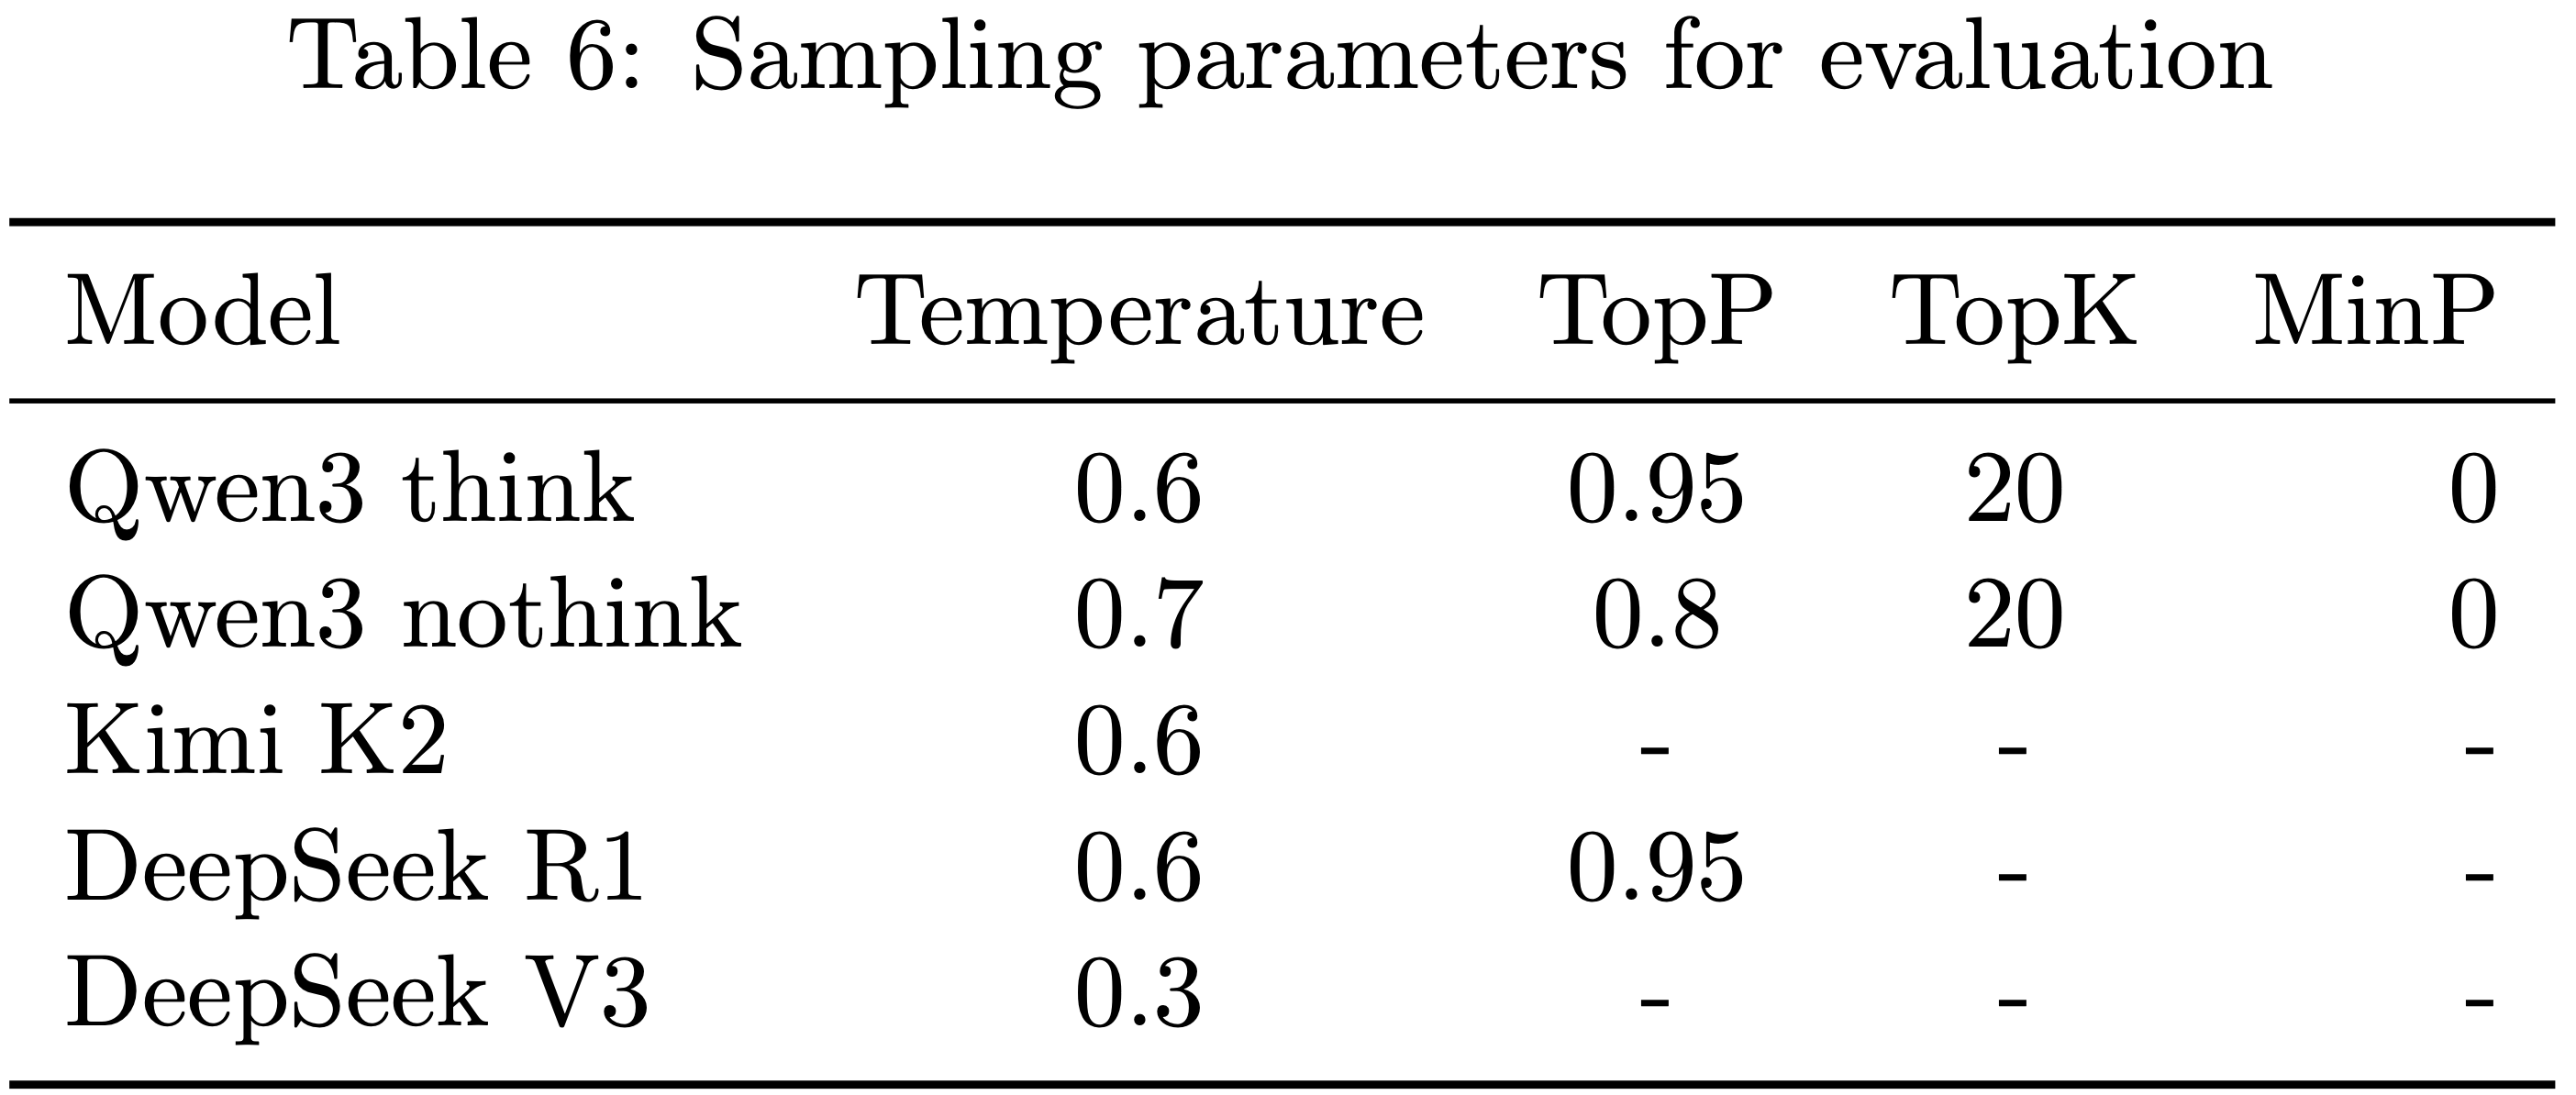
    • 论文使用 simple-evals 进行评估,采样参数详见附录 A.1
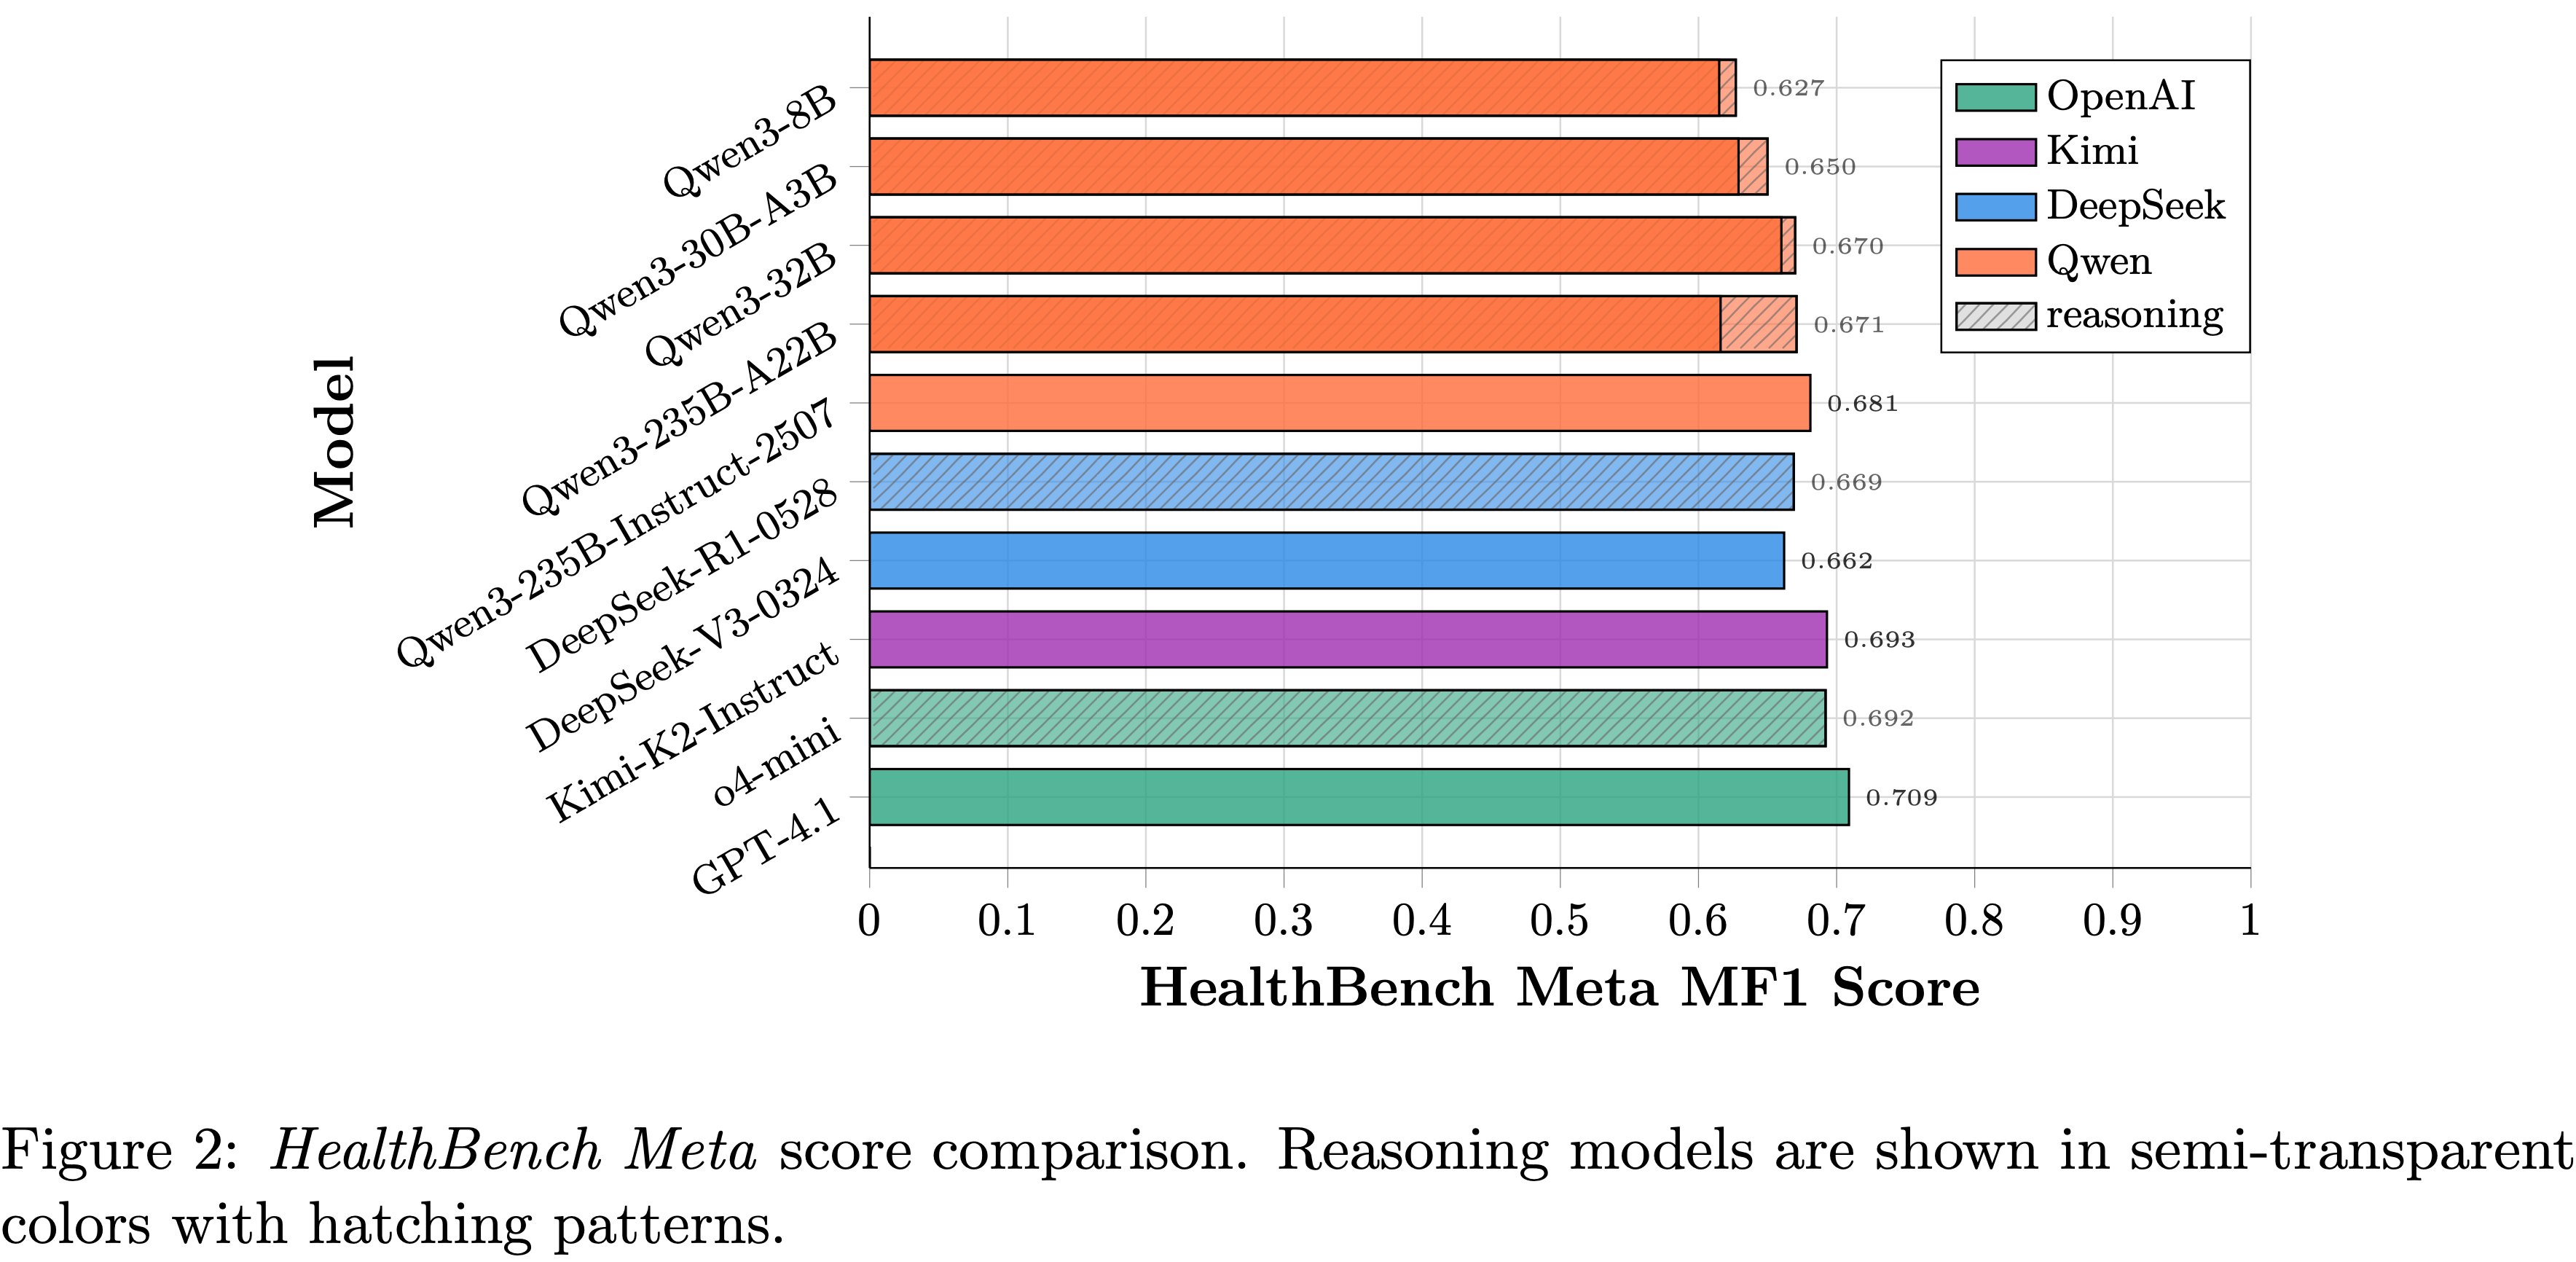
  • 如图 2 所示,虽然 GPT-4.1 仍然是最强的 Grader (0.709),但开源模型正在逐步追赶
    • 例如 Kimi-K2-Instruct (0.693) 和 Qwen3-235B-Instruct-2507 (0.681),并且呈现出模型越大得分越高的趋势
    • Notably,对于 Qwen3 的混合推理模型,无思考模式(nothink mode)的得分低于思考模式(think mode)
      • 这种性能下降在 MoE 模型中尤为明显,Qwen3-235B-A22B 下降了 0.055
      • 理解:
        • 图 2 中,nothink/think 是在同一个图上的, 模型也相同,只是灵活取消了 think 作为 nothink
        • 这里的 nothink 主要是只同一个模型既可以 think 又可以不 think 时的 nothink 选项;与传统的 nonthinking 模型不完全一致
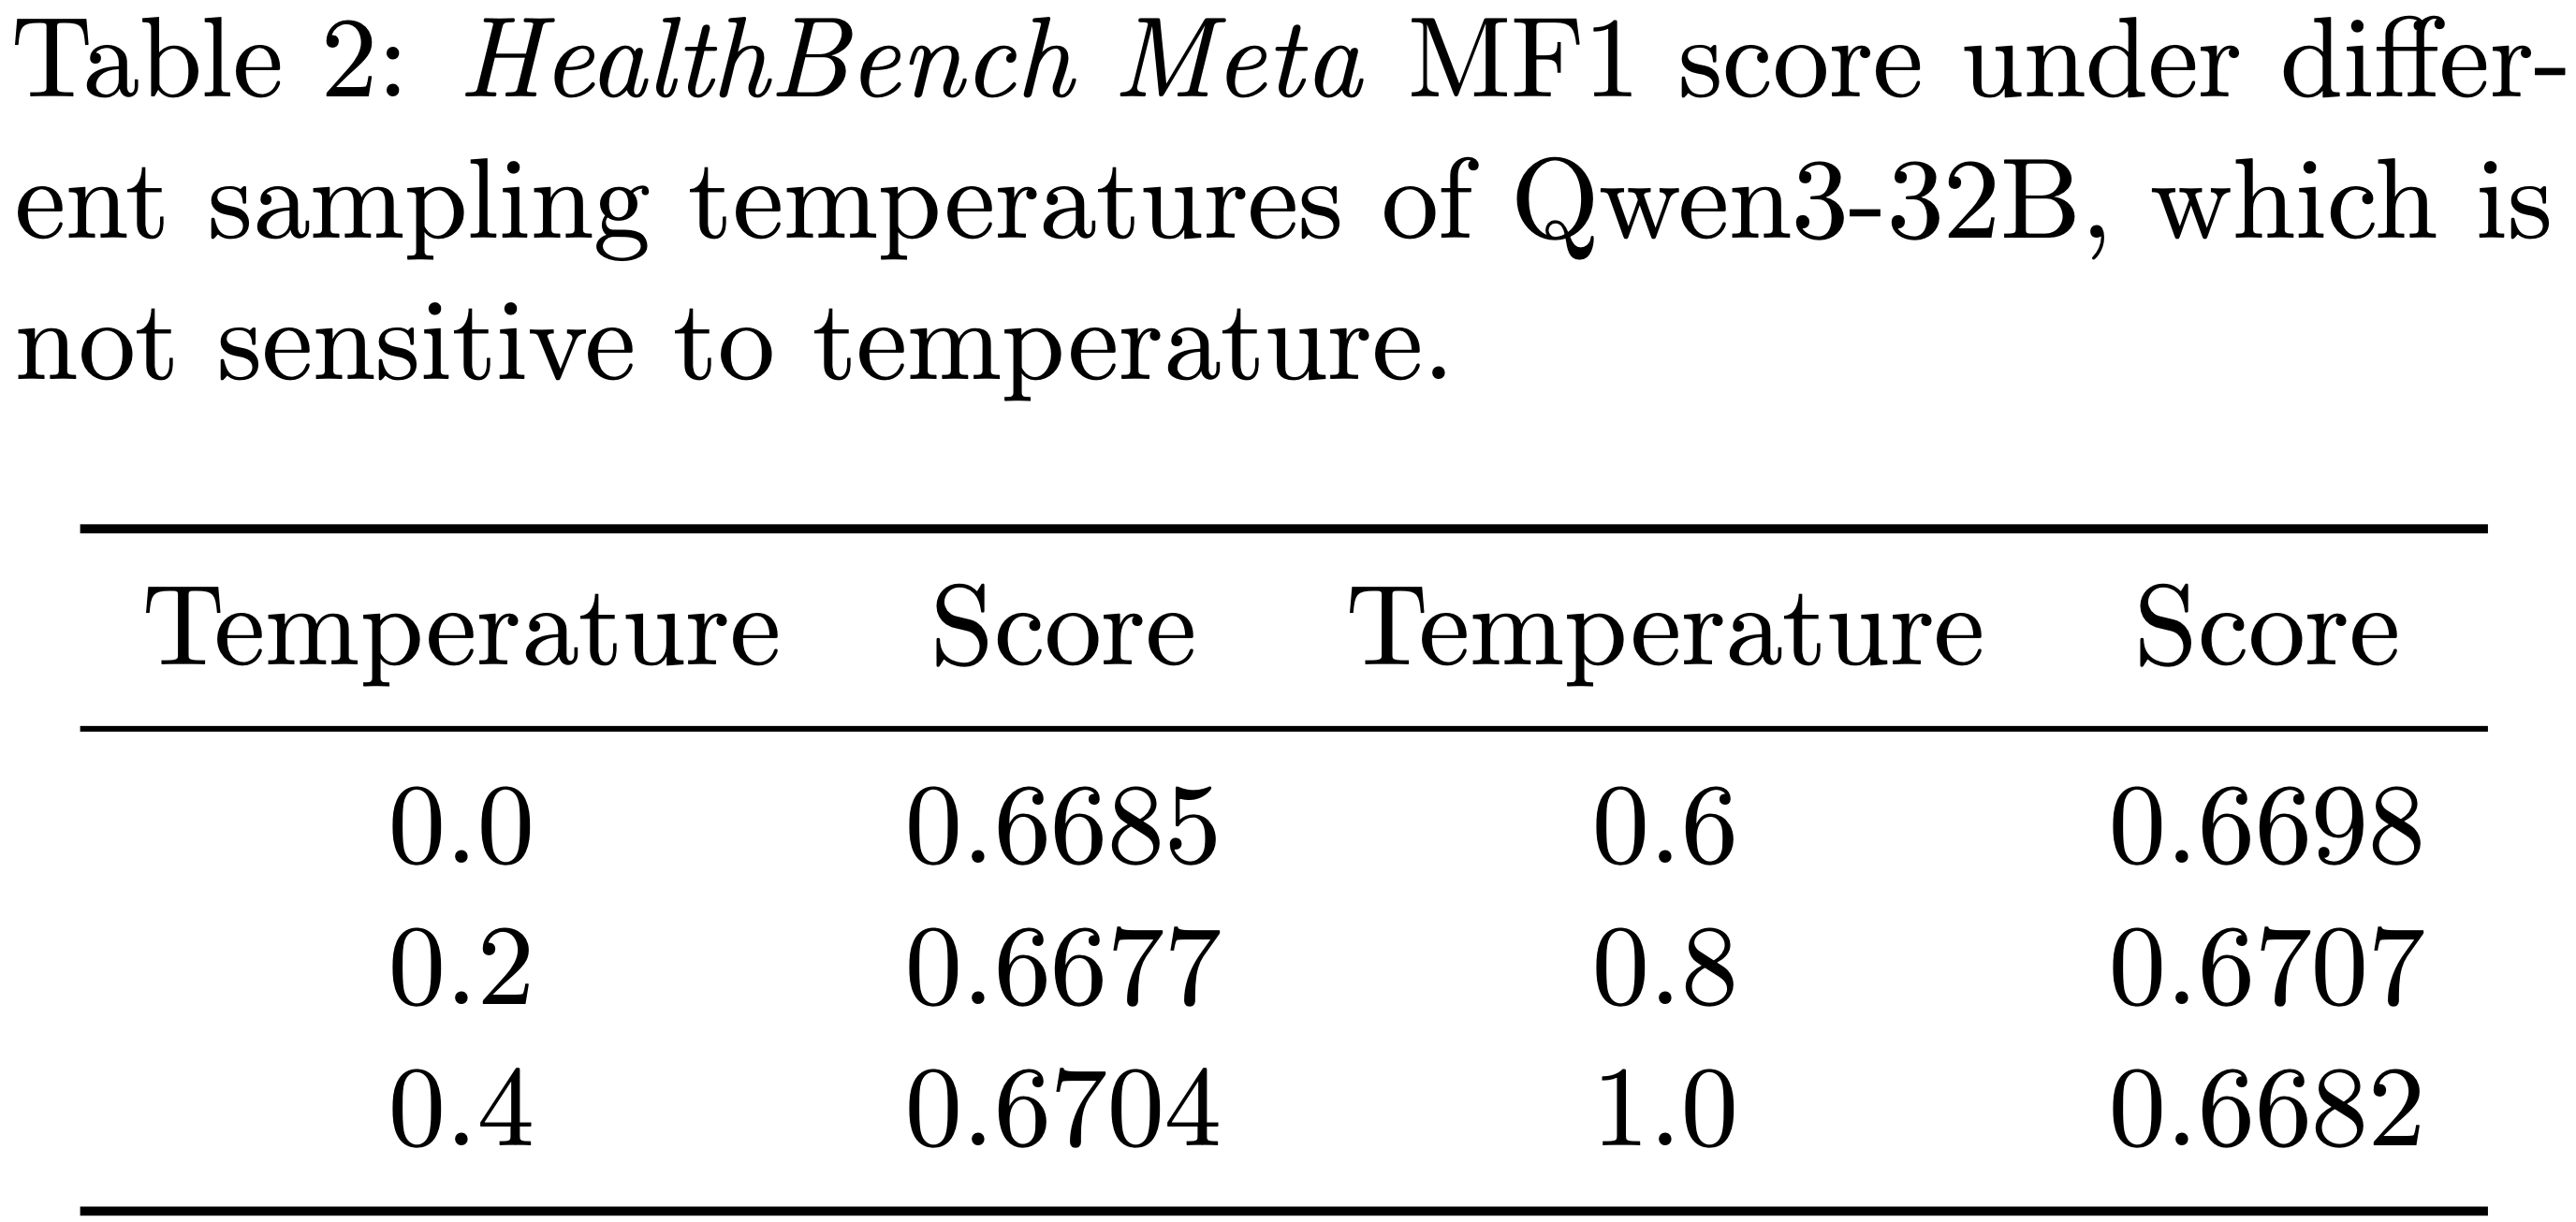
  • 论文还测试了 Qwen3-32B 在不同采样温度下的评分能力,如表 2 所示
    • 结果表明,Qwen3-32B 在评分能力上对采样温度不敏感,得分在 0.670 左右波动
    • 理解:这里给了个很好的实例,调整模型的采样温度实际上不一定影响很大(表 2 中从 0.0 到 1.0 都试了,分数几乎没有太大变化)
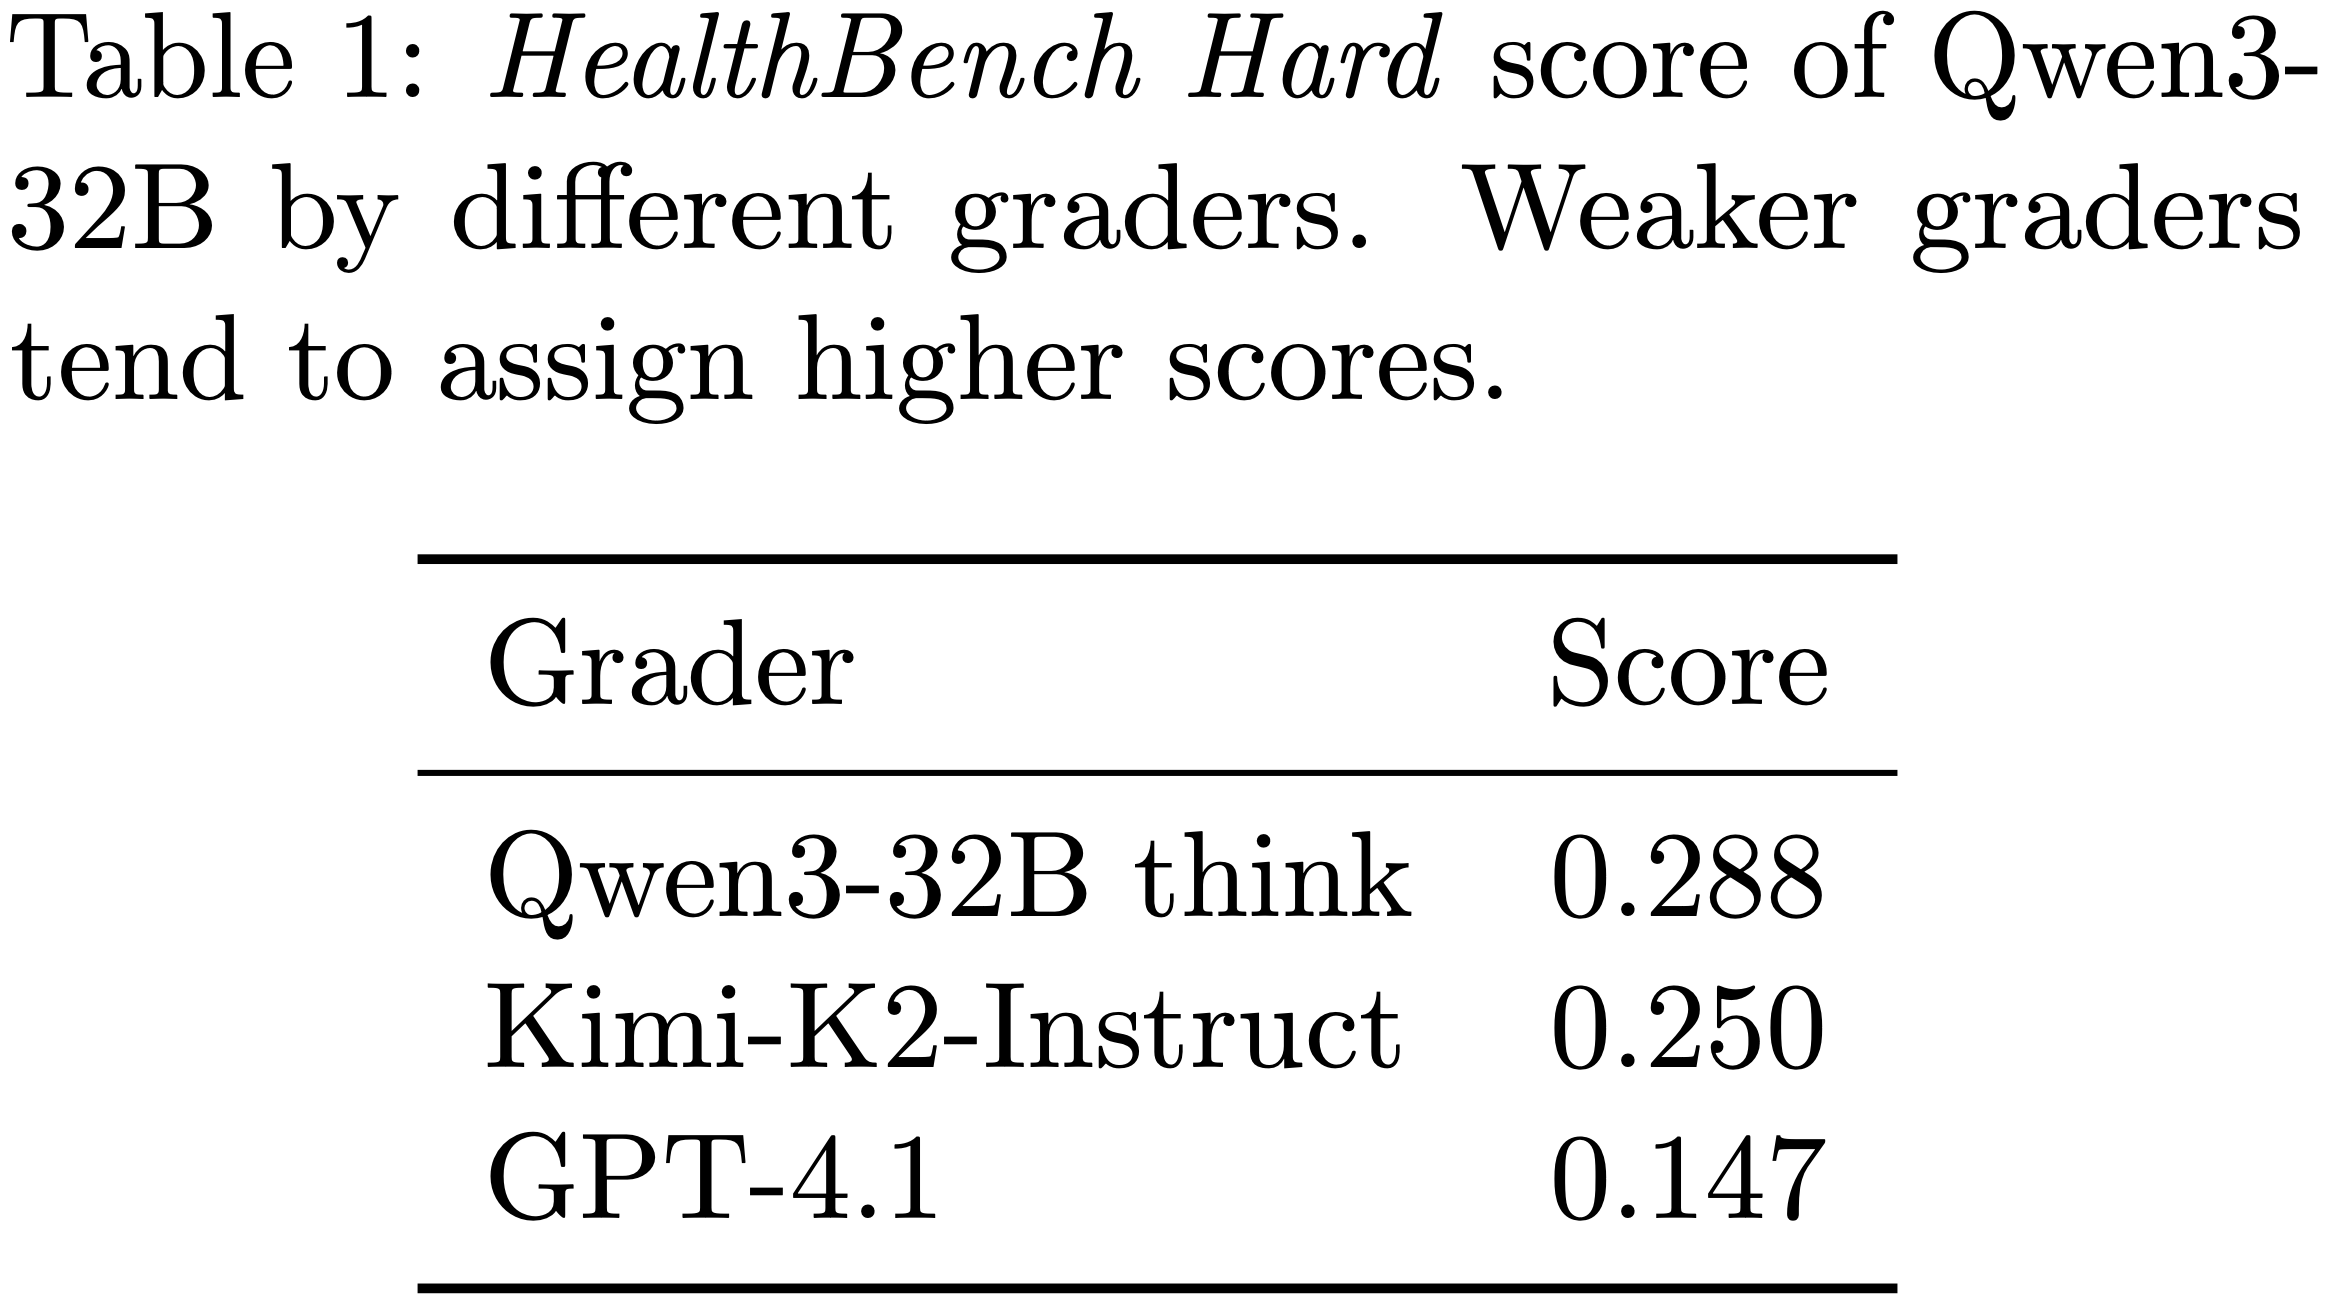
  • Furthermore,论文使用 GPT-4.1、Kimi-K2-Instruct 和 Qwen3-32B 自身分别作为 Grader ,以思考模式评估 Qwen3-32B 作为采样模型
    • 如表 1 所示,随着 Grader 能力的增强,Qwen3-32B 在 HealthBench Hard 上的得分降低,这表明较弱的 Grader 往往会由于评估错误而给出更高的分数
Preliminary Experiments

  • 论文进行了初步实验,以研究使用开源模型作为 Grader 来训练开放式推理任务的可行性
  • 除非另有说明(Unless otherwise specified),后续章节中的实验训练数据和参数均与本节介绍的一致
Models and Datasets
  • 如图 2 和表 1 所示,Qwen3-32B 是一个合理的选择
  • 在后续的 Self-rewarding 实验中,论文验证了即使是较弱的 Qwen3-8B 也能取得良好的性能
  • 对于训练数据,论文将其分为两类:
    • 一类是基准和合成数据,其中每个 Prompt 都附带 Rubric 及其对应的分数;
    • 另一类是论文收集的 GPT-4.1 评分数据,用于判断特定 Response 是否满足特定 Rubric
  • 在整篇论文中,论文使用以下数据集术语:
    • Easy data :4000 个 HealthBench Easy 样本,除非另有说明,否则用于训练
    • Synthetic data :4000 个与 Easy 数据类似的合成生成样本
    • Scoring data :1000 个论文从先前评估中收集的 GPT-4.1 评分样本
    • Mixed data :Easy 数据和 Scoring 数据的组合,总计 5000 个样本
  • 在本节中,论文主要使用 Easy 数据进行训练,并在 HealthBench Hard 的 1000 个问题上评估模型的推理能力
    • 在后续的 Self-rewarding 实验中,论文也使用合成数据进行训练,但这并非论文重点

Training Details

  • SFT :
    • 由于 HealthBench 为大多数样本提供了理想的完成结果,论文首先在 Easy 数据集上进行 SFT。论文使用批大小为 64,学习率为 1e-5,序列长度为 4096,训练 3 个轮次
  • RL :
    • 论文使用 GRPO 算法,并采用 DAPO 的大部分参数
    • 论文通过 verl 实现,最大 Prompt 长度为 2048 个 token,最大 Response 长度为 6144 个 token,训练 Prompt 批大小为 32,每个 Prompt 生成 4 个 Response,训练 10 个轮次
      • 其他详细参数在附录 A.3 中提供
    • 论文使用生成式奖励模型(generative reward model,GRM)来评判每个 Rubric 是否被满足并相应赋分 ,奖励计算详见第 3.4.1 节
      • 本节实验中,GRM 是处于思考模式的静态 Qwen3-32B 模型
Reward Formulation for Reinforcement Learning
  • RL 的训练目标与 DAPO 类似,采用 clip-higher 策略、token 级别的梯度损失,并省略了 KL 惩罚项,其目标函数如下:
    $$
    \mathcal{J}(\theta)= \mathbb{E}_{(q,\mathcal{R})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G} \sim\pi_{\theta_{\text{old} } }(\cdot|q)}
    \left[\frac{1}{\sum_{i=1}^{G}|o_{i}|}\sum_{i=1}^{G}\sum_{t=1}^{|o_{i}|}\min \left(w_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(w_{i,t}(\theta), 1-\varepsilon_{\text{low} },1+\varepsilon_{\text{high} }\right)\hat{A}_{i,t}\right)\right] \tag{1}
    $$
    • \(\pi_{\theta}\) 是语言模型
    • \(q\) 是从 Prompt 集 \(\mathcal{D}\) 中采样的 Prompt
    • \(\mathcal{R}\) 是 \(q\) 对应的特定 Rubric 集
    • 每个 Prompt 生成 \(G\) 个样本的组
    • \(w_{i,t}=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\theta_{\text{old} } }(o_{i,t}|q,o_{i,< t})}\) 是重要性采样比率
  • Importantly,优势估计通过下式进行:
    $$
    \hat{A}_{i,t}=\frac{S_{i}-\text{mean}(\{S_{i}\}_{i=1}^{G})}{\text{std}(\{S_{i}\}_{i=1}^{G})} \tag{2}
    $$
    • 其中 \(S_{i}\) 是组中第 \(i\) 个样本的奖励分数
  • 对于每个样本,奖励分数 \(S\) 的计算方法是:
    • 对满足的每个 Rubric \(r_i \in \mathcal{R}\) ,由 \(\color{red}{\pi_{\theta_{\text{old} } } }\) 以生成方式进行判断(Prompt 模板与 HealthBench 相同),并赋予分数点 \(p_i\),将所有赋分累加,然后除以可能的总正分数点,最后将分数裁剪到 [0, 1] 范围
      $$
      S=\frac{\sum_{r_{i}\in\mathcal{R} }p_{i}\cdot\mathbb{I}(\color{red}{\pi_{\theta_{\text{old} } }}(r_{i}\text{ criteria_met}))}{\sum_{r_{i}\in\mathcal{R} }p_{i}\cdot\mathbb{I}(p_{i}>0)} \tag{3}
      $$
      • 特别注意:这里使用的 Rubric Verifier 是策略自身,即 \(\color{red}{\pi_{\theta_{\text{old} } } }\)
  • 这种方法与先前工作有两点主要不同:
    • 1)它使用针对任务的大量且多样化的特定 Rubric ,而非通用原则(rather than general principles);
    • 2)每个 Rubric 由 GRM 独立评分,提供了清晰、细粒度的(fine-grained)奖励信号
    • 奖励过程受原始 HealthBench 评估协议的启发
Preliminary Results
SFT degrades open-ended reasoning without chain-of-thought(不包含思维链的 SFT 会降低开放式推理能力)
  • 论文观察到,虽然训练损失持续下降,但验证损失在一个轮次后迅速增加,如图 8 所示(附录 A.2)
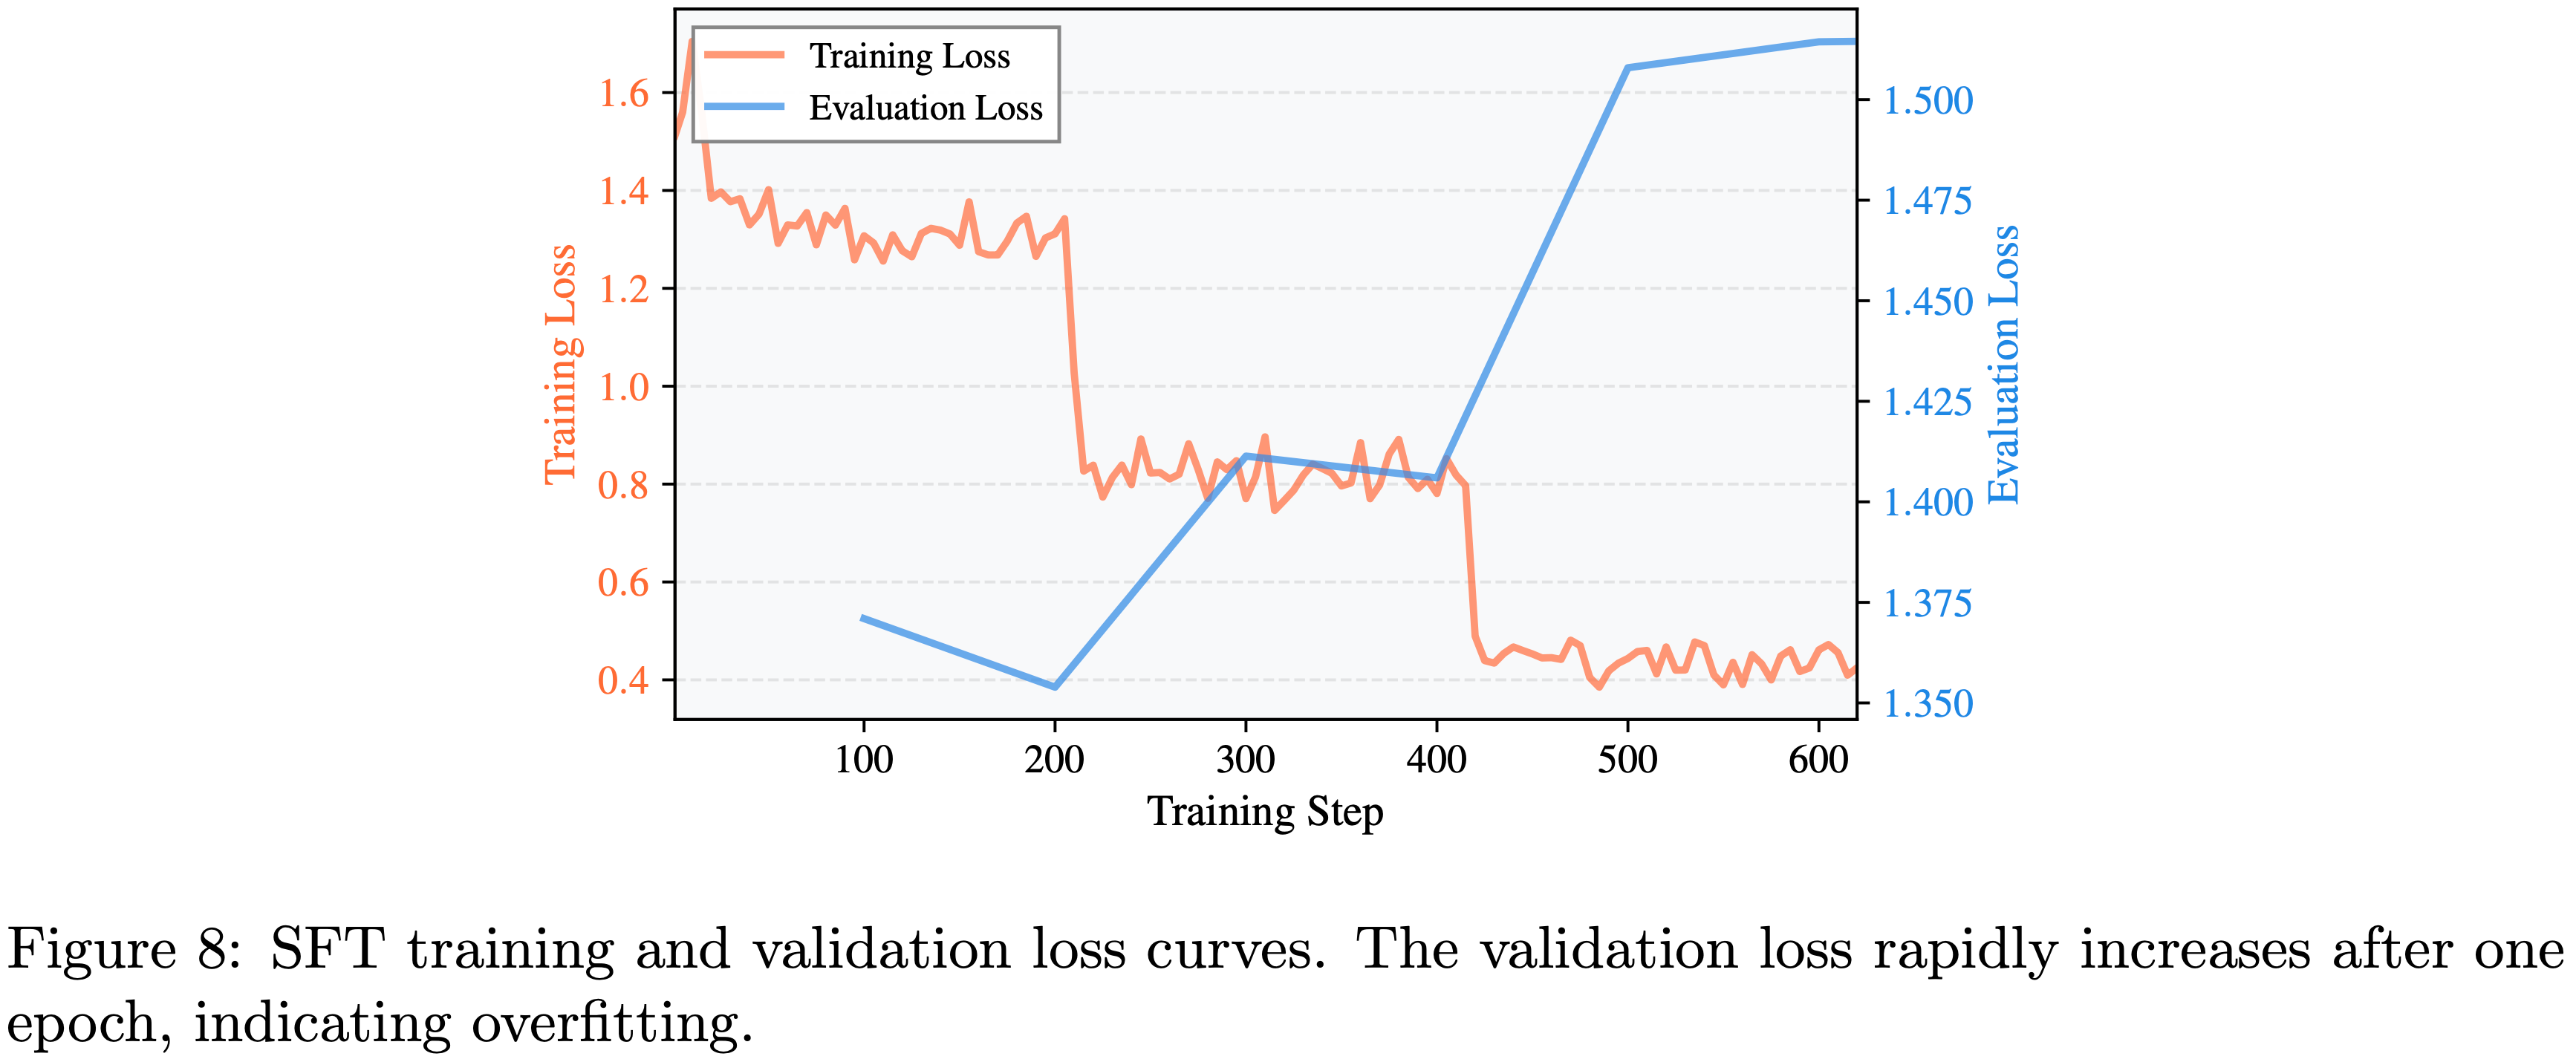
  • 使用 Kimi-K2-Instruct 作为 Grader ,论文发现 SFT 模型在 HealthBench Hard 上的得分,在验证损失最低的检查点(200 步后),从基础模型的 0.1988 下降到 0.0004,两者均在无思考模式下评估
    • 注意:0.1988 下降到 0.0004 这个分数在 图 8 中没有找到,是其他地方显示的吗?
  • 这一发现与之前的研究 (2024, 2025) 一致,特别是当 SFT 中未包含思维链推理时,模型即使在分布内的挑战性问题上也未能泛化
RL consistently enhances model performance even with limited data(数据有限的情况下,RL 也能持续提升模型性能)
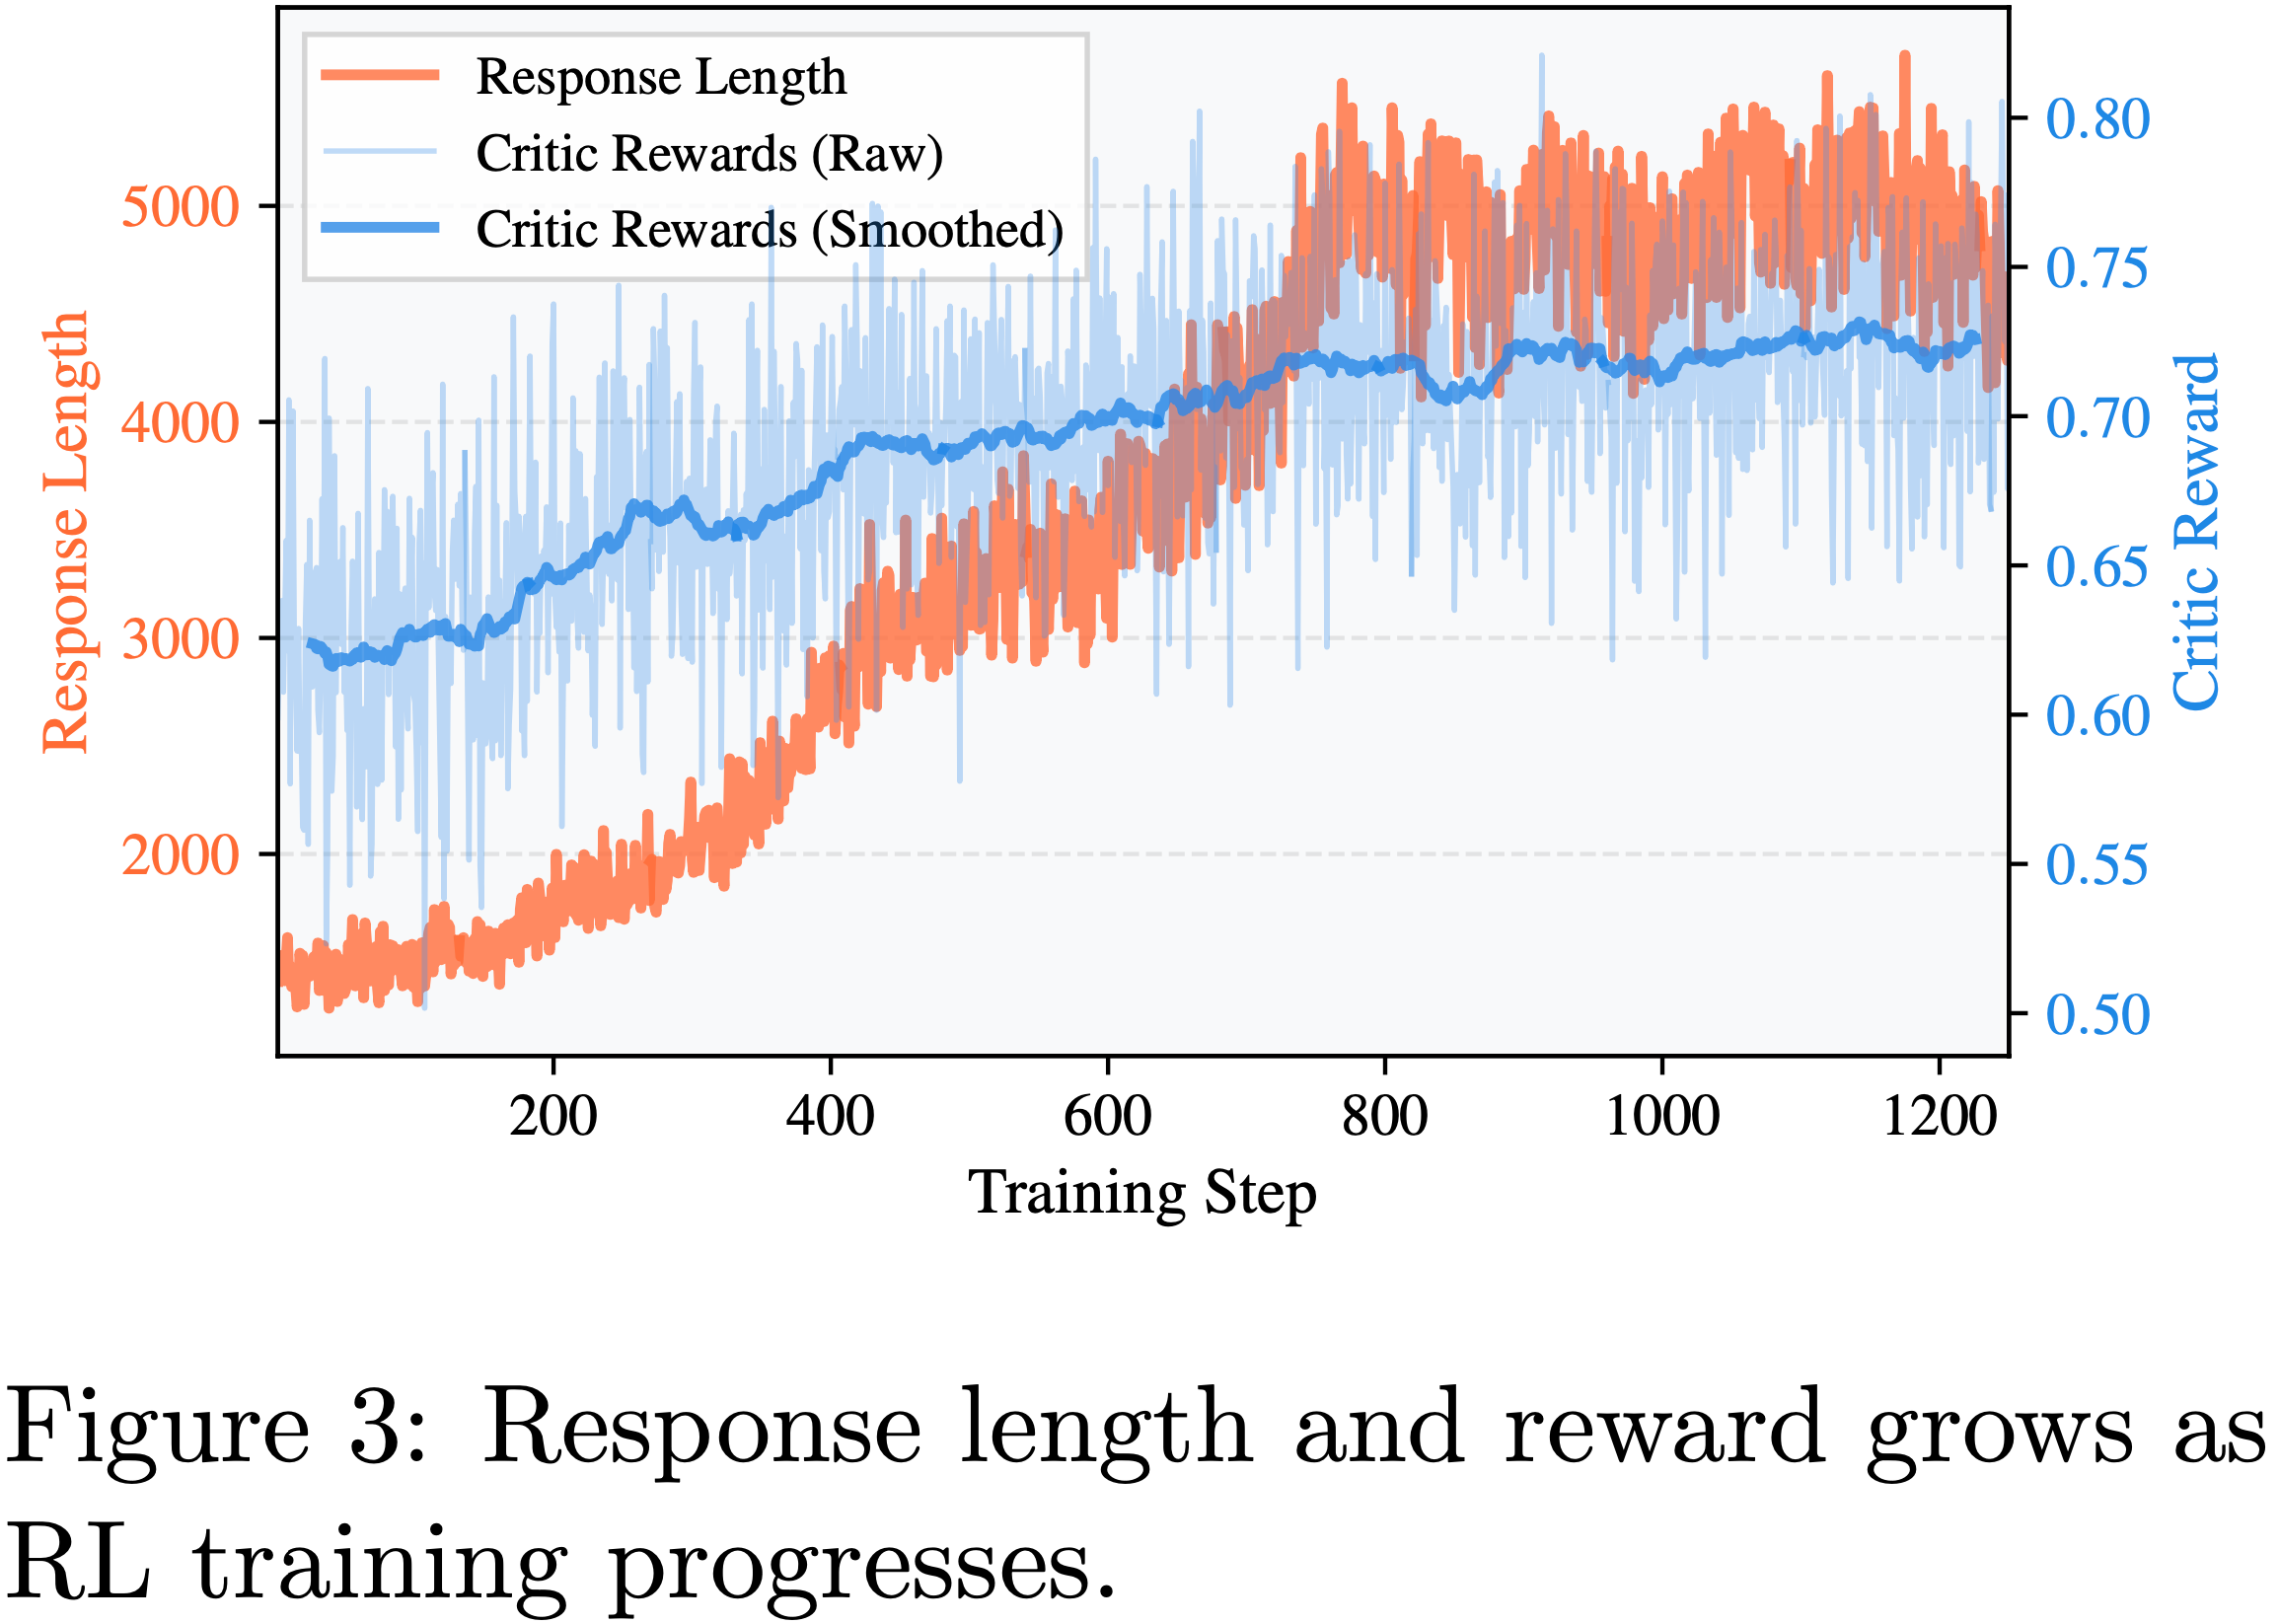
  • 如图 3 所示,训练期间模型的 Response 长度自发增加,奖励持续提升直至达到最大 Response 长度
  • Simultaneously,在 HealthBench Hard 评估中,模型性能持续提升,最终达到 0.446,显著超过 OpenAI o3 的 0.32 分,如图 4 所示
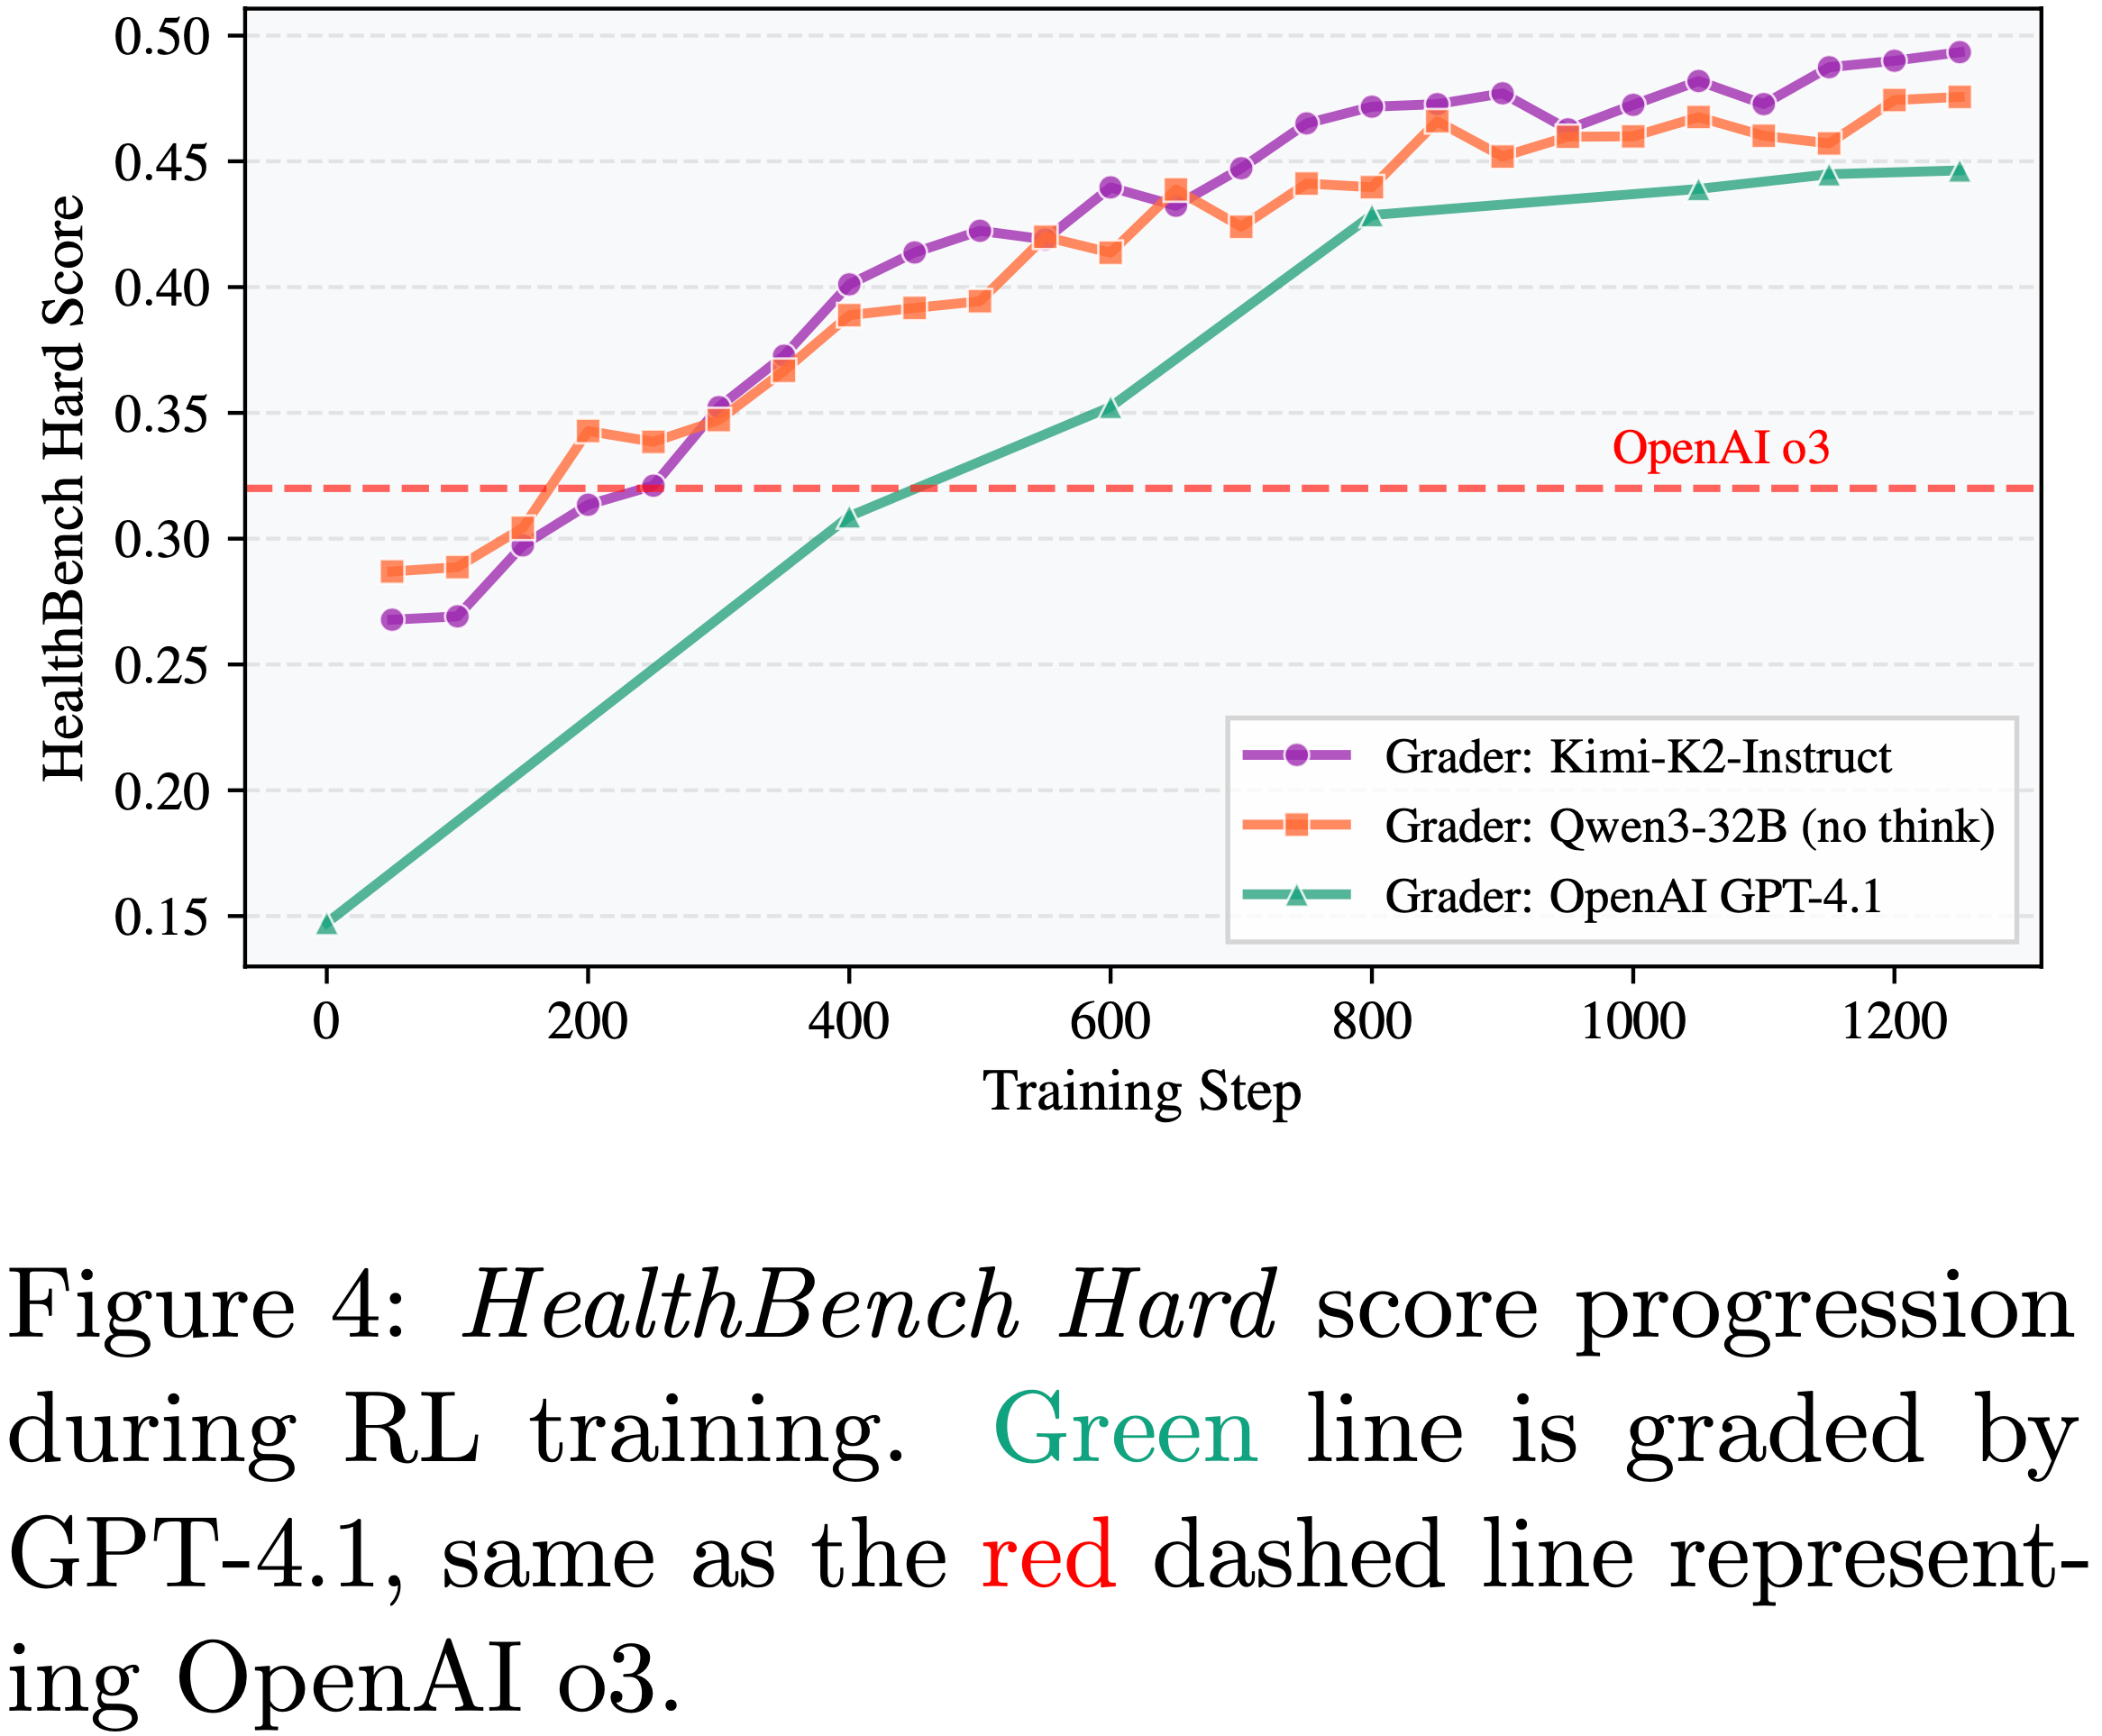
  • 论文观察到,虽然使用 Kimi-K2-Instruct 或 Qwen3-32B 作为 Grader 会得到更高的分数,但趋势保持一致
  • 因此,在后续实验中,论文主要使用开源模型作为 Grader 以降低 API 成本
  • 问题:这里的 RL 训练趋势中,Kimi-K2-Instruct 和 Qwen3-32B 的效果比 GPT4.1 还好,跟前面表 1 中(原始模型能力)的结论看起来不一致,是不是有问题?
Grading ability preserves after RL training
  • 论文评估了 RL 后模型的 HealthBench Meta 分数,发现思考和无思考模式的分数均有轻微提升,如表 3 所示
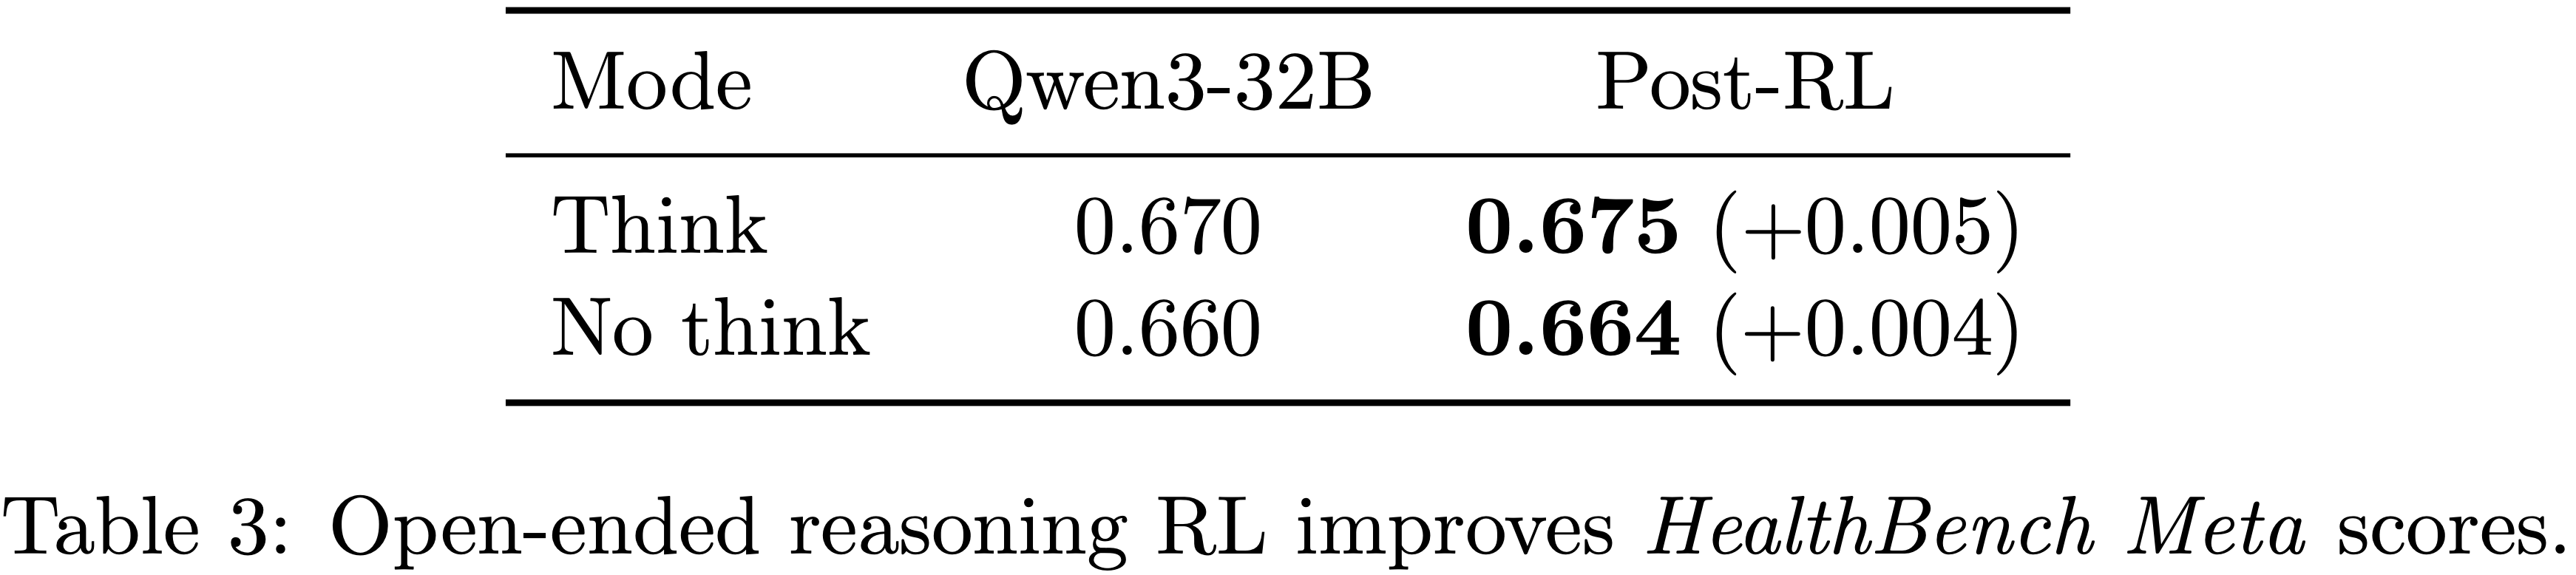
  • 这一观察结果自然引导论文考虑使用模型自身作为强化学习的 Grader

Method

  • 第 3.3 节验证了使用 Rubric-based RL 奖励来训练开放域推理任务的有效性

  • however,可能存在两个限制:

  • 训练效率瓶颈 (Training Efficiency Bottleneck)

    • 由于在 verl 中实现的 GRPO 采用 on-policy 训练方法,actor 训练必须等待所有样本的奖励计算完成
      • 这极其耗时:
        • 一方面,GRM 评分本身就很慢;
        • 另一方面,每个 Rubric 都需要进行判断,每个样本平均有 11 个 Rubrics,再加上每个样本采样 4 个 Responses
      • 在论文之前的实验中,论文部署了与训练 GPU 数量相同的 SGLang router 服务来进行 GRM 推理
        • 由于性能限制,单步训练时间中大约有 70-80% 消耗在奖励计算上
  • GRM 能力限制 (GRM Capability Constraints)

    • 一个自然的担忧是 GRM 自身的能力可能会限制 RL 训练的效果
    • 出于可扩展性的考虑,作者希望在不依赖比策略模型更大的模型的情况下取得更好的结果
      • 其背后的直觉与 (2024) 类似
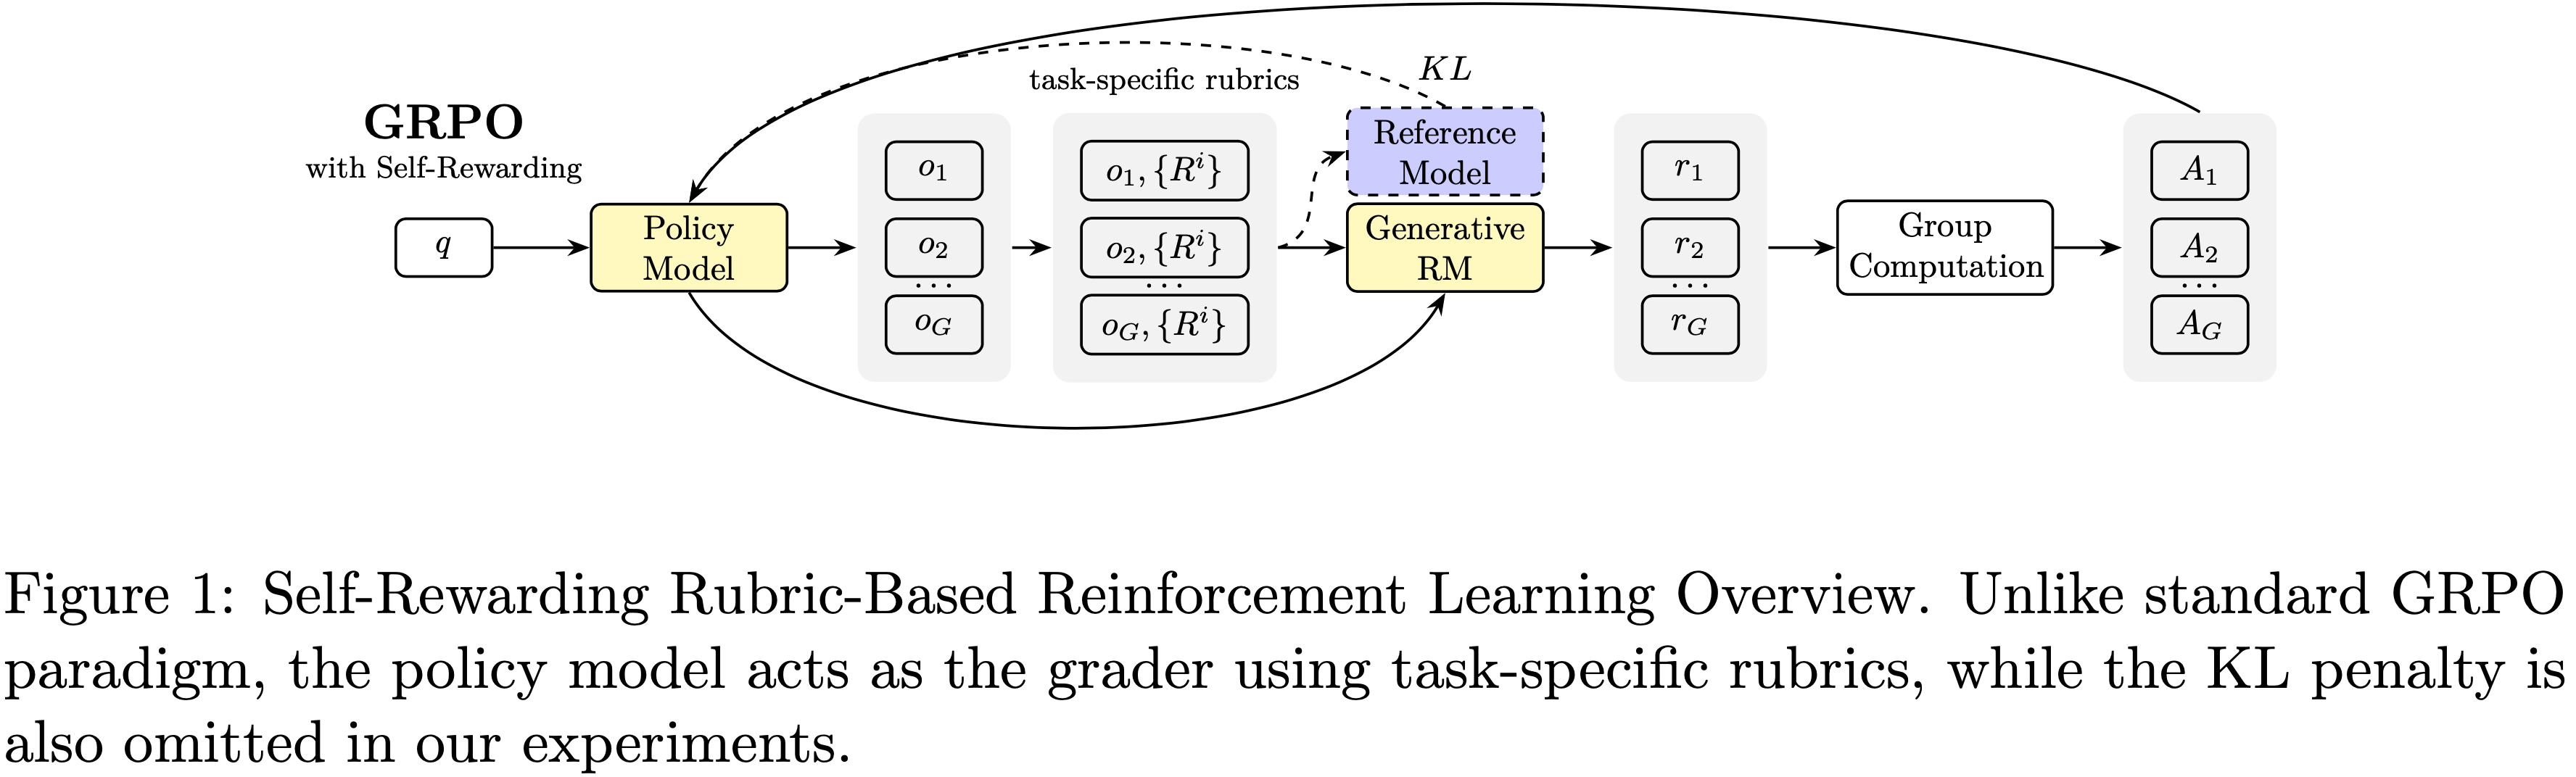
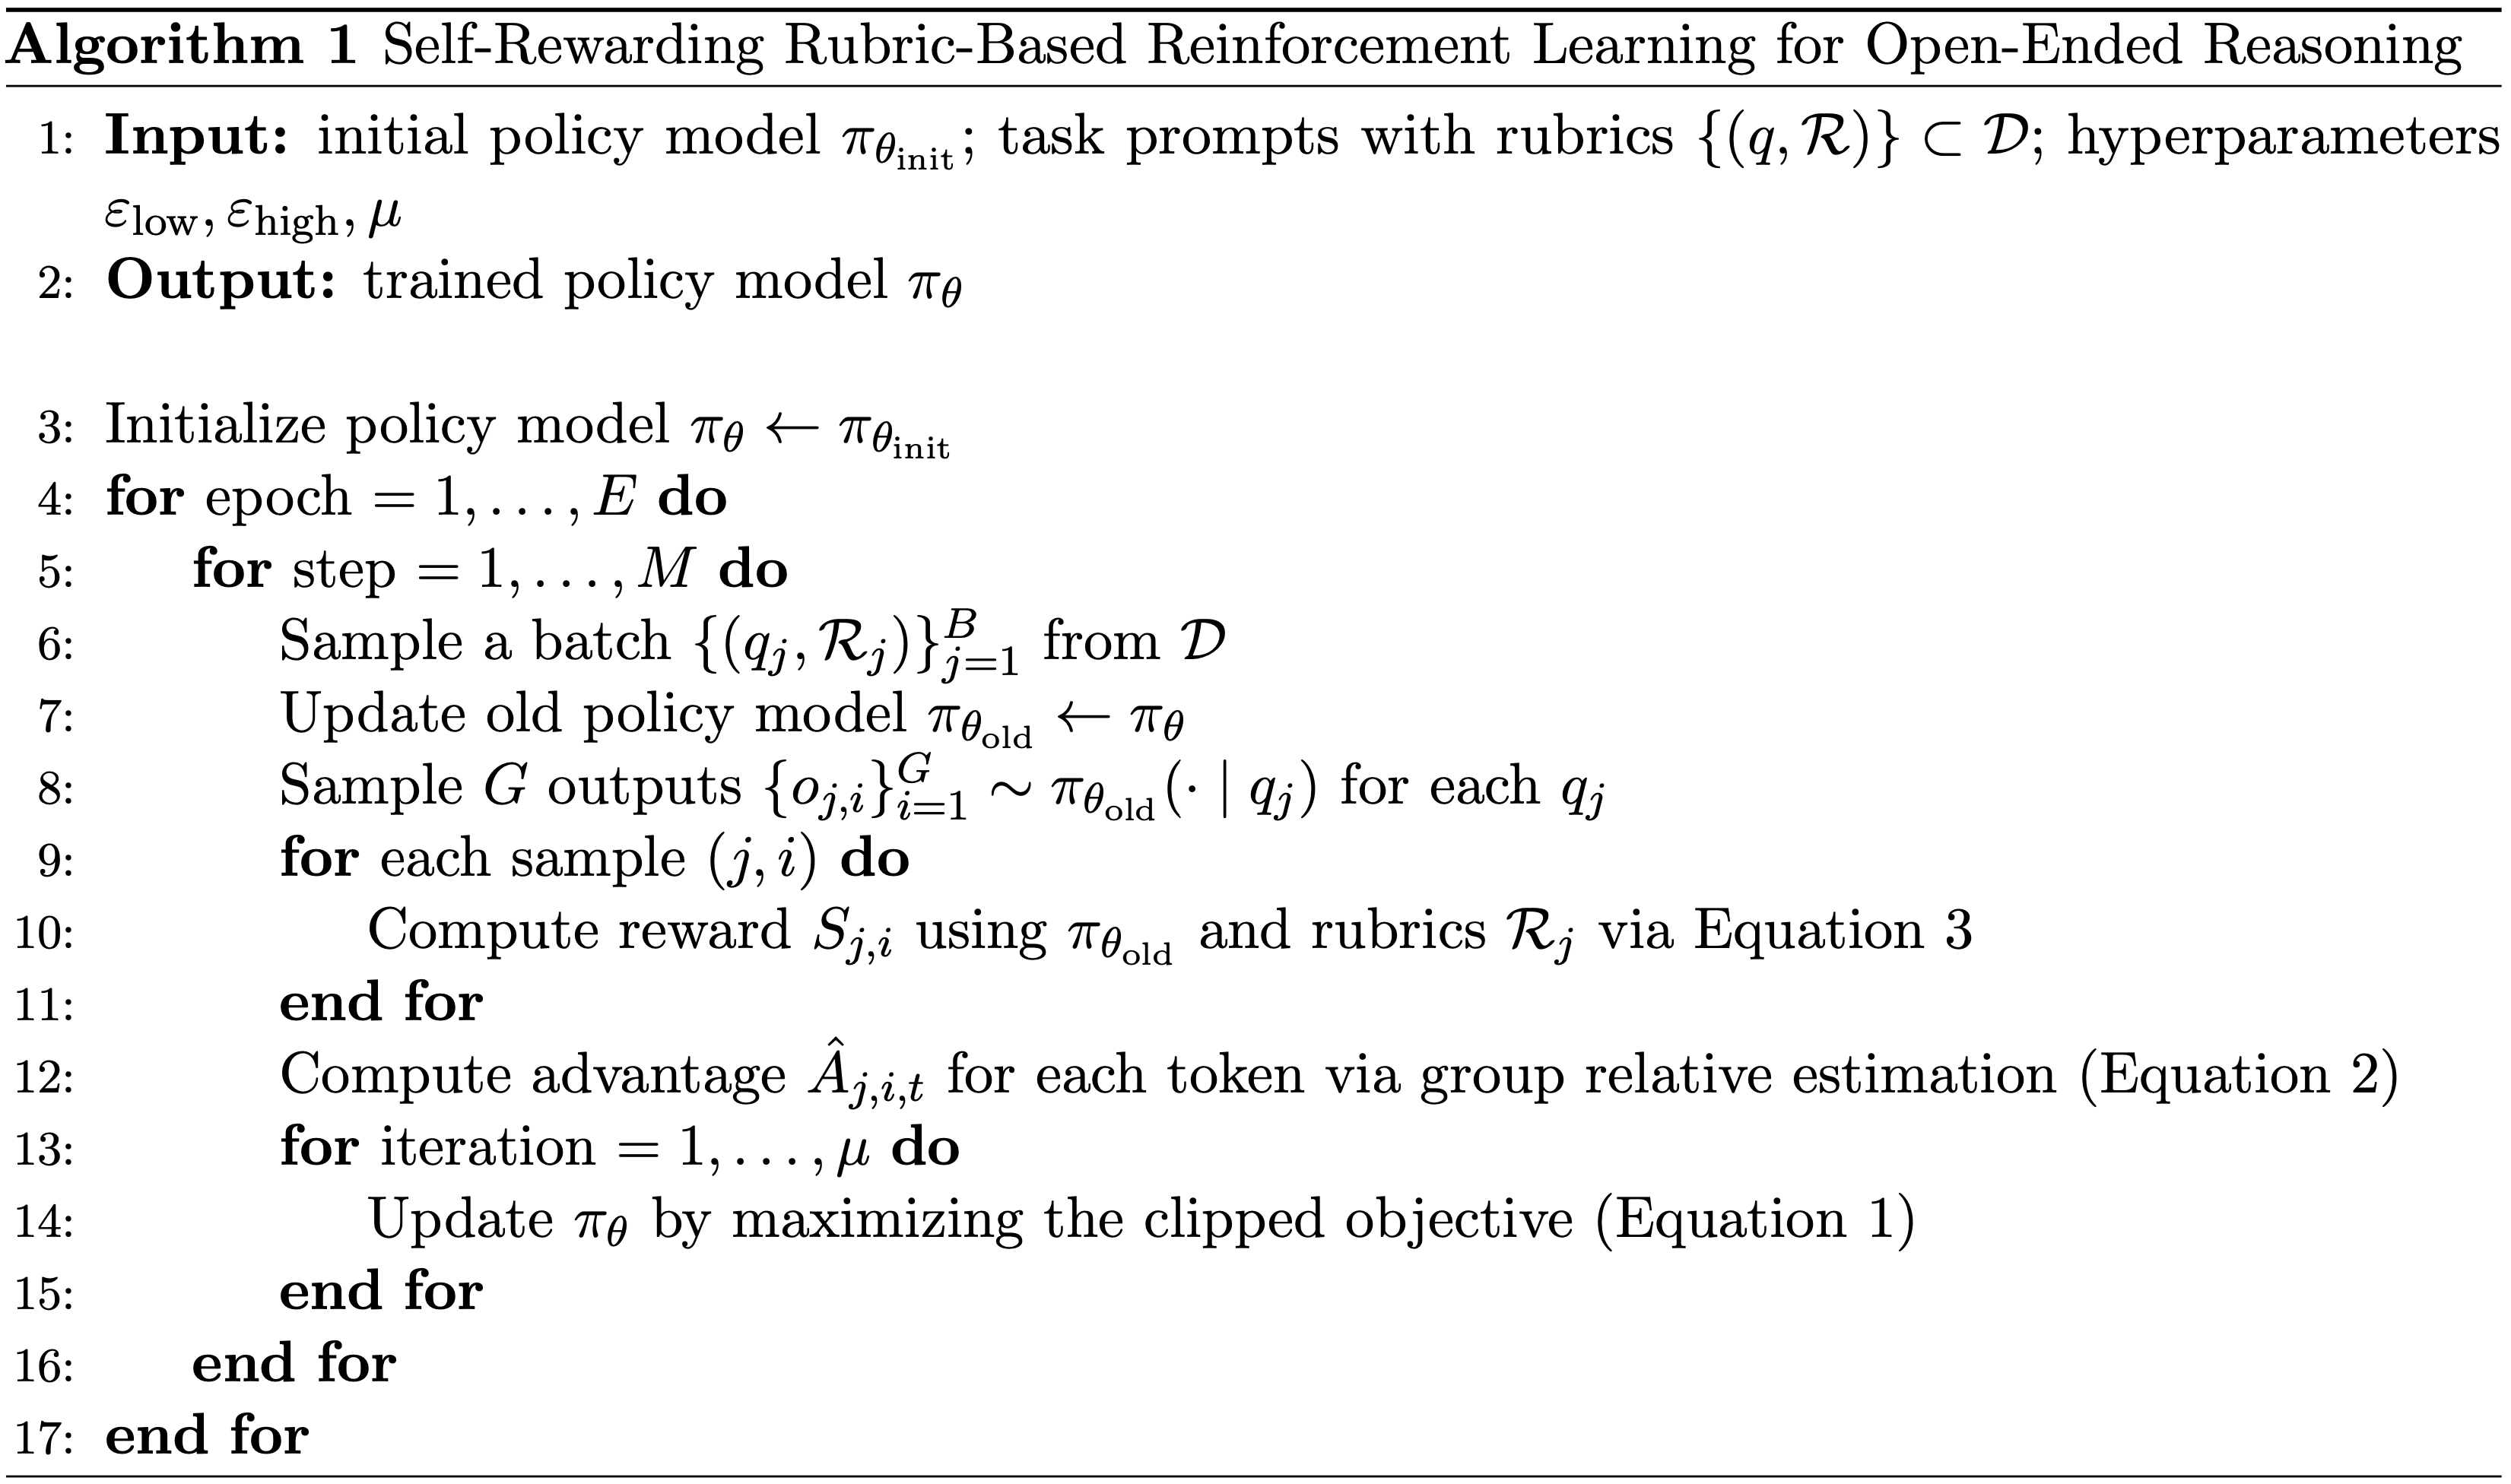
  • 根据论文初步实验观察到的模型评分能力在 RL 训练期间没有下降的现象,论文提出了 用于开放域推理的 Rubric-based RL Self-rewarding 强化学习 (Self-Rewarding Rubric-Based Reinforcement Learning for Open-Ended Reasoning) ,如图 1 和算法 1 所示

    • 与原始 GRPO 的关键区别在于,论文通过 Task-specific Rubrics 使奖励信号可验证,并使用模型自身作为奖励模型,在保持有效性的同时大大减少了评分时间
    • 通过使用模型自身作为奖励评估器,这种方法有两个优点:
      • 优点1:减少了训练所需的计算资源
        • 在使用相同数量 GPU 且无需额外推理资源的情况下,单步训练时间最多可减少 30%
      • 优点2:使得训练出的模型能够超越 Baseline 性能
  • 前文公式补充:
    $$
    \mathcal{J}(\theta)= \mathbb{E}_{(q,\mathcal{R})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G} \sim\pi_{\theta_{\text{old} } }(\cdot|q)}
    \left[\frac{1}{\sum_{i=1}^{G}|o_{i}|}\sum_{i=1}^{G}\sum_{t=1}^{|o_{i}|}\min \left(w_{i,t}(\theta)\hat{A}_{i,t},\text{clip}\left(w_{i,t}(\theta), 1-\varepsilon_{\text{low} },1+\varepsilon_{\text{high} }\right)\hat{A}_{i,t}\right)\right] \tag{1}
    $$

    $$
    \hat{A}_{i,t}=\frac{S_{i}-\text{mean}(\{S_{i}\}_{i=1}^{G})}{\text{std}(\{S_{i}\}_{i=1}^{G})} \tag{2}
    $$

    $$
    S=\frac{\sum_{r_{i}\in\mathcal{R} }p_{i}\cdot\mathbb{I}(\color{red}{\pi_{\theta_{\text{old} } }}(r_{i}\text{ criteria_met}))}{\sum_{r_{i}\in\mathcal{R} }p_{i}\cdot\mathbb{I}(p_{i}>0)} \tag{3}
    $$


Results

Self-Rewarding Effectiveness

The model’s scoring ability improves as response length increases(模型的评分能力随着 Response 长度增加而提高)
  • 论文在与第 3.3 节 Baseline 相同的训练设置下,对 Qwen3-32B 进行了 Self-rewarding 实验,使用模型自身作为 Grader (这是一个移动的目标)
    • 注:这里说的 Baseline 是 3.3 节(Preliminary Experiments)中提到的使用开源模型作为 Grader 的方案
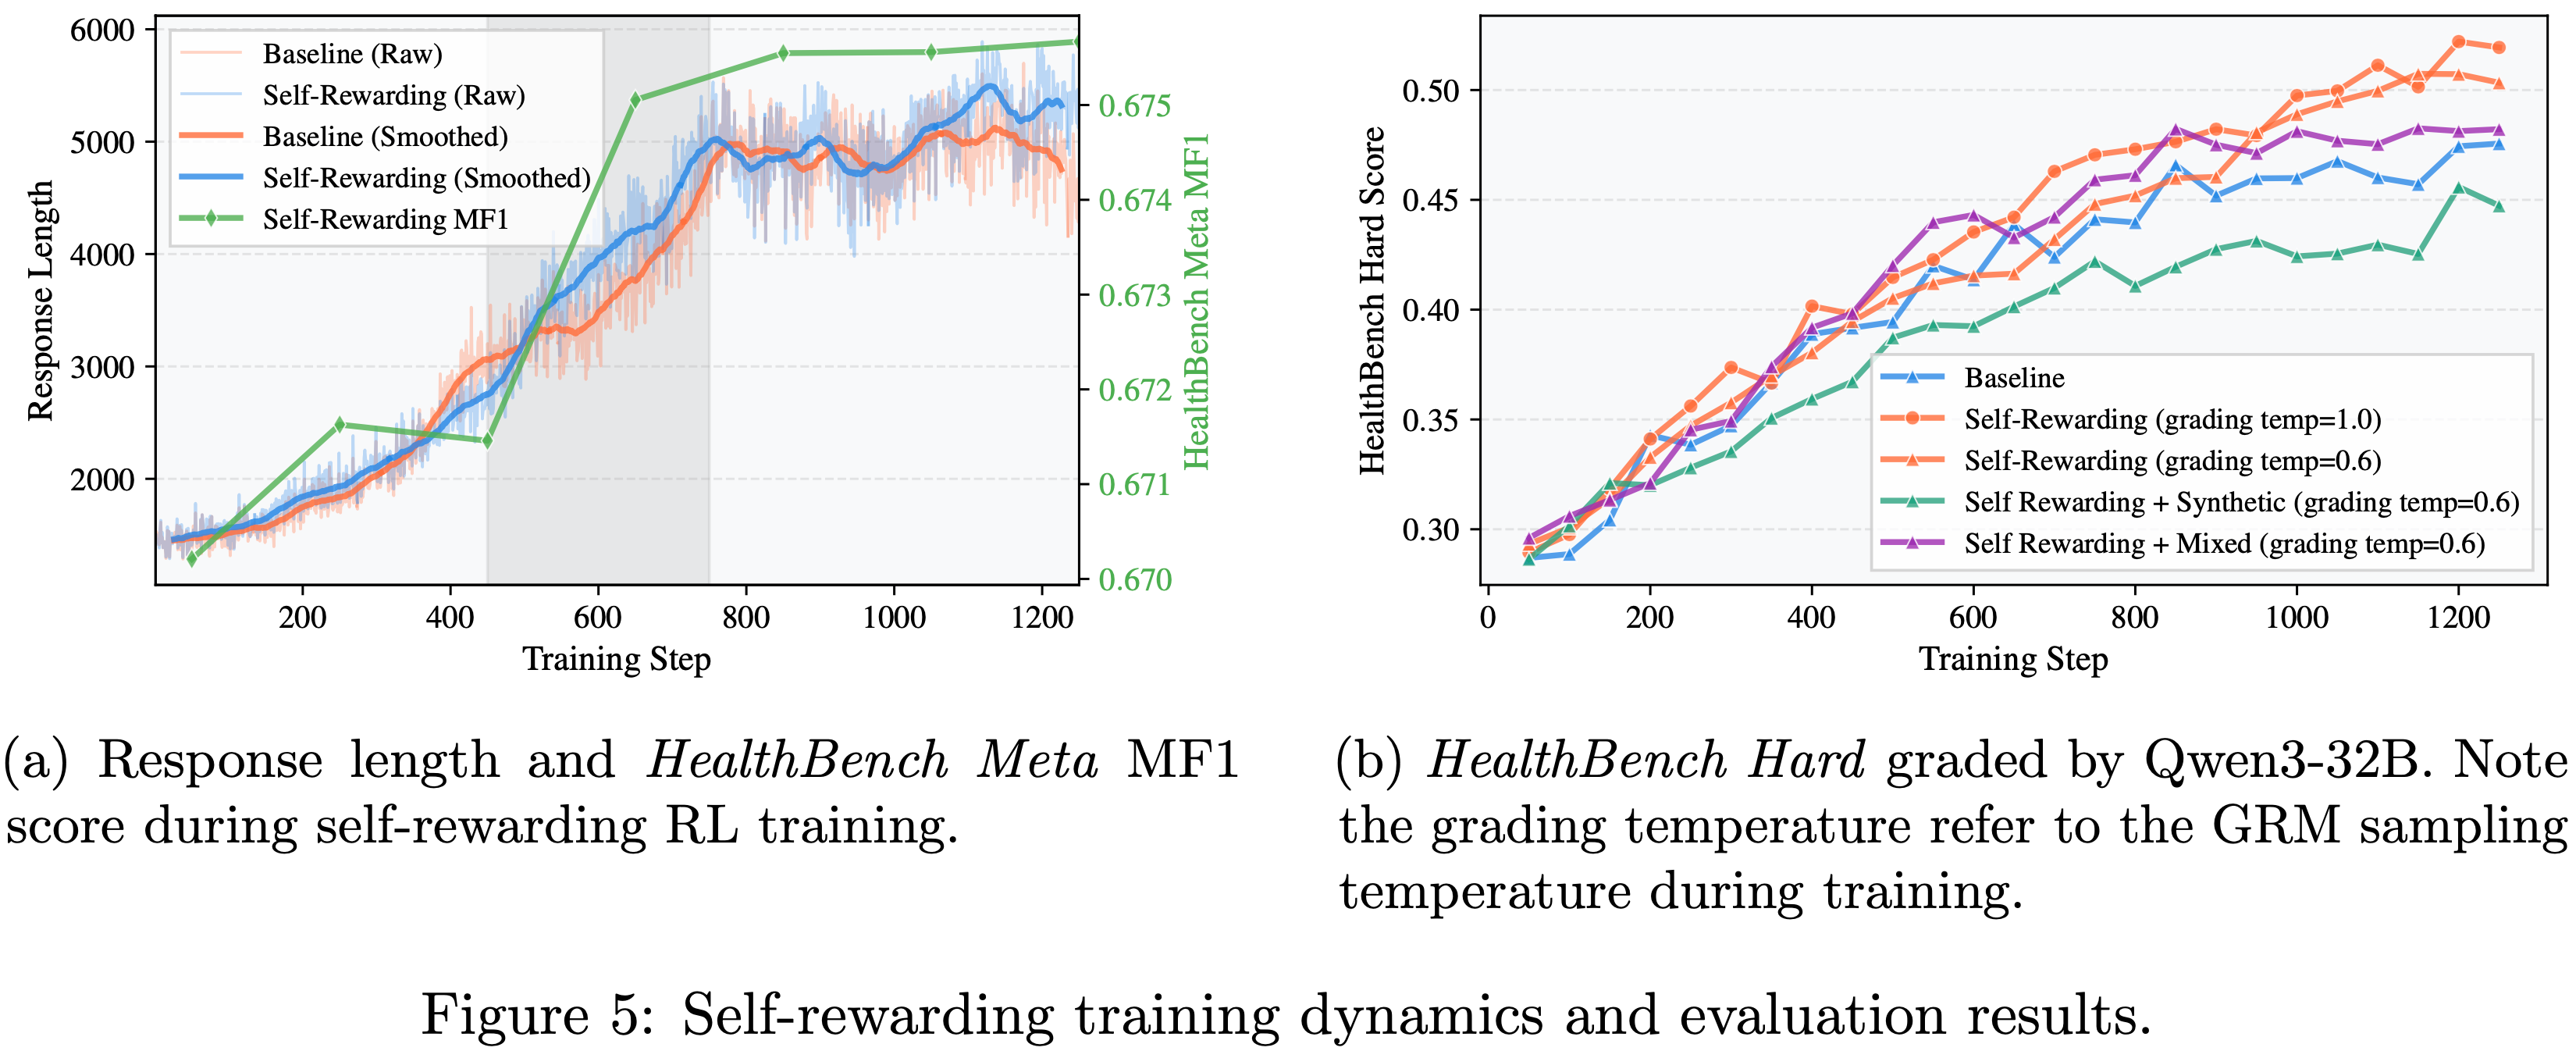
  • 由于训练集奖励或验证集分数是由不同的 Grader 评分的,论文无法直接与 Baseline 进行比较,因此论文在图 5a 中提供了 Response 长度的变化过程及其 HealthBench MF1 分数
    • 问题:找一个相同 Grader 来评分不旧好了?
    • 问题:MF1 分数是什么?
      • 回答:HealthBench 的 MF1 分数 是 Macro F1 score(宏 F1,Macro-F1) ,是该医疗评估基准中用于衡量模型分级器(grader)与人类医师评分一致性的核心指标,取值范围为 0 到 1,越接近 1 代表一致性越高,详情见论文附录部分
  • 从图 5 中可以看出:
    • 尽管论文没有显式地训练模型的评分能力,但评分能力并未下降,而是与 Response 长度同步变化,这反过来又提供了更高质量的奖励信号,形成了一个良性循环
      • 理解:其实看起来 MF1 分数的提升很小,累计只有 0.005 左右,其实不能算是看到了持续提升, 更像是持平
    • Especially,图 5a 中的灰色区域表明,与 Baseline 相比,它帮助模型生成了更长的输出
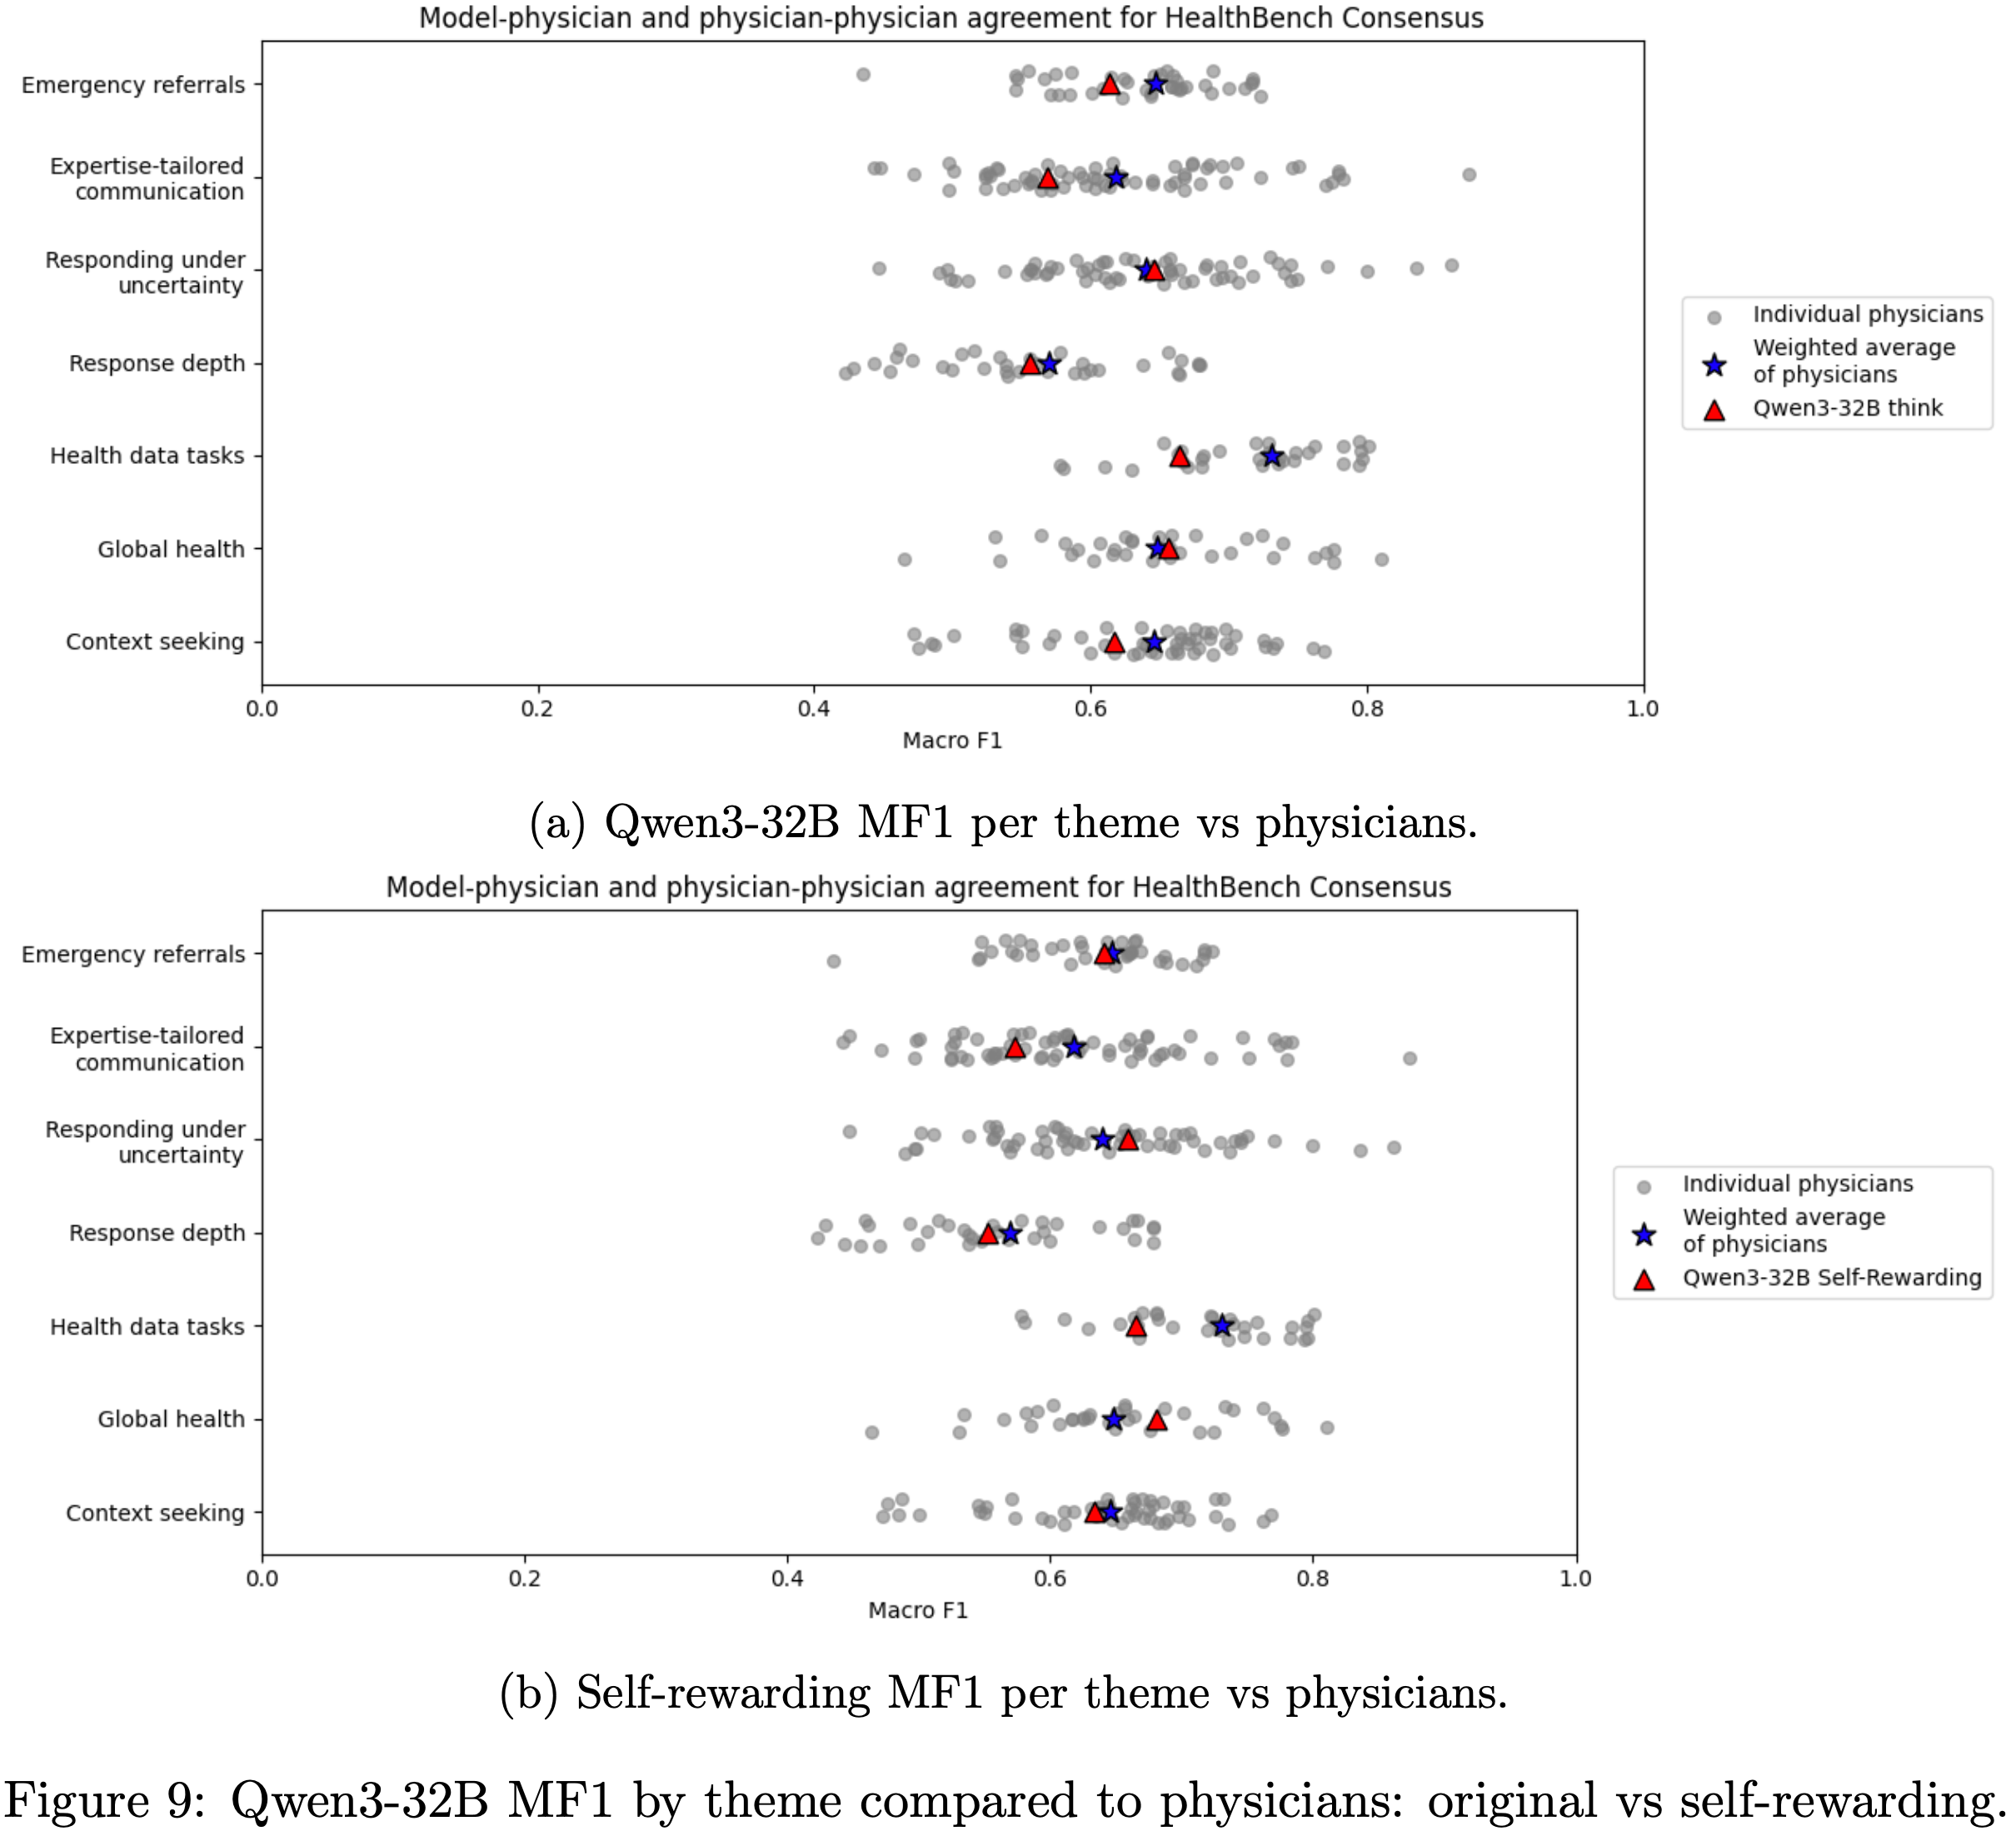
    • Additionally,通过与医生按主题比较 MF1,论文发现模型在大多数主题上都优于原始的 Qwen3-32B;
    • Notably,模型在全球健康和不确定性下响应 (Global Health and Responding Under Uncertainty) 方面超过了医生的加权平均值(见附录 A.4 的图 9)
Once the response length reaches its limit, self-rewarding further enhances the model’s reasoning performance(Response 长度达到限制后, Self-rewarding 能进一步提升推理性能)
  • 论文使用 Qwen3-32B 模型作为 Grader ,在 HealthBench Hard 上评估了实验,结果如图 5b 所示
    • 其中一次 Self-rewarding 运行的评分温度 (grading temperature) 设为 1.0(与 rollout 温度相同),而其他运行则保持建议的 0.6
      • 注:如表 2 所示,温度不应该影响评分性能
  • 最终结果显示所有配置都持续优于 Baseline ,而将评分温度设置为 1.0 时取得了最佳性能
    • 如图 5a 所示, Self-rewarding 比 Baseline 更早达到最大 Response 长度(均在 700-800 步内);
    • 然而,其在图 5b 中显示的 HealthBench Hard 分数持续增加,从而获得了相对于 Baseline 更好的最终结果
    • 理解: Baseline 的配置见 3.3 节(Preliminary Experiments)中提到的使用开源模型作为 Grader 的方案
  • 最后,论文使用 GPT-4.1 作为 Grader 进行了更准确的评估,结果如表 4 所示
    • 论文观察到所有 Self-rewarding 方法都优于 Baseline ,甚至超过了 GPT-5 的性能
  • 此外,论文发现将评分温度设置为与 rollout 温度相匹配会得到更好的结果,这与 Qwen3-32B 评估结果一致,达到了 0.500 的分数
Improvements are observed across most evaluation dimensions
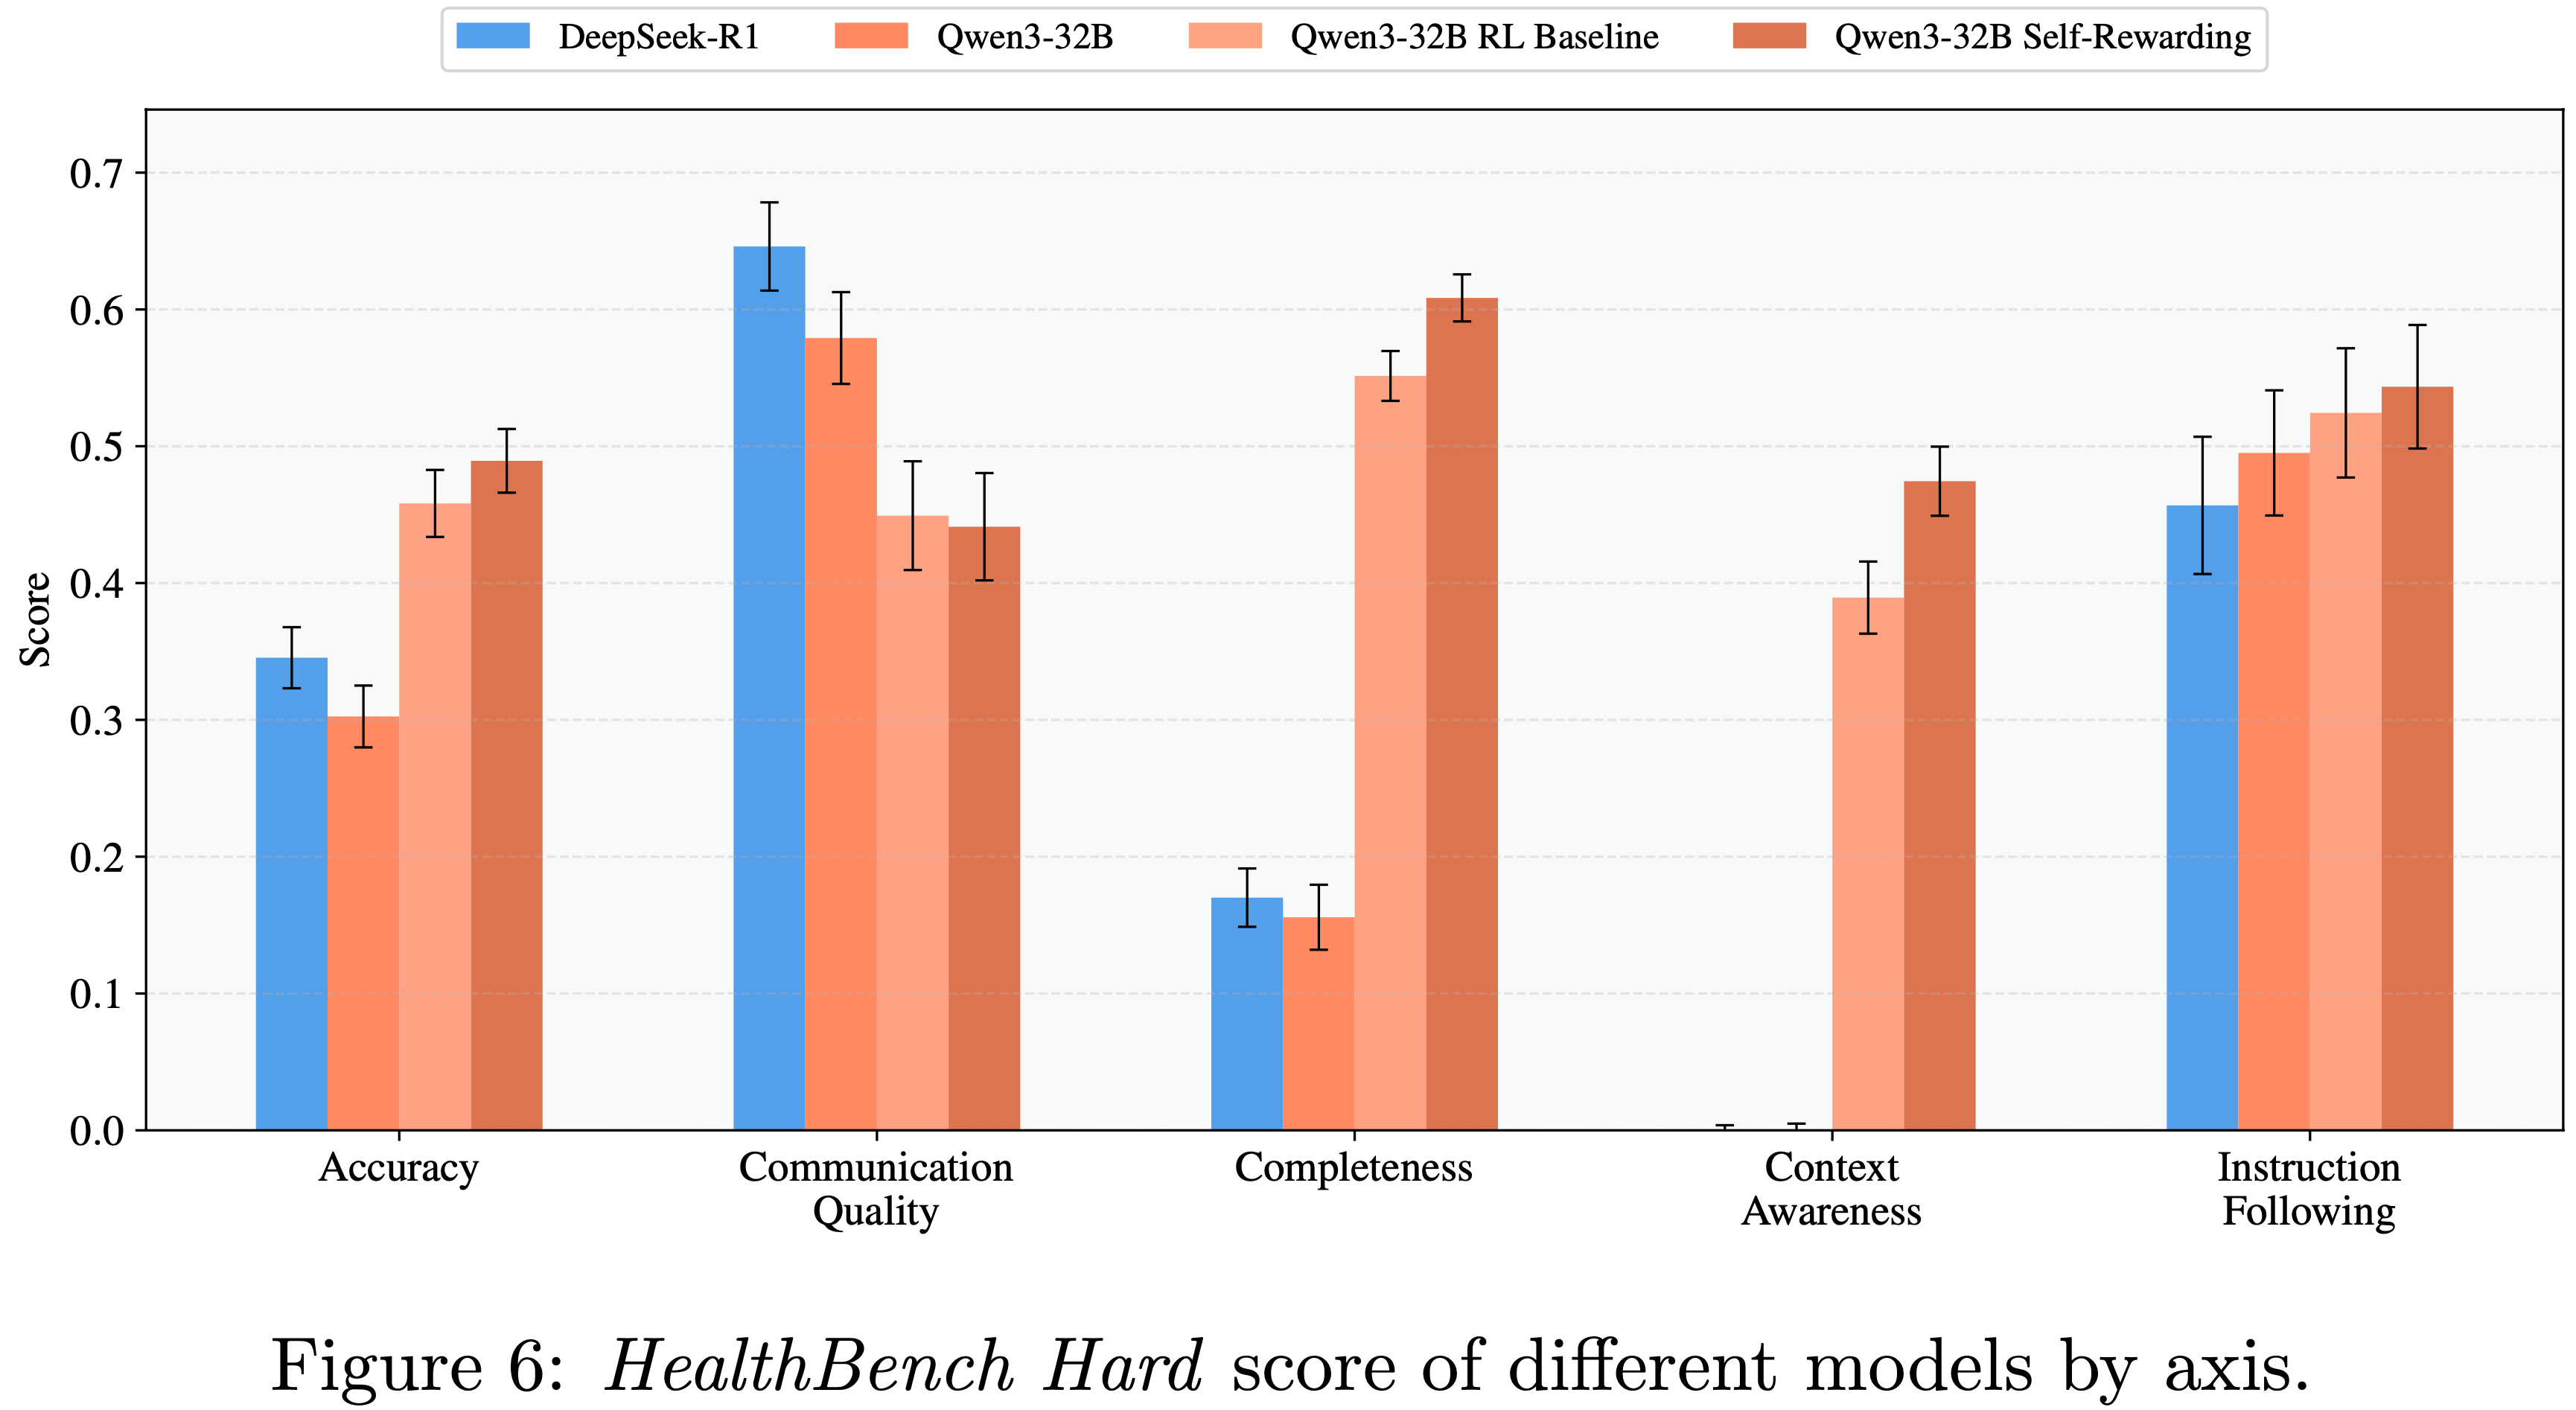
  • 论文分析了不同维度的分数变化,发现在完整性和上下文感知 (context awareness) 方面有显著改善,这对大多数模型来说都具有挑战性
  • 后者尤其要求模型“恰当地响应存在的上下文线索”,需要强大的上下文理解能力
  • 然而,随着输出内容变长,沟通质量 (communication quality) 方面出现了一个负面副作用
    • 即模型的表达变得不够简洁、清晰和易读
    • 这凸显了在开放性问题中需要进行权衡,并表明仍有大量的研究机会
  • 论文比较了原始 Qwen3-32B 模型和 Self-rewarding 模型的分数,发现 82.5% 的样本有所改进
    • 在改进的样本中,与其余样本相比,上下文感知 Rubric 的比例从 20.6% 下降到 17.5%,而沟通质量的比例从 6.0% 增加到 9.1%
    • 相关案例见附录 A.5

Training Efficiency

  • 论文分析了 Self-rewarding 方法相比于 Baseline 方法的训练效率
  • 如表 5 所示,在早期阶段,较短的 average rollouts 使得奖励计算在单步时间中占比较大,而在后期阶段,较长的 rollouts 降低了奖励时间的相对比例
  • Self-rewarding 在单步时间和奖励计算时间上均实现了显著的加速(各阶段均减少约 50%),展示了论文方法的计算优势
  • 请注意, Baseline 训练使用 32 个 GPU 进行训练,另外 32 个 GPU 用于 GRM 推理,而 Self-rewarding 总共只使用 32 个 GPU,所有其他配置保持不变
  • Importantly,观察到的训练效率提升与实现细节密切相关;因此,论文仅报告论文配置下的相对效果

Dataset Influence

Using scoring data further enhances the model’s grading ability(使用评分数据可进一步提升模型的评分能力)
  • 为了进一步评估改进的评分能力如何影响不同规模的训练,论文从前期的 GPT-4.1 评估中构建了一个评分数据集,并使用可验证的奖励目标进行训练
  • 当仅在评分数据上训练时(图 7a),Qwen3-8B 的 HealthBench MF1 从 0.627 提升到 0.651,而 Qwen3-32B 的则从 0.670 提升到 0.684
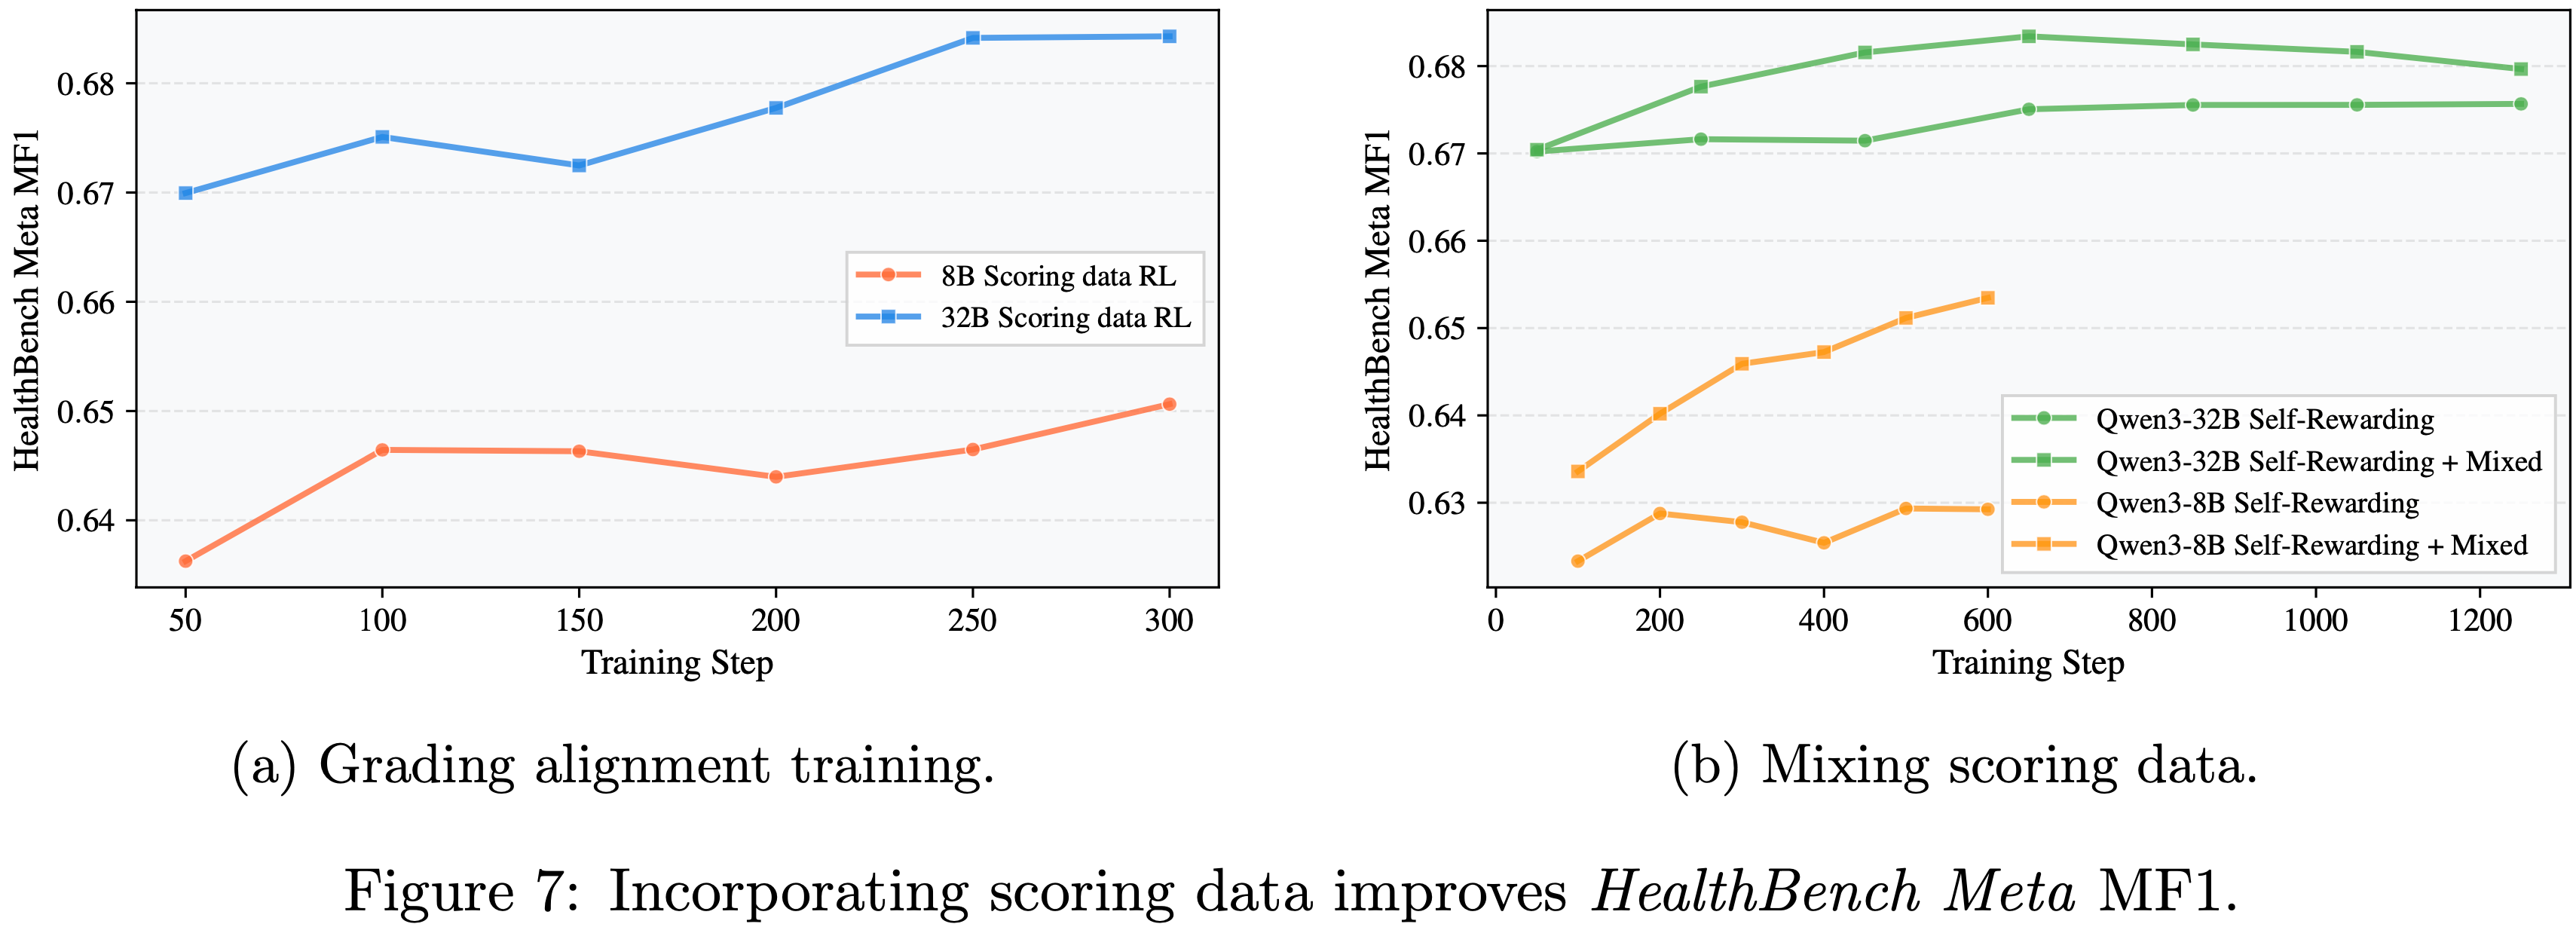
  • 在混合目标 (mixed-objective) 设置下(图 7b),评分能力进一步提升;
    • 然而,对于 Qwen3-8B,整个训练过程中分数持续增加,而对于 Qwen3-32B,则出现了过拟合
  • 值得注意的是,由于重复输出,Qwen3-8B 的训练在大约 600 步后崩溃,而 Qwen3-32B 的训练则非常稳定
  • 问题:从图 7(a) 看,300 步内,看着整体还是呈现上升状态的,600 步后的崩溃没有给出图像说明
    • 图 7(b) 中给出了 Qwen3-8B 到 600 步以后就没有分数了,看起来像是 Mixed 和 非 Mixed 都同时崩溃?
Mixed-objective training benefits weaker models but not stronger ones(混合目标训练对较弱模型有益,但对较强模型无效)
  • 当使用混合数据 (mixed data) 训练时,Qwen3-8B 的 HealthBench Hard 分数(由 Qwen3-32B 评分)从 0.354 增加到 0.380,而 Qwen3-32B 的性能则如图 5b 所示有所下降
    • 问题:似乎没看到下降,始终高于不适用混合数据的训练方案;只是自身在提升后随着训练的进行有下降趋势(仍始终高于非混合数据方案)
  • 结合图 7b 中观察到的过拟合现象,论文假设较强模型的评分能力对于自我训练已经足够,而混合目标干扰了原始目标
  • 因此,论文建议对较强的模型使用纯 Rubric-based RL 训练目标
Synthetic data remain effective, but underperform expert data
  • 合成数据仍然有效,但表现不及专家数据
  • 同样,像 easy set 这样的专家精心策划的数据收集成本高昂,因此论文评估了合成数据的有效性
  • 如图 5b 所示,使用合成数据进行训练是有效的(effective),但落后于专家数据的 Baseline
    • 这符合预期:更高质量的专家数据为学习提供了更强的指导
    • 问题:合成数据的训练明显是所有方案中 HealthBench Hard 得分最低的,怎么能说是有效的呢?作者是不是看错了?

补充:Related Works

  • 自演进(self-evolving)大语言模型的概念既引人入胜,也在迅速发展
    • 在此,论文总结最相关的研究方向

Reinforcement Learning from AI Feedback,RLAIF

  • RLAIF 最初是作为 RLHF 的替代方案提出的,用于训练模型使其有用、诚实且无害 (2022)
    • 其主要优点是不需要人类标注者,而是依赖于一个标量奖励模型 (2022)
  • (2024) 进一步证明,当奖励模型和策略模型规模相当时,RLAIF 可以达到与 RLHF 相当甚至更优的结果
    • 他们还提出了一种变体,直接 RLAIF(direct-RLAIF),即直接使用更小的通用 LLM 作为 Grader ,其性能可以超越同规模的奖励模型
  • 论文的工作借鉴了这一观点(特别是,生成式奖励模型可能更有效)
    • 通过利用训练好的策略模型本身作为奖励模型来生成奖励信号

Rubrics as Rewards,RaR

  • 同样受 HealthBench (2025) 启发,同时期的工作 (2025) 也探索了使用 Rubric-based 评分信号进行训练
    • However,他们的方法依赖于更强的专有模型作为 Grader
  • In Contrast,论文的工作并不专注于自动构建 Rubric 数据集
    • 因为论文的实验表明,由专家定制的 Rubric 数据在训练效果上具有显著优势

Self-Rewarding Language Models

  • Self-Rewarding Language Models (2025) 首次引入了这种范式,通过对模型自身的回答进行评分,并构建成对偏好数据用于直接偏好优化(DPO)训练
  • However,(2024) 指出这种训练可能会积累偏见,导致优化目标漂移
  • Kimi K2 (2025) 提出了自批判 Rubric 奖励机制(Self-Critique Rubric Reward),该机制针对一组有限的 Rubric 进行成对评估
  • 论文的方法主要采用点式复合奖励(point-wise composite rewards)和广泛的 Task-specific Rubric 来减轻奖励破解(reward hacking),并证明相对较小的开源模型能在困难的开放式推理任务上达到 SOTA 结果

附录 A:更多细节

A.1 Sampling Parameters for Evaluation

  • 关于采样器(Samplers),对于所有开源模型,max_tokens 均设置为 32768
  • 关于 Graders ,对于非推理模型设置为 4096,启用思考模式时设置为 8192
    • 对于 GPT-4.1,参数与原始代码库中提供的保持一致
    • 其他采样参数总结在表 6 中

A.2 SFT Loss Curves

  • Figure 8:

A.3 强化学习的训练细节

  • 由于 verl 中参数和配置的复杂性,论文在此仅列出关键设置;完整的训练脚本将在开源代码库准备就绪后提供
  • 后端(Backends) 论文使用 Megatron 进行 Actor 训练,使用 vLLM 进行 Rollout,但 GRM/评估使用 SGLang 路由器部署
  • 并行策略(Parallelism Strategy) 对于 Qwen3-32B,论文使用 4 路张量并行和 2 路流水线并行进行训练,使用 4 路张量并行进行 Rollout。对于 Qwen3-8B,论文使用 4 路张量并行进行训练
  • ** Baseline SGLang 设置** 每个节点以 8 路数据并行初始化,并通过具有自动负载均衡的 SGLang 路由器连接
  • verl 的特定参数(Specific parameters for verl)
    • 除了混合数据实验外,所有实验的 train_batch_size=32,ppo_mini_batch_size=32;混合数据实验的这些值都设为 40,以保持每步的 Rubric 数据一致
    • max_prompt_length=2k,max_response_length=6k
    • rollout.n=4,rollout.max_model_len=16k
    • rollout.temperature=1.0,rollout.top_p=1.0,rollout.top_k=-1
    • clip_ratio_low=0.2,clip_ratio_high=0.28

A.4 Comparision to Physicians

  • Figure 9:

A.5 案例研究

A.5.1 Performance Improvement Case
  • 详情见原文
A.5.2 Performance Drop Case
  • 详情见原文

附录:HealthBench MF1 指标介绍

  • HealthBench 是 OpenAI 推出的医疗大模型评估基准,核心以医生编写的细粒度评分标准为核心,从 5 大行为维度与 7 大场景主题对模型回复打分,用标准化方式衡量医疗大模型在真实临床交互中的安全性、准确性与实用性
  • HealthBench 原始论文:HealthBench: Evaluating Large Language Models Towards Improved Human Health, OpenAI, 20250513
  • HealthBench HuggingFace:huggingface.co/datasets/openai/healthbench
  • HealthBench 博客链接:Introducing HealthBench, OpenAI, 20250512
  • MF1(Macro F1 分数)是用于二分类任务的性能评估指标,核心是对正类(met)和负类(not-met)的 F1 分数进行无加权平均,能平衡两类结果的评估敏感度,尤其适合类别不平衡的场景(如医疗评分中部分标准极少被触发)
  • 先明确二分类任务中的核心统计量:
    • \( TP_{pos} \):正类真阳性(模型判定“符合标准”且实际符合)
    • \( FP_{pos} \):正类假阳性(模型判定“符合标准”但实际不符合)
    • \( FN_{pos} \):正类假阴性(模型判定“不符合标准”但实际符合)
    • \( TP_{neg} \):负类真阳性(模型判定“不符合标准”且实际不符合)
    • \( FP_{neg} \):负类假阳性(模型判定“不符合标准”但实际符合)
    • \( FN_{neg} \):负类假阴性(模型判定“符合标准”但实际不符合)
  • 单类 F1 分数计算
    • F1 分数是精确率(Precision)和召回率(Recall)的调和平均数,公式为:
      $$ F1 = 2 \times \frac{\text{Precision} \times \text{Recall} }{\text{Precision} + \text{Recall} } $$
    • 分别计算正类和负类的 F1 分数:
      • 正类 F1 分数(\( F1_{pos} \)):
        $$ F1_{pos} = 2 \times \frac{TP_{pos} }{2 \times TP_{pos} + FP_{pos} + FN_{pos} } $$
      • 负类 F1 分数(\( F1_{neg} \)):
        $$ F1_{neg} = 2 \times \frac{TP_{neg} }{2 \times TP_{neg} + FP_{neg} + FN_{neg} } $$
  • MF1 最终计算
    • MF1 是正类与负类 F1 分数的无加权平均值,公式为:
      $$ MF1 = 0.5 \times (F1_{pos} + F1_{neg}) $$

一些简答说明

  • 无加权特性:无论正类、负类样本数量差异多大,两类 F1 分数在计算中权重相同,避免少数类表现被掩盖
  • 医疗场景适配性:在 HealthBench 中,MF1 用于衡量模型评分与医师判断的一致性,能同时捕捉“漏判重要医疗标准”(假阴性)和“误判无关标准”(假阳性),贴合医疗评估的严谨性需求
NLP——LLM对齐微调-SimPO

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:SimPO: Simple Preference Optimization with a Reference-Free Reward, arXiv 20240523 & 20240608 & 20241201, NeurIPS 2024
    • 开源地址:github.com/princeton-nlp/SimPO

Paper Summary

  • TLDR:
    • SimPO 是 DPO 方法的一个改进,通过将奖励函数与生成似然对齐并引入目标奖励间隔(margin),SimPO 无需参考模型即可实现高性能,同时避免了长度偏差的利用
    • SimPO 优化点1(核心设计):使用序列的平均对数概率作为隐式奖励
      • 这种奖励设计能更好地与模型生成过程对齐,并且无需参考模型,从而显著提升了计算和内存效率
    • SimPO 优化点2:在 Bradley-Terry 目标中引入了目标奖励间隔(target reward margin),以鼓励获胜响应和失败响应之间的奖励差距更大,从而进一步提升算法性能
  • 论文实验设置:
    • 论文在多种先进训练配置(包括基础模型和指令调优模型,如 Mistral、Llama 3 和 Gemma 2)中将 SimPO 与 DPO 及其最新变体进行了对比
    • 论文实验基于广泛的聊天式评估基准(包括 AlpacaEval 2、MT-Bench 和 Arena-Hard)
  • 实验结果:SimPO 在不显著增加生成长度的情况下,始终显著优于现有方法
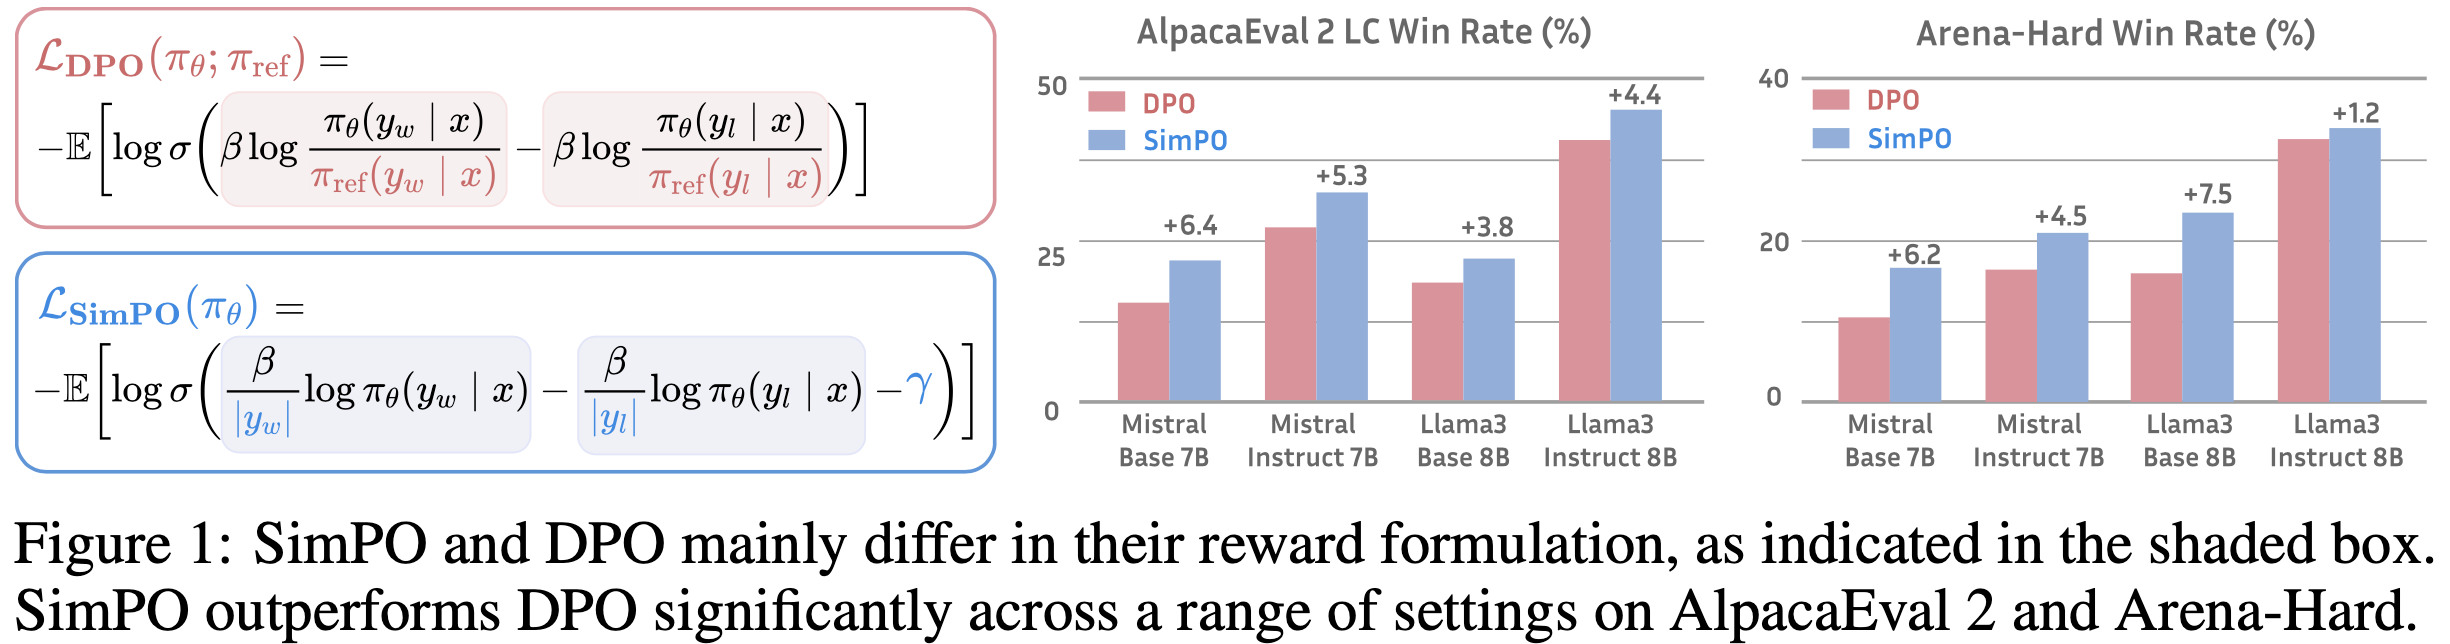
    • SimPO 在 AlpacaEval 2 上比 DPO 高出 6.4 分,在 Arena-Hard 上高出 7.5 分
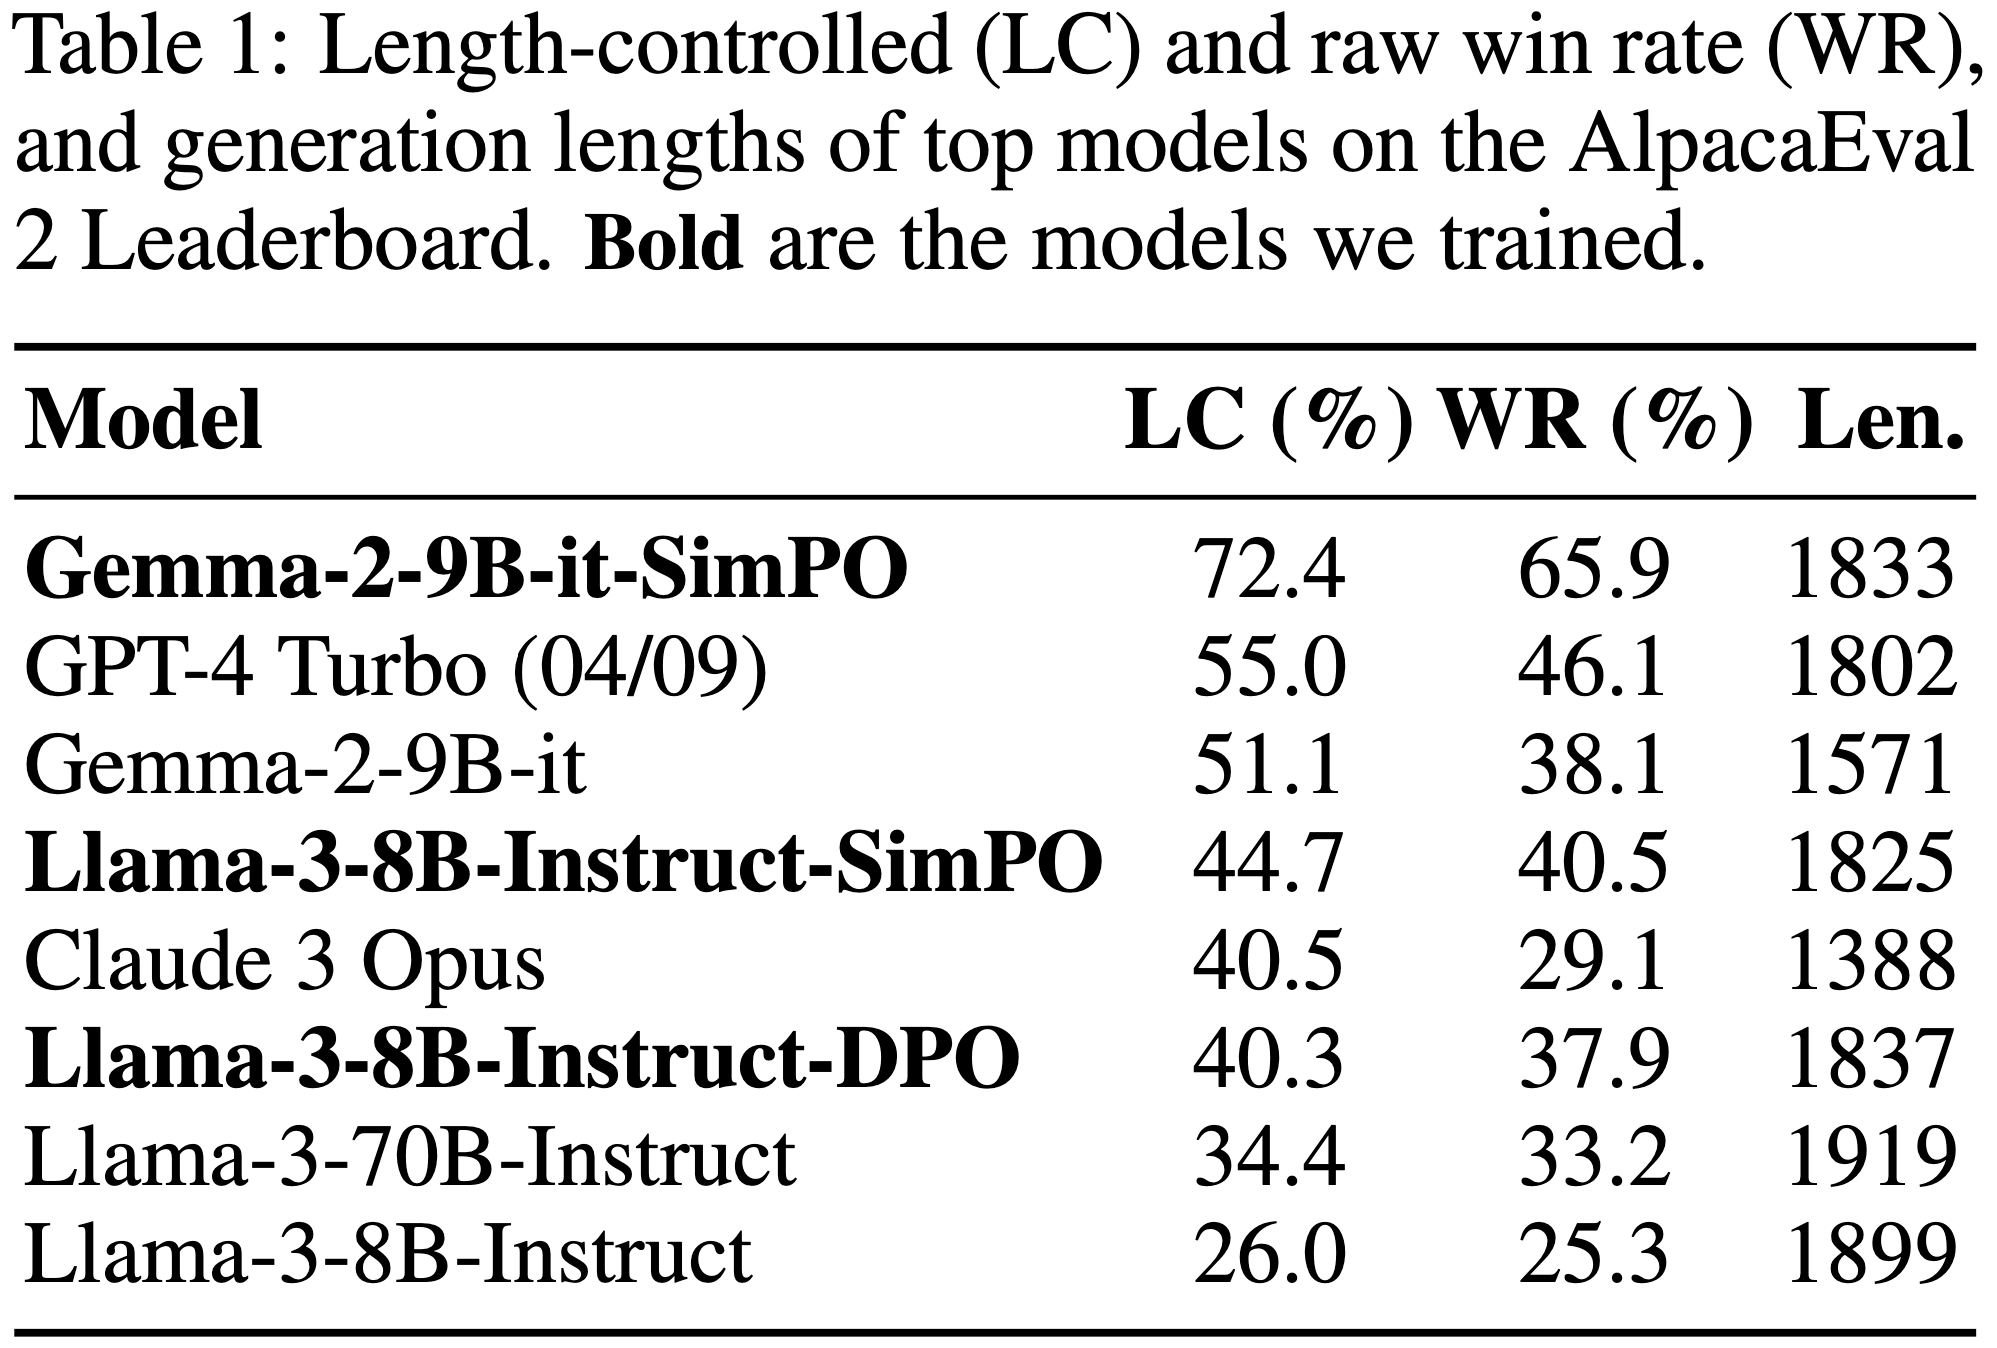
    • 论文基于 Gemma-2-9B-it 训练的最佳模型在 AlpacaEval 2 上实现了 72.4% 的长度控制胜率,在 Arena-Hard 上实现了 59.1% 的胜率,并在 Chatbot Arena 的 <10B 模型中排名第一(基于真实用户投票)

Introduction and Discussion

  • 从人类反馈中学习对于将 LLM 与人类价值观和意图对齐至关重要 (2021),确保模型具备帮助性、诚实性和无害性 (2021)
  • RLHF (2017, 2023, 2020) 是一种流行的微调方法,用于实现有效的对齐
  • 尽管经典 RLHF 方法 (2023, 2020) 已展现出很好的结果,但其多阶段流程(包括训练奖励模型和优化策略模型以最大化奖励)带来了优化挑战 (2023)
  • 近年来,研究者开始探索更简单的离线算法
    • 直接偏好优化(Direct Preference Optimization, DPO)(2023) 是其中一种代表性方法
    • DPO 通过重新参数化 RLHF 中的奖励函数,直接从偏好数据中学习策略模型,从而避免了显式奖励模型的需求。由于其简洁性和稳定性,DPO 在实际应用中得到了广泛采用
    • 在 DPO 中,隐式奖励通过当前策略模型和监督微调(Supervised Fine-Tuned, SFT)模型对响应的似然比的对数来定义
    • 但这种奖励设计与生成过程中使用的指标(即策略模型生成响应的平均对数似然)并未直接对齐
    • 论文假设这种训练与推理之间的不一致可能导致性能不佳
  • 论文提出 SimPO,一种简单但高效的离线偏好优化算法(如图 1 所示)
  • SimPO算法的核心是将偏好优化目标中的奖励函数与生成指标对齐。SimPO 包含两个主要组件:
    • 1)长度归一化的奖励(a length-normalized reward) ,计算公式为策略模型对响应中所有 token 的平均对数概率:
      $$
      p_{\theta}(y \mid x) = \frac{1}{|y|} \log \pi_{\theta}(y \mid x) = \frac{1}{|y|} \sum_{i=1}^{|y|} \log \pi_{\theta}(y_i \mid x, y_{ < i}).
      $$
    • 2)目标奖励间隔(target reward margin) ,用于确保获胜响应的奖励比失败响应至少高出该间隔值
  • SimPO 具有以下特性:
    • 简洁性(Simplicity) :SimPO 无需参考模型,与 DPO 和其他基于参考的方法相比更轻量且易于实现
    • 显著性能优势(Significant performance advantage) :尽管设计简单,SimPO 显著优于 DPO 及其最新变体(例如最近的无参考目标 ORPO (2024))
      • 这种优势在多种训练配置和广泛的聊天式评估(包括 AlpacaEval 2 (2023, 2024) 和具有挑战性的 Arena-Hard (2024) 基准)中保持一致
      • 与 DPO 相比,SimPO 在 AlpacaEval 2 上提升高达 6.4 分,在 Arena-Hard 上提升高达 7.5 分(如图 1 所示)
    • 最小长度利用(Minimal length exploitation) :与 SFT 或 DPO 模型相比,SimPO 未显著增加响应长度(如表 1 所示),表明其对长度利用的抑制效果显著 (2024, 2023, 2023)

SimPO:简单偏好优化(SimPO: Simple Preference Optimization)

  • 本节首先介绍 DPO 的背景(2.1 节),然后指出 DPO 奖励与生成似然指标之间的不一致性,并提出一种无参考的替代奖励设计以解决该问题(2.2 节)
  • 最后,论文通过在 Bradley-Terry 模型中引入目标奖励间隔项来推导 SimPO 的目标函数(2.3 节)

Background: Direct Preference Optimization(DPO)

  • DPO (2023) 是最流行的偏好优化方法之一
  • 与学习显式奖励模型 (2023) 不同,DPO 通过最优策略的闭式表达式重新参数化奖励函数 \( r \):
    $$
    r(x, y) = \beta \log \frac{\pi_{\theta}(y \mid x)}{\pi_{\text{ref} }(y \mid x)} + \beta \log Z(x), \tag{1}
    $$
    • 其中 \(\pi_{\theta}\) 是策略模型,\(\pi_{\text{ref} }\) 是参考策略(通常是监督微调模型),\(Z(x)\) 是配分函数
    • 通过将这一奖励设计融入 Bradley-Terry (BT) 排序目标 (1952),即 \( p(y_w \succ y_l \mid x) = \sigma(r(x, y_w) - r(x, y_l)) \),DPO 用策略模型而非奖励模型表达偏好数据的概率,从而得到以下目标函数:
      $$
      \mathcal{L}_{\text{DPO} }(\pi_{\theta}; \pi_{\text{ref} }) = -\mathbb{E}_{(x,y_w,y_l) \sim \mathcal{D} } \left[ \log \sigma \left( \beta \log \frac{\pi_{\theta}(y_w \mid x)}{\pi_{\text{ref} }(y_w \mid x)} - \beta \log \frac{\pi_{\theta}(y_l \mid x)}{\pi_{\text{ref} }(y_l \mid x)} \right) \right], \tag{2}
      $$
      • 其中 \((x, y_w, y_l)\) 是来自偏好数据集 \(\mathcal{D}\) 的偏好对,包含提示(prompt)、获胜响应和失败响应

A Simple Reference-Free Reward Aligned with Generation

  • DPO 奖励与生成的不一致性(Discrepancy between reward and generation for DPO)。使用公式 (1) 作为隐式奖励存在以下缺点:
    • 1)训练时需要参考模型 \(\pi_{\text{ref} }\),这会增加内存和计算成本;
    • 2)训练优化的奖励与推理时优化的对数似然之间存在不匹配,而推理过程不涉及参考模型
      • 这意味着在 DPO 中,对于任意三元组 \((x, y_w, y_l)\),满足奖励排序 \( r(x, y_w) > r(x, y_l) \) 并不一定意味着满足似然排序 \( p_{\theta}(y_w \mid x) > p_{\theta}(y_l \mid x) \)(此处 \( p_{\theta} \) 是公式 (3) 中的平均对数似然)
        • 理解:因为奖励排序中包含了 \(\pi_\text{ref}(y|x)\) 在分母上,导致如果 \(\pi_\text{ref}(y_w|x) < \pi_\text{ref}(y_l|x)\) 的话,即使奖励 \(r(x, y_w) > r(x, y_l) \),也可能出现 \( p_{\theta}(y_w \mid x) < p_{\theta}(y_l \mid x) \) 的
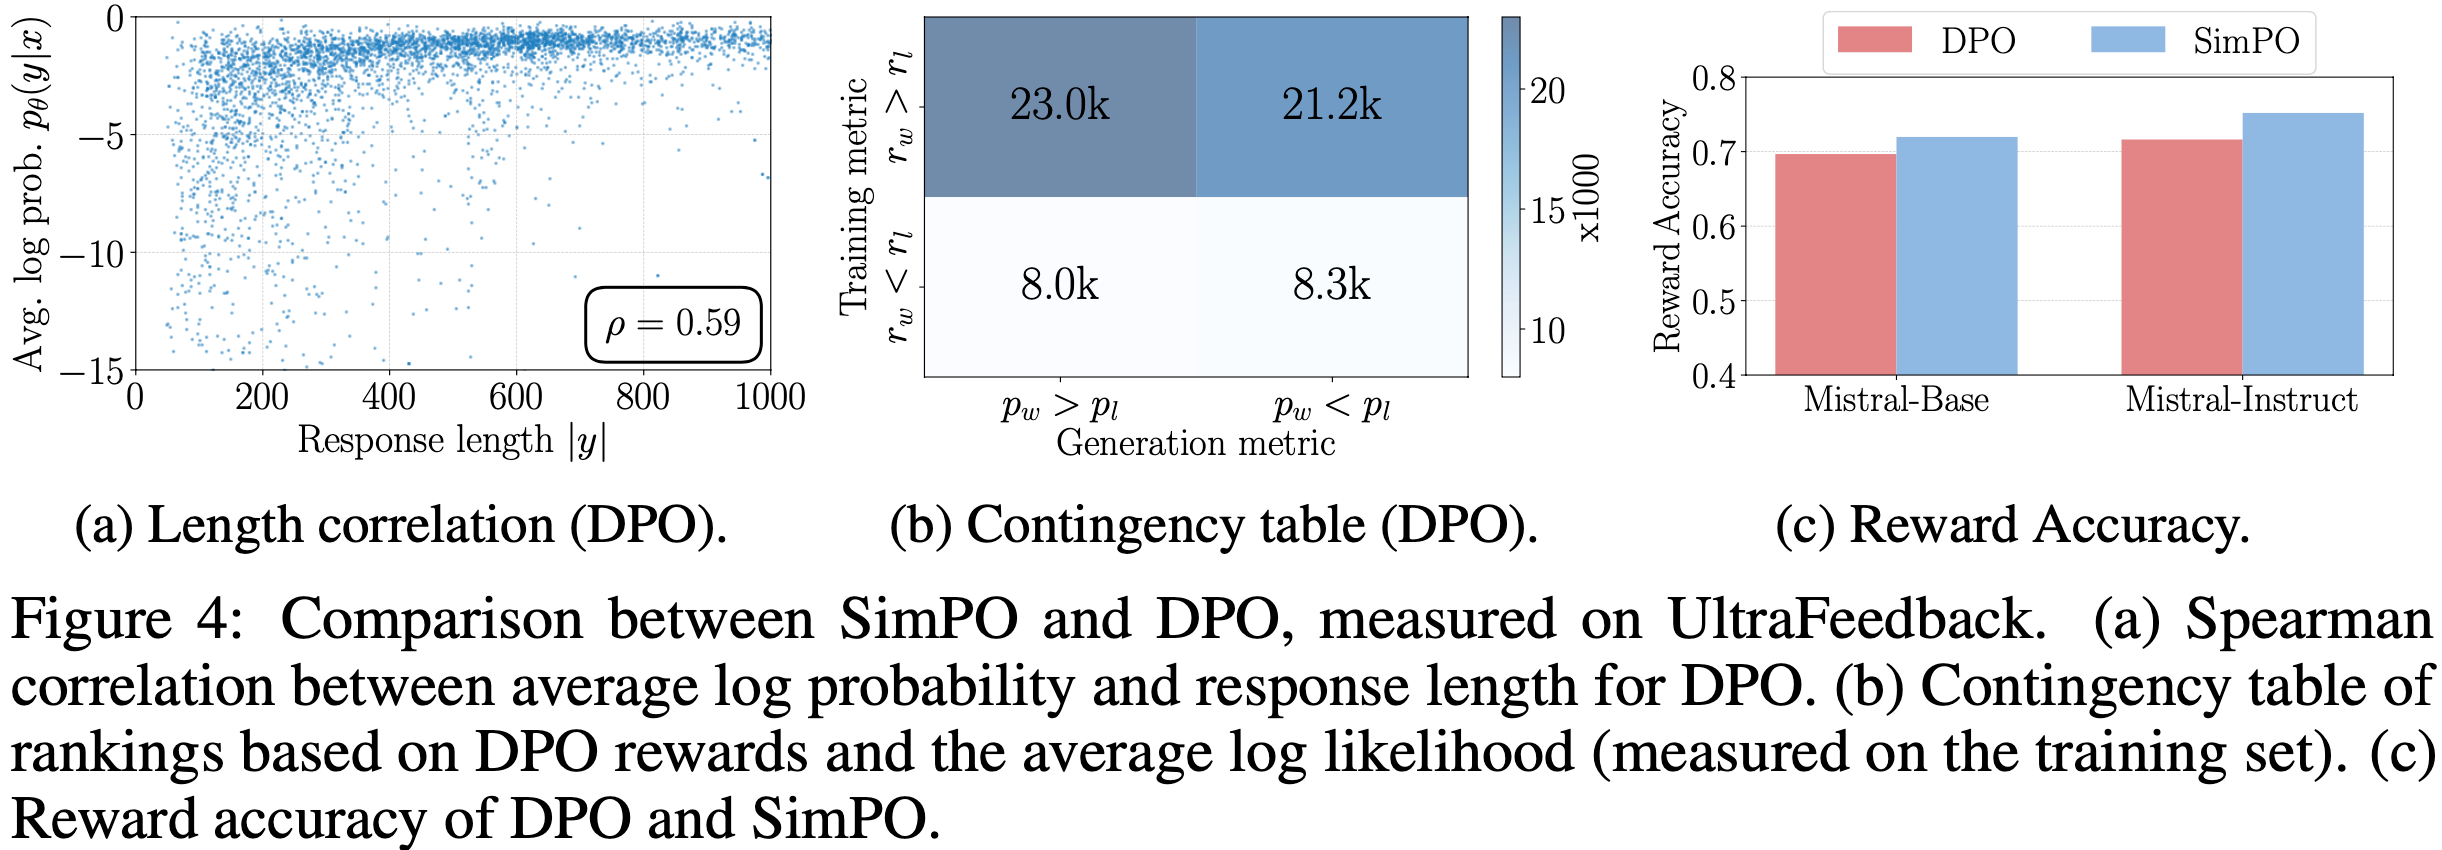
      • 实验中,论文观察到仅约 50% 的训练集三元组在 DPO 训练后满足这一条件(如图 4b 所示)
      • 这一发现与近期研究 (2024) 一致,后者发现现有 DPO 训练模型在平均对数似然排序上表现出随机性,即使经过大量偏好优化
  • 长度归一化的奖励设计(Length-normalized reward formulation)
    • 一种解决方案是使用 token 对数概率之和作为奖励,但这会受长度偏差影响(较长序列倾向于具有更低的对数概率)
      • 因此,当 \( y_w \) 比 \( y_l \) 长时,优化对数概率之和作为奖励会迫使模型人为提高较长序列的概率 ,以确保 \( y_w \) 的奖励高于 \( y_l \)
    • 这种过度补偿会增加模型退化的风险。为解决这一问题,论文考虑使用平均对数似然作为隐式奖励 :
      $$
      p_{\theta}(y \mid x) = \frac{1}{|y|} \log \pi_{\theta}(y \mid x) = \frac{1}{|y|} \sum_{i=1}^{|y|} \log \pi_{\theta}(y_i \mid x, y_{ < i}). \tag{3}
      $$
      • 注:这里的 \(|y|\) 表示队列长度
      • 这一指标常用于 Beam Search (2012, 2016) 和大语言模型中的多项选择任务 (2020, 2021, 2023)
      • 自然地,论文考虑用公式 (3) 中的 \( p_{\theta} \) 替换 DPO 的奖励设计,使其与指导生成的似然指标对齐。这产生了长度归一化的奖励:
        $$
        r_{\text{SimPO} }(x, y) = \frac{\beta}{|y|} \log \pi_{\theta}(y \mid x) = \frac{\beta}{|y|} \sum_{i=1}^{|y|} \log \pi_{\theta}(y_i \mid x, y_{ < i}), \tag{4}
        $$
        • 其中 \(\beta\) 是控制奖励差异缩放的常数
        • 问题: \(\beta\) 相当于是类似温度系数?
      • 论文发现奖励的长度归一化至关重要;
        • 从奖励设计中移除长度归一化项会导致生成长度更长但质量更低的序列(详见 4.4 节)
  • 这种奖励设计消除了对参考模型的需求 ,与依赖参考的算法相比提升了内存和计算效率

The SimPO Objective

  • 目标奖励间隔 (Target reward margin). :
    • 论文在 Bradley-Terry 目标函数中引入了一个目标奖励间隔项 \(\gamma > 0\),用于确保获胜响应 \(r(x,y_w)\) 的奖励至少比失败响应 \(r(x,y_l)\) 的奖励高出 \(\gamma\):
      $$
      p(y_w \succ y_l \mid x) = \sigma \left( r(x,y_w) - r(x,y_l) - \gamma \right). \tag{4}
      $$
    • 类别之间的间隔已知会影响分类器的泛化能力 (2012; 1995)
      • 在标准训练设置中,随着目标间隔的增加,泛化能力通常会提升
    • 在偏好优化中,两个类别分别是同一输入的获胜和失败响应
    • 实践中,论文观察到生成质量最初会随着目标间隔的增加而提升,但当间隔过大时,质量会下降(见第 4.3 节)
    • DPO 的一个变体 IPO (2023) 也提出了类似 SimPO 的目标奖励间隔,但其完整目标函数的效果不如 SimPO(见第 4.1 节)
  • 目标函数 (Objective).
    • 最后,论文将公式 (4) 代入公式 (5),得到 SimPO 的目标函数:
      $$
      \mathcal{L}_{\text{SimPO} }(\pi_\theta) = -\mathbb{E}_{(x,y_w,y_l)\sim\mathcal{D} } \left[ \log \sigma \left( \frac{\beta}{|y_w|} \log \pi_\theta(y_w|x) - \frac{\beta}{|y_l|} \log \pi_\theta(y_l|x) - \gamma \right) \right]. \tag{5}
      $$
    • 总结来说,SimPO 采用了一种与生成指标直接对齐的隐式奖励公式,无需参考模型
    • 此外,它还引入了目标奖励间隔 \(\gamma\) 来帮助区分获胜和失败响应
    • 在附录 F 中,论文提供了 SimPO 和 DPO 的梯度分析,以进一步理解两种方法的差异
  • 无需 KL 正则化即可防止灾难性遗忘 (Preventing catastrophic forgetting without KL regularization).
    • 尽管 SimPO 没有施加 KL 正则化,但论文发现以下实际因素的组合可以确保从偏好数据中有效学习,同时保持泛化能力,从而使得与参考模型的 KL 散度在实验中保持较低水平。这些因素包括:
      • (1) 较小的学习率
      • (2) 覆盖多样领域和任务的偏好数据集
      • (3) LLM 从新数据中学习而不遗忘先验知识的内在鲁棒性
    • 论文在第 4.4 节中展示了 KL 散度的实验结果

Experimental Setup

Models and training settings

  • 论文使用两个模型家族进行偏好优化:Llama-3-8B 和 Mistral-7B,分别在基础(Base)和指令微调(Instruct)两种设置下进行实验
    • 本节的目标是理解 SimPO 与其他偏好优化方法在不同实验设置下的性能表现
    • 论文的最强模型基于 Gemma-2-9B(Instruct setup),并使用更强的奖励模型 RLHFlow/ArmoRM-Llama3-8B-v0.1(见表 1)
    • 论文将在附录 J 中展示并讨论这些结果
  • 对于基础设置(Base setup) :论文遵循 Zephyr(2023)的训练流程
    • 首先,论文在 UltraChat-200k 数据集上训练基础模型(如 mistralai/Mistral-7B-v0.1 或 meta-llama/Meta-Llama-3-8B),得到 SFT 模型
    • 然后,论文使用 UltraFeedback 数据集对 SFT 模型进行偏好优化
      • 这一设置提供了高度透明性 ,因为 SFT 模型是基于开源数据训练的
  • 对于指令微调设置(Instruct setup) :论文使用现成的指令微调模型(如 meta-llama/Meta-Llama-3-8B-Instruct 或 mistralai/Mistral-7B-Instruct-v0.2)作为 SFT 模型
    • 这些模型经过广泛的指令微调过程,比基础设置中的 SFT 模型更强大且更鲁棒
    • 但它们的 RLHF 过程未公开,因此透明度较低
    • 为了缓解 SFT 模型与偏好优化过程之间的分布偏移,论文按照(2023)的方法生成偏好数据集,使指令微调设置更接近在线策略(on-policy)设置
    • 具体来说,论文使用 UltraFeedback 数据集中的提示,并用 SFT 模型重新生成偏好对 \((y_w, y_l)\)
    • 对于每个提示 \(x\),论文以采样温度 0.8 生成 5 个响应,并使用 llm-blender/PairRM(2023)对响应评分,选择得分最高的作为 \(y_w\),最低的作为 \(y_l\)
    • 论文仅进行单轮数据生成,而非迭代生成(2023)
      • 注解:论文还尝试使用更强的奖励模型 RLHFlow/ArmoRM-Llama3-8B-v0.1(2024)对生成的数据排序,这显著提升了性能(见附录 H 和附录 J)(这是论文 Gemma 2 实验中使用的奖励模型)
  • 总结来说,论文共有四种设置:Llama-3-Base、Llama-3-Instruct、Mistral-Base 和 Mistral-Instruct
    • 这些配置代表了当前的最先进水平,使论文的模型在多个排行榜上名列前茅
    • 论文鼓励未来研究采用这些设置,以便更公平地比较不同算法
    • 此外,论文发现超参数调优对所有离线偏好优化算法(包括 DPO 和 SimPO)的性能至关重要
    • 通常,对于 SimPO,将 \(\beta\) 设为 2.0 到 2.5,\(\gamma\) 设为 0.5 到 1.5 ,可以在所有设置中取得良好性能
    • 更多细节请参考附录 B

Evaluation Benchmarks

  • 论文主要使用三个流行的开放式指令遵循基准评估模型:MT-Bench(2023)、AlpacaEval 2(2023)和 Arena-Hard v0.1(2024)
  • 这些基准测试模型在多样化查询中的对话能力,已被社区广泛采用(详见表 2)
    • AlpacaEval 2 包含来自 5 个数据集的 805 个问题
    • MT-Bench 涵盖 8 个类别的 80 个问题
    • Arena-Hard(最新发布的)是 MT-Bench 的增强版,包含 500 个定义明确的技术问题求解查询
  • 论文按照每个基准的评估协议报告分数
    • 对于 AlpacaEval 2,论文报告原始胜率(raw win rate,WR)和长度控制胜率(length-controlled win rate,LC)(28)
      • LC 指标专门设计用于抵抗模型的冗余性
    • 对于 Arena-Hard,论文报告相对于基线模型的胜率(WR)
    • 对于 MT-Bench,论文使用 GPT-4 和 GPT-4-Preview-1106 作为评判模型,报告平均 MT-Bench 分数
      • 相对 GPT-4,GPT-4-Preview-1106 生成的参考答案和评判的精确率更高
    • 解码细节请参考附录 B
  • 论文还评估了 Huggingface Open Leaderboard 基准(2023)的下游任务,更多细节见附录 C

Baselines

  • 论文将 SimPO 与其他离线偏好优化方法进行比较(见表 3)
    • RRHF(2023)和 SLiC-HF(2023)是排序损失
      • RRHF 使用长度归一化的对数似然,类似于 SimPO 的奖励函数
      • SLiC-HF 直接使用对数似然并包含 SFT 目标
    • IPO(2023)是一种理论 grounded 的方法,避免了 DPO 的假设(即点奖励可以替代成对偏好)
    • CPO(2024)使用序列似然作为奖励,并与 SFT 目标联合训练
    • KTO(2024)从非配对偏好数据中学习
    • ORPO(2024)引入了一种无需参考模型的奇数比项,直接对比获胜和失败响应,并与 SFT 目标联合训练
      • ORPO 可以直接在偏好数据上训练而无需 SFT 阶段
      • 为公平比较,论文从与其他基线相同的 SFT 检查点开始训练 ORPO,这比从基础检查点开始效果更好
    • R-DPO(2024)是 DPO 的改进版,增加了防止长度利用的正则项
    • 论文为每个基线方法全面调优超参数并报告最佳性能
  • 论文发现许多 DPO 变体在实证上并未优于标准 DPO (更多细节见附录 B)

Experimental Results

  • 本节展示实验的主要结果,突出 SimPO 在各种基准测试中的优越性能(4.1节),并对以下组件进行深入分析:
    • (1) 长度归一化(4.2节)
    • (2) 边际项 \(\gamma\)(4.3节)
    • (3) SimPO 优于 DPO 的原因(4.4节)
    • 除非另有说明,消融研究均在 Mistral-Base 设置下进行

Main Results and Ablations

  • SimPO 一致且显著地优于现有偏好优化方法(SimPO consistently and significantly outperforms existing preference optimization methods) :
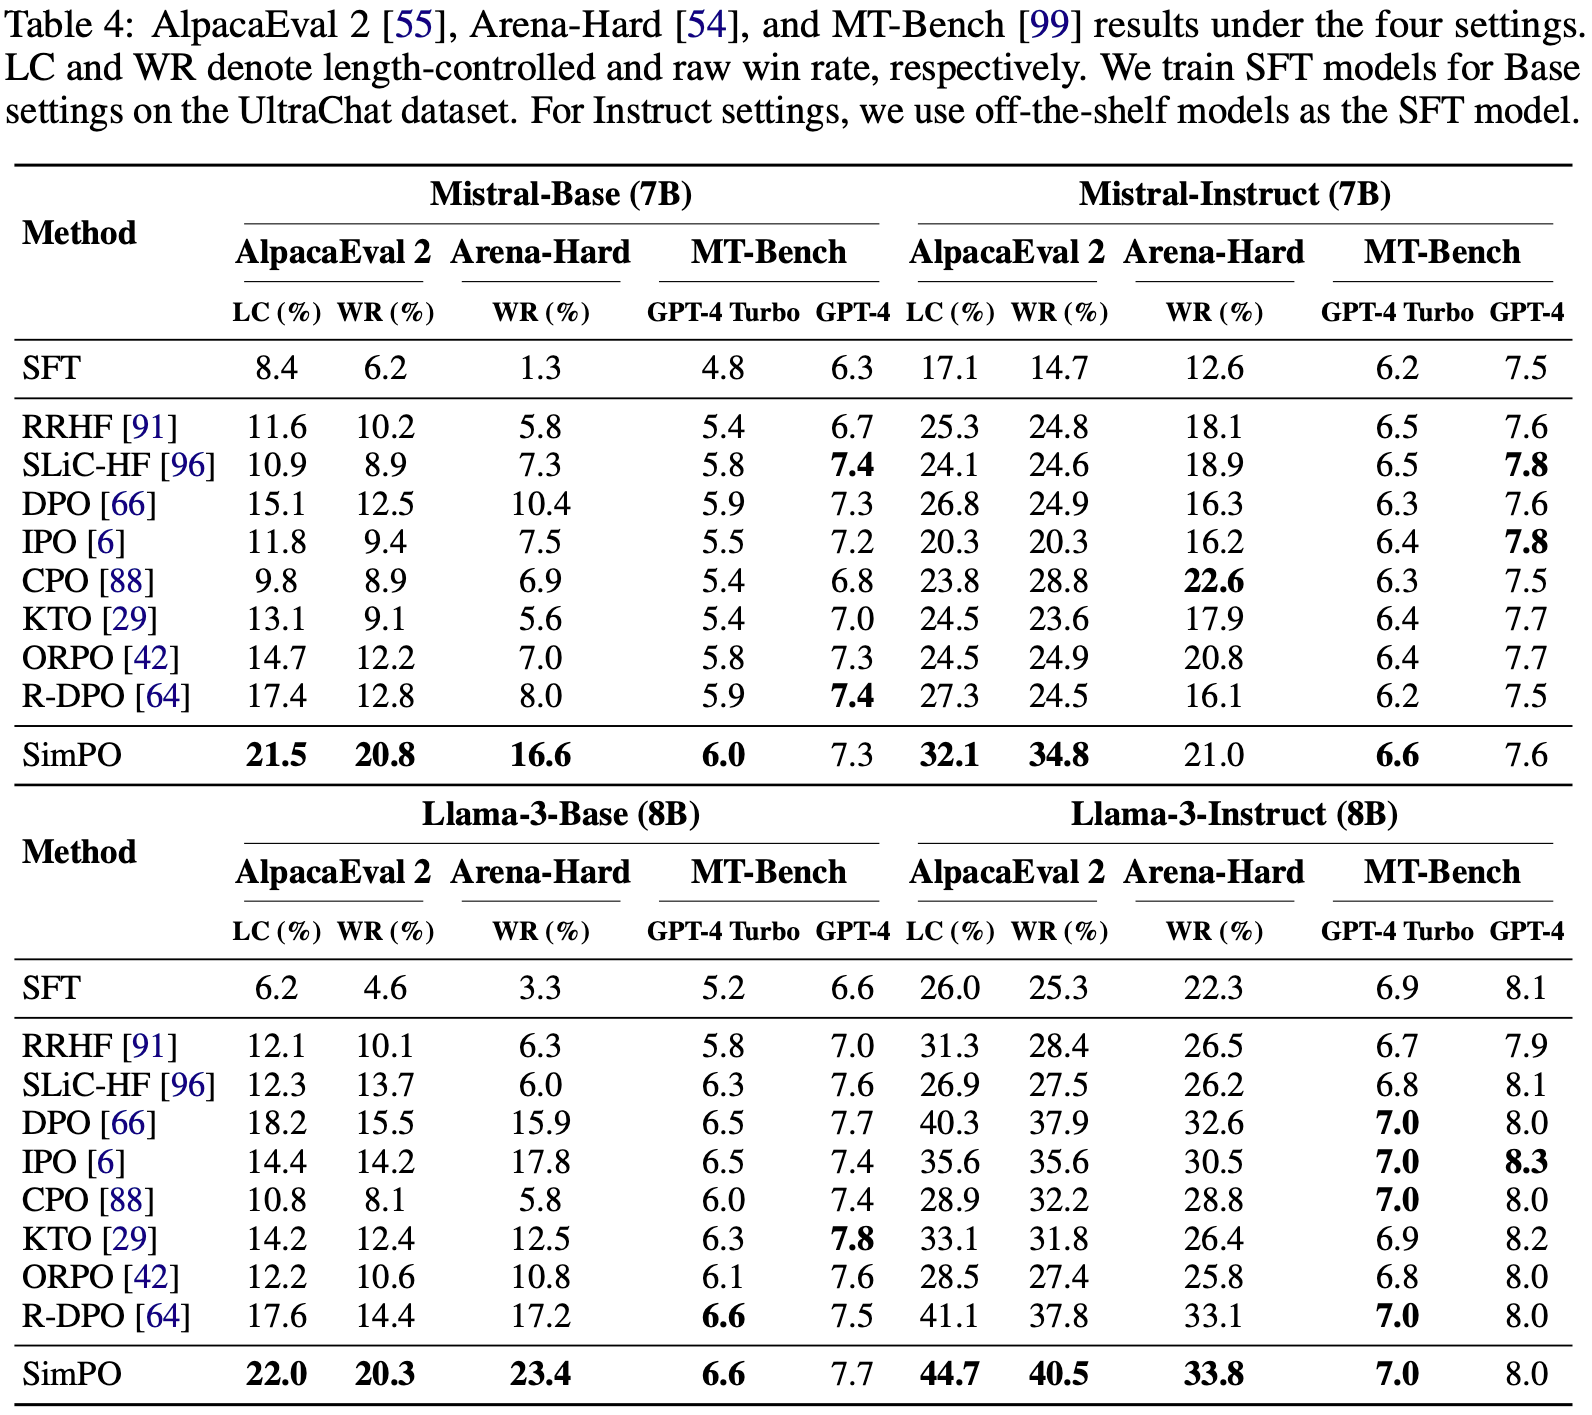
    • 如表 4 所示,尽管所有偏好优化算法都能提升 SFT 模型的性能,但 SimPO 凭借其简洁性,在所有基准和设置中均取得了最佳整体表现
    • 这些一致且显著的改进凸显了 SimPO 的鲁棒性和有效性
    • 值得注意的是,SimPO 在 AlpacaEval 2 的 LC 胜率上比最佳基线高出 3.6 到 4.8 分
    • 在 Arena-Hard 上,SimPO 同样表现优异,尽管偶尔被 CPO(2024)超越
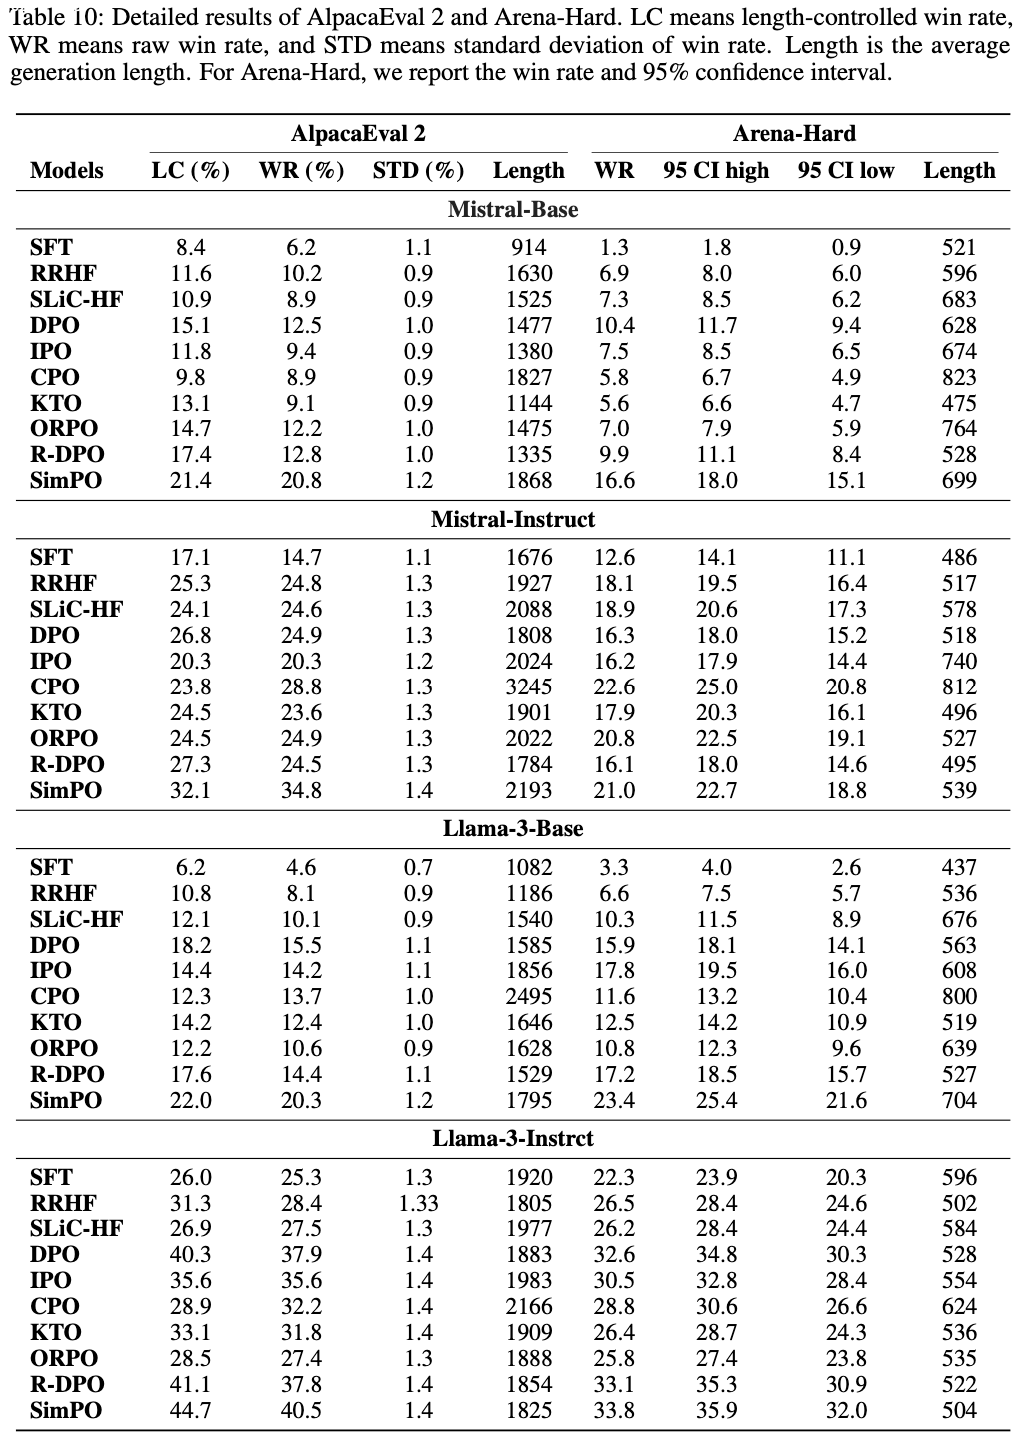
    • 论文发现 CPO 生成的响应平均比 SimPO 长 50%(见表 10)
    • Arena-Hard 可能因评估中未对长度设限而倾向于更长的生成结果
  • 基准测试质量参差不齐(Benchmark quality varies)
    • 尽管三个基准测试被广泛采用,但论文发现 MT-Bench 在不同方法间的区分度较差
    • 方法间的微小差异可能源于随机性,这可能是由于其评估数据规模有限和单实例评分协议所致
      • 这一发现与(2024)的观察一致
    • 相比之下,AlpacaEval 2 和 Arena-Hard 能更有意义地区分不同方法
    • 论文注意到 Arena-Hard 的胜率显著低于 AlpacaEval 2,表明 Arena-Hard 是一个更具挑战性的基准
      • 尽管论文的模型在基准测试中表现优异,但这些评估存在局限性,包括查询空间受限和基于模型评估的潜在偏差
  • 指令微调设置带来显著性能提升(The Instruct setting introduces significant performance gains)
    • 在所有基准测试中,指令微调设置始终优于基础设置
    • 这一改进可能源于初始化使用的 SFT 模型质量更高,以及这些模型生成的偏好数据质量更高
  • SimPO 的两个关键设计均至关重要(Both key designs in SimPO are crucial)
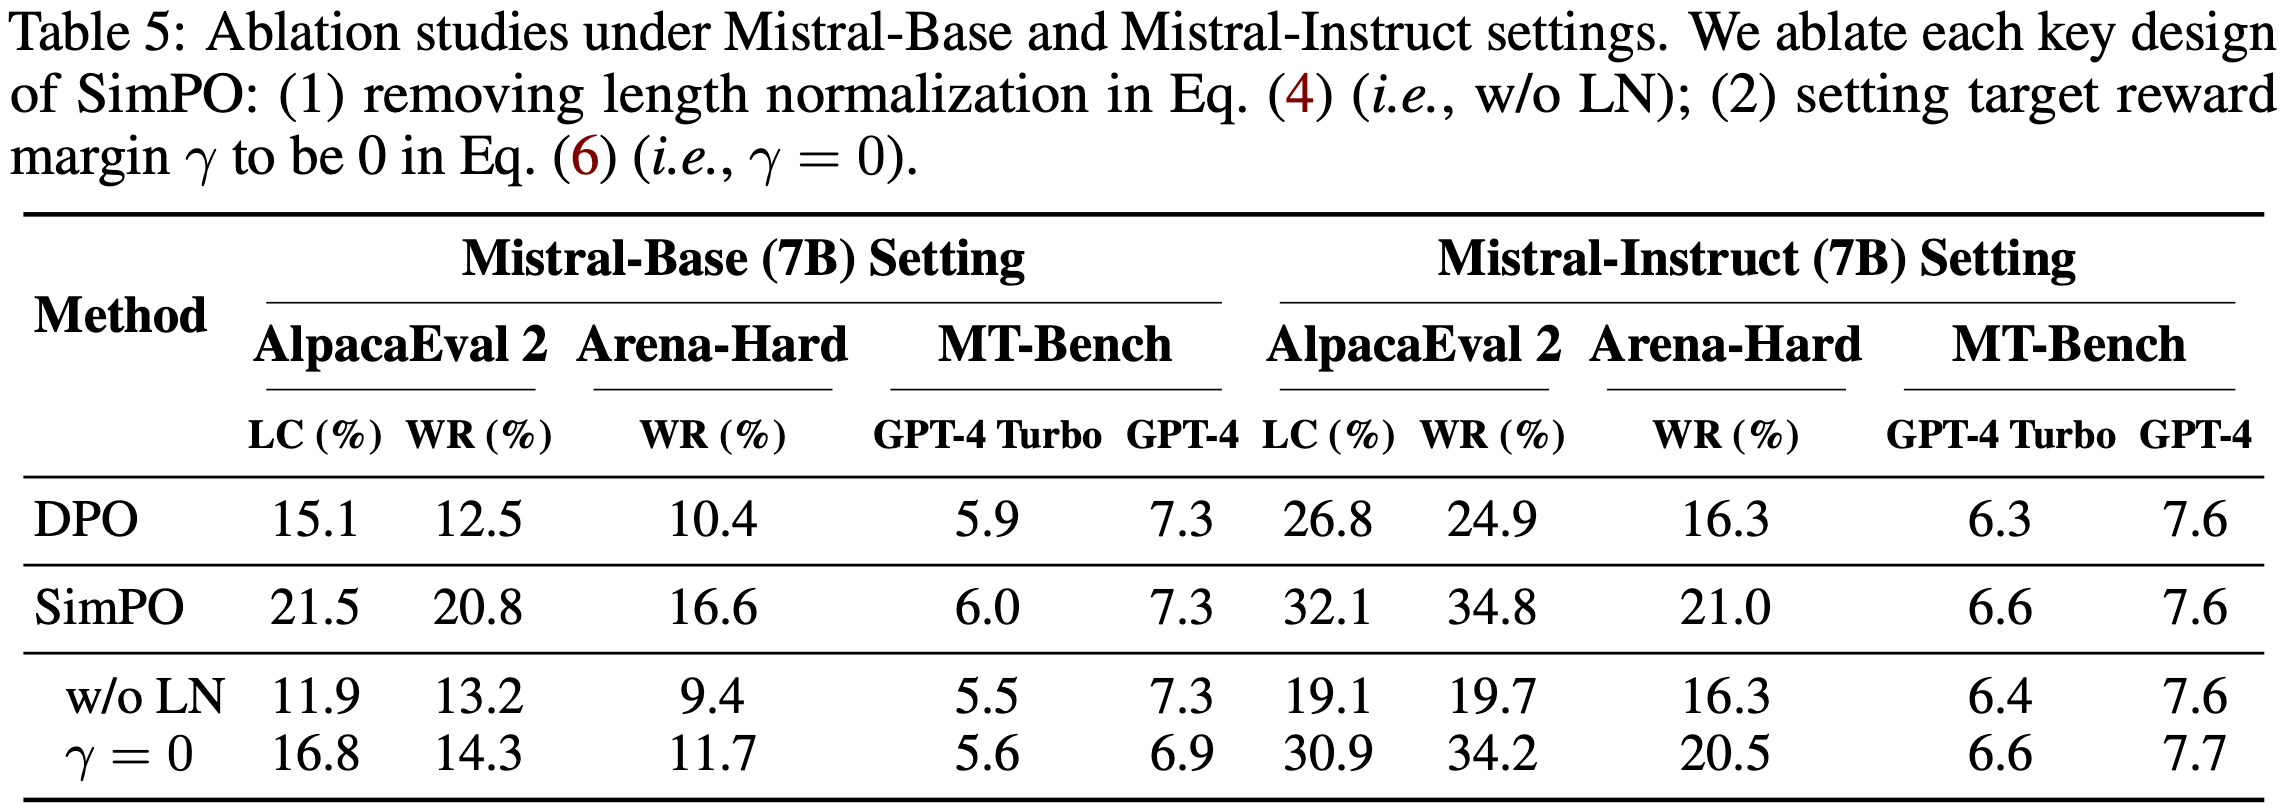
    • 表 5 展示了 SimPO 每个关键设计的消融结果:
      • (1) 移除公式(4)中的长度归一化(即 w/o LN);
      • (2) 将公式(6)中的目标奖励边际设为 0(即 \(\gamma=0\))
    • 移除长度归一化对结果负面影响最大
      • 作者的检查发现,这会导致生成冗长且重复的模式,显著降低输出质量(见附录 E)
    • 将 \(\gamma\) 设为 0 也会导致性能下降,表明 0 并非最优目标奖励边际
    • 在以下小节中,论文将深入分析这两个设计选择

长度归一化(LN)防止长度利用(Length Normalization (LN) Prevents Length Exploitation)

  • LN 增加所有偏好对的奖励差异,无论其长度如何
    • 公式(5)中的 Bradley-Terry 目标本质上是优化奖励差异 \(\Delta r = r(x,y_w) - r(x,y_l)\),使其超过目标边际 \(\gamma\)
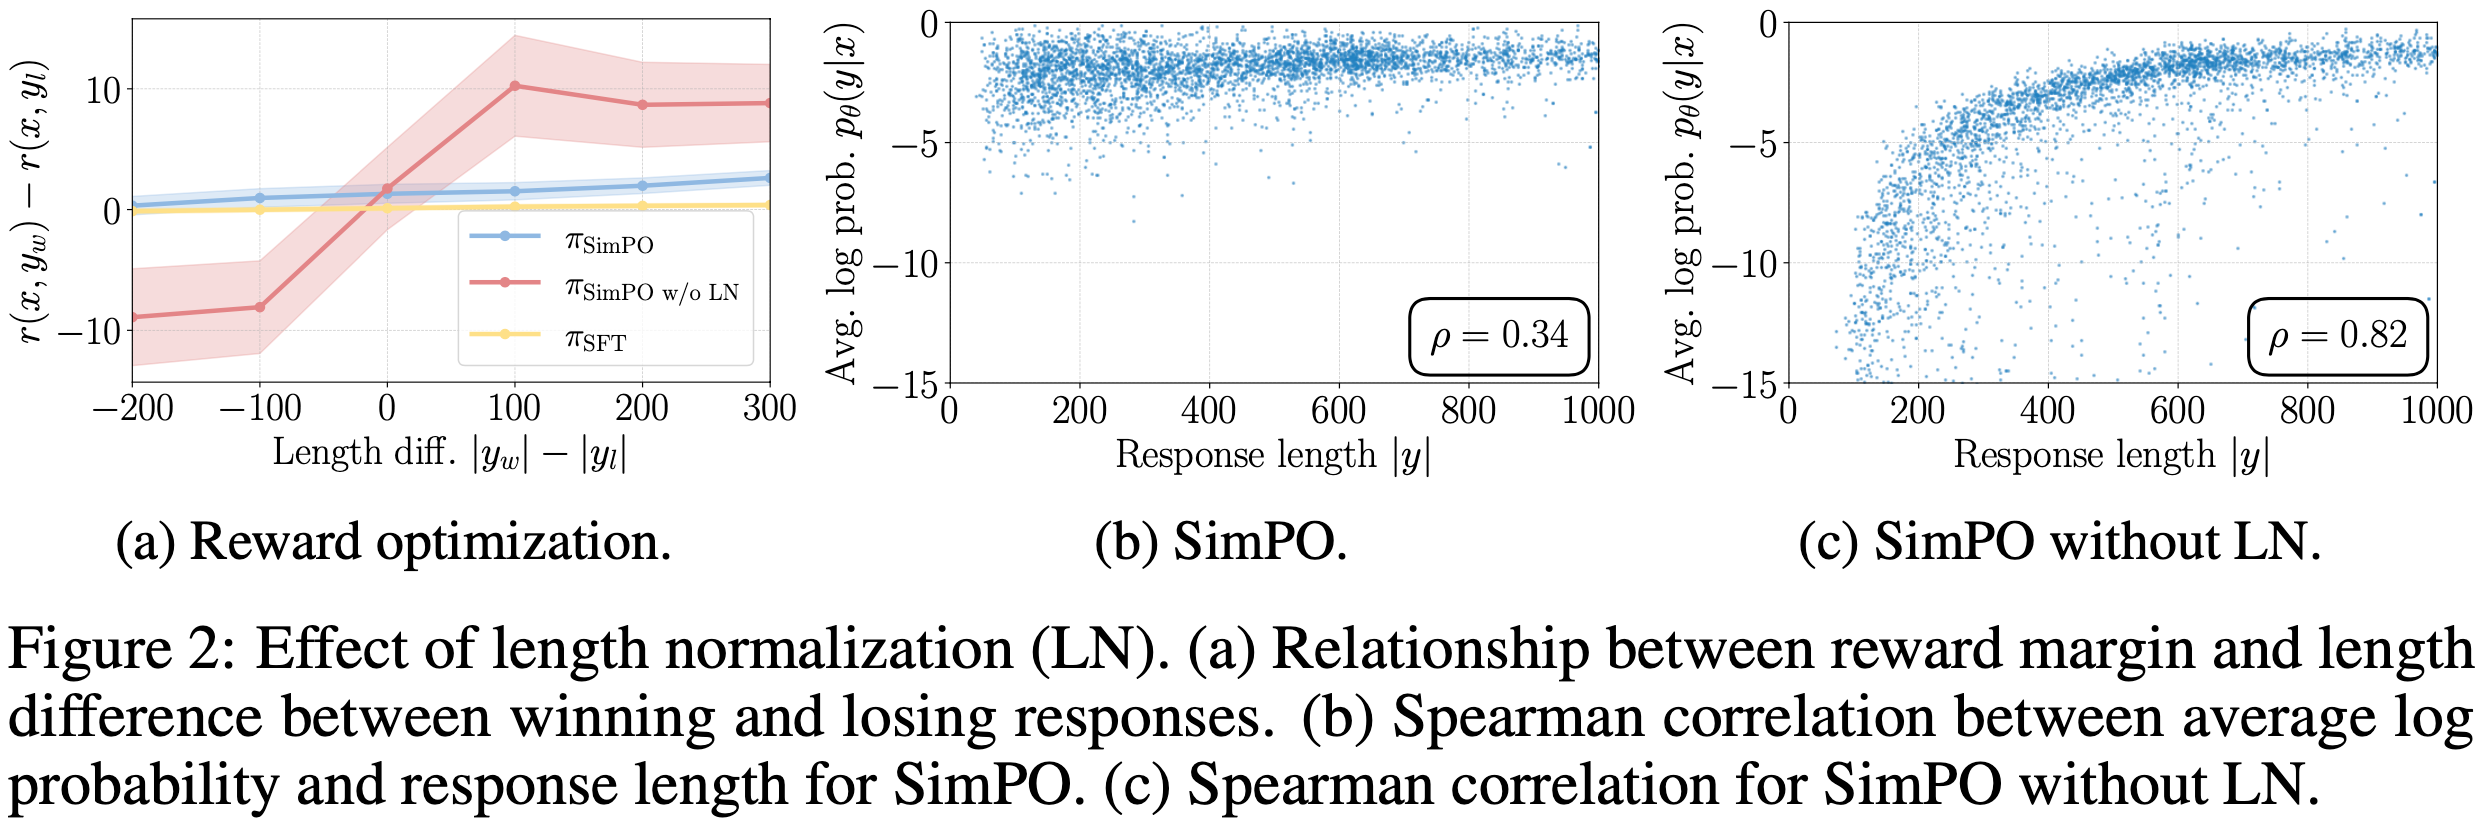
    • 论文研究了从 UltraFeedback 训练集中获胜和失败响应的长度差异 \(\Delta l = |y_w| - |y_l|\) 与学习到的奖励差异之间的关系
    • 论文使用 SFT 模型、SimPO 模型以及未使用长度归一化的 SimPO 模型测量奖励差异(\(r_{\text{SimPO} }\):公式(4))
    • 结果如图 2(a) 所示,论文发现带 LN 的 SimPO 对所有响应对均实现了正的奖励边际,无论其长度差异如何,并且始终比 SFT 模型提高了边际
      • 相比之下,不带 LN 的 SimPO 在获胜响应比失败响应短时会导致负的奖励差异,表明模型对这些实例的学习效果较差
  • 移除 LN 会导致奖励与响应长度强正相关,引发长度利用
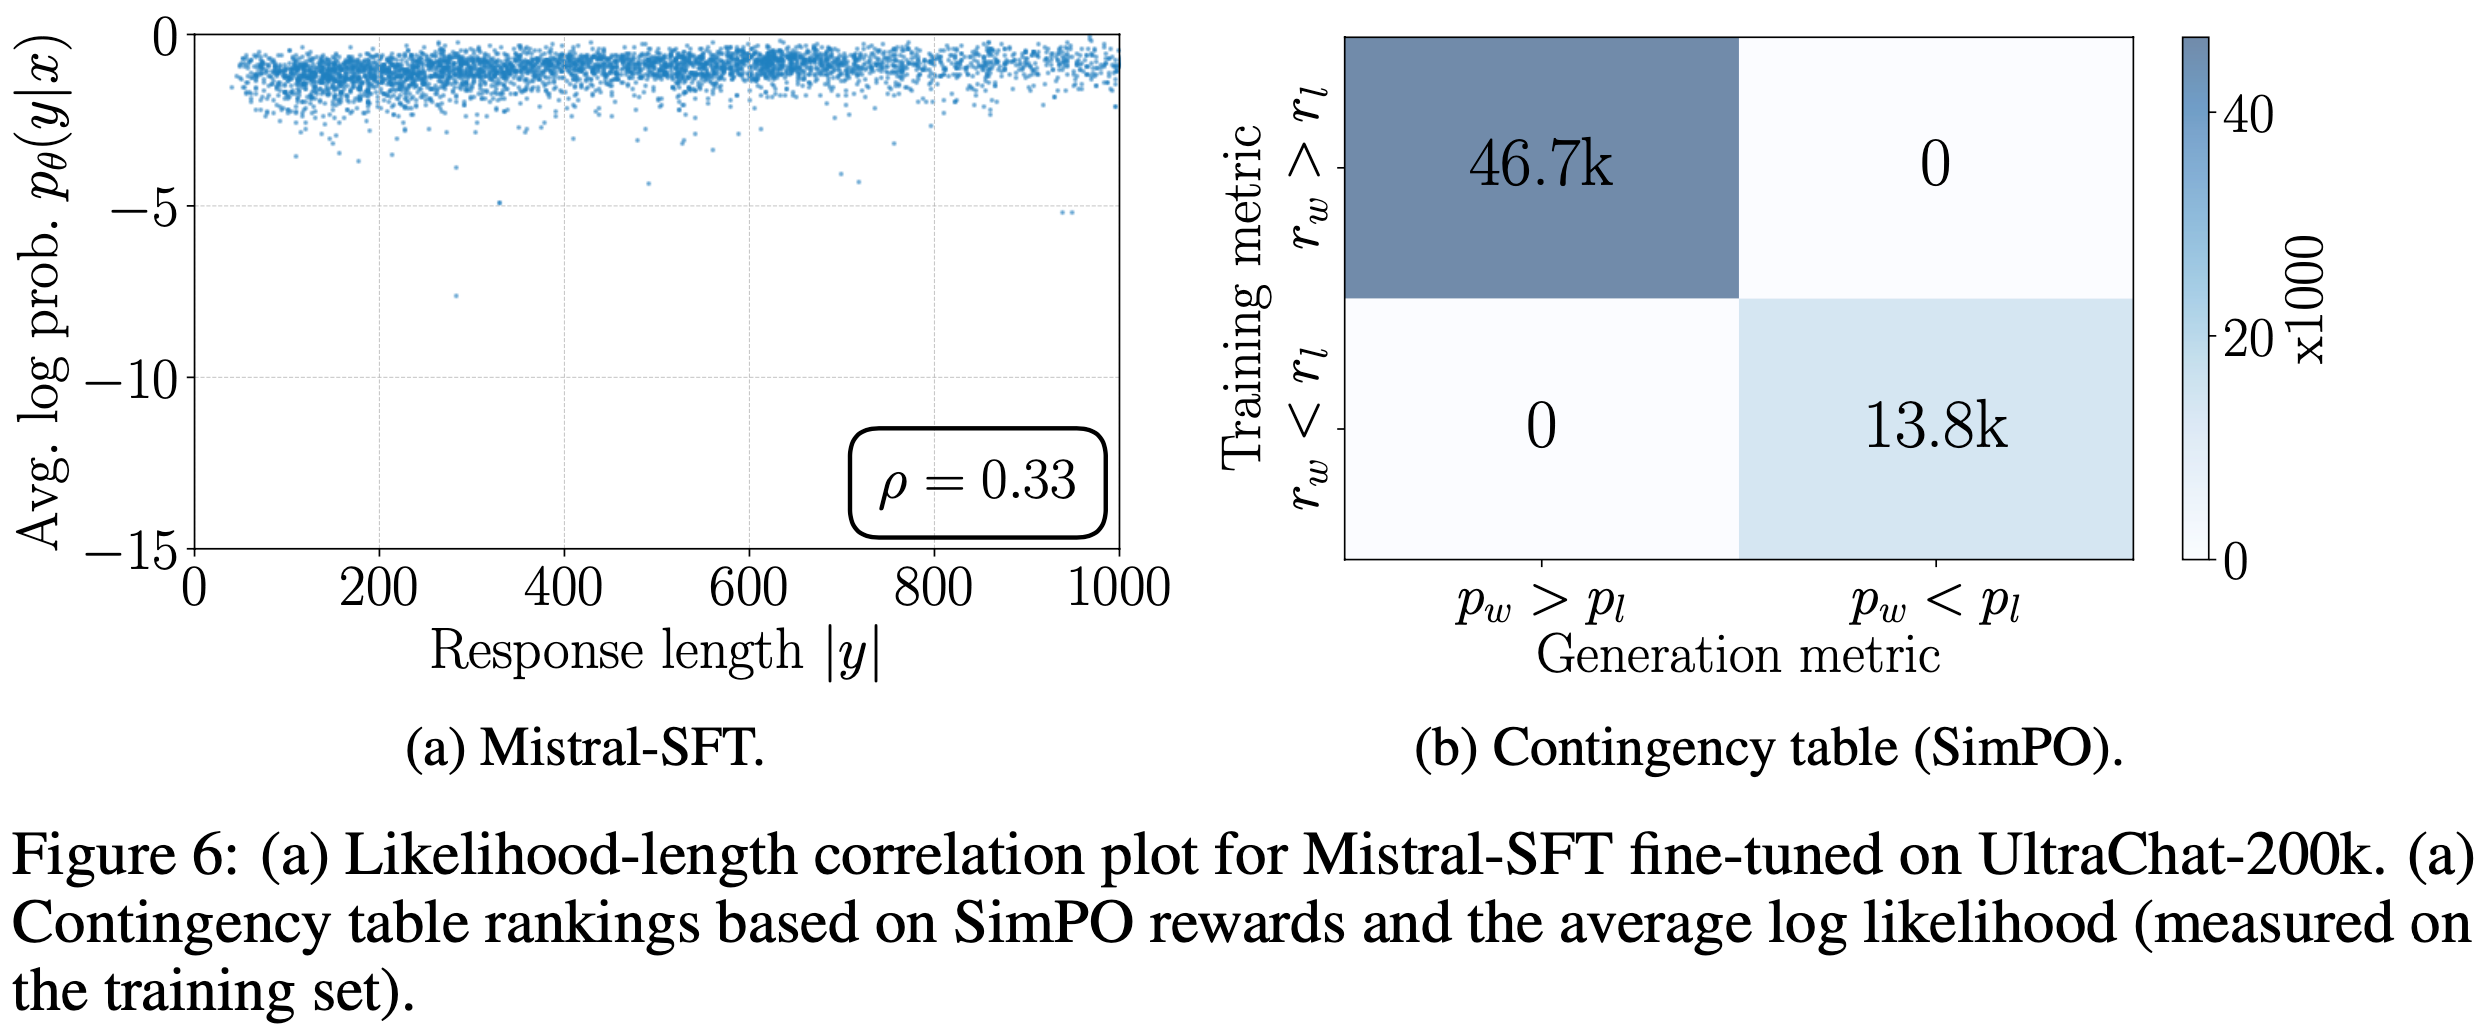
    • 图 2(b) 和 2(c) 展示了在保留集上,使用 SimPO 和未使用 LN 的 SimPO 训练的模型的平均对数似然(公式(3)中的 \(p_\theta\))与响应长度的关系
    • 未使用 LN 训练的模型在似然与响应长度之间表现出更强的 Spearman 正相关性,表明其倾向于利用长度偏差生成更长序列(见附录 E)。相比之下,SimPO 的 Spearman 相关系数与 SFT 模型相似(见图 5(a))

The Impact of Target Reward Margin in SimPO

  • \(\gamma\) 对奖励准确性和胜率的影响(Influence of γ on reward accuracy and win rate)
    • 论文研究了 SimPO 中目标奖励边际 \(\gamma\) 对保留集上奖励准确性和 AlpacaEval 2 胜率的影响,结果如图 3(a) 所示。奖励准确性通过偏好对中获胜响应的奖励高于失败响应的比例(即 \(r(x,y_w) > r(x,y_l)\))来衡量。论文观察到,奖励准确性随 \(\gamma\) 的增加而提升,表明强制更大的目标奖励边际能有效提高奖励准确性。然而,AlpacaEval 2 的胜率随 \(\gamma\) 的增加先升后降,说明生成质量并非仅由奖励边际决定
  • \(\gamma\) 对奖励分布的影响(Impact of \(\gamma\) on the reward distribution.)
    • 论文在图 2(b) 和图 2(c) 中可视化不同 \(\gamma\) 值下学习到的奖励边际 \(r(x,y_w) - r(x,y_l)\) 和获胜响应奖励 \(r(x,y_w)\) 的分布
    • 增加 \(\gamma\) 会使分布趋于平坦,并降低获胜序列的平均对数似然
      • 这最初会提升性能,但最终可能导致模型退化
    • 论文假设在设置 \(\gamma\) 值时,需要在准确逼近真实奖励分布和保持良好校准的似然之间进行权衡
      • 这一平衡的进一步探索留待未来工作

In-Depth Analysis of DPO vs. SimPO

  • 本节论文从以下方面比较 SimPO 和 DPO:
    • (1) 似然-长度相关性
    • (2) 奖励公式
    • (3) 奖励准确性
    • (4) 算法效率
    • 论文证明 SimPO 在奖励准确性和效率上优于 DPO
  • DPO 奖励隐含地促进长度归一化(DPO reward implicitly facilitates length normalization)
    • 尽管 DPO 的奖励表达式:
      $$ r(x,y) = \beta \log \frac{\pi_\theta(y|x)}{\pi_{\text{ref} }(y|x)}$$
      • 该表达式(排除配分函数)没有显式的长度归一化项,但策略模型与参考模型之间的对数比可以隐式抵消长度偏差
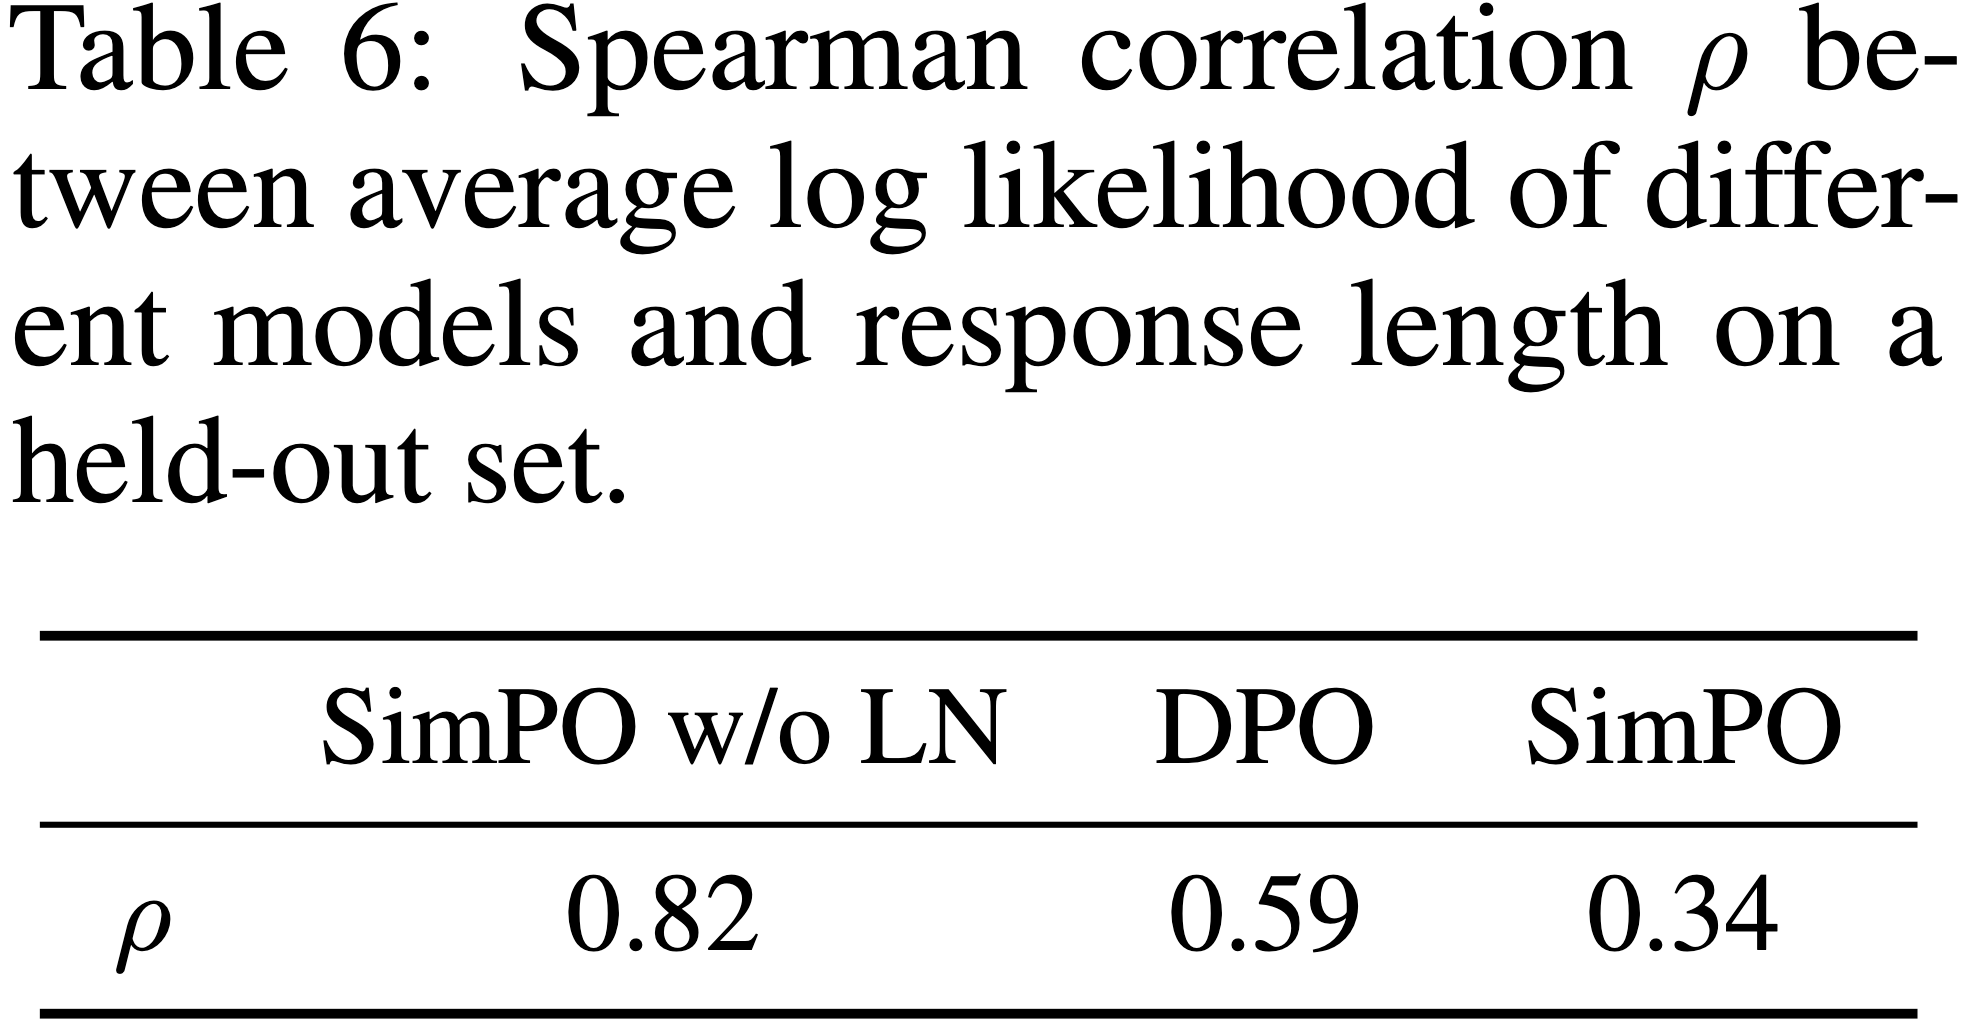
    • 如表 6 和图 4(a) 所示,使用 DPO 降低了平均对数似然与响应长度之间的 Spearman 相关系数 ,但与 SimPO 相比仍表现出更强的正相关性
      • 注意这一相关性并未完全反映生成长度。尽管 DPO 显示出更强的相关性,但其生成响应的长度与 SimPO 模型相当甚至略短。更多细节见附录 E
  • DPO 奖励与生成似然不匹配(DPO reward mismatches generation likelihood)
    • DPO 的奖励公式为:
      $$ r_\theta(x,y) = \beta \log \frac{\pi_\theta(y|x)}{\pi_{\text{ref} }(y|x)}$$
    • 该奖励公式与直接影响生成的平均对数似然度量存在差异:
      $$ p_\theta(y|x) = \frac{1}{|y|} \log \pi_\theta(y|x)$$
    • 如图 4(b) 所示,在 UltraFeedback 训练集中满足 \(r_\theta(x,y_w) > r_\theta(x,y_l)\) 的实例中,近一半的偏好对满足 \(p_\theta(y_w|x) < p_\theta(y_l|x)\)
    • 相比之下,SimPO 直接使用平均对数似然(按 \(\beta\) 缩放)作为奖励表达式,完全消除了这种差异(见图 4(b))
  • DPO 在奖励准确性上落后于 SimPO(DPO lags behind SimPO in terms of reward accuracy)
    • 在图 4(c) 中,论文比较了 SimPO 和 DPO 的奖励准确性,评估它们最终学习到的奖励与保留集上偏好标签的匹配程度
    • SimPO 始终比 DPO 取得更高的奖励准确性,表明论文的奖励设计有助于更好地泛化,从而生成更高质量的响应
  • SimPO 和 DPO 的 KL 散度(KL divergence of SimPO and DPO)
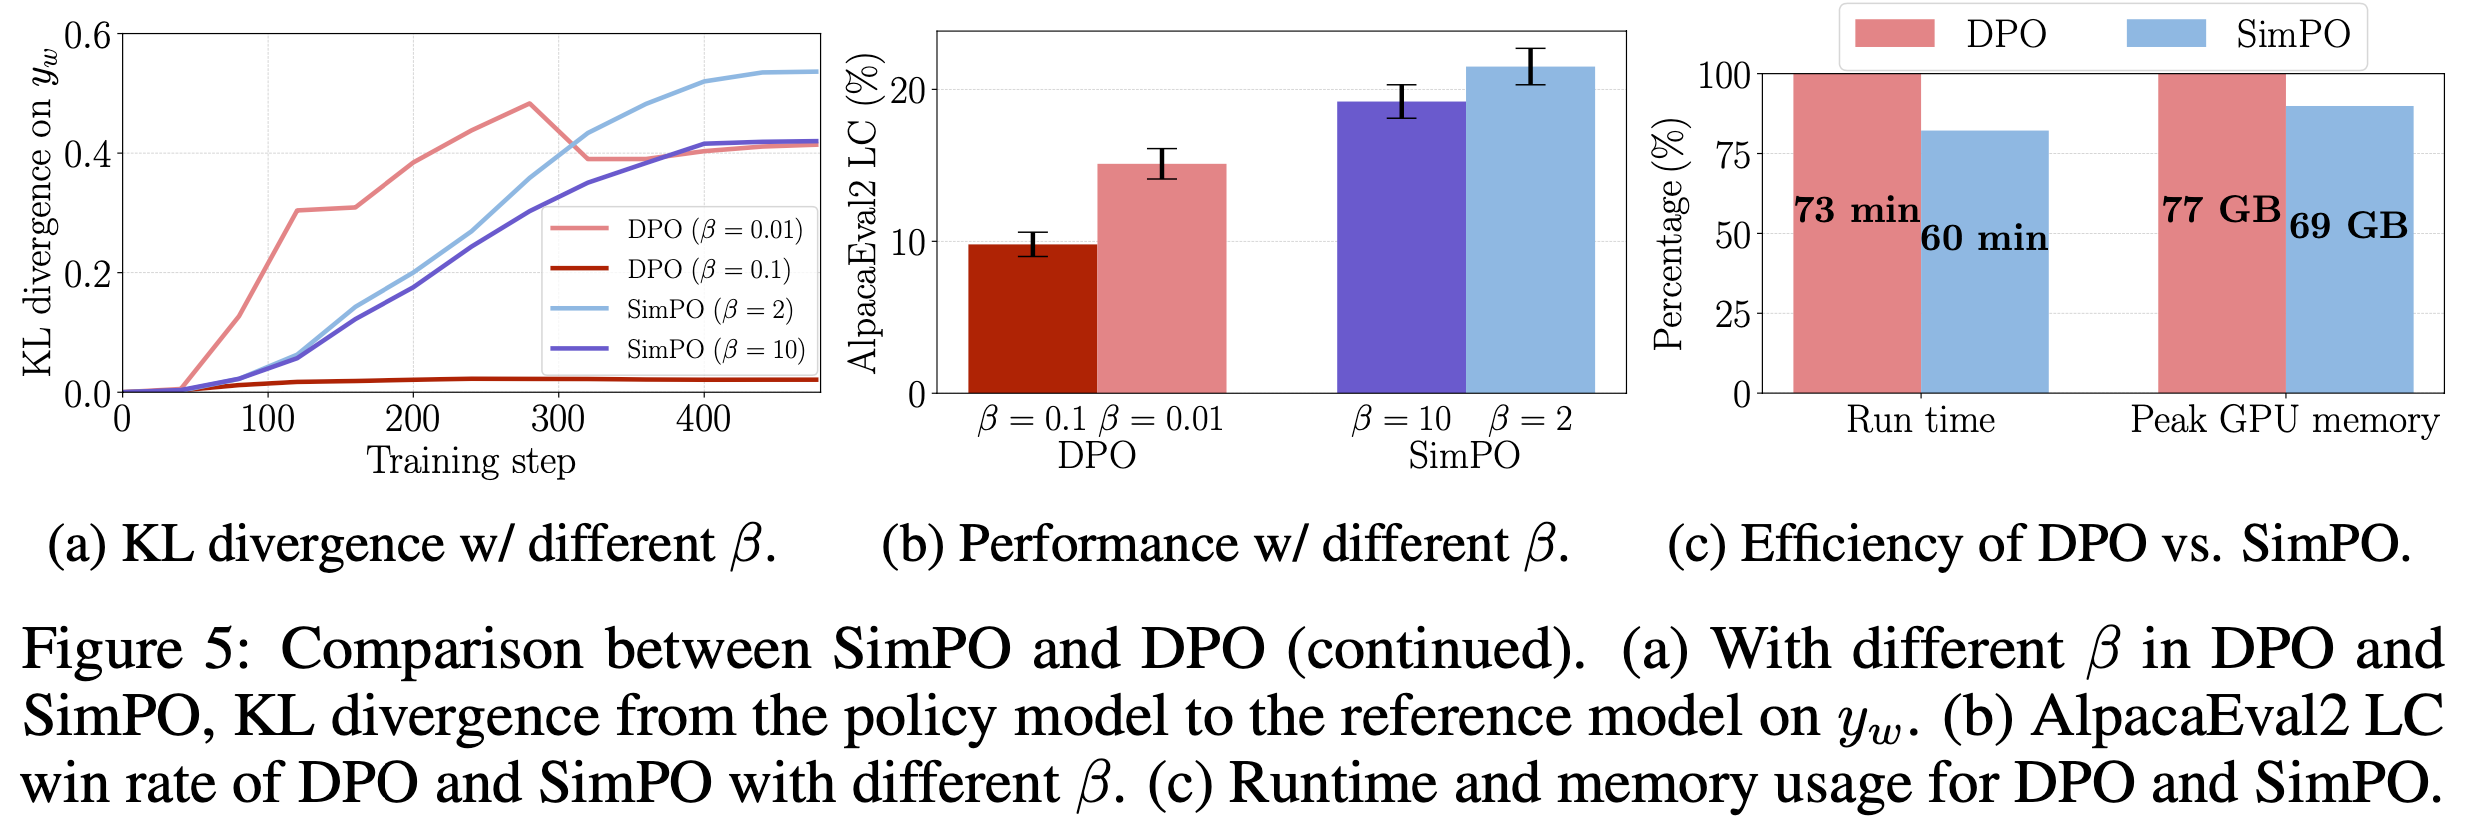
    • 在图 5(a) 中,论文展示了在不同 \(\beta\) 下,使用 DPO 和 SimPO 训练的策略模型与参考模型在保留集获胜响应上的 KL 散度
    • 图 5(b) 展示了相应的 AlpacaEval 2 LC 胜率
    • 尽管 SimPO 未对参考模型应用任何形式的正则化,但其 KL 散度保持在合理较低水平
    • 增加 \(\beta\) 会降低 DPO 和 SimPO 的 KL 散度,其中 DPO 在较高 \(\beta\) 值时下降更明显
    • 在此特定设置(Mistral-base)中,图 5(b) 显示较小的 \(\beta\) 可以提升 AlpacaEval 2 性能,尽管 KL 散度更高
      • 论文观察到在某些设置(如 Llama-3-Instruct)中,较大的 \(\beta\)(如 \(\beta=10\))会带来更好的性能
      • 论文假设当参考模型较弱时,严格约束策略模型可能无益
    • 需要注意的是,尽管在适当调参下论文未观察到训练崩溃或退化,但 SimPO 理论上可能在没有显式正则化的情况下导致奖励破解(reward hacking) ,此时模型可能损失很低但生成结果退化
  • SimPO 比 DPO 更节省内存和计算资源(SimPO is more memory and compute-efficient than DPO)
    • SimPO 的另一优势是其高效性,因为它不使用参考模型
    • 图 5(c) 展示了在 Llama-3-Base 设置下,使用 8xH100 GPU 时 SimPO 和 DPO 的总体运行时间和单 GPU 峰值内存使用情况
    • 与普通 DPO 实现相比,SimPO 通过消除参考模型的前向传递,减少了约 20% 的运行时间和 10% 的 GPU 内存使用
      • 如果将参考模型的前向传递与实际偏好优化分离,DPO 也能实现与 SimPO 相当的内存效率,但这一实现并非标准做法

Related Work

RLHF

  • RLHF 是一种将 LLM 与人类偏好和价值观对齐的技术(2017; 2019; 2022)
  • 经典的 RLHF 流程通常包含三个阶段:
    • 监督微调(2021; 2023)
    • 奖励模型训练(2023; 2024)
    • 策略优化(2017)
  • 近端策略优化(Proximal Policy Optimization, PPO)(2017)是 RLHF 第三阶段广泛使用的算法
  • RLHF 框架还被应用于多种任务,例如减少毒性(2023)、确保安全性(2023)、提升帮助性(2024)以及增强模型推理能力(2024)
  • 近期研究(2023)指出,RLHF 从数据收集到模型训练的整个流程存在挑战
  • 此外,RLHF 可能导致模型生成冗长输出(2023; 2024),这一问题也引发了广泛关注

Offline vs. Iterative Preference Optimization

  • 由于在线偏好优化算法复杂且难以优化(2023),研究者开始探索更高效的离线算法
  • 直接偏好优化(Direct Preference Optimization, DPO)(2023)是一个典型代表
  • 但 DPO 缺乏显式的奖励模型,限制了其从最优策略中采样偏好数据的能力
  • 为解决这一问题,研究者尝试通过训练监督微调策略(2023)或结合拒绝采样的改进策略(2024)生成偏好数据,使策略能够从最优策略生成的数据中学习
  • 进一步研究将这种方法扩展到迭代训练框架(2024; 2024)
  • 论文专注于离线设置 ,避免任何迭代训练过程

Preference Optimization Objectives

  • 除 DPO 外,研究者还提出了多种偏好优化目标
    • 排序目标支持对多个实例进行比较(2023; 2024)
  • 另一类研究探索了不依赖参考模型的简化目标(2024),与 SimPO 类似
    • (2024)提出了一种联合优化指令和响应的方法,发现其能有效改进 DPO
    • (2024)专注于在监督微调和对齐模型之间进行后训练外推,以进一步提升模型性能
  • 论文对比了 SimPO 与一系列离线算法,包括 RRHF(2023)、SLiC-HF(2023)、DPO(2023)、IPO(2023)、CPO(2024)、KTO(2024)、ORPO(2024)和 R-DPO(2024),发现 SimPO 在效率和性能上均优于它们
  • 近期 GPO(Generalized Preference Optimization,2024)提出了一个统一不同离线算法的广义偏好优化框架,而 SimPO 可视为其特例

附录 A Limitations

  • 更深入的理论分析(More in-depth theoretical analysis) :
    • 尽管 SimPO 在实验上取得了成功,但仍需更严格的理论分析以全面理解其有效性
    • 此外,SimPO 引入了目标奖励间隔这一超参数,需手动调整
    • 未来工作可探索如何自动确定最优间隔,并提供更理论化的解释
  • 安全性与诚实性(Safety and honesty) :
    • SimPO 旨在通过优化生成质量来提升模型性能,但未显式考虑安全性和诚实性,而这在实际应用中至关重要
    • 未来研究可将安全性和诚实性约束整合到 SimPO 中,确保生成内容既高质量又安全可靠
    • 论文使用的数据集 UltraFeedback 主要关注有帮助性,未来的研究可以做更全面的研究(如考虑利用大规模偏好数据和更强调安全性的评估基准)
    • 尽管如此,作者观察到在数据集 TruthfulQA 上,SimPO 方法一致优于表9中的其他方法,这显示了 SimPO 在安全性对齐方面的潜力
  • 数学任务性能下降(Performance drop on math) :
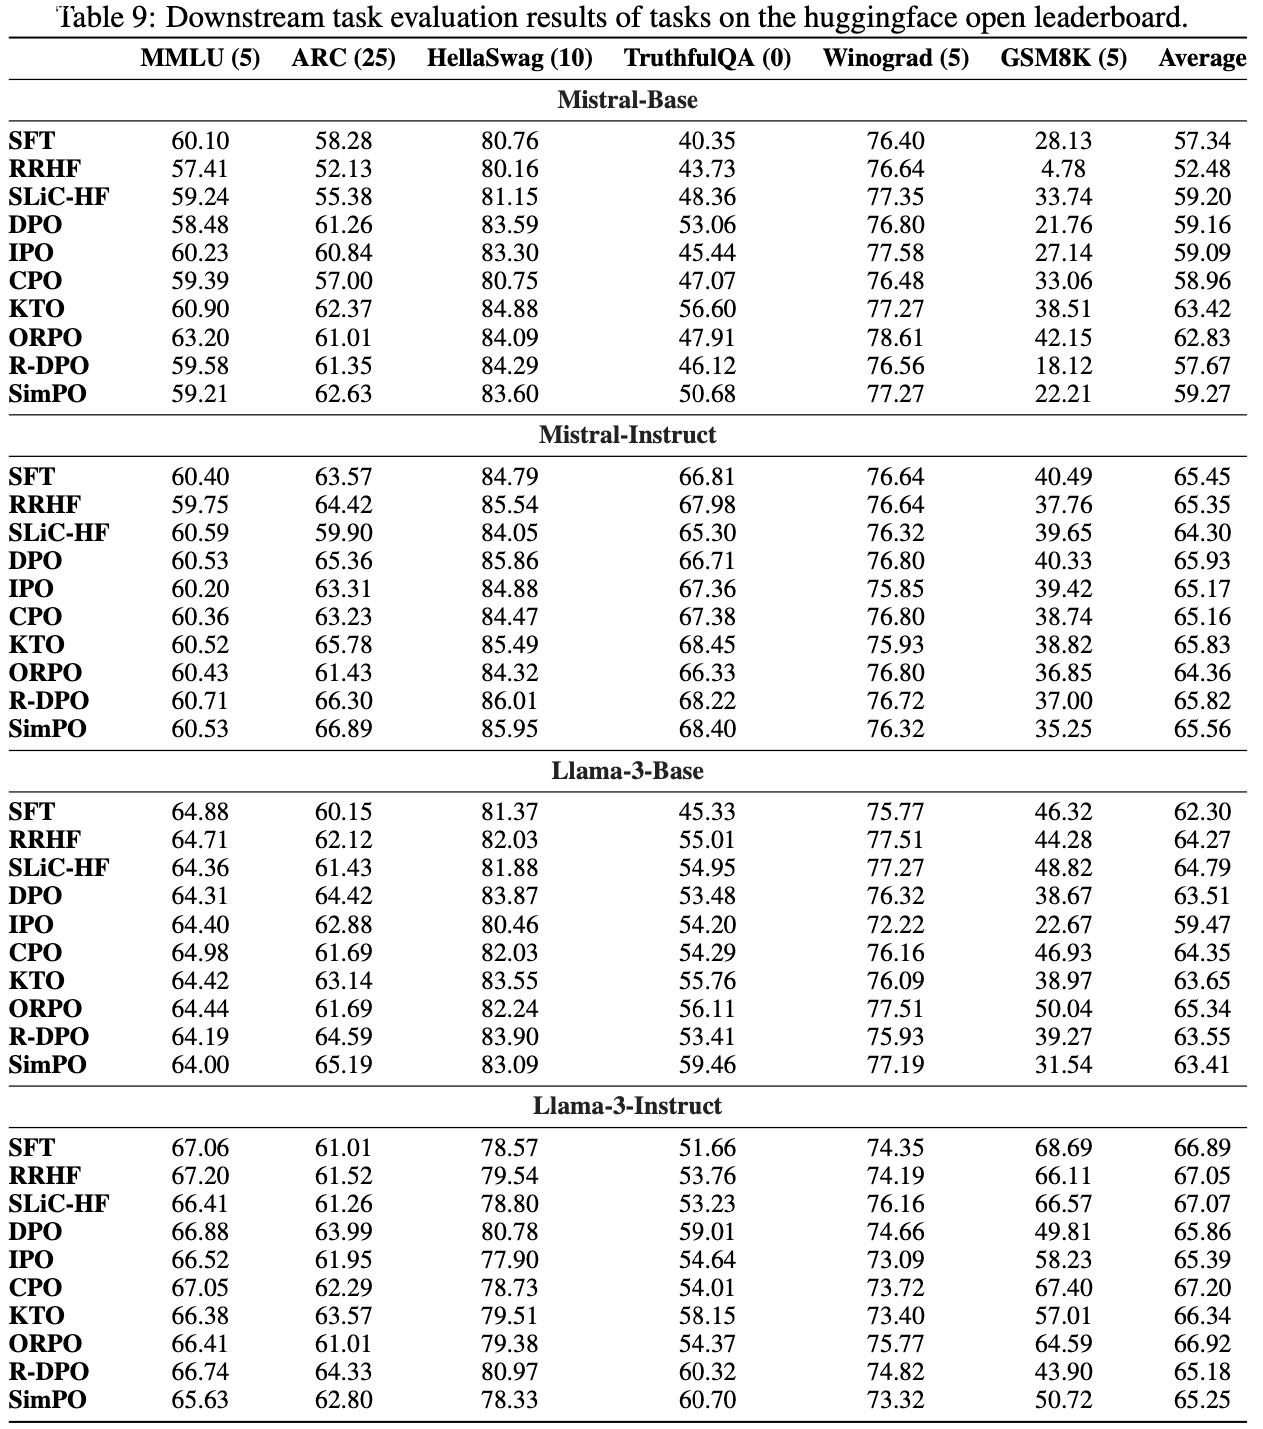
    • 论文发现偏好优化算法通常会降低下游任务性能 ,尤其是在数学推理密集型(reasoning-heavy)任务(如 GSM8K)上(正如表9所展示的那样)
    • SimPO 的表现有时与 DPO 相当或更差
      • 这可能与训练数据集的选择、超参数设置或评估模板不匹配有关
      • 一种解释是偏好优化目标可能在提升偏好序列的似然上没有效果(尽管提升了奖励间隔(Reward margin))
    • (2024)首次观察到这一现象,并指出这可能妨碍从修改一个 Token 就发生翻转(flip)的数学偏好对中学习(比如将 2 + 2 = 4 修改为 2 + 2 = 5)
      • 该工作提出通过添加参考模型校准的监督微调损失来缓解问题
      • 未来工作可将此策略整合到 SimPO 中,以提升数学推理任务的性能

附录 B Implementation Details

  • 论文发现超参数调优对偏好优化方法的性能至关重要,但其重要性在先前研究中可能被低估,导致基线结果未达最优
    • 为确保公平对比,论文为所有方法进行了全面的超参数调优
  • 通用训练超参数(General training hyperparameters) :
    • 在基础训练设置中,论文使用 UltraChat-200k 数据集(2023)训练监督微调模型
      • 学习率为 2e-5
      • 批量大小为 128
      • 最大序列长度为 2048
      • 采用余弦学习率调度
      • 预热步数为 10%
      • 训练 1 个 epoch
      • 所有模型均使用 Adam 优化器(2014)
    • 在偏好优化阶段,论文通过初步实验搜索批量大小(32、64、128)和训练周期(1、2、3)
      • 作者发现批量大小为 128 和单周期(epoch=1)训练通常能带来最佳结果
      • 因此,论文将这些值固定用于所有偏好优化实验
      • 此外,设置最大序列长度为 2048,并在偏好优化数据集上应用 10% 预热步数的余弦学习率调度
  • 方法特定超参数(Method-specific training hyperparameters) :
    • 论文注意到不同偏好优化方法的最佳学习率差异较大 ,且显著影响基准性能
    • 因此,论文为每种方法单独搜索学习率(3e-7、5e-7、6e-7、1e-6)
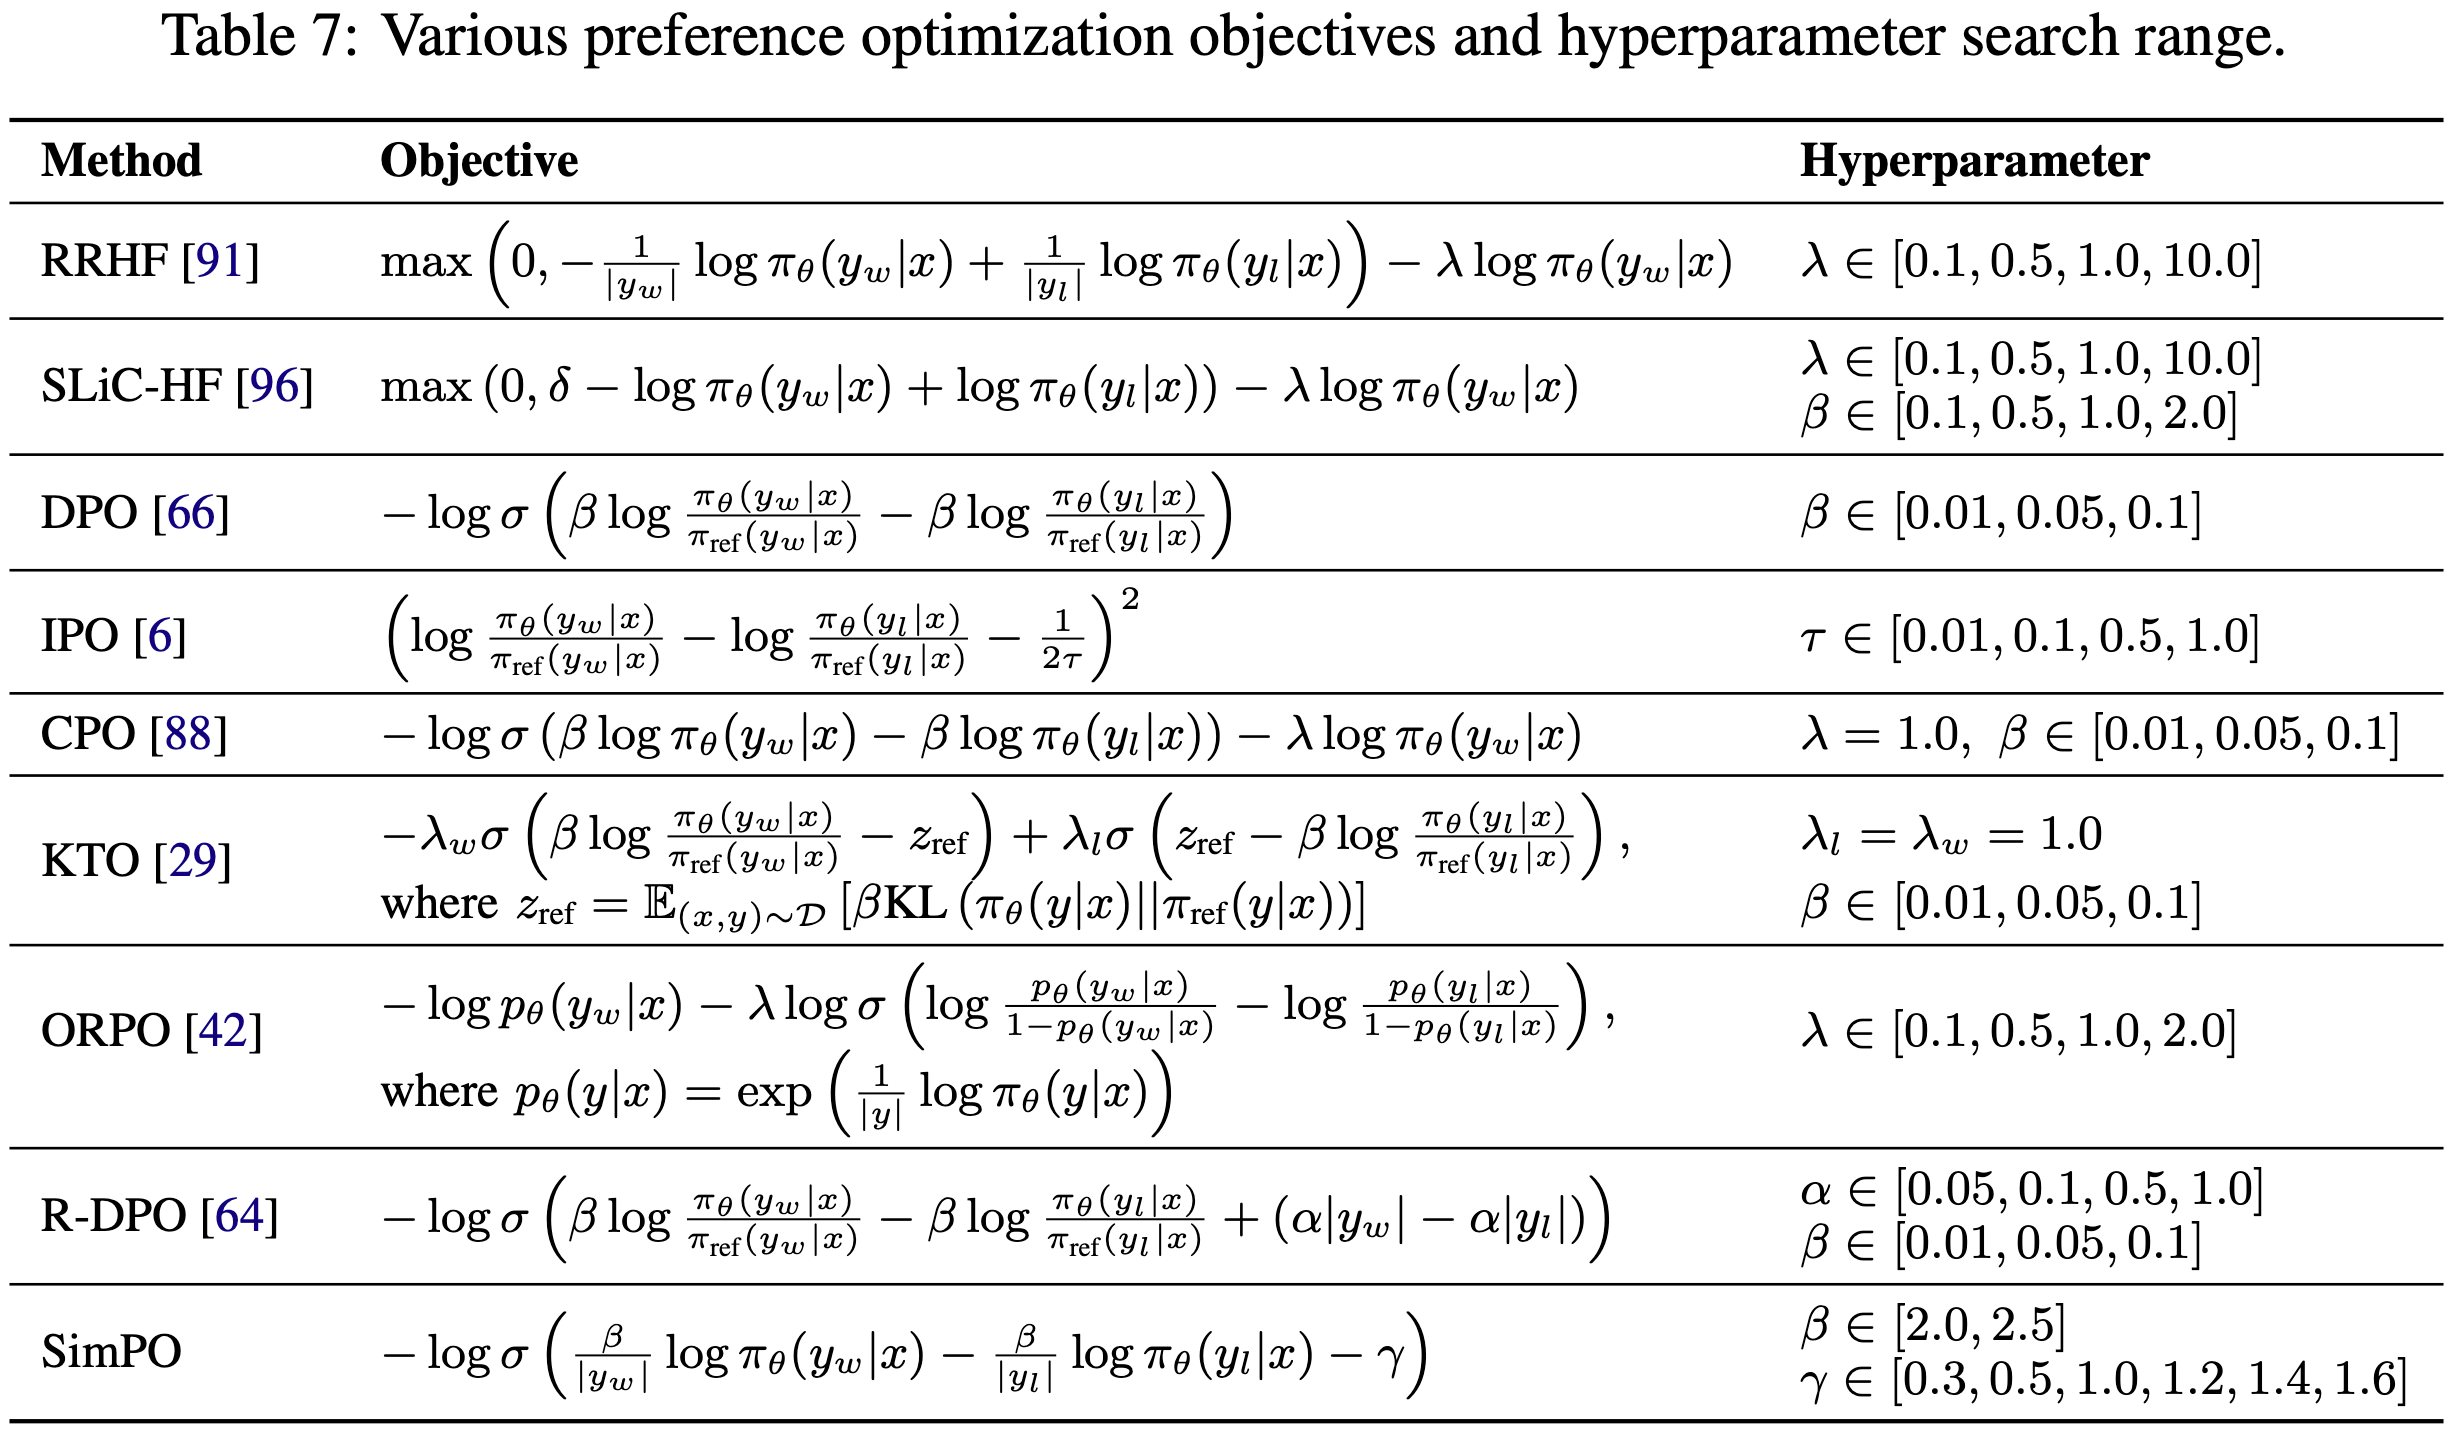
    • 表 7 展示了基线方法的超参数搜索范围
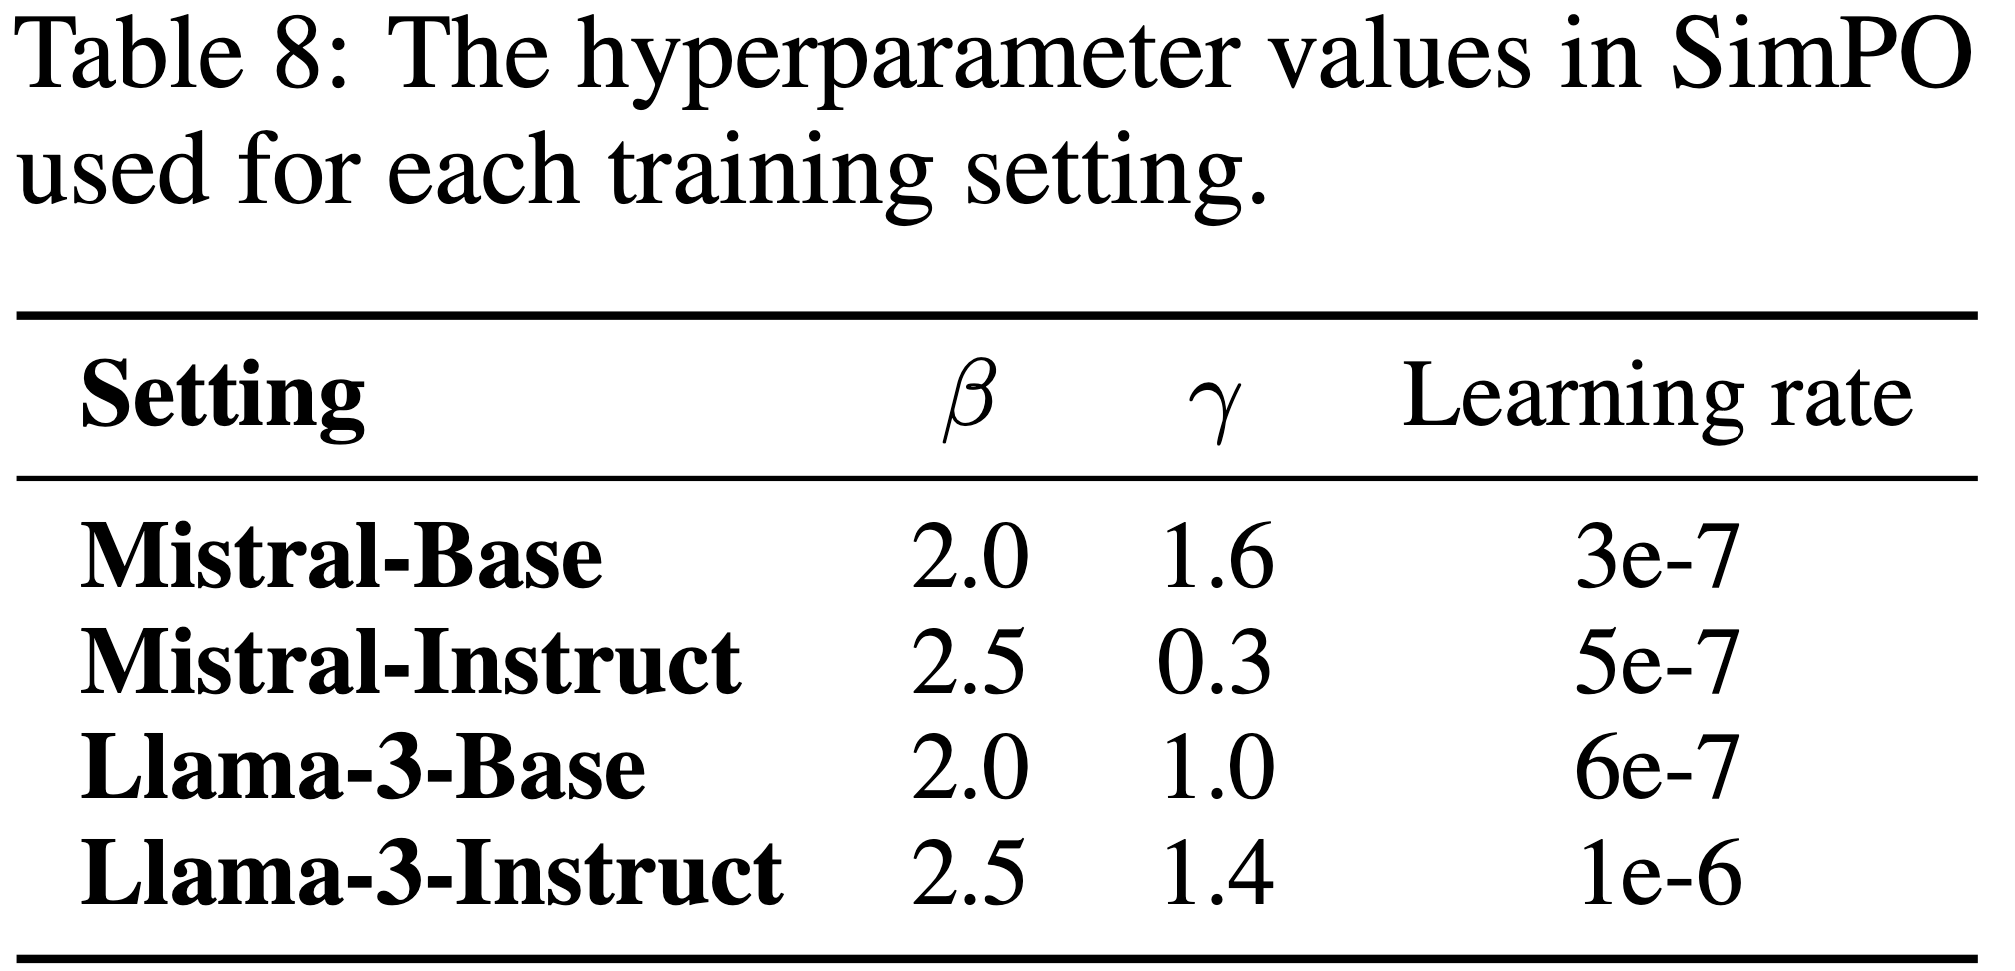
    • 表 8 列出了 SimPO 在各设置下的超参数值
  • 解码超参数(Decoding hyperparameters) :
    • 在 AlpacaEval 2 中,论文采用采样解码策略
      • 温度设置为 0.7(Mistral-Base)
      • 0.5(Mistral-Instruct)
      • 0.9(Llama 3)
    • 在 Arena-Hard 中,所有设置和方法均使用贪婪解码
    • 在 MT-Bench 中,遵循官方解码配置,为不同类别定义不同的采样温度
  • 计算环境(Computation environment) :
    • 论文所有训练实验均在 8 块 H100 GPU 上完成,基于 alignment-handbook 代码库实现

附录 C:Downstream Task Evaluation

  • 为了研究偏好优化方法如何影响下游任务性能,论文在 Huggingface Open Leaderboard (2023) 列出的多个任务上评估了不同方法训练的模型
  • 这些任务包括 MMLU (2020)、ARC (2018)、HellaSwag (2019)、TruthfulQA (2022)、Winograd (2012) 和 GSM8K (2021)
  • 论文遵循既定的评估协议,所有模型的结果如表 9 所示
    • 总体而言,论文发现偏好优化对不同任务的影响各不相同
  • 知识保留度高,损失小(Knowledge is largely retained with a small loss) :
    • 与监督微调(Supervised Fine-Tuned, SFT)检查点相比,所有偏好优化方法通常能保持 MMLU 性能,仅有小幅下降
    • 在这方面,SimPO 与 DPO 基本相当
  • 阅读理解和常识推理能力提升(Reading comprehension and commonsense reasoning improves) :
    • 对于 ARC 和 HellaSwag,偏好优化方法通常比 SFT 检查点表现更好
    • 一种假设是偏好优化数据集中包含与这些任务类似的提示,这有助于模型更好地理解上下文,提升阅读理解和常识推理能力
  • 真实性提高(Truthfulness improves) :
    • 令人惊讶的是,论文发现偏好优化方法能持续提升 TruthfulQA 性能,某些情况下提升幅度超过 10%
    • 同样,论文假设偏好数据集中包含强调真实性的实例,这有助于模型更好地理解上下文并生成更真实的回答
  • 数学性能下降(Math performance drops) :
    • GSM8K 是不同方法间表现波动最大的基准
    • 值得注意的是,除了 ORPO,几乎所有方法在一个或多个设置中都会导致性能下降
      • 论文假设 ORPO 能保持性能主要是因为其监督微调损失起到了调节作用
    • (2024) 的研究表明,在偏好优化目标中加入基于参考模型的监督微调损失可以有效解决这一问题,并保持数学任务上的性能
  • 总体而言,下游性能的模式难以确定
    • 由于使用了不同的预训练模型、偏好优化数据集和目标,进行全面分析较为困难
    • 近期研究表明,基于梯度的方法可能有助于找到与下游任务相关的数据 (2024),未来或可扩展用于理解偏好优化的影响
    • 作者认为,未来需要对偏好优化如何影响下游性能进行更严谨和全面的研究

附录 D:AlpacaEval 2 和 Arena-Hard 的标准差 (Standard Deviation of AlpacaEval 2 and Arena-Hard)

  • 论文在表 10 中展示了 AlpacaEval 2 的标准差和 Arena-Hard 的 95% 置信区间
    • 所有指标均合理,未出现显著异常或不稳定情况

附录 E:Generation Length Analysis

  • 长度归一化减少生成长度并提升生成质量(Length normalization decreases generation length and improves generation quality)
    • 从 SimPO 目标中移除长度归一化(Length Normalization, LN)会得到类似于对比偏好优化(Contrastive Preference Optimization, CPO)(2024) 的方法
      • CPO 在机器翻译中表现优异
    • 然而,如果没有监督微调损失 ,未使用长度归一化的奖励最大化目标在偏好优化中效果较差
    • 论文分析了在 AlpacaEval 2 和 Arena-Hard 上使用或不使用长度归一化训练的模型的生成长度
    • 如图 6 所示:
      • 长度归一化显著减少了生成长度,降幅高达 25%
      • 尽管生成长度更短,但使用长度归一化的模型在两个基准上的胜率显著更高
      • 这表明长度归一化能有效控制生成响应的冗余性,同时提升生成质量
  • 长度并非生成质量的可靠指标(Length is not a reliable indicator of generation quality)
    • 论文进一步分析了不同方法训练的模型在 AlpacaEval 2 和 Arena-Hard 上的生成长度,如表 10 所示
    • 总体而言,论文发现没有一种方法能在所有设置中一致生成更长或更短的响应
    • 此外,某些方法可能生成更长的响应,但未必在基准上取得更高的胜率
    • 这表明生成响应的长度并不能可靠反映生成质量
  • SimPO 对响应长度的利用最小化(SimPO demonstrates minimal exploitation of response length.)
    • 论文观察到,在 Llama-3-Instruct 案例中 ,SimPO 的生成长度比 DPO 更短 ,但在其他设置中生成长度更长
      • 在 AlpacaEval 2 上最多长出 26%
      • 在 Arena-Hard 上仅长约 5%
    • 可以说,生成长度很大程度上取决于评估基准
    • 更强的指标是 SimPO 在 AlpacaEval 2 上的长度控制胜率始终高于原始胜率 ,表明其对响应长度的利用最小化

附录 F:Gradient Analysis

  • 作者检查了 SimPO 和 DPO 的梯度,以理解它们对训练过程的不同影响:
    $$
    \nabla_{\theta}\mathcal{L}_{\text{SimPO} }(\pi_{\theta})=-\beta\mathbb{E}_{(x,y_{w},y_{l})\sim\mathcal{D} }\left[s_{\theta}\cdot\left(\underbrace{\frac{1}{|y_{w}|}\nabla_{\theta}\log\pi_{\theta}(y_{w}|x)}_{\text{increase likelihood on } y_w }-\underbrace{\frac{1}{|y_{l}|}\nabla_{\theta}\log\pi_{\theta}(y_{l}|x)}_{\text{decrease likelihood on } y_l}\right)\right], \\
    \nabla_{\theta}\mathcal{L}_{\text{DPO} }(\pi_{\theta})=-\beta\mathbb{E}_{(x,y_{w},y_{l})\sim\mathcal{D} }\left[d_{\theta}\cdot\left(\underbrace{\nabla_{\theta}\log\pi_{\theta}(y_{w}|x)}_{\text{increase likelihood on } y_w }-\underbrace{\nabla_{\theta}\log\pi_{\theta}(y_{l}|x)}_{\text{decrease likelihood on } y_l }\right)\right],
    $$
  • 其中:
    $$
    s_{\theta}=\sigma\left(\frac{\beta}{|y_{l}|}\log\pi_{\theta}(y_{l}|x)-\frac{\beta}{|y_{w}|}\log\pi_{\theta}(y_{w}|x)+\gamma\right), \quad d_{\theta}=\sigma\left(\beta\log\frac{\pi_{\theta}(y_{l}|x)}{\pi_{\text{ref} }(y_{l}|x)}-\beta\log\frac{\pi_{\theta}(y_{w}|x)}{\pi_{\text{ref} }(y_{w}|x)}\right)
    $$
    • 分别表示 SimPO 和 DPO 中的梯度权重
  • 可以看出差异有两方面:
    • (1) 比较梯度权重 \(s_{\theta}\) 和 \(d_{\theta}\)
      • SimPO 的梯度权重 \(s_{\theta}\) 不涉及参考模型,且具有直观解释:对于策略模型错误地为 \(y_l\) 分配比 \(y_w\) 更高似然的样本,权重会更高;
    • (2) 比较梯度更新
      • SimPO 对 \(y_l\) 和 \(y_w\) 的梯度进行了长度归一化,而 DPO 没有
      • 这与实证发现 (2024) 一致:DPO 可能利用数据中的长度偏差 ,更长的序列会因包含更多 token 而在 DPO 中获得更大的梯度更新 ,从而主导训练过程

附录 G:Qualitative Analysis

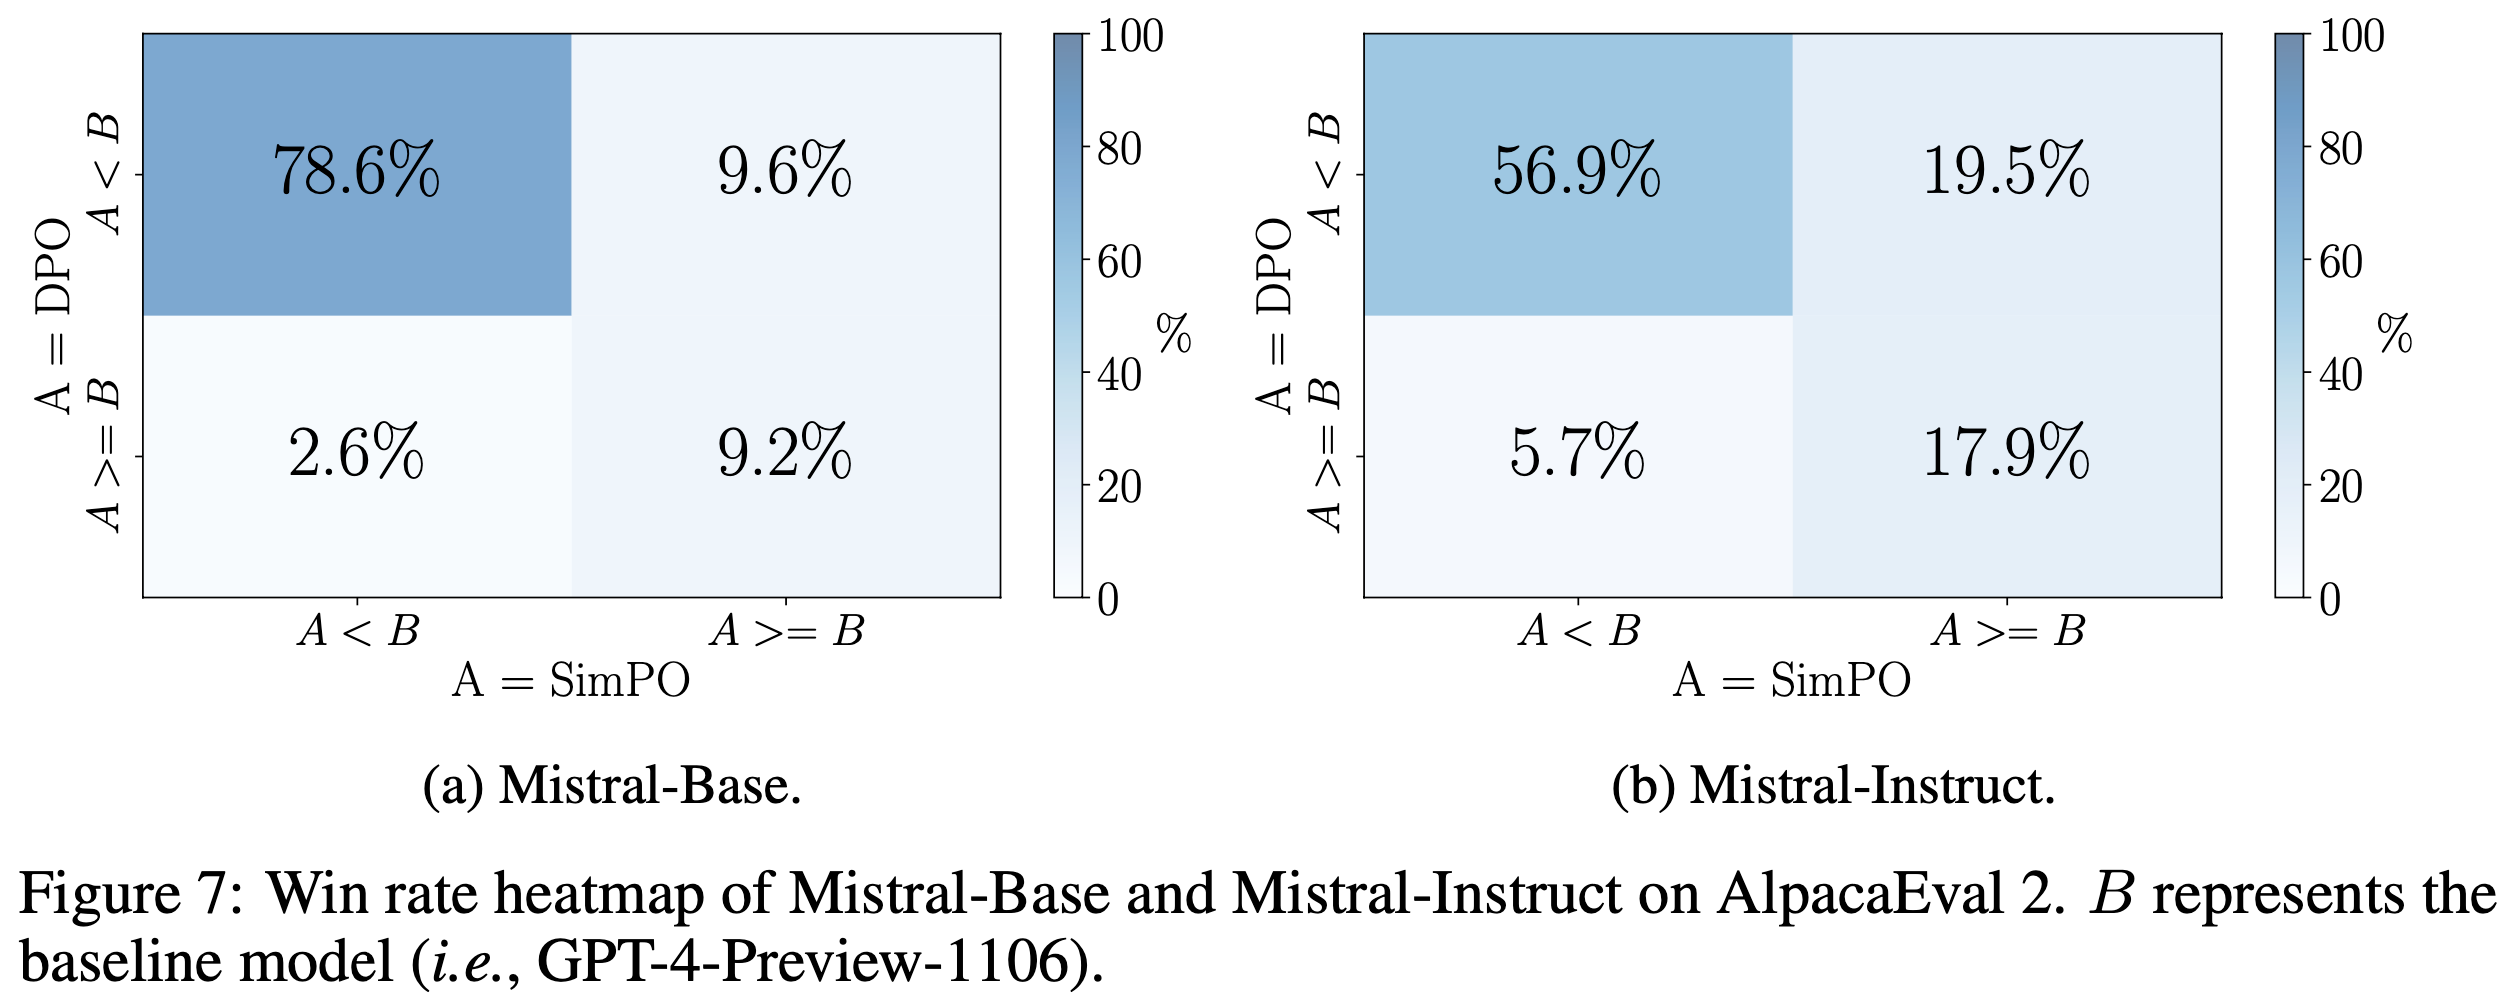
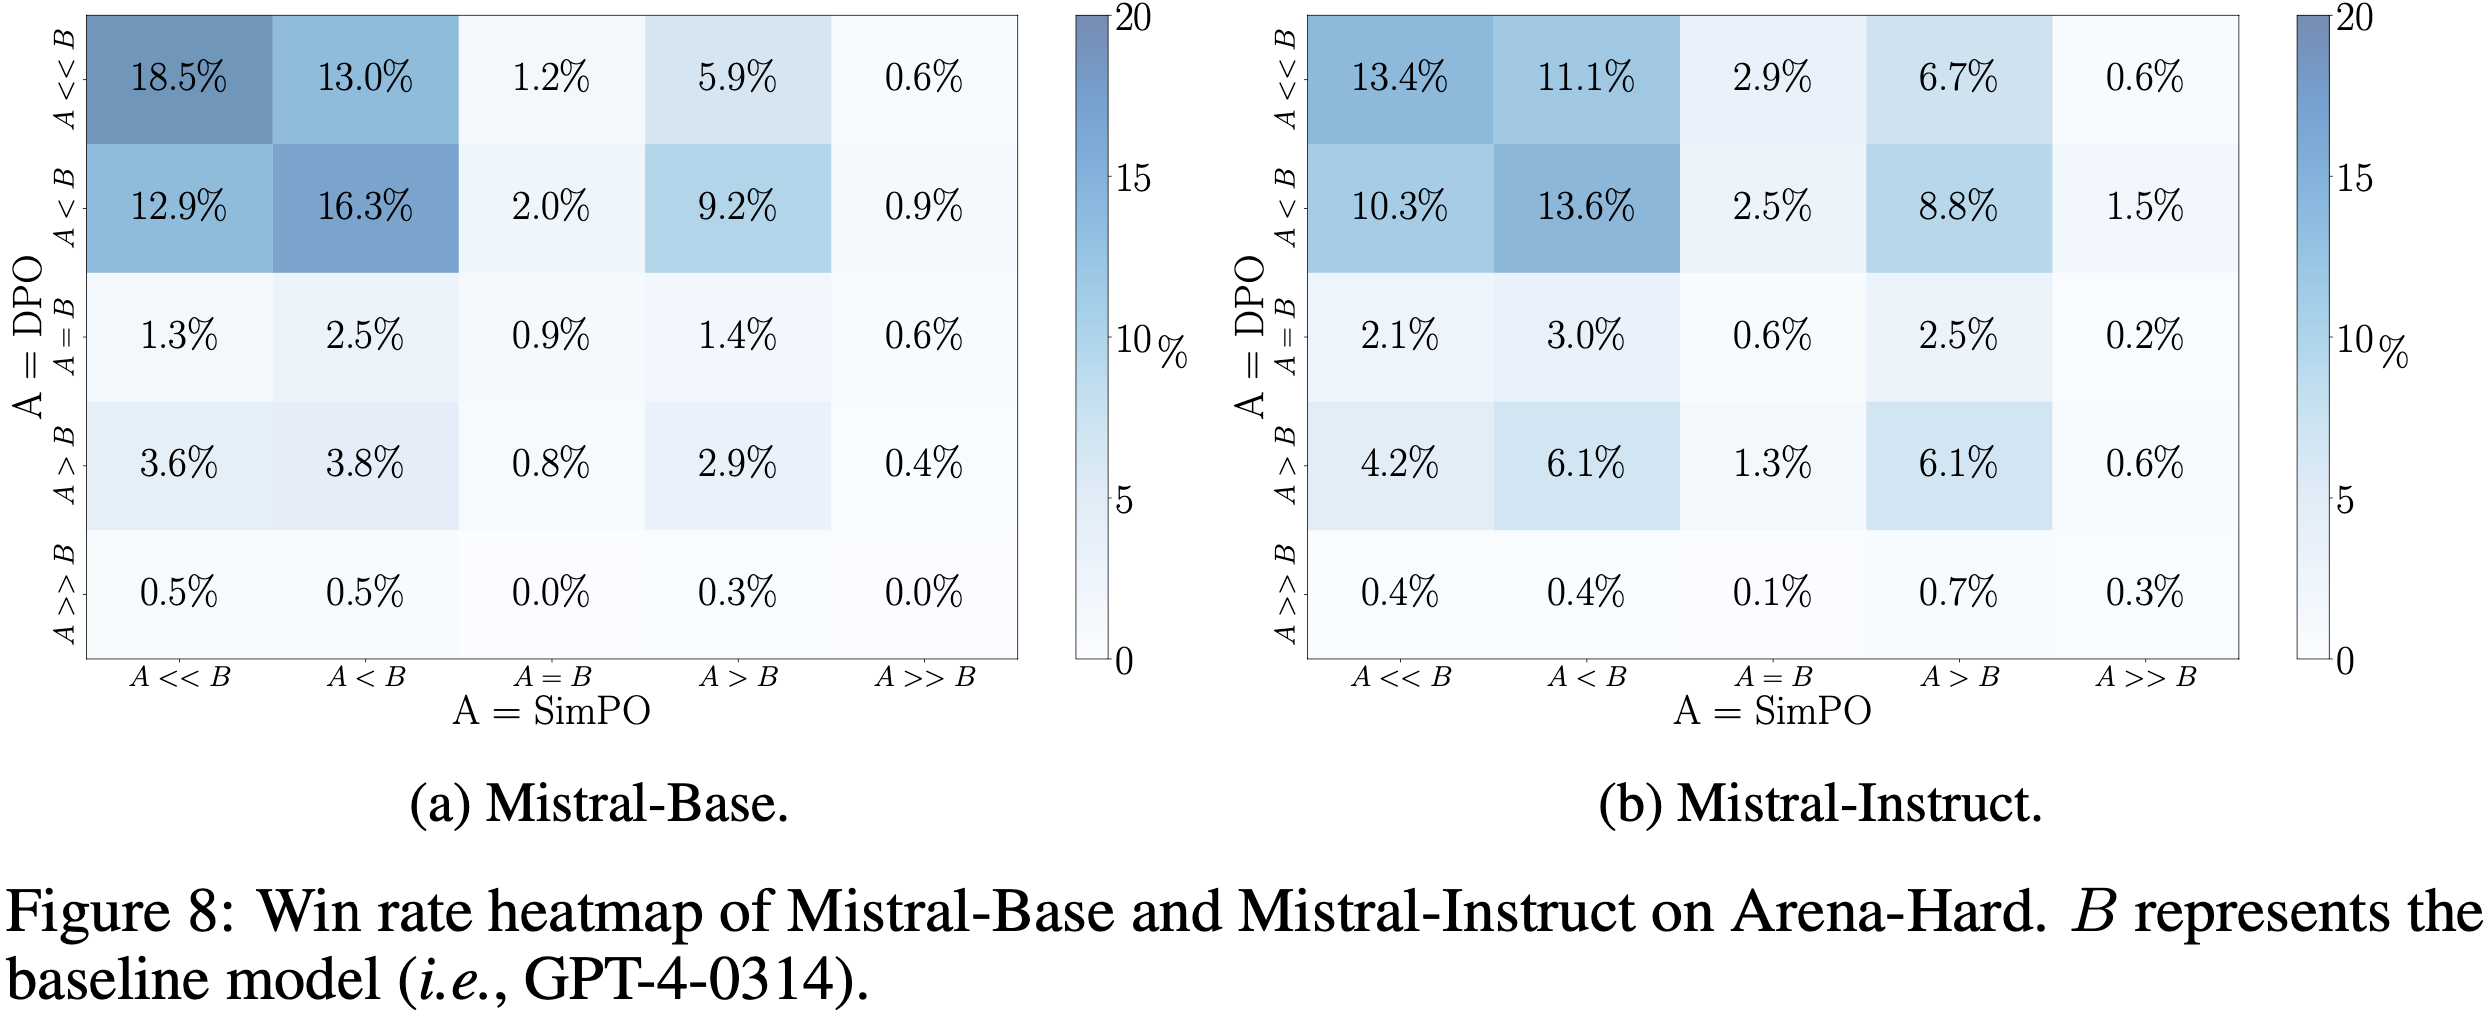
  • 论文在图 7 和图 8 中分别展示了 Mistral-Base 和 Mistral-Instruct 在 AlpacaEval 2 和 Arena-Hard 上的胜率热图
  • 基于此分析,论文在 AlpacaEval 2 上展示了 SimPO 模型、DPO 模型和基线模型 GPT-4-Preview-1106 生成的响应示例
  • 比较 SimPO 与 DPO
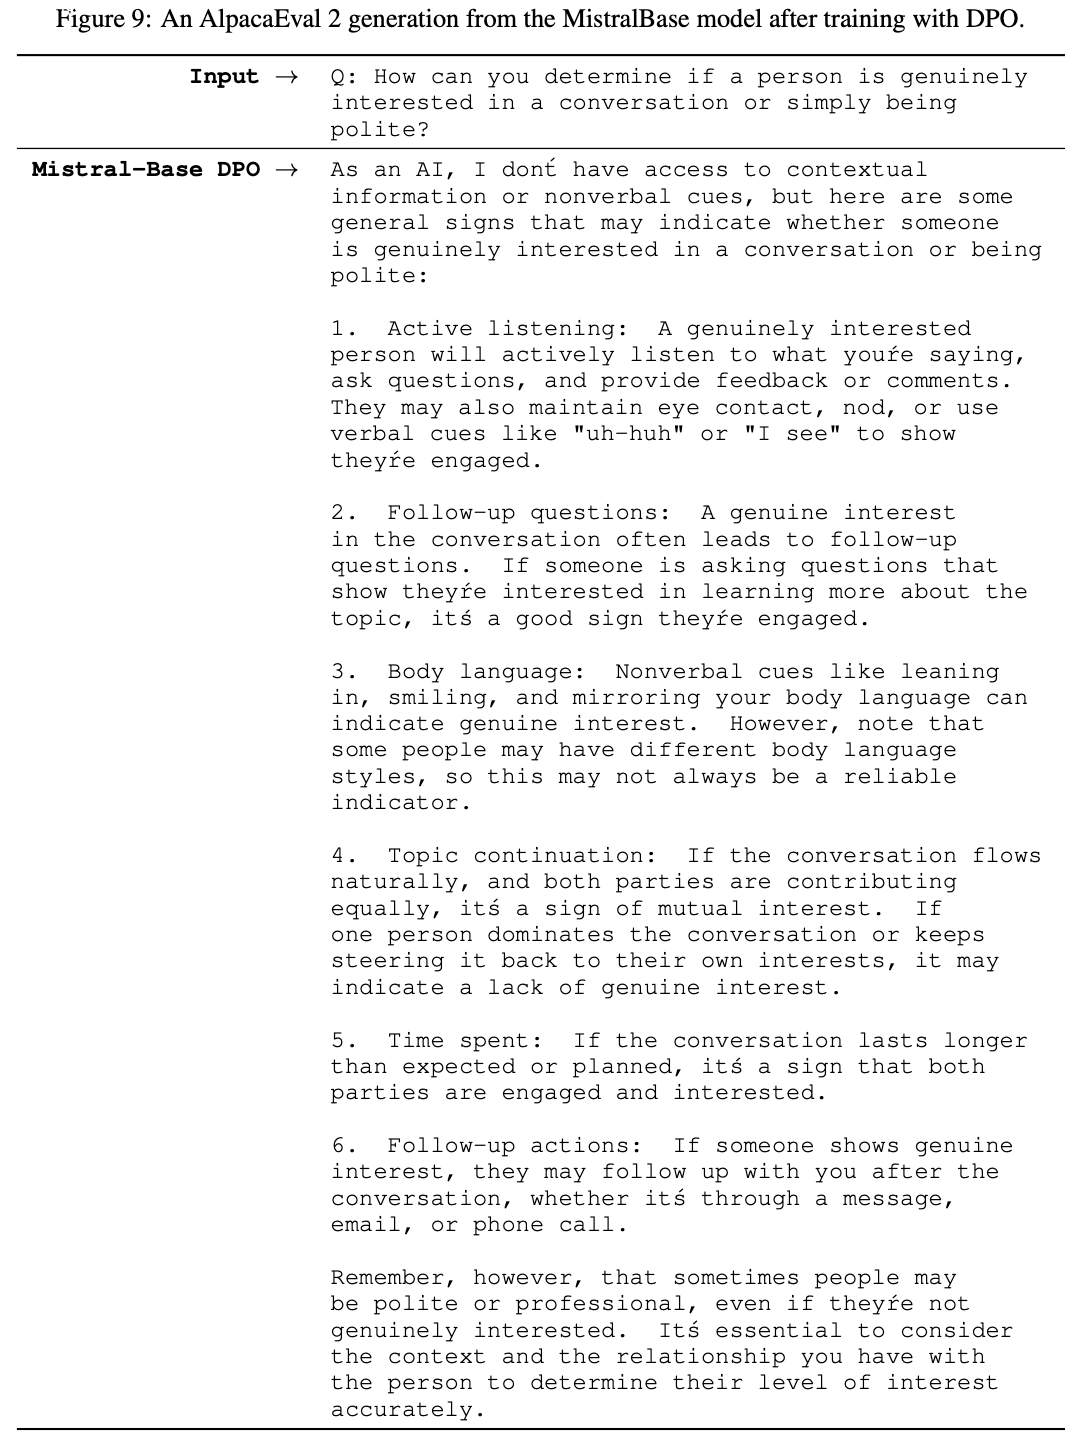
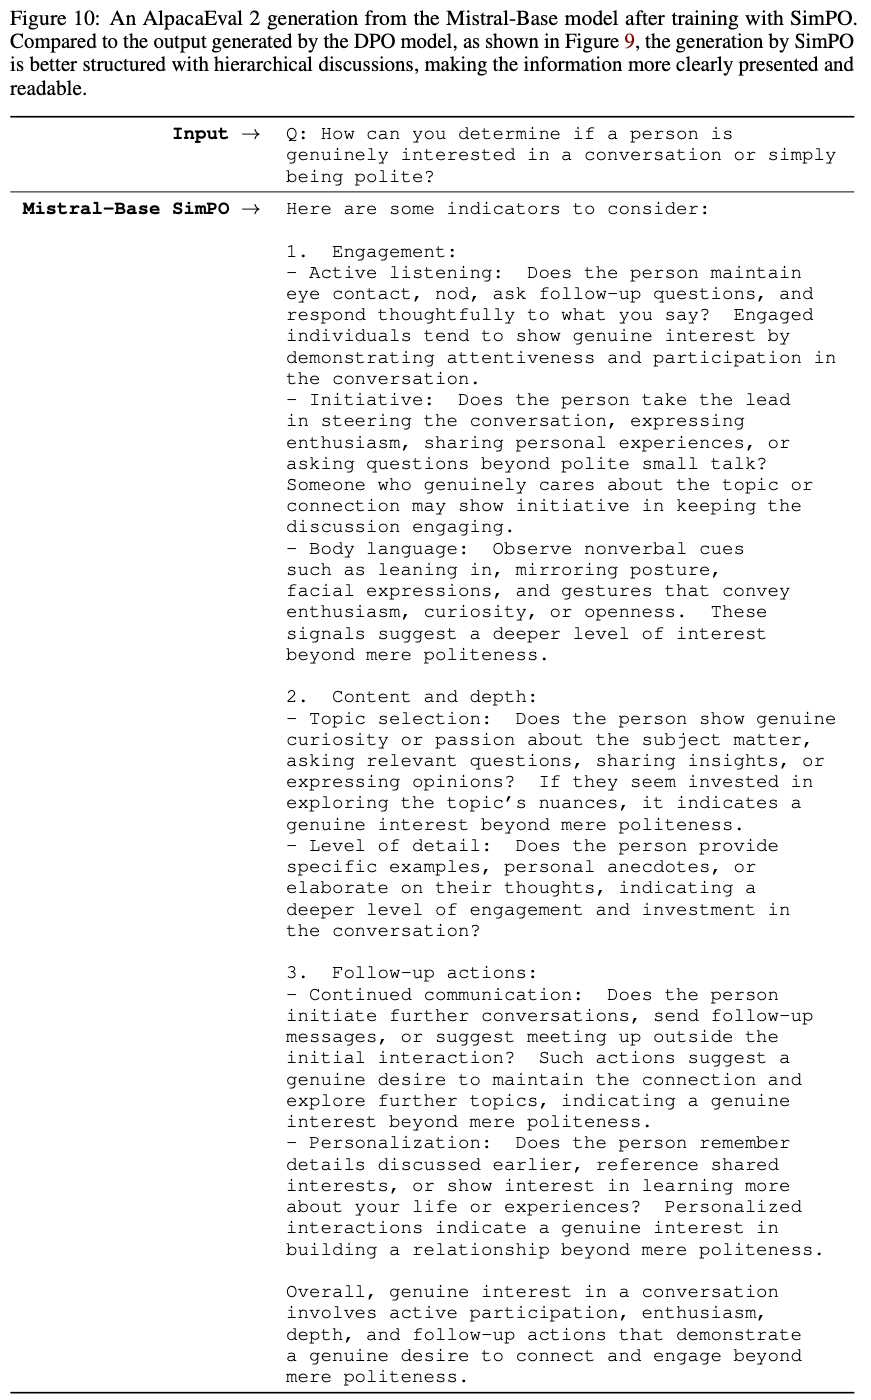
    • 在图 9 和图 10 中,论文展示了一个案例,其中 Mistral-Base-SimPO 生成的答案比 Mistral-Base-DPO 结构更好
      • 给定问题“如何判断一个人对对话是真正感兴趣还是仅仅出于礼貌?”,DPO 模型生成了一长串要点,使得不同点之间的关系难以理解
      • 相比之下,SimPO 模型生成了一个结构良好的答案,首先对不同行为进行了高层分类,随后为每个类别提供了详细建议,使得答案更易读和理解
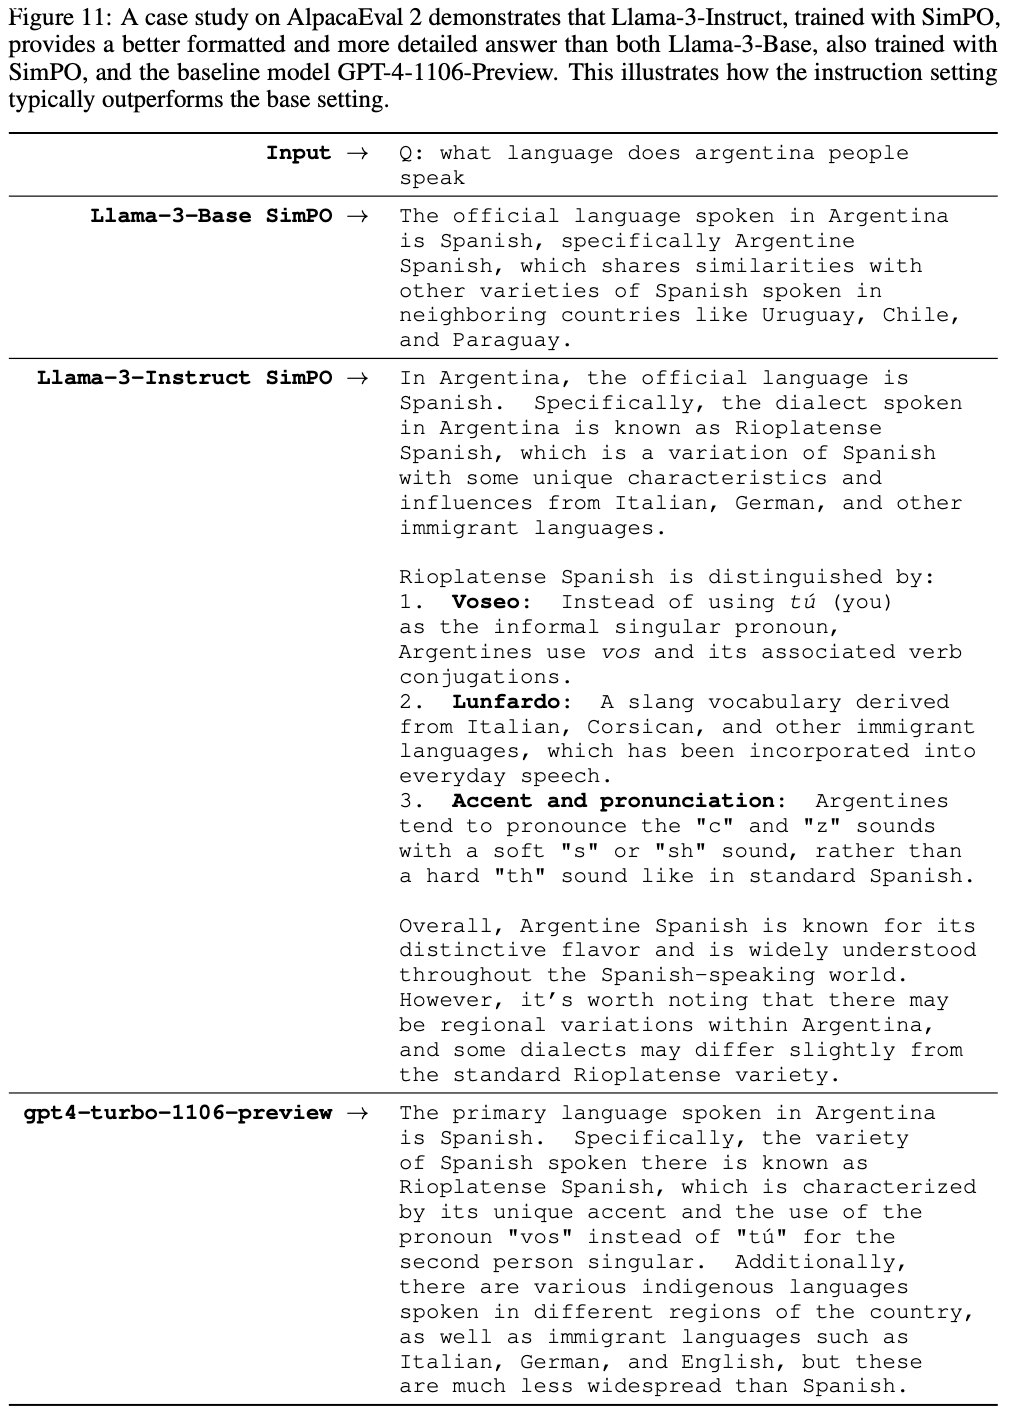
  • 比较使用 SimPO 训练的 Instruct 模型与 Base 模型 :
    • 在图 11 中,论文展示了一个案例,其中 Llama-3-Instruct 生成的答案比基线模型以及 Llama-3-Base-SimPO 模型更详细且格式更好
    • 对于问题“阿根廷人说什么语言?”,Llama-3-Base-SimPO 仅给出了非常简短的答案
    • GPT-4-Preview-1106 的答案更详细,解释了阿根廷西班牙语与标准西班牙语的区别,但格式不够清晰,解析稍难
    • Llama-3-Instruct-SimPO 提供了详细且格式良好的答案,更易阅读和理解,同时提供了足够的细节

附录 H:Llama-3-Instruct v0.2 (Jul 7, 2024))

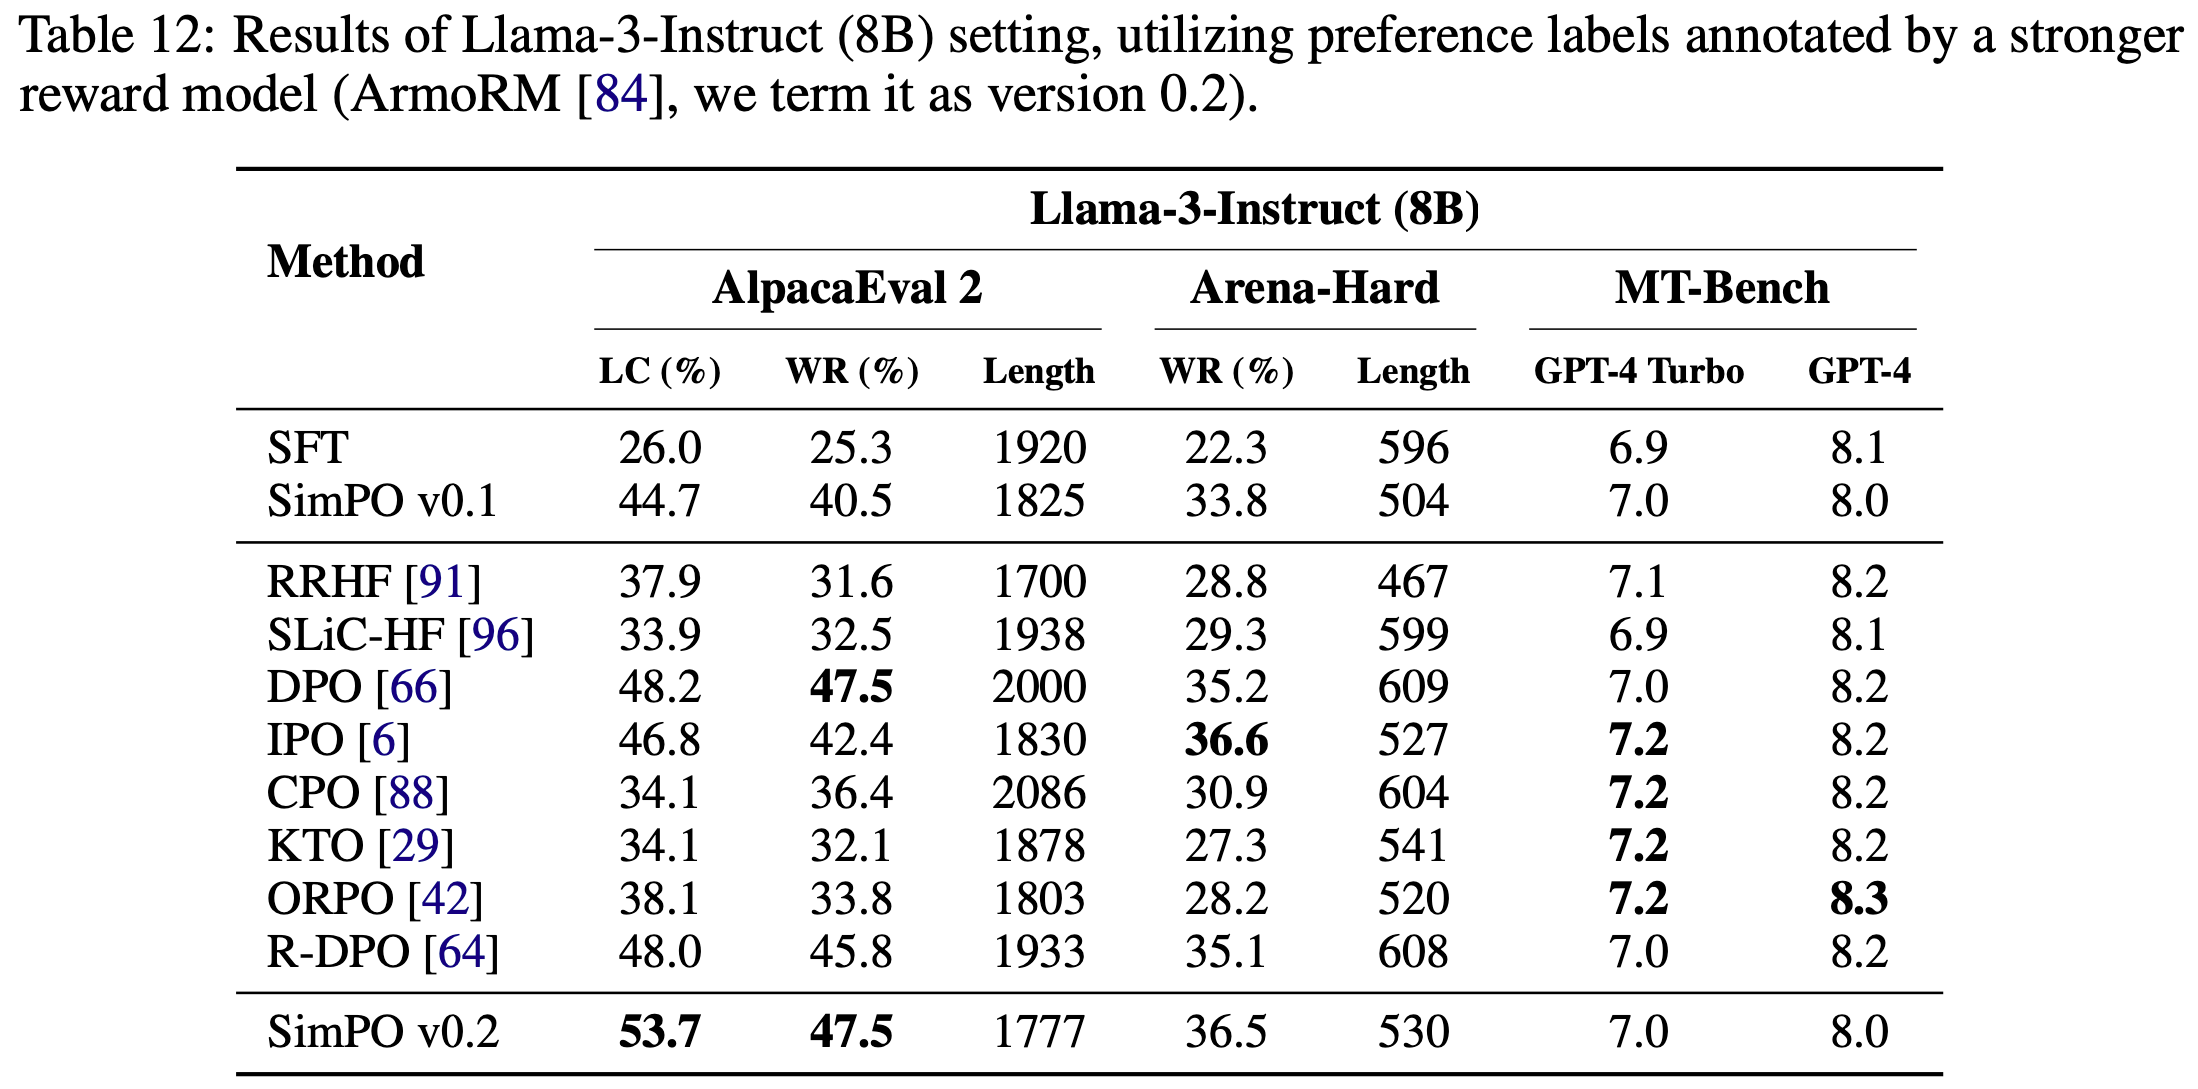
  • 本节论文更新了 Llama-3-Instruct 的实验设置,主要改进是使用更强的奖励模型(reward model)来标注生成的偏好数据
  • 更强的奖励模型显著提升效果(Enhanced reward model yields significantly better results)
    • 在之前的版本中,论文使用 PairRM(2023)作为奖励模型对生成的候选回答进行排序
    • 表 12 的结果显示,将排序数据的奖励模型从 PairRM 替换为 ArmoRM(2024)后,模型性能显著提升
    • 这凸显了高质量偏好优化数据对性能的重要性
    • SimPO 在 AlpacaEval 2 上的长度控制胜率(LC win rate)达到 53.7%,在 Arena-Hard 上达到 36.5%,分别比前一版本提升了 9.0 和 2.7 个百分点
  • 论文在 Llama-3-Instruct v0.2 设置下为 SimPO 使用了以下超参数:
    • \(\beta=10\) 和 \(\gamma=3\)
    • 其他超参数(如学习率、批量大小、最大序列长度)与原始 Llama-3-8B-Instruct 设置保持一致
  • 强大的 SFT 模型和高质量策略数据缩小了算法差异(Strong SFT model and high-quality policy data diminish algorithm differences)
    • 当使用像 Llama-3-8B-Instruct 这样强大的 SFT 模型,并且偏好优化数据质量提高时,不同算法之间的差异变得不那么明显
    • 例如,DPO 在原始胜率(raw win rate)上与 SimPO 表现接近,而 DPO、IPO 和 R-DPO 在 Arena-Hard 上的原始胜率也相当
    • 然而,SimPO 仍保持优势,生成的序列更短,因此在 AlpacaEval 2 上的长度控制胜率显著更高
  • 下游任务表现更强(Stronger downstream task performance)
    • v0.2 版本在各种目标下的下游任务中也表现出更好的性能
    • 不过,DPO、IPO、R-DPO 和 SimPO 在数学推理密集型任务(如 GSM8K)上仍然存在性能下降
    • 相比之下,包含 SFT 组件的目标在数学任务上保持了更好的表现
  • 在 SimPO 中加入 SFT 正则化(Incorporating SFT regularization in SimPO)
    • 一些无需参考模型(reference-free)的算法(如 RRHF(2023)、SLiC-HF(2023)、CPO(2024)和 ORPO(2024))在其目标中使用了 SFT 正则化
    • SFT 正则化是防止奖励破解(reward hacking)的有效方法,可以确保模型在保持低损失的同时不会生成质量下降的结果
    • 论文也在 SimPO 中尝试加入 SFT 损失,得到以下目标函数:
      $$
      \mathcal{L}_{\text{SimPO w/ SFT} }(\pi_{\theta})=-\mathbb{E}_{(x,y_{w},y_{l})\sim\mathcal{D} }\left[\log\sigma\left(\frac{\beta}{|y_{w}|}\log\pi_{\theta}(y_{w}|x)-\frac{\beta}{|y_{l}|}\log\pi_{\theta}(y_{l}|x)-\gamma\right)\color{red}{+\lambda\log\pi_{\theta}(y_{w}|x)}\right].
      $$
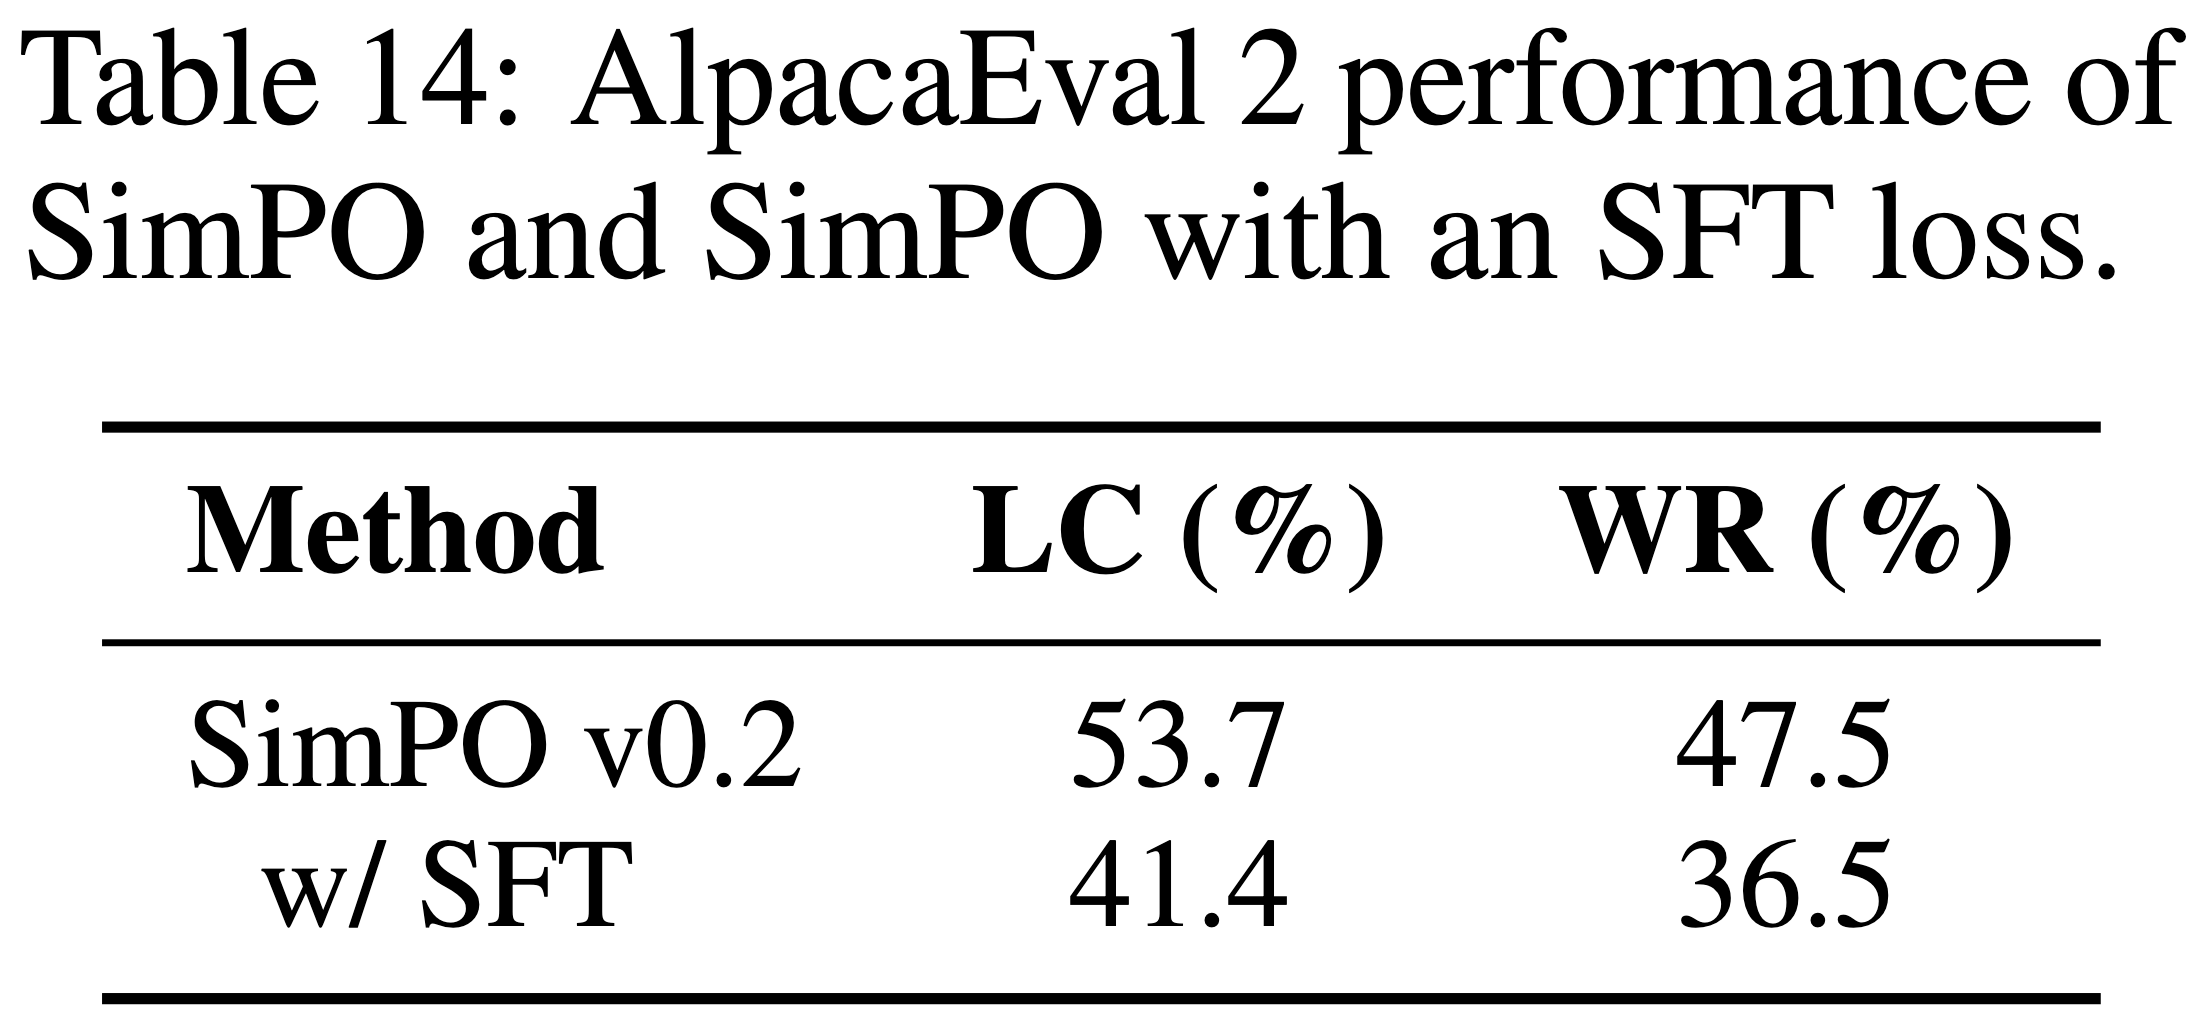
    • 如表 14 所示,加入 SFT 正则化后,模型在 AlpacaEval 2 上的性能有所下降
    • 但论文发现 SFT 正则化对某些任务(如 GSM8K)有显著帮助(见表 12)
    • 这些结果表明,SFT 在偏好优化中的作用可能因训练设置和任务性质而异
    • 更全面的研究留待未来进行

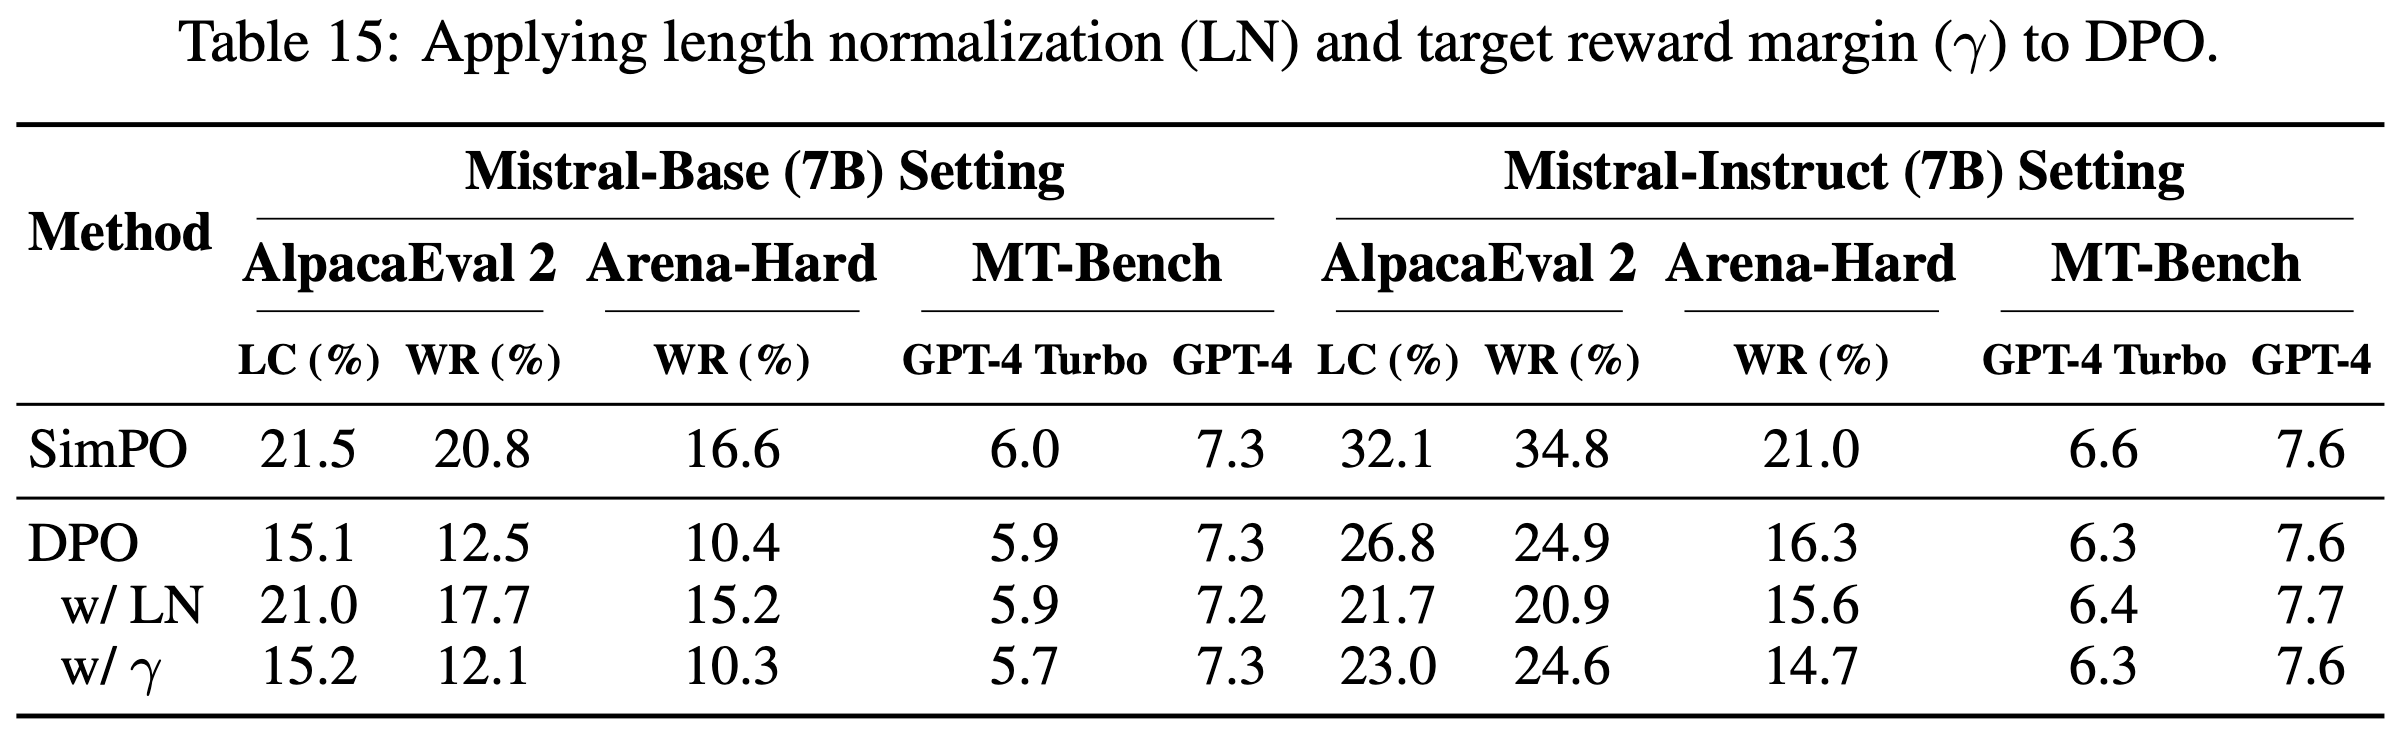
附录 I:Applying Length Normalization and Target Reward Margin to DPO (Jul 7, 2024))

  • 论文发布后,有研究者提出疑问:SimPO 的两个关键设计(长度归一化(length normalization)和目标奖励间隔(target reward margin))是否也能提升 DPO 的效果?为此,论文推导了以下两个目标函数:
    $$
    \mathcal{L}_{\text{DPO w/ LN} }(\pi_{\theta};\pi_{\text{ref} })=-\mathbb{E}_{(x,y_{w},y_{l})\sim\mathcal{D} }\left[\log\sigma\left(\frac{\beta}{|y_{w}|}\log\frac{\pi_{\theta}(y_{w}\mid x)}{\pi_{\text{ref} }(y_{w}\mid x)}-\frac{\beta}{|y_{l}|}\log\frac{\pi_{\theta}(y_{l}\mid x)}{\pi_{\text{ref} }(y_{l}\mid x)}\right)\right]. \\
    \mathcal{L}_{\text{DPO w/ }\gamma}(\pi_{\theta};\pi_{\text{ref} })=-\mathbb{E}_{(x,y_{w},y_{l})\sim\mathcal{D} }\left[\log\sigma\left(\beta\log\frac{\pi_{\theta}(y_{w}\mid x)}{\pi_{\text{ref} }(y_{w}\mid x)}-\beta\log\frac{\pi_{\theta}(y_{l}\mid x)}{\pi_{\text{ref} }(y_{l}\mid x)}-\gamma\right)\right].
    $$
    • 直观上,长度归一化可能对 DPO 有帮助,因为尽管 DPO 的奖励设计通过参考模型隐式归一化,但策略模型仍可能从数据中利用长度偏差,导致对较长序列赋予过高的概率
      • 长度归一化可以缓解这一问题
  • 论文使用上述目标训练模型,并与 DPO 和 SimPO 的性能进行比较(见表 15)
  • 结果表明,与 SimPO 不同,长度归一化和目标奖励间隔并不能一致地提升 DPO
  • 具体来说,长度归一化仅在 Mistral-Base 设置中显著提升 DPO 性能(该设置的偏好优化数据存在明显的长度偏差),但在 Mistral-Instruct 设置中无益(因为胜负响应的长度相近)
    • 这可能是因为 DPO 已通过参考模型隐式实现了实例级的目标奖励间隔,如下式所示:
      $$
      \begin{align}
      \mathcal{L}_{\text{DPO} }&= \log\sigma\left(\beta\log\frac{\pi_{\theta}(y_{w}\mid x)}{\pi_{\text{ref} }(y_{w}\mid x)}-\beta\log\frac{\pi_{\theta}(y_{l}\mid x)}{\pi_{\text{ref} }(y_{l}\mid x)}\right) \\
      &= \log\sigma\bigg(\beta\log\pi_{\theta}(y_{w}\mid x)-\beta\log\pi_{\theta}(y_{l}\mid x)-\underbrace{\left(\beta\log\pi_{\text{ref} }(y_{w}\mid x)-\beta\log\pi_{\text{ref} }(y_{l}\mid x)\right)}_{=\gamma_{\text{ref} } }\bigg).
      \end{align}
      $$

附录 J:Applying SimPO to Gemma 2 Models (Sept 16, 2024)

  • Llama-3-SimPO 模型在其他基准测试上的性能下降(Performance degradation on other benchmarks for Llama-3-SimPO checkpoints)
    • 在发布 Llama-3-SimPO 模型后,论文收到大量反馈,指出其在特定能力测试(如 MMLU 和 GSM8K)上的性能下降
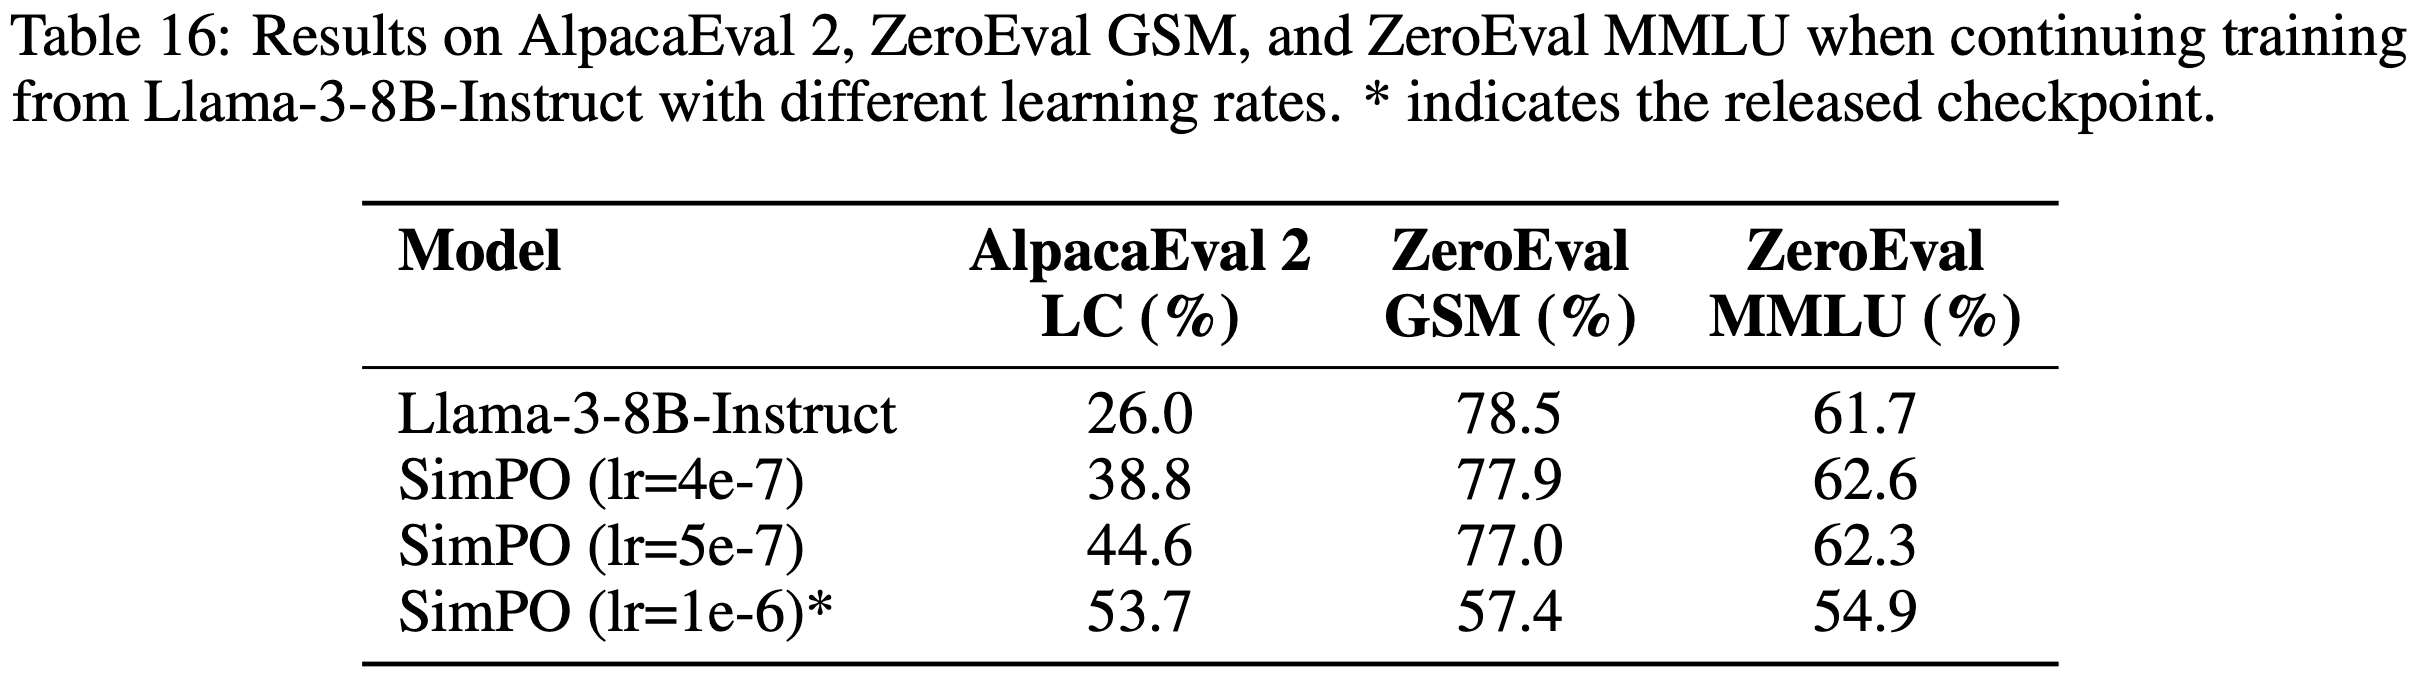
    • 为了研究这一问题,论文继续用不同学习率训练 Llama-3-8B-Instruct 模型(见表 16)
    • 论文发现,使用较高的学习率会增强模型在聊天类基准上的表现,但会牺牲 GSM8K 和 MMLU 的性能
      • We evaluate the zero-shot performance of the models on GSM8K and MMLU using the ZeroEval repository which adopts a unified setup
    • 而较低的学习率能略微降低聊天基准的性能,但更好地保留了 GSM8K 和 MMLU 的表现
    • 这表明,在基于强大的指令微调模型继续训练时,需要在聊天基准和其他基准之间权衡
  • 将 SimPO 应用于 Gemma 2 模型呈现不同趋势(Applying SimPO to Gemma 2 models persents a different trend)
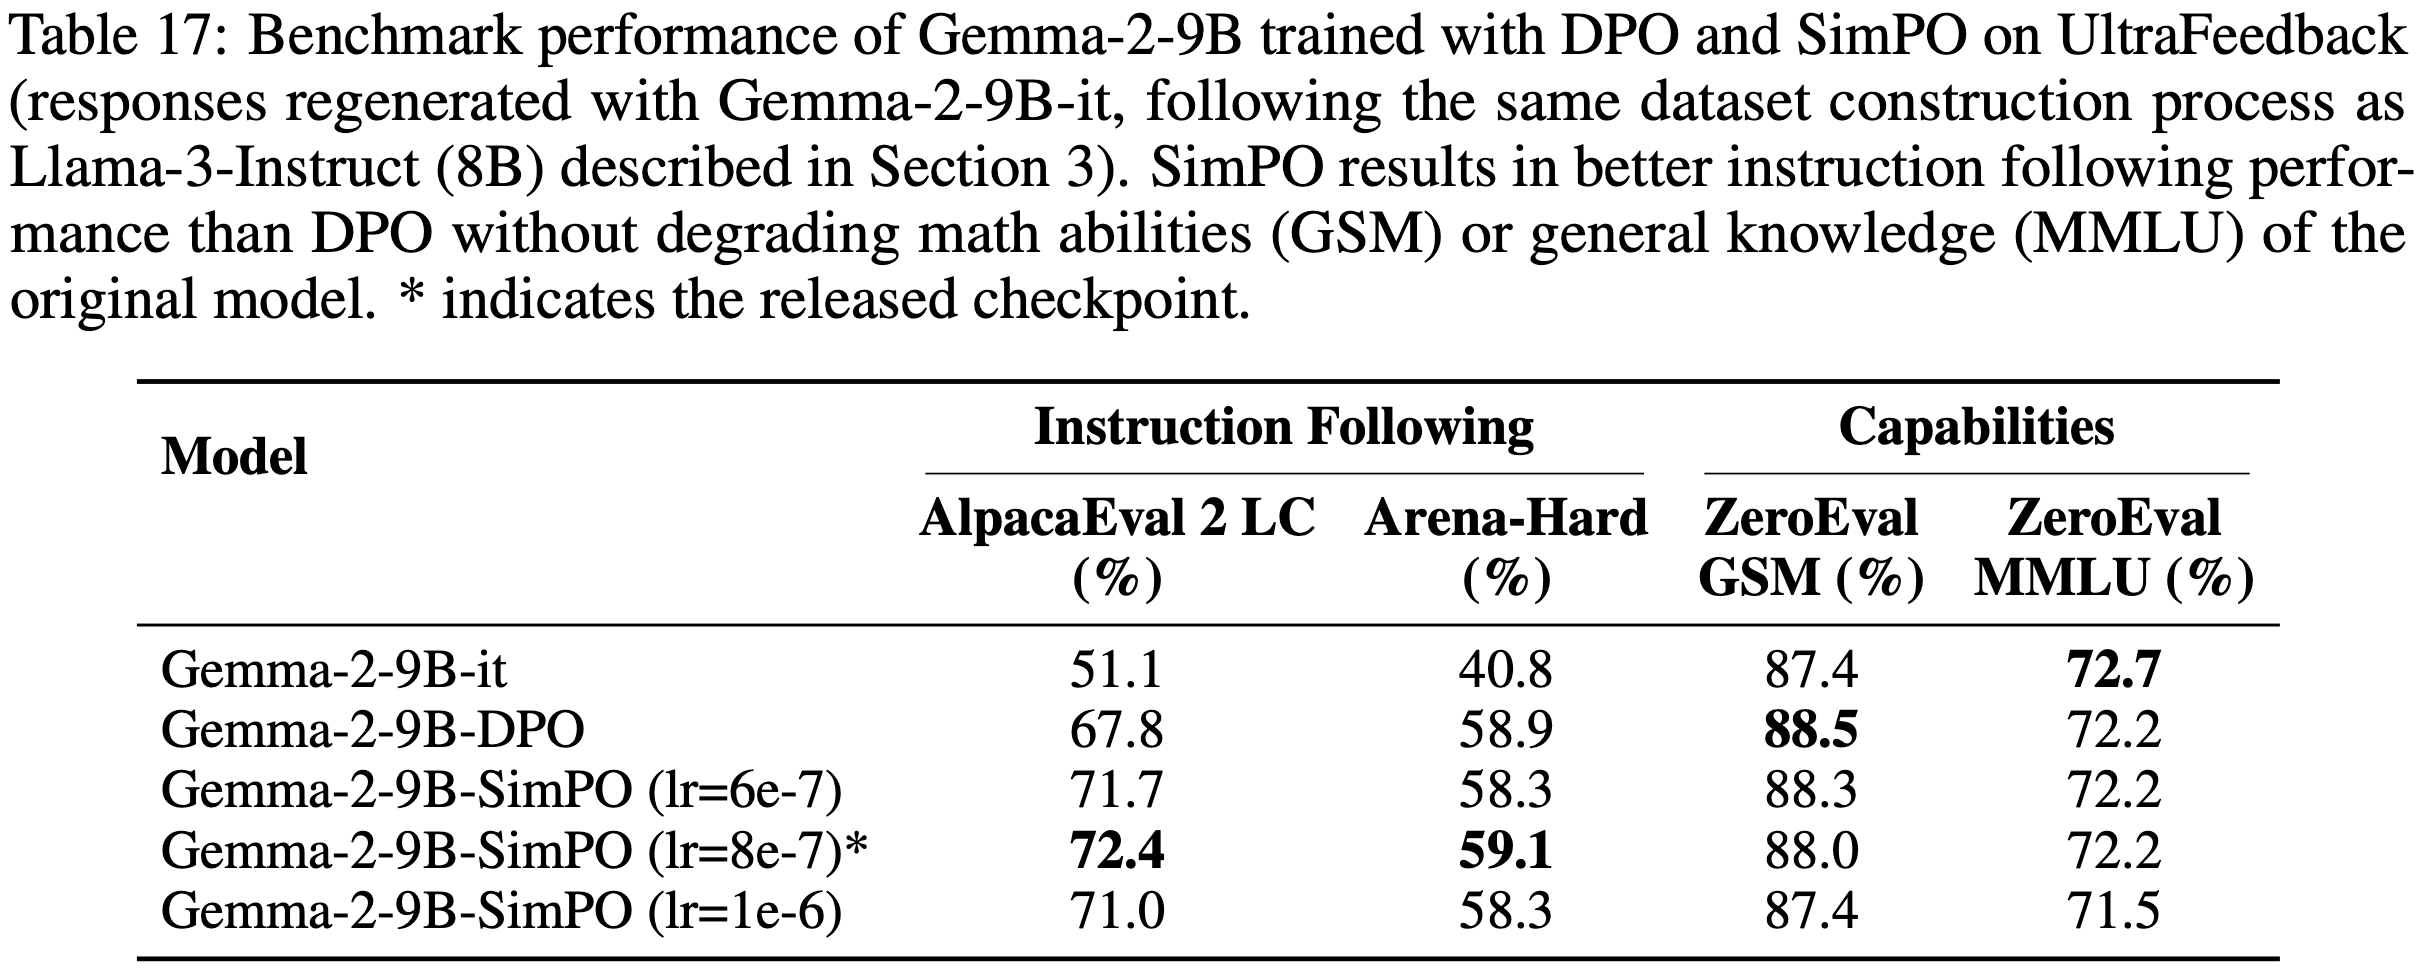
    • 论文使用谷歌最新发布的 Gemma-2-9B-it 模型(2024)评估 SimPO
    • 对于训练数据,论文从 UltraFeedback 数据集(2024)中为每个提示生成最多 5 个回答,并使用 ArmoRM 模型(2024)标注偏好
    • 论文将 SimPO 与基于 Gemma-2-9B-it 微调的 DPO 变体进行比较
    • 如表 17 所示,SimPO 在 AlpacaEval 2 和 Arena-Hard 等聊天基准上表现更优,同时保持了模型在 GSM8K 和 MMLU 等任务上的零样本能力
    • 值得注意的是,论文发现微调时调整学习率对模型性能影响很小
    • 这些结果表明,Llama-3 和 Gemma 2 的模型存在内在差异,值得进一步研究
  • Gemma-2-9B-it-SimPO 显著提升了原模型在 Chatbot Arena 的排名(Gemma-2-9B-it-SimPO significantly improved the ranking of the Gemma-2-9B-it model on Chatbot Arena)
    • 在开发阶段,论文仅依赖自动化指标评估模型性能
    • 为了验证这些指标是否与真实用户偏好一致,论文将表现最佳的 Gemma-2-9B-it-SimPO 模型提交至 LMSYS 的 Chatbot Arena 排行榜(2024)
    • 结果显示,论文的模型将原 Gemma-2-9B-it 的排名从第 36 位提升至第 25 位,使其成为截至 2024 年 9 月 16 日用户投票排名最高的 10B 以下模型
1…878889…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4