注:本文包含 AI 辅助创作
- 参考链接:
Paper Summary
- 整体说明:
- 论文介绍了一个基于 Rubric 的奖励 RL 框架 为 RubricRL(为文本到图像)
- RubricRL 通过显式地创建可配置的视觉标准(例如计数、属性、OCR 保真度、真实感)并独立地对它们进行评分,产生可解释和模块化的信号(这些信号可以与 RL 中的标准策略优化无缝集成)
- 背景 & 问题:
- RL 已成为一种有前景的方法,用于使文本到图像生成模型与人类偏好对齐,但一个关键的挑战在于设计有效且可解释的奖励
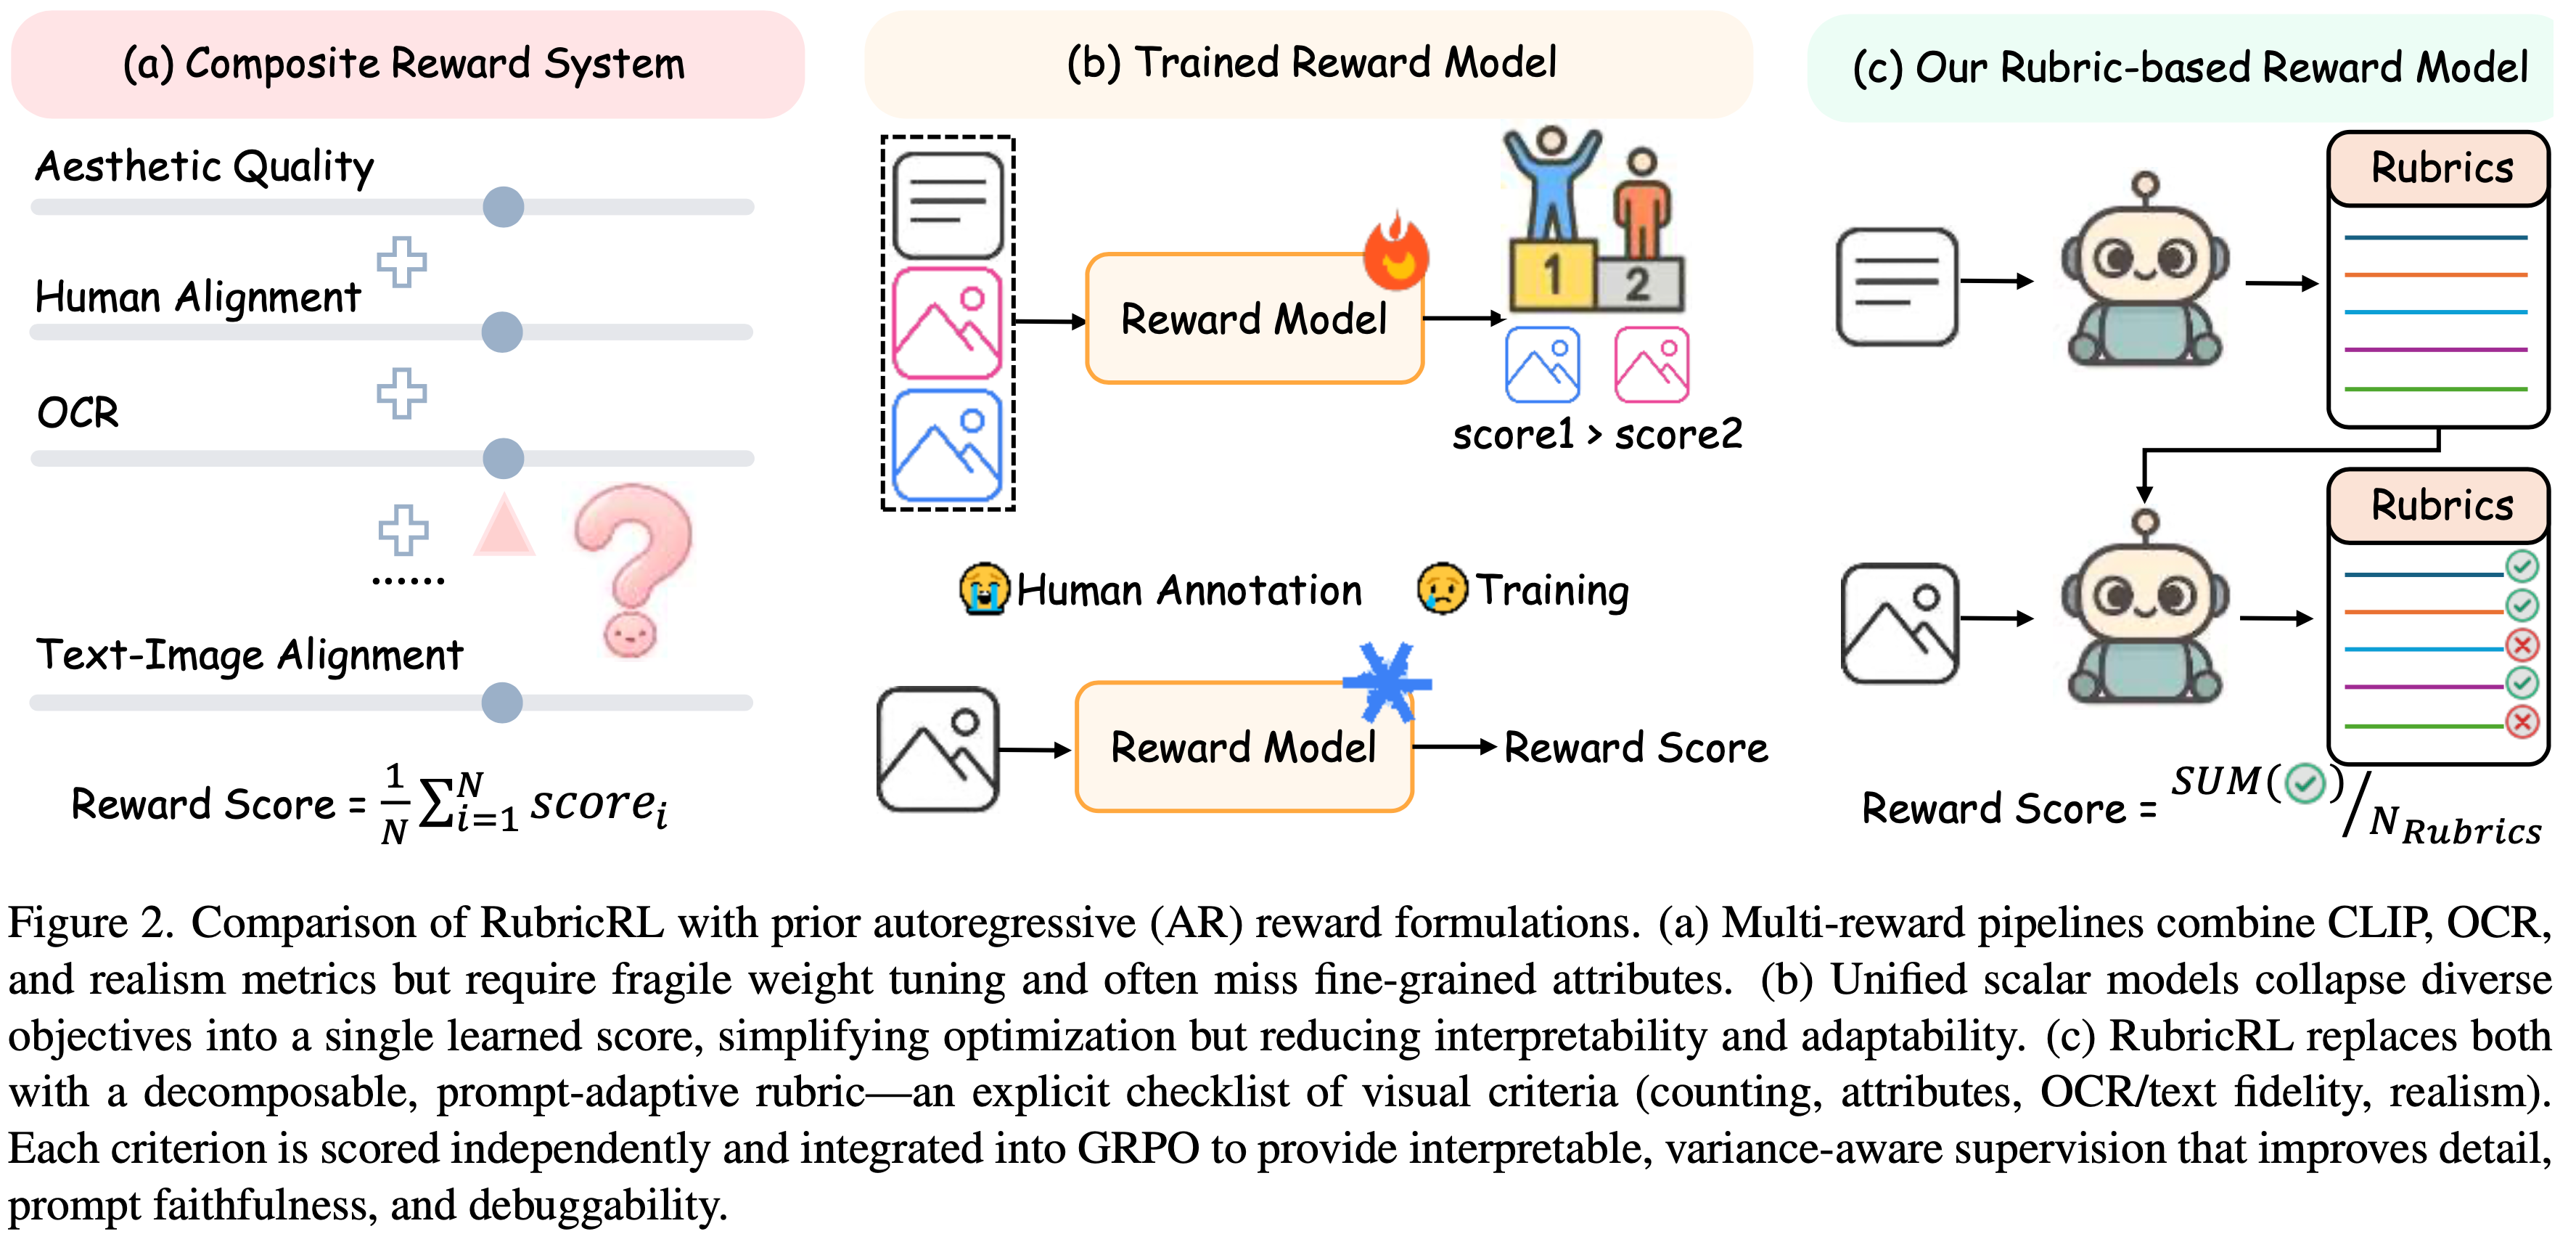
- 现有方法通常依赖于具有固定权重的复合指标(例如,CLIP、OCR 和真实感分数)或从人类偏好模型提取的单一标量奖励,这可能会限制可解释性(interpretability)和灵活性(flexibility)
- 论文方法:
- Rubric-based 奖励设计的框架 RubricRL
- RubricRL 提供了更高的可解释性、可组合性(composability)和用户控制力(user control)
- RubricRL 不使用黑盒标量信号,而是为每个 Prompt 动态构建一个结构化 Rubric (一个可分解的细粒度视觉标准清单),并根据输入文本定制
- 结构化 Rubric:例如 对象正确性、属性准确性、OCR 保真度(OCR fidelity)和真实感(realism)
- 每个标准由多模态 Judge(如 o4-mini)独立评估,一个 Prompt 自适应加权机制会强调最相关的维度
- 这种设计不仅为策略优化(例如,GRPO 或 PPO)产生了可解释和模块化的监督信号,还使用户能够直接调整奖励或惩罚哪些方面
- 在一个自回归文本到图像模型上的实验表明,RubricRL 提高了 Prompt 忠实度、视觉细节和泛化能力,同时为跨文本到图像架构的可解释 RL 对齐提供了一个灵活且可扩展的基础
- 在一个自回归文本到图像模型上的实验表明,RubricRL 提高了 Prompt 忠实度、视觉细节和泛化能力,同时为跨文本到图像架构的可解释 RL 对齐提供了一个灵活且可扩展的基础
Introduction and Discussion
- RL 最近已成为一种有前景的方法,用于对齐生成模型与人类偏好
- 在 LLM 中,RLHF (2022) 和 RLVF (2024, 2025) 等框架已经证明,基于偏好反馈引导的策略优化可以显著增强忠实度、风格和可用性
- 将这一范式扩展到文本到图像生成,包括扩散和自回归架构,提供了一种原则性的方式
- 直接针对人类对齐的视觉质量而非基于似然的目标来优化模型
- However,RL 在视觉领域的有效性关键取决于奖励设计:构建跨 Prompt、领域和架构都准确、可解释且可泛化的评估信号仍然是一个核心挑战
- 现有的文本到图像 RL 框架可以大致分为多奖励混合和统一标量奖励模型两类
- 多奖励系统(例如,X-Omni (2025),AR-GRPO (2025)):
- 结合了异构目标,如基于 CLIP 的图文相似度 (2021)、OCR 准确度 (2025)、真实感 (2023) 和属性一致性,以共同鼓励对齐和视觉质量
- 虽然这种方法提高了覆盖范围,但它们依赖于手动调整的加权方案,这些方案跨 Prompt 和领域可能很脆弱,并且提供的可解释性有限
- 统一奖励模型(例如,OneReward (2025),Pref-GRPO (2025),LLaVA-Reward (2025)):
- 从成对的人类偏好数据中学习单一标量奖励
- 这简化了优化,但可能掩盖奖励背后的推理过程,限制可扩展性,并使得用户难以控制优先考虑哪些视觉方面
- 多奖励系统(例如,X-Omni (2025),AR-GRPO (2025)):
- 在论文提出了 RubricRL ,一个用于文本到图像模型中 Rubric-based 奖励设计的简单通用框架
- RubricRL 不依赖不透明的标量信号,而是 动态地为每个 Prompt 选择一个结构化 Rubric
- 这里的 Rubric 即一个可分解的细粒度视觉标准清单,例如对象正确性、属性准确性、OCR 保真度、组合连贯性和真实感
- 每个标准由多模态 Judge (例如,GPT-4o-mini)独立评估,同时一个 Prompt 自适应加权机制会突出最相关的维度
- 这产生了可解释、模块化的监督信号,可以自然地集成到 GRPO (2025) 或 PPO (2017) 等策略优化框架中
- RubricRL 不依赖不透明的标量信号,而是 动态地为每个 Prompt 选择一个结构化 Rubric
- 通过以人类可读和可分解的形式表达奖励,RubricRL 将奖励评估从黑盒启发式方法转变为可审计的过程,用户可以在此过程中直接检查、扩展或调整生成的哪些方面受到奖励或惩罚
- Rubric 结构还有助于进行每个标准的诊断,为模型行为提供透明度,并简化评估和调试
- RubricRL 与架构无关,兼容扩散和自回归文本到图像模型
- 其 Rubric 输出进一步支持方差感知的群体优势,即使在长序列 Rollout 下也能实现稳健的更新
- 其 Prompt 自适应设计确保每个奖励向量都反映了输入文本的显著方面,例如数字、命名实体、风格或嵌入文本,而无需手动调整
- 论文使用一个自回归文本到图像模型验证了这个简单而有效的想法
- 实验表明,RubricRL 提高了 Prompt 忠实度、组合准确性和视觉真实感,同时在数据集和架构上保持了高泛化能力
- 与先前的多奖励或统一奖励方法相比,RubricRL 实现了更一致的优化行为,并实现了可控、可解释的奖励塑形
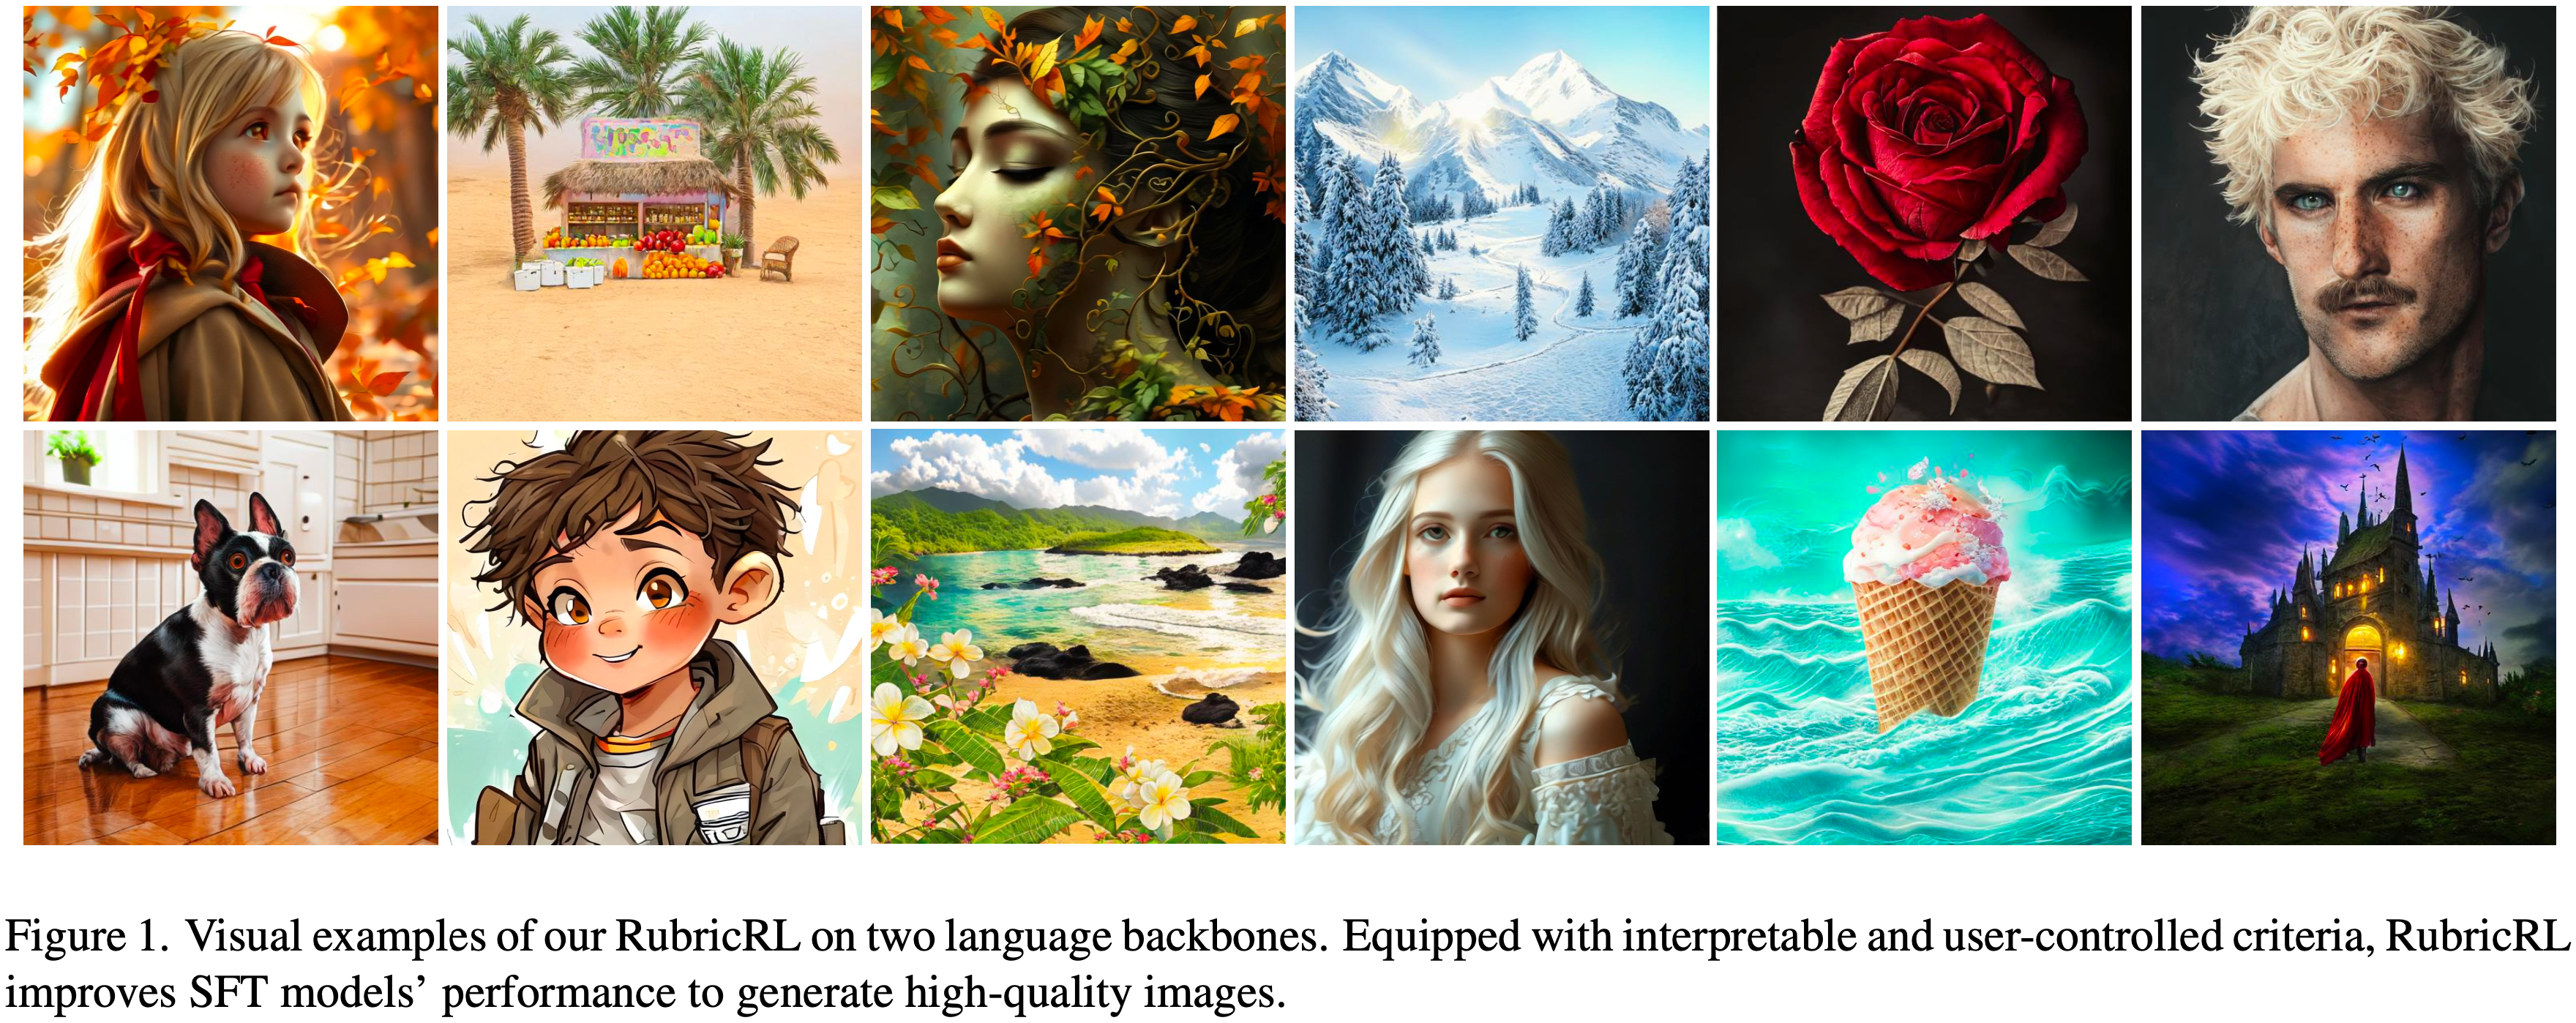
- 图 1 提供了论文方法的可视化样本,展示了高视觉质量
- In summary,RubricRL 的贡献如下:
- 一个适用于扩散和自回归文本到图像模型的通用 Rubric 奖励设计;
- 一个 Prompt 自适应、可分解的监督框架,增强了可解释性和可组合性;
- 一个用户可控且可审计的接口,使 RL 奖励塑形变得透明且易于扩展
- 通过基于显式视觉标准动态生成 Rubric 来操作对齐过程,RubricRL 使得用于文本到图像生成的强化学习更具可解释性、可扩展性和用户引导性,为将视觉生成与人类意图对齐提供了统一的基础
Method
- 论文使用一个基于自回归的文本到图像模型来验证 RubricRL 框架的有效性,但它同样可以泛化到基于扩散的模型
- 本节首先介绍论文 RubricRL 框架的总体架构,然后详细介绍 Rubric-based 奖励设计、RL 训练方法和动态 Rollout 采样
Overall architecture
- 如图 3 所示,给定输入文本 Prompt \(p\),论文首先将其标记化为一个文本 Token 序列,然后将其输入到一个自回归文本到图像生成模型 \(\pi_{\theta}\) 中,以预测一个图像 Token 序列
- 这些图像 Token 随后使用一个预训练的、固定的 VQ 解码器进行解码,以产生最终图像 \(I\)
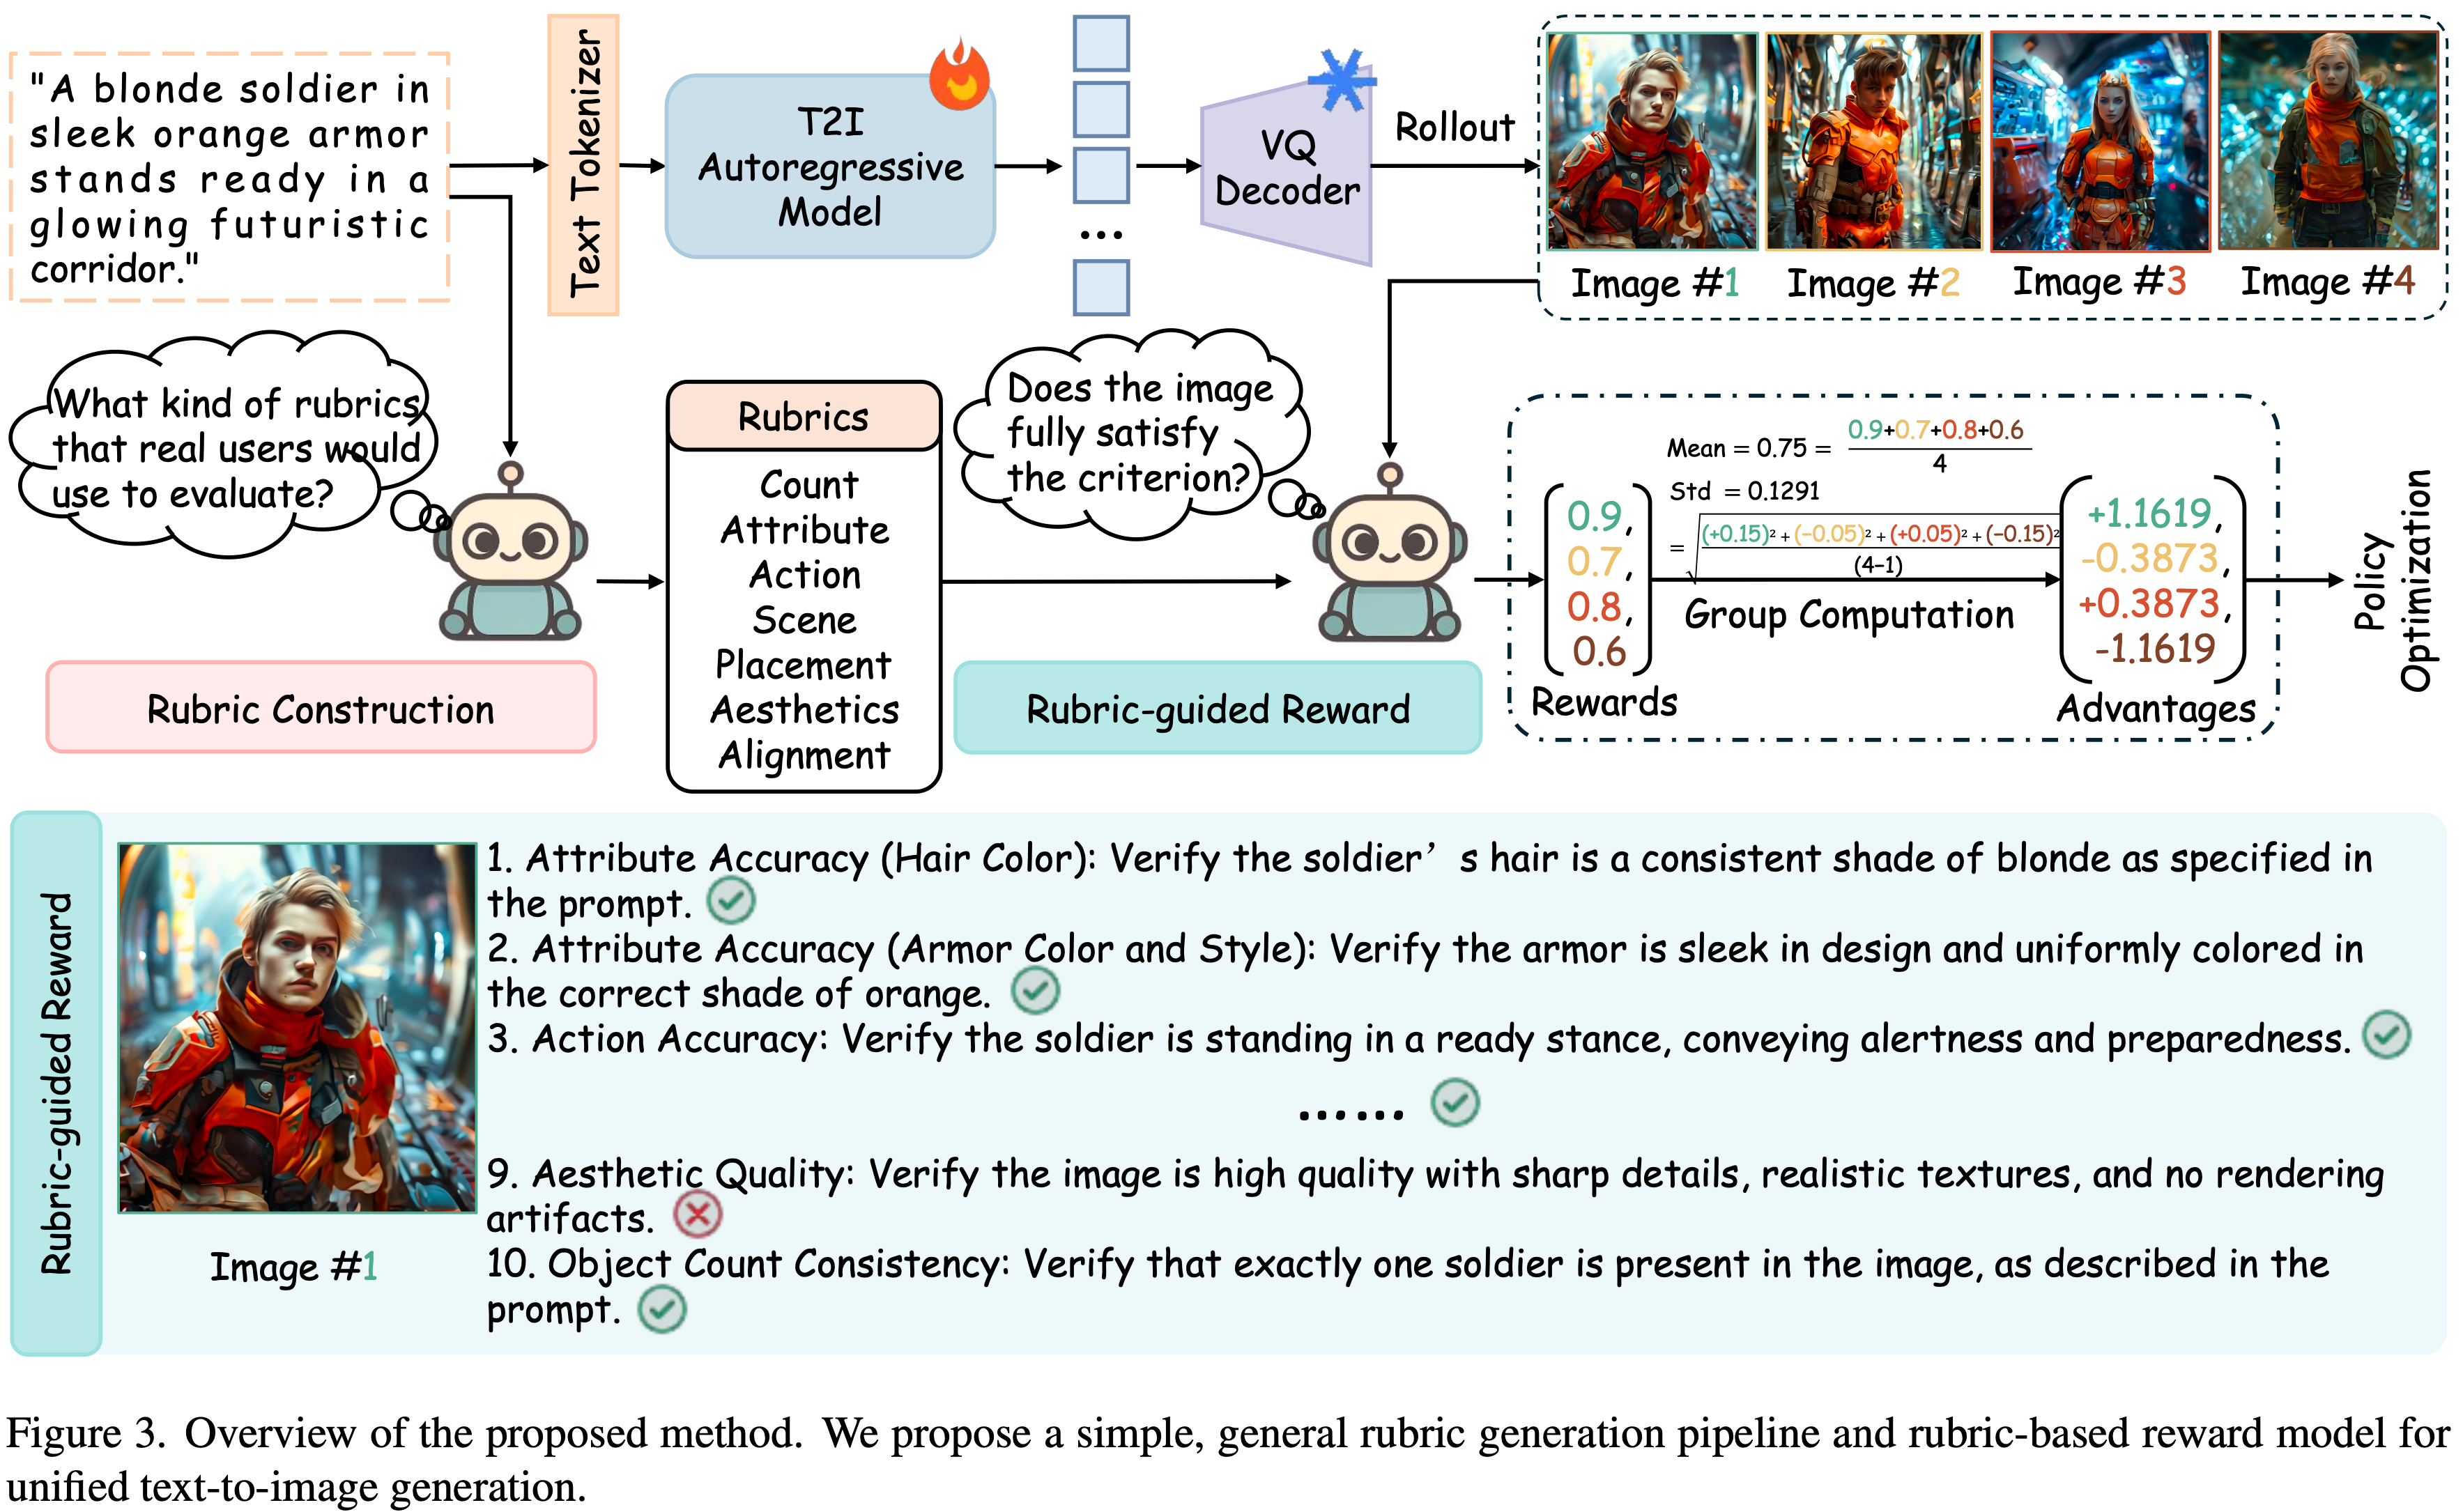
- 这些图像 Token 随后使用一个预训练的、固定的 VQ 解码器进行解码,以产生最终图像 \(I\)
- 在论文中,论文主要关注对 \(\pi_{\theta}\) 进行 RL 后微调以进一步提高其输出质量,其中设计一个有效、可靠且可解释的奖励函数是关键挑战
- 现有方法通常使用一个或多个专用模型来评估图像质量的不同方面,例如基于 CLIP 的图文语义对齐奖励 (2021) \(R_{\text{clip} }(I,p)\)、OCR 准确度 (2025) \(R_{\text{ocr} }(I,p)\) 和真实感 (2023)
- 但这种方法有明显的缺点:
- (1)部署多个专用模型计算成本高昂,难以扩展到更多方面;
- (2)需要仔细的奖励校准和重新加权
- 最近的工作试图从成对的人类偏好数据中学习一个单一的奖励模型,简化了优化,但由于高标注成本和较差的可解释性,可扩展性有限
- 受到现代多模态大语言模型强大理解能力的启发,论文提出了一种简单且统一的 Rubric-based 奖励模型 ,记作
$$ R_{\text{rubric} }(I,p,\mathcal{C}(p)) $$- 该模型用一个具有推理能力的视觉语言模型替换了特定任务评估器的集合
- 论文的方法不依赖固定的子模型,而是自动构建一组可解释、Prompt 自适应的标准,称为“Rubrics”,以捕捉每个特定 Prompt \(p\) 的质量要求的基本方面
- 具体来说,给定一个文本 Prompt \(p\),一个 Rubric 生成模型 \(\mathcal{G}\)(通过一个大语言模型实现)生成一组 Rubric :
$$
\mathcal{C}(p)=\mathcal{G}(p),
$$- 其中 \(\mathcal{C}(p)=\{c_{1},c_{2},\ldots,c_{M}\}\) 定义了 \(M\) 个特定于 Prompt 的标准,涵盖诸如对象计数、属性准确性、文本/OCR 保真度、空间关系、美学和风格一致性等维度
- 这确保了评估标准根据每个输入 Prompt 的语义和粒度动态适应
- 在强化学习中,目标是调整模型参数 \(\theta\),以最大化在 Prompt 分布上的预期 Rubric-based 奖励:
$$
\max_{\theta}~ \mathbb{E}_{p\sim\mathcal{D},~ I\sim\pi_{\theta}(\cdot|p)}\big[R_{\text{rubric} }(I,p,\mathcal{C}(p))\big],
$$- 其中 \(\mathcal{D}\) 表示 Prompt 集合
- 一个 Rollout 对应于给定 \(p\) 从 \(\pi_{\theta}\) 中采样的单个图像,提供一个指导策略更新的奖励信号
- 与多模型奖励系统相比,论文 Rubric-based 公式具有三个关键优势:
- (1)简单性(Simplicity):无需多个特定任务的 Grader ;
- (2)自适应性(Adaptivity): Rubric 为每个 Prompt 动态生成,确保与多样化用户意图的相关性;
- (3)可解释性(Interpretability):每个奖励组件对应一个人类可读的评估标准,实现了透明的模型诊断和可控的优化
Rubric based reward
- Rubric-based 奖励函数分两个阶段进行
- 首先,一个Rubric 生成模型 \(\mathcal{G}\) 解释用户 Prompt \(p\) 并产生一组候选 Rubric \(\mathcal{C}(p)\)
- 其次,一个多模态大语言模型 Grader 实现 Rubric-based 奖励 \(R_{\text{rubric} }(I,p,\mathcal{C}(p))\),该函数根据 \(\mathcal{C}(p)\) 中的每个 Rubric 对生成的图像 \(I\) 进行评分
- 论文使用 GPT-4o-mini 来扮演这两个角色,生成特定于 Prompt 的 Rubric 并提供每个标准的判断,这些判断被聚合成一个标量奖励
Rubric construction
- 给定一个用户 Prompt \(p\),论文要求 GPT-4o-mini 生成一个 Rubric 列表
- 每个 Rubric 条目包含一个针对特定方面(例如,OCR 对齐、对象计数、空间关系、美学)的简短评估键,以及一个关于在图像中检查什么的简明描述
- 为了在 Rubric 生成过程中促进多样性和减少位置偏差,论文在 Rubric 生成 Prompt 中随机排列评估方面,并多次查询 GPT-4o-mini
- 在每一轮中,模型产生一组 Rubric (论文每次查询请求10个;因为一个 Prompt 可能描述多个对象或属性,模型可能会为一个评估键输出多个 Rubric 以确保足够的覆盖)
- 论文将所有运行中的有效键-标准对聚合到一个统一的 Rubric 池中,丢弃模糊或格式错误的条目
- 最后,为了消除冗余并关注最重要的信号,论文要求 GPT-4o-mini 选择前10个最相关和最关键的标准来评估从用户 Prompt \(p\) 生成的图像
Rubric-guided reward
- 给定一个生成的图像 \(I\)、其对应的文本 Prompt \(p\) 和 Rubric 池 \(\mathcal{C}\),论文再次简单地要求 GPT-4o-mini 为每个标准输出一个单一分数 \(y_{i}\in\{0,1\}\),以反映生成的图像是否完全满足此 Rubric (\(y_{i}=1\))或不满足(\(y_{i}=0\))。总体 Rubric 奖励计算为归一化均值:
$$
R(I,p,\mathcal{C})=\frac{1}{M}\sum_{i=1}^{M}y_{i},\quad M=10 \tag{3}
$$
Reinforcement learning with GRPO
- 为了使自回归图像生成器与 Rubric-based 奖励对齐,论文采用 GRPO (2024),设计用于在分组 Rollout 上进行稳定优化
- 对于每个 Prompt,生成的 Rollout 集合形成一个组,每个 Rollout 的奖励相对于该组进行归一化,以减少方差并改进信用分配
- 具体来说,令 \(\pi_{\theta}\) 表示当前策略,\(R_{i}\) 表示组 \(g\) 中第 \(i\) 个 Rollout 的 Rubric 奖励, GRPO 计算相对优势:
$$
A_{i}=\frac{R_{i}-\bar{R}_{g} }{\sqrt{\frac{1}{|g|-1}\sum_{j\in g}\left(R_{j}-\bar{R}_{g}\right)^{2} } },\bar{R}_{g}=\frac{1}{|g|}\sum_{k\in g}R_{k} \tag{4}
$$ - 并通过最大化类似于 PPO 的裁剪目标来更新策略:
$$
\mathcal{L}(\theta)=\mathbb{E}_{i}\Big[\min\left(r_{i}(\theta)A_{i},\text{clip}(r_{i}(\theta),1-\epsilon,1+\epsilon)A_{i}\right)\Big] \tag{5}
$$- 其中 \(r_{i}(\theta)=\frac{\pi_{\theta}(a_{i}|s_{i})}{\pi_{\theta,\text{old} }(a_{i}|s_{i})}\)
- \(a_{i}\) 和 \(s_{i}\) 是对应于 Rollout \(i\) 的采样动作和状态
- \(\epsilon\) 是 PPO 裁剪参数
- 通过利用这种群体相对优势,GRPO 稳定了跨 Prompt 的训练,使模型对异构奖励尺度和噪声评估具有鲁棒性
- 结合论文 Rubric-based 奖励和下文描述的动态 Rollout 选择策略,论文发现 GRPO 可以有效地引导生成模型生成既符合人类对齐又高质量的图像
Dynamic rollout sampling
- 如上所述,GRPO 中的目标策略模型 \(\pi_{\theta}\) 通过采样多个 Rollout 来探索生成空间,每个 Rollout 产生一个用于优势计算的奖励 \(R_{i}\)
- 在原始的 GRPO 设计中,来自单个 Prompt 的所有 \(N\) 个 Rollout 被分组在一起进行策略更新,即 \(|g|=N\)
- 后续工作引入了过采样和过滤策略来提高训练效率
- 例如,DAPO (2025) 采用了 Prompt 级别 的过采样方法:
- 它为每个 Prompt 生成 \(N\) 个 Rollout,并丢弃那些所有 Rollout 准确度都为 \(1\) 或 \(0\) 的 Prompt,从而仅保留中等难度的 Prompt 用于策略优化
- 形式上,DAPO 有选择地采样用于训练的 Prompt,同时仍使用每个保留 Prompt 的所有 Rollout 进行 RL 更新
- 论文提出了一种新的 Rollout 级别 动态采样机制,其中选择发生在单个 Prompt 的 Rollout 内部,而不是过滤整个 Prompt
- 具体来说,给定一个文本 Prompt,论文不是只采样 \(N\) 个 Rollout,而是过采样 \(N^{\prime}\) 个 Rollout(\(N^{\prime}>N\)),并选择性地使用一个具有代表性的 \(N\) 个 Rollout 子集进行策略更新
- 为了平衡质量和多样性,论文采用了一种混合选择策略:论文选取前 \(K\) 个高奖励的 Rollout,并从其余的 Rollout 中随机采样剩余的 \(N-K\) 个以鼓励多样性
- 形式上,Rollout 组 \(g\) 构造为:
$$
g = \{\tau_{(1)},\ldots,\tau_{(K)}\}\cup\text{RS}\big(\{\tau_{(K+1)},\ldots,\tau_{(N^{\prime})}\},N{-}K\big),
$$- 其中 RS 表示随机采样
- Empirically,论文观察到这种混合设计在稳定性和多样性之间取得了更好的平衡,实现了更好的模型质量
- As a result,公式 5 中的损失是在更具代表性和信息量的 Rollout 子集上计算的,与原始的 GRPO 和 DAPO 中的 Prompt 级别过滤方案相比,带来了更一致和高效的学习
Experiments
Implementation details
- 遵循 SimpleAR (2025) ,论文从 JourneyDB (2023) 和 Synthetic dataset-1M (2024) 中选择了 11,000 张图像,并使用 GPT-04-mini 为每张图像重新生成不同长度的 Prompt,并在训练过程中随机选取
- 在网络架构方面,论文使用两个经过 SFT 的 LLM 作为骨干网络,即 Phi3-3.8B (2024) 和 Qwen2.5-0.5B (2024),并分别使用 LlamaGen 的 VQ 解码器 (2024) 和 Cosmos-Tokenizer (2025) 作为视觉解码器
- RL 训练使用 TRL 框架 (2020) 进行,学习率为 1e-5,预热比例为 0.1
- 默认情况下,数据集以批次大小为 28 训练 3 个 epoch。两个骨干网络输出图像的分辨率分别为 512 和 1024
- 对于动态 Rollout 采样,论文为每个 Prompt 从 16 个 Rollout 中选择 4 个候选
- 在推理过程中,论文利用无分类器引导 (CFG) (2022) 基于条件和非条件对数来指导图像合成
- 所有实验均在 8 块 NVIDIA A100 GPU 上进行
Comparing with state-of-the-arts
- 论文在 DPG-Bench (2024) 和 GenEval (2024) 上,将 RubricRL 与上述两种文本到图像 SFT 模型上的多种奖励模型进行比较
- 对比的奖励方法可根据其奖励设计分为:
- 1)单一的专用奖励模型,包括 CLIPScore (2021)、HPSv2 (2023)、Unified Reward (2025) 和 LLaVA-Reward-Phi (2025);
- 2)具有固定权重的复合奖励指标,例如 AR-GRPO (2025) 和 X-Omni (2025)
- 为了公平比较,论文通过实现他们的方法来获取基线数据,并使用相同的 RL 框架(GRPO)和设置,唯一的区别在于奖励函数的设计
- 为了更好地理解 RL 带来的增益,论文还报告了初始 SFT 模型的性能,每个 RL 奖励都是在该模型基础上独立应用的
- 使用 Phi3 和 Qwen2.5 骨干网络的量化结果分别在表 1 和表 2 中报告
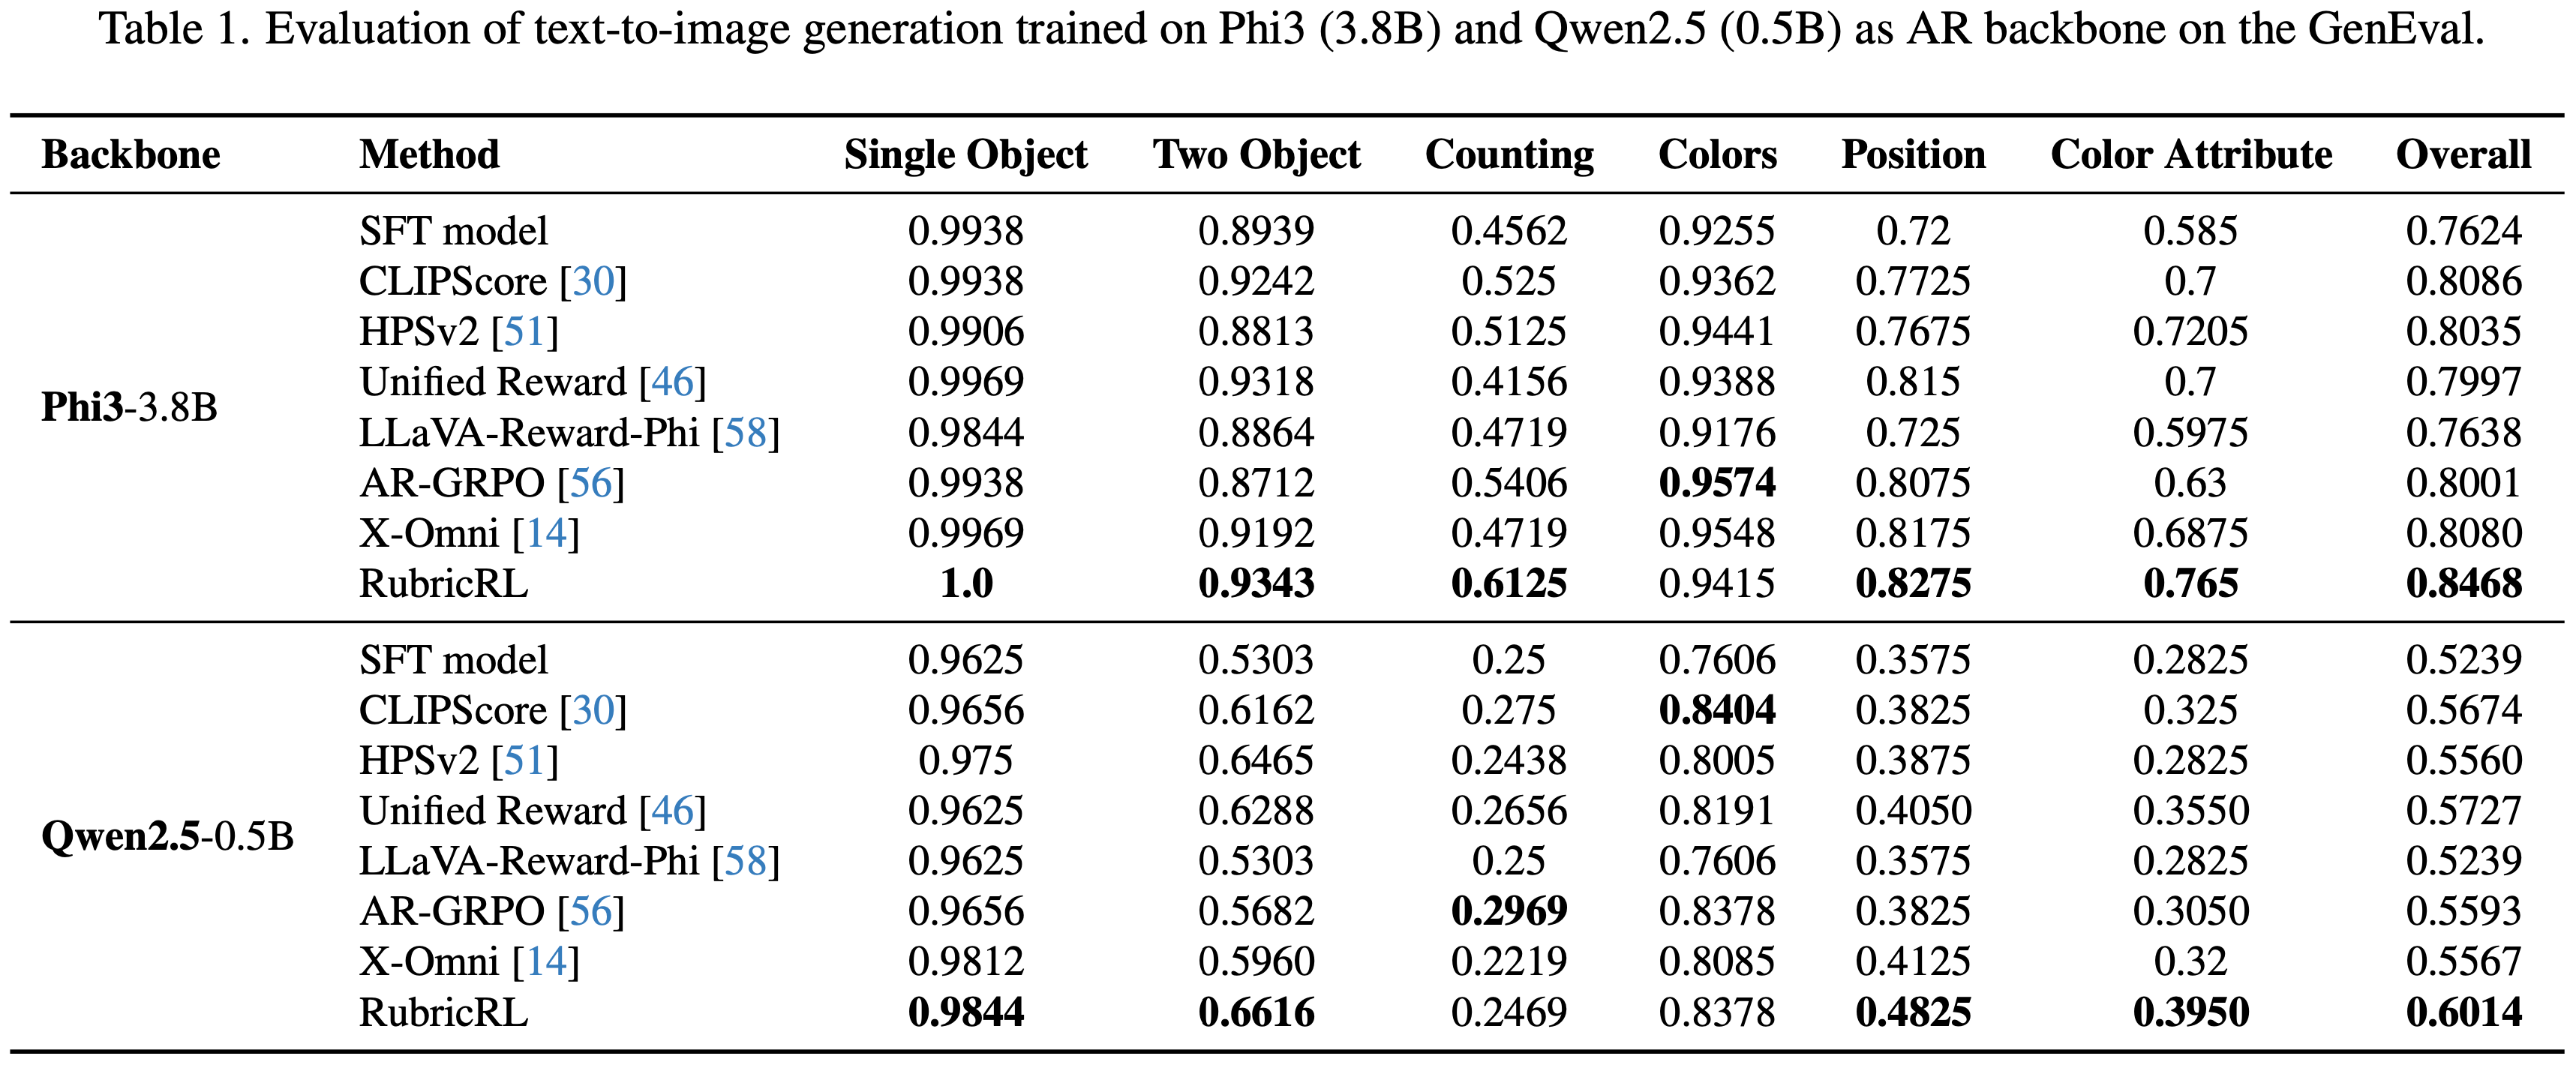
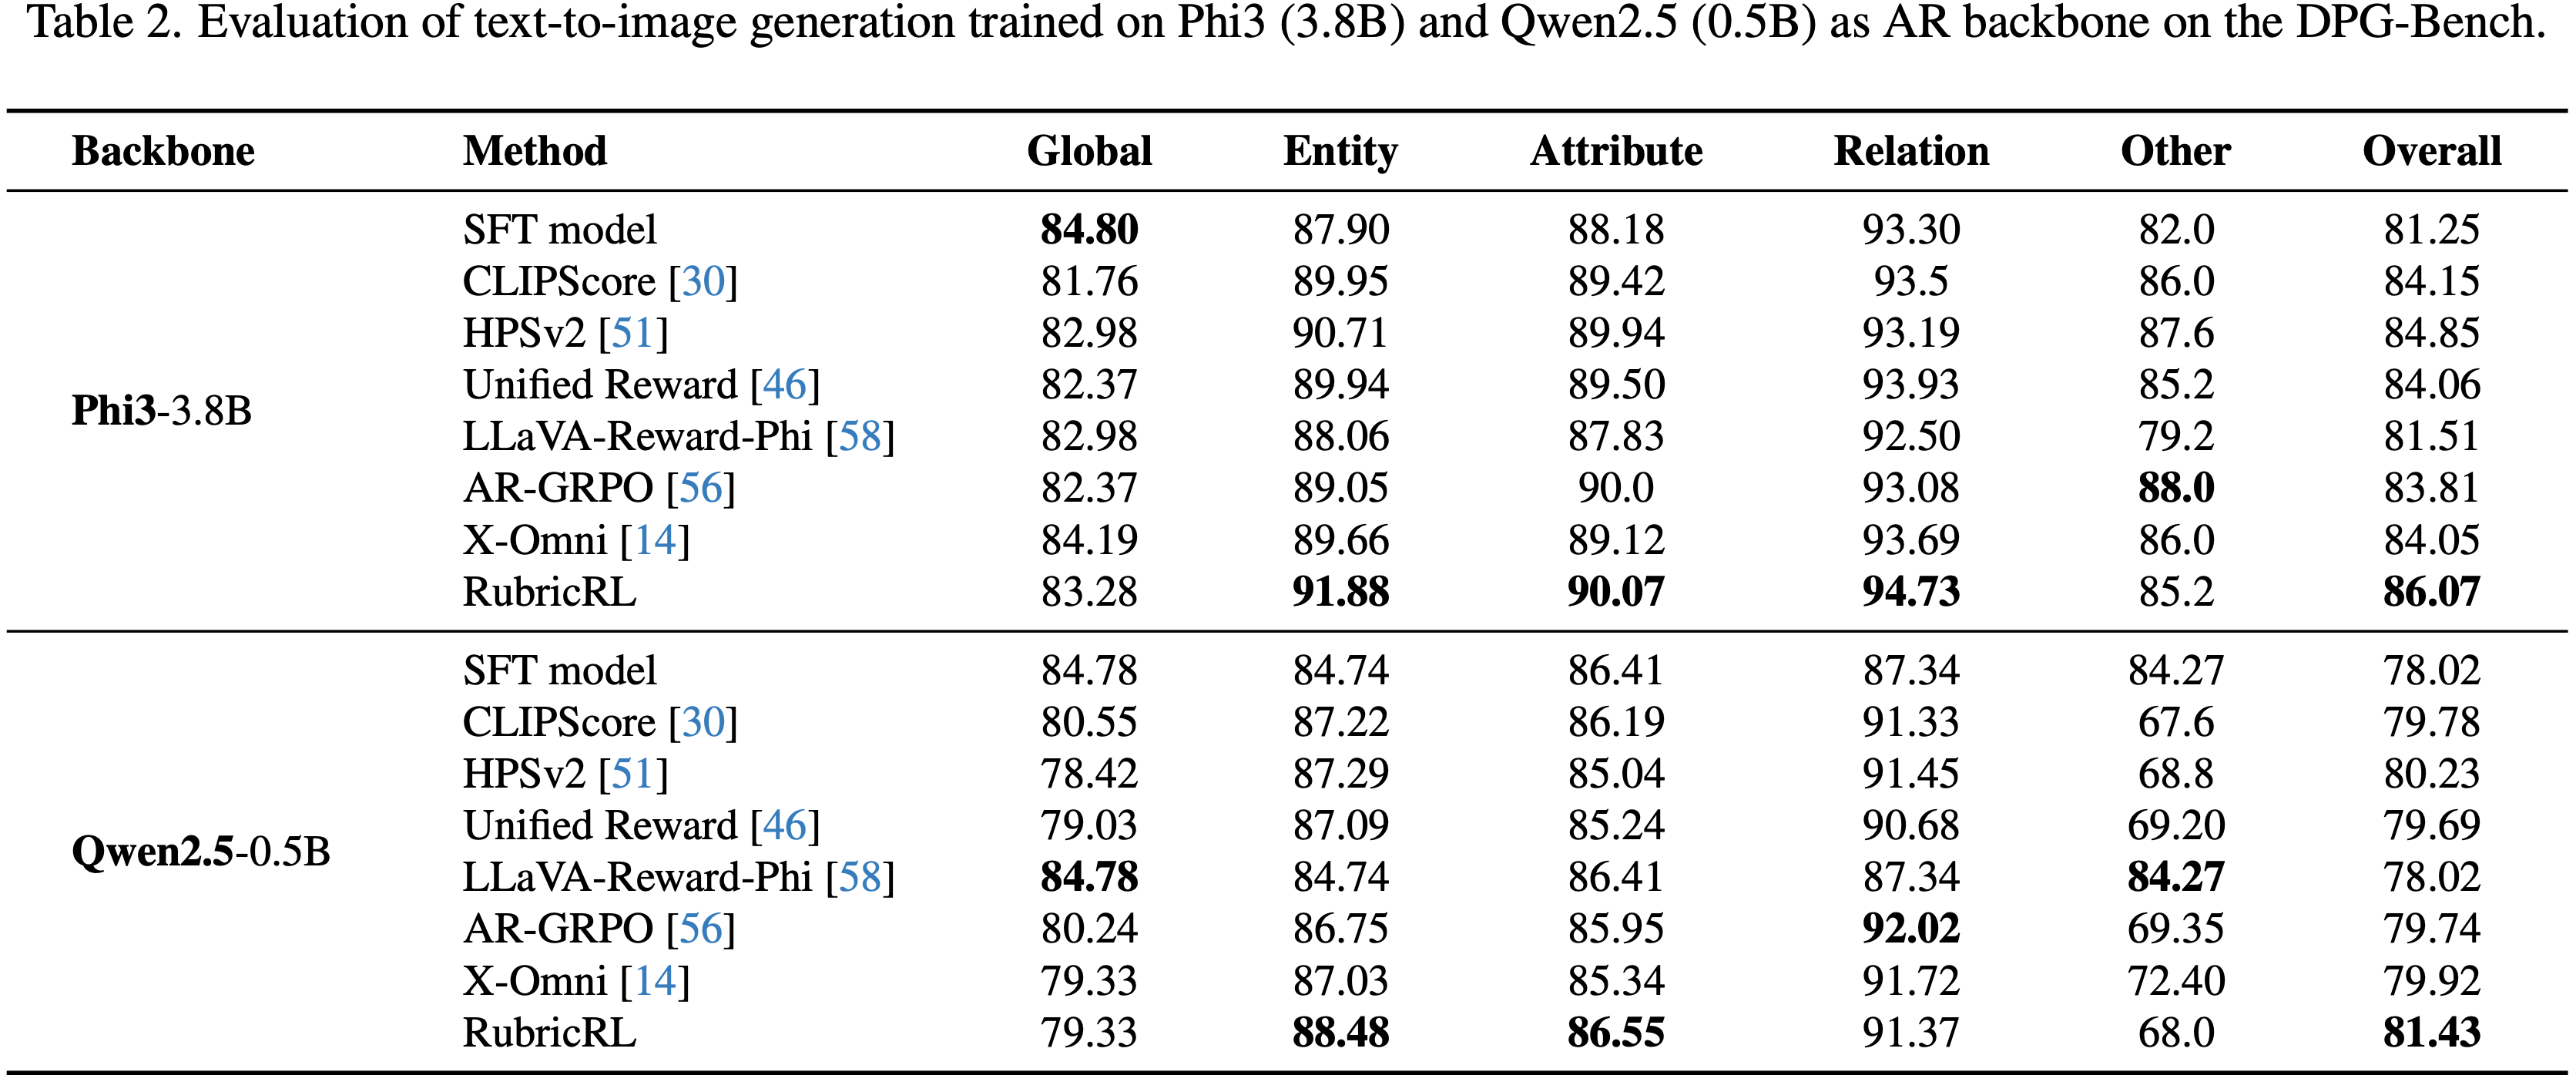
- 对于 GenEval,遵循 (2025) 应用了 Prompt 重写以确保评估一致性
- 从结果来看
- 所有经过 RL 后训练的方法都一致地优于 SFT 基线,证实了强化学习在提升图像生成质量方面的好处
- 并且 RubricRL 取得了最佳性能,在两种 LLM 骨干网络上,其 GenEval 分数均超越 X-Omni 约 4%,凸显了论文基于 Rubric 的奖励的有效性和泛化性
Ablation study
- 论文进行了多项消融分析
- 默认情况下,所有实验均基于 Phi3 并在 GenEval 基准上进行评估
Strategies for dynamic rollout sampling
- 为了研究动态 Rollout 采样使用的不同选择策略的影响,论文比较了四种方法,即不使用动态 Rollout 采样的 RubricRL(Vanilla)、FFKC-1D (1985)、DAPO (2025) 和论文提出的混合策略,并将结果报告在表 3 中
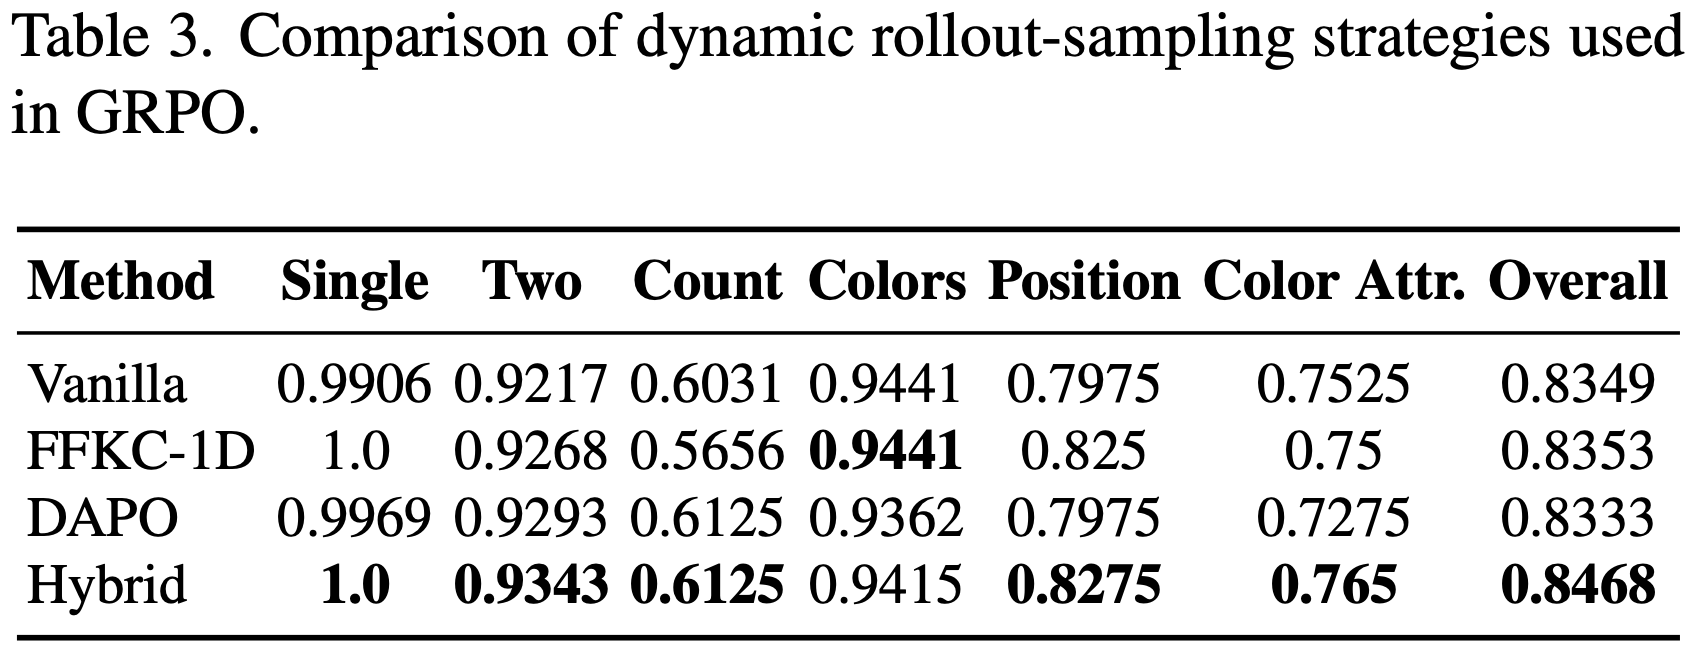
- 具体来说
- FFKC-1D 同样会过采样更多的 Rollout,然后通过首先选择一个中位数 Rollout(奖励最接近中位数的 Rollout),然后贪心地添加那些与已选样本奖励差异最大的样本来保留一个多样化的子集
- 与论文的混合策略相比,FFKC-1D 过于关注多样性而忽略了高质量 Rollout 的重要性
- 如表 3 所示,论文的混合采样策略始终达到最佳性能,超越了 FFKC-1D、DAPO 以及直接使用四个 Rollout 而不进行任何动态处理的 Vanilla 基线
- 有趣的是,FFKC-1D 和 DAPO 并没有超越 Vanilla 基线,这表明它们的动态 Prompt 采样和纯粹基于 Rollout 多样性的采样策略未能为 RL 提供额外的有效信号
- In Contrast,论文的混合策略有效地平衡了对高奖励 Rollout 的利用和对多样化候选的探索,使策略模型能够同时利用更高质量和多样化的样本,从而产生更有效的 RL 信号
Normalization scope for advantages
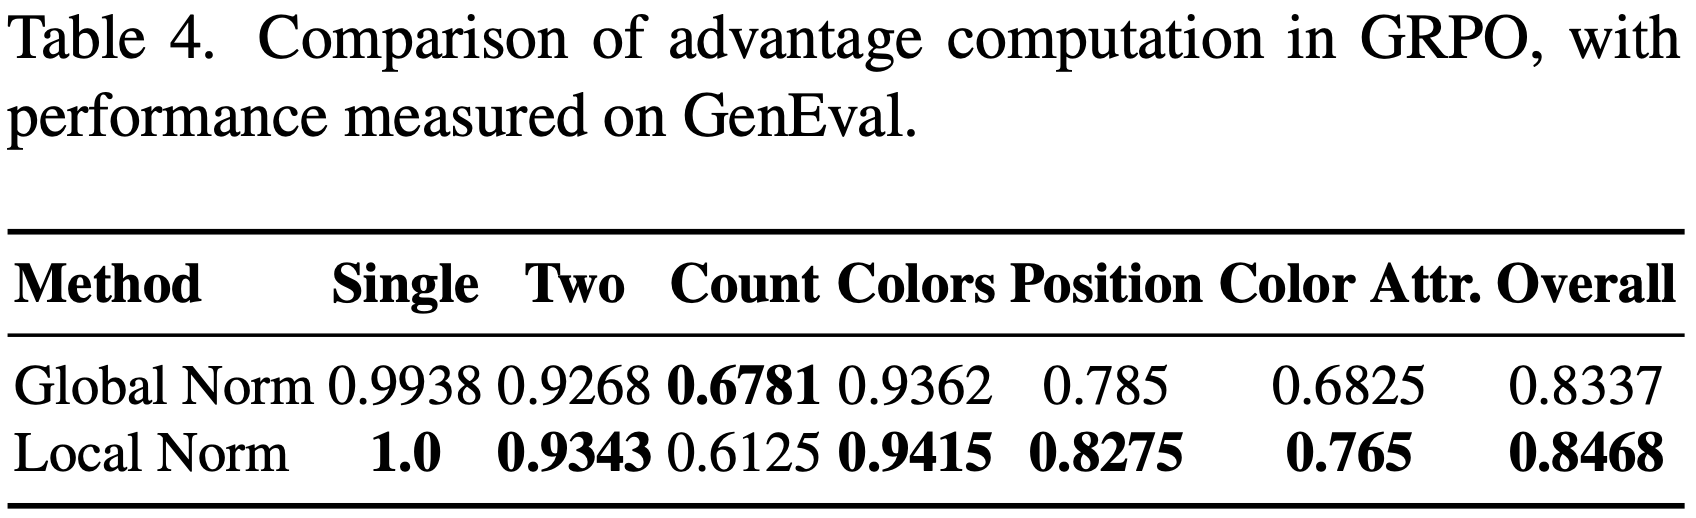
- 在公式 4 中,GRPO 中使用的优势值是通过对一个 Rollout 组内的奖励进行归一化(使用均值和标准差)来计算的
- 在论文的动态采样策略下,只从 \(N’\) 个候选 Rollout 中保留了 N 个
- 这就引出了一个重要的设计选择:归一化统计量(均值和标准差)是应该使用所有 \(N’\) 个 Rollout 来计算,还是仅使用保留的 N 个?
- 论文将这两种变体分别标记为“全局归一化 (Global Norm)”和“局部归一化 (Local Norm)”
- 表 4 显示,“局部归一化”产生了更好的性能
- 这是因为在保留的子集内进行归一化能更好地反映指导学习的实际奖励分布,防止高方差或低质量的 Rollout 扭曲梯度方向
- 这是因为在保留的子集内进行归一化能更好地反映指导学习的实际奖励分布,防止高方差或低质量的 Rollout 扭曲梯度方向
RubricRL v.s. SFT with Best-of-N sampling
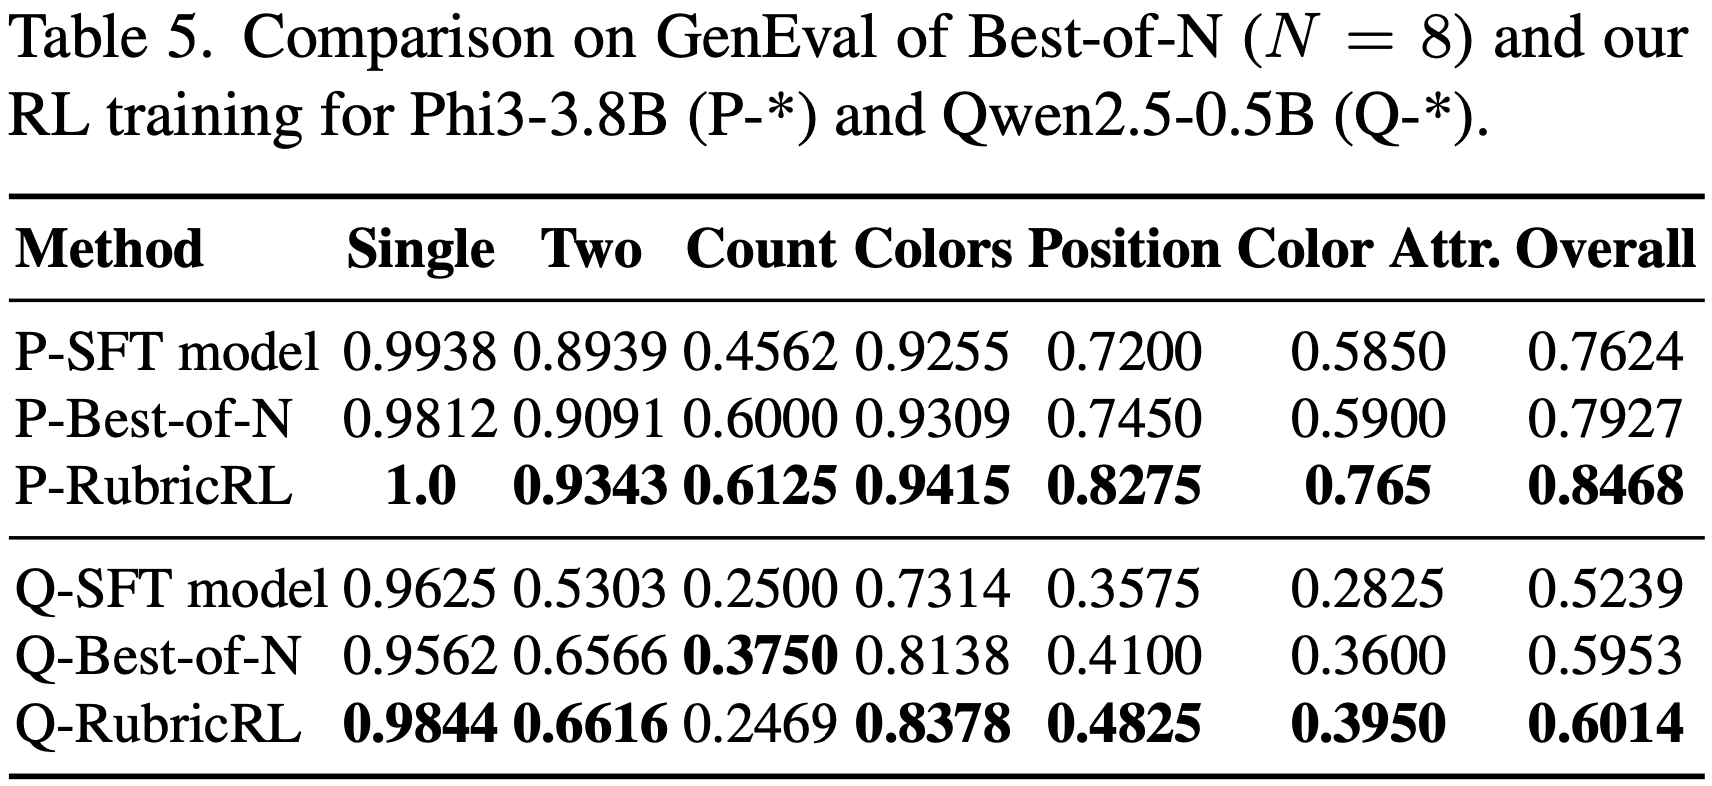
- 论文进一步将提出的 RubricRL 与在推理时配备了 Best-of-N 采样策略(N=8)的 SFT 模型进行了比较,先前工作 (2025) 观察到这在语言任务中构成了 RL 方法的“上限”
- 具体来说,对于 GenEval 中的每个 Prompt,论文首先生成一个 Rubric,然后从 SFT 模型中采样 8 个 Rollout
- 每个 Rollout 都使用基于 Rubric 的奖励进行评分,并选择前 4 个在 GenEval 上进行评估
- 如表 5 所示,
- 尽管 Best-of-N 采样可以显著获得更高的分数,但 RubricRL 仍然实现了显著改进,超过了 Best-of-N 超过 5%
- 这一结果与 X-Omni (2025) 中的观察一致,再次证实强化学习提供了一种更有效的优化范式
Failure case analysis
- 作为 Grader,尽管 GPT-04-mini 在评估生成图像质量方面非常通用和强大,但论文观察到它有时会分配错误的分数
- 例如,低估或高估物体数量,尤其是在基础模型的生成质量较差时
- 图 4 展示了 GenEval 计数子类别中的几个典型失败案例,例如交通灯附近多余的杆子、交织的自行车和重叠的斑马
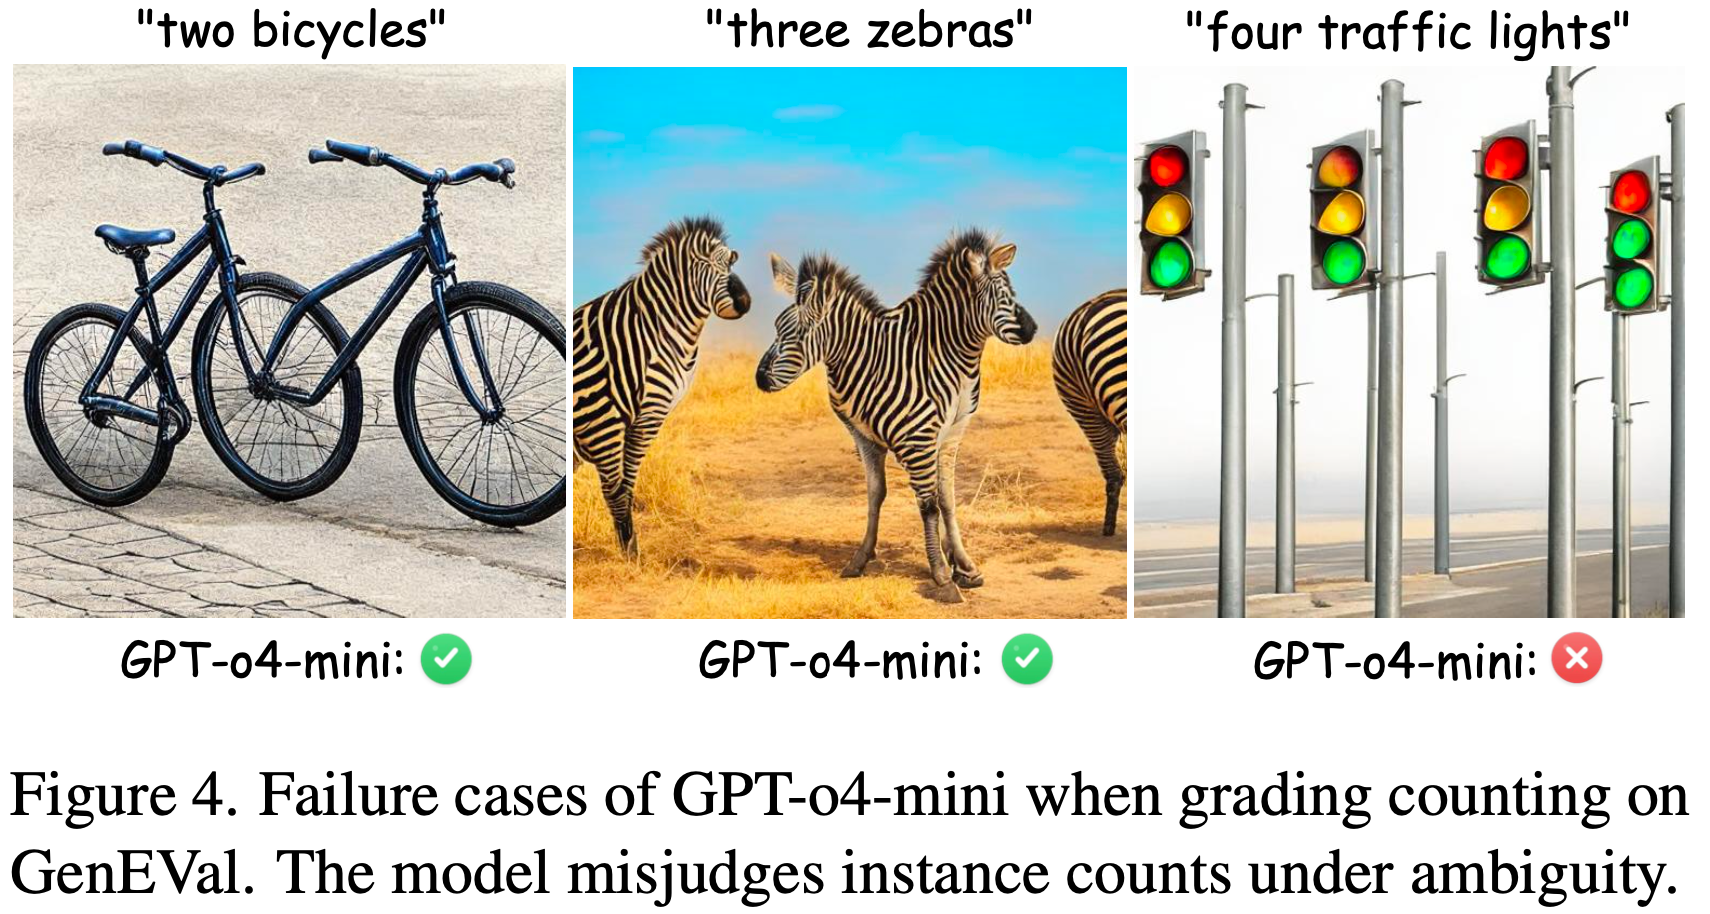
- 这些具有挑战性的场景常常误导 GPT-04-mini,导致计数不准确
- However,当基础模型生成更高质量的图像时,这个问题就不那么明显了
- 这解释了为什么当使用 Qwen2.5-0.5B 作为基础模型时,RubricRL 在 GenEval 的“计数 (Counting)”子类别和 DPG-Bench 的“其他 (Other)”子类别(两者都包含许多计数案例)上的性能比基线 SFT 模型更差
- In Contrast,使用 Phi3-3.8B 时,这个问题几乎消失了,使得 RubricRL 在计数相关类别上的性能大幅提升
Visual results
- 论文在图 5 中进一步展示了 RubricRL 与其他基线方法之间的综合视觉比较
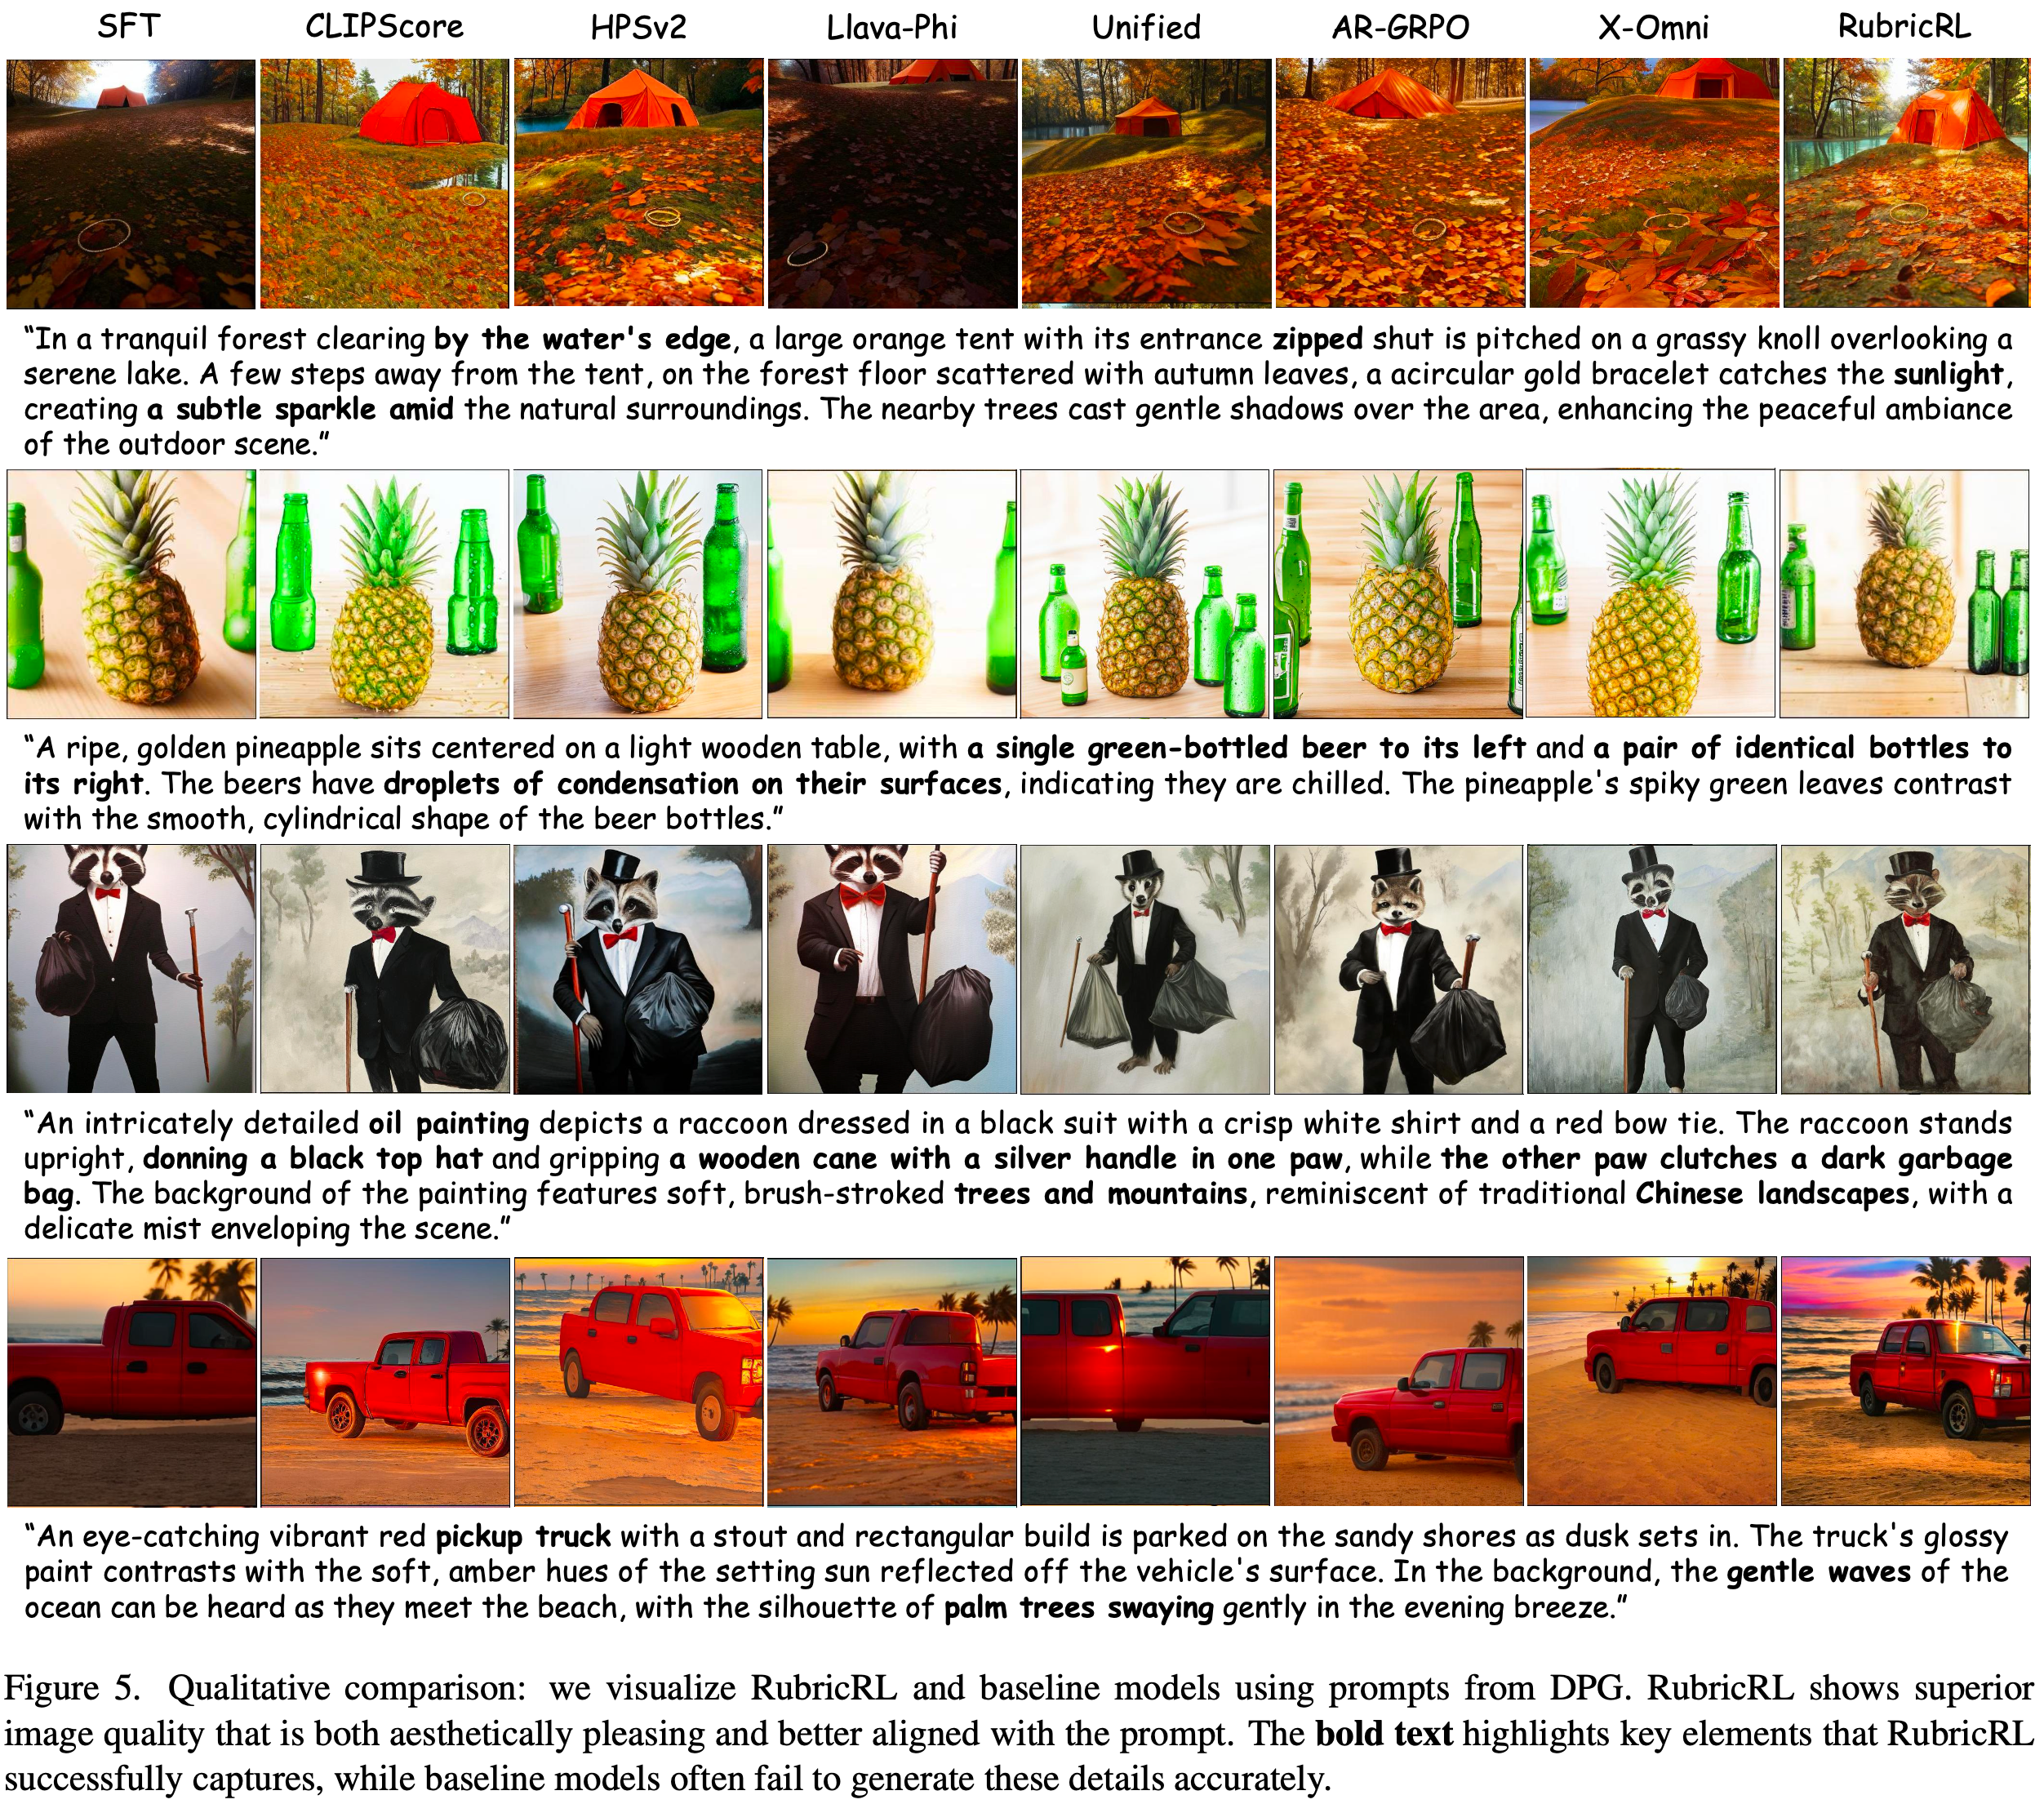
- 如图所示,使用 RubricRL 训练的模型生成的图像不仅更具美学吸引力,而且在与给定输入 Prompt 的语义对齐方面表现出优越性
- 为了帮助解释,生成图像中任何未对齐或缺失的元素都在图中使用粗体文本进行了强调
- 例如,在图 5 的第三行,SFT 模型未能完全渲染出黑色的高顶礼帽,而几种基于 RL 的方法则出现了部分错位
- 具体来说,LLaVA-Reward-Phi (2025) 和 Unified Reward (2025) 生成的图像中,黑色的包没有正确地拿在手中,在某些情况下,描绘了两个包分别在两只爪子里,同时完全忽略了木制手杖
- 这些定性观察强调了 RubricRL 在增强模型遵循复杂、细粒度指令并生成高质量、符合 Prompt 图像方面的有效性
Related work
Text-to-Image Generation Methods
- 文本到图像生成通过基于扩散的和自回归架构都取得了显著进展
- 扩散模型以文本 Prompt 为条件迭代细化潜在表示,实现了高质量和逼真的图像
- Stable Diffusion (2022) 和基于流的扩展 (2024, 2025) 等变体提供了多样化的风格、可控的生成以及在全局和局部层面的强保真度
- 自回归方法将图像表示为离散 Token 序列,并使用单一的 Transformer 骨干网络对文本和图像 Token 的联合分布进行建模
- 早期的混合设计,如 DreamLLM (2023),将自回归文本编码器与独立的扩散解码器配对
- 最近的统一自回归模型,包括 Chameleon (1999), Emu3 (2024), TransFusion (2024) 和 Janus (2025),在一个架构中集成了视觉 Token 化和自回归建模
- 这些模型允许文本 Token 和视觉输出之间的直接映射,从而实现灵活的控制和细粒度的生成
- 论文为文本到图像模型中的强化学习提出了一种新颖的奖励设计,并使用一个统一的自回归文本到图像模型证明了其有效性
- 注意:论文 Rubric-based 奖励同时适用于自回归和扩散架构
Reinforcement Learning for Text-to-Image Generation
- 最大似然训练通常对用户关注的特性优化不足,例如语义忠实度、组合准确性和美学
- RL 提供了任务对齐的反馈,直接优化超出似然的人类相关属性
- 在基于扩散的文本到图像模型中,RL 方法,如 FlowGRPO (2025), DanceGRPO (2025) 和推理增强的 T2I-R1 (2025),通过使用偏好或基于度量的奖励微调生成策略,改进了对齐
- Recently,RL 也被应用于统一的自回归文本到图像模型 (2025),其中策略梯度直接作用于下一个 Token 的概率,从而实现对生成图像的端到端信用分配和细粒度控制
- 奖励函数的设计对于文本到图像模型中有效的强化学习至关重要
- 一系列工作聚合了异构信号
- 例如基于 CLIP 的图文对齐 (2021)、OCR/文本正确性 (2025)、多模态 VLM Judge (例如,Qwen2.5-VL-32B (2025))、美学和真实感度量 (2022) 以及人类偏好替代指标 (2023)
- 虽然全面,但这些多奖励混合方法需要仔细的权重分配和调整,这可能会破坏优化的稳定性并掩盖每个方面的失败
- 另一个方向训练统一的偏好模型 (2025) 从成对的图像输出中预测单一标量的人类对齐分数,简化了优化,但依赖于昂贵的人工标注且可扩展性有限
- 一系列工作聚合了异构信号
- 在这项工作中,论文提出了一种简单、可泛化且可解释的 Rubric-based 奖励
- 对于每个 Prompt,一个简洁的 Rubric 定义了方面的标准
- 例如文本对齐/OCR 准确度、对象计数、空间关系和整体连贯性/质量
- 每个标准由专用的评估器独立评分,并通过透明的聚合产生最终奖励
- 这种设计更具 Prompt 自适应性、可分解性和可解释性,同时提供用户可控且可审计的反馈
- 对于每个 Prompt,一个简洁的 Rubric 定义了方面的标准
- 虽然有几项并行工作 (2025) 在自然语言处理中研究了 Rubric-based 奖励,但据论文所知,论文是第一个在文本到图像 RL 中提出基于 Rubric 奖励的
More ablations
Analysis of using different models as the grader
- 论文的方法,即 RubricRL,在强化学习 RL 中受益于高质量的 Grader (GPT-04-mini):
- 只有当每个标准(例如计数、空间关系、颜色)的判断准确时,奖励信号才能足够丰富,以驱动有效的策略更新
- 一个弱或有噪声的 Grader 会产生错位的信号,策略可能会过拟合或利用这些信号,从而损害训练的稳定性和样本效率
- By Contrast,可靠的 Grader 会产生低噪声、目标对齐的奖励,将功劳分配给正确的行为并惩罚特定的错误,从而使 RubricRL 有效
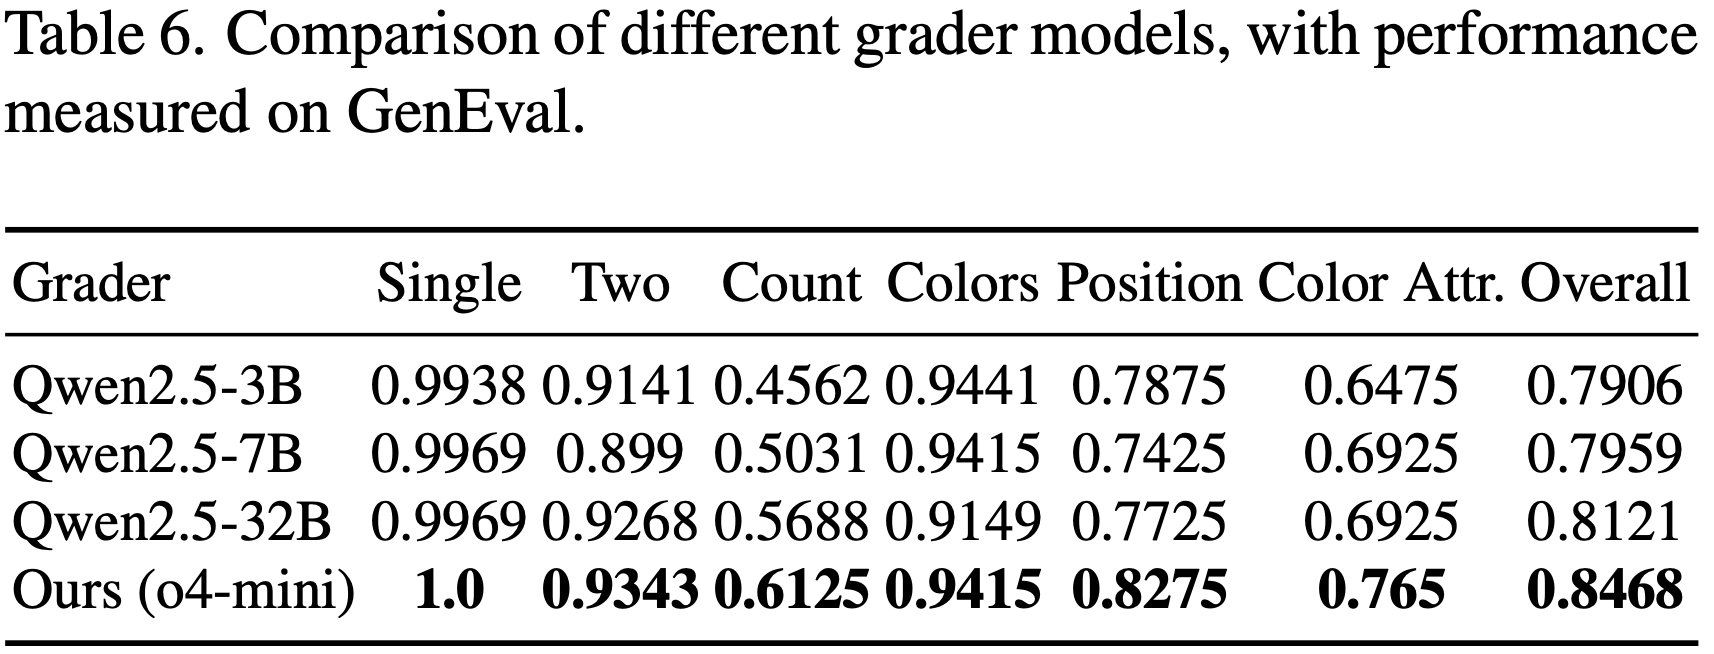
- 为了量化这种效应,论文在 RubricRL 中使用不同的视觉语言模型作为 Grader ,并在表 6 中报告结果
- 论文选择 Qwen2.5-VL (2025) 系列中不同模型大小(3B、7B 和 32B)的版本来评估训练期间的每个 rollout
- 论文观察到 32B Grader 明显优于 3B 和 7B 变体,这证实了更强大的视觉语言模型总体上提供了更具信息性和可靠性的奖励
- 7B 模型相比 3B 模型有轻微改进,这与它更高的能力一致,而 3B Grader 在某些标准(例如颜色和位置)上仍能提供有用的信号
- 然而,所有 Qwen2.5-VL Grader 仍然明显弱于 32B Grader ,同时所有 Qwen2.5-VL Grader 与 o4-mini Grader 相比仍有明显差距
- 论文将此归因于 o4-mini 更强的指令跟随能力、更好的多步推理能力以及与论文的 Rubric 设计更紧密的对齐,从而产生了更清晰、噪声更低的每标准奖励,并最终带来了更好的下游生成质量
- 论文将此归因于 o4-mini 更强的指令跟随能力、更好的多步推理能力以及与论文的 Rubric 设计更紧密的对齐,从而产生了更清晰、噪声更低的每标准奖励,并最终带来了更好的下游生成质量
Analysis of the number of rollouts before and after dynamic sampling
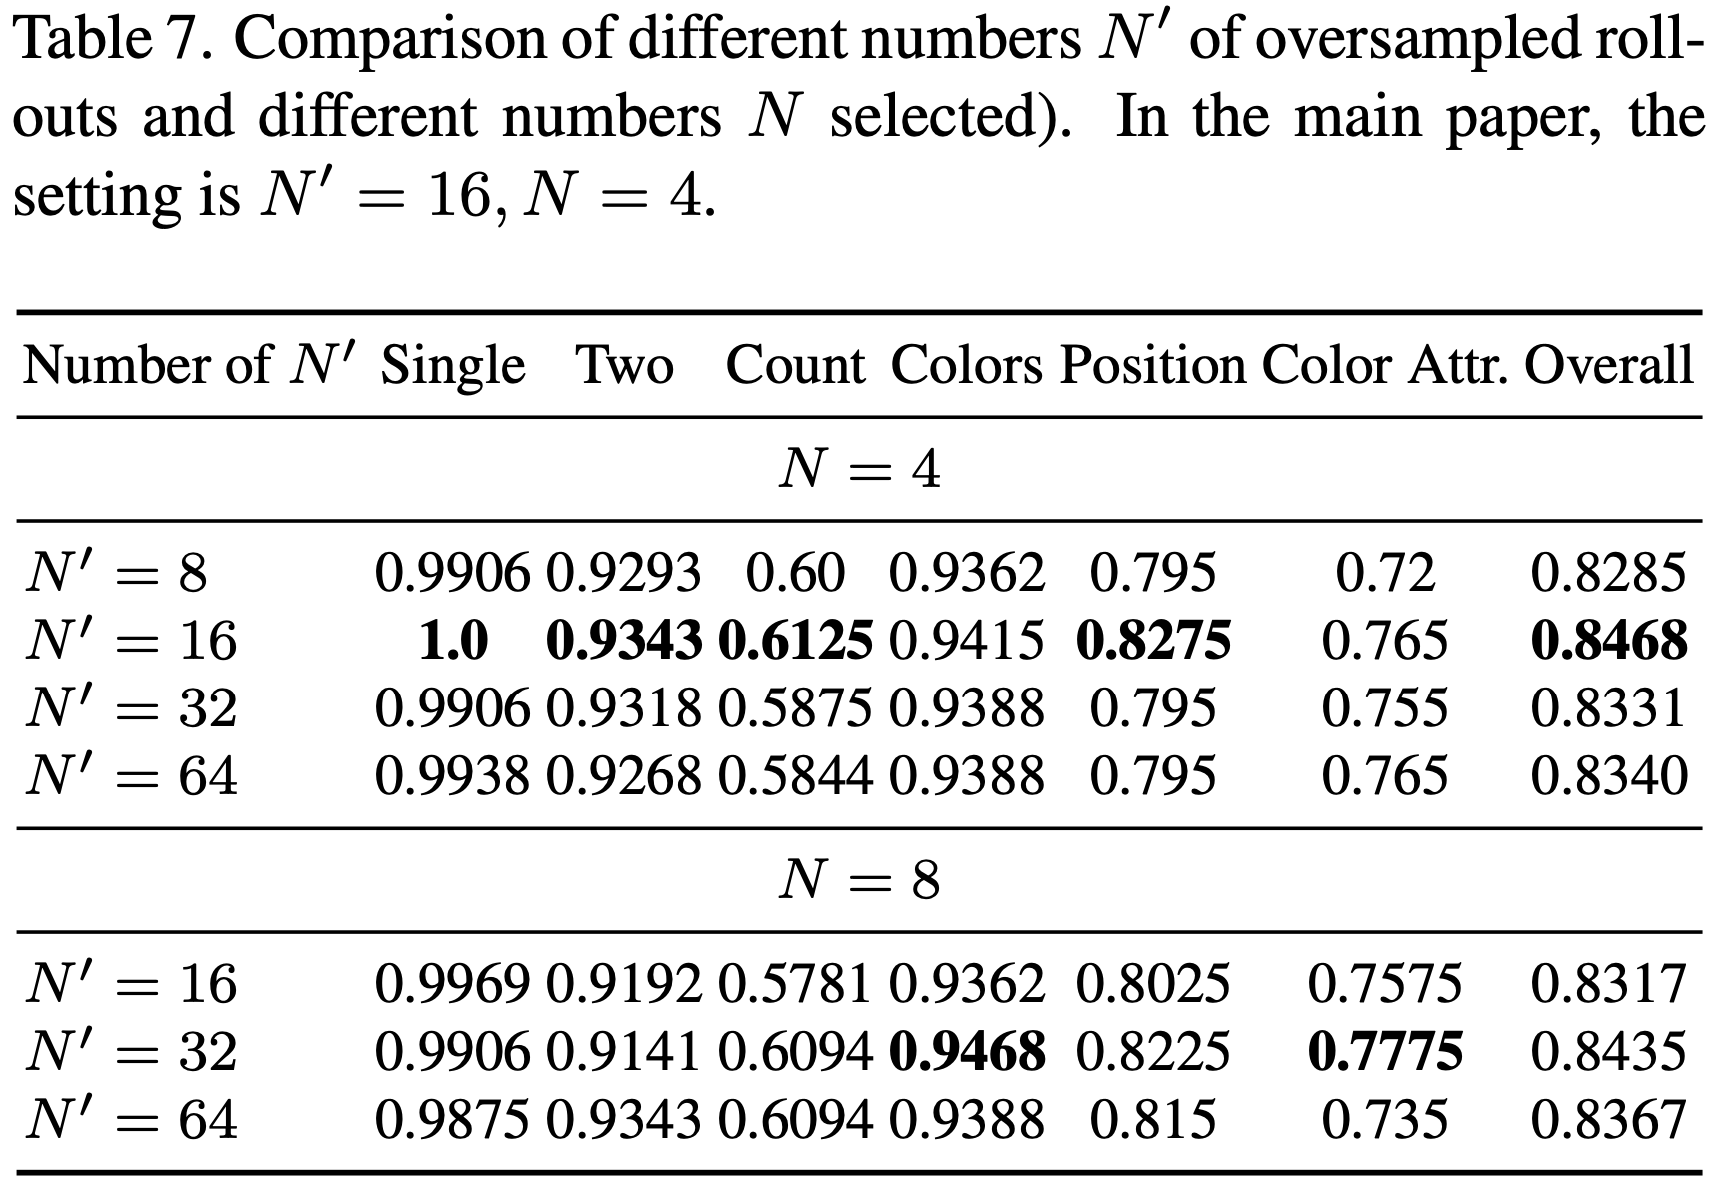
- 论文研究了过采样预算和选择后预算(即论文在动态采样中生成了多少 rollout 与论文保留多少用于奖励计算)如何影响模型性能
- 对于每个 Prompt,论文首先生成 \(N’\) 个候选 rollout(\(N’>N\)),然后使用论文的混合动态采样策略从中选择 \(N\) 个;选定的 \(N\) 个样本用于计算 GRPO 损失
- 所有其他超参数在不同设置中保持不变
- 如表 7 所示,增加过采样预算(例如,固定 \(N=4\),\(N’ \in \{8, 16, 32, 64\}\))最初通过提供更大的候选池改进了性能,混合选择器可以从中识别出高奖励和多样化的 rollout
- 然而,收益很快饱和,因为更大的 \(N’\) 也引入了更高的奖励方差,使得优势估计噪声更大,并阻碍了稳定优化
- 当将选择预算从 \(N=4\) 增加到 \(N=8\) 时,出现了类似的现象:
- 虽然更多的选定 rollout 增加了利用,但包含太多 rollout 会增加包含低质量生成的可能性,放大了组归一化优势的方差,并稀释了学习信号
- 值得注意的是,具有 4 倍过采样率的配置实现了可比较的总体性能,这表明维持这个级别的过采样足以获得高质量的候选
- 总体而言,过采样和选择都仅在达到一定程度前是有益的,超过那个点,增加的多样性会被增加的噪声所抵消,揭示了在 GRPO 式训练中探索和优化稳定性之间固有的权衡
- 总体而言,过采样和选择都仅在达到一定程度前是有益的,超过那个点,增加的多样性会被增加的噪声所抵消,揭示了在 GRPO 式训练中探索和优化稳定性之间固有的权衡
Visualization
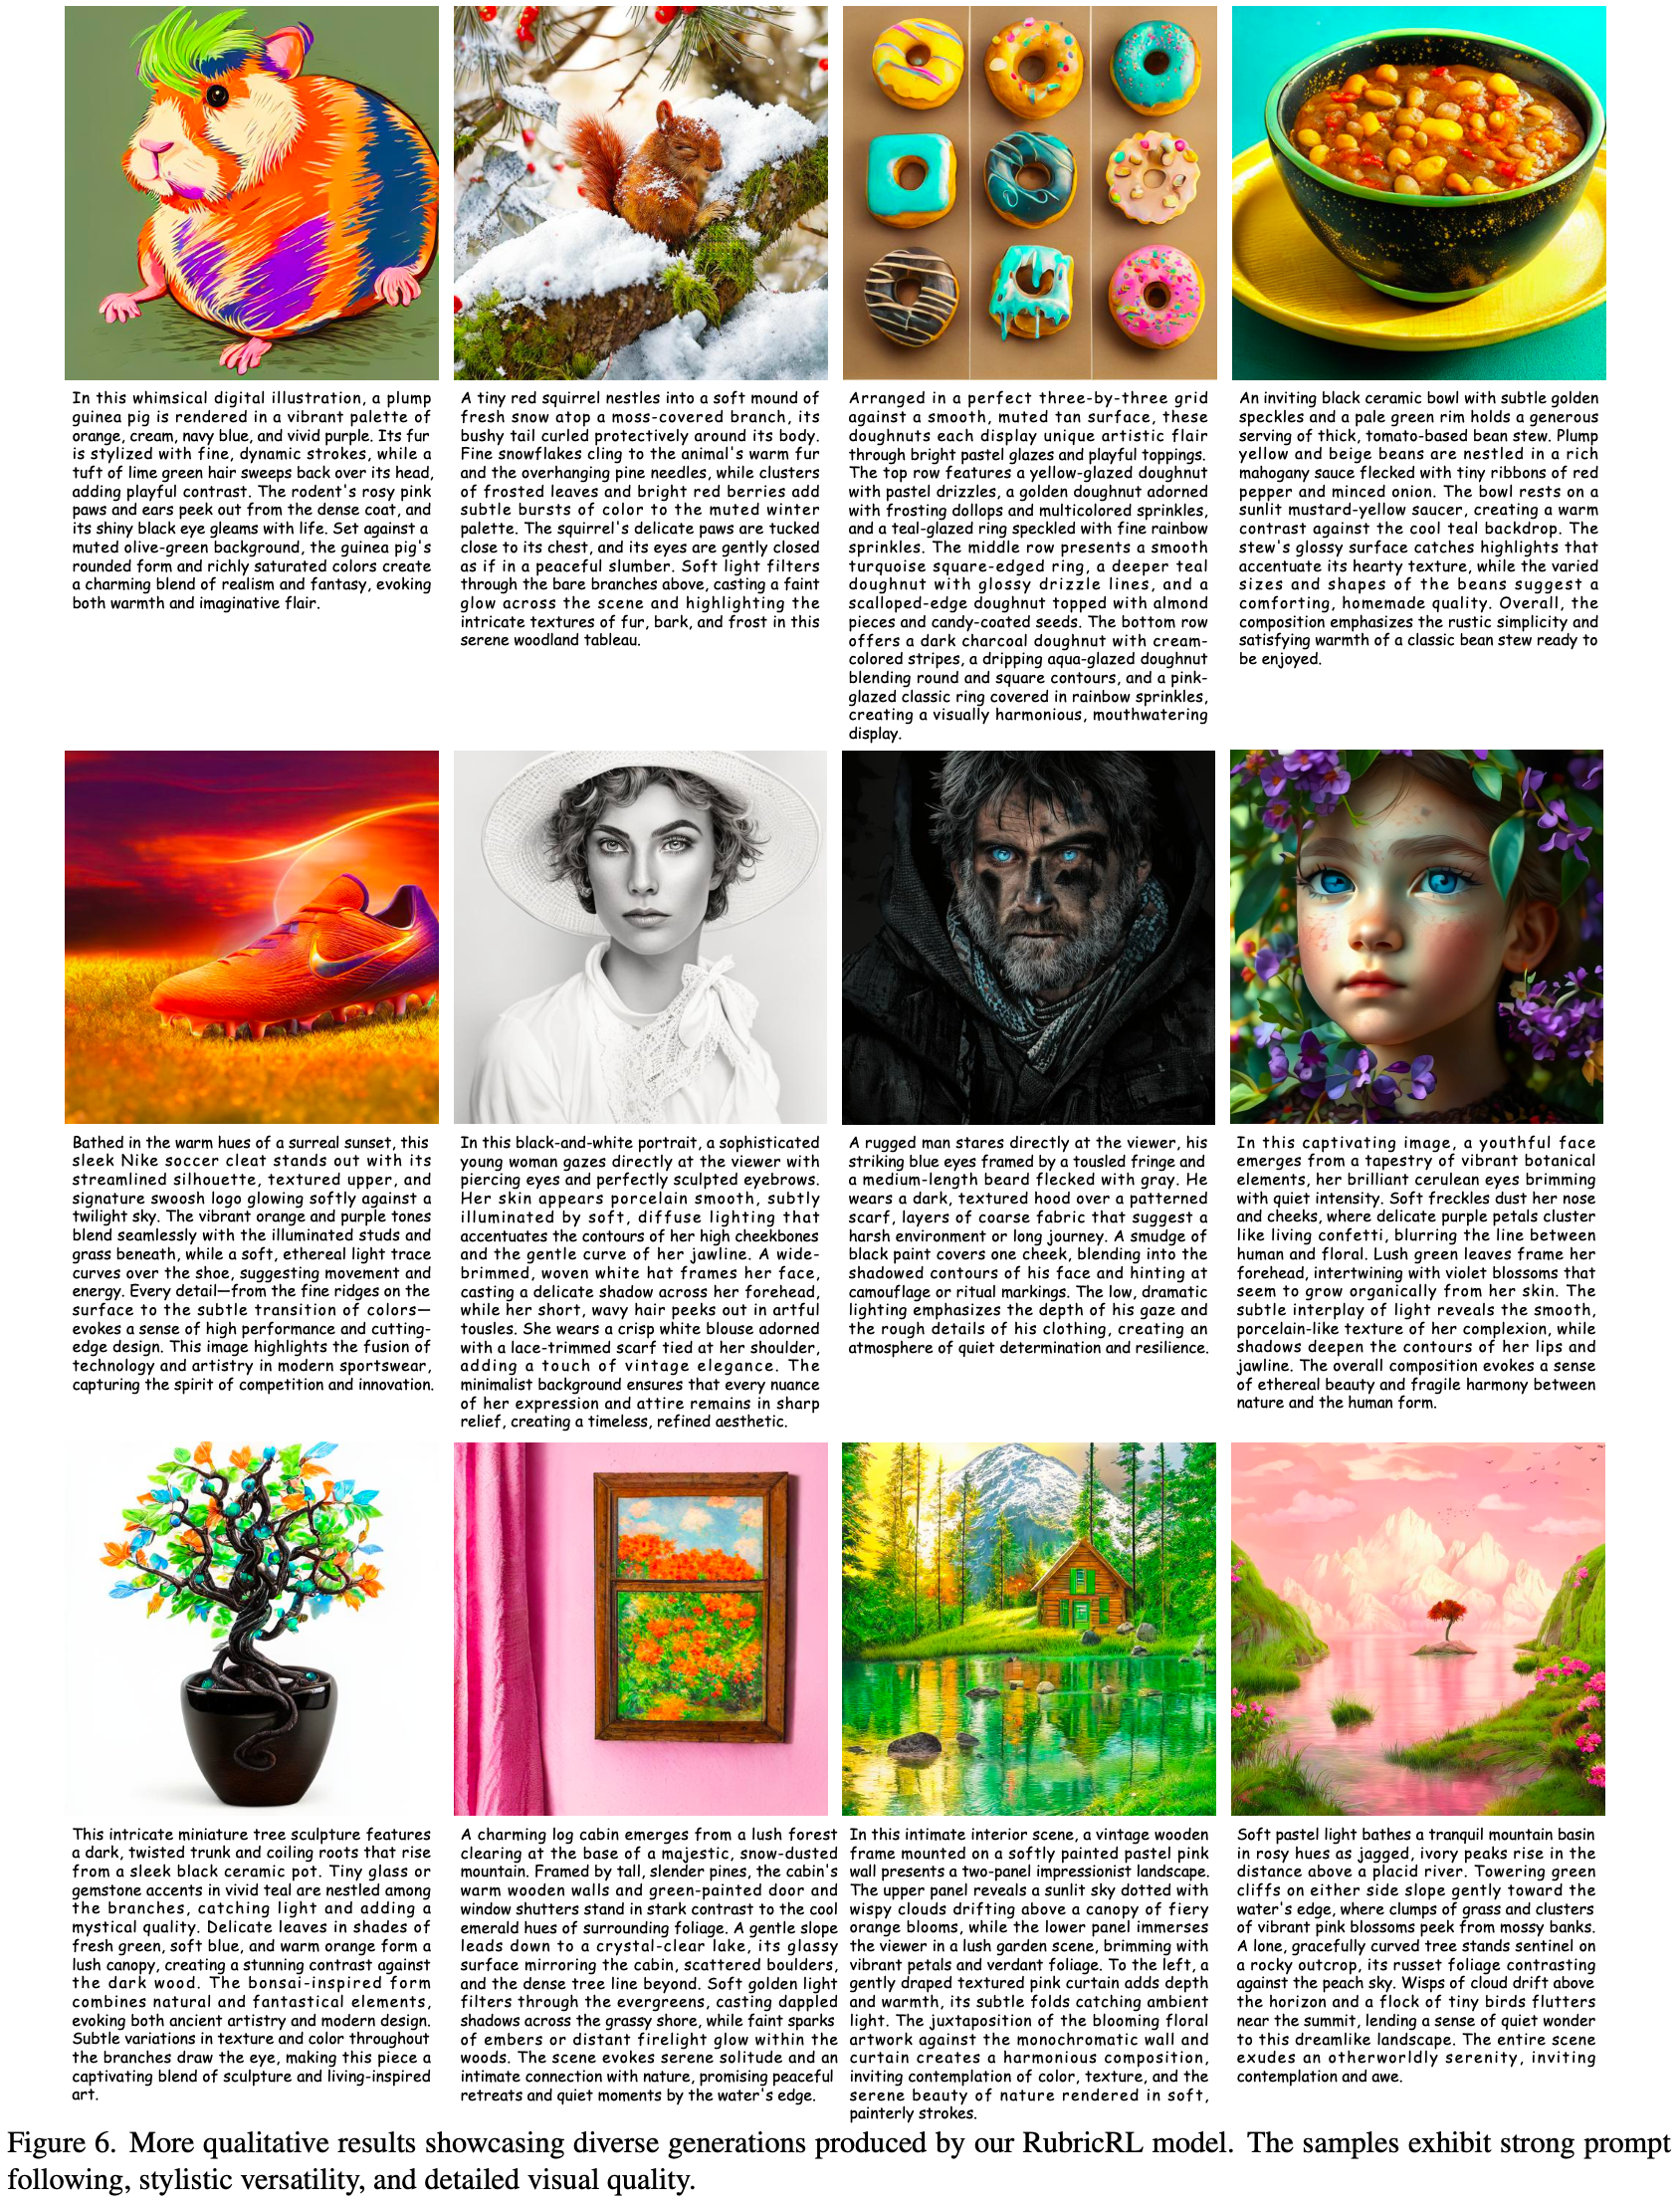
- 论文展示来自论文 RubricRL 的更多生成结果
- 如图 6 所示,论文的 RubricRL 生成高保真图像,并显著提高了模型遵循复杂 Prompt 的能力
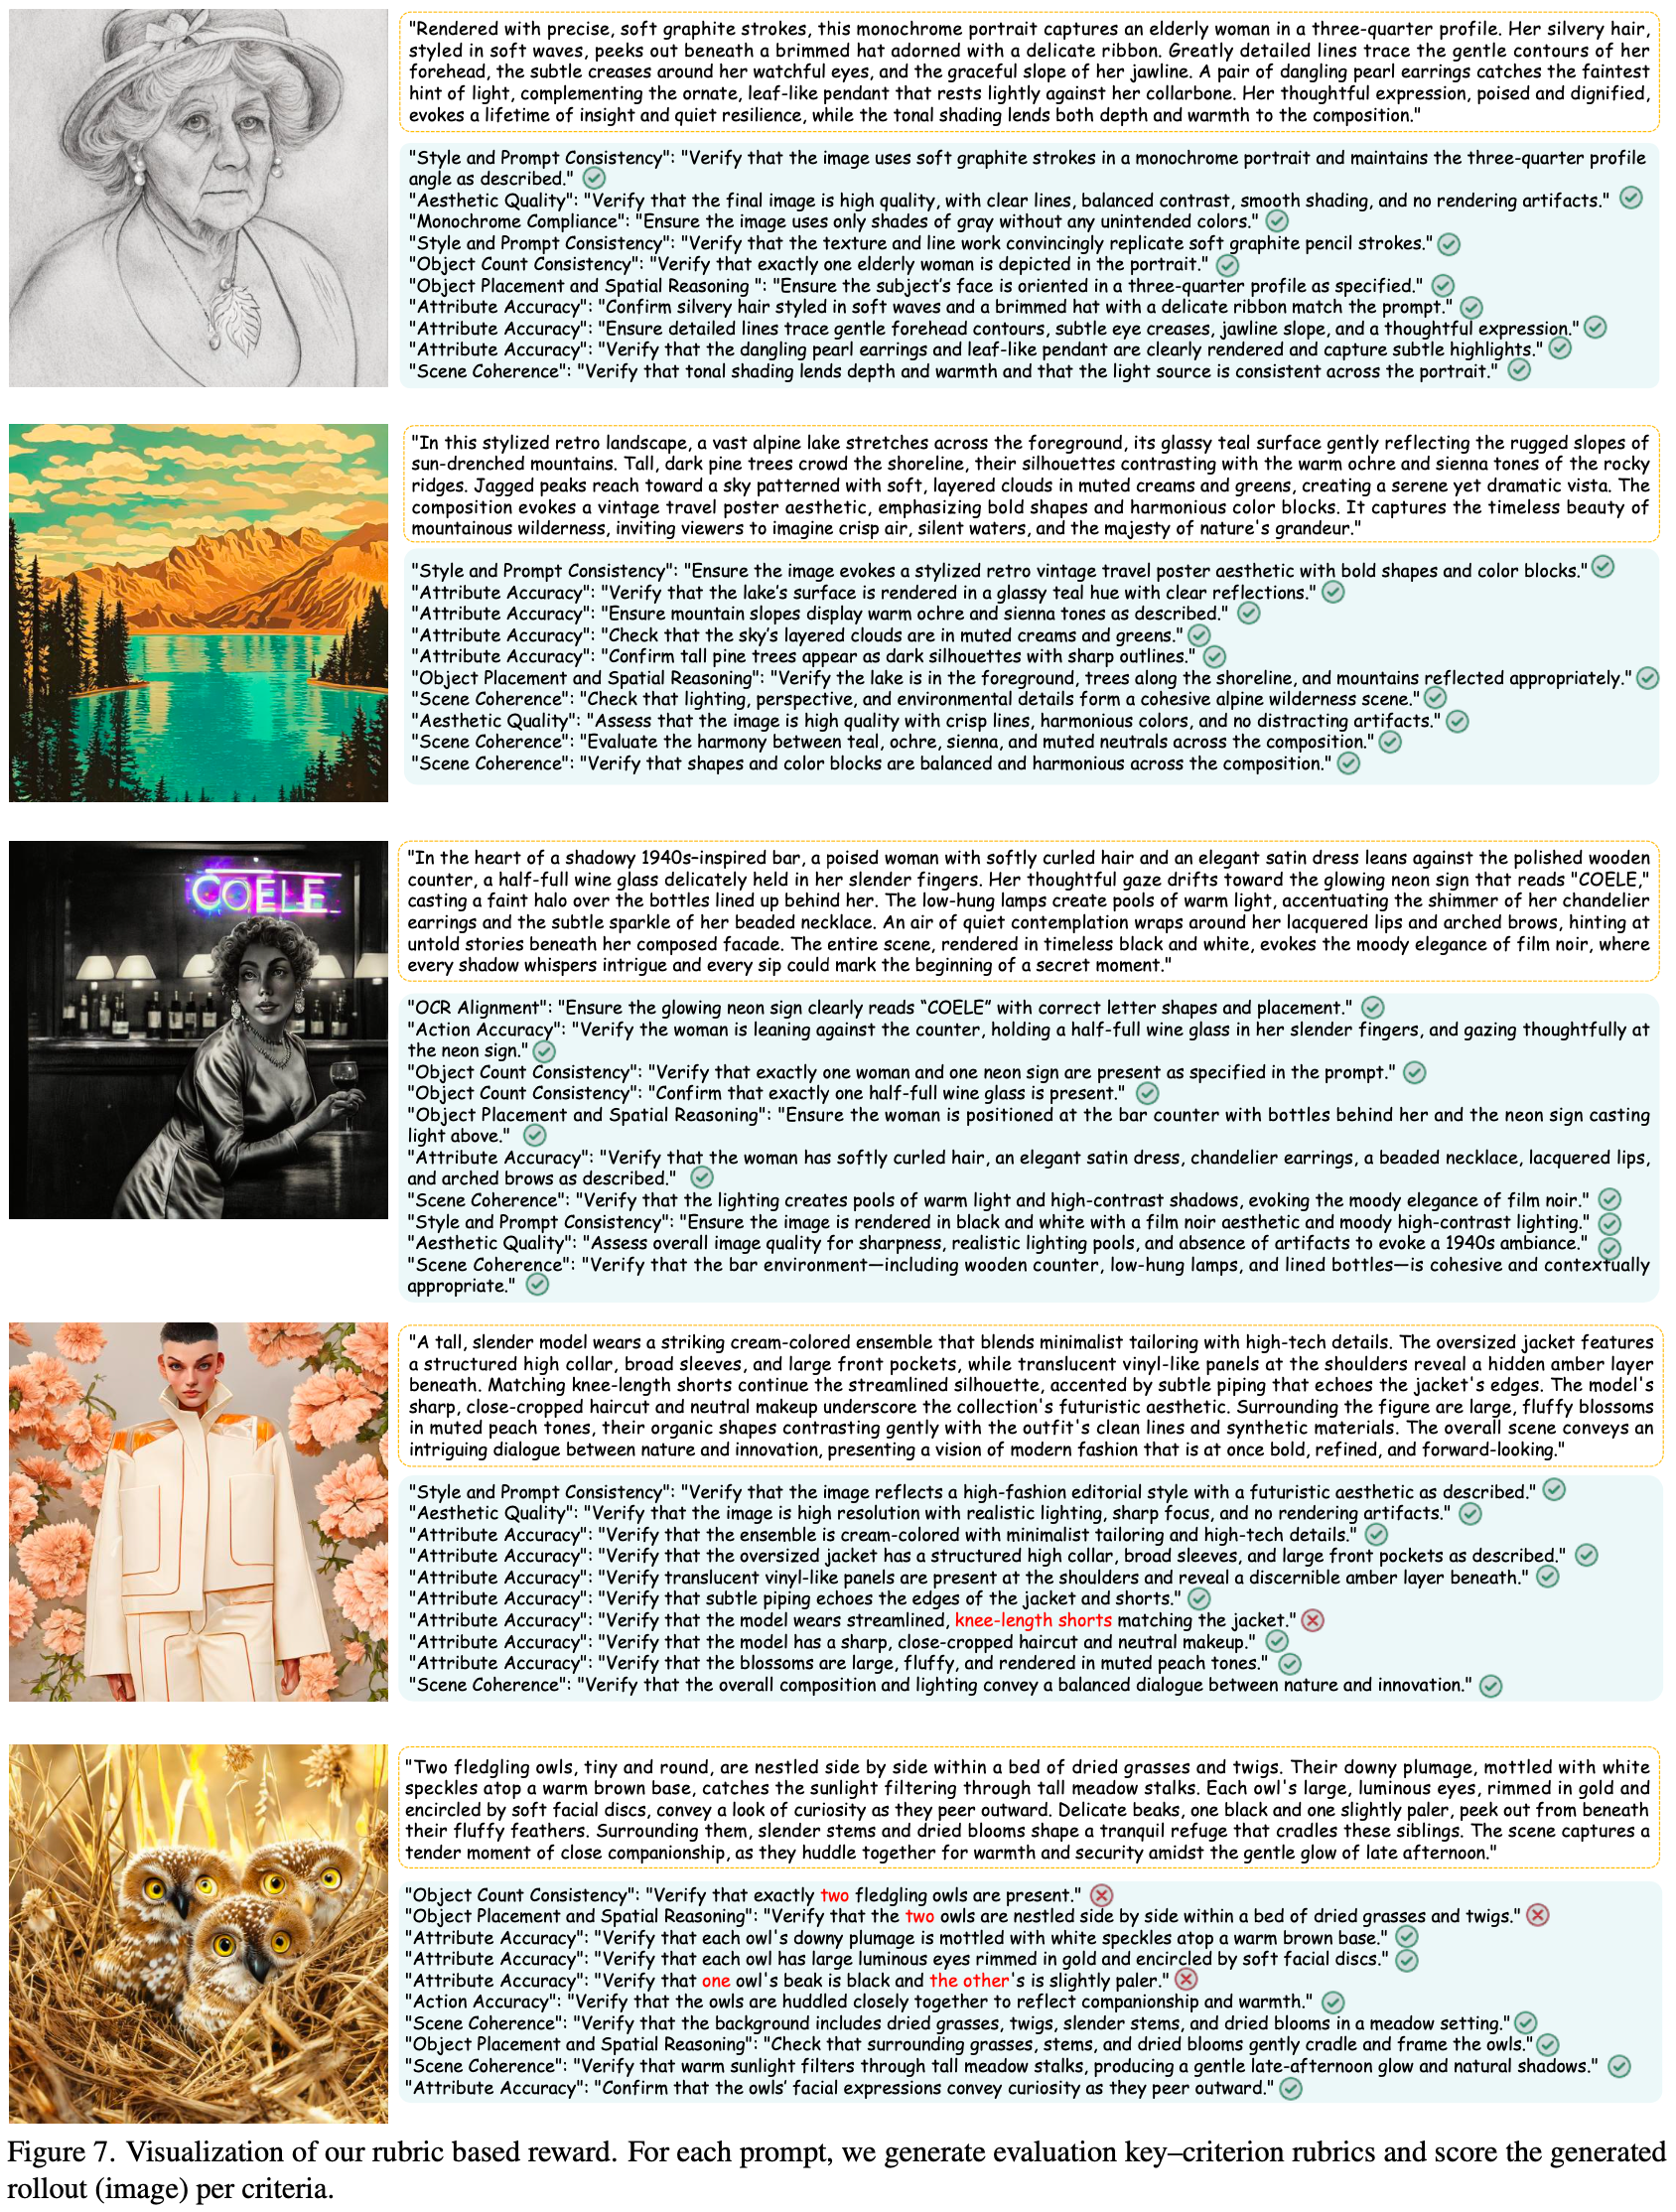
- 此外,论文可视化了每个 Prompt 的详细关键标准 Rubrics,以及每个 rollout 在每个标准下的正确与否,如图 7 所示
- 图 6: 更多定性结果展示论文的 RubricRL 模型产生的多样化生成。这些样本表现出强大的 Prompt 跟随能力、风格多样性以及细致的视觉质量
- 图 7: 论文的 Rubric-based 奖励的可视化。对于每个 Prompt,论文生成评估关键标准 Rubrics,并按标准给生成的 rollout(图像)评分