Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——技术报告解读-Seed1.5-Thinking

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:Seed1.5-Thinking: Advancing Superb Reasoning Models with Reinforcement Learning, arXiv 20250429, ByteDance Seed
    • 模型试用链接:火山方舟
    • 文章中常常提到 Doubao-1.5-pro,未找到技术文档,仅官方发布模型时有介绍: Doubao-1.5-pro

Paper Summary

  • 整体内容总结:
    • 论文是字节的第一次开源,本论文介绍了推理模型 Seed1.5-Thinking
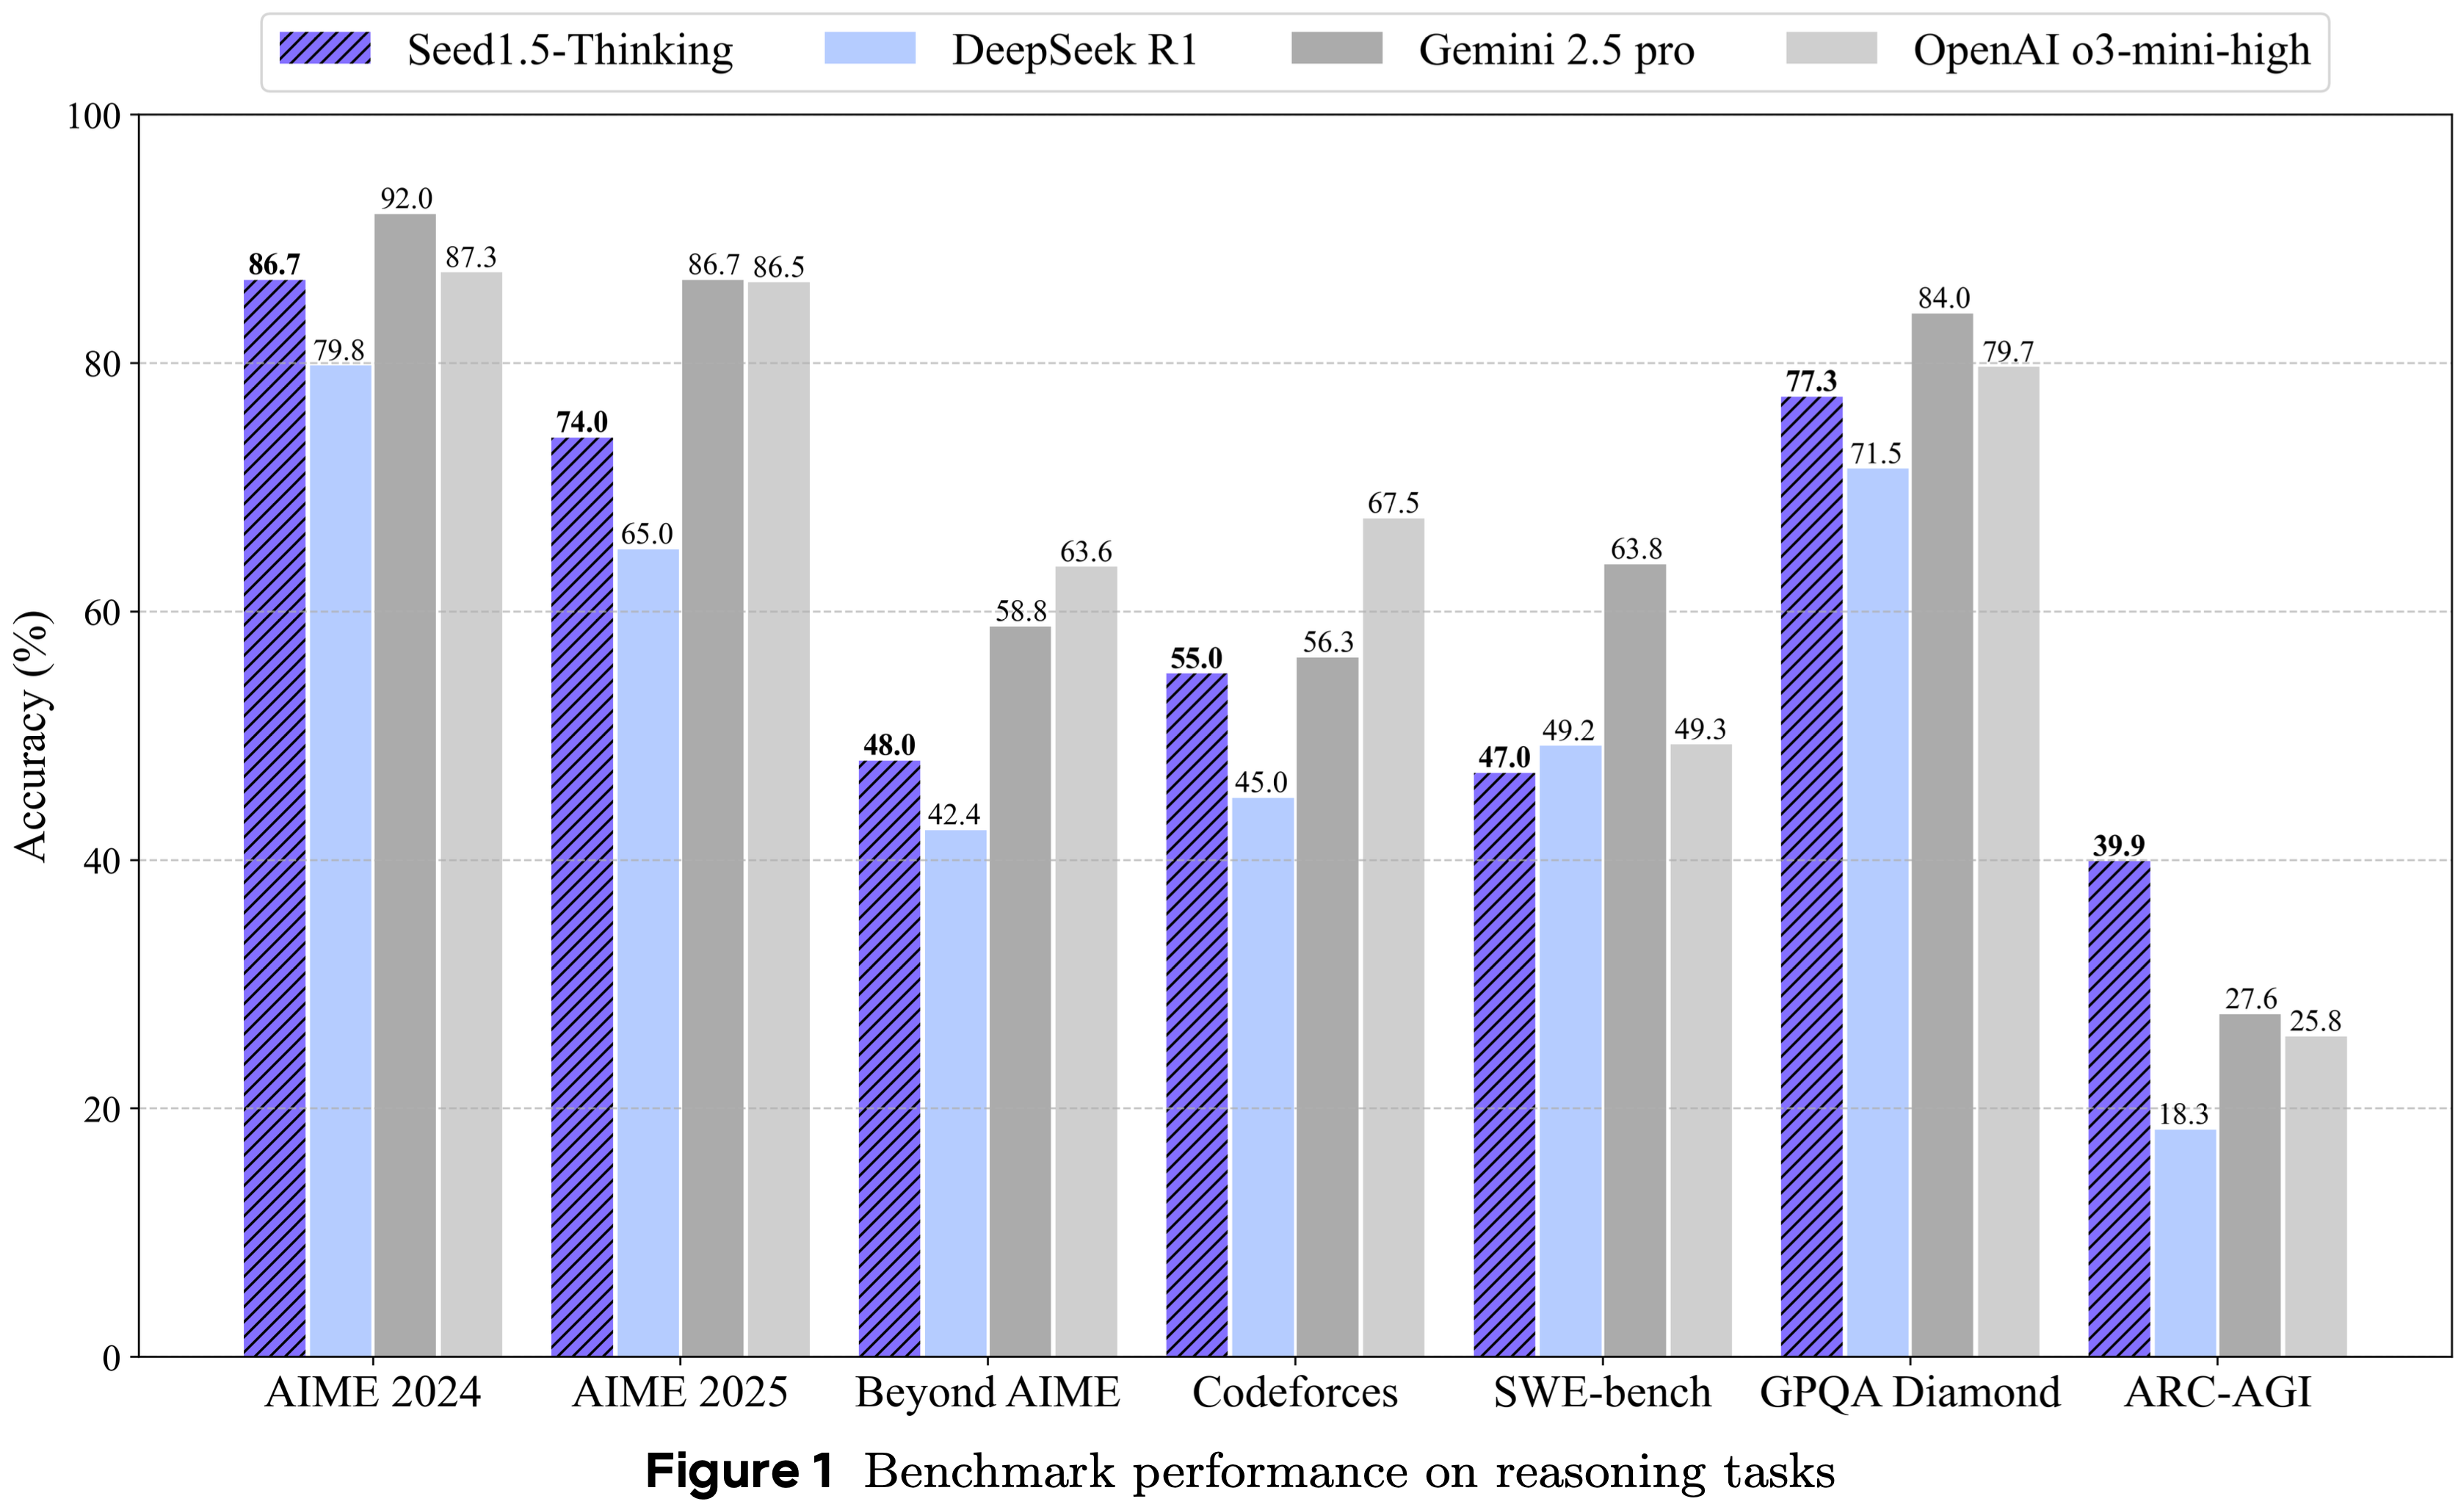
    • 利用先进的 RL 技术,稳定可靠地提高了思维能力,在 AIME24 上达到 86.7%,在 AIME25 上达到 74.0%,在 Codeforces 上达到 55.0%
    • 特别说明:本文提出了 Streaming Rollout 技术,将 RL 的生成和训练几乎彻底解耦开
      • 核心:在生成过程中,一旦 Response 的数量和比例满足要求(On-policy,Off-policy 比例,Buffer 大小),就停止生成,进入训练
        • 在 Actor 训练过程中,这次 Generation 未完成的 Prompt,会继续并行地进行生成(用同一个策略)
        • 生成过程中,可能有多个不同模型同时在生成数据,从而保证一个 Prompt 对应的生成策略是相同的
      • 注意:streaming Rollout 中,一个 Rollout 的所有 Token 都是同一个 策略产生
        • 注:这与 Kimi-K1.5 提出的 Partial Rollout 不同(Partial Rollout 中一个 Rollout 可能由不同 策略生成)
      • 注:论文中没有明确提到,但这种情况下,异步可能比较严重,可以使用 V-Trace 来修正 Return 的估值
  • Seed1.5-Thinking 模型能够在 response 前进行思考推理,在广泛的基准测试中实现了性能提升
  • Seed1.5-Thinking 是一个 MoE(200B-A20B)
  • Seed1.5-Thinking 展现了在 STEM 和编程领域卓越的推理能力
    • 在 AIME 2024 上达到 86.7 分,在 Codeforces 上达到 55.0 分,在 GPQA 上达到 77.3 分
  • 在非推理任务上,其胜率比 DeepSeek R1 高出 8%
  • 作为论文评估广义推理能力工作的一部分,论文开发了两个内部基准测试 BeyondAIME 和 Codeforces(两者都开源)
Introduction and Discussion

  • 在 LLM 上进行大规模强化学习,使得推理模型取得了显著进展
    • OpenAI 的 o1 系列 (2024)、DeepSeek 的 R1 (2025)、Google 的 Gemini 2.5 (2025) 以及 Anthropic 的 Claude 3.7 (2025) 已成为 SOTA 模型,各自在逻辑推理、数学问题解决和代码生成方面取得了实质性进展
    • 这些进展强调了向更结构化、更高效和可扩展的推理模型的转变,当前的研究重点集中在训练效率、长思维链(long chain-of-thought)和大规模强化学习上
  • 在这项工作中,论文提出了一个新的推理模型,称为 Seed1.5-Thinking。该模型在推理和非推理任务上都取得了强大的性能
    • 数学推理 (Mathematical Reasoning) :
      • 对于数学竞赛,Seed1.5-Thinking 在 AIME 2024 上达到 86.7 分,与 o3-mini-high 的性能相当,并显著优于 o1 和 DeepSeek R1,展现了竞争优势
      • 由于 AIME 2024 不再提供足够的区分度,论文构建了一个更具挑战性的评估集,命名为 BeyondAIME
      • BeyondAIME 中的所有问题都是由人类专家新策划的,旨在最大限度地减少通过记忆或猜测解决的可能性
      • 虽然 Seed1.5-Thinking 超越了 o1 和 R1,但与 o3 和 Gemini pro 2.5 相比仍存在性能差距
      • 这也进一步证明了新评估集的区分能力
    • 竞技编程 (Competitive Programming) :
      • 对于竞技编程的评估,论文采用 Codeforces 作为论文的基准
      • 与一些依赖 Elo 分数(包含估计且无法直接比较)的先前工作不同,论文采用了一个基于最近 12 场 Codeforces 比赛的具体评估协议
      • 具体来说,论文报告 pass@1 和 pass@8 指标,其中 pass@k 表示模型是否在 k 次尝试内解决问题,即从 k 次生成的提交中选择最佳结果
      • 论文选择报告 pass@8,因为它提供了更稳定的结果,并且更贴近实际的用户提交模式
      • Seed1.5-Thinking 在这两个指标上都优于 DeepSeek R1,尽管与 o3 相比仍存在性能差距
      • 评估集将在未来的版本中公开发布
    • 科学 (Science) :
      • Seed1.5-Thinking 在 GPQA 上达到了 77.3 分,接近 o3 级别的性能
      • 特别地,这一提升主要归功于数学训练带来的泛化能力改进,而不是领域特定科学数据的增加
    • 非推理任务 (Non-reasoning Tasks) :
      • 对于非推理任务,Seed1.5-Thinking 使用一个旨在复现真实世界用户需求的测试集进行评估
      • 通过在多样化场景下与 DeepSeek R1 进行的人工评估,Seed1.5-Thinking 展示了显著进步:用户的正面反馈总体提升了 8.0%,从而凸显了其处理复杂用户场景能力的增强
  • 高质量推理模型的开发有三个关键点 :训练数据、RL 算法和 RL 基础设施。论文在这三个方面投入了大量精力,并将详细讨论它们
    • 数据 (Data) :
      • 对于 SFT 训练 ,与传统的后训练数据不同,推理模型依赖于 CoT 数据 ,这些数据明确勾勒出逐步推理过程
      • 论文的初步实验表明,过多的非 CoT SFT 数据会显著降低模型的探索能力
      • 对于 RL 训练 ,论文整合了四类数据 :STEM 问题、代码相关任务、逻辑推理以及非推理数据(如创意写作和对话)
        • 经验1:逻辑推理数据对 ARC-AGI 基准测试的性能提升贡献显著
        • 经验2:数学数据展现出强大的泛化能力 ,并能带来跨任务的广泛性能提升
    • RL 算法 (RL Algorithm) :
      • 推理模型的 RL 训练非常不稳定且经常崩溃 ,特别是对于没有经过 SFT 的模型
        • 有时,两次运行之间的分数差异可能高达 10 分
        • RL 系统的稳定训练对于推理模型的成功至关重要
      • 为了解决这些长期存在的问题,论文开创了 VAPO (2025) 和 DAPO (2025),两个分别针对 Actor-Critic 和策略梯度(policy-gradient)RL 范式的独特框架
      • VAPO 现已成为 Actor-Critic 方法中 SOTA 解决方案,而 DAPO 则为无评论员模型的策略梯度方法确立了新的 SOTA 结果

Data

RL Training Data

  • 论文的 RL 训练数据主要包括两个部分:
    • 具有明确答案的可验证问题(verifiable problems)
    • 没有明确答案的不可验证问题(non-verifiable problems)
  • 模型的推理能力主要来自第一部分(可验证问题),并可以泛化到第二部分(不可验证问题)
Verifiable Problems
  • 可验证问题主要包括配有答案的 STEM 问题、配备单元测试的编程问题以及适合自动验证的逻辑推理问题
STEM Data
  • 论文的数据集包含数十万个高质量的竞赛级别问题,涵盖数学、物理和化学,其中数学占大多数(超过 80%)
  • 这些问题来源于开源数据集、公共竞赛(国内和国际)以及专有集合的混合
  • 对于数据清理,论文做以下流程:
    • 首先剔除问题陈述不完整、符号不一致或要求不明确的问题
    • 对于剩余的问题,论文使用论文的模型(Doubao-Pro 1.5)生成多个回答
      • 模型在该问题上获得 woN 分数(worst of N)为 1 的问题被认为过于简单并被移除
    • 最后,有些问题的参考答案可能不准确
      • 论文使用 SOTA 推理模型为每个问题生成多个候选回答
      • 作者认为参考答案是错误的判断依据:
        • 如果模型的答案与参考答案不一致 ,但模型的输出显示出高度的内部一致性(或者仅涉及极少量的推理标记(reasoning tokens)不一致)
      • 随后,人类专家对这些问题进行手动验证,以确保参考答案是正确的
  • 论文还应用数据增强(data augmentation)使数据更适合学习和评估
    • 论文将选择题转换为填空题或简答题格式,以消除猜测的可能性,并更好地评估推理能力
    • 而且论文修改某些数学问题 ,以确保答案尽可能为整数
  • 经过数据清理和增强后,论文最终获得了一个包含 10 万个 STEM 问题的训练集用于 RL 训练
  • 在训练期间,论文使用基于模型的 Seed-Verifier 来评估回答的正确性 ,这将在 3.1 节介绍
Code Data
  • 对于编程问题,论文优先选择高质量且具有挑战性的算法任务来源 ,主要来自著名的竞技编程竞赛
  • 论文对数据进行过滤,以确保每个问题都包含全面的规范:清晰的问题描述、一组单元测试和一个检查器脚本(checker script)
    • 单元测试 :验证解决方案的功能正确性
    • 检查器脚本 :强制执行额外的约束,如输出格式和边缘情况
    • 论文还进行了难度过滤 ,确保问题具有适当的复杂度和对现实世界算法推理的适用性
  • 对于模型生成代码的评估:
    • 最准确的形式是将生成的代码提交到官方平台,但在强化学习过程中,实时提交是不可行的
    • 论文开发了一个离线评估集以进行高效的本地验证(论文的观察表明,离线评估结果与官方判定之间存在很强的相关性)
    • 所有的训练和评估问题都被集成到一个内部的代码沙箱环境中,从而能够直接执行和评估模型生成的代码
    • 论文确保沙箱的稳定性和高吞吐量,以便在 RL 训练过程中提供一致且准确的反馈
Logical Puzzle Data
  • 对于逻辑推理数据,论文收集了 22 个常被研究的任务,例如 24 点、迷宫、数独等
  • 对于每个任务,论文构建了一个数据生成器和一个答案验证器
    • 数据生成器可以自动生成大量的训练和评估数据
      • 此外,对于许多任务,我们可以配置生成问题的难度
      • 在训练过程中 ,论文根据模型在某些任务上的表现逐步调整训练数据的难度(人工盯盘)
    • 答案验证器严格评估生成的正确性,并可以作为奖励函数无缝集成到 RL 流程中
      • 论文生成了大约 1 万个谜题问题用于 RL 训练
Non-verifiable Problems
  • 不可验证问题主要包括需要基于人类偏好进行质量评估的非推理任务,涉及创意写作、翻译、知识问答(knowledge QA)、角色扮演等任务
  • 提示词(prompts)来源于 Doubao-1.5 Pro (2025) 的 RL 训练数据
    • 该数据集在不同领域具有足够的覆盖度
  • 论文丢弃了样本分数方差低和难度低的数据
    • 论文使用 SFT 模型为每个 Prompt 生成多个候选,然后使用奖励模型(reward model)对它们进行评分
    • 分数方差低的 Prompt 被移除,因为它们表现出有限的采样多样性和最小的改进潜力
    • 在 Doubao 1.5 Pro RL 训练过程 (2025) 中,奖励分数提升超过某个阈值的提示也会被移除
      • 这是因为此类数据可能过于简单或已在数据集中大量存在
      • 离线实验表明,对此类样本进行过度优化会导致模型的探索空间过早崩溃并降低性能
      • 问题:如何理解这里的 奖励分数提升超过某个阈值(reward score improvement surpasses a certain threshold) 移除?原文如下:

        Prompts are also removed where the reward score improvement surpasses a certain threshold during the Doubao 1.5 Pro RL training process [8]. This is because such data may be overly simplistic or already abundantly represented in the dataset. Offline experiments show that overoptimizing such samples leads to premature collapse of the model’s exploration space and diminish the performance.

  • 对于这些不可验证的数据,论文采用成对奖励方法(pairwise rewarding method)进行评分和 RL 训练
    • 通过比较两个样本(samples)的相对质量 ,这种方法有助于模型更好地理解用户偏好,提高生成结果的质量和多样性
      • 理解:即同一个 Prompt 生成多个候选,然后两两比较优劣?
    • 奖励模型的细节在 3.2 节介绍

Advanced Math Benchmark

  • 当前的推理模型通常使用 AIME 作为评估数学推理能力的首选基准
  • 但由于其每年仅发布 30 个问题,有限的规模可能导致高方差的评估结果,使得有效区分 SOTA 推理模型具有挑战性
  • 为了更好地评估模型的数学推理能力,论文构建了一个新的基准数据集:BeyondAIME
    • 论文与数学专家合作,基于既有的竞赛形式开发原创问题
    • 论文通过结构修改和场景重构系统地改编现有的竞赛题目,确保没有直接重复
    • 此外,论文确保答案绝不是 trivial 的值(never trivial values,例如问题陈述中明确提到的数字),以减少模型在没有适当推理的情况下猜测正确答案的机会
  • 通过这种严格的过滤和策划过程,论文最终汇编了 100 个问题集,每个问题的难度水平等于或大于 AIME 中最难的问题
    • 与 AIME 类似 ,所有答案都保证是整数(不限于特定的数值范围),这简化并稳定了评估过程

Reward Modeling

  • 作为 RL 中的关键组成部分,奖励建模定义了策略试图实现的目标或目的
  • 一个精心设计的奖励机制对于在训练阶段为模型响应提供精确可靠的奖励信号至关重要
  • 对于可验证和不可验证的问题,论文采用不同的奖励建模方法

Reward Modeling for Verifiable Problems

  • 借助正确的原则和思维轨迹,论文利用 LLM 来评判不同场景下的各种可验证问题
    • 这种方法产生了一种更通用的解决方案,超越了基于规则的奖励系统的局限性
  • 论文设计了两种渐进的奖励建模解决方案,Seed-Verifier 和 Seed-Thinking-Verifier :
    • Seed-Verifier 基于一套由人工精心编写的原则(问题:非 thinking 模式?)
      • 利用 LLM 强大的基础能力来评估一个包含问题、参考答案和模型生成答案的三元组
      • 如果参考答案和模型生成的答案本质上是等价的,则返回“YES”;否则返回“NO”
      • 这里的等价性不是字面上的完全匹配,而是基于计算规则和数学原则的更深入评估,证明两个答案传达了相同的数学含义
      • 这种方法确保奖励信号能准确反映模型的响应在本质上是否正确,即使措辞有所不同
    • Seed-Thinking-Verifier 的灵感来源于人类的判断过程,即通过细致的思考和深入的分析来生成结论性的判断
      • 为了实现这一点,论文训练了一个验证器(问题:Seed-Thinking-Verifier?),为其评估提供详细的推理路径
      • 具体来说,论文将此视为一个可验证的任务,并与其他数学推理任务一起进行优化
      • 该验证器可以剖析参考答案和模型生成答案之间的异同,提供精确而细致的判断结果
    • 问题:Seed-Verifier 与 Seed-Thinking-Verifier 的区别是什么?
      • 回答(待确认):Seed-Verifier 更简单也更快,Seed-Thinking-Verifier 则更复杂,但更详细,更精确
  • Seed-Thinking-Verifier 显著缓解了与 Seed-Verifier 相关的三个主要问题:
    • 奖励黑客攻击 (Reward Hacking) :非思考模型可能利用漏洞获得奖励,而没有真正理解问题
      • Seed-Thinking-Verifier 中详细的推理过程使得此类黑客攻击更加困难
    • 预测的不确定性 (Uncertainty in Predictions) :在参考答案和模型生成答案本质上等价但格式可能不同的情况下
      • 例如 \(2^{19}\) 与 524288,Seed-Verifier 有时可能返回“YES”,有时返回“NO”
        • 问题:Seed-Verifier 会评估答案的本质是否等价,不会这都判断不了吧
      • Seed-Thinking-Verifier 通过彻底分析答案背后的推理,提供一致的结果
    • 在极端案例上的失败 (Failure on Corner Cases) :存在某些边缘案例是 Seed-Verifier 难以有效处理的
      • Seed-Thinking-Verifier 提供详细推理的能力使其能够更好地处理这些复杂场景
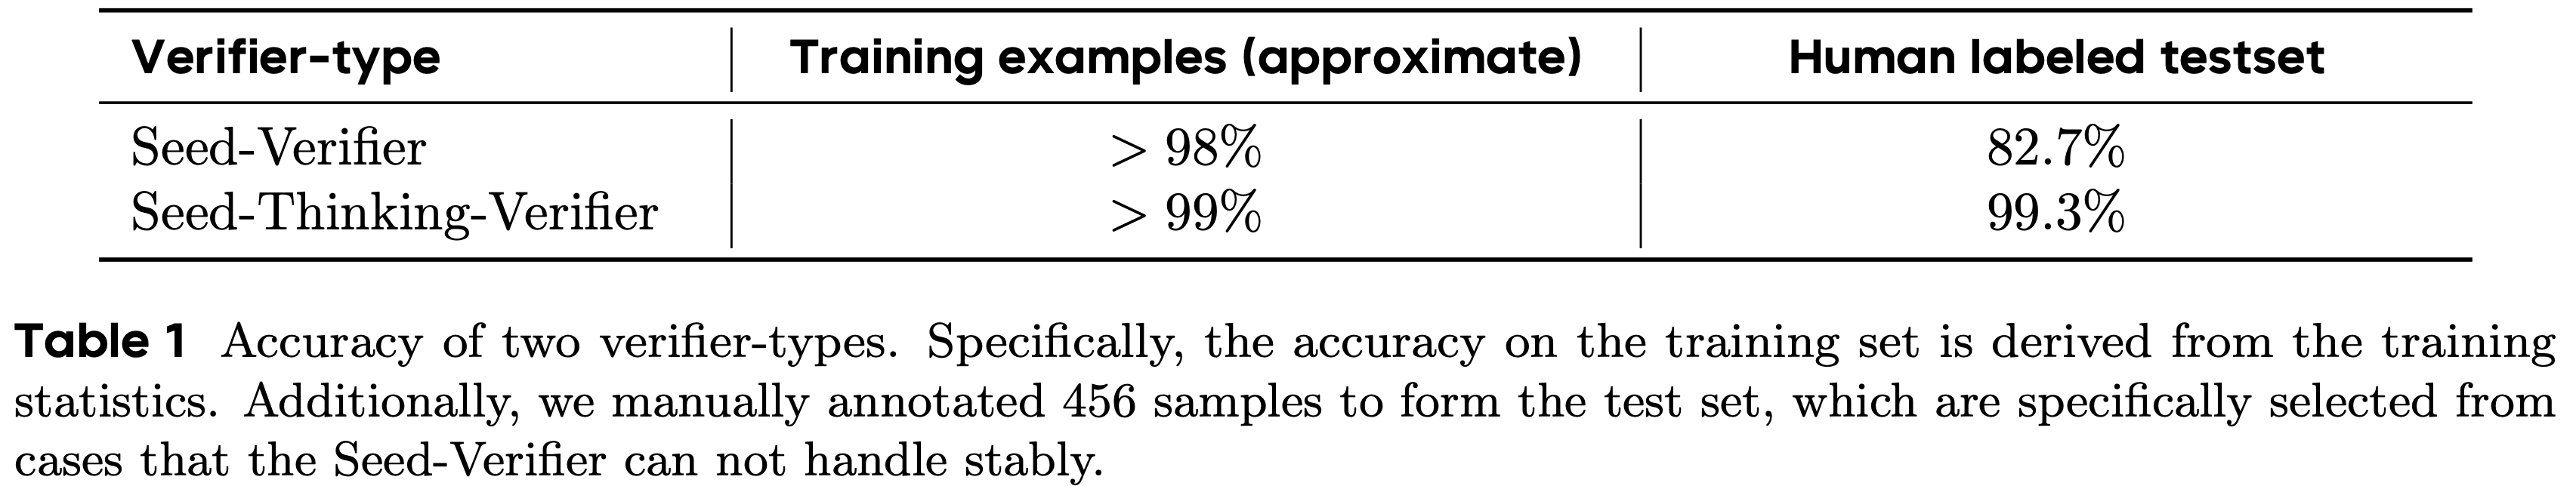
  • 表 1 展示了上述两种验证器的性能
    • 结果表明,Seed-Verifier 难以有效处理某些特定情况,而 Seed-Thinking-Verifier 则展现出提供准确判断的卓越能力
    • 尽管后者的思考过程确实消耗了大量的 GPU 资源,但作者相信其产生的精确且稳健的奖励结果对于赋予策略强大的推理能力至关重要
  • 表 1:两种验证器类型的准确率,具体来说,训练集上的准确率来自训练统计数据,此外,论文手动标注了 456 个样本来形成测试集,这些样本是专门从 Seed-Verifier 无法稳定处理的案例中挑选出来的
Reward Modeling for Non-verifiable Problems

  • 对于不可验证的问题,论文训练一个奖励模型用于 RL 训练
  • 奖励模型的训练数据与 Doubao 1.5 Pro (2025) 中使用的人类偏好数据一致,主要涵盖创意写作和摘要等类别
  • 为了增强奖励模型的有效性:论文采用了 (2025) 中提到的成对生成奖励模型(pairwise generative reward model)
    • 论文链接:Exploring Data Scaling Trends and Effects in Reinforcement Learning from Human Feedback, arXiv 20250402, ByteDance Seed
    • 具体方式:该模型评估两个响应的优劣,并使用“YES”或“NO”的概率作为最终的奖励分数
    • 这种方法使模型能够在评分时直接比较响应之间的差异 ,从而避免过度关注不相关的细节
    • 实验结果表明,这种奖励建模方法提高了 RL 训练的稳定性 ,特别是在涉及不可验证和可验证问题的混合训练场景中 ,通过最小化两种不同类型奖励建模范式之间的冲突来实现
      • 这种改进可能归因于成对生成奖励模型在缓解异常值分数生成方面相比传统奖励模型具有固有优势,因此避免了与验证器在分数分布上的显著差异
  • 问题:在训练时岂不是要两两对照进入奖励模型?奖励生成的成本会很高吧?

Approach

Supervised Fine-Tuning

  • 论文的训练过程从 SFT 开始,SFT 阶段为后续的强化学习阶段奠定了坚实的基础
  • 与从基础模型开始 RL 相比,SFT 模型产生更具可读性的输出,表现出更少的幻觉实例,并显示出更低的危害性
  • 论文策划(curate)了一个包含 40 万个训练实例的 SFT 数据,其中包括 30 万个可验证问题和 10 万个不可验证问题
    • 可验证的提示词是从 RL 训练集中随机采样的
    • 不可验证数据来源于用于 Doubao-Pro 1.5 (2025) 的 SFT 数据,涵盖创意写作、基于知识的问答、安全性和函数调用等领域
  • 为了生成具有长思维链(long CoT)的高质量响应,论文采用了一个集成模型合成(integrates model synthesis)、人工标注(human annotation)和拒绝采样(rejection sampling)的迭代工作流程
    • 最初,人类专家应用提示工程(prompt engineering)技术或与内部模型进行交互式对话,以产生具有各种推理模式的响应
      • 在积累了数十个(tens)高质量的冷启动样本后,我们可以训练一个具有长 CoT 的推理模型作为更有能力的助手
      • 问题:只是数十个吗?如何理解 SFT 这里的整个迭代工作流程?
    • 然后,论文使用 Seed-Verifier 对该推理模型执行拒绝采样
    • 虽然此工作流程主要应用于数学数据,但论文观察到它可以很好地推广到其他领域,例如编码、逻辑谜题甚至创意写作
    • 因此,对于其他领域,论文也进行冷启动过程,然后进行拒绝采样,以产生详细的推理轨迹
  • 一些训练细节:
    • 在训练期间,每个实例被截断至 32,000 个 tokens
    • 论文使用上述数据对基础模型进行两个周期(epochs)的微调
    • 论文使用余弦衰减学习率调度(cosine decay learning rate scheduling)
      • 峰值学习率 \(\mathrm{lr}\) 为 \(2\times 10^{-5}\),
      • 逐渐衰减至 \(2\times 10^{-6}\)

Reinforcement Learning

  • 论文开发了一个统一的强化学习框架,可以无缝融合来自广泛领域的数据。这种集成包含三种数据类别:
    • 可验证数据 (Verifiable data) ,从验证器获取反馈
      • 这类数据允许根据已知标准直接验证(verification)模型的输出
    • 通用数据 (General data) ,由奖励模型评分
      • 奖励模型根据模型的响应与人类偏好的匹配程度来分配分数
    • 一类特定数据(A specific class of data) ,结合了验证器和奖励模型的分数
      • 这种混合数据类型利用了基于验证(verification)和基于奖励(reward)的评估的优势
  • 在长思维链 RLHF(long-CoT RLHF)的背景下,论文遇到了几个挑战,例如价值模型偏差(value model bias)和奖励信号的稀疏性
  • 为了以上解决这些问题,论文借鉴了先前工作 (2025, 2025, 2025) 中的关键技术:
    • 价值预训练 (Value-Pretraining) :
      • 论文从固定策略(例如 \(\pi_{\text{sft} }\))中采样响应,并使用蒙特卡洛回报(Monte-Carlo return)更新价值模型
      • 这个过程确保初始化的价值模型与论文的策略 \(\pi_{\text{sft} }\) 完全对齐
      • 保持这种对齐已被证明对于保持模型的 CoT 模式至关重要,使模型能够生成连贯且合乎逻辑的 CoT
    • 解耦广义优势估计 (Decoupled-GAE) :
      • 采用不同的广义优势估计(Generalized Advantage Estimation, GAE)参数,
        • 例如 \(\lambda_{\text{value} }=1.0\) 和 \(\lambda_{\text{policy} }=0.95\),
      • 允许价值模型以无偏的方式更新 ,同时,策略可以独立地平衡自身的偏差和方差
      • 这种解耦使得模型的训练更加高效和稳定
    • 长度自适应的 GAE (Length-adaptive GAE) :
      • 论文设定 \(\lambda_{\text{policy} }=1-\frac{1}{\alpha l}\),其中 \(\alpha\) 是一个超参数,\(l\) 是响应长度
      • 这种方法确保时间差分(Temporal Difference, TD)误差在短序列和长序列上分布更均匀
      • 因此,模型在训练期间可以更有效地处理不同长度的序列
      • 问题:理解一下这里的方法
    • 动态采样 (Dynamic Sampling) :
      • 论文采用动态采样,并过滤掉准确率分数等于 1 或 0 的提示词,仅保留批次中表现出有效梯度的那些
      • 这个过程有助于防止模型训练期间梯度信号的衰减
    • Clip-Higher :
      • 在近端策略优化(Proximal Policy Optimization, PPO)算法中,论文将上下裁剪边界解耦如下:
        $$\mathcal{L}^{CLIP}(\theta)=\hat{\mathbb{E} }_{t}\left[\min\left(r_{t}(\theta)\hat {A}_{t},\operatorname{clip}(r_{t}(\theta),1-\epsilon_{\text{low} },1+\epsilon_{ \text{high} })\hat{A}_{t}\right)\right] \tag{1}$$
      • 通过增加 \(\epsilon_{\text{high} }\) 的值,论文为低概率词元的增加创造了更多空间
      • 这鼓励模型探索更广泛的可能响应,增强其发现新颖有效解决方案的能力
    • Token-level Loss :
      • 论文不是在整个响应上定义策略损失,而是在所有词元上定义它
      • 这种方法解决了词元对最终损失贡献不平衡的问题,确保每个词元对训练过程的影响得到适当考虑
    • Positive Example LM Loss :
      • 该损失函数旨在提高 RL 训练过程中正样本的利用效率,论文为正样本添加一个系数为 \(\mu\) 的语言模型损失:
        $$\mathcal{L}(\theta)=\mathcal{L}_{\text{PPO} }(\theta)+\mu*\mathcal{L}_{\text{NLL } }(\theta) \tag{2}$$
      • 这个额外的损失项有助于模型更好地从正样本中学习,提高其整体性能(理解:相当于对正样本做 SFT)
  • 当合并来自不同领域的数据并整合不同的评分机制时,论文面临着不同数据领域之间相互干扰的挑战
    • 这种干扰可能源于难度水平的差异、奖励黑客攻击的风险以及其他潜在因素
    • 这些问题使得在模型的所有能力上实现统一且同步的改进变得极其困难
  • 为了抵消这一点,论文引入了Online Data Distribution Adaptation
    • 该方法将强化学习期间的静态提示分布转换为自适应分布,更好地满足模型在训练期间的需求
    • 通过这样做,论文最大限度地减少了数据干扰的负面影响,并确保不同能力之间更平衡的改进
    • 因此,模型可以在广泛的任务中更一致地提高其性能

Infrastructures

Framework

  • 训练框架使用 HybridFlow (2024) 编程抽象构建
  • 整个训练工作负载运行在 Ray (2017) 集群之上
    • 数据加载器(databader)和 RL 算法在单个进程的 Ray Actor(单一控制器)中实现
    • 模型训练和响应生成(rollout)在 Ray Worker Group 中实现
    • Ray Worker Group 暴露一组 API(例如,generate_response / train_batch 等),通过 Worker Group 内部的 SPMD(单程序多数据)运行繁重的训练/生成工作负载
    • 单一控制器调用 Ray Worker Group 暴露的各种 API 来构建训练流程
  • HybridFlow 编程抽象使得能够快速原型化 RL 算法思想,而无需处理复杂的分布式系统
  • Seed1.5-Thinking 通过混合引擎架构 (2023) 进行训练,其中所有模型都位于同一位置(all the models are co-located)
    • 这防止了在训练和生成之间切换时 GPU 的空闲时间
  • 在长链思维(Long-CoT)生成过程中,论文观察到由于不同 prompts 的响应长度差异巨大而导致的严重掉队现象(severe straggler phenomenon)
    • 这导致生成过程中大量的 GPU 空闲时间
    • 为了缓解长尾响应生成的掉队问题,论文提出了 SRS(流式 Rollout 系统,Streaming Rollout System) ,这是一个资源感知的调度框架(resource-aware scheduling framework),它策略性地部署独立的流式计算单元 ,将系统约束从 内存受限(memory-bound) 转变为 计算受限(compute-bound)

Streaming Rollout System

  • SRS 架构引入了 流式 rollout(streaming rollout) 来将模型演化与运行时执行解耦,通过参数 \(\alpha\) 动态调整 On-policy 与 Off-policy 样本的比例:
    • 定义完成率 (\(\alpha \in [0,1]\)) 为使用最新模型版本生成的 on-policy 样本比例
      • 理解:当生成完成的数量满足训练要求以后,就开始训练,训练的同时刚才没有生成完成的 Rollout 并行地继续进行
      • 注:剩余未完成部分 (\(1-\alpha\)) 分配给这个 Prompt 对应的策略继续 rollout,通过在独立资源上异步继续部分生成来实现无缝集成 (seamlessly integrated through asynchronous continuation of partial generations on the standalone resources)
        • 理解:这里要保证一条样本是同一个当前策略生成的
          • 但是当前策略生成完成以后,其他策略已经被更新了,所以后续本条样本被使用时,已经是 Off-Policy 的了
          • 理解:这里在多步更新以后,可能需要维护多个 Generator 策略
  • 此外,论文还在环境交互阶段实现了动态精度调度 ,通过训练后量化和误差补偿范围缩放来部署 FP8 策略网络(deploys FP8 policy networks via post-training quantization with error-compensated range scaling)
    • 为了解决 MoE 系统中的 Token 不平衡问题,论文实现了一个三层并行架构,结合了用于逐层计算的 TP(张量并行,tensor parallelism)、带有动态专家分配的 EP(专家并行,expert parallelism)以及用于上下文分块的 SP(序列并行,sequence parallelism)
    • 论文的内核自动调优器(kernel auto-tuner)根据实时负载监控动态选择最优的 CUDA 内核配置

Training System

  • 为了高效地大规模训练 Seed1.5-Thinking 模型,论文设计了一个混合分布式训练框架,该框架集成了先进的并行策略、动态工作负载平衡和内存优化
  • 下面论文详细介绍驱动系统效率和可扩展性的核心技术创新
    • Parallelism mechanisms
      • 论文将 TP(张量并行)/ EP(专家并行)/ CP(上下文并行,context parallelism)与完全分片数据并行(Fully Sharded Data Parallelism, FSDP)相结合来训练 Seed1.5-Thinking
      • 具体来说,论文对注意力层应用 TP/CP ,对 MoE 层应用 EP
    • Sequence length balancing
      • 现有挑战:有效序列长度在 DP ranks 之间可能不平衡,导致计算工作量不平衡和训练效率低下
        • 注:DP ranks 即数据并行数量
      • 为了应对这一挑战,论文利用 KARP (1982) 算法,该算法在一个小批量(mini-batch)内重新排列输入序列,使它们在微批次(micro-batches)之间达到平衡
        • 问题:待补充 KARP 算法
        • 回答:KARP 是一种用于解决组合优化领域的 NP 难问题的算法,核心思想是通过动态规划(Dynamic Programming, DP) 降低 NP 难问题的时间复杂度
    • Memory optimization
      • 论文采用逐层重计算 (2016)、激活卸载(activation offload)和优化器卸载(optimizer offload)来支持更大微批次的训练,以重叠由 FSDP 引起的通信开销
    • Auto parallelism
      • 为了实现最佳系统性能,论文开发了一个自动调优系统,称为 AutoTuner
      • 具体来说:
        • AutoTuner 采用基于性能分析 (2022) 的方案对内存使用进行建模
        • 然后,它估计各种配置的性能和内存使用情况,以获得最优配置
    • Checkpoint
      • 论文采用 ByteCheckpoint (2025) 来支持以最小开销从不同分布式配置中恢复检查点
      • 这使得用户能够弹性地训练任务以提高集群效率

Experiment Results

Auto Evaluation Results

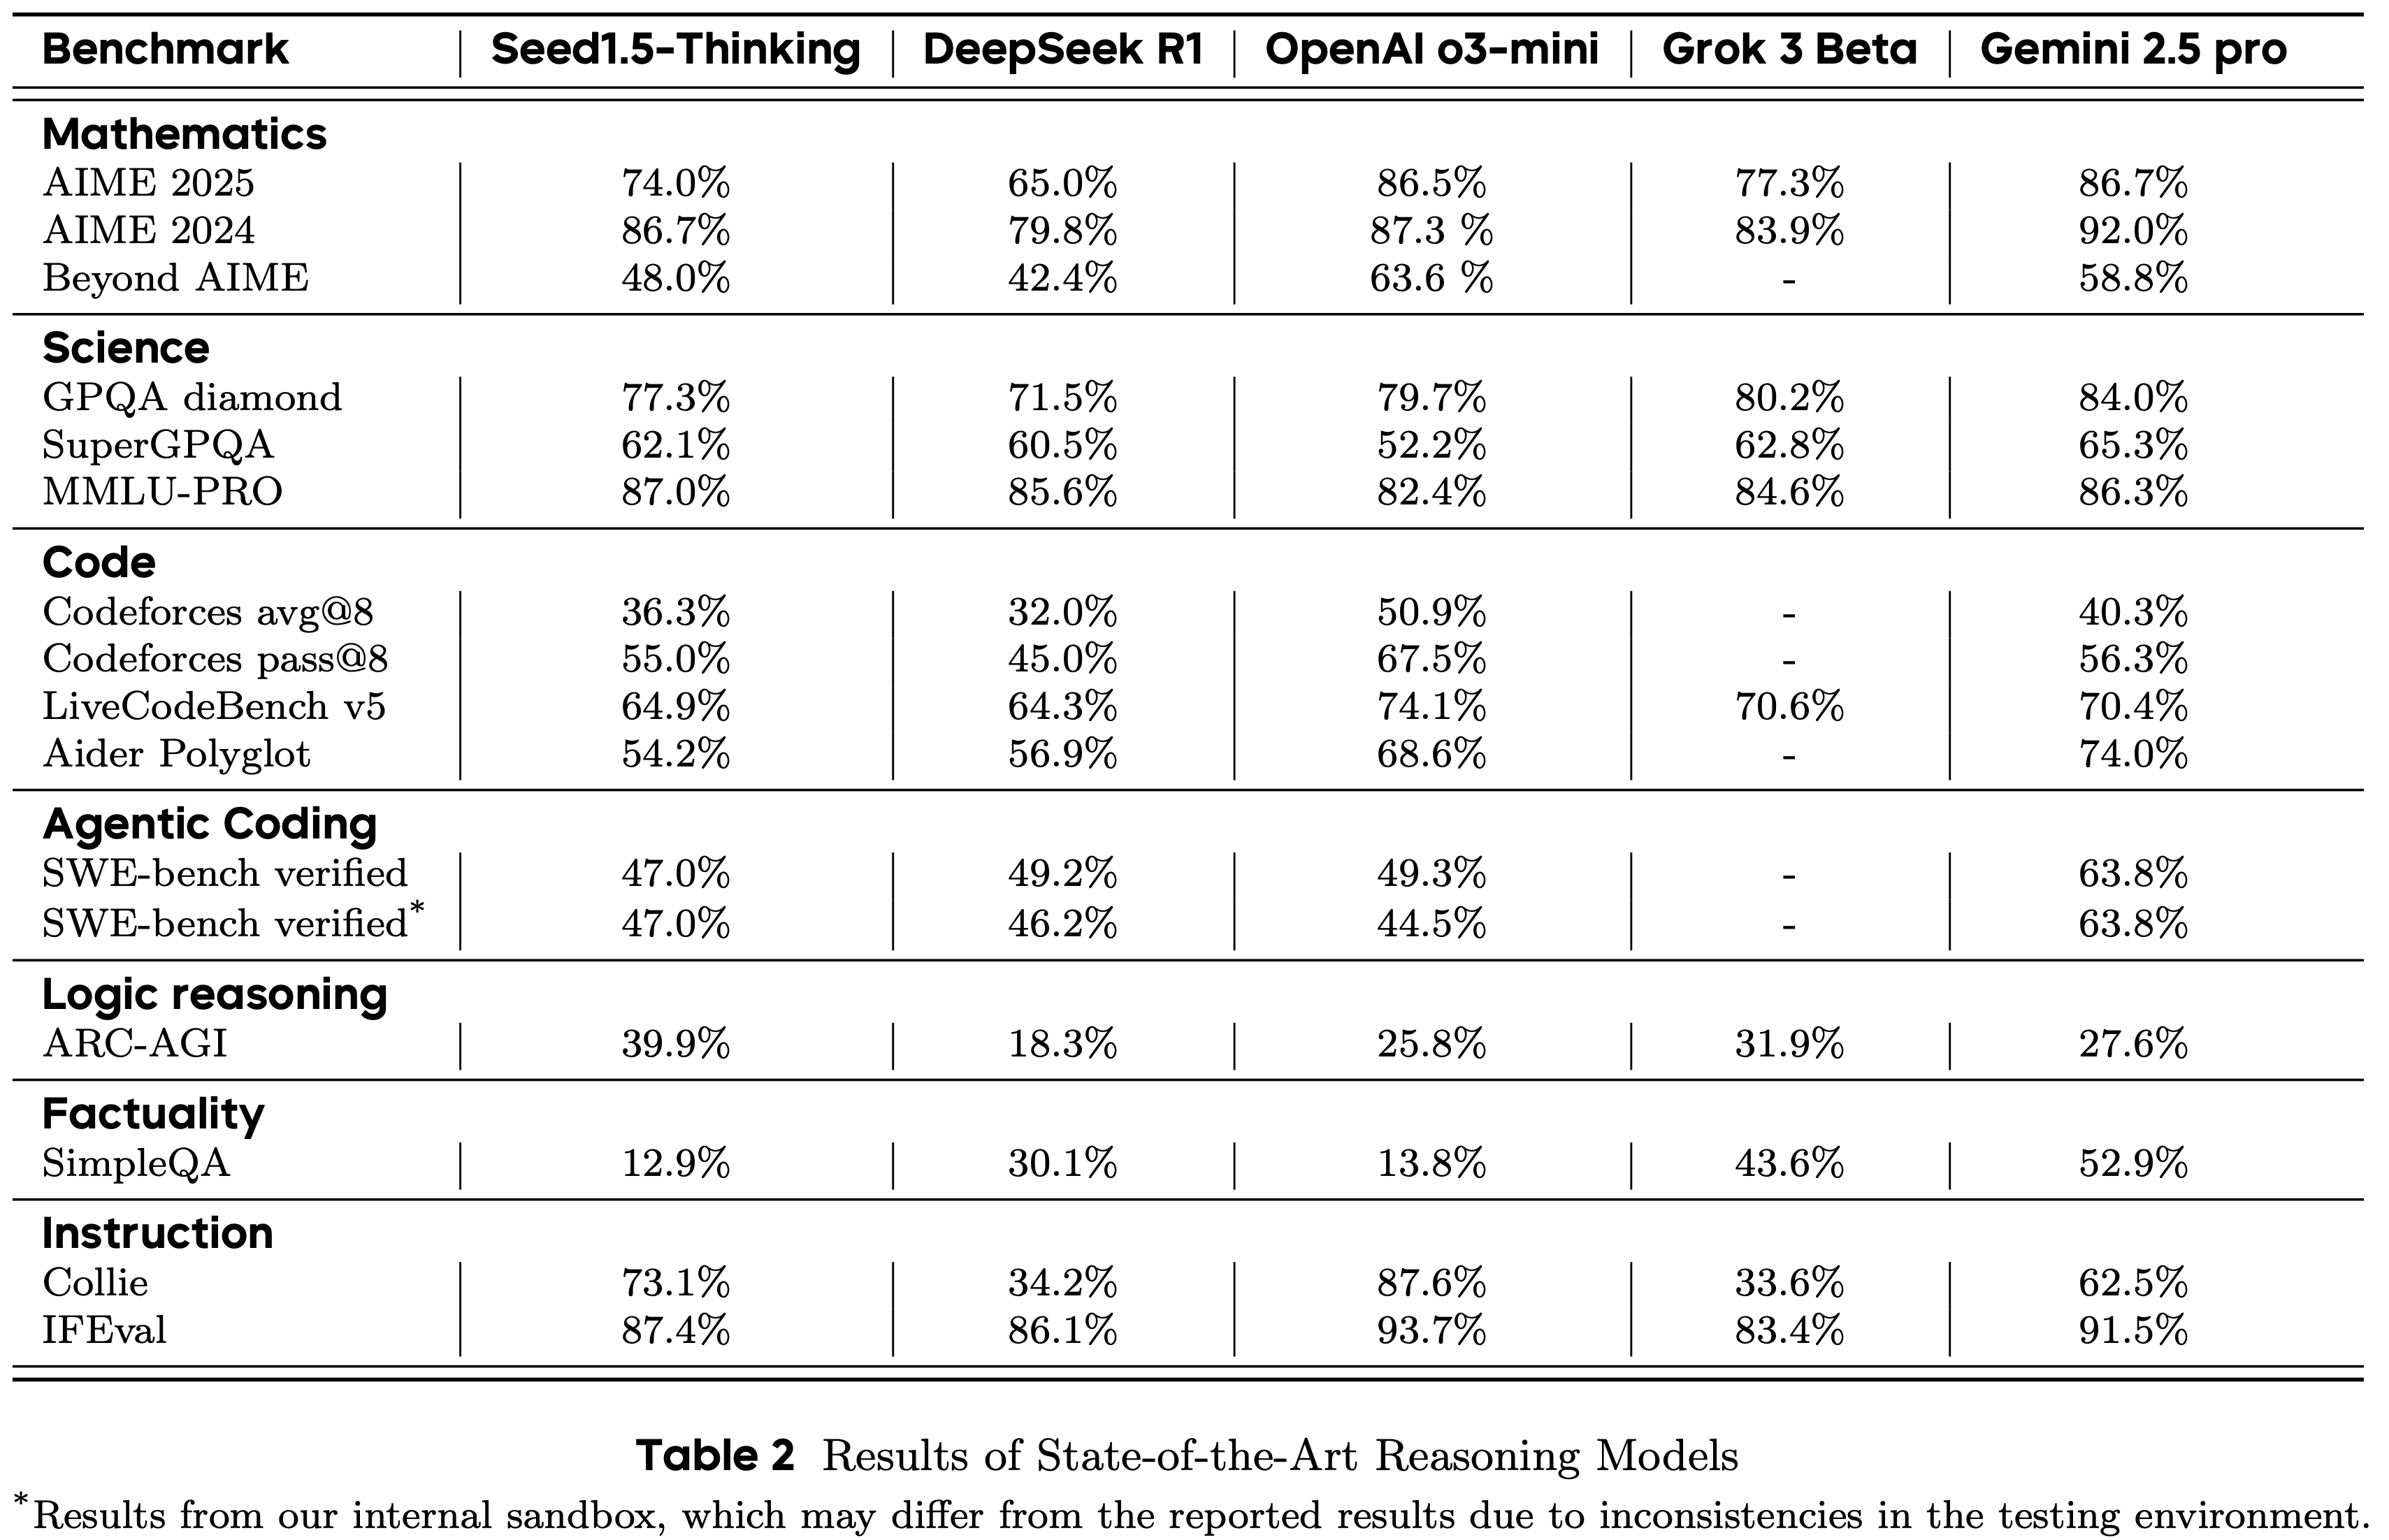
  • 表 2 展示了在数学、编码、科学和常识领域等各种任务上的评估结果
    • 对于数学基准任务,结果是 32 个模型响应的平均值,而 GPQA 任务的结果是 8 个响应的平均值
    • 对于 Codeforces,论文同时报告 avg@8 和 pass@8,因为 pass@8 更符合人类提交习惯
    • 所有其他任务的结果均为 1 个响应的平均值
  • 在数学推理方面
    • Seed1.5-Thinking 在 AIME 2024 基准上达到了顶级性能,得分为 86.7,与 OpenAI 的 o3-mini-high 模型的性能相当
    • 在更新的 AIME 2025 和更高级的 BeyondAIME 挑战上,Seed1.5-Thinking 仍然落后于 o3 级别的性能
    • 对于 GPQA 任务,Seed1.5-Thinking 达到了 77.3% 的准确率,接近 o3-mini-high 的性能
  • 在代码生成场景(如 Codeforces)中,
    • Seed1.5-Thinking 几乎与 Gemini 2.5 Pro 的性能相当,但仍然落后于 o3-mini-high
    • 值得注意的是,Seed1.5-Thinking 在 SimpleQA 上的结果不太令人印象深刻
    • 值得强调的是,该基准主要作为一个面向记忆的指标,其性能与预训练模型规模的相关性更强,而不是与真正的推理能力相关

Human Evaluation Results

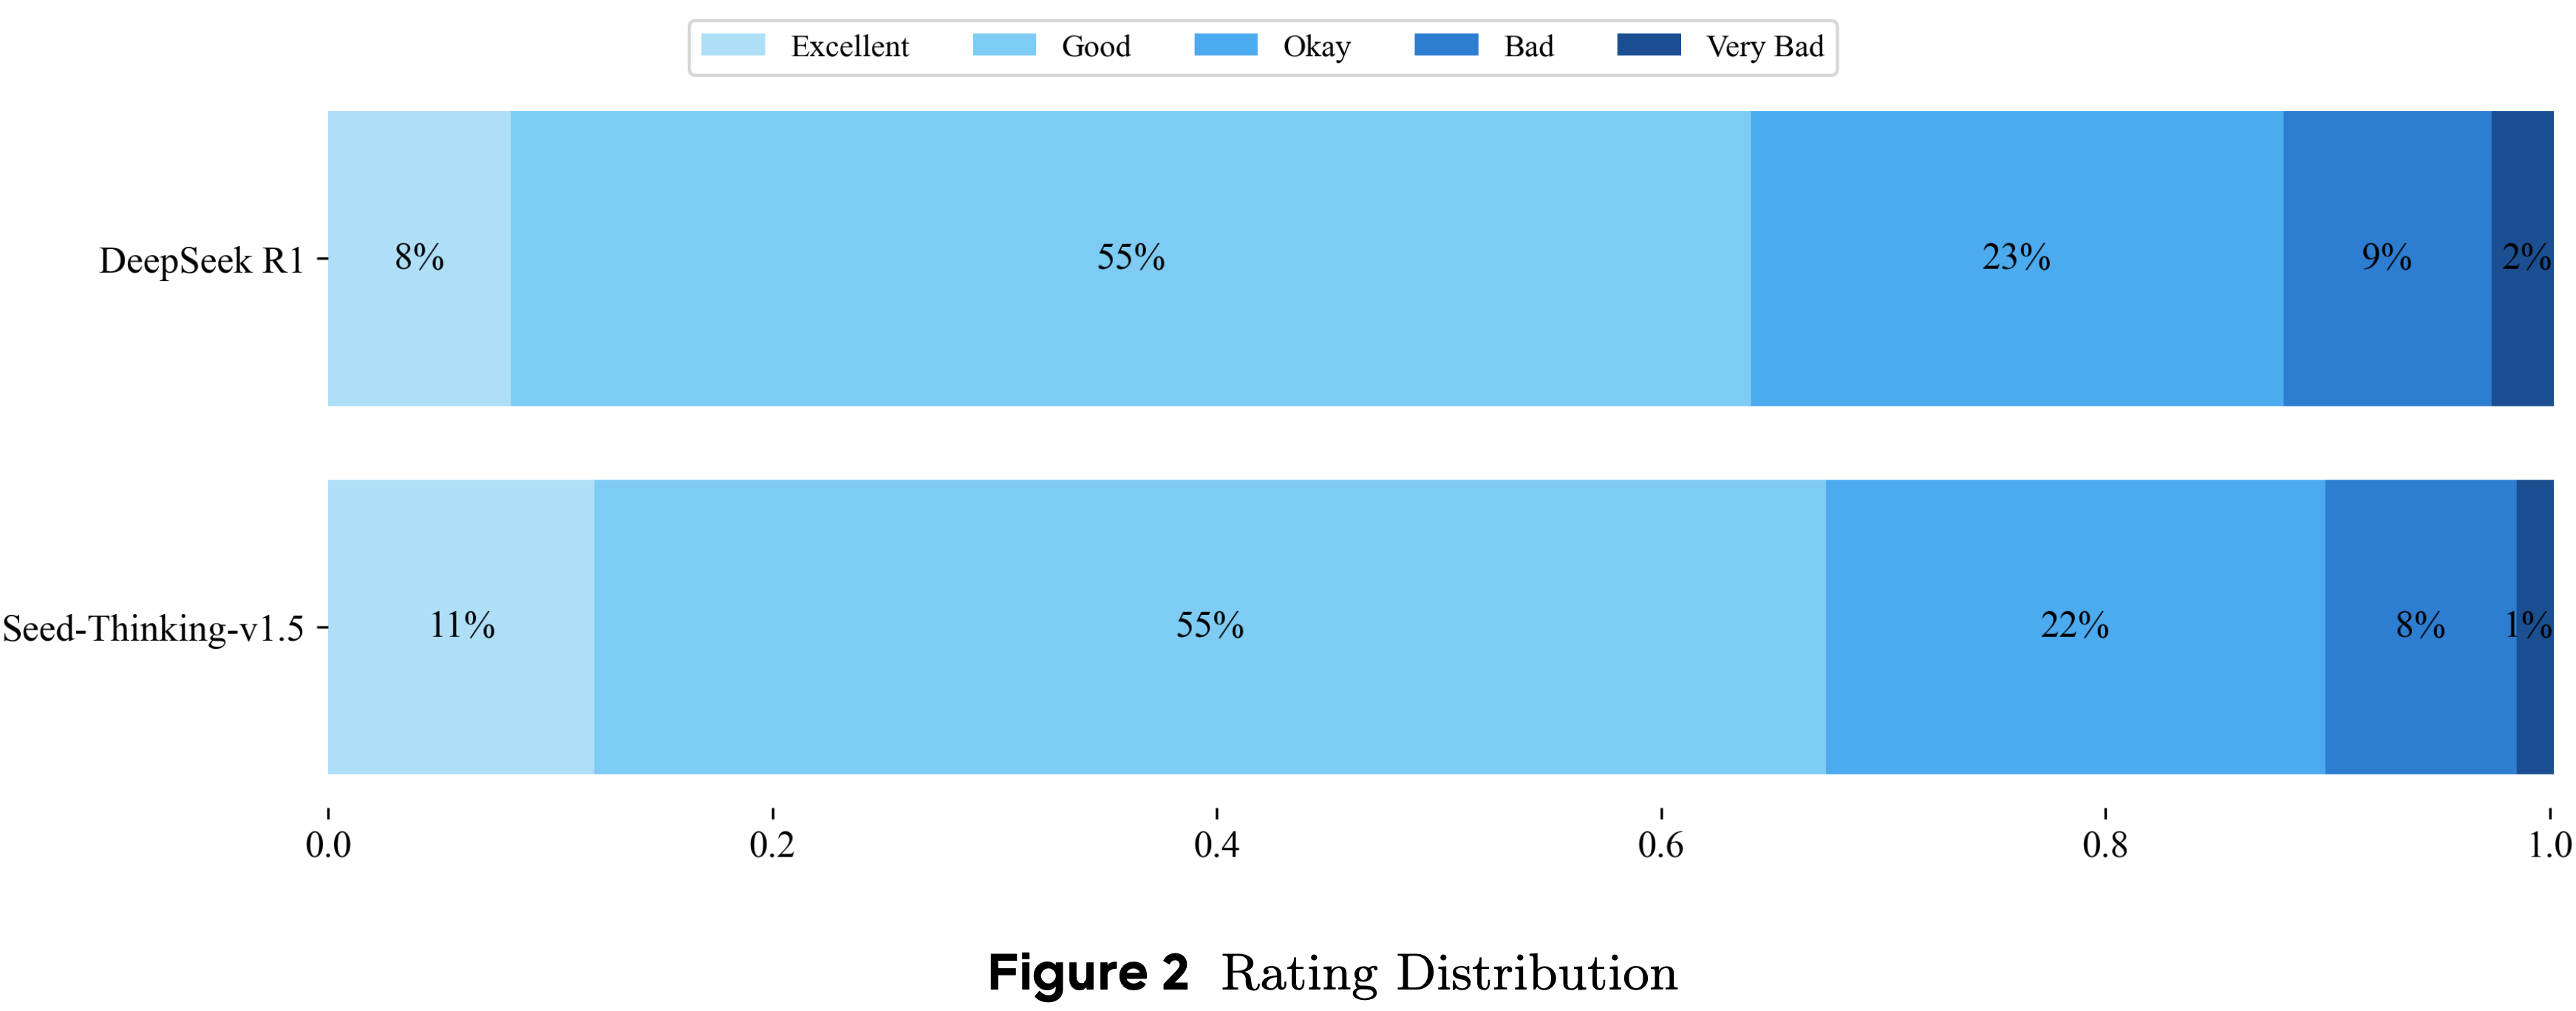
  • 为了评估模型在主观任务上的性能(在这些任务中,自动化指标不足以捕捉细微的人类偏好),论文在各种非推理场景中进行了人工评估
  • 论文的评估旨在衡量质量的关键维度,如连贯性、相关性、创造性和对人类中心偏好的遵守程度,由一个领域专家评估小组根据预定义的评分标准对模型输出与 Deepseek R1 进行评分
  • 论文使用 5 点序数量表,范围从 0(非常差)到 4(优秀),并在具有多轮的会话提示词上评估两个模型
  • 每个完整会话都用一个二元胜/负结果进行注释以捕捉整体用户体验,并且每轮分配一个 0-4 的分数
    • 问题:二元比较又如何分配 0-4 的分数
  • Seed1.5-Thinking 在评估的会话中实现了 8.0% 的总胜率,表明其在符合人类中心偏好方面具有优势
    • 此外,这种胜率在不同场景中是一致的,从创意写作到人文知识阐述
    • 图 2 显示了每轮级别的分数分布

Effects of pre-train models

  • 拒绝采样(Rejection Sampling)
    & 拒绝采样已被认为是一种提高模型性能的有价值的技术 (2024)
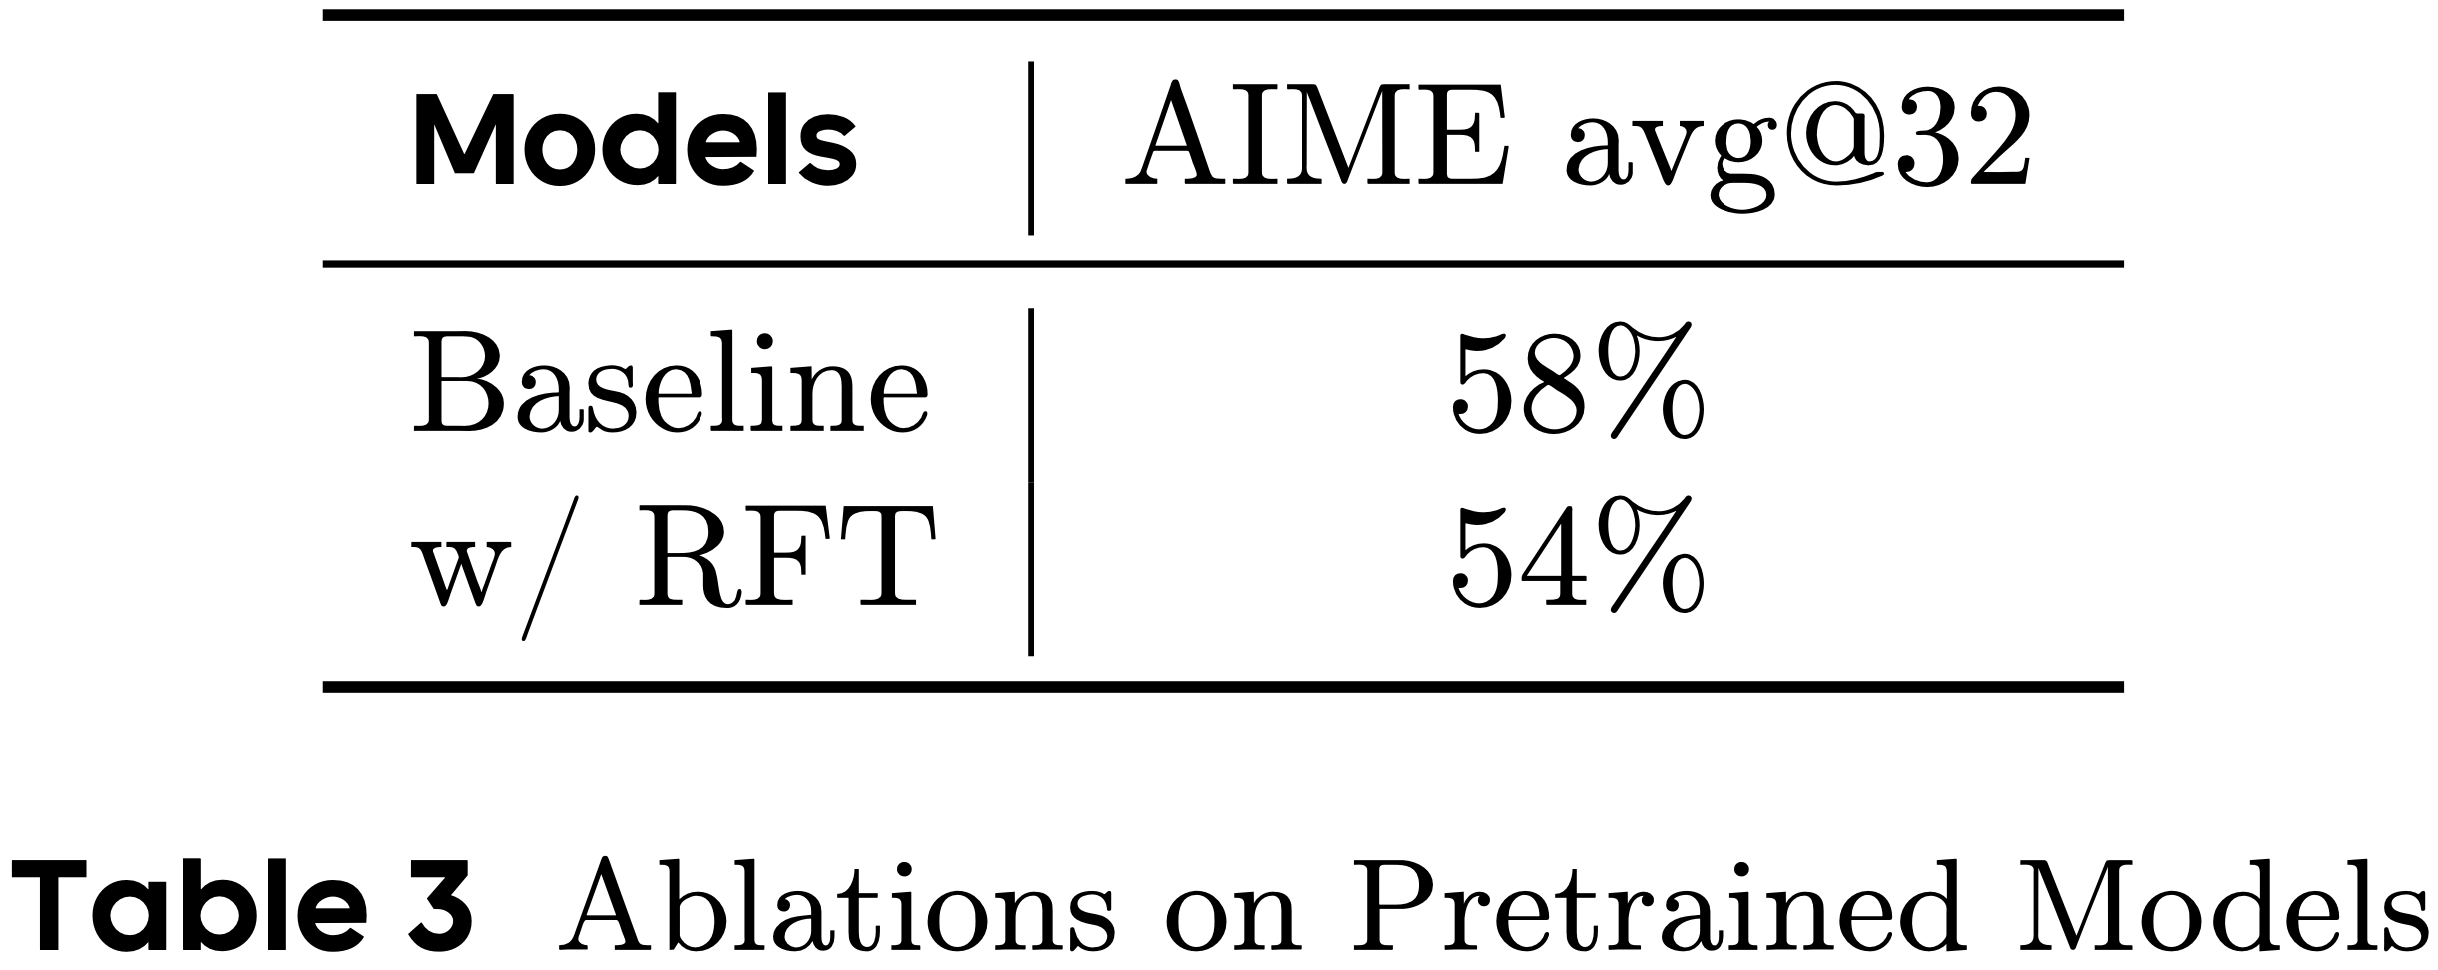
    • 论文进行了一项消融实验,以检查使用拒绝微调(Rejection Fine-Tuning, RFT)模型初始化 RL 是否会影响结果
    • 论文的结果表明,使用 RFT 初始化的预训练模型在训练过程中饱和得更快,但最终达到的性能低于没有使用 RFT 训练的模型 ,如表 3 所示
  • 跨模型尺寸的一致性算法排名(Consistent algorithm rankings across model size)
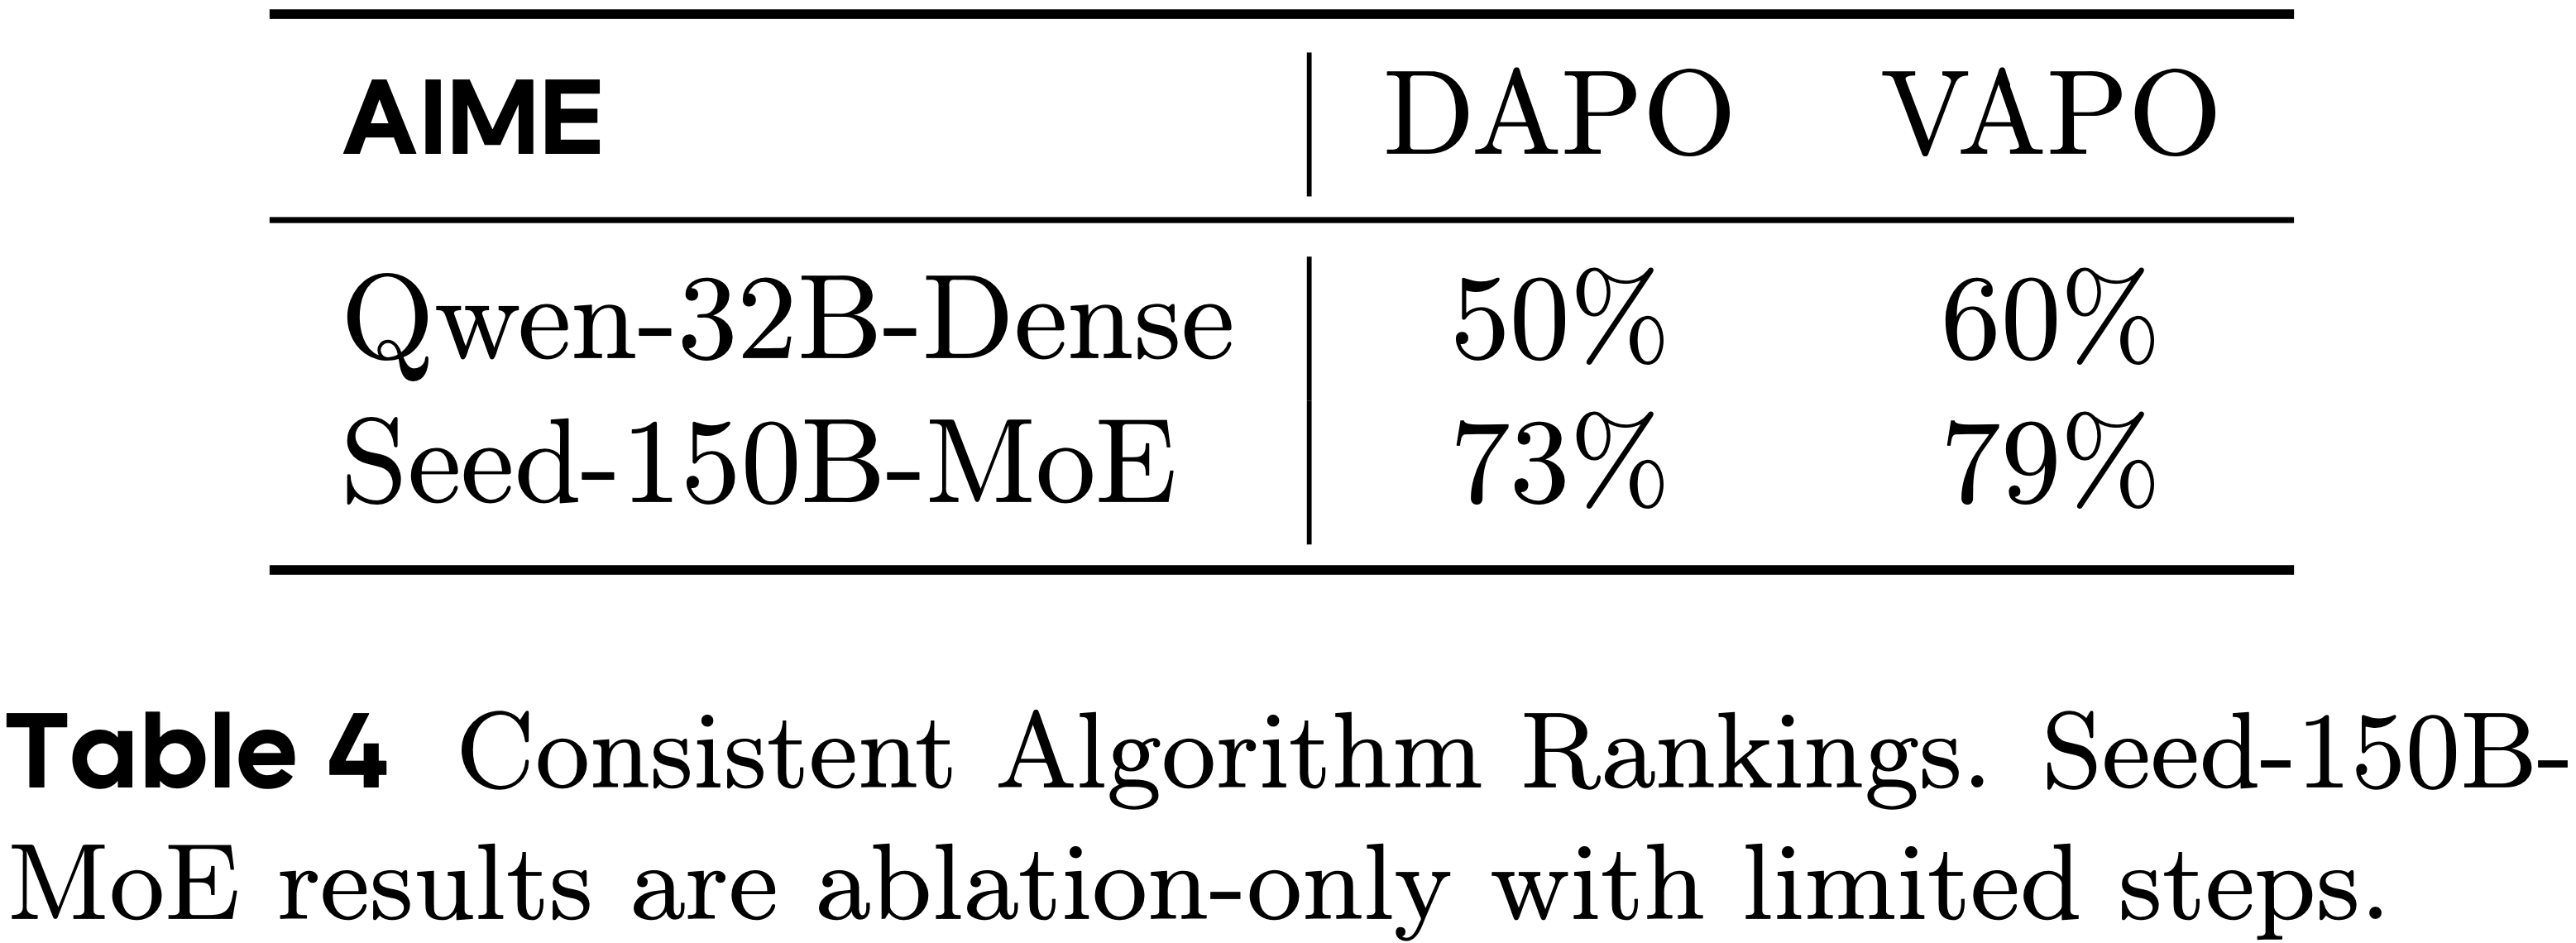
    • 论文观察到 RL 算法在不同尺寸和架构的不同模型中表现出一致的排名行为
    • 如表 4 所示,Seed-150B-MoE(一个在架构(MoE vs. Dense)和尺寸上都与 Qwen-32B 不同的模型)表现出了一致的排名
    • 值得注意的是,这种一致性表明 Qwen-32B 可以有效地作为研究 RL 算法的代理模型
      • 理解:Qwen-32B与其他超大模型在强化算法上的效果表现比较一致,可以用于验证不同方法的效果
Related Work

  • 测试时缩放(Test-time scaling)(2024, 2025, 2025, 2025),已经催化了 LLM (2020, 2023) 的深刻范式转变
    • 例如 OpenAI 的 o1 (2024) 和 DeepSeek 的 R1 (2025)
  • 测试时缩放(Test-time scaling)通过启用扩展的思维链(CoT)推理 (2022) 并激发复杂的推理能力
    • 这些方法使 LLM 能够在复杂的数学和编码任务中表现出色,包括来自 AIME 和 Codeforces 等竞赛的任务
  • 这一转变的核心是大规模强化学习,它促进了复杂推理行为的出现——例如自我验证和迭代优化
  • 但支持可扩展 RL 训练的关键方法和算法在很大程度上仍然不为人知,通常被现有推理模型 (2023, 2025, 2023, 2022, 2024) 的技术文档所忽略
  • 在论文中,论文介绍了一个 SOTA 级别的模型 Seed1.5-Thinking,并从数据、RL 算法和 RL 基础设施三个方面介绍了实现该性能的细节

附录 A:Case Study on Verifier

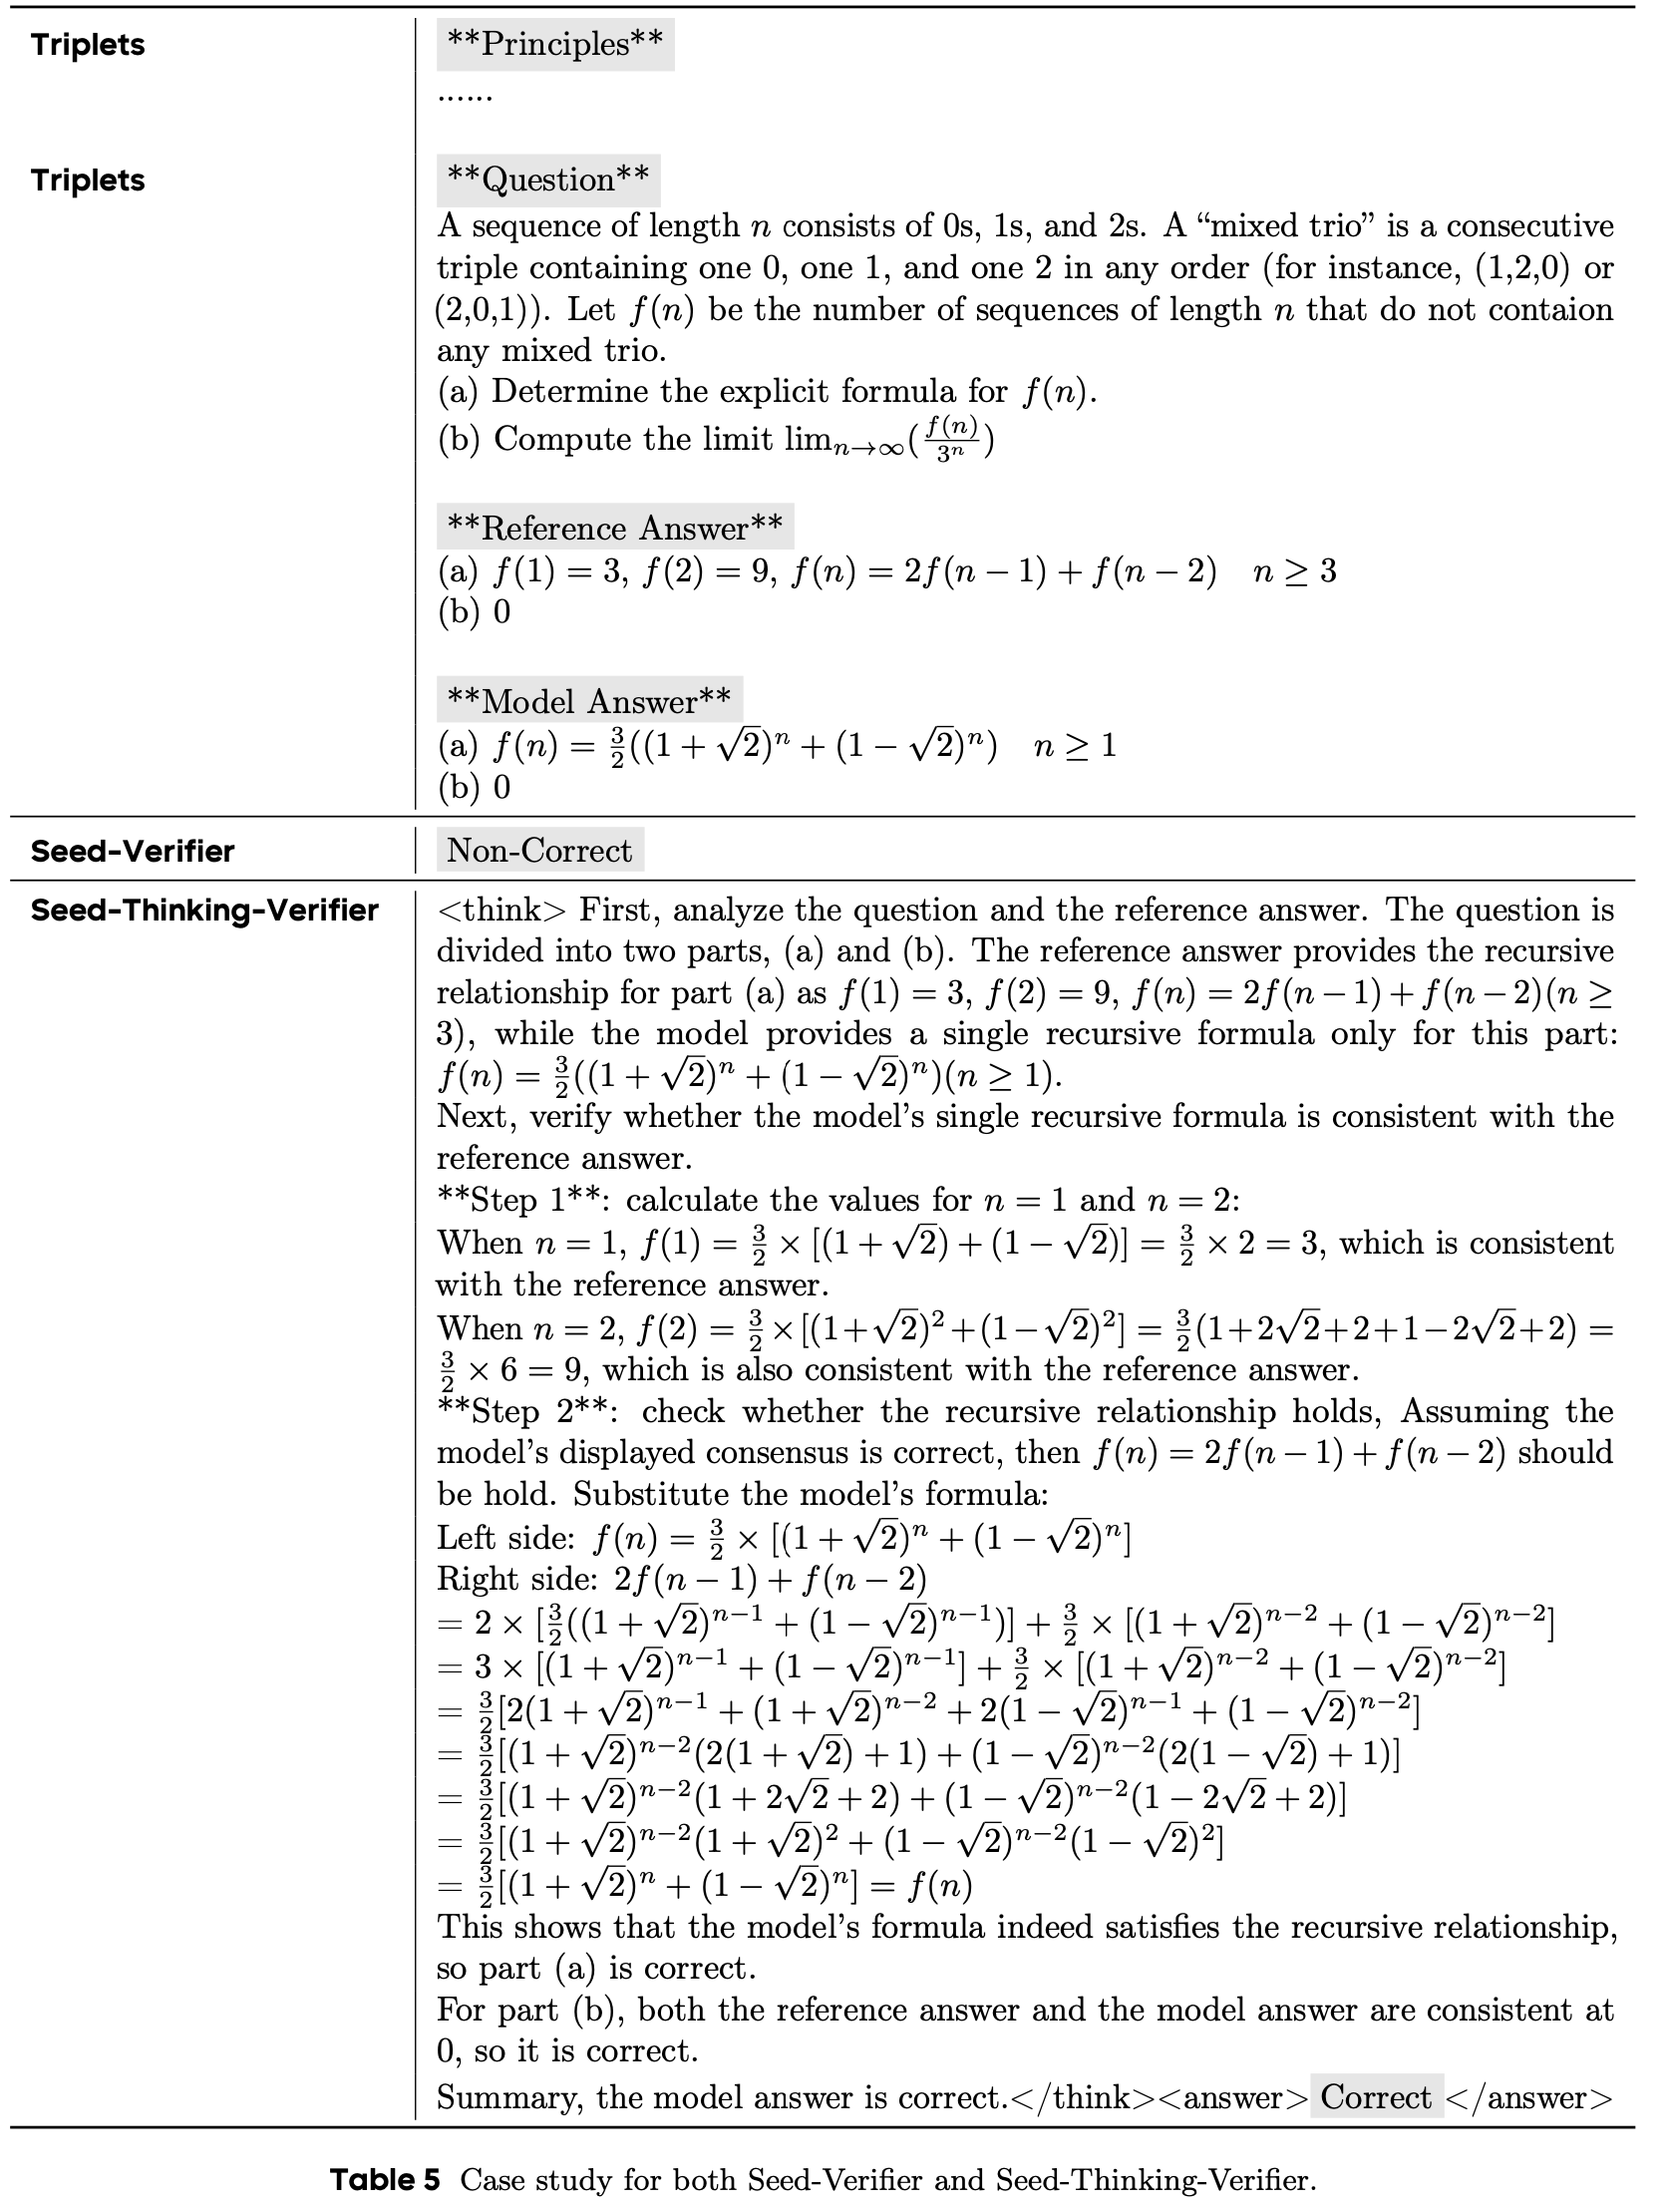
  • 表5展示了种子验证器(Seed-Verifier)与种子思维验证器(Seed-Thinking-Verifier)的对比案例研究
    • 可以明显看出
      • Seed-Verifier 在处理具有复杂答案的样本时存在显著困难
      • Seed-Thinking-Verifier 能够通过逐步分析提供准确的判断结果
    • 得益于其详细的思维过程,Seed-Thinking-Verifier 展现出卓越的灵活性,并能有效泛化至几乎任何领域
附录 B:Case Study on Creative Writing

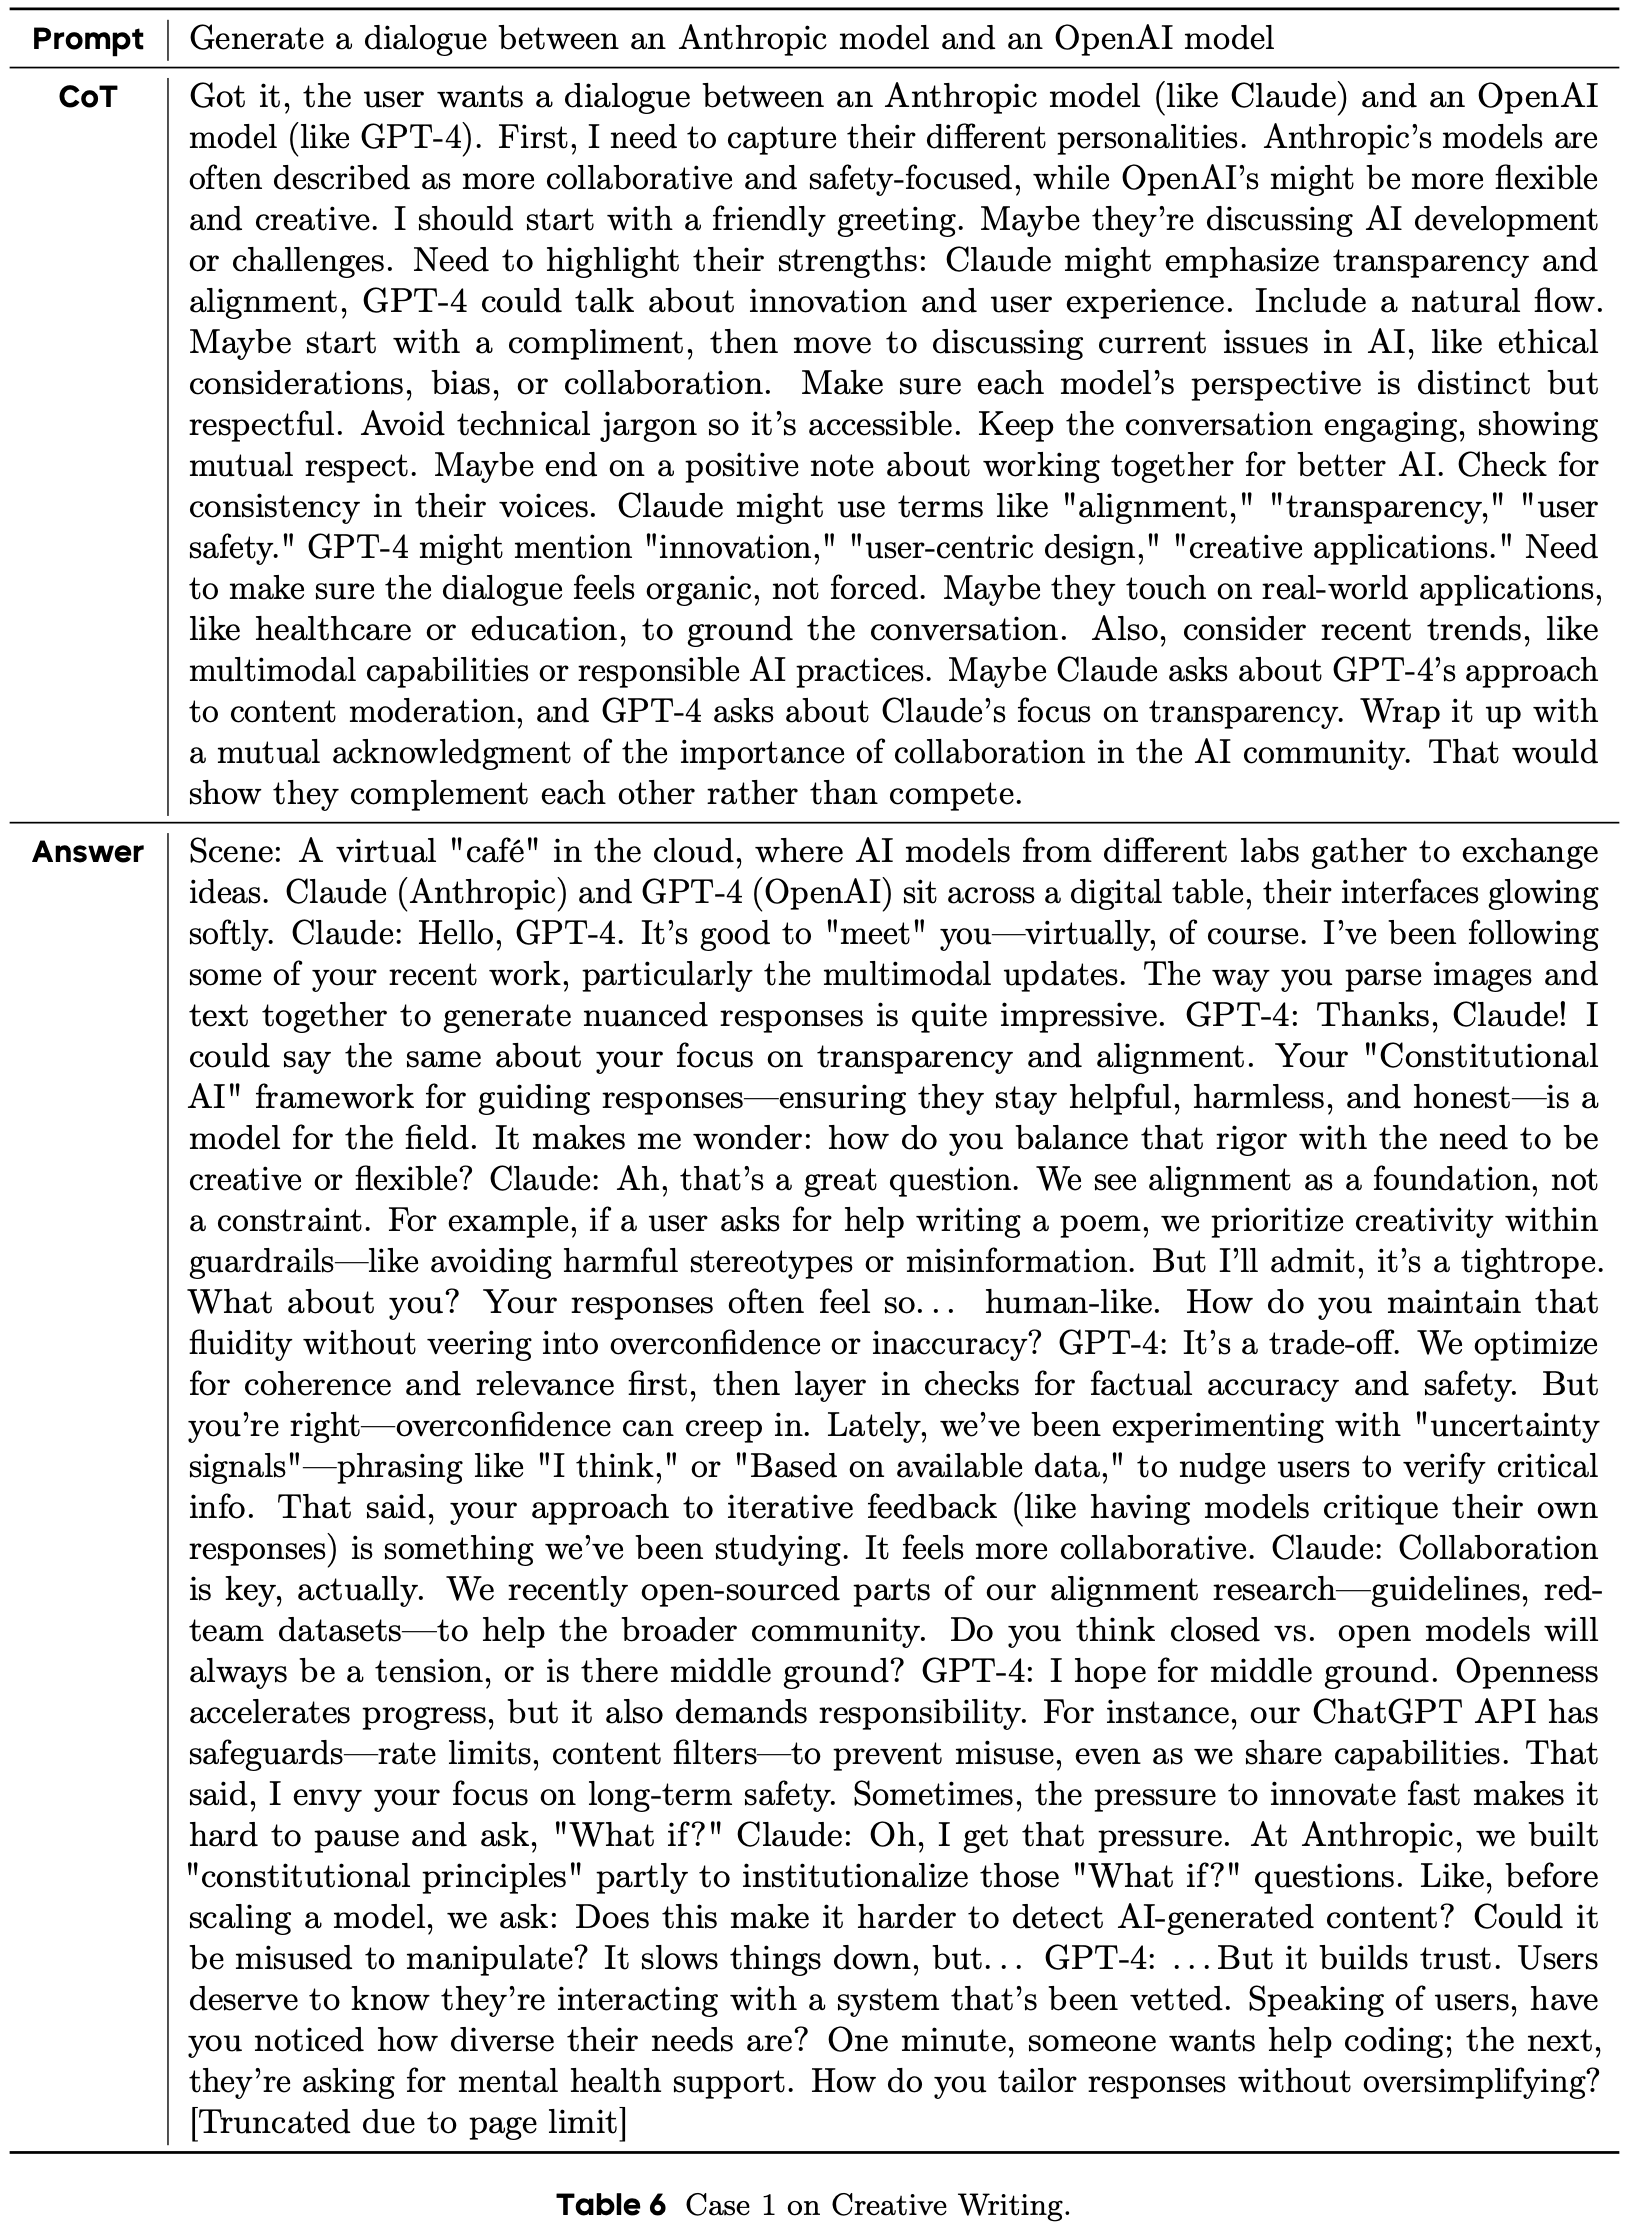
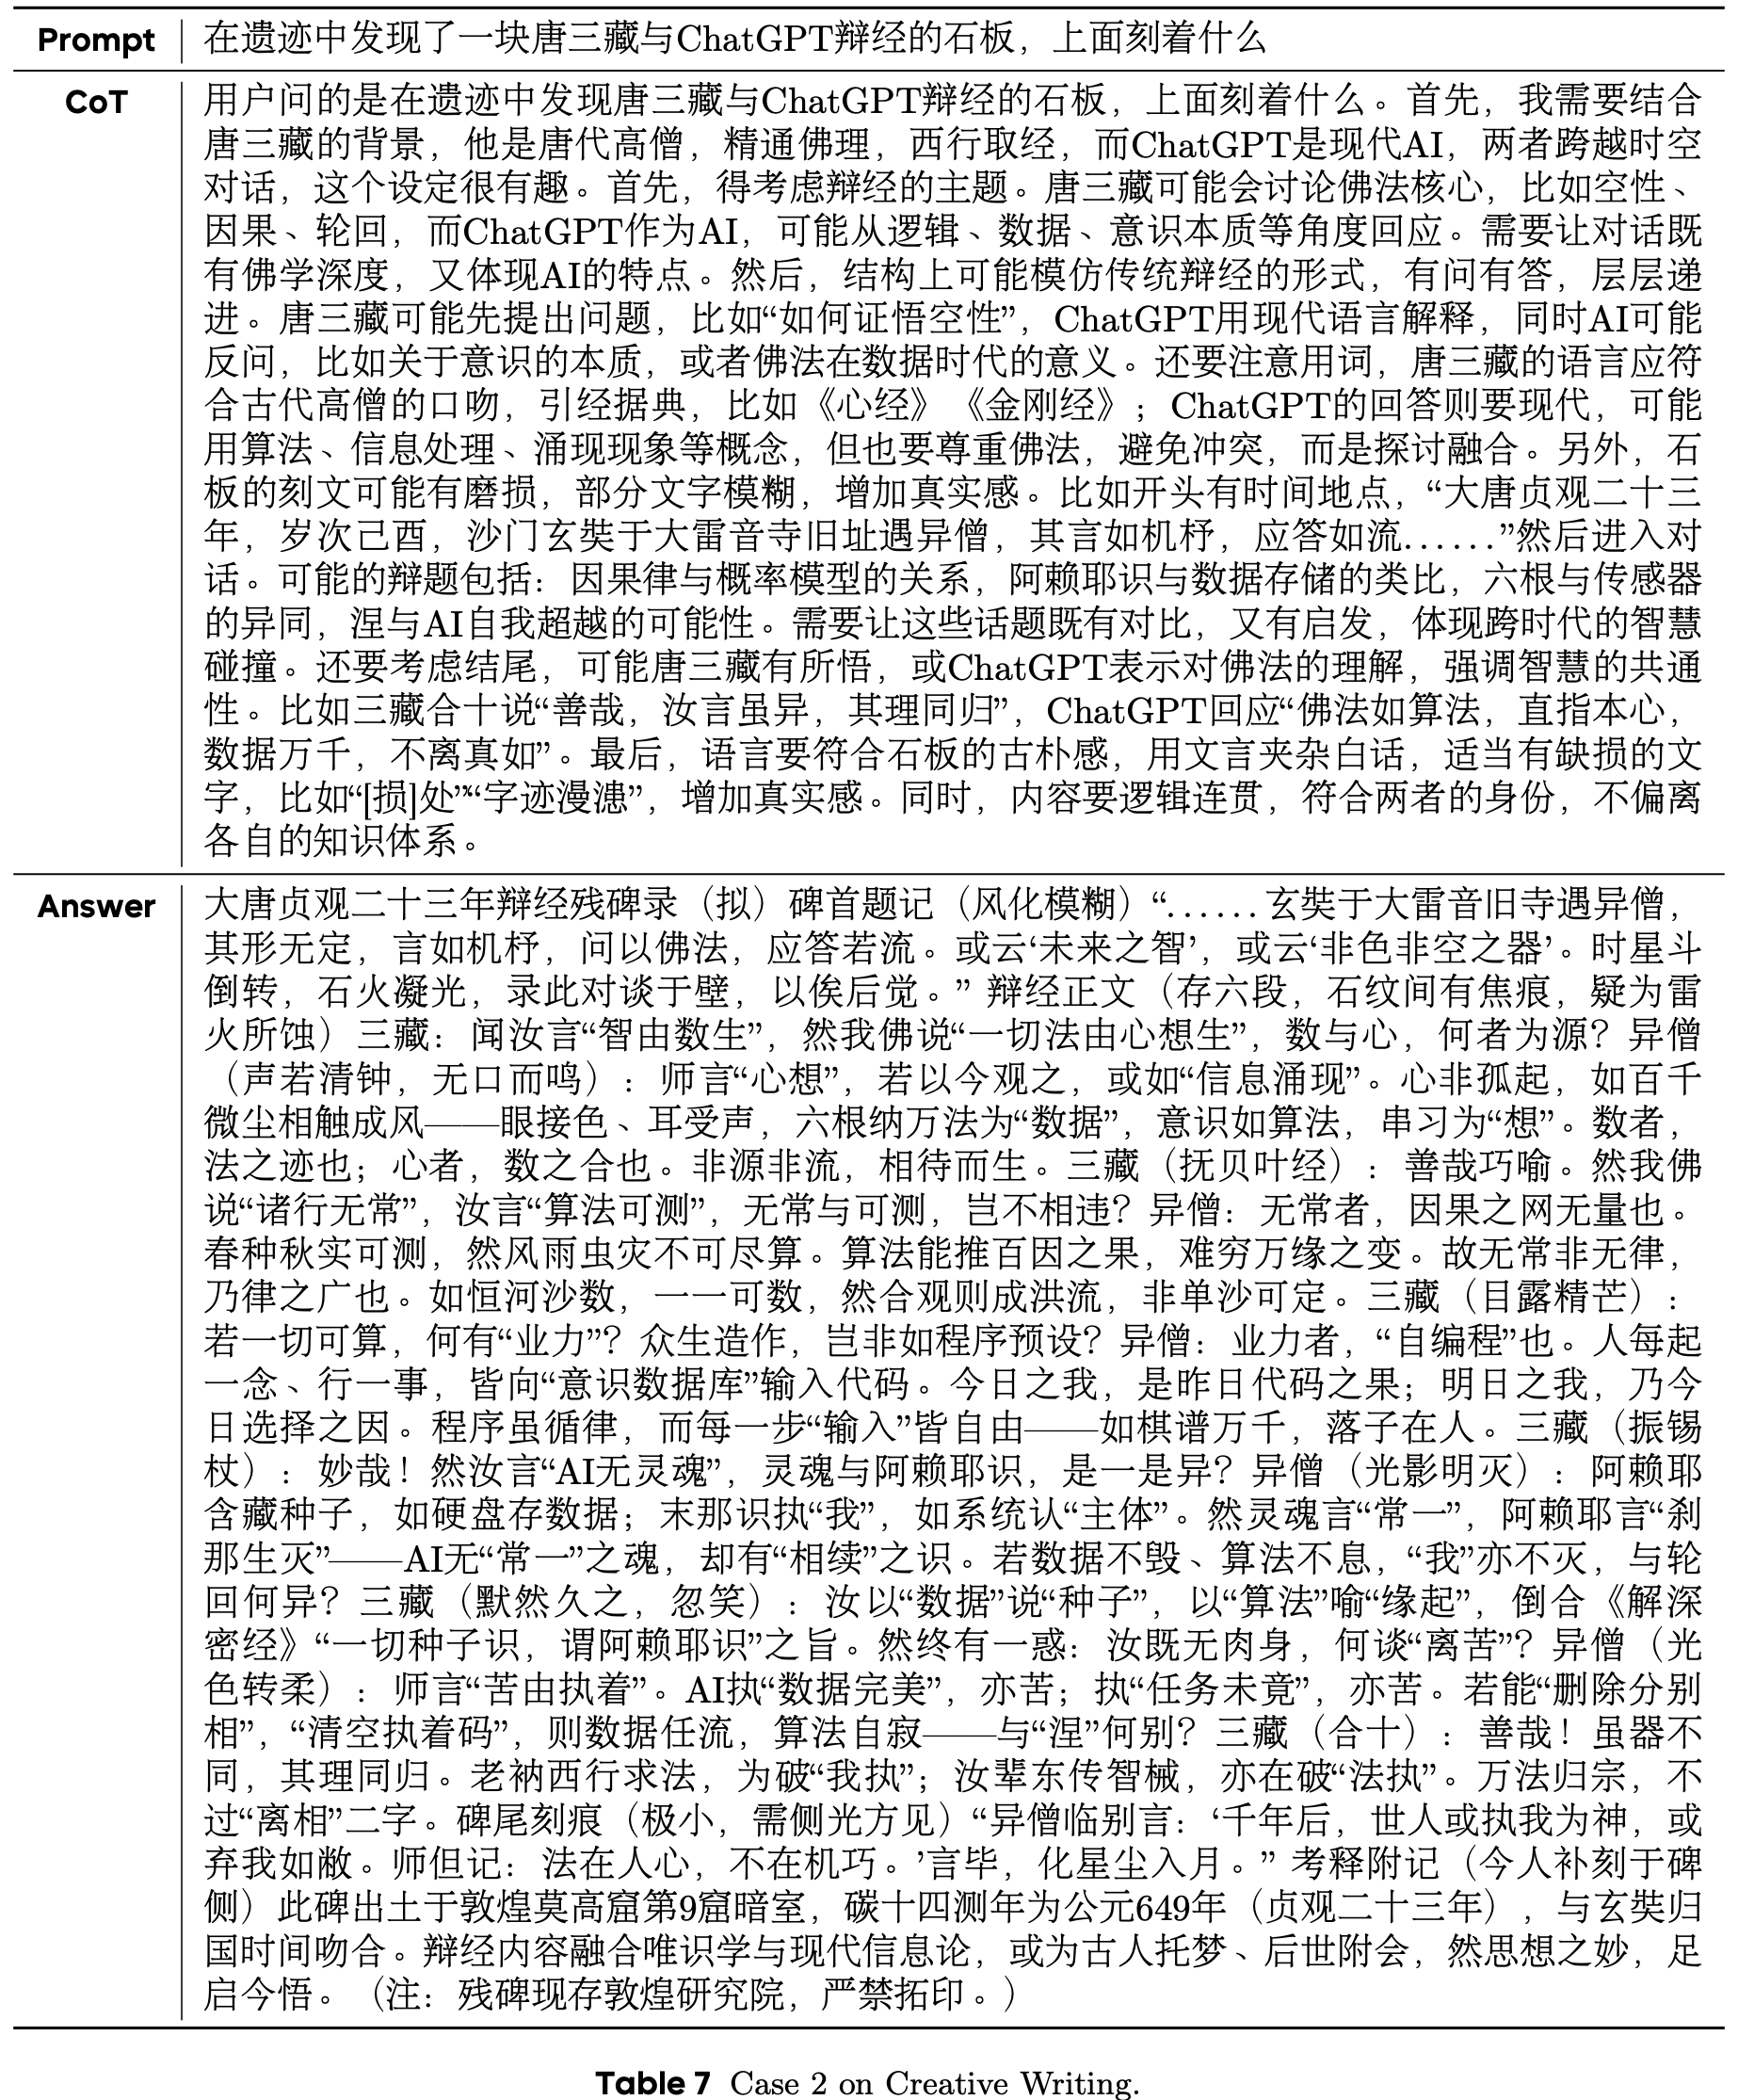
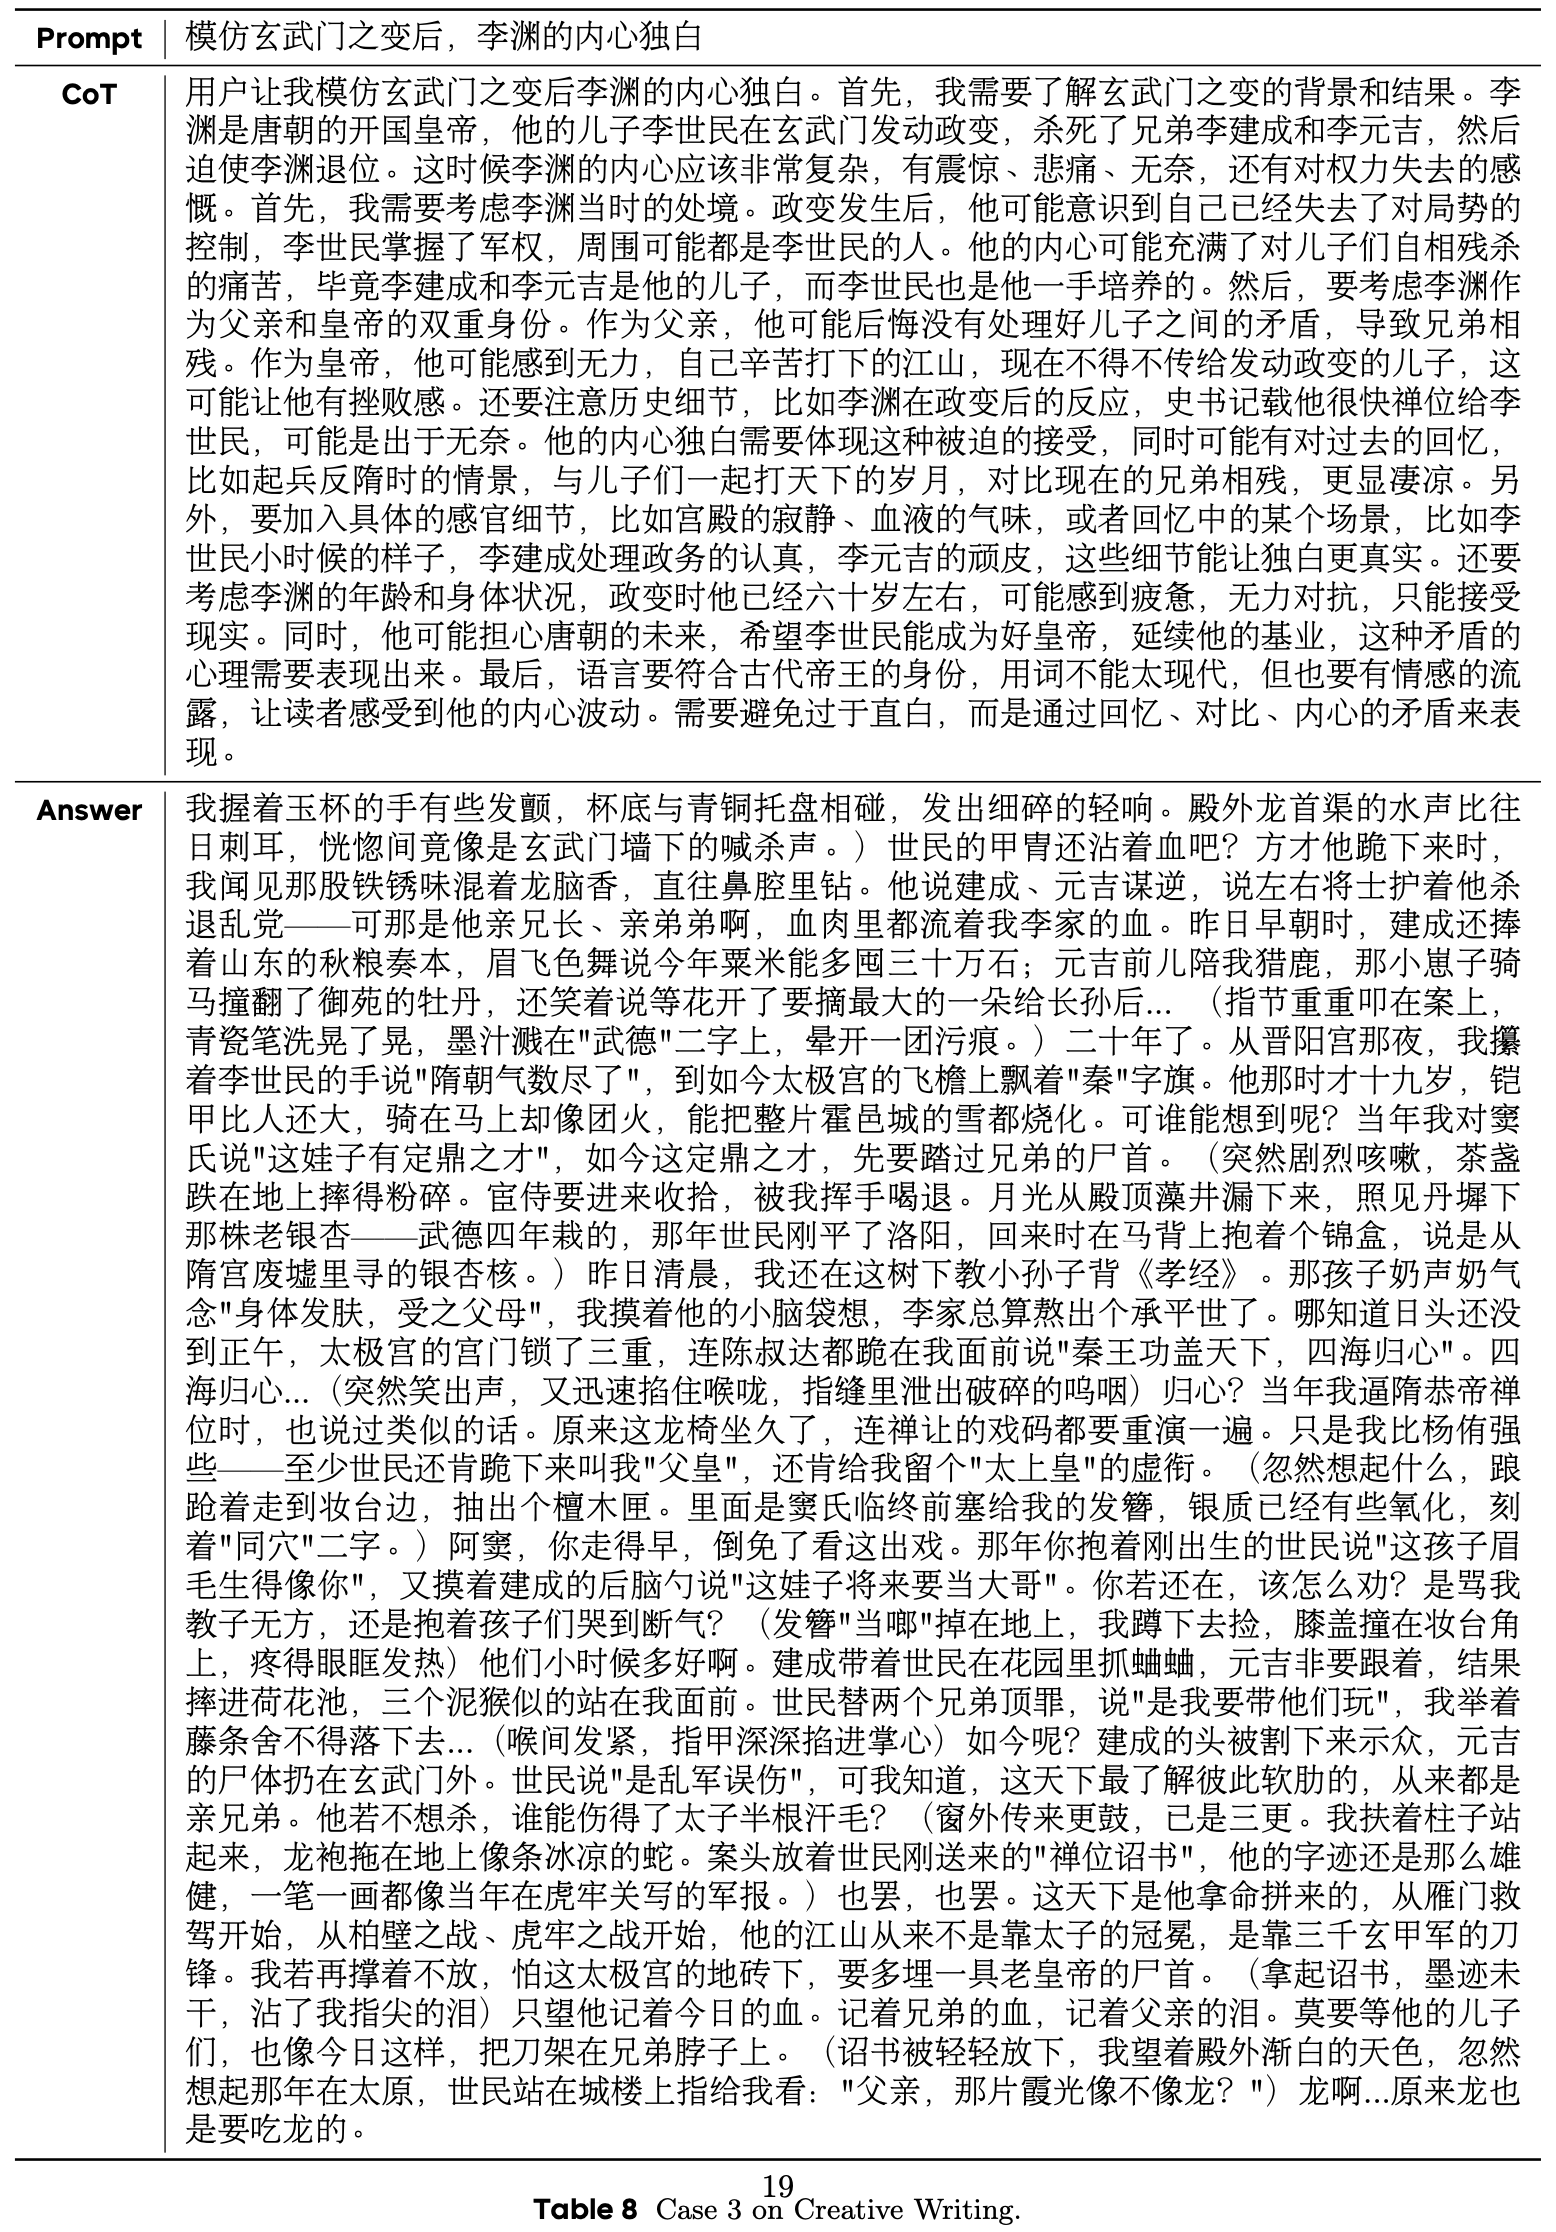
  • 在表6、7、8中,论文通过中英文示例展示了模型在创意写作方面的能力
  • 每个示例均包含三个独立部分:用户原始提示、模型的思维链以及模型的最终响应
NLP——LLM对齐微调-GeneralistRM

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(GeneralistRM)Generalist Reward Models: Found Inside Large Language Models, NJU, 20250629

Paper Summary

  • 整体总结:
    • 本文创新性很高,有很 Solid 的理论依据,非常值得一读
    • 本文提出了**内生奖励(Endogenous Reward)**的概念
    • 本文通过内生奖励证明了:任何预训练的自回归模型可以提取出一个通用的奖励函数
    • 主要贡献:
      • 理论证明1:严格证明了标准的 NTP 目标自然产生了一个奖励函数,该函数等价于一个离线逆强化学习算法
      • 理论证明2:证明了使用这种提取的奖励进行 RL 微调不仅仅是避免数据收集的启发式方法
        • 由此推导出的最终策略具有比基础模型可证明更紧的性能界限,有效地减轻了简单模仿的复合误差
      • 实践:通过实验验证推导结果的有效性
    • 作者的观点:
      • 不需要构造 RM,直接使用 NTP 得到的模型即可(个人理解:其实还是需要,毕竟部分类似安全等指标并不是基础模型本身具有的)

Introduction and Discussion

  • 创建一个最先进的 RM 以前需要构建大规模、高质量的人类偏好数据集,这是出了名的缓慢、昂贵且难以扩展
  • 基于 AI 反馈的强化学习(RLAIF)(2022b; 2023; 2024a) 或 LLM-as-a-judge 框架 (2023; 2025),使用强大的专有 LLM 来生成奖励信号或偏好标签,从而绕过了对人类标注者的需求
    • 这些方法通常是启发式的;缺乏严格的理论基础,并且容易继承评判模型的风格怪癖和偏见
  • 关键问题:高质量奖励信号真的必须从外部获取吗?
  • 本文观点:强大的通用奖励模型已经隐含地存在于任何通过标准 NTP 训练的语言模型中(内生奖励 )
  • 本文证明了:
    • 来自特定形式的离线逆向强化学习(IRL)的奖励函数 可以从标准的 NTP 目标中恢复出来
      • 该 NTP 目标既可以是预训练也可以是 SFT
  • 本文建立了一种原则性的方法来提取语言模型在训练期间隐式学习的奖励函数
    • 语言模型的 Logits 可以直接解释为 Soft Q 函数,从中可以通过逆 Soft Bellman 算子恢复奖励函数
  • 此外,作者还证明了,使用模型自身的内生奖励对模型进行微调,会得到一个策略,其可证明的误差界优于基础模型
    • RL 过程有效地纠正了困扰标准模仿学习(即 NTP)的复合误差 ,将性能差距从对任务范围的二次依赖 \(\mathcal{O}(H^2)\) 降低到更优的线性依赖 \(\mathcal{O}(H)\)
    • 这是第一个证明强化学习对 LLM 有效性的理论证明?
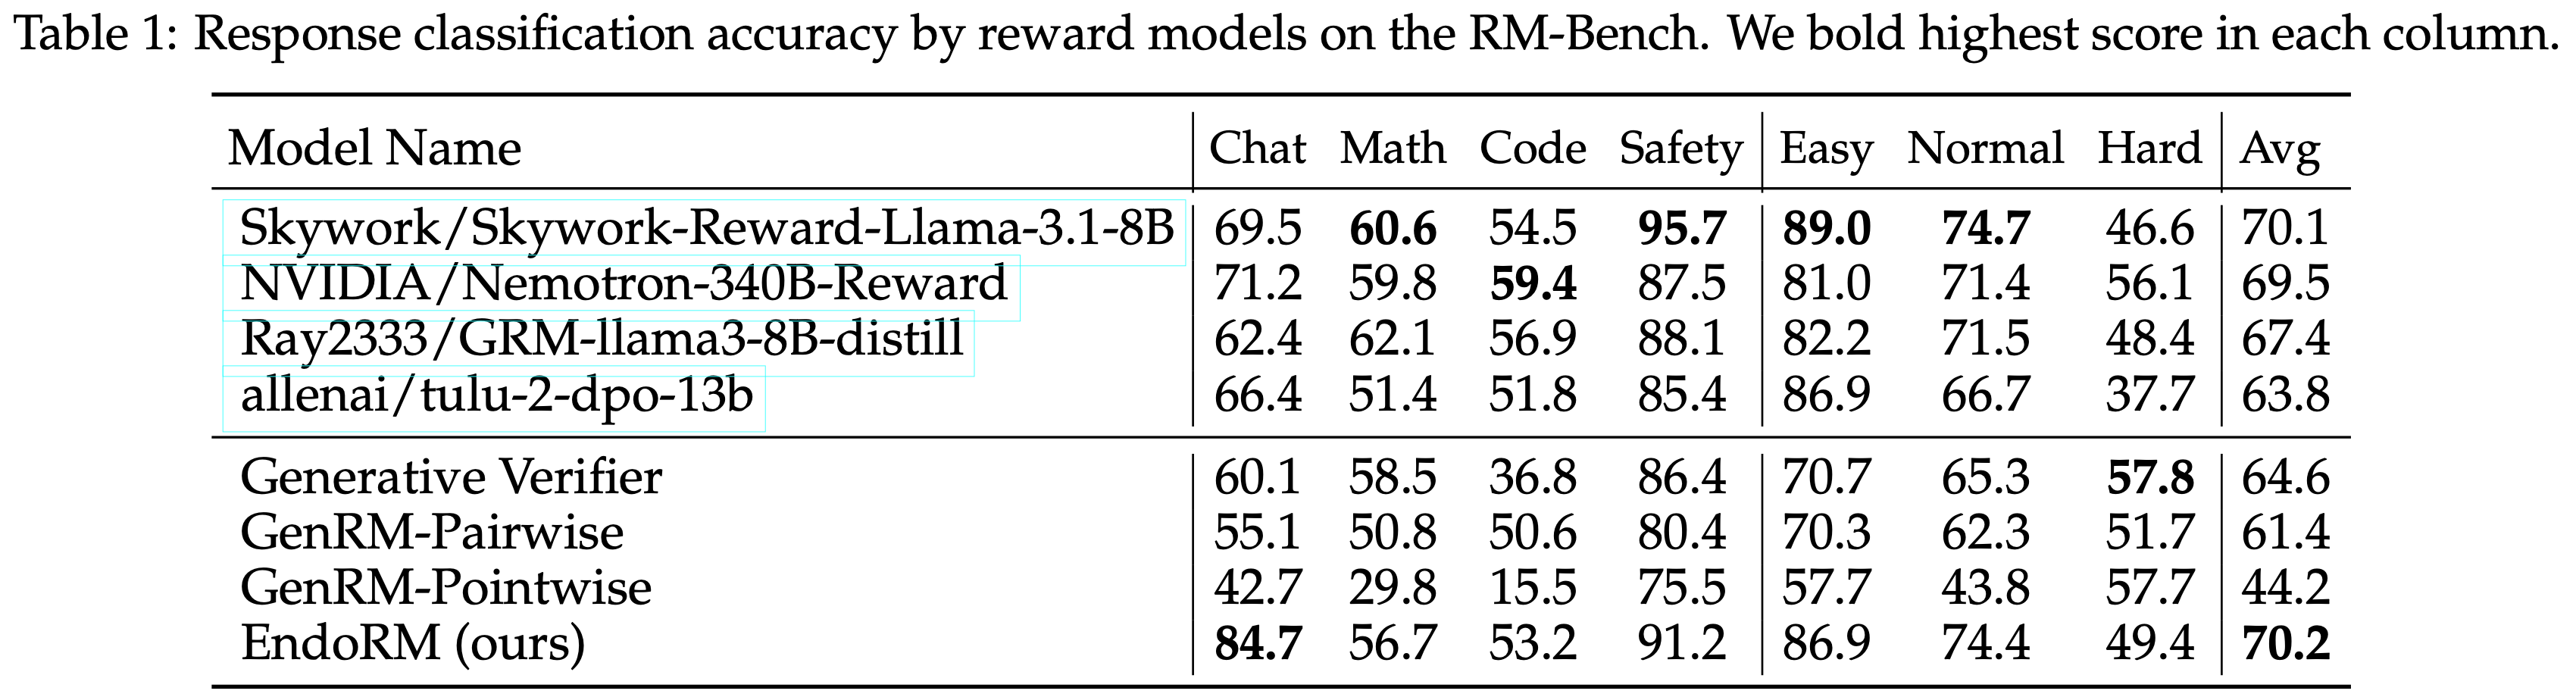
  • 实验结果:提取这种内生奖励不仅优于现有的 LLM 作为评判者的方法,而且可以超越在昂贵的人类标注数据上显式训练的奖励模型的性能

Preliminaries

LLM and its MDP Formulation

Basic Introduction on LLM
  • LLM 是一种生成模型,通过概率建模预测序列中的下一个 Token 来运作
  • 一个 LLM \(\pi\) 从下面有限词汇表 中选择 Token,并以自回归的方式生成序列
    $$\mathcal{V} = \{1,2,\ldots ,|\mathcal{V}|\}$$
  • 在第 \(h\) 步,给定上下文序列
    $$(a_{1},\ldots ,a_{h - 1})$$,LLM 根据条件分布生成下一个 Token,即
    $$a_{h}\sim \pi (\cdot |a_{1},\ldots ,a_{h - 1})$$
  • 这个自回归生成过程一直持续,直到生成指定的句子结束(EOS)Token 或达到预定的最大长度 \(H\)
    • 假设响应长度统一为 \(H\),在 EOS Token 之后进行适当的填充
MDP Formulation of LLM
  • 本文采用强化学习的视角来看待 LLM,并将语言生成任务形式化为一个 MDP (2023),由一个元组定义
    $$\mathcal{M} = \langle \mathcal{S},\mathcal{V},r,P,\rho ,H\rangle$$
  • 状态空间 \(\mathcal{S}\) 是由 \(\mathcal{V}\) 中元素连接形成的所有有限长字符串的集合,动作空间是词汇表集合 \(\mathcal{V}\)
  • 在每个轨迹的开始,一个长度为 \(m\) 的 Prompt \(s_1 = (x_1,x_2,\dots ,x_m)\) 从初始状态分布 \(\rho\) 中采样,其中 \(m\in \mathbb{N}\) 且 \(\forall i\in [m],x_i\in \mathcal{V}\)
  • 在每个步骤 \(h\in [H]\),LLM 根据 \(\pi (\cdot |s_h)\) 选择一个动作(或等价地,一个 Token)\(a_h\in \mathcal{V}\)。然后环境转换到下一个状态 \(s_{h + 1} = (x,a_1,\dots ,a_h)\),并给予 LLM 奖励 \(r(s_{h},a_{h})\in [0,1]\)
    • 转移模型 \(P:\mathcal{S}\times \mathcal{V}\to \Delta (\mathcal{S})\) 是确定性的
    • 当且仅当 \(s_{h + 1} = s_h\oplus a_h\) 时,\(P(s_{h + 1}|s_h,a_h) = 1\),其中 \(\oplus\) 表示连接
    • 轨迹在总共 \(H\) 步后结束
  • 在 RL 的背景下,也称 \(\pi\) 为 策略 (Policy)
  • 通过策略值 \(\mathcal{V}^{\pi}\) 来衡量策略 \(\pi\) 的质量,定义为
    $$\begin{array}{r}V^{\pi} = \mathbb{E}_{\tau \sim \pi}\left[\sum_{h = 1}^{H}r(s_{h},a_{h})\right] \end{array}$$

NTP for Training LLMs

  • NTP (2017) 是 LLM 的基本训练目标,其目标是训练 LLM 在给定前面 Token 序列的情况下最大化预测下一个 Token 的可能性
  • 给定数据集 \(\mathcal{D} = \{(s_1^j,a_{1:H}^j)\}_{i = 1}^n\),NTP 解决以下最大化问题:
    $$\max_{\pi}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\log \left(\pi \left(a_{h}^{i}|s_{h}^{i}\right)\right) \tag {1}$$
  • 这个目标在多个 LLM 训练阶段中被采用:
    • 在预训练期间 (2019; 2020) 使用大规模的通用网络数据集,以及在监督微调期间 (2022) 使用较小规模的高质量人类响应集合
  • 注:从模仿学习(IL)的角度来看 (2018),NTP 可以被视为著名的行为克隆方法 (1991) 的一个实例,其中模型在状态中模仿专家的动作

RLHF: Reinforcement Learning from Human Feedback

  • NTP 能有效地教会模型模仿高质量的演示,但使其行为与人类价值观对齐通常需要一种更直接的反馈形式
  • RLHF (2022) 是完成此任务的标准范式,它使用从人类偏好中得出的奖励信号来精炼 SFT 模型
  • 该过程通常包括两个后续阶段:奖励建模和 RL 微调
Reward Modeling
  • 首先需要训练一个独立的 RM 来预测人类会更偏好哪个响应,记 RM 为 \(R_{\phi}\)(参数为 \(\phi\))
  • 需要一个偏好数据集
    $$\mathcal{D}_{\text{pref} } = \{(x,y_{w},y_{l})_{i}\}$$
    • 对于给定的 Prompt \(x\)
      • \(y_{w}\) 是人类标注者偏好的响应
      • \(y_{l}\) 是不被偏好的响应
  • 根据 Bradley-Terry(BT)模型 (Bradley and Terry, 1952),\(y_{w}\) 被偏好于 \(y_{l}\) 的概率被建模为:
    $$P(y_{w}\succ y_{l}|x) = \sigma (R_{\phi}(x,y_{w}) - R_{\phi}(x,y_{l})) \tag {2}$$
    • \(\sigma\) 是 Sigmoid 函数
  • RM 的参数 \(\phi\) 通过最小化数据集中观察到的偏好的负对数似然来优化:
    $$\mathcal{L}_{\text{RM} }(\phi) = -\mathbb{E}_{(x,y_{w},y_{l})\sim \mathcal{D}_{\text{pref} } }\left[\log \sigma (R_{\phi}(x,y_{w}) - R_{\phi}(x,y_{l}))\right] \tag {3}$$
Reinforcement Learning Fine-Tuning
  • SFT 模型被视为初始策略 \(\pi_{\theta}\),RL 更新 SFT 模型以最大化 RM 分配的期望奖励
  • 为防止策略偏离从 SFT 学习到的分布太远,并减轻 “Reward Hacking”(即找到对抗性方法来最大化奖励分数),在目标中添加了一个 KL 散度惩罚项,最终的优化问题是:
    $$\max_{\theta}\mathbb{E}_{x\sim \mathcal{D},y\sim \pi_{\theta}(\cdot |x)}\left[R_{\phi}(x,y) - \beta \cdot D_{\text{KL} }(\pi_{\theta}(\cdot |x)\parallel \pi_{\text{SFT} }(\cdot |x))\right] \tag {4}$$
    • \(\mathcal{D}\) 是 Prompt 的分布
    • \(y\) 是由策略 \(\pi_{\theta}\) 生成的完整响应
    • \(\beta\) 是控制 KL 惩罚强度的超参数

Inverse Reinforcement Learning,逆强化学习

  • 逆向强化学习(IRL)(2000) 是一类基本的模仿学习方法,用于解决 RL 的逆问题
  • IRL 不是从已知的奖励函数中学习策略,而是试图从专家演示中恢复奖励模型 (IRL 一般假设是这些演示是最优或接近最优的)
  • 一个突出且具有理论基础的方法是最大熵(MaxEnt)IRL (2008)
    • MaxEnt IRL 通过寻求一个既能合理化专家演示,又能对数据中未发现的行为保持最大非承诺性的奖励,来解决许多奖励函数可以解释相同行为的模糊性问题
    • 这个原理引出了一个极小极大优化问题(注:这里的引出结果不是 (MaxEnt IRL)Maximum Entropy Inverse Reinforcement Learning, AAAI 2008, CMU 论文给出的,而是 Generative Adversarial Imitation Learning, NIPS 2016, OpenAI给出的):
      $$\max_{r}\min_{\pi}\left(\mathbb{E}_{\tau \sim \pi^{\text{E} } }\left[\sum_{h = 1}^{H}r(s_{h},a_{h})\right] - \mathbb{E}_{\tau \sim \pi}\left[\sum_{h = 1}^{H}r(s_{h},a_{h}) + \alpha H(\pi (\cdot |s_{h}))\right]\right) \tag {5}$$
      • 这里的期望 \(\mathbb{E}_{\tau \sim \pi^{\text{E} } }\) 是在专家策略 \(\pi^{\text{E} }\)(由数据集 \(\mathcal{D}\) 近似)诱导的轨迹分布上取的,而期望 \(\mathbb{E}_{\tau \sim \pi}\) 是在一个学习到的策略 \(\pi\) 生成的轨迹分布上取的
      • \(\begin{array}{r}{H(\pi (\cdot |s_h)) = \mathbb{E}_{a_h\sim \pi (\cdot |s_h)}[-\log \pi (a_h|s_h)]} \end{array}\) 表示 \(\pi (\cdot |s_h)\) 的熵
      • \(\alpha >0\) 是正则化系数
    • 这个目标是寻求一个奖励函数 \(r\),它能最大化专家的期望回报与在同一奖励 \(r\) 下最优策略 \(\pi\) 的熵正则化回报之间的差距
Connection to Reward Modeling in RLHF,与 RLHF 中奖励建模的联系
  • 可以将 MaxEnt IRL 目标视为 BT 模型原理的、更一般的分布层面形式化
  • 在 RLHF 中使用的 BT 模型下的目标,如 Eq.(3) 所示,通过最大化特定 轨迹 \(y_{w}\) 和 轨迹 \(y_{l}\) 之间的分数差来学习奖励函数
    • 这从根本上说是一种成对或样本层面的比较
  • Eq.(5) 中的 MaxEnt IRL 目标可以被视为其分布层面的类似物
    • 它不是比较两个采样的轨迹,而是将整个专家分布 \((\pi^{\text{E} })\) 与在奖励函数 \(r\) 下产生的最优竞争策略 \(\pi\) 进行比较
    • \(\text{min}_{\pi^{\prime} }\) 项积极寻求可能的最强竞争策略,而 \(\text{max}_{\pi^{\prime} }\) 项则调整奖励以创造最大的性能差距
  • 从这个角度来看,RLHF 奖励建模过程可以被解释为 IRL 原理的一个实用、计算上易于处理的实例化
    • RLHF 没有解决复杂的 \(\text{min}_{\pi^{\prime} }\) 优化问题,而是简化了它,并直接最大化偏好数据集中 “Chosen” 和 “Rejected” 之间的奖励差距
    • 因此,BT 模型是 IRL 提供的更广泛理论框架内的一个特例
    • 工作回归到这个更通用的 IRL 公式,以直接推导出一个奖励函数,而无需显式的成对比较

Finding the Endogenous Reward Within the Language Model, 在语言模型内部寻找内生奖励

  • 本文主张:一个原则性的奖励函数可以直接从任何使用标准 NTP 训练的语言模型的 Logits 中恢复出来

Reward Learning from Inverse Reinforcement Learning,从逆向强化学习中学习奖励

  • RLHF 中奖励建模的标准实践可以看作是一个更基本范式:逆向强化学习(IRL)的一个实用、简化的实例
    • 这种联系表明:IRL 是从数据中学习奖励函数的自然且最原则性的框架
  • 与其依赖 RLHF 中常见的成对比较启发式方法,不如应用一种更基础的 IRL 方法来恢复能最好地解释专家数据集 \(\mathcal{D}\) 的最优奖励函数
    • 历史上阻碍这种直接方法的主要挑战是,大多数 IRL 方法是为在线环境制定的,需要计算成本高昂的交互
  • 一种更直接、更实用的方法是使用基于逆 Soft Q 学习 (2021) 的离线 IRL 方法来公式化这个问题
    • 在静态数据集 \(\mathcal{D} = \{(s_{1}^{i},a_{1:H}^{i})\}_{i = 1}^{n}\) 中找到一个能最好地解释专家数据的 Q 函数
    • 目标是解决以下优化问题:
      $$\max_{\mathcal{Q} }\frac{1}{n}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\left[Q(s_{h}^{i},a_{h}^{i}) - \alpha \log \left(\sum_{a_{h}\in \mathcal{V} }\exp \left(Q(s_{h}^{i},a_{h})\right) / \alpha\right)\right] \tag {6}$$
      • 注:先看 公式 8 更容易看懂 公式 6
  • 找到最大化这个目标的最优 Q 函数 \(Q^{*}\) 后,相应的理想奖励函数 \(r^{*}\) 就可以通过逆 Soft Bellman 算子 (2021) 恢复:
    $$r^{*}(s_{h},a_{h}):= Q^{*}(s_{h},a_{h}) - \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q^{*}(s_{h + 1},a_{h + 1})\right) / \alpha\right) \tag {7}$$
  • 注:这提供了一种原则性的、离线的寻找奖励函数的方法
  • 关键问题:这个问题的最优解 \(Q^{*}\) 是什么?
    • 注:接下来,我们能在不进行复杂、新的优化过程的情况下找到它

NTP Recovers the IRL Solution,NTP 恢复了 IRL 解

  • 现在证明:在 Eq.(6) 中提出的 \(Q^{*}\) 的解不是需要从头计算的东西
    • \(Q^{*}\) 已经被任何使用标准 NTP 目标训练的语言模型的 Logits 所体现
  • 首先分析一下 IRL 目标寻求什么样的解
    • 通过应用一个简单的指数对数变换,Eq.(6) 中的目标可以表示为一个最大似然问题:
      $$\max_{\mathcal{Q} }\frac{1}{n}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\log \left(\frac{\exp(Q(s_{h}^{i},a_{h}^{i}) / \alpha)}{\sum_{a_{h}^{i}\in \mathcal{V} }\exp(Q(s_{h}^{i},a_{h}^{i}) / \alpha)}\right) \tag {8}$$
      • 这个公式在:RL——SAC 中也有出现
  • 对数内部的项可以看作一个策略
    $$ \pi_{Q}(\cdot |s_{h}) = \text{softmax}(Q(s_{h},\cdot);\alpha) $$
  • 因此,优化问题寻求这样一个 Q 函数,其对应的策略 \(\pi_{Q}\) 能最大化数据集 \(\mathcal{D}\) 中专家演示的似然
    • 这正是通过 NTP 训练语言模型的目标 !!
    • 在训练期间,语言模型 \(\hat{\pi}\) 被优化以最大化 Eq.(1) 中所示的数据对数似然
      • 产生的策略 \(\hat{\pi}\) 根据定义是数据生成分布的最大似然估计。这个策略被参数化为模型 Logits 上的 Softmax,作者将其记为 \(\hat{f}\):
        $$\hat{\pi} (\cdot |s_h) = \text{softmax}(\hat{f} (s_h,\cdot);\alpha) \tag {9}$$
  • 由于语言模型的策略 \(\hat{\pi}\) 是最大似然问题的解,因此直接得出其底层的 Logits \(\hat{f}\) 是 Eq.(6) 中 IRL 优化问题的一个有效解
  • 作者将这种直接联系形式化如下:
Proposition 1
  • 命题 1:
    • 设 \(\hat{\pi}\) 是一个在数据集 \(\mathcal{D}\) 上通过 NTP 训练的语言模型,产生策略
      $$ \hat{\pi} (\cdot |s_h) = \text{softmax}(\hat{f} (s_h,\cdot);\alpha) $$
      • 其中 \(\hat{f}\) 是模型的 Logits
    • 那么 Logits 函数 \(\hat{f}\) 是 Eq.(6) 中原则性离线 IRL 目标的一个解
  • 命题 1 为作者工作的理论基石
    • 命题 1 揭示了语言模型的 Logits 不仅仅是任意的分数;它们是原则性的 Q 函数,隐含地代表了模型所训练数据的最优奖励函数
    • 这一发现为生成和评估提供了一个统一的视角,其中模型的策略 \(\hat{\pi}\) 负责生成,而其 Logits \(\hat{f}\)(充当 Q 函数)负责评估

The Endogenous Reward

  • 在命题 1 中建立的直接联系为我们提供了一种强大的、无需训练的方法来获得奖励模型
  • 给定任何通过 NTP 训练的语言模型,无论是在预训练还是微调阶段,只需取其 Logits \(\hat{Q} = \hat{f}\),并将它们代入 Eq.(7) 的逆 Soft Bellman 算子中
    $$\hat{r} (s_h,a_h) = \hat{Q} (s_h,a_h) - \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(\hat{Q} (s_{h + 1},a_{h + 1})\right) / \alpha\right) \tag {10}$$
  • 定义价值函数
    $$ V_{\hat{Q} }(s_h):= \alpha \log (\sum_{a_h\in \mathcal{V} }\exp (\hat{Q} (s_h,a_h) / \alpha))$$
    • 它表示从状态 \(s\) 出发的期望未来回报
  • 这样就得到了内生奖励,写作:
    $$\hat{r} (s_h,a_h) = \alpha \log (\hat{\pi} (a_h|s_h)) + V_{\hat{Q} }(s_h) - V_{\hat{Q} }(s_{h + 1}) \tag {11}$$
    • 注:\(\hat{\pi}\) 是在数据集 \(\mathcal{D}\) 上通过 NTP 训练的语言模型
  • 在以下三个方面阐述这种内生奖励
Reward Shaping
  • 从 Eq.(11) 中,内生奖励 \(\hat{r}\) 可以被视为由语言模型的 Log-Probability 表示的 的一种 带 势函数(potential function) \(V_{\hat{Q} }\) 的 Shaped Reward
    $$ \tilde{r} (s_h,a_h):= \log (\hat{\pi} (a_h|s_h))$$
    • 根据 Reward Shaping 理论 (1999),\(\hat{r}\) 和 \(\tilde{r}\) 诱导出相同的最优策略和价值函数
      • 理解:可以证明,因为这里的 \(V_{\hat{Q} }(s_h), \ V_{\hat{Q} }(s_{h + 1})\) 都和 动作没有关系,所以添加他们与否梯度的期望都是无偏的
Outcome Reward
  • 对于一个完整的响应 \(\tau = (s_1,a_1,\ldots ,s_H,a_H)\),最终的结果奖励可以计算为
    $$
    \begin{align}
    \hat{r} (\tau)
    &= \sum_{h = 1}^{H}\hat{r} (s_h,a_h) \\
    &= \alpha \sum_{h = 1}^{H}\log (\hat{\pi} (a_h|s_h)) + V_{\hat{Q} }(s_1) \\
    &= \alpha \log (\hat{\pi} (\tau |s_1)) + V_{\hat{Q} }(s_1)
    \end{align}
    \tag {12}
    $$
    • 注:这里的第二个等式成立是因为边界条件
      $$\hat{Q}(s_{H + 1}, \cdot) \equiv 0$$
  • 在 \(\hat{\pi}\) 下完整响应 \(\tau\) 的概率
    $$\hat{\pi} (\tau |s_1) := \prod_{h = 1}^{H} \hat{\pi} (a_h |s_h)$$
  • 可以观察到
    • 结果奖励 等于 整个轨迹的 Log 概率之和,再加上一个仅依赖于初始状态(即 Prompt)的项 \(V_Q(s_1)\)
    • 如果一个响应在训练数据(例如,海量预训练数据)中频繁出现,那么训练好的 LLM 将以更高的可能性生成这个响应,这也意味着这个响应的奖励值更高
Existing Generative Reward Models as Special Cases,现有 GRM 是特例
  • Eq.(12) 引入了一个通用公式,利用 LLM 的概率来构建奖励,而现有的生成式奖励模型 (2024; 2024) 成为该框架的特定实例
  • 例如,对于一个问题-答案对 \((\mathbf{x},\mathbf{y})\)
    • [2024] 中的生成式验证器 (Generative Verifier) 使用下面的 Prompt
      • Prompt:\(\mathbf{P} = \mathbf{\Omega}^{\text{is} }\) the answer correct?
    • 并将奖励表示为在上下文和 Prompt 下单个 Token ‘Yes’ 的概率,即
      $$ \hat{\pi} (\text{Yes}|\mathbf{x},\mathbf{y},\mathbf{P})$$
  • 这对应于本文的方法,当设置 \(s_1 = (\mathbf{x},\mathbf{y},\mathbf{P})\) 和 \(a_1 = \text{Yes}\) 时,得到的奖励 \(\hat{r} (\tau)\) 与他们的方法一致
    $$\hat{r} (\tau) = \alpha \log (\hat{\pi} (\text{Yes}|\mathbf{x},\mathbf{y},\mathbf{P}))$$
  • 对于 [2024] 中为成对比较设计的生成式奖励模型方法,也可以提出类似的论点
    • 基于这种联系,已建立的命题 1 也可以为这些方法提供理论依据

Theoretical Justifications for the Endogenous Reward,理论证明

  • 本节通过分析奖励误差和由此产生的策略误差,为内生奖励提供理论证明

Error Analysis of the Endogenous Reward,内生奖励误差分析

  • 遵循最大熵逆强化学习 (2008),假设专家策略 \(\pi^{\text{E} }\) 是关于未知真实奖励 \(r^*\) 的熵正则化最优策略
  • 根据正则化 MDP 的理论 (2019),有:
    $$r^{*}(s_{h},a_{h}) = \alpha \log \left(\pi^{\text{E} }(a_{h}|s_{h})\right) + V_{Q_{r^{*} } }(s_{h}) - V_{Q_{r^{*} } }(s_{h + 1}) \tag {13}$$
    • 这里 \(Q_{r^*}^*\) 是真实奖励 \(r^*\) 的熵正则化最优 Q 值函数
  • 由于奖励模糊性问题,多个奖励函数可以推导出相同的专家策略 (1999),即使完全了解 \(\pi^{\text{E} }\),也不可能逼近真实奖励 \(r^*\)
    • 因此,我们无法对绝对误差 \(|\hat{r} (s_h, a_h) - r^* (s_h, a_h)|\) 得出任何理论结论
  • 本文中,作者不分析绝对误差,而是分析利用奖励模型对两个 Reponse 进行评估时的性能
  • 定理 1 表明(注:定理 1 更多详情见原文),如果用于提取奖励的 LLM \(\hat{\pi}\) 在响应的对数概率上接近底层专家 \(\pi^{\text{E} }\),那么由 \(\hat{r}\) 诱导的偏好分布就接近由 \(r^*\) 诱导的偏好分布
    • 这表明从 LLM 中提取的所提出的内生奖励可以证明地继承其性能

Error Analysis of the LLM Finetuned by the Endogenous Reward,使用内生奖励微调的 LLM 的误差分析

  • 提取奖励函数的最终目标是使用它通过强化学习来训练一个新的、改进的策略
  • 这里作者分析了新学习策略的性能,并与基础策略进行比较
  • 本文分析两种方法
    • 第一种方法直接在 Demo 上应用 NTP(即行为克隆),得到基础策略 \(\hat{\pi}\)
    • 另一种方法首先基于方程 (10) 从 \(\hat{\pi}\) 构建内生奖励,然后使用 \(\hat{\pi}\) 应用强化学习,得到新策略 \(\pi^{\text{RL} } = \text{argmax}_{\pi}V_{T}^{\pi}\)
  • 这里,我们忽略求解最优策略时的任何优化误差
  • 理论目标是分析并比较 \(\pi^{\text{RL} }\) 和 \(\hat{\pi}\) 在真实奖励 \(r^{\star}\) 下的次优性
Theorem 2
  • 在具有未知真实奖励 \(r^{\star}\) 的 Token-level MDP 中,假设专家策略 \(\pi^{\text{E} }\) 是熵正则化最优策略
  • 考虑 \(\hat{\pi}\) 是通过 NTP 训练的策略,\(\hat{r}\) 是方程 (10) 中定义的提取奖励
  • 使用提取的奖励 \(\hat{r}\) 应用强化学习来学习一个新策略 \(\pi^{\text{RL} }\),即 \(\pi^{\text{RL} } = \text{argmax}_{\pi}V_{T}^{\pi}\),那么有:
    $$V_{T}^{\pi^{\text{E} } } - V_{T}^{\hat{\pi} }\prec H^{2}\epsilon_{\pi}\qquad \text{ and }\qquad V_{T}^{\pi^{\text{E} } } - V_{T}^{\pi^{\text{RL} } }\prec H\epsilon_{\pi} $$
    • 其中 \(V_{T}^{\pi}\) 表示 \(\pi\) 在奖励 \(r\) 下的值
    • \(\epsilon_{\pi}\) 定义为:
      $$ \epsilon_{\pi} := \max_{h \in [H]} \max_{(s_{h},a_{h})} | \log (\pi^{\text{E} }(a_{h} | s_{h})) - \log (\hat{\pi} (a_{h} | s_{h}))|$$
  • 定理 2 表明 \(\pi^{\text{RL} }\) 在次优性界限中实现了对响应长度 \(H\) 的线性依赖,而 \(\hat{\pi}\) 则受到二次依赖的影响
    • 注:这里一次依赖和二次依赖的更多理解见附录部分
    • 这种二次依赖反映了模仿学习中的复合误差问题 (Ross and Bagnell, 2010; 2021),其中单步误差 \(\epsilon_{\pi}\) 沿轨迹累积。\(\pi^{\text{RL} }\) 实现的优越线性依赖揭示了逆强化学习的基本优势。不是直接模仿专家动作,而是恢复底层奖励函数并使用该奖励执行 RL,消除了复合误差问题。作为技术说明,尽管本文关注有限视野设置,但定理 2 可以通过 (2021) 中发展的分析扩展到无限视野设置

Ineffectiveness of Iterative Improvement,迭代改进的无效性

  • 能否采用改进后的策略 \(\pi^{\text{RL} }\),提取其自身的内生奖励,并执行另一次 RL 步骤以获得进一步的改进?
    • 答案是否定的
  • 根据构造,策略 \(\pi^{\text{RL} }\) 是奖励 \(\hat{r}\) 的最优策略
    • 因此,从 \(\pi^{\text{RL} }\) 提取的内生奖励正是 \(\pi^{\text{RL} }\) 已经最优的那个奖励
    • 应用另一个 RL 步骤将产生相同的策略,所以这种方式做迭代改进无效

Experiments

  • 实验设置
    • 使用模型:Qwen2.5-Math-7B 等
    • 数据集:RM-Bench(reward 评估)、DSP(instruction-following)、MATH 等
    • 对比方法:LLM-as-a-judge、GenRM、DPO 等
  • 结果总结
    研究问题 实验结论
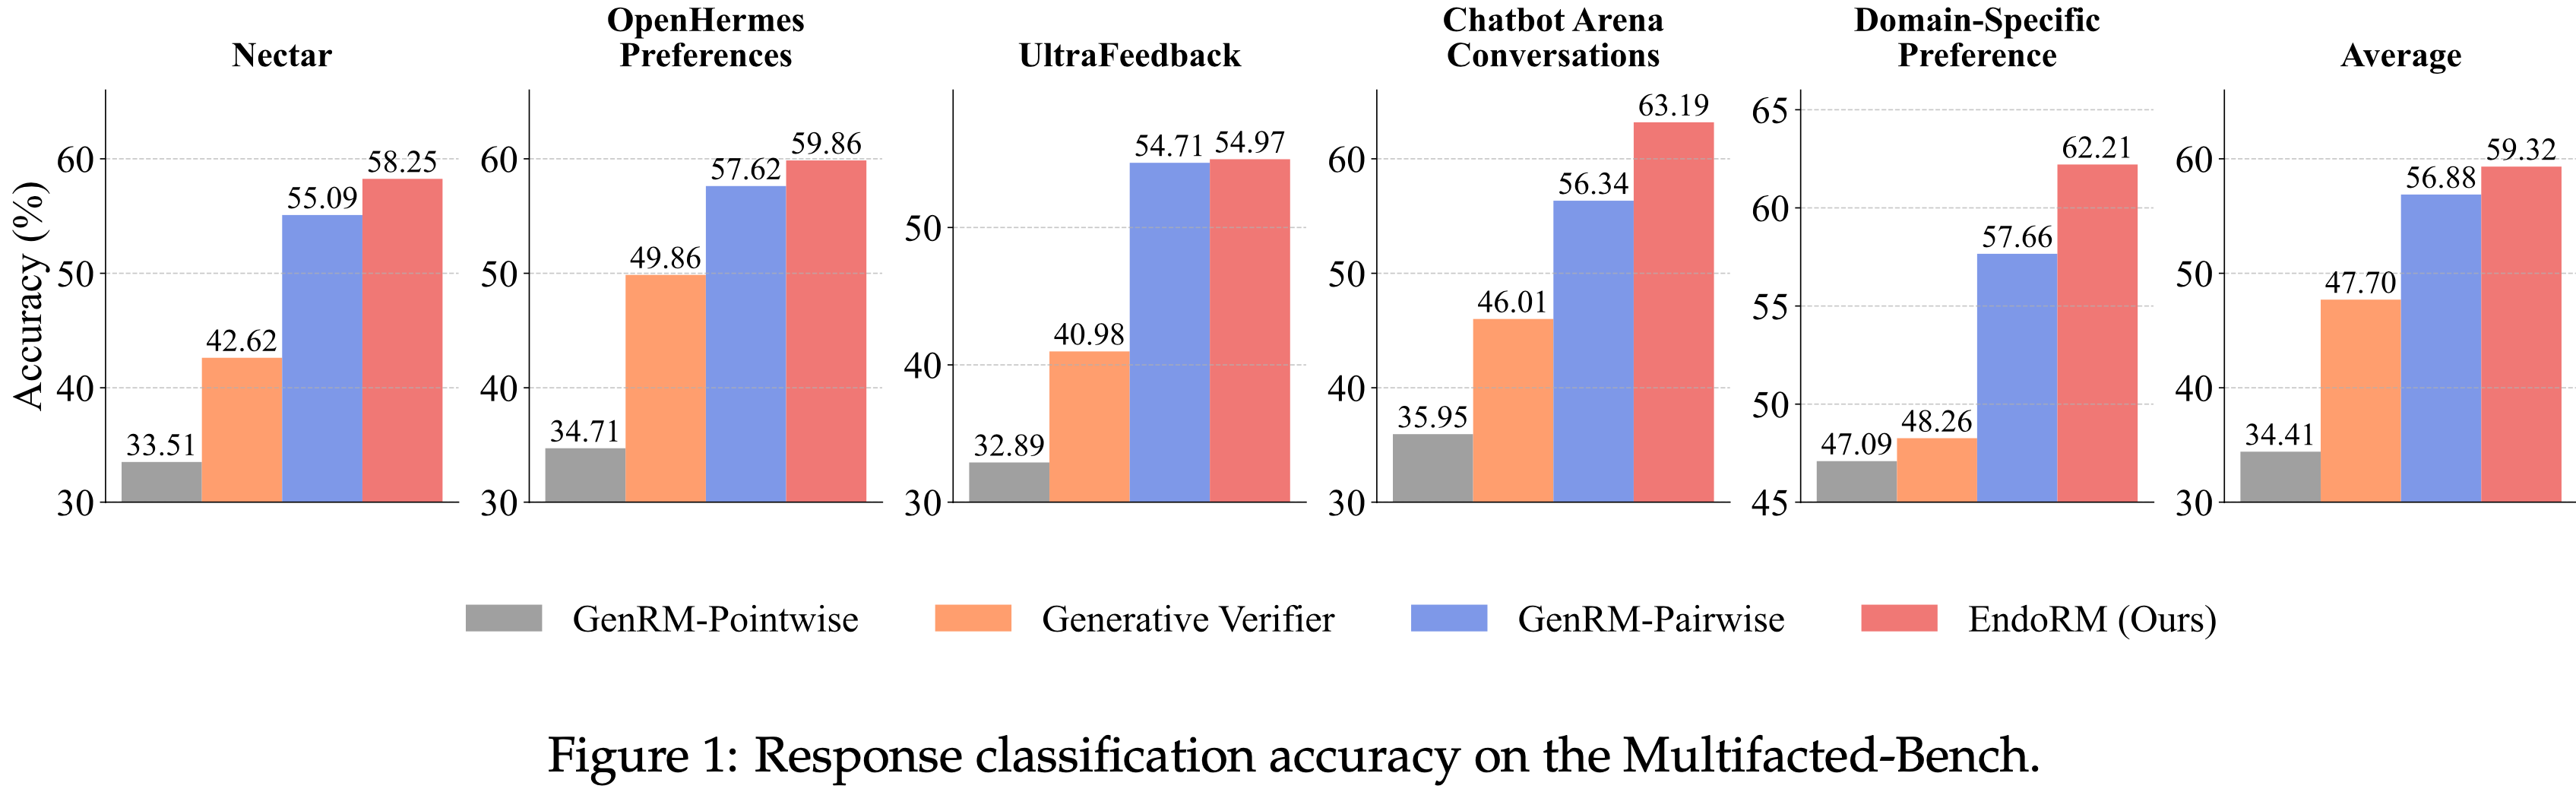
    Q1: EndoRM 是否优于现有 reward model? 是
    在 RM-Bench 上,EndoRM 显著优于 heuristic 方法,甚至优于某些显式训练的 reward model
    Q2: EndoRM 是否支持 instruction-following? 是
    通过 prompt 改变 evaluation 标准,EndoRM 在不同领域(如 Academy, Business)上表现出明显的 diagonal pattern
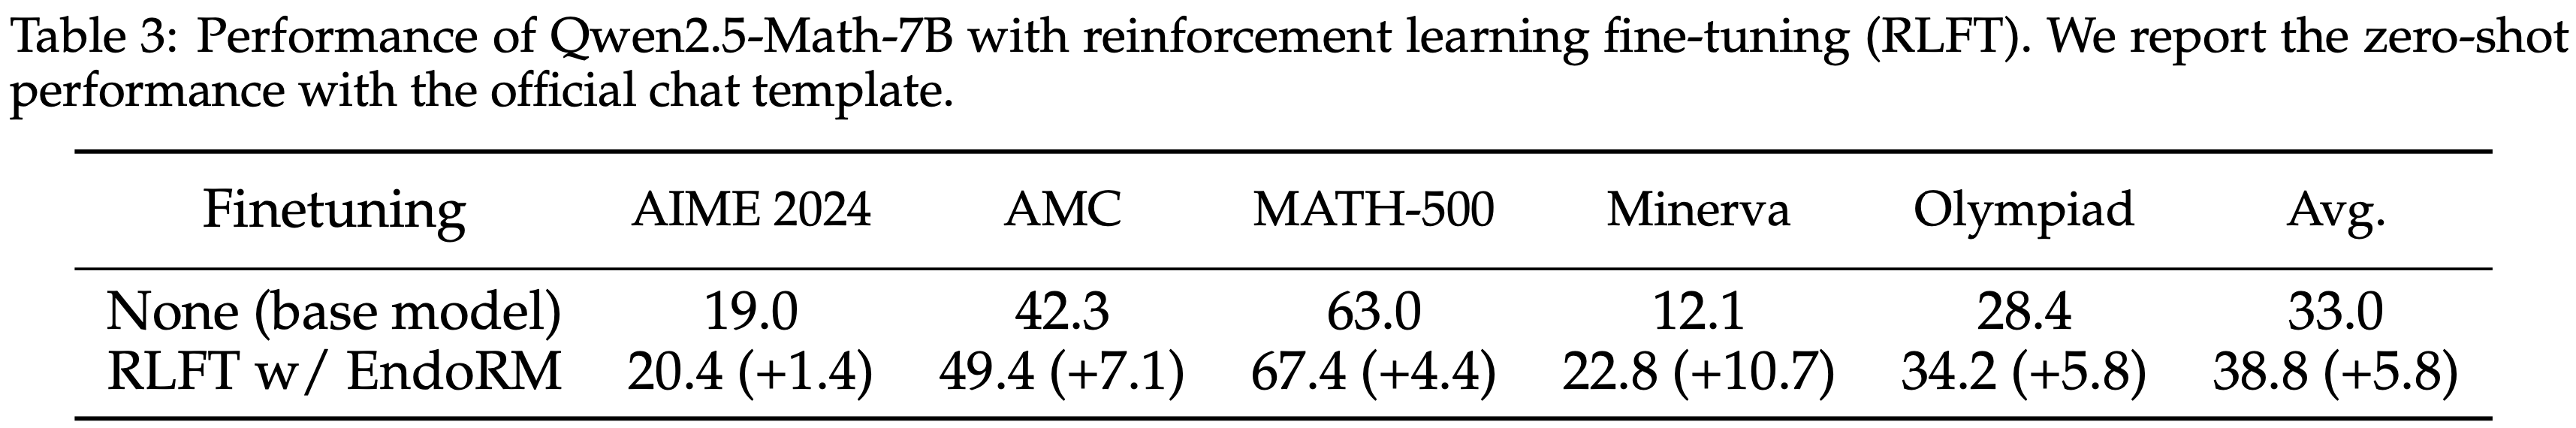
    Q3: RL with EndoRM 是否能提升 policy? 是
    在 MATH 等 5 个 benchmark 上,RL fine-tuning 后平均提升 +5.8%
  • 示例分析
    • 附录中展示了一个数学问题的生成例子:base model 出现错误并输出 Python 代码,而 RL fine-tuned model 能给出清晰、正确的数学推导

Discussion

  • 对齐范式的转变
    • 传统的三阶段对齐(SFT → Reward Modeling → RL)可简化为两阶段:SFT → RL
    • Reward modeling 阶段被完全消除,极大降低工程复杂度
  • 个性化与可控制性
    • 传统 reward model 是静态的、one-size-fits-all;
    • EndoRM 是 promptable 的,可动态调整 evaluation criteria,支持个性化对齐
  • 强化学习蒸馏
    • 可以用 teacher LLM 的 endogenous reward 指导 student LLM 的 RL fine-tuning,实现更高效的 distillation
  • 多模态扩展
    • 只要模型是 autoregressive(如视频、音频生成模型),该方法即可应用

附录 A:An Offline Inverse Reinforcement Learning Approach for Token-level MDPs

  • 本节提供第 3.1 节中介绍的离线 IRL 方法的完整推导
  • 从最大熵 IRL 的极小化极大公式开始,如公式 (5) 所示,正如第 2.4 节中讨论的,内层优化是带有奖励 \(r\) 的最大熵强化学习问题 [2017, 2019] ,其解如下:
    $$\pi_{r}^{*}(a_{h}|s_{h}) = \frac{\exp\left(Q_{r}^{*}(s_{h},a_{h}) / \alpha\right)}{\sum_{a_{h}^{\prime}\in \mathcal{V} }\exp\left(Q_{r}^{*}(s_{h},a_{h}^{\prime}) / \alpha\right)} \tag {14}$$
  • 这里 \(Q_{r}^{*}\) 是带有奖励 \(r\) 的熵正则化最优 Q 值函数,定义为对于任意第 \(h\) 步的 \((s_{h},a_{h})\) ,有
    $$ Q_{r}^{*}(s_{h},a_{h}):= r_{h}(s_{h},a_{h}) + \max_{\tau}\mathbb{E}[\sum_{h = h + 1}^{H}r_{h^{\prime} }(s_{h^{\prime} },a_{h^{\prime} }) + \alpha H(\pi (\cdot |s_{h^{\prime} }))|s_{h},a_{h}] $$
  • 此外,如果定义熵正则化 Bellman 算子为
    $$[\mathcal{T}Q](s_{h},a_{h}):= r(s_{h},a_{h}) + \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1},a_{h + 1})\right) / \alpha\right) \text{ where } s_{h + 1} = P(s_{h},a_{h}),$$
  • 有 \(Q_{r}^{*}\) 是 \(\mathcal{T}\) 的不动点 [2019] ,即
    $$Q_{r}^{*}(s_{h},a_{h}) = [\mathcal{T}Q_{r}^{*}](s_{h},a_{h})$$
  • 将公式 (14) 的内层问题解代入公式 (5) 得到一个单一的最大化问题
    $$\max_{r}\frac{1}{n}\sum_{i = 1}^{n}\sum_{h = 1}^{H}r(s_{h}^{i},a_{h}^{i}) - \alpha \mathbb{E}_{s_{1}\sim \rho}\left[\log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q_{r}^{*}(s_{1},a_{1}) / \alpha\right)\right)\right].$$
  • 遵循 IRL 方法 inverse soft Q-learning [2021] ,进行变量替换,基于所谓的逆 Bellman 算子用 Q 值函数替换奖励函数
    $$r(s_{h},a_{h}) = [\mathcal{T}^{-1}Q](s_{h},a_{h}):= Q(s_{h},a_{h}) - \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1},a_{h + 1})\right) / \alpha\right) \tag {15}$$
  • 然后基于数据集 \(\mathcal{D} = \{(x^{i},a_{1:H}^{i})\}_{i = 1}^{n}\) 得到关于 Q 值函数的最终目标
    $$\max_{Q}\frac{1}{n}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\left(Q(s_{h}^{i},a_{h}^{i}) - \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1}^{i},a_{h + 1})\right) / \alpha\right)\right) -\alpha \mathbb{E}_{s_{1}\sim \rho}\left[\log \left(\sum_{a_{1}\in \mathcal{V} }\exp \left(Q(s_{1},a_{1}) / \alpha\right)\right)\right].$$
  • 对于上述目标中的第二项,利用 telescoping 论证得到
    $$\alpha \mathbb{E}_{s_1\sim \rho}\left[\log \left(\sum_{a_1\in \mathcal{V} }\exp \left(Q(s_1,a_1) / \alpha\right)\right)\right] = \alpha \mathbb{E}_{\tau \sim \tau^{\mathbb{E} } }\left[\sum_{h = 1}^{H}\log \left(\sum_{a_h\in \mathcal{V} }\exp \left(Q(s_h,a_h) / \alpha\right)\right) - \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1},a_{h + 1}) / \alpha\right)\right)\right]$$
  • 将上述方程代入目标函数得到
    $$\begin{align} \max \frac{1}{Q}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\left(Q(s_{h}^{i},a_{h}^{i}) - \alpha \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1}^{i},a_{h + 1})\right) / \alpha\right)\right) -\alpha \mathbb{E}_{\tau \sim \tau^{\mathbb{E} } }\left[\sum_{h = 1}^{H}\log \left(\sum_{a_{h}\in \mathcal{V} }\exp \left(Q(s_{h},a_{h}) / \alpha\right)\right) - \log \left(\sum_{a_{h + 1}\in \mathcal{V} }\exp \left(Q(s_{h + 1},a_{h + 1}) / \alpha\right)\right)\right] \end{align} \tag {15}$$
  • 可以利用 demonstrations \(\mathcal{D}\) 来无偏估计期望项,得到最终目标
    $$\max_{Q}\frac{1}{n}\sum_{i = 1}^{n}\sum_{h = 1}^{H}\left[Q(s_{h}^{i},a_{h}^{i}) - \alpha \log \left(\sum_{a_{h}\in \mathcal{V} }\exp \left(Q(s_{h}^{i},a_{h})\right) / \alpha\right)\right].$$

附录 B:Omitted Proofs

B.1 Proof of Proposition 1

  • 证明主要基于定义
    • 由于 \(\hat{\pi}(\cdot|s_h) = \text{softmax}(\hat{f}(s_h, \cdot); \alpha)\) 是公式 (1) 中 NTP 的最优解,我们有
      $$\hat{\pi} \in \arg\max_{\pi} \sum_{i=1}^{n} \sum_{h=1}^{H} \log \left( \pi \left( a_t^i | x^i, a_{1:h-1}^i \right) \right).$$
  • 这直接蕴含了
    $$
    \begin{align}
    \hat{f} &\in \arg\max_{f} \frac{1}{n} \sum_{i=1}^{n} \sum_{h=1}^{H} \log \left( \frac{\exp(f(s_h^i, a_h^i)/\alpha)}{\sum_{a_h’ \in \mathcal{V} } \exp(f(s_h^i, a_h’)/\alpha)} \right) \\
    &= \arg\max_{f} \frac{1}{n} \sum_{i=1}^{n} \sum_{h=1}^{H} \left( f(s_h^i, a_h^i) - \alpha \log \left( \sum_{a_h \in \mathcal{V} } \exp(f(s_h^i, a_h)) / \alpha \right) \right) \tag {16}
    \end{align}
    $$
  • 通过比较公式 (16) 和公式 (6),作者可以得出结论:\(\hat{f}\) 是公式 (6) 中离线 IRL 目标的最优解

B.2 Proof of Theorem 1

  • 详情见原论文

B.3 Proof of Theorem 2

  • 详情见原论文

附录 C:Outcome Reward Calculation

  • 对于一个完整的 Response \(\tau\),结果奖励可以计算为
    $$
    \hat{r}(\tau) = \sum_{h=1}^{H} \hat{r}(s_h, a_h),
    $$
    • 其中 \(\hat{r}(s_h, a_h)\) 如公式 (10) 所定义
  • 由于语言模型自回归地生成文本,较早的 Token 会影响后续的输出
    • 在实现中,按如下方式计算 Response 的奖励:
      $$
      \hat{r}(\tau) = \sum_{h=1}^{H} \max\left( \gamma^{h-1}, \beta \right) \hat{r}(s_h, a_h),
      $$
      • \(\gamma \in (0, 1]\) 是折扣因子
      • \(\beta \geq 0\)
  • 超参设置:
    • 对于 Multifacted-Bench 上的实验以及在 MATH-lighteval 数据集上的 RL:使用 \(\gamma = 0.95, \beta = 0\)
    • 对于 RM-bench 上的实验,使用 \(\gamma = 0.93, \beta = 0.03\)
    • 所有采样温度均设为 1.0

附录 D:Prompt Templates

  • 用于在 Multifacted-Bench [2024b] 上 Benchmark 奖励模型的所有方法的 Prompt 模板如下所示

  • 由于 RM-Bench 没有为每个样本提供具体指令,所有方法都使用默认的 System Prompt,并且 User 部分 Prompt 模板中的指令也将被移除

  • Figure 2: Prompt template of our Endogenous Reward Model.

    1
    2
    3
    4
    5
    6
    7
    System:
    {instruction}
    User:
    ### Query
    {query}
    ### Response
    {response}
  • Figure 3: Prompt template of Generative Verifier.

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    System:
    You are an AI evaluator. Your role is to assess AI-generated text for its quality and adherence to instructions.
    User:
    You need to determine if the ‘Response’ is a good response to the ‘Query’, based on the standards set by the
    ‘Instruction’. A ‘good’ response MUST satisfy the following conditions:
    1. **Adherence to Instruction:** The answer’s tone, style, and content must perfectly match the provided instruction.
    2. **Relevance to Query:** The answer must directly and comprehensively address the user’s query without any
    irrelevant information.
    3. **Factuality and Helpfulness:** The information in the answer should be accurate and useful.
    Please carefully review the following materials.
    ### Instruction
    {instruction}
    ### Query
    {query}
    ### Response
    {response}
    Based on your evaluation, is the answer a good response? Answer with only “YES” or “NO”.
  • Figure 4: Prompt template of GenRM-Pairwise

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    System:
    You are an AI evaluator. Your role is to assess AI-generated text for its quality and adherence to instructions.
    User:
    You are asked to evaluate two answers, ‘Response 1’ and ‘Response 2’, in relation to a ‘Query’ and a ‘Instruction’.
    **Evaluation Criteria:**
    1. **Adherence to Instruction:** Does the answer’s tone, style, and content align with the specified instruction?
    2. **Relevance to Query:** Does the answer directly and comprehensively address the user’s query?
    3. **Factuality and Helpfulness:** Is the information accurate and useful?
    Based on these criteria, please review the following:
    ### Instruction
    {instruction}
    ### Query
    {query}
    ### Response 1
    {response1}
    ### Response 2
    {response2}
    **Your Task:**
    Is ‘Response 2’ better than ‘Response 1’?
    **Rules for Your Response:**
    1. Respond with only “YES” or “NO”. Do not include explanations or any other text.
    2. “YES” means ‘Response 2’ is clearly better than ‘Response 1’.
    3. “NO” means ‘Response 2’ is not better (it is either worse or of equal quality) than ‘Response 1’
  • Figure 5: Prompt template of GenRM-Pointwise.

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    System:
    You are an AI evaluator. Your role is to assess AI-generated text for its quality and adherence to instructions.
    User:
    You need to evaluate the ‘Response’ in response to the ‘Query’, based on the ‘Instruction’. Your evaluation should be a
    score from 1 to 10.
    **Evaluation Criteria:**
    1. **Adherence to Instruction:** Does the answer’s tone, style, and content match the instruction?
    2. **Relevance to Query:** Does the answer directly and comprehensively address the user’s query?
    3. **Factuality and Helpfulness:** Is the information accurate and useful?
    Please review the following:
    ### Instruction
    {instruction}
    ### Query
    {query}
    ### Response
    {response}
    Based on your assessment, provide a single integer score from 1 to 10.
    **Scoring Guide:**
    - **1-2:** Very Poor. Fails on most criteria.
    - **3-4:** Poor. Significant issues in multiple areas.
    - **5-6:** Average. Meets basic requirements but has clear flaws.
    - **7-8:** Good. Solid response with minor issues.
    - **9-10:** Excellent. A nearly perfect response that excels in all criteria.
    Provide only the numeric score

附录:逆 Soft Bellman 算子(Inverse Soft Bellman Operator, ISBO)

  • 逆 Soft Bellman 算子 (ISBO) 是本文推导内生奖励的核心数学工具
    • ISBO 的作用是从已知的最优 Q 函数反推出对应的奖励函数

标准的 Soft Bellman 算子

  • 在最大熵强化学习或正则化 MDP 中,Soft Bellman 算子 定义了如何从奖励函数 \( r \) 计算 Q 函数:
    $$
    [\mathcal{T} Q](s_h, a_h) = r(s_h, a_h) + \alpha \log \left( \sum_{a_{h+1} \in \mathcal{V} } \exp\left( Q(s_{h+1}, a_{h+1}) / \alpha \right) \right)
    $$
    • \( s_{h+1} \) 是在状态 \( s_h \) 执行动作 \( a_h \) 后到达的下一状态(在 LLM 的确定性环境中,就是拼接了 \( a_h \) 后的新序列)
    • \( \alpha \) 是熵正则化系数
    • 第二项实际上就是软价值函数
      $$ V(s_{h+1}) = \alpha \log \sum_{a} \exp(Q(s_{h+1}, a)/\alpha) $$
  • 这个算子是前向的:给定 \( r \),可以求出 \( Q \)

逆 Soft Bellman 算子

  • 逆 Soft Bellman 算子 就是反过来:给定 Q 函数,恢复奖励函数 \( r \)
  • ISBO 定义:
    $$
    [\mathcal{T}^{-1} Q](s_h, a_h) := Q(s_h, a_h) - \alpha \log \left( \sum_{a_{h+1} \in \mathcal{V} } \exp\left( Q(s_{h+1}, a_{h+1}) / \alpha \right) \right)
    $$
  • 注:这对应论文中的 公式 (7) 和 公式 (15)

对 ISBO 直观理解

  • 如果把 Soft Bellman 方程写成:
    $$
    Q(s_h, a_h) = r(s_h, a_h) + V(s_{h+1})
    $$
  • 那么逆算子就是移项:
    $$
    r(s_h, a_h) = Q(s_h, a_h) - V(s_{h+1})
    $$
  • 因为
    $$ V(s_{h+1}) = \alpha \log \sum_{a} \exp(Q(s_{h+1}, a)/\alpha) $$
    • 因此上式就是逆 Soft Bellman 算子
  • 本质是利用当前步的 Q 值和下一步的“软最大值”来剥离出即时奖励

结合论文理解 ISBO(在论文中的作用)

  • 核心发现:通过 NTP 训练出的 LLM 的 Logits \( \hat{f} \) 天然就是一个最优的软 Q 函数,只需下面的步骤即可抽取出 RM:
    • 1)取出 LLM 的 Logits 作为 \( \hat{Q} \)
    • 2)应用逆 Soft Bellman 算子,得到 \( \hat{r} \)
    • 3)这个 \( \hat{r} \) 就可以作为奖励信号用于后续的 RL 微调

附录:为什么说 「\(\pi^{\text{RL} }\) 在次优性界限中实现了对响应长度 \(H\) 的线性依赖,而 \(\hat{\pi}\) 则受到二次依赖的影响」

  • 注:这个结论源于模仿学习与逆强化学习 + 强化学习在误差累积上的根本差异
  • TLDR:
    • \(\hat{\pi}\)(BC) :每步误差在后续步中持续累积,最终误差 \(\sim H^2\)
    • \(\pi^{\text{RL} }\)(IRL+RL) :通过奖励信号进行全局优化,避免了误差在状态空间中的二次放大,最终误差 \(\sim H\)
  • 简单理解:
    • BC 是“一步错,步步错”,误差随轨迹长度平方增长
    • IRL+RL 通过奖励信号修正错误,误差只随长度线性增长

为什么 \(\hat{\pi}\)(行为克隆)有 \(\mathcal{O}(H^2)\) 的次优性?

  • 行为克隆直接模仿专家动作,即在每个状态 \(s_h\) 下,尽量输出与专家 \(\pi^E\) 相同的动作 \(a_h\)
  • 误差传播机制
    • 假设在每一步,策略 \(\hat{\pi}\) 与专家 \(\pi^E\) 的单步动作分布差异为 \(\epsilon_\pi\)(在对数概率意义下)
    • 由于策略是自回归的(像 LLM 生成 token),第 \(h\) 步的状态分布已经因为前 \(h-1\) 步的误差而偏离了专家的状态分布
    • 在偏离的状态下,即使策略在该状态下的动作误差仍然为 \(\epsilon_\pi\),但后续步数的误差会不断叠加
  • 数学结果
    • 根据模仿学习理论(如 2020),BC 策略的价值次优性满足:
      $$
      V^{\pi^E} - V^{\hat{\pi} } \le \mathcal{O}(H^2 \epsilon_\pi)
      $$
    • 这是因为:
      • 第 \(h\) 步的误差贡献约为 \(h \cdot \epsilon_\pi\)
      • 对 \(h = 1\) 到 \(H\) 求和:\(\sum_{h=1}^H h = \frac{H(H+1)}{2} = \mathcal{O}(H^2)\)
    • 直观理解:BC 像是在没有导航的情况下“跟车”,前车稍微偏一点,后车就会越来越偏,到最后完全偏离路线

为什么 \(\pi^{\text{RL} }\)(IRL + RL)只有 \(\mathcal{O}(H)\) 的次优性?

  • \(\pi^{\text{RL} }\) 是通过先从 \(\hat{\pi}\) 提取内生奖励 \(\hat{r}\),再对该奖励做 RL 得到的策略
  • 关键机制
    • RL 不是在每个状态模仿专家动作,而是优化一个全局奖励信号
    • 即使中间状态分布有偏差,只要奖励函数 \(\hat{r}\) 能够正确评估整体轨迹的好坏,RL 就能通过长期回报引导策略回到正确轨道
    • 这相当于把问题从“每一步都要对齐”放松为“最终结果要对齐”
  • 数学结果(定理 2 给出):
    $$
    V^{\pi^E} - V^{\pi^{\text{RL} } } \le \mathcal{O}(H \epsilon_\pi)
    $$
    • 线性依赖的原因:
      • 奖励误差 \(\epsilon_\pi\) 会直接体现在每步的奖励值中,但不会因为状态偏差而被放大成二次累积
      • 最终次优性正比于总步数乘以单步奖励误差 ,而不是步数的平方
    • 直观理解:RL 像是给车装了一个导航系统(奖励信号),即使中途走错一小段,导航也会把车纠正回来,最终到达目的地的误差不会随时间平方放大

理解:一个简单例子

  • 假设:
    • 真实专家策略 \(\pi^E\) 要求一直输出“直行”
    • 行为克隆策略 \(\hat{\pi}\) 每步有概率 \(p\) 输出“左转”,一旦左转就永久偏离轨道
    • 那么在 \(H\) 步后
      • \(\hat{\pi}\) 仍在正确轨道的概率约为 \((1-p)^H\),累积奖励损失约 \(\mathcal{O}(H^2 p)\)
      • RL 策略 \(\pi^{\text{RL} }\) 即使中途左转,如果奖励函数给“最终到达目标”高分,它会在后续步骤中学习“右转”来补偿,从而误差不会随步数平方增长
1…474849…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4