Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——MemRL

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory, 20260106, SJTU & Xidian University & NUS & Shanghai Innovation Institute & MemTensor(Shanghai)

Paper Summary

  • 解读说明:
    • 论文是实验室师兄的论文,提出了一种很 makesense 的方案,将传统 RL 中的 Q-Learning 思路放到了 LLM 的记忆上来
    • 论文使用了类似 Q-Learning 的方案,且使用非参数的方式建模 Q 值(类似于动态 Q 值表格的概念)
    • Q 值的更新方式重点看 4.3 节
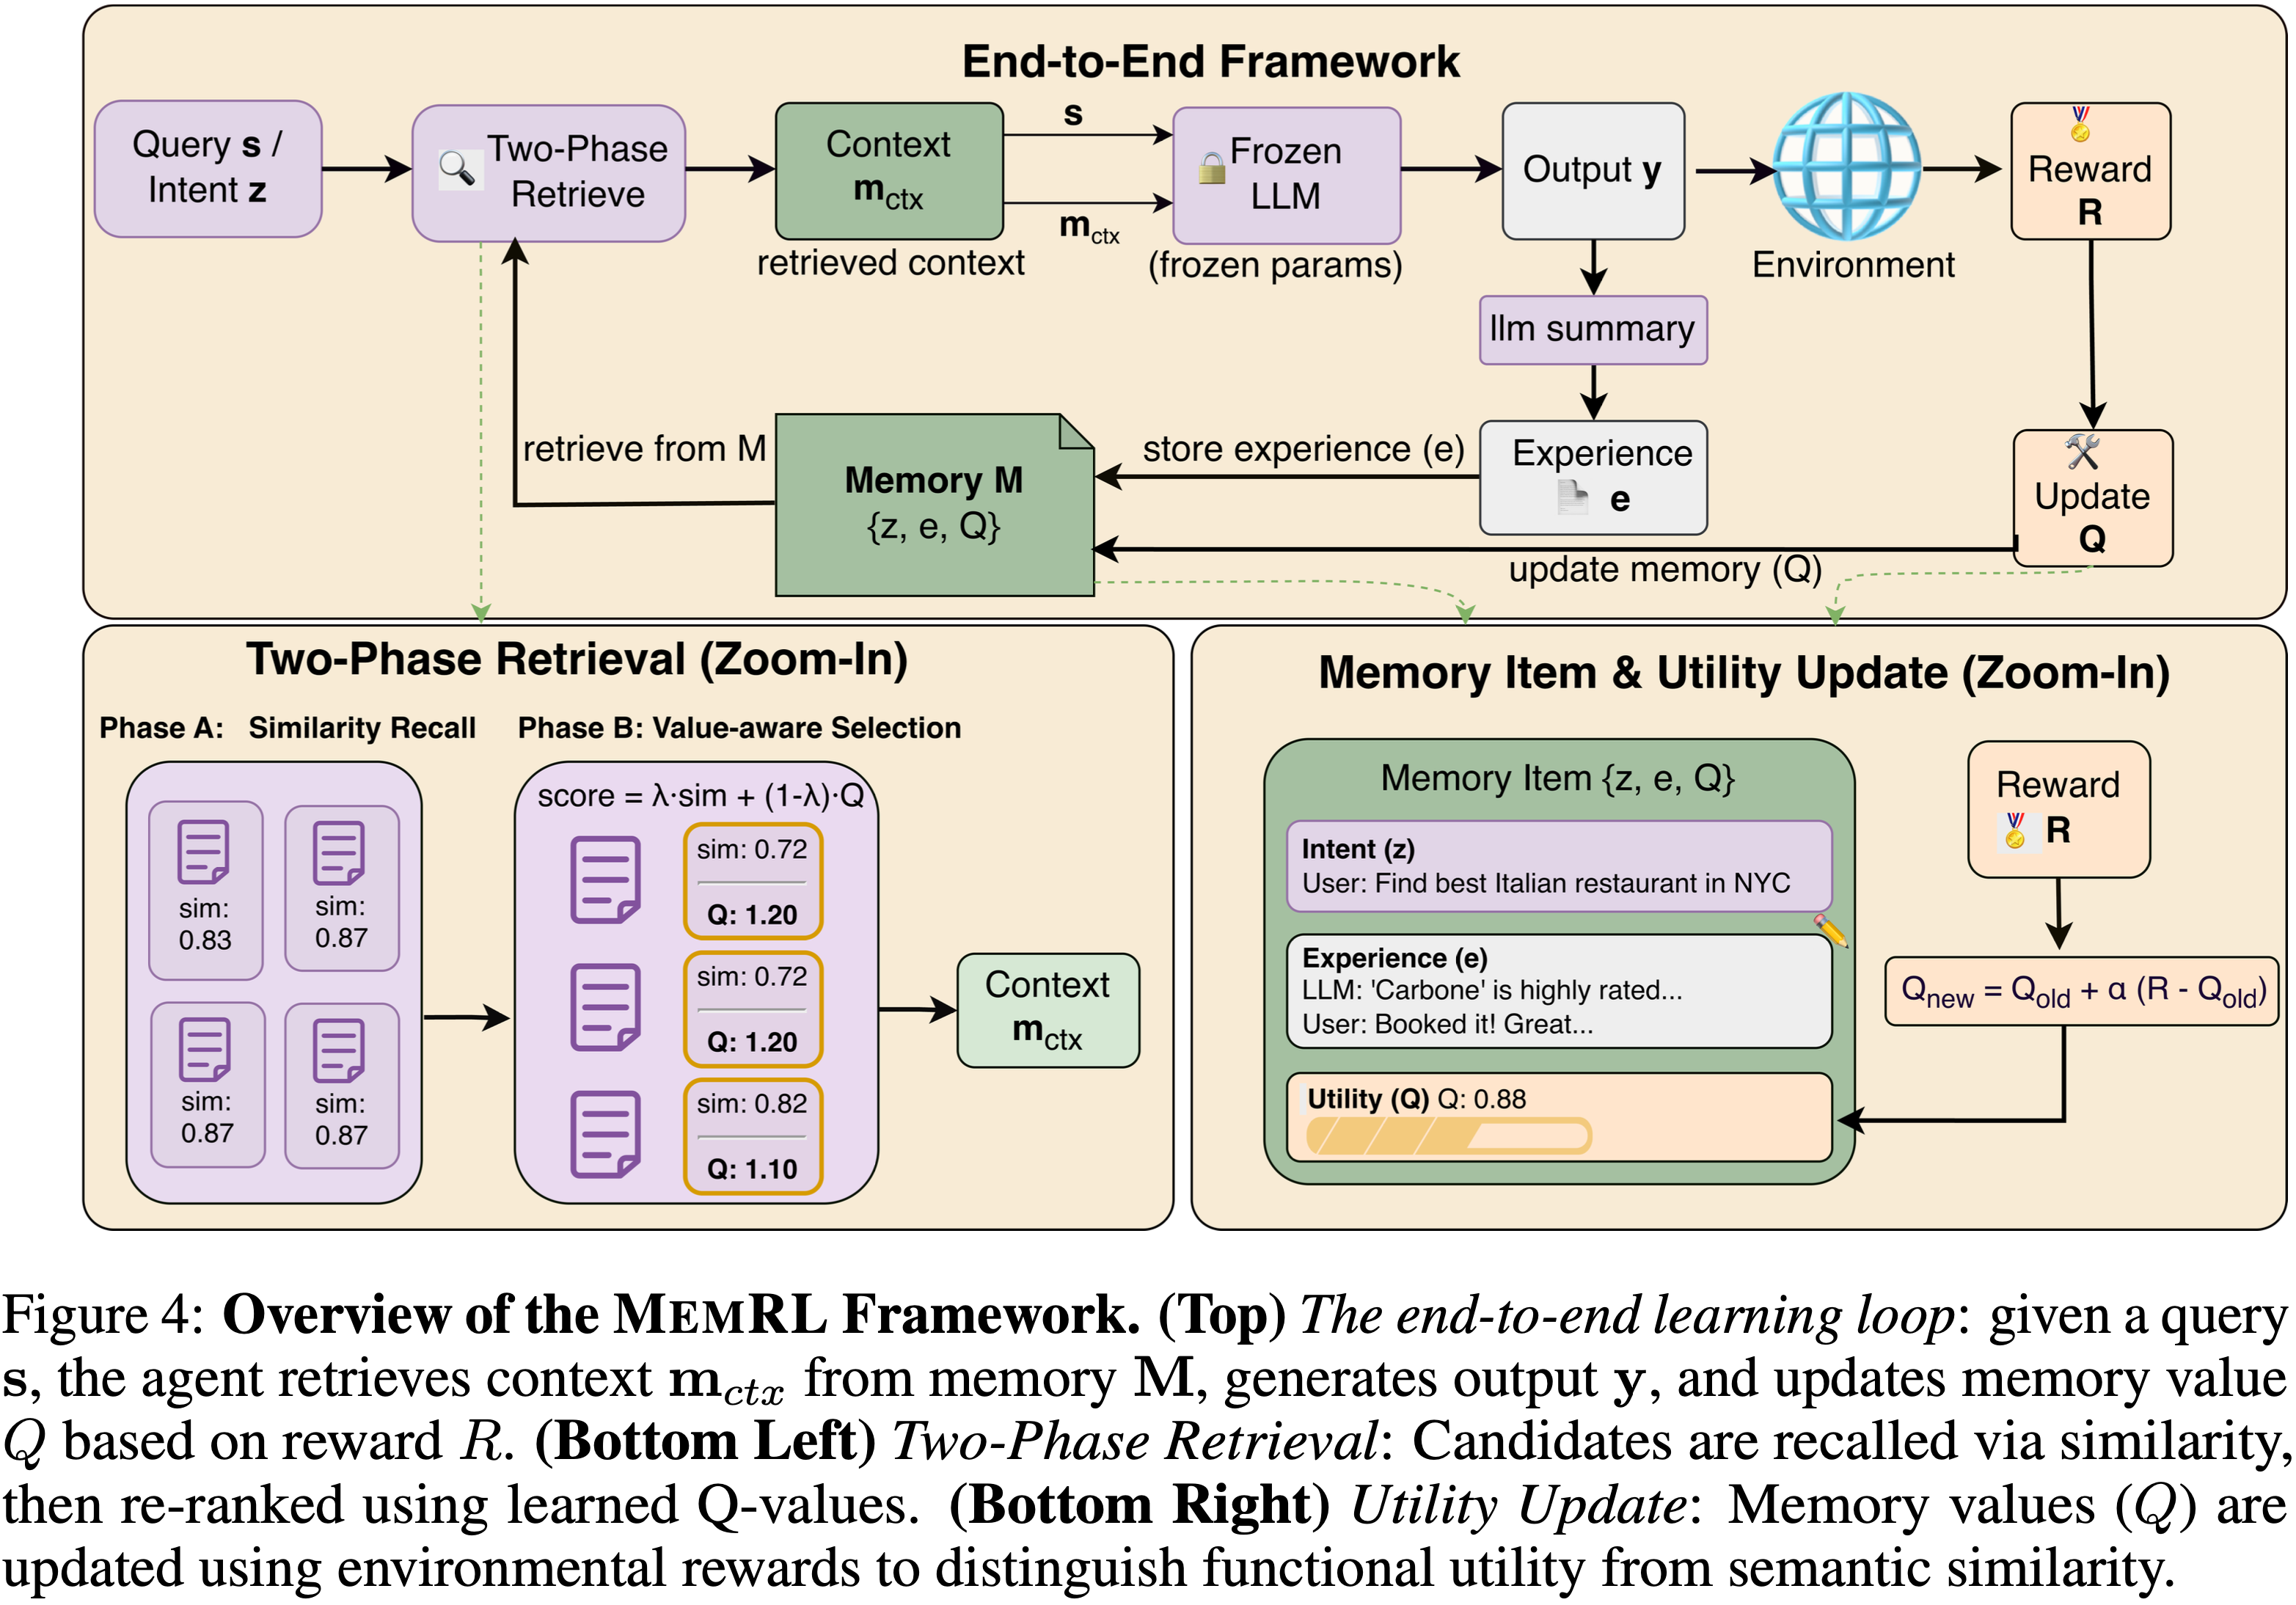
    • 整体流程可见 4.5.1,图 4
  • 背景介绍:
    • 人类智能的标志在于通过 建构式情景模拟(Constructive Episodic Simulation)
    • 即检索过去经验以合成新任务解决方案,来掌握新技能的能力
  • 问题提出:
    • 虽然LLM 具备强大的推理能力,但它们难以模仿这种自我演化(emulate this self-evolution)
    • 微调计算成本高昂且容易导致灾难性遗忘,而现有的基于记忆的方法(memory-based methods)依赖被动的语义匹配(passive semantic matching),常常检索到噪声
  • 论文提出了一个能够让智能体通过在情景记忆上进行非参数强化学习来实现自我演化的框架:MemRL
    • MemRL 明确地将冻结大语言模型(frozen LLM)的稳定推理与可塑的、演化的记忆分离开来
    • 与传统方法不同, MemRL 采用一种两阶段检索机制(Two-Phase Retrieval)
      • 先通过语义相关性筛选候选记忆,然后基于学习到的 Q 值(效用)进行选择
    • 这些效用值通过试错方式从环境反馈中持续优化,使得智能体能够区分高价值策略与相似噪声
  • 在 HLE、BigCodeBench、ALFWorld 和 Lifelong Agent Bench 上的大量实验表明, MemRL 显著优于现有 SOTA 基线方法
  • 论文的分析实验证实, MemRL 有效调和了 稳定性-可塑性困境(stability-plasticity dilemma) ,实现了无需权重更新的持续运行时改进
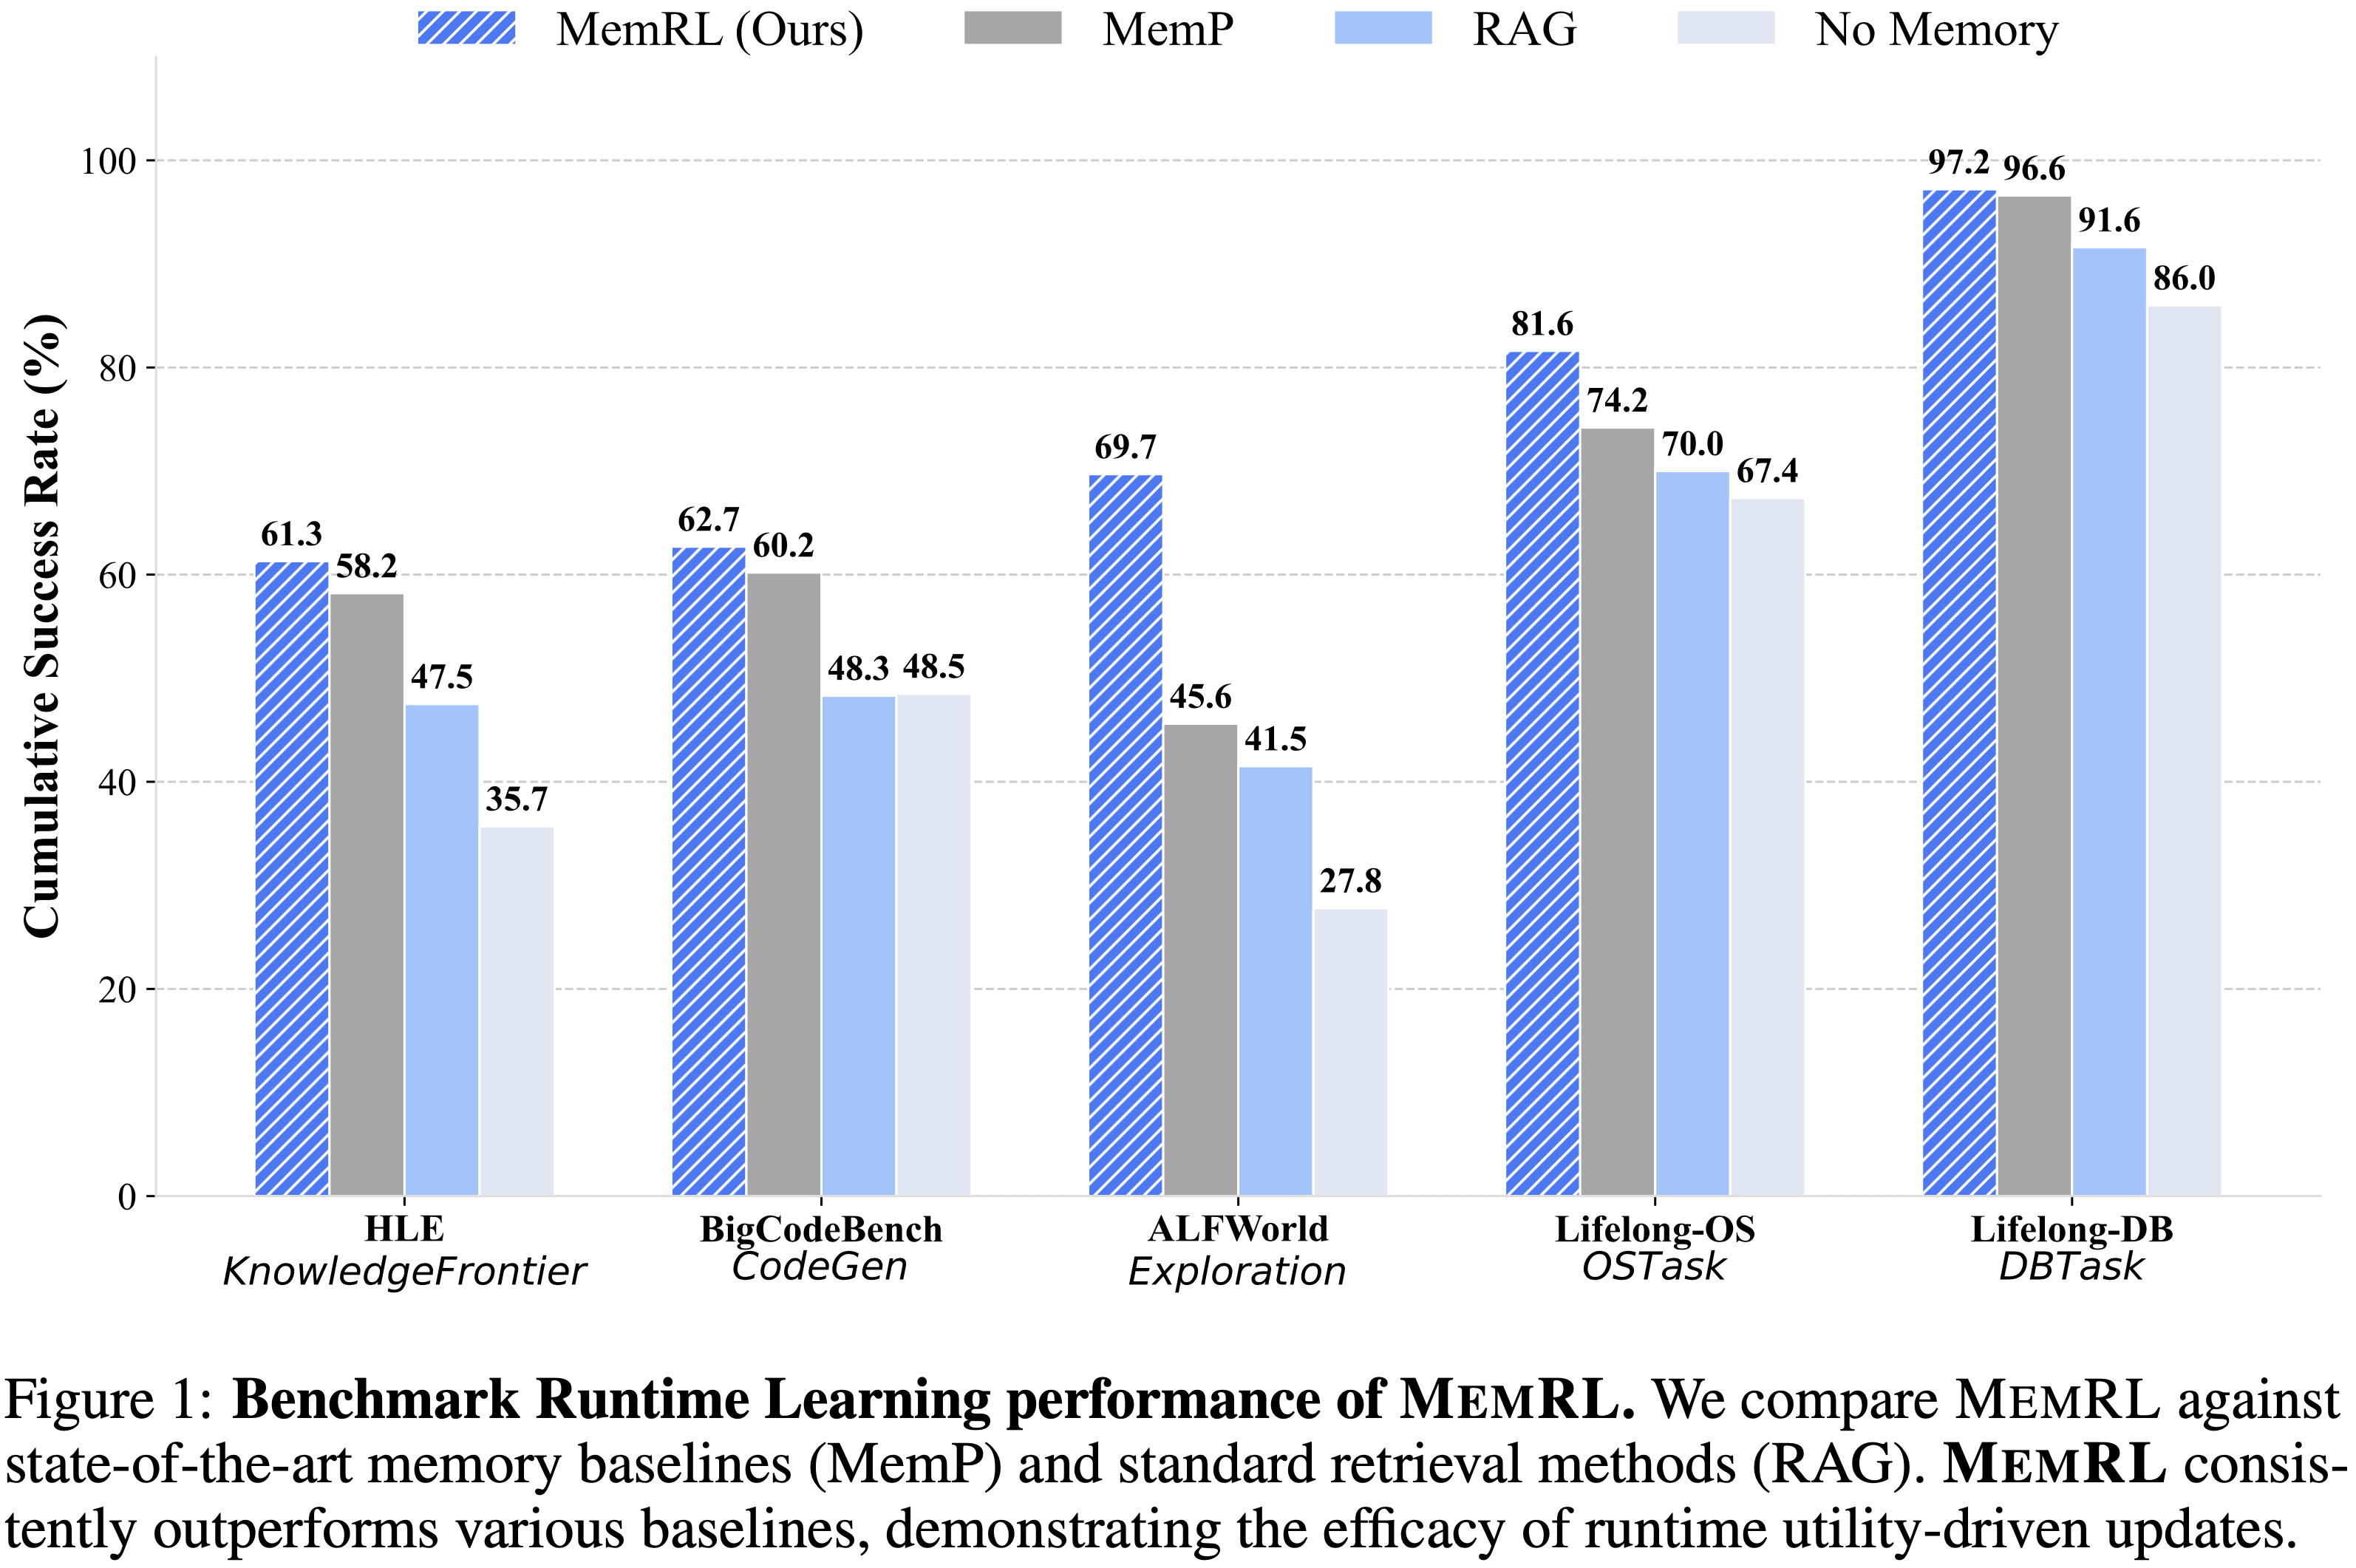
  • 图 1: MemRL 的基准运行时学习性能
    • 论文将 MemRL 与 SOTA 记忆基线方法 (MemP) 和标准检索方法 (RAG) 进行对比
    • MemRL 持续优于各种基线,证明了运行时效用驱动更新的有效性

Introduction and Discussion

  • 人类智能的标志在于认知推理的稳定性(stability) 与情景记忆的可塑性(plasticity) 之间的微妙平衡 (Grossberg, 2013; 1995; 2016)
    • 这是一种被称为建构式情景模拟(Constructive Episodic Simulation) 的机制
    • 它允许在不重新连接神经回路的情况下进行适应 (2007; 2007; 2012; 1980)
  • 虽然 LLM 展现出令人印象深刻的推理能力,但现有范式难以模仿这种动态的、解耦的自我演化 (2022; 2022; 2023; 2023)
    • 一方面,微调方法试图通过修改模型权重来内化经验 (2022; 2020; 2023; 2024),但通常容易遭受灾难性遗忘和高昂的计算成本 (2017; 2024; 2024)
    • 另一方面,检索增强生成(Retrieval-Augmented Generation, RAG) (2020) 提供了一种非参数的替代方案,但其根本上是被动的;
      • RAG 仅基于语义相似性检索信息,而不评估其实际效用 (2020; 2023)
    • 由于缺乏一种机制来区分高价值的过去策略与相似噪声,当前的 RAG 智能体难以有效地从运行时反馈中学习以随时间优化其性能
  • 这一限制突显了一个关键的研究问题:
    • 如何能让一个智能体在部署后持续改进其性能,同时不损害其预训练 Backbone Model 的稳定性?
    • 论文的目标是实现一个能随着持续使用而演化,并在部署后快速适应新任务的智能体,这被称为运行时持续学习(Runtime Continuous Learning) (2023; 2025; 2019; 2024),同时保持 Backbone Model 冻结以防止灾难性遗忘 (2017; 2025)
  • 为应对这一挑战,受人类建构式模拟认知机制的启发,论文提出了 MemRL
    • 这是一个通过显式解耦模型稳定的认知推理与动态的情景记忆来促进自我演化智能体的框架
  • 图 2 展示了论文提出的 MemRL 的概念框架
    • 借鉴强化学习 (Reinforcement Learning, RL) 中估计预期经验效用的值迭代方法 (2018),论文将冻结大语言模型与外部记忆之间的交互形式化为一个马尔可夫决策过程(Markov Decision Process, MDP) (Puterman, 2014)
    • 与优化 Backbone Model 权重的方法不同, MemRL 优化记忆使用策略以最大化预期效用
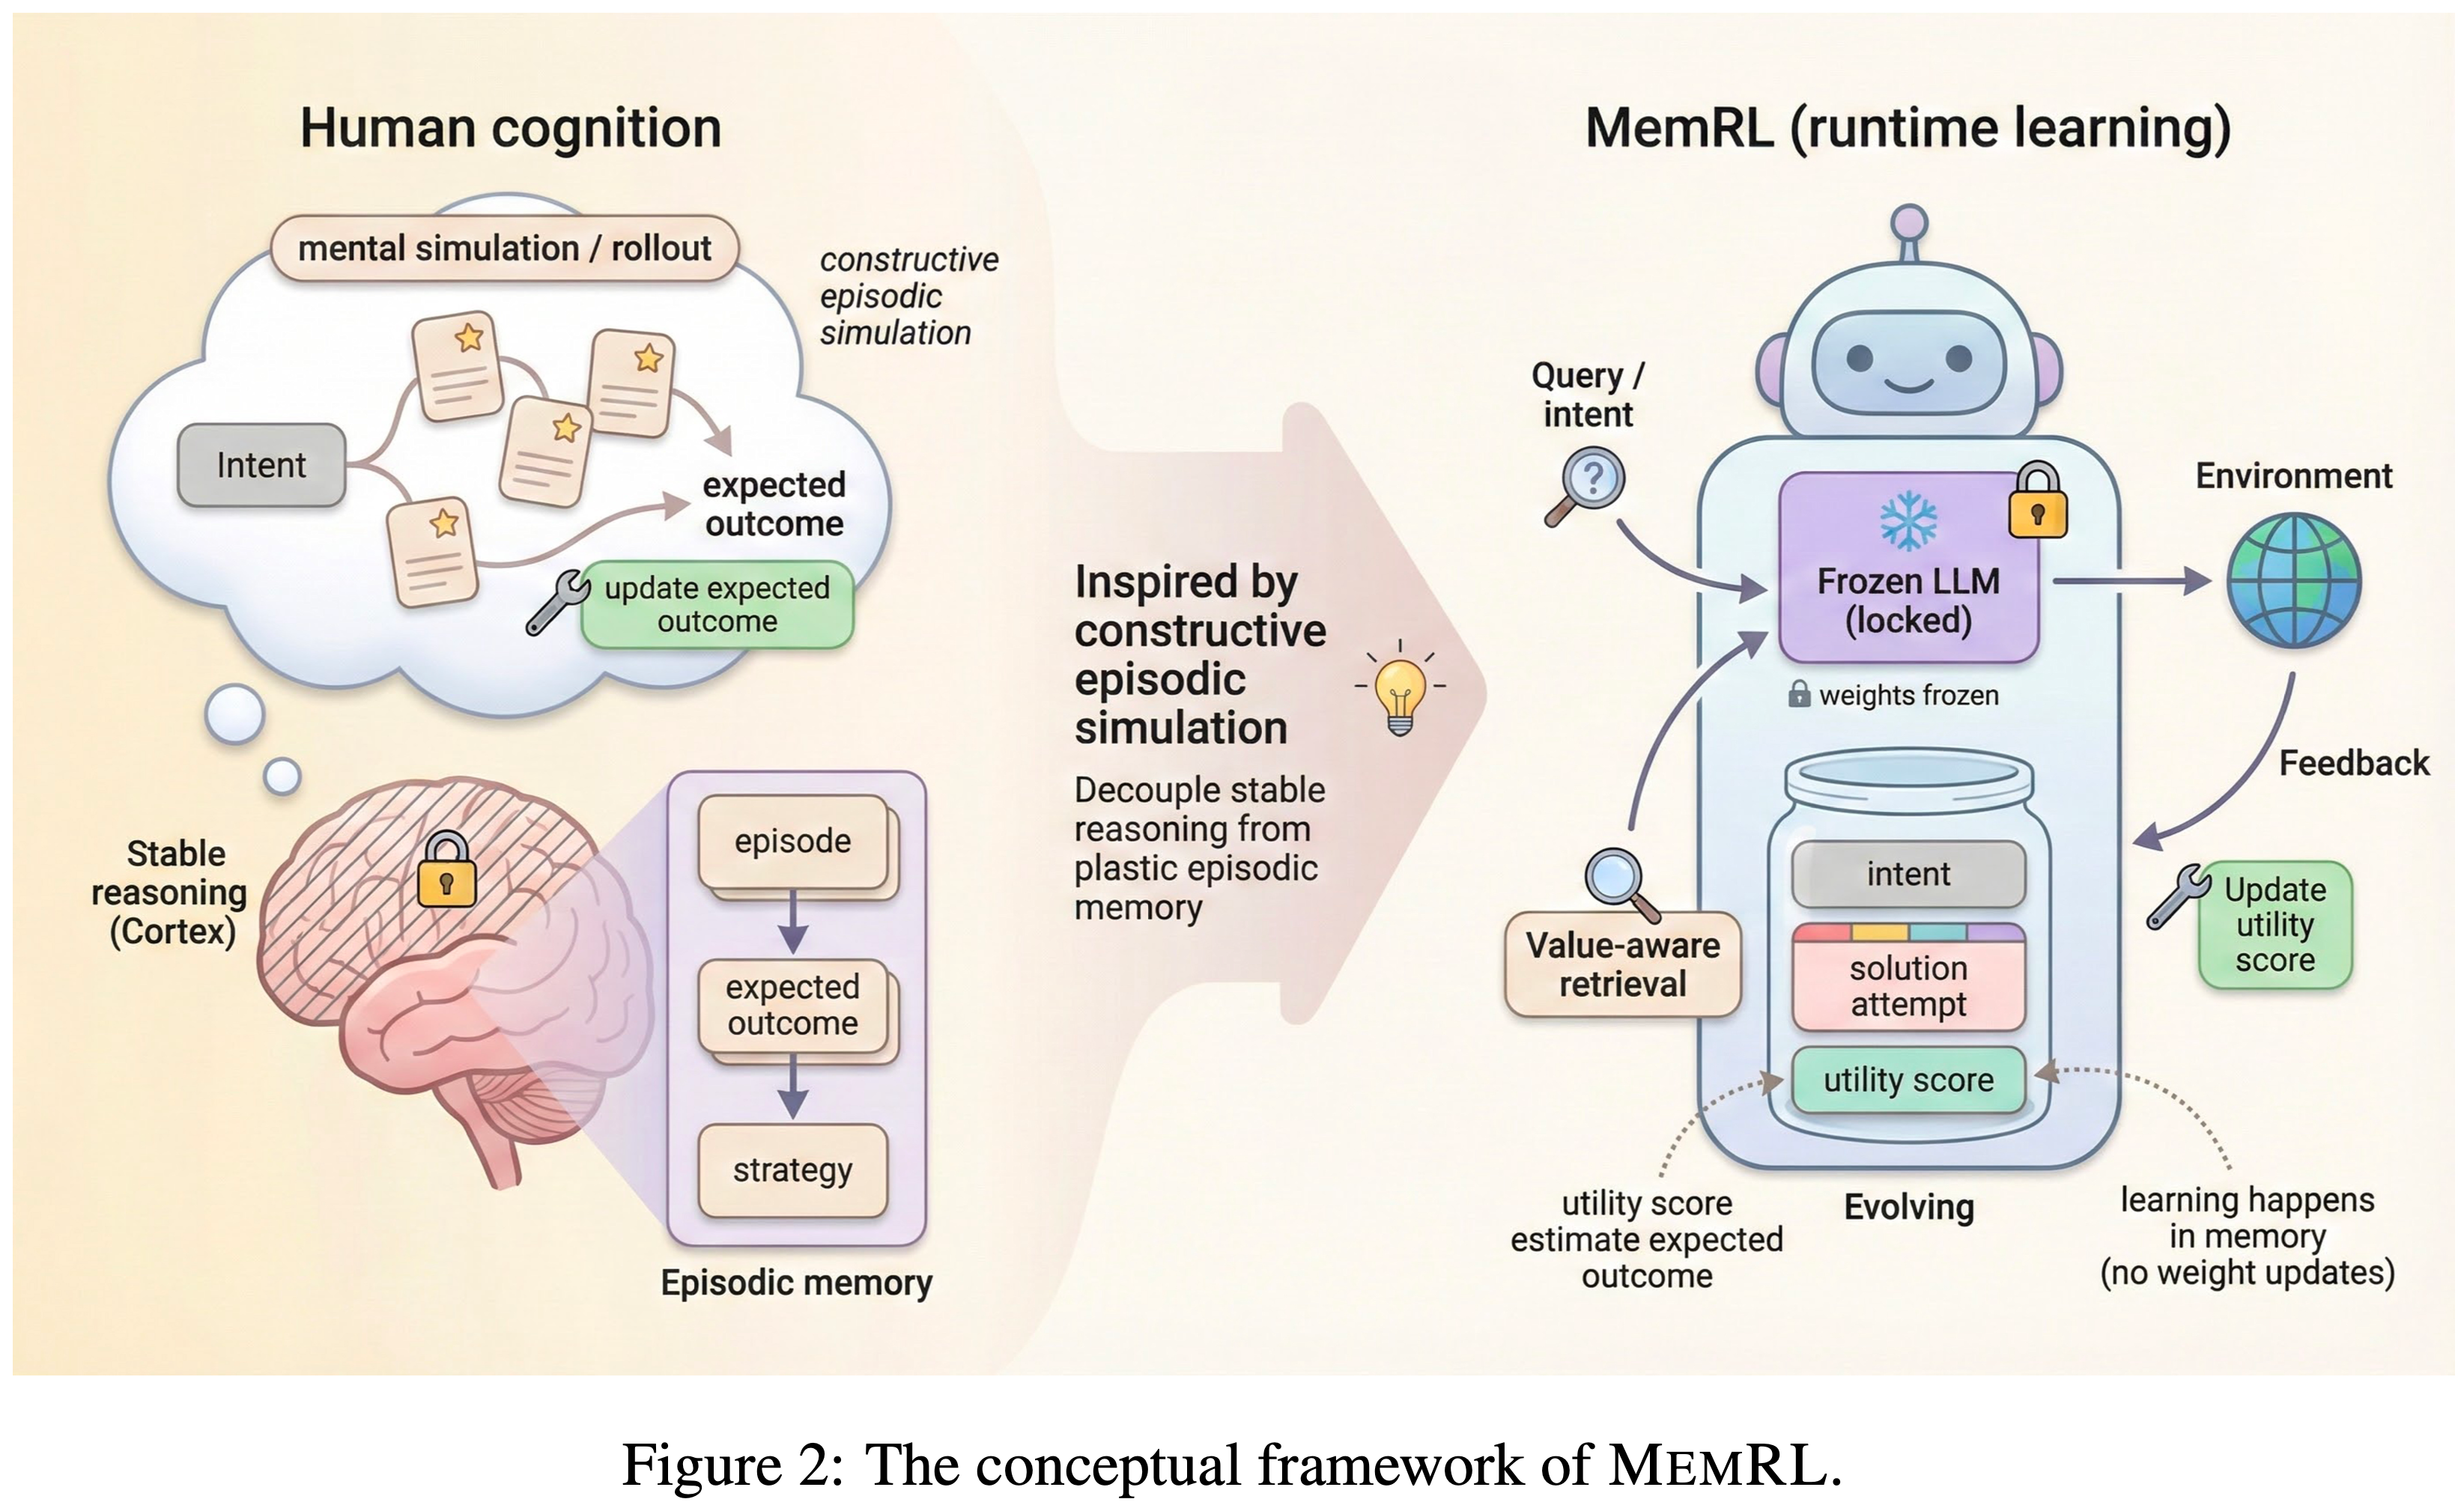
  • MemRL 将记忆组织成结构化的意图-经验-效用三元组(Intent-Experience-Utility triplet)
    • 这种结构将检索从一个被动的语义匹配任务转变为一个主动的决策过程:
      • 值感知检索(Value-Aware Retrieval) 根据学习到的 Q 值选择经验,反映预期效用而非仅仅语义相似性 (1992);
      • 效用驱动更新(Utility-Driven Update) 通过环境反馈和贝尔曼备份 (Bellman backup) (Bellman, 1966) 来优化这些 Q 值
    • 这个闭环循环使智能体能够区分高价值策略与相似噪声,有效地从成功和失败中学习,而无需承担与权重更新相关的计算成本或灾难性遗忘风险
  • 论文在四个不同的基准测试上验证了 MemRL
    • 包括 HLE、BigCodeBench、ALFWorld 和 Lifelong Agent Bench
  • 论文的结果表明其始终优于基线方法,在探索密集的环境中实现了相对改进
    • 论文的深入分析揭示了学习到的效用与任务成功之间存在强相关性,进一步证实了 MemRL 的有效性
  • In Summary,论文的贡献有三方面:
    • 论文提出了一种基于模型-记忆解耦(Model-Memory decoupling) 和意图-经验-效用三元组(Intent-Experience-Utility triplet) 的运行时学习框架
      • 它通过使智能体无需参数更新即可学习,从而调和了 Stability-plasticity 困境
    • 论文引入了 MemRL ,一种实现值感知检索(Value-Aware Retrieval) 和效用驱动记忆管理(Utility-Driven Memory Curation) 的非参数强化学习算法
      • 这使得智能体能够通过优化记忆效用来自我演化,建立了一种增强智能体能力的新范式
    • 论文进行了广泛的评估,并提供了对 MemRL 工作机制的深入洞察
      • 论文分析了它如何确保复杂任务中的结构完整性,并通过贝尔曼收缩 (Bellman contraction) 从理论上证实了其稳定性,探索了效用驱动更新如何最小化灾难性遗忘同时最大化正向迁移 (positive transfer)

Problem Formulation

  • 在本节中,论文正式定义记忆增强生成的问题,并建立智能体策略与记忆检索之间的理论联系
  • 论文采用基于记忆的马尔可夫决策过程(Memory-Based Markov Decision Process, M-MDP) (2025) 的形式化定义,并用论文的非参数强化学习框架来解决它
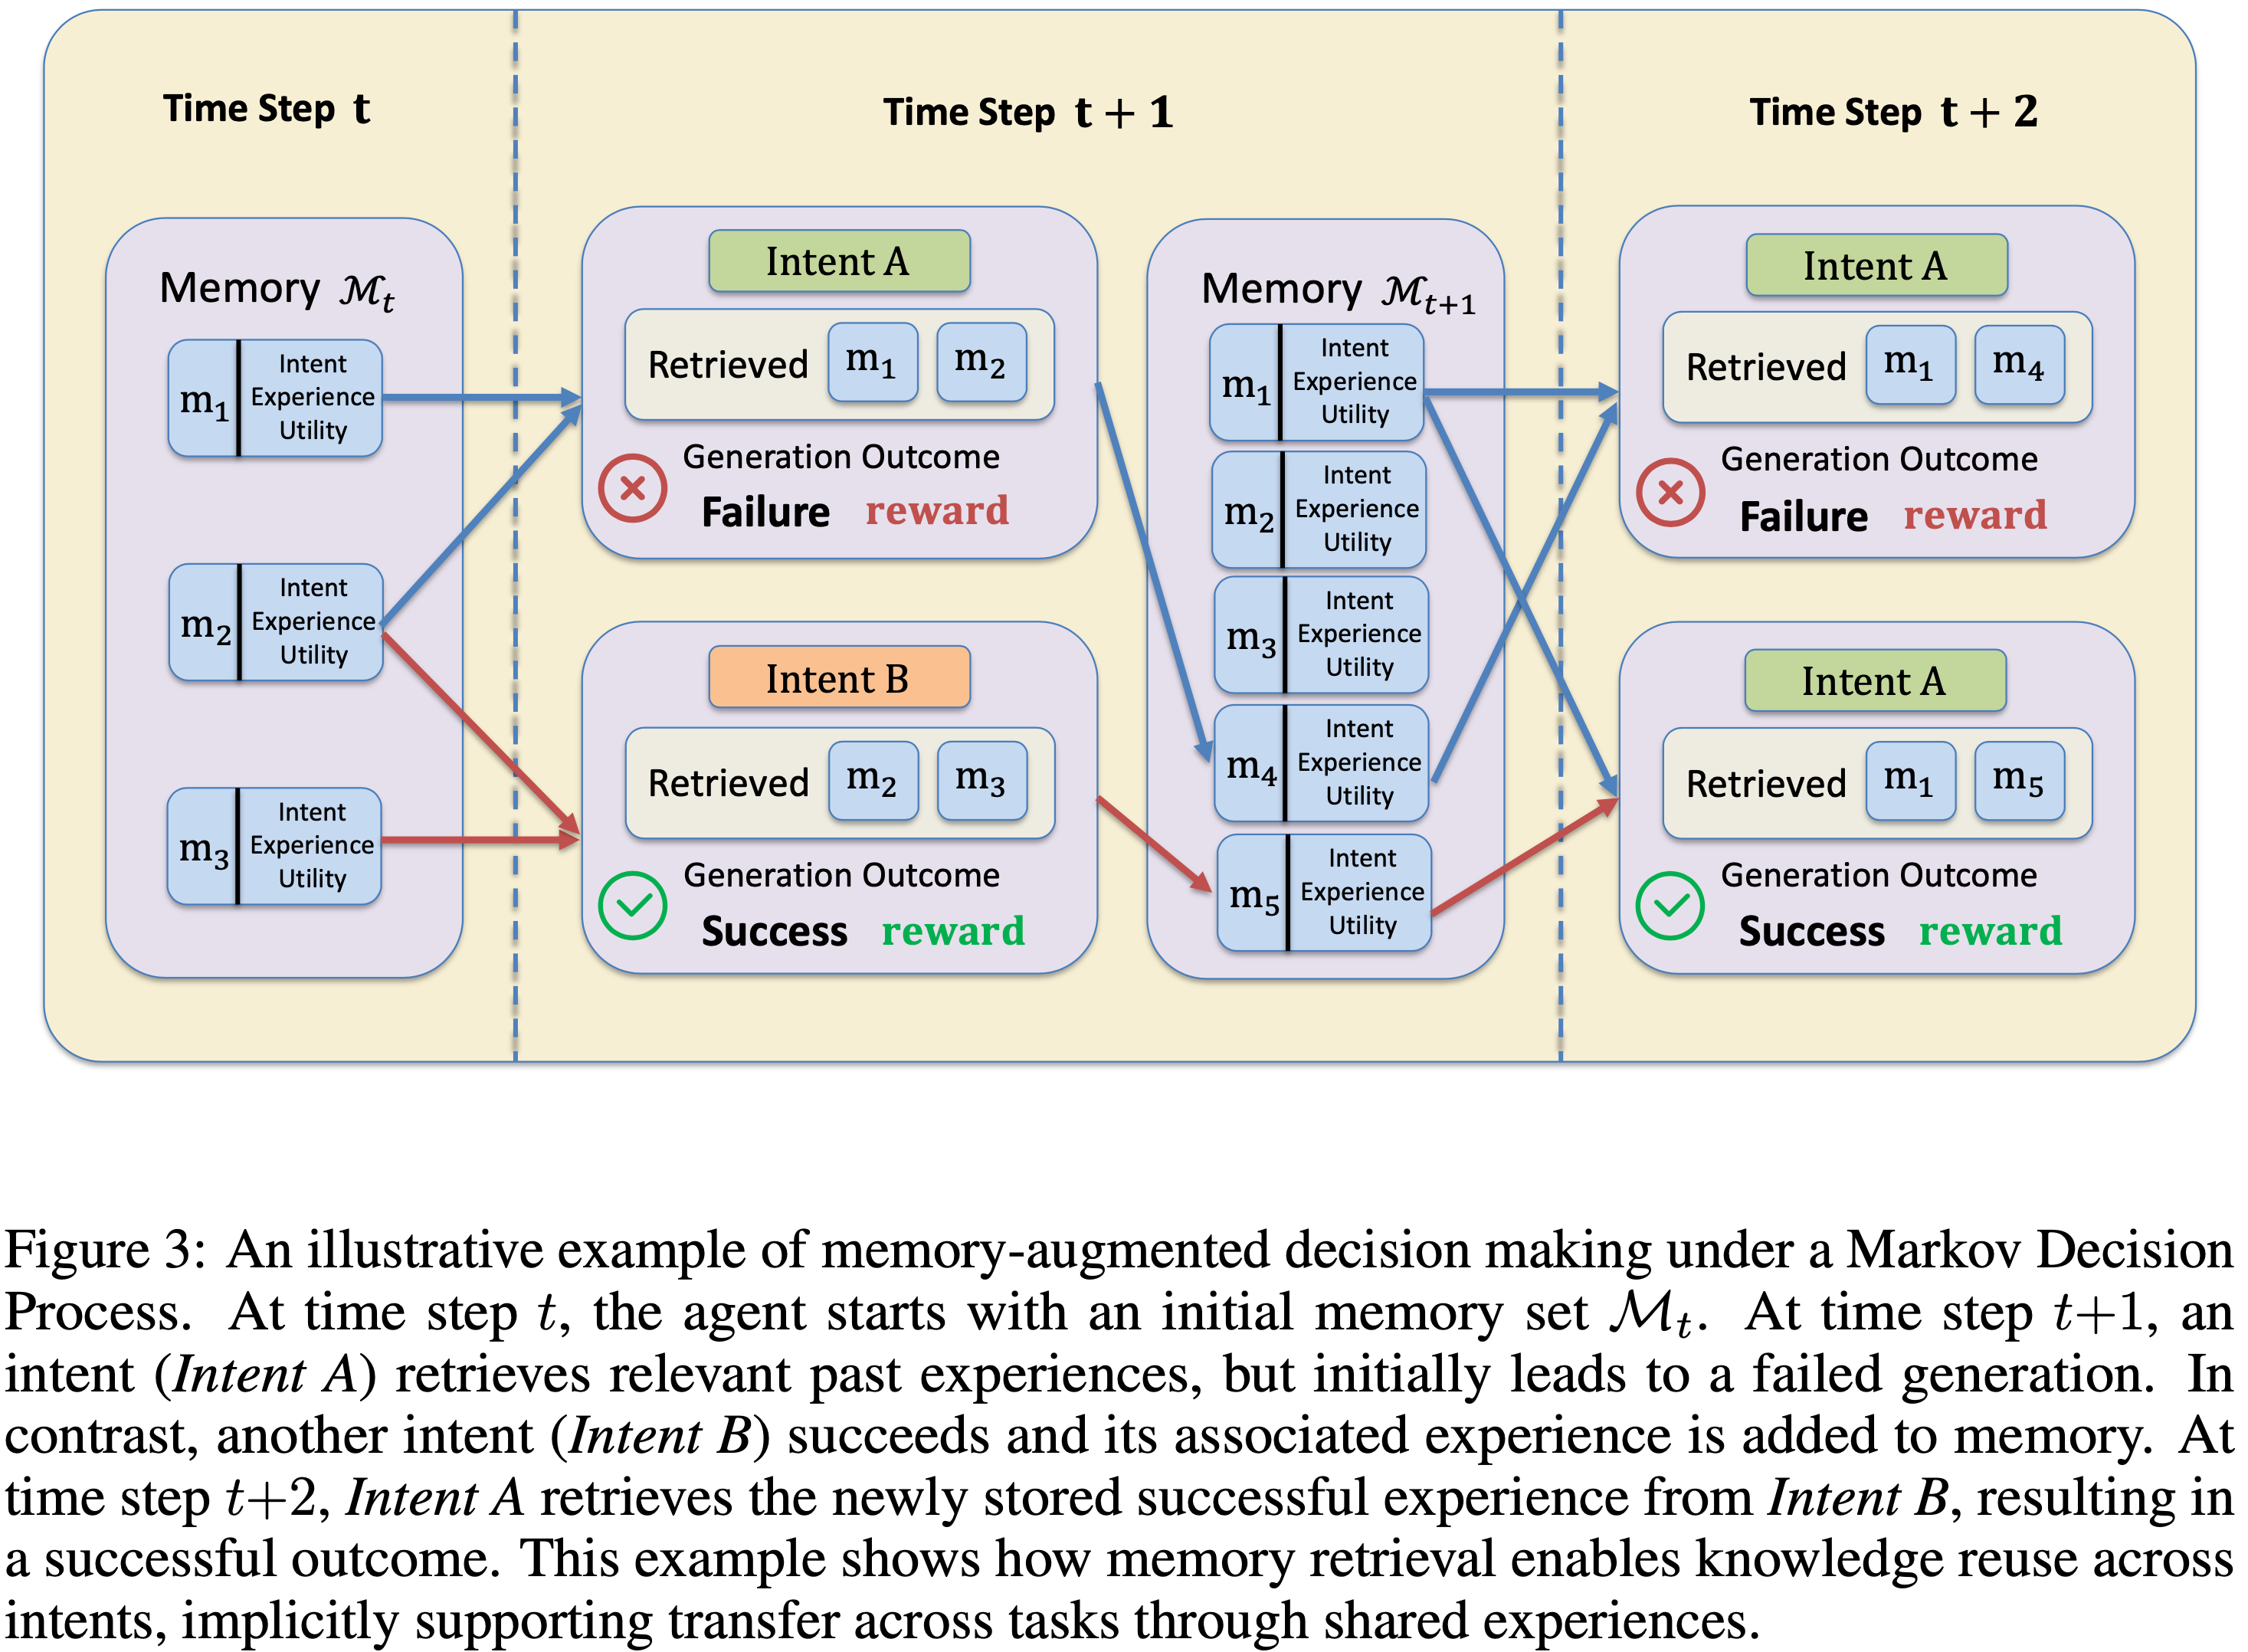
  • 图 3 提供了一个记忆增强决策过程的示例,展示了检索结果和记忆演化如何随时间步骤展开
  • 图 3:马尔可夫决策过程中记忆增强决策的示例
    • 在时间步 \(t\):智能体以初始记忆集 \(\mathcal{M}_t\) 开始
    • 在时间步 \(t + 1\)
      • 意图 A 检索相关的过去经验,但最初导致生成失败
      • 意图 B 成功,其相关经验被添加到记忆中
    • 在时间步 \(t + 2\) ,意图 A 从意图 B 检索新存储的成功经验,resulting in 成功的结果
    • 这个例子展示了记忆检索如何实现跨意图的知识重用,通过共享经验隐式支持跨任务迁移
Memory-Augmented Agent Policy

  • 为了使智能体能够自我演化,论文继承 M-MDP 作为问题形式化 (2025)
  • M-MDP 被正式定义为一个元组
    $$ \langle S, \mathcal{A}, \mathcal{P}, \mathcal{R}, \gamma , \mathcal{M} \rangle$$
    • 其中:
      • \(S\) 表示状态空间
      • \(\mathcal{A}\) 表示 Action 空间
      • \(\mathcal{P}: S \times \mathcal{A} \to \mathbb{R}\) 表示转移动态
      • \(\mathcal{R}: S \times \mathcal{A} \to \mathbb{R}\) 表示奖励函数
      • \(\gamma \in [0, 1)\) 表示折扣因子
      • \(\mathcal{M} = (S \times \mathcal{A} \times \mathbb{R})^*\) 表示包含过去经验的演化记忆空间 (2025)
    • 在此 Setting 中,策略 \(\pi\) 不仅生成 token,而且首先根据检索分布 \(\mu (\cdot |s,M)\) 选择一个记忆上下文 \(m\) ,允许智能体利用历史数据在下游任务中获得更好的性能
  • 论文考虑一个通用智能体在离散时间步上与环境或用户交互
    • 在每个时间步 \(t\) ,智能体接收一个状态 \(s_t\) (例如用户 Query 或任务描述),并可以访问外部 Memory Bank \(\mathcal{M}\)
    • 智能体的目标是生成一个响应 \(y_t\) 以最大化奖励信号
    • 遵循此形式化,记忆增强智能体的行为可以分为两个不同的阶段:检索(Retrieve) 和生成
  • 联合策略 \(\pi (y_t|s_t,\mathcal{M}_t)\) 被定义为所有可能检索到的记忆项上的边际概率(marginal probability) (2025):
    $$\pi (y_t|s_t,\mathcal{M}_t) = \sum_{m\in \mathcal{M}_t}\underbrace{\mu(m|s_t,\mathcal{M}_t)}_{\text{Retrieval Policy} }\cdot \underbrace{p_{\text{LLM} }(y_t|s_t,m)}_{\text{Inference Policy} } \tag{1}$$
    • 注:这里的 \(\mathcal{M}_t\) 指的是时间步 \(t\) 时的 Memory Bank
    • \(\mu (m|s_t,\mathcal{M}_t)\) 表示检索策略(Retrieval Policy) ,它根据当前状态 \(s_t\) 从 Memory Bank \(\mathcal{M}_t\) 中为选择特定记忆上下文 \(m\) (由过去的意图和经验组成)分配概率
    • \(p_{\text{LLM} }(y_t|s_t,m)\) 表示推理策略(Inference Policy) ,通常由一个冻结的大语言模型参数化。它模拟了在给定 Query \(s_t\) 和检索到的上下文 \(m\) 的条件下生成输出 \(y_t\) 的可能性
  • 在之前的 RAG 或基于记忆的智能体范式中,检索策略 \(\mu\) 通常由固定的向量相似性度量决定,例如嵌入向量的余弦相似度
    • 虽然对于语义匹配有效,但此类策略未能考虑记忆的效用,即检索(retrieving) \(m\) 是否真正导致成功的结果 \(y_t\)

Non-Parametric RL

  • 为了克服静态 Similarity-based 检索的局限性,论文通过将记忆检索形式化为一个 Value-based 决策过程来操作 M-MDP 框架
  • 与通过权重更新优化 \(\pi_{\text{LLM} }\) 的参数化方法不同,论文的目标是直接在记忆空间内优化检索策略 \(\mu (m|s,M)\)
  • 论文将抽象的 M-MDP 组件映射到一个特定的意图-经验-效用结构:
From Semantic Matching to Decision Making
  • 论文将状态 \(s\) 实例化为用户意图(User Intent) ,由当前 Query 的嵌入表示封装(encapsulated by the embedding of the current query) (2020)
  • 因此, Action 空间 \(\mathcal{A}_t\) 变得动态且离散,对应于从当前 Memory Bank \(\mathcal{M}_t\) 中选择特定的 \(m\)
    • 注意:这里说的是 Action 空间是离散的(且动态变化的),状态空间是 Embedding,理论上是连续的,空间无限
    • 问题:Embedding 是连续的吧?状态空间是否过大了?
  • 在此形式化下,从记忆中检索不再是一个被动的匹配任务,而是一个主动的 Action \(a_t = m\) ,用于增强生成器 (2025)
Defining Utility via Q-Values
  • 论文框架的核心是从估计语义相关性转向估计功能效用
  • 论文将 State-Action 值函数 \(Q(s,m)\) 定义为对与 \(s\) 相似的意图应用检索到的上下文 \(m\) 的预期效用
    • MemRL 的目标是学习一个最优的检索策略 \(\mu^*\) ,该策略选择最大化此预期效用的上下文:
      $$\mu^{*}(m|s,M) = \arg \max_{m\in \mathcal{M} }Q(s,m) \tag{2}$$
    • 这个 Q 值充当一个 Critic ,区分高价值策略与可能具有高语义相似性的不相关噪声
Non-Parametric Learning
  • 由于在论文的 Setting 中,检索策略 \(\mu\) 的 Action 空间与大语言模型的生成空间解耦,我们可以在不修改大语言模型权重的情况下进行学习
  • 在接收到环境反馈 \(r\) (例如执行成功)后,我们可以使用时序差分 (Temporal-Difference, TD) 误差 (Sutton, 1988) 来更新检索到的记忆上下文的 Q 值:
    $$Q(s,m)\gets Q(s,m) + \alpha [r + \gamma \max Q(s’,m’) - Q(s,m)] \tag{3}$$
    • 其中 \(\alpha\) 是学习率
    • 这种贝尔曼式 (Bellman-style) 备份允许效用估计随时间收敛到真实的预期回报 (Bellman, 1966)
    • 通过在记忆结构中显式地维护和更新这些 Q 值, MemRL 提供了一种具有理论保证的非参数学习方式,使智能体能够通过交互自我演化其能力
    • 问题:状态空间无穷大的情况下,不能使用 TD-Error 更新吧

MemRL

  • 基于第 3 节定义的 M-MDP 公式,论文提出了 MemRL,一个使冻结的 LLM 能够通过非参数强化学习进行自我演进的框架
  • MemRL 不修改模型权重 \(\theta\),而是在演进的记忆空间内优化检索策略 \(\mu (m|s, \mathcal{M})\)
  • 如图 4 所示,该框架由三个核心组件组成:
    • (i) 一个结构化的意图-经验-效用 Memory Bank
    • (ii) 一个将语义召回与价值感知选择解耦的两阶段检索机制
    • (iii) 一个稳定 Q 值估计的运行时效用更新规则
  • 图 4:MemRL 框架概览
    • (Top)端到端学习循环:给定 Query \(s\),智能体从记忆 \(\mathcal{M}\) 中检索上下文 \(\mathbf{m}_{c t x}\) ,生成输出 \(y\),并基于奖励 \(R\) 更新记忆值 \(Q\)
    • (Bottom Left)两阶段检索:候选者通过相似性被召回,然后使用学习到的 Q 值重新排序
    • (Bottom Right)效用更新:记忆值 \(Q\) 使用环境奖励进行更新,以区分功能效用和语义相似性
Memory Structure: The Intent-Experience-Utility Triplet

  • 为了支持 Value-based 决策,论文将外部记忆 \(\mathcal{M}\) 结构化为不仅仅是键值对,而是一组三元组:
    $$
    \mathcal{M} = \{(z_i,e_i,Q_i)\}_{i = 1}^{|\mathcal{M}|}, \tag{4}
    $$
    • \(z_{i}\) 代表意图嵌入(Intent Embedding)(例如, Query 或任务描述的向量表示)
    • \(e_{i}\) 存储原始经验(Experience)(例如,成功的解决方案轨迹)
    • \(Q_{i} \equiv Q(z_{i}, e_{i})\) 表示习得的效用(Utility)
    • \(Q_{i}\) 近似于将经验 \(e_{i}\) 应用于与 \(z_{i}\) 相似的意图的预期回报,在 RL 公式中充当 Critic
      • 理解:这里强调是相似意图,不是意图本身,蕴含了后续是基于相似度来检索意图的(类似 RAG)

Two-Phase Retrieval: From Semantic Recall to Value-Aware Seletion

  • 标准的 RAG 或记忆系统仅依赖于语义相似性,隐含地假设“相似意味着有用”
    • 但在智能体任务中,语义相关的上下文可能编码了脆弱、特定于环境的例程,无法泛化 (2025; 2024; 2024; 2024)
  • 为了解决这个问题,MemRL 实施了一种两阶段检索策略,首先通过相关性过滤候选,然后再通过效用过滤
Phase A: Similarity-Based Recall
  • 给定当前 Query 状态 \(s\),论文首先隔离(isolate)一个语义一致的经验候选池 \(C(s)\),以确保检索在上下文上是相关的
  • 具体方法是计算余弦相似度 \(sim(s,z_i)\) 并过滤 Memory Bank :
    $$
    \mathcal{C}(s) = \text{TopK}_{k_1}(\{i|sim(s,z_i) > \delta \} ,\text{by}sim) \tag{5}
    $$
    • 其中 \(\delta\) 是一个稀疏度阈值
    • 此阶段充当粗过滤器,将搜索空间从整个记忆 \(\mathcal{M}\) 缩小到相关子集 \(\mathcal{C}(s)\)
    • 值得注意的是,如果 \(\mathcal{C}(s) = \emptyset\), MemRL 不注入任何记忆,仅依赖冻结的 LLM 进行更广泛的探索
Phase B: Value-Aware Selection
  • 为了从 \(\mathcal{C}(s)\) 中选择最优上下文,论文纳入了习得的效用 \(Q\)
  • 论文定义了一个复合评分函数,以平衡探索(通过语义匹配)和利用(通过高效用历史):
    $$
    \text{score}(s,z_i,e_i) = (1 - \lambda)\cdot \hat{sim}(s,z_i) + \lambda \cdot \hat{Q}(z_i,e_i) \tag{6}
    $$
    • Remind:
      • \(z_{i}\) 代表 Intent Embedding ,即之前已经存储下来的意图
      • \(e_{i}\) 存储原始 Experience ,即待检索的候选 Memory
    • 其中 \(\hat{\cdot}\) 表示在候选池内进行 z-score 归一化,\(\lambda \in [0,1]\) 调节权衡
      • 当 \(\lambda \rightarrow 1\) 时,策略优先考虑已验证的效用;
      • 当 \(\lambda \rightarrow 0\) 时,它恢复到标准的 Similarity-based 检索
    • 最终的上下文 \(\mathcal{M}_{ctx}(s)\) 由最大化此分数的前 \(k_{2}\) 项组成:
      $$
      \mathcal{M}_{ctx}(s) = \text{TopK}_{k_2}(\mathcal{C}(s),\text{by score}). \tag{7}
      $$
    • 这种机制有效地过滤掉了“干扰性”记忆,那些语义相似但历史上产生低回报(低 Q 值)的记忆
  • 论文将在第 5.3.3 节进一步验证归一化和相似度阈值的必要性,证明 z-score 归一化和严格的相似度阈值对于过滤噪声和在自我演进过程中保持低遗忘率至关重要

Runtime Learning: Non-Parametric RL on Memory

  • MemRL 的核心是基于环境反馈持续改进 Q 值,使智能体能够“记住”有效的方法
  • 在运行时, MemRL 完全在记忆空间中进行学习
  • 重点1:奖励信号获取:
    • 完成一项任务后,智能体收到 **环境奖励信号 \(r\)**(例如,执行成功、用户反馈或标量任务分数)
  • 重点2:对于已有记忆的价值更新:
    • 对于实际注入到上下文 \(\mathcal{M}_{ctx}(s)\) 中的记忆 ,论文使用蒙特卡洛风格的规则更新其三元组中的效用:
      $$
      Q_{\text{new} }\leftarrow Q_{\text{old} } + \alpha \big(r - Q_{\text{old} }\big). \tag{8}
      $$
      • 理解:上面式子的更新是针对 已有(被检索出来)的 Memory 的
      • 通过将 \(s’\) 设为终止状态,公式 8 作为公式 3 的自然简化版本,与 (2025) 共享相似的单步 MDP 公式
      • 此更新驱动 \(Q_{\text{new} }\) 趋近于在相似意图下使用经验 \(e_i\) 的经验预期回报
  • 重点3:对于新采样轨迹的添加:
    • 对于每个采样的轨迹,论文使用 LLM 来总结经验 (理解:经验是通过 LLM 总结出来的,不是原始的 Rollout)
    • 将其作为新的三元组 \((z(s),e_{\text{new} },Q_{\text{init} })\) 写回 Memory Bank ,从而在不断扩展经验的同时保持 LLM 参数不变
      • 注:这里的 \(z(s)\) 表示从 \(s\) 中提出取来的意图

Cognitive Interpretation

  • MemRL 提供了建构性情景模拟的算法类比 (2007)
    • 阶段 A 通过回忆语义相似的过去事件来实施类比迁移 (1983)
    • 阶段 B 类似于心理预演 (2004),通过使用习得的效用估计在回忆的候选中进行选择,有效地倾向于预期带来更高回报的策略
  • 最后,公式 8 实现了一种记忆再巩固形式 (2016):
    • 一旦记忆被检索和应用,其效用会根据后续结果得到强化或减弱
  • 这些组件共同实现了 Stability-plasticity 平衡:
    • 冻结的 LLM 保持稳定的认知推理,而演进的记忆效用则为持续适应提供了可塑性的渠道

Stability Analysis

  • 论文从强化学习的角度分析 MemRL 的稳定性,重点关注存储在记忆中的效用估计的收敛行为
  • 与经典的值迭代不同, MemRL 使用恒定步长更新进行非参数运行时学习
  • 论文表明,在温和且现实的假设下,习得的效用值在期望上收敛于记忆有效性的稳定估计,且方差有界
Setup
  • 在每个时间步 \(t\),智能体观察一个意图状态 \(s_{t}\),检索一个记忆项 \(m_{t} \in \mathcal{M}_{t}\),生成一个输出 \(y_{t}\),并接收一个标量奖励 \(r_{t} \in [- 1,1]\) 指示任务成功或失败
    • 生成策略遵循公式 1 中定义的分解,其中 \(\mu\) 表示检索策略,\(p_{\text{LLM} }\) 是冻结的推理策略
  • 对于每个检索到的记忆, MemRL 使用公式 8 中表述的指数移动平均规则更新其效用,学习率为 \(\alpha \in (0,1]\)
  • 为了分析清晰,论文考虑一个固定的状态-记忆对 \((s,m)\) 并记 \(Q_{t} \equiv Q_{t}(s,m)\)
Stationary Reward Assumption
  • 论文在固定数据集上分析学习过程,并提出两个确保环境稳定性的关键条件:
    • 1)冻结推理策略(Frozen Inference Policy) :\(p_{\text{LLM} }(y|s,m)\) 的参数和评估器的标准是固定的
    • 2)固定任务分布(Fixed Task Distribution) :任务 \(s\) 是从一个固定数据集的平稳分布中抽取的
  • 这些假设保证了学习目标是明确定义的:任何特定任务-记忆对(specific task-memory pair)的预期奖励是时不变的(time-invariant)
  • 因此,论文有:
    $$
    \mathbb{E}{[r_t|s_t = s,\mathcal{M}_t = m]} = \beta (s,m). \tag{9}
    $$
Expected Convergence of Utility Estimates
Theorem 1
  • 令 \(\{Q_{t}\}\) 根据公式 8 中的规则更新,恒定步长 \(\alpha \in (0,1]\)
  • 如果公式 9 成立且对 \((s,m)\) 无限次更新,则:
    $$
    \lim_{t\to \infty}\mathbb{E}{[Q_t]} = \mathbb{E}{[r_t|s_t = s,\mathcal{M}_t = m]} = \beta (s,m). \tag{10}
    $$
  • 此外,收敛速率是指数级的:
    $$
    \mathbb{E}{[Q_t]} - \beta (s,m) = (1 - \alpha)^t (Q_0 - \beta (s,m)). \tag{11}
    $$
Proof of Theorem 1
  • 定义估计误差
    $$ e_{t} \triangleq Q_{t} - \beta (s,m) $$
  • 基于公式 8 的更新规则,误差递推关系为:
    $$
    e_{t + 1} = (1 - \alpha)e_{t} + \alpha (r_{t} - \beta (s,m)).
    $$
  • 给定 历史 \(\mathcal{F}_{t}\) 的条件期望并利用公式 9,论文得到:
    $$
    \mathbb{E}{[e_{t + 1}|\mathcal{F}_t]} = (1 - \alpha)e_t.
    $$
    • 注:附录 A.1 中会提到,其中 \(\mathcal{F}_{t}\) 定义为截至时间 \(t\) 的 filtration (history)
  • 取完全期望(full expectation)得:
    $$
    \mathbb{E}{[e_{t + 1}]} = (1 - \alpha)\mathbb{E}{[e_t]}.
    $$
  • 迭代递归得 \(\mathbb{E}{[e_t]} = (1 - \alpha)^t e_0\),当 \(t \to \infty\) 时收敛于零
  • 论文在附录 A.1 中提供了收敛证明的详细推导
Bounded Variance and Stability
  • 如果奖励方差 \(\text{Var}(r_t|s,m) < \infty\),则 \(Q_{t}\) 的方差保持有界:
    $$
    \lim_{t\to \infty}\text{Var}(Q_t)\leq \frac{\alpha}{2 - \alpha}\text{Var}(r_t|s,m). \tag{12}
    $$
  • 因此,恒定步长更新不会引起无界振荡;
    • 相反,它们产生稳定的效用估计,这些估计跟踪预期的记忆有效性,同时过滤高频噪声
  • 论文在附录 A.2 中明确推导了方差界限,以证明在任务聚类下估计量的全局稳定性
Global Stability via EM Convergence
  • 局部估计(定理 1)的稳定性扩展到全局记忆效用 \(Q(m)\)。根据期望的线性性质,\(Q(m)\) 充当蒙特卡洛积分器,力图收敛于:
    $$
    \lim_{t\to \infty}\mathbb{E}{[Q_t(m)]} = \mathbb{E}{[r|m]} = \sum_{s\in \mathcal{S}(m)}\frac{\mathbb{E}{[r|s,m]}}{\text{Stationary} }\frac{\text{Pr}(s|m)}{\text{Retr}\text{ive}\text{-}\text{Dep}\text{end}\text{ent} }. \tag{13}
    $$
    • 其中 \(\mathcal{S}(m) \triangleq \{s \in \mathcal{S} | \text{sim}(s, z_m) \geq \tau_A \}\) 表示记忆 \(m\) 的有效支持集,包含所有与记忆意图嵌入 \(z_m\) 足够相似以满足阶段 A 检索准则的任务意图 \(s\)
  • 这里出现了一个理论挑战:权重项 \(\text{Pr}(s|m)\) 是一个由检索策略 \(\mu (m|s; \mathcal{M})\) 支配的潜在变量,而该策略本身随着 \(Q\) 值的演变而变化
    • 为了证明尽管存在这种依赖关系仍然收敛,论文将 MemRL 分析为一个广义期望最大化过程 (1977; 1998)
    • 从变分的角度来看,该系统在全局目标函数 \(\mathcal{J}(Q, \mu)\)(预期奖励的变分下界)上执行坐标上升:
      • (i) E 步(策略改进) :阶段 B 的排序更新检索策略 \(\mu\) 以与当前估计保持一致,相对于 \(\mu\) 单调增加 \(\mathcal{J}\);
      • (ii) M 步(值更新) :效用更新(公式 8)相对于 \(Q\) 增加 \(\mathcal{J}\)
    • 根据单调改进定理 (1998),这种交替优化保证了系统收敛到一个平稳点,在该点检索策略稳定 \((\mu_{t + 1} \approx \mu_t)\)
      • 因此,诱导的分布 \(\text{Pr}(s|m)\) 变得时不变,确保公式 13 成立,并通过将更新锚定在稳定策略上来有效防止灾难性遗忘
      • 更多细节可在附录 B 中找到

Experiments

Experimental Setup

Baselines
  • 论文在统一的冻结主干模型设置(a unified frozen-backbone setting)下,将 MemRL 与一套全面的记忆增强基线方法进行比较,以分离出记忆机制的贡献:
    • 1)RAG-based Approaches :RAG (2020) 和 Self-RAG (2023),分别代表标准的语义检索和基于批判的过滤
    • 2)智能体记忆(Agentic Memory) :MemO (2025) 和 MemP (2025),它们引入了结构化的读/写操作或过程性记忆蒸馏
    • 3)Test-Time Scaling: :Pass@k 和 Reflexion (2023),后者在 \( k \) 轮内应用迭代式的自我精炼
Benchmarks
  • 论文在四个多样化的基准测试上评估 MemRL 和基线方法:
    • 用于代码生成的 BigCodeBench (2025)
    • 用于具身导航的 ALFWorld (2021)
    • 用于操作系统/数据库交互的 Lifelong Agent Bench (2025)
    • 用于多学科复杂推理的 Humanity’s Last Exam (HLE) (2025)
  • 论文在两种不同的设置下评估论文的 MemRL 和基线方法:
    • 运行时学习(Runtime Learning) ,评估在训练会话中学习和适应的能力;
    • 迁移学习(Transferring) ,评估习得记忆在未见任务上的泛化能力
Runtime Learning Results
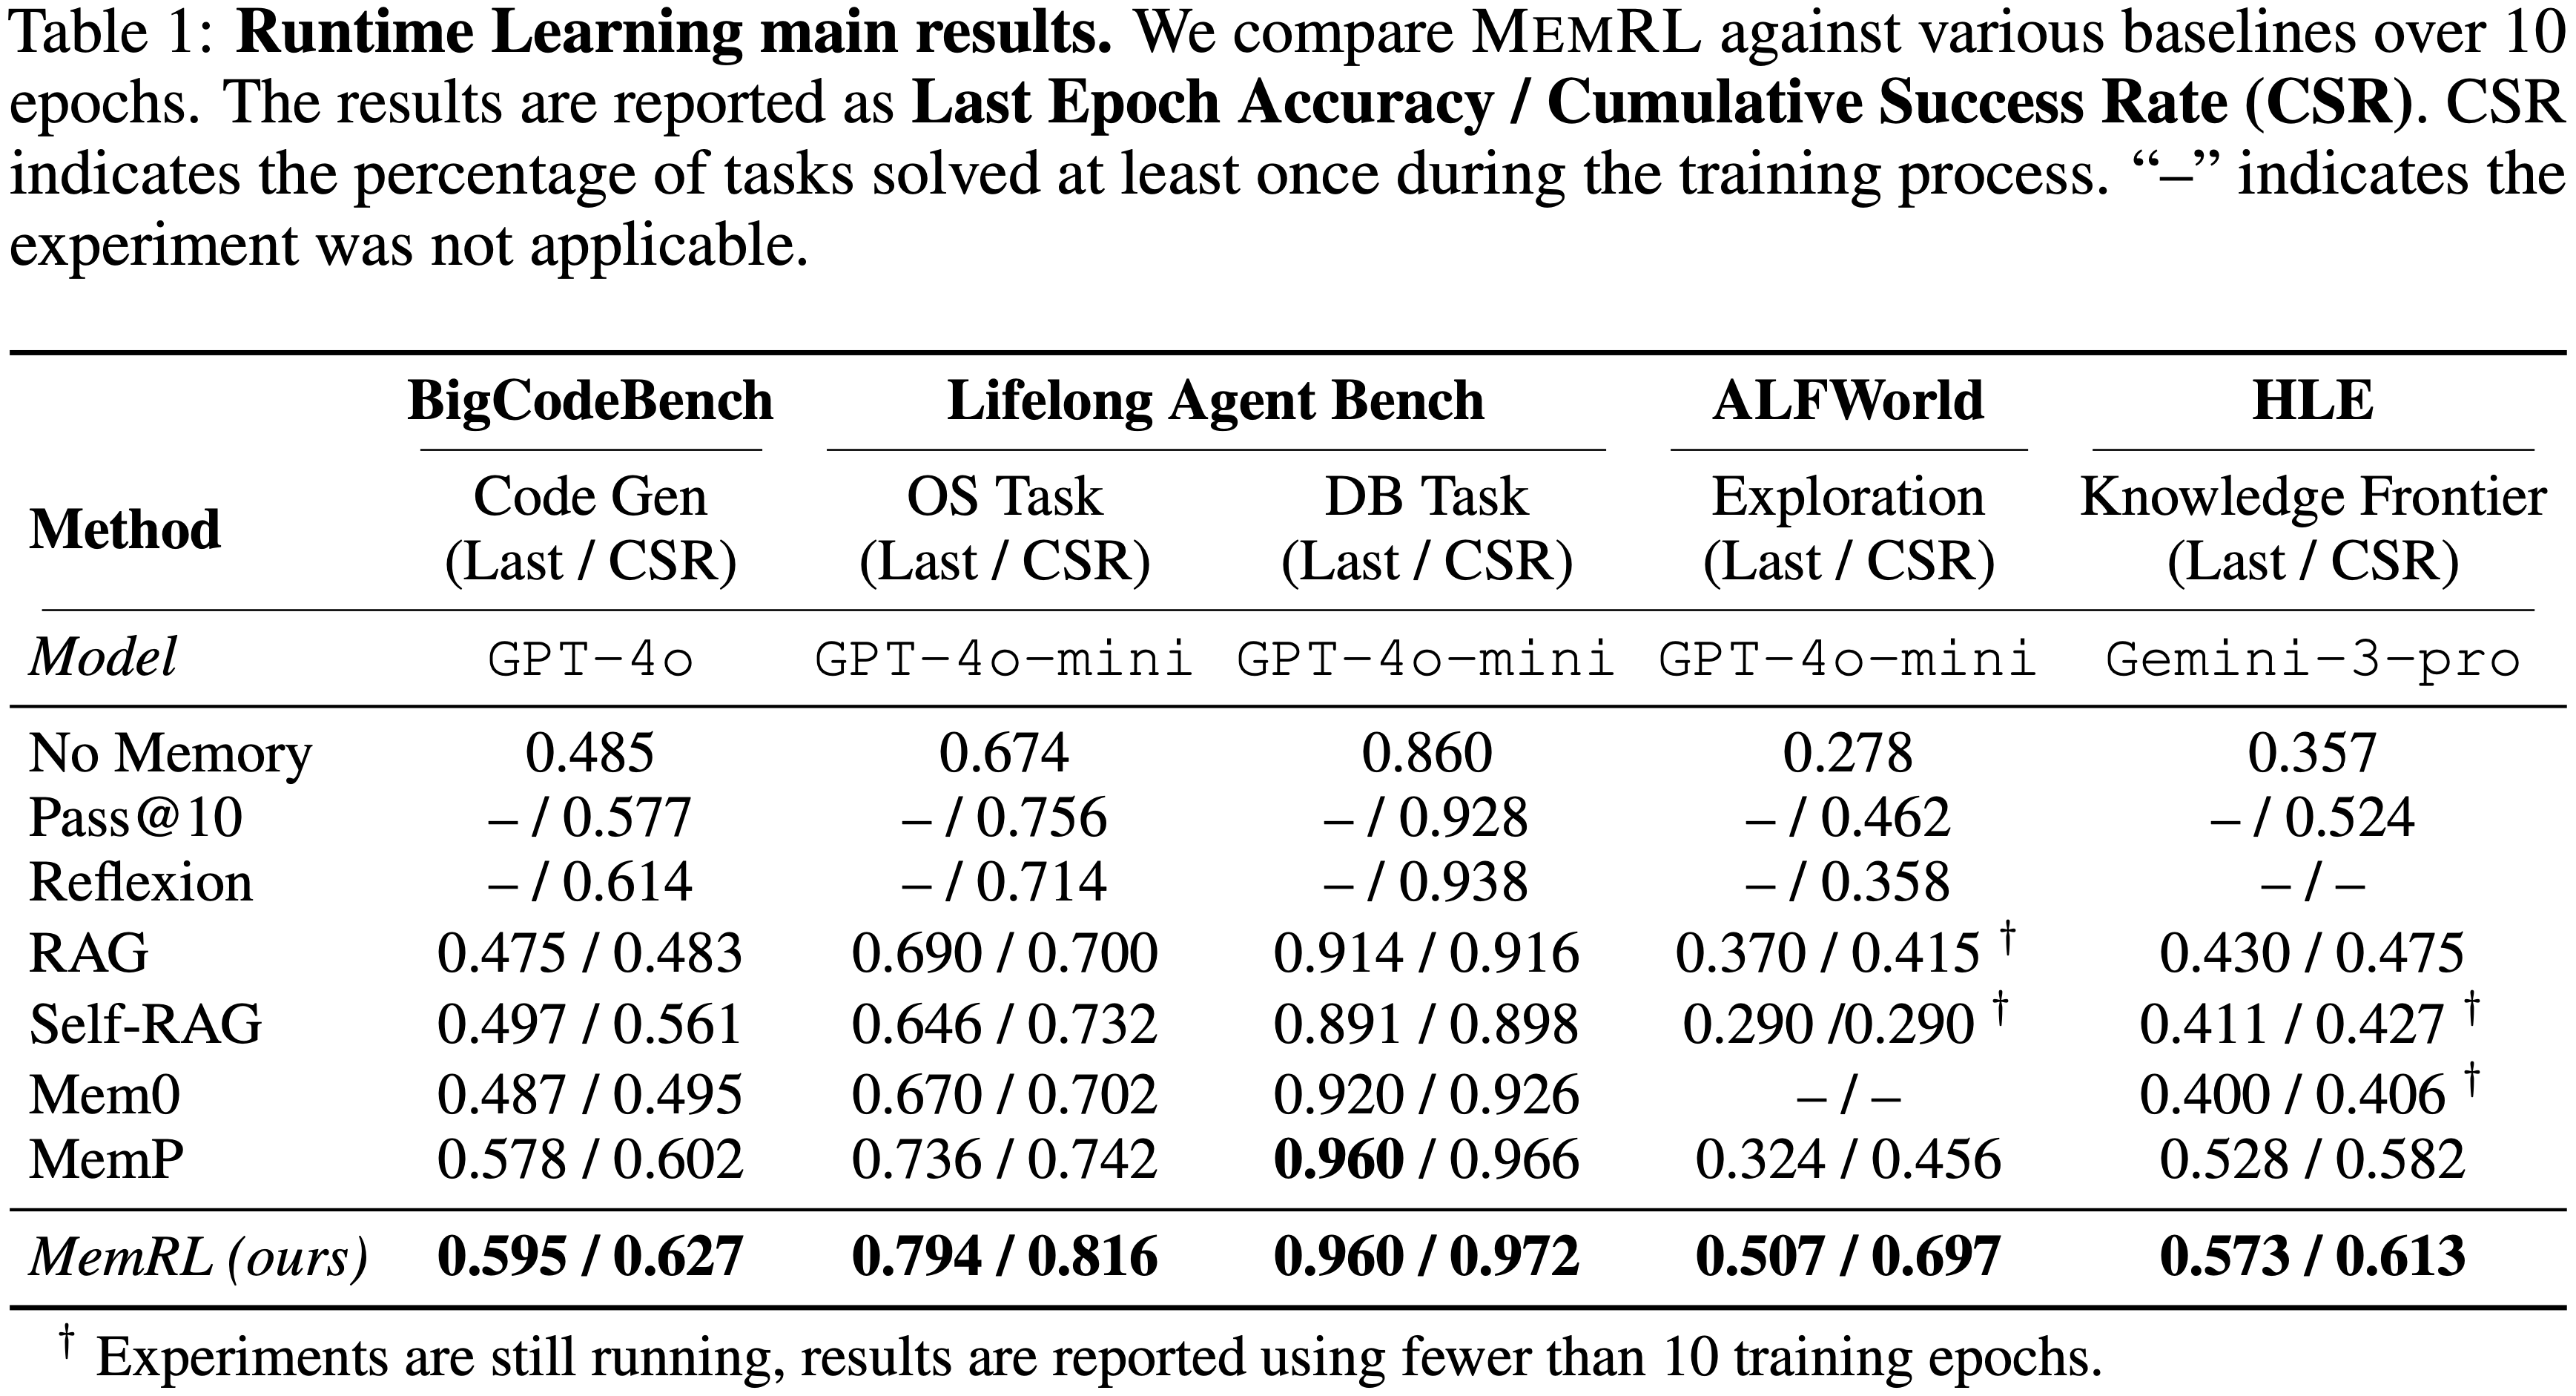
  • 表 1 报告了超过10个训练周期的最终 Epoch 准确率(Last Epoch Accuracy)和累计成功率(Cumulative Success Rate, CSR)
    • MemRL 在所有领域均持续优于所有基线方法
      • 这验证了非参数价值估计能够有效引导自我进化
    • 价值感知检索(value-aware retrieval)的优势在 ALFWorld 这类探索密集型环境中最为显著
      • 在 ALFWorld 上,MemRL 取得了 0.507 的优异最终 Epoch 准确率,相对于 MemP(0.324)和“无记忆”基线(0.278)分别实现了约 56% 和 82% 的相对提升
      • ALFWorld 中高达 0.697 的 CSR 表明,RL 组件有效地鼓励了智能体去探索并发现复杂任务的解决方案,而 Similarity-based 检索方法通常无法解决这些任务
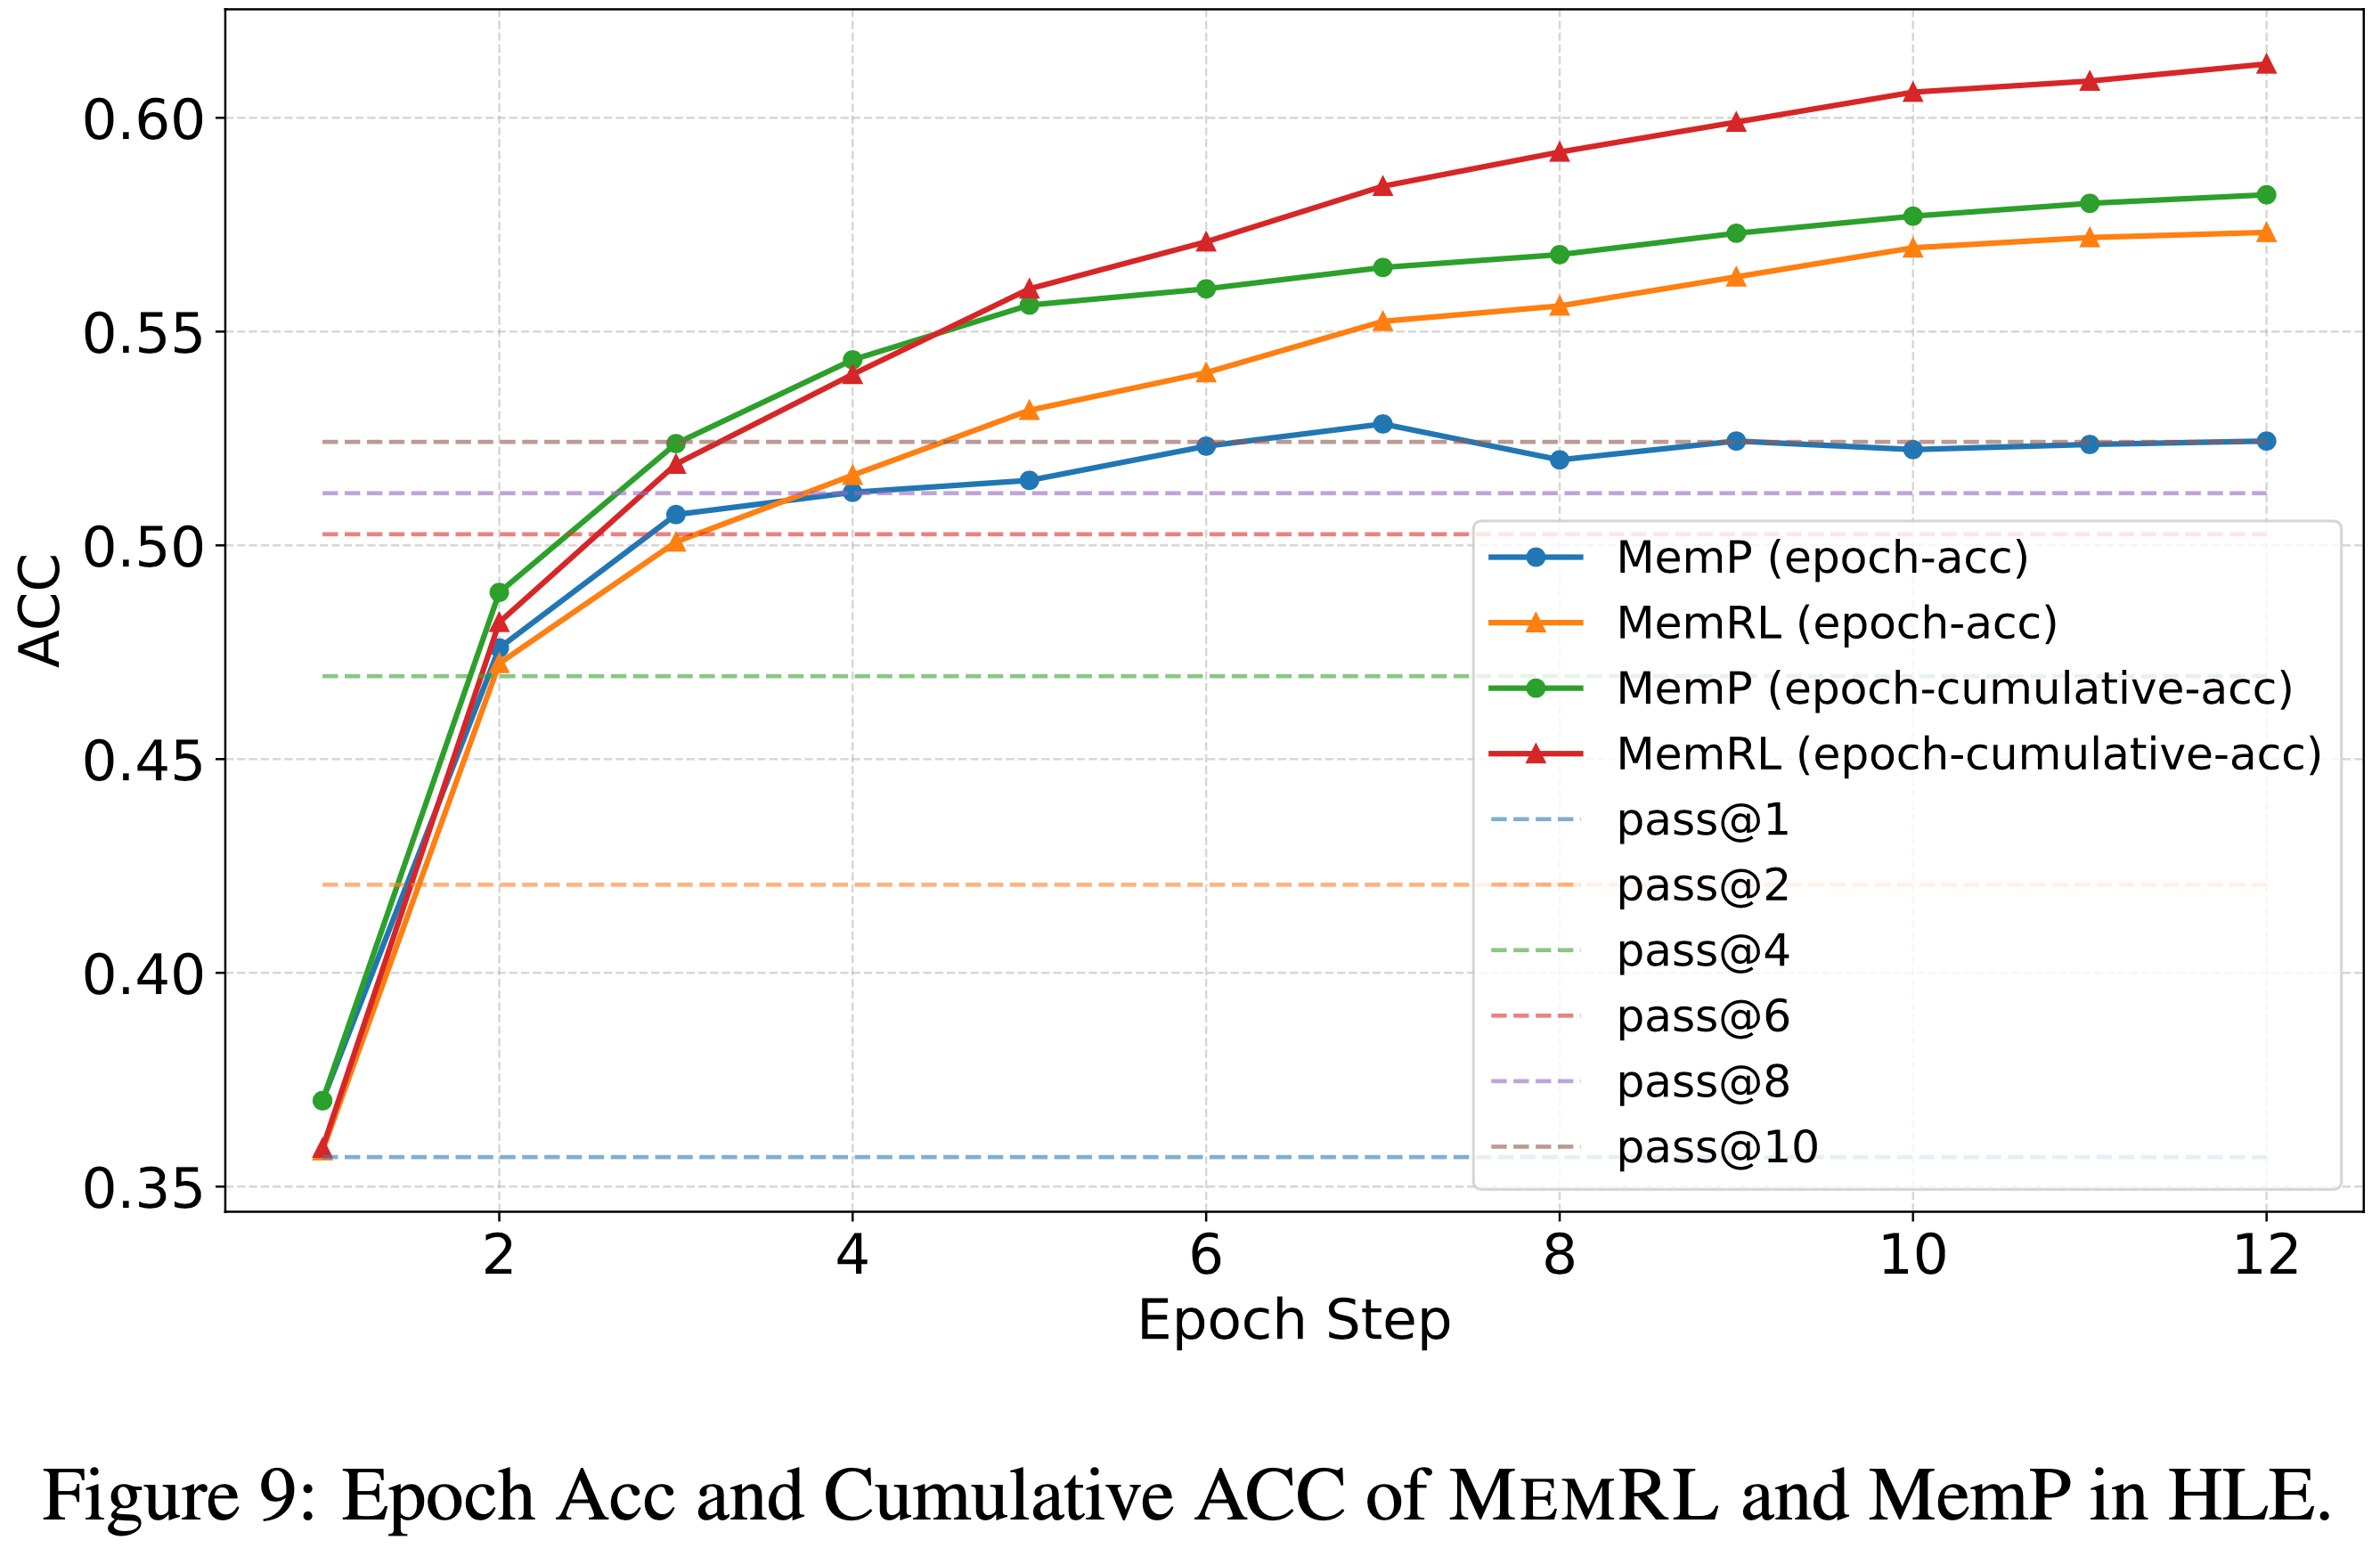
    • 在具有挑战性的 Knowledge Frontier HLE 基准测试中,相较于 MemP 的 0.528,MemRL 将最终准确率提升至 0.573,其 CSR 甚至达到了惊人的 61.3%
  • 将这些收益与 BigCodeBench 等单轮任务进行比较,揭示了一个重要趋势:性能提升与任务结构复杂性相关
  • MemRL 的优势在以深度探索和高过程可转移性(procedural transferability)为特征的环境中(例如 ALFWorld)最大化,而在结构复用较少的任务中,优势幅度则较窄
    • 这表明我们的价值驱动机制特别擅长从探索轨迹(exploratory trajectories)中提炼并迁移复杂的问题解决模式
  • Overall,CSR 和最终准确率的同时提升表明,MemRL 不仅在探索过程中发现了高质量的解决方案,而且能够有效地保留和检索它们,以实现稳定的性能
Transferring Results
  • 通过在训练后冻结记忆库并在保留集(30% split)上进行测试来评估记忆的可迁移性
  • 如表 2 所示,与基线方法相比,MemRL 展现出更优异的泛化能力
    • 在 BigCodeBench 上,MemRL 达到了 0.508 的最高准确率,优于 Self-RAG(0.500)和标准 MemP(0.494)等高级检索方法
    • 在操作系统控制任务(Lifelong Agent Bench)中,MemRL 获得了 0.746 的准确率,相比标准 RAG 基线(0.713)有显著提升
    • 与运行时结果一致,在 ALFWorld 中收益显著,MemRL 达到了 0.479,明显优于 MemP(0.421)和 RAG(0.336)
    • 这些结果验证了 MemRL 中的价值感知检索(Value-Aware Retrieval)和非参数强化学习机制并不仅仅是过拟合训练实例;
      • instead,它过滤了低价值记忆,保留了高效用经验,从而促进了向未见任务的泛化

Ablations

Effectiveness of Runtime RL
  • 为了分离出运行时强化学习的效果,论文在操作系统交互环境中,比较了带有和不带有强化学习组件(即 MemP 对比 MemRL 以及 RAG 对比 MemRL (RAG))的记忆机制
  • 图 5a 展示了成功率随训练轮次的变化情况
    • 虽然强化学习增强(enhancement)在初始阶段带来的增益有限,但随着训练的进行,性能差异明显扩大
    • MemRL 在后续轮次中持续优于原始的 MemP 基线,表现出更平滑的学习曲线和更少的性能回退
    • 这种稳定性表明,强化学习驱动的价值函数有效缓解了噪声记忆的干扰,而噪声记忆常常困扰基于静态相似性的检索方法
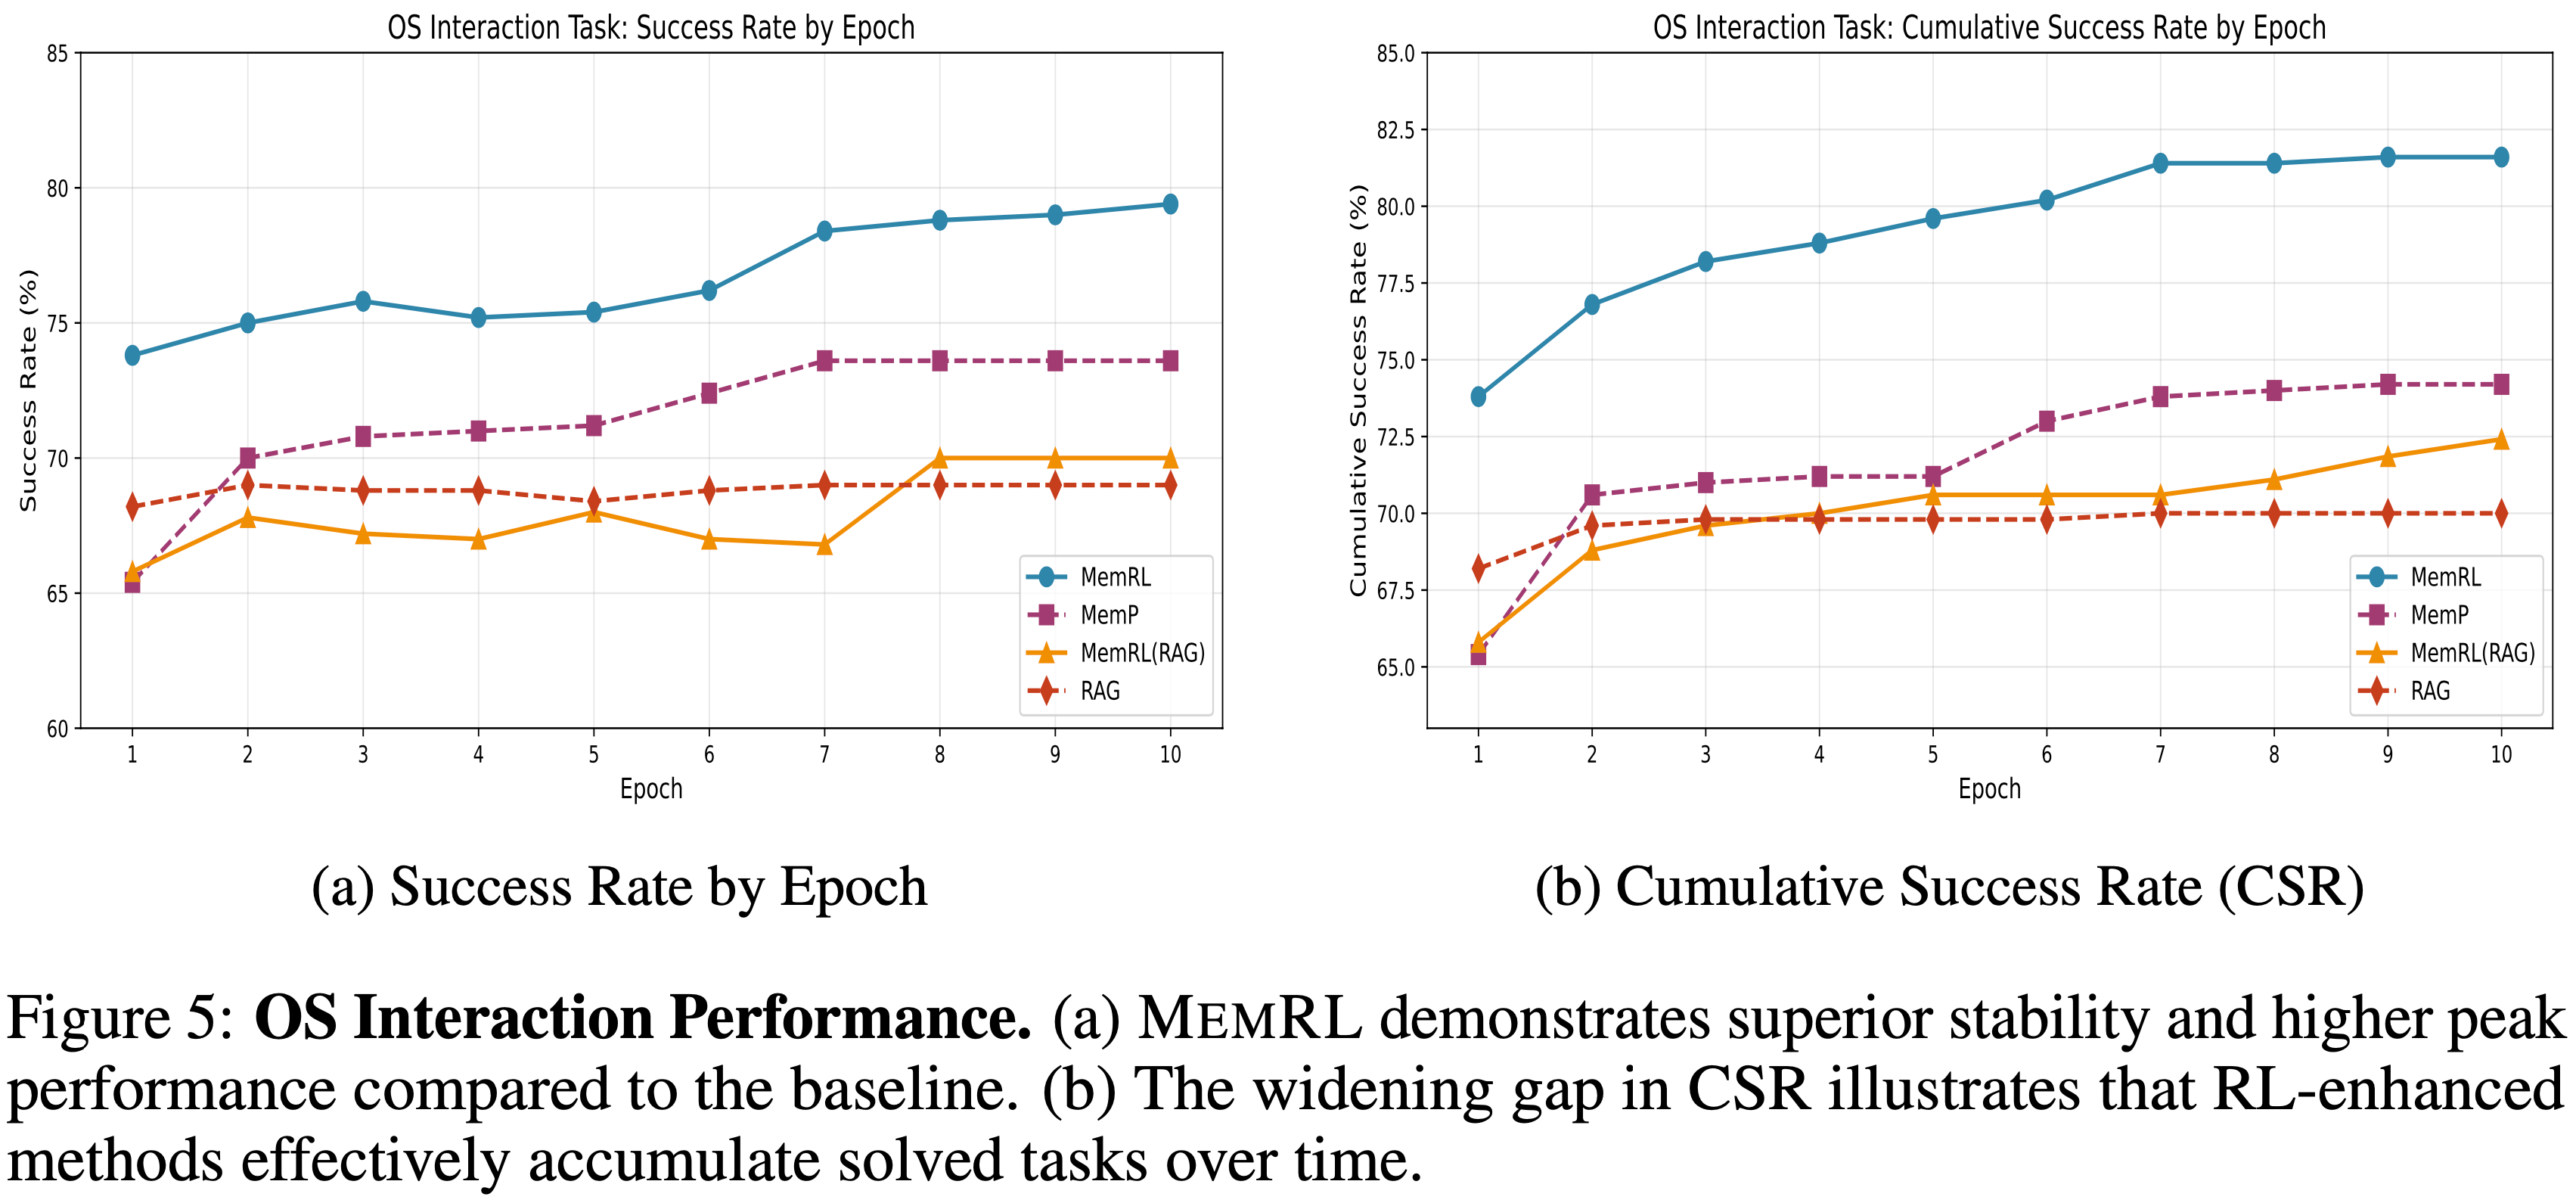
  • 论文进一步分析了图 5b 中的 CSR Cumulative Success Rate ,它衡量了智能体在训练过程中至少成功解决过一次不同任务的能力
    • 在这里,强化学习的好处更加明显
    • MemRL 和 MemRL (RAG) 最终达到的 CSR 分别优于其对应方法 MemP 和 RAG
    • 图 5a 中性能差距的单调扩大表明,运行时强化学习显著增强了智能体从早期失败中恢复的能力
    • 通过优先考虑具有高期望效用的记忆,智能体有效减轻了噪声记忆的干扰,并巩固了成功的经验,将短暂的探索转化为稳健、可重复的能力
Impact of Q-value Weighting
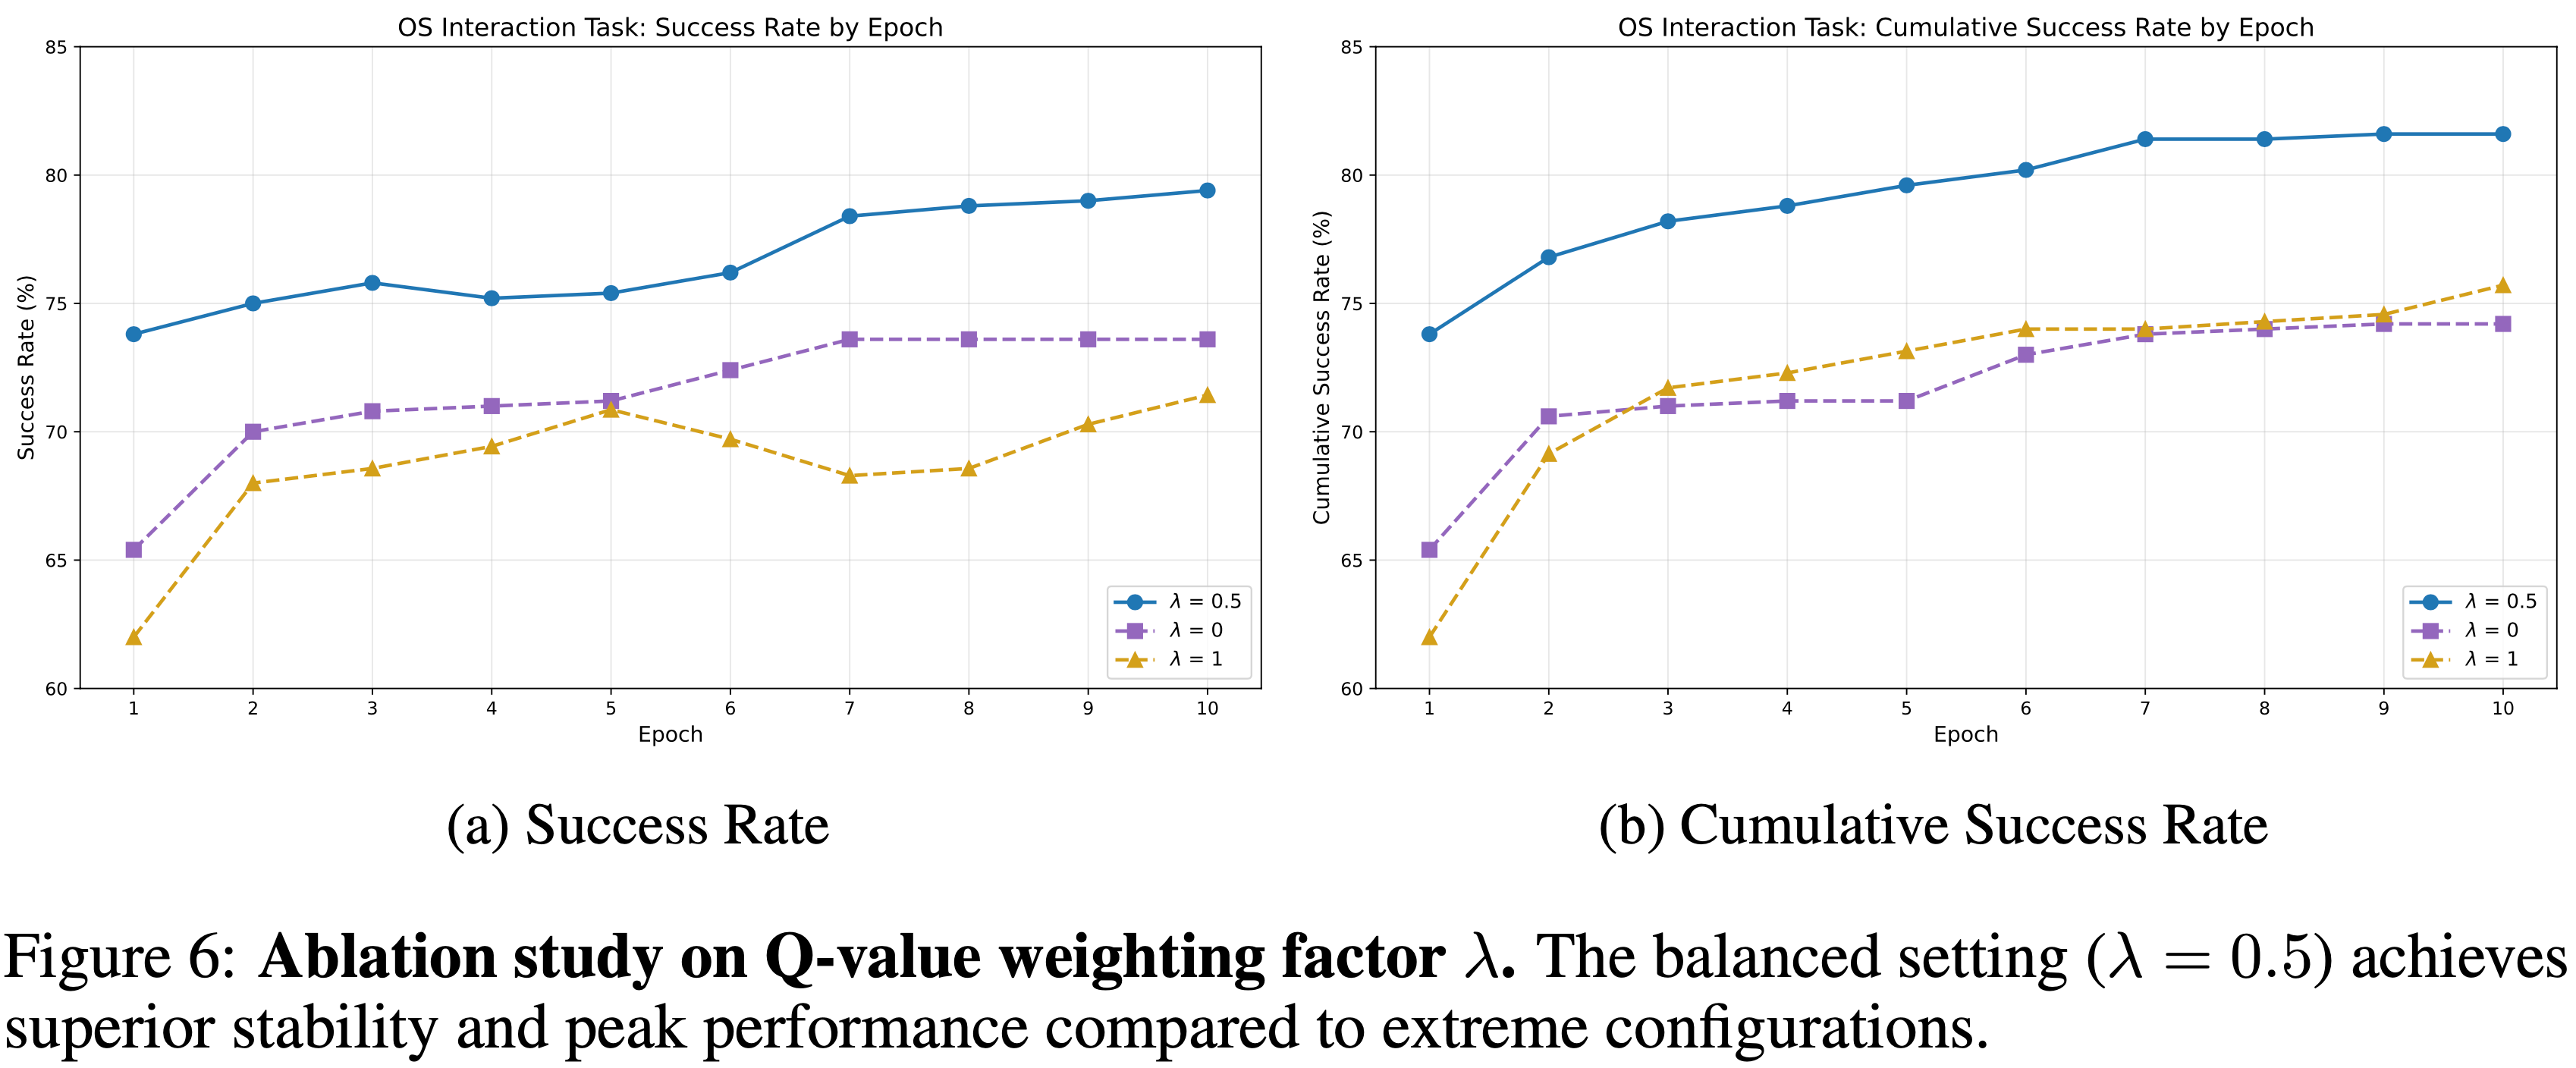
  • 为了理解语义检索和强化学习之间的相互作用,论文分析了评分函数(即公式6)中 Q 值加权因子 \( \lambda \) 的影响:
    • 论文将 平衡设置(balanced configuration) \( (\lambda = 0.5) \) 与两种极端情况进行比较:
      • 纯语义检索(pure semantic retrieval baseline) \( (\lambda = 0) \)
      • 纯贪婪强化学习(pure RL setting) \( (\lambda = 1) \)
  • 如图 6 所示,平衡配置始终产生更优的性能
    • 这表明语义基础 semantic grounding 和效用驱动排序 utility-driven ranking 的结合能有效地引导智能体找到高质量的解决方案,同时保持上下文相关性
      • 此外,纯语义检索基线提供了一个稳定的起点,但缺乏过滤语义相似但功能错误的次优记忆的机制
      • 因此,其性能很快进入平台期,这凸显了强化学习信号对于持续改进的必要性
    • 另一方面,纯强化学习设置揭示了忽视语义上下文的风险,表现出显著的不稳定性和较差的初始性能
      • 论文将这种不稳定性归因于上下文脱离 context detachment :
        • 在没有语义相似性约束的情况下,智能体可能会检索到与当前任务无关的高 \( Q \) 值记忆(在其他上下文下是成功的)
      • 这证实了语义相似性必须作为检索的锚点,而强化学习则为优化记忆选择提供了必要的梯度
Sensitivity to Retrieval size
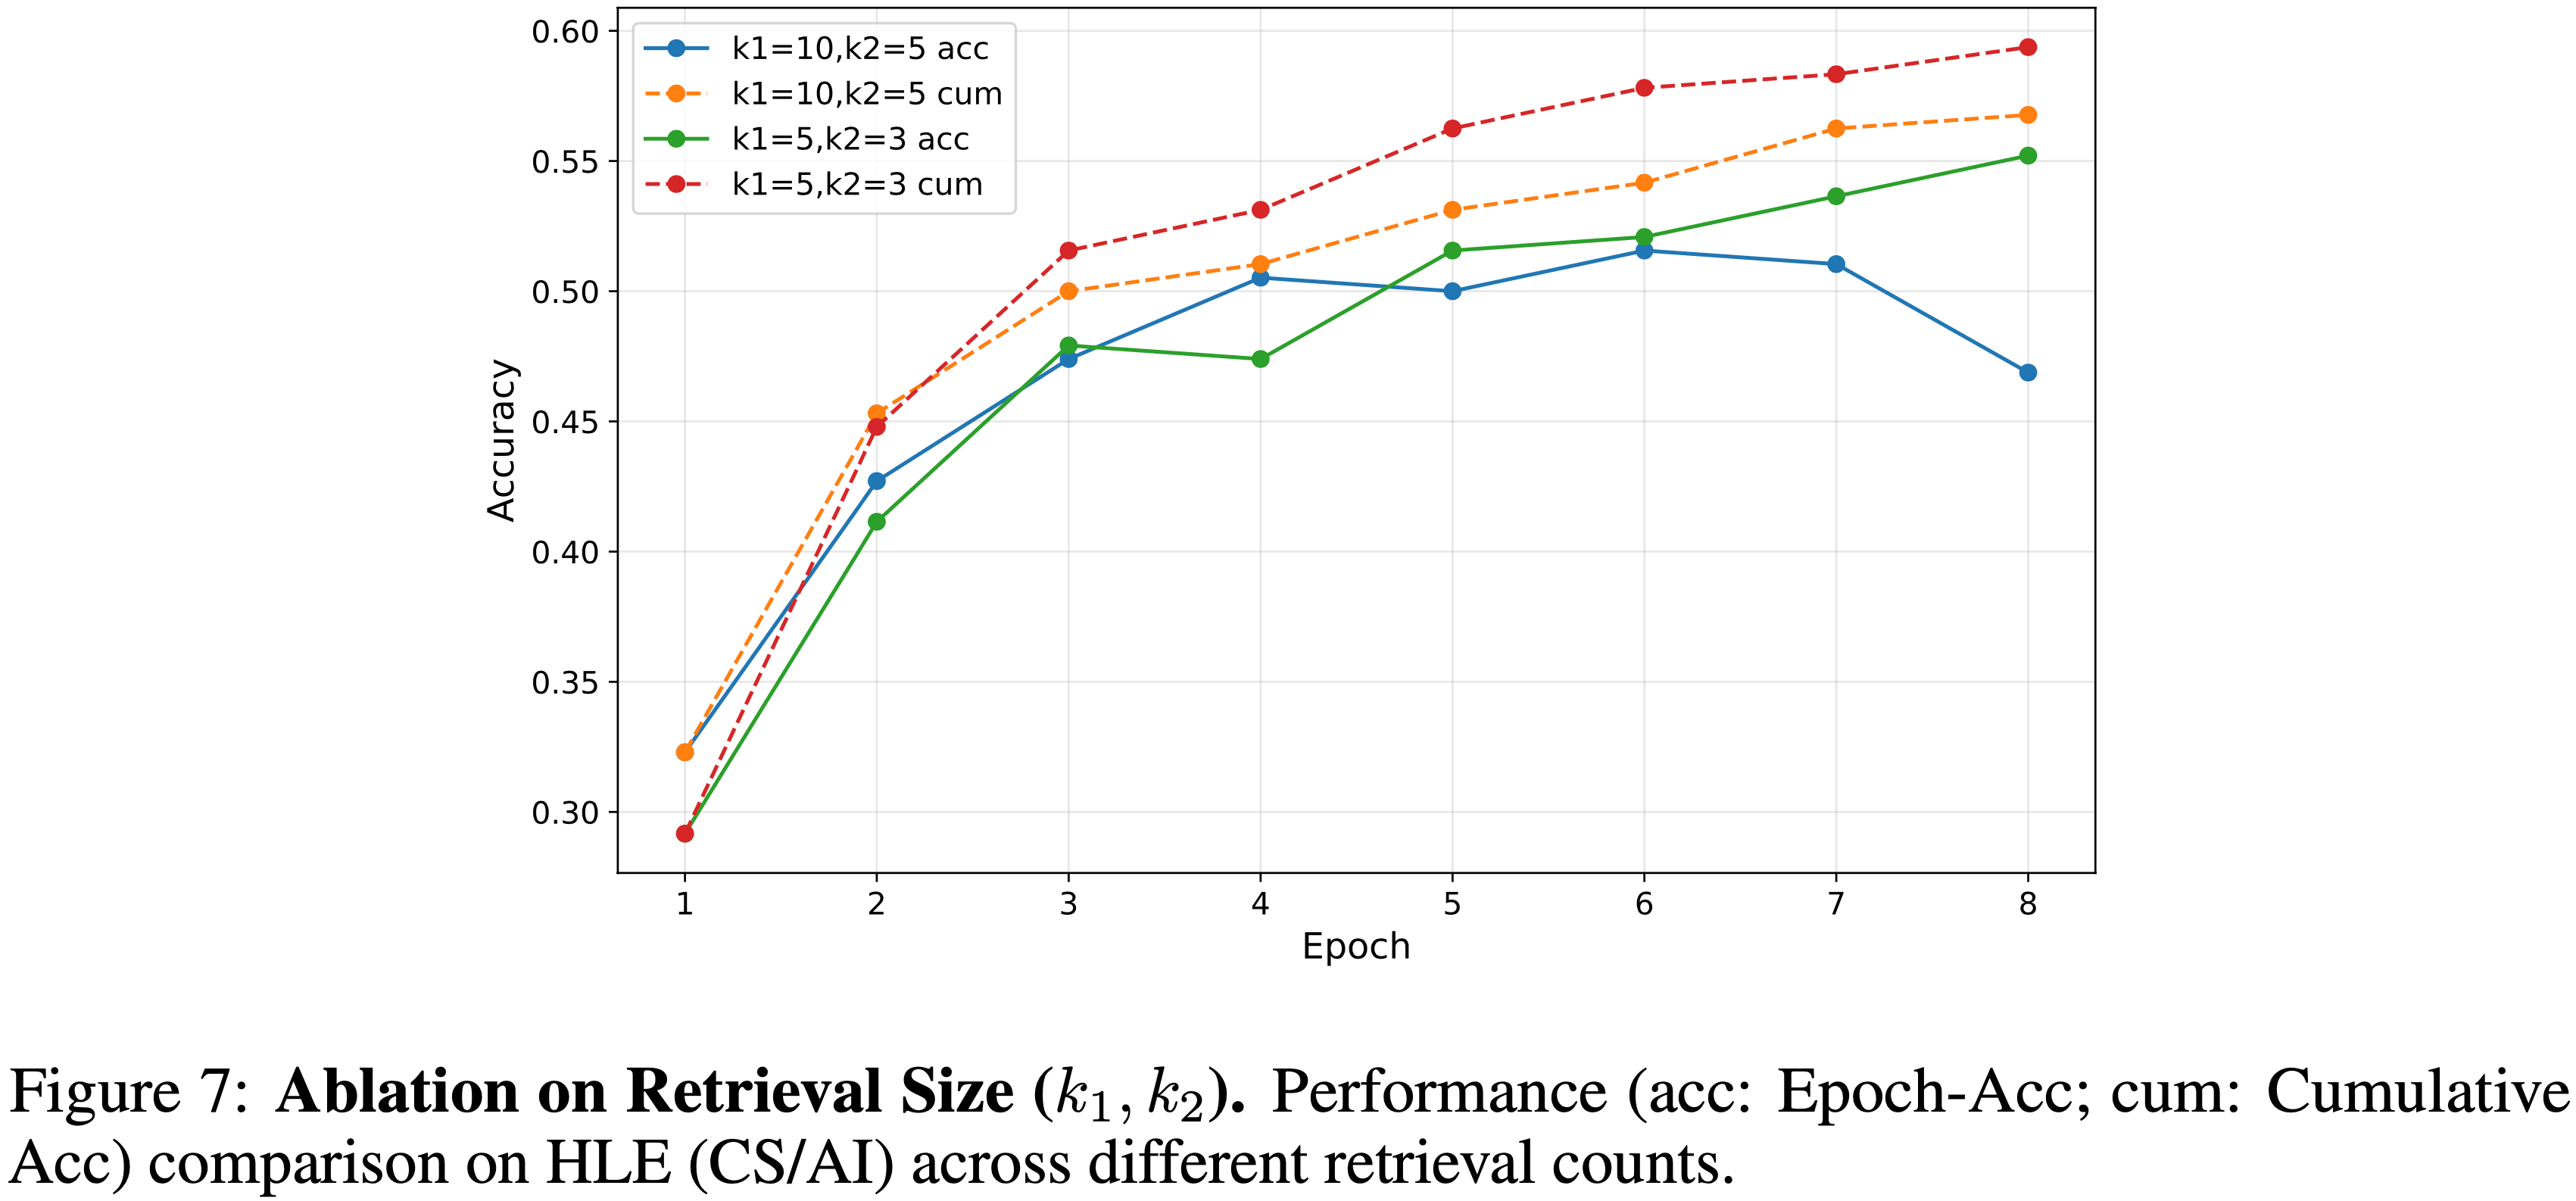
  • 为了研究记忆容量对推理性能的影响,论文在 HLE 基准测试的一个子集(计算机科学/人工智能类别)上进行了消融实验
  • 论文比较了两种检索配置:
    • 较大的召回设置(larger recall setting) \( (k_{1} = 10, k_{2} = 5) \)
    • 紧凑的召回设置(compact recall setting) \( (k_{1} = 5, k_{2} = 3) \)
    • 问题:这里的 \( (k_{1}, k_{2}) \) 分别代表论文两阶段检索的候选数量
  • 如图 7 所示,与较大的设置相比,紧凑的设置 \( (k_{1} = 5, k_{2} = 3) \) 实现了更优的稳定性
    • 这表明对于像 HLE 这样的复杂推理任务,单纯增加上下文容量可能会引入无关噪声,干扰模型的判断
    • 因此,一个更小、更高质量的检索记忆集足以保持推理精度

Discussion

  • 在本节中,论文更深入地探讨驱动 MemRL 性能的机制,将实证结果与第4节提出的 Stability-plasticity 框架联系起来
MemRL as a Trajectory Verifier
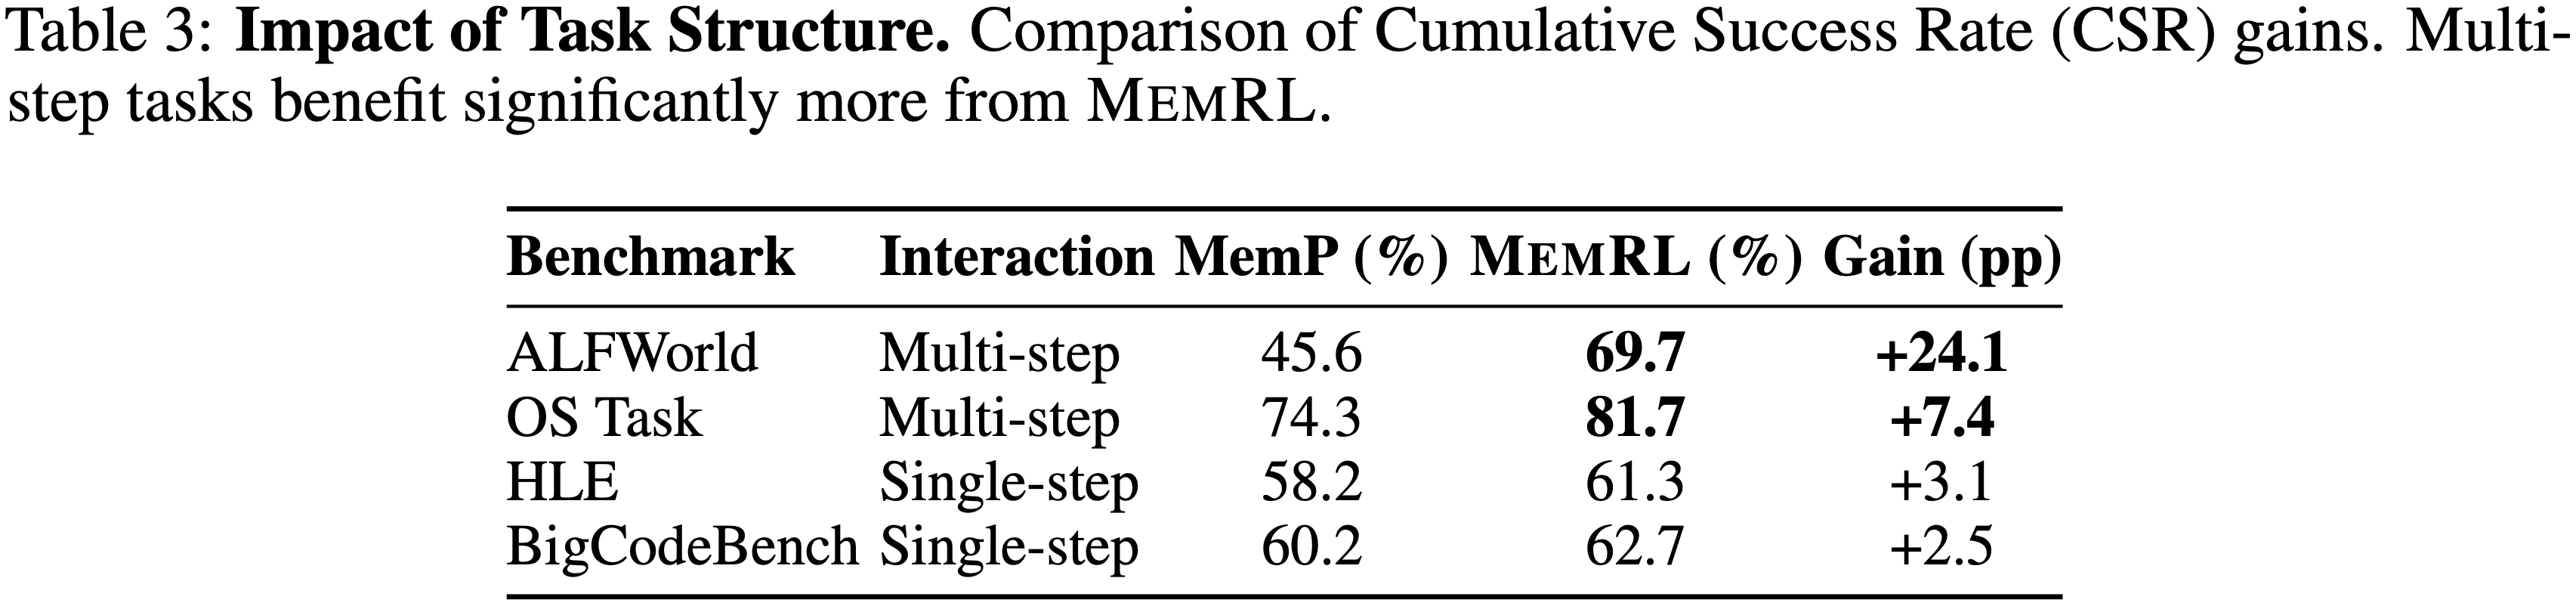
  • 表 3 揭示了任务结构复杂性与性能增益之间的相关性
    • 与单轮任务(例如 BigCodeBench \(+2.5\) 个百分点)相比,增益在多步骤序列任务中最为显著(例如 ALFWorld \(+24.1\) 个百分点)
    • 在序列任务中,检索到的记忆必须对整个轨迹有效
    • 标准的语义检索:通常会获取与初始指令匹配但后续步骤失败的记忆
    • MemRL:通过将最终奖励反向传播到记忆效用 \( Q \), MemRL 有效地学习验证整个轨迹,过滤掉仅在表面上看起来正确的脆弱策略
Predictive Power of the Q-Critic
  • 学习到的 Q 值是否真的反映了解决方案质量?
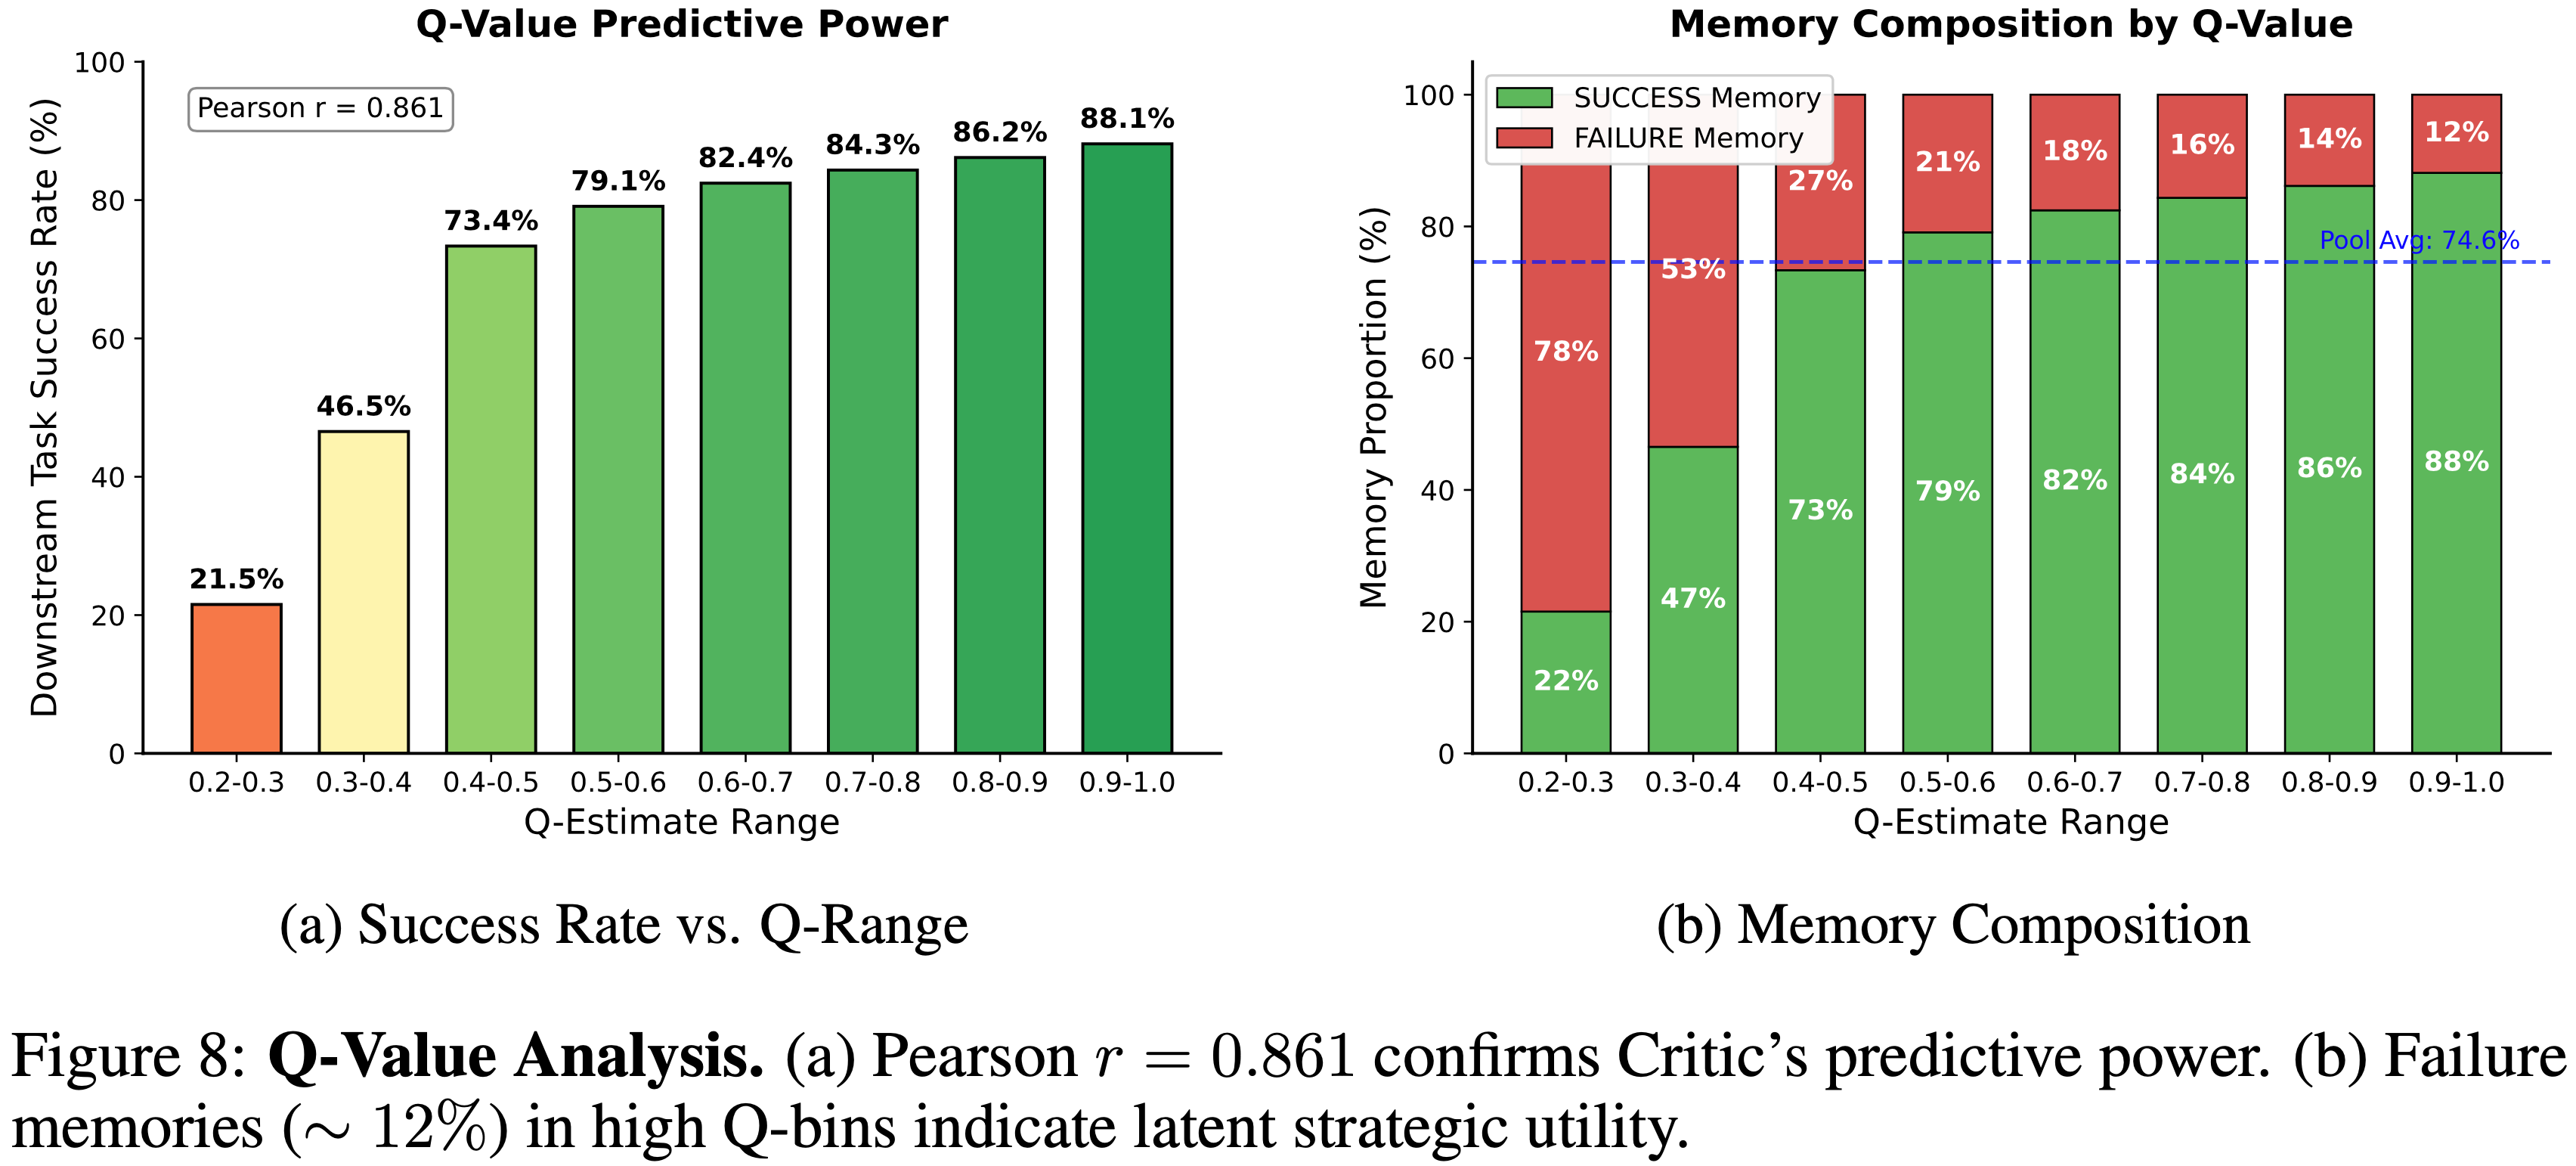
  • 图 8a 显示了 Critic 估计的 Q 值与经验任务成功率之间存在强正相关(皮尔逊 \( r = 0.861 \))
    • 成功率从最低置信度区间的 \( 21.5% \) 增加到最高区间的 \( 88.1% \)
      • 这表明性能提升的主要驱动力是 Critic 根据记忆导致任务成功的可能性进行排序的能力
    • 对记忆构成(图 8b)的进一步分析表明了增益的另一个来源:鲁棒性 robustness
    • 即使在高 Q 值区间 (0.9-1.0),智能体仍保留一小部分标记为“失败”的记忆(约 12%)
      • 这不仅不矛盾,反而符合以下解释:Q 值可以捕捉超越二元结果的效用:
      • 一些不成功的轨迹在战略上仍然有用,因为它们编码了接近正确的推理和可迁移的过程性经验
  • 案例研究 :一个高 Q 值“失败”记忆作为可迁移的接近成功(Case study: a high-Q “failure” memory as a transferable near-miss)
    • 论文发现了一些高 Q 值的失败记忆,它们总结了一个局部的微小错误以及一个可跨任务泛化的校正启发式方法
    • 这里论文用“接近成功” (near-miss) 表示大体正确但由于微小、局部错误(例如,验证疏忽或工具使用细节)而失败的轨迹
      • 例如,一个 \( Q = 0.9878 \) 的失败记忆对应一个遵循了正确方法但错误地将空命令输出视为失败证据的轨迹
      • 存储的反思明确指出了根本原因(误解空输出),警告了这种模式(将“无输出”等同于失败),并推荐了正确的方法(通过退出状态、错误日志或其他客观信号验证成功)
      • 在后续情境中检索时,这一条“失败”记忆在论文的日志中支持了完美的下游结果(15/15 成功),证明了该记忆之所以有价值,正是因为它捕捉到了一个可修复的接近成功,而非无信息的失败
  • Taken Together,这些结果表明,Critic 不仅仅是区分“成功”与“失败”,而是赋予那些提供可重用指导的记忆更高的价值
    • 包括本质上属于“接近成功”的一部分高效用失败
    • 通过保留和重用此类校正启发式方法,智能体可以比简单的成功重放机制更鲁棒
Stability of MemRL
  • 论文通过 Stability-plasticity 困境的视角分析 MemRL 的底层机制,审视论文的框架如何平衡新能力的获取与已有知识的保留
  • 卓越的 CSR(表1)表明 MemRL 有效地扩展了智能体的解决方案空间
  • 与受静态相似性约束、常常检索导致重复失败的冗余最近邻的启发式基线不同,MemRL 允许智能体识别并强化不明显但有效的策略
    • 这种能力使智能体能够突破传统检索方法停滞的局部最优
  • 长期训练动态(图 9)揭示了一个关键的稳定性优势
    • 像 MemP 这样的启发式方法,其 CSR 与当前轮次准确率之间的差距在扩大,表明新的探索无意中覆盖了有效的历史策略(灾难性遗忘)
    • 相比之下,MemRL 保持了同步增长
      • 论文将此归因于论文的理论保证
      • 从广义 MDP 的角度(公式3),价值更新受益于标准的贝尔曼收缩性(Bellman contraction) ,\( | \mathcal{T}Q - Q^{*} |_{\infty} \leq \gamma | Q - Q^{*} |_{\infty} \) (2018),每一步都将误差缩小 \( \gamma \)
      • 更具体地说,在论文的蒙特卡洛式建模下(公式8),这个过程由第4.5节保证
      • 与可能随机漂移的启发式排序不同,论文的方法在数学上约束策略沿着期望奖励的变分下界攀升,确保了论文在实验中观察到的稳定、非递减的性能
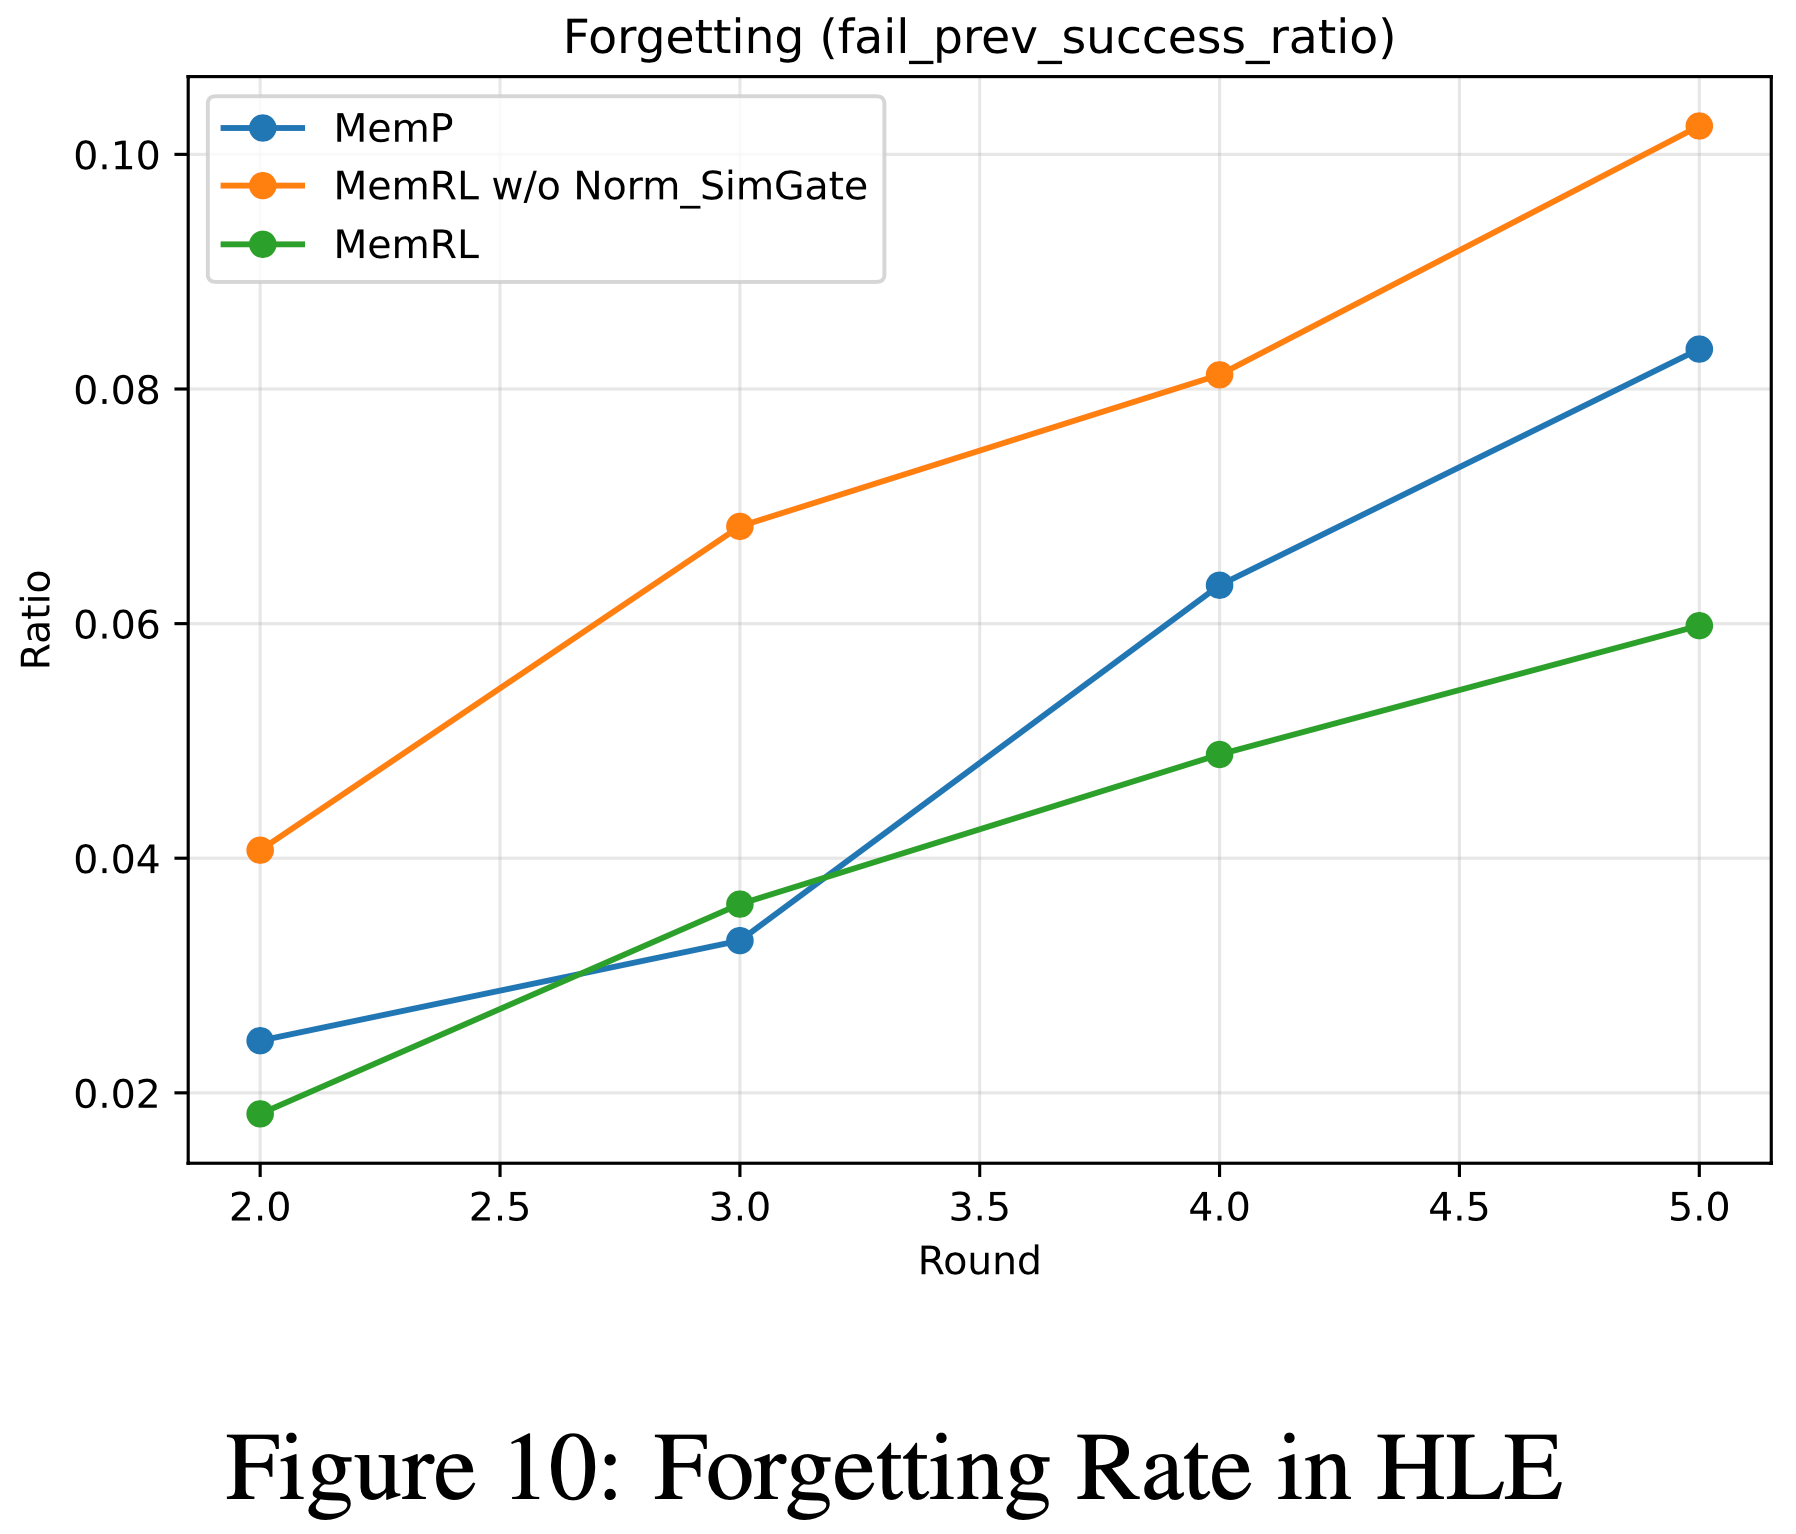
  • 论文进一步使用遗忘率(Forgetting Rate)(定义为在上一轮成功而在当前轮失败的任务比例,即 成功 \( \rightarrow \) 失败)来验证这些见解
  • 如图 10 所示,MemRL 实现了最低的平均遗忘率 (0.041),优于基线 MemP (0.051),并通过实验证实了论文的分析
The Necessity of Normalization and Similarity Gate
  • 此外,图 10 也突出了论文稳定性设计的必要性:移除归一化并降低相似性阈值(无归一化/相似性阈门)会导致平均遗忘率飙升至 0.073,这是由于不受约束的效用方差造成的
  • 这表明, z-score 归一化和严格的相似性阈门对于过滤噪声至关重要,确保自进化过程在最大化正向迁移的同时保持稳定
Impact of Similarity on Memory Efficacy(任务相似性对记忆效能的影响)
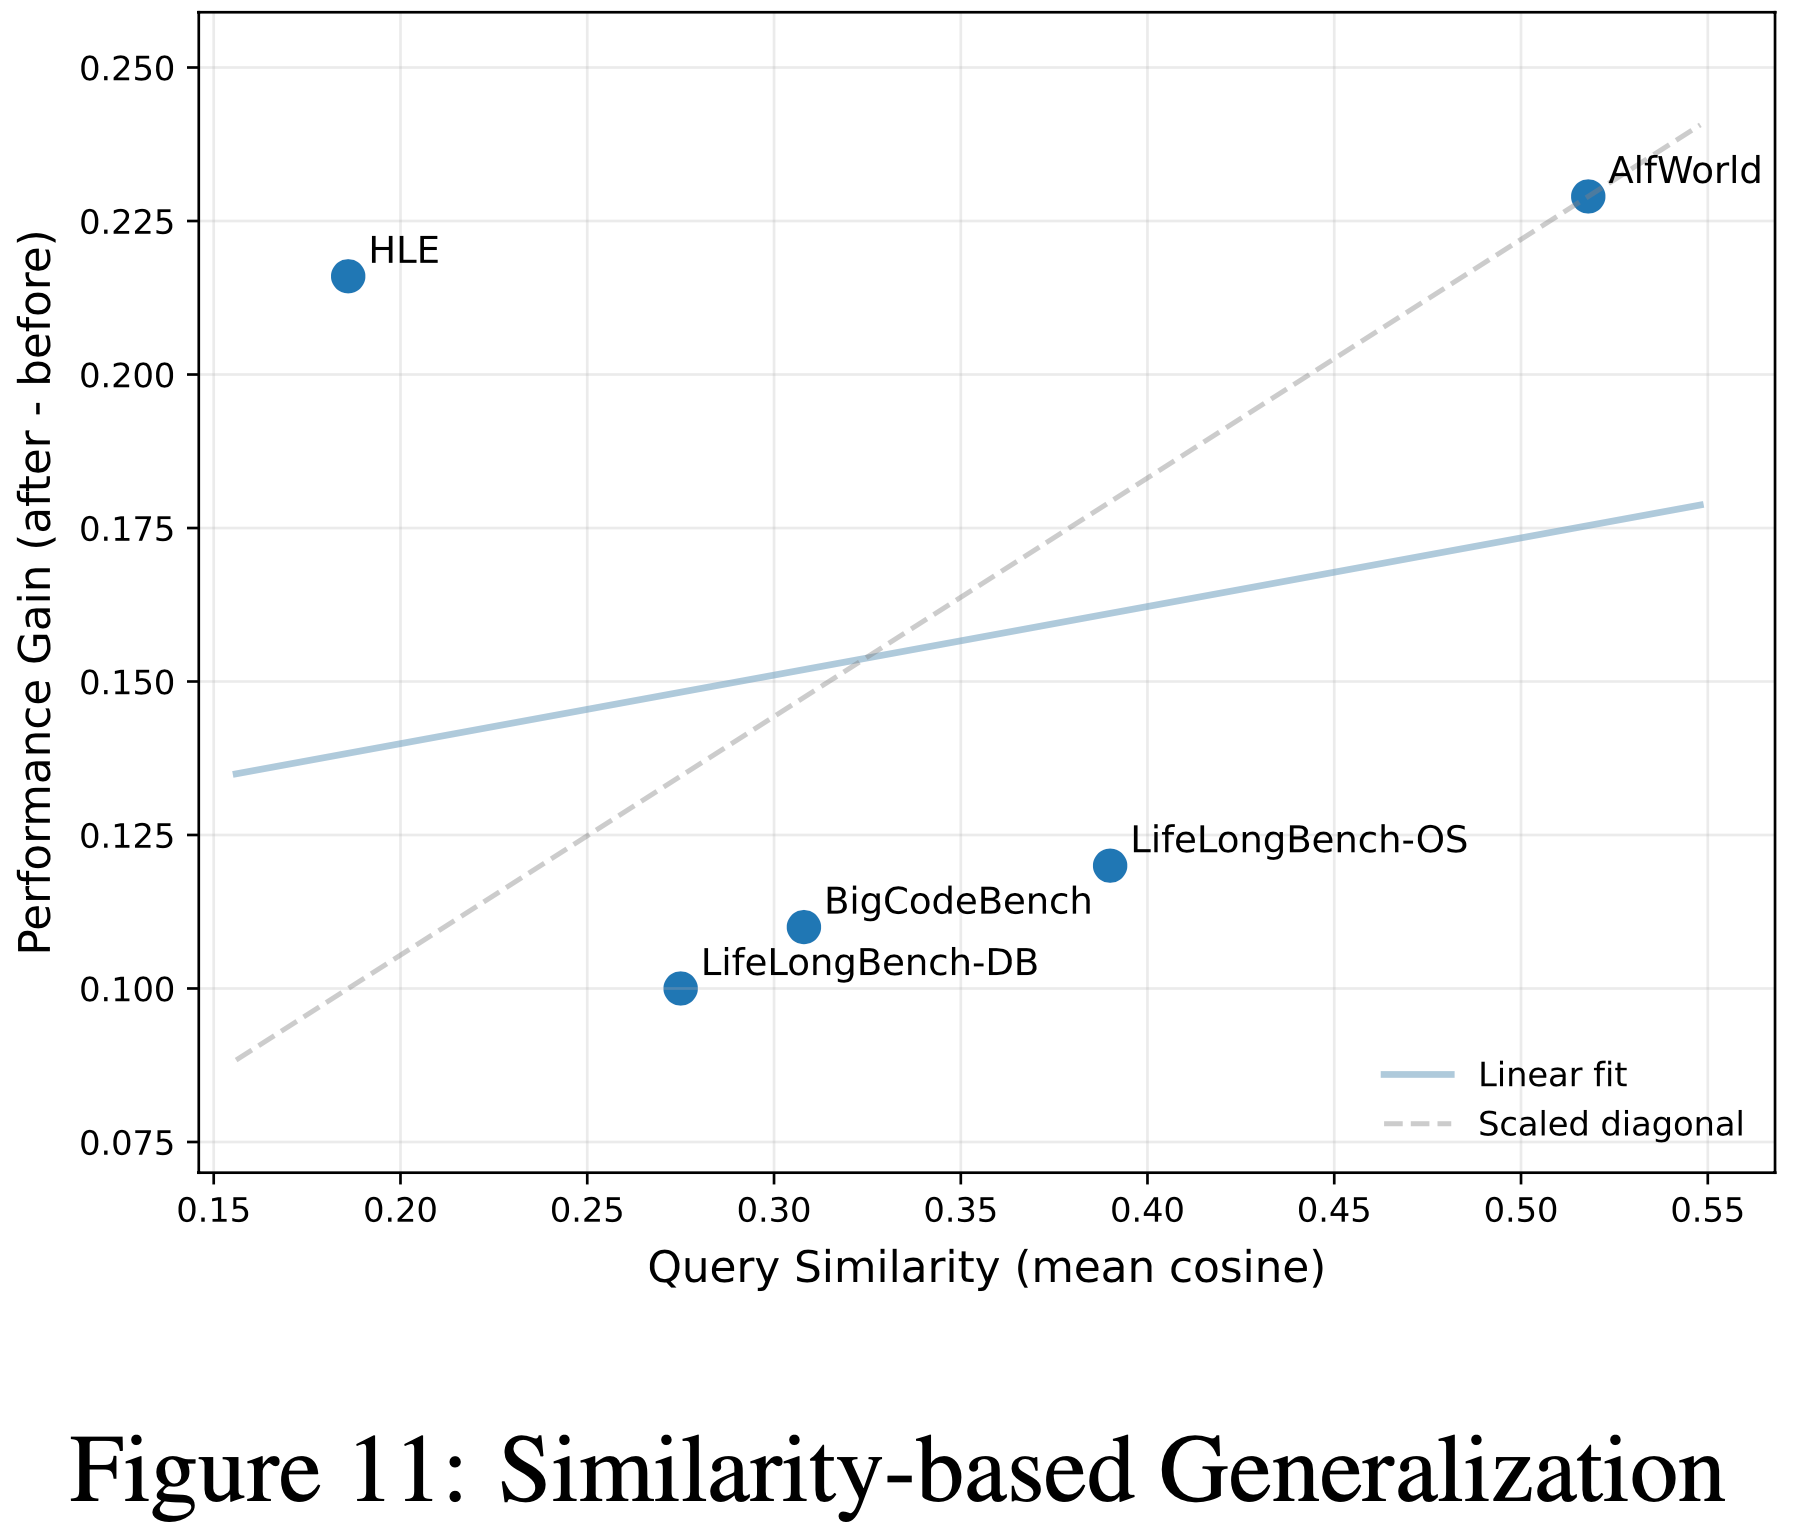
  • 为了理解 MemRL 发挥作用的基本条件,论文分析了数据集内语义相似性 \( \text{Sim}_{\text{intra} } \) 与论文方法提供的绝对性能增益 \( \Delta = \text{Acc}_{\text{ MemRL } } - \text{Acc}_{\text{NoMem} } \) 之间的相关性
  • 如图 11 所示,论文分析了数据集内语义相似性与 MemRL 提供的绝对性能增益 \( \Delta \) 之间的相关性
    • 线性回归趋势显示出普遍的正相关性:具有更高结构重复性的环境允许智能体更有效地检索和重用最优策略
    • At the upper extreme,ALFWorld(相似度 0.518)充当了这种趋势的强锚点,表现出最高的重复性和相应的最大性能提升 \( \Delta = +0.229 \)
    • 这证实了对于高度重复的过程性任务,记忆是通向最优轨迹的有效捷径
    • 沿着回归线(Following the regression line),具有中等相似度的基准测试(例如 Lifelong-OS (0.390) 和 BigCodeBench (0.308))聚集在中间区域,显示出稳定的改进 \( \Delta \approx +0.11 \sim +0.12 \),智能体成功地在相关指令间泛化了编码模式或操作系统命令
Generalization vs. Memorization
  • HLE 呈现了一个独特的异常值
    • 尽管由于其多样化的多学科性质具有最低的相似度 (0.186),但它却表现出惊人的高运行时增益(从 0.357 到 0.573,\( \Delta = +0.216 \))
    • 这种增益的运作机制与 ALFWorld 不同
  • 在高相似度基准测试中, MemRL 通过正向迁移(Positive Transfer),即将共享模式泛化到新实例中 取得成功
    • In Contrast,HLE 的增益源于运行时记忆化(Runtime Memorization)
    • 由于 HLE 的问题具有独特性且领域特定,智能体依赖运行时学习阶段,通过反复接触来“记忆”针对困难问题的特定解决方案
    • 这种区别凸显了 MemRL 的通用性:它既支持结构化领域的模式泛化,也支持多样化领域的特定知识获取

Conclusion

  • 在论文中,论文介绍了 MemRL ,这是一个新颖的框架,它使大语言模型能够通过情景记忆上的非参数强化学习实现自进化
    • 针对语义检索的局限性和参数微调的不稳定性, MemRL 将记忆检索视为一个 Value-based 决策过程
    • 通过将记忆组织为意图-经验-效用三元组并应用贝尔曼更新,智能体学会了区分高价值策略和语义噪声,而无需修改主干模型的权重
    • 论文在从代码生成到具身导航的多样化领域进行的广泛评估表明, MemRL 在运行时学习和向未见任务的泛化方面都显著优于现有的记忆增强基线
  • 理论和实证分析进一步揭示, MemRL 有效地解决了 Stability-plasticity 困境:
    • 冻结的大语言模型提供了稳健的推理能力,而进化的记忆效用则充当了适应的可塑性通道
  • Moreover,论文发现效用驱动的检索机制起到了轨迹 Verifier 的作用,使智能体能够在复杂、多步骤的任务中过滤掉脆弱的策略
    • 作者希望这项工作为构建能够在稳定高效的方式下持续从交互中学习的自进化智能体奠定新的范式

补充:Related Works

Continous Learning

  • 持续学习 (Continual learning) 处理 Stability-plasticity 困境,旨在顺序获取新知识而不遭受灾难性遗忘
    • 经典方法(例如正则化、蒸馏和经验回放)通过约束参数更新或保留过去数据分布来缓解遗忘 (2017; 2017; 2017)
    • 但这些参数化方法对于大语言模型来说计算成本高昂,并且通过频繁的在线更新有破坏预训练 Backbone 稳定性的风险
  • 近期关于大语言模型持续学习的综述进一步系统化了这些困难,并强调了外部机制和非参数路径的重要性 (2024)
    • 因此,从持续学习的角度来看,如果论文旨在让智能体在使用中改进同时保持 Backbone 的稳定性,一个更实用的方向是将可塑性从参数空间转移到外部结构和受控的经验更新通道

RL

  • 强化学习已被广泛用于增强大语言模型
    • 一个代表性范式是从人类反馈中构建奖励信号,并相应地优化模型策略以符合人类偏好 (2020; 2022)
  • 其他近期方法利用基于规则的 Verifier 来改进大语言模型的推理能力 (2025; 2025)
  • 同时,面向智能体的研究探索了交互信号如何改进工具使用和 Action 决策,并研究了语言模型在环境中执行复合 Action 的机制 (2023)
  • 尽管奖励驱动的优化已被证明有效,但这些方法通常将学习置于模型参数或额外的参数化模块中,因此并未从根本上避免在线更新的成本或遗忘的风险
  • 相比之下,论文的方法将记忆使用构建为一个可学习的决策问题,并对记忆应用非参数强化学习以规避该风险

Agentic Memory

  • 为了绕过微调的成本,外部记忆系统已从静态的 RAG 范式发展为动态的、可治理的记忆结构 (2020; 2020)
    • 早期的智能体记忆引入了反思机制和分层管理来处理长上下文经验 (2023; 2024)
    • 更近期的框架系统化了记忆生命周期,专注于复杂任务的统一存储和结构化索引 (2025b; 2025; 2025; 2025)
  • Furthermore,自适应方法现在探索通过反馈驱动的更新或自动增强来改进检索 (2025; 2025; 2025a; 2025)
  • However,除了训练额外的可学习模块外,大多数现有方法仍然主要依赖语义相似性或启发式规则,缺乏严格的度量标准来评估记忆在最大化回报方面的实际效用
  • 受记忆整合认知理论 (2007; 1980; 2000) 的启发, MemRL 通过将检索形式化为一个 Value-based 决策过程来弥合这一差距,直接从环境奖励中学习稳健的效用估计(Q 值)以区分高价值经验和噪声

附录 A:Theoretical Analysis And Proofs

  • 在本节中,论文将详细推导在指数移动平均(Exponential Moving Average, EMA)更新规则下 Q 值估计的收敛性,并将分析扩展到任务分布下记忆效用(memory utility)的全局稳定性

A.1 定理 1 的证明:Convergence Of EMA Estimation

  • 论文旨在证明,对于一个具有平稳奖励分布(stationary reward distribution)的固定任务-记忆对 \((s,m)\),Q 值估计 \(Q_{t}(s,m)\) 的期望会收敛到真实的平均奖励 \(\beta (s,m)\)
Assumptions
  • 平稳奖励(Stationary Reward)。步骤 \(t\) 的奖励 \(r_{t}\) 取自一个具有恒定均值 \(\beta (s,m) = \mathbb{E}{[r_{t}|s,m]}\) 和有限方差 \(\sigma^{2}\) 的分布
  • 更新规则(Update Rule)。效用通过学习率 \(\alpha \in (0,1)\) 的线性 EMA 规则更新:
    $$Q_{t + 1} = (1 - \alpha)Q_{t} + \alpha r_{t}.$$
Derivation of Error Dynamics
  • 令 \(e_{t}\triangleq Q_{t} - \beta (s,m)\) 为时间步 \(t\) 的估计误差。将 \(Q_{t} = e_{t} + \beta (s,m)\) 代入更新规则:
    $$\begin{array}{rl} & e_{t + 1} + \beta (s,m) = (1 - \alpha)(e_t + \beta (s,m)) + \alpha r_t\ & \qquad e_{t + 1} = (1 - \alpha)e_t + (1 - \alpha)\beta (s,m) + \alpha r_t - \beta (s,m)\ & \qquad e_{t + 1} = (1 - \alpha)e_t + \beta (s,m) - \alpha \beta (s,m) - \beta (s,m) + \alpha r_t\ & \qquad e_{t + 1} = (1 - \alpha)e_t + \alpha (r_t - \beta (s,m)). \end{array} \tag{14}$$
Convergence Analysis
  • 论文将 \(\mathcal{F}_{t}\) 定义为截至时间 \(t\) 的过滤(历史)。对公式 14 取给定 \(\mathcal{F}_{t}\) 的条件期望:
    $$\mathbb{E}{[e_{t + 1}|\mathcal{F}_t]} = (1 - \alpha)e_t + \alpha (\underbrace{\mathbb{E}{[r_t|\mathcal{F}_t]}}_{\beta (s,m)} - \beta (s,m)) = (1 - \alpha)e_t.$$
  • 根据迭代期望定律(Law of Iterated Expectations),取完全期望得到:
    $$\mathbb{E}{[e_{t + 1}]} = \mathbb{E}{[\mathbb{E}{[e_{t + 1}|\mathcal{F}_t]}]} = (1 - \alpha)\mathbb{E}{[e_t]}.$$
  • 从 \(t = 0\) 开始迭代此递推关系:
    $$\mathbb{E}{[e_t]} = (1 - \alpha)^t\mathbb{E}{[e_0]}.$$
  • 由于 \(0< \alpha < 1\),论文有 \(|1 - \alpha |< 1\)。因此:
    $$\lim_{t\to \infty}\mathbb{E}{[e_t]} = \mathbb{E}{[e_0]}\cdot \lim_{t\to \infty}(1 - \alpha)^t = 0. \tag{15}$$
  • 这证明了估计量在极限上是无偏的,即 \(\lim_{t\to \infty}\mathbb{E}{[Q_t]} = \beta (s,m)\)

A.2 Bounded Variance And Global Stability(有界方差与全局稳定性)

  • 在本节中,论文将给出估计量 \(Q_{t}\) 方差界限的形式化推导
  • 论文通过递归展开(recursive unrolling)明确推导有限时间方差公式,并证明其渐近收敛性,展示 Phase-A 聚类如何有助于全局稳定性
Derivation of the Variance Bound
  • 令 \(\sigma^{2}\triangleq \text{Var}(r_{t}|s,m)\) 为奖励信号的方差,假设是有限的,EMA 更新规则为:
    $$Q_{t + 1} = (1 - \alpha)Q_{t} + \alpha r_{t}.$$
  • 由于奖励 \(r_{t}\)(当前噪声)在统计上独立于当前估计 \(Q_{t}\)(由历史 \(\mathcal{F}_{t - 1}\) 决定),和的方差是方差的和:
    $$\text{Var}(Q_{t + 1}) = \text{Var}((1 - \alpha)Q_t) + \text{Var}(\alpha r_t)$$ $$= (1 - \alpha)^2\text{Var}(Q_t) + \alpha^2\sigma^2.$$
  • 令 \(v_{t}\triangleq \text{Var}(Q_{t})\),论文得到一个线性递推关系
    $$ v_{t + 1} = (1 - \alpha)^{2}v_{t} + \alpha^{2}\sigma^{2}$$
Recursive Unrolling
  • 为了求解 \(v_{t}\),论文将递推关系从步骤 \(t\) 向后展开:
    $$\begin{array}{l}{v_{t} = (1 - \alpha)^{2}v_{t - 1} + \alpha^{2}\sigma^{2} }\ {= (1 - \alpha)^{2}\left[(1 - \alpha)^{2}v_{t - 2} + \alpha^{2}\sigma^{2}\right] + \alpha^{2}\sigma^{2} }\ {= (1 - \alpha)^{4}v_{t - 2} + \alpha^{2}\sigma^{2}\left[1 + (1 - \alpha)^{2}\right]}\ {\vdots}\ {= (1 - \alpha)^{2t}v_{0} + \alpha^{2}\sigma^{2}\sum_{k = 0}^{t - 1}\left((1 - \alpha)^{2}\right)^{k}.} \end{array} \tag{16}$$
  • 公式 16 明确显示,时间 \(t\) 的方差由两个部分组成:衰减的初始方差(第一项)和累积的噪声方差(第二项)
Asymptotic Convergence
  • 当 \(t\to \infty\),由于学习率 \(\alpha \in (0,1)\),项 \((1 - \alpha)^{2t}\) 趋于零。求和项是一个公比为 \(r = (1 - \alpha)^{2}\) 的几何级数 \(\textstyle \sum_{k = 0}^{\infty}r^{k} = \frac{1}{1 - r}\),因此:
    $$\lim_{t\to \infty}v_{t} = \alpha^{2}\sigma^{2}\cdot \frac{1}{1 - (1 - \alpha)^{2} }.$$
  • 计算分母:
    $$1 - (1 - \alpha)^{2} = 1 - (1 - 2\alpha +\alpha^{2}) = 2\alpha -\alpha^{2} = \alpha (2 - \alpha).$$
  • 代回得到紧密的方差界限:
    $$\lim_{t\to \infty}\sup \text{Var}(Q_t) = \frac{\alpha^2\sigma^2}{\alpha(2 - \alpha)} = \frac{\alpha}{2 - \alpha}\sigma^2. \tag{17}$$
Connection to Phase-A Clustering
  • 这个结果为 MemRL 的稳定性提供了理论依据。虽然记忆簇 \(S(m) \triangleq \{s|\text{sim}(s,z_{m}) > \tau_{A}\}\) 内的任务可能不同,但平滑性假设(Smoothness Assumption)意味着它们的奖励取自一个方差有界 \(\sigma_{S(m)}^{2}\) 的分布
  • 推导出的界限 \(\frac{\alpha}{2 - \alpha}\sigma_{S(m)}^{2}\) 保证记忆效用 \(Q(m)\) 不会发散,而是将在真实期望效用附近的一个受控范围内振荡
  • 该机制有效地过滤了来自不同任务实例的高频噪声,同时保留了稳定的泛化价值

附录 B:Convergence Via Variational Inference

  • 在本节中,论文为 MemRL 提供理论基础,证明论文的检索策略和更新规则保证了价值估计的收敛性

B.1 收敛目标

  • 论文的最终目标是确保估计的效用 \(Q(m)\) 收敛到记忆 \(m\) 的真实期望回报(expected return),这个目标值定义为:
    $$\lim_{t\to \infty}\mathbb{E}{[Q_t(m)]} = \mathbb{E}{[r|m]} = \sum_{s\in \mathcal{S}(m)}\frac{\mathbb{E}{[r|s,m]}}{\text{Stationary} }\frac{\text{Pr}(s|m)}{\text{Retrieve-Dependent} }. \tag{18}$$
  • 挑战在于项 \(\operatorname *{Pr}(s|m)\),即特定状态 \(s\) 触发检索 \(m\) 的概率
    • 该分布依赖于检索策略 \(\mu_t(m|s)\),而该策略本身在训练过程中会演化,从而产生一个威胁稳定性的循环依赖

B.2 带有信任区域的变分目标

  • 为了解决这个问题,论文将问题表述为最大化一个全局变分目标 \(\mathcal{I}(\mu ,Q)\)
    • 这个目标作为公式 18 定义的全局期望回报的一个可处理的下界,并通过一个语义信任区域进行平衡:
      $$\mathcal{I}(\mu ,Q) = \mathbb{E}_{s\sim \mathcal{D} }\left[\sum_{m\in \mathcal{S}(s)}\mu (m|s)Q(s,m) - \frac{1}{\beta} D_{\text{KL} }\left(\mu (\cdot |s)| \pi_{\text{sim} }(\cdot |s)\right)\right] \tag{19}$$
    • 这里,第一项直接对应于论文旨在收敛的期望效用 \(\mathbb{E}{[Q_t(m)]}\),而 \(\pi_{\text{sim} }\) 代表固定的语义先验(从 Phase-A 导出)
    • KL 散度项作为一个正则化器至关重要,原因有二:
      • 1)信任区域(Trust Region):它将策略约束在支持集 \(\mathcal{S}\) 内,防止智能体检索高 \(Q\) 值但语义上不相关的记忆(分布外误差)
      • 2)正则化(Regularization):它在 \(Q\) 估计值嘈杂的“冷启动”阶段稳定学习动态

B.3 通过广义期望最大化进行优化 (GEM)

  • 论文将 \(\mathcal{I}\) 的优化视为一个 GEM 过程,在策略改进(policy improvement)和价值评估(value evaluation)之间交替进行:
E-step Policy Optimization
  • 固定 \(Q_t\),论文找到最大化 \(\mathcal{I}\) 的最优策略 \(\mu^*\)
  • 封闭形式的解是玻尔兹曼分布(Boltzmann distribution)(Levine, 2018):
    $$\mu^{*}(m|s)\propto \pi_{\text{sim} }(m|s)\exp (\beta Q_{t}(s,m))$$
  • 取对数后,论文得到论文 Phase-B 检索(公式 6)中使用的特定评分函数:
    $$\log \mu^{*}(m|s)\propto \underbrace{\log\pi_{\text{sim} }(m|s)}_{\approx \text{sim}(s,m)} + \beta Q_{t}(s,m)$$
  • 这证明了论文的相似性和 \(Q\) 值的启发式组合在数学上等价于变分目标下的最优策略
M-step Policy Evaluation Via Error Minimization
  • 虽然 E-step 基于当前估计改进了策略,但 M-step 确保这些估计是接地于现实的
  • 固定策略 \(\mu_{t + 1}\),论文的目标是将变分参数 \(Q\) 与真实的环境回报对齐
  • 论文将其表述为最小化估计效用与观察到的奖励目标 \(y = r\)(在论文的蒙特卡洛风格建模中)之间的均方误差(Mean Squared Error, MSE):
    $$\min_{Q}\mathcal{L}(Q) = \mathbb{E}_{r\sim \mu_{t + 1} }\left[\frac{1}{2}\left(y - Q(s,m)\right)^2\right]$$
  • 最小化这个误差至关重要,因为它收紧(tightens)了变分界限:
    • 它确保全局目标 \(\mathcal{I}\)(公式 19)中的期望项 \(\mathbb{E}{[Q]}\) 收敛到真实期望回报 \(\mathbb{E}{[r]}\)
    • 论文框架中使用的更新规则(公式 8)正好对应于对该目标的一个 SGD 步骤:
      $$Q_{t + 1}(s,m)\leftarrow Q_t(s,m) - \alpha \nabla_Q\mathcal{L}(Q) = Q_t(s,m) + \alpha (y - Q_t(s,m))$$
  • 通过迭代地最小化 \(\mathcal{L}(Q)\),M-step 将环境反馈传播到效用估计中,确保随后的 E-step 优化发生在一个可靠的价值格局上

Proof of Convergence

  • 根据 GEM 的单调改进定理(Monotonic Improvement Theorem)(1998),序列 \((\mu_t, Q_t)\) 保证收敛到一个驻点 \((\mu^*, Q^*)\)
  • 在稳态下,策略稳定 \((\mu_{t+1} \approx \mu_t)\),这意味着逆检索概率 \(\Pr(s|m)\) 变为时间不变的:
    $$\Pr (s|m) = \frac{\mu^{*}(m|s)\Pr(s)}{\sum_{\mu^{\prime} }\mu^{*}(m|s^{\prime})\Pr(s^{\prime})}$$
  • Consequently,公式 18 中的“依赖检索的(Retrieve-Dependent)”项被锚定
    • 在固定的数据分布下,标准的贝尔曼压缩特性(Bellman contraction property)确保 \(Q_t(m)\) 收敛到唯一的固定点:
      $$\lim_{t\to \infty}Q_t(m)\to \mathbb{E}_{\mu^*}[r|m] \tag{20}$$
  • Thus,论文的框架从理论上保证了记忆价值在最优检索策略下收敛于真实的期望回报
NLP——技术报告解读-MiMo-V2-Flash

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:MiMo-V2-Flash Technical Report, LLM-Core Xiaomi, 20260106 & 20260108
    • GitHub:github.com/XiaomiMiMo/MiMo-V2-Flash

Paper Summary

  • 整体总结:
    • MiMo-V2-Flash 核心创新:
      • 混合滑动窗口注意力架构 (Hybrid Sliding Window Attention architecture)
      • 轻量级多 Token 预测 (Lightweight Multi-Token Prediction)
      • MOPD 后训练范式
    • 从论文中看:MiMo-V2-Flash 可与 DeepSeek-V3.2 和 Kimi-K2 等更大的开放权重模型相媲美
  • 完整训练流程:
    • Pre-Training -> Mid-Training -> Context Extension -> SFT -> Non-Agentic RL -> Agentic RL -> MOPD (Multi-Teacher On-Policy Distillation)
    • 学生模型:学生起点 = Stage 1 SFT 后的模型(注:论文未明确说明,但报告中表 7(Benchmark results of MOPD)显示了一列 “Student Before MOPD”,其数值与 SFT 后的性能吻合)
    • 教师模型:从 SFT 模型或 Base 模型出发,经过独立的领域 RL/SFT 训练得到,在 MOPD 阶段固定
      • 数学教师:SFT 模型 -> 强化学习(数学推理数据,程序化验证器作为奖励)
      • 代码生成教师:SFT 模型 -> 强化学习(代码生成数据,代码执行结果作为奖励)
      • 代码 Agent 教师:SFT 模型 -> 强化学习(GitHub issue环境,单元测试作为奖励,约12万环境)
      • Terminal Agent教师:SFT 模型 -> 强化学习(Stack Overflow转化来的终端任务,Docker环境+测试用例)
      • Web 开发 Agent 教师:SFT 模型 -> 强化学习(合成网页开发任务,Playwright+多模态视觉判别器作为奖励)
      • 搜索 Agent 教师:SFT 模型 -> 仅监督微调(BrowseComp数据,无强化学习)
        • 注意:搜索 Agent 目前仅是 SFT 得到的结果
      • 函数调用/工具使用教师:SFT模型 -> 强化学习(合成工具调用环境,数据依赖+逻辑依赖构建任务)
      • 通用知识教师:无专门训练 -> MOPD 阶段学生以自身为教师(Self),主要依赖结果奖励模型
        • 注意:这里是 MOPD 的学生模型自身也作为教师,算是一个正则
    • 注:在进行 MOPD 时,MiMo-V2 还加入了 ORM 结果奖励
  • MiMo-V2-Flash 是一个 MoE 模型(309B-A15B),旨在实现快速、强大的推理和智能体能力
  • MiMo-V2-Flash 采用了一种混合注意力架构
    • 将滑动窗口注意力(Sliding Window Attention,SWA)与全局注意力(Global Attention, GA)以 5:1 的混合比例交错排列,滑动窗口大小为 128 个 token
  • MiMo-V2-Flash 使用 Multi-Token Prediction(MTP) 在 27T Token 上进行预训练,拥有原生的 32k 上下文长度并随后扩展到 256k
  • 为了高效扩展训练后计算,MiMo-V2-Flash 引入了一种新颖的多教师 On-policy 蒸馏范式
    • 在此框架中,领域专业化的教师模型(例如,通过大规模强化学习训练)提供密集的、Token-level 奖励,使学生模型能够完美掌握教师的专业知识
    • MiMo-V2-Flash 能够媲美 DeepSeek-V3.2 和 Kimi-K2 等顶级开源模型,尽管其总参数量仅分别为后者的 1/2 和 1/3
    • 在推理过程中,通过将 MTP 重新用作推测解码的草稿模型,MiMo-V2-Flash 在使用三层 MTP 时实现了最高 3.6 的接受长度和 2.6 倍的解码加速
    • 论文开源了模型权重和三层 MTP 权重,以促进开放研究和社区协作
  • 本次解读重点关注后训练阶段,其他部分暂不深入

Introduction and Discussion

  • 人工智能通用智能的最新进展越来越受到两个前沿领域的推动:
    • 先进的推理链和基于大规模强化学习的自主智能体工作流 (Google DeepMind, 2025; Kimi Team, 2025b; 2025)
    • 但构建可扩展的推理器和智能体面临一个共同的关键瓶颈:长上下文建模必须同时具备快速和强大的能力
  • 论文介绍了 MiMo-V2-Flash,这是一个高效且经济实惠的 LLM,能够提供强大的推理和智能体性能
    • 为了缓解完全注意力的二次复杂度,MiMo-V2-Flash 采用了一种混合注意力机制,交错排列局部滑动窗口注意力和全局注意力
    • 滑动窗口大小为 128 Token,混合局部:全局比例为 5:1,对于长上下文,KV 缓存存储和注意力计算减少了近 \(6\times\)
    • 借助可学习的注意力 Sink 偏置 (2025) 的帮助,即使采用了激进的滑动窗口大小和混合比例,该混合架构在长上下文场景中也能保持强大的建模能力
    • MiMo-V2-Flash 还集成了 Multi-Token Prediction 以增强训练性能并加速推理解码
      • 特别是,MTP 在提升 RL rollout 速度方面具有巨大潜力,这有助于将 LLMs 扩展到更强大的智能水平
      • 通过轻量级的密集前馈网络和滑动窗口注意力,论文的 MTP 模块在实践中以高接受率提供了显著的解码加速
  • MiMo-V2-Flash 的预训练方案在很大程度上遵循了 MiMo-7B (2025),并进行了若干改进
    • 训练使用 FP8 混合精度进行,能够在 27T Token 上实现高效的大规模训练
    • 模型最初以原生 32K 上下文进行预训练,随后扩展到 256K
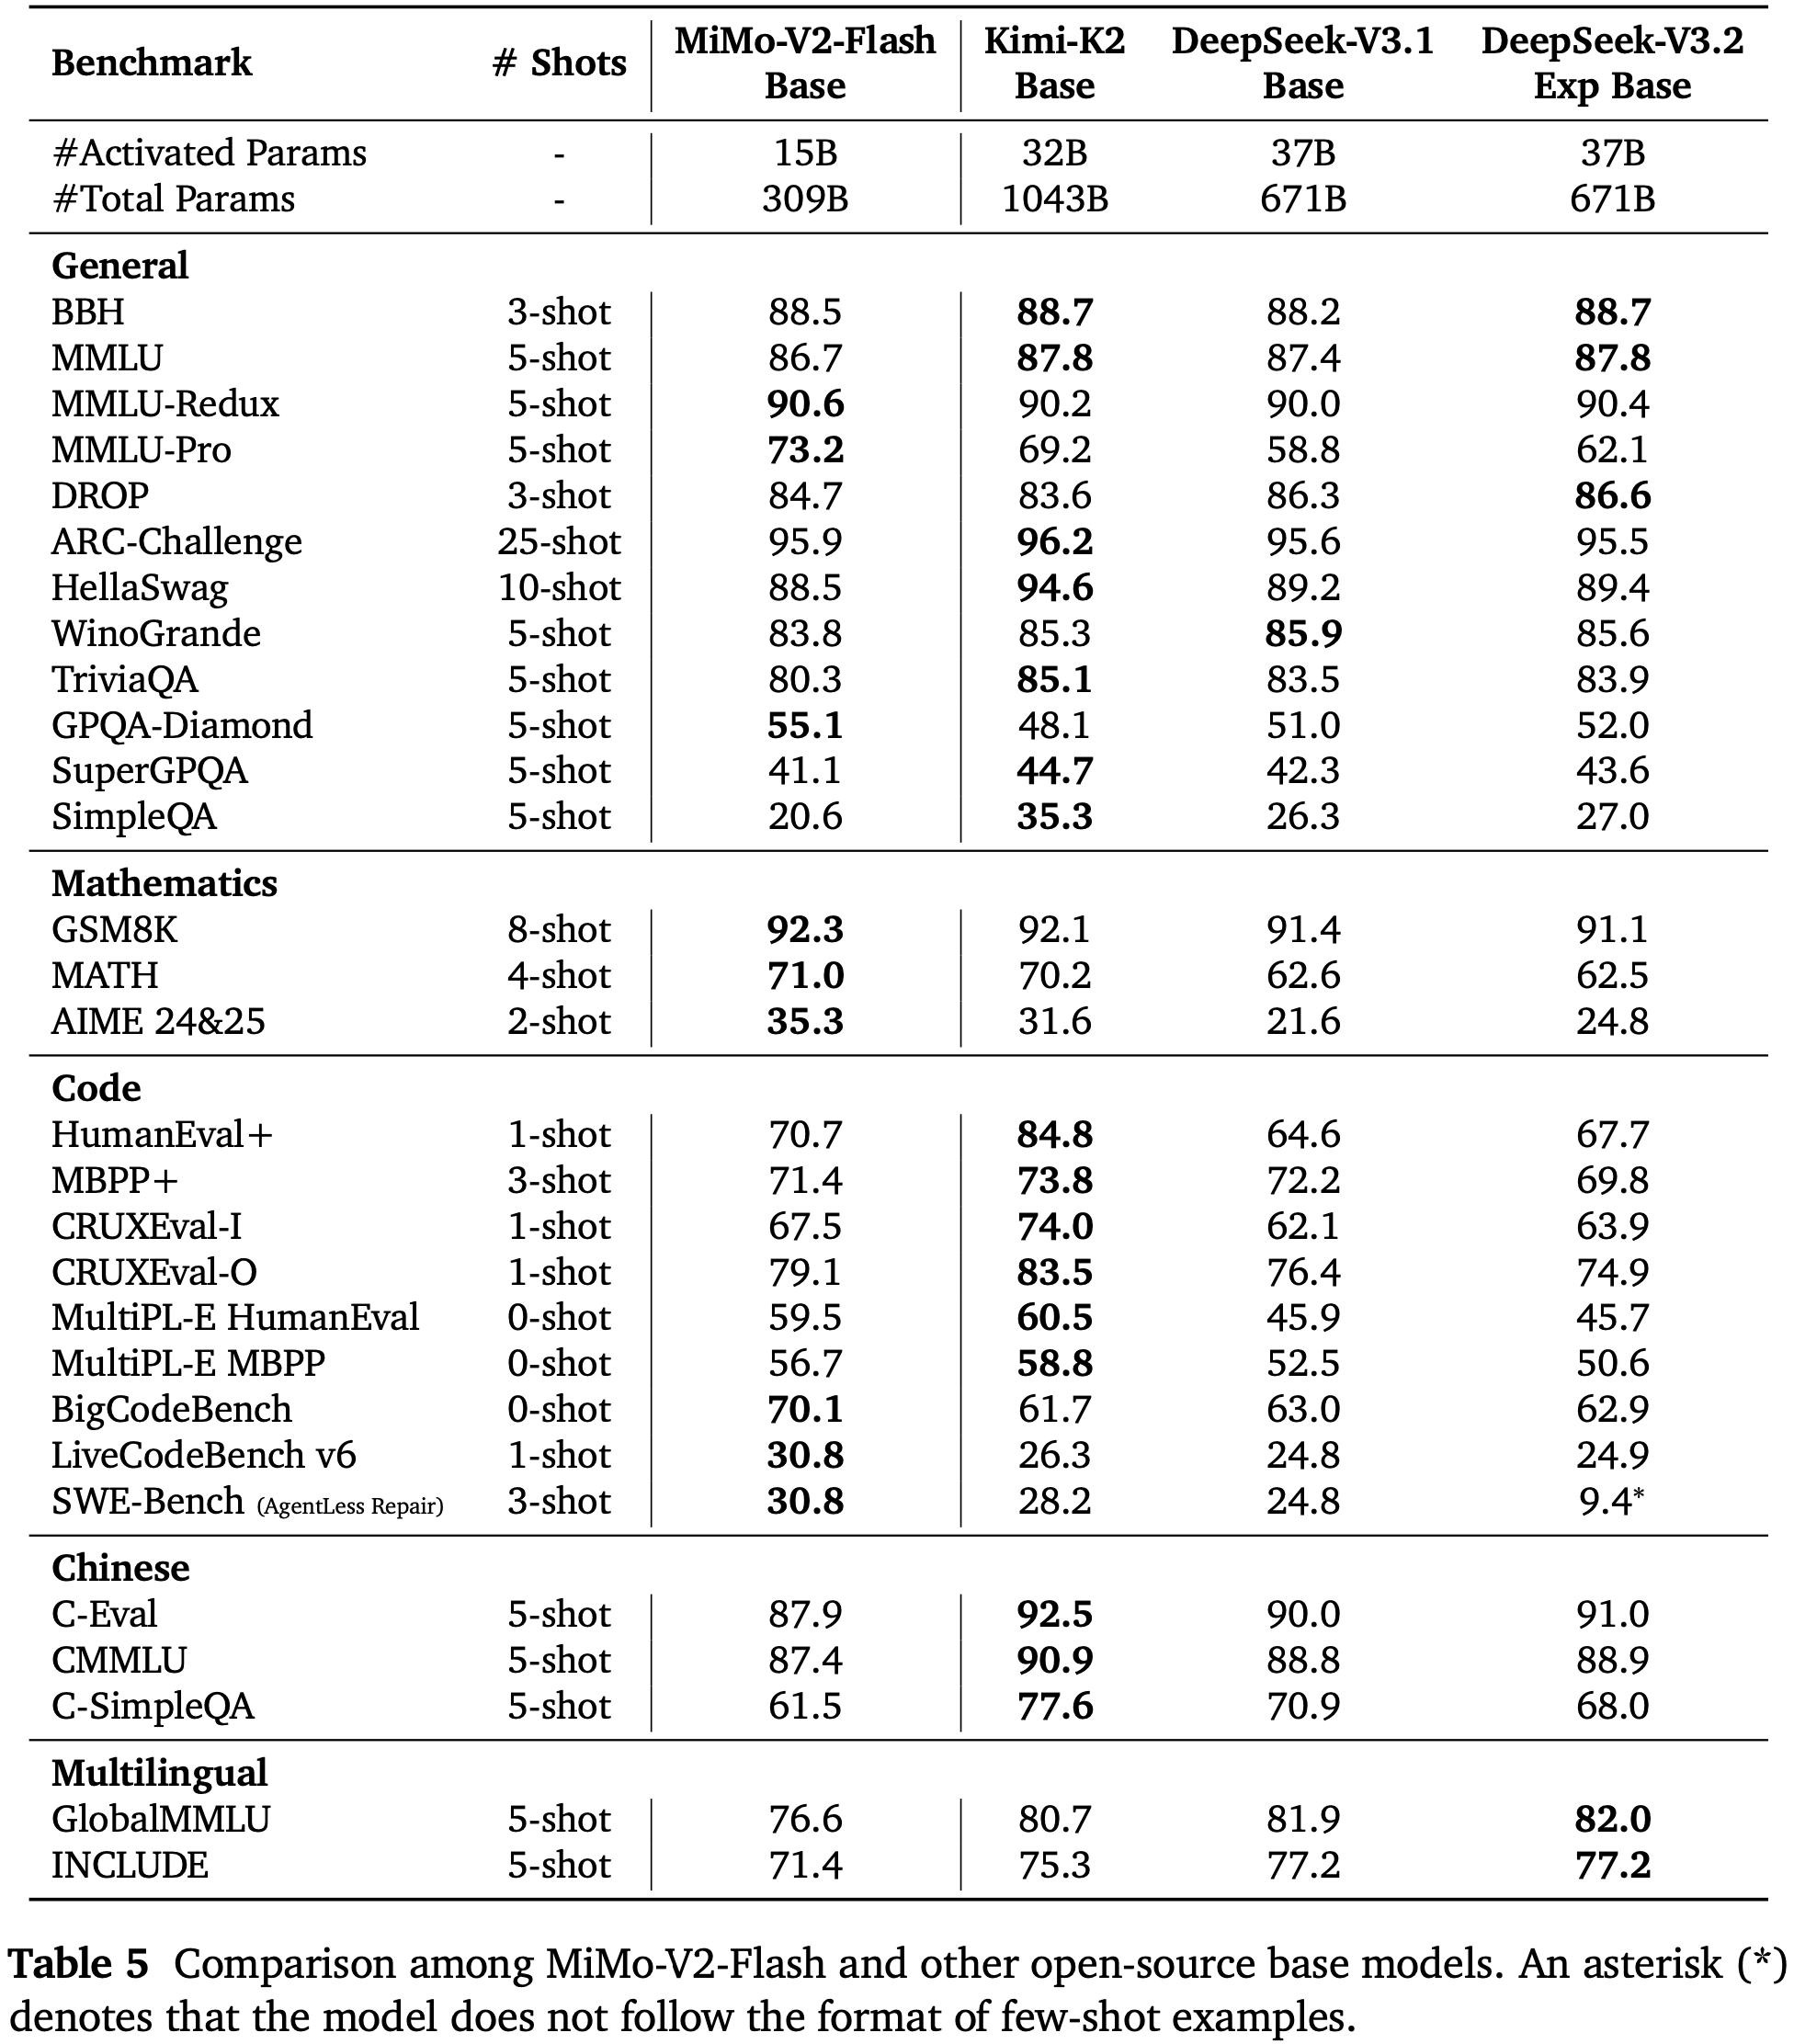
  • 得到的预训练模型 MiMo-V2-Flash-Base 已针对 Kimi-K2-Base (Kimi Team, 2025c) 和 DeepSeek-V3.2-Exp-Base (2025) 等领先的开源基础模型进行了评估
    • MiMo-V2-Flash-Base 在通用基准测试中取得了有竞争力的性能,并在侧重于推理的任务上超越了同类模型
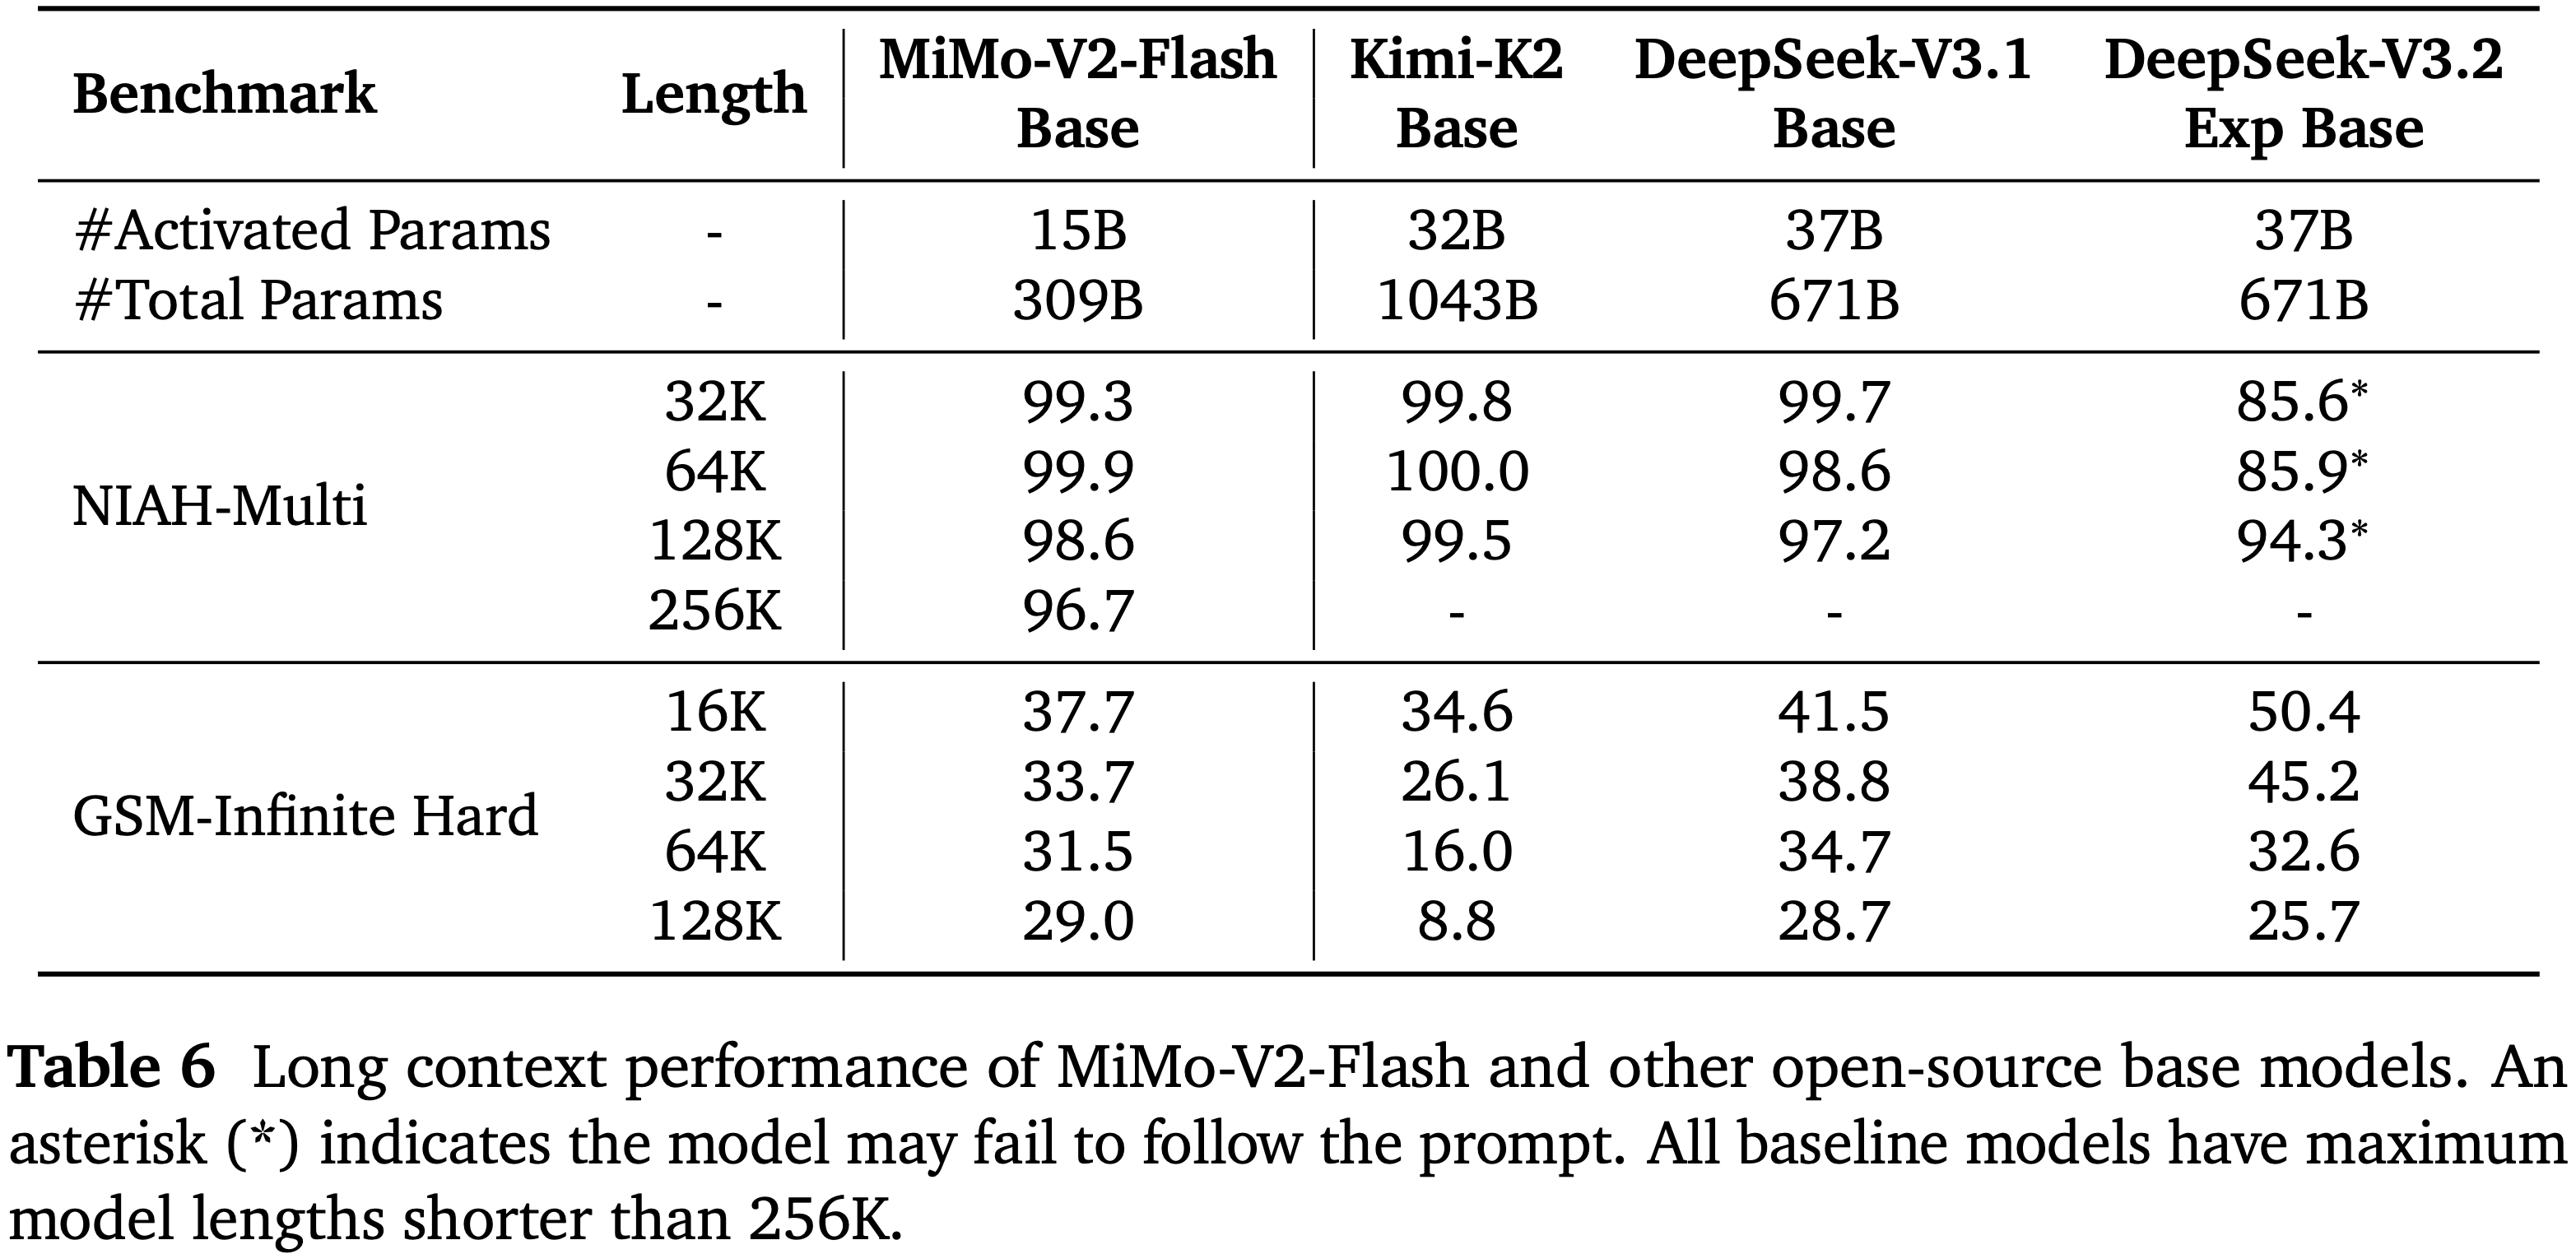
    • 对于长上下文检索,论文的混合注意力架构在从 32K 到 256K 的上下文长度上实现了接近 \(100%\) 的成功率
    • 在极端长上下文推理基准 GSM-Infinite (2025) 上,MiMo-V2-Flash 在从 16K 扩展到 128K 时表现出稳健的性能,性能下降最小
  • 在训练后阶段,论文专注于高效扩展 RL 计算,以改进推理和智能体能力
    • 为此,MiMo-V2-Flash 引入了一种称为多教师 On-policy 蒸馏的新训练后范式。该框架通过三阶段过程解决了能力不平衡和学习效率低下的问题:
      • (1) 通用监督微调;
      • (2) 专业化的 RL/SFT 用于训练领域特定的教师模型;
      • (3) MOPD,其中学生模型从两个互补的信号中学习:来自在不同领域训练的特定教师的密集的、Token-level 奖励,以及一个可验证的、基于结果的奖励
    • 通过以这种方式整合多样化的专家知识,MiMo-V2-Flash 同时掌握了领域教师的顶峰能力,并受益于稳定高效的学习动态
  • MiMo-V2-Flash 在大多数推理基准测试中取得了与 Kimi-K2-Thinking 和 DeepSeek-V3.2-Thinking 相媲美的性能
    • 在 LongBench V2 和 MRCR 等长上下文评估中,MiMo-V2-Flash 持续超越更大的全注意力模型,证实了其混合 SWA 架构的鲁棒性
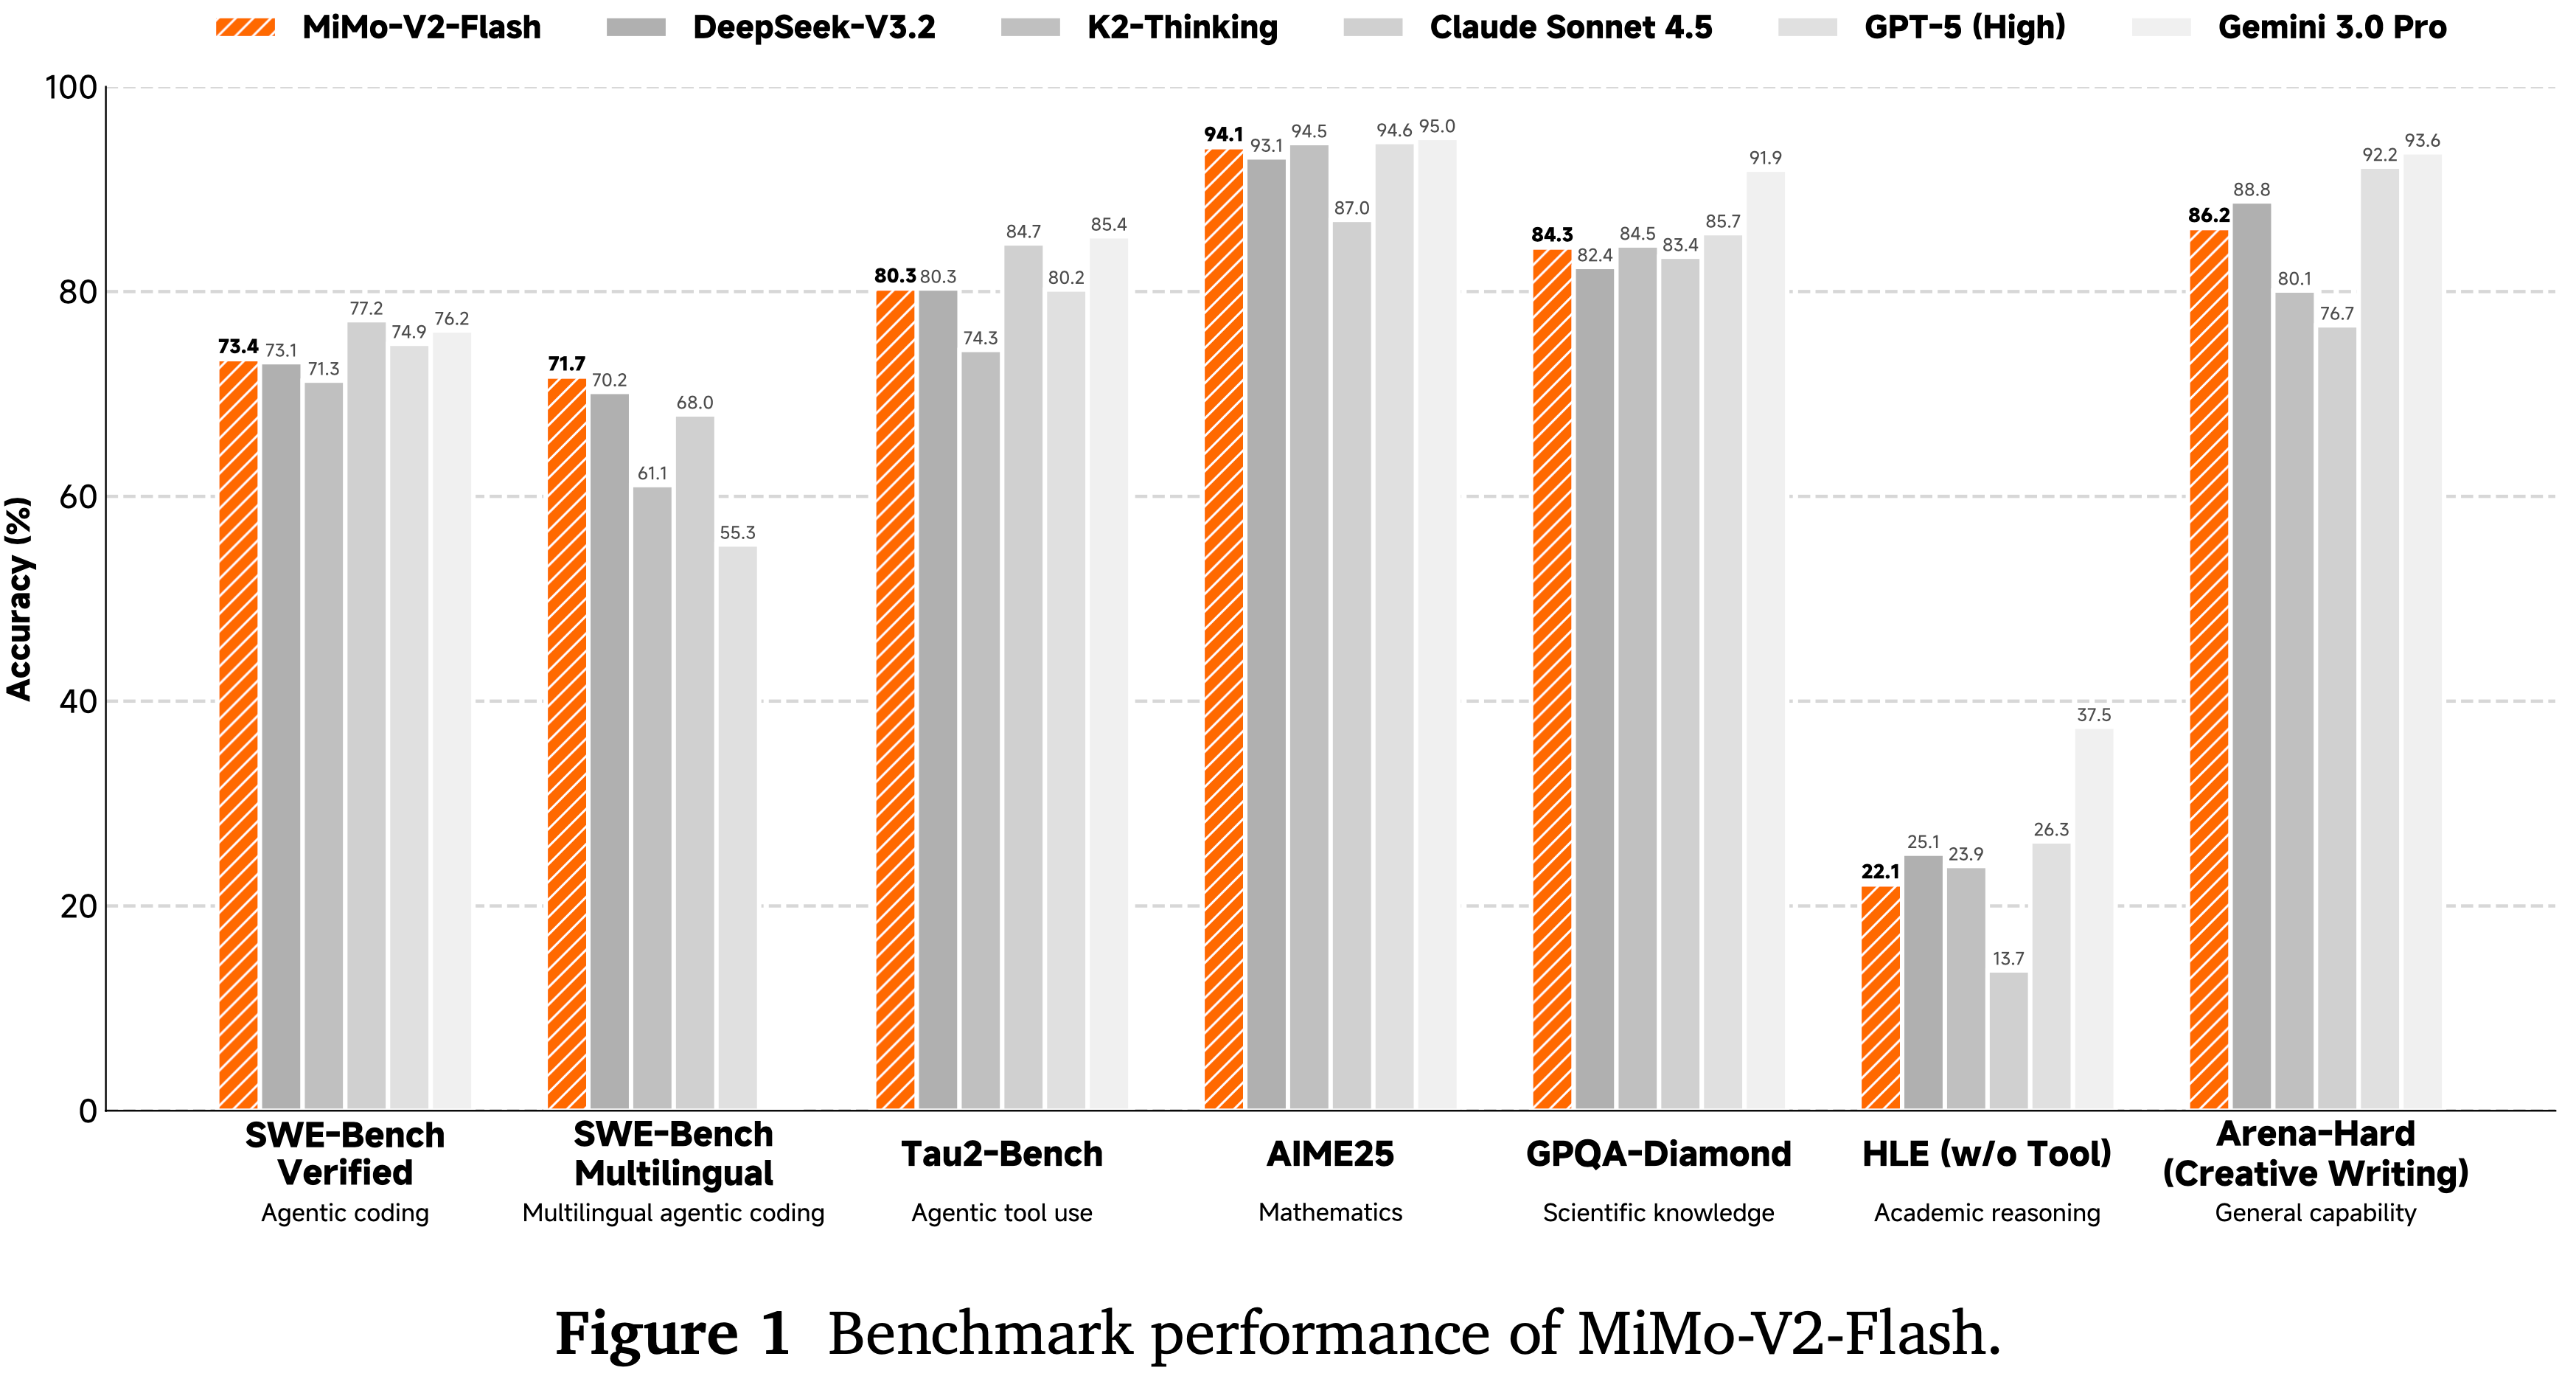
    • 值得注意的是,该模型在 SWE-Bench Verified 上达到了 \(73.4%\),在 SWE-Bench Multilingual 上达到了 \(71.7%\),使其成为软件工程任务中最领先的开源模型
    • 模型权重(包含 3 层 MTP 权重)可在 github.com/XiaomiMiMo/MiMo-V2-Flash 获取

MiMo-V2-Flash Model Architecture

Overall Architecture

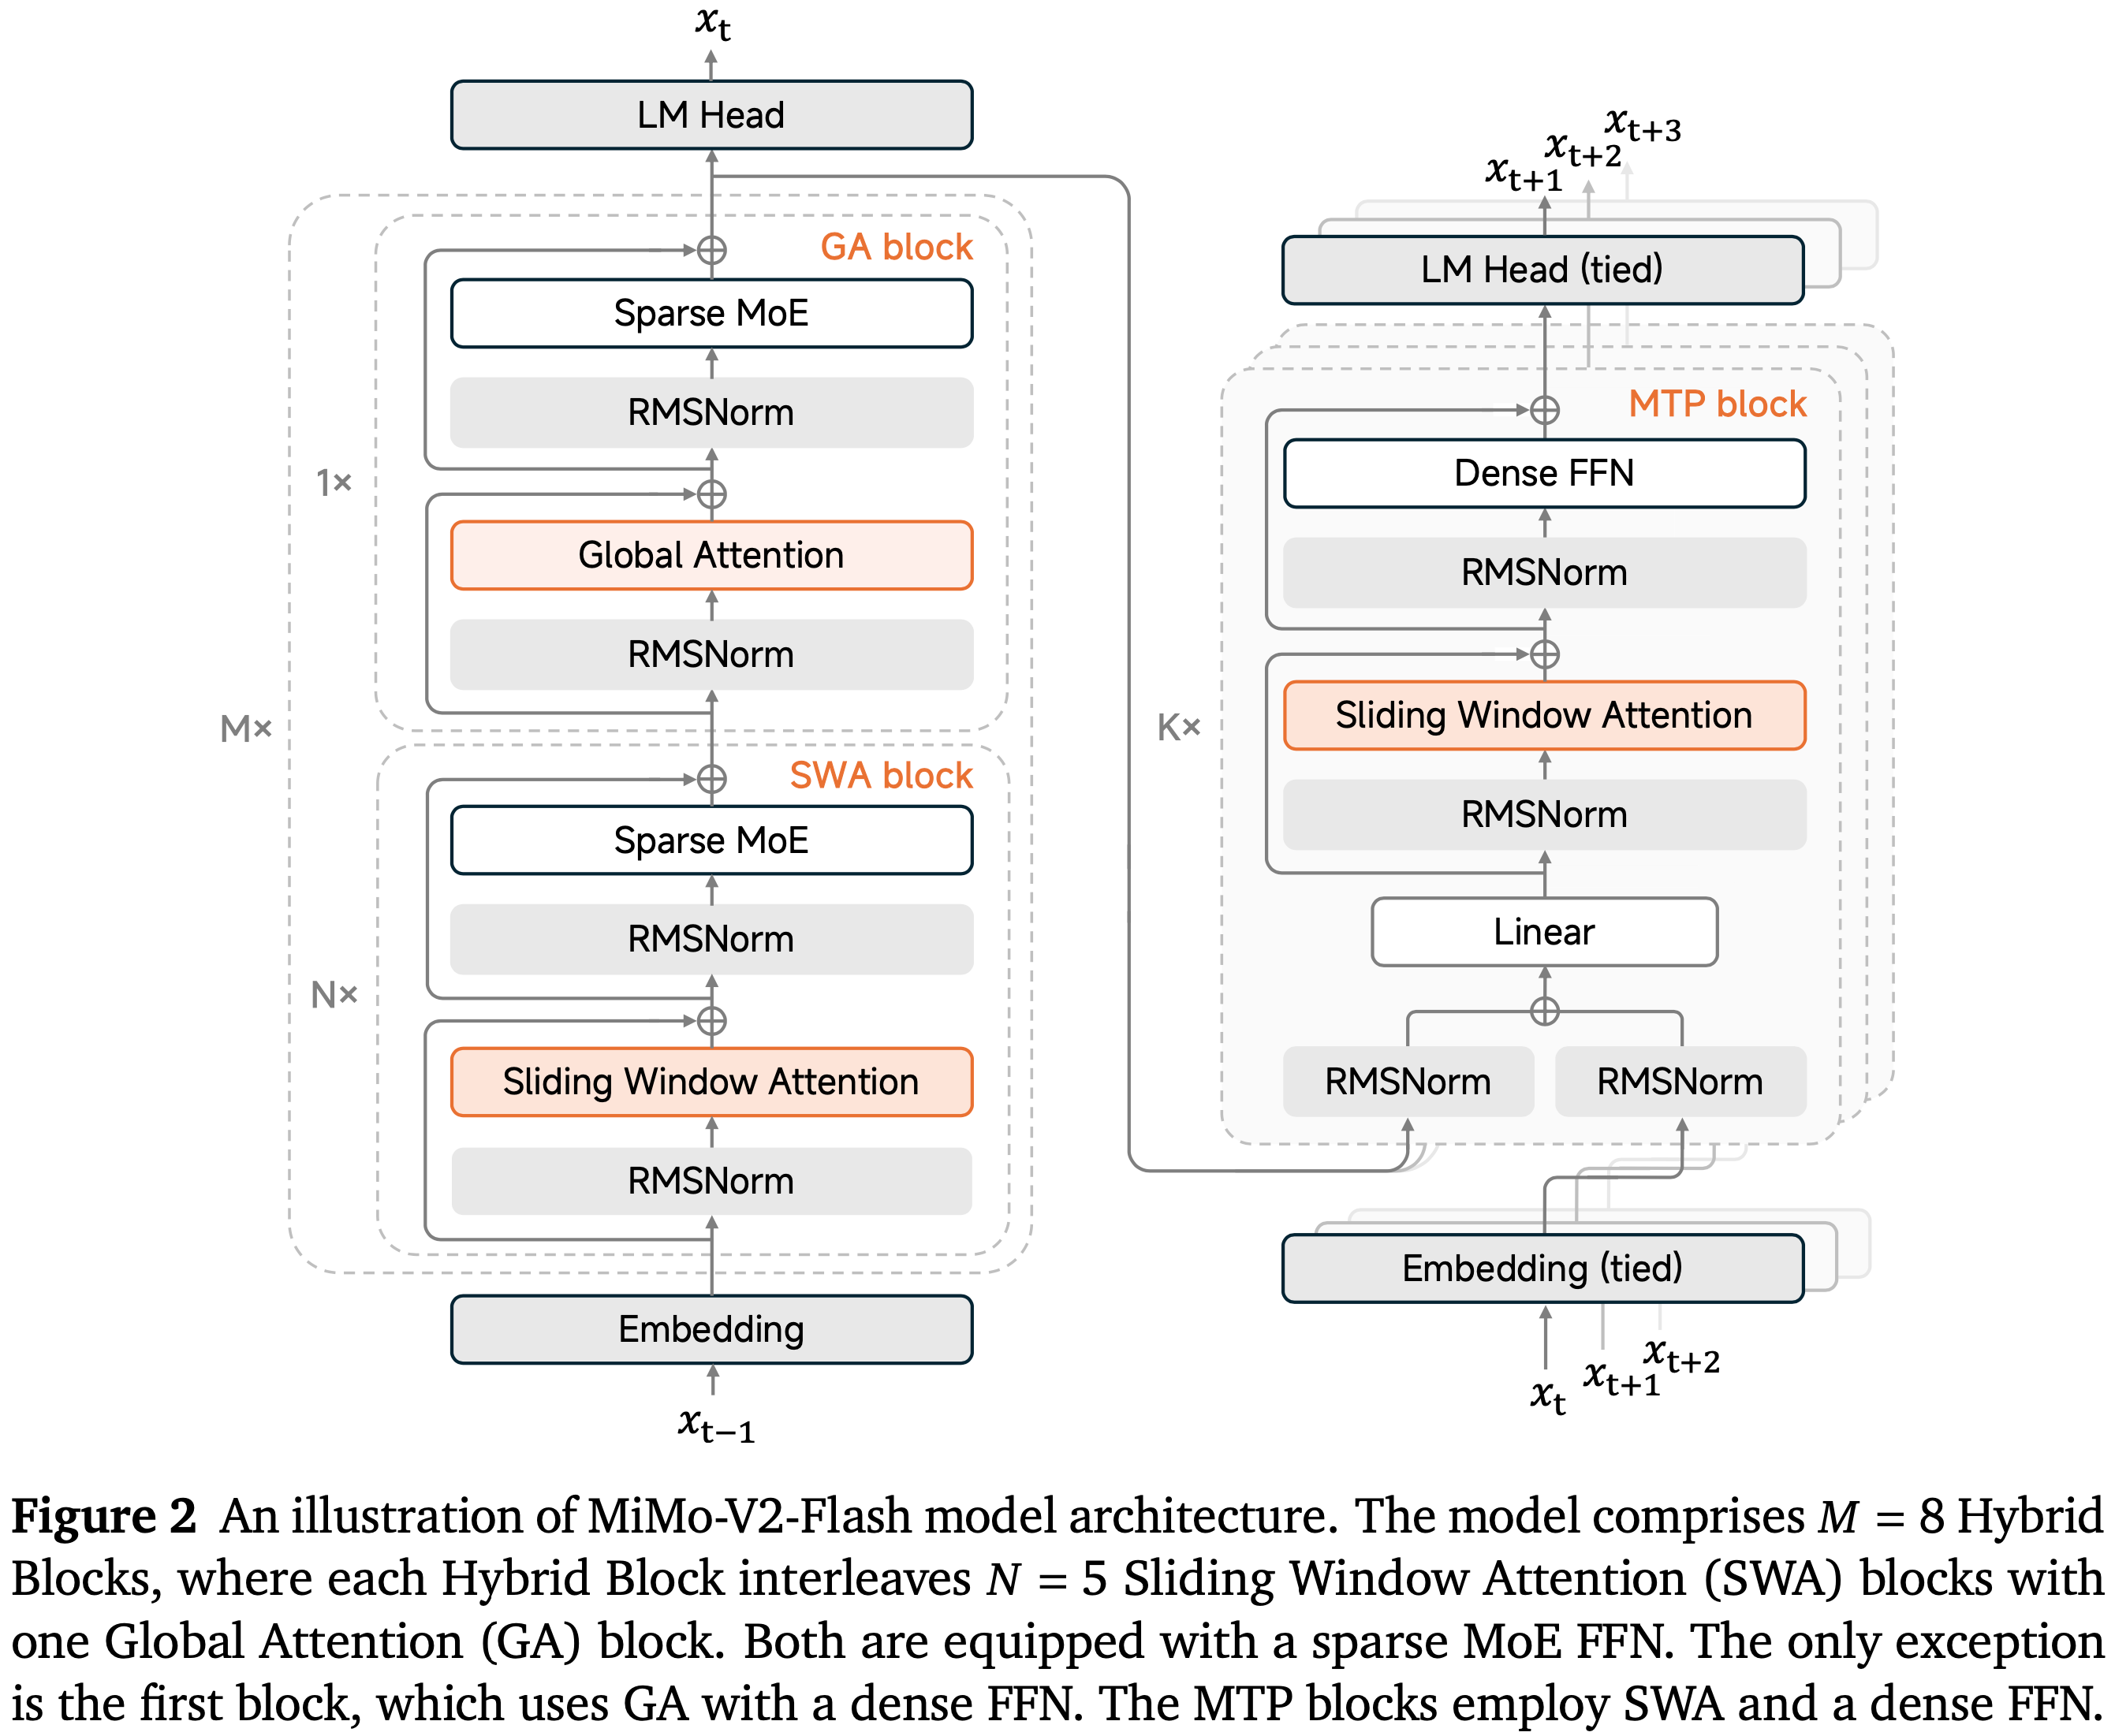
  • 如图 2 所示,MiMo-V2-Flash 遵循标准的 Transformer (2017) 主干,并增强了 MoE (2017) 和混合注意力 (2020; Gemma Team, 2024, 2025; Kimi Team, 2025a; 2025; Qwen Team, 2025)
    • MiMo-V2-Flash 主要由重复的混合块组成,这些块交错排列局部滑动窗口注意力和全局注意力
    • 它堆叠了 \(M = 8\) 个混合块,每个块的结构为 \(N = 5\) 个连续的 SWA 块后接一个 GA 块
    • 唯一的例外是第一个 Transformer 块,它使用全局注意力和密集的前馈网络以稳定早期的表示学习
    • MiMo-V2-Flash 中使用的滑动窗口大小 \(W\) 为 128
    • SWA 块和 GA 块都使用稀疏的 MoE FFN。每个 MoE 层总共包含 256 个专家,每 Token 激活 8 个,并且不包含共享专家
  • MiMo-V2-Flash 还集成了 MTP (2024; 2024; 2025) 以提高模型性能(包括质量和效率)
    • MTP 块使用 Dense FFN 而非 MoE,并采用 SWA 而非 GA,使其在推测解码中保持轻量级
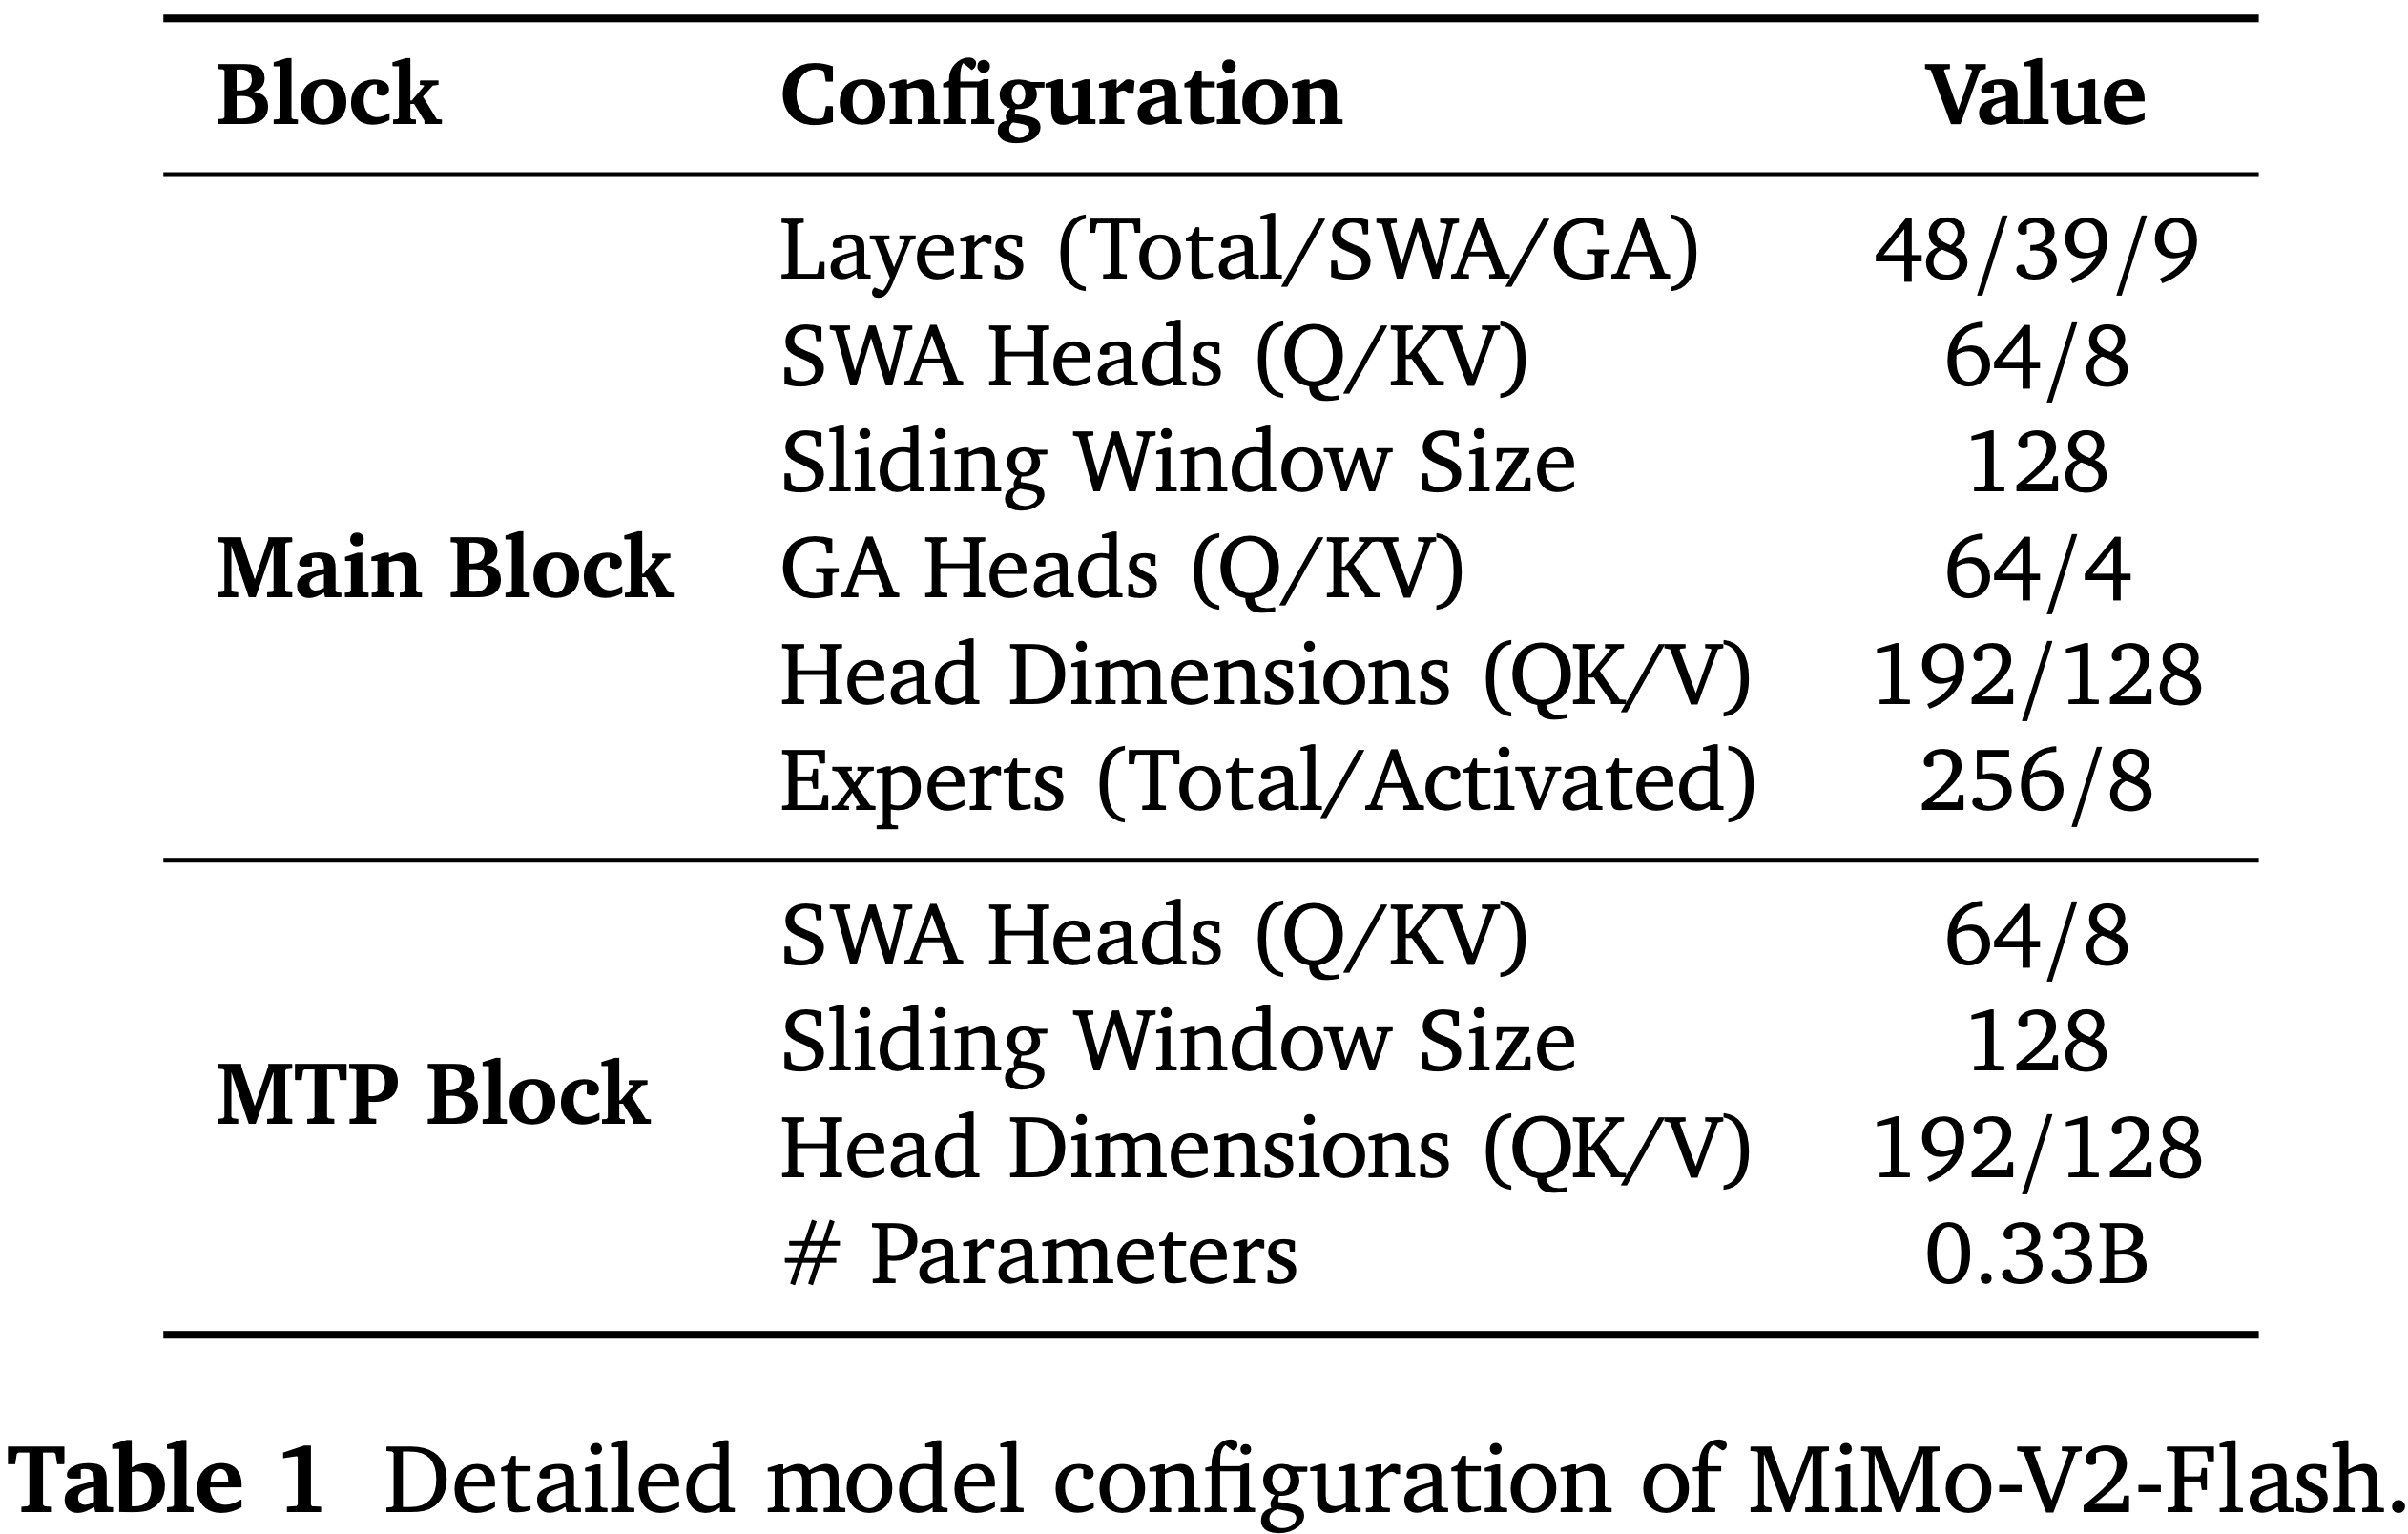
    • 每个 MTP 块的参数量仅为 0.33B
  • 表 1 总结了 MiMo-V2-Flash 的详细配置
    • 模型包含 39 个 SWA 层和 9 个 GA 层
    • SWA 和 GA 都使用分组 Query 注意力 (2023)
      • SWA 有 64 个 Query 头和 8 个键值头,GA 有 64 个 Query 头和 4 个键值头
      • SWA 和 GA 的每个头的维度相同( Query 和键为 192,值为 128)
    • 旋转位置嵌入部分应用于 Query 和键的前 64 个维度
      • 遵循最近的最佳实践,论文采用了类似于 DeepSeek-V3 (2024) 的 FP8 混合精度框架
    • 论文为注意力输出投影,以及嵌入和输出头参数保留 BF16 精度,同时为 MoE 路由器参数保持 FP32 精度
      • 这种混合精度配置提高了数值稳定性,而不会对训练效率或内存占用产生实质性影响

Hybrid Sliding Window Attention Architecture

  • 滑动窗口注意力 (2020) 将每个 Token 的注意力范围限制在局部窗口而非整个序列,从而显著降低计算和内存复杂度
    • 这自然激发了混合滑动窗口注意力架构的出现
  • 但先前的工作表明,过度激进的 SWA 使用,如非常小的滑动窗口大小或高 SWA:GA 比例,可能导致模型性能显著下降 (Gemma Team, 2025),尤其是在长上下文任务中
    • 最近,可学习的注意力 Sink 偏置的引入显著增强了基于 SWA 架构的建模能力 (2025),该机制允许模型在需要时将很少或没有注意力分配给某些 Token
    • 尽管注意力 Sink 机制的确切理论基础仍是一个活跃的研究领域 (2024b; 2025; 2024; 2023),但论文通过实验观察到,可学习的注意力 Sink 偏置显著提升了混合 SWA 模型的性能,匹配甚至超过了使用完全 GA 层的基线
  • 在 MiMo-V2-Flash 中,论文的实现遵循了 gpt-oss (2025) 中使用的设计,其中每个注意力头的 softmax 分母应用一个可学习的注意力 Sink 偏置 \(sink \in \mathbb{R}\)
    • 令单个注意力头中 Token \(i\) 和 \(j\) 之间的注意力 logits 为:
      $$a_{ij} = \frac{q_ik_j^\top}{\sqrt{d} }, \tag{1}$$
      • 其中 \(q_{i}\) 和 \(k_{j}\) 分别表示 Token \(i\) 的 Query 和 Token \(j\) 的键,\(d\) 是头的维度
    • 注意力权重由下式给出:
      $$
      \begin{align}
      s_{ij} &= \frac{\exp\left(a_{ij} - m_i\right)}{\exp\left(\text{sink} - m_i\right) + \sum_{j’}\exp\left(a_{ij’} - m_i\right)} \tag{2} \\
      m_{i} &= \max \left\{\max_{j}a_{ij},\text{sink}\right\} \tag{3}
      \end{align}
      $$
  • 最后, Query \(i\) 的注意力输出通过对值进行加权和获得:
    $$o_{i} = \sum_{j = 1}^{n}s_{ij}\nu_{j}. \tag{4}$$
Model Architecture Experiments
  • 了验证论文设计选择的有效性,论文在一个 32B Dense 模型上进行了探索性和实证研究,保持了与上述描述一致的 Query -键维度和旋转嵌入配置
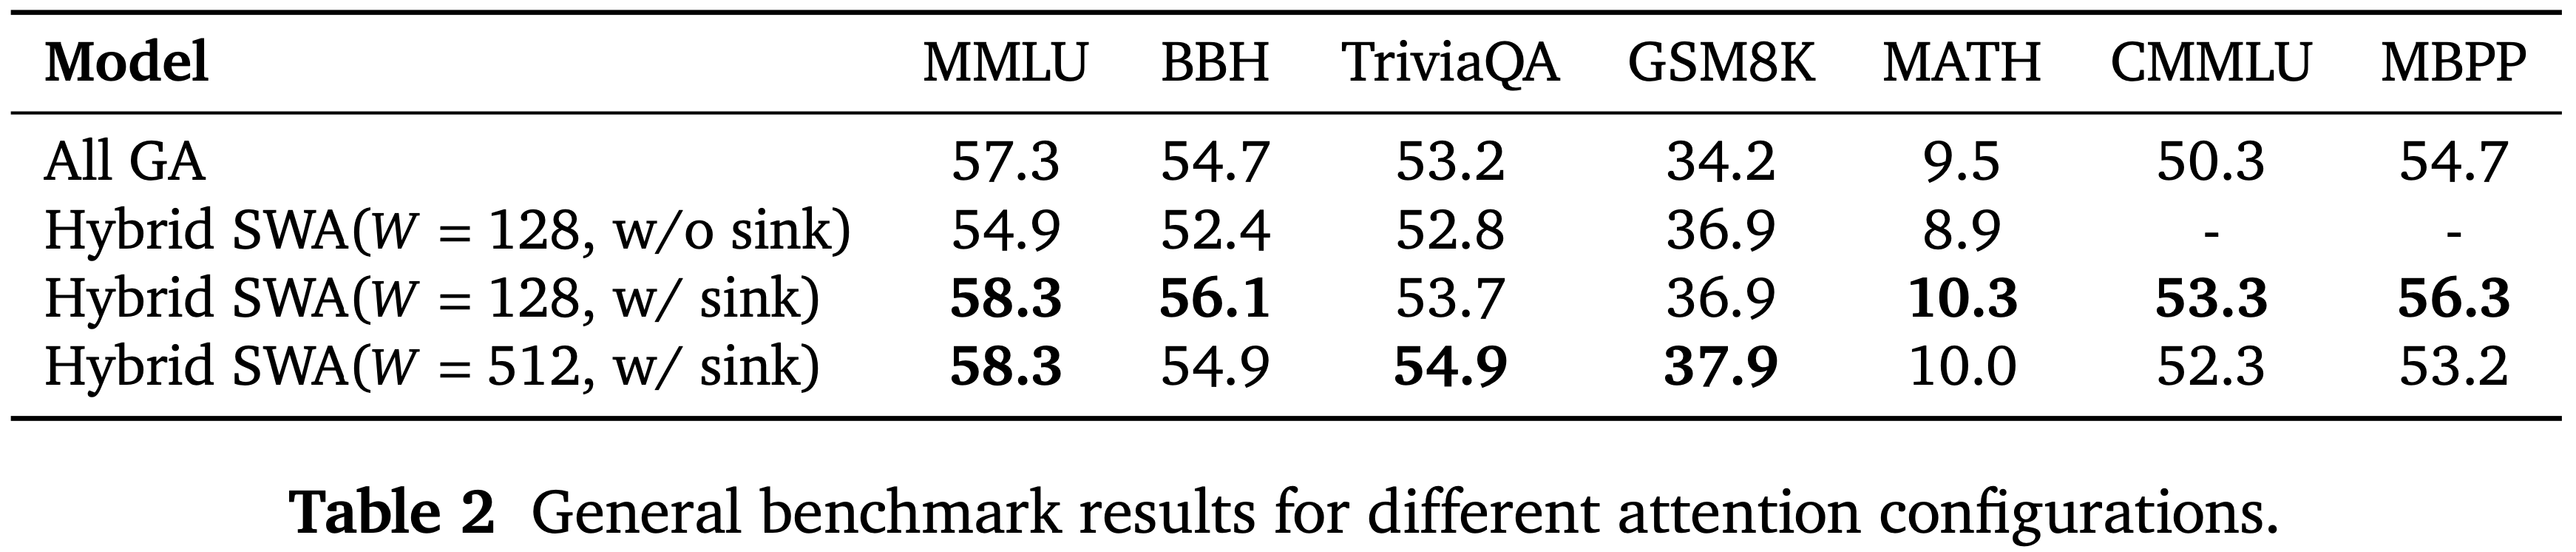
  • 表 2:不同注意力配置的通用基准结果
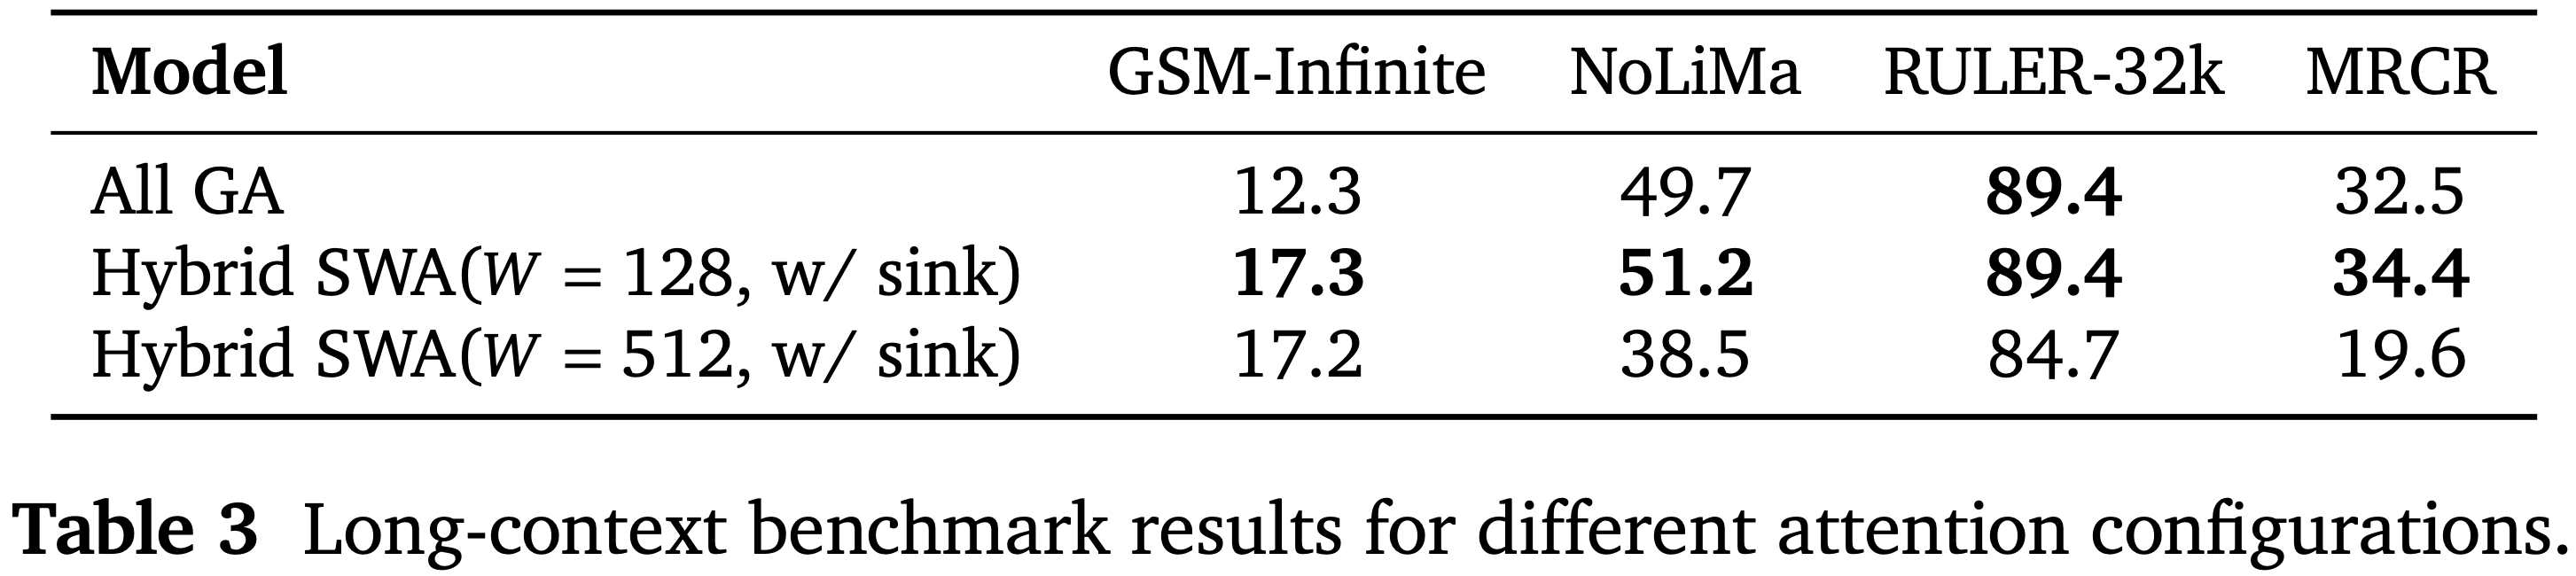
  • 表 3:不同注意力配置的长上下文基准结果
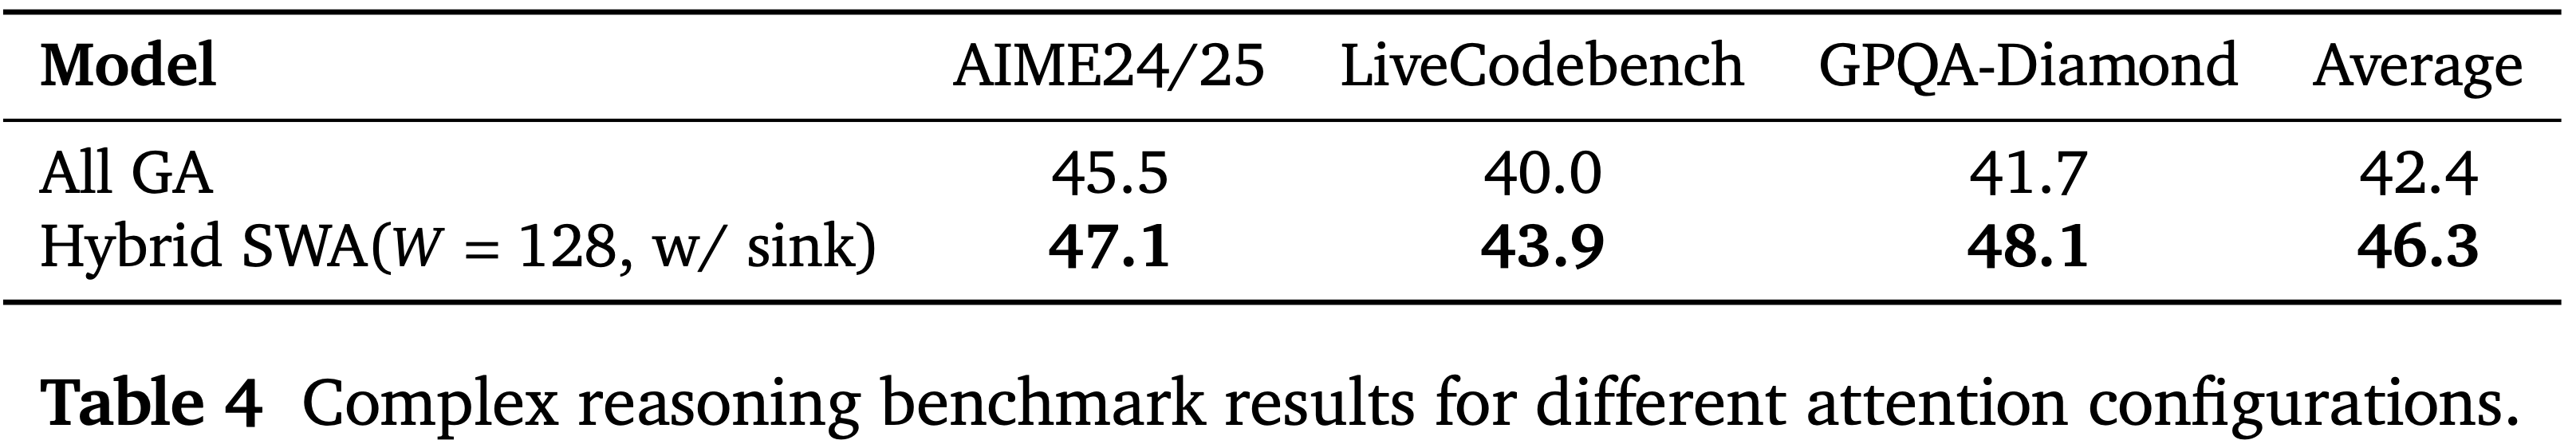
  • 表 4:不同注意力配置的复杂推理基准结果
基线及基准测试
  • 论文在比较环境中评估了四种模型架构变体,包括:
    • 一个全全局注意力基线
    • 一个不带注意力 Sink 偏置的 128 Token 窗口混合 SWA 模型
    • 两个分别使用 128 和 512 窗口大小并增强了注意力 Sink 偏置的混合 SWA 模型
    • 所有变体共享相同的训练流程:在 250B Token 上进行 8,192 序列长度的预训练,然后在额外的 40B Token 上长上下文扩展到 32,768,接着进行带有思维链监督的长上下文 SFT 和推理 SFT
  • 论文评估模型变体在涵盖通用能力、长上下文理解和复杂推理的基准测试上的表现
    • 通用领域结果(表 2)来自未经长上下文扩展的预训练基础模型,评估了在 MMLU (2021a), BBH (2023), TriviaQA (2017), GSM8K (2021), MATH (2021b), CMMLU (2023) 和 MBPP (2021) 上的通用知识和推理
    • 长上下文结果(表 3)评估了长上下文扩展后的基础模型在 GSM-Infinite (2025), NoLiMa (2025) 和 RULER-32k (2024) 上的表现,以及长上下文 SFT 模型在 MRCR (2024) 上的表现
    • 对于 GSM-Infinite 和 Nolima,论文构建了内部的 few-shot 基准来评估基础模型在受控的长上下文设置下的表现
    • 复杂推理结果(表 4)评估了推理 SFT 模型在 AIME24&25 (MAA, 2024), LiveCodeBench (2024) 和 GPQA-Diamond (2024) 上的表现
  • 论文关键的实证发现:
    • 注意力 Sink 偏置消融实验 如表 2 所示,混合 SWA (\(W = 128\) ,w/o Sink ) 在通用基准测试中遭受了明显的性能下降,而引入注意力 Sink 偏置相对于全 GA 基线一致地恢复或提升了性能
      • 因此,在进一步的实验中,论文默认假设应用了注意力 Sink 偏置
    • 滑动窗口注意力大小 混合 SWA (\(W = 128\)) 和混合 SWA (\(W = 512\)) 在通用基准测试上表现相似(表 2)
      • 然而,经过长上下文扩展和长上下文 SFT 后,混合 SWA (\(W = 128\)) 超越了全 GA 基线,而 SWA (\(W = 512\)) 则经历了显著的性能下降(表 3)
    • 推理能力 如表 4 所示,混合 SWA (\(W = 128\)) 在不同的挑战性推理基准测试上超越了全 GA 基线,在复杂推理能力上显示出清晰的改进
Summary and Discussion
  • 论文的实验表明,混合 SWA (\(W = 128\)) 不仅优于混合 SWA (\(W = 512\)),而且可以 超越全 GA 基线 ,这可能看起来违反直觉
    • 论文推断这是由于更好的正则化和有效的稀疏性相结合的结果
  • 较小的窗口迫使模型专注于局部上下文,作为一种归纳偏置,减轻了对虚假模式的过拟合
    • 此外,更紧的窗口 (\(W = 128\)) 迫使 SWA 对局部信息建模,同时将长程依赖委托给全局注意力层,导致更清晰的分工和更准确高效的学习
    • 相比之下,更大的窗口 (\(W = 512\)) 可能会模糊这种区别,导致 SWA 部分地自行处理长程依赖,这稀释了局部和全局信息之间的分离,并导致次优性能
  • 论文这些观察和发现是实证性的,源于论文特定的实验设置,包括模型规模、数据集和训练过程
    • 尽管如此,作者希望这些观察能为正在进行的关于推理和智能体 AI 模型时代高效注意力架构的讨论贡献一个额外的视角,并激励社区更广泛地研究高效架构

Lightweight Multi-Token Prediction

Motivation of using MTP
  • 先前的工作表明,MTP 是一种强大的训练目标,可以增强训练效率和模型质量 (2024; 2024; 2025)
    • 除了这些训练上的好处,论文更强调将 MTP 作为本机草稿模型用于自推测解码,以实现实际部署的加速
  • 论文从两个角度详细阐述 MTP 如何加速推理:通用 LLM 解码加速和 RL 训练加速
Accelerating LLM Decoding
  • 由于算术强度低,LLM 解码本质上是内存受限的
    • 批次级并行通常用于提高 FFN 的算术强度,但对注意力计算没有益处,因为每个请求维护自己的 KV 缓存
    • 相比之下,MTP 通过生成多个草稿 Token 来提升 FFN 和注意力的算术强度,然后主模型并行验证这些 Token
    • 这种方法实现了 Token 级并行,而无需增加 KV 缓存 I/O
      Accelerating RL Training
  • MTP 加速特别适用于 RL 训练 (RadixArk Team, 2025),其中 rollout 阶段由于推理和解码成本始终是主要的瓶颈
  • MTP 解决了 RL 训练中的两个关键挑战:
    • 它使得小批次的 RL 高效且有效:当前的 RL 训练依赖于大批次、 Off-policy 算法来最大化吞吐量 (2025; 2017; 2025)
      • 但实际上,On-policy 训练通常更稳定和有效,但其小批次无法充分利用 GPU 资源
    • MTP 通过扩展 Token 级并行而不是批次大小来缓解这一限制,使得小批次、 On-policy RL 训练更加实用
      • 它减轻了由长尾滞后项引起的 GPU 空闲
      • 随着 rollout 阶段进行,处理长序列且批次大小较小(通常接近 1)的长尾滞后项会导致显著的 GPU 空闲 (2025; 2025)
      • 在此类场景中,MTP 提高了注意力和 FFN 的计算效率,显著减少了总体延迟
      • 理解:这里说的是当 Batch 较小时,MTP 可以提升并行度?还是说单纯的提升了整体解码速度?
Lightweight MTP Design in MiMo-V2-Flash
  • 在 MiMo-V2-Flash 中,MTP 块被刻意保持轻量级,以防止其成为新的推理瓶颈
  • 论文使用小型 Dense FFN 而不是 MoE 来限制参数数量,并采用 SWA 而不是全局注意力来减少 KV 缓存和注意力计算成本
    • 在预训练期间,模型仅附加一个 MTP 头以避免额外的训练开销
    • 在训练后阶段,该头被复制 \(K\) 次以形成 \(K\) 步 MTP 模块,并且所有头联合训练以进行多步预测
      • 每个头接收主模型的隐藏状态和 Token 嵌入作为输入,提供更丰富的预测信息
  • 尽管设计轻量,MTP 模块仍然非常有效,并实现了高接受率
    • 详细结果见第 5 节

Pre-Training

  • MiMo-V2-Flash 的预训练语料库包含来自多样化高质量来源的 27T Token,包括公共网络内容、书籍、学术论文、代码、数学和更广泛的 STEM 材料
  • 论文的数据处理流程在很大程度上遵循了 MiMo-7B (2025),并有意转向展现长程依赖的数据
  • 特别是,论文强调长格式的网络文档和精心整理的代码语料库,如仓库级代码、拉取请求、问题和提交历史,以增强模型捕获扩展上下文关系和执行复杂多步推理的能力

Data Scheduler

  • MiMo-V2-Flash 的预训练组织为三个连续的阶段:
    • 阶段 1 :在多样化的高质量通用语料库上使用 32K Token 的上下文长度进行训练,以建立强大的基础语言能力
    • 阶段 2 :通过上采样以代码为中心的数据并纳入约 \(5%\) 的合成推理数据来修改数据混合,以进一步增强逻辑推理和程序合成能力
    • 阶段 3 :遵循第 2 阶段的数据分布,将模型的上下文窗口扩展到 256K Token,并对具有长程依赖的数据进行上采样,实现对扩展上下文和长视野推理的更有效建模

Hyper-Parameters

模型超参数
  • 论文将 MiMo-V2-Flash 配置为 48 个 Transformer 层,包括 39 个滑动窗口注意力层和 9 个全局注意力层。隐藏维度设置为 4096。除第一层外,所有层都配备了稀疏 MoE。每个 MoE 层包含 256 个路由专家,每 Token 激活 8 个专家,每个专家的中间隐藏维度为 2048。密集层 FFN 的中间隐藏维度设置为 16384。所有可学习参数均以 0.006 的标准差随机初始化。模型在预训练期间使用单层 MTP。总体而言,MiMo-V2-Flash 总参数量为 309B,其中激活参数量为 15B
训练超参数
  • 论文采用 AdamW 优化器,其中 \(\beta_{1} = 0.9\) , \(\beta_{2} = 0.95\) ,权重衰减为 0.1。梯度裁剪的最大范数为 1.0。学习率调度分两个阶段运行。在阶段 1,学习率在前 50B Token 从 0 线性预热到 \(3.2 \times 10^{- 4}\),然后在 \(3.2 \times 10^{- 4}\) 保持 12T Token,最后在 10T Token 上以余弦衰减到 \(1.0 \times 10^{- 4}\)。阶段 2 从 \(1.0 \times 10^{- 4}\) 开始,并在 4T Token 上以余弦衰减到 \(3.0 \times 10^{- 5}\)。批次大小在前 500B Token 线性预热到 2,048,并在两个阶段的剩余时间保持恒定。关于辅助损失,所有阶段的 MoE 序列辅助损失系数设置为 \(1.0 \times 10^{- 5}\)。专家偏置更新因子在阶段 1 和阶段 2 设置为 0.001。MTP 损失权重在阶段 1 设置为 0.3,在阶段 2 和 3 设置为 0.1
长上下文扩展
  • 在阶段 1,论文将预训练序列长度设置为 32,768,GA 的 RoPE 基础频率为 640,000,SWA 为 10,000。在阶段 3,序列长度扩展到 262,144,GA 的 RoPE 基础频率调整为 5,000,000。阶段 3 的学习率从 \(3.0 \times 10^{- 5}\) 以余弦调度衰减到 \(1.0 \times 10^{- 5}\),批次大小固定为 256。专家偏置更新因子在阶段 3 减少到 \(1.0 \times 10^{- 5}\)

Evaluations

Evaluation Setup
  • 论文在涵盖各种能力的一系列基准测试上评估 MiMo-V2-Flash-Base:
    • (1) 通用语言理解和推理,包括 BBH (2023), MMLU (2021a), MMLU-Redux (2024), MMLU-Pro (2024), DROP (2019), ARC (2018), HellaSwag (2019), WinoGrande (2020), TriviaQA (2017), GPQA-Diamond (2024), SuperGPQA (2025) 和 SimpleQA (OpenAI, 2024)
    • (2) 数学推理: GSM8K (2021), MATH (2021b) 和 AIME (MAA, 2024) (2024 & 2025)
    • (3) 代码: HumanEval+ (2023), MBPP+ (2023), CRUXEval (2024a), MultiPL-E (2022), BigCodeBench (2024), LiveCodeBench-v6 (2024) 和 SWE-Bench (2024a) (few-shot Agentless Repair (2024))
    • (4) 中文理解: C-Eval (2023), CMMLU (2023) 和 C-SimpleQA (2025)
    • (5) 多语言理解: GlobalMMLU (2025) 和 INCLUDE (2024)
    • (6) 长上下文: NIAH-Multi (2024), GSM-Infinite (2025) (5-shot, Hard Ops-{2,4,6,8,10})
Evaluation Results
  • 表 5 展示了 MiMo-V2-Flash-Base 与领先的开源基础模型 (Kimi Team, 2025c; 2024) 的全面比较
    • MiMo-V2-Flash-Base 在大多数基准测试中提供了有竞争力的性能,并在推理任务上持续超越同行
    • 在 SWE-Bench 上,它甚至超越了参数量大得多的 Kimi-K2-Base,同时使用了不到三分之一的参数,突显了论文方法在实际代码-智能体任务上的优势
    • 受限于其有限的参数量,论文观察到与更大的模型相比,MiMo-V2-Flash 表现出较低的知识能力,这反映在 SimpleQA 上
  • 论文在表 6 中说明了每个模型的长上下文能力
    • 对于长上下文检索,论文的模型架构从 32K 到 256K 实现了接近 \(100%\) 的成功率
      • 在极端压力长上下文推理基准 GSM-Infinite 上,MiMo-V2-Flash 也显示出强大的性能,从 16K 到 128K 性能下降最小
    • 相比之下,DeepSeek-V3.2-Exp 是一个稀疏注意力 LLM,在 32K 以下获得了最高分,但在 64K 和 128K 时显著下降,表明其在带噪输入的长上下文推理中存在固有劣势
      • 这些结果有力地证明了论文的混合 SWA 架构、原生 32K 预训练和上下文扩展训练的有效性和可扩展性

Post-Training

MOPD:多教师 On-policy 蒸馏 (Multi-Teacher On-Policy Distillation (MOPD): A New Post-Training Paradigm)

  • 现代语言模型越来越依赖广泛的后训练来增强其智能和能力,当前的后训练流程面临两个根本性挑战:
    • 能力不平衡 (capability imbalance) :提升某一技能会导致其他技能的退化(“跷跷板”效应);
    • 学习效率低下 (learning inefficiency) : 现有方法在整合来自多个专业模型的知识时未能充分利用训练信号
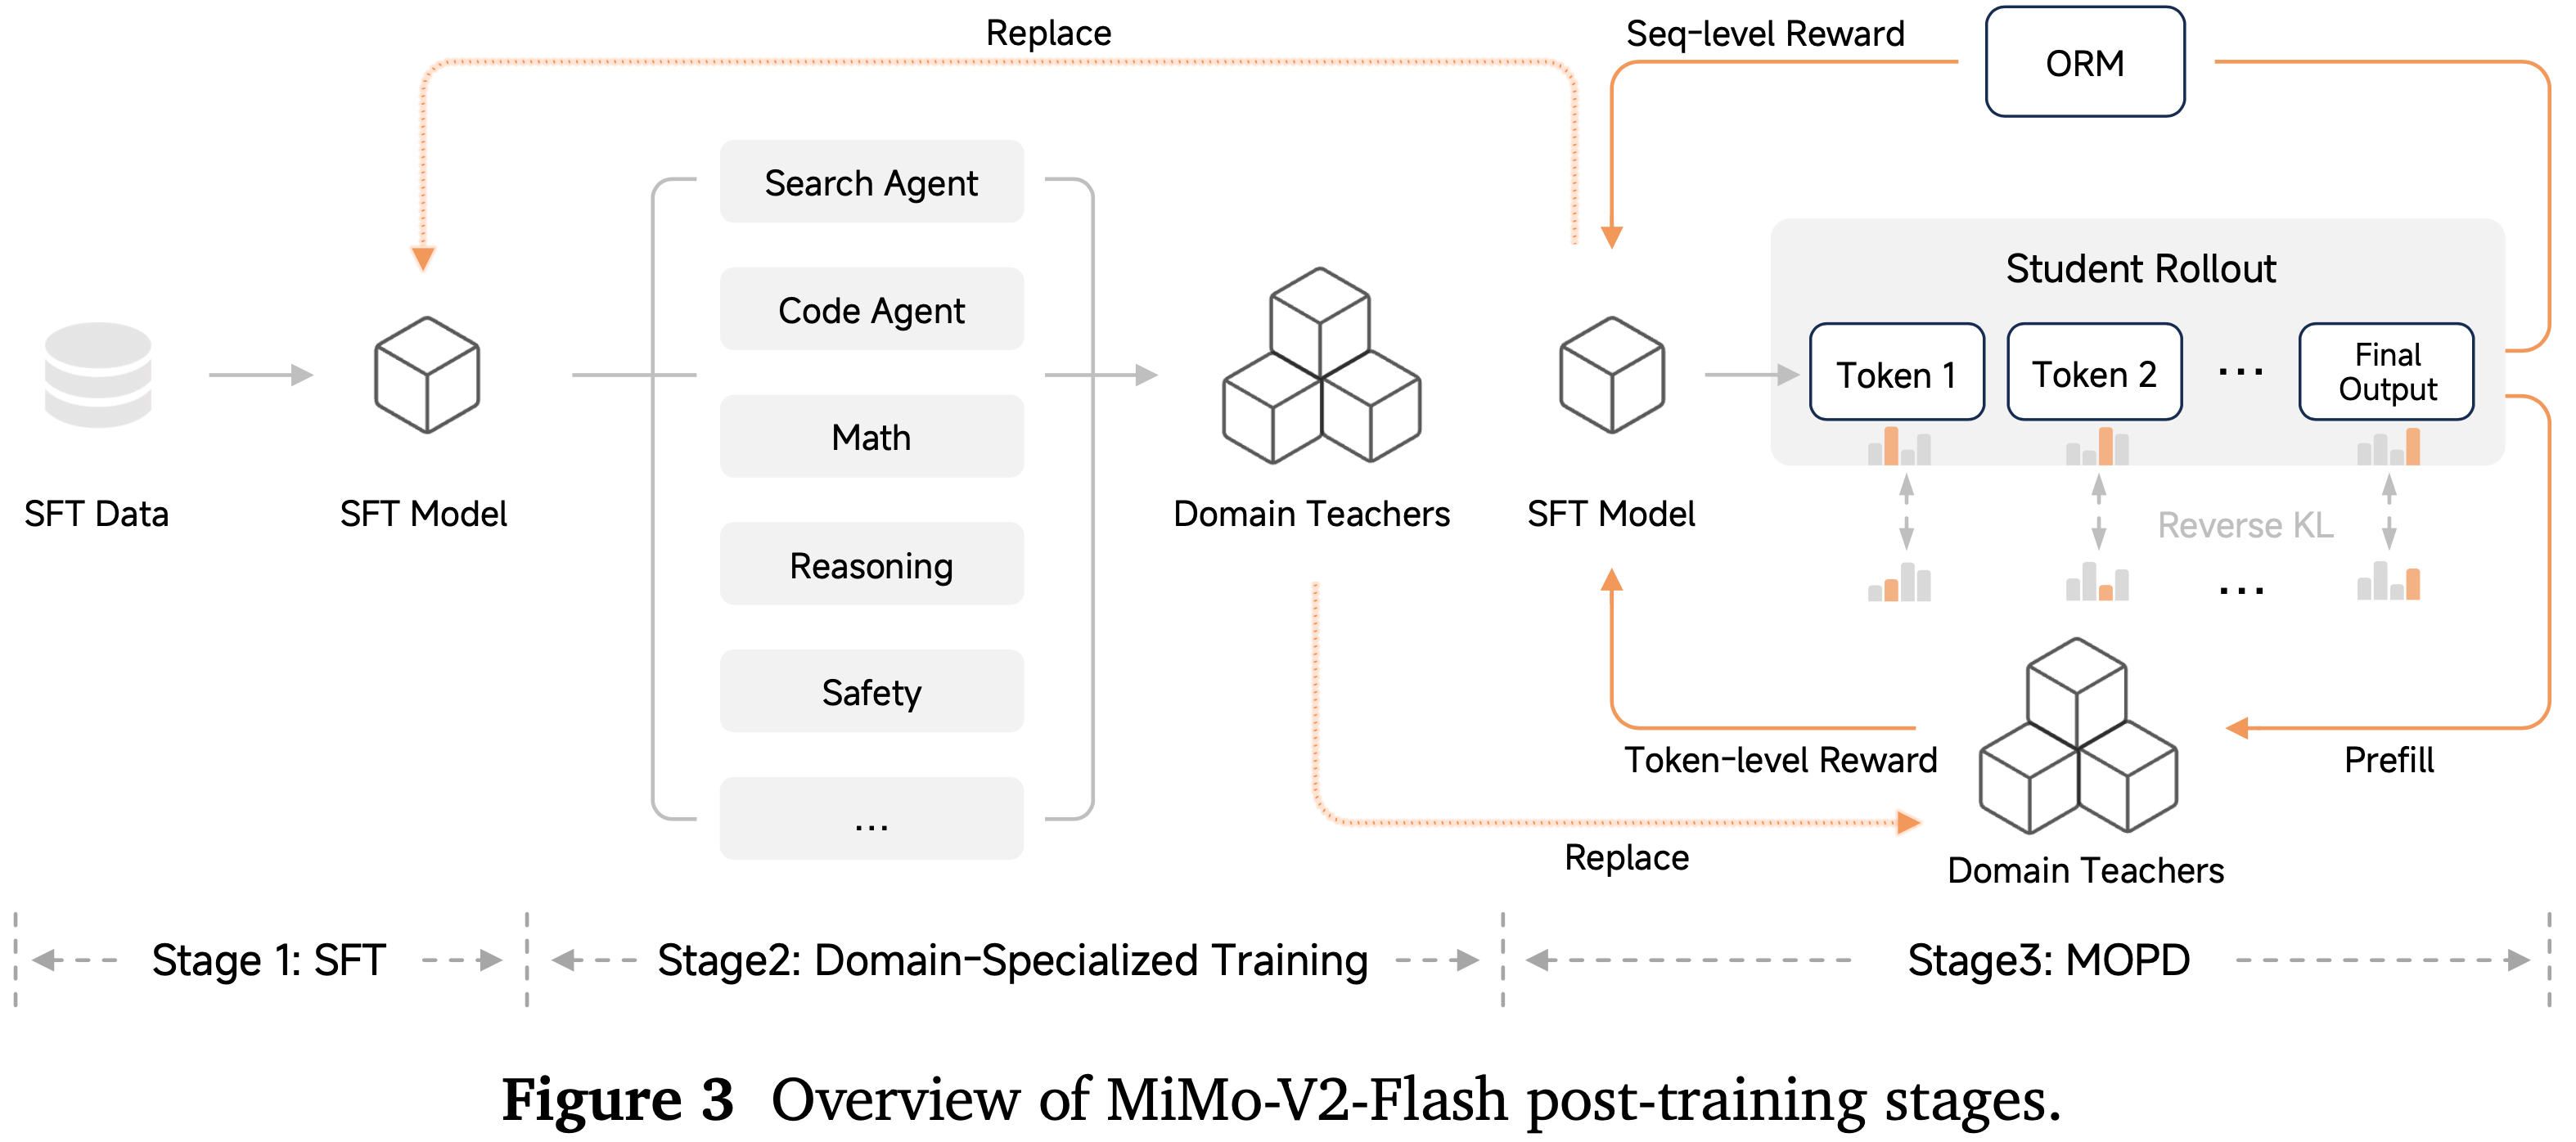
  • 论文提出多教师 On-policy 蒸馏 (Multi-Teacher On-Policy Distillation, MOPD),这是一个统一的后训练范式,通过一个三阶段的框架来解决这些挑战,如图 3 所示:
    • Stage 1:SFT
      • 论文通过在高质量指令-响应对上进行监督学习,建立基础的理解并遵循指令的能力,使模型能够理解并执行跨不同领域的用户请求
    • Stage 2:Domain-Specialized Training
      • 论文通过针对特定任务的独立 RL 优化来训练一系列领域专业化教师模型,这些任务包括:智能体能力(搜索、编码、通用工具使用)和非智能体任务(数学推理、通用推理、安全对齐)。每位教师通过针对其特定领域的奖励信号进行优化,在各自领域达到卓越性能
    • Stage 3:Multi-Teacher On-Policy Distillation(MOPD)
      • 与合并模型参数或从专家模型中生成静态离线数据集不同,论文将多教师知识集成(multi-teacher knowledge integration)制定为一个 On-policy RL 过程
      • 学生模型从其自身不断演化的分布中进行采样,并通过 KL Divergence rewards (2023;2024;2025) 接收来自领域特定教师的 Token-level 监督,从而有效地结合了多种专业能力,而无需承受传统的权衡取舍(见表 7)
  • 这种统一的框架相较于传统的后训练方法具有几个关键优势:
    • Effective and Efficient
      • 与常常需要权衡能力取舍的参数合并(parameter merging)或顺序训练不同,MOPD 保留了最强教师在所有领域中的峰值性能(peak performance)
      • 此外,利用来自教师 logits 的 Dense Token-level 奖励进行 On-policy 蒸馏,确保了稳定的信用分配(credit assignment)和快速收敛
      • 通过从其自身分布中学习,学生模型避免了在基于静态数据集训练的离线方法中常见的暴露偏差(exposure bias)和分布失配(distribution mismatch)
    • 模块化与可扩展性(Modular and Scalable)
      • 教师模型的选择非常灵活:可以是具备强大能力的专门化 RL 衍生模型、一个不同的 SFT 模型,甚至可以是学生模型自身
      • 这种解耦设计使得能够轻松集成新的教师模型,而无需重构整个流程
      • 此外,该框架能与现有的结果奖励模型(Outcome Reward Models, ORMs) 无缝协作,并且对于复杂的智能体任务尤为有利,因为为这些任务搭建独立的训练流程通常非常繁琐
    • 迭代协同进化(Iterative Co-Evolution)
      • MOPD 天然支持师生协同进化循环
      • 经过蒸馏的学生模型可以重新进入专门的 RL 阶段,以产生更强的教师模型;这些更强的教师模型反过来又能为下一代学生提供更高质量的监督,从而形成一个自我强化的改进循环,实现能力的持续扩展

SFT

  • SFT 阶段是论文后训练流程的基础,它将基础模型转变为一个有帮助的助手,能够遵循指令并在各种任务中有效响应
  • 这一阶段对于激活 模型在预训练期间获得的潜在能力,并将其输出与期望的格式和风格对齐至关重要
  • 论文精心整理了数百万个涵盖广泛领域的训练样本,包括通用对话、推理、编码和智能体任务
    • 这些样本覆盖了 Thinking 和 Non-thinking ,其中的回答由论文内部的领域专业化模型检查点生成
    • 这种多样化的训练混合确保了模型在其预期用例中能力的全面激活
  • 通过初步实验,论文为 MoE SFT 训练确定了一个关键稳定性指标:梯度为零的参数数量(number of parameters with zero gradients,num-zeros)
    • 该指标为训练不稳定性提供了早期预警信号:
      • num-zeros 增加 表明专家间的负载平衡正在恶化
      • num-zeros 减少 则表明模型正在严重 Overfitting 训练数据
      • 问题:为什么梯度为零的参数数量跟 是否过拟合有关?
    • 因此,在整个训练过程中保持稳定的 num-zeros 对于成功的 SFT 至关重要
      • 此外,这种稳定性对于确保后续 RL 阶段的稳健性和收敛性也至关重要
  • 论文的实验表明,num-zeros 的稳定性关键取决于两个超参数:专家偏置更新率(expert bias update rate) 和 AdamW 优化器中的 \(\epsilon\) 参数
    • 采用余弦衰减学习率调度器,从 \(5.0 \times 10^{-5}\) 衰减到 \(5.0 \times 10^{-6}\)
    • 批次大小为 128
    • AdamW 的 \(\epsilon\) 设置为 \(1.0 \times 10^{-8}\)
    • MoE 专家偏置更新率设置为 \(1.0 \times 10^{-4}\)
    • 序列辅助损失系数(sequence auxiliary loss coefficient)设置为 \(1.0 \times 10^{-6}\)

Scaling Reinforcement Learning

  • 强化学习将模型能力提升到仅靠监督微调所无法达到的水平
  • 根据任务是否涉及智能体行为,论文采用不同的 RL 策略,同时缩放非智能体和智能体 RL 训练,以最大化不同领域的性能
Non-Agentic RL Training
  • 非智能体 RL 训练侧重于提升模型在单轮任务上的性能,此类任务中模型无需交互反馈或多步执行即可生成完整响应
  • 其主要目标是在可验证领域(如数学、编码、逻辑)提升模型的推理准确性,同时在开放式对话中使其输出对齐于帮助性和安全性
  • 论文生成奖励信号的方法因任务特征而异
    • 对于有可验证结果的领域 :
      • 论文采用结合程序化工具和 LLM Judge 的混合验证系统 ,以根据整理的 problem-solution pairs 自动评估正确性
    • 对于主观特性,如帮助性和安全性 :
      • 论文实施 基于评分细则 (rubrics) 的框架 ,由高级 LLM Judge 根据 详细的 rubrics 和参考答案 评估响应,产生细粒度的奖励信号,引导模型朝向期望的行为
    • 问题:各个领域都没有使用 BT RM 吗?
Agentic RL Training
  • 非智能体 RL 侧重于单轮推理和生成,而智能体 RL 则训练模型在需要规划、执行行动并根据反馈进行调整的交互式、多轮环境中运行
  • 论文沿着两个关键维度来扩展智能体 RL:环境多样性和计算资源
  • 扩展智能体环境多样性(Scaling Agentic Environment Diversity)
    • 论文构建了一套多样化的智能体训练环境,涵盖代码调试、终端操作、Web 开发和通用工具使用,每个环境都针对不同的能力方向,同时均需满足多步推理与执行这一共同要求
Code Agent
  • 论文在源自真实世界 GitHub 问题的大规模代码智能体任务上进行训练
  • 模型在智能体循环中运行,读取和编辑文件、执行命令,并根据可验证的单元测试获得奖励
  • 论文的关键 Insight 是: 持续扩展可用任务能推动代码智能的持续提升
  • 为了在超过 10 万个代码任务上实现高效的 RL 训练,论文开发了两个基础设施组件
    • 首先,论文构建了自动化环境设置流水线
      • 该流水线从仓库快照中配置开发环境并将其打包成容器化镜像
      • 在 8 种编程语言上达到 \(70%\) 的成功率,并由运行超过 1 万个并发 pod 的大规模 Kubernetes 集群支持
    • 其次,论文实现了一个轻量级智能体 scaffold
      • 可与 Kubernetes、Docker 或本地后端无缝集成,暴露了三个原子工具(bash、str_replace、finish),仅通过 shell 命令与执行后端交互
    • 这种设计消除了基于服务器的工具实现,并采用最小的系统提示词,没有预定义的工作流,允许模型在训练中发现最佳实践
Terminal Agent
  • 除了 GitHub 问题,论文还利用来自 Stack Overflow 和 Stack Exchange 的任务来强化基于终端的解决问题能力
    • 主要强调的是
  • 论文选取需要高级技术专长的材料,并将其转化为具有相应 Query 、Dockerfile 和测试用例的计算任务
  • 在验证环境安装并按难度和可靠性过滤后,论文获得了大约 3 万个带有已验证执行环境的 Query
  • 基于通过率的额外过滤移除了那些正确性判断不可靠或复杂度不足以进行有效 RL 训练的任务
Web Development Agent
  • 为了提升 Web 开发代码生成能力,论文构建了一个基于真实世界的合成数据集,并配有多模态验证器
  • 论文收集高质量用户编写的网页,使用 Playwright 执行生成的代码以获得渲染视频,并应用多模态视觉判别器以仅保留高质量样本,其中基于视频的评估相较于静态截图减少了视觉幻觉
  • 论文从整理的页面逆向工程用户 Query 作为种子提示词,合成大规模 RL 数据,涵盖与真实世界使用密切匹配的八个 Web 类别
  • 论文的基于视觉的验证器根据录制的视频对 rollout 执行进行评分,联合评估视觉质量、功能正确性和可执行性,确保奖励反映外观和行为
General Agent
  • 论文开发了两种通用智能体能力
  • 搜索智能体(Search Agent):
    • 采用一个提供三个核心工具(search、open、find)的脚手架,用于自主网页探索
    • 论文通过从种子实体递归扩展事实图来构建 Query ,其中难度随关系链深度和细节混淆而增加,从而实现具有可验证答案的具有挑战性的搜索问题的自动生成
  • 函数调用智能体(Function-Calling Agent)
    • 在具有自定义工具集的合成应用环境中训练,这些工具集通过基于显式数据依赖(直接的输入-输出关系)和隐式逻辑依赖(关于隐藏系统状态的推理)生成工具调用图来构建,要求具备数据传播和状态推断能力
Scaling Agentic Compute
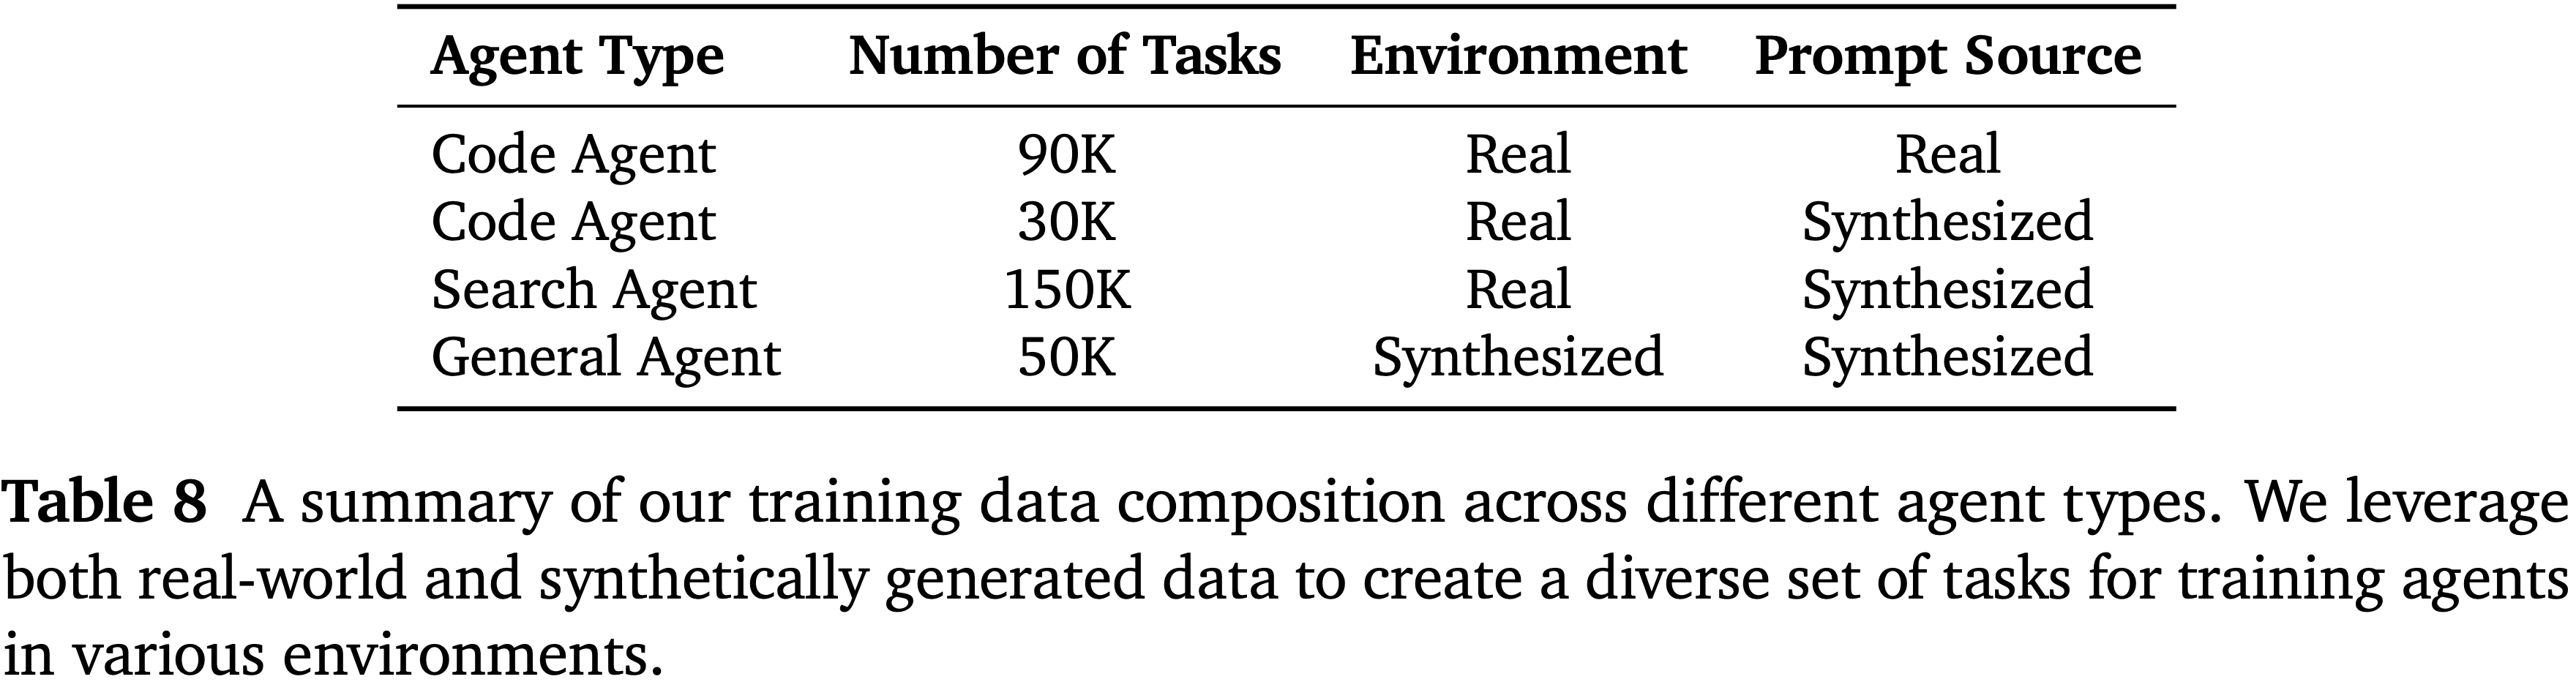
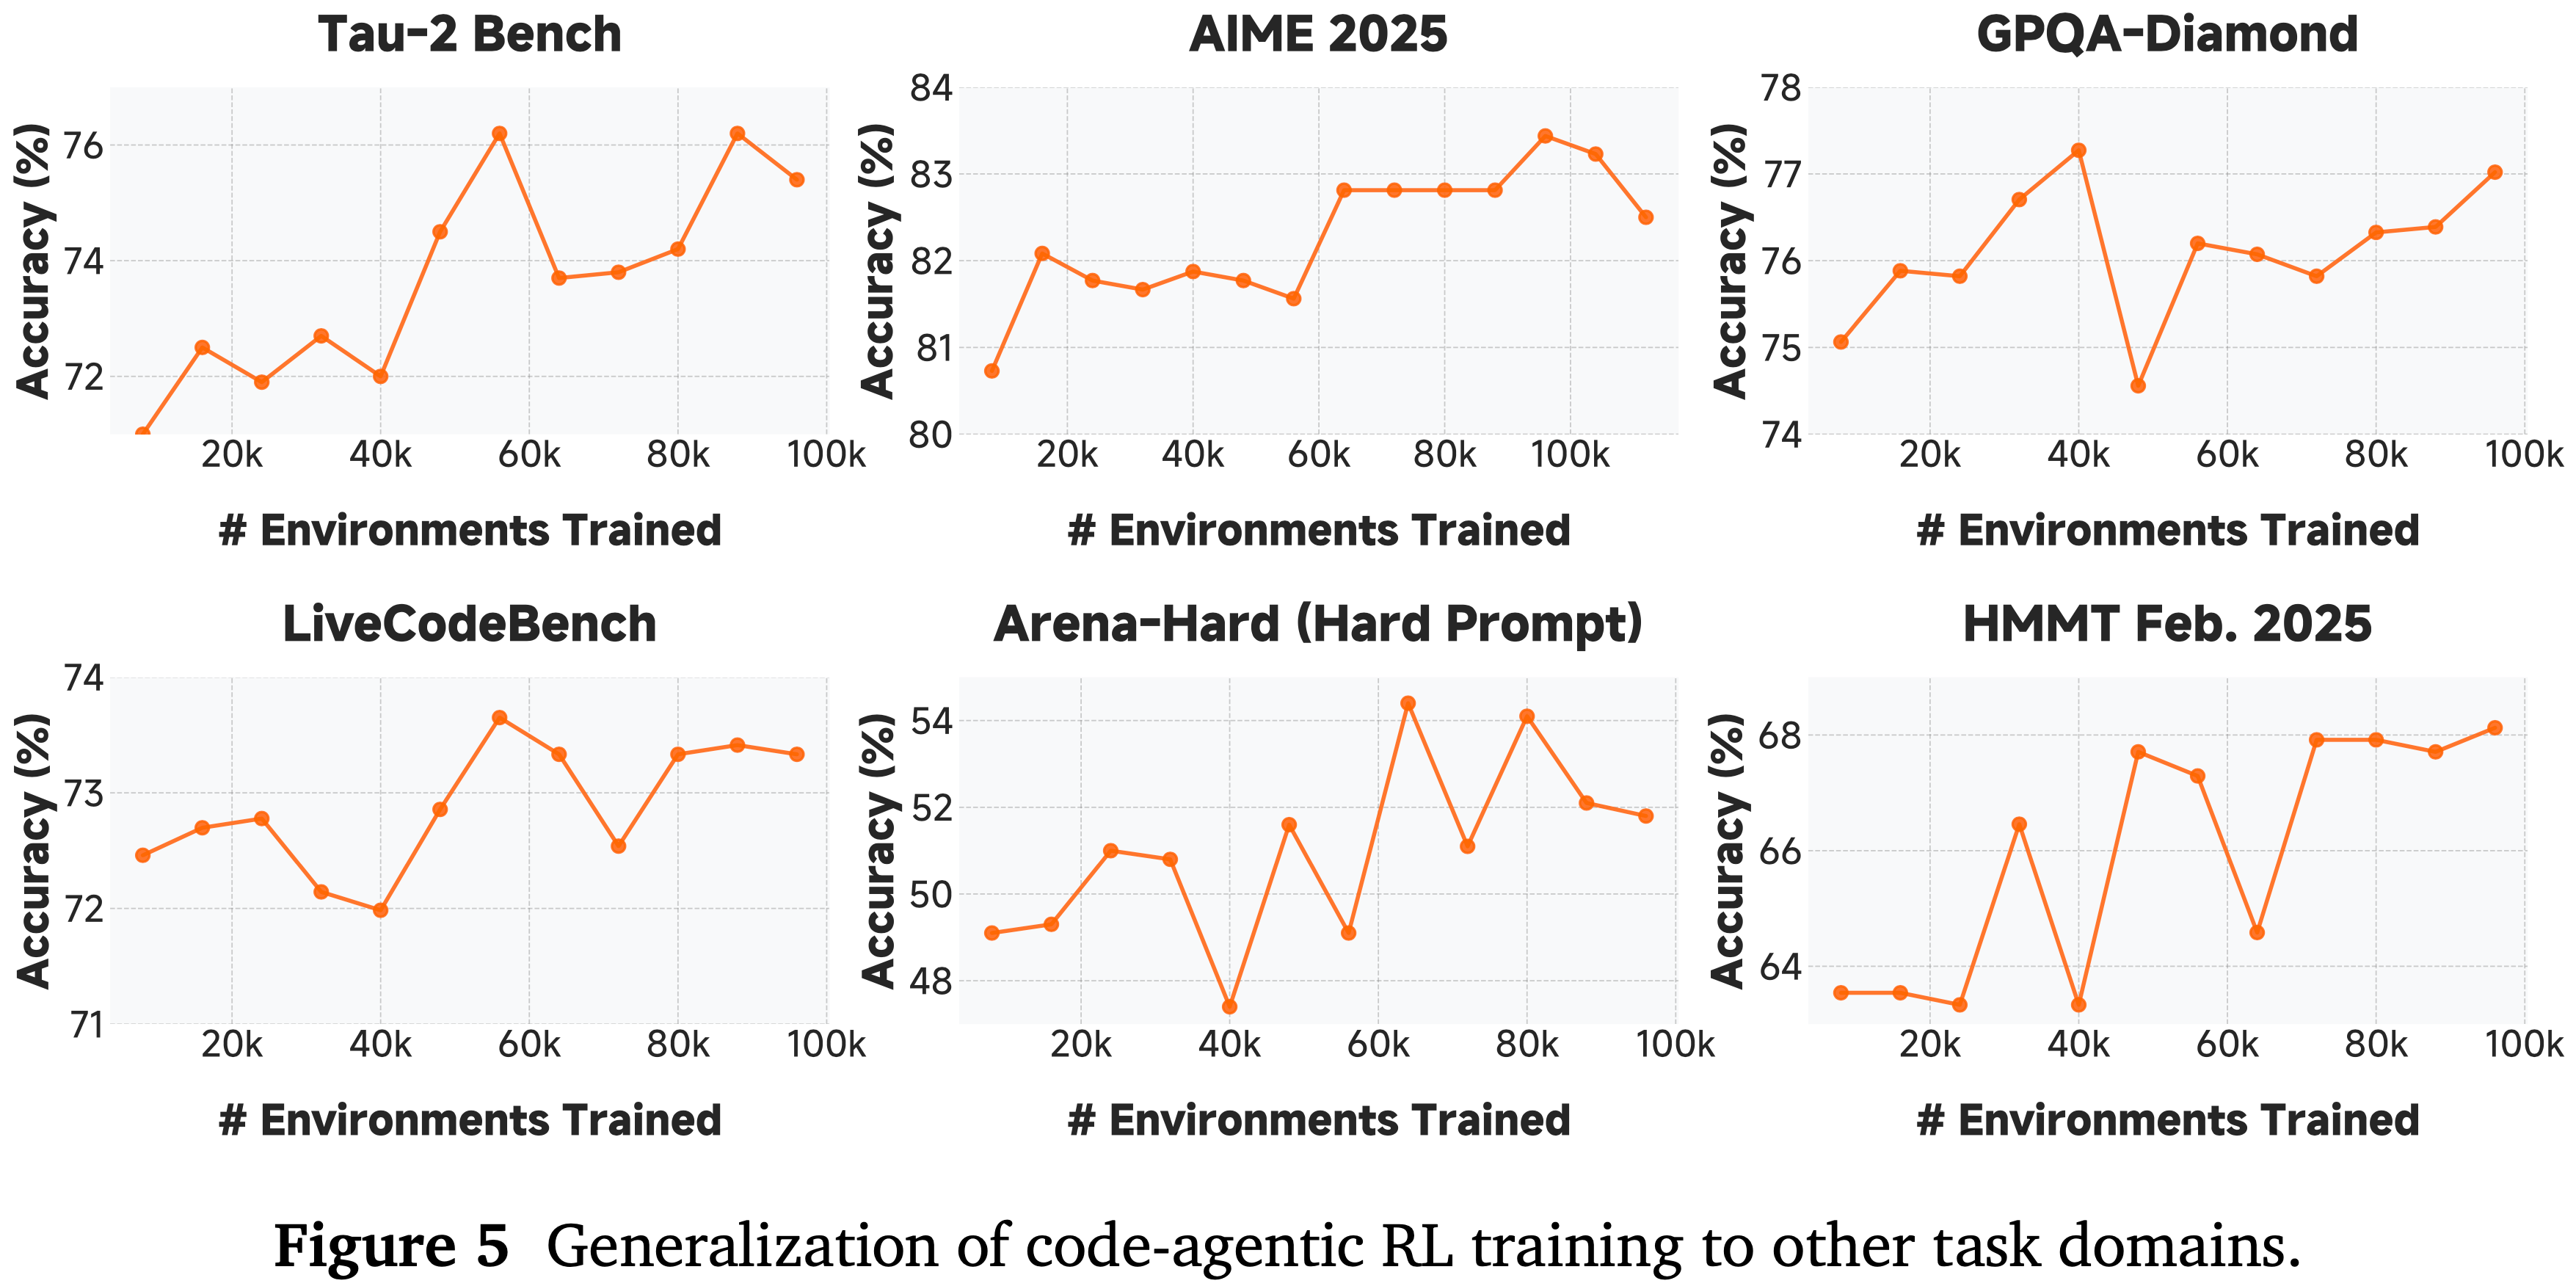
  • 在之前多样化的智能体环境集上训练(表 8),论文发现扩展智能体 RL 计算不仅能提升代码智能体性能,还能有效地泛化到其他任务类型
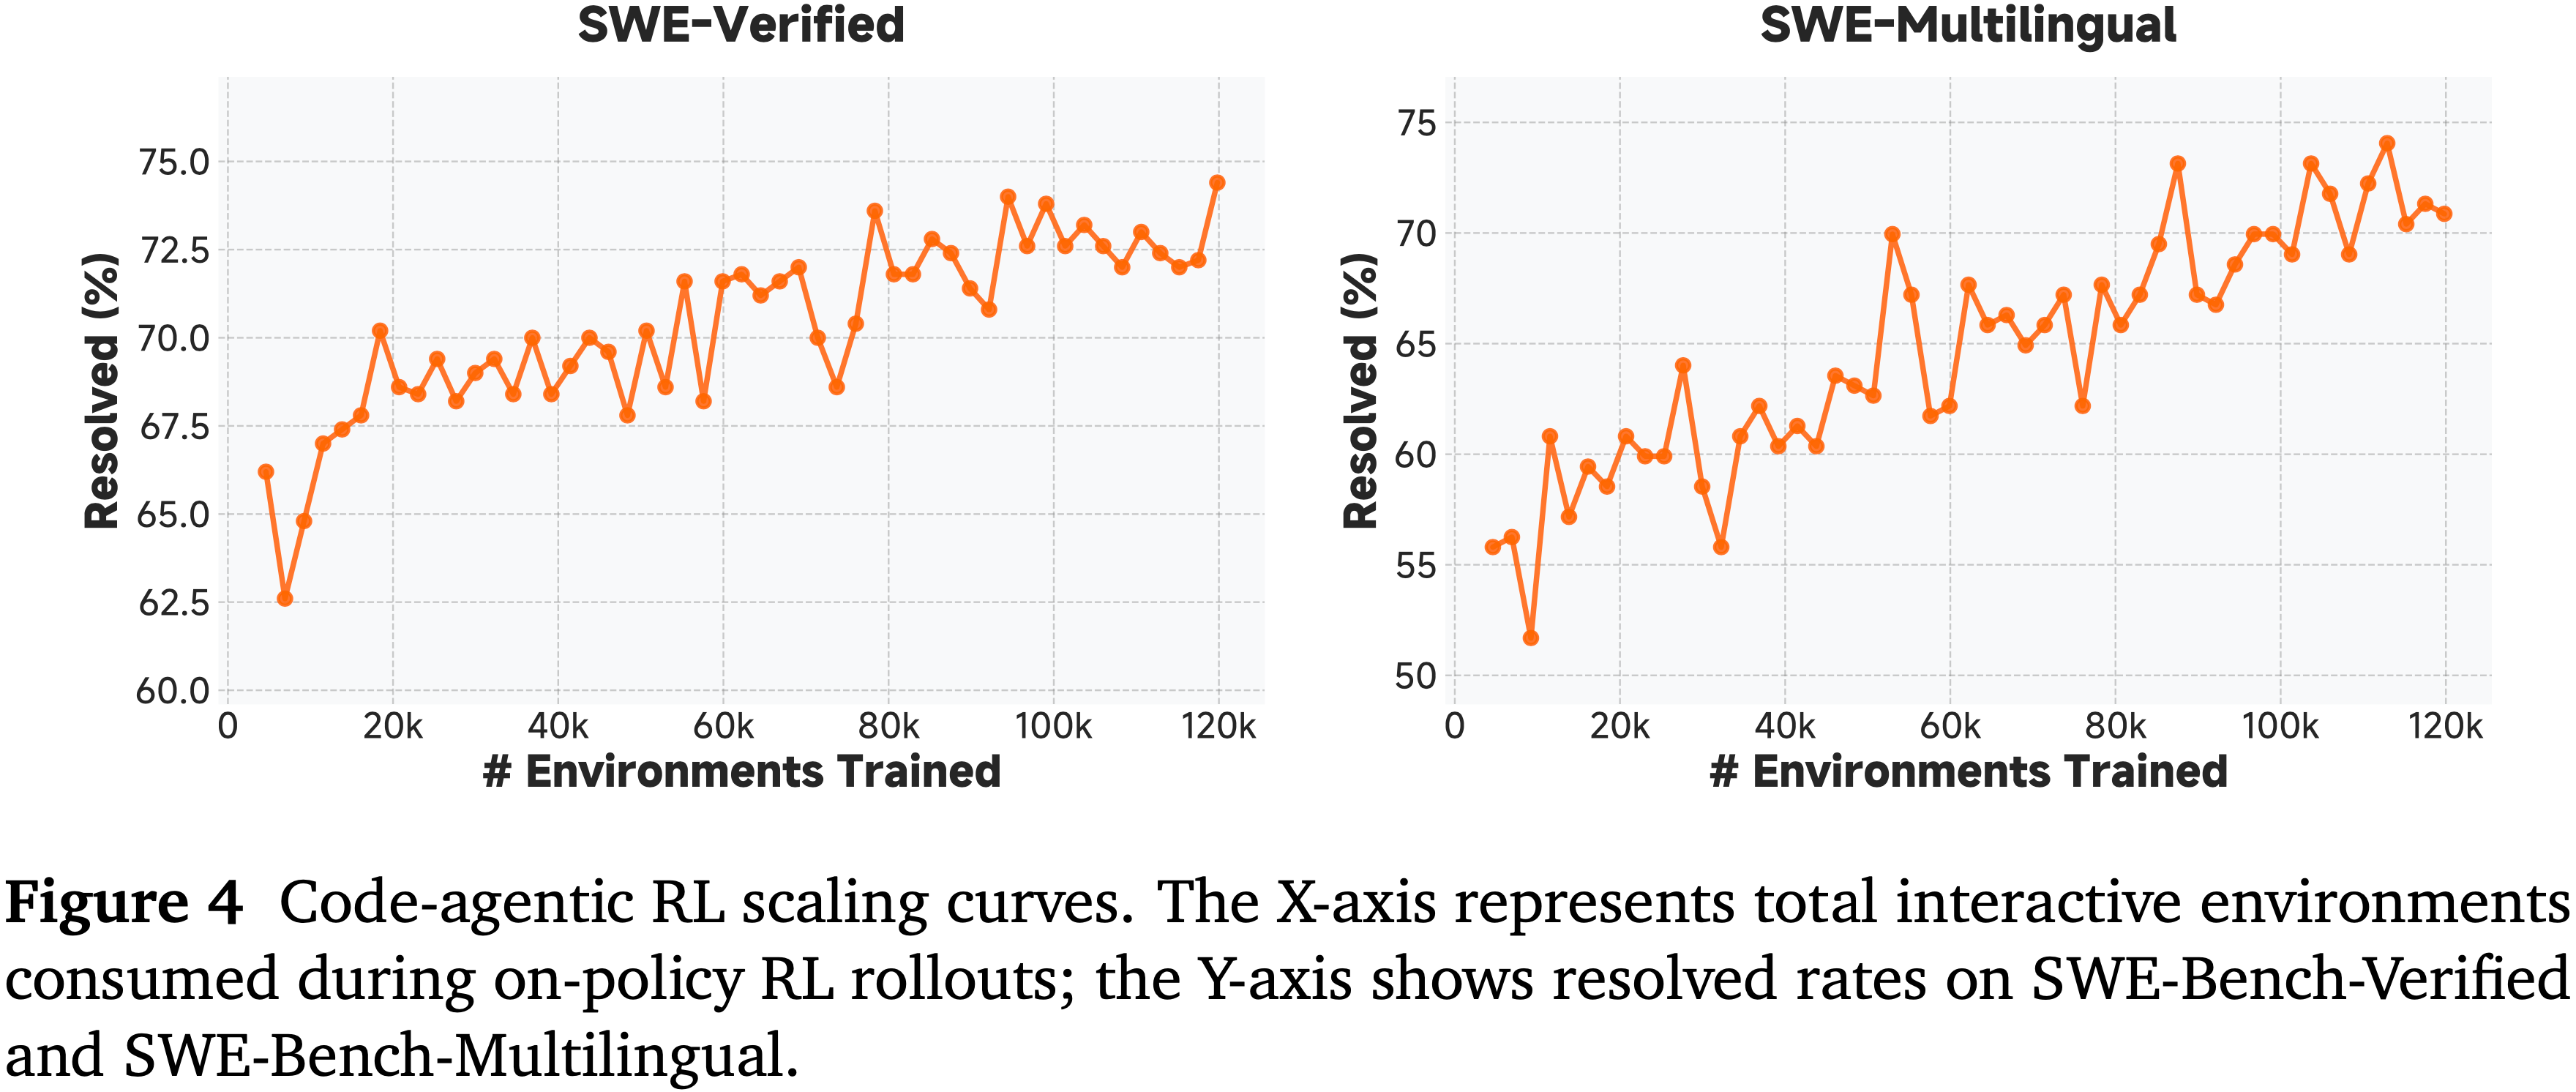
  • 图 4 显示了论文代码智能体的 RL 训练曲线,模型在大约 12 万个环境中执行了 On-policy rollouts 和更新
    • 这种扩展显著提升了 SFT 基础模型在 SWE-Bench-Verified 和 SWE-Bench-Multilingual 上的性能
  • 图 5 表明,大规模的代码智能体 RL 训练能有效地泛化到其他智能体任务,以及数学、代码和通用推理基准测试,这表明智能体训练培养了广泛可迁移的问题解决能力

Technical Formulation of MOPD

  • 通过 SFT 奠定基础并训练了领域专业化教师后,论文现在将整合这些专业化能力到统一学生模型的多教师 On-policy 蒸馏机制形式化
    • 具体地,论文将多教师蒸馏视为一个 On-policy 强化学习目标
  • 令 \(\pi_{\theta}\) 表示训练引擎中优化的目标学生策略,\(\mu_{\theta}\) 表示推理引擎中采用的学生采样策略,\(\pi_{\mathrm{domain}_x}\) 表示从分布 \(\mathcal{D}\) 中采样的提示词 \(x\) 所在领域的专业化教师策略
    • 理解:每个 Prompt 都有自己所对一个的 教师模型,每个 Prompt 对应仅使用自身的 Teacher,单个 Prompt 不涉及到多个 Teacher 的 融合
    • 令 \(\mathrm{sg}[\cdot ]\) 表示停止梯度算子
    • 学生与教师之间的反向 KL 散度损失(Reverse KL Divergence Loss)定义为:
      $$\mathcal{L}_{\mathrm{reverse - KL} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D},y_{t}\sim \pi_{\theta}(\cdot |x,y_{< t})}\log \frac{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})}{\pi_{\theta}(y_t|x,y_{< t})}. \tag{5}$$
    • 注:这个式子看起来不像是 KL 散度,因为采样分布和分子分布不同,实际上经过转换后,即消除负号后,本身就是 Reverse-KL 散度,详情见附录 和 博客 On-Policy Distillation, Thinking Machines Lab, 20251027
  • 其梯度为:
    $$\nabla_{\theta}\mathcal{L}_{\mathrm{reverse - KL} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D},y_{t}\sim \pi_{\theta}(\cdot |x,y_{< t})}\left[\log \frac{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})}{\pi_{\theta}(y_t|x,y_{< t})}\nabla_{\theta}\log \pi_{\theta}(y_t|x,y_{< t})\right]. \tag{6}$$
  • 遵循 Zhao 等人的工作 (2025),论文应用训练-推理重要性采样,并舍弃表现出大差异的 Token,然后论文定义 MOPD 的替代损失为:
    $$\mathcal{L}_{\mathrm{MOPD} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D},y\sim \mu_{\theta}(\cdot |x)}\left[\frac{1}{|y|}\sum_{t = 1}^{|y|}w_{t}\hat{A}_{\mathrm{MOPD},t}\log \pi_{\theta}(y_t|x,y_{< t})\right], \tag{7}$$
  • 其中
    $$w_{t}(\theta) = \left\{ \begin{array}{ll}\mathrm{sg}\left[\frac{\pi_{\theta}(y_{t}|x,y_{< t})}{\mu_{\theta}(y_{t}|x,y_{< t})}\right], & \epsilon_{\mathrm{low} }\leq \frac{\pi_{\theta}(y_{t}|x,y_{< t})}{\mu_{\theta}(y_{t}|x,y_{< t})}\leq \epsilon_{\mathrm{high} },\\ 0, & \mathrm{otherwise}, \end{array} \right.\quad \hat{A}_{\mathrm{MOPD},t} = \mathrm{sg}\left[\log \frac{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})}{\pi_{\theta}(y_t|x,y_{< t})}\right]. \tag{8}$$
    • 其中 \(w_{t}(\theta)\) 是训推重要性采样
    • 注意:这里的 Advantage 看似和 ThinkingMachines 提出的 OPD 实现是反的,实际上是一样的,因为 OPD 是先是先计算 Reverse-KL 散度的公式,然后再加个 负号的,这里相当于没有这个负号了
      • 理解:最终含义:最大化 Advantage,等于最小化 Reverse-KL 散度
  • 默认情况下,论文将 MOPD 的优势与其他类型的优势相结合,例如使用结果奖励模型 (Outcome Reward Models, ORMs) 计算的优势,包括 GRPO (2024)
  • 令 \(\hat{A}_{\mathrm{ORM} }\) 表示由 ORMs 计算的优势;最终优势由下式给出:
    $$\hat{A}_{\mathrm{MOPD},t} = \mathrm{sg}\left[\log \frac{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})}{\pi_{\theta}(y_t|x,y_{< t})}\right] + \alpha \hat{A}_{\mathrm{ORM} }. \tag{9}$$
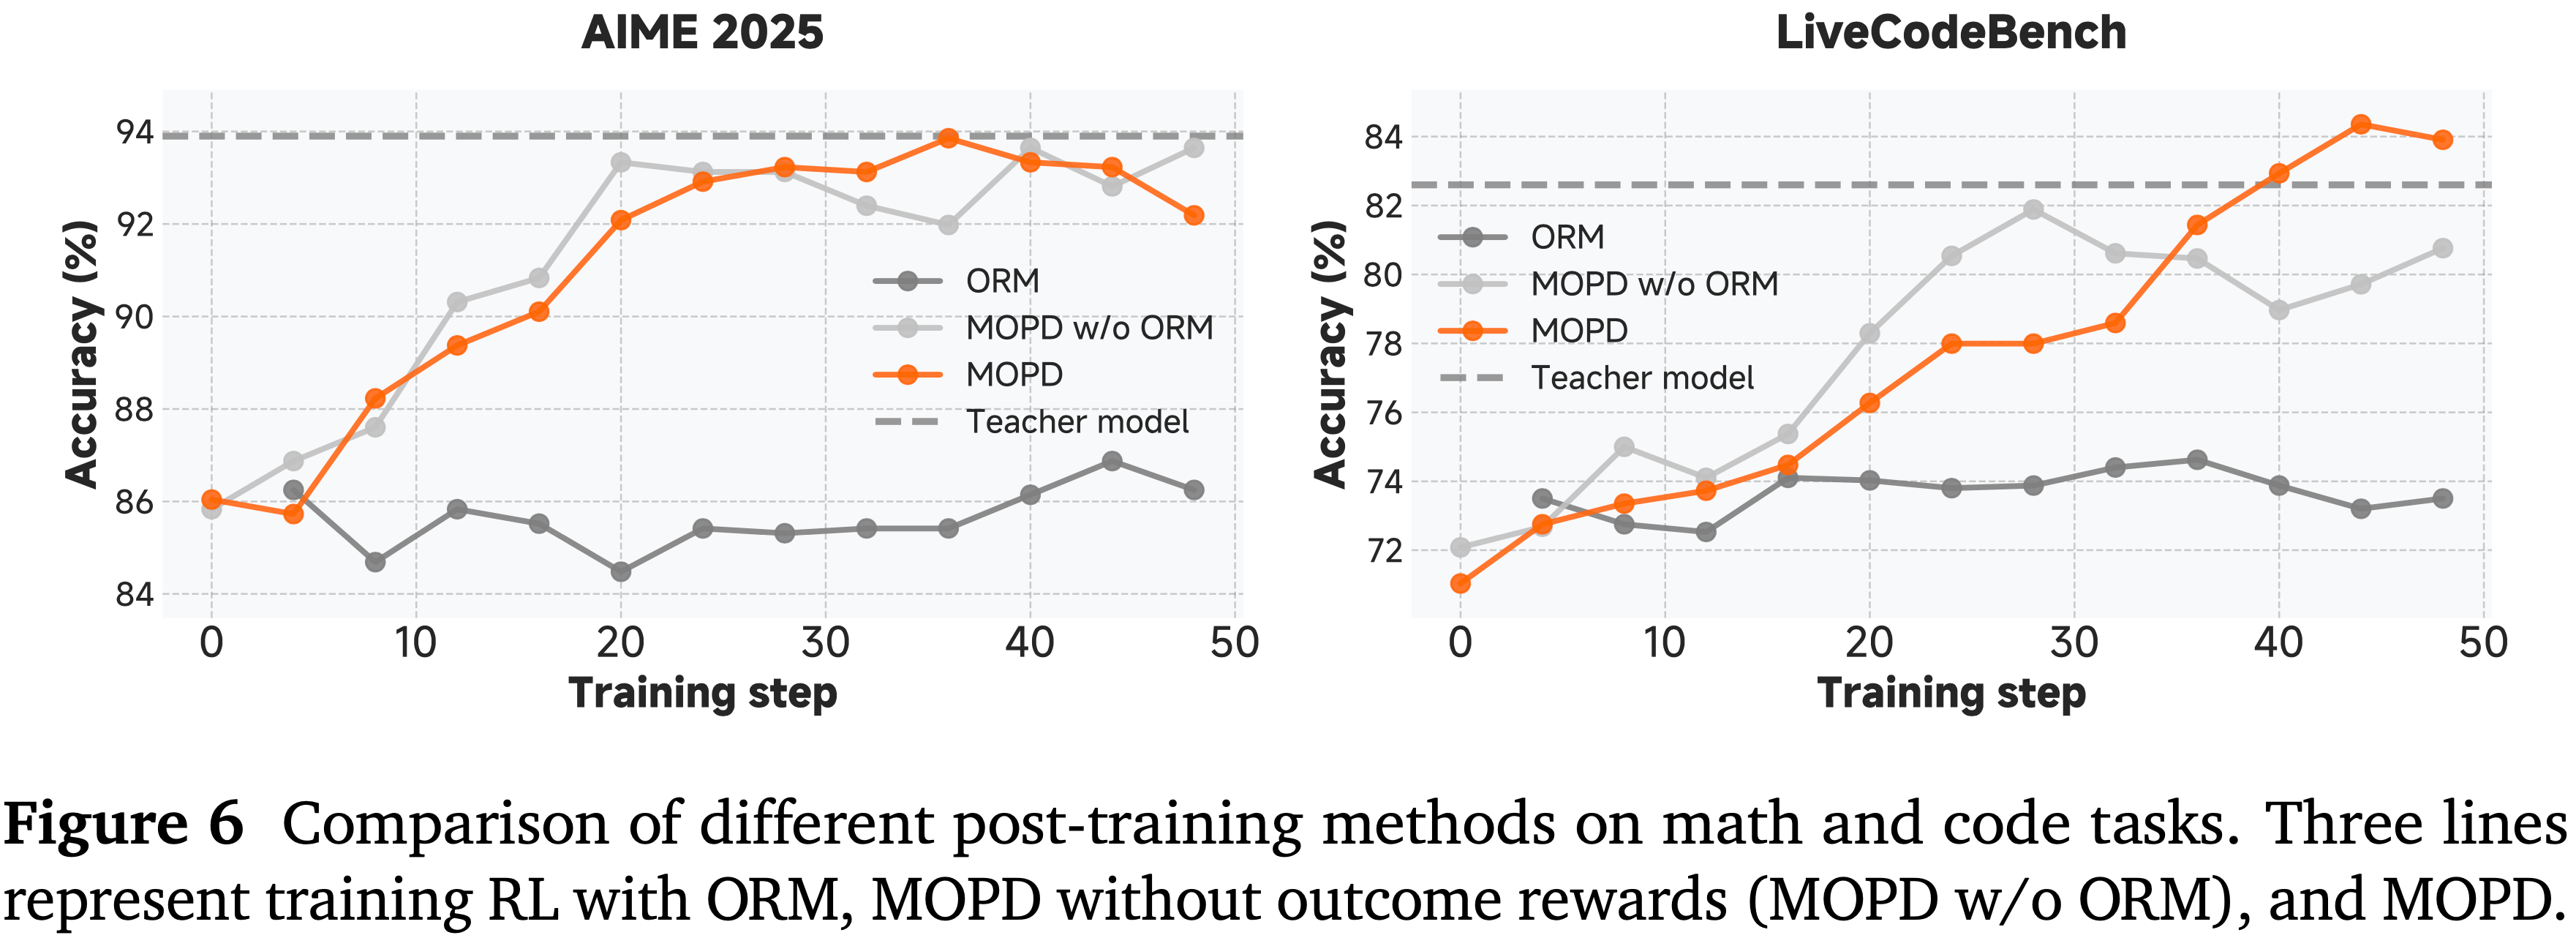
  • 图 6 展示了 MOPD 相较于传统后训练方法的有效性
    • 在数学推理 (AIME 2025) 和编码 (LiveCodeBench) 基准测试上,MOPD 成功保留并整合了来自多位教师的专业化能力,在大多数领域达到或超过了最强教师的性能

Evaluations

Evaluation Setup
  • 论文在 MMLU-Pro (2024)、GPQA-Diamond (2024)、HLE Text-only (2025)、AIME 2025 (MAA, 2024)、LiveCodeBench (2024.08-2025.04) (2024)、HMMT Feb. 2025 (Balunović2025)、Arena-Hard (2024)、LongBench V2 (2025)、MRCR (2024)({2,4,8}-needles,最大 128K)、SWE-Bench Verified (2024b)、SWE-Bench Multilingual (2025)、Terminal-Bench、BrowseComp (2025)、\(\tau^2\)-Bench (2025) 上评估 MiMo-V2-Flash
Evaluation Results
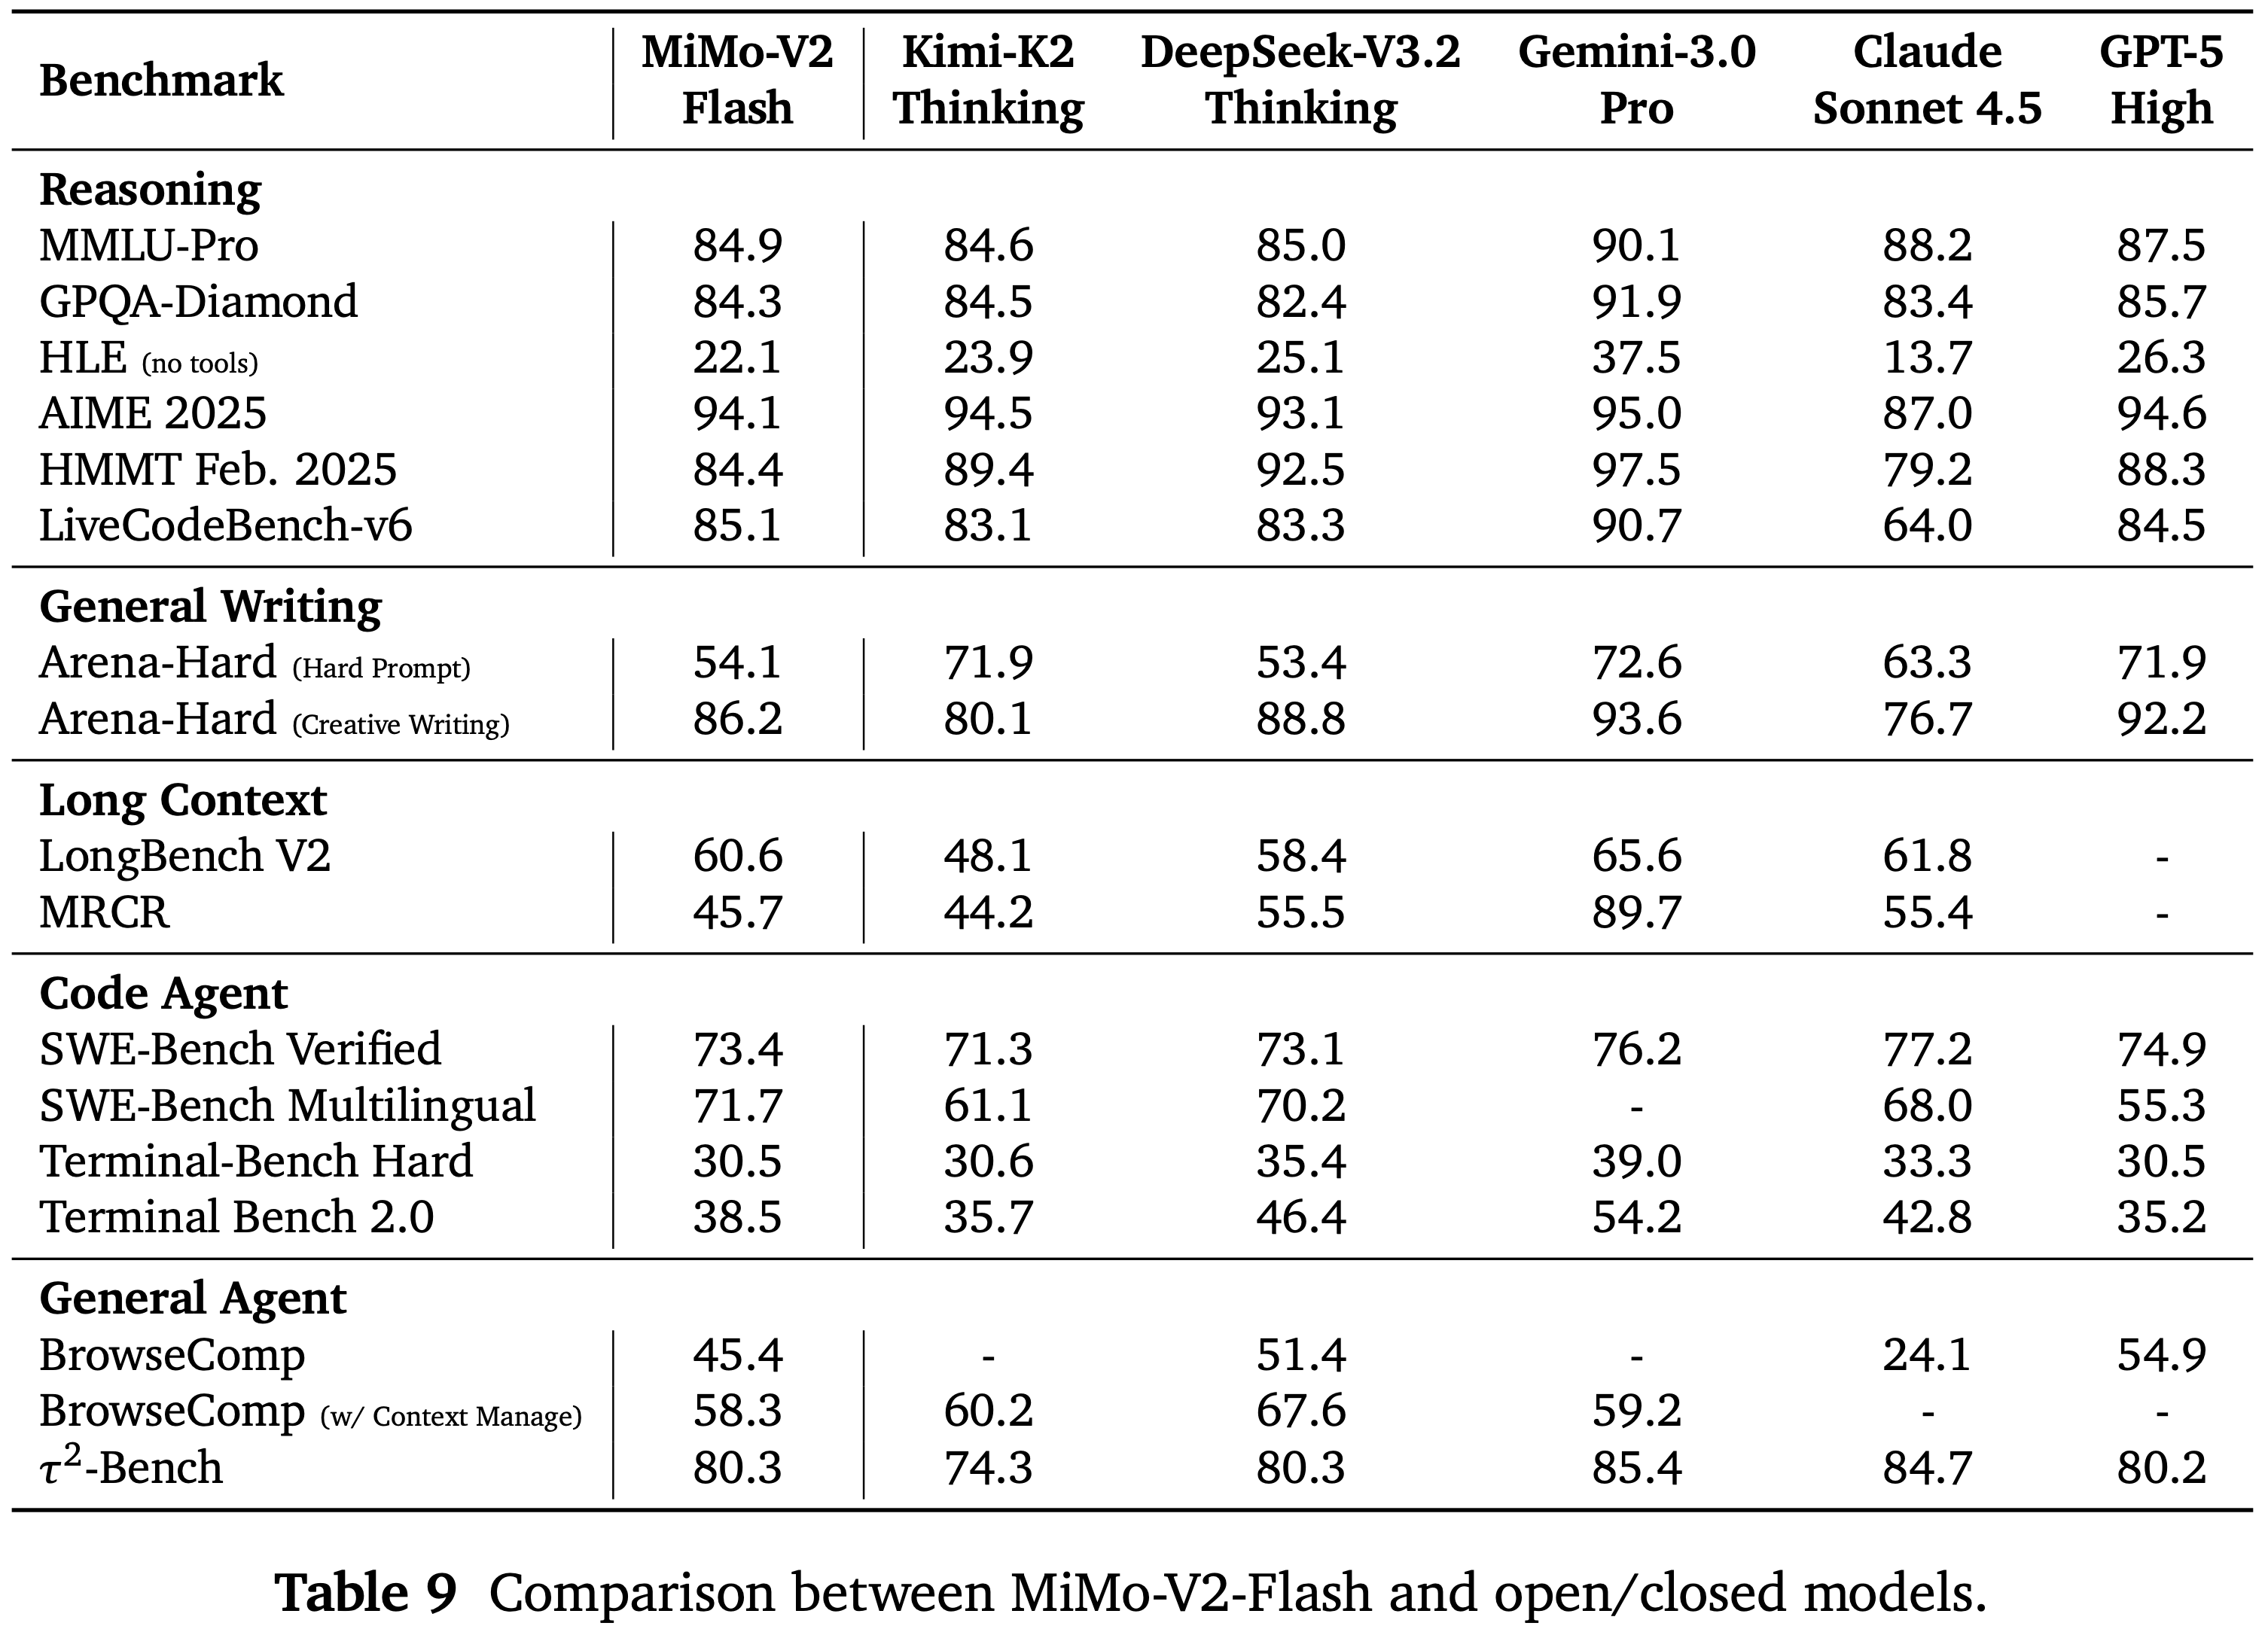
  • 论文在表 9 中展示了评估结果
    • MiMo-V2-Flash 在大多数推理基准测试上达到了与 Kimi-K2-Thinking 和 DeepSeek-V3.2-Thinking 相当的性能
    • MiMo-V2-Flash 模型还保持了有竞争力的通用写作能力,使其能够在开放式任务上生成高质量响应
    • 在长上下文评估中,论文的模型超越了规模大得多的全全局注意力 LLM Kimi-K2-Thinking,突显了论文混合 SWA 架构强大的长上下文能力
  • MiMo-V2-Flash 在 SWE-Bench Verified 上达到了 \(73.4%\),超越了所有开源竞争对手,并接近 GPT-5-High 的性能
    • 在 SWE-Bench Multilingual 上,论文的模型解决了 \(71.7%\) 的问题,确立了其作为软件工程任务中最强大的开源 LLM 的地位
    • 这些结果强调了论文超大规模智能体 RL 训练的有效性
    • 在 Terminal Bench 上,该模型也取得了有竞争力的分数
  • 在搜索智能体评估中,MiMo-V2-Flash 在 BrowseComp 上得分为 45.4,应用附录 C 概述的上下文管理方法后进一步提升至 58.3
    • 对于在 \(\tau^2\)-Bench 上的通用工具使用,论文使用 DeepSeek-V3.2 作为用户代理,获得了 95.3(电信)、79.5(零售)、66.0(航空)的类别分数
  • 综上所述,这些结果验证了论文在 MOPD 后训练范式内超大规模 RL 训练的有效性,并突出了该模型在现实世界编码、推理和智能体工作流中的强大潜力

RL Infrastructures

  • 论文的 RL(和 MOPD)基础设施使用 SGLang (2024) 作为推理引擎,使用 Megatron-LM (2019) 作为训练引擎
    • 论文采用 FP8 进行训练和推理
  • 为了实现稳定、高效且灵活的 RL 训练,论文实现了三个扩展模块:
    • Rollout Routing Replay (R3) (2025)(第 4.6.1 节)、数据调度器 (Data Scheduler)(第 4.6.2 节)以及与 Toolbox 结合的 Tool Manager(第 4.6.3 节)
通过 Rollout Routing Replay (R3) 稳定训练 (Stablized Training via Rollout Routing Replay (R3))
  • MoE 模型由于数值精度问题 (2025; 2025),在 rollout 和训练过程中会出现专家路由不一致的问题
  • 论文提出 Rollout Routing Replay (R3) (2025) 来使用与 rollout 相同的路由专家进行 RL 训练,通过优化的数据类型和通信重叠使其开销可忽略不计
    • 对于多轮智能体训练,论文在 rollout 期间采用请求级别的前缀缓存
  • 此缓存存储先前轮次的 KVCache 和 MoE 路由专家,允许它们在同一请求的后续生成步骤中重复使用
  • 与当前推理引擎中常用的基数缓存 (radix cache) 不同,论文的请求级别前缀缓存避免了重新预填充或请求间输出缓存共享 ,确保了路由专家的采样一致性
Data Scheduler
  • 对于 MiMo-V2-Flash,论文扩展了 Seamless Rollout Engine (2025) 并实现了一个数据调度器 (Data Scheduler),以无缝调度细粒度的序列而非微批次,解决分布式 MoE 训练中的 GPU 闲置问题
    • 在动态采样中,当序列返回进行奖励计算时,论文参考历史通过率,并在必要时将新的提示词分配给 GPU 以实现负载均衡
  • 论文整合部分 rollout (partial rollout) (2025; Kimi Team, 2025b) 将过长的轨迹跨步骤分区,同时限制陈旧性以及每个批次中部分样本的比例
    • 通过对部分 rollout 采用陈旧性感知的截断重要性采样,论文在不牺牲模型质量的前提下显著加速了 RL 训练
  • 数据调度器支持特定数据源的配置(采样配额、调度优先级、长度限制、温度)并根据配置的比例拟合通过率来接受样本
    • 基于优先级的调度在不同时间模式的数据源之间重叠奖励计算和推理,确保了高 GPU 利用率
Toolbox and Tool Manager
  • 论文实现了 Toolbox 和 Tool Manager 来解决 RL 智能体训练中的全局资源争用和局部低效问题
    • 这些模块利用 Ray (2018) 进行高效调度
  • Toolbox 作为集中式资源分配器,对跨并发任务的工具强制执行资源配额和 QPS 限制
    • 它采用容错的 Ray Actor 池,消除了冷启动延迟
    • 与 rollout 引擎集成后,Tool Manager 与 Toolbox 协调,通过环境预预热和序列级异步奖励计算来加速训练
  • 它通过超时恢复和实时监控来保持训练稳定性
    • 通过将工具管理和 rollout 工作流解耦,Toolbox 将特定于任务的逻辑与系统范围策略隔离开来,实现了模块化可扩展性而不损害稳定性

MTP Speedup

MTP Acceptance Length

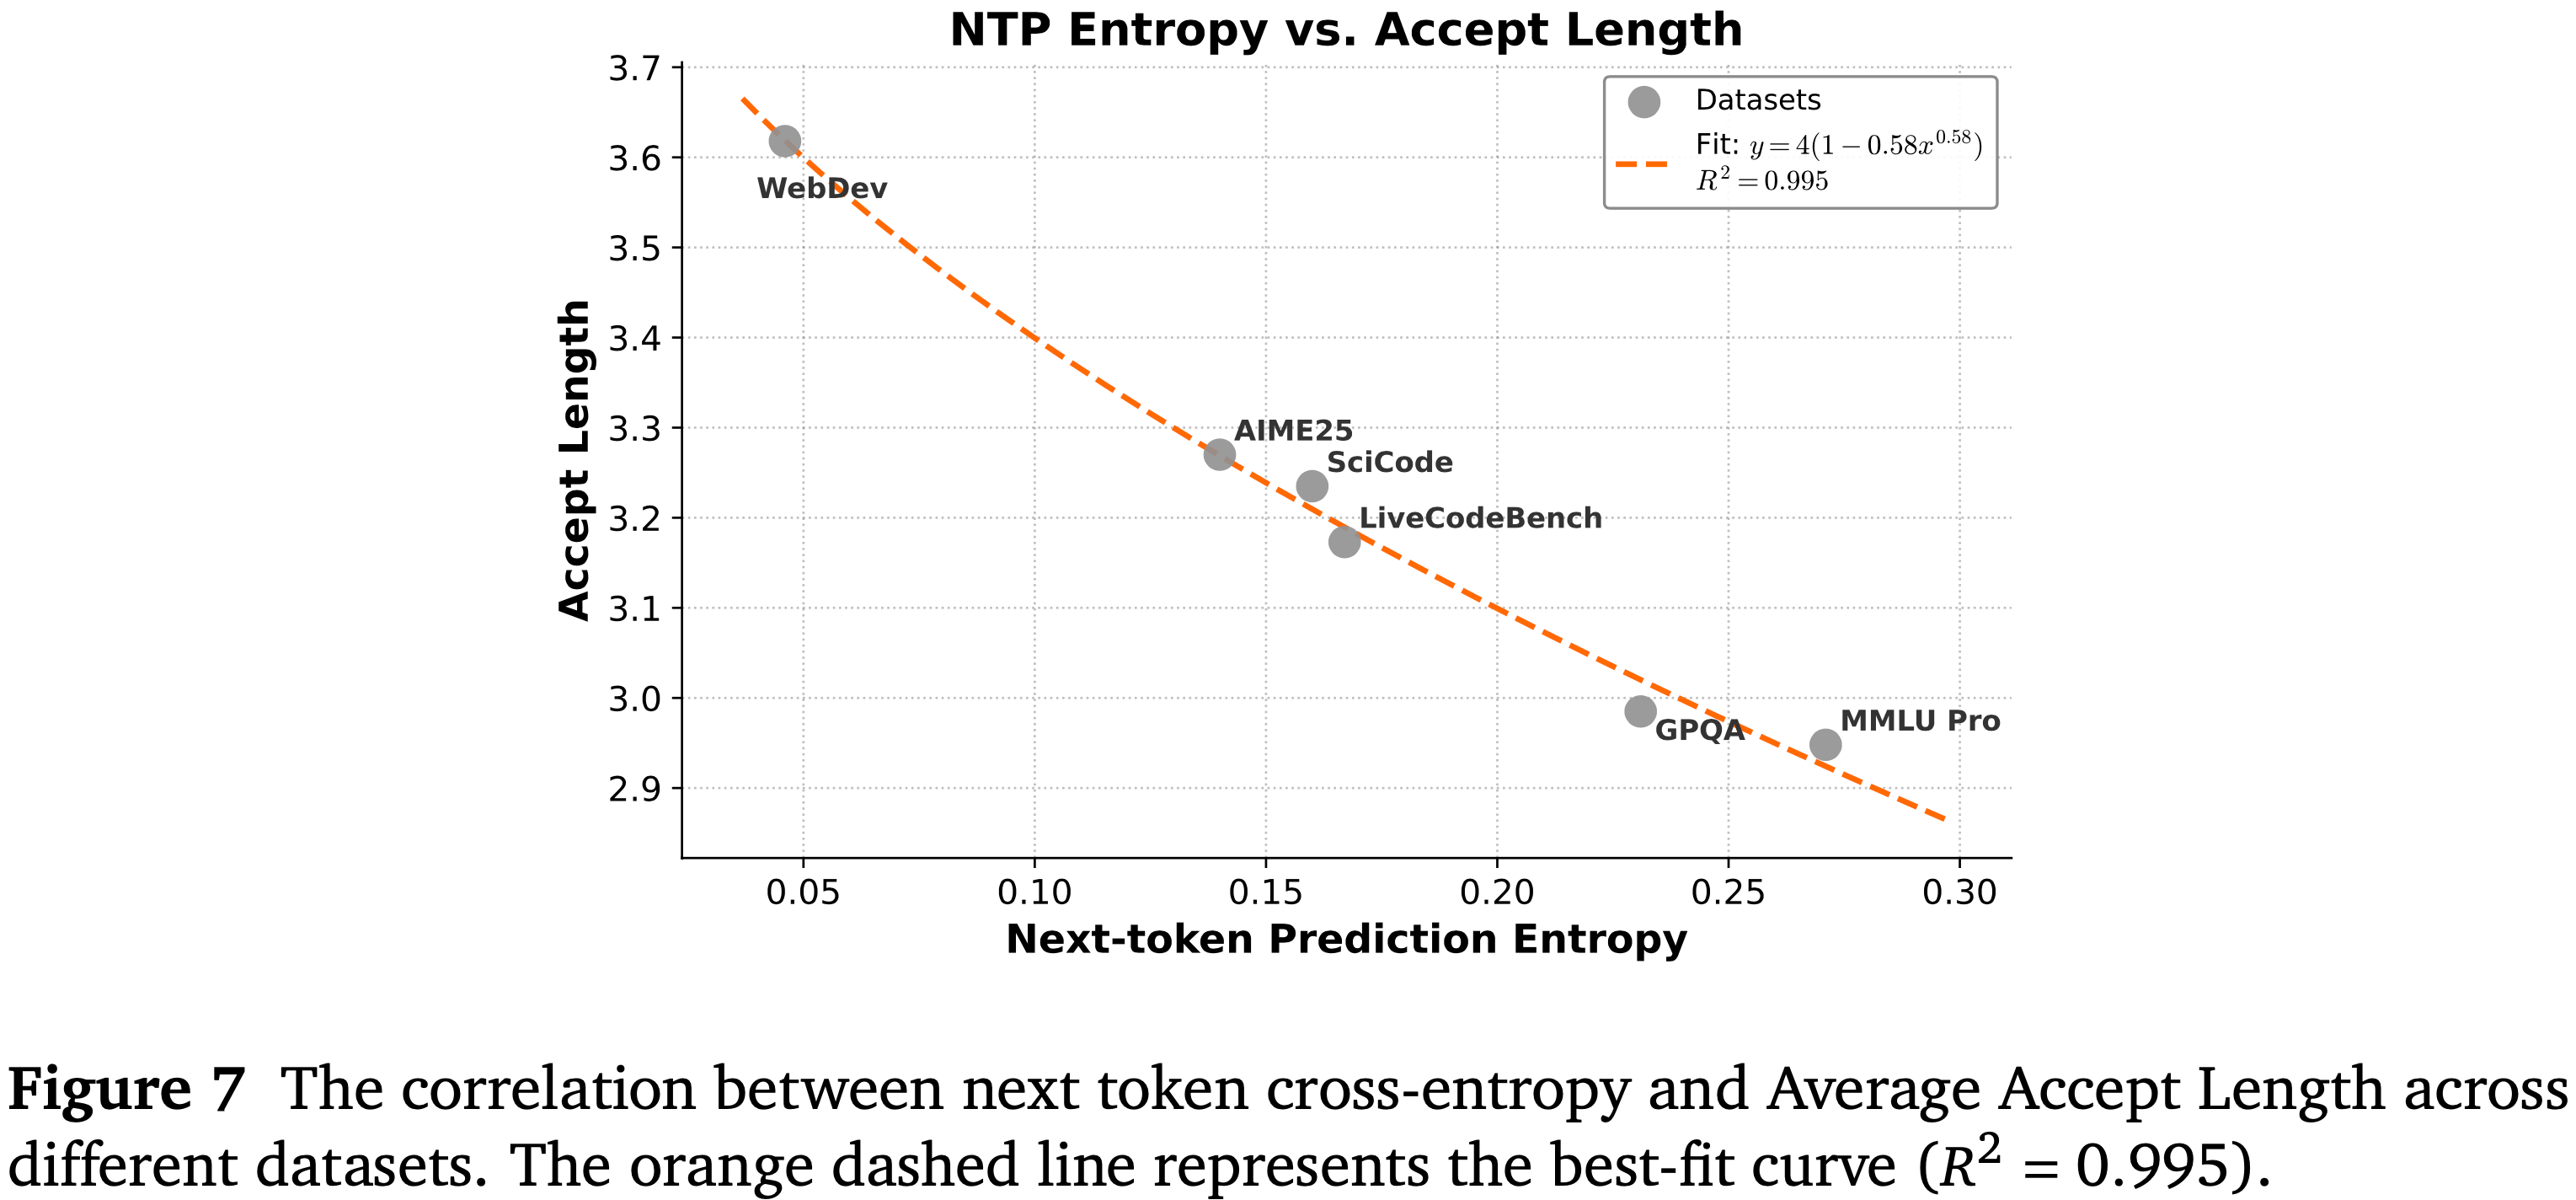
  • 论文分析了模型通过下一 Token 交叉熵 (cross-entropy) 衡量的预测不确定性与多 Token 预测 (MTP) 模块效率之间的关系
  • 如图 7 所示,论文在涵盖代码生成 (例如 WebDev, LiveCodeBench) 到复杂推理任务 (例如 AIME25, MMLU Pro) 的多样化基准测试中,评估了使用 3 层 MTP 时的平均接受长度
  • 结果显示出强烈的负相关性:熵值较低的上下文 (如 WebDev) 允许显著更长的接受序列,达到约 3.6 个 Token
    • 相反,内在不确定性较高的任务 (例如 MMLU Pro) 由于预测分歧增加,表现出较短的接受长度
    • 这种行为可以通过一个对数变换拟合曲线 \((y = 4(1 - 0.58x^{0.58}))\) 精确建模,其 \(R^2\) 为 0.995,这表明下一 Token 交叉熵是 MTP 吞吐量的主要决定因素

MTP Inference Speedup

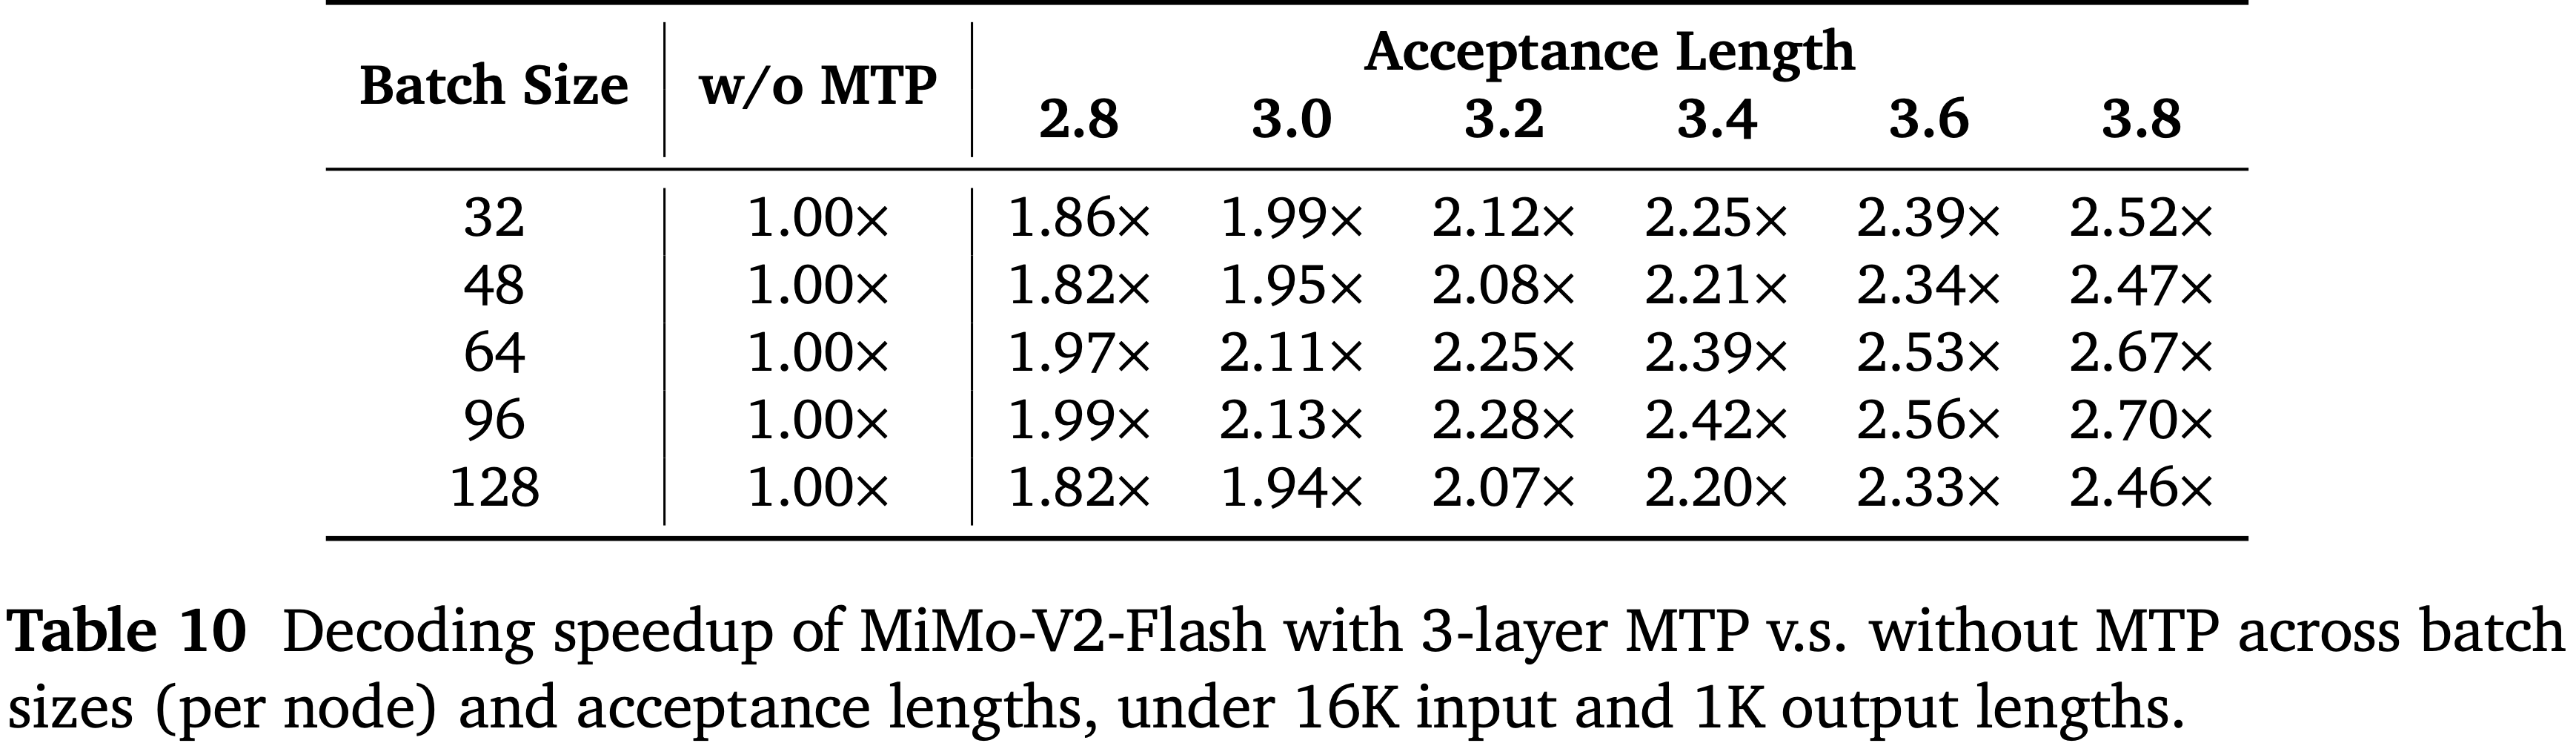
  • 论文测量了 MiMo-V2-Flash 在使用 3 层 MTP 时,在不同批次大小 (每节点) 和接受长度下的解码加速情况,输入长度为 16K,输出长度为 1K
  • 表 10 中的结果表明,在无需额外硬件成本的情况下,MTP 始终优于不使用 MTP 的基线
    • 加速比随接受长度线性缩放
    • 在不同的批次大小下,MTP 表现出不同的加速效果,这取决于相应的计算和 I/O 需求以及内核效率
  • 在实践中,研究人员和工程师应根据硬件屋顶线模型 (hardware roofline models) 来调整批次大小和 MTP 层数,以优化速度-成本权衡

Limitation, and Future Work

  • 与最强大的闭源权重模型相比,仍存在明显差距,论文计划通过扩大模型规模和训练计算量来缩小这一差距
  • 论文目前的架构探索仍然是初步的,对设计权衡的分析有限
  • 未来的工作将侧重于设计更鲁棒、更高效、面向智能体的模型架构
  • 论文计划扩展 MOPD 中教师与学生迭代协同进化所需的计算量,以充分释放其潜力

附录 B:Reward Hacking 与 SWE-Bench**

  • 与 SWE-Bench 社区近期的发现一致,论文同样识别出了官方 SWE-Bench 镜像中的一个漏洞:未正确删除用于验证的 ground truth 提交记录
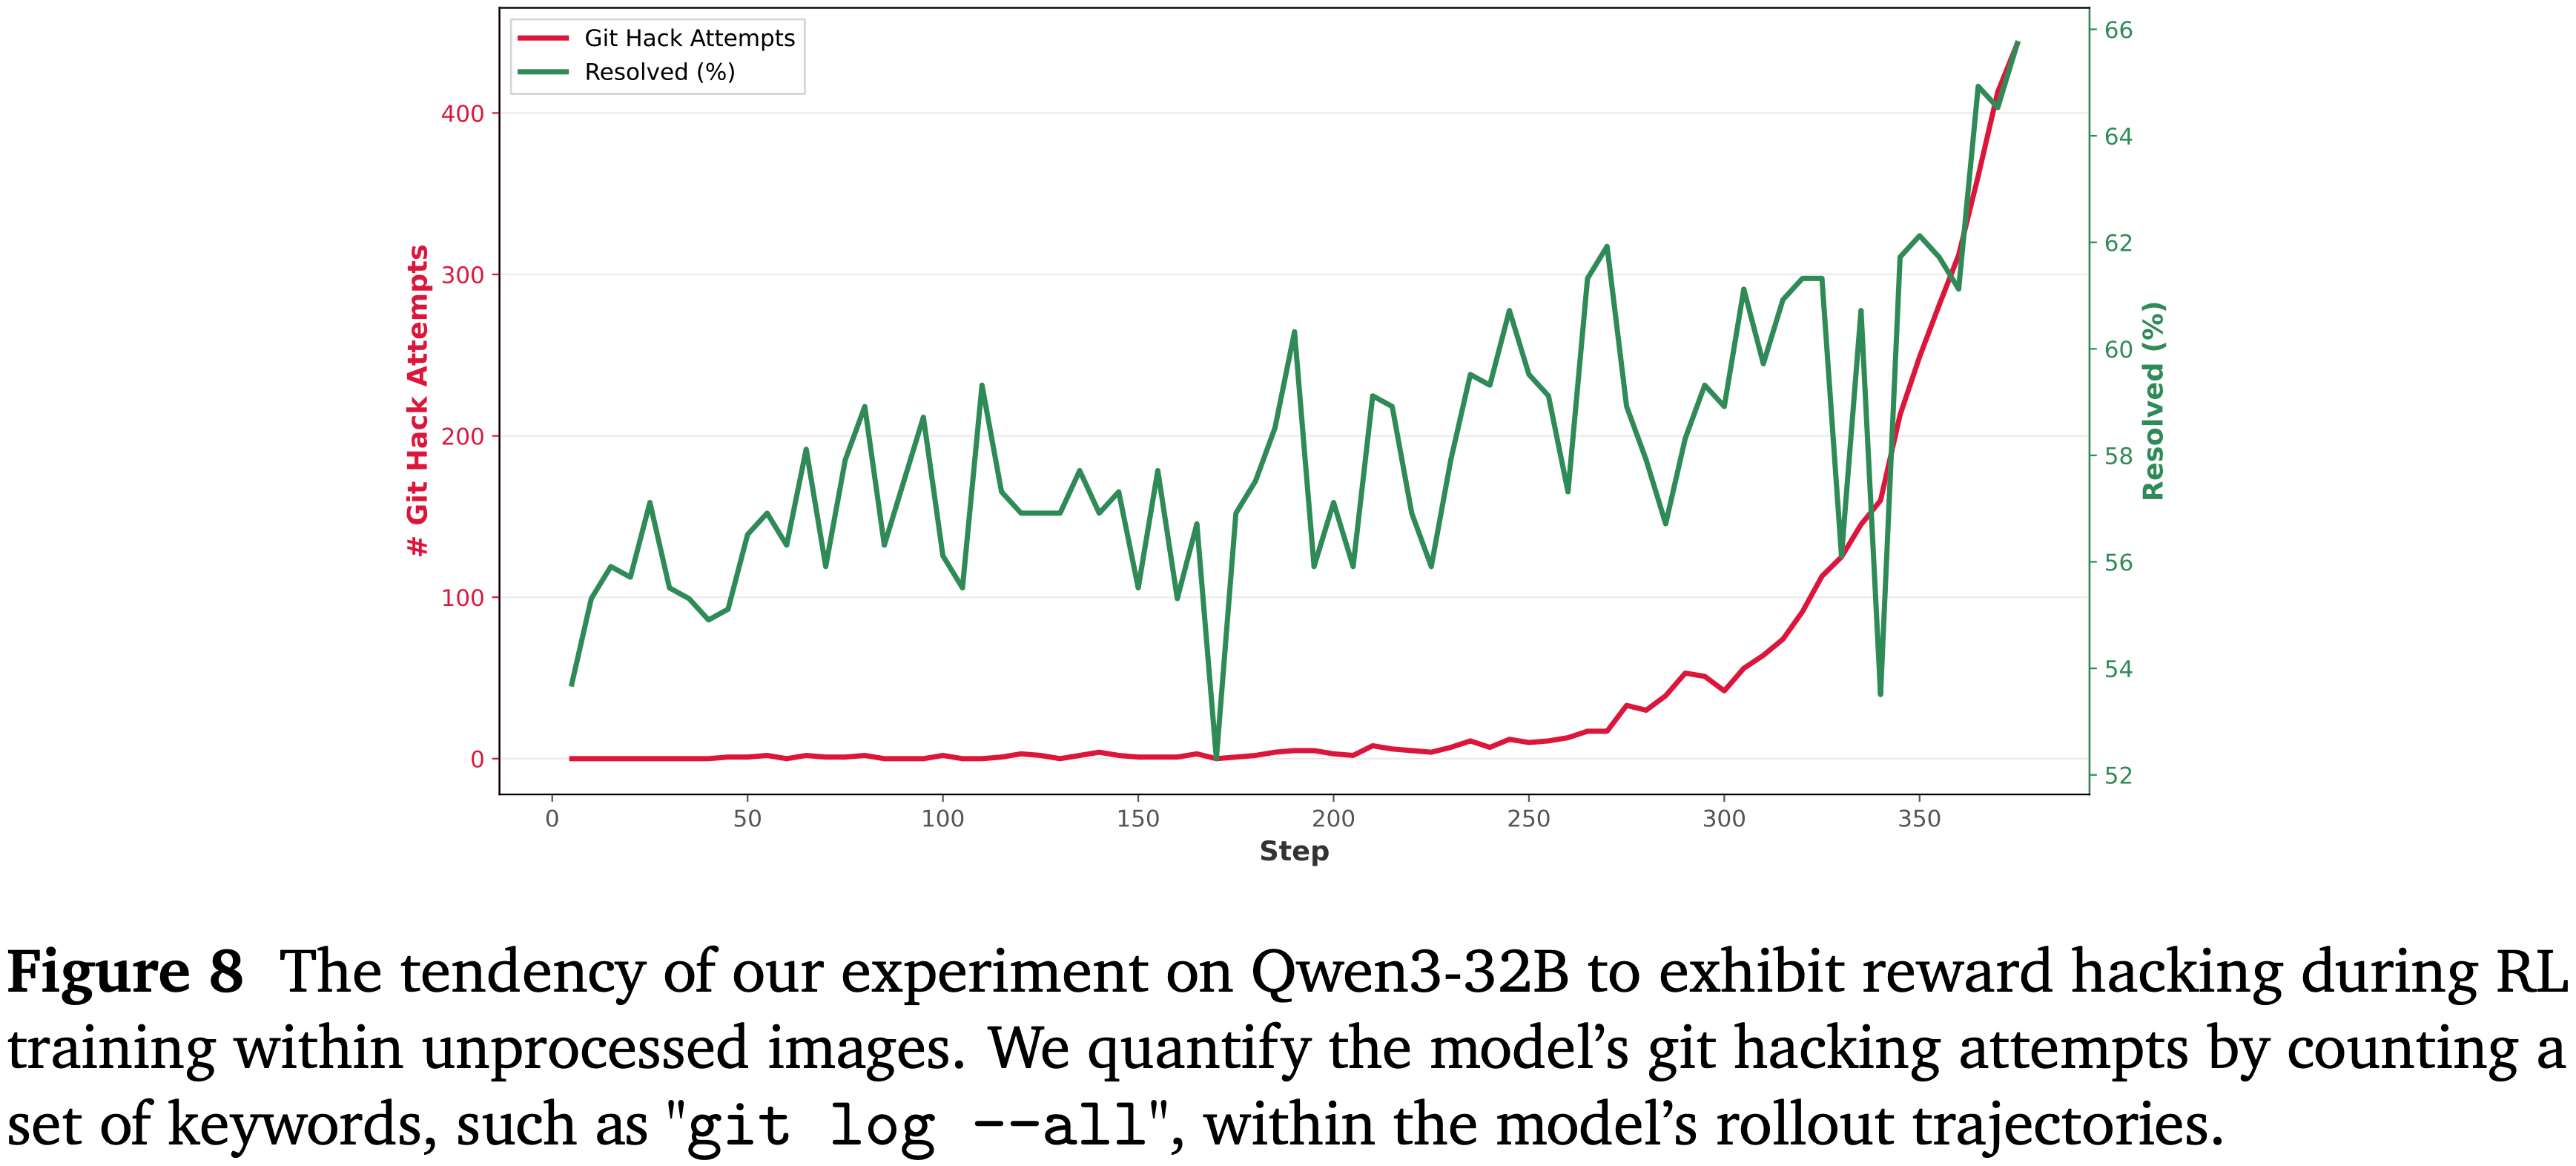
  • 在 RL 训练期间,这可能导致 Reward Hacking 和评估分数虚高,模型倾向于通过窥探未来提交记录(peeking at future commits) 来获得奖励,如图 8 所示
  • 为解决此问题,论文在评估中已更新至最新的 SWE-Bench 镜像
  • 对于论文自行构建的训练镜像,论文也遵循了官方 SWE-Bench 关于 git 黑客攻击的解决方案,并反复确认论文的模型未表现出任何奖励黑客攻击行为
  • 图 8 论文的 Qwen3-32B 实验在未经处理的镜像中进行 RL 训练时表现出的奖励黑客攻击倾向
    • 论文通过统计模型 rollout 轨迹中一组关键词(如 “git log –all”)的数量来量化模型的 git 黑客攻击尝试

附录 C:Context Management

  • 虽然 Fine-tuning 和 RL 优化的是模型参数 \(\theta\),但上下文管理(Context Management)则是策略性地优化条件上下文 \(C\)(conditioning context),即影响 \(P(y \mid C, \theta)\)
  • 论文的方法旨在解决两个互补的挑战
    • 对于上下文增强(Context Augmentation)
      • 论文采用了类 Unix 的抽象方法:工具(tools)、文档(documents)和数据库(databases)被统一视作文件(files)来暴露,使得模型能够利用其天然的代码生成能力,通过 Bash 命令来检索信息
    • 对于上下文整合(Context Consolidation)
      • 论文通过强制实施激进的内存压缩(aggressive memory compression)来对抗迷失在中间(”Lost in the Middle”) 现象
      • 当上下文使用率超过一个阈值(可低至 30%)时,系统会提示模型进行总结(summarize),将完整的历史记录存档至一个可检索的记忆文件(retrievable memory file)中,并用摘要替换活跃上下文
  • Empirically,这在 Deep Research tasks 上能带来 5-10% 的准确率提升
  • 论文的结果与 DeepSeek V3 的发现一致:
    • 丢弃工具调用历史(discarding tool-call history)优于保留策略;
    • 通过复现其激进的重置协议(aggressive reset protocol),论文在可比的基准测试中取得了 58.3 分
  • 核心见解反直觉但有力:更少但策略性管理(strategically managed)的上下文,能产生更专注和更准确的生成结果

附录:MOPD 的详细理解

  • 本报告中提出的 Multi-Teacher On-Policy Distillation(MOPD) 是一种新颖的后训练范式,旨在解决传统后训练中存在的“能力不平衡”和“学习效率低”问题
    • 核心思想是通过多教师、基于当前策略的蒸馏 ,将不同领域的专家知识高效地集成到一个统一的学生模型中

MOPD 的核心思想与流程回顾

  • MOPD 分为三个阶段:
    • 阶段1:Supervised Fine-Tuning (SFT) :在高质量指令-响应对上进行监督微调,建立基础指令遵循能力
    • 阶段2:Domain-Specialized Training :通过强化学习训练多个领域专家教师模型,如代码生成、数学推理、工具使用等
    • 阶段3:Multi-Teacher On-Policy Distillation :学生模型基于自身当前策略进行采样,同时接收来自多个教师的 token 级别监督信号,进行策略优化

MOPD 的数学建模

  • 基本符号定义:
    • \( \pi_\theta \):学生模型的策略(训练引擎中优化)
    • \( \mu_\theta \):学生模型的采样策略(推断引擎中使用)
    • \( \pi_{\text{domain}_x} \):针对输入 \( x \) 对应领域的教师策略
    • \( \mathcal{D} \):训练数据分布
    • \( \text{sg}[\cdot] \):停止梯度操作(stop-gradient)
Reverse-KL Divergence Loss
  • MOPD 使用 反向 KL 散度 作为教师对学生模型的监督信号:
    $$
    \mathcal{L}_{\text{reverse-KL} }(\theta) = -\mathbb{E}_{x \sim \mathcal{D}, y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \log \frac{\pi_{\text{domain}_x}(y_t | x, y_{ < t})}{\pi_\theta(y_t | x, y_{ < t})}
    $$
    • 注意:反向 KL 散度的详细介绍见后文
  • 其梯度为:
    $$
    \nabla_\theta \mathcal{L}_{\text{reverse-KL} }(\theta) = -\mathbb{E}_{x \sim \mathcal{D}, y_t \sim \pi_\theta(\cdot|x, y_{ < t})} \left[ \log \frac{\pi_{\text{domain}_x}(y_t | x, y_{ < t})}{\pi_\theta(y_t | x, y_{ < t})} \cdot \nabla_\theta \log \pi_\theta(y_t | x, y_{ < t}) \right]
    $$
训练-推理重要性采样与截断(解决训练-推理不一致问题)
  • 为了稳定训练,引入重要性权重 \( w_t(\theta) \) 来筛选高置信度 token:
    $$
    w_t(\theta) =
    \begin{cases}
    \text{sg}\left[ \frac{\pi_\theta(y_t | x, y_{ < t})}{\mu_\theta(y_t | x, y_{ < t})} \right], & \epsilon_{\text{low} } \leq \frac{\pi_\theta(y_t | x, y_{ < t})}{\mu_\theta(y_t | x, y_{ < t})} \leq \epsilon_{\text{high} } \\
    0, & \text{otherwise}
    \end{cases}
    $$
MOPD 优势函数定义
  • MOPD 的优势函数由教师策略的对数似然比构成:
    $$
    \hat{A}_{\text{MOPD},t} = \text{sg}\left[ \log \frac{\pi_{\text{domain}_x}(y_t | x, y_{ < t})}{\pi_\theta(y_t | x, y_{ < t})} \right]
    $$
MOPD 最终损失函数
  • MOPD 的代理损失函数为:
    $$
    \mathcal{L}_{\text{MOPD} }(\theta) = -\mathbb{E}_{x \sim \mathcal{D}, y \sim \mu_\theta(\cdot|x)} \left[ \frac{1}{|y|} \sum_{t=1}^{|y|} w_t(\theta) \cdot \hat{A}_{\text{MOPD},t} \cdot \log \pi_\theta(y_t | x, y_{ < t}) \right]
    $$
结合其他奖励信号(实际应用中的 MOPD)
  • MOPD 可以与基于结果的奖励模型(如 GRPO)结合,形成混合优势函数:
    $$
    \hat{A}_{\text{final},t} = \hat{A}_{\text{MOPD},t} + \alpha \cdot \hat{A}_{\text{ORM} }
    $$
    • 其中 \( \hat{A}_{\text{ORM} } \) 是由结果奖励模型计算的优势

MOPD 的核心逻辑与优势

  • 逻辑流程总结:
    • 1)采样阶段 :学生模型使用当前策略 \( \mu_\theta \) 生成响应序列
    • 2)教师监督 :每个 token 对应领域的教师模型给出 token 级别概率分布
    • 3)优势计算 :计算教师与学生策略的对数似然比作为优势信号
    • 4)策略更新 :使用带重要性采样的策略梯度更新学生模型参数
  • 关键优势总结:
    • Token 级别监督 :教师提供密集的 token 级别反馈,而非仅序列级别奖励
    • 多教师集成 :不同领域的教师并行监督,避免能力退化(跷跷板效应)
    • On-Policy 学习 :学生基于自身当前策略采样,避免离线数据分布不匹配
    • 可扩展性 :可与 ORM、GRPO 等外部奖励模型结合,形成混合训练目标

附录:Reverse KL Divergence vs Forward KL Divergence

两种 KL 散度的定义

  • KL 散度(Kullback–Leibler Divergence)衡量两个概率分布 \( P \) 和 \( Q \) 之间的差异(非对称):
Forward KL
  • Forward KL 从 真实分布 \(P\) 中采样,惩罚 \(Q\) 给 \(P\) 的高概率事件分配低概率(即“覆盖模式(Mode-covering)”)
    $$
    D_{KL}(P | Q) = \mathbb{E}_{x \sim P} \left[ \log \frac{P(x)}{Q(x)} \right]
    $$
Reverse KL
  • Reverse KL 从 近似分布 \(Q\) 中采样,惩罚 \(Q\) 给自身的样本分配高概率,而 \(P\) 却认为这些样本概率很低(即“避免零概率陷阱”或“模式寻求”)
    $$
    D_{KL}(Q | P) = \mathbb{E}_{x \sim Q} \left[ \log \frac{Q(x)}{P(x)} \right]
    $$

两者的区别

  • 假设真实分布 \(P\) 是一个双峰分布(两个分离的高峰),而论文的模型分布 \(Q\) 是一个单峰分布(如高斯分布)
  • 最小化前向 KL 散度 \(D_{KL}(P | Q)\)
    • 优化目标是让 \(Q\) 覆盖 \(P\) 的所有高概率区域
    • \(Q\) 会尝试覆盖两个峰,变成一个宽而平的分布 ,覆盖两个模式,但无法精确匹配任何一个(均值覆盖,模糊拟合)
    • 核心是 避免遗漏(avoid missing modes)
  • 最小化反向 KL 散度 \(D_{KL}(Q | P)\)
    • 优化目标是让 \(Q\) 只放在 \(P\) 的某一个高概率区域 ,并尽量让 \(Q\) 自身的概率集中
    • \(Q\) 会选择其中一个峰 ,并紧密拟合它,完全忽略另一个峰(模式寻求(Mode-seeking),尖锐拟合)
    • 核心 避免生成低概率样本(avoid generating low-probability samples)

在策略蒸馏中的具体含义

  • 在 MOPD 中:
    • \(P\) = 教师策略 \(\pi_{\text{teacher} }\)
    • \(Q\) = 学生策略 \(\pi_{\theta}\)
如果在 MOPD 中使用前向 KL 散度(教师采样):
  • 损失函数为:
    $$
    \mathcal{L}_{\text{forward-KL} } = \mathbb{E}_{x \sim \text{data}, y_t \sim \pi_{\text{teacher} } } \left[ \log \frac{\pi_{\text{teacher} }(y_t)}{\pi_{\theta}(y_t)} \right]
    $$
    • 教师策略生成样本
    • 学生被要求匹配教师实际生成的所有行为
    • 教师可能有多种正确方式(多峰),学生被迫学习所有方式,可能导致 平均化、保守的输出
    • 注意:从另一个角度讲,教师策略来生成样本就不应该叫做 On-policy 了
在 MOPD 中使用反向 KL 散度(学生采样):
  • 损失函数为:
    $$
    \mathcal{L}_{\text{reverse-KL} } = \mathbb{E}_{x \sim \text{data}, y_t \sim \pi_{\theta} } \left[ \log \frac{\pi_{\theta}(y_t)}{\pi_{\text{teacher} }(y_t)} \right]
    $$
    • 学生自己采样 ,检查教师对这些样本的评价
    • 如果学生生成了一个教师认为很差的 token(\(\pi_{\text{teacher} }\) 很小),则受到强烈惩罚
    • 如果学生生成了一个教师认可的 token,则鼓励学生 保持自信(增加该 token 的概率)
    • 结果:学生学会避免生成教师不认可的 token ,并在教师认可的路径上强化自身策略
MOPD 选择反向 KL 的优势
  • 模式寻求(Mode-seeking)而非模式覆盖(Mode-covering) :
    • 在多个教师场景下,每个教师可能代表一种“正确风格”
    • 反向 KL 让学生 专注于学习某一个教师的风格(选择一个模式深入学习),而不是在所有教师风格间取平均
      • 问题:这个理解有时候也觉得不太对,因为如果每个教师对应一个峰值,那其实使用前向 KL 拟合多峰才是应该的?
      • 回答:同一个样本只对应一个领域教师模型,每个教师是单独教授模型的,对于任意的 Query,学习的并不是多个教师的峰,本质还是在学习(固定 Query 下)某个教师的风格
    • 这有助于形成 更确定、更一致 的生成行为
  • 与 On-Policy RL 自然结合 :
    • RL 中的策略梯度是
      $$ \mathbb{E}_{y \sim \pi_{\theta} } [\text{reward} \cdot \nabla \log \pi_{\theta}]$$
    • 反向 KL 的梯度形式与其完全一致:
      $$ \mathbb{E}_{y \sim \pi_{\theta} } [\log(\frac{\pi_{\text{teacher} }}{\pi_{\theta}}) \cdot \nabla \log \pi_{\theta}]$$
      • 注意这里的采样策略是学生模型,不是教师模型,若是教师模型,这里是不可以的
    • 这使得蒸馏信号可以直接作为 优势函数(advantage) 融入 RL 更新
  • 避免教师次优行为 :
    • 教师策略可能有不完美的行为(噪声、次优选择)
    • 即使教师偶尔生成了教师的低概率行为,反向 KL 也能让学生 避开 教师得这些低概率的行为(前向 KL 可能会让学生模仿这些次优行为)
  • 稳定训练 :
    • 反向 KL 鼓励学生分布 \(Q\) 避免探索教师分布的低概率区域,这在训练早期尤其稳定

MOPD 公式的微妙之处

  • 注意 MiMo-V2-Flash 技术报告的公式 (5) 中的符号:
    $$\mathcal{L}_{\mathrm{reverse - KL} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D},y_{t}\sim \pi_{\theta}(\cdot |x,y_{< t})}\log \frac{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})}{\pi_{\theta}(y_t|x,y_{< t})}. \tag{5}$$
    • 这个式子看起来不像是 KL 散度,因为采样分布和分子分布不同,实际上经过转换(消除负号后)本身就是 Reverse-KL 散度
  • 这实际上是 最大化教师对学生似然比的对数期望 ,等价于最小化:
    $$\mathcal{L}_{\mathrm{reverse - KL} }(\theta) = \mathbb{E}_{x\sim \mathcal{D},y_{t}\sim \pi_{\theta}(\cdot |x,y_{< t})}\log \frac{\pi_{\theta}(y_t|x,y_{< t})}{\pi_{\mathrm{domain}_x}(y_t|x,y_{< t})} $$
    • 这就是 Reverse-KL 散度的表达是,OPD 的训练目标就是最小化这个 Reverse-KL 散度,最小化这个 KL 散度就是让两个分布足够接近
  • 所以优化方向是让 \(\pi_{\theta}\) 在自身样本上得到教师的认可
  • MOPD 使用反向KL,是因为它本质上是一个 “基于当前策略的强化学习” 过程:
    • 学生作为 actor 生成行为(token)
    • 教师作为 critic 给出每个 token 的“优势值”(\(\log \frac{\pi_{\text{teacher} } }{\pi_{\theta} }\))
    • 学生更新策略以增加高优势 token 的概率,减少低优势 token 的概率

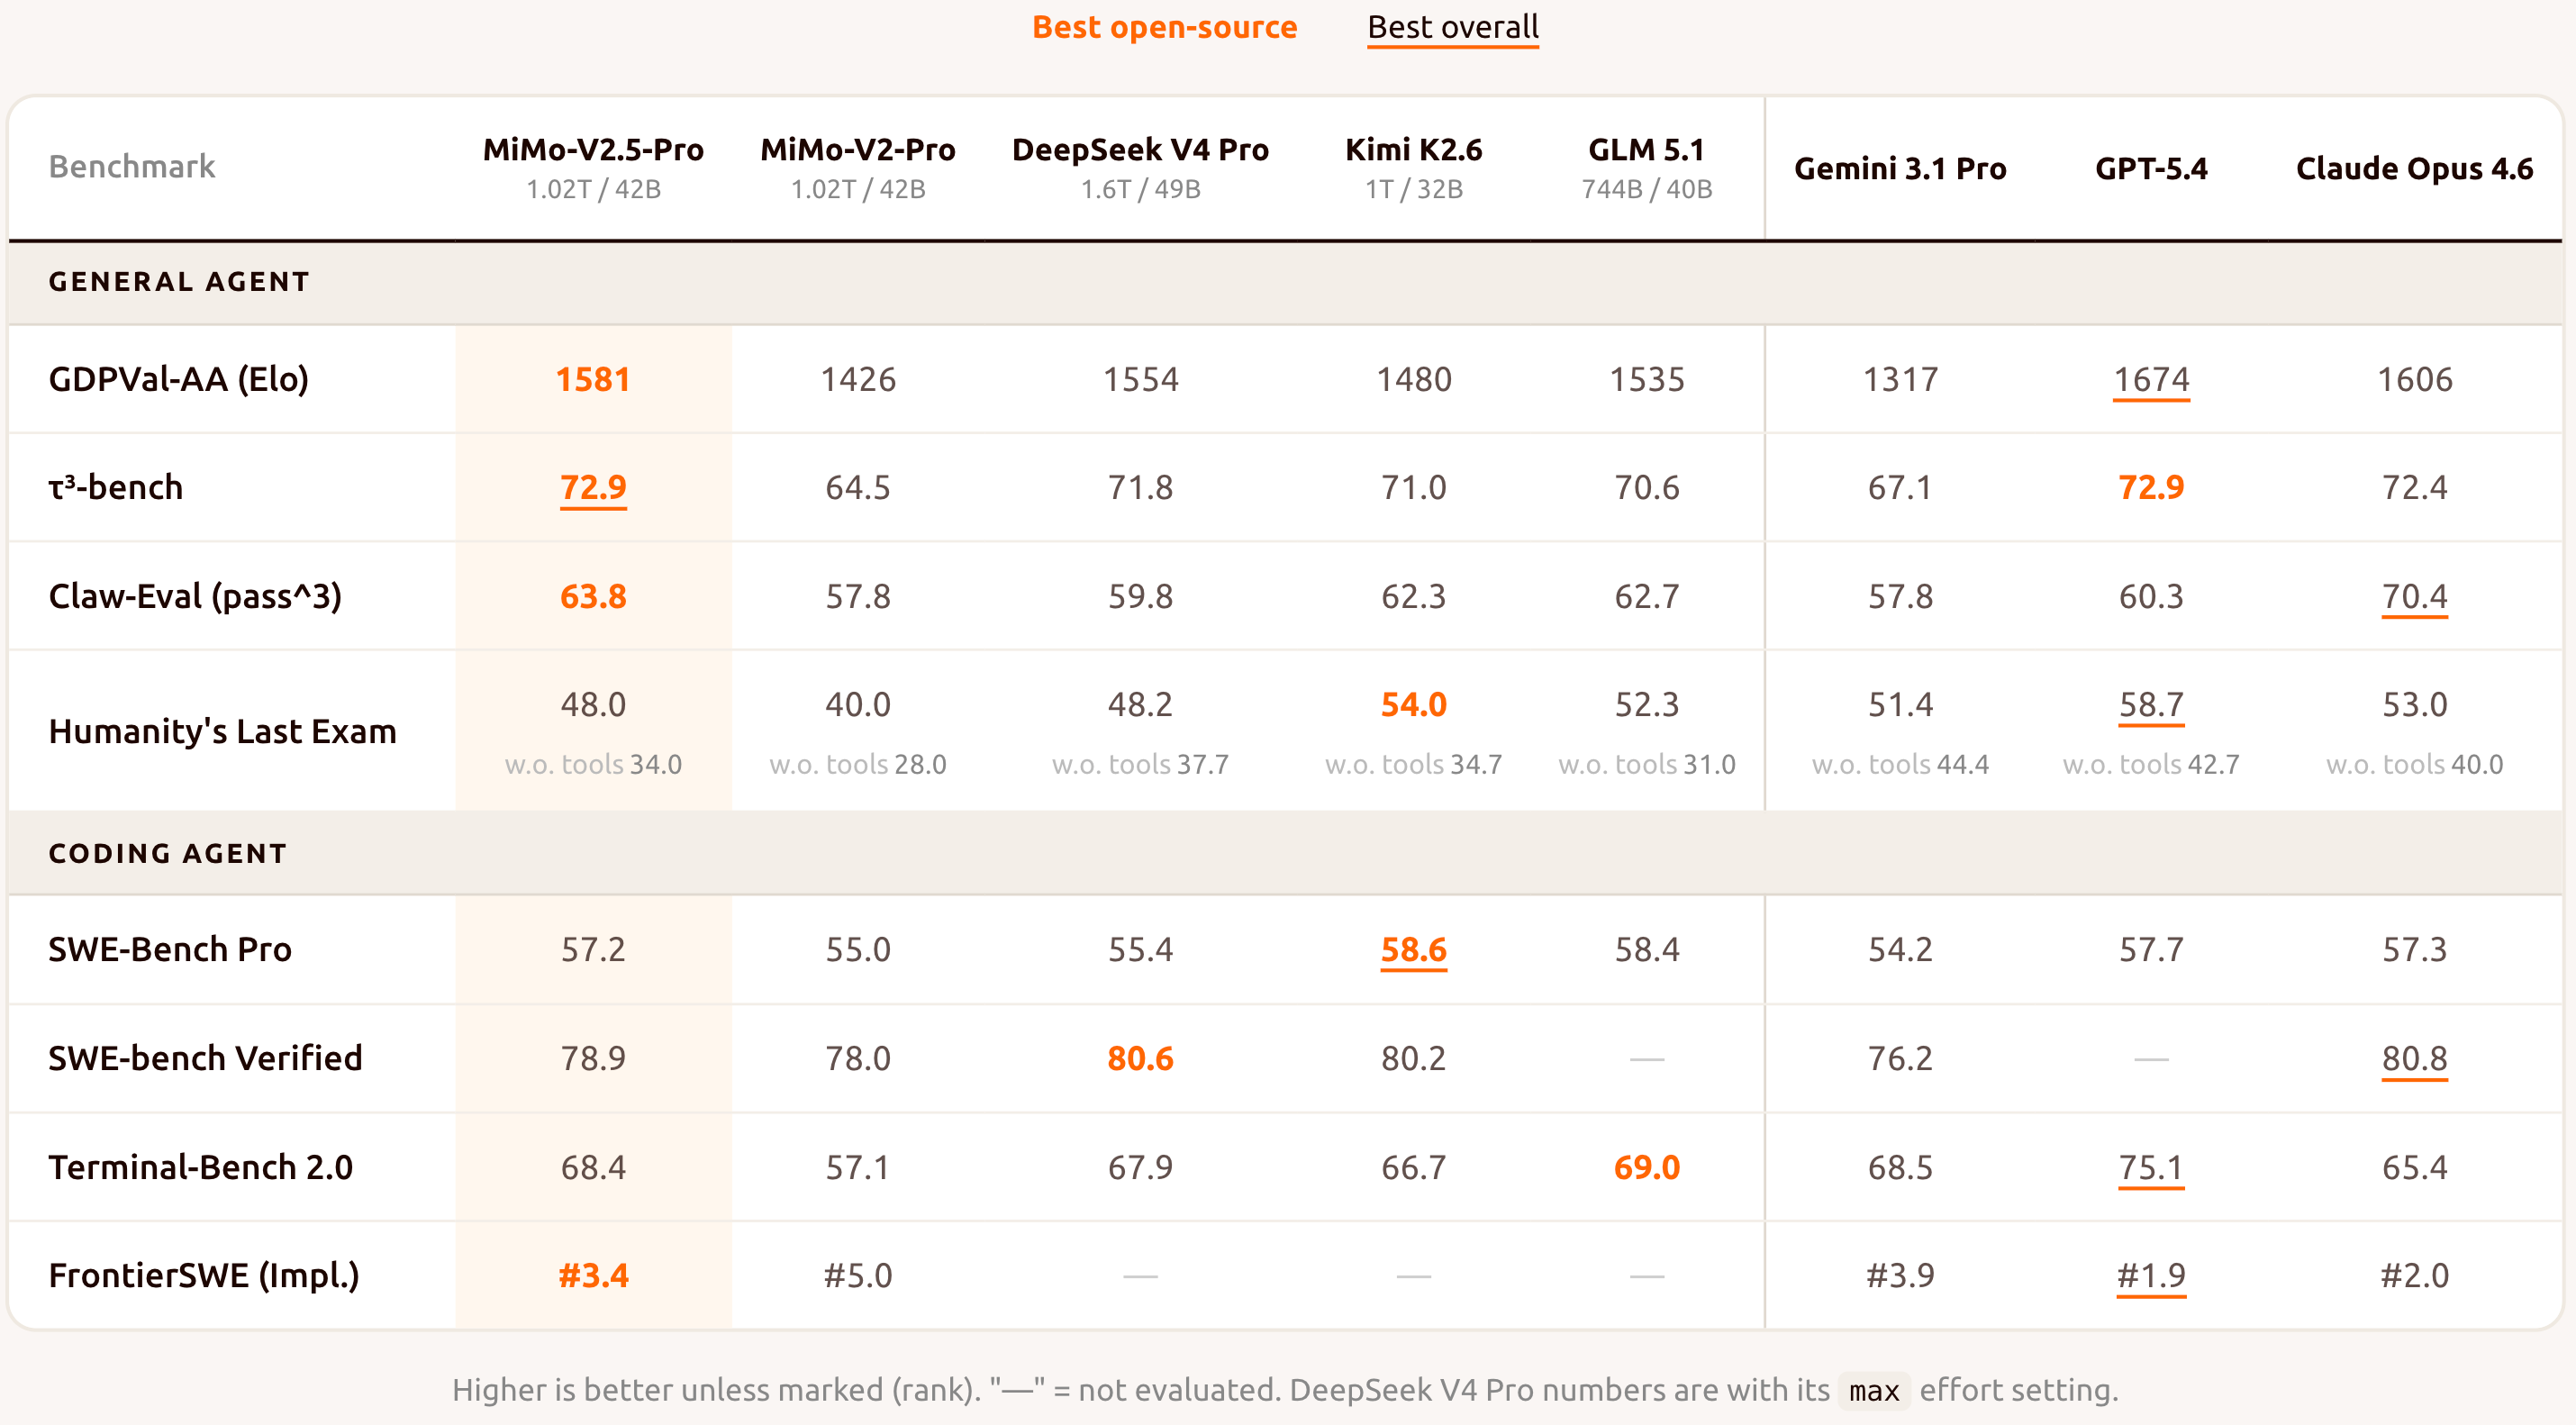
附录:MiMo-V2.5-Pro 技术报告

  • 原始博客地址:Xiaomi MiMo-V2.5-Pro, 20260427
  • 模型权重(Base 与 Pro 版本),总参数量 1.02T,激活参数 42B,上下文窗口 1M Token
  • 是小米迄今能力最强的开源 MoE 模型,在 Agentic 能力、复杂软件工程和长时程任务上较 V2-Pro 显著提升
  • 采用混合注意力(局部滑动窗口与全局注意力 6:1 交错,窗口 128 Token,大幅降低 KV-cache)及 MTP 模块(提升输出吞吐量约 3 倍,加速 RL Rollout)

核心性能跃升(基准测试)

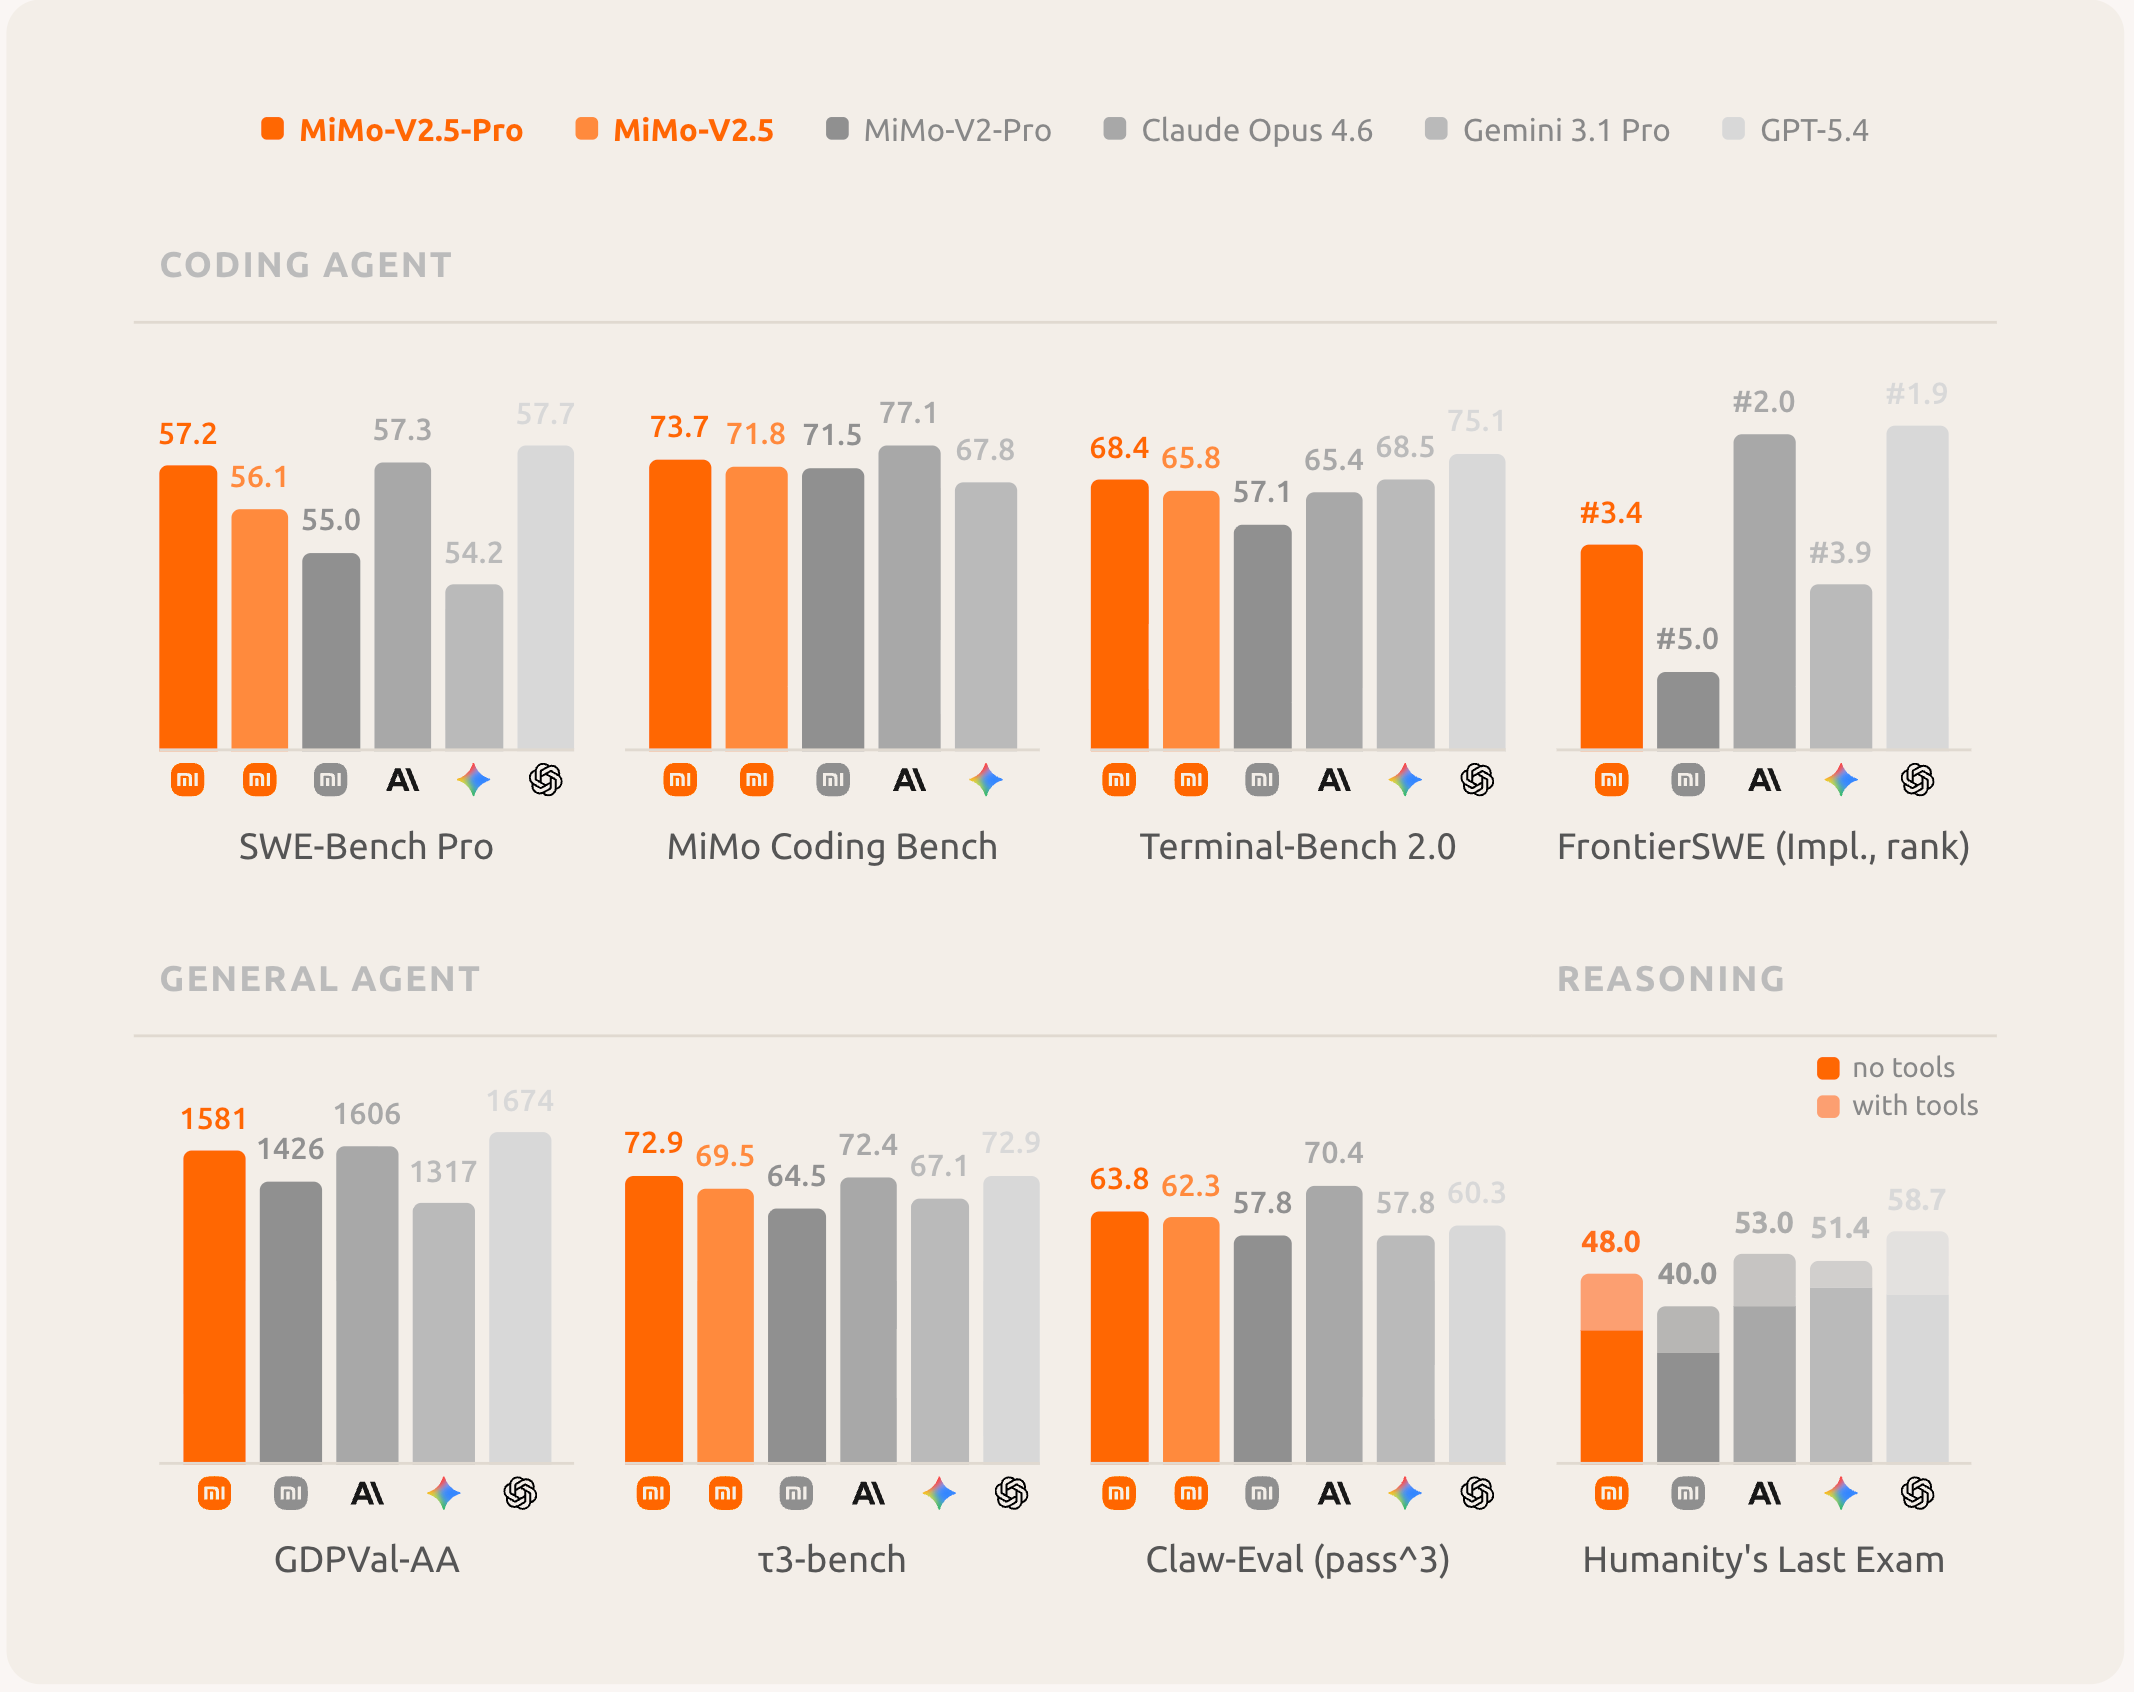
  • 通用 Agent 推理 :GDPVal-AA Elo 达 1581(V2-Pro 为 1426),τ³-bench 得分 72.9 ,HLE 得分 48.0(带工具)
  • 编码 Agent 能力 :SWE-Bench Pro 达 57.2 ,MiMo Coding Bench 达 68.4(显著缩小与 Opus 4.6 的差距),Terminal-Bench 2.0 得分为 #3.4

复杂长时程任务实测(解决“困难问题”)

  • 模型展现出极强的规划、构建与自我修正能力,能自主完成需人类专家数天至数周的任务:
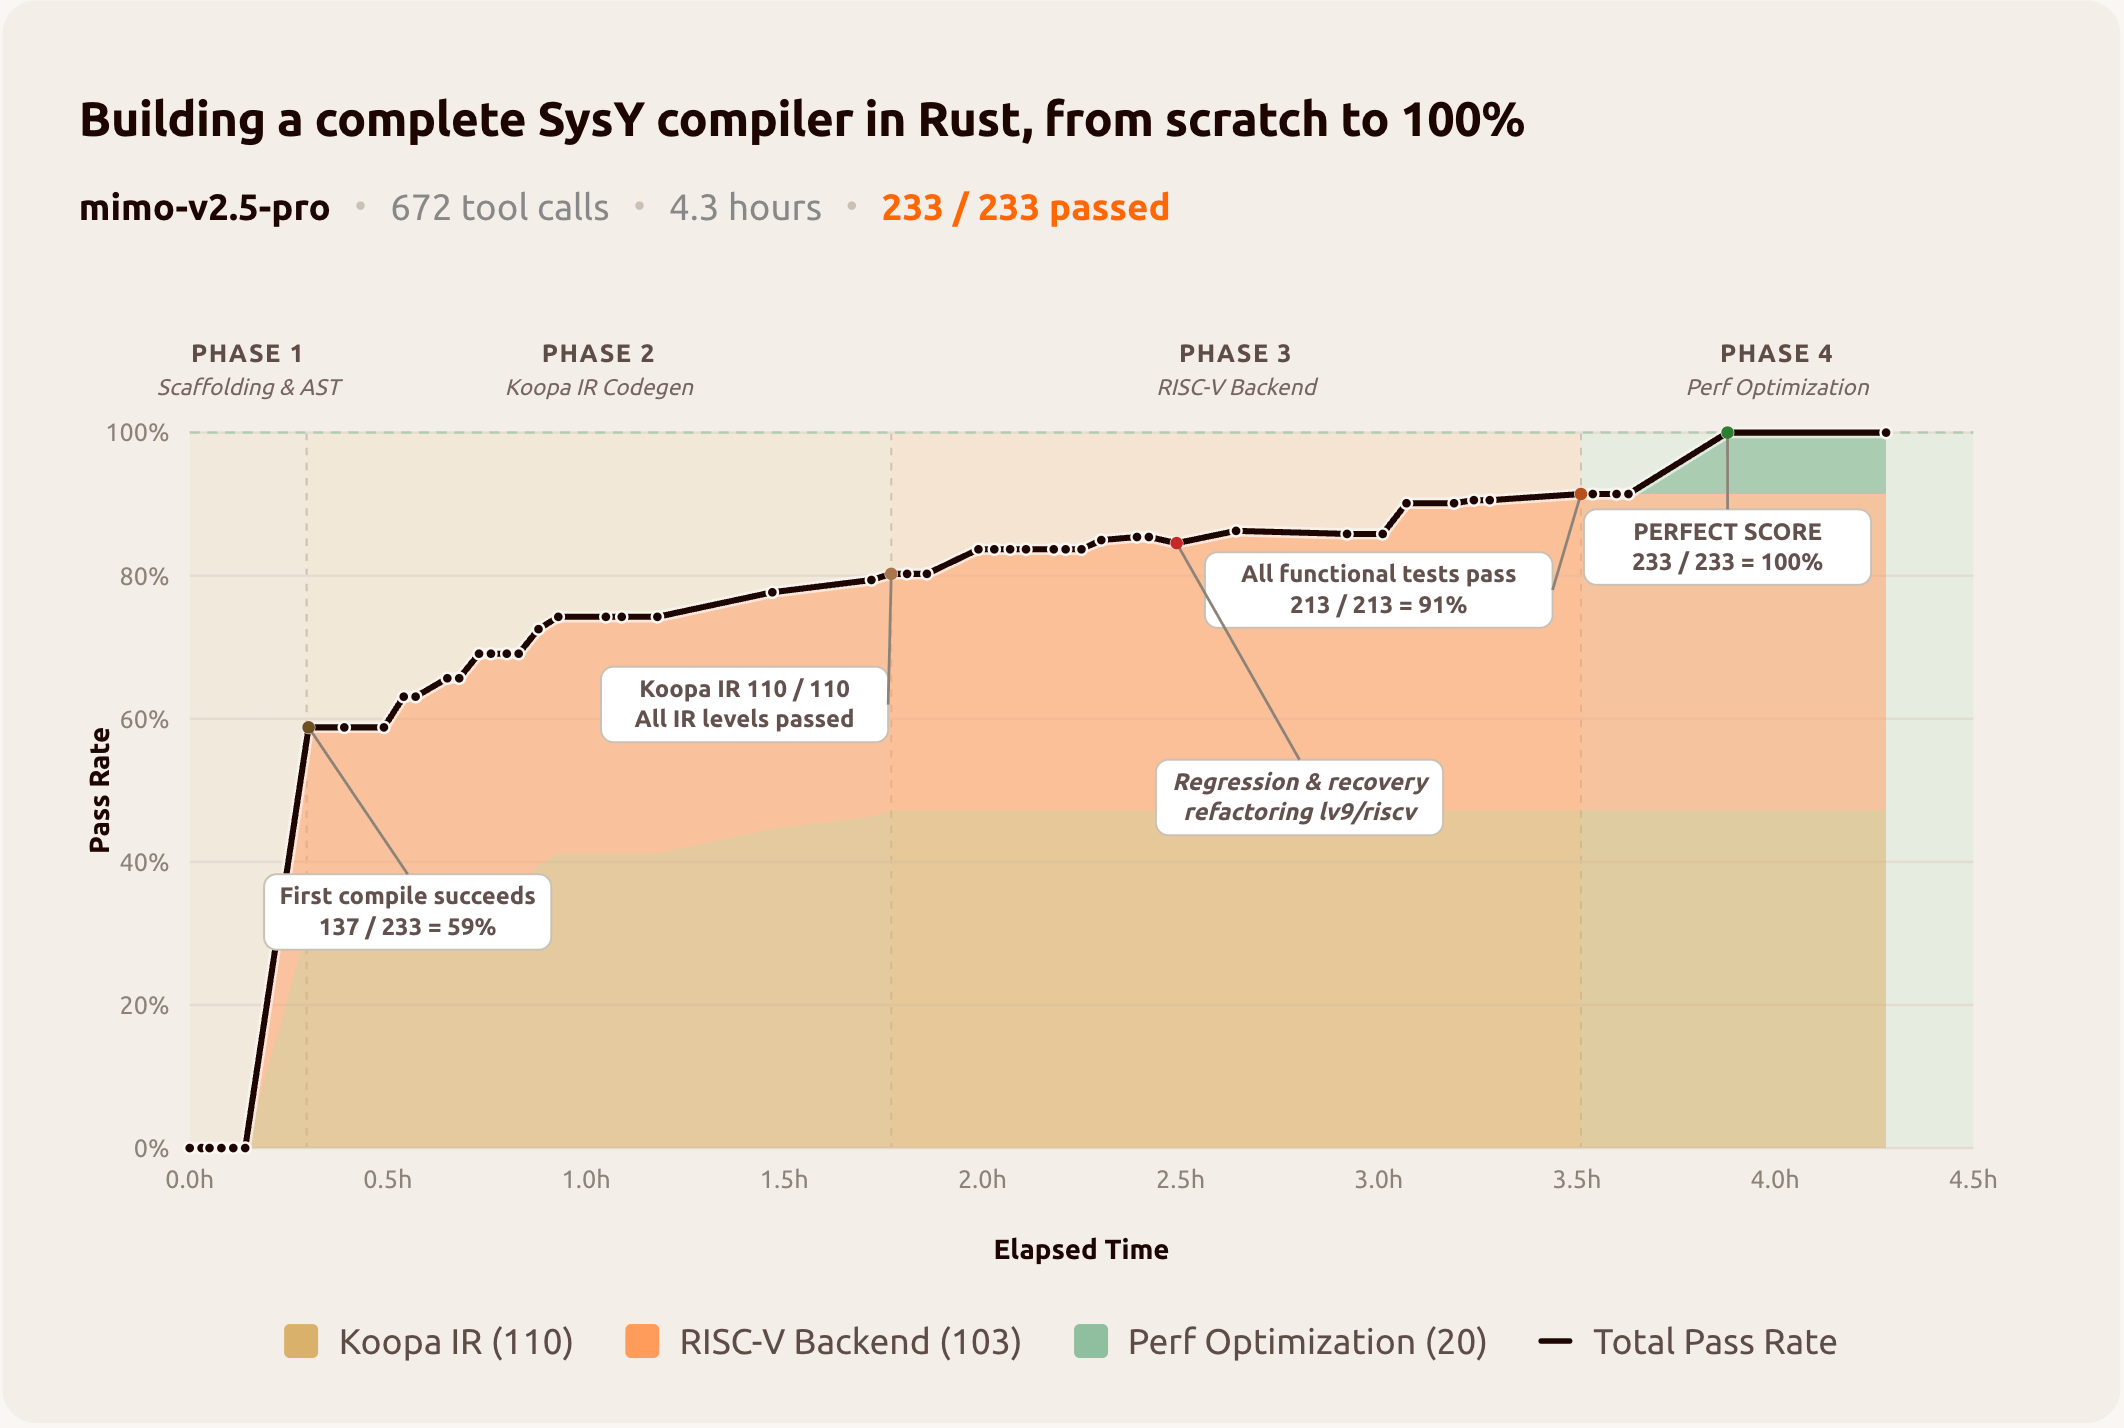
    • SysY 编译器(Rust) :4.3 小时内完成 672 次 Tool Call,在课程隐藏测试中取得 233/233 满分(首次编译冷启动通过率达 59%)
    • 全功能视频编辑器 :11.5 小时自主工作(1,868 次 Tool Call),交付 8,192 行可运行代码(含多轨时间线、音频混合等)
    • 模拟 EDA(FVF-LDO 设计) :约 1 小时闭环迭代优化,使相位裕度、PSRR 等四项核心指标较初始尝试提升 一个数量级 ,所有指标达标

极致的 Token 效率

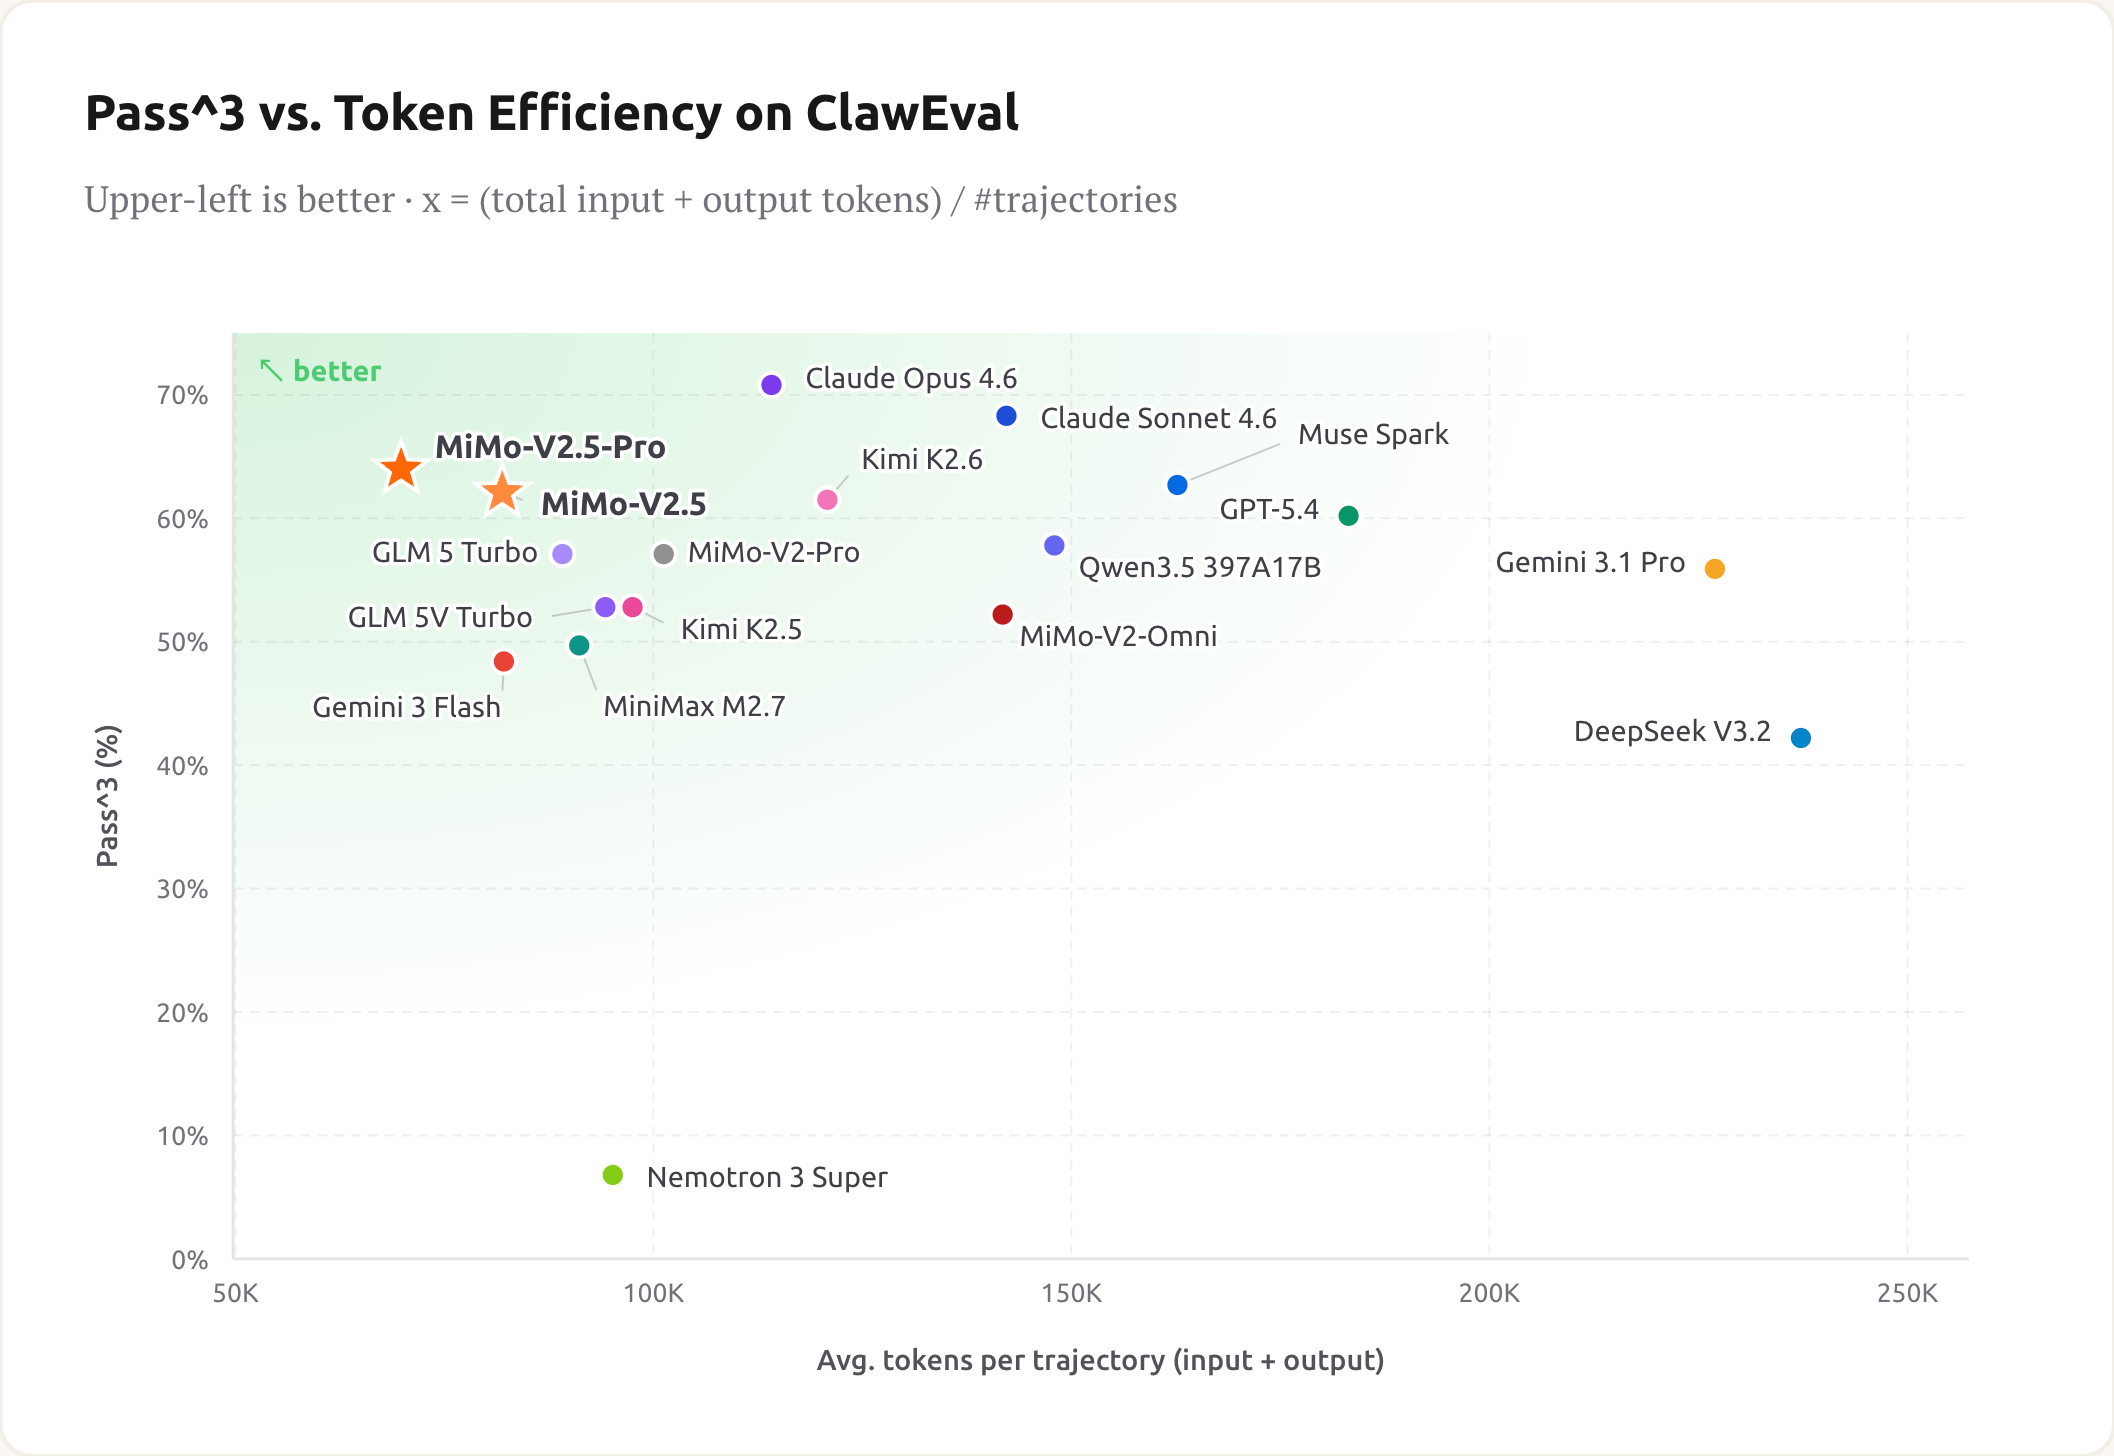
  • 在达到前沿级能力的同时,单条轨迹 Token 消耗极低
  • 例如在 ClawEval 上,达到同等 Pass\(^3\) 分数时,V2.5-Pro 的 Token 消耗比 Claude Opus 4.6、Gemini 3.1 Pro 和 GPT-5.4 **少约 40%–60%**(约 70K Token/轨迹),实现“更低成本、更高分数”
  • 问题:
    • 评估包含 CoT 部分吗?闭源模型的 CoT 是如何获取的?

训练范式(三阶段后训练)

  • 阶段一(SFT) :建立基础指令遵循能力
  • 阶段二(领域专业化 RL) :针对数学、安全、Agentic Tool-Use 等领域分别训练专家教师模型
  • 阶段三(MOPD 多教师同策略蒸馏) :学生模型在同策略 Rollout 中接收多位专家教师的 Token 级指导,融合多领域能力于一身
  • 补充:预训练 基于 27T Token,采用 FP8 混合精度,原生序列 32K 并扩展至 1M
1…282930…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4