Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

DL——对比学习


整体说明

  • TLDR:对比学习(Contrastive Learning)是自监督学习中的一种方法,其核心思想是通过学习数据样本之间的相似性和差异性 ,使得相似样本在表示空间(embedding space)中靠近,不相似样本相互远离,从而学习一个表示空间
  • 对比学习的目标是:学习一个表示空间(embedding space),使得在这个表示空间中,满足下面的条件
    • 正样本对(相似的样本)的表示距离尽可能近
    • 负样本对(不相似的样本)的表示距离尽可能远
  • 注:通过这种对比机制,模型无需人工标注即可从数据中自动学习有意义的特征表示

详细方法说明

正负样本构造

  • 正样本 :同一数据的不同增强视图(如裁剪、旋转、颜色变换后的同一图像),或语义相似的样本
  • 负样本 :随机选择的其他数据样本,或显式定义的 dissimilar 样本
    • 常用的策略有:同一batch内的其他样本、动态队列(历史batch中的样本)等
    • 一些特殊的模型,比如BYOL(Bootstrap Your Own Latent)提出了 免负样本策略 ,详情见附录

常用损失函数

  • InfoNCE Loss(Noise Contrastive Estimation):
    $$
    \mathcal{L} = -\log \frac{\exp(sim(q, k_+) / \tau)}{\sum_{i=0}^K \exp(sim(q, k_i) / \tau)}
    $$
    • \(q\):查询样本的表示
    • \(k_+\):正样本表示,\(k_i\) 为负样本表示
    • \(\tau\):温度系数,控制分布的尖锐程度
    • \(sim(\cdot)\):相似度函数(如余弦相似度)
  • Triplet Loss :(三元组损失)
    $$
    \mathcal{L} = \max(d(a, p) - d(a, n) + \text{margin}, 0)
    $$
    • \(a\):锚点(Anchor)样本
    • \(p\):为正(Positive)样本
    • \(n\):为负(Negative)样本
    • 三元组损失的含义也就是 \(<a,p,n>\) 三元组
    • \(\text{margin}\) 是超参数,用于控制正负样本之间的最小间隔

模型网络架构

  • 通常使用双分支网络,两个分支可共享权重或不共享

对比学习的优势

  • 无监督/自监督:无需人工标注,利用数据自身结构学习
  • 迁移能力强:预训练的表示可泛化到下游任务(如分类、检测)
  • 鲁棒性:通过数据增强学习到不变性特征(如CV中的光照、旋转不变性)

应用场景

  • 计算机视觉:图像分类(SimCLR)、目标检测(MoCo)
  • 自然语言处理:句子表示学习(SimCSE)
  • 多模态学习:图文匹配(CLIP)、视频-文本对齐

附录:BYOL 的免负样本策略

  • 原始论文:Bootstrap Your Own Latent A New Approach to Self-Supervised Learning, NeurIPS 2020, Google DeepMind
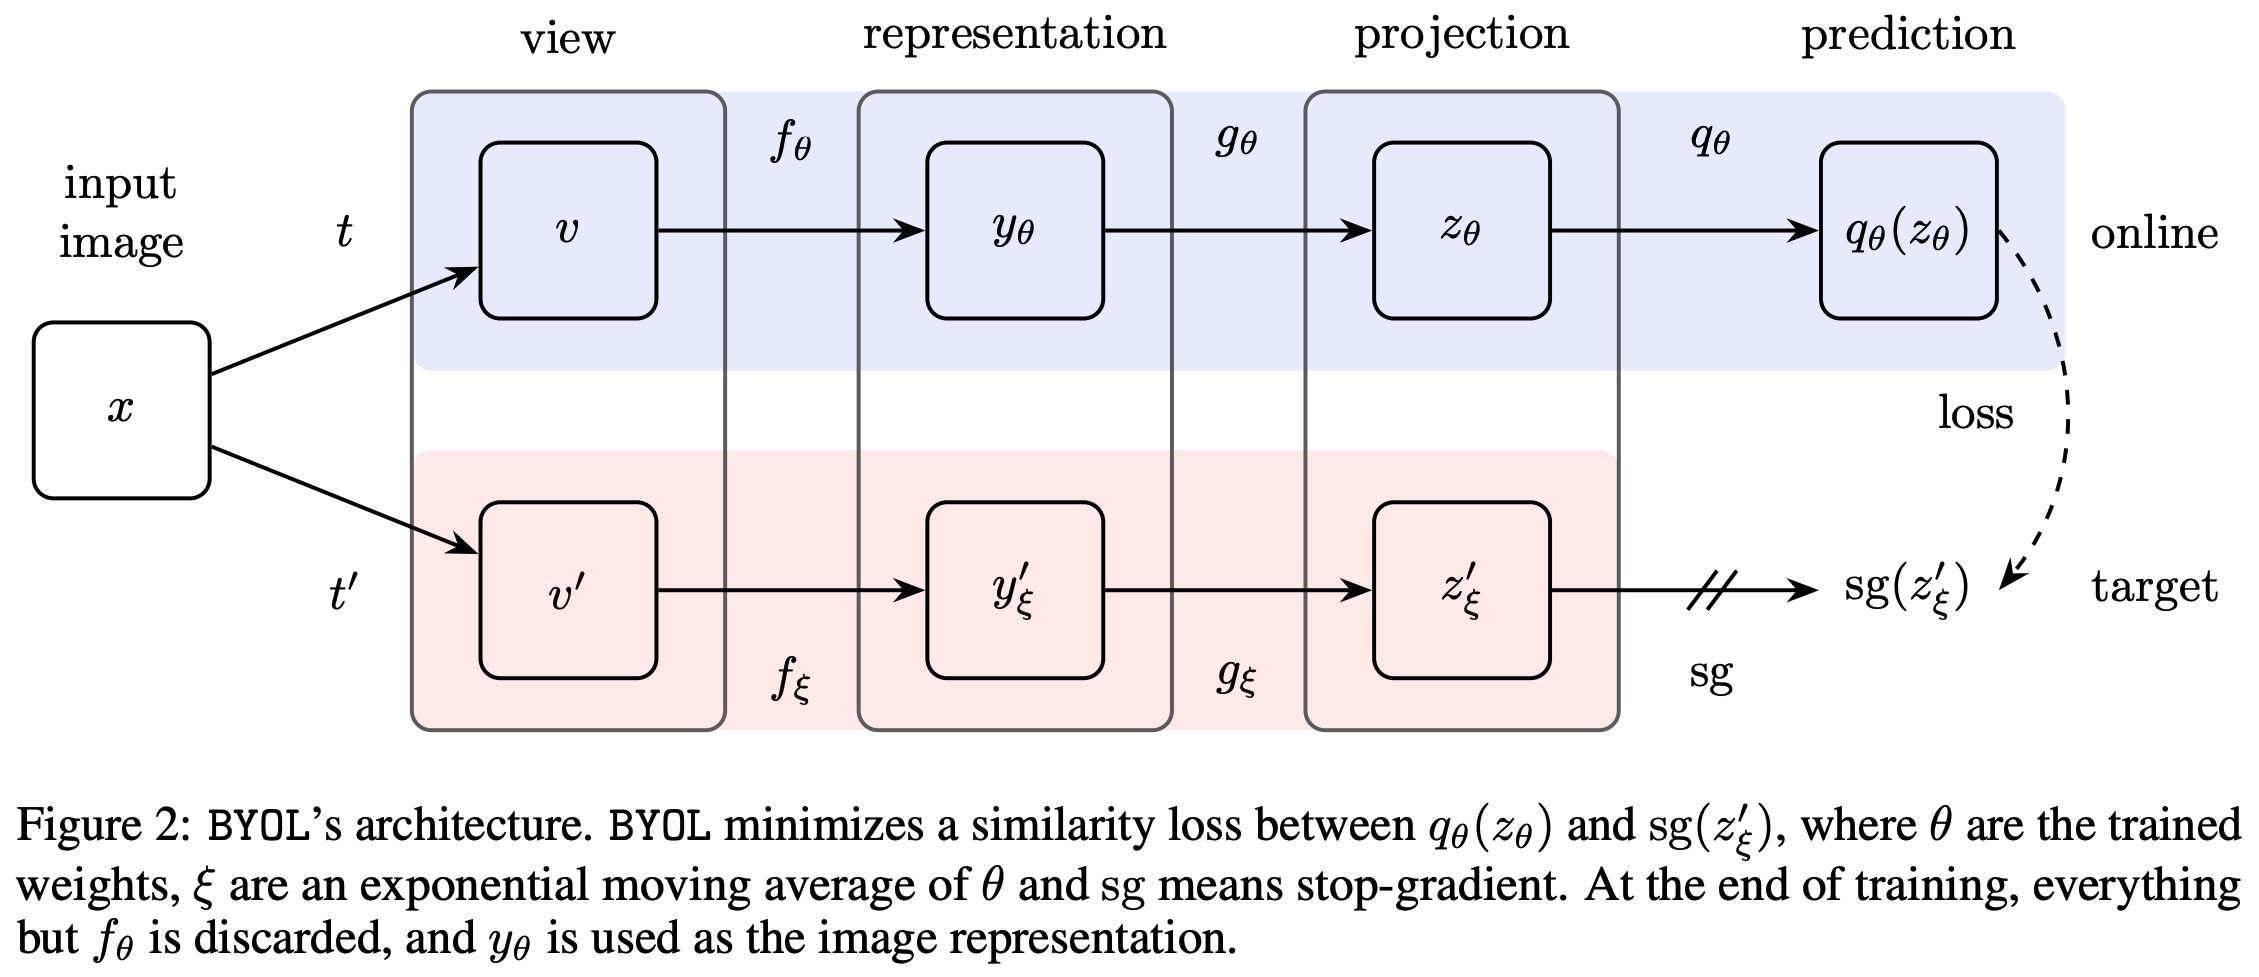
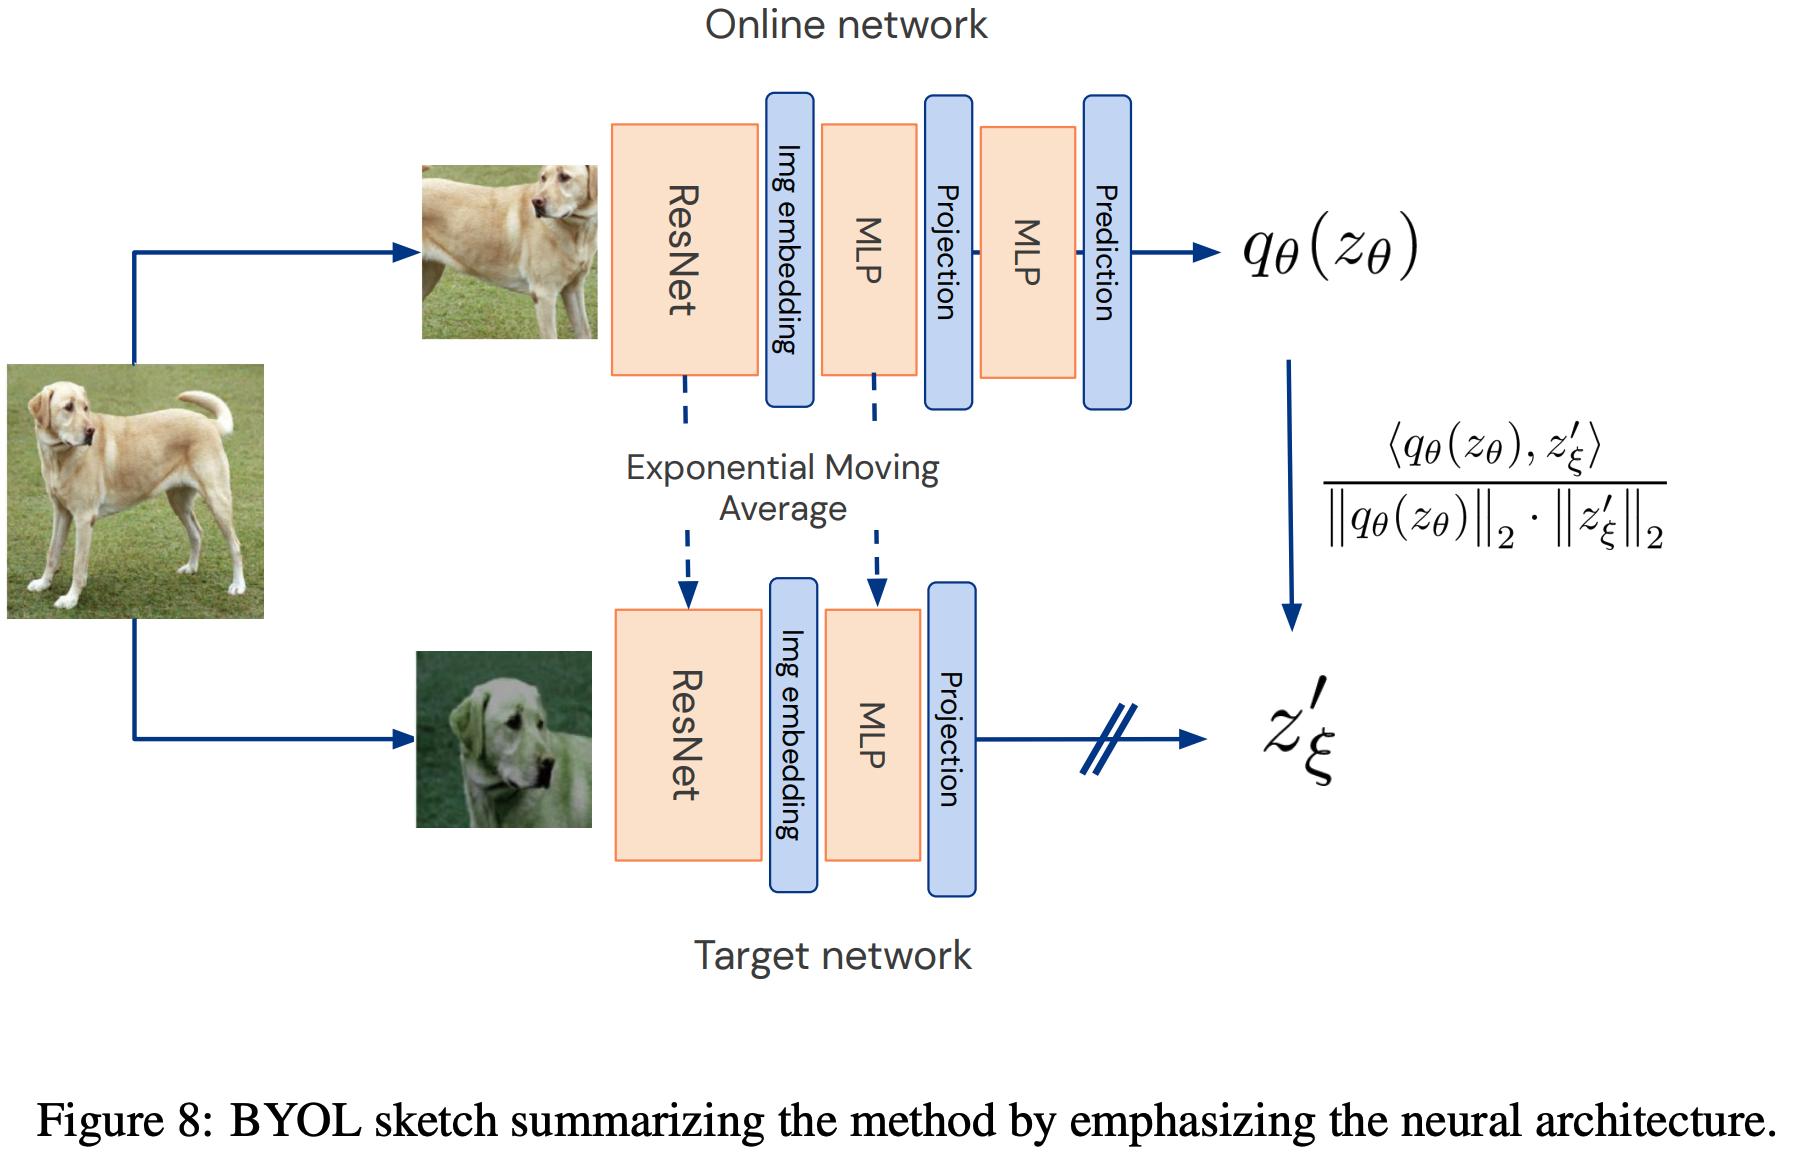
  • 比如BYOL(Bootstrap Your Own Latent)提出了 免负样本策略 ,其中Target网络的参数通过指数移动平均(EMA)从Online网络缓慢更新(动量更新),模型学习目标是最小化同一图像的不同增强视图(正样本对,分别输入Target网络和Online网络中)的表示距离
  • BYOL模型的整体架构图如下:
  • 一种更容易理解的架构图:

附录:NCE 和 InfoNCE 损失

  • InfoNCE 和 NCE 的核心区别可以一句话概括为:
    • NCE 用“二分类”把真实样本从 K 个噪声里挑出来;
    • InfoNCE 用“K+1 类 Softmax”把真实样本从 K 个负样本里挑出来,并直接最大化互信息下界
  • 下面给出各自的损失函数(公式均为单样本版本,可简单批平均得到最终损失)

Noise Contrastive Estimation (NCE)

  • 目标:估计归一化常数 Z,同时学习打分函数 \(s_\theta(x)\)
  • NCE 损失(对一条真实样本 \(x\) 和 K 条噪声 \(x’\sim q\)):
    $$
    \mathcal L_{\text{NCE} } = -\log \frac{e^{s_\theta(x)} }{e^{s_\theta(x)} + K e^{s_\theta(x’)}/Z} - \sum_{k=1}^K \log \frac{e^{s_\theta(x’_k)}/Z}{e^{s_\theta(x)} + K e^{s_\theta(x’_k)}/Z}
    $$
    • 实际实现时通常把 Z 也当可学习参数,上式退化为二分类交叉熵:
      • 正类 logits 为 \(s_\theta(x)-\log Z\)
      • 负类 logits 为 \(s_\theta(x’)-\log Z\)

InfoNCE

  • InfoNCE 又称“对比预测编码”损失(Contrastive Predictive Coding Loss),也可简称为 CPC Loss
  • 目标:最大化互信息 \(I(x; c)\) 的下界,其中 \(c\) 为上下文/表征
  • 对一条正样本 \((x, c)\) 和 K 条负样本 \(\{(x’_k, c)\}\):
    $$
    \mathcal L_{\text{InfoNCE} } = -\log \frac{e^{f(x,c)/\tau} }{\displaystyle e^{f(x,c)/\tau} + \sum_{k=1}^K e^{f(x’_k,c)/\tau} }
    $$
    • 这里 \(f(\cdot,\cdot)\) 是兼容函数(通常用内积或余弦相似度),\(\tau>0\) 为温度超参
    • 当 \(K\rightarrow\infty\) 时,该损失给出的下界趋于真实的互信息,因此得名 InfoNCE

互信息 与 InfoNCE 的关联

  • 互信息衡量了两个分布的依赖程度,当两个分布完全独立,他们的互信息为 0,当两个分布完全依赖,他们的互信息为其中一个分布的熵
  • InfoNCE 损失的设计目标是最大化互信息的下界 ,而非直接计算互信息
  • 当负样本数量 \(K\rightarrow\infty\) 时,InfoNCE 损失对应的下界会收敛到真实的互信息 \(I(X;Y)\),这也是该损失函数命名的核心原因

DL——梯度检查点技术

  • 参考链接:
    • 原始论文 Training Deep Nets with Sublinear Memory Cost, MIT, 2016:论文以这篇文章的内容为主进行介绍,后续会补充一些 transformer 场景下的梯度检查点技术

整体总结

  • 梯度检查点(Gradient Checkpointing)技术广泛应用于当前大规模深度学习模型训练中,能有效降低显存的使用
  • 梯度检查点技术也叫做 重计算(re-materialization)技术
  • Training Deep Nets with Sublinear Memory Cost, MIT, 2016这篇文章的核心贡献是:
    • 提出并系统化了一种 “用计算换内存”的通用方法(在自动微分领域也被称为梯度检查点技术)
    • 通过分段和重计算,巧妙地将深度学习训练过程中的内存瓶颈从 \(O(n)\) 降低到 \(O(\sqrt{n})\),甚至理论上的 \(O(\log n)\),极大地拓展了论文使用现有硬件能够训练的模型规模和深度

核心问题:为什么训练深度网络如此消耗内存?

  • 在训练神经网络时,标准的训练流程包含两个步骤:
    • 前向传播 (Forward Pass) :
      • 输入数据从网络的第一层开始,逐层计算,直到最后一层得到输出
      • 在这个过程中,每一层的输出(称为“激活”或“特征图”)都需要被保存下来
    • 反向传播 (Backward Pass) :
      • 计算输出的损失(预测值与真实值的差距),然后从最后一层开始,反向逐层计算梯度
      • 为了计算某一层参数的梯度,通常需要用到该层在前向传播时产生的激活值
  • 问题出现:
    • 为了进行反向传播,必须在内存中保留网络中每一层的激活值
    • 如果一个网络有 \(n\) 层,那么内存消耗就大致与 \(n\) 成正比 ,即内存成本为 \(O(n)\)
    • 对于现在动辄成百上千层的深度模型(如 ResNet),这笔内存开销会迅速占满顶配 GPU 的几十 GB 显存,从而限制了探索更深、更复杂模型的能力

传统内存优化方法(治标不治本)

  • 论文首先提到了一些已有的内存优化技术,这些技术主要通过分析计算图 (Computation Graph) 来实现
    • 原地操作 (In-place Operation) :
      • 如果一个操作的输入值在后续计算中不再需要,那么其输出可以直接覆盖输入的内存空间
      • 例如,y = relu(x),如果 x 后面用不到了,y 的结果可以直接写在 x 的内存里
    • 内存共享 (Memory Sharing) :
      • 分析所有变量的“生命周期”,将生命周期不重叠的变量共享同一块内存
  • 这些方法能将内存占用降低2到3倍,但无法改变内存消耗随网络层数线性增长的趋势,当网络深到一定程度时,内存瓶颈依然存在

梯度检查点:用计算换内存 (Trade Computation for Memory)

  • 既然保存所有中间结果是内存消耗的根源,那么论文提出的核心思想非常直接:
    • 不保存所有中间结果,只保存其中一部分
    • 当反向传播需要用到某个被丢弃的中间结果时,再临时重新计算它
  • 这是一种典型的“用时间换空间”的策略
    • 虽然会增加一些计算量(因为需要重新执行部分前向计算),但可以极大地降低内存峰值

工作原理一:\(O(\sqrt{n})\) 内存成本算法(实用策略)

  • 这是论文提出的主要实用算法
  • \(O(\sqrt{n})\) 内存成本算法原理如下:
    • 1)分段 (Segmenting) :将一个包含 \(n\) 层的网络链条,切分成 \(k\) 个小段(segment)
    • 2)前向传播 :在正常的前向传播过程中,只保存每个分段的最终输出 ,而丢弃每个分段内部的所有中间激活值
    • 3)反向传播 :
      • 当反向传播进行到第 \(i\) 段时,由于计算该段的梯度需要其内部的激活值(这些值已经被丢弃了),算法会执行一次“局部前向传播”:
        • 利用保存的第 \(i-1\) 段的输出作为输入,重新计算一次第 \(i\) 段的前向传播,以得到所有需要的激活值
      • 计算完梯度后,这些临时重新计算的激活值可以立即被丢弃

关键推导:为什么是 \(O(\sqrt{n})\)?

  • 内存成本分析:假设网络总共有 \(n\) 层,被均匀地切分成 \(k\) 段,那么每一段的长度就是 \(n/k\)层
  • 总内存成本主要由两部分构成:
    • 1)段间内存 (Inter-segment Memory) :用于存储 \(k\) 个分段的输出,以便在反向传播时作为“检查点”(checkpoint)
      • 这部分的成本是 \(O(k)\)
    • 2)段内内存 (Intra-segment Memory) :在对任何一段进行反向传播时,需要临时重新计算并存储该段内部的所有激活值
      • 由于所有段中最大的内存开销决定了峰值,这部分的成本是 \(O(n/k)\)
  • 因此,总的内存成本可以表示为:
    $$\text{Cost}(n, k) = O(k) + O(n/k)$$
  • 为了让总成本最低,论文需要让这两部分达到一个平衡。一个简单的优化方法是让它们的量级相等(实际上等价于导数为 0 的推导):
    $$k \approx \frac{n}{k} \implies k^2 \approx n \implies k = \sqrt{n}$$
  • 当选择 \(k=\sqrt{n}\) 时,总内存成本为:
    $$\text{Cost} = O(\sqrt{n}) + O(n/\sqrt{n}) = O(\sqrt{n}) + O(\sqrt{n}) = O(\sqrt{n})$$
  • 至此,我们就成功地将内存成本从线性 \(O(n)\) 降到了亚线性 \(O(\sqrt{n})\)
  • 作为代价,整个训练过程大约需要额外进行一次完整的前向传播计算(因为每个分段都被重新计算了一次),使得训练时间增加了约 30%
    • 问题:30% 的计算时间怎么来的呢?
    • 回答:反向传播的时间复杂度大约是前向传播的 2~3 倍,折合计算以后大致能算出这个数字(增加了一次前向传播计算),详情见附录

工作原理二:\(O(\log n)\) 内存成本算法(理论极限)

  • 论文进一步展示,通过递归 (Recursion) 的方式,可以实现更低的内存成本
  • 我们可以把一个分段本身看作一个“超级操作符”
  • 对这个超级操作符内部的计算,作者同样可以再次应用分段和重计算的策略

关键推导:\(O(\log n)\) 的递推关系

  • 让 \(g(n)\) 表示训练一个 \(n\) 层网络所需的内存
  • 假设将这个网络分成 \(k+1\) 个子问题,每个子问题的规模是 \(n/(k+1)\)
  • 为了连接这些子问题,需要存储 \(k\) 个中间结果
  • 那么,\(g(n)\) 可以表示为递推公式:
    $$g(n) = k + g\left(\frac{n}{k+1}\right)$$
    • 这是一个典型的对数关系
    • \(k\) 是存储这 \(k\) 个结果的成本
    • \(g\left(\frac{n}{k+1}\right)\) 是解决其中一个子问题所需的成本
    • 注:这里使用 \(k+1\) 或 \(k\) 不影响最终结果
  • 通过解这个递推公式,我们可以得到:
    $$g(n) = k \cdot \log_{k+1}(n)$$
  • 作为一个特例,如果每次只将问题一分为二,即只存储一个中间结果(\(k=1\)),那么递推关系变为 \(g(n) = 1 + g(n/2)\),解得:
    $$g(n) = \log_2(n)$$
    • 注:简单理解一下,展开 \(g(n)\) 后,大致共有 \(\log_2(n)\) 个 1
  • 这揭示了一个终极的理论可能性:
    • 训练一个 \(n\) 层网络的内存成本可以降低到 \(O(\log n)\)
    • 不过,这种方法的计算开销会大得多(需要 \(O(\log n)\) 次额外的前向传播,因此在实践中不如 \(O(\sqrt{n})\) 策略常用

实验效果与结论

  • 作者通过在深度残差网络 (ResNet) 和长短期记忆网络 (LSTM) 上的实验,验证了该方法的有效性
    • 对于一个 1000层 的 ResNet,标准优化方法需要 48GB 显存,而使用亚线性算法后仅需 7GB
    • 在 LSTM 上,该方法同样带来了 超过4倍 的内存节省
    • 代价是训练速度降低了大约30%,这对于能够训练原本无法训练的模型来说,是一个非常值得的交换

Transformer 中的梯度检查点

  • Transformer中的梯度检查点(Gradient Checkpointing)与上述论文中的基本原理上是完全相同的 ,但其应用方式和带来的收益上,针对Transformer 的结构有更多特点
  • 无论是用于CNN、RNN还是Transformer,梯度检查点的核心思想始终是:
    • 目标 :打破模型训练时内存消耗与网络深度(层数)之间的线性关系
    • 方法 :在前向传播时,不再保存所有中间层的激活值,而是只保存少数几个关键节点(检查点)
    • 代价 :在反向传播时,当需要用到被丢弃的激活值时,就从最近的一个检查点开始,重新进行一小段前向计算来恢复它们
    • 权衡 :本质上都是“用计算换内存”的策略

针对 Transformer 结构的应用说明

  • Transformer的独特结构使得梯度检查点的应用非常直接,且效果尤其显著
  • 1. 应用位置非常明确
    • 一个标准的 Transformer 模型是由一个个完全相同的 Transformer Block 堆叠而成的
      • 每个块通常包含一个多头自注意力(Multi-Head Self-Attention)层和一个前馈神经网络(Feed-Forward Network, FFN)层
    • 最自然、最常见的应用方式就是 将每一个Transformer块作为一个分段(Segment)
      • 前向传播时 :
        • 当数据流经第 \(i\) 个Transformer块时,只保留送入这个块的输入(也就是第 \(i-1\) 块的输出)
        • 在块内部计算过程中产生的所有中间结果,例如注意力分数矩阵(Attention Scores)、注意力权重(Attention Weights)、FFN层的中间激活等,计算完毕后立即被丢弃
      • 反向传播时 :
        • 当反向传播回第 \(i\) 个块时,算法会利用之前保存的输入,重新执行一次该块的前向计算,从而得到计算梯度所必需的那些中间结果
  • 2. 带来的收益为何对 Transformer 尤其显著
    • 梯度检查点能极大缓解Transformer在两个维度上的内存压力:
    • 深度(层数 \(L\)) :
      • 现代的大型语言模型(如GPT、LLaMA)可以有几十甚至上百层
      • 如果没有梯度检查点,内存消耗会随着层数 \(L\) 线性暴增。梯度检查点将这个成本从 \(O(L)\) 降到了 \(O(\sqrt{L})\) ,使得训练极深的Transformer 成为可能
    • 序列长度(Sequence Length \(S\)) :这是Transformer最独特的内存瓶颈
      • 注意力矩阵的二次方开销 :
        • 自注意力机制的核心是计算一个注意力分数矩阵,其大小为 (序列长度 x 序列长度)
        • 这意味着内存开销与序列长度成二次方关系 ,即 \(O(S^2)\)
        • 当序列很长时(例如4096、8192甚至更长),这个矩阵会变得异常巨大
      • 梯度检查点的作用 :
        • 梯度检查点不能改变单次注意力计算需要 \(O(S^2)\) 内存峰值的事实
        • 但它能确保不必同时在内存中保留每一层的这个巨大矩阵
        • 在没有检查点的情况下,内存中需要为 \(L\) 个注意力矩阵的激活值(或其相关值)分配空间
        • 有了检查点,在任何时候,只需要为当前正在重计算的那一个块的注意力矩阵分配内存
        • 这极大地降低了总体的内存占用

附录:梯度检查点技术增加了多少训练成本?

  • 论文中 “训练时间增加了约30%” 这个数字主要是一个经验性的测量结果 ,来源于作者在特定硬件上进行的基准测试,并且这个结果也与理论上的计算开销分析相符

实验测量结果(经验来源)

  • 作者在论文的第5.4节 (Impact on Training Speed) 和 图7 专门讨论了这个问题
    • 测试方法 :
      • 作者在单个 Titan X GPU 上对不同的内存分配策略进行了速度基准测试
      • 测量了在 ResNet 和 LSTM 两种模型上,处理一个批次(batch)数据所需的实际运行时间(秒)
    • 对比对象 :
      • 比较了采用标准内存优化(论文中称为 “sharing”)的策略和采用亚线性内存成本(”sublinear plan”)策略的速度
    • 测量结论 :
      • 实验结果图表(图7)直观地显示,”sublinear plan” 的时间成本曲线始终在 “sharing” 曲线之上
      • 论文在图7的说明文字和正文中明确指出,使用亚线性内存方案会带来“大约30%的额外运行时成本”

理论计算分析(理论支撑)

  • 训练一个批次的主要计算量如下:
    • 标准训练流程 :包含一次完整的前向传播(Forward Pass)和一次完整的反向传播(Backward Pass):
      $$ 总计算量 \approx 1F + 1B $$
    • 亚线性方案的流程 :它在反向传播过程中需要重新计算前向传播,因此:
      $$ 总计算量 \approx 1F + (1F_recompute + 1B) = 2F + 1B $$
  • 论文中提到,通常一次反向传播的计算量大约是前向传播的两倍(\(B \approx 2F\))
    • 实际上是大约 2~3 倍的样子
  • 基于上述这个假设,我们可以估算增加的计算开销:
    • 标准流程计算量 :
      $$T_{standard} = T_F + T_B \approx T_F + 2T_F = 3T_F$$
    • 亚线性方案计算量 :
      $$T_{sublinear} = 2T_F + T_B \approx 2T_F + 2T_F = 4T_F$$
  • 增加的运行时间百分比约为:
    $$\frac{T_{sublinear} - T_{standard}}{T_{standard}} = \frac{4T_F - 3T_F}{3T_F} = \frac{1T_F}{3T_F} = \frac{1}{3} \approx 33.3%$$
  • 这个理论计算出的 33.3% 与实验中测量到的 约30% 基本吻合(考虑到反向传播大致是前向传播的 2~3 倍,那就基本符合了)
1…229230231…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4