文本介绍Conditional Diffusion的相关知识
- 参考链接:
- 生成扩散模型漫谈(九):条件控制生成结果:论文的证明大多参考自苏神的博客
- What are Diffusion Models?:Lilian Weng的博客
- Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021:第一篇条件扩散模型的文章,Classifier Guidance 方法;
- 文章附录:Supplemental中有相关推导
- 实现讲解:sunlin-ai.github.io/guided-diffusion
- Classifier-Free Diffusion Guidance, Google Research, Brain team, 2022:第一篇使用Classifier-free Guidance方法的文章
- Score-based generative modeling through stochastic differential equations, Stanford & Google, 2021:随机微分方程的视角
- 【笔记】扩散模型(五):Classifier-Free Guidance 理论推导与代码实现
整体概述
- 在图像生成领域,条件一般可以分成类别标签或者是一段文本
- 从方法上来看,条件控制生成的方式主要分两种:Classifier Guidance 和 Classifier-free Guidance
- Classifier Guidance :先训练无条件的模型,训练后在生成时引入条件分类器(Classifier)。这种方式灵活,无需重新训练,但是生成效果较差
- Classifier-free Guidance:训练时引入条件,生成时无需Classifier。这种方式需要重新训练Diffusion模型,但生成效果更好些
前置推导
- 正太分布 \(\mathbf{x} \sim \mathcal{N}(\mathbf{\mu}, \sigma^2 \boldsymbol{I})\) 的梯度计算如下:
$$\nabla_{\mathbf{x}}\log p(\mathbf{x}) = \nabla_{\mathbf{x}} \Big(-\frac{1}{2\sigma^2}(\mathbf{x} - \boldsymbol{\mu})^2 \Big) = - \frac{\mathbf{x} - \boldsymbol{\mu}}{\sigma^2} = - \frac{\boldsymbol{\epsilon}}{\sigma}$$ - 结合 \(q(\mathbf{x}_t \vert \mathbf{x}_0) \sim \mathcal{N}(\sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t)\boldsymbol{I})\),可得:
$$
\mathbf{s}_\theta(\mathbf{x}_t, t)
\approx \nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t)
= \mathbb{E}_{q(\mathbf{x}_0)} [\nabla_{\mathbf{x}_t} q(\mathbf{x}_t \vert \mathbf{x}_0)]
= \mathbb{E}_{q(\mathbf{x}_0)} \Big[ - \frac{\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)}{\sqrt{1 - \bar{\alpha}_t}} \Big]
= - \frac{\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)}{\sqrt{1 - \bar{\alpha}_t}}
$$- 其中 \(\mathbf{s}_\theta(\mathbf{x}_t, t) \) 是Noise Conditional Score Network (NCSN),详情参见论文:(NCSN)Generative Modeling by Estimating Gradients of the Data Distribution, Stanford, 2020
Classifier Guidance 方法
Classifier Guidance Diffusion的直观理解
- 参考自:通俗理解Classifier Guidance 和 Classifier-Free Guidance 的扩散模型
2021年OpenAI在「Diffusion Models Beat GANs on Image Synthesis」中提出Classifier Guidance,使得扩散模型能够按类生成。后来「More Control for Free! Image Synthesis with Semantic Diffusion Guidance」把Classifier Guidance推广到了Semantic Diffusion,使得扩散模型可以按图像、按文本和多模态条件来生成,例如,风格化可以通过content和style两者共同进行引导,这些都是通过梯度引导来实现
- Classifier Guidance可以通过Score function(问题:Score function是什么?)直观地解释,用贝叶斯定理将条件生成概率进行对数分解:
$$
\begin{align}
\nabla_{x_t} \log p(x_t|y) &= \nabla_{x_t} \log \Big( \frac{p(x_t)p(y|x_t)}{p(y)}\Big) \\
&= \nabla_{x_t} \log p(x_t) + \nabla_{x_t} \log p(y|x_t) - \nabla_{x_t} \log p(y) \\
&= \underbrace{\nabla_{x_t} \log p(x_t)}_{\text{unconditional score}} + \underbrace{\nabla_{x_t} \log p(y|x_t)}_{\text{classifier gradient}}
\end{align}
$$ - 从上式可以看到,Classifier Guidance条件生成只需额外添加一个classifier的梯度来引导。从成本上看,Classifier Guidance 需要训练噪声数据版本的classifier网络,推理时每一步都需要额外计算classifier的梯度
- Classifier Guidance可以通过Score function(问题:Score function是什么?)直观地解释,用贝叶斯定理将条件生成概率进行对数分解:
- 以上是简单的理解,推导不严谨,论文接下来对DDPM和DDIM对应的Classifier Guidance Diffusion方法进行详细推导
Conditional Diffusion Process
- 本小节相关推导参考自:Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021——Supplemental
- 条件扩散模型相关定义 :
- 参考普通扩散模型的前向过程 \(q(x_{t+1}|x_{t})\) 和后向过程为 \(q(x_{t}|x_{t+1})\)
- 定义带条件的扩散模型的前向过程 \(\hat{q}(x_{t+1}|x_{t}, y)\) 和后向过程为 \(\hat{q}(x_t|x_{t+1}, y)\)
- 设定:条件扩散模型的前向过程与普通扩散模型的前向过程一致,与条件无关
$$
\begin{align}
\hat{q}(x_0) &:= q(x_0) \\
\hat{q}(y|x_0) &:= \text{Known labels per sample} \\
\hat{q}(x_{t+1}|x_t,y) &:= q(x_{t+1}|x_t) \\
\hat{q}(x_{1:T}|x_0,y) &:= \prod_{t=1}^T \hat{q}(x_{t}|x_{t-1}, y) \\
\end{align}
$$- 直观理解:上式表名前向过程中对 \(x_0\) 如何增加噪音(\(\epsilon \sim \mathcal{N}(0,1)\))确实与 \(x_0\) 类别无关
- 进一步地,我们可以推导得到,前向过程中的每一步加噪都与条件无关(以下内容详细推导可见论文:Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021——Supplemental):
$$
\begin{align}
\hat{q}(x_{t+1}|x_{t}) &= \hat{q} (x_{t+1}|x_{t},y) \\
\hat{q}(x_{1:T}|x_0) &= q(x_{1:T}|x_0) \\
\hat{q}(x_t) &= q(x_t) \\
\hat{q}(y|x_t, x_{t+1}) &= \hat{q}(y|x_t) \\
\hat{q}(x_{t}|x_{t+1}) &= q(x_{t}|x_{t+1}) \\
\end{align}
$$- 注意,其中: \(\hat{q}(x_{t}|x_{t-1})\) 中不含有条件,实际是一个边际分布(或边缘分布):
- \(\hat{q}(x_{t}|x_{t-1}) = \mathbb{E}_{y}[\hat{q}(x_{t}, y|x_{t-1})]\)
- 同理有: \(\hat{q}(x_t) = \mathbb{E}_{y}[\hat{q}(x_t,y)] = \mathbb{E}_{y}[\mathbb{E}_{x_{0:t-1}}[\hat{q}(y,x_0,\cdots,x_{t})]]\)
- 或: \(\hat{q}(x_t) = \mathbb{E}_{x_{0:t-1}}[\hat{q}(x_0,\cdots,x_{t})] = \mathbb{E}_{x_{0:t-1}}[\mathbb{E}_{y}[\hat{q}(y,x_0,\cdots,x_{t})]]\)
- 关于 \(\hat{q}(y|x_t, x_{t+1}) = \hat{q}(y|x_t)\) 的理解:因为 \(x_{t+1}\) 是 \(x_t\) 增加前向噪音得到的,而前向过程不依赖于条件,该式子的证明如下:
$$
\begin{align}
\hat{q}(y|x_{t},x_{t+1}) &= \frac{\hat{q}(y,x_{t},x_{t+1})}{\hat{q}(x_{t},x_{t+1})} = \frac{\hat{q}(x_{t+1}|y,x_{t})\hat{q}(y|x_{t})\hat{q}(x_{t})}{\hat{q}(x_{t+1}|x_{t})\hat{q}(x_{t})} \\
&= \hat{q} (x_{t+1}|x_{t}, y) \frac{\hat{q}(y|x_{t})}{\hat{q}(x_{t+1}|x_{t})} \\
&= \hat{q} (x_{t+1}|x_{t}) \frac{\hat{q}(y|x_{t})}{\hat{q}(x_{t+1}|x_{t})}\\
&= \hat{q}(y|x_{t}) \\
\end{align}
$$- 其他补充说明 :因为前向过程与条件无关 ,可以理解为已知 \(x_t\) 时,条件 \(y\) 就与反向过程的前一步 \(x_{t+1}\) 无关了,故可以消掉 \(x_{t+1}\) ;但由于反向过程依赖条件 \(y\),不能消掉 \(x_t\),即 \(\hat{q}(y|x_t, x_{t+1}) \neq \hat{q}(y|x_{t+1})\),可理解为在相同的 \(x_{t+1}\) 下, \(x_t\) 与条件 \(y\) 相关( \(x_{t+1}\) 想通的条件下不同的条件 \(y\) 会生成不同的 \(x_t\) )
- 关于 \(\hat{q}(x_{t}|x_{t+1}) = q(x_{t}|x_{t+1})\) 的理解:,该式子的证明如下:
$$
\begin{align}
\hat{q}(x_{t}|x_{t+1}) &= \frac{\hat{q}(x_{t+1}|x_{t})\hat{q}(x_{t})}{\hat{q}(x_{t+1})} = \frac{q(x_{t+1}|x_{t})q(x_{t})}{q(x_{t+1})} = q(x_t|x_{t+1})
\end{align}
$$
- 注意,其中: \(\hat{q}(x_{t}|x_{t-1})\) 中不含有条件,实际是一个边际分布(或边缘分布):
- 接下来我们到了最终目标:推导条件扩散模型的反向过程
$$
\begin{align}
\hat{q}(x_{t}|x_{t+1},y) &= \frac{\hat{q}(x_{t},x_{t+1},y)}{\hat{q}(x_{t+1},y)} = \frac{\hat{q}(y|x_{t},x_{t+1})\hat{q}(x_{t}|x_{t+1})\hat{q}(x_{t+1})}{\hat{q}(y|x_{t+1})\hat{q}(x_{t+1})} \\
&= \frac{\hat{q}(y|x_{t},x_{t+1})\hat{q}(x_{t}|x_{t+1})}{\hat{q}(y|x_{t+1})} \\
&= \frac{\hat{q}(y|x_{t})\hat{q}(x_{t}|x_{t+1})}{\hat{q}(y|x_{t+1})} \\
&= \frac{q(x_{t}|x_{t+1})\hat{q}(y|x_{t})}{\hat{q}(y|x_{t+1})} \\
\end{align}
$$ - 至此,在已知 \(x_{t+1}\) 时,在条件 \(y\) 下,为了采样生成 \(x_t\),我们可以按照带条件的后向过程的概率 \(\hat{q}(x_{t}|x_{t+1},y) = \frac{q(x_{t}|x_{t+1})\hat{q}(y|x_{t})}{\hat{q}(y|x_{t+1})}\) 采样来实现。其中 \(\hat{q}(y|x_{t+1})\) 与 \(x_t\) 无关,可以设置为常数;于是可按照下面的形式采样(这里使用 \(\frac{1}{Z}\) 更容易理解):
$$ x_t \sim \frac{1}{Z} q(x_{t}|x_{t+1})\hat{q}(y|x_{t}) $$- 具体场景下, \(q(x_{t}|x_{t+1})\) 是无条件的Diffusion后向过程,可以通过无条件的Diffusion网络 \(p_\theta(x_{t}|x_{t+1})\) 来实现; \(\hat{q}(y|x_{t})\) 则可通过在扰动后的数据集 \(x_t \sim q(x_t)\) 上训练一个分类器(Classifier)来实现;故最终采样形式可以表示如下形式:
Classifier Guidance DDPM
本小节相关推导参考自:Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021——Supplemental,论文附录有其他相关推导可做参考
推导过程:
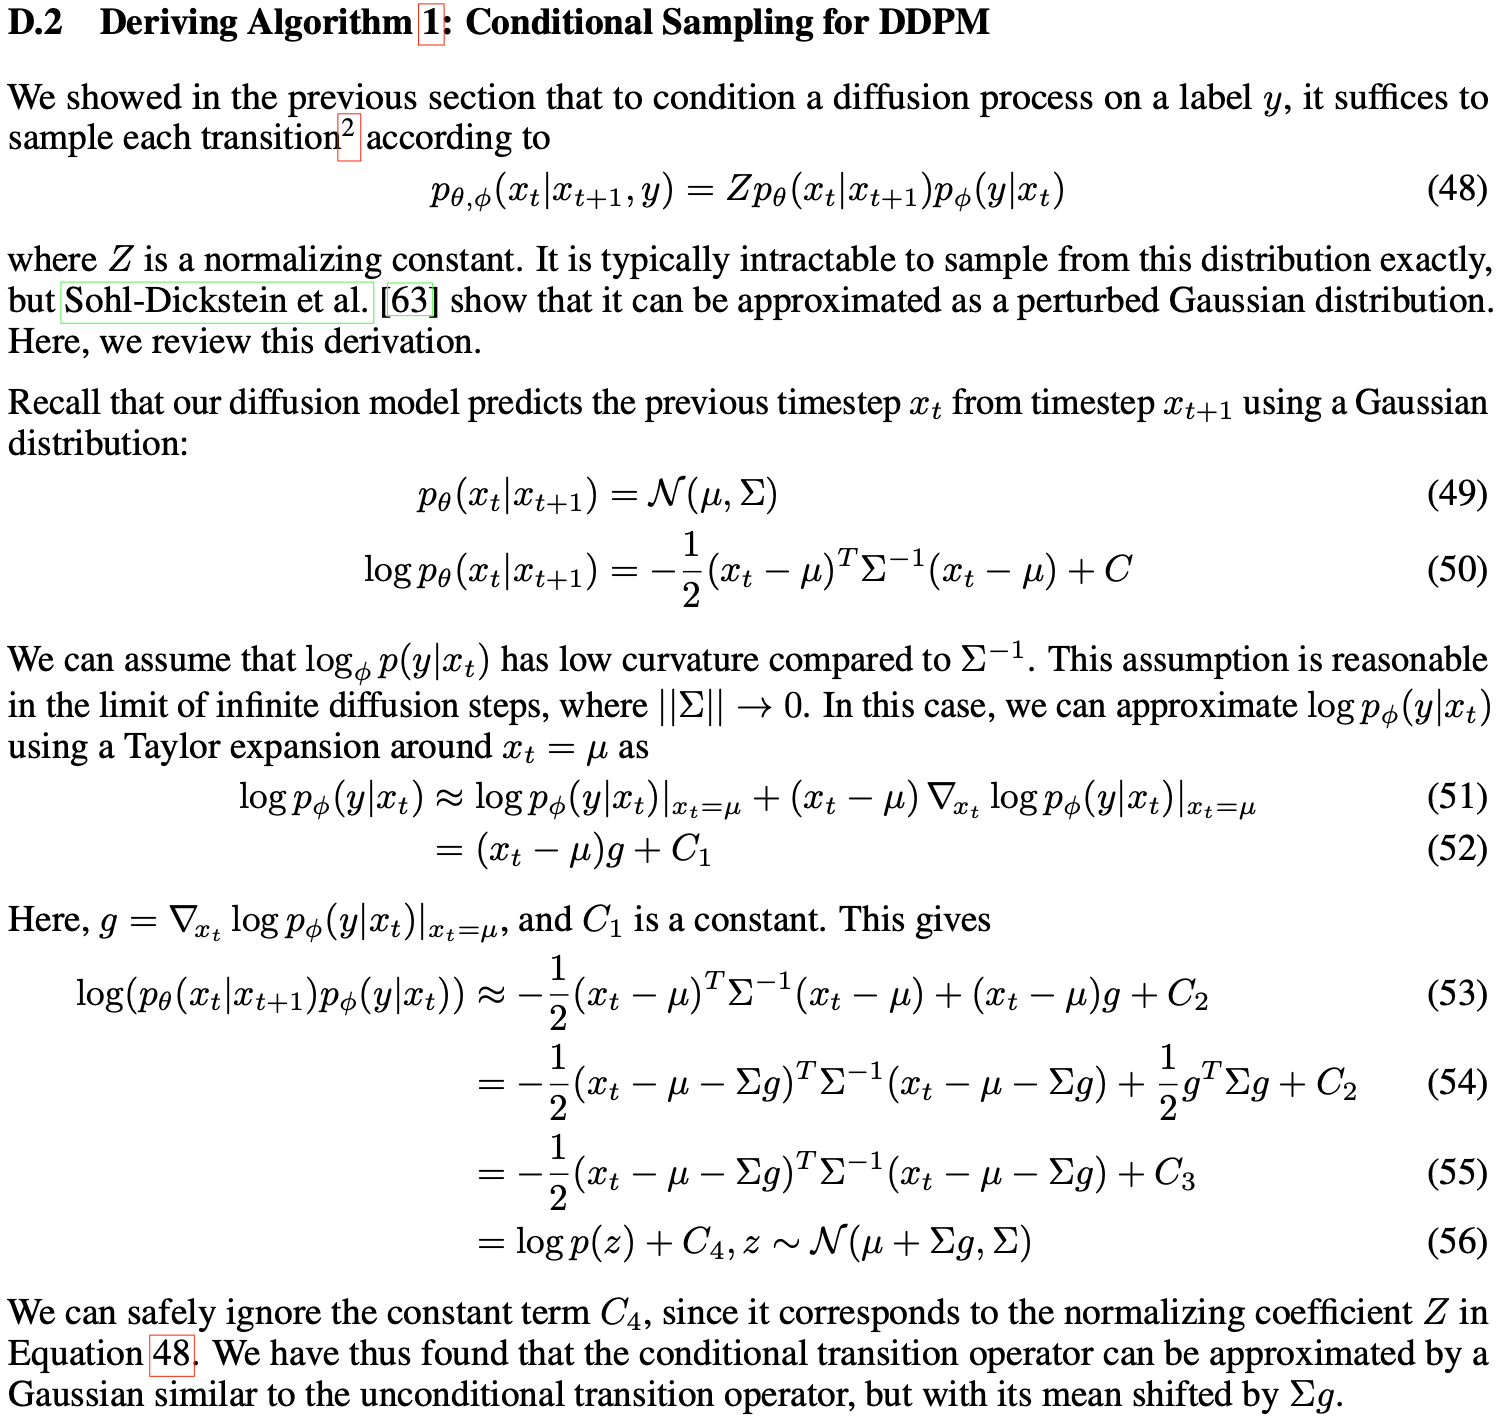
- 推导过程中使用到一个技巧,在高斯分布相关的推导中,将指数函数临时取对数来进行推导,推导完成后得到的仍然可以看做一个高斯分布的指数部分(在论文附录中提供的另一种推导方法没有使用到这个点)
其他说明:在Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021中,作者发现,在分类器上增加一个梯度缩放参数 \(s\) (gradient scale \(s\) )可以更好的调节生成效果:
$$
\begin{equation}\boldsymbol{x}_{t-1} = \boldsymbol{\mu}(\boldsymbol{x}_t) \color{red}{+} {\color{red}{\underbrace{ \color{black}{s} \sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)}_{\text{新增项}}}} + \sigma_t\boldsymbol{\varepsilon},\quad \boldsymbol{\varepsilon}\sim \mathcal{N}(\boldsymbol{0},\boldsymbol{I})\end{equation}
$$- 当 \(s > 1\) 时,生成过程中将更多由Classifier主导,提升生成结果和条件 \(y\) 的相关性,降低生成结果的多样性(没有改变方差,实际上多样性不会变化吧?);反之,则会降低生成结果的相关性,增加多样性
- 关于 \(s\) 这个参数还有更多理解和推导,讨论详情可见:生成扩散模型漫谈(九):条件控制生成结果:
- \(s\) 可以理解为在概率函数上的指数,用来控制图片的聚焦程度, \(s\) 越大,下面的条件概率 \(\tilde{p}(\boldsymbol{y}|\boldsymbol{x}_t)\) 越趋近于one-hot
$$\begin{equation}\tilde{p}(\boldsymbol{y}|\boldsymbol{x}_t) = \frac{p^{s}(\boldsymbol{y}|\boldsymbol{x}_t)}{Z(\boldsymbol{x}_t)},\quad Z(\boldsymbol{x}_t)=\sum_{\boldsymbol{y}} p^{s}(\boldsymbol{y}|\boldsymbol{x}_t)\end{equation}$$
- \(s\) 可以理解为在概率函数上的指数,用来控制图片的聚焦程度, \(s\) 越大,下面的条件概率 \(\tilde{p}(\boldsymbol{y}|\boldsymbol{x}_t)\) 越趋近于one-hot
其他证明方式见附录
Classifier Guidance DDIM
本小节相关推导参考自:Diffusion Models Beat GANs on Image Synthesis, OpenAI, 2021——Supplemental,论文附录有其他相关推导可做参考
推导过程:
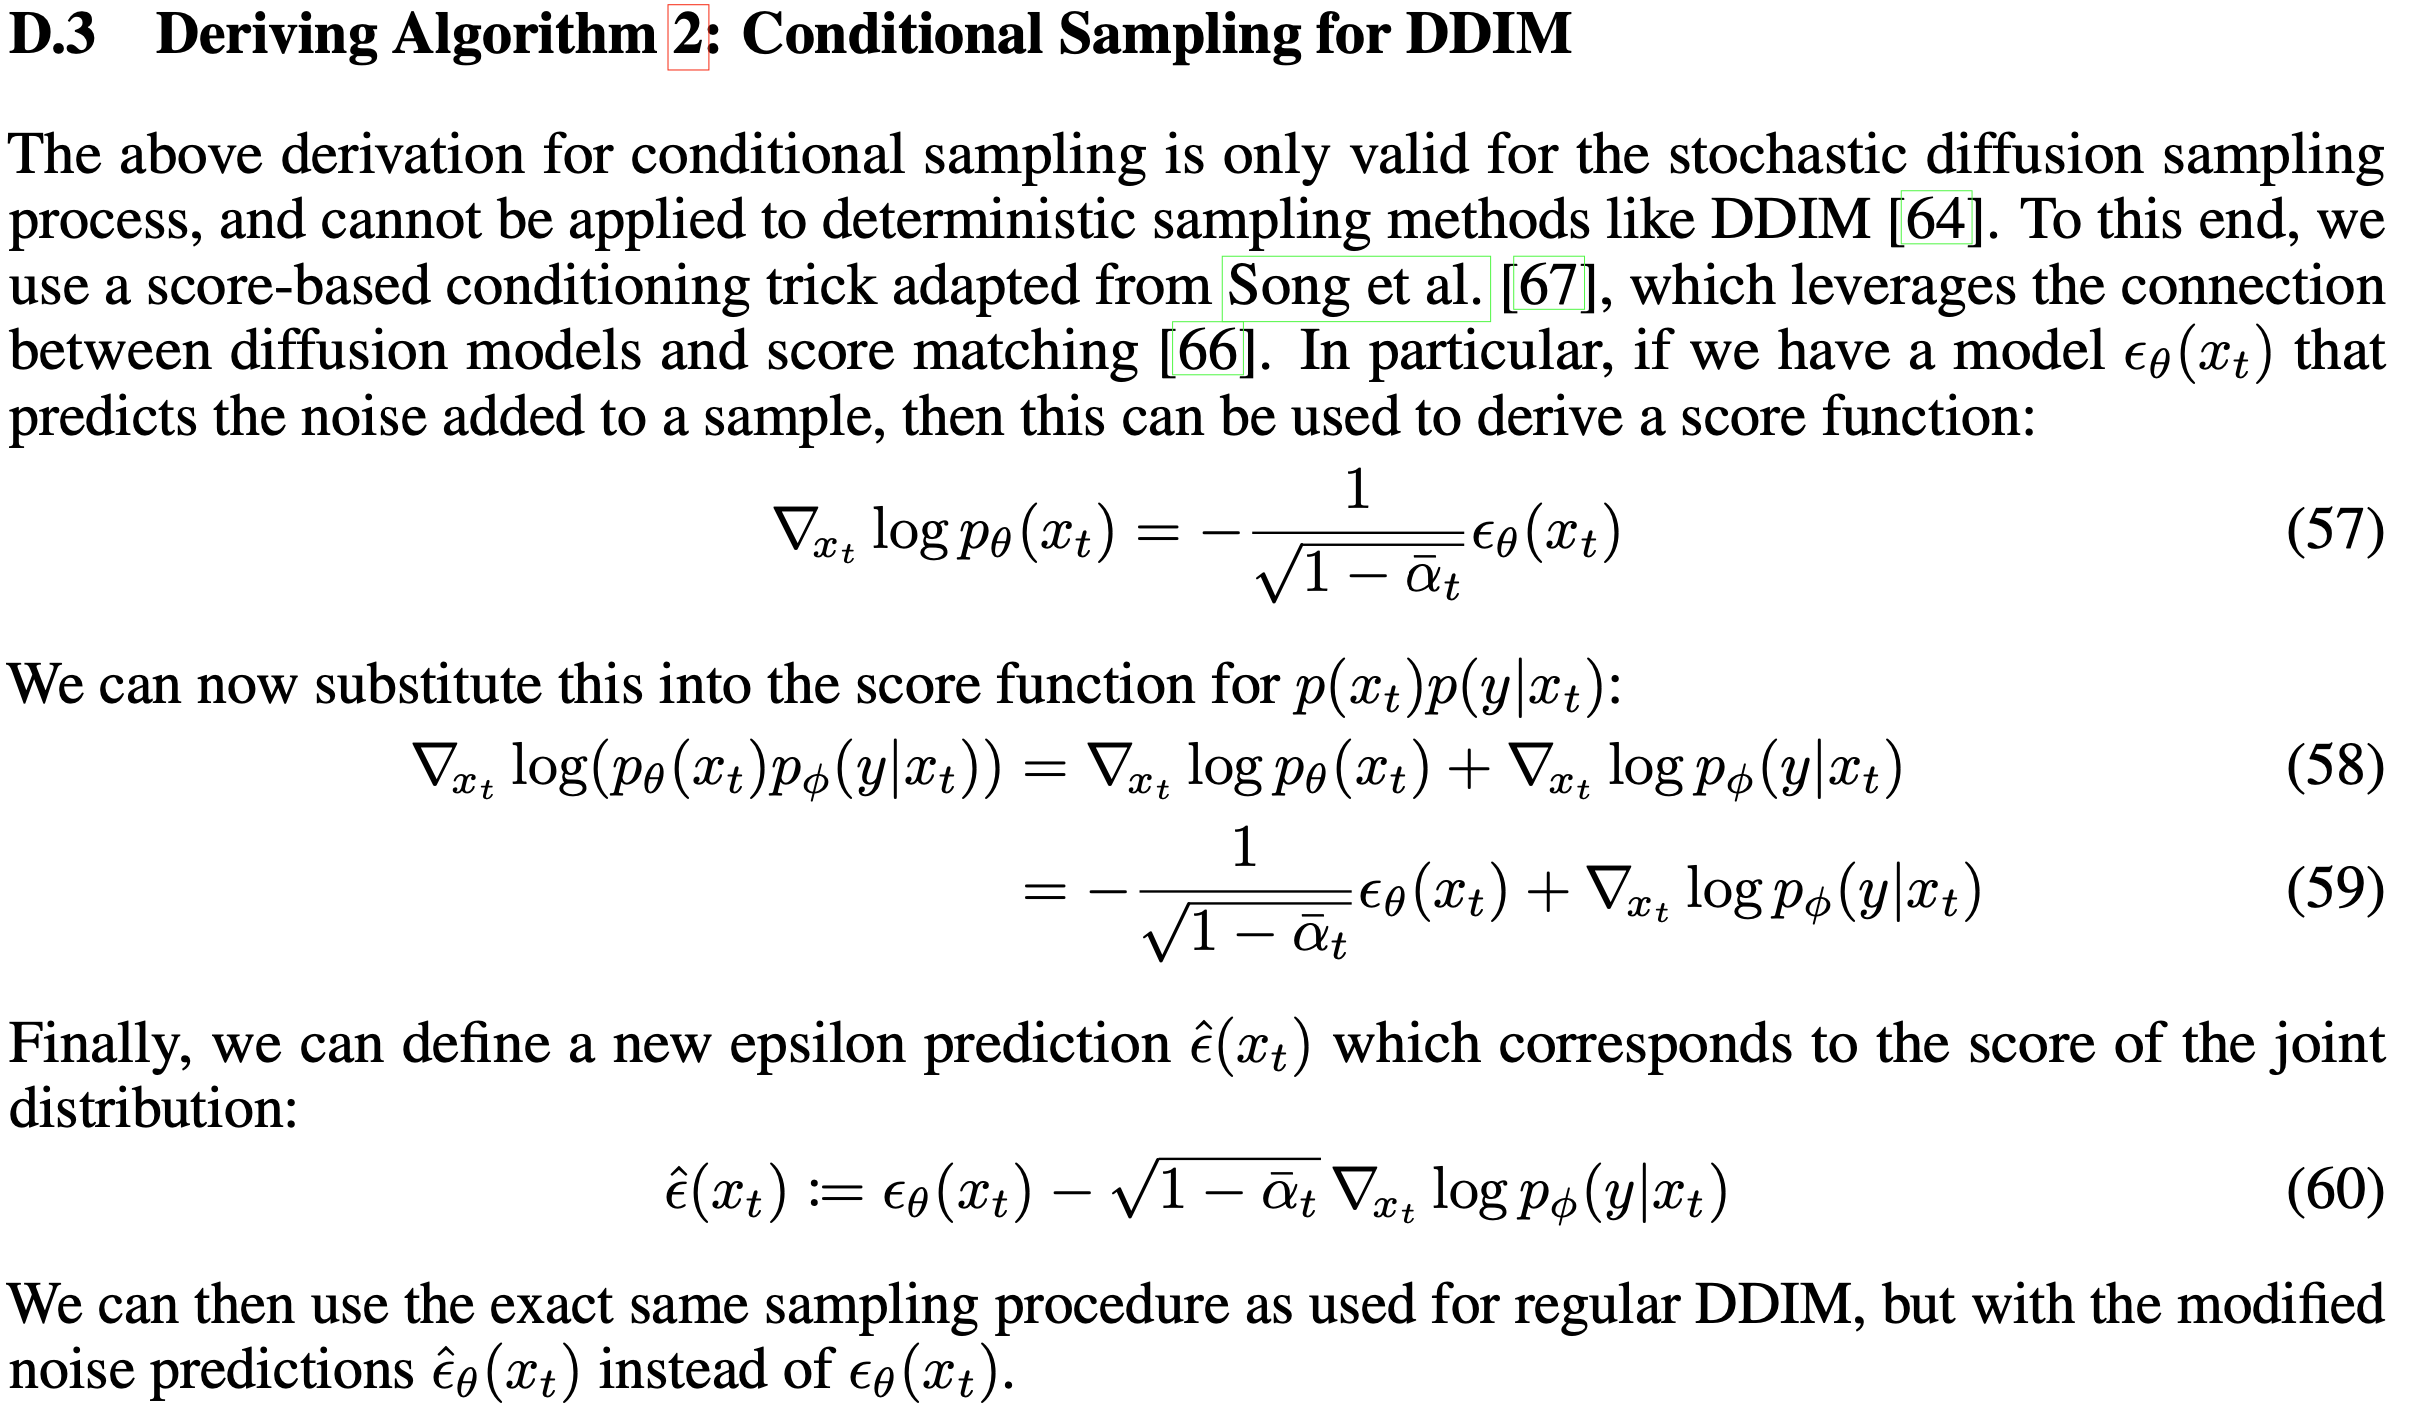
- 上图第一个公式中的梯度证明见论文的“前置推导”
- 推导过程中使用了一个技巧,通过求解梯度的相似形式来对比得到最终结果
- 公式(58)中 \(p_\theta(x_t)p_\phi(y|x_t)\) 没有直接来源,但可以从下面的推导看出,\(\nabla_{x_t} \log (p_\theta(x_t)p_\phi(y|x_t)) = \nabla_{x_t} \log p(x_t|y)\)
$$
\begin{align}
\nabla_{x_t} \log p(x_t|y) &= \nabla_{x_t} \log p(x_t) +\nabla_{x_t} \log p(y|x_t) - \nabla_{x_t} \log p(y) \\
&= \nabla_{x_t} \log p(x_t) +\nabla_{x_t} \log p(y|x_t) \\
&= \nabla_{x_t} \log (p(x_t)p(y|x_t)) \\
\end{align}
$$
其他说明,这里也可以在分类器的梯度上增加一个权重 \(w\),调节条件相关性和多样性:
$$ \hat{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t) = \boldsymbol{\epsilon}_\theta(x_t, t) - \sqrt{1 - \bar{\alpha}_t} w \nabla_{\mathbf{x}_t} \log p_\phi(y \vert \mathbf{x}_t) $$其他证明方式见附录
基于Classifier Guidance的DDPM和DDIM的采样过程
Classifier Guidance DDPM和DDIM下伪代码如下:
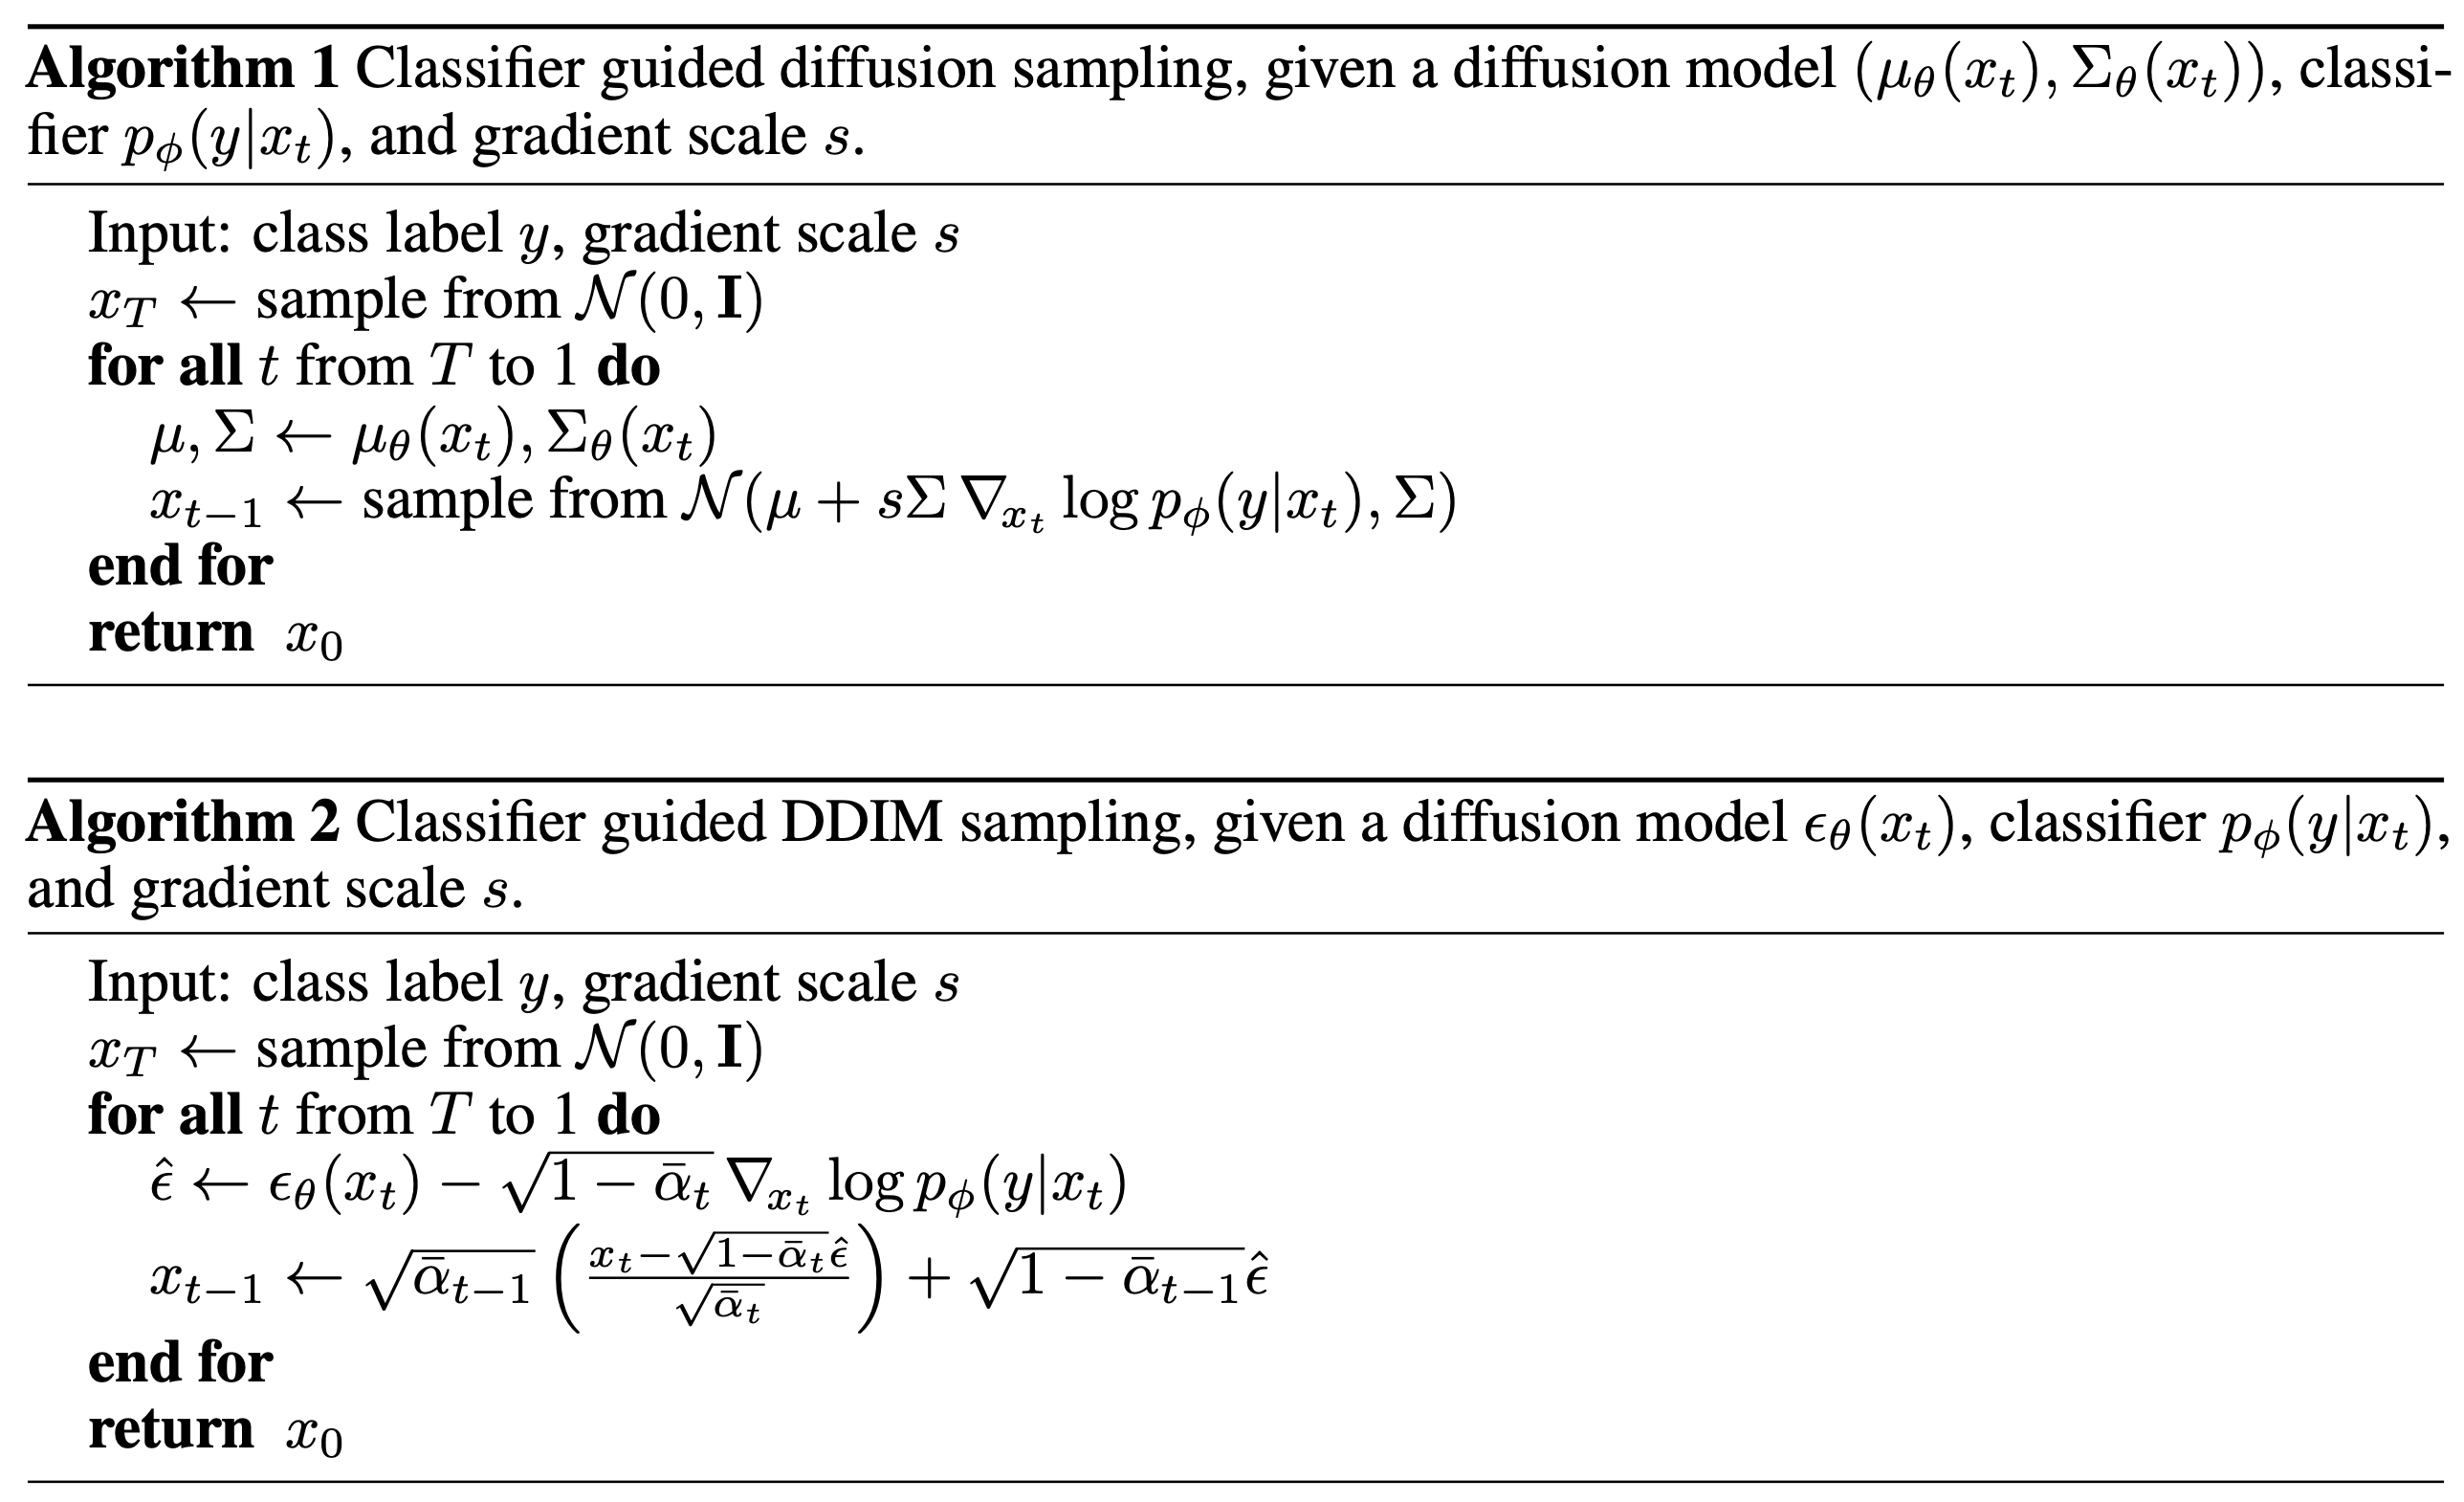
- 其中 \(\Sigma\) 表示协方差矩阵,有不同的实现方式,IDDPM中,使用了 \(\mathbf{\Sigma}_\theta(\mathbf{x}_t, t) = \exp(\mathbf{v} \log \beta_t + (1-\mathbf{v}) \log \tilde{\beta}_t)\), \(\mathbf{v}_{\theta}(x_t, t)\) 维度是与 \(\mathbf{x}_t\) 相同的,(详情见improved_diffusion源码:模型定义和improved_diffusion源码:向量使用)
- 问题:矩阵 \(\Sigma\) 和梯度向量相乘的结果是向量,这里梯度向量是列向量才能相乘
Classifier-free Guidance
- Classifier-free Guidance的方法直接讲条件添加到原始Diffusion模型中,从而使得模型在训练时就能感知到条件,因此,在采样(生成)时,不需要额外训练Classifier了
- 一个直观的解释是:
- 在原始分布 \(p(x_{t-1}|x_t)\) 增加条件 \(y\),则原始分布变成 \(p(x_{t-1}|x_t,y)\)
$$
\begin{equation}
p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t, \boldsymbol{y}) = \mathcal{N}(\boldsymbol{x}_{t-1}; \boldsymbol{\mu}(\boldsymbol{x}_t, \boldsymbol{y}),\sigma_t^2\boldsymbol{I})
\end{equation}$$ - 接着,在训练时,噪声网络上也增加输入 \(y\),即 \(\epsilon_\theta(x_t, y, t)\)
- 最后,可以使用下面的式子来实现加权
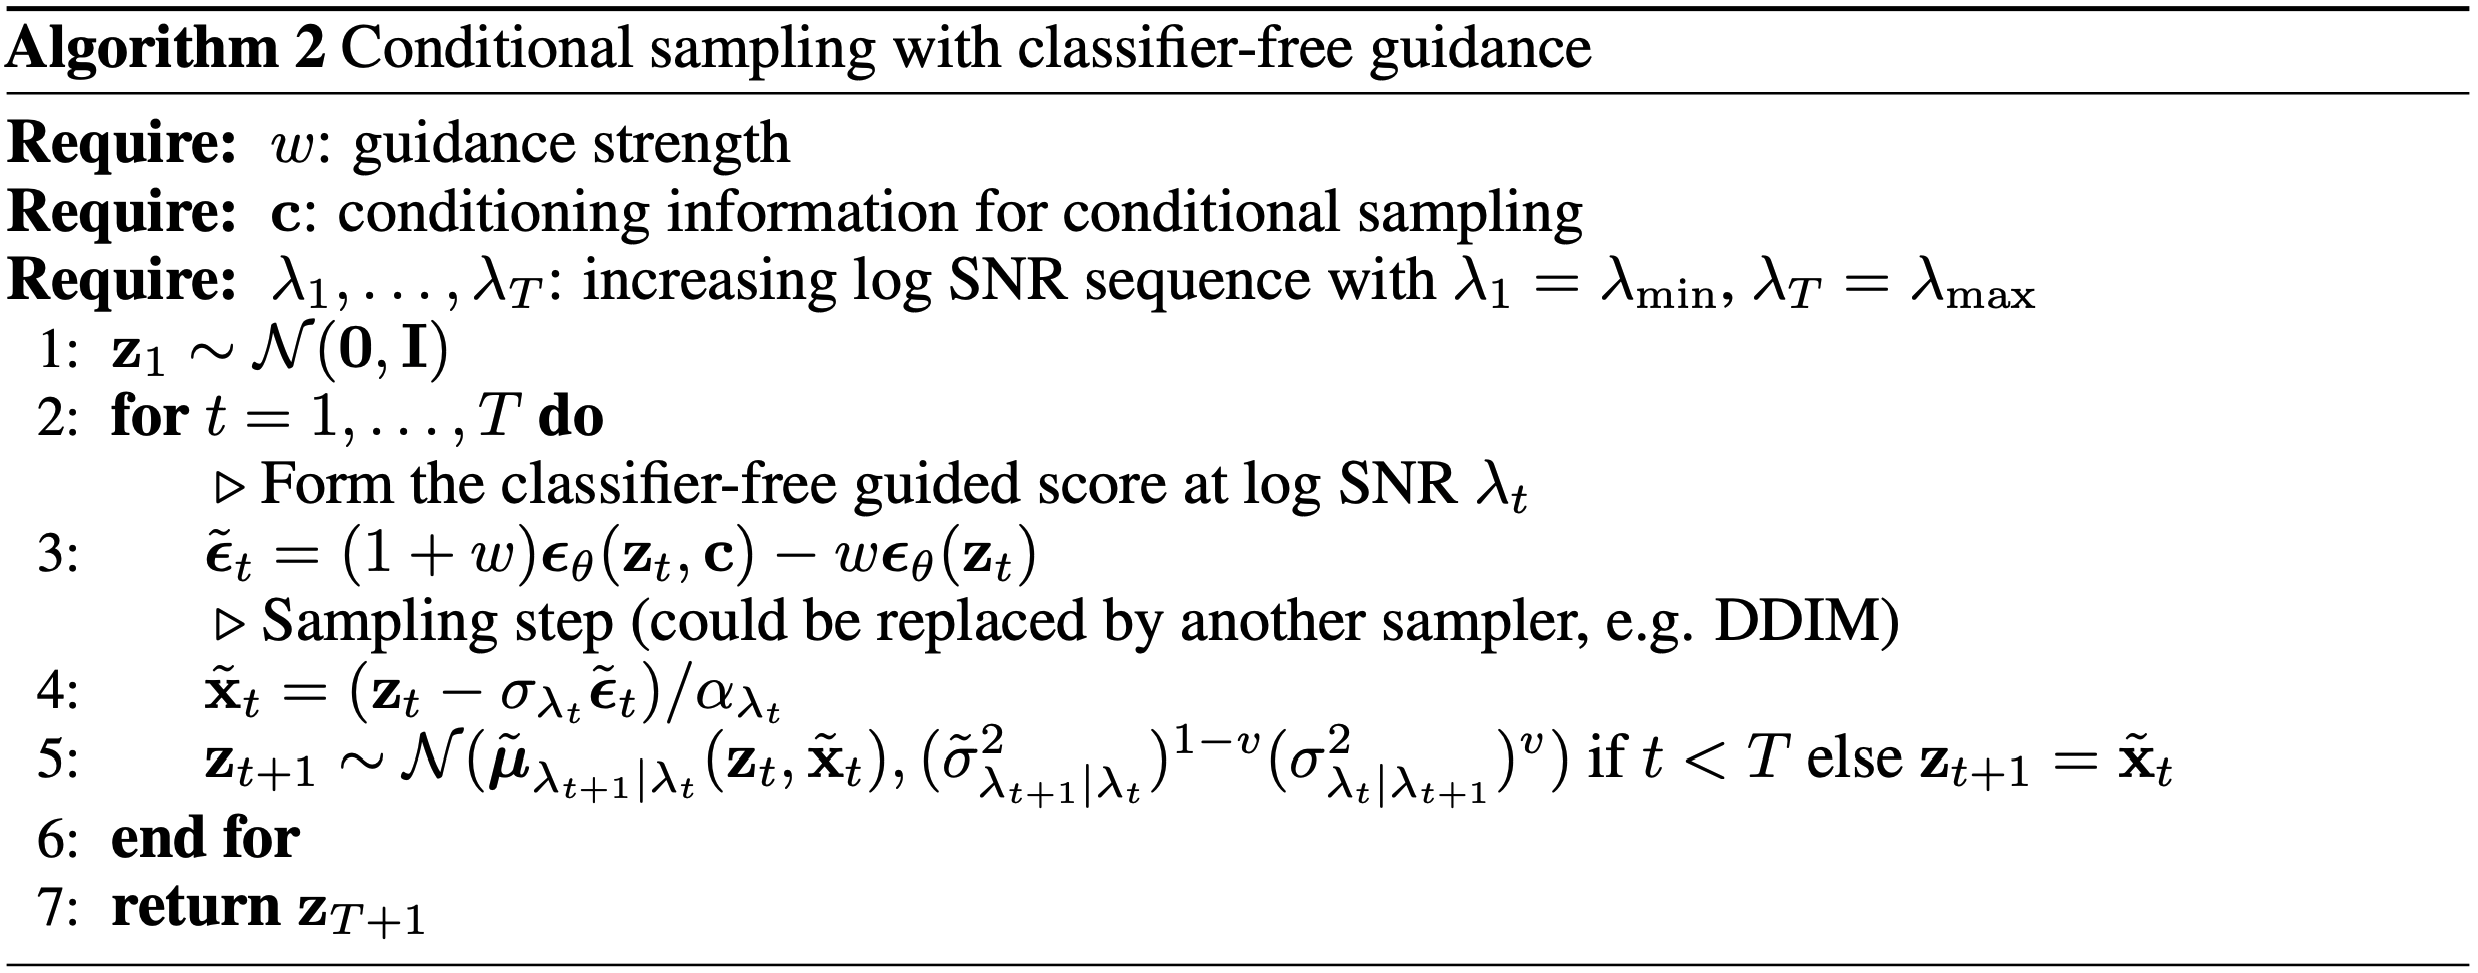
$$\begin{equation}\tilde{\boldsymbol{\epsilon}}_{\boldsymbol{\theta}}(\boldsymbol{x}_t, \boldsymbol{y}, t) = (1 + w)\boldsymbol{\epsilon}_{\boldsymbol{\theta}}(\boldsymbol{x}_t, \boldsymbol{y}, t) - w \boldsymbol{\epsilon}_{\boldsymbol{\theta}}(\boldsymbol{x}_t, t)\end{equation}
$$- 其中,无条件的 \(\epsilon_\theta(x_t, t)\) 通过设置一个特定的条件 \(\varnothing\) 获得,即 \(\epsilon_\theta(x_t, t) = \epsilon_\theta(x_t, \varnothing, t)\)
- \(w\) 也叫做 guidance scale,用于调整生成条件相关性和多样性
- 在原始分布 \(p(x_{t-1}|x_t)\) 增加条件 \(y\),则原始分布变成 \(p(x_{t-1}|x_t,y)\)
- 接下来我们介绍详细推导过程,首先,回顾条件概率转换:
$$
\begin{align}
\nabla_{x_t} \log p(x_t|y) &= \nabla_{x_t} \log \Big( \frac{p(x_t)p(y|x_t)}{p(y)}\Big) \\
&= \nabla_{x_t} \log p(x_t) + \nabla_{x_t} \log p(y|x_t) - \nabla_{x_t} \log p(y) \\
&= \underbrace{\nabla_{x_t} \log p(x_t)}_{\text{unconditional score}} + \underbrace{\nabla_{x_t} \log p(y|x_t)}_{\text{classifier gradient}}
\end{align}
$$ - 于是有:
$$ \nabla_{\mathbf{x}_t} \log p(y \vert \mathbf{x}_t) = \nabla_{\mathbf{x}_t} \log p(\mathbf{x}_t \vert y) - \nabla_{\mathbf{x}_t} \log p(\mathbf{x}_t) $$ - 进一步地,有(以下推导来自What are Diffusion Models?的推导):
$$
\begin{aligned}
\nabla_{\mathbf{x}_t} \log p(y \vert \mathbf{x}_t)
&= \nabla_{\mathbf{x}_t} \log p(\mathbf{x}_t \vert y) - \nabla_{\mathbf{x}_t} \log p(\mathbf{x}_t) \\
&= - \frac{1}{\sqrt{1 - \bar{\alpha}_t}}\Big( \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t, y) - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \Big) \\
\end{aligned}
$$ - 回顾DDIM Classifier Guidance里面的推导有:
$$
\begin{aligned}
\bar{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t, y)
&= \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t, y) - \sqrt{1 - \bar{\alpha}_t} \ w \nabla_{\mathbf{x}_t} \log p(y \vert \mathbf{x}_t) \\
&= \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t, y) + w \big(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t, y) - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \big) \\
&= (w+1) \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t, y) - w \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)
\end{aligned}
$$ - 采样时,利用将DDPM或者DDIM中的 \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) 替换为 \(\bar{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t, y)\), 正常采样即可
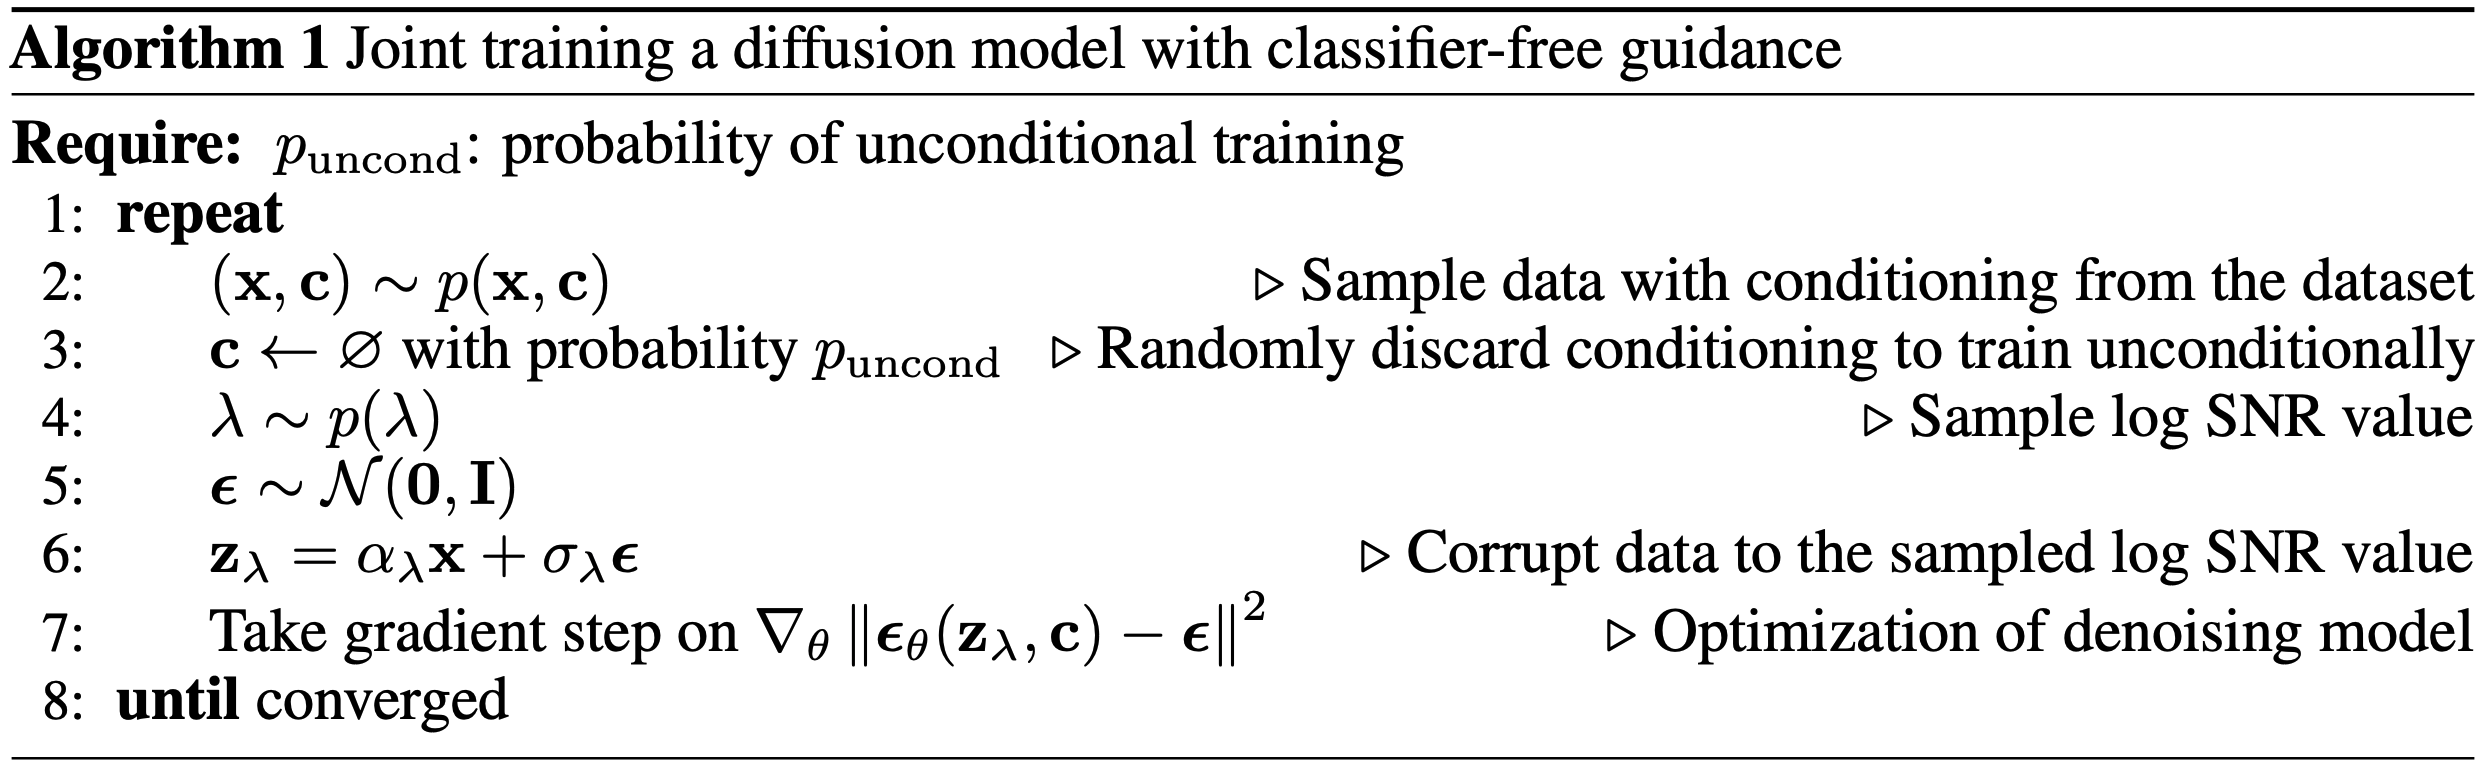
- 总结一下,Classifier-free Guidance方法的训练流程和采样流程如下:
Classifier-free Guidance和Classifier Guidance谁更好?
- GLIDE: Towards Photorealistic Image Generation and Editing with Text-Guided Diffusion Models, OpenAI, 2022对CLIP Guidance和Classifier-free Guidance两种策略进行实验,结果发现Classifier-free Guidance效果更好
The guided diffusion model, GLIDE (Nichol, Dhariwal & Ramesh, et al. 2022), explored both guiding strategies, CLIP guidance and classifier-free guidance, and found that the latter is more preferred. They hypothesized that it is because CLIP guidance exploits the model with adversarial examples towards the CLIP model, rather than optimize the better matched images generation.
附录:DDPM和DDIM加入条件以后的采样形式为什么不同呢?
- 可以证明,在设置DDPM中协方差矩阵 \(\Sigma\) 使用固定值后,DDPM和DDIM的Classifier Guidance 形式基本是非常相似的,都可以看做是用梯度 \(\nabla_{x_t}\log p_\phi(y|x_t)\) 对 \(\mathbf{\epsilon}_\theta(x_t, t)\) 进行修正【有时间时可以详细推导一下】
- 补充对比:
带条件的训练形式:
原始DDPM采样形式
$$ x_{t-1} = \frac{1}{\sqrt{\alpha_t}}\Big( x_t - \frac{1-\alpha_t}{\sqrt{1-\bar{\alpha}_t}}\epsilon_\theta(x_t, t) \Big) + \sigma_t z $$原始DDIM采样形式
$$x_s = \sqrt{\bar{\alpha}_s}\left(\frac{x_k-\sqrt{1-\bar{\alpha}_k}\epsilon_{\theta}(x_k,k)}{\sqrt{\bar{\alpha}_k}}\right) + \sqrt{1-\bar{\alpha}_s-a_1\sigma_k^2}\epsilon_{\theta}(x_k,k) + a_2\sigma_k \epsilon$$
附录:其他推导-Classifier Guidance DDPM
- 下面的推导参考苏神生成扩散模型漫谈(九):条件控制生成结果的推导
- 在推导过程中,在原始分布 \(p(x_{t-1}|x_t)\) 增加条件 \(y\),则原始分布变成 \(p(x_{t-1}|x_t,y)\)
- 根据贝叶斯公式有:
$$\begin{equation}p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t, \boldsymbol{y}) = \frac{p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t)p(\boldsymbol{y}|\boldsymbol{x}_{t-1}, \boldsymbol{x}_t)}{p(\boldsymbol{y}|\boldsymbol{x}_t)}\label{eq:bayes-1}\end{equation}$$ - 由于前向过程与条件无关, \(x_t\) 是由 \(x_{t-1}\) 加上与条件无关的噪声得到的,所以 \(p(\boldsymbol{y}|\boldsymbol{x}_{t-1}, \boldsymbol{x}_t) = p(\boldsymbol{y}|\boldsymbol{x}_{t-1})\),这在前文已经得到证明
- 于是有:
$$ \begin{equation}p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t, \boldsymbol{y}) = \frac{p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t)p(\boldsymbol{y}|\boldsymbol{x}_{t-1})}{p(\boldsymbol{y}|\boldsymbol{x}_t)} = p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t) \exp({\log p(\boldsymbol{y}|\boldsymbol{x}_{t-1}) - \log p(\boldsymbol{y}|\boldsymbol{x}_t)})\label{eq:bayes-2}\end{equation} $$ - 接下来我们要求解 \(\log p(\boldsymbol{y}|\boldsymbol{x}_{t-1}) - \log p(\boldsymbol{y}|\boldsymbol{x}_t)\) 这一项,首先做一下近似,当 \(T\) 足够大时,有 \(x_t\) 和 \(x_{t-1}\) 非常接近,故而可以用泰勒展开来近似:
$$ \begin{equation}\log p(\boldsymbol{y}|\boldsymbol{x}_{t-1}) - \log p(\boldsymbol{y}|\boldsymbol{x}_t)\approx (\boldsymbol{x}_{t-1} - \boldsymbol{x}_t)\cdot\nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)\end{equation}$$- 其中 \(\nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)\) 是一种简写形式,实际上有 \(\nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t) = \nabla_{\boldsymbol{x}} \log p(\boldsymbol{y}|\boldsymbol{x})\vert_{\boldsymbol{x} = \boldsymbol{x}_t}\),表示函数在 \(\boldsymbol{x}_t\) 处的梯度
- 假设 \(p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t)=\mathcal{N}(\boldsymbol{x}_{t-1};\boldsymbol{\mu}(\boldsymbol{x}_t),\sigma_t^2\boldsymbol{I})\propto \exp({-\frac{\Vert \boldsymbol{x}_{t-1} - \boldsymbol{\mu}(\boldsymbol{x}_t)\Vert^2}{2\sigma_t^2}})\),则有
$$
\begin{aligned}
p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t, \boldsymbol{y}) =&\ p(\boldsymbol{x}_{t-1}|\boldsymbol{x}_t) \exp({\log p(\boldsymbol{y}|\boldsymbol{x}_{t-1}) - \log p(\boldsymbol{y}|\boldsymbol{x}_t)}) \\
\propto&\ \exp\Big({-\frac{\Vert \boldsymbol{x}_{t-1} - \boldsymbol{\mu}(\boldsymbol{x}_t)\Vert^2}{2\sigma_t^2} + (\boldsymbol{x}_{t-1} - \boldsymbol{x}_t)\cdot\nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)}\Big) \\
\propto&\ \exp\Big(\frac{-\Vert \boldsymbol{x}_{t-1} - \boldsymbol{\mu}(\boldsymbol{x}_t) - \sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)\Vert^2}{2\sigma_t^2}\Big)
\end{aligned}
$$- 其中 \(\exp\Big({-\frac{\Vert \boldsymbol{x}_{t-1} - \boldsymbol{\mu}(\boldsymbol{x}_t)\Vert^2}{2\sigma_t^2} + (\boldsymbol{x}_{t-1} - \boldsymbol{x}_t)\cdot\nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)}\Big) \propto\ \exp\Big(\frac{-\Vert \boldsymbol{x}_{t-1} - \boldsymbol{\mu}(\boldsymbol{x}_t) - \sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)\Vert^2}{2\sigma_t^2}\Big) \) 是指数中配方后,略去了与 \(\boldsymbol{x}_{t-1}\) 无关的项,所以使用的是“正比于”(在指数部分,包括 \(\boldsymbol{x}_{t}\) 也与 \(\boldsymbol{x}_{t-1}\) 无关,可以略去,因为分布仅留下与 \(\boldsymbol{x}_{t-1}\) 相关的部分即可,注:标准的正太分布概率密度函数为 \(p(x) = \frac{1}{\sqrt{2\pi}\sigma} \exp(-\frac{(x-\mu)^2}{2\sigma^2}) \propto \exp(-\frac{(x-\mu)^2}{2\sigma^2})\),只关注与 \(x\) 有关的项即可)
- 将上面的形式转换成正太分布,有:
$$ \mathcal{N}(\boldsymbol{x}_{t-1};\boldsymbol{\mu}(\boldsymbol{x}_t) + \sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t),\sigma_t^2\boldsymbol{I})$$ - 也就是说按照下面形式采样即可实现条件的加入:
$$
\begin{equation}\boldsymbol{x}_{t-1} = \boldsymbol{\mu}(\boldsymbol{x}_t) \color{red}{+} {\color{red}{\underbrace{\sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)}_{\text{新增项}}}} + \sigma_t\boldsymbol{\varepsilon},\quad \boldsymbol{\varepsilon}\sim \mathcal{N}(\boldsymbol{0},\boldsymbol{I})\end{equation}
$$ - 在原始论文Diffusion Models Beat GANs on Image SynthesisClassifier Guidance DDPM的采样形式为:
$$\begin{equation}\sigma_t^2 \nabla_{\boldsymbol{x}_t} \log p(\boldsymbol{y}|\boldsymbol{x}_t)|_{\boldsymbol{x}_t=\boldsymbol{\mu}(\boldsymbol{x}_t)}\end{equation}$$- 这个形式与论文推导结果不同,生成扩散模型漫谈(九):条件控制生成结果中指出两者差不多(问题:零阶近似是指在 \(x_t=\mu(x_t)\) 处进行泰勒展开吗?需要进一步理解):
论文中梯度项在 \(\boldsymbol{\mu}(\boldsymbol{x}_t)\) 处的结果而非 \(\boldsymbol{x}_t\) 处,而一般情况下 \(\boldsymbol{\mu}(\boldsymbol{x}_t)\) 的零阶近似正是 \(\boldsymbol{x}_t\),所以两者结果是差不多的
- 理解:梯度的位置决定了建模价值模型时使用 \(\boldsymbol{x}_t\) 还是 \(\boldsymbol{\mu}(\boldsymbol{x}_t)\),直观上理解,应该是在 \(\boldsymbol{\mu}(\boldsymbol{x}_t)\) 上进行梯度偏移,所以应该是在 \(\boldsymbol{\mu}(\boldsymbol{x}_t)\) 的梯度才对
- Diffuser中代码实现比较奇怪,与论文伪代码不同:这部分实现的Diffuser详细代码可见Diffuser源码-采样函数
- 其他代码实现参考:
- 这个形式与论文推导结果不同,生成扩散模型漫谈(九):条件控制生成结果中指出两者差不多(问题:零阶近似是指在 \(x_t=\mu(x_t)\) 处进行泰勒展开吗?需要进一步理解):
附录:其他推导-Classifier Guidance DDIM
本小节推导主要参考自What are Diffusion Models?
- 由[(NCSN)Generative Modeling by Estimating Gradients of the Data Distribution, Stanford, 2020]和[Score-based generative modeling through stochastic differential equations, Stanford & Google, 2021]可以知道,只需要求得目标分布的对数概率梯度即可按照该梯度进行采样,原始分布的对数概率梯度为(详细证明见论文“前置推导”):
$$ \nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t) = - \frac{1}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) $$ - 增加条件以后的联合概率梯度为(此时的 \(\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t, y)\) 与 \(\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t\vert y)\) 是等价的,因为 \(\nabla_{\mathbf{x}_t}\log q(y)=0\) ):
$$
\begin{aligned}
\nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t, y)
&= \nabla_{\mathbf{x}_t} \log q(\mathbf{x}_t) + \nabla_{\mathbf{x}_t} \log q(y \vert \mathbf{x}_t) \\
&\approx - \frac{1}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) + \nabla_{\mathbf{x}_t} \log f_\phi(y \vert \mathbf{x}_t) \\
&= - \frac{1}{\sqrt{1 - \bar{\alpha}_t}} (\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) - \sqrt{1 - \bar{\alpha}_t} \nabla_{\mathbf{x}_t} \log f_\phi(y \vert \mathbf{x}_t))
\end{aligned}
$$ - 对照两个概率的梯度形式,可以得到 \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) 变成如下形式即可将 \(q(\mathbf{x}_t)\) 替换为带条件的 \(q(\mathbf{x}_t, y)\):
$$\bar{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t) = \boldsymbol{\epsilon}_\theta(x_t, t) - \sqrt{1 - \bar{\alpha}_t} \nabla_{\mathbf{x}_t} \log f_\phi(y \vert \mathbf{x}_t)$$ - 为了权衡Classifier Guidance的强度,可以添加一个权重 \(w\):
$$ \bar{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t) = \boldsymbol{\epsilon}_\theta(x_t, t) - \sqrt{1 - \bar{\alpha}_t} w \nabla_{\mathbf{x}_t} \log f_\phi(y \vert \mathbf{x}_t) $$
附录:问题汇总
- Classifier Guidance方法在训练Classifier时,需要包含随机扰动后的数据吧?
- DDPM推导时(附录和正文)得到了两种不同的梯度位置 \(x_t\) 和 \(\mu_t\),实现时应该是用哪个呢?
- Classifier Guidance方法训练过程中有哪些需要注意的?
- Classifier-free Guidance方法训练过程中有哪些需要注意的?