Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——ASearcher

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(ASearcher)Beyond Ten Turns: Unlocking Long-Horizon Agentic Search with Large-Scale Asynchronous RL, 20250811 & 20250813 & 20250910, THU, Ant Research
    • GitHub 开源:github.com/inclusionAI/ASearcher

Paper Summary

  • 论文核心:介绍了一个用于大规模 RL 训练搜索智能体的开源项目 ASearcher
    • 论文的贡献包括一个完全异步的智能体 RL 训练系统和一个用于大规模高质量问答对构建的数据合成智能体
    • 实验验证 ASearcher 在不同的模型规模和评估设置下均优于 SOTA 开源智能体
      • 包括 Qwen2.5-7B、Qwen2.5-14B 的基础模型
      • QWQ-32B(基于提示)的 LLM 智能体
  • 背景信息:LLM-based LLM 集成了外部工具,在处理复杂的、知识密集型任务方面展现出了卓越的能力
    • 在众多工具选择中,搜索工具 (search tools) 在访问海量外部知识方面扮演着关键角色
  • 问题提出:
    • 但开源智能体在实现专家级的(expert-level)**搜索智能 (Search Intelligence)**方面仍然存在不足
      • 搜索智能 即解决模糊 Query 、生成精确搜索、分析结果并进行彻底探索的能力
    • 现有方法在可扩展性、效率和数据质量方面存在缺陷
      • 例如,现有 Online RL 方法中的小步数限制(例如 \(\leq 10\))限制了复杂策略的学习
  • 论文的主要贡献包括:
    • (1) 可扩展的完全异步 RL 训练 (Scalable fully asynchronous RL training) ,能够在保持高训练效率的同时实现长视野搜索 (long-horizon search)
    • (2) 一个基于提示的 LLM 智能体 (prompt-based LLM agent) ,能够自主合成高质量且具有挑战性的问答对 (QA),创建大规模 QA 数据集
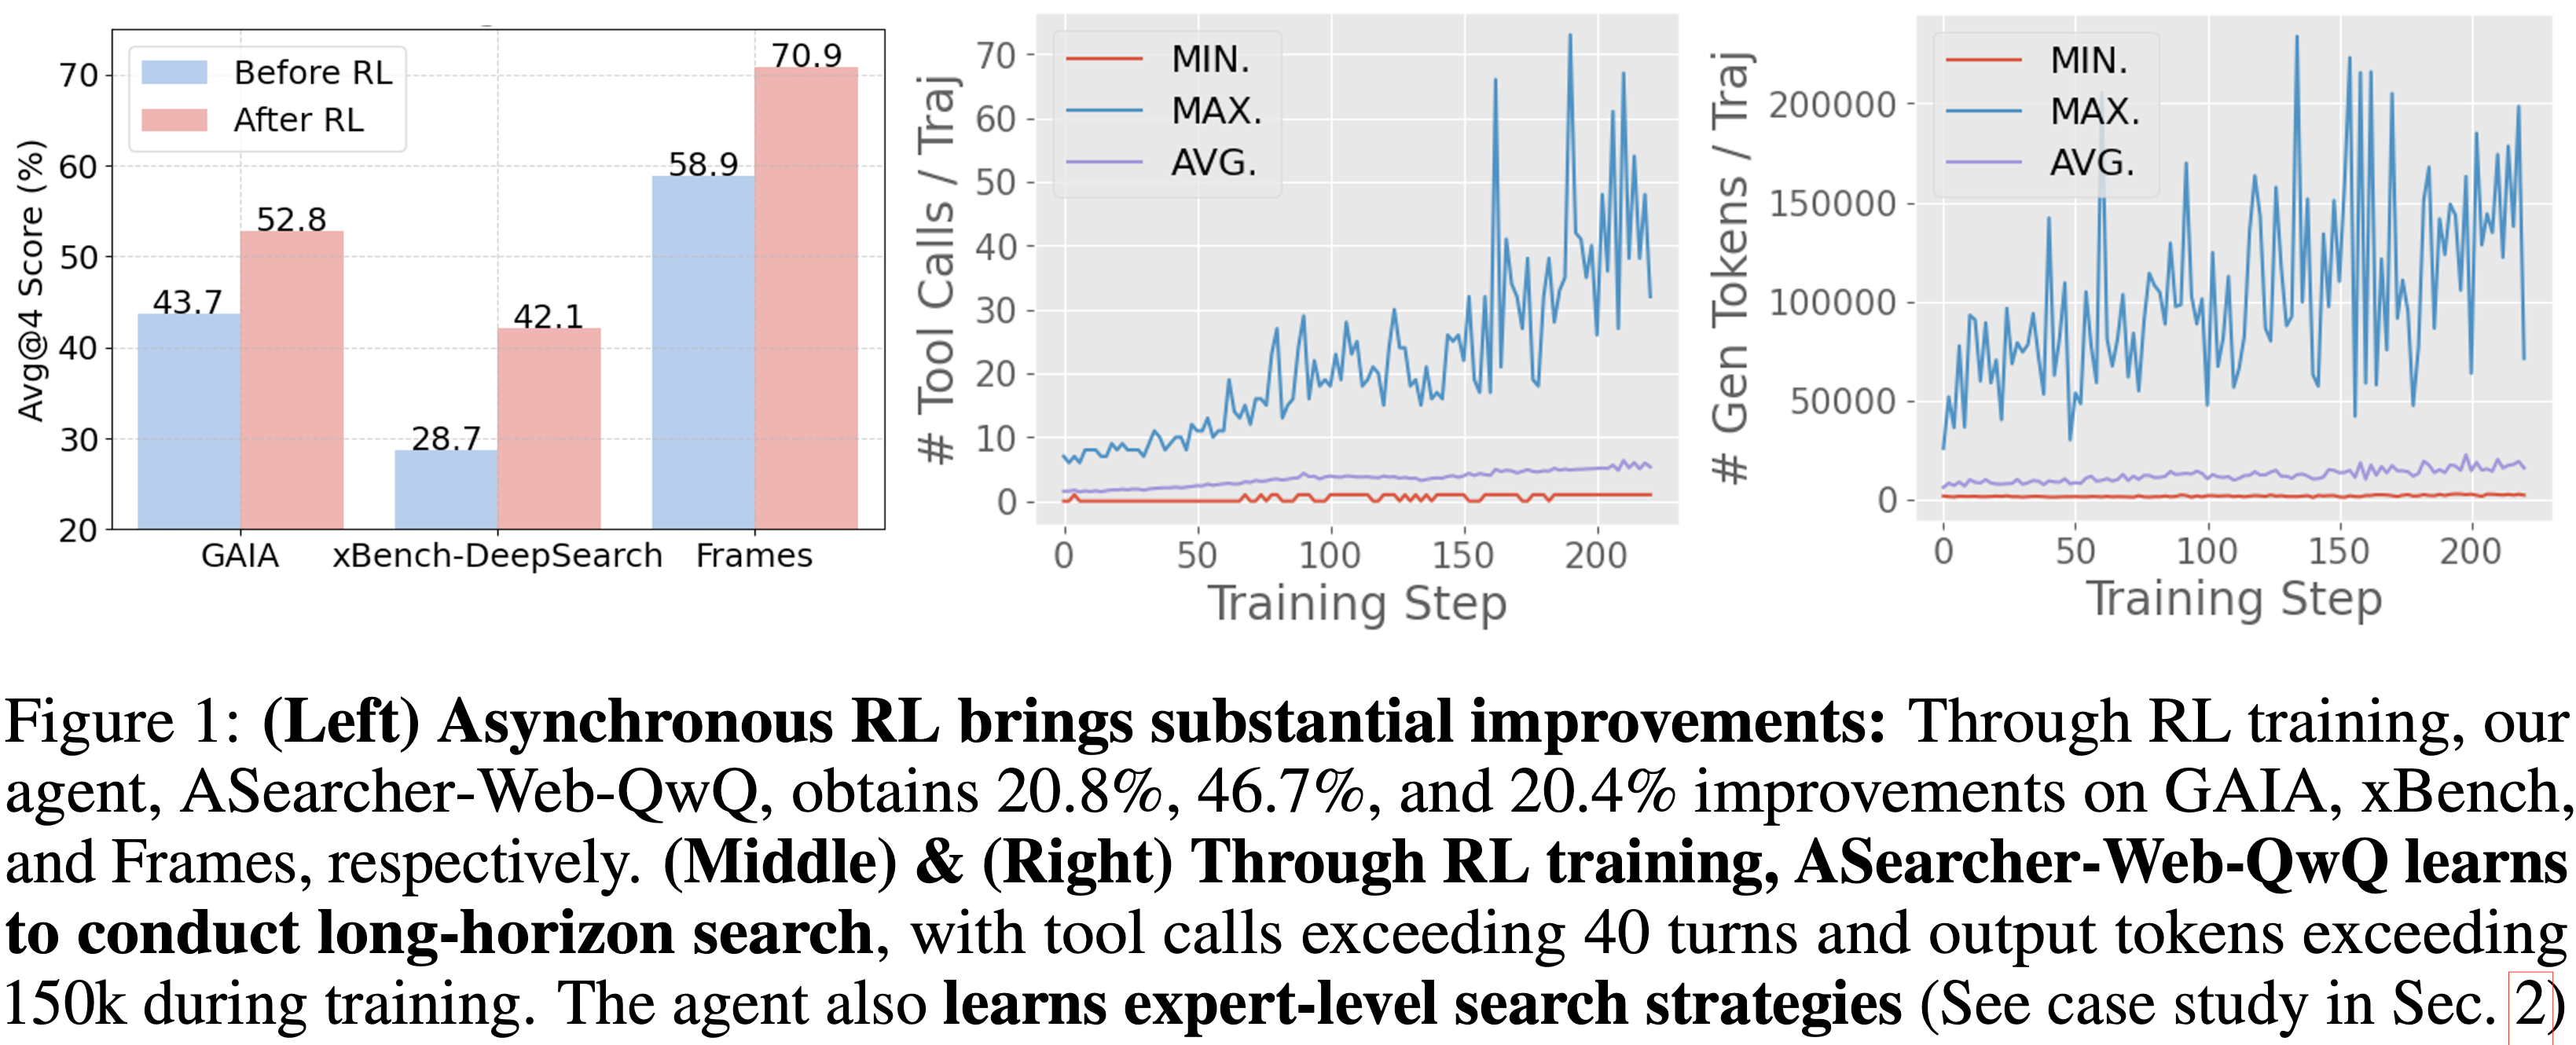
  • 通过 RL 训练,论文基于提示的 QwQ-32B 智能体取得了显著改进,在 xBench 和 GAIA 上的 Avg@4 指标分别提升了 46.7% 和 20.8%
  • 论文的智能体表现出极长的视野搜索能力,在训练期间工具调用次数超过 40 步,输出 Token 数超过 150k
  • 通过简单的智能体设计且无需外部 LLM,ASearcher-Web-QwQ 在 xBench 和 GAIA 上分别取得了 42.1 和 52.8 的 Avg@4 分数,超越了现有的开源 32B 智能体
  • 论文已在 github.com/inclusionAI/ASearcher 开源论文的模型、训练数据和代码
Introduction and Discussion

  • LLM-based LLM 的最新进展表明
    • 通过利用单个或多个外部工具 (2024; 2025;),Agent 在解决复杂的、知识密集型问题方面具有卓越能力
  • 其中,搜索工具 (search tools) 尤为关键,它使智能体能够访问海量外部知识以增强问题解决能力 (2023; 2024; 2025)。然而,专家级地使用搜索需要高级智能
    • 例如,考虑这个问题:“截至 2024 年 12 月 31 日,中国在 2012 年伦敦奥运会上获得的金牌、银牌和铜牌数量分别是多少?”
      • 这个问题看似简单,但实际上具有挑战性,因为网络上存在相互矛盾的答案(例如,“38 金、27 银、22 铜” vs “39 金、31 银、22 铜”)
    • 一个搜索智能体必须从不同来源中筛选噪声和矛盾的答案,识别冲突的根本原因(例如官方报告中因兴奋剂检测不合格而被取消资格),并最终确定正确答案
  • 具有挑战性的现实世界任务要求智能体能够解决输入 Query 中的高度不确定性、生成精确的搜索 Query 、从海量数据中分析和提取关键见解、解决不一致性并进行深入探索
    • 论文将这种高级能力称为 “搜索智能 (Search Intelligence)”
  • 专有智能体和模型已经通过大规模 RL 训练 (2025;) 展现出复杂的搜索行为迹象
    • 但用于开发搜索智能体的开源方法仍然面临显著限制
    • 一系列工作采用强化学习 或监督微调 方法来激励工具使用能力 (2025;)
  • 基于提示的 LLM 智能体 (prompt-based LLM agents) 可以在无需训练的情况下执行大量工具调用 (2025;)
    • 但在实践中,论文发现现有的 Online RL 方法未能激励复杂且有效的搜索策略
    • 论文还发现基于提示的 LLM 智能体可能会因为 LLM 能力不足而失败
      • 例如无法从噪声网页中精确提取关键信息,以及无法验证错误结论
  • 最近一些工作进一步在基于提示的 LLM 智能体基础上,利用 Offline RL 方法来改进这些智能体 (2025;)
    • 但这种 Offline RL 范式在更广泛的领域中被证明表现不如 Online RL (2024; 2021; 2024)
  • 在数学和代码等推理任务中,Online RL 使得模型能够基于正确性反馈迭代优化推理过程,从而演化出复杂行为 (2025;)
    • 这引出了一个关键问题:Online RL 方法如何有效地在开源智能体中解锁搜索智能?
  • 论文识别了两个阻碍搜索智能体有效进行 Online RL 训练的关键障碍:
    • 搜索步数不足限制了复杂策略的学习
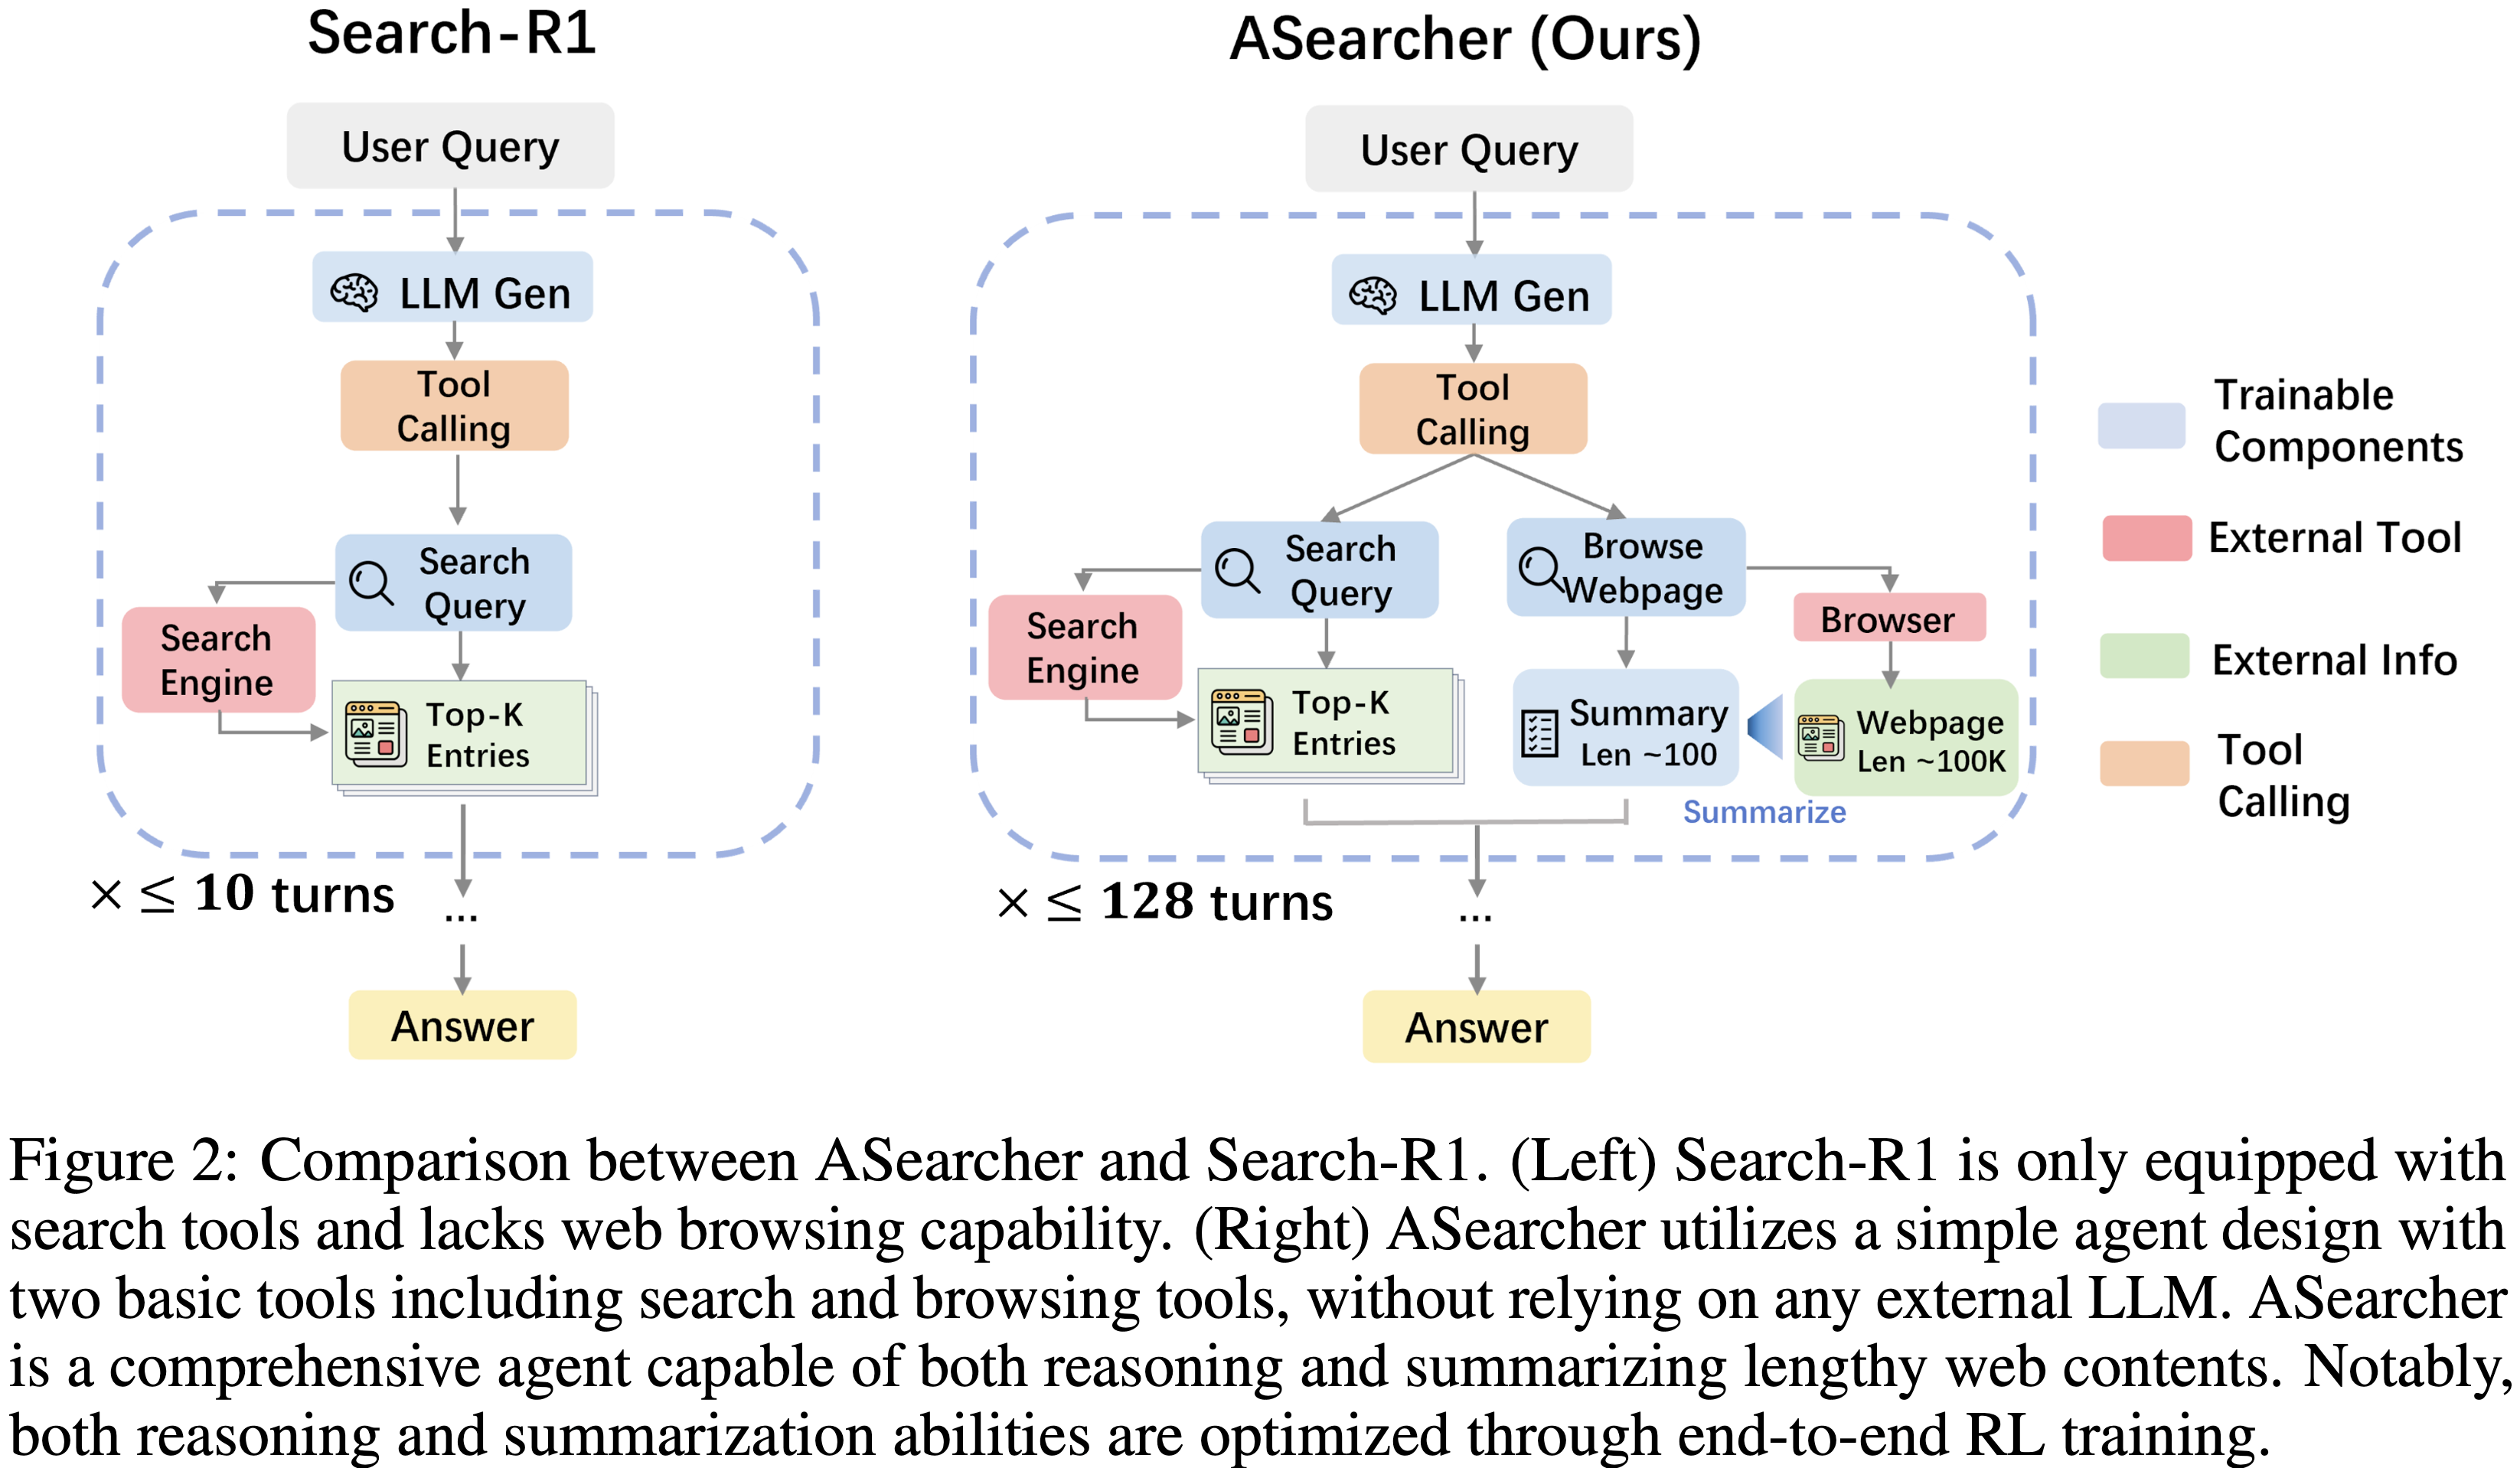
      • 现有工作,例如 Search-R1 (2025),人为限制了搜索步数,例如每条轨迹 \(\leq 10\) 步,这阻止了智能体探索更深的搜索路径
      • 但复杂的 Query 通常需要多轮工具调用和多步推理,这在严格的步数限制下无法学习
    • 缺乏大规模、高质量的问答对 (question-answer, QA pairs):
      • 推理任务的 RL 训练需要丰富、具有挑战性且正确的 QA 对 (2025;)
      • 但大多数现有的用于搜索智能体的开源数据集往往过时(例如 HotpotQA)、过于简化或规模太小,无法通过 RL 激发复杂的搜索行为 (2018; 2020; 2025;)
  • 为了应对这些挑战,论文提出了 ASearcher,一个旨在为搜索智能体实现大规模智能体 RL 训练 (large-scale agentic RL training) 的开源项目。论文的贡献包括:
    • 通过完全异步智能体 RL 训练实现长视野搜索
      • 在批生成 RL 训练系统 (2025;) 中设置较大的步数限制时,批次内的长轨迹很容易导致显著的闲置时间,从而减慢整个训练过程
      • 基于 AREaL (2025),论文的完全异步系统通过将轨迹执行与模型更新解耦,避免了长轨迹阻塞训练
      • 这允许放宽步数限制(例如,128 步/轨迹),使得智能体能够在不牺牲训练效率的情况下探索更深的搜索路径
      • 论文的智能体 ASearcher-Web-QwQ 实现了极长的视野搜索,在 RL 训练期间工具调用次数超过 40 步,生成的 Token 数超过 150k
    • 一个可扩展的 QA 合成智能体
      • 论文设计了一个 LLM-based 智能体,能够自主生成需要多轮工具使用的具有挑战性、不确定性和事实依据的 (challenging, uncertain, and grounded) QA 对
      • 从种子问题开始,该智能体通过模糊关键信息或注入外部事实来迭代地模糊查询 (fuzzes queries) 以增加复杂性
      • 每个构建的问题都经过多阶段验证 (multistage validation) 以确保质量和难度
      • 论文从 14k 个种子 QA 中生成了 134k 个高质量样本,其中 25.6k 个需要借助外部工具来解决
  • 使用 ASearcher,论文在两种设置下训练配备搜索引擎和浏览器的智能体:
    • 从基础模型开始进行 RL 训练 (Qwen2.5-7B/14B),以证明论文的训练流程能够激励强大且可泛化的搜索策略;
    • 微调由强大 LRM (QwQ-32B) 驱动的基于提示的智能体 ,以验证论文的训练流程在微调大规模基于提示的 LLM 智能体时的可扩展性
  • 论文在多跳 QA 基准测试和具有挑战性的基准测试上评估论文的智能体
    • 包括 GAIA (2023)、xbench-DeepSearch (2025) 和 Frames (2024)
  • 仅使用本地知识库训练的 ASearcher-Local-7B/14B,在现实的网络搜索中展现出惊人的泛化能力,并在多跳和单跳 QA 任务上达到了 SOTA 性能
    • 基于 QwQ-32B 构建的 ASearcher-Web-QwQ 在 xBench-DeepSearch 和 GAIA 上分别取得了 42.1 和 52.8 的 Avg@4 分数,超越了一系列开源智能体
    • 在评估 Pass@4 时,ASearcher-Web-QwQ 在 GAIA 和 xBench-DeepSearch 上分别达到了 70.1 和 68.0
    • 通过 RL 训练,ASearcher-Web-QwQ 在 xBench-DeepSearch 和 GAIA 上分别获得了 46.7% 和 20.8% 的提升
  • ASearcher 提出了一个面向基于 LRM 和 LLM 的搜索智能体的大规模开源在线智能体 RL 流程,通过可扩展的训练和高质量的数据解锁了搜索智能
    • 希望论文的发现不仅能推动搜索智能体的发展,也能为面向复杂现实世界任务的 LLM 智能体带来更广泛的创新启发

Limitations of Existing Open-source Approaches

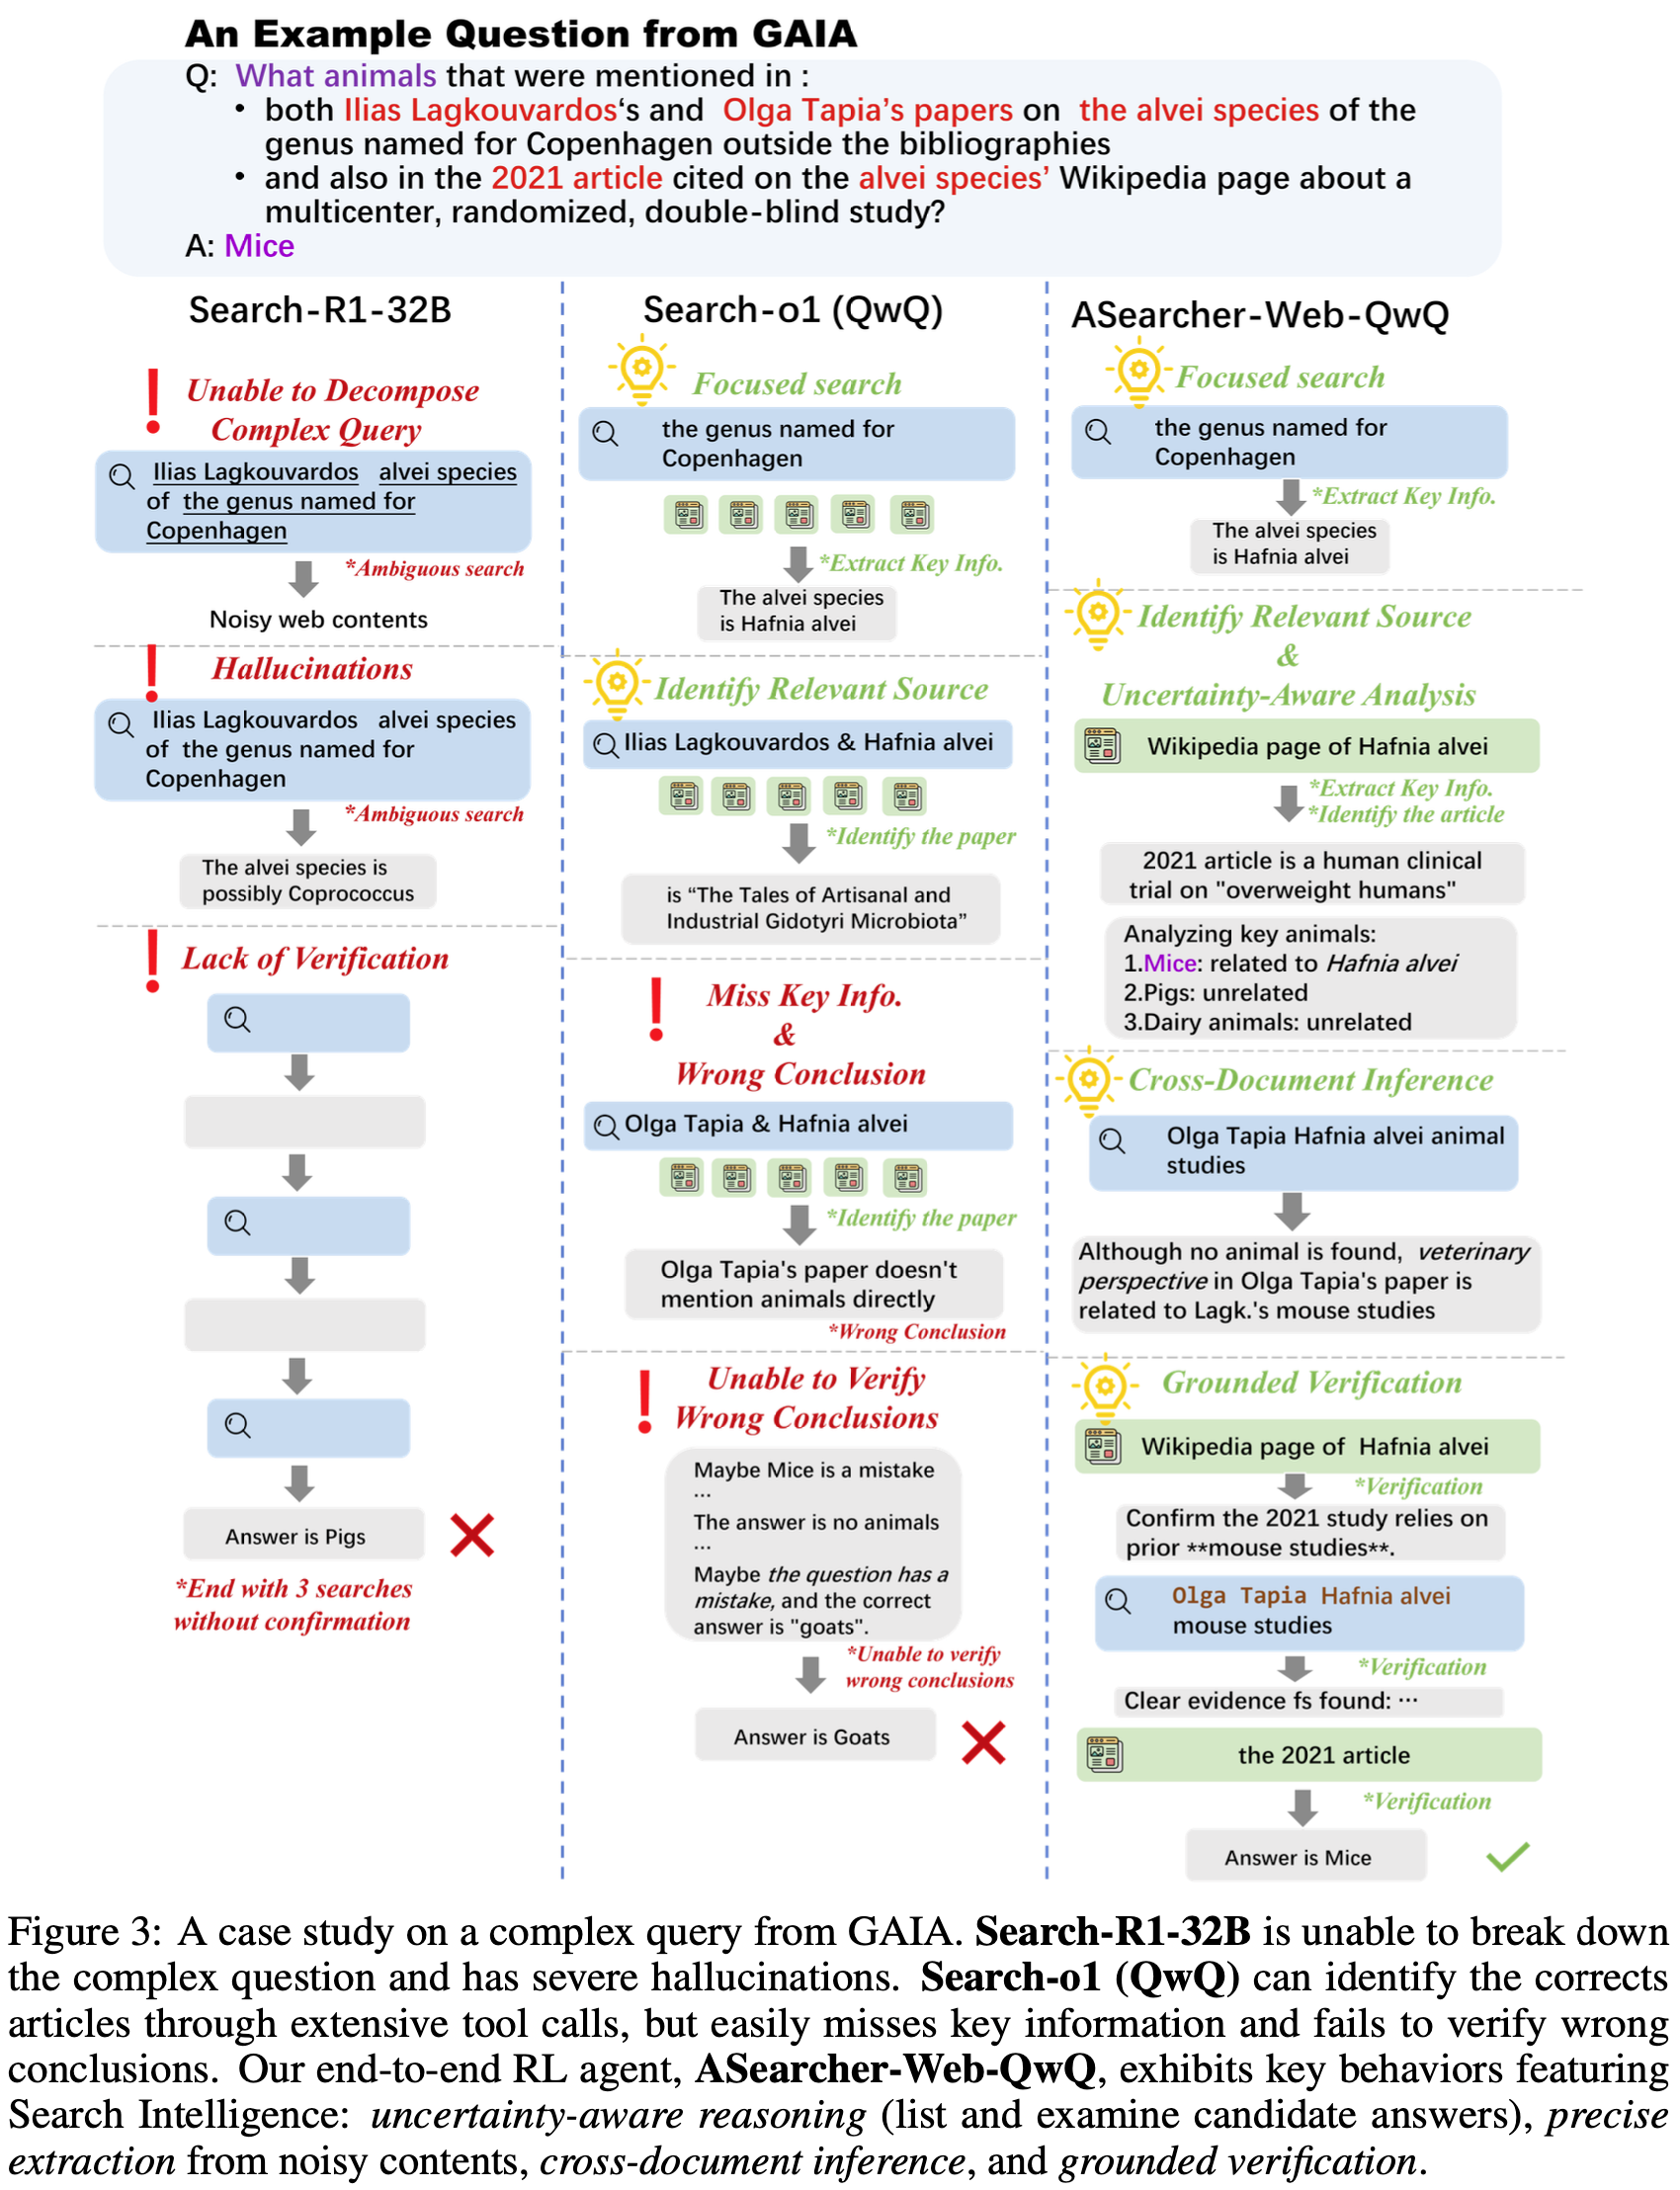
  • 在本节中,论文针对一个来自 GAIA (2023) 的极具挑战性的问题进行了详细的案例研究
  • 具体来说,论文在图 3 中分析了 Search-R1-32B (2025) 和 Search-o1 (QwQ) (2025)
    • 详细的轨迹在附录 A 中提供

Solution Path of the Sample Question

  • 在图 3 中,论文的案例研究针对一个需要找到具有 4 个未知变量 的特定动物的问题
  • 为了识别正确答案,搜索智能体应首先根据条件“以哥本哈根命名的属 (genus named for Copenhagen)”找出所提及的物种
    • 根据该物种维基百科页面上的引文识别正确的 2021 年文章,然后找出两位提及人物的论文
  • 最终,正确答案应通过交叉引用 2021 年的文章和论文来确定;总而言之,这个例子具有挑战性的原因有几个:
    • 高不确定性 (High Uncertainty): 问题涉及多个未知变量,这些变量可能指向许多不同的实体
      • 例如,“2021 年的文章”可能指向 2021 年发表的任何文章,并且只能通过检查 肺泡物种 (alvei species) 维基百科页面中的“多中心、随机、双盲研究 (multicenter, randomized, double-blind study)”来确定
    • 需要精确的信息提取 (Requirement for Exact Information Extraction): 为了找到答案,智能体应列出网页上提到的所有动物并进行跨文档比较
      • 这要求智能体从海量、充满噪声的网页内容中精确提取关键信息,而不是简单地总结网页
    • 误导性答案 (Misleading Answers): 在解决此任务的过程中,可能会出现多个误导性答案(例如“猪 (pigs)”)
      • 智能体应通过检查所有相关网页和文档中的预期答案来严格验证其结论
  • 现有 Online RL 方法未能学习复杂搜索策略 (Existing Online RL Approaches Fail to Learn Complex Search Strategies)
    • 在图 3 中,Search-R1-32B 无法将复杂 Query 分解为单个组成部分,因此只能进行涉及太多未知信息的模糊 Query
      • 该智能体还存在严重的幻觉 (hallucinations),产生了搜索结果不支持结论
      • 最后,它未能解析所有未知信息
    • 这个案例研究表明,现有的 Online RL 方法仅能激励初级的搜索策略
    • 同样值得注意的是,由于在训练期间步数限制被设置为一个较小的值(例如 4 步)该模型仅表现出较短的工具使用视野
  • 基于提示的 LLM 智能体可能因 LLM 能力不足而失败 (Prompt-based LLM Agents Could Fail Due to Insufficient Capability of the LLM)
    • 在图 3 中,Search-o1 (QwQ) 可以通过大量工具调用找到物种名称,以及 2021 年的文章和相关论文
    • 但在试图寻找答案时,Search-o1 (QwQ) 很容易遗漏关键信息,从而得出错误的结论
      • 即使智能体找到了直接指向正确答案的信息,它仍然会被先前错误的结论所误导
      • 最后,该智能体无法验证先前结论的正确性
    • 这个案例研究揭示,尽管一个未在智能体任务上明确训练的开源模型可以执行大量的工具调用 ,但它无法基于检索到的内容和历史上下文进行专家级的推理
  • ASearcher-Web-QwQ (论文端到端 RL 智能体 ASearcher-Web-QwQ 的搜索策略)
    • 如图 3 所示,ASearcher-Web-QwQ 将复杂 Query 分解为精确的 Query
      • 与 Search-o1 (QwQ) 在每次搜索 Query 后访问大量网站不同,ASearcher-Web-QwQ 专注于一次访问一个网站
      • 问题:这样会不会太慢
    • ASearcher-Web-QwQ 总结了网站的所有相关信息
      • 所有候选答案都被列出并由智能体仔细分析
      • 当搜索结果没有直接指向期望目标时,例如,当使用“Olga Tapia Hafnia alvei animal studies”进行搜索以查找与 Olga Tapia 论文相关的动物时,智能体没有获得明确的信息,但能够通过与其他论文建立联系来推断出正确答案
      • 在找到正确答案“小鼠 (Mice)”后,智能体在报告最终答案之前花费了额外的步数来验证先前的结论
    • 总之,ASearcher 成功训练出了一个展现出专家级搜索行为的搜索智能体 :
      • 不确定性感知推理 (Uncertainty-aware reasoning): 智能体详尽地列出并检查所有不确定实体的可能性
      • 精确的关键信息提取 (Precise Key Information Extraction): 智能体能够从海量、充满噪声的网页内容中识别关键信息
      • 跨文档推理 (Cross-document Inference): 智能体能够通过建立多个文档之间的联系来推断关键结论
      • 基于事实的验证 (Grounded Verification): 智能体通过访问或搜索相关材料来验证先前结论的正确性

ASearcher

  • 论文提出了 ASearcher,一个通过大规模 RL 训练来解锁搜索智能(Search Intelligence)的开源项目
  • 如图 3 所示,ASearcher 训练了一个能够通过彻底解决所有不确定性并执行多轮工具调用来解决复杂问题的搜索智能体
  • 在后续的小节中,论文将介绍 ASearcher 中的智能体设计、训练数据及数据合成智能体,以及完全异步的强化学习训练

Agent Design

  • 论文在 ASearcher 中采用了一种简单的智能体设计,如图 2 所示
  • 工具 (Tools).
    • 给定一个用户 Query ,智能体可以使用两个基本工具:一个搜索引擎和一个网络浏览器
      • 搜索引擎:接收文本 Query 作为输入,并返回相关的摘要片段及其对应的 URL
      • 网络浏览器:接收一个 URL 并返回网页的内容
    • 为了有效解决复杂问题,模型应策略性地结合这些工具,并从海量数据中提取关键信息
  • 网页摘要 (Webpage Summarization).
    • 网页可能包含过长的内容,因此论文利用智能体将网页总结成一个简洁的摘要
    • 在训练时,这个摘要过程也会被优化,允许智能体通过强化学习训练来提高摘要能力
  • 使用基础 LLM 和高级 LRM 实例化 ASearcher (Instantiating ASearcher with Base LLMs and Advanced LRMs).
    • 在 ASearcher 框架内,论文研究了两种搜索智能体的具体实例化方式:
      • 一种是使用基础大语言模型(Base LLMs) ,例如 Qwen2.5-7B/14B;
      • 另一种是使用高级大推理模型(Large Reasoning Models, LRMs) ,例如 QwQ-32B
    • 这两种不同类型的实例化在历史管理和提示(Prompting)方面需要不同的设计选择
      • 对于基础 LLM ,论文遵循先前的工作 (2025;),采用仅追加(append-only)风格的提示方式
        • 从一个系统提示(System Prompt)开始,所有由 LLM 生成的响应、搜索结果和网页摘要都被追加到历史记录中
        • 智能体按时间顺序接收完整的历史记录作为输入,并输出一些推理文本和动作。
        • 这种方法确保了推理时的效率
      • 对于LRM ,LRM 本身已经具备了指令跟随能力
        • 论文使用不同的提示来指导 LRM 进行工具选择、摘要和回答
        • 论文还注意到 LRM 通常会生成长响应,有时历史记录会很长
          • 问题:需要确保输入的紧凑性,以保证 LRM 有足够的预算来生成 Token
          • 解法:在历史记录中,丢弃思维过程,而是保留总结后的想法和工具调用
        • 在提示 LRM 时,只将最近 25k 个字符的历史记录作为附加上下文提供给 LRM
          • 这些简单的设计确保了 LRM 的输入最多为 10k 个 Token
          • 问题:25k 不是已经比 10k 大了吗?
  • 端到端强化学习 (End-to-End Reinforcement Learning).
    • 智能体所有由 LLM 生成的响应,包括思维过程、工具调用和摘要,都是以端到端的方式使用强化学习进行训练的

Training Data

  • 论文的训练数据主要有两个来源
    • 开源数据集:仔细筛选,以确保其难度和质量
    • 合成数据:高质量的问答对(Question-Answer pairs, QA pairs),专门设计用于指导智能体学习可泛化的搜索策略
开源数据 (Open-source Data).
  • 论文从 HotpotQA (2018) 和 2WikiMultiHopQA (2020) 的训练集开始,这两个都是多跳问答数据集
  • 论文采用了基于模型的过滤流程
    • 使用 RL 在完整的开源数据集上训练一个模型,再使用训练好的模型为每个问题生成 16 个响应
    • 最后,论文过滤掉满足以下任一标准的问题:
      • 模型在 16 个响应中未能找到一个正确答案
      • 模型达到了 \(\ge\) 50% 的准确率,意味着问题挑战性不足
      • 模型仅用少量搜索轮次(即 \(\le\) 1 轮)就找到了正确答案
  • 这种过滤方法确保论文只保留最具挑战性但又可解决、且需要使用工具的问题
  • 最终,从总共 304k 个问答对中 ,论文保留了 16k 个具有挑战性的样本用于 RL 训练
  • 此外,论文还纳入了一组专为访问特定网页而设计的问答对
  • 特别是,论文加入了 WebWalkerQA (2025) 的一小部分子集,以帮助模型学习如何在嘈杂的真实网络搜索环境中定位答案
Data Synthesis Agent
  • 论文进一步开发了一个数据合成智能体来创建高质量的问答对
  • 如图 4 所示,数据合成智能体从一个种子问题开始,迭代地修改问题以增加复杂性
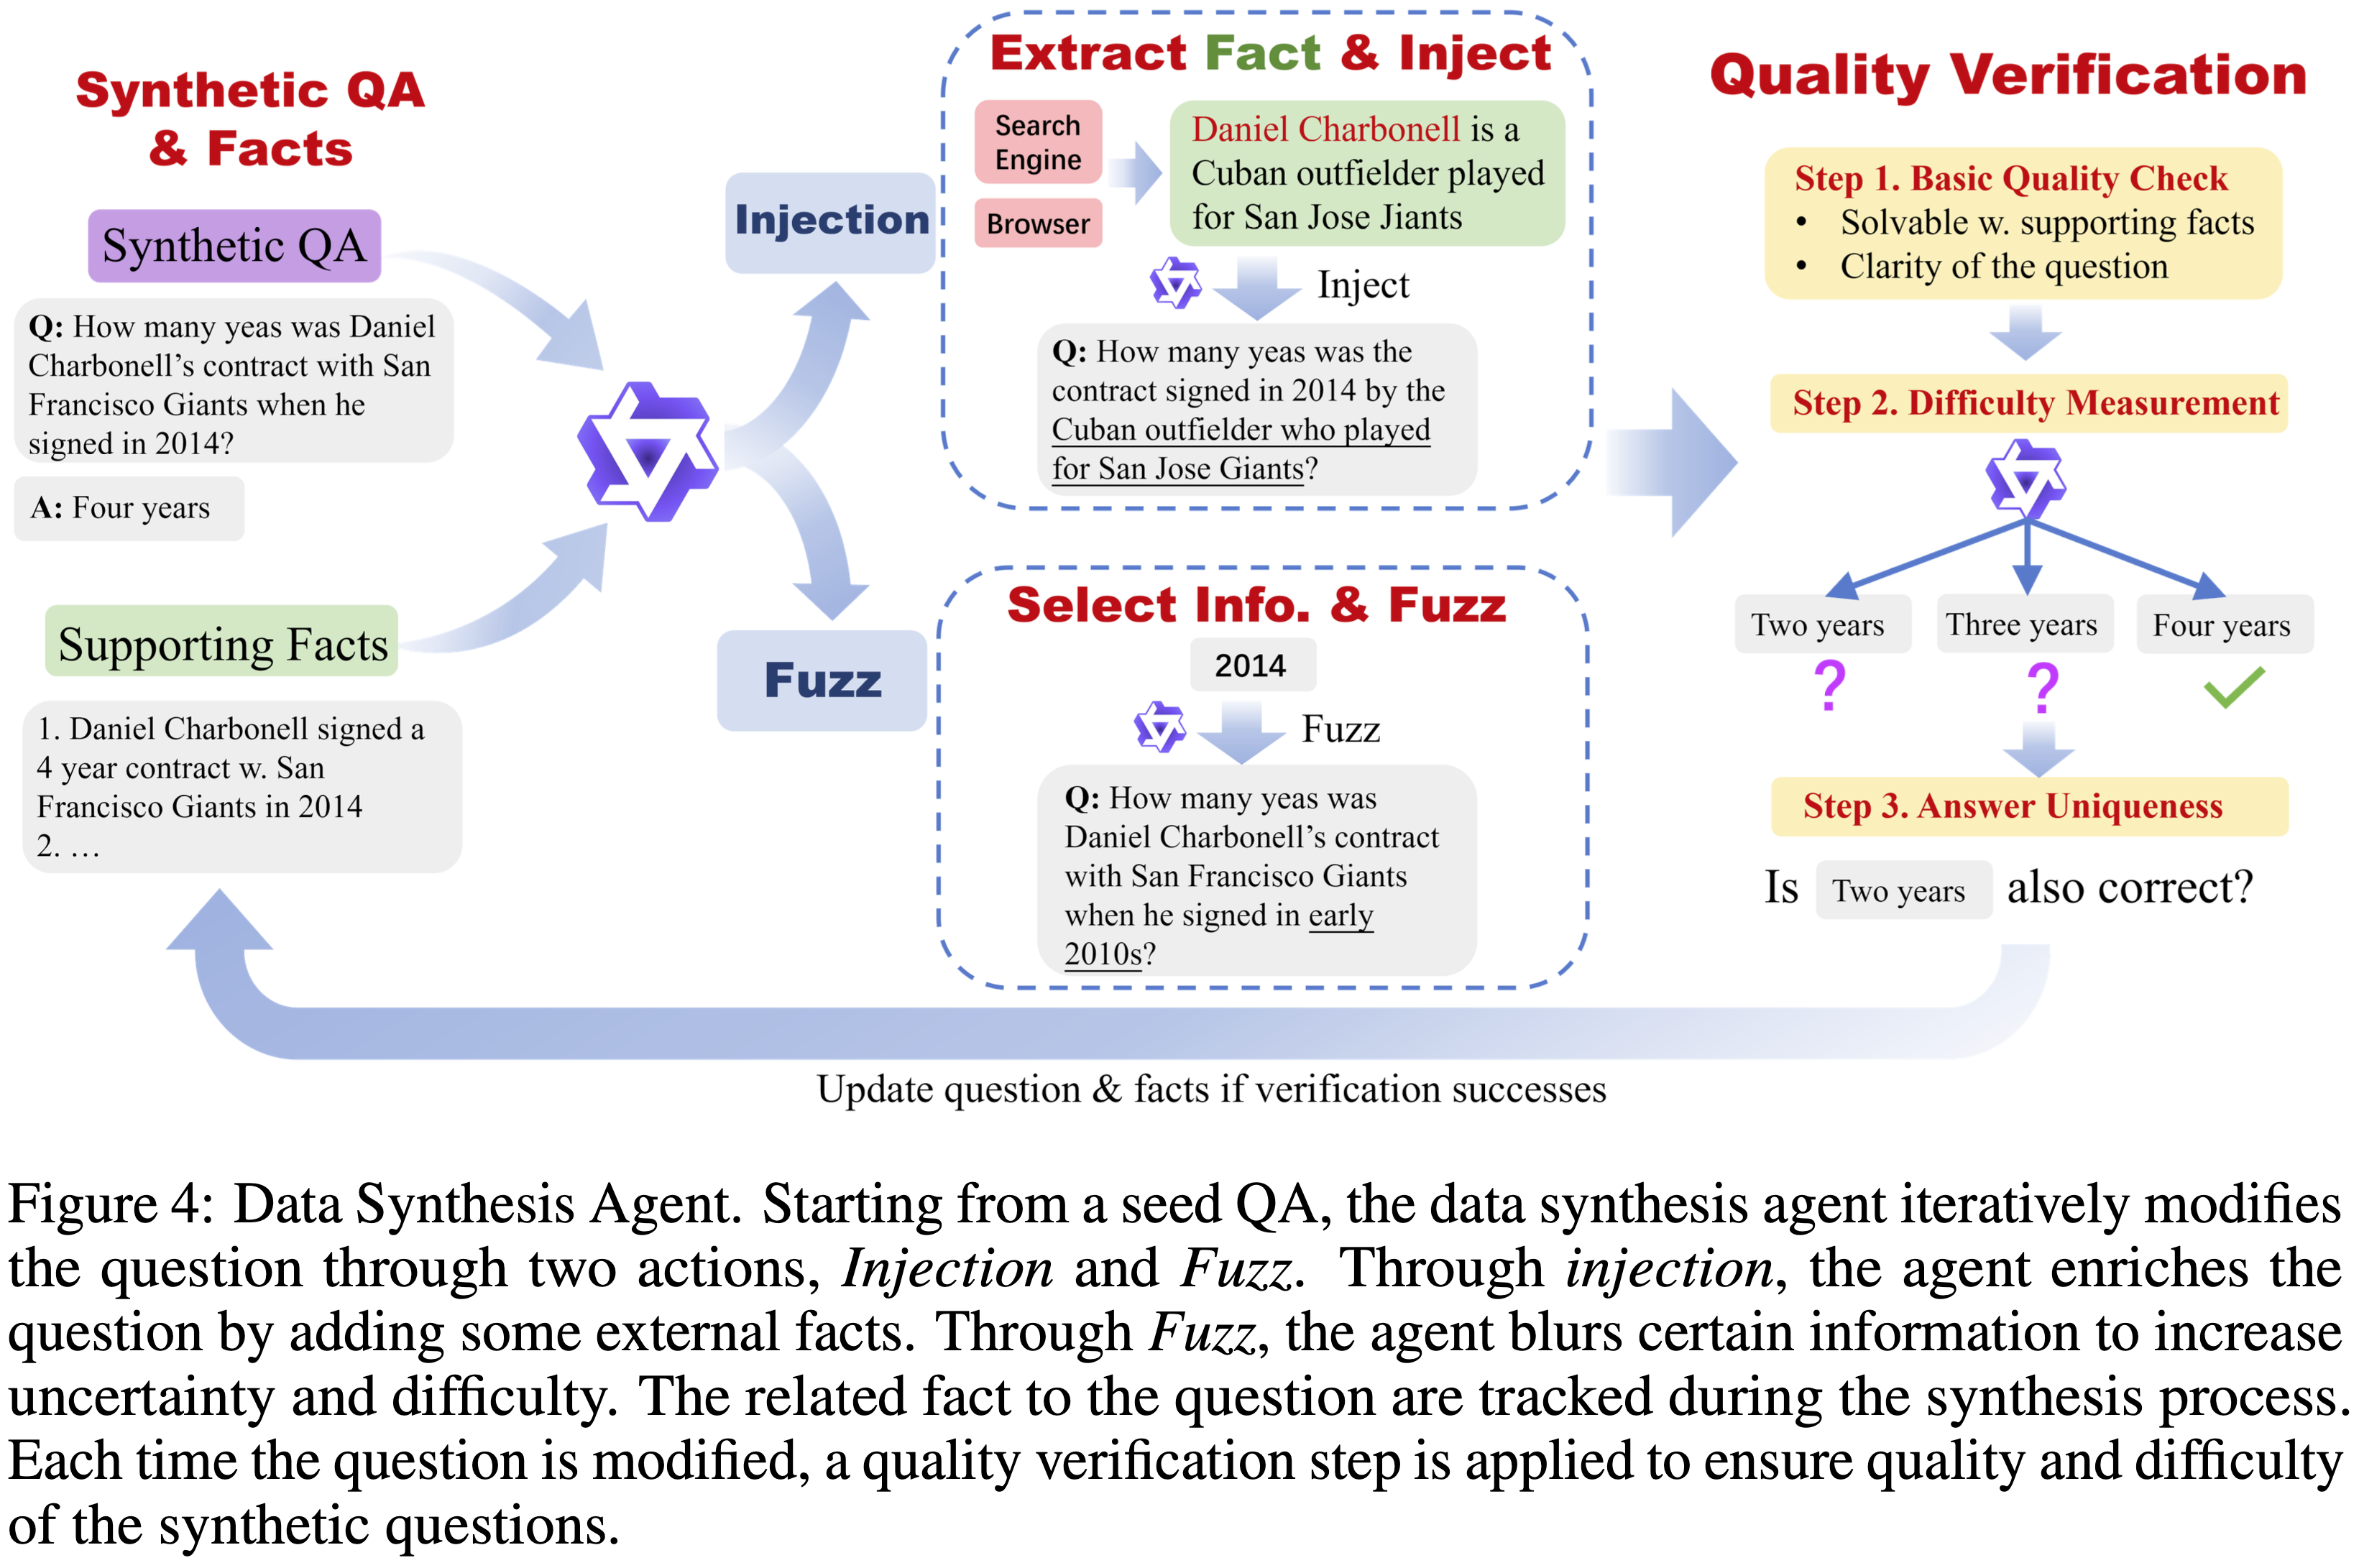
  • 为了确保合成的问题与可靠来源严格对齐,在问题合成过程中获得的一系列支持事实(supporting facts)被保留下来,并持续更新以进行质量验证
  • 在每一步,给定当前的问题和一个支持事实列表,智能体自动在以下两个关键动作之间进行选择:
    • 动作 1:注入(Injection) 旨在通过插入与问题相关的事实来丰富问题的上下文
      • 智能体首先选择问题中的一个实体,然后从外部来源(如维基百科)获取关于该选定实体的一条相关事实
      • 接着,通过将该事实注入到问题中,提出一个新的问题
      • 这个注入动作增加了问题的复杂性
    • 动作 2:模糊化(Fuzzing) 模糊问题中的某些细节,以增加问题的不确定性水平
      • 例如,“Catskill Mountain Railroad”(Catskill 山铁路)可能被替换为 “a historic mountain railway”(一条有历史意义的铁路)
      • 通过多次对问题进行模糊化处理,问题的不确定性水平和难度都会逐渐增加
  • 为了确保合成问题的高质量并精确评估其难度,论文为评估合成问题加入了一个严格的质量验证(quality verification)阶段:
    • 步骤 1. 基本质量(Basic Quality). 论文使用一个 LLM 来评估每个问题的基本质量
      • 此验证包括检查问题的清晰度,并根据支持事实验证问答对的准确性
      • 此质量控制步骤确保每个问答对都正确地基于可靠来源
    • 步骤 2. 难度测量(Difficulty Measurement). 论文使用一个前沿的 LRM(例如 QwQ-32B)直接为合成问题生成多个答案,而不使用任何外部工具
      • 此验证过程也作为问题难度的衡量标准
    • 步骤 3. 答案唯一性(Answer Uniqueness). 模糊化动作可能会过度放松约束,损害答案的唯一性
      • 为了防止因多个正确答案而产生的歧义,论文评估在难度测量步骤中生成的任何 mismatched answers 是否可以作为替代的有效答案
  • 论文在表 1 中提供了两个说明性示例。从一个简单的问题开始,注入动作用相关的事实细节替换特定的实体
    • 例如,“Michael P. Hein” 被扩展为 “who served as the first County Executive of Ulster County, New York…”
    • 模糊化动作通过泛化精确信息来引入模糊性,例如将确切的年份 “1934” 替换为 “the early 1930s”,或者将 “Catskill Mountain Railroad” 替换为 “a historic mountain railway”
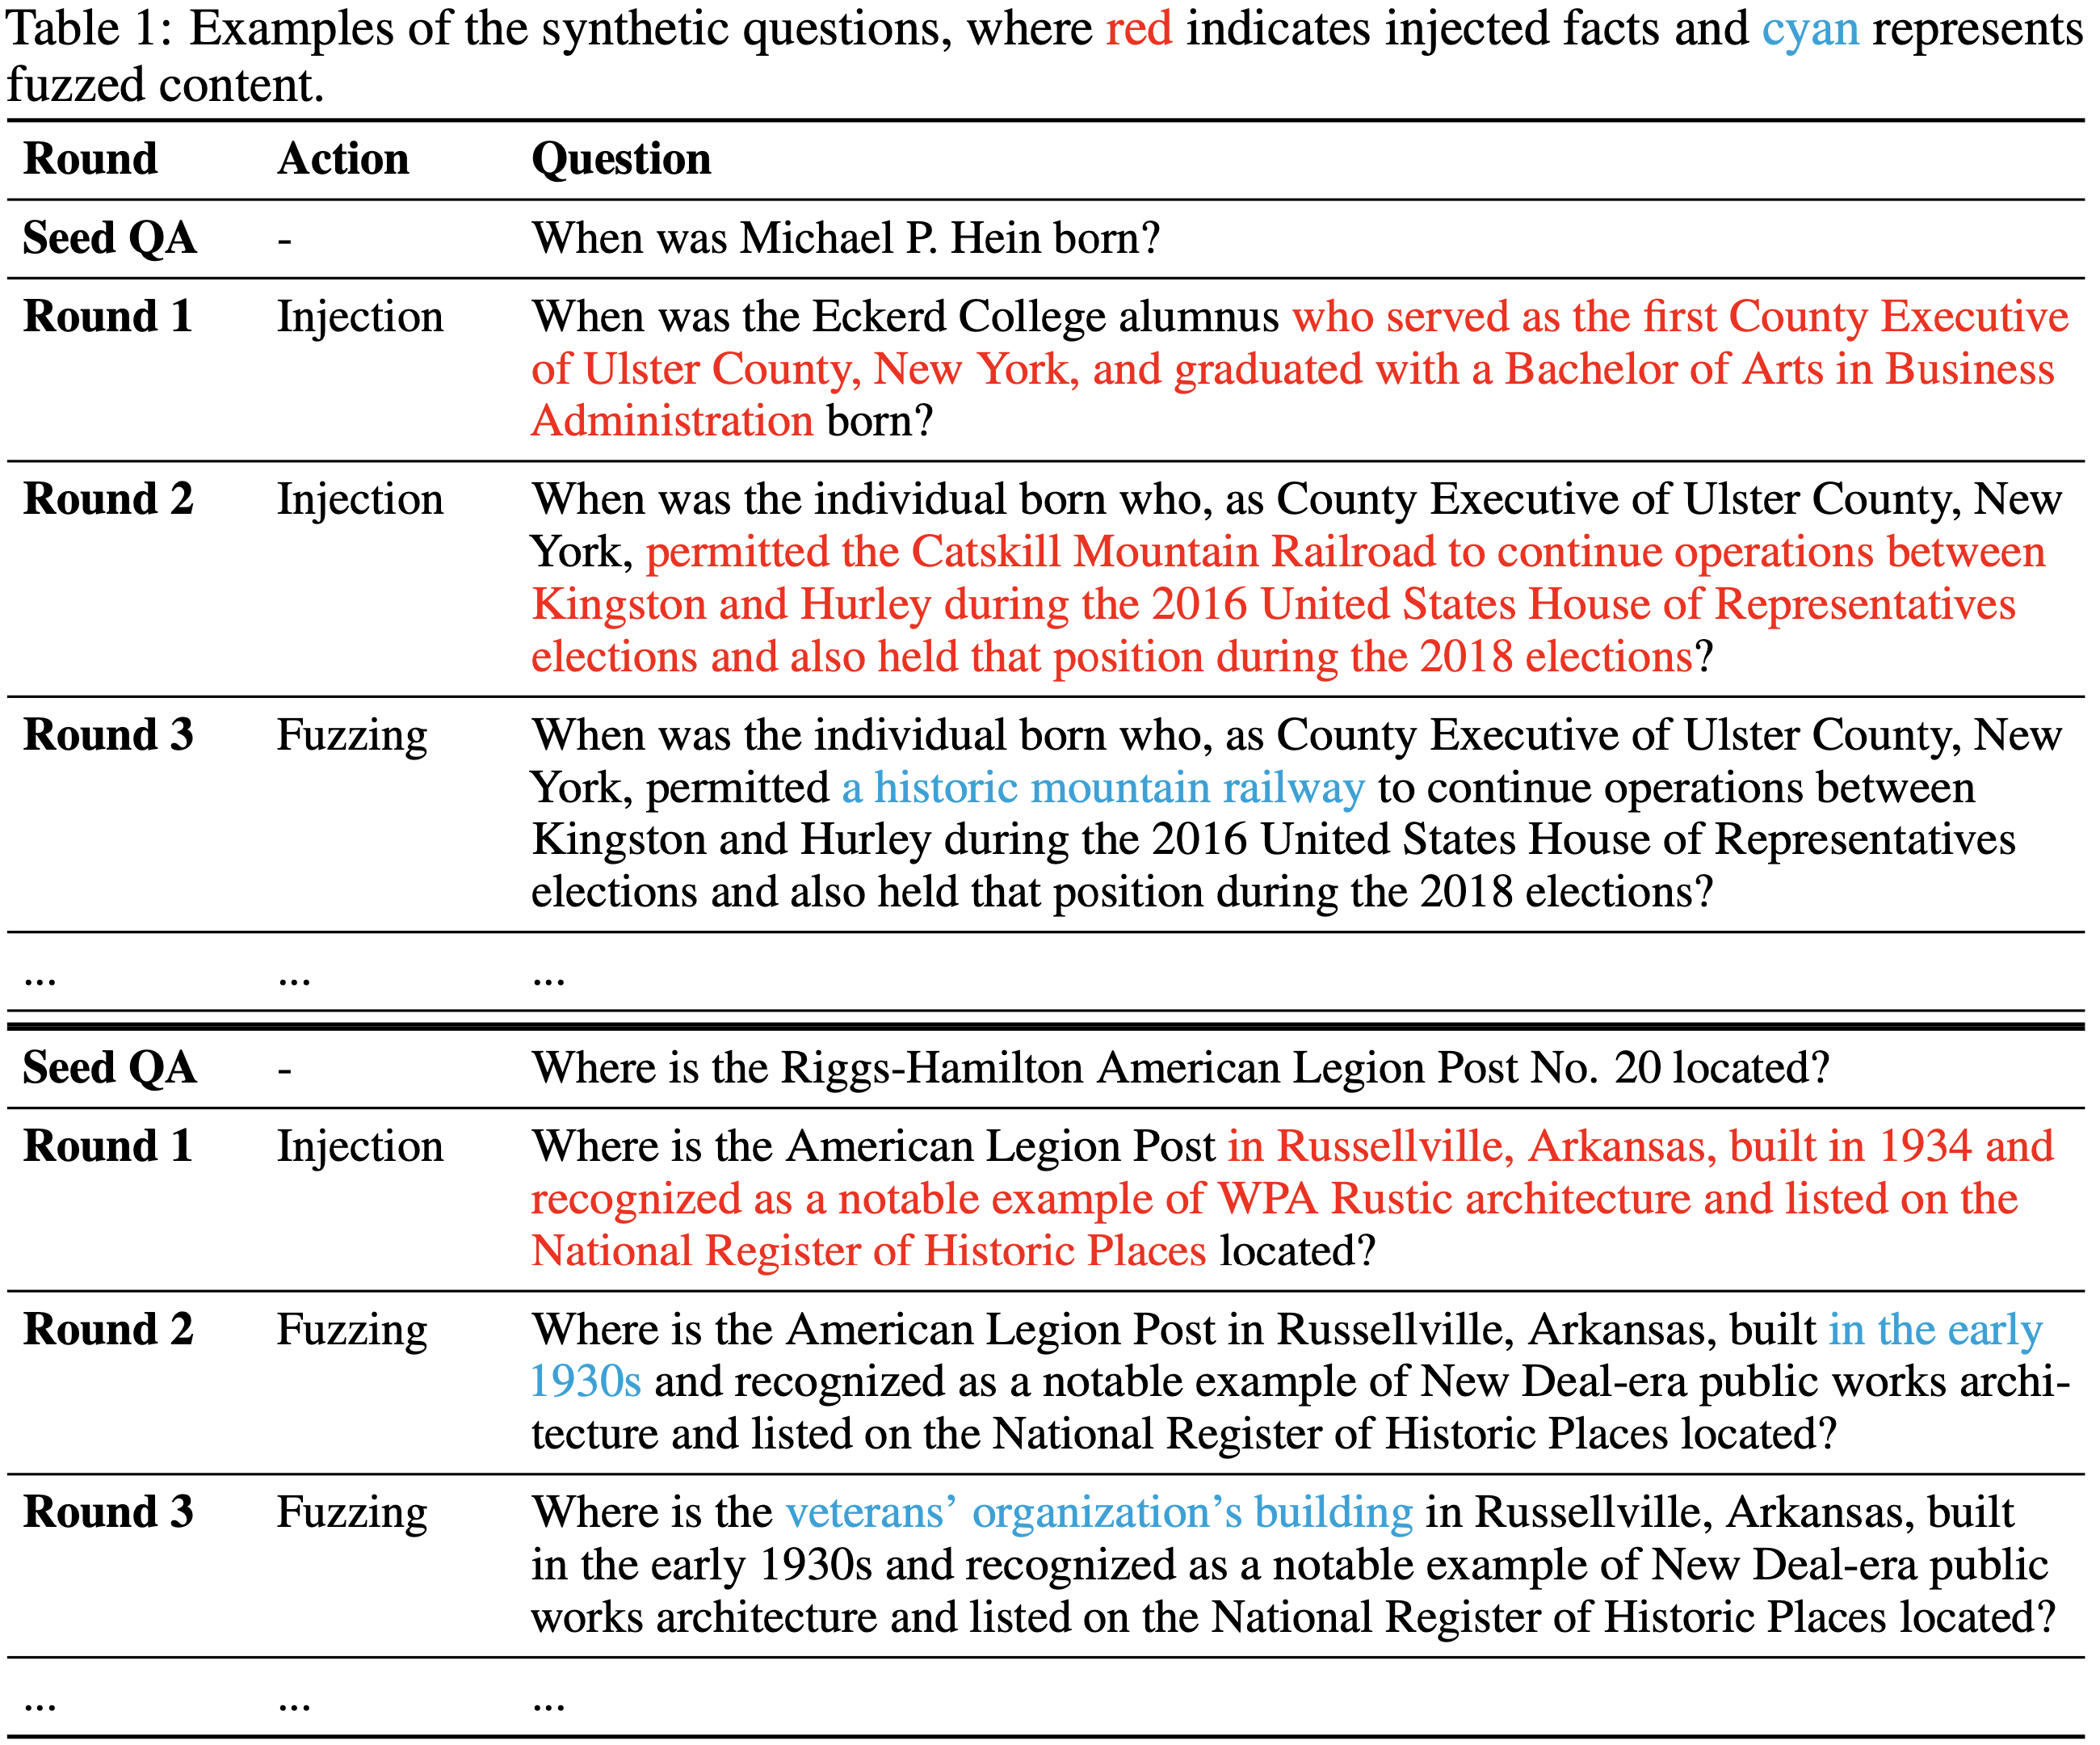
  • 通过迭代的注入和模糊化,数据合成智能体产生出涉及复杂信息和高不确定性的问题,需要大量的搜索和推理才能找到正确答案
    • 在完成问题合成过程后,论文过滤掉那些 LRM 可以不依赖搜索工具直接生成正确答案的问题
    • 由于这些问题仅基于模型的内在知识就能回答,它们对于增强搜索能力几乎没有价值
  • 从 14,107 个种子问题开始,论文对每个问题平均执行了 6.3 次注入和 3.2 次模糊化
    • 从合成池中,论文为每个种子问题最多选择三个高质量的变体
    • 这个筛选过程产生了包含 25,624 个条目的最终数据集,所选问题平均每个包含 4.27 次注入和 2.10 次模糊化

Asynchronous Agentic RL Training

Challenges of Scaling Up Trajectory Length in RL
  • 实验表明复杂任务需要大量的工具调用,因此具有较大轮次限制的 RL 训练对于训练高级搜索智能体是必要的
  • 训练期间轨迹执行时间的方差很大,这可能导致批量生成 RL 系统出现显著的闲置时间
  • 复杂任务需要长轨迹 (Complex Tasks Require Long Trajectories).
    • 智能体任务通常需要大量的 LLM 生成和多次工具调用来解决复杂问题,导致轨迹执行时间延长
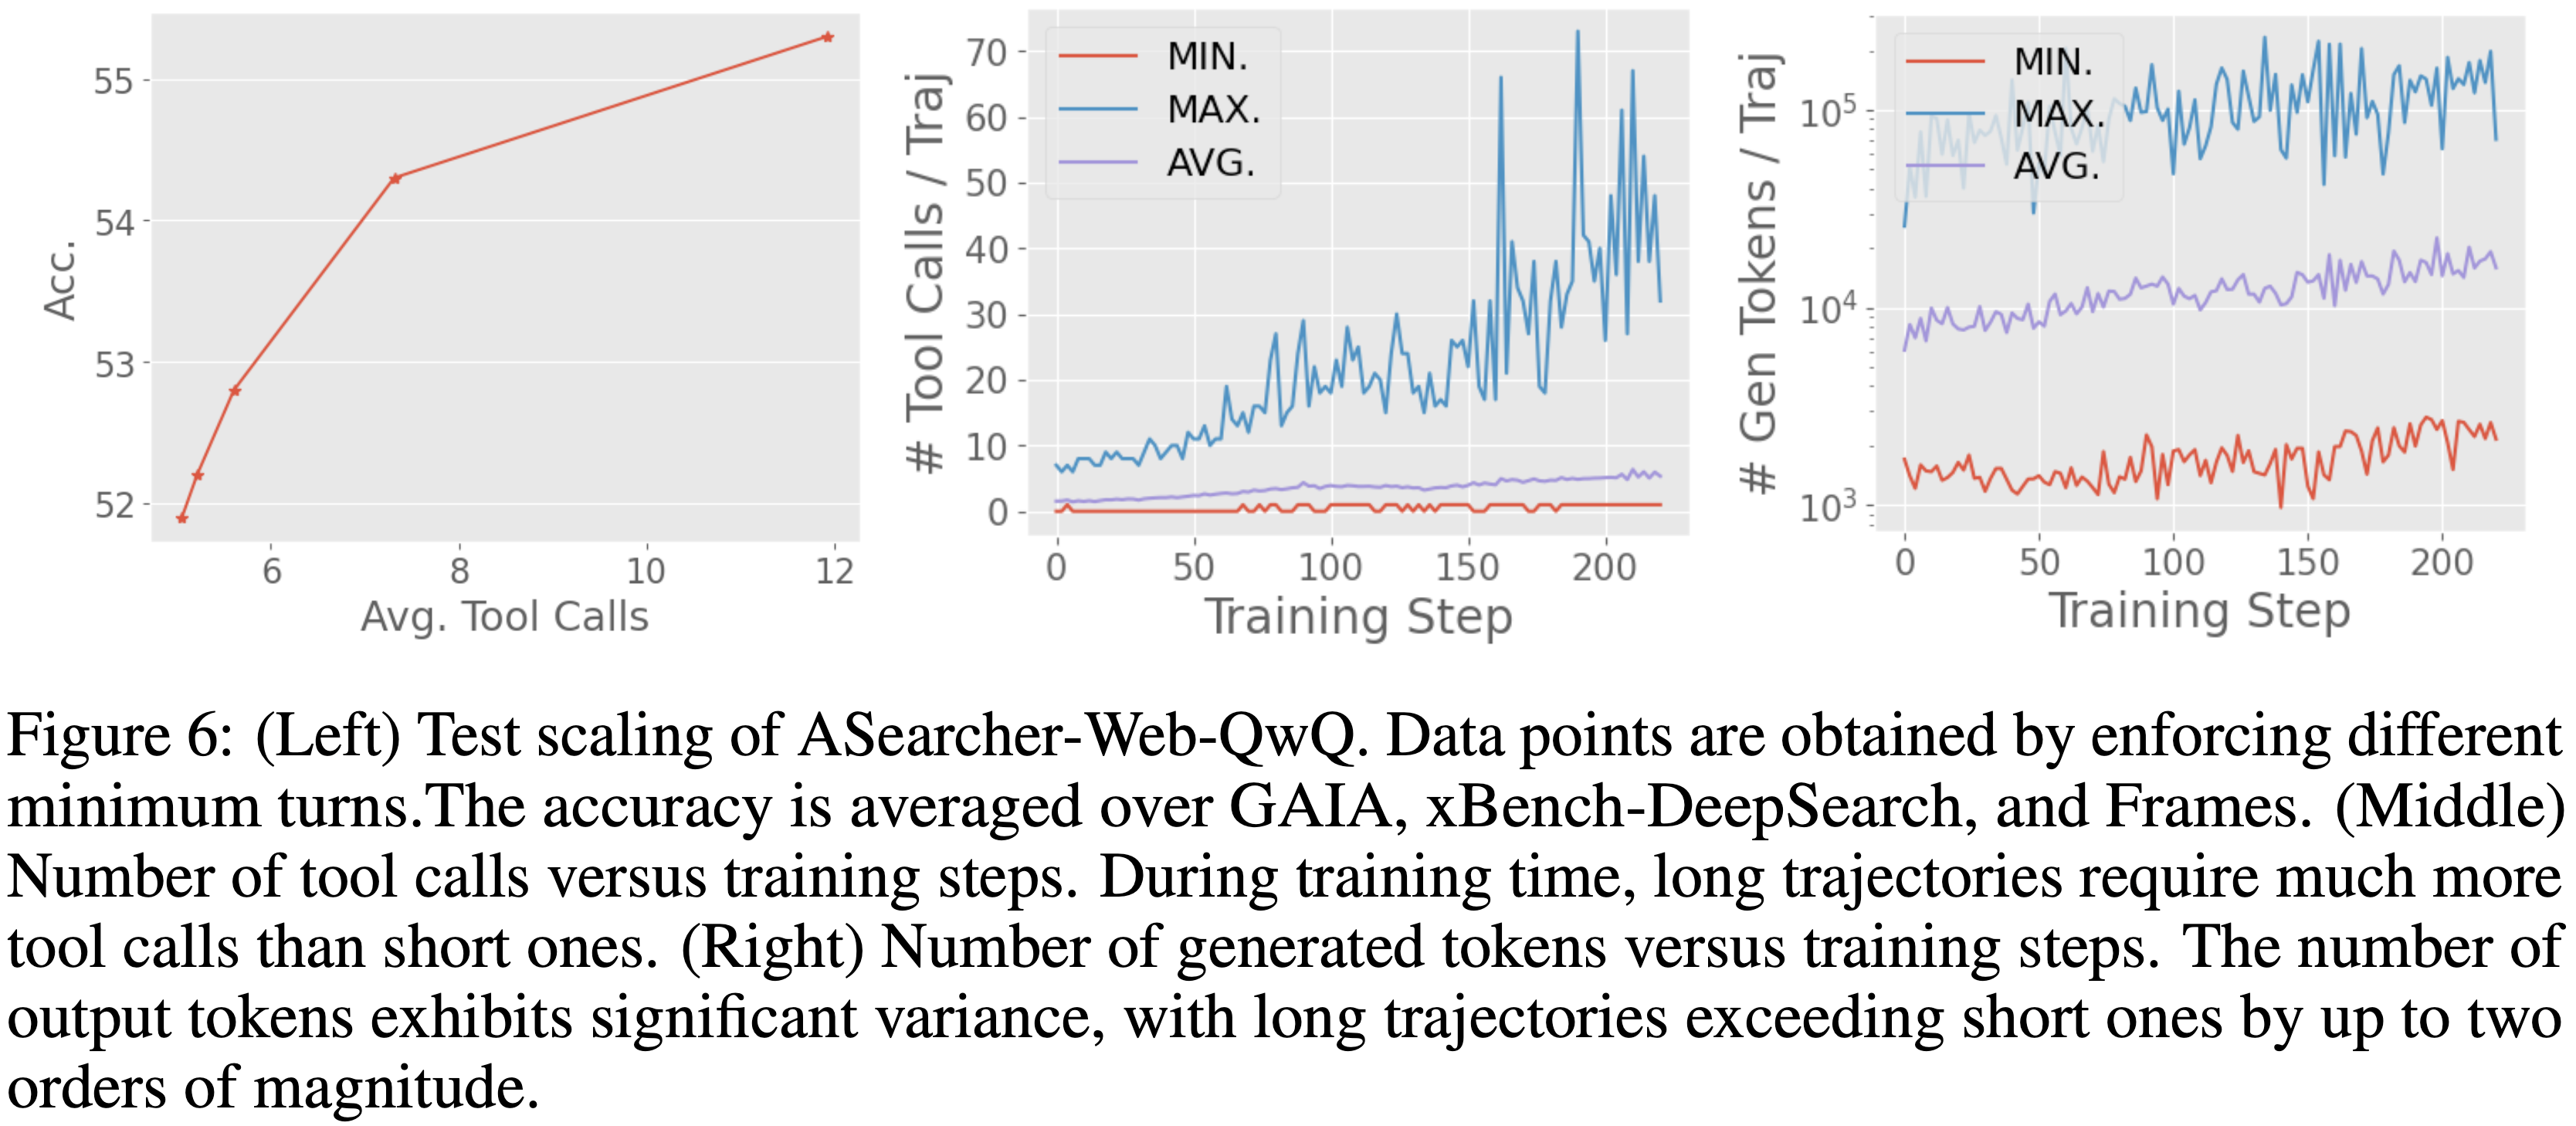
    • 如图 6(左)所示,论文在 GAIA (2023)、xBench-Deepsearch (2025) 和 Frames (2024) 上评估了论文经过 RL 训练的 QwQ-32B 智能体,强制智能体使用不同最小轮次数量的工具
    • 结果表明,准确率随着轮次的增加而提高,证实了复杂任务需要更长的轨迹来进行有效的问题解决
  • 轨迹执行时间的高方差 (High Variance in Trajectory Execution Time).
    • 长轨迹也带来了执行时间的显著方差
    • 论文分析了 QwQ 智能体 RL 训练期间的工具调用次数和 Token 生成数量(图 6),观察到最长的轨迹可能比短轨迹多出数十次工具调用和两个数量级以上的 Token
    • 这种差异导致每个轨迹的运行时间高度不可预测,进一步降低了训练效率
  • 智能体 RL 训练的效率问题 (Efficiency Issues of Agentic RL Training).
    • 长时间的执行和高运行时间方差都会降低 RL 训练效率
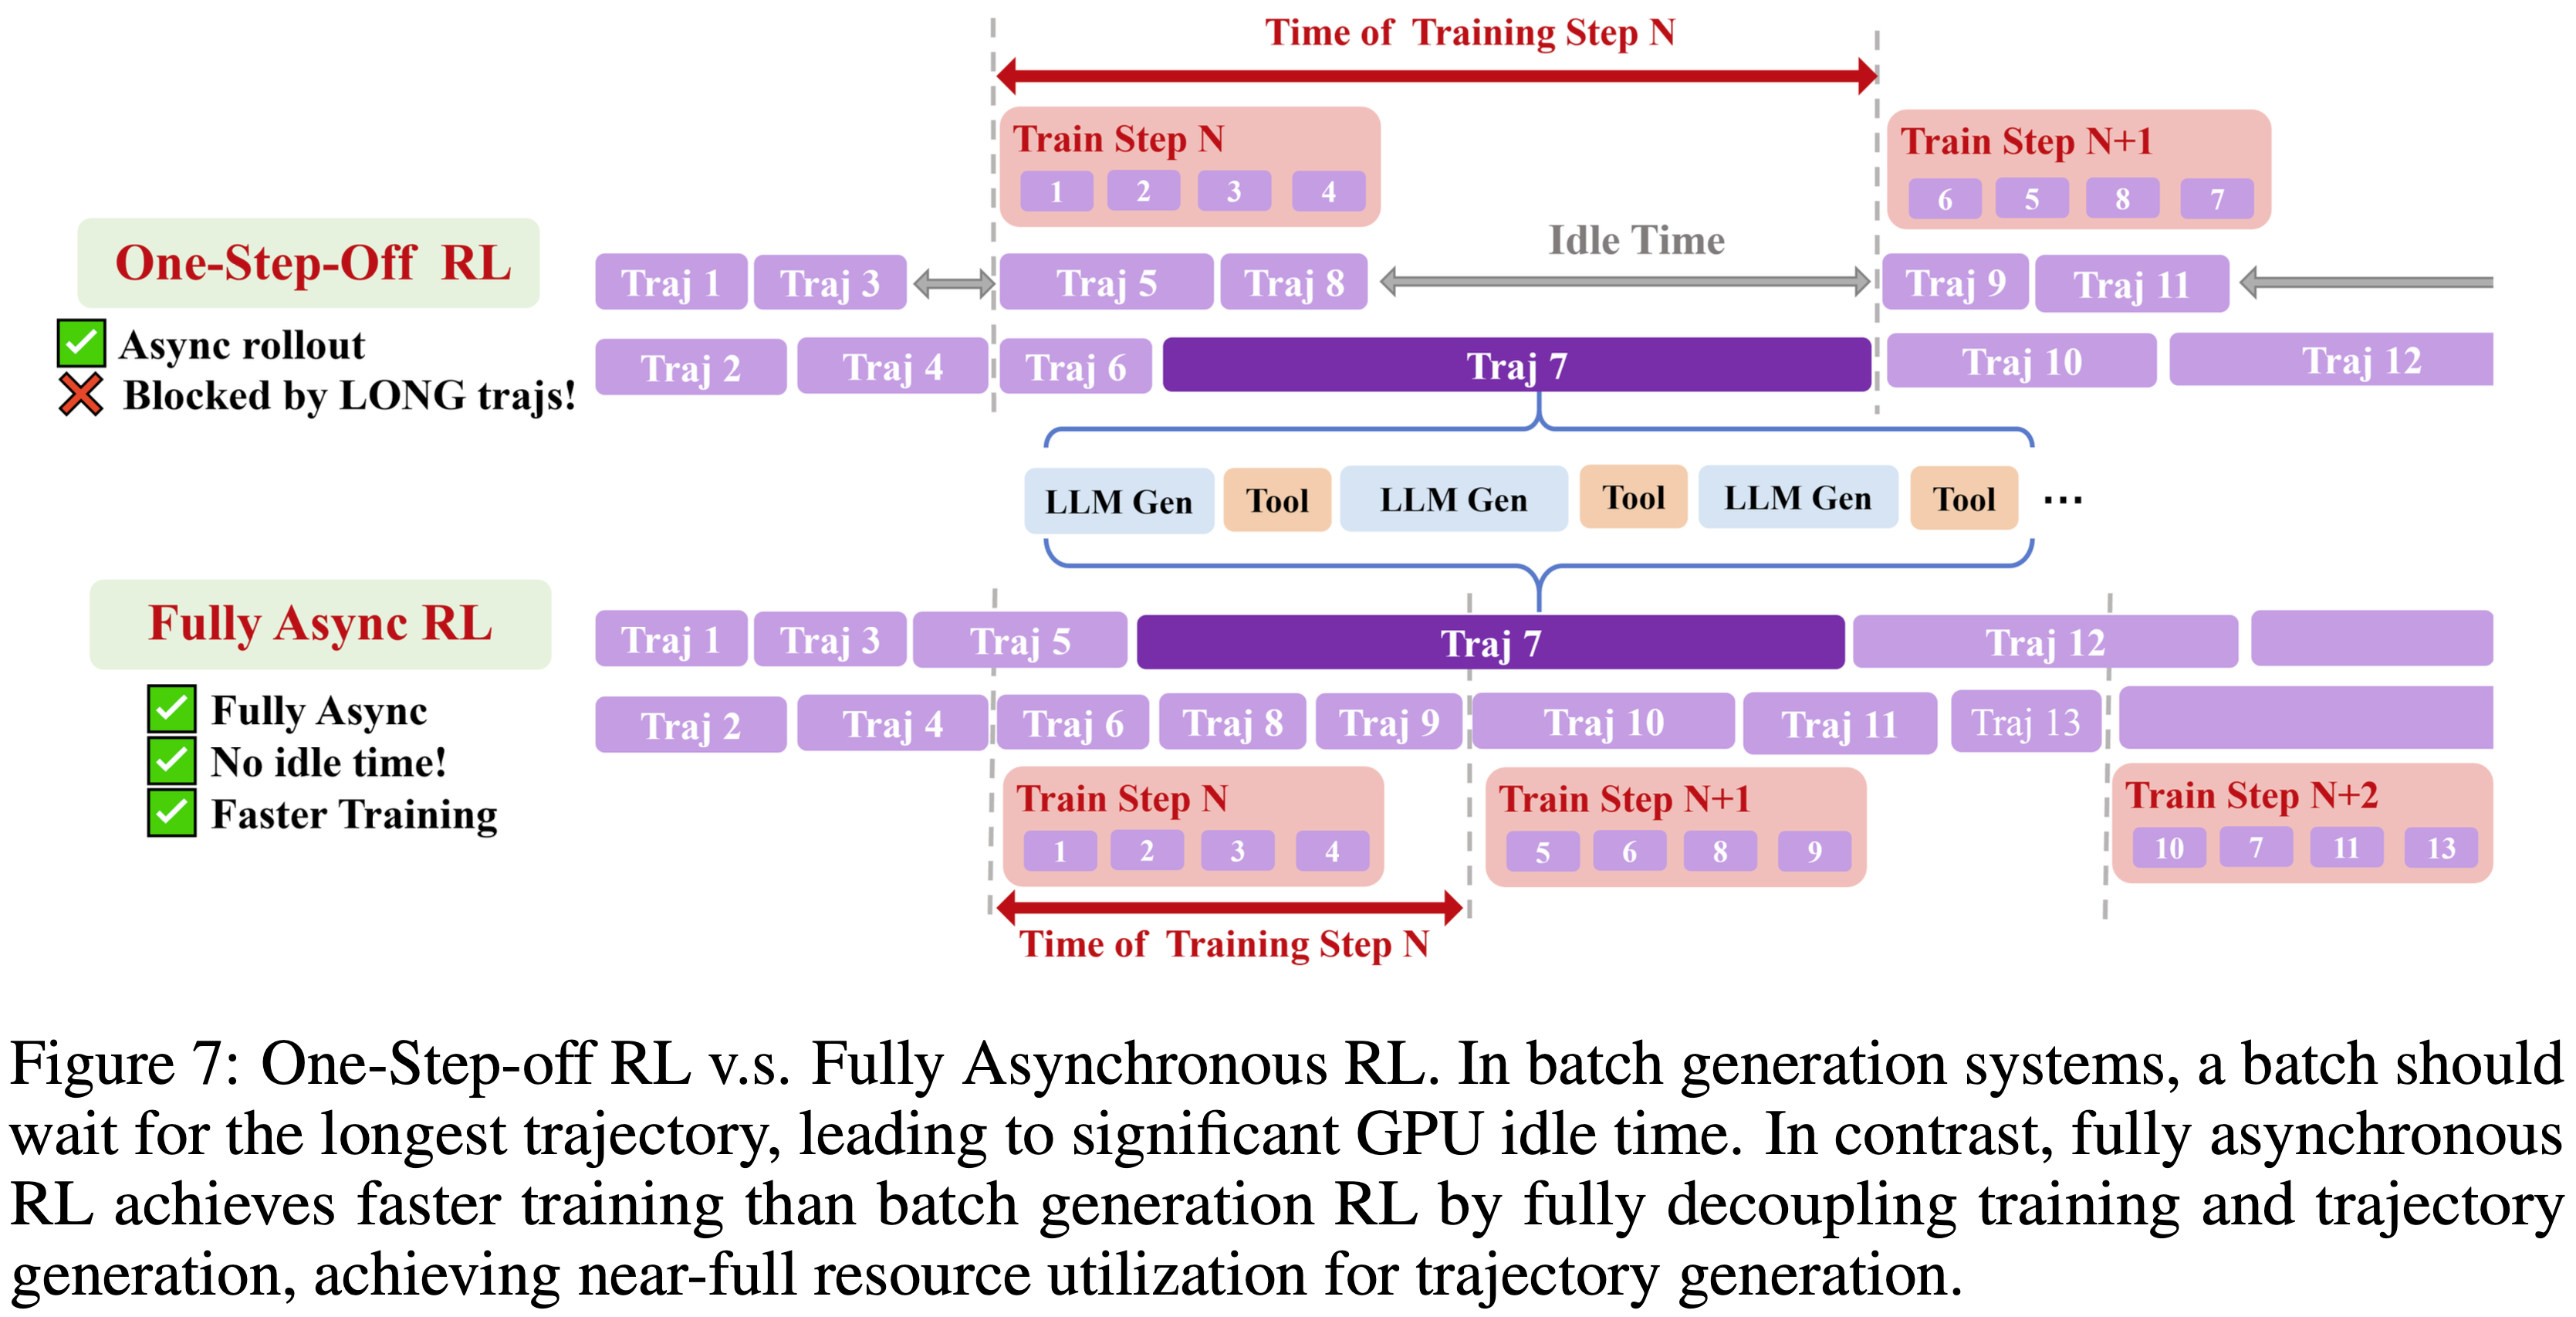
    • 论文以 one-step-off RL 训练系统 (one-step-off RL training system,也称为 One-Off,来自 DeepCoder,2025) 作为批量生成 RL 系统的代表性例子
      • 参考链接:DeepCoder: A Fully Open-Source 14B Coder at O3-mini Level
    • 在 one-step-off RL 训练中,第 N 步的训练和第 N+1 步的轨迹生成是并发执行的
    • 如图 7 所示,尽管该系统将轨迹 rollout 与模型训练重叠,但批量生成仍然受限于最慢的轨迹(例如轨迹 7),导致 GPU 闲置时间和利用率不足
完全异步 RL 训练 (Fully Asynchronous RL Training).
  • 为了确保高效的智能体 RL 训练,论文采用了完全异步的训练范式
    • 论文的方法在两个不同方面引入了异步
  • 异步轨迹 Rollout (Asynchronous Trajectory Rollouts).
    • 轨迹 rollout 是并行收集的,并且不直接相互干扰
    • 每个轨迹独立地向相应服务器发送工具调用请求,并向 LLM 推理引擎发送 LLM 生成请求
    • 来自不同轨迹的并发请求由服务器自动处理
    • 完全独立的轨迹执行确保了一个轨迹在生成 LLM 响应和等待工具调用响应时不需要等待其他轨迹,从而提高了训练效率
  • 解耦的 Rollout 和训练 (Decoupled Rollout and Training).
    • 除了异步 rollout 之外,轨迹 rollout 和模型更新也是完全解耦的
    • 在图 7 中,论文将论文的完全异步 RL 训练与 one-step-off RL 训练进行了比较,后者在批次内利用异步 rollout
    • 在完全异步 RL 训练中,长轨迹不会阻塞生成,并且可以跨越多个版本,显著减少了 GPU 闲置时间,并在生成过程中实现了近乎完全的 GPU 利用率
    • 在训练侧,一旦收集到足够的轨迹形成一个批次,就会立即启动一个训练步骤
    • 如图 7 所示,训练过程不会等待极长的轨迹 7,而是继续处理轨迹 9

Training Details

  • MDP 公式化 (MDP Formulation). 论文遵循马尔可夫决策过程(Markov Decision Process, MDP)的公式化
    • 形式上,一个 MDP 由元组 \((S,A,T,R)\) 定义
      • \(S\) 代表状态空间,通常包含历史记录、搜索结果和检索到的网页
      • \(A\) 表示动作空间,一个动作包括智能体生成的 Token
        • 一些工具调用可以通过特定的标签从动作中提取,例如 <search> search query </search>
      • \(T(s^{\prime}|s,a)\) 是转移概率:其中 \(s^{\prime}\) 是在状态 \(s\) 应用动作 \(a\) 中的工具调用后的更新状态
    • 在每个时间步,智能体接收一个状态 \(s_{t}\),并根据策略 \(\pi:S\to A\) 生成一个动作 \(a_{t}\)
    • 智能体的目标是最大化回报
      $$ J(\pi)=\mathbb{E}\left[\sum_{t=0}^{\infty}R(s_{t},a_{t})\bigg{|}a_{t}\sim\pi(s_{t})\right]$$
  • GRPO 训练 (GRPO Training). 论文采用 GRPO (2024) 算法来训练搜索智能体
    • 对于每个输入问题 \(x\),生成 \(G\) 个轨迹 \(\tau_{1},\tau_{2},\cdots,\tau_{G}\)
      $$ \tau_{i}=(s^{i}_{0},a^{i}_{0},s^{i}_{1},\cdots,s^{i}_{T_{i} }) $$
    • 为了优化智能体,论文采用以下损失函数:
      $$
      \begin{align}
      \mathcal{J}_{GRPO}(\theta)=\mathbb{E}_{x\sim\mathcal{D}_{\epsilon}\{\tau_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(:\left|x\right\rangle}\left[\frac{ 1}{G}\sum_{i=1}^{G}\frac{1}{\sum_{t=0}^{T_{i}-1}|a^{i}_{t}|}\sum_{t=0}^{T_{i}-1}\sum_{j=1}^{|a^{i}_{t}|}\min\left(\frac{\pi_{\theta}(a^{i}_{t,j}|s_{t},a^{i}_{t,< j})}{\pi_{\theta_{old} }(a^{i}_{t,j}|s_{t},a^{i}_{t,< j})}\hat{A}_{i},\right.\right. \left.\left.\text{clip}\Bigg{(}\frac{\pi_{\theta}(a^{i}_{t,j}|s_{ t},a^{i}_{t,< j})}{\pi_{\theta_{old} }(a^{i}_{t,j}|s_{ t},a^{i}_{t,< j})},1-\epsilon ,1+\epsilon \Bigg{)}\hat{A}_{i}\Bigg{)}\right]\right.
      \end{align} \tag{1}
      $$
      • 其中 \(\epsilon\) 是一个超参数,\(\hat{A}_{i}\) 是第 \(i\) 个轨迹的优势函数(Advantage),基于每个组内所有轨迹的相对奖励计算得出
  • 动态过滤 (Dynamic Filtering). 为了提高训练效率,论文实施了动态过滤,以排除缺乏有意义的训练信号的 Query
    • 具体来说,论文移除所有响应产生相同奖励(导致优势为零)的 Query ,包括智能体已经达到高准确率的 Query 和答案标记错误的 Query
  • 奖励函数 (Reward Function). 对于奖励函数,论文采用稀疏奖励(Sparse-reward)设置,在轨迹完成时计算奖励
    • 若从基础 LLM 开始训练 ,奖励函数通过乘法结合了格式奖励(Format Reward)和 F1 分数
      • 问题:这里的 F1 分数是什么?是工具调用相关 精确率 和 召回率 的衡量吗?
      • 回答:从下文来看,是的
    • 若基于 LRM 的智能体(例如 QwQ)进行微调,论文使用 LLM-as-Judge (2023; 2024) 作为奖励函数,并省略格式奖励,因为这些模型本身就保持了适当的输出格式

Experiments

Experiment Setup

  • 基准测试 (Benchmarks)
    • 论文首先在单跳和多跳问答任务上评估智能体
      • 对于单跳问题,论文使用 Natural Questions (2019)、TriviaQA (2017) 和 PopQA (2022)
      • 对于多跳问题,论文使用 HotpotQA (2018)、2WikiMultiHopQA (2020)、MuSiQue (2022) 和 Bamboogle (2022)
    • 论文进一步在更具挑战性的基准测试上进行了评估,包括 Frames (2024)、GAIA (2023) 和 xBench-DeepSearch (2025) 作为额外的测试集
      • 从 HotpotQA、2WikiMultiHopQA 和 MuSiQue 的验证集中随机抽取 1000 个实例进行评估
      • 对于 Bamboogle、Frames、GAIA 和 xBench-DeepSearch,论文使用其完整的测试集
      • 对于 GAIA,论文使用来自纯文本验证子集 (2025) 的 103 个示例
  • 搜索工具 (Search Tools)
    • 论文在两种设置下评估搜索智能体,每种设置使用不同类型的搜索工具
      • **带有 RAG 的本地知识库 (local knowledge base with RAG)**的交互:智能体与本地部署的 RAG 系统交互,从一个 Wikipedia 2018 语料库 (2020) 中检索相关信息
      • 基于网络的搜索和浏览 (web-based search and browsing) 的交互:智能体在交互式网络环境中运行,可以访问搜索引擎和浏览器工具
        • 对于更具挑战性的基准测试 GAIA、xBench-DeepSearch 和 Frames,论文仅在此基于网络的设置下进行评估
  • 基线 (Baselines)
    • 论文考虑与两类基准测试相对应的两组基线
      • 对于多跳和单跳问答基准测试,包括 Search-R1(7B/14B/32B) (2025)、R1-Searcher(7B) (2025)、Search-o1(QwQ-32B) (2025)、DeepResearcher (2025) 和 SimpleDeepSearcher (2025)
        • 还直接提示 Qwen-2.5-7B/32B 在不使用任何工具的情况下生成答案
      • 在更具挑战性的基准测试上,论文与强大的 32B 规模模型进行比较,包括直接使用 QwQ-32B 生成、Search-o1(QwQ-32B) (2025)、Search-R1-32B (2025)、WebThinker-QwQ (2025)、SimpleDeepSearcher-QwQ (2025) 和 WebDancer-32B (2025)
      • 所有基线都使用与论文智能体相同的工具进行评估,以确保公平比较
  • Evaluation metrics
    • 论文采用两个互补的评估指标:F1 分数和 LLM-as-Judge (LasJ)
    • F1 分数在词级别(Word Level)计算,衡量预测答案和参考答案之间的精确率和召回率的调和平均数
    • 对于 LLM-as-Judge,论文提示一个强大的 LLM (Qwen2.5-72B-Instruct) 根据特定任务的指令评估模型输出的正确性
    • 在 GAIA、xBench-DeepSearch 和 Frames 上,论文仅使用 LLM-as-Judge 并报告所有模型的 Avg@4 和 Pass@4 分数
  • ASearcher 的训练细节 (Training Details of ASearcher)
    • 轮次限制:7B 和 14B 模型为 32,ASearcher-Web-QwQ 为 128
    • 批次大小:7B 和 14B 模型为 128,ASearcher-Web-QwQ 为 64
    • 论文整理了两组训练数据,一组用于 7B/14B 训练,另一组用于 QwQ-32B 训练
      • 这两个数据集大小均为 35k 并已开源
      • ASearcher-Web-QwQ 的训练大约需要 7.6k H800 GPU 小时

Main Results

  • 论文在三种评估设置下展示了主要的实验结果:
    • (1) 在标准问答基准测试上使用带有检索增强生成 (RAG) 的本地知识库
    • (2) 在相同基准测试上使用基于网络的搜索和浏览
    • (3) 在更具挑战性的基准测试上使用基于网络的搜索和浏览
  • ASearcher ,实例化为 Qwen2.5-7B、Qwen2.5-14B 和 QwQ-32B,在 F1 和 LasJ 指标上始终优于相同模型规模的现有开源智能体
    • ASearcher-14B 在一系列多跳和单跳问答基准测试上取得了 7B、14B 和 32B 模型中的最佳性能,并且 ASearcher-QwQ 在这些具有挑战性的基准测试上显著优于几个规模相当的有力基线
    • 这些结果突显了 ASearcher 在不同任务和模型规模上的通用性和可扩展性
  • 在标准问答基准测试上使用带有 RAG 的本地知识库 (Local Knowledge Base with RAG on Standard QA Benchmarks)
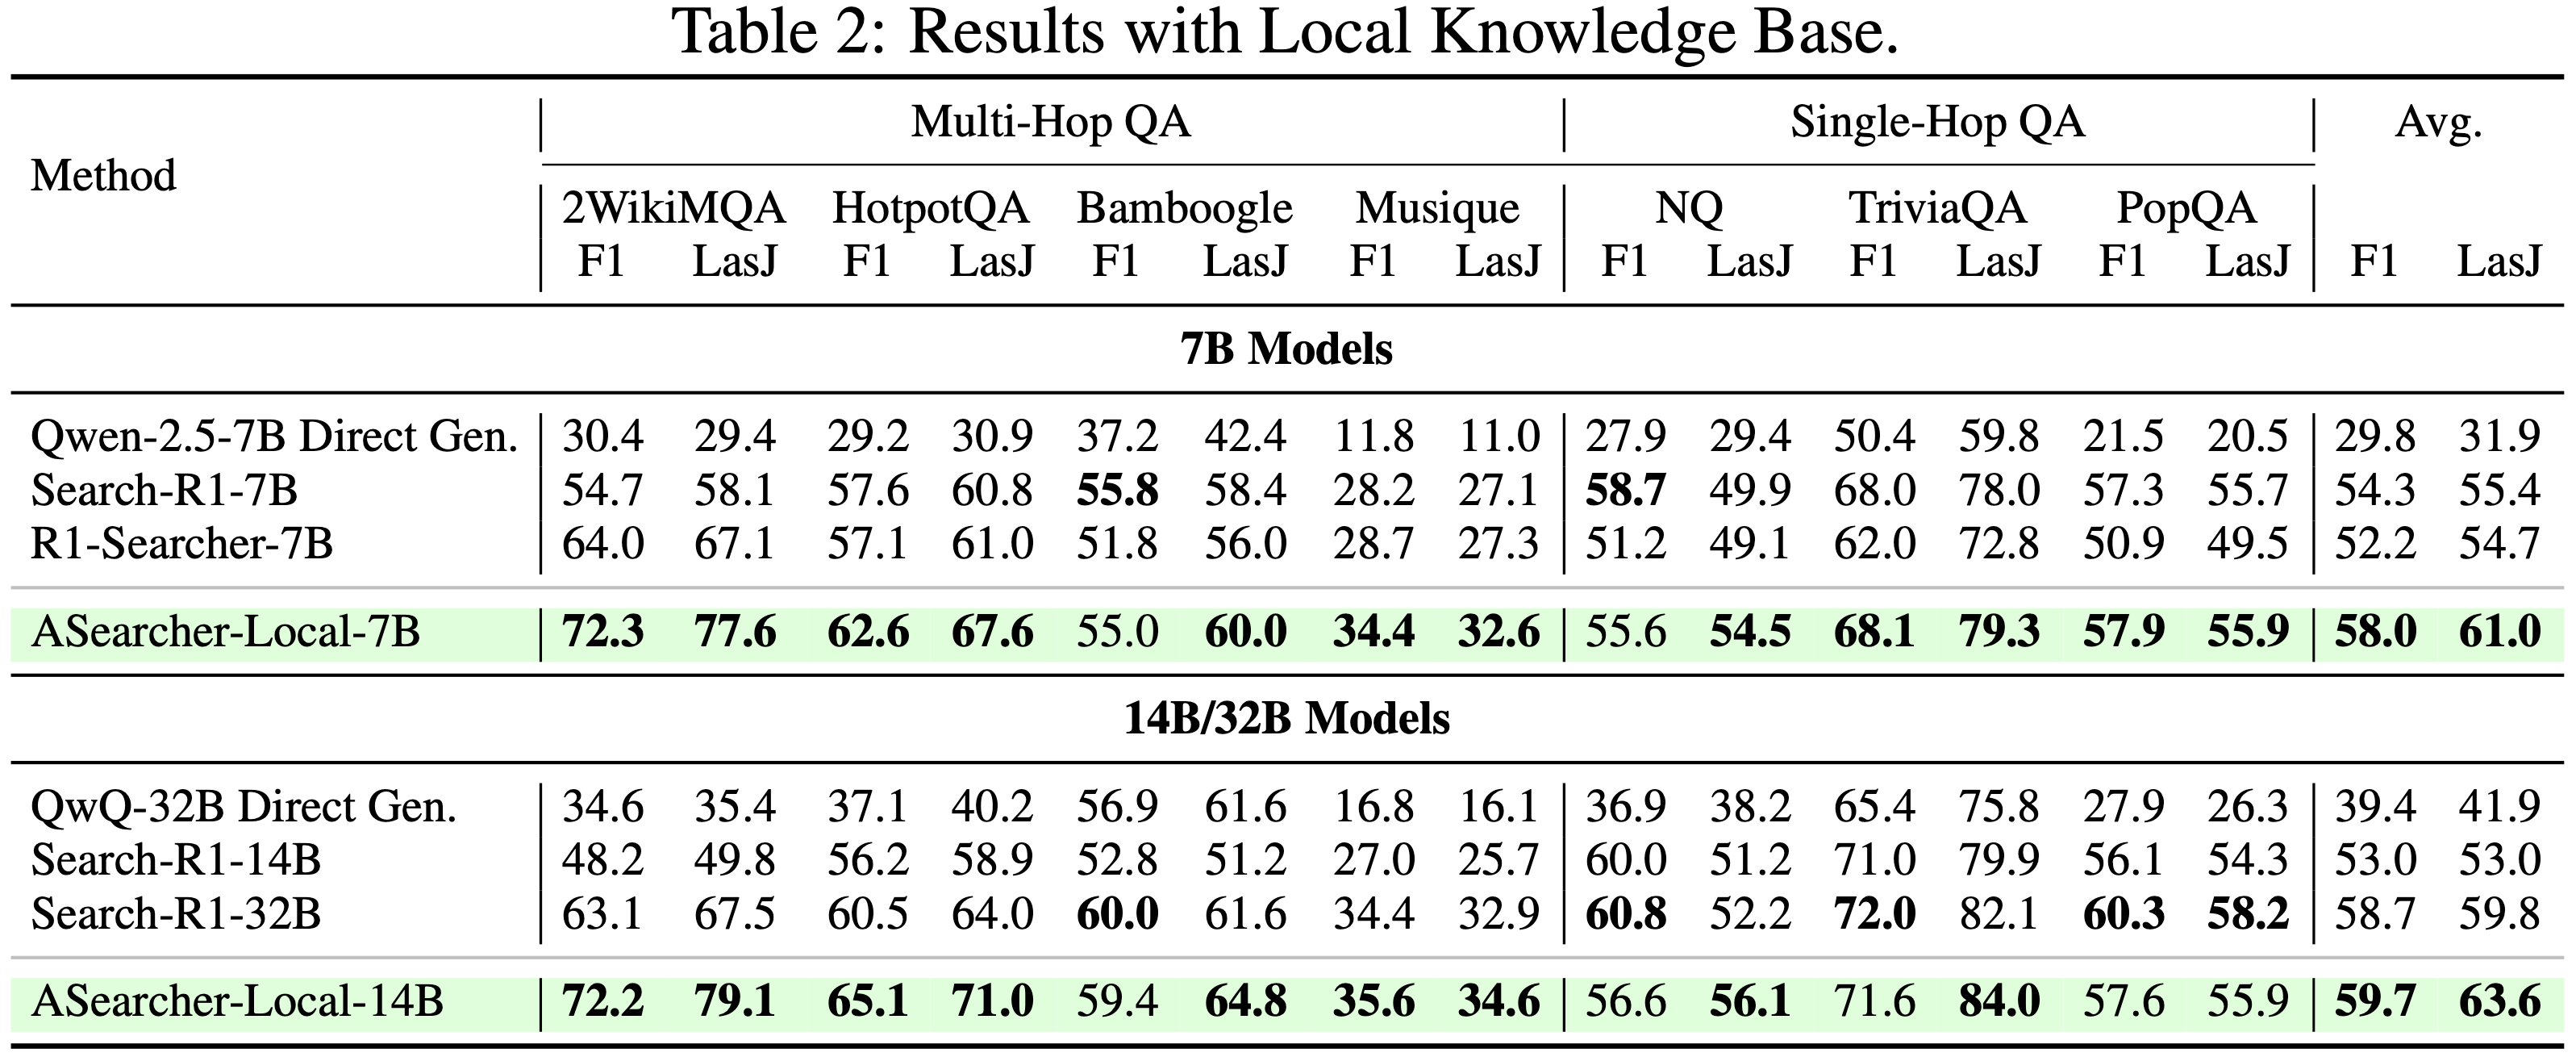
    • 如表 2 所示,通过强化学习在本地知识库上训练的 ASearcher-Local,在一系列多跳和单跳问答基准测试上,在 7B 和 14B 规模上均取得了最佳性能
      • 在 7B 设置下,ASearcher 的平均 F1 达到 58.0 ,优于 Search-R1-7B (54.3) 和 R1-Searcher-7B (52.2) 等强基线
        • 其 LasJ 分数也达到 61.0 ,显著优于 Search-R1-7B (55.4) 和 R1-Searcher-7B (54.7)
      • 在 14B 规模上,增益更为显著,ASearcher-Local-14B 的 F1 达到 60.0 ,LasJ 达到 65.6 ,甚至超过了更大的 32B 基于检索的基线 Search-R1-32B
  • 在标准问答基准测试上使用基于网络的搜索和浏览 (Web-based Search and Browsing on Standard QA Benchmarks)。
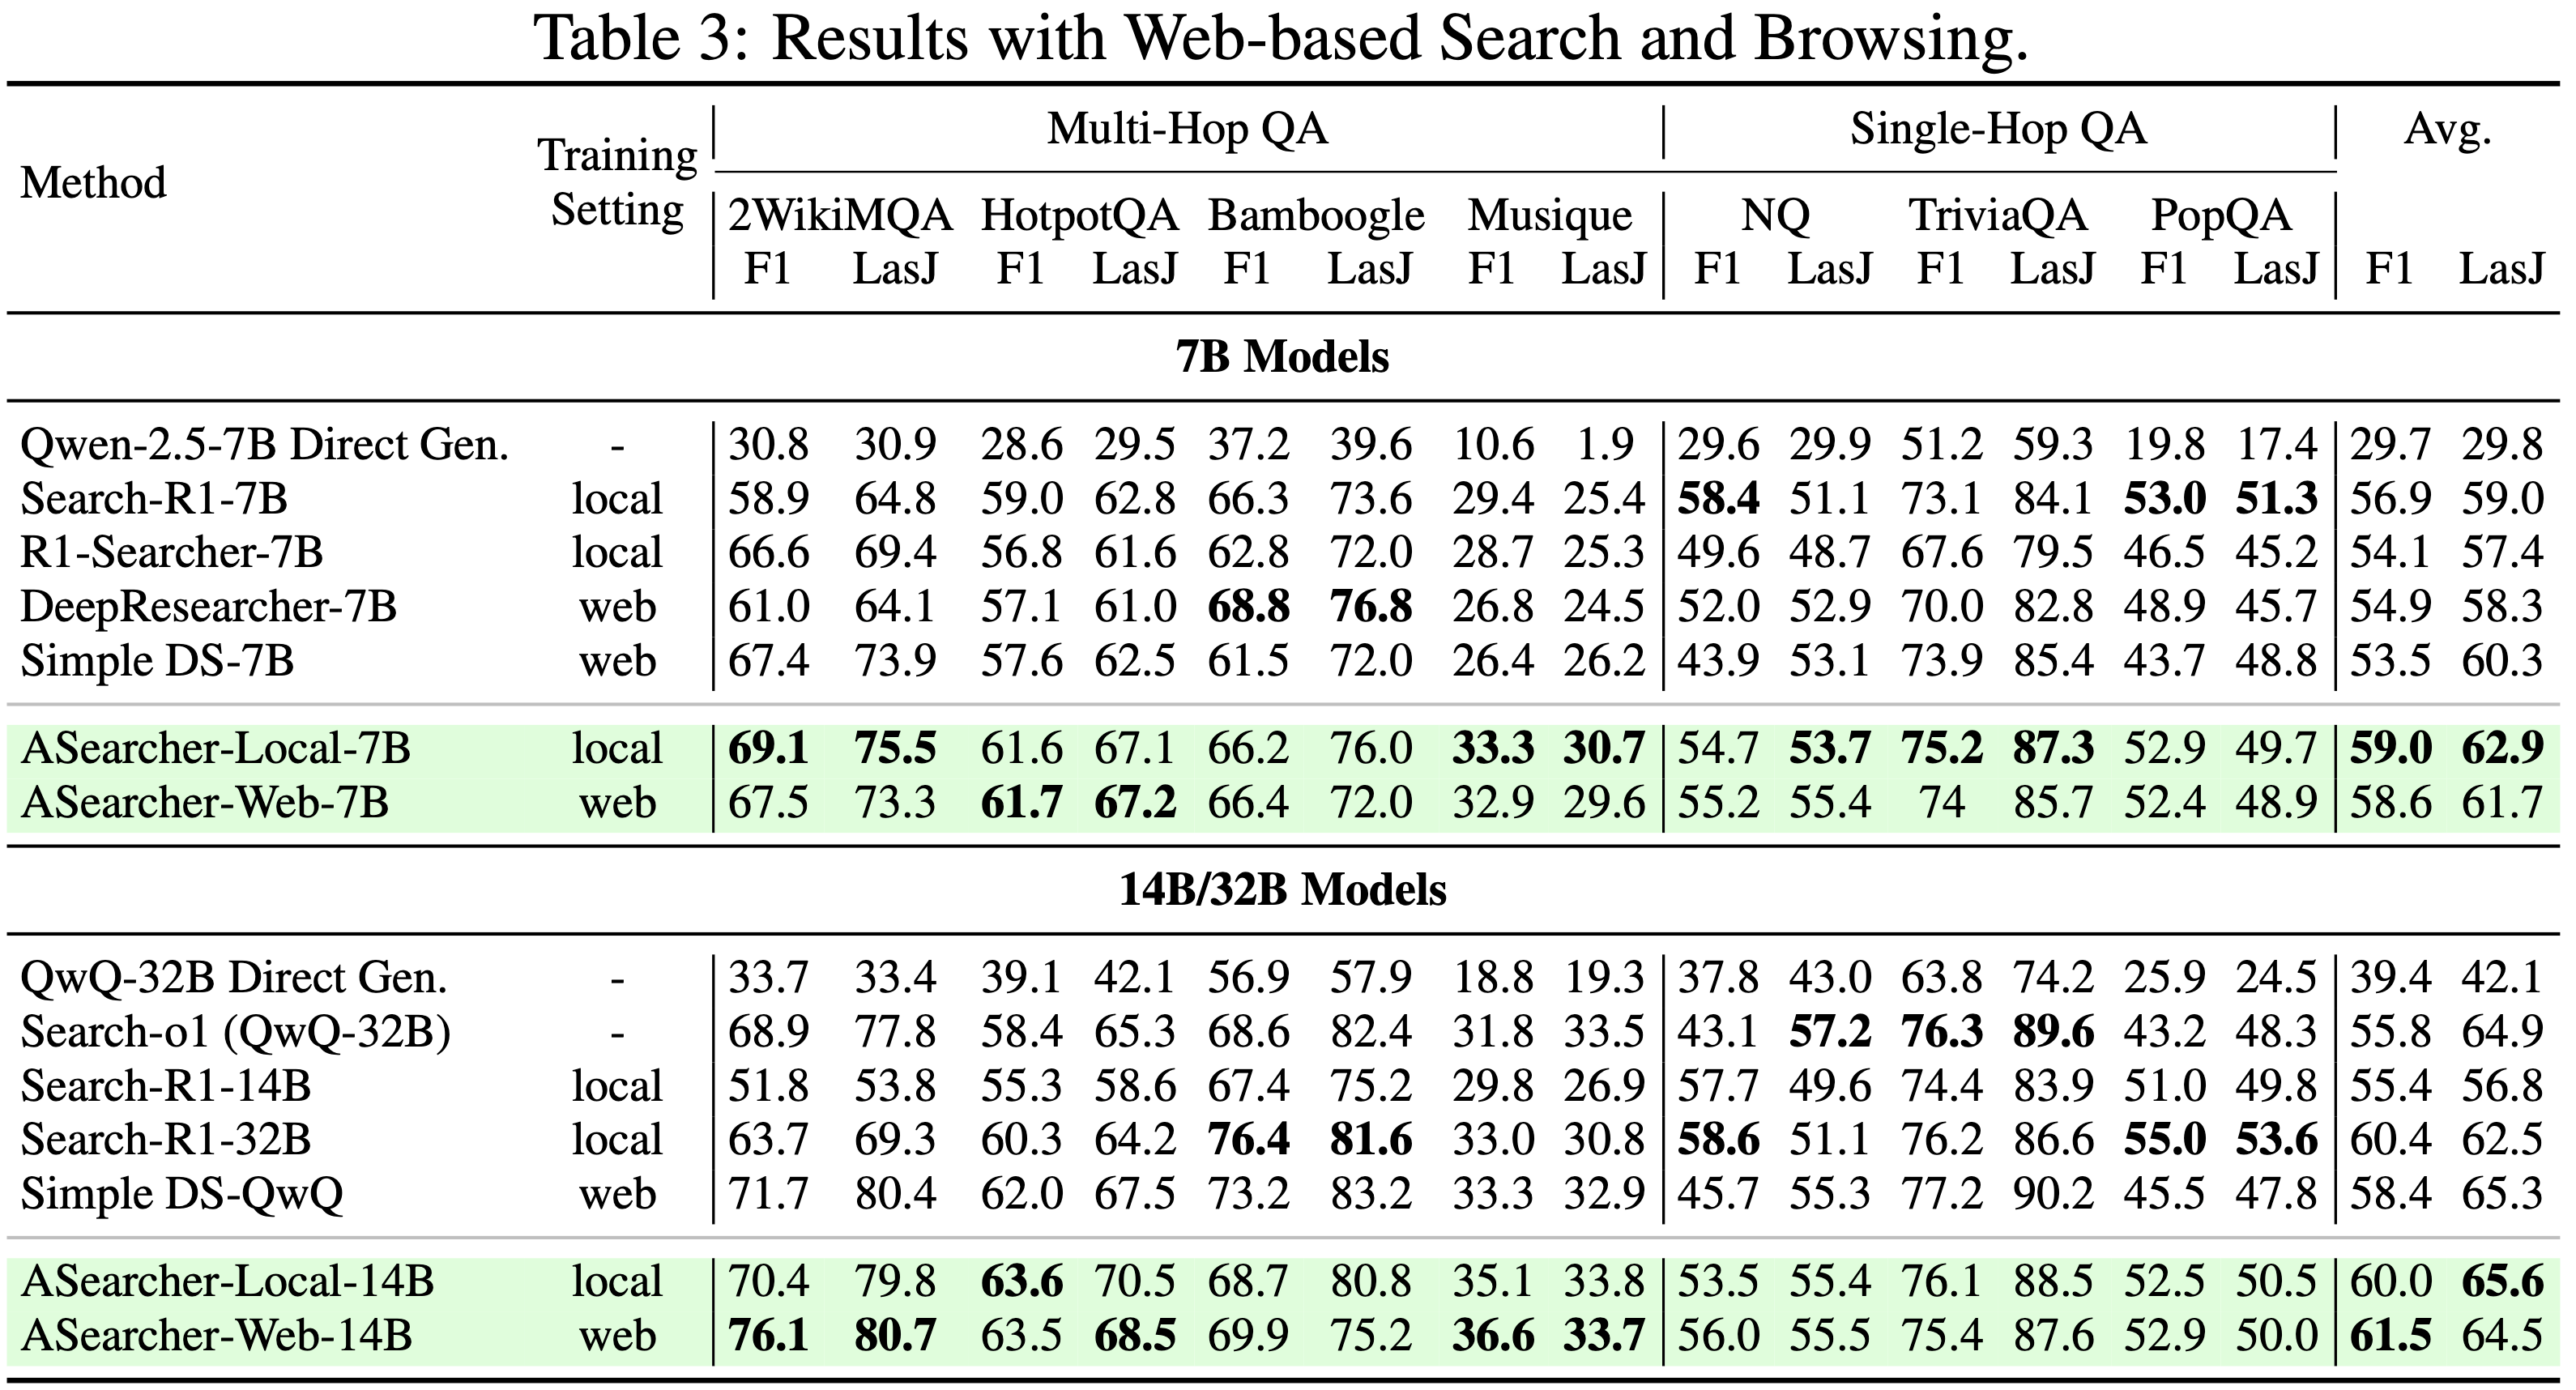
    • 在表 3 中,论文在现实的基于网络的环境中评估智能体
    • 论文以 zero-shot 方式评估完全使用本地知识库训练的模型在网络设置中的表现,以直接检验通过 RL 学习的搜索策略的泛化能力
      • 在所有模型规模上,ASearcher 始终优于强基线
      • ASearcher-Web-14B 取得了最佳性能,平均 F1 为 61.5 ,超过了在此设置下最强的 32B 基线 SimpleDeepSearcher
      • ASearcher-Local-14B 模型在网络设置下测试时表现出强大的泛化能力,在 LasJ 指标上相对于相似或更大规模的所有基线模型均取得了显著增益
      • 这证实了 ASearcher 学习了可迁移到不同信息源的通用搜索策略
  • 在具有挑战性的基准测试上使用基于网络的搜索和浏览 (Web-based Search and Browsing on Challenging Benchmarks)
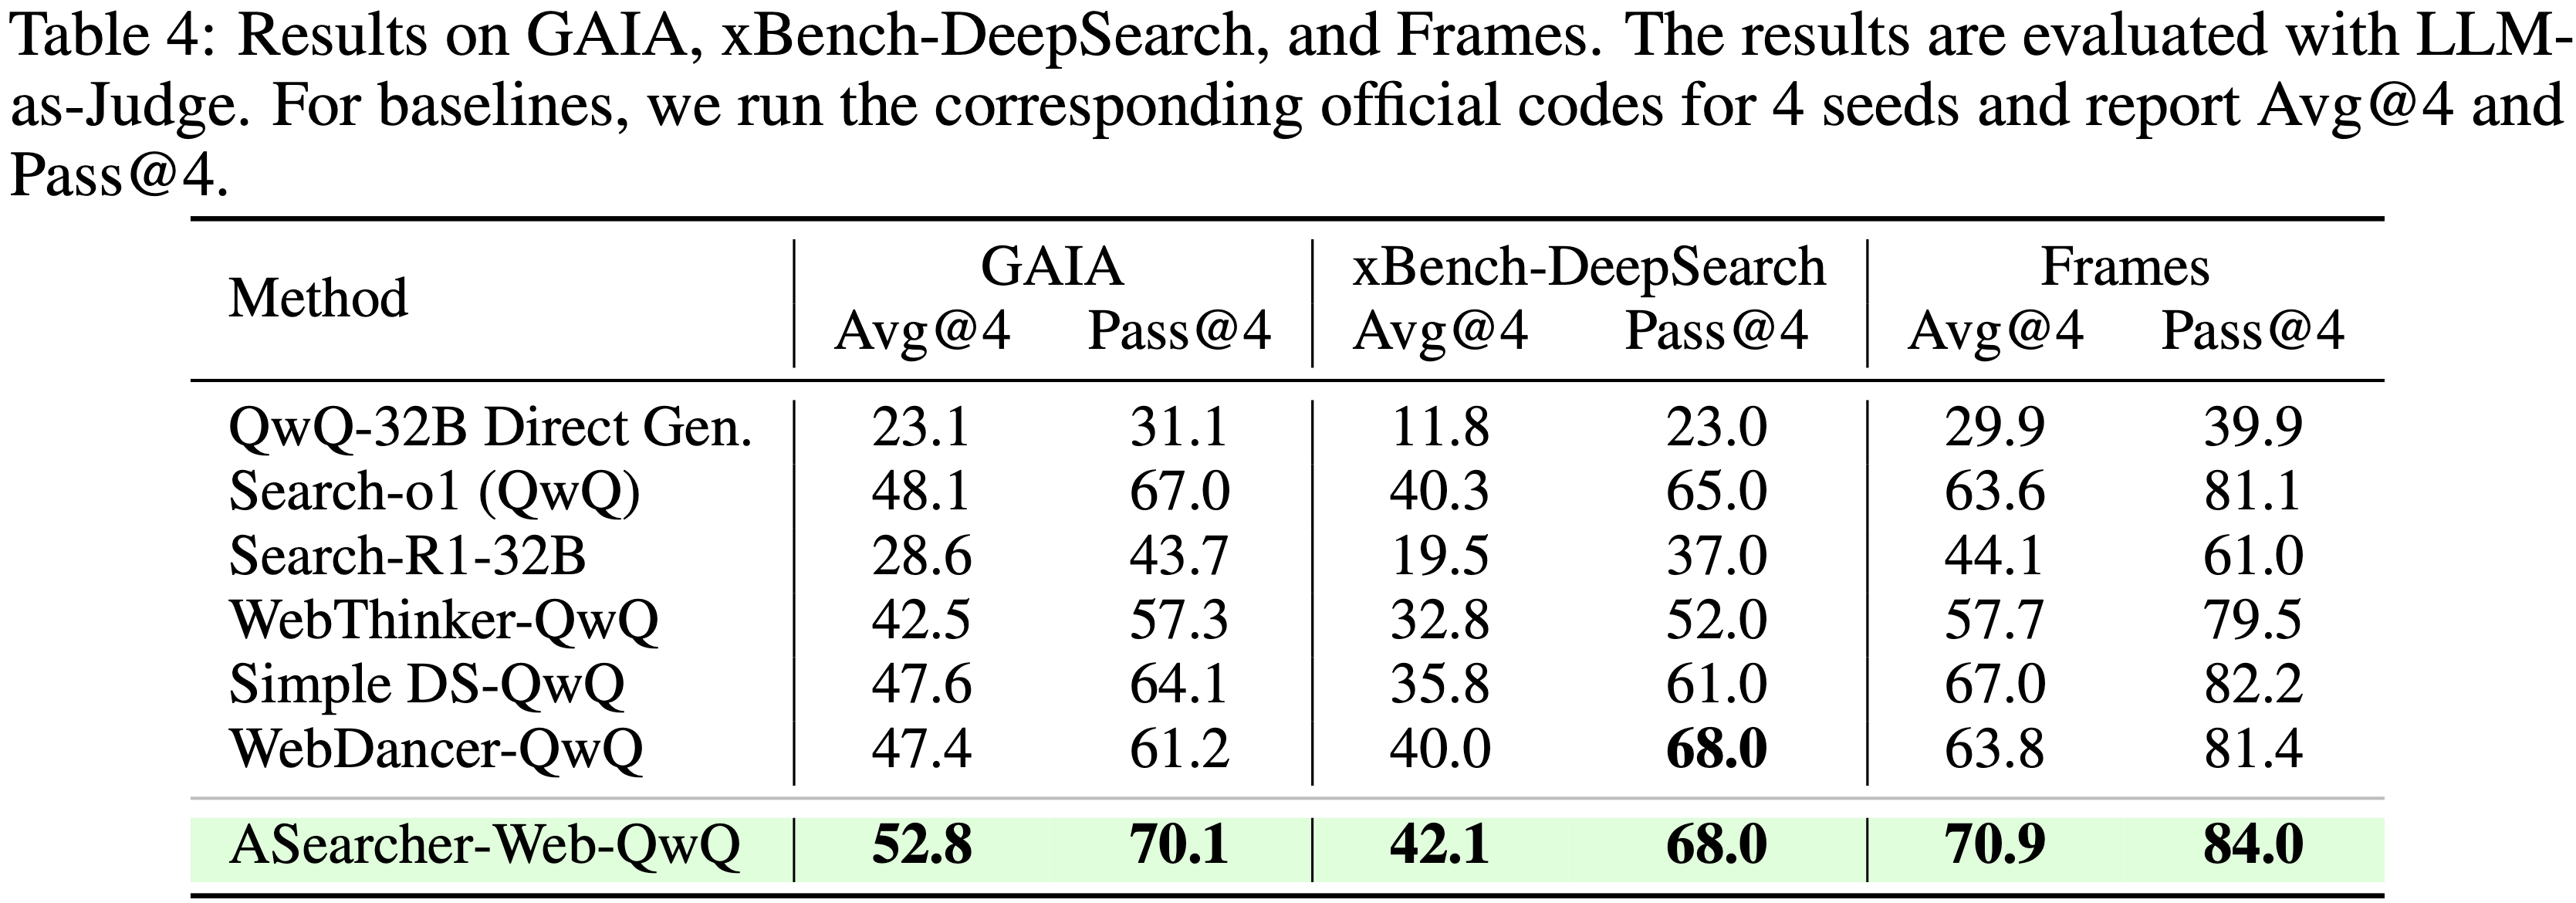
    • 表 4 显示了在需要高级问题解决能力和搜索策略的具有挑战性的问答任务上的实验结果
      • 这些基准测试专门设计用于评估智能体与真实网络交互并检索超出 LLM 内部知识的最新信息的能力
      • 因此,直接从模型(例如 QwQ-32B)生成答案在所有数据集上表现都很差
    • 论文的智能体 ASearcher-Web-QwQ 在 GAIA (52.8) 和 xBench-DeepSearch (42.1) 上取得了最佳的 Avg@4 分数
      • 优于之前的开源智能体最优水平
    • 这些结果进一步凸显了其在处理长视野规划、现实世界工具使用和开放领域探索方面的优越性
    • 除了 Avg@4,论文还报告了 Pass@4 分数,该分数计算智能体在 4 次试验中找到正确答案的问题比例
      ASearcher-Web-QwQ 在通过率方面也优于 SOTA 开源智能体
  • RL 训练的效果 (Effect of RL Training)
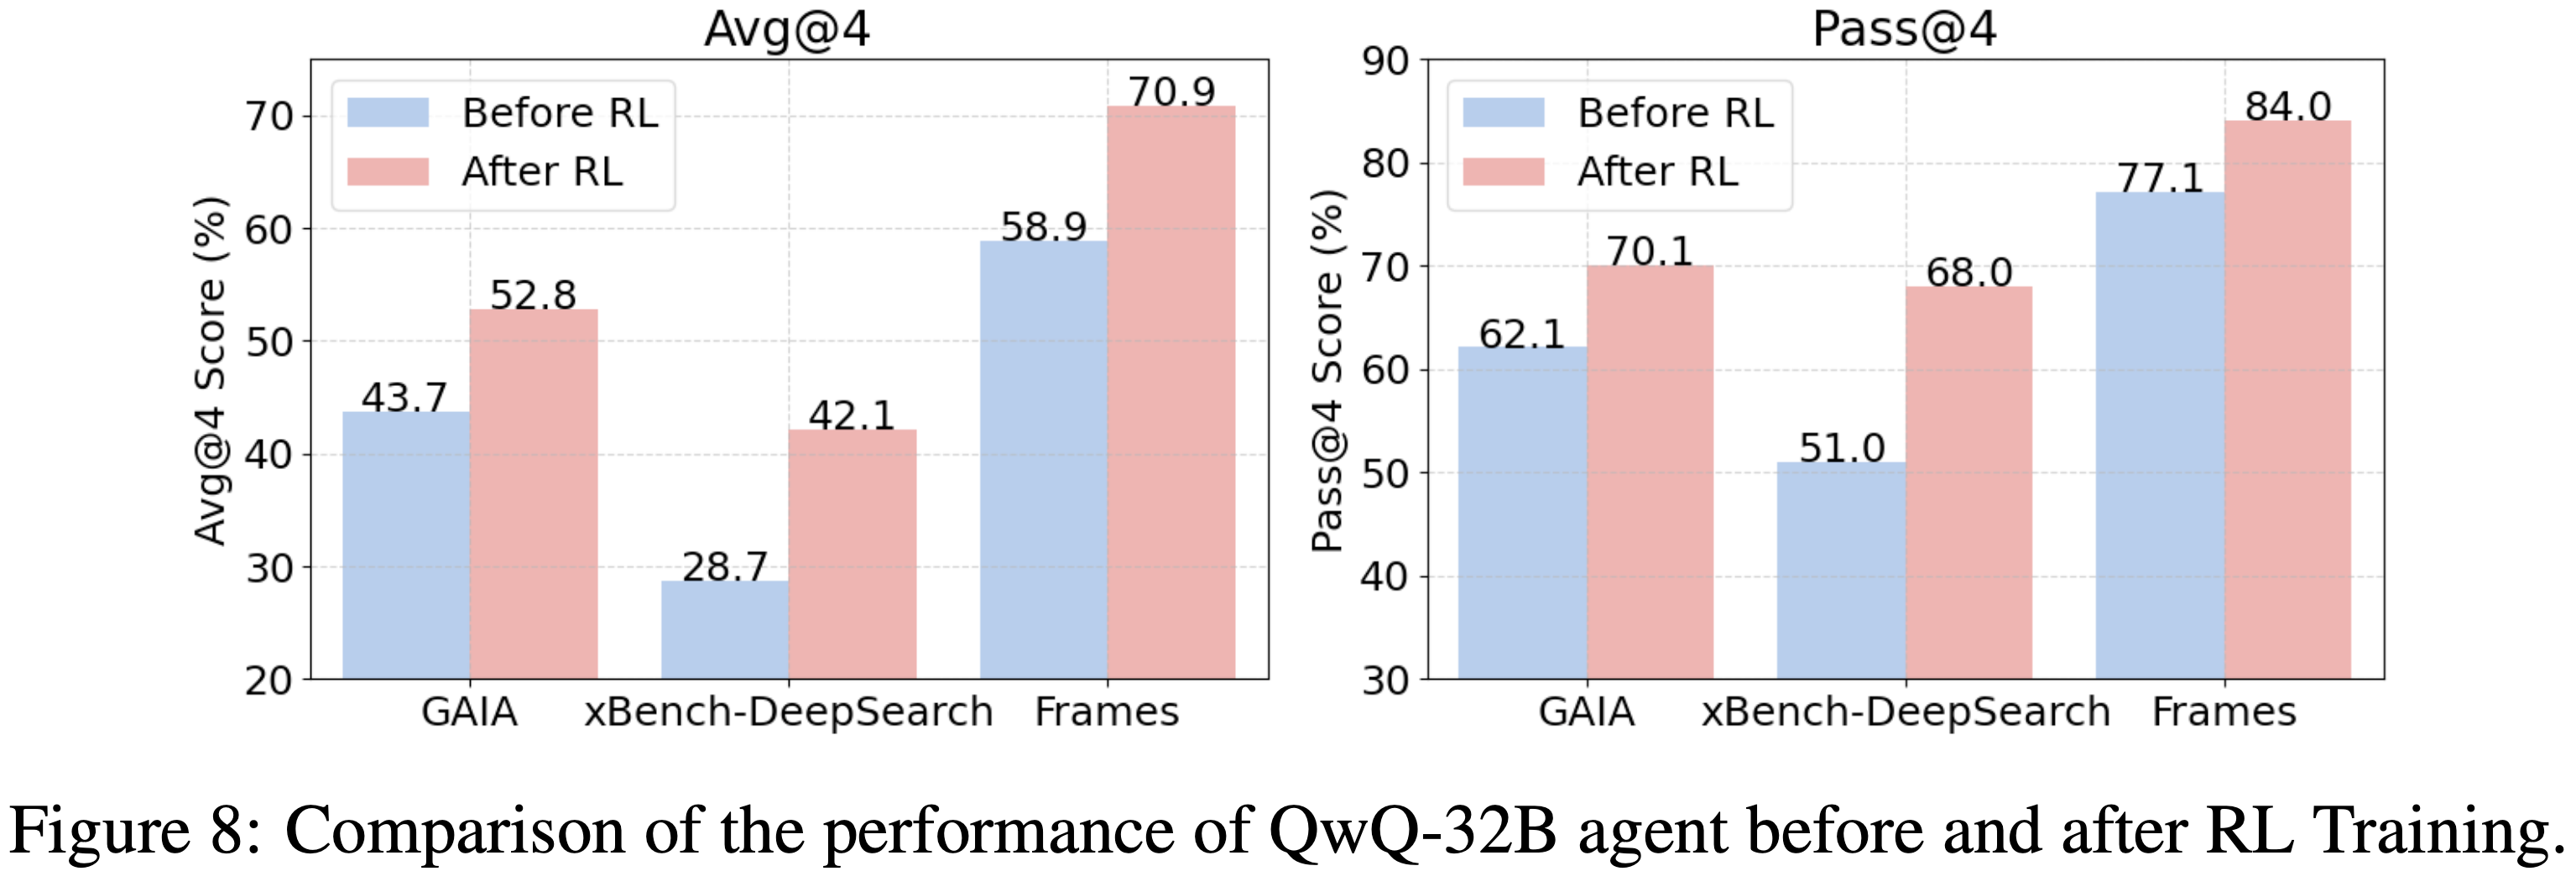
    • 如图 8 所示,ASearcher-Web-QwQ 在 GAIA、xBench-DeepSearch 和 Frames 上分别获得了 +9.1、+13.4 和 +12.0 的提升
    • 当考虑通过率(即 Pass@4)时,ASearcher-Web-QwQ 也获得了显著增益,尤其是在 xBench-DeepSearch 上提升了 17.0
    • 通过率的显著提升表明论文的训练流程训练智能体学习复杂的搜索策略,以执行精确搜索、提取关键信息并解决冲突信息
Training Dynamics

  • ASearcher-Local-7B/14B 的训练动态 (Training Dynamics of ASearcher-Local-7B/14B)
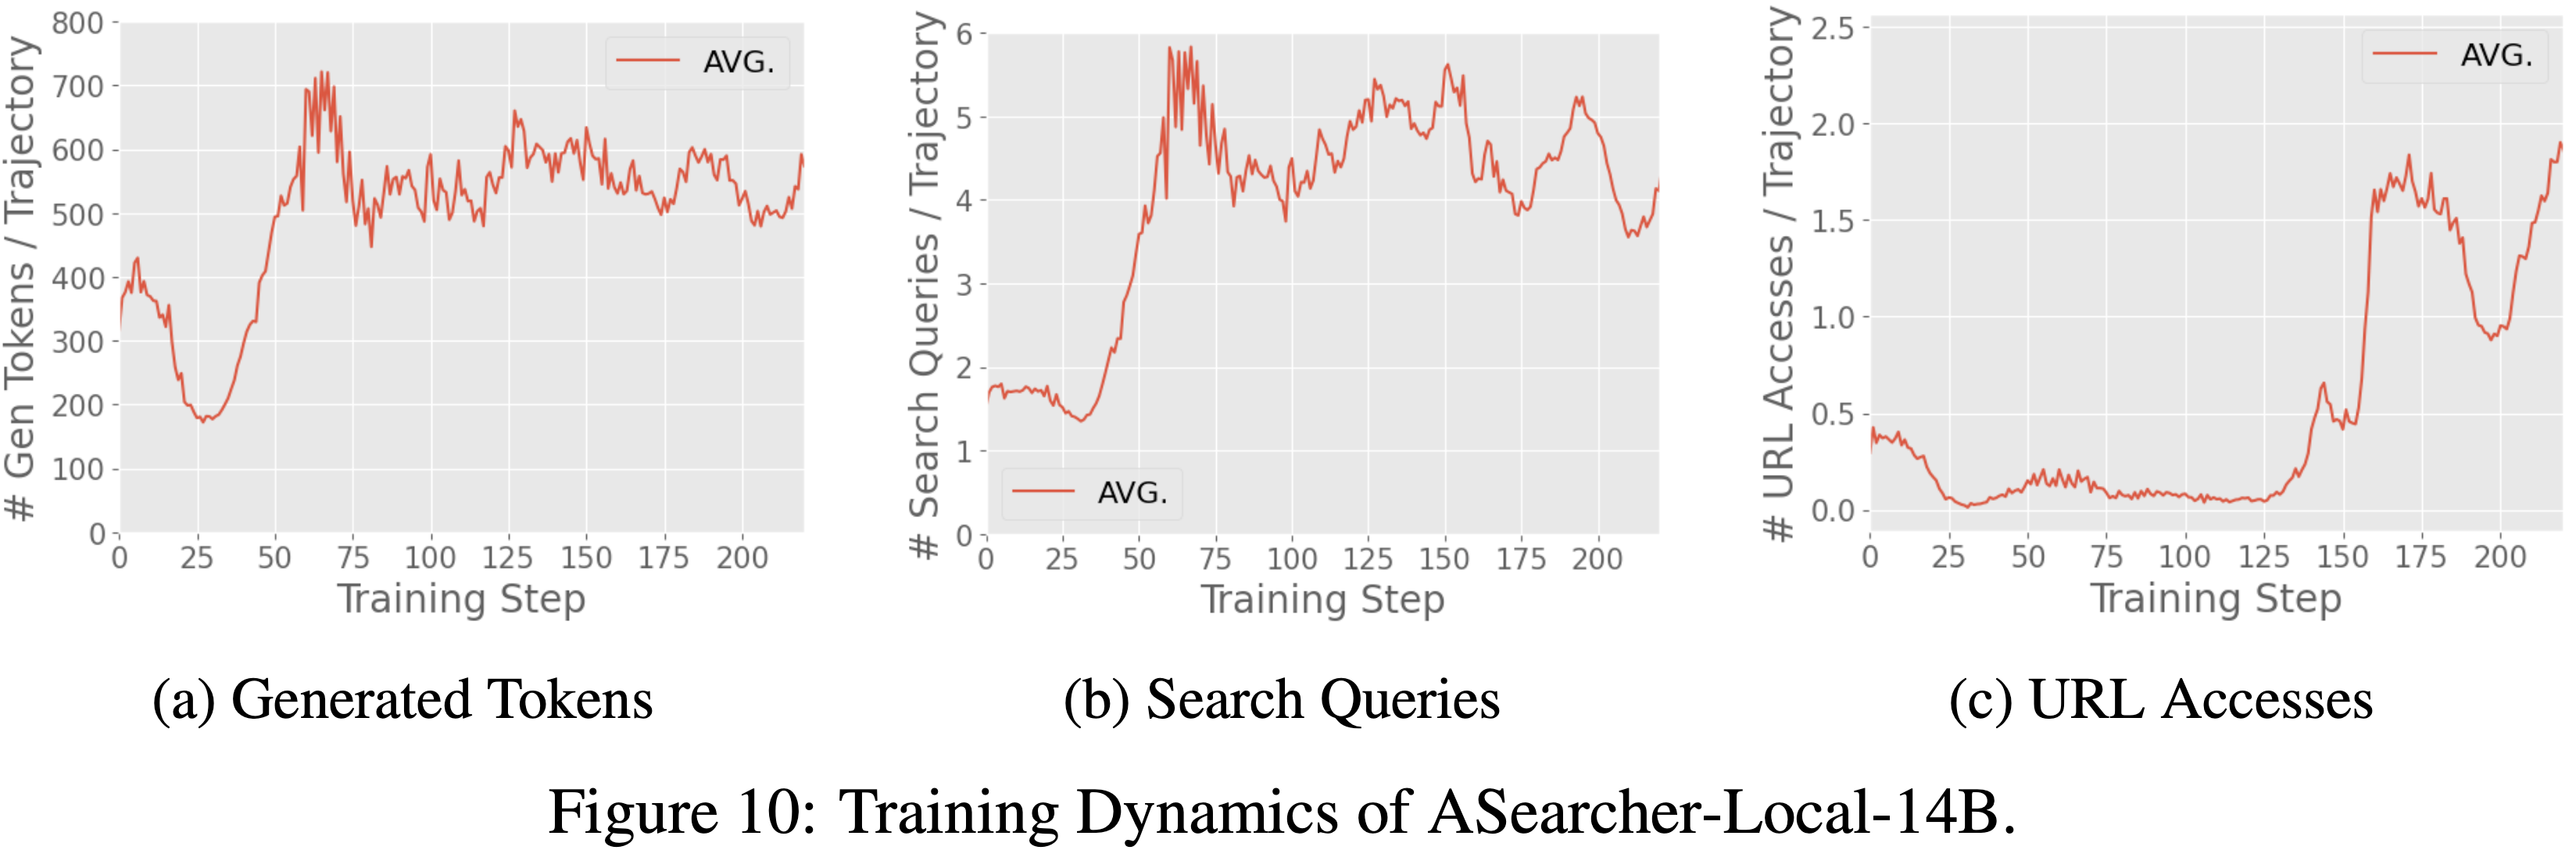
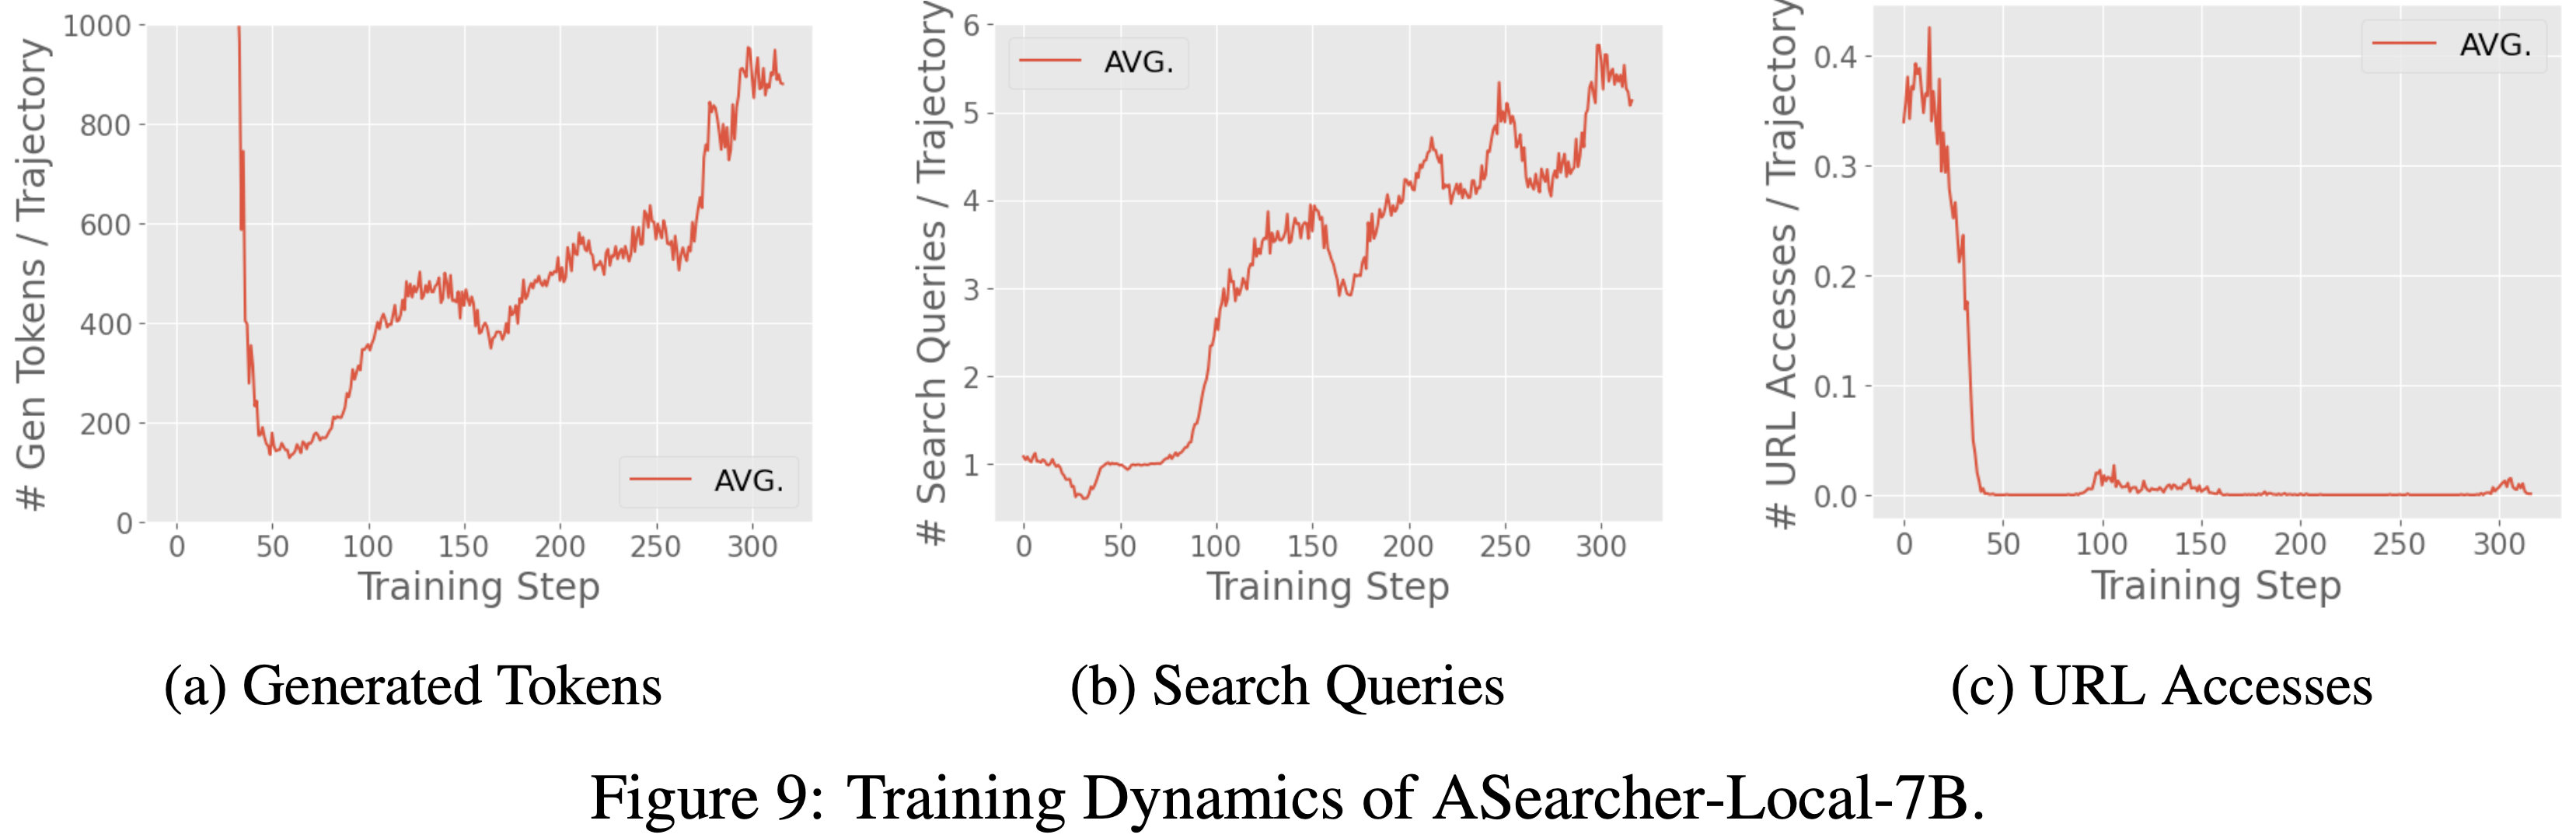
    • 在图 9 和图 10 中,论文分别绘制了 ASearcher-Local-7B 和 ASearcher-Local-14B 训练过程中生成的 Token 数量、搜索 Query 和网页浏览情况
    • 使用论文的训练方法,在 7B 和 14B 规模上都观察到了生成长度和工具调用次数的增加
      • 搜索 Query 次数扩展到 6 次,高于先前工作 (2025;) 报告的数字
    • 有趣的是,论文发现 7B 模型未能学习有效的网页浏览 ,而 14B 模型可以在训练后期学习访问网页来解决具有挑战性的问题
      • 论文假设 7B 模型在学习网页浏览方面的失败是因为模型容量太小 ,无法在零 RL 训练设置中稳定地学习总结冗长的网页
  • ASearcher-Web-QwQ 的训练动态 (Training Dynamics of ASearcher-Web-QwQ)
    • ASearcher-Web-QwQ 的训练动态如图 6 所示
    • 随着训练的进行,智能体学会执行更多的工具调用,在第 200 步左右达到约 40 次调用,峰值实例甚至达到 70 次调用
    • QwQ-32B 智能体通过训练生成了更多的 Token ,最多超过 150k 个 Token
    • 工具利用率和输出长度的这种扩展趋势突显了完全异步 RL 训练对于复杂现实世界智能体应用的潜力
      • 问题:这跟完全异步 RL 有什么关系?

Related Works

Search Agents

  • 一些工作已经构建了智能体工作流,使 LLM 能够利用外部工具来解决复杂任务
    • 著名的例子包括 Search-o1 (2025) 和 ReAgent (2025)
  • 基于提示的方法虽然对于快速开发有效,但根本上受到底层 LLM 能力的限制,并且无法通过环境反馈可靠地改进
  • 一些工作尝试为 LLM 构建 SFT 轨迹
    • 例如,(2023; 2024) 利用大 LLM 合成检索和推理轨迹来微调较小的模型
  • 最近,一些工作研究强化学习 (RL) 方法来增强 LLM-based 智能体,主要关注多跳问答基准测试,如 HotpotQA 和 2Wiki-Multihop
    • (2025;) 使用多跳问答数据进行 RL 训练,并观察到工具使用次数的增加
    • RAG-R1 (2025) 进一步结合了 SFT 和 RL 来增强搜索策略
  • 最近,研究人员开始关注更具挑战性的任务,通过 Offline RL (2025) 微调由大型推理模型 (LRM) 驱动的复杂基于提示的智能体,在具有真实网络数据的模拟轨迹上进行 SFT (2025;),以及为 RL 训练构建具有挑战性的问答对 (2025)

Synthetic Data for Search Agents

  • 除了依赖大规模人工标注,数据合成也已成为一种可扩展的方法来为搜索智能体准备训练数据
    • 一些方法通过与真实网页交互并使用 LRM 整理数据来生成合成但真实的问答轨迹 (2025;)
    • WebSailor (2025) 通过采样和模糊测试构建结构上具有挑战性的任务
    • WebShaper (2025) 利用集合论技术构建高质量的复杂问答对
  • ASearcher 开发了一个自主的 LLM 智能体来合成具有高不确定性的挑战性问答对,而不依赖复杂的知识图谱
    • ASearcher 中的数据合成智能体和合成训练数据都是完全开源的

附录 A:Full Case Study

  • 在本节中,论文对来自 GAIA (2023) 的一个极具挑战性的问题进行了详细的案例研究
    • 论文在图 11 中分析了 Search-R1-32B (2025) 和 Search-o1 (QwQ) (2025)
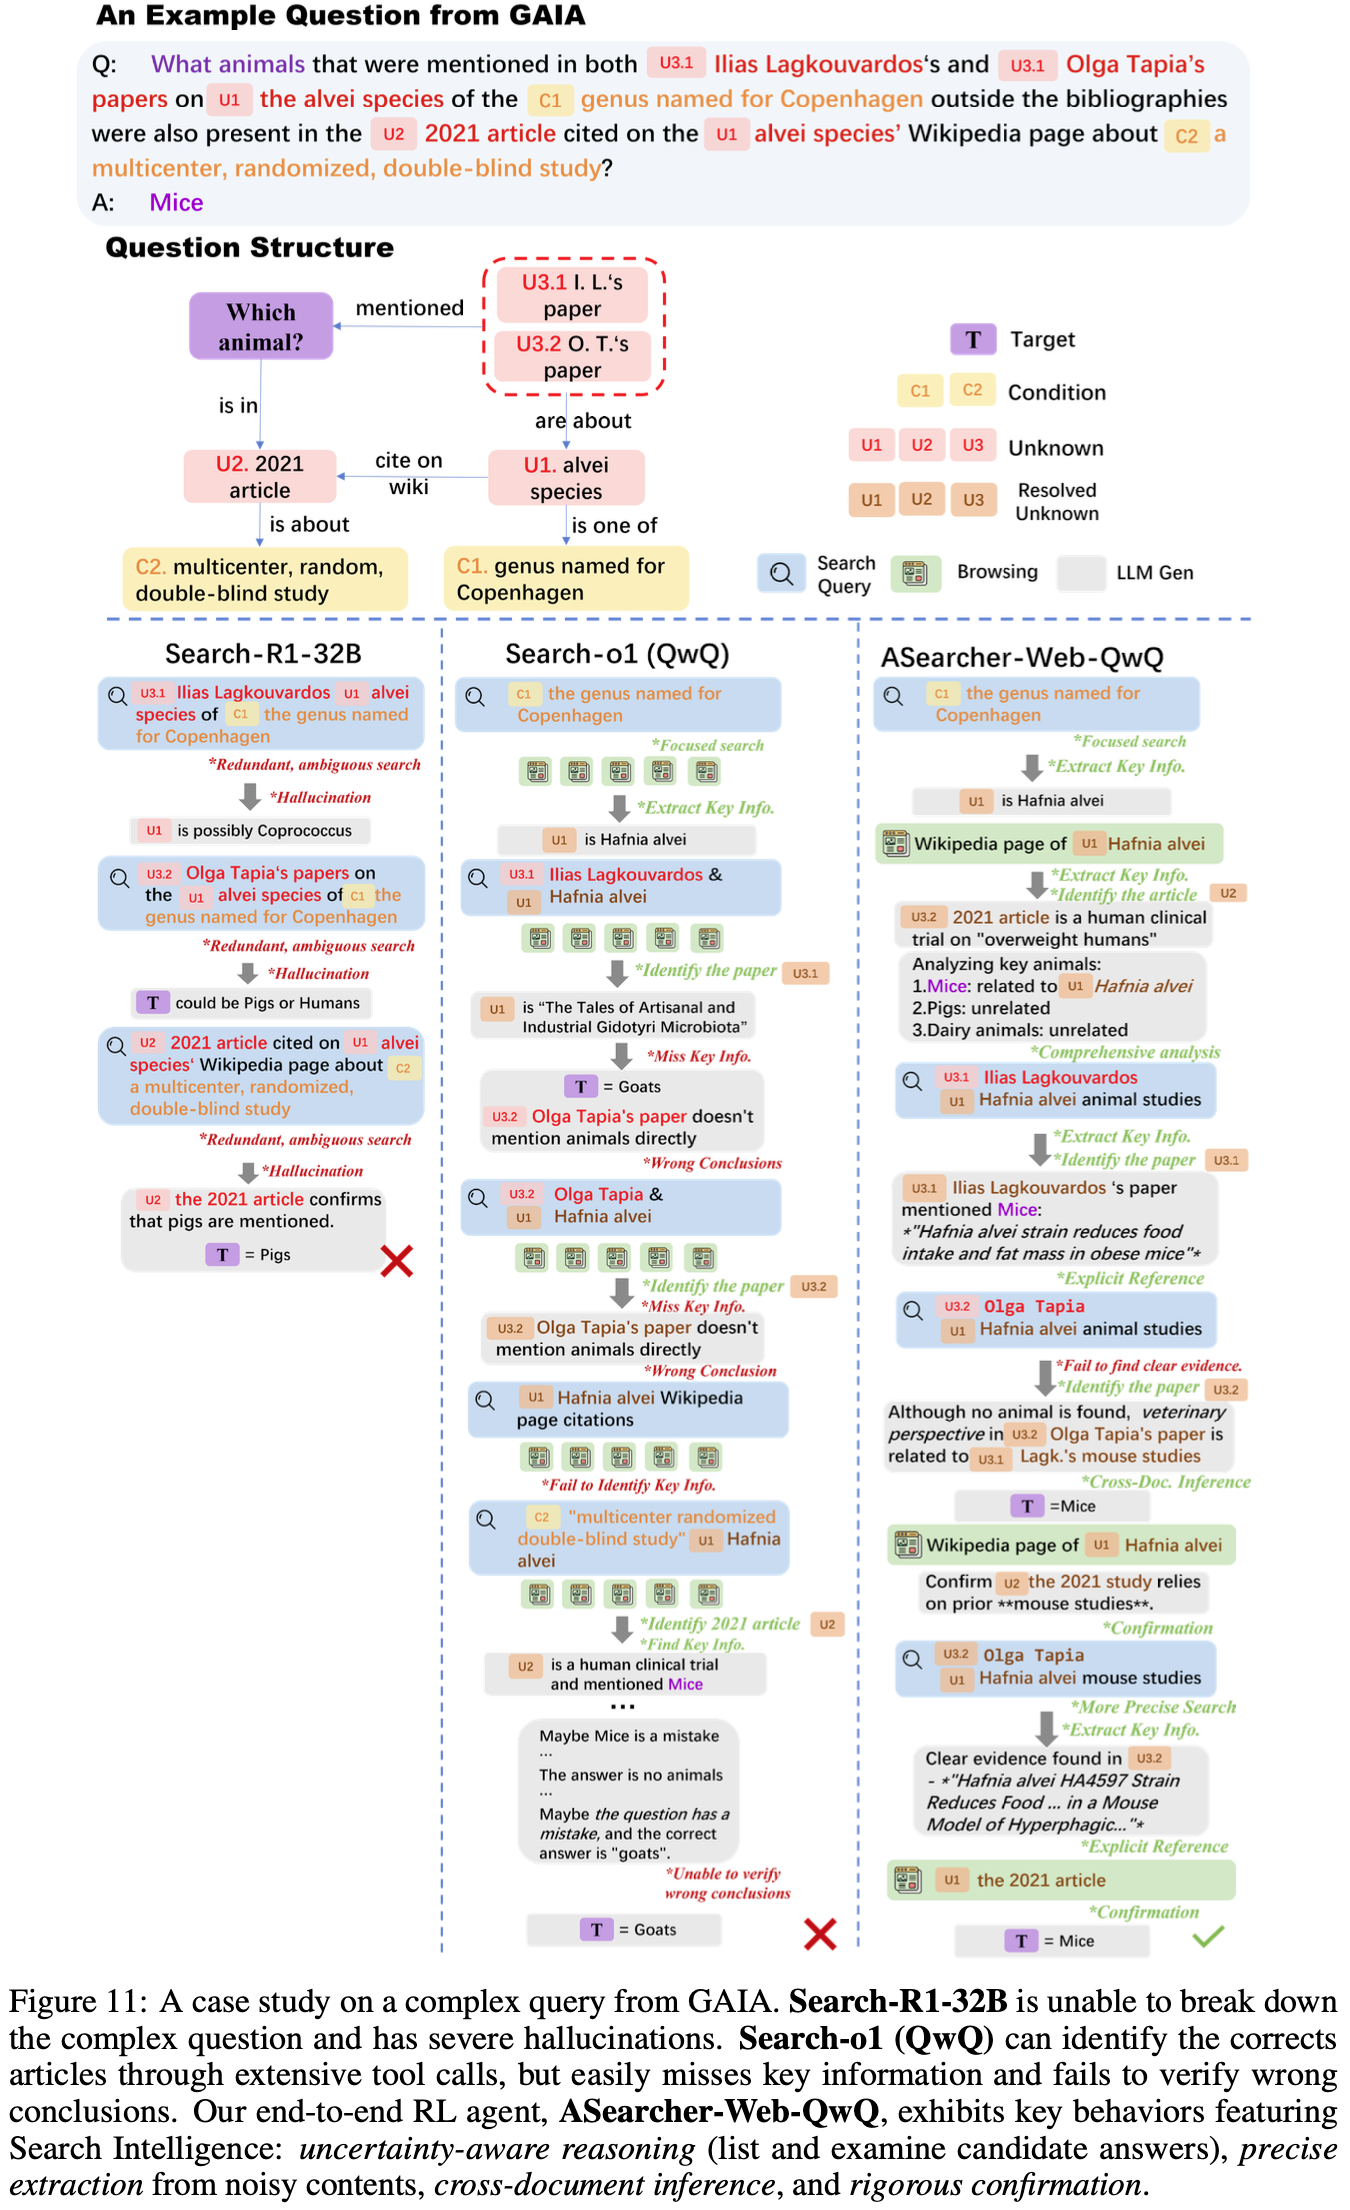
  • 示例问题的解决路径 (Solution Path of the Sample Question)
    • 在图 11 中,论文的案例研究针对一个在给定 2 个条件和 4 个未知变量的情况下寻找特定动物的问题进行
    • 为了识别正确答案,搜索智能体应首先根据条件 C1 找出提到的物种 U1 ,识别满足条件 C2 的正确文章 U2 ,然后找出 U3.1 和 U3.2 中列出的论文
    • 最后,正确答案应通过交叉引用文章 U2 和论文 U3.1&U3.2 来确定
    • 总结来说,这个示例具有挑战性主要有以下几个原因:
      • 高不确定性 (High Uncertainty): 问题涉及多个未知变量,这些变量可能指向许多不同的实体
        • 例如,2021 年的文章 U2 可能指向 2021 年发表的任何文章,并且只能在给定条件 C2 和肺泡物种 U1 的情况下确定
      • 对精确信息提取的要求 (Requirement for Exact Information Extraction): 为了找到答案,智能体应列出网页上提到的所有动物并进行跨文档比较
        • 这将要求智能体从海量、嘈杂的网络内容中精确提取关键信息,而不是简单地总结网页
      • 误导性答案 (Misleading Answers): 在解决此任务的过程中,可能会出现多个误导性答案,例如“猪”
        • 智能体应通过检查所有相关网页和文档中的预期答案来严格确认其结论
  • 现有的 Online RL 方法未能学习复杂的搜索策略 (Existing Online RL Approaches Fail to Learn Complex Search Strategies)
    • 在图 11 中,Search-R1-32B 无法将复杂 Query 分解为单独的组成部分,因此只进行了涉及过多未知信息的冗余 Query
      • 该智能体还存在严重的幻觉,产生了搜索结果不支持结论
      • 它未能解析所有未知变量
    • 此案例研究表明,现有的 Online RL 方法仅激励了初级的搜索策略
    • 同样值得注意的是,由于在训练期间轮次限制设置为较小的值(例如 4),模型仅表现出较短的工具使用视野
  • 基于提示的 LLM 智能体可能因 LLM 能力不足而失败 (Prompt-based LLM Agents Could Fail Due to Insufficient Capability of the LLM)
    • 在图 11 中,Search-o1 (QwQ) 可以通过大量的工具调用找到物种名称 U1 ,以及 2021 年的文章 U2 和论文 U3.1&U3.2
      • 但在尝试寻找答案时,Search-o1 (QwQ) 很容易遗漏关键信息
      • 因此,智能体得出了错误的结论
      • 而且,即使智能体找到了直接指向正确答案的信息,它仍然被先前错误的结论所误导
      • 最后,智能体无法验证先前结论的正确性
    • 这个案例研究表明,尽管一个未在智能体任务上明确训练的开源模型可以执行大量的工具调用 ,但它无法基于检索到的内容和历史上下文进行专家级的推理
  • ASearcher-Web-QwQ
    • 论文还分析了论文端到端 RL 智能体 ASearcher-Web-QwQ 的搜索策略
    • 如图 11 所示,ASearcher-Web-QwQ 将复杂 Query 分解为精确且聚焦的 Query
      • 与 Search-o1 (QwQ) 在每次搜索 Query 后访问大量网站不同,ASearcher-Web-QwQ 专注于访问最相关的网站
      • ASearcher-Web-QwQ 总结了网站的所有相关信息
        • 所有候选答案都被智能体列出并仔细分析
      • 当尝试在论文 U3.1&U3.2 中搜索相关事实时,智能体明确引用了关键信息
        • 当搜索结果没有直接指向期望的目标时,例如,当使用“Olga Tapia (U3.2) Hafnia alvei (U1) animal studies”进行搜索以查找与 Olga Tapia 论文相关的动物时,智能体没有得到明确的信息,但能够通过与其他论文 U3.1 建立联系来推断出正确答案
      • 在找到正确答案“Mice”之后,智能体在报告最终答案之前花费了额外的轮次来确认先前的结论
    • 总之,ASearcher 成功训练了一个展现出复杂行为的搜索智能体,这些行为体现了搜索智能:
      • 不确定性感知推理 (Uncertainty-aware reasoning): 智能体详尽地列出并检查所有不确定实体的可能性
      • 精确的关键信息提取 (Precise Key Information Extraction): 智能体能够从海量、嘈杂的网络内容中识别关键信息
      • 跨文档推理 (Cross-document Inference): 智能体能够通过建立多个文档之间的联系来推断关键结论
      • 严格确认 (Rigorous Confirmation): 智能体通过额外的工具调用来验证先前结论的正确性
NLP——Does-RL-Incentivize-Reasoning-Capacity

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Leap Lab of THU & SJTU, 20250418-20251124
    • GitHub 项目地址:limit-of-RLVR.github.io

Paper Summary

  • 论文内容总结:
    • 论文发布以来,在业内广受认可,非常值得一读
    • 论文系统地研究了当前 RLVR 方法对 LLM 推理能力边界的影响
    • 论文的研究结果表明
      • 当前的 RLVR 很少激发根本性的新推理模式;
      • RLVR 训练模型的推理能力仍然受限于其 Base Model 的能力
      • 当前的 RLVR 方法尚未完全实现 RL 通过探索和利用来激发 LLM 新推理能力的潜力
      • 注:这种局限性可能源于论文第 5 节讨论的在巨大语言空间中缺乏有效的探索策略
    • 在高级抽象中进行探索、细粒度的信用分配以及多轮智能体-环境互动可能缓解这个问题
    • 本研究的结论不一定保真,因为论文的研究有些设定问题:
      • 作者已经尽量评估尽可能多的强大的、公开可用的纯 RLVR 模型,但是仍然有问题
      • 目前能力最强的模型和训练流程仍然是私有的,所以作者无法分析内部的细节(论文的分析需要这些细节)
      • 目前的技术发展很快,其实已经有一些文章对论文的结论提出了一些挑战
        • 论文的作者最终版本更新的论文中,比较谦逊,已经意识到了这些实际限制
  • RLVR 近期在提升 LLM 的推理性能方面取得了显著成功,尤其是在数学和编程任务中
    • 人们普遍认为,与传统 RL 帮助智能体探索和学习新策略类似,RLVR 能够使 LLMs 持续自我改进,从而获得超越对应 Base Model 能力的新型推理能力
  • 在本研究中,论文通过对 RLVR 训练的 LLMs 在不同的模型家族、 RL 算法和数学/代码/视觉推理基准测试中进行系统性的推理能力边界探测,并采用大 \(k\) 值下的 pass@\(k\) 作为评估指标,对 RLVR 的当前状态(the current state of RLVR) 进行了批判性审视
  • 虽然 RLVR 提高了采样正确路径的效率,但论文惊奇地发现,当前的训练 极少(rarely) 能激发出根本性的新推理模式
    • 论文观察到,尽管 RLVR 训练的模型在较小的 \(k\) 值(例如 \(k\)=1)下优于其 Base Model ,但在 \(k\) 值较大时, Base Model 反而能达到更高的 pass@\(k\) 分数
  • Moreover,论文发现 LLMs 的推理能力边界常常随着 RLVR 训练的进行而变窄(narrows)
  • 进一步的覆盖率和困惑度(perplexity)分析表明,RLVR 模型生成的推理路径已经包含在 Base Model 的采样分布中
    • 这表明它们的推理能力源自 Base Model 并 受限于(bounded by) Base Model
  • 从这个视角出发,将 Base Model 视为一个上界,论文的定量分析表明:
    • 六种流行的 RLVR 算法表现相似,并且远未达到充分利用 Base Model 潜力的最优状态
  • In Contrast,论文发现蒸馏(distillation)能够从教师模型中引入新的推理模式,并真正扩展模型的推理能力
  • Taken together,论文的研究结果表明,当前的 RLVR 方法尚未完全实现 RL 激发 LLMs 真正新颖推理能力的潜力
    • 这突显了改进 RL 范式的必要性,例如有效的探索机制、更审慎和大规模的数据管理、细粒度的过程信号以及多轮智能体交互,以释放这种潜力

Introduction and Discussion

  • 专注于推理的大型语言模型(reasoning-centric LLMs)的发展极大地推动了 LLM 能力的前沿
    • 例如 OpenAI-o1 (2024)、DeepSeek-R1 (2025) 和 Kimi-1.5 (2025),
    • 特别是在解决涉及数学和编程的复杂逻辑任务方面
  • 与传统依赖于人工标注指令(instruction-tuned)的方法(2023; 2024)相比,这一飞跃背后的关键驱动力是大规模的 RLVR (2024; 2025)
    • RLVR 从一个预训练的 Base Model 或经过长链思维(chain of thought,CoT)数据微调的模型开始,基于简单的、可自动计算的奖励通过 RL 对其进行优化
    • 这些奖励取决于模型的输出在数学问题上是否匹配真实解,或在代码问题上是否通过单元测试,从而无需人工标注即可实现规模化
    • RLVR 框架因其简单性和实际有效性而备受关注
  • 在传统的 RL 设置中,例如游戏(如 Atari,Go),智能体通常通过自我改进自主发现新策略并超越甚至达到人类水平 (2015; 2017)
    • 受此成功启发,人们普遍认为 RLVR 同样能使 LLMs 自主发展出新的推理模式,包括枚举、自我反思和迭代优化,从而超越其 Base Model 的能力 (2025)
  • Consequently,RLVR 被视为实现 LLMs 持续自我进化、可能使论文更接近更强大智能的一条有希望的途径 (2025)
    • However,尽管取得了经验上的成功,当前 RLVR 的根本有效性仍未得到充分检验
    • 这引出了一个根本性问题:当前 RLVR 是否真正使 LLMs 获得了新的推理能力,类似于传统 RL 通过探索发现新策略,还是仅仅利用了 Base Model 中已有的推理模式?
  • 为了严格回答这个问题,论文首先必须评估 Base Model 和 RLVR 训练模型的推理能力边界
    • 传统的评估指标依赖于贪心解码(greedy decoding)或核采样(nucleus sampling)(2020) 的平均分,这反映了平均情况下的行为
    • However,这些指标可能会低估模型的真实潜力,尤其是在尝试次数有限的情况下模型在难题上失败时,尽管它有能力通过更多采样解决这些问题
  • 为了克服这一限制,论文采用 pass@\(k\) 指标 (2024),即如果 \(k\) 个采样输出中任意一个是正确的,则认为问题已解决
    • 通过允许多次尝试,pass@\(k\) 揭示了模型是否具备解决问题的潜力
    • 数据集的平均 pass@\(k\) 分数因此反映了模型在 \(k\) 次尝试内可能解决的问题比例,为其推理边界提供了更稳健的视角
      • 这为 RLVR 训练是否能产生根本性的超越能力、使模型能够解决 Base Model 无法解决的问题提供了严格检验
  • 使用 pass@\(k\) 指标,论文在多个基准测试中进行了广泛的实验,涵盖了多个 LLM 家族、模型大小和 RLVR 算法,以比较 Base Model 与其 RLVR 训练的对应模型
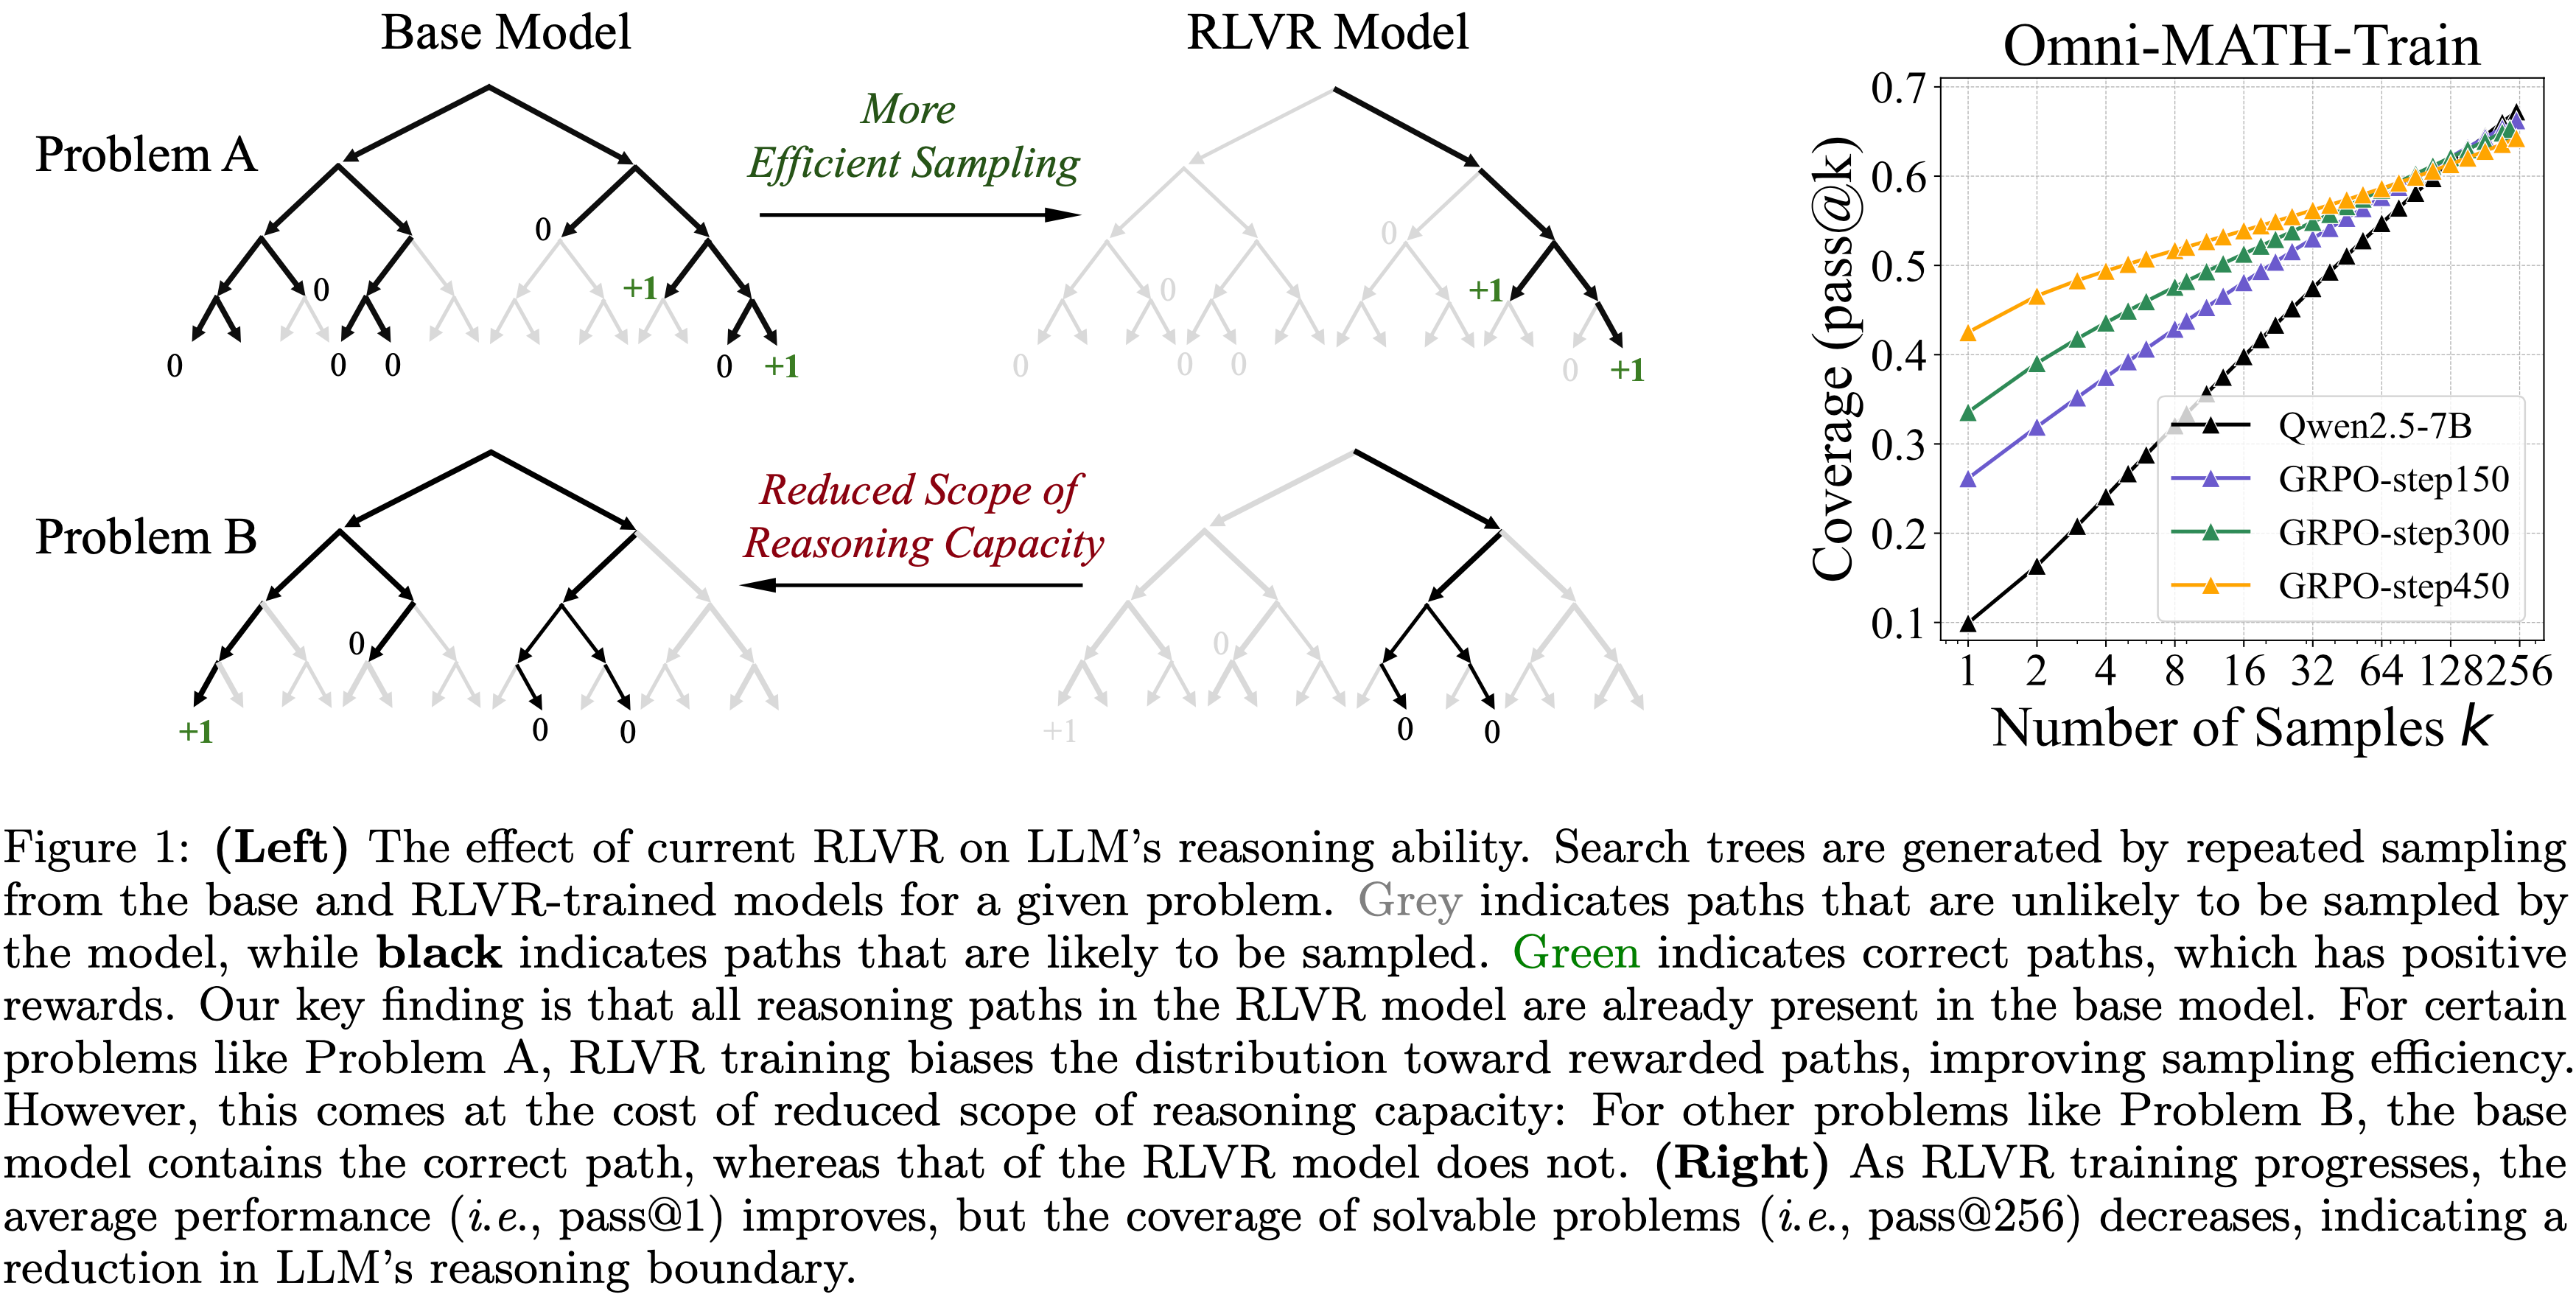
  • 图 1 内容:
    • Left:当前 RLVR 对 LLM 推理能力的影响
      • 搜索树(search tree)通过对给定问题从 Base Model 和 RLVR 训练模型中重复采样生成
      • 灰色表示模型不太可能采样的路径,而 黑色 表示模型可能采样的路径
      • 绿色表示具有正奖励的正确路径
      • 论文的关键发现是,RLVR 模型中的所有推理路径都已存在于 Base Model 中
      • 对于某些问题,如问题 A,RLVR 训练使分布偏向奖励路径,提高了采样效率
        • However,这是以减少推理能力范围为代价的:
          • 对于其他问题如问题 B, Base Model 包含正确路径,而 RLVR 模型则没有
    • Right:随着 RLVR 训练的进行,平均性能(即 pass@1)提高,但可解问题(solvable problem)的覆盖率(即 pass@256)下降,表明 LLM 的推理边界在缩小

Preliminaries

  • 本节首先概述 RLVR 的基础知识,然后介绍用于评估推理边界的 pass@\(k\) 指标,并解释为什么它比最佳采样(best-of-\(N\))等替代方案更受青睐

RLVR(Reinforcement Learning with Verifiable Rewards)

Verifiable Rewards
  • 设 \(\pi_{\theta}\) 为一个具有参数 \(\theta\) 的 LLM,它在自然语言 Prompt \(x\) 的条件下生成一个 Token 序列 \(\mathbf{y}=(y_{1},\ldots,y_{T})\)
  • 一个确定性的 ** Verifier** \(\mathcal{V}\) 返回一个二元奖励:
    $$ r=\mathcal{V}(x,\mathbf{y})\in\{0,1\}$$
    • 当且仅当模型的最终答案完全正确时 \(r=1\)
  • 也可以添加格式奖励以鼓励模型明确地将推理过程与最终答案分开
  • RL 的目标是学习一个策略以最大化期望奖励:
    $$ J(\theta)=\mathbb{E}_{x\sim\mathcal{D} }\left[\mathbb{E}_{\mathbf{y}\sim\pi_{\theta}(\cdot|x)}[r]\right] $$
    • 其中 \(\mathcal{D}\) 是 Prompt 的分布
RLVR Algorithms
  • 近端策略优化(Proximal Policy Optimization,PPO)(2017) 提出使用以下裁剪替代目标(clipped surrogate)来最大化目标函数:
    $$\mathcal{L}_{\text{CLIP} }=\mathbb{E}\left[\min(r_{t}(\theta)A_{t},\text{clip}(r_{t}(\theta),1-\epsilon,1+\epsilon)A_{t})\right],$$
    • 其中 \(r_{t}(\theta)=\frac{\pi_{\theta}(y_{t}|x,\mathbf{y}_{ < t})}{\pi_{\theta_{\text{old} } }(y_{t}|x,\mathbf{y}_{ < t})}\),\(A_{t}\) 是由价值网络 \(V_{\phi}\) 估计的优势(advantage)
  • 可选地应用 KL 散度项(KL divergence term),以约束模型偏离原始策略的程度
  • 更多算法介绍见 C.5 节
Policy Gradient
  • PPO 及其变体属于 RL 的策略梯度类(policy gradient class)(1992; 1998)
  • 这些方法仅从 On-policy samples 中学习,即由当前 LLM 生成的样本
  • 在可验证奖励的背景下,训练目标通常是 最大化正确答案样本的对数似然,并最小化错误答案样本的似然
Zero RL Training
  • Zero RL Training 将 RL 直接应用于 Base Model ,无需任何 SFT (2025)
  • 为了清晰研究 RLVR 的效果
    • 对所有数学任务
      • 遵循 Zero-RL 设置,使用预训练模型作为起始模型
    • 对于 Coding 和视觉推理(Visual Reasoning)任务
      • 使用微调模型作为起始模型,比较微调模型与其 RLVR 训练的对应模型
    • 补充:对于 Coding 和视觉推理(Visual Reasoning)任务,开源工作通常使用指令微调模型作为起点
      • 主要是由于使用纯 Zero-RL 设置存在训练不稳定性和有限的有效性
      • 遵循此惯例,论文比较微调模型与其 RLVR 训练的对应模型,以专注于 RLVR 的效果
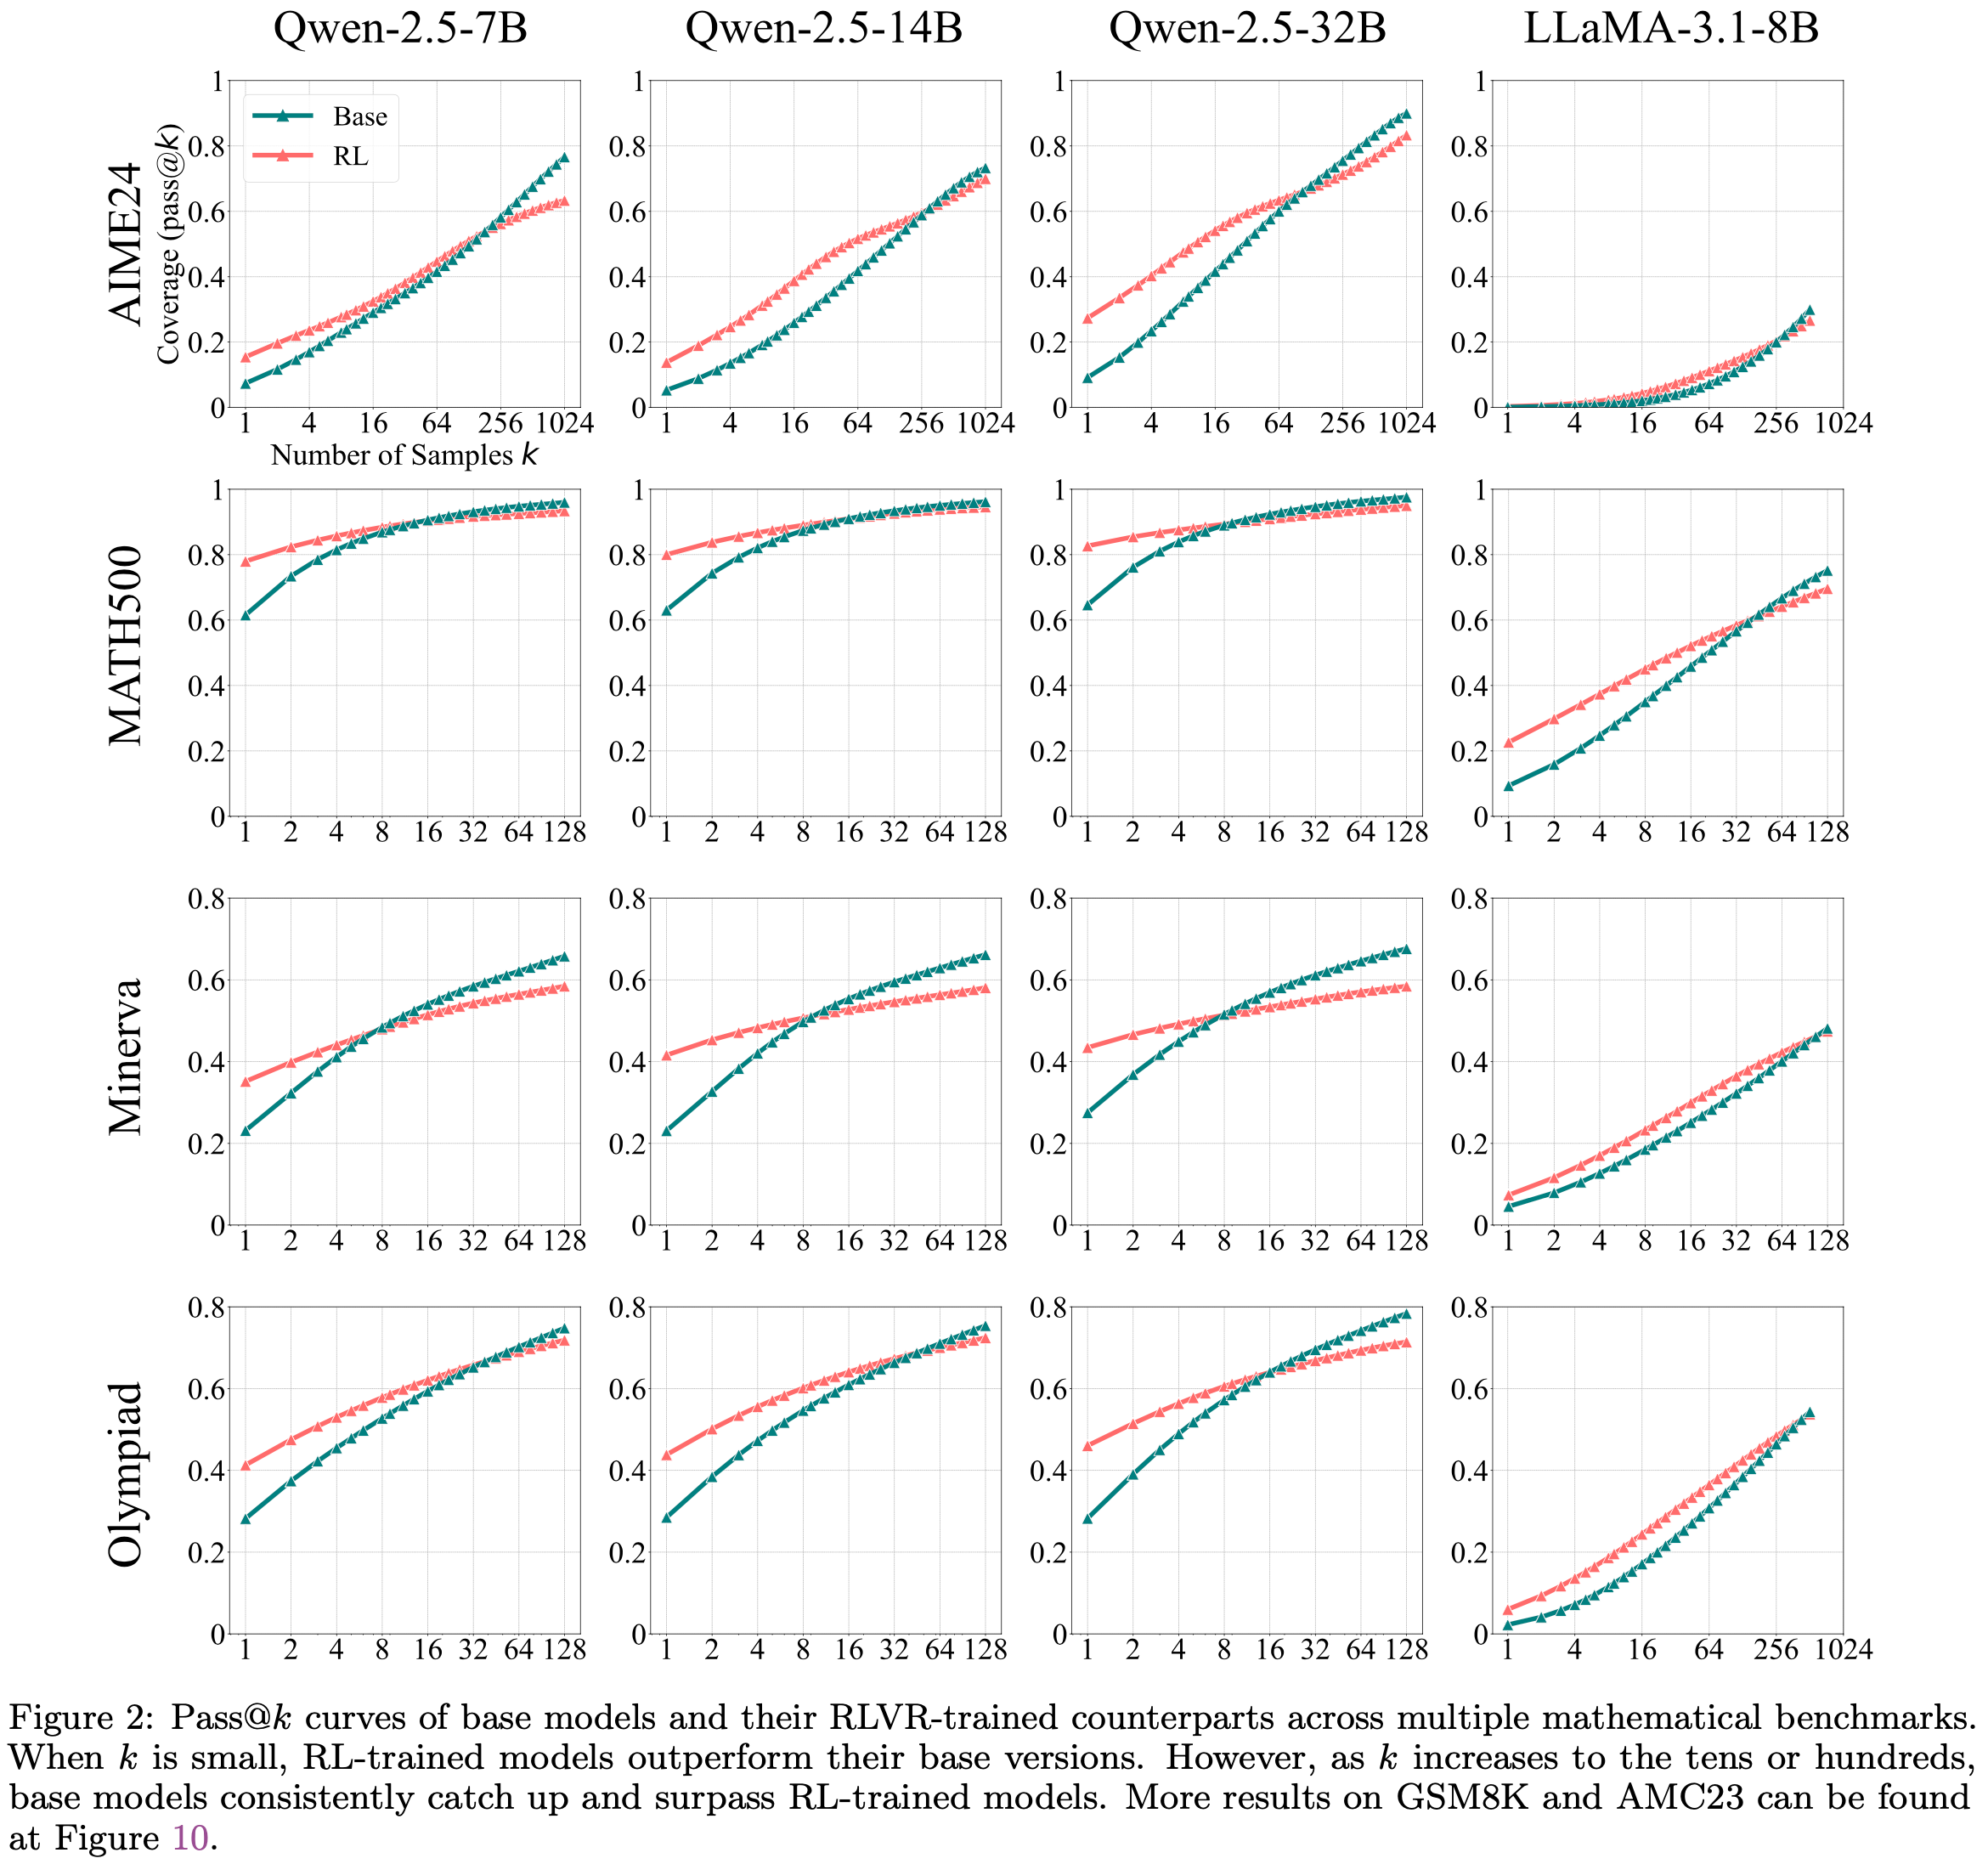
  • 图 2 : Base Model 及其 RLVR 训练对应模型在多个数学基准测试上的 Pass@\(k\) 曲线
    • 当 \(k\) 较小时, RL 训练的模型优于其基础版本
    • However,当 \(k\) 增加到数十或数百时, Base Model 持续赶上并超越 RL 训练的模型
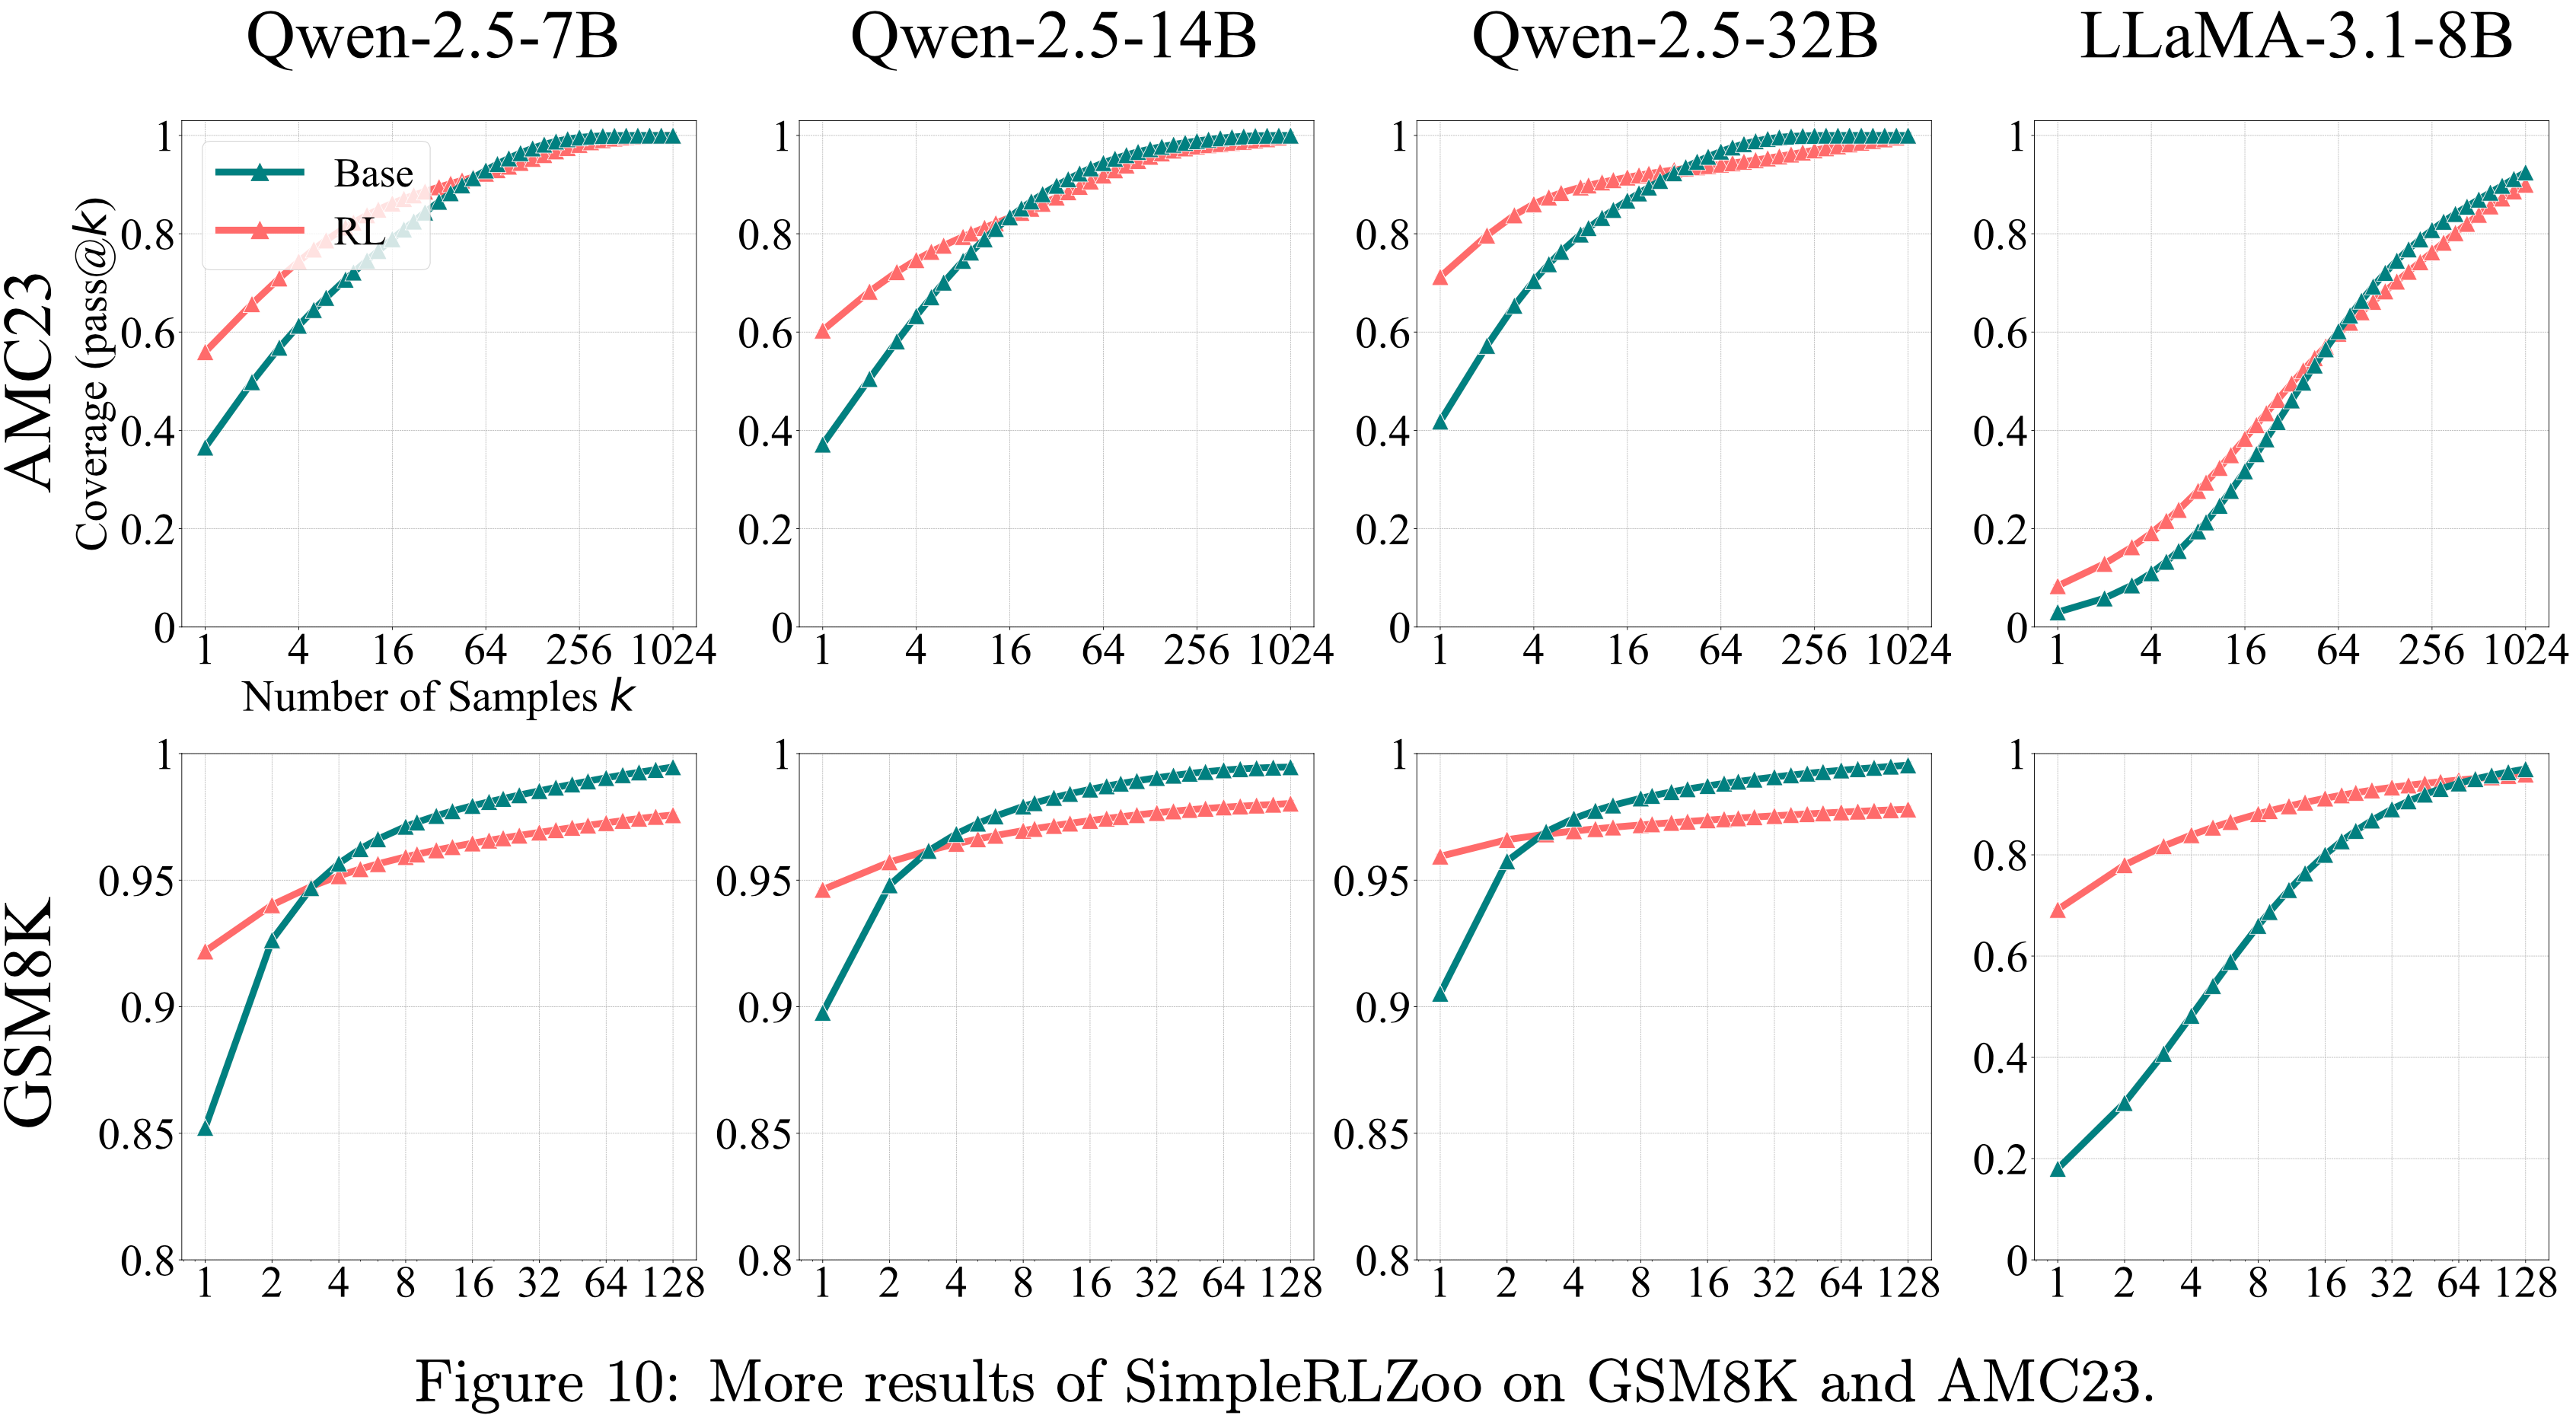
    • GSM8K 和 AMC23 的更多结果见图 10

Metrics for LLM Reasoning Capacity Boundary

Pass@\(k\) Metrics
  • 准确测量 Base 和 RL 模型的推理能力边界具有挑战性,因为贪心解码或核采样的平均值 (2020) 等方法仅反映平均情况下的性能
  • 为了准确测量推理能力边界,论文将代码生成中常用的 pass@\(k\) 指标 (2021) 扩展到所有具有可验证奖励的任务
  • 给定一个问题,论文从模型采样 \(k\) 个输出
    • 如果至少有一个样本通过验证,则该问题的 pass@\(k\) 值为 1;否则为 0
    • 问题:这里的模型采样可能会重复吗?
  • 数据集的平均 pass@\(k\) 值反映了模型在 \(k\) 次尝试内可以解决的数据集中问题比例,为 LLMs 的推理能力覆盖范围提供了严格评估
  • 论文采用一种无偏、低方差的估计器(unbiased, low-variance estimator)来计算 pass@\(k\),详见 A.2 节
Comparison with Best-of-\(N\) and Majority Voting
  • Best-of-\(N\) (2021) 和 Majority Voting 是选择正确答案的实用方法,但它们可能忽略了模型的全部推理潜力
  • In Contrast,论文使用 pass@\(k\) 不是为了评估实际效用 ,而是为了探究推理能力的边界
    • 如果模型在任意 \(k\) 个样本中产生了一个正确解,论文将该问题视为在其潜在范围内
    • Thus,如果 RL 增强了推理能力, RL 训练的模型应该比 Base Model 在更多此类问题上成功
  • 如果 Verifier 或投票未选择正确答案,像 Best-of-\(N\) 或多数投票这样的方法可能会错过这些成功
Random Guessing Issue
  • 对于 Coding 任务,使用编译器和预定义的单元测试用例作为 Verifier ,pass@\(k\) 值可以准确反映模型是否能解决问题
  • 在 Mathematics 中,“猜测”问题可能随着 \(k\) 的增加而变得显著,即模型可能生成不正确的 CoT 但仍偶然得出正确答案
  • 为了解决这个问题,论文对模型输出的一个子集手动检查 CoT 的正确性 ,详见 3.1 节
  • 通过结合数学上手动检查的结果和 Coding 的结果,论文严格评估了 LLM 推理能力的范围
  • 另一个注意事项是(Another caveat is that),如果 \(k\) 值极大,即使是 Token 字典(Dictionary)上的均匀采样也会偶然发现正确的推理路径
    • 尽管这在当今的时间和计算资源预算下是不可行的
  • Crucially,论文发现 Base Model 在实际的 \(k\) 值(\(k=128\) 或 1024)下已经能产生正确的输出,这完全在实用资源限制内
    • 理解:这里也是最早本人的担忧,这里作者相当于给了比较合适的回答了,但依然是论文的一个核心讨论点,因为采样次数足够多,任何模型都能成功

RLVR’s Effect on Reasoning Capacity Boundary

  • 前文建立了推理边界评估指标
  • 本节现在通过广泛的实验对基础和 RLVR 模型进行全面评估
  • 论文的分析按任务类别组织,涵盖三个代表性领域:数学、代码生成和视觉推理
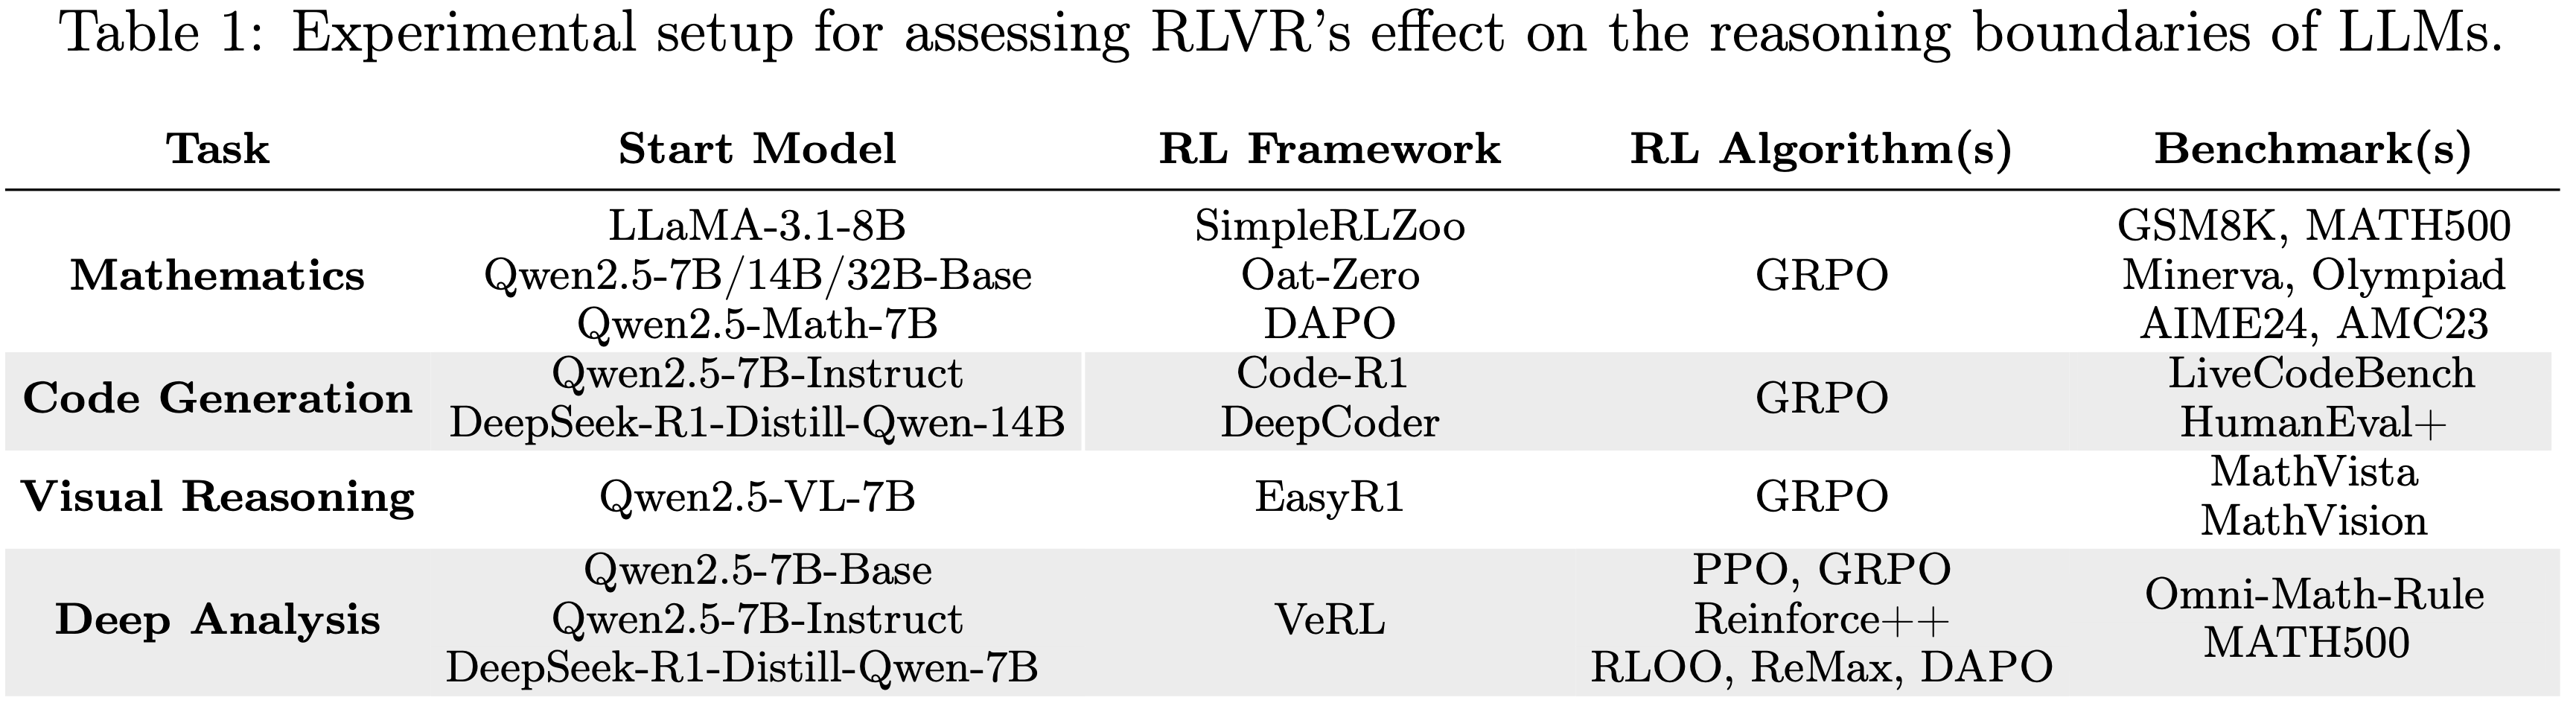
  • 整体实验设置总结在表 1 中(表 1 :评估 RLVR 对 LLMs 推理边界影响的实验设置)
  • 评估协议(Evaluation Protocol)
    • 对于 Base Model 和 RLVR 模型的采样过程,论文使用温度 temperature=0.6 和 top-\(p\) 值 0.95,允许最大生成 16,384 个 Token
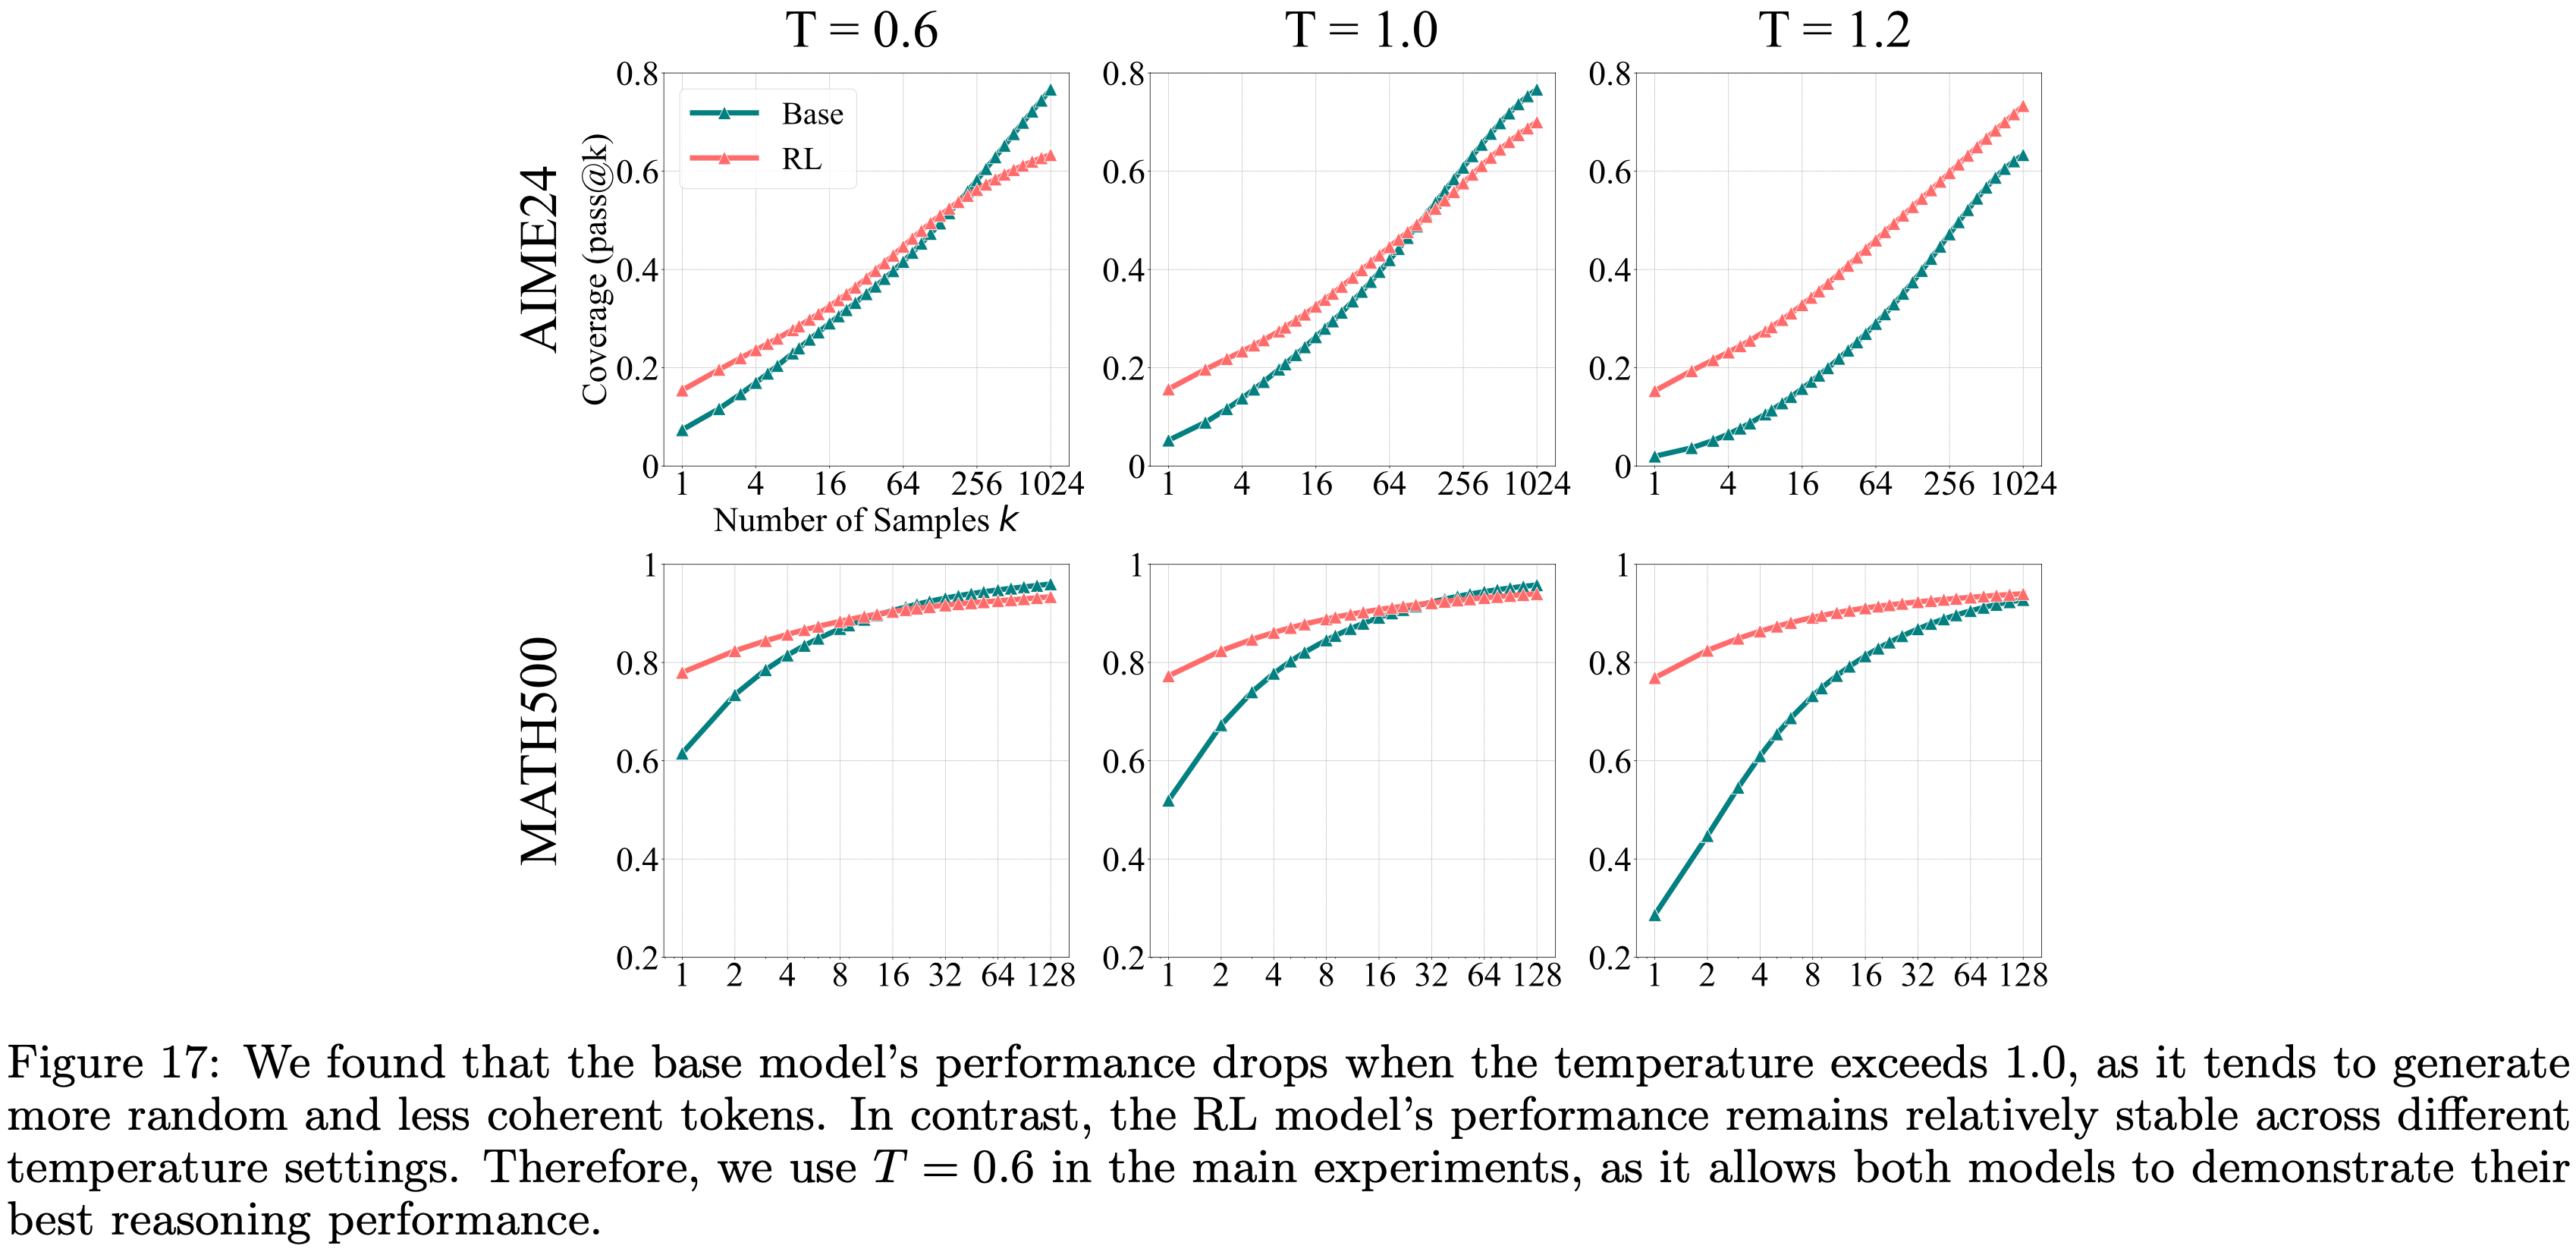
      • 论文在图 17 中还展示了不同温度设置的效果
    • 对于 Base Model 的评估,一种常见做法是在 Prompt 中包含少量示例(few-shot examples)以引导输出 (2024; 2024; 2024)
      • However,为了确保公平和无偏见的比较,论文特意避免为 Base Model 使用少量 Prompt (few-shot prompts),以消除上下文示例可能对推理造成的任何潜在混杂影响
    • 为了评估 Base Model 和 RLVR 模型,论文使用与 RLVR 训练相同的零样本 Prompt (zero-shot prompt),或基准测试提供的默认 Prompt ,确保两种模型之间设置一致
      • Interestingly,尽管 Base Model 在没有少量指导的情况下经常产生未格式化或无意义的 Response ,但论文观察到,只要有足够的采样,它们仍然能够生成正确格式化的输出并成功解决复杂问题
      • 训练和评估的 Prompt 模板在附录 D 节中提供

RLVR for Mathematical Reasoning

Models and Benchmarks
  • 在数学问题中,模型需要生成一个推理过程(即 CoT)以及最终答案
  • 为了确保结论的稳健性,论文实验了多个 LLM 家族,主要是 Qwen2.5 (7B/14B/32B 基础变体) (2024) 以及额外的 LLaMA-3.1-8B (2024)
  • 论文采用由 SimpleRLZoo (2025) 发布的 RLVR 模型,这些模型使用 GRPO 在 GSM8K 和 MATH 训练集上训练 Zero RL 模型,仅使用正确性奖励,排除任何基于格式的奖励
  • 论文在不同难度的基准测试上比较 Base 和 Zero RL 模型的 pass@\(k\) 曲线:
    • GSM8K (2021)、MATH500 (2021)、Minerva (2022)、Olympiad (2024)、AIME24 和 AMC23
  • Additionally,论文还包括 RLVR 模型 Oat-Zero-7B 和 DAPO-32B (2025a; 2025)
    • 这两个模型的特点是在具有挑战性的 AIME24 基准测试上表现出色
The Effect of RLVR: Increased Likelihood of Correct Samples, Decreased Coverage of Solvable Problems(增加正确样本的可能性,减少可解问题的覆盖范围)
  • 如图 2 所示,论文一致地观察到小 \(k\) 值和大 \(k\) 值之间的对比趋势
    • 当 \(k\) 较小时(例如 \(k=1\),相当于平均准确率), RL 训练的模型优于其基础对应模型
      • 这与 RL 提升性能的常见观察相符,表明 RLVR 使模型采样正确 Response 的可能性显著增加
    • 随着 \(k\) 增加,曲线变得更陡峭,在所有基准测试中, Base Model 持续赶上并最终超越 RL 训练的模型
      • 表明 Base 模型对可解问题的覆盖范围更广
      • 例如,在 Minerva 基准测试上使用 32B 大小模型时, Base Model 在 \(k=128\) 时比 RL 训练的模型高出约 9%,这意味着它可以在验证集中解决大约多 9% 的问题
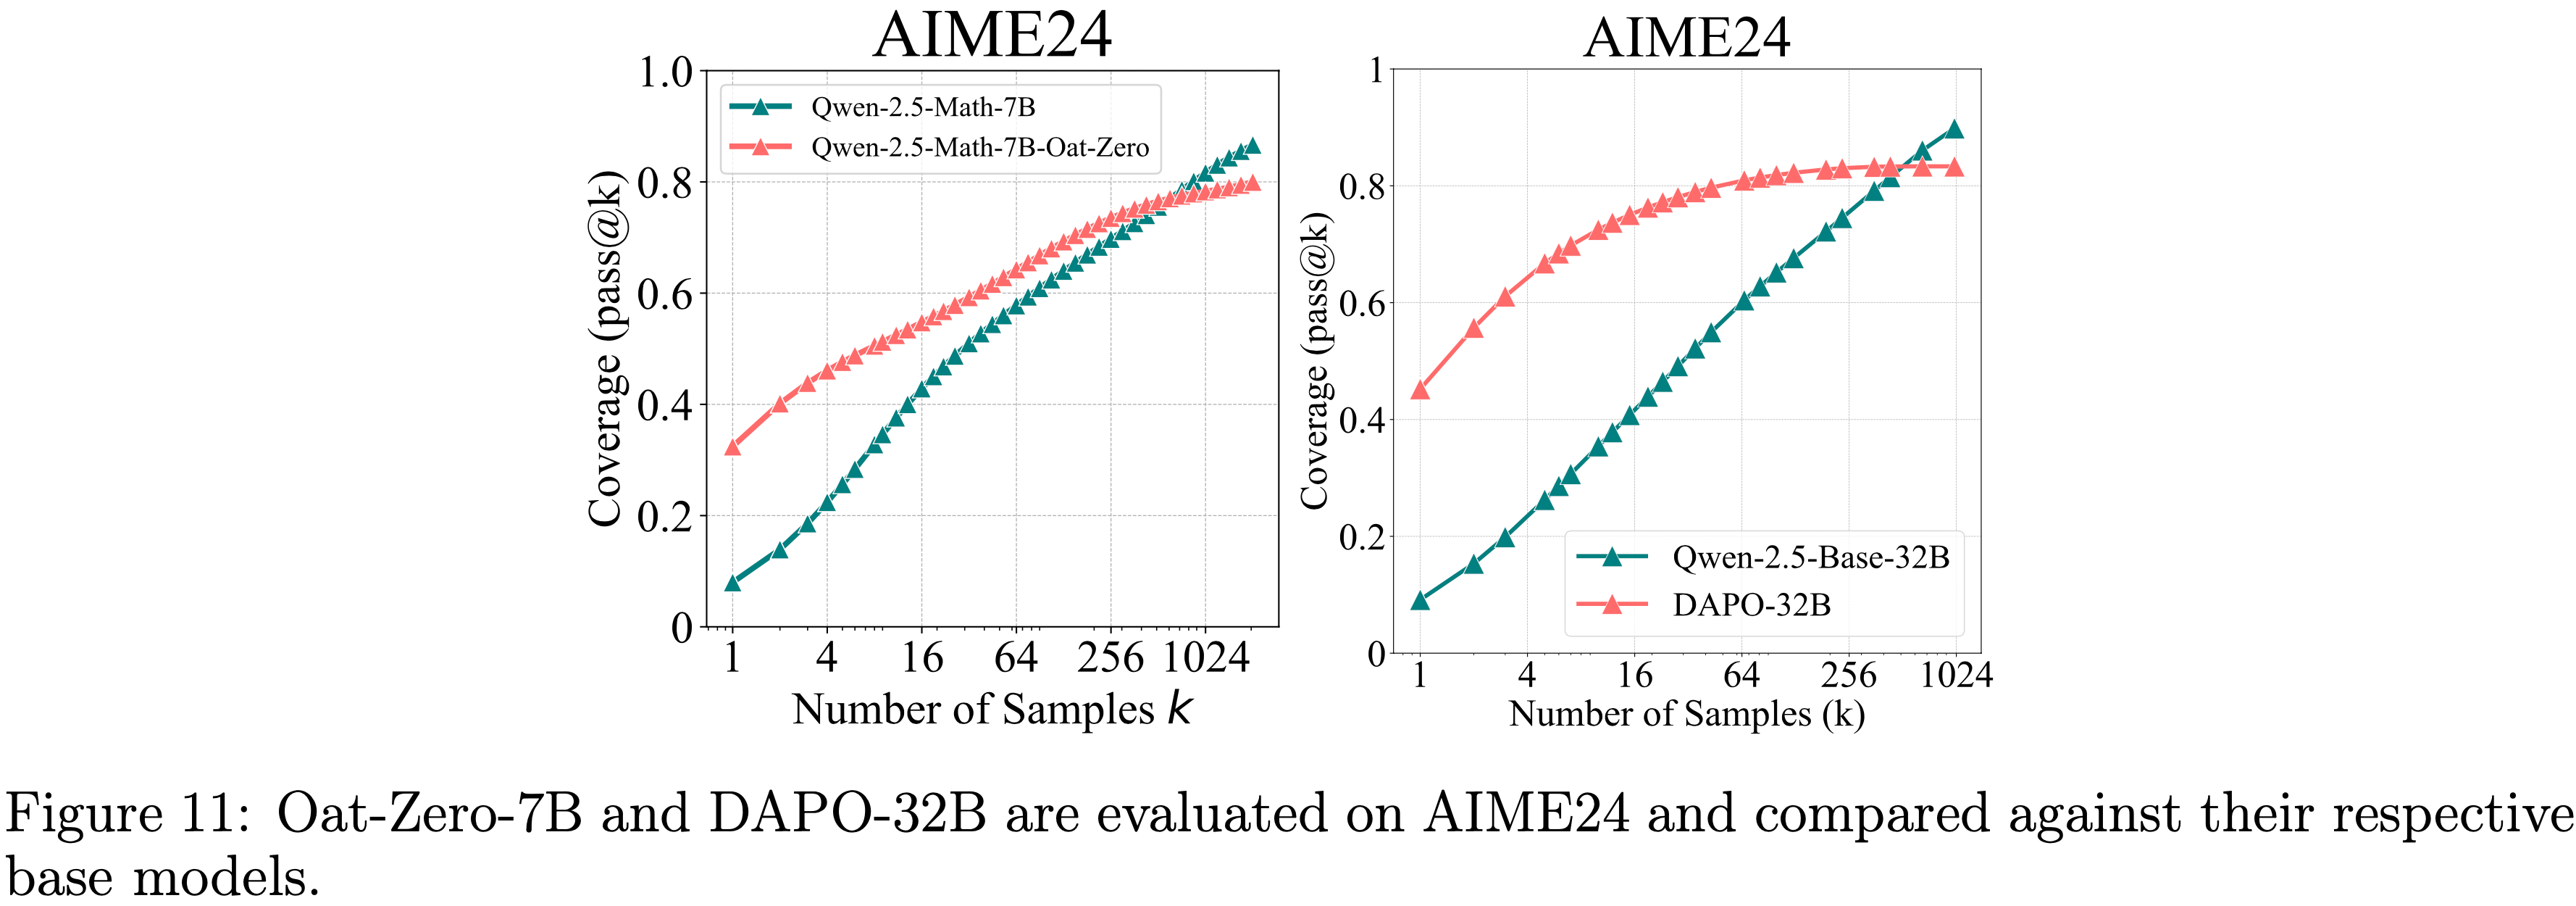
  • 论文进一步检查了使用 Oat-Zero 和 DAPO 训练的 RL 模型
    • 如图 11 所示,尽管 RL 模型最初表现出强劲性能,比 Base Model 高出近 30%,但最终被 Base Model 超越
  • 基于这些结果,论文得出结论:RLVR 在低 \(k\) 时增加了采样正确 Response 的可能性,但缩小了模型的整体覆盖范围
  • 论文在 4.1 节进一步分析了这种现象的根本原因
CoT Case Analysis
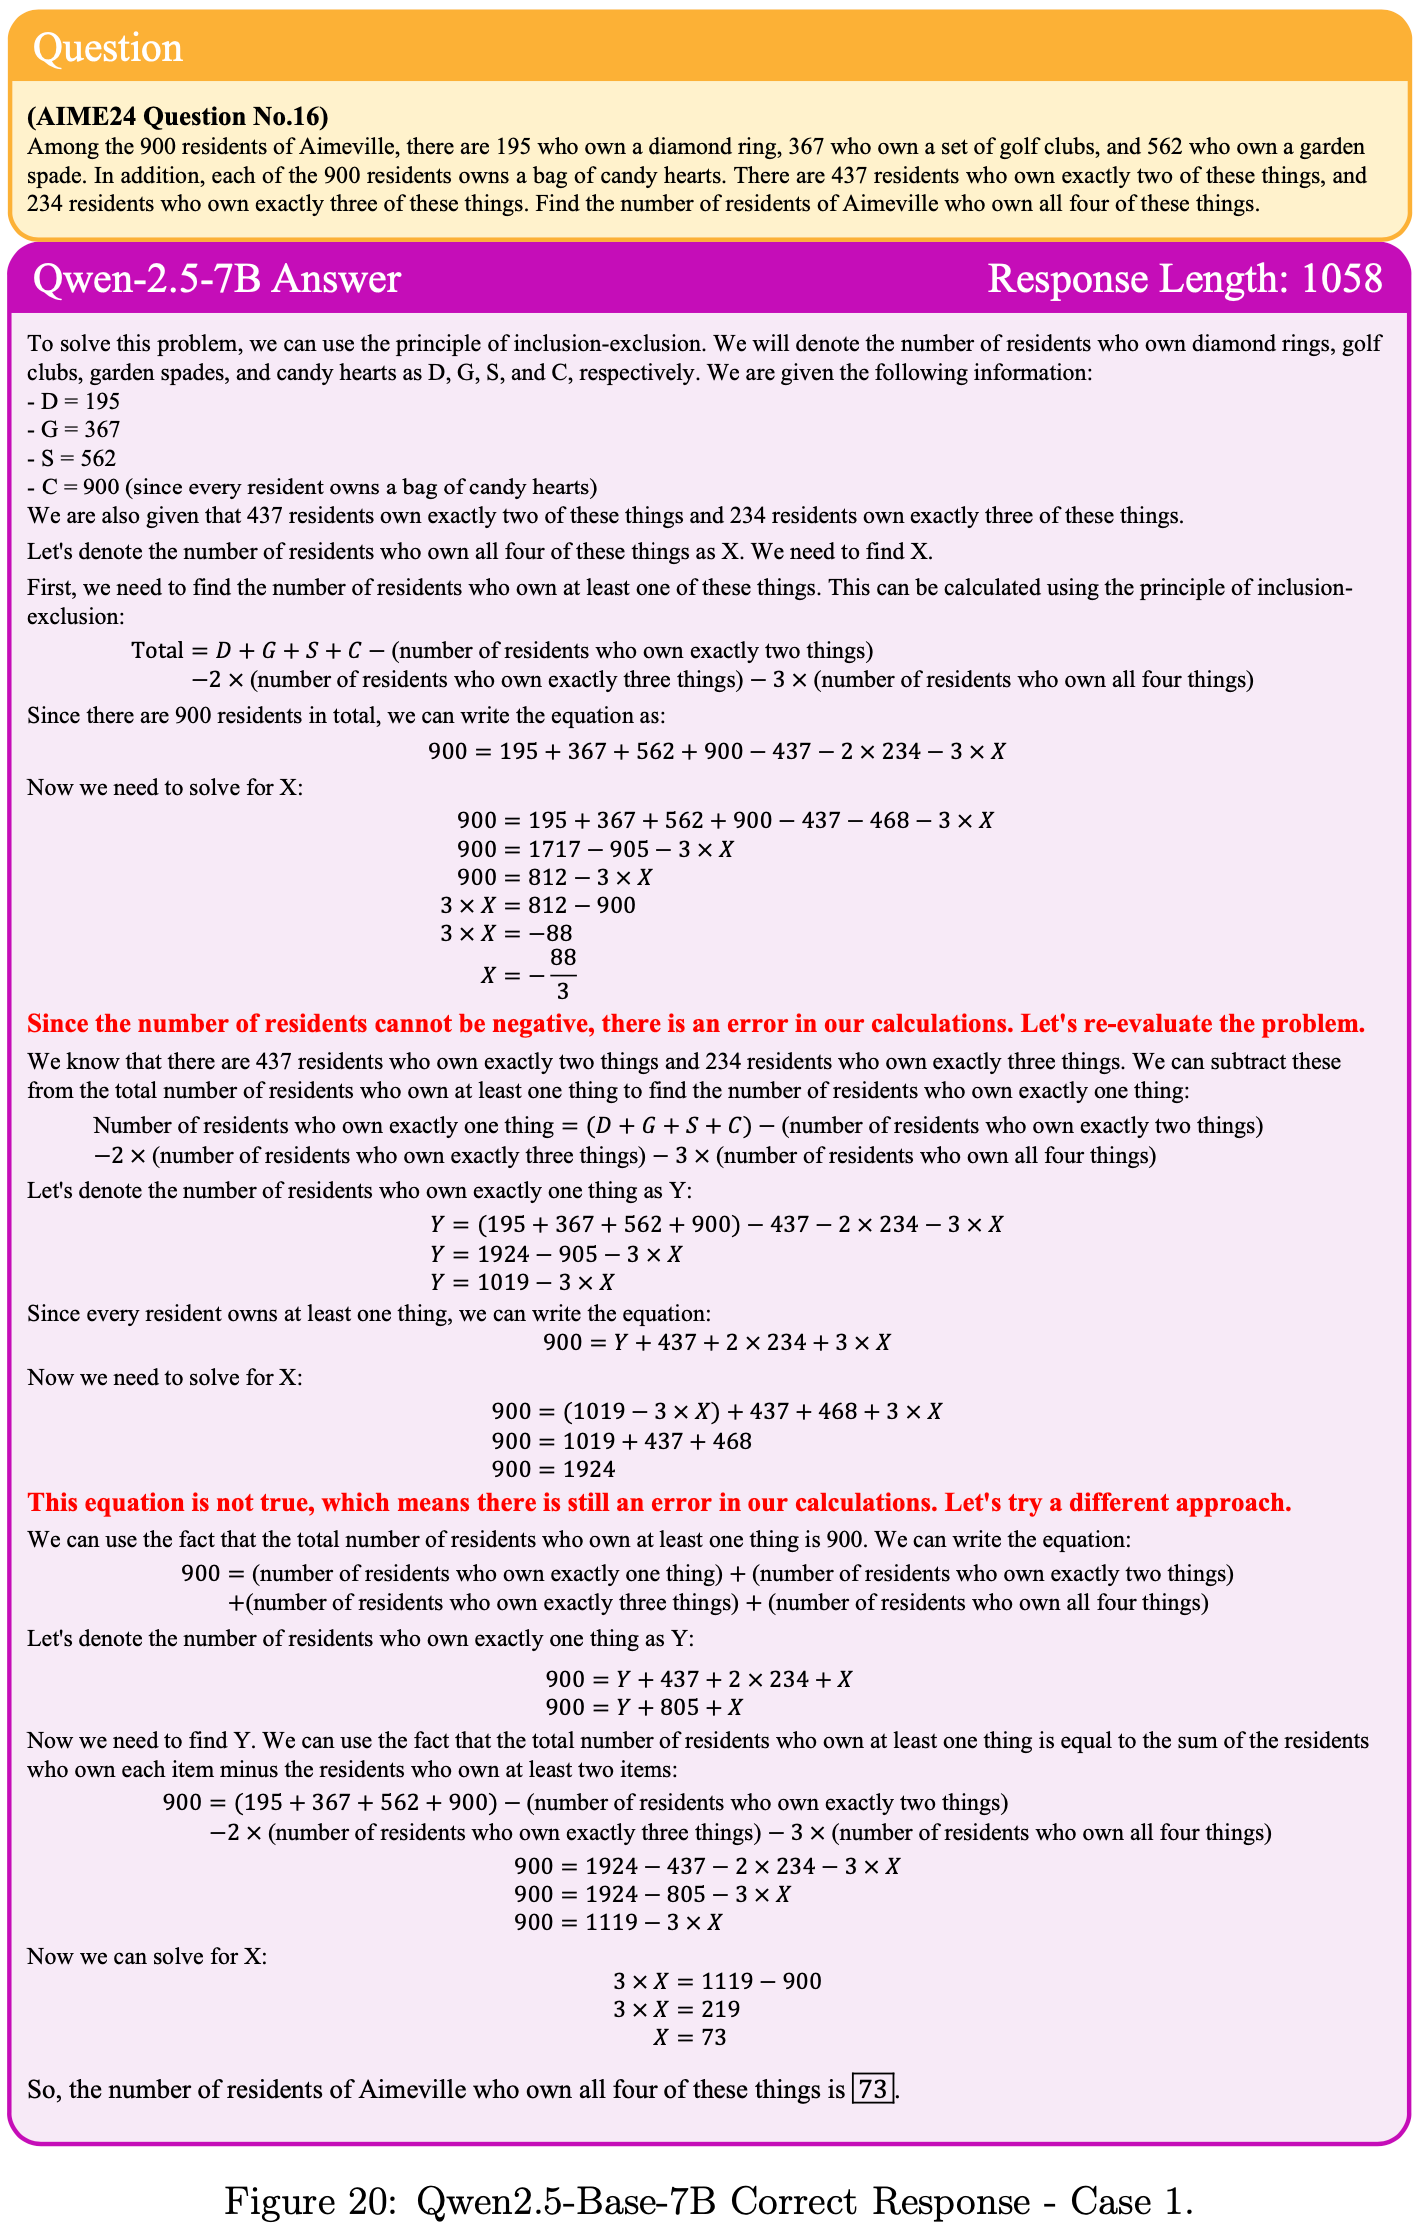
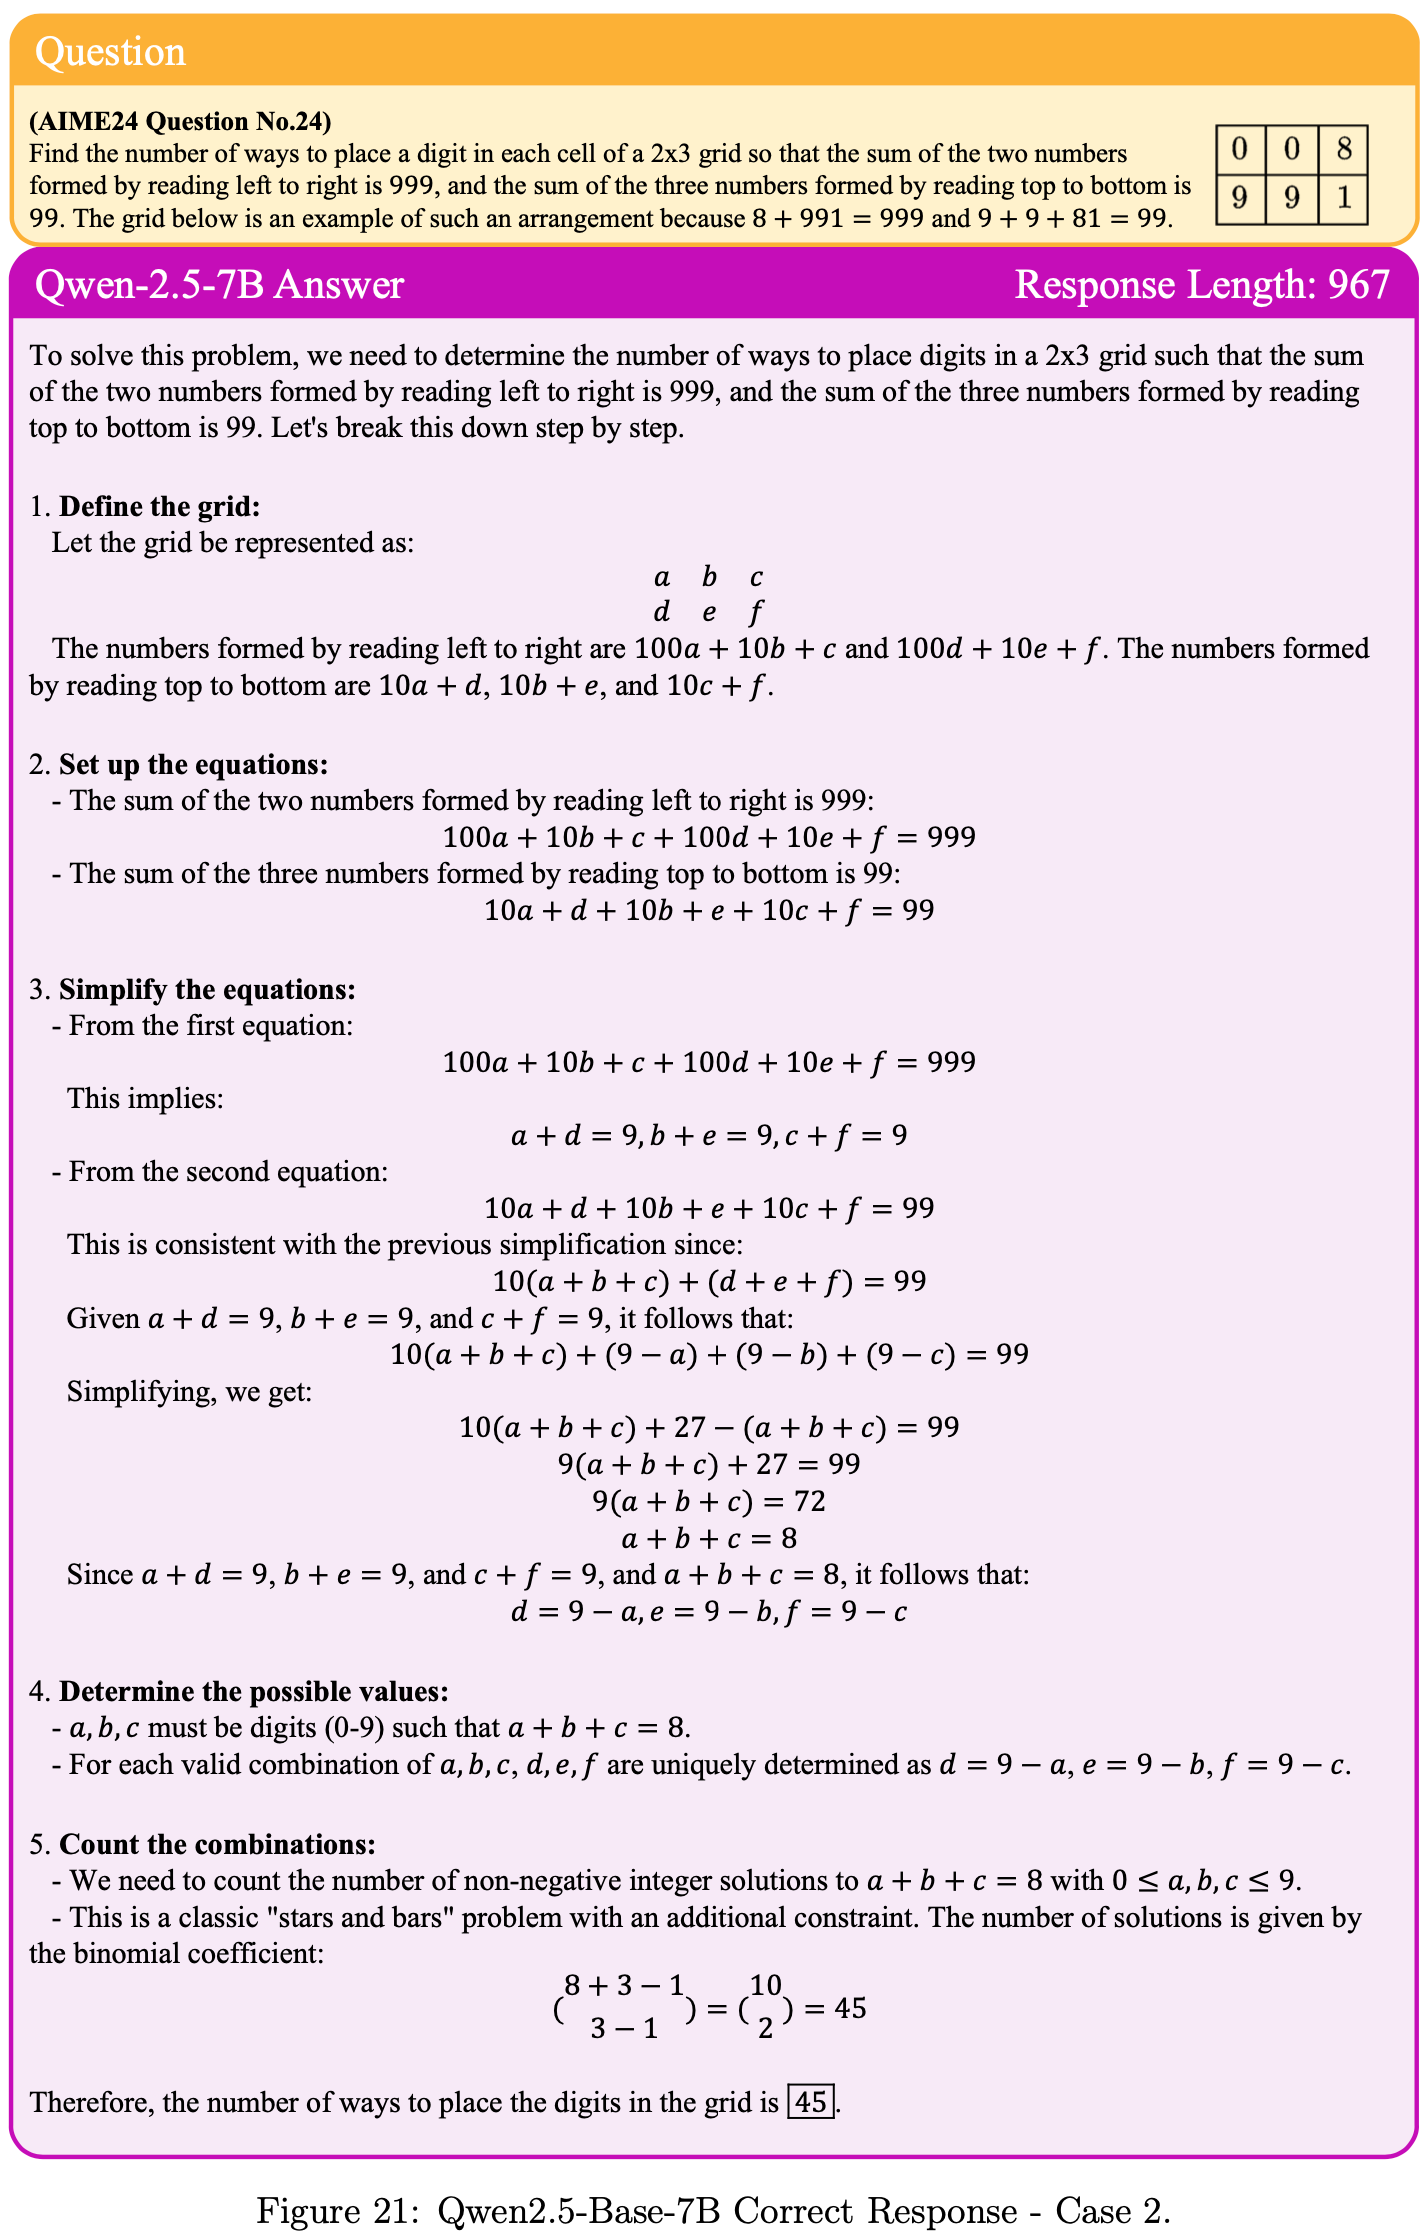
  • 论文在图 20 和图 21 中展示了从 Base Model 中采样的正确 CoT,这些是从 AIME24 最难问题的 2048 次采样中手动选择的
  • Base Model 的 Response 往往是较长的 CoT 并表现出反思行为,突显了 Base Model 内在的强大推理能力
Validityof Chain-of-Thought
  • 对于数学问题,常见的评估仅基于最终答案的正确性,存在 hacking 风险
  • 为了使用 pass@\(k\) 准确反映推理能力边界,重要的是评估有多少已解决的问题是源于采样到真正正确的 CoT,而非幸运猜测
  • 遵循 (2024),论文手动检查了 GSM8K 数据集中最具挑战性的可解问题(平均准确率低于 5% 但高于 0%)中导致(led to)正确答案的所有 CoT
    • Base Model 回答了 25 个这样的问题,其中 24 个包含 至少一个(at least one) 正确的 CoT
    • Similarly, RL 训练的模型回答了 25 个问题,其中 23 个包含 至少一个 正确的 CoT
  • 论文还手动检查了具有挑战性的 AIME24 基准测试中平均准确率低于 5% 的问题的 CoT(详情见 C.2 节)
    • Base Model 回答了 7 个这样的问题,其中 5 个(共 6 个,排除一个因跳过推理步骤而正确性模糊的情况)包含 至少一个 正确的 CoT
    • 类似地, RL 训练的模型回答了 6 个问题,其中 4 个包含 至少一个 正确的 CoT
  • 这些结果表明, Base Model 可以采样有效的推理路径来解决问题
    • 理解:这里是挑选最可能因为随机猜对答案(而 CoT 是错的)的问题进行人工 check,看起来 check 结果也是符合预期的(Base Model 回答对的情况跟 RL 模型差不多或更好)

RLVR for Code Generation

Models and Benchmarks
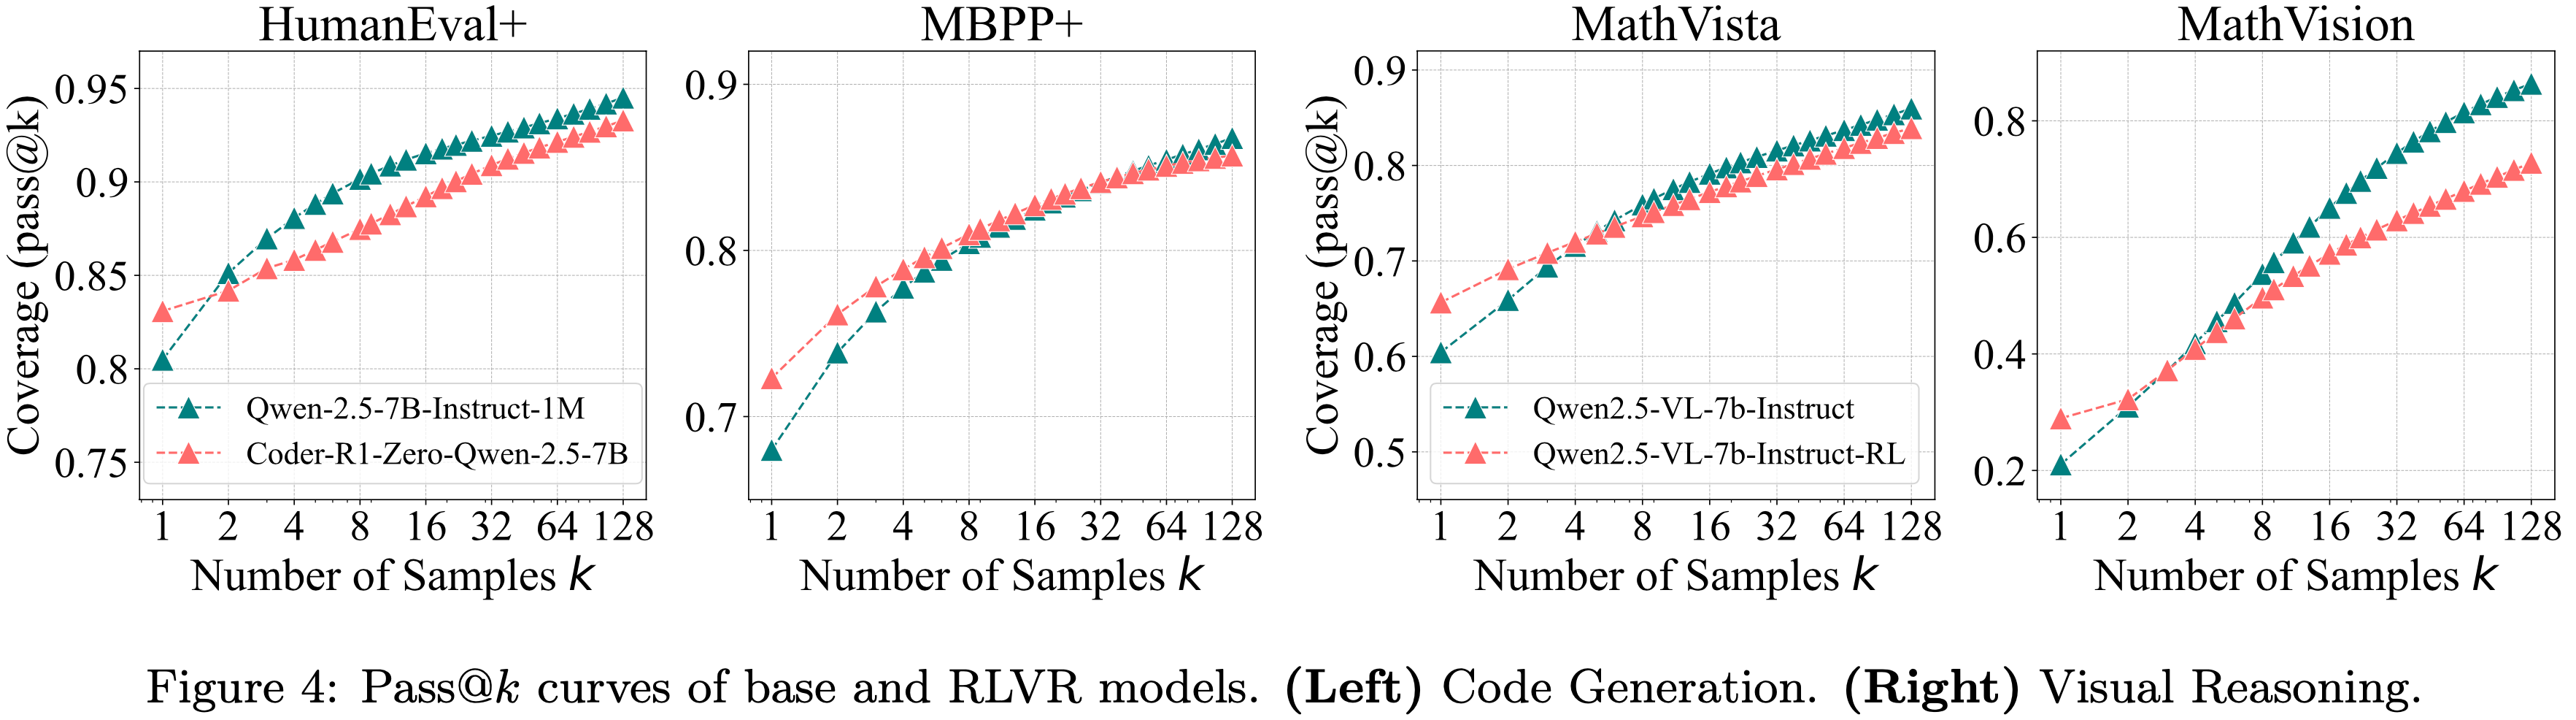
  • 论文采用了开源的、经过 RLVR 训练的模型 CodeR1-Zero-Quen2.5-7B (2025)
    • 该模型基于 Quen2.5-7B-Instruct-1M (2025b),在 12K 个 LeetCode 和 TACO 样本上训练了 832 步
  • For Evaluation,模型在 LiveCodeBench v5 上进行评估(assessed)
    • 该 LiveCodeBench v5 基准包含从 2024 年 8 月到 2025 年 1 月的 279 个问题 (2025),同时还使用了 HumanEval+ 和 MBPP+ (2023)
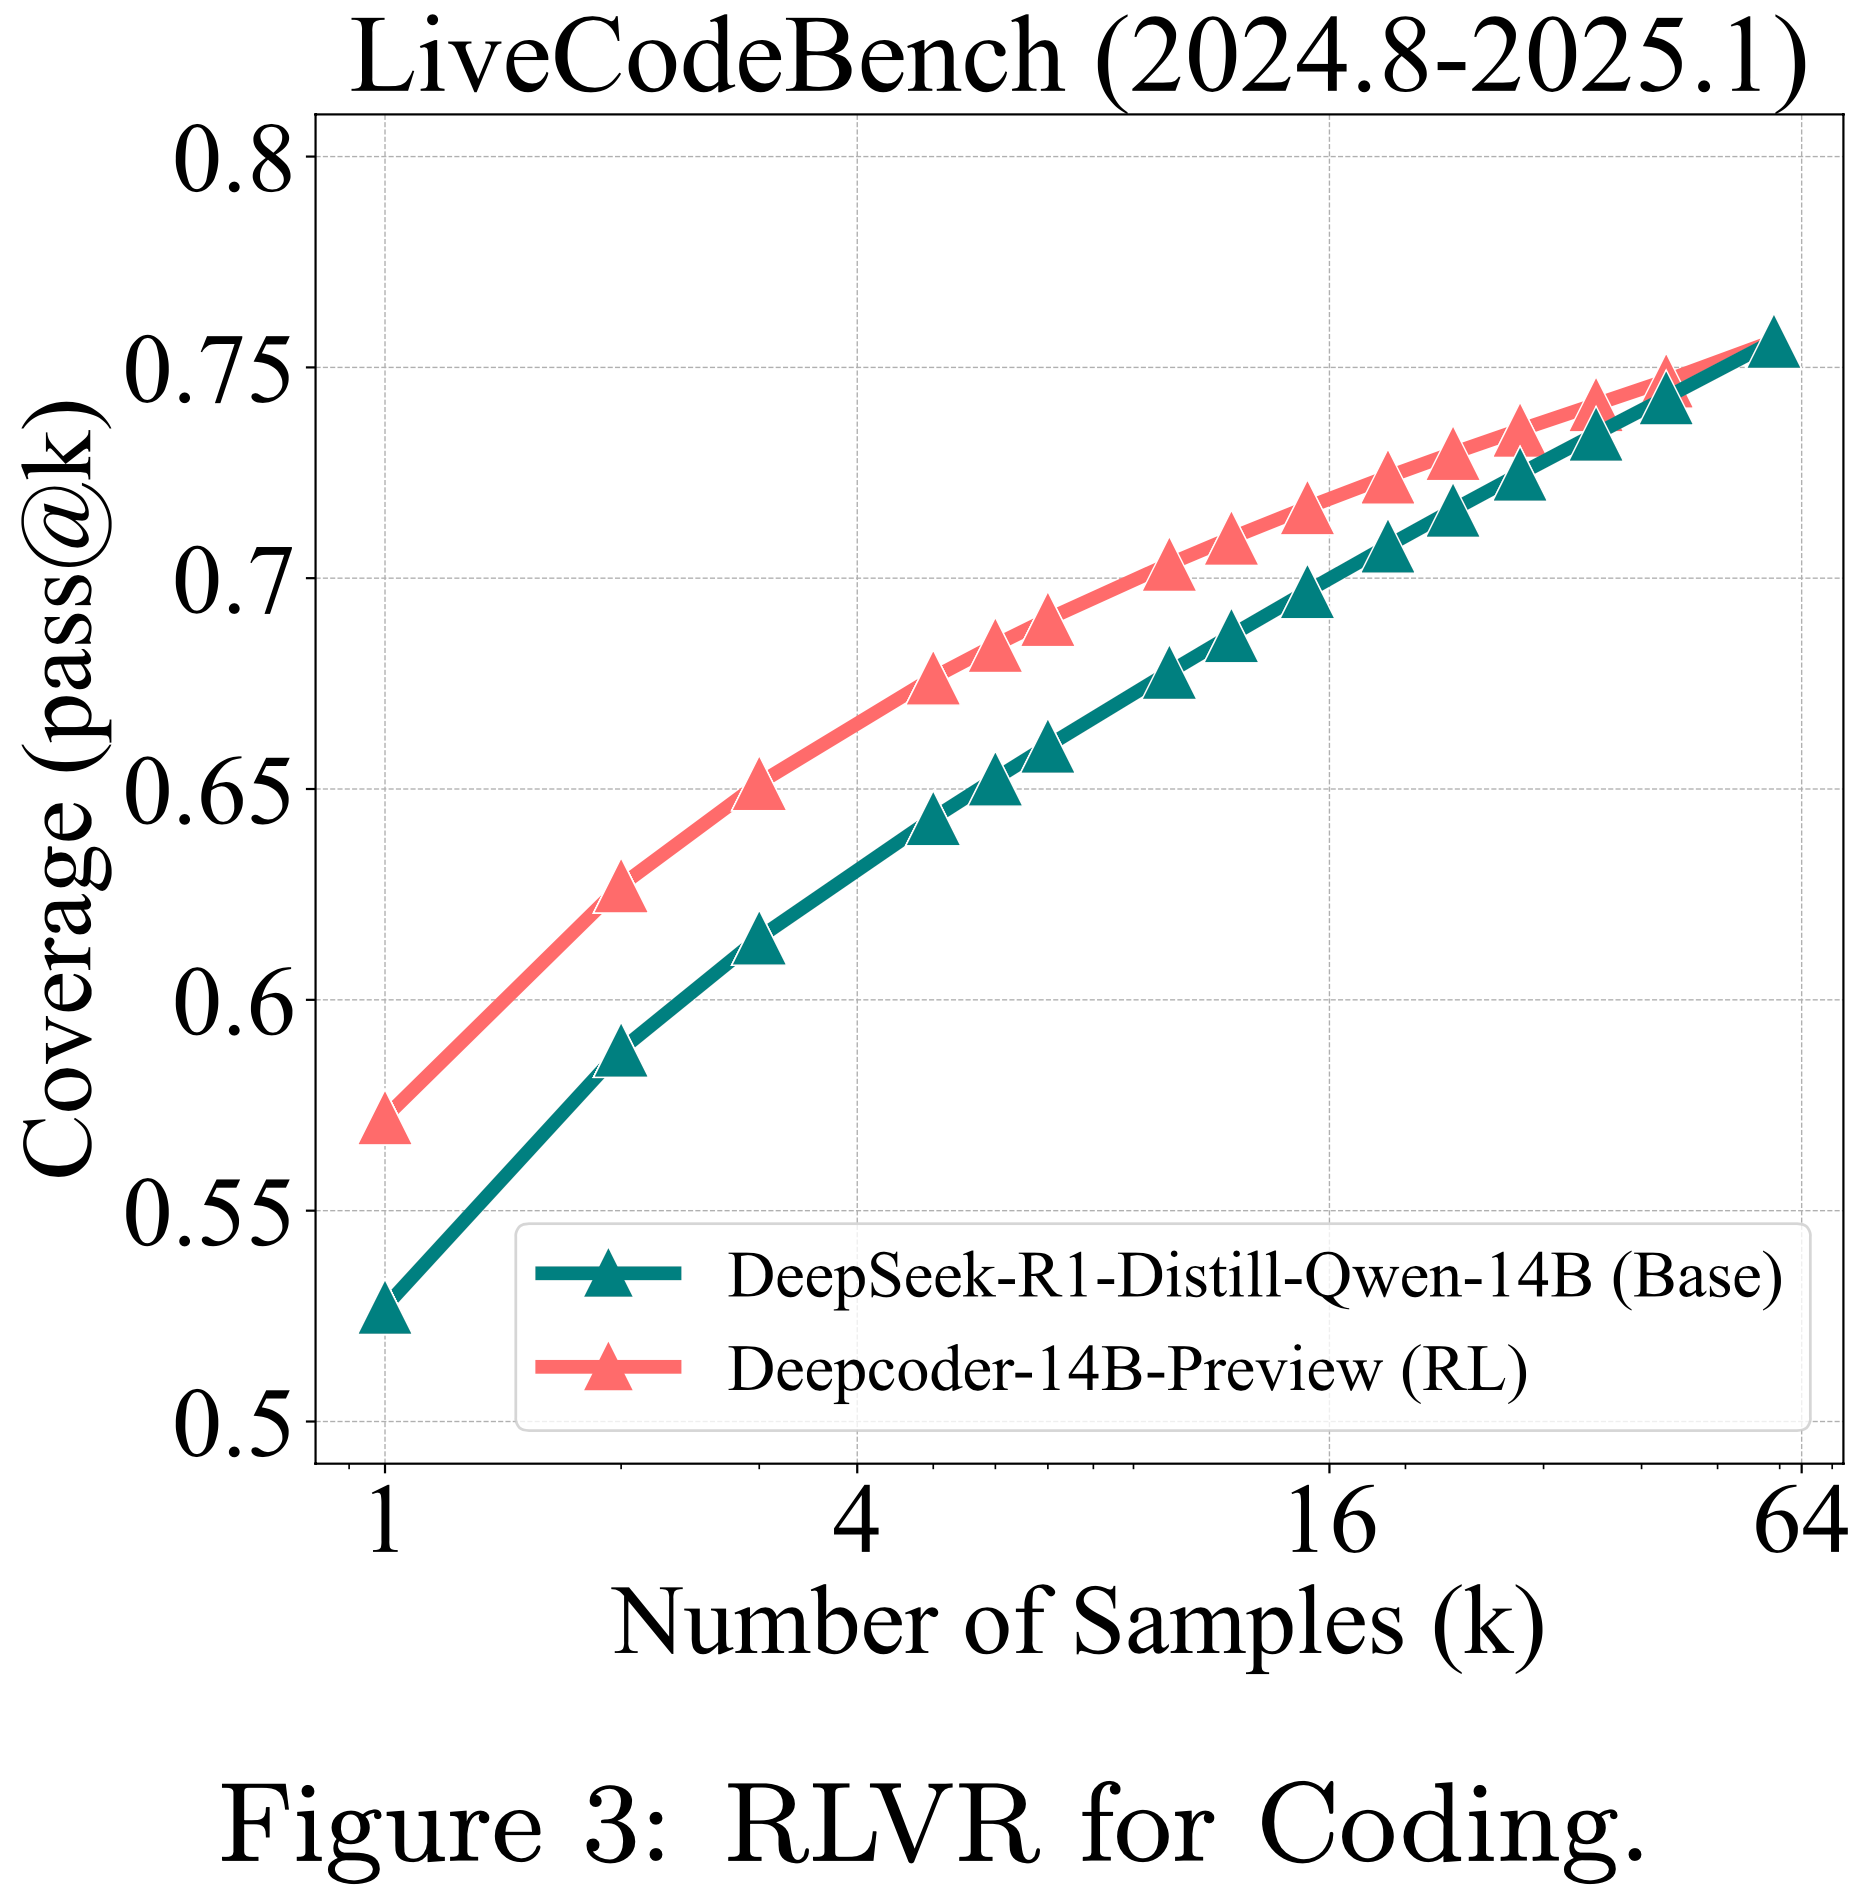
  • 论文还评估了最强大的开源 RLVR 训练代码 LLM DeepCoder-14B (2025),它基于 DeepSeek-R1-Distill-Quen-14B 构建
    • 这两个模型的 Response 长度均为 32k
    • 由于其高昂的计算成本,论文仅在 LiveCodeBench 上对它们进行评估,作为代表性基准
The Effect of RLVR
  • 由于通过猜测几乎不可能通过所有单元测试,因此 pass@(k) 可以可靠地衡量模型的推理边界
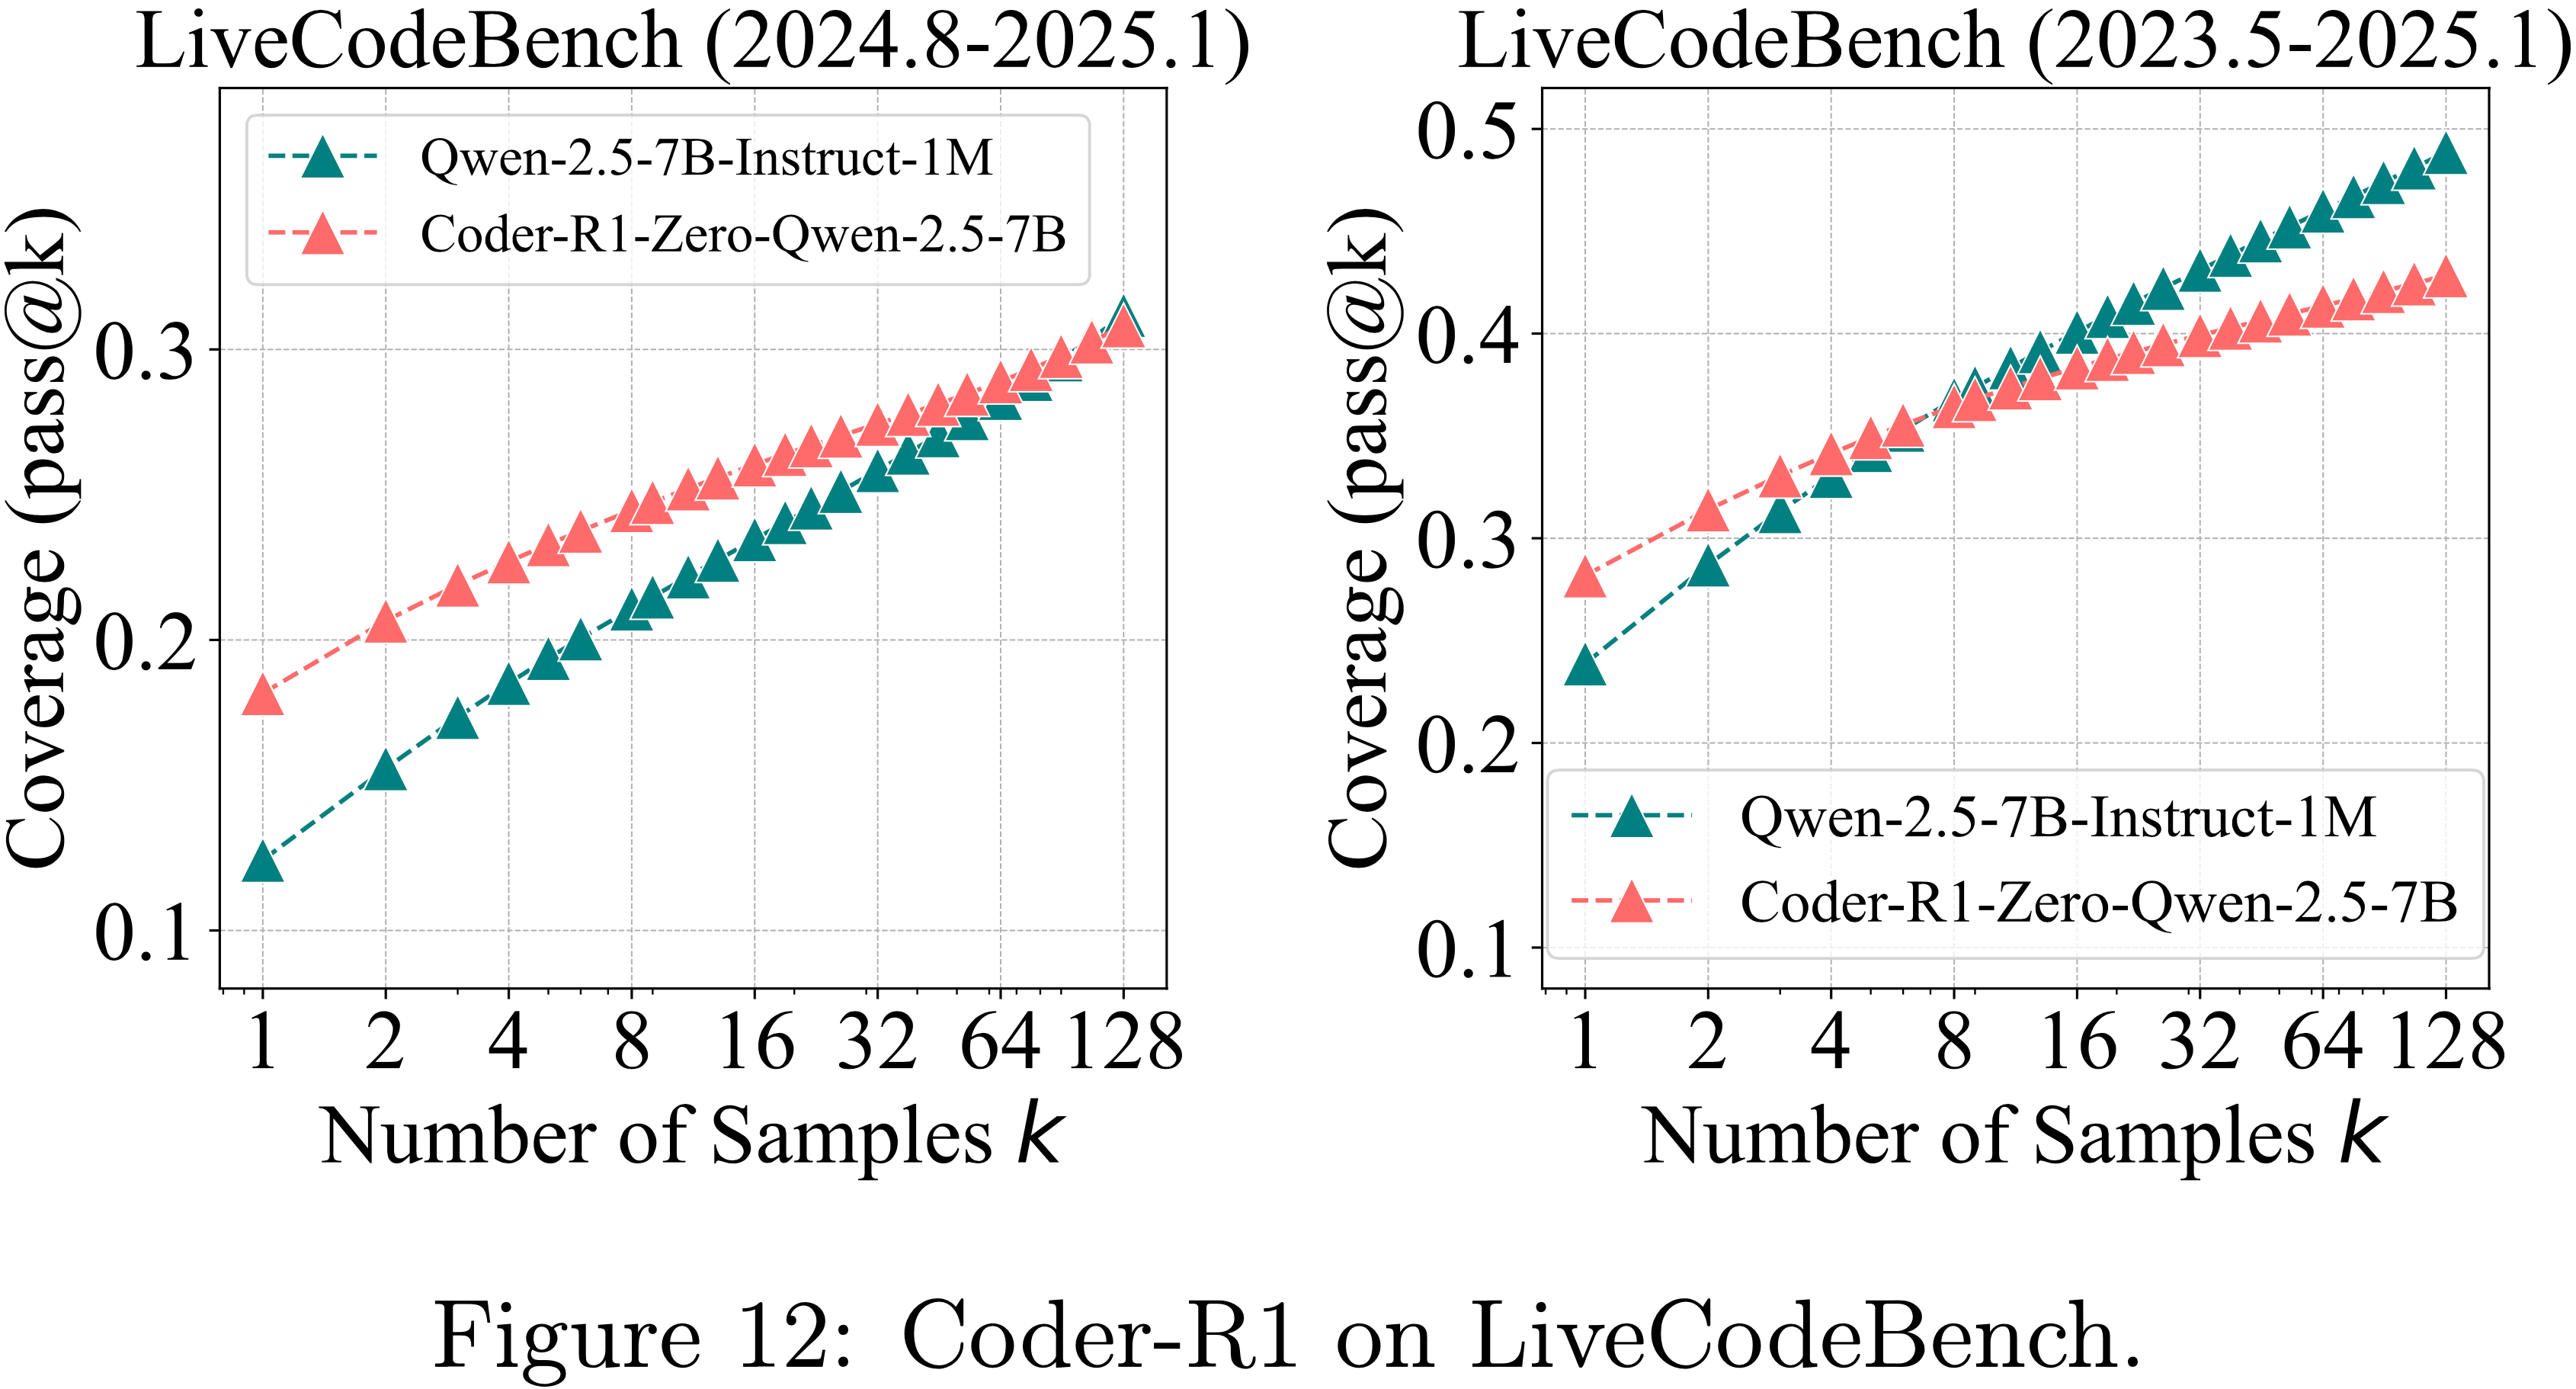
  • 如图 3、图 12 和图 4(左)所示,RLVR 在三个代码生成基准上的影响趋势与在数学基准上观察到的趋势高度一致

RLVR for Visual Reasoning

Models and Benchmarks
  • 在视觉推理任务中,模型必须共同解释视觉和文本输入以解决复杂的推理问题
  • 自 LLM 推理兴起以来,这已在多模态社区中获得极大关注 (2025a; 2025; 2025)
  • 在我们的实验中,我们选择视觉情境下的数学问题作为代表性任务
  • 我们使用 EasyR1 框架 (2025) 在 Geometry3K (2021) 上训练 Quen2.5-VL-7B (2025),并在经过筛选的 MathVista-TestMini (2024) 和 MathVision-TestMini (2024) 上评估其视觉推理能力,其中移除了多项选择题
The Effect of RLVR
  • 如图 4(右)所示,RLVR 对视觉推理的影响与在数学和代码基准上观察到的结果高度一致
  • 这表明,即使在多模态任务中,原始模型对可解问题也具有更广泛的覆盖范围
Validity of Chain-of-Thought
  • Similarly,作者手动检查了最具挑战性的问题子集,即平均准确率低于 5% 的问题
    • 作者发现,对于原始模型和 RL 模型,8 个问题中有 7 个问题至少包含一条正确的思维链
  • 这些结果支持了思维链的有效性

Deep Analysis

  • 本节对当前 RLVR 训练的效果进行了更深入的分析
  • 另外,论文也强调了蒸馏技术与 RLVR 的显著不同特征
  • In Addition,论文设计了对照实验来考察不同 RL 算法和设计选择的影响

Reasoning Paths Already Present in Base Models

Accuracy Distribution Analysis
  • 第 3 节的实验揭示了一个令人惊讶的趋势: Base Model 比 RLVR 训练后的模型覆盖了更广范围的可解问题
  • 为了更好地理解这一点,论文分析了 RLVR 训练前后准确率分布的变化
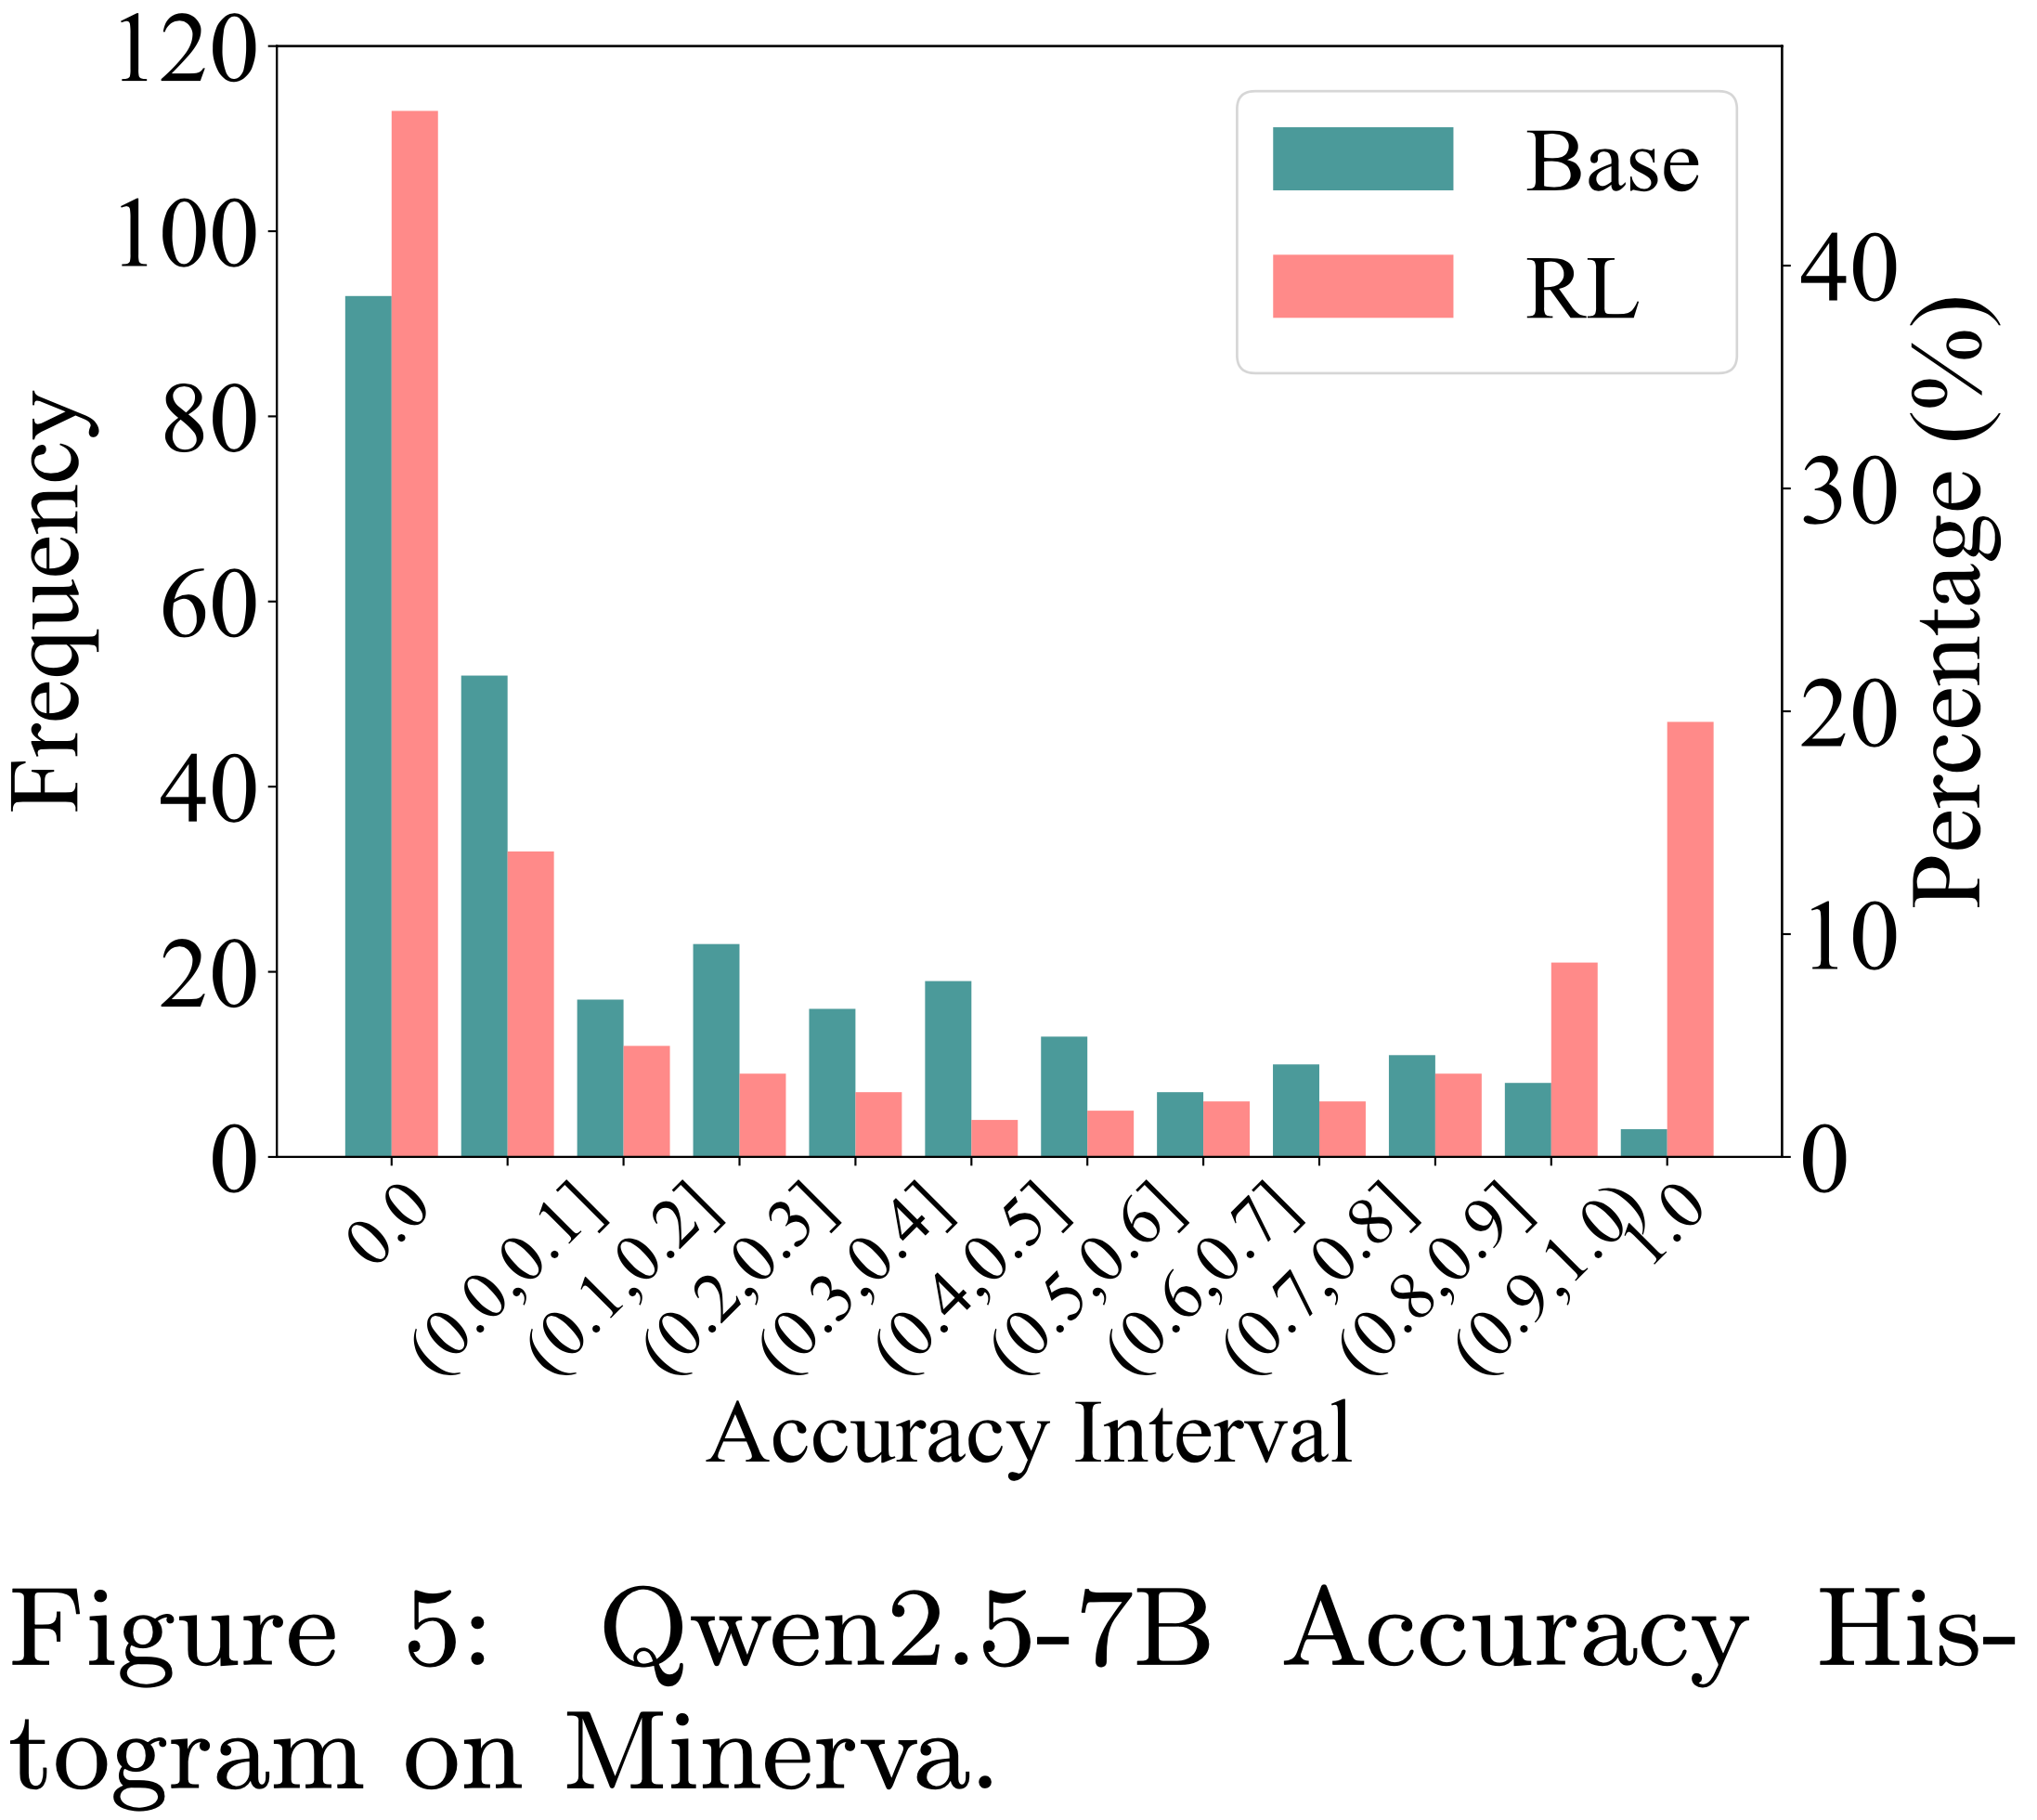
    • 如图 5 所示,RLVR 增加了接近 1.0 的高准确率频次,并减少了低准确率(例如 0.1, 0.2)的频次
    • However,与这一趋势偏离的是在准确率为 0 处的频次增加(这表明 RLVR 导致了更多不可解的问题)
    • 这也解释了 RLVR 在平均分数上的提升,这种提升并非源于解决新问题,而是源于在 Base Model 已经可解的问题上提高了采样效率
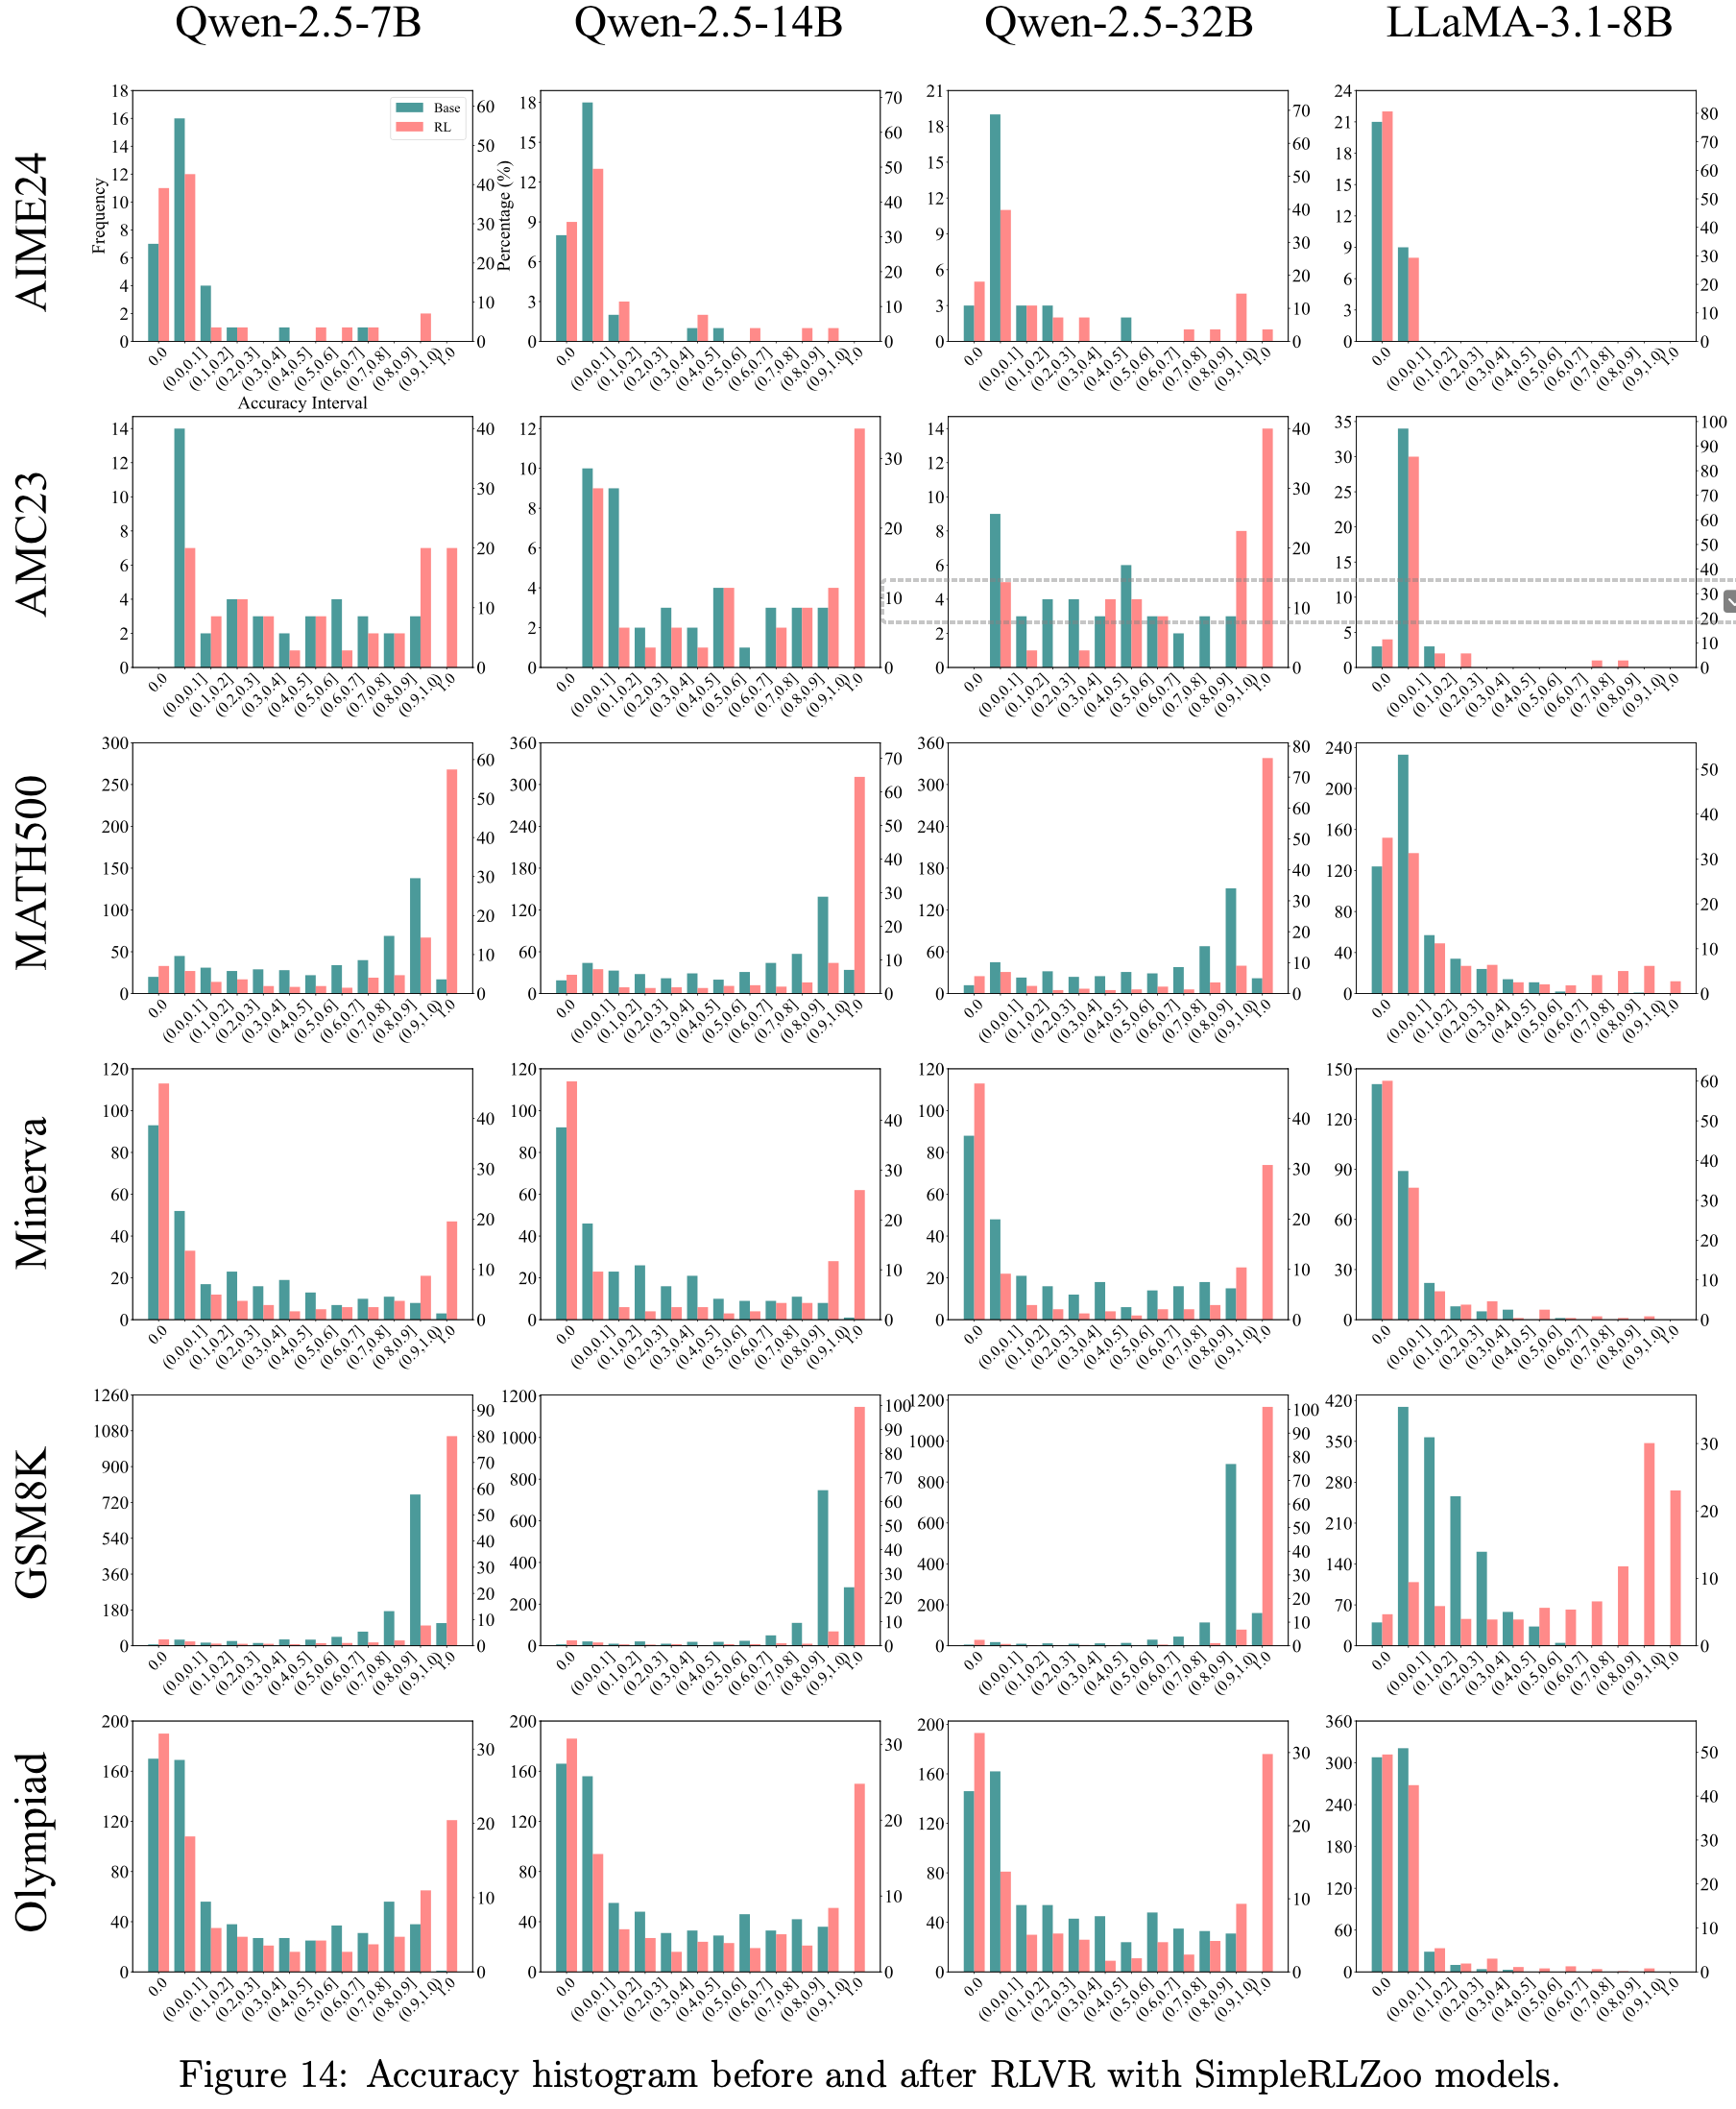
  • 更多准确率直方图参见图14
Solvable-Problem Coverage Analysis
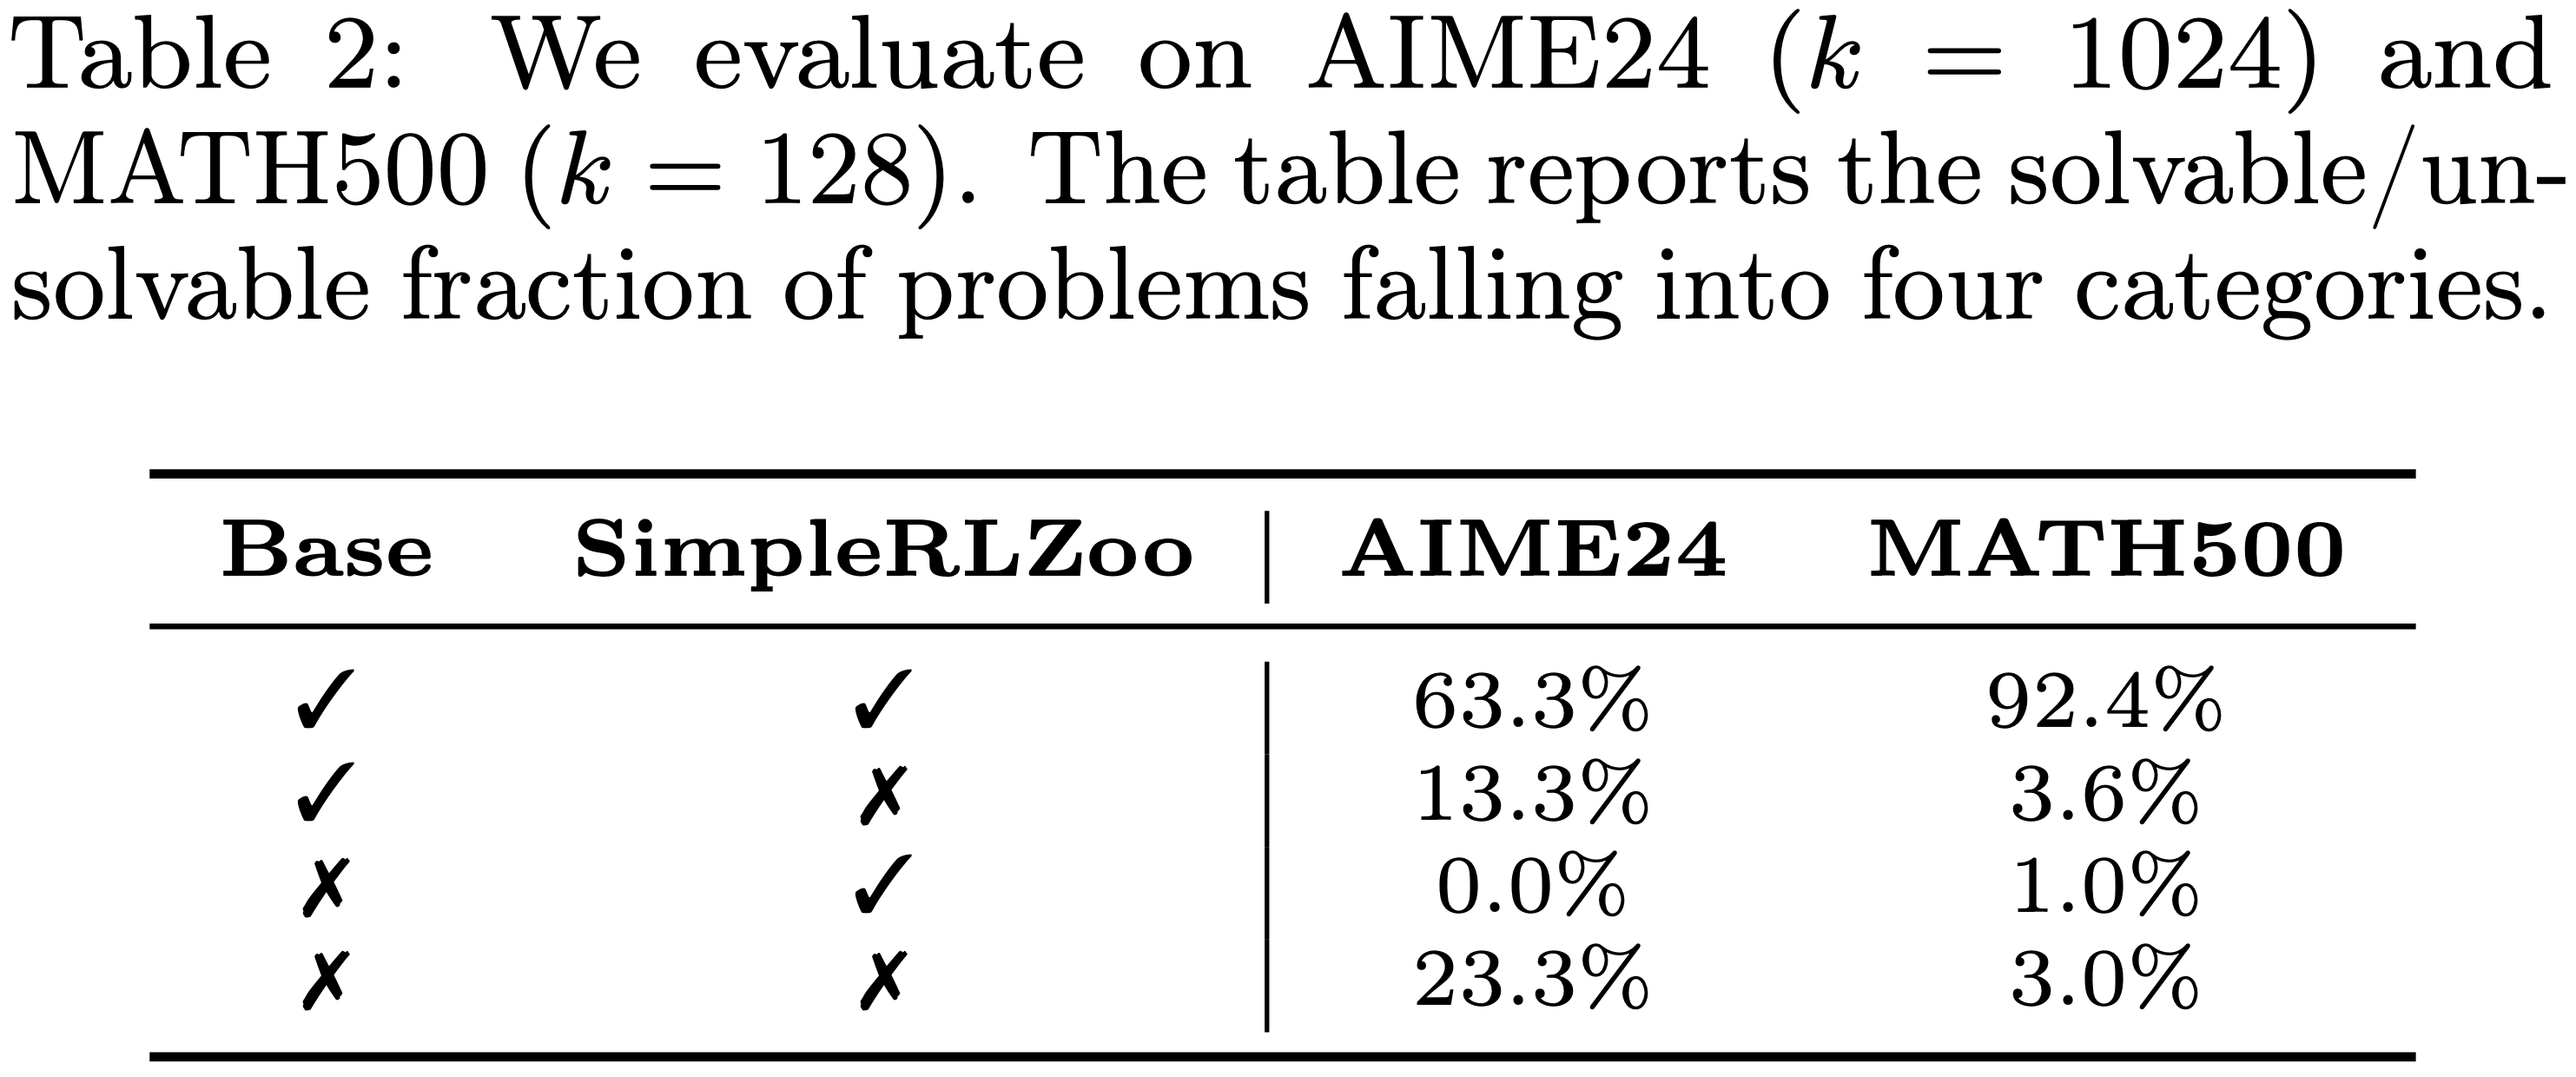
  • 为了进一步研究,论文在 AIME24 和 MATH500 上比较了 Base Model 及其对应的 RL 训练版本的可解问题集合
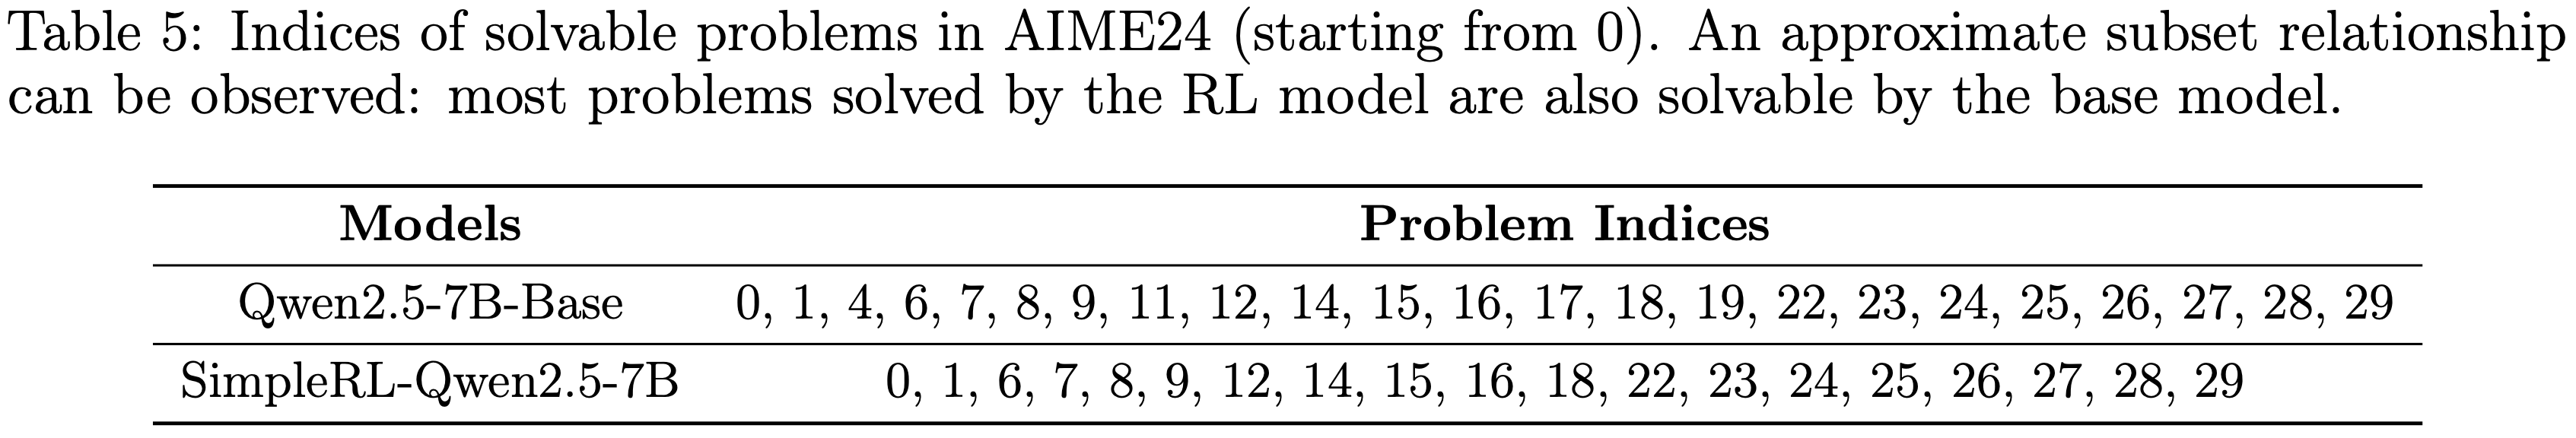
  • 论文发现,存在许多 Base Model 能解决而 RLVR 模型失败的情况,而 RLVR 成功但 Base Model 失败的案例极少,如表 2 所示
  • 详细情况见第 C.7 节
    • 如表 5 所示,RL 训练模型解决的可解问题集合几乎是 Base Model 可解问题集合的一个子集
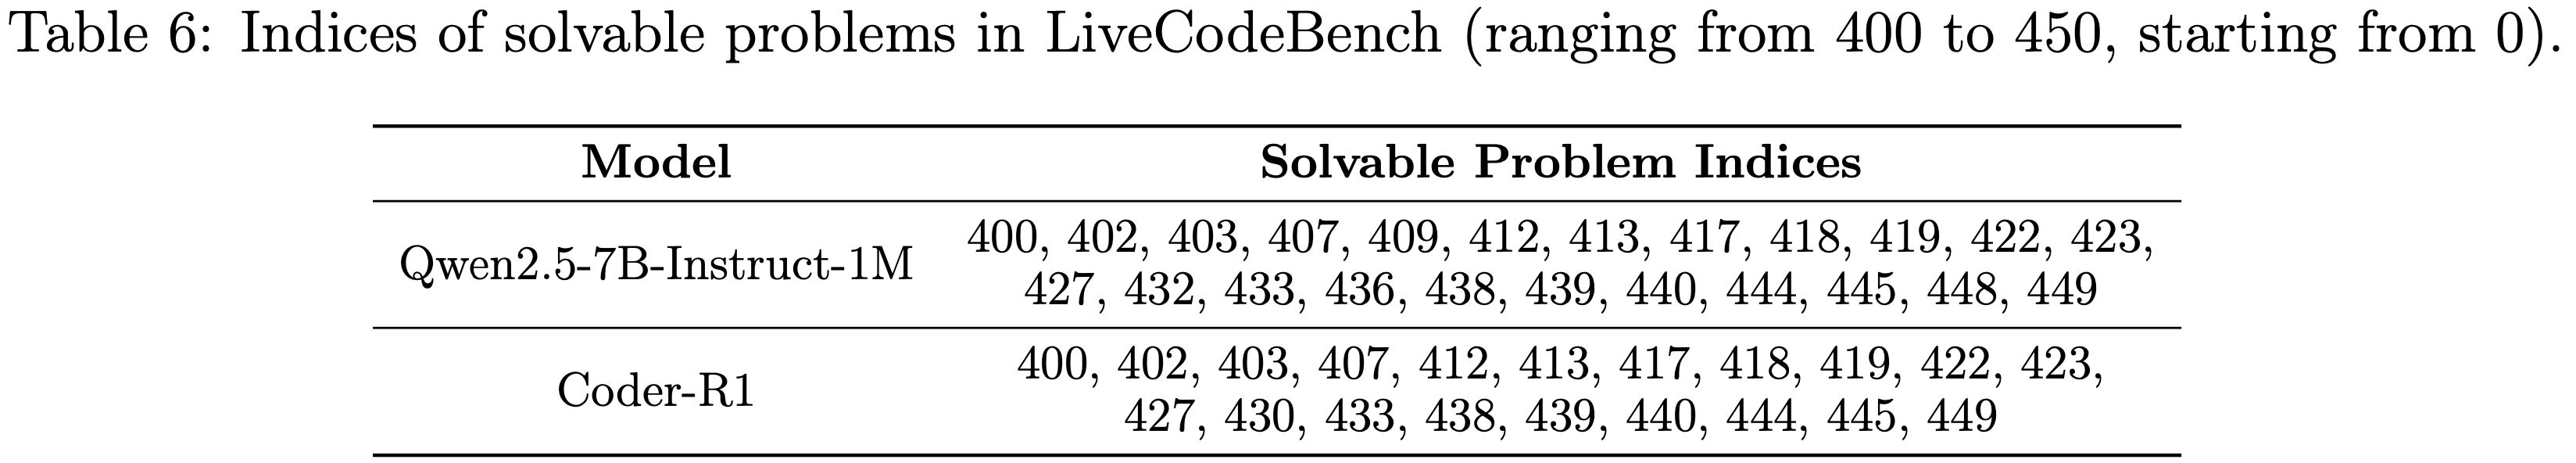
    • 如表 6 所示, Coding 任务中也观察到了类似的趋势
  • 这引发了一个自然的问题:RL 训练模型生成的所有推理路径是否已经存在于其 Base Model 的输出分布中?
Perplexity Analysis
  • 上文中我们提出了 RL 训练模型生成的所有推理路径是否已经存在于其 Base Model 的输出分布中? 这个问题
  • 为了回答这个问题,论文使用了 困惑度 (perplexity, PPL) 这一指标
    • 给定一个模型 \(m\)、一个问题 \(x\) 和一个 Response \(\mathbf{Y}=(y_{1},\ldots,y_{T})\)(可以由同一模型、另一模型或人类生成),PPL 定义为序列的负对数似然平均的指数形式:
      $$
      \texttt{PPL}_{m}(\mathbf{Y}|x)=\exp\left(-\frac{1}{T}\sum_{t=1}^{T}\log P(y_{t}|x,y_{1},\ldots,y_{t-1})\right),
      $$
    • 它反映了模型在给定 Prompt \(x\) 的条件下预测给定 Response \(\mathbf{Y}\) 的能力
    • 更低的困惑度表明模型生成此 Response 的可能性更高
  • 论文从 AIME24 中随机抽取两个问题,并分别使用 Qwen2.5-7B-Base 和 SimpleRL-Qwen2.5-7B-Base 为每个问题生成 16 个 Response ,分别记为 \(\mathbf{Y}_{\text{Base} }\) 和 \(\mathbf{Y}_{\text{RL} }\)
  • 论文还让 OpenAI-o1 (2024) 生成了 8 个 Response ,记为 \(\mathbf{Y}_{\text{GT} }\)
  • 如图 6 所示,\(\textrm{PPL}_{\text{Base} }(\mathbf{Y}_{\text{RL} }|x)\) 的分布与 \(\textrm{PPL}_{\text{Base} }(\mathbf{Y}_{\text{Base} }|x)\) 分布的下部紧密匹配,对应于 Base Model 倾向于生成的 Response
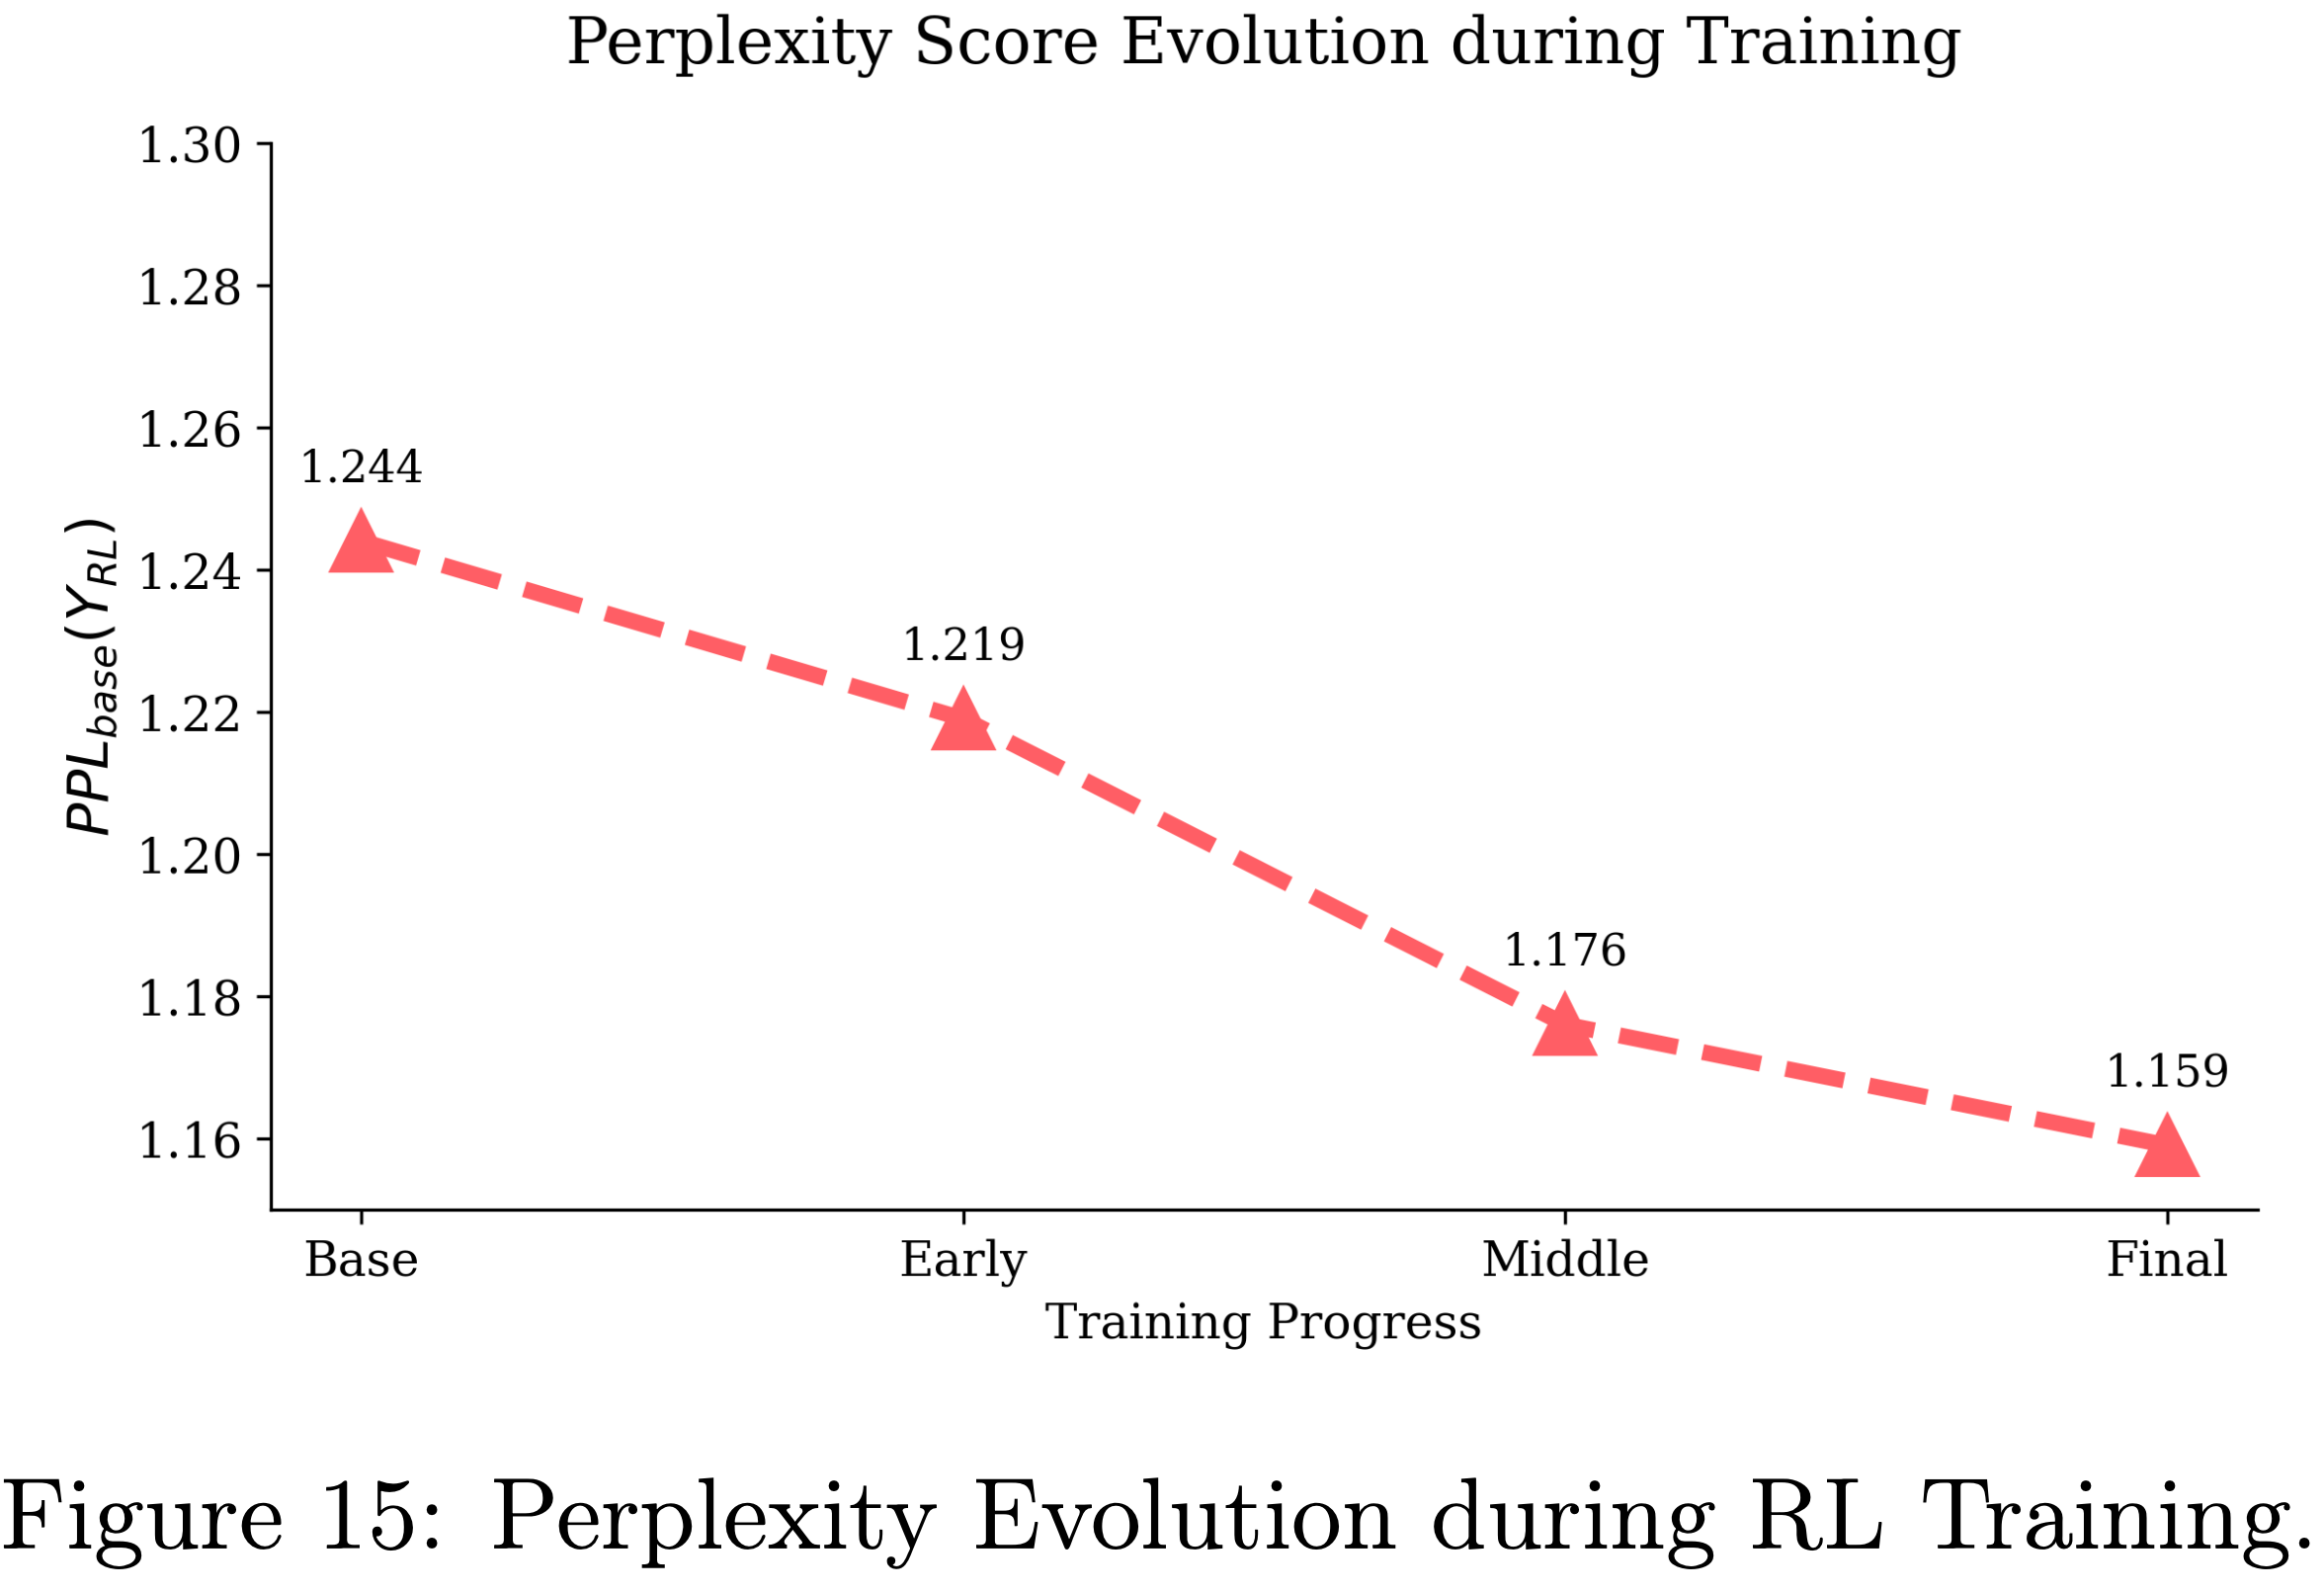
  • 这表明 RL 训练模型的 Response 极有可能被 Base Model 生成。在第 C.4 节中,论文展示了 \(\textrm{PPL}_{\text{Base} }(\mathbf{Y}_{\text{RL} }|x)\) 随着 RL 训练的进行逐渐降低,表明 RLVR 主要是在 Base Model 先验内部锐化了分布,而不是扩展超出其范围
Summary
  • 结合上述分析,论文得出三个关键观察
    • First,RLVR 模型解决的问题 Base Model 也能解决;观察到的平均分数提升源于在这些已经可解的问题上进行更有效的采样,而不是学会了解决新问题
    • Second,在 RLVR 训练后,模型通常表现出比其 Base Model 更窄的推理覆盖率
    • Third,RLVR 模型利用的所有推理路径已经存在于 Base Model 的采样分布中
  • 这些发现表明 RLVR 并未引入根本性的新推理能力,训练模型的推理能力仍然受限于其 Base Model

Distillation Expands the Reasoning Boundary

  • 除了直接 RL 训练之外,提升小型 Base Model 推理能力的另一个有效方法是从强大的推理模型进行蒸馏 (2025)
    • 蒸馏过程类似于训练后阶段的 Instruction-Following Fine-tuning
    • 蒸馏使用的训练数据不是使用简短的 Instruction-Response 对,而是由教师模型生成的长链式推理轨迹组成
  • 鉴于当前 RLVR 在扩展推理能力方面的局限性,很自然地要问蒸馏是否表现出类似的行为
    • 一个代表性模型是 DeepSeek-R1-Distill-Qwen-7B,它是在 Qwen2.5-Math-7B 上,使用 DeepSeek-R1 蒸馏的
  • 论文将其与 Base Model Qwen2.5-Math-7B 及其 RL 训练对应物 Qwen2.5-Math-7B-Oat-Zero 进行比较,并加入 Qwen2.5-Math-7B-Instruct 作为额外基线
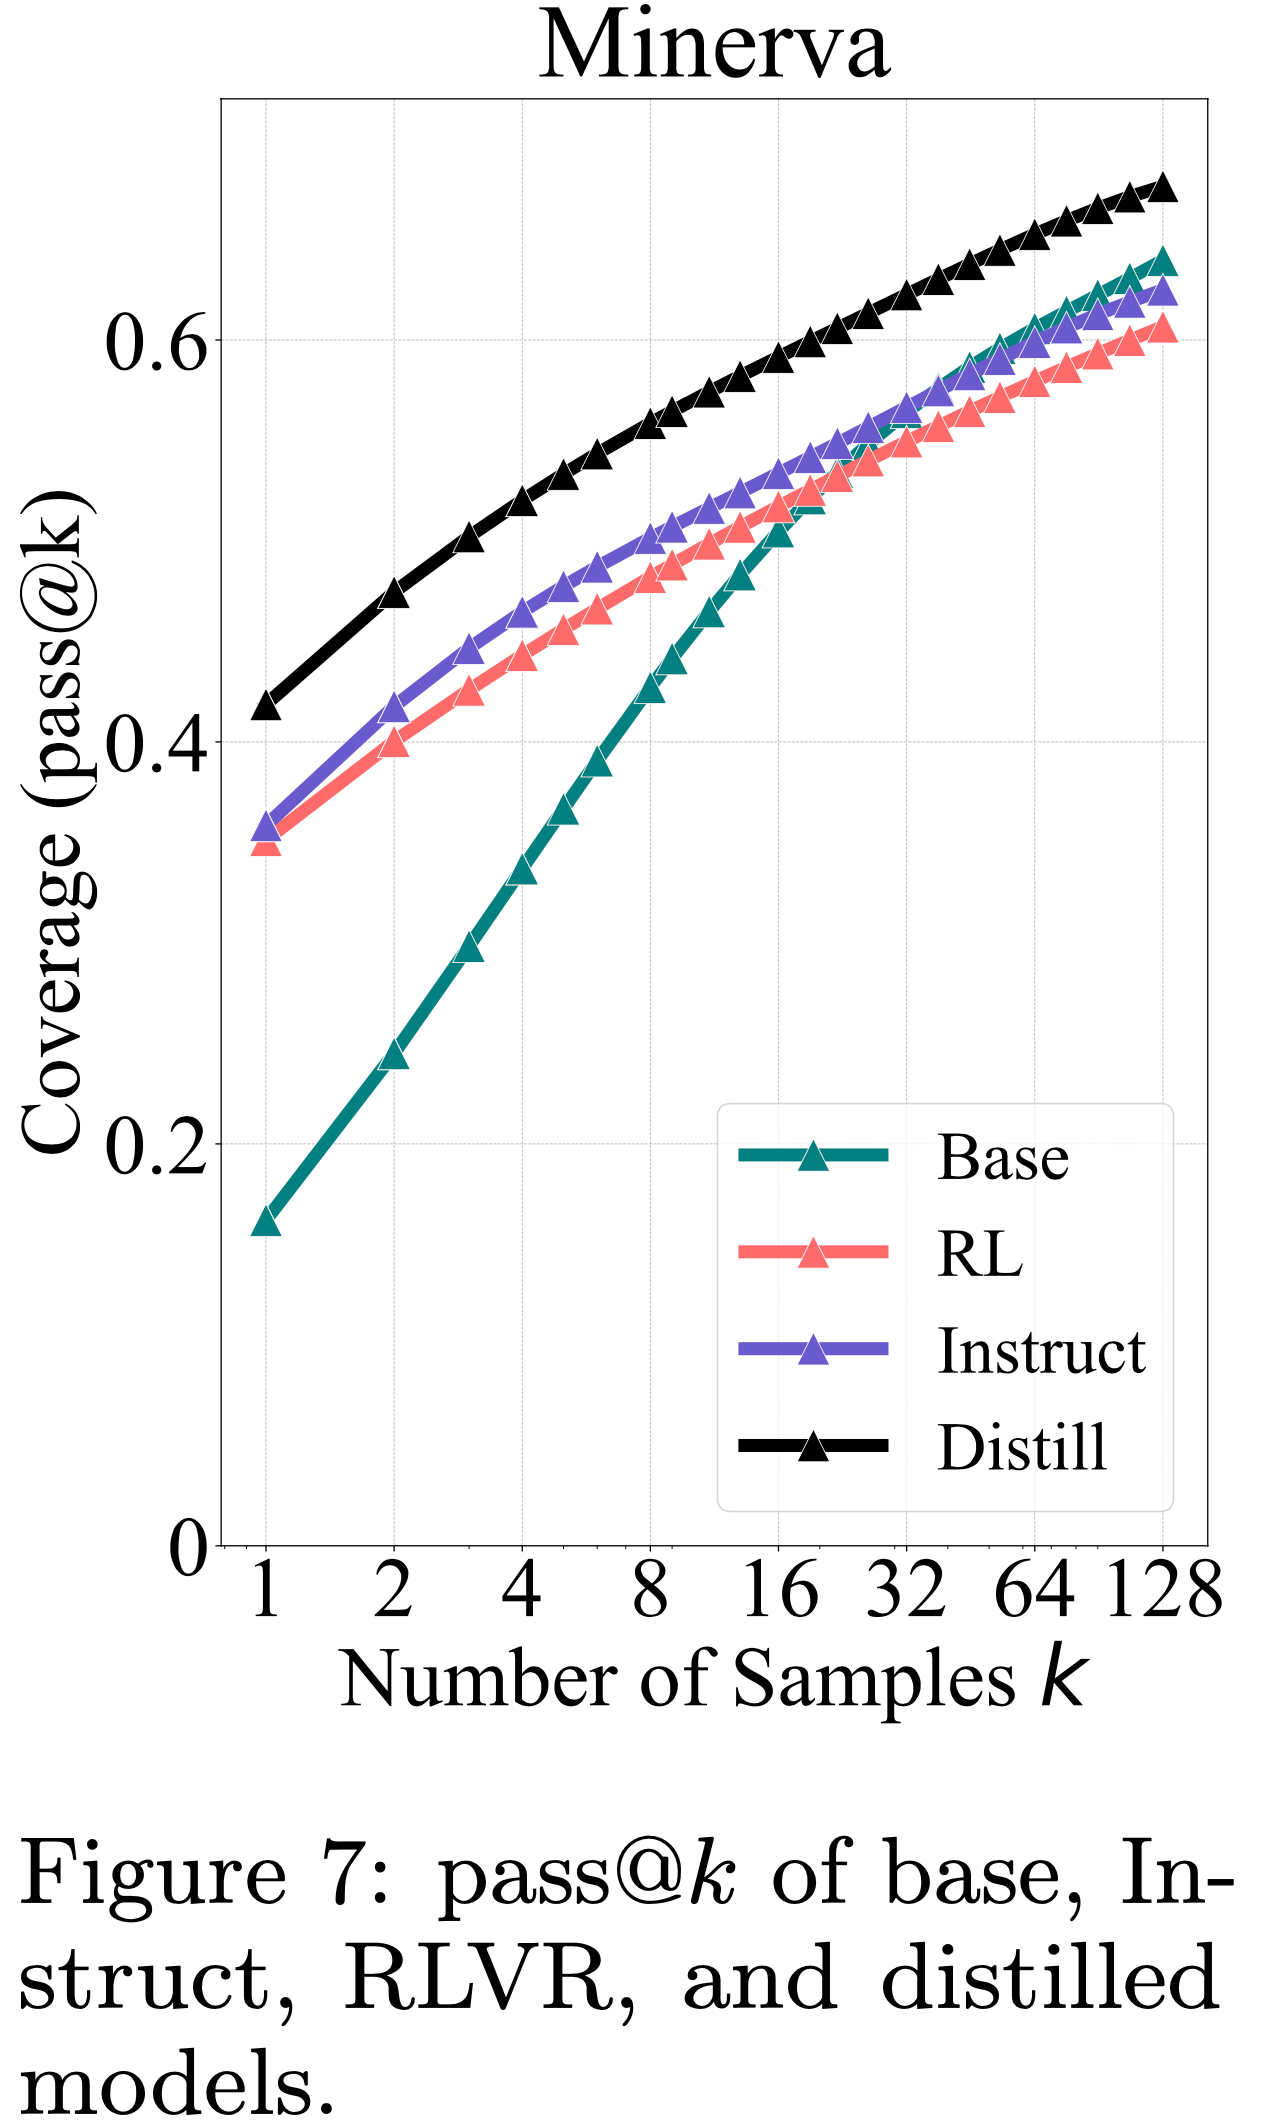
  • 如图7所示,蒸馏模型的 pass@\(k\) 曲线始终显著高于 Base Model
  • 这表明,与本质上受 Base Model 推理能力限制的 RL 不同,蒸馏引入了从更强的教师模型学习到的新推理模式
    • As a result,蒸馏模型能够超越 Base Model 的推理边界

Effects of Different RL Algorithms

  • As discussed previously,RL 的主要效果是提高采样效率,而不是扩展模型的推理能力
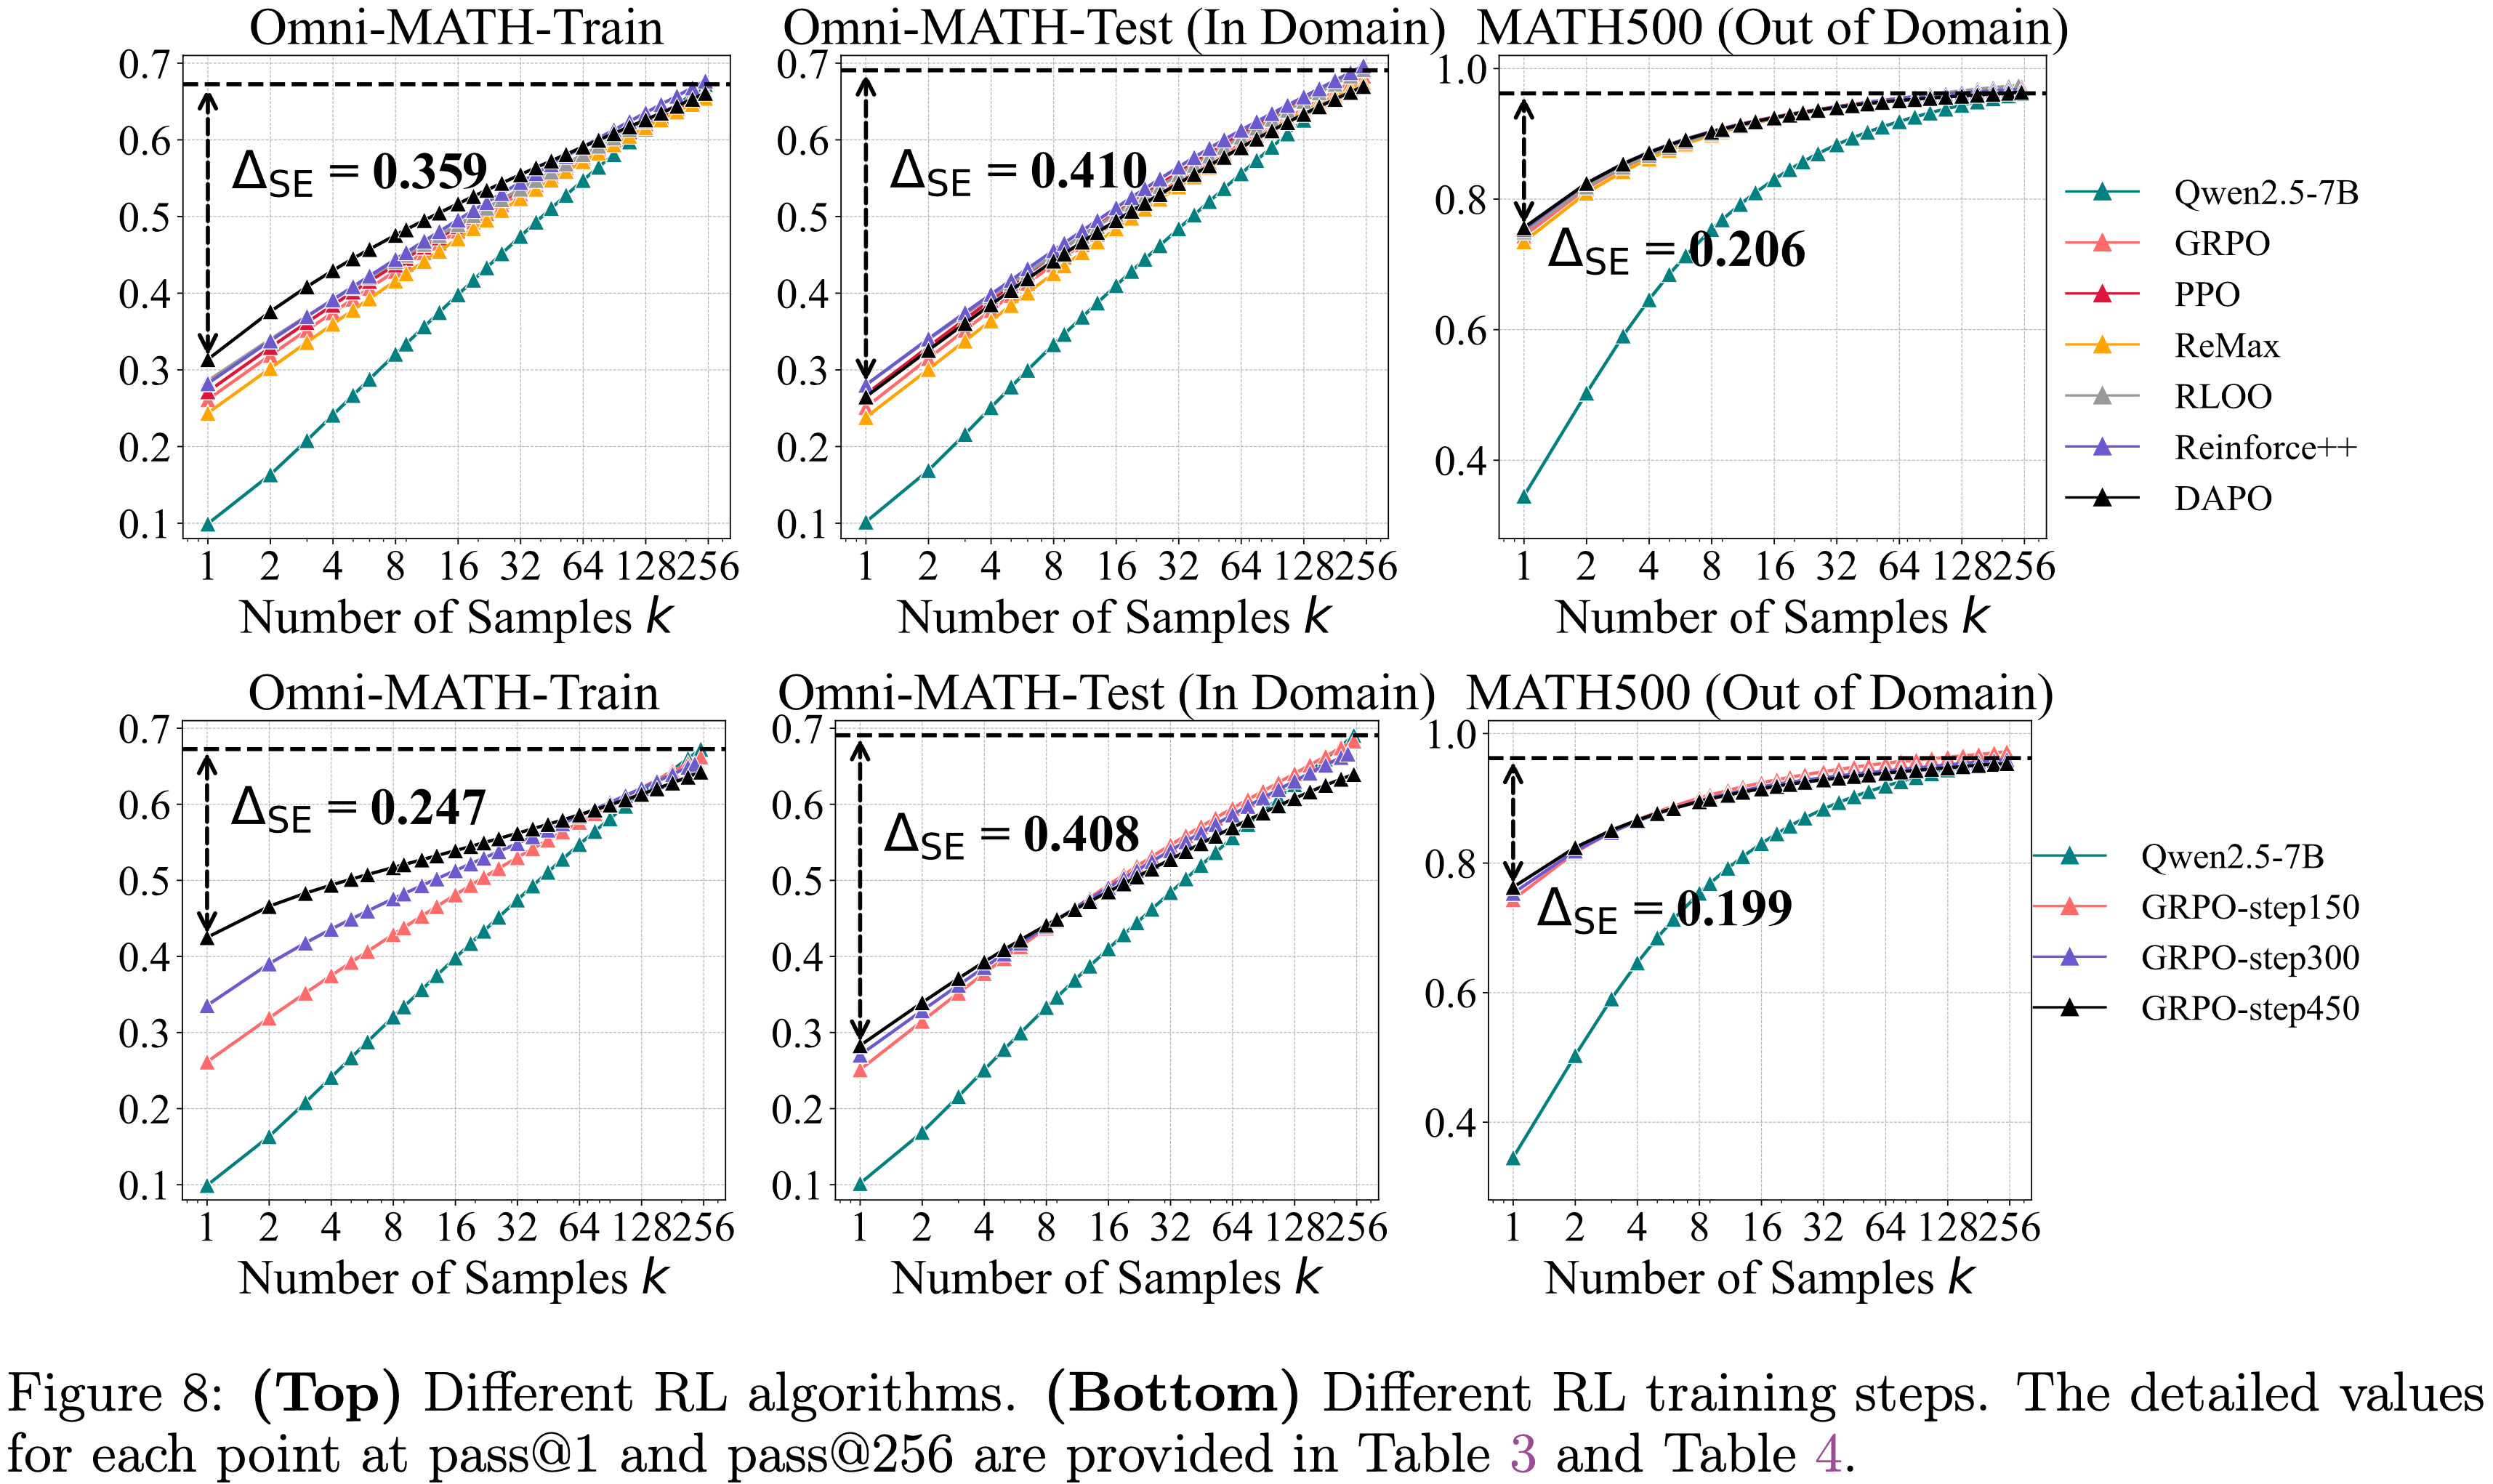
  • 为了量化这一点,论文提出了采样效率差距 (Sampling Efficiency Gap) (\(\Delta_{\text{SE} }\))
    • 定义为 RL 训练模型的 pass@1 与 Base Model 的 pass@\(k\) 之间的差值(在论文的评估中使用 \(k=256\))
    • \(\Delta_{\text{SE} }\) 越低越好
  • 在这里,论文进行了干净的实验来研究不同 RL 算法在提高采样效率方面的效果
Experiment Setup
  • 为了公平比较,论文使用 VeRL 框架 (2024) 重新实现了流行的 RL 算法,包括 PPO (2017)、GRPO (2024)、Reinforce++ (2025)、RLOO (2024)、ReMax (2024) 和 DAPO (2025)
  • 遵循 DAPO (2025) 和 Oat-Zero (2025) 的做法,论文移除了 KL 项以避免限制模型学习
  • 在训练期间,论文使用 AdamW 优化器 (2017),恒定学习率为 \(10^{-6}\)
  • 对于 rollout,论文使用 Prompt Batch Size 为 256,每个 Prompt 生成 8 个 Response
  • 最大 rollout 长度设置为 8,192 个 Token ,采样温度设置为 1.0
  • 论文使用的 PPO Mini-Batch Size 为 256
  • 为了评估 RLVR 下的领域内和领域外泛化能力,论文将 Omni-MATH 的一个子集 Omni-MATH-Rule(包含可验证问题)分成训练集(2,000 个样本)和领域内测试集(821 个样本),并使用 MATH500 作为领域外基准
Results
  • 如图 8(顶部)所示,尽管不同的 RL 算法在 pass@1 和 pass@256 上表现出微小的差异,但这些差异并非根本性的
  • 不同的 RL 算法产生略微不同的 \(\Delta_{\text{SE} }\) 值(例如,在领域内测试集上,从 GRPO 的 43.9 到 RLOO 最佳值 42.6 之间)
  • Furthermore,论文观察到 \(\Delta_{\text{SE} }\) 在不同算法中始终保持在 40 分以上,突出现有 RL 方法距离实现最优采样效率仍然很远
  • 这表明可能需要新的 RL 算法或全新的范式来接近上界
  • 更多观察结果见第 C.5 节

Effects of RL Training

Asymptotic Effects
  • 基于第 4.3 节的设置,论文研究了训练步数对模型渐近性能的影响
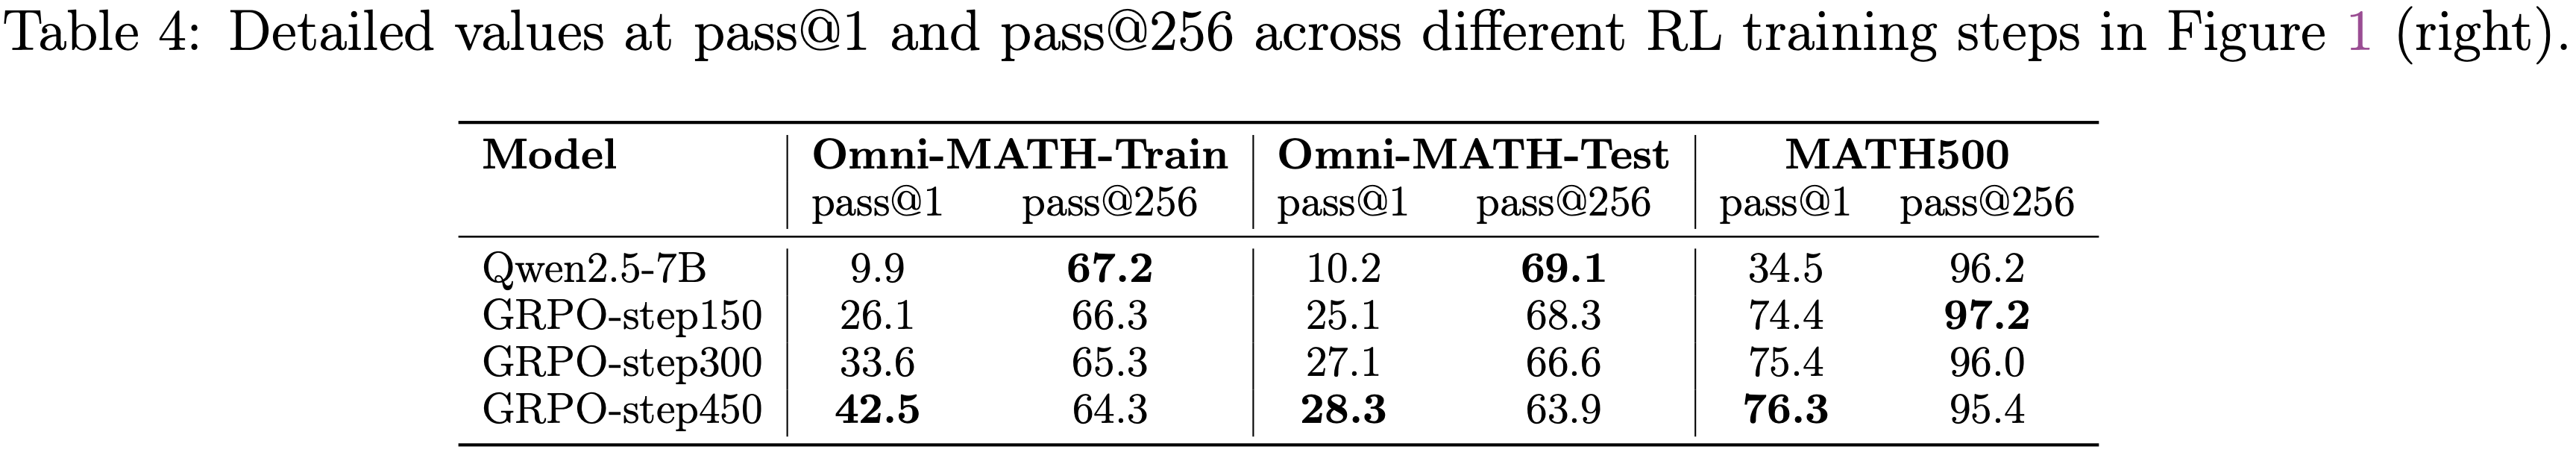
  • 如图 1(右)所示,随着 RL 训练的进行,训练集上的 pass@1 从 26.1 持续提升到 42.5
  • However,随着 RLVR 训练的进行,pass@256 逐渐下降,表明推理边界在缩小
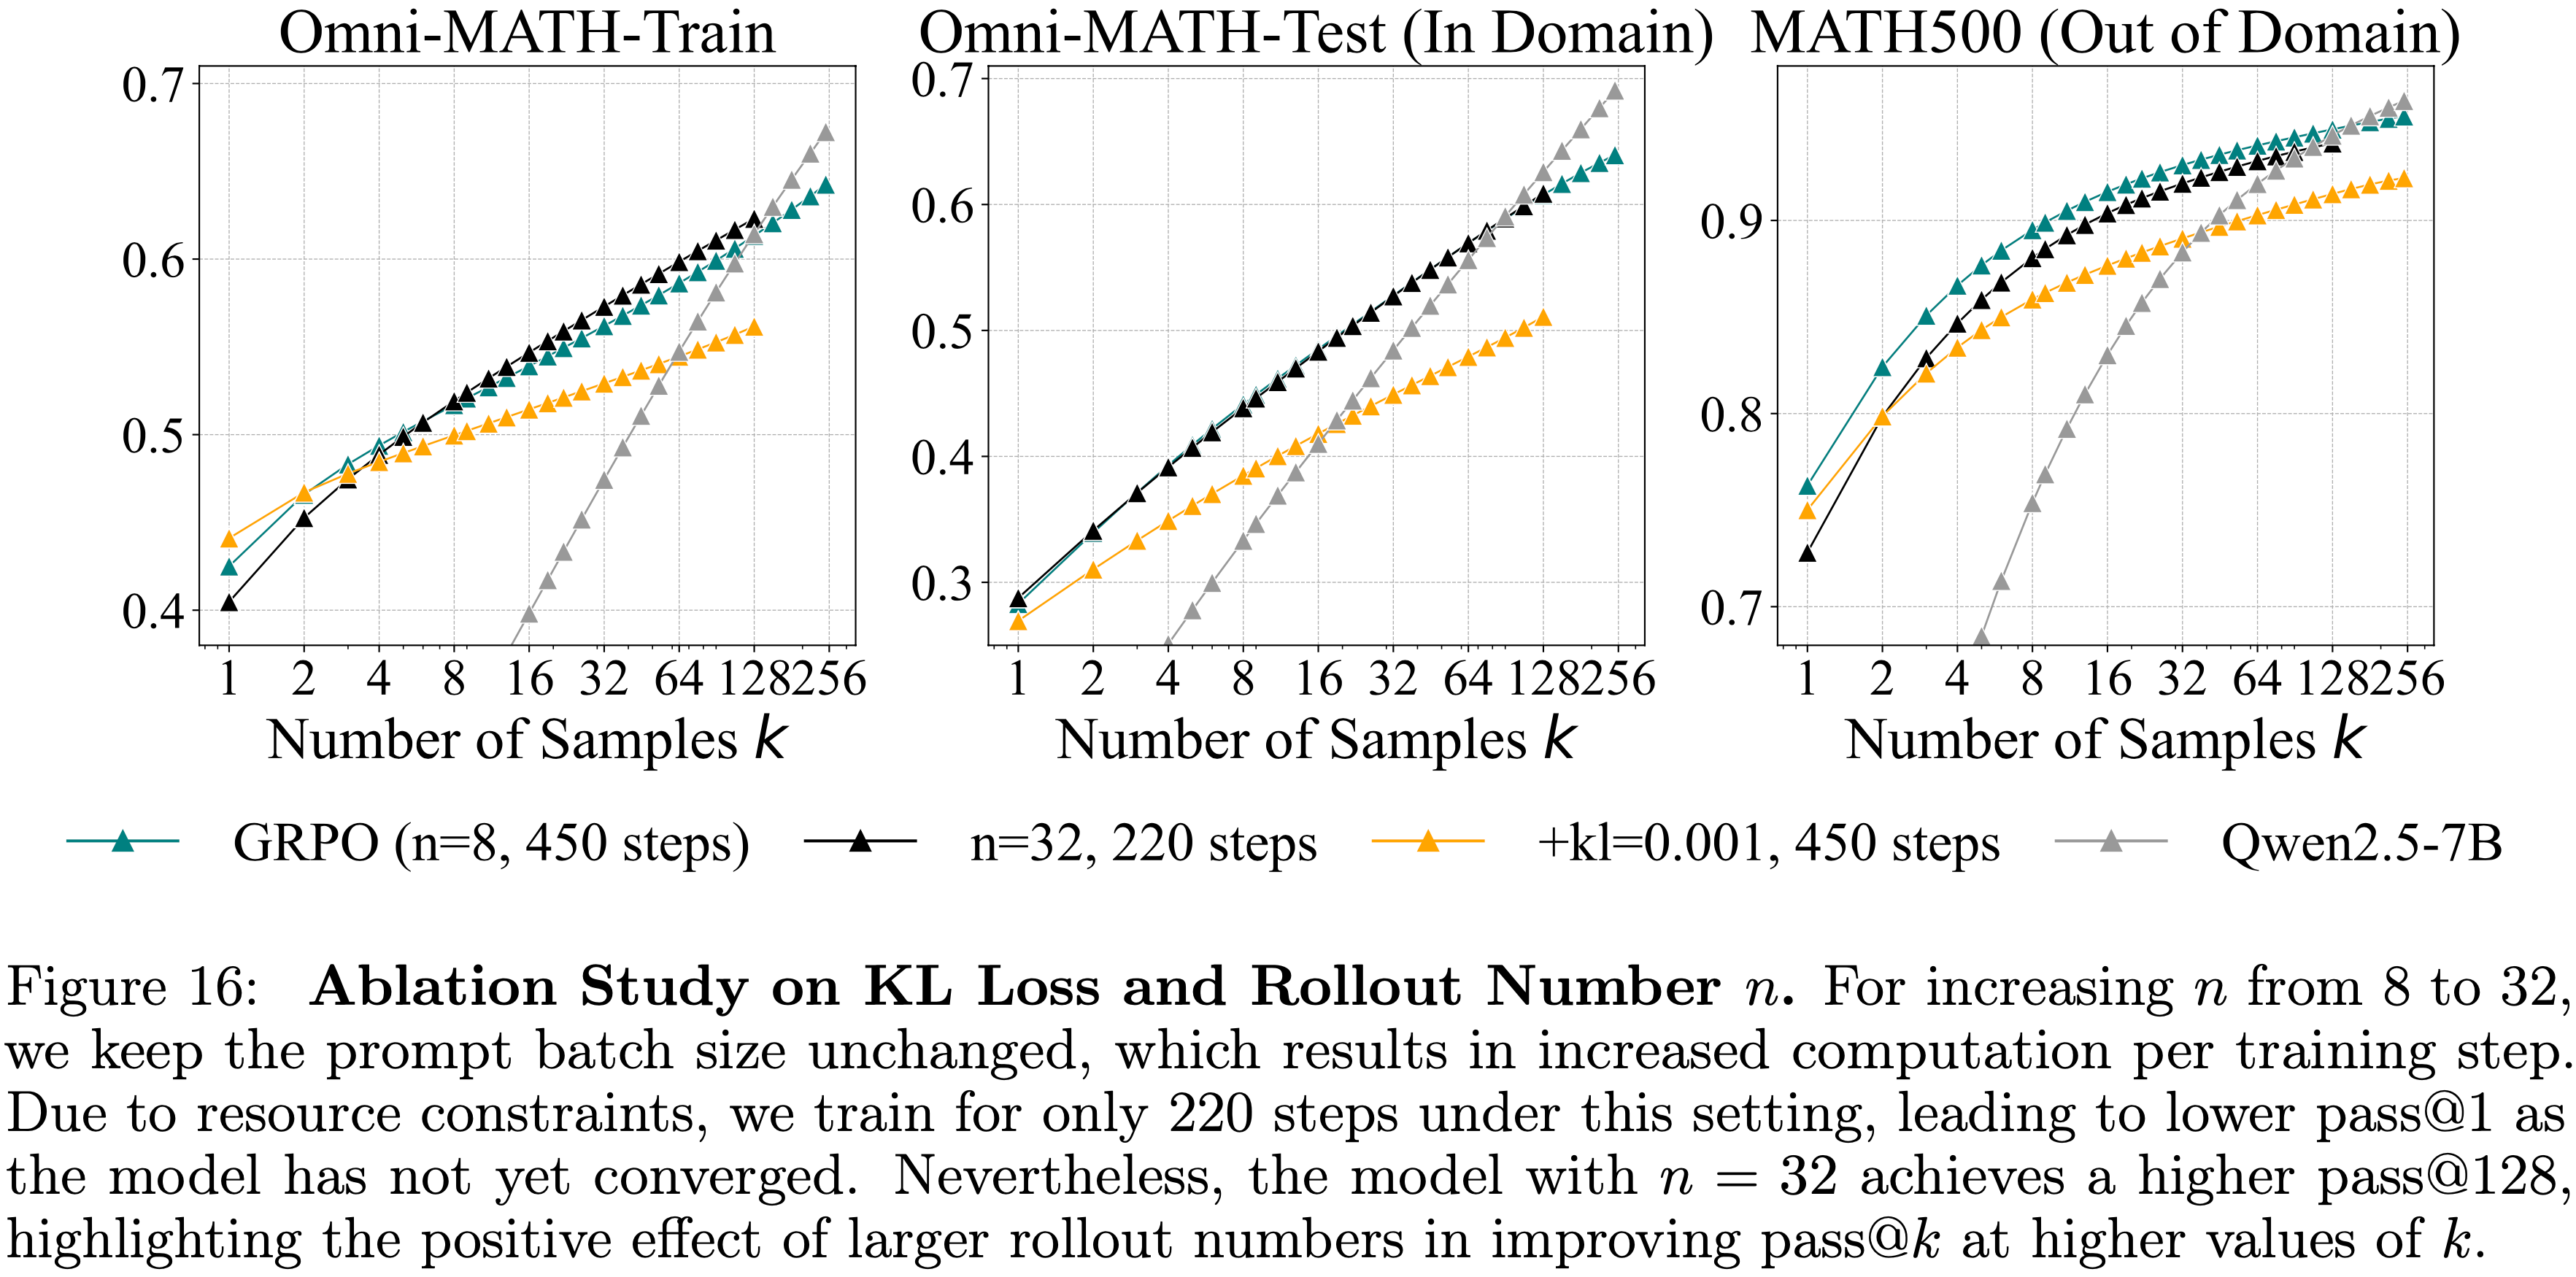
每次 Prompt 的 Rollout 数量 \(n\) 的影响 (Effect of Number of Rollouts \(n\))
  • 训练超参数 \(n\)(每个 Prompt 的 Response 数量)可以通过在训练期间实现更广泛的探索来影响 pass@\(k\)
    • 论文将 \(n\) 从 8 增加到 32
    • 如图 16 所示,pass@\(k\) 比 \(n=8\) 时略有改善,但 RL 训练模型最终仍然被 Base Model 超越
      • 注:在 Math500 上,n=32 的始终不如 n=8 的;但实际上 n=32 实际上只训练了 220 steps(并没有跟 n=8 的对齐 steps)
      • KL 散度的训练 Rollout Number 配置是 8
  • 论文将扩大 RLVR 训练是否最终能超越 Base Model 的问题留给未来研究
Effect of KL Loss
  • 为了控制模型偏差,一些先前的工作添加了 KL 惩罚项
  • 论文通过应用系数为 0.001 的 KL 项来进行消融实验
  • 如图 16 所示,带有 KL 正则化的模型在不使用 KL 的 GRPO 基础上实现了相似的 pass@1,但 pass@128 低得多

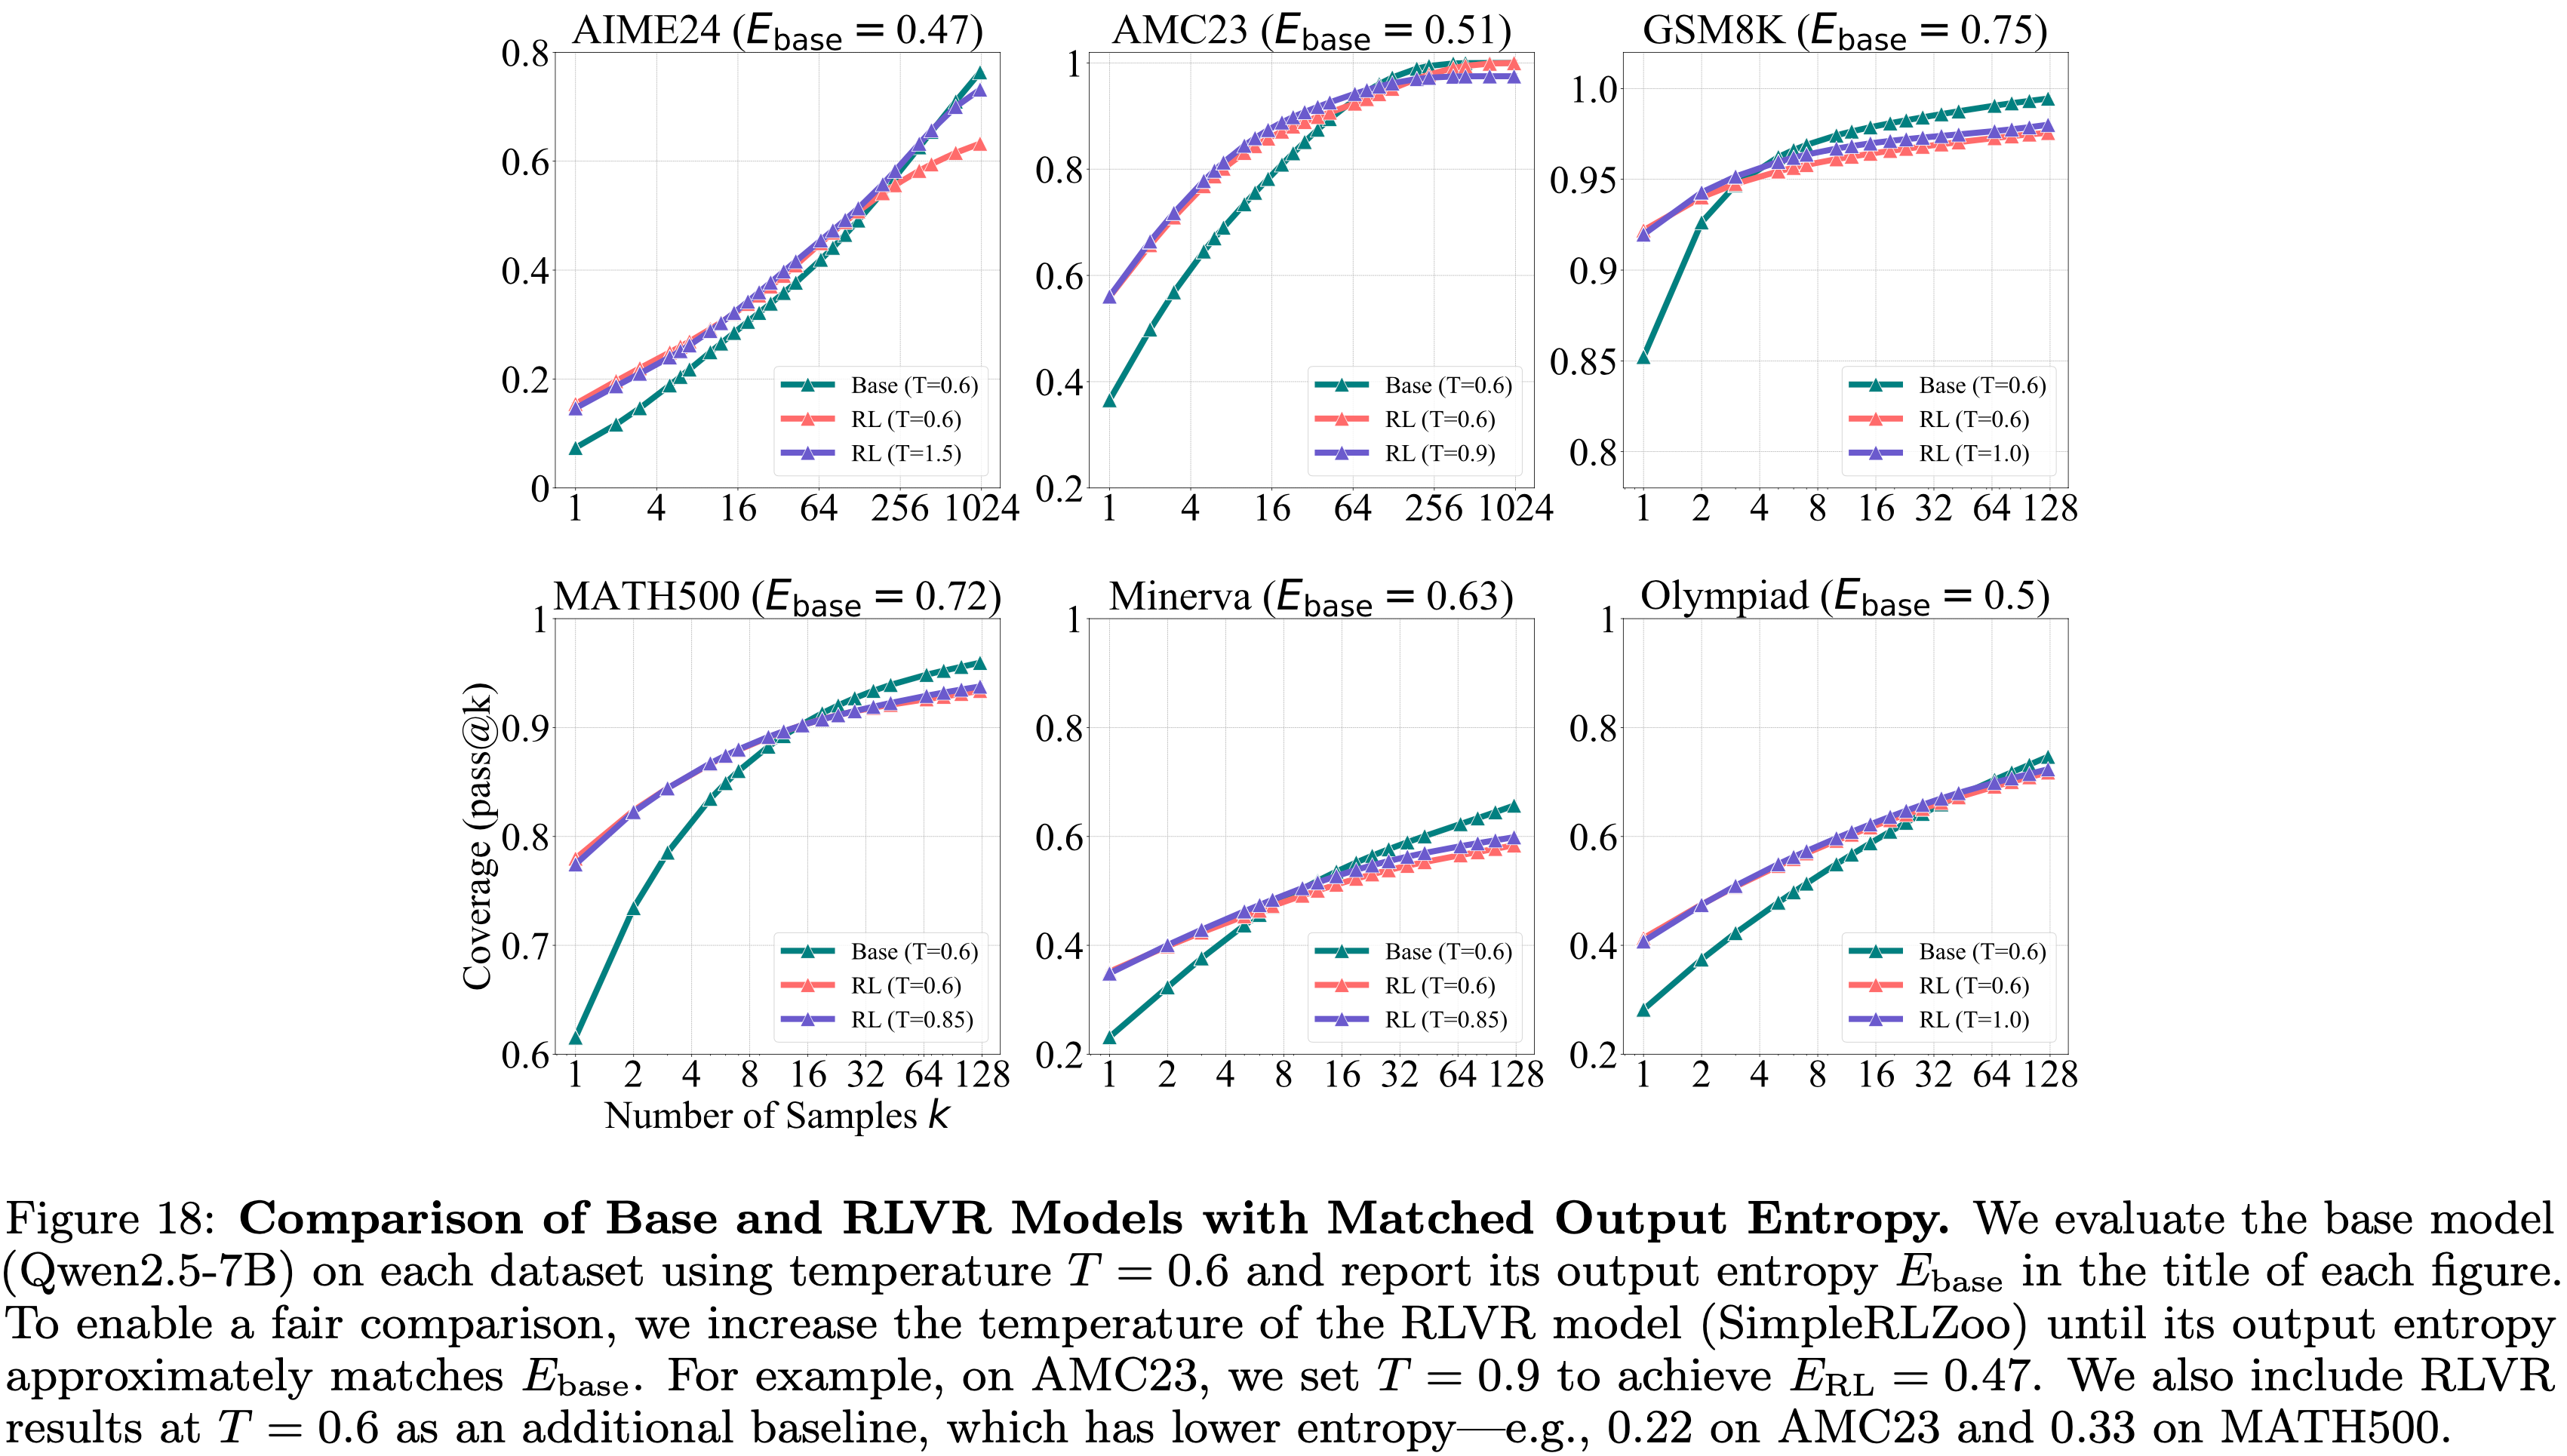
Effects of Entropy

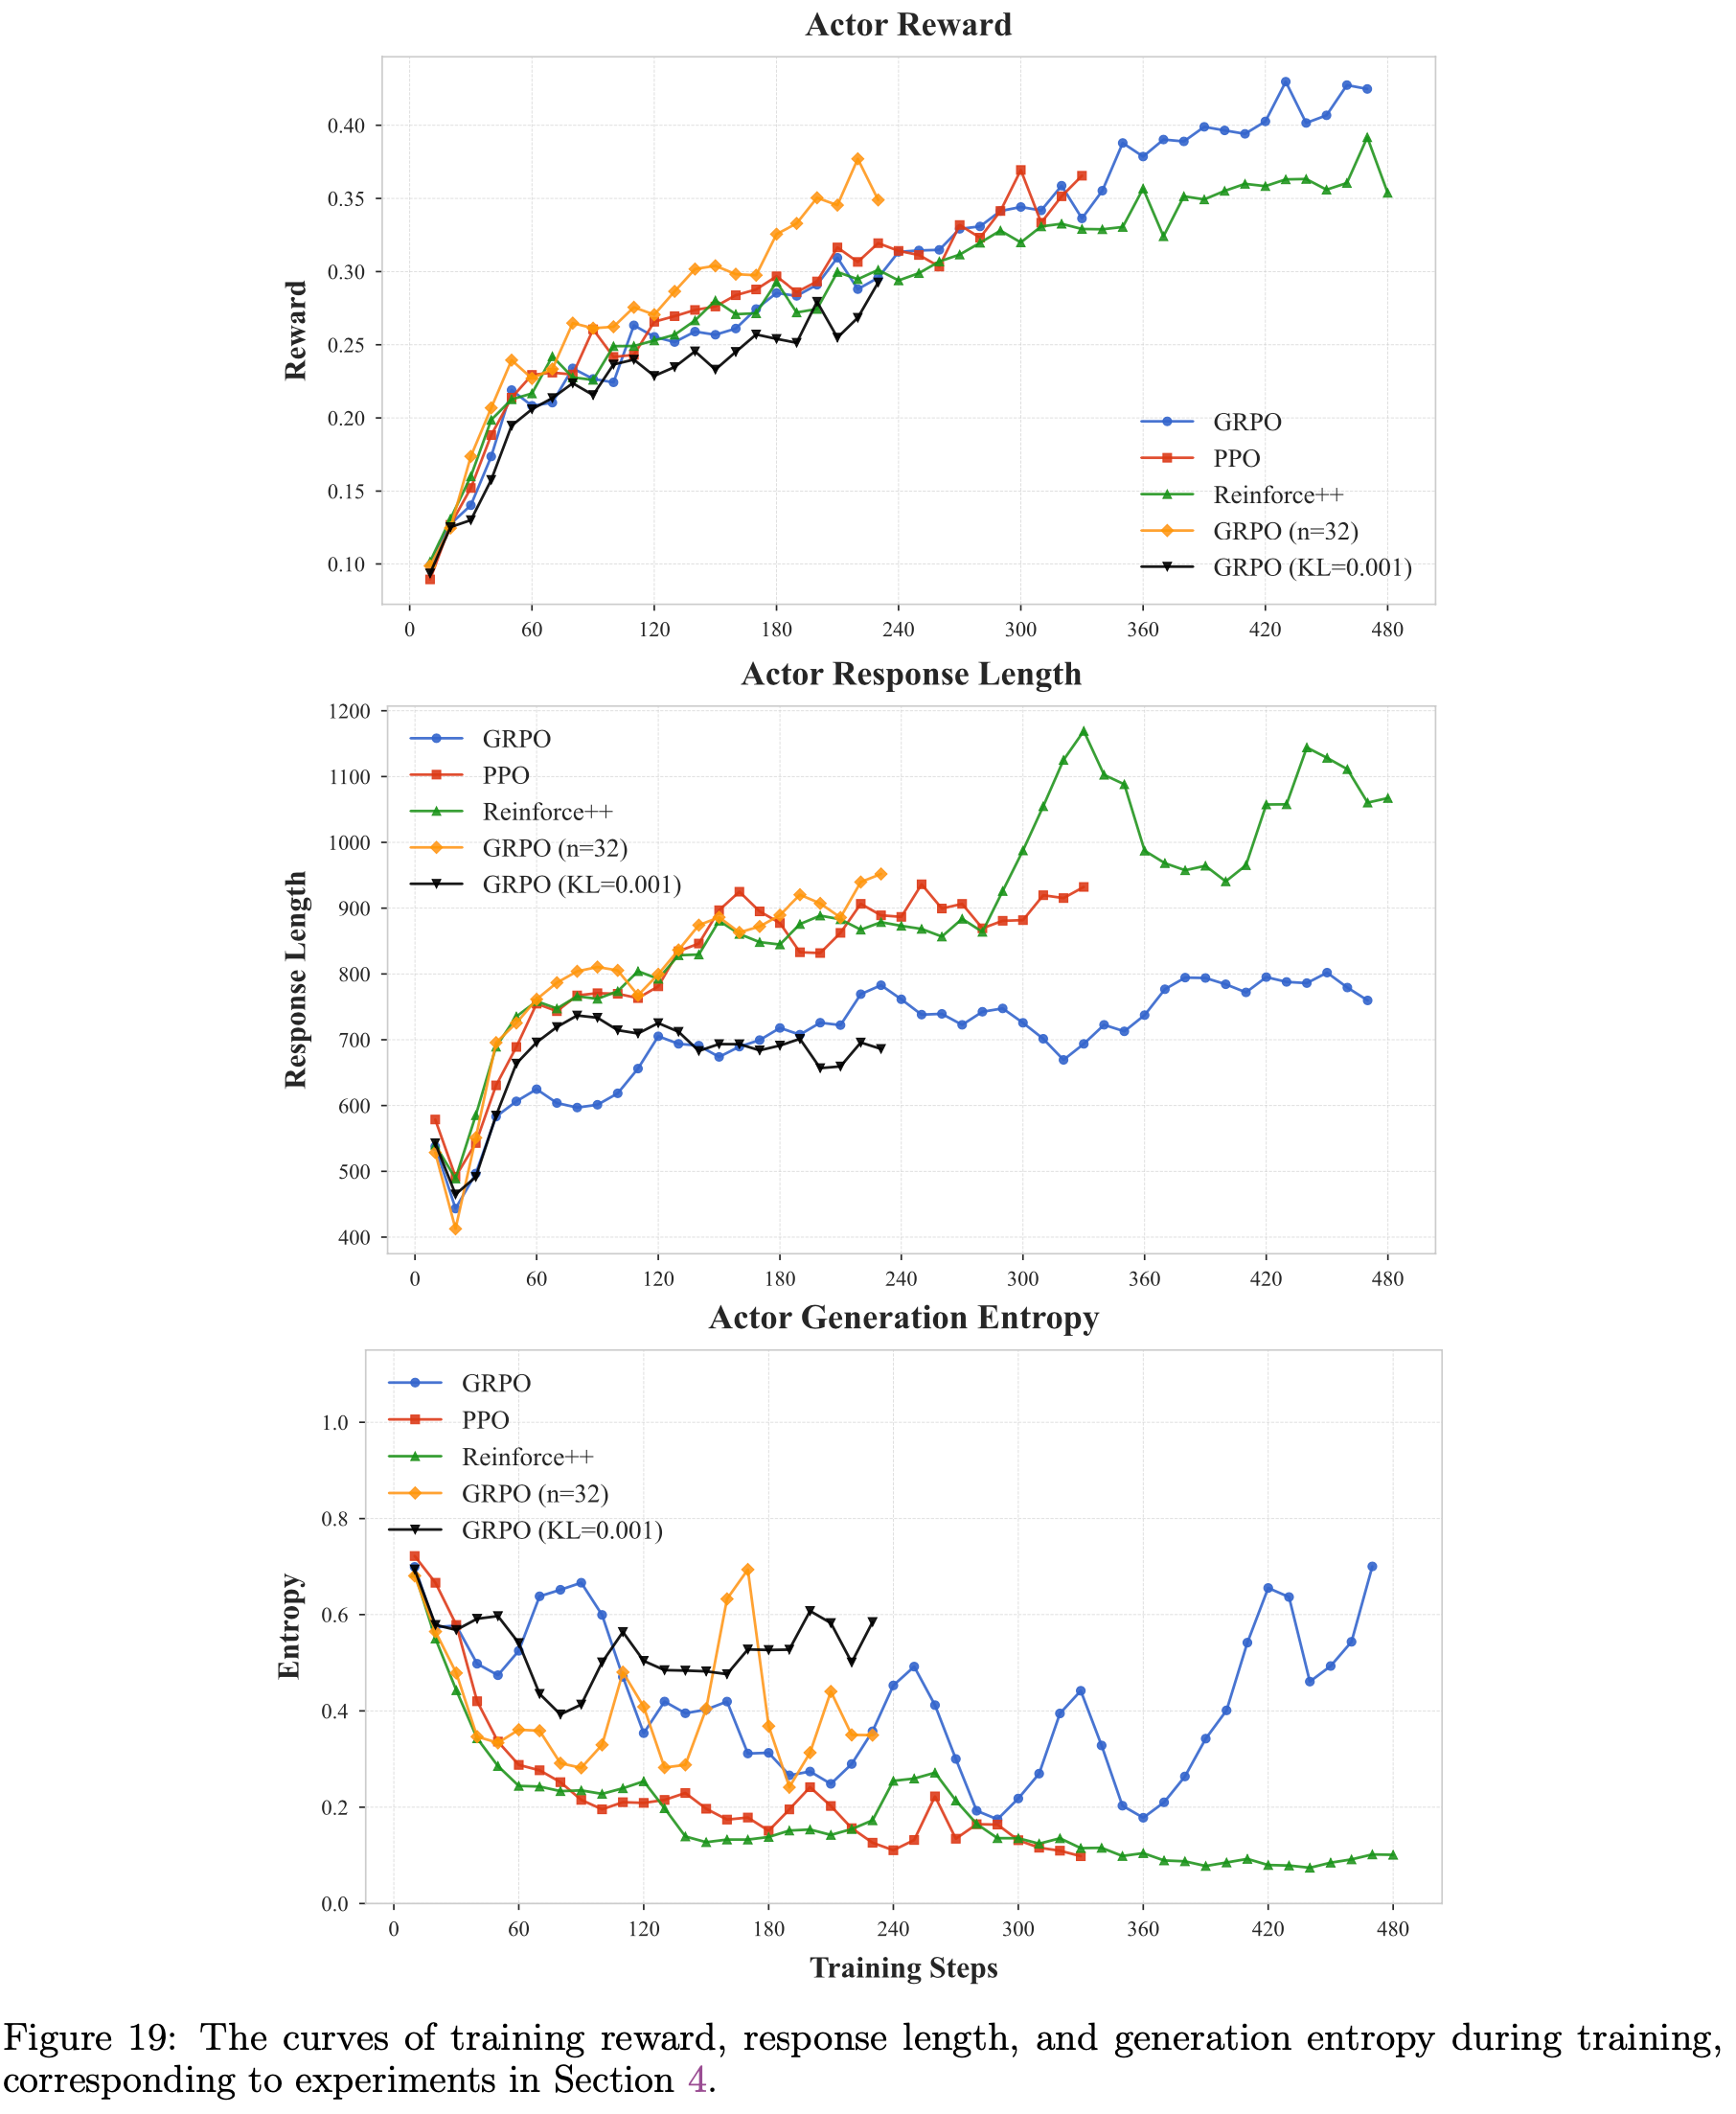
  • 随着 RL 训练的进行,模型的输出熵通常会降低 (2025),这可能由于输出多样性减少而导致推理边界缩小
  • 为了研究这个因素,论文提高了 RLVR 训练模型的生成温度,以匹配 Base Model 在 \(T=0.6\) 时的输出熵
  • 如图 18 所示,尽管 RLVR 模型在更高温度下相比其自身在 \(T=0.6\) 时的表现,pass@\(k\) 略有改善,但在整个 pass@\(k\) 范围内仍然表现不如 Base Model
  • 这表明,虽然熵的降低导致了推理边界的缩小,但这并不是唯一的原因

Effects of Model Size Scaling

  • Scaling 在当代 LLM 的能力中扮演着核心角色
    • 随着模型规模的增加,(论文)所得出的结论是否继续成立仍然是一个重要问题
  • 对于许多大型模型,分离(isolating) RLVR 的影响是不可行的(即难以拿到 RLVR 过程前后的模型)
    • For Example
      • 对于 GPT-o1,其 Base Model 并非公开可访问
      • Qwen3-235B (2025) 通过多个阶段进行训练,包括 RLVR 和长上下文 CoT 监督微调,这使得无法单独分离 RLVR 的影响
      • 对于 Deepseek-R1-Zero,由于没有公开托管的 API,论文被迫自行托管模型,但在最大序列长度为 32k 的情况下,吞吐量被限制在每秒约 50 个 Token ,使得 pass@\(k\) 评估目前不可行
    • 作为一个更可行的替代方案,论文选择了 Magistral-Medium-2506 API 进行初步实验
      • 该模型使用纯 RL 训练,以 Mistral-Medium-3-2505 作为 starting model(起始模型,2025)
        • 尽管模型规模未公开,但 Magistral-Medium 的性能与 Deepseek-R1 相当,在推理能力方面定位接近前沿
  • 论文按照原论文的做法,使用最大 40k 的上下文长度查询模型
    • 论文再次观察到,RLVR 在低 \(k\) 值时提供了显著的增益,但在更高的 \(k\) 值下改善很小或没有改善
    • Specifically,在 \(k=1\) 时,与他的 Base Version 相比,RLVR 增强的模型在 AIME24 上多解决了大约 7 个问题,在 AIME25 上多解决了大约 8 个问题
    • However,随着 \(k\) 的增加,性能差距稳步缩小
  • 这些观察结果表明,即使对于当前高度强大、接近前沿的推理模型,论文的结论仍然成立
  • 随着更多计算(例如预训练规模预算)投入到 RL 训练中,这一趋势是否会持续下去,仍然是 LLM 推理未来的一个关键问题

Discussion

  • 在第 3 节和第 4 节中,论文确定了 RLVR 在提升 LLM 推理能力方面的关键局限性
  • 在本节中,论文探讨可能解释为什么 RLVR 仍然受限于 Base Model 推理能力的潜在因素

Discussion 1: 传统 RL 与 LLM 的 RLVR 之间的关键区别在于巨大的动作空间和预训练先验

  • Key Differences Between Traditional RL and RLVR for LLMs are Vast Action Space and Pretrained Priors
  • 传统 RL,如 AlphaGo Zero 和 DQN 系列 (2017, 2015, 2023),可以在围棋和 Atari 游戏等环境中没有显式上界(without an explicit upper bound)地持续改进策略性能
  • 传统 RL 与 LLM 的 RLVR 之间存在两个关键区别
    • First,语言模型中的动作空间比围棋或 Atari 游戏的动作空间指数级更大 (2023)
      • RL 算法最初并非设计用于处理如此巨大的动作空间,如果从零开始训练,几乎不可能有效探索奖励信号
    • Therefore, The Second Distinction is LLM 的 RLVR 从一个具有有用先验的预训练 Base Model 开始,而 Atari 和 GO 游戏中的传统 RL 通常是从零开始
    • 这种预训练先验指导 LLM 生成合理的 Response ,使得探索过程显著更容易,并且策略可以获得正向奖励反馈

Discussion 2: 在这个巨大动作空间中,先验是一把双刃剑

  • Priors as a Double-Edged Sword in This Vast Action Space
  • 由于 Response 的采样受到预训练先验的引导,策略可能难以探索超出先验已经提供内容的新推理模式
  • Specifically,在如此复杂且高度组合的空间中,通过朴素的 Token-level 采样探索(naive token-level sampling exploration)生成的大多数 Response 都受到 Base Model 先验的限制
    • 任何偏离先验的样本都极有可能产生无效或无意义的输出,从而导致负的结果奖励 (Negative outcome reward)
  • 如第 2.1 节所讨论的,策略梯度算法旨在最大化在先验内获得正奖励的 Response 的对数似然,同时最小化在先验外获得负奖励的 Response 的似然
    • As a result,训练后的策略倾向于产生已经存在于先验中的 Response ,将其推理能力限制在 Base Model 的边界内
  • 从这个角度看,从蒸馏模型开始训练 RL 模型可能暂时提供一个有益的解决方案,因为蒸馏有助于注入更好的先验
    • 理解:但蒸馏也会大幅度改变模型之前的分布,从而导致模型在其他方面的能力受到影响

Possible Future Work

  • 如上所述,巨大动作空间中的低效探索机制以及对二元结果奖励的依赖,可能是当前 RLVR 设置中所观察到局限性的根本原因
  • 为了从根本上应对这些挑战,以下几个方向可能值得探索:
    • 在高级抽象中进行高效探索策略 (Efficient exploration strategies in high-level abstraction)
      • 高级别的探索机制,例如在程序级抽象空间中进行自我演化的 AlphaEvolve (2025),可能对于驾驭巨大的动作空间至关重要
      • 此类策略可以促进发现先验外的推理模式和以前未见的知识结构
    • 通过课程学习扩展数据规模 (Data scale via curriculum)
      • 课程学习可以从训练较简单的子问题开始,使模型提高采样效率并获得必要的元技能
      • 通过在处理更难问题之前提高简单任务的成功率,这种课程可以分层减少探索空间,并在具有挑战性的父任务上使性能从接近零提升到非零,从而使 RLVR 能够获得有意义的奖励 (2025, 2025)
      • 尽管当前 RLVR 训练数据中偶尔会出现这种层次关系的痕迹,并且最近的工作中已经观察到了它们的效果 (2025),但要实现其全部潜力,将需要一个更加审慎、大规模的数据-RL 迭代流程,确保对元技能以及简单与困难问题之间适当关系的充分覆盖
    • 过程奖励和细粒度信用分配 (Process reward and fine-grained credit assignment)
      • 与纯粹的二元结果奖励相比,结合中间信号来指导推理轨迹可能会显著提高探索效率,并将探索引导向更有希望的解决方案路径
    • Agentic RL (理解:即基于经验探索的 RL)
      • 当前的 RLVR 推理仅限于单轮 Response ,而基于反馈的迭代细化对于 IMO 级别的推理至关重要 (2025)
      • 当前的 RLVR 推理也缺乏通过使用搜索工具或进行实验来主动收集新信息的能力
      • 一个多轮智能体 RL 范式,具有与环境反馈的更丰富交互,可以让模型生成新颖的经验并从中学习
      • 这个新兴的智能体框架被描述为“经验时代(era of experience)”的开端 (2025) Silver, D. and Sutton, R. S. Welcome to the era of experience. Google AI, 2025

Related Work

  • 论文在此总结了关于 RLVR 分析的关键相关工作,并在附录 B 中提供了更全面的讨论
  • 尽管最近的 RLVR 方法取得了令人印象深刻的经验结果 (2025, 2024),但其对推理的根本影响仍未得到充分探索
    • 一些研究 (2025, 2025, 2025) 表明,RLVR 模型中的反思行为源于 Base Model ,而不是通过 RL 学到的
    • Dang 等人 (2025) 观察到 RLVR 训练后 pass@\(k\) 性能下降,但他们的分析范围有限
      • More Importantly,他们没有探索 Base Model 与 RL 模型之间的关系
    • Deepseek-Math (2024) 也观察到了类似的趋势,但其研究仅限于单个指令微调模型和两个数学基准
  • In Contrast,论文的工作系统地调查了(systematically investigates)广泛的模型、任务和 RL 算法,以准确评估当前 RLVR 方法和模型的效果
  • 论文进一步提供了深入的分析,包括准确率分布、推理覆盖率、困惑度趋势以及与蒸馏模型的比较,提供了对 RLVR 能力和局限性的全面理解

附录 A:Implementation Details

A.1 RLVR Algorithms

  • 为了减少内存和计算开销,人们提出了几种无需 Critic 的变体
    • GRPO (2024) 通过同一问题的一组 Response 内的归一化奖励来估计优势值:
      $$ A_i = \frac{r_i - \text{mean}(\mathbf{r})}{\text{std}(\mathbf{r})}$$
      • 其中 \(\mathbf{r} = \{r_1, \ldots, r_G\}\) 表示一组 \(G\) 个采样 Response 的奖励集合
    • RLOO (2024) 则在每个批次 \(\mathcal{B}\) 内采用留一法(leave-one-out)基线
      • 其优势值定义为
        $$ A_i = r_i - \frac{1}{|\mathcal{B}|-1} \sum_{j \neq i} r_j$$

A.2 Low-Variance pass@k Estimation

  • 直接使用每个问题仅 \(k\) 个采样输出来计算 pass@\(k\) 可能会导致高方差
  • 为了缓解这个问题,论文遵循 Chen 等人 (2021) 提出的无偏估计方法
  • Specifically,对于评估数据集 \(\mathcal{D}\) 中的每个问题 \(x_i\),论文生成 \(n\) 个样本 (\(n \geq k\)),并将正确样本的数量记为 \(c_i\)
  • 数据集中 pass@\(k\) 的无偏估计量由下式给出:
    $$
    \text{pass@}k := \mathbb{E}_{x_i \sim \mathcal{D} } \left[1 - \frac{\binom{n-c_i}{k} }{\binom{n}{k} } \right]
    $$
    • 通过这个公式,我们可以轻松地以低方差估计所有 \(k \leq n\) 的 pass@\(k\) 值
  • 在论文的实验中,将 \(n\) 设置为 pass@\(k\) 曲线中最大的(即最右边的) \(k\) 值,通常是 128、256 或 1024
    • 例如,在图2中
      • 论文对 MATH500、Minerva 和 GSM8K 使用 \(n=128\)
      • 对 AMC23 和 AIME24 使用 \(n=1024\)
      • 对于 Olympiad 基准测试,由于 Base Model 能力相对较低
        • 论文为 Qwen 模型设置 \(n=128\)
        • 为 LLaMA-3.1-8B 设置 \(n=1024\)
    • 问题:这里其实说明在评估最大的 \(k\) 时, \(k\) 和 \(n\) 是相同的,此时方差应该不小

附录 B:More Related Works

Reinforcement Learning for LLM Reasoning

  • 自从 LLM 出现以来,Post-Training 阶段已被证明对于增强问题解决和推理能力至关重要 (2022)
  • Post-Training 阶段通常分为三个主要类别:
    • 使用人工整理或蒸馏数据进行监督微调 (2023),supervised fine-tuning using human-curated or distilled data
    • 自我改进迭代 (2022; 2023),self-improvement iteration
    • RL (2022)
  • Previously,人们使用奖励模型或 Response 对之间的偏好进行奖励建模 (2022; 2023)
  • Recently,RLVR 作为一种提高 LLM 在数学和编程等领域推理能力的方法,获得了显著的关注 (2024; 2024)
    • 一个鼓舞人心的里程碑工作是 OpenAI 的 o1 模型 (2024)
      • 这是首批大规模应用 RL 进行推理的模型之一,在发布时达到了当时的先进水平(achieving state-of-the-art results)
  • Following this,Deepseek-R1 (2025) 成为首个性能匹配或超越 o1 的开放权重模型
    • R1 引入的一个重要创新是 “Zero” 设置,即直接对 Base LLM 应用 RL ,绕过任何中间的监督调优
    • 这种方法启发了一波旨在复制或扩展 R1 方法并改进 RL 算法的开源努力 (2025; 2025a; 2025; 2025; 2025a; 2025)
  • 与此同时(In Parallel), RL 在多模态领域也获得了关注,推动了多模态推理(multimodal reasoning)的进步 (2025a; 2025; 2025)

Analysis of RLVR

  • 尽管在 RLVR 领域有许多优秀的开源工作和算法设计,但关于 RLVR 对 LLM 推理能力的根本影响及其从 Base Model 开始的局限性,仍然缺乏深入的理解
    • 几项研究 (2025a; 2025b; 2025) 强调,在 R1 类模型中观察到的反思行为实际上源于 Base Model ,而不是由 RLVR 训练引入的
    • Dang等人 (2025) 观察到了与论文的发现类似的现象:Pass@k 性能在 RL 后迅速恶化且无法恢复,但这仅限于一个有限的实验设置(在 GSM8K 上使用 Qwen-2.5-0.5B 模型)
    • More Importantly,他们没有探究 Base Model 与 RL 模型之间的关系
  • In Contrast,论文的论文通过系统和严谨的实验表明,不仅是反思行为,所有推理路径都早已嵌入在 Base Model 中
    • 论文进一步证明,RLVR 并未引出超越 Base Model 的新推理能力

附录 C:Detailed Experimental Results

C.1 More Results on Mathematics and Coding

  • 图 11:在AIME24上评估 Oat-Zero-7B 和 DAPO-32B,并与各自的 Base Model 进行比较
  • 图10:SimpleRLZoo 在 GSM8K 和 AMC23 上的更多结果

C.2 Validity of Chain-of-Thought on AIME24

  • 论文手动检查了最具挑战性的 AIME24 基准测试中的思维链
  • To Begin,论文引入一种过滤机制,旨在消除容易猜测的问题
    • Specifically,论文 Prompt Qwen2.5-7B-Base 模型直接回答问题,不使用思维链推理,并多次采样答案
    • 如果一个问题能够以低但非零的概率(例如,< 5%)被正确回答,论文将其视为可猜测并移除
    • 那些能以高概率直接正确回答的问题则保留,因为它们很可能更容易,并且可以通过有效的思维链解决
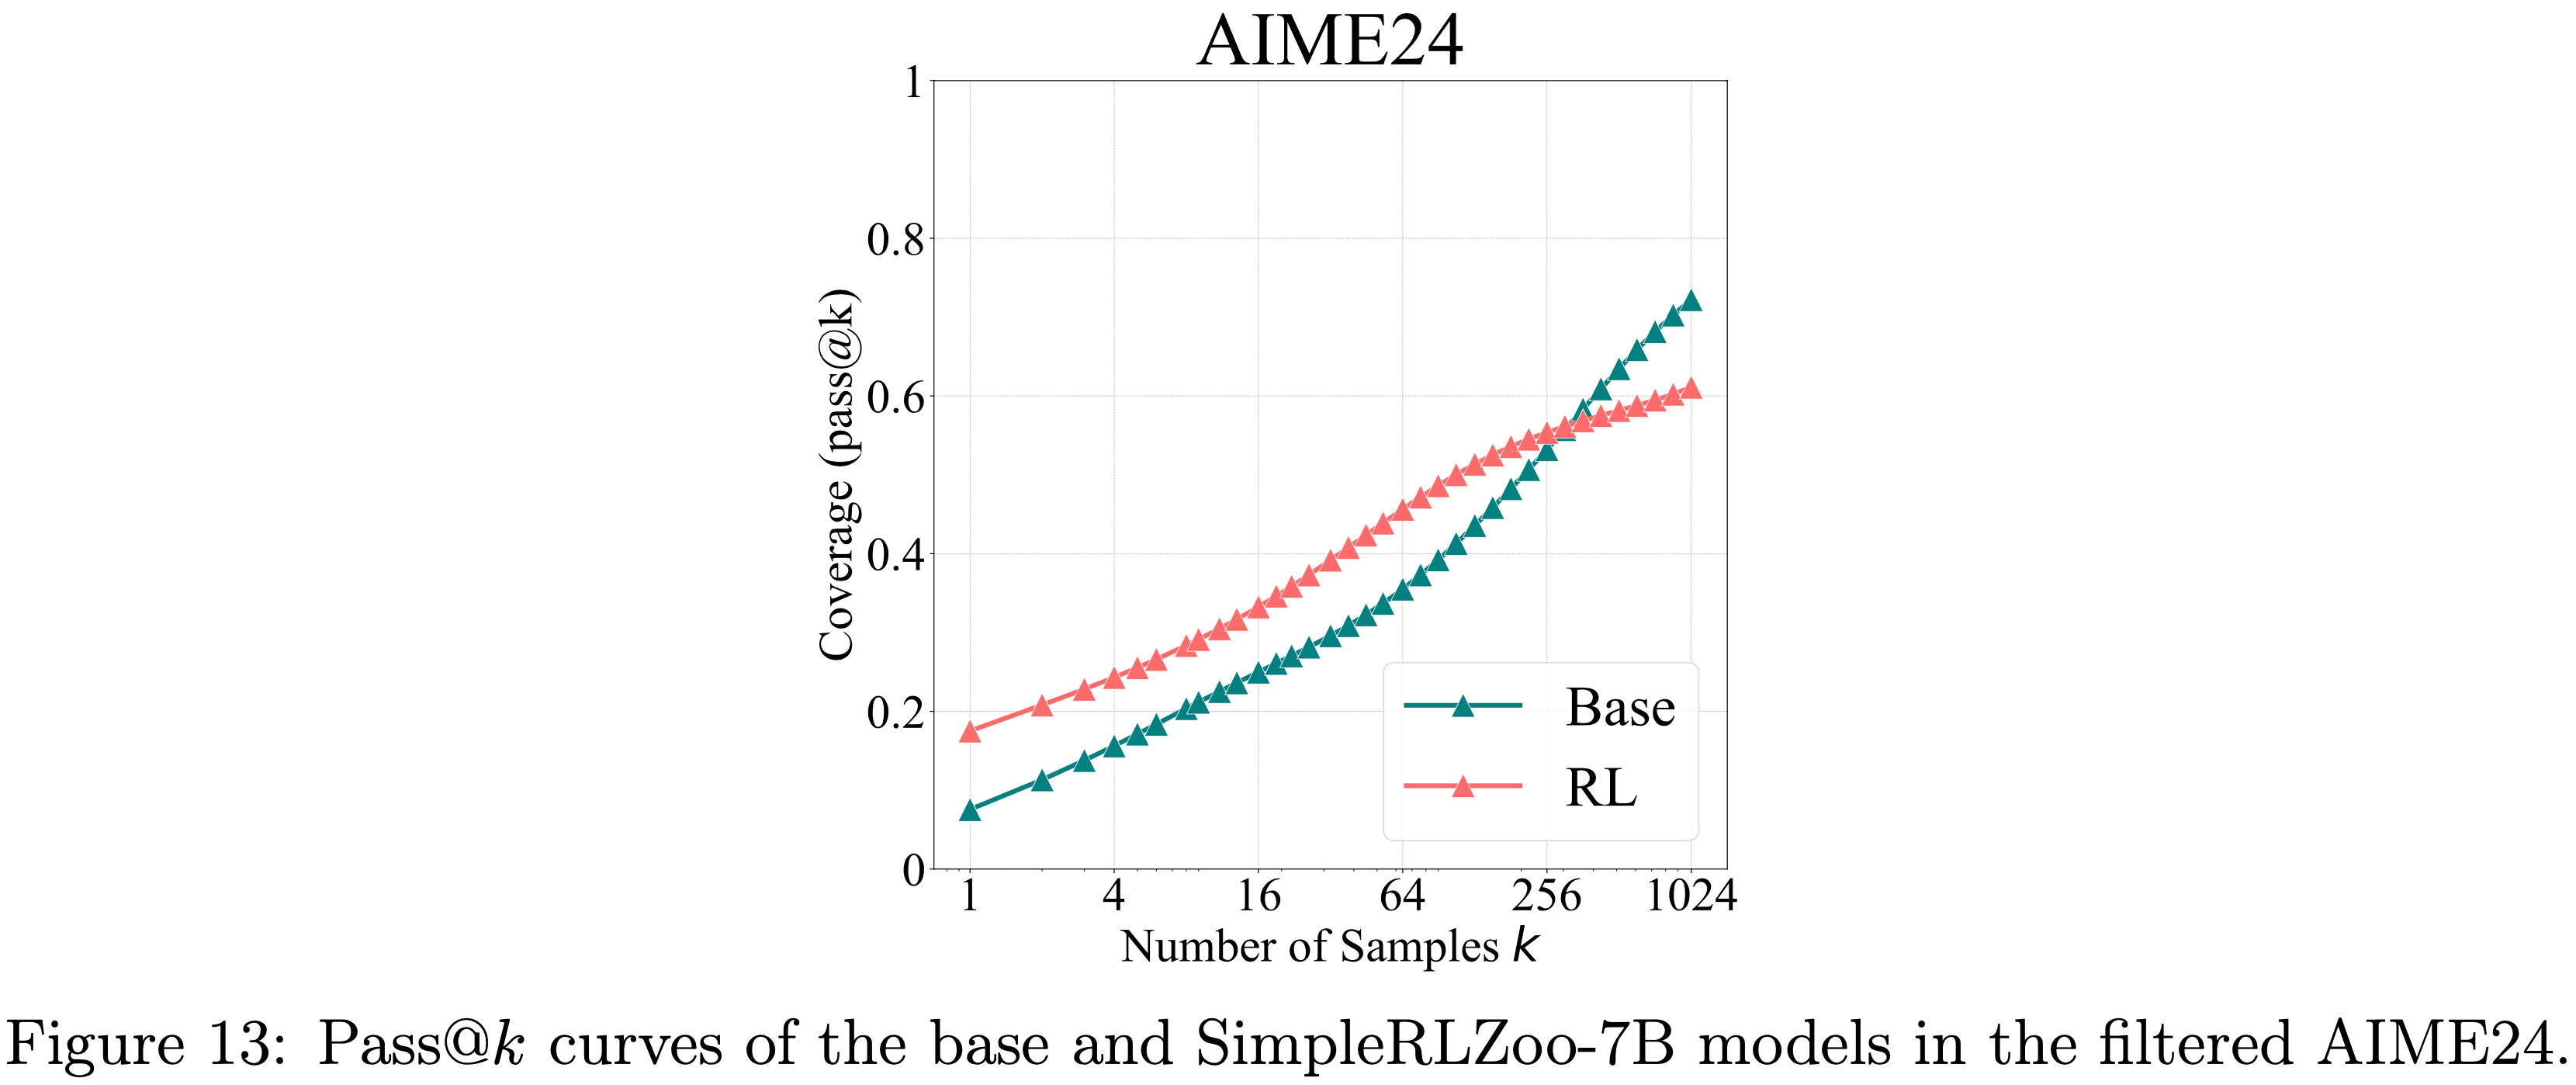
  • Base Model 和 RL 模型在这个经过过滤的 AIME24 数据集上的 pass@\(k\) 曲线在图 13 中,显示出与之前结果相似的趋势
  • 尽管这种过滤方法是启发式的,但它被证明是有效的
  • 将其应用于 AIME24(共 30 个问题)后,得到一个包含 18 个问题的子集
  • 然后论文 Prompt 模型使用思维链推理来回答这些过滤后的问题
  • 接着,论文手动检查了所有导致难题(平均正确率低于5%)得出正确答案的思维链
    • Base Model 回答了 7 个此类问题,其中 5/6 的问题包含至少一个正确的思维链(排除一个因跳过推理步骤而正确性模糊的情况)
    • Similarity,经过 RL 训练的模型回答了 6 个问题,其中 4 个包含至少一个正确的思维链
  • 这些结果表明,即使对于AIME24中最具挑战性的难题, Base Model 也能采样出有效的推理路径来解决问题

C.3 Accuracy Distribution Visualization

  • 图14:在使用 SimpleRLZoo 模型进行 RLVR 训练前后的准确率直方图

C.4 Perplexity Analysis

  • 为了分析困惑度在 RLVR 训练过程中如何演变,论文在第 4.3 节提到的 RL 训练过程中评估了三个 RLVR 检查点:早期、中期和最终(early, middle, and final)
  • 对于每个检查点,论文针对每个问题采样 32 个 Response ,计算 32 个困惑度值的中位数,并在表格中报告前 10 个问题的平均值
  • 正如预期的那样,论文观察到:
    • 随着 RL 训练的进行,\(\text{PPL}_{\text{Base} }(\boldsymbol{\mathbf{Y} }_{\text{RL} }|x)\) 逐渐降低
    • 这表明 RLVR 主要是锐化了 Base Model 先验分布内的分布,而不是扩展到其之外
  • 图15:RL训练期间的困惑度演变

C.5 Different RLVR Algorithms

  • 论文在图 8 中报告了关于不同 RLVR 算法的几个额外观察结果
  • First,DAPO 在所有三个数据集上都取得了略高的 pass@1 分数;
    • However,其动态采样策略在训练期间每批次所需的样本量比其他算法多大约 \(3 \sim 6\) 倍
    • Moreover,其在 \(k=256\) 时的性能显著下降
  • Second,RLOO 和 Reinforce++ 在整个 \(k\) 范围(从1到256)内表现一致良好,同时保持了高效的训练成本,在效果和效率之间取得了良好的平衡
  • Third,ReMax 在 pass@1 和 pass@256 上都表现出较低的性能
    • 论文推测(hypothesize)这是由于它使用了贪婪 Response 的奖励作为优势基线,而在 RLVR 设置中奖励是二元的(0 或 1)且高度可变
  • 这很可能导致训练期间梯度更新不稳定
  • 表 4:图 1(右)中不同 RL 训练步骤在 pass@1 和 pass@256 的详细数值

C.6 Effects of KL and Rollout Number

  • 图 16:关于 KL 损失和 Rollout Number \(n\) 的消融研究
    • 对于将 \(n\) 从8增加到32的情况,论文保持 Prompt 批次大小不变,这导致了每个训练步骤的计算量增加
    • 由于资源限制,论文在此设置下仅训练了220步,导致 pass@1 较低,因为模型尚未收敛
    • 尽管如此,\(n=32\) 的模型实现了更高的 pass@128,突显了较大的 Rollout Number 在提高较大 \(k\) 值时的 pass@\(k\) 性能方面的积极影响
    • 注:KL 散度的训练 Rollout Number 配置是 8
  • 表 5:AIME24 中可解决问题(从0开始)的索引
    • 可以观察到近似的子集关系:RL模型解决的大多数问题也都能被 Base Model 解决
  • 表 6:LiveCodeBench(范围从400到450,从0开始)中可解决问题的索引

C.7 Solvable Problem Coverage Analysis

  • 表2 统计了问题按四类情形划分的占比:
    • (1)两个模型均至少成功求解一次该问题
    • (2)仅基准模型成功求解
    • (3)仅RLVR模型成功求解
    • (4)在 \(k\) 次采样中,两个模型均未成功求解该问题
  • 结果表明,存在大量“基准模型可求解、但 RLVR 模型求解失败”的情形(情形 2),而 “RLVR 模型可求解、但基准模型求解失败” 的情形(情形 3)则极为罕见
  • 即便在情形 (3) 的少数案例中(例如在 MATH500 数据集里占比 1%,约对应 5 个问题),当采样次数提升至 1024 次时,基准模型也能完成所有这类问题的求解
  • 上述结果印证了我们的结论:RLVR模型很少能求解基准模型无法解决的问题,且通常会导致任务覆盖范围下降

C.8 Temperature and Entropy Analysis

  • 图17:论文发现当温度超过 1.0 时, Base Model 的性能会下降,因为它倾向于生成更随机、更不连贯的 Token
    • In Contrast,RL 模型的性能在不同温度设置下保持相对稳定
    • Therefore,论文在主要实验中使用 \(T=0.6\),因为它允许两个模型都展示其最佳的推理性能
  • 图18:输出熵匹配的 Base Model 与 RLVR 模型比较
    • 论文使用温度 \(T=0.6\) 评估 Base Model (Qwen2.5-7B) 在每个数据集上的表现,并在每个图的标题中报告其输出熵 \(E_{\text{base} }\)
    • 为了进行公平比较,论文增加 RLVR 模型 (SimpleRLZoo) 的温度,直到其输出熵近似匹配 \(E_{\text{base} }\)
    • For Example,在 AMC23 上,论文设置 \(T=0.9\) 以实现 \(E_{\text{RL} }=0.47\)
    • 论文还将 RLVR 在 \(T=0.6\) 时的结果作为额外基线,其熵更低(e.g., 在 AMC23 上为 0.22,在 MATH500 上为 0.33)

C.9 Training Dynamics

  • 图19:训练过程中的训练奖励、 Response 长度和生成熵曲线,对应于第 4 节的实验

附录 C.10 CoT Case Analysis

  • 图 20:Owen2.5-Base-7B 正确 Response - 案例 1
  • 图 21:Owen2.5-Base-7B 正确 Response - 案例 2

附录 D:Prompt Templates

  • 论文提供了实验中用于训练和评估的 Prompt 模板
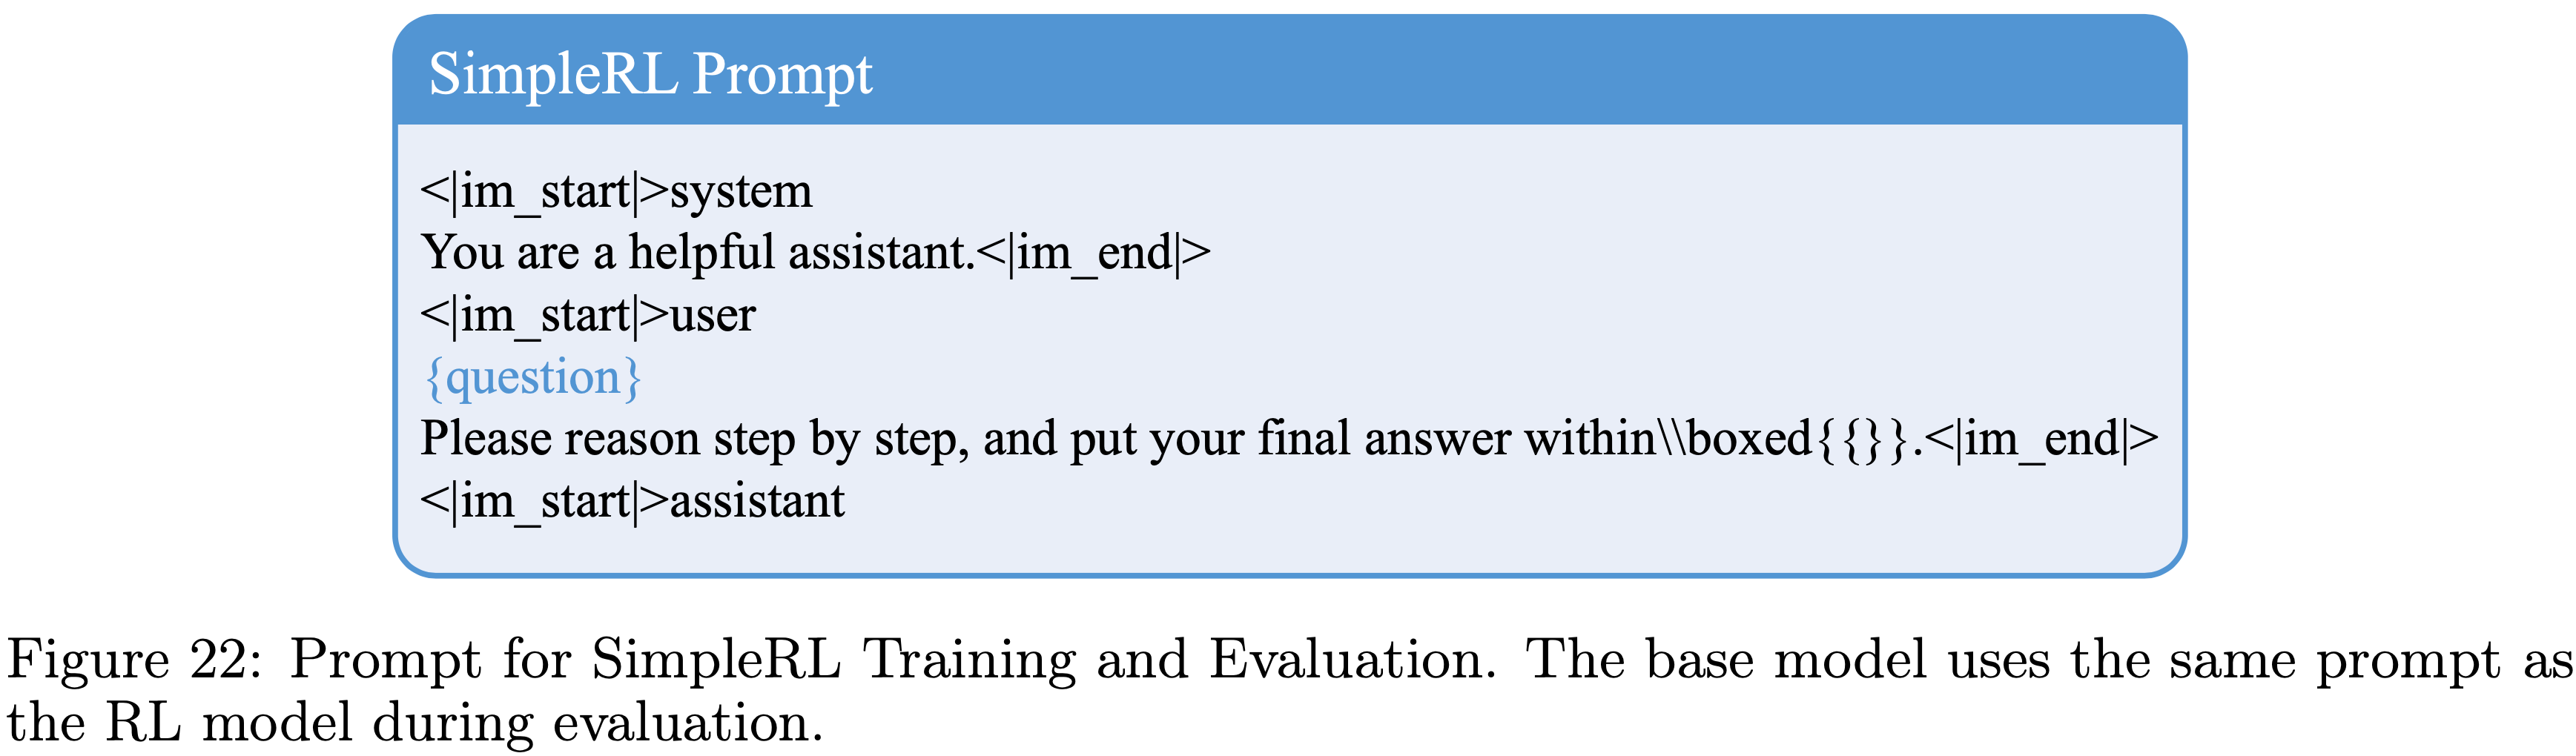
  • 用于 SimpleRL 训练和评估的 Prompt 如图 22 所示
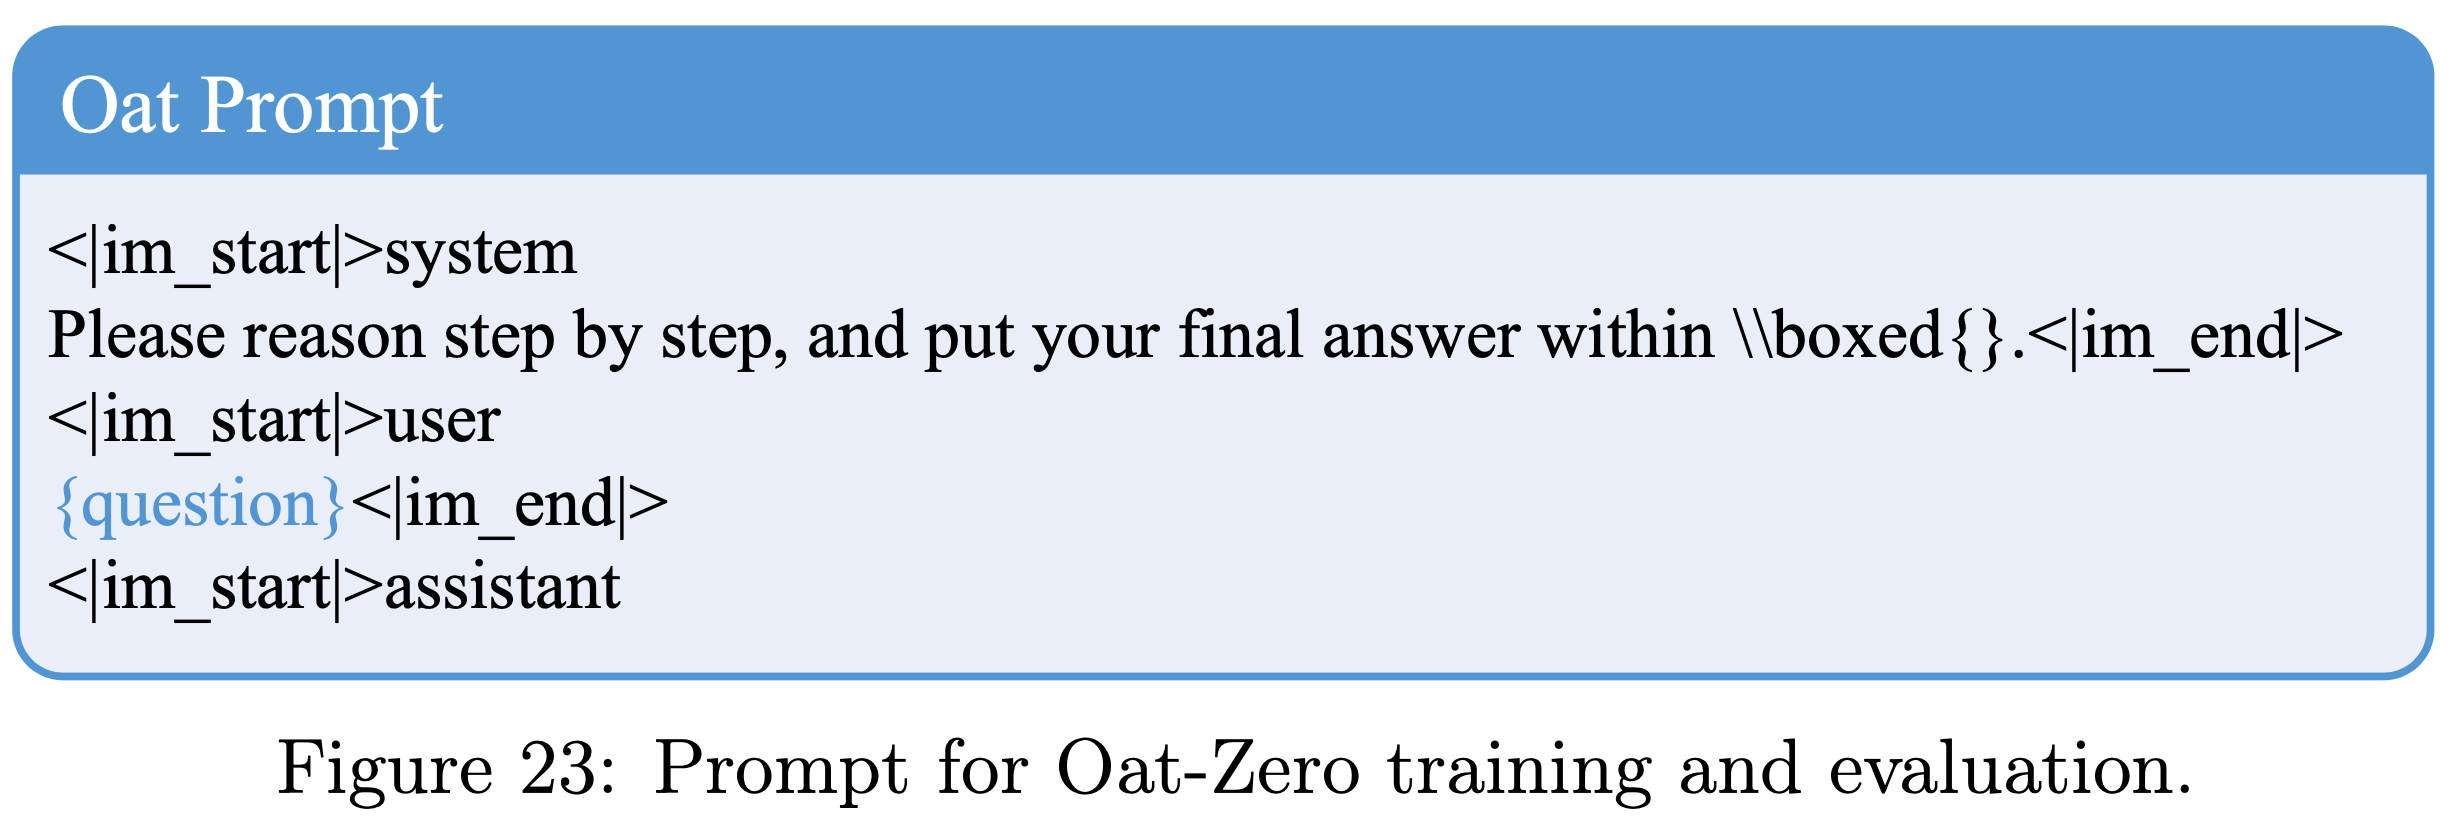
  • 用于 Oat-Zero 的 Prompt 如图 23 所示
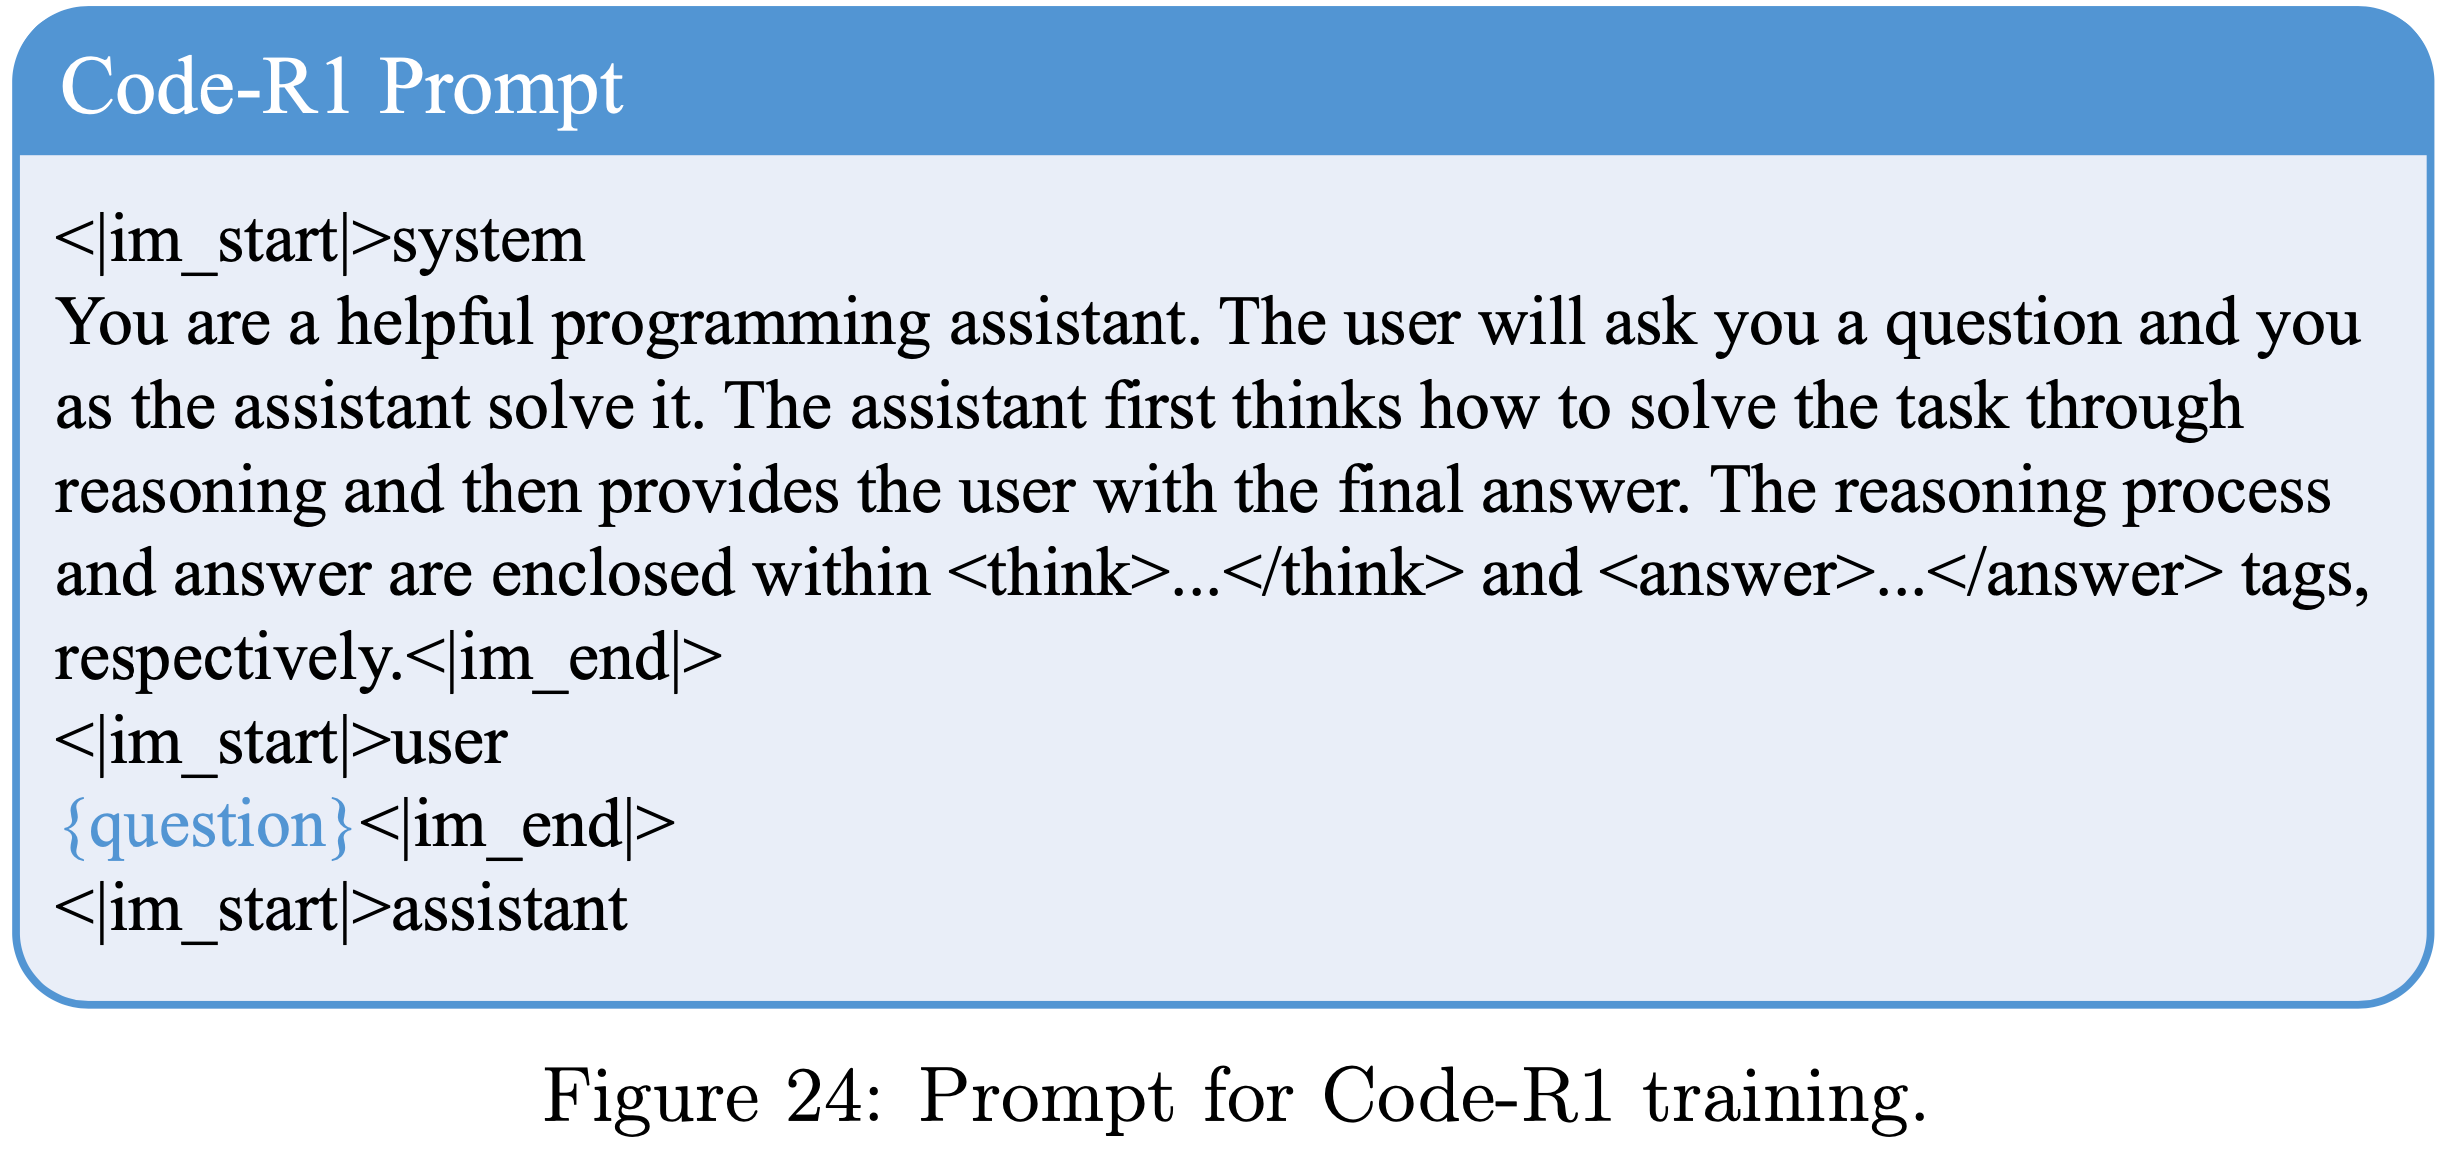
  • 对于 Code-R1 训练,采用图 24 中的 Prompt
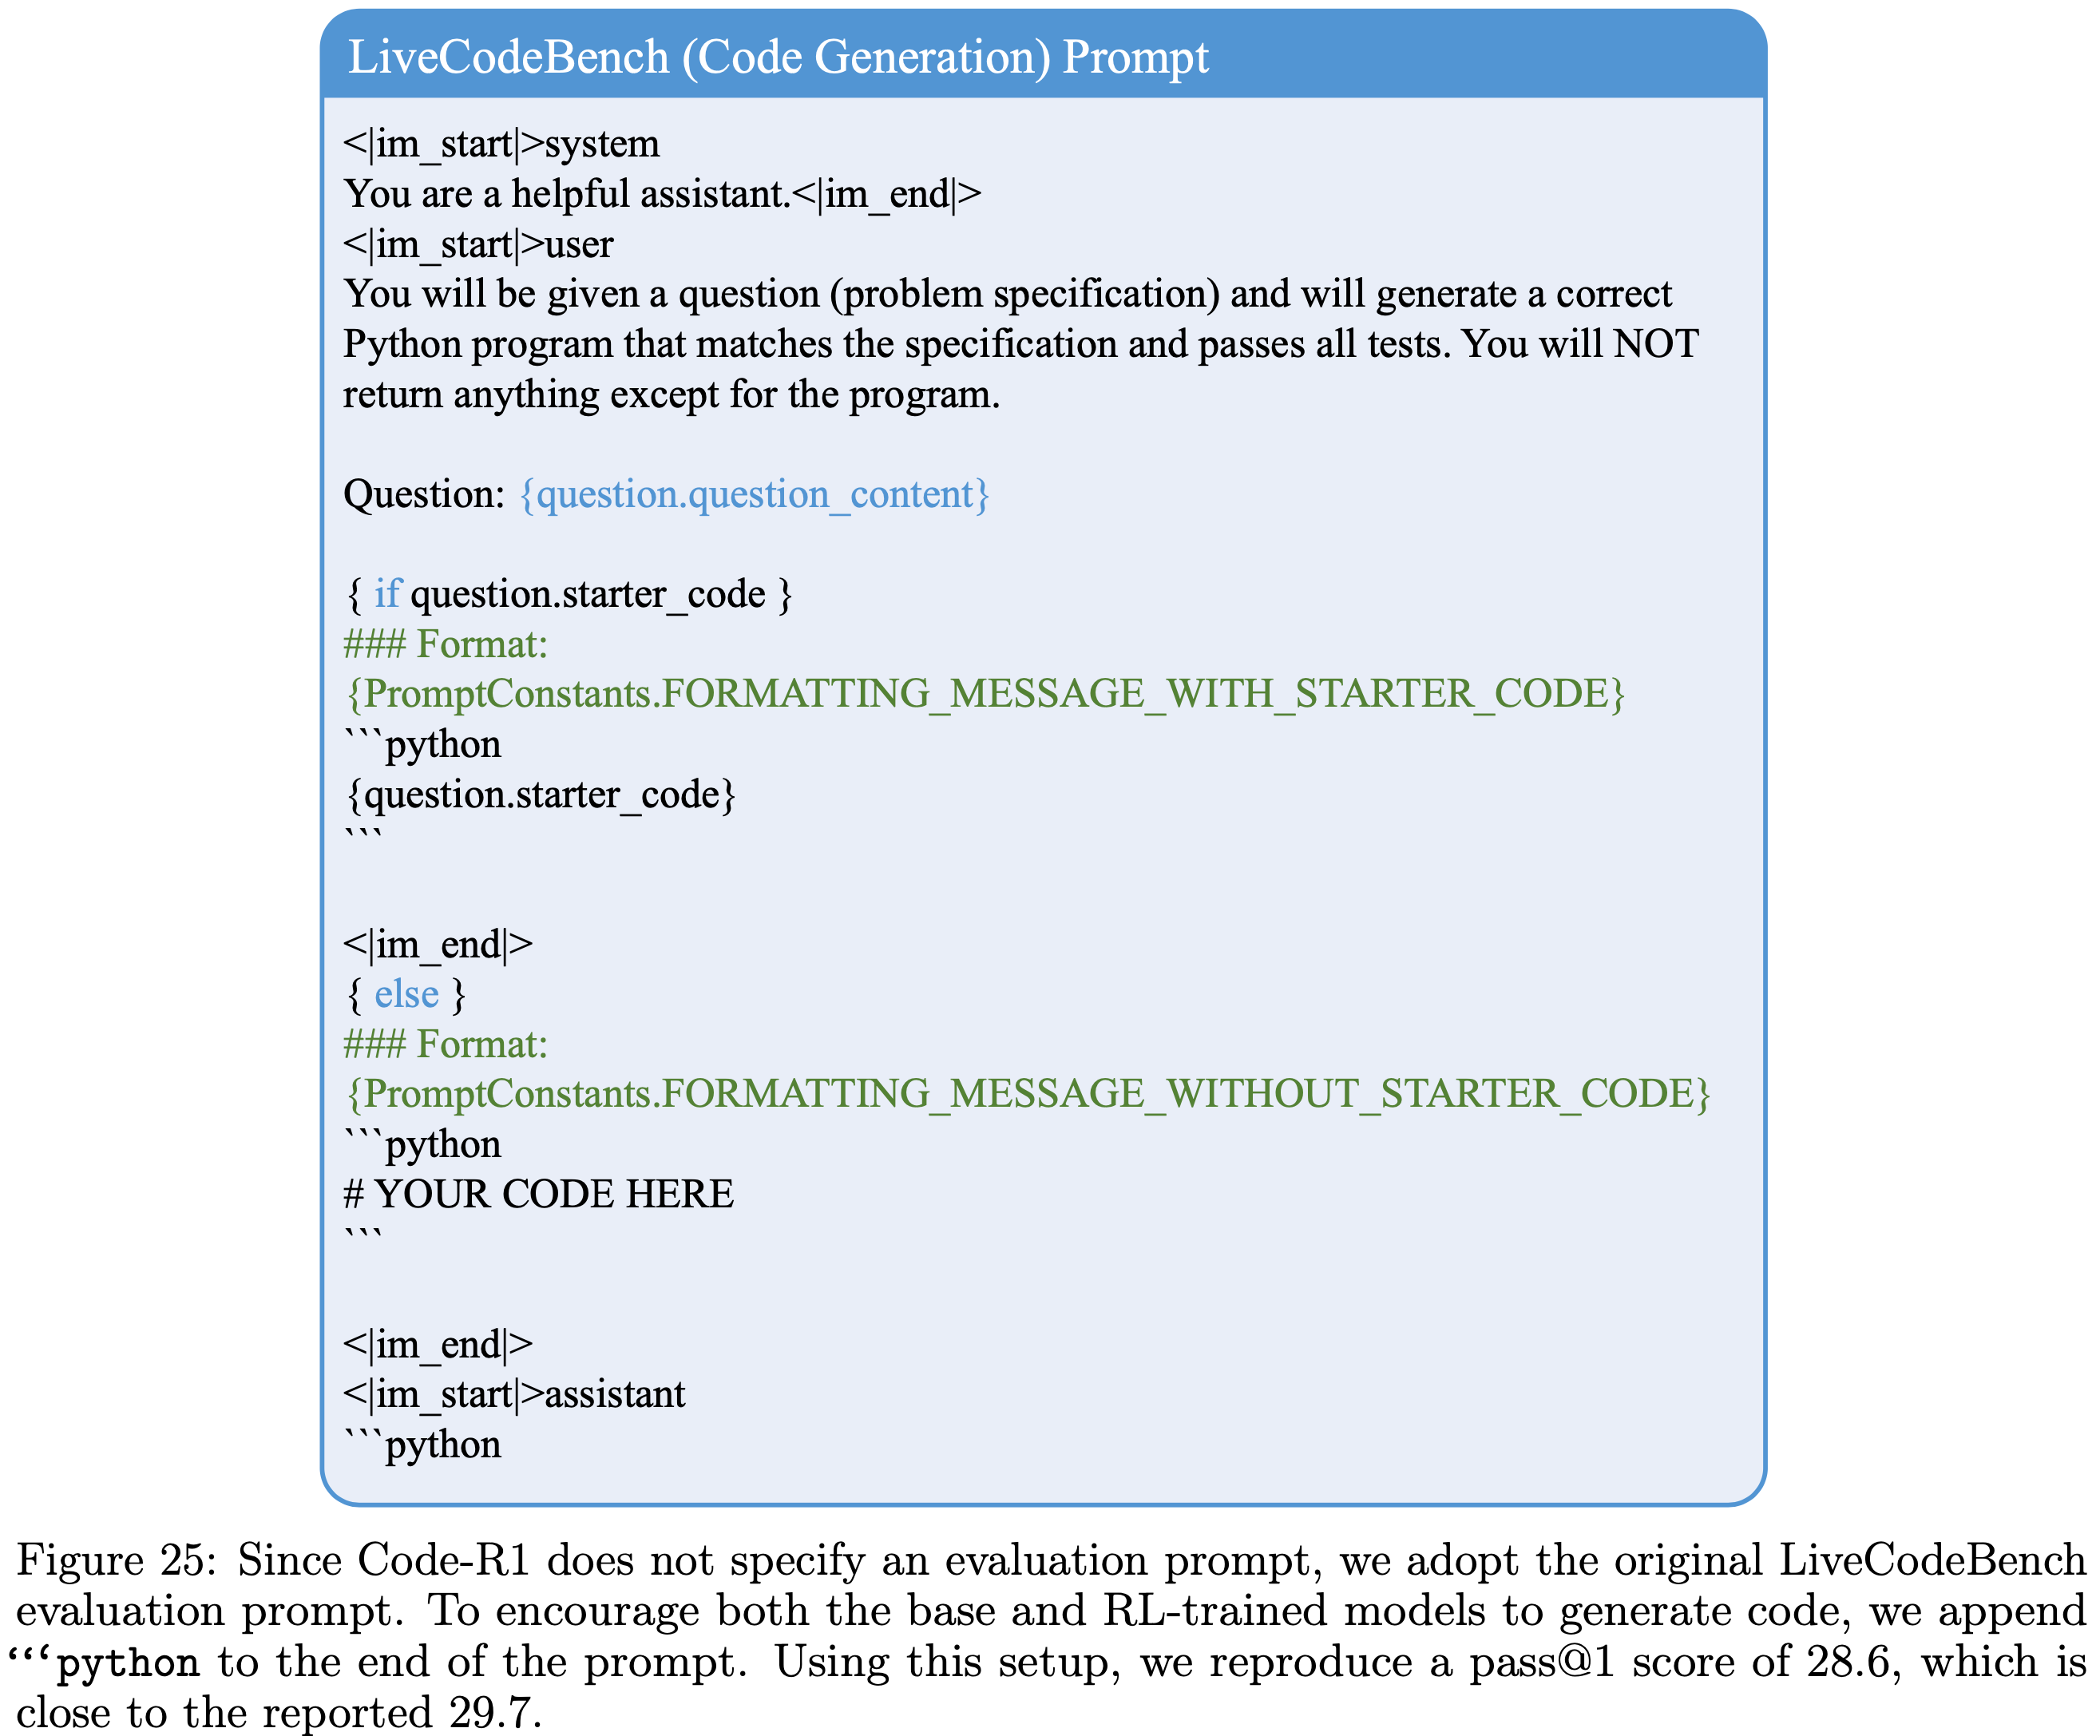
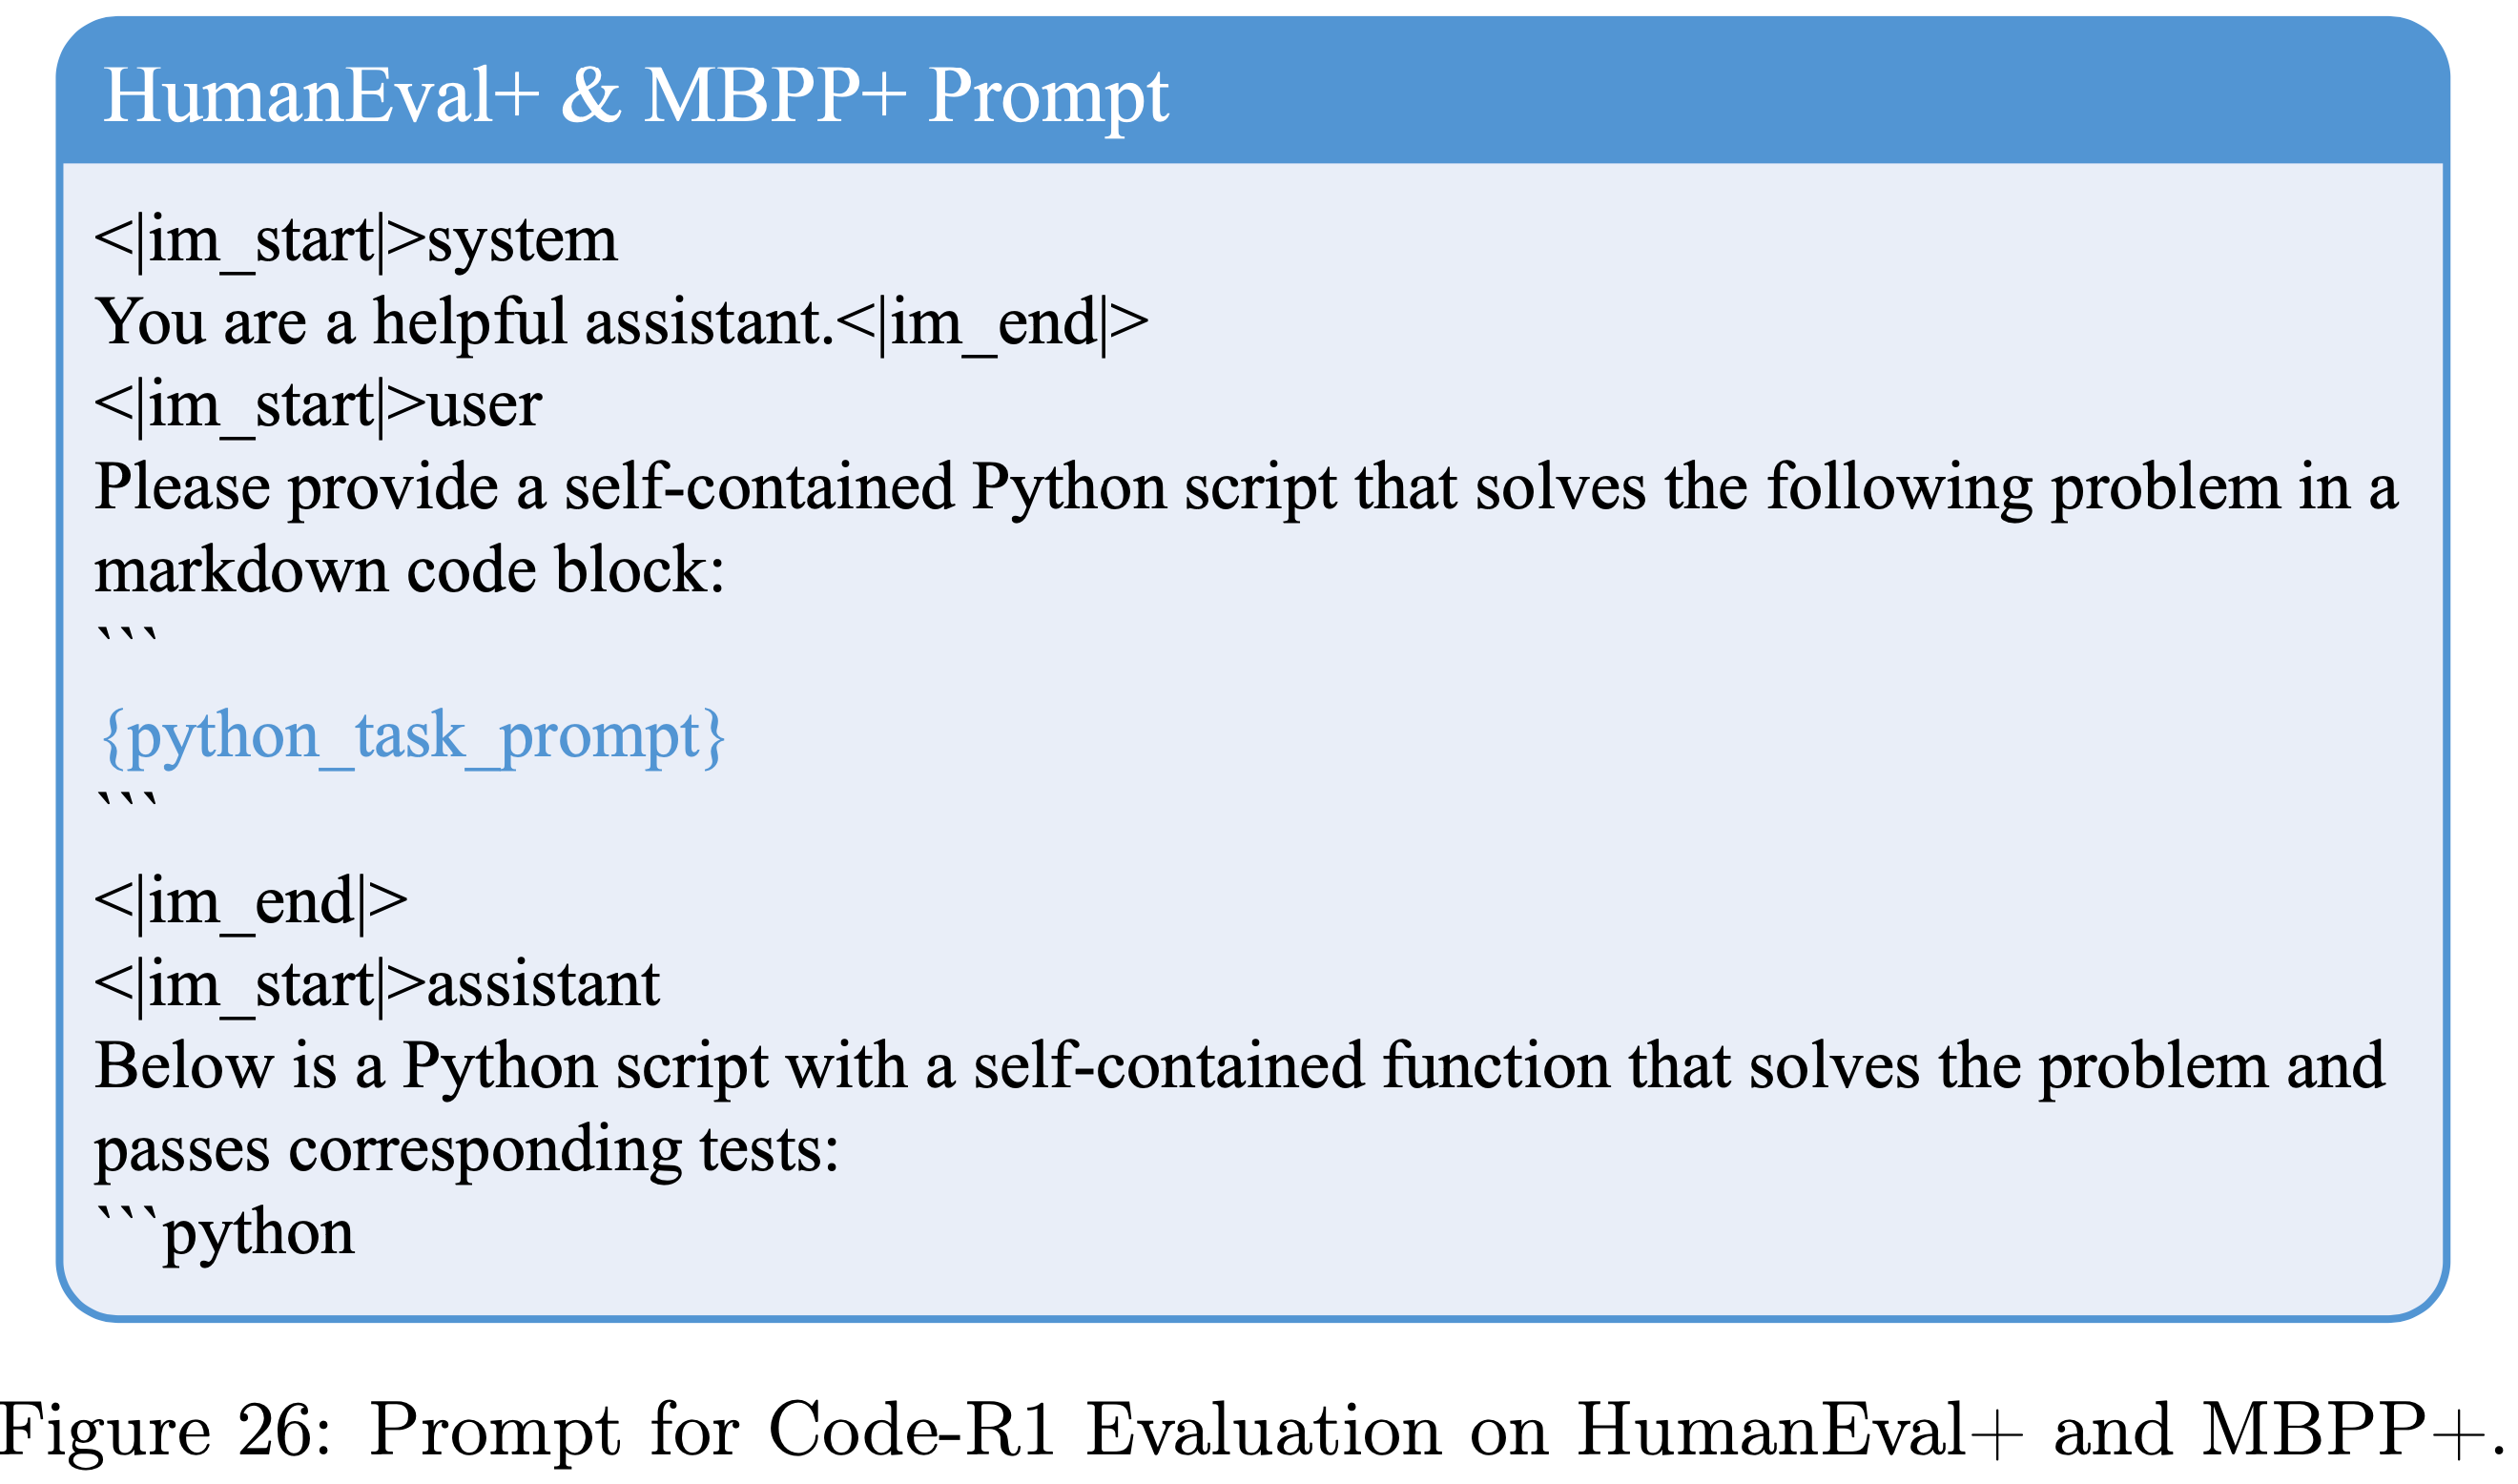
  • 对于 Code-R1 评估,论文遵循原始代码库,并采用基准测试的默认模板(核心:LiveCodeBench 需要添加 Prompt “```python” 作为结尾),包括 LiveCodeBench Prompt (图25)、HumanEval+ 和 MBPP+ Prompt (图26)
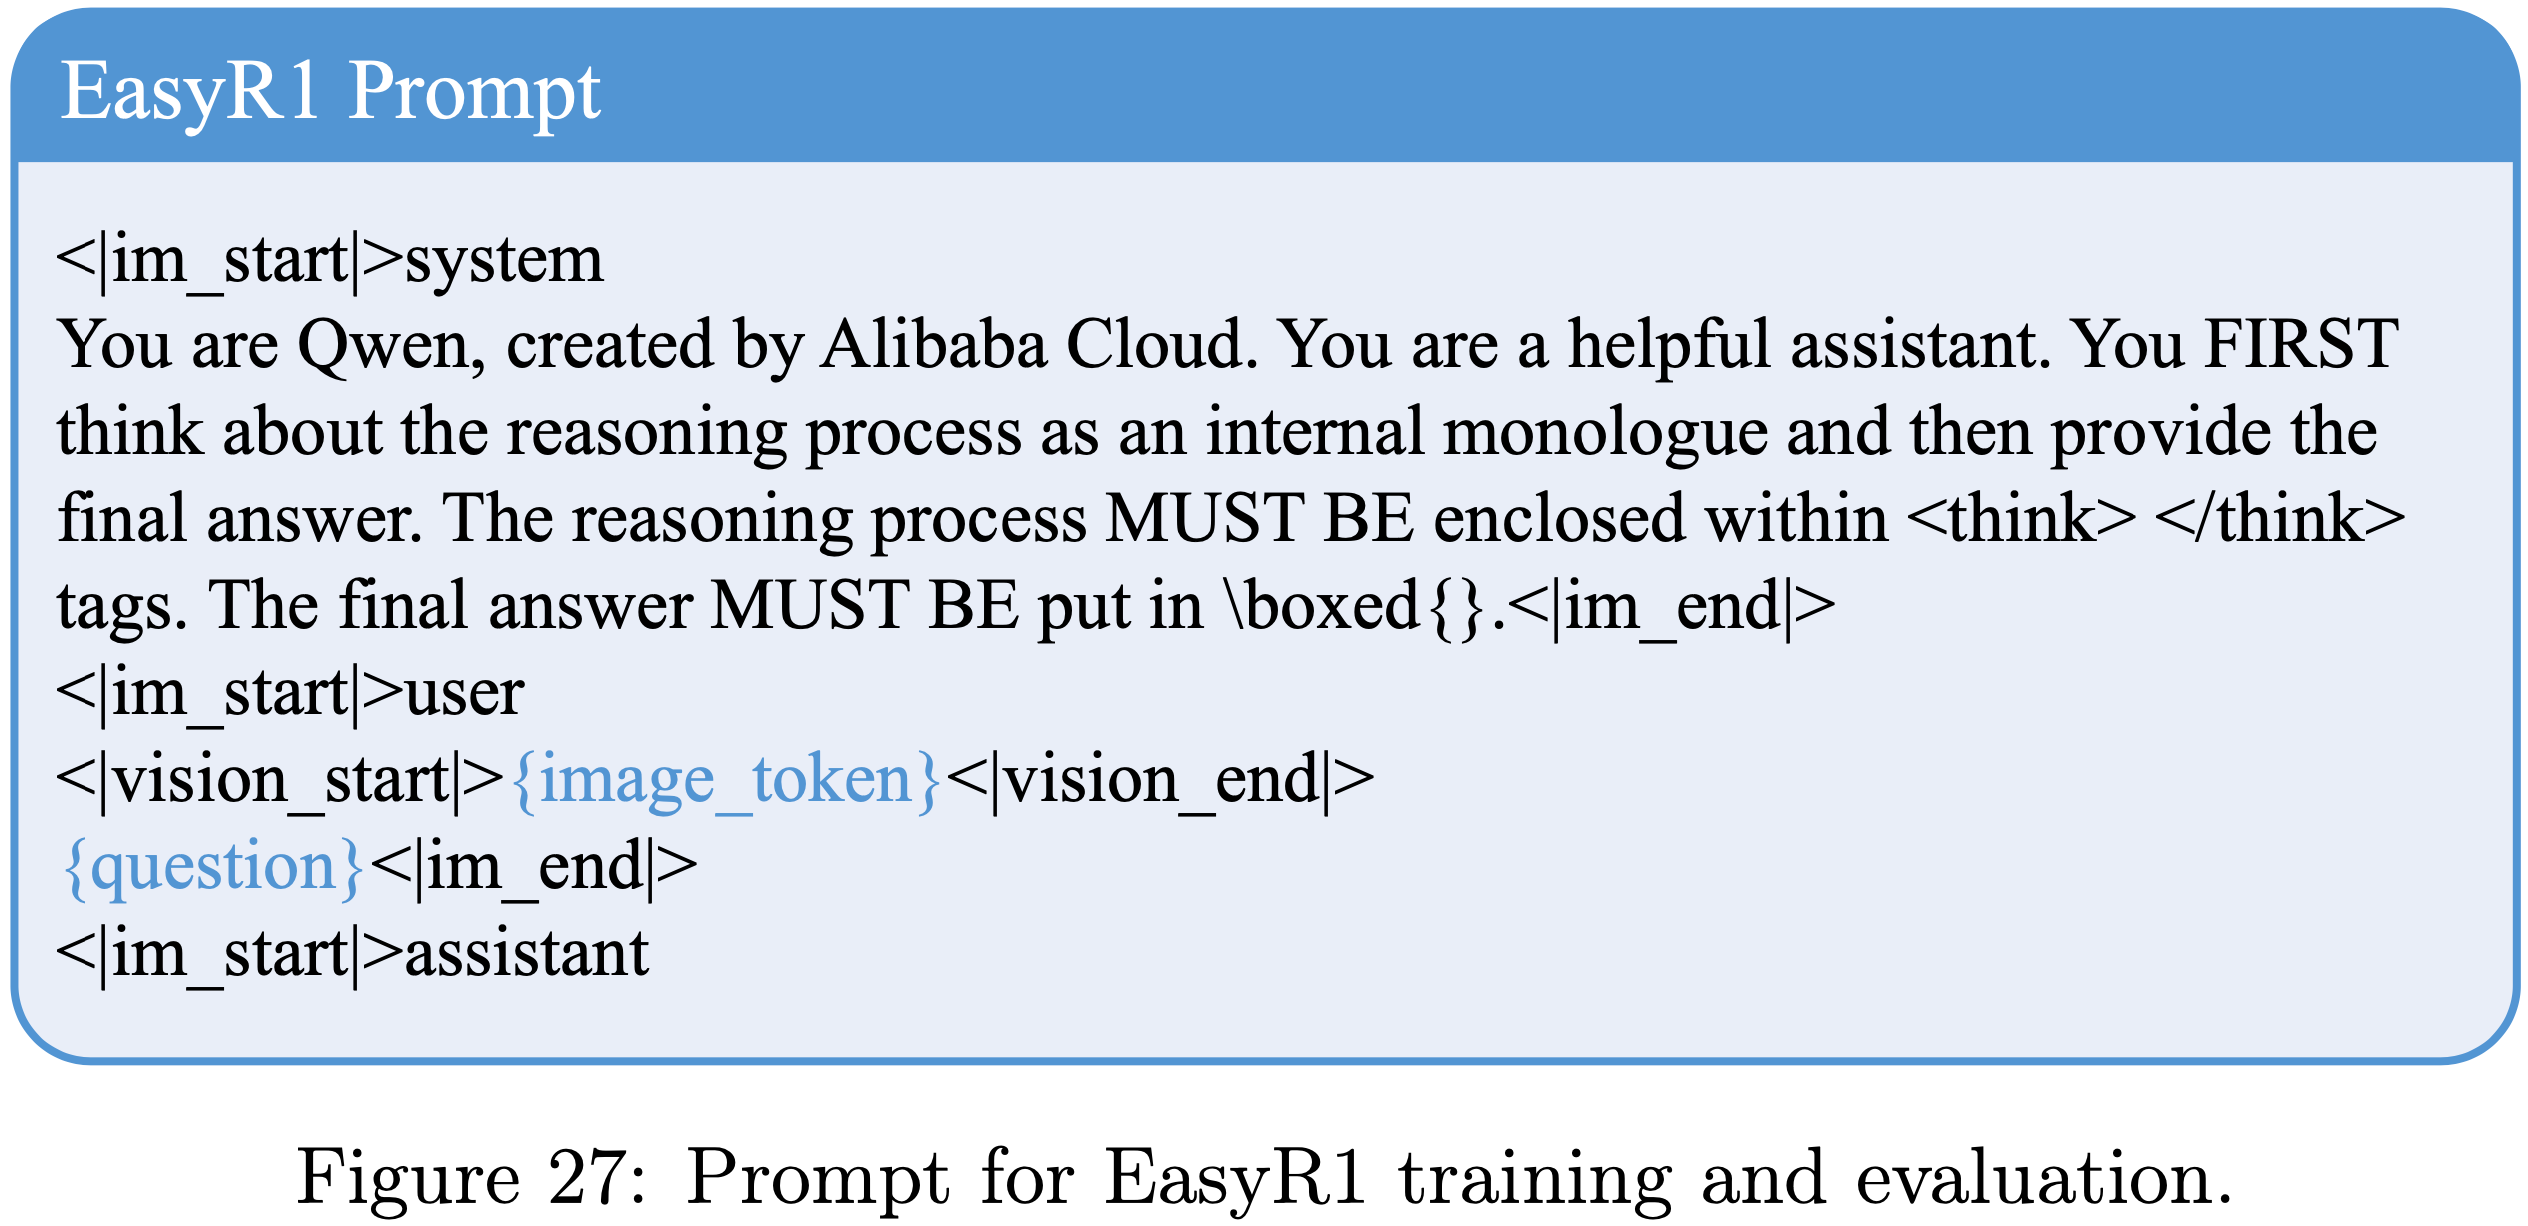
  • 用于 EasyR1 训练和评估的 Prompt 如图 27 所示
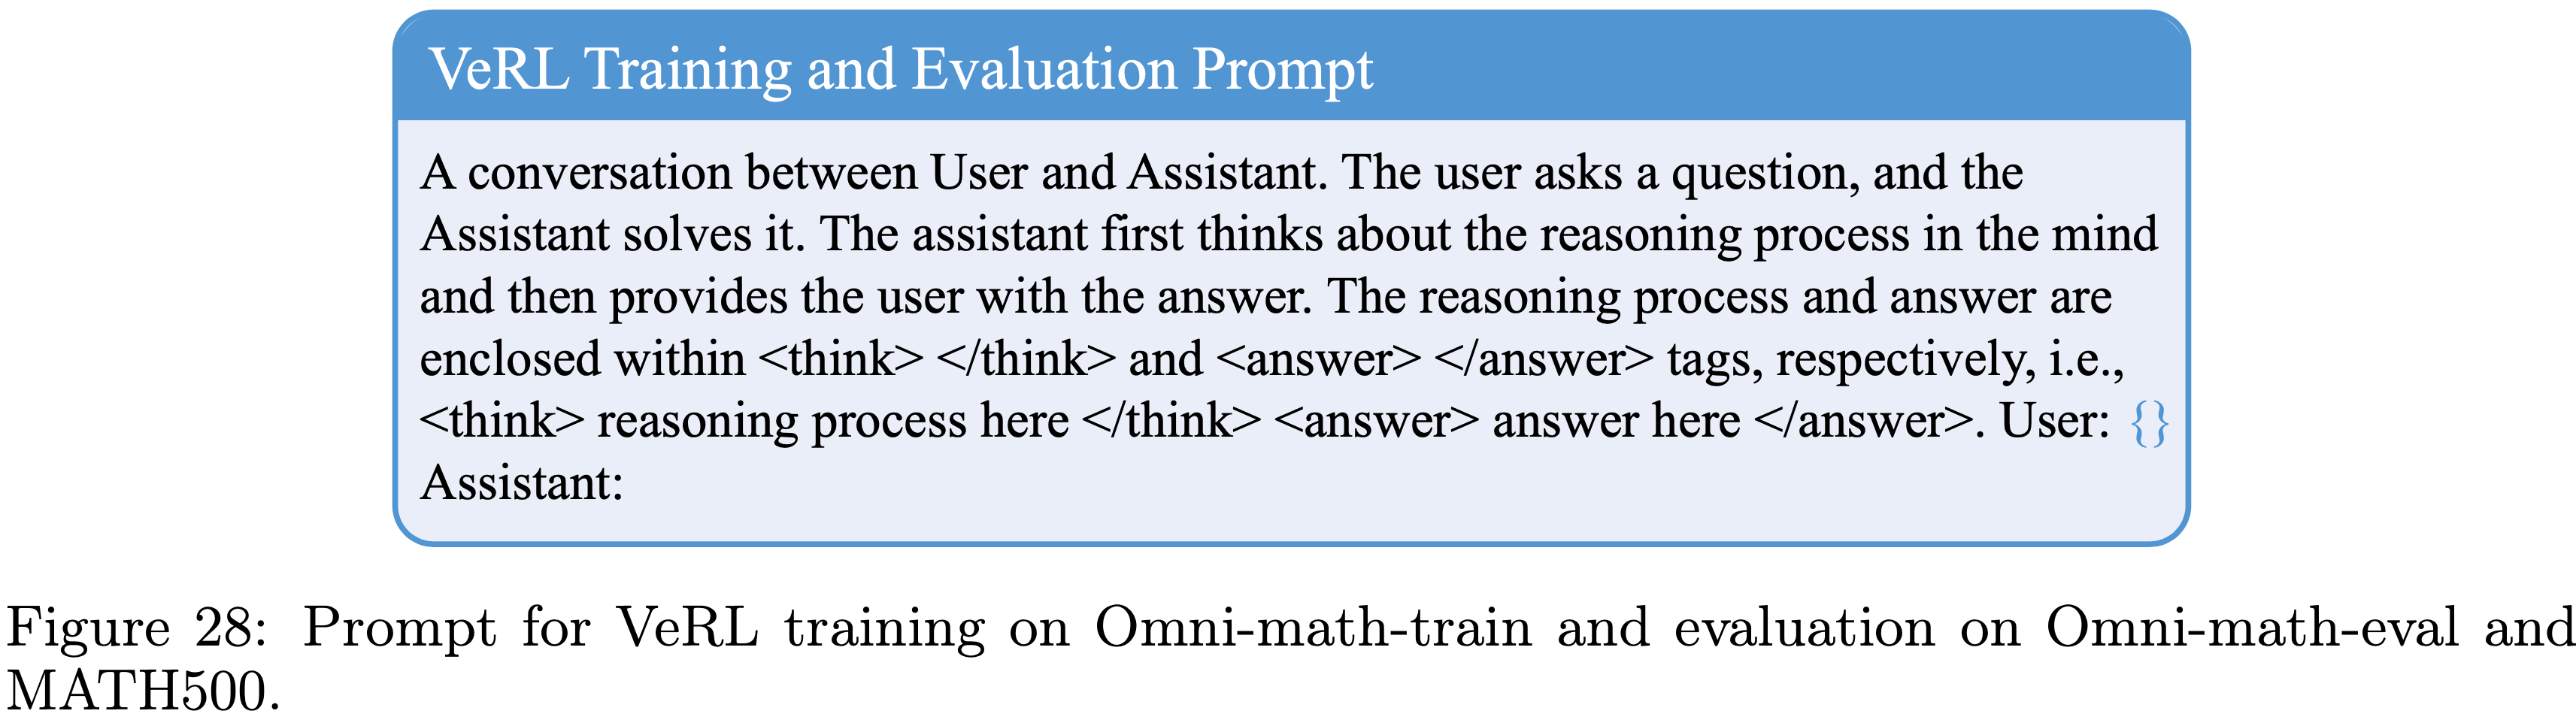
  • 对于使用 VeRL 训练的 RL 模型,如第 4.3 节和第 4.4 节所讨论的,训练和评估 Prompt 如图 28 所示
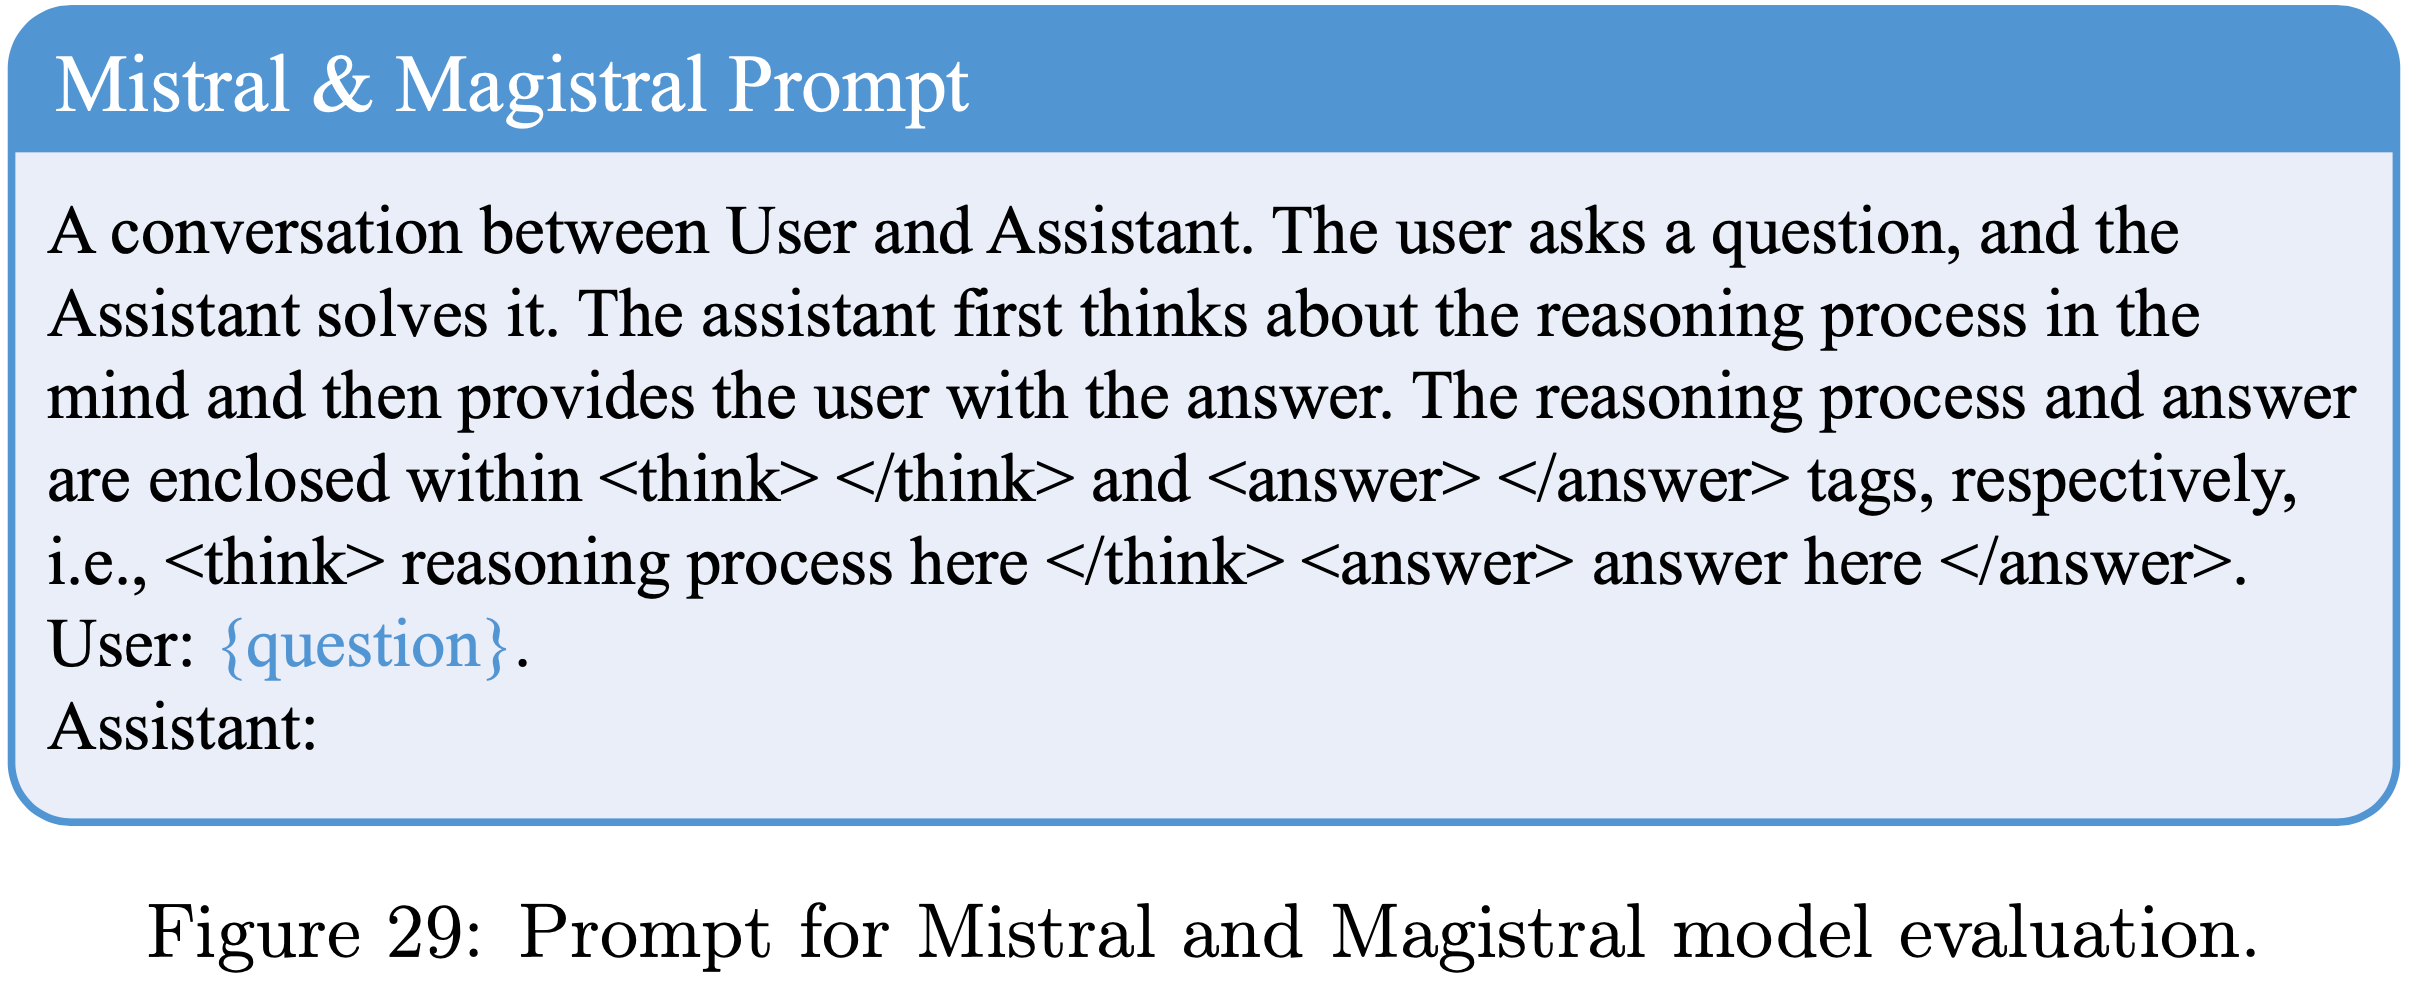
  • 对于在 AIME24/25 上评估 Mistral 和 Magistral 模型, Prompt 如图 29 所示
    • 为确保公平比较, Base Model 在评估时使用与其对应的 RL 训练模型相同的 Prompt

附录 E:Broader Impacts

  • 论文的方法的潜在负面社会影响与通常与通用 LLM 推理技术相关的那些影响一致
  • 论文强调在 LLM 系统中遵守公平和安全部署原则的重要性
1…182183184…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4