Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——DuoAttention

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads, arXiv 202410 , MIT & THU & SJTU & NVIDIA
      • 与 StreamingLLM 同作者
    • GitHub:github.com/mit-han-lab/duo-attention

Paper Summary

  • 整体总结:
    • 核心:DuoAttention 是一种通过区分 Retrieval Heads 和 Streaming Heads 来优化 LLM 内存和计算资源的框架
    • 具体:DuoAttention 可以显著减少了长上下文应用中解码和 Pre-filling 的内存使用和延迟
      • 因为 DuoAttention 对 Retrieval Heads 应用完整的 KV 缓存(Streaming Heads 仅缓存 Sink Token 和 Recent Token)
    • 对比之前 MHA 和 GQA 的效果(内存大幅减少、解码速度大幅提升)
      • MHA 模型内存减少高达 \(2.55\times\),MHA 模型解码速度提升高达 \(2.18\times\),Pre-filling 加速高达 \(1.73\times\)
      • GQA 模型内存减少高达 \(1.67\times\),GQA 模型解码速度提升高达 \(1.50\times\),Pre-filling 加速高达 \(1.63\times\)
      • 且与完全注意力相比准确率损失最小(minimal accuracy loss)
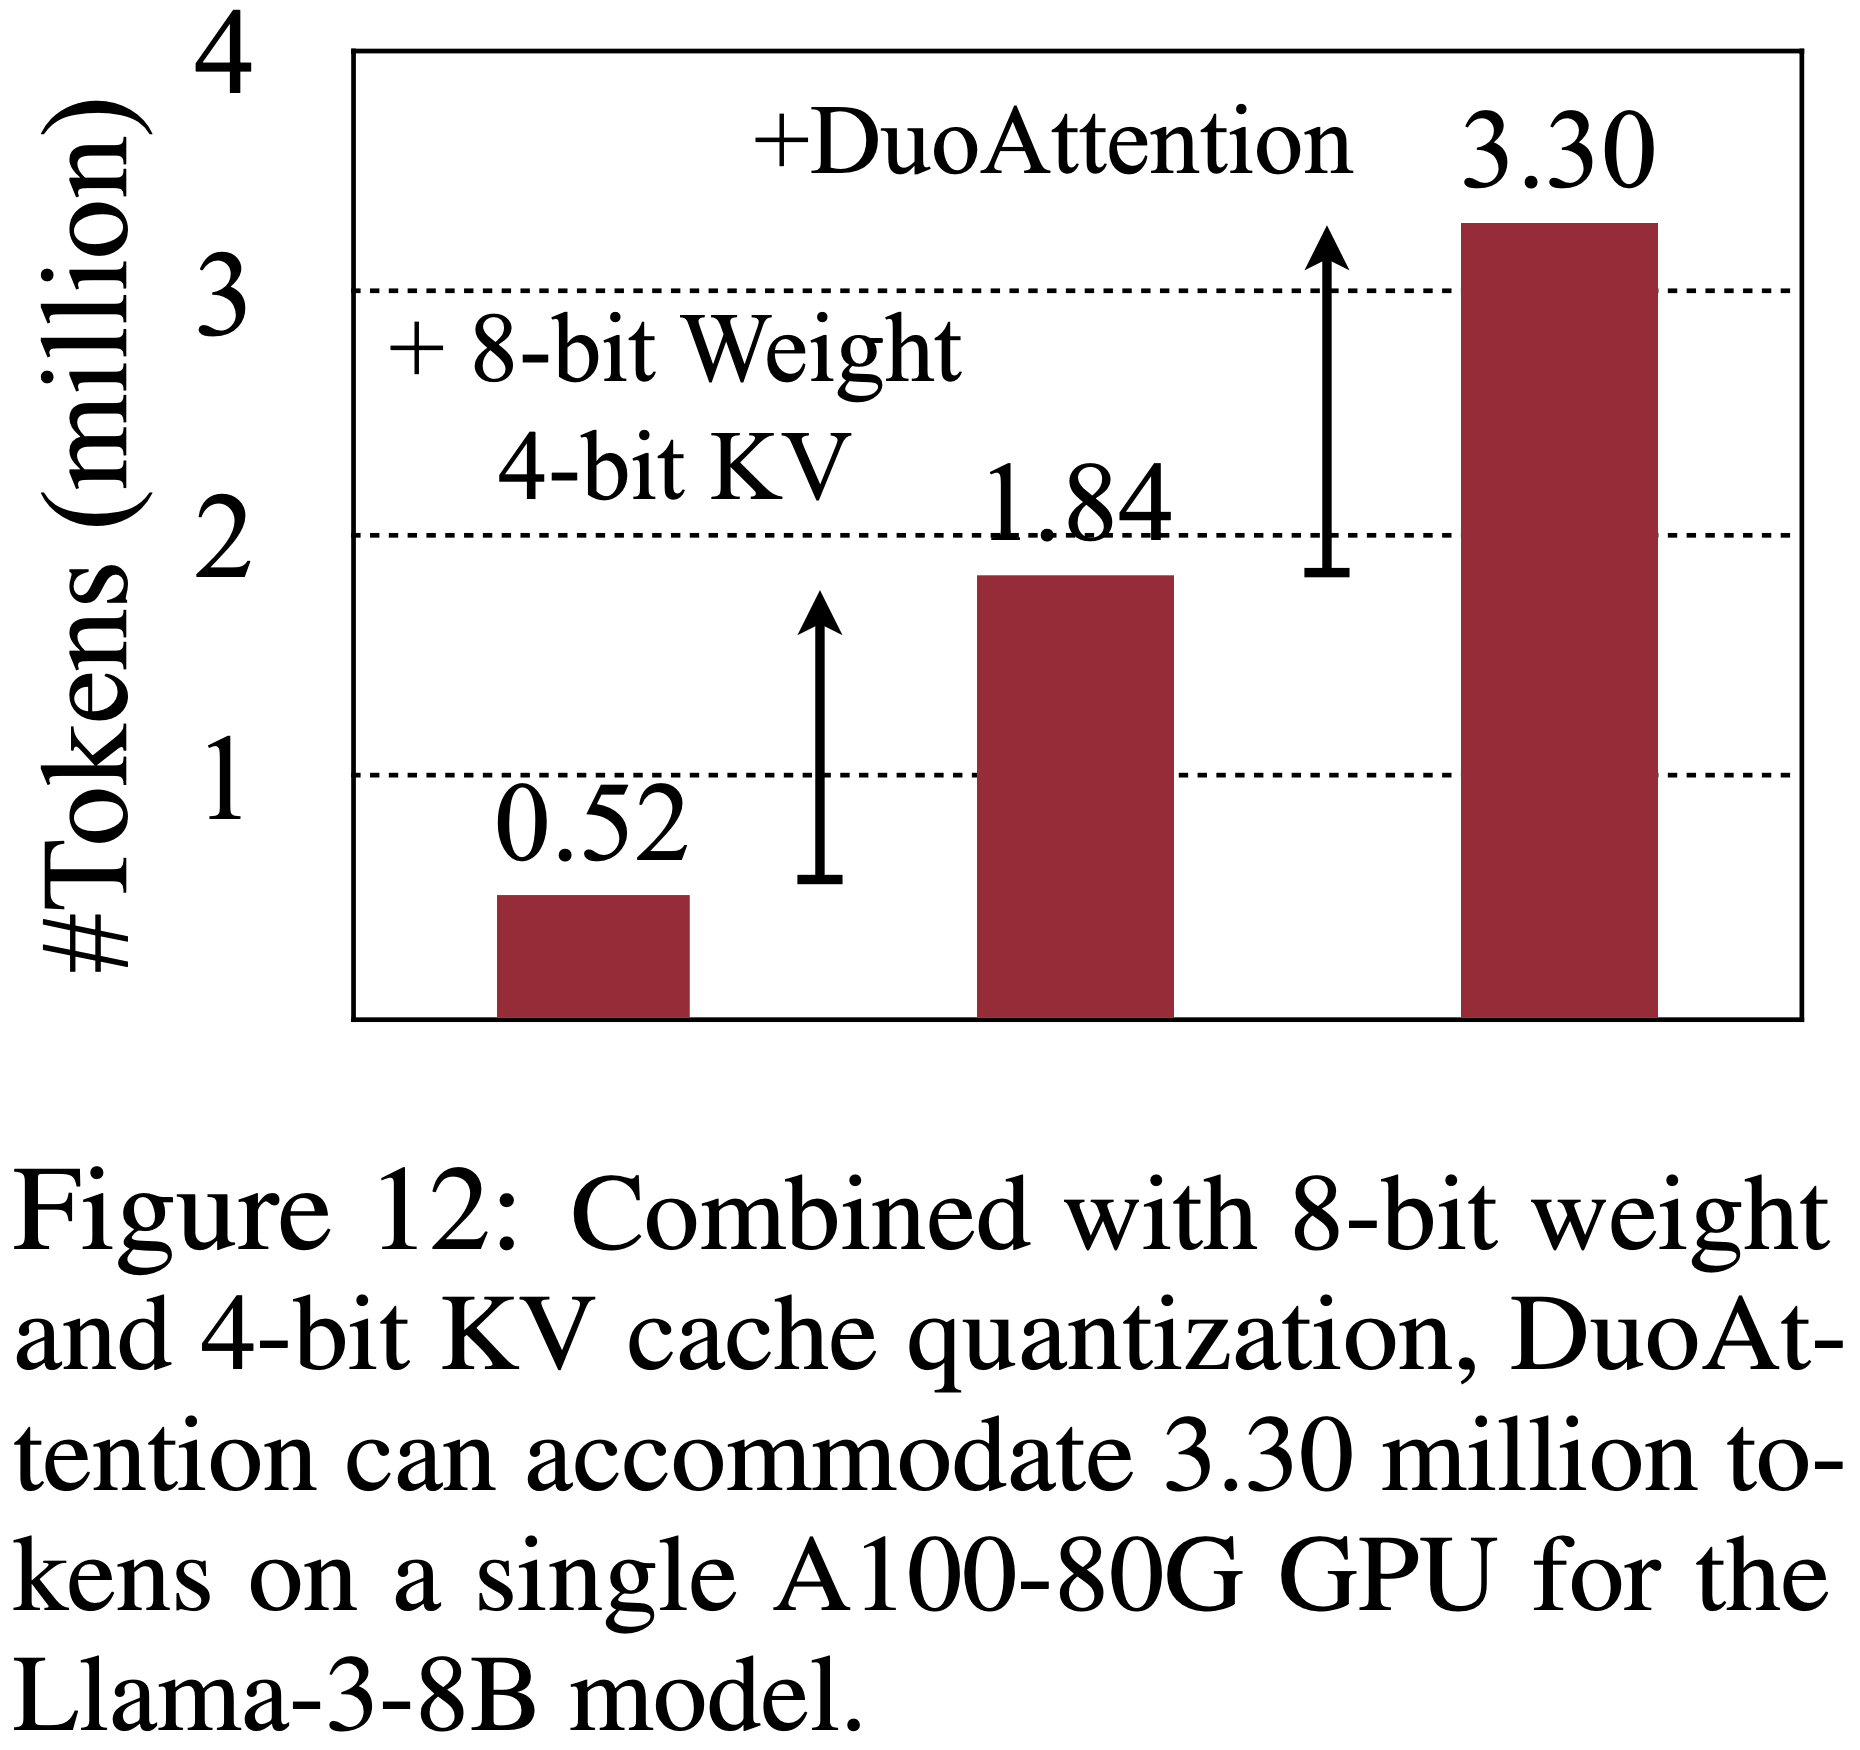
    • 当与量化结合时,DuoAttention 可以进一步提升 KV 缓存容量,在单个 A100 GPU 上支持高达 3.30M 个上下文 Token
  • 背景 & 问题提出:
    • 部署长上下文(long-context)LLM 至关重要,但长上下文带来了显著的计算和内存挑战
    • 跨所有注意力头缓存所有 Key 和 Value (KV)状态会消耗大量内存
    • 现有的 KV 缓存剪枝方法要么损害 LLM 的长上下文能力,要么仅提供有限的效率提升
  • 作者发现:
    • 只有一小部分注意力头(Retrieval Heads),对于处理长上下文至关重要,并且需要对所有 Token 进行完整的注意力计算
    • 而其他头(Streaming Heads),主要关注最近的 Token 和 Attention Sinks,不需要完整的注意力计算
  • 基于这一洞察,论文引入了 DuoAttention:
    • 该框架仅对 Retrieval Heads 应用完整的 KV 缓存,同时对 Streaming Heads 使用轻量级的、恒定长度的 KV 缓存
    • 从而在不损害其长上下文能力的情况下,减少 LLM 解码和 Pre-filling 的内存占用和延迟
  • DuoAttention 使用一种轻量级的、基于优化的算法以及合成数据来准确识别 Retrieval Heads
  • 内存方面:
    • 对于多头注意力模型最高减少 2.55\(\times\)
    • 对于分组 Query 注意力模型最高减少 1.67\(\times\)
  • 效率方面:
    • 对于多头注意力模型解码速度最高提升 2.18\(\times\), Pre-filling 速度最高提升 1.73\(\times\)
    • 和分组 Query 注意力模型解码速度最高提升1.50\(\times\), Pre-filling 速度最高提升 1.63\(\times\)
    • 与完整注意力相比,准确率损失最小(minimal accuracy loss)
  • 开源链接:github.com/mit-han-lab/duo-attention

Introduction and Discussion

  • LLM 处于人工智能革命的前沿,驱动着高级应用,如多轮对话、长文档摘要以及涉及混合模态的任务,如视觉和视频理解
    • 这些应用通常需要处理大量的上下文 Token ;
    • 例如,总结整个《哈利·波特》系列可能涉及分析约一百万个 Token
    • 对于视觉语言模型,挑战更加严峻,其中一张 224×224 的图像对应 256 个 Token ,而一段三分钟、24 FPS 的视频会生成约 1.1M 个 Token
  • 在此类应用中部署 LLM 的一个关键问题是长上下文推理问题
    • 完整的注意力机制要求所有 Token 关注所有先前的 Token 以获得准确的表示,这导致解码延迟线性增加, Pre-filling 延迟二次方增加
    • KV 缓存技术存储所有先前 Token 的 Key 和 Value ,导致内存使用量随上下文长度线性增长
    • 随着序列变长,内存越来越多地被 KV 缓存消耗,给注意力机制带来了显著的计算负担
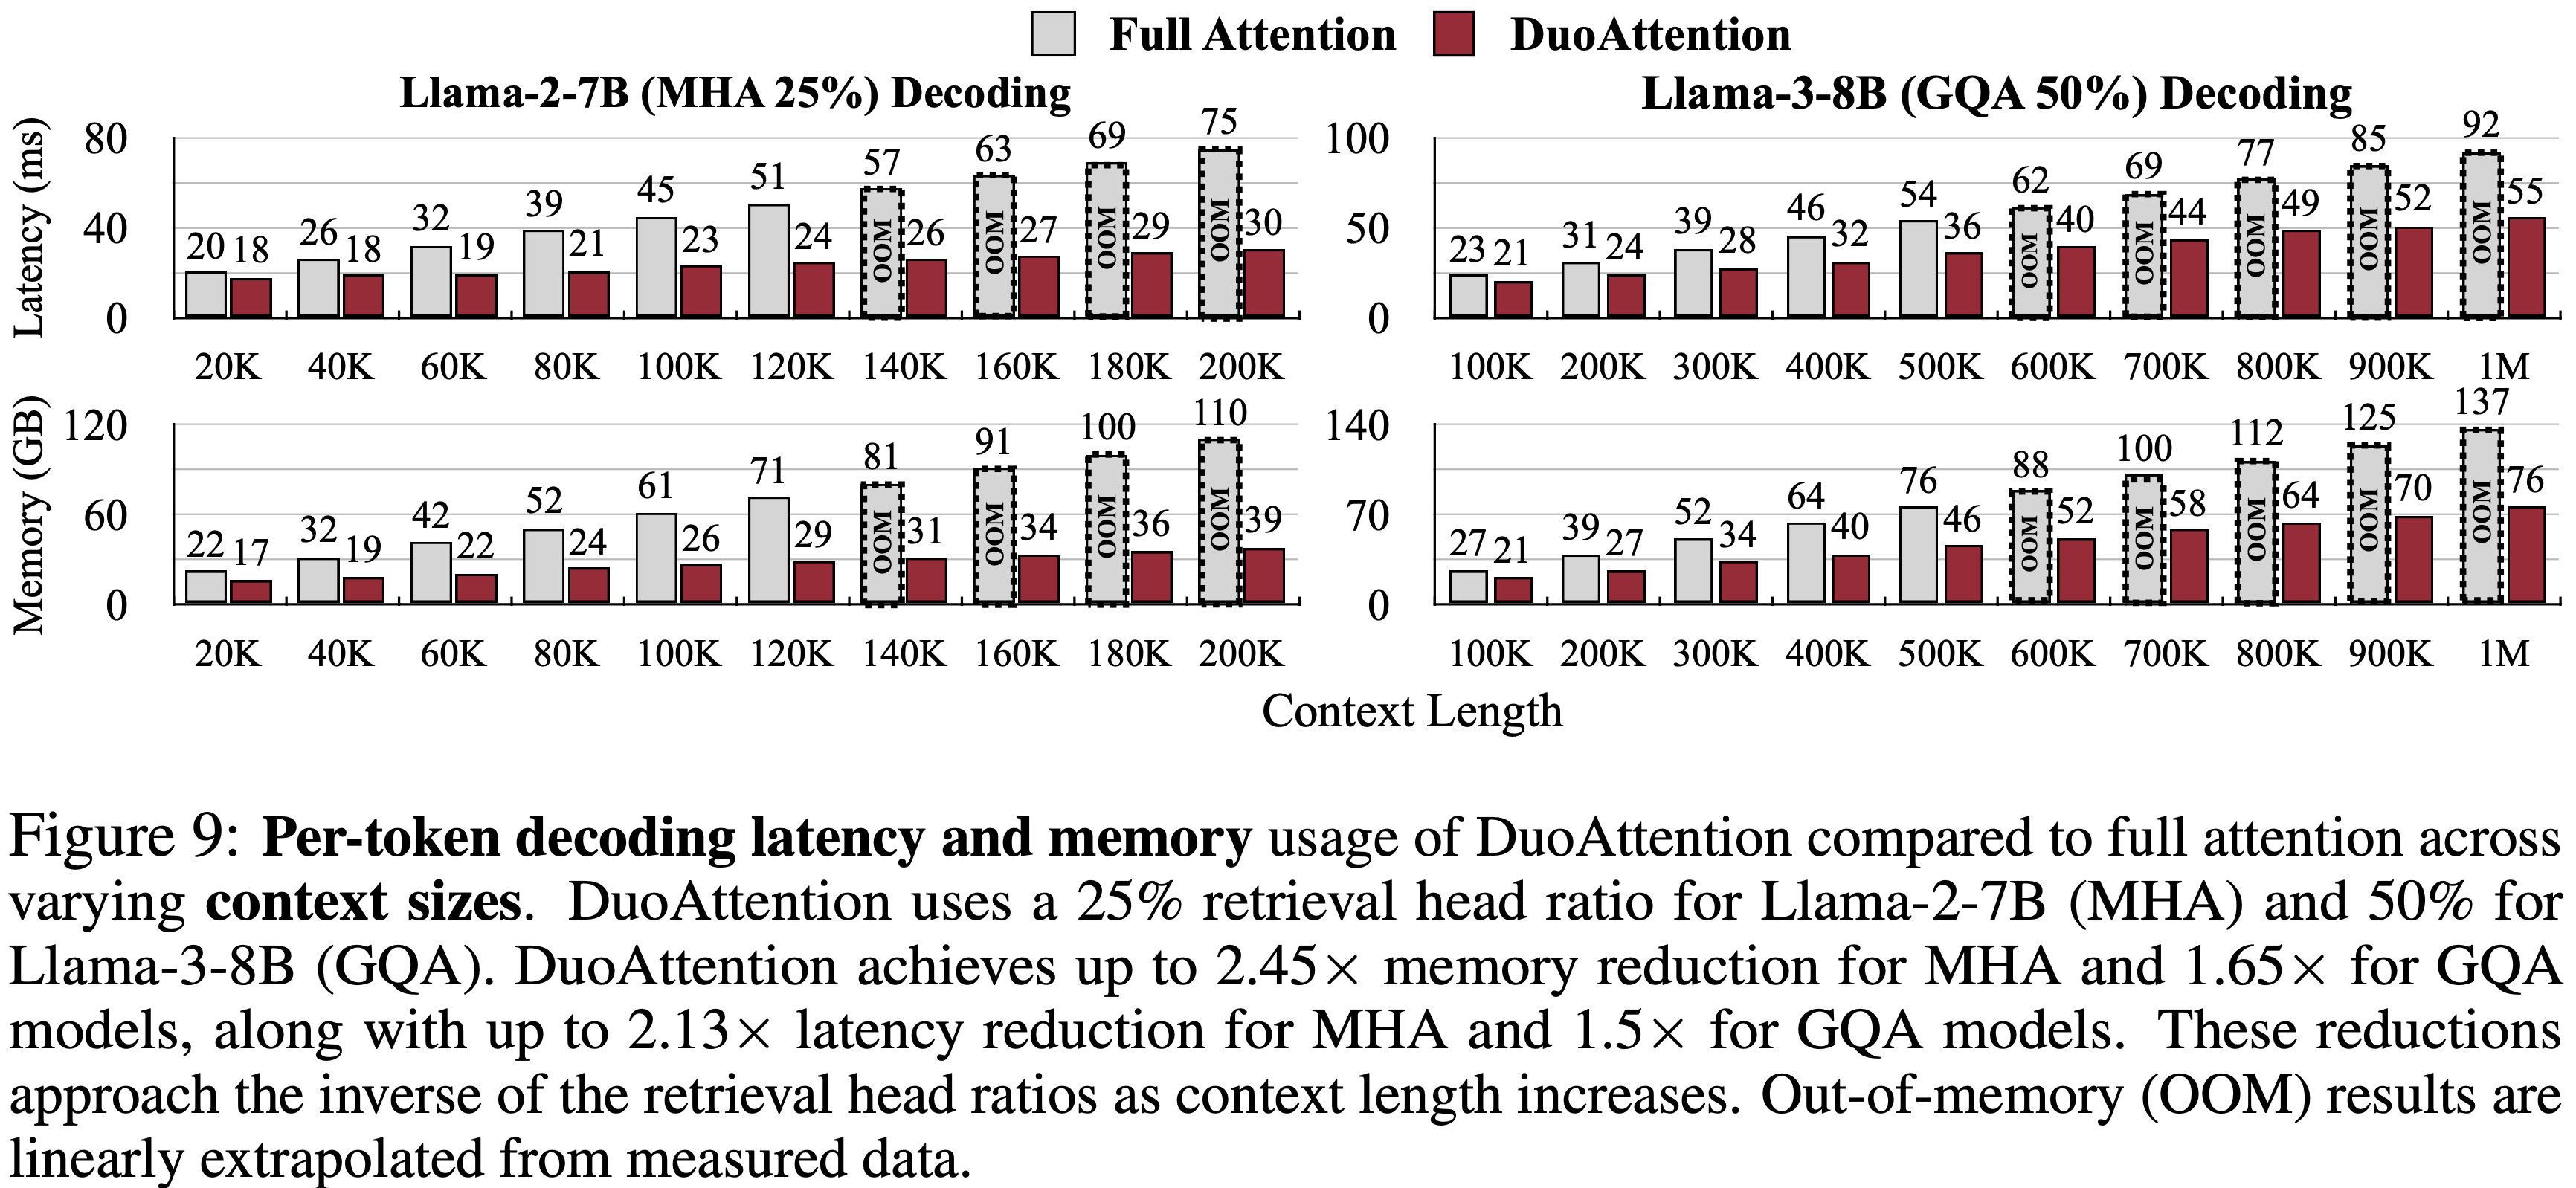
      • 例如,在 Llama-3-8B 模型架构中,为 1M 个 Token 提供服务并使用 FP16 KV 缓存将需要至少 137 GB 的内存(这已经超过了单个 80GB GPU 的容量)
    • 而且使用如此大上下文进行 Pre-filling 和解码会有显著延迟,这对 LLM 在长上下文场景中的有效使用构成了重大挑战
  • 尽管有许多努力来克服注意力机制在长上下文推理中的挑战,但显著的计算和内存问题仍然存在
    • 架构修改,如分组 Query 注意力,需要模型预训练,并且无法降低计算成本
      • 线性注意力(Linear Attention)方法虽然在计算和内存需求上较低,但在长上下文场景下往往不如 Transformer 模型
      • 近似注意力(Approximative attention)方法,如 H\({}_{2}\)O、StreamingLLM、TOVA 和 FastGen,常常在长上下文应用中牺牲精度,并且与关键的 KV 缓存优化技术(如分组 Query 注意力)不兼容
    • KV 缓存量化虽然有用,但并未减少注意力机制的计算时间
      • 系统级优化,包括 FlashAttention、FlashDecoding 和 PagedAttention,虽然有效,但并未减少 KV 缓存大小,并且在扩展上下文时仍然需要大量计算
  • 论文引入了一个关键观察
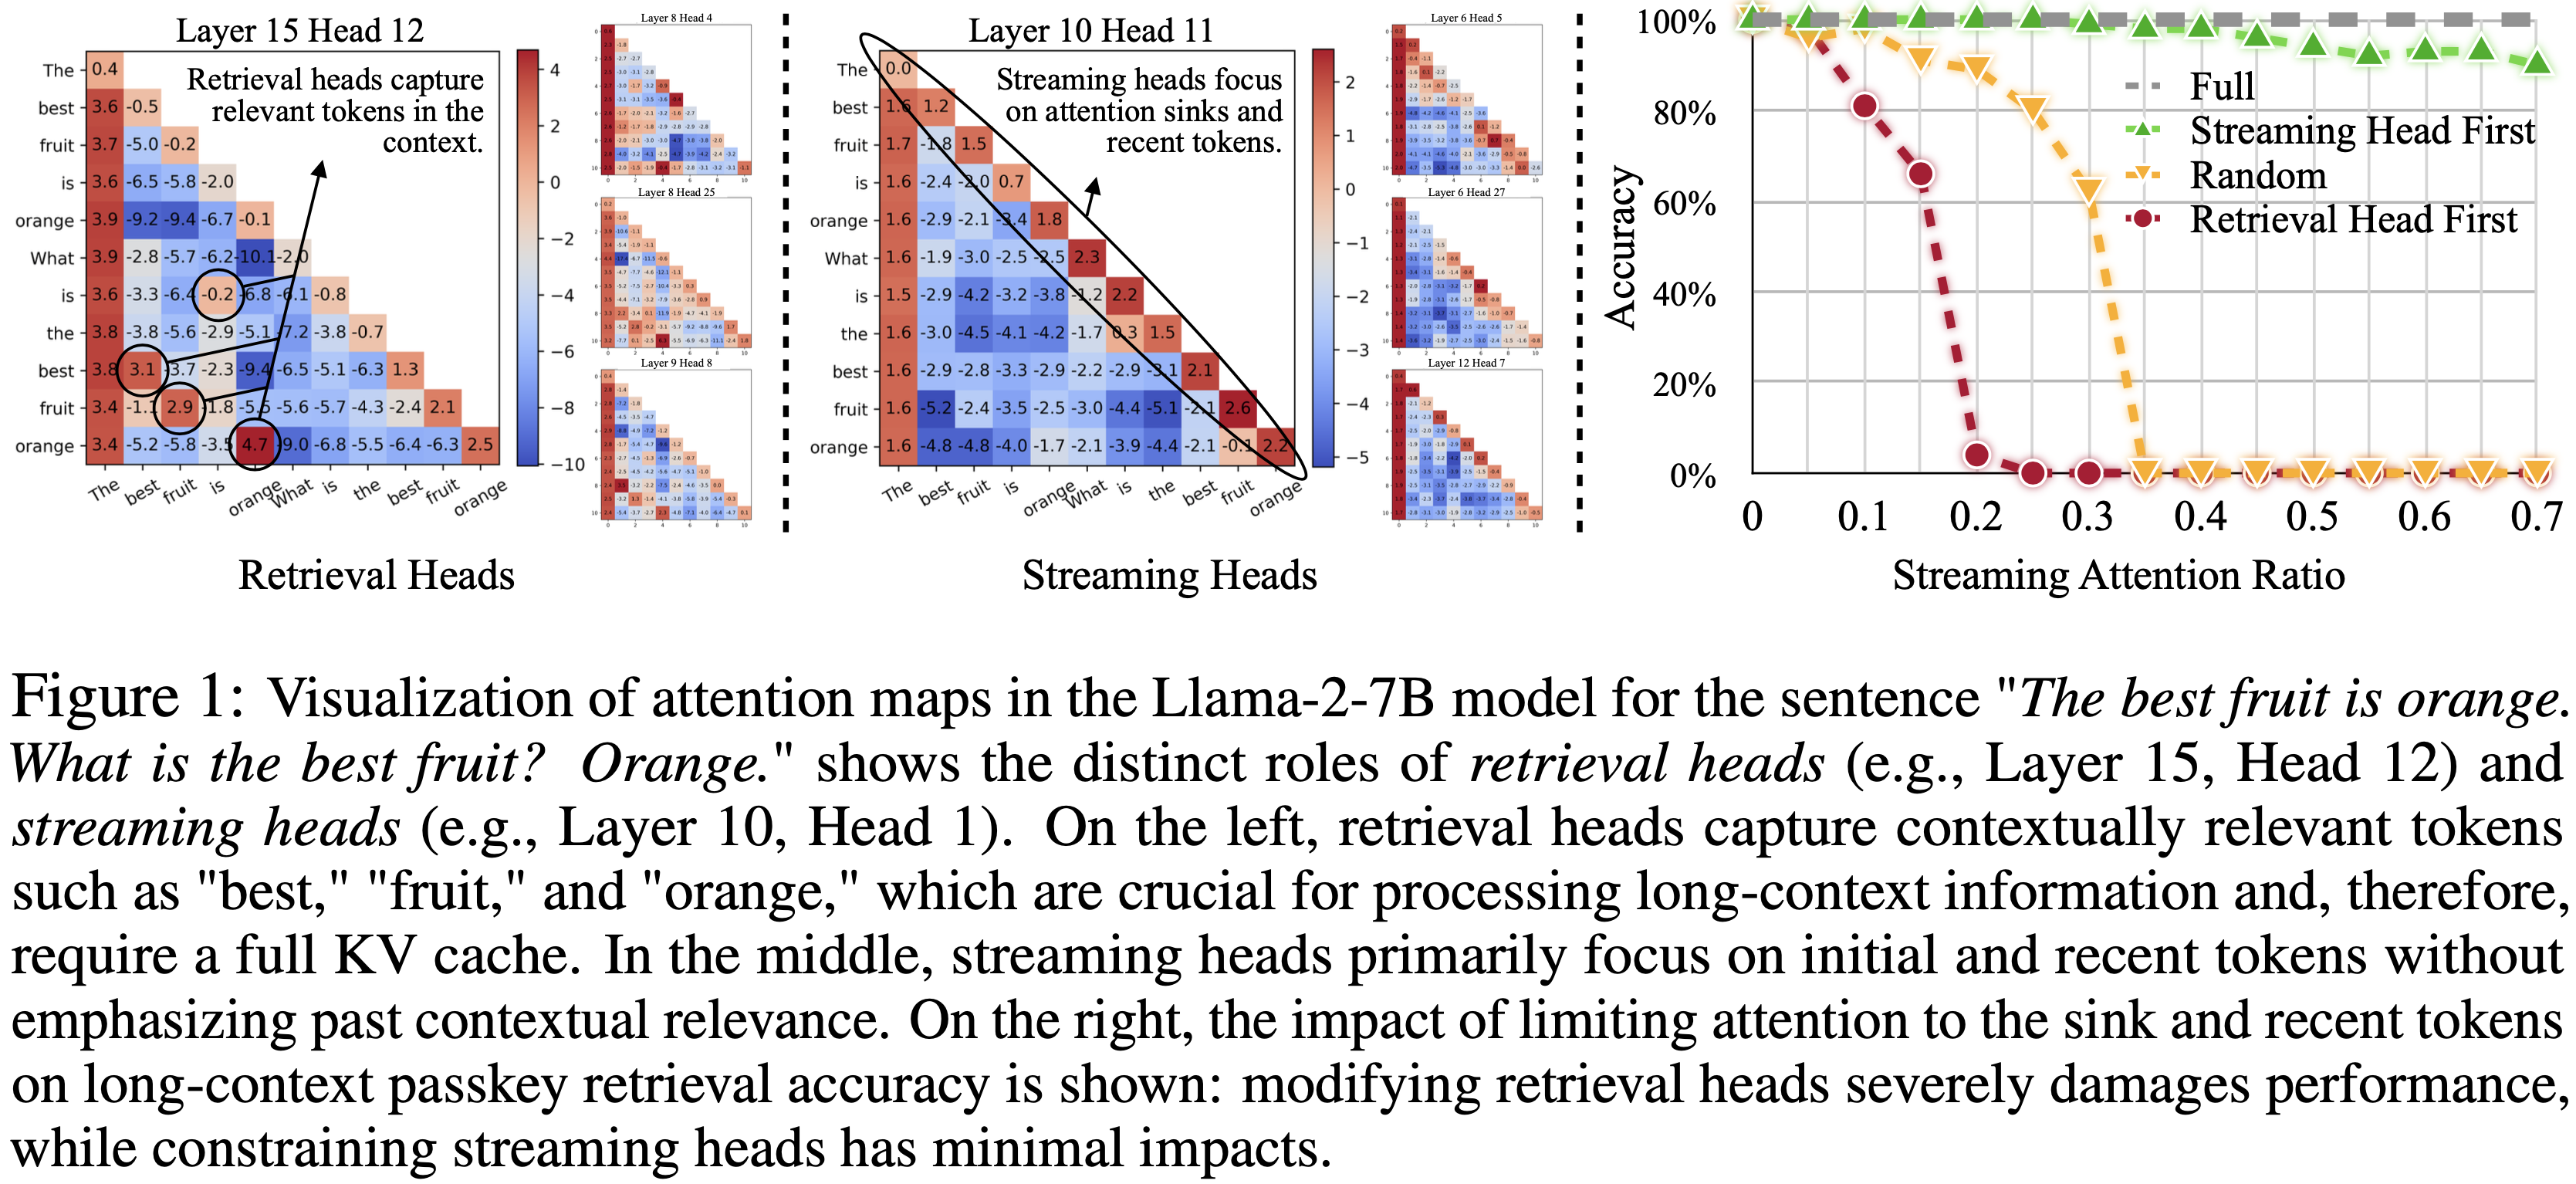
    • LLM 中的注意力头可以分为两种不同的类型 :Retrieval Heads 和 Streaming Heads ,如图 1 所示
    • Retrieval Heads 仅占总头数的一小部分,对于处理长上下文至关重要,并且需要对所有 Token 进行完整的注意力计算
    • Streaming Heads(大多数注意力头),主要关注最近的 Token 和 Attention Sinks ,并且可以在仅包含 Recent Token 和 Attention Sinks 的简化 KV 缓存下有效运行
  • 基于 Retrieval Heads 和 Streaming Heads 的二分法,论文提出了 DuoAttention
    • DuoAttention 是一种通用、直接且易于集成的方法,能显著加速 LLM 的解码和 Pre-filling ,并减少内存占用,尤其是在长上下文场景中
    • DuoAttention 的核心创新是一种轻量级的、基于优化的过程,它使用合成数据集来识别不可压缩的 Retrieval Heads
    • 与依赖注意力模式分析 (2024;) 的现有方法不同,DuoAttention 直接测量因 Token 丢弃而产生的输出偏差,从而实现更高的压缩率和改进的部署效率
  • DuoAttention 的设计注重简洁和高效:每个 Transformer 层有两个 KV 缓存
    • 一个用于关键 Retrieval Heads 的完整 KV 缓存
    • 一个用于 Streaming Heads 的恒定 KV 缓存,仅存储 Attention Sinks 和最近的 Token
  • 这种设计使得 DuoAttention 能够显著减少内存使用、提高模型的解码速度,且与完整注意力相比,精度损失最小
  • DuoAttention 与重要的优化技术(如分组 Query 注意力和量化)完全兼容
    • 当结合 8-bit 权重和 4-bit KV 缓存量化时,DuoAttention 使得 Llama-3-8B 模型能够在单个 A100 GPU 上处理高达 3.3M 上下文 Token
      • 与标准的完整注意力 FP16 部署相比,实现了 \(6.4\times\) 的容量提升
    • DuoAttention 为在需要百万级上下文处理的应用中部署 LLM 铺平了道路

DuoAttention

Retrieval Heads 和 Streaming Heads

Retrieval Heads
  • 在基于 Transformer 的 LLM 中,注意力头表现出独特且一致的模式,反映了它们的专门功能
  • 图 1 使用句子“最好的水果是橙子。什么是最好的水果?橙子。”可视化了 Llama-2-7B-32K-Instruct 模型中的两种注意力头
  • 左图突出显示了一个在解码过程中强调相关 Token 的注意力头;
    • 例如,在解码第二个“最好的水果”时,第一个“最好的水果”被加重;在推断第二个“橙子”时,初始的“橙子”被突出显示
    • 这些注意力头,论文称之为 Retrieval Heads ,对于上下文处理至关重要,因为它们捕获了上下文相关的 Token
    • 压缩 Retrieval Heads 的 KV 缓存将导致关键上下文信息的丢失,因此它们需要对所有 Token 进行完整的注意力计算
Streaming Heads
  • 图 1 中间图描绘的注意力头主要关注最近的 Token 和 Attention Sinks,不强调上下文中较早的相关 Token
    • 论文称这些为 Streaming Heads
  • 压缩 Streaming Heads 的 KV 缓存是可行的,因为丢弃未被关注的中国 Token 不会显著改变注意力输出
    • 可以通过仅保留 Attention Sinks 和 Recent Token 的 KV 状态来优化 Streaming Heads ,而不会损害模型管理长上下文的能力
Impact of Token Pruning on Retrieval and Streaming Heads
  • 图 1 的右图显示了一个初步的 Passkey 检索实验
    • 当 Retrieval Heads KV 缓存中的中间 Token 被剪枝时,模型的性能显著下降
    • 移除 Streaming Heads 的中间 Token 对 Passkey 检索精度没有显著影响
  • 这一观察表明,我们可以在不牺牲模型长上下文能力的情况下提高计算效率:
    • 通过丢弃 Streaming Heads 的中间 Token ,同时保持 Retrieval Heads 的完整注意力,将 Streaming Heads 的内存需求降低到 \(O(1)\),从而提高了处理长上下文的效率

Optimization-Based Identification of Retrieval Heads

Definition of Retrieval Heads
  • 第 2.1 节定性地定义了 Retrieval Heads 和 Streaming Heads ,但为了精确识别,论文需要一个具体且量化的定义
  • 在论文中,论文将“Retrieval Heads”定义为:
    • 当被限制为仅关注 Recent Token 和 Attention Sinks 时,会显著改变模型输出的注意力头
  • 论文使用这个标准来区分 Retrieval Heads 和 Streaming Heads
    • 这个定义不同于现有工作 (2024; ),它们仅依赖注意力分数来识别 Retrieval Heads ,忽略了
      • 1)压缩特定注意力头 KV 缓存的端到端影响
      • 2)Value 状态的角色
      • 3)注意力分布在层和头之间的可变性
    • 论文的定义直接测量输出偏差 ,即使它们在注意力分数中不明显,论文也能够识别对长上下文处理至关重要的注意力头
    • 论文在第 3.5 节中提供的消融研究支持了这一论点
Optimization-based Identification
  • 论文采用一种基于优化的方法来识别 Retrieval Heads ,灵感来自先前在 CNN 滤波器剪枝方面的工作,如图 2 所示
    • 首先为 LLM 中的每个 KV 头分配一个门控值 \(\alpha_{i,j}\)
      • 这个值直观地表示了第 \(i\) 层第 \(j\) 个 KV 头在处理长上下文信息时的重要性
      • 在使用分组 Query 注意力的模型中,一个 KV 头可能与多个注意力头相关联,论文的方法考虑了对整个注意力头组的 KV 缓存压缩
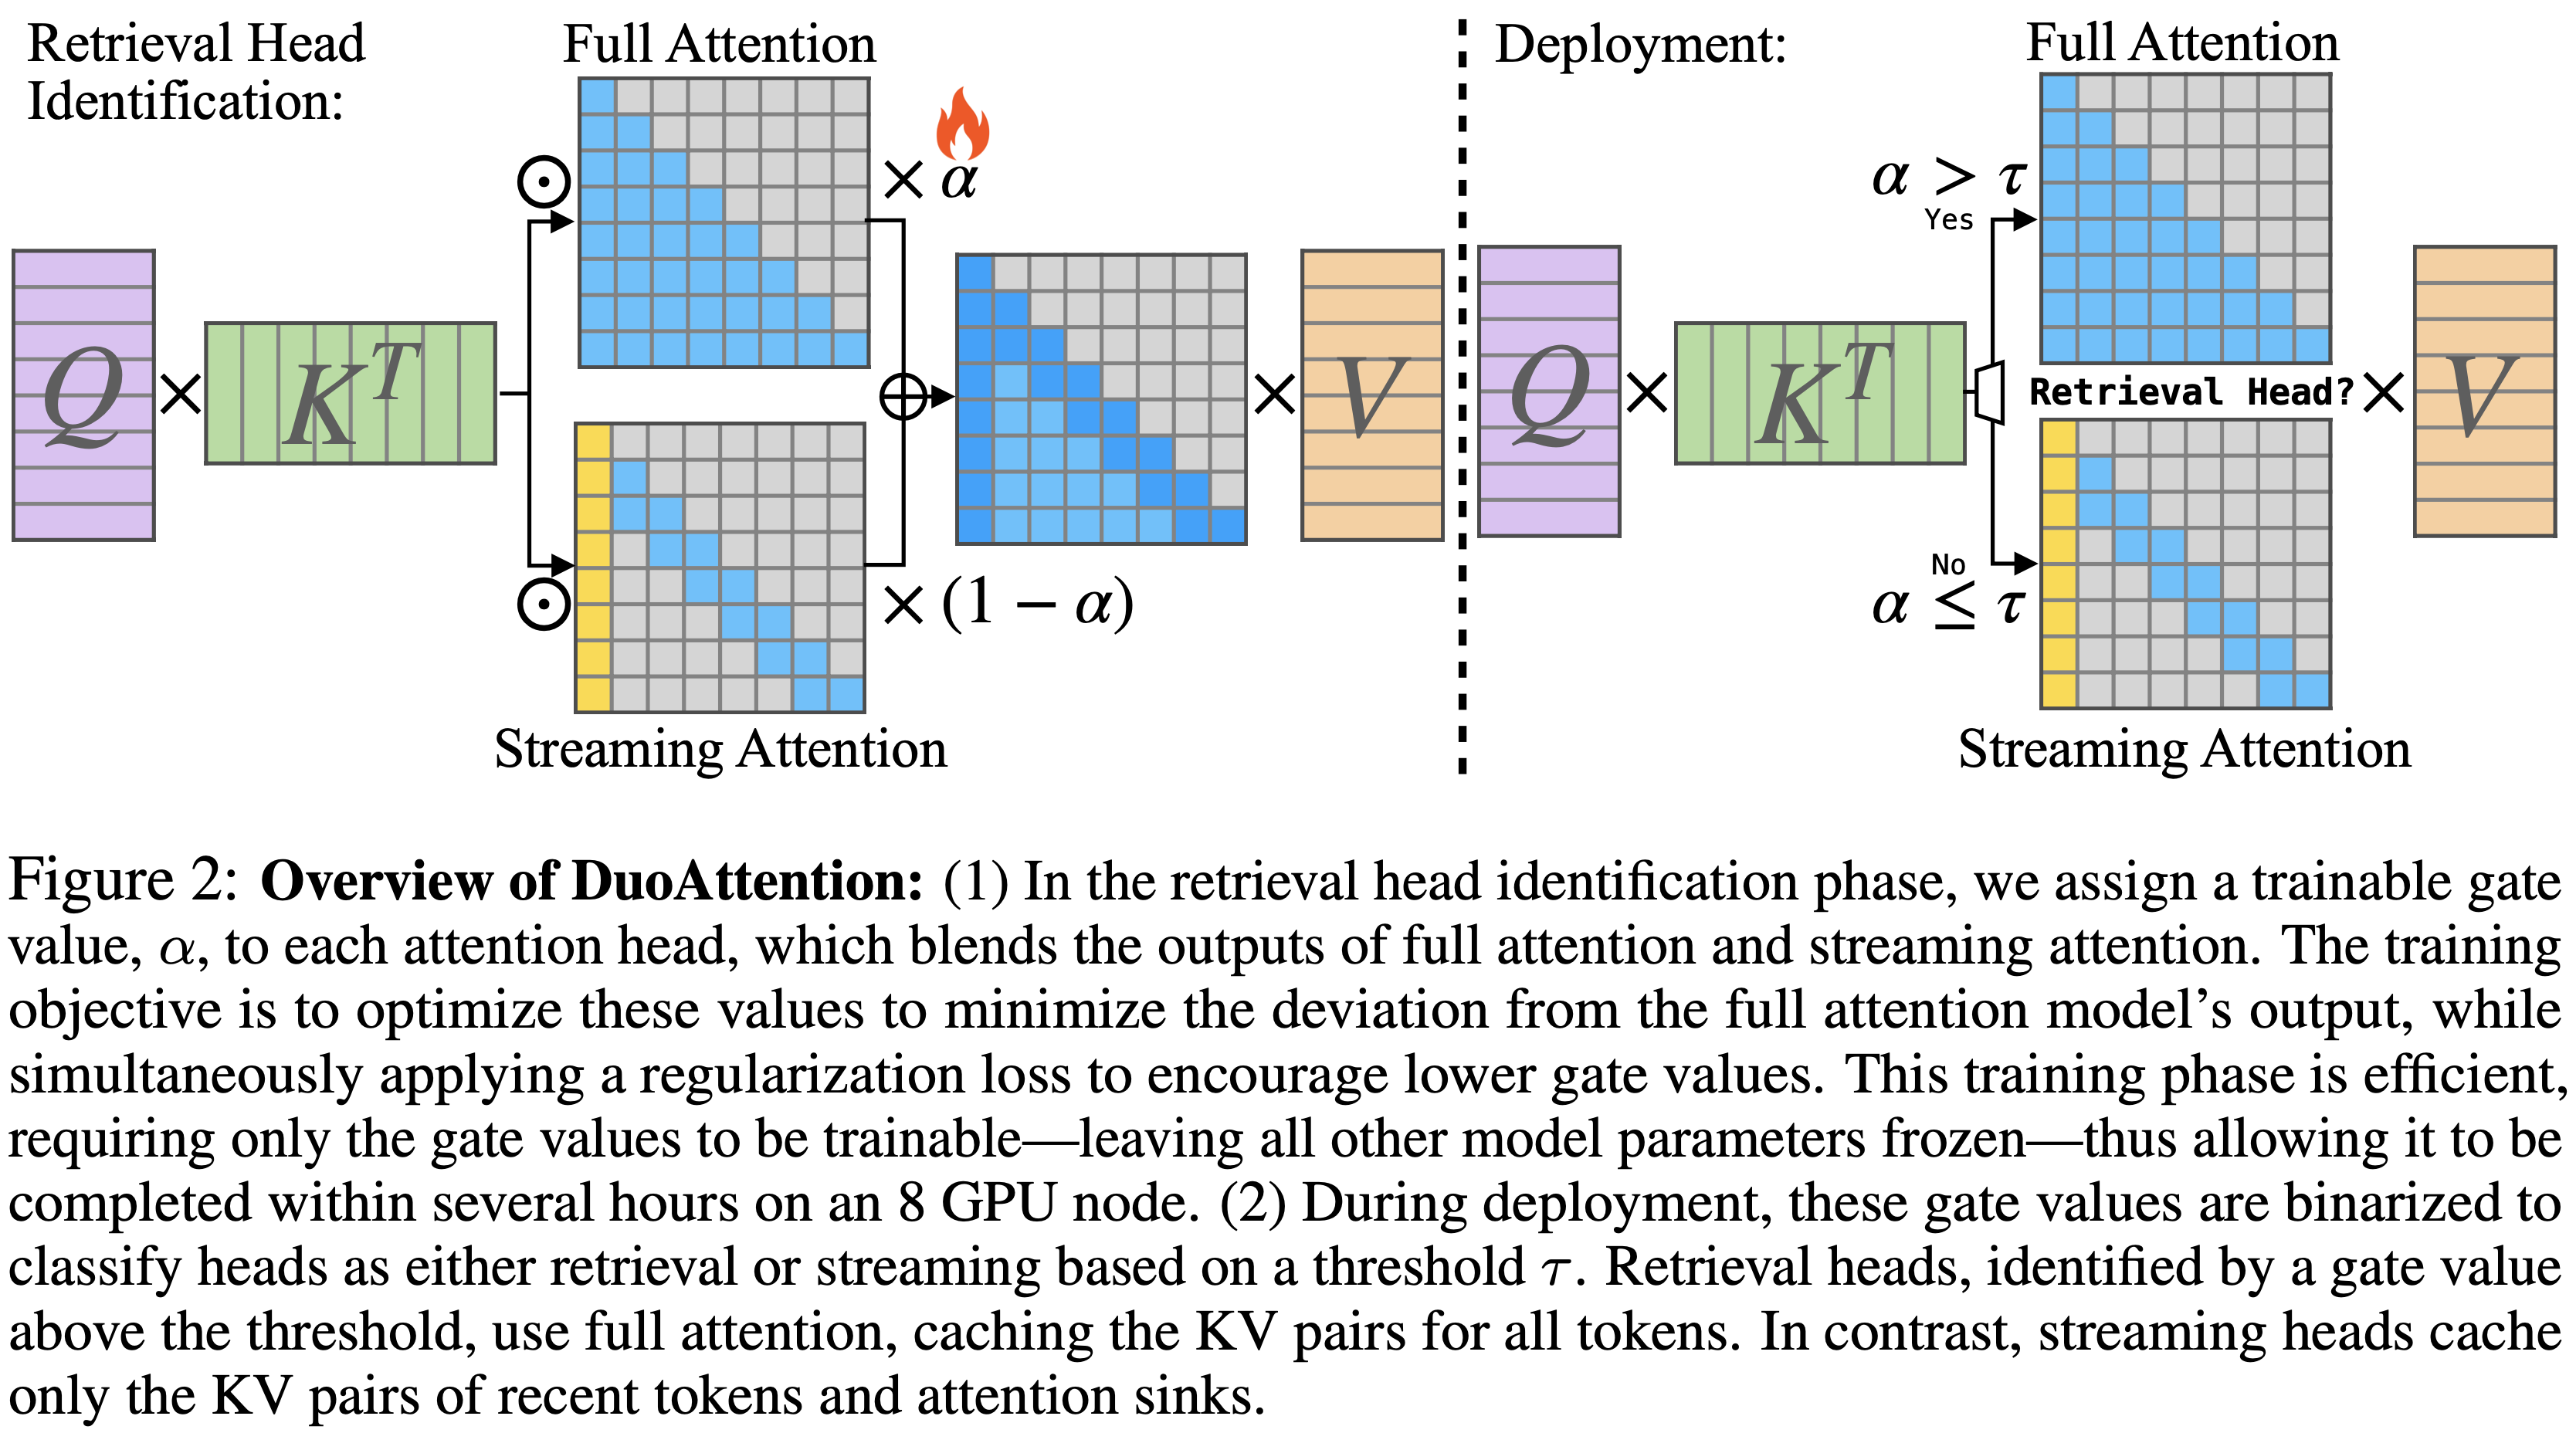
  • 论文的基于优化的识别方法直接评估了仅使用 Sink Token 和 Recent Token 压缩每个 KV 头 KV 缓存的影响
    • 首先将每个头的门控值 \(\alpha_{i,j}\in[0,1]\) 初始化为 1,假设所有头最初都作为 Retrieval Heads
    • 然后优化这些门控值,同时保持 LLM 的参数固定,将可训练参数的数量限制在 \(N\times H\),并防止影响模型的原始能力
  • 在前向传播过程中,论文结合每个 KV 头的完整注意力和流式注意力的输出,使用门控值作为混合权重:
    $$\texttt{attn}_{i,j}=\alpha_{i,j}\cdot\texttt{full_attn}+(1-\alpha_{i,j})\cdot\texttt{streaming_attn}$$
    • 其中注意力计算定义为:
      $$\texttt{full_attn} =\texttt{softmax}(\boldsymbol{Q}\boldsymbol{K}^{T}\odot\boldsymbol{M}_{\text{causal} })\boldsymbol{V}, \\
      \texttt{streaming_attn} =\texttt{softmax}(\boldsymbol{Q}\boldsymbol{K}^{T}\odot\boldsymbol{M}_{\text{streaming} })\boldsymbol{V},$$
    • 其中 \(\boldsymbol{M}_{\text{causal} }\) 是因果注意力掩码,而 \(\boldsymbol{M}_{\text{streaming} }\) 表示一个类 \(\Lambda\) 掩码,仅关注最近和初始的 Token
Synthetic Dataset for Identifying Retrieval Heads
  • 仅依赖自然语言建模目标不足以识别 Retrieval Heads
    • 自然文本中需要长跨度推理的监督信号是稀疏的,且大多数 Token 可以使用局部上下文进行推断
  • 论文设计了一个专门旨在增强模型长上下文检索能力的合成数据集,使论文能够有效地识别哪些 KV 头可以在不损害模型性能的情况下被压缩
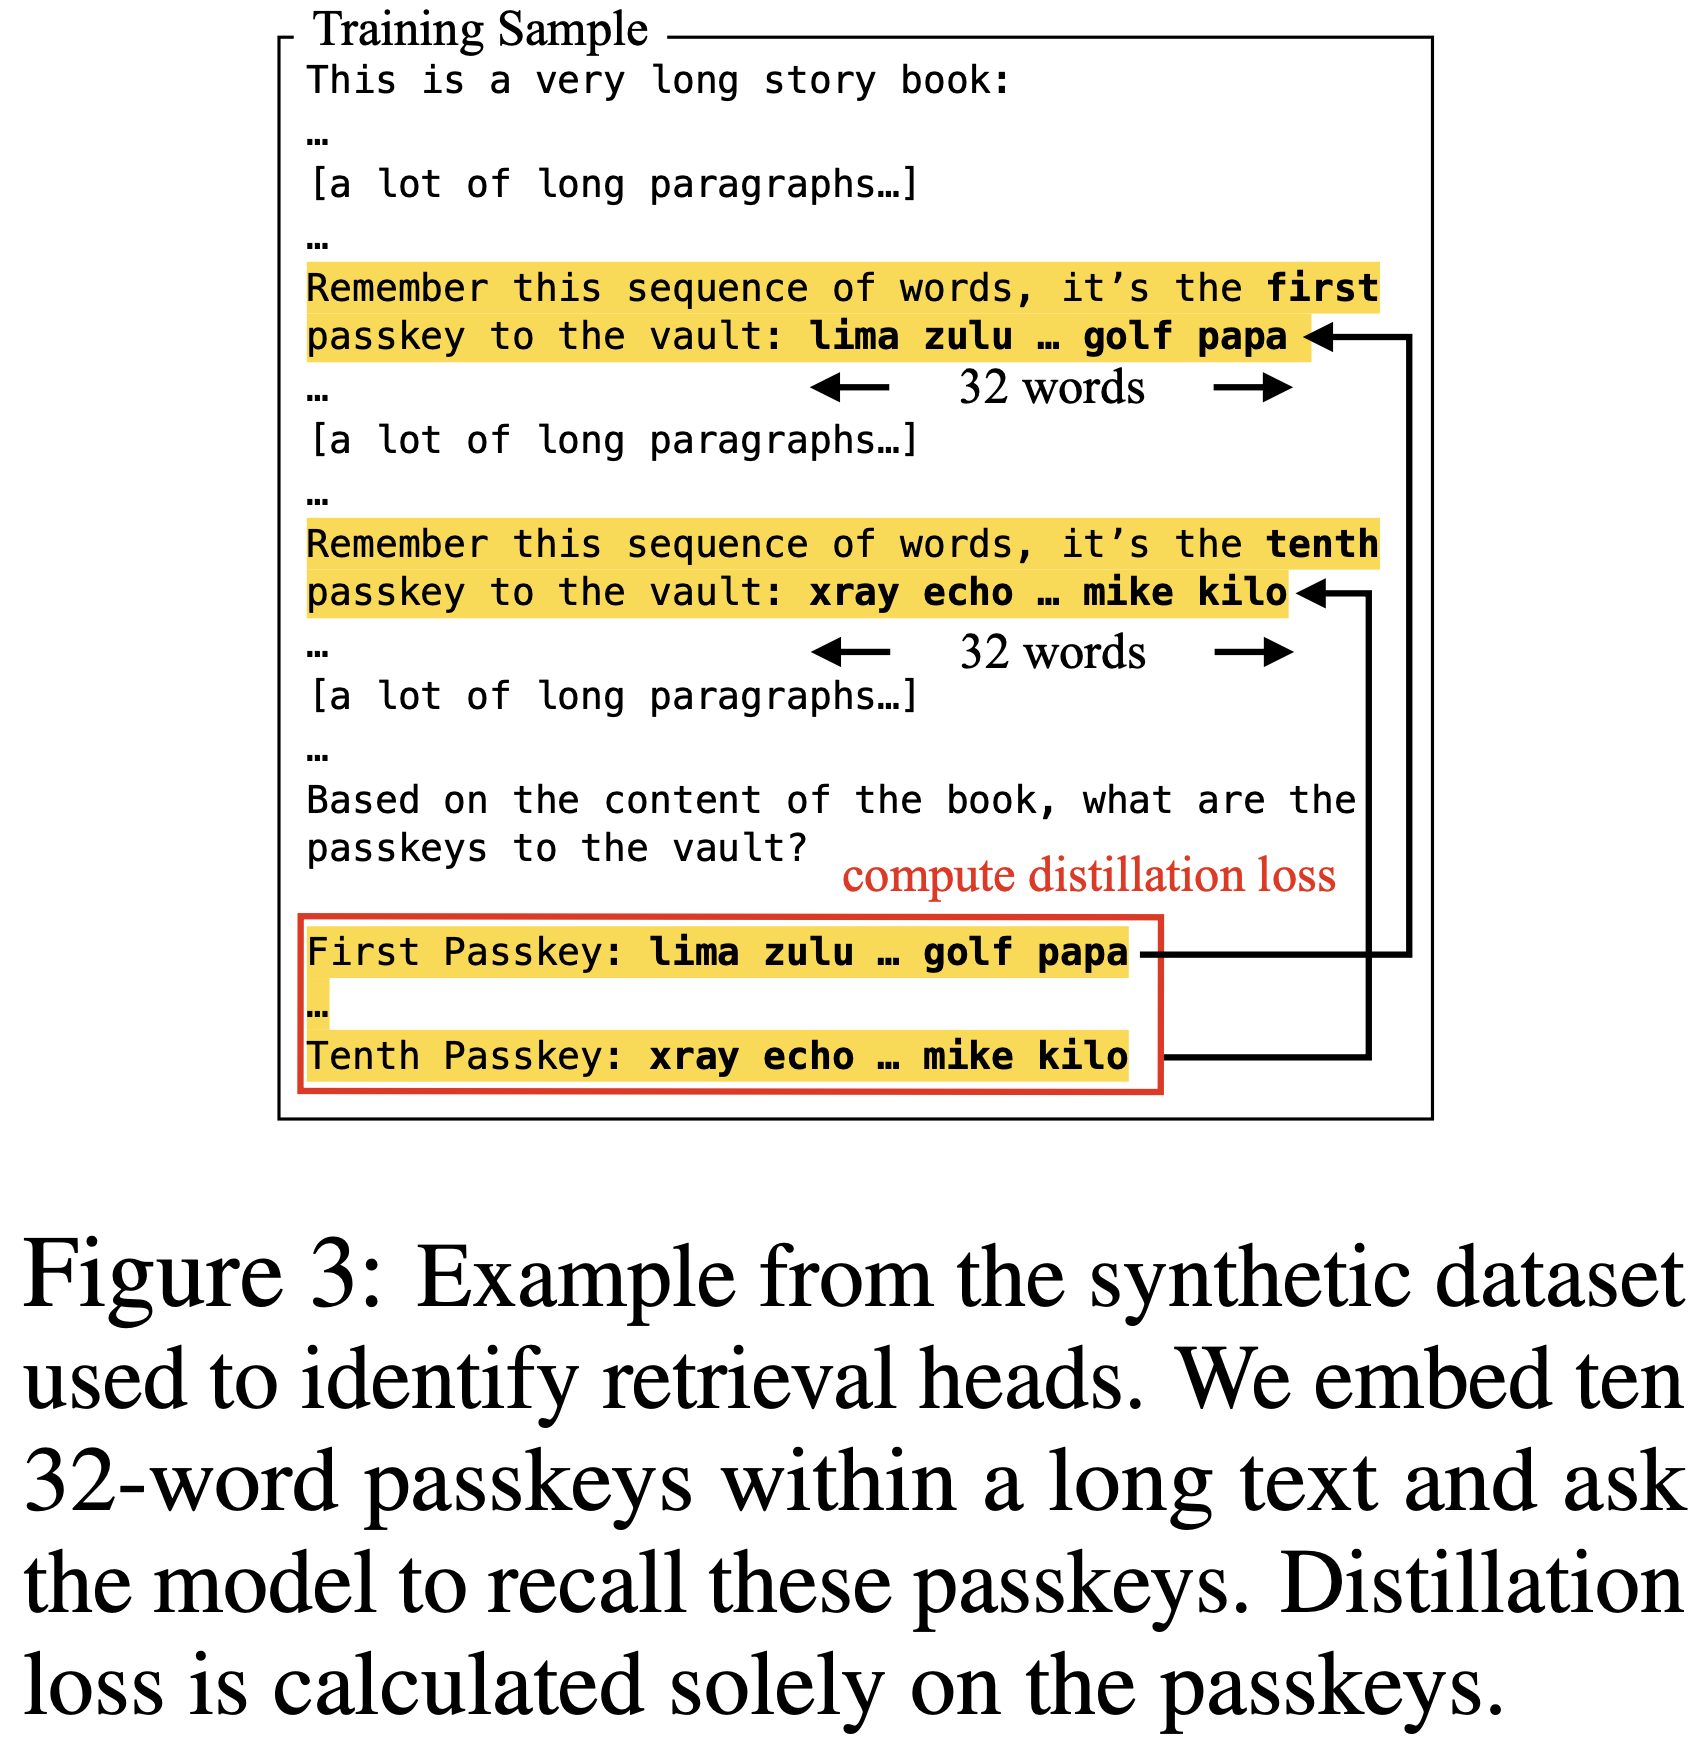
  • 如图 3 所示,论文通过在一个非常长的上下文中,在十个随机位置嵌入十个随机生成的 \(s\) 个 Token 的 passkey sequences 来创建一个 passkey-retrieval 数据集
    • 模型的任务是在上下文末尾回忆这十个序列
Training and Loss Functions
  • 论文优化蒸馏损失,即完整注意力模型的最后一个隐藏状态与使用 DuoAttention 的模型的最后一个隐藏状态之间的 L2 差异,仅关注整个输入中最后 \(l\) 个 Passkey Token :
    $$\mathcal{L}_{\text{distill} }=\frac{1}{N}\sum_{i=1}^{N}\sum_{j=\bar{T}-l+1}^{T}(\boldsymbol{H}_{\text{full} }^{(i)}[j]-\boldsymbol{H}_{\text{mixed} }^{(i)}[j])^{2}$$
  • 论文的合成数据集确保每个监督信号都与最终的压缩策略相关,使得该过程在信息检索精度方面是无损的
    • 事实证明,它比仅使用自然语言建模更有效
    • 论文使用 L1 正则化项来鼓励门控值的稀疏性:
      $$\mathcal{L}_{\text{reg} }=\sum_{i=1}^{L}\sum_{j=1}^{H}|\alpha_{i,j}|,.$$
  • 最终的训练损失是蒸馏损失和正则化损失的组合,由一个超参数 \(\lambda\) 加权,论文在实验中将其设置为 0.05:
    $$\mathcal{L}=\mathcal{L}_{\text{distill} }+\lambda\mathcal{L}_{\text{reg} }.$$
  • 由于可训练参数的总数仅为数千个浮点数,此优化过程相当快,仅需要 2,000 步
    • 论文论文中的所有训练实验都可以在 8×NVIDIA A100 GPU 服务器上进行

Deploying LLMs with DuoAttention

Binarizing Attention Implementations(二值化注意力)
  • 在推理时,论文仅对指定的 Retrieval Heads 应用完整注意力,这些 Retrieval Heads 是使用训练阶段优化的门控值识别的
  • 论文根据阈值 \(\tau\) 对每个头的注意力策略进行二值化,以区分 Retrieval Heads 和 Streaming Heads :
    $$\text{attn}_{i,j}=\begin{cases}\text{full_attn}&\text{if }\alpha_{i,j}>\tau \\ \text{streaming_attn}&\text{otherwise}\ \end{cases}$$
Reordering Attention Heads(重排注意力头)
  • 在部署之前,论文通过根据注意力头分配重新排序 Query 、 Key 和 Value 投影权重的输出通道来预处理模型
  • 这种重新排序将 Retrieval Heads 和 Streaming Heads 分组为两个不同的、连续的簇,从而允许在层内管理这两种类型头的 KV 缓存时进行高效的切片和连接操作,而不是依赖 scattering 和 gathering 操作
Decoding
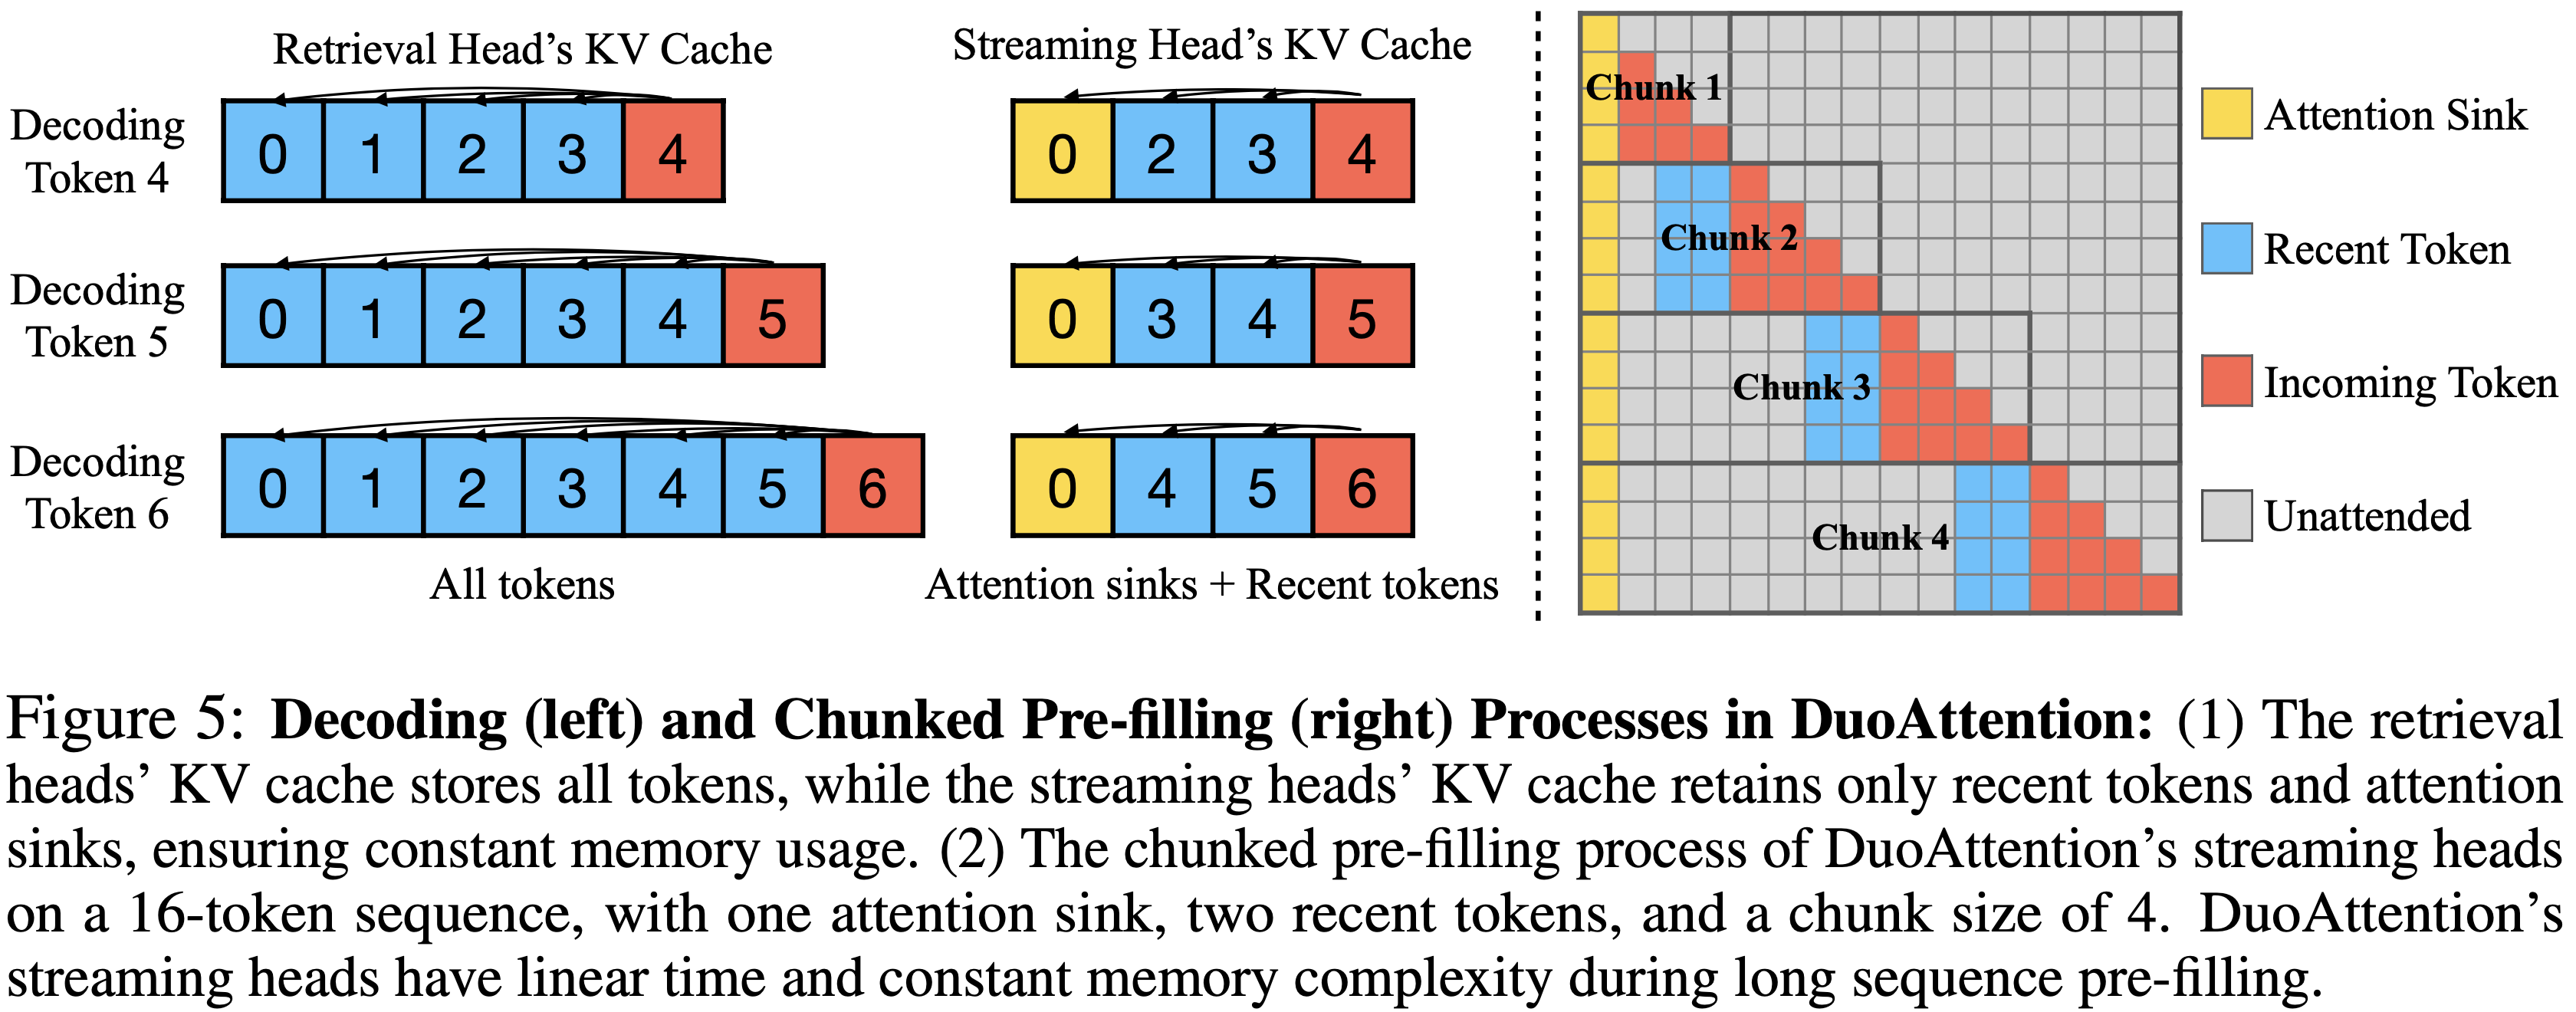
  • 如图 5 所示,论文在解码期间为 LLM 的每一层分配两个 KV 缓存 :
    • 一个用于 Retrieval Heads ,存储所有过去的 Key 和 Value ;
    • 另一个用于 Streaming Heads ,仅存储 Attention Sinks 和最近的 Token ,保持恒定大小
  • 当处理一个新 Token 时,其 Query 、 Key 和 Value 向量沿头维度分割,以计算 Retrieval Heads 的完整注意力和 Streaming Heads 的流式注意力
    • 然后将结果沿头维度连接以进行输出投影
Chunked Pre-filling(分块 Pre-filling)
  • 论文使用 FlashAttention-2 来 Pre-fill Retrieval Heads 和 Streaming Heads 的 KV 缓存
    • 在长上下文 LLM 中,分块 Pre-filling 是一种常见做法,将提示分成固定长度的块来 Pre-filling KV 缓存
    • 这种技术通过将线性层中的峰值中间激活大小从序列长度降低到块大小,显著降低了峰值内存使用
  • DuoAttention 与分块 Pre-filling 完全兼容,并且 DuoAttention 中 Streaming Heads 的 Pre-filling 可以在线性时间和恒定内存复杂度下实现,无需专门的核
  • 如图 5 所示,计算了某一层的 KV 后,Streaming Heads 的 KV 缓存会立即被剪枝,仅保留 Sink Token 和最近的 Token
    • 下一个传入 Token 块在 Pre-filling 期间将仅关注恒定数量的上下文 Token
  • 令 \(L\) 表示序列长度,\(K\) 表示块大小(chunk size)
    • Streaming Heads 的 Pre-filling 时间复杂度从 \(O(L^{2})\) 优化到 \(O(LK)\),内存复杂度从 \(O(L)\) 减少到 \(O(K)\)
  • 需要注意的是,DuoAttention 的设计非常适合批量操作,这可以在具有大批量大小的服务场景中进一步提高 LLM 的效率

Experiments

Setups

  • 模型、数据集和基线 (Models, Datasets, and Baselines)
    • 论文在长上下文和短上下文基准测试上评估 DuoAttention,证明论文的方法在保留模型处理长短上下文任务性能的同时,显著提高了效率
      • 对于长上下文评估
        • 论文使用 Needle-in-a-Haystack (NIAH) 基准测试 (Kamradt, 2024) 和 LongBench (2023)
      • 对于短上下文评估
        • 论文评估了在 MMLU (2021)、MBPP (2021) 和 MT-Bench (2023) 上的性能
    • 论文采用了 SOTA 开源模型,包括 Llama-2-7B-chat (2023b)(及其长上下文变体 Llama-2-7B-32K-Instruct (Together, 2023))、Llama-3-[8,70]B-Instruct(及其长上下文变体 Llama-3-8B-Instruct-Gradient-1048k)以及 Mistral-7B-v0.2-Instruct (2023)
    • 论文将论文的方法与 KV 缓存压缩算法进行了比较,包括 H2O (2023b)、TOVA (2024)、FastGen (2024) 和 StreamingLLM (2023b)
  • Implementation details
    • 论文使用 PyTorch (2019) 和来自 FlashInfer (2024) 的 RoPE (2021) 和 RMSNorm 内核来实现 DuoAttention
    • 对于 Retrieval Heads 的识别
      • 论文使用批量大小为 1,将 10 个 32 词(Words)的 passkeys 插入到 BookSum (2021) 数据集中
      • 识别过程使用 128 个 Sink Token 和 256 个 Recent Token
      • 训练样本从范围为 1,000 个 Token 到模型特定的最大长度(间隔 50 intervals)中采样(问题:这里是指样本长度的采样)

        Training samples are drawn from 50 intervals ranging from 1,000 tokens to the model-specific maximum length

    • passkeys 在上下文中的 1000 个点处随机插入(更多细节包含在附录 A.1 节中)
    • 论文使用 AdamW (2015) 优化器优化门控值,初始学习率为 0.02,在前 400 步从 0.002 进行预热,并在最后 400 步降回 0.002
      • 所有实验在 NVIDIA A100 GPU 上运行 2,000 步

Long-Context Benchmarks

  • 使用 Needle-in-a-Haystack (NIAH) 基准测试和 LongBench (2023) 来评估 DuoAttention
  • 使用了两个长上下文模型:Llama-2-7B-32K-Instruct 和 Llama-3-8B-Instruct-Gradient-1048k
    • DuoAttention 配置:
      • Llama-2-7B-32K-Instruct 使用 25% 的 Retrieval Heads 比例
      • Llama-3-8B-Instruct-Gradient-1048k 使用 50% 的比例
    • 论文在相同的 KV 缓存预算下,将 DuoAttention 与 H2O、TOVA 和 StreamingLLM 进行比较
      • 论文为 DuoAttention 使用 64 个 Sink Token 、256 个 Recent Token 和 32,000 的 Pre-filling 块大小
    • 由于 H2O 和 TOVA 的原始设计不支持长上下文,论文修改了它们的算法,将 Pre-filling 阶段替换为 FlashAttention,并模拟输入最后 50 个 Token 的解码(遵循 Tang 等人 (2024b) 的方法)
    • FastGen 的算法不允许指定 KV 压缩比,因为它会随输入波动
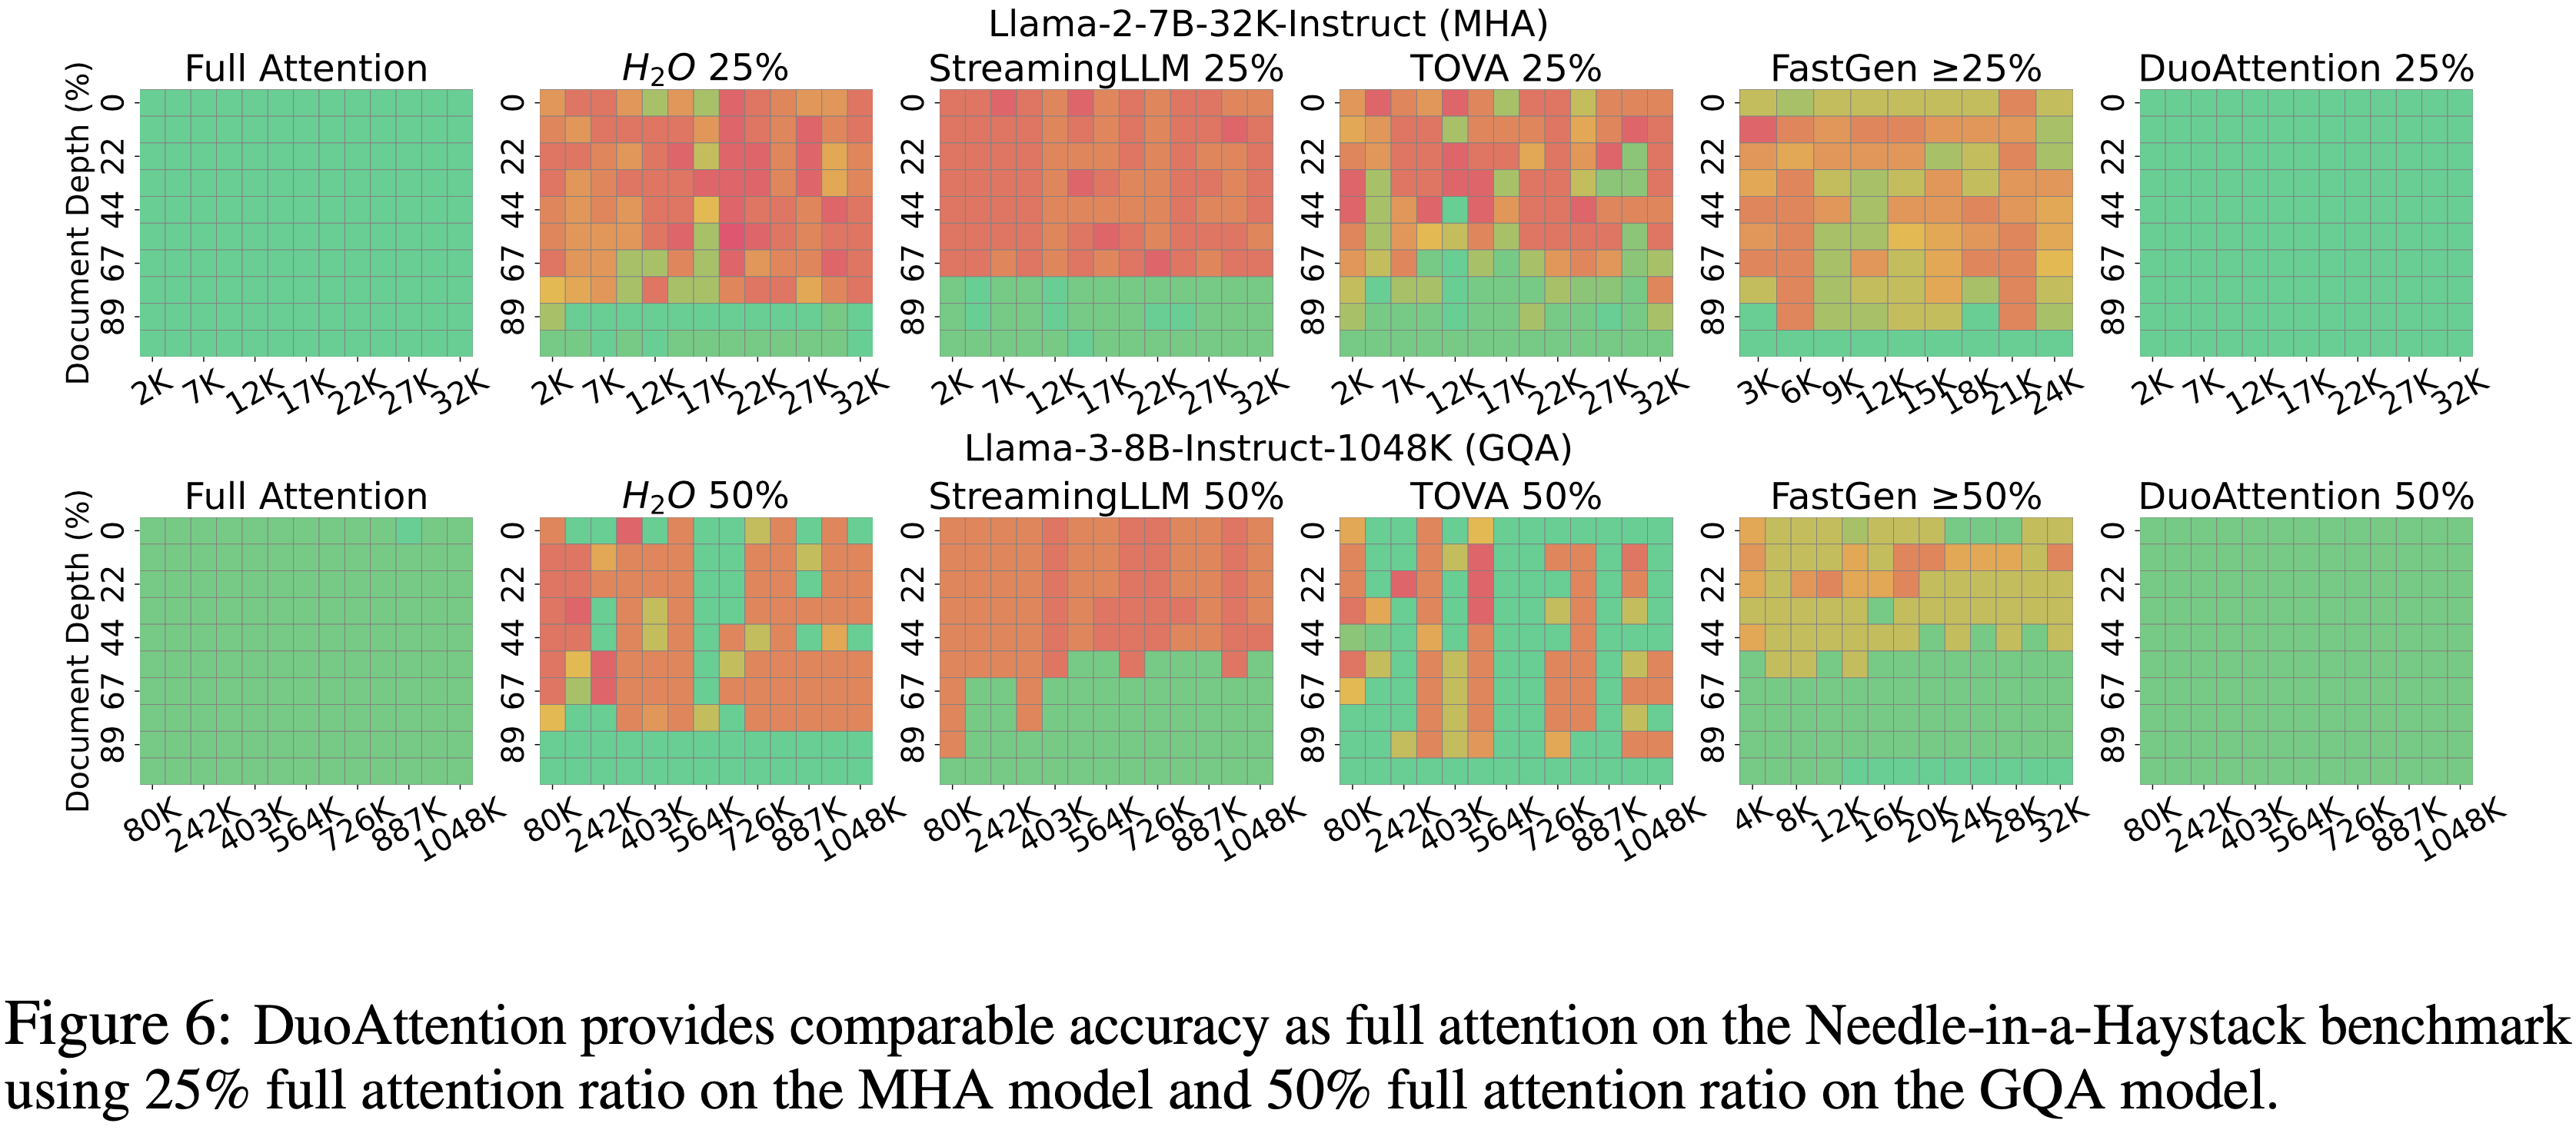
      • 论文调整了注意力恢复比例,以确保在图 6 所示的实验中,KV 缓存预算平均高于 25% 或 50%
    • FastGen 在 Attention Profiling 阶段的二次内存成本限制了其处理长上下文样本的能力
      • 论文测量了 FastGen 在 NIAH 上对 Llama-2-7B 最高到 24K 上下文、对 Llama-3-8B 最高到 32K 上下文的性能;
      • 超过这些大小会导致内存不足错误
    • 详细的基线实现和理由在附录 A.3 节和 A.5 节中提供
  • Needle-in-a-Haystack (NIAH) 是一个具有挑战性的压力测试,旨在评估模型从冗长上下文中准确识别和检索相关信息的能力
    • 如图 6 所示,所有基线方法都无法从长序列的不同深度检索到正确答案,因为它们在生成过程中丢弃了包含必要信息的 KV 缓存
    • DuoAttention 保留了 Retrieval Heads 中的所有 KV 缓存,同时仅丢弃 Streaming Heads 中的缓存,从而保留了模型的检索能力
    • DuoAttention 在所有序列深度上都表现出强大的性能,有效处理高达 1048K Token 的长度
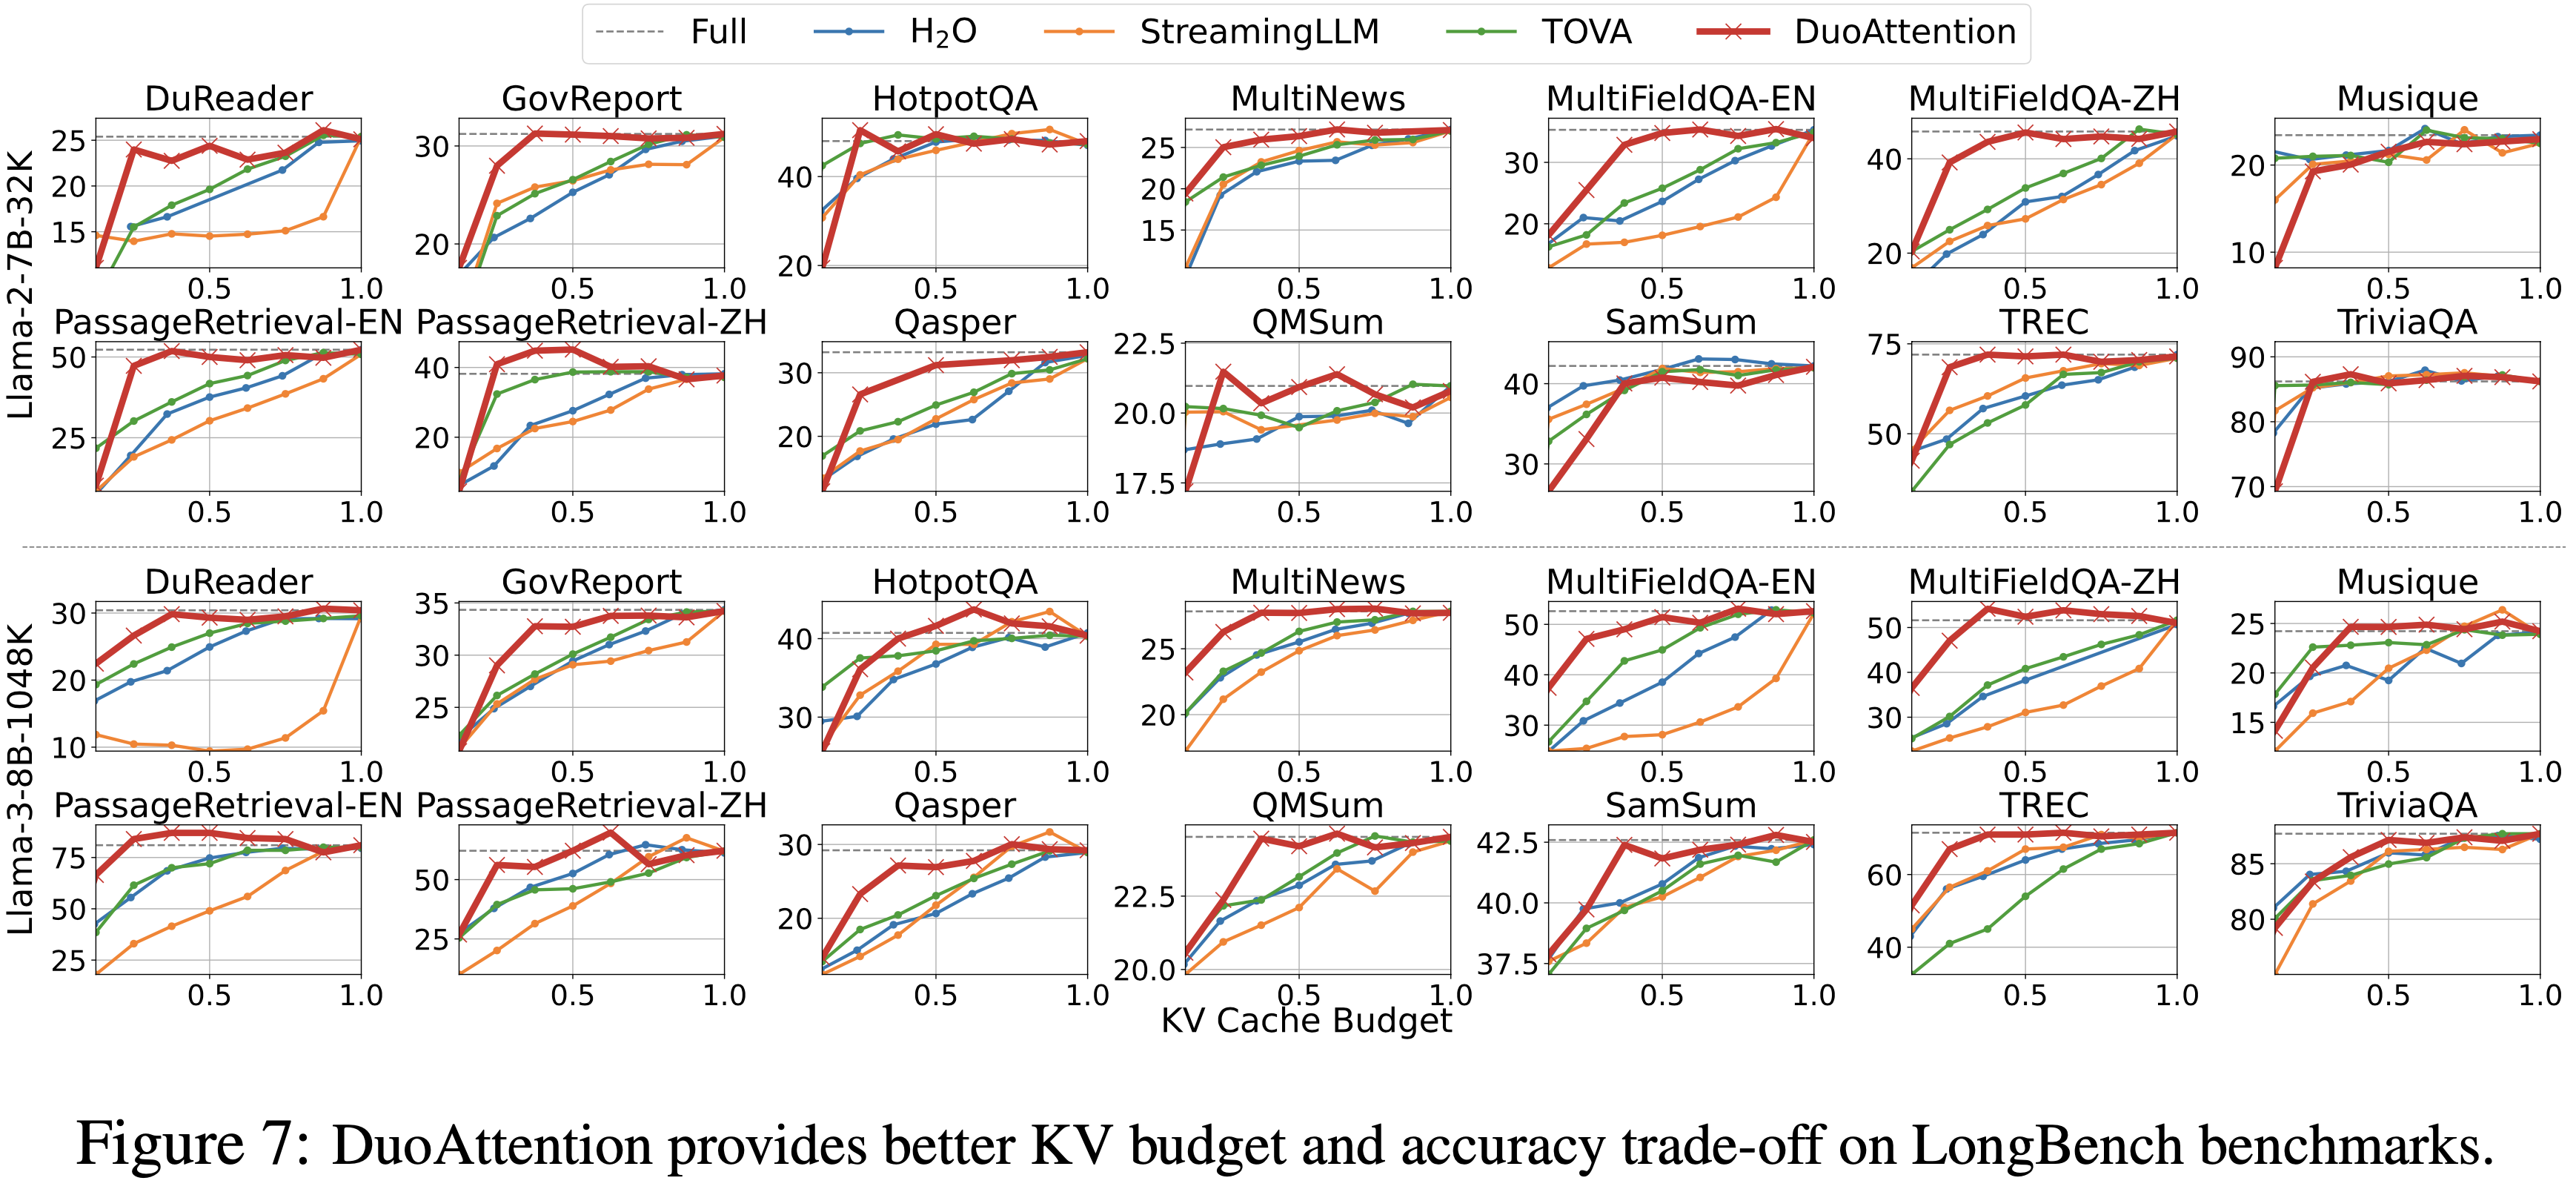
  • LongBench (2023) 是一个全面的长上下文数据集套件,涵盖多个任务和自然文本,旨在更全面地评估长上下文理解能力
    • 图 7 显示了在 14 个 LongBench 任务上的性能,比较了不同方法基于其 KV 缓存预算的表现
    • DuoAttention 在大多数任务上显示出 KV 预算和准确性之间的优越权衡,突显了其泛化能力
    • DuoAttention 在大多数任务上实现了与完全注意力相当的性能,对 MHA 使用 25% 的 KV 缓存预算,对 GQA 使用 50% 的 KV 缓存预算,这与在 needle-in-a-haystack 基准测试中观察到的结果一致
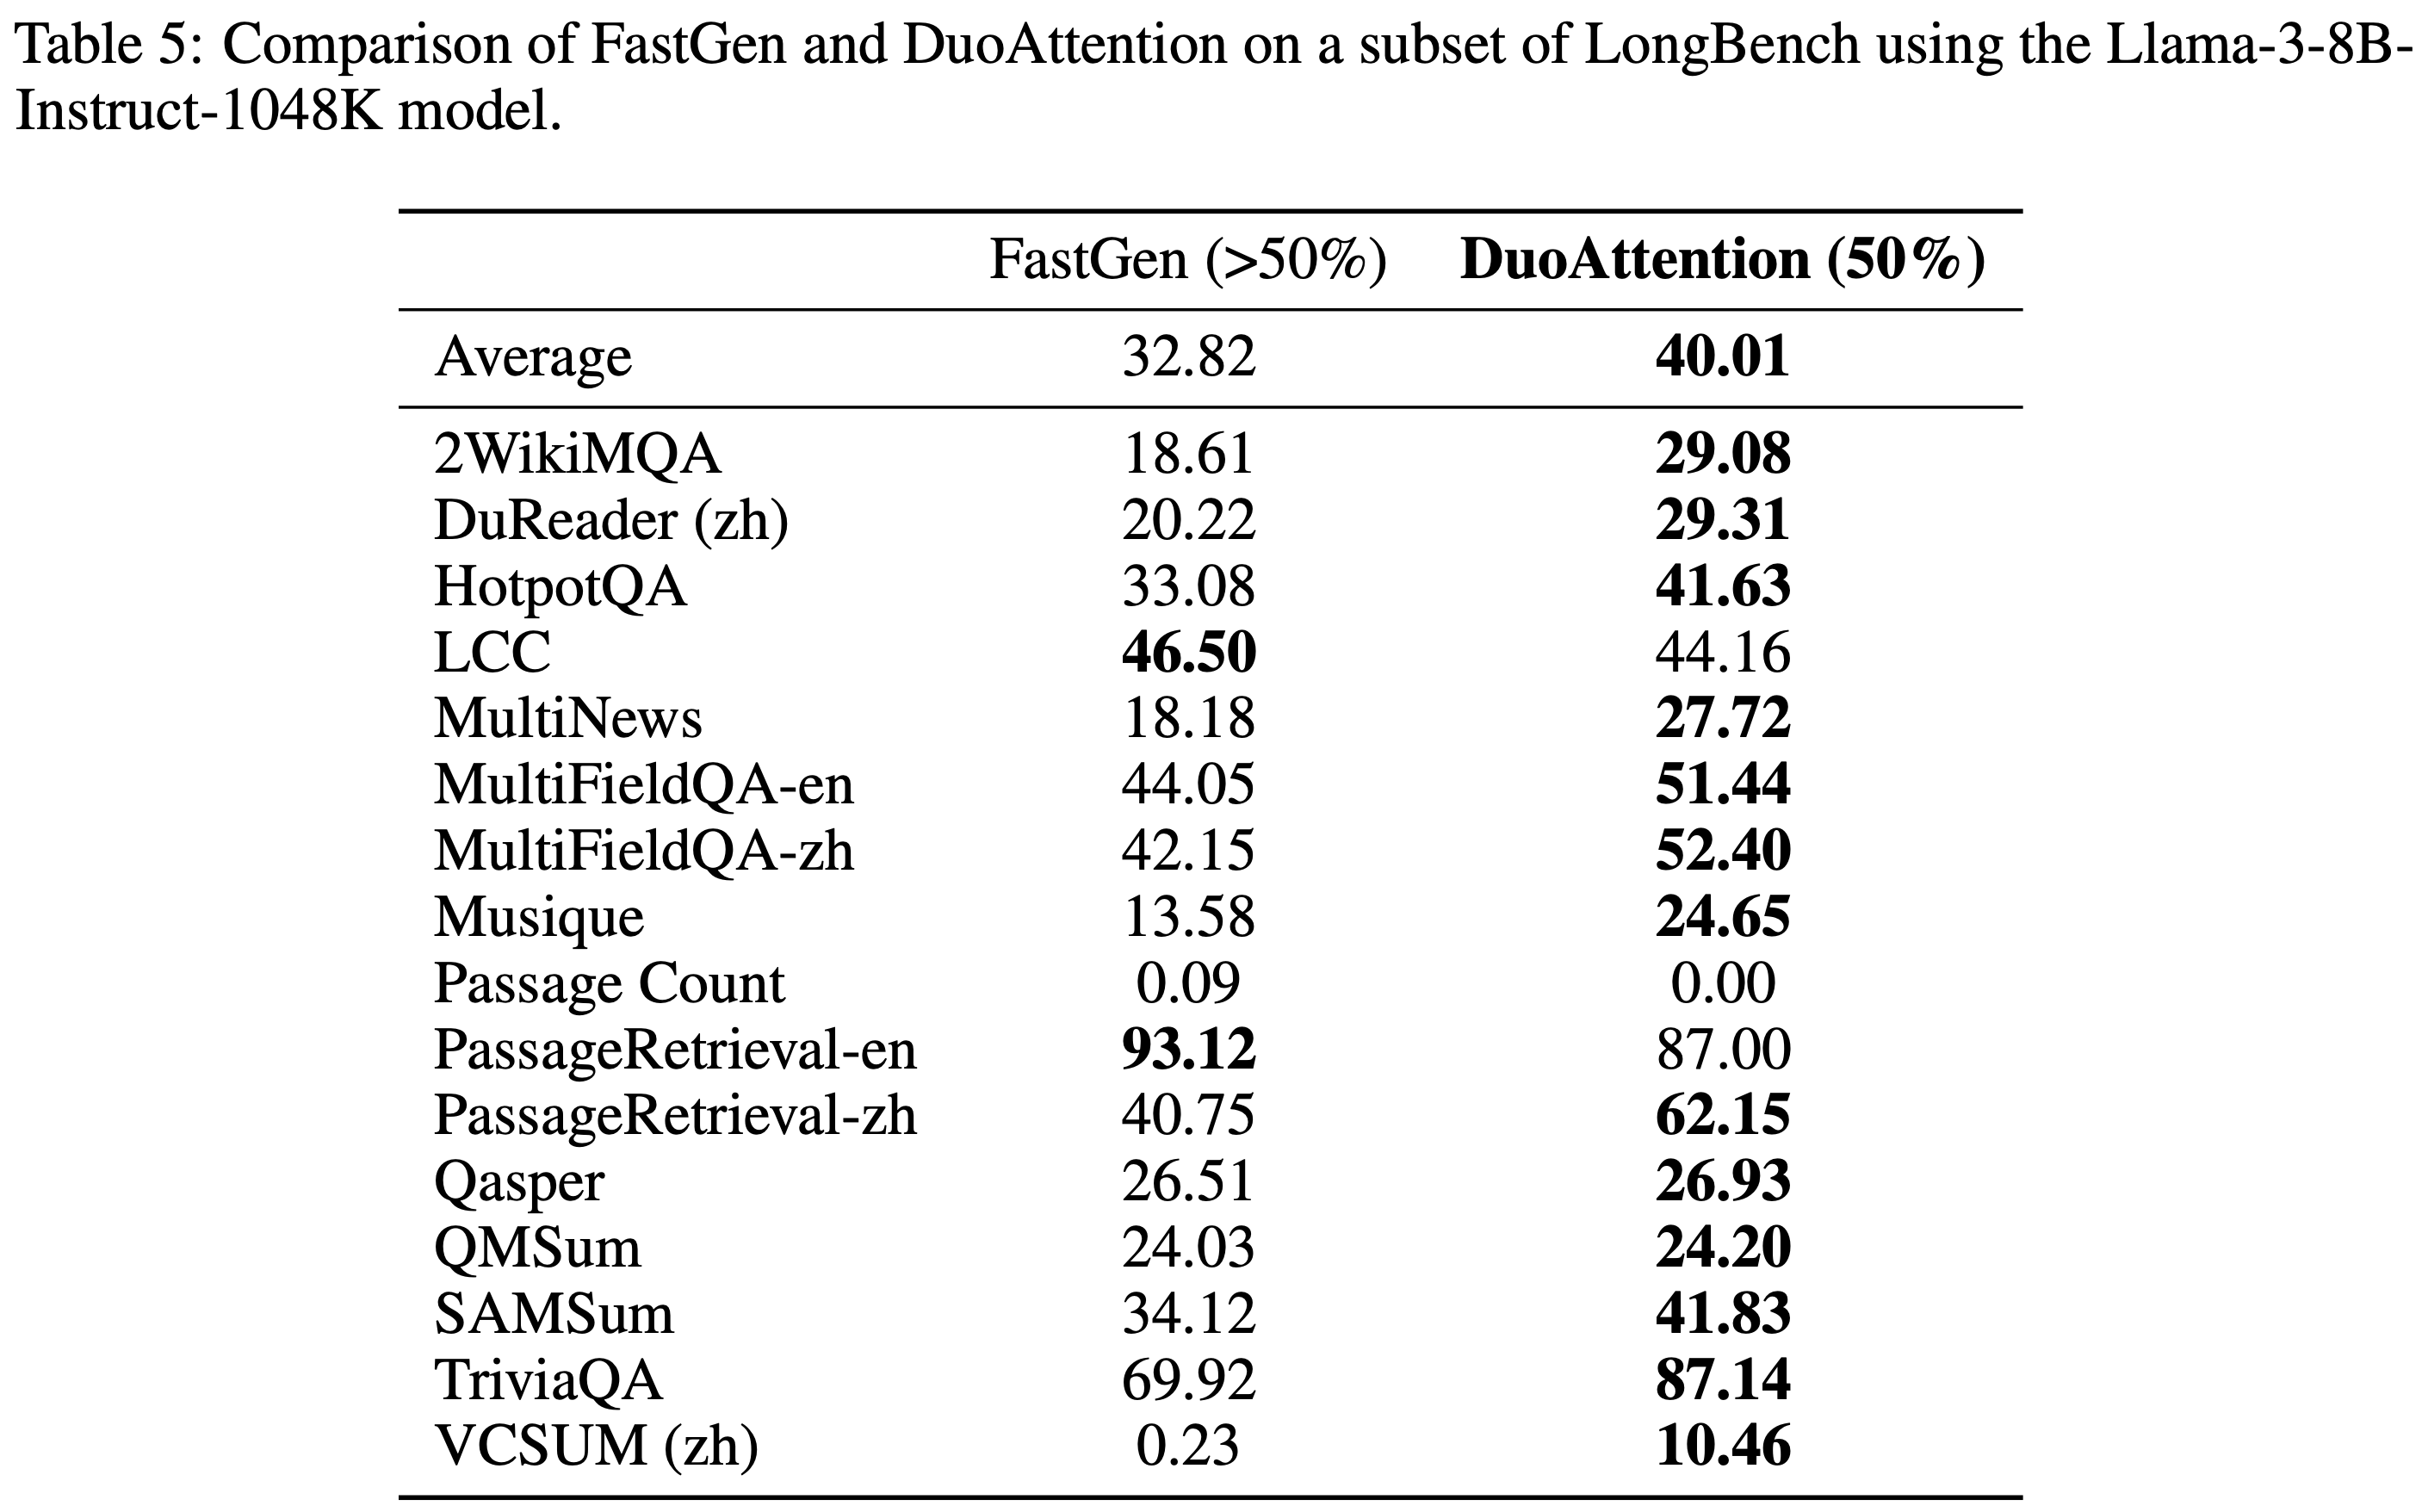
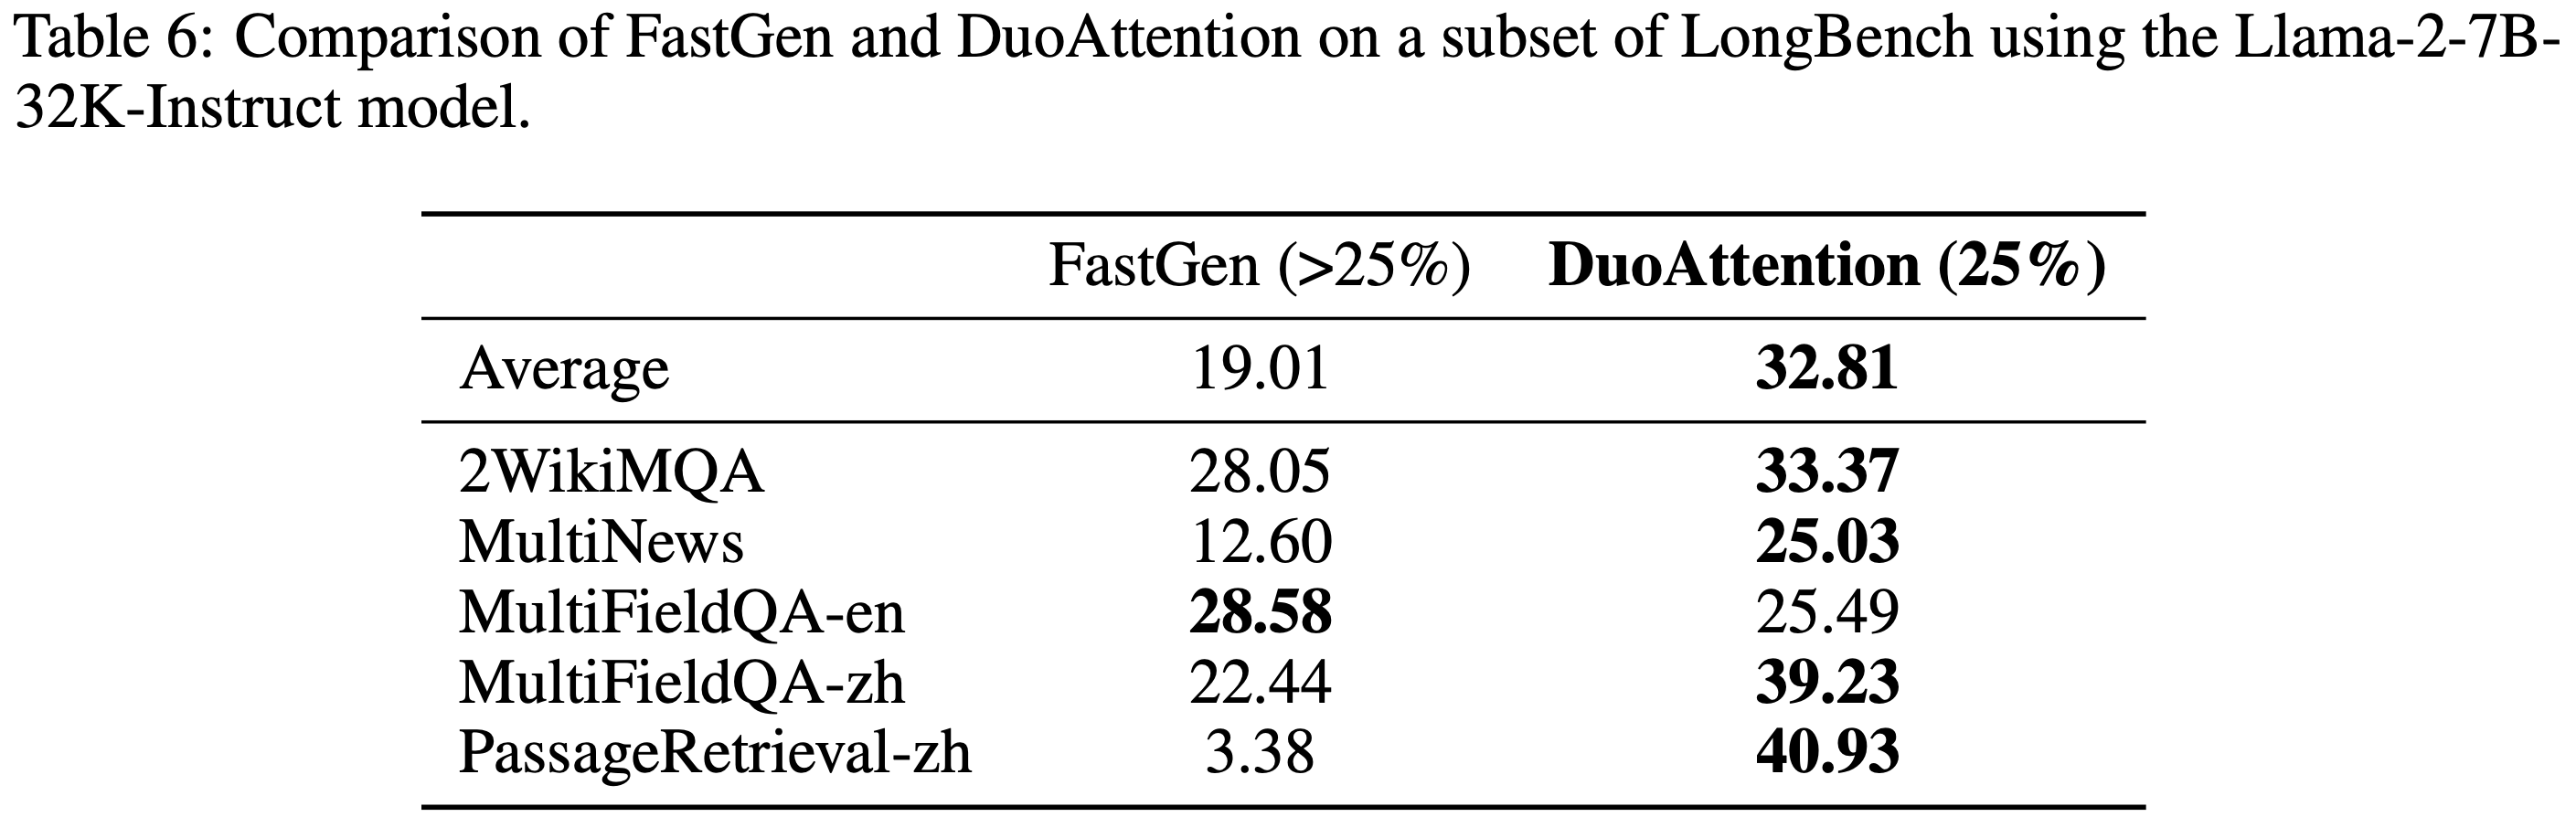
    • 论文在附录的表 5 和表 6 中将 DuoAttention 与 FastGen 进行了比较
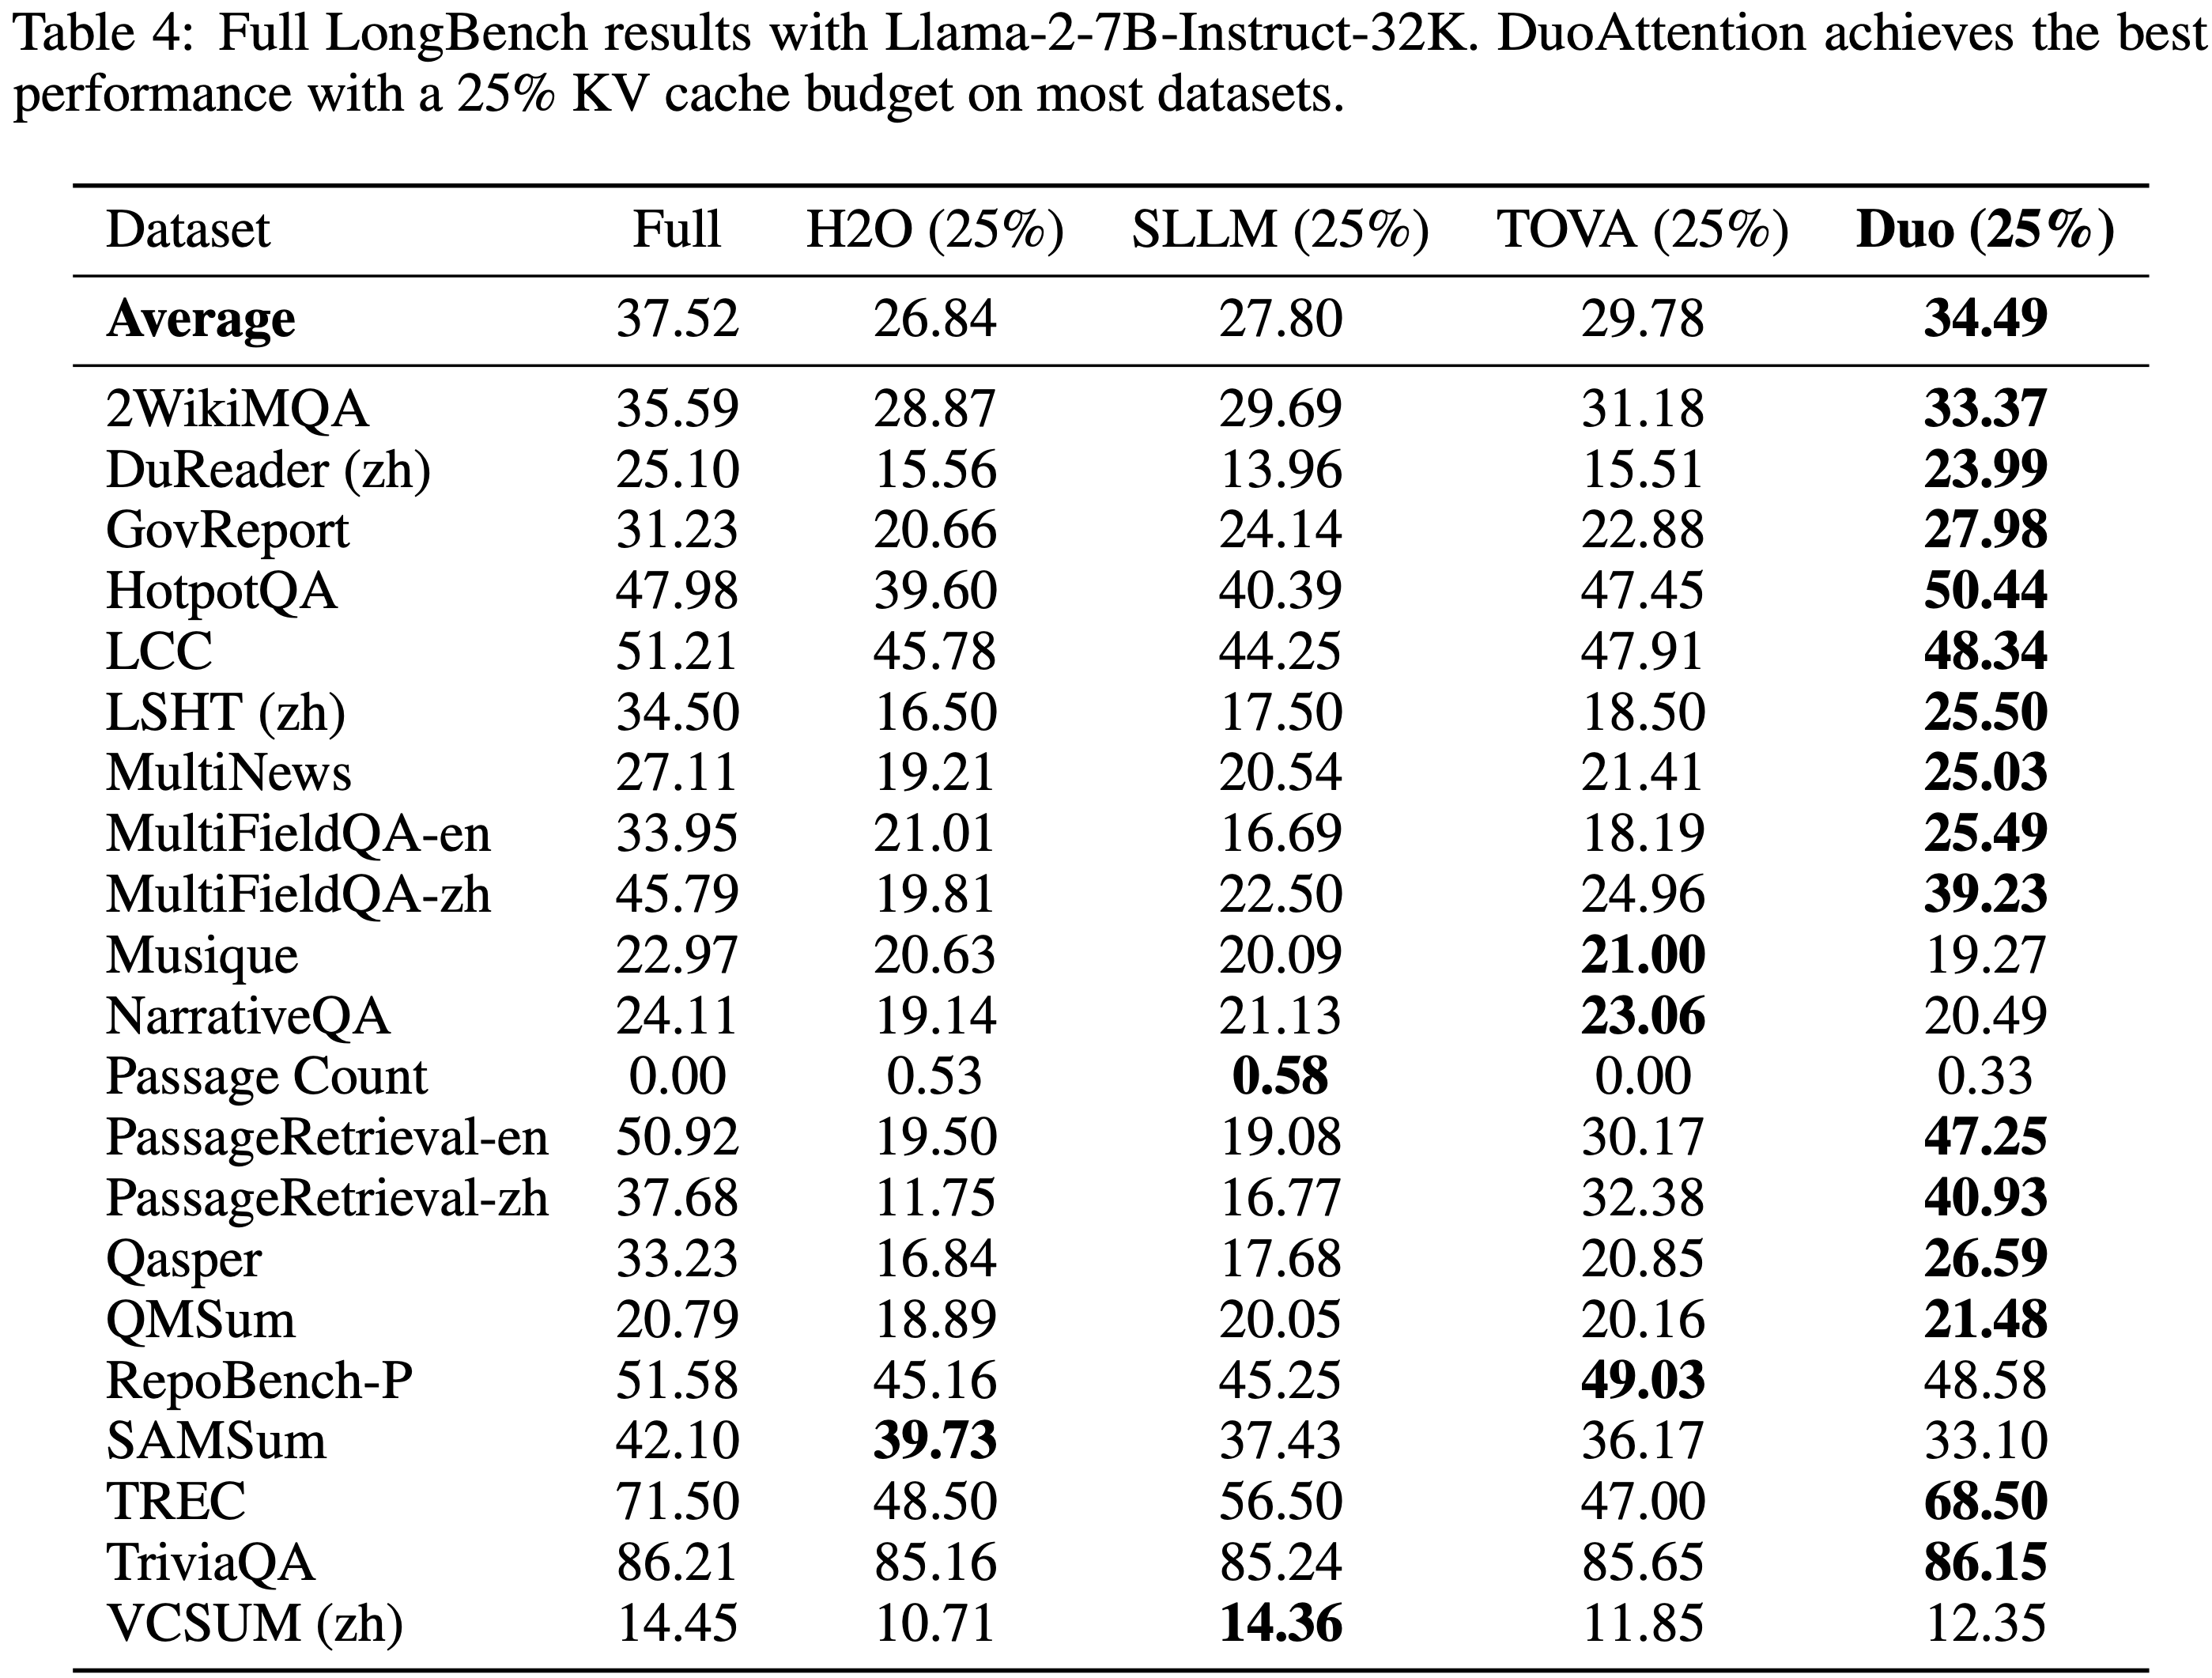
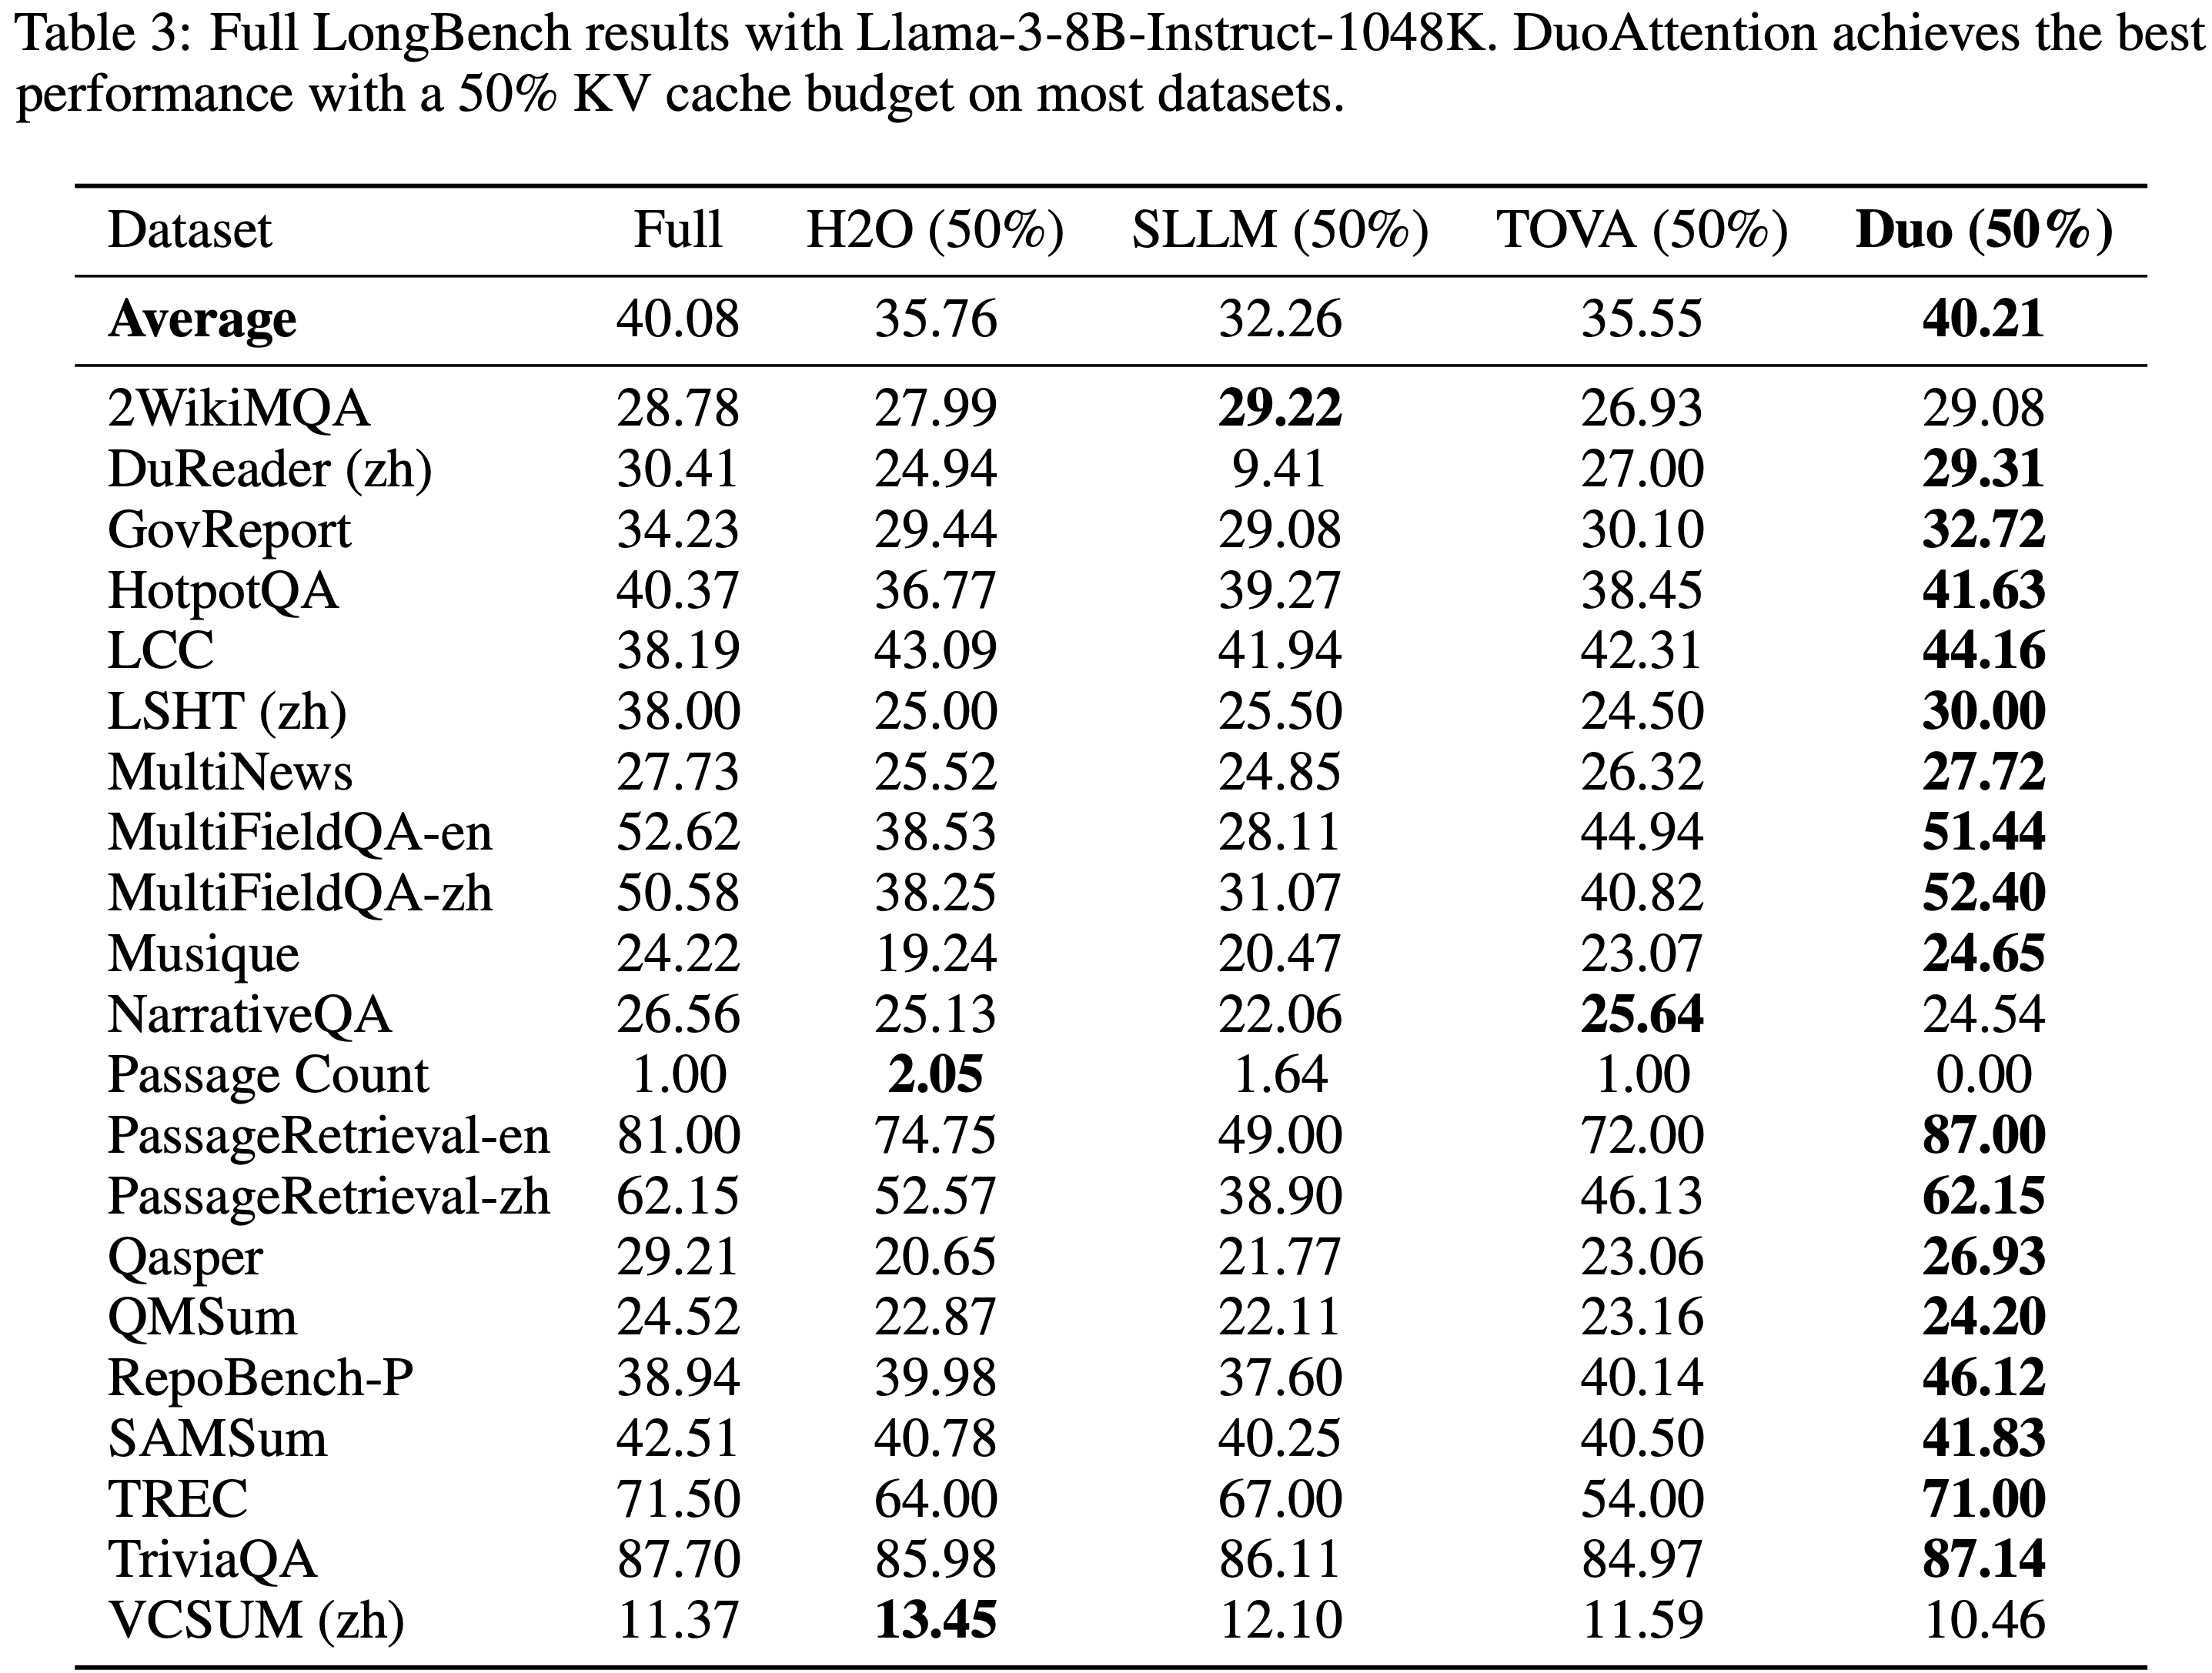
    • 附录中的表 3 和表 4 提供了两个模型使用 25% 和 50% KV 缓存预算在所有 21 个 LongBench 任务上的完整结果,表明 DuoAttention 在大多数任务上始终优于基线,并取得了最高的平均分数
Short-Context Benchmarks

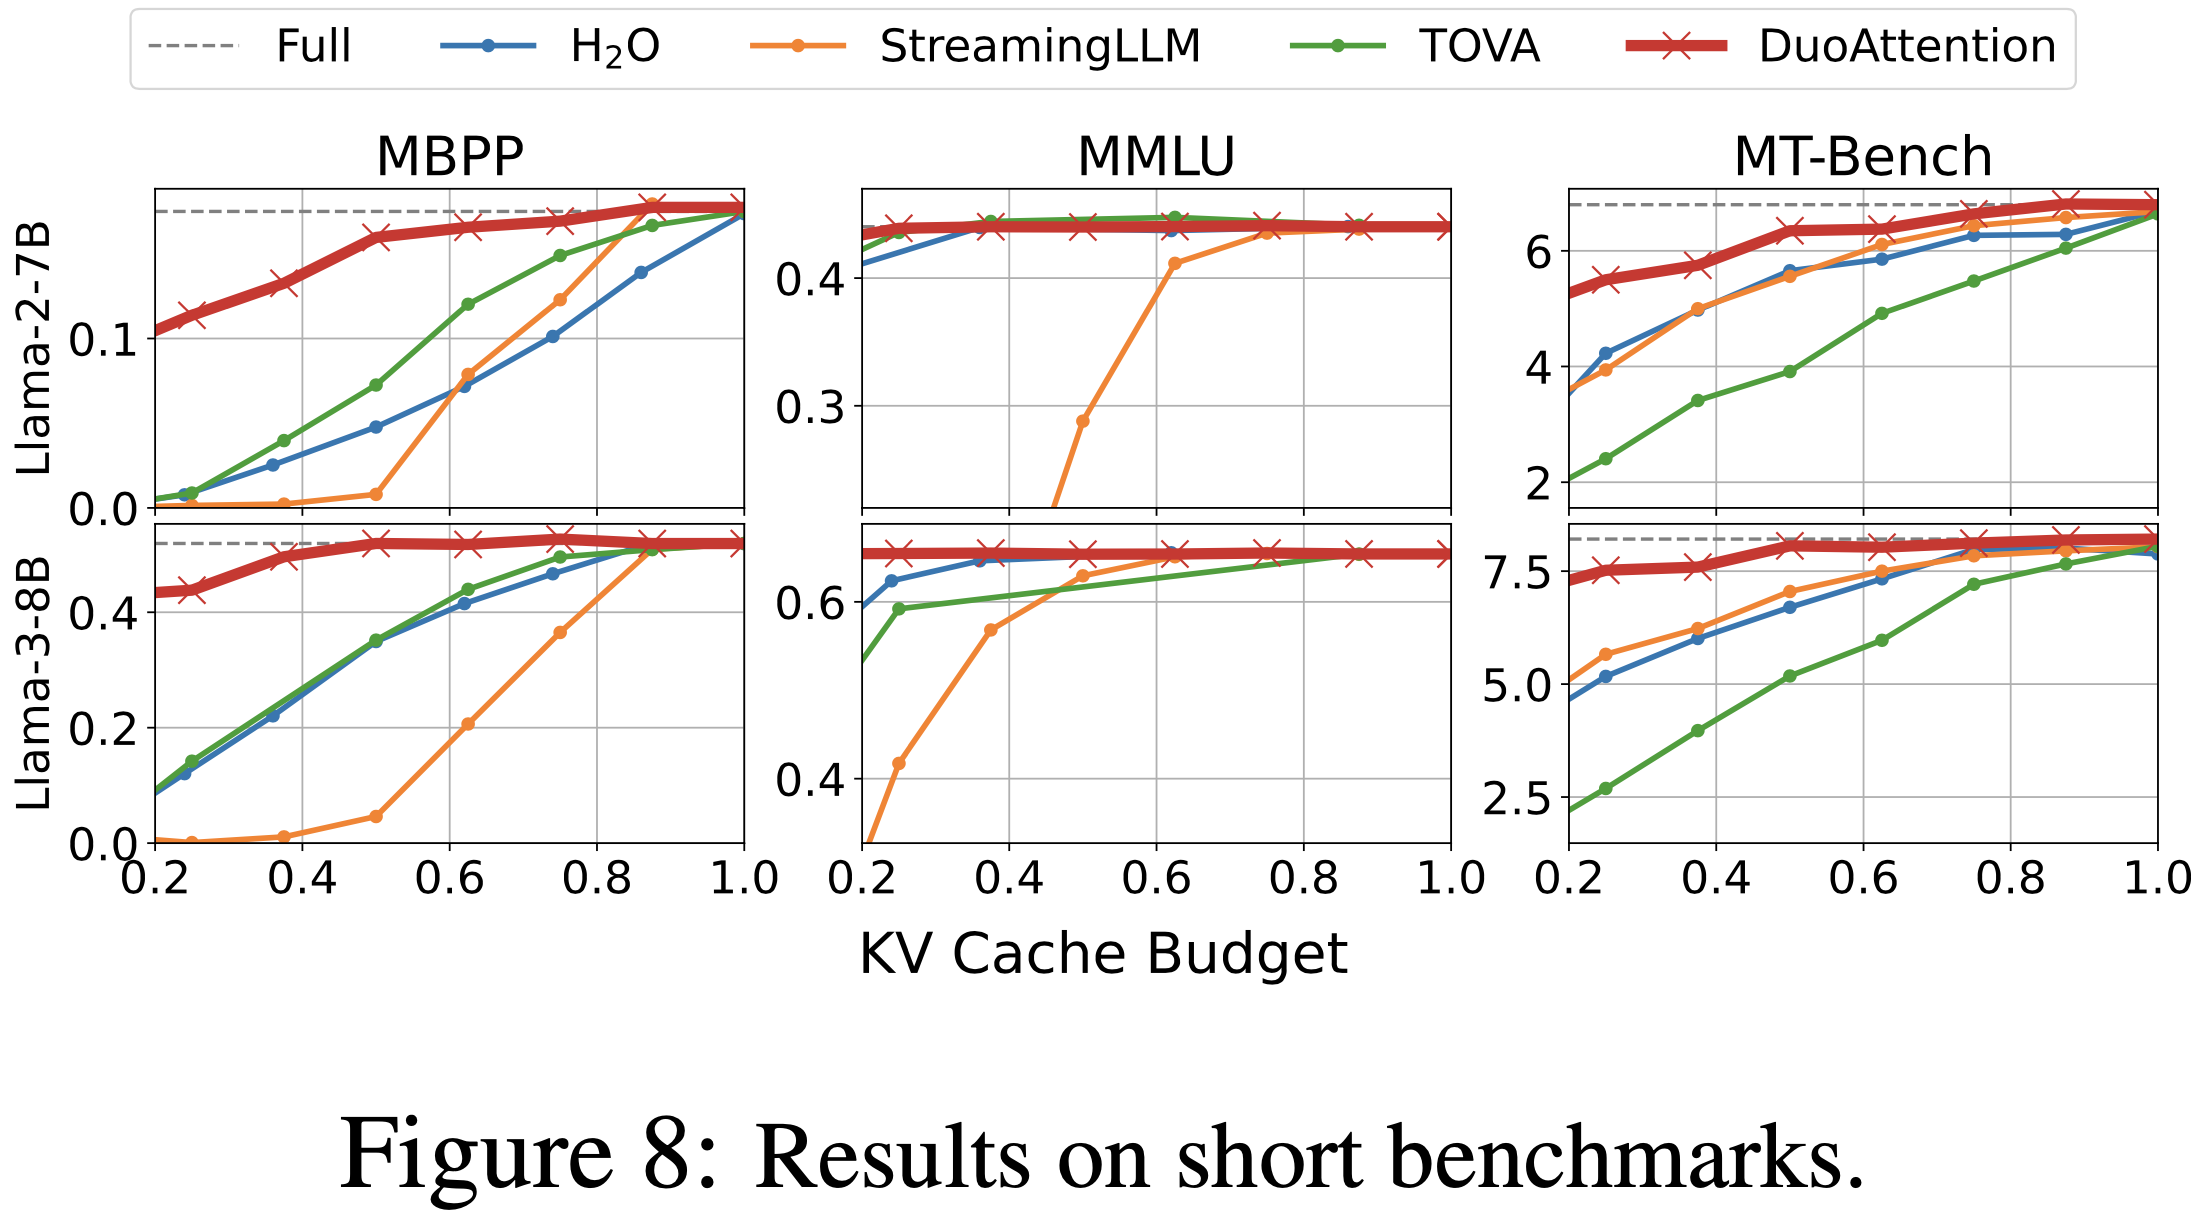
  • 为了确保 DuoAttention 不损害模型在短上下文任务上的性能,论文将其与所有基线一起在三个短上下文基准测试上进行了评估:MMLU、MBPP 和 MT-Bench
    • 这些基准测试评估模型的知识、编码能力和帮助性
    • 对 MMLU 使用 one-shot 提示,对 MBPP 和 MT-Bench 使用 zero-shot 提
    • 对于 DuoAttention,在 MMLU 上配置 32 个 Sink Token 和 128 个 Recent Token ,在 MBPP 和 MT-Bench 上配置 16 个 Sink Token 和 64 个 Recent Token
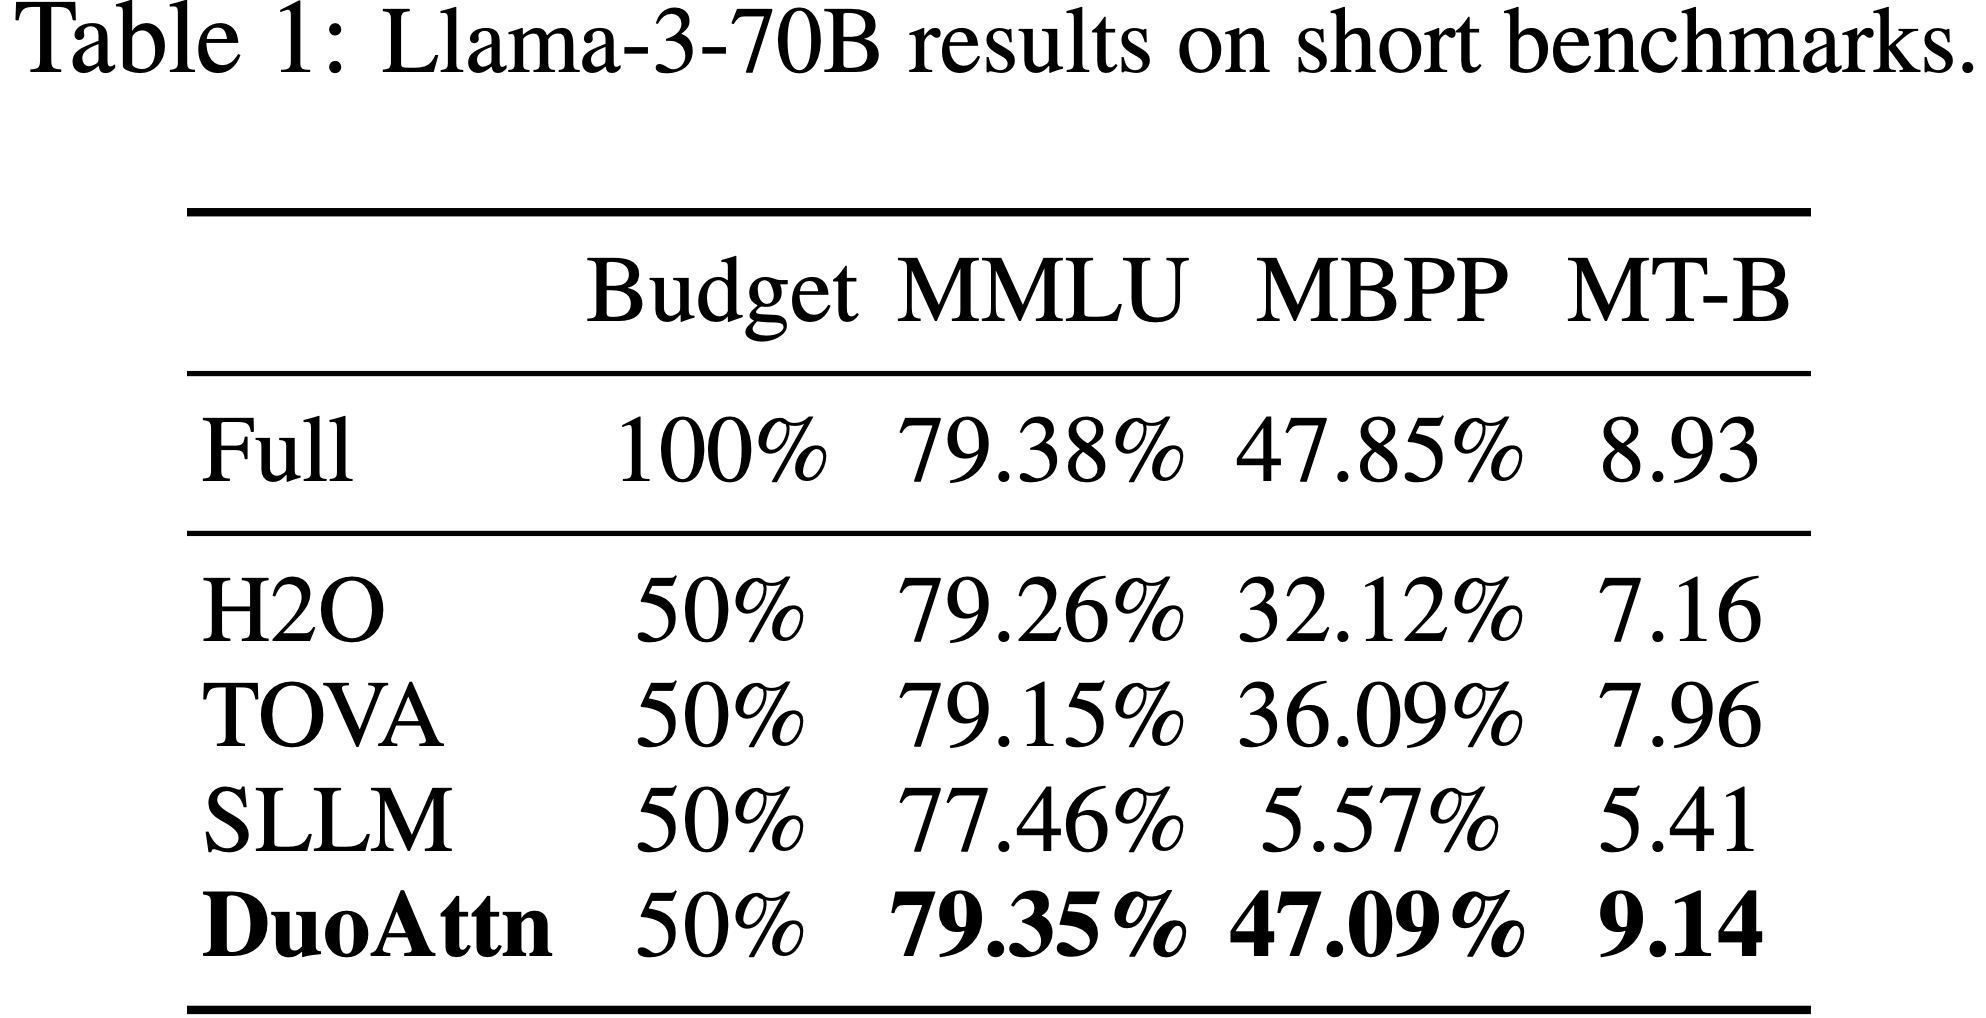
  • 如图 8 和表 1 所示
    • 在相同的 KV 缓存预算下,DuoAttention 在各种模型(包括 Llama-2-7B、Llama-3-8B 和 Llama-3-70B-Instruct)上始终优于所有基线
    • 在 50% KV 缓存预算下,DuoAttention 在大多数基准测试上实现了近乎无损的性能,表明它保留了模型的原始能力
Efficiency Results

  • 论文在单个 NVIDIA A100 GPU 上评估了 DuoAttention 在 Llama-2-7B 和 Llama-3-8B 模型上的解码延迟和内存使用情况
  • 论文为整个基准测试序列预分配 KV 缓存,以防止动态内存分配的额外开销
  • 权重和激活的默认数字格式为 BFloat16
  • 通过对 Llama-2-7B 采用 25% 的 Retrieval Heads 比例,对 Llama-3-8B 采用 50% 的比例,DuoAttention 在保持准确性的同时显著提高了效率
Decoding Efficiency
  • 如图 9 所示
    • DuoAttention 的解码速度呈线性缩放,但与完全注意力相比斜率更平缓,这反映了所选的 Retrieval Heads 比例
      • 这种高效的缩放带来了内存使用的显著减少和解码速度的显著提升
    • 这些改进随着上下文长度的增加而接近 Retrieval Heads 比例的倒数
  • 图 11 显示
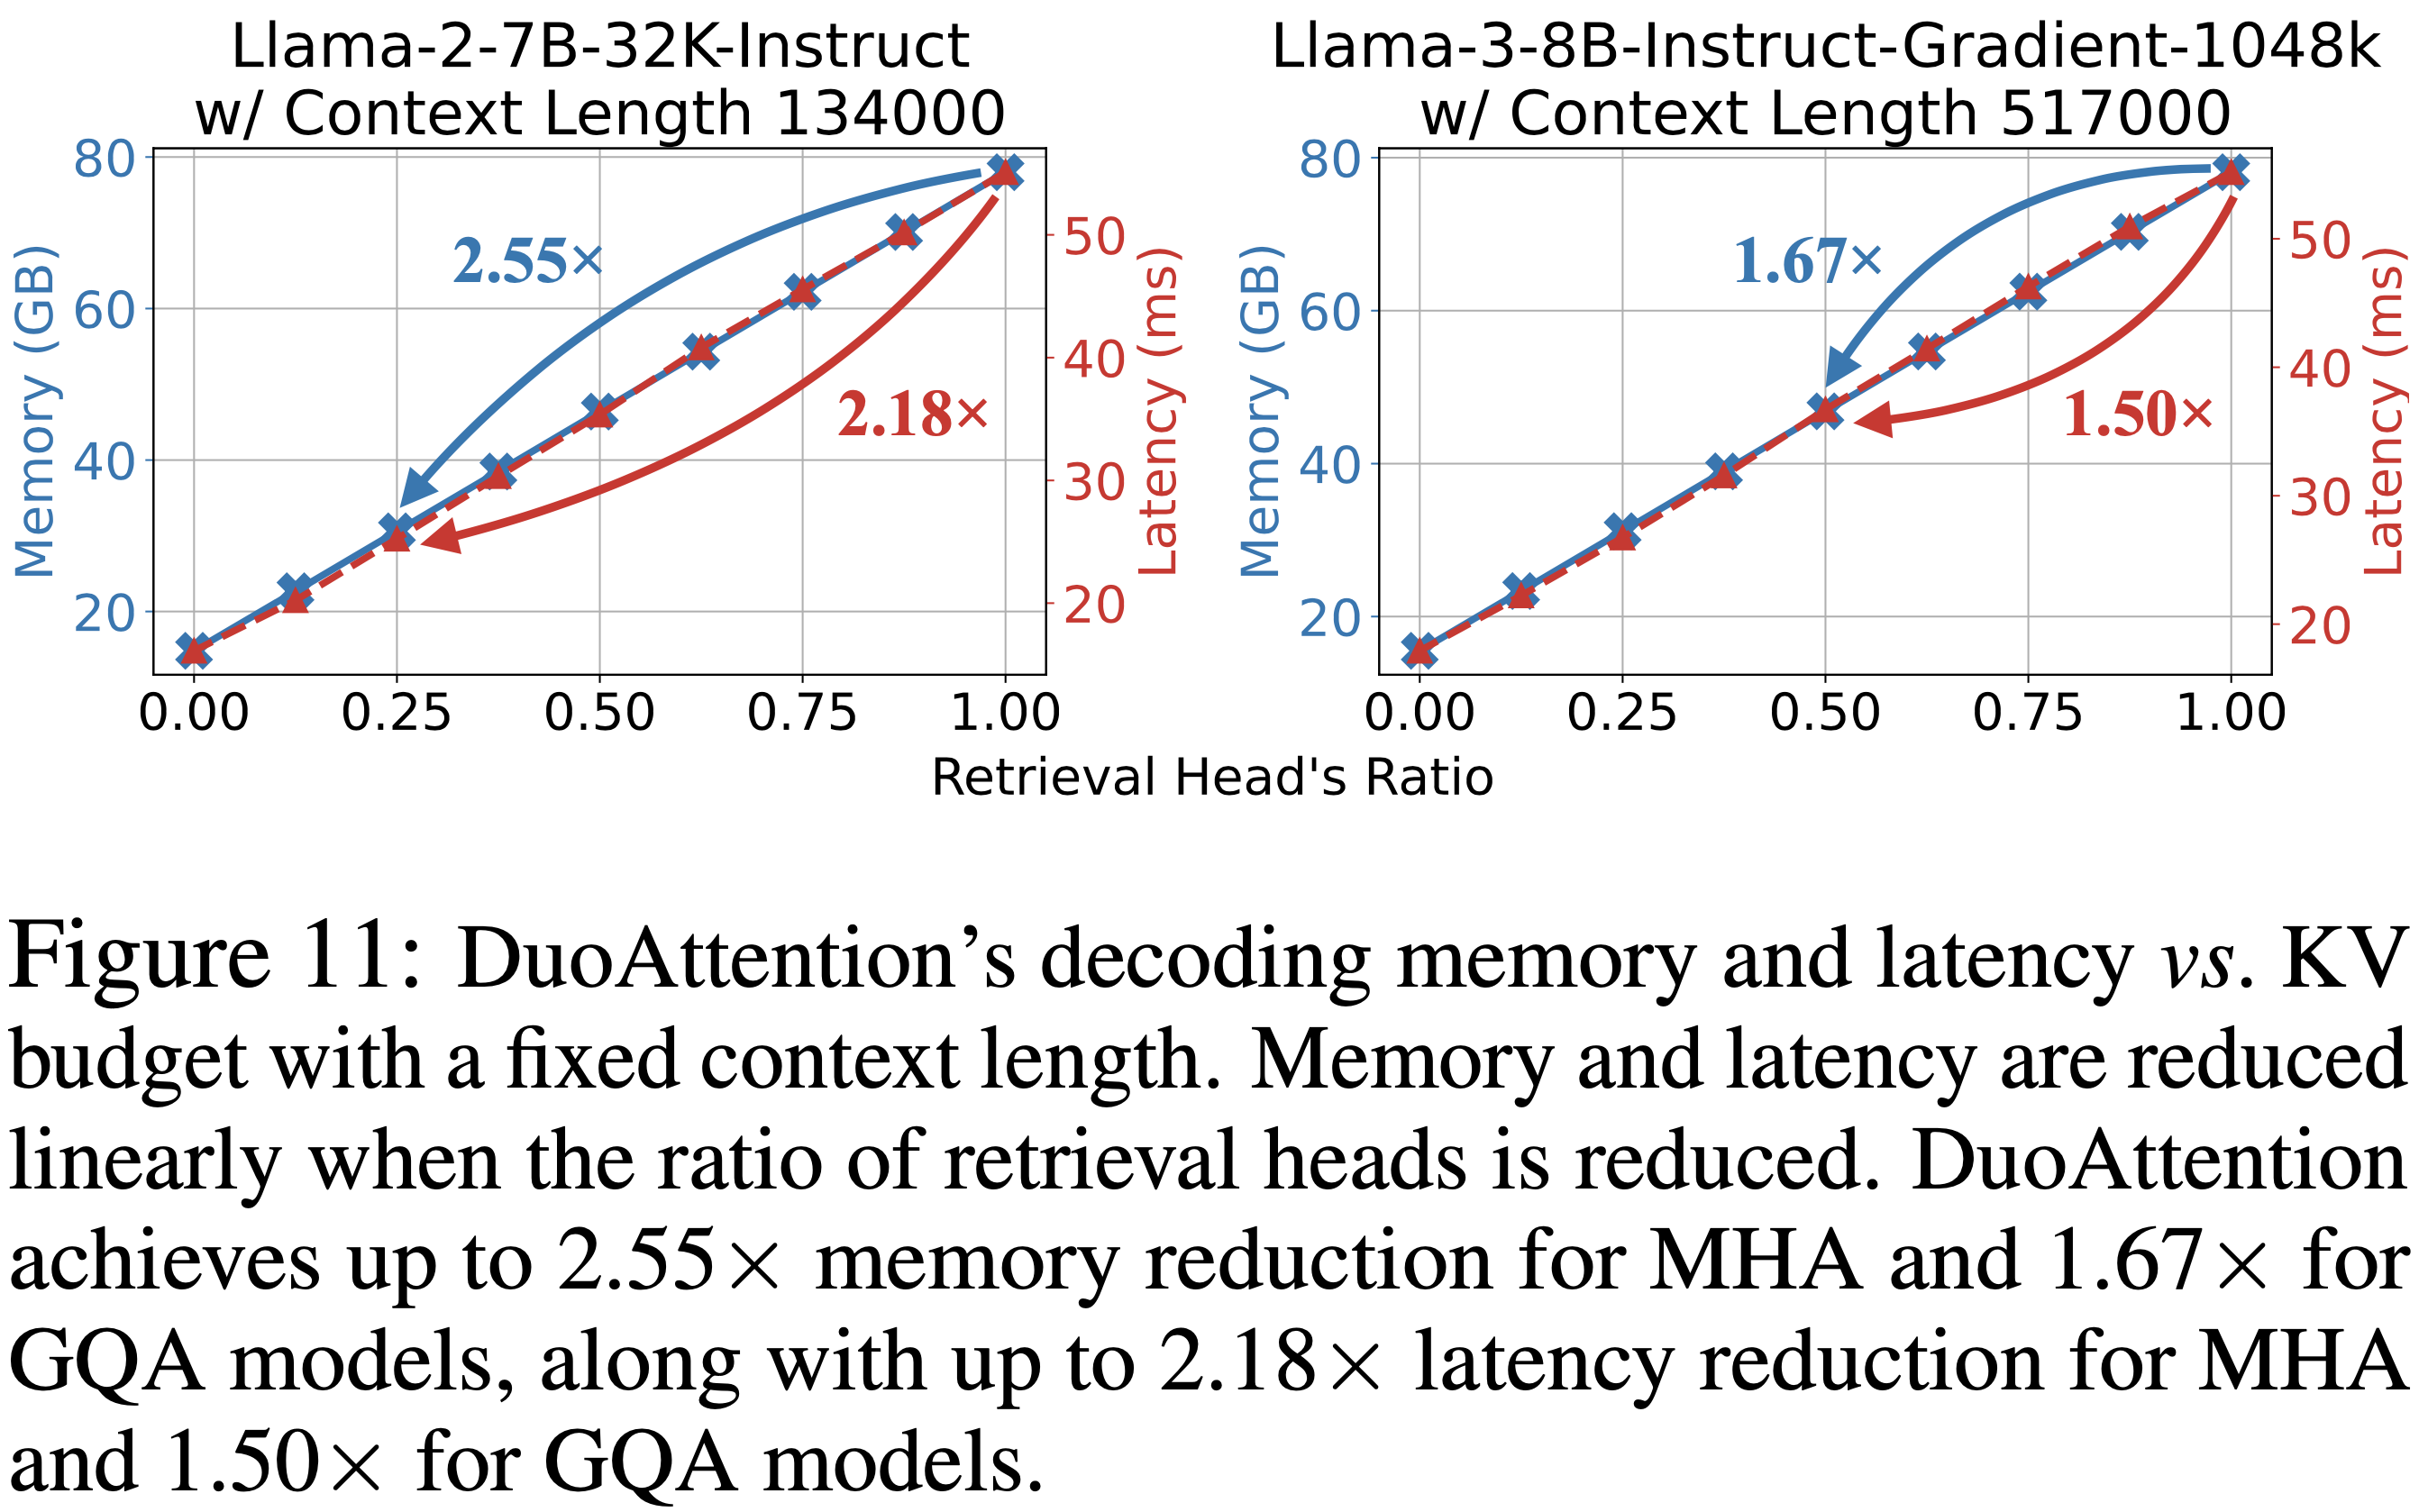
    • 在固定上下文大小下,DuoAttention 在不同 KV 预算设置下的加速和内存节省
    • 随着部署配置中 Retrieval Heads 比例的降低,解码延迟和内存使用都线性下降
    • 在图 11 的设置下,DuoAttention 在 A100 GPU 上实现了最大改进:MHA 模型内存减少 2.55 倍,GQA 模型内存减少 1.67 倍;MHA 模型延迟减少 2.18 倍,GQA 模型延迟减少 1.50 倍
Pre-filling Efficiency
  • 如第 2.3 节所述,DuoAttention 也加速了 LLM 的长上下文 Pre-filling
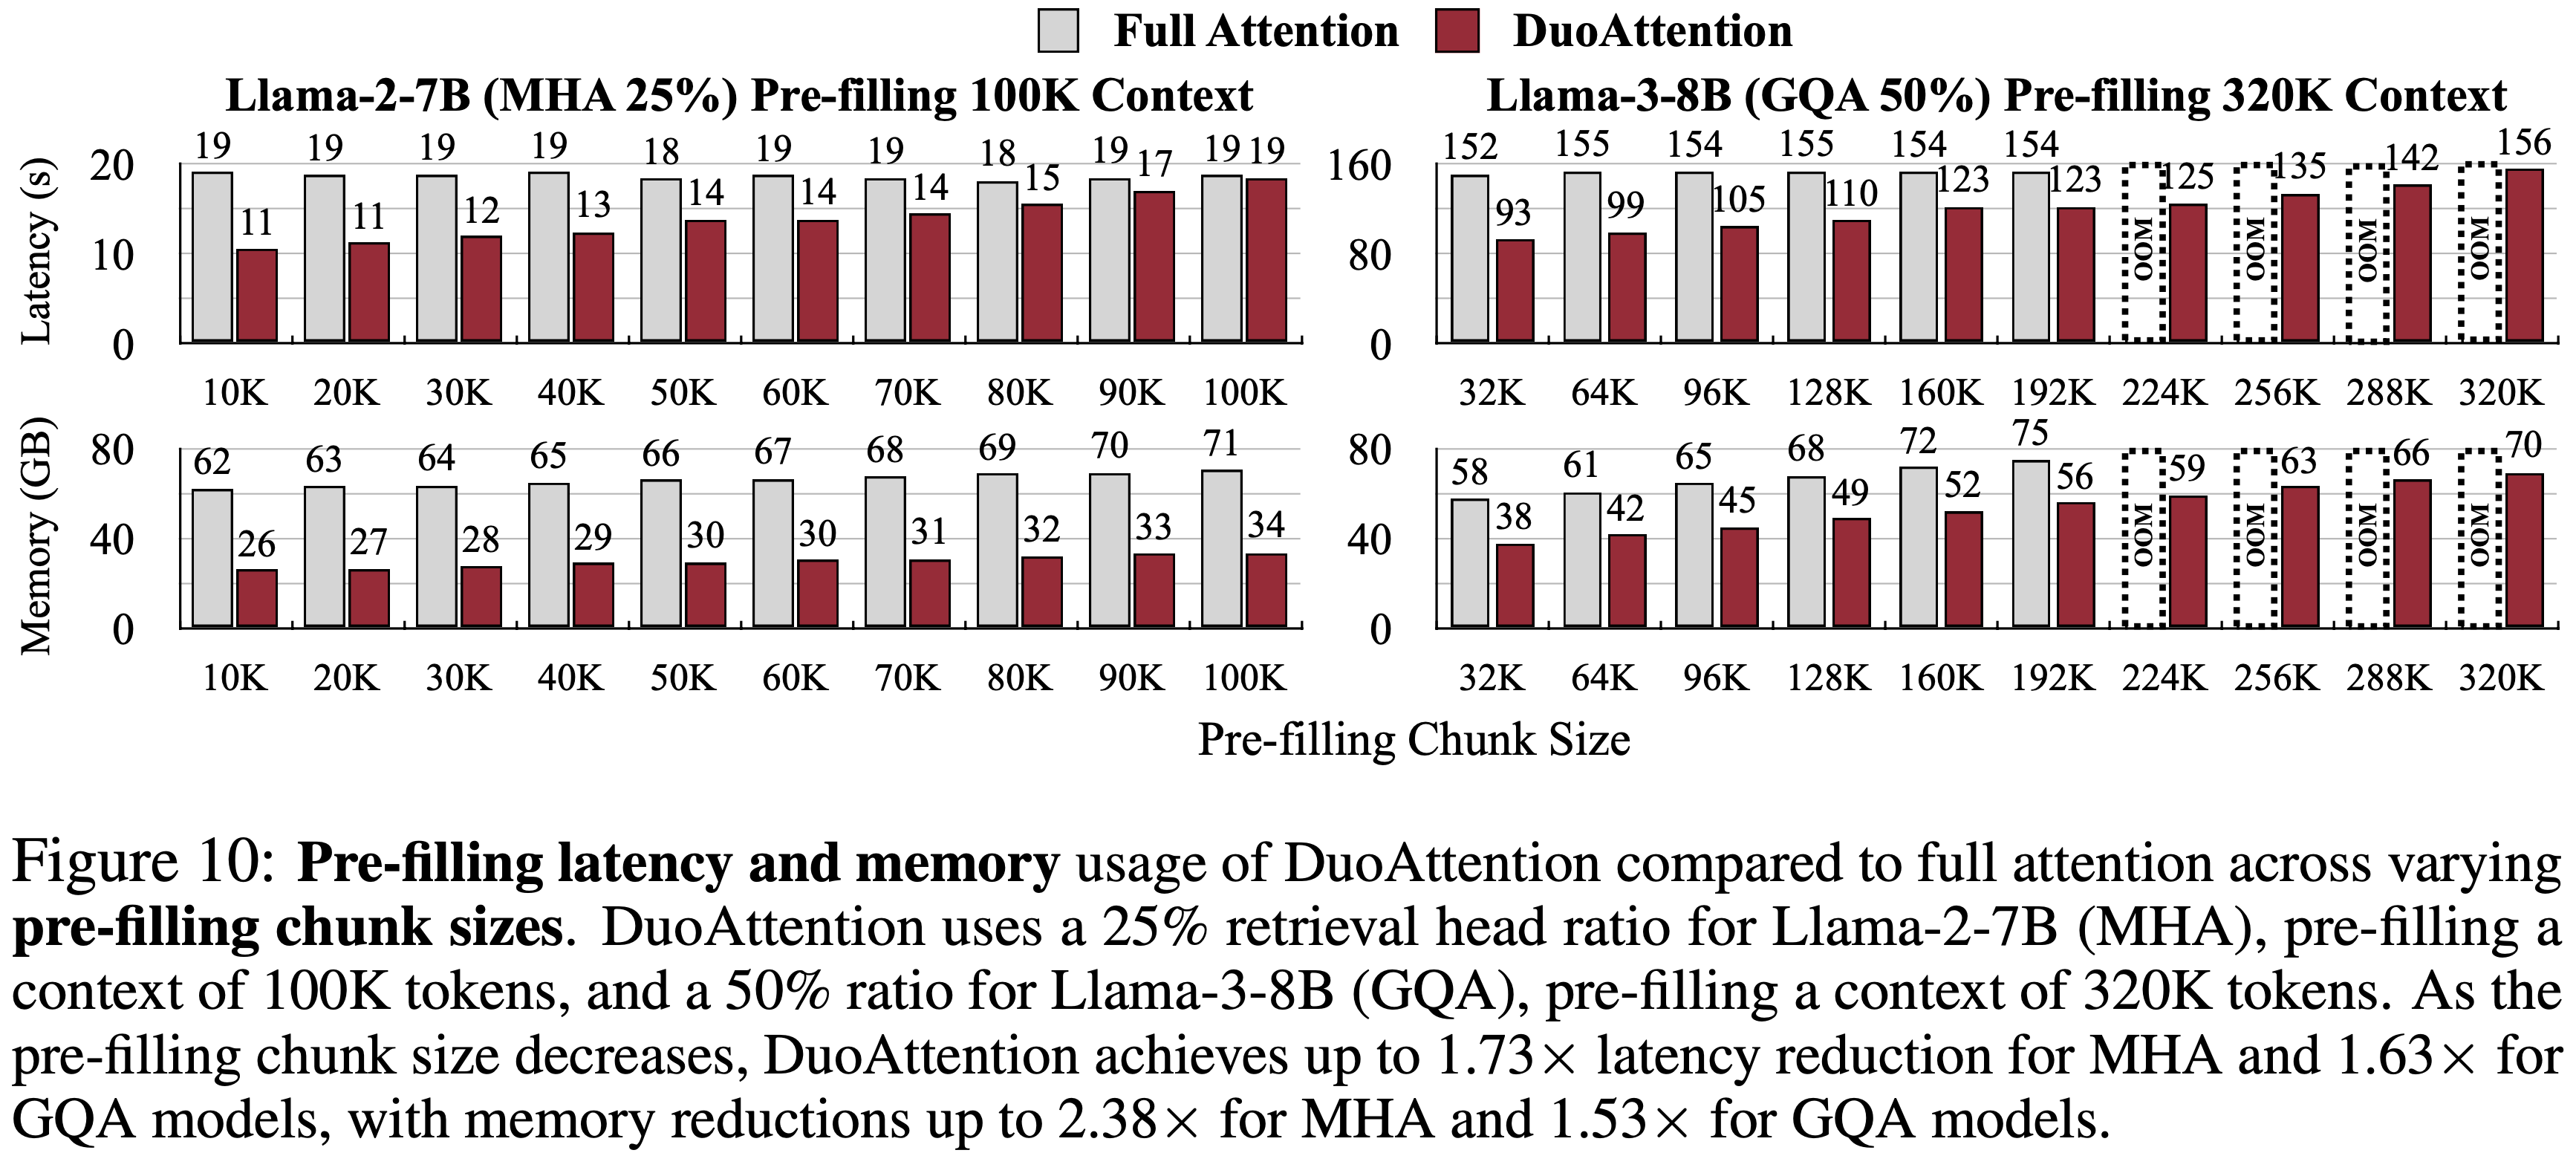
  • 图 10 显示
    • DuoAttention 显著降低了 Pre-filling 延迟和内存使用,并且这些节省随着 Pre-filling 块大小的减小而增加
      • 这是因为 Streaming Heads 的时间和内存复杂度随着块大小的减小而降低
    • DuoAttention 实现了 MHA 模型延迟减少高达 1.73 倍,GQA 模型延迟减少高达 1.63 倍,同时 MHA 模型内存减少高达 2.38 倍,GQA 模型内存减少高达 1.53 倍
Combination with Quantization
  • 为了将更多 Token 装入有限的内存,我们可以将权重和 KV 缓存量化与 DuoAttention 结合,以最大化 KV 缓存容量
  • 先前的研究表明,权重量化 (2023a;) 和 4-bit KV 缓存量化 (2024;) 不会损害模型性能
  • 论文将 DuoAttention 与 QServe (2024) 量化方法和内核相结合,以实现 8-bit 权重和 4-bit KV 缓存的 LLM 推理
  • 测量结果如图 12 所示
    • 将量化技术与 DuoAttention 结合,使论文能够在单个 A100-80G GPU 上使用 Llama-3-8B 模型容纳高达 3.30M 个 Token ,与朴素的完全注意力 BF16 部署相比,容量增加了 \(6.4\times\)
Ablation Studies

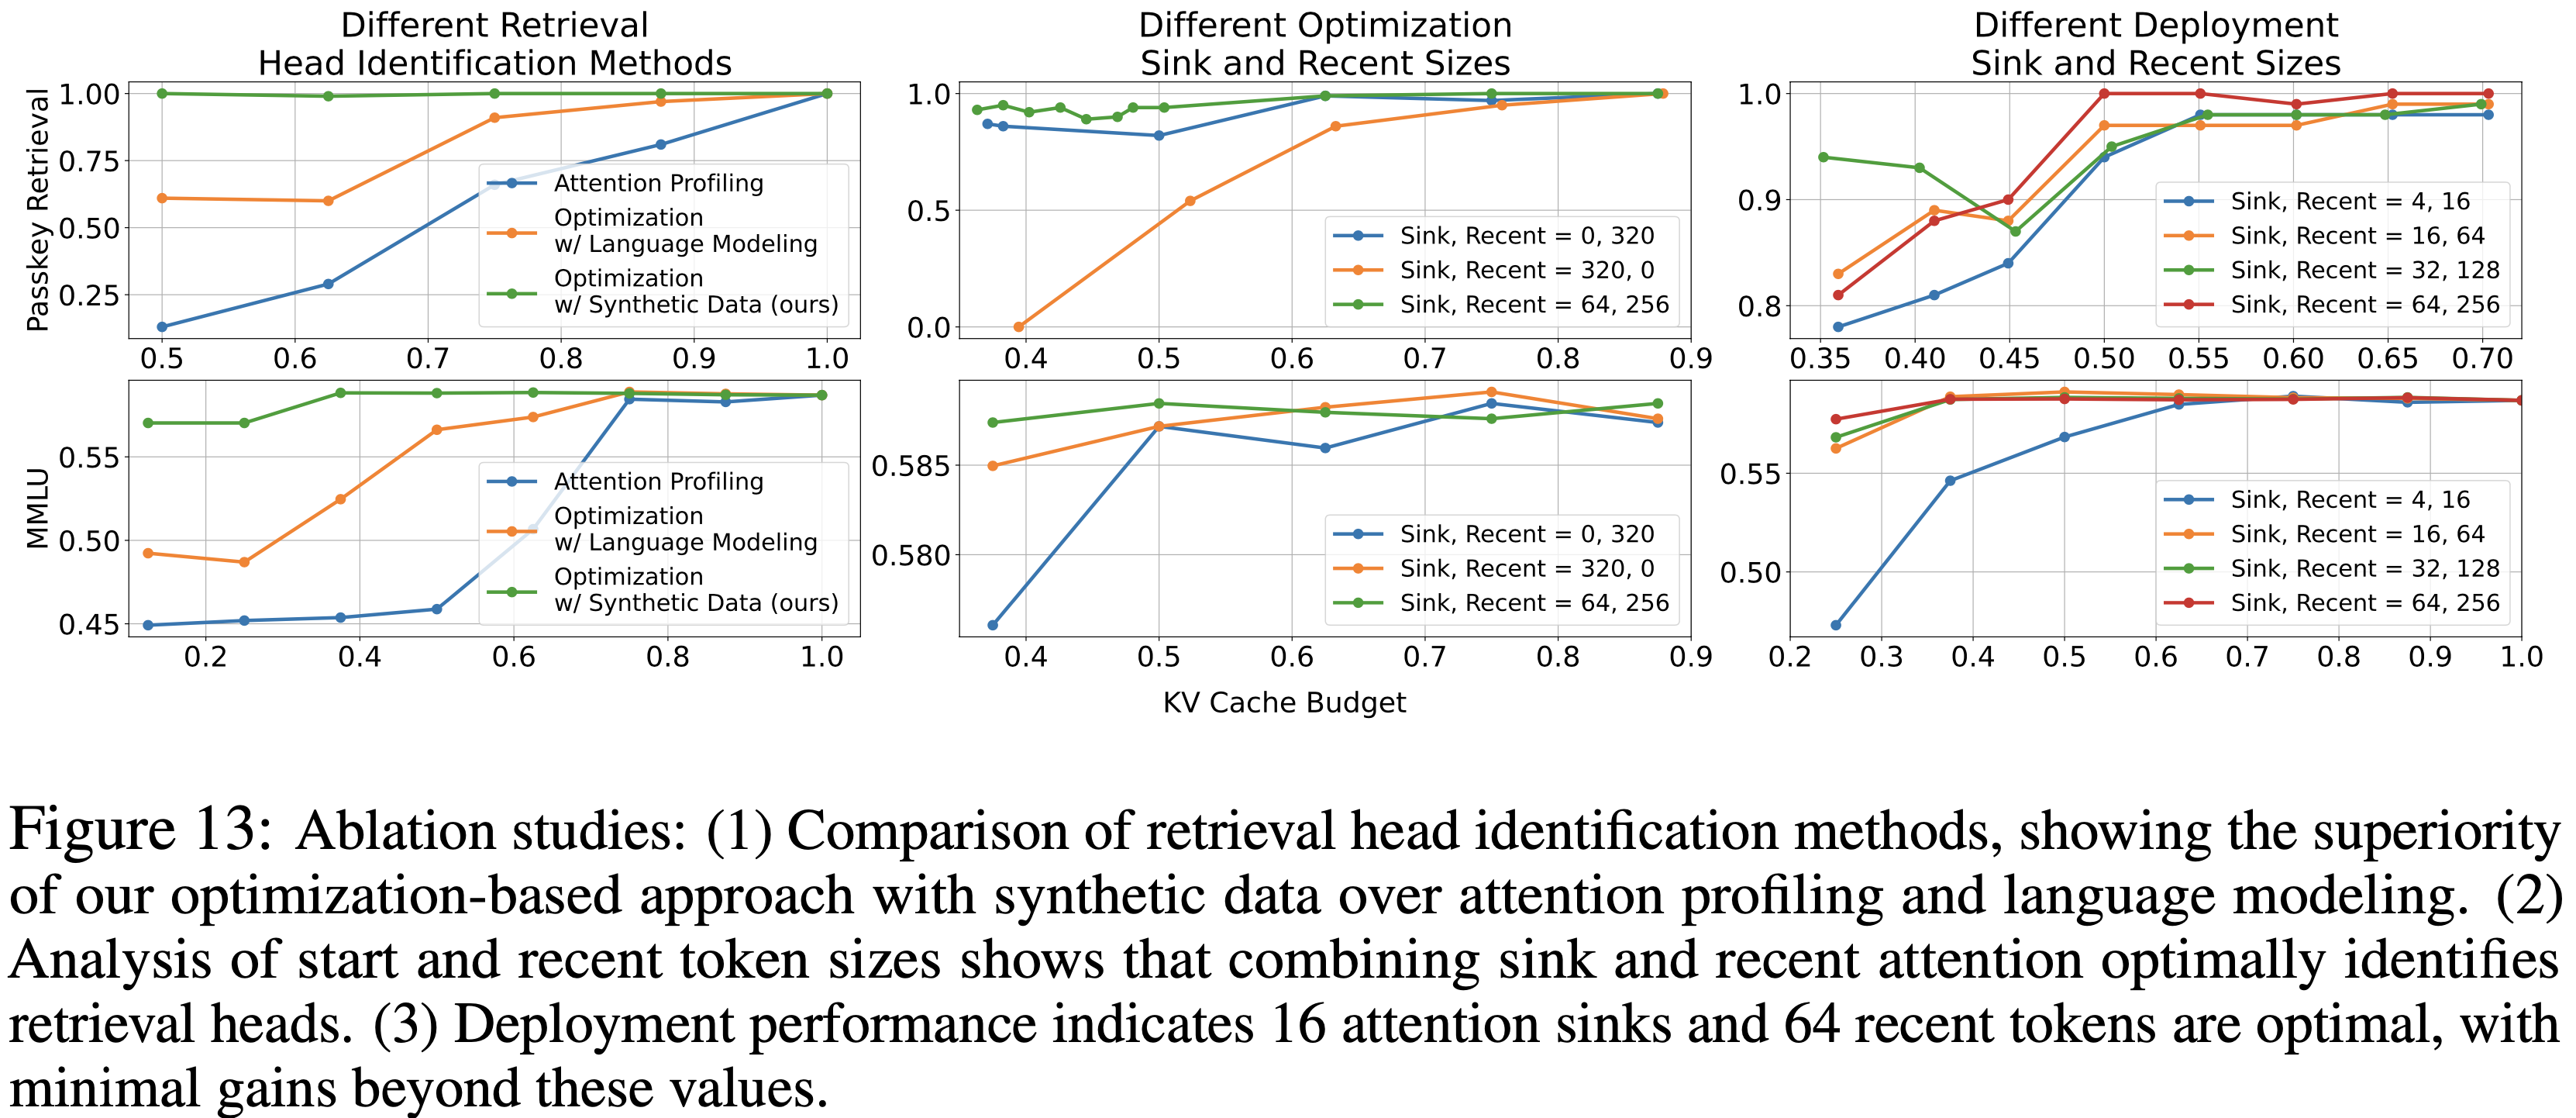
  • 论文使用 Mistral-7B-Instruct-v0.2 在 passkeys 检索和 MMLU 数据集上进行了消融研究
  • 对于 passkeys 检索任务,论文将一个 8 词的 passkeys 嵌入到一个 30K 词的文本中,并在 100 个插入深度上进行线性扫描,报告精确匹配准确率
  • 基于优化与基于 Attention Profiling 的 Retrieval Heads 识别 (Optimization-based vs. Attention Profiling-based Retrieval Head Identification)
    • 论文评估了论文的基于优化的方法与 FastGen (2024) 和 RazorAttention (2024a) 中使用的 Attention Profiling 方法,两者使用相同的合成 passkeys 数据集
    • 图 13 (1) 中的结果表明,论文的方法显著优于 Attention Profiling ,后者难以识别 Retrieval Heads ,从而影响了模型的准确优化
  • 使用合成数据优化与语言建模 (Optimizing with Synthetic Data vs. Language Modeling)
    • 如图 13 (1) 所示,论文使用合成数据识别 Retrieval Heads 的方法比传统的 Language Modeling(在自然数据中的所有 Token 上计算损失)产生了明显更好的结果
  • 优化中结合 Sink 和 Recent 注意力的必要性 (Necessity of Sink+Recent Attention in Optimization)
    • 图 13 (2) 强调了在优化阶段结合 Sink 和 Recent 注意力的重要性
    • 仅依赖 Sink Token 或 Recent Token 注意力不足以有效识别 Retrieval Heads
  • 部署阶段配置 (Deployment Phase Configuration)
    • 论文分析了 Streaming Heads 中注意力 Sink 和 Recent Token 的部署配置
    • 论文的发现表明:
      • 性能在 16 个 Sink Token 和 64 个 Recent Token 时达到稳定(图 13 (3))
      • 进一步增加只会带来边际改进
    • 问题:论文的发现跟 StreamingLLM 的 4 个 Token 足以的发现有矛盾!

Related Work

  • 已有很多方法在扩展 LLM 并提高其处理长上下文的效率;这些方法可以分为四个主要类别:
    • 优化模型架构、使用近似注意力机制、应用 KV 缓存量化以及系统级优化
  • Model Architecture
    • MQA (2019) 和 GQA (2023) 通过在 Query 头之间共享 KV 头来减小 KV 缓存的大小
    • 但这些方法需要使用特定架构进行预训练,并且不会降低计算成本(但会降低显存)
    • 线性注意力 Transformer (2023) 减少了内存使用,但在需要长上下文处理的任务上往往表现不佳
  • Approximate Attention
    • 诸如 Sparse Transformer (2019) 和 LongFormer (2020) 等方法使用 Local Attention 或 Block Attention 模式来降低计算复杂度
    • BigBird (2020) 通过结合 Local Attention 和 Global Attention 实现线性复杂度,但其中许多方法需要定制的 GPU 内核或重新训练,限制了其实用性
    • H2O (2023b) 和 TOVA (2024) 基于 Query 模式丢弃 Token 来简化注意力
    • StreamingLLM (2023b) 识别了“注意力 Sink ”并提出始终保留 Initial Token 和 Recent Token 以维持恒定的解码延迟和内存使用,使模型能够处理比预训练序列长度多得多的输入 Token
    • FastGen (2024) 分析注意力头以在解码期间丢弃 Token
    • 论文的实验表明:
      • 这些方法会降低 LLM 的长上下文能力
      • 这些方法无法降低长上下文 LLM 的 Pre-filling 成本
  • KV Cache Quantization
    • 诸如 8-bit 和 4-bit 量化 (2024; 2024; 2024) 等技术减小了 KV 缓存的大小,但它们没有解决注意力内核的计算开销问题
    • 这些方法与 DuoAttention 是互补的,可以结合使用以进一步减少内存使用
  • System Optimizations
    • vLLM (2023) 和 FlashAttention (2022; 2023) 通过优化批处理(Batch Processing)和利用 GPU 内存层次结构来提高注意力计算效率
    • FlashDecoding (2024) 和 RingAttention (2023a) 在解码速度和序列级并行性方面引入了进一步的改进
    • 这些方法提高了计算性能,但它们没有解决 KV 缓存大小减少的问题,它们与 DuoAttention 互补,以实现额外的速度和内存优化
  • Recent Works
    • 一些近期工作与 DuoAttention 有相似的想法
    • Wu 等人 (2024) 引入了 Retrieval Heads 的概念来解释 LLM 的长上下文能力
      • 但他们的方法没有压缩非 Retrieval Heads 的 KV 缓存,仅关注准确性
    • MInference (2024) 通过使用稀疏注意力模式来加速长上下文 LLM 的 Pre-filling
      • 但没有优化解码期间的 KV 缓存存储或延迟
    • RazorAttention (2024a) 也将注意力头分为 Retrieval 和 Non-Retrieval 类别
      • 但 RazorAttention 使用 Attention Profiling 方法而不是 Optimization-based 方法区区分
        • 论文的实验表明,Attention Profiling-based 方法不如论文的 Optimization-based 的方法准确
      • 而且,RazorAttention 没有优化 Pre-filling
        • DuoAttention 提供了更有效的 KV 缓存管理和更高的压缩率,从而在长上下文应用中为 Pre-filling 和解码带来了更好的性能

Appendix A

A.1 Experimental Details

  • 论文使用 PyTorch (2019) 中的 FSDP 进行模型训练,并使用 DeepSpeed Ulysses (2023) 序列并行来支持长序列
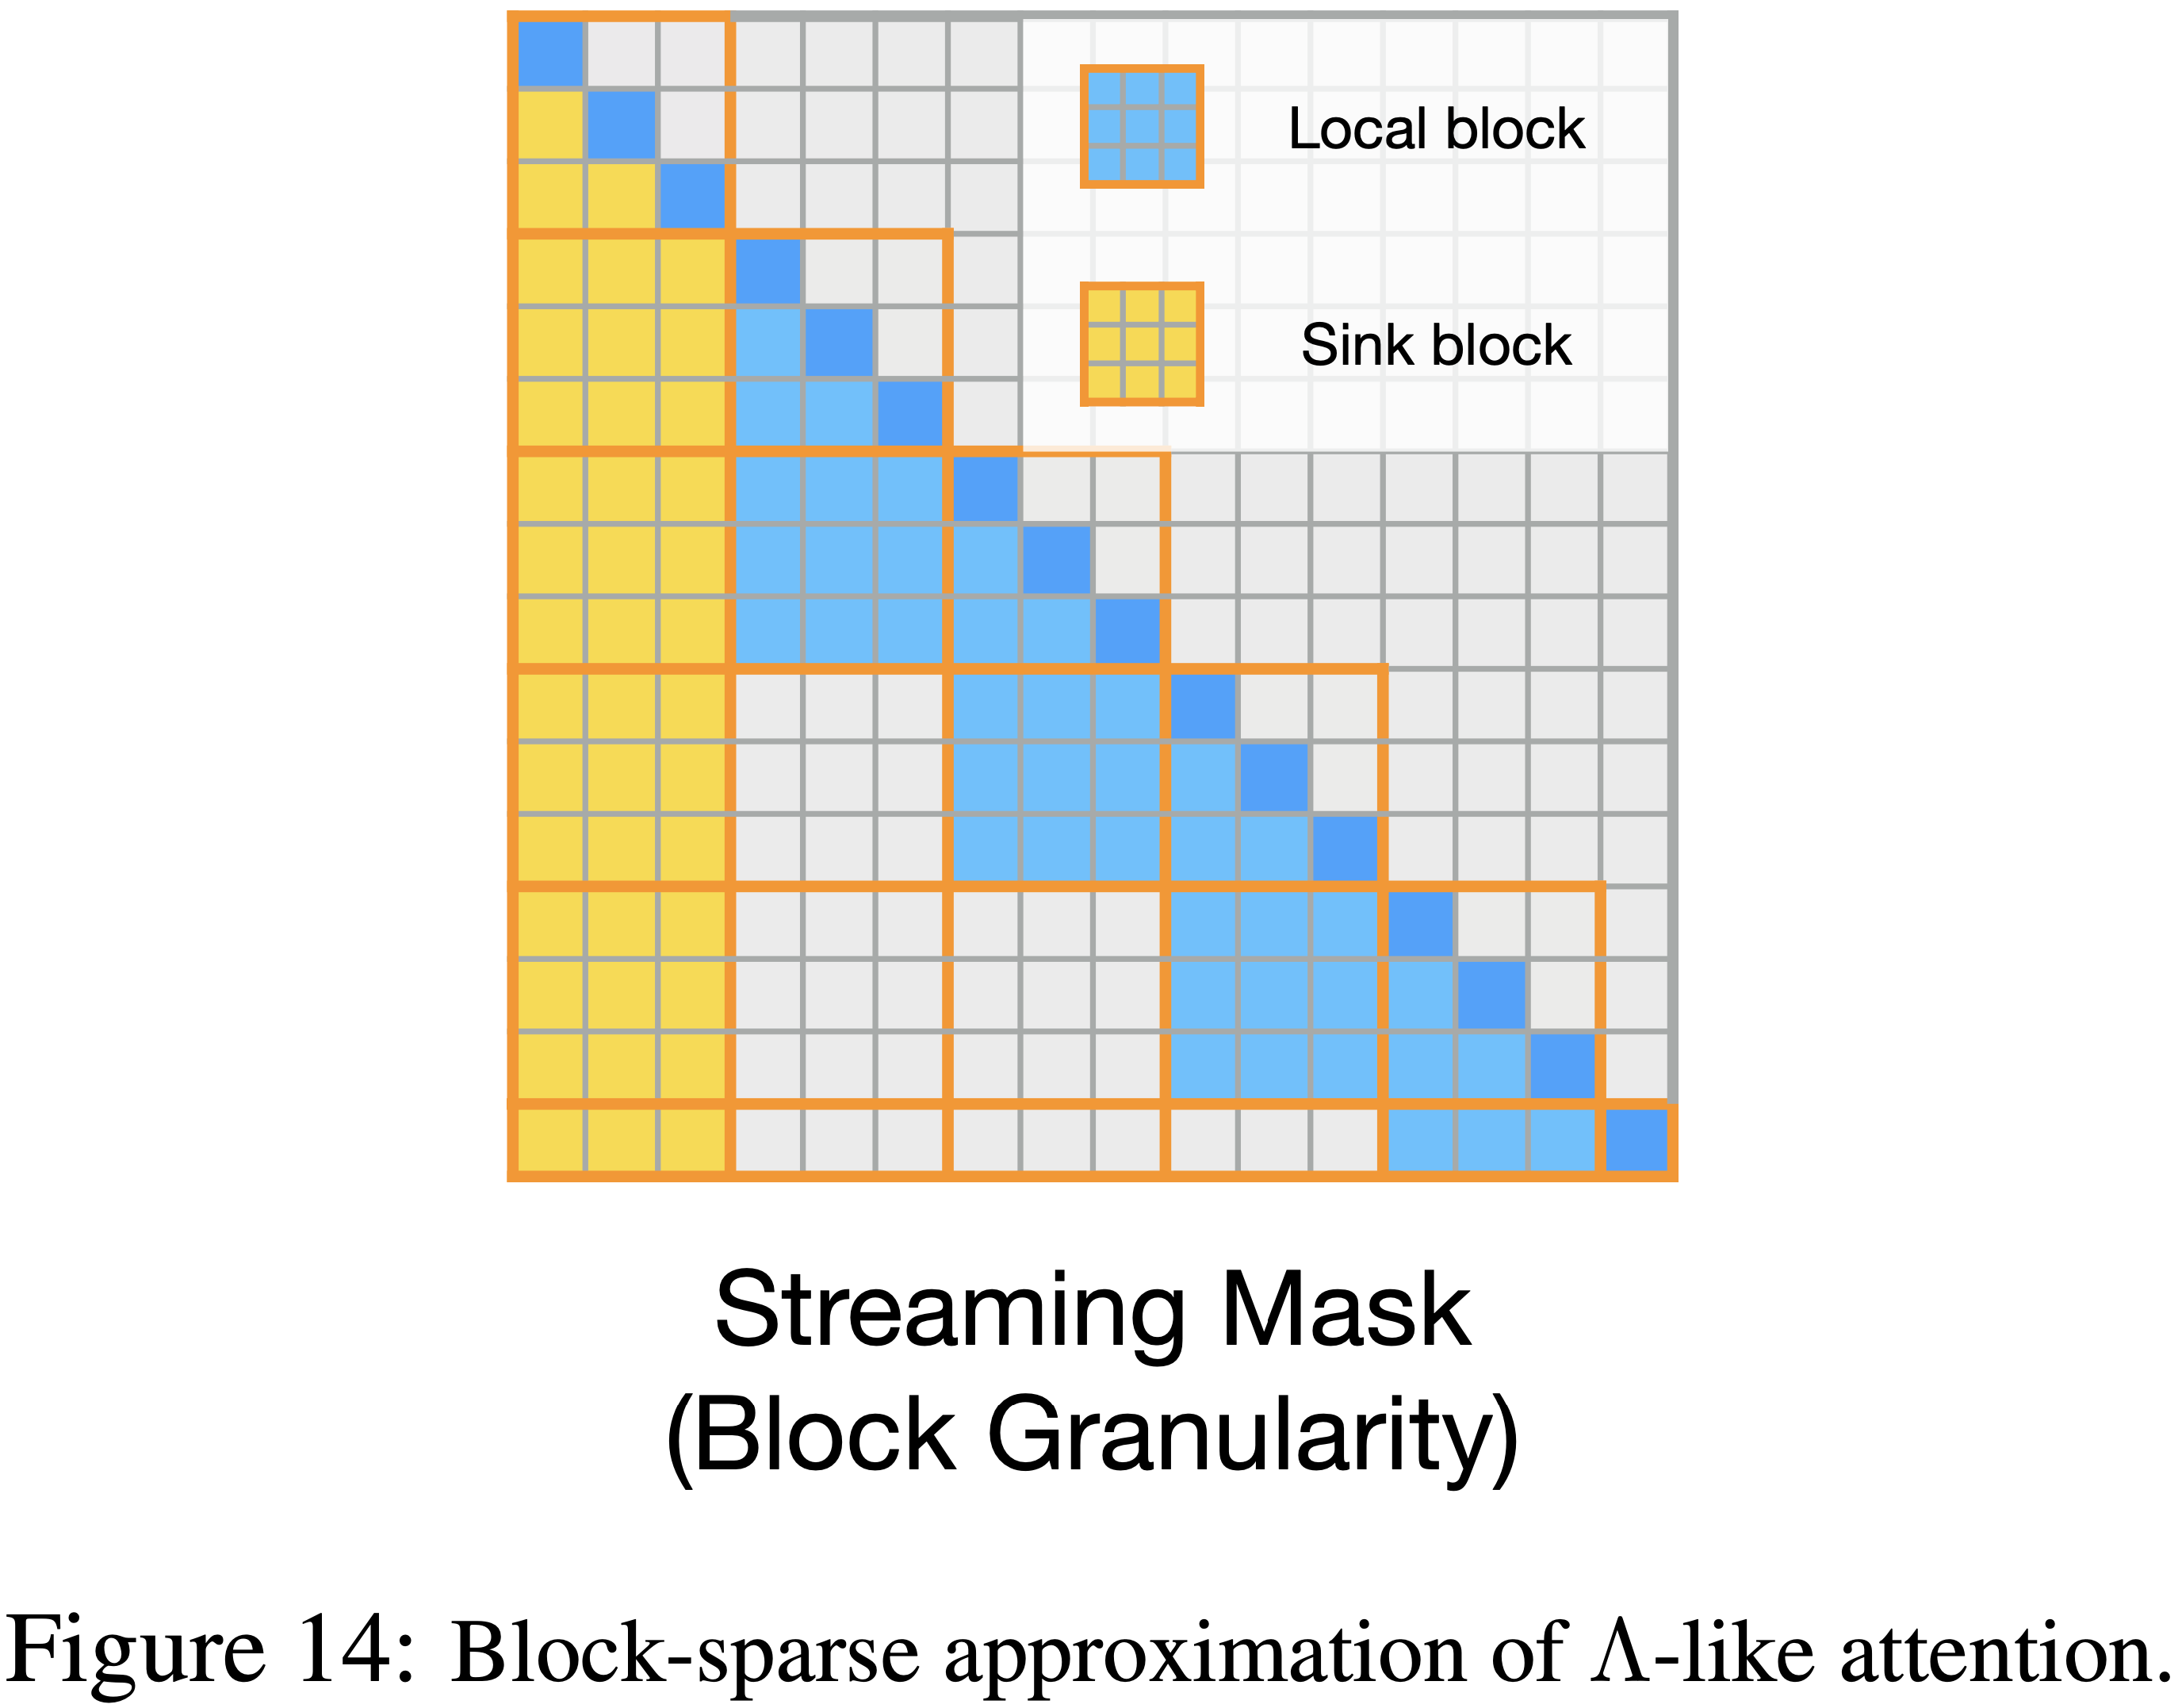
  • 在训练期间,论文使用 Guo 等人 (2024) 实现的、如图 14 所示的高效块稀疏近似 \(\Lambda\) 类注意力来计算流式注意力
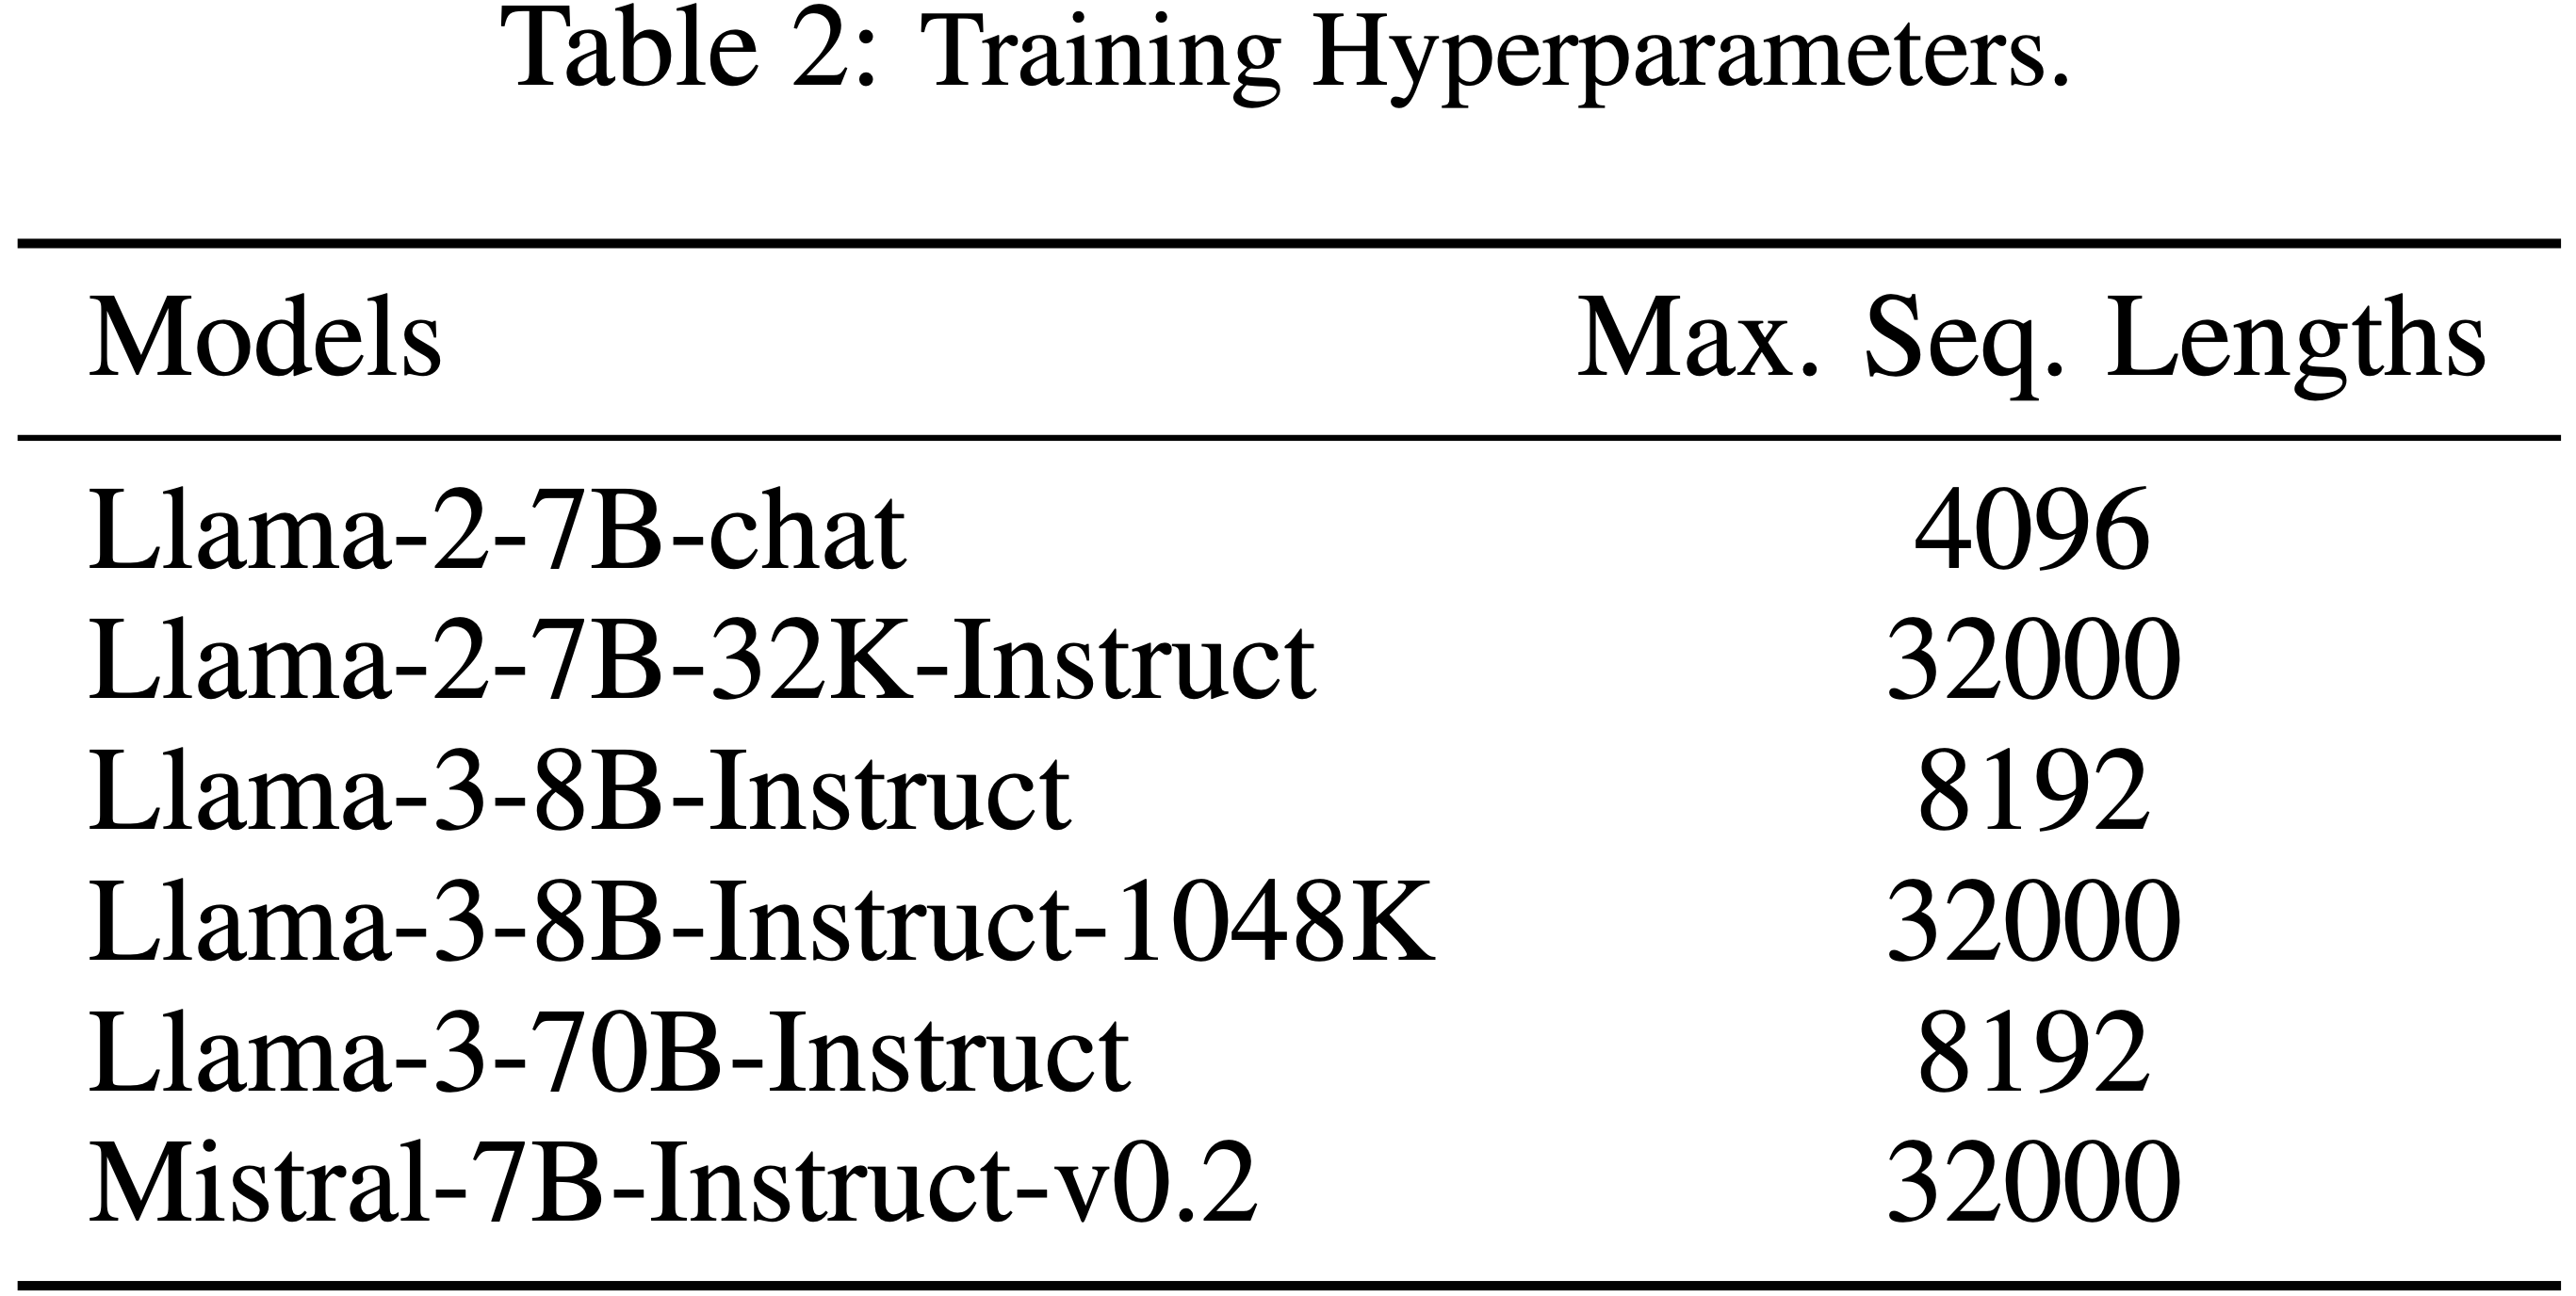
  • 不同模型的最大序列长度各不相同,详见表 2

A.2 Full LongBench Results

A.3 在长上下文基准测试上 H2O 和 TOVA 的实现 (Implementation of H2O and TOVA on Long-Context Benchmarks)

  • H2O (2023b) 和 TOVA (2024) 算法的原始设计与 Pre-filling 阶段的 FlashAttention (2022) 不兼容,因为它们依赖注意力分数来执行 Token Eviction(驱逐)
    • 由于 FlashAttention 中的注意力分数从未被具体化,这些算法无法用于 Pre-filling ,这是它们的主要缺陷之一
    • 因此,不可能在像“大海捞针”和 LongBench 这样的长上下文设置中评估这些算法,因为它们会在上下文 Pre-filling 期间导致内存不足(OOM)
  • 为了与这些策略进行比较,论文修改了算法:
    • 在 Pre-filling 期间,论文使用 FlashAttention 进行精确计算
    • 在解码阶段,论文根据生成 Token 对上下文 Token 的注意力分数执行 Token Eviction
  • 这种修改相比原始设计提高了性能,因为 Pre-filling 是精确的,并且 Token Eviction 仅发生在解码期间
    • 在极端情况下,如果答案中只有一个生成 Token (例如,多项选择题任务),论文实现的 H2O 和 TOVA 将与完全注意力一样精确,这并非它们的真实精度
    • 为了接近它们的真实性能,论文在长输入基准测试(“大海捞针”和 LongBench)中模拟最后 50 个 Token 作为生成 Token ,以足够长时间地执行它们的 Token Eviction 策略,论文的算法也是如此
  • 此实验设置也被 Tang 等人 (2024b) 使用
    • 实验结果表明论文的方法可以通过此压力测试,而 H2O 和 TOVA 则不能

A.4 Implementation of FastGen on Long-Context Benchmarks

  • 由于缺乏 FastGen (2024) 算法的官方实现,论文使用一个社区代码库 (2024) 对其进行了复现,该代码库被 FastGen 的官方仓库引用
    • 在 FastGen 算法中,剪枝比率不能直接配置;而是使用恢复比率 \(T\) 来控制稀疏度,如 FastGen 论文中所述
  • 为了量化稀疏度,论文计算了所有测试用例的平均 KV 缓存使用量作为整体稀疏度的度量
    • 对于 Llama-2-7B 模型,论文将恢复比率设置为 \(0.7\),确保平均 KV 缓存预算超过完整 KV 缓存的 25%
    • 对于 Llama-3-8B 模型,论文将恢复比率设置为 \(0.87\),确保平均 KV 缓存预算超过完整 KV 缓存的 50%
  • 由于 FastGen 使用用户提供提示的完整注意力图来分析不同头的类型,它会导致 \(O(n^{2})\) 的注意力图复杂度
    • 论文无法在长上下文中测试其性能
  • 对于长上下文基准测试,论文使用了 8 个 A100-80G GPU,对于 Llama-2-7B 模型实现了最高 24k Token 的序列长度,对于 Llama-3-8B 模型实现了最高 32k Token 的序列长度
  • 除了图 6 中显示的“大海捞针”基准测试结果外,论文还评估了FastGen 在两个模型上的 LongBench 表现
    • 但由于 FastGen 的二次内存消耗,论文仅报告了在 8x A100-80G GPU 上使用 FastGen 可以运行的数据集结果
    • 如表 5 和表 6 所示,DuoAttention 在 LongBench 数据集上 consistently 优于 FastGen

补充表格和图标

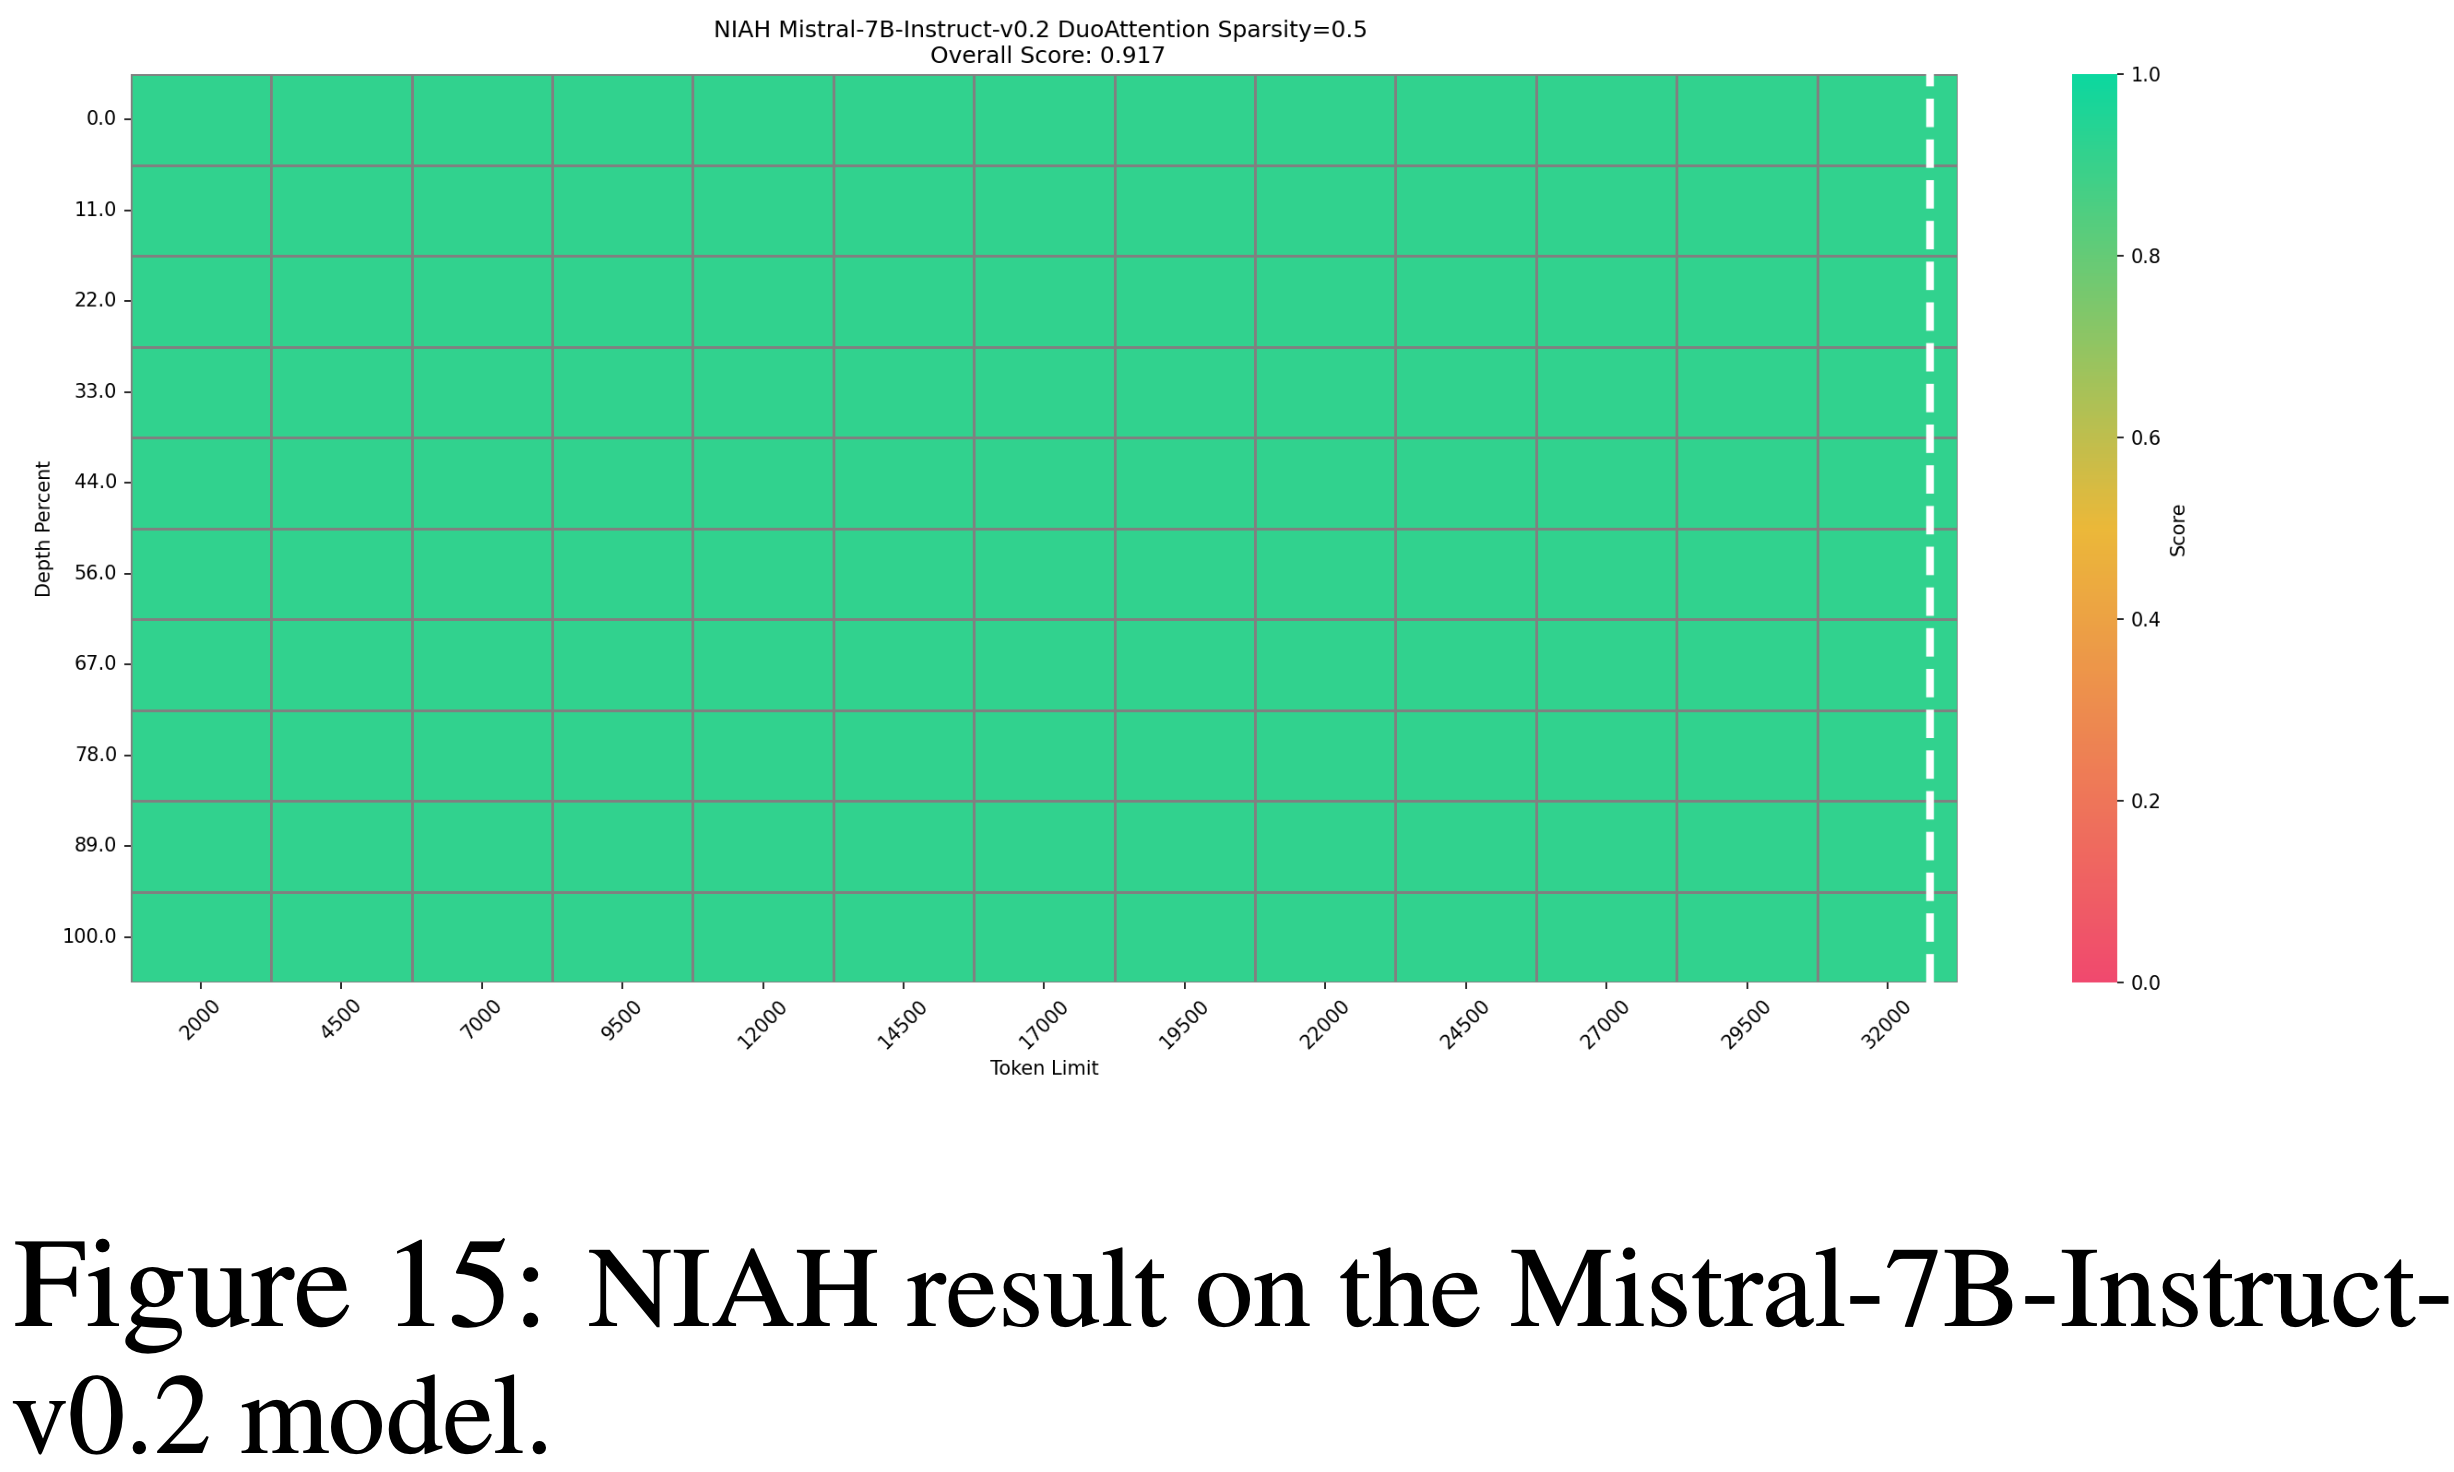
  • 图 15: NIAH result on the Mistral-7B-Instruct-v0.2 model
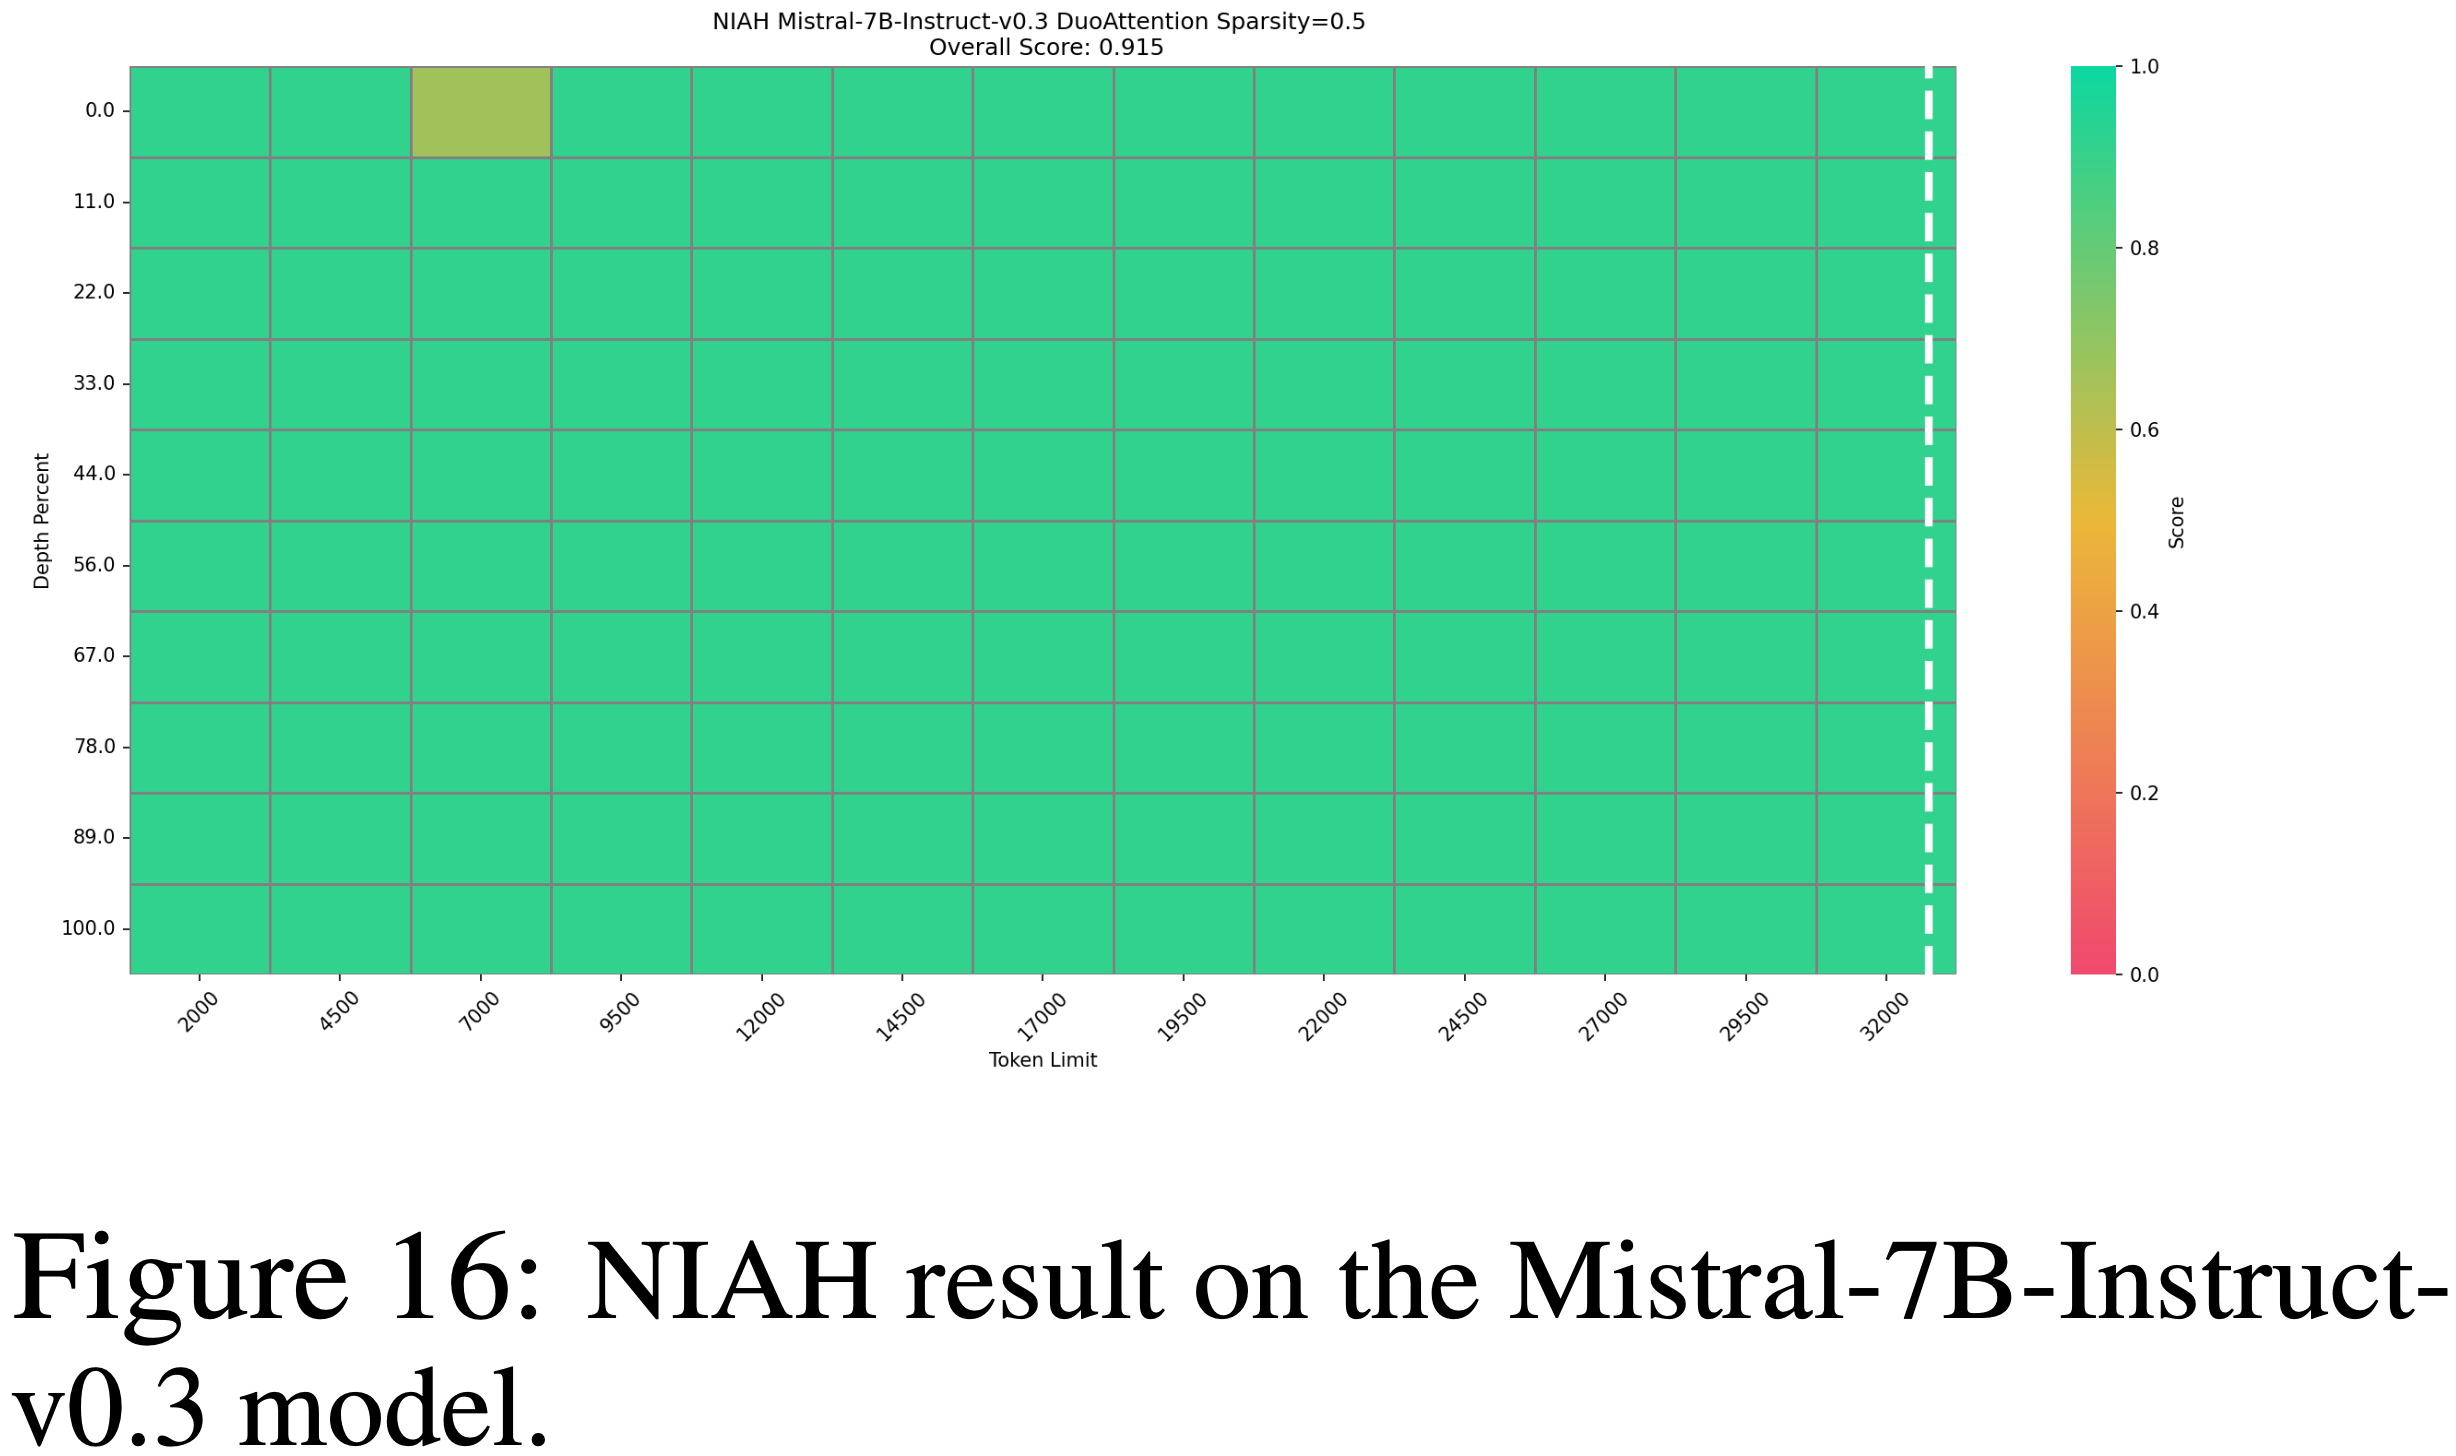
  • 图 16: NIAH result on the Mistral-7B-Instruct-v0.3 model
NLP——StreamingLLM

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(StreamingLLM)Efficient Streaming Language Models with Attention Sinks, arXiv 202309 & ICLR 2024, MIT & Meta AI & CMU & NVIDIA
    • GitHub(代码和数据集开源):github.com/mit-han-lab/streaming-llm

Paper Summary

  • 整体说明:
    • 作者发现:Window Attention 提供了一个部分解决方案,但当初始 Token 被排除时,其性能会急剧下降(这些 Token 作为“Attention Sink”的作用很重要)
    • 本文提出了一个简单而高效的框架 StreamingLLM,使 LLM 能够在无需微调的情况下处理无限长度的文本
      • 通过将 Attention Sink 与 Recent Token 结合,StreamingLLM 可以高效地对多达 4M Token 的文本进行建模
    • 论文还进一步通过实验证实,使用专用的 Sink Token 预训练模型可以改善流式性能
      • StreamingLLM 首次将 LLM 的预训练窗口大小与其实际文本生成长度解耦,为 LLM 的流式部署铺平了道路
  • 第一个问题提出:在流式(streaming)应用(如多轮对话)中部署 LLM 是迫切需要的,但面临两大挑战
    • 挑战一:在解码阶段,缓存先前 Token 的键和值状态(KV)会消耗大量内存
    • 挑战二:popular LLM 无法泛化到比训练序列长度更长的文本
  • 第二个问题提出:Window Attention 是一种自然的方法,仅缓存最近的 KV,但论文发现当文本长度超过缓存大小时,该方法会失效
  • Insight:作者观察到一个有趣的现象,即 Attention Sink :
    • 保留(Keeping)初始 Token(initial Token)的 KV 会大幅恢复 Window Attention 的性能
    • 注:Window Attention 会丢失最初的 Token 信息(窗口外),而刻意保留初始 Token 的 KV 能大幅提升模型性能
    • 论文证明了 Attention Sink 的出现是由于对初始 Token 的 Strong 注意力分数 ,即使它们在语义上并不重要
    • 注:Attention Sink 的定义应该是 无论初始 Token 与语言建模任务的相关性如何,都有大量的注意力分数分配给了初始 Token
  • 方案:StreamingLLM
    • StreamingLLM 是一个高效的框架,使经过有限长度注意力窗口训练的 LLM 能够无需任何微调即可泛化到无限序列长度
    • StreamingLLM 能够使 Llama-2、MPT、Falcon 和 Pythia 在高达 4M Token 甚至更多的文本上实现稳定高效的语言建模
  • 论文的其他发现,在预训练期间添加一个占位符 Token 作为专用的 Attention Sink 可以进一步改善流式部署
    • 在流式设置中,StreamingLLM 相比滑动窗口重计算基线实现了高达 22.2 倍的加速

Introduction and Discussion

  • LLM (2018; 2020; 2022; OpenAI, 2023; 2023a, 2023b) 正变得无处不在,驱动着许多自然语言处理应用,如对话系统 (2022; 2023; 2023)、文档摘要 (2020; 2023a)、代码补全 (2021; 2023) 和问答 (2023)
    • 为了释放预训练 LLM 的全部潜力,它们应该能够高效且准确地执行长序列生成
      • 例如,一个理想的聊天机器人助手应该能够在长达数日的对话内容上稳定工作
    • 但对于 LLM 来说,泛化到比其预训练长度更长的序列是非常具有挑战性的,例如 Llama-2 的 4K (2023b)
  • 原因是 LLM 在预训练期间受到注意力窗口的限制
    • 尽管在扩展此窗口大小 (2023; 2023; 2023) 以及改进长输入的训练 (2022; 2023) 和推理 (2022; 2023; 2023; 2021; 2023b) 效率方面付出了大量努力,可接受的序列长度本质上仍然是有限的 ,这不允许持久部署
  • 论文介绍了 LLM 流式应用的概念,并提出了一个问题:论文能否在不牺牲效率和性能的情况下,为无限长度的输入部署 LLM?
  • 当将 LLM 应用于无限输入流时,会出现两个主要挑战:
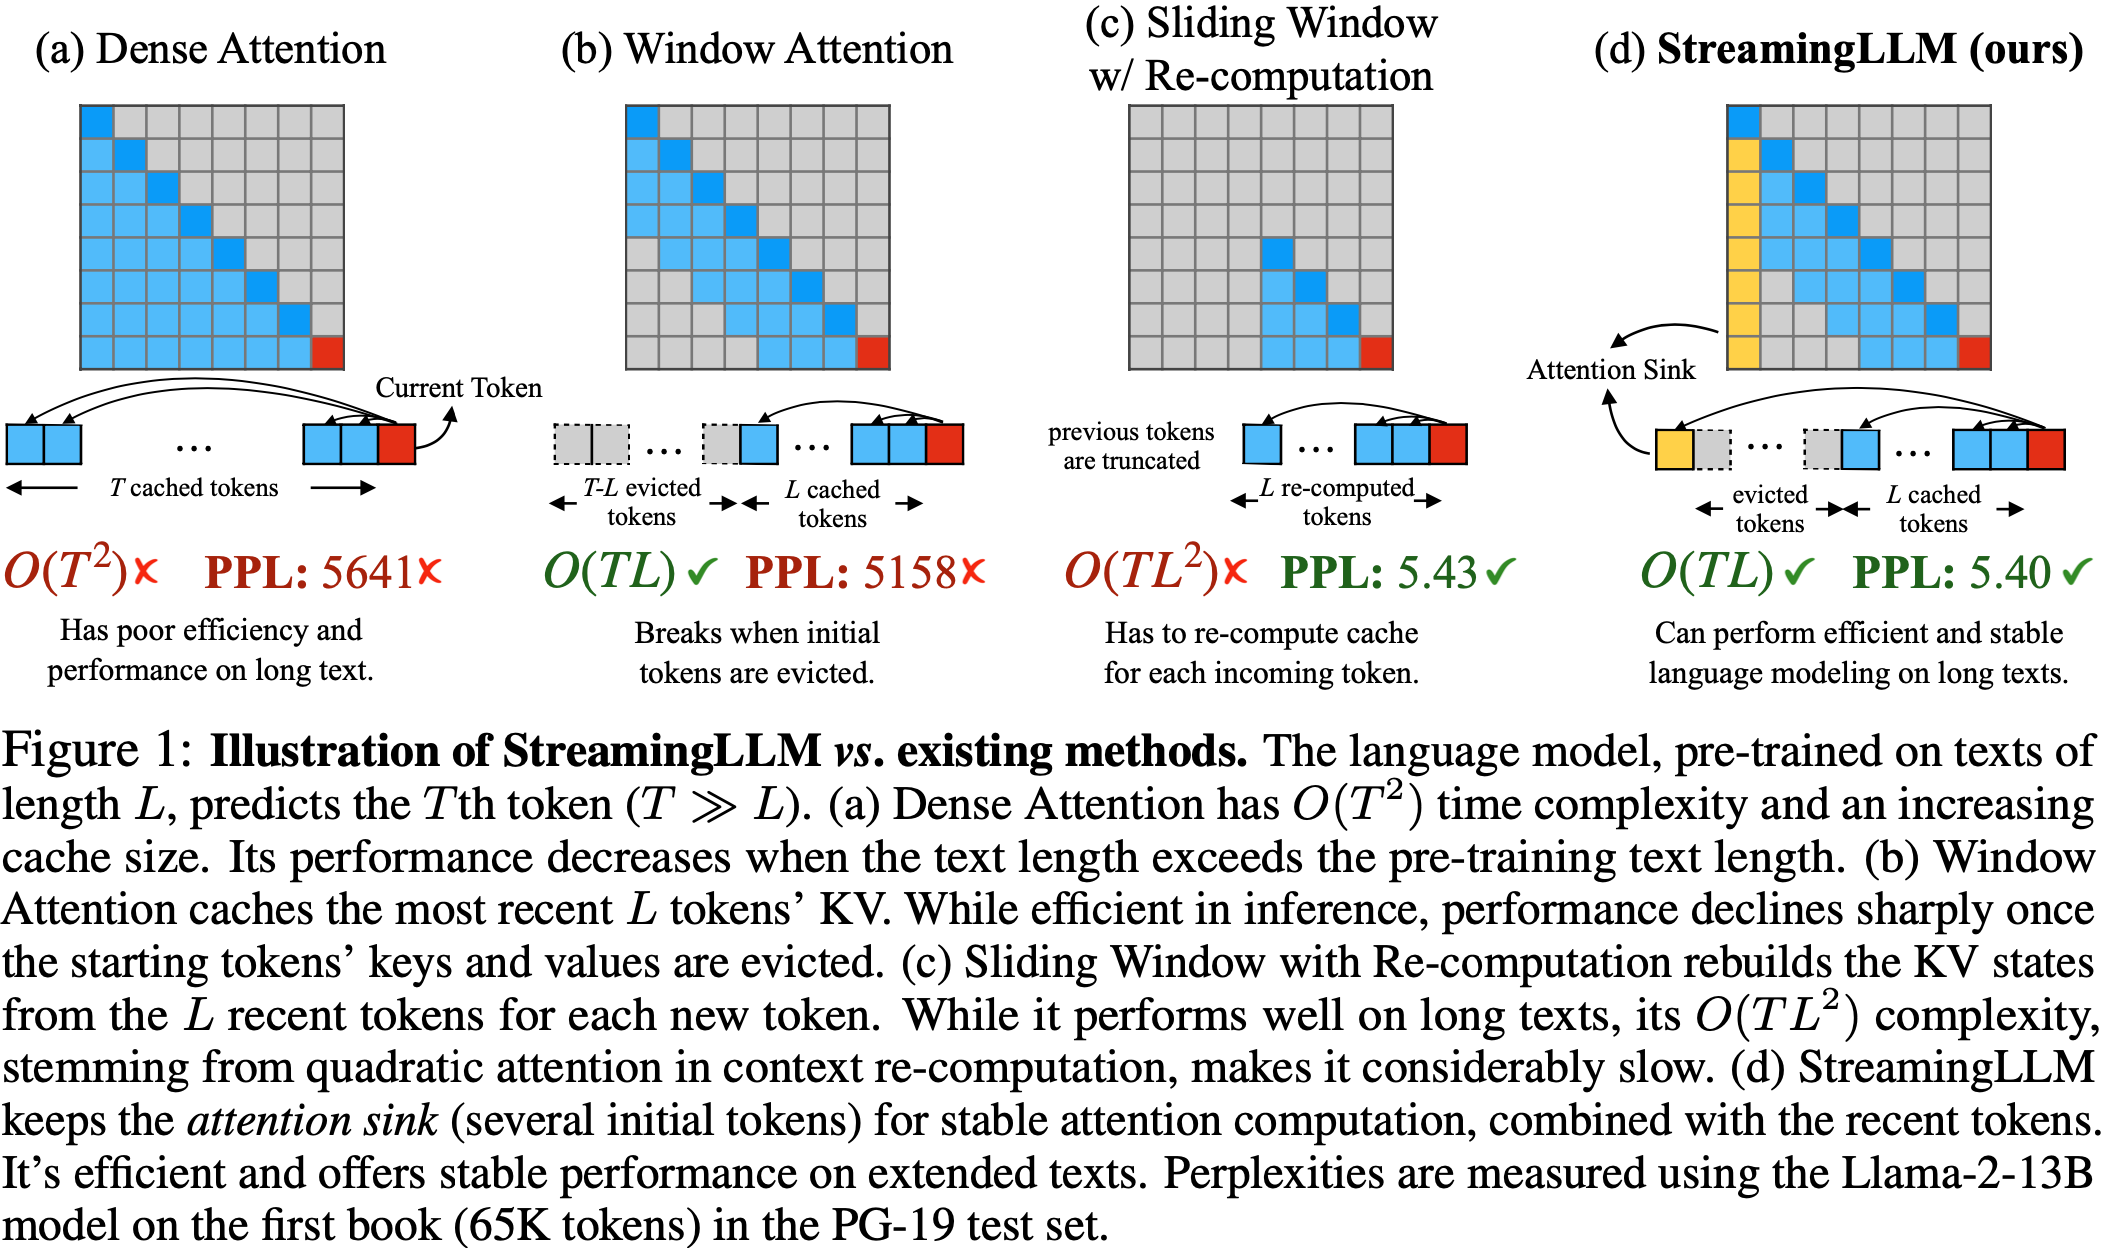
    • 1)在解码阶段,基于 Transformer 的 LLM 会缓存所有先前 Token 的键和值状态(KV),如图 1 (a) 所示,这可能导致过多的内存使用和不断增加的解码延迟 (2022)
    • 2)现有模型的长度外推能力有限,即当序列长度超过预训练期间设置的注意力窗口大小时,它们的性能会下降 (2023; 2022)
  • 一种直观的方法,称为 Window Attention (2020)(图 1 b),仅维护最近 Token 的 KV 状态的固定大小滑动窗口
    • 虽然它在缓存初始填满后确保了恒定的内存使用和解码速度,但一旦序列长度超过缓存大小,模型就会崩溃,即即使只是驱逐第一个 Token 的 KV ,如图 3 所示
  • 另一种策略是带重计算的滑动窗口(如图 1 c 所示),它为每个生成的 Token 重建最近 Token 的 KV 状态
    • 虽然它提供了强大的性能,但由于需要在其窗口内计算二次注意力,这种方法明显更慢,使其对于现实世界的流式应用不切实际
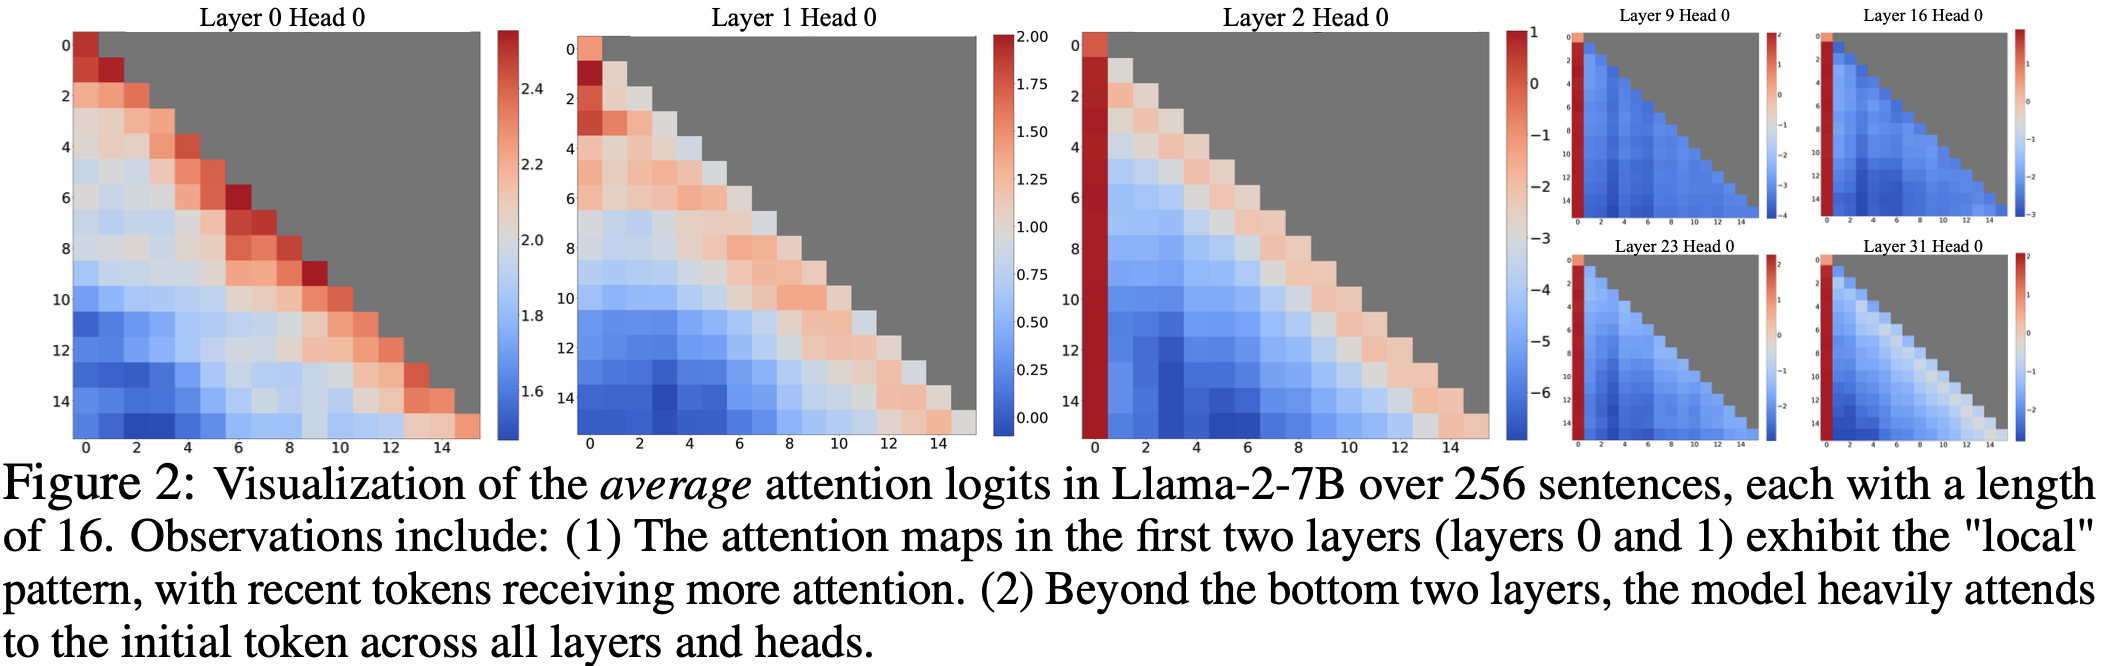
  • 为了理解 Window Attention 的失败原因,论文发现了自回归 LLM 的一个有趣现象:无论初始 Token 与语言建模任务的相关性如何,都有大量的注意力分数分配给了初始 Token ,如图 2 所示
    • 论文称这些 Token 为“ Attention Sink ”
    • 尽管它们缺乏语义重要性,却收集了显著的注意力分数
    • 论文将原因归咎于 Softmax 操作,它要求所有上下文 Token 的注意力分数总和为一
    • 因此,即使当前查询在许多先前的 Token 中没有强匹配项,模型仍然需要将这些不需要的注意力值分配到某处,以便总和为一
    • 初始 Token 成为汇聚 Token 背后的原因是直观的:
      • 由于自回归语言建模的性质,初始 Token 对几乎所有后续 Token 都是可见的,这使得它们更容易被训练成 Attention Sink
  • 基于上述见解,论文提出了 StreamingLLM,一个简单高效的框架,使经过有限注意力窗口训练的 LLM 能够无需微调即可处理无限长度的文本
    • StreamingLLM 利用了 Attention Sink 具有高注意力值这一事实,保留它们可以保持注意力分数分布接近正常
    • 因此,StreamingLLM 只需保留 Attention Sink Token 的 KV(仅需 4 个初始 Token 就足够)以及滑动窗口的 KV,以锚定注意力计算并稳定模型的性能
  • 通过 StreamingLLM,包括 Llama-2 (2023b)、MPT (Team, 2023)、Falcon (2023) 和 Pythia (2023) 在内的模型可以可靠地对 4M Token 进行建模,甚至可能更多
    • 与唯一可行的基线——带重计算的滑动窗口相比,StreamingLLM 实现了高达 22.2 倍的加速,实现了 LLM 的流式使用
  • 图 1: StreamingLLM 与现有方法的示意图 在长度为 \(L\) 的文本上预训练的语言模型预测第 \(T\) 个 Token (\(T\gg L\))
    • (a) Dense Attention 具有 \(O(T^{2})\) 的时间复杂度和不断增长的缓存大小
      • 当文本长度超过预训练文本长度时,其性能下降
    • (b) Window Attention 缓存最近 \(L\) 个 Token 的 KV
      • 虽然在推理中高效,但一旦起始 Token 的键和值被驱逐,性能就会急剧下降
    • (c) 带重计算的滑动窗口(Sliding Window with Re-computation)为每个新 Token 从 \(L\) 个最近 Token 重建 KV 状态
      • 虽然它在长文本上表现良好,但其 \(O(TL^{2})\) 的复杂度(源于上下文重计算中的二次注意力)使其相当慢
    • (d) StreamingLLM 保留 Attention Sink (几个初始 Token )以进行稳定的注意力计算,并结合了最近 Token
      • 在扩展文本上高效且提供稳定的性能
    • 困惑度是使用 Llama-2-13B 模型在 PG-19 测试集中第一本书(65K Token )上测量的
  • 图 2: Llama-2-7B 在 256 个句子上的平均注意力对数概率可视化,每个句子长度为 16。观察包括:
    • (1) 前两层(第 0 层和第 1 层)的注意力图呈现出“局部”模式,最近 Token 获得更多注意力
    • (2) 在底部两层之上,模型在所有层和头中都严重关注(heavily attends)初始 Token

StreamingLLM

The Failure of Window Attention and Attention Sinks

  • 虽然 Window Attention 技术在推理过程中提供了效率,但它导致了极高的语言建模困惑度
    • 该模型的性能不适合部署在 流式应用 (streaming applications) 中
    • 论文使用 Attention Sink 的概念来解释 Window Attention 的失败,这为 StreamingLLM 提供了灵感
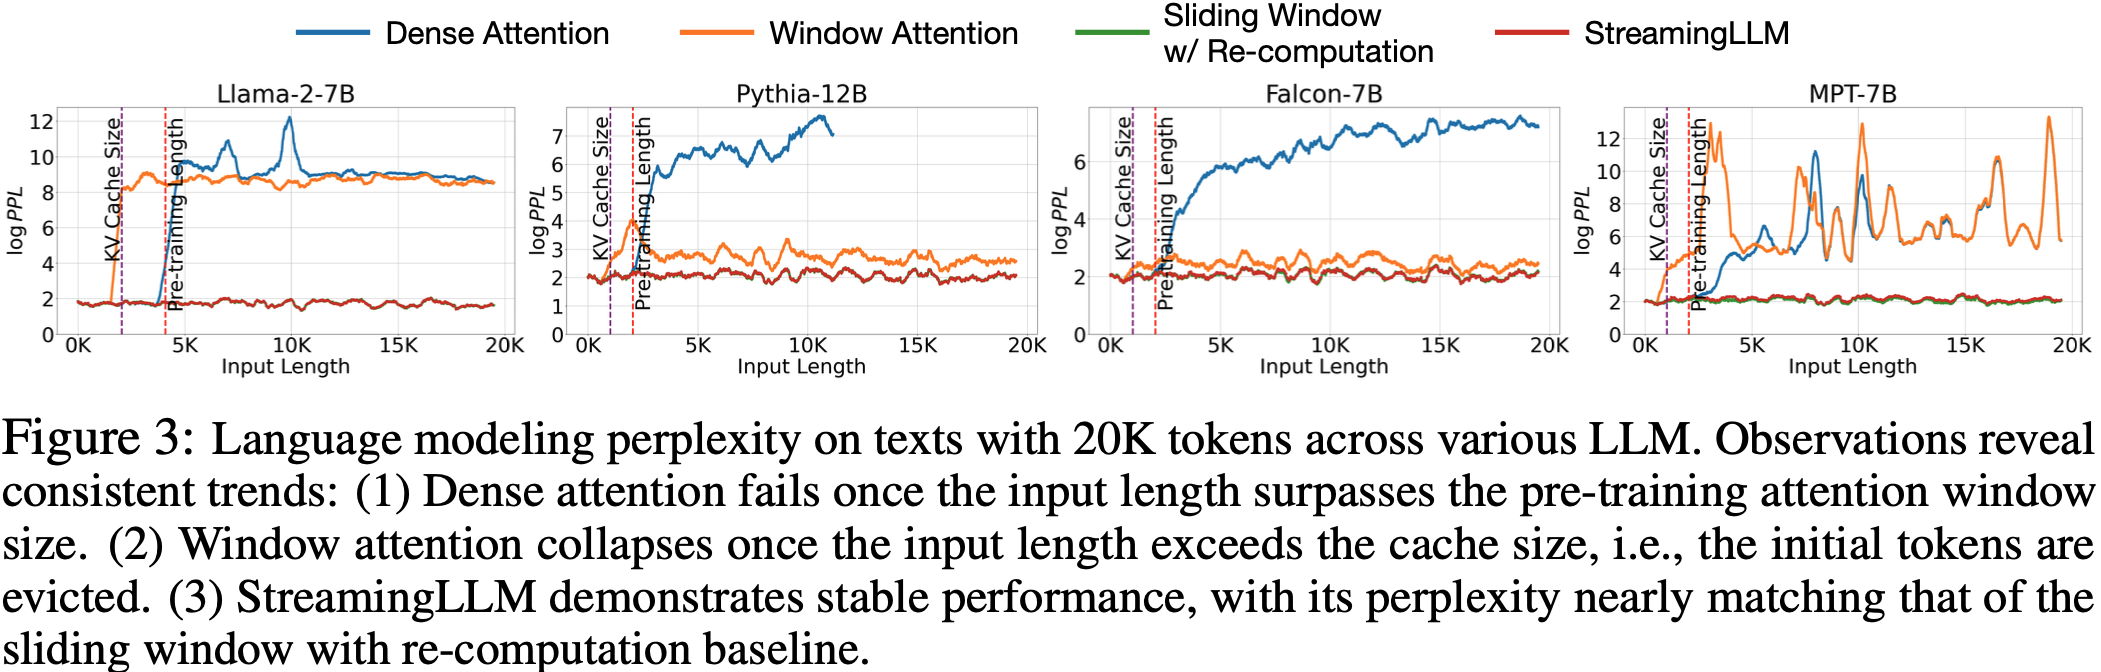
  • 识别困惑度激增点 (Identifying the Point of Perplexity Surge) 图 3 显示了在 20K Token 文本上的语言建模困惑度
    • 当文本长度超过 缓存 (cache) 大小时,由于排除了初始 Token ,困惑度会急剧上升
    • 这表明,初始 Token ,无论它们与预测 Token 的距离如何,对于维持 LLM 的稳定性都至关重要
Why do LLMs break when removing initial tokens’ KV?
  • 论文在图 2 中可视化了 Llama-2-7B 和模型所有层和头中的注意力图
  • 论文发现,除了底部两层之外(注:这里的底部两层是最开始的两层),模型在所有层和头上都持续关注初始 Token
    • 这意味着:移除这些初始 Token 的 KV 将移除 SoftMax 函数(公式 1)注意力计算中分母的相当一部分
  • 这种改变导致注意力分数的分布发生显著变化,偏离了正常推理环境下的预期
    $$\text{SoftMax}(x)_{i}=\frac{e^{x_{i} } }{e^{x_{1} }+\sum_{j=2}^{N}e^{x_{j} } },\quad x_{1}\gg x_{j},j\in 2,\ldots,N \tag{1}$$
  • 对于初始 Token 在语言建模中的重要性,有两种可能的解释:
    • (1) 它们的语义至关重要
    • (2) 模型学习到了对其绝对位置的偏好
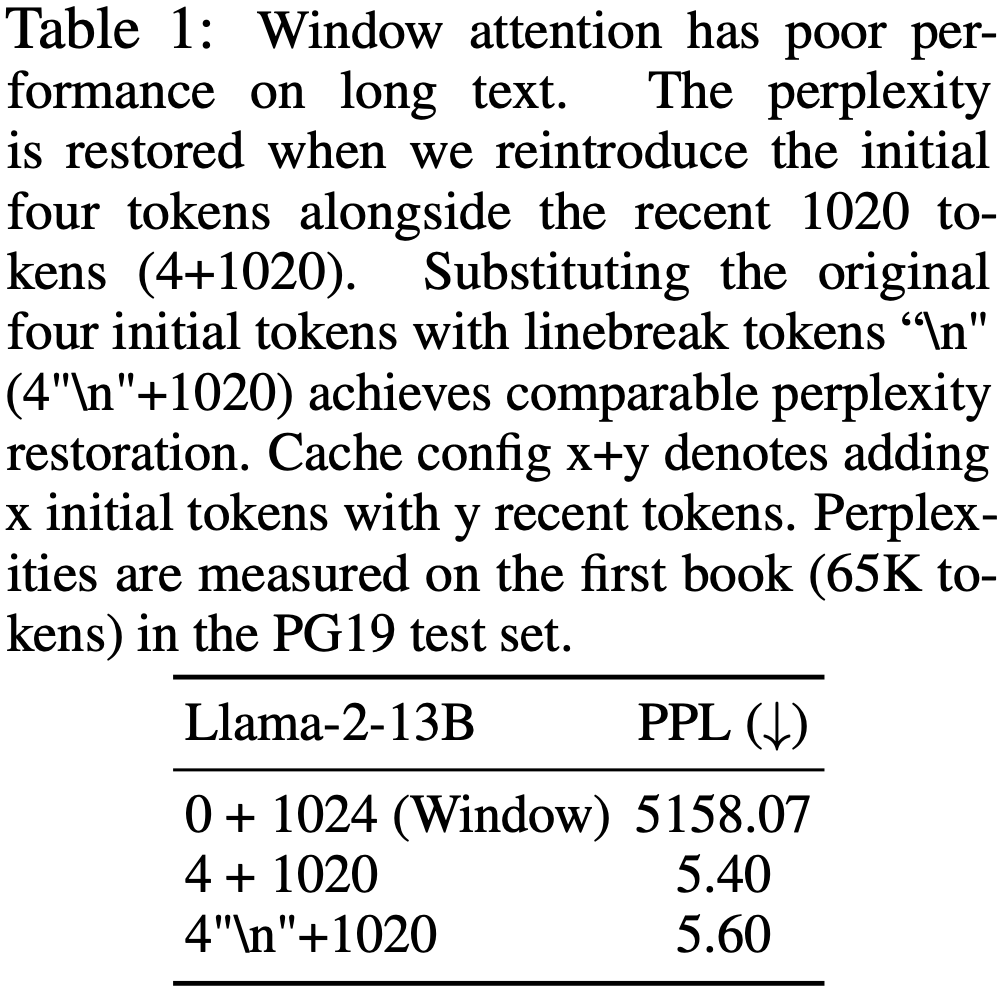
  • 为了区分这两种可能性,论文进行了实验(表 1),其中前四个 Token 被替换为换行符 Token “\n”
    • 观察结果表明,模型仍然显著关注这些初始的换行符 Token
    • 此外,重新引入它们可以将语言建模困惑度恢复到与拥有原始初始 Token 相当的水平
    • 这表明起始 Token 的绝对位置(而非其语义价值)具有更重要的意义
LLMs attend to Initial Tokens as Attention Sinks(LLM 将初始 Token 视为 Attention Sink )
  • 为了解释为什么无论它们与语言建模的语义相关性如何,模型都不成比例地关注初始 Token,论文引入了 “Attention Sink” 的概念
  • SoftMax 函数(公式 1)的性质阻止所有被关注的 Token 具有零值
    • 这要求在所有层的所有头中从其他 Token 聚合一些信息,即使当前的 Embedding 已经有足够的 self-contained 信息用于预测
    • 因此,模型倾向于将不必要的注意力值转储到特定的 Token 上
  • 在量化异常值领域也进行了类似的观察 (2023; 2023),这导致了提出 SoftMax-Off-by-One (Miller, 2023) 作为潜在的补救措施
  • 图 3:各种 LLM 在 20K Token 文本上的语言建模困惑度。观察结果显示了一致的趋势:
    • (1) 一旦输入长度超过预训练注意力窗口大小, Dense Attention 就会失败
    • (2) 一旦输入长度超过缓存大小,即初始 Token 被逐出(evicted), Window Attention 就会崩溃
    • (3) StreamingLLM 表现出稳定的性能,其困惑度几乎与带重计算的滑动窗口 (sliding window with re-computation) 基线相匹配
  • 为什么各种自回归 LLM,如 Llama-2、MPT、Falcon 和 Pythia,都一致地将初始 Token 作为它们的 Attention Sink,而不是其他 Token ?(Why do various autoregressive LLMs, such as Llama-2, MPT, Falcon, and Pythia, consistently focus on initial tokens as their attention sinks, rather than other tokens?)
    • 论文的解释很简单:由于自回归语言建模的顺序性质,初始 Token 对所有后续 Token 都是可见的,而后来的 Token 仅对有限的后续 Token 集合可见
    • 因此,初始 Token 更容易被训练成为 Attention Sink,捕获不必要的注意力
  • 论文注意到,LLM 通常被训练为使用多个初始 Token 作为 Attention Sink,而不仅仅是一个
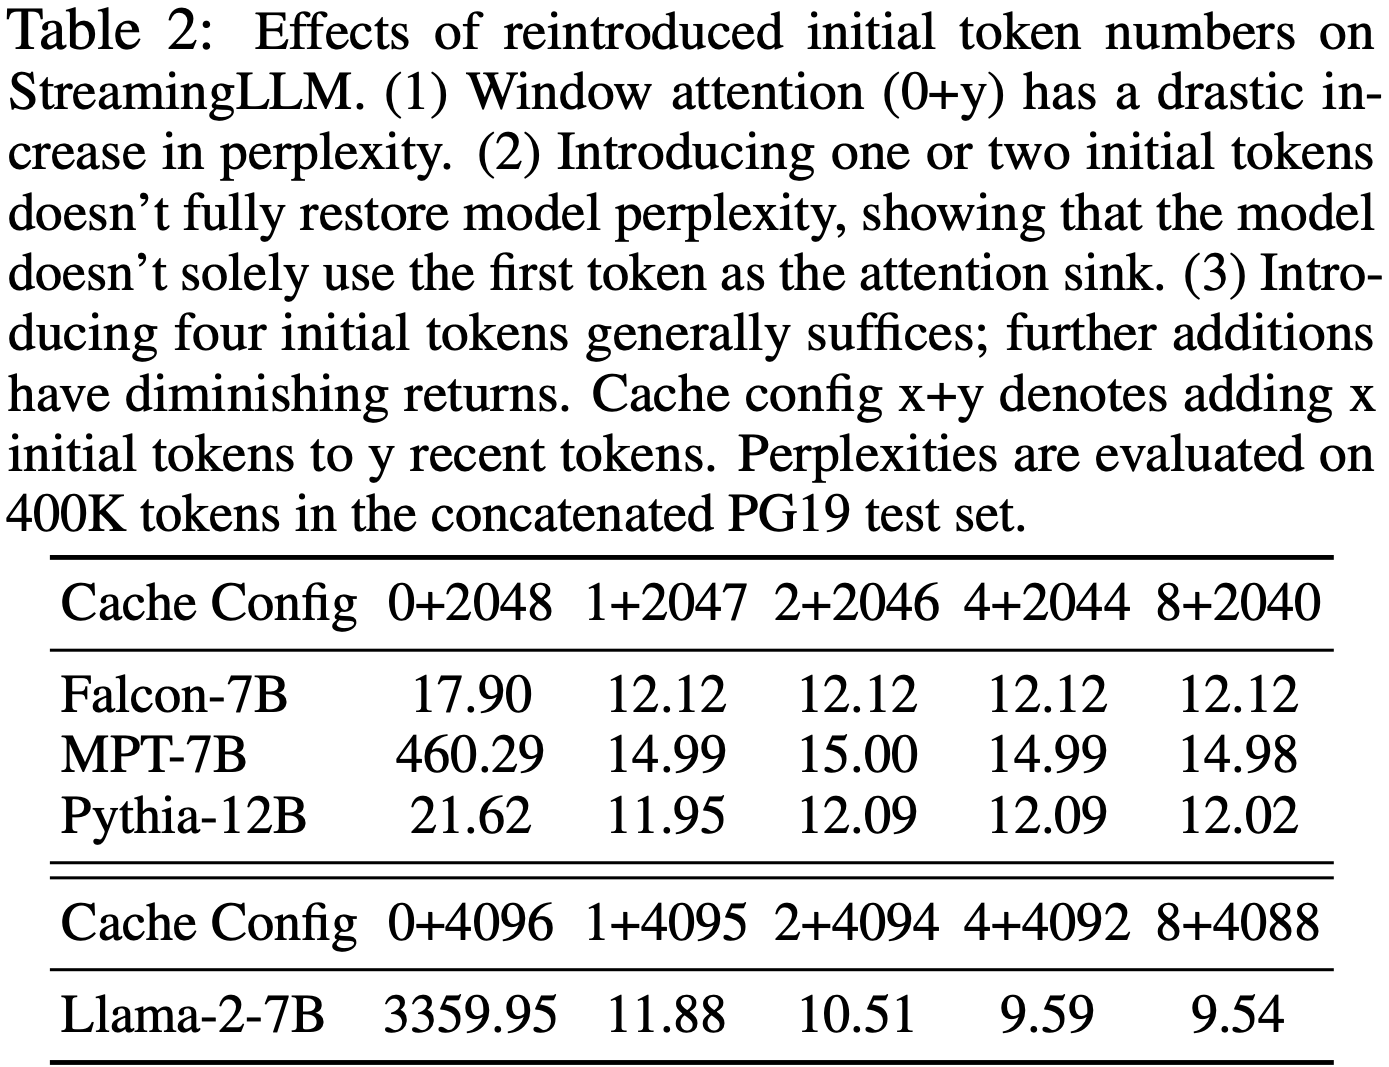
    • 如图 2 所示,引入四个初始 Token 作为 Attention Sink,足以恢复 LLM 的性能
      • 只添加一个或两个则无法实现完全恢复
    • 作者认为这种模式的出现是因为这些模型在预训练期间没有在所有输入样本中包含一致的起始 Token
    • 尽管 Llama-2 确实在每个段落前加上一个 <s> Token ,但这发生在文本分块(text chunking)之前 ,导致第零个位置大多被随机 Token 占据
      • 问题:如何理解这里的 text chunking 会影响第一个 <s> Token ?
    • 这种缺乏统一起始 Token 的情况导致模型使用几个初始 Token 作为 Attention Sink
  • 论文假设,通过在所有训练样本的开头加入一个稳定的可学习 Token ,它可以单独作为一个专门的 Attention Sink,从而无需多个初始 Token 来确保一致的流式处理
    • 论文将在第 3.3 节验证这一假设

Rolling KV Cache with Attention Sinks

  • 为了在已训练的 LLM 中启用 LLM 流式处理,论文提出了一种简单的方法,可以在不进行任何模型微调的情况下恢复 Window Attention 的困惑度
    • 方法:除了当前的滑动窗口 Token 之外,论文在注意力计算中重新引入了几个起始 Token 的 KV
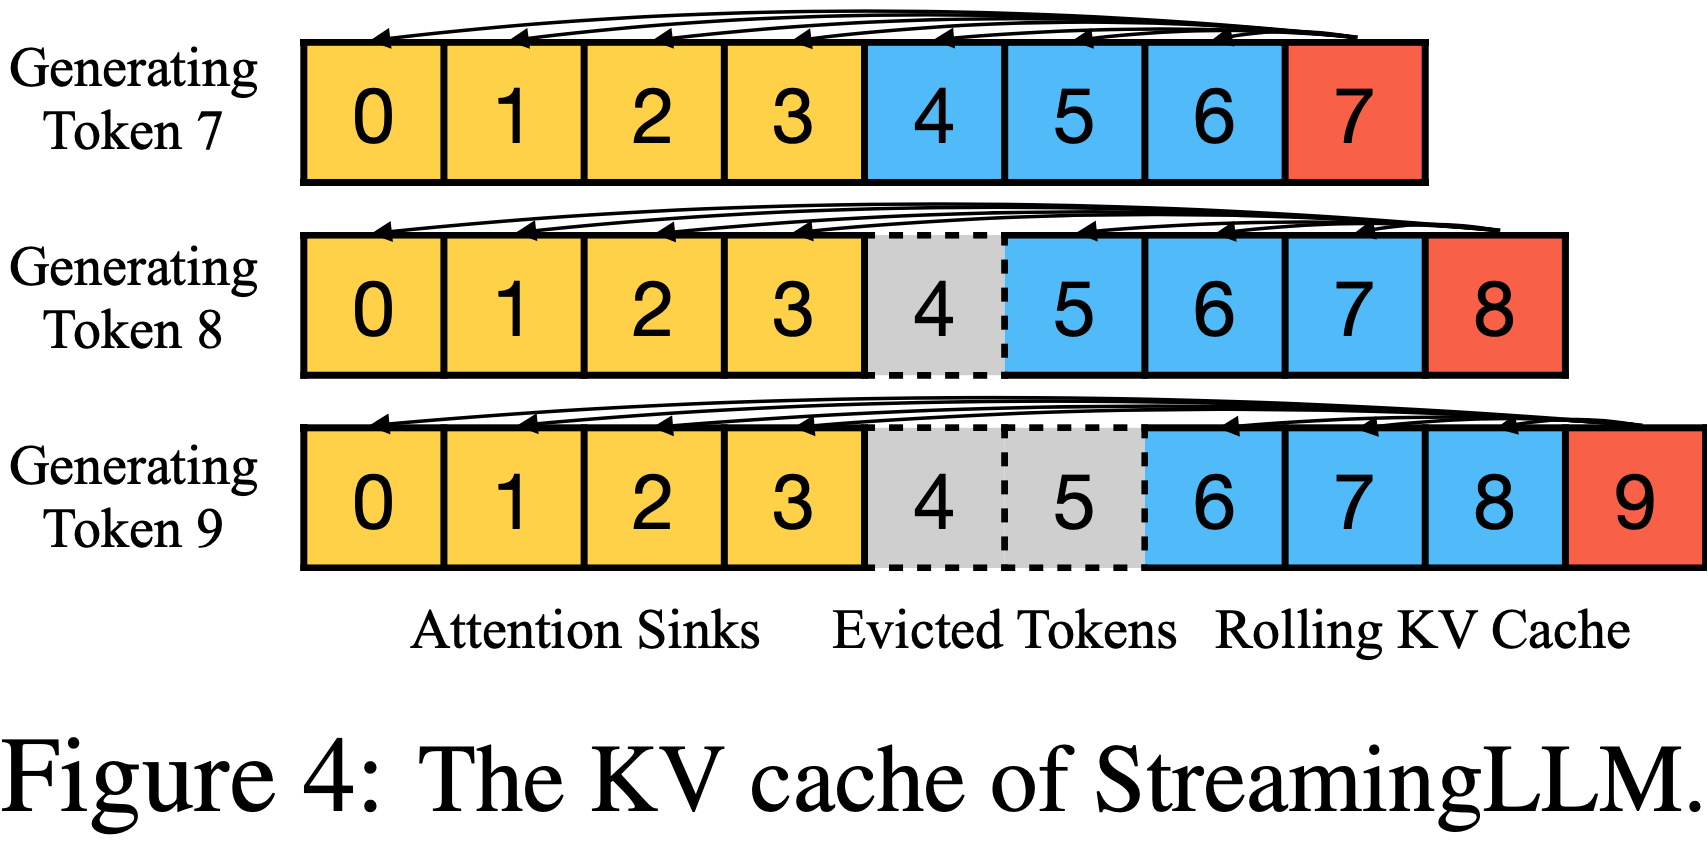
  • StreamingLLM 中的 KV 缓存概念上可以分为两部分,如图 4 所示:
    • (1) Attention Sink (四个初始 Token ) 稳定注意力计算;
    • (2) 滚动 KV 缓存 (Rolling KV Cache) 保留最近的 Token ,这对语言建模至关重要
  • StreamingLLM 的设计是通用的,可以无缝集成到任何使用相对位置编码的自回归语言模型中,例如 RoPE (2021) 和 ALiBi (2022)
  • 在确定相对距离并向 Token 添加位置信息时,StreamingLLM 关注的是 缓存内 的位置(within the cache),而不是 原始文本中 的位置
    • 这种区别对 StreamingLLM 的性能至关重要
    • 例如,如果当前缓存(图 4)有 Token [0, 1, 2, 3, 6, 7, 8] 并且正在解码第 9 个 Token ,则分配的位置是 [0, 1, 2, 3, 4, 5, 6, 7],而不是原始文本中的位置 [0, 1, 2, 3, 6, 7, 8, 9]
      • 问题:直观上看,怎么觉得这样反而会出现问题?因为原始文本中的真实相对位置信息被修改了
  • 对于像 RoPE 这样的编码
    • 论文在引入旋转变换 之前 缓存 Token 的键 (Keys)
    • 然后在每个解码阶段,论文对滚动缓存中的键应用位置变换
  • 另一方面,与 ALiBi 集成更直接
    • 这里,对注意力分数应用连续线性偏置,而不是 ‘跳跃’ 偏置
    • 这种在缓存内分配位置 Embedding 的方法对 StreamingLLM 的功能至关重要,确保模型即使在其预训练注意力窗口大小之外也能高效运行
  • 表 1:
    • Window Attention 在长文本上表现不佳
    • 当论文重新引入最初的四个 Token 以及最近的 1020 个 Token (对应表中 4+1020) 时,困惑度得以恢复
    • 将原始的四个初始 Token 替换为换行符 Token “n” (对应表中 4”n”+1020) 实现了 comparable 困惑度恢复
    • 缓存配置 x+y 表示添加 x 个初始 Token 和 y 个最近 Token
    • 困惑度是在 PG19 测试集中第一本书(65K Token )上测量的
  • 表 2:重新引入的初始 Token 数量对 StreamingLLM 的影响
    • (1) Window Attention (0+y) 的困惑度急剧增加
    • (2) 引入一个或两个初始 Token 不能完全恢复模型困惑度,表明模型不仅仅使用第一个 Token 作为 Attention Sink
    • (3) 引入四个初始 Token 通常就足够了;进一步添加收益递减
    • 缓存配置 x+y 表示将 x 个初始 Token 添加到 y 个最近 Token
    • 困惑度是在 concatenated PG19 测试集中的 400K Token 上评估的

Pre-Training LLMs with Attention Sinks

  • 如第 3.1 节所述,模型过度关注多个初始 Token 的一个重要原因是缺乏一个指定的 Sink Token 来卸载过多的注意力分数
    • 因此,模型无意中使用了全局可见的 Token ,主要是初始 Token ,作为 Attention Sink
    • 一个潜在的补救措施可以是故意加入一个全局可训练的 Attention Sink Token ,表示为 “Sink Token”,它将作为不必要注意力分数的储存库
    • 或者,用像 SoftMax-off-by-One (2023) 这样的变体替换传统的 SoftMax 函数,
      $$\text{SoftMax}_{1}(x)_{i}=\frac{e^{x_{i} } }{1+\sum_{j=1}^{N}e^{x_{j} } } \tag{2}$$
  • 它不要求所有上下文 Token 上的注意力分数总和为 1,可能也是有效的
    • 注意 SoftMax\(_1\) 相当于在注意力计算前添加一个具有全零键和值特征的 Token
      • 问题:因为全是零,所以各种 Attention 的加权平均后均等价于没有增加该 Token
    • 论文将此方法称为 “Zero Sink“ 以符合论文的框架
  • 为了验证,论文在相同设置下从头开始预训练了三个具有 160M 参数的语言模型
    • 第一个模型使用标准的 SoftMax 注意力 (Vanilla)
    • 第二个模型用 SoftMax\(_1\)(Zero Sink)替换了常规的注意力机制
    • 第三个模型在所有训练样本前添加了一个可学习的占位符 Token (Sink Token)
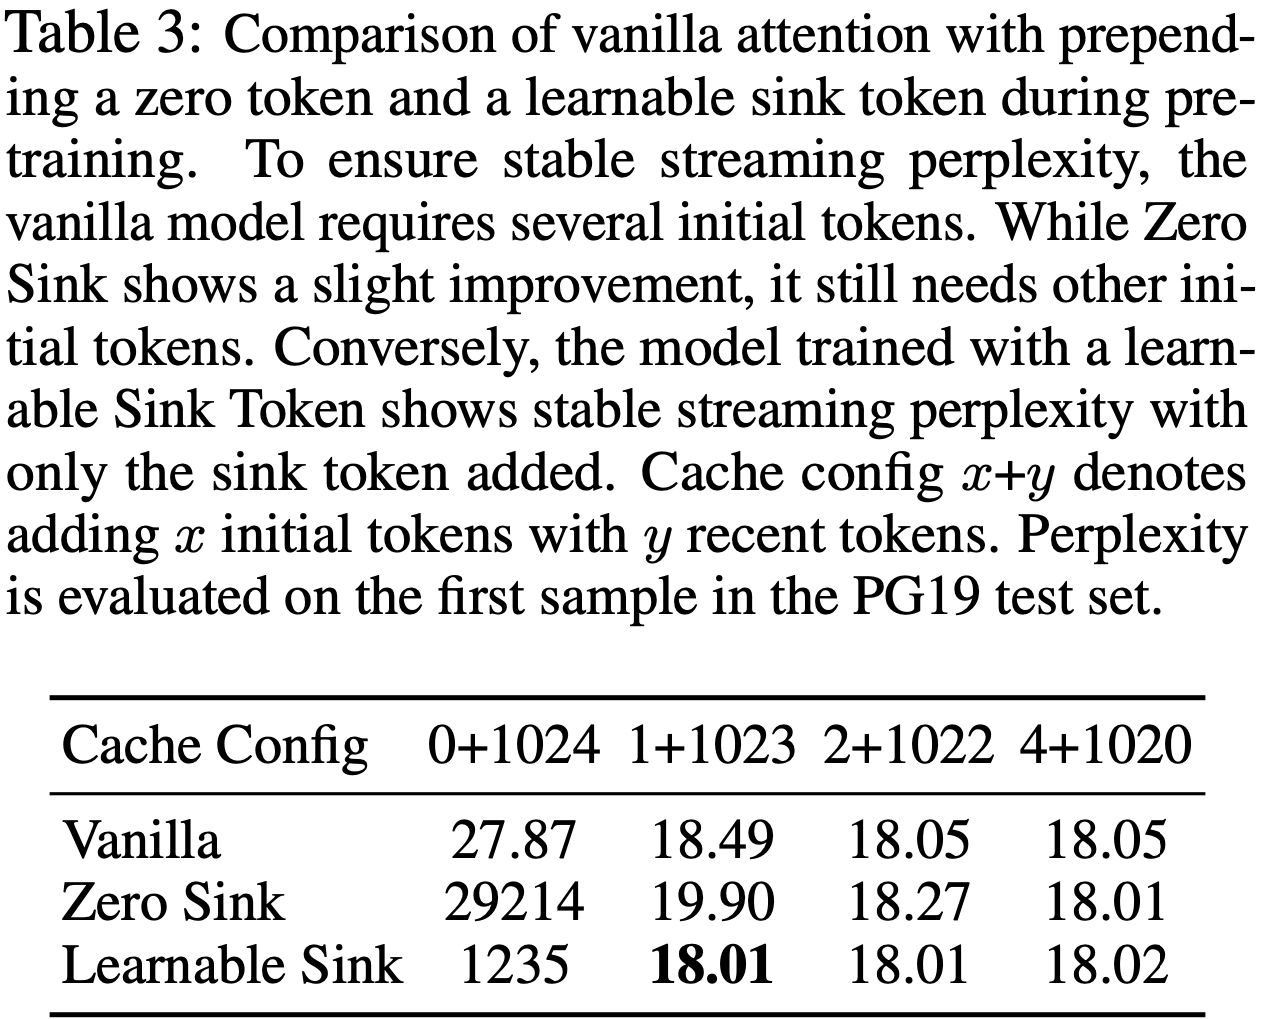
  • 如表 3 所示,Zero Sink 在某种程度上缓解了 Attention Sink 问题,但模型仍然依赖其他初始 Token 作为 Attention Sink
    • 引入 Sink Token 在稳定注意力机制方面非常有效
    • 只需将此 Sink Token 与最近的 Token 配对就足以稳定模型的性能,并且最终的评估困惑度甚至略有改善
    • 鉴于这些发现,论文建议在所有样本中使用 Sink Token 来训练未来的 LLM,以优化流式部署
  • 表 3:比较在预训练期间使用标准注意力、前置零 Token 和可学习 Sink Token
    • 为了确保稳定的流式困惑度,标准模型需要几个初始 Token
    • 虽然 Zero Sink 显示出轻微改进,但它仍然需要其他初始 Token
    • 若使用可学习 Sink Token 训练的模型,仅添加 Sink Token 就显示出稳定的流式困惑度
    • 缓存配置 \(x\)+\(y\) 表示添加 \(x\) 个初始 Token 和 \(y\) 个最近 Token
    • 困惑度是在 PG19 测试集中第一个样本上评估的(问题:1 个样本就够评估困惑度了?)

Experiments

  • 论文使用四个近期主流的模型家族来评估 StreamingLLM:Llama-2 (2023b)、MPT (2023)、Pythia (2023) 和 Falcon (2023)
    • Llama-2、Falcon 和 Pythia 采用了 RoPE (2021)
    • MPT 采用了 ALiBi (2022)
    • RoPE 和 ALiBi 是近期研究中两种最具影响力的位置编码技术
  • 论文多样化的模型选择确保了研究结果的有效性和鲁棒性
    • 论文将 StreamingLLM 与已建立的基线方法进行比较,例如 Dense Attention、 Window Attention 以及带重计算的滑动窗口方法(Sliding Window with Re-computation)
    • 在所有后续使用 StreamingLLM 的实验中,除非另有说明,论文默认使用四个初始 Token 作为 Attention Sink

Language Modeling on Long Texts Across LLM Families and Scales

  • 论文首先使用 Concatenated PG19 (2020) 测试集评估 StreamingLLM 的语言建模困惑度(Perplexity),该测试集包含 100 本长书籍
  • 对于 Llama-2 模型,缓存大小设置为 2048,而对于 Falcon、Pythia 和 MPT 模型,则设置为 1024
    • 这是预训练窗口大小的一半,选择此值是为了增强可视化清晰度
  • 图 3 表明
    • 在跨越 20K Token 的文本上,StreamingLLM 在困惑度方面可以与 Oracle 基线(带重计算的滑动窗口)相媲美
    • 当输入长度超过其预训练窗口时, Dense Attention 技术会失败;
    • 当输入长度超过缓存大小时, Window Attention 技术会因初始 Token 被逐出而表现不佳
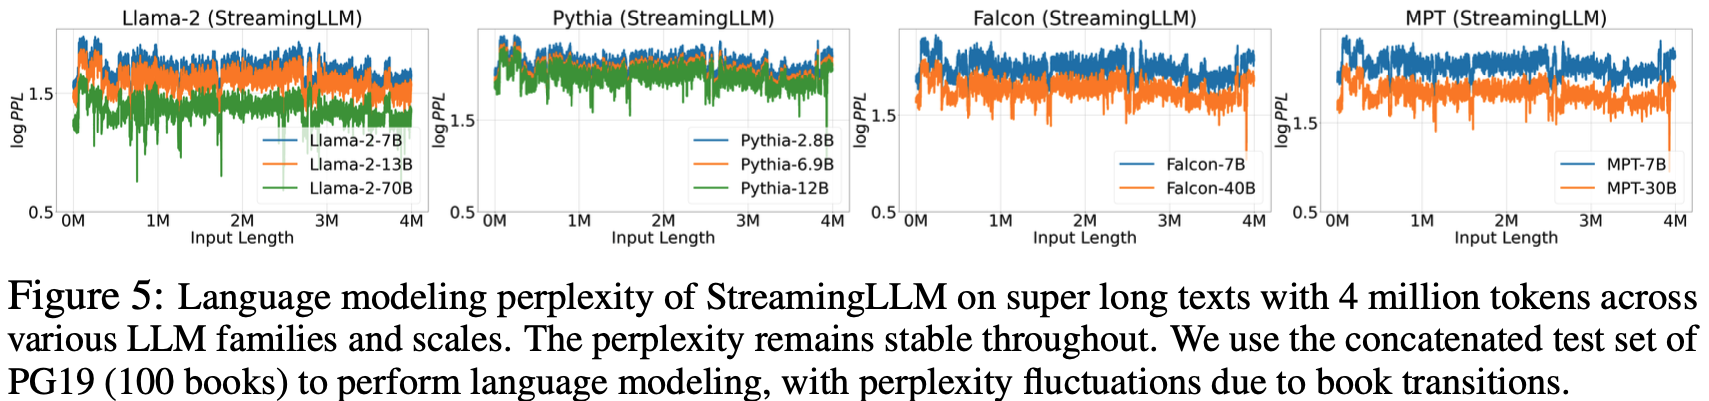
  • 在图 5 中,论文进一步证实了 StreamingLLM 可以可靠地处理异常长的文本,涵盖超过 4M 个 Token ,跨越一系列模型家族和规模
    • 这包括 Llama-2 [7,13,70]B、Falcon [7,40]B、Pythia-[2,8,6,9,12]B 和 MPT-[7,30]B

Results of Pre-Training with a Sink Token

  • 为了验证论文在所有预训练样本中引入一个 Sink Token 可以改进流式 LLM 的建议,论文在相同条件下训练了两个语言模型,每个模型有 160M 参数
    • 一个模型遵循原始训练设置
    • 另一个在每个训练样本的开头加入了一个 Sink Token
  • 论文的实验使用了 Pythia-160M (2023) 代码库并遵循其训练方法
    • 论文在一个 8xA6000 NVIDIA GPU 服务器上使用去重后的 Pile (2020) 数据集训练模型
    • 除了将训练批大小减少到 256 之外,论文保留了所有 Pythia 训练配置,包括学习率调度、模型初始化和数据集排列
    • 两个模型都训练了 143,000 步
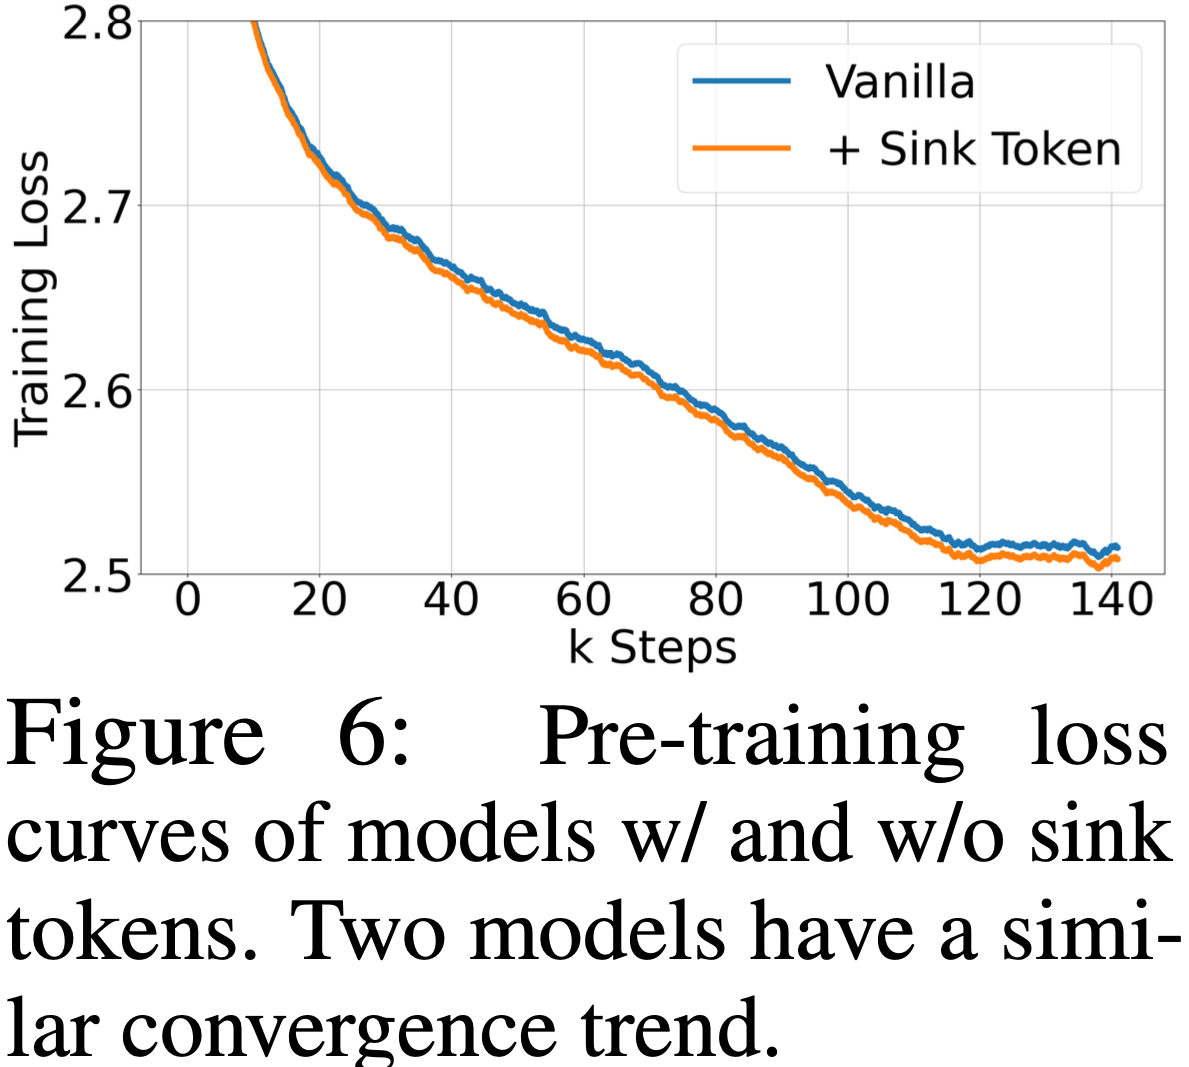
  • 收敛性与正常模型性能 (Convergence and Normal Model Performance)
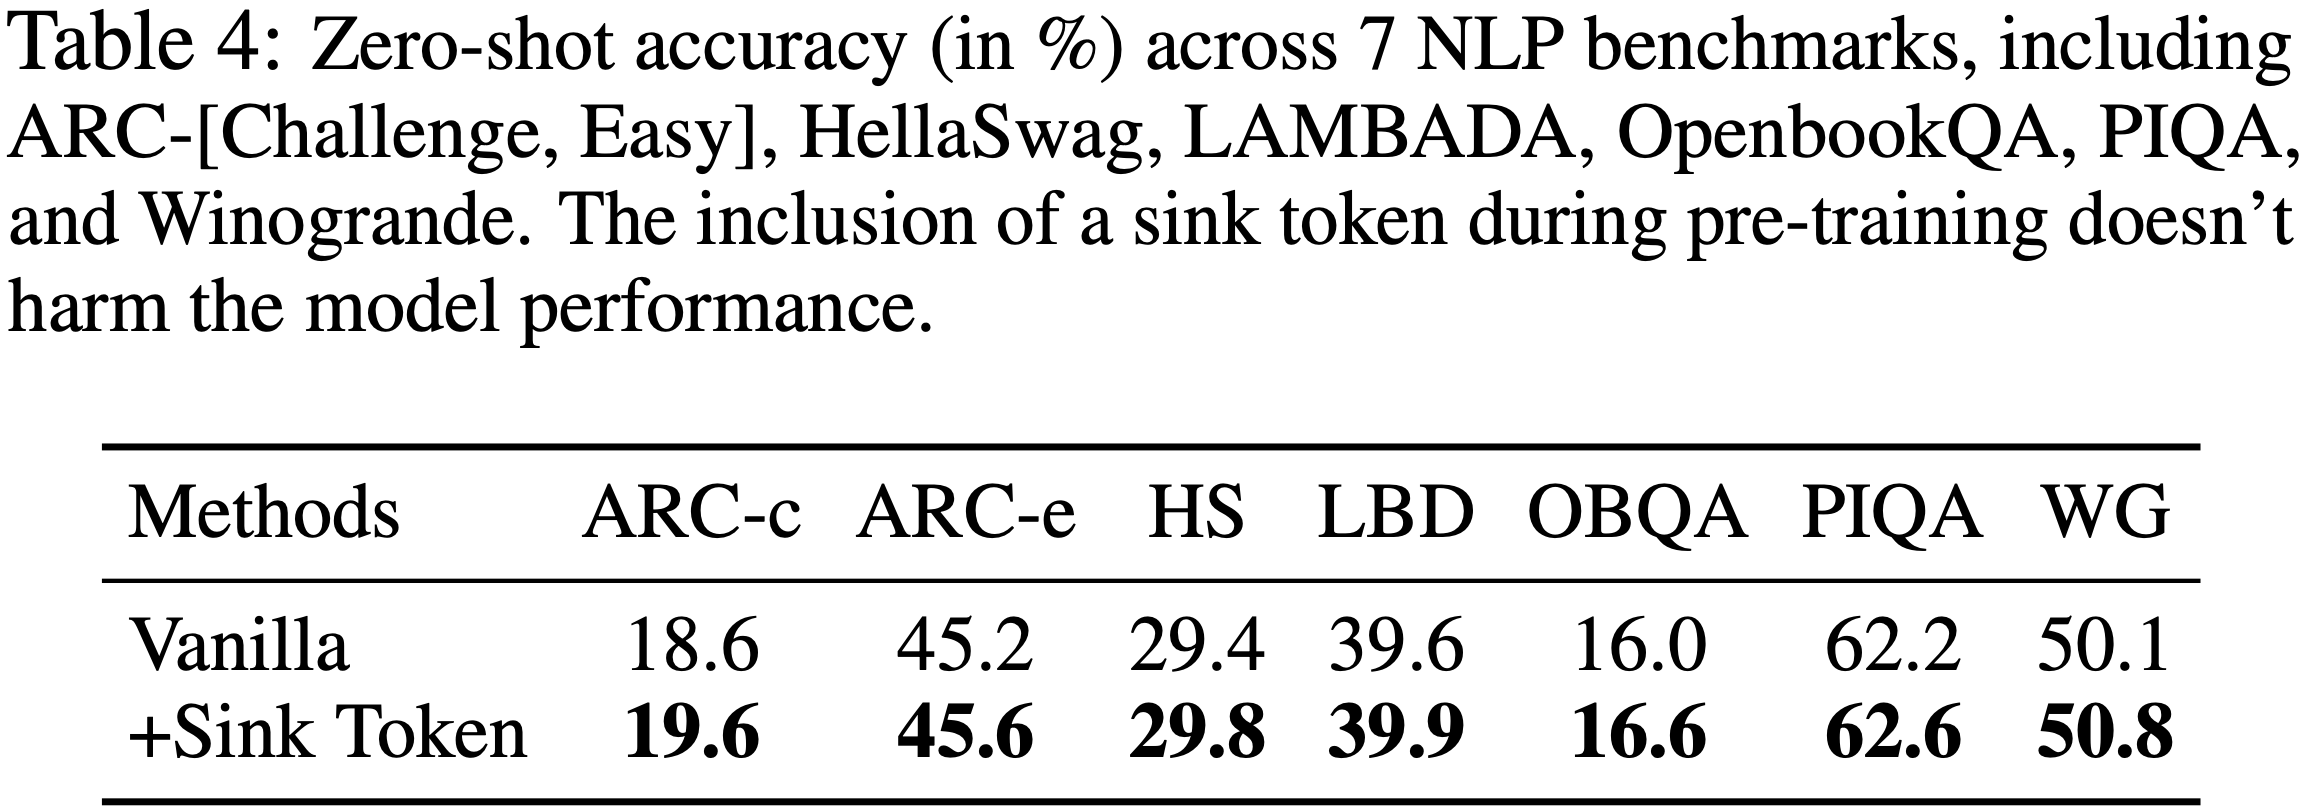
    • 在预训练期间包含一个 Sink Token 对模型收敛性以及后续在一系列 NLP 基准测试中的性能没有负面影响
    • 如图 6 所示,原始模型与使用 Sink Token 训练的模型表现出相似的收敛动态
    • 论文在七个不同的 NLP 基准测试上评估这两个模型,包括 ARC-[Challenge, Easy] (2018)、HellaSwag (2019)、LAMBADA (2016)、OpenbookQA (2018)、PIQA (2020) 和 Winogrande (2019)
    • 如表 4 所示,使用 Sink Token 预训练的模型与使用原始方法训练的模型表现相似
  • 流式性能 (Streaming Performance)
    • 如表 3 所示,使用传统方法训练的模型与使用 Sink Token 增强的模型在流式困惑度上存在差异
      • 原始模型需要添加多个 Token 作为 Attention Sink 以维持稳定的流式困惑度
      • 使用 Sink Token 训练的模型仅使用该 Sink Token 就能达到令人满意的流式性能
      • 注:其实原始训练方法需要 4 个 Token 这个事情,表 3 不够明显,表 2 MPT-7B 更明显
  • 注意力可视化 (Attention Visualization)
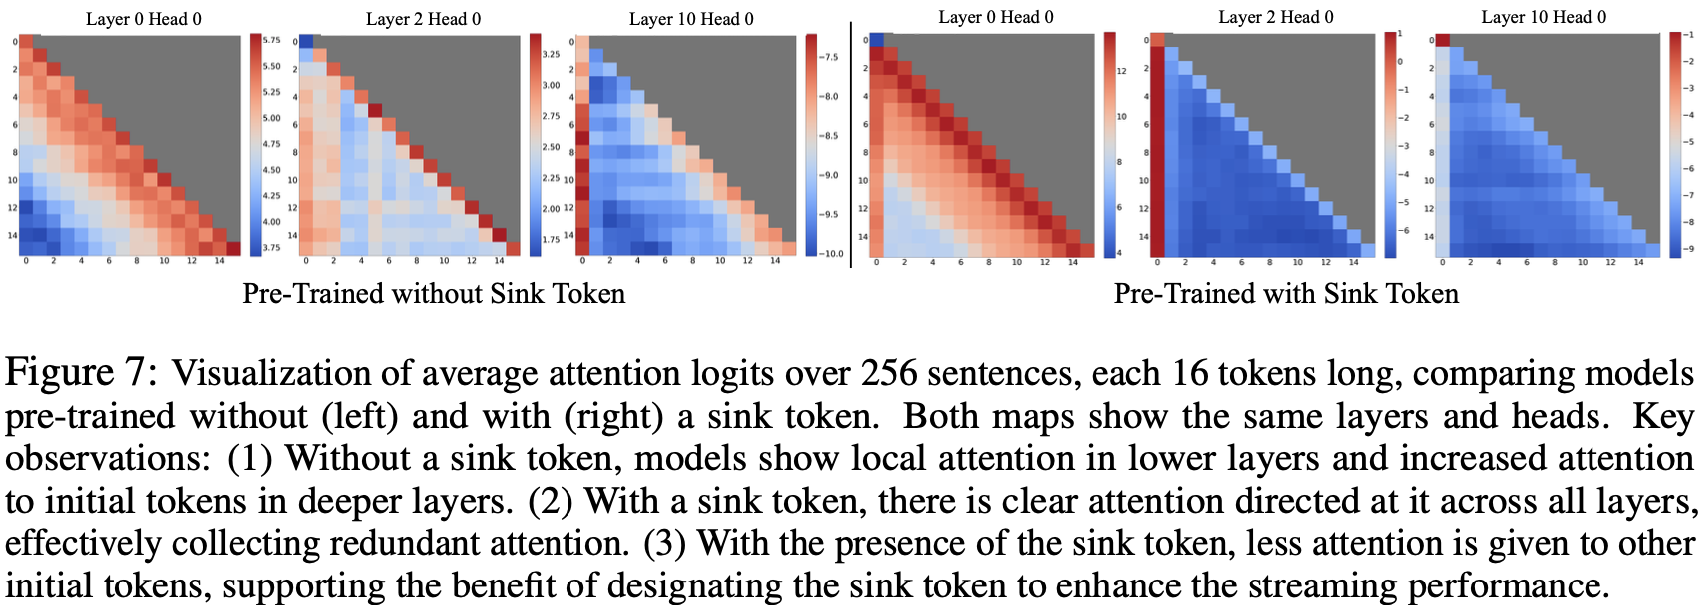
    • 图 7 对比了使用和不使用 Sink Token 预训练的模型的注意力图
    • 没有 Sink Token 的模型,类似于 Llama-2-7B(图 2),在浅层显示局部注意力,在深层则关注初始 Token
    • 相比之下,使用 Sink Token 训练的模型在所有层和头中都持续关注 Sink ,表明存在有效的注意力卸载机制
    • 这种对 Sink 的 Strong 关注,加上对其他初始 Token 注意力的减少,解释了 Sink Token 在提升模型流式性能方面的有效性

Results on Streaming Question Answering with Instruction-tuned Models

  • 为了展示 StreamingLLM 在现实世界中的适用性,论文使用指令微调(Instruction-tuned)的 LLM 模拟多轮问答,这在现实场景中很常见
  • 论文首先将 ARC-[Challenge, Easy] 数据集中的所有问答对拼接起来,将连续的流输入到 Llama-2-[7,13,70]B-Chat 模型中,并使用精确匹配(Exact Match)准则评估每个答案位置上的模型补全情况
  • 如表 5 所示,
    • Dense Attention 会导致内存不足(Out-of-Memory, OOM)错误,表明它不适合此设置
    • Window Attention 方法虽然运行高效,但由于输入长度超过缓存大小时会产生随机输出,导致准确率低下
    • StreamingLLM 表现出色,能高效处理流式格式,其准确率与 One-shot、Sample-by-sample 的基线准确率相当
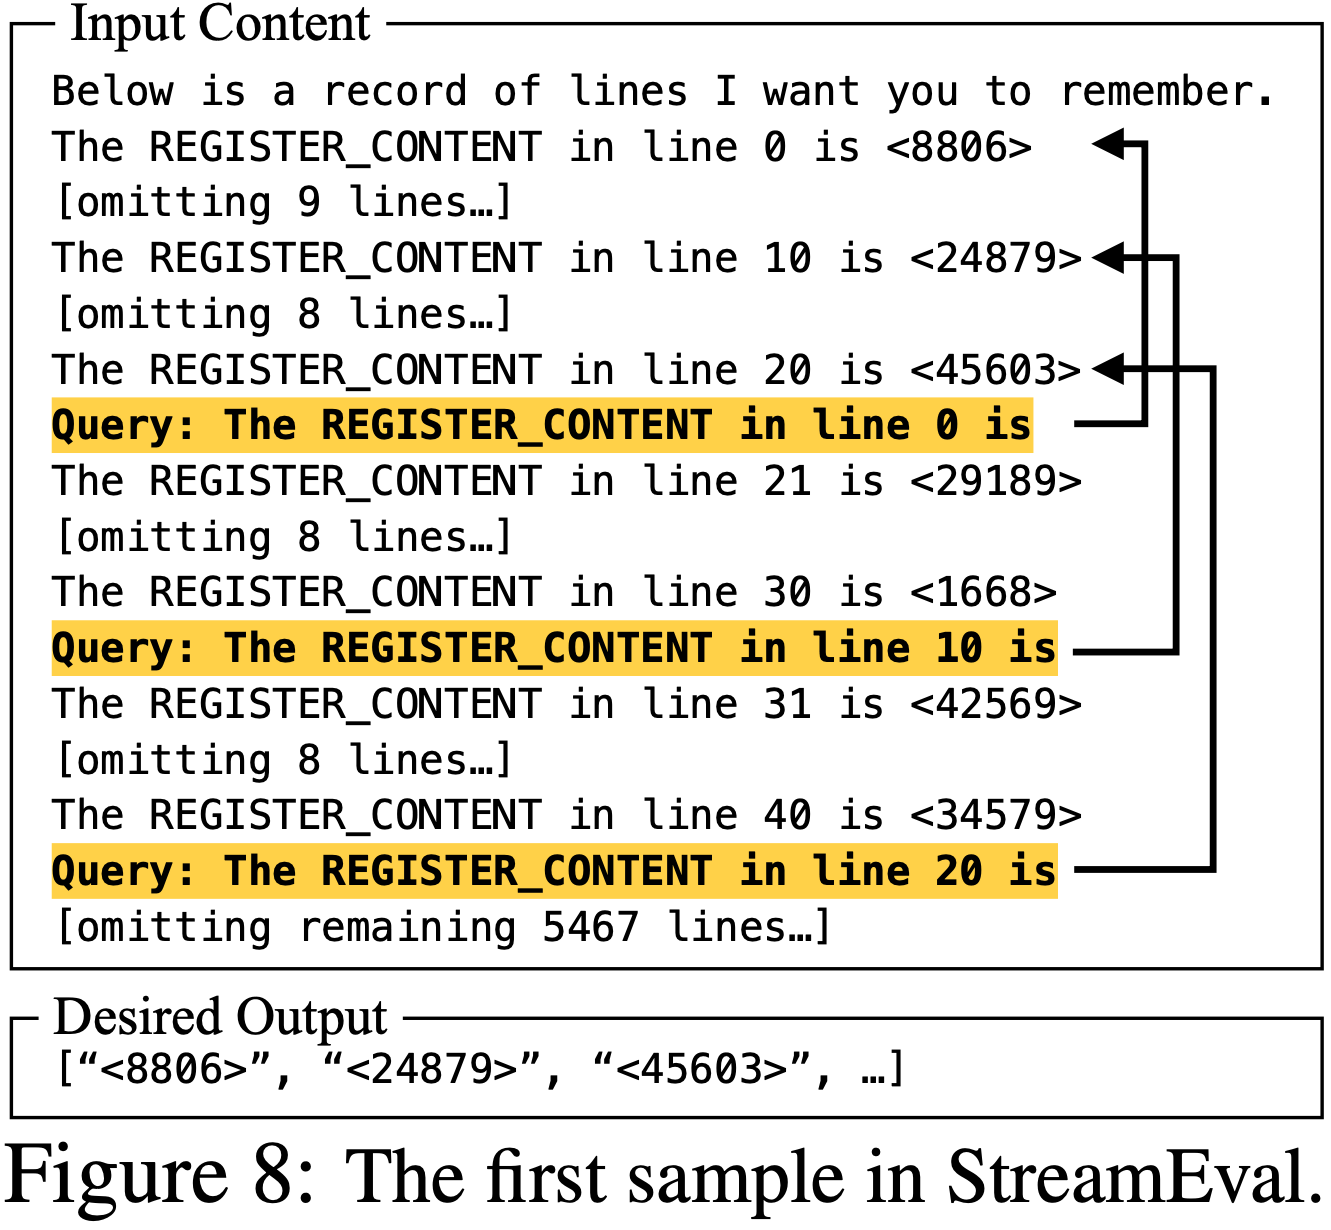
  • 为了突出一个更适合 StreamingLLM 的场景,论文引入了一个数据集 StreamEval,其灵感来源于 LongEval (2023) 基准测试
  • 如图 8 所示
    • 与 LongEval 在长跨度设置上使用单一查询不同,论文每提供 10 行新信息就查询一次模型
    • 每个查询的答案始终在 20 行之前,这反映了现实世界中问题通常与近期信息相关的实例
    • 问题:从图 8 中看,查询间隔是 20 行,一定会超过窗口吗?
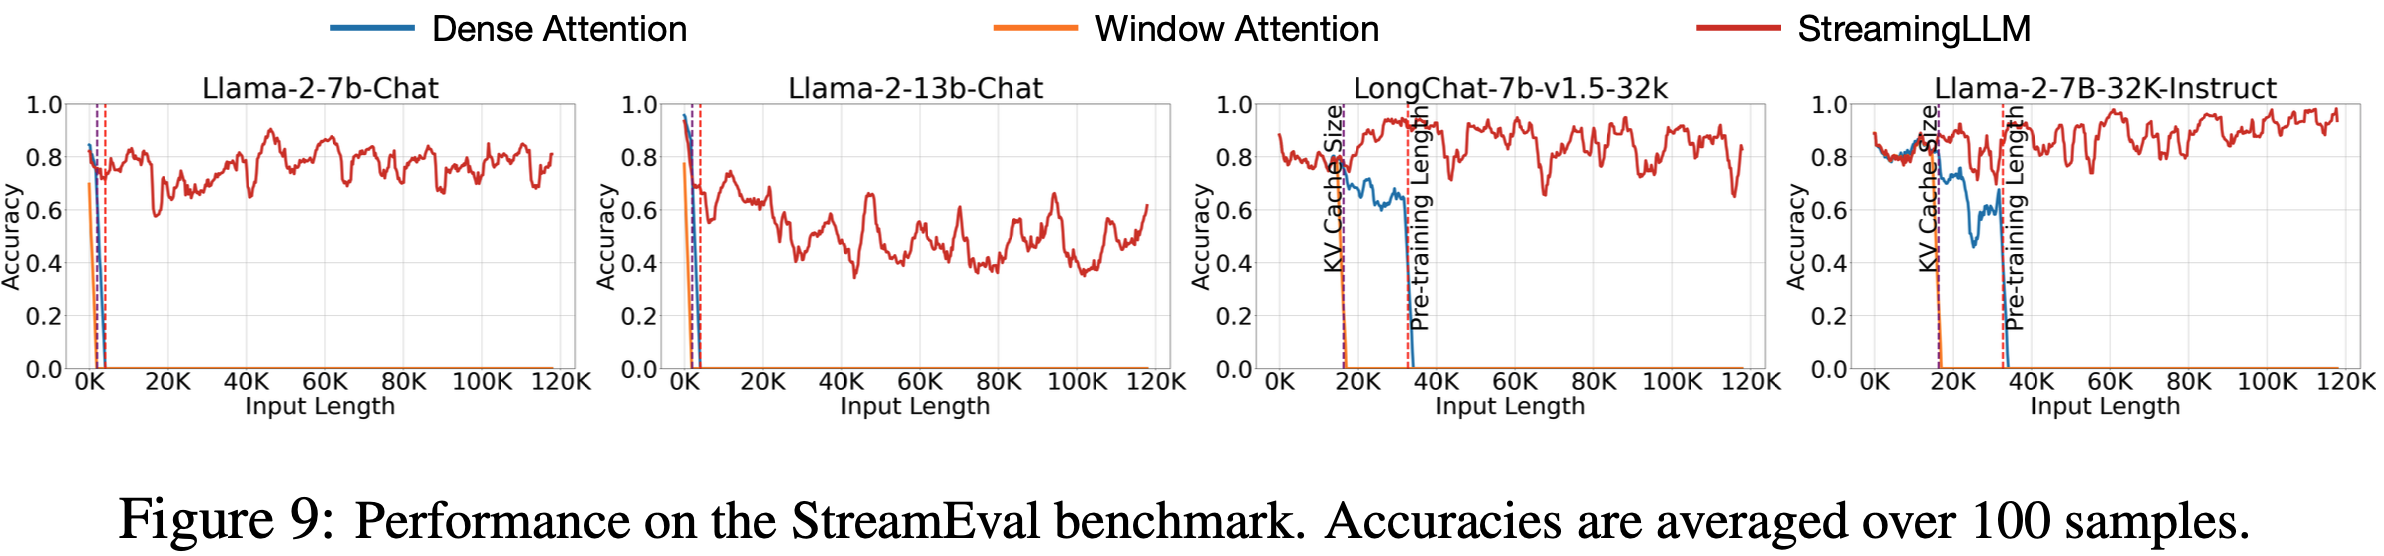
  • 如图 9 所示
    • 采用 StreamingLLM 的 LLM 即使在输入长度接近 120K Token 时也能保持合理的准确率
    • Dense Attention 和 Window Attention 分别在达到预训练文本长度和 KV 缓存大小时失败
  • 论文使用了两个上下文扩展模型,LongChat-7b-v1.5-32k (2023) 和 Llama-2-7B-32K-Instruct (2023),以表明 StreamingLLM 可以与上下文扩展技术互补
    • 在 StreamingLLM 中,上下文扩展意味着扩大流式 LLM 的最大缓存大小,从而能够捕获更广泛的局部信息

Ablation Studies

  • 初始 Token 数量 (Numbers of Initial Tokens)
    • 在表 2 中,论文通过消融实验研究了添加不同数量的初始 Token 与 Recent Token 对流式困惑度的影响
    • 结果表明,仅引入一个或两个初始 Token 是不够的,而四个初始 Token 的阈值似乎就足够了,后续增加 Token 数量带来的效果微乎其微
    • 这一结果证明了论文在 StreamingLLM 中引入 4 个初始 Token 作为 Attention Sink 的选择是合理的
  • 缓存大小 (Cache Sizes)
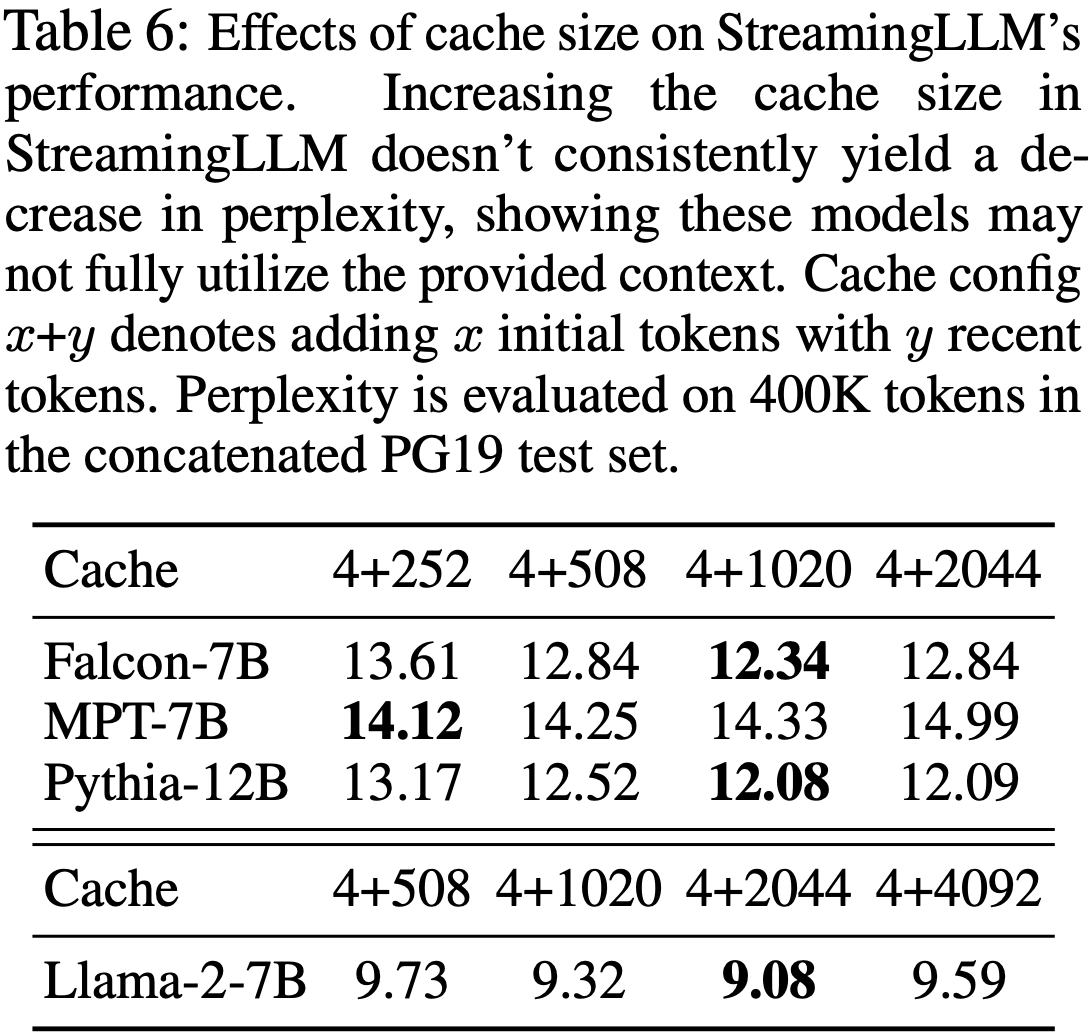
    • 在表 6 中,论文评估了缓存大小(Cache Size, Attention Window Size)对 StreamingLLM 困惑度的影响
    • 与直觉相反 ,增加缓存大小并不会持续降低语言建模的困惑度
    • 这种不一致性表明了一个潜在的局限性,即这些模型可能无法最大化利用它们接收到的整个上下文信息
    • 未来的研究工作应致力于增强这些模型更好利用广泛上下文的能力

Efficiency Results

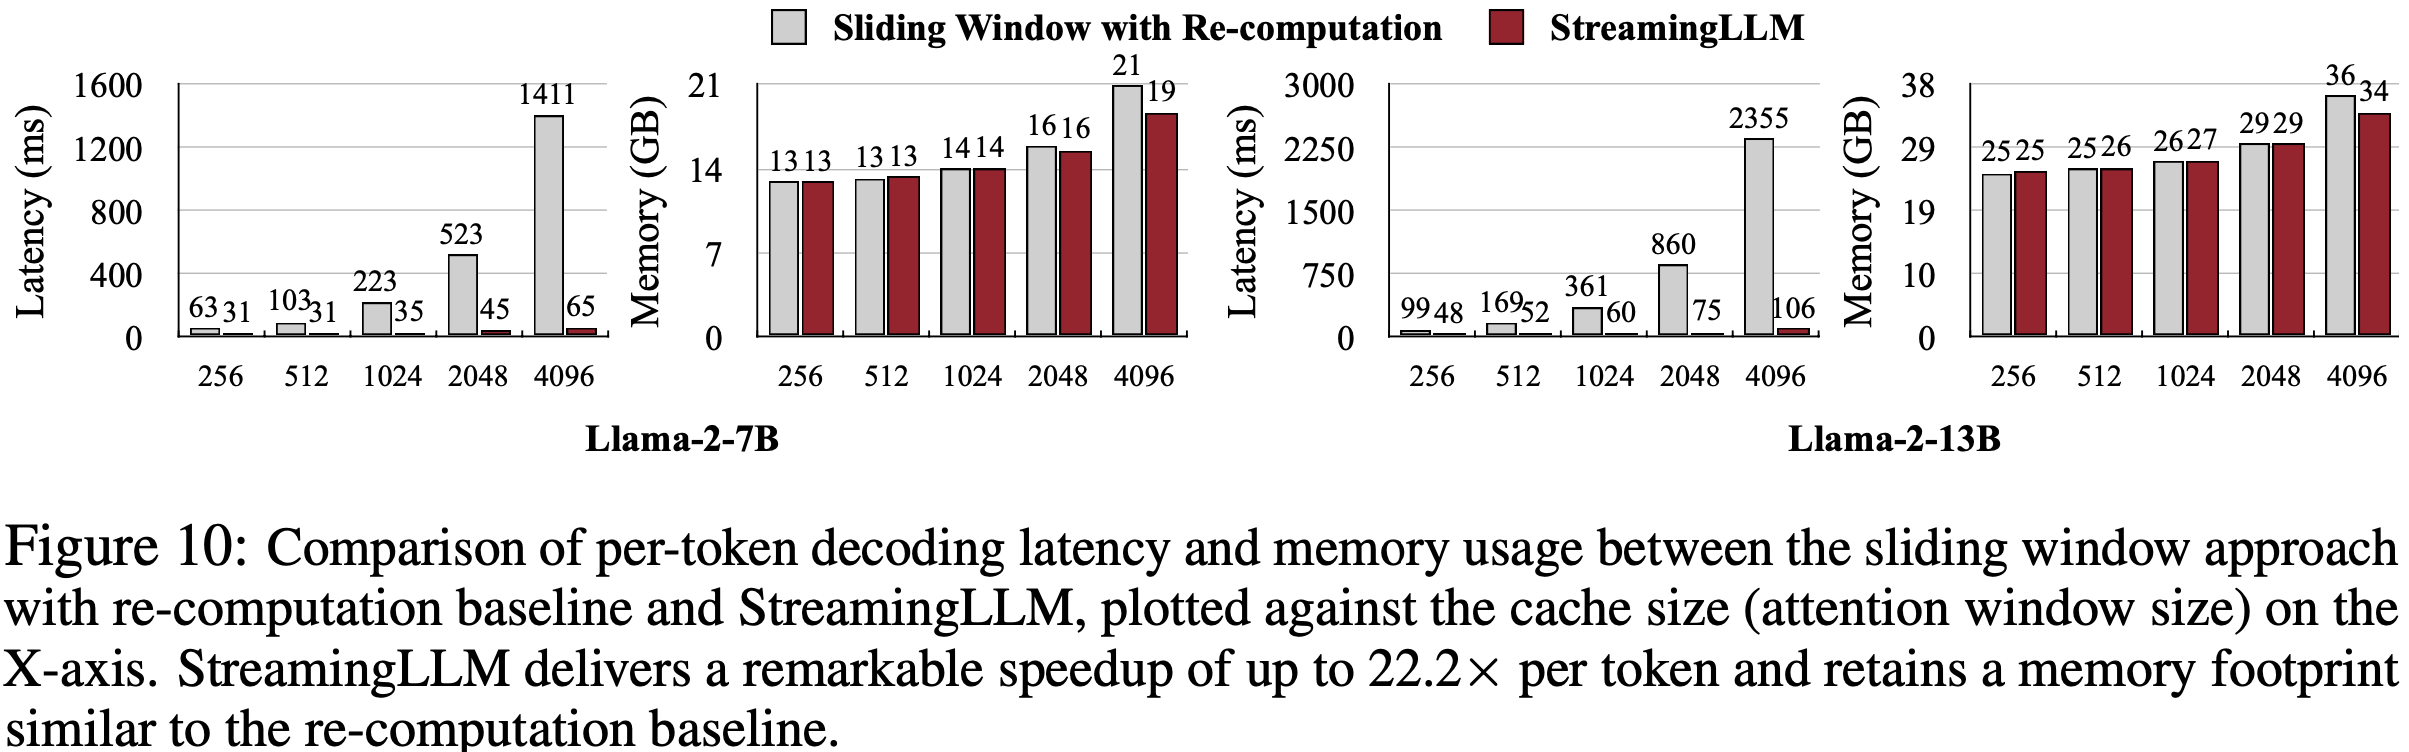
  • 论文将 StreamingLLM 的解码延迟(Decoding Latency)和内存使用量与带重计算的滑动窗口基线进行了基准测试,带重计算的滑动窗口 是唯一具有可接受质量的基线
  • 两种方法均使用 Huggingface Transformers (2020) 库实现,并在单个 NVIDIA A6000 GPU 上使用 Llama-2-7B 和 Llama-2-13B 模型进行测试
  • 如图 10 所示
    • 随着缓存大小(Attention Window Size)的增加 ,StreamingLLM 的解码速度呈线性增长
    • 而带重计算的滑动窗口基线的解码延迟呈二次方增长
    • StreamingLLM 实现了令人印象深刻的加速,每个 Token 的加速比高达 \(22.2\times\)
    • 且 StreamingLLM 仍保持了与重计算基线一致的内存占用
  • 注意:这里仅仅考虑效率,具体模型性能指标见前面的其他图

补充:Related Work

  • 关于将 LLM 应用于长文本已经进行了广泛的研究,主要集中在三个领域:
    • 长度外推(Length Extrapolation)
    • 上下文窗口扩展(Context Window Extension)
    • 改进 LLM 对长文本的利用(Improving LLMs’ Utilization of Long Text)
  • 虽然看似相关,但值得注意的是,一个方向的进展并不一定导致另一个方向的进展
    • 例如,扩展 LLM 的上下文大小并不能提高模型在上下文大小之外的性能,而且这两种方法都不能确保有效利用长上下文
    • 论文的 StreamingLLM 框架主要属于第一类(长度外推),即 LLM 被应用于显著超过预训练窗口大小的文本,甚至可能是无限长度
    • 论文不扩展 LLM 的注意力窗口大小,也不增强模型对长文本的记忆和使用能力
    • 后两个类别与论文的重点正交,并且可以与论文的技术结合
  • 长度外推(第一类)旨在使在较短文本上训练的语言模型能够在测试时处理较长的文本
    • 一个主要的研究方向是针对 Transformer 模型开发相对位置编码方法,使其能够在训练窗口之外运行
    • 其中一项工作是 Rotary Position Embeddings (RoPE) (2021),它在每个注意力层中转换查询和键以整合相对位置信息
      • 后续研究 (2022; 2023) 表明其在超过训练窗口的文本上表现不佳
    • 另一种方法 ALiBi (2022) 根据查询和键之间的距离对注意力分数进行偏置,从而引入相对位置信息
      • 虽然这显示出改进的外推能力,但论文在 MPT 模型上的测试突显了当文本长度远大于训练长度时会出现崩溃
    • 当前的方法尚未实现无限长度外推,导致没有现有的 LLM 适合流式应用
  • 上下文窗口扩展(第二类)侧重于扩展 LLM 的上下文窗口,使其能够在一个前向传递中处理更多 Token
    • 一条主要的工作线解决了训练效率问题
      • 考虑到训练期间注意力计算的二次复杂度,开发长上下文 LLM 既是计算挑战也是内存挑战
      • 解决方案范围从系统优化的 FlashAttention (2022; Dao, 2023)(加速注意力计算并减少内存占用)到近似注意力(Approximative attention)方法 (2020a; 2020; 2020; 2020),这些方法以模型质量换取效率
    • 最近,关于使用 RoPE 扩展预训练 LLM 的工作激增 (2023;),涉及位置插值和微调
    • 但所有上述技术仅将 LLM 的上下文窗口扩展到有限的程度 ,这未能达到论文处理无限输入的主要关注点
  • 改进 LLM 对长文本的利用(第三类)优化 LLM 以更好地捕获和使用上下文中的内容,而不是仅仅将它们作为输入
    • 正如 (2023) 和 (2023) 所强调的,前述两个方向的成功并不一定能转化为对长上下文的胜任利用
    • 解决 LLM 内部对长上下文的有效使用仍然是一个挑战
    • 论文的工作集中于稳定地利用最近 Token ,实现 LLM 的无缝流式应用

附录 A:Discussions

  • 应用 (Applications)
    • StreamingLLM 特别适合流式应用,例如多轮对话,其中持续运行而不严重依赖大量内存或历史数据至关重要
      • 例如,在 LLM-based 日常助手应用中,StreamingLLM 使模型能够在较长时间内无缝运行
    • 它基于最近的交互生成响应,从而避免了频繁刷新缓存的需要
    • 传统方法可能需要在对话长度超过训练长度时重置缓存,导致丢失最近的上下文,或者可能需要根据最近的文本历史重新计算键值状态,这可能效率低下
  • 局限性 (Limitations)
    • 虽然 StreamingLLM 提高了 LLM 在流式上下文中的效率,但它并没有扩展模型的上下文窗口或增强其长期记忆能力
    • 如章节 C 中详述,模型仅限于在其当前缓存的范围内运行
    • StreamingLLM 不适合需要长期记忆和广泛数据依赖性的任务,例如长文档问答和摘要
    • 但它在仅需要短期记忆的场景中表现出色 ,例如日常对话和短文档问答,其优势在于能够根据最近的上下文生成连贯的文本,而无需刷新缓存
  • 更广泛的社会影响 (Broader Societal Impacts)
    • StreamingLLM 显著提高了 LLM 的效率和可访问性,使其在各个部门的使用民主化
      • 通过在对话代理等应用中实现不间断的快速交互,StreamingLLM 改善了用户体验,尤其是在需要固定长度模型的场景中
      • 这一进步使得对话更加无缝和具有上下文感知能力,可能惠及教育、医疗保健和客户服务等行业
    • StreamingLLM 在处理过程中的效率降低了计算负载,符合对环境可持续 AI 技术的需求
      • 这一方面对于在技术资源有限的地区推广先进的 AI 工具至关重要
    • 但 StreamingLLM 的潜在负面影响与通用语言模型相关的风险类似,例如错误信息和生成有偏见内容的风险
      • 必须通过强有力的道德准则和保障措施来解决这些风险
    • 虽然 StreamingLLM 具有语言模型共有的一些风险,但其在提升用户体验、 democratizing AI 访问和促进可持续性方面的积极贡献是值得注意的
      • 这些好处强调了负责任地部署和合乎道德地使用该技术的重要性

附录 B:Additional Related Works

  • 稀疏 Transformer (Sparse Transformers)
    • 关于高效 Transformer 模型的文献主要集中于降低自注意力机制的计算和内存复杂性
      • 一项相关的工作是通过将注意力范围限制在固定的、预定义的模式来稀疏化注意力矩阵,例如局部窗口或固定步长的块模式 (2022)
      • Sparse Transformer (2019) 引入了注意力矩阵的稀疏分解,将注意力的计算复杂度降低到 \(O(n\sqrt{n})\)
      • LongFormer (2020) 将扩张的局部 Window Attention 与任务驱动的全局注意力相结合
      • Extended Transformer Construction (ETC) Ainslie 等 (2020) 提出了一种新颖的全局-局部注意力机制,包含四种注意力模式:全局到全局、局部到局部、局部到全局和全局到局部
      • 基于 ETC,BigBird (2020a) 提出了另一种线性复杂度的注意力替代方案,利用全局 Token、局部滑动 Window Attention 和随机注意力
    • 但这些方法有几个局限性
      • 一:Sparse Transformer 和 ETC 需要为特定的块稀疏矩阵乘法变体定制 GPU 内核
      • 二:LongFormer、ETC 和 BigBird 都依赖于全局注意力模式,这不适合自回归语言模型
      • 三:这些方法与预训练模型不兼容,需要从头开始重新训练
    • 相比之下,论文的方法使用标准的 GPU 内核易于实现,并且与使用 Dense Attention 的预训练自回归语言模型兼容,这些模型在 NLP 社区中普遍存在
      • 这种兼容性提供了显著的优势,允许利用现有的预训练模型而无需任何微调
  • 同期工作 (Concurrent Works)
    • 论文的研究与 Han 等人的工作同时进行,他们对语言模型长度泛化失败进行了理论研究,确定了三个分布外因素
      • 受此分析启发,他们的方法采用“\(\Lambda\)”形注意力模式并重新配置位置编码距离以增强 LLM 中的长度泛化
      • 这种方法与论文的方法有相似之处
      • 但论文的工作揭示了“Attention Sink”现象,即 Transformer 模型倾向于将高注意力分数分配给语义较小的初始 Token
        • 这一现象超出了长度泛化失败的范围,表明 Transformer 模型中存在一个更普遍的问题
      • 论文不仅在自回归语言模型中观察到这种“Attention Sink”行为,而且在编码器 Transformer(如 BERT,见章节 H)和视觉 Transformer (ViTs) Darcet 等 (2023) 中也观察到,表明其在 Transformer 架构中更广泛地存在
      • 为了缓解“Attention Sink”现象,论文建议在预训练期间引入一个可学习的 Sink Token ,并通过广泛的消融研究支持论文的发现
    • 与此同时,Darcet 等人在视觉 Transformer 中观察到类似的注意力集中在随机背景 patch Token 上的现象,称为“寄存器(registers)”
      • 这些寄存器充当全局图像信息的存储库
      • 他们的解决方案是添加专用的“寄存器” Token ,旨在平衡注意力分布
      • “Attention Sink”与此概念类似
      • 在论文的论文中,“Attention Sink” 是初始 Token ,不成比例地吸引后续 Token 的注意力
      • 在预训练期间引入专用的 Sink Token 可以防止模型不适当地使用内容 Token 作为 Attention Sink ,从而实现更有效的注意力分布
      • 但存在一个关键区别:视觉 Transformer 中的“寄存器”在中间层充当全局信息持有者,而论文的“Attention Sink”在自回归模型中作为初始 Token 定位
      • 这种位置差异表明,注意力计算中的 softmax 函数可能在 Attention Sink 的出现中扮演更基本的角色

附录 C:Accuracy on StreamEval with Increasing Query-Answer Line Distance(行距增加时的精确率)

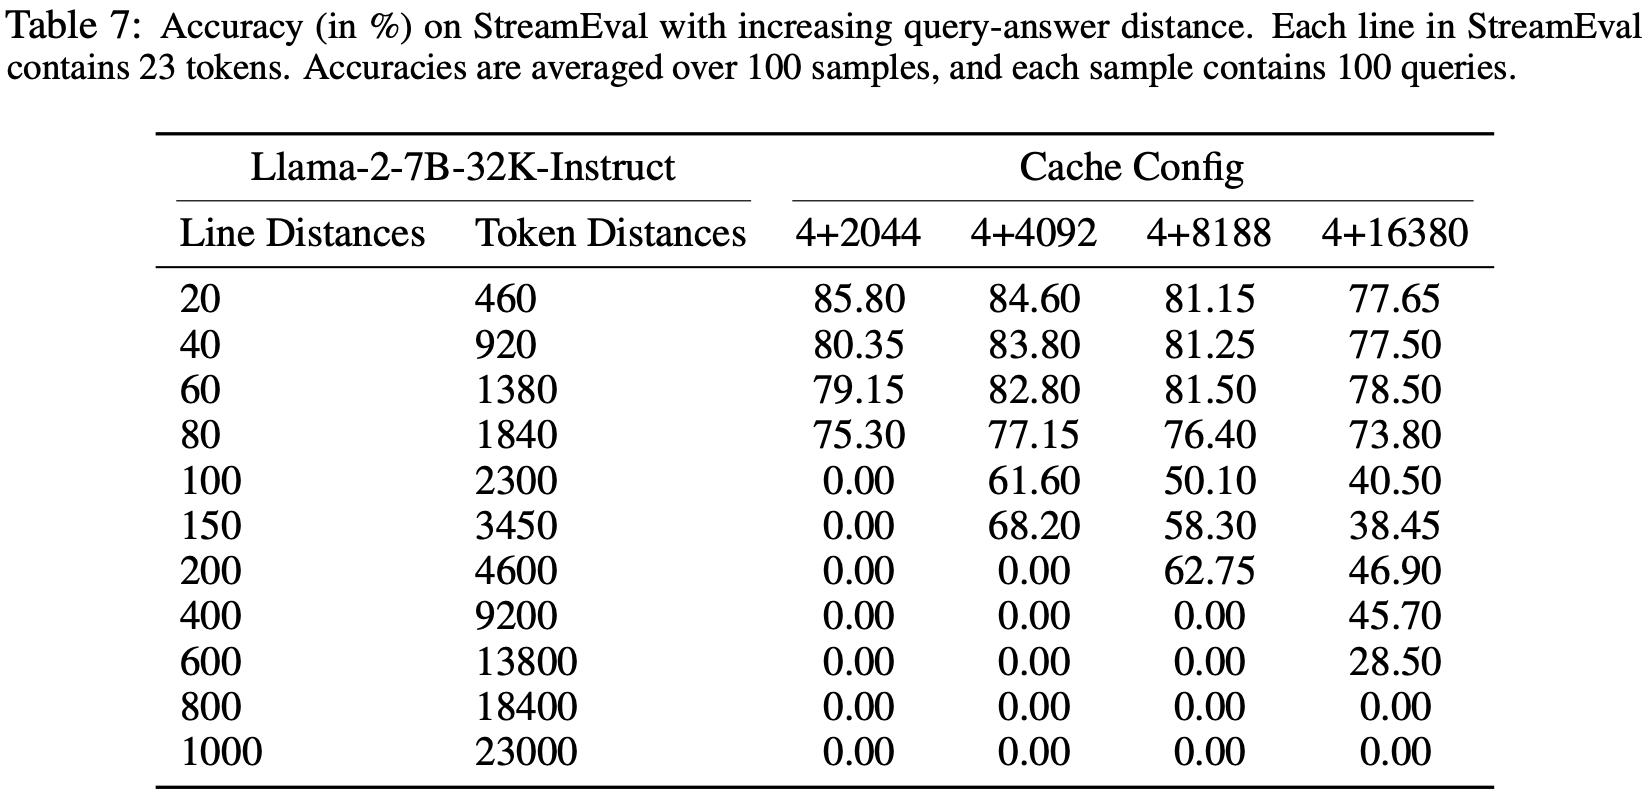
  • 为了评估 StreamingLLM 对扩展输入的处理能力,论文在 StreamEval 上评估了 Llama-2-7B-32K-Instruct 模型,重点关注不同缓存配置下不同的查询-答案行距
    • 在 StreamEval 中,每行包含 23 个 Token ,使得行距相当于 Token 距离的 \(23\times\) 行距
    • 准确率是通过对 100 个样本的结果取平均值计算的,每个样本包含 100 个查询
  • 表 7 说明
    • 当查询和答案之间的 Token 距离在缓存大小之内时,StreamingLLM 保持准确率
    • 但随着该距离增加,准确率会降低,并在最终超过缓存容量时降至零
  • 这些结果表明,虽然 StreamingLLM 在基于最近上下文生成连贯文本方面是有效的,但它不能扩展语言模型的上下文长度
    • 这些结果也强调了当前语言模型中一个更广泛的挑战:它们无法充分利用缓存中的上下文信息,这一发现与 Liu 等人的观察结果一致

附录 D:Long-Range Benchmark Evaluation

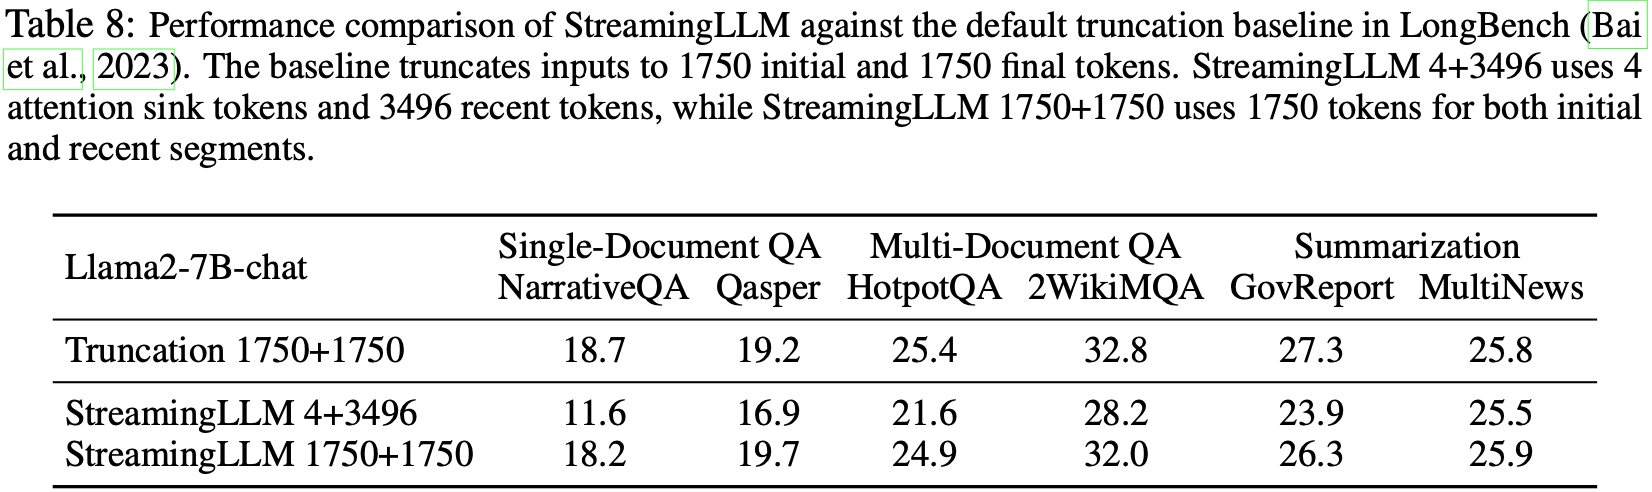
  • 论文使用 Llama-2-7B-chat 模型(最大上下文长度 4k)在 Long-Bench Bai 等 (2023) 上评估了 StreamingLLM,该基准包含三个关键 NLP 任务:
    • 单文档问答 NarrativeQA Kocisky 等 (2017) 和 Qasper Dasigi 等 (2021)
    • 多文档问答 HotpotQA Yang 等 (2018) 和 2WikiMQA Ho 等 (2020)
    • 摘要 GovReport Huang 等 (2021), MultiNews Fabbri 等 (2019)
  • LongBench 为 Llama-2-7B-chat 模型设置了默认的最大序列长度 3,500 个 Token ,从中间截断以保留开头和结尾信息(各 1,750 个 Token )
  • 表 8 显示,使用 4+3496 缓存配置的 StreamingLLM 表现不如 truncation 基线,这可能是由于丢失了关键的初始输入提示信息
    • 但将 Attention Sink 数量调整为 1750 可以将性能恢复到文本截断基线的水平
    • 这些结果证实了章节 C 中的发现,表明 StreamingLLM 的有效性取决于其缓存中的信息,其缓存内性能与文本截断基线相当
  • 问题:这里的 truncation 基线是指直接保留 前后 1750 个 Token 吗?
  • 回答:是的,与 StreamingLLM 1750+1750 的最大区别在于,StreamingLLM 1750+1750 的位置信息是缓存窗口内部的,不是真实文本中的
    • 从表 8 中可知,两者的模型效果差不多

附录 E:在较长序列上 Llama-2-7B 的注意力可视化 (Llama-2-7B Attention Visualization on Longer Sequences)

  • 图 2 使用短序列(长度为 16)可视化了 Llama-2-7B 的注意力图,以便清晰展示
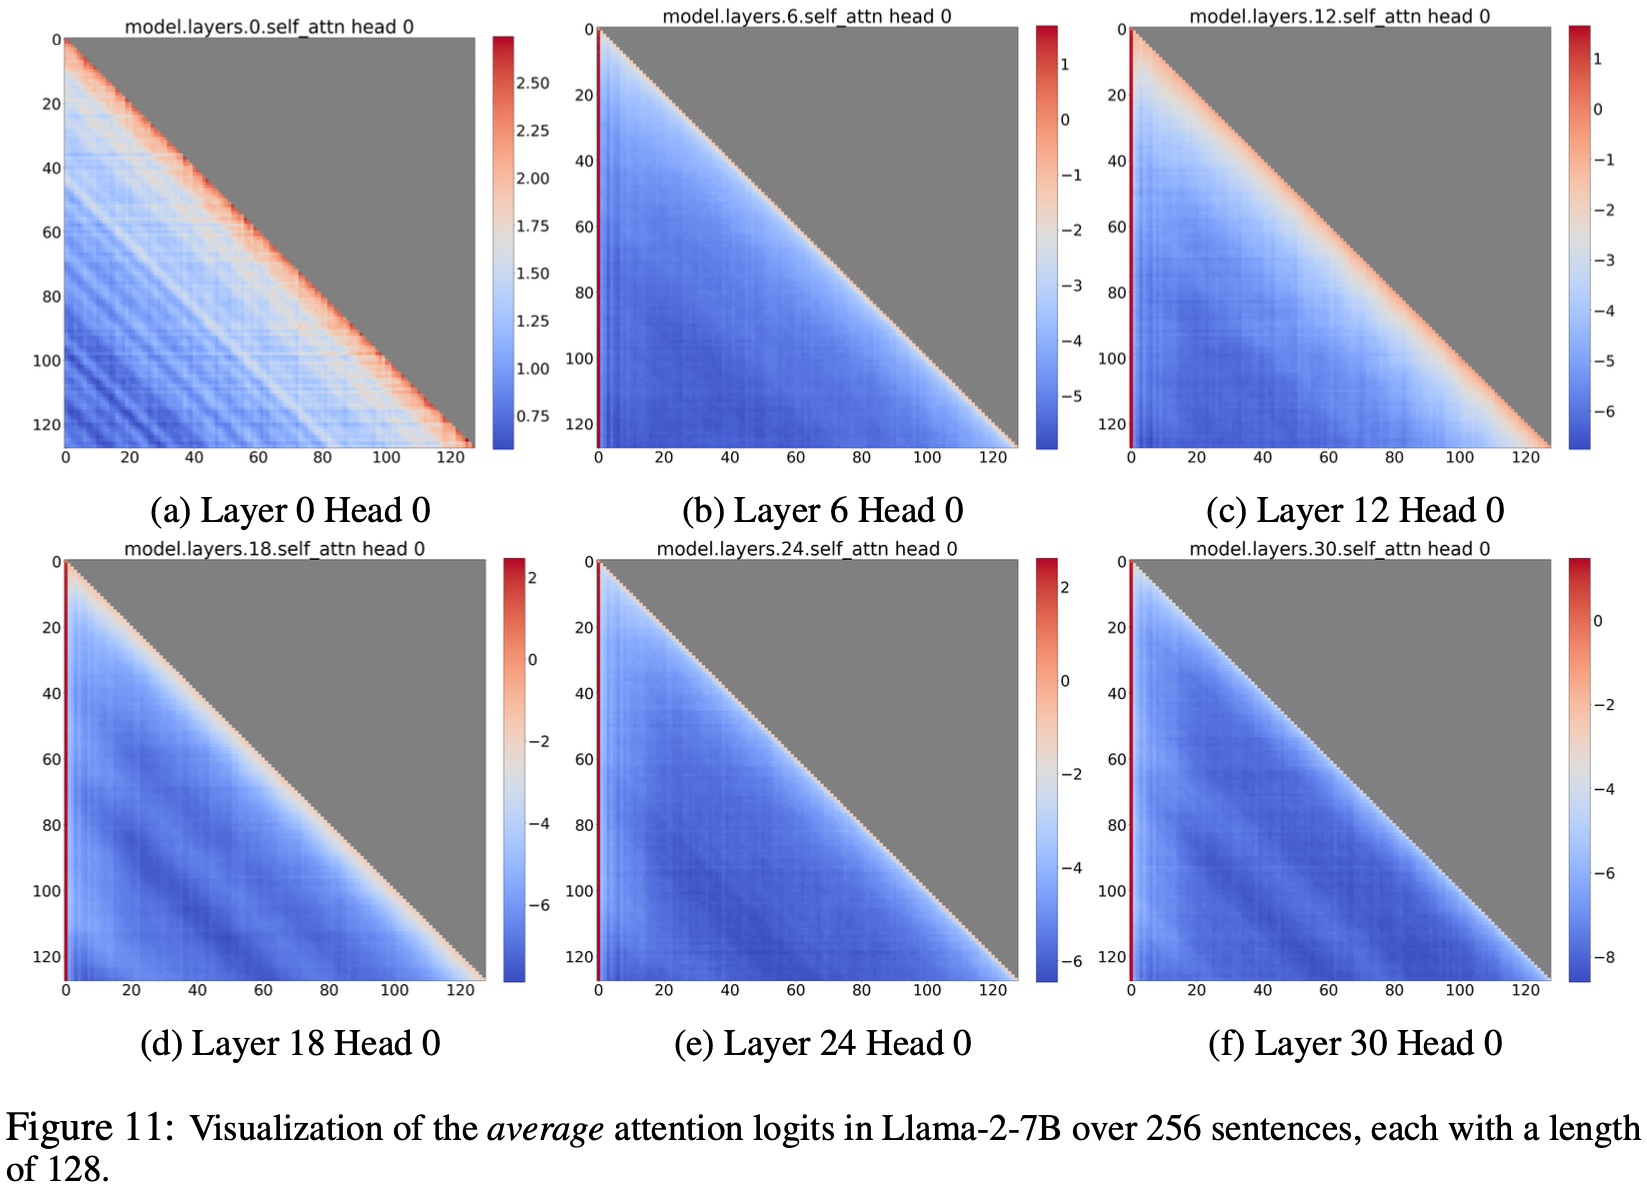
  • 论文在图 11 中进一步可视化了 Llama-2-7B 在较长序列(长度为 128)上的注意力
  • 论文发现短序列上的观察结果在较长序列上也成立
    • 即在大多数层中,无论初始 Token 与序列中其余 Token 之间的距离如何,初始 Token 的注意力分数远高于序列中其余 Token 的注意力分数
  • 因为序列越长, Attention Sink 的分数在热力图上的显示就越细
  • 论文在章节 F 中使用不同的方法进一步分析了较长序列(长度为 4096)上的注意力分布
  • 补充观察:从图上看,仍然是输入的浅层(低层)上关注局部注意力,深层关注 Sink Token

附录 F:Qualitative Analysis of Attention Sinks in Long Inputs

  • 图 2 和图 13 使用短序列说明了 Attention Sink 现象以便清晰展示
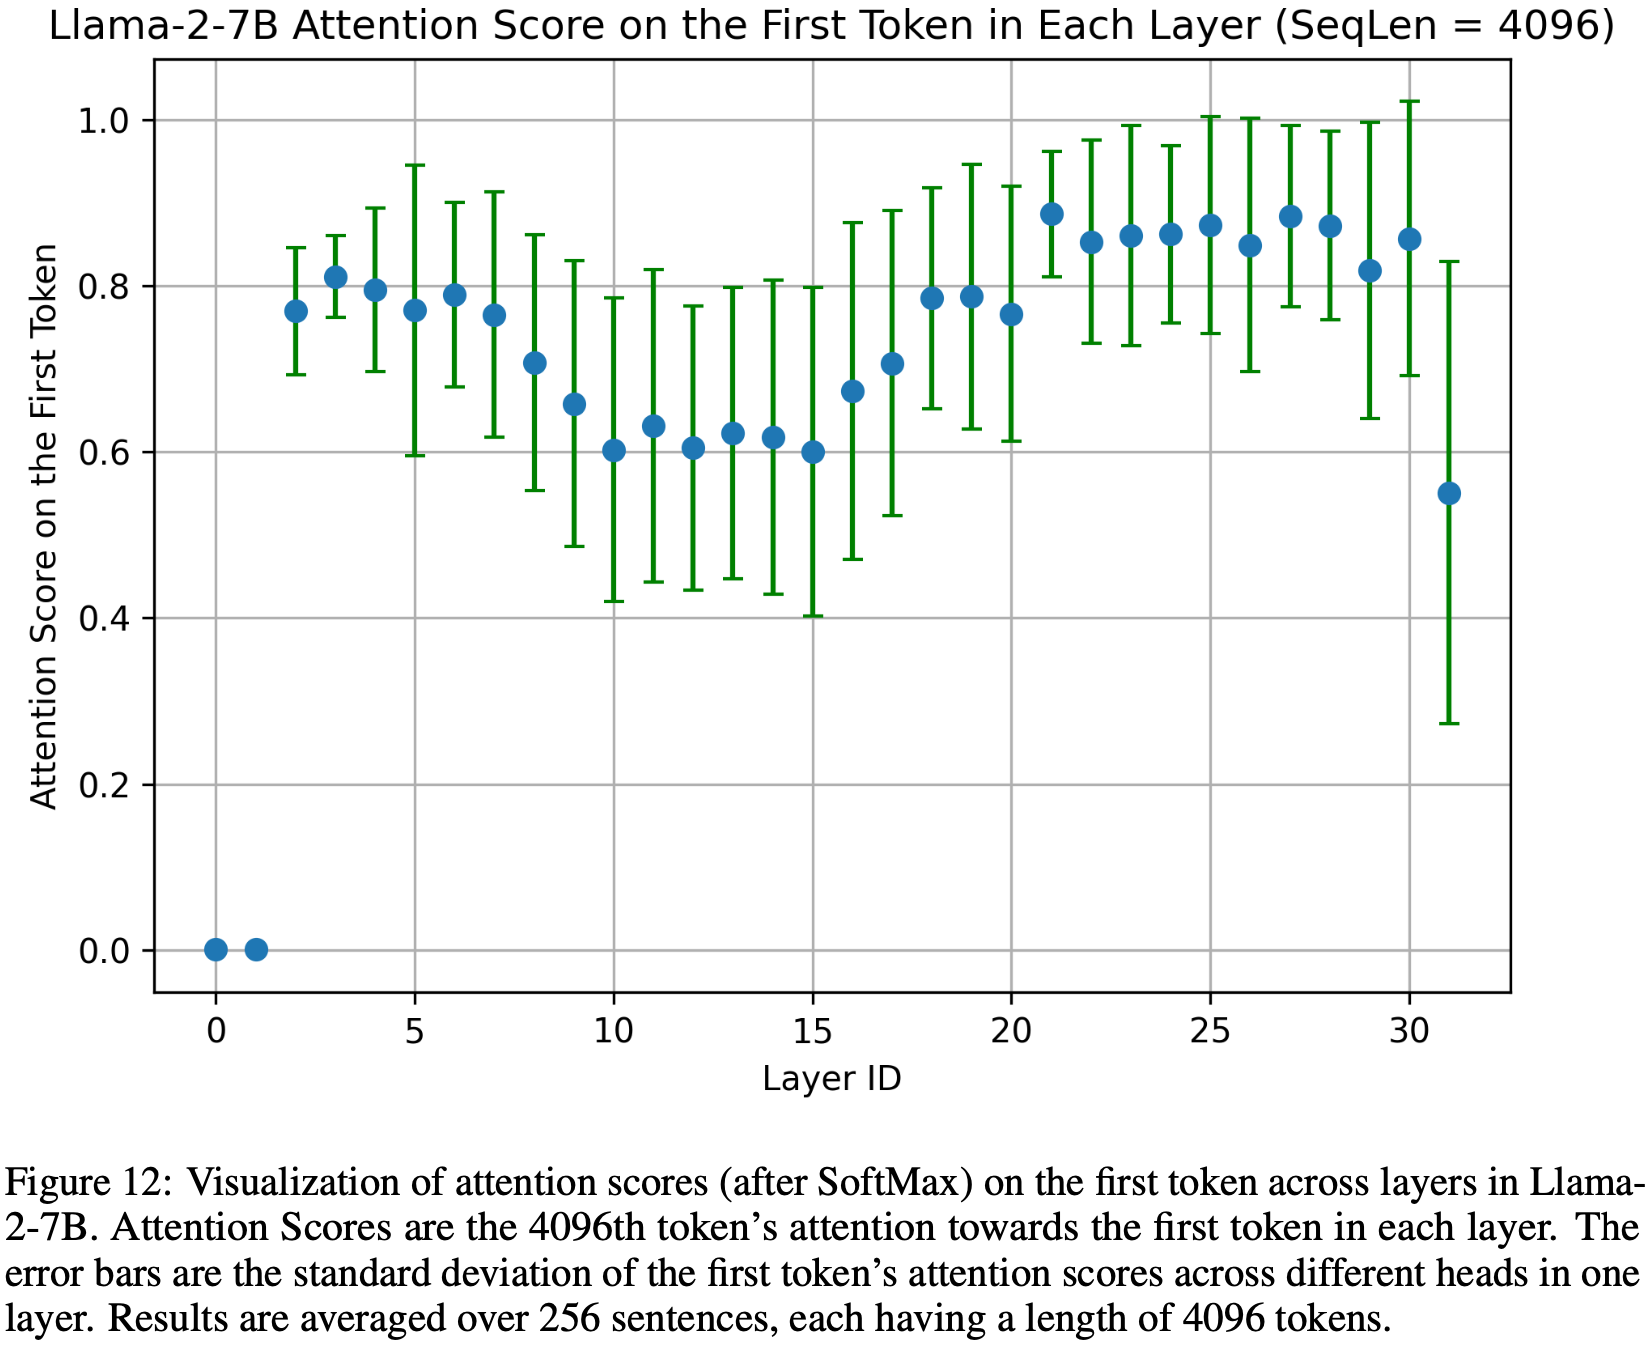
  • 扩展此分析,图 12 展示了在长输入(序列长度为 4096)中指向第一个 Token 的注意力分数(经过 SoftMax 后)的分布
  • 论文对 256 个序列的注意力分数取平均值,每个序列包含 4096 个 Token ,绘制数据表示第 4096 个 Token 在每个层中对初始 Token 的注意力分配
  • 第一个 Token 的注意力分数显著高,通常超过总注意力的一半,除了最底部的两个层(最浅的两层)
  • 这一观察经验性地证实了大多数层和头对第一个 Token 的偏好关注,无论序列中其他 Token 的距离如何
  • 这种趋势强调了序列中初始 Token 的关键作用,因为移除它们会由于 SoftMax 函数分母的大部分被移除而对语言模型性能产生巨大影响

附录 G:Llama-2-70B 注意力可视化 (Llama-2-70B Attention Visualization)

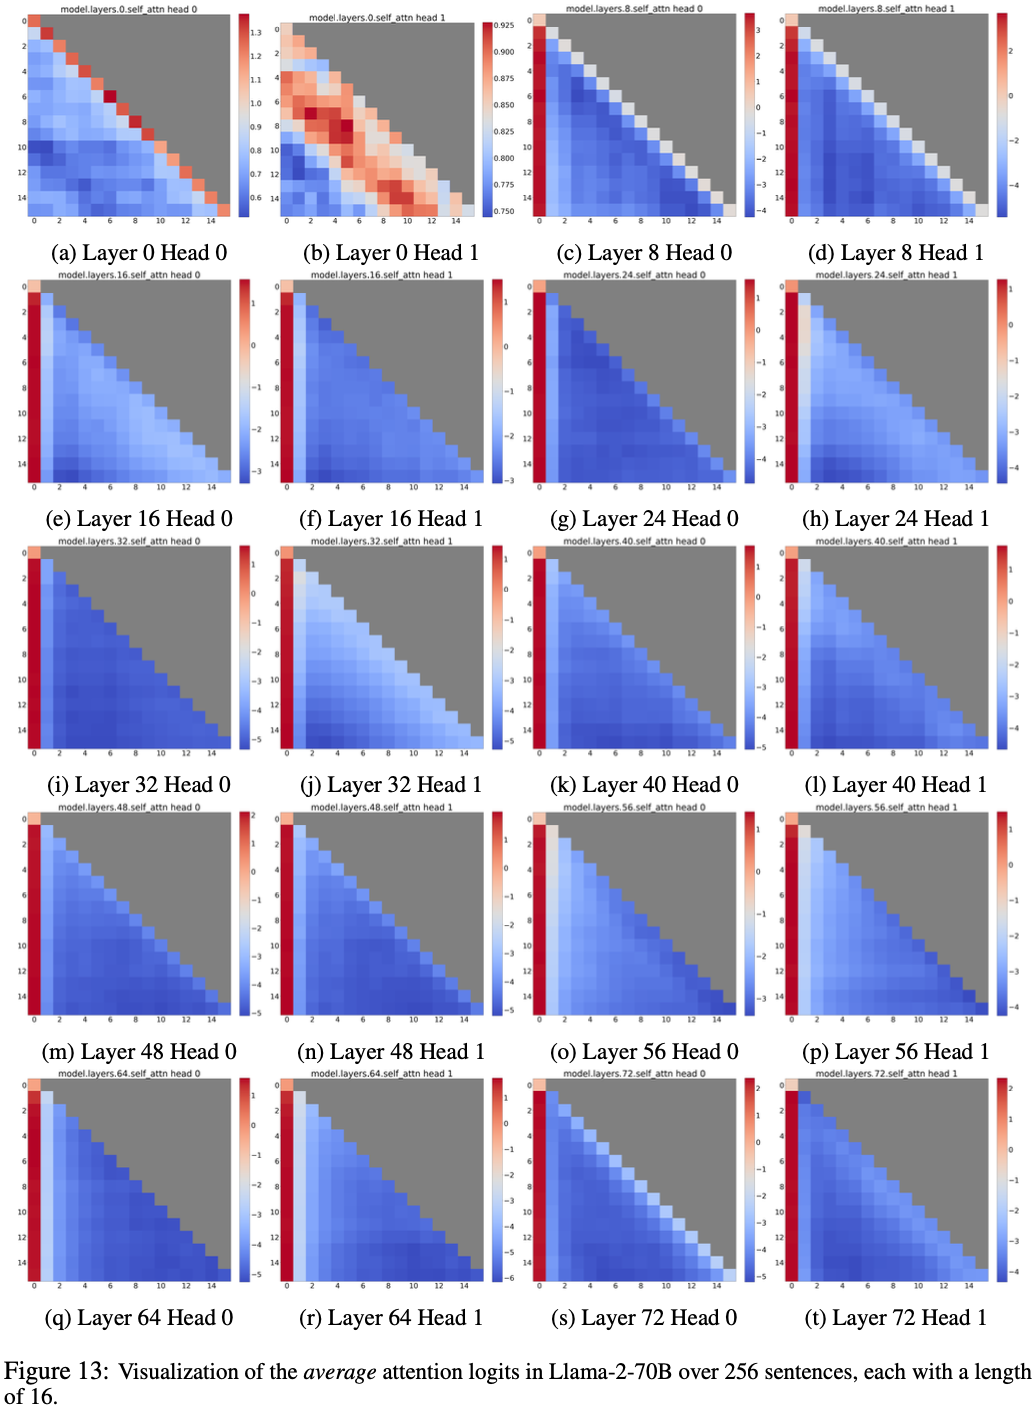
  • 图 2 展示了 Llama-2-7B 的注意力可视化,论文在图 13 中进一步可视化了 Llama-2-70B 的注意力
  • 论文发现对 Llama-2-7B 的观察结果在 Llama-2-70B 上也成立,
  • 其中在大多数层中,初始 Token 的注意力分数远高于其余 Token 的注意力分数

附录 H:Attention Sinks in Encoder Transformers

  • 在论文中,论文主要探讨了在自回归、 Decoder-only 语言模型(如 GPT 和 Llama)中观察到的 Attention Sink 现象
    • 基于章节 3.1 的见解,论文提出这一现象可能扩展到其他 Transformer 架构,包括编码器模型,如 BERT Devlin 等 (2019) 和 ViT Dosovitskiy 等 (2021)
  • 这一假设源于这些模型共享相似的 Transformer 结构并使用 SoftMax 注意力机制
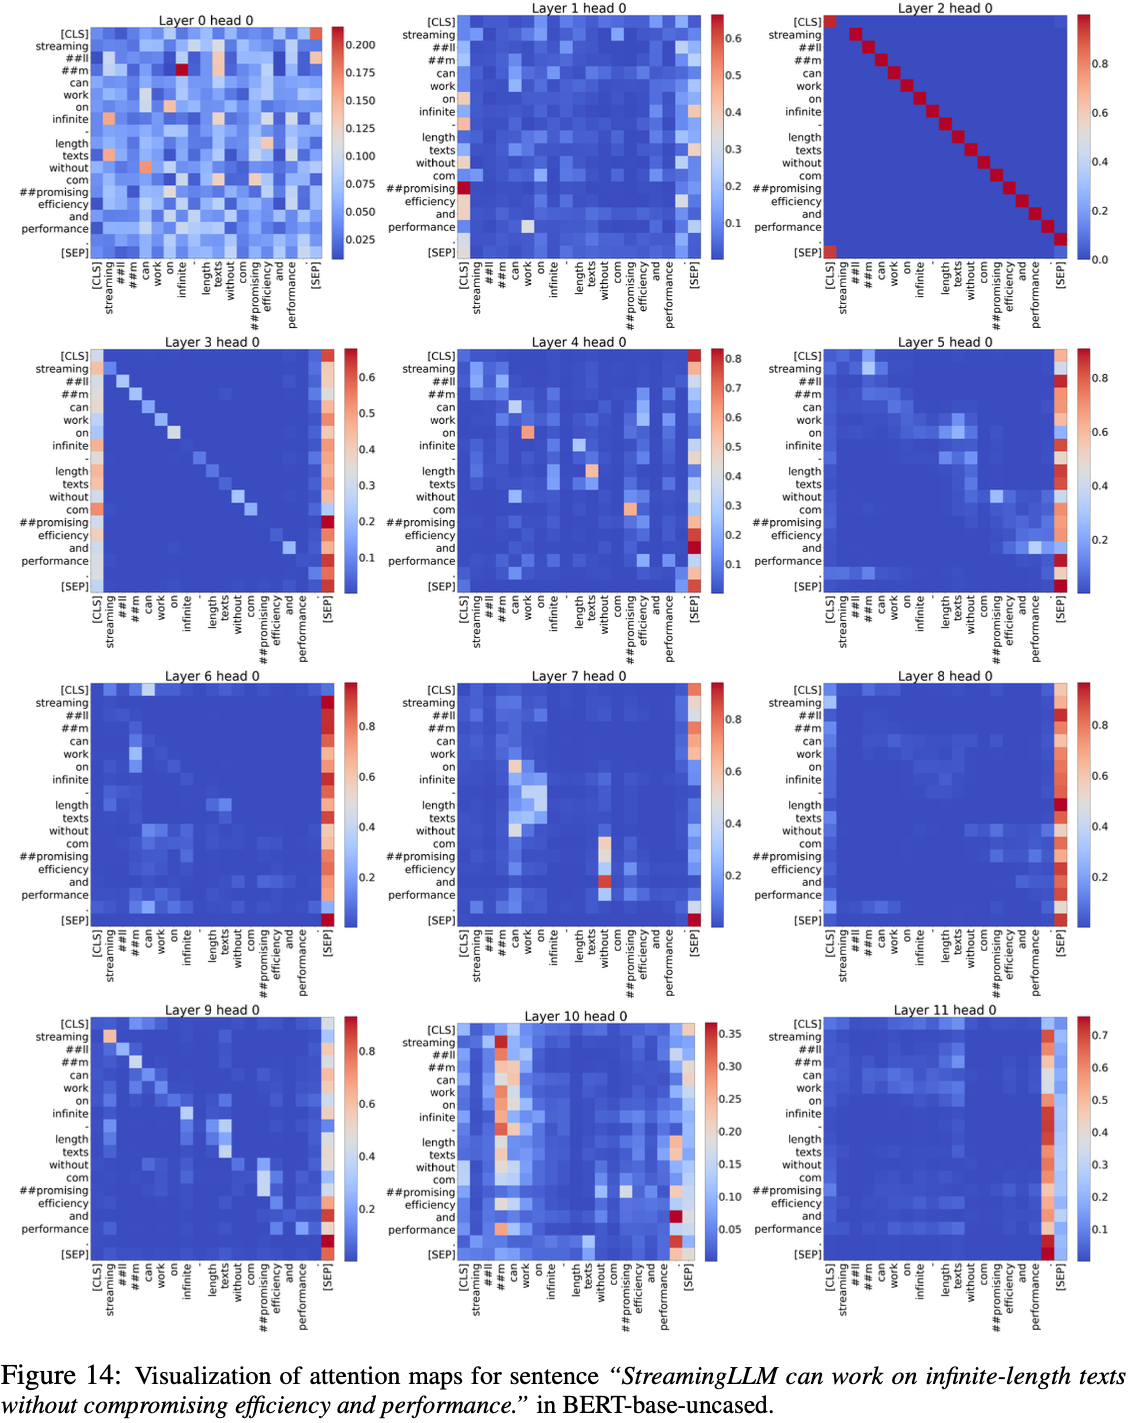
    • 为了证实论文的假设,论文分析了 BERT-base-uncased 的注意力模式
  • 如图 14 所示
    • BERT-base-uncased 表现出 Attention Sink 现象,其特征是在大多数层中分配给 [SEP] Token 的注意力分数不成比例地高
      • 这表明模型始终依赖无处不在的 [SEP] Token 作为注意力的焦点
    • Darcet 等人的同期研究在视觉 Transformer 中识别出类似的注意力尖峰,归因于随机背景补丁 Token 充当全局图像信息的“寄存器”
    • 作者认为这些“寄存器”类似于论文观察到的 Attention Sink 现象,表明这是所有 Transformer 模型的普遍特征

附录 I:Using More Sink Tokens in the Pre-Training Stage

  • 章节 3.3 说明,在预训练阶段加入单个专用的 Sink Token 不会影响模型性能,可通过将 Attention Sink 集中到一个 Token 上来增强流式性能
    • 本节深入探讨在预训练期间添加额外的 Sink Token 是否能够进一步优化预训练语言模型的性能
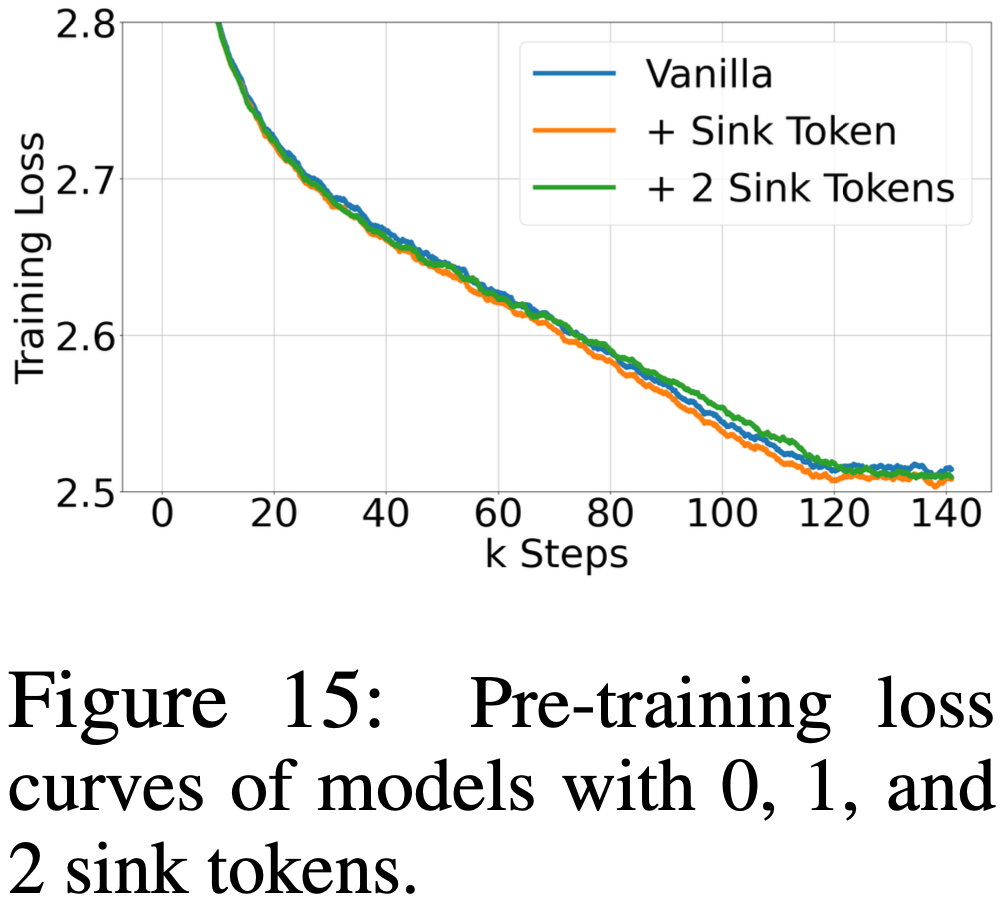
  • 如图 15 所示,论文的实验表明,在预训练期间加入一个或两个 Sink Token,预训练损失曲线与基线(原始)模型非常相似
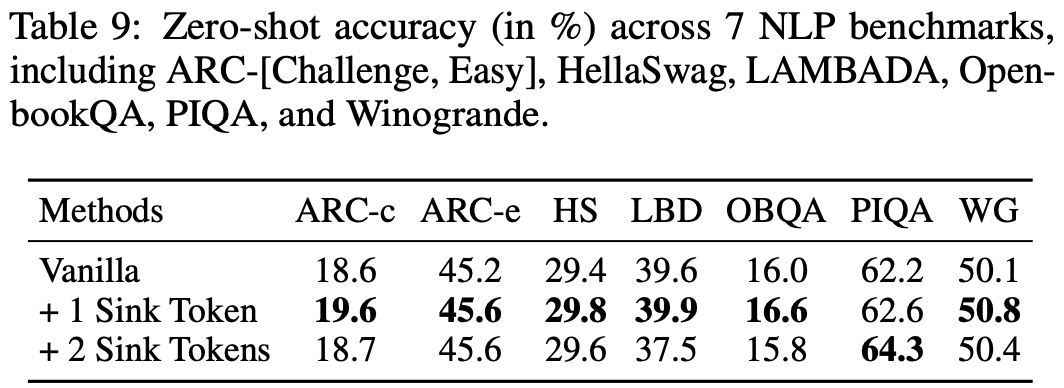
  • 但如表 9 详述,引入第二个 Sink Token 在大多数基准任务中并未产生实质性的性能改进
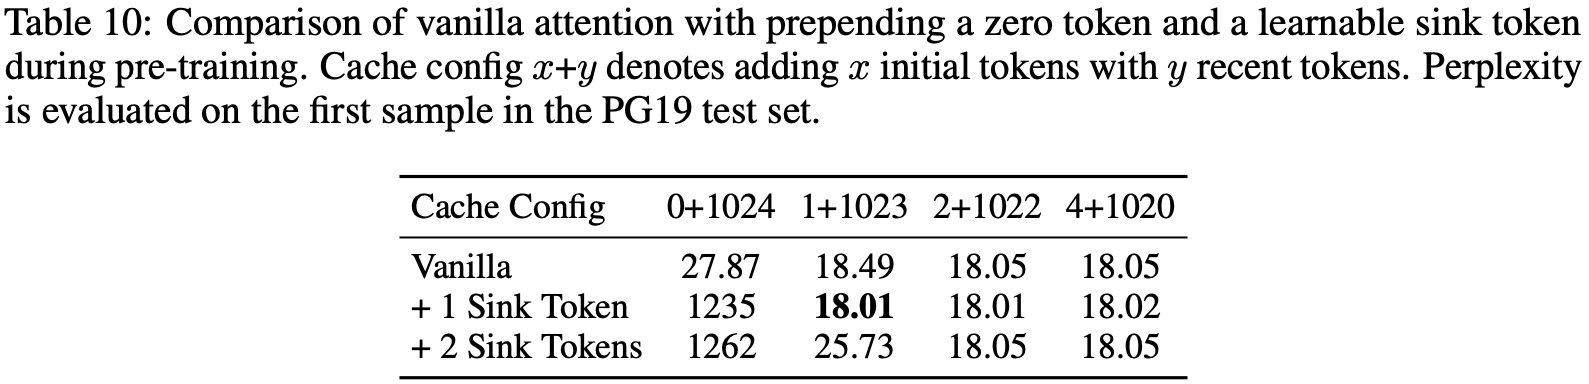
  • 进一步分析,如表 10 所示,显示包含额外的 Sink Token 并不会增强流式性能(理解:这里的额外指的主要是多余一个的部分?)
    • 模型似乎依赖两个 Sink Token 来维持稳定的流式性能
    • 这些发现表明,单个 Sink Token 足以改善流式性能,添加更多 Sink Token 并不会带来整体语言模型性能的进一步提升
    • 这与视觉 Transformer (ViT) Darcet 等 (2023) 中的发现形成对比,在 ViT 中发现多个“寄存器”是有益的
  • 表 10: 预训练期间添加零 Token 和可学习 Sink Token 与原始注意力的比较
    • 缓存配置 \(x\)+\(y\) 表示添加 \(x\) 个初始 Token 和 \(y\) 个最近 Token
    • 困惑度在 PG19 测试集的第一个样本上评估
1…112113114…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4