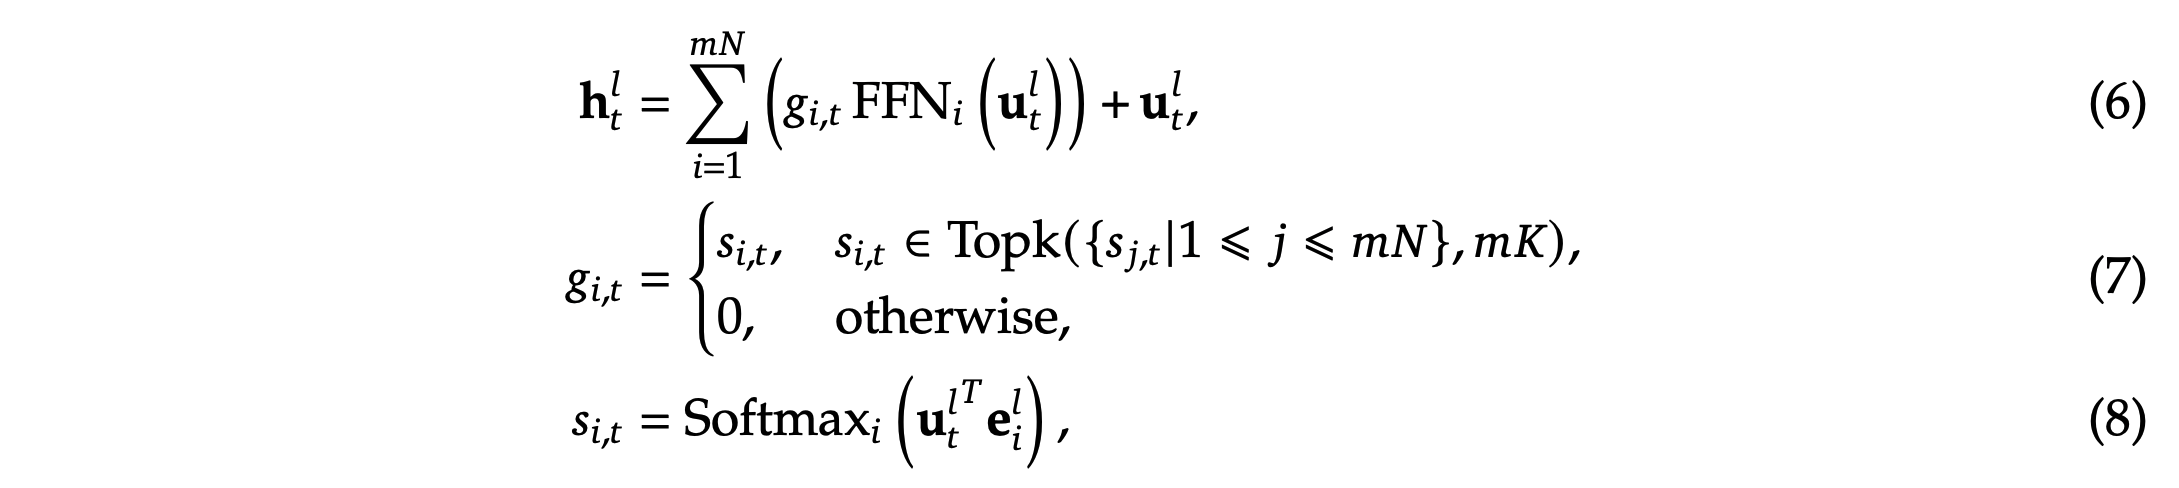Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——DeepSpeed框架介绍

  • 参考链接:
    • 官方文档:deepspeed.readthedocs.io

整体介绍

  • DeepSpeed 是由微软开发的开源的深度学习优化库,旨在提高大规模模型训练的效率和可扩展性
  • DeepSpeed 框架的核心技术有:
    • ZeRO 冗余优化技术 :通过分布式内存管理,将模型参数、梯度和优化器状态进行分区,大幅降低显存占用,是首次支持千亿级参数模型训练的框架
    • 3D 并行策略 :支持数据并行、流水线并行和张量切片模型并行,并可灵活组合
    • 混合精度训练 :自动混合精度训练(AMP)将单精度和半精度浮点数结合使用,降低内存需求的同时提升计算效率
    • 智能推理优化器 :支持张量并行与异构内存技术,提供低延迟高吞吐的分布式推理服务,可将成本降低 70%
    • 全链路内存管理 :集成 CPU 卸载与显存碎片整理技术,单卡即可训练百亿级模型,资源利用率提升 6 倍
  • DeepSpeed 框架的组件构成有:
    • Apis :提供易用的 API 接口
    • 运行时组件 :管理、执行和性能优化,基于 Python 语言实现,负责部署训练任务到分布式设备、数据分区、模型分区等
    • 底层内核 :用 C++ 和 CUDA 实现,优化计算和通信
  • DeepSpeed 生态兼容性极好 :原生兼容 PyTorch 与 Hugging Face 生态,通过简洁 API 可快速迁移项目,开发效率提升 300%

安装 DeepSpeed

  • 仅需一行安装命令即可:

    1
    pip install deepspeed
  • 暗转完成后,可以使用 ds_report 命令验证安装是否成功

    • 这个命令可以查看环境配置信息

DeepSpeed 的使用

  • 代码修改 :仅仅需要非常少的代码修改即可将原始训练代码切换到 DeepSpeed 框架上(DeepSpeed 与 PyTorch 无缝集成,只需少量修改即可启用加速)

    • 第一步:通过 deepspeed.initialize 将模型包装为 DeepSpeed 引擎,自动应用优化
    • 第二步:使用 model_engine.backward 和 model_engine.step 替换PyTorch原本的 loss.backward() 和 optimizer.step()
  • 配置 DeepSpeed :DeepSpeed 的优化行为通过 JSON 配置文件(ds_config.json)指定

    • 一般的项目都会自带一些配置好的 .json 文件示例,可直接修改使用
  • 运行训练 :使用 DeepSpeed 的命令行工具启动训练

    • 单节点训练命令为:

      1
      deepspeed train.py --deepspeed_config ds_config.json
    • 对于多节点集群,使用下面的命令:

      1
      deepspeed --num_gpus 8 --num_nodes 2 train.py --deepspeed_config ds_config.json
      • 其中--num_gpus 指定每节点使用的 GPU 数量,--num_nodes 指定集群中的节点数
    • 其他常用参数:

      • 使用--log_dir 参数启用日志记录,监控内存使用、训练速度等
  • 特别说明:使用了 DeepSpeed 框架的代码需要使用 deepspeed 命令来启动

    • 补充:直接使用 python 命令启动时会出现 deepspeed.initialize 调用的错误
    • 原因:DeepSpeed 作为一个分布式训练库,需要特殊的启动器来管理多个进程和 GPU 之间的通信和资源分配

DeepSpeed 使用示例(基于 PyTorch)

  • DeepSpeed 使用示例:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    62
    63
    64
    65
    66
    67
    68
    69
    70
    71
    72
    73
    74
    75
    76
    77
    78
    79
    80
    81
    import torch
    import torch.nn as nn
    from torch.utils.data import DataLoader, Dataset
    import deepspeed

    class DiyModel(nn.Module):
    def __init__(self, input_dim, output_dim):
    super(DiyModel, self).__init__()
    self.fc = nn.Sequential(
    nn.Linear(input_dim, 128),
    nn.ReLU(),
    nn.Linear(128, output_dim)
    )

    def forward(self, x):
    return self.fc(x)

    class RandomDataset(Dataset):
    def __len__(self):
    return 1000

    def __getitem__(self, idx):
    x = torch.randn(32)
    y = torch.randint(0, 10, (1,)).item()
    return x, y

    # 初始化模型和数据(无需为 DeepSpeed 特别处理)
    model = DiyModel(32, 10)
    train_dataset = RandomDataset()
    train_loader = DataLoader(train_dataset, batch_size=32)

    # 初始化 DeepSpeed 引擎(仅需使用 deepspeed.initialize 初始化模型得到 model_engine 即可)
    # 注:这一步会自动将模型参数移动到 GPU 上,下面使用的数据也需要将数据移动到对应的 GPU 上才能运行,否则会出现 设备不一致的错误(CPU vs GPU)
    # zero_optimization 字段的 stage 键值对应如下效果
    ## stage: 0:不使用 ZeRO 优化(默认值是 0)
    ## stage: 1:优化器状态分片
    ## stage: 2:优化器状态和梯度分片
    ## stage: 3:优化器状态、梯度和参数分片(最高内存效率)
    model_engine, optimizer, _, _ = deepspeed.initialize(
    args=None,
    model=model,
    model_parameters=model.parameters(),
    config={
    "train_batch_size": 32,
    "optimizer": {
    "type": "Adam",
    "params": {
    "lr": 0.001,
    "betas": [0.9, 0.999]
    }
    },
    "fp16": {
    "enabled": True,
    "loss_scale": 0,
    "loss_scale_window": 1000,
    "initial_scale_power": 16
    },
    "zero_optimization": {
    "stage": 2, # 这里指定Zero层级(0、1、2、3)
    "offload_optimizer": {
    "device": "cpu" # 可选:指定优化器卸载设备
    }
    }
    }
    )

    # 训练过程(训练时不再使用原来的模型,使用 model_engine)
    for epoch in range(10):
    for batch_idx, (data, target) in enumerate(train_loader):
    # 将数据挪到和模型相同的 GPU 上
    device = model_engine.device
    model_dtype = next(model_engine.parameters()).dtype # 通过模型的第一个参数获取dtype
    data = data.to(device, dtype=model_dtype) # 将数据移至模型所在设备并转换为与模型相同的dtype
    target = target.to(device)

    outputs = model_engine(data) # 使用(deepspeed.initialize 初始化得到的)model_engine 来进行前向过程
    loss = nn.CrossEntropyLoss()(outputs, target)
    model_engine.backward(loss) # 使用 model_engine 来进行后向过程
    model_engine.step() # 使用 model_engine 来更新模型参数(注:此时不再需要显示调用 optimizer)
    if batch_idx % 100 == 0:
    print(f"Epoch {epoch}, Batch {batch_idx}, Loss: {loss.item()}")

附录:如何指定目标 GPU

启动时指定 CUDA_VISIBLE_DEVICES 环境变量

  • 在运行命令前设置环境变量来限制 DeepSpeed 可见的 GPU:

    1
    CUDA_VISIBLE_DEVICES=0,1,2,3 deepspeed your_script.py --args ...
  • 该方案是最常用的方法 ,且适用于常见的很多框架

在 Python 脚本中设置环境变量

  • 也可以在Python脚本中通过os.environ设置这个环境变量:

    1
    2
    3
    4
    5
    6
    7
    import os
    os.environ["CUDA_VISIBLE_DEVICES"] = "0,1" # 指定使用GPU 0和1

    import deepspeed
    import torch

    # 训练逻辑
  • 注:需要在导入DeepSpeed或PyTorch之前设置

  • 该方案同样适用于常见的很多框架,但因为需要修改代码,不常用

使用 deepspeed 命令的 --include 参数

  • 如果使用的是 DeepSpeed 的 launcher,也可以通过--include参数指定使用的 GPU:
    1
    deepspeed --include localhost:0,1 your_script.py --args ...

多机多卡如何指定 GPU

  • 如果你使用的是单机多卡,以上方法都能很好地工作
  • 对于多机多卡训练,通常需要结合 deepspeed 命令的其他参数如 --hostfile 等一起使用

附录:数据加载位置管理

  • 由于 deepspeed 会自动将模型参数加载到指定 GPU 上,所以数据也要加载到指定 GPU,否则会出现设备不一致的错误
  • 加载命令如下(亲测解决方案):
    1
    2
    device = model_engine.device
    data = data.to(device)

附录:混合精度训练数据格式管理

  • 由于 deepspeed 在启动混合精度训练时,可能会按照指定格式来指定参数形式,此时数据也需要转换为指定类型
  • 解决方式如下(亲测遇到错误时的解决方案):
    1
    2
    model_dtype = next(model_engine.parameters()).dtype # 通过模型的第一个参数获取类型,注:写这么复杂的原因是,当前还不支持直接调用 model_engine.dtype()
    data = data.to(device, dtype=model_dtype)
NLP——DeepSeek-R1相关技术总结

本文主要介绍 DeepSeek-R1 相关的解读,笼统而简单的介绍,详情可查看本人的其他博客

  • 相关链接:
    • 开源技术报告:DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 20250120
    • 博客:DeepSeek-R1 技术报告解读 - 绝密伏击的文章 - 知乎

Background

2025年01月20日,deepseek 正式发布 DeepSeek-R1,并同步开源模型权重

  • 开源 DeepSeek-R1 推理大模型,与 o1 性能相近。‍‍(冷启动 SFT -> RL -> COT + 通用数据SFT(80W)-> 全场景RL)
  • 开源 DeepSeek-R1-Zero,预训练模型直接 RL,不走 SFT。(纯强化学习)
  • 开源用 R1 数据蒸馏的 Qwen、Llama 系列小模型,蒸馏模型超过 o1-mini 和 QWQ。(直接使用80W数据进行SFT)

报告核心说明

  • 首次验证了纯 RL 也可以训练出大模型的推理能力
  • aha moment:顿悟时刻,主要指DeepSeek-R1-Zero模型训练过程中,模型在某个关键时刻突然学会自我反省的情况

DeepSeek-R1-Zero

  • 预训练后直接进入RL阶段

DeepSeek-R1-Zero奖励模型

  • 直接采用了一种基于规则的奖励系统,包括两种奖励模型作为评估指标,分别是准确率奖励模型和格式奖励模型
    • 准确率奖励模型 :评估response是否准确
    • 格式奖励模型 :评估格式是否准确,具体来说,格式奖励要求模型将思考过程放在“和”标签之间

DeepSeek-R1-Zero演化过程


DeepSeek-R1

DeepSeek-R1 使用了冷启动 + 多阶段训练的方式:

  • 阶段1:使用少量高质量的 CoT 数据进行冷启动,预热模型。(相较于直接RL,冷启动预热能让模型快速进入稳定训练阶段)
  • 阶段2:进行面向推理的强化学习,提升模型在推理任务上的性能
  • 阶段3:使用拒绝采样和监督微调,进一步提升模型的综合能力
  • 阶段4:再次进行强化学习,使模型在所有场景下都表现良好

DeepSeek-R1之MoE

  • 参考链接:Deepseek-MOE架构图解(V1->V2->V3) - 假如给我一只AI的文章 - 知乎

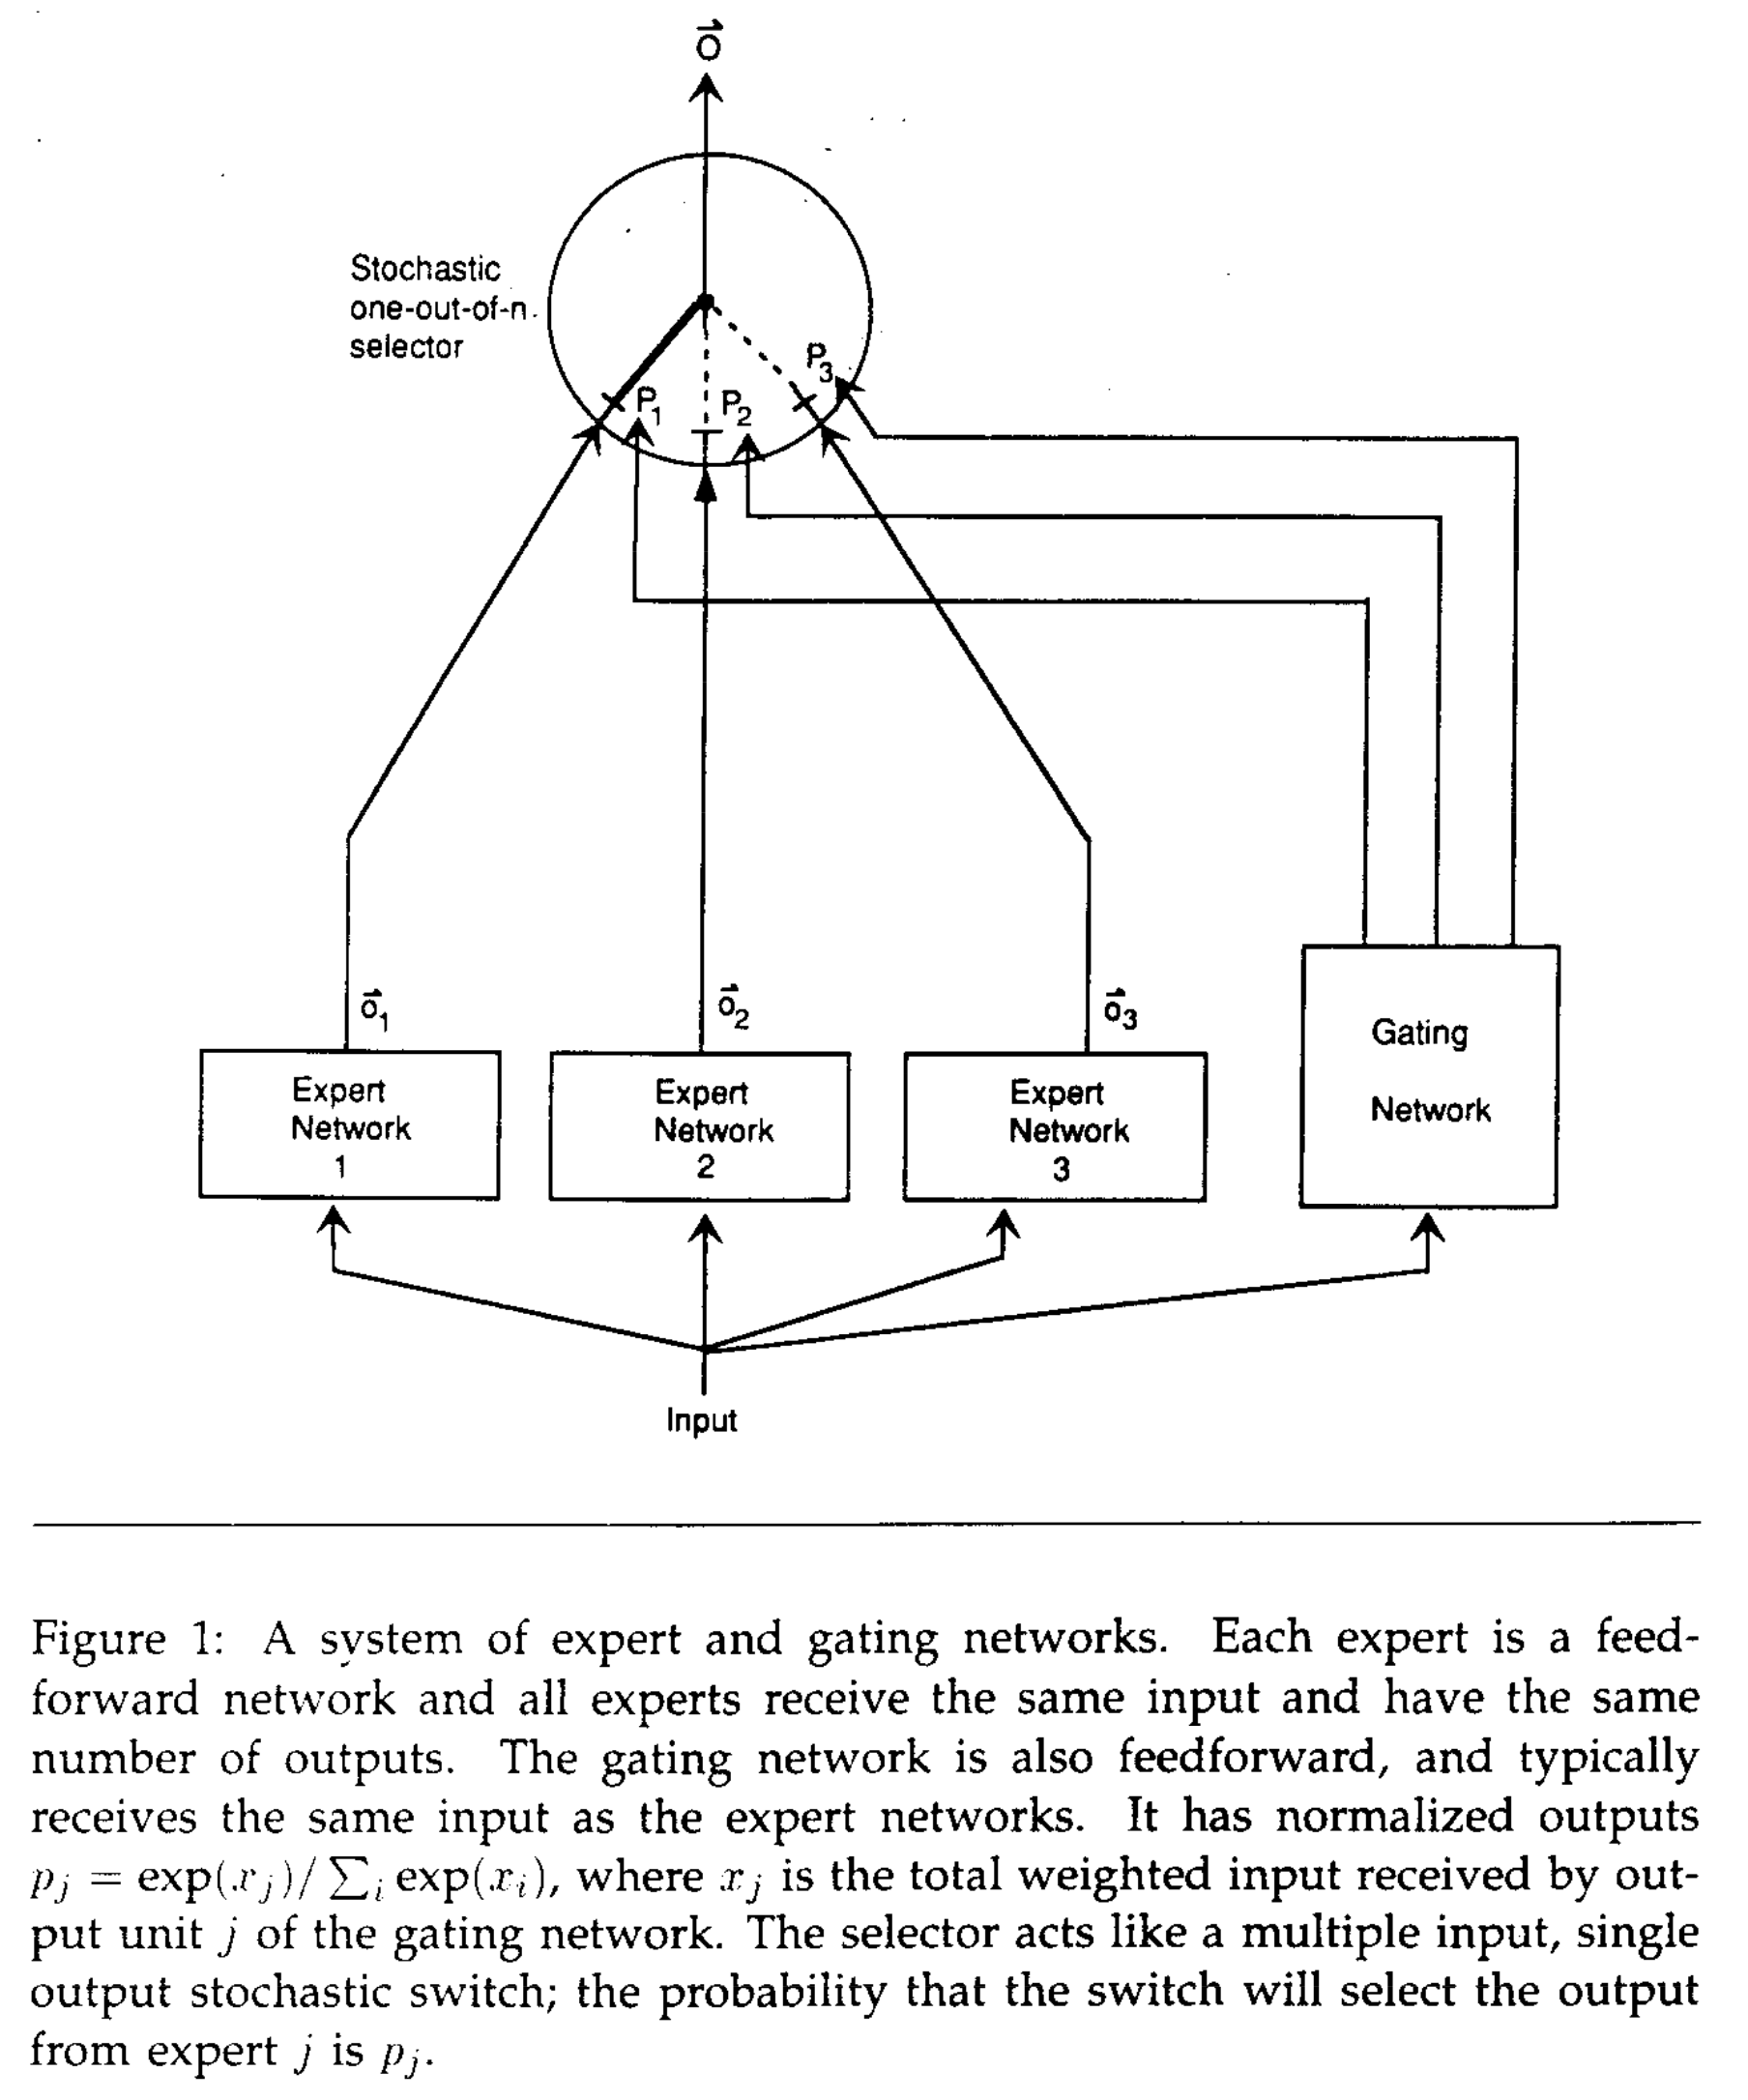
普通的MoE

  • Mixture of Experts,混合专家模型。最早1991年的论文《Adaptive Mixtures of Local Experts》中提出了混合专家模型的雏形,架构图如下:

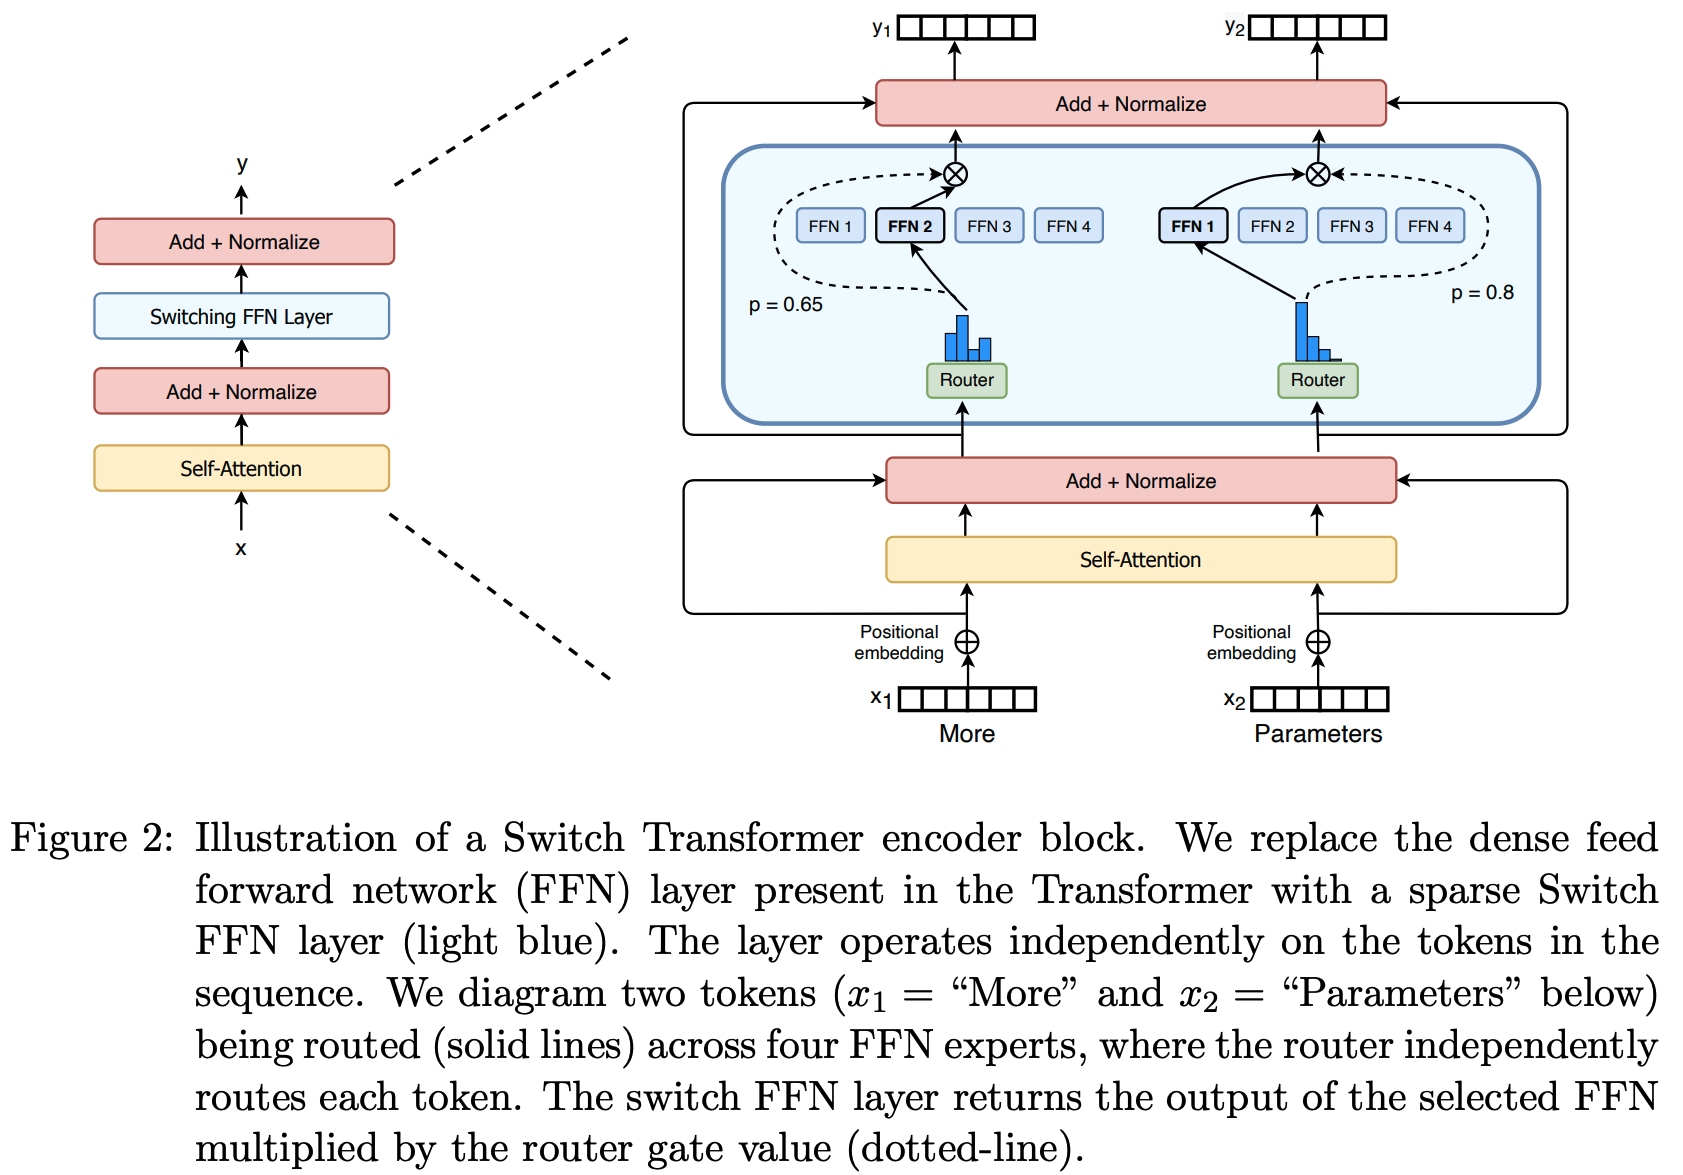
Switch Transformer中的MoE

  • 原始论文:Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, Google

  • 架构图(后面会在和DeepSeekMoE比较时给出数学表达式)

  • Transformer-MoE的本质是对Transformer层的FNN进行改进,改为带MoE的FNN

DeepSeekMoE(DeepSeek-V1)

  • 原始论文:DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models

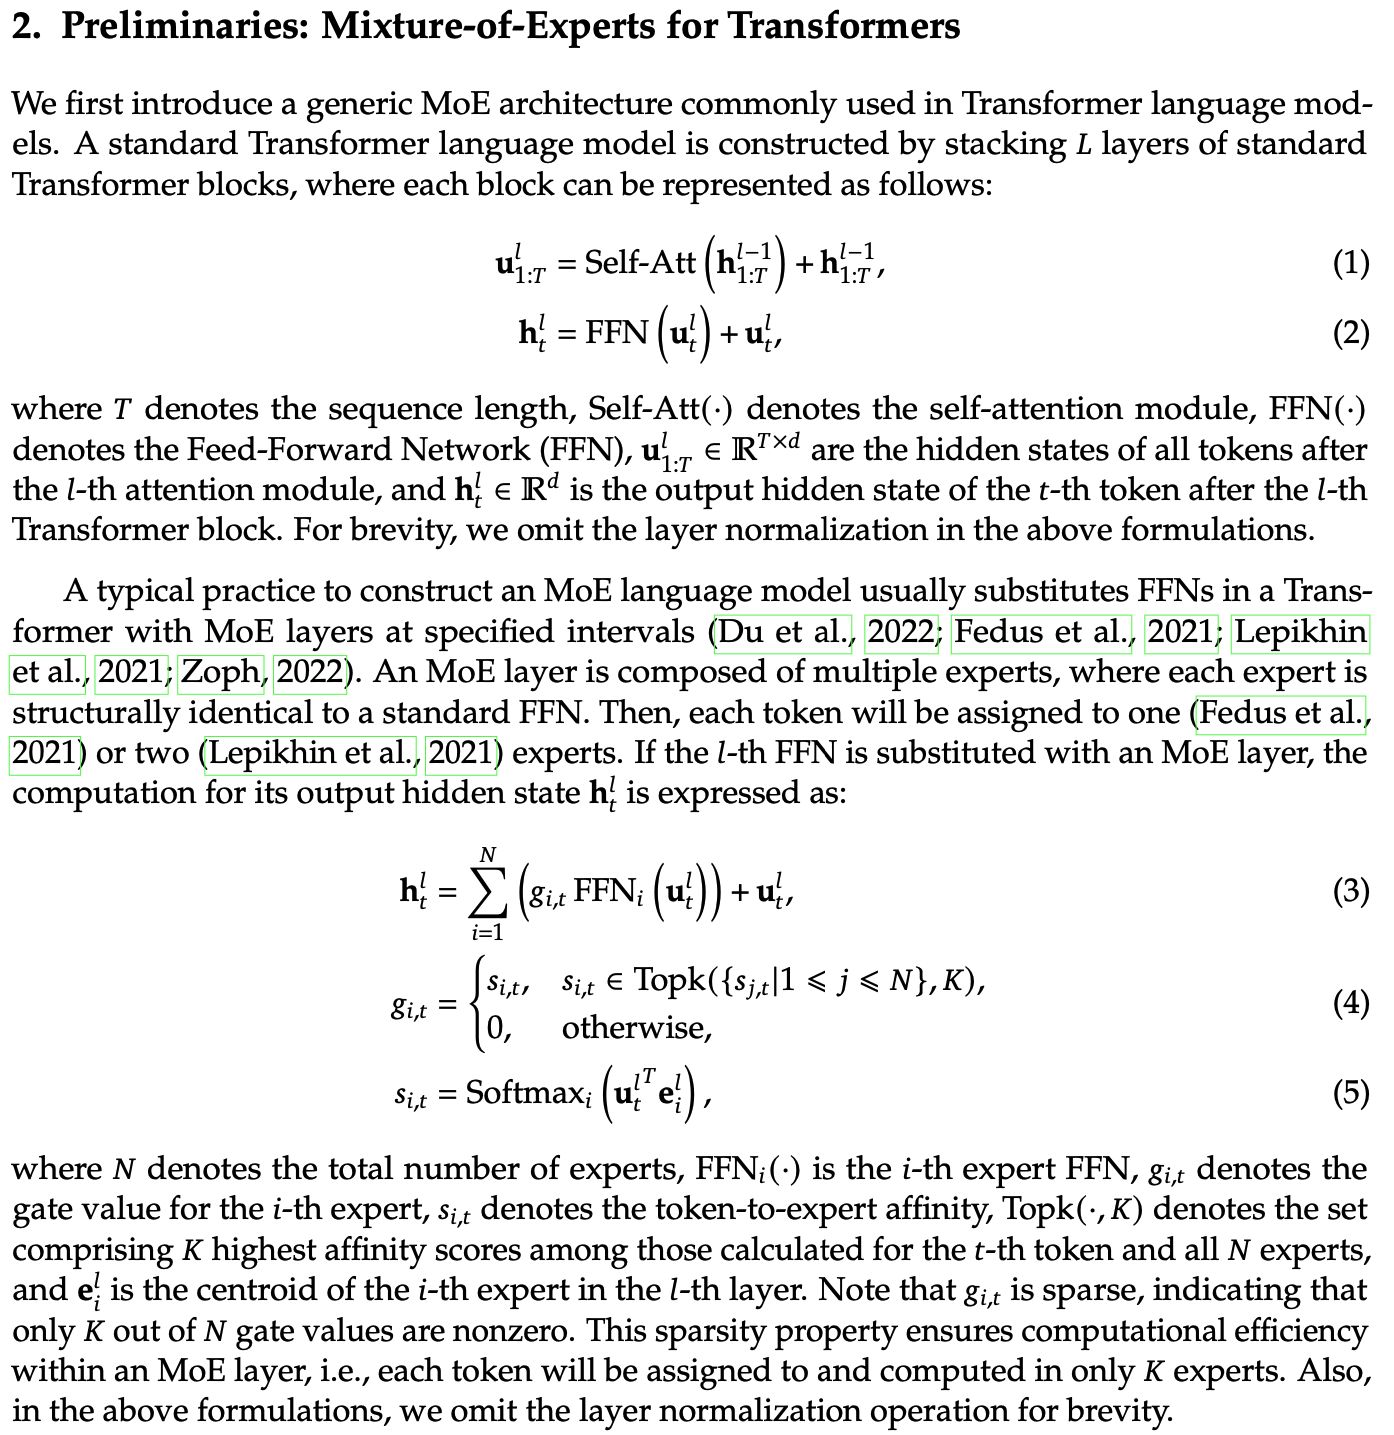
  • 传统的Transformer和MoE

  • 问题:上图中说 \(\boldsymbol{e}_i^l\) 是每个专家的质心(Centroid),但是未给出这个质心是怎么来的,是否可训练?

    • 回答:在上述原始论文中确实没有说清楚,但是一些文章中有提到,比如 GSHARD: SCALING GIANT MODELS WITH CONDITIONAL COMPUTATION AND AUTOMATIC SHARDING 中 Algorithm1 提到输入门控网络的该值是可训练的权重,上图中的乘法实际上也就是一个线性层,实现可以如下:
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      def __init__():
      ...
      # 门控网络
      self.gate = nn.Linear(input_dim, num_experts)

      def forward(self, x):
      # 计算门控权重
      gate_logits = self.gate(x)
      gate_probs = F.softmax(gate_logits, dim=-1)

      # 选择top-k专家
      topk_values, topk_indices = torch.topk(gate_probs, self.k)
      topk_gates = topk_values / topk_values.sum(dim=-1, keepdim=True)
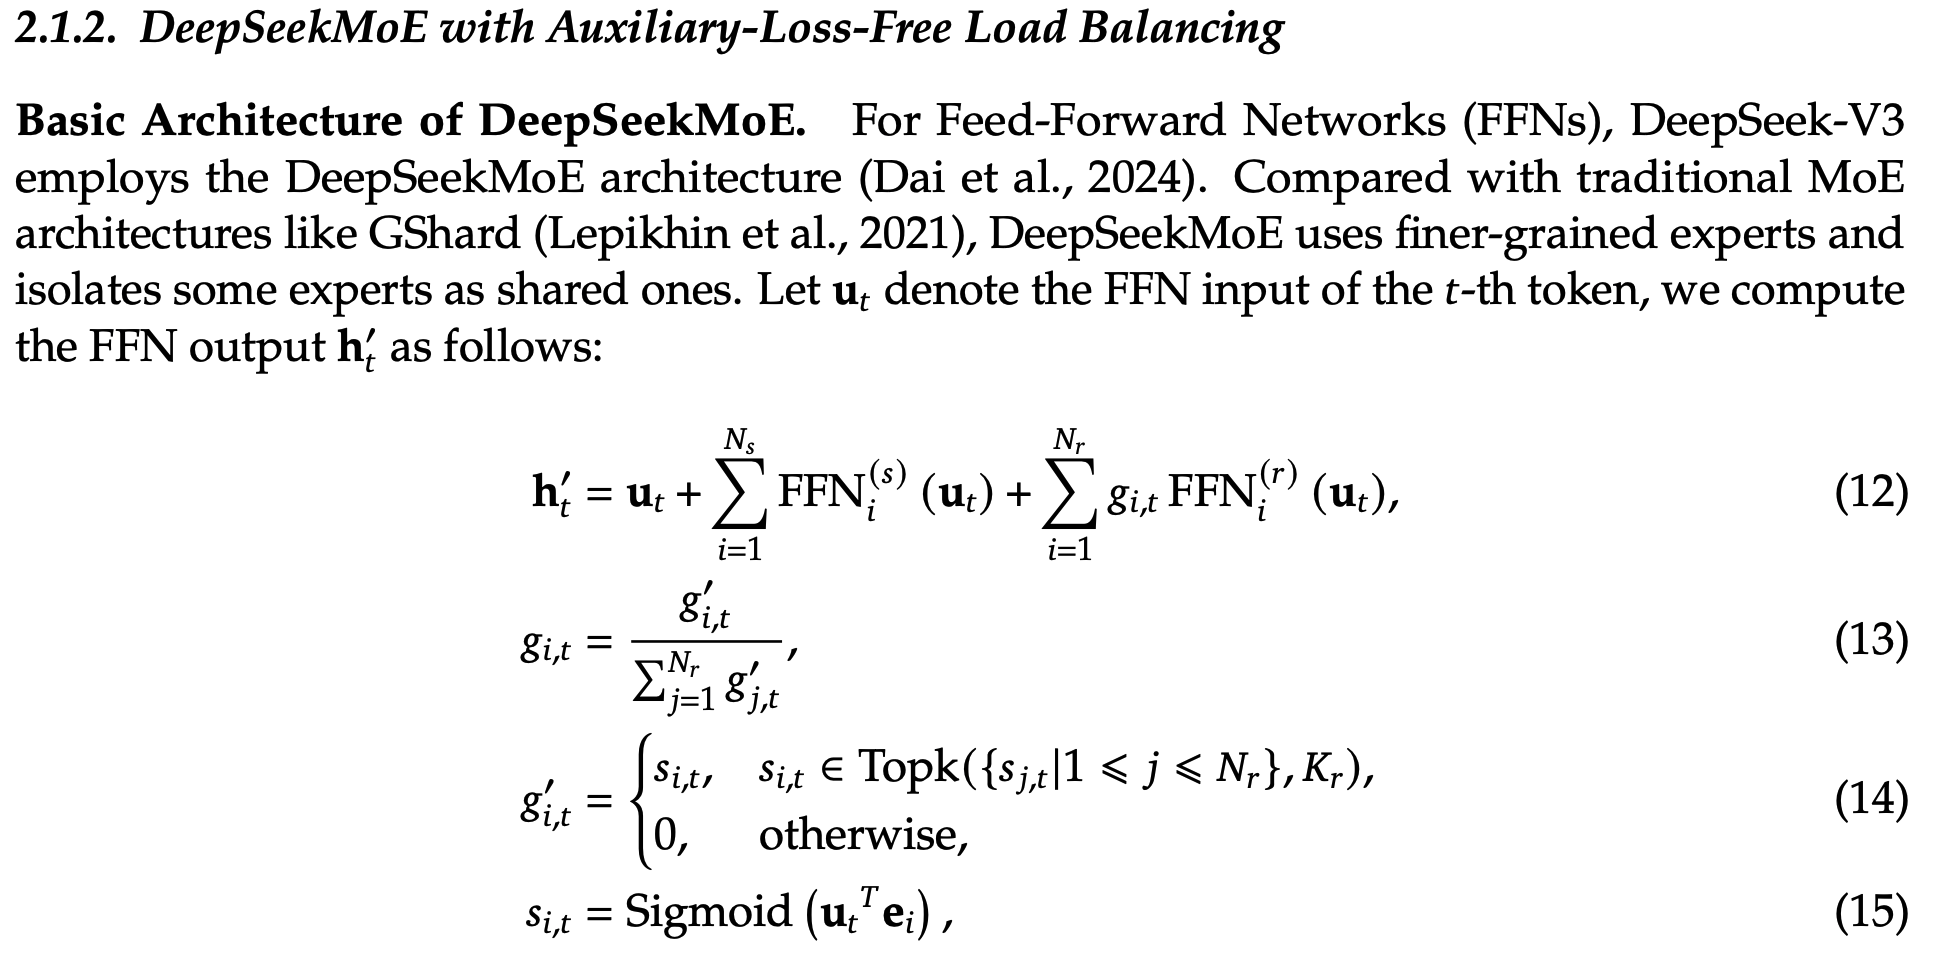
  • 个人思考:以上被选中的FNN系数和不为1(小于1),但因为在每一个Transformer层中,FNN的结果和上一层的隐向量叠加后,都有LayerNorm存在(将每个token的隐向量分别归一化为均值为0,方差为1的向量),所以隐向量的值不会越来越小,在V3版本的公式中,会考虑在选择了 TopK FNN 后,再进行一次归一化

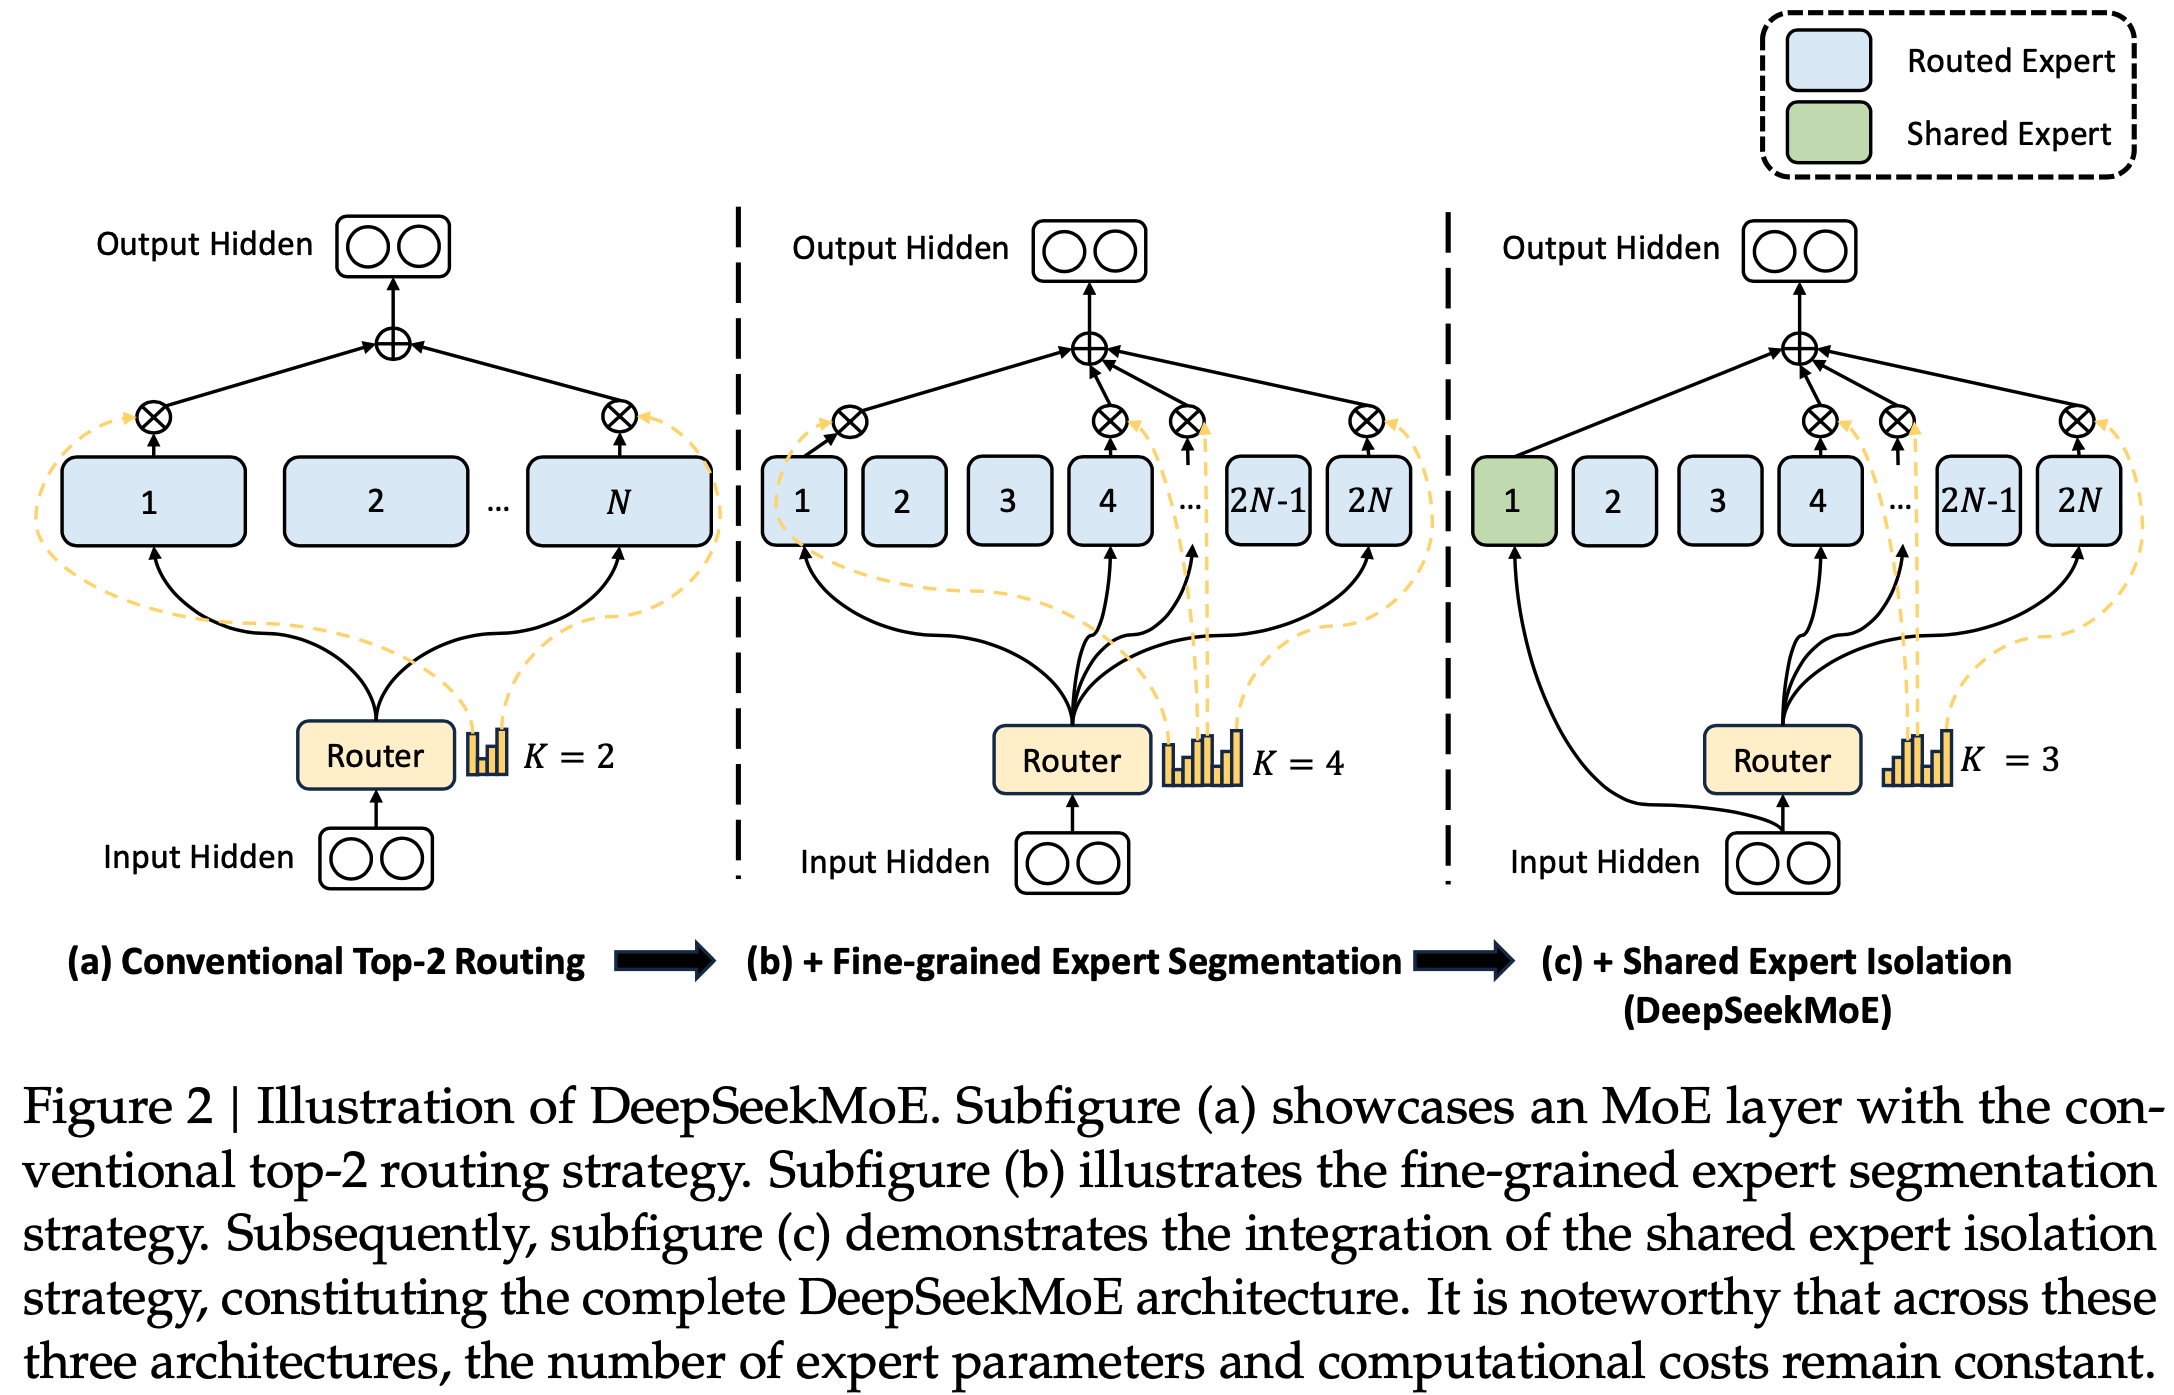
  • 改进一:Fine-Grained Expert Segmentation,更精细化的专家拆分

    • DeepSeekMoE的精细化MoE:可以看出DeepSeekMoE中将原始的 \(N\) 个FNN扩展为 \(mN\) 个(注意:只是拆分的更细,参数总量是相同的),选择的FNN数量也从 \(K\) 个扩展到 \(mK\) 个
  • 改进二:Shared Expert Isolation,独立的共享专家

    • 使用了 \(K_s\) 个固定的共享专家,需要路由的专家数量为 \(mN - K_s\)
    • 最终的MOE层输出由3部分组成,共享专家的输出结果 + Top_K个路由专家输出结果 + 残差
  • 改进三:Load Balance Consideration,负载均衡考量

    • Expert-Level Balance Loss(专家级别的负载均衡损失函数):
    • Device-Level Balance Loss(设备级别的负载均衡损失函数):
  • DeepSeekMoE结构图:

  • 其他说明:DeepSeek-R1共61个Transformer层,其中前三个层是正常的FNN层,后面的4-61层均用MoE取代FNN层

DeepSeek-V2

  • 参考链接:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
  • 在DeepSeekV1的基础上,沿着负载均衡继续做了3个优化

DeepSeek-V3

  • 参考链接:DeepSeek-V3 Technical Report

  • 门控函数从SoftMax优化为了Sigmoid

    • 个人理解:为什么用Sigmoid更好?因为本来选择了topK就还需要再做一次归一化的(这次归一化是直按线性权重分配,不使用Softmax),使用Sigmoid速度更快,不影响选择topK且归一化后效果一致?

DeepSeek-R1之MLA

  • 详情参考:NLP——LLM-Attention优化之MLA
  • 其他参考链接:
    • 原始论文:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
    • deepseek技术解读(1)-彻底理解MLA(Multi-Head Latent Attention) - 姜富春的文章 - 知乎
    • MLA(Multi-Head Latent Attention)—DeepSeek-V2/V3 Attention方案 - 浮生梦晓的文章 - 知乎
    • 缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA——科学空间

DeepSeek-R1之GRPO

  • 原始论文:DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
  • 核心思路:使用多次采样的归一化结果作为reward,放弃Critic Model,减少显存使用
  • 一个有趣的对比:DeepSeek GRPO在简单控制系统上和PPO的对比 - 王兴兴的文章 - 知乎
    • 对于整个系统中间过程和信息,比较清晰的问题(中间过程能被价值评价清晰),比如类似上面的控制系统(或者其他机器人系统),PPO还是最简单粗暴出效果很好的;但对于像DeepSeek用来搞数学RL推理,由于中间过程没法很好的描述和计算中间过程的价值,确实还是GRPO更快更方便(只看最终结果);

  • 注意,GRPO中使用了KL散度的近似形式,Approximating KL Divergence —— 来自:Deepseek的RL算法GRPO解读 - AIQL的文章 - 知乎
    • 估计形式为(注意以下式子中右边是左边的无偏梯度的前提是 \(o_{i,t} \sim \pi_\theta(\cdot \vert q,\mathbf{o}_{i,<t})\) ):
      $$
      \mathbb{D}_\text{KL}[\pi_\theta\Vert\pi_{\text{ref}}] \approx \frac{\pi_{\text{ref}}(o_{i,t}\vert q,\mathbf{o}_{i,<t})}{\pi_\theta(o_{i,t}\vert q,\mathbf{o}_{i,<t})} - \log \frac{\pi_{\text{ref}}(o_{i,t}\vert q,\mathbf{o}_{i,<t})}{\pi_\theta(o_{i,t}\vert q,\mathbf{o}_{i,<t})} - 1, \quad o_{i,t} \sim \pi_\theta(\cdot \vert q,\mathbf{o}_{i,<t})
      $$
      • 直观理解:上面的式子右边满足KL散度的基本特性
        • 当两个分布足够接近时,第一项趋近于1,第二项趋近于0,整体趋近于0;
        • 两个分布不相等时,上式右边取值总是大于0,可以通过求导证明:当 \(x>0\) 时,有 \(x - \log x - 1 \ge 0\)
  • 其他团队对GRPO的改进:阶跃&清华新论文:DeepSeek-R1的GRPO 可以更简洁 - 机器之心的文章 - 知乎

    阶跃星辰与清华大学近期的一项研究发现,只需使用带 GAE (λ= 1,γ= 1)的普通 PPO 以及基于规则的简单奖励函数,无需任何 KL 正则化,就足以扩展在推理任务上的响应长度和基准性能,类似于在 DeepSeek-R1-Zero 上观察到的现象
    使用这种极简方法,他们打造了 Open-Reasoner-Zero,这是首个面向大规模推理的强化学习训练的开源实现。并且该实现在 GPQA Diamond 基准上的表现优于 DeepSeek-R1-Zero-Qwen-32B,同时仅需使用 1/30 的训练步数。需要强调,该团队不仅开源了代码,还发布了参数设置、训练数据和模型权重


DeepSeek-R1之MTP

  • 参考链接:deepseek技术解读(2)-MTP(Multi-Token Prediction)的前世今生 - 姜富春的文章 - 知乎
  • 基本思想:
    • 预测阶段(Predict) :通过 K 个头一次生成 K 个 token 的预测
    • 验证阶段(Verify) :将 K 个 token 组装成 K 个 <input,label> 对,并行地利用输入 Main Model 作为评估验证,如果输出 label 与 Main Model 一致,则接受该 token
    • 接受阶段(Accept) :最终接受满足 Main Model 的最大长度 tokens 作为输出

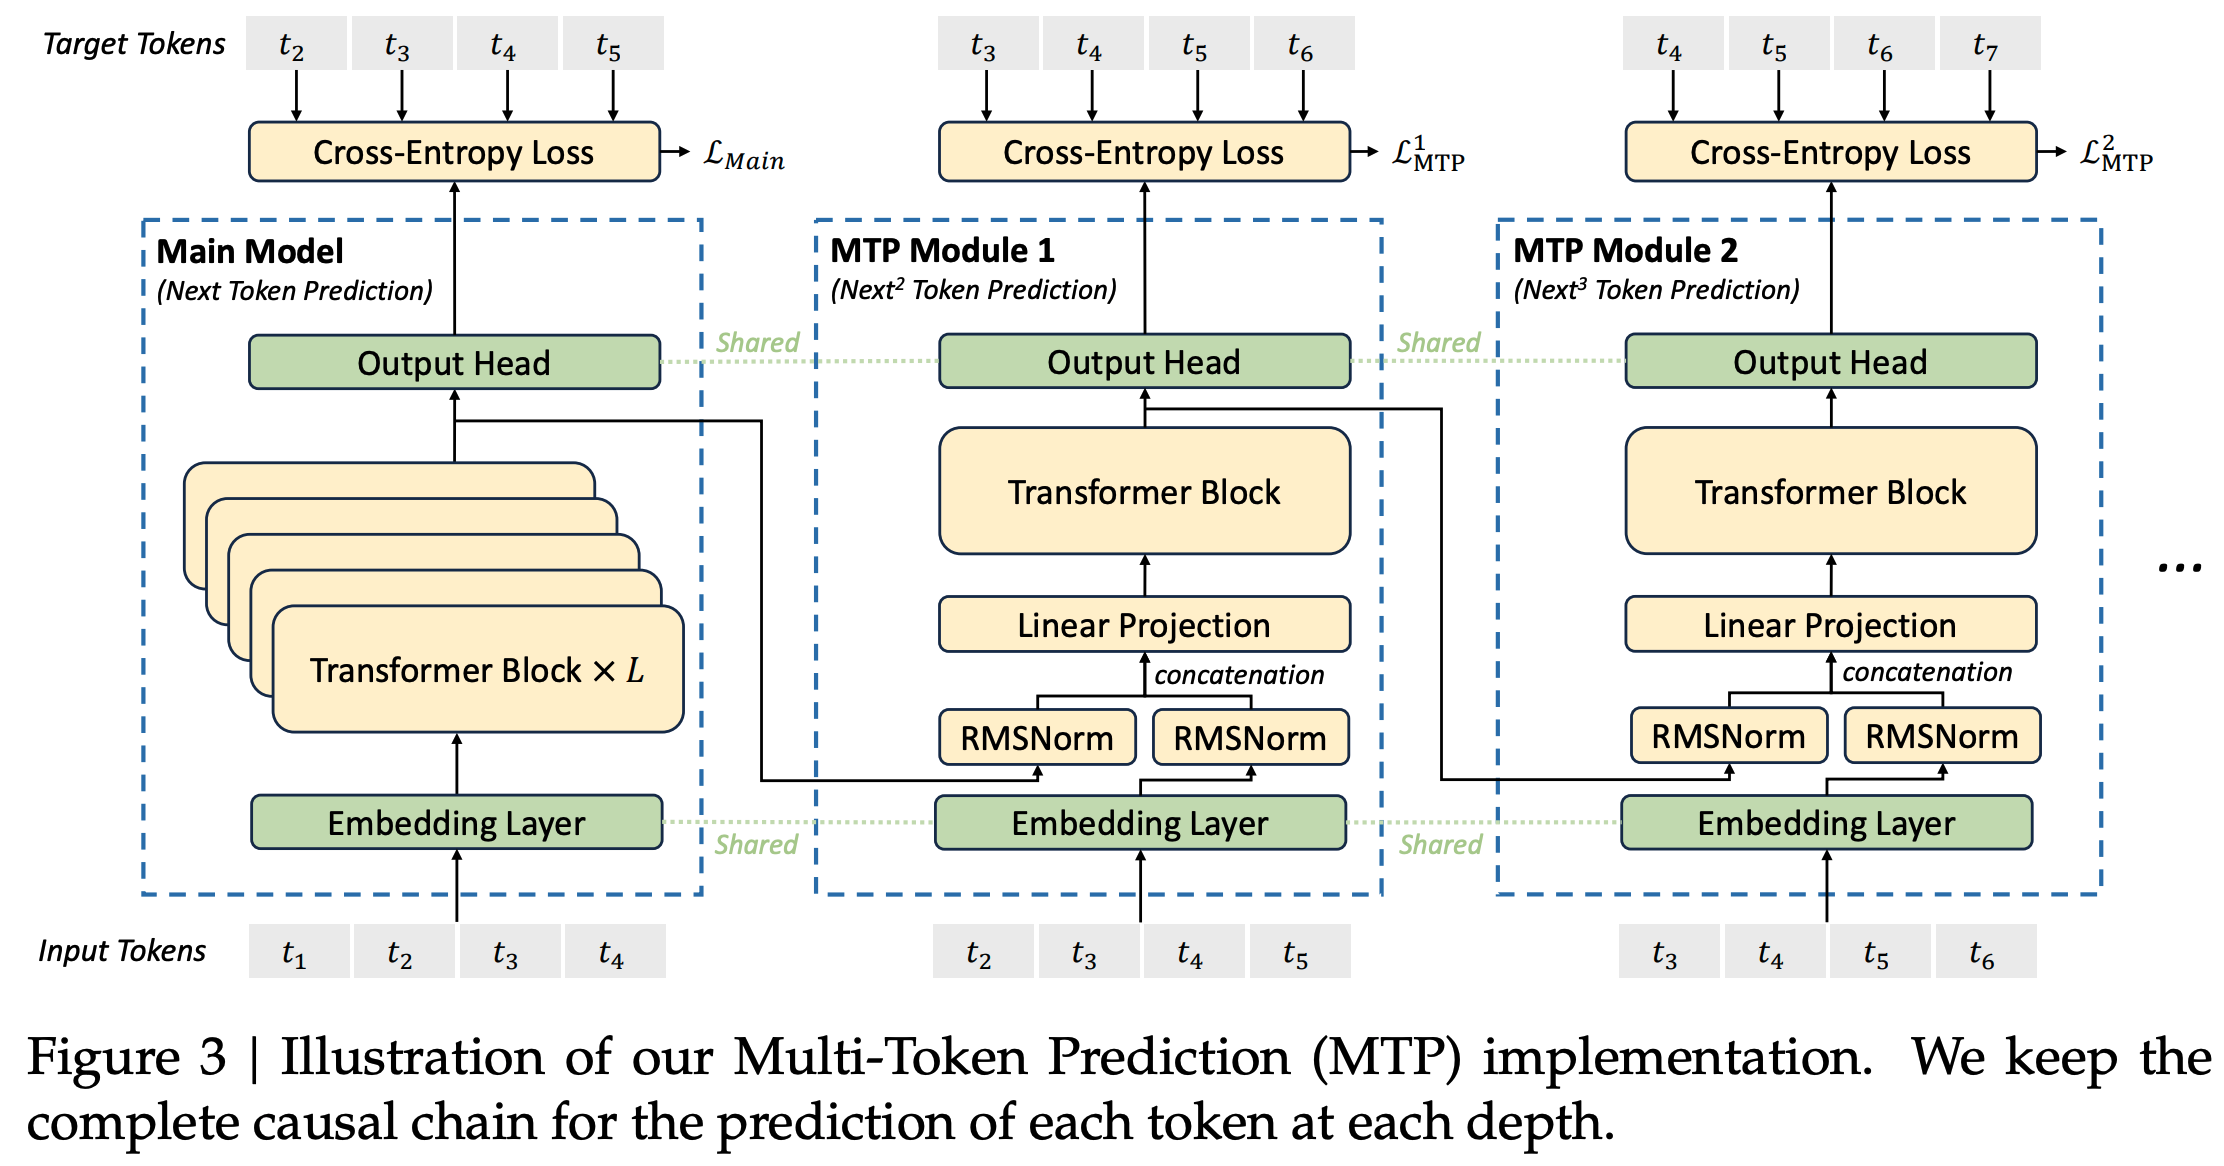
Deepseek MTP实现细节

  • 原始报告:DeepSeek-V3 Technical Report内容如下

  • 问题:上面图中设计的MTP中,无法做到整整的并行,比如,仅知道 \(t_1\) 时,只能预测得到 \(t_2\) ,无法得到 \(t_3\) ,因为在任意一个Module中, \(t_2\) 都依赖着 \(t_3\) 作为输入(只是输入后不用再过 \(L\) 层Transformer Block了,仅过一层就行)

  • 训练时:使用多个MTP Module,综合大家的损失共同更新梯度
    $$\mathcal{L}_\text{MTP} = \frac{\lambda}{D}\sum_{k=1}^D \mathcal{L}_\text{MTP}^k$$

  • 推断时:Deepseek直接丢弃了MTP Module,仅使用第一个(相当于跟普通不使用MTP的时候一致,只是吃到了训练的红利),部分文章中提到最多使用2个

    Our MTP strategy mainly aims to improve the performance of the main model, so during inference, we can directly discard the MTP modules and the main model can function independently and normally. Additionally, we can also repurpose these MTP modules for speculative decoding to further improve the generation latency.


DeepSeek-R1 API远程调用

  • 参考链接:如何使用 Python 调用 DeepSeek-R1 API?超详细的图文教程

附录:Sparse MoE实现Demo

  • Sparse MoE 的简单实现示例
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    62
    63
    64
    65
    66
    67
    import torch
    import torch.nn as nn

    class Expert(nn.Module):
    def __init__(self, input_size, output_size):
    super(Expert, self).__init__()
    self.fc = nn.Linear(input_size, output_size)

    def forward(self, x):
    return self.fc(x)

    # Dense MoE实现,对每个Token,所有专家都参与计算
    class MoE(nn.Module):
    def __init__(self, num_experts, input_size, output_size):
    super(MoE, self).__init__()
    self.experts = nn.ModuleList([Expert(input_size, output_size) for _ in range(num_experts)])
    self.gate = nn.Linear(input_size, num_experts)

    def forward(self, x):
    gate_scores = torch.softmax(self.gate(x), dim=1)
    expert_outputs = [expert(x) for expert in self.experts]
    expert_outputs = torch.stack(expert_outputs, dim=1)
    output = torch.sum(gate_scores.unsqueeze(-1) * expert_outputs, dim=1)
    return output

    # SparseMoE实现,对每个Token,仅少量专家参与计算
    class SparseMoE(nn.Module):
    def __init__(self, num_experts, input_size, output_size, k=2):
    super(SparseMoE, self).__init__()
    self.experts = nn.ModuleList([Expert(input_size, output_size) for _ in range(num_experts)])
    self.gate = nn.Linear(input_size, num_experts)
    self.k = k

    def forward(self, x):
    gate_scores = self.gate(x)
    topk_scores, topk_indices = torch.topk(gate_scores, k=self.k, dim=1)

    batch_size = x.size(0)
    expert_outputs = []
    for b in range(batch_size):
    # 获取当前样本选中的K个专家的输出
    selected_outputs = [self.experts[idx](x[b].unsqueeze(0)) for idx in topk_indices[b]]
    # 堆叠输出,维度为 (1, k, output_size)
    selected_outputs = torch.stack(selected_outputs, dim=1)
    expert_outputs.append(selected_outputs)

    # 合并所有样本,维度为 (batch_size, k, output_size)
    expert_outputs = torch.cat(expert_outputs, dim=0)

    # 计算选中专家的权重 (batch_size, k)
    weights = torch.softmax(topk_scores, dim=1)

    # 加权求和,维度为 (batch_size, output_size)
    output = torch.sum(weights.unsqueeze(-1) * expert_outputs, dim=1)
    return output

    # 使用Demo
    num_experts = 4
    input_size = 10
    output_size = 5
    batch_size = 32
    moe = SparseMoE(num_experts, input_size, output_size)
    input_data = torch.randn(batch_size, input_size)
    output = moe(input_data)
    print(output.shape)

    # torch.Size([32, 5])
1…113114115…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4