注:本文包含 AI 辅助创作
Paper Summary
- 一句话:IndexCache,这是一种通过利用负责 Token 选择的 Indexer 的跨层冗余来加速稀疏注意力的方法
- 智谱从 GLM-5 开始就一直在用这种方法(补充:202608 新发的 GLM-5.3 技术博客中提到使用了这种方法)
- 注:智谱的博客喜欢称 IndexCache 为 IndexShare
- 长上下文 Agentic 工作流下,注意力效率对推理速度和推理服务成本都非常重要
- 当前的稀疏注意力有效应对了这一挑战
- DeepSeek Sparse Attention (DSA) 是一个具有代表性的生产级解决方案:
- DSA 使用一个轻量级的 Lightning Indexer 为每个 Query 选择 Top-\(k\) 个最相关的 Token,将核心注意力复杂度从 \(O(L^2)\) 降低到 \(O(Lk)\)
- 但 DSA 的 Indexer 本身依然保持 \(O(L^2)\) 的复杂度,且必须在每一层独立运行
- 发现:DSA 产生的 Top-\(k\) 选择结果在连续层之间具有高度相似性
- DeepSeek Sparse Attention (DSA) 是一个具有代表性的生产级解决方案:
- 本文提出 IndexCache 方法:
- 将层划分为少量运行自身 Indexer 的 Full 层 和大多数直接复用最近 Full 层(F 层 ) Top-\(k\) 索引的 Shared 层 (S 层 )
- 理解:本质是在利用 DSA 中发现的这种跨层冗余
- 和大多数复用继承来的 Top-\(k\) 索引的 S 层
- 本文提出了两种互补的方法来确定和优化这种配置
- Training-free IndexCache 应用贪心搜索算法,通过在校准集上直接最小化语言建模损失来选择保留哪些层的 Indexer,无需任何权重更新
- Training-aware IndexCache 引入了一种多层蒸馏损失,使每个保留的 Indexer 针对其服务的所有层的平均注意力分布进行训练,即使是简单的交错模式也能达到与完整 Indexer 相当的精度
- 将层划分为少量运行自身 Indexer 的 Full 层 和大多数直接复用最近 Full 层(F 层 ) Top-\(k\) 索引的 Shared 层 (S 层 )
- 实验结果(在 30B DSA 模型上):
- IndexCache 可以 移除 75% 的 Indexer 计算且质量几乎不下降
- 与标准 DSA 相比,实现了高达 \(1.82\times\) 的 Prefill 加速和 \(1.48\times\) 的 Decode 加速
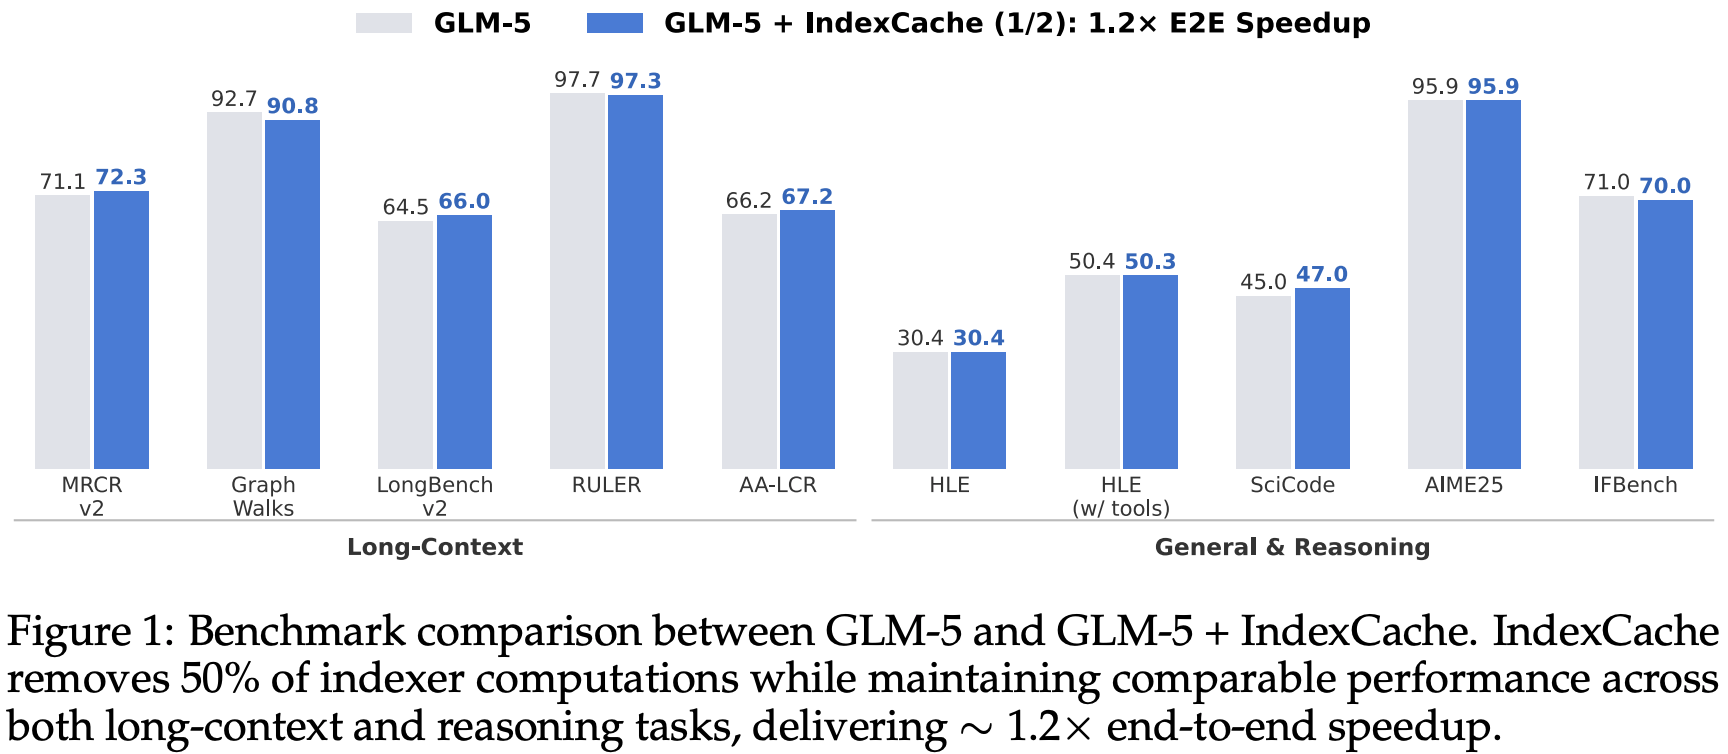
背景 & 问题提出
- Agentic 工作流和复杂推理任务 给 LLM Long-Context 场景下推理效率提出了更多挑战
- PS:Transformer 模型中的 Self-Attention 机制的 \(O(L^2)\) 复杂度(\(L\) 为序列长度)成为了主要性能瓶颈
- 现有解决方案:DeepSeek Sparse Attention, DSA
DSA 是一种稀疏注意力机制,引入了一个轻量级的 “Lightning Indexer” 模块- 对于每个 Query,Indexer 会从所有之前的 Token 中筛选出 Top-\(k\)(\(k=2048\))个最相关的 Token,随后 Core Attention 只在这 \(k\) 个 Token 上计算,将复杂度从 \(O(L^2)\) 降至 \(O(Lk)\)
- DSA 的问题:
- 虽然 Core Attention 变快了,但 Indexer 本身仍然需要对整个序列(\(O(L^2)\))进行评分,并且 每一 Layer 都要独立运行一次 Indexer
- 随着层数 \(N\) 增加,总 Indexer 成本为 \(O(NL^2)\)
- 在极长上下文(如 200K)下,Indexer 的计算占据了总延迟的绝大部分(论文首页右图)
- Key Insight:
- 论文发现,在 DSA 中,相邻层的 Indexer 选出的 Top-\(k\) Token 集合有极高的重叠度(70%-100%)
- 这意味着大量的 Indexer 计算是冗余的
IndexCache 方法
- IndexCache 的核心思想是跨层索引复用
- 将 Transformer 的 \(N\) 层划分为两类(用二进制模式字符串 \(\mathbf{c}\) 表示,\(c_{\ell} \in \{\mathbb{F}, \mathbb{S}\}\)):
- 1)Full 层(\(\mathbb{F}\)) :保留完整的 Indexer
- 该层正常计算 Top-\(k\) 索引 \(\mathcal{T}_t^{(\ell)}\),并执行稀疏 Core Attention
- 2)Shared 层(\(\mathbb{S}\)) :移除 Indexer
- 该层直接复用最近的前一个 \(\mathbb{F}\) 层 生成的索引,即
$$ \mathcal{T}_t^{(\ell)} \leftarrow \mathcal{T}_t^{(f(\ell))}$$- 其中 \( f(\ell)\) 即前一个 F 层的编号
$$ f(\ell) = \max \{j < \ell : c_j = \mathbb{F}\} $$ - 该层只进行 Core Attention
- 其中 \( f(\ell)\) 即前一个 F 层的编号
- 该层直接复用最近的前一个 \(\mathbb{F}\) 层 生成的索引,即
- 1)Full 层(\(\mathbb{F}\)) :保留完整的 Indexer
- 基本思路:
- 让大部分层共享前层的索引结果,消除了 \(75%\) 甚至更多的 Indexer 前向计算
- 在推理时,只需在循环中加入一个简单的条件判断(若为 \(\mathbb{F}\) 则计算 Indexer 并缓存,若为 \(\mathbb{S}\) 则直接读取缓存)
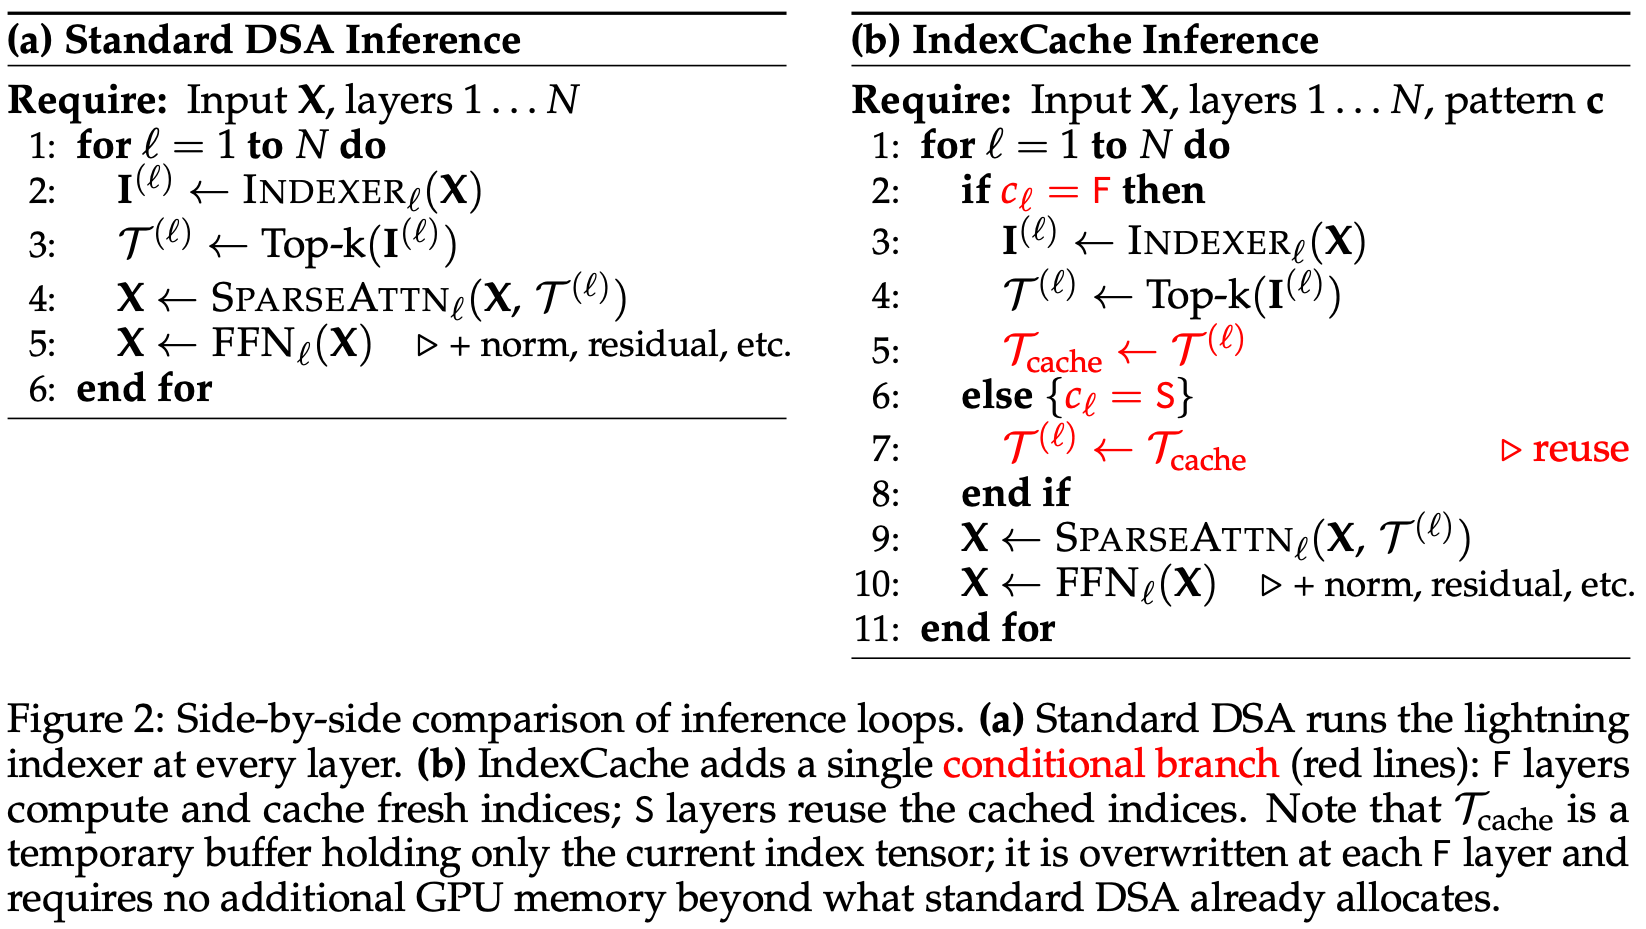
- 论文提出了两种互补的方法来确定哪些层应设为 \(\mathbb{F}\),哪些设为 \(\mathbb{S}\)
方法一:Training-Free IndexCache
- Training-Free IndexCache 适用于已预训练好的 DSA 模型,无需更新权重
- 关键在于找到一个最优的模式 \(\mathbf{c}\),使得模型质量下降最小
- 问题:为什么均匀交错(Uniform Interleaving)不是最优的?
- 简单的每隔几层保留一个 Indexer(如 FSSFSS…)忽略了不同层对 Indexer 的敏感性差异
- 实验证明,早期和过渡层的 Indexer 一旦被移除,性能会急剧下降
核心算法:Greedy Layer Selection
- 算法通过贪心策略,一步步将 \(\mathbb{F}\) 转为 \(\mathbb{S}\),每一步都选择对语言建模损失(LM Loss)影响最小的那一层进行转换
- 校准集(Calibration Set) :从训练数据中缓存少量 Mini-Batch 作为评估基准 \(\mathcal{D}\)
- 损失评估函数 :\(\text{EVALLOSS}(M, \mathcal{D}, \mathbf{c})\) 表示在给定模式 \(\mathbf{c}\) 下,模型 \(M\) 在校准集上的损失
- 算法流程(Algorithm 1) :
- 1)初始化所有层为 \(\mathbb{F}\)(即 \(\mathbf{c}\gets \mathbb{F}^N\)),第一层强制固定为 \(\mathbb{F}\)
- 2)设定目标 Shared 层数量 \(K\)(例如 \(K = 3N/4\),即只保留 \(1/4\) 的 Indexer)
- 3)循环 \(K\) 步:
- 遍历当前所有候选的 \(\mathbb{F}\) 层(除第一层),尝试将该层临时改为 \(\mathbb{S}\)
- 计算该模式下的 \(\text{EVALLOSS}\)
- 选出损失最低的那一层,永久将其改为 \(\mathbb{S}\)(提交该翻转)
- 4)返回最终优化的模式 \(\mathbf{c}^*\)
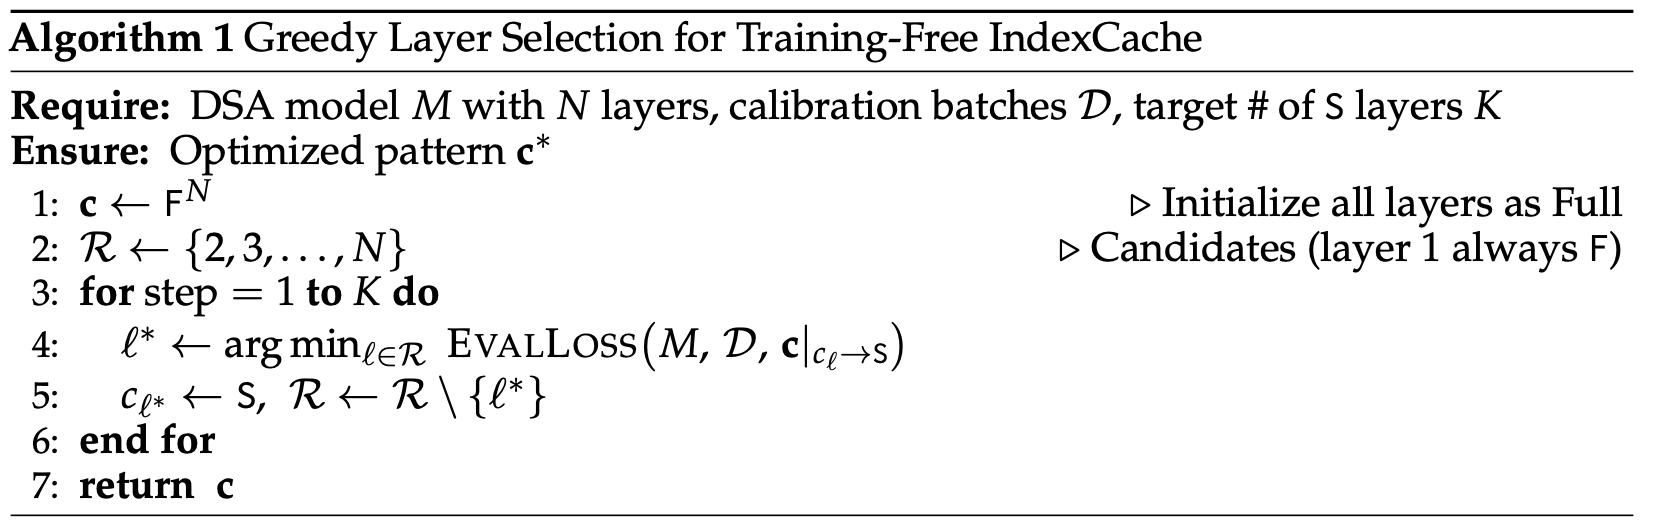
- 加速策略 :结合流水线并行(Pipeline Parallelism),将模型分为 \(P\) 个块,每块内独立搜索,使总前向传播次数减少约 \(P\) 倍
- 贪心解的性质 :
- 1)性能显著优于均匀交错
- 2)LM 验证损失曲线呈现出明显的“容易层”(前 20 步)和“关键层”(35 步以后)的分离,证明 Indexer 重要性存在自然排序
- 3)对不同的校准集具有稳定性,说明重要性排序是模型的内在属性
方法二:Training-Aware IndexCache,训练感知的 IndexCache
- Training-Aware IndexCache 通过 Multi-Layer Distillation 在训练阶段调整模型参数,使其更好地适应索引复用
从单层蒸馏到多层蒸馏
- 标准 DSA 训练中,第 \(\ell\) 层的 Indexer 通过 KL 散度拟合该层的全注意力分布 \(\mathbf{p}_t^{(\ell)}\)(由多头 Softmax 注意力平均得到),即
$$ \mathcal{L}^1 = \sum_t D_{\text{KL} }(\mathbf{p}_t^{(\ell)} \parallel \mathbf{q}_t^{(\ell)})$$- 其中 \(\mathbf{q}_t^{(\ell)}\) 是 Indexer 的输出分布
$$ \mathbf{q}_t^{(\ell)} = \text{Softmax}(\mathbf{I}_t^{(\ell)}) $$
- 其中 \(\mathbf{q}_t^{(\ell)}\) 是 Indexer 的输出分布
- 在 IndexCache 中,假设第 \(\ell\) 层是 \(\mathbb{F}\) 层,它要为后续的 \(\ell+1\) 到 \(\ell+m\) 层(均为 \(\mathbb{S}\) 层)提供索引
- 多层蒸馏损失定义为:
$$\mathcal{L}_{\text{multi} }^{\text{I} } = \sum_{j = 0}^{m}\frac{1}{m + 1}\sum_{t}D_{\text{KL} }\left(\mathbf{p}_t^{(\ell +j)}\parallel \mathbf{q}_t^{(\ell)}\right)$$ - 基本思路:强制 Indexer 不仅拟合自己的注意力分布,还要拟合它负责的所有后续层的注意力分布,确保生成的 Top-\(k\) 索引对整组层都有用
数学等价性(Proposition 1)
- 论文中证明了,优化上述多目标 KL 散度之和,等价于优化 Indexer 输出分布 \(\mathbf{q}\) 与所有目标层注意力分布的平均值之间的 KL 散度
- 定义平均目标分布为
$$ \bar{\mathbf{p} }_t = \sum_{j = 0}^m\frac{1}{m + 1}\mathbf{p}_t^{(\ell +j)} $$ - 对应的单目标损失为:
$$\mathcal{L}_{\text{avg} }^{\text{I} } = \sum_{t}D_{\text{KL} }\left(\bar{\mathbf{p} }_t\parallel \mathbf{q}_t^{(\ell)}\right)$$ - 证明结果:
$$ \nabla_{\theta}\mathcal{L}_{\text{multi} }^{\text{I} } = \nabla_{\theta}\mathcal{L}_{\text{avg} }^{\text{I} }$$- 因为 \(\mathbf{q}\) 是唯一可导项,\(\mathbf{p}\) 在梯度计算中作为常数,线性求和可合并)
- 结论 :多层蒸馏实际上是让 Indexer 学习所有服务层 Attention 的“共识”(Centroid),而不是简单地做平均,这有效避免了过拟合单一层