注:本文包含 AI 辅助创作
- 参考链接:
Paper Summary
- 整体总结
- 提出了一个任务分离式 RL 框架(AsyncFlow),提供模块化和可扩展的后训练能力
- 引入 TransferQueue:流式数据加载器,提供具有分布式存储能力的集中式数据管理
- 开发了一个基于生产者-消费者抽象的异步工作流,在陈旧度阈值内策略性地延迟参数更新过程,最小化计算空闲
- 可用性设计方面实现了一套面向服务的接口,提供算法工作流和后端引擎的两级抽象,这可以有效地弥合理论研究与工业部署之间的差距
- 注:本文所提到的 One-Step 异步方案本质是 One-Off 方案
- 提出了一个任务分离式 RL 框架(AsyncFlow),提供模块化和可扩展的后训练能力
Introduction and Discussion
- 背景 & 问题总结:
- RL 框架复杂
- 比如 PPO 算法(2017)包含六个不同的任务:Actor Rollout、Reference Inference、Critic Inference、Reward Inference、Actor Update 和 Critic Update
- 数据间的依赖关系以及复杂的并行策略也复杂
- RL 框架复杂
- 现有 RL 后训练框架可根据任务放置策略分为任务共置式(task-collocated) 或 任务分离式(task-separated)
- 共置式框架:
- 典型的任务共置式框架(例如 DeepSpeed-Chat(2023))将所有任务分配到同一组设备上
- 在训练过程中,一次只运行一个任务,占用所有计算资源直至完成
- 这种范式存在几个严重缺陷:
- 内存效率低 :将所有模型参数存储在 GPU 内存中会带来过高的内存开销,要么限制训练效率,要么引发昂贵的内存卸载开销
- 重分片开销 :Actor Rollout 和 Actor 更新需要不同的并行策略,在这些任务之间切换需要模型重塑,带来显著的延迟
- 次优并行性 :在处理不同规模的模型时,较小的模型可能因扩展效率低下而无法充分利用所有计算资源
- 理解:这里是指将大小不同的模型 Collocated 到同一个地方时,轮到小模型时无法充分利用资源
- 任务分离式框架中:
- 不同的 RL 任务被分配到不同规模的资源池中,以适应其工作负载需求
- 在典型的任务分离式框架(例如 OpenRLHF(2024))中,引入了分布式资源管理和执行工具(例如 Ray(2018))来调度 RL 工作流
- 但 RL 算法中固有的数据依赖性限制了完全并行化:诸如 Reference 前向和 Critic 更新等任务必须等待 Actor Rollout 完成,导致长时间的资源空闲,从而延迟后训练过程
- 更复杂的是,LLM 的嵌套并行策略使得跨最小实例间的任务数据流变得复杂,进一步降低了计算效率,并给算法开发带来了额外困难
- 共置式框架:
- 另一个关键问题在于框架的可用性
- 现有大多数 RL 框架与特定的训练和推理引擎紧密耦合,例如:
- NeMo-Aligner(2024)仅能运行于 Megatron-LM(2019)和 TensorRT-LLM(2024)之上
- OpenRLHF 则要求 DeepSpeed(2020)和 vLLM(2023)作为强制性后端
- 这种设计范式严重限制了灵活性和适应性,特别是对于通常依赖基于定制后端构建的现有训练和推理集群的工业用户而言
- 理想情况下,RL 框架应提供高层抽象,能够无缝集成异构的训练和推理引擎,从而满足多样化的定制需求
- 其他问题:缺乏统一的算法控制器加剧了开发开销,并阻碍了需要频繁修改算法的学术研究工作流
- 现有大多数 RL 框架与特定的训练和推理引擎紧密耦合,例如:
- 本文提出了 AsyncFlow:一种基于任务分离架构的异步 RL 框架,构建于基于昇腾的(Ascend-powered)后训练框架 MindSpeed-RL(2025)之上
- 设计了一个名为 TransferQueue 的分布式数据存储与传输模块,用于优化实例间的数据流
- TransferQueue 收集推理引擎产生的所有 Response,并根据请求将样本动态分发给下游 RL 任务的实例,实现了流式数据流控制
- TransferQueue 消除了显式定义跨实例数据依赖链的需求,从而实现了 RL 任务间的自动负载均衡和 Pipeline 重叠
- 提出了一种基于生产者-消费者模型的异步工作流优化算法(For 为充分释放任务分离框架的架构潜力)
- 通过延迟更新 Rollout 实例(Instances)的参数更新过程,实现了一种稳定的异步工作流,在可控陈旧度下最小化空闲时间
- 理解:这里的 Rollout Instances 是指 Rollout 所用的模型实例,严格 On-policy 下,其参数本应该和 Actor 完全一致
- 结合动态负载均衡策略,后训练效率可得到显著提升
- 通过延迟更新 Rollout 实例(Instances)的参数更新过程,实现了一种稳定的异步工作流,在可控陈旧度下最小化空闲时间
- AsyncFlow 作为 RL 算法的高层调度层,通过最简的面向服务接口进行封装,以适应各种后端引擎
- 这一设计原则实现了高效且可定制的用户体验,能够兼顾研究灵活性与工业部署需求,弥合理论探索与工业应用之间的鸿沟
- 本文所提出的优化集成到 MindSpeed-RL 中,该框架可在 https://gitee.com/ascend/MindSpeed-RL 公开获取
- 设计了一个名为 TransferQueue 的分布式数据存储与传输模块,用于优化实例间的数据流
- 本文贡献总结如下:
- 设计了一个分布式数据管理模块,实现了 RL 任务间的自动负载均衡和 Pipeline 重叠,极大提升了任务分离式 RL 框架的训练效率
- 提出了一种基于生产者-消费者模型的异步工作流,能够很好地平衡训练效率与 RL 算法的收敛性
- 提供了用户友好的面向服务 API,支持多种训练/推理后端引擎,弥合了学术研究需求与工业部署可扩展性之间的差距
- 针对最先进的RL后训练框架进行了大量实验,在大规模集群上观察到相比基线最高可达 \(2.03\times\) 的吞吐量提升
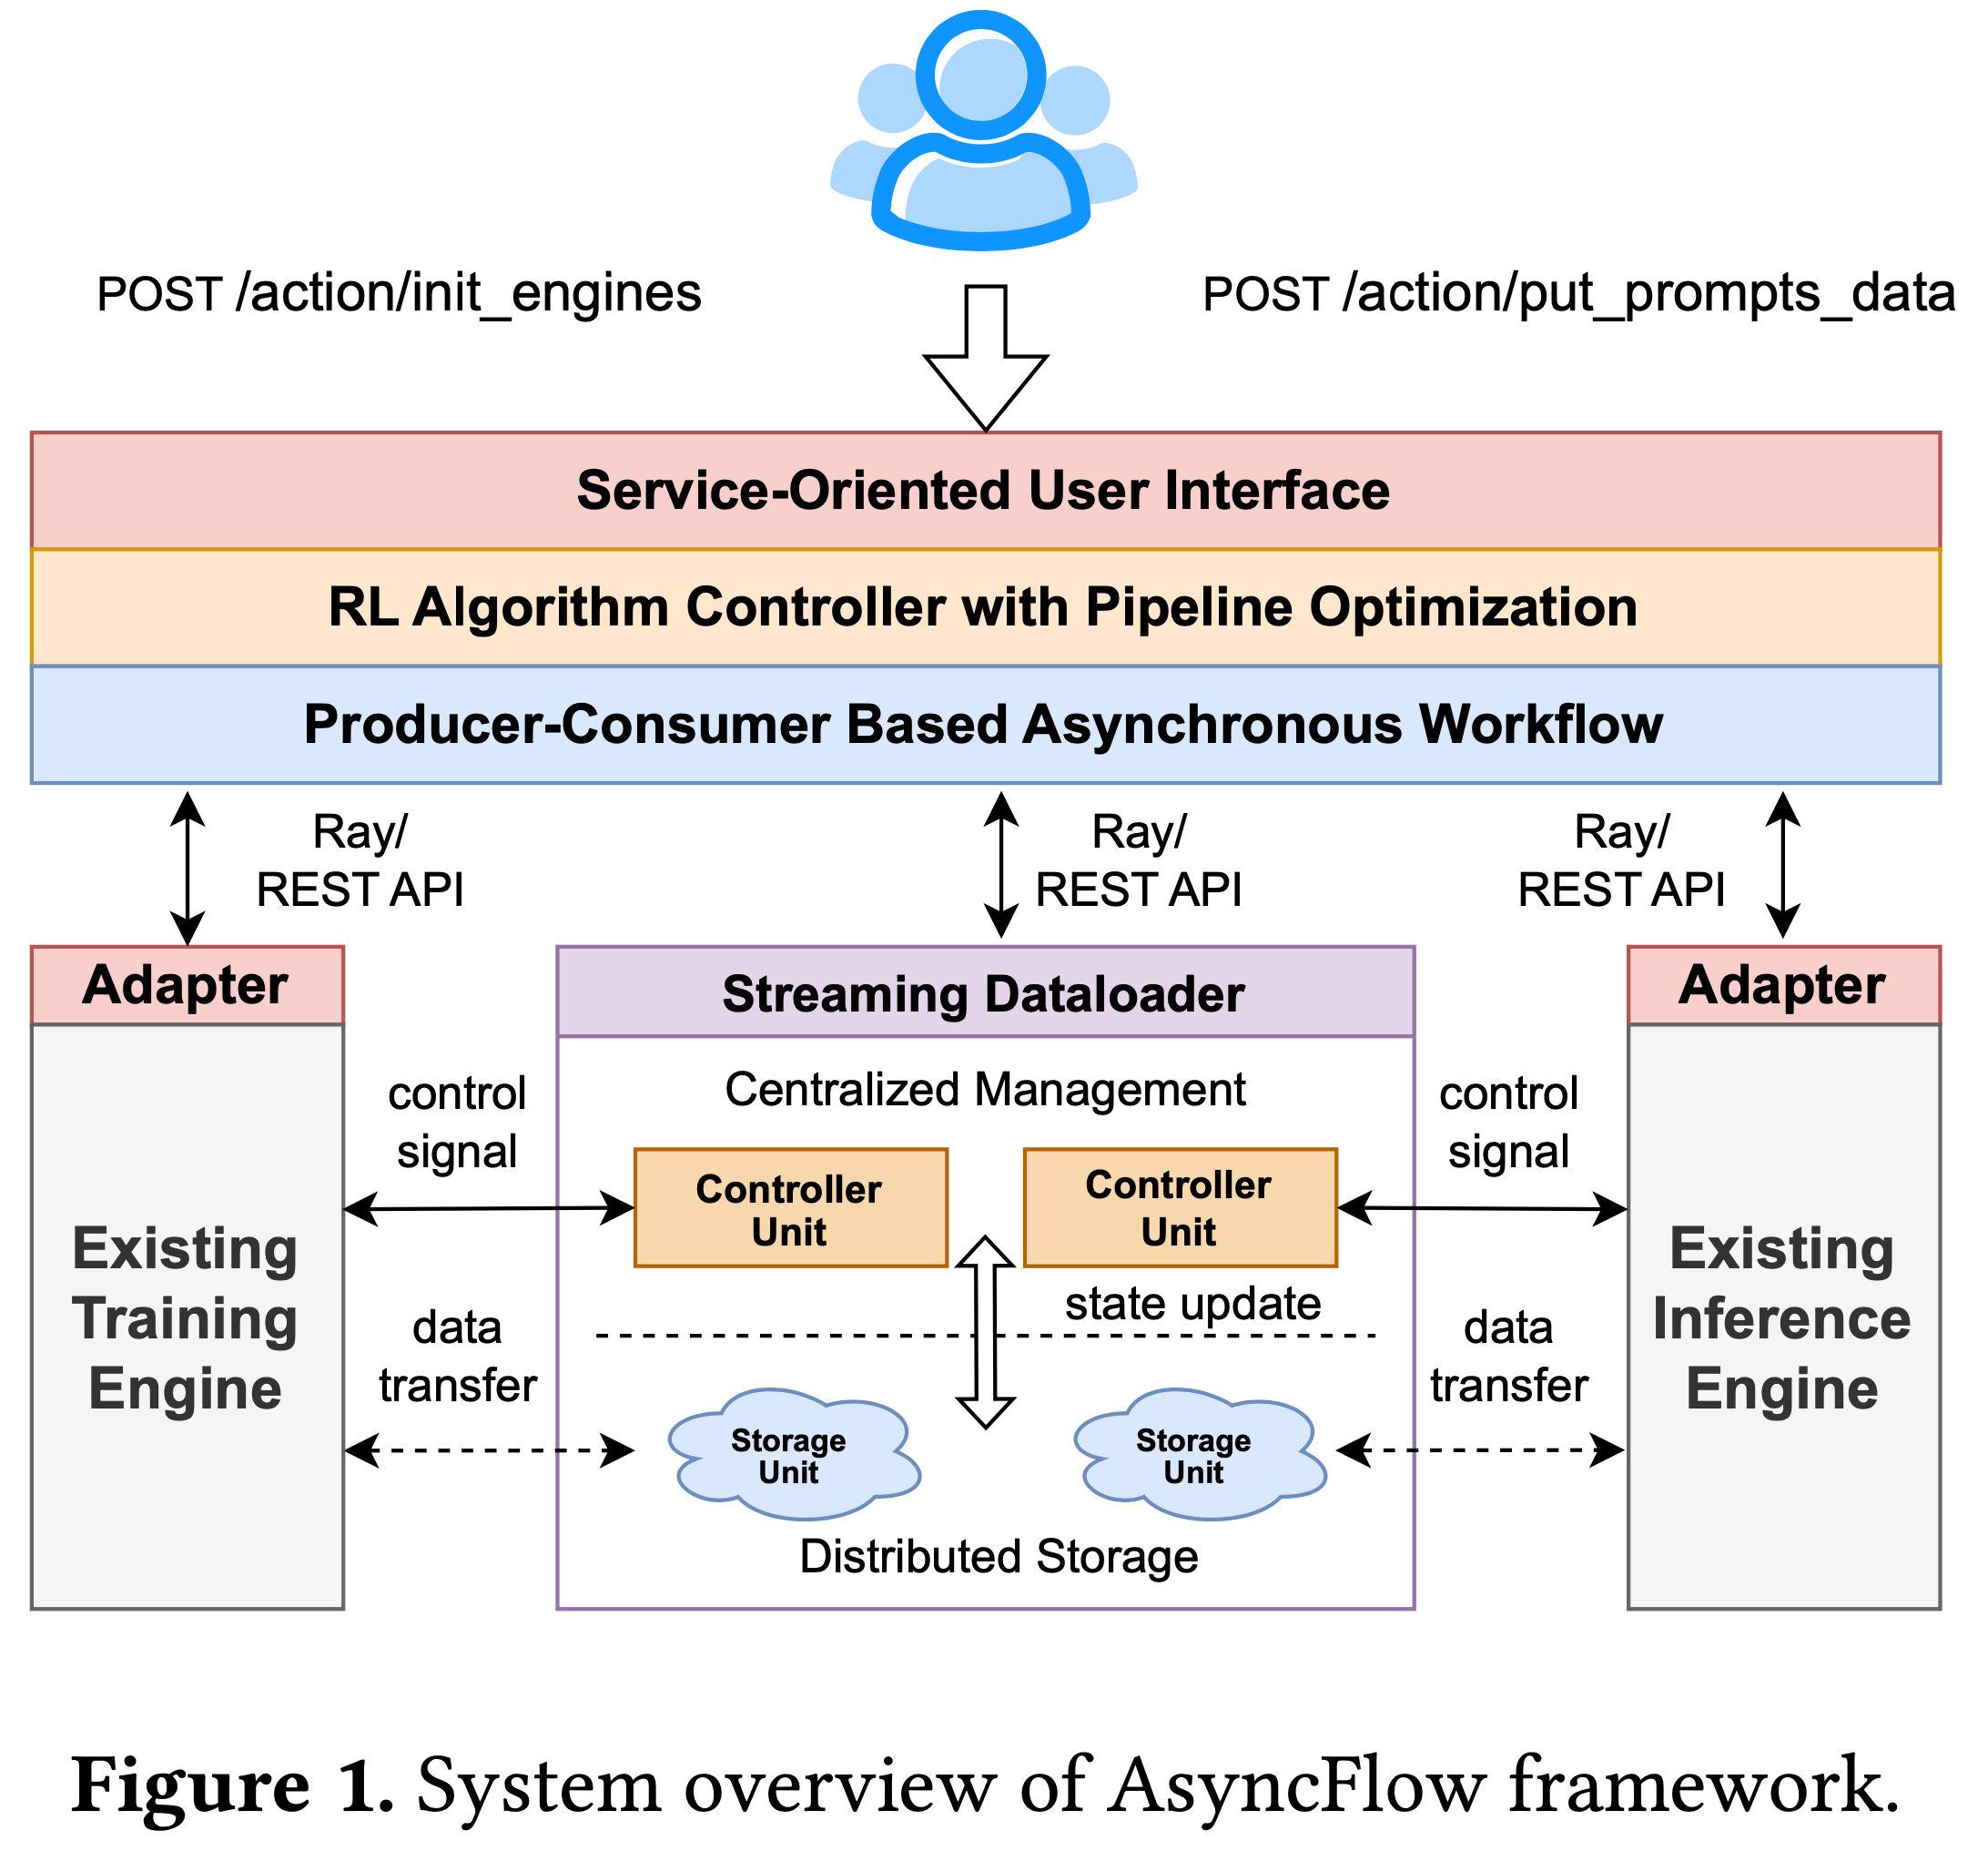
System Overview
- 图 2 中展示了 AsyncFlow 的架构设计(可扩展后训练的异步流式 RL 框架)
- 资源层利用 Ray 来管理计算资源,硬件分配通过执行时间模拟器预先优化以确保高效训练
- 后端层为不同的异构训练和推理引擎提供了模块化适配器
- 因此,RL 任务可以在这些后端引擎上实例化,同时保持引擎无关性
- 优化层致力于解决任务分离框架在数据流管理和资源利用方面的两个关键挑战
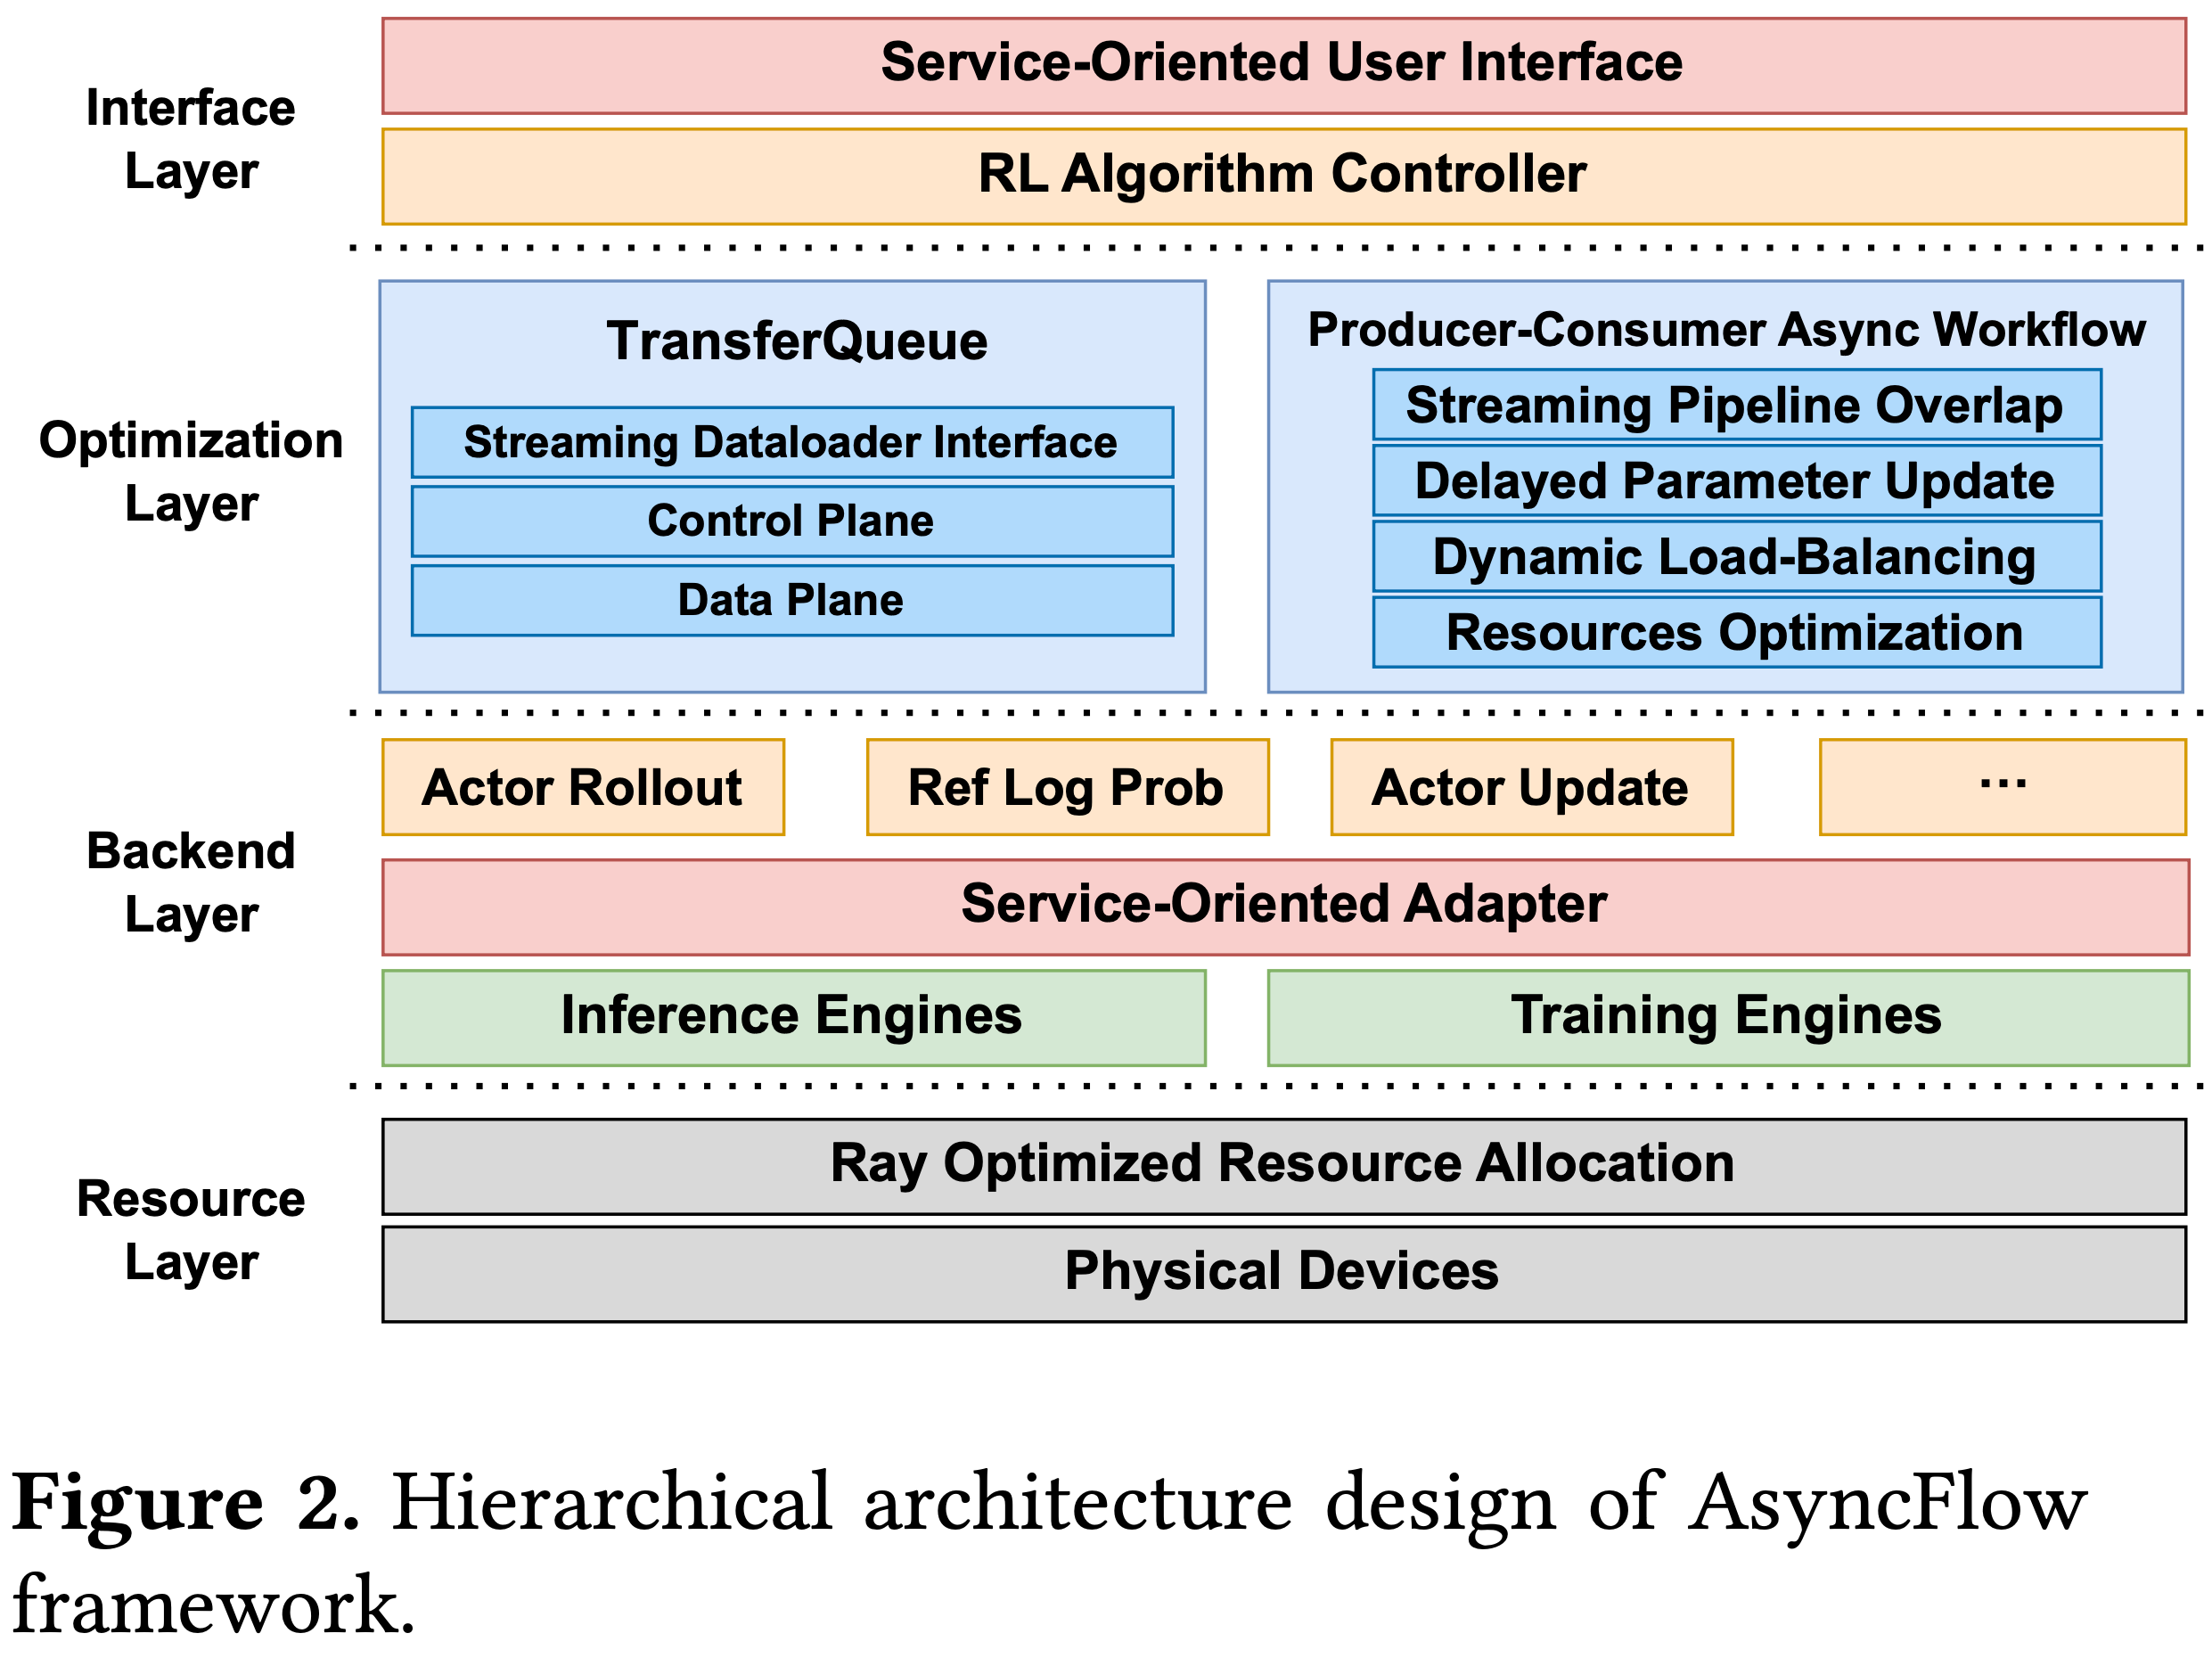
- 引入 TransferQueue 作为流式数据加载器,以动态调度跨 RL 任务不同并行策略的复杂数据流
- 提出一种基于生产者-消费者模型的异步工作流,以实现高计算资源利用率
- 结合流式 Pipeline 重叠和延迟参数更新机制,能显著减少任务分离框架中的空闲时间
- 在可用性设计方面,接口层提供了统一的算法入口点
- 它作为一个单一控制器,满足算法研究的需求
- 与此相辅相成的是,AsyncFlow 为工业工作流提供了一套面向服务的 API,能够无缝集成到现有的训练和推理集群中
- In Summary,AsyncFlow 旨在通过提供一个兼顾灵活性与可扩展效率的统一框架,弥合 LLM 后训练中算法研究与工业部署之间的鸿沟
TransferQueue:High-Performance Asynchronous Streaming DataLoader,高性能异步流式数据加载器
- 在 RL 后训练过程中,任务间的数据依赖性对任务分离式框架设计构成了重大挑战
- 现有实现仅针对整个训练数据集提供基础的数据存储和传输能力,导致下游任务出现大量资源空闲
- AsyncFlow 引入了 TransferQueue
- TransferQueue 是一个具有分布式存储能力的集中式数据管理模块,充当异步流式数据加载器
- 在任务分离式 RL 框架中,该设计通过使下游任务能够访问部分训练样本进行计算 ,而无需等待整个数据集就绪 ,从而实现了流式 Pipeline 重叠(Pipeline overlapping)
- 在数据管理能力方面,旨在为每个 RL 任务提供数据状态的集中视图
- 此特性消除了手动定义多个 RL 任务中各个 DP 组之间所有数据流的需求
- 该设计不同于现有解决方案如 OpenRLHF(2024)和 StreamRL(2025),提供了一种更灵活、更高效的编程范式
- 这种集中视图能够实现更好的负载均衡策略
- 在数据存储与传输方面,旨在支持大规模后训练中的高并发异步请求
- 受软件定义网络(SDN)的启发,将数据 Plane(Data Plane)与控制 Plane(Control Plane)解耦,并在每个 Plane 中实例化多个控制器和数据存储对象
- 该设计缓解了潜在的 I/O 和网络瓶颈,并支持不同的存储系统,从而实现可扩展的后训练
Architecture Overview
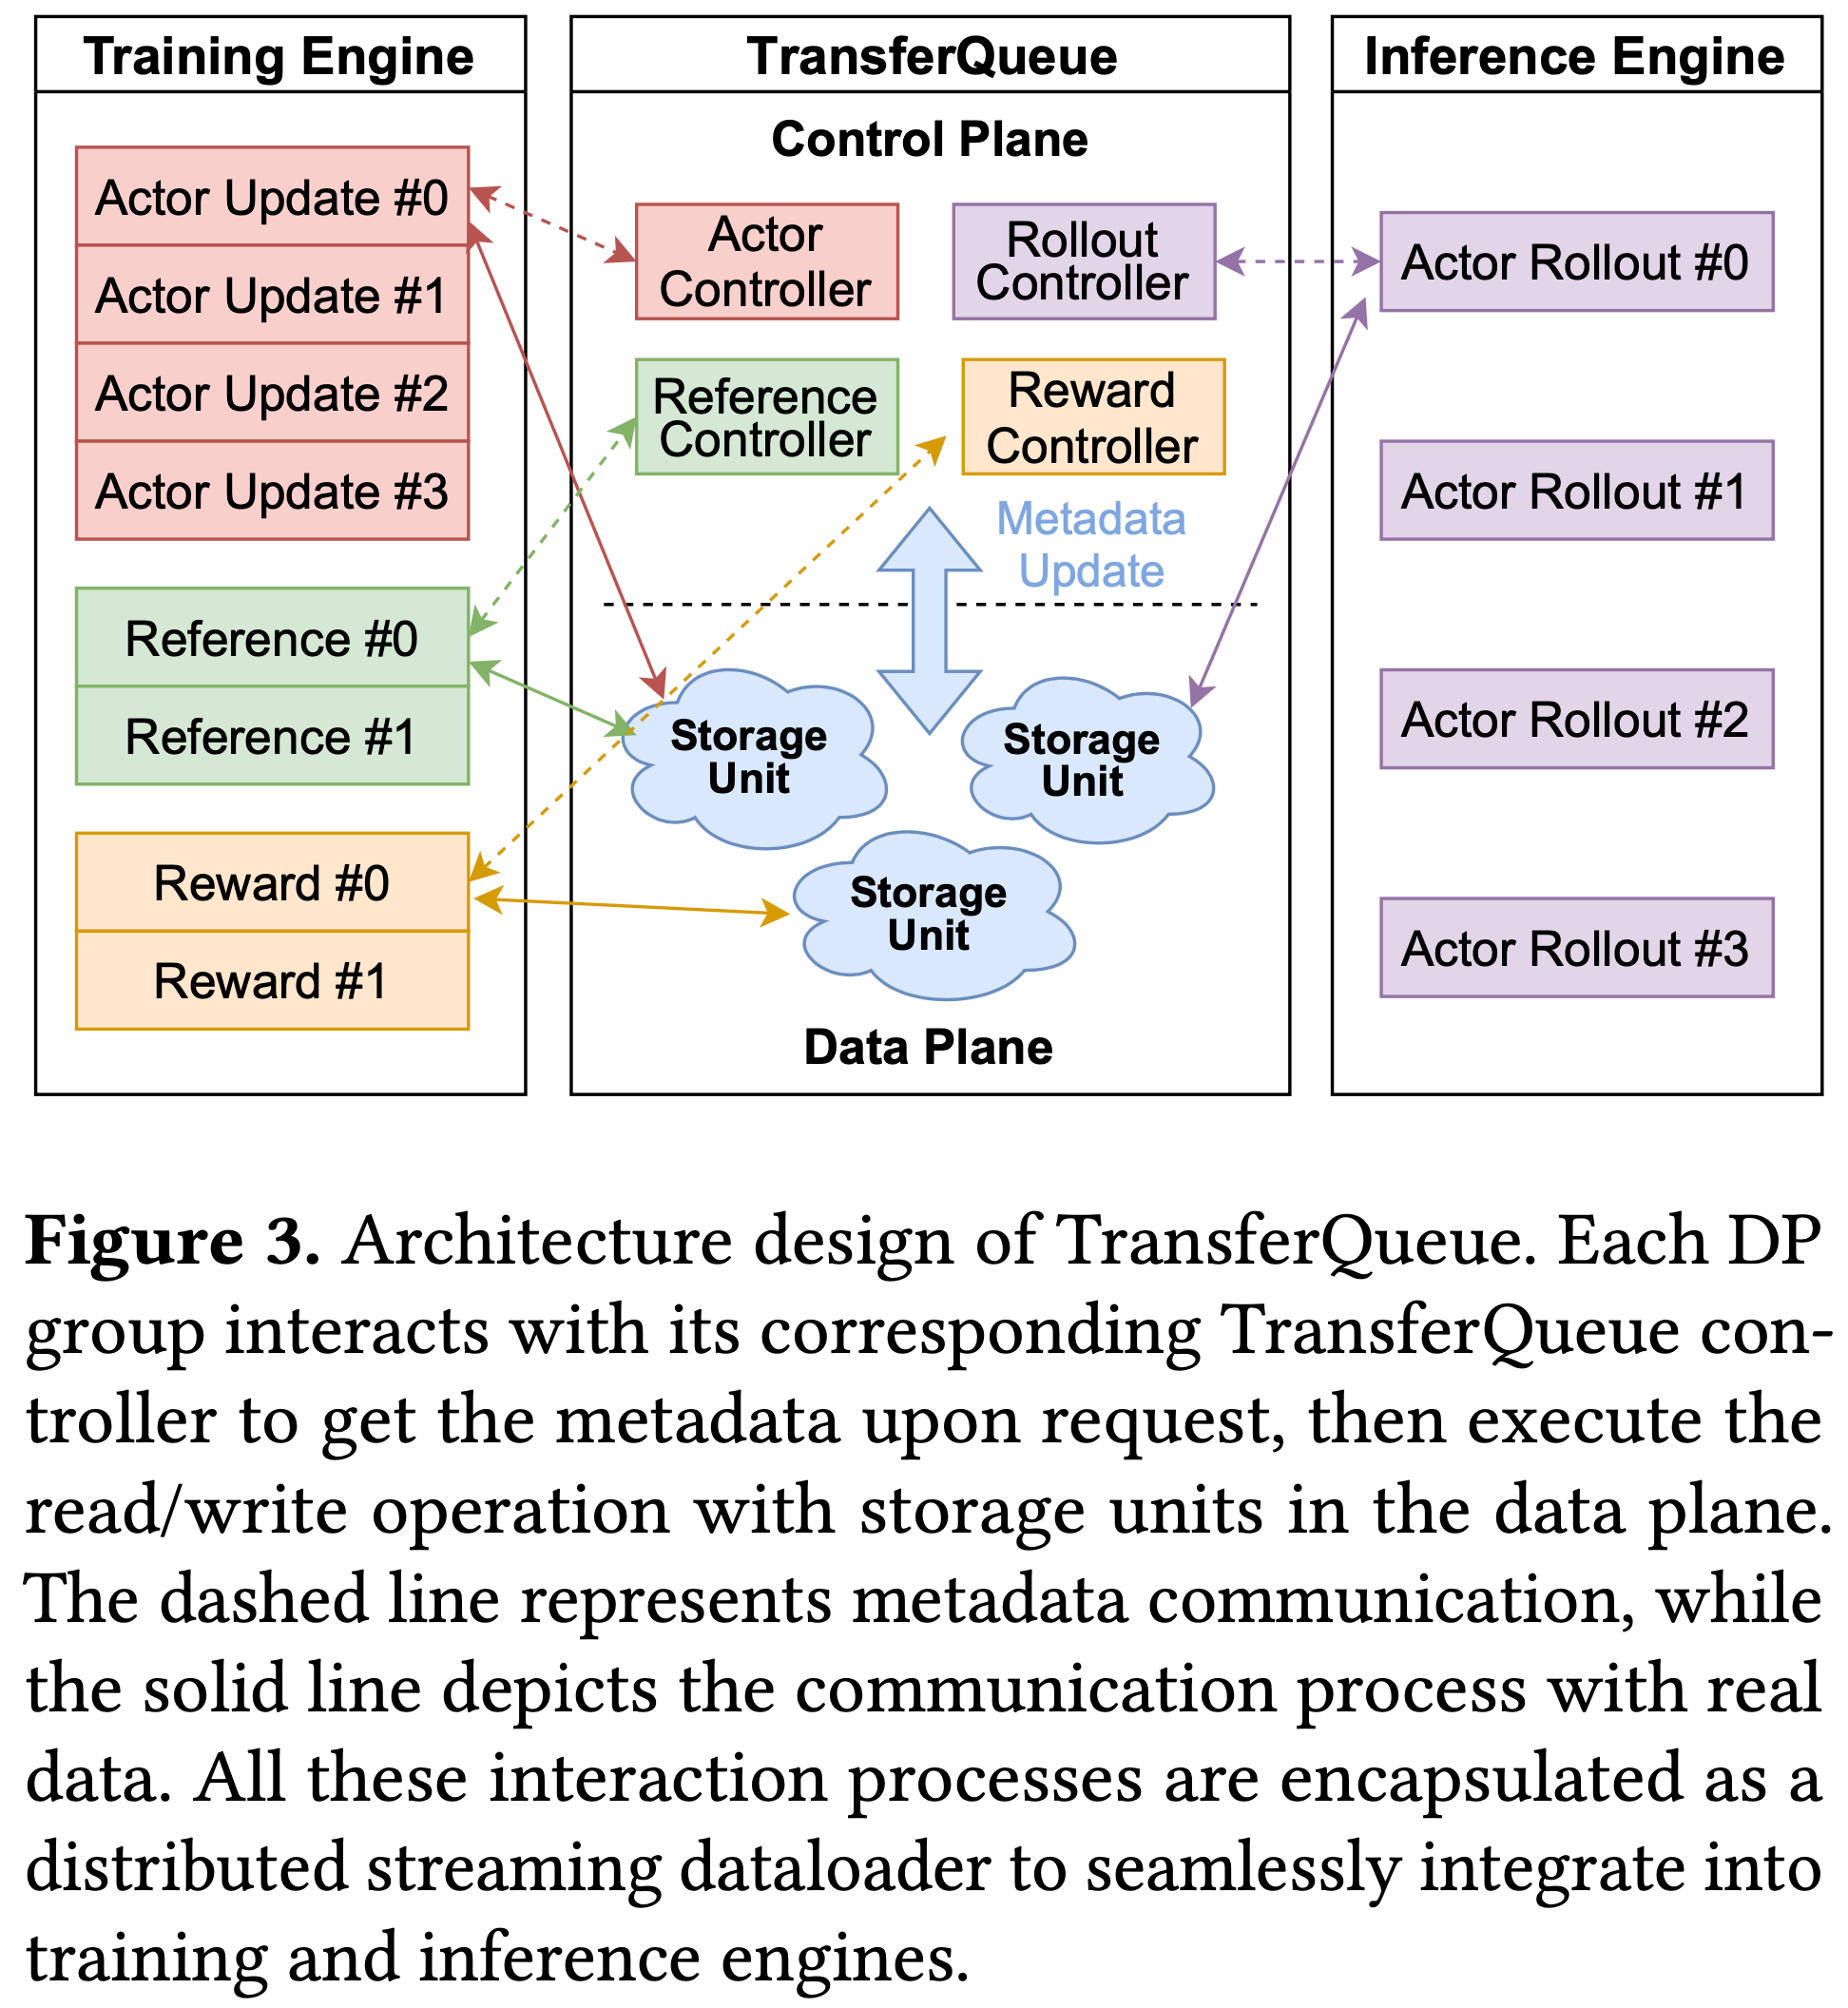
- 如图 3 所示,TransferQueue 充当连接训练集群和推理集群的流式数据调度器,管理 RL 后训练过程中的全部数据流
- 每个 RL 任务配备一个专用的 TransferQueue 控制器,该控制器维护训练样本的元数据
- 元数据包括存储位置、数据状态和消费状态
- 这些控制器独立运行,因为 RL 任务之间天然不存在算法干扰
- 对于数据存储,每个存储单元负责当前全局批次中的一部分样本
- 这些样本被分配全局索引,以确保所有分布式控制器能够准确定址
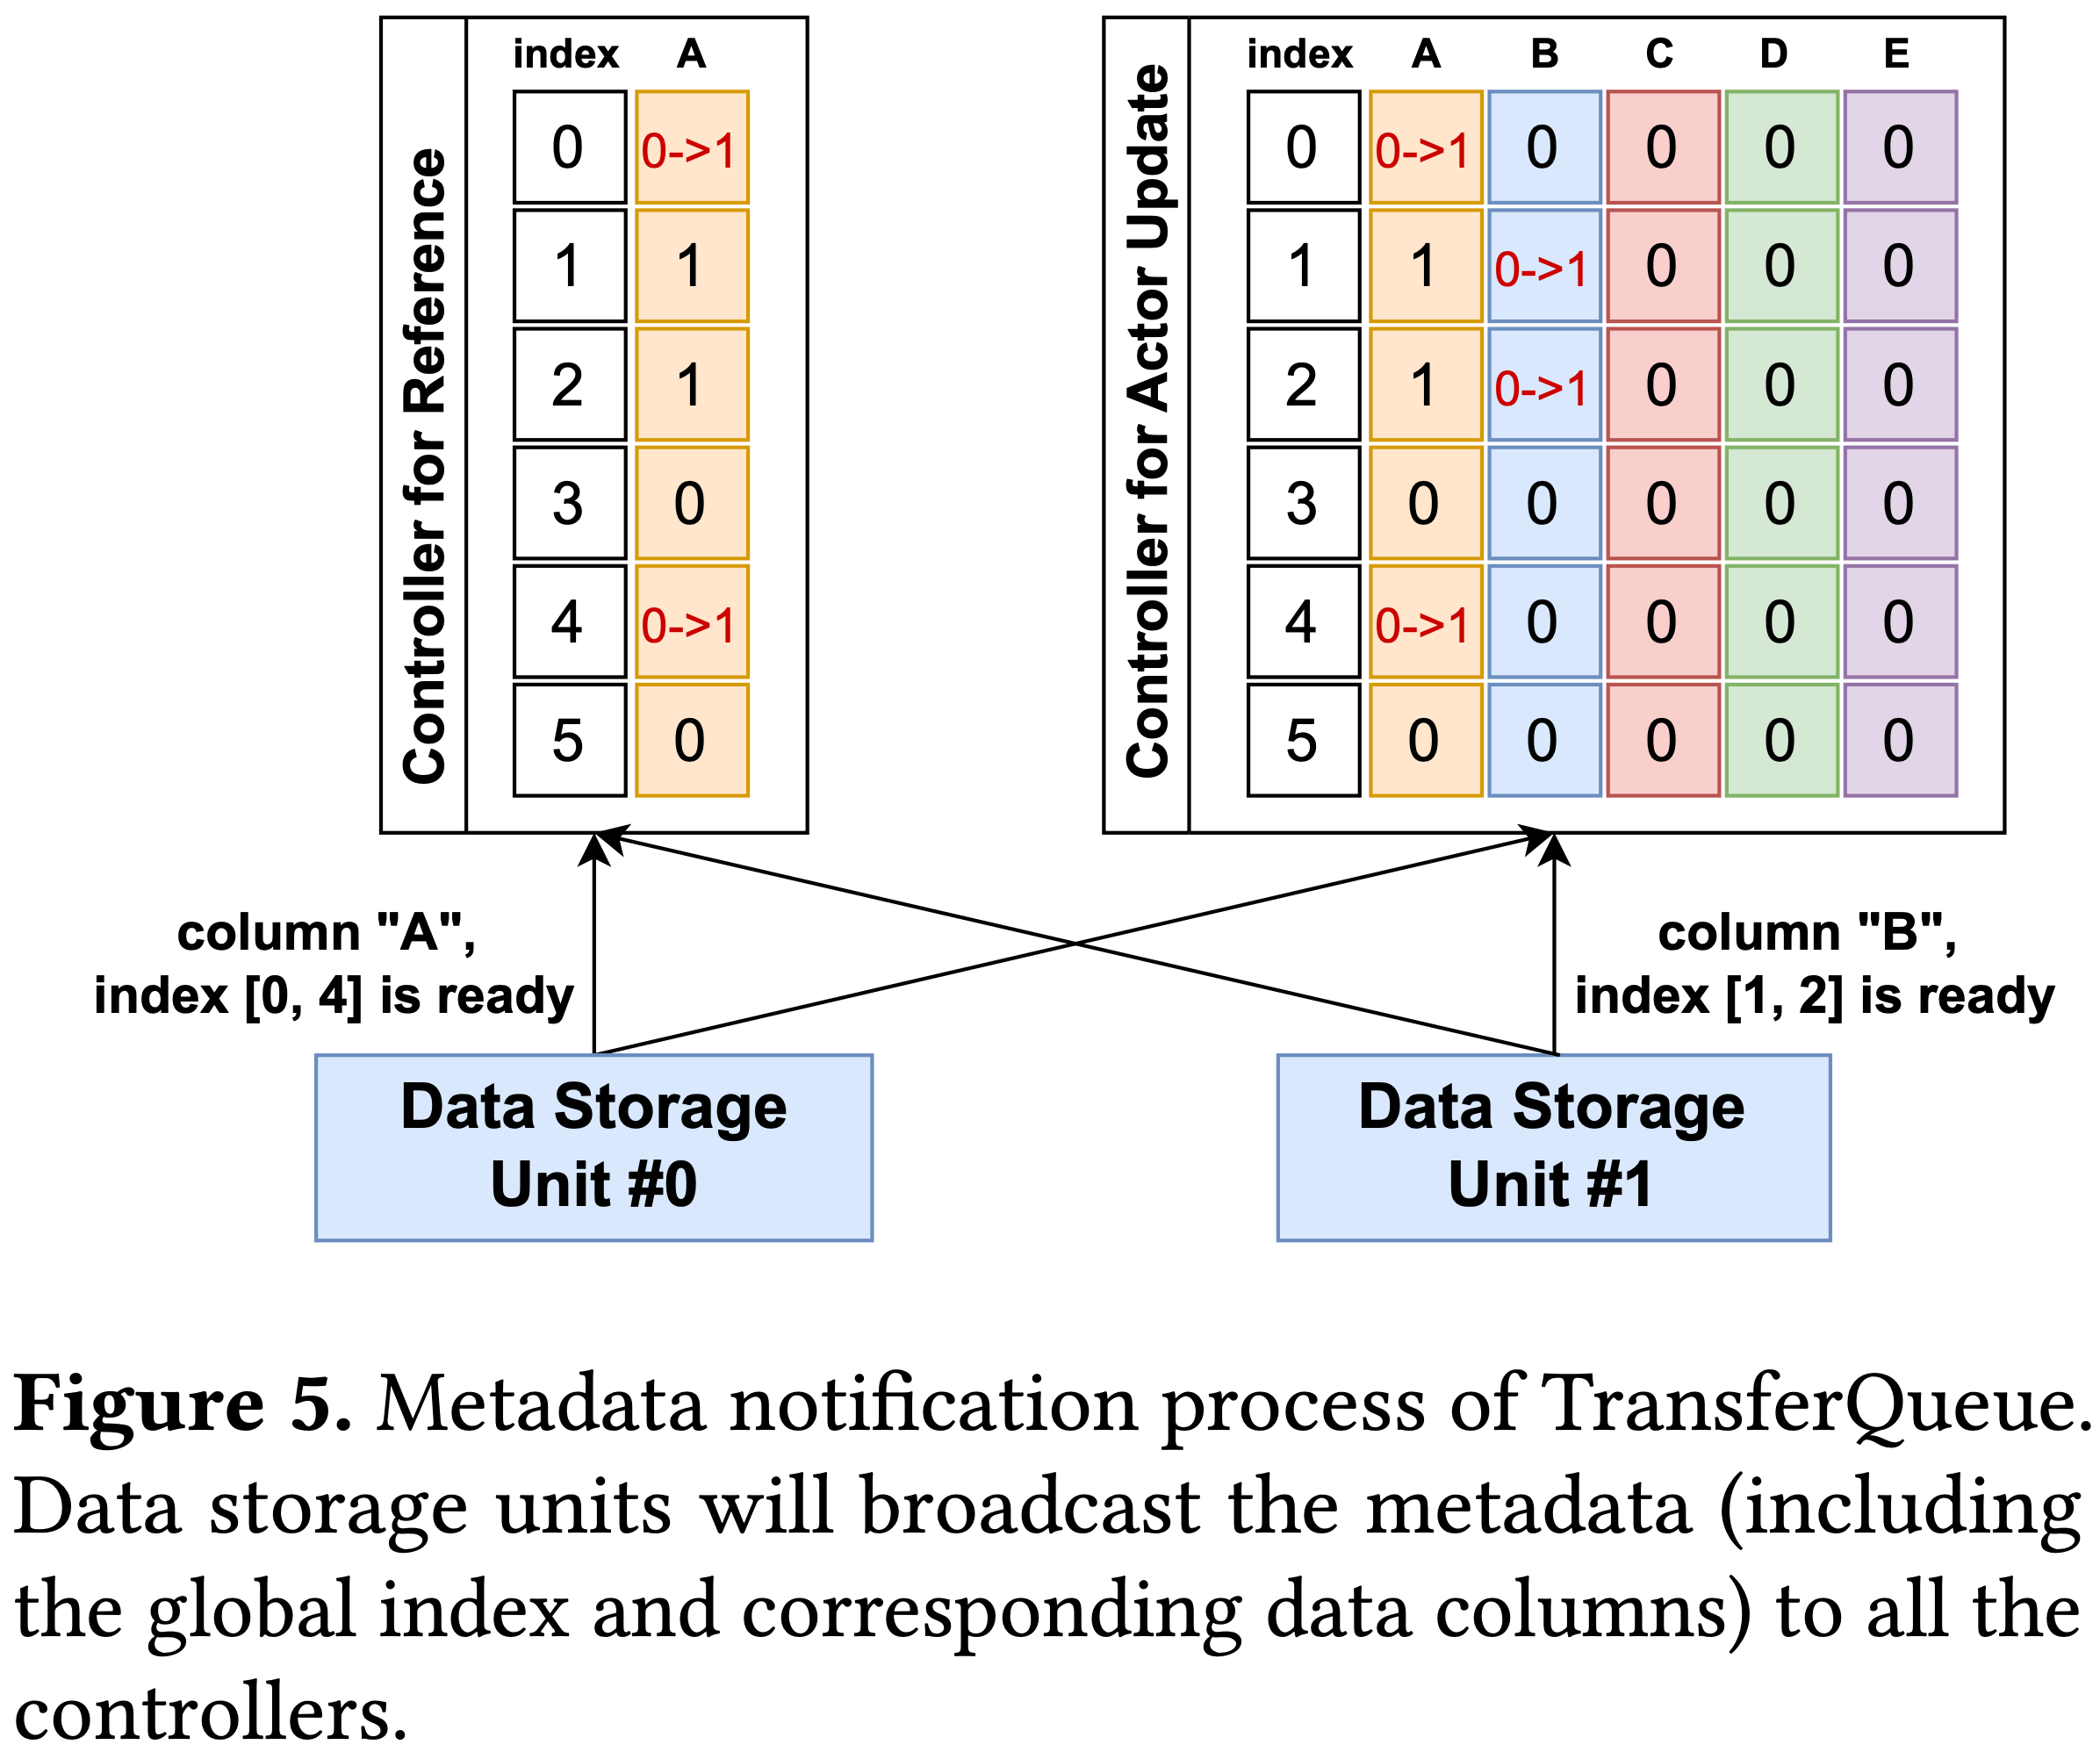
- 当新数据被写入存储单元时,会触发向所有控制器更新其元数据的通知 :该机制允许每个 RL 任务在请求时动态访问新近可用的数据
- 每个 RL 任务配备一个专用的 TransferQueue 控制器,该控制器维护训练样本的元数据
- 当一个 DP 组需要新数据时,流程为
- Step 1:需要数据的 DP 组通过向其对应的控制器发送读请求来启动该过程
- Step 2:DP 组对应的控制器从当前可用数据中动态组装一个 Batch,并将这些样本的元数据返回给请求者
- Step 3:然后,DP 组利用提供的元数据从分布式存储单元中检索相应的数据
- 为确保每个 DP 组能访问不同的样本而不重复,控制器跟踪每个样本的消费记录
- 保证同一 RL 任务中只有一个 DP 组能访问该样本的元数据
- 理解:同一个 RL 任务可能有多个 DP 组,每个组负责一部分样本, DP 组之间维护的样本没有 Overlap
- 类似地,在 DP 组完成计算后,DP 组通过元数据将结果原子性地写回存储单元 ,以保证分布式组件间的一致性
- 为确保与训练和推理引擎的输入格式兼容,将上述交互逻辑封装到 PyTorch DataLoader 中
- 这使得用户能将 TransferQueue 作为一个分布式流式数据加载器无缝集成 ,而无需了解底层实现细节
Data Plane: Distributed Data Transfer and Storage
Data Structure
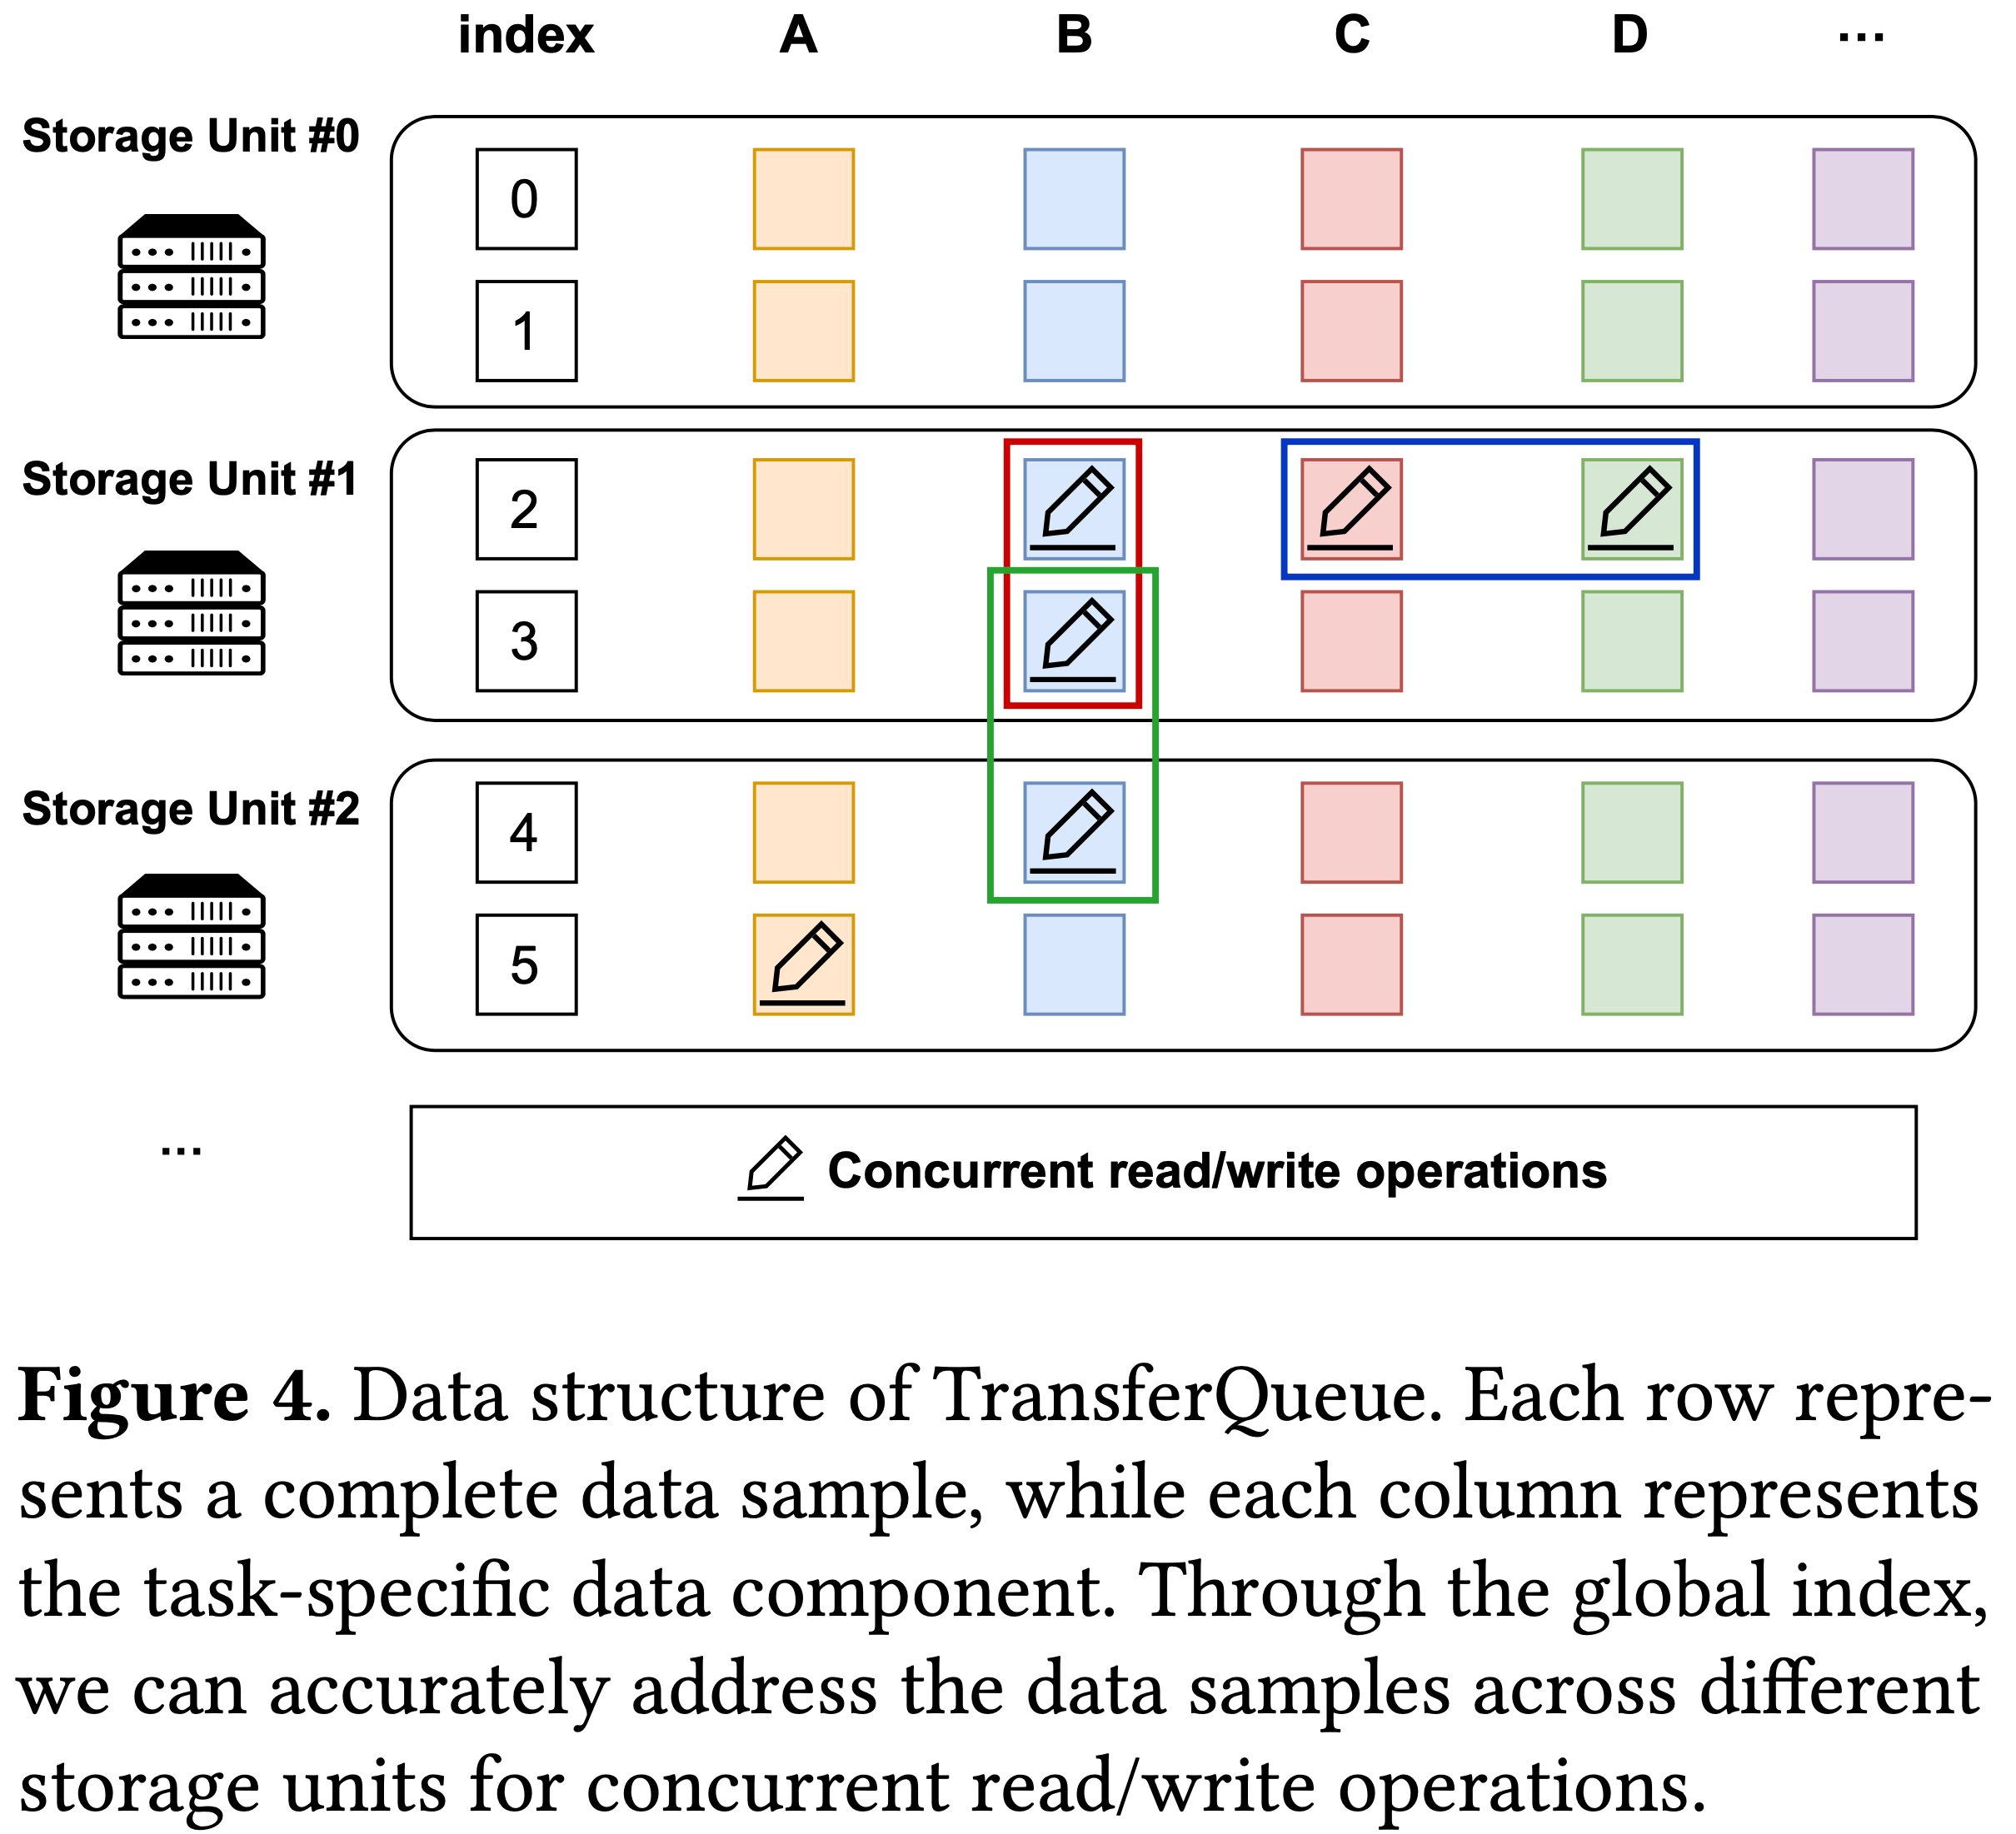
- 为满足 RL 任务多样化的数据需求,采用了一种 2D 列式数据结构,如图 4 所示
- 在该设计中
- 列(Columns)对应任务特定的数据组件,如 Actor Responses 和 Reference log probabilities
- 理解:因为一行数据(一个完整样本)包含了 Response,log Probs 等部分,所以这里将列和这些部分对应起来,方便索引和读取
- 行(Rows)代表完整的训练样本,每个样本可通过全局索引唯一寻址
- 列(Columns)对应任务特定的数据组件,如 Actor Responses 和 Reference log probabilities
- 这种结构使得 RL 任务能仅检索算法所需的特定数据组件
- 例如,需要输入 Token IDs 和 Responses 的 Reference 模型可以仅请求相关列,从而最小化不必要的数据传输
- 此外,这种组织方式 支持在不同位置进行并发的读写操作,增强了高并发场景下的可扩展性
- 理解:类似一个 Dict 结构的数据,对于没有逻辑依赖的 Key,不同的 key 是可以被并发读写的
- 考虑到潜在的 I/O 和带宽瓶颈,将训练样本以分布式方式存储
- 每个存储单元(Storage Unit)维护数据项(即 Rows)的一个子集,以将存储和通信开销分摊到整个系统中
- 理解:一个 Storage Unit 可以存储多个 Rows
Metadata Notification,元数据通知
- 当新数据被写入数据存储单元时,它会触发向控制器更新其元数据的通知
- 如图 5 所示,在写入过程完成后,数据存储单元将相应的行索引和列标识广播给所有(在初始化时注册的)控制器
- 理解:这里是广播给所有 Controller
- 该机制确保控制器能立即知晓这些位置的数据已准备就绪可供消费
Control Plane: Centralized View of Data Management,数据管理的集中视图
- LLM 训练中固有的嵌套并行策略,加上多个并发的 RL 任务,导致后训练期间数据流复杂
- 为理清这些复杂的数据依赖关系:
- 本文 利用 TransferQueue 的 Control Plane 作为集中式数据管理模块,确保每个任务中分布式 worker 间的协调一致性
- 本文 为每个 RL 任务初始化不同的 TransferQueue 控制器
- 控制器维护其对应任务范围内的数据状态元数据,包含所需列的所有条目(Entries)
- 数据状态元数据使用二进制状态指示符:
- 状态 0 表示数据不可用
- 状态 1 表示数据已准备好可检索
- 注:如原文 第 3.2.2 节所述,这些元数据条目在新数据写入数据存储单元时会被动态更新
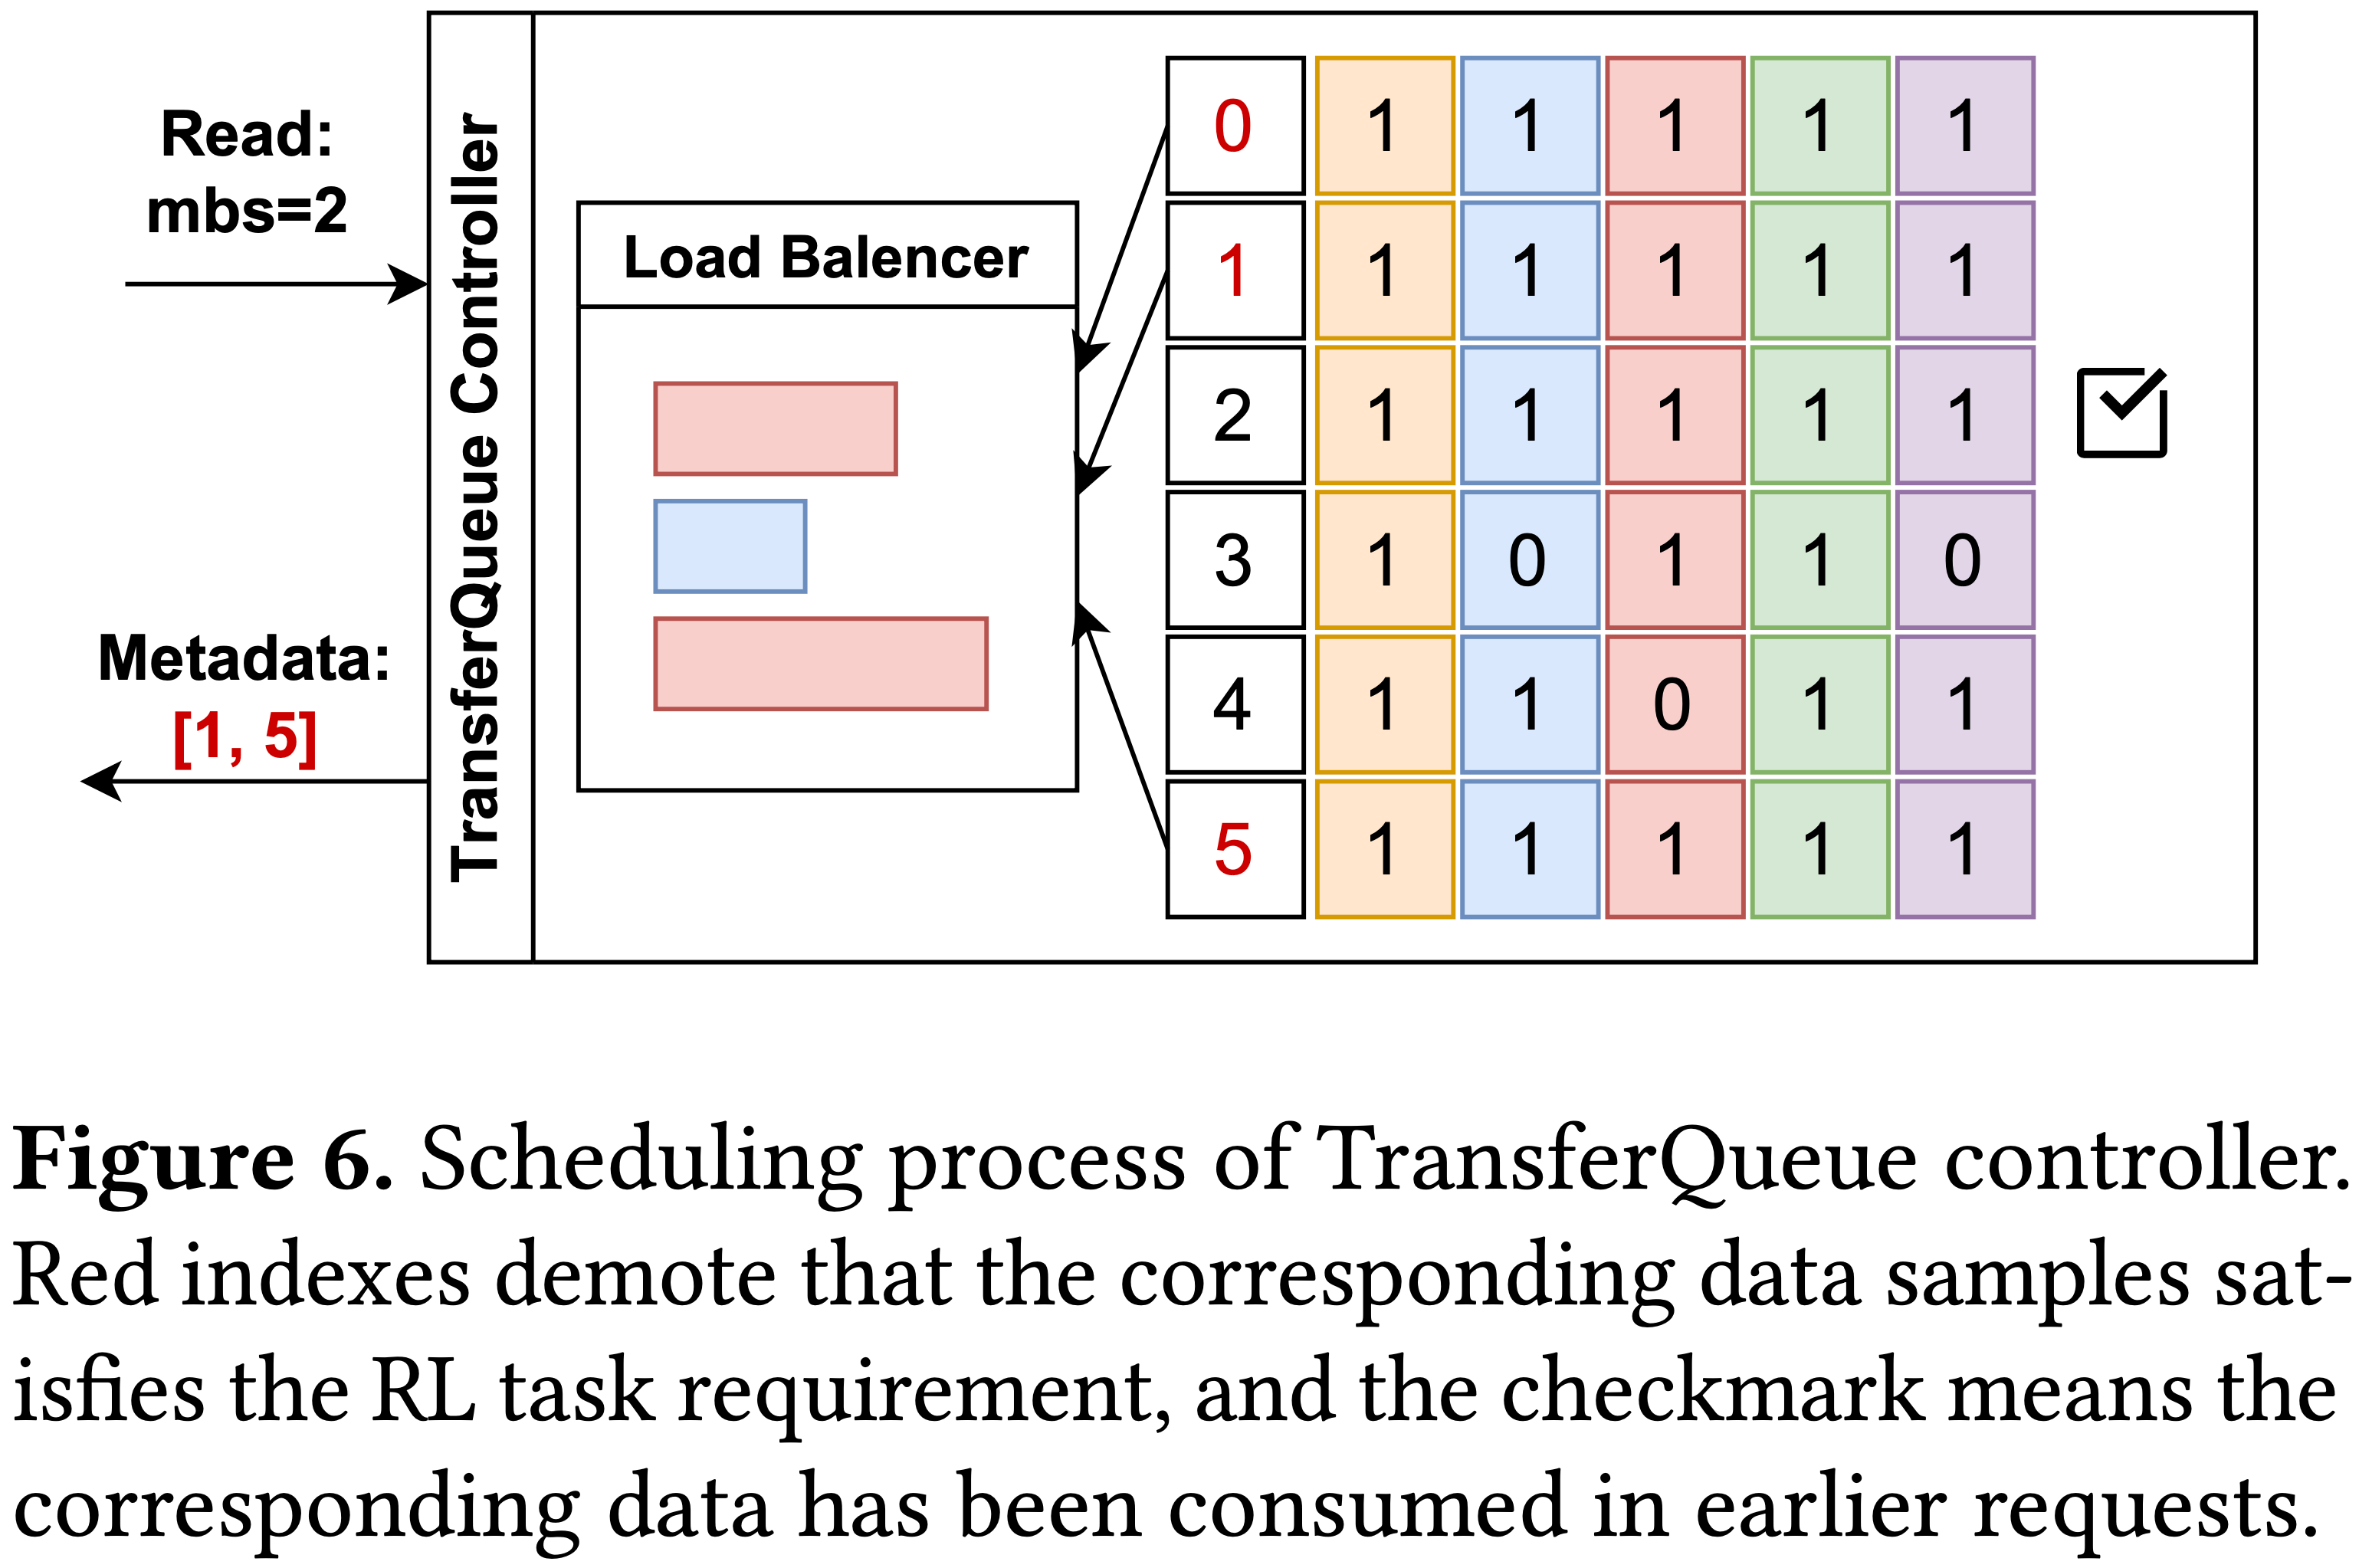
- 如图 6 所示,在收到读请求后,TransferQueue 控制器会扫描元数据,以识别满足 RL 任务要求的条目
- 满足 RL 任务要求的条目:所有列状态都等于 1 且之前未被其他 DP 组消费过的条目
- 如果当前可用数据超过请求的 micro-batch size,控制器会根据负载均衡策略选择并将元数据打包成一个 micro-batch
- 这些样本随后被标记为已消费,以防止同一 RL 任务中的其他 DP 组重复消费
- 理解:因为每个 RL 任务都有一个自己的 TransferQueue 控制器,所以这个控制器只维护自己当前的数据状态
- 某个数据生产完成时广播给所有 RL 任务的 Controller
- 当 Entry 被某个 RL 任务消费时,这个 RL 任务对应的 Controller 对应的 Entry 的元数据被更新
- 这种设计方式可以保证每个 RL 任务对应的 Entries 就绪情况 和 消费情况都被自己的 Controller 记下来
- 理解:因为每个 RL 任务都有一个自己的 TransferQueue 控制器,所以这个控制器只维护自己当前的数据状态
- 借助这些元数据,消费者与分布式数据存储单元通信以执行实际的数据检索过程
- 这些样本随后被标记为已消费,以防止同一 RL 任务中的其他 DP 组重复消费
- 本文 架构的一个关键优势在于其集中式数据管理
- 通过控制器动态调度所有可用数据,而非预先分配给各个 DP 组,TransferQueue 实现了先进的负载均衡策略
- 例如,速度更快的实例(由于硬件异构性或较短的 Response 长度)可以动态请求更多数据,从而提高整体效率
- 此外,还可以实现主动负载均衡,以确保各个 DP 组间处理的 Token 分布均匀,从而最小化 Actor 更新过程中的计算空闲
Interaction Interface
- 为简化 TransferQueue 的使用,本文将其功能封装到了 PyTorch DataLoader 中
- 如代码 1 所示
- 用户首先通过指定当前 RL 任务、所需输入数据列和 Micro-batch 大小,将 TransferQueue 初始化为流式数据加载器
- 在每个前向步骤中,所需数据可通过迭代器包装器轻松获取
- 该接口简化了 TransferQueue 的集成,确保与现有训练工作流的无缝兼容
- 代码 1: TransferQueue 使用示例
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# In class RolloutWorker(BaseWorker):
def generate_sequences(self):
# define the data columns and initialize the TransferQueue
experience_consumer_stage = 'actor_rollout'
experience_columns = ['prompts', 'prompt_length']
experience_count = self.rl_config.rollout_dispatch_size
data_loader = self.create_stream_data_loader(
experience_consumer_stage=experience_consumer_stage,
experience_columns=experience_columns,
experience_count=experience_count,
use_vllm=True,
pad_to_multiple_of=self.generate_config.infer_tensor_parallel_size,
)
data_iter = iter(data_loader)
for batch_data, index in data_iter:
# do inference
prompts_data = batch_data['prompts']
responses = self.rollout.generate_sequences(prompts_data)
# write generated responses to TransferQueue
self.collect_transfer_queue_data(responses, index)
High-Concurrency Design,高并发
- TransferQueue 通过三个步骤来应对大规模后训练的挑战
- 步骤一:
- 其解耦的控制 Plane 和数据 Plane 架构支持可扩展的数据存储单元扩展,以满足高并发操作需求
- 当 I/O 或网络带宽瓶颈出现时,可以轻松初始化额外的数据存储单元以扩展总带宽并降低系统延迟
- 该设计还支持未来轻松切换到其他存储后端,如 Mooncake Store(2025)、Redis(2025)或其他针对 LLM 训练定制的存储系统
- 此外,控制 Plane 中的调度过程和数据 Plane 中的 I/O 操作并发执行,形成 Pipeline 工作流,高效处理多个传入请求
- 步骤二:
- TransferQueue 通过在每个 DP 组内指定单个 rank 与系统交互来优化通信效率 ,这是基于每个 DP 组中的 rank 应接收相同数据这一事实(在不考虑序列并行时)
- 检索到的数据随后被广播给 DP 组内的其他rank
- 这种方法在大规模后训练场景中显著减少了直接发往 TransferQueue 的请求量
- TransferQueue 通过在每个 DP 组内指定单个 rank 与系统交互来优化通信效率 ,这是基于每个 DP 组中的 rank 应接收相同数据这一事实(在不考虑序列并行时)
- 步骤三:
- 在数据存储和传输过程中消除了不必要的填充
- TransferQueue 天然支持变长数据传输
- 对于设备到设备的华为集合通信库(HCCL)通信,张量沿序列维度拼接以进行广播操作,然后使用长度元数据恢复接收到的张量
- 该策略最小化了由填充引起的冗余通信开销,特别是在大 Micro-batch 大小的设置下
- In Summary,这些设计缓解了数据存储和传输瓶颈,确保了大规模后训练工作负载的鲁棒高并发性能
Producer-Consumer-Based Asynchronous Workflow Optimization,基于生产者-消费者的异步工作流
- 任务分离式框架面临的一个关键挑战源于 Pipeline 气泡(pipeline bubbles)
- Pipeline Bubbles:即由于部署在不同设备集上的任务之间存在数据依赖关系而导致的硬件资源空闲
- 为了克服这一挑战,AsyncFlow 实施了一系列 Pipeline 优化技术,以最大化硬件利用率
- 第一,本文流式数据加载器(streaming dataloader)实现了 RL 任务之间的 Pipeline Overlapping
- 这极大地减少了端到端的后训练执行时间
- 第二,在 off-policy 场景中,本文设计了一种 Delayed 参数更新机制,能够很好地平衡算法收敛性和训练效率
- 允许 Actor Rollout 和 Actor Update 之间保持连续的 One-Step 异步化(one-step asynchronization),这种方法通过最小化 Warm-up 和 Cool-down 阶段有效地消除了气泡
- 第三,通过主动的资源规划和动态负载均衡策略实现了细粒度的执行时间优化
- 充分释放了任务分离式框架在 LLM 后训练中的可扩展性
- 第一,本文流式数据加载器(streaming dataloader)实现了 RL 任务之间的 Pipeline Overlapping
Streaming Pipeline Overlapping across RL Tasks
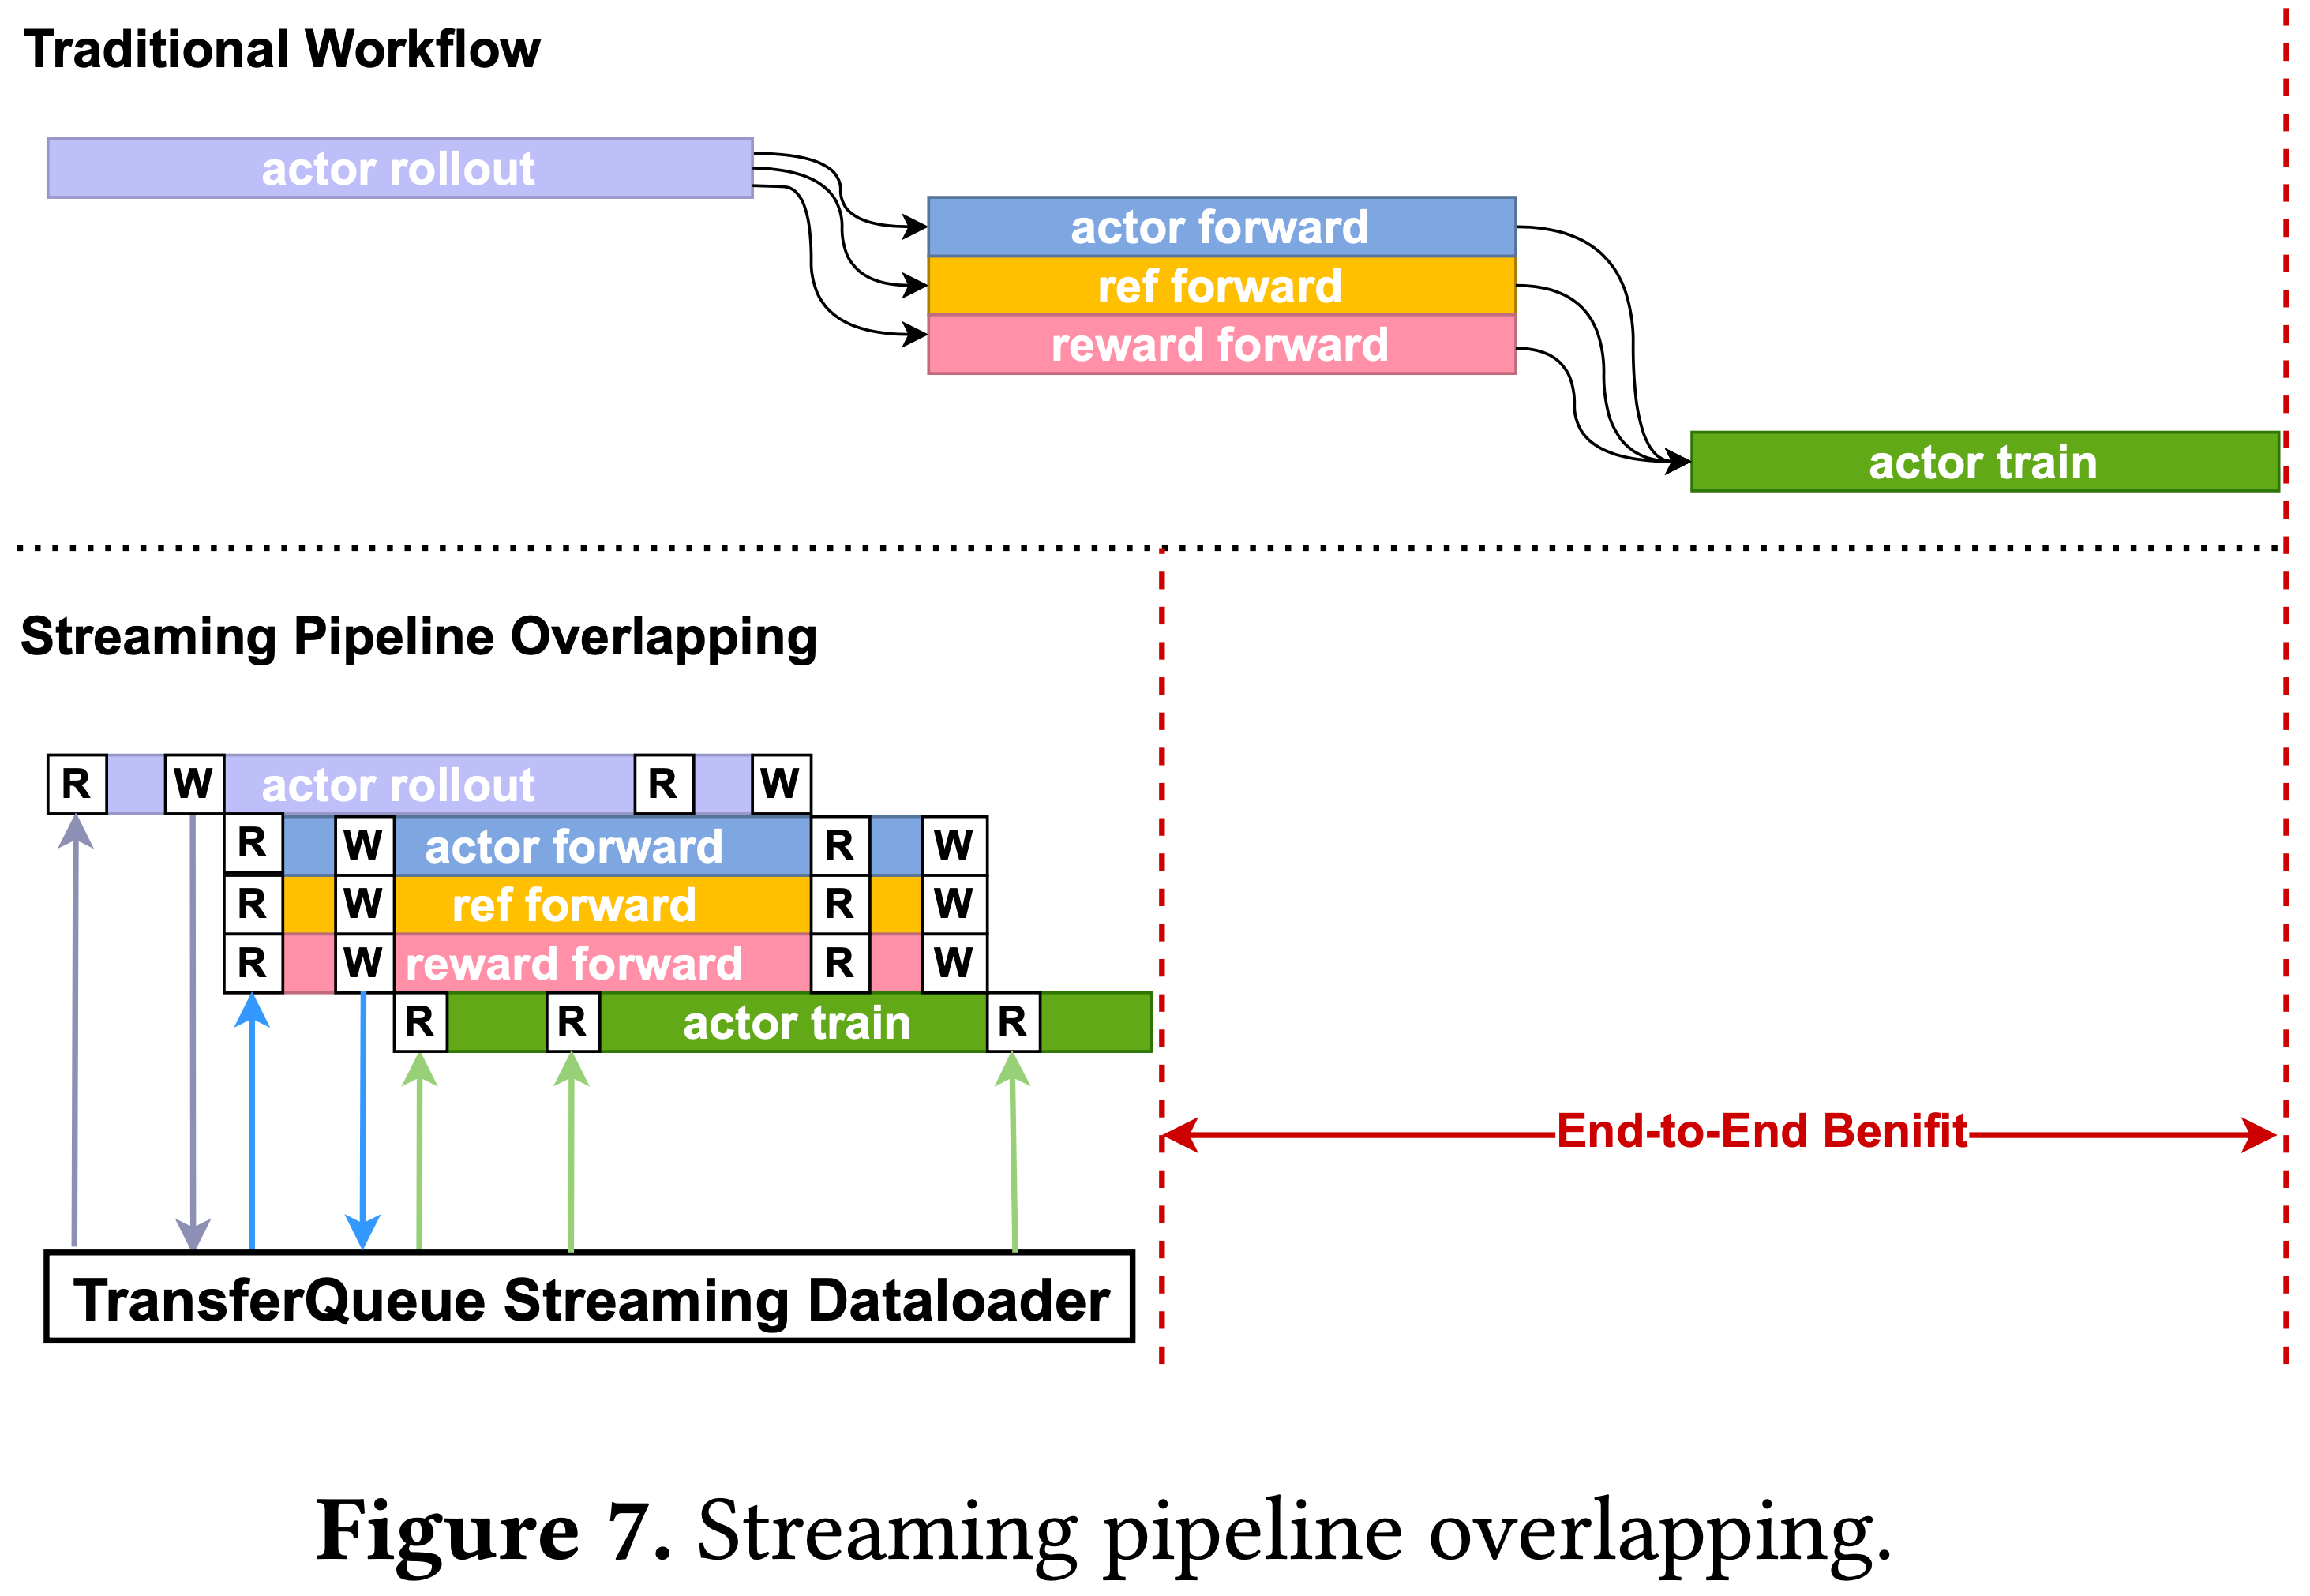
- 借助 TransferQueue,AsyncFlow 不仅简化了数据流管理,还通过实现 RL 任务间的 Pipeline 重叠来提升训练吞吐量
- 在这种范式中,所有训练和推理实例只需与流式数据加载器交互,该加载器动态地调度并在任务间路由最细粒度的数据样本
- 这种架构天然支持 Pipeline 重叠,如图 7 所示
- 与现有框架(2024;2025)的设计不同,我们可以轻松地将这种重叠策略扩展到具有不同任务的任何 RL 算法,无需手动重新调度数据流
- 与现有框架(2024;2025)的设计不同,我们可以轻松地将这种重叠策略扩展到具有不同任务的任何 RL 算法,无需手动重新调度数据流
Asynchronous Off-Policy Bubble Reduction,减少 Bubble
Basic asynchronous RL algorithm
- 用于 LLM 后训练的传统 RL 算法主要采用同步 On-Policy(synchronous on-policy)范式( Actor Rollout 和 Actor Update 在相同的参数状态下运行)
- 这确保了算法的收敛性,但其计算低效:严格的同步要求,严重限制了大规模后训练的可扩展性
- 近期的进展对这一范式提出了挑战:
- 诸如 Partial rollout(2025)和 Streaming rollout(2025)等优化技术通过允许更新阶段使用由旧模型生成的 Response 数据,实际上放宽了 On-Policy 的假设
- 这些创新为探索异步 Off-Policy(asynchronous off-policy)框架创造了机会,该框架有望通过 Pipeline 重叠在训练效率上取得显著提升,同时保持收敛性保证
- On-Policy 算法
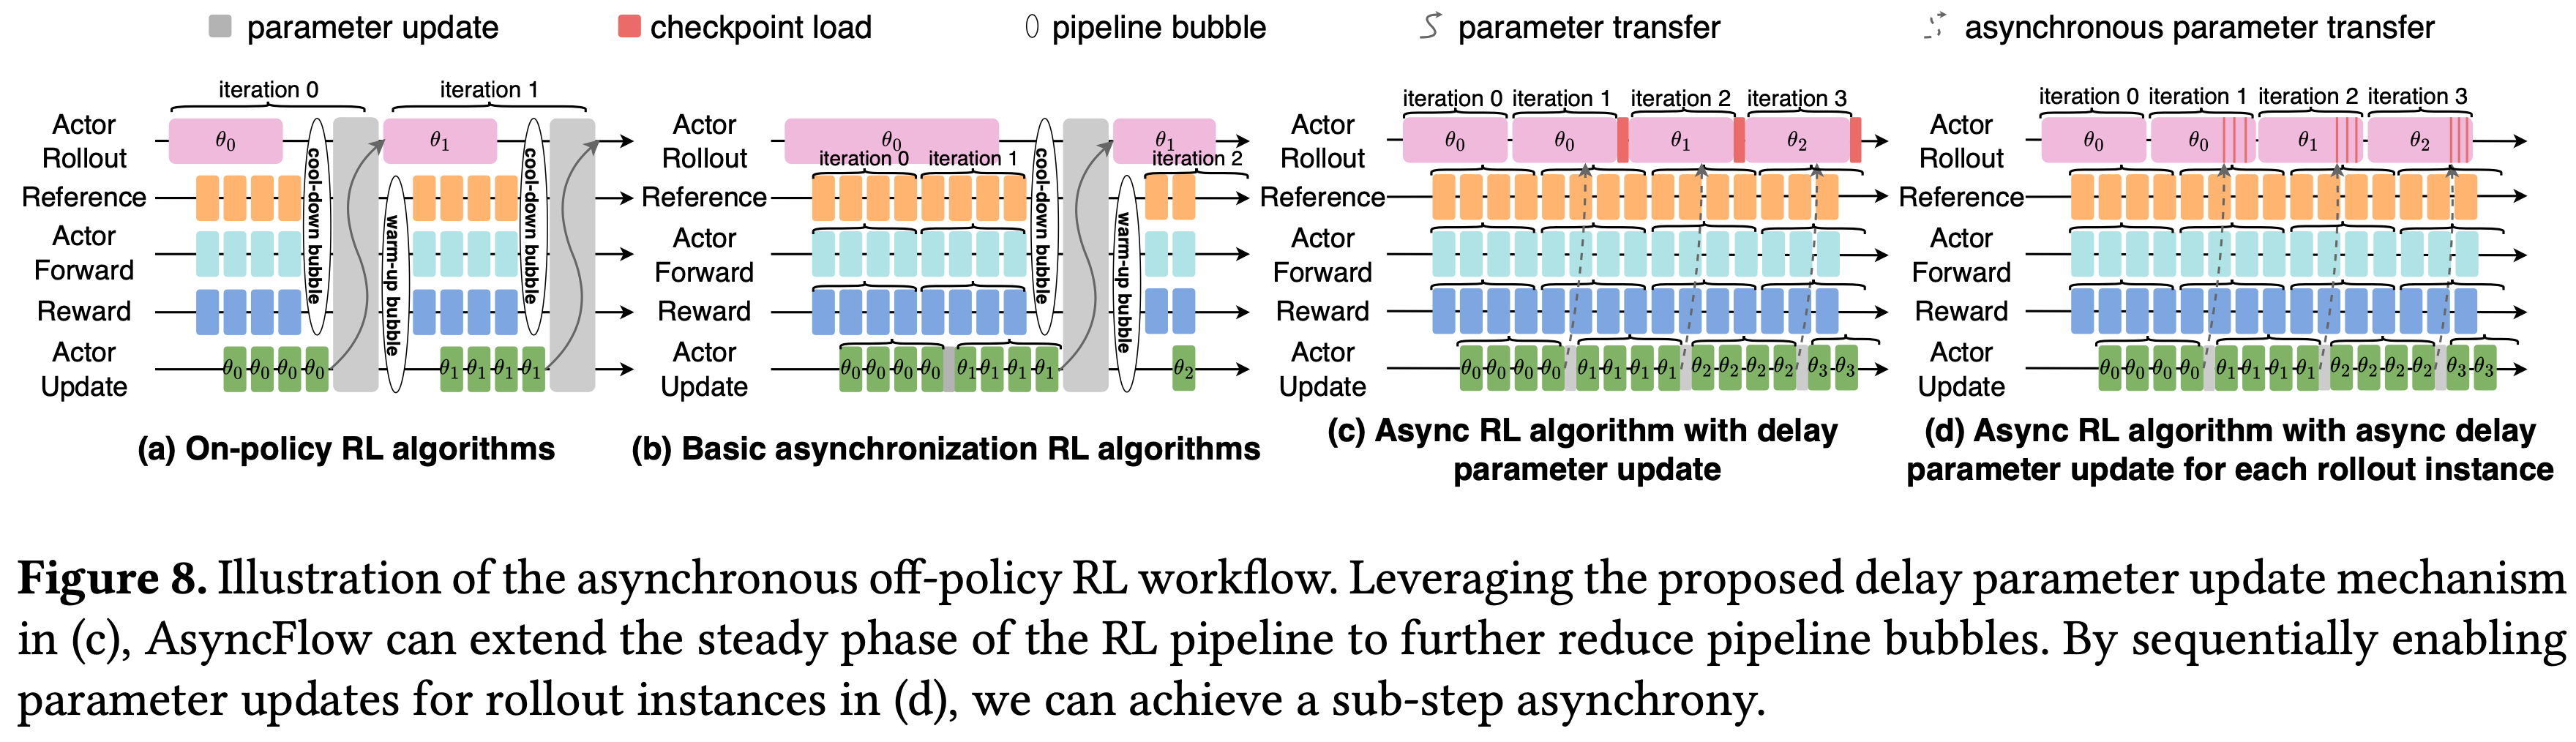
- 如图 8(a) 所示,On-Policy 方法在 Actor Rollout 和 Actor Update 阶段之间强制执行严格同步,这导致迭代间出现启动和冷却气泡
- Off-Policy 算法:
- 一个直接的缓解策略是增大 Actor Rollout 阶段的全局 Batch Size,过渡到如图 8(b) 所示的异步 Off-Policy 场景,其中 Actor Update 使用由陈旧参数生成的 Response
- 这种调整延长了 RL Pipeline 的稳定阶段,从而减少了启动和冷却阶段中 Pipeline 气泡的比例
- 但算法收敛性约束对 Actor Rollout 和 Actor Update 之间允许的版本差异施加了严格限制
- 实证研究表明,Actor Rollout 和 Actor Update 之间的单步异步化不会导致显著的性能或收敛性下降(2024;2025)
- 随着版本差异超过此阈值,性能会呈对数级下降
- 这种权衡突显了在大规模 LLM 后训练中协调训练效率与算法稳定性的机制需求
- 注:这里 8(b) 的内容表示的是一次 Rollout 更多个 Query,然后更新多步
- 一个直接的缓解策略是增大 Actor Rollout 阶段的全局 Batch Size,过渡到如图 8(b) 所示的异步 Off-Policy 场景,其中 Actor Update 使用由陈旧参数生成的 Response
Delayed parameter update mechanism
- 为了解决上述困境,本文提出了一种延迟参数更新机制,通过解耦 Actor Rollout 和 Actor Update 的模型权重,进一步消除 Pipeline 气泡
- 如图 8(c) 所示,该机制将参数更新延迟一步,使得在迭代间的过渡期间能够持续进行 Rollout
- Actor Rollout Worker 在 Actor Update 完成时不会立即停止生成,继续使用旧的模型权重生成 Response,同时异步地将接收到的新参数写入 Host 内存
- 当当前生成迭代完成时,新参数将加载到 Ascend NPU 上,将 exposed 同步开销(synchronization overhead)减少为相对快速的 host-to-device(H2D)传输
- 问题: host-to-device 与 synchronization 的区别是什么?
- 通过允许连续的 One-Step 异步化,它使得稳定阶段几乎可以无限延长,因为消除了启动和冷却阶段
- 虽然在概念上与 StreamRL(2025)相似,但本文的方法通过 TransferQueue 的集中式数据流管理
- 这进一步增强了可扩展性,使得训练引擎内的所有 RL 任务都能重叠
- 这种设计有效地减少了 RL 后训练工作流中的启动和冷却 Pipeline 气泡,充分发掘了任务分离式框架的架构潜力
- 如图 8(d) 所示,本文还提出了一种新颖的参数更新机制,实现了子步骤异步(sub-step asynchronous)算法工作流
- 为了高效地为下游任务提供数据,本文通常为 Actor Rollout 任务分配充足的硬件资源
- 这种设置允许部分 Rollout 实例按顺序执行参数更新,而其余实例则继续满足下游训练任务的数据需求
- 在每次迭代中,我们可以利用最新更新的参数来生成部分数据,实现子步骤异步
- 此外,这种设计也最小化了检查点加载的开销,从而提升了系统效率
- 注:本文作者将此机制的实现细节留待未来工作
- 理解:这里 8(d) 的思路是多个 Rollout 的实例的参数不需要完全一致,即同一个 Update Step 中,既有 On-policy 的数据,也有 Off-policy 的数据(但最多 Off-policy 一步)
Parameter update overlapping
- 参数更新模块主要由部署在训练集群上的 WeightSender 和推理集群上的 WeightReceiver 组成
- 为了最小化 RL 训练 Pipeline 中的权重传输时间,发送端和接收端被设计为同时支持同步和异步模式
- 在同步模式:
- 此时 Actor Rollout 被参数更新过程阻塞
- 为了缩短 Exposed 传输时间,本文利用 Ascend NPU 间的高带宽 HCCL 链路来传输模型权重
- 异步模式:
- 为了进一步减少端到端时间,本文进一步开发了一个异步参数更新过程,该过程可以完全与异步 RL 算法的计算任务重叠
- 来自训练引擎的模型权重被卸载到 Host 设备,并通过 Host 网络异步传输到推理引擎,将计算工作负载与权重同步过程解耦
- 这种设计确保参数更新过程既不会暂停也不会干扰正在进行的计算任务,从而维持连续的 RL 工作流
- 在同步模式:
Task Resource Planning
- 为了实现图 8(c) 所示的理想工作流,本文构建了一个基于图的资源规划模块,该模块能够在给定资源约束下精确搜索最优配置
- 通过模拟不同配置下的计算和通信时间,本文可以获得最小化整个 RL 工作流端到端时间的资源分配设置和超参数
- 理解:自动搜索超参,优化底层性能,太秀了
- 鉴于 LLM 后训练的庞大搜索空间,本文采用了一种结合基于分析的方法和 Profiling-Based 方法的混合成本模型
- 基于分析的方法利用硬件规格以及理论计算和通信量来估计执行时间
- 提供快速评估,可以迅速缩小搜索空间
- Profiling-Based 方法通过实际运行训练和推理任务来提供块级性能
- 它提供了准确的评估,但代价是更高的时间消耗
- 利用混合成本模型,本文确保了效率和准确性之间的良好平衡,使其非常适合于优化 LLM 后训练的复杂 RL 工作流
- 基于分析的方法利用硬件规格以及理论计算和通信量来估计执行时间
Service-Oriented User Interface
- 为了提供增强的用户体验,RL 框架应提供一个高层抽象层,来编排所有算法特定的任务
- 对于学术研究而言,这种设计为算法开发提供了一个统一的入口点,通过标准化的 API 实现快速实验
- 对于工业场景而言,支持各种训练和推理后端,同时保持架构灵活性至关重要
- 因此,维护一个恰当的用户界面至关重要
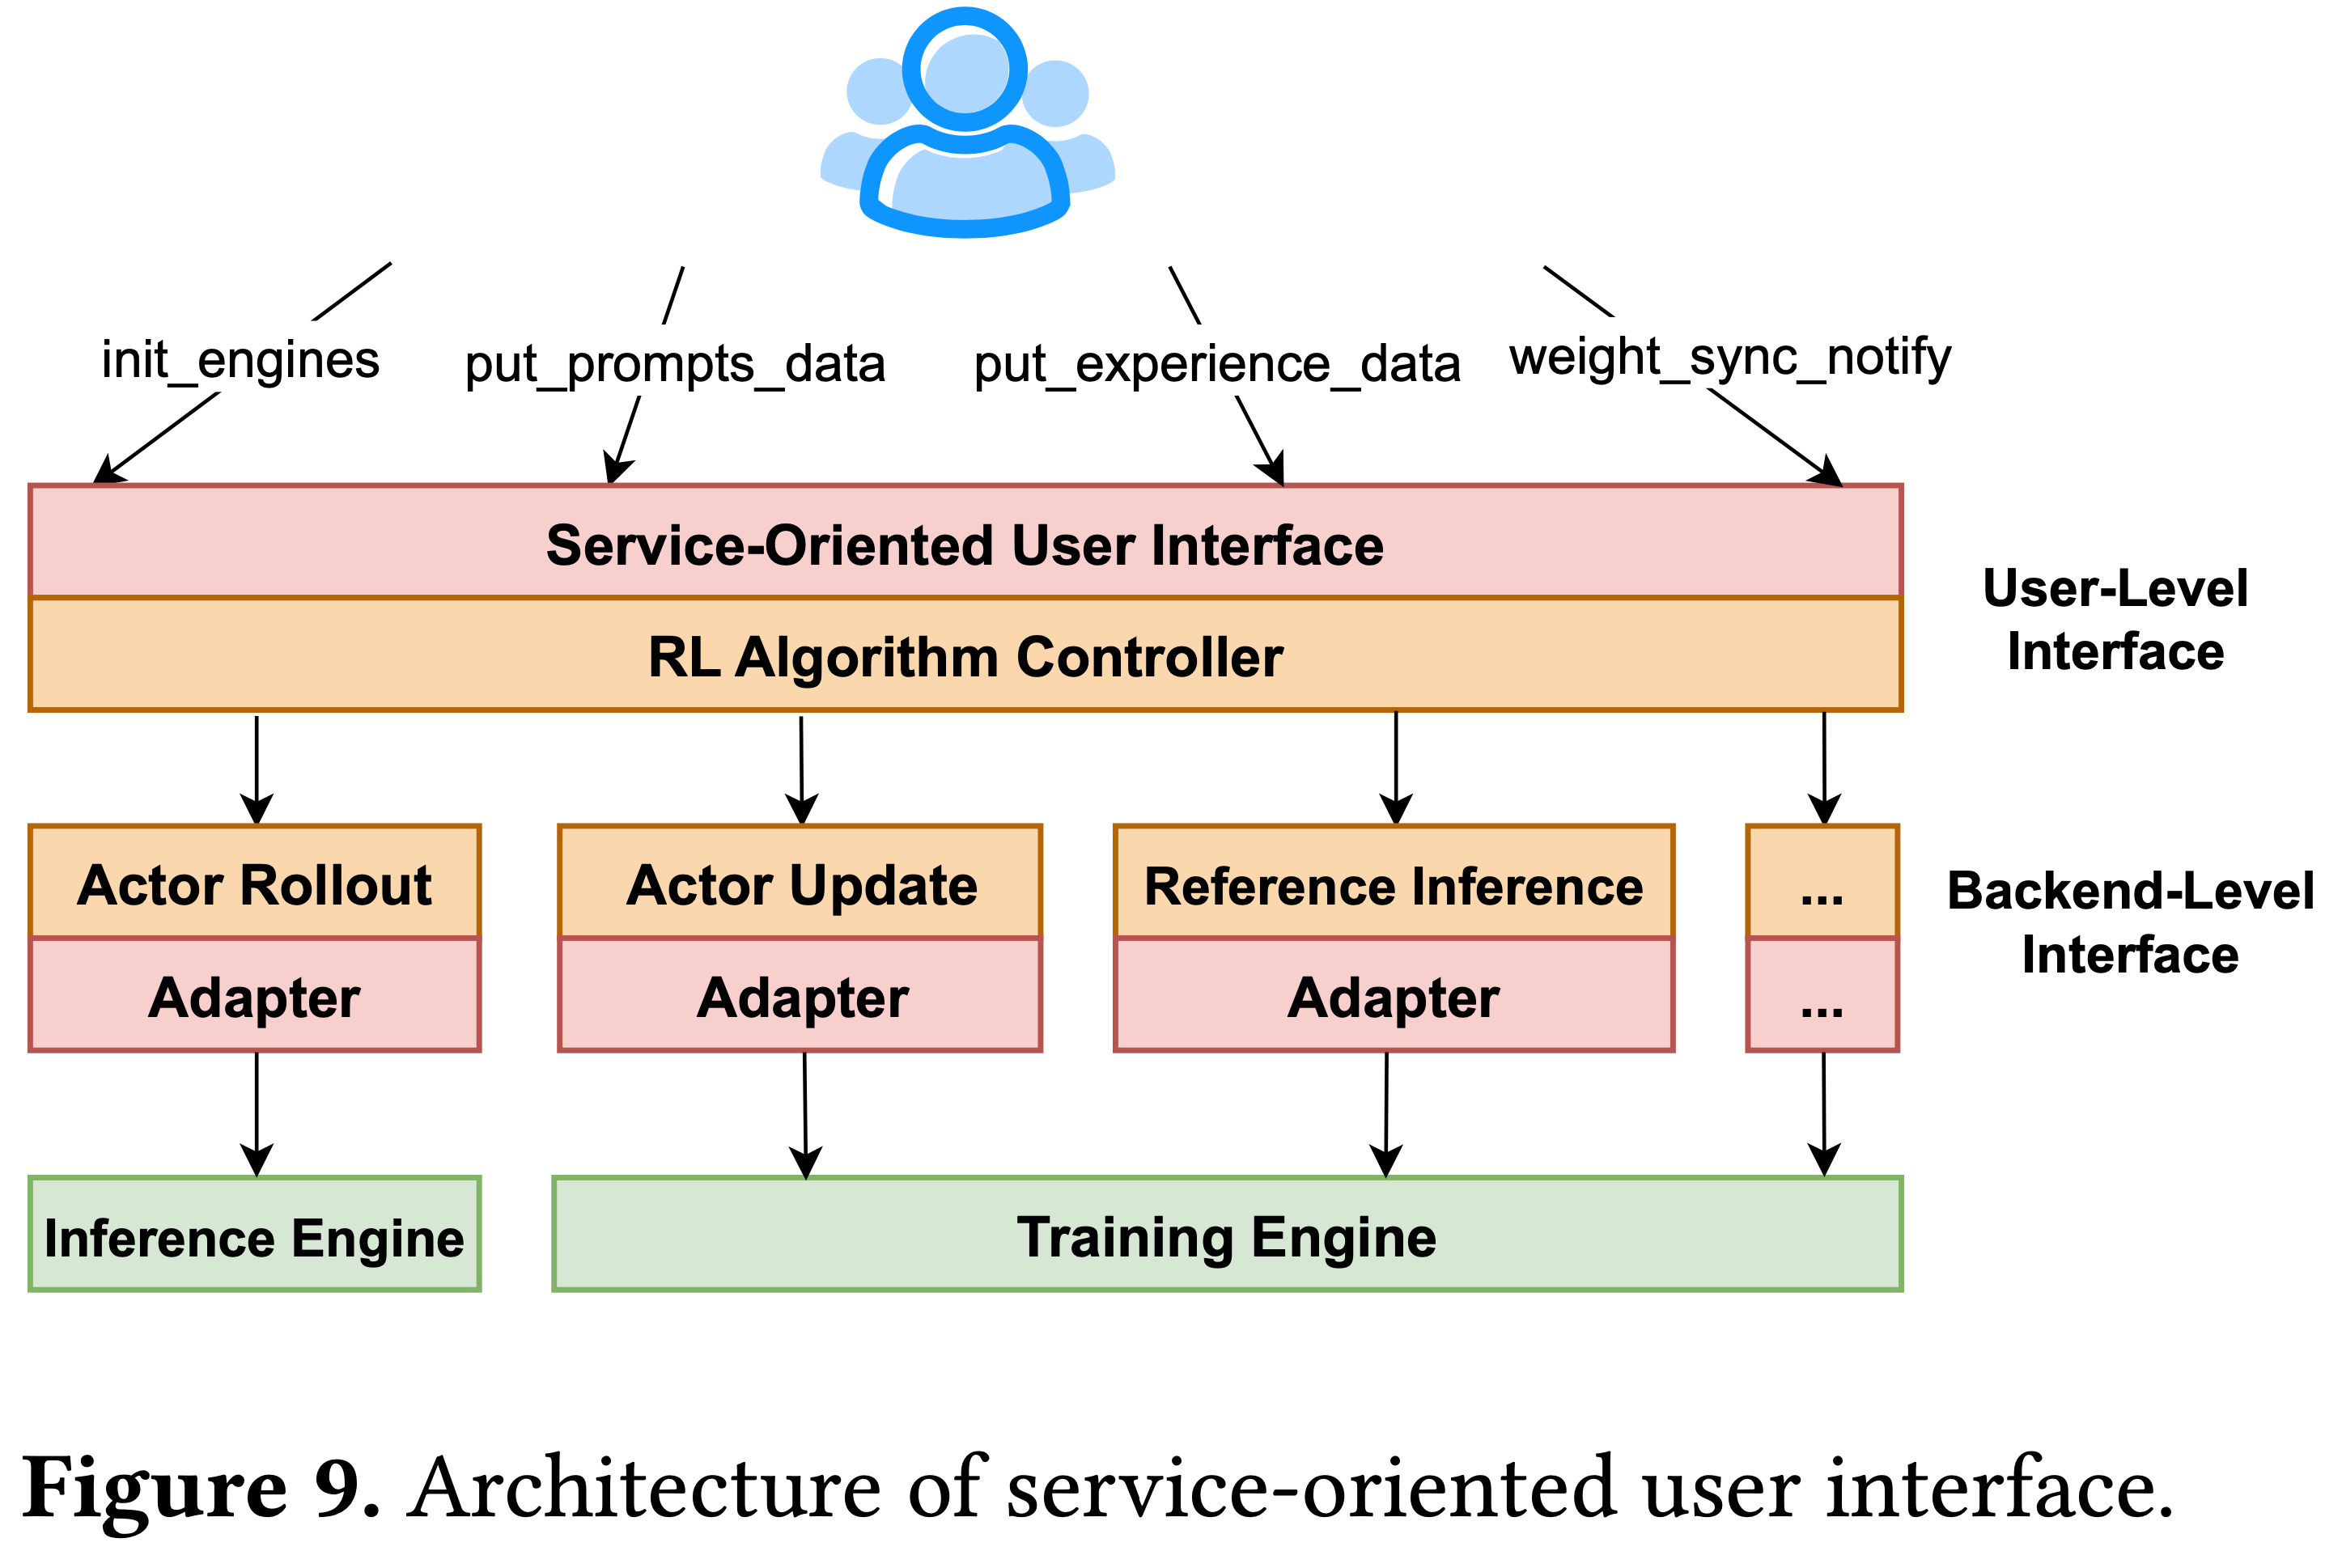
- 在 AsyncFlow 中,本文实现了一个分层的面向服务的界面,如图 9 所示
- User-level interface 为最终用户封装了 RL 算法逻辑,公开了一组关键 API 来控制后训练工作流
- Backend-level interface 提供了 RL 任务的模块化抽象,通过多个后端适配器将算法逻辑与执行引擎解耦
- 上述设计实现了关注点的清晰分离:
- 算法研究人员可以与高层 API 交互进行算法设计,而基础设施工程师可以专注于底层实现以实现更高的效率
- 这些界面的协同作用很好地平衡了学术灵活性与工业可扩展性,确保 AsyncFlow 既能服务于快速的算法迭代,也能满足生产级部署需求
User-Level Interface
- AsyncFlow 在 Trainer 类中提供了一个 RL 算法控制器,作为主要训练工作流的集中入口点
- 这种抽象无缝地组织了关键的 RL 任务,例如 generate_sequences 和 update
- 研究人员可以通过 Trainer 类轻松修改核心 RL 算法
- 为促进工业场景中的工作流自动化,本文实现了几个关键的 API,用于以最少的配置启动完整的后训练任务,例如:
- init_engines:初始化训练和推理引擎
- put prompts data:将 Prompt 数据集加载到后训练系统
- put_experience_data 和 get_experience_data:协调训练和推理引擎之间生成的 Experience 数据
- weight sync_notify:通知训练和推理引擎更新模型权重
- 上述用户级界面提供了对后训练工作流的直观控制,从而简化了系统使用
Backend-Level Interface
- 考虑到不同的训练和推理后端引擎,通过 Adapter 类设计了 RL 任务的底层抽象,如代码 2 所示
- 这一层确保了不同训练/推理后端(例如 FSDP, DeepSpeed, vLLM)的无缝集成,同时保持与定制设计框架的兼容性
- 允许工程师优化硬件利用率或切换系统,而不会影响工作流的完整性
- 代码 2:Backend-level 界面
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# Base adapter
class RLAdapter:
pass
class MindSpeedAdapter(RLAdapter):
def __init__(self, forward_backward_func, model, batches, forward_step):
self.forward_backward_func = forward_backward_func
self.forward_step = forward_step
self.model = model
self.batches = batches
...
# Abstraction for RL task: compute_log_prob
def compute_log_prob(self):
...
losses_reduced = self.forward_backward_func(
forward_step_func=self.forward_step,
data_iterator=iter(self.batches),
model=self.model,
micro_batch_size=self.micro_batch_size,
forward_only=True,
collect_non_loss_data=True,
)
...
class VLLMAdapter(RLAdapter):
pass
Evaluation
Experiment Setup
- Models:选择 Qwen2.5 系列模型(2024),参数规模从 7B 到 32B
- RL algorithms
- 实现了 GRPO(2024)作为代表性的 RL 算法进行评估
- 对 PPO(2017)的支持目前正在开发中
- Datasets
- 采用 DeepScaleR 数据集(2025)进行 RL 后训练
- 包含超过 4 万个数学问题-答案-解法对,这些数据精心编纂自 AIME、AMC 等
- 利用该数据集,DeepScaleR-1.5B-Preview 在多个基准测试中超越了 OpenAI o1-Preview(2024)的性能,证明了该数据集的有效性
- 注:在最近开发的 RL 后训练框架(2025)中,DeepScaleR 是一个常见的数据集选择
- 采用 DeepScaleR 数据集(2025)进行 RL 后训练
- Hardware configuration and parallelism strategies
- 本文使用大规模的 Ascend NPU 集群来评估所提出的 RL 框架
- 每个节点有 16 个 NPU,系统内存为 2880 GB
- Software versions
- 使用 Ascend Extension for PyTorch 7.0.0(PyTorch-2.5.1)和 Ascend Compute Architecture for Neural Networks (CANN) 8.1.RC1 作为支持 NPU 的基础软件平台
- 在 AsyncFlow 中,使用 vLLM-Ascend 0.7.3 作为推理后端,以及 MindSpeed 作为训练后端
- Baselines
- 与 verl(2024)进行比较,verl 是最先进的任务共置式 RL 框架,利用高效的 3D-HybridEngine 来减少重分片开销
- 除了高训练效率外,其单控制器和多控制器相结合的模式也极大地简化了软件开发
- 在实验过程中,选择 Pytorch FSDP 作为训练后端,vLLM-ascend 0.7.3(2023)作为推理后端
- 为了在 Ascend NPU 平台上运行,本文对 verl(日期为 2025 年 4 月 7 日,提交 d13434f)进行了必要的适配
Overall Performance Analysis
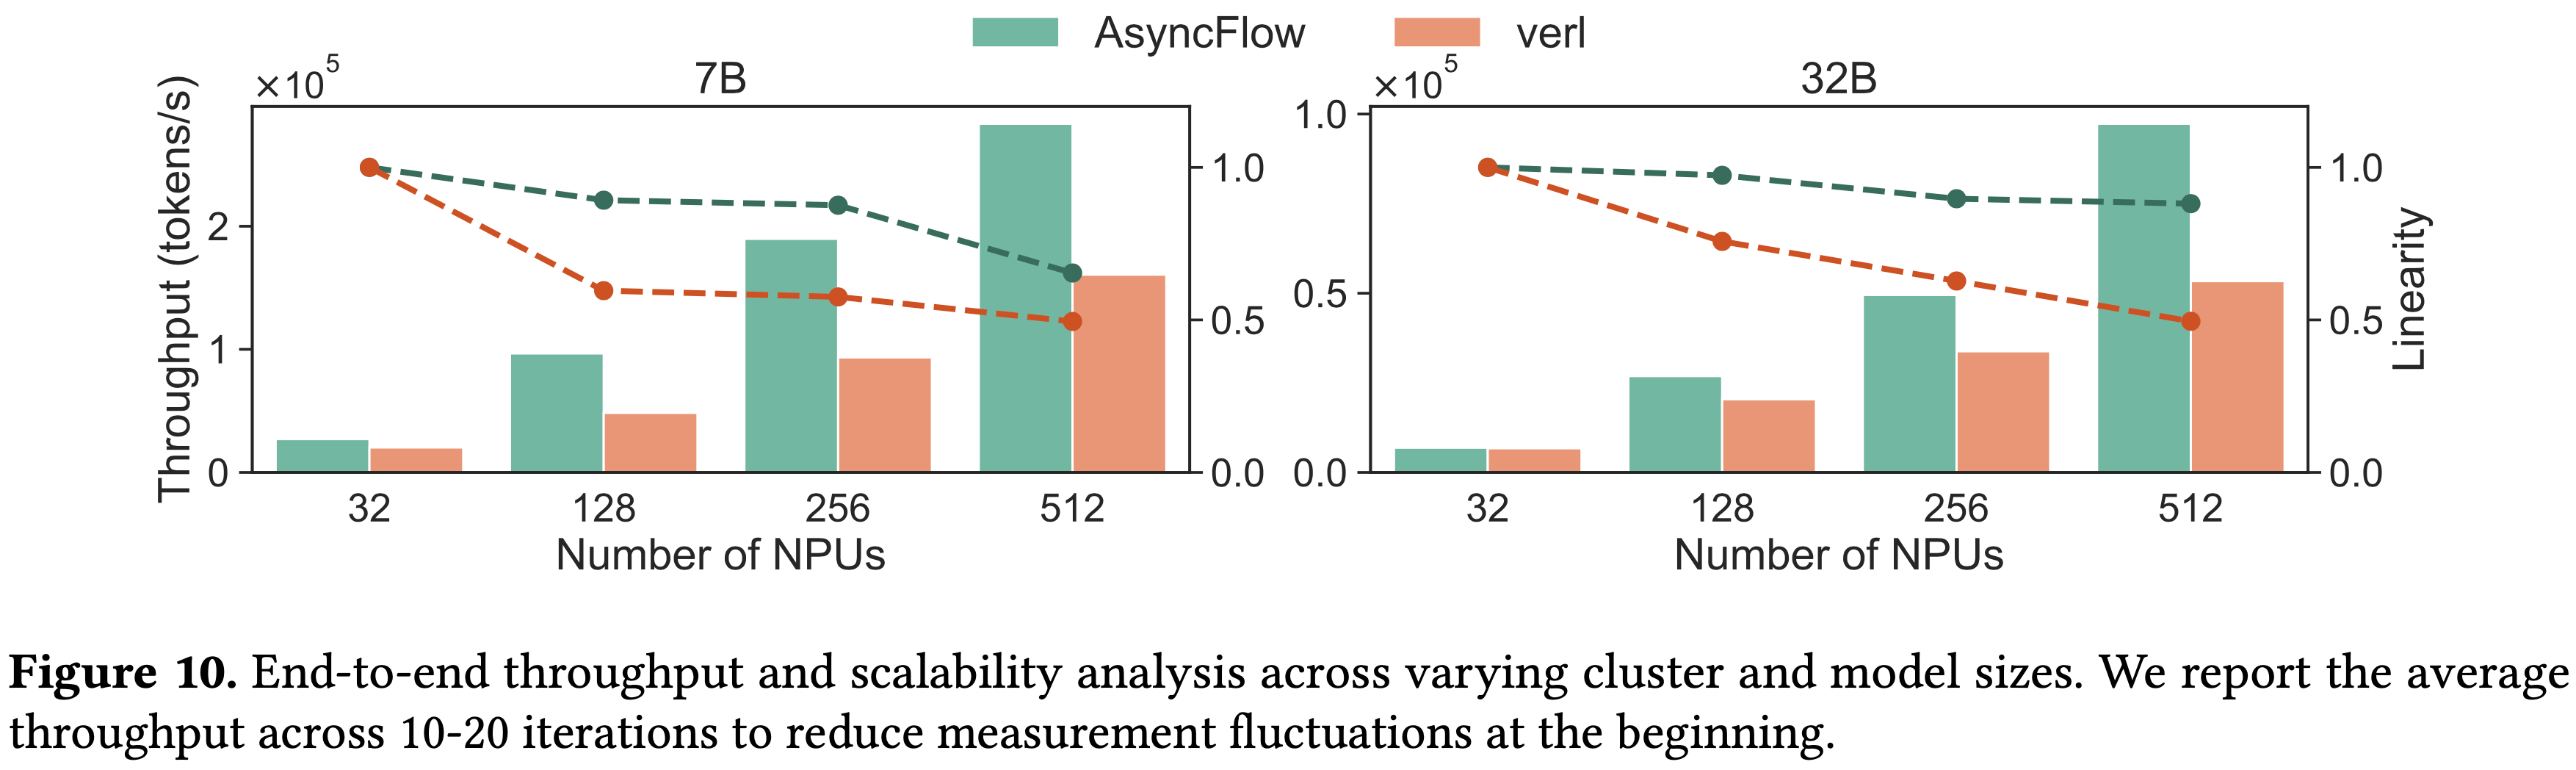
- 在从 32 到 1024 个 NPU 的集群上进行了大量实验,评估了 AsyncFlow 在 Qwen2.5-7B 和 Qwen2.5-32B 模型上的性能
- 如图 10 所示,AsyncFlow 在所有配置下均持续优于 verl 基线,实现了平均 \(1.59\times\) 的吞吐量增益
- AsyncFlow 在大规模集群中表现出显著的性能提升
- 在 256 个 NPU 上,7B 模型的峰值性能达到了 \(2.03\times\)
- 对于 512 个 NPU,AsyncFlow 的吞吐量仍然达到了 verl 的 \(1.76\times\) 和 \(1.82\times\)
- 在 32 个 NPU 上,AsyncFlow 对于 7B 模型仍保持了比 verl 高 \(33.4%\) 的吞吐量,展示了其对资源受限环境的强大适应性
- 这一现象与先前的研究一致,其中任务分离式框架在大规模场景中 显示出卓越 的潜力(2024;2025)
- AsyncFlow 保持了较高的扩展效率,当集群规模扩大 \(16\times\) 时,线性度分别维持在 0.65 和 0.88
- 这一突破为在工业规模上高效训练 LLM 推理 Agent 铺平了道路
- 这一突破为在工业规模上高效训练 LLM 推理 Agent 铺平了道路
- AsyncFlow 在大规模集群中表现出显著的性能提升
Ablation Studies
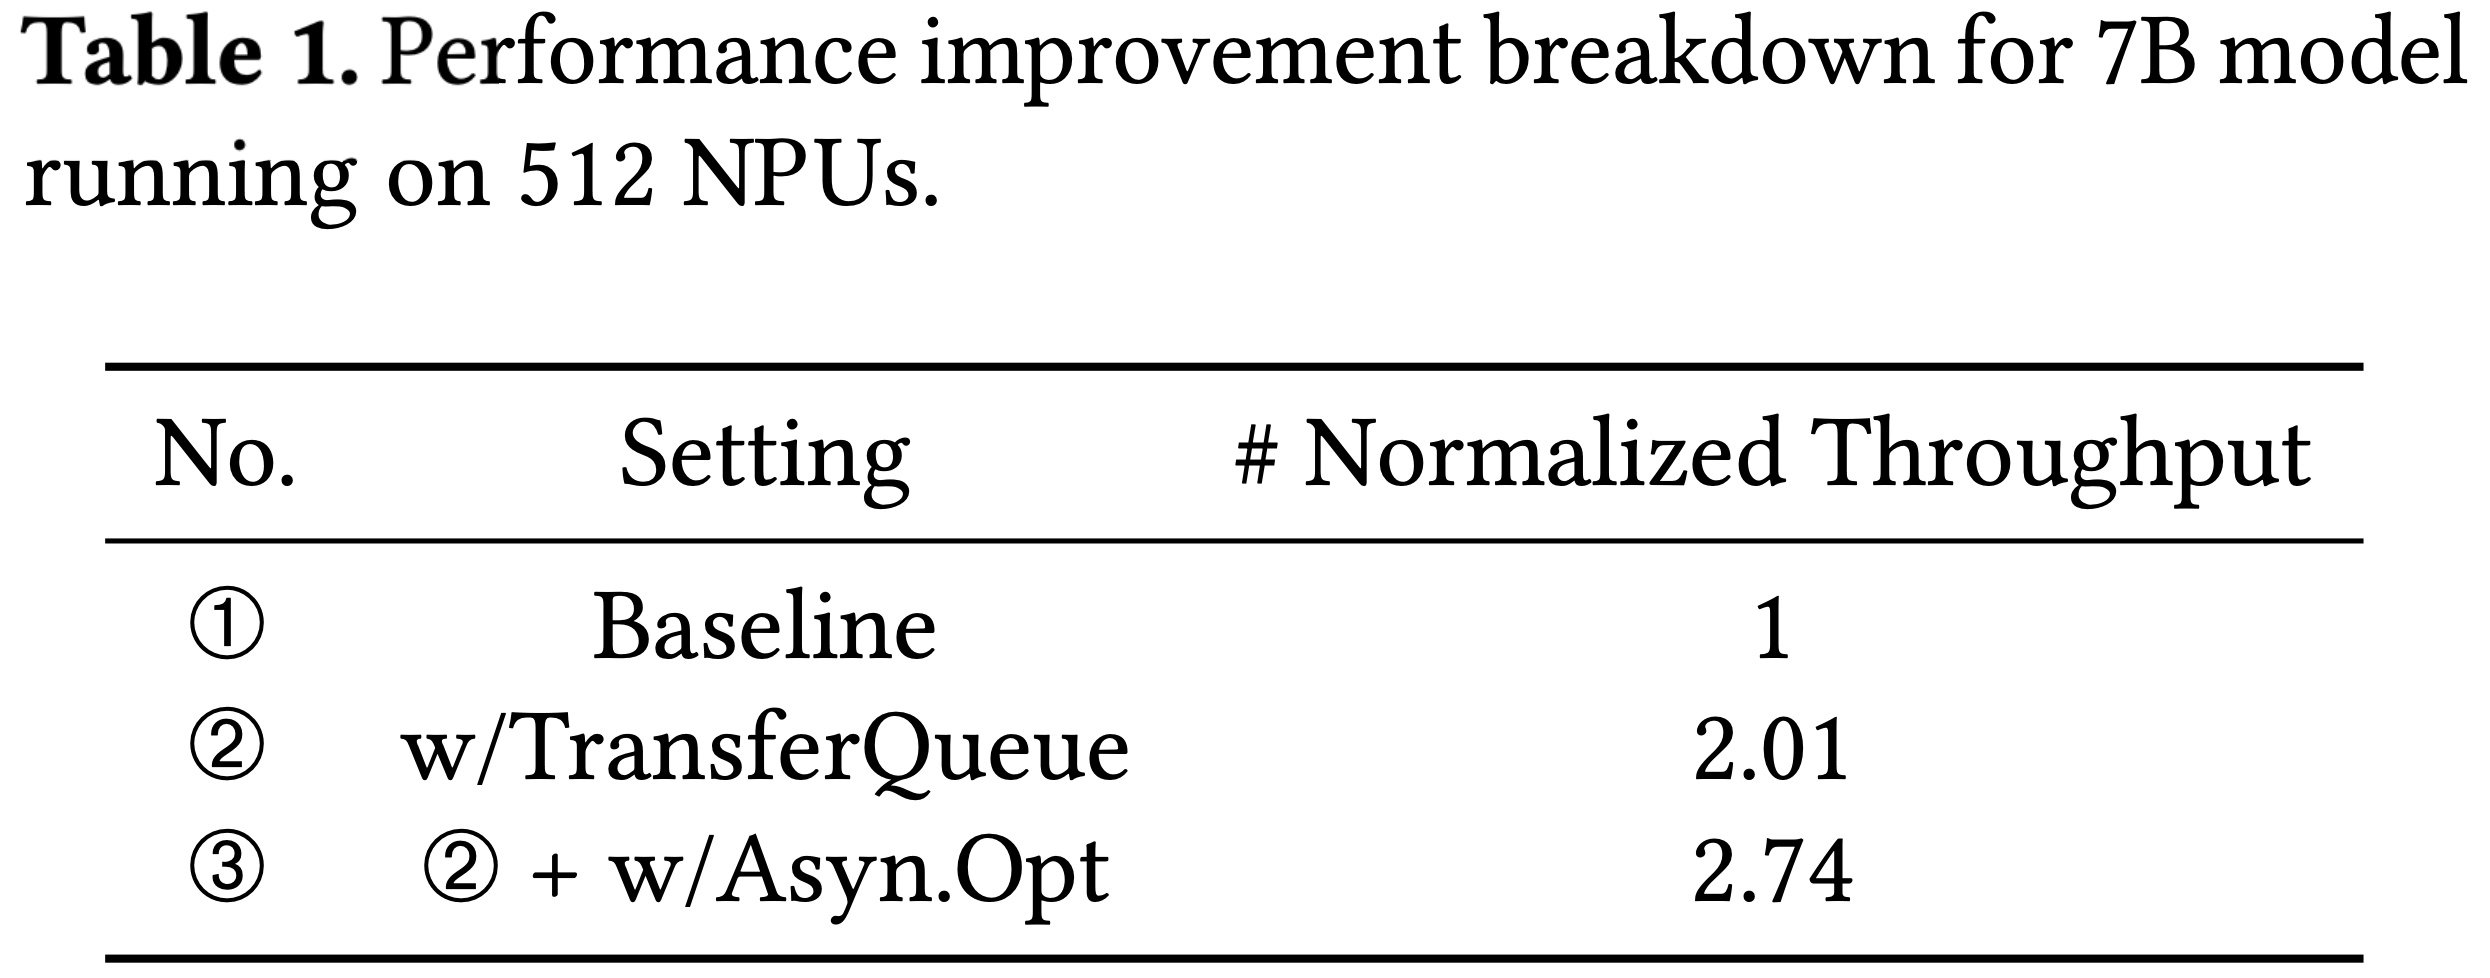
- 消融研究总结在表 1 中
- Baseline
- 通过禁用所有提出的优化来建立一个代表传统任务分离式 RL 框架的基线场景
- 在此场景中,每个 RL 任务被分配到独立的硬件资源上,并且任一时刻只执行一个任务
- 该顺序工作流如图 7 顶部所示
- TransferQueue
- 作为 AsyncFlow 的核心特性,TransferQueue 实现了 RL 任务间的细粒度重叠
- 与基线相比,集成 TransferQueue 带来了 2.01 倍的吞吐量
- Asynchronous workflow optimization
- 为了最小化迭代间的空闲周期,本文实现了一个优化的异步工作流
- 它包括延迟参数更新机制、重叠技术和任务资源分配策略
- 与启用 TransferQueue 的基线相比,该优化进一步将吞吐量提高了 \(36.3%\)
- 为了最小化迭代间的空闲周期,本文实现了一个优化的异步工作流
Optimized Workflow of AsyncFlow
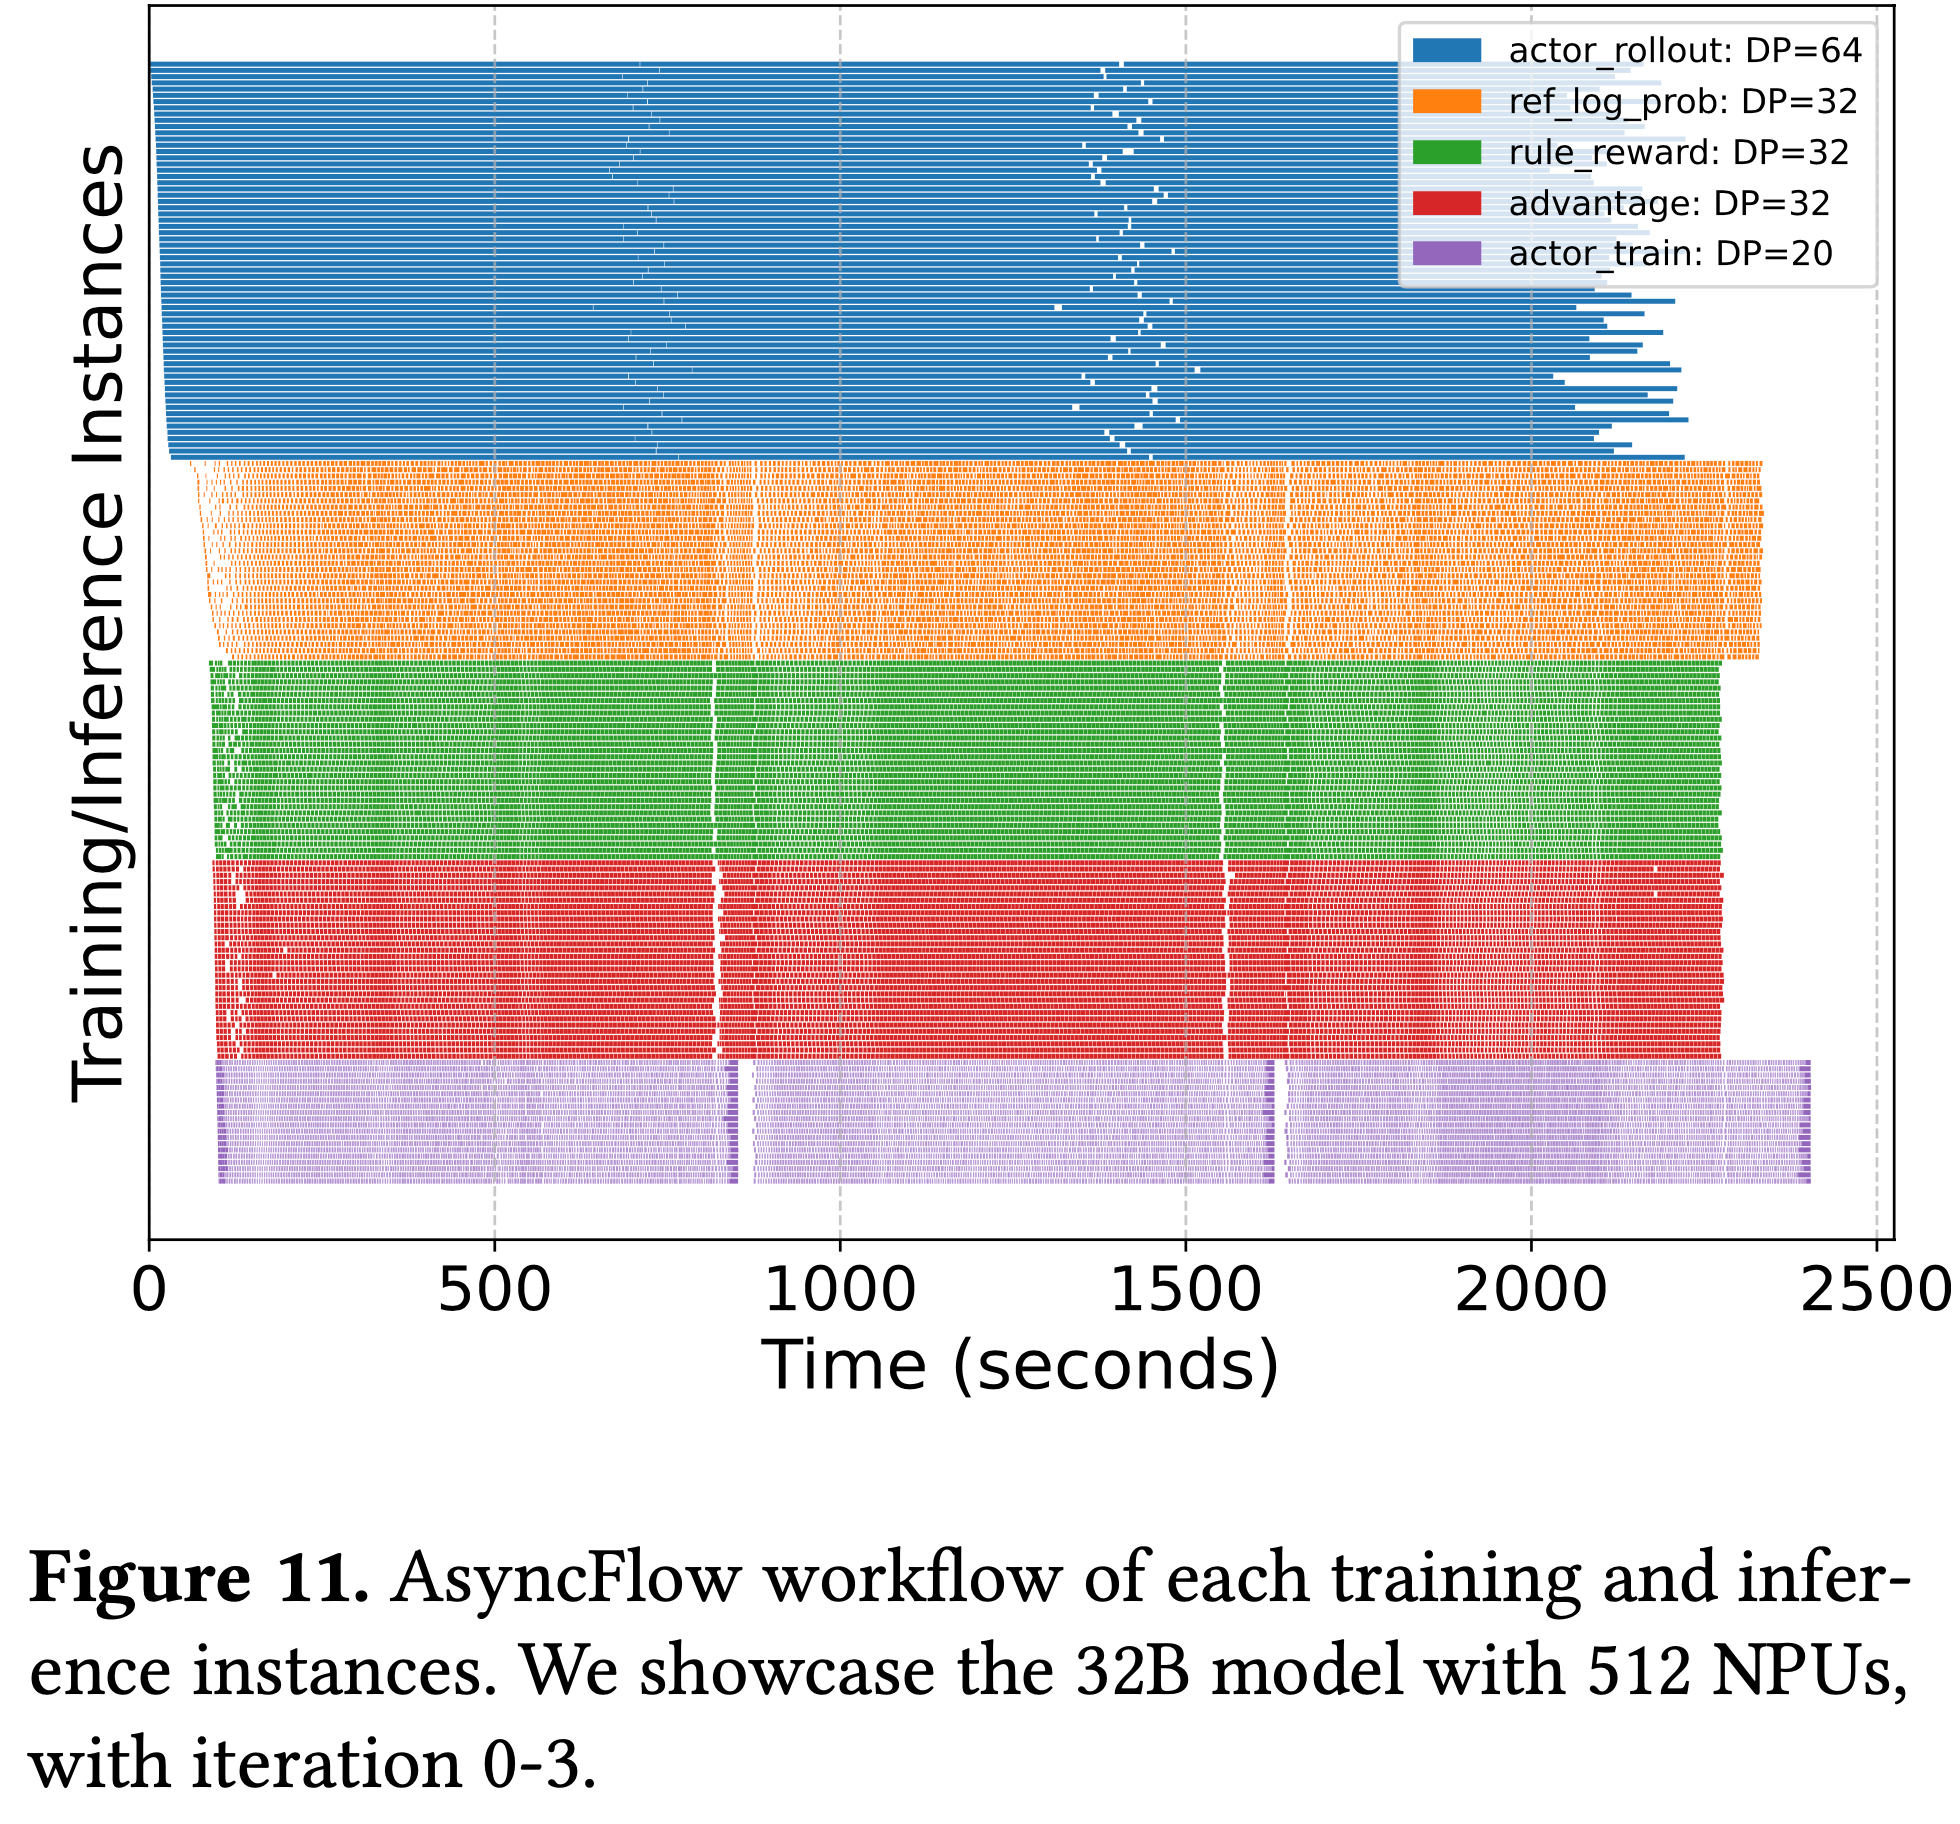
- 为严格评估所提出的异步 Off-Policy 工作流的有效性,本文在甘特图(图 11)中展示了分布式训练和推理实例的经验执行时间线
- 它揭示了在优化数据流调度下,RL 任务实现了实质性的并行性,任务间空闲时间极短
- 这一观察实证验证了任务分离式 RL 框架可以在资源利用率和可扩展性之间取得良好平衡,从而为大规模环境实现高效的后训练
Stability of Asynchronous RL Algorithm
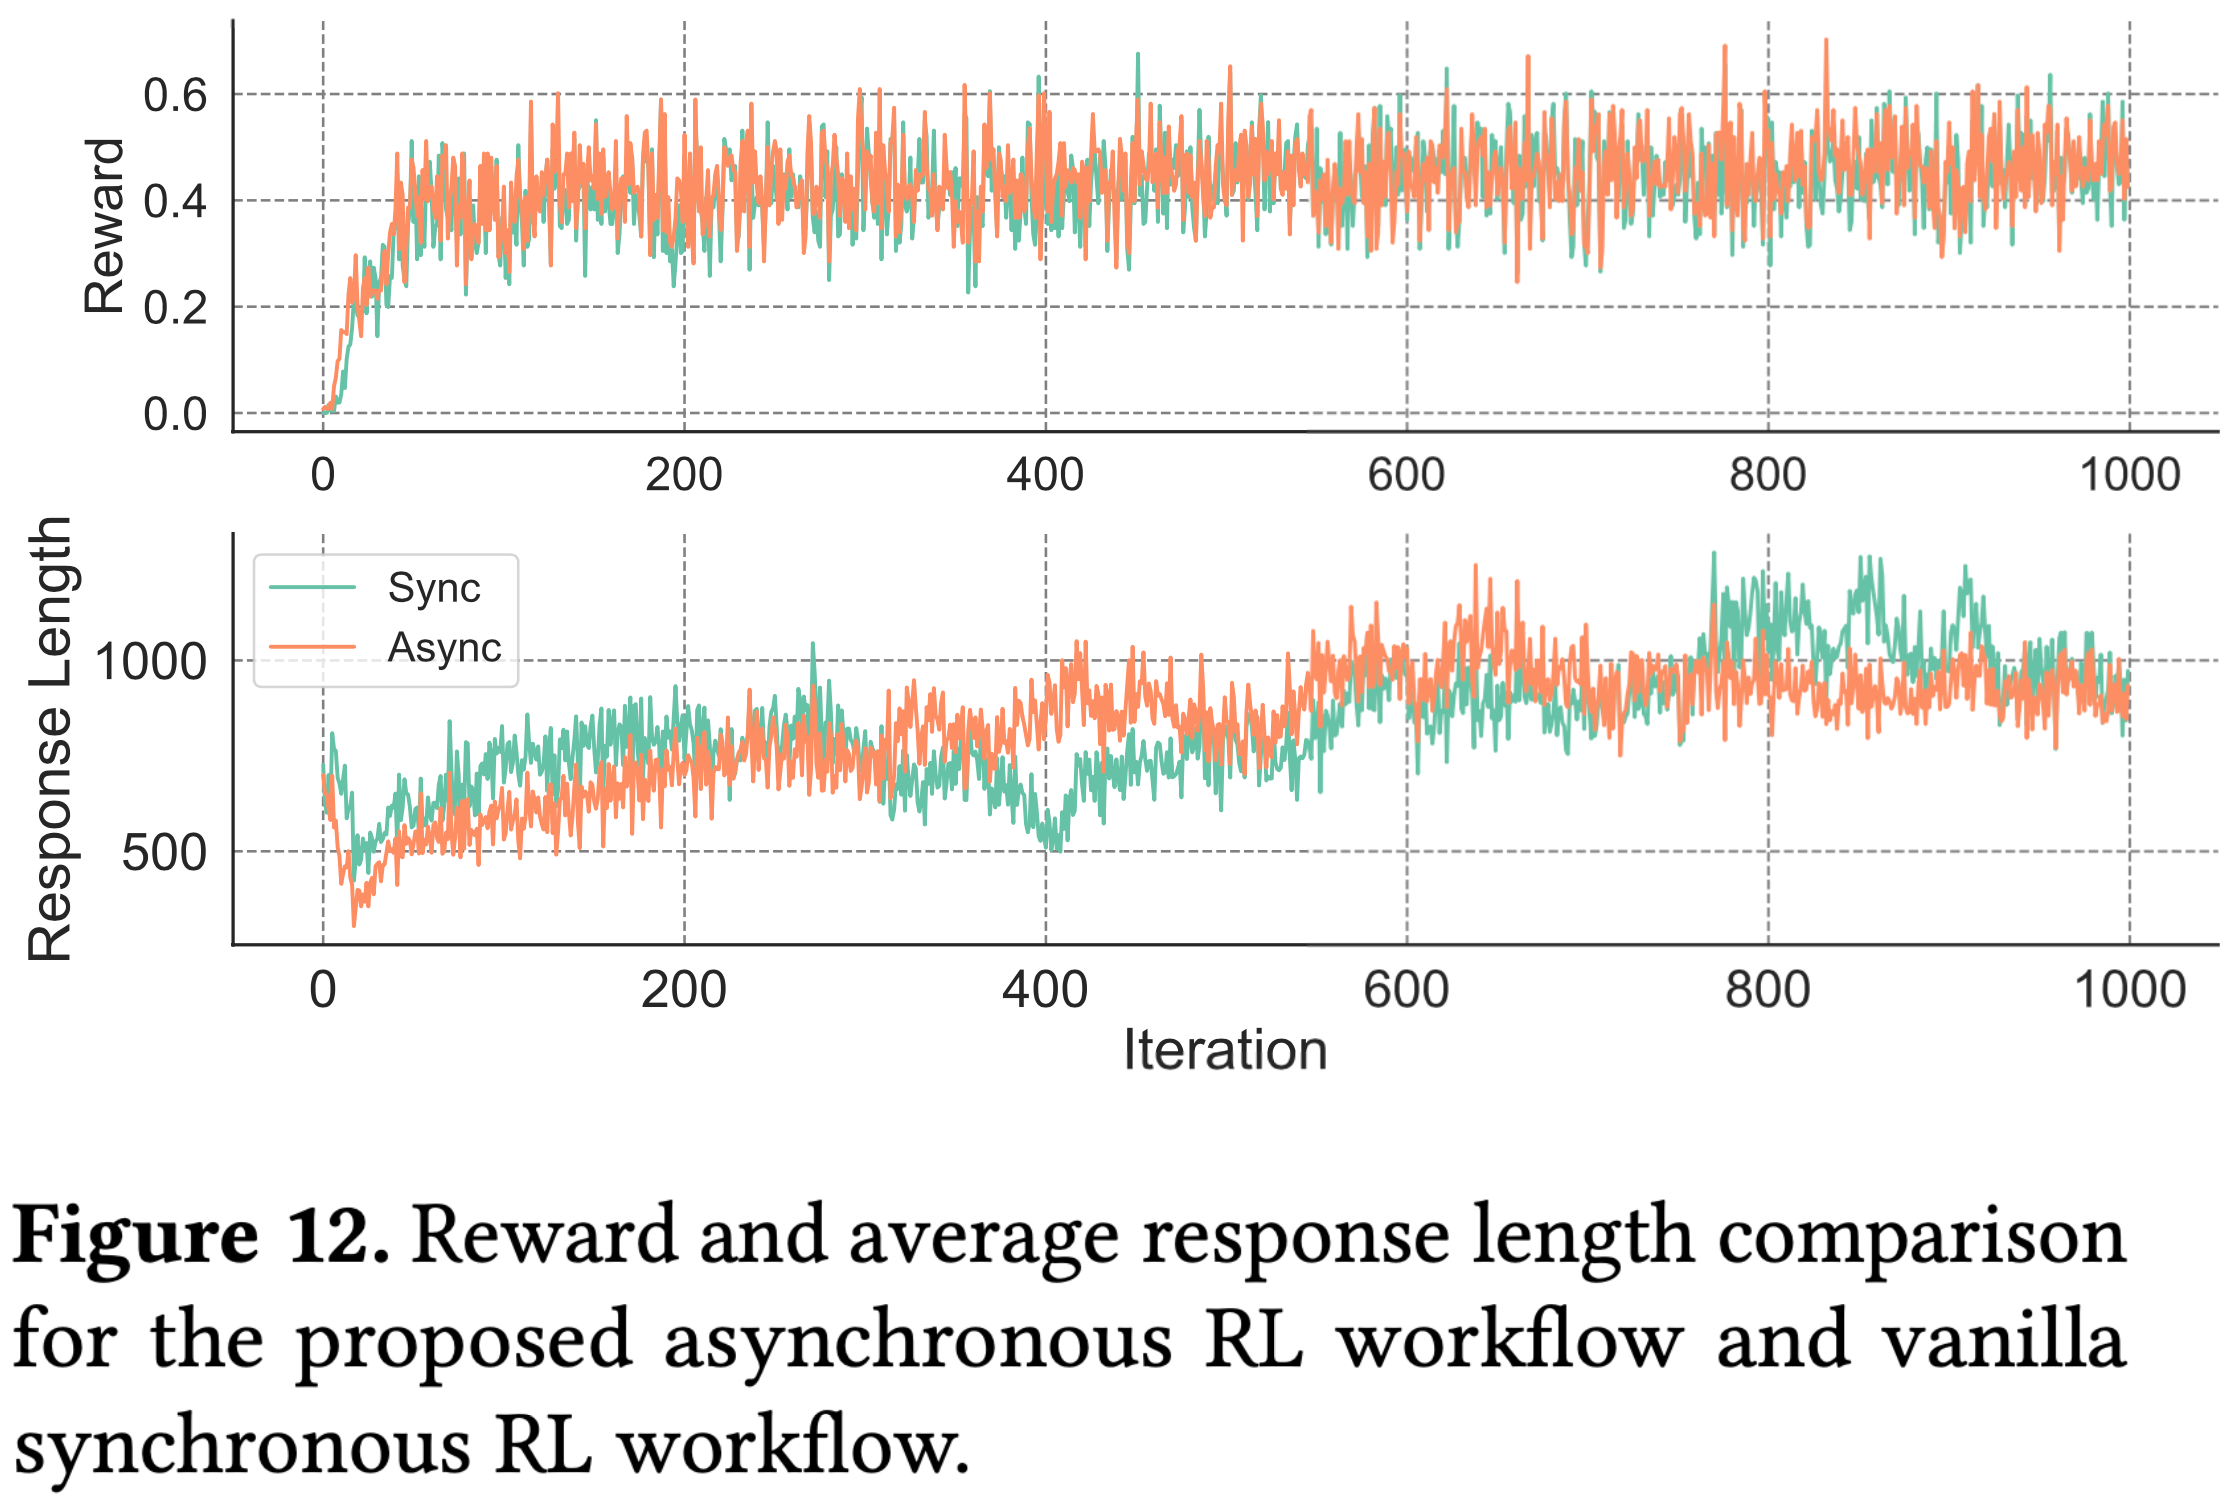
- 为评估所提出的异步 RL 工作流是否影响模型性能,本文在相同的时钟时间约束下测量了平均奖励和 Response 长度,如图 12 所示
- 实验在部署于 16 个 NPU 上的 7B 模型上进行,异步工作流被交替启用和禁用
- 结果表明奖励分数的差异可以忽略不计,并且 Response 长度的方差呈现出收敛趋势
Related Work
LLM Post-Training Frameworks
- RL 训练框架众多,本文根据强化学习任务如何映射到物理设备,将后训练框架分为两种范式:
- 任务共置式(task-collocated)
- 任务分离式(task-separated)
- 任务共置式框架在同一组设备上执行 Actor Rollout 和 Actor Update
- 例子包括 TRL (2020), DeepSpeed-Chat (2023), NeMo-Aligner (2024), RLHFuse (2025), 和 verl (2024)
- 这些框架在小型后训练中实现了高资源利用率,因为在任何给定时间,所有设备都在执行相同的计算任务
- 任务分离式框架将 Actor Rollout 和 Actor Update 解耦到不同的硬件资源上
- 近期的高质量框架如 OpenRLHF (2024), k1.5 (2025), Seed1.5-Thinking (2025), StreamRL (2025), 和 AReaL (2025) 在大规模后训练场景中展现出强大的竞争力
- 这种范式与 LLM 推理(内存密集型)和训练(计算密集型)的不同计算需求相一致
- 理解:这里更像是同步和异步框架的差异,因为一些框架完全可以选择是否 Collocated 的
RLHF Algorithms
- PPO 是 RLHF 基础算法,包含多个模型
- GRPO 通过策略和参考输出之间的组相对比较来近似优势,从而移除了 Critic 模型
- DAPO 通过利用历史策略检查点作为自适应基线 的动态参考策略进一步消除了 Reference 模型
- 理解:这里的表达有错,其实 DAPO 的观点是:由于在 long-CoT 推理训练中,模型分布会与初始模型产生显著偏离,因此 KL 散度惩罚项是不必要的,所以直接将其从目标函数中移除
- DAPO 在 LongCoT 推理训练中,直接移除了 KL 散度
- 理解:这里的表达有错,其实 DAPO 的观点是:由于在 long-CoT 推理训练中,模型分布会与初始模型产生显著偏离,因此 KL 散度惩罚项是不必要的,所以直接将其从目标函数中移除
- 这些简化旨在减少计算开销,但本质上会权衡某些功能,例如 PPO 中显式值函数估计所提供的稳定性保证
LLM Post-Training System Optimization
- 考虑到 RL 后训练工作流端到端时间的构成,Actor Rollout 阶段因其自回归推理的特性而引起了广泛的研究关注,这使其从根本上区别于训练任务
- RLHFuse(2025)引入了阶段间融合策略,通过自动迁移机制实现 Actor Rollout 与下游任务的并发执行
- StreamRL(2025)通过结合 Response 长度预测器进一步增强了调度灵活性
- 通过将 Prompt 分类为几个 Response 长度级别,它动态地将它们分派到不同的实例,平衡了吞吐量最大化和长尾 Response 引起的偏斜
- 在 k1.5(2025)中引入了 Partial Rollout 技术,该技术截断长 Response,以便在不等待完整生成完成的情况下使下游任务 Pipeline 化
- 与推理服务相比,后训练系统中的 Rollout 阶段缺乏严格的服务水平目标(SLO),这使得可以采用更广泛的调度策略来最大化系统吞吐量