注:本文包含 AI 辅助创作
Paper Summary
- 整体总结:
- 现有两种 RL 架构:
- 共置架构(colocated architecture):即两个阶段通过时间复用共享资源
- 分离式架构(disaggregated architecture):即为每个阶段分配专用资源
- 传统 观点:认为共置架构优于分离式架构
- 本文 观点:认为分离式架构相对于共置架构具有的显著优势:灵活的资源分配、对异构硬件的支持以及跨数据中心的可扩展性
- 本文实践认知:
- 共置架构存在资源耦合(resource coupling)问题,即两个阶段被迫使用相同的资源
- 这种耦合损害了共置 RL 在大规模训练中的可扩展性和成本效率
- 分离式架构允许灵活的资源分配,支持异构训练配置,并便于跨数据中心部署
- 共置架构存在资源耦合(resource coupling)问题,即两个阶段被迫使用相同的资源
- 本文实践认知:
- StreamRL(从根本上采用分离式架构设计)解决了现有解耦 RL 框架中存在的 Pipeline Bubble 和由偏斜引起的低效问题
- 解决由阶段依赖导致的流水线气泡(pipeline bubbles)
- StreamRL 通过流式生成(stream generation)打破同步 RL 算法中传统的阶段边界,并在异步 RL 中实现完全重叠
- 解决由长尾输出长度分布导致的偏斜气泡(skewness bubbles)
- StreamRL 采用输出长度排序器模型(output-length ranker model)来识别长尾样本,并通过偏斜感知的调度与分发(skewness-aware dispatching and scheduling)来减少生成时间
- 解决由阶段依赖导致的流水线气泡(pipeline bubbles)
- 实验:与当前最先进的 RL 框架相比,StreamRL 实现了高达 \(2.66 \times\) 的加速,在异构跨数据中心环境中,成本效益最高提升 \(1.33\times\)
- 现有两种 RL 架构:
Introduction and Discussion
- LLM 的早期 RL 训练框架自然采用了分离式架构
- 如 OpenRLHF 和 NeMo
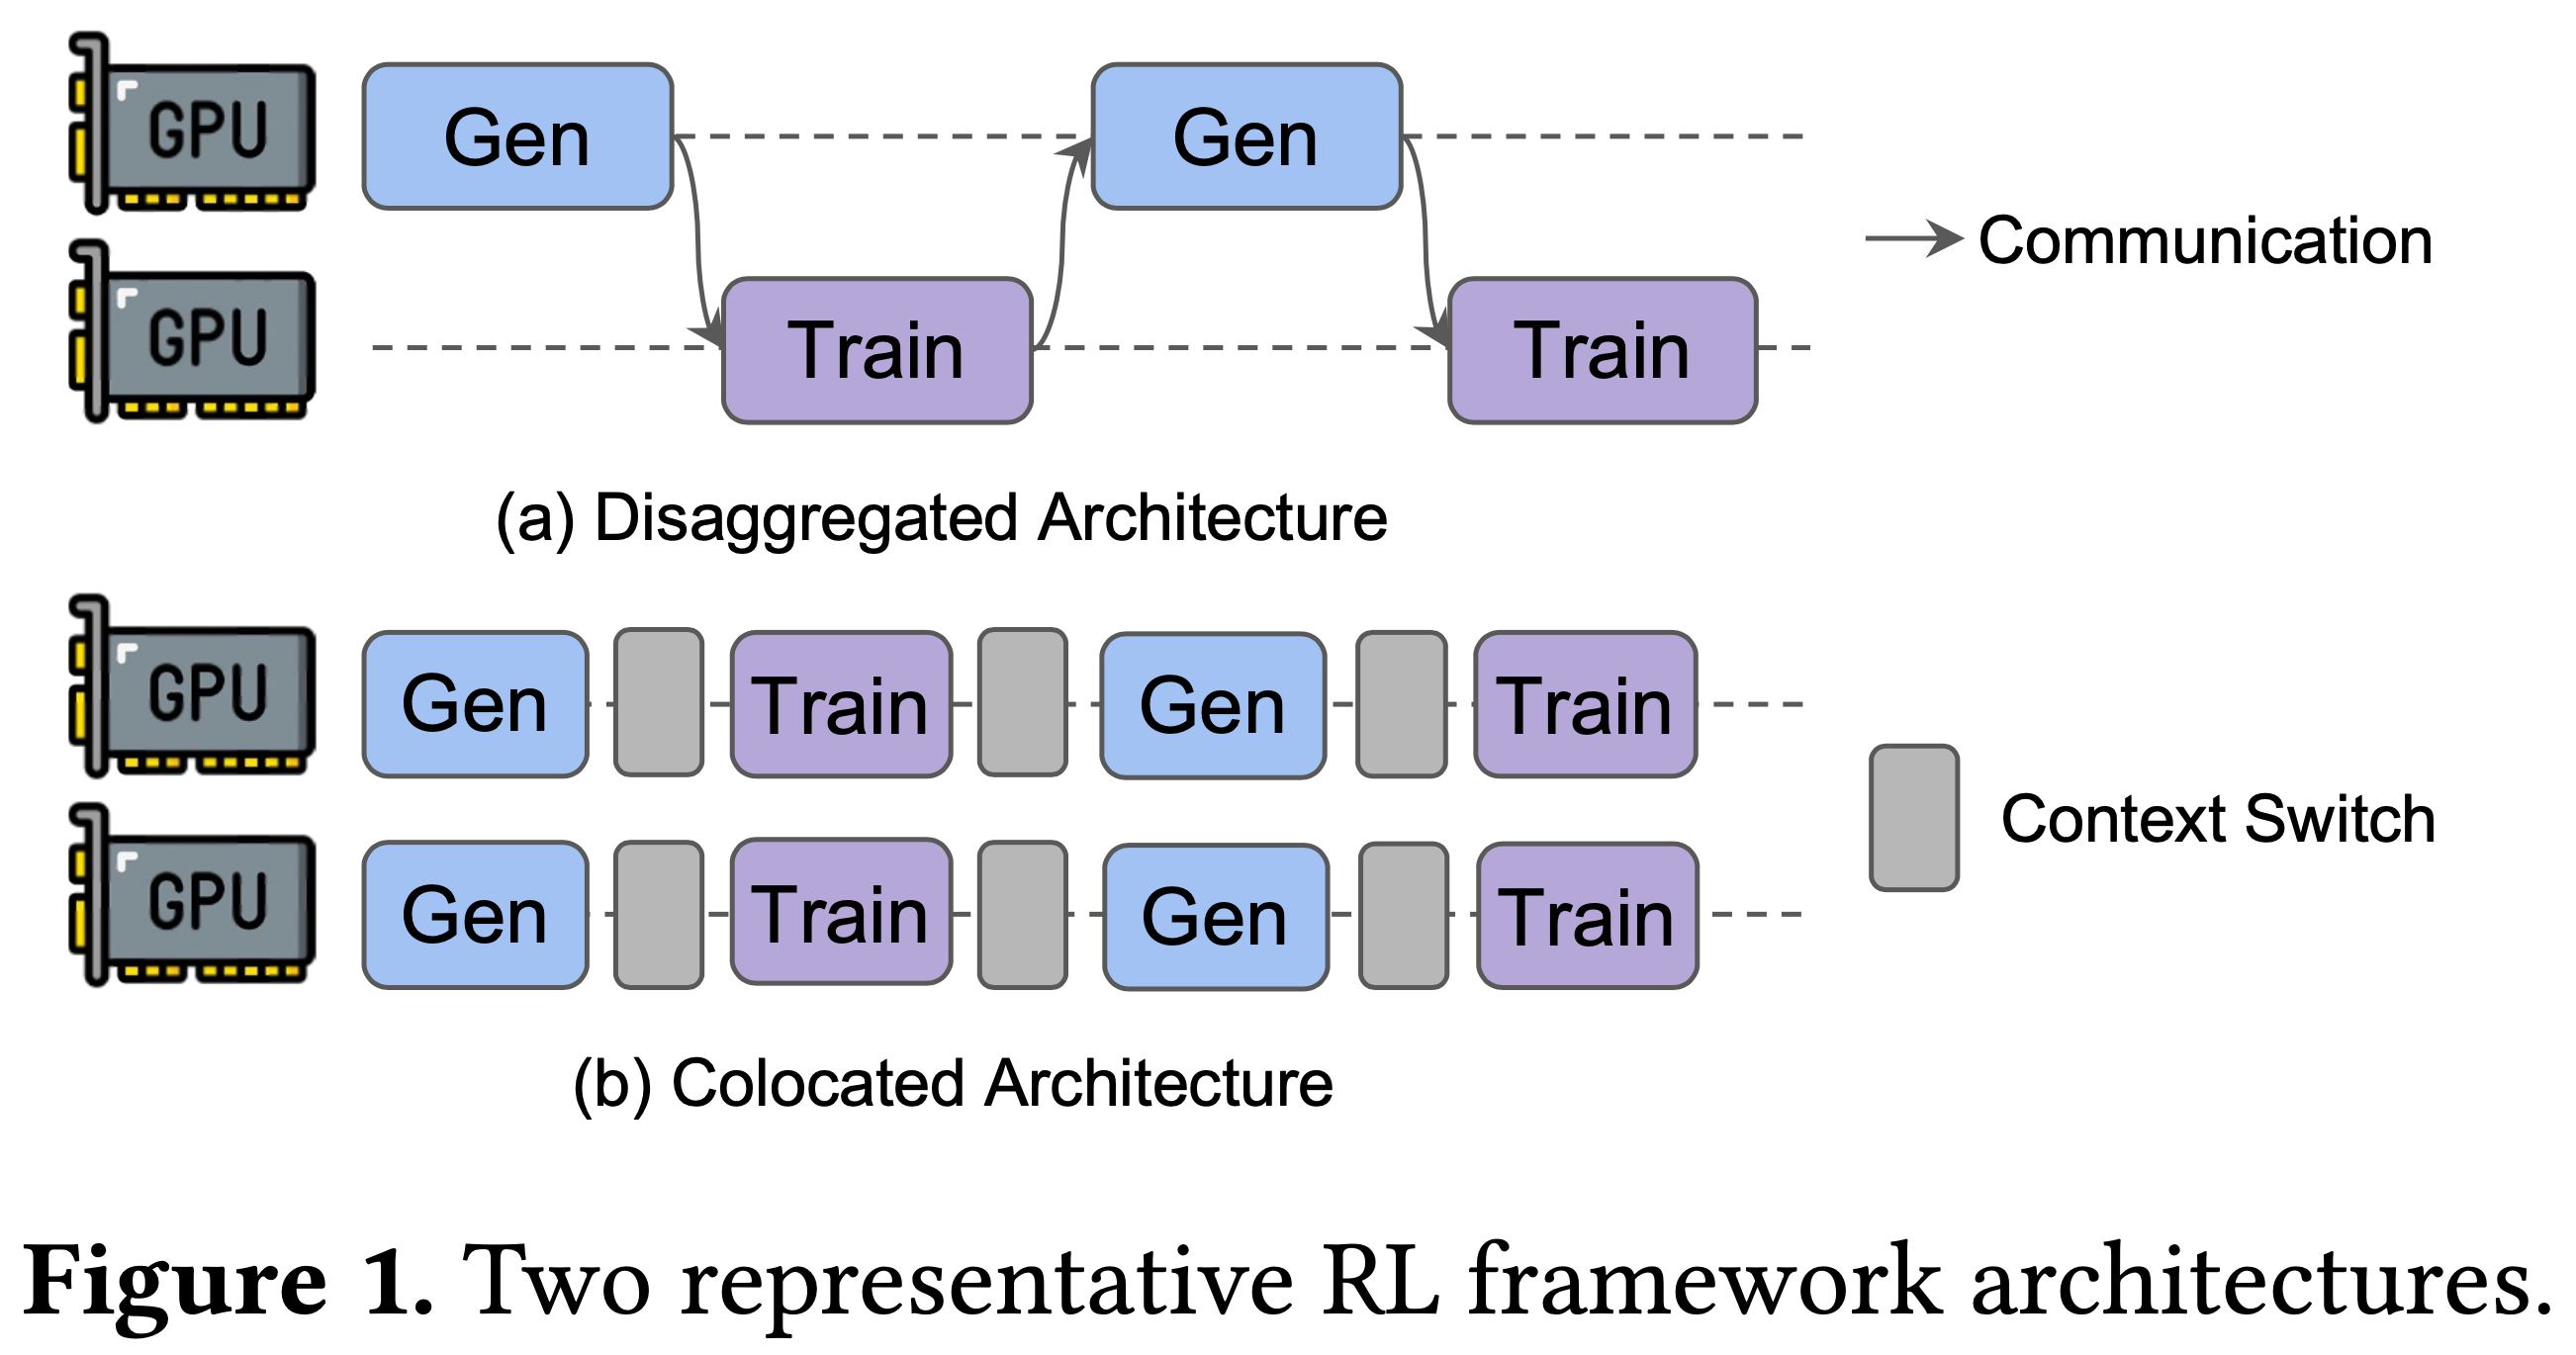
- 如 图 1(a) 所示,为每个阶段分别分配专用的计算资源
- 生成阶段采用现有的推理框架如 vLLM 来生成样本,然后将样本传输到训练阶段,训练阶段使用DeepSpeed 或 Megatron-LM 等训练框架
- 更新后的模型权重再传回推理框架,用于下一次迭代的生成。这种架构选择能够有效复用现有基础设施,并便于快速部署各种 RL 算法,因此获得了广泛的初步采用
- 分离式架构的一个显著缺点是串行依赖导致的资源空闲:训练阶段分配的 GPU 资源在生成阶段处于空闲状态,反之亦然
- 为了解决这一低效问题,近期的 RL 训练框架采用了共置架构,此时共置架构成为主流选择,并被广泛认为优于分离式架构
- 如 verl、Real 和 RLHFuse
- 如图 1(b) 所示,将生成阶段和训练阶段共置于相同的 GPU 资源上
- 当一个阶段处于活动状态时,另一阶段的状态(如模型权重和优化器状态)临时存储在 CPU 内存中
- 阶段边界处发生上下文切换,实现对 GPU 资源的时分复用
- 这种架构转变解决了资源空闲问题,提升了训练效率
- 本文作者最初也持有相同看法,并为内部 RL 框架选择了共置架构
- 但在实际部署中观察到随着训练规模的扩大,共置架构遇到了资源耦合问题
- 原因在于两个阶段具有根本不同的工作负载特征:
- 生成阶段明显受内存带宽限制(memory-bandwidth-bound)
- 训练阶段通常受计算限制(compute-bound)
- 但由于共置,两个阶段必须共享相同的资源数量和硬件类型,与其迥异的计算特征产生了内在冲突
- 当扩展资源时,生成阶段的性能加速比计算受限的训练阶段达到平台期的速度要快得多
- 共置架构限制了两个阶段的资源数量必须相同,从而降低了整体资源利用率
- 同时,它也无法为每个阶段分别选择最合适且最具成本效益的硬件类型
- 受政策、成本和电力供应等因素的制约,建设单一的大规模数据中心可能既困难又昂贵
- 企业通常运营多个中等规模的数据中心,配备不同代际和类型的GPU,形成跨数据中心的异构资源池
- 随着 RL 训练规模的扩大,共置架构难以有效利用整个资源池,因为训练阶段通常涉及 full-mesh 通信操作
- 这会在跨数据中心场景下产生显著的通信开销
- 此时分离式架构重新焕发光彩
- 首先,生成阶段和训练阶段的资源数量不必相同,允许更灵活高效的资源分配
- 其次,它允许为每个阶段选择最合适的硬件,例如在生成阶段采用更具成本效益的推理 GPU,而将更昂贵的高性能 GPU 专用于训练阶段
- 此外,RL 的两个阶段之间是点对点数据传输,即使跨数据中心,通信开销也可控
- 通过将两个阶段放置在不同的数据中心,RL 训练可以突破单一同构数据中心的限制,充分利用整个跨数据中心的异构资源池
- 但分离式架构在现有框架中面临两个挑战,使其无法充分释放潜力
- 第一个是如图 1(a) 所示的资源空闲问题
- 朴素的分离式方案由于两个阶段的串行执行而引入流水线气泡
- 第二个挑战与底层架构无关,源于 LLM 推理工作负载中固有的长尾输出长度分布
- 在生成的后期阶段,系统中仅剩少量长尾样本,导致 GPU 严重利用不足
- 这一问题在现代推理模型 RL 训练中广泛使用 Long CoT 生成的情况下进一步加剧
- 第一个是如图 1(a) 所示的资源空闲问题
- 为解决上述问题,本文提出了一个专为分离式架构设计的 RL 训练框架: StreamRL
- StreamRL 的核心思想是将生成和训练阶段分别抽象为流式生成服务(Stream Generation Service,SGS)和 Trainer
- Trainer 向 SGS 提交生成请求
- SGS 收到 Prompt 并开始生成后,以流式方式将每个完成的样本及时返回给 Trainer,使 Trainer 能够执行后续操作,从而减少资源空闲
- 借助流式机制,StreamRL 能够增强现有的朴素解决方案,如 minibatch pipelining,以实现 SGS 和 Trainer 更灵活高效的并发执行,并在异步 RL 下实现完全重叠执行
- 在这种流式架构下,需要在两个阶段之间进行精细的资源分配以平衡其执行时间,否则仍可能出现流水线气泡
- StreamRL 利用基于性能分析(profiler)的资源分配算法,在训练前决定资源分配
- 推理 LLM 的一些近期进展表明,在 RL 训练过程中,随着 LLM 输出长度的增加,模型能力会得到提升
- 鉴于两个阶段对工作负载变化的敏感度不同,StreamRL 还提供了动态资源调整机制,以弹性地维持两个阶段在整个训练过程中的执行平衡
- 为解决长尾问题,StreamRL 利用输出长度排序器模型来识别长尾样本,然后采用偏斜感知的调度机制,选择性地将资源分配给长尾样本并调整批大小,以减少整体生成延迟
- 在各种 LLM 和真实数据集上的实验表明,与现有最先进系统相比,StreamRL 的吞吐量最高提升 \(2.66\times\),并且在异构跨数据中心环境下,成本效益最高可进一步提升 \(1.33\times\)
- 本文贡献总结:
- 分析了当前共置 RL 框架中固有的关键可扩展性和效率问题,并提出重新审视分离式架构
- 提出了 StreamRL,以有效缓解流水线气泡和长尾问题,充分释放分离式架构的潜力
- 进行了广泛的实验,评估 StreamRL 相对于当前最先进 RL 框架的性能,并展示了其在异构跨数据中心场景中的有效性
Background and Motivation
Background
RL for LLMs
- 每次 RL 迭代包含两个主要阶段:生成和训练
- 在生成阶段,对于每个给定的 Prompt,Agent 模型首先通过一次前向传播处理所有 Token 以生成第一个输出 Token,这称为预填充阶段(prefill phase)
- 同时,它建立键值缓存(key-value cache),用于存储每个 Token 的中间状态
- 随后,在解码阶段(decoding phase),模型自回归地生成后续 Token,复用键值缓存以避免冗余计算
- 完成后,每个 Prompt 与生成的 Token 组合在一起,形成一个训练样本
- 为提高样本效率,每次迭代会批量生成数百个样本
- 在训练阶段,生成的样本被赋予奖励分数
- 根据算法的不同,奖励计算可以由额外训练好的奖励模型(Reward Model)执行,也可以由基于规则的函数执行
- 除粗粒度的样本级奖励外,某些 RL 算法(如 PPO)还引入了一个 Critic 模型来为每个 Token 提供细粒度的动作级奖励
- 为增强训练稳定性,引入了一个参考模型(Reference Model),从训练前的 Agent 模型初始化,并在训练过程中保持冻结,用于提供 KL 散度正则化,防止 Agent 模型在训练过程中偏离过远
- 最终损失函数结合了样本级和 Token 级奖励以及 KL 散度来训练 Agent 模型
- 参数更新后,进入下一次迭代的生成阶段
- 在生成阶段,对于每个给定的 Prompt,Agent 模型首先通过一次前向传播处理所有 Token 以生成第一个输出 Token,这称为预填充阶段(prefill phase)
LLM Parallelization
- 为扩展 LLM 训练规模,已开发了多种并行化技术
- 数据并行(Data Parallelism,DP)涉及在设备间复制模型并将数据集分割,使每个副本能够并发处理不同的数据子集
- 在每个训练步骤后,所有副本之间必须同步梯度
- 张量并行(Tensor Parallelism,TP)将单个操作划分到多个 GPU 上,每个 GPU 负责部分计算
- 由于其高通信开销,TP 通常限制在节点内部署,以便利用 NVLINK 等高速互联
- 流水线并行(Pipeline Parallelism,PP)将模型层划分为多个阶段,分别分配给不同的设备或节点
- 输入批次进一步划分为 microbatches,实现流水线执行和全批次梯度累积
- 由于每种方法各有优劣,现代训练系统通常结合这三种方法以最大化可扩展性和效率
- 数据并行(Data Parallelism,DP)涉及在设备间复制模型并将数据集分割,使每个副本能够并发处理不同的数据子集
Problems with Colocation
- 如第 1 节所述,RL 框架的共置架构在资源效率方面具有优势,似乎是更优选择
- 但随着实际部署时间的推移,模型规模和训练规模持续增长,共置架构开始暴露出其根本性限制,即资源耦合
- 在共置架构中,生成和训练阶段必须共享同一组设备
- 但这两个阶段代表了完全不同的工作负载
- 生成阶段是受限于内存带宽的
- 生成阶段的解码过程中,每个样本仅计算上一步新生成的 Token,但仍需访问完整的模型参数集,这使得该阶段高度受限于内存带宽
- 理解:这里是因为 Transformer 的 NTP 模式导致的,每个 Token 要用到之前所有 Token 做 Attention
- 训练阶段是计算受限的
- 前向和后向传播同时计算批次中所有 Token,很容易使 GPU 的计算单元达到饱和
- 由于共置,两个阶段必须共享相同的资源数量和硬件类型,与其迥异的计算特征产生了内在冲突
Resource quantities
- 期望:迭代时间随资源增加而减少
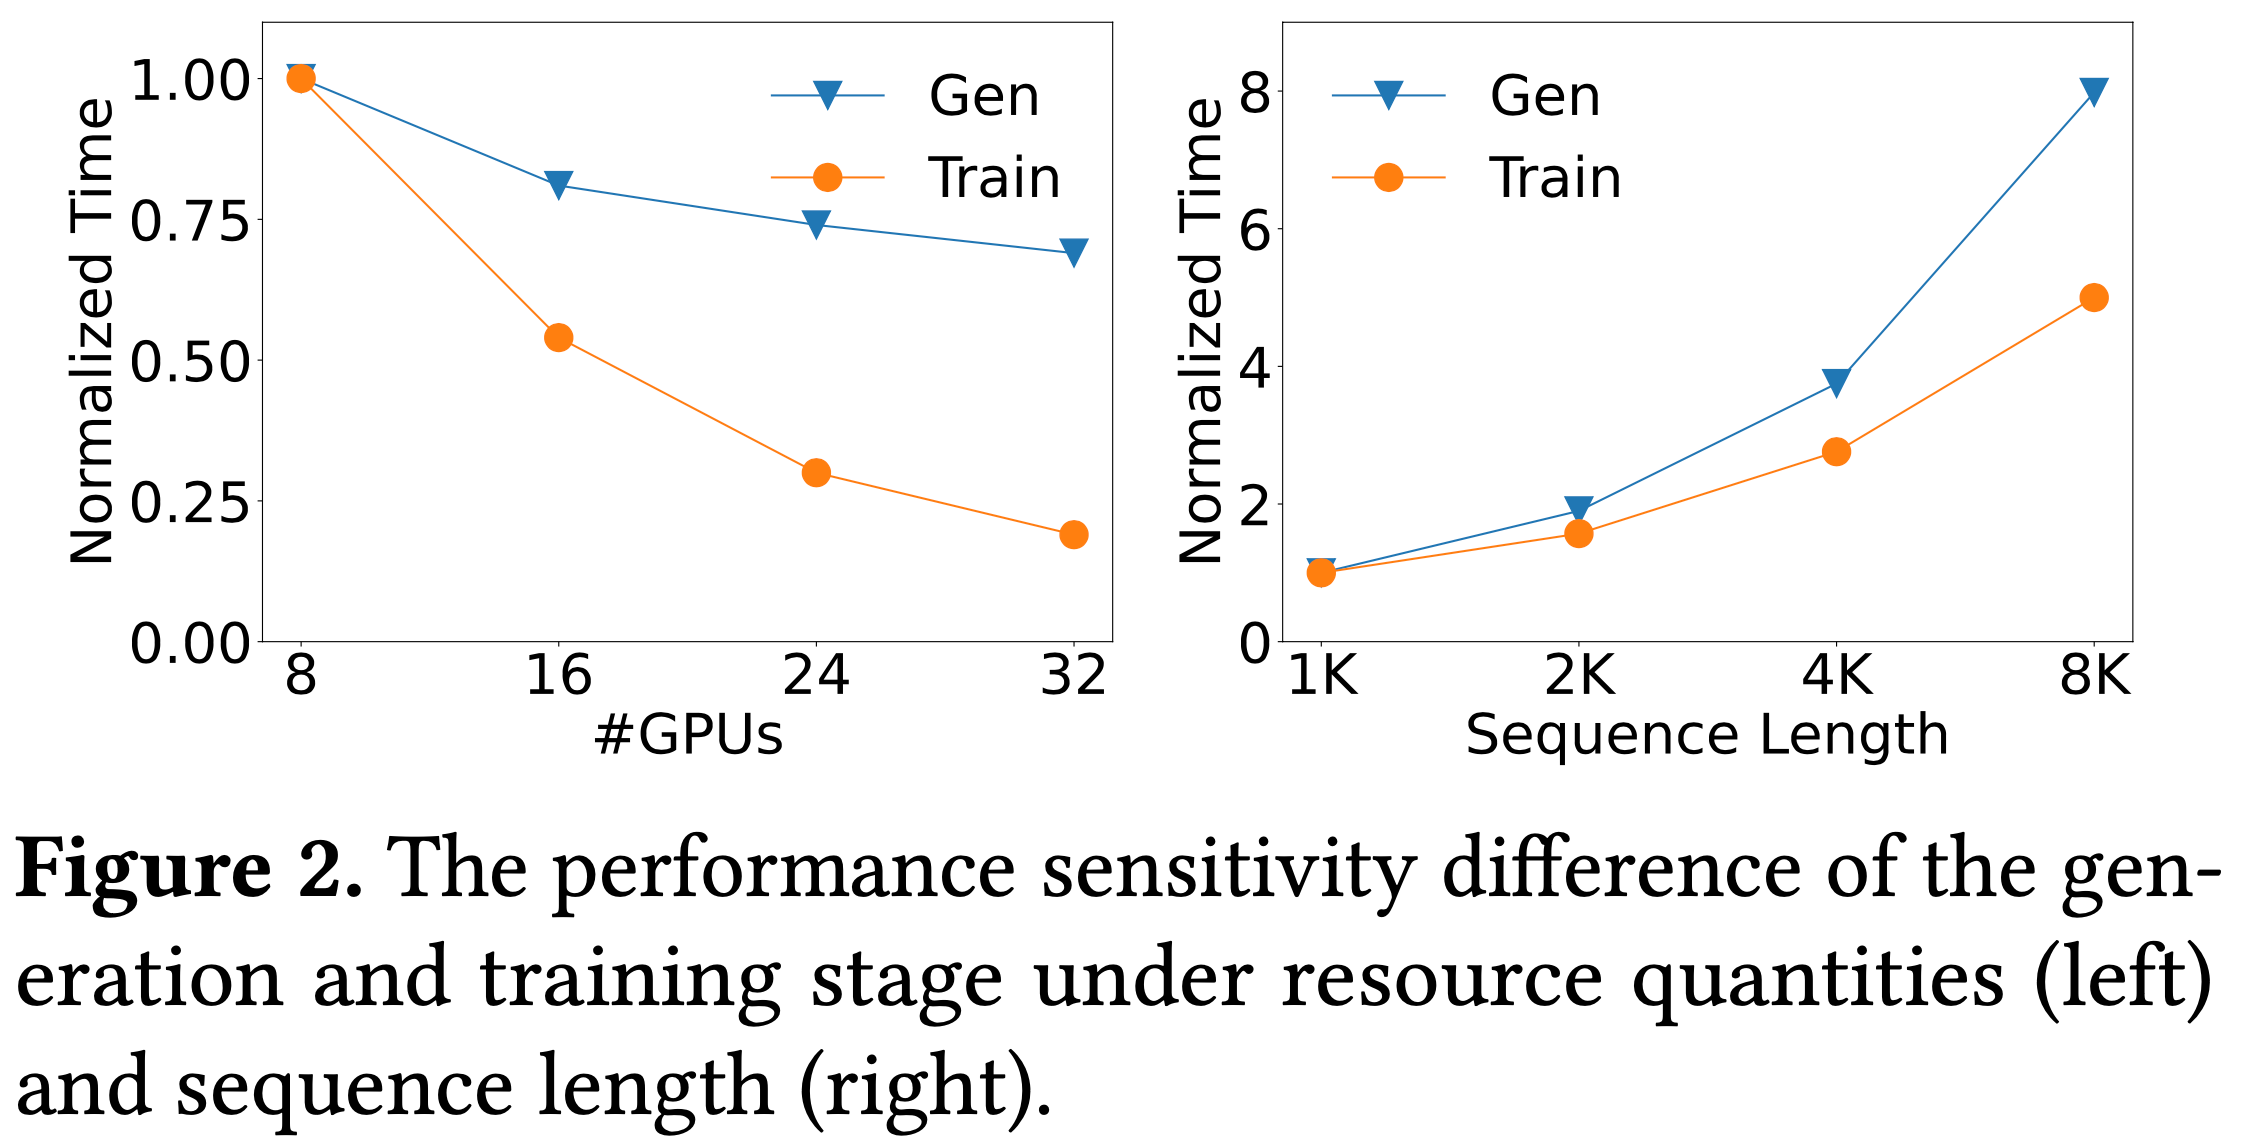
- 但由于生成和训练阶段的不同计算特征,它们对资源数量的扩展敏感度显著不同
- 在训练 7B LLM、固定工作负载和序列长度为 8192 的条件下,分析了不同资源配置下各阶段的执行延迟
- 如图 2 左侧所示
- 随着资源增加,生成时间很快达到平台期
- 这是因为受限于内存带宽,生成时间主要取决于整体内存带宽
- 在并行策略中,只有增加张量并行(TP)规模才能有效增加整体带宽
- 但由于 TP 的高通信开销,其通常仅限于节点内部署,以便利用 NVLINK
- 因此,扩展生成阶段的资源主要增加了生成实例的数量,即 DP 规模,这对减少生成时间的效果有限
- 理解:这里 DP 规模扩大的话,生成时间是线性减少的吧?除非 DP 已经超过样本数量了,图 2 似乎并不是针对单个样本而言?
- 由于训练阶段是计算受限的,它从资源扩展中获益更多,实现了更好的加速
- 随着资源增加,生成时间很快达到平台期
- 这种扩展敏感度差异的后果是
- 当扩展资源时,生成阶段的资源利用率较低,因为增加资源并不能转化为相应的性能提升
- 随着长思维链生成的重要性日益增加,模型输出变长,生成时间在总迭代时间中的占比不断上升,这一问题愈发突出
Hardware types
- 资源耦合的另一个表现在于硬件选择
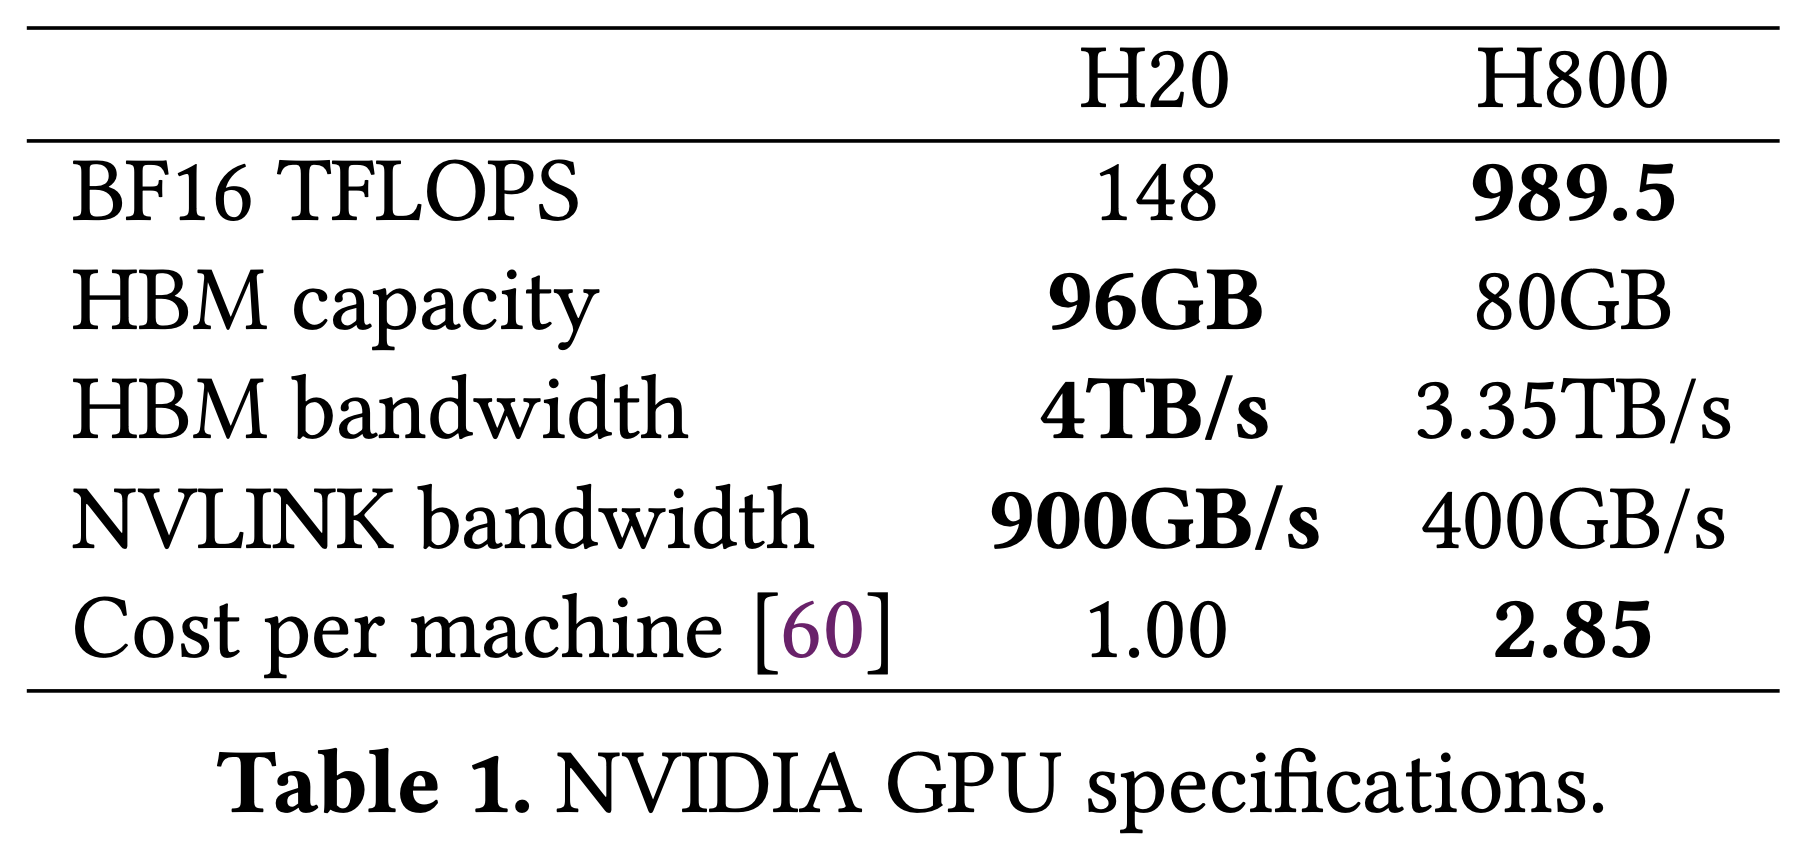
- 如表 1 所示,不同的 NVIDIA GPU 类型在计算能力、内存带宽和成本之间存在权衡
- 某些 GPU,如 H20,专为内存带宽受限的工作负载(如推理)而设计,甚至提供比旗舰型 H800 更高的 HBM 带宽和更大的 HBM 容量,而成本仅约为其 \(35\%\)
- 因此,从训练成本的角度(例如每单位成本的吞吐量)共置架构无法为每个阶段选择最具成本效益的硬件
Motivations for Disaggregation
- 分离式架构具有若干独特优势,值得重新考虑
- Flexibility(灵活性)
- 在分离式架构下,上述资源耦合问题立即得以消除,允许针对两个阶段的不同工作负载进行专用的资源配置
- 此外,它还能为每个阶段选择最合适的硬件,灵活利用异构资源来改善训练成本和整体成本效益
- Scalability(可扩展性)
- 由于各种限制,许多组织运营多个中等规模的数据中心,而非单一的巨型数据中心
- 随着训练规模扩大,如果可行,跨数据中心训练将变得极具吸引力
- 但传统的 LLM 训练涉及大量的 full-mesh 通信操作,对网络带宽要求极高,使得跨数据中心部署面临挑战
- 分离式 RL 架构所需的阶段间通信相对较低
- 生成的样本及相关元数据规模较小,虽然需要传输模型权重,但仅需点对点传输而非 full-mesh 网络拓扑
- 这非常适合于数据中心间的专用链路,使得跨数据中心 RL 训练切实可行
- 此外,生成实例完全独立,可分布在多个数据中心,从而充分利用整个资源池并实现扩展
- Flexibility(灵活性)
Challenges for Disaggregation
- 分离式架构对于两阶段 RL 工作流而言看似自然且有前景,但要充分释放其潜力并超越现有共置架构的性能,仍需解决若干挑战
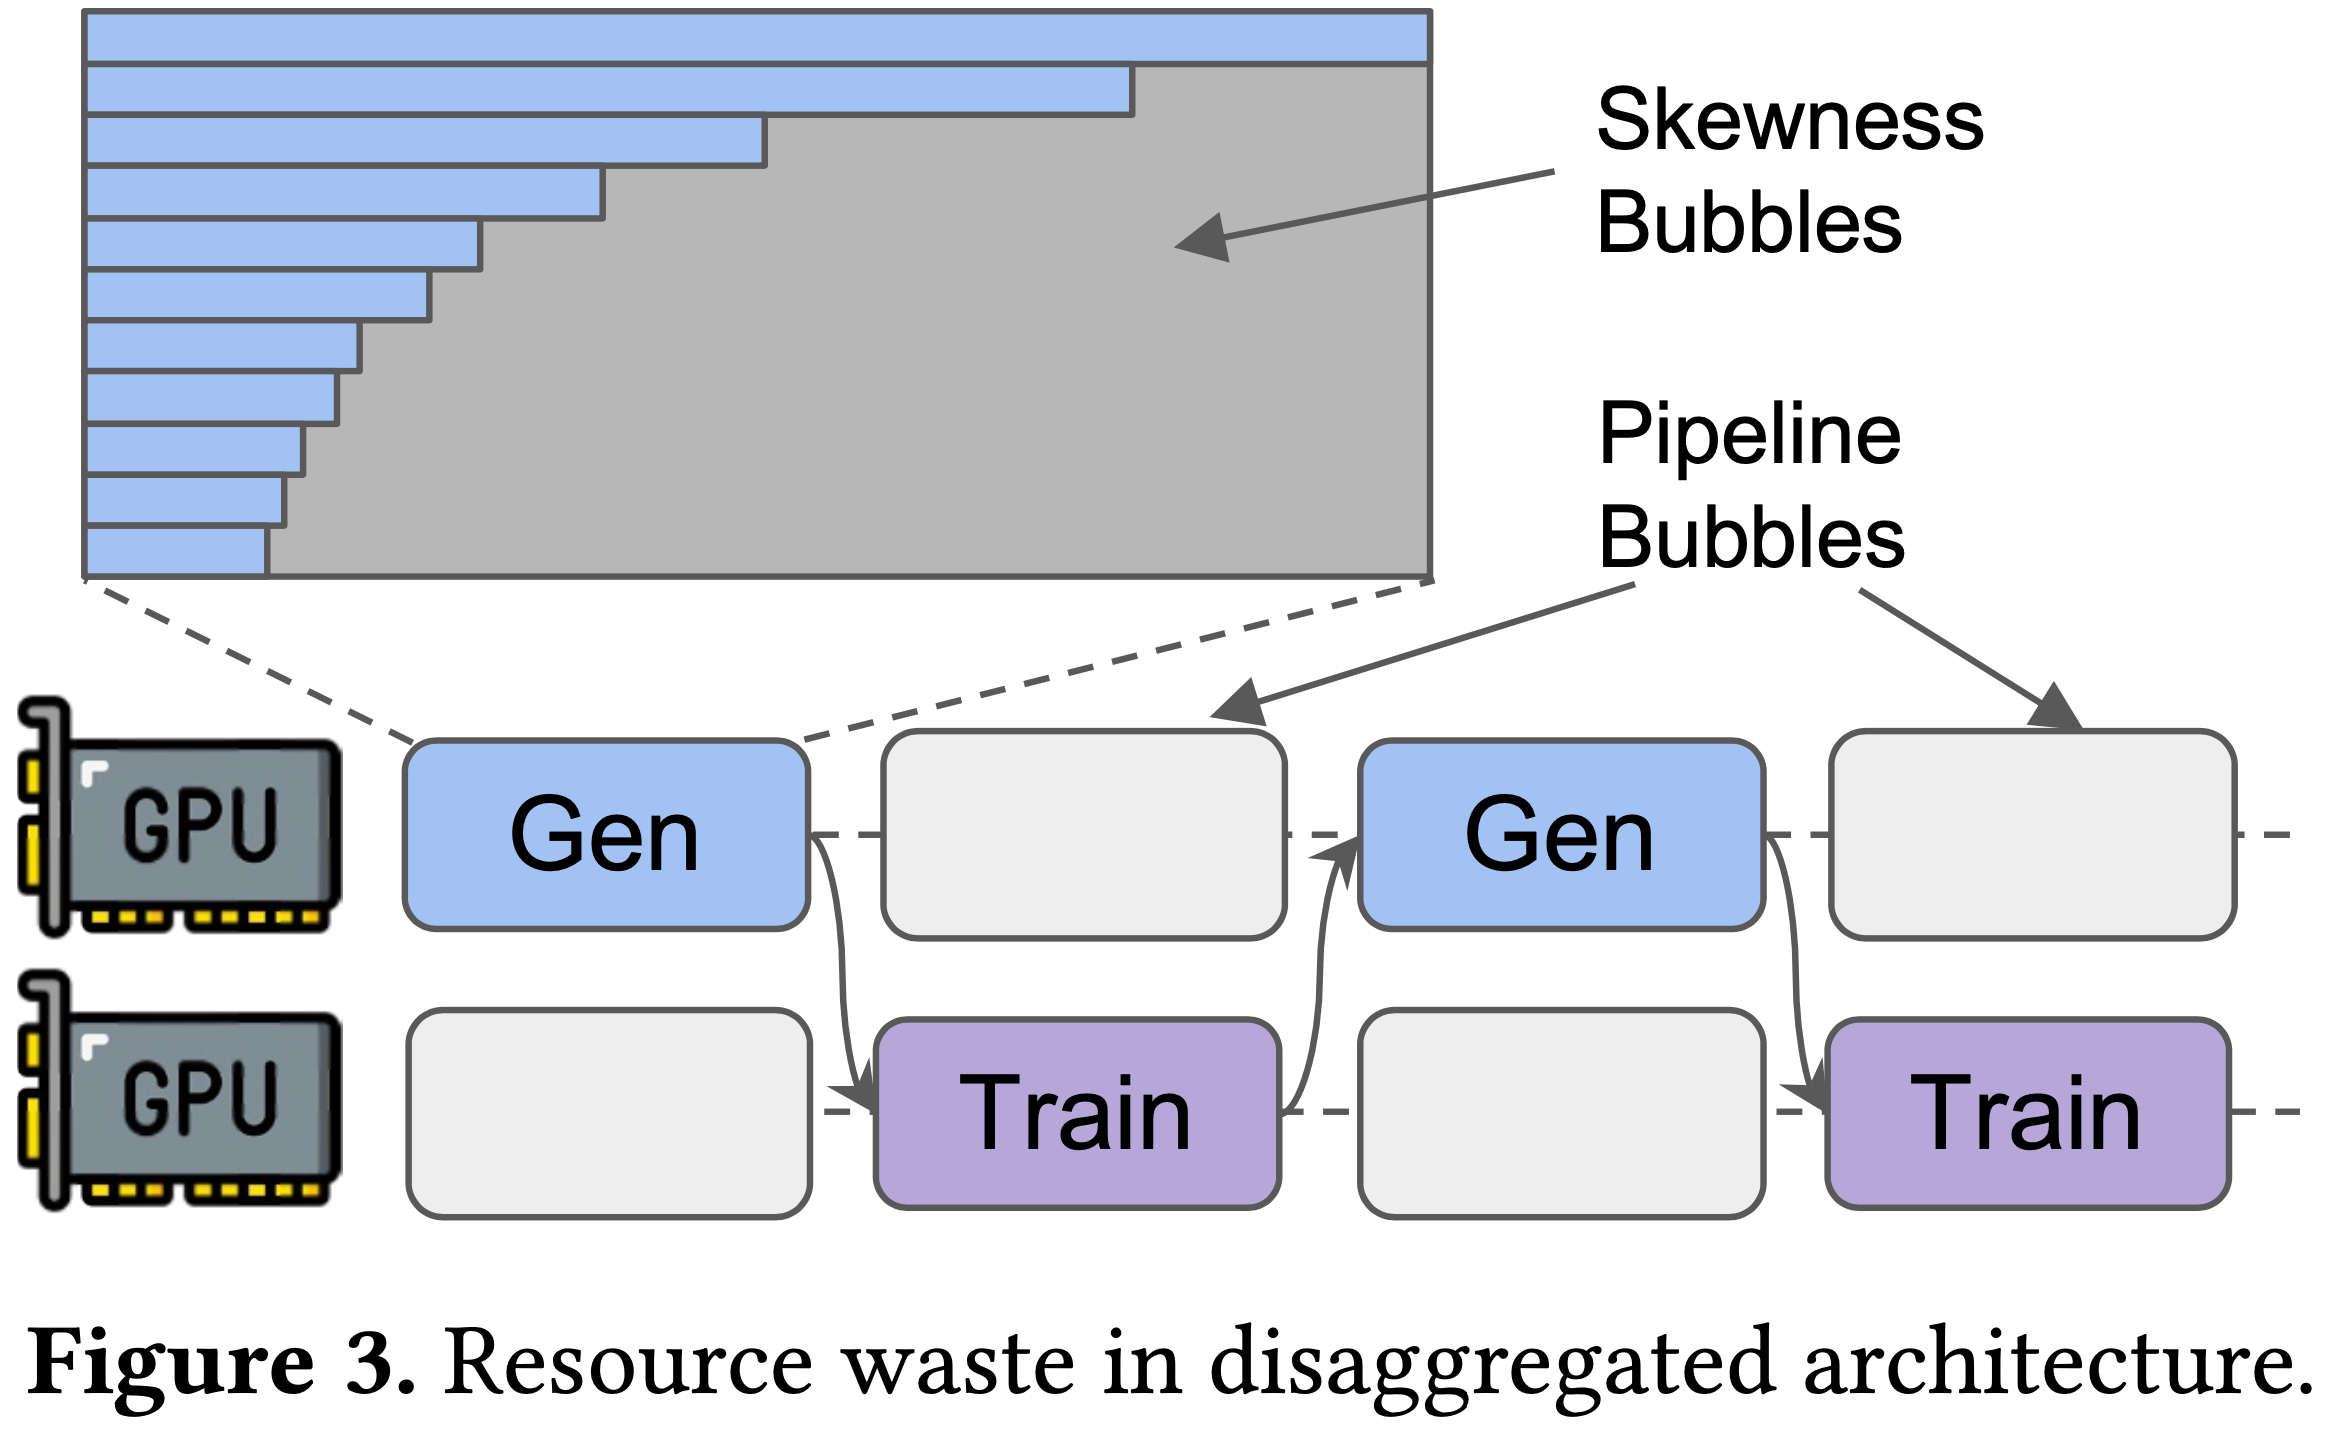
- 如图 3 所示,朴素分离式方案下的训练时间线显示了两种类型的气泡,导致 GPU 利用不足
Pipeline bubbles
- 这是现有分离式框架低效的主要来源
- 生成阶段仅在所有样本生成完成后才将样本发送给训练阶段,在此期间,分配给训练阶段的资源保持空闲
- 类似地,当训练阶段活跃时,生成阶段的资源也未被使用,等待更新后的模型权重
- 传统的 LLM 训练是相对静态的工作负载,而在 RL 训练中,样本是在线生成的,因此具有动态行为
- 如 DeepSeek-R1 技术报告所述,LLM 会随时间自发增加其生成长度,通过自我反思增强推理能力
- 但生成和训练时间对这种工作负载变化的响应不同
- 如图 2 右侧所示,随着序列长度增加,生成时间的增长比训练更显著
- 这主要是由于键值缓存大小增大,为了避免内存溢出(OOM),生成过程中被迫使用更小的批量大小,从而降低了 GPU 利用率
- 这主要是由于键值缓存大小增大,为了避免内存溢出(OOM),生成过程中被迫使用更小的批量大小,从而降低了 GPU 利用率
- 为了更好地处理分离式架构下的流水线气泡,期望两个阶段的执行时间能够紧密匹配,以便应用如微批流水线 和异步流水线 等重叠技术(第4.1节)
- 但动态工作负载下延迟增长的不同导致了阶段不平衡,引入了新的气泡
Skewness bubbles
- 另一类气泡源于 RL 工作负载本身
- 在生成阶段,输出长度呈偏斜分布,只有一小部分样本远长于大多数样本
- 随着生成的进行,系统中仅剩少量长尾样本
- 这损害了 GPU 利用率,因为生成的解码阶段需要大批量(通常为数百)才能维持其内存带宽受限特性的高吞吐量
- 更糟糕的是,在推理时扩展的指导下,输出长度持续增长,使得偏斜气泡成为实际部署中的紧迫问题
- 一种工程上的变通方法(Kimi-K1.5)是将部分生成的长尾样本临时存储在回放缓冲区(replay buffer)中,并在每次迭代中生成其中一部分
- 但这改变了原始输出长度分布,可能对模型质量产生负面影响,引入了精度与效率之间的权衡
- 另一种基于共置架构的解决方案由 RLHFuse 采用
- 它将长尾样本压缩到一小部分资源上,并利用释放出的机器在生成长尾样本的同时预执行训练阶段的部分工作(如 KL 散度计算和奖励推导),从而有效填充偏斜气泡
- 但这种方法不适用于两个阶段物理分离的分离式架构
StreamRL Overview
- StreamRL 是一个从根本上采用分离式设计的高效 RL 框架
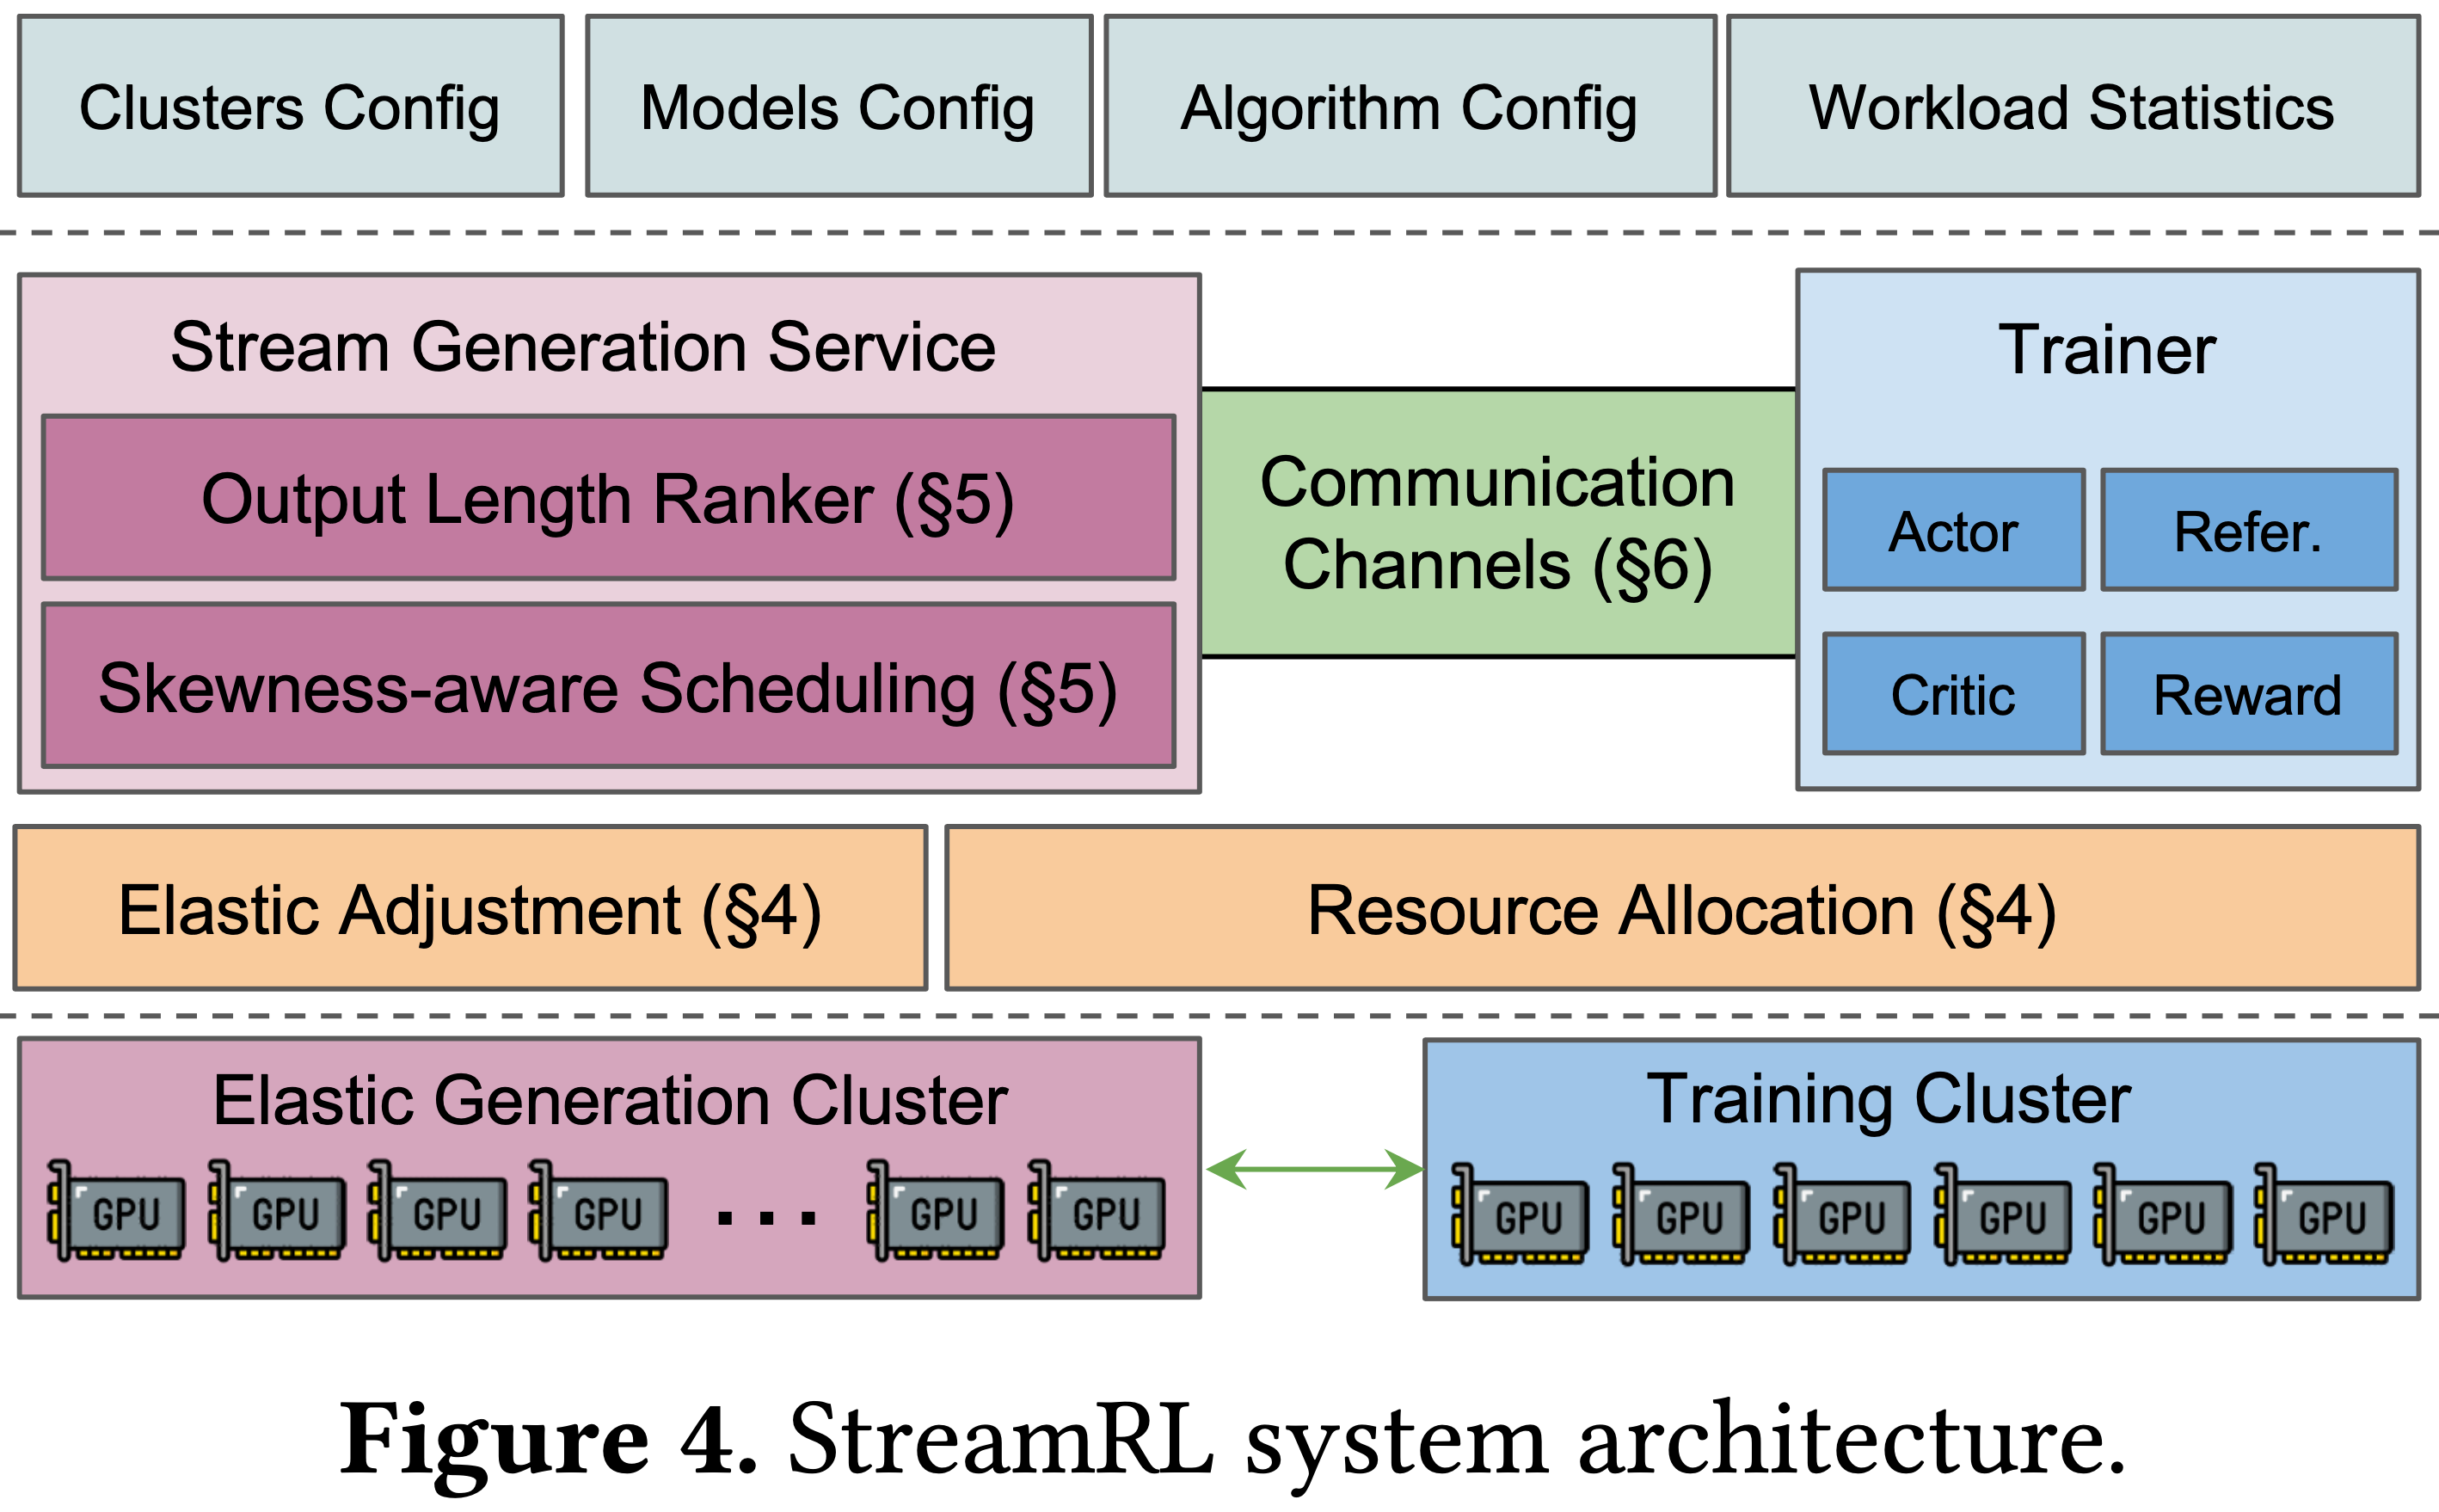
- 如图 4 所示,StreamRL 将生成和训练阶段分别抽象为 Stream Generation Service(SGS)和 Trainer
- SGS 和 Trainer 部署在物理上分离的资源上,甚至可能位于通过点对点链路连接的不同数据中心
- 这种架构设计充分释放了第 2.3 节中讨论的分离式架构的优势,实现了:
- (1) 灵活的资源分配
- (2) 异构硬件选择
- (3) 跨数据中心训练
Workflow
- 给定集群、模型和算法配置后,StreamRL 首先确定如何在 SGS 和 Trainer 之间分配资源,以及为各自采用何种并行策略
- 在训练过程中,SG 向 Trainer 暴露两个外部 API:
update(weights)和generate(prompts)- Trainer 通过调整权重更新的时机以及根据特定 RL 算法处理早期流式返回的样本来解决流水线气泡
- 为解决偏斜气泡,SGS 利用输出长度排序器识别长尾样本
- 基于预测结果,它将 Prompt 分发到特定的生成实例并决定调度顺序,从而有效缓解长尾样本造成的瓶颈
- 问题:这里的 输出长度排序器 是怎么来的?
- 尽管静态配置确保了训练开始时生成和训练时间的平衡,但 RL 工作负载的动态特性要求弹性资源调整,以在整个训练过程中维持两个阶段执行时间的接近
- 为此,SGS 持续监控 Trainer 的执行时间
- 随着工作负载演化和序列长度增加,如果生成时间超过训练时间达到一定阈值,SGS 通过增加 DP 规模自动扩展,以维持执行时间的动态平衡
Tackle Pipeline Bubbles
Overlapping Design
- 为解决流水线气泡问题,关键在于确保在生成进行的同时,训练阶段保持活跃
- 主流的 RL 算法通常可以分为两类:同步 (synchronous) 和异步 (asynchronous),具体取决于训练样本是否使用最新的模型权重生成
- 针对每种类型,本文介绍了当前现有的简易解决方案,并描述了在流式传输的支持下,如何进一步提高重叠的效率
Strawman solution 1: Mini-batch pipelining
- Mini-batch pipelining 最早来自 DeepCoder(2025)
- 在同步 RL 中,权重更新发生在所有样本处理完成之后
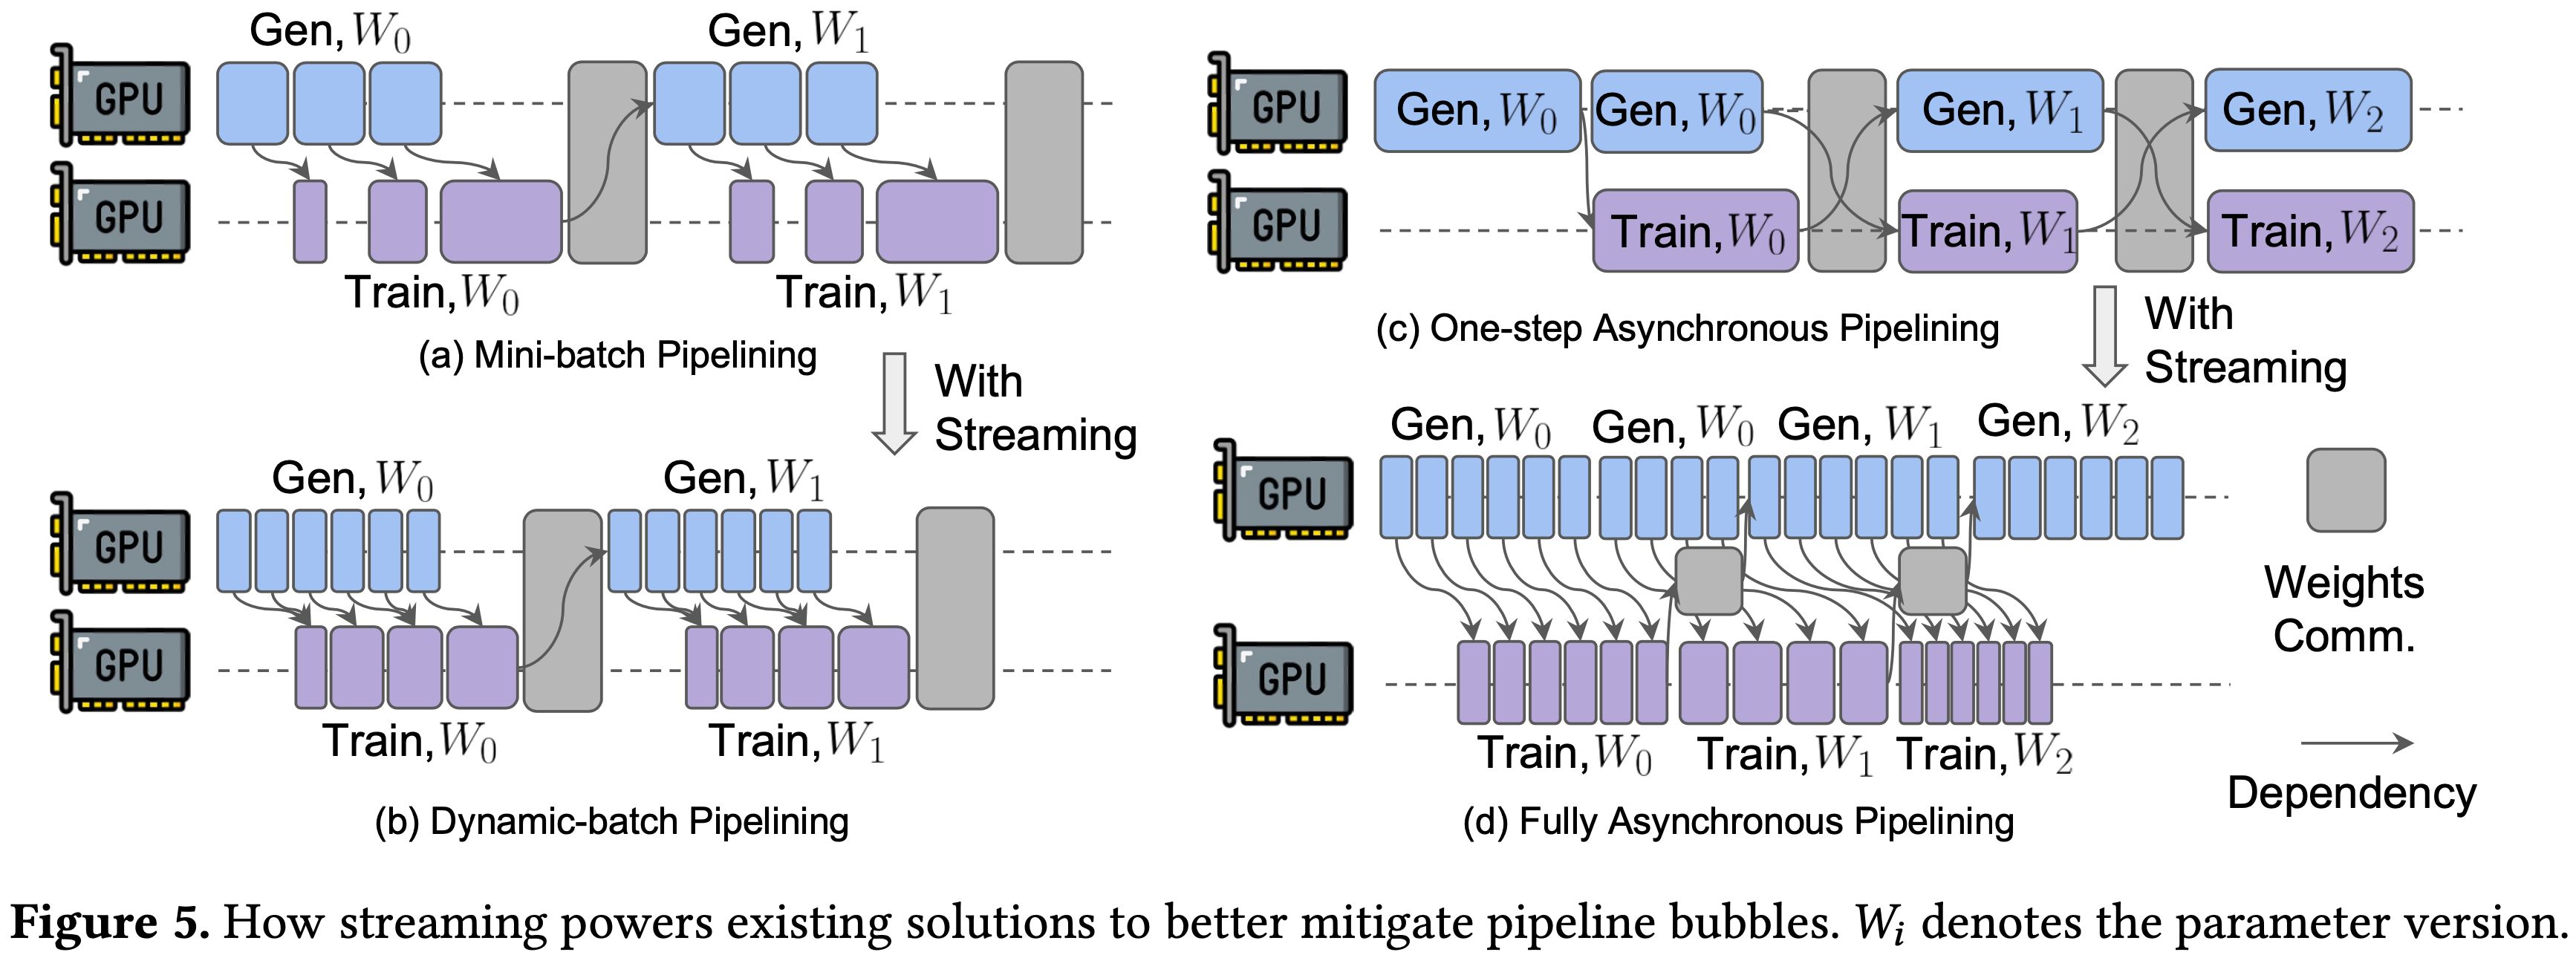
- 如图 5(a) 所示,样本可以均匀地分成多个小批次,类似于流水线并行 (pipeline parallel)
- 一旦生成的样本数量达到一个小批次的大小,它们就被传递到训练阶段进行处理
- 一旦生成的样本数量达到一个小批次的大小,它们就被传递到训练阶段进行处理
- 这种方法需要手动设置小批次大小:
- 如果设置得太大,会降低重叠的效果
- 如果太小,则会损害训练效率
- 在实践中,小批次大小会根据经验设置为一个合适的常数
- 但由于长尾效应,后续小批次的序列长度逐渐增加
- 结果,最后几个小批次的训练常常会在生成结束后仍在进行,从而产生显著的流水线气泡
- 此外,由于小批次之间的不平衡,很难设置一个能够避免训练阶段空闲时间的小批次大小
Our solution: Dynamic-batch pipelining
- 本文提出用流式生成 (stream generation) 替换当前的批次生成 (batched generation),即样本一旦完成就立即发送到训练阶段
- 这使得样本级别的操作,如 Reference Model 推理、KL 损失计算和奖励计算,能够立即开始
- 如图 5(b) 所示,训练阶段一旦接收到足够填满 GPU 的样本就可以开始,从而能够根据生成速度进行动态批处理 (dynamic batching)
- 这消除了训练阶段除第一个小批次之外的空闲时间,并有效减少了由最后几个小批次引起的气泡
Strawman solution 2: One-step asynchronous pipelining
- One-step asynchronous pipelining 最早来自 DeepCoder(2025)
- 本质上,同步 RL 中的两个阶段仍然处理同一批样本,因此每个迭代内的串行依赖仍然存在,使得无法实现完美的重叠
- 最近,许多工作探索了 Off-policy 异步 RL,其中用于训练的样本不一定是用最新权重生成的,从而允许一定程度的陈旧性 (staleness)
- 现有研究以及作者的实验 7.4 表明,对于 LLMs 来说,单步异步 RL 不会影响模型性能或收敛性
- 如图 5(c) 所示,可以首先生成一个额外的批次,同时训练阶段处理来自前一个迭代的样本,从而将依赖关系转移到跨迭代的方式,实现更好的重叠
- 但这种批次级流水线的问题在于
- 每个迭代仍然以全局同步来传输权重而结束,在此期间两个阶段都处于空闲状态
- 此外,由于在线生成的动态性,不同迭代的生成和训练时间可能存在波动,这些波动很难通过资源调整来精确对齐,从而导致新的气泡
Our solution: Fully asynchronous pipelining
- 如图 5(d) 所示,上述问题可以通过流式传输来解决
- 首先,权重传输可以与下一个迭代的训练重叠,因为前一个迭代的样本已经被流式传输并缓存在训练缓冲区中
- 同时,当前迭代的生成不依赖于最新的权重,也可以并行进行
- 这将权重传输完全移出关键路径 (critical path)
- 此外,即使不同迭代的生成和训练时间存在波动,只要它们的平均速度匹配且波动有限,就不会产生新的气泡
- 请注意,这里没有引入超过一步的异步样本 ,因此训练语义与简易解决方案完全相同
Stage Balancing
- 为了实现 SGS 和 Trainer 之间更好的重叠,需要仔细平衡两个阶段的执行时间
- 因此,为每个阶段确定合适的并行策略和 GPU 数量对于最小化整体迭代时间至关重要
Parallel configuration
- 在决定为每个阶段分配多少资源之前,首先解决一个子问题:在给定工作负载和 GPU 预算下,确定 SGS 或 Trainer 的最优执行时间
- 这实质上归结为优化并行策略,这对于 LLM 训练和生成都是一个研究充分的问题
- 对于 Trainer,采用了一种基于性能分析 (profiler-based) 的方法,该方法受先前关于自动化并行的工作启发
- 由于 DNN 执行时间的确定性,可以在固定 GPU 预算下,通过最少的性能分析来准确地建模训练时间
- 对于 SGS,生成时间取决于推理过程中的调度策略
- 幸运的是,在本文的偏斜感知调度 (§5.3) 下,对于给定的工作负载,生成时间也是确定的,这使得本文可以类似地对其进行建模
- 请注意,本文假设可以访问 RL 工作负载
- 在实践中,这可以从最近训练迭代生成的样本中获取,或者从训练前由 LLM 生成的样本中进行引导 (bootstrapped)
Resource allocation
- 在上述策略的基础上,可以确定为每个阶段分配的资源
- StreamRL 在生产 RL 训练中支持两种部署方案
- 第一种是单数据中心部署,其中 SGS 和 Trainer 位于同一数据中心内,配备同质 (homogeneous) 硬件资源
- 这是先前 LLM 训练系统中的标准设置
- 第二种:StreamRL 支持跨数据中心部署,利用 RL 工作流中 SGS 和 Trainer 的解耦特性,将 SGS 和 Trainer 放置在具有异构 (heterogeneous) 硬件(例如,H20 对比 H800)的独立数据中心
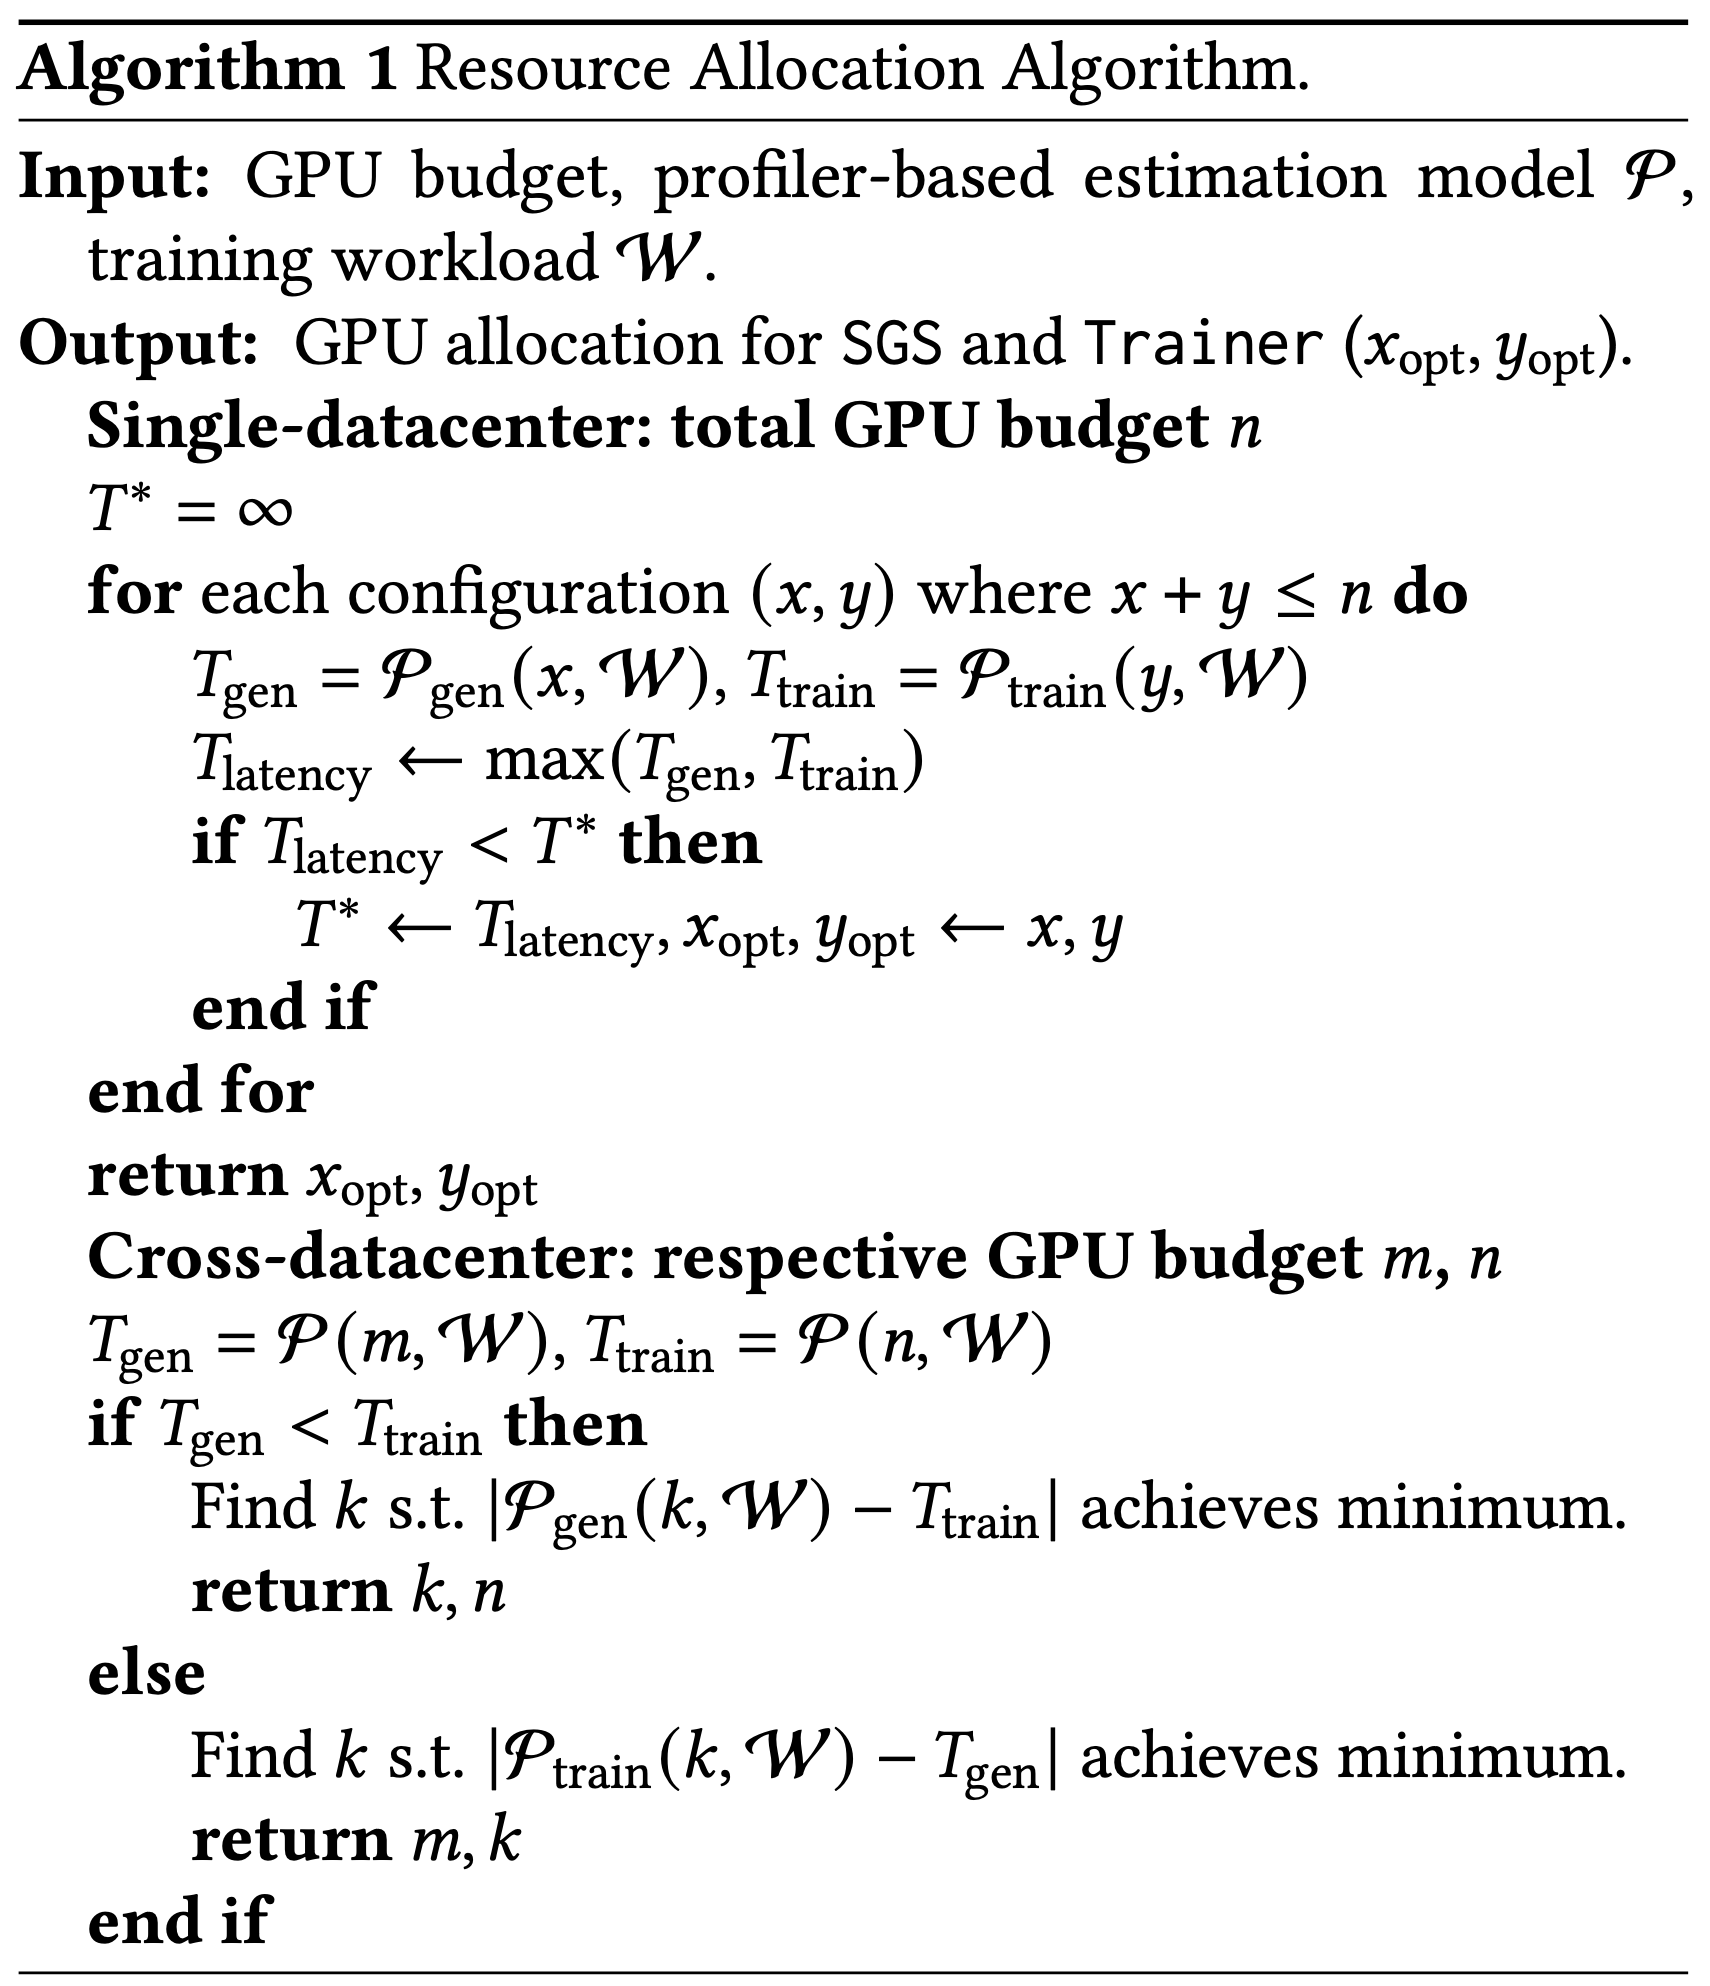
- 本文在算法 1 中展示了两种不同部署下的资源分配算法
- 本文在算法 1 中展示了两种不同部署下的资源分配算法
- 第一种是单数据中心部署,其中 SGS 和 Trainer 位于同一数据中心内,配备同质 (homogeneous) 硬件资源
Single-datacenter
- 本文将分配给 SGS 和 Trainer 的 GPU 数量分别定义为 \(x\) 和 \(y\)
- 资源约束为 \(x + y \leq n\),其中 \(n\) 表示 GPU 总预算
- 为了确定最优分配策略,本文枚举所有分配配置
- 对于每种情况,本文可以分别使用上述基于性能分析的建模得到生成时间和训练时间
- 然后,本文取两者中的较大值作为估计延迟,并选择最小化整体迭代时间的最优 \((x, y)\) 组合
Cross-datacenter
- 对于跨数据中心部署
- 设 \(m\) 和 \(n\) 分别表示 SGS 和 Trainer 部署所在数据中心可用的 GPU 数量
- 资源约束为 \(x \leq m\) 和 \(y \leq n\),使得 \(x\) 和 \(y\) 成为独立变量
- 一个朴素的选择是 \((x, y) = (m, n)\),这完全利用了所有资源
- 然而,由于迭代时间由 SGS 和 Trainer 中较慢的阶段决定,这种完全分配可能导致资源浪费
- 为了解决这个问题,本文识别出在完全分配下较快的阶段,并逐渐减少其 GPU 使用量,直到两个阶段达到相似的执行时间
- 此策略消除了不必要的 GPU 使用,允许将剩余资源重新分配给各自数据中心内的其他任务
Dynamic adjustment
- 上述技术仅能确保两个阶段在训练开始时是平衡的
- 正如 DeepSeek-R1 技术报告中观察到的,LLM 的生成长度在 RL 训练过程中会逐渐增加,导致 SGS 和 Trainer 阶段的计算和内存需求发生变化
- 但这两个阶段在工作负载变化时的延迟敏感性不同
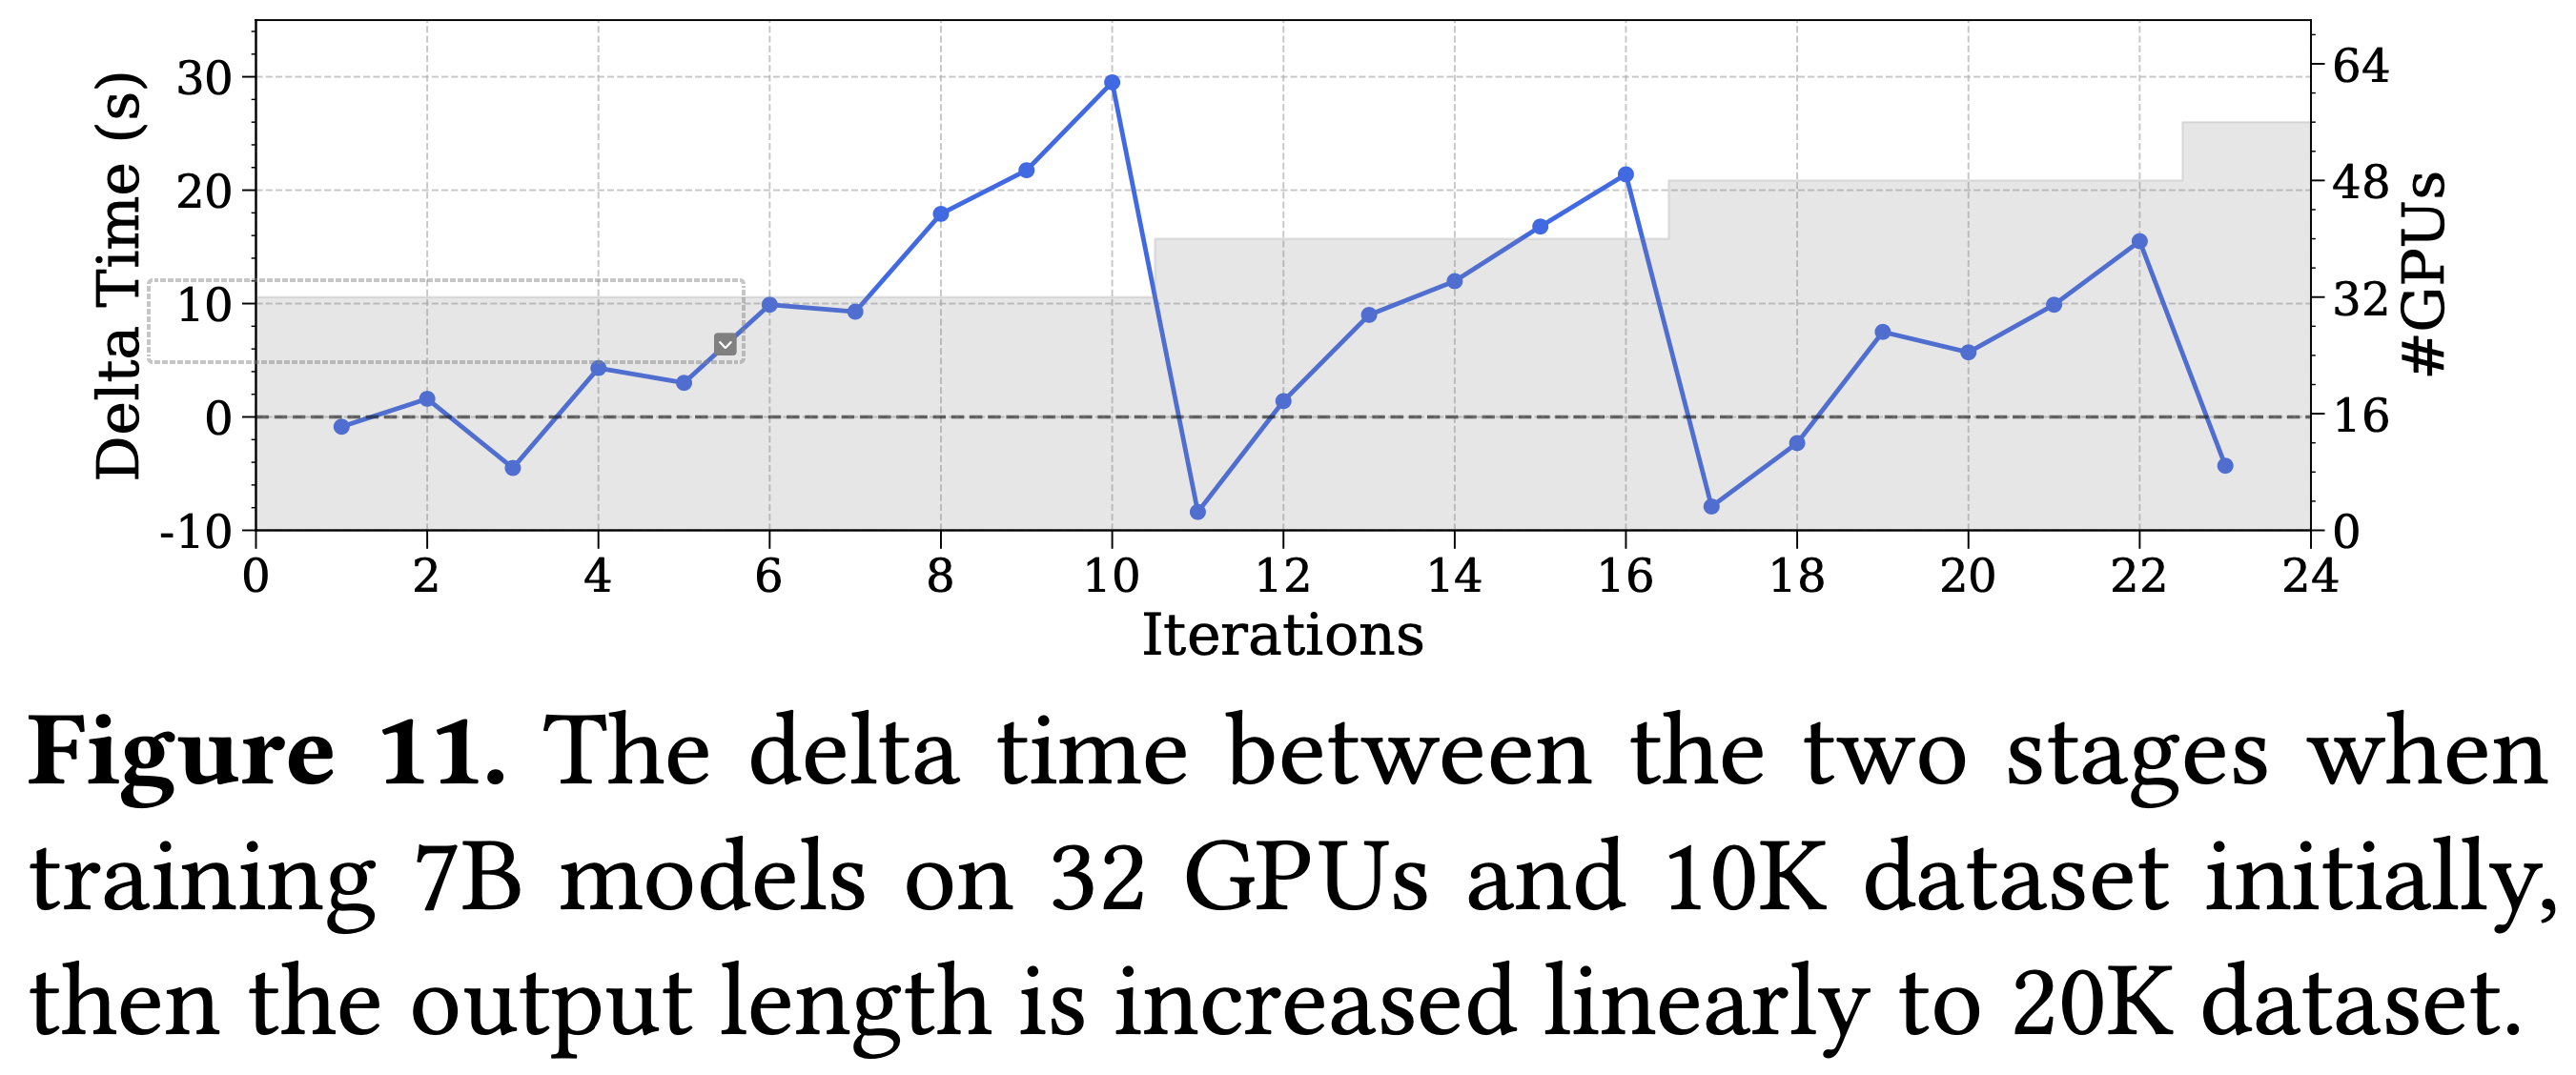
- 为了解决这个问题,本文提出了一种动态调整机制,用于监控生成和训练之间的执行时间差距,记为 \(\delta\)
- 如图 2 所示,生成时间的增长速度比训练快,这意味着 \(\delta\) 会随着训练的进行而逐渐增加
- 理想情况下,当 \(\delta\) 超过某个阈值时,可以重新运行资源分配算法来重新平衡这两个阶段
- 但在实践中,Trainer 中的所有 GPU 通过 3D 并行的通信组紧密耦合
- 更改并行策略或为 Trainer 重新分配资源需要重启整个训练运行时,这会带来显著的开销
- SGS 中的生成实例本质上是解耦的
- 因此,StreamRL 估计通过向 SGS 添加一个数据并行 (DP) 单元所能实现的生成时间缩减量 \(\delta^{\prime}\)
- \(\delta^{\prime}\) 是使用上述性能分析器和当前 RL 工作负载计算得出的
- 当 \(\delta \geq \delta^{\prime}\) 时,通过向 SGS 添加一个 DP 单元来触发调整
- 这种重新分配不会中断训练,其开销仅限于初始化新增的 DP 单元,相对于整个 RL 训练时间而言可以忽略不计
Tackle Skewness Bubbles
- 从高层来看,SGS 旨在最小化给定资源下的生成时间
Problems and Opportunities
Problem 1
- 现有系统不区分长尾样本和常规样本,为了实现工作负载均衡,Prompts 通常随机分配给各个生成实例
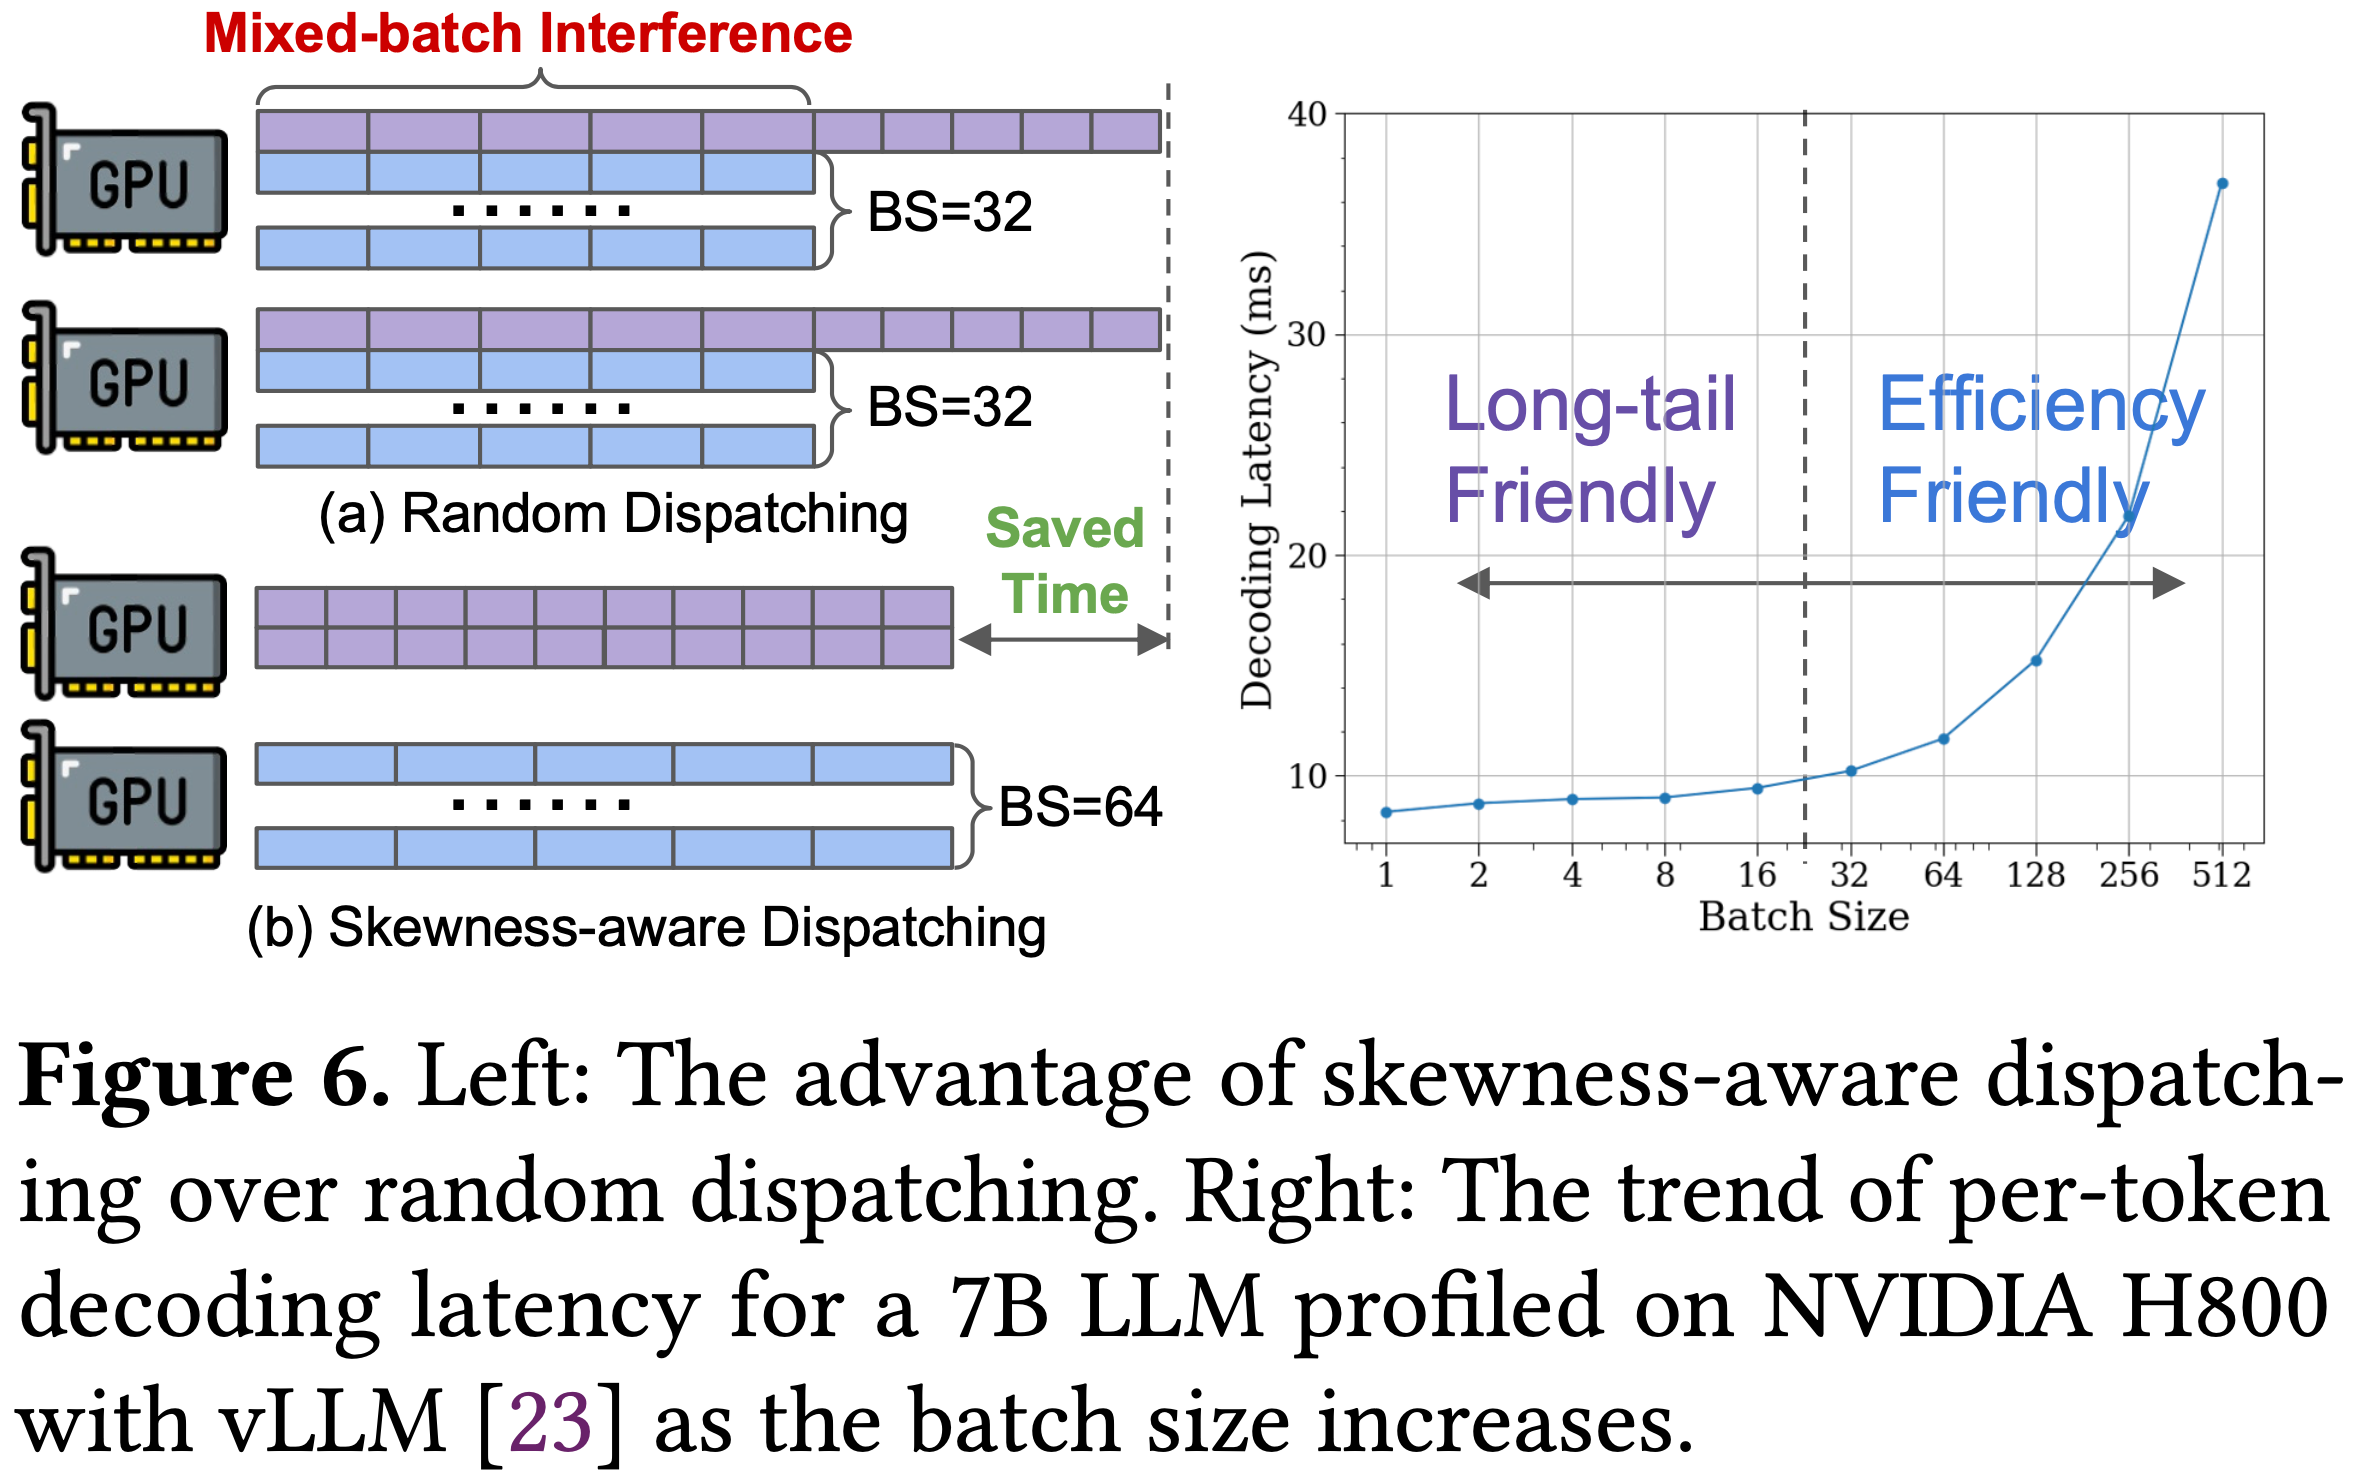
- 图 6(a) 显示了一个简单示例,其中生成 DP 大小为 2,有 2 个输出长度是其余 64 个样本两倍的长尾样本
- 在随机调度策略下,每个生成实例接收一个长尾样本以及一半的常规样本
- 由于批量推理,这在生成的前半段导致长尾样本受到显著干扰
- 图 6 的右侧显示了在 NVIDIA A100 GPU 上,随着 batch size 的增加,一个 13B 模型的每 token 解码延迟趋势
- 可以观察到,在达到计算瓶颈之前,延迟增长缓慢,之后几乎呈线性增长
- 为了提高吞吐量,现有系统通常通过随机调度为每个实例累积足够大的批次大小
- 但在存在长尾样本的情况下,这种方法不仅会在早期减慢它们的解码速度,而且会导致后期利用率极低,因为系统中只剩下少数长尾样本
Opportunity 1
- 在对问题有了直观理解之后,继续探讨解决方案,一个样本的生成延迟可以建模为:
$$Sample: Latency = PTL(BS)\times L \tag {1}$$- per-token latency (PTL) 是关于 Batch Size (BS) 的函数,可以预先进行性能分析
- 理解:PTL 随 BS 变化而变化
- \(L\) 是输出长度
- per-token latency (PTL) 是关于 Batch Size (BS) 的函数,可以预先进行性能分析
- 可以观察到,随机调度策略仅基于 \(L\) 来均衡负载,而没有考虑 PTL
- 对于 \(L\) 较长的样本,实际上希望降低它们的 PTL(即降低它们的 BS)因为 PTL 是 BS 的单调递增函数
- 解决方案的启发式方法自然浮现:
- 可以提取出长尾样本,并将它们分配给少数几个具有较小批次大小的专用实例,使它们能够以尽可能快的速度解码,并消除由批处理引起的干扰
- 注:后来的 ROLL 框架就是这么做的
- 同时,常规样本可以组成大批次以充分利用 GPU 资源
- 通过将原来的一维负载均衡扩展到二维方案,可以有效地减少生成延迟,如图 6(b) 所示
- 可以提取出长尾样本,并将它们分配给少数几个具有较小批次大小的专用实例,使它们能够以尽可能快的速度解码,并消除由批处理引起的干扰
Problem 2
- 上述方法依赖于一个关键假设:长尾样本可以在生成开始之前被识别出来
- 但 LLM 生成的输出长度通常被认为是先验未知的
Opportunity 2
- 虽然难以预测每个样本的确切生成长度,但可以使用另一个模型来估计输出长度的相对排名
- 直观地说,排名问题本质上是一个分类问题,因为更复杂的 Prompt 通常需要更多的推理(即更长的输出长度)
- 排名模型本质上根据 Prompt 的难度对其进行分类
- 难度是 Prompt 本身固有的属性,可以泛化到不同的 LLM,从而获得相对较高的预测精度
- 确切的输出长度是 LLM 本身的特征,预测起来要困难得多
- 本文实验 (§7.2) 表明,前 20% 的长尾样本的召回率 (recall rate) 接近 90%,这与本文的假设高度一致
- 由于生成时间的瓶颈主要在于长尾样本,因此,与存在先知 (oracle) 的上限加速相比,准确识别它们足以获得大部分性能提升 (§7.2)
- 接下来将详细说明如何将上述观察结果融入到输出长度排名器 (§5.2) 和偏斜感知调度 (§5.3) 的设计中
Output Length Ranker
Method
- 为了训练排名器模型
- 本文收集一组输入 Prompt 及其对应的来自目标 LLM 的输出长度
- 这些 (Prompt,length) 对可以从在线推理服务中获取,或者在训练前离线生成
- 然后将 Prompt 与其对应的输出长度连接起来,形成一个训练数据集
- 使用这个数据集,直接在一个小型 LLM 上进行 SFT 作为排名器模型
- 问题:SFT 的数据长啥样,需要 CoT 吗?
- 本文收集一组输入 Prompt 及其对应的来自目标 LLM 的输出长度
- 微调之后,排名器模型可以接收一批 Prompt 作为输入,并估计它们的绝对输出长度
- 这些估计的长度随后用于对 Prompt 进行排序,产生最终的排名结果
- 注:SFT 过程涉及预测绝对长度
- 随着 RL 训练的进行和目标 LLM 参数的演变,即使是相同的 Prompt 也可能产生不同的输出长度
- 因此,在经过一段时间的训练后,本文使用最近的生成结果,按照相同的方法对排名器模型进行在线微调
- 特别地:Prompt 的难度是一个固有属性,并且保持稳定
- 因此,即使绝对预测发生偏移,排名器产生的相对排名仍然保持合理准确,从而减少了频繁在线微调的需要
Overhead,开销
- 一个担忧是排名器模型引入的开销
- 首先,排名器模型训练非常快,只需要几分钟即可收敛
- 训练完成后,对用于 RL 的数据集进行一次性的离线预处理,估计每个 Prompt 的实际输出长度
- 这些估计值作为后续偏斜感知调度的基础
- 注意,此预处理完全离线进行,这意味着排名器模型不会对 RL 训练过程产生在线开销,也不会影响原始的训练效率
Skewness-aware Scheduling
- 在输出长度排名器的帮助下,SGS 将接收一批 Prompt 及其估计的输出长度
- 然后需要做出两个决定:确定如何将 Prompt 分派到不同的生成实例,以及在分派之后决定每个实例内的调度顺序
Dispatching
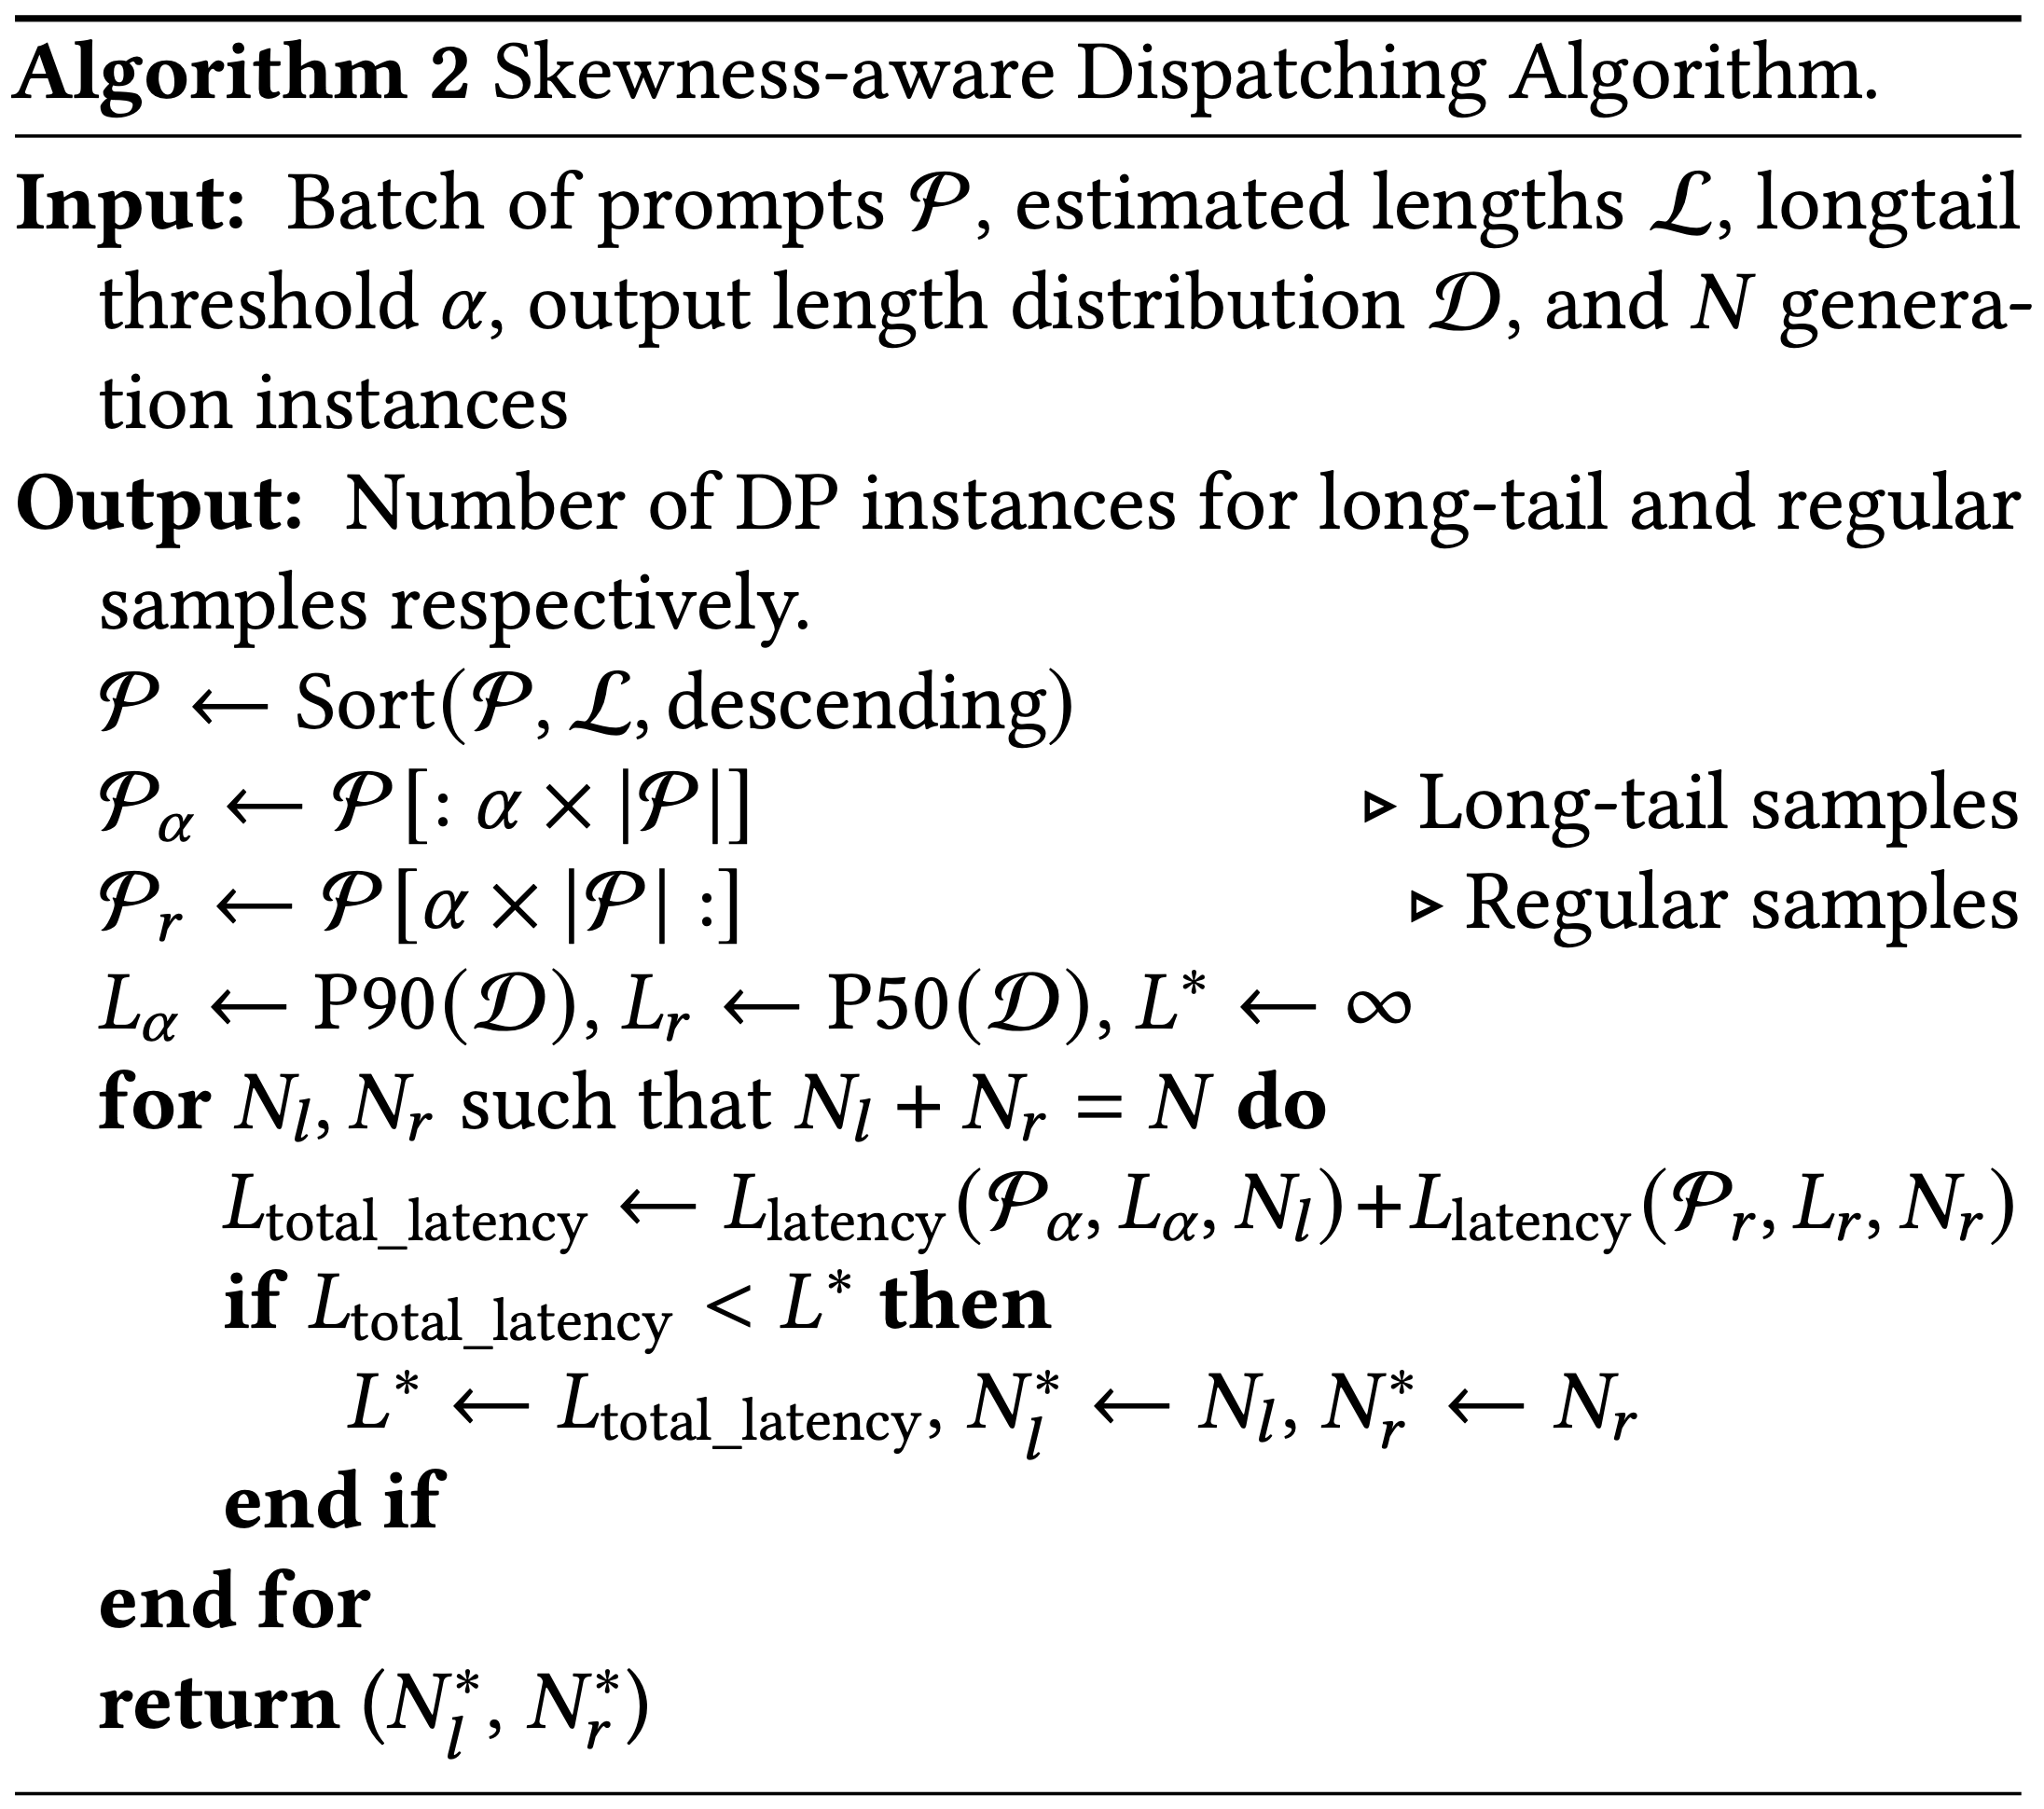
- 给定一批 Prompt
- 首先根据它们估计的输出长度从长到短进行排序
- 在确定相对顺序后,将其中最长的 \(\alpha \%\) 标记为长尾样本,其中 \(\alpha\) 是一个超参数
- 在实践中,将 \(\alpha\) 设置为 20 可以获得良好的结果 (§7.4)
- 接下来,需要从 \(N\) 个生成实例中选择 \(N_{l}\) 个来处理长尾样本,而剩余的 \(N_{r}\) 个实例用于常规样本
- 为了确保工作负载平衡,需要估计常规样本和长尾样本的实际工作负载
- 这里假设可以访问待训练 LLM 的输出长度分布 \(\mathcal{D}\)
- 这个工作负载特征可以从训练期间最近生成的样本中获得,或者通过让 LLM 预先生成一组样本进行引导 (bootstrapping) 来获得
- 本文使用 \(\mathcal{D}\) 的 P50 和 P90 分别估计常规样本和长尾样本的平均输出长度
- 在此基础上,本文将样本延迟 (1) 扩展为估计单个实例的生成延迟:
$$Latency = PTL(BS)\times L_{avg}\times \lceil \frac{M}{BS}\rceil \tag {2}$$- \(L_{avg}\) 是分配给该实例的样本的估计平均输出长度
- 这取决于该实例处理的是常规样本还是长尾样本
- 理解:只可能取两个值 P50 和 P90
- \(M\) 是分配给该实例的 Prompt 数量
- 理解:BS 是每次 Rollout 的 Prompt 数量, \(M\) 是分配给该实例的 Prompt 总数量,所以针对 \(M\) 个 Prompt 需要的轮数为 \(\lceil \frac{M}{BS}\rceil\)
- \(L_{avg}\) 是分配给该实例的样本的估计平均输出长度
- 理想情况下,我们希望 \(BS = M\),以便所有样本都可以在一轮内处理完
- 但对于较长的输出长度,较大的 \(BS\) 将导致更高的 KV 缓存内存使用量,因此 \(BS\) 受限于 GPU 内存容量
- 理解:所以 BS 会比 M 小一些,慢慢来,多轮 Rollout 完
- 利用公式 2,可以遍历所有 \((N_{l}, N_{r})\) 配置,并找到最小化生成时间的配置
- 算法 2 显示了偏斜感知分派算法的伪代码
- 之后,长尾样本和常规样本可以在它们各自的实例内均匀分布
- 之后,长尾样本和常规样本可以在它们各自的实例内均匀分布
Scheduling Order
- 如前所述,BS 受 KV 缓存内存使用量的限制,因此分配给每个实例的样本数量 \(M\) 可能超过生成期间使用的 BS
- 在这种情况下,需要多轮生成,这就引入了决定样本调度顺序的需求
- 这个问题是 \(P||C_{\text{max} }\)(makespan minimization,最小化最大完工时间)问题的一个变体
- \(P\) 表示并行处理单元
- \(C_{\text{max} }\) 是最大完成时间
- 在本文案例中,每轮批次大小为 \(BS\) 的生成被视为 \(BS\) 个并行处理单元
- 本文采用一种众所周知的贪心算法,即最长处理时间优先 (longest-processing-time-first, LPT) 调度来解决这个问题
- 具体方法:
- 样本按照其估计输出长度的降序分配给批次
- 一旦一个样本完成,具有最长剩余输出长度的样本就会被添加到批次中
- 这个过程一直持续到所有样本都被处理完
- 具体方法:
- 先前的工作已经证明 LPT 调度是 \(4 / 3\) 近似 (approximation) 的,即它的完成时间最多是最优调度的 \(4 / 3\) 倍
Implementation
RL Training Framework
- SGS 采用了一个用 \(\mathbb{C} + +\) 实现的内部推理引擎,并带有优化的 CUDA 内核,支持连续批处理 (continuous batching) 以提前释放短样本,以及前缀共享 (prefix sharing) 以节省 KV 缓存 (key-value cache) 的使用
- Trainer 实现了类似于先前工作的 3D 并行
- 为了解决 GPU 内存限制,本文开发了动态 CPU 卸载 (dynamic CPU offloading) 技术,通过内存交换 (memory swapping) 来交错执行不同的模型
Tensor-native RPC Library
- 传统的分布式计算框架在传输张量数据时通常会产生显著的序列化 (serialization) 和反序列化 (deserialization) 开销
- 本文开发了 RL-RPC,这是一个为优化 SGS 和 Trainer 之间数据传输而设计的通信框架
- 该系统采用 GPU-Direct RDMA 进行零拷贝 (zero-copy) 张量传输,绕开 CPU 参与并消除了序列化开销,从而最小化通信成本
- 通过在不消耗 GPU SM 资源的情况下充分利用 RDMA 带宽,RL-RPC 通过通信与计算的重叠来防止性能下降
- TCP 回退 (fallback) 机制确保了在不同网络环境(包括非 RDMA 的跨数据中心连接)中的兼容性
Weights transmission
- 在 Trainer 端的权重分片 (weights sharding) 之后,StreamRL 采用一个网络感知 (network-aware) 传输引擎来高效地将权重从 Trainer 广播到 SGS
- 该引擎动态构建针对网络拓扑优化的广播树
- 在单数据中心设置中,两者都位于同一个 RDMA 网络上,它创建多个以不同 DP rank 为根的树,在树之间进行负载均衡以保持所有 DP 的带宽饱和
- 对于带宽有限的跨数据中心部署,只有根节点 (DP rank 0) 将权重发送到远程数据中心中的一个指定 SGS DP 实例 ,然后进行本地广播 ,以最小化跨数据中心流量
Testbed,试验台
- 本文在一个拥有 16 个节点和 128 个 GPU 的 H800 集群上部署 StreamRL
- 每个节点有 8 个 NVIDIA H800-80GB GPU
- 节点通过基于 RoCEv2 的 \(8*200\) Gbps RDMA 网络连接,并采用 rail-optimized 拓扑
- 对于异构和跨数据中心实验 (§7.3),本文还使用了一个基于云的 H20 集群,该集群有 4 个节点和 32 个 GPU
- 每个节点有 8 个 NVIDIA H20-96GB GPU
- 节点通过 100Gbps TCP 网络连接
- H800 和 H20 集群通过一条 80Gbps 的专线连接
- H800 和 H20 之间的其他规格列于表 1
Models
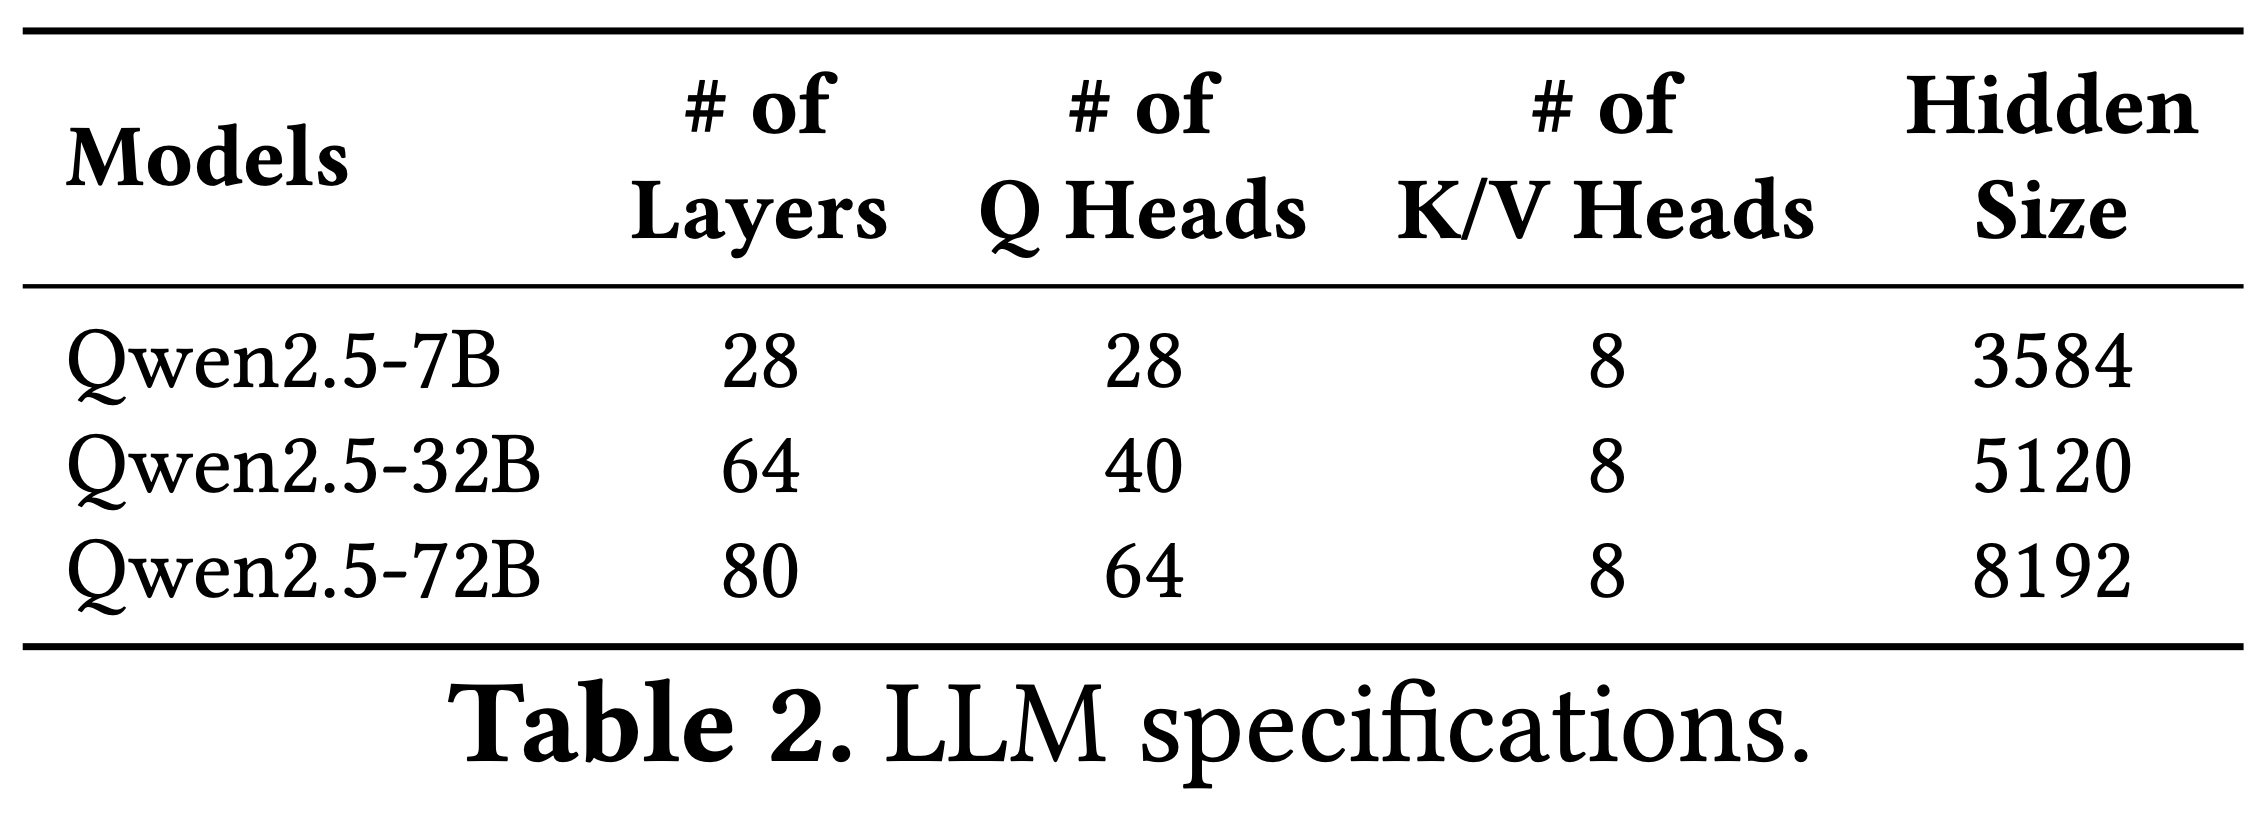
- 选择 Qwen2.5 模型,范围从 7B 到 72B,详细的模型架构列于表 2
Dataset
- 使用一个内部的 CodeMath Prompt 数据集,并从 DeepSeek-R1(一个开源的先进推理模型)收集响应作为 Ground truth
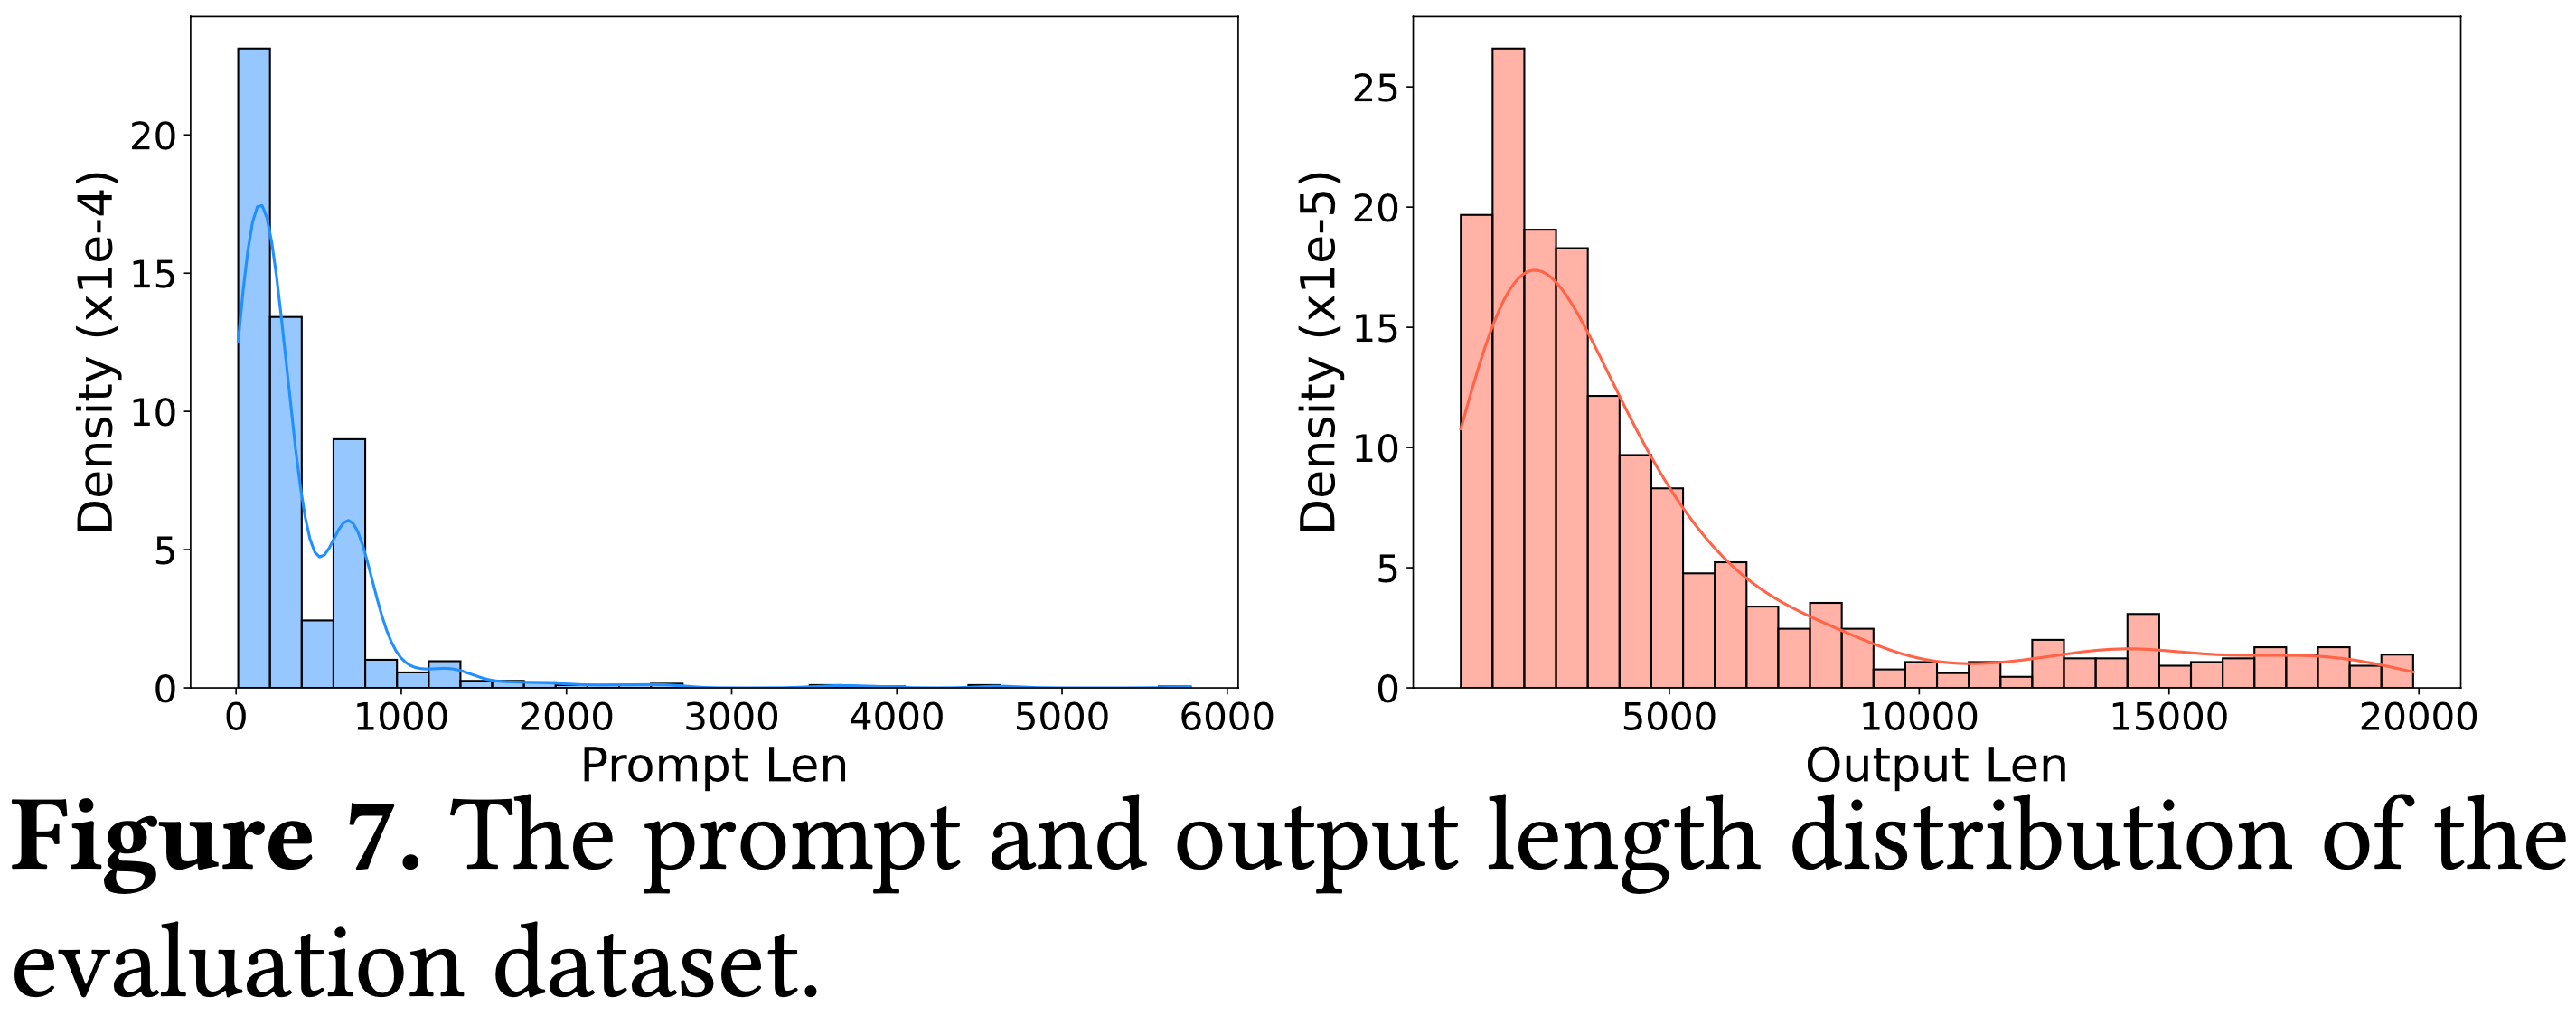
- 数据集中 Prompt 长度和输出长度的分布如图 7 所示
- 最大输出长度为 20K,且分布呈现显著的长尾特性
- 最大输出长度为 20K,且分布呈现显著的长尾特性
- 为了训练 StreamRL 的输出长度排名器模型,按 7:2:1 的比例将数据集划分为训练集、验证集和测试集
- 所有性能评估均在测试集的样本上进行
- 为了避免因不同 RL 框架底层运行时的数值差异导致的生成长度不一致,修改了所有 RL 框架中的推理代码,使其按照每个 Prompt 的真实答案生成相同长度的输出
- 这不仅有助于模拟在实际 RL 训练中观察到的长尾效应,同时也确保了在不同 RL 框架之间进行公平的比较
Settings
- 使用在 RL 后训练中广泛使用的 PPO 算法
- 注:StreamRL 的有效性不依赖于任何特定的 RL 算法,并且可以推广到其他算法,如 GRPO
- 本文将 Actor、Critic 和 Reference Model 设置为相同大小
- 不使用显式的 Reward Model,而是基于 DeepSeek-R1 使用一个 Rule-based verifier 来提供奖励
- 本文还按比例将输出长度缩小两倍和四倍,以模拟 RL 训练的早期和中期阶段,此时输出长度尚未变得特别长
- 这产生了三个数据集,为清晰起见,本文将其记为 5K、10K 和 20K
- 在每次迭代中,遵循原始 PPO 算法使用 1024 的全局批次大小
Metrics
- 对于端到端实验,按照 RLHFuse 测量样本吞吐量(定义为每秒平均处理的样本数)
- 在每种设置下,记录预热 (warm-up) 后连续 20 次训练迭代的样本吞吐量
Evaluation
- 使用从 7B 到 72B 的不同规模的 LLM,在真实世界数据集上评估 StreamRL
- 7.1:在单数据中心设置下将 StreamRL 的端到端性能与其他 RL 训练框架进行比较
- 7.2:进行消融实验以展示作者提出技术的有效性
- 7.3:展示 StreamRL 在异构、跨数据中心设置下的性能,以展示分离式架构的灵活性和可扩展性
- 7.4:提供训练曲线以证明异步 RL 达到了与同步 RL 相当的性能和收敛性
End-to-end Experiments
- 将 StreamRL 的端到端性能与以下基线框架进行比较
- verl (2024) 是当前最先进的开源 RL 训练框架,也是共置架构的代表
- 它提出了一种用于 RL 数据流的分层混合编程模型,并优化了每个模型的并行策略
- 选择 vLLM (2023) 作为其推理引擎,并选择 Megatron-LM (2020) 作为其训练后端
- ColocationRL 是基于共置架构的内部 RL 训练框架
- 它与 StreamRL 共享相同的推理和训练后端实现
- 加入此基线以展示解耦以及在第 4 节和第 5 节中的技术带来的性能提升
- 消除了因底层实现差异以及 LLM 生成和训练中与本文的核心贡献正交的其他优化技术而导致的不公平比较
- verl (2024) 是当前最先进的开源 RL 训练框架,也是共置架构的代表
- 本文没有与其他基于分离式架构的开源框架(如 OpenRLHF (2024) 和 NeMo (2025))进行比较,因为正如 (2024) 所报道的,由于资源闲置(第 2.2 节),它们的吞吐量低于 verl
- 对于 StreamRL,本文展示了两个变体
- StreamRL-Sync 实现了 PPO 的同步版本,与基线相同
- StreamRL-Async 实现了一步异步版本以最大化吞吐量
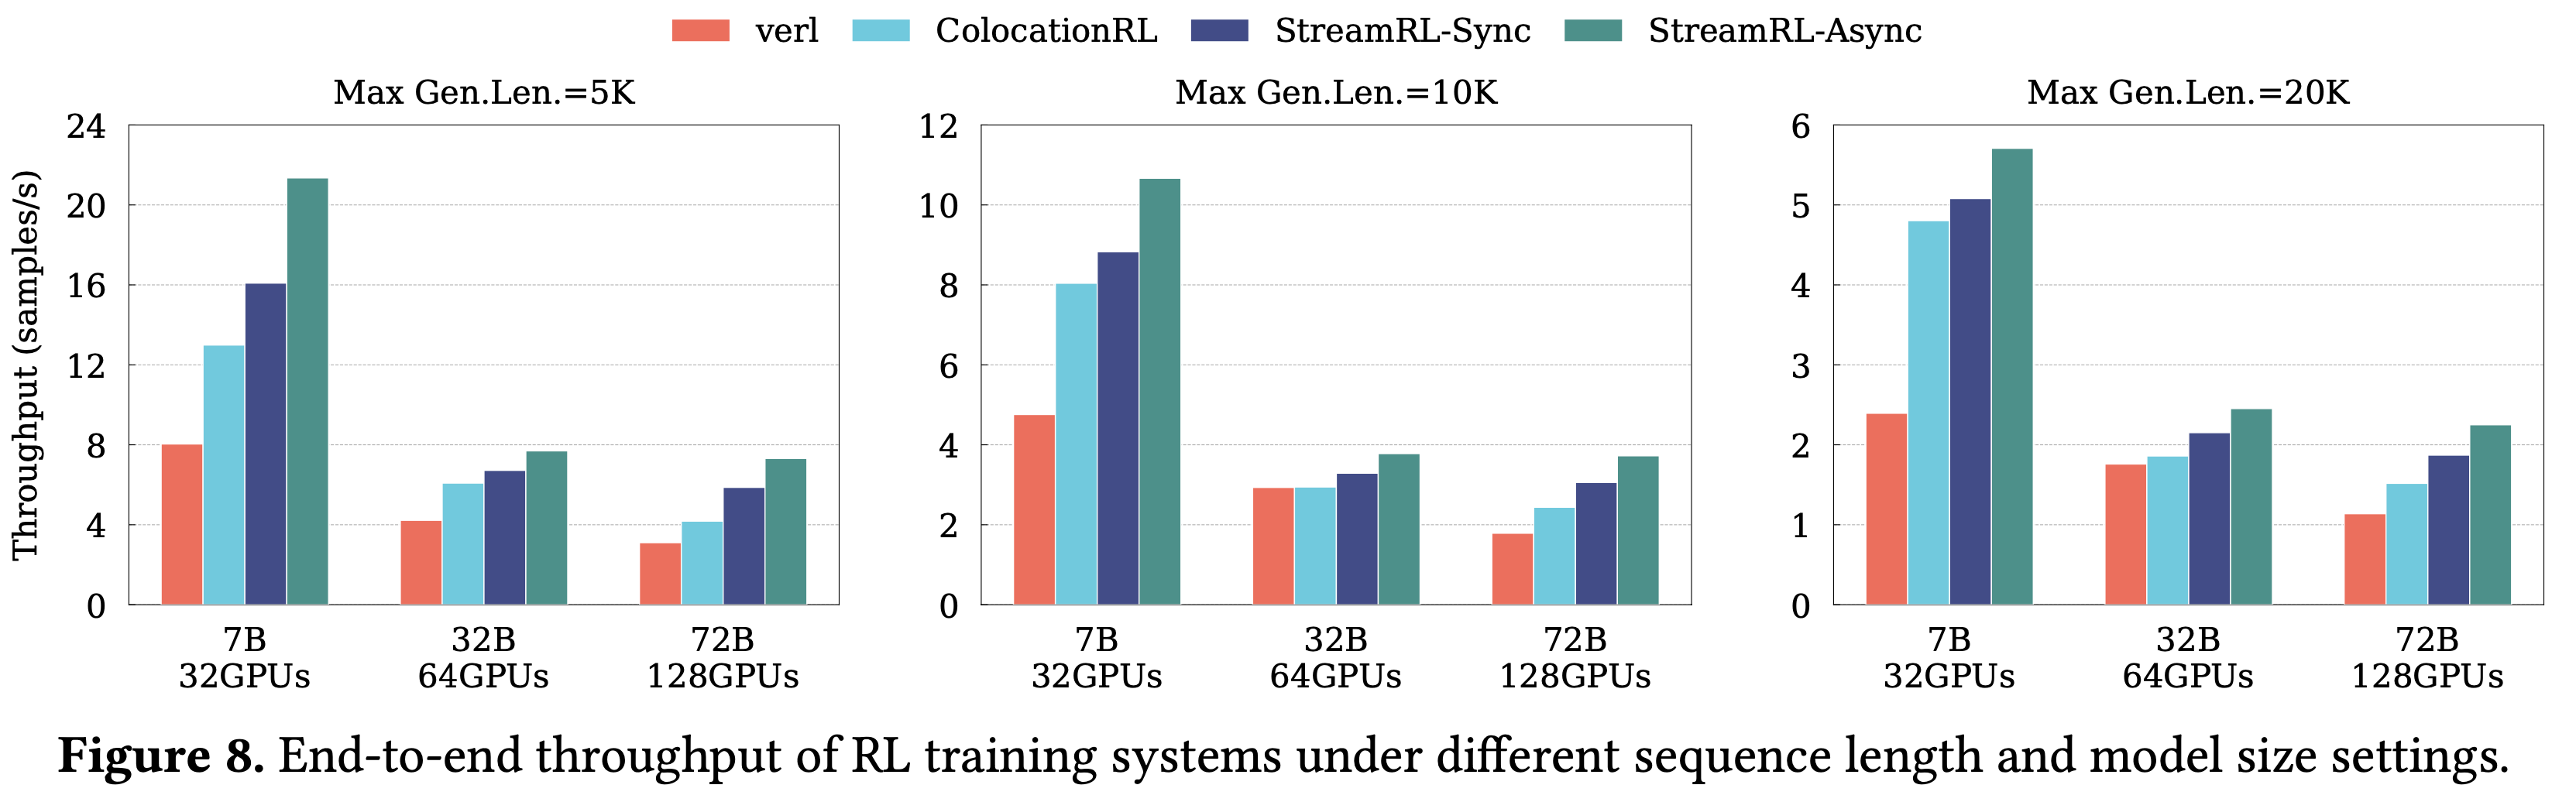
- 图 8 展示了在各种最大序列长度和模型大小下,不同 RL 框架的端到端吞吐量
- 与 verl 相比,StreamRL-Sync 实现了 \(1.12\times - 2.12\times\) 的加速,这部分归功于底层推理和训练框架的优化
- 与 verl 相比,StreamRL-Sync 实现了 \(1.12\times - 2.12\times\) 的加速,这部分归功于底层推理和训练框架的优化
- 与 ColocationRL 相比,StreamRL-Sync 通过利用解耦流式生成和偏斜感知调度实现了 \(1.06\times - 1.41\times\) 的加速
- 在共置设置下,生成高度受内存带宽限制,导致 GPU 利用率低
- 解耦使 StreamRL-Sync 能够灵活且明智地为生成分配资源,并通过流式传输有效重叠两个阶段,从而提高了 GPU 利用率
- 然而,即使使用流式传输,由于数据的长尾分布和阶段依赖关系,解耦带来的性能提升部分被抵消
- StreamRL-Async 通过采用一步异步训练来完全重叠 Pipeline Bubble,进一步解决了这些限制,实现了 \(1.30\times - 2.66\times\) 的吞吐量提升
Ablation Studies
Improvement breakdown
表 3 详细展示了本文提出的技术在最大长度为 20K 的数据集上训练 72B 模型时的提升分解
- 观察:表 3 Idx-2 偏斜感知调度相较于 ColocationRL 将吞吐量提升了 \(8\%\),主要通过优化生成时间实现
- 使用输出长度 Ranker 模型识别长尾样本,为其分配专用计算资源和较小的 Batch Size 来加速其生成
- 这种偏斜感知调度的有效性取决于 Ranker 模型对长尾样本的预测准确性
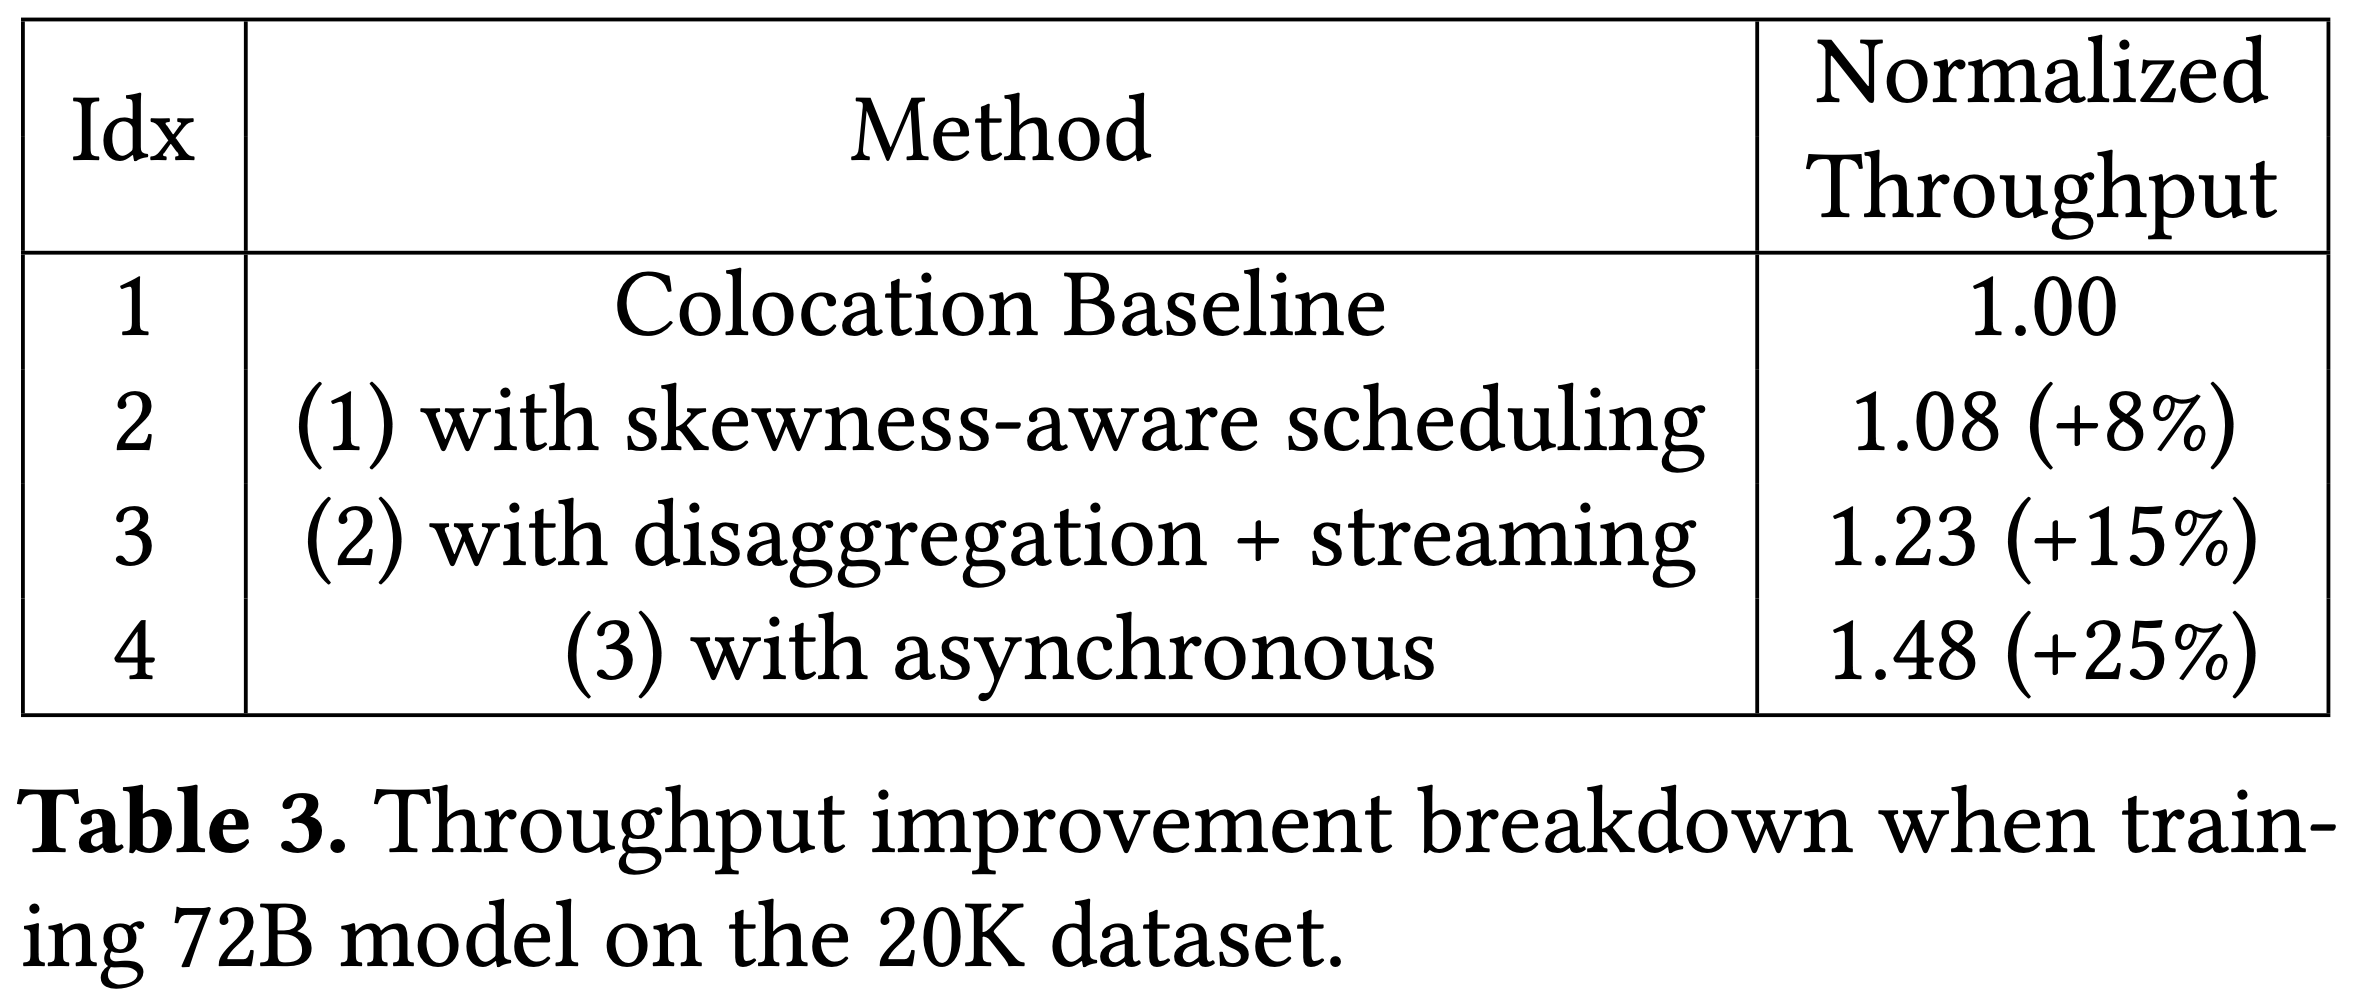
表 4 显示了使用不同规模的基础模型训练后,对不同比例的长尾样本的召回率
- 对于最长的 \(20\%\) 样本,可以实现高达 \(87\%\) 的召回率
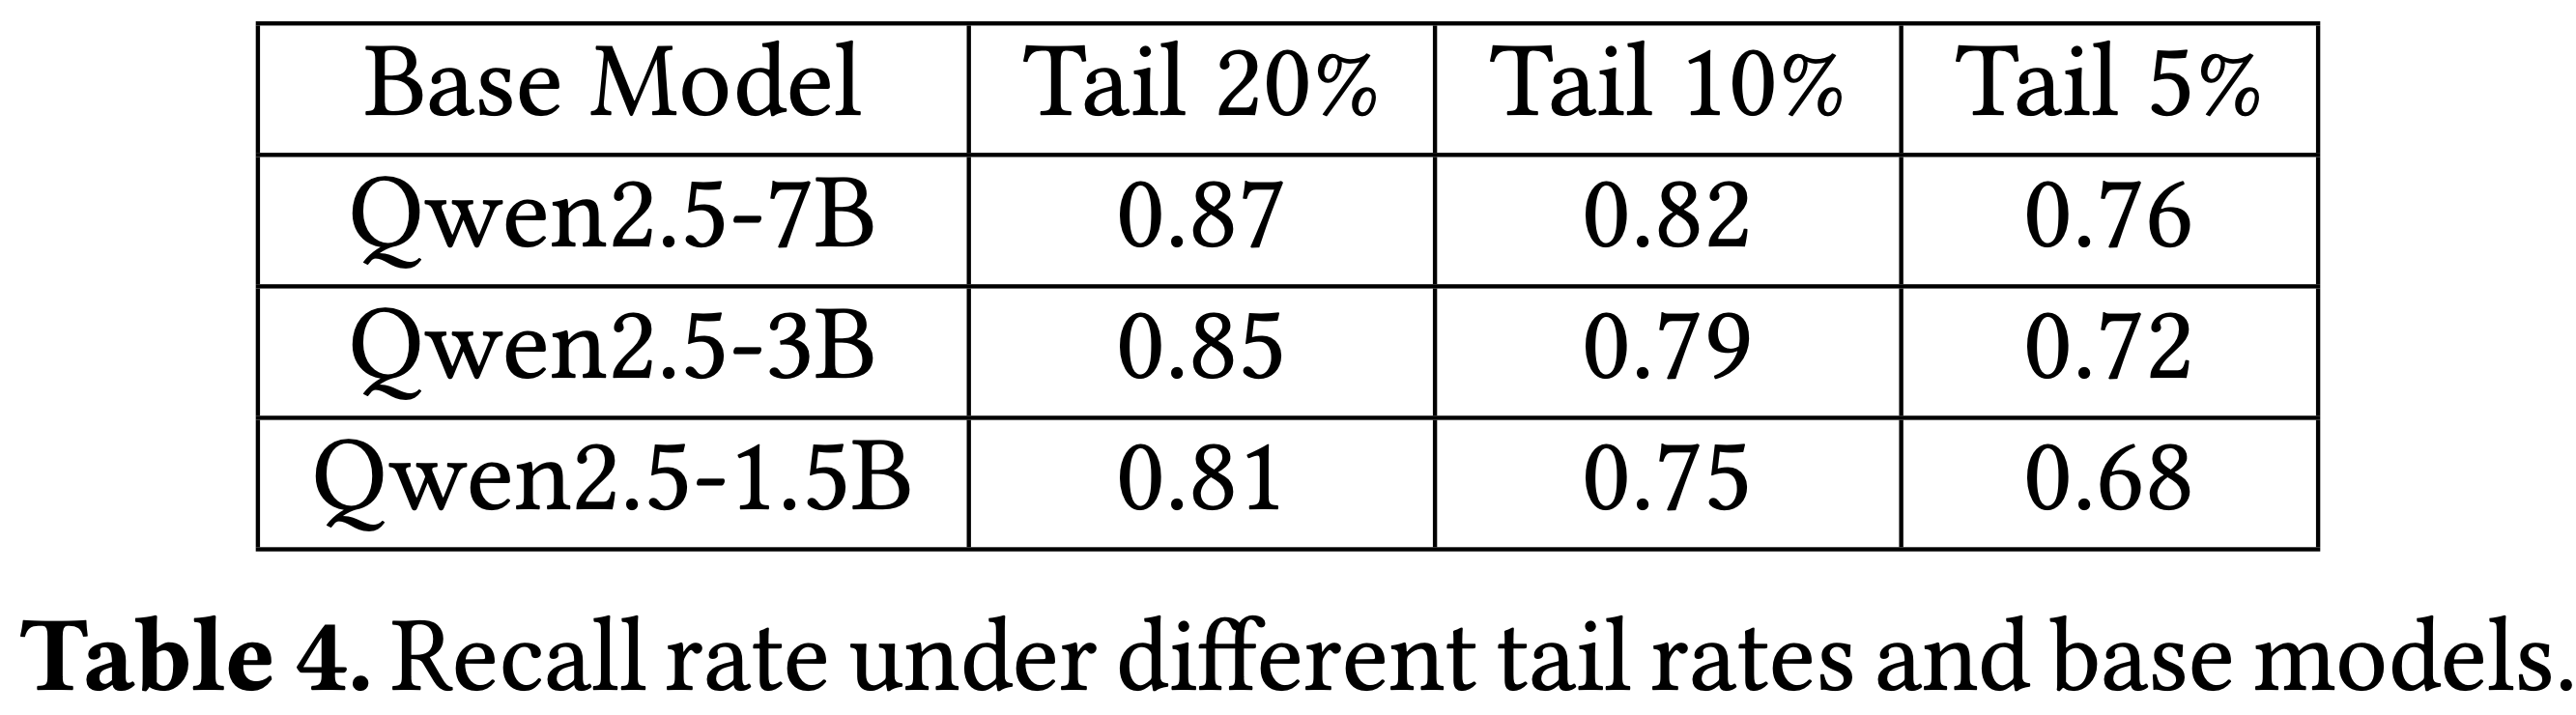
- 对于最长的 \(20\%\) 样本,可以实现高达 \(87\%\) 的召回率
剩余未被预测到的长尾样本对性能影响有多大?
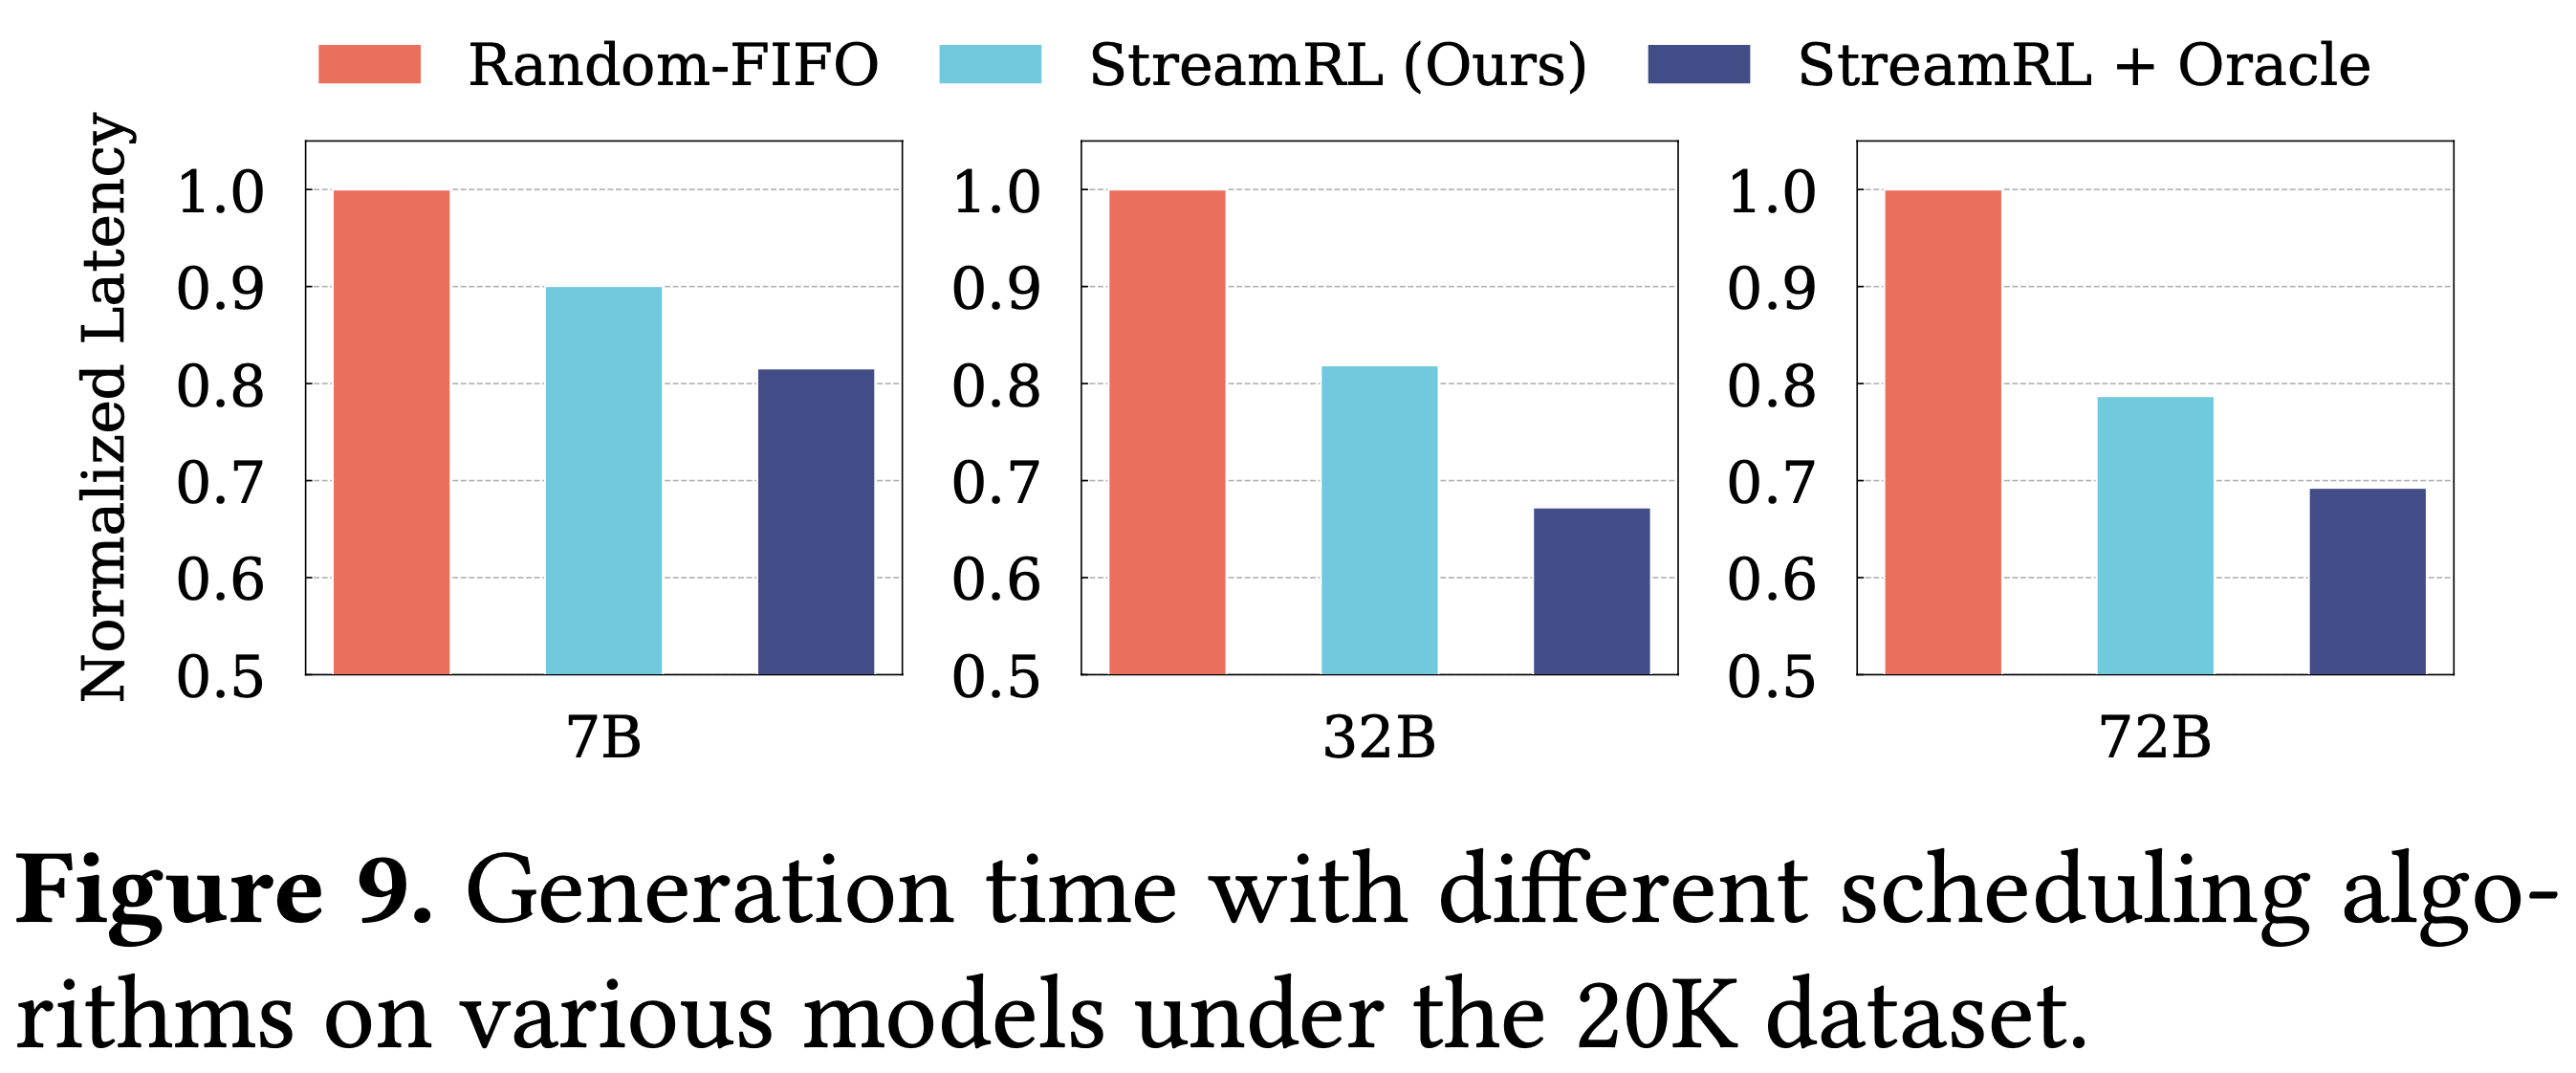
- 本文比较了随机调度和偏斜感知调度下的生成时间,并评估了一个 Oracle 设置(即预先知道输出长度)作为加速上限
如图 9 所示,通过 Ranker 模型实现了大部分潜在收益
- 随着 RL 训练的进行,LLM 的输出长度分布会发生变化
- 为了保持预测准确性,定期使用最近生成的样本对 Ranker 模型进行在线微调,以适应分布漂移
- 此训练过程的收敛时间仅为几分钟,与整个 RL 训练时间相比可以忽略不计
在偏斜感知调度的基础上,表 3 Idx-3 解耦流式传输进一步将吞吐量提升了 \(15\%\),表 3 Idx-4 异步训练又带来了额外的 \(25\%\) 提升
- 这些改进根本上源于解耦能够为生成阶段分配适当的资源,从而提高其 GPU 利用率
- 要将这种回收的利用率转化为端到端的加速,必须解决由阶段依赖关系引起的 Pipeline Bubble
- 流式传输重叠了部分 Bubble,而异步训练几乎实现了完全重叠
Resource allocation
- 为了实现更好的重叠,平衡两个阶段的延迟也至关重要
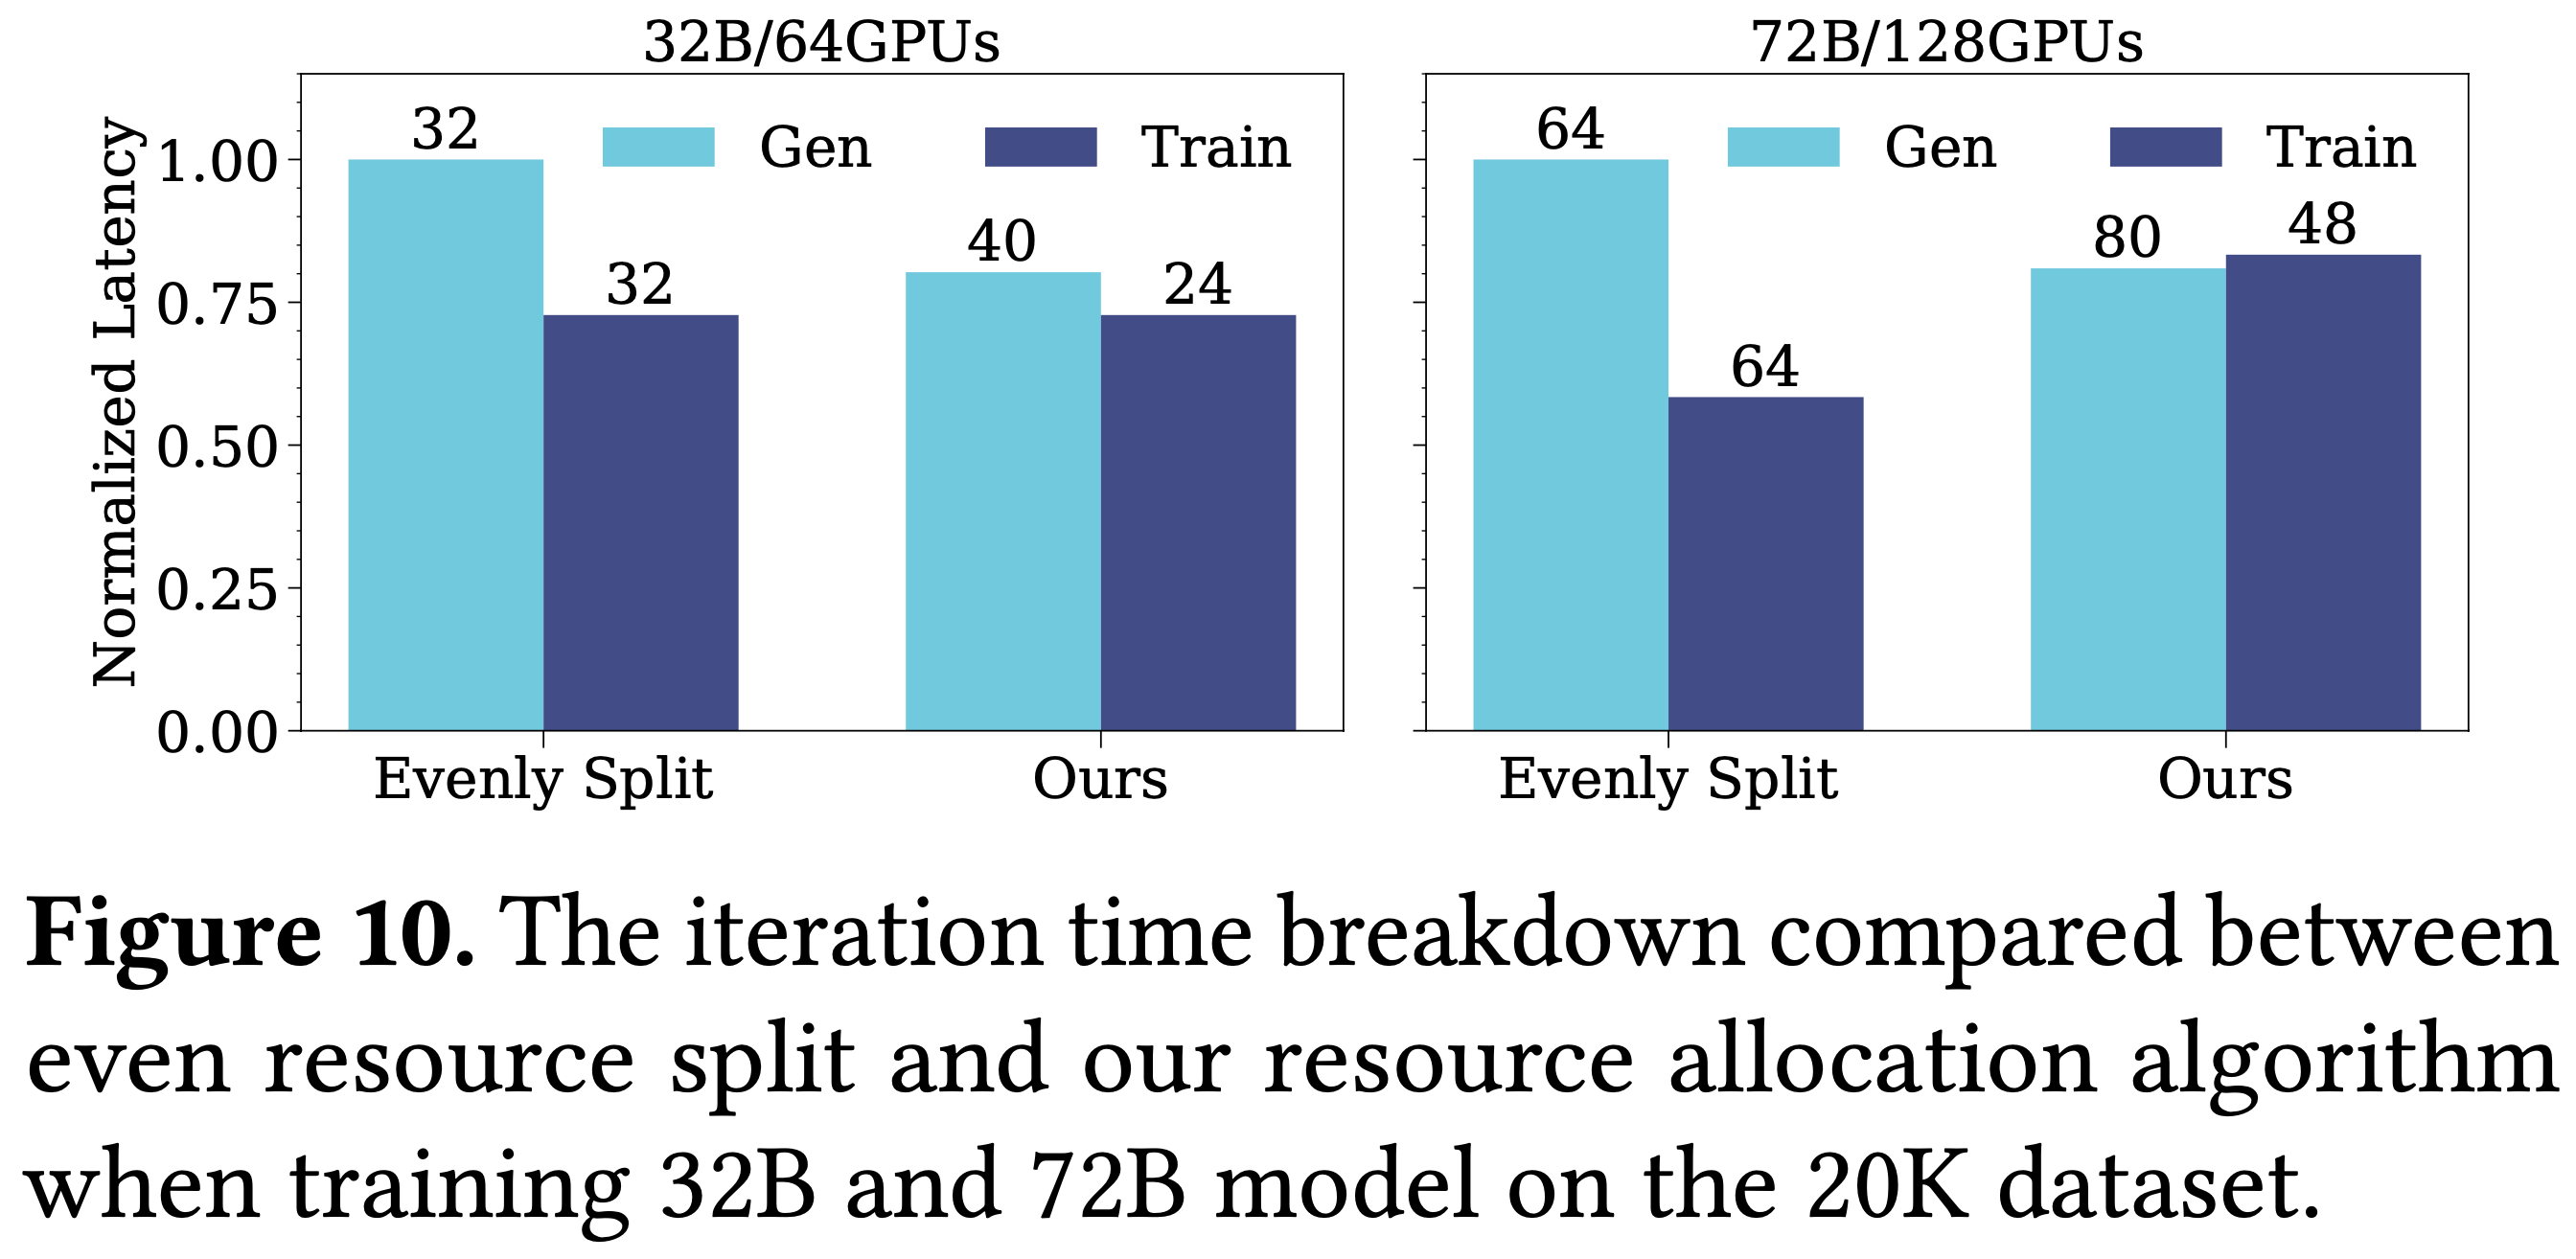
- 图 10 比较了在简单均分方案和 StreamRL 资源分配算法所选方案下的迭代时间分解
- 每个柱状图顶部标注了每个阶段使用的 GPU 数量
- 如图所示,通过调整并行策略和资源分配,本文实现了良好的阶段延迟平衡
- 在异步训练中,迭代时间由两个阶段中较慢的一个决定,因此平衡的阶段延迟直接转化为 \(1.25\times\) 的加速
- 图 10.:在 20K 数据集上训练 32B 和 72B 模型时,均分资源与作者的资源分配算法之间的迭代时间分解比较
- 为了展示动态调整算法的有效性,本文在 32 个 GPU 上部署 StreamRL-Async 来训练 7B 模型,并将数据集的最大输出长度从 10K 线性增加到 20K
- 图 11 显示了每次迭代中两个阶段之间的 Delta 时间
- 如图所示,在第 10 次和第 16 次迭代之后,StreamRL 检测到不平衡,并自动向 SGS 阶段添加一个包含 8 个 GPU 的节点,以恢复阶段平衡
- 图 11:初始在 32 个 GPU 上使用 10K 数据集训练 7B 模型,然后将输出长度线性增加到 20K 数据集时,两个阶段之间的 Delta 时间
Cross-Datacenter and Heterogeneity,跨数据中心与异构性
- 如第 2 节所述,解耦的一个有前景的潜力在于使每个阶段能够利用最合适的硬件资源并支持跨数据中心训练
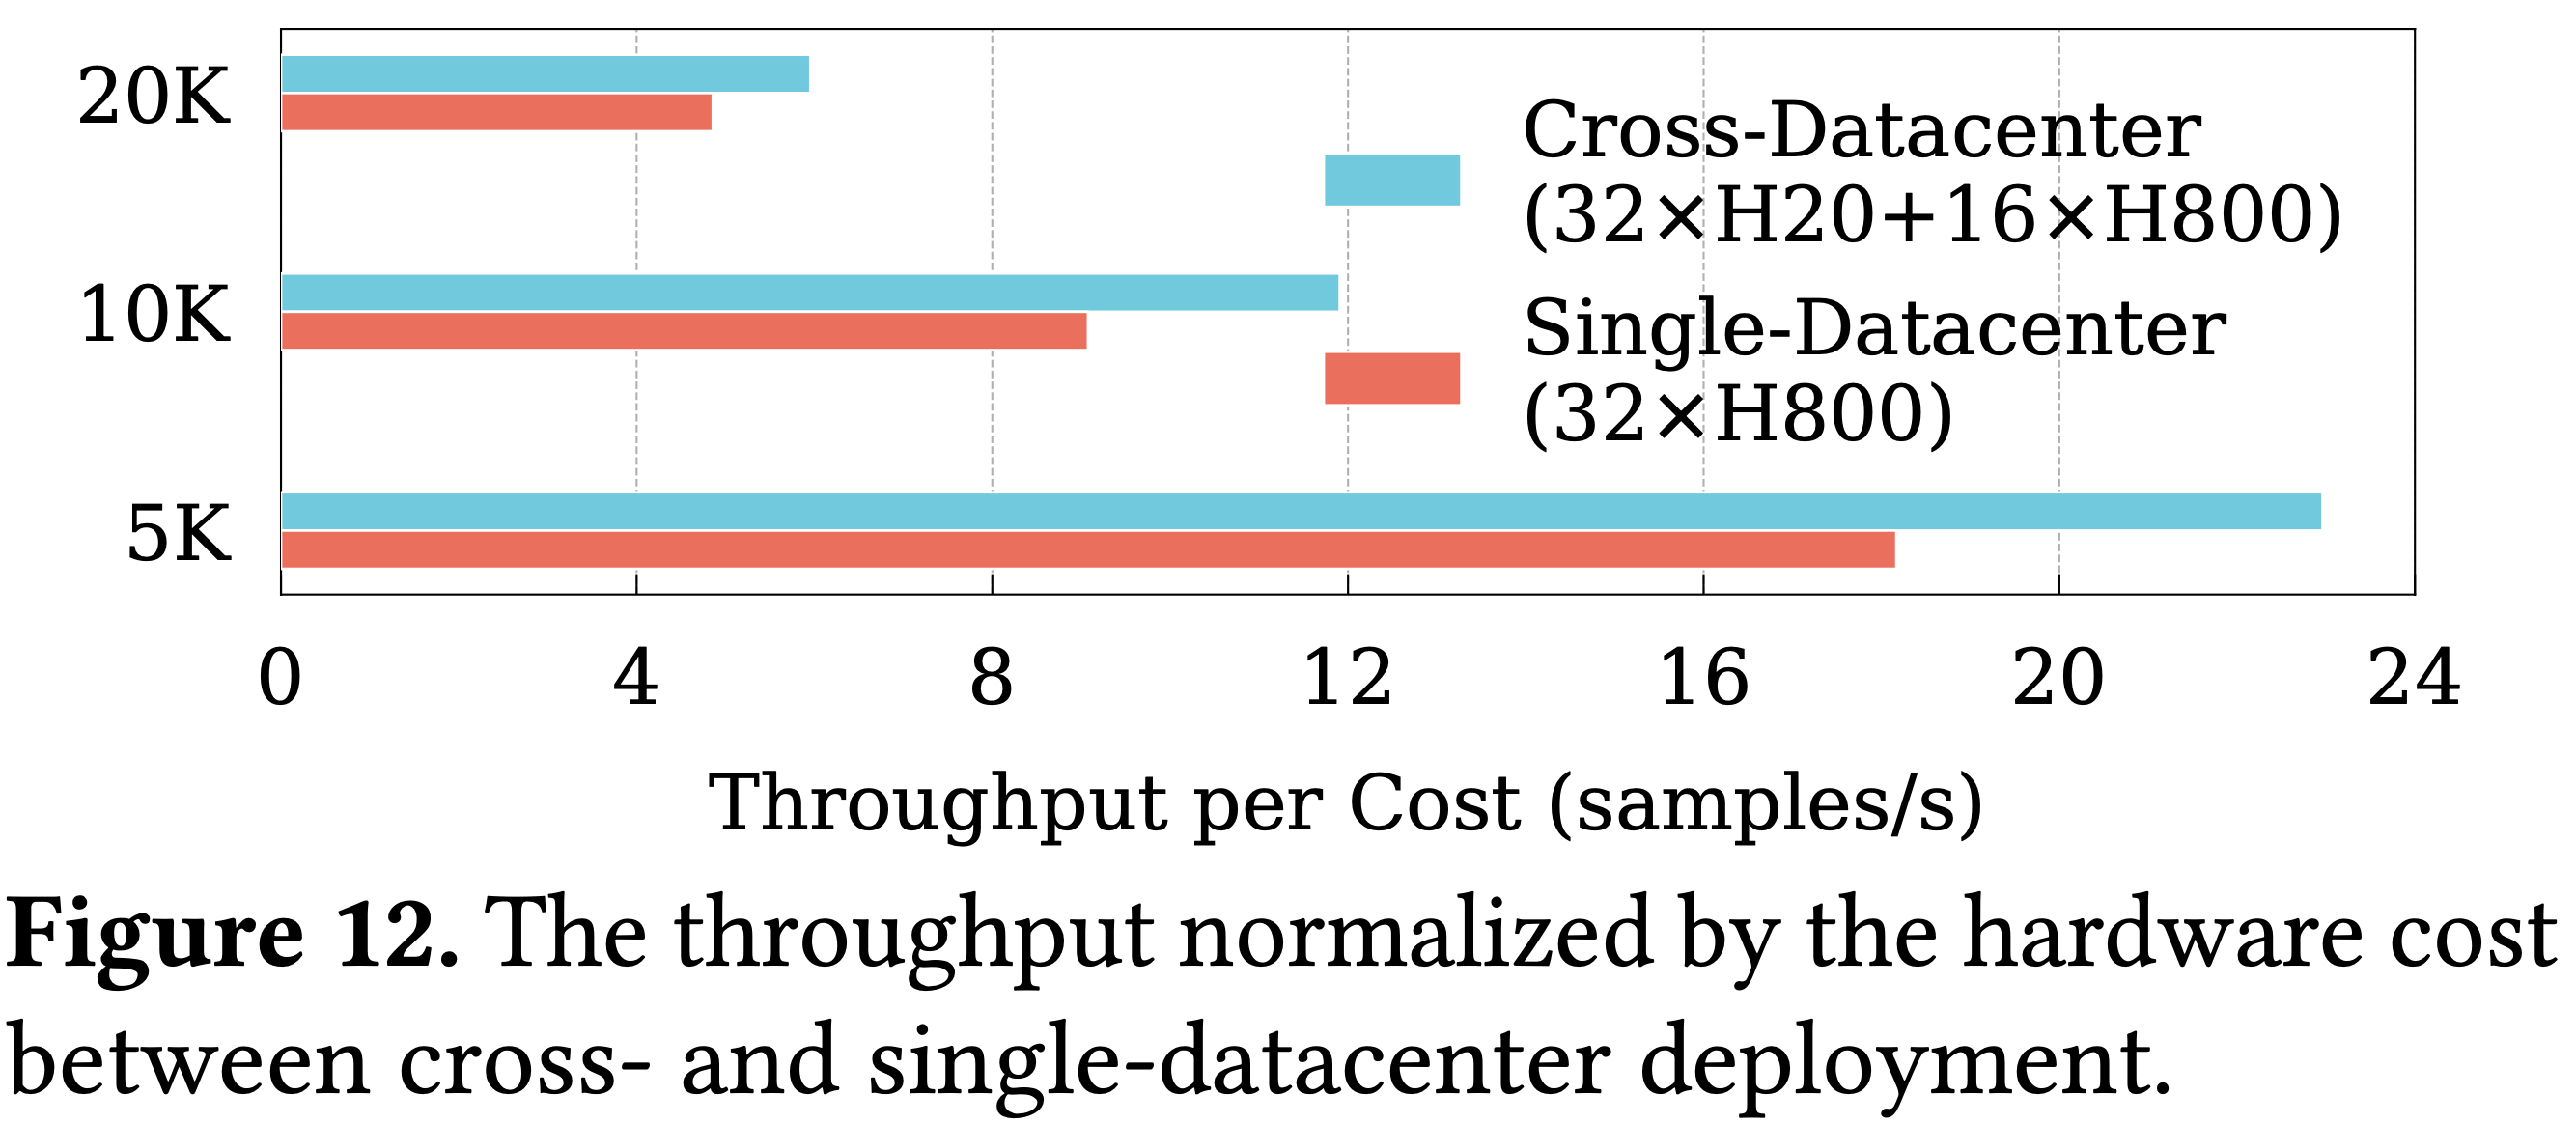
- 为了证明这一点,本文采用与 7B 模型端到端实验相同的设置,但将 StreamRL 的 SGS 移动到一个基于云的拥有 32 个 GPU 的 H20 集群中
- Trainer 仍然放置在 H800 集群中
- 本文将其性能与原始的单数据中心设置进行比较
- 如图 12 所示
- 在异构部署下,StreamRL 实现了按硬件成本归一化后高出 \(1.23\times - 1.31\times\) 的吞吐量
- 这种改进源于 H20 在生成工作负载方面更高的成本效益
- 此外,跨数据中心通信引入的通信开销很小:每次迭代仅在权重更新期间需要通信
- 即使对于 72B 模型,通过 80 Gbps 专用链路的传输开销也小于 10 秒,不到总迭代时间的 \(2\%\)
- 理解:这里需要注意
- 共置式架构的通信是几乎没有的,生成和训练共享同一批 GPU 物理资源,通过时分复用切换,因此确实没有这种跨阶段的网络通信开销
- 这里所谓的通信量小,主要是用 解耦式 RL 训练 对比 传统的大规模 LLM 预训练或常规分布式训练,通信开销要小得多
- 图 12. 跨数据中心部署与单数据中心部署之间按硬件成本归一化的吞吐量
Algorithmic Behavior of Asynchronous RL,异步 RL 的算法行为
- 异步 RL 对 LLMs 的有效性已被一些先前的工作 (2025; 2025; 2025) 观察和验证
- 为了确认这一点,本文还在一个内部数据集上使用 Qwen2.5-32B (2024) 作为基础模型进行了基于 PPO 的 RL 训练
- 保持所有其他 Setting 相同,图 13 显示了一步异步版本的奖励曲线与同步版本非常接近
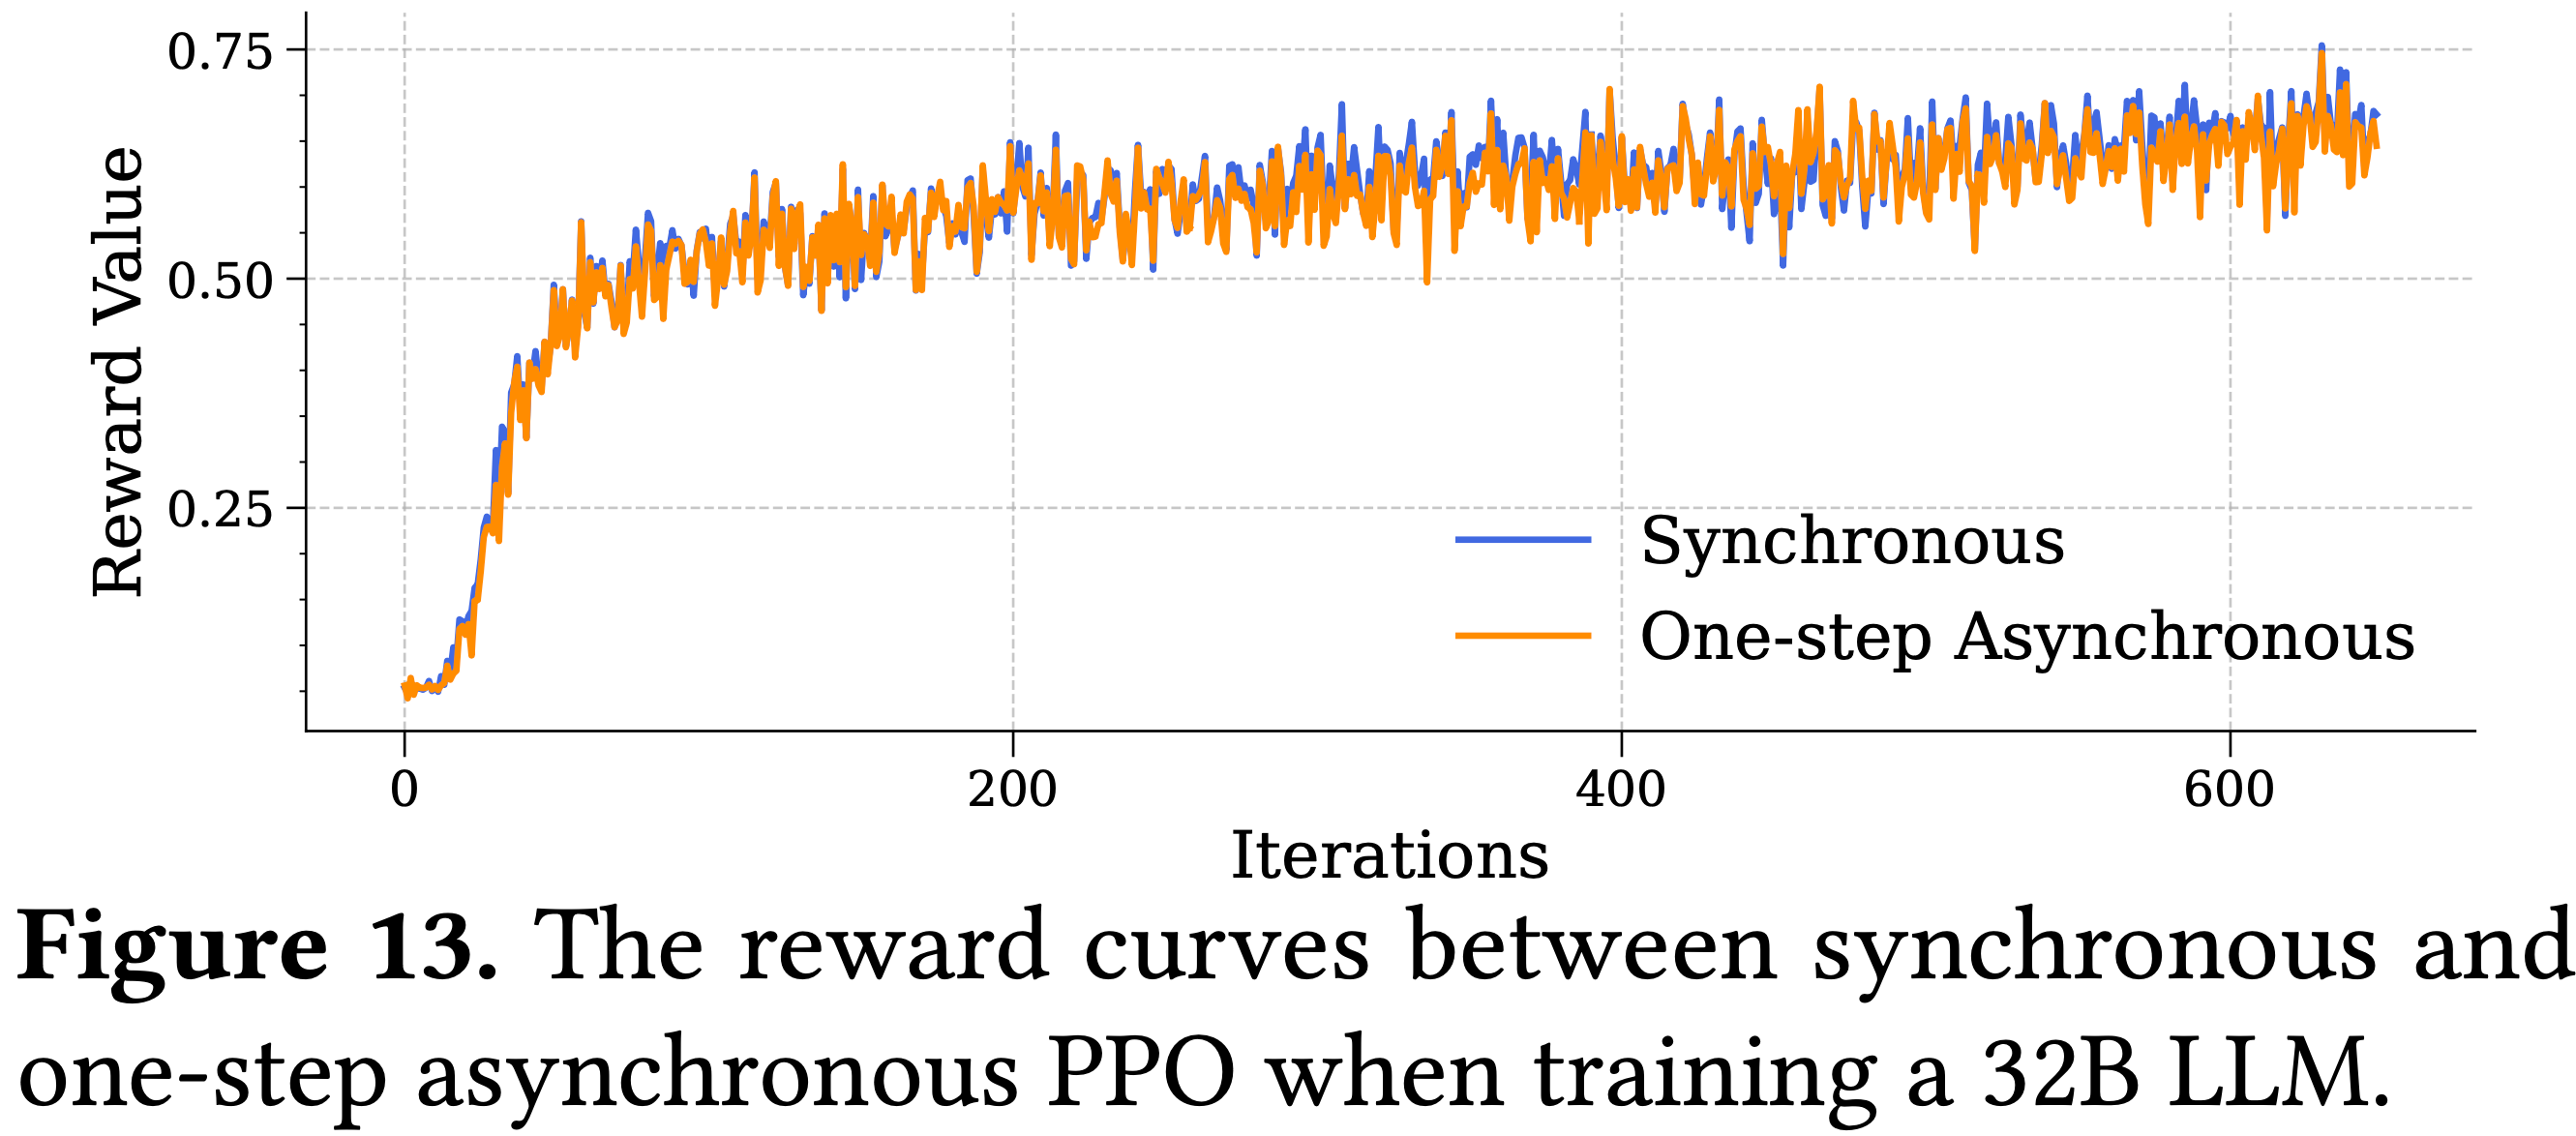
- 这证明了通过算法-系统协同设计来最大化训练效率是可能的,而不会影响模型性能和收敛性
- 注:这个案例研究仅凭经验验证了异步训练在特定 LLM 任务上的可行性
- 其通用性和理论保证超出了本文的范围
- 担心异步可能带来的模型收敛问题,也可以使用解耦和流式传输来提高效率,而无需改变训练语义
Related Work
RL training frameworks
- 一类 RL 框架,如 NeMo (2025) 和 OpenRLHF (2024),将 GPU 集群划分为多个子集,以服务于 RL 训练的不同阶段
- 它们是低效的,因为一次只能执行一个阶段,导致资源闲置
- 另一类框架,verl (2024),RLHFuse (2025),Real (2024) 和 PUZZLE (2024) 将不同阶段共置在同一个 GPU 池上以最大化资源利用率
- Real (2024) 通过参数重分配来避免利用不足
- RLHFuse (2025) 进一步提出了阶段融合以减少子阶段级别的空闲
- PUZZLE (2024) 提出了轻量级上下文切换以减少切换开销
- 但它们都存在资源耦合问题,而 StreamRL 解决了这个问题
LLM inference optimizations
- 已经提出了许多优化来加速 LLM 推理, 它们也适用于 RL 训练的生成阶段
- ORCA (2022) 提出了选择性批处理 (selective batching) 以批处理不同长度的请求
- vLLM (2023) 提出了 PagedAttention 以减少各种请求的内存碎片
- FastServe (2023) 使用抢占式调度来减少长请求的队头阻塞问题
- Splitwise (2024) 和 DistServe (2024) 将 Prefill 和 Decoding 阶段拆分,以避免它们之间的干扰
- 与 StreamRL 类似,它们也采用了资源解耦的思想,但是在 LLM 推理的背景下
- LoongServe (2024) 提出了弹性序列并行以使用不同程度的并行性来服务不同的请求
- 它们与 StreamRL 是正交的,并且其中大部分已在 StreamRL 中实现以改进生成
LLM training optimizations
- LLM 训练在过去几年中得到了广泛研究
- 张量并行 (tensor parallelism) (2020),数据并行 (data parallelism) 和流水线并行 (pipeline parallelism) (2019) 被广泛用于在不同维度上并行化 LLM 训练
- Alpa (2022) 提出了一个统一框架来自动搜索最优并行策略
- CoDDL (2021),Pollux (2021) 和 ElasticFlow (2023) 弹性调整并行策略以适应工作负载
- MegaScale (2024) 总结了优化超大规模训练的各种最佳实践
- StreamRL 针对的是 RL 训练,其中 LLM 训练只是整个过程中的一个阶段