注:本文包含 AI 辅助创作
SkillRL 简单总结
- 当前 LLM Agent 在执行任务时存在一个根本性缺陷:每次任务执行都是孤立的事件 ,Agent 无法从过去的成功或失败中学习,这严重阻碍了其演化能力
- 现有的 Memory-based 方法主要分为两类:
- 1)原始轨迹存储 :如 ReAct、Reflexion、Mem0、ExpeL 等方法,直接将原始 Trajectories 存入外部数据库,作为未来类似任务的参考
- 但原始轨迹通常冗长、冗余且含有大量噪声,使得模型难以提取关键信息
- 2)轨迹压缩与在线更新 :如 MemRL、EvolveR 等方法,尝试压缩 Trajectories 并通过在线训练更新记忆库
- 然而,这些方法仍然只是“模仿”过去的解决方案,无法提炼出核心原则 ,也无法使 Agent 的内部 Policy 真正适应并利用记忆来指导决策
- 1)原始轨迹存储 :如 ReAct、Reflexion、Mem0、ExpeL 等方法,直接将原始 Trajectories 存入外部数据库,作为未来类似任务的参考
- 核心 Insight:有效的经验迁移需要抽象
- 人类专家不会记住每种情境下的每一个动作,而是发展出 Skills
- Skills 是一种紧凑、可重用的策略,它们捕捉了如何完成特定子任务的核心本质
- 受此启发,本文提出了 SkillRL 框架
- 人类专家不会记住每种情境下的每一个动作,而是发展出 Skills
SkillRL 框架总体设计
框架核心思想
- SkillRL 通过 自动技能发现 和 递归演化 ,架起了原始经验与 Policy 改进之间的桥梁,其三个核心组件为:
- 1)基于经验的技能蒸馏机制(Experience-based Skill Distillation)
- 2)分层技能库 SkillBank(Hierarchical Skill Library)
- 3)递归技能演化机制(Recursive Skill Evolution)
整体流程概览
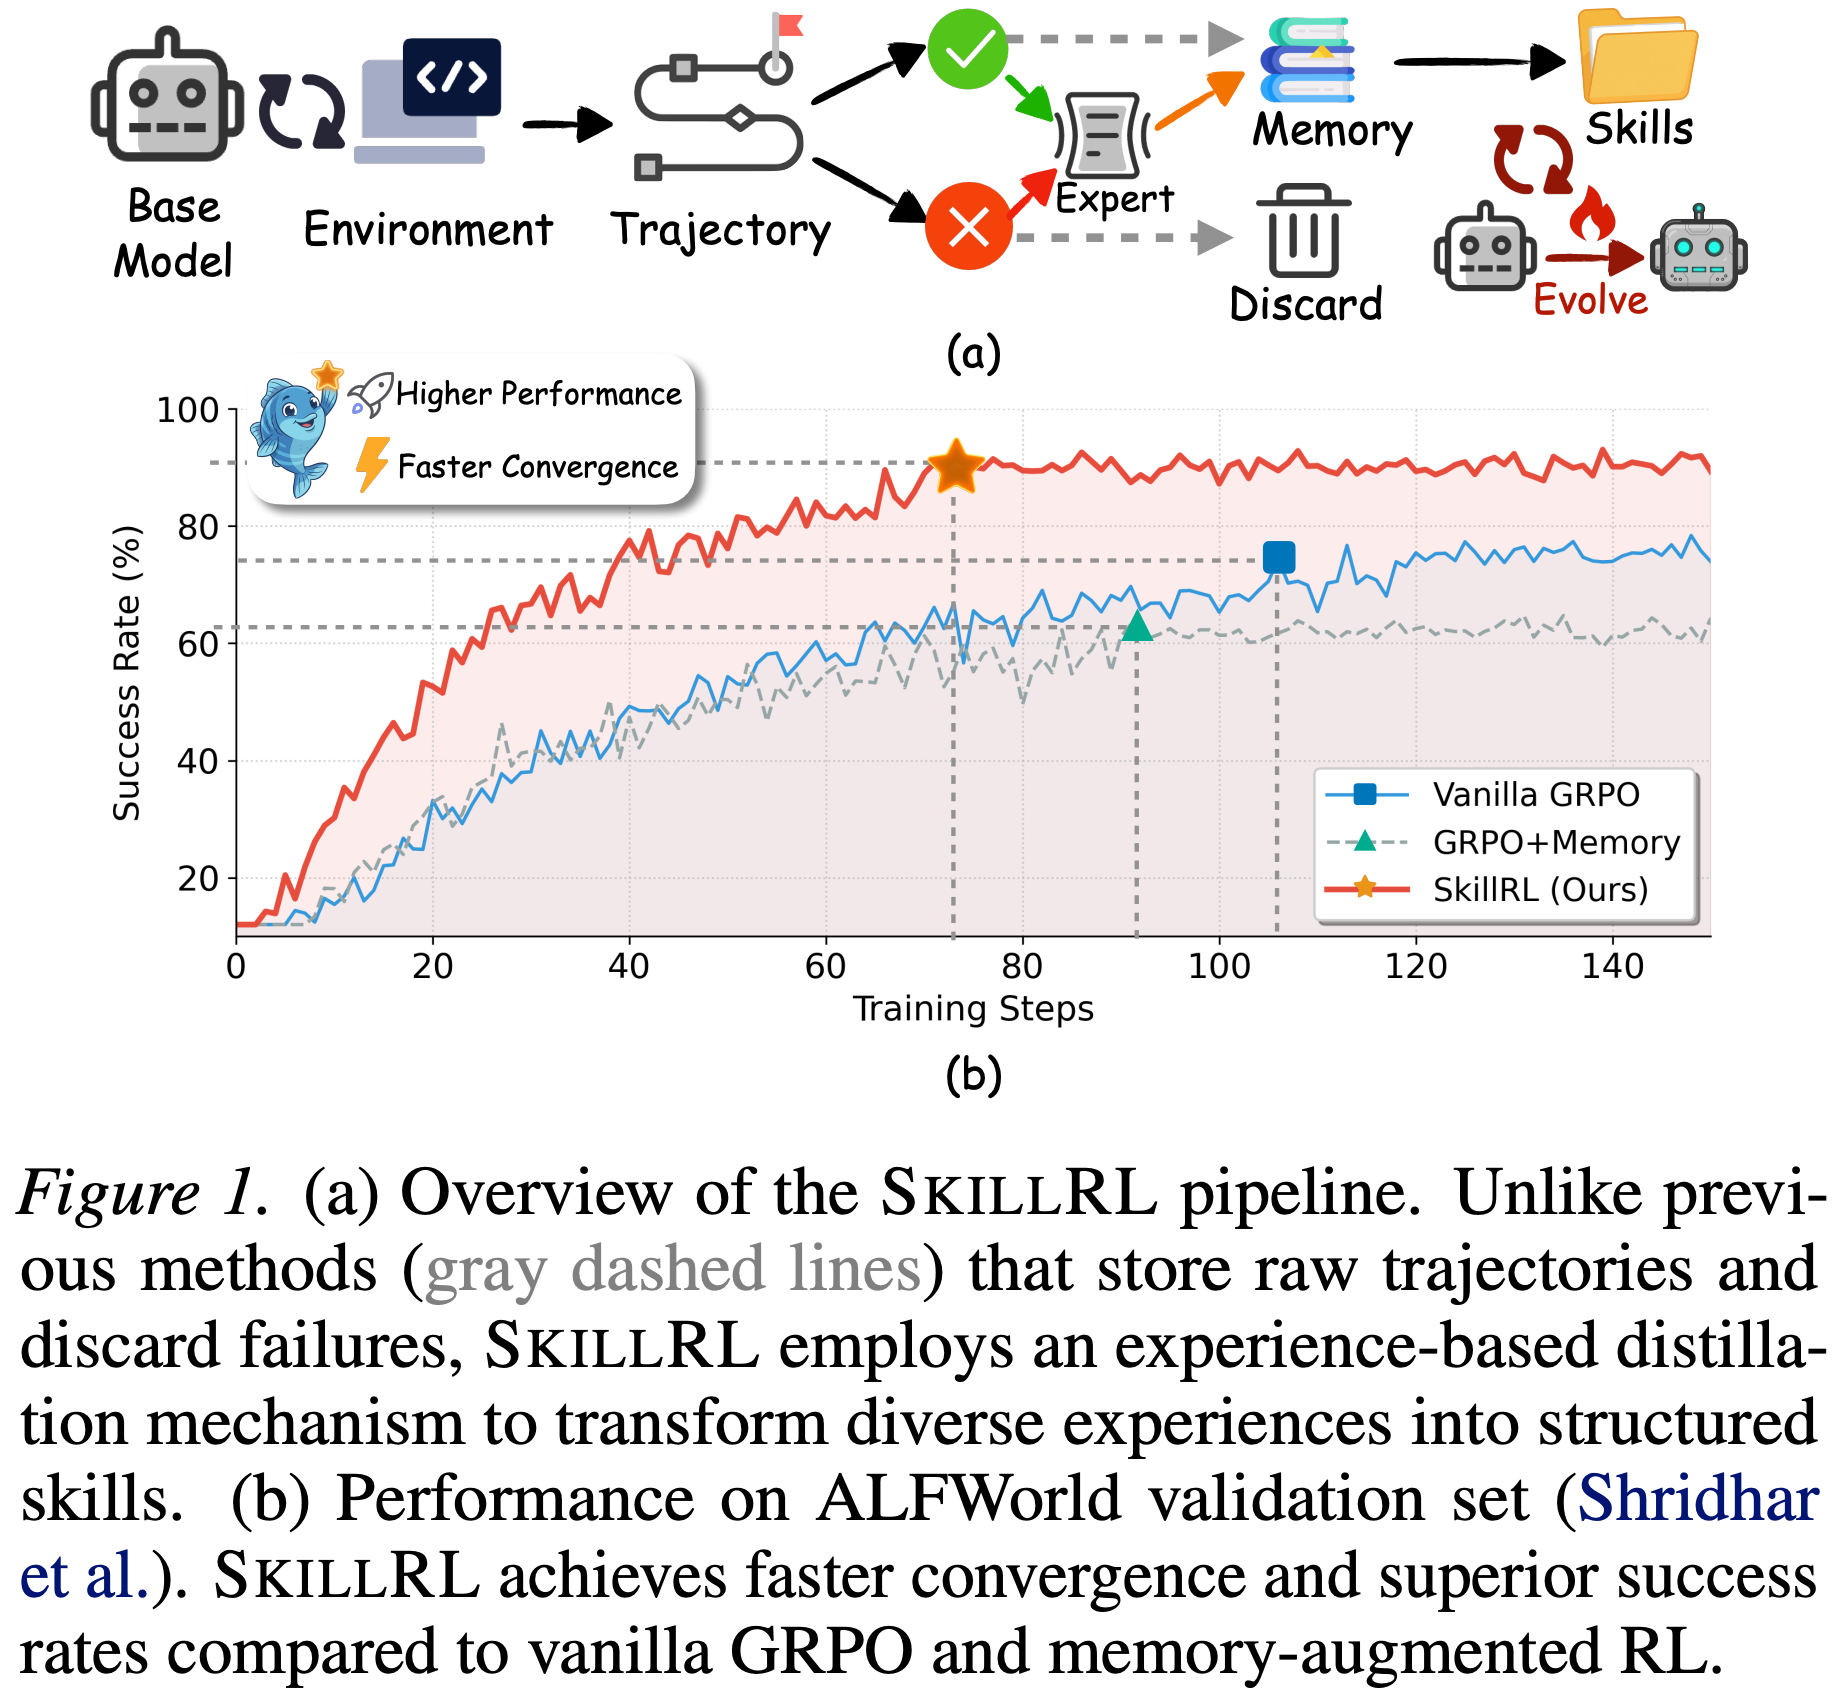
- 如论文 Figure 1(a) 所示,SkillRL 的完整 Pipeline 包括:
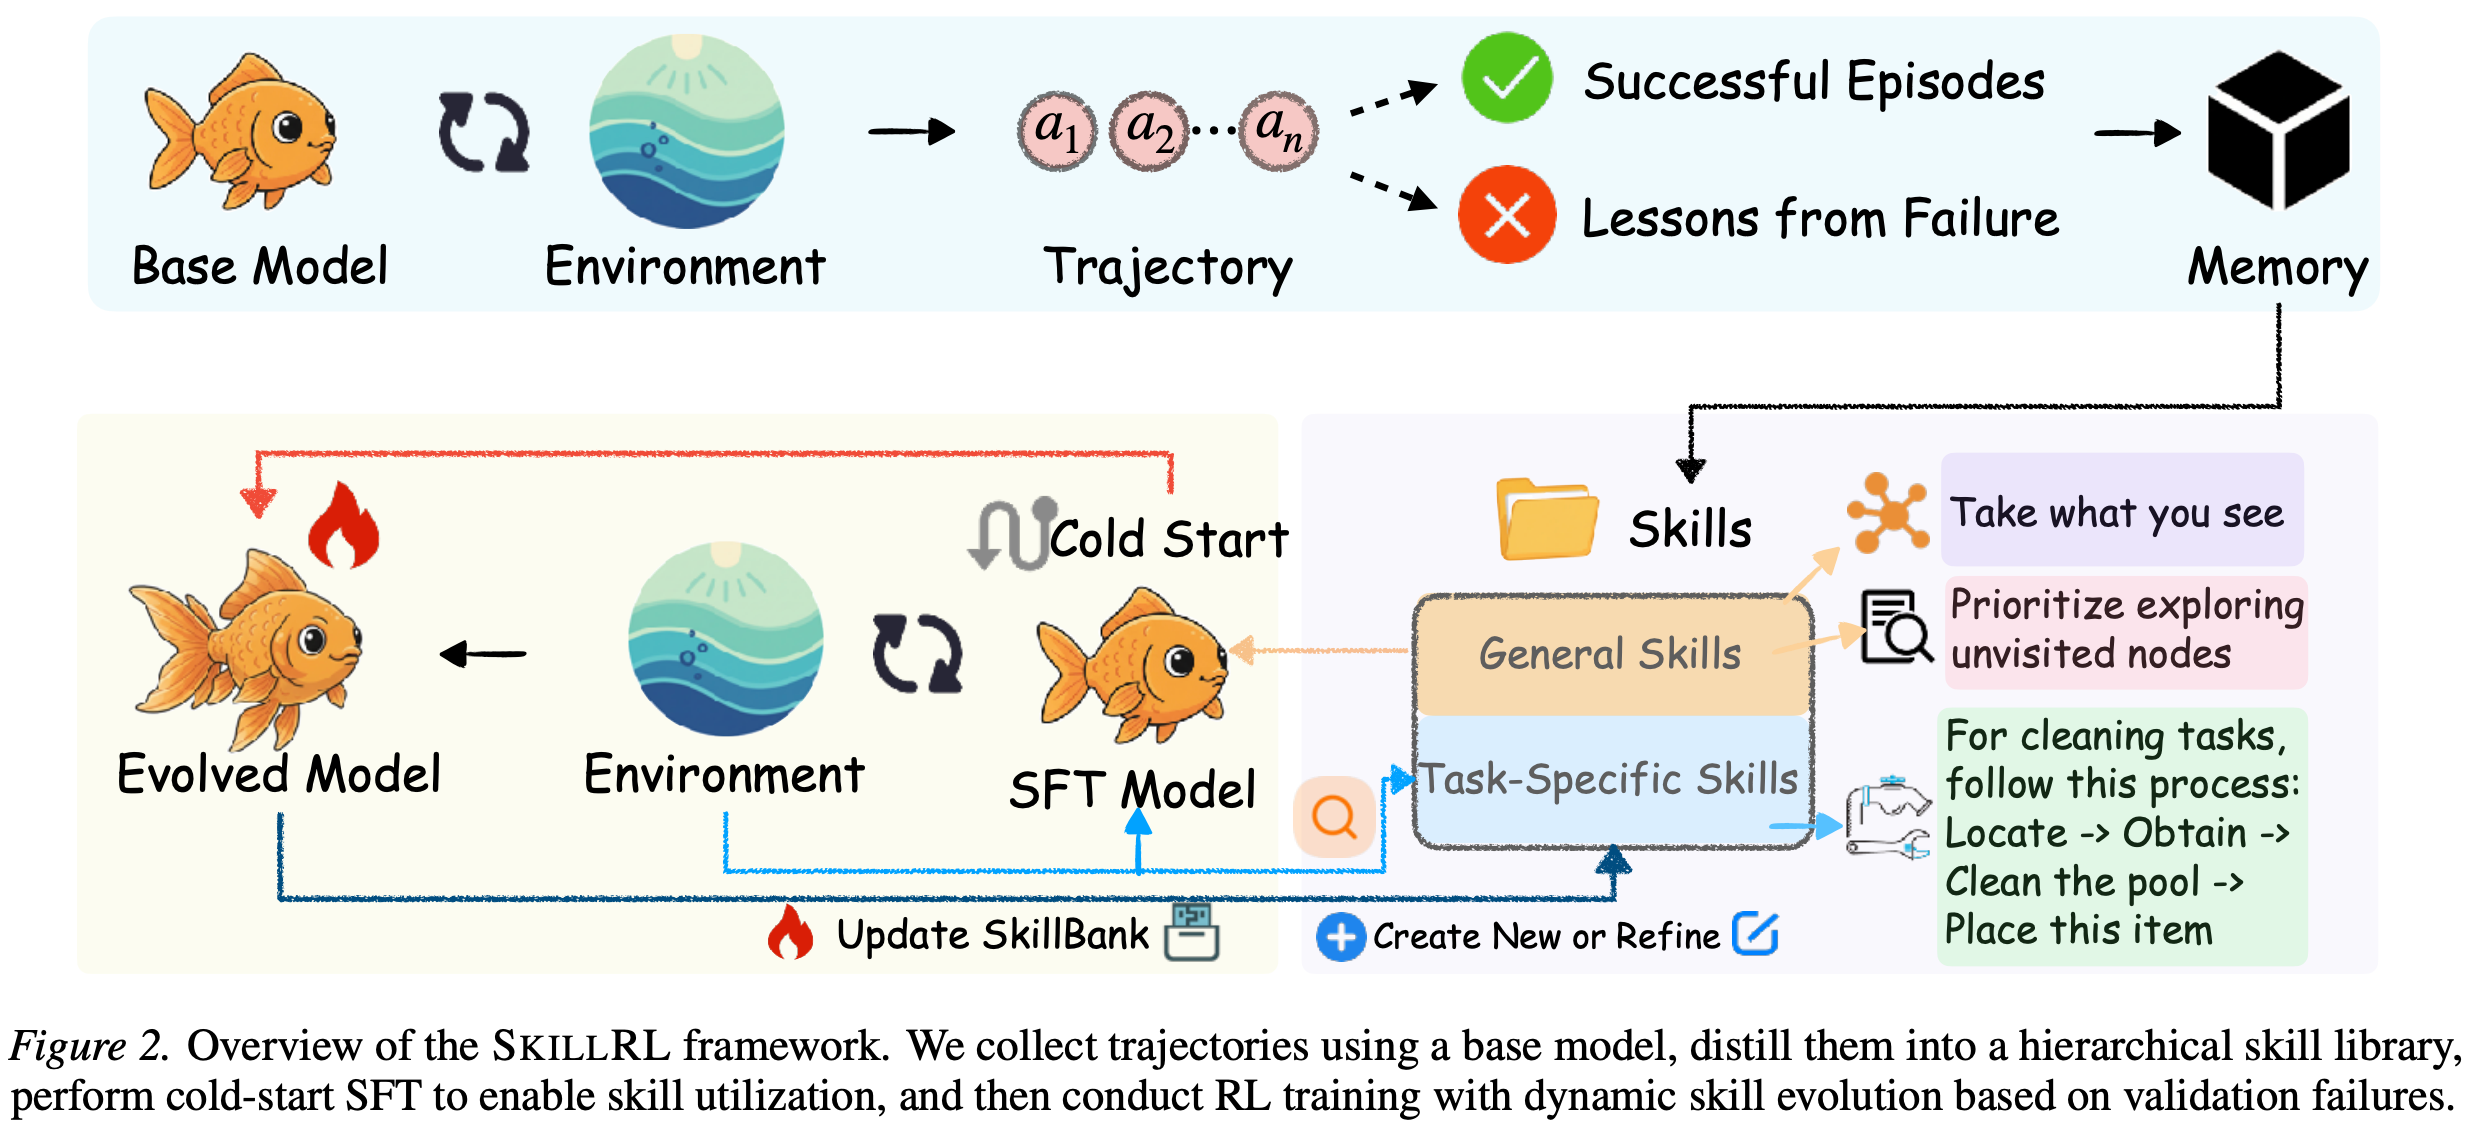
- 1)使用 Base Model 在环境中收集 Trajectories
- 2)通过 Teacher Model 将 Trajectories 蒸馏为结构化 Skills
- 3)构建分层 Skill Library(SkillBank)
- 4)冷启动 SFT(Cold-start Supervised Fine-Tuning)使 Agent 学会使用 Skills
- 5)基于 GRPO 的 RL 训练,同时进行递归 Skill Evolution
SkillRL 详解
- SkillRL 整体概览
补充:LLM Agent 形式化
- 将 Agent 置于交互环境 \(\mathcal{E}\) 中
- 在时间步 \(t\),Agent 依次
- 观察状态 \(o_t \in \mathcal{O}\)
- 选择动作 \(a_t \in \mathcal{A}\)
- 获得奖励 \(r_t\) 和下一个观察 \(o_{t+1}\)
- 一个 Trajectory 捕获了一次完整的交互 Episode
$$ \tau = (o_0, a_0, r_0, \ldots, o_T, a_T, r_T)$$ - 任务由自然语言描述 \(d\) 指定, LLM Agent 实现了 Policy:
$$
\pi_{\theta}(a_t | o_{\leq t}, d, c)
$$- \(c\) 表示额外的上下文(如 Skills、Demonstrations)
- 目标是最大化期望回报:
$$
\max_{\theta} \mathbb{E}_{\tau \sim \pi_{\theta} } \left[ \sum_{t=0}^{T} \gamma^t r_t \right]
$$ - 同时受限于上下文长度约束 \(|c| \leq L_{\text{max} }\)
Experience-based Skill Distillation
Trajectory 收集
- 首先部署 Base LLM Agent \(\pi_{\text{base} }\) 在目标环境 \(\mathcal{E}\) 中收集多样的 Trajectories
- 与以往只保留成功 Episode 的方法不同,论文刻意同时保留 :
- 成功 Trajectories:\(\mathcal{T}^+ = \{\tau_i : r(\tau_i) = 1\}\)
- 失败 Trajectories:\(\mathcal{T}^- = \{\tau_i : r(\tau_i) = 0\}\)
- 其中 \(r(\tau)\) 表示二值任务成功指示符
- 失败 Trajectories 揭示了失败模式和边界条件:这些信息很难仅从成功中推断出来
- 与以往只保留成功 Episode 的方法不同,论文刻意同时保留 :
差异化处理策略
- 对于成功 Trajectories \(\tau^+ \in \mathcal{T}^+\) :
- 使用 Teacher Model \(\mathcal{M}_T\) 提取导致任务完成的策略模式:
$$
s^+ = \mathcal{M}_T(\tau^+, d)
$$ - Teacher Model 需要识别:
- 关键决策点
- 正确动作背后的推理
- 超越特定任务实例的可泛化模式
- 使用 Teacher Model \(\mathcal{M}_T\) 提取导致任务完成的策略模式:
- 对于失败 Trajectories \(\tau^- \in \mathcal{T}^-\) :
- 由于直接包含原始 Trajectories 在上下文中不可行(长度和噪声问题),将其合成为简洁的失败教训:
$$
s^- = \mathcal{M}_T(\tau^-, d)
$$ - 分析需要识别:
- 1)失败点(Point of Failure)
- 2)有缺陷的推理或动作(Flawed Reasoning/Action)
- 3)应该采取的正确做法(What Should Have Been Done)
- 4)防止类似失败的一般原则(General Principles)
- 这实际上是将冗长的失败 Episode 转化为反事实(Counterfactuals)
- 由于直接包含原始 Trajectories 在上下文中不可行(长度和噪声问题),将其合成为简洁的失败教训:
- 设计思路解读:这种差异化处理的核心设计思路是:
- 成功提供正样例 :展示“什么该做”以及“为什么这样做有效”
- 失败提供边界条件 :展示“什么不该做”以及“为什么会失败”
- 通过 Teacher Model 的抽象能力 ,将冗长的、带噪声的低层交互转化为高密度的、可操作的知识
分层技能库 SkillBank
技能组织架构
- 遵循 Agent Skills(Anthropic, 2024)的设计原则,SkillBank 分为两个层级:
- 层级1:通用技能 \(\mathcal{S}_g\)(General Skills)
- 捕捉适用于环境中所有任务类型的通用策略原则,典型包括:
- 探索策略(如系统化搜索模式、优先访问未探索位置)
- 状态管理原则(如在执行动作前验证前置条件)
- 目标追踪启发式(如维护进度计数器、仅在验证完成后终止)
- 通用技能提供跨不同任务类别迁移的基础性指导
- 捕捉适用于环境中所有任务类型的通用策略原则,典型包括:
- 层级2:任务特定技能 \(\mathcal{S}_k\)(Task-Specific Skills)
- 为任务类别 \(k\) 编码的专业知识,典型包括:
- 领域特定的动作序列
- 任务特定的前置条件和约束
- 该任务类型独有的常见失败模式
- 利用任务结构的优化流程
- 通过在收集时按任务类型组织 Trajectories,可以提取细粒度的、类别特定的策略
- 为任务类别 \(k\) 编码的专业知识,典型包括:
- 层级1:通用技能 \(\mathcal{S}_g\)(General Skills)
- 完整的技能库为:
$$
\text{SkillBank} = \mathcal{S}_g \cup \bigcup_{k=1}^{K} \mathcal{S}_k
$$ - 每个 Skill \(s \in \text{SkillBank}\) 都包含结构化信息:
- 简洁名称(Concise Name)
- 原则描述(Principle):描述策略内容
- 适用条件(When-to-apply):指定适用性场景
- 这种格式既支持高效检索,又为应用提供清晰的指导
技能检索机制
- 在推理时,给定任务描述 \(d\),Agent 检索相关的 Skills 来增强其上下文:
- 通用技能 \(\mathcal{S}_g\):始终包含,作为基础性指导
- 任务特定技能 :通过语义相似度检索:
$$
\mathcal{S}_{\text{ret} } = \text{TopK} \left( \{s \in \mathcal{S}_k : \text{sim}(e_d, e_s) > \delta \},\ K \right)
$$- \(e_d, e_s\) 分别是任务描述和 Skill 的 Embedding
- \(\delta\) 为相似度阈值
- \(K\) 控制检索的 Skill 数量
- Policy 在检索到的 Skills 条件下进行决策:
$$
a_t \sim \pi_{\theta}(a_t | o_{\leq t}, d, \mathcal{S}_g, \mathcal{S}_{\text{ret} })
$$
Token 压缩优势
- Skill 蒸馏相比原始 Trajectories 实现了 \(10-20\times\) 的 Token 压缩 ,同时提升了而非降低原始经验的效用
- 理解:Skill 本身就比原始历史轨迹更短,所以将轨迹压缩为 Skill 后,上下文就更短了
- 这种压缩使得 Agent 能够在有限的上下文窗口中利用丰富的经验知识
设计思路解读
- 分层设计的关键考量:
- 通用 vs 特定的分离 :通用技能提供稳定的基础,任务特定技能提供针对性的专业知识,二者互补
- 结构化格式 :Name + Principle + When-to-apply 的三元组结构使得 Skills 既可检索又可解释
- 语义检索 :通过 Embedding 相似度实现灵活的、任务自适应的 Skill 召回
递归技能演化
- 这是论文最核心的创新点: 将 Skill Library 视为动态组件而非静态知识源
冷启动初始化
- 在 RL 训练之前,面临一个关键挑战:Base Agent 尚未学会如何有效利用 Skills :仅仅向未改变的模型提供 Skills 收益有限
- 论文引入冷启动 SFT 阶段:
- 1)Teacher Model \(\mathcal{M}_T\) 生成 \(N\) 条 Skill 增强的推理轨迹:
$$
\mathcal{D}_{\text{SFT} } = \{(d_i, \mathcal{S}_i, \tau_i^+)\}_{i=1}^N
$$- 这些轨迹展示了如何在决策过程中检索、解释和应用 Skills
- 2)Base Model 在这些 Demonstrations 上微调:
$$
\theta_{\text{sf} } = \arg \min_{\theta} \mathcal{L}_{\text{CE} }(\mathcal{D}_{\text{SFT} }; \theta)
$$- 其中 \(\mathcal{L}_{\text{CE} }\) 为交叉熵损失
- 3)得到的模型 \(\pi_{\theta_{\text{sf} } }\) 既是 RL 训练的起点,也是 KL 正则化的参考 Policy \(\pi_{\text{ref} }\)
- 1)Teacher Model \(\mathcal{M}_T\) 生成 \(N\) 条 Skill 增强的推理轨迹:
递归技能演化机制
- 静态 Skill Library 无法预知 Agent 将遇到的所有场景
- 随着 Policy 改进并探索新的状态区域,Agent 会面临现有 Skills 无法提供充分指导的情况
- 演化流程如下:
- 触发条件 :在每个验证 Epoch 后,监控每个任务类别 \(C\) 的成功率 \(Acc(C)\)
- 只有当 \(Acc(C) < \delta\) 时,才触发该类别的 Skill 演化
- 失败轨迹收集 :使用多样性感知的分层采样策略收集失败 Trajectories:
$$
\mathcal{T}_{\text{val} } = \{\tau_j : r(\tau_j) = 0\}_{j=1}^{M}
$$- 按类别分组 Trajectories
- 按失败严重程度(负奖励)排序
- 通过 Round-robin 采样维持类别熵(Categorical Entropy)
- 新技能生成 :Teacher Model 分析这些样本以识别差距:
$$
\mathcal{S}_{\text{new} } = \mathcal{M}_T(\mathcal{T}_{\text{val} }, \text{SkillBank})
$$- Teacher Model 被提示:
- 1)识别当前 Skills 未覆盖的失败模式
- 2)提出新 Skills 来覆盖这些差距
- 3)建议对已证明无效的现有 Skills 进行改进
- Teacher Model 被提示:
- 库更新 :
$$
\text{SkillBank} \leftarrow \text{SkillBank} \cup \mathcal{S}_{\text{new} }
$$ - 这创造了一个良性循环 :
- Agent 改进 → 遇到新挑战 → 驱动 Skill Library 扩展 → 支持进一步改进
- 触发条件 :在每个验证 Epoch 后,监控每个任务类别 \(C\) 的成功率 \(Acc(C)\)
设计思路解读
- 递归演化的核心设计哲学:
- 1)Co-evolution(协同演化) :Skill Library 和 Agent Policy 不是独立优化的,而是相互促进、共同演化
- 2)失败驱动 :从验证失败中学习,而非仅仅从成功中学习,确保 Skills 不断覆盖失败边界
- 3)按需扩展 :只对表现不佳的任务类别触发演化,保证 Library 的紧凑性和针对性
- 4)多样性采样 :通过分层采样确保覆盖多样的失败模式,避免过度专注于某一种失败类型
SkillRL 完整算法流程
- 论文 Algorithm 1 总结了完整流程:
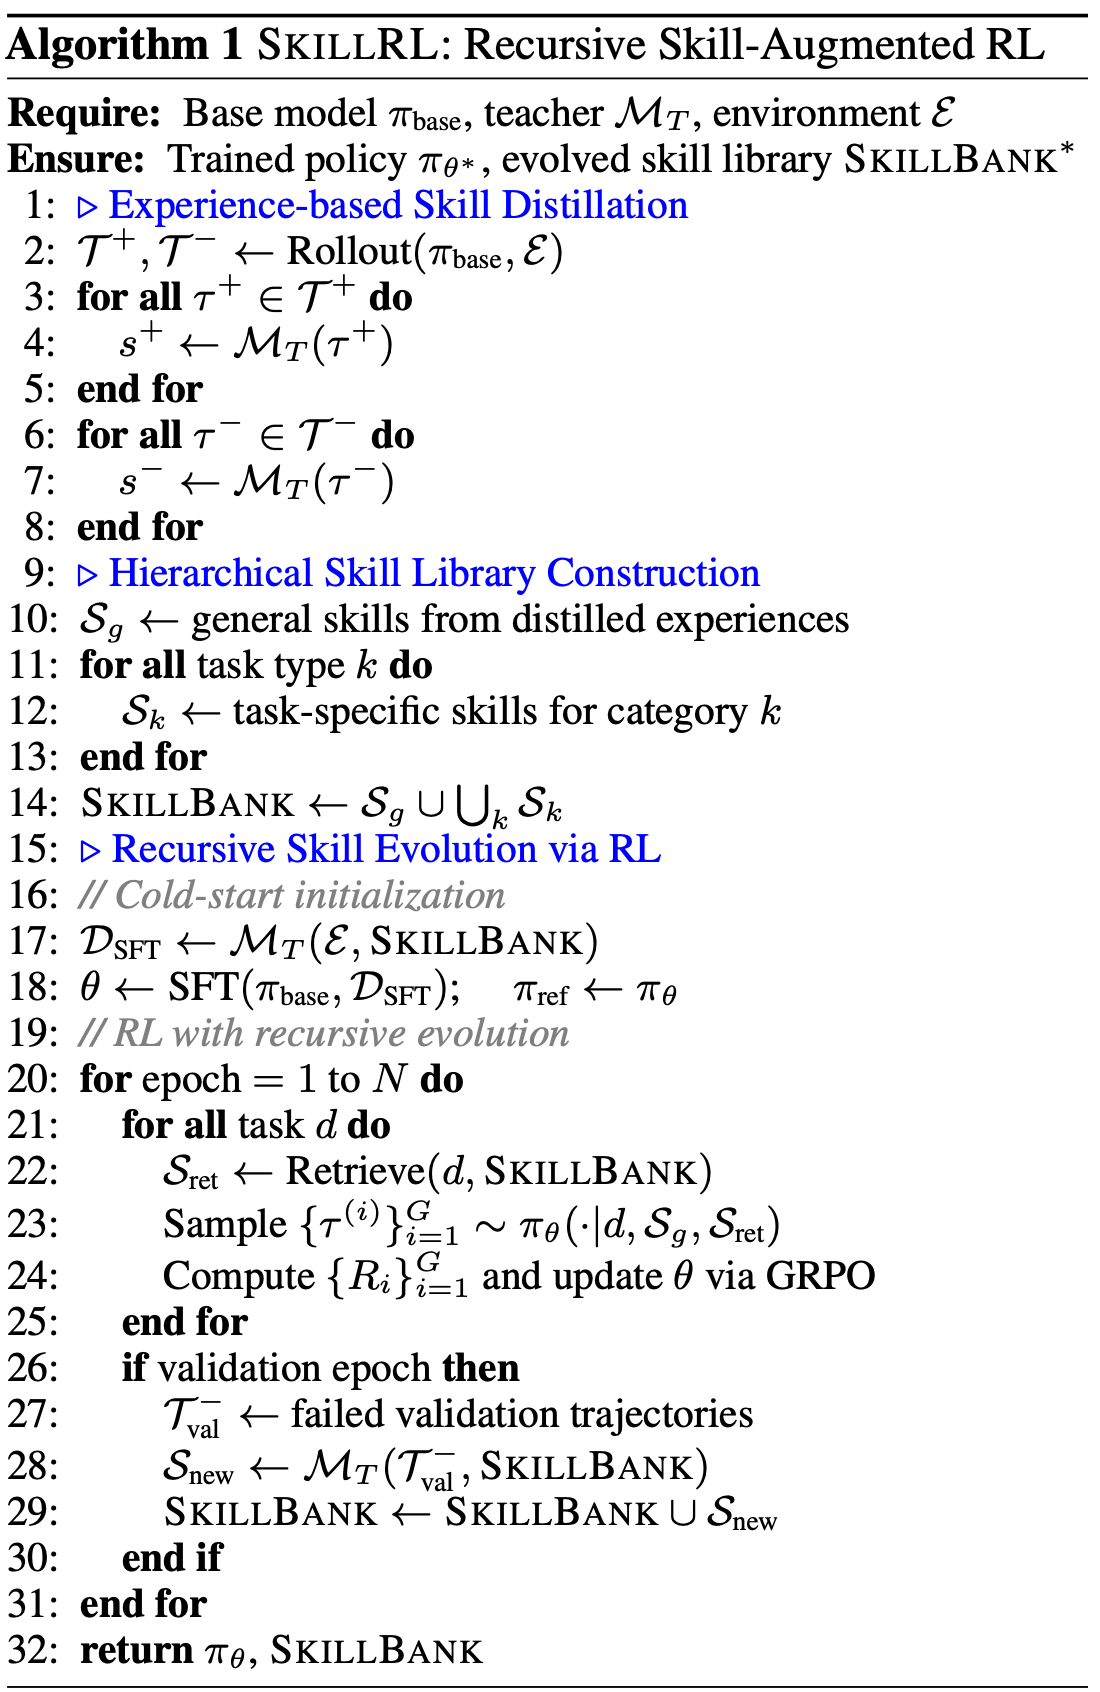
- 核心点:
- 在 RL 训练过程中,根据得到的错误轨迹,会继续添加新的 Skills,从而实现了 Skills 的进化
- 理解:这里是没有删除 SkillBank 中的 Skills 的,都是合并操作
RL-based Policy Optimization 细节
- 使用 GRPO 优化 Skill 增强的 Policy,对于每个任务描述 \(d\):
- 1)检索相关 Skills
- 2)从当前 Policy \(\pi_\theta\) 采样 \(G\) 条完整 Trajectories
$$ \{\tau^{(1)}, \ldots, \tau^{(G)}\} $$ - 3)每条 Trajectory \(\tau^{(i)}\) 获得二值奖励
$$ R_i = r(\tau^{(i)}) \in \{0, 1\} $$ - 4)归一化 Advantage:
$$
A_i = \frac{R_i - \text{mean}(\{R_j\}_{j=1}^G)}{\text{std}(\{R_j\}_{j=1}^G)}
$$ - 5)优化目标:
$$
\mathcal{J}(\theta) = \mathbb{E}_{d,\{\tau^{(i)}\} } \left[ \frac{1}{G} \sum_{i=1}^{G} \min \left( \rho_i A_i,\ \text{clip}(\rho_i, 1-\epsilon, 1+\epsilon) A_i \right) - \beta D_{\text{KL} }(\pi_\theta | \pi_{\text{ref} }) \right]
$$- 其中 \(\rho_i\) 是 Skill 增强上下文上的重要性比率
$$
\rho_i = \frac{\pi_{\theta}(\tau^{(i)} | d, \mathcal{S}_g, \mathcal{S}_{\text{ref} })}{\pi_{\text{old} }(\tau^{(i)} | d, \mathcal{S}_g, \mathcal{S}_{\text{ref} })}
$$
- 其中 \(\rho_i\) 是 Skill 增强上下文上的重要性比率
- KL 惩罚锚定到 \(\pi_{\text{ref} } = \pi_{\theta_{\text{sf} } }\),确保 RL 优化在提升任务性能的同时保持已学的 Skill 利用能力
实验
实验设置
- 环境与任务:论文在 9 个挑战性 Benchmark 上评估:
- 1)ALFWorld :文本游戏环境,Agent 需要通过文本命令导航和交互完成家庭任务
- 2)WebShop :模拟在线购物环境,Agent 需要找到并购买满足用户规格的产品
- 3)Search-augmented QA :7 个数据集
- Single-hop QA:NQ、TriviaQA、PopQA
- Multi-hop QA:HotpotQA、2Wiki、MuSiQue、Bamboogle
- 基线方法:分为四类:
- 1)Closed-source LLMs :GPT-4o、Gemini-2.5-Pro
- 2)Prompt-based Agentic/Memory-based :ReAct、Reflexion、Mem0、ExpeL、MemP、SimpleMem
- 3)RL-based :RLOO、GRPO
- 4)Memory-augmented RL-based :MemRL、EvolveR、Mem0+GRPO、SimpleMem+GRPO
- 实现细节
- Base Model :Qwen2.5-7B-Instruct
- Teacher Model :OpenAI o3(用于 Skill 蒸馏和 SFT 数据生成)
- RL 优化器 :GRPO
- 学习率:\(1 \times 10^{-6}\)
- Batch size:16
- Group size:8
- Gradient accumulation steps:4
- Skill 检索 :\(K = 6\),\(\delta = 0.4\)
主要实验结果
- ALFWorld 与 WebShop 性能:
- 如 Table 1 所示,SkillRL 实现了:
- ALFWorld:\(89.9%\) 成功率
- WebShop:\(72.7%\) 成功率
- 关键 Insight :
- 1)相比 Prompt-based 方法的显著提升 :SkillRL 大幅超越最佳 Prompt-based 基线
- 说明 In-context Learning 虽然能利用过去经验,但难以从冗长 Trajectories 中提取可操作知识
- 2)超越 Vanilla RL :相比 GRPO,SkillRL 表现如下:
- 在 ALFWorld 上有 \(12.3%\) 的绝对提升(从 \(77.6%\) 到 \(89.9%\))
- 这直接归因于 Skill 增强机制而非算法差异
- 在复杂子任务如 Cool 和 Pick2 上,分别提升 \(23.0%\) 和 \(22.8%\)
- 在 ALFWorld 上有 \(12.3%\) 的绝对提升(从 \(77.6%\) 到 \(89.9%\))
- 3)超越 Memory-Augmented RL :相比 Mem0+GRPO(\(54.7%\))和 EvolveR(\(43.8%\))
- SkillRL 有约 \(35.2%\) 的绝对成功率差距,验证了高层 Skill 抽象和协同演化 Library 的核心假设
- 4)超越 Closed-source 模型 :用 Qwen2.5-7B 的 SkillRL 显著超越 GPT-4o(+\(41.9%\))和 Gemini-2.5-Pro(+\(29.6%\))
- 证明有效的 Skill 学习可以弥补模型规模的不足
- 1)相比 Prompt-based 方法的显著提升 :SkillRL 大幅超越最佳 Prompt-based 基线
- 如 Table 1 所示,SkillRL 实现了:
- Search-Augmented QA 性能
- 如 Table 2 所示,SkillRL 实现了 \(47.1%\) 的平均分,显著优于 Search-R1(\(38.5%\))和 EvolveR(\(43.1%\))
- 关键 Insight:
- 1)卓越的多跳推理能力 :在 Bamboogle 上超越 EvolveR 达 \(19.4%\)
- 2)强泛化能力 :尽管只在 NQ 和 HotpotQA 上训练,在 OOD 任务如 TriviaQA 和 2Wiki 上仍保持竞争力
消融与分析
- 组件消融:
- 如 Table 3 所示:
变体 ALFWorld WebShop SkillRL(完整) 89.9% 72.7% w/o 分层结构 76.8% 61.4% w/o Skill Library(原始 Trajectories) 61.7% 50.2% w/o 冷启动 SFT 65.2% 46.5% w/o 动态演化 84.4% 70.3% - 重要 Insight :
- 1)分层结构至关重要 :移除分层结构导致 ALFWorld 下降 \(13.1%\),说明通用技能提供必要的基础性指导
- 2)抽象优于记忆 :用原始 Trajectories 替代 Skill Library 导致最大性能下降(最高 \(25%\)),验证了抽象的核心价值
- 3)冷启动 SFT 不可或缺 :没有 SFT 时性能下降约 \(20%\),说明 Base Model 需要明确的 Demonstration 阶段来学习如何使用 Skills
- 4)动态演化贡献稳定 :带来约 \(5.5%\) 的提升,确保 Skill Library 是动态组件而非静态数据库
- 如 Table 3 所示:
- Per-Task 分析
- 在 ALFWorld 上,最大提升在 PickTwo(+\(23%\))、Cool(+\(22%\))和 Heat(+\(15%\))
- 这些都是需要多步规划和状态跟踪的最具挑战性的任务
- 任务特定 Skills 在这里特别有价值
- Skill Library 增长(如 Figure 3 所示):
- 初始:55 个 Skills(12 个通用,43 个任务特定)
- 最终(Step 150):100 个 Skills
- 增长主要由任务特定 Skills 驱动(43 → 80)
- 通用 Skills 稳步增长(12 → 20)
- 各任务类别间平衡扩展
- 上下文效率(如 Figure 4 所示):
- 原始记忆方法:平均 \(\sim 1,450\) Tokens,高波动
- SkillRL:平均 \(\leq 1,300\) Tokens,约 \(10.3%\) 的上下文长度缩减
- 演化动力学(如 Figure 5 所示):
- SkillRL(无演化):稳步改进
- SkillRL(有演化):显著更高的学习率和更优的渐近性能
- 60 步内成功率超过 \(80%\)
- 基线需约 90 步达到更低峰值
- 定性分析:
- 如 Figure 6 所示,Case Study 展示了 Agent 如何:
- 有效检索和执行来自 SkillBank 的 Skills
- 在 WebShop 中:调用 “Prioritize Core Keywords” + “Focus Key Query”
- 在 ALFWorld 中:协调 “Progressive Goal Decomposition” + “No Appliance Before Object”
- 这证明 Agent 并非记忆 Trajectories,而是发展了结构化的任务逻辑理解
- 如 Figure 6 所示,Case Study 展示了 Agent 如何:
Skill Library 示例
- ALFWorld Skills(Table 5)
ID Skill Title Principle When to Apply gen_001 Systematic Exploration Search every plausible surface/container once before revisiting Anytime goal count not met and unexplored areas remain gen_002 Immediate Acquisition Take required object immediately when visible and reachable Upon first visual confirmation of goal-relevant object gen_003 Destination First Policy Navigate directly to known target receptacle after picking up object Holding goal object while target location is identified gen_005 Use State-Changing Tools Early Use nearest suitable appliance before placement After picking up object requiring temperature/cleanliness change gen_014 Loop Escape Trigger Switch to untried search branch after 3-5 no-progress actions After several consecutive no-progress observations gen_015 Pre-Action Sanity Check Confirm prerequisites before manipulative commands Right before commands that could legally fail - WebShop Skills(Table 7)
ID Skill Title Principle When to Apply gen_001 Prioritize Core Keywords Include product type, functional attributes, hard constraints Before first search or refining over-specific queries gen_002 Iterative Refinement Adjust keywords or filters instead of repeating failed query When results are irrelevant gen_003 Scan Before You Click Read titles, thumbnails, prices before opening link On search results pages gen_004 Verify Early, Abort Fast Check constraints immediately; leave if violated Within first observation on product detail page gen_007 Check Variant Pricing Select exact variant to verify specific price Whenever price changes with variant selection gen_013 Purchase Decisively Execute ‘Buy Now’ once all constraints confirmed After validating every constraint
失败模式与缓解策略
- 论文还提供了对常见失败的系统化分类(Table 6 和 Table 8),例如:
- ALFWorld 失败 :
err_001Redundant Revisit:缺乏对已探索区域的显式记忆 → 维护探索地图err_006Skipping State Changes:混淆存在性与目标满足 → 整合状态前置条件检查
- WebShop 失败 :
err_001Missing Constraints in Query:遗漏规格或价格上限 → 构建完整需求列表err_004Price Shift Oversight:选择变体后未注意价格变化 → 每次选项变化后重新读取价格err_005Premature Purchase:未设置必要变体就点击购买 → 验证所有选项已选择
- ALFWorld 失败 :
补充:相关工作
LLM Agent
- ReAct 交织推理和行动
- Reflexion 引入通过自我反思的言语强化
- AutoGen 和 CAMEL 展示通用多 Agent 能力
- 但早期方法主要依赖 In-context Learning,将每次交互视为孤立事件
Agent 中的记忆机制
- 从静态 RAG 范式和原始轨迹存储(Mem0、SimpleMem),到自改进记忆、将交互蒸馏为高层见解(ExpeL、MemP),再到通过在线训练更新记忆库(MemRL、Mem\(\alpha\))
- 但现有方法仍难以区分高价值经验和噪声,或无法提炼指导内部决策的核心原则
Agentic Skills 与 RL 的演化
- 传统 Continual Learning 关注预定义任务中的知识保持,但自演化 Agent 旨在开放环境中主动获取技能
- RL 被广泛用于对齐 LLM 或通过基于规则的验证器改进推理,但应用于 Agentic Skills 仍面临稀疏奖励和长 Horizon 的挑战
- SkillRL 的关键区别在于将 Skill Library 作为与 Policy 协同演化的动态组件
附录:值得关注的细节
- Skill 蒸馏需要 Teacher Model(OpenAI o3),存在 API 调用成本
- 演化质量依赖于 Teacher Model 的推理能力