注:本文包含 AI 辅助创作
- 参考链接:
- 原始论文:Rethinking Entropy Interventions in RLVR: An Entropy Change Perspective, ZJU & Tencent, 20251011-20260429
- ACL Outstanding Paper Award
- 原始论文:Rethinking Entropy Interventions in RLVR: An Entropy Change Perspective, ZJU & Tencent, 20251011-20260429
Paper Summary
- RLVR 中常常遇到 熵崩溃(Entropy Collapse) 问题:即训练期间策略熵的快速下降(2025b)
- 熵崩溃会导致:
- 1)限制探索 :模型生成的推理轨迹趋于同质化,无法发现新颖或正确的解决方案
- 2)破坏优化 :在 GRPO 这类基于 Group 的算法中,轨迹同质化使得计算出的优势值区分度降低,导致训练停滞
- 现有方法的局限 :
- (1) Clip-Higher(更高裁剪),增加重要性采样比率的上界
- (2) Positive-Reweighting(正向重新加权),降低具有高生成概率的正样本的权重
- (3) Entropy-Aware Advantage(熵感知优势),为具有高熵的 Token 分配更大的优势
- 它们基本上是启发式的,对其影响熵的潜在机制的理解很大程度上仍不透明
- 它们的有效性是有限的,熵仍然只被粗略地控制
- 本文贡献 :
- 首次推导出 Token 级熵变化的精确解析近似,揭示了控制熵动态的四个关键因素
- 基于该理论,统一解释并评估了现有方法的有效性与局限性
- 提出 STEER(Stabilizing Token-level Entropy-change via Reweighting) ,一种原则性的、细粒度的熵调制方法
- 首次推导出 Token 级熵变化的精确解析近似,揭示了控制熵动态的四个关键因素
Introduction and Discussion
- RLVR 的一个主要缺陷:熵崩溃(entropy collapse)
- 本工作对 RLVR 中的熵动态进行了全面的理论和实证分析
- 仔细审视了每一步训练中细粒度的 Token 级熵变
- 注:虽然之前的一些工作(2025b)对熵进行了初步探索,但他们的分析依赖于不切实际的假设,导致估计非常不精确(参见第 3 节,Remark 1),并且无法解释现有熵干预方法背后的机制
- 本文的分析产生了两个主要见解:
- (1) 推导出了 Token 级熵变的一个精确解析近似,揭示了它由四个关键因素控制
- 裁剪策略(clipping strategy)、优势(advantage)、Token 概率(token probability)和条件熵(conditional entropy)
- 进一步阐明了现有方法如何影响这些因素,从而解释了它们的经验成功
- (2) 识别了先前方法的关键局限性:
- 它们的启发式调制仅应用于一小部分 Token,忽略了其他可能也经历严重熵崩溃的 Token
- 而且:它们仅考虑了部分相关因素,这降低了它们的有效性,甚至在某些情况下可能加速熵崩溃
- (1) 推导出了 Token 级熵变的一个精确解析近似,揭示了它由四个关键因素控制
- 仔细审视了每一步训练中细粒度的 Token 级熵变
- 本文引入了 STEER(通过重新加权稳定 Token 级熵变,Stabilizing Token-level Entropy-changE via Reweighting)
- STEER 是一种简单但基于原则的熵调制方法,植根于本文的理论分析
- STEER 直接将理论估计的熵变转化为自适应的 Token 级权重
- 通过降低具有过大熵变的 Token 的权重,STEER 实现了对逐步熵动态的细粒度调制,并有效地引导策略朝向持续探索
- STEER 评估:
- 在六个数学推理和三个代码生成基准上实验,STEER 显著且持续地优于最先进的基线方法
- STEER 还能很好地跨模型规模(1.5B/7B/14B)、模型家族(Qwen/Llama/Mistral)和 RL 算法(GRPO/RLOO/OPO)泛化,持续保持稳定的熵动态并实现更强的性能
- 主要贡献:
- 本文推导出了 Token 级熵动态的一个紧致解析近似,揭示了四个控制因素,从而解释了现有启发式熵干预策略的机制
- 本文提出了 STEER,一种基于理论的熵调制方法,自适应地降低易于发生剧烈熵衰减的 Token 的权重
- 本文在六个数学推理和三个代码生成基准上全面评估了 STEER,展示了其相对于强基线的优越性,以及跨不同模型和 RL 算法的泛化能力
Preliminaries
RLVR Algorithms
- 与 PPO 不同, GRPO 通过消除价值模型来减少内存开销,在一个采样组内计算相对优势
- 令 \(q\) 为从数据集 \(\mathcal{D}\) 中采样的 Query,\(\pi_{\theta}\) 为策略模型
- GRPO 从参考策略 \(\pi_{\text{old} }\) 中采样一组响应(rollouts)\(\{o_i\}_{i=1}^G\)
- 对于响应 \(o_i\) 中的第 \(t\) 个 Token \(o_{i,t}\),优势计算如下:
$$A_{i,t} = \frac{R_i - \text{mean}(\{R_i\}_{i=1}^G)}{\text{std}(\{R_i\}_{i=1}^G)},\tag {1}$$- \(R_{i}\in \{1, -1\}\) 表示 \(o_{i}\) 的正确性
- 此优势 \(A_{i,t}\) 通常对响应内的所有 Token 保持不变
- 遵循 Token 级公式(2025),GRPO 最大化以下目标:
$$
\begin{align}
\mathcal{J}(\theta) = \mathbb{E}_{q\sim \mathcal{D}, \{o_i\}_{i = 1}^G\sim \pi_{\text{old} }(\cdot |q) } \left[\frac{1}{L}\sum_{i = 1}^{G}\sum_{t = 1}^{|o_i|}\min \left(r_{i,t}A_{i,t}, \text{clip}\left(r_{i,t},1 - \epsilon ,1 + \epsilon\right)A_{i,t}\right)\right].
\end{align}
\tag {2}
$$- \(r_{i,t} = \frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,< t})}\) 表示重要性采样比率
- \(L = \sum_{i=1}^{G}|o_{i}|\) 表示一个组内响应长度的总和
- 注:这里的 \(L\) 涉及到归一化方式,这里的写法是 DAPO 的设定, 不是原始的 GRPO
- 注:这里作者遵循 Shao 等人(2024)的做法省略了 KL 散度项,已有研究表明这能带来更好的性能和更广泛的探索(2026;2025)
Policy Entropy of LLMs
- 香农熵(Shannon entropy)量化了给定状态下策略模型选择动作的不确定性(2018)
- 对于 LLM,可以在每个 Token 生成步骤量化熵
- 对于每个采样的响应 \(o_{i}\) 及其第 \(t\) 个 Token 的生成,策略 \(\pi_\theta\) 下的 Token 级熵为:
$$\mathcal{H}(q,o_{i,< t}) = -\mathbb{E}_{a\sim \pi_{\theta}(\cdot |q,o_{i,< t})}[\log \pi_{\theta}(a\mid q,o_{i,< t})].\tag {3}$$ - (全局)策略熵衡量模型在 Query 数据集上的生成不确定性(每个 Query 包含一组 Response),可以通过对采样响应上的 Token 级熵进行平均来估计:
$$\mathcal{H}(\pi_{\theta}) = \mathbb{E}_{q\sim \mathcal{D}, \{o_i\}_{i=1}^G \sim \pi_{\theta}(\cdot|q)}\frac{1}{L}\sum_{i = 1}^{G}\sum_{t = 1}^{|o_{i}|}\mathcal{H}(q,o_{i,< t}).\tag {4}$$- 注意:这里是针对一个 Query 的一组 Response 统计的
- 对于每个采样的响应 \(o_{i}\) 及其第 \(t\) 个 Token 的生成,策略 \(\pi_\theta\) 下的 Token 级熵为:
- 在实践中,可以使用训练数据集来估计 \(\mathcal{H}(\pi_{\theta})\),经验表明该估计能很好地泛化到未见数据
- 在 RL 训练期间,维持足够的策略熵对于平衡探索和利用至关重要(2018;2008),但 RLVR 训练经常遭遇熵崩溃,即策略熵迅速下降(2025;2025b;2025b)
- 这种臭名昭著的现象在两个方面是有害的:
- (1) 它严重削弱了探索,限制了模型发现信息丰富且可能正确的解决方案的能力
- (2) 它也破坏了训练效果,对于像 GRPO(2024)这样的基于组的方法,日益同质的 Rollout 产生的相对优势得分 \(A_{i,t}\) 缺乏区分度,导致训练停滞
- 这种臭名昭著的现象在两个方面是有害的:
Analyses on Entropy Dynamics
- 本节对熵变进行全面的理论和实证分析
- 本文的研究在细粒度的 Token 级进行,这使得能够精确监控熵动态
- 为清晰起见,本节主要关注代表性的 GRPO 算法
- 不失一般性,这些理论结果可以无缝推广到其他高级 RLVR 算法(例如,PPO(2017)、RLOO(2024)和 OPO(2025);参见附录 C.2)
- 为了定量刻画一次更新后每个 Token 的熵变,本文将 GRPO 策略梯度(公式 (2))重写为:
$$
\begin{align}
\nabla_{\theta}\mathcal{J}(\theta) = \mathbb{E}_{q\sim \mathcal{D}, \{o_i\}_{i = 1}^G\sim \pi_{\text{old} }(\cdot |q) } \left[\frac{1}{L}\sum_{i = 1}^{G}\sum_{t = 1}^{|o_i|}
\mathbb{I}_{\text{clip} }r_{i,t}A_{i,t}\nabla_{\theta}\log \pi_{\theta}(o_{i,t}\mid q,o_{i,< t}) \right]
\end{align}
\tag {5}
$$- 其中裁剪指示器 \(\mathbb{I}_{\text{clip} }\) 源自比率裁剪操作,定义如下:
$$\mathbb{I}_{\text{clip} } = \left\{ \begin{array}{ll}0, & A_{i,t} > 0 \text{ and } r_{i,t} > 1 + \epsilon ,\\ 0, & A_{i,t} < 0 \text{ and } r_{i,t} < 1 - \epsilon ,\\ 1, & \text{ otherwise }. \end{array} \right.
\tag {6}
$$ - 为简化符号,将状态(即上下文)表示为 \(s\triangleq (q,o_{i,< t})\),并缩写 \(\pi_{\theta}(a\mid s)\) 为 \(\pi_{\theta}\),\(A(s,a)\) 为 \(A\)
- 其中裁剪指示器 \(\mathbb{I}_{\text{clip} }\) 源自比率裁剪操作,定义如下:
- 然后本文推导出以下关于 Token 级熵变的定理
- 定理 1 (Token 级熵变,Token-level Entropy Change)
- 对于一个使用 GRPO 训练、学习率为 \(\eta\) 的 Logit 独立(logit-independent)策略模型 \(\pi_{\theta}\),在状态 \(s\) 上,连续两步之间的 Token 级熵变可以近似为:
$$\Omega (s)\triangleq -\frac{\eta}{L}\mathbb{E}_{\pi_{\theta}(\cdot |s)}\Big[\frac{\mathbb{I}_{\text{clip} }A}{\pi_{\text{old} } }\pi_{\theta}(1 - \pi_{\theta}) \big(\log \pi_{\theta} + \mathcal{H}(s)\big)\Big] \tag {7}$$- 并且近似误差以 \(O(\eta^{2})\) 为界
- 理解:其中的 \(\pi_\theta(1-\pi_\theta) = \pi_\theta(o|s)(1-\pi_\theta(o|s))\),即:
$$
\Omega (s) \triangleq -\frac{\eta}{L}\mathbb{E}_{a \sim \pi_{\theta}(\cdot |s)}\Big[\frac{\mathbb{I}_{\text{clip} }A}{\pi_{\text{old}} (a|s)}\pi_{\theta}(a|s)(1 - \pi_{\theta}(a|s)) \big(\log \pi_{\theta}(a|s) + \mathcal{H}(s)\big)\Big]
$$
- 证明见附录 G
- 该定理并非 GRPO 特有,也适用于其他算法(参见附录 C.2)
- 对于一个使用 GRPO 训练、学习率为 \(\eta\) 的 Logit 独立(logit-independent)策略模型 \(\pi_{\theta}\),在状态 \(s\) 上,连续两步之间的 Token 级熵变可以近似为:
- 关于定理 1 ,本文强调三个重要 Remarks:
- Remark 1:Accurate Estimator :
- 在实践中,由于学习率 \(\eta\) 通常很小 \((< 10^{-4})\),定理 1 提供了一个 Token 级熵动态的精确闭式估计器
- 先前的工作 (Clip-Cov & KL-Cov)The Entropy Mechanism of Reinforcement Learning for Reasoning Language Models, 20250528, Shanghai AI Lab & THU 也探索了熵变,但它假设同一批次内不同 Query 的熵分布是均匀的
- 这个假设在实践中很少满足,导致对真实熵变的近似不准确
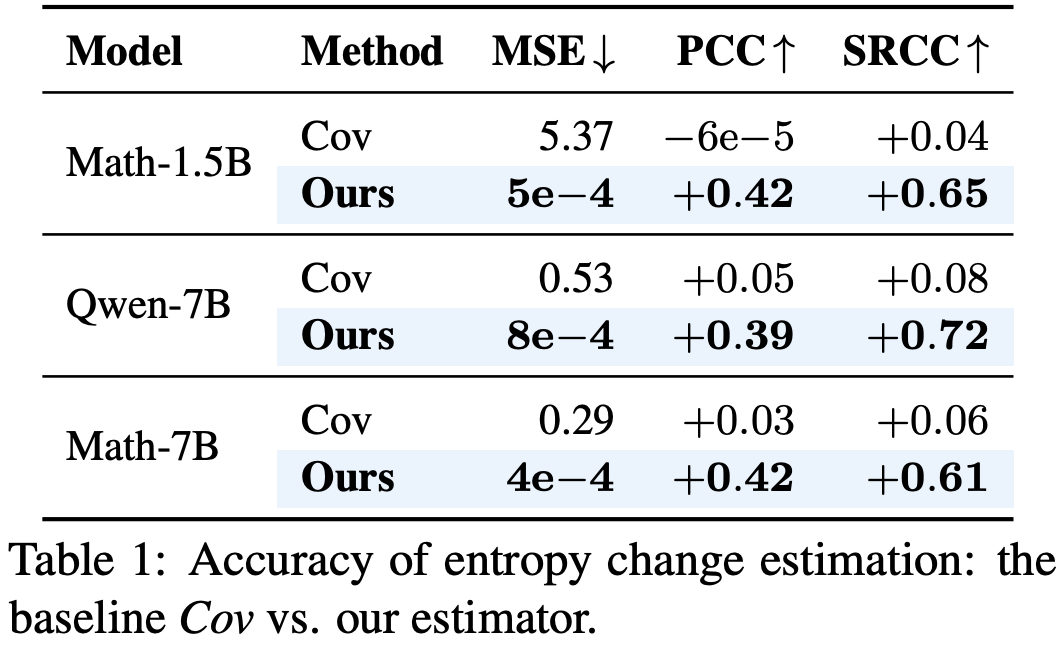
- 将本文的熵变估计与他们的估计(表示为 Cov)在标准 GRPO 训练过程中进行比较
- 表 1 报告了真实熵变与估计值之间的均方误差(MSE)、皮尔逊相关系数(PCC)和斯皮尔曼等级相关系数(SRCC)
- 在所有三个指标上,本文方法都比 Cov 实现了数量级更低的 MSE 以及显著更高的 PCC 和 SRCC
- 本文估计器的 MSE 在 1e-4 量级,展示了其卓越的精度
- 本文估计器的 MSE 在 1e-4 量级,展示了其卓越的精度
- 在所有三个指标上,本文方法都比 Cov 实现了数量级更低的 MSE 以及显著更高的 PCC 和 SRCC
- Remark 2:Four Governing Factors :定理 1 表明,Token 级熵变由多个因素共同决定:
- 裁剪指示器 \(\mathbb{I}_{\text{clip} }\),它防止具有过大或过小重要性采样比率的 Token 的熵变
- 优势 \(A\) 和旧策略项 \(\pi_{\text{old} }\),它们作为熵变的加权因子
- Token 生成概率 \(\pi_{\theta}\)
- 当前状态的 Token 熵 \(\mathcal{H}(s)\)
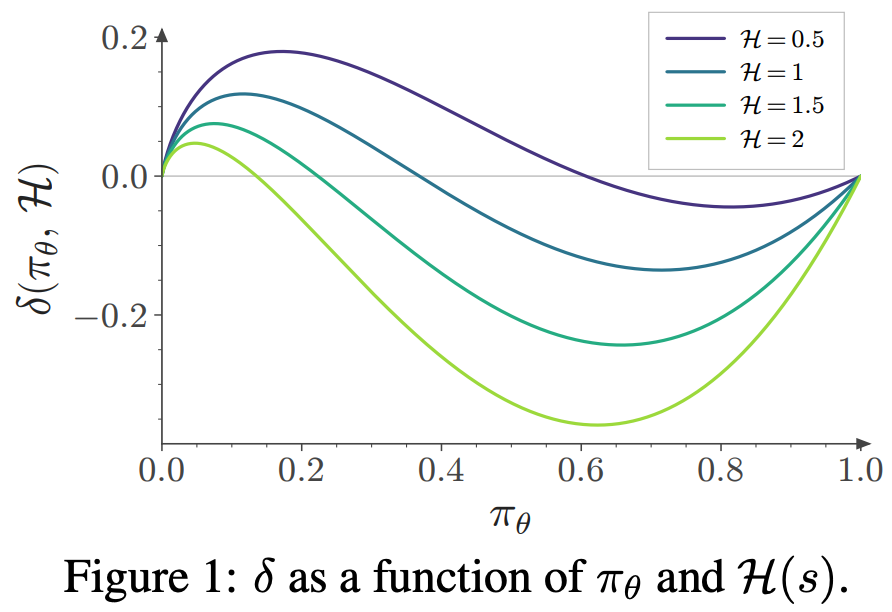
- \(\pi_{\theta}\) 和 \(\mathcal{H}(s)\) 对熵变的贡献可以用以下函数表示:
$$\delta (\pi_{\theta},\mathcal{H})\triangleq -\pi_{\theta}(1 - \pi_{\theta})\left[\log (\pi_{\theta}) + \mathcal{H}(s)\right].\tag {8}$$- \(\pi_{\theta}\) 和 \(\mathcal{H}(s)\) 对函数 \(\delta (\pi_{\theta},\mathcal{H}(s))\) 的影响如图 1 所示
- \(\pi_{\theta}\) 和 \(\mathcal{H}(s)\) 对函数 \(\delta (\pi_{\theta},\mathcal{H}(s))\) 的影响如图 1 所示
- \(\pi_{\theta}\) 和 \(\mathcal{H}(s)\) 对熵变的贡献可以用以下函数表示:
- Remark 3 (熵变方向,Entropy Change Direction) :本文进一步研究熵变的方向(增加或减少),这由优势(advantage)和 Token 概率(token probability)的联合效应控制
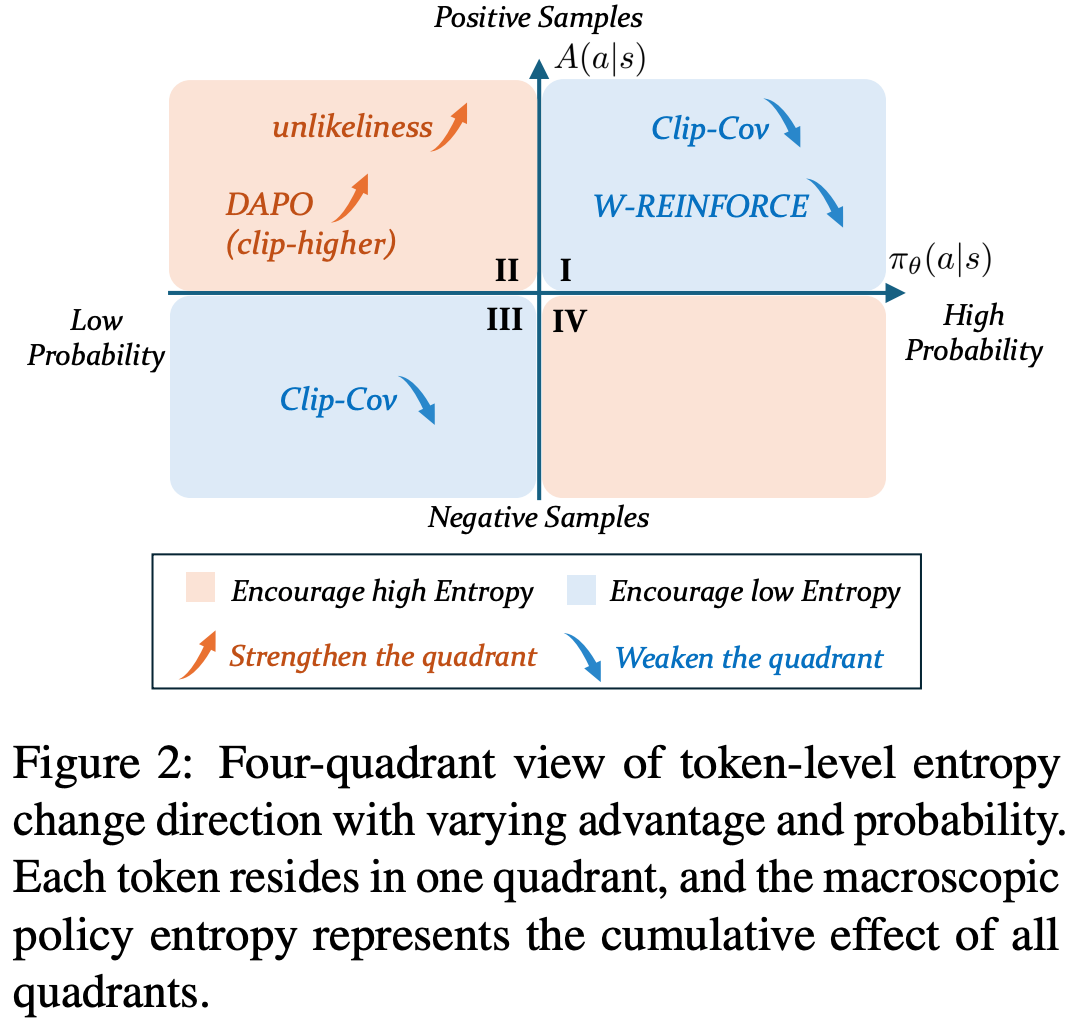
- 鉴于对于高概率 Token,函数 \(\delta (\pi_{\theta},\mathcal{H})\) 取负值,而对于低策略概率 Token 取正值,作者将这种联合效应概念化为图 2 所示 \((A,\pi_{\theta})\) 空间中的四个定性象限:
- 象限 I(利用,熵减) :\( A > 0, \delta < 0 \)
- 高概率的正确 Token 被强化,分布更集中,熵减少
- 奖励一种专门化的行为会集中概率质量,从而减少熵
- 象限 II(探索,熵增) :\( A > 0, \delta > 0 \)
- 低概率的正确 Token 被鼓励,分布更多样,熵增加
- 奖励一种罕见但正确的行为会使策略多样化,从而增加熵
- 象限 III(抑制,熵减) :\( A < 0, \delta > 0 \)
- 低概率的错误 Token 被惩罚,分布更集中,熵减少
- 惩罚罕见行为会进一步集中概率质量,从而减少熵
- 象限 IV(纠错,熵增) :\( A < 0, \delta < 0 \)
- 高概率的错误 Token 被惩罚,分布被“压平”,鼓励探索替代方案,熵增加
- 惩罚过度自信的错误会使分布变得平坦,以鼓励寻求替代方案,这往往会增加熵
- 理解:这里没有明确定义高熵和低熵的具体数值,详情见本人之前的推导:Math——多项式分布下的熵变化详细讨论
- 前提:在 Softmax 分布下调整单一类别的概率
- 1)如果调整的类别概率非常大(大于 \(0.5\)),压低它必然增熵 ,提升它必然减熵
- 2)如果调整的类别概率非常小(小于 \(1/n\)),提升它必然增熵 ,压低它必然减熵
- 3)如果它的概率处于中间地带(在 \(1/n\) 到 \(0.5\) 之间),需要计算剩余类别的熵 \(H_\text{rest}\) 来确定临界点 \(p^*\),再判断它是减熵还是增熵
- 前提:在 Softmax 分布下调整单一类别的概率
- 象限 I(利用,熵减) :\( A > 0, \delta < 0 \)
- 注:本文进一步通过对每个象限中的样本进行干预来进行实证分析
- 实证观察与理论发现高度一致*(可参考附录 D.3 了解更多细节和结果)
- 在 RLVR 过程中,这四个象限级别的动态作为塑造策略的竞争力量共存
- 全局策略熵源于这些竞争性更新的综合效应
- 因此,熵崩溃可以被理解为一种状态,即由利用驱动的、减少熵的更新(象限 I 和 III)持续地压倒了由探索驱动的、增加熵的更新(象限 II 和 IV)
- 个人理解 全局熵崩溃的本质 :当熵减象限(I 和 III)的更新强度持续压倒熵增象限(II 和 IV)时,全局熵就会持续下降,导致崩溃
- 鉴于对于高概率 Token,函数 \(\delta (\pi_{\theta},\mathcal{H})\) 取负值,而对于低策略概率 Token 取正值,作者将这种联合效应概念化为图 2 所示 \((A,\pi_{\theta})\) 空间中的四个定性象限:
Analyses on Existing Entropy Intervention Methods
- 基于上述理论发现,本节对现有的熵干预技术进行全面分析,以揭示其内在机制和局限性
Entropy Effect of Clip-Higher
- DAPO 将下裁剪边界和上裁剪边界解耦为 \(\epsilon_{\text{high} }\) 和 \(\epsilon_{\text{low} }\),并表明增大 \(\epsilon_{\text{high} }\) 可以缓解熵坍缩
- 其内在机制可以解释如下:
- 从重要性比率 \(r = \frac{\pi_{\theta} }{\pi_{\text{old} } }\) 来看,当 \(\pi_{old}\) 相对较小时,该比率更可能取较大的值
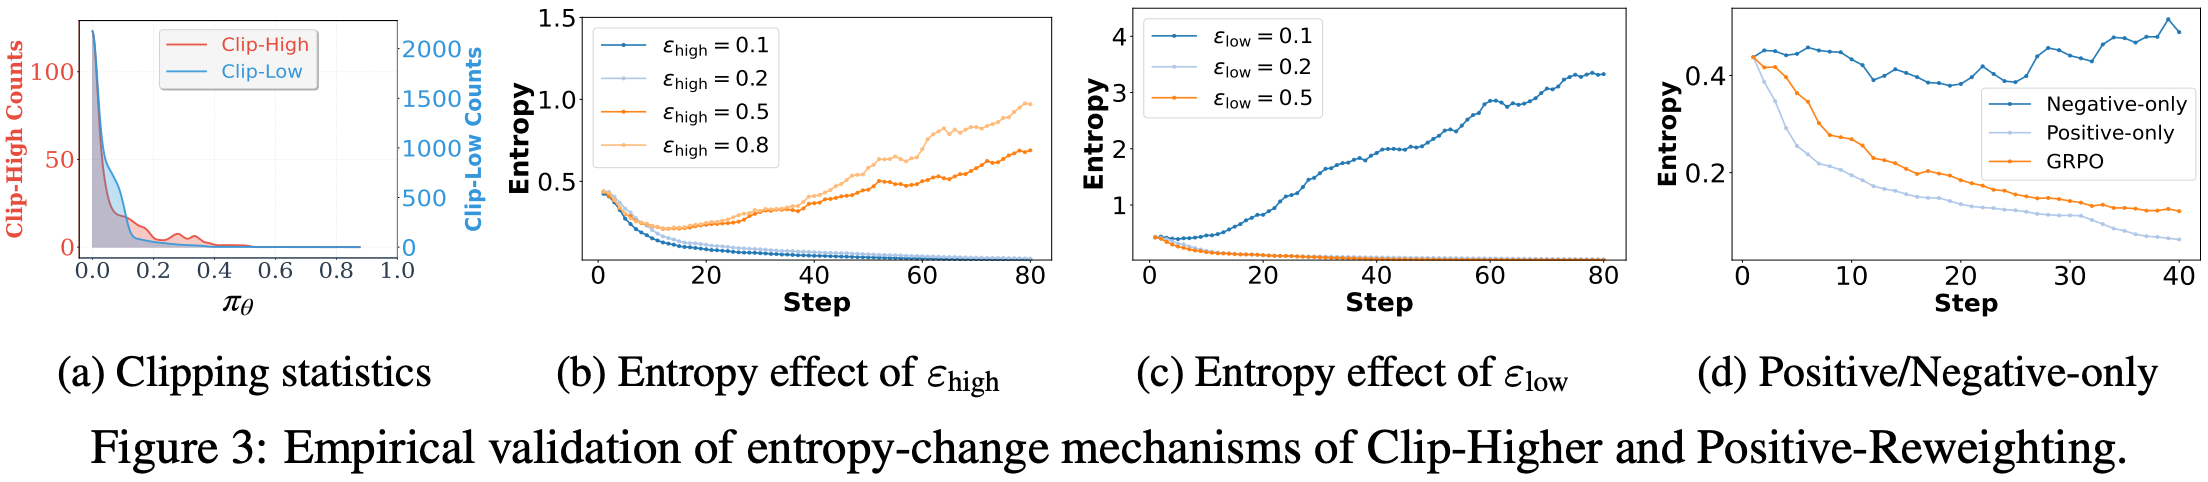
- 因此,裁剪主要针对低概率 Token 触发,这一点在作者图 3a 中的实证观察中得到了证实,该图统计了 GRPO 前 10 步中的裁剪事件
- 在这种情况下,通过 \(\epsilon_{\text{high} }\) 进行的裁剪充当了一个过滤器,移除了相当数量的低概率正样本,这些样本通常属于第二象限
- 因此,增大 \(\epsilon_{\text{high} }\) 会减少被过滤的实例数量,允许更多样本对熵增做出贡献,从而缓解坍缩
- 类似的推理也适用于 \(\epsilon_{\text{low} }\) 的作用:
- 增大 \(\epsilon_{\text{low} }\) 会减少对第三象限实例的过滤,这反过来会加剧熵坍缩
- 增大 \(\epsilon_{\text{low} }\) 会减少对第三象限实例的过滤,这反过来会加剧熵坍缩
- 从重要性比率 \(r = \frac{\pi_{\theta} }{\pi_{\text{old} } }\) 来看,当 \(\pi_{old}\) 相对较小时,该比率更可能取较大的值
- Empirical Evidence
- 本文通过实证实验进一步验证了这些观察
- 图 3b 和图 3c 展示了改变 \(\epsilon_{\text{high} }\) 和 \(\epsilon_{\text{low} }\) 的影响
- 观察结果:增大 \(\epsilon_{\text{high} }\) 可以缓解甚至逆转熵坍缩,而增大 \(\epsilon_{\text{low} }\) 则会加剧坍缩
- 本文通过实证实验进一步验证了这些观察
- Limitation:
- 调整裁剪阈值对熵动态的影响可以解释为对图 2 中第二象限和第三象限 Token 的重新加权
- 但这种启发式方法仍然是粗粒度的:例如,DAPO 试图通过控制第二象限中某些 Token 的更新来影响熵,而没有显式控制其他象限的 Token
Entropy Effect of Re-weighting Positives
- 近期研究表明,对正样本进行重新加权可以缓解熵坍缩,例如
- Unlikeliness (2025a) 对第二象限的 Token 进行上加权(增强熵增),对第一象限的 Token 进行下加权(降低熵减)
- W-REINFORCE (2025) 则在训练中对所有正样本进行下加权
- Unlikeliness 的效果从图 2 中可以清晰地看出:它增强了熵增象限,削弱了熵减象限,从而增加了 Policy 熵
- W-REINFORCE 认为 Token 级别的更新由高概率 Token 主导,因为它们更有可能被采样
- 因此,对所有正样本进行下加权主要削弱了来自第一象限的熵减贡献,从而增加了 Policy 熵
- 理解:这里对正样本进行降权的操作本质上也会对第二象限进行降权,但是这里应该是对第二象限的影响不如第一象限导致熵增
- Empirical Evidence
- 本文在 GRPO 设置中进行了仅正样本和仅负样本的实验,其中 Policy 模型分别仅使用正样本或仅使用负样本进行训练
- 结果如图 3d 所示,与前面分析一致:
- 仅在正样本上训练会迅速导致 Policy 熵坍缩
- 仅在负样本上训练则能持续保持高熵
- Limitation:
- 虽然这些正样本重加权方法改善了全局熵,但它们仅对 Token 的一个子集进行重新加权,使得其余 Token 仍然容易发生熵坍缩
Entropy Effect of Entropy-aware Advantage
- 一些研究提出将熵相关项纳入优势函数以缓解熵坍缩,例如 Entro. Adv. (2026) 和 GTPO (2025)
- 这些方法为具有较高熵的 Token 分配较大的优势
- 但本文发现表明这些方法并非普遍有效
- 事实上,它们有时会加剧而非缓解熵坍缩
- Mechanism:
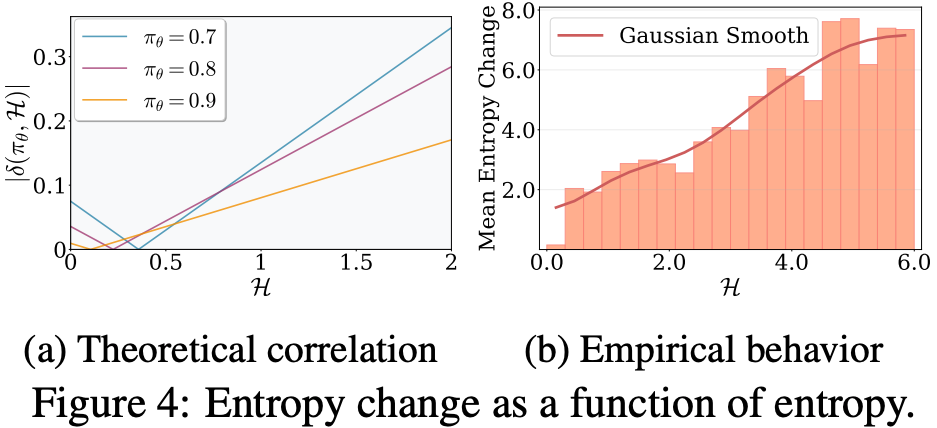
- 基于公式 (8),在图 4a 中绘制了 \(\delta (\pi_{\theta}, \mathcal{H})\) 作为 \(\mathcal{H}\) 的函数
$$\delta (\pi_{\theta},\mathcal{H})\triangleq -\pi_{\theta}(1 - \pi_{\theta})\left[\log (\pi_{\theta}) + \mathcal{H}(s)\right].\tag {8}$$ - 可以推断,高熵 Token 倾向于引起较大的熵变
- 这一机制在图 4b 的训练过程中的经验行为得到了证实,该图跟踪了前 50 个训练步骤的平均熵变:
- 具有较高熵的 Token 表现出较大的熵变
- 因此,为高熵 Token 分配更大的优势可能会放大它们的熵变
- 理解:这里的高熵 Token 并不是一个特定的 Token,而是针对一个特定的前缀而言的策略熵 \(\mathcal{H}(s)\)
- 当 Policy 进入熵减阶段时,这种放大效应会加剧而非缓解坍缩
- 具有较高熵的 Token 表现出较大的熵变
- 这一机制在图 4b 的训练过程中的经验行为得到了证实,该图跟踪了前 50 个训练步骤的平均熵变:
- 基于公式 (8),在图 4a 中绘制了 \(\delta (\pi_{\theta}, \mathcal{H})\) 作为 \(\mathcal{H}\) 的函数
- Empirical Evidence
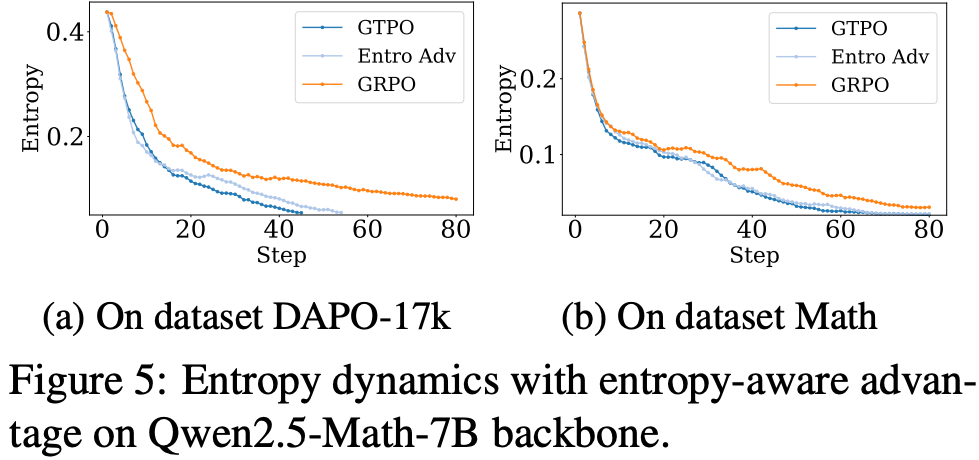
- 通过检查图 5 中这些方法的熵动态来验证这一机制:
- 与 GRPO 相比,当 Policy 进入熵减阶段时,Entro. Adv. 和 GTPO 都表现出更快的熵坍缩
- 当 Policy 熵开始下降时,这些方法甚至可能加速熵坍缩
- 通过检查图 5 中这些方法的熵动态来验证这一机制:
- Limitation:
- 这一发现揭示了这些方法的一个缺陷:
- 它们并非可靠地鼓励探索,反而可能加剧熵的下降
- 这一发现揭示了这些方法的一个缺陷:
Limitations of Existing Methods
- 虽然上述熵干预策略在实践中可以部分缓解熵坍缩,但它们在很大程度上仍是启发式的,缺乏原则性指导
- 这些策略仅对公式 (7) 中的一个或两个因素进行定性调整,如表 2 所示,而忽略了其他相关因素,未能捕捉它们对熵动态的联合影响
$$\Omega (s)\triangleq -\frac{\eta}{L}\mathbb{E}_{\pi_{\theta}(\cdot |s)}\Big[\frac{\mathbb{I}_{\text{clip} }A}{\pi_{\text{old} } }\pi_{\theta}(1 - \pi_{\theta}) \big(\log \pi_{\theta} + \mathcal{H}(s)\big)\Big] \tag {7}$$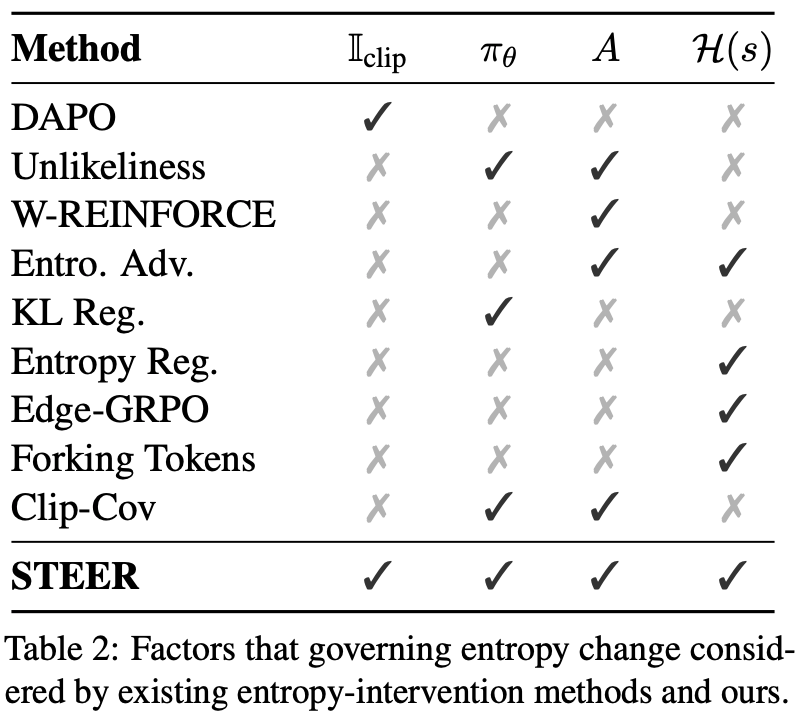
- 它们的干预与实际训练中观察到的熵演化之间存在显著差距,其有效性受到了损害
Stabilizing Token-level Entropy-change via Reweighting,通过重新加权稳定 Token 级别的熵变
- 本文提出一种细粒度的、有理论依据的方法 STEER
- STEER 的核心思想是直接利用理论估计的熵变(entropy change) \(\Omega (s)\),将其转换为自适应的 Token 级别缩放权重 \(\lambda (s)\),并融入每个 Token 的损失函数中
- 对于容易发生剧烈熵衰减的 Token,STEER 主动削弱其梯度贡献,将其熵变从 \(\Omega (s)\) 近似调节为 \(\lambda (s)\Omega (s)\)
- 这一机制使 STEER 能够执行精确的 Token 级别熵调制,超越了先前方法对全局期望的粗粒度监控
- 为了实现这一点,本文通过一个简单的指数衰减函数引入 \(\lambda (s)\):
$$\lambda (s) = \exp \left(-\alpha \frac{|\Omega(s)|}{\max_{s\in B}|\Omega(s)|}\right),\tag {9}$$- \(\alpha > 0\) 是控制衰减率的超参数
- \(B\) 是当前批次的所有 Token 粒度的熵变
- 该公式满足两个期望特性:
- (1) 它相对于归一化熵变是单调递减的
- (2) 指数形式确保所有权重严格为正
- 这里应用绝对值 \(|\Omega (s)|\) 来衡量熵变的大小,因为大的熵增也可能是次优的
- 将增加和减少都控制在稳定范围内可以实现更稳定的训练动态
- 通过批次最大值进行归一化确保了数值稳定性
- 超参数 \(\alpha\) 控制衰减曲线的斜率
- \(\alpha\) 决定了最小可达到的权重 \(\lambda_{\min} = \exp (-\alpha)\)
- 公式 (9) 可以解释为将熵变逆映射到范围 \([\lambda_{\min}, 1]\) 内,熵变越大对应的权重越小
- 在实践中,调整 \(\lambda_{\min}\) 比调整 \(\alpha\) 更方便,因为它具有更好的可解释性
- STEER 还具有显著的实用优势,计算成本极低,并且可以轻松集成到现有方法中
- STEER 仅涉及 \(\Omega (s)\) 的额外计算,其复杂度可以忽略不计
- STEER 可以无缝应用于各种 LLM 架构和 RL 算法
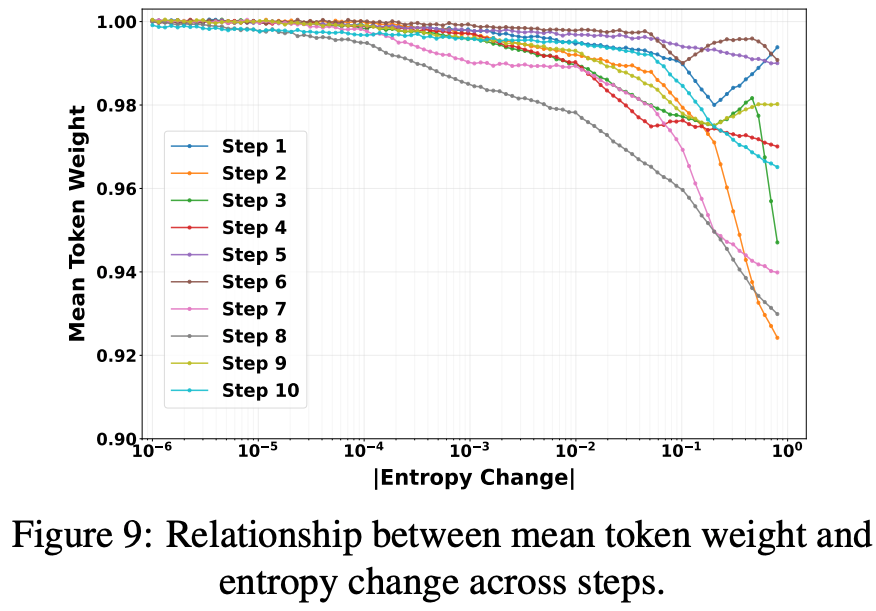
- 理解:公式 9 的本质是,熵变越大的(容易发生剧烈熵衰减的)Token,削弱起贡献(Advantage),详细示例见图 9
Experiments and Results
- 从以下几个方面评估 STEER
- 首先在六个数学推理基准和三个代码基准上将 STEER 与强基线进行比较
- 其次检查 STEER 在 RLVR 训练中的熵控制能力
- 最后测试 STEER 在多种模型规模、模型家族和 RL 算法上的泛化能力
- 更多结果参见附录 F
Experimental Setup
Training
- 遵循 verl (2025) 中标准 GRPO 的默认训练方案
- 为了公平比较,严格遵循近期工作 (2025; 2025a) 中使用的实验设置
- STEER 引入的唯一超参数 \(\lambda_{\min}\) 设置为 0.7
- 为确保可靠性,主要实验中报告的所有结果均为两次独立训练运行的平均值
- 对于数学推理任务
- 在四种不同的模型上进行实验,包括 Qwen2.5-Math-1.5B/7B、Qwen2.5-14B (2024a) 和 Llama-3.2-3B (2024)
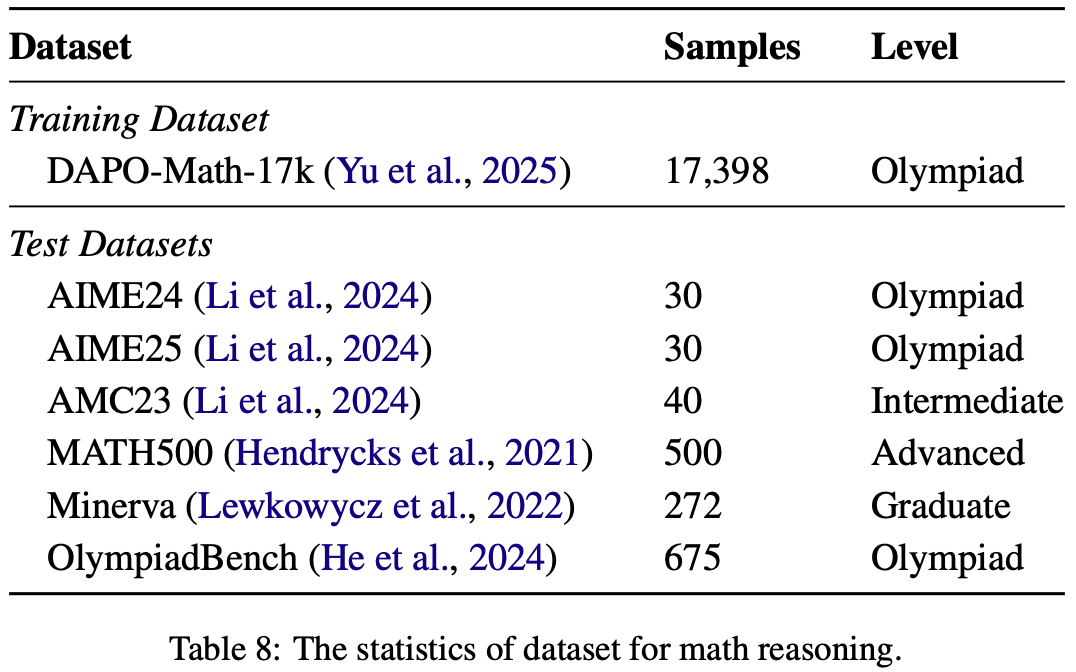
- 在 DAPO-Math-17k (2025) 上进行训练,该数据集包含 17K 个 Prompt,每个 Prompt 都配有一个 ground-truth 整数答案
- 对于代码任务
- 在四种不同的模型上进行对比实验,包括 Qwen2.5-Coder-3B/7B/14B (2024) 和 Mistral-7B (2023)
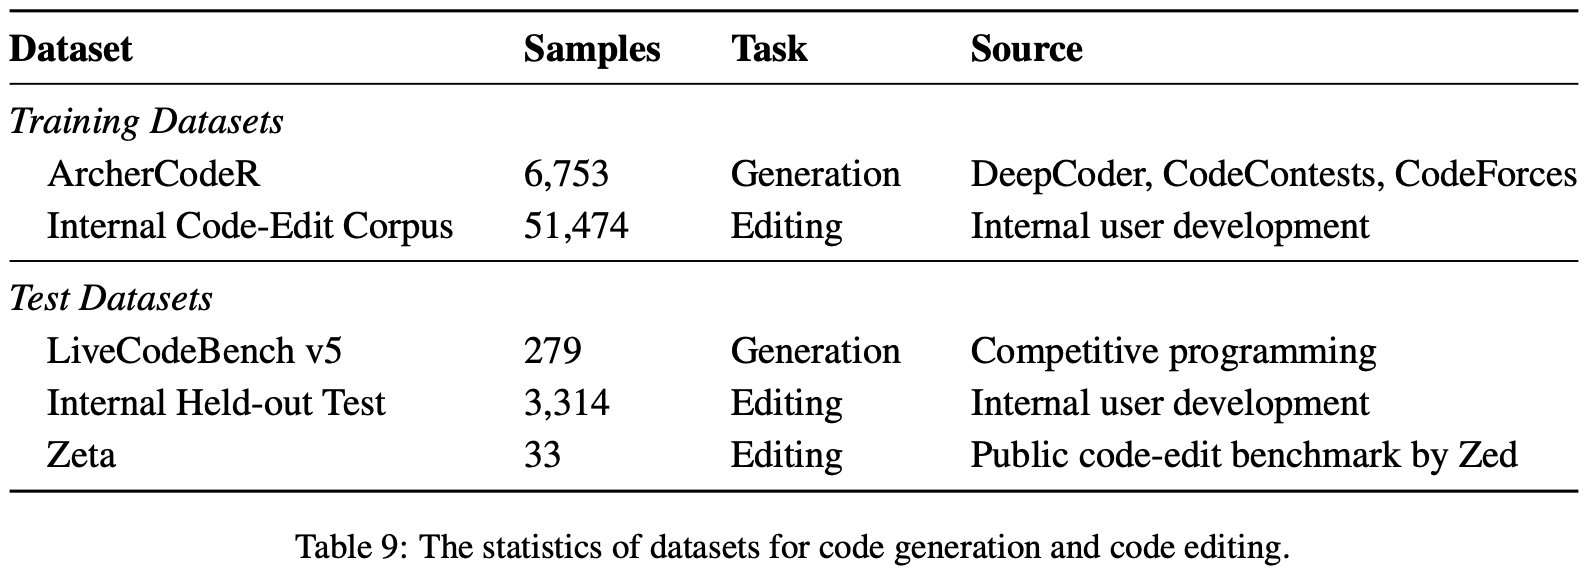
- 对于代码生成任务,采用 ArcherCoderR 进行训练
- 对于代码编辑任务,由于没有大规模开源数据集可用,采用内部的实用代码编辑基准进行训练
Evaluation
- 对于数学推理任务,在六个广泛使用的数学推理基准上评估作者的模型和基线:AIME24、AIME25、AMC23、MATH-500、Minerva Math 和 OlympiadBench
- 对于代码生成任务,采用广泛使用的 LiveCodeBench v5 (2024) 进行评估
- 代码生成任务报告 avg@4,遵循 (2025b)
- 对于代码编辑,在内部保留的测试集划分和 Zeta (Zed Industries, 2025) 上评估模型
- 报告代码编辑任务的 exact-match 准确率
- 本文方法及基线的更多训练和评估细节列于附录 E
Baselines
- 为了进行全面的比较,在数学推理任务上将 STEER 与 11 个基线进行比较,包括
- 标准 GRPO (2024)
- SimpleRL-Zoo (2025)
- Eurus-PRIME (2025a)
- OPO (2025)
- 带 clip-high 的 GRPO (2025)
- 带熵损失的 GRPO (2017)
- 带 Fork Tokens 的 GRPO (2025c)
- W-REINFORCE (2025)
- Entro. Adv. (2026)
- Clip-Cov 和 KL-Cov (2025b)
- 在代码任务上,将 STEER 与 GRPO 进行比较
- 对于所有基线,RLVR 中的默认训练超参数与 STEER 保持一致,而新引入的超参数则按照原始实现进行配置,详见附录 E.2
Main Results
Math Reasoning Tasks
- 数学推理任务的主要结果如表 3 所示
- STEER 在所有数据集上都优于经典的 RLVR 基线和现有的熵干预基线
- 问题:为什么 添加了熵优化的 Clip-Cov 和 Entro. Adv. 等还比不过 标准的 GRPO?
- 注:看起来 STEER 也没有比 GRPO 好太多
- STEER 在所有基线中,平均性能比第二名 (OPO) 提高了 2.2 个百分点,比第三名 (Clip-Cov) 提高了 2.9 个百分点
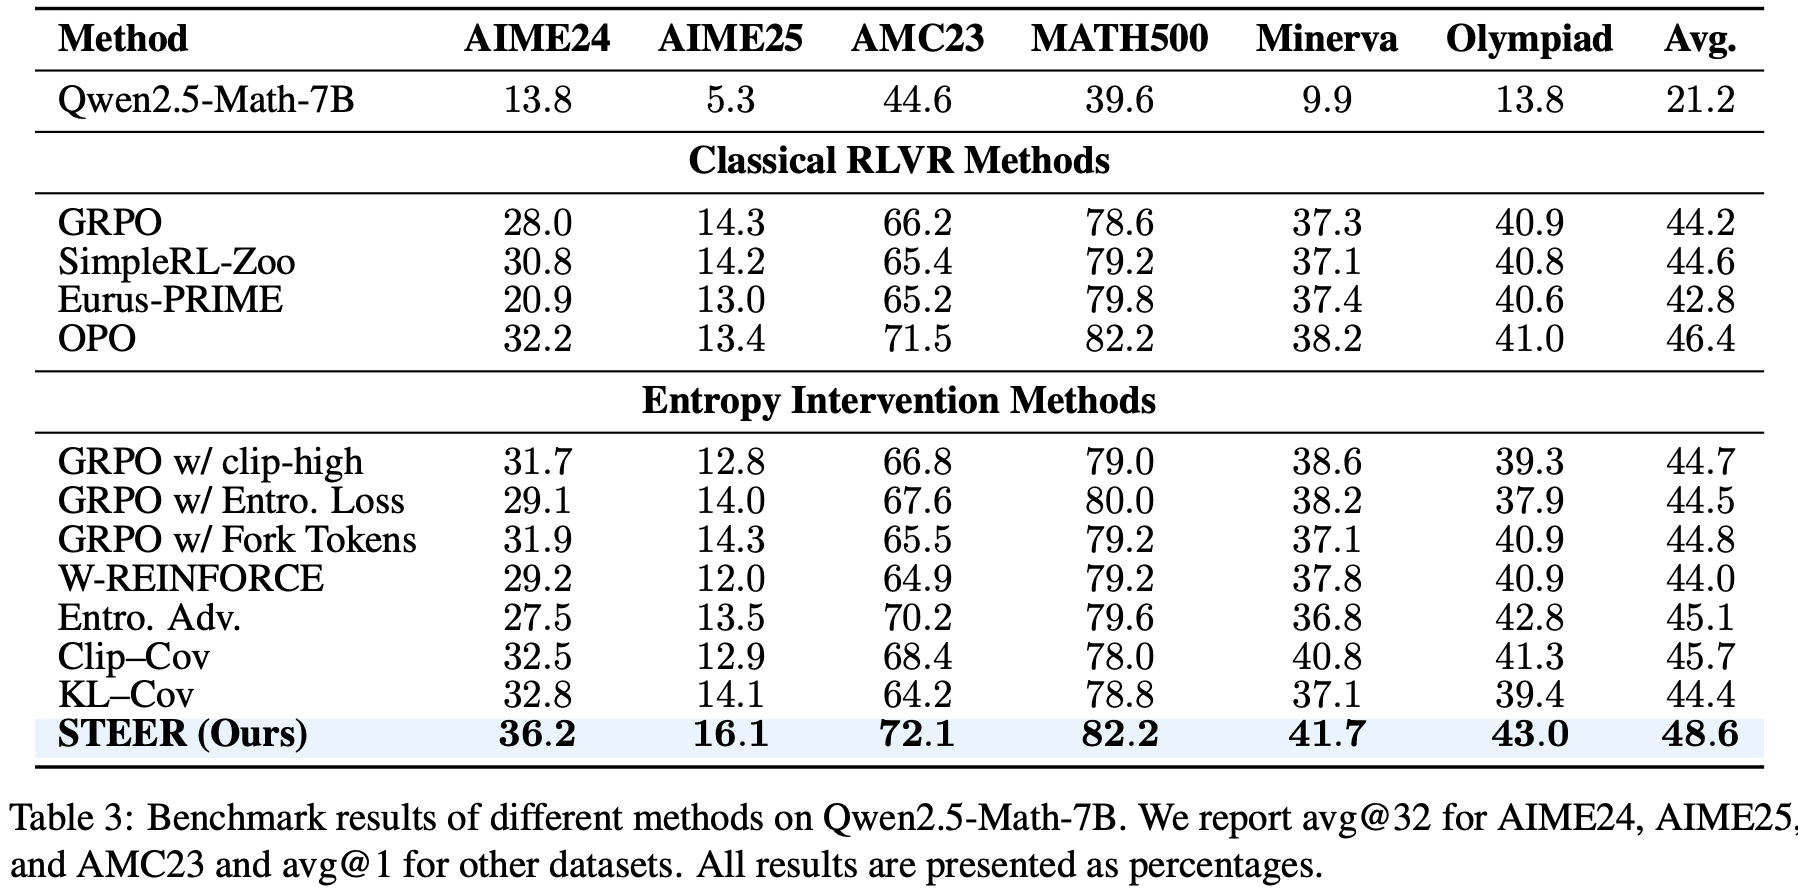
- STEER 在所有数据集上都优于经典的 RLVR 基线和现有的熵干预基线
- 在 Qwen2.5-14B 上的性能实验如表 4 所示,与表 3 中的前三名竞争者(即 OPO、Clip-Cov 和 Entro. Adv.)进行了比较
- STEER 也持续取得了最高的平均性能,展示了其在提升数学推理能力方面卓越的泛化能力
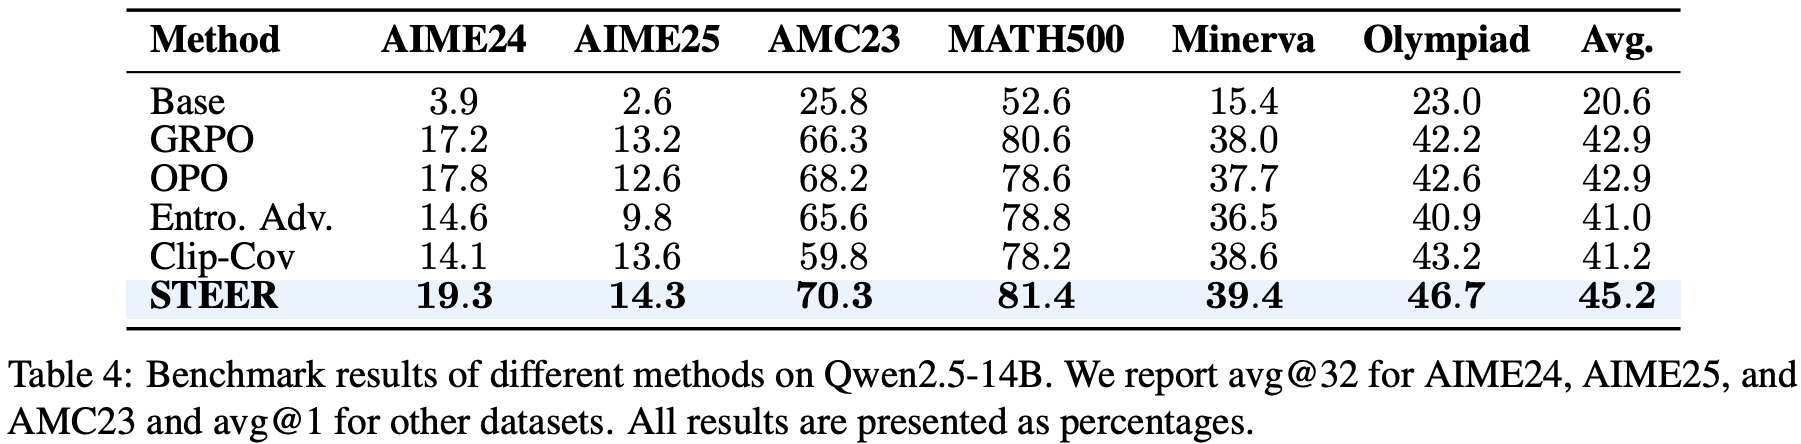
- STEER 也持续取得了最高的平均性能,展示了其在提升数学推理能力方面卓越的泛化能力
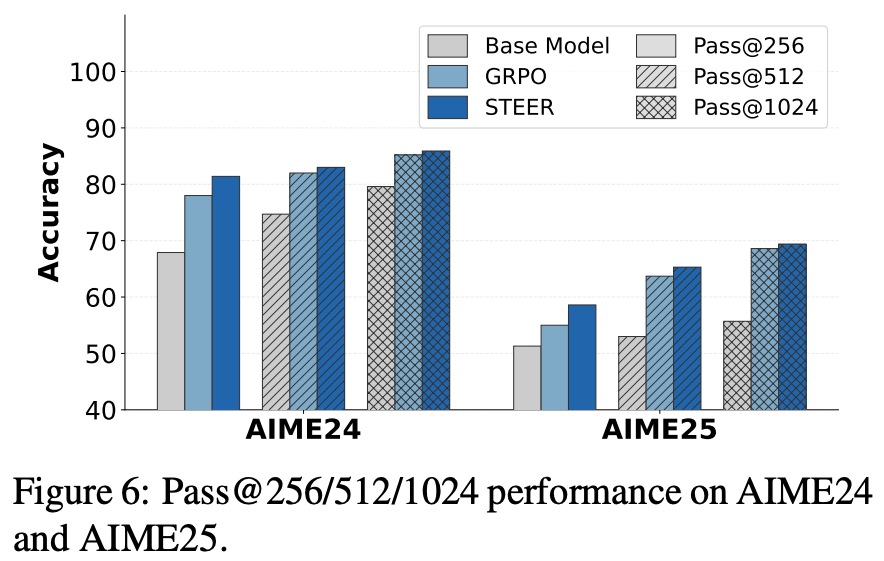
- 除了表 3 中的指标 avg@32 和 avg@1,数学推理中的 Pass@256/512/1024 结果如图 6 所示
- 可以观察到,STEER 在 AIME24/25 上均提供了最佳的 Pass@256/512/1024 以及最高的平均值
- 通过显式地调节熵,STEER 保留了足够的探索能力以发现更多信息丰富的轨迹,从而实现了更好的性能
Coding Tasks
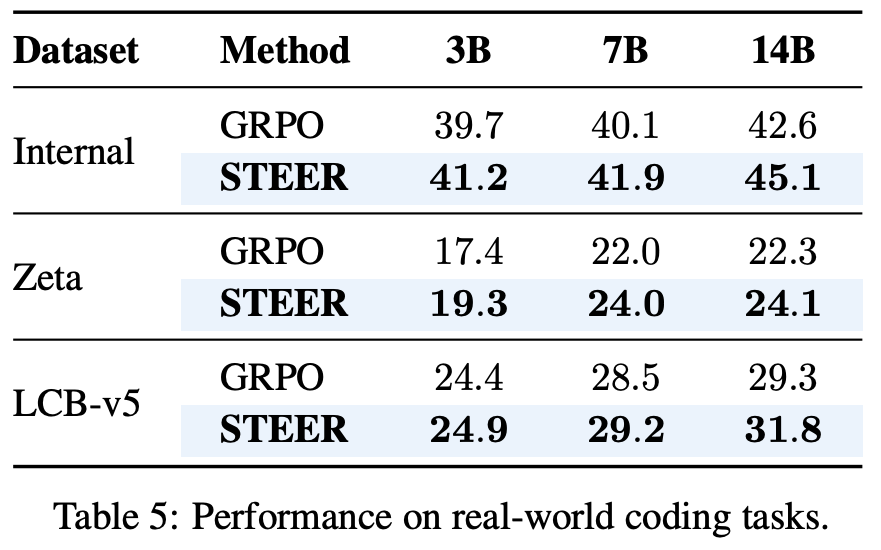
- 表 5 将 STEER 与 GRPO 在三个 Qwen2.5-coder 模型上进行了比较
- 在每个模型和测试集上,STEER 都比 GRPO 至少高出 \(1%\)。这些结果展示了 STEER 在各种场景下的优越性能
- 更多性能评估详见附录 F
Training Dynamics
- 图 7 显示了训练过程中的测试准确率曲线
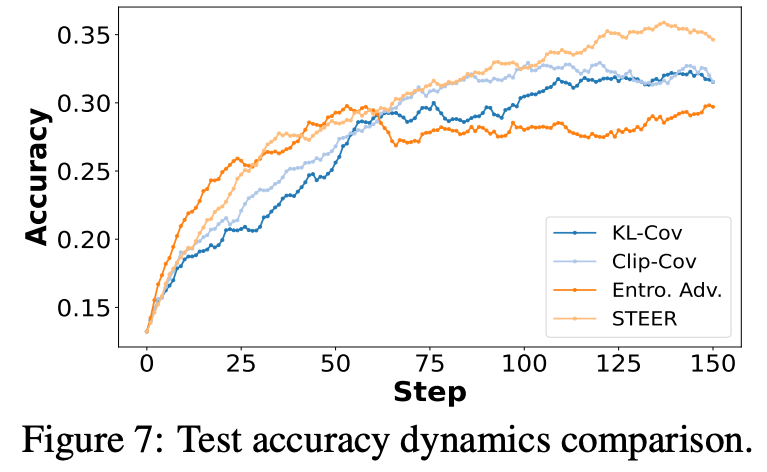
- STEER 呈现出稳定的上升轨迹,最终取得了相比基线更优的最终性能
- 理解:只训练了 150 步,有点短,因为本文的方案理论上可能会影响学习率,所以或许会有一定影响
Empirical Results for Entropy Modulation
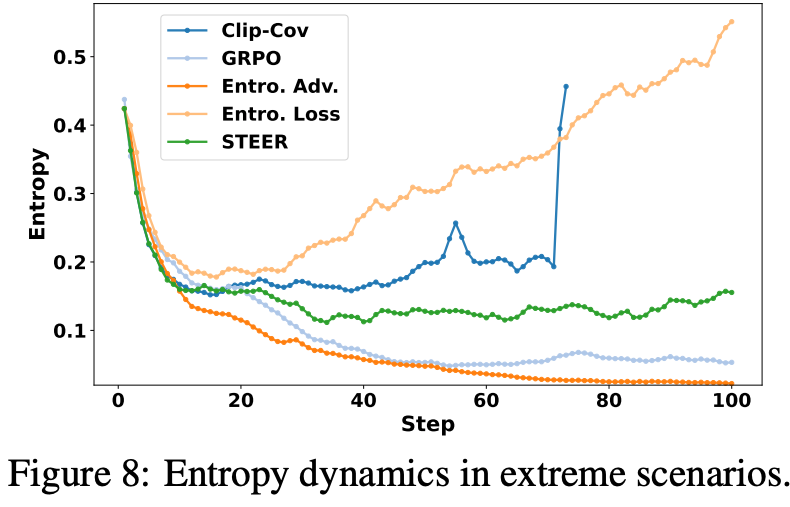
- 为了更好地展示 STEER 在广泛范围内调节熵的能力,本文采用了一种极端的训练设置
- \(\epsilon_{\text{high} } = 5\) 且 \(\epsilon_{\text{low} } = 0.99\),此时几乎不应用比率裁剪
- 在这种情况下,由于极端裁剪比率下不稳定的梯度更新,RL 训练是脆弱的
- 结果如图 8 所示
- 大多数方法无法维持稳定的熵:
- GRPO 和 Entro. Adv. 倾向于熵坍缩
- 添加熵损失会迅速推高熵,导致过度的不确定性
- Clip-Cov 无法可靠地控制熵
- STEER 在初始下降后趋于稳定,并在此后保持稳定的熵
- 大多数方法无法维持稳定的熵:
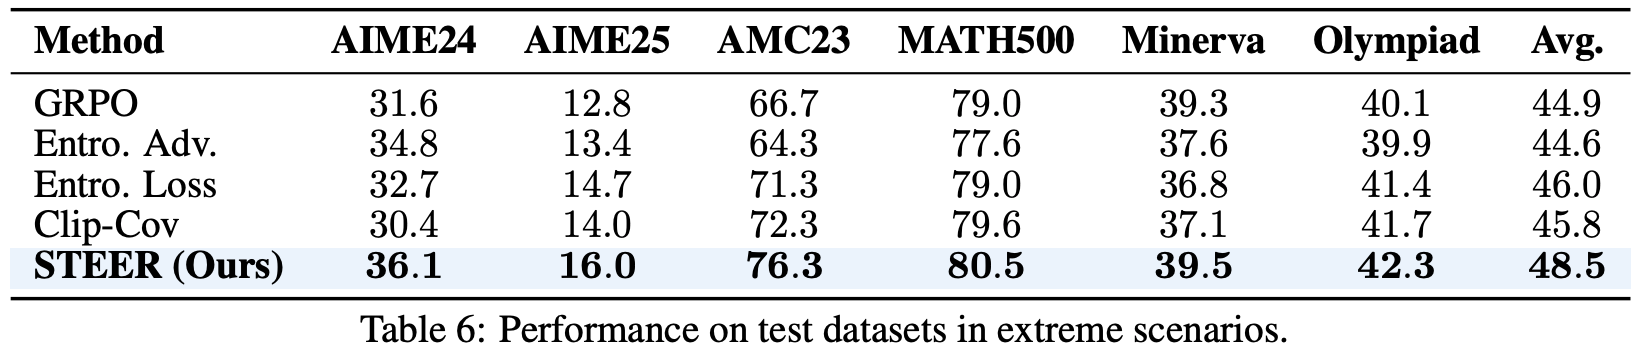
- 本文在此训练设置下测试了熵干预方法,测试集准确率如表 6 所示
- 观察:即使在裁剪操作几乎完全被移除的训练场景中,STEER 相比其他熵干预方法仍能保持相对稳定的性能,并在所有测试集上取得了最高的准确率
- 观察:即使在裁剪操作几乎完全被移除的训练场景中,STEER 相比其他熵干预方法仍能保持相对稳定的性能,并在所有测试集上取得了最高的准确率
- 图 9 描绘了前 10 步中平均 Token 权重随绝对 Token 熵变变化的趋势
- 当熵变较小时,大多数权重保持在 1 附近
- 只有熵变较大的 Token 获得显著降低的权重,这表明 STEER 在不阻碍学习的情况下稳定了训练
Generalization Study
- 在额外的 Backbone 上进行了实验,包括用于数学推理的 Llama-3.2-3B-Instruct (2024) 和用于代码编辑的 Mistral-7B-v0.3 (2023)
- 对于每项任务,使用与主要实验相同的 STEER 超参数,而不是针对每个 Backbone 重新调整
- 结果见附录 F.3,STEER 产生了一致的性能提升
- 本文还评估了 STEER 在不同模型规模(包括 1.5B/7B/14B)下的性能
- 如表 3、表 4 和附录 F.3 所示, STEER 在多种模型规模下都表现出优越的性能
- 如表 3、表 4 和附录 F.3 所示, STEER 在多种模型规模下都表现出优越的性能
- 在另外两种代表性的 RL 算法 RLOO (2024) 和 OPO (2025) 上评估了 STEER,使用 verl 实现中的默认设置
- 结果也显示在附录 F.3 中
- STEER 将 RLOO 的平均分从 \(45.8\) 提高到 \(46.8\),将 OPO 的平均分从 \(46.4\) 提高到 \(47.5\),表明 STEER 可以有效地应用于其他 RLVR 算法,而不仅限于 GRPO
Limitations
- 待探索的方向:
- 没有可验证奖励的 RL 训练
- Agentic 和 Long-Horizon RL
附录 B:Related Work
B.1 Reinforcement Learning with verlfiable Rewards in LLMs
- RLVR
- GRPO
- PPO
- DeepSeek-R1
B.2 Entropy-Oriented RL Methods for LLM Reasoning
- 熵正则化 (2016;2018;2023;2025;2023b) 是传统 RL 中的早期工作,可能会在关键状态下误导动作选择 (2025c),并且已被证明在 LLM 训练中对系数高度敏感 (2026;2025b;2025c;2024b;2025b;2026a;2026)
- 部分工作 (2025b) 认为 KL 惩罚保留了熵并充当正则化器,确保在线策略接近稳定的参考策略,从而稳定学习并减少对误导性奖励信号的过拟合
- 在本文的工作中,排除了当前策略 \(\pi_{\theta}\) 与参考策略 \(\pi_{\text{ref} }\) 之间的 KL 散度项
- 因为近期工作 (2025;2026;2025) 表明,在推理任务中其实际影响通常可以忽略不计甚至适得其反
- 在本文的工作中,排除了当前策略 \(\pi_{\theta}\) 与参考策略 \(\pi_{\text{ref} }\) 之间的 KL 散度项
- 一种解决熵崩溃的典型方法是在推理过程中提高采样温度
- 但部分研究 (2025) 的最新发现表明,虽然这种方法可以推迟熵崩溃的发生,但并不能阻止它,因为熵在整个训练过程中持续下降
- 近期研究试图通过调整策略优化的关键要素来缓解熵崩溃
- 例如 PPO 风格的比率裁剪 (2025;2025a)、平衡正负样本 (2025) 以及应用 KL 正则化 (2025b)
- 但这些方法较为宽泛,缺乏 Token 级别的精细控制,其机制往往未能以统一或有原则的方式得到充分解释
- 一些方法尝试通过基于熵的优势函数 (2026;2025;2025c;2025b;2025) 来鼓励探索
- 其直觉是强调不确定的状态将促进探索并提高整体策略熵
- 但在实践中,作者发现这种设计通常无法可靠地缓解熵崩溃,因为它不成比例地增强了高熵 Token 上的学习,从而放大了熵变化,导致熵控制不可靠
- 尽管先前的工作 (2025b) 考虑了熵变化,但由于其不合理的状态等价假设,所得估计存在偏差
- 其熵控制方案存在两个问题:
- (i) 根据熵变化强制执行硬性的二元分割,而不考虑其组内差异
- (ii) 可能阻碍学习过程,因为对探索有信息量的高熵变化 Token 被过度惩罚
- 其熵控制方案存在两个问题:
附录 C:Formulations of Entropy Shaping
C.1 A Unified Token-level Gradient Reweighting Framework
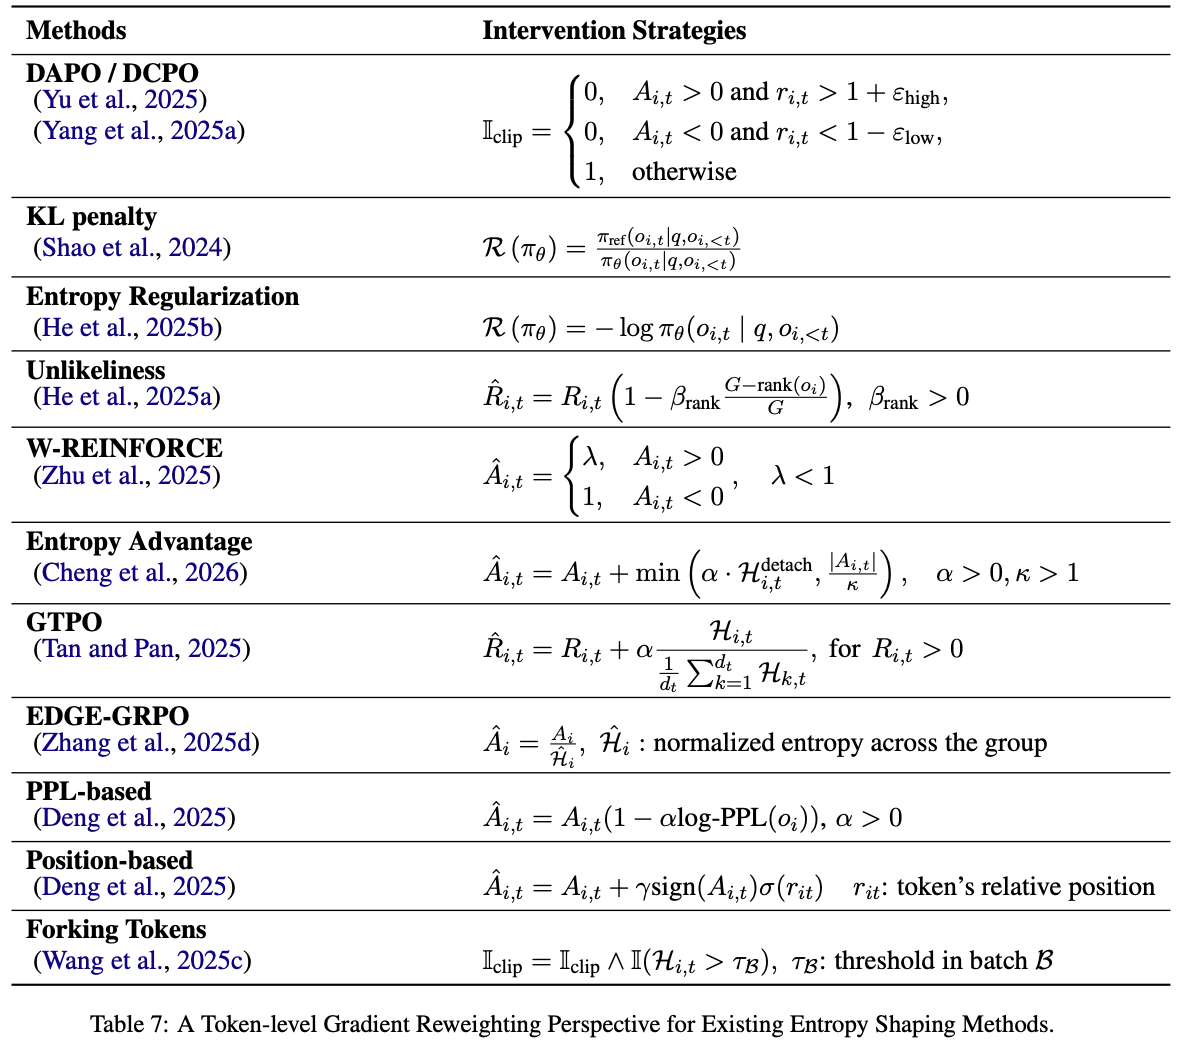
- 现有的熵干预方法尽管设计多样,但都通过修改单一量来运作:Token 级梯度权重
- 这一统一视角直接联系到定理 1 中确定的四个控制因素
- 广泛 RL 算法族的策略梯度可以表达如下:
$$
\begin{align}
\nabla_{\theta}\mathcal{J}(\theta) = \mathbb{E}_{q\sim \mathcal{D}, \{o_i\}_{i = 1}^G\sim \pi_{\text{old} }(\cdot |q) } \left[\frac{1}{\sum_{i=1}^{G}|o_i|}\sum_{i = 1}^{G}\sum_{t = 1}^{|o_i|}
w_{i,t}(q)\nabla_{\theta}\log \pi_{\theta}(o_{i,t}\mid q,o_{i,< t}) \right]
\end{align}
\tag {10}
$$- 其中 \(w_{i,t}(q)\) 为:
$$ w_{i,t}(q) = \mathbb{I}_{\text{clip} }r_{i,t}A_{i,t} + \beta \mathcal{R}(\pi_{\theta}) $$- \(r_{i,t}\) 表示重要性采样比率:
$$ r_{i,t} = \frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\text{old} }(o_{i,t}|q,o_{i,< t})} $$ - 优势 \(A_{i,t}\) 通过奖励 \(R_{i,t}\) 计算
- 裁剪指示器 \(\mathbb{I}_{\text{clip} }\) 源自比率裁剪操作,定义如下:
$$\mathbb{I}_{\text{clip} } = \left\{ \begin{array}{ll}0, & A_{i,t} > 0 \text{ and } r_{i,t} > 1 + \epsilon ,\\ 0, & A_{i,t} < 0 \text{ and } r_{i,t} < 1 - \epsilon ,\\ 1, & \text{ otherwise }. \end{array} \right.
\tag {6}
$$ - \(\mathcal{R}(\pi_{\theta})\) 是一个可选的正则化项,一些算法设置 \(\beta = 0\)
- 例如本文主要部分的 GRPO
- \(r_{i,t}\) 表示重要性采样比率:
- 其中 \(w_{i,t}(q)\) 为:
- 表 7 将每种现有的熵干预方法映射到其对 \(w_{i,t}\) 的具体修改
- 这些方法仅调整四个控制因素中的一部分,这既解释了它们的部分有效性,也说明了它们固有的局限性
- 这些方法仅调整四个控制因素中的一部分,这既解释了它们的部分有效性,也说明了它们固有的局限性
- 问题:KL Penalty 和 Entropy Regularization 应该是单独的,与目标相对隔离的吧,不会刚添加到 Advantage 那个位置,表 7 中的写法有些问题
C.2 Theoretical Analyses Extended to Other RL Algorithms
- 虽然本文的主要理论分析是在 GRPO 更新下呈现的,但它们不仅限于 GRPO,还可以扩展到其他策略梯度 RL 算法
- 本文的推导基于策略梯度的公式化表达,并且可以通过基于公式 (10) 进行微小修改,将 GRPO 策略梯度表达式调整为其他方法
- 不同的 RL 算法可以通过以下方式恢复:
- GRPO (2024) : \(A_{i,t} = A_{\text{group} }\)
- PPO (2017) : PPO 与 GRPO 共享相同的裁剪比率结构;区别在于优势估计器 \(A_{i,t} = A_{\text{GRE} }\)
- RLOO (2024) : 它是 REINFORCE 风格的算法,带有留一法 (leave-one-out) 基线,即 \(r_{i,t} = 1\) 且
$$A_{i,t} = R_{i} - \frac{1}{G - 1}\sum_{j\neq i}R_{j}\tag {12}$$ - OPO (2025) : 它是一种具有最优奖励基线的 On-policy RL 算法,因此通常 \(r_{i,t} = 1\) 且 \(A_{i,t}\) 是基线校正后的优势
- 将上述广义策略梯度形式代入定理 1 的证明中,可以得到相应的广义熵变估计量:
$$\begin{array}{r}\Omega (s) = -\frac{\eta}{L}\mathbb{E}_{\pi_{\theta}(\cdot |s)}\Big[\mathbb{L}_{\text{clip} }r_{i,t}A_{i,t}\ \pi_{\theta}(1 - \pi_{\theta})(\log \pi_{\theta} + \mathcal{H}(s))\Big]. \end{array}\tag {13}$$ - 这表明,对于多种 RL 算法,可以在同一分析框架内推导出统一的熵变估计量,具体优势函数的选择由上述定义给出
- 因此,为 GRPO 开发的理论见解也适用于其他 RL 算法
附录 D:Supplementary Empirical Analysis for RLVR Entropy
D.1 Empirical Properties of Policy Entropy
- 本小节展示了 RLVR 中策略熵动态的几个基本经验特性,提供了训练期间熵行为的一个整体视图
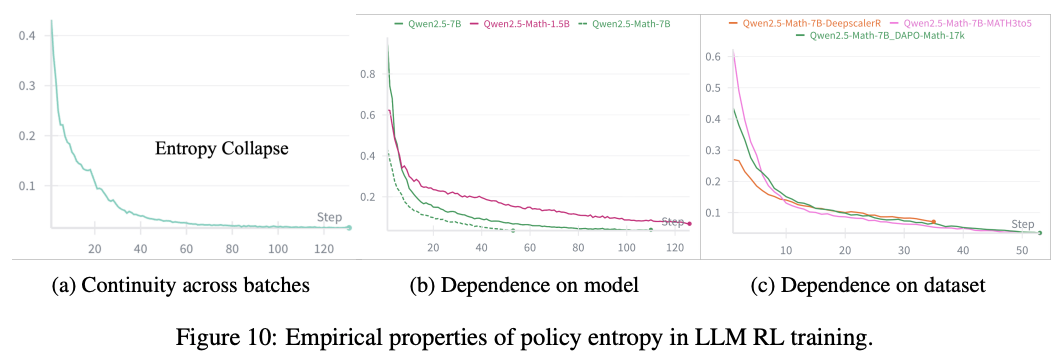
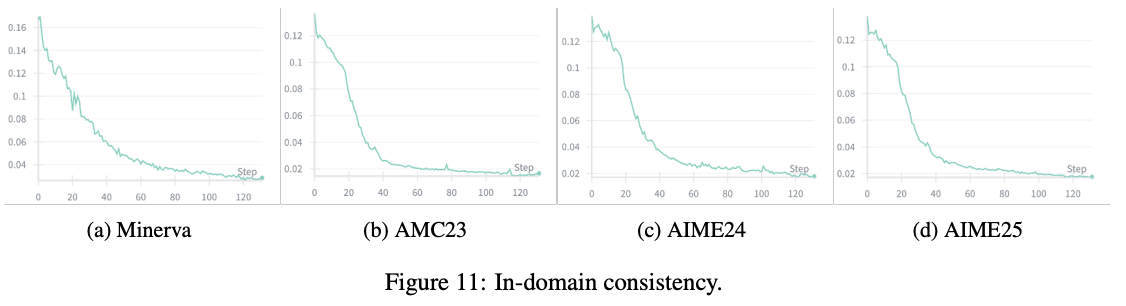
- 图 10 总结了 RLVR 中策略熵的几个经验特性
- 首先,批次间的连续性(图 1)显示,在标准 GRPO 运行下,策略熵逐步平滑衰减,熵崩溃表现为一个渐进趋势而非突然跳跃
- 其次,对模型的依赖性(图 2)比较了不同的骨干网络(例如,Qwen2.5-Math-1.5B / 7B 对比 Qwen2.5-7B),并揭示虽然所有模型最终都会经历熵崩溃,但初始水平和衰减速度随模型大小和预训练情况而变化
- 第三,对数据集的依赖性(图 3)表明,在不同数学数据集(Math-3to5, DAPO-MATH, DeepScaleR)上训练会导致不同的熵曲线,表明熵动态也受数据分布和难度的影响
- 最后,域内一致性(图 11)显示,在固定训练运行中,在同一领域(Minerva, AMC23, AIME24, AIME25)的多个测试集上测量的熵遵循高度相似的单调递减轨迹,意味着一个单一的全局熵趋势控制着广泛的任务
- 总结:这些观察结果提供了在应用任何额外干预之前,策略熵在 RLVR 中整体表现的概况
D.2 Entropy Change Estimation Comparison
- 正文中表 1 在三个指标上的对比结果强力验证了定理 1 中推导的估计器的有效性
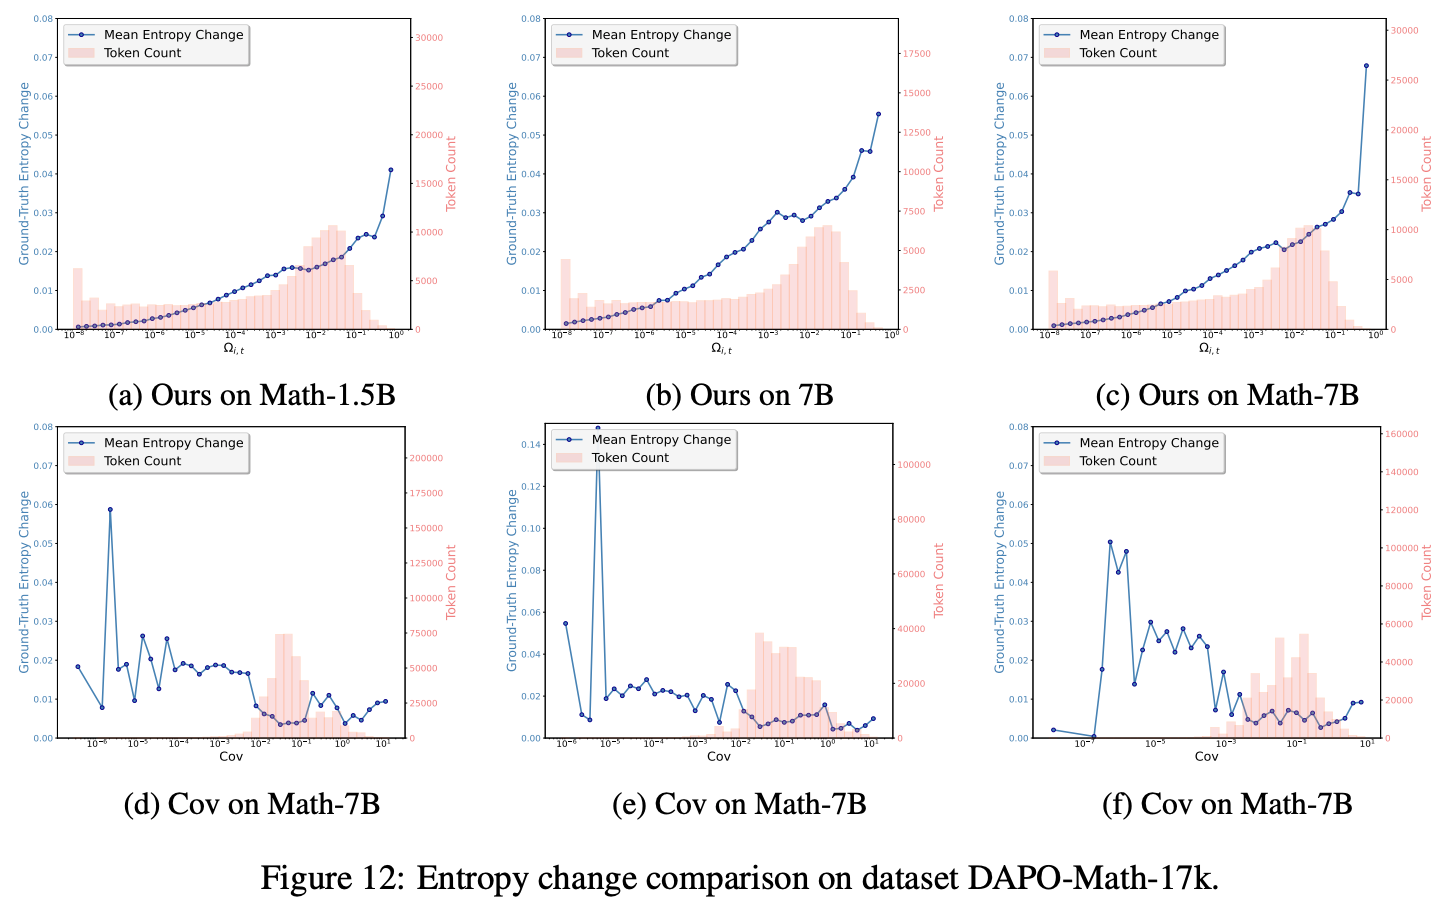
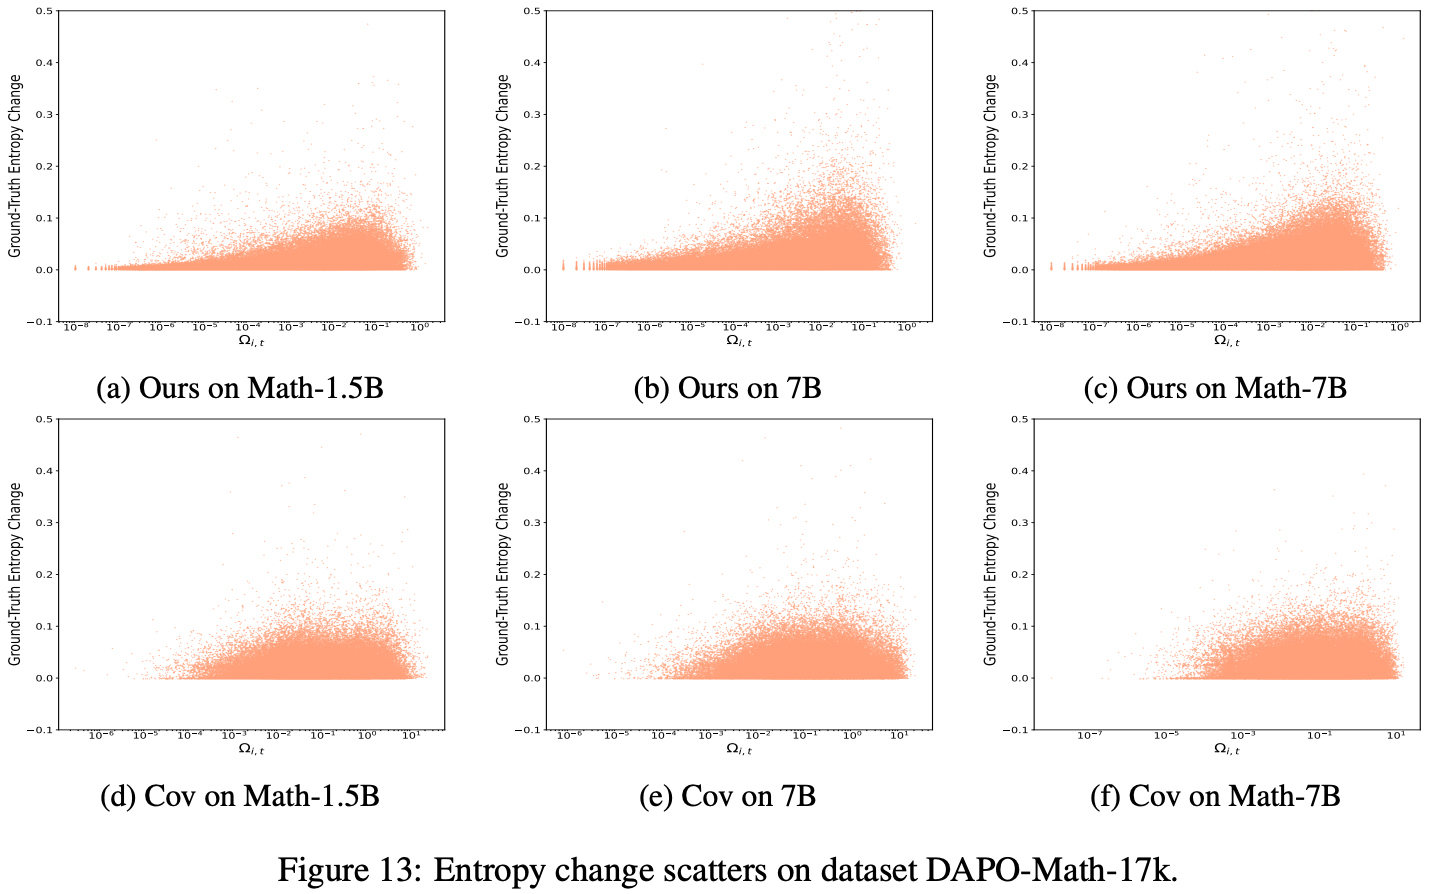
- 这里记录了不同模型和数据集在最初 10 个训练步骤中的 Token 熵变化
- 图 12 和图 13 显示了在数据集 DAPO-Math-17k 上的结果
- 曲线表示估计值与真实熵变(左轴),直方图显示每个区间的 Token 数量(右轴)
- 横轴是预估值,纵轴左边是预估值,可以看到本文的方法预估值和真实值呈现正相关关系(但是似乎不是很准确,比如预估值为 0.1 时的真实值偏低)
- 可以看出,本文方法展现出与真实熵变明显的正相关性,这有力地支持了作者的理论框架
- 相比之下,Cui (2025b) 中的估计方案没有显示出明确的相关性
- 曲线表示估计值与真实熵变(左轴),直方图显示每个区间的 Token 数量(右轴)
D.3 Influencing Entropy Dynamics by Strengthening or Weakening the Quadrants,通过增强或减弱象限来影响熵动态
- 本节探究这些关于象限层面趋势的理论发现是否可用于在实践中主动引导熵
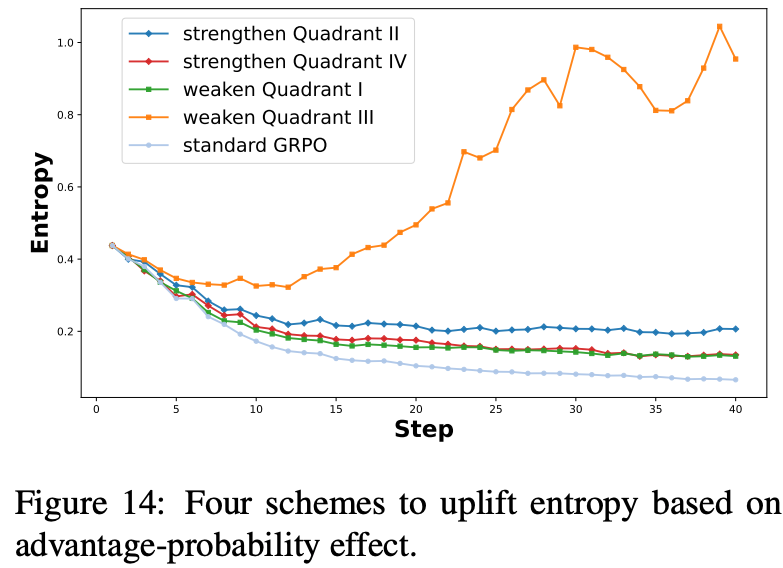
- 根据上述象限层面趋势,本文设计了一个简单的干预措施,对每个象限中 \(10%\) 的 Token 进行操作以增加熵:
- 对于增加熵的象限(II 和 IV),将其更新权重加倍,而对于减少熵的象限(I 和 III),屏蔽其更新,然后跟踪得到的策略熵
验证 1
- 如图 14 所示,与标准 GRPO 基线相比,所有四种干预措施均一致地提高了策略熵,支持了本文的分析
- 具体设定:
- 随机选择生成概率大于 0.8 且优势大于 0 的样本(第一象限),以及生成概率小于 0.2 且优势小于 0 的样本(第三象限),并随机屏蔽 \(10%\) 的这些 Token
- 对于生成概率大于 0.8 且优势小于 0(第四象限),或生成概率小于 0.2 且优势大于 0 的样本(第二象限),将 \(10%\) 的这些 Token 的权重设置为原始权重的两倍
- 具体设定:
验证 2
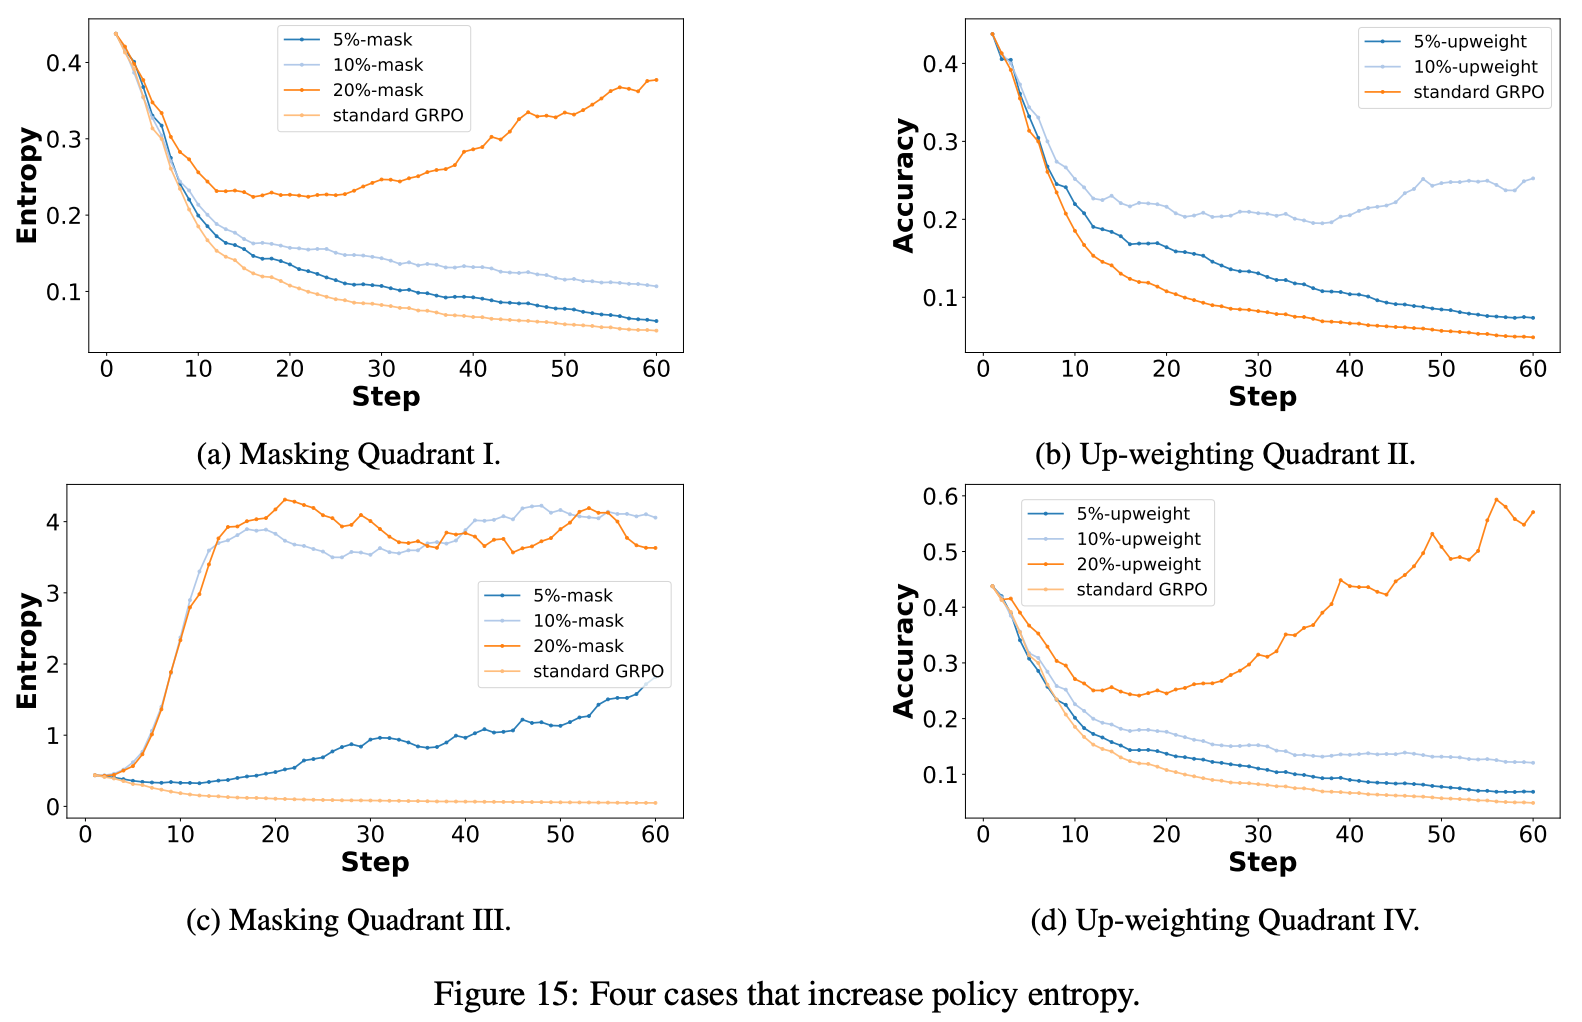
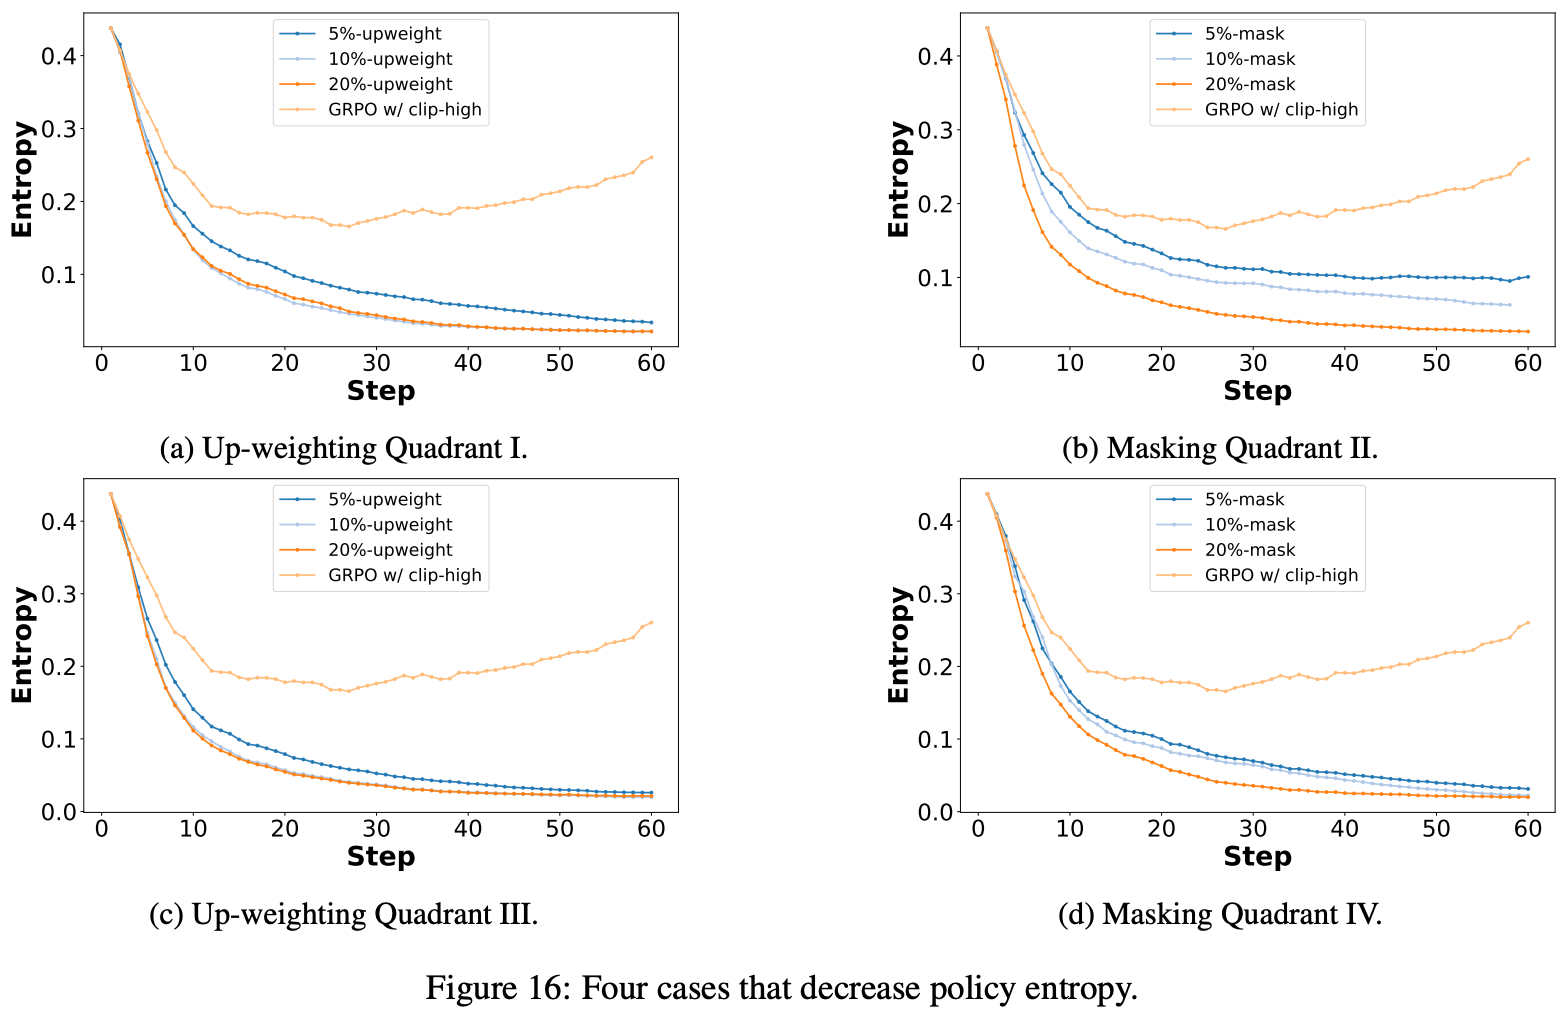
- 为了进一步验证图 2 中关于优势与概率的熵变模式,以不同强度增强(提升权重)或削弱(屏蔽)四个象限中的每一个,以分别诱导熵增加或减少
- 与图 14 中干预 \(10%\) Token 的设置不同,在此提供了更全面的验证
- 与图 14 中干预 \(10%\) Token 的设置不同,在此提供了更全面的验证
- 图 15 显示了以标准 GRPO \((\epsilon_{\text{high} } = 0.2, \epsilon_{\text{low} } = 0.2)\) 为基线,对每个象限应用旨在增加熵的干预措施
- 图 16 以带高裁剪的 GRPO \((\epsilon_{\text{high} } = 0.28, \epsilon_{\text{low} } = 0.2)\) 为基线,展示了旨在降低熵的干预措施
- 基本结论:
- 在每种情况下,被屏蔽或上权重的 Token 比例从 \(5%\) 到 \(20%\) 不等
- 在所有情况下,可以观察到 Token 级干预对熵的影响与本文的定量分析框架一致,并且随着干预比例的增加(从 \(5%\) 到 \(20%\) ),影响变得更加显著
D.4 Entropy Effect of Clipping Operation
- 本小节调整 GRPO 中的裁剪阈值来引导熵变化,并评估不同熵水平下的 RLVR 性能
- 裁剪操作引起的熵动态如正文图 3b 和 3c 所示
- 高裁剪(即 \(\epsilon_{\text{high} }\) ):
- 所有设置在早期阶段熵都下降
- 较大的 \(\epsilon_{\text{high} }\) 会在后期导致明显的熵反弹和持续增长
- 小的 \(\epsilon_{\text{high} }\) 则导致持续衰减和低最终熵
- 低裁剪(即 \(\epsilon_{\text{low} }\) ):
- 行为更加分化
- 当 \(\epsilon_{\text{low} } = 0.1\) 时,熵在训练过程中单调增加
- 当 \(\epsilon_{\text{low} } \geq 0.2\) 时,驱使熵迅速趋向(接近)零,显示出更强的熵崩溃倾向
- 行为更加分化
- 高裁剪(即 \(\epsilon_{\text{high} }\) ):
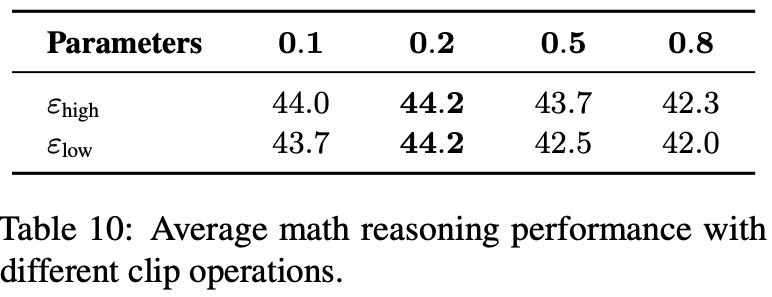
- 不同裁剪操作下的平均数学推理性能报告在表 10 中
- 在熵崩溃和熵爆炸情况下性能均会下降,而将熵维持在一个稳定范围内则能持续获得更好的结果
- 这凸显了稳定熵动态的重要性,这与本文提出的 STEER 方法一致
- 为什么大的熵增长会损害训练?
- 这种现象可以解释如下:过高的熵使得策略过于随机,降低了采样到能提供有效训练信号的信息丰富推理轨迹的可能性
- 在 GRPO 风格的训练中,这可能导致大部分 Rollout 获得接近零的奖励,阻碍优化
- 先前的工作 (2025a) 也对“熵爆炸”提出了类似的担忧
- 理解:熵太大说明模型本身就没有收敛,Pass@1 的分数不会太高
附录 E:Training Settings
E.1 Detailed Information for Dataset
- 详情见图表
E.2 作者的方法及基线的训练细节 (Training Details for Our Method and Baselines)
- 所有算法均基于 veRL 框架内的官方 GRPO 代码库实现
Training settings
- 生成 Batch Size :512;更新 Batch Size :32;Rollout 数量 :每组 8 个
- 训练中移除了 KL 散度项和熵损失项(遵循 DAPO 和 DeepScaleR 的做法)
- Temperature:1.0
- Top-p:1.0
- 学习率:1e-6 ,无 Warm-up
- 最大输入/输出长度:
- 数学任务为 1024/3072
- 代码编辑任务为 4096/1024
- 训练最多 200 个 Rollout 步,每 10 步保存一次 Checkpoint,并选择在 AIME24 上准确率最高的 Checkpoint 进行最终测试
- 所有实验在配备 NVIDIA H20 GPU 的集群上进行
Evaluation settings
- 使用 Math-Verify 和 Qwen-Verify 进行验证和最终评估
- 所有评估均为 Zero-shot ,无额外 Prompt
- 采样温度:1.0;Top-p:0.7
Specific settings for baselines
- 表 3 报告了主要结果,本小节详述了所有比较基线的训练设置
- GRPO :遵循官方 VeRL 训练配方,所有超参数保持不变
- SimpleRL-Zoo :采用官方仓库的训练配方,但将训练数据替换为 DAPO-Math-17k
- Eurus-PRIME :直接使用在 Qwen2.5-Math-7B 上训练的公开 Checkpoint
- OPO :遵循 VeRL 中的参考实现,无新增超参数
- GRPO w/ clip-high :设置上裁剪阈值 \( \epsilon_{\text{high} } = 0.28 \),其余与 GRPO 一致
- GRPO w/ Entro. Loss :添加熵损失项,在 \( \{0.01, 0.001, 0.0001\} \) 中调优权重并报告最佳结果
- GRPO w/ Fork Tokens :仅对熵最高的 Top 20%/30%/40% Token 使用策略梯度,报告最佳配置
- W-REINFORCE :对正样本分配降低的权重,在 \( \lambda \in \{0.1, 0.2\} \) 中调优并报告最佳结果
- Entro. Adv. :遵循原始论文,固定 \( \kappa = 2 \),设置 \( \alpha = 0.4 \)
- Clip-Cov 和 KL-Cov :仅对生成 Token 的一小部分(比例为 0.0002)应用裁剪或 KL 惩罚约束
附录 F:Supplementary Performance Evaluation
F.1 Ablation Study
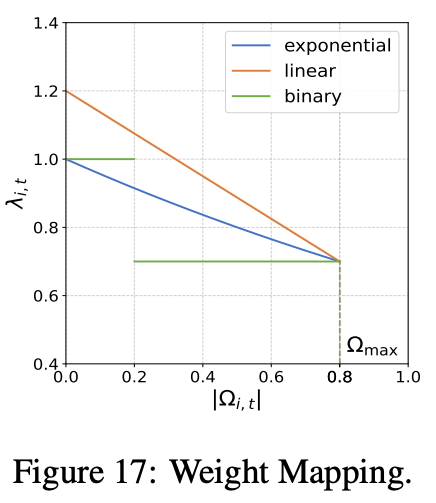
- 为了证明 指数映射(Exponential Mapping) 的必要性,作者对比了三种不同的权重映射方式:
- 1)Exponential(指数映射) :即论文 Eq. (9) 中的 \( \lambda(s) = \exp\left(-\alpha \frac{|\Omega(s)|}{\max_{s \in B} |\Omega(s)|}\right) \)
- 2)Linear(线性映射) :权重与熵变幅度成线性反比关系
- 3)Binary(二值映射) :仅对熵变最大的 Top 20% Token 分配 \( \lambda_{\min} = 0.7 \),其余 Token 权重保持为 1
- 图 17 展示了这三种映射方式的示意图,直观地比较了它们随熵变幅度增加而变化的趋势
- 表 11 报告了三种映射方式在 Qwen2.5-Math-7B 上的性能对比:
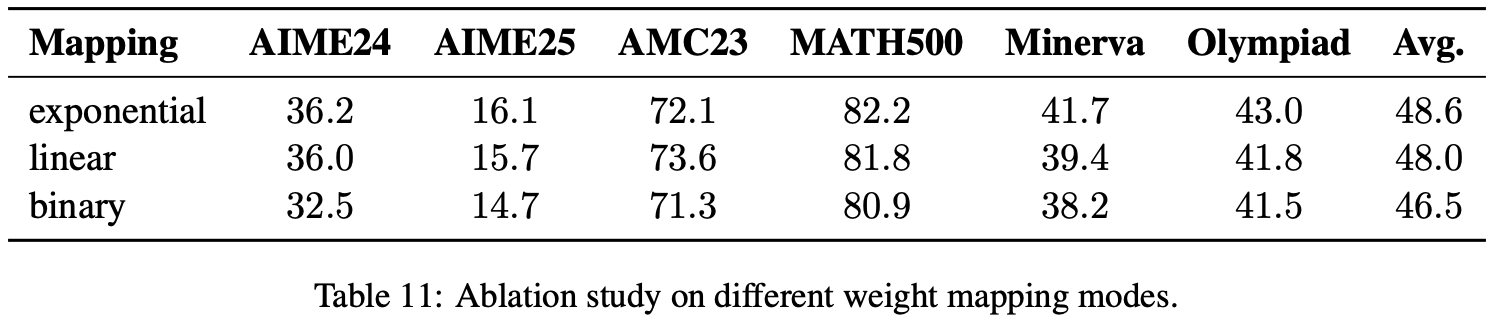
- 最终结论 :二值映射性能下降明显,线性映射虽不损害性能但不如指数映射
- 这证明了连续、平滑的 Token 级重加权是必要的,截断式的粗放控制无法精确调控熵变
F.2 Hyperparameter Sensitivity,超参数敏感性
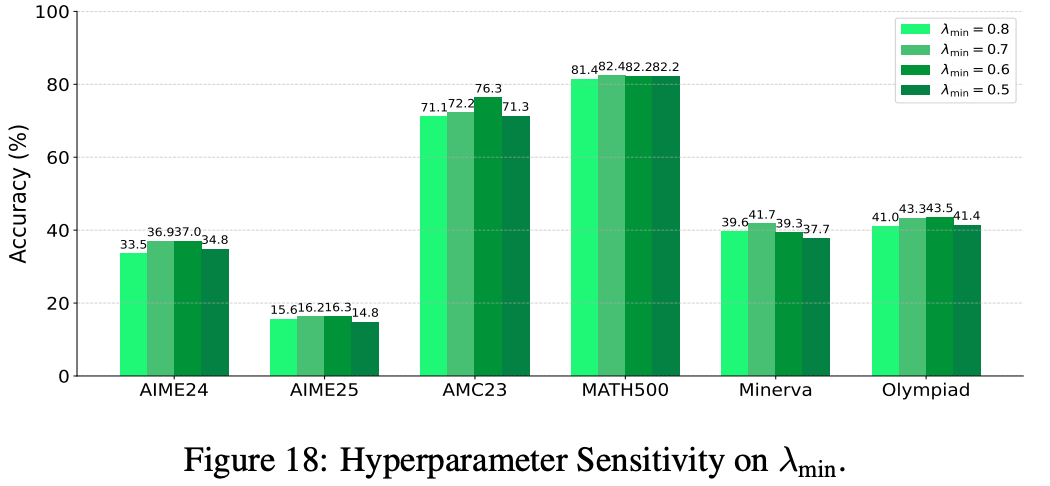
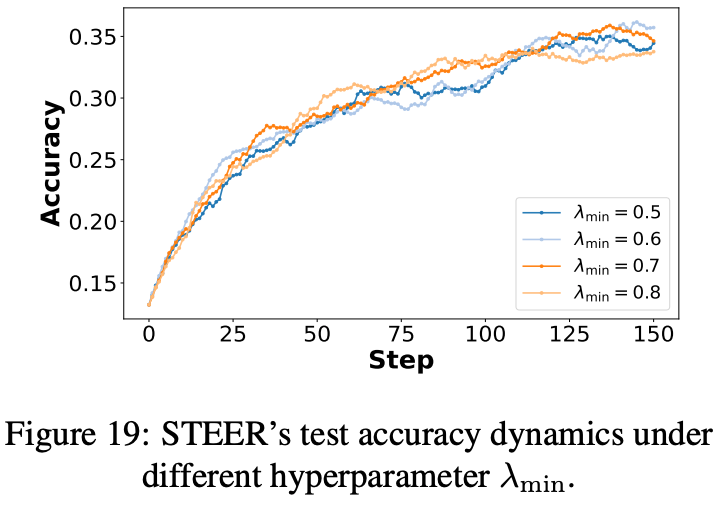
- 实验结果对公式 (9) 中超参数 \(\lambda_{\min}\) 的敏感性
- 过小的 \(\lambda_{\min}\) 可能会阻碍模型学习并导致训练不稳定
- 过大的 \(\lambda_{\min}\) 则会削弱模型控制熵的能力
- 如图 18 所示,当 \(\lambda_{\min}\in [0.5,0.8]\) 时,本文方法表现 consistently well
- 图 19 展示了不同超参数下的测试准确率曲线,进一步证明了 STEER 的稳定性和优越性
F.3 Empirical Results Extended to Other Base Models and Other RL Algorithms
- 本节结论 :STEER 的超参数设置具有良好的可迁移性,其有效性不依赖于特定模型架构(Qwen/Llama/Mistral)、模型规模(1.5B/3B/7B)或 RL 算法(GRPO/RLOO/OPO),充分证明了其强泛化能力
跨基座模型泛化(Cross-Model Generalization)
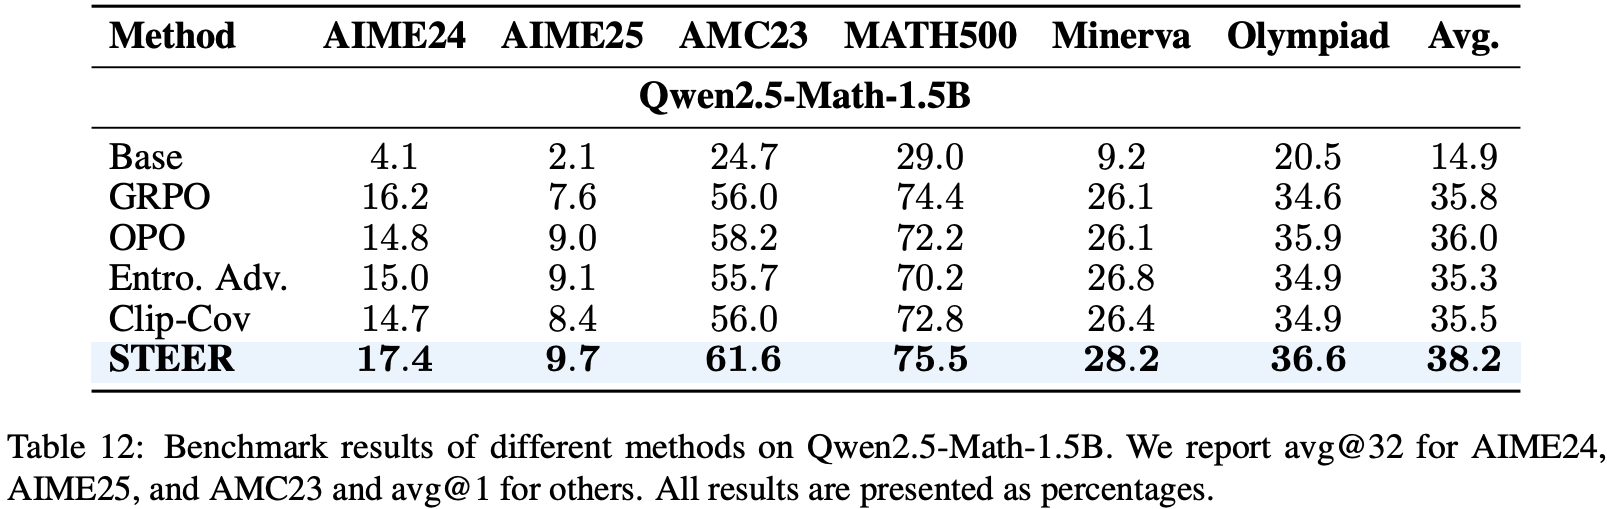
- 将 STEER 应用于 Qwen2.5-Math-1.5B、Llama-3.2-3B-Instruct(数学推理)和 Mistral-7B-v0.3(代码编辑),且使用与主实验完全相同的超参数(\( \lambda_{\min} = 0.7 \)) ,未针对各模型重新调参
- 表 12 报告了 Qwen2.5-Math-1.5B 上的结果。STEER 将平均准确率从 GRPO 的 35.8% 提升至 38.2% ,在所有数据集上均取得最优
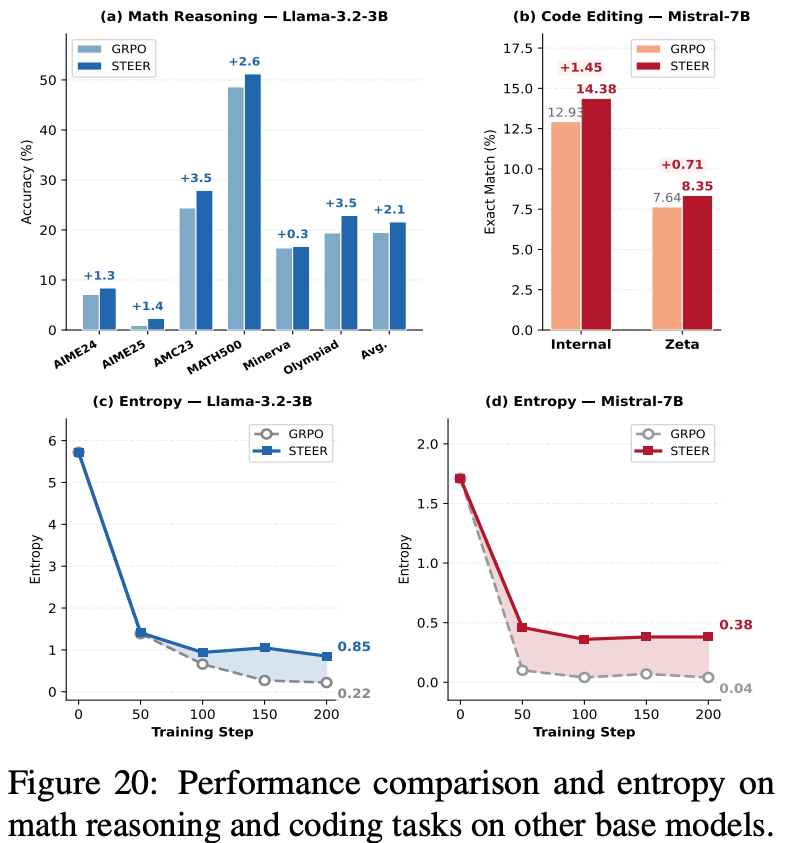
- 图 20
- 上半部分展示了 Llama-3.2-3B 在数学任务上的性能对比和熵动态
- STEER 将平均准确率从 19.5% 提升至 21.6% ,并在第 200 步时将熵从 GRPO 的 0.22 显著提升至 0.85
- 下半部分展示了 Mistral-7B 在代码编辑任务上的结果
- STEER 在内部测试集上从 12.93% 提升至 14.38% ,在 Zeta 上从 7.64% 提升至 8.35% ,熵值在第 200 步从接近 0(0.04)提升至 0.38
- STEER 在内部测试集上从 12.93% 提升至 14.38% ,在 Zeta 上从 7.64% 提升至 8.35% ,熵值在第 200 步从接近 0(0.04)提升至 0.38
- 上半部分展示了 Llama-3.2-3B 在数学任务上的性能对比和熵动态
跨 RL 算法泛化(Cross-Algorithm Generalization)
- 将 STEER 集成到 RLOO(2024)和 OPO(2025)两种 RLVR 算法中,核心设置与主实验保持一致
- 图 21(Figure 21) 展示了将 STEER 应用于 RLOO 和 OPO 时的性能对比
- STEER 将 RLOO 的平均准确率从 45.8% 提升至 46.8% ,将 OPO 的平均准确率从 46.4% 提升至 47.5%
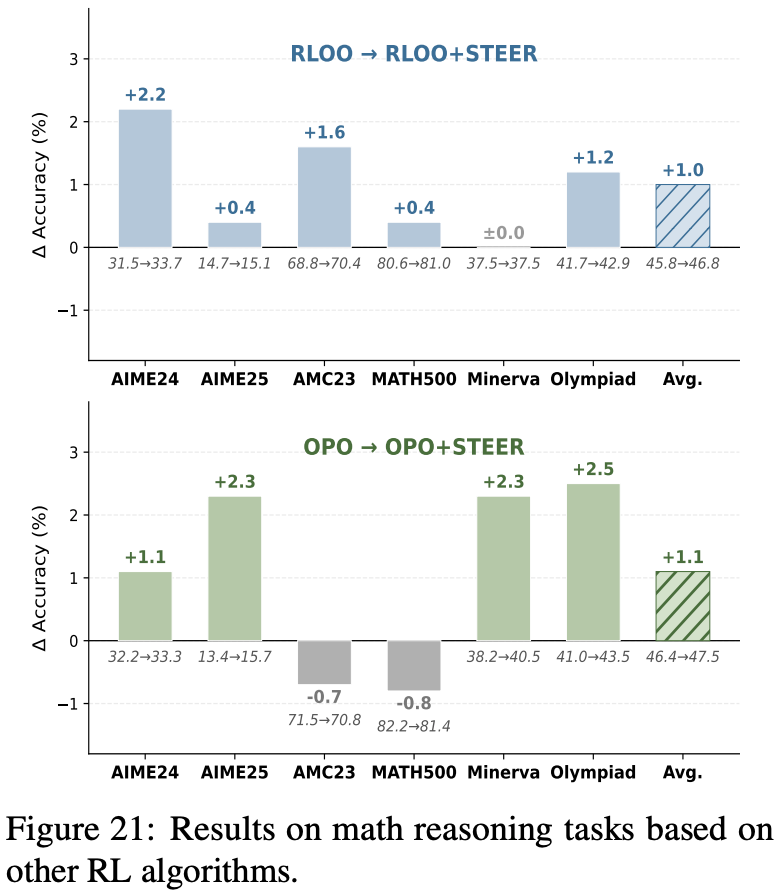
- STEER 将 RLOO 的平均准确率从 45.8% 提升至 46.8% ,将 OPO 的平均准确率从 46.4% 提升至 47.5%
附录 G:Theorem Proof Details(待详细推导)
- 在 RLVR 训练期间,Token logits 由相互纠缠的内部参数所决定,这使得熵变化难以量化
- 为了捕捉训练过程中分布偏移的本质,采用以下弱假设
- 假设 1(Parameter-independent softmax)
- 对于任何上下文(状态) \(s = (q,o_{< t})\) ,词汇表 \(\nu\) 中的每个 Token(动作) \(a\) 都与一个独立的 logit 参数 \(z_{s,a}(\theta)\) 相关联
- 在训练的第 \(k\) 个更新步骤, \(\pi_{\theta}^{k}\) 的下一个 Token 分布遵循
$$\pi_{\theta}^{k}(\cdot |s) = \text{softmax}(z^{k}(s)),$$- 其中 \(z^{k}(s)\) 是状态 \(s\) 下所有动作的 logit 参数向量
- 假设 1 表明,对采样 Token 进行的梯度步骤不会实质性地影响词汇表中其他 Token 的 logits
- 在此假设下,本文推导出以下关于 Token 熵变化的定理
- 定理 1(First-order entropy change estimation)
- 设策略模型 \(\pi_{\theta}\) 满足假设 1
- 对于任何上下文(状态) \(s = (q,o_{< t})\) ,将两个更新步骤之间的 Token 级熵变化定义为
$$\Delta \mathcal{H}(s)\triangleq \mathcal{H}(\pi_{\theta}^{k + 1}\mid s) - \mathcal{H}(\pi_{\theta}^{k}\mid s).$$ - 在公式 (2) 中的单次 GRPO 更新下, \(\Delta \mathcal{H}(s)\) 可分解为
$$\Delta \mathcal{H}(s) = \Omega (s) + \Phi (s),\tag {14}$$ - 其中一阶估计项为
$$\Omega (s) = -\frac{\eta}{L}\mathbb{E}_{a\sim \pi_{\theta}^{k}(\cdot |s)}\Big[\frac{\mathbb{I}_{clip}(s,a)A(s,a)}{\pi_{old}(a\mid s)}\pi_{\theta}^{k}(a\mid s)\big(1 - \pi_{\theta}^{k}(a\mid s)\big)\big(\log \pi_{\theta}^{k}(a\mid s) + \mathcal{H}(\pi_{\theta}^{k}\mid s)\big)\Big],\tag {15}$$ - 高阶余项 \(\Phi (s)\) 满足
$$|\Phi (s)|\leq C\eta^{2}\left[\frac{A_{\max}r_{\max} }{L}\right]^{2},\tag {16}$$- \(L\) 是 GRPO 更新中的总解码长度
- \(A_{\max},r_{\max}\) 界定了 Token 级优势和重要性比率
- \(C > 0\) 是一个依赖于策略参数化的常数
定理 1 的证明
- 分五步证明该定理如下
步骤 1:一阶泰勒展开(First-order Taylor expansion)
- 对 \(\Delta \mathcal{H}(s)\) 在 \(z^{k}(s)\) 附近进行一阶泰勒展开,有
$$
\begin{align}
\Delta \mathcal{H}(s) &= \mathcal{H}(\pi_{\theta}^{k + 1}\mid s) - \mathcal{H}(\pi_{\theta}^{k}\mid s)\\
&= \underbrace{\left(\frac{\partial\mathcal{H}(\pi_{\theta}^{k}\mid s)}{\partial z},z^{k + 1}(s) - z^{k}(s)\right)}_{\text{first-order term }\Omega (s)} + \underbrace{\mathcal{O}(| z^{k + 1}(s) - z^{k}(s)|_{2}^{2})}_{\text{higher-order remainder }\Phi (s)}
\end{align}
\tag {17}
$$- 其中 \(z(s) = (z_{s,a})_{a\in \mathcal{V} }\) 是状态 \(s\) 下所有动作的 logit 向量
步骤 2:熵关于 logits 的梯度(Gradient of entropy w.r.t. logits)
- 对于固定的状态 \(s\) ,策略 \(\pi_{\theta}^{k}(\cdot |s)\) 的条件熵为
$$\mathcal{H}(\pi_{\theta}^{k}\mid s) = -\sum_{a\in \mathcal{V} }\pi_{\theta}^{k}(a\mid s)\log \pi_{\theta}^{k}(a\mid s).$$ - 在参数独立的 softmax 参数化下,每个 Token \(a\in \mathcal{V}\) 有一个 logit \(z_{s,a}^{k}\) ,并且
$$\pi_{\theta}^{k}(a\mid s) = \frac{\exp(z_{s,a}^{k})}{\sum_{b\in \mathcal{V} }\exp(z_{s,b}^{k})}.$$ - 对 \(\mathcal{H}(\pi_{\theta}^{k} | s)\) 关于单个 logit \(z_{s,b}\) 进行微分,使用 softmax 导数,有
$$\frac{\partial\pi_{\theta}^{k}(a | s)}{\partial z_{s,b} } = \pi_{\theta}^{k}(a | s)\left(1\{a = b\} -\pi_{\theta}^{k}(b | s)\right).$$ - 然后得到
$$\begin{array}{rl} \frac{\partial\mathcal{H}(\pi_{\theta}^{k} | s)}{\partial z_{s,b} } & = -\sum_{a\in \mathcal{V} }\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\frac{\partial\pi_{\theta}^{k}(a | s)}{\partial z_{s,b} } \\ & = -\sum_{a\in \mathcal{V} }\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\pi_{\theta}^{k}(a | s)\left(1\{a = b\} -\pi_{\theta}^{k}(b | s)\right) \\ & = -\left(\log \pi_{\theta}^{k}(b | s) + 1\right)\pi_{\theta}^{k}(b | s)\left(1 -\pi_{\theta}^{k}(b | s)\right) + \pi_{\theta}^{k}(b | s)\sum_{a\neq b}\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\pi_{\theta}^{k}(a | s) \\ & = -\left(\log \pi_{\theta}^{k}(b | s) + 1\right)\pi_{\theta}^{k}(b | s)\left(1 -\pi_{\theta}^{k}(b | s)\right) + \pi_{\theta}^{k}(b | s)\left(\sum_{a\in \mathcal{V} }\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\pi_{\theta}^{k}(a | s) - \left(\log \pi_{\theta}^{k}(b | s) + 1\right)\pi_{\theta}^{k}(b | s)\right) \\ & = -\left(\log \pi_{\theta}^{k}(b | s) + 1\right)\pi_{\theta}^{k}(b | s) + \pi_{\theta}^{k}(b | s)\sum_{a\in \mathcal{V} }\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\pi_{\theta}^{k}(a | s), \end{array}$$- 其中 \(\mathcal{V}\) 表示词汇表,注意
$$\sum_{a\in \mathcal{V} }\pi_{\theta}^{k}(a | s) = 1,\quad \sum_{a\in \mathcal{V} }\log \pi_{\theta}^{k}(a | s) \pi_{\theta}^{k}(a | s) = -\mathcal{H}(\pi_{\theta}^{k} | s).$$
- 其中 \(\mathcal{V}\) 表示词汇表,注意
- 因此,
$$\sum_{a\in \mathcal{V} }\left(\log \pi_{\theta}^{k}(a | s) + 1\right)\pi_{\theta}^{k}(a | s) = -\mathcal{H}(\pi_{\theta}^{k} | s) + 1.$$ - 代回得到
$$\begin{array}{rl} \frac{\partial\mathcal{H}(\pi_{\theta}^{k} | s)}{\partial z_{s,b} } & = -\left(\log \pi_{\theta}^{k}(b | s) + 1\right)\pi_{\theta}^{k}(b | s) + \pi_{\theta}^{k}(b | s)\left(-\mathcal{H}(\pi_{\theta}^{k} | s) + 1\right) \\ & = -\pi_{\theta}^{k}(b | s)\left(\log \pi_{\theta}^{k}(b | s) + \mathcal{H}(\pi_{\theta}^{k} | s)\right). \end{array}$$ - 因此,对于任何 \(a \in \mathcal{V}\) ,
$$\frac{\partial\mathcal{H}(\pi_{\theta}^{k} | s)}{\partial z_{s,a} } = -\pi_{\theta}^{k}(a | s)\left(\log \pi_{\theta}^{k}(a | s) + \mathcal{H}(\pi_{\theta}^{k} | s)\right).\tag {18}$$
步骤 3:logit 空间中的单步 GRPO 更新(One-step GRPO update in logit space)
- 公式 (2) 中 GRPO 的策略梯度可以写为
$$\begin{array}{rl} \nabla_{\theta}J(\theta) & = \mathbb{E}_{q\sim \mathcal{D},\{o_i\}_{i=1}^G\sim \pi_{\text{old} }(\cdot|q)}\left[\frac{1}{\sum_{i=1}^G |o_i|}\sum_{i=1}^G \sum_{t=1}^{|o_i|} \mathbb{I}_{\text{clip} }(t) \frac{\pi_{\theta}^{k}(o_{i,t} | q, o_{i,<t})}{\pi_{\text{old} }(o_{i,t} | q, o_{i,<t})} A_{i,t} \nabla_{\theta}\log \pi_{\theta}(o_{i,t} | q, o_{i,<t})\right], \end{array}\tag {19}$$- \(\mathbb{I}_{\text{clip} }(t)\) 是 clipping indicator
- \(A_{i,t}\) 是 token-level advantage
- 为简化符号,固定特定的 Token 位置 \((t)\) 并记
$$s \triangleq (o_{i,<t}),\quad a \triangleq o_{i,t}.$$ - 我们有
$$\frac{\partial}{\partial z_{s,a} }\log \pi_{\theta}^{k}(a\mid s) = 1 - \pi_{\theta}^{k}(a\mid s),$$ - 而同一状态 \(s\) 下非采样动作 \(a^{\prime}\neq a\) 的 logits 的导数被忽略,因此,沿 GRPO 梯度方向、以学习率 \(\eta\) 对 \(z_{s,a}\) 进行的更新贡献为
$$\begin{array}{rl} & {\frac{z_{s,a}^{k + 1} - z_{s,a}^{k} }{\sum_{i^{\prime} = 1}^{G}\left|\sigma_{i^{\prime} }\right|}\mathbb{I}_{\text{clip} }(i,t)\frac{\pi_{\theta}^{k}(a\mid s)}{\pi_{\text{old} }(a\mid s)} A_{i,t}\frac{\partial}{\partial z_{s,a} }\log \pi_{\theta}^{k}(a\mid s)} { = \eta \frac{1}{\sum_{i^{\prime} = 1}^{G}\left|\sigma_{i^{\prime} }\right|}\mathbb{I}_{\text{clip} }(i,t)\frac{\pi_{\theta}^{k}(a\mid s)}{\pi_{\text{old} }(a\mid s)} A_{i,t}\left(1 - \pi_{\theta}^{k}(a\mid s)\right).} \end{array}\tag {20}$$ - 通过显式地转换为 \((s,a)\) 符号,我们得到简化的更新式
$$z_{s,a}^{k + 1} - z_{s,a}^{k} = \eta \frac{1}{\sum_{i^{\prime} = 1}^{G}\left|\sigma_{i^{\prime} }\right|}\mathbb{I}_{\text{clip} }(s,a)\frac{\pi_{\theta}^{k}(a\mid s)}{\pi_{\text{old} }(a\mid s)} A(s,a)\left(1 - \pi_{\theta}^{k}(a\mid s)\right).\tag {21}$$ - 对于同一状态 \(s\) 下的非采样动作 \(a^{\prime}\) ,其相应的 logits \(z_{s,a^{\prime} }\) 在此更新中保持不变
步骤 4:一阶估计 \(\Omega (s)\)
- 将 (18) 和 (21) 代入内积,我们有
$$\begin{array}{rl} & {\Omega (s) = \left\langle \frac{\partial\mathcal{H}(\pi_{\theta}^{k}\mid s)}{\partial z},z^{k + 1}(s) - z^{k}(s)\right\rangle} \\ & {\qquad = \sum_{a\in \mathcal{V} }\frac{\partial\mathcal{H}(\pi_{\theta}^{k}\mid s)}{\partial z_{s,a} }\left(z_{s,a}^{k + 1} - z_{s,a}^{k}\right)} \\ & {\qquad = \sum_{a\in \mathcal{V} }\left[-\pi_{\theta}^{k}(a\mid s)\left(\log \pi_{\theta}^{k}(a\mid s) + \mathcal{H}(\pi_{\theta}^{k}\mid s)\right)\right]\left[\frac{\eta}{L}\frac{\mathbb{I}_{\text{clip} }(s,a)A(s,a)}{\pi_{\text{old} }(a\mid s)}\pi_{\theta}^{k}(a\mid s)\left(1 - \pi_{\theta}^{k}(a\mid s)\right)\right]} \\ & {\qquad = -\frac{\eta}{L}\sum_{a\in \mathcal{V} }\frac{\mathbb{I}_{\text{clip} }(s,a)A(s,a)}{\pi_{\text{old} }(a\mid s)}\left[\pi_{\theta}^{k}(a\mid s)\right]^{2}\left(1 - \pi_{\theta}^{k}(a\mid s)\right)\left(\log \pi_{\theta}^{k}(a\mid s) + \mathcal{H}(\pi_{\theta}^{k}\mid s)\right)} \\ & {\qquad = -\frac{\eta}{L}\mathbb{E}_{a\sim \pi_{\theta}^{k}(\cdot |s)}\left[\frac{\mathbb{I}_{\text{clip} }(s,a)A(s,a)}{\pi_{\text{old} }(a\mid s)}\pi_{\theta}^{k}(a\mid s)\left(1 - \pi_{\theta}^{k}(a\mid s)\right)\left(\log \pi_{\theta}^{k}(a\mid s) + \mathcal{H}(\pi_{\theta}^{k}\mid s)\right)\right],} \end{array}\tag {22}$$ - 其中 \(L\) 表示 \(\sum_{i^{\prime} = 1}^{G}\left|\sigma_{i^{\prime} }\right|\) 。在最后一行,我们通过将一个因子 \(\pi_{\theta}^{k}(a\mid s)\) 吸收到测度中,将求和重写为在 \(a\sim \pi_{\theta}^{k}(\cdot \mid s)\) 下的期望。这正是公式 (15)
步骤 5:余项 \(\Phi (s)\)
- 根据多元泰勒定理,高阶余项可以写成 logit 增量的二次型,因此存在常数 \(C > 0\) ,使得对于任何状态 \(s\) ,
$$|\Phi (s)|\leq C\left| z^{k + 1}(s) - z^{k}(s)\right|_{2}^{2}.\tag {22}$$ - 对于给定的状态 \(s\) ,只有被采样的动作 \(a\) 具有非零的 logit 更新,因此
$$\left| z^{k + 1}(s) - z^{k}(s)\right|_{2}^{2} = \left(z_{s,a}^{k + 1} - z_{s,a}^{k}\right)^{2}.$$ - 记 \(L\triangleq \sum_{i^{\prime} = 1}^{G}\left|\sigma_{i^{\prime} }\right|, r(s,a)\triangleq \frac{\pi_{\theta}^{k}(a\mid s)}{\pi_{\text{old} }(a\mid s)}\) ,并假设重要性比率和 Token 级优势(token-level advantage)是一致有界的:
$$|r(s,a)|\leq r_{\max},\qquad |A(s,a)|\leq A_{\max}\quad \text{for~all}(s,a).$$ - 使用公式 (21) 中的 GRPO 更新,我们得到
$$\begin{array}{rl} \left| z^{k + 1}(s) - z^{k}(s)\right|_{2}^{2} & = \left(z_{s,a}^{k + 1} - z_{s,a}^{k}\right)^{2} \\ & = \eta^{2}\left[\frac{\mathbb{I}_{\text{clip} }(s,a)A(s,a)}{L} r(s,a)\left(1 - \pi_{\theta}^{k}(a\mid s)\right)\right]^{2} \\ & \leq \eta^{2}\left[\frac{\mathbb{I}_{\text{clip} }(s,a)A(s,a)}{L} r(s,a)\right]^{2} \\ & \leq \eta^{2}\left[\frac{A(s,a)r(s,a)}{L}\right]^{2} \\ & \leq \eta^{2}\left[\frac{A_{\text{max} }r_{\text{max} } }{L}\right]^{2}, \end{array}$$ - 将此界与 (22) 结合,并将所有固定常数吸收到 \(C\) 中,得到
$$|\Phi (s)| \leq C \eta^{2} \left[\frac{A_{\text{max} } r_{\text{max} } }{L}\right]^{2}.\tag {23}$$ - 因此,余项为 \(\mathcal{O}(\eta^{2})\) 阶,并且在 GRPO 中进一步被每次更新的归一化因子 \(L^{- 2}\) 所抑制
- 证毕