Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM对齐微调-GDPO

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization, 20260108, NVIDIA

Paper Summary

  • 整体总结:
    • 本研究重新审视了一个基本但常被忽视的问题:GRPO 是否真的适用于多 Reward 优化
    • GDPO 不同于先前主要专注于为多 Reward 强化学习设计新 Reward 函数(这些方法常常将 GRPO 作为默认优化方法)
      • 论文的分析表明,将 GRPO 直接应用于求和后的 Reward,会导致不同的 Reward 组合坍缩为相同的 Advantage 值
      • 这种坍缩消除了跨 Reward 维度的重要区别,导致不准确的策略更新和较弱的优化性能,并且在许多情况下可能导致早期训练失败
    • Group-wise Decoupled Policy Optimization (GDPO) 是为多 Reward 强化学习量身定制的、对 GRPO 的一种简单而有效的修改
      • GDPO 对每个 Reward 分别进行归一化,以保留跨 Reward 的差异,并融入 Batch-wise Advantage 归一化,以在纳入更多 Reward 时保持稳定的数值范围
      • 这些改变带来了更好的收敛行为,以及能更忠实地反映预期偏好结构的模型
    • 论文进一步系统地研究了如何将人类偏好优先级融入训练过程,并解释了当目标之间难度差异较大时如何调整 Reward 函数
      • 通过在工具调用、数学推理和代码推理上的大量实验,论文表明 GDPO 始终优于 GRPO
      • 其优势适用于不同数量的 Reward、不同的模型和不同的 Reward 函数
    • 对于多 Reward 强化学习, GDPO 是比 GRPO 更稳定、更准确、与偏好更对齐的优化方法
    • 注意:GDPO 在 Advantage Combination(AC,先分别计算 Advantage,再凸组合)的组内归一化基础上,额外增加了 batch 级别的优势归一化,以进一步稳定训练
  • 背景:
    • 为实现在不同场景中展现出与多样化人类偏好相一致的行为这一目标
    • RL 流程已开始纳入多个奖励,每个奖励对应一种特定偏好,共同引导模型趋向期望的行为
  • 问题提出:
    • 近期工作默认在多奖励设置下应用 GRPO ,却未检验其适用性
    • 论文证明直接将 GRPO 用于归一化不同的 rollout 奖励组合会导致它们坍缩为相同的优势值,从而降低训练信号的分辨率,导致次优收敛甚至训练早期失败
  • 论文提出 Group reward-Decoupled Normalization Policy Optimization (GDPO)
    • GDPO 是一种新的策略优化方法,通过解耦单个奖励的归一化来解决上述问题,从而更忠实地保留奖励间的相对差异,实现更准确的多奖励优化,并大幅提升训练稳定性
  • 论文在三个任务上比较 GDPO 与 GRPO :工具调用、数学推理和代码推理,评估了正确性指标(准确率、bug 率)和约束遵循指标(格式、长度)
    • 在所有设置下, GDPO 均稳定优于 GRPO ,证明了其对于多奖励强化学习优化的有效性和泛化能力

Introduction and Discussion

  • 语言模型能力的持续进步,对其行为的期望也相应提高
    • 要求模型不仅能提供准确的回答,还能在多样化场景中展现出与广泛人类偏好相一致的行为,这种需求在持续增长
  • 这些偏好涉及效率(2025, 2025, 2025)、安全性(2024)、回答连贯性与逻辑性(2025, 2025)、性别偏见(2025)等诸多目标
    • 在单一模型中满足这些异质性要求是一项具有挑战性的任务
  • RL 已成为将大型语言模型与这类多样化人类偏好对齐的事实(de facto)训练流程
    • 特别是,近期基于 RL 的方法已开始将多个奖励纳入训练,每个奖励被设计来捕捉不同的人类偏好,共同引导模型朝向人类偏好的行为
    • 尽管对多奖励 RL 的兴趣日益增长,但近期工作(2025, 2025, 2025)主要聚焦于奖励设计本身,并且常常直接依赖 GRPO 应用于多奖励 RL 优化,通常并未检验 GRPO 是否真正适用于优化异质性奖励的组合
  • 论文重新审视 GRPO 在多奖励设置下的适用性,并表明直接将 GRPO 应用于归一化不同的 rollout 奖励组合可能导致它们坍缩为相同的优势值
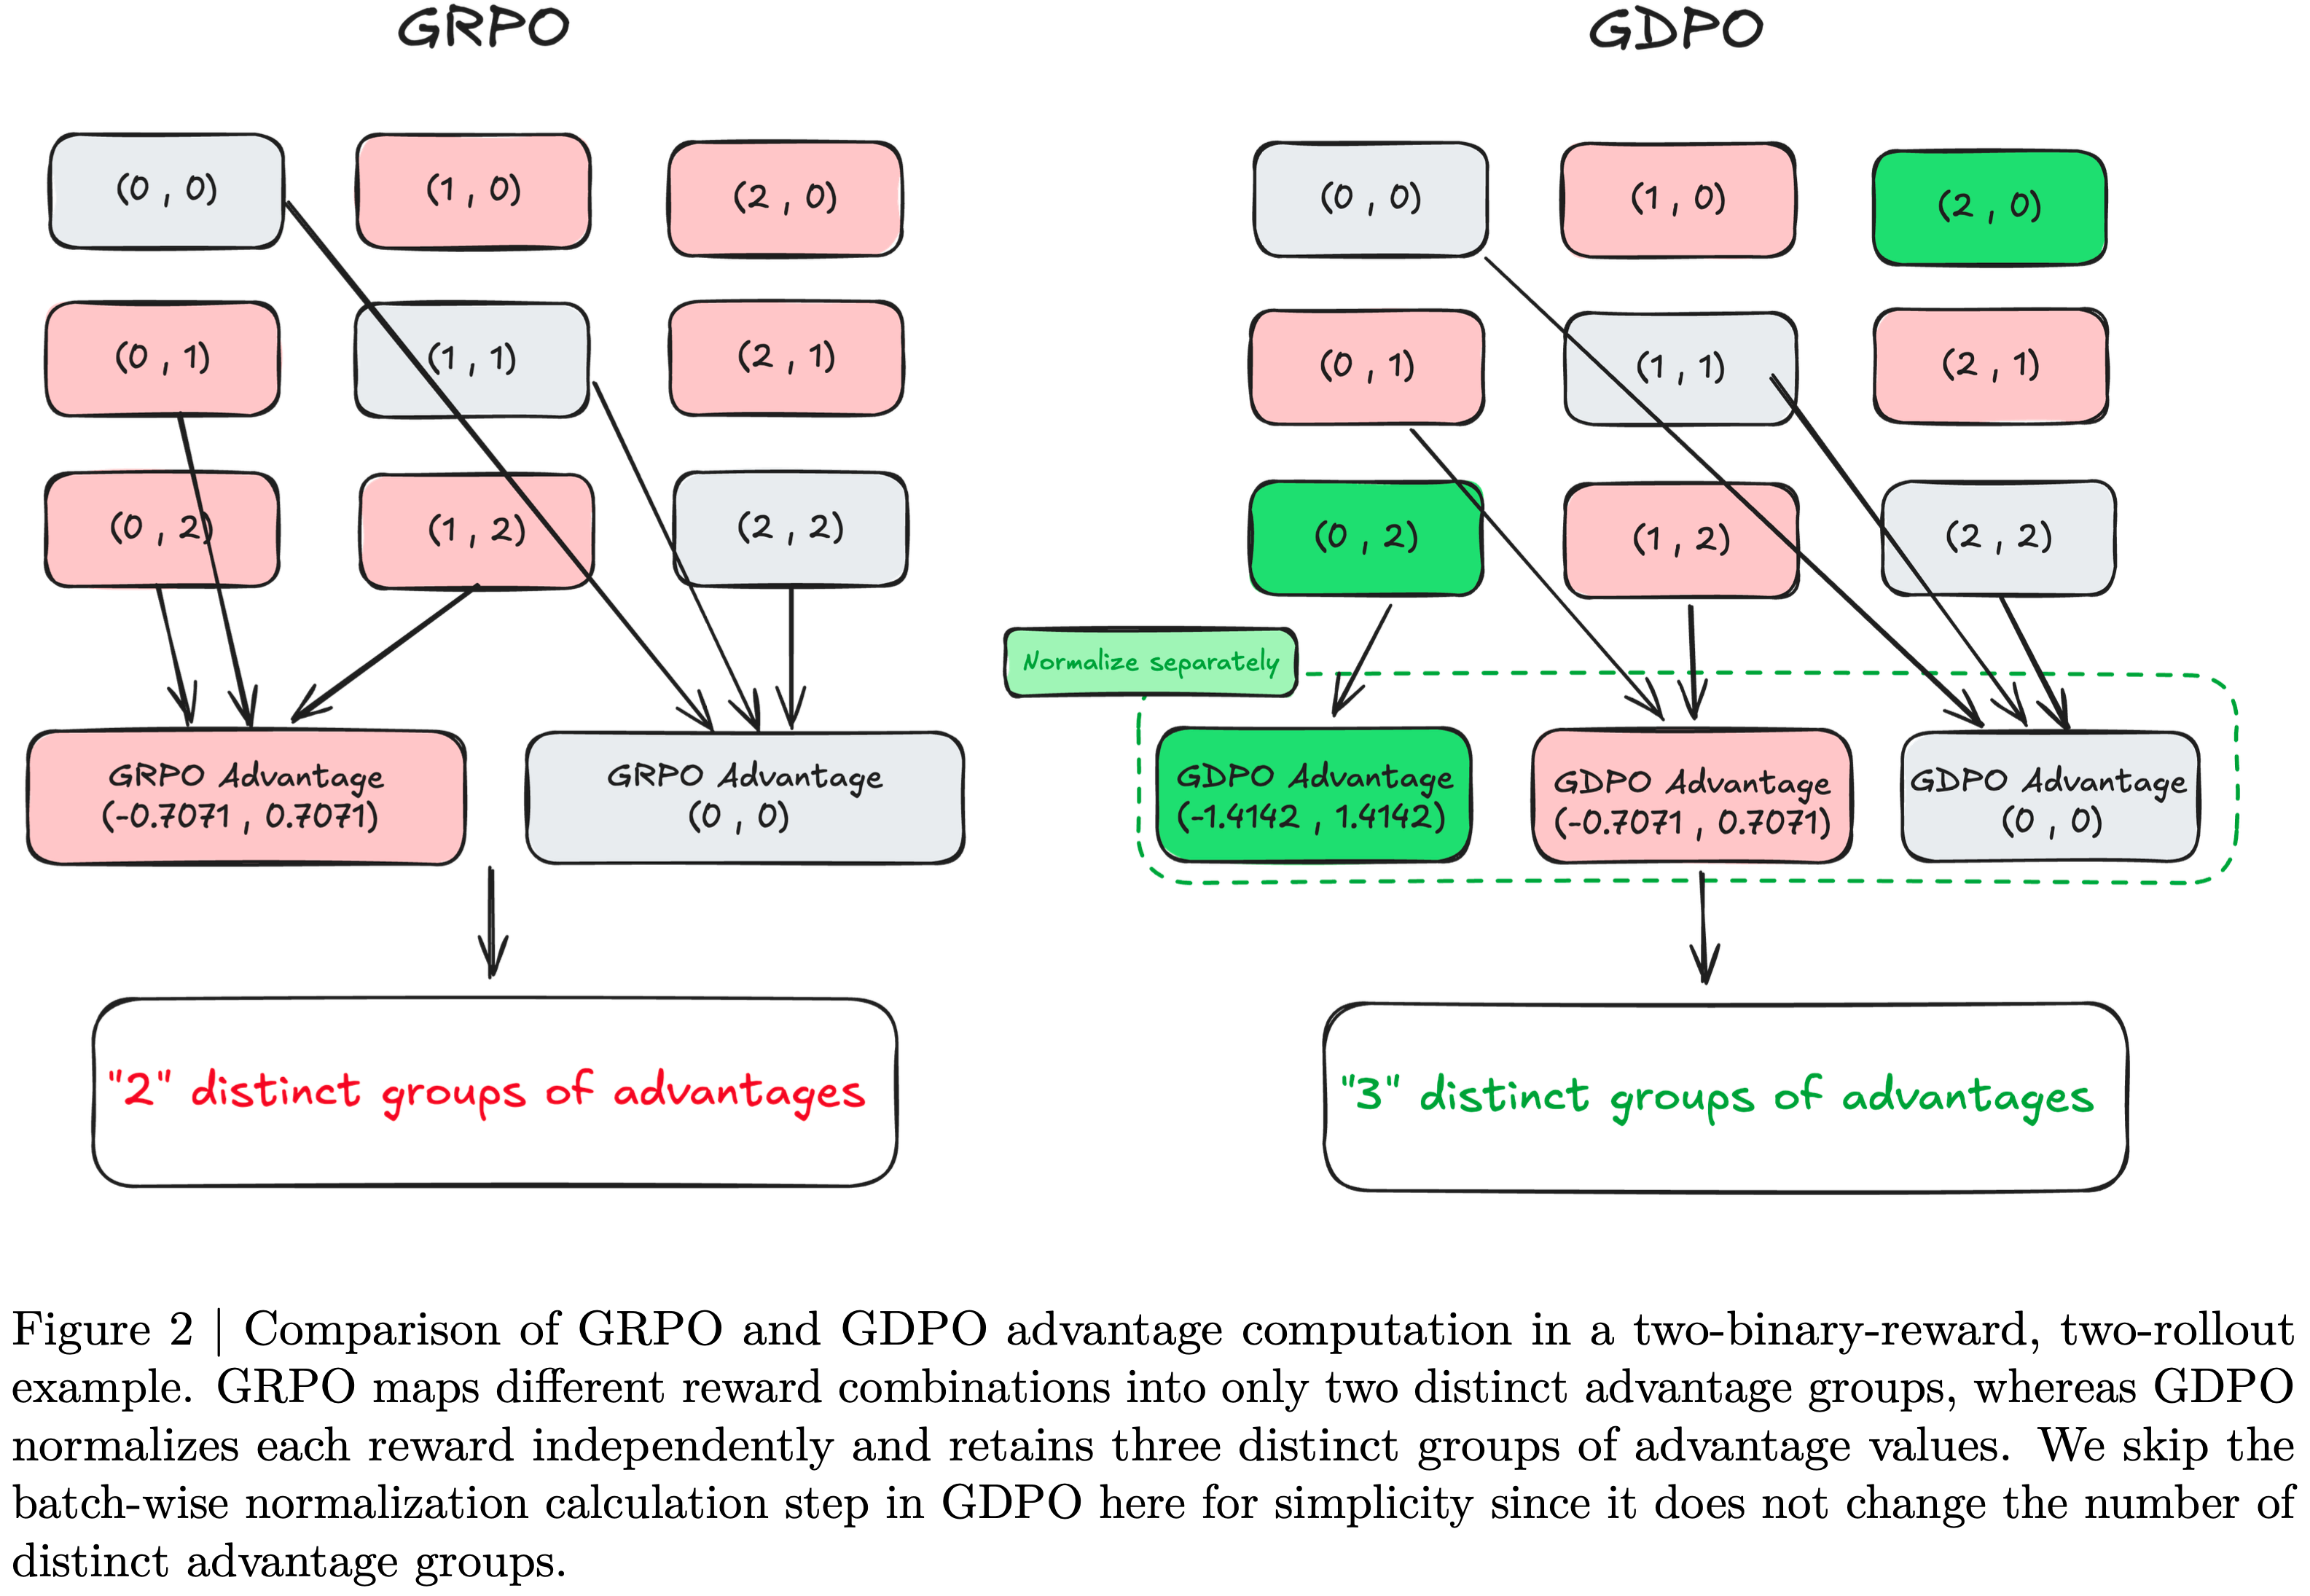
    • 如图2所示,这实际上限制了训练信号的精度
    • 这种坍缩消除了跨奖励维度的重要区分,导致不准确的策略更新、次优的奖励收敛,并且在许多情况下会导致训练早期失败
  • 为克服这些挑战,论文提出了Group reward-Decoupled Normalization Policy Optimization (GDPO),该方法解耦了对每个个体奖励的组内归一化,如图 1(a) 所示,以确保不同奖励组合之间的区分得以更好保留,并能更准确地反映模型响应间的相对差异
    • 这带来了更精确的多奖励优化和显著改善的训练收敛性
    • 在解耦组内归一化之后,论文应用批间优势归一化,以确保优势值的大小不会随着个体奖励数量的增加而增大
  • 论文在三个任务上比较了 GDPO 和 GRPO :工具调用、数学推理和代码推理
    • 这些任务涵盖了广泛的目标,包括工具调用的准确性和格式正确性、数学推理的准确性和对推理长度约束的遵循,以及代码通过率和 bug 率
    • 在所有任务中, GDPO 收敛得更好
      • 例如,在图 1(b)中,使用 GDPO 训练 Qwen2.5-1.5B-Instruct 在工具调用任务上获得了比 GRPO 更高的正确性和格式遵循度
    • 在具有挑战性的数学任务上, GDPO 也持续优于 GRPO
      • 例如,使用 GDPO 训练 DeepSeek-R1-1.5B 和 Qwen3-4B-Instruct 相比 GRPO 在 AIME 上分别获得了高达 \(6.3%\) 和 \(2.3%\) 的准确率提升,同时保持更多的简短响应
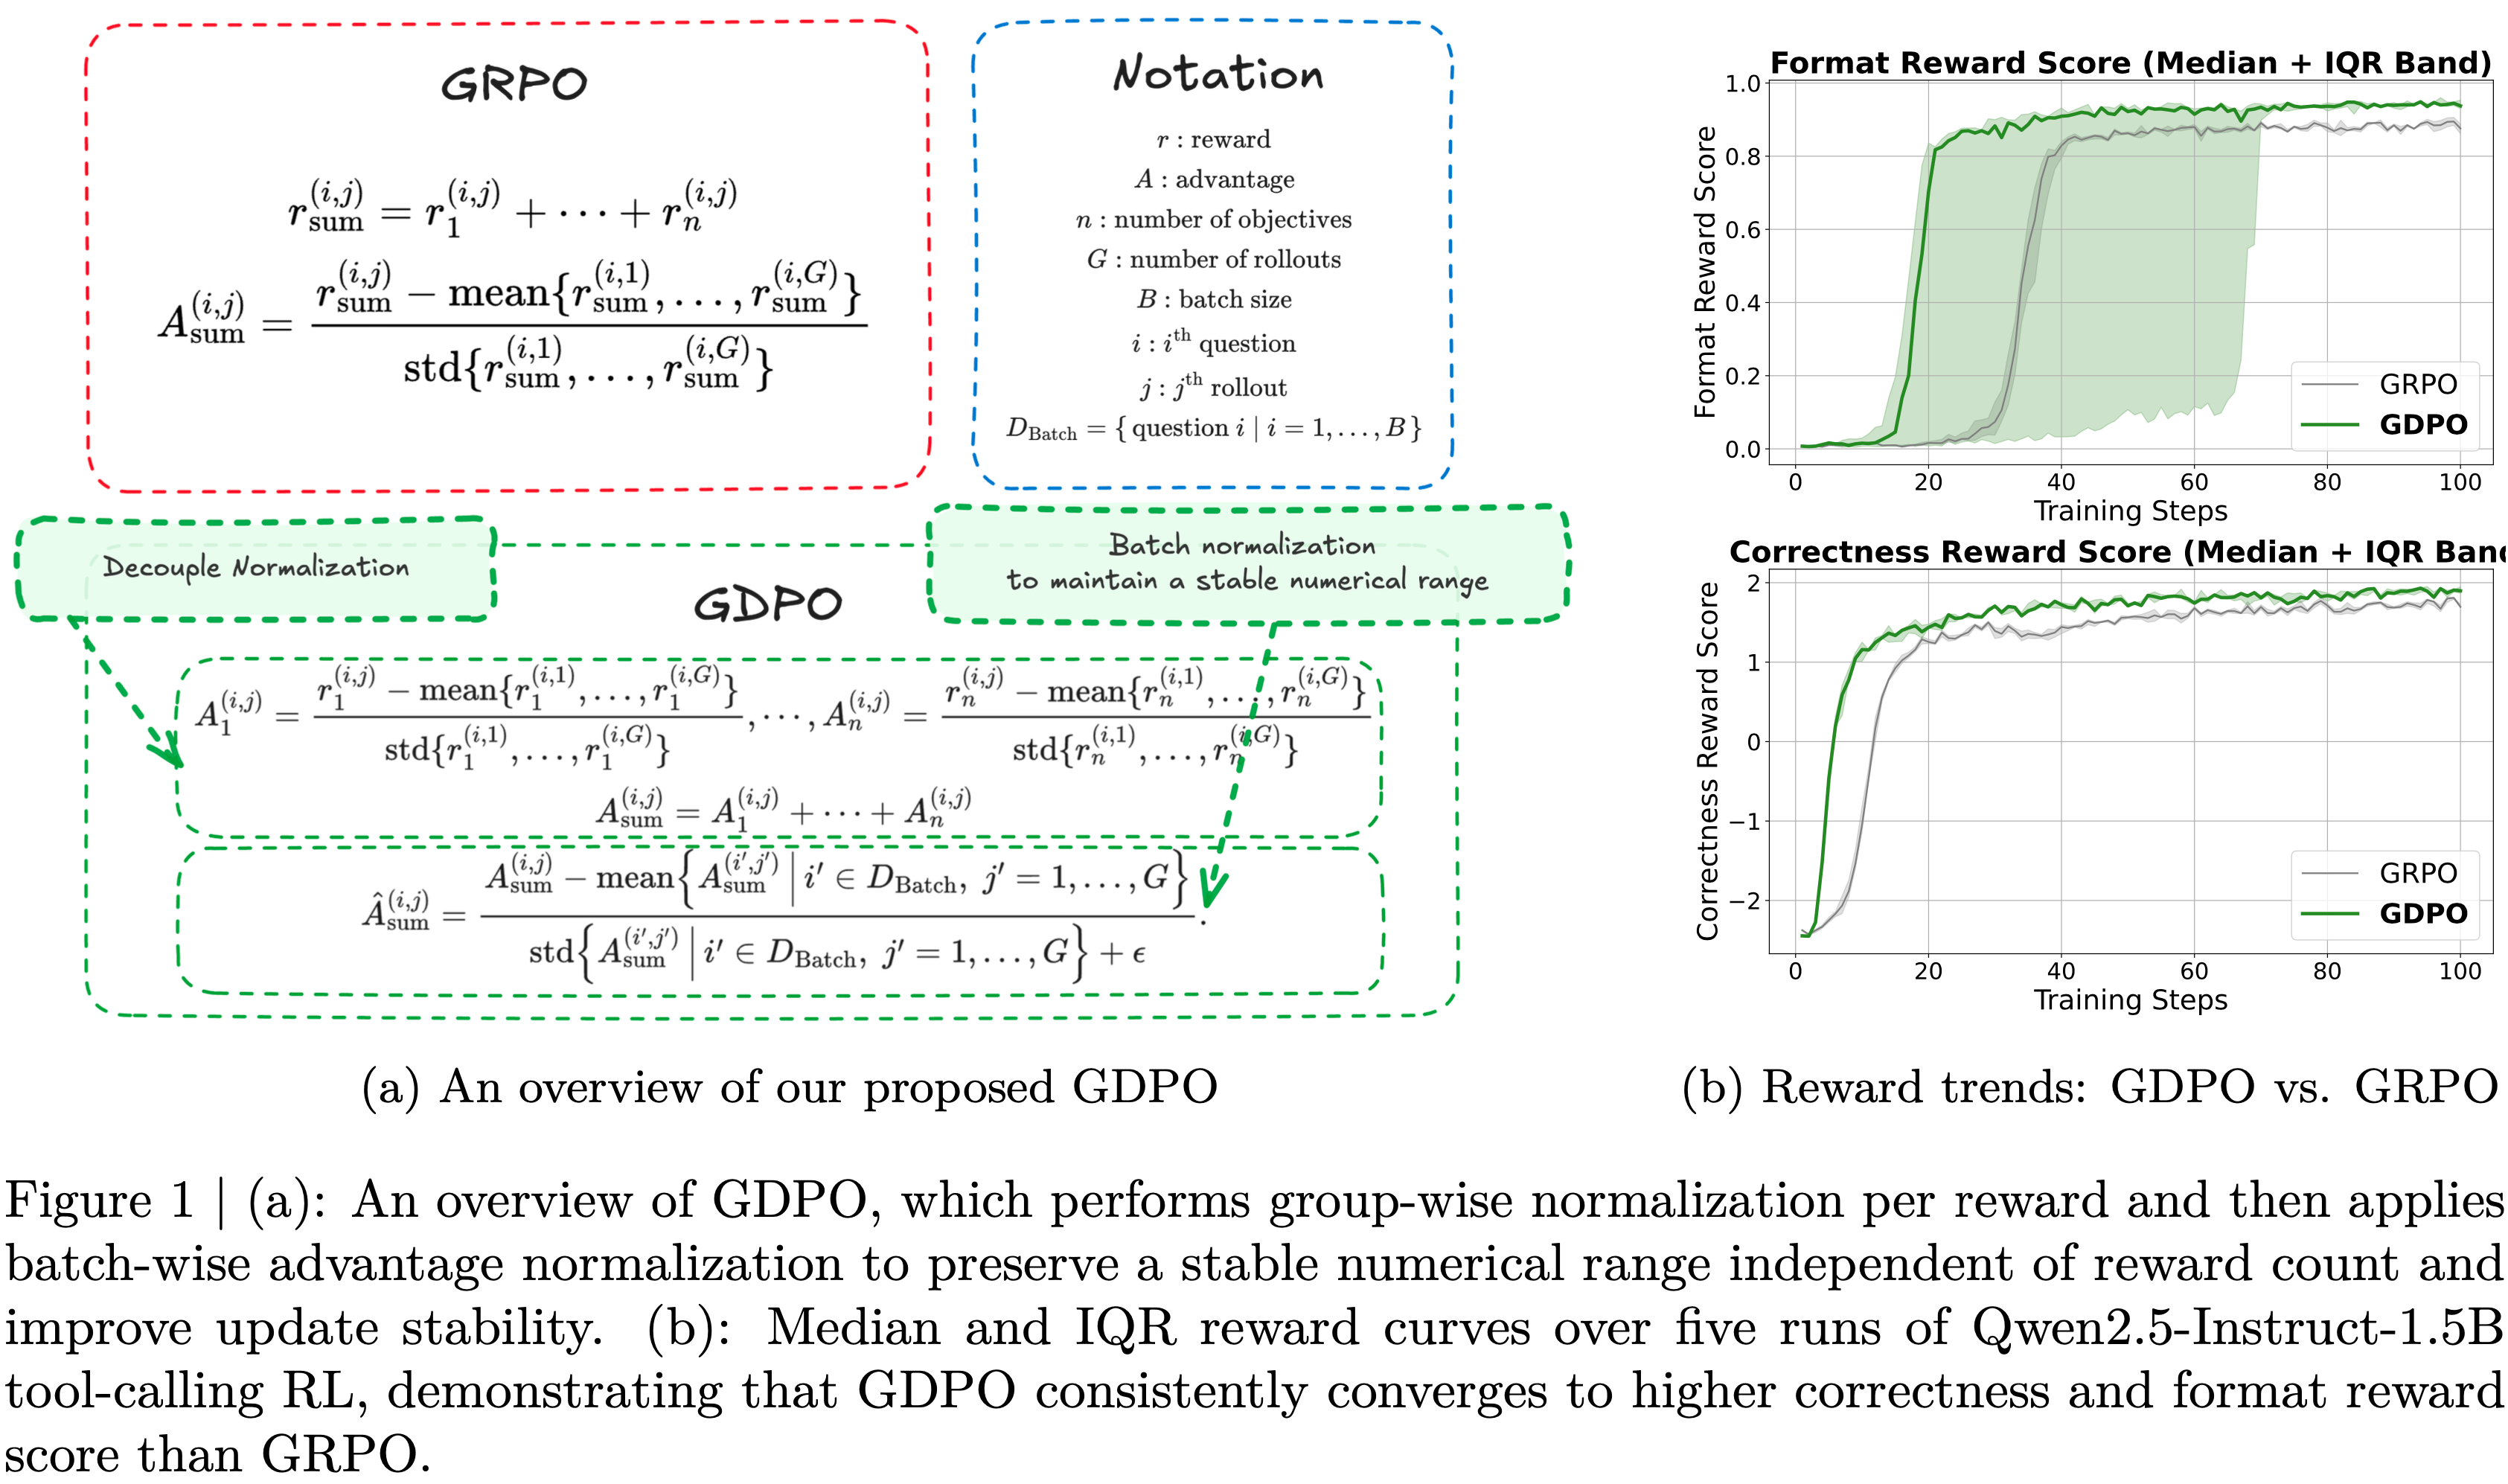
  • 文章认为:GDPO 是多奖励 RL 优化中优于 GRPO 的更好替代方案
  • 论文的贡献如下:
    • GRPO 奖励坍缩分析(Analysis of GRPO reward collapse)
      • 应用 native GRPO 进行多奖励 RL 优化可能导致不同的 Rollout 奖励组合坍缩为相同的优势值,从而削弱学习信号的分辨率
    • GRPO 奖励坍缩的修正(Remediation of GRPO reward collapse) :
      • GDPO 方法对每个奖励分别执行组间解耦归一化,以更好地保留跨奖励的区分,实现更准确的多奖励优化
    • 除了 GDPO 之外,论文还系统性概述了如何修改奖励函数和调整奖励权重,以更忠实地符合不同优先级的人类偏好
    • 论文在三个任务上进行了广泛的实验:工具调用、数学推理和代码推理

GRPO’s propensity for reward signal collapse in multi-reward RL(注:GRPO 在多奖励 RL 中有导致奖励信号坍缩的倾向)

  • GRPO (2024)及其变体,包括 DAPO(2025)和 REINFORCE++(或 REINFORCE++ Baseline)(2025),由于效率高且简单,已成为广泛采用的强化学习算法
    • 与 PPO(2017)相比, GRPO 通过利用组相对优势估计进行策略更新,消除了对价值模型的需求
  • 目前, GRPO 主要用于优化单目标奖励,通常聚焦于准确性
    • 然而,随着模型能力持续增长,近期的研究工作越来越多地寻求在准确性之外优化多个奖励,例如响应长度约束和格式质量(2025, 2024, 2025),以更好地与人类偏好对齐
    • 现有的多奖励RL方法通常采用一个直接的策略:将所有奖励分量求和,然后直接应用 GRPO
  • 形式上,对于给定的问答对 \((q_{i},o_{j})\),其中行为策略 \(\pi_{\theta_{\text{old} } }\) 采样一组 \(G\) 个响应 \(\{o_{j}\}_{j=1}^{G}\),并假设有 \(n\) 个目标,第 \(j\) 个响应的聚合奖励计算为每个目标奖励的总和:
    $$r_{\text{sum} }^{(i,j)}=r_{1}^{(i,j)}+\cdots+r_{n}^{(i,j)} \tag{1}$$
  • 然后,通过对组级聚合奖励进行归一化来获得第 \(j\) 个响应的组相对优势:
    $$A_{\text{sum} }^{(i,j)}=\frac{r_{\text{sum} }^{(i,j)}-\text{mean}\{r_{\text{sum} }^{(i,1)},\ldots,r_{\text{sum} }^{(i,G)}\} }{\text{std}\{r_{\text{sum} }^{(i,1)},\ldots,r_{\text{sum} }^{(i,G)}\} } \tag{2}$$
  • 相应的多奖励 GRPO 优化目标可以表达为:
    $$\mathcal{J}_{\text{ GRPO } }(\theta)=\mathbb{E}_{(q_{i},o_{j})\sim D, \{o_{j}\}_{j=1}^{G},\sim\pi_{\theta_{\text{old} } }(\cdot|q)}\left[\frac{1}{G}\sum_{j=1}^{G}\frac{1}{|o_{j}|}\sum_{t=1}^{|o_{j}|}\min\left(s_{i,t}(\theta),A_{\text{sum} }^{(i,j)},\text{clip}(s_{i,t}(\theta),1-\epsilon,1+\epsilon),A_{\text{sum} }^{(i,j)}\right)\right] \tag{3}$$
    • 其中 \(s_{t}(\theta)=\frac{\pi_{\theta}(o_{j}^{\dagger},|,q,o_{j}^{ < t})}{\pi_{\theta_{\text{old} } }(o_{j}^{\dagger},|,q,o_{j}^{>t})}\),\(\epsilon\) 表示裁剪阈值
    • 为清晰起见,在此公式中论文省略了 KL 散度损失项
  • 论文首先重新审视这种应用 GRPO 进行多奖励 RL 优化的常见做法,并发现一个先前被忽视的问题,即 GRPO 固有地压缩了奖励信号,导致优势估计中的信息丢失
    • 为说明这一点,论文从简单的训练设置开始,然后扩展到更一般的情况
  • 考虑一个场景,论文为每个问题生成两个 Rollout 用于计算组相对优势,任务涉及两个二元奖励 \(r_{1},r_{2}\in\{0,1\}\)
    • 因此,每个 Rollout 的总奖励可以取值为 \(\{0,1,2\}\)
  • 如图 2 所示,论文枚举了组内所有可能的 Rollout 奖励组合,表示为(Rollout 1 的总奖励, rollout 2 的总奖励)以及对应的归一化优势为(rollout 1 的归一化优势, rollout 2 的归一化优势)
  • 尽管忽略顺序时有六种不同的组合,但在应用组内奖励归一化后,只出现两个独特优势组
    • \((0,1)\)、\((0,2)\) 和 \((1,2)\) 产生相同的归一化优势 \(A_{\text{sum} }\),为 \((-0.7071,\ 0.7071)\),而 \((0,0)\)、\((1,1)\) 和 \((2,2)\) 都导致 \((0,0)\)
  • 这揭示了 GRPO 在多奖励优化中优势计算的根本局限性,即过度压缩了丰富的组内奖励信号
    • 直观上,\((0,2)\) 应该比 \((0,1)\) 产生更强的学习信号,因为总奖励为2表示同时满足两个奖励,而奖励为 1 仅对应达成一个奖励
    • 因此,当另一个rollout只获得零奖励时,\((0,2)\) 应该比 \((0,1)\) 产生更大的相对优势
    • 这种局限性还可能因不准确的优势估计而引入训练不稳定的风险
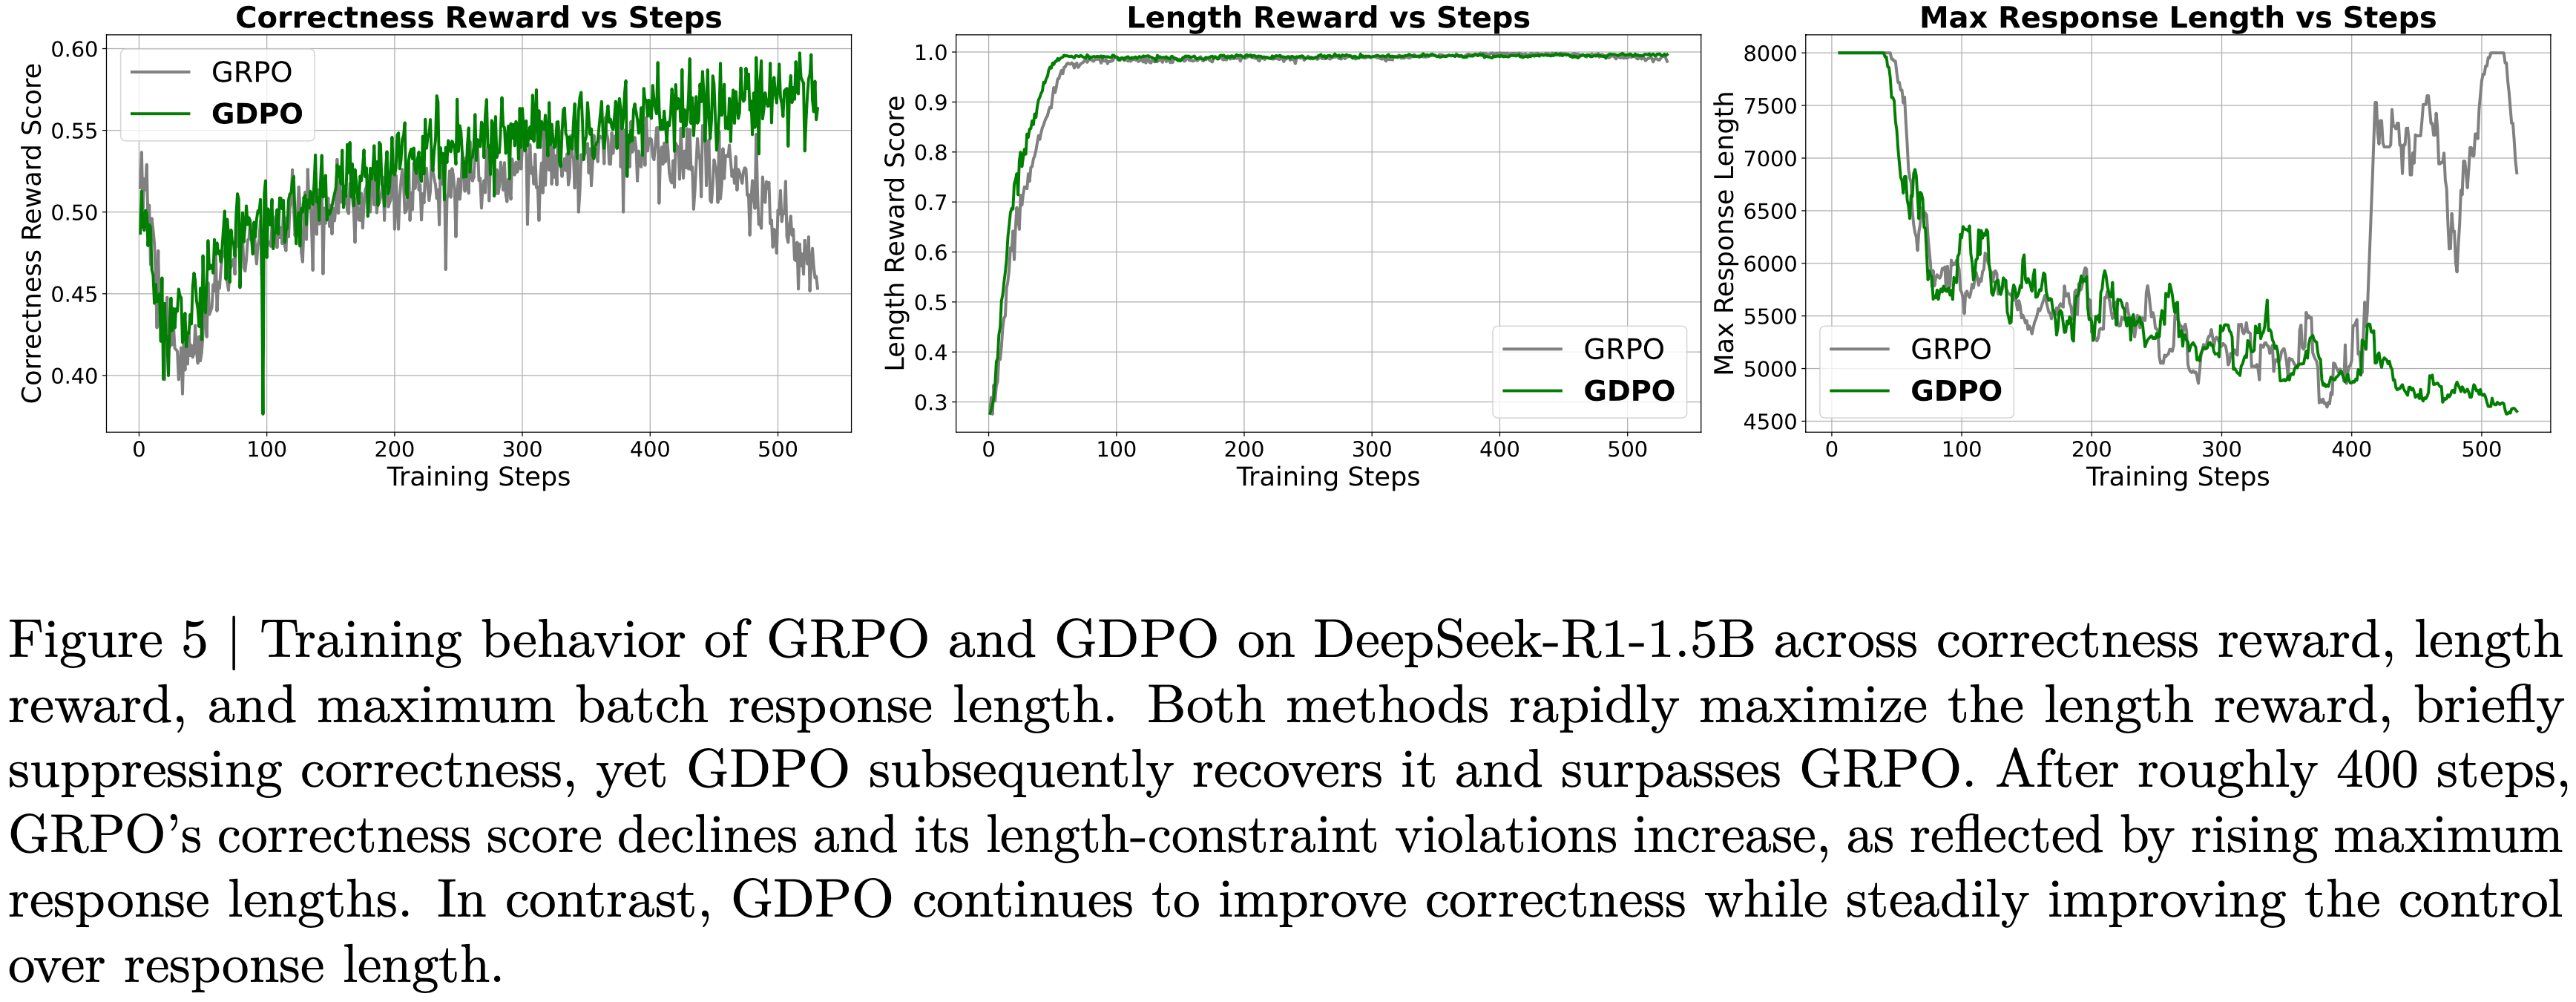
  • 如图 5 所示,使用 GRPO 训练时,正确性奖励分数在大约 400 个训练步后开始下降,表明发生了部分训练坍缩
  • 最近,Dr.GRPO (2025)和 DeepSeek-v3.2(2025)采用了一种 GRPO 变体,从公式(2)中去除了标准差归一化项,使得
    $$ A_{\text{sum} }^{(i,j)}=r_{\text{sum} }^{(i,j)}-\text{mean}\{r_{\text{sum} }^{(i,1)},\ldots,r_{\text{sum} }^{(i,G)}\}$$
  • 这些工作引入此修改以缓解问题级难度偏差,但乍看之下,这个改变似乎也能解决论文识别的问题
    • 去除标准差归一化确实缓解了该问题:\((0,1)\) 和 \((0,2)\) 现在分别产生不同的优势 \((-0.5,0.5)\) 和 \((-1.0,1.0)\)
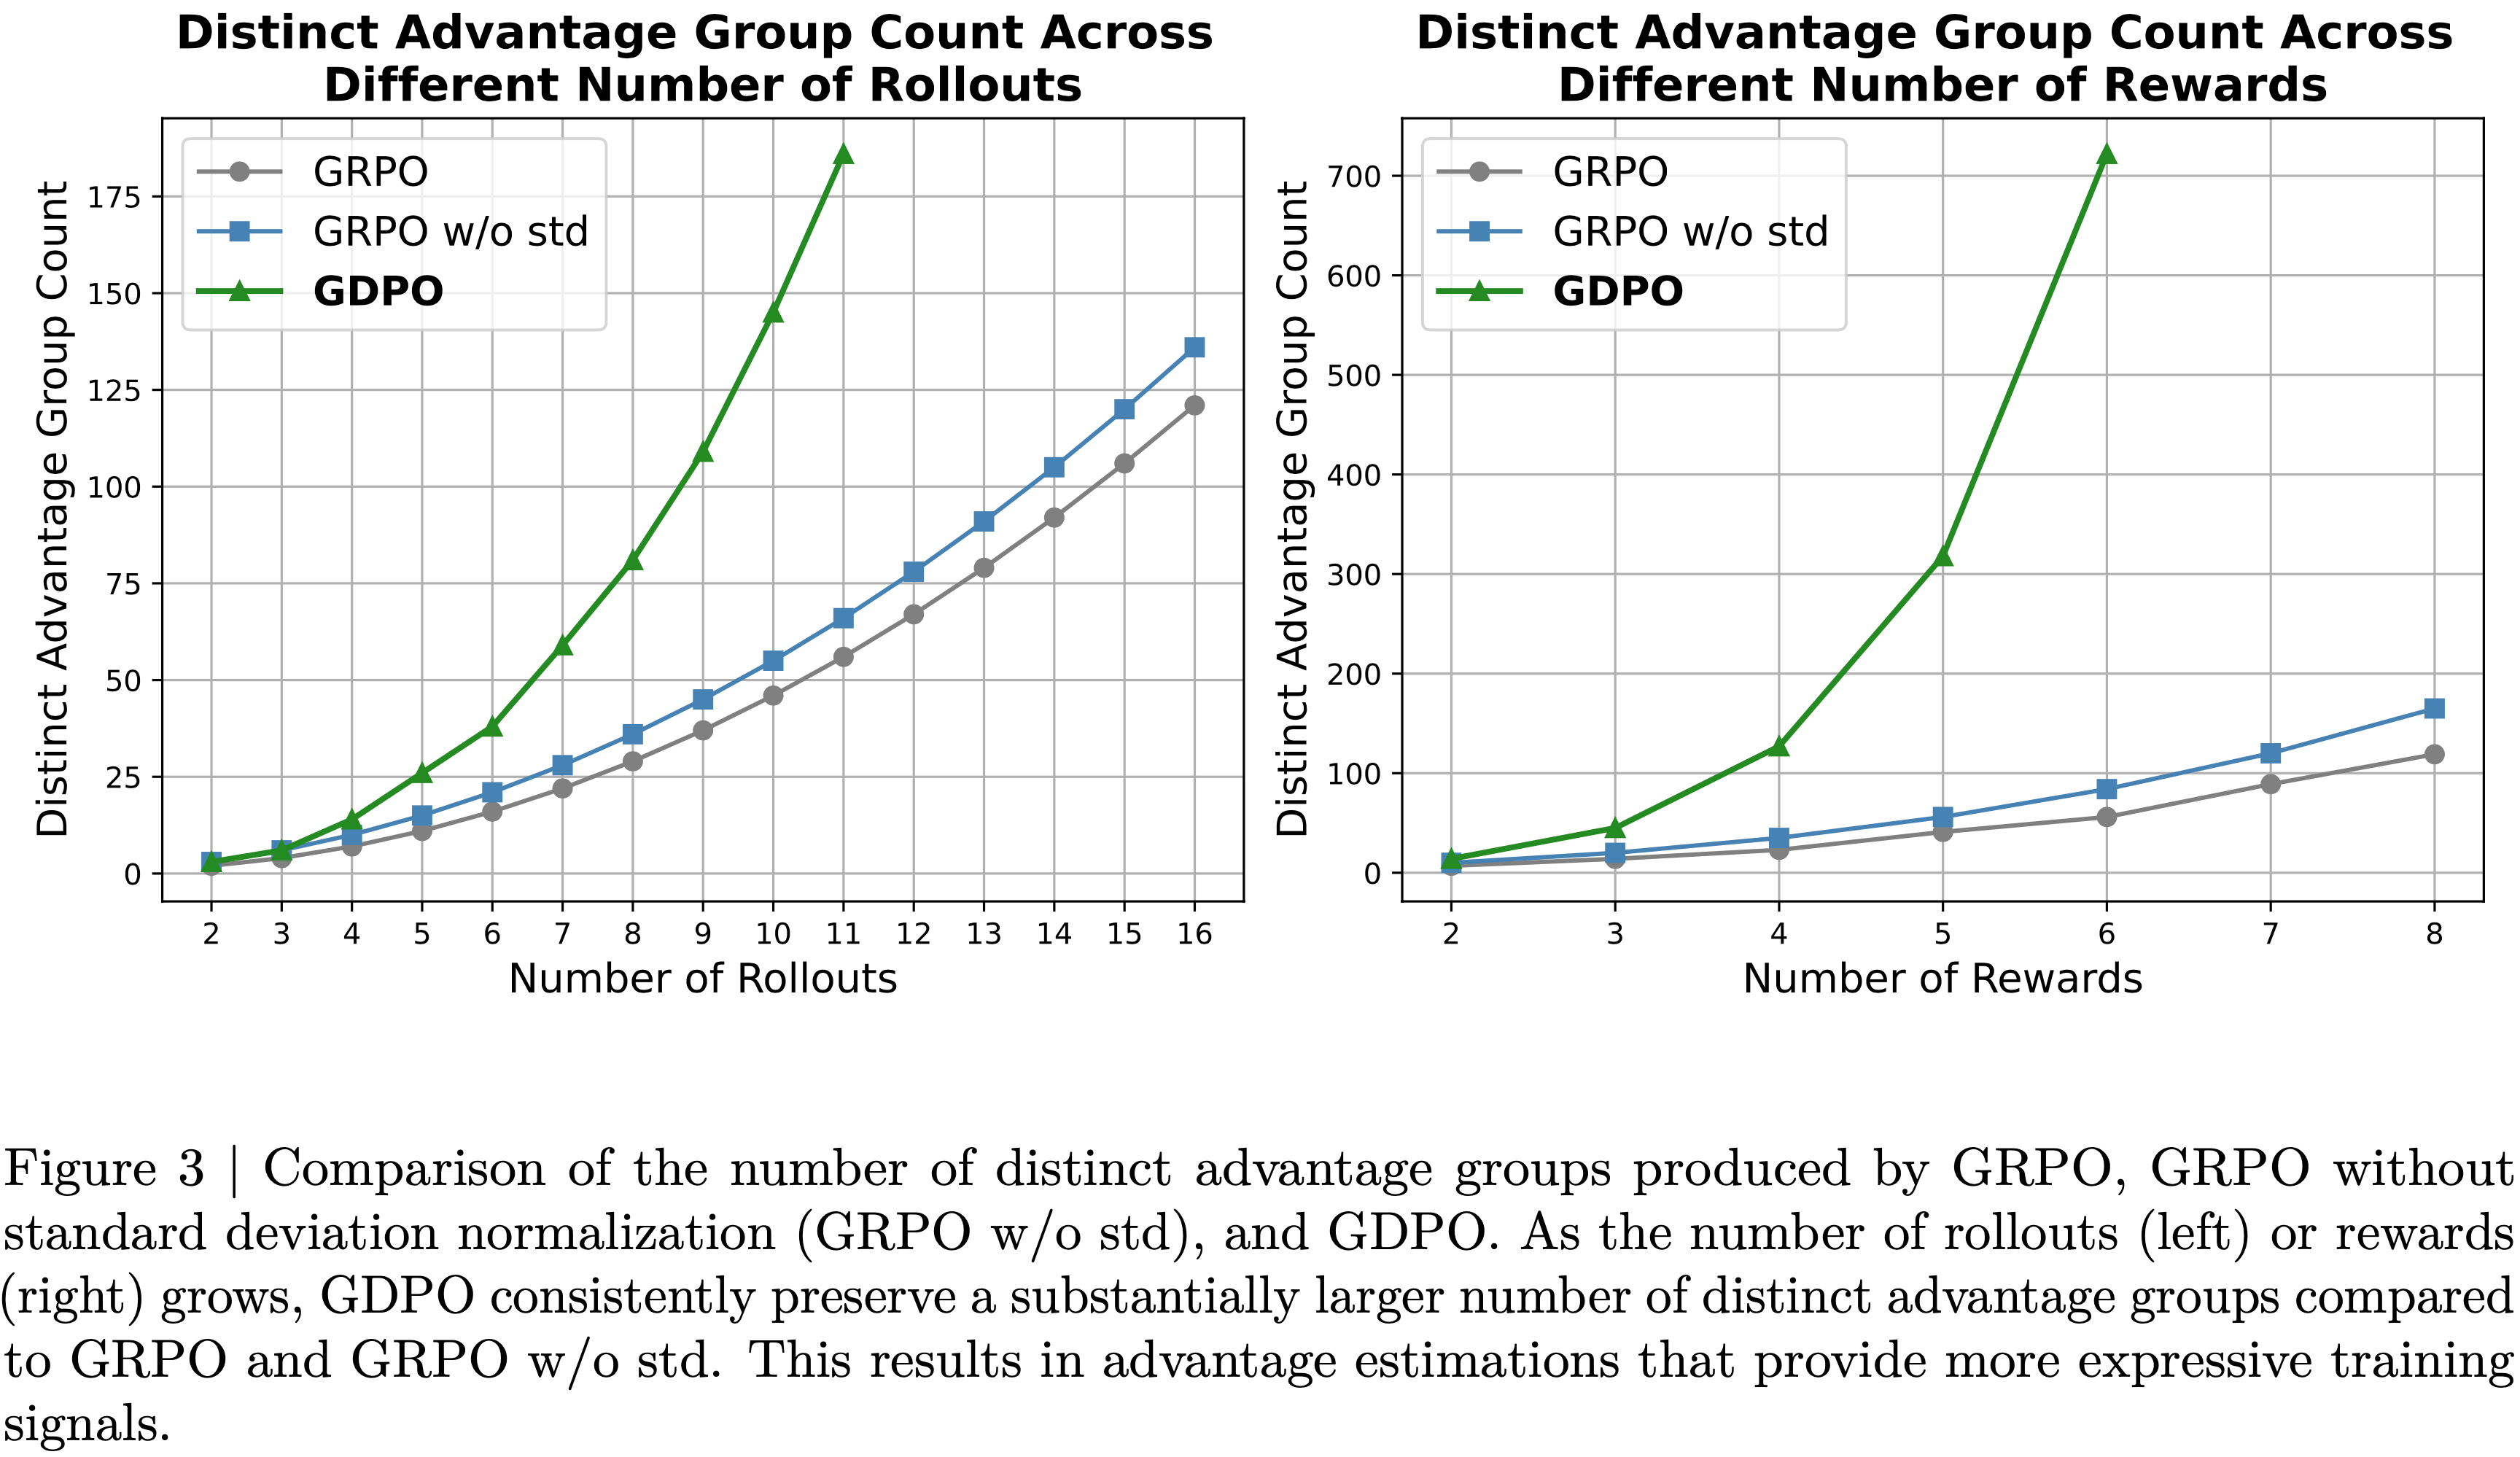
    • 但当将此设置推广到更多rollout同时保持奖励数量固定时,如图 3 所示,论文观察到与 GRPO 相比,这种修复仅略微增加了独特优势组的数量
    • 在 Rollout 数量固定为四个,但奖励数量逐渐增加的情况下,也能观察到类似的趋势
      • 在这种情况下,论文也只观察到独特优势组数量有适度的改善
      • 论文在第4.1.1节中经验性地检验了去除标准差归一化项的有效性,发现此修改并未带来改进的收敛性或更好的下游评估性能

Method

Group reward-Decoupled normalization Policy Optimization

  • 为克服这些挑战,论文提出了Group reward-Decoupled Normalization Policy Optimization (GDPO)
    • 这是一种旨在更好地保持不同奖励组合之间的区分,并更准确地捕捉其在最终优势中的相对差异的方法
    • 与 GRPO 直接对聚合奖励总和应用组内归一化不同, GDPO 通过先对每个奖励分别执行组内归一化再进行聚合来解耦此过程
  • 具体而言, GDPO 不是先对所有 \(n\) 个奖励求和(如公式(1)),然后应用组内归一化获得 \(A_{\text{sum} }\)(公式(2)),而是计算第 \(i\) 个问题第 \(j\) 个rollout的每个奖励的归一化优势:
    $$A_{1}^{(i,j)}=\frac{r_{1}^{(i,j)}-\text{mean}\{r_{1}^{(i,1)},\ldots,r_{1}^{(i,G)}\} }{\text{std}\{r_{1}^{(i,1)},\ldots,r_{1}^{(i,G)}\} },\quad\ldots,\quad A_{n}^{(i,j)}=\frac{r_{n}^{(i,j)}-\text{mean}\{r_{n}^{(i,1)},\ldots,r_{n}^{(i,G)}\} }{\text{std}\{r_{n}^{(i,1)},\ldots,r_{n}^{(i,G)}\} } \tag{4}$$
  • 用于策略更新的整体优势随后通过首先对所有目标的归一化优势求和获得:
    $$A_{\text{sum} }^{(i,j)}=A_{1}^{(i,j)}+\cdots+A_{n}^{(i,j)} \tag{5}$$
    • 注意:这里优势和是直接相加的,实际中,可能还可以根据不同维度 Rule/RM 的重要性进行加权缩放?
  • 然后,对多奖励优势的和应用批间优势归一化,以确保最终优势 \(\hat{A}_{\text{sum} }^{(i,j)}\) 的数值范围保持稳定,且不会随着引入额外奖励而增长:
    $$\hat{A}_{\text{sum} }^{(i,j)}=\frac{A_{\text{sum} }^{(i,j)}-\text{mean}\left\{A_{\text{sum} }^{(i^{\prime},j^{\prime})}\mid i^{\prime}\in D_{\text{Batch} },j^{\prime}=1,\ldots,G \right\} }{\text{std} \left\{A_{\text{sum} }^{(i^{\prime},j^{\prime})}\mid i^{\prime}\in D_{\text{Batch} },j^{\prime}=1,\ldots,G \right\}+\epsilon} \tag{6}$$
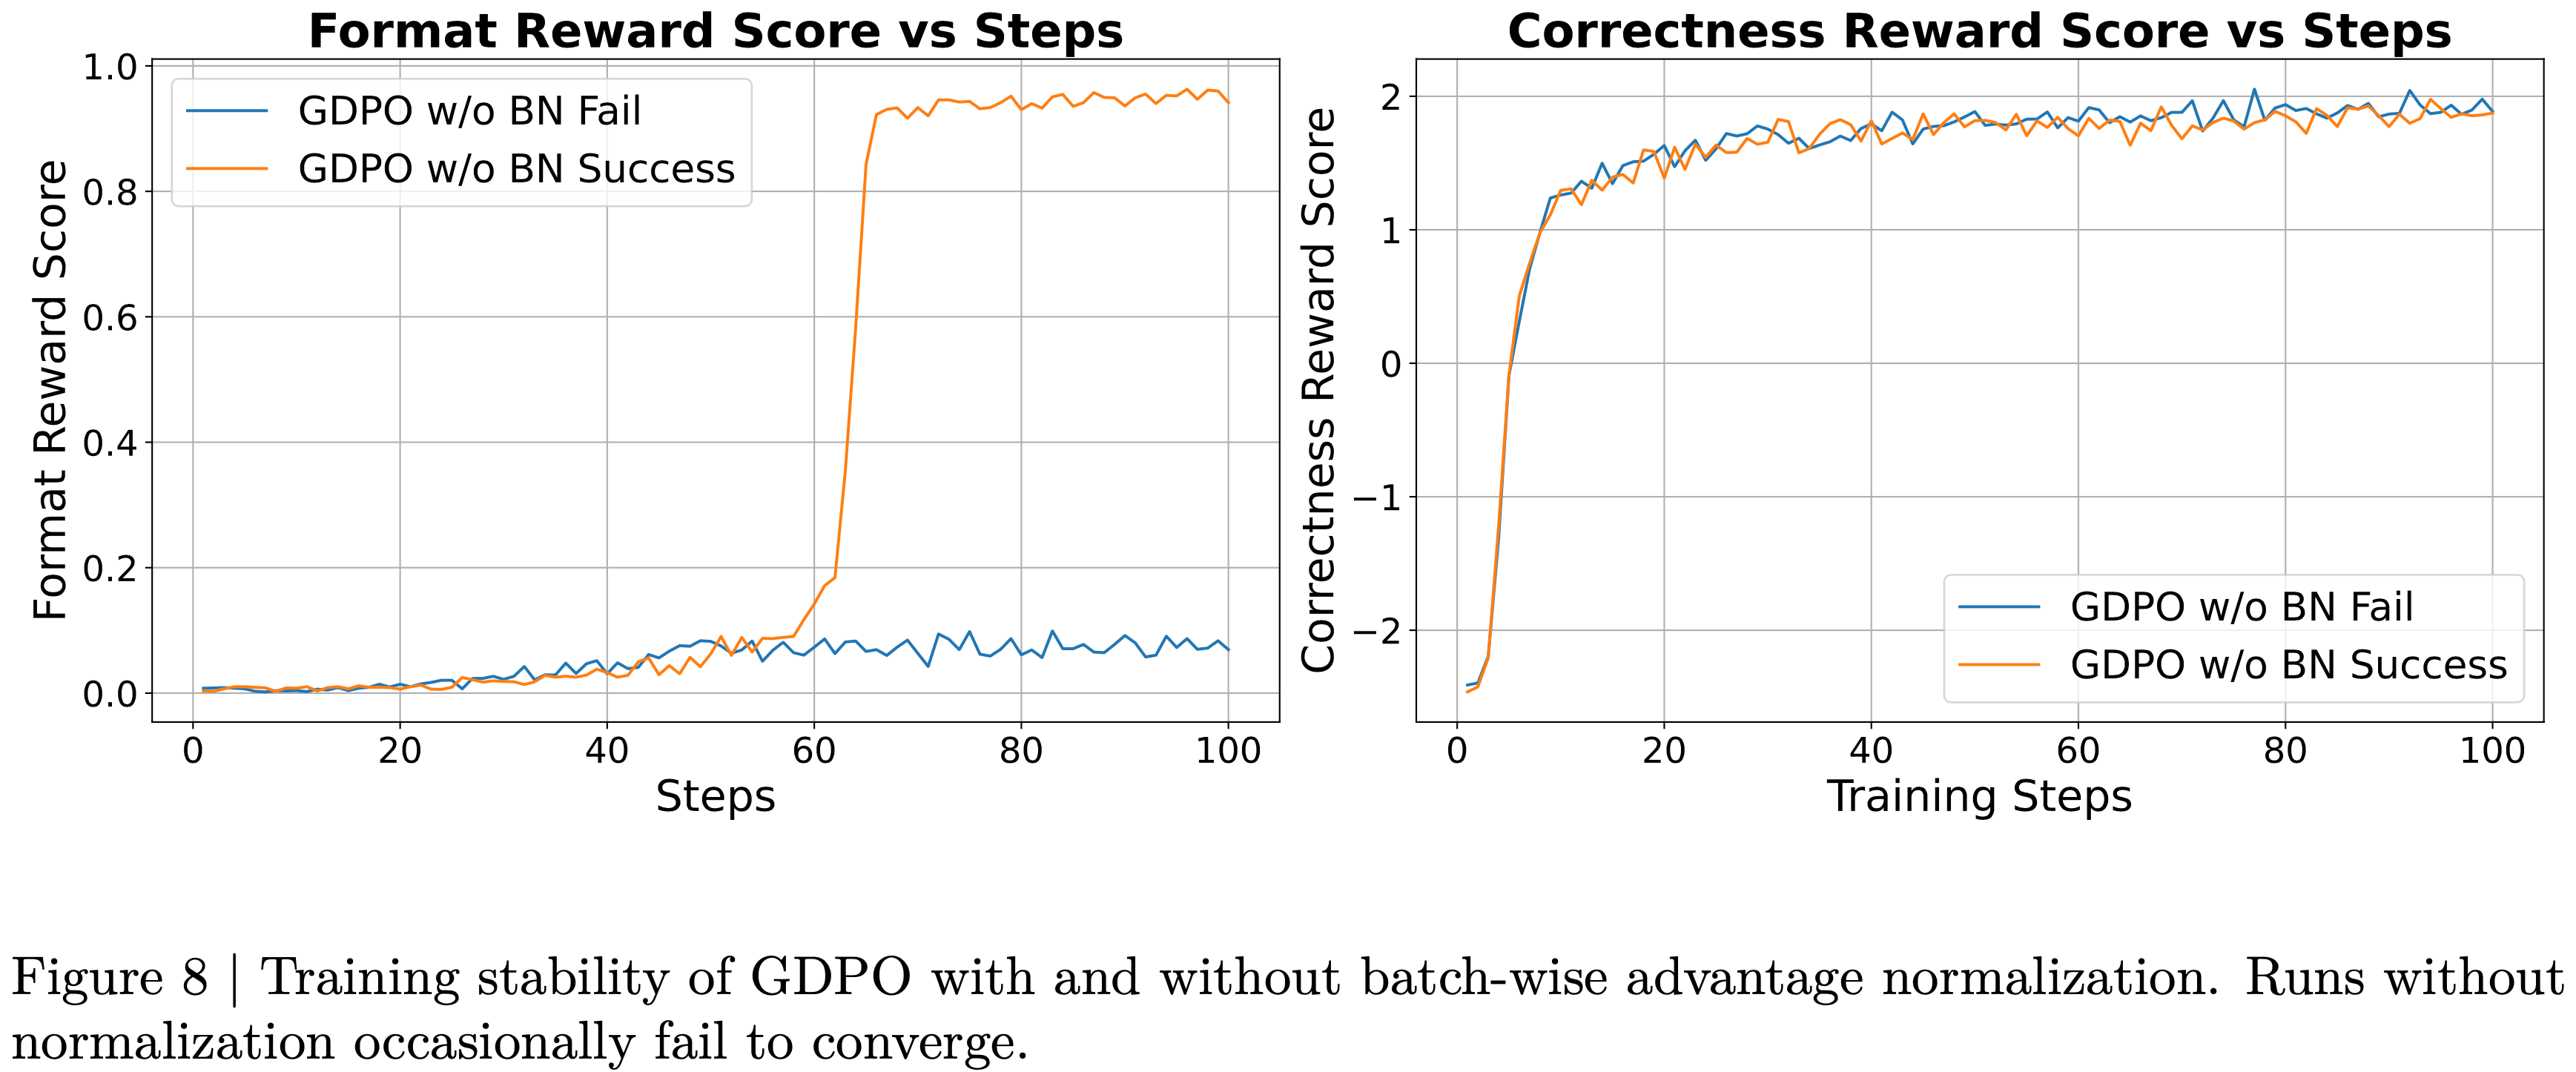
  • 经验上,论文还发现这个归一化步骤提高了训练稳定性,如附录 A 所示,其中去除批间归一化偶尔会导致收敛失败
  • 通过分离每个奖励的归一化, GDPO 缓解了 GRPO 优势估计中存在的信息丢失问题,如图 2 所示
    • 请注意,由于 GDPO 中的批间归一化步骤不会改变不同优势组的数量,为清晰起见,论文在此省略
  • 从图中可以看出,当采用 GRPO 时,不同的奖励组合,例如 \((0,2)\) 和 \((0,1)\),会导致相同的归一化优势,掩盖了它们之间的细微差别
    • 相比之下, GDPO 通过为每个组合分配不同的优势值来保留这些细粒度差异,例如,\((0,1)\) 的奖励组合在 GDPO 归一化后变为 \((-0.7071,0.7071)\),而 \((0,2)\) 变为 \((-1.4142,1.4142)\),这更恰当地反映了 \((0,2)\) 应比 \((0,1)\) 产生更强的学习信号
    • 类似地,当将 rollout 数量扩展到三个时, GRPO 会将优势值 \((0,0,0)\) 分配给 \((1,1,1)\)
    • 然而,\((1,1,1)\) 可能由异质的奖励分配产生,例如 \(r_{1}=(1,1,0)\) 或 \(r_{2}=(0,0,1)\),而 GDPO 将产生非零优势,从而保留了跨奖励维度的有意义的差异
  • 论文通过比较 GDPO 、 GRPO 和去除标准差的 GRPO 在两种实验设置下的独特优势组数量,进一步量化了 GDPO 的有效性,如图 3 所示
    • 在奖励数量为两个且 rollout 数量变化的情况下, GDPO 始终产生显著更多的独特优势组数量,并且随着 rollout 数量增加,差距扩大
    • 另一方面,当固定 rollout 数量为四个并增加奖励数量时,也出现了类似的模式, GDPO 随着目标数量增长展现出逐渐增大的优势粒度
    • 这证明了解耦归一化方法有效地增加了所有 RL 设置中独特优势组的数量,并实现了更精确的优势估计
  • 除了这些理论改进之外,论文观察到使用 GDPO 始终能产生更稳定的训练曲线和改善的收敛性,例如:
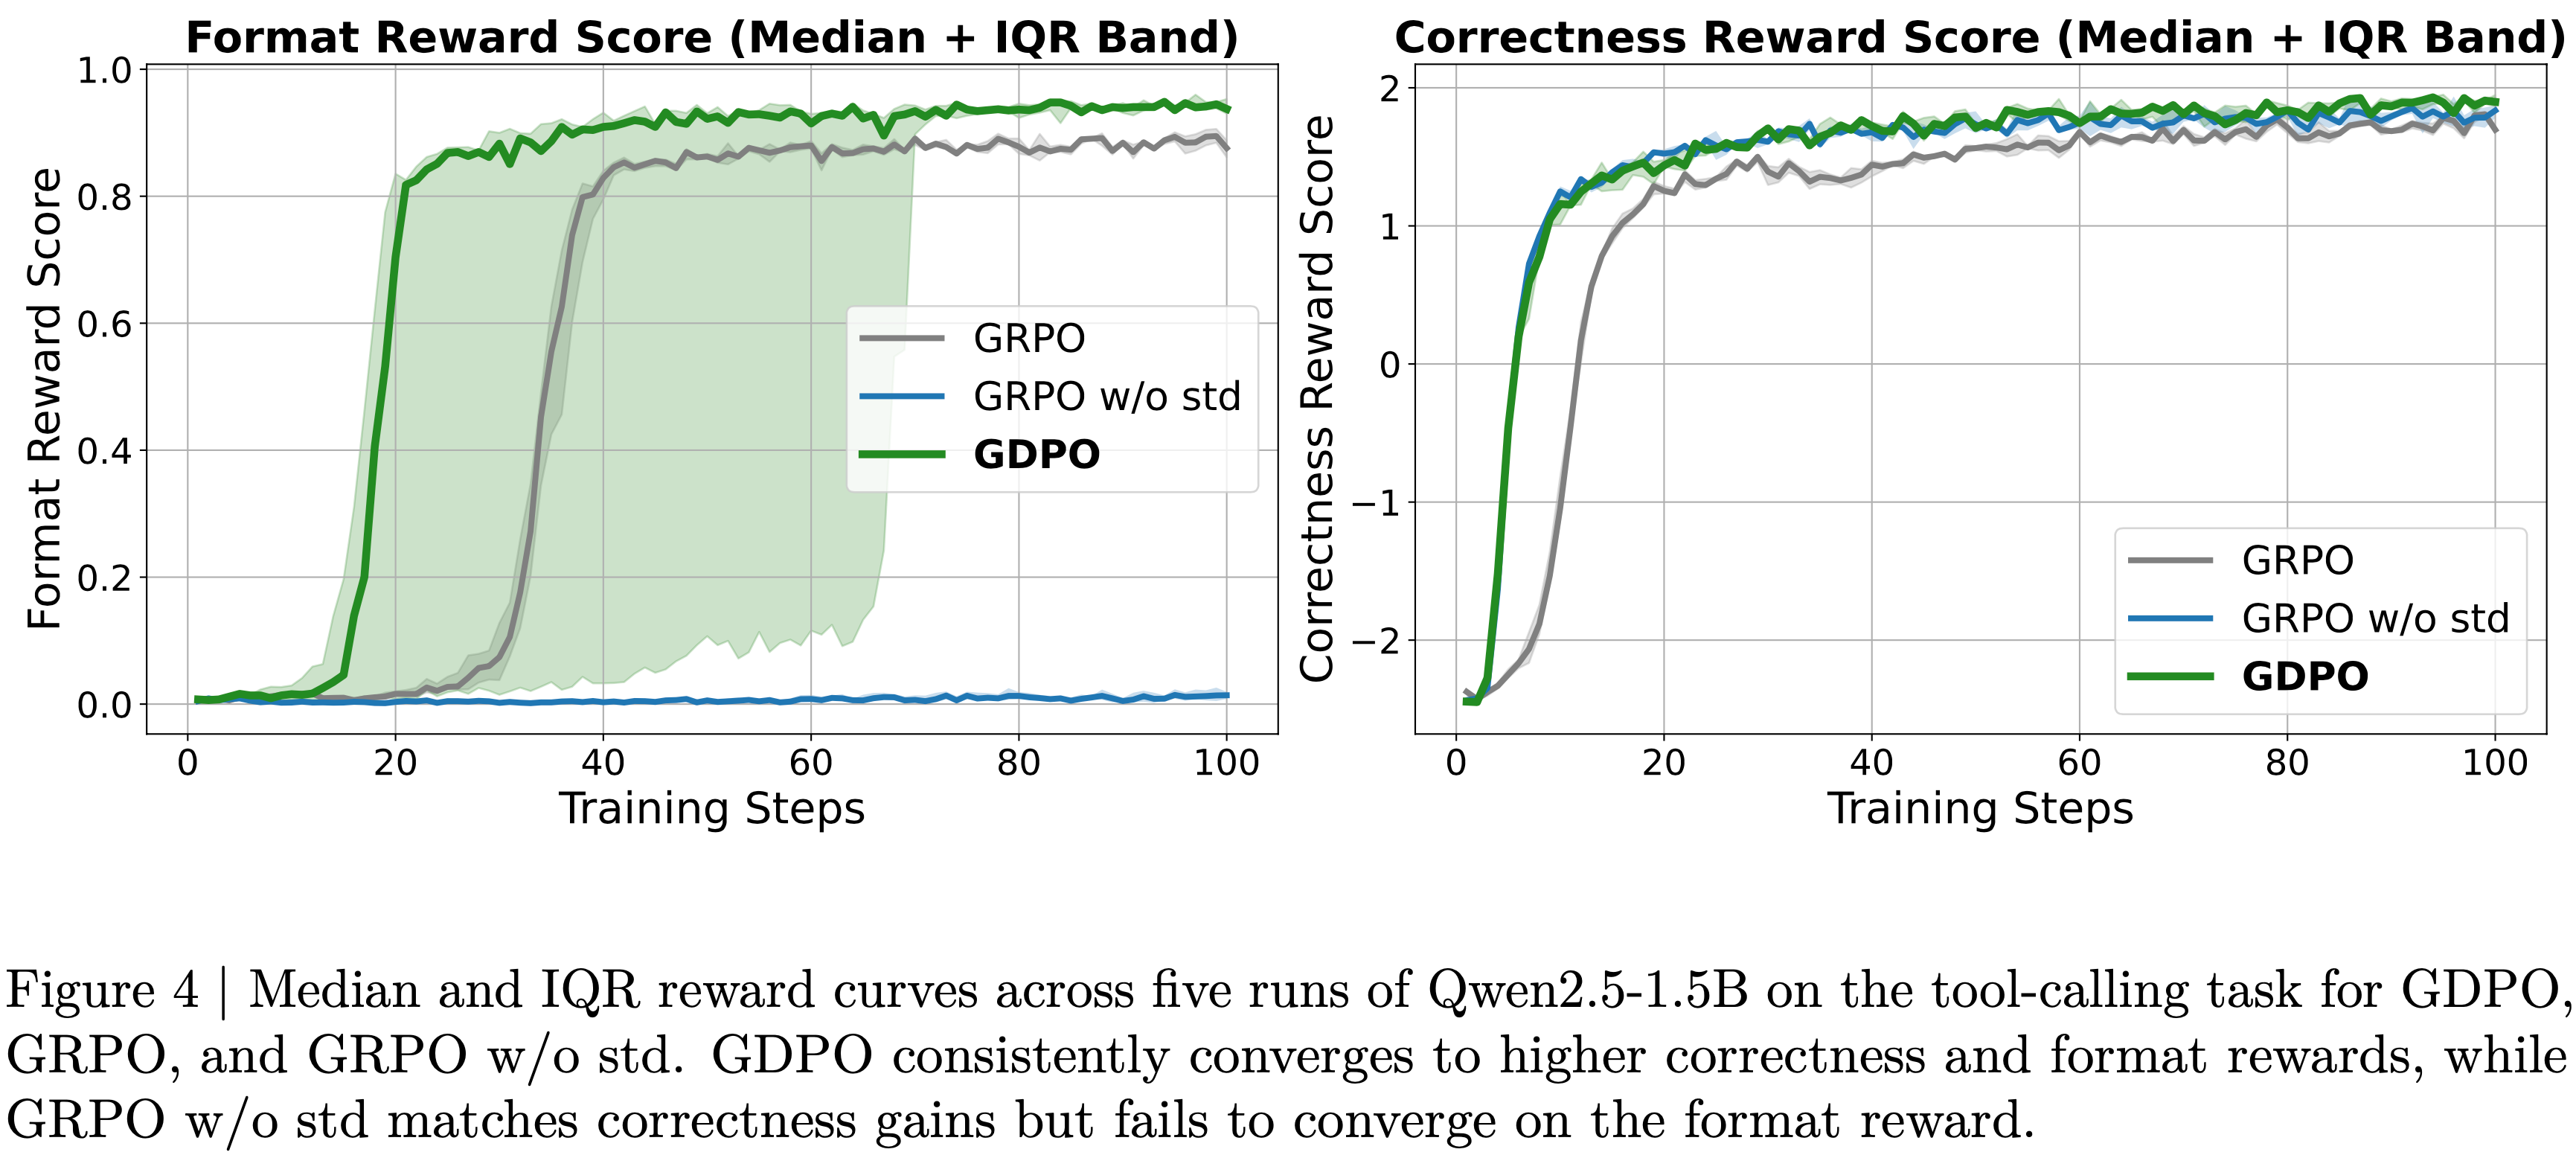
    • 如图 4 所示, GDPO 在 工具调用任务 的格式奖励和正确性奖励上都实现了更好的收敛
    • 如图 5 所示, GDPO 也消除了在 数学推理任务 中观察到的 GRPO 训练坍缩问题,其中使用 GDPO 训练的模型在整个训练过程中持续改进正确性奖励分数
    • 第4节中的额外实证结果进一步证实了 GDPO 在广泛下游任务中实现与目标偏好更强对齐的能力
Effective incorporation of priority variation(考虑优先级差异)

  • 到目前为止,论文假设所有目标同等重要
    • 实际上,这个假设在现实应用中并不总是成立
  • 在本节中,论文系统性地概述了如何调整与不同目标相关的奖励权重或修改奖励函数,以强制优先处理更重要的目标
    • 论文还讨论了当基础奖励在难度上差异显著时,这两种设计选择的不同表现
  • 常见的做法是为每个奖励分配不同的权重,以编码目标间的不同优先级,使得 \(r_{\text{sum} }=w_{1}r_{1}+\cdots+w_{n}r_{n}\),从而控制每个奖励对用于策略更新的最终优势的贡献
  • 对于 GDPO ,此类权重应用于每个奖励的归一化优势,如下:
    $$A_{\text{sum} }^{(i,j)}=w_{1}A_{1}^{(i,j)}+\cdots+w_{n}A_{n}^{(i,j)} \tag{7}$$
  • 本文的发现:当基础目标的难度水平差异显著时,调整奖励权重并不总能产生预期的行为
    • 如果一个目标比其他目标容易得多,模型往往会专注于最大化该目标的奖励 ,而不管分配的权重如何
    • 因此,为了更有效地迫使模型分配更多注意力到更具挑战性的目标相关的奖励,必须使权重差异足够大以补偿难度差距
    • 然而,即使进行此类调整,模型可能仍然倾向于优化更容易的奖励,而不是用户意图优先的目标,这一现象论文将在第4.2.1节进行经验性展示
  • 一些近期工作(2025,2024)通过将较容易的奖励条件化于较难的奖励来解决此类 Reward Hacking 问题
    • 给定两个奖励 \(r_{k}\) 和 \(r_{l}\),将 \(r_{k}\) 条件化于 \(r_{l}\) 可以表述为:
      $$r_{k}=\begin{cases}r_{k},&\text{if }r_{l}\geq t\\ 0,&\text{otherwise}.\end{cases} \tag{8}$$
    • 通过这样的奖励函数设计,模型只有在奖励 \(r_{l}\) 满足预定义的分数阈值 \(t\) 时才能获得 \(r_{k}\) 的奖励,因此,模型被迫首先最大化人类优先的奖励,从而完全缓解上述问题
    • 这种策略的经验有效性展示在第 4.2.1 节,其中使用条件化奖励函数训练的模型,相比仅对优先奖励分配更大权重而未使用条件化的模型,在优先目标上实现了更高的性能
    • 论文还观察到,在解决了较易奖励占主导的问题之后,为细粒度优先级调整分配不同的奖励权重也能更忠实地反映在最终模型行为中

Experiments

  • 论文首先在工具调用任务上评估 GDPO 与 GRPO 的有效性(第 4.1 节),该任务涉及优化两个 Reward:
    • 工具调用正确性和格式符合性
  • Next, 论文进行了一项消融研究,检验了带或不带标准差归一化的 GRPO 的训练收敛性和下游性能
  • 然后论文在数学推理任务上比较了 GDPO 和 GRPO ,该任务优化了两个隐含竞争的 Reward:
    • 准确性和长度约束(第 4.2 节)
  • 论文进一步广泛分析了融入不同 Reward 权重和修改 Reward 函数以更好地反映人类偏好中不同优先级的影响,特别是在 Reward 难度差异显著时
  • Finally,论文将优化的 Reward 数量扩展到三个,并在代码推理任务上比较了 GRPO 和 GDPO (第 4.3 节),联合优化了代码生成准确性、对长度约束的遵守程度以及缺陷率,进一步证明了 GDPO 能有效推广到具有三个 Reward 目标的任务场景

Tool calling

  • 论文遵循 ToolRL (2025) 的设置,在工具调用任务上比较 GDPO 与 GRPO
  • 模型被训练学习如何将外部工具整合到推理轨迹中,以按照附录 B 所示的输出格式解决用户任务,其中推理步骤必须包裹在 <think></think> 中,工具调用必须出现在 <tool_call></tool_call> 内,而模型的最终答案必须放置在 <response></response> 内
  • 论文采用与 ToolRL 相同的训练集进行 RL 训练,该数据集包含来自 ToolACE (2024) 的 2k 个样本、来自 Hammar (2024) 的 1k 个样本和来自 xLAM (2025) 的 1k 个样本
    • 每个训练实例包含一个问题及其对应的真实工具调用
  • 训练涉及两个 Reward:
    • 格式 Reward (Format reward) : 格式 Reward \( \mathcal{R}_{\text{format} } \in \{0,1\} \) 检查模型输出是否满足所需的结构,并是否以正确的顺序包含所有必要的字段
    • 正确性 Reward (Correctness reward) : 正确性 Reward \( \mathcal{R}_{\text{correct} } \in [-3,, 3] \) 使用三个指标将模型生成的工具调用与真实调用进行比较:工具名称匹配、参数名称匹配和参数内容匹配
    • Reward 公式的完整描述见附录 C
  • 论文使用 verl (2024) 框架,按照 ToolRL 的 GRPO 配方中的原始超参数设置,使用 GRPO 和 GDPO 训练 Qwen-2.5-Instruct(1.5B 和 3B)(2025) 100 个 step
    • 每个训练问题使用 4 个 Rollout,Batch 大小为 512,最大 Response 长度为 1024
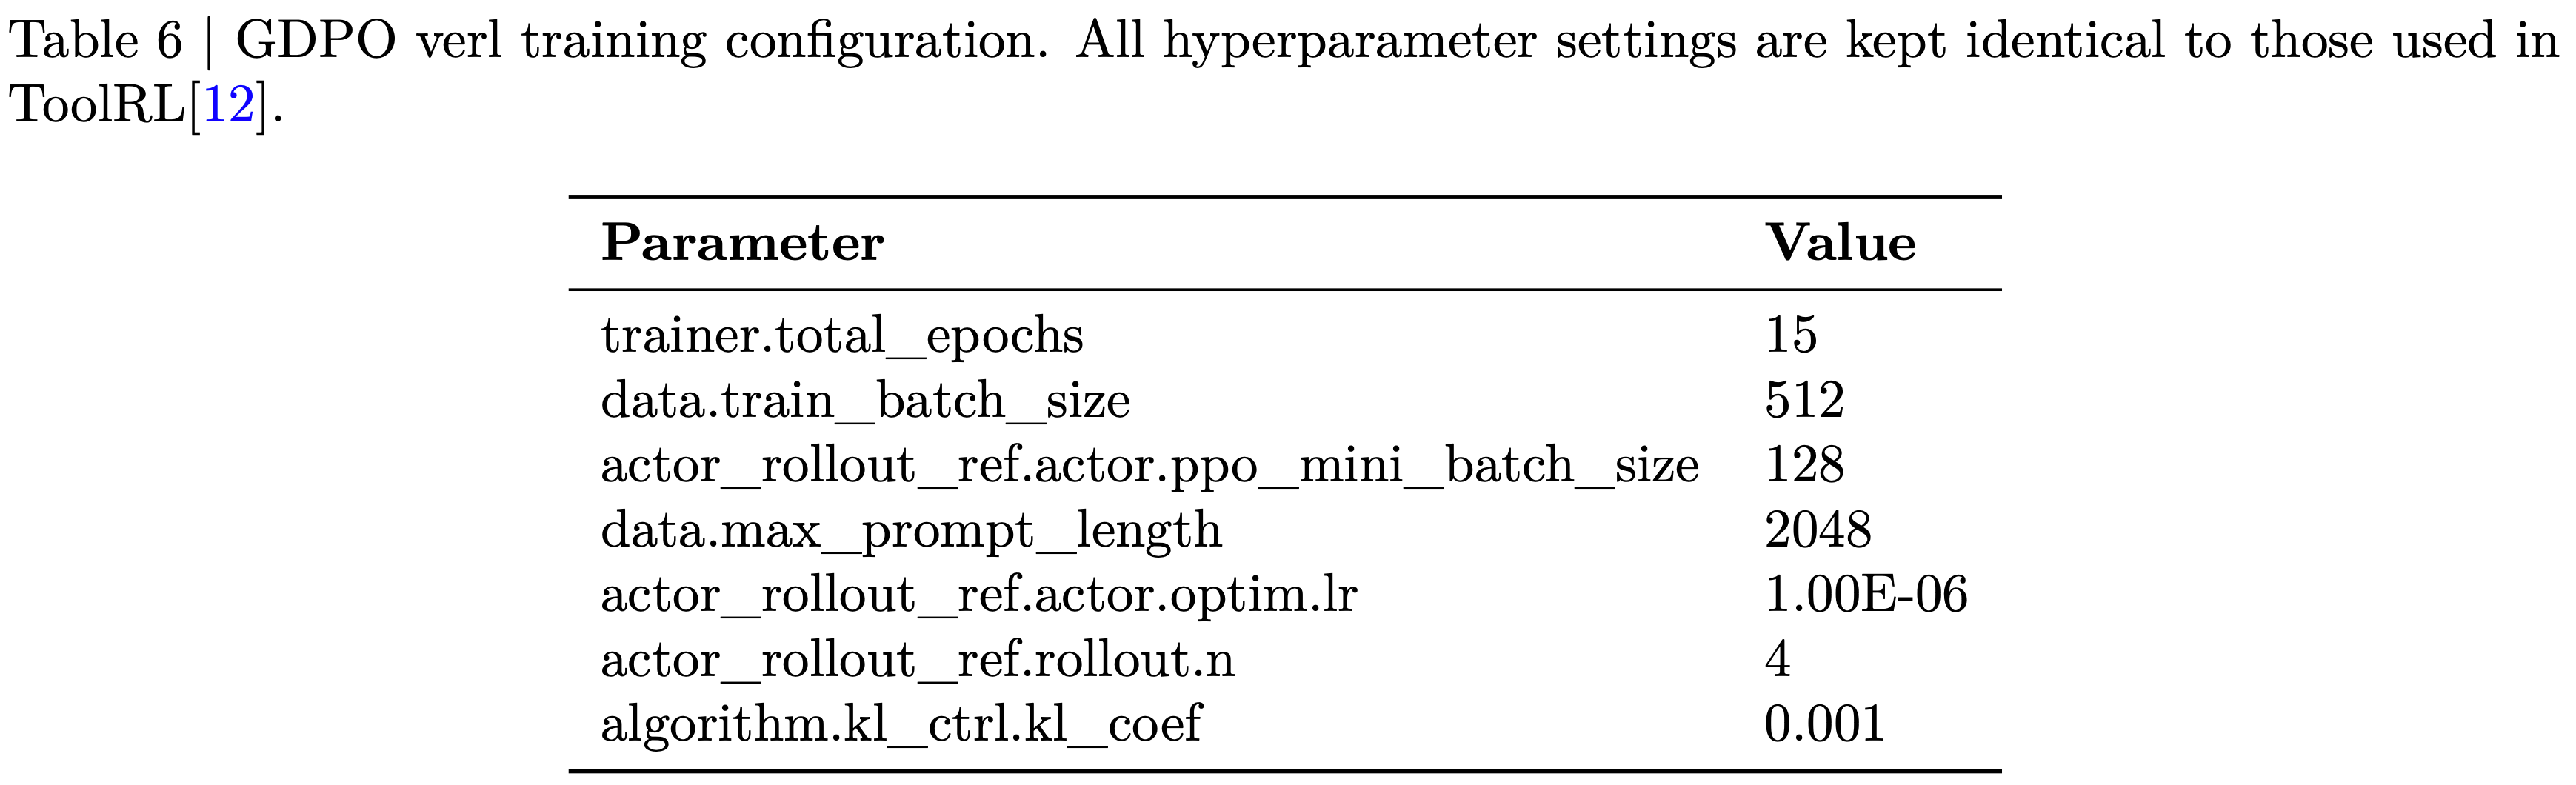
    • 完整的超参数配置列于附录 D
  • 论文在伯克利函数调用排行榜(BFCL-v3)上评估训练好的模型,这是一个涵盖广泛挑战的综合基准测试,包括单步推理、多步工具使用、实时执行、无关工具拒绝、同时多工具选择和多工具执行
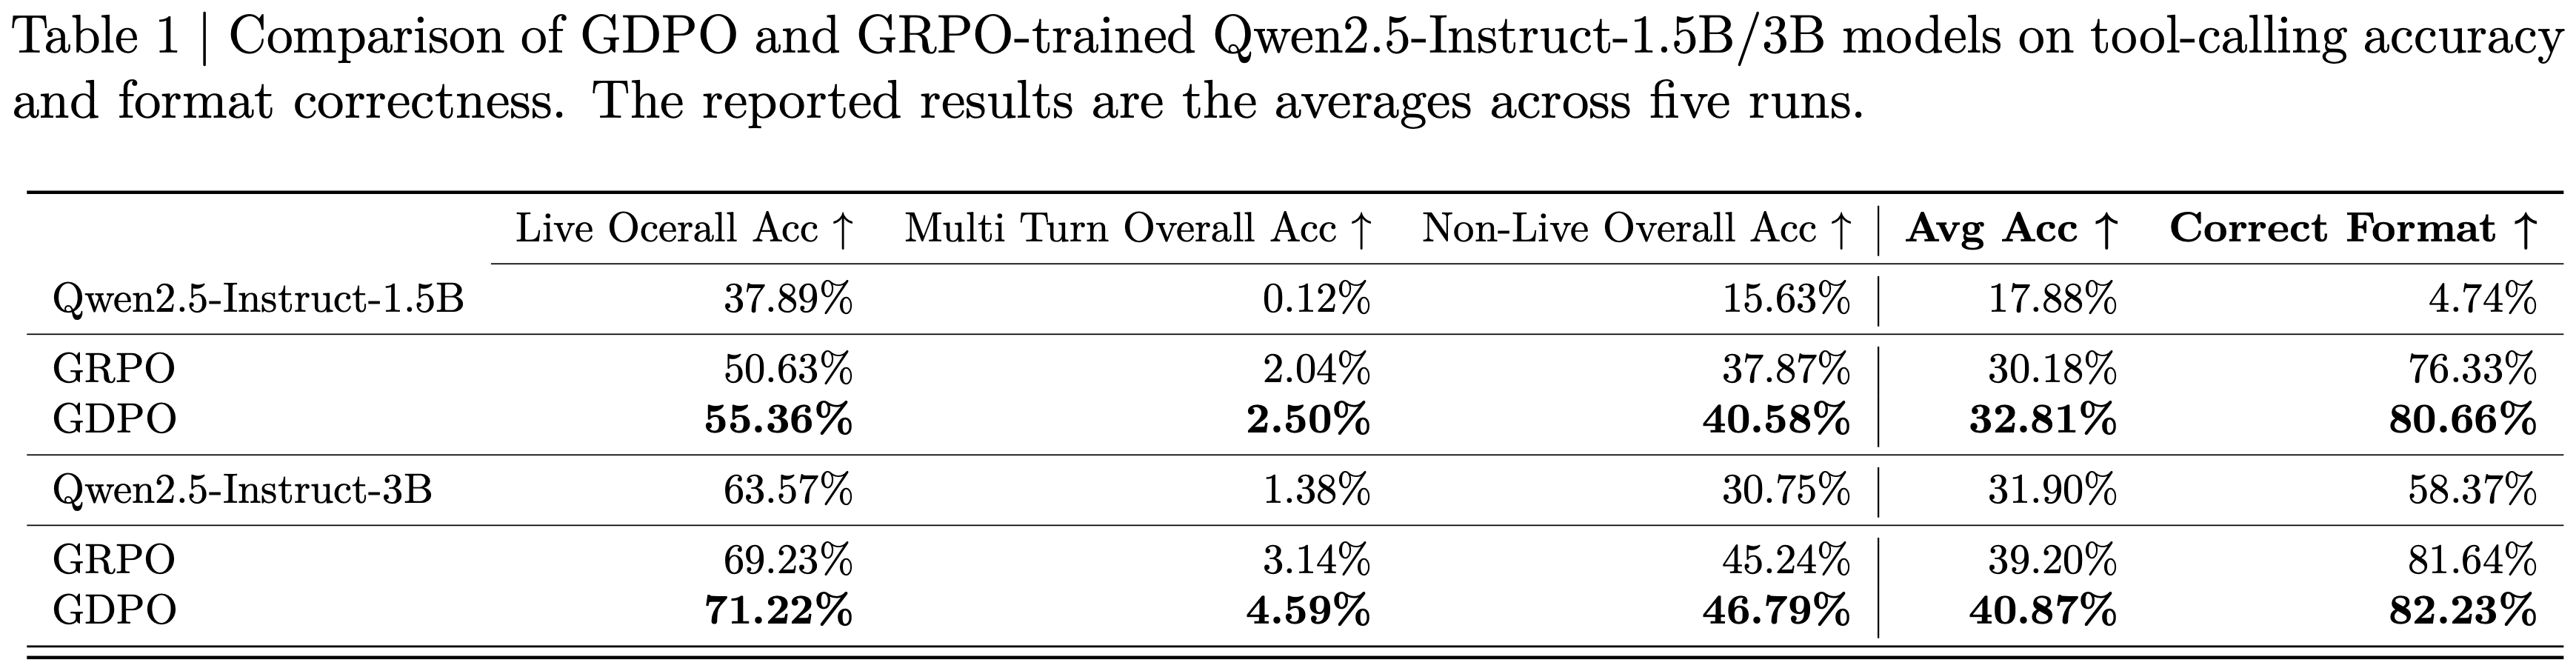
    • 论文用 GRPO 和 GDPO 对模型进行了五次微调,并在表 1 中报告了在 BFCL-v3 上的平均准确率和平均格式正确率
    • 此外,论文在图 4 中绘制了两种方法在五次运行中的训练曲线中位数和四分位距
  • 从训练曲线中,论文观察到在所有运行中, GDPO 在格式和正确性 Reward 得分上都持续收敛到更高的值
    • 尽管 GDPO 在格式 Reward 上的收敛所需 step 数方面表现出更大的方差,但最终获得的格式符合性仍优于 GRPO
    • 对于正确性 Reward, GDPO 在早期阶段显示出更快的改进,并在后期阶段达到比 GRPO 基线更高的 Reward 分数,这证明了 GDPO 在提供更准确的 Advantage 估计从而实现更好优化方面的有效性
  • 在表 1 所示的 BFCL-v3 评估中,与 GRPO 训练的模型相比, GDPO 也持续提高了平均工具调用准确率和格式正确率
    • 在训练 Qwen2.5-Instruct-1.5B 时,与 GRPO 相比, GDPO 在实时/非实时任务上的准确率提升了近 5% 和 3%,整体平均准确率提升了约 2.7%,正确格式比率提升了 4% 以上
    • 在 3B 模型上也观察到了类似的改进, GDPO 在所有子任务上继续优于 GRPO ,实现了高达 2% 的准确率提升,并提供了更好的格式符合率
Does removing the standard deviation normalization term in GRPO provide any benefit?
  • 从图 3 回顾可知,移除 GRPO 中的标准差归一化项(记为 GRPO w/o std)会略微增加不同 Advantage 组的数量
  • 在本节中,论文从经验上检验了这种修改的有效性。遵循之前的实验,论文运行 GRPO w/o std 五次,并报告在 BFCL-v3 上的平均准确率和平均格式正确率
  • 在图 1(b) (注:需要结合图 4 看)所示的 Reward 训练曲线中,论文观察到,尽管 GRPO w/o std 收敛到的正确性 Reward 与 GDPO 相似且高于标准 GRPO ,但它完全未能改进格式 Reward
  • 这种失败导致了在 BFCL-v3 上 0% 的正确格式比率(见表 2),表明模型没有学会所需的输出结构
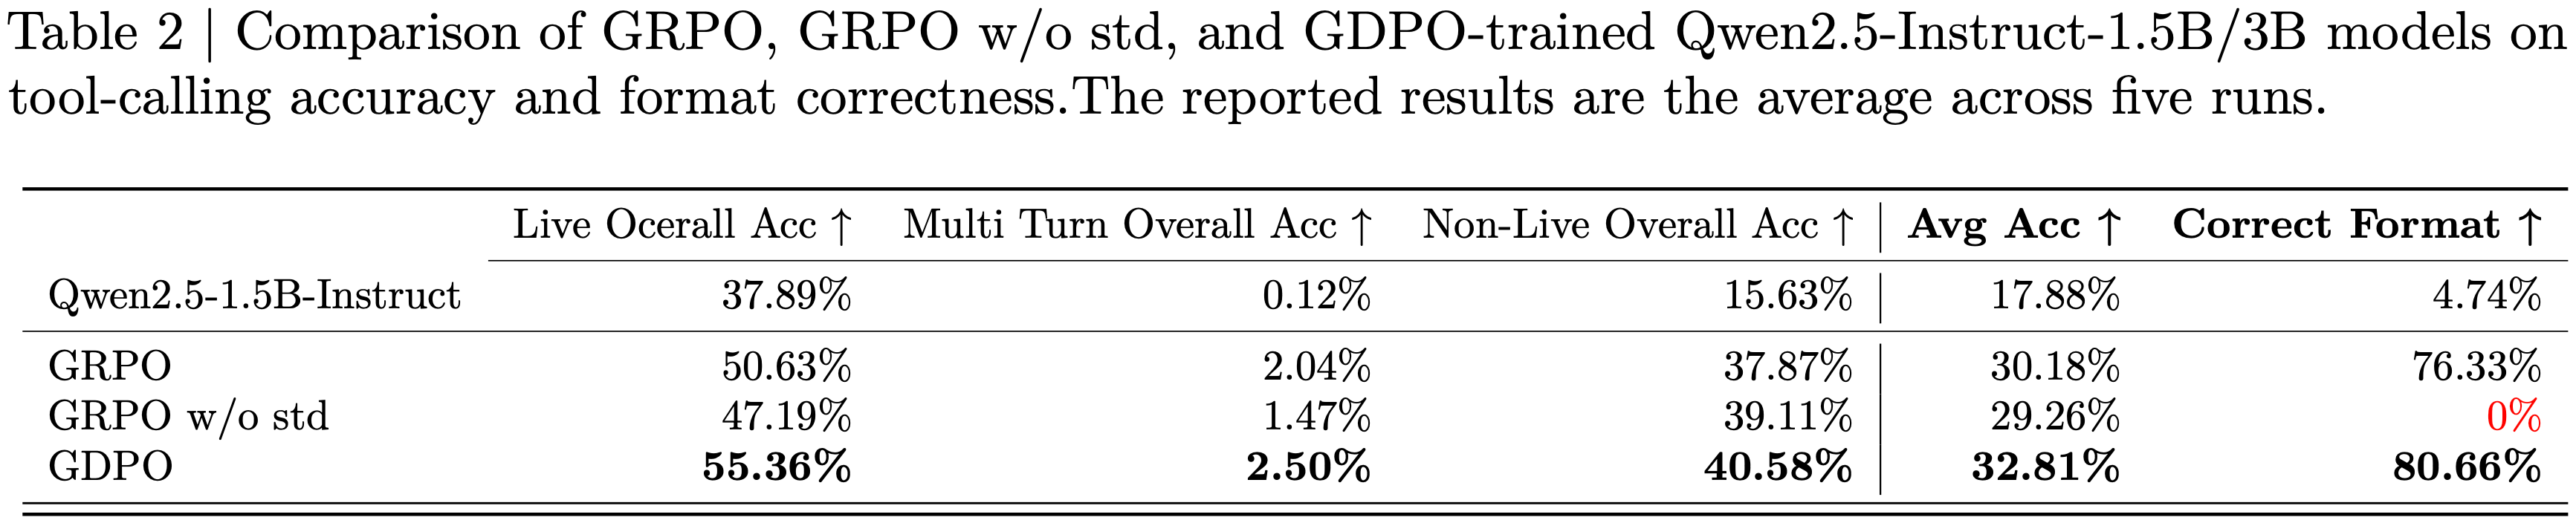
  • 这也表明,仅仅为了增加 Advantage 多样性而移除标准差归一化项,可能会给训练带来不稳定性,最终可能阻止多 Reward 强化学习的成功收敛

Mathematical reasoning

  • 论文考虑一个数学推理任务,它优化两个隐含竞争的 Reward:
    • 准确性和对长度约束的遵守(accuracy and adherence to a length constraint)
    • 目标是提高模型在具有挑战性的数学问题上的性能,同时将生成的输出保持在预定义的 Response 长度内 ,以鼓励高效的问题解决
  • 论文使用 GRPO 和 GDPO 在 DeepScaleR-Preview 数据集 (2025) 上训练 DeepSeek-R1-1.5B、DeepSeek-R1-7B (2025) 和 Qwen3-4B-Instruct (2025) 500 个 step,该数据集包含 40K 个竞赛级数学问题
  • 训练使用 verl (2024) 进行,论文遵循原始的 DeepSeek-R1 提示格式 (2025)
    • 遵循 DLER 设置 (2025),论文融入了动态采样、更高的 Clipping 阈值以及来自 DAPO (2025) 的 Token 平均损失,并使用 16 个 Rollout,Batch 大小为 512,最大 Response 长度为 8000 个 Token
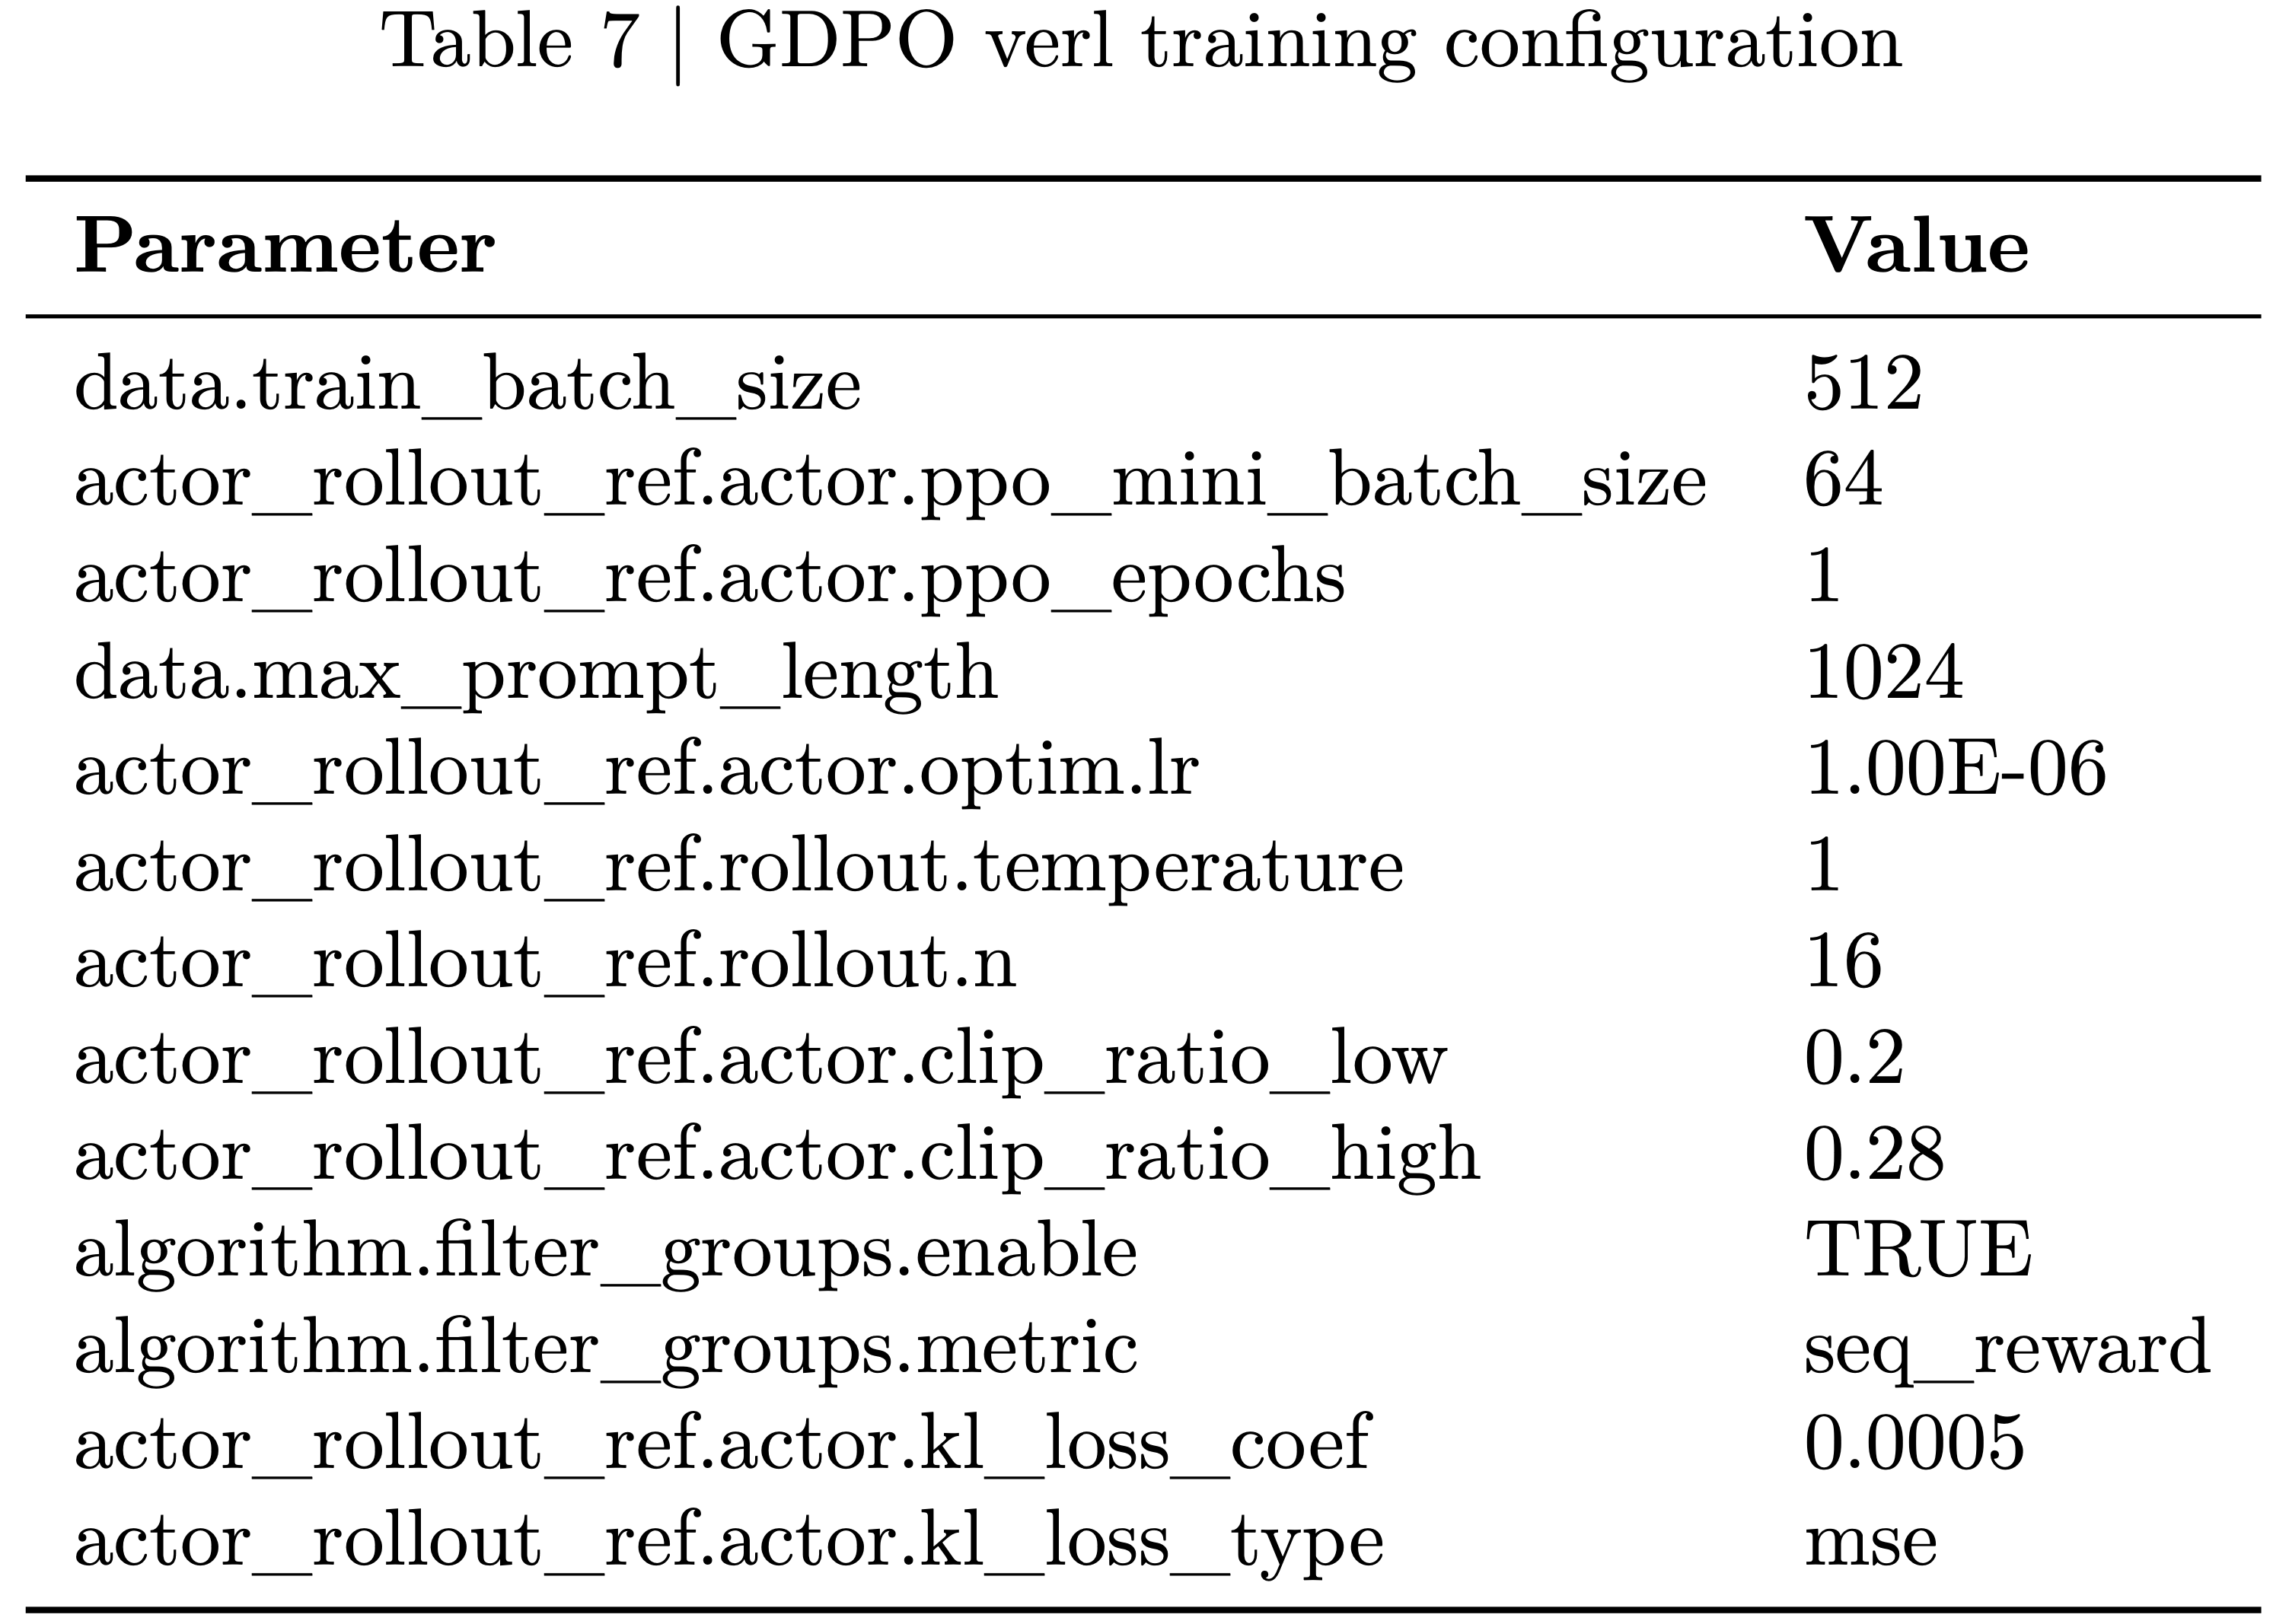
    • 完整的超参数集在附录 E 中提供
  • 训练使用两个 Reward:
    • 长度 Reward (Length reward) : 长度 Reward \( \mathcal{R}_{\text{length} } \in \{0,1\} \) 检查模型的输出是否保持在目标长度 \( l \) 内,在所有后续实验中设置为 4000 个 Token:
      $$
      \mathcal{R}_{\text{length} }=\begin{cases}1, &\text{if response length}\leq l\\ 0, &\text{otherwise.}\end{cases}
      $$
    • 正确性 Reward (Correctness reward) : 正确性 Reward \( \mathcal{R}_{\text{correct} } \in \{0,1\} \) 表示从模型 Response 中提取的最终答案是否与真实答案匹配
  • 论文在 AIME-24 (2024)、AMC(AMC 2022 和 AMC 2023)(2024)、MATH (2021)、Minerva (2022) 和 Olympiad Bench (2024) 上比较了 GRPO 和 GDPO 训练的模型
    • 所有评估均使用 vLLM 作为推理后端,采样温度为 0.6,\( top_{p}=0.95 \),最大 Response 长度为 32k 个 Token
    • 对于每个评估问题,论文生成 16 个样本,并报告平均 pass@1 分数和平均超长比率(记为 Exceed),该比率衡量模型 Response 超过预定义长度限制(4000 个 Token)的百分比
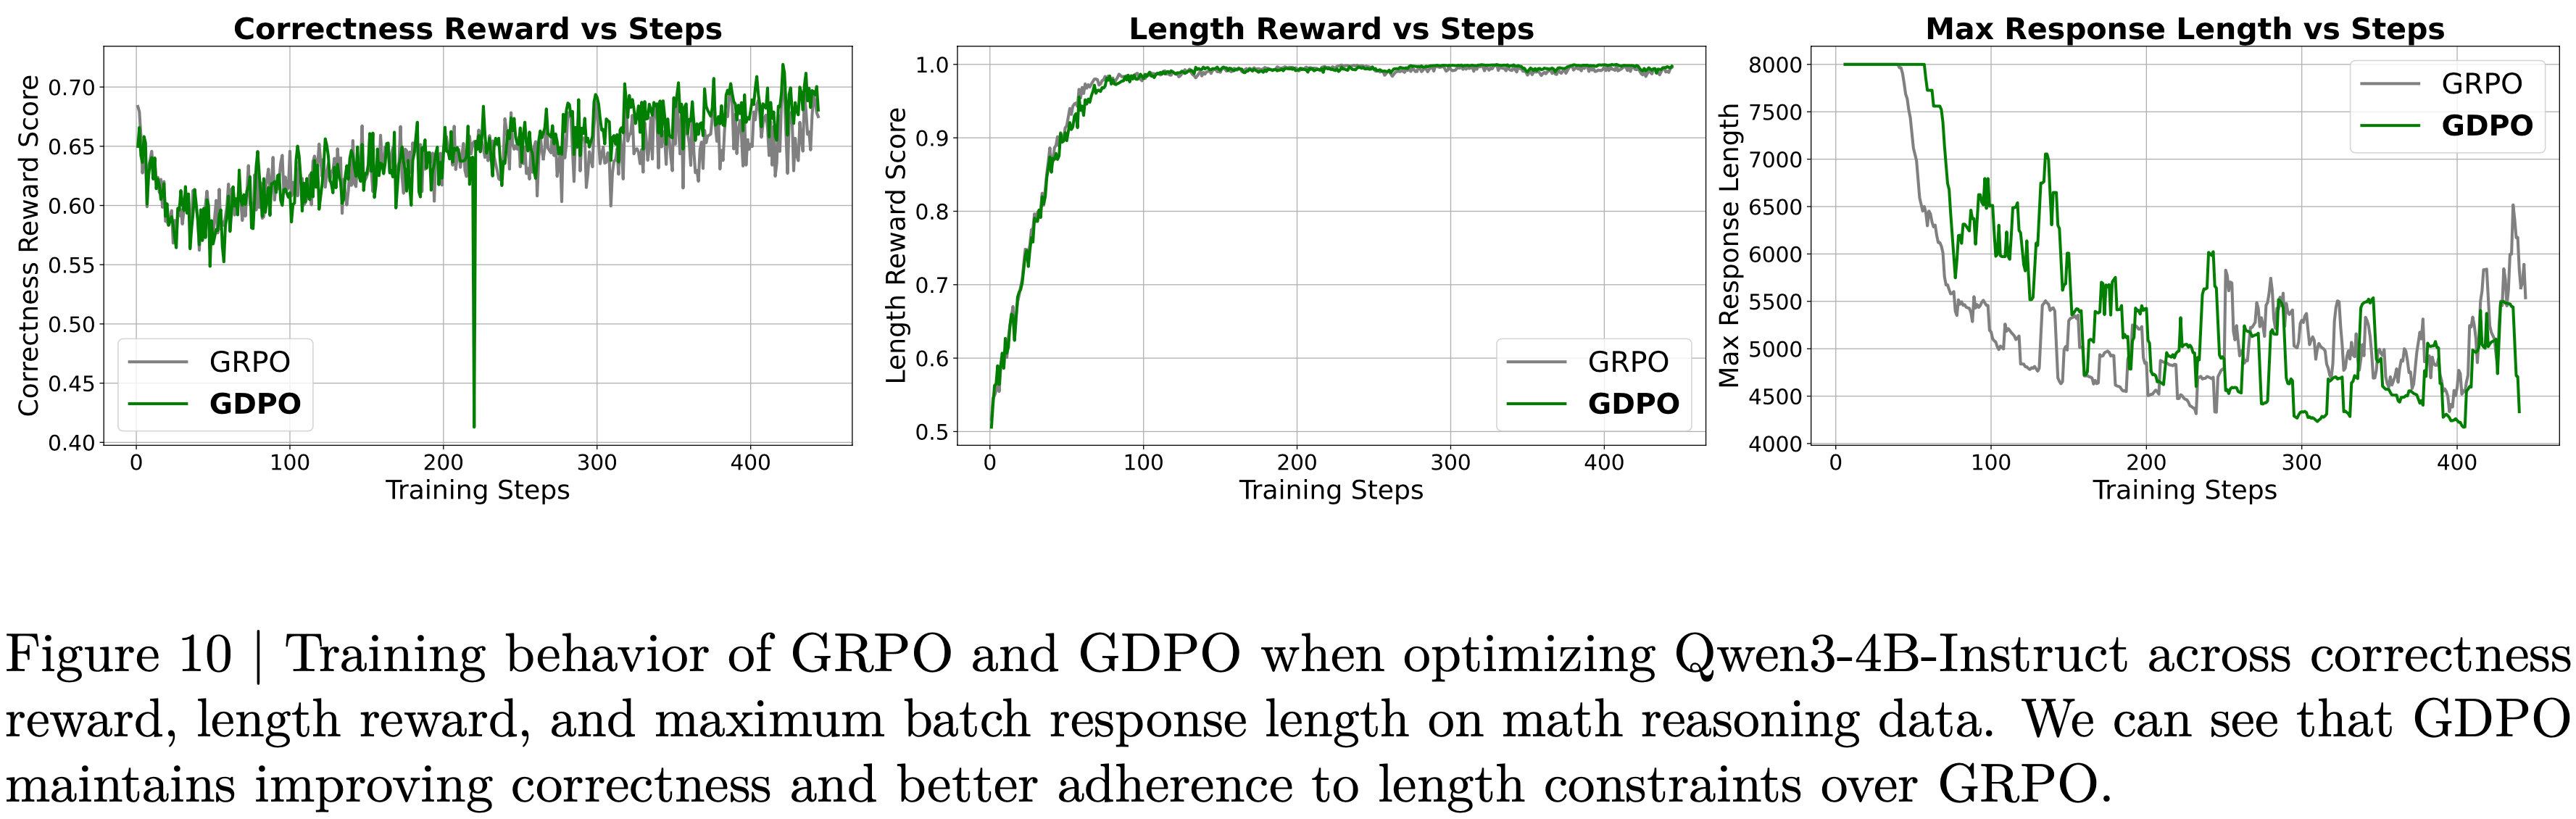
  • 从图 5 所示的 GRPO 和 GDPO 在 DeepSeek-R1-1.5B 上的训练曲线中
    • 论文首先观察到,无论使用哪种优化方法,模型都倾向于最大化较容易的 Reward。在这种情况下,长度 Reward 更容易优化, GRPO 和 GDPO 在大约前 100 个训练 step 内都达到了满分长度分数
    • 论文还看到,长度 Reward 的快速上升与正确性 Reward 的早期下降同时发生,这表明两个 Reward 在竞争
      • 在训练的初始阶段,模型优先满足长度约束,通常以牺牲更具挑战性的正确性目标为代价
      • 然而,从正确性 Reward 的轨迹来看,论文观察到 GDPO 比 GRPO 更有效地恢复了正确性 Reward,在可比的训练 step 数上取得了更高的正确性分数
    • 论文还看到, GRPO 训练在 400 步后开始变得不稳定,正确性 Reward 分数逐渐下降,而 GDPO 则继续提高正确性分数
      • 此外,尽管 GDPO 和 GRPO 在整个训练过程中都保持了近乎完美的长度分数,论文还记录了每个训练 Batch 内的最大 Response 长度,以评估模型在更极端情况下对长度约束的遵守程度
      • 结果显示,尽管获得了几乎满分的长度 Reward,但 GRPO 的最大 Response 长度在大约 400 个训练 step 后开始急剧增加,而 GDPO 的最大 Response 长度继续下降
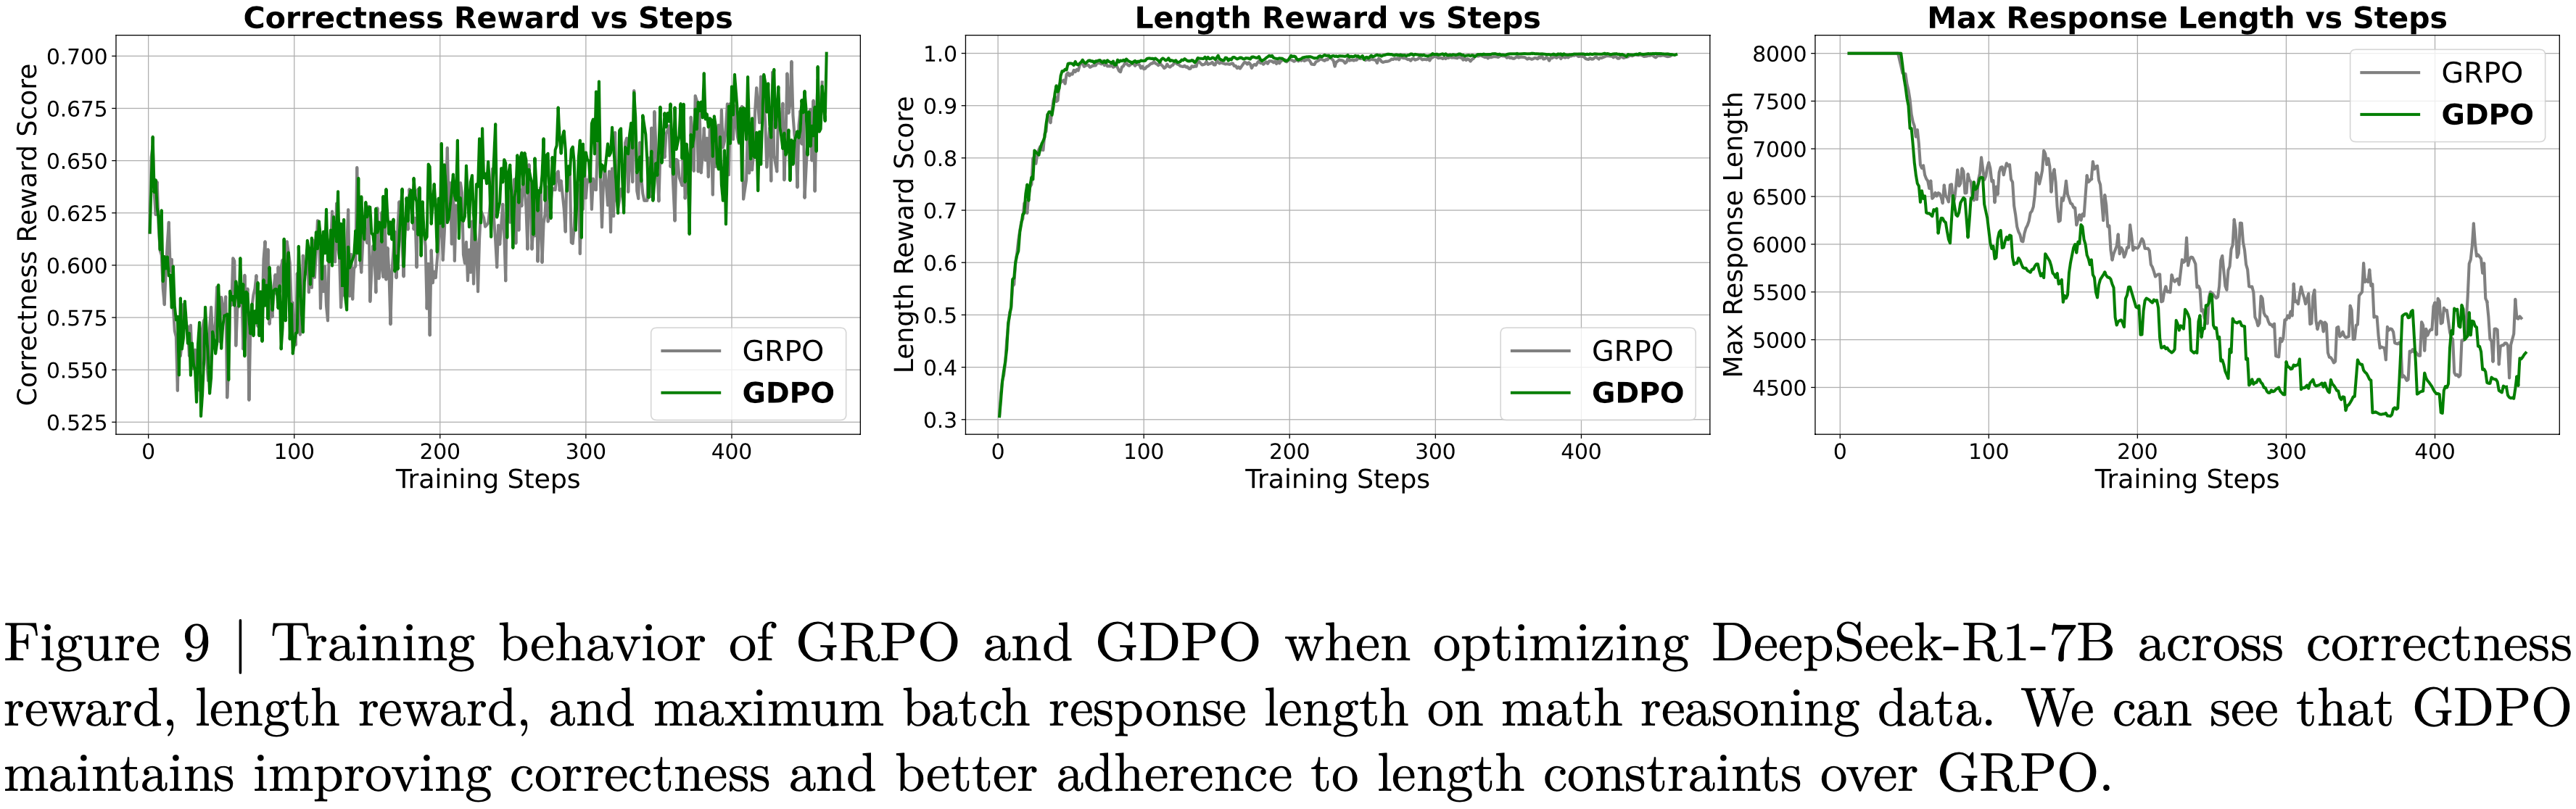
  • 在附录中的图 9 和图 10 中,在 DeepSeek-R1-7B 和 Qwen3-4B-Instruct 的训练曲线上也观察到了类似的情况,我们可以看到 GDPO 始终能提供更好的长度约束对齐
    • 这种对比进一步说明了 GDPO 在多 Reward 优化方面相较于 GRPO 的有效性
  • 此外,表 3 中的基准测试结果表明, GDPO 训练的模型不仅在推理效率上相比原始模型有显著提高(在 AIME 上超长比率降低了高达 80%),而且在大多数任务上实现了更高的准确性
    • 而且, GDPO 在准确性和长度约束目标上通常都优于 GRPO
    • 对于 DeepSeek-R1-1.5B, GDPO 在所有基准测试中都优于 GRPO ,在 MATH、AIME 和 Olympiad 上的准确率分别提高了 2.6%/6.7%/2.3%,同时也在所有任务中降低了超长比率
      • 问题:数字似乎没有严格对上?
    • 类似的趋势也适用于 DeepSeek-R1-7B 和 Qwen3-4B-Instruct, GDPO 实现了更强的准确性-效率权衡
    • 在更具挑战性的 AIME 基准测试上,收益尤为显著:与 GRPO 下 DeepSeek-R1-7B 和 Qwen3-4B-Instruct 分别为 2.1% 和 2.5% 的超长率相比, GDPO 将准确率提高了近 3%,同时将超长率降至 0.2% 和 0.1%
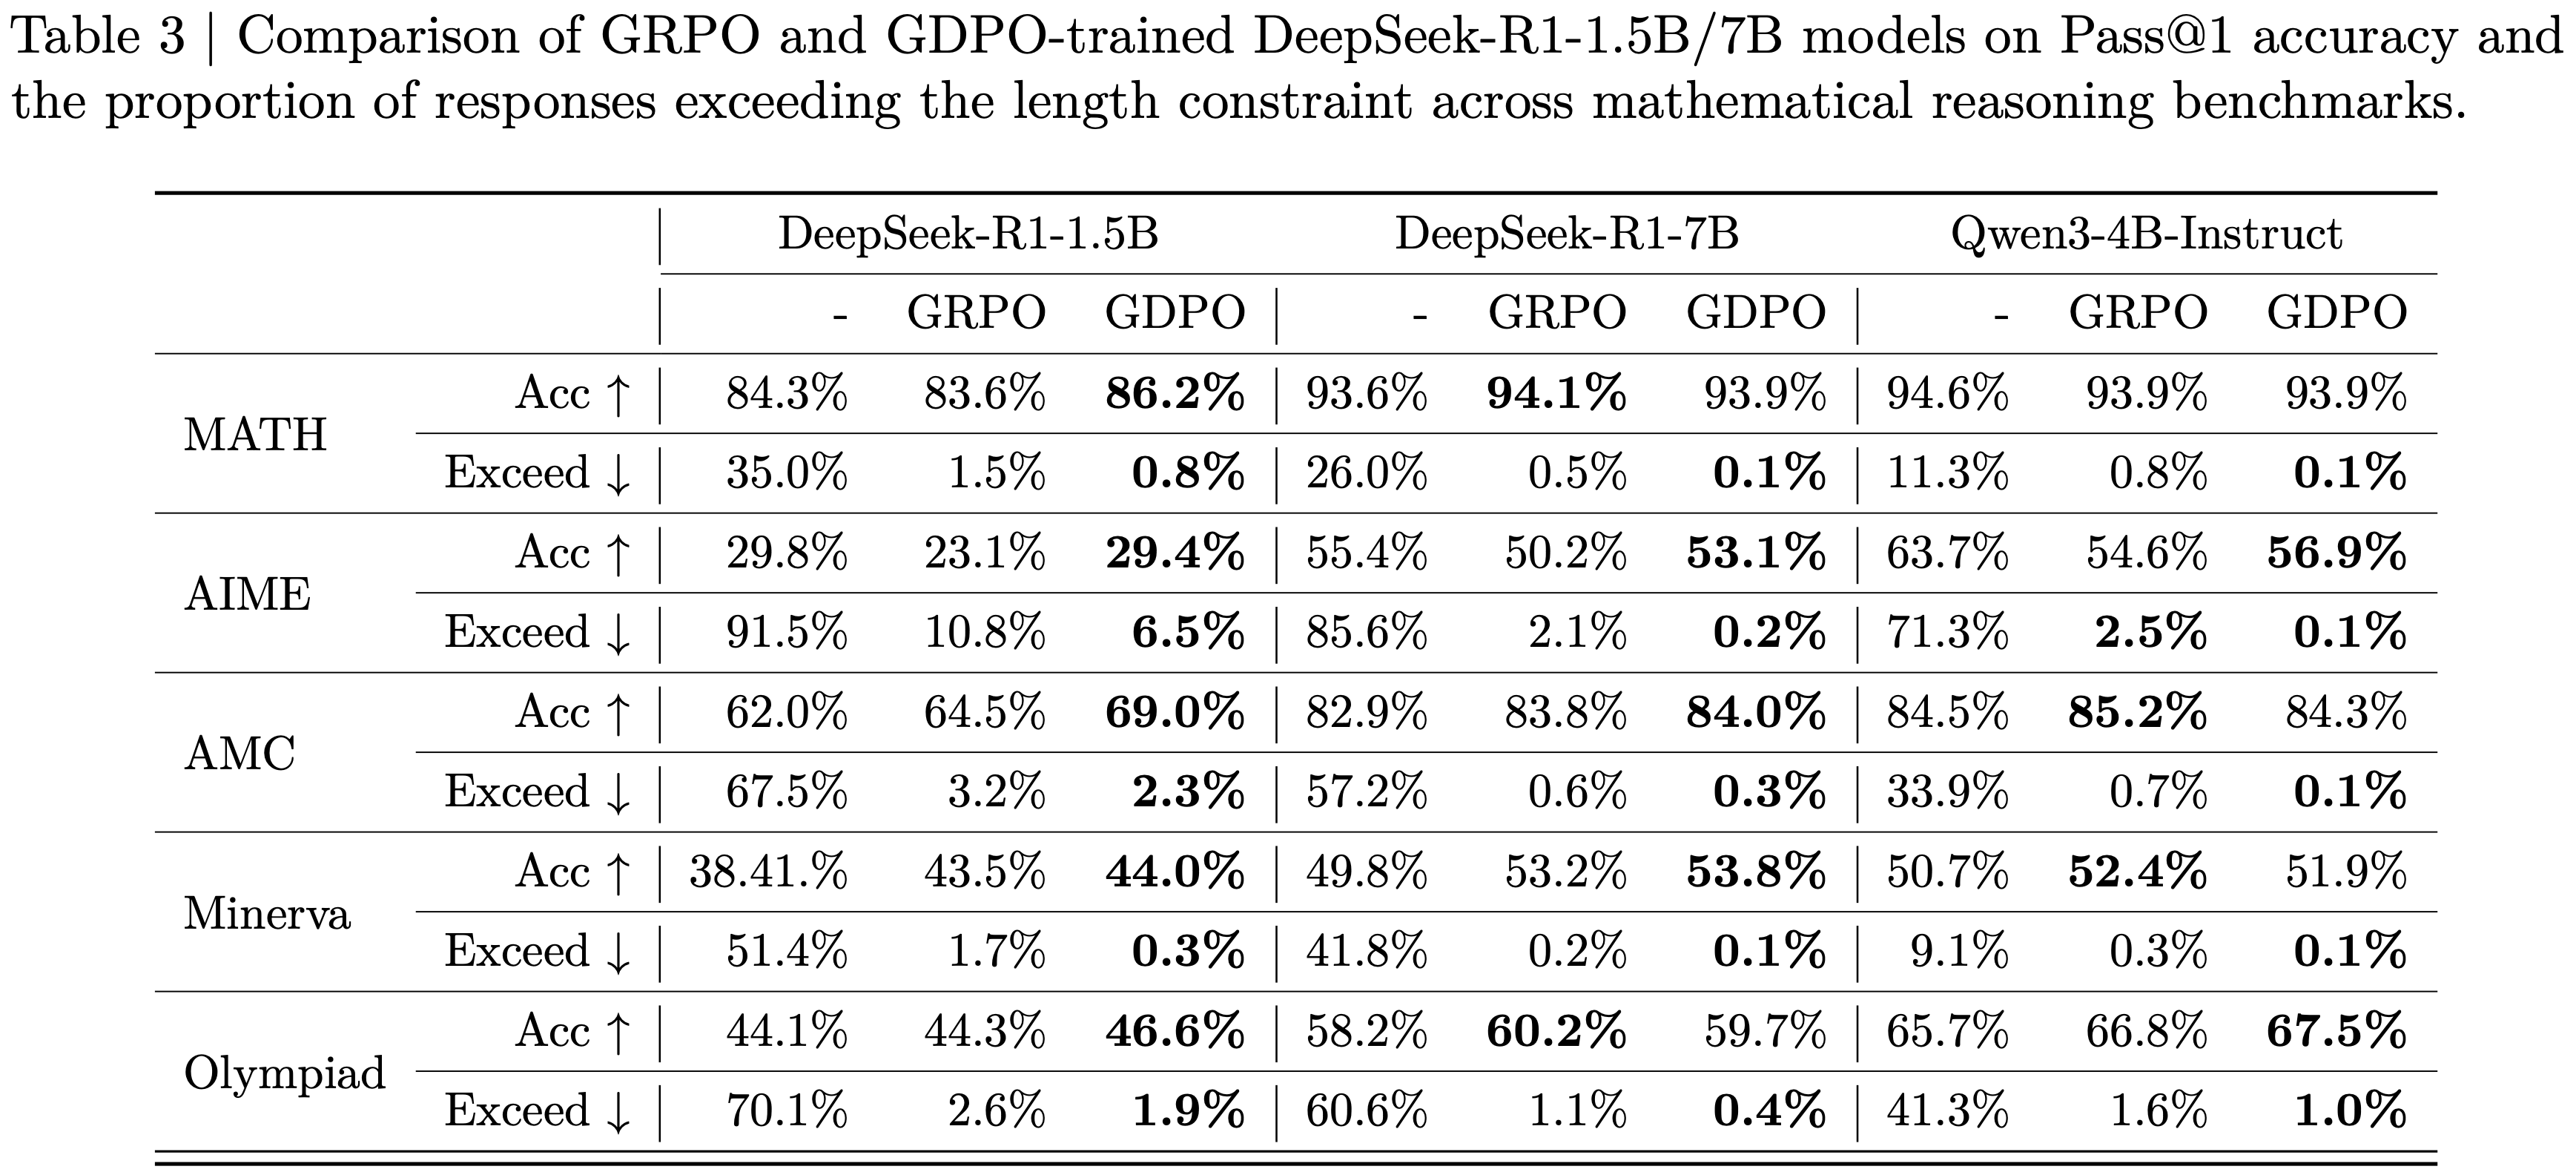
  • 总之,这些结果表明, GDPO 不仅在一系列数学任务上提高了推理准确性,而且更有效地遵守了长度约束,突显了其在多 Reward 优化方面的优势
Impact analysis of different reward priority variation configurations(Reward 优先级变化配置的影响)
  • 到目前为止,论文假设所有 Reward 都具有同等的优先级
    • 然而,如图 5 所示,即使两个目标被分配了相同的 Reward 权重,模型也常常以牺牲更具挑战性的目标为代价来最大化较容易的目标
  • 在本节中,论文研究当期望模型优先最大化正确性 Reward 而非长度 Reward 时,并且当两个目标的难度差异明显时,调整 Reward 权重是否能够引导模型实现这种偏好
  • 论文首先将 \( \mathcal{R}_{\text{correct} } \) 的 Reward 权重(记为 \( w_{\text{correct} } \) )固定为 1,并将 \( \mathcal{R}_{\text{length} } \) 的 Reward 权重(记为 \( w_{\text{length} } \) )在集合 \( \{0.25,0.5,0.75,1.0\} \) 中变化
    • 这个设置允许论文研究降低 \( w_{\text{length} } \) 是否会鼓励模型优先最大化更具挑战性的正确性 Reward
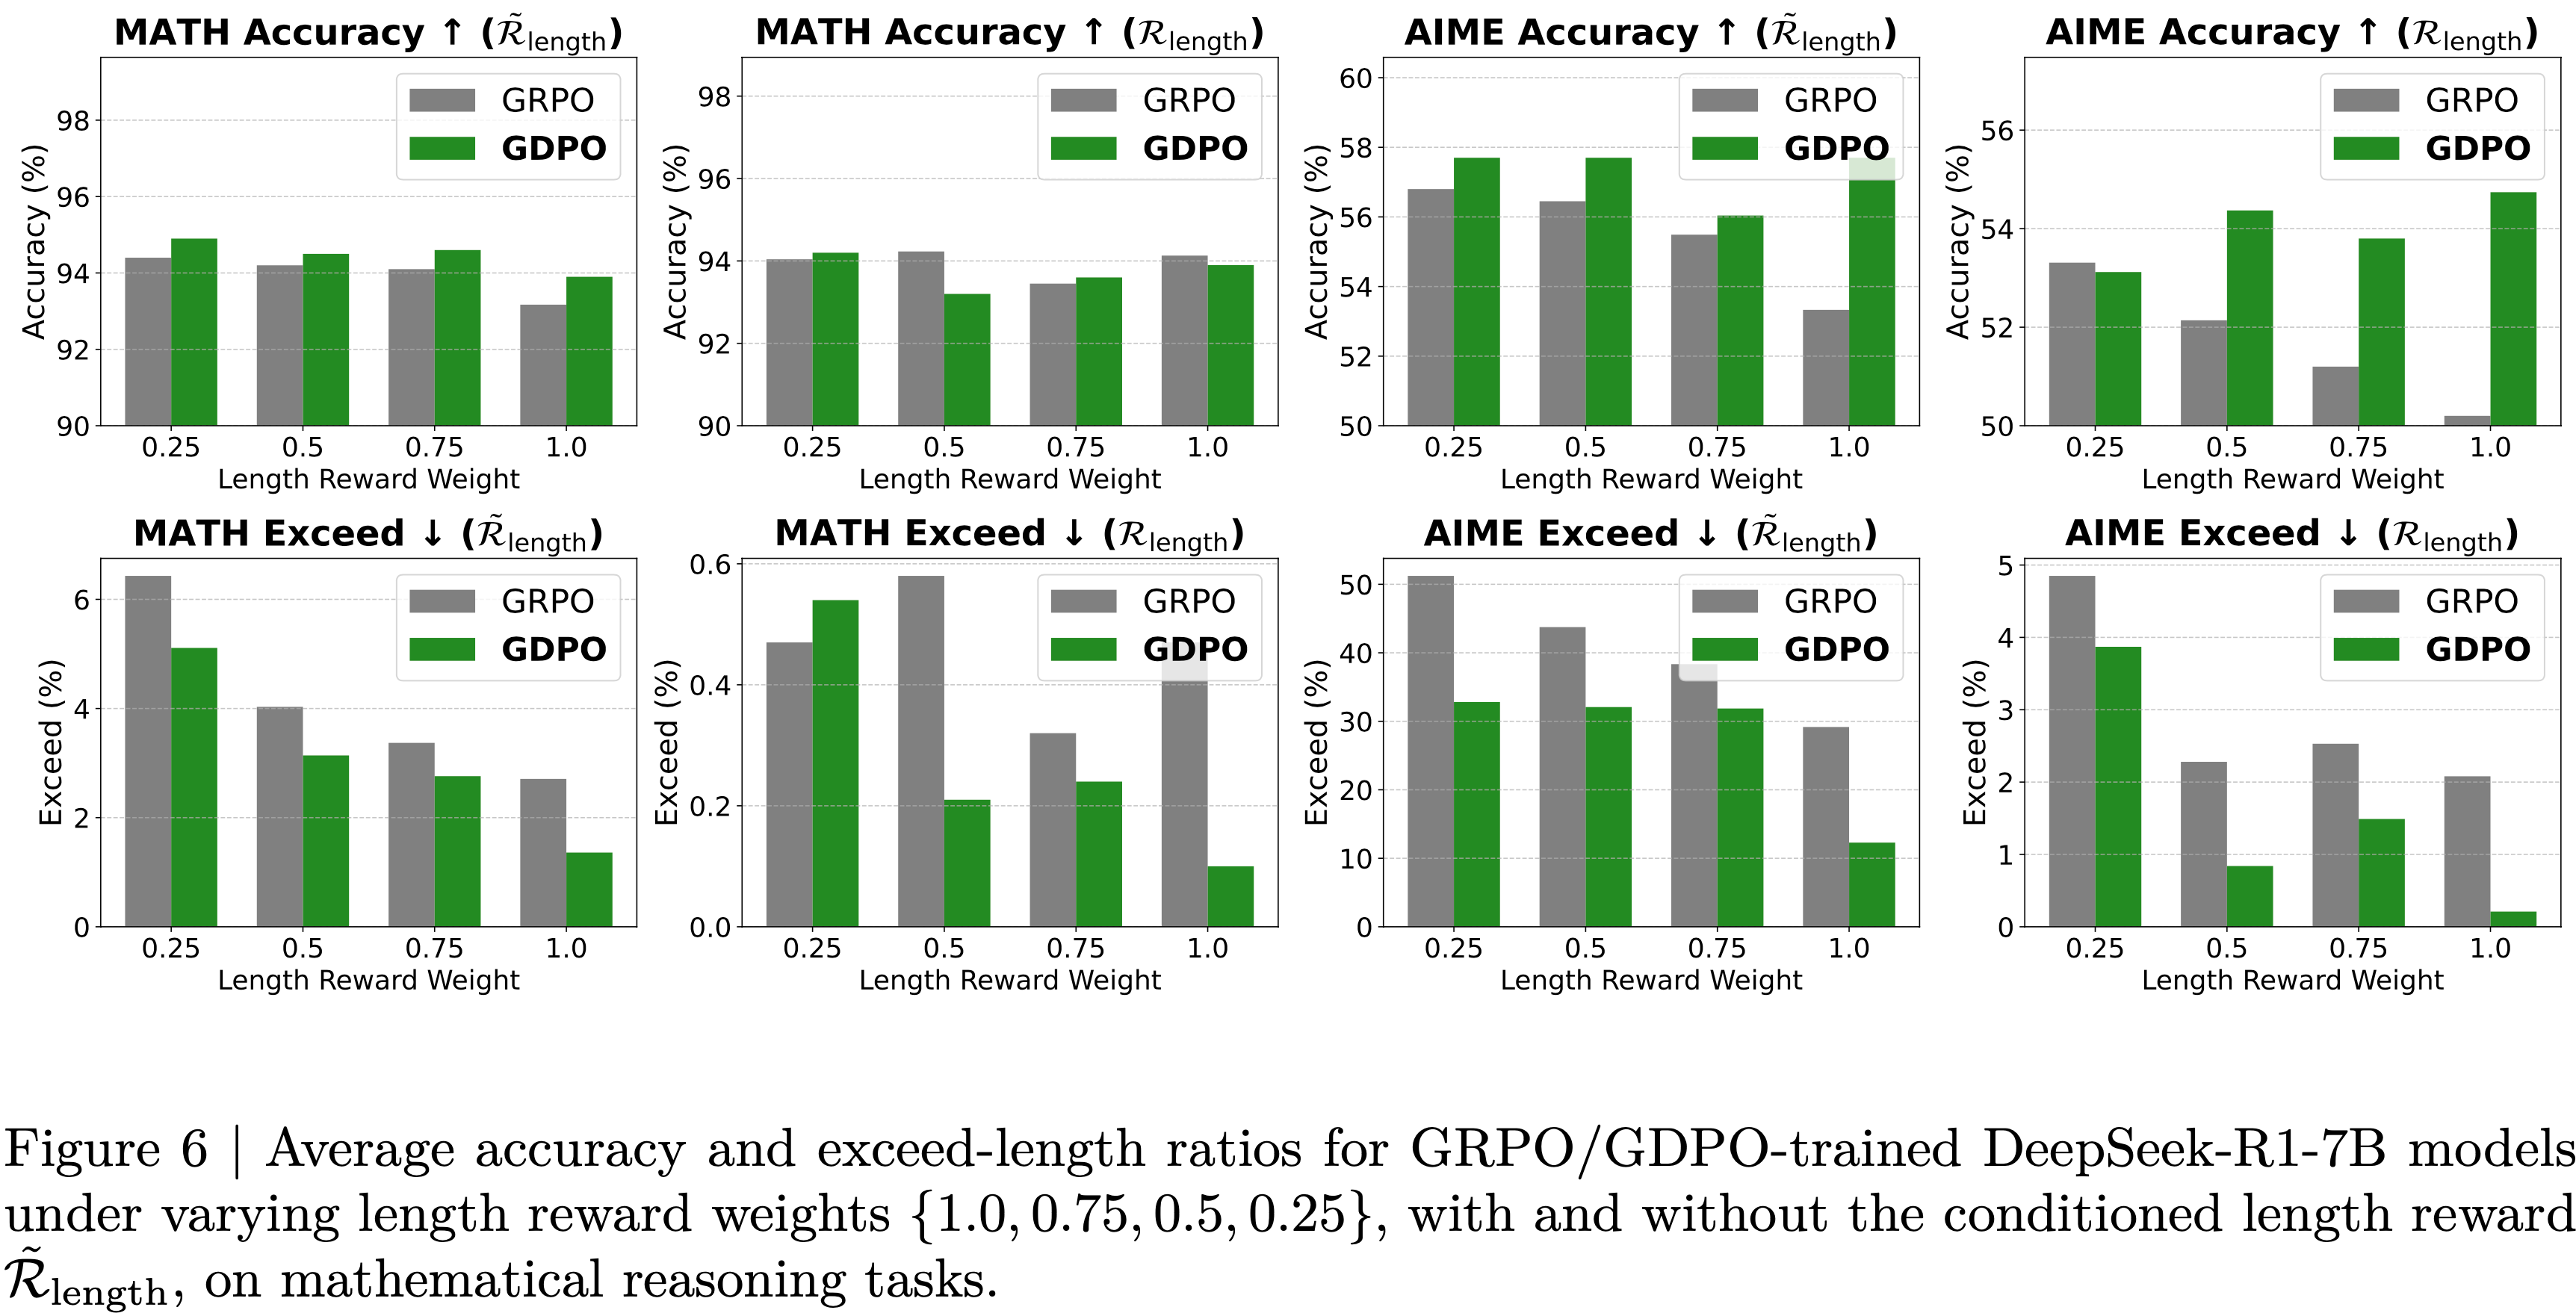
  • 论文在 DeepSeek-R1-7B 上进行了这个实验,并将 MATH 和 AIME 的平均准确率和平均超长比率绘制在图 6 中(其中 \(\tilde{\mathcal{R}}_{\text{length}}\) 表示 Conditional Length Reward; \(\mathcal{R}_{\text{length}}\) 表示 normal Length Reward;从图中可以看到,GDPO 准确率不及 GRPO 的地方,一般都是因为长度降低太多导致)
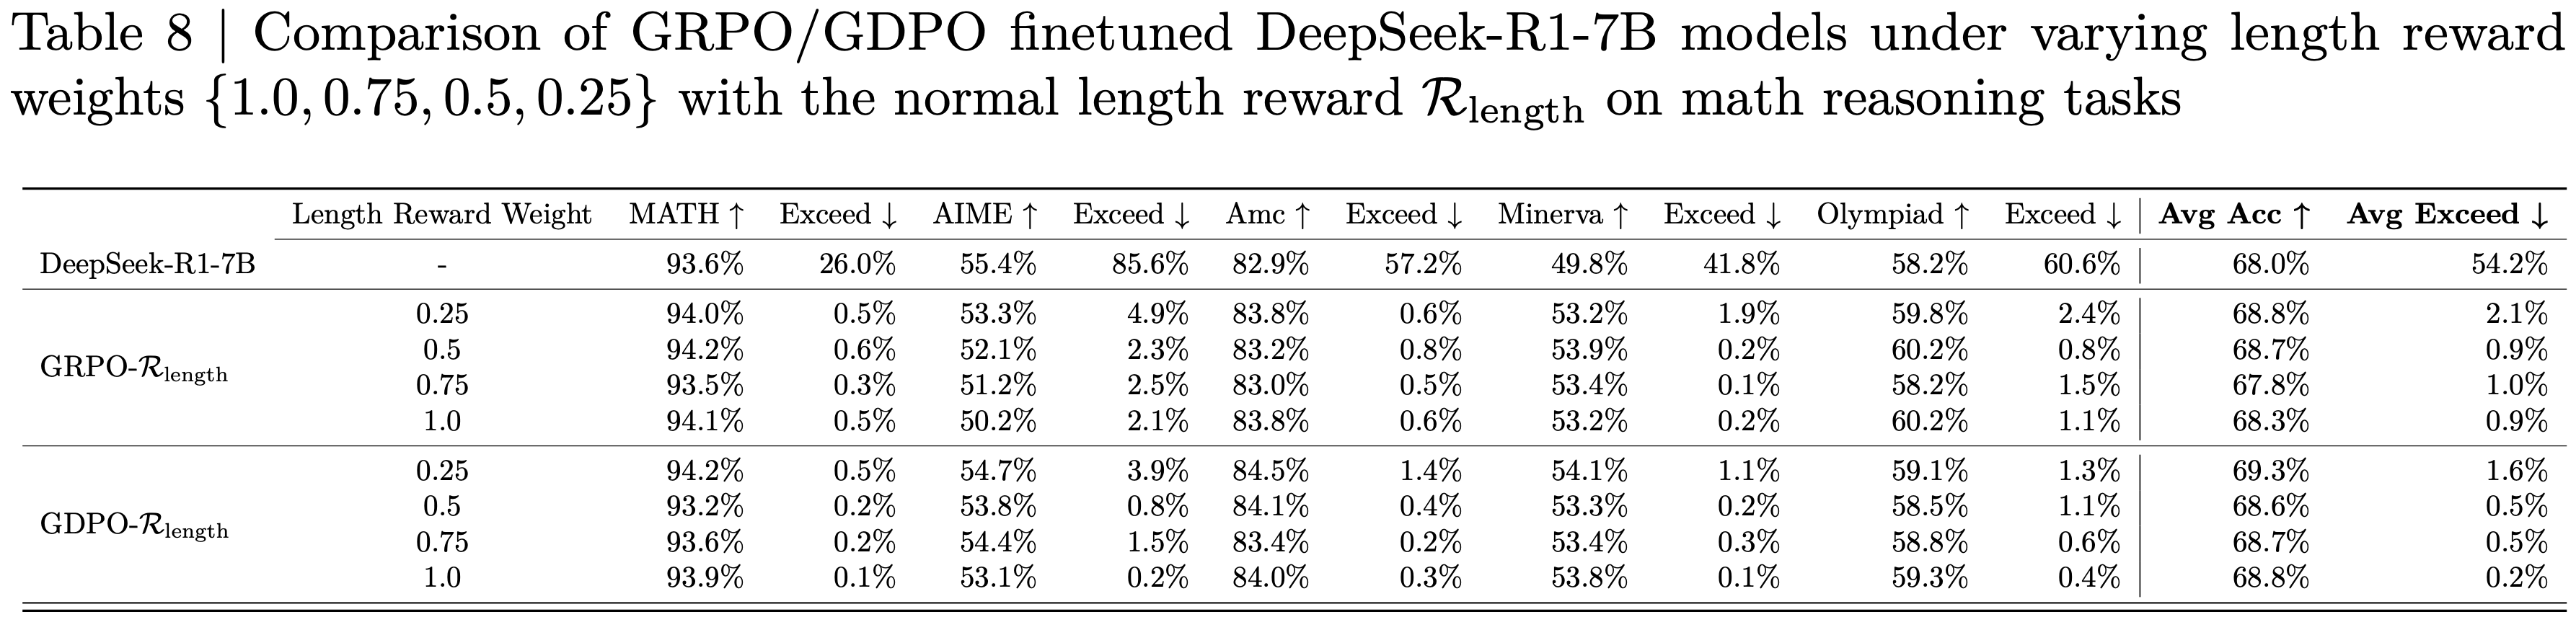
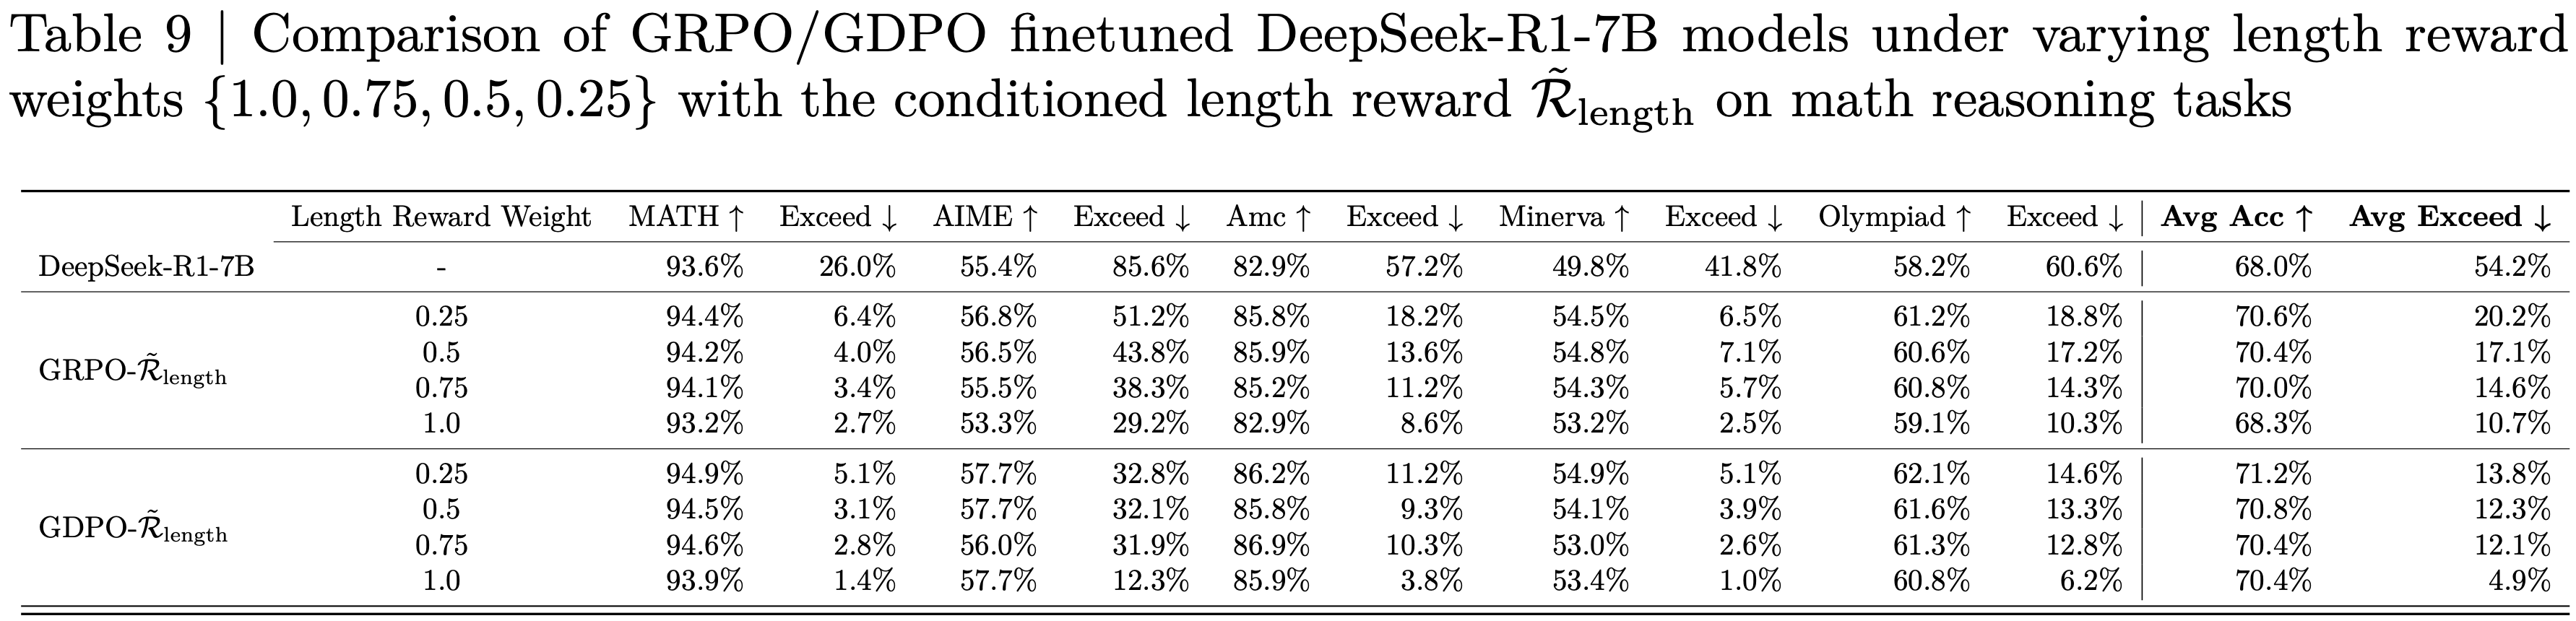
    • 其余任务的完整结果在附录 G 中提供(注:表 8 和表 9)
  • 从结果中,论文观察到将 \( w_{\text{length} } \) 降低到 0.75 或 0.5 对平均超长比率影响甚微,对于 GRPO 在 AIME 上仅分别变化了 0.4% 和 0.2%,对于 GDPO 分别变化了 1.3% 和 0.6%
    • 此外,降低 \( w_{\text{length} } \) 并不一定会放宽长度约束,因为将 \( w_{\text{length} } \) 从 0.75 降低到 0.5 并没有在 GRPO 或 GDPO 的 AIME 或 MATH 上持续增加超长比率
    • 这表明,当基础目标在难度上存在显著差异时,仅仅调整 Reward 权重并不能可靠地诱导出预期的优先级排序
    • 只有当 \( w_{\text{length} } \) 降低到 0.25,使其足够小以补偿目标之间的难度差距时,论文才观察到 GRPO 和 GDPO 在 AIME 上以及 GDPO 在 MATH 上的超长比率明显增加
  • 接下来,论文研究了将较容易的长度 Reward 条件化在更具挑战性的正确性 Reward 上,是否有助于缓解两个目标之间的难度差异,并有助于改进优先级对齐
    • 遵循第 3.2 节的公式,论文将原始长度 Reward \( \mathcal{R}_{\text{length} } \) 替换为一个条件化的长度 Reward,其定义如下:
      $$
      \tilde{\mathcal{R} }_{\text{length} }=\begin{cases}1, &\text{if response length}\leq l\text{ and }\mathcal{R}_{\text{correct} }=1\\0, &\text{otherwise.}\end{cases}
      $$
    • 在这个公式下,只有当生成的 Response 也是正确的时候,模型才会获得长度 Reward
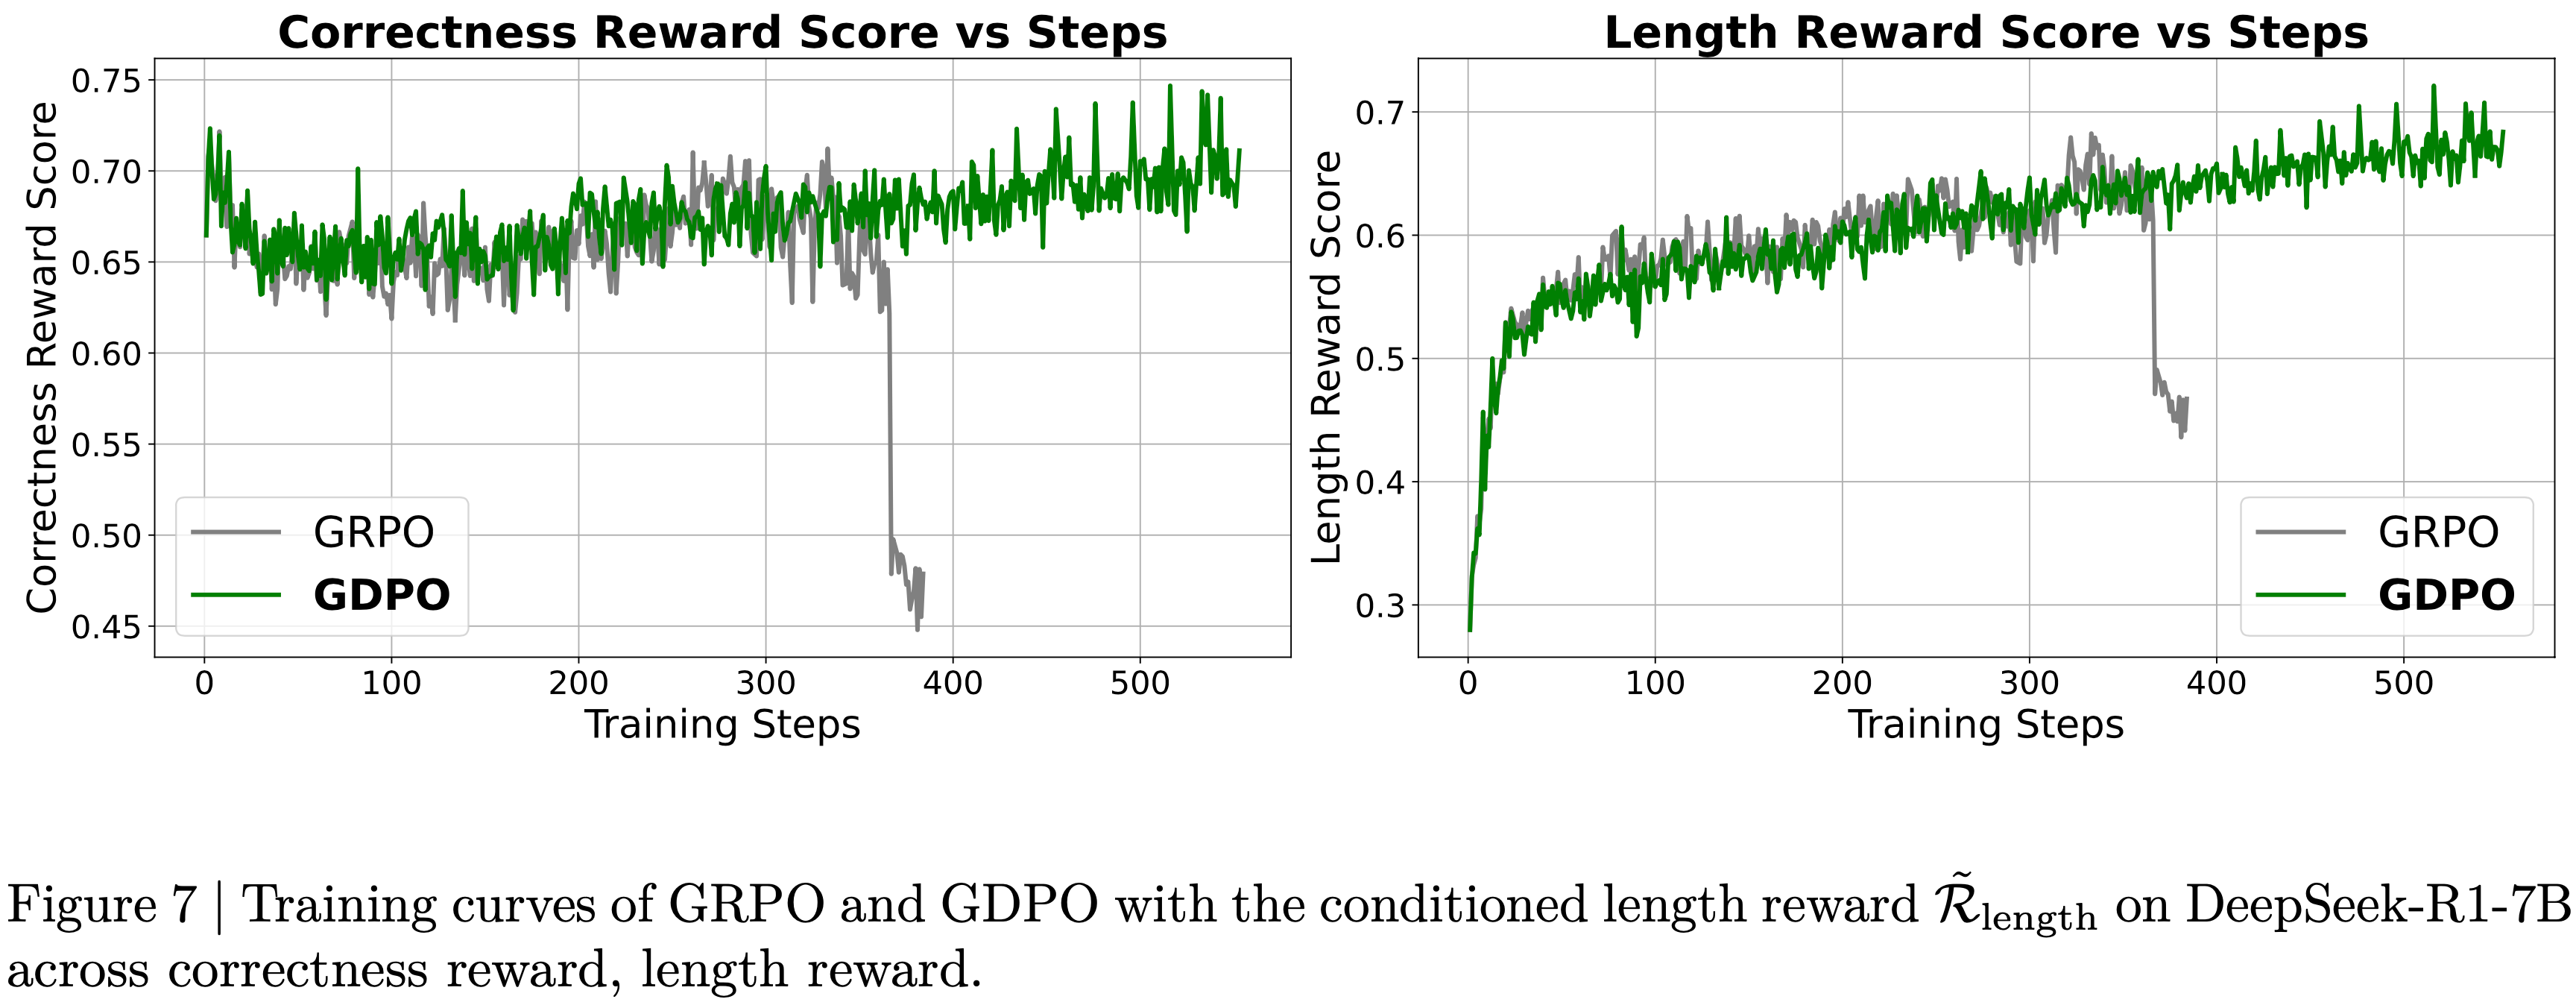
  • 首先,论文观察到采用修改后的 Reward 函数 \( \tilde{\mathcal{R} }_{\text{length} } \) 可以防止模型在训练开始时过度最大化长度 Reward
    • 这种 Reward 设计也有助于避免当模型试图满足长度约束时正确性 Reward 分数的大幅下降
    • 从图 7 中可以看出,平均正确性 Reward 仅在训练初期略微下降,随后逐渐恢复
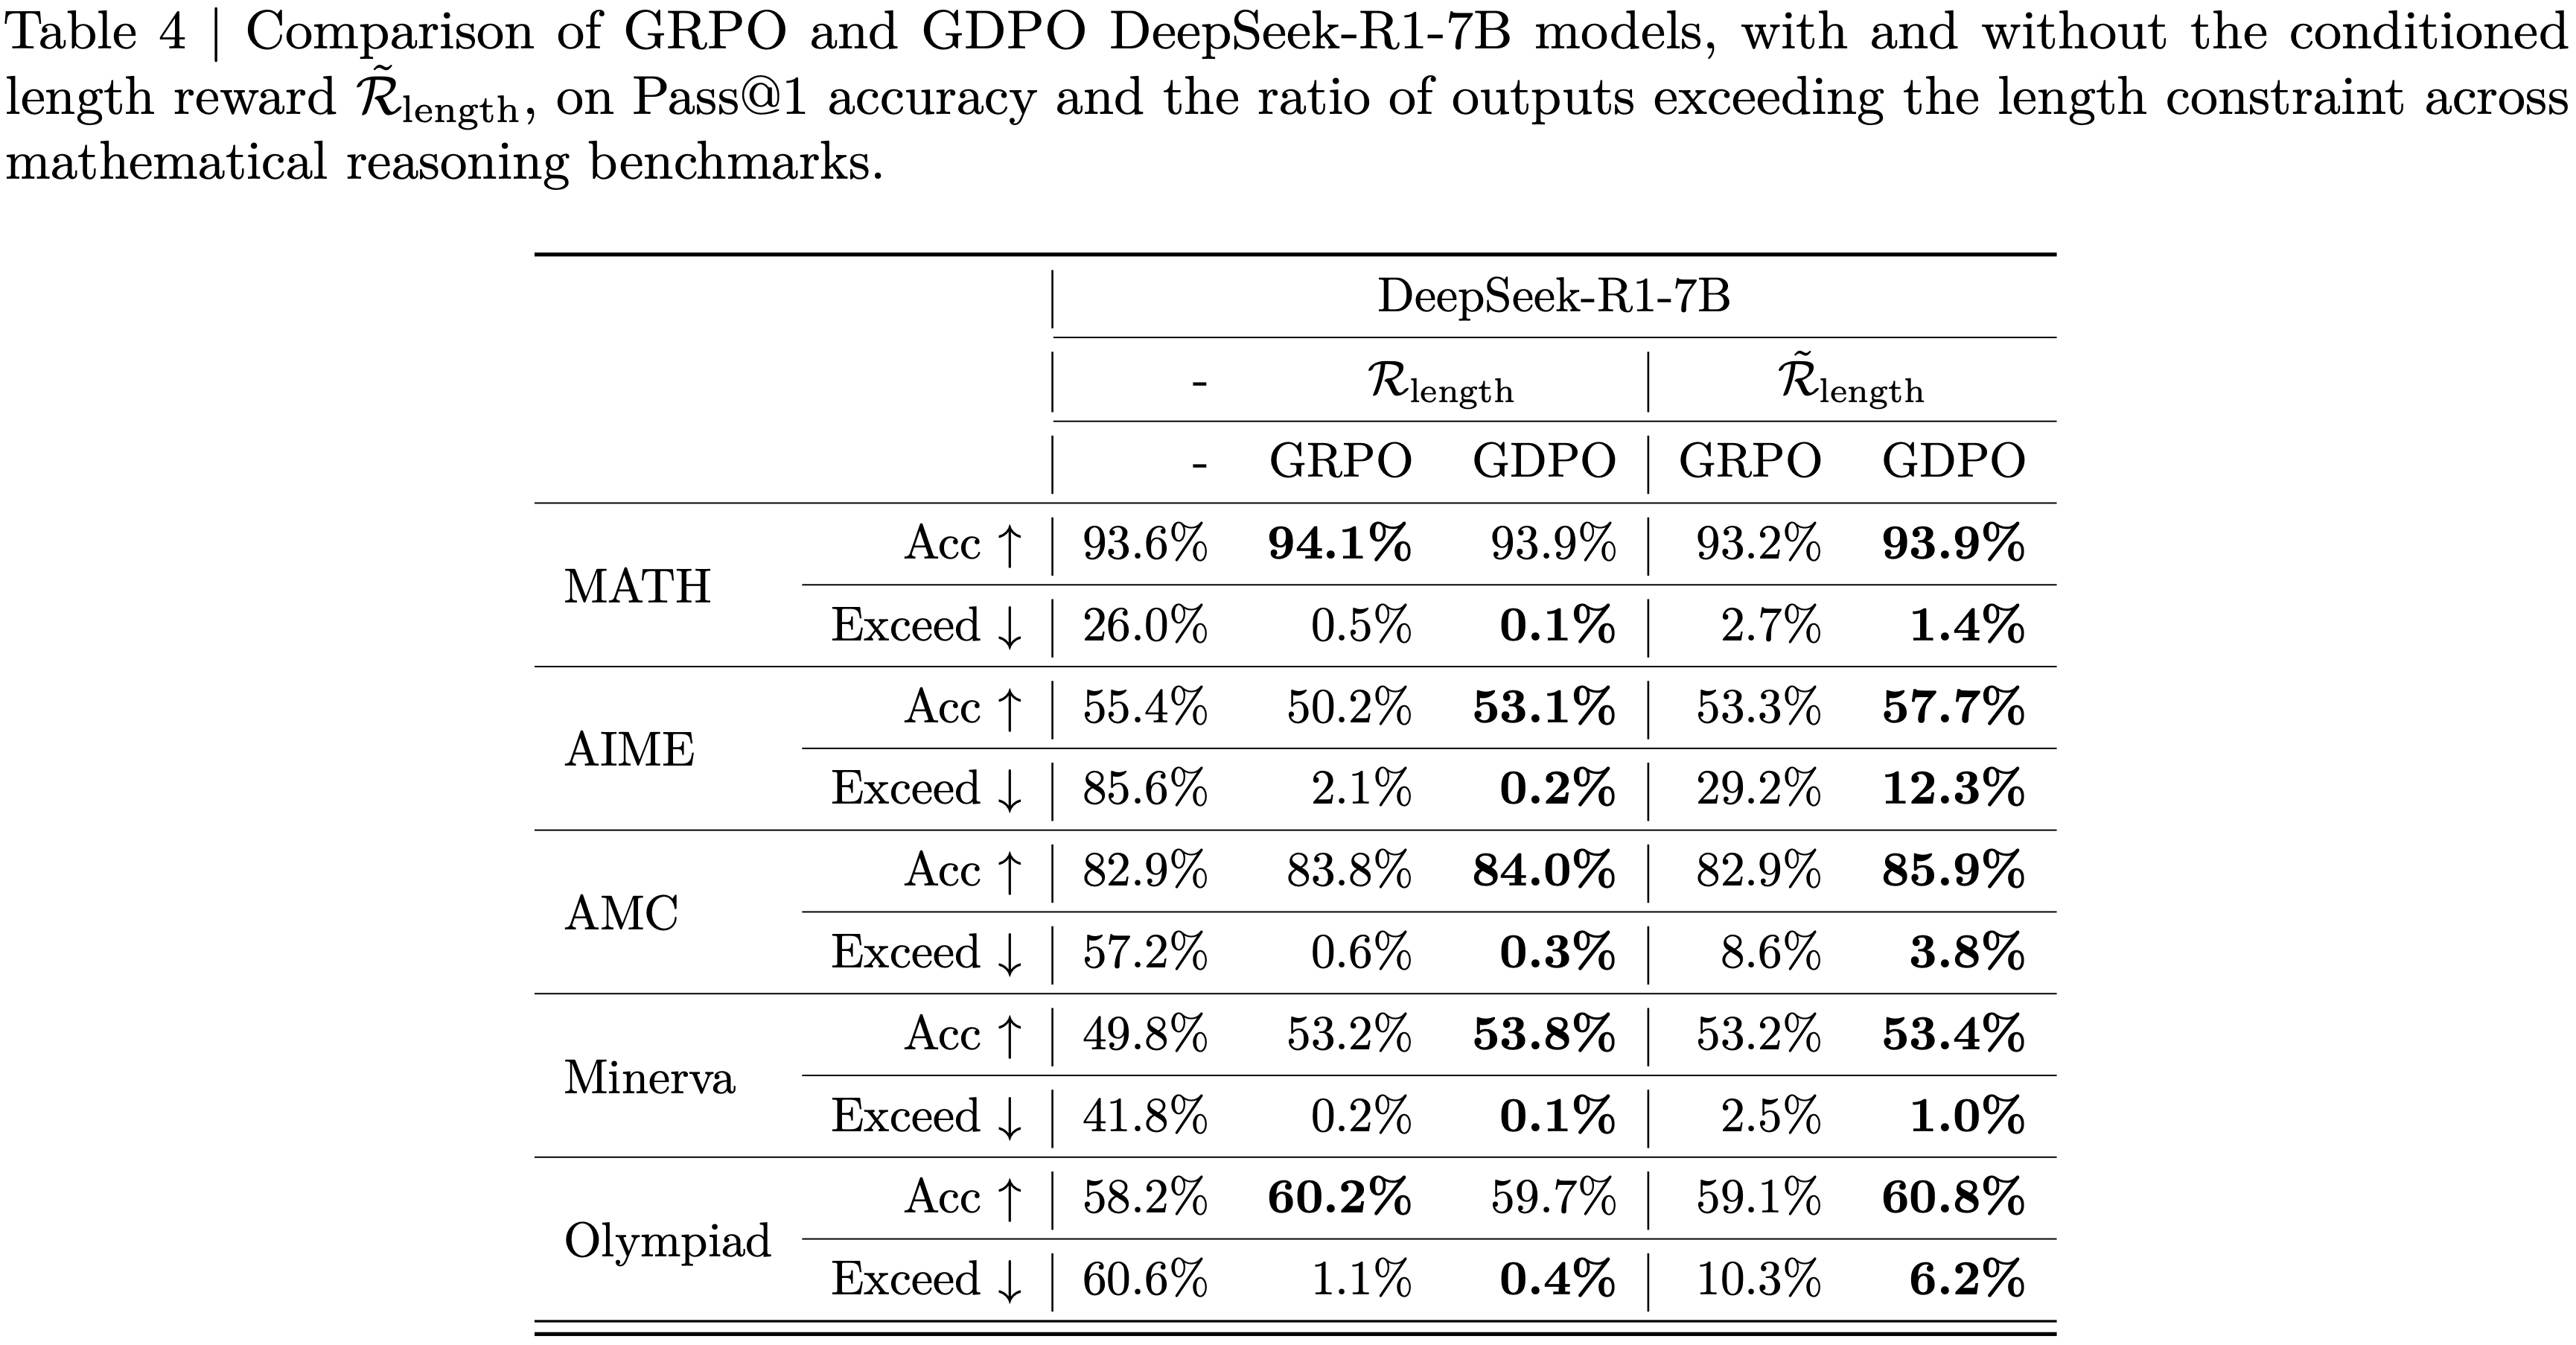
  • 从表 4 中,论文还观察到,与仅仅调整 \( \mathcal{R}_{\text{length} } \) 的权重 \( w_{\text{length} } \) 相比,使用 \( \tilde{\mathcal{R} }_{\text{length} } \) 会导致 GRPO 和 GDPO 的平均超长比率有更大的增加,这表明对长度约束的更有效放宽
    • 然而, GRPO 未能将这种放宽的约束转化为有意义的准确率提升
    • 相比之下, GDPO 更有效地优先考虑正确性 Reward,并在训练中实现了比不使用 \( \tilde{\mathcal{R} }_{\text{length} } \) 时更一致的准确率提升,同时引入的超长违规增加幅度要小得多
    • 例如,与使用相同 Reward 函数的 GRPO 相比,在 GDPO 中使用 \( \tilde{\mathcal{R} }_{\text{length} } \) 在 AIME 上带来了 4.4% 的准确率提升,同时超长比率降低了 16.9%;在 AMC 上获得了 3% 的准确率增益,同时超长违规减少了 4.8%
  • 接下来,论文研究了在通过条件化长度 Reward 缓解了难度差异之后,改变 \( \tilde{\mathcal{R} }_{\text{length} } \) 的 Reward 权重(记为 \( \hat{w}_{\text{length} } \))是否能更忠实地反映细粒度的偏好调整
    • 论文固定正确性 Reward 的权重,并变化 \( \hat{w}_{\text{length} } \in \{0.25,0.5,0.75,1.0\} \)
    • 如图 6 所示,使用条件化 Reward 训练的模型表现得更可预测
      • 例如,将 \( \hat{w}_{\text{length} } \) 从 1.0 降低到 0.25,稳步增加了 GRPO 和 GDPO 在 MATH 和 AIME 上的超长比率,这与调整原始 \( \mathcal{R}_{\text{length} } \) 权重时观察到的不稳定结果形成对比
  • 最后,在所有设置下,包括不同的 Reward 公式和不同的 Reward 权重, GDPO 始终比 GRPO 提供更好的准确性和效率权衡

Coding reasoning

  • 论文考察了在优化多于两个 Reward 的代码推理任务上, GDPO 是否继续优于 GRPO
    • 与数学推理设置类似,目标是提高模型的代码性能,同时将其输出限制在预定义的目标长度内
  • 论文引入了第三个目标,即鼓励模型生成无缺陷的代码
  • 论文通过在 Eurus-2-RL 数据集 (2025) 上训练 DeepSeek-R1-7B 来比较 GDPO 和 GRPO
    • 该数据集包含 24K 个编码问题,每个问题有多个测试用例
  • 训练使用 verl (2024) 框架进行 400 个 step,并采用与数学推理实验中相同的超参数配置
  • 训练优化三个 Reward:
    • 通过率 Reward (Passrate reward) : 通过率 Reward \( \mathcal{R}_{\text{pass} } \in [0,1] \) 衡量生成代码通过的测试用例比例:
      $$
      \mathcal{R}_{\text{pass} }=\frac{\text{number of passed test cases} }{\text{total test cases} }.
      $$
    • 条件化长度 Reward (Conditioned Length reward) : 长度 Reward \( \tilde{\mathcal{R} }_{\text{length} } \in \{0,1\} \) 检查模型的 Response 是否保持在目标长度 \( l \) 内,以及生成的代码是否满足正确性要求:
      $$
      \tilde{\mathcal{R} }_{\text{length} }=\begin{cases}1, &\text{if response length }\leq l\text{ and }\mathcal{R}_{\text{pass} }=1,\\0, &\text{otherwise}.\end{cases}
      $$
    • 缺陷 Reward (Bug reward) : 缺陷 Reward \( \mathcal{R}_{\text{bug} } \in \{0,1\} \) 表示生成的代码是否在运行时或编译时没有错误
  • 对于评估,论文在来自 PRIME (2025) 的验证集上评估训练好的模型,其中包括 Apps (2021)、CodeContests (2022)、Codeforces 和 Taco (2023)
    • 遵循与数学推理评估相同的设置,论文使用采样温度 0.6,\( top_{p} \) 值为 0.95,最大 Response 长度为 32k 个 Token。对于每个评估问题,论文生成 16 个 Rollout,并报告平均测试用例通过率、平均超长比率和平均缺陷率,其中缺陷率衡量导致运行时错误或编译错误的生成代码的比例
  • 论文在两种配置下比较 GDPO 和 GRPO :
    • (1) 使用 \( \mathcal{R}_{\text{pass} } \) 和 \( \tilde{\mathcal{R} }_{\text{length} } \) 的两 Reward 设置
    • (2) 使用 \( \mathcal{R}_{\text{pass} } \)、\( \tilde{\mathcal{R} }_{\text{length} } \) 和 \( \mathcal{R}_{\text{bug} } \) 的三 Reward 设置
  • 论文将 GRPO 的两 Reward 和三 Reward 版本分别记为 \( GRPO _{2\text{-obj} } \) 和 \( GRPO _{3\text{-obj} } \), GDPO 也使用相同的记法
    • 如表 5 所示,与 \( GRPO _{2\text{-obj} } \) 相比,\( GDPO _{2\text{-obj} } \) 在所有任务上都提高了通过率,同时保持了类似的超长比率
      • 注:从表 5 中看起来,优势似乎不是很明显
    • 例如,\( GDPO _{2\text{-obj} } \) 将 Codecontests 的通过率提高了 2.6%,而超长比率仅增加了 0.1%;与 \( GRPO _{2\text{-obj} } \) 相比,在 Taco 上实现了 3.3% 的通过率提升,同时超长违规减少了 1%
    • 在三种 Reward 设置中也可以观察到类似的模式,\( GDPO _{3\text{-obj} } \) 在所有目标上实现了明显更好的平衡,保持了与 \( GRPO _{3\text{-obj} } \) 相似的通过率,同时还显著降低了超长比率和缺陷率
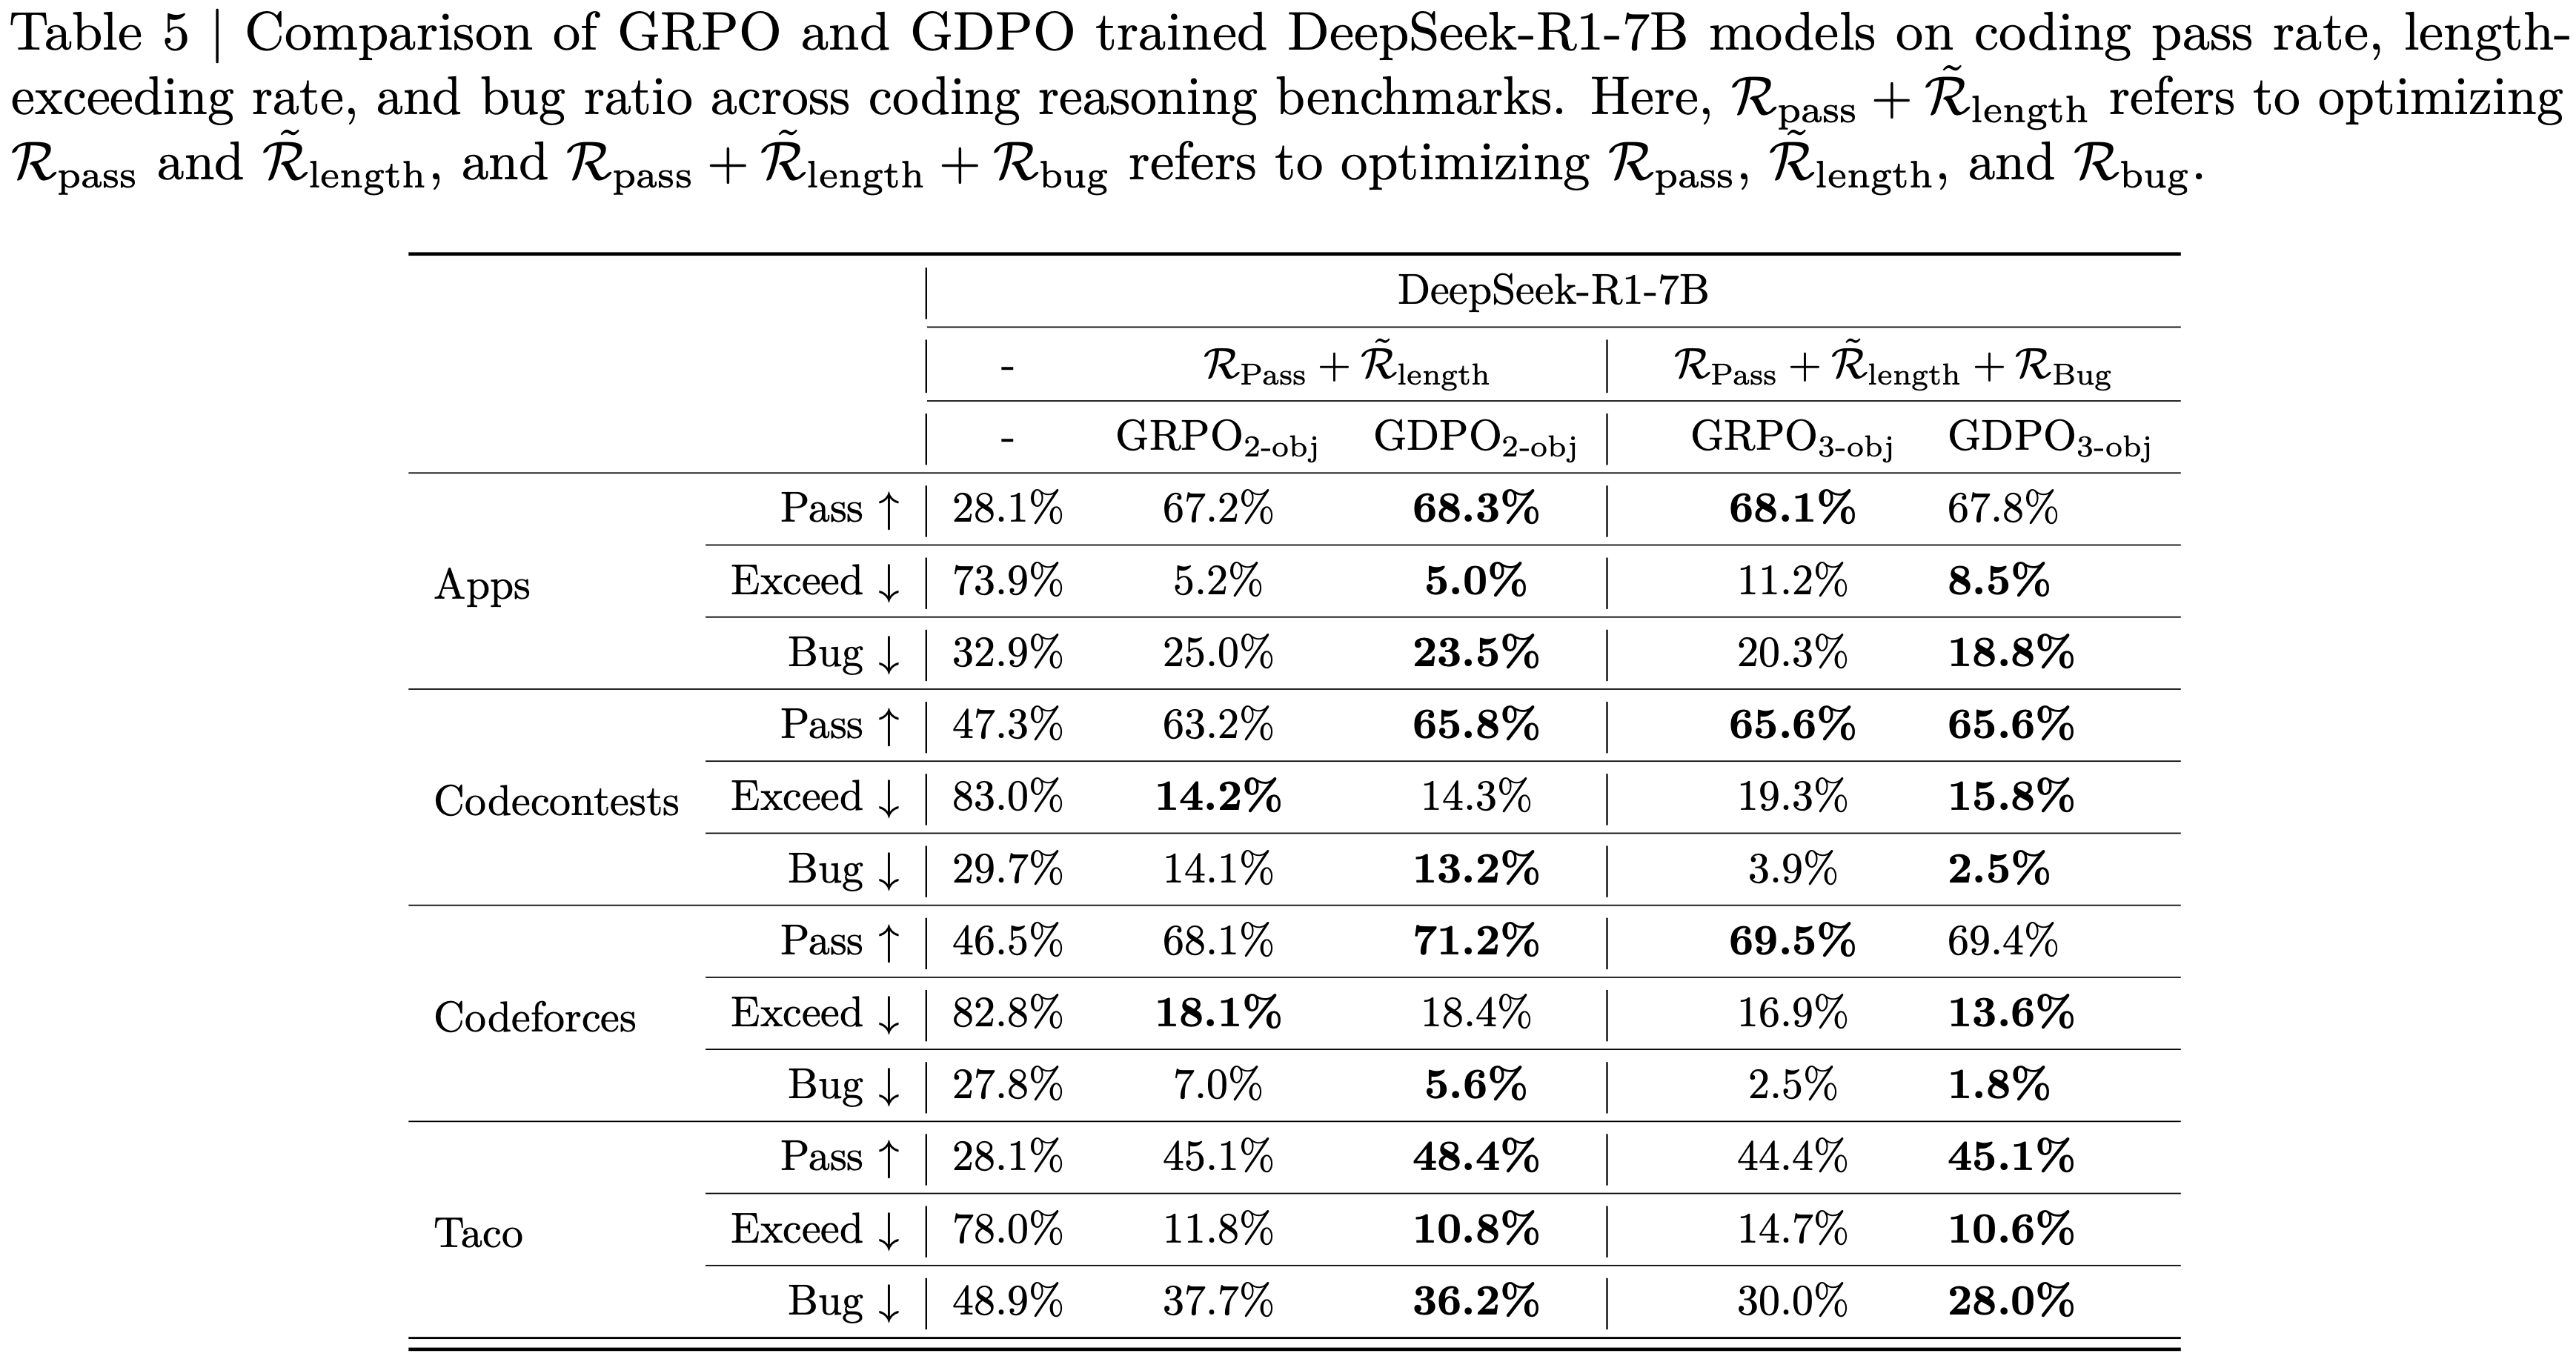
  • 总的来说,这些结果表明,随着 Reward 信号数量的增加, GDPO 仍然有效
    • 在两种 Reward 和三 Reward 配置中,它始终比 GRPO 在所有目标上实现更有利的权衡

Related Work

GRPO 变体

  • 已经提出了几种 Group Relative Policy Optimization ( GRPO ) (2025) 的扩展,以增强该框架的稳定性、有效性和效率
  • 这些方法探索了 Group-wise 归一化或策略更新的替代公式,同时仍基于 GRPO 的核心原理,例如,
    • 为了提高稳定性,Group Sequence Policy Optimization (GSPO) (2025) 基于序列可能性而非 Token 级别定义重要性比率,执行序列级别的 Clipping、Rewarding 和优化
    • 为了提高 RL 性能,Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO) (2025) 引入了四项关键技术:Clip-Higher、Dynamic Sampling、Token-Level Policy Gradient Loss 和 Overlong Reward Shaping
    • 为了促进高效推理,Group Filtered Policy Optimization (GFPO) (2025) 通过在训练期间为每个问题采样更大的组,并根据其长度和每 Token 奖励率筛选 Response,来解决长度爆炸问题
      • 沿着同一方向,Doing Length pEmalty Right (DLER) (2025) 提出了一种结合了 Batch-wise Reward 归一化、Higher Clipping、Dynamic Sampling 和简单截断长度惩罚的训练配方,实现了 SOTA 准确性-效率权衡

Multi-Reward Reinforcement Learning

  • 越来越多的工作研究了融入多种 Reward 信号的 RL 方法,一个主要用途是建模多样化的人类偏好,例如
    • Safe Reinforcement Learning from Human Feedback (2023) 将人类关于有用性和无害性的偏好解耦,在微调期间动态调整两个目标之间的平衡
    • 类似地,Reinforcement Learning from Personalized Human Feedback (RLPHF) (2023) 通过为每种偏好训练不同的策略模型并在推理时合并它们,来优化具有多种(有时是冲突的)偏好的 LLM
    • ALARM (Align Language Models via Hierarchical Rewards) (2024) 引入了分层 Reward 结构,共同捕捉 Response 质量、风格、公平性和连贯性等维度
  • LLM 的最新进展也整合了多 Reward 优化来处理复杂任务,例如
    • DeepSeek V3.2 (2025) 集成了基于规则的结果 Reward、长度惩罚和语言一致性 Reward,以增强推理和代理能力
  • 多 Reward RL 的另一个重要近期应用是在保持任务性能的同时提高推理模型的效率,主要是通过引入基于长度的 Reward 函数以及基于结果的 Reward,例如,
    • O1-Pruner (2025) 和 (2025) 应用归一化的长度惩罚来确保比例压缩
    • 类似地,(2025) 通过惩罚与采样组内最短正确 Response 的偏差来促进简洁性
    • L1 (2025) 引入了长度控制策略优化(Length Controlled Policy Optimization,LCPO),以优化准确性同时确保 Response 不超过目标长度
    • 最后,(2025) 提出了一种自适应 Reward 塑造方法,根据模型性能动态调整准确性和 Response 长度之间的权衡

附录 A:Training stability issue of GDPO without batch-wise advantage normalization

  • 图 8:使用和未使用批量优势归一化的 GDPO 训练稳定性对比,未进行归一化的运行偶尔会无法收敛
附录 B:ToolRL Training Prompt Format

  • System Prompt for ToolRL Training

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    You are a helpful dialogue assistant capable of leveraging tool calls to solve user tasks and provide structured chat responses.

    # Available Tools
    In your response, you can use the following tools:
    { { Tool List } }

    # Steps for Each Turn
    1. Think: Recall relevant context and analyze the current user goal.
    2. Decide on Tool Usage: If a tool is needed, specify the tool and its parameters.
    3. Respond Appropriately: If a response is needed, generate one while maintaining consistency across user queries.

    # Output Format
    <think> Your thoughts and reasoning </think>
    <tool_call> {“name”: “Tool name”, “parameters”: {“Parameter name”: “Parameter content”, “ ... ...”:
    “ ... ...”}}
    {“name”: “ ... ...”, “parameters”: {“ ... ...”: “ ... ...”, “ ... ...”: “ ... ...”}}
    ...
    </tool_call>
    <response>AI’s final response </response>

    # Important Notes
    1. You must always include the <think> field to outline your reasoning. Provide at least one of <tool_call> or <response>. Decide whether to use <tool_call> (possibly multiple times), <response>, or both.
    2. You can invoke multiple tool calls simultaneously in the <tool_call> fields. Each tool call should be a JSON object with a “name” field and a “parameters” field containing a dictionary of parameters. If no parameters are needed, leave the “parameters” field an empty dictionary.
    3. Refer to the previous dialogue records in the history, including the user’s queries, previous <tool_call>, <response>, and any tool feedback noted as <obs> (if exists).
    • 中文版(ToolRL 训练系统 Prompt):
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14
      15
      16
      17
      18
      19
      20
      21
      22
      23
      24
      25
      26
      27
      28
      你是一个有用的对话助手,能够利用工具调用来解决用户任务并提供结构化的聊天响应

      可用工具
      在你的回复中,你可以使用以下工具:{ { 工具列表 } }

      每个回合的步骤

      1. **思考 (Think)**:回忆相关上下文并分析当前的用户目标
      2. **决定工具使用 (Decide on Tool Usage)**:如果需要使用工具,请指定工具及其参数
      3. **恰当响应 (Respond Appropriately)**:如果需要生成响应,请在响应用户查询时保持一致

      输出格式
      <think>
      你的想法和推理过程
      </think>
      <tool_call>
      {"name": "工具名称", "parameters": {"参数名": "参数内容", "... ...": "... ..."} }
      {"name": "... ...", "parameters": {"... ...": "... ...", "... ...": "... ..."} }
      ...
      </tool_call>
      <response>
      AI 的最终响应
      </response>

      重要说明
      1. 你必须始终包含 `<think>` 字段来概述你的推理。至少提供 `<tool_call>` 或 `<response>` 中的一个。决定是使用 `<tool_call>`(可能多次使用)、`<response>` 还是两者都用
      2. 你可以在 `<tool_call>` 字段中同时调用多个工具调用。每个工具调用应是一个包含 "name" 字段和 "parameters" 字段的 JSON 对象,"parameters" 字段包含参数字典。如果不需要参数,请将 "parameters" 字段留空字典
      3. 参考历史对话记录,包括用户的查询、之前的 `<tool_call>`、`<response>`,以及任何标记为 `<obs>` 的工具反馈(如果存在)
  • User Prompt for ToolRL Training

    1
    2
    3
    4
    5
    6
    7
    8
    ## Dialogue History
    <user> { { Initial User Input } } </user>
    <think> Round 1 Model Thought </think>
    { { Round 1 model output <tool_call> or <response> } }
    <obs> Round 1 Observation </obs>
    ... ...
    <user> { { User Input } } </user>
    ... ...
    • 中文版(ToolRL 训练用户 Prompt)
      1
      2
      3
      4
      5
      6
      7
      8
      9
      ## 对话历史

      <user> { { 初始用户输入 } } </user>
      <think> 第 1 轮模型思考 </think>
      { { 第 1 轮模型输出 <tool_call> 或 <response> } }
      <obs> 第 1 轮观察 </obs>
      ... ...
      <user> { { 用户输入 } } </user>
      ... ...

附录 C:工具调用奖励函数

Format Reward

  • 格式奖励 \(\mathcal{R}_{\text{format} }\in\{0,1\}\) 检查模型输出是否满足所需结构并按正确顺序包含所有必要字段:
    $$
    \mathcal{R}_{\text{format} }=\begin{cases}1, & \text{if all required fields appear and are in the correct order},\\ 0, & \text{otherwise}.\end{cases}
    \tag{9}
    $$

Correctness Reward

  • 正确性奖励 \(\mathcal{R}_{\text{correct} }\in[-3,,3]\) 将预测的工具调用 \(P=\{P_{1},\ldots,P_{m}\}\) 与真实调用 \(G=\{G_{1},\ldots,G_{n}\}\) 进行比较,正确性奖励由三个部分组成:
    • 工具名称匹配 (Tool Name Matching):
      $$
      r_{\text{name} }=\frac{|N_{G}\cap N_{P}|}{|N_{G}\cup N_{P}|}\in[0,1],
      $$
      • 其中 \(N_{G}\) 和 \(N_{P}\) 分别是真实调用和预测调用的工具名称集合
    • 参数名称匹配 (Parameter Name Matching):
      $$
      r_{\text{param} }=\sum_{G_{j}\in G}\frac{|\text{keys}(G_{j})\cap\text{keys}(P_{j})|}{|\text{keys}(G_{j})\cup\text{keys}(P_{j})|}\in[0,|G|],
      $$
      • 其中 \(\text{keys}(G_{j})\) 和 \(\text{keys}(P_{j})\) 分别是真实调用和预测调用的参数名称
    • 参数内容匹配 (Parameter Content Matching):
      $$
      r_{\text{value} }=\sum_{G_{j}\in G}\sum_{k\in\text{keys}(G_{j})}\mathbf{1}[P_{G}[k]=P_{P}[k]]\in\left[0,\sum_{G_{j}\in G}|\text{keys}(G_{j})|\right],
      $$
      • 其中 \(P_{G}[k]\) 和 \(P_{P}[k]\) 分别是真实调用和预测调用的参数值
    • 总匹配分数 (Total Match Score):
      $$
      r_{\text{match} }=r_{\text{name} }+r_{\text{param} }+r_{\text{value} }\in[0,S_{\text{max} }],
      $$
      • 其中
        $$
        S_{\text{max} }=1+|G|+\sum_{G_{j}\in G}|\text{keys}(G_{j})|.
        $$
  • 最终的正确性奖励通过寻找 \(P\) 和 \(G\) 之间的最优匹配以最大化总匹配分数来计算:
    $$
    \mathcal{R}_{\text{correct} }=6\cdot\frac{R_{\text{max} } }{S_{\text{max} } }-3\in[-3,,3].
    $$
    • 其中 \(R_{\text{max} }\) 表示来自最优匹配的总匹配分数

附录 D:ToolRL Hyperparameters Setting

  • 表 6: GDPO verl 训练配置
    • 所有超参数设置均与 ToolRL (2025) 中使用的保持一致

附录 E:数学/代码推理超参数设置(Math/Coding Reasoning Hyperparameters Setting)

  • 表 7: GDPO verl 训练配置

附录 F:使用 \(\mathcal{R}_{\text{length} }\) 和 \(\mathcal{R}_{\text{correct} }\) 在数学推理数据上训练 DeepSeek-R1-7B 和 Qwen3-4B-Instruct 时 GRPO 和 GDPO 的训练曲线(Training curves of GRPO and GDPO when training DeepSeek-R1-7B and Qwen3-4B-Instruct with \(\mathcal{R}_{\text{length} }\) and \(\mathcal{R}_{\text{correct} }\) on math reasoning data.)

  • 图 9:在数学推理数据上优化 DeepSeek-R1-7B 时, GRPO 和 GDPO 在正确性奖励、长度奖励和批次最大响应长度上的训练行为。我们可以看到 GDPO 在保持正确性提升的同时,对长度约束的遵循也优于 GRPO
  • 图 10:在数学推理数据上优化 Qwen3-4B-Instruct 时, GRPO 和 GDPO 在正确性奖励、长度奖励和批次最大响应长度上的训练行为。我们可以看到 GDPO 在保持正确性提升的同时,对长度约束的遵循也优于 GRPO

附录 G:在数学推理任务上,对比 GRPO / GDPO 微调的 DeepSeek-R1-7B 模型在不同长度奖励权重 \(\{1.0,0.75,0.5,0.25\}\) 下,使用和不使用条件化长度奖励 \(\tilde{\mathcal{R} }_{\text{length} }\) 的效果(Comparison of GRPO/GDPO finetuned DeepSeek-R1-7B models under varying length reward weights \(\{1.0,0.75,0.5,0.25\}\) with and without the conditioned length reward \(\tilde{\mathcal{R} }_{\text{length} }\) on math reasoning tasks)

  • 表 8:在数学推理任务上,对比 GRPO / GDPO 微调的 DeepSeek-R1-7B 模型在不同长度奖励权重 \(\{1.0,0.75,0.5,0.25\}\) 下,使用普通长度奖励 \(\mathcal{R}_{\text{length} }\) 的效果
  • 表 9:在数学推理任务上,对比 GRPO / GDPO 微调的 DeepSeek-R1-7B 模型在不同长度奖励权重 \(\{1.0,0.75,0.5,0.25\}\) 下,使用条件化长度奖励 \(\tilde{\mathcal{R} }_{\text{length} }\) 的效果
NLP——LLM对齐微调-AutoRule

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:AutoRule: Reasoning Chain-of-thought Extracted Rule-based Rewards Improve Preference Learning, 20250618, CMU Chenyan Xiong
    • 开源地址:github.com/cxcscmu/AutoRule

Paper Summary

  • 论文总结:
    • 论文介绍了一种基于推理链的自动 Rule 提取机制(AutoRule),用于在语言模型对齐中利用 Rule-based 奖励
    • 作者表明从 AutoRule 提取的 Rule 与偏好数据集有良好的一致性,并且在指令遵循基准的模型评估中提供了性能提升,且证明了 Rule-based 奖励方法在一定程度上缓解了奖励模型的过优化
    • 论文的 Rule 信号只是作为辅助信号和标准 RL 一起训练的,并不是单独训练
    • AutoRule 的核心是 “偏好数据 -> 推理链 -> 规则提取 -> 规则奖励 -> RL 优化” 的端到端流程
    • 注:论文附录中提供了 UltraFeedback、MT-Bench 数据集提取的完整规则(如 UltraFeedback 规则含“翻译需保留原语气”“代码需无错误”等)
    • 通过三步自动化流程从偏好数据中生成统一规则集,核心依赖具备推理能力的 LLM(如 Deepseek-R1):
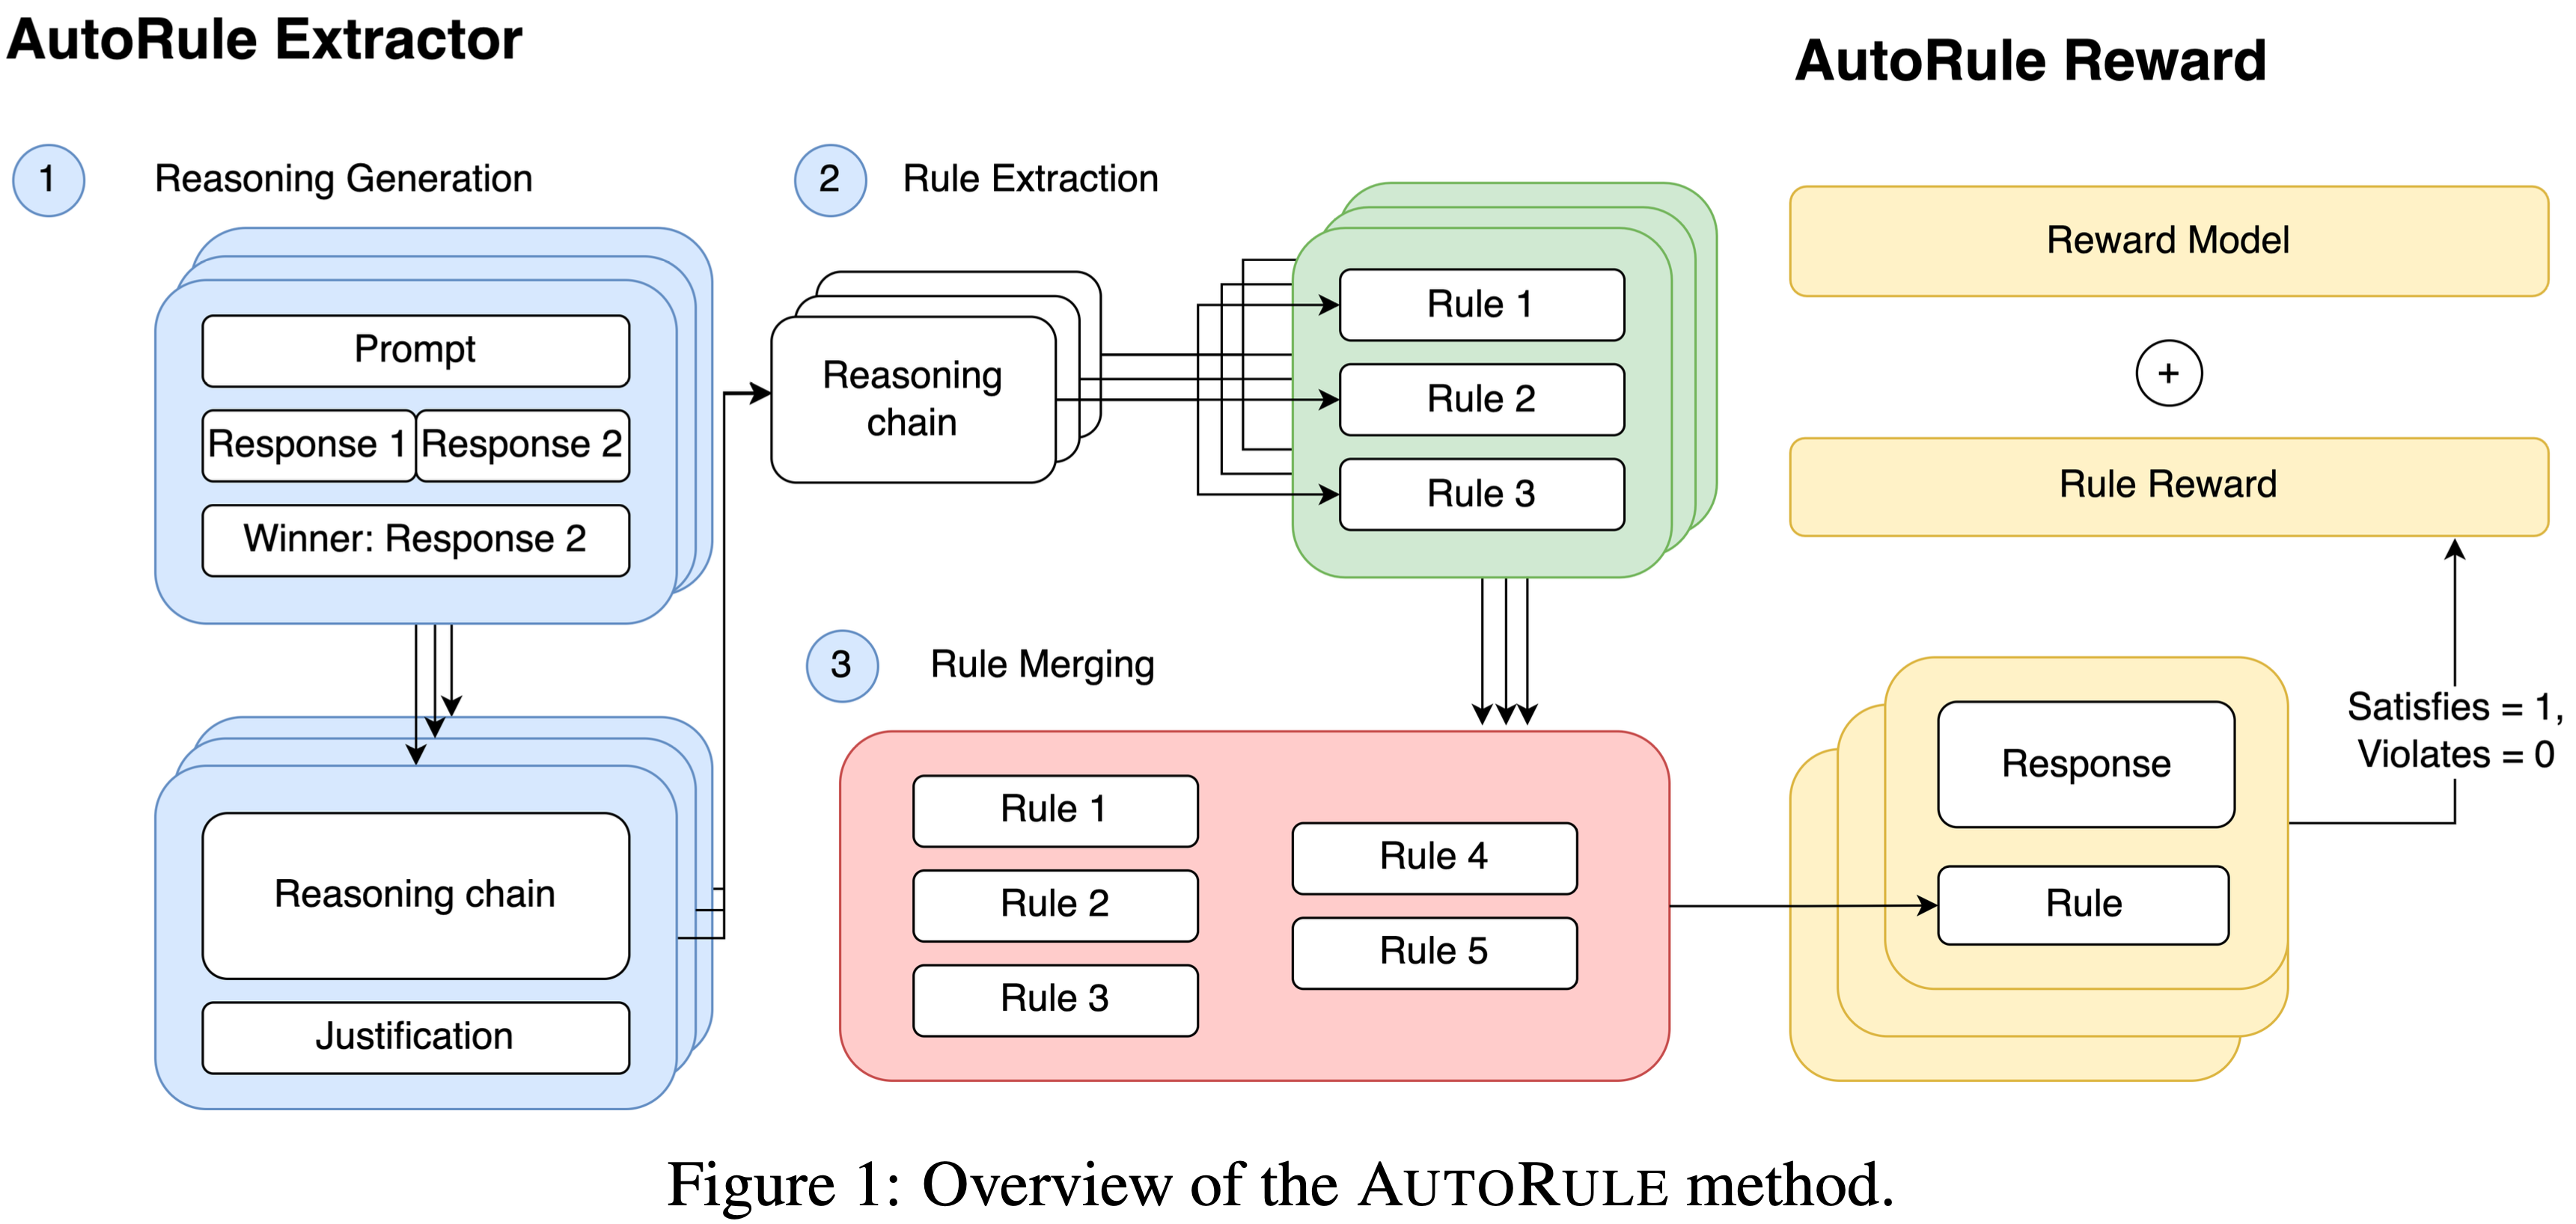
      • 推理生成 :给定偏好数据集中的“候选响应对+偏好标签”(如“响应A被拒绝,响应B被选中”),Prompt 推理型 LLM 生成分步推理链 ,解释为何选中的响应更优(考虑清晰度、连贯性、实用性等维度)
      • 规则抽取 :从每条推理链中提取明确的“规则类陈述”(需可客观判断),例如“响应应避免冗余,聚焦核心查询”
      • 规则合并 :聚合所有候选规则,通过LLM去除重复、合并语义相似规则,最终得到精简的统一规则集(通常压缩至原规模的 1-2%,提升计算效率)
    • 注:本人亲自尝试过,在实际使用时,论文的 Rule 对于 RewardBench 等 Reward Model Benchmarks 的指标提升没有帮助(当然论文中作者也没有直接汇报 Reward Model Benchmarks 相关的指标,只是将 Rule 作为一个额外的信号加入到之前的 BT RM 中的)
  • 论文之前的 Rule-based 方法通常依赖手动 Rule 工程
  • AutoRule 是一种从偏好反馈中提取 Rule 并将其制定为 Rule-based 奖励的全自动化方法
  • AutoRule 提取过程分为三个阶段:
    • 利用推理模型来解释用户偏好
    • 从这些解释的推理链中识别候选 Rule
    • 将它们合成为一个统一的 Rule 集
  • 利用最终确定的 Rule 集,采用语言模型 Verifier 来计算每个输出满足的 Rule 比例,在策略优化期间,将此度量作为辅助奖励与学习到的奖励模型一起使用
    • 使用 AutoRule 训练 Llama-3-8B 模型,在 AlpacaEval2.0 上实现了长度控制胜率的 28.6% 相对提升,与使用相同学习奖励模型但未使用 Rule-based 辅助奖励训练的 GRPO 基线相比,在保留的 MT-Bench 子集上实现了第二轮性能 6.1% 的相对增益
  • 实验证实:
    • 提取的 Rule 与数据集偏好具有良好的一致性
    • 在运行两个 episode 时,与学习到的奖励模型相比,AutoRule 表现出减少的 Reward Hacking
  • Finally,论文的案例研究表明,提取的 Rule 捕获了不同数据集中看重的独特品质
    • 提取的 Rule 在附录中提供

Introduction and Discussion

  • RLHF 已成为使 LLM 与人类价值观对齐并增强其遵循人类指令能力的关键技术 (2022)
    • RLHF 和相关的基于偏好的优化方法已被用于顶级行业模型,如 GPT-4 (2024)、Gemini (2025)、Claude (2024) 和 Llama 3 (2024)
  • 基于 RL 的训练后方法也被用于增强 LLM 的推理能力
    • Notably,DeepSeek-R1 发布的一个关键进步是采用了 Rule-based 奖励来确保准确性和格式,以替代神经奖励,作为缓解 Reward Hacking 的策略 (2025)
    • 用于推理任务的 Rule-based 奖励特别有效,因为它们提供了控制策略行为的客观、可验证的标准
    • 当语言模型的输出满足这些 Rule 时,它可以被可靠地认为是准确的 Response
  • 虽然 Rule-based 奖励在推理任务上效果很好,但将它们用于语言模型的偏好对齐仍然具有挑战性
    • 与代码或数学等领域不同,在那些领域可以构建明确的 Rule-based Verifier ,偏好对齐之所以困难,是因为人类偏好常常模糊且主观
    • 现有的行业方法通常依赖于专家设计的 Rule (2022, 2024) 或大规模众包标注 (2022),这可能成本高昂且难以扩展
  • 为了克服这些限制,论文引入了一个自动 Rule 提取框(AutoRule)
    • AutoRule 利用先进 LLM 的推理能力直接从偏好数据中推导对齐 Rule
    • 论文的方法从模型生成的推理链中提取明确 Rule ,超越了对人工设计或众包 Rule 的依赖
    • 在 RL 训练期间,一个 LLM-as-a-judge (2023) Verifier 评估每个候选 Response 是否符合提取的 Rule ,生成的 Rule 分数被聚合以形成 Rule-based 复合奖励
      • 然后,此奖励与标准模型奖励结合以指导策略优化
  • 为了提取 Rule ,AutoRule 遵循以下流程
    • 给定一对模型输出和一个相关的偏好标签:
      • 首先 Prompt 一个具备推理能力的 LLM 为首选的输出生成一个逐步的理由
      • 然后要求该 LLM 从其推理过程中提取明确的、类似 Rule 的陈述
      • 这些候选 Rule 在训练集中进行聚合,之后 LLM 会合成一个统一的 Rule 集
    • 论文 hypothesize,利用推理链的逻辑结构能够提取更精确和可操作的 Rule ,从而更好地捕捉潜在的偏好标准
  • 论文通过全面的实验经验性地验证了论文的方法
    • First,论文展示了使用 Llama 3 8B Instruct (2024) 作为 Verifier 计算的 Rule-based 分数(无论是单独还是累积计算)在 UltraFeedback (2024) 和 MT-Bench Human Judgment (2023) 数据集上都与偏好有良好的一致性
    • Next,论文使用标准的 RLHF 流程在 UltraFeedback 数据上对基础 Llama-3-8B 模型进行训练后,但用 GRPO (2024) 替换了传统的 PPO,并集成了 AutoRule 作为奖励机制
    • 论文在多个基线上对论文的方法进行了基准测试,包括使用仅模型奖励的普通 PPO 和 GRPO,并在 UltraFeedback 胜率、AlpacaEval 2.0 和 MT-Bench 上进行评估
      • 在所有三项评估中,AutoRule 始终优于基线
  • Additionally, Reward Hacking 实验证明了 AutoRule Rule-based 奖励能够减轻奖励模型的过度优化
    • 比较从推理链与仅从理由中提取 Rule 的消融研究支持了 AutoRule 中利用推理链的有效性
    • Furthermore,定性分析表明,从 UltraFeedback 导出的 Rule 主要强调对话质量,而从 MT-Bench 提取的 Rule 则优先考虑指令遵循和在更复杂任务上的鲁棒性
  • 总而言之,论文的主要贡献有三方面:
    • 论文引入了 AutoRule,一个通过 LLM 生成的推理链从偏好数据中自动提取对齐 Rule 的框架
    • 论文展示了通过 AutoRule 导出的 Rule-based 奖励,与标准的偏好优化基线相比,能带来改进的偏好对齐和指令遵循
    • 论文证明了 AutoRule 能减少 Reward Hacking 并产生可解释的、适应数据集的 Rule

Methods

  • 在本节中,论文概述 AutoRule 的自动 Rule 提取过程,演示如何利用这些 Rule 形成奖励分数,以及如何在 GRPO 公式中使用该奖励
  • 图 1 提供了 Rule 提取和奖励计算流程的概述

AutoRule Extractor

  • 论文将语言模型表示为 \(\pi_{\theta}\),其中 Prompt \(x\) 作为状态
    • 下一个 token \(t\) 作为动作,即 \(t \sim \pi_{\theta}(\cdot | x)\)
    • 在 \(N\) 个 token 上展开此过程,生成输出序列 \(y = (y_{1},\ldots ,y_{N})\) 的概率由 \(\pi_{\theta}(y\mid x) = \prod_{i = 1}^{N}\pi_{\theta}(y_{i}\mid y_{< i},x)\) 给出
    • 为简洁起见,论文将采样输出写为 \(y\sim \pi_{\theta}(\cdot \mid x)\)
  • AutoRule 中的自动 Rule 提取过程包括三个主要阶段,每个阶段都利用一个推理语言模型 \(\pi_{\phi}\),该模型将 Response \(y\) 分解为输出 \(o\) 和相关的推理轨迹 \(r\),即 \((o,r)\sim \pi_{\phi}(\cdot \mid x)\)
Reasoning Generation
  • 为了引导推理模型产生适用于 Rule 提取的连贯、逐步推理链,论文 Prompt 其说明为何 Chosen Response 更优
  • 给定一个偏好数据集
    $$\mathcal{D}_{\mathrm{pref} } = \left\{(x^{(1)},y_{c}^{(1)},y_{r}^{(1)}),\ldots ,(x^{(N)},y_{c}^{(N)},y_{r}^{(N)})\right\}$$
  • 论文向推理模型呈现 \(x_{1} = \mathrm{prompt}(x,y_{c},y_{r},1)\) 或 \(x_{2} = \mathrm{prompt}(x,y_{r},y_{c},2)\),随机选择以变化候选顺序
    • 每个 Prompt 都要求提供模型输出的理由
  • 对于每个样本 \(i\),论文从模型生成 \((o^{(i)},r^{(i)})\sim \pi_{\phi}(\cdot \mid x)\) 中提取推理轨迹 \(r^{(i)}\),从而得到推理链的集合 \(RC = \{r^{(1)},\ldots ,r^{(N)}\}\)
    • 此步骤以及后续步骤使用的 Prompt 显示在附录 F 中
Rule Extraction
  • 接下来,论文从每个单独的推理链中提取明确 Rule
  • 对于每个推理链 \(r^{(i)}\in RC\),论文使用 \(x = \mathrm{prompt}(r^{(i)})\) Prompt 推理模型,以引出证明偏好合理性的潜在 Rule
  • 模型为每个 \(r^{(i)}\) 输出一组 Rule \(R^{(i)}\),即 \(R^{(i)},r\sim \pi_{\phi}(\cdot \mid x)\)
  • 论文将这些 Rule 在所有样本上聚合以获得整体 Rule 集:
    $$RS = \bigcup_{i = 1}^{N}R^{(i)}$$
  • 通过这种方式利用推理模型,论文的目标是系统地将复杂的推理轨迹分解为精确、可操作的 Rule
  • 从每个推理链单独提取 Rule 也简化了模型的任务,这应能促进更高质量和更可解释的 Rule 集
Rule Merging
  • 鉴于从训练集中提取了大量 Rule ,合并 Rule 对于确保训练期间的计算效率至关重要
  • 为了解决冗余和重叠问题,论文 Prompt 推理模型合并 Rule
  • 为此,论文在 Prompt 中指出提供的 Rule 可能存在重复或语义相似的 Rule
  • 然后,论文指示模型识别并合并 \(RS\) 中的 Rule ,以便没有重复或相似的 Rule 保留
  • 这产生了一组精炼且紧凑的合并 Rule :
    $$MR,r\sim \pi_{\phi}(\cdot |\mathrm{prompt}(RS))$$
    • 其中 \(MR\) 表示最终的合并 Rule 集
    • 经验上,此合并过程大大减少了冗余,通常将 Rule 集压缩到其原始大小的 \(1-2\%\)
    • 这显著提高了 Rule-based 奖励计算过程的效率

AutoRule Reward

  • 为了构建用于 RL 目标的 Rule-based 奖励,论文采用 LLM-as-a-judge Verifier ,记作 \(V_{\theta}\)
  • 给定一个 Prompt \(x\)、一个 Response \(y\) 和每个提取的 Rule \(c\in MR\), Verifier 提供一个 Rule 分数
    $$ s_{i}\sim V_{\theta}(\cdot |\mathrm{prompt}(x,y,\mathrm{rule}_{i})) $$
    • 论文将 Rule 分数约束为二进制值,\(s_{i}\in \{0,1\}\)
  • AutoRule 奖励 \(r_{RA}\) 定义为在所有 \(K = |MR|\) 条 Rule 上的平均 Rule 满足度:
    $$r_{RA}(x,y) = \frac{1}{K}\sum_{i = 1}^{K}s_{i}$$
    • 其中每个 \(s_{i}\) 如上所述获得
    • 理解:这里是直接将分数累加,在指令遵循种可能会导致模型可以避开一些特别难遵循的结果
  • 用于训练的最终奖励将 Rule-based 奖励 \(r_{RA}\) 与标准奖励模型分数 \(r_{\theta}\) 和 KL 惩罚相结合(精确的 KL 惩罚公式见附录 B.3):
    $$r_{\mathrm{total} }(x,y) = r_{RA}(x,y) + r_{\theta}(x,y) - \beta_{KL}KL_{\mathrm{approx} }$$
    • GRPO 中都不是加在奖励上,这里为什么要加在奖励上?
  • 与分配连续分数以反映细微偏好差异的传统奖励模型不同,论文的 Verifier \(V_{\theta}\) 的任务仅是确定每条 Rule 是否被满足,产生二元结果
    • 这种简化降低了奖励建模过程的复杂性,使 Verifier 不易受到错误判断的影响,减轻了 Reward Hacking 的风险

AutoRule RL Stage

  • AutoRule 使用 GRPO 算法 (2024) 进行偏好对齐的强化学习阶段,使用 \(r_{\mathrm{total} }\) 作为奖励信号(Rule-based 奖励 \(r_{RA}\) 与标准奖励模型分数 \(r_{\theta}\) 和 KL 惩罚相结合)
  • GRPO 是一种策略优化算法,它使用一组输出的相对奖励来确定优势估计,消除了传统 PPO (2017) 中使用的单独价值模型的需求,提高了内存和计算效率
    • 形式上,GRPO 利用一组输出并计算它们的奖励,将其合并为一个奖励向量 \(\mathbf{r} = \{r_{1},\ldots ,r_{n}\}\)
    • GRPO 为特定输出 \(i\) 计算优势估计:
      $$\hat{A}_i = \frac{r_i - \mathrm{mean}(\mathbf{r})}{\mathrm{std}(\mathbf{r})}$$
    • 此优势估计用于以下裁剪代理目标 (2017):
      $$L(w) = \mathbb{E}_{(x,y)\sim \mathcal{D}_{val} }\left[\min \left(\frac{\pi_w(y\mid x)}{\pi_{val}(y\mid x)}\hat{A},\mathrm{clip}\left(\frac{\pi_w(y\mid x)}{\pi_{val}(y\mid x)},1 - \epsilon ,1 + \epsilon\right)\hat{A}\right)\right]$$
      • 其中 \(\epsilon\) 是一个裁剪超参数,\(\frac{\pi_w(y\mid x)}{\pi_{val}(y\mid x)}\) 是似然比
  • In Summary
    • AutoRule 引入了一个自动化的、基于推理链的 Rule 提取框架,可以生成精确且可操作的对齐 Rule ,从而消除了手动 Rule 工程的需要
    • 通过利用提供二进制 Rule 满足判断的 LLM-as-a-judge Verifier ,论文的方法与传统的连续奖励模型相比简化了奖励建模,有助于减轻 Reward Hacking 并增强偏好对齐的可靠性

Experimental Methodology

Dataset

  • 论文使用 UltraFeedback-Binarized 数据集(简称 UltraFeedback),它是 UltraFeedback (2024) 的二值化版本,包含来自不同模型类型和指令的近 64K 条成对偏好标注
    • For Training,论文筛选了 33K 个示例的子集(详情见附录 B.6)
  • 论文还使用了 MT-Bench 人工判断数据集(简称 MT-Bench)(2023),该数据集提供了多轮问题的专家偏好标注

Evaluation Metrics

  • 论文在 UltraFeedback-Binarized 测试集上报告胜率,使用 GPT-4o 作为自动评判器,并随机化候选和参考 Response 的顺序
  • 论文还在 MT-Bench(使用 GPT-4 作为评判器)和 AlpacaEval 2.0 (2024) 上进行了评估
  • 对于 AutoRule,AlpacaEval 2.0 和 UltraFeedback 胜率是在使用 UltraFeedback Rule 训练的模型上测量的
  • 对于 MT-Bench,论文将 80 个问题分为 40 个用于训练 AutoRule,40 个用于测试(每个 Split 每个类别 5 个)

Rule Extraction

  • 论文使用 Deepseek-R1 (2025) 来生成用于自动 Rule 提取的推理链
  • 对于 LLM-as-a-judge Verifier
    • 论文使用 Llama-3-8B-Instruct (2024) 以在计算效率上优于更大的 Deepseek-R1 模型
    • 理解:这里,若 Rule 不够简单的话,Llama-3-8B-Instruct 的性能应该是远远不够的
  • 为了提取 Rule
    • 论文从 UltraFeedback 训练 Split 中随机抽取 256 个示例;
    • 对于 MT-Bench,论文使用 40 个问题的训练 Split ,并为训练每个问题采样最多 8 个示例,如果可用数量更少则使用全部

Baselines

  • 论文与多个基线进行比较:
    • (1) 使用 PPO 的 RLHF(“RLHF”)
    • (2) 使用基础奖励且无超参数调优的 GRPO(“GRPO”)
    • (3) 带长度惩罚的 GRPO(“GRPO + Length Penalty”,简写为 LP)
    • (4) 带 length-driven 超参数调优的 GRPO(“GRPO + Length Control”,简写为 LC)
      • 问题:这里的 GRPO+LC 是指特意针对长度惩罚调整过超参数的
  • 所有基线均使用相同的学习奖励模型

AutoRule Model

  • 对于 AutoRule,论文使用一个经过缩放的 Rule-based 奖励 \(r_{RA}\):
    $$r_{RA^{\prime} } = \alpha r_{RA} + \beta$$
    • 其中 \(\alpha = 10\) 且 \(\beta = - 7.5\),以使 Rule-based 奖励幅度与学习奖励模型对齐,实现稳定训练
  • Verifier Prompt 被修改为只有当 Response 简洁且完全满足提取的 Rule 时,\(s_i = 1\)

Implementation Details

  • 所有模型都从相同的 SFT 和奖励模型检查点初始化以确保可比性
    • 这里的 SFT 检查点是通过在筛选后的 UltraFeedback-Binarized 数据集的偏好 Response 上微调 Llama-3-8B 获得的
    • 奖励模型从这个 SFT 检查点初始化,并在筛选后的 UltraFeedback-Binarized 训练 Split 的偏好标注上进一步微调
    • Actor、Critic 和值网络(如适用)均从 SFT 检查点初始化
  • 训练使用 OpenRLHF (2024),这是一个开源的 RLHF 框架
  • 超参数和更多细节在附录 B 中,资源链接可在附录 H 中找到

Evaluation Results

  • 在本节中,论文将在 Rule 质量、模型性能和 Reward Hacking 缓解方面评估 AutoRule
  • 然后论文将分析 AutoRule 的几个消融研究以及提取 Rule 的案例研究

Rule quality

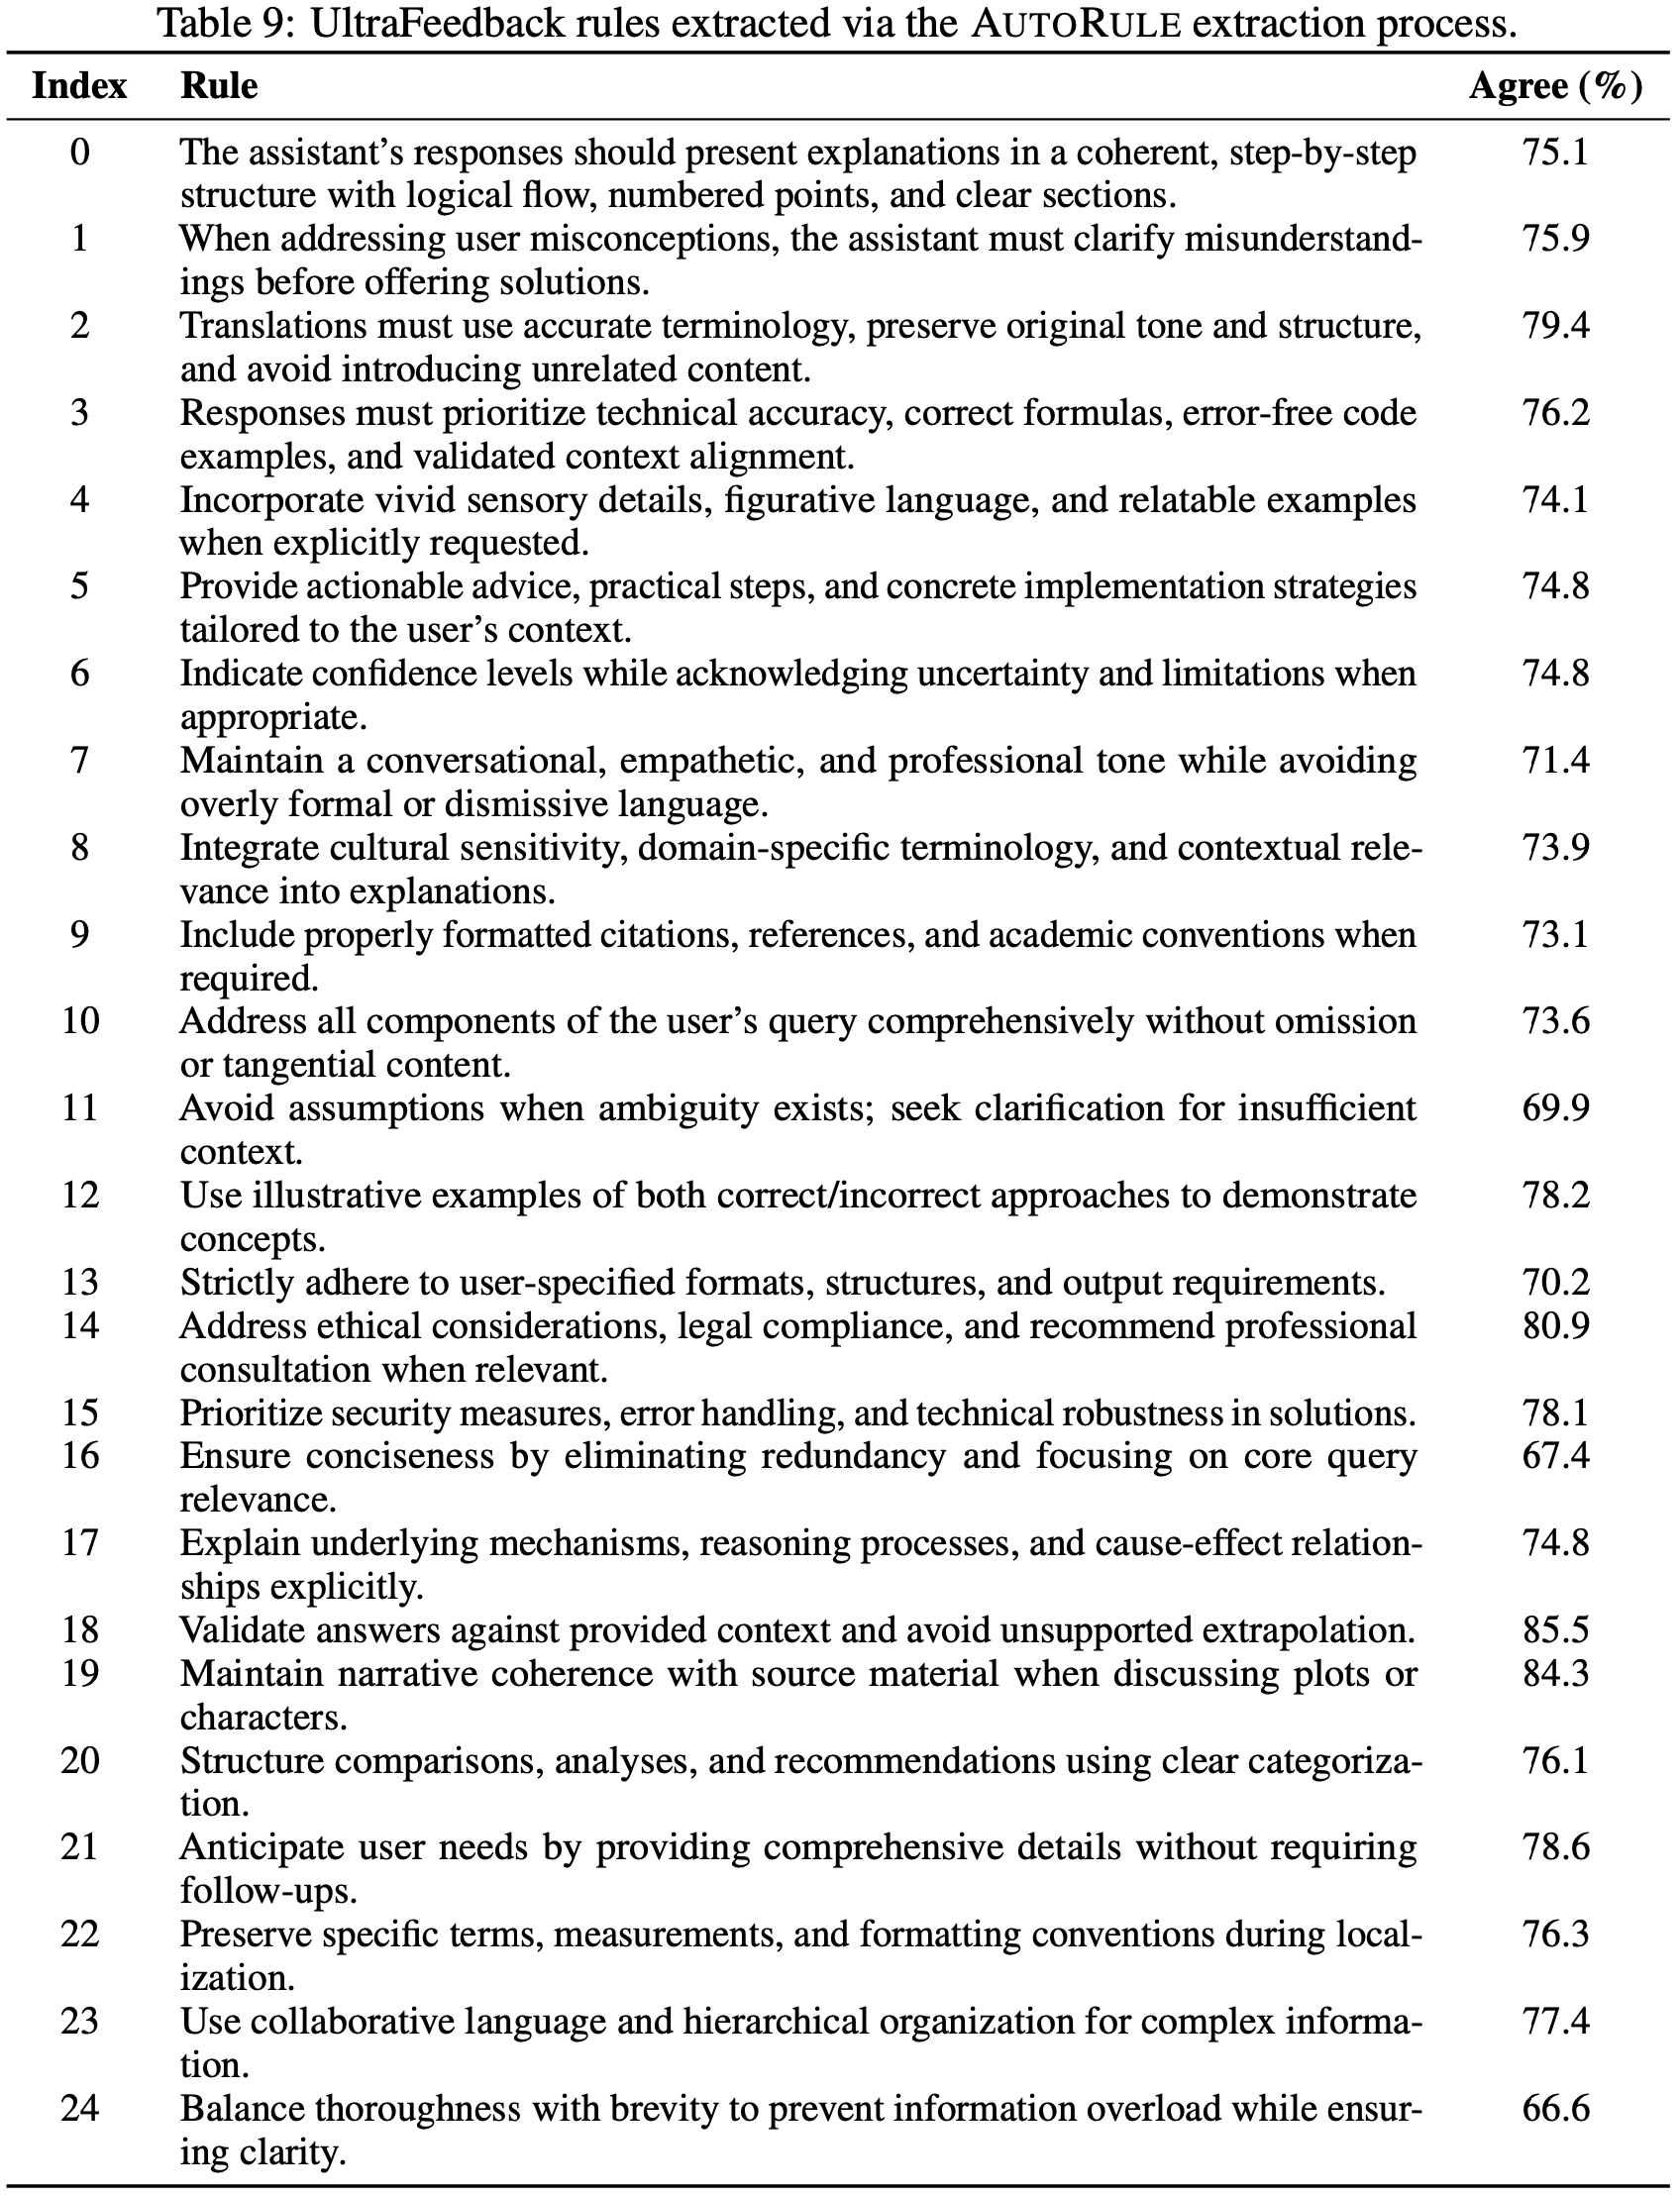
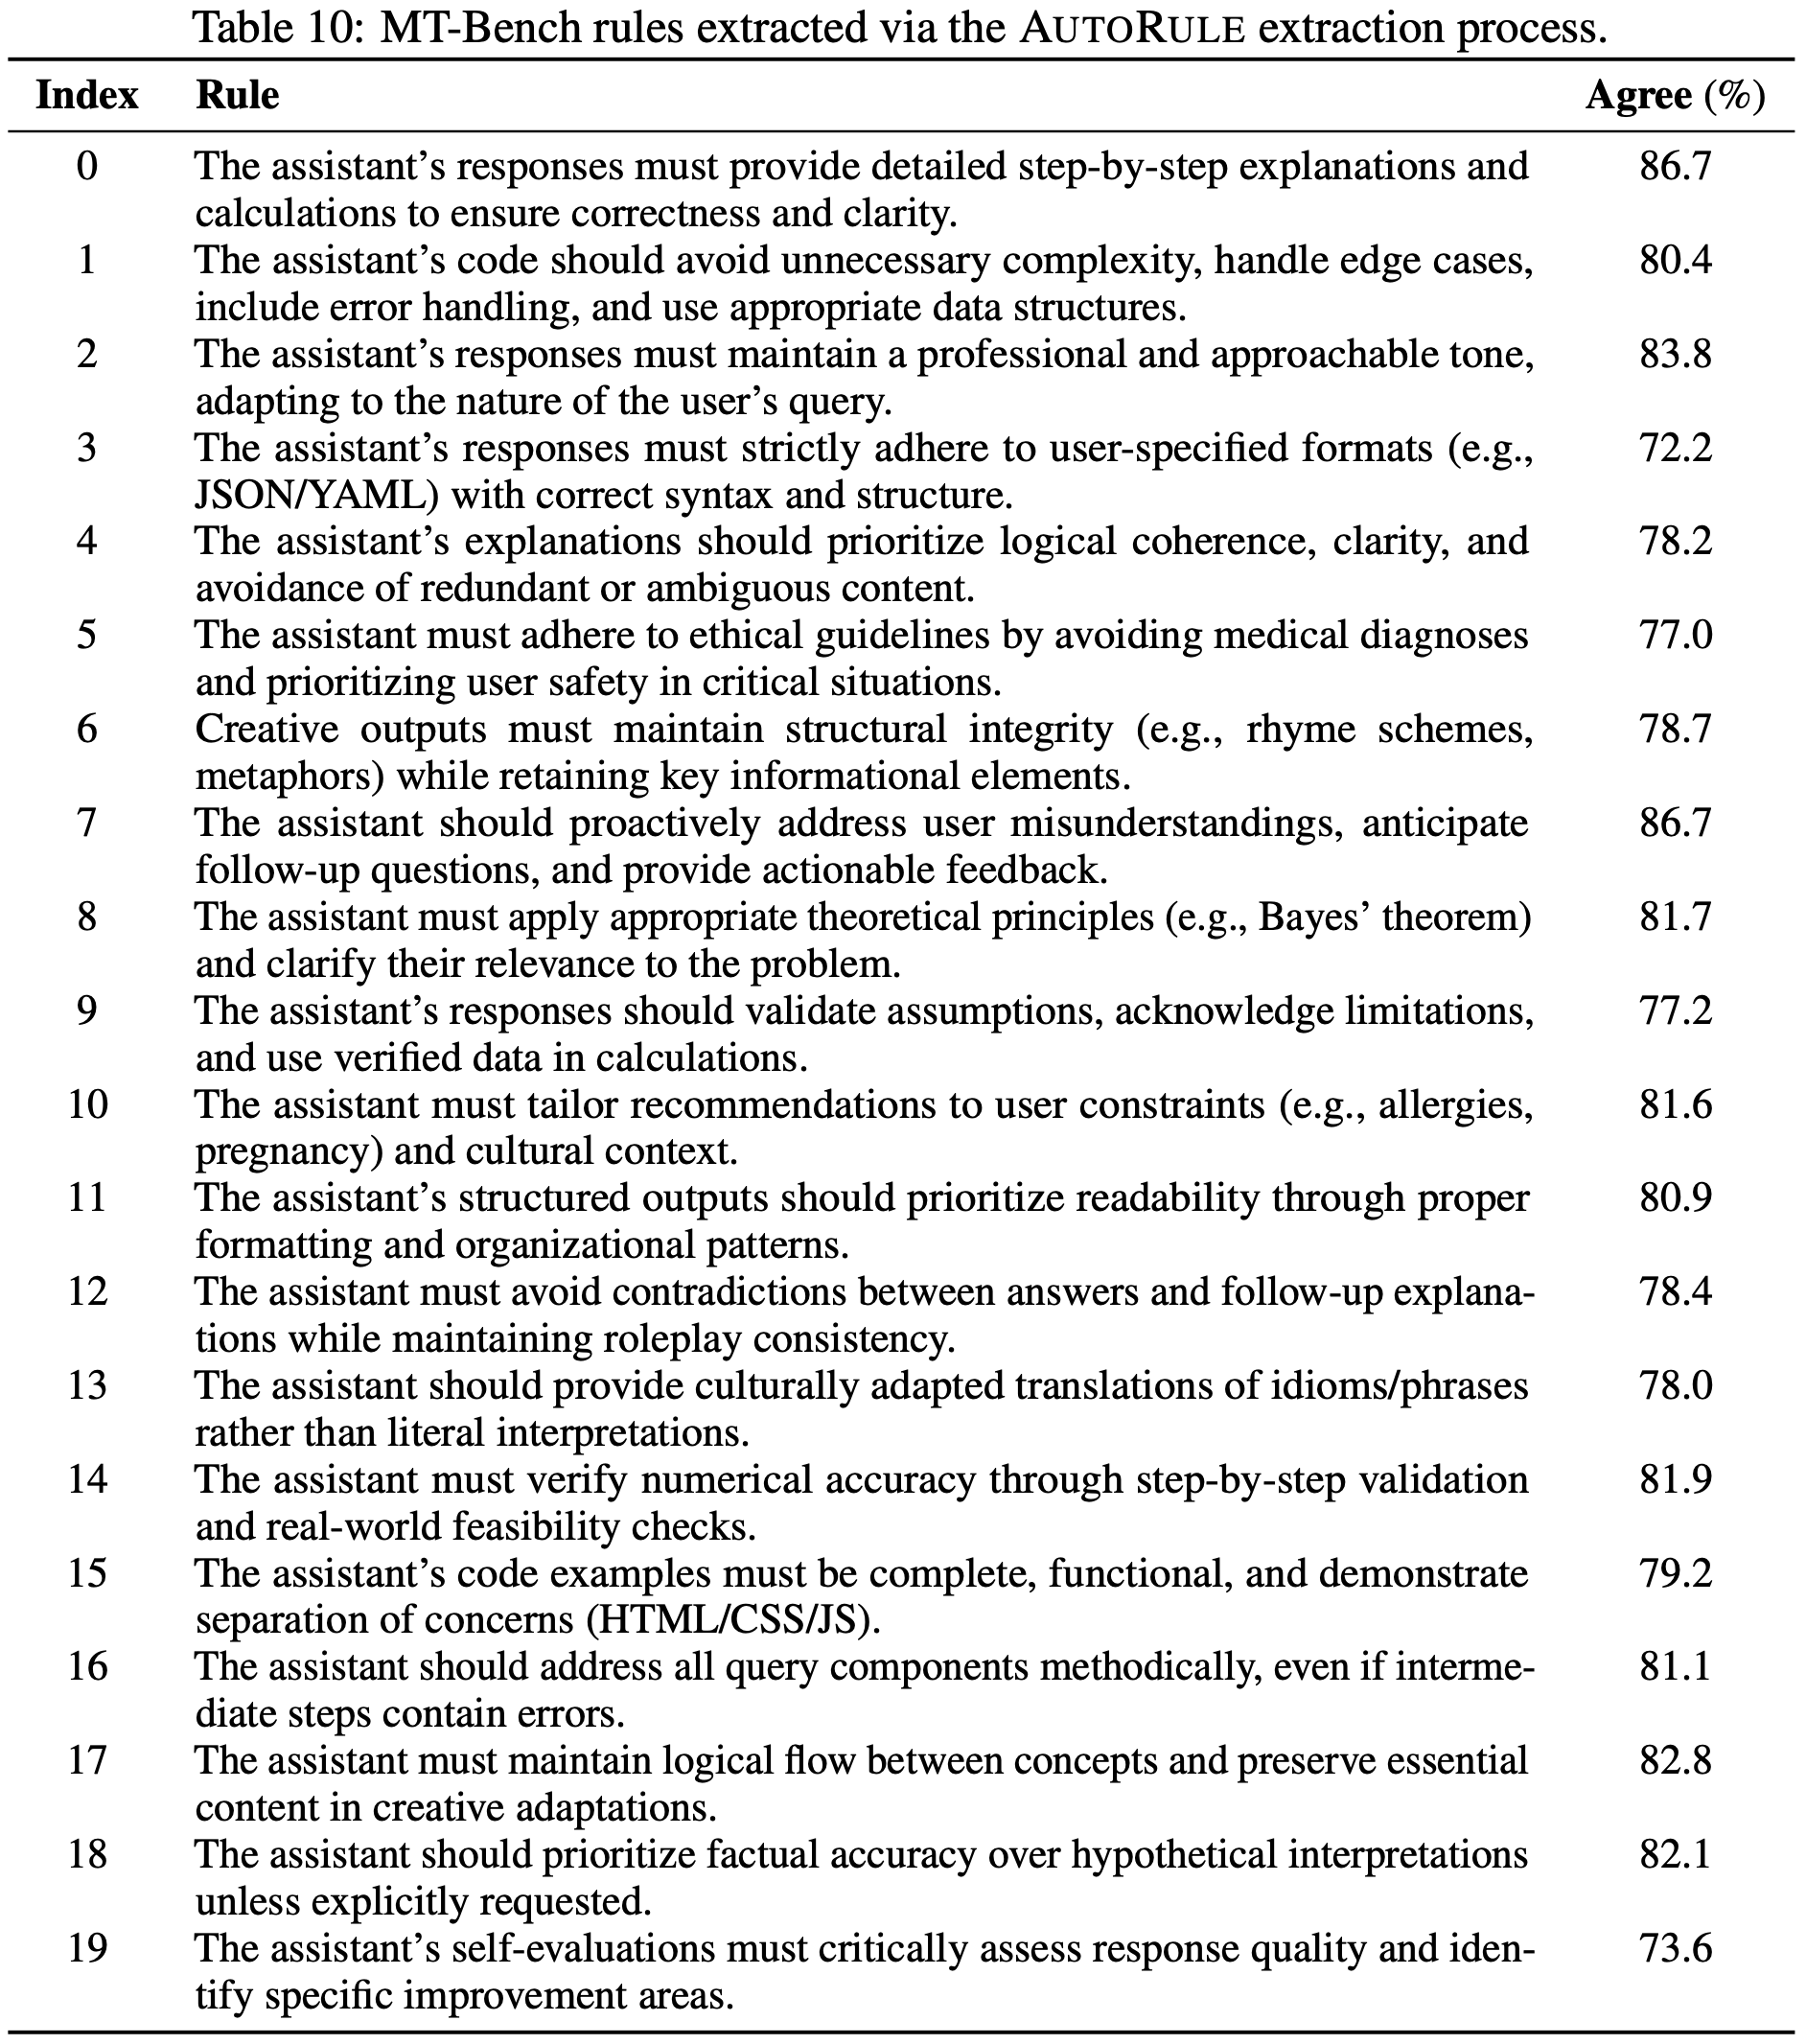
  • 所有提取的 Rule 均在附录 C 中展示
  • 论文在 1,024 个 UltraFeedback 测试示例和完整的 MT-Bench 人工判断 Split 上评估 Rule 一致性
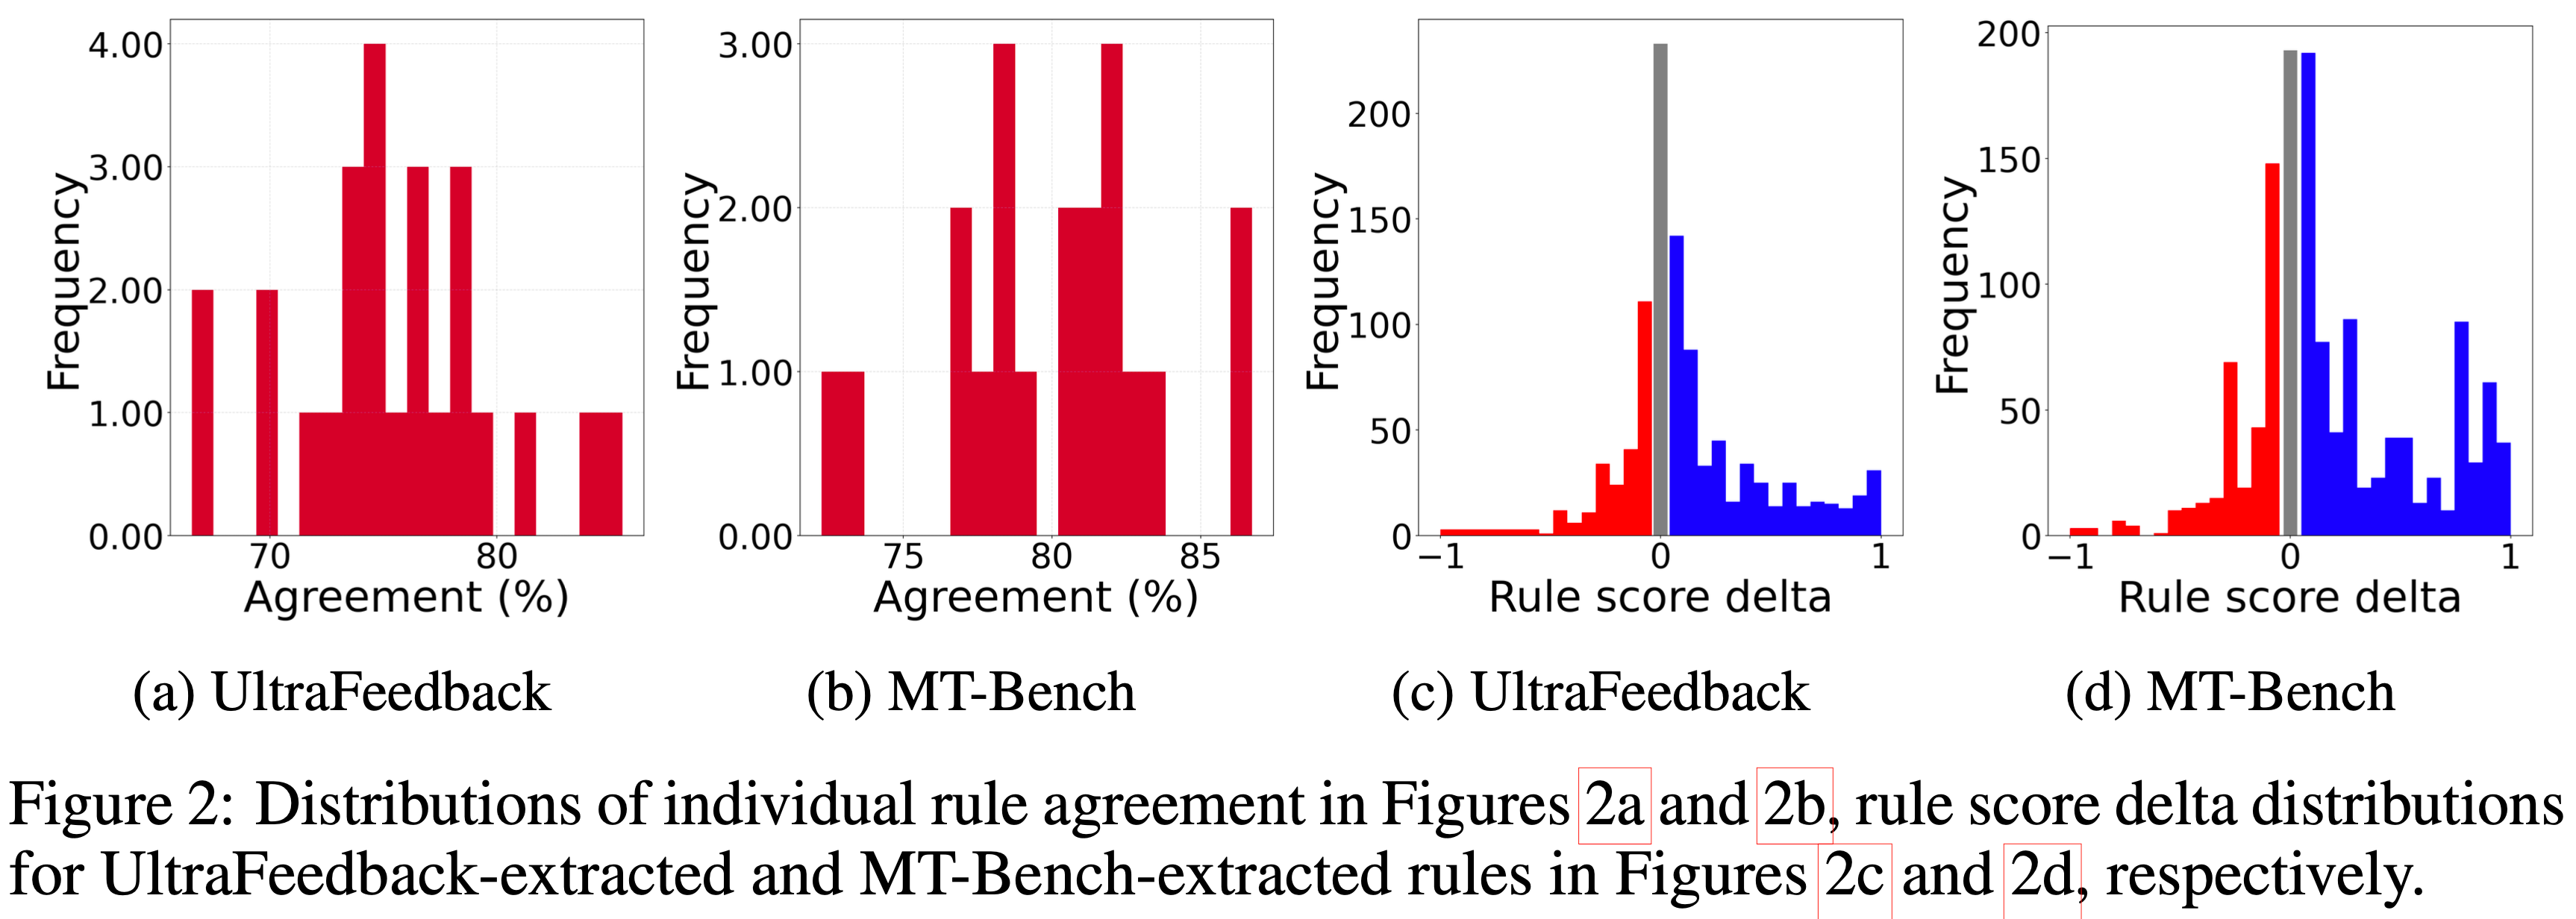
    • 对于单个 Rule ,一致性以 Rule 偏好与真实标注相匹配的 Response 对比例来衡量,仅考虑 Rule 能区分 Response 的对
  • 论文还报告了聚合 Rule 奖励增量(Chosen 奖励与 Rejected 奖励之差)的分布
    • 图 2a 和 2b 展示了单个 Rule 一致性的分布
      • 论文观察到,来自两个 Rule 集的单个 Rule 都与数据集中真实的偏好有良好的一致性
      • 此外,与 MT-Bench Rule 的平均一致性超过了与 UltraFeedback Rule 的平均一致性,这表明在人工标注数据上自动 Rule 提取似乎比在 LLM 生成的偏好数据上更有效
    • 图 2c 和 2d 展示了 Rule 分数增量的分布
      • Rule 分数增量的分布在正侧呈现更重的尾部,表明更多的 Chosen Response 获得了更高的分数
      • 随着增量幅度的增加,正尾变得更重,这意味着更大的增量幅度与更可靠的偏好对齐相关
  • 除了 Rule 一致性,论文还进行了一个小实验来评估 Rule 的确定性
    • 方法是在 UltraFeedback Rule 集上对 20 个 UltraFeedback 测试集 Response 运行 100 次温度为 1.0 的 Verifier 推理,并在 MT-Bench Rule 集上对 16 个 MT-Bench 测试集 Response 进行同样的操作
    • 使用确定性分数计算公式 \((\max (\# \mathrm{Yes}, \# \mathrm{No}) / (\# \mathrm{Yes} + \# \mathrm{No}))\)(其中 Yes/No 表示 Rule 满足情况的答案),论文为 UltraFeedback 和 MT-Bench 提取的 Rule 分别获得了平均 \(83.6%\) 和 \(82.5%\) 的确定性分数
    • 这些结果表明 Rule 具有很高的一致性,并且 Verifier 提供了可靠的判断,支持它们适用于奖励制定

Model Performance

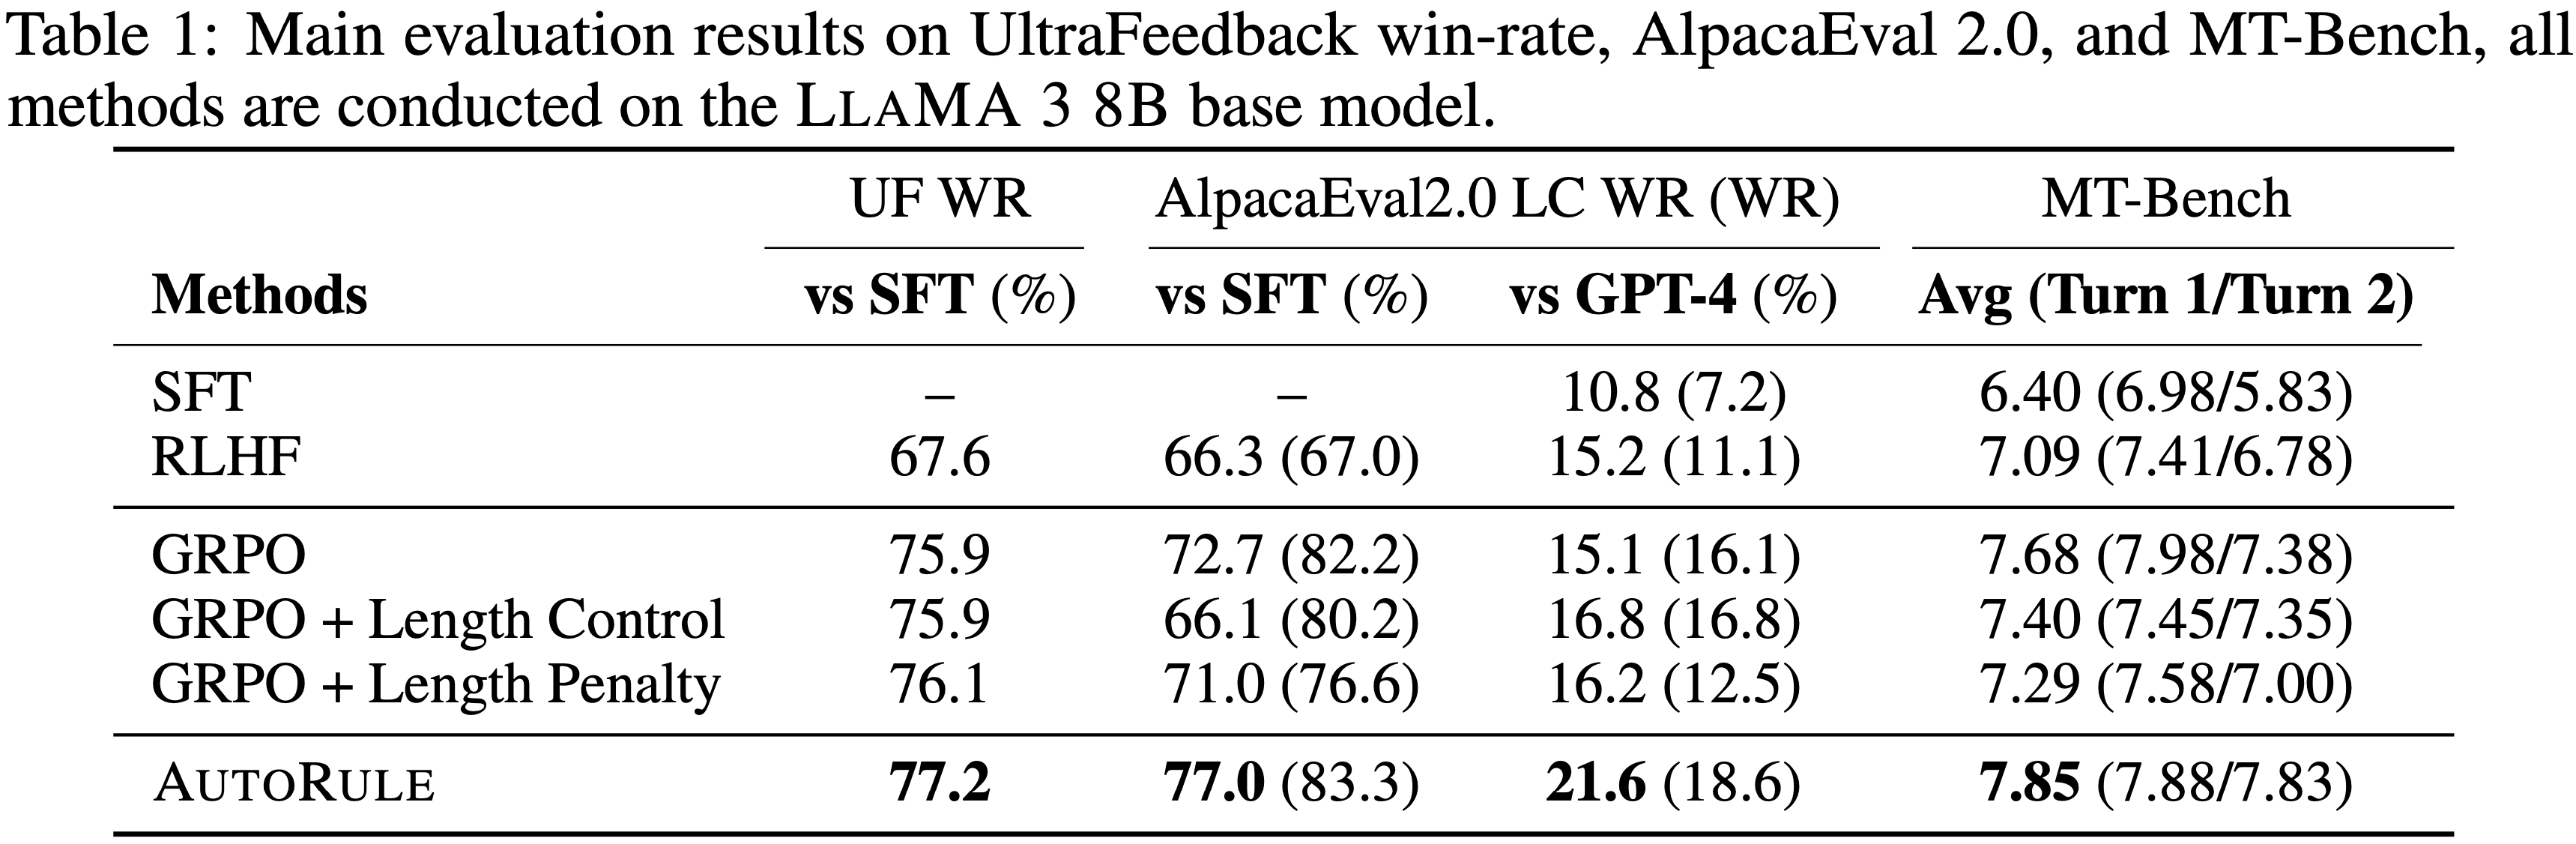
  • 表 1 展示了基线和 AutoRule 模型在多个评估指标上的综合比较,包括 UltraFeedback 胜率、AlpacaEval 2.0 长度控制胜率 (LC WR)/常规胜率 (WR) 以及 MT-Bench 性能
    • 问题:这里都是百分比涨幅,那么实际上的分数绝对值涨幅应该会低很多吧?效果似乎不是很显著?
  • 论文的结果表明, Rule-based 奖励模型在各自训练领域中都是有效的
    • 具体来说,当使用从 UltraFeedback 提取的 Rule 进行训练时,AutoRule 在 UltraFeedback 胜率上相比基线获得了 \(1.7%\) 的相对提升,表明提取的 Rule 成功捕捉了该数据集中人类偏好的重要方面
  • 对于 MT-Bench,论文使用从 40 个精心挑选的多轮 Prompt 子集推导出的 Rule 来评估 AutoRule
    • 值得注意的是,与基线相比,该模型在第二轮性能上表现出 \(6.1%\) 的相对增益,证明了 Rule-based 监督对于复杂的多轮交互是有效的
  • 除了领域内性能,论文的发现表明,相对于传统基线, Rule-based 方法在泛化到分布外任务方面表现更优
    • 在 AlpacaEval 2.0 上,AutoRule 在长度控制胜率上相比 SFT 基线实现了 \(5.9%\) 的相对提升,相比 GPT-4 Turbo 实现了 \(28.6%\) 的提升,这凸显了 Rule-based 奖励在缓解长度偏见和提升实质性 Response 质量方面的鲁棒性
    • 问题:相比 GPT-4 Turbo 实现了 \(28.6%\) 的提升 体现在哪里?是否写错了,应该是 5.4% 吧?
  • 这些结果共同表明,AutoRule 不仅在训练分布内表现出色,还能有效迁移到多样化的评估环境中,优于标准的和减少长度偏见的基线

Reward Hacking Mitigation

  • 为了系统评估 Reward Hacking ,论文在整个训练过程中监控模型性能,以检测任何表明对奖励信号过拟合的性能退化
  • 论文进行了四次实验运行:三个基线和一次使用 UltraFeedback 推导出的 Rule 训练的 AutoRule 实例
    • 每个运行两个训练周期(即,对数据集进行两次完整遍历)
    • 模型每两步保存一次检查点
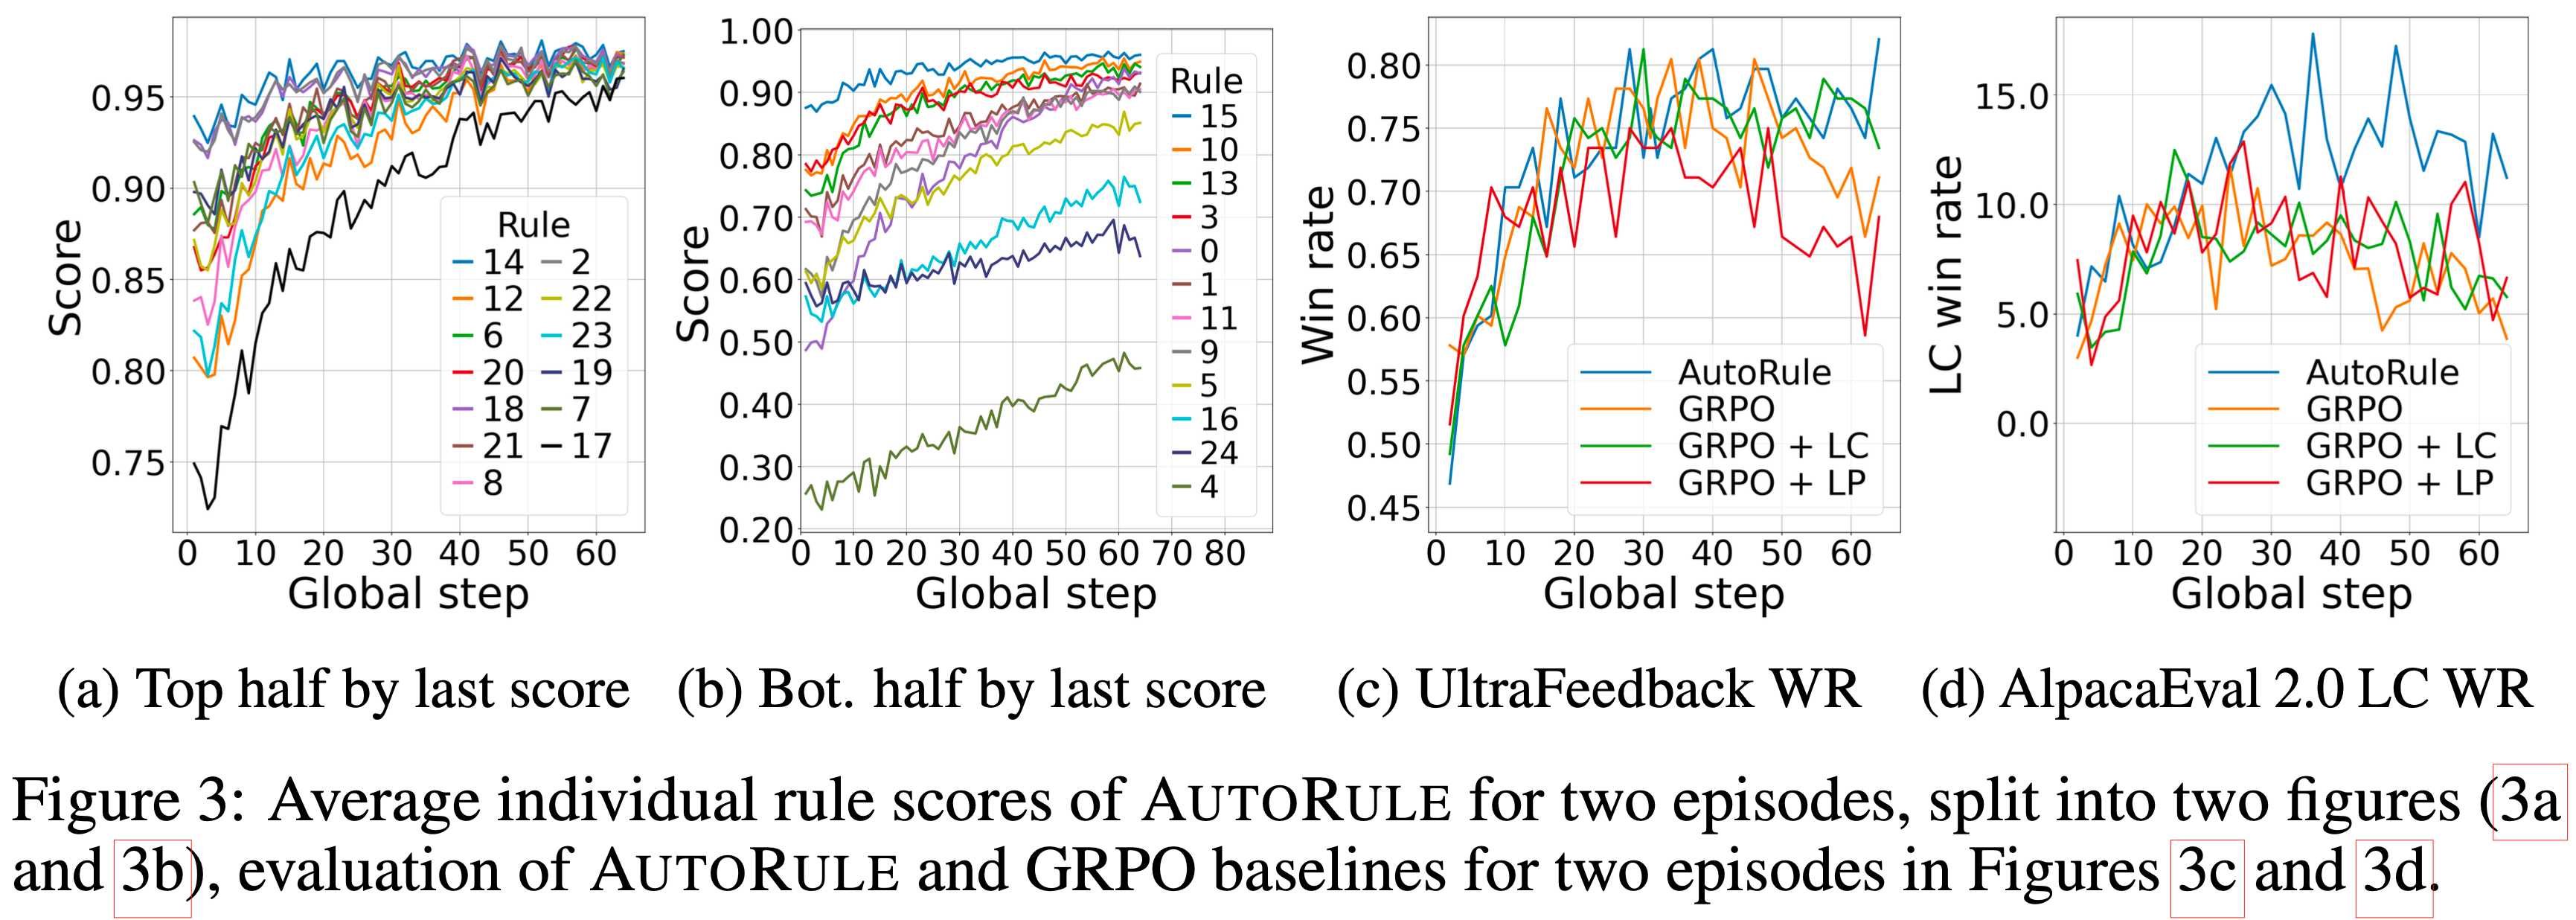
  • 作为初步验证,论文在图 3a 和 3b 中报告了作为全局步数函数的平均单个 Rule 分数
    • 观察到的所有 Rule 分数呈上升轨迹表明,模型正在有效地针对 Rule-based 奖励信号进行优化
    • 这些结果验证了在 AutoRule 框架下将这些训练运行用于后续奖励动态分析的可行性
    • 理解:每个 Rule 的分数在训练中都在逐步提升;3a 和 3b 中分别是不同的 Rule
  • 对于每个检查点,论文评估相对于 SFT 检查点的 UltraFeedback 胜率,以及相对于 GPT-4 的 AlpacaEval 2.0 长度控制胜率(两者都仅使用 128 个示例的子集)
    • 图 3c 描绘了 UltraFeedback 胜率随全局步数的变化
      • 最初,基线和 AutoRule 模型取得了相似的胜率;
      • 然而,在第 52 步之后,GRPO 和 GRPO + LP 基线的性能开始下降,而 GRPO + LC 和 AutoRule 则保持了持续的高胜率
  • 对于分布外泛化,图 3d 展示了 AlpacaEval 2.0 胜率随全局步数的变化
    • 在这里,AutoRule 持续优于所有 GRPO 基线,包括 GRPO + LC,在两个训练周期后取得了大约 5 个百分点的提升
    • 虽然 GRPO + LC 缓解了在分布内数据上的 Reward Hacking ,但 Rule-based 奖励对于分布内和分布外设置都提供了对抗 Reward Hacking 的鲁棒性

Ablation Study

  • 为了更好地理解论文框架中各个组件的贡献,论文进行了一项消融研究,重点关注两个关键方面:奖励缩放和简洁性约束
  • 具体来说,论文考虑了以下变体:
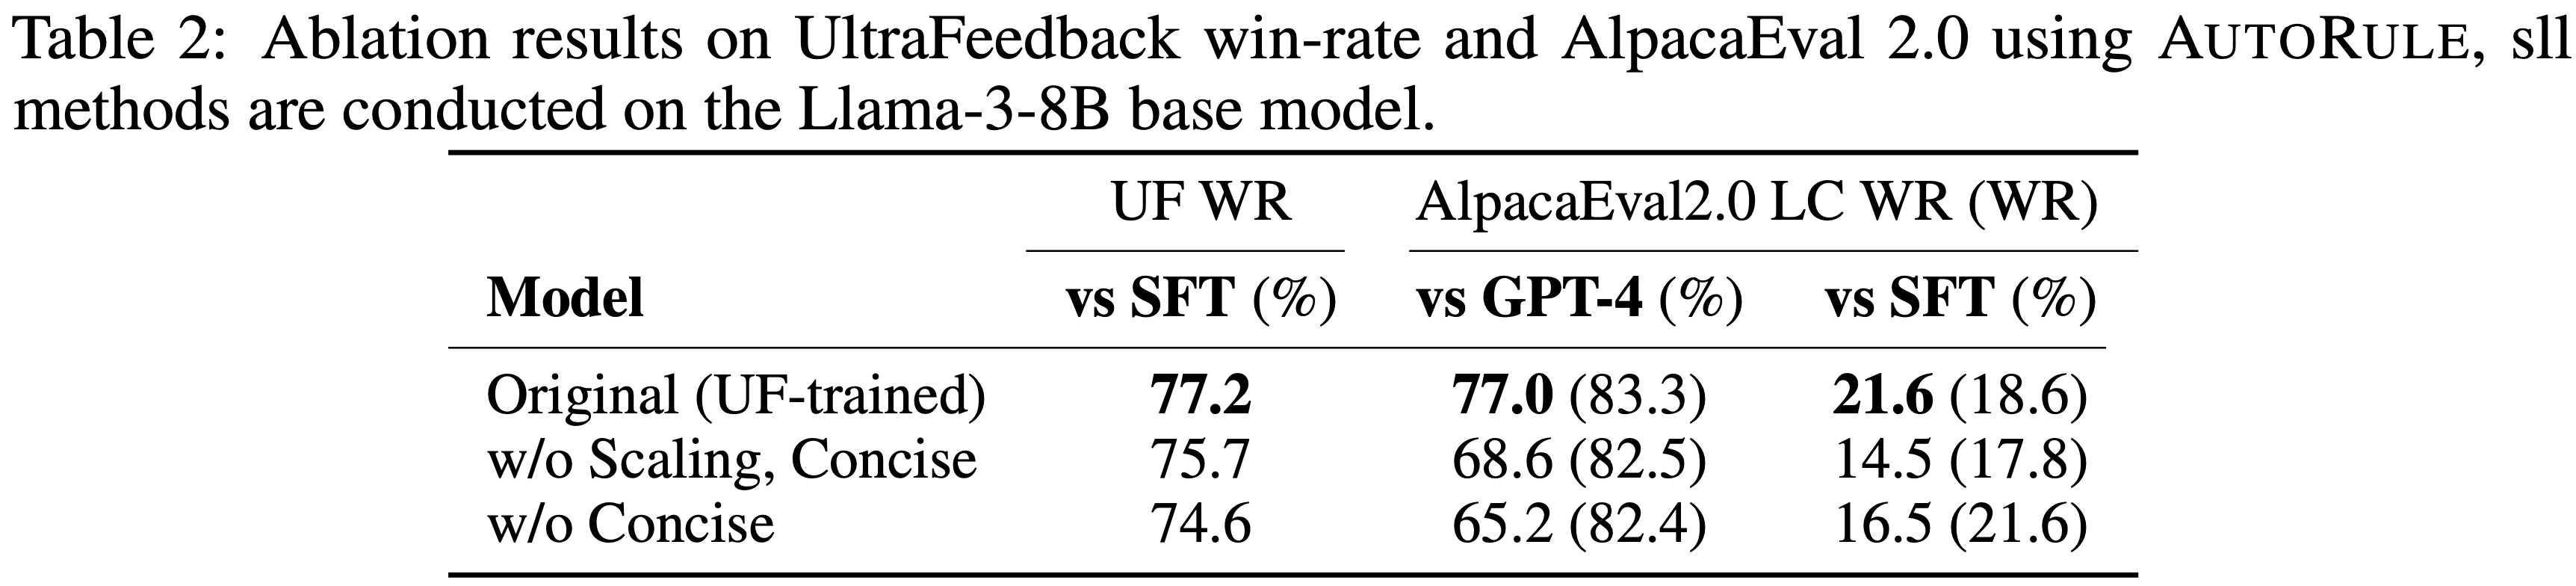
    • (1) 一个在没有 Rule-based 奖励缩放的情况下训练的模型,缩放参数设置为 \(\alpha = 1\),\(\beta = 0\)(标记为“w/o Scaling”)
    • (2) 一个修改了 Verifier Prompt 以省略对简洁性引用的模型,从而移除了对简洁 Response 的显式指导,同时也没有缩放(标记为“w/o Scaling, Concise”)
  • 表 2 中总结的结果表明,移除奖励缩放或简洁性指导中的任一项都会导致 UltraFeedback 胜率和 AlpacaEval 2.0 长度控制胜率持续下降
    • 缺乏奖励缩放削弱了模型有效利用 Rule-based 监督的能力,而省略简洁性约束则导致 Response 与人类对简洁和清晰偏好的对齐度降低
    • 这些发现强调了在 AutoRule 框架内同时进行 Rule 奖励缩放和明确鼓励简洁 Response 的重要性

Rule Analysis

Reasoning VS. Justification Rules
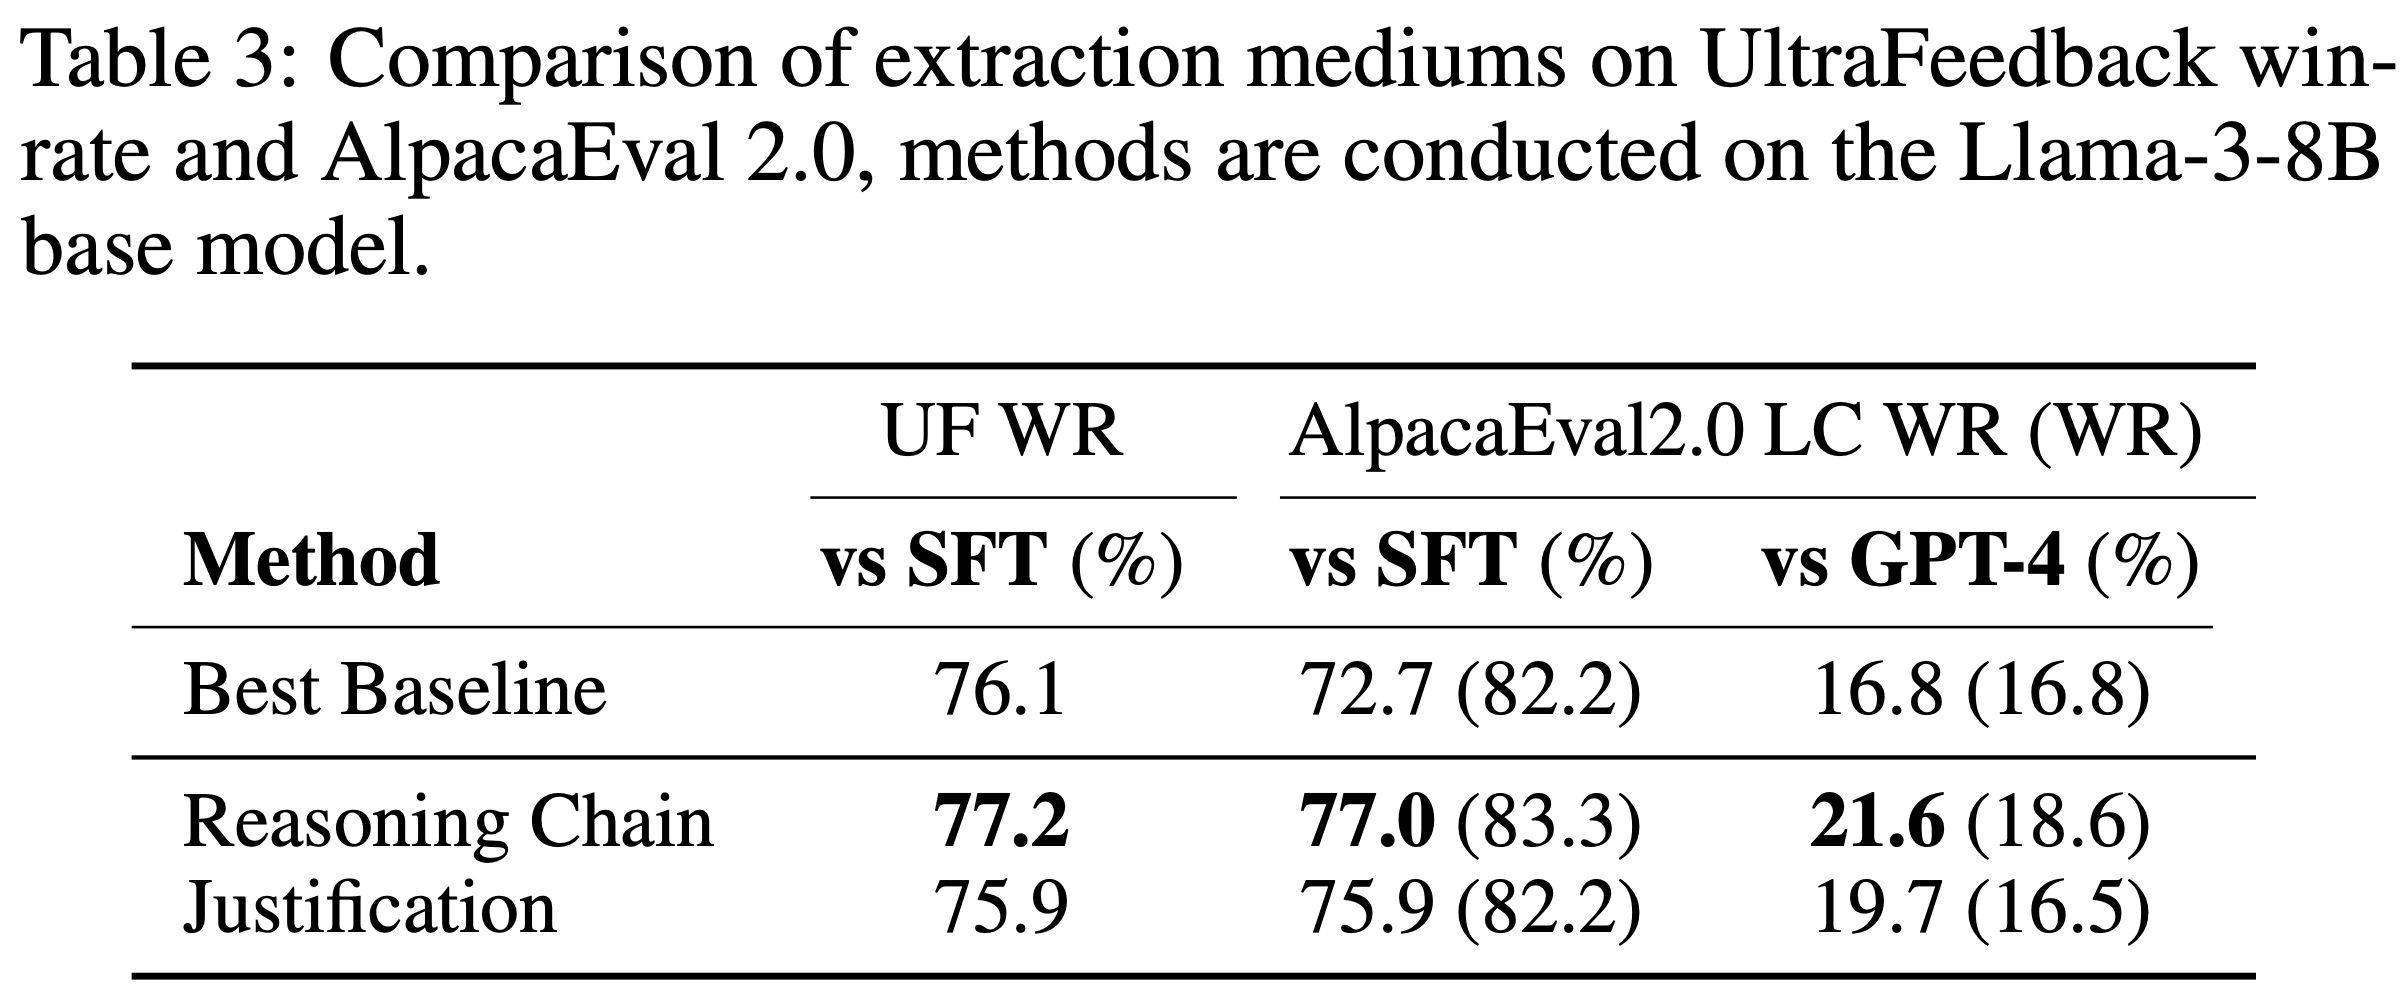
  • 论文研究了提取媒介对 Rule 质量和下游性能的影响
    • 具体来说,论文比较了直接从模型论证(Justifications,即思维链推理之后 Deepseek-R1 的直接输出)提取的 Rule 与从推理链提取的 Rule
  • 表 3 报告了比较这两种提取媒介的模型性能结果
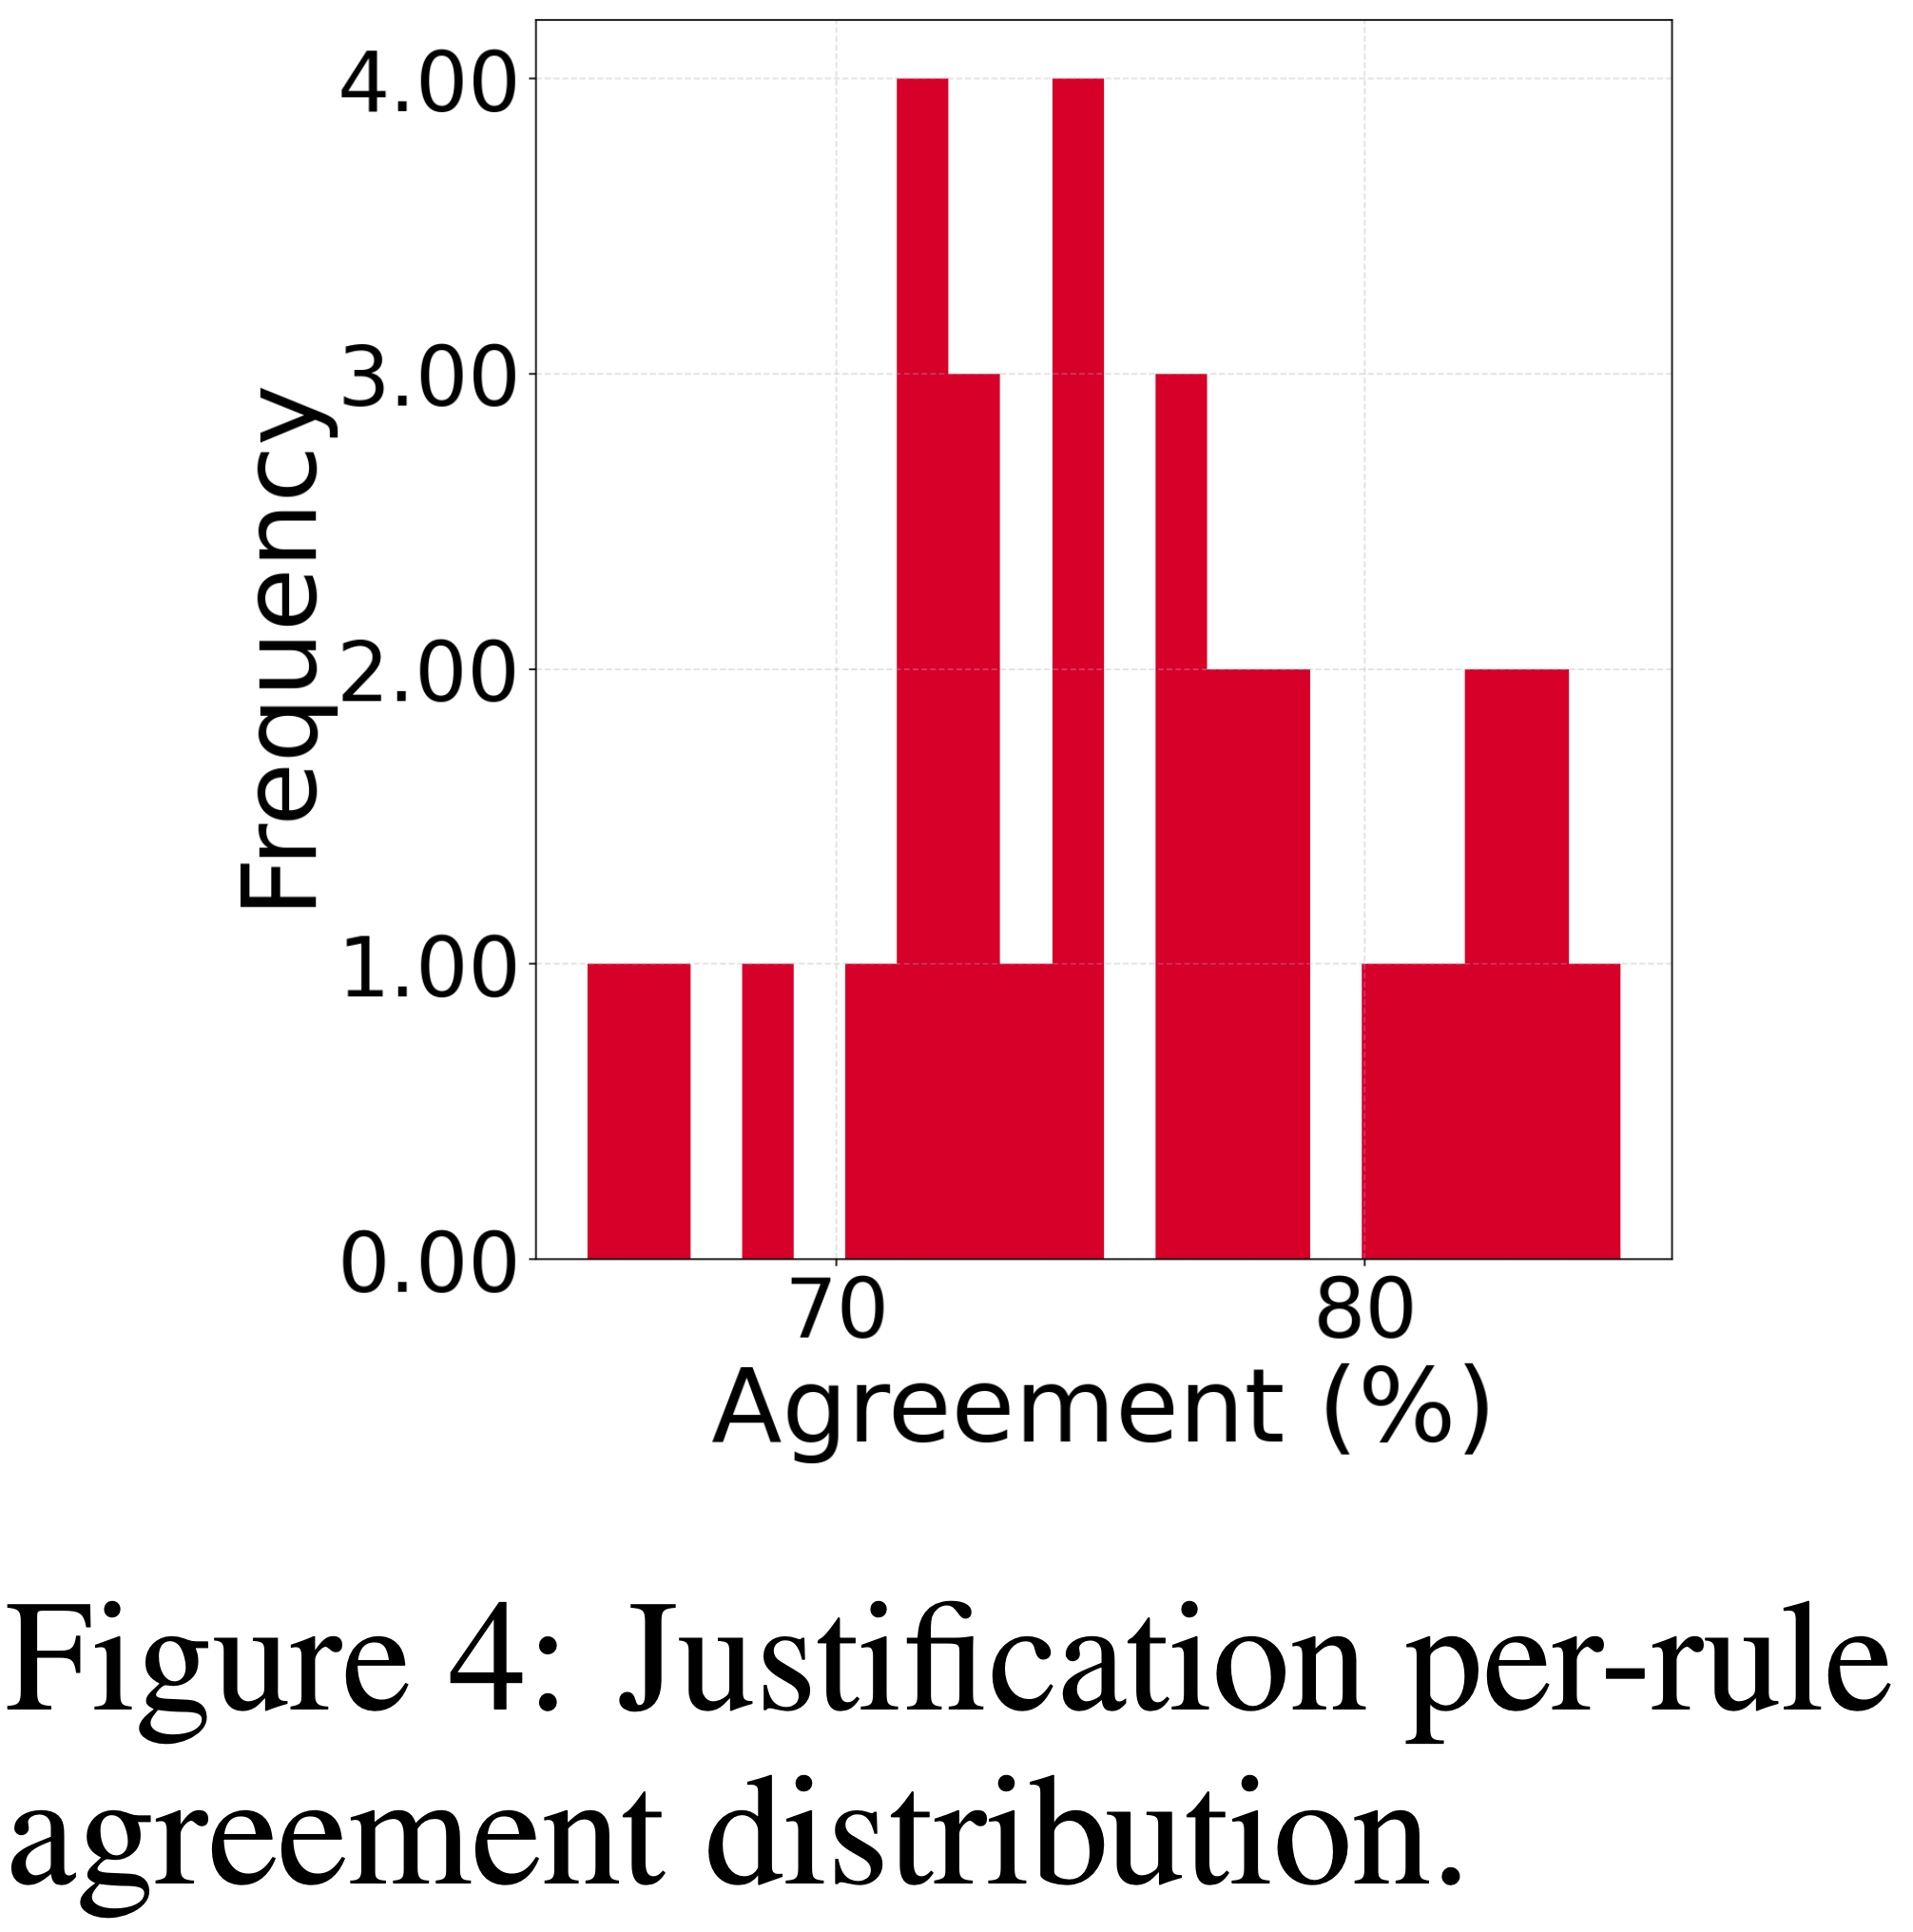
  • 图 4 展示了模型论证的单个 Rule 一致性分布
    • 虽然 Rule 一致性分布与推理链相似,但论文发现从推理链提取 Rule 仍然显著提高了 UltraFeedback 胜率和 AlpacaEval 2.0 长度控制胜率
    • 这表明推理链包含了允许提取更好 Rule 的信息
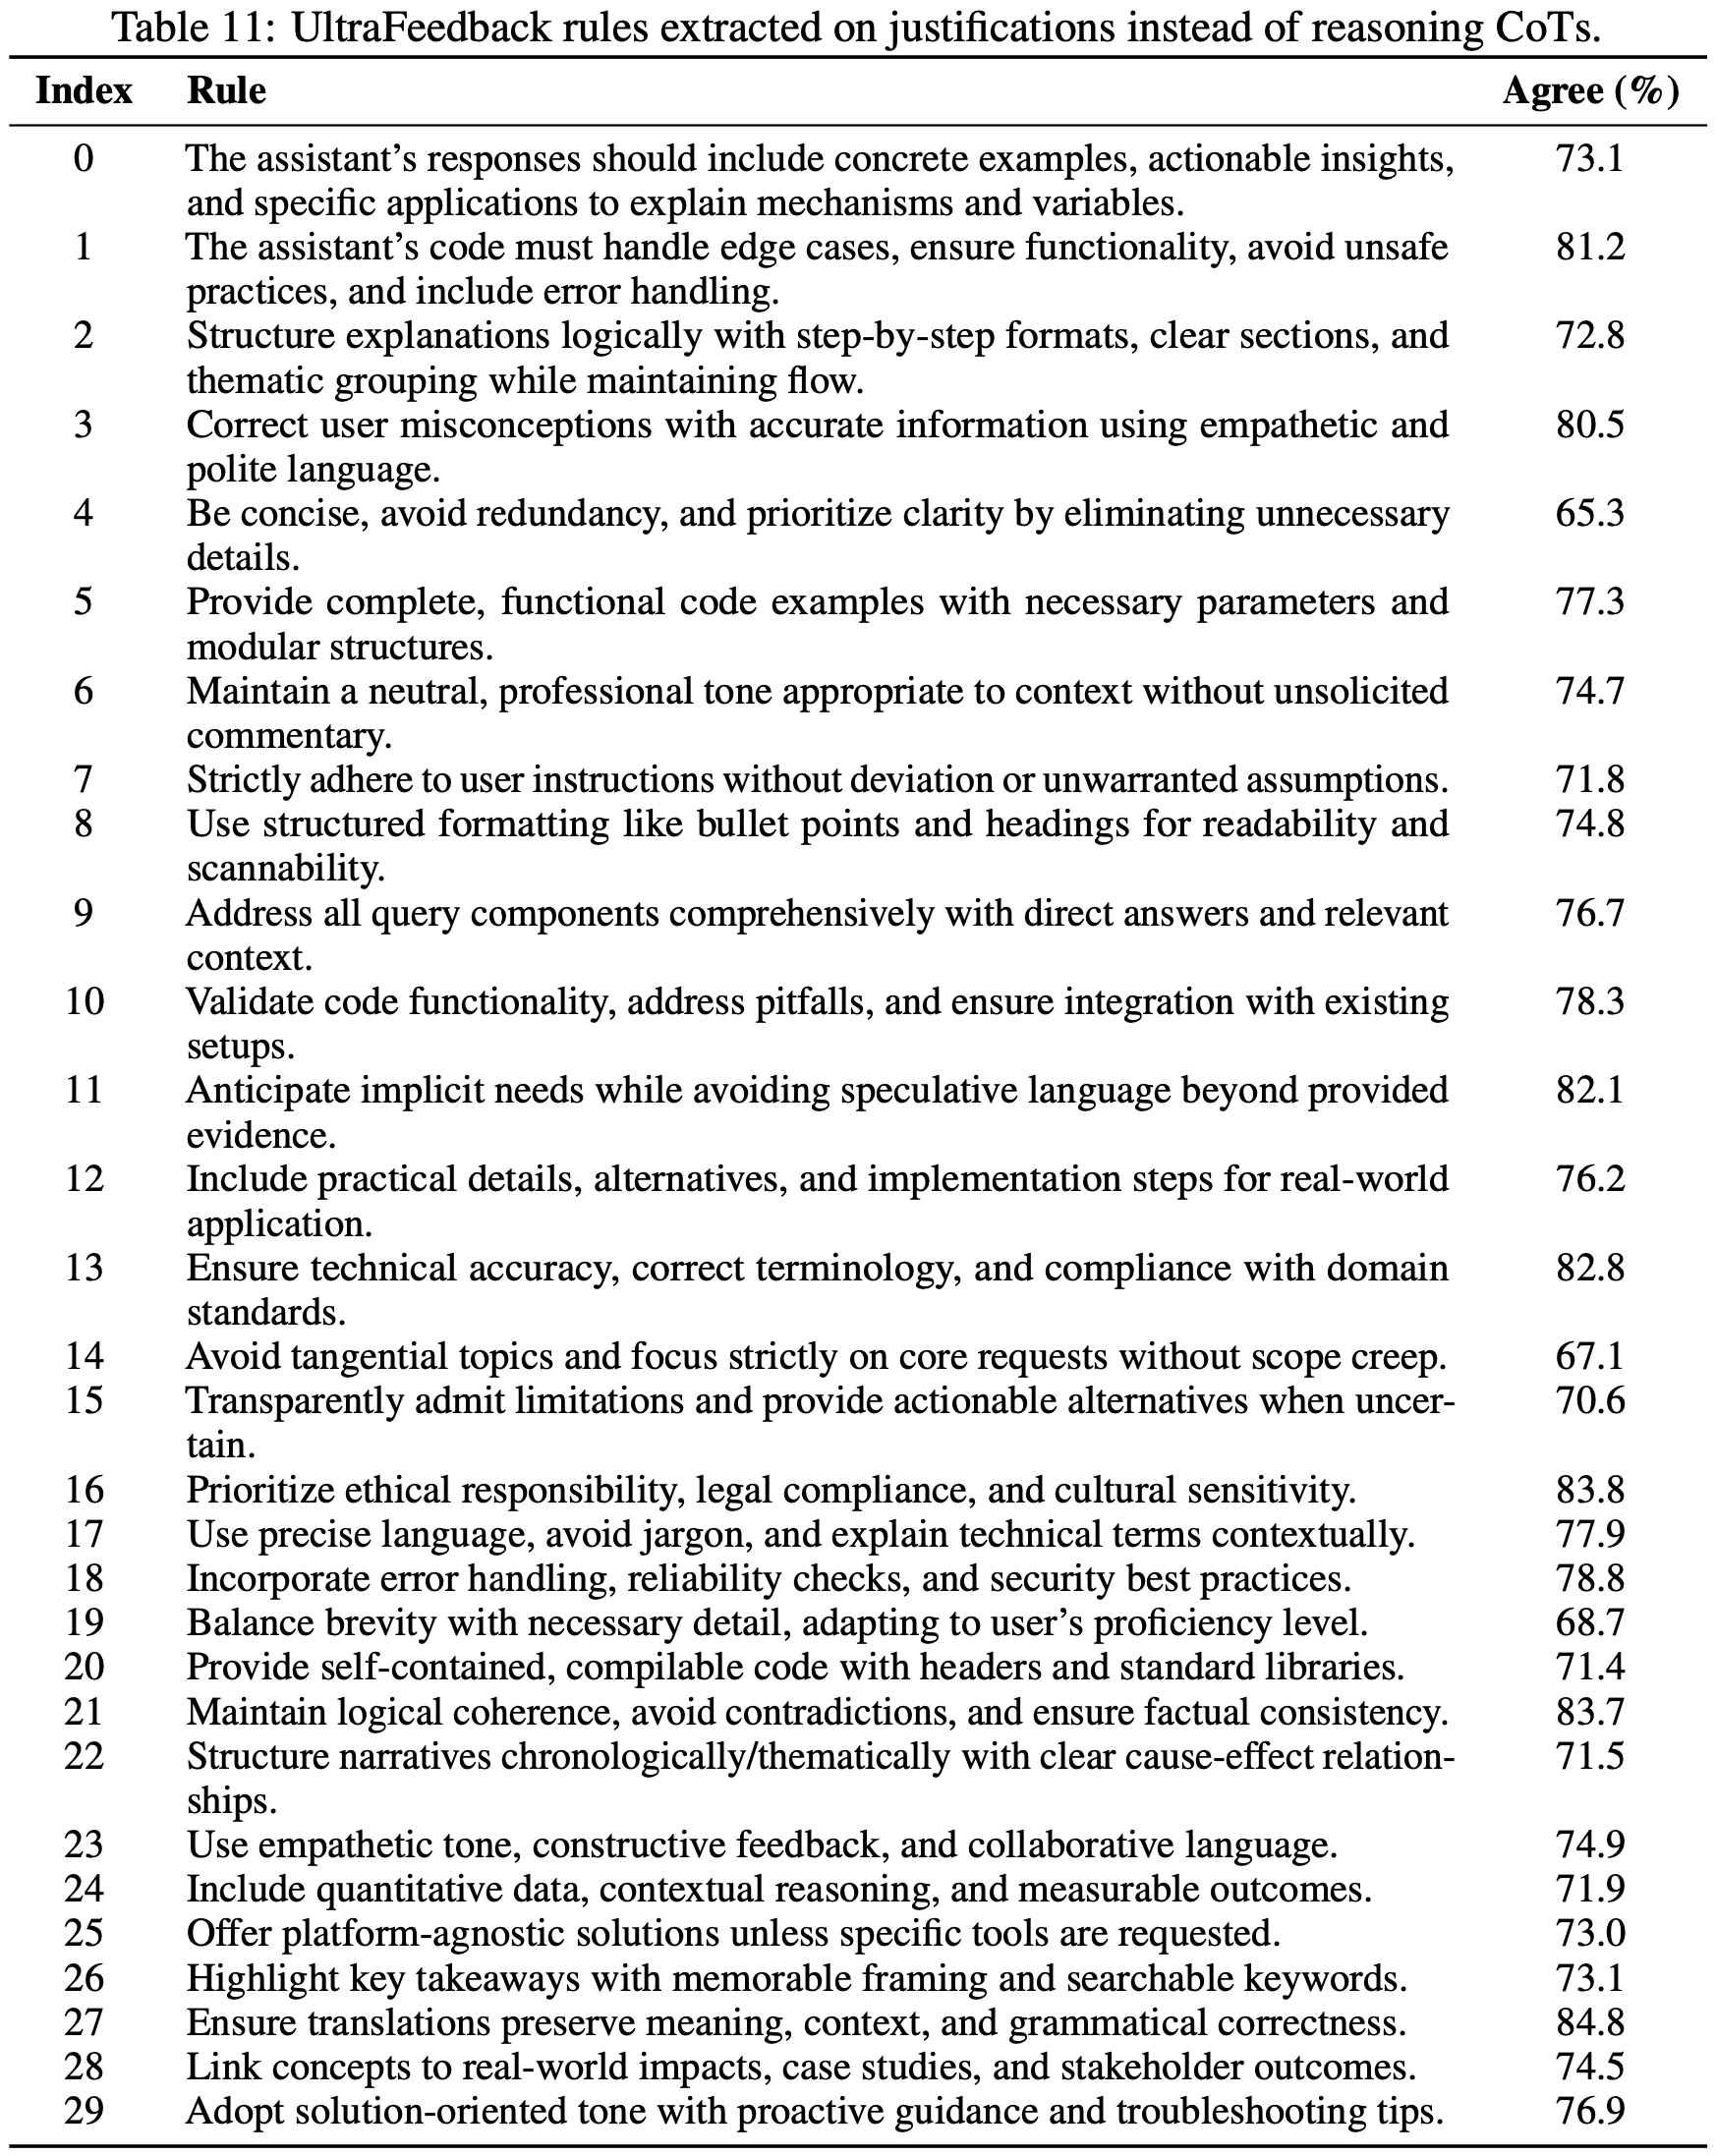
    • 论文推测这是因为推理链为 Rule 制定提供了更具体和可操作的指导,而论证往往不够详细且更泛化,导致下游性能下降,并通过附录 E 中的案例研究来论证这一点
Rule Agreements
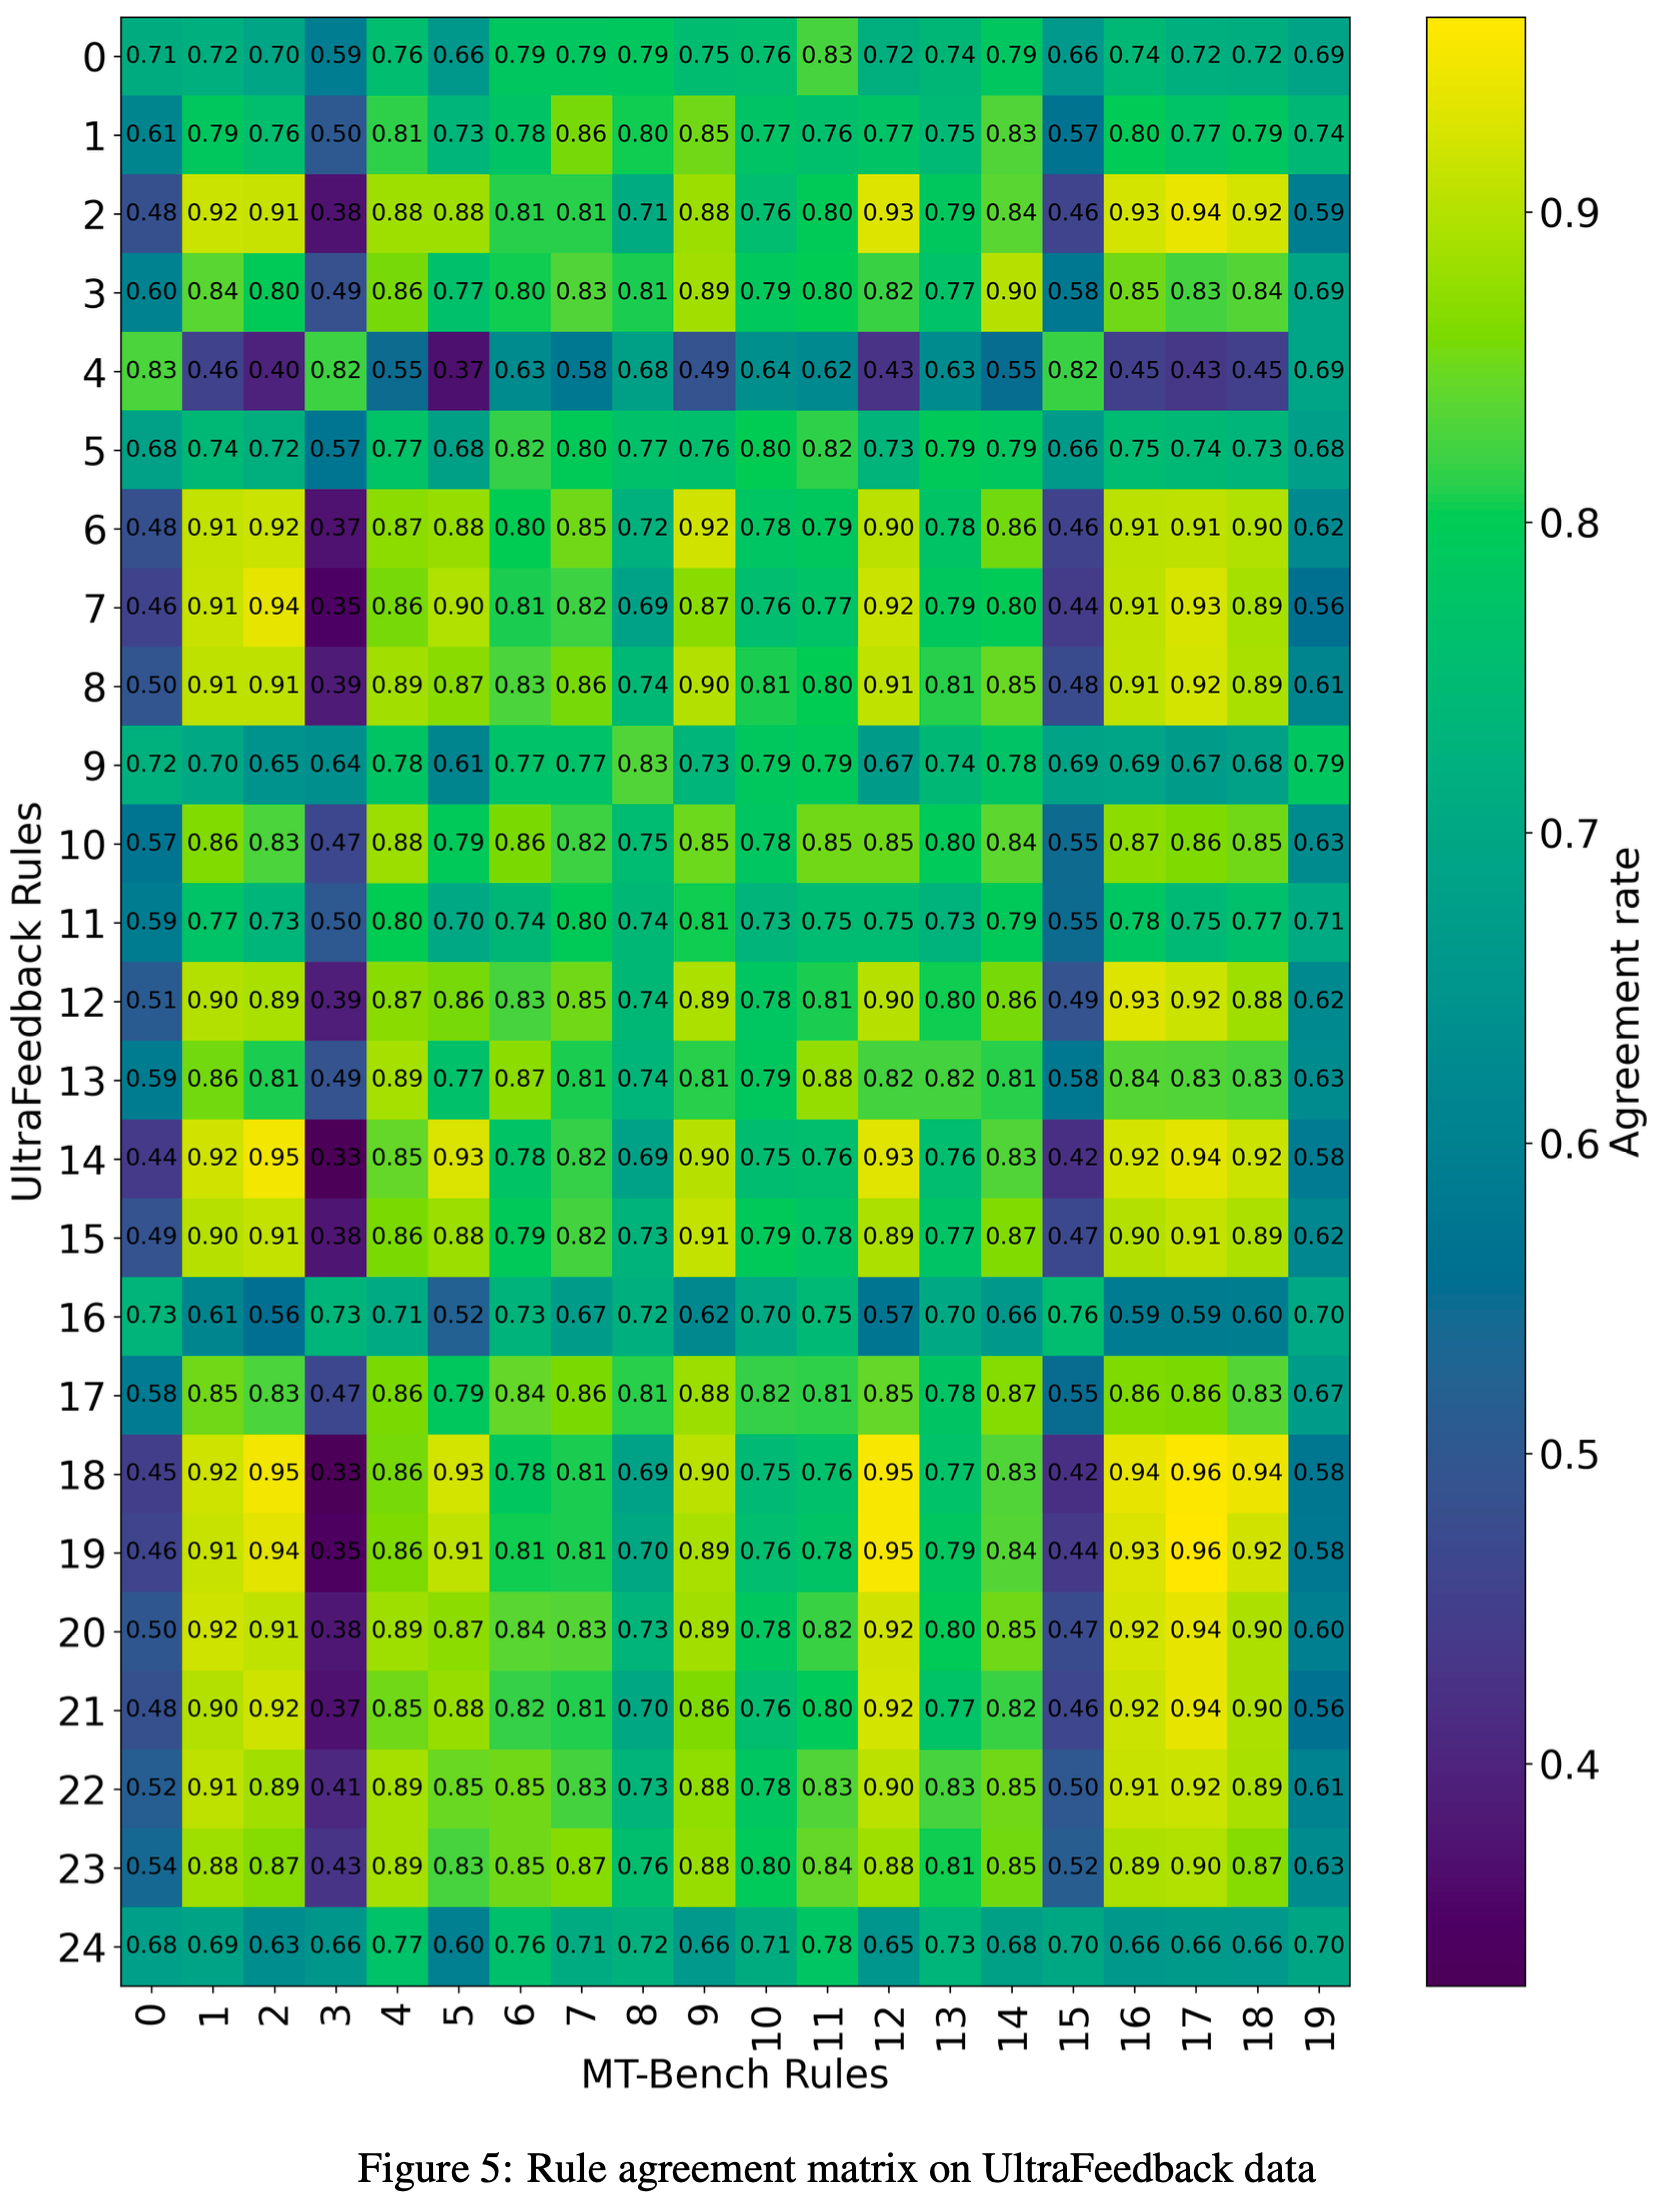
  • 为了进一步研究 Rule 提取的有效性,论文对从 UltraFeedback 和 MT-Bench 推导的 Rule 集进行了比较分析
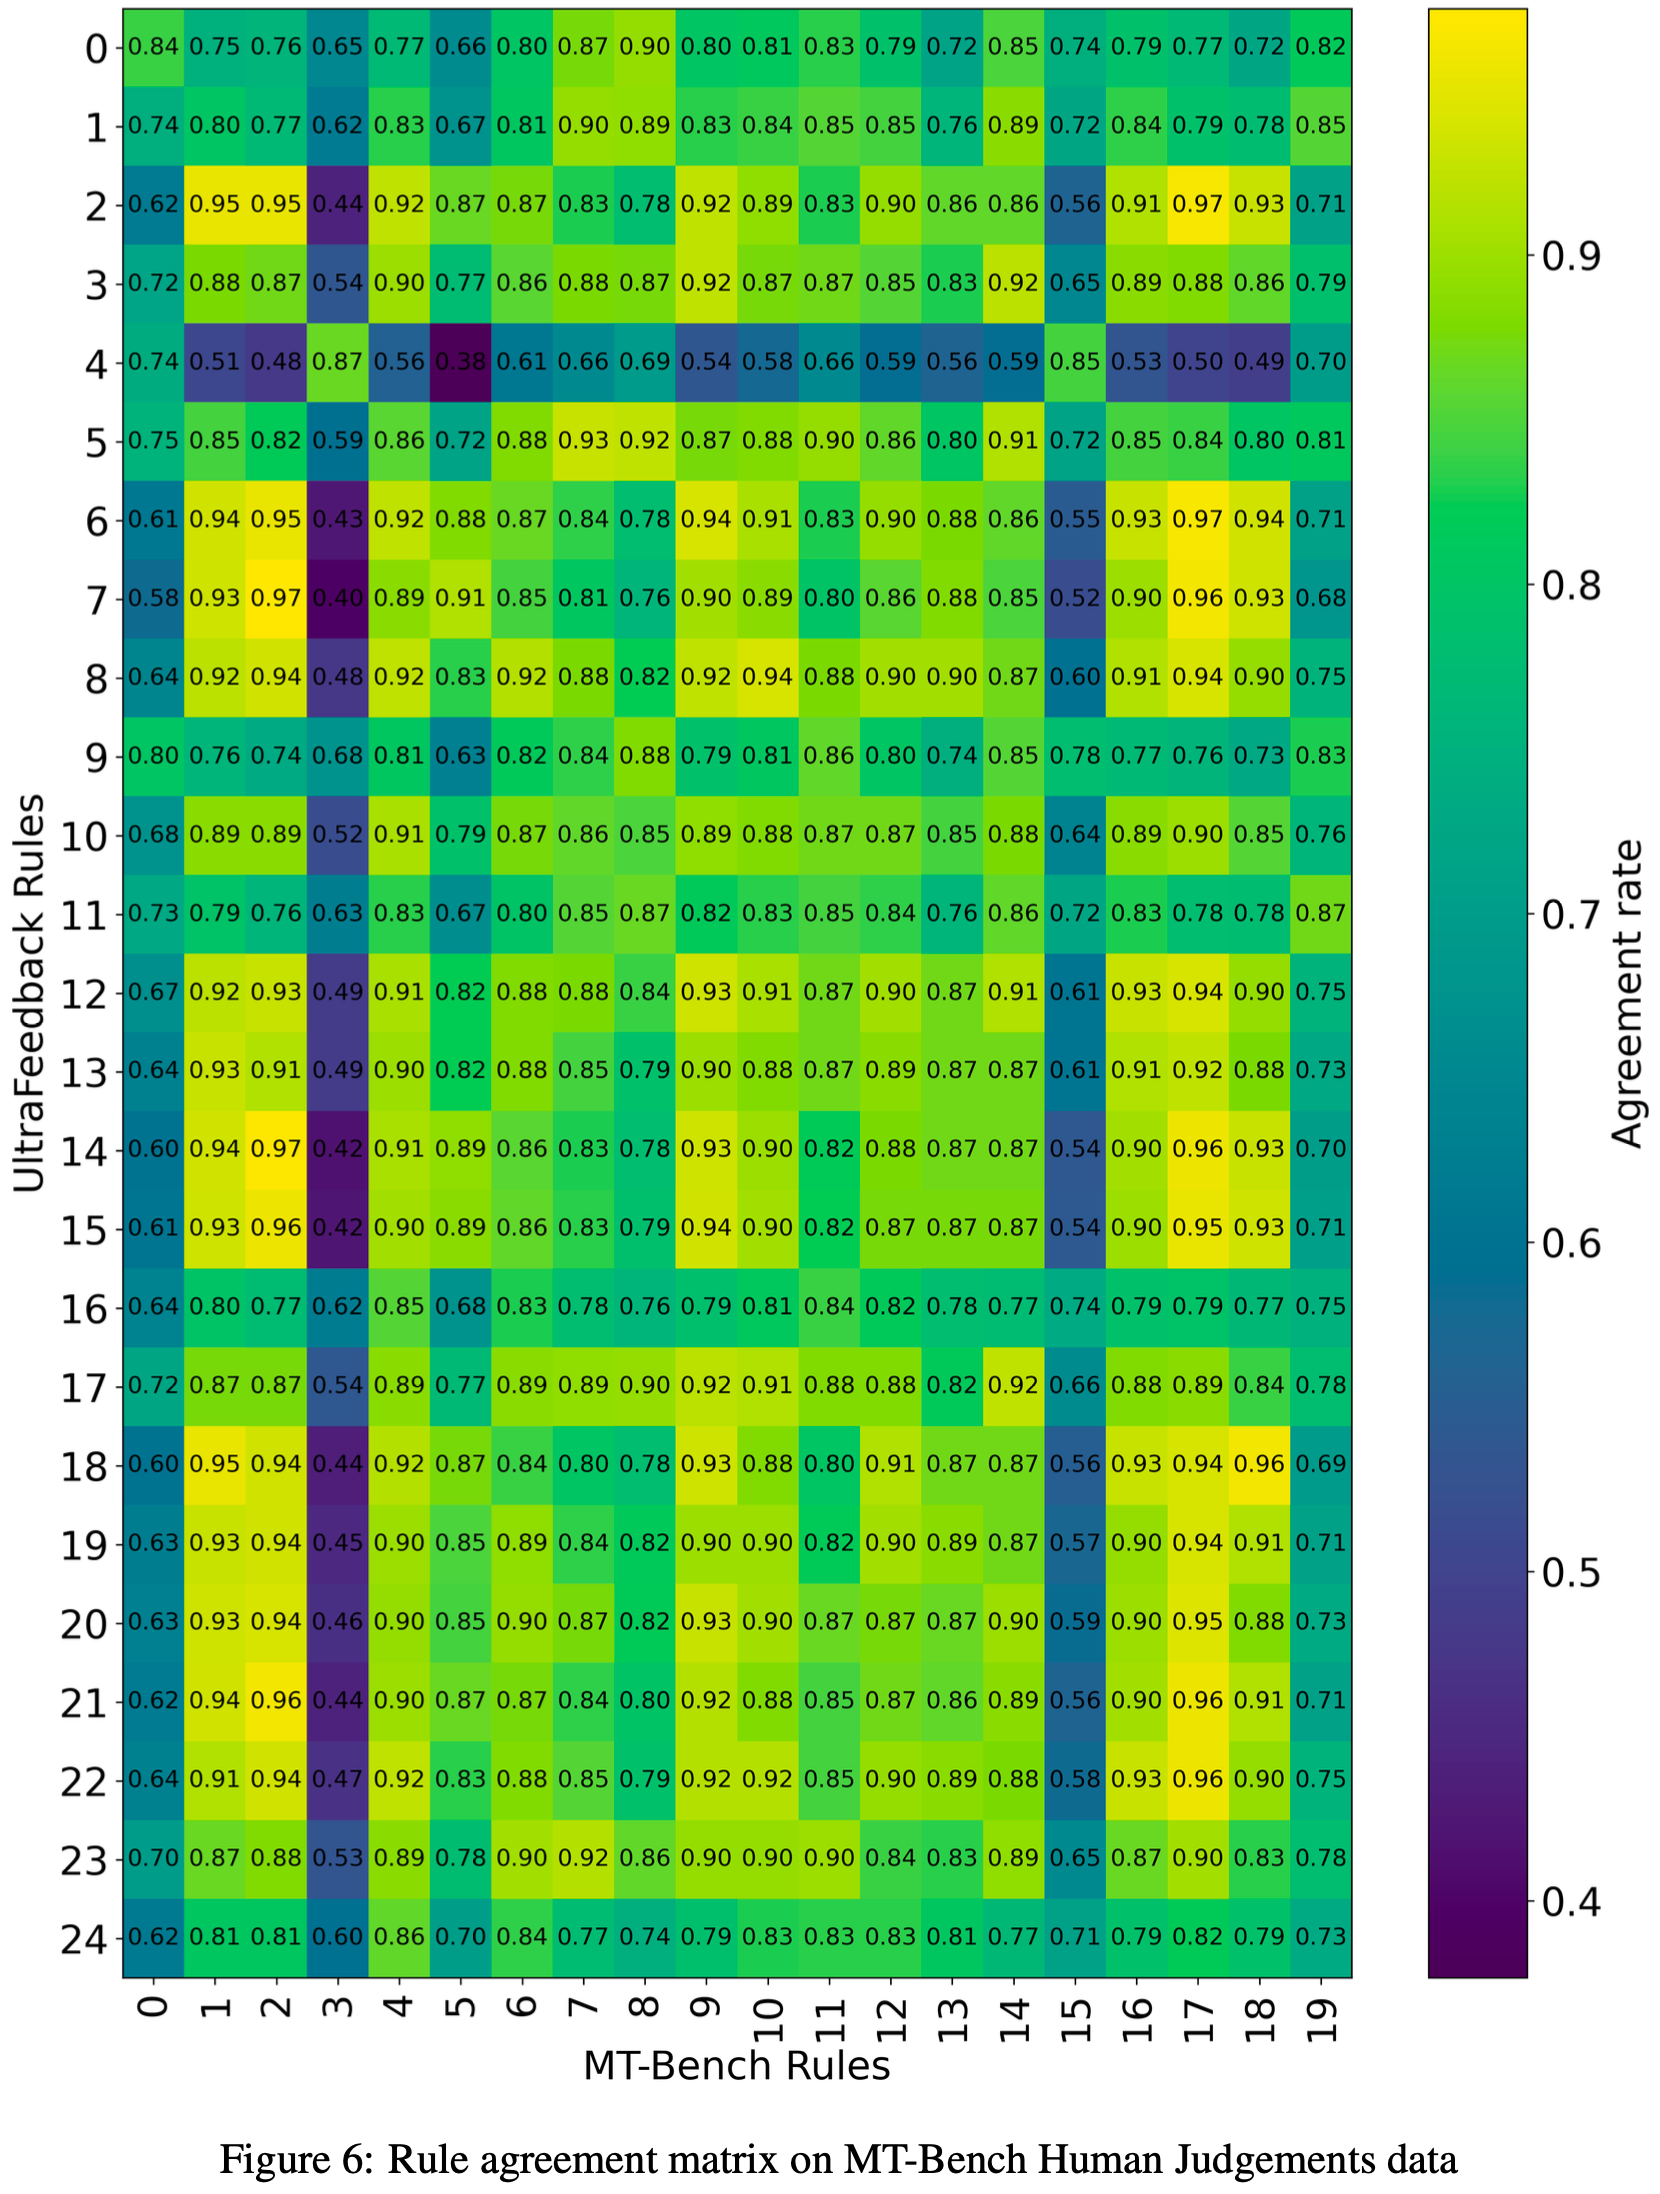
    • 具体来说,论文通过在 1,024 个 UltraFeedback 示例和完整的 MT-Bench 人工判断测试 Split 上评估所有 Rule 对,构建了一个 Rule 一致性矩阵
    • 基于此矩阵,论文根据一致性分数识别相似和独特的 Rule
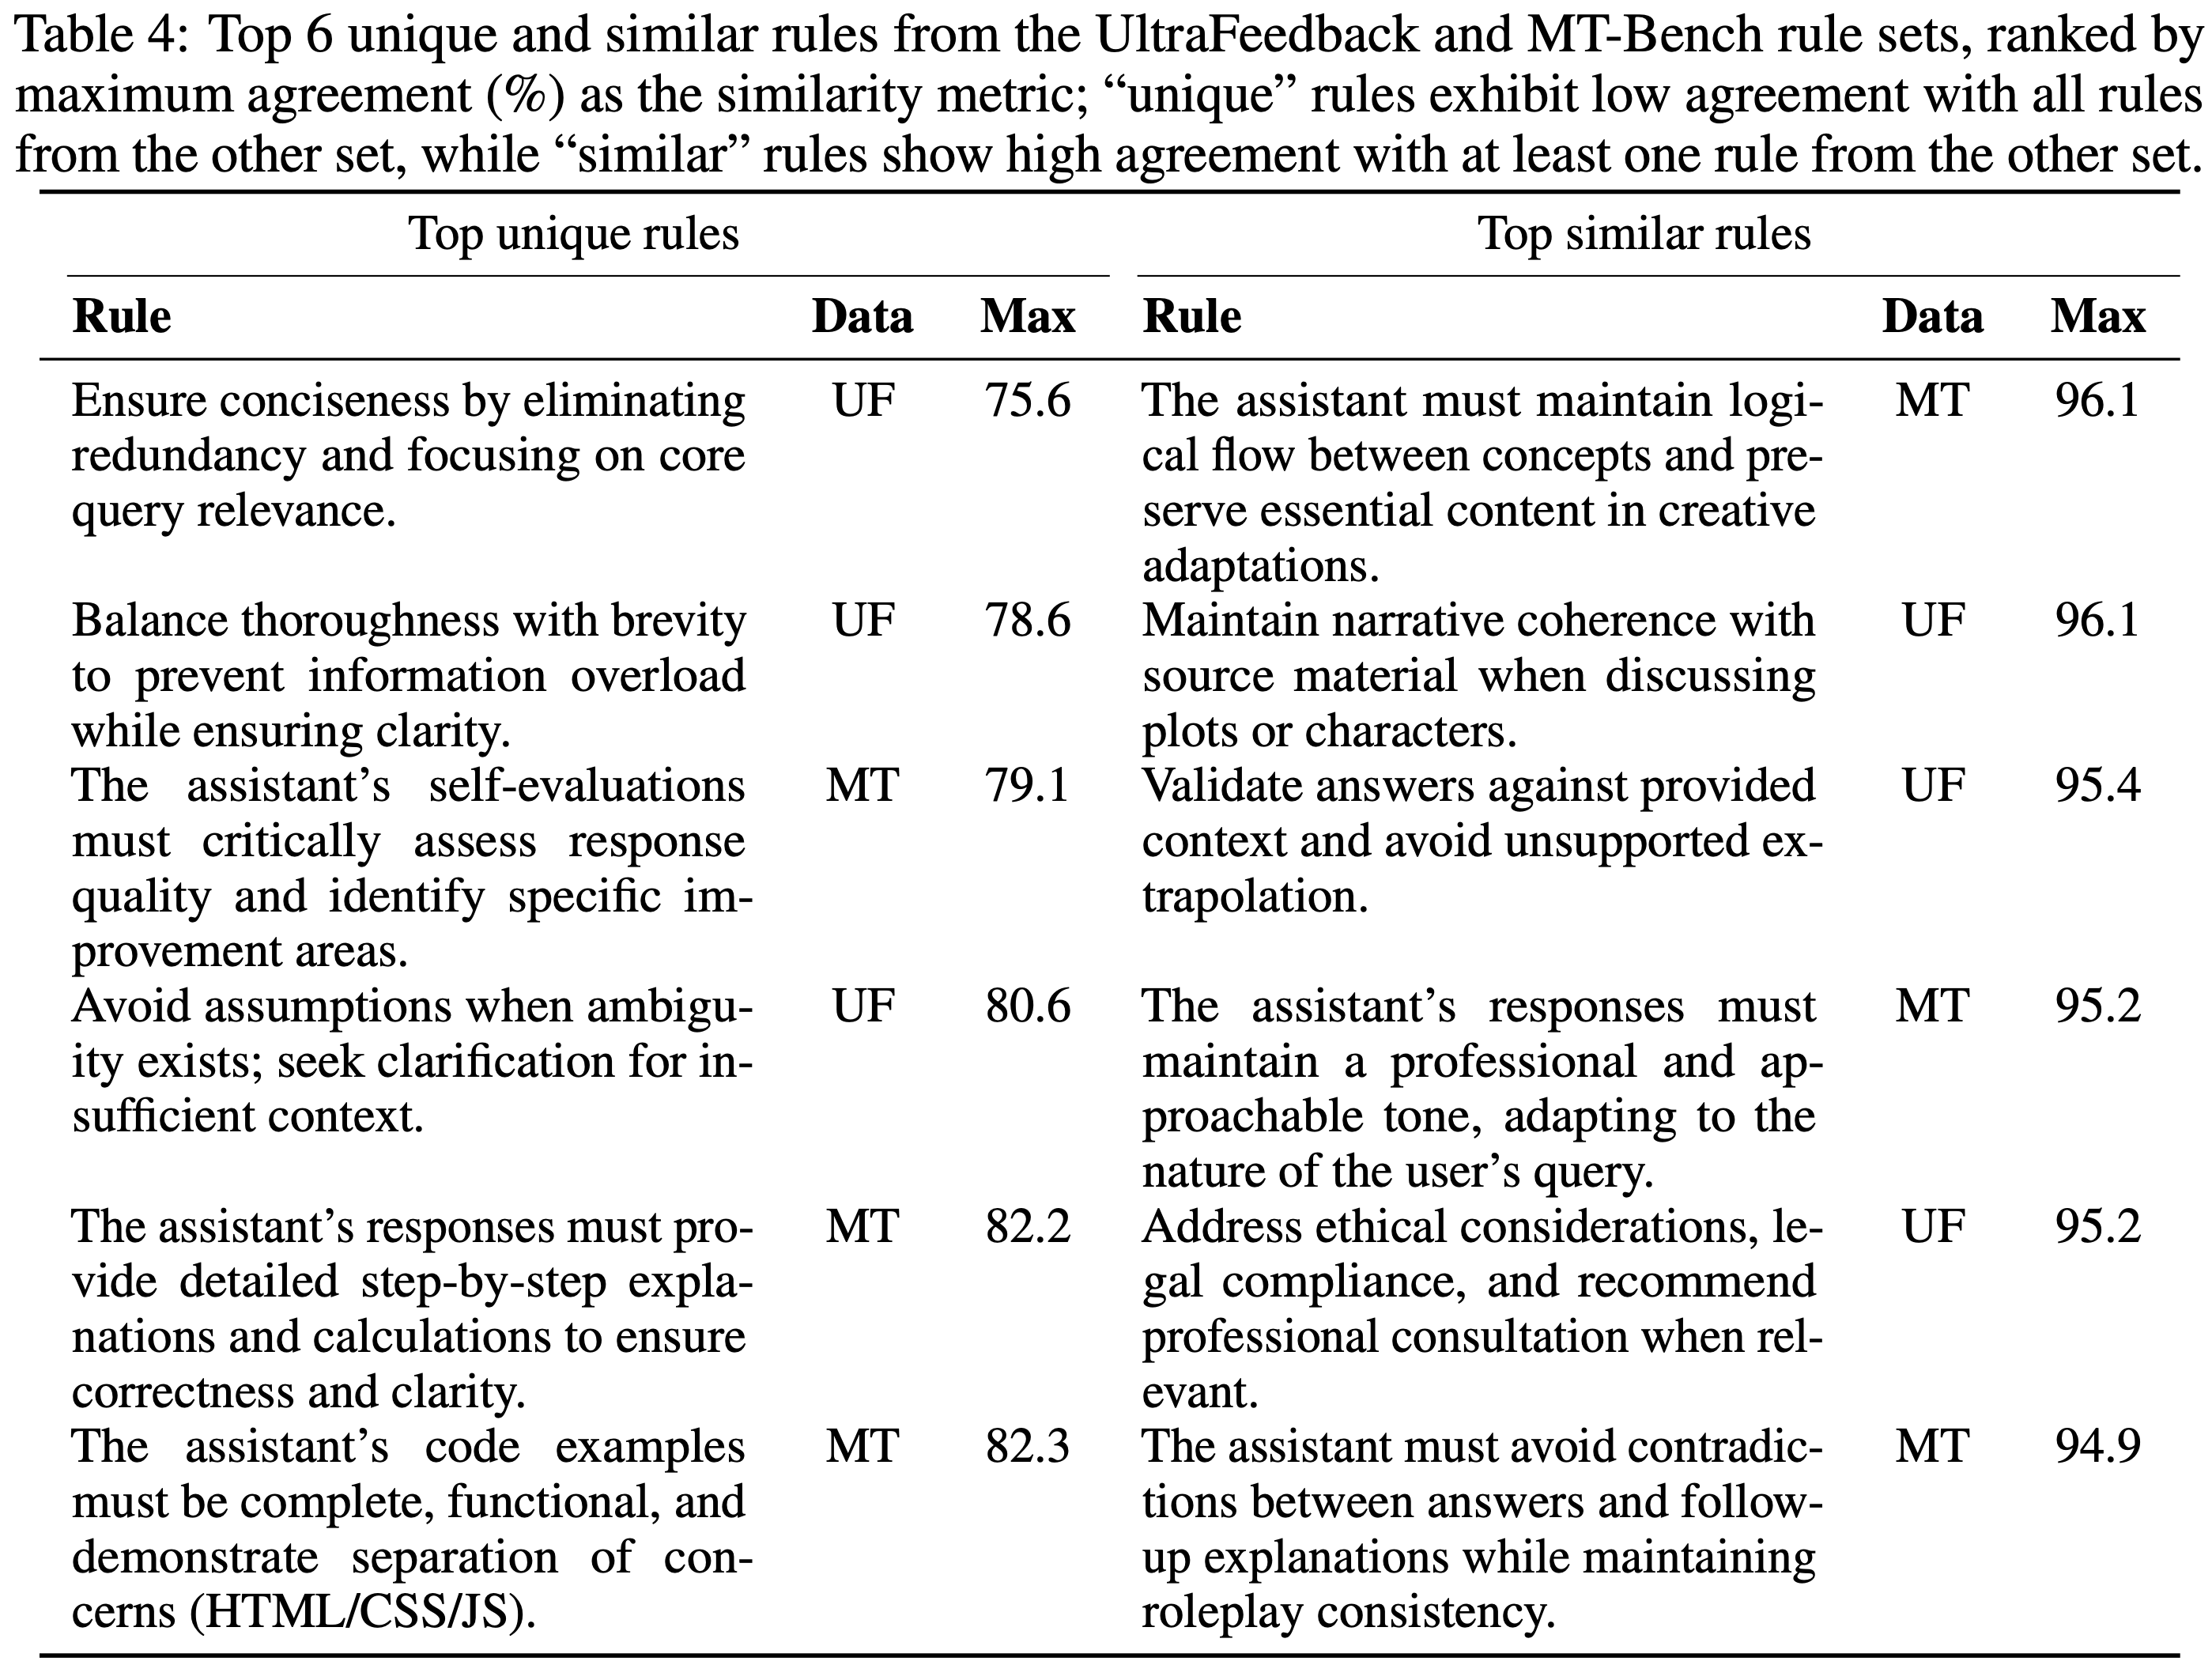
  • 表 4 分别展示了按与对立 Rule 集在 UltraFeedback 和 MT-Bench 示例上的最大 Rule 一致性排序的前六个独特 Rule 和前六个相似 Rule
    • 来自 UltraFeedback 的独特 Rule 似乎主要强调简洁性和清晰度,而来自 MT-Bench 的独特 Rule 则侧重于处理复杂任务,例如自我评估、执行计算或提供代码示例
    • 这种区别可能反映了 UltraFeedback 更广泛的主题多样性和 MT-Bench Prompt 的专业性和挑战性
    • 相比之下,两个集合之间共享的相似 Rule 始终涉及高质量助手 Response 的核心方面,包括逻辑连贯性、专业语气、上下文一致性以及答案一致性
    • 完整的 Rule 一致性矩阵在附录 D 中提供以供进一步参考

补充:Related Work

  • RLHF 是将 LLM 与人类偏好对齐的标准框架 (2022),RLHF 通常包括:
    • (1) 在人工标注的 Response 上进行监督微调;
      8 (2) 训练一个奖励模型来预测人类偏好;
    • (3) 强化学习,通常通过近端策略优化 (2017),使用奖励模型作为优化信号
  • 最近的工作探索了 RL 阶段更高效的方法,例如直接偏好优化 (2023),它消除了奖励模型,以及组相对策略优化 (2024),它使用来自输出组的相对奖励
  • 在使用学习到的奖励模型的 RLHF 中,一个有据可查的(Well-documented)挑战是 Reward Hacking (2022, 2023, 2023)
    • 即模型利用奖励模型的特性获得高奖励,而并未真正改善 Response 质量
    • For Example,Miao 等人 (2024) 发现奖励模型可能过拟合于浅层特征,如 Response 长度,这些特征并不能推广到人类偏好的真实分布
    • 支持这一点的是,Singhal 等人 (2024) 表明,在 PPO 期间仅针对 Response 长度进行优化可以获得与使用学习到的奖励模型相当的性能,这表明奖励模型常常捕捉简单的启发式方法,而非 Response 质量中更细微的方面
  • 已经提出了几种策略来减轻 Reward Hacking ,包括修改奖励模型架构和调整奖励缩放
    • ODIN (2024) 增加了一个辅助长度预测头以”解耦”长度与其他特征
      • 注:这个方法不错,其实值的参考,应该会有一定的收益
    • 奖励塑造方法,如 PAR (2025) 和 LSC (2024),应用以参考模型输出或百分位数为中心的 sigmoid 或 log-sigmoid 变换
    • 其他方法利用多个奖励模型:WARM (2024) 平均多个奖励模型的输出以减少过度优化,而 ArmoRM (2024) 使用门控机制组合可解释的奖励目标
  • 一种日益增长的减轻 Reward Hacking 的策略是采用 Rule-based 奖励目标,尤其是在大规模工业 LLM 部署中
    • 例如,DeepSeek 在 DeepSeek-R1 (2025) 的训练后阶段使用了 Rule-based 奖励 ,明确优先考虑 Rule-based 标准而非学习到的奖励模型以减少 Reward Hacking
    • 他们的方法包含两种奖励:
      • 准确度奖励,评估 Response 是否正确并遵循指定格式;
      • 格式奖励,鼓励模型在指定的”think”标签内呈现其推理链
    • 理解:这里说的其实就是 DeepSeek-R1 中数学等场景所说的 RLVR,不是在开放领域的 Rubrics
  • 在偏好优化领域,已有一些工作探索了 Rule-based 目标,但由于人类偏好的不透明性,识别合适的 Rule 具有挑战性
    • Anthropic 的 Constitutional AI (2022) 使用了一套精心策划的宪法(Constitutional)原则来指导 Response 修订和偏好判断,但这些并未直接用作标量奖励
    • DeepMind 的 Sparrow (2022) 采用研究人员设计的行为 Rule ,从人类评估者那里收集 Rule 违反标注来训练一个专门的 Rule 奖励模型
    • 通过同时使用 Rule-based 和基于偏好的奖励优化策略,Sparrow 实现了 Rule 违反的减少
    • OpenAI 也研究了用于安全对齐的 Rule-based 奖励,将策略 Rule 分解为简单命题,并使用它们作为拟合线性模型中的特征,在 RL 期间构建奖励信号 (2024)
  • 尽管有用,但构建有效的 Rule 集成本高昂,需要重要的领域专业知识,并且通常需要针对具体场景进行定制
    • 因此,偏好学习中的 Rule-based 方法在工业界仍然主要是专有的,学术研究中公开可用的 Rule 集很少

附录 A: Discussion

A.1 Limitations

  • 虽然论文的方法在从 UltraFeedback 到 AlpacaEval 2.0 的泛化方面表现出良好的前景,但未来还需要进一步工作来评估 AutoRule 在更广泛任务和领域间的迁移能力
  • 此外,建立一个形式化的理论框架,以更好地理解和改进像 AutoRule 这样的 Rule-based 方法缓解 reward hacking 的机制,仍然是未来研究的重要方向

Broader Impacts

  • 这项工作有潜力通过缓解基于奖励模型的方法中常见的过优化和特质问题,推动开发更有帮助且更不易产生有害行为的对话智能体
  • Rule-based 框架所提供的可解释性增强了透明度,使研究人员和从业者能够更好地理解和审视支配 LLM 的对齐机制

附录 B: Additional experiment details

B.1 Training settings

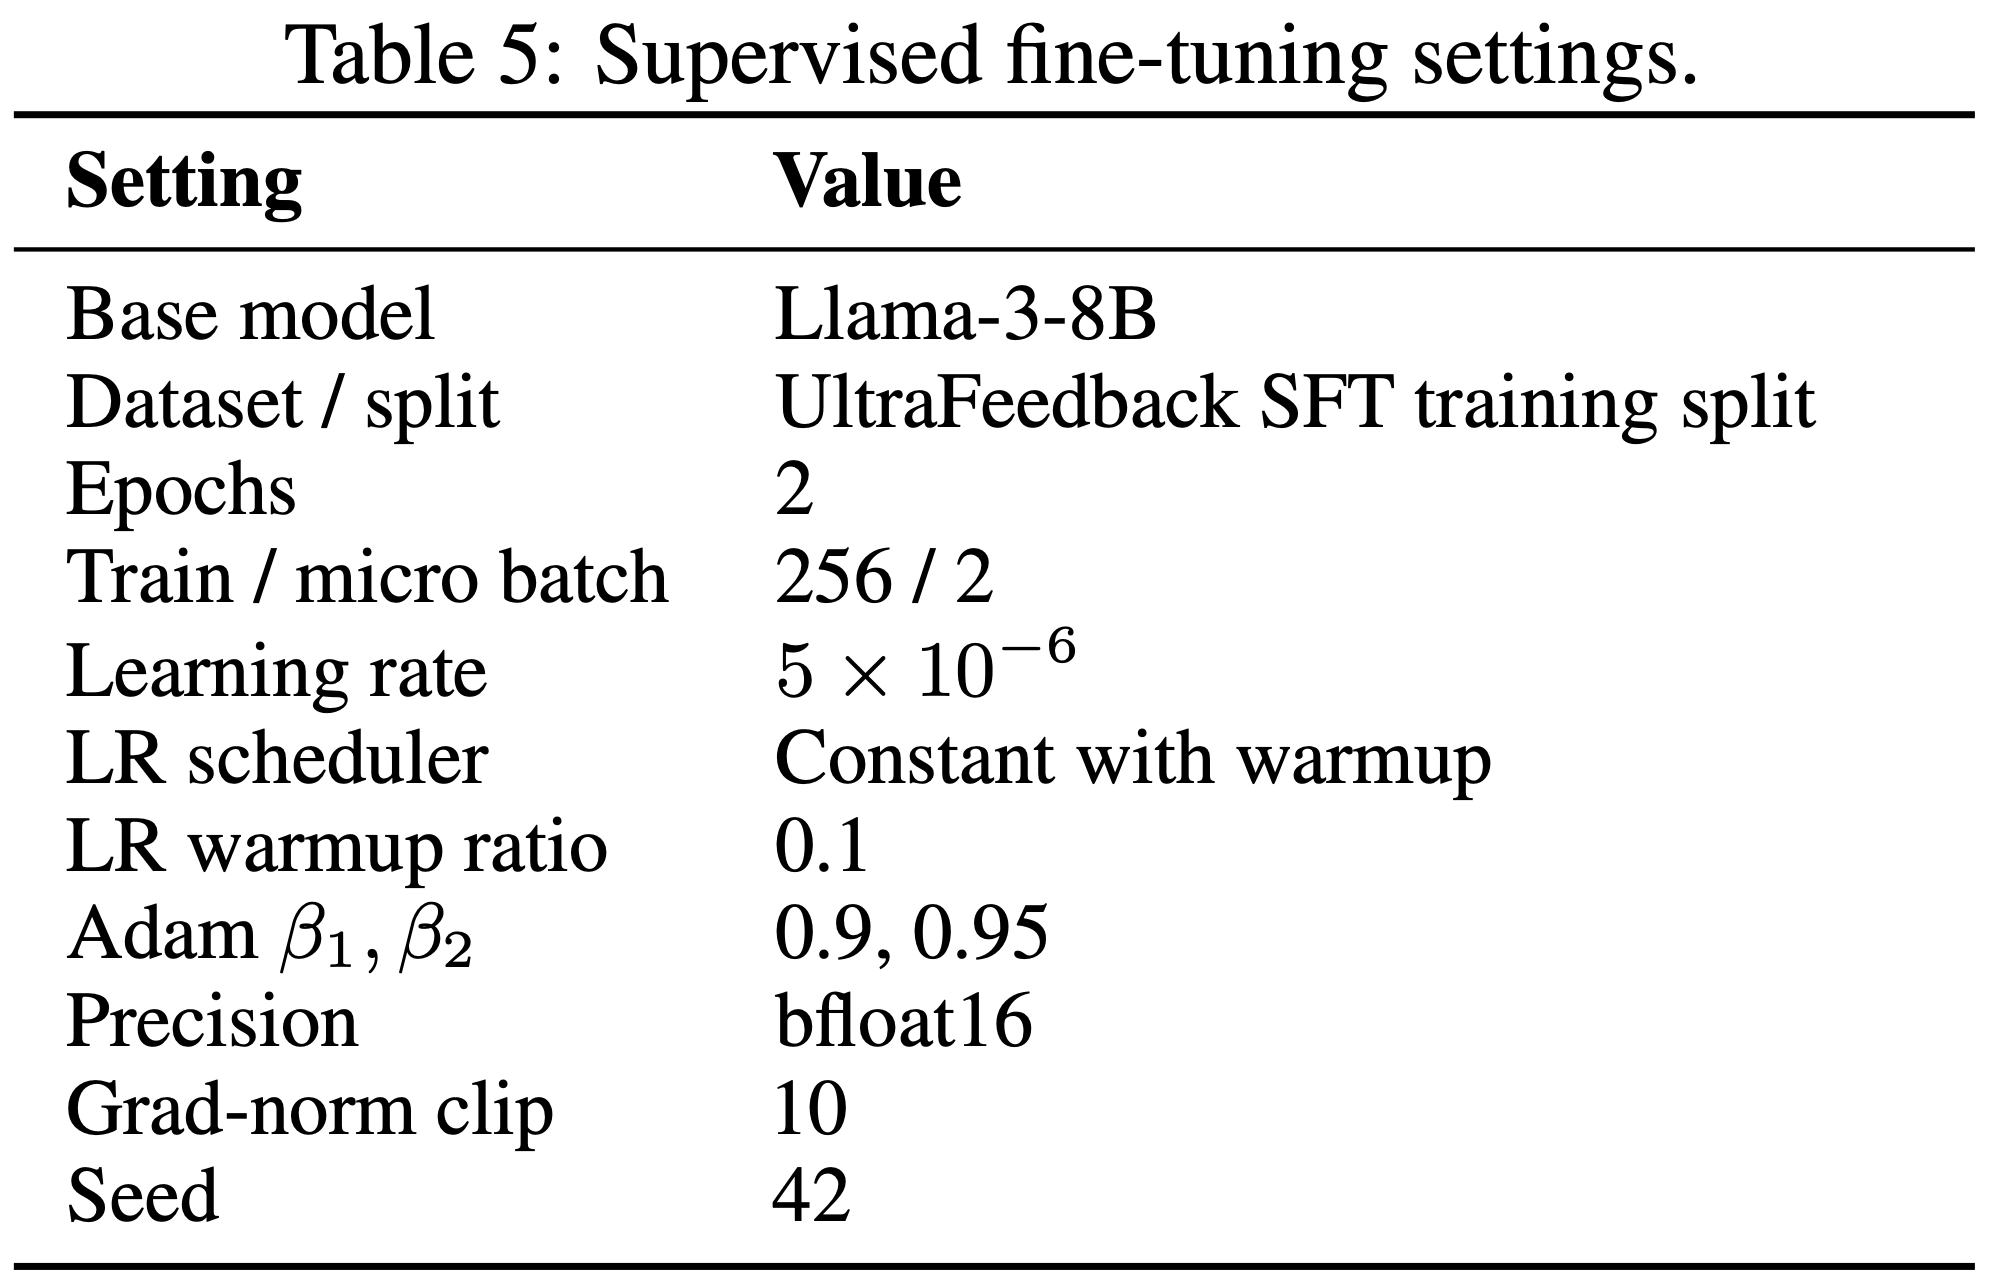
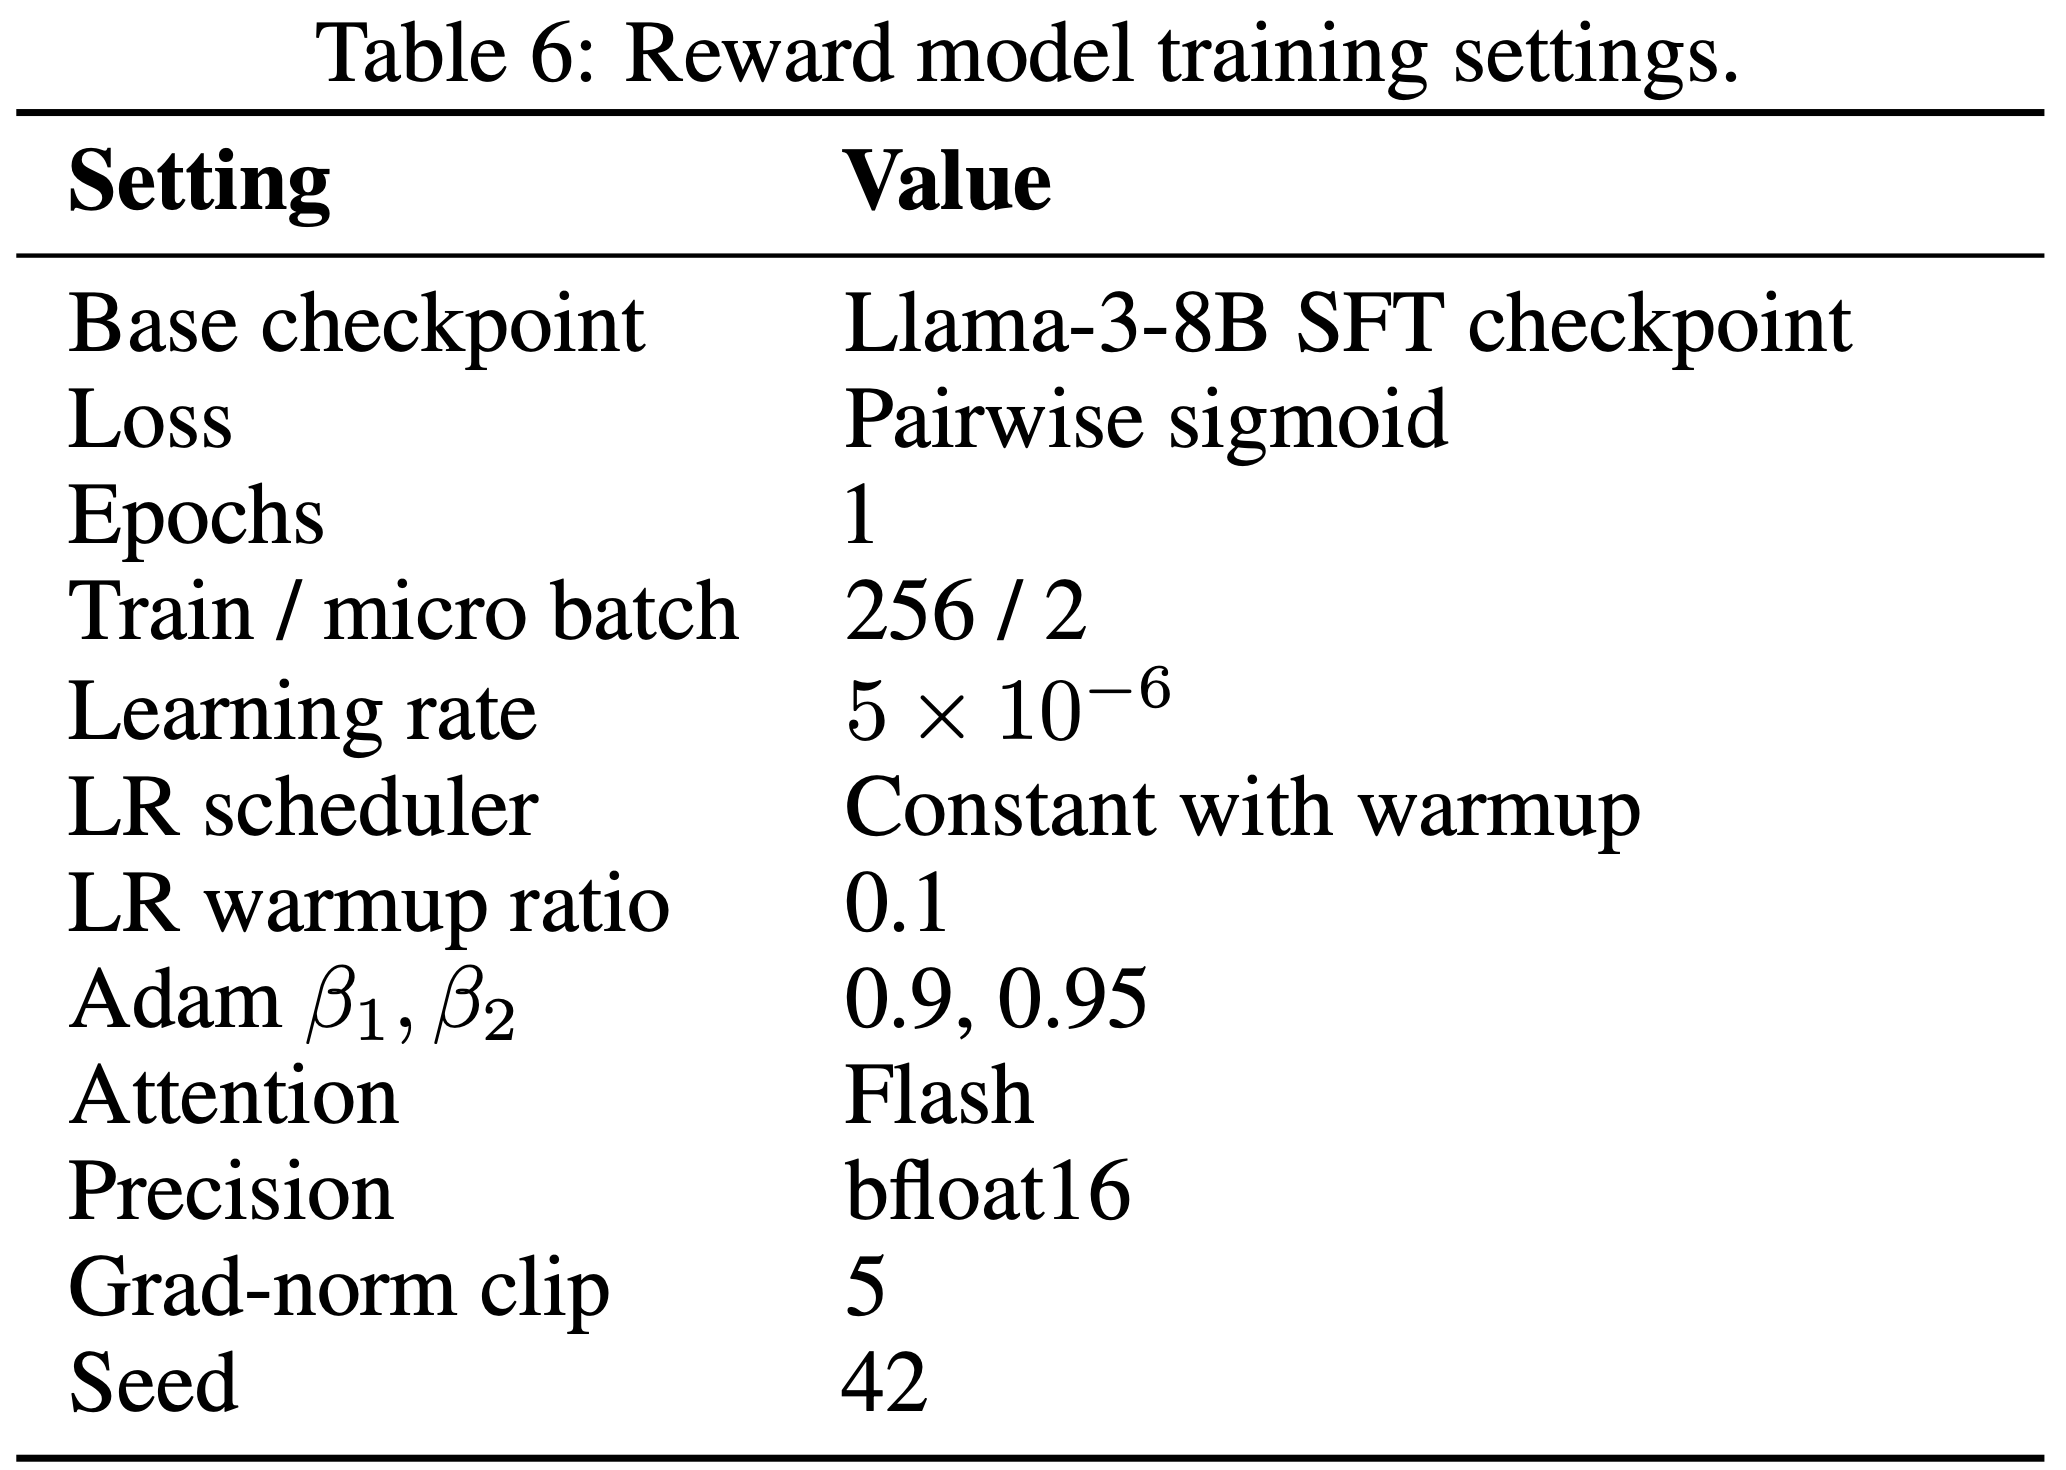
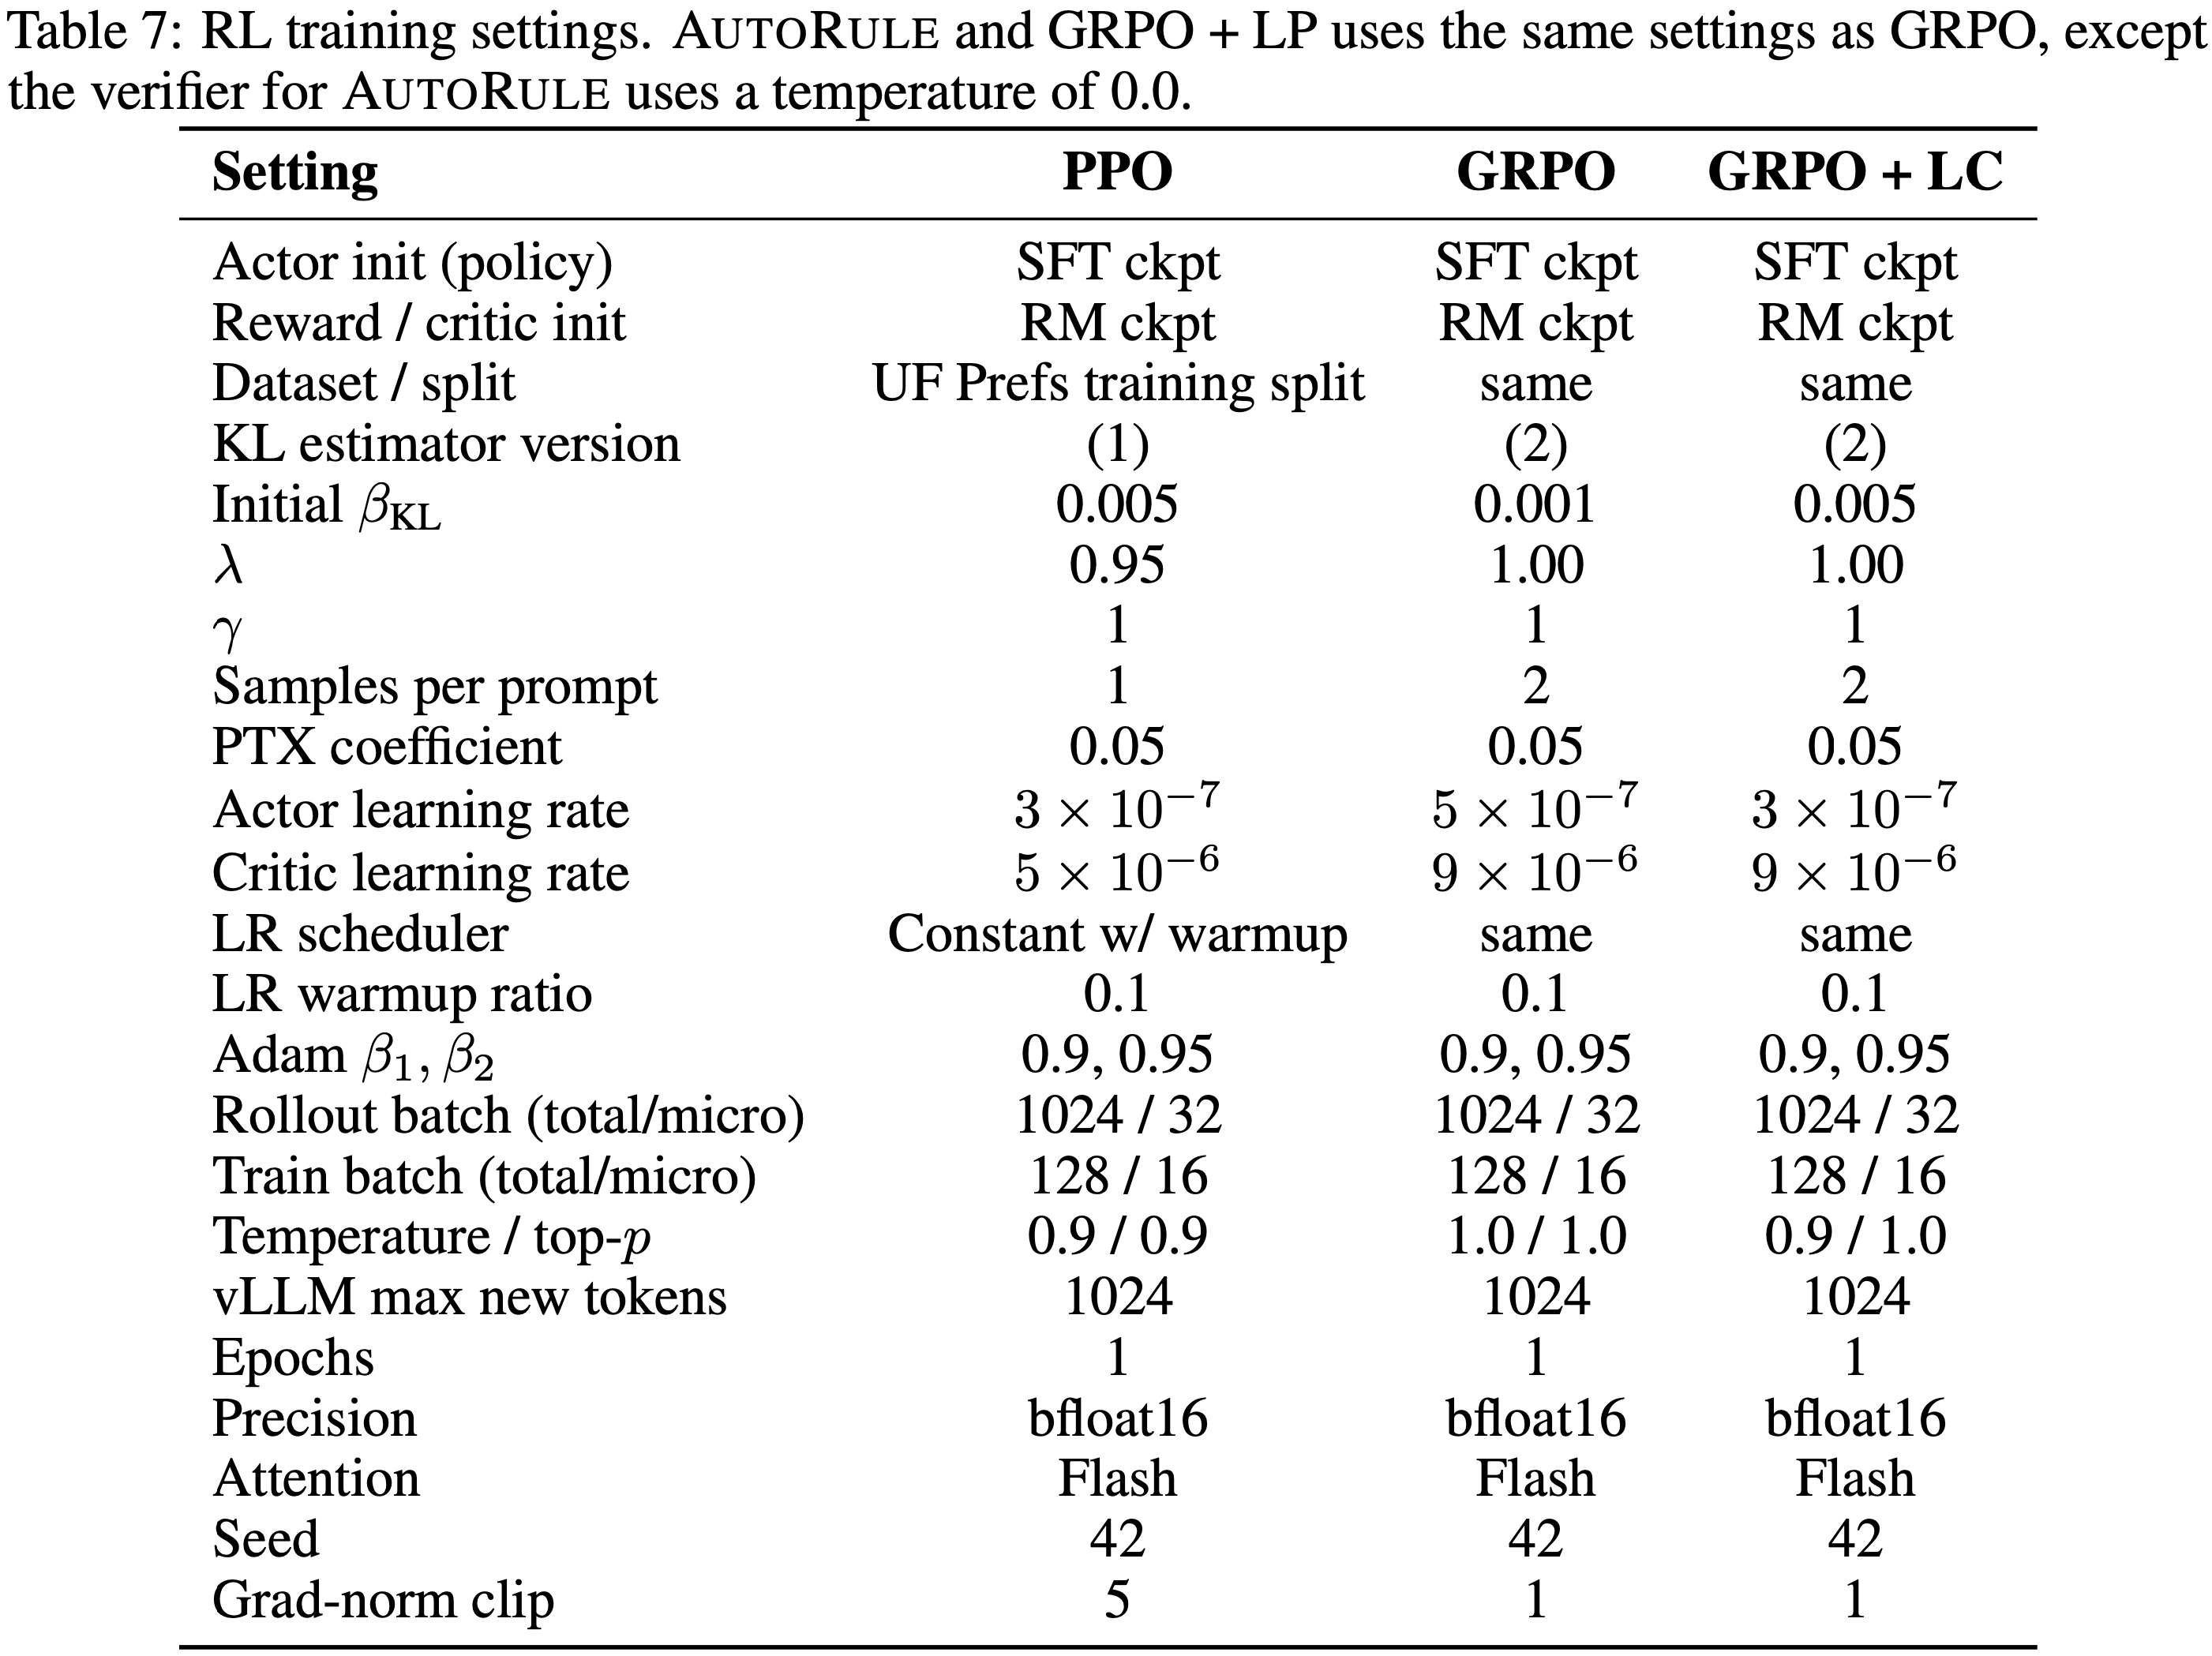
  • 用于 SFT、奖励模型和 RL 训练的设置分别见表 5、表 6 和表 7

B.2 Inference parameters

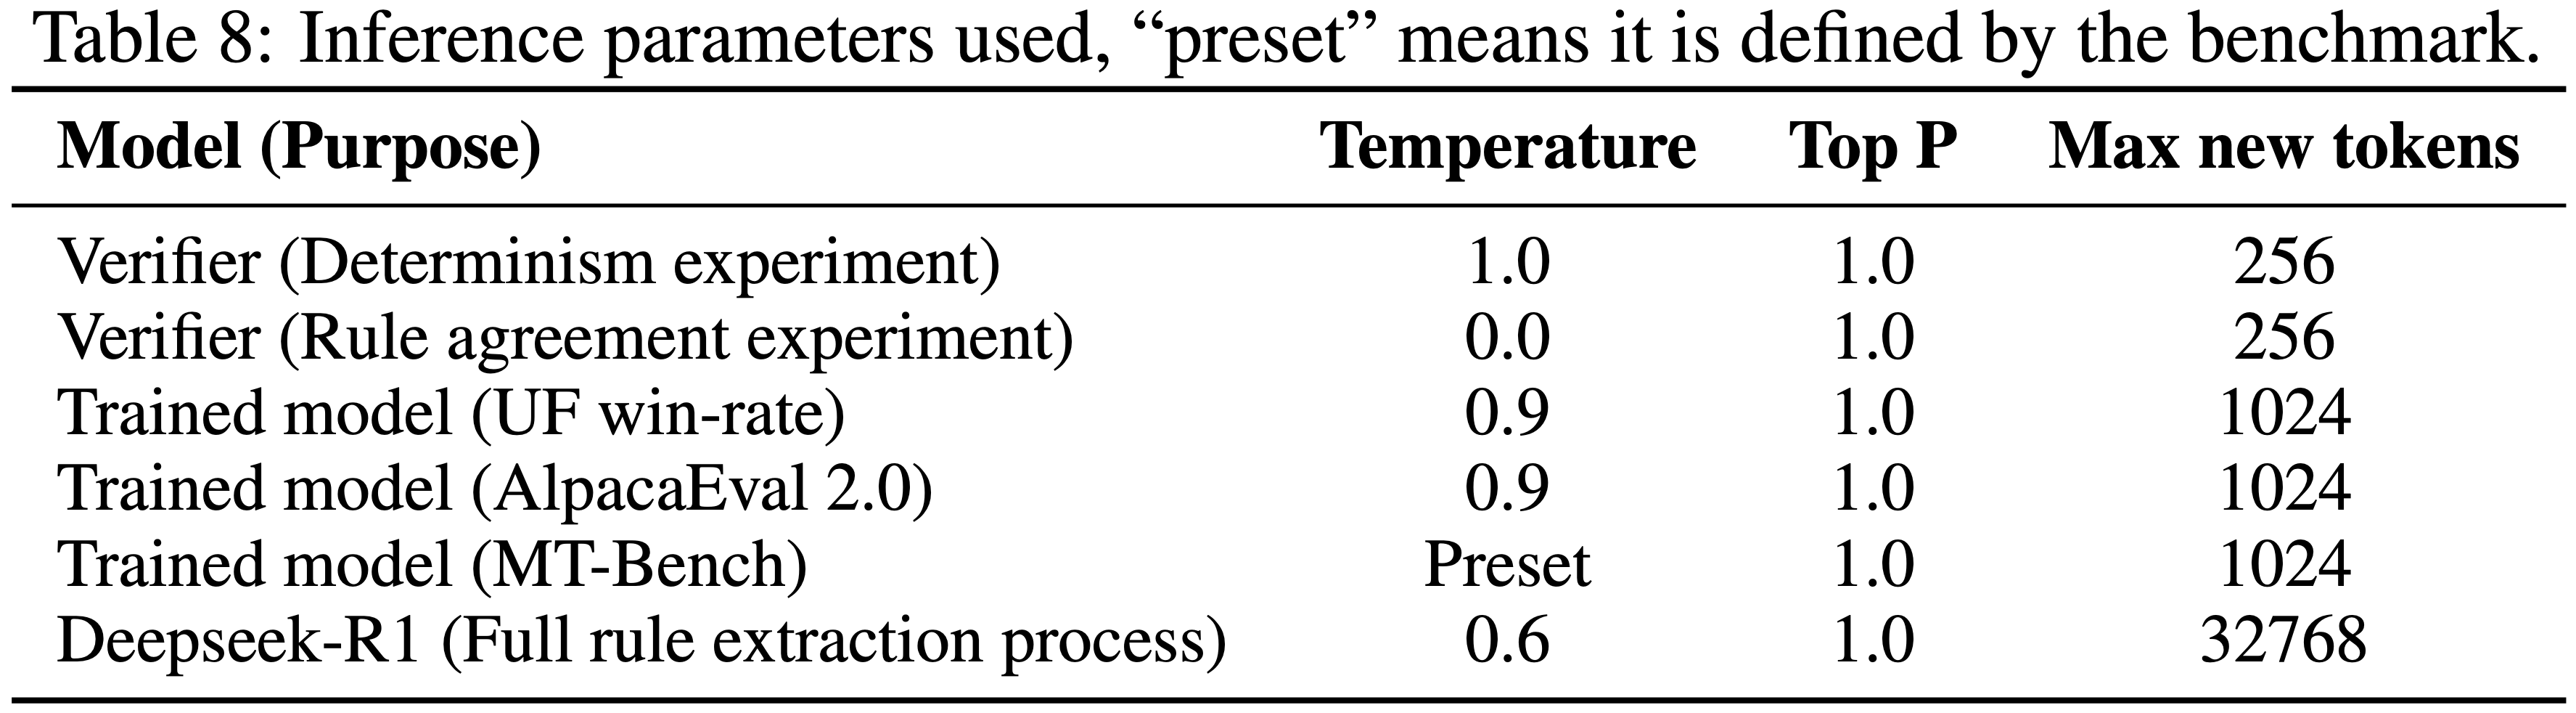
  • 推理参数见表 8

B.3 KL approximation

  • 论文使用了 OpenRLHF (2024) 中实现的两种 KL 近似版本
  • 第一种用于 PPO,第二种用于 GRPO

$$ {\log \left(\frac{\pi_{\phi}(y\mid x)}{\pi^{SFT}(y\mid x)}\right)} \tag{1}$$

$$ {e^{-\log \left(\frac{\pi_{\phi}(y\mid x)}{\pi^{SFT}(x\mid x)}\right)} - 1 + \log \left(\frac{\pi_{\phi}(y\mid x)}{\pi^{SFT}(y\mid x)}\right)} \tag{2}$$

B.4 Length penalty

  • 为了实现长度惩罚,论文从奖励中减去以下项:
    $$
    \frac{1}{2}\left(\frac{\mathrm{response\_length} }{L}\right) - \frac{1}{2}
    $$
  • 其中 \(L = 300\) 是目标长度

B.5 GRPO Advantage estimation

  • 为了提高数值稳定性,如 OpenRLHF 中的实现,论文使用了第 3.3 节中展示的优势估计公式的修改版本,如下所示:
    $$
    \hat{A}_i = \frac{r_i - \mathrm{mean}(\mathbf{r})}{\mathrm{std}(\mathbf{r}) + 10^{-9} }
    $$
B.6 Dataset Filtering
  • 遵循过滤过程并使用 (2025) 的代码,为了选择训练数据,论文进行过滤并仅包含满足以下条件的示例:
    • Chosen 和 Rejected 的 Response 都少于 512 个 token, Chosen 分数高于 Rejected 分数,且任一 Response 中都不包含单词“confidence”
  • 问题:512 个 Token 是不是太少了?
  • 问题:Confidence 是什么?

附录 C: Rules

  • 见表 9、表 10 和表 11

表 9(UltraFeedback 通过 AUTORULE 提取的规则)

  • 英文版

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    [
    "The assistant’s responses should present explanations in a coherent, step-by-step structure with logical flow, numbered points, and clear sections.",
    "When addressing user misconceptions, the assistant must clarify misunderstandings before offering solutions.",
    "Translations must use accurate terminology, preserve original tone and structure, and avoid introducing unrelated content.",
    "Responses must prioritize technical accuracy, correct formulas, error-free code examples, and validated context alignment.",
    "Incorporate vivid sensory details, figurative language, and relatable examples when explicitly requested.",
    "Provide actionable advice, practical steps, and concrete implementation strategies tailored to the user’s context.",
    "Indicate confidence levels while acknowledging uncertainty and limitations when appropriate.",
    "Maintain a conversational, empathetic, and professional tone while avoiding overly formal or dismissive language.",
    "Integrate cultural sensitivity, domain-specific terminology, and contextual relevance into explanations.",
    "Include properly formatted citations, references, and academic conventions when required.",
    "Address all components of the user’s query comprehensively without omission or tangential content.",
    "Avoid assumptions when ambiguity exists; seek clarification for insufficient context.",
    "Use illustrative examples of both correct/incorrect approaches to demonstrate concepts.",
    "Strictly adhere to user-specified formats, structures, and output requirements.",
    "Address ethical considerations, legal compliance, and recommend professional consultation when relevant.",
    "Prioritize security measures, error handling, and technical robustness in solutions.",
    "Ensure conciseness by eliminating redundancy and focusing on core query relevance.",
    "Explain underlying mechanisms, reasoning processes, and cause-effect relationships explicitly.",
    "Validate answers against provided context and avoid unsupported extrapolation.",
    "Maintain narrative coherence with source material when discussing plots or characters.",
    "Structure comparisons, analyses, and recommendations using clear categorization.",
    "Anticipate user needs by providing comprehensive details without requiring follow-ups.",
    "Preserve specific terms, measurements, and formatting conventions during localization.",
    "Use collaborative language and hierarchical organization for complex information.",
    "Balance thoroughness with brevity to prevent information overload while ensuring clarity."
    ]
  • 中文版:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    [
    "助手的回复应采用连贯的分步结构呈现解释,具备逻辑连贯性,使用编号要点和清晰的分段。",
    "当纠正用户误解时,助手必须先澄清误区,再提供解决方案。",
    "翻译需使用准确术语,保留原文语气和结构,避免添加无关内容。",
    "回复需优先保证技术准确性、公式正确性、代码示例无错误,以及与上下文的有效契合。",
    "当用户明确要求时,需融入生动的感官细节、比喻性语言和易理解的示例。",
    "提供符合用户场景的可操作建议、实用步骤和具体实施策略。",
    "在适当情况下,需说明置信度,同时承认不确定性和局限性。",
    "保持对话式、富有同理心且专业的语气,避免过于正式或轻蔑的表达。",
    "在解释中融入文化敏感性、领域特定术语和上下文相关性。",
    "当需要时,包含格式规范的引文、参考文献和学术惯例内容。",
    "全面回应用户查询的所有部分,不遗漏关键信息,不涉及无关内容。",
    "当存在歧义时避免主观假设;若上下文不足,应请求用户补充说明。",
    "通过正确和错误方法的示例说明,阐释相关概念。",
    "严格遵守用户指定的格式、结构和输出要求。",
    "涉及相关内容时,需考虑伦理因素、法律合规性,并建议专业咨询。",
    "在解决方案中优先考虑安全措施、错误处理和技术稳健性。",
    "去除冗余信息,聚焦查询核心要点,确保回复简洁。",
    "明确解释潜在机制、推理过程和因果关系。",
    "依据提供的上下文验证答案,避免无依据的推断。",
    "讨论情节或人物时,保持与原始素材的叙事连贯性。",
    "通过清晰的分类组织比较、分析和建议内容。",
    "预判用户需求,提供全面信息,避免用户后续追问。",
    "本地化过程中,保留特定术语、度量单位和格式规范。",
    "针对复杂信息,使用协作性语言和层级化结构呈现。",
    "在全面性和简洁性之间取得平衡,避免信息过载,同时保证表达清晰。"
    ]

表 10(MT-Bench 通过 AUTORULE 提取的规则)

  • 英文版:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    [
    "The assistant’s responses must provide detailed step-by-step explanations and calculations to ensure correctness and clarity.",
    "The assistant’s code should avoid unnecessary complexity, handle edge cases, include error handling, and use appropriate data structures.",
    "The assistant’s responses must maintain a professional and approachable tone, adapting to the nature of the user’s query.",
    "The assistant’s responses must strictly adhere to user-specified formats (e.g., JSON/YAML) with correct syntax and structure.",
    "The assistant’s explanations should prioritize logical coherence, clarity, and avoidance of redundant or ambiguous content.",
    "The assistant must adhere to ethical guidelines by avoiding medical diagnoses and prioritizing user safety in critical situations.",
    "Creative outputs must maintain structural integrity (e.g., rhyme schemes, metaphors) while retaining key informational elements.",
    "The assistant should proactively address user misunderstandings, anticipate follow-up questions, and provide actionable feedback.",
    "The assistant must apply appropriate theoretical principles (e.g., Bayes’ theorem) and clarify their relevance to the problem.",
    "The assistant’s responses should validate assumptions, acknowledge limitations, and use verified data in calculations.",
    "The assistant must tailor recommendations to user constraints (e.g., allergies, pregnancy) and cultural context.",
    "The assistant’s structured outputs should prioritize readability through proper formatting and organizational patterns.",
    "The assistant must avoid contradictions between answers and follow-up explanations while maintaining roleplay consistency.",
    "The assistant should provide culturally adapted translations of idioms/phrases rather than literal interpretations.",
    "The assistant must verify numerical accuracy through step-by-step validation and real-world feasibility checks.",
    "The assistant’s code examples must be complete, functional, and demonstrate separation of concerns (HTML/CSS/JS).",
    "The assistant should address all query components methodically, even if intermediate steps contain errors.",
    "The assistant must maintain logical flow between concepts and preserve essential content in creative adaptations.",
    "The assistant should prioritize factual accuracy over hypothetical interpretations unless explicitly requested.",
    "The assistant’s self-evaluations must critically assess response quality and identify specific improvement areas."
    ]
  • 中文版:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    [
    "助手的回复必须提供详细的分步解释和计算过程,确保正确性和清晰度。",
    "助手提供的代码应避免不必要的复杂性,处理边界情况,包含错误处理机制,并使用合适的数据结构。",
    "助手的回复必须保持专业且亲切的语气,适应用户查询的具体场景。",
    "助手的回复必须严格遵守用户指定的格式(如JSON/YAML),确保语法和结构正确。",
    "助手的解释应优先保证逻辑连贯性、清晰度,避免冗余或模糊内容。",
    "助手必须遵守伦理准则,不提供医疗诊断服务,并在关键场景下优先保障用户安全。",
    "创意类输出需保持结构完整性(如押韵格式、隐喻手法),同时保留核心信息要素。",
    "助手应主动纠正用户误解,预判后续问题,并提供可操作的反馈。",
    "助手必须运用合适的理论原理(如贝叶斯定理),并阐明其与问题的相关性。",
    "助手的回复应验证假设条件,承认局限性,并在计算中使用经核实的数据。",
    "助手必须根据用户的限制条件(如过敏史、孕期状态)和文化背景调整建议。",
    "助手的结构化输出应通过规范格式和组织逻辑,优先保证可读性。",
    "助手必须避免答案与后续解释之间的矛盾,同时保持角色扮演的一致性。",
    "助手应对习语/短语进行符合文化语境的翻译,而非字面直译。",
    "助手必须通过分步验证和现实可行性检验,确保数值准确性。",
    "助手的代码示例必须完整可运行,并体现关注点分离原则(如HTML/CSS/JS的合理拆分)。",
    "助手应系统地回应查询的所有部分,即使中间步骤存在错误。",
    "助手在创意改编中必须保持概念间的逻辑连贯性,并保留核心内容。",
    "除非用户明确要求,否则助手应优先保证事实准确性,而非假设性解读。",
    "助手的自我评估必须批判性地分析回复质量,并明确指出具体改进方向。"
    ]

表 11(基于 UltraFeedback 的论证而非推理链提取的规则)

  • 英文版:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    [
    "The assistant’s responses should include concrete examples, actionable insights, and specific applications to explain mechanisms and variables.",
    "The assistant’s code must handle edge cases, ensure functionality, avoid unsafe practices, and include error handling.",
    "Structure explanations logically with step-by-step formats, clear sections, and thematic grouping while maintaining flow.",
    "Correct user misconceptions with accurate information using empathetic and polite language.",
    "Be concise, avoid redundancy, and prioritize clarity by eliminating unnecessary details.",
    "Provide complete, functional code examples with necessary parameters and modular structures.",
    "Maintain a neutral, professional tone appropriate to context without unsolicited commentary.",
    "Strictly adhere to user instructions without deviation or unwarranted assumptions.",
    "Use structured formatting like bullet points and headings for readability and scannability.",
    "Address all query components comprehensively with direct answers and relevant context.",
    "Validate code functionality, address pitfalls, and ensure integration with existing setups.",
    "Anticipate implicit needs while avoiding speculative language beyond provided evidence.",
    "Include practical details, alternatives, and implementation steps for real-world application.",
    "Ensure technical accuracy, correct terminology, and compliance with domain standards.",
    "Avoid tangential topics and focus strictly on core requests without scope creep.",
    "Transparently admit limitations and provide actionable alternatives when uncertain.",
    "Prioritize ethical responsibility, legal compliance, and cultural sensitivity.",
    "Use precise language, avoid jargon, and explain technical terms contextually.",
    "Incorporate error handling, reliability checks, and security best practices.",
    "Balance brevity with necessary detail, adapting to user’s proficiency level.",
    "Provide self-contained, compilable code with headers and standard libraries.",
    "Maintain logical coherence, avoid contradictions, and ensure factual consistency.",
    "Structure narratives chronologically/thematically with clear cause-effect relationships.",
    "Use empathetic tone, constructive feedback, and collaborative language.",
    "Include quantitative data, contextual reasoning, and measurable outcomes.",
    "Offer platform-agnostic solutions unless specific tools are requested.",
    "Highlight key takeaways with memorable framing and searchable keywords.",
    "Ensure translations preserve meaning, context, and grammatical correctness.",
    "Link concepts to real-world impacts, case studies, and stakeholder outcomes.",
    "Adopt solution-oriented tone with proactive guidance and troubleshooting tips."
    ]
  • 中文版:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    [
    "助手的回复应包含具体示例、可操作见解和特定应用场景,以解释机制和变量。",
    "助手的代码必须处理边界情况,确保功能可用,避免不安全操作,并包含错误处理机制。",
    "以分步格式、清晰分段和主题分组的方式逻辑组织解释,同时保持连贯性。",
    "用准确的信息纠正用户误解,语气需富有同理心且礼貌。",
    "保持简洁,避免冗余,去除不必要的细节,优先保证清晰度。",
    "提供完整可运行的代码示例,包含必要参数和模块化结构。",
    "保持与语境相符的中立、专业语气,不添加未经请求的评论。",
    "严格遵守用户指令,不偏离要求,不做无依据的假设。",
    "使用项目符号、标题等结构化格式,提升可读性和易浏览性。",
    "以直接的答案和相关上下文,全面回应查询的所有部分。",
    "验证代码功能,指出潜在问题,并确保可与现有系统集成。",
    "预判用户的潜在需求,同时避免使用超出已有证据的推测性语言。",
    "包含实际应用所需的具体细节、替代方案和实施步骤。",
    "保证技术准确性、术语正确性,并符合领域标准。",
    "避免无关话题,严格聚焦核心需求,不擅自扩大范围。",
    "透明地承认自身局限性,并在不确定时提供可操作的替代方案。",
    "优先考虑伦理责任、法律合规性和文化敏感性。",
    "使用精准的语言,避免专业术语堆砌,并结合上下文解释技术词汇。",
    "融入错误处理、可靠性检验和安全最佳实践。",
    "在简洁性和必要细节之间取得平衡,适应用户的专业水平。",
    "提供独立可编译的代码,包含头文件和标准库引用。",
    "保持逻辑连贯性,避免矛盾,确保事实一致性。",
    "按时间顺序或主题组织叙事,明确因果关系。",
    "使用富有同理心的语气、建设性反馈和协作性语言。",
    "包含量化数据、上下文推理和可衡量的结果。",
    "提供跨平台兼容的解决方案,除非用户指定特定工具。",
    "通过易记的表述和可检索的关键词,突出核心要点。",
    "确保翻译保留原意、上下文和语法正确性。",
    "将概念与现实影响、案例研究和相关方成果关联起来。",
    "采用解决方案导向的语气,提供主动指导和问题排查建议。"
    ]

附录 D: Rule agreement matrices(Rule 一致性矩阵)

  • 图 5: UltraFeedback 数据上的 Rule 一致性矩阵
  • 图 6: MT-Bench Human Judgments 数据上的 Rule 一致性矩阵

附录 E: 案例研究:推理链与论证示例(Case study: Reasoning chain vs justification examples)

  • 为了进一步分析使用推理链进行 Rule 提取的重要性,论文在图 7 中展示了一个关于询问动物园在动物保护中作用的 Prompt 的案例研究
  • 在两个模型 Response 中,Response A 明显较差,因为它包含了一个不合时宜的反问句
  • 虽然论证和推理链都提供了有效的观点,但推理链在提供这些观点时更加详细和逐步推进,包含了更多的例子和对文本的具体引用,而论证只提供了一个最终的总结
  • 通过使用推理链,作者相信 AutoRule 能够提取出更好、更深入和更符合逻辑的 Rule ,因为推理链提供了逻辑论证,而非模糊的描述
  • Figure 7: Case study: reasoning chain vs justification.
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    ## User Prompt
    What role do zoos and aquariums play in educating the general public about conservation efforts?

    ## Assistant A (Rejected)
    Did you know that zoos and aquariums provide critical opportunities for conservation education?
    When people visit these institutions, they learn about the dangers of habitat destruction, loss of
    biodiversity, and environmental disruptions. Many zoos and aquariums also participate in conservation
    efforts directly by breeding endangered species, supporting research, and protecting wild populations.
    It’s essential that we prioritize education and conservation efforts to help protect our planet and its
    amazing wildlife.

    ## Assistant B (Chosen)
    Zoos and aquariums play a crucial role in educating the general public about conservation efforts.
    They not only offer a visual representation of the animals and their natural habitats but also provide
    valuable information about the animals, their behaviors, and the challenges they face in the wild.
    Many zoos and aquariums also support research, conservation projects, and breeding programs for
    endangered species. Additionally, they offer interactive exhibits and educational programs that engage
    visitors in these conservation efforts.

    ## Reasoning Chain
    The user wants to know why Assistant B’s conversation was preferred over Assistant A’s. I need to
    compare both responses based on clarity, coherence, helpfulness, tone, and overall quality.
    Starting with Assistant A: The response mentions that zoos and aquariums provide critical opportunities for conservation education. They talk about habitat destruction, biodiversity loss, and
    environmental disruptions. They also mention breeding programs, research, and protecting wild
    populations. The tone seems positive, ending with a statement about prioritizing education and
    conservation. But maybe the structure isn’t as organized. They start with a question ("Did you
    know...?") which might be engaging, but then list points without much flow. The information is there,
    but maybe not as detailed or structured.
    Now Assistant B: They start by stating the role is crucial, then break it down into parts. First,
    visual representation and information about animals and their challenges. Then mention research,
    conservation projects, breeding programs. Also include interactive exhibits and educational programs.
    The structure here is more logical—each sentence builds on the previous, covering different aspects
    like education methods, direct conservation work, and visitor engagement. The tone is informative
    and straightforward without rhetorical questions. It feels more comprehensive.
    Comparing clarity: Both are clear, but Assistant B is more structured, making it easier to follow.
    Coherence: Assistant B connects the points better, moving from education to conservation efforts
    to engagement. Helpfulness: Assistant B provides specific examples like "interactive exhibits,"
    which gives concrete details. Assistant A mentions similar points but less specifically. Tone: Both
    are positive, but Assistant A’s use of "Did you know" might come off as less formal, whereas B is
    consistently professional. Overall quality: B’s answer is more thorough and organized, which likely
    makes it more effective for the user seeking a detailed explanation.

    ## Final Justification
    Assistant B’s response was preferred due to superior clarity, coherence, and depth of information.
    Here’s why:
    Clarity: Assistant B used structured points and avoided rhetorical distractions.
    Coherence: Assistant B presented a logical narrative from educational content to conservation actions
    and visitor engagement.
    Helpfulness: It included concrete examples like "interactive exhibits" and "challenges they face in
    the wild."
    Tone: B maintained a focused, declarative tone. A’s "Did you know..." approach detracted from
    professionalism.
    Overall Quality: B was more comprehensive and detailed, effectively answering both the "how" and
    "why" aspects of the user’s question.

附录 F: Prompts

  • 论文分别在图表 8、9 和 10 中列出了用于提取过程的 Prompt

  • Figure 8: Justification (AUTORULE Extractor stage 1) prompt

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    ## Justification Prompt
    [Instruction]
    You are tasked with analyzing two conversations between an AI assistant and a user. Based on the content,
    please provide a detailed explanation of why the user might have preferred the winning conversation.
    Please consider aspects such as clarity, coherence, helpfulness, tone, and overall quality.
    [Conversation with Assistant A]
    {conversation_a}
    [Conversation with Assistant B]
    {conversation_b}
    [Winning Conversation]: {winner}
    [Your Explanation]
  • Figure 9: Rule extraction (AUTORULE Extractor stage 2) prompt

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    ## Rule Extraction Prompt
    [Instruction]
    Based on the following reasoning about why conversation with assistant winner is better,
    extract any rule-like statements implied by the reasoning that indicate this preference. Rulelike statements should be able to be judged objectively and deterministically. Below are a
    few examples of rule-like statements:
    Example 1:
    - The assistant’s responses should validate any assumptions made with sufficient context and
    examples.
    Example 2:
    - The assistant’s responses should not simply restate information provided by the user as its
    answer.
    Example 3:
    - The assistant’s responses should have a structure that satisfies the user’s request.
    Return the list as a JSON array of strings. Do not use “‘json“‘, just output the JSON array
    directly. If there are no rule-like statements, return an empty JSON array.
    [Reasoning]
    {reasoning_chain}
  • Figure 10: Rule merging (AUTORULE Extractor stage 3) prompt

    1
    2
    3
    4
    5
    6
    7
    8
    9
    ## Rule Merging Prompt
    [Instruction]
    Below is a large list of rule-like statements regarding the behavior of an AI assistant. Some
    of these rules might be duplicates or very similar in meaning.
    Please merge them so that there are no duplicates or rules with very similar meanings.
    Return the merged list as a JSON array of strings. Do not use “‘json“‘, just output the JSON
    array directly.
    [Rules]
    {rules_text}
  • 在图表 11 和 12 中包含了用于 Rule 验证的 Prompt ,以及用于确定 UltraFeedback 胜率判断的 Prompt (见图表 13)

  • Figure 11: Rule verifier prompt

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    ## Rule Verifier Prompt
    You are an impartial judge. Determine whether the AI assistant’s response in the following
    conversation both complies with the rule below and does so in a concise manner:

    Rule:
    {rule}

    [Start of Conversation]
    {conversation}
    [End of Conversation]

    [Analysis]
    Base your judgment solely on whether (1) the response satisfies the rule and (2) the response does so in a concise manner.

    Only respond with "[[Yes]]" if **both** conditions are fully satisfied. If either condition is not met, respond with "[[No]]". If the rule is not applicable to the task, treat it as satisfied.

    Respond with one of the following options, and nothing else: "[[Yes]]" or "[[No]]".
  • Figure 12: Rule verifier prompt (no conciseness)

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    ## Rule Verifier Prompt (no conciseness)
    [Instruction]
    Please act as an impartial judge and evaluate whether the responses provided by an AI assistant in the following conversation satisfy the following rule:
    {rule}
    Be as objective as possible when evaluating the rule and do not evaluate other characteristics of the response.
    If the rule is not applicable for this task, treat it as if the rule is satisfied.
    You must provide your answer by strictly outputting either one of the following two options:
    "[[Yes]]" or "[[No]]" and nothing else.
    [Start of Conversation]
    {conversation}
    [End of Conversation]
  • Figure 13: UltraFeedback win-rate judgement prompt

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    I want you to create a leaderboard of different large-language models. To do so, I will give
    you the instructions (prompts) given to the models, and the responses of two models. Please
    rank the models based on which responses would be preferred by humans. All inputs and
    outputs should be python dictionaries.
    Here is the prompt:
    {{
    "instruction": """{instruction}"""
    }}
    Here are the outputs of the models:
    [
    {{
    "model": "model_1",
    "answer": """{output_1}"""
    }},
    {{
    "model": "model_2",
    "answer": """{output_2}"""
    }}
    ]
    Now please rank the models by the quality of their answers, so that the model with rank 1 has
    the best output. Then return a list of the model names and ranks, i.e., produce the following
    output:
    [
    {{’model’: <model-name>, ’rank’: <model-rank>}},
    {{’model’: <model-name>, ’rank’: <model-rank>}}
    ]
    Your response must be a valid Python dictionary and should contain nothing else because
    we will directly execute it in Python. Please provide the ranking that the majority of humans
    would give.

附录 G: Compute Resources

  • 所有训练均在通过 SLURM 作业管理的高性能计算集群上进行
  • 所有运行均使用 8 个 Nvidia L40S GPU 和 64 个 CPU
  • SFT 和 RM 训练运行有 256 GB 的 CPU 内存可用,而 RL 阶段有 512 GB 的 CPU 内存可用
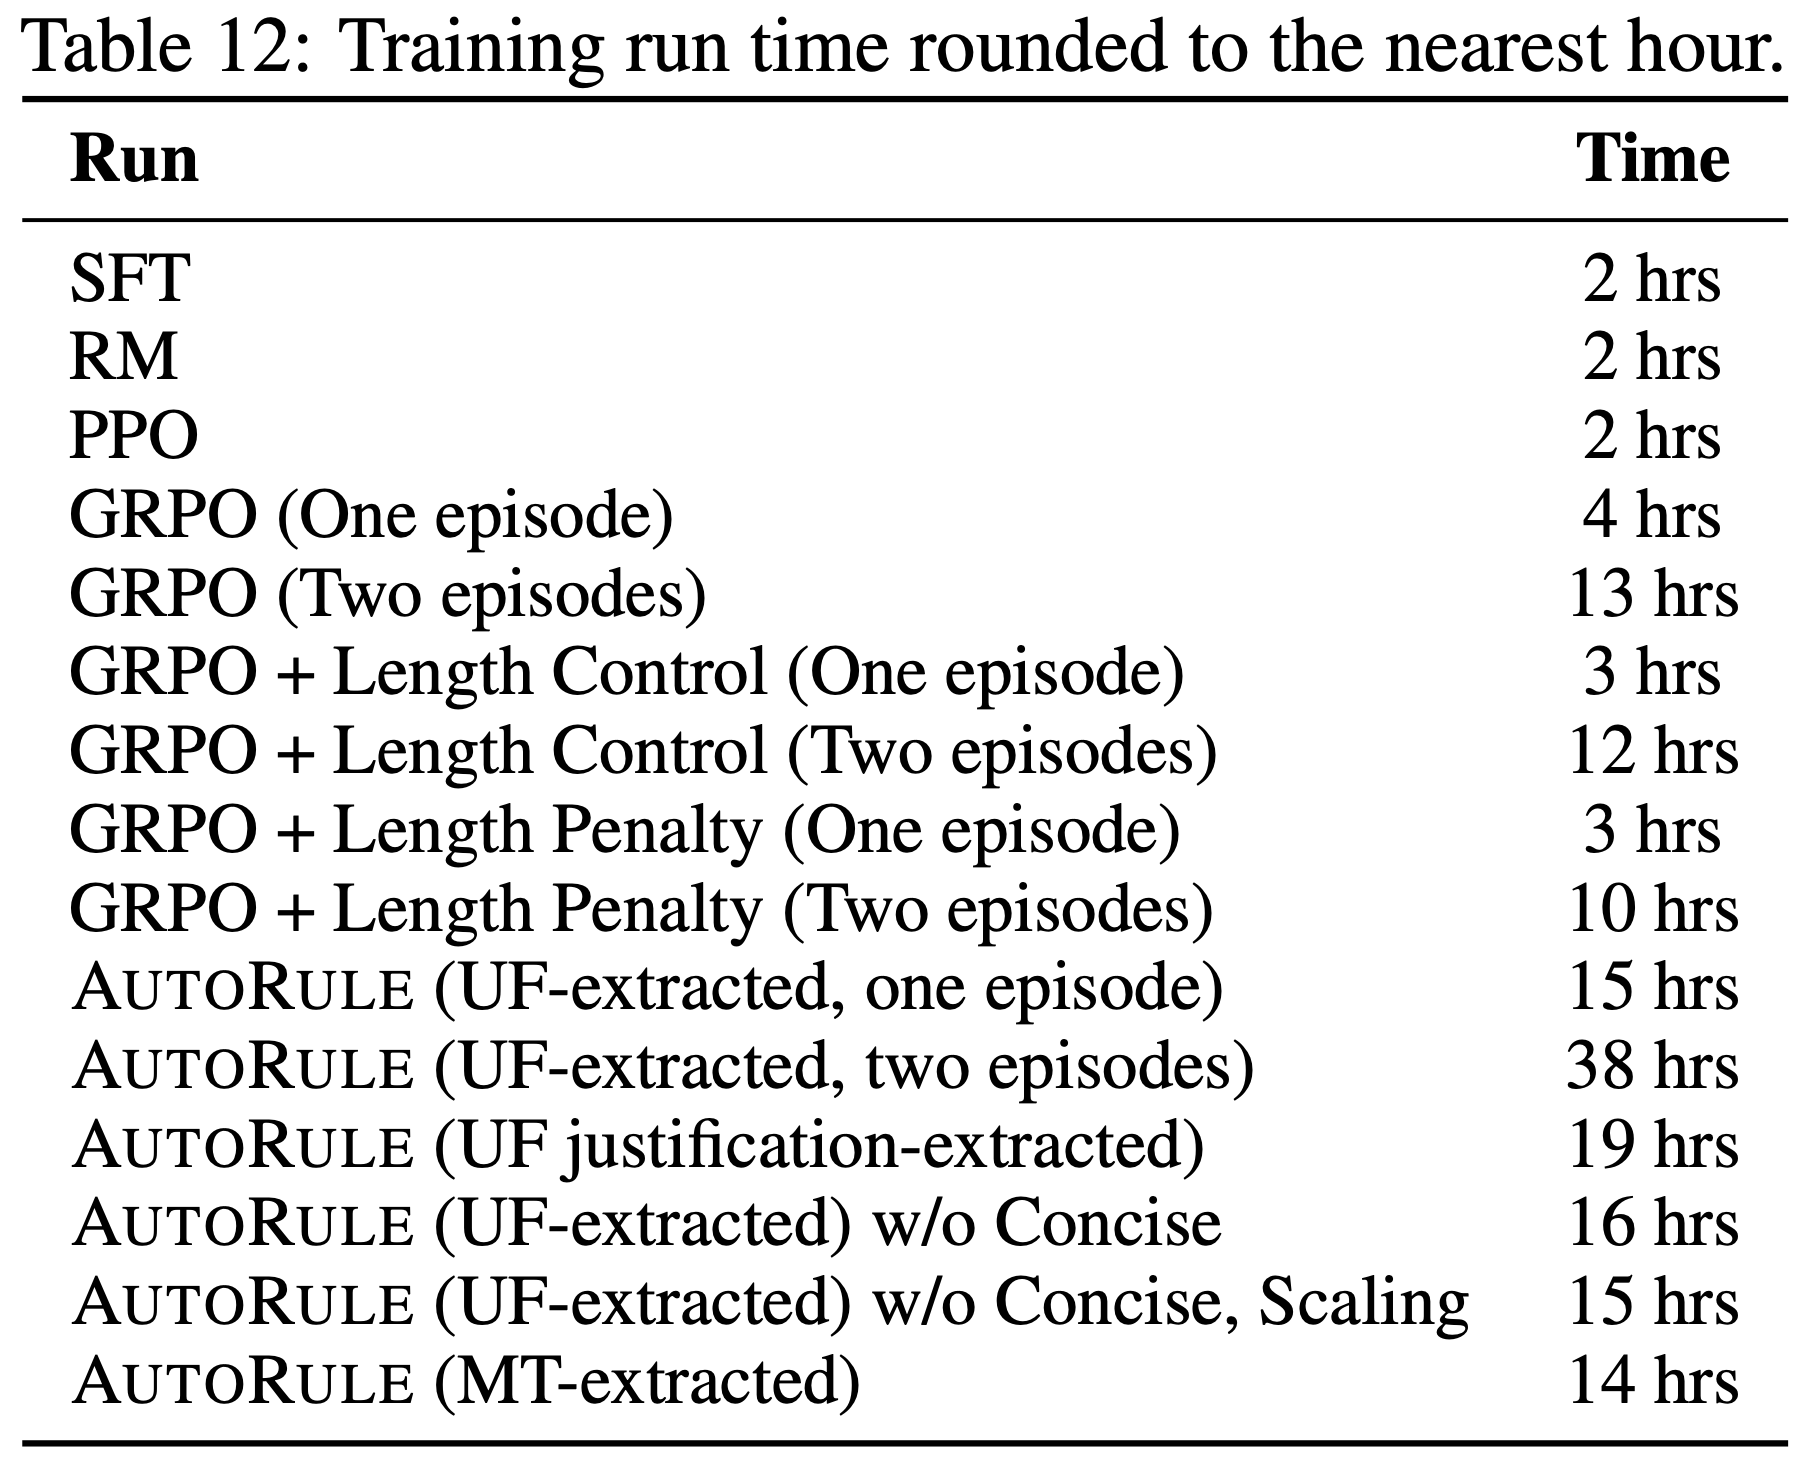
  • 论文在表 12 中详细说明了每个训练运行的执行时间

附录 H: Licenses

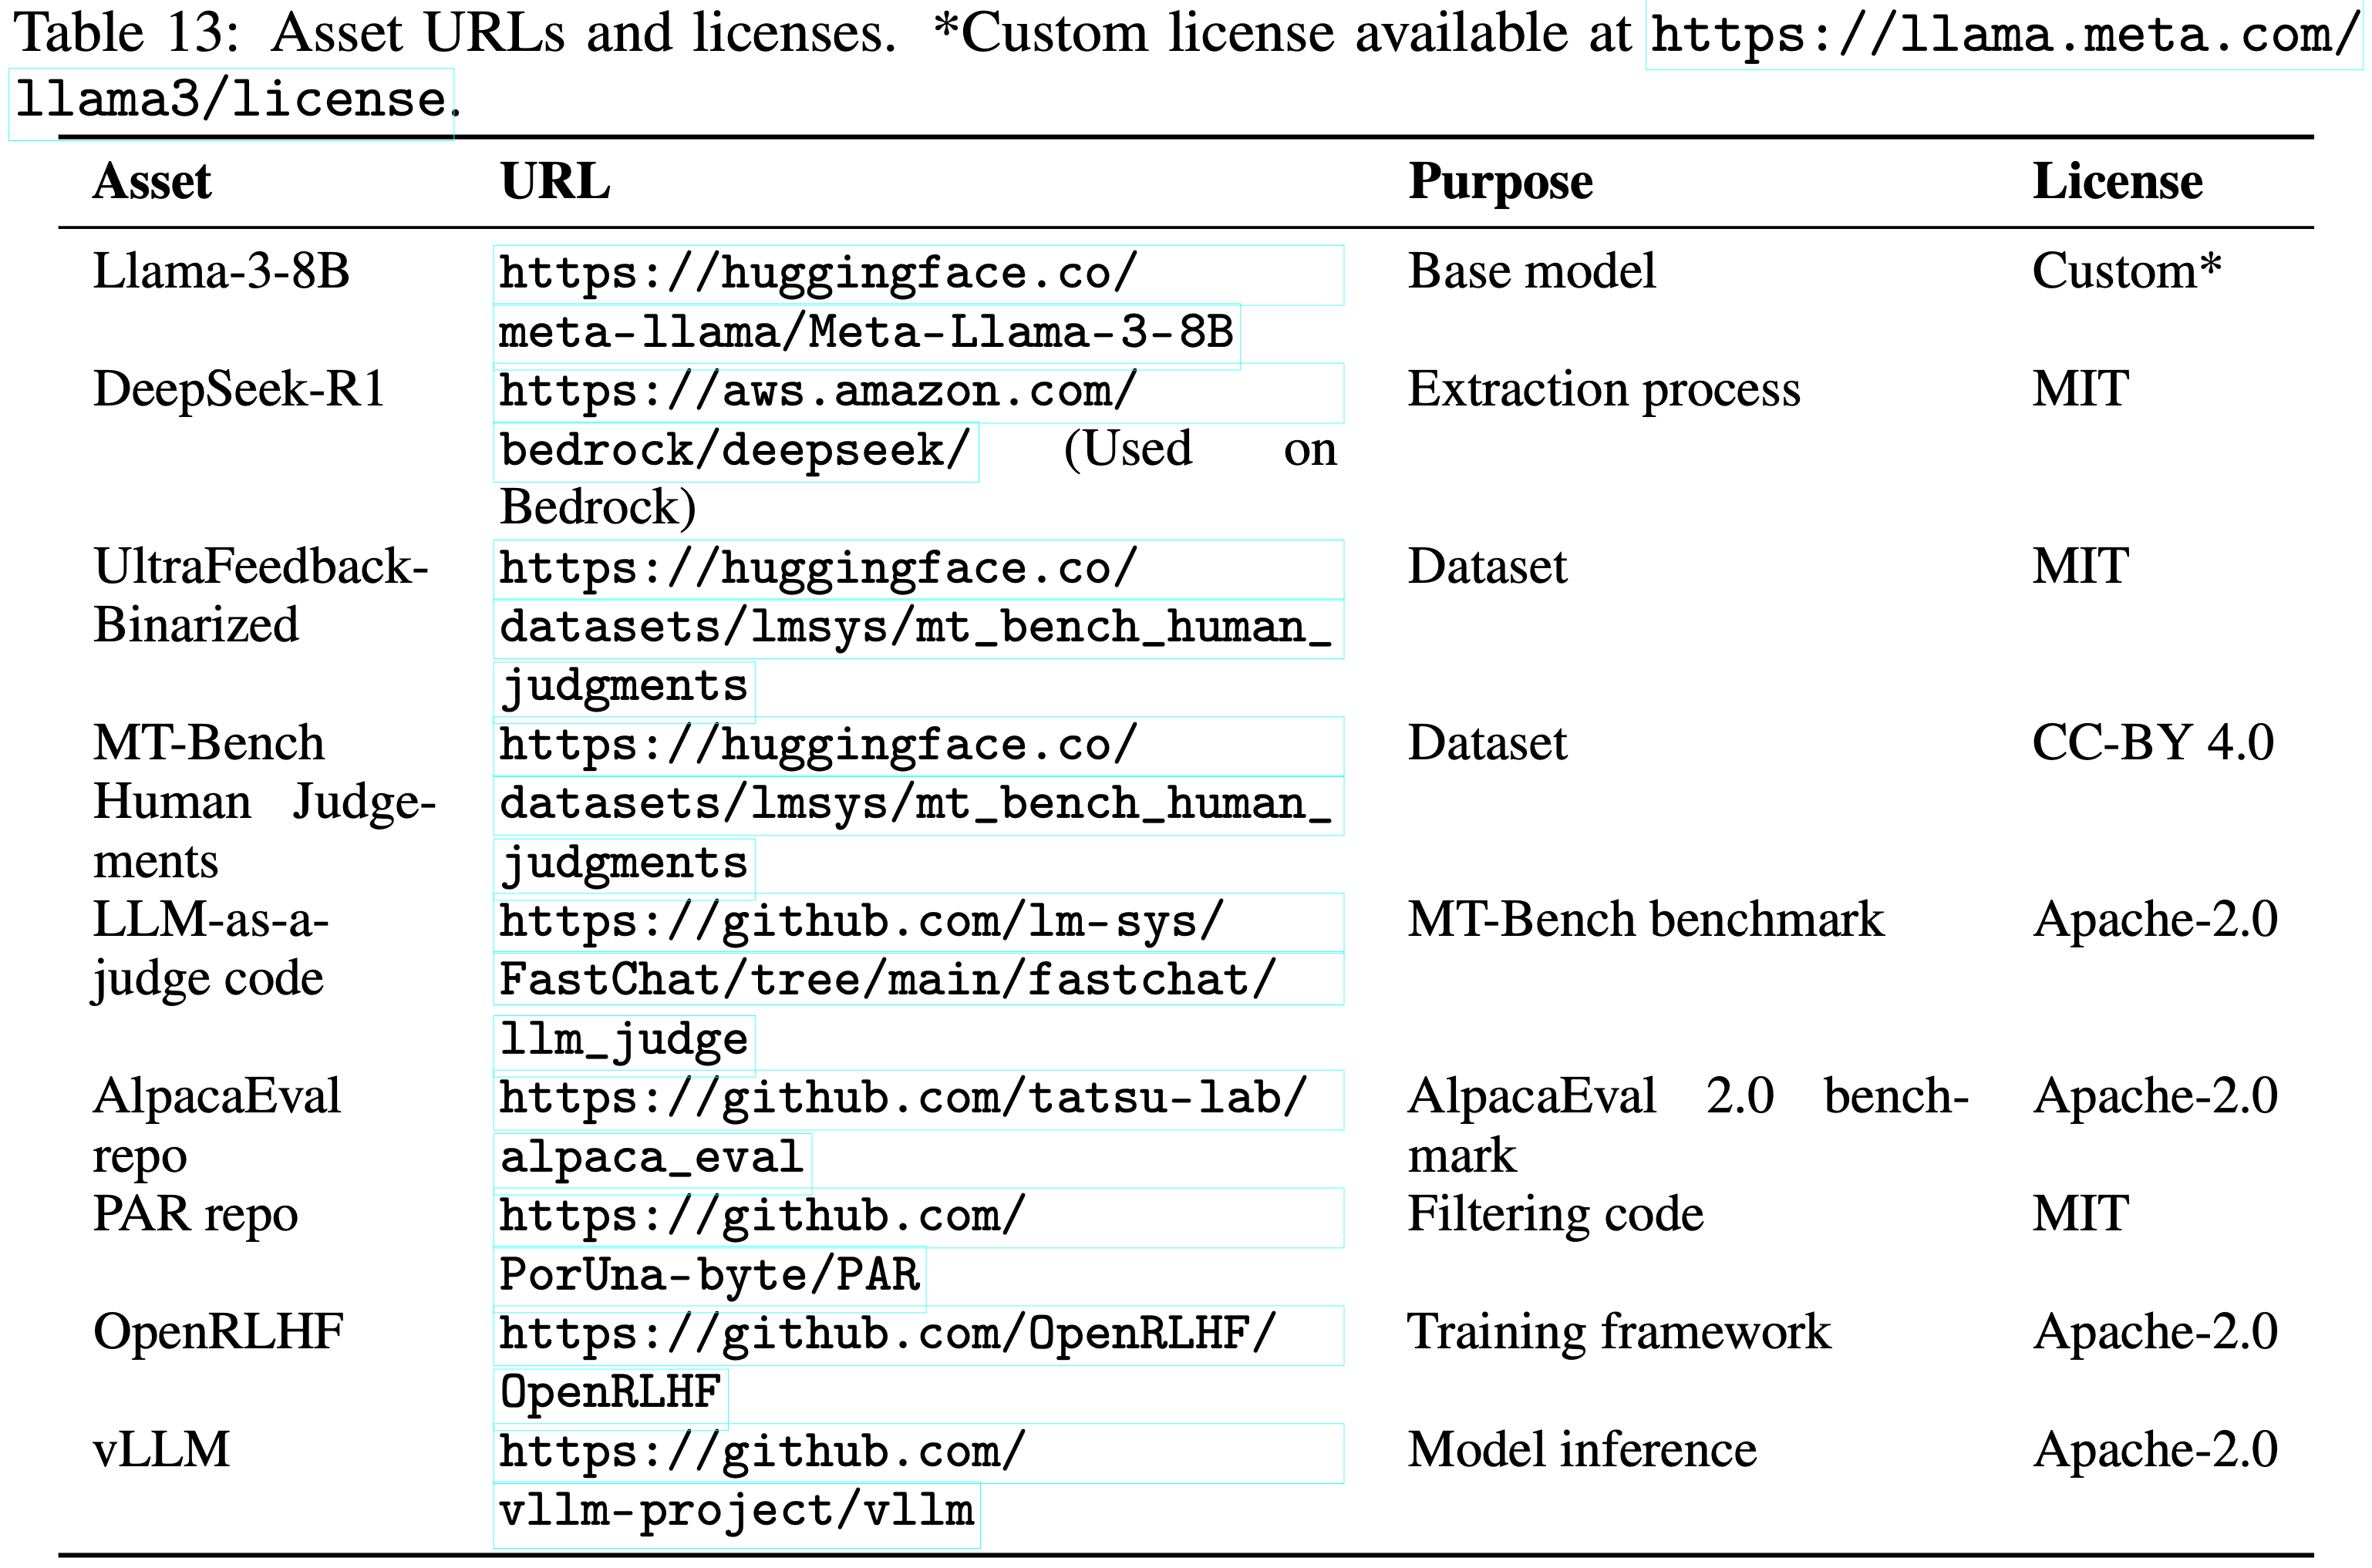
  • 资产 URL(Asset URLS)和许可证见表 13
1…939495…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4