Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM对齐微调-DAPO

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:DAPO: An Open-Source LLM Reinforcement Learning System at Scale, THU, ByteDance, 202503
    • verl库原始论文:HybridFlow: A Flexible and Efficient RLHF Framework, EuroSys 2025, HKU & ByteDance

Paper Summary

  • 总结:
    • DAPO 作为 GRPO 的扩展算法,其提出的众多改进方式已经成为了 GRPO 方法的默认 Features
    • DAPO 算法共包含了四项关键技术,具体内容详见原文第3节:
      • Clip-Higher :提升系统多样性,避免熵崩溃;
      • 动态采样 :提高训练效率和稳定性;
      • 词级策略梯度损失 :在长思维链RL场景中至关重要;
      • 过长奖励调整 :减少奖励噪声,稳定训练
  • 推理能力的扩展使 LLM 具备了前所未有的推理能力,而 RL 是激发复杂推理的核心技术
  • 然而,当前 SOTA 推理型 LLM 的关键技术细节(例如 OpenAI 的博客和 DeepSeek R1 技术报告中所述)并未公开,因此学术界仍难以复现其 RL 训练结果
  • 论文工作总结如下:
    • 提出了解耦裁剪与动态采样策略优化(Decoupled Clip and Dynamic sAmpling Policy Optimization,DAPO)算法
    • 开源了一个基于 Qwen2.5-32B 基础模型的大规模 RL 系统,该系统在 AIME 2024 上达到了50分的成绩
      • 与以往隐瞒训练细节的研究不同,论文介绍了算法中的 4 项关键技术 ,这些技术使得大规模 LLM 的 RL 训练成为可能
    • 论文还开源了基于 verl 框架的训练代码,以及经过精心整理和处理的数据集
  • 这些开源组件增强了研究的可复现性,并为未来大规模 LLM RL 研究提供了支持
  • 补充:项目主页网址为 https://dapo-sia.github.io/

Introduction and Discussion

  • Test-time scaling 技术:
    • 如 OpenAI 的 o1 和 DeepSeek-R1 等 Test-time scaling 为 LLM 带来了深刻的范式转变
    • Test-time scaling 能够支持更长的思维链(Chain-of-Thought)推理,并激发复杂推理行为,使模型在竞争性数学和编程任务(如 AIME 和 Codeforces)中表现卓越
  • 推动这一变革的核心技术是大规模 RL ,它能够激发诸如自我验证(self-verification)和迭代优化等复杂推理行为
  • 但现有推理模型的技术报告中并未公开可扩展RL训练的实际算法和关键方法
  • 论文揭示了大规模 RL 训练中的主要障碍(obstacles),并开源了一个可扩展的 RL 系统,包括完全公开的算法、训练代码和数据集,为学术界提供了工业级 RL 结果的民主化解决方案
  • 论文以 Qwen2.5-32B 作为 RL 训练的预训练模型进行实验。在初始的 GRPO 实验中,模型在 AIME 上的得分仅为 30 分,远低于 DeepSeek 的 RL 结果(47分)
    • 深入分析表明,朴素的 GRPO 基线存在熵崩溃、奖励噪声和训练不稳定等关键问题
    • 学术界在复现 DeepSeek 的结果时也遇到了类似挑战,这表明 R1 论文中可能遗漏了开发工业级、大规模且可复现RL系统所需的关键训练细节
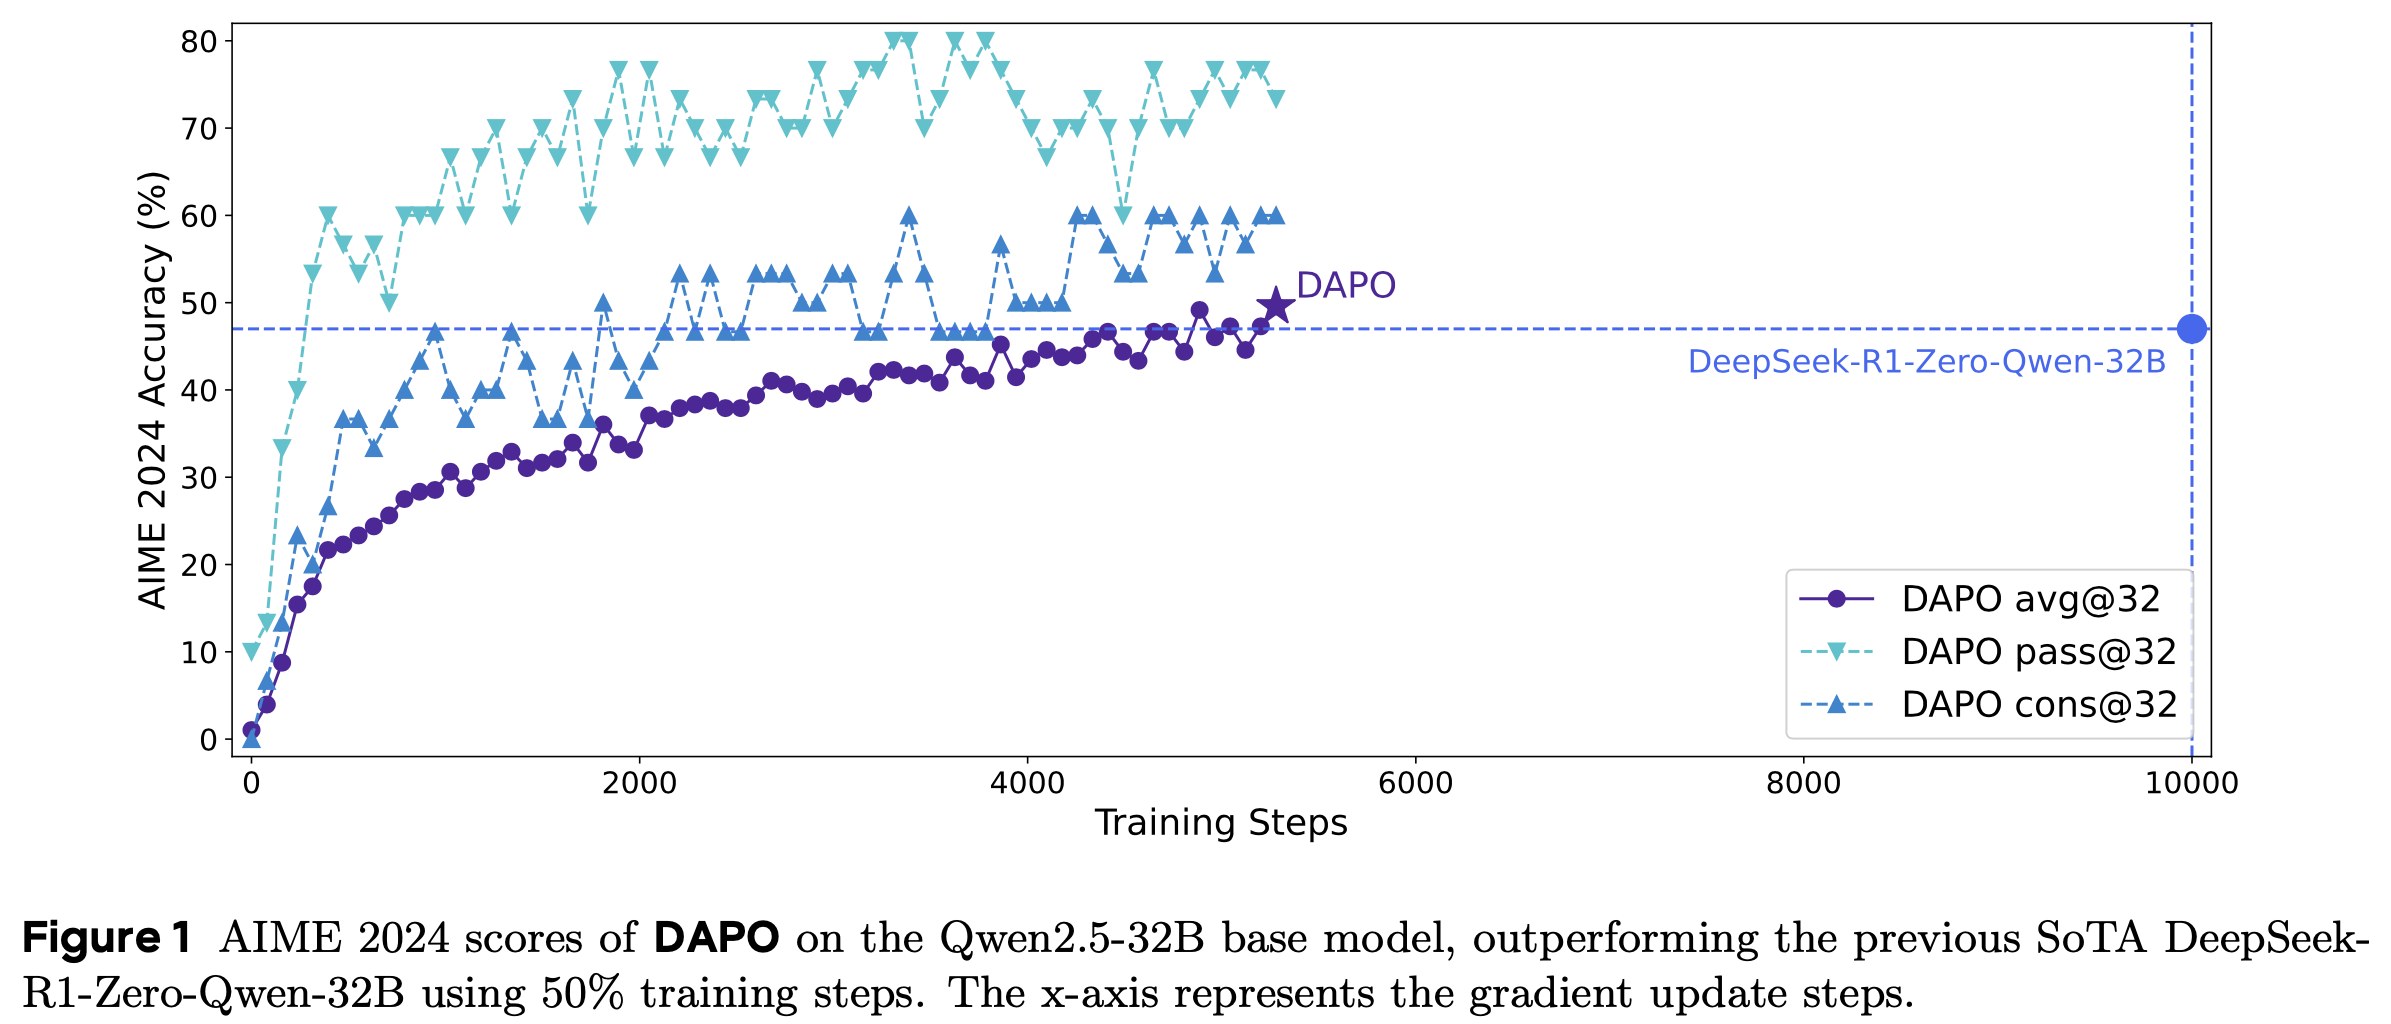
  • 为填补这一空白,论文开源了一个基于 Qwen2.5-32B 模型的大规模 LLM RL 系统,该系统在 AIME 2024 上达到了 50 分的成绩,优于 DeepSeek-R1-Zero-Qwen-32B 的 47 分,且训练步数减少了 50%(图1)
    • 问题:图1 中的 cons@32 是什么指标?
    • 回答:猜测是类似多数投票的结果(补充已经证实,就是多数投票的结果(cons 表示 consensus,即 共识):详情见 NLP——技术报告解读-DeepSeek-R1)
  • 论文的实现基于 verl 框架。通过完全开源包括训练代码和数据在内的最先进 RL 系统,作者希望为大规模 LLM RL 研究提供有价值的见解,造福更广泛的学术界

Preliminary

PPO

  • PPO 引入了一种裁剪替代目标函数用于策略优化。通过裁剪重要性采样比率将策略更新限制在先前策略的近端区域内,PPO能够稳定训练并提高样本效率。具体而言,PPO通过最大化以下目标函数更新策略:
    $$
    \mathcal{J}_{\textrm{PPO} }(\theta)=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},o_{\leq t}\sim\pi_{\theta_\textrm{old} }(\cdot|q)}\left[\min\left(\frac{\pi_{\theta}(o_{t}\mid q,o_{ < t})}{\pi_{\theta_\textrm{old} }(o_{t}\mid q,o_{ < t})}\hat{A}_{t},\operatorname{clip}\left(\frac{\pi_{\theta}(o_{t}\mid q,o_{ < t})}{\pi_{\theta_\textrm{old} }(o_{t}\mid q,o_{ < t})},1-\varepsilon,1+\varepsilon\right)\hat{A}_{t}\right)\right],
    $$
    • \((\mathbf{q},\mathbf{a})\) 是数据分布 \(\mathcal{D}\) 中的 question-answer 对
    • \(\varepsilon\) 是重要性采样比率的裁剪范围
    • \(\hat{A}_{t}\) 是时间步 \(t\) 的优势估计值: 给定价值函数 \(V\) 和奖励函数 \(R\),\(\hat{A}_{t}\) 通过广义优势估计(GAE)计算:
      $$
      \hat{A}_{t}^{\textrm{GAE}(\gamma,\lambda)}=\sum_{l=0}^{\infty}(\gamma\lambda)^{l}\delta_{t+l},
      $$
      • 其中:
        $$
        \delta_{l}=R_{l}+\gamma V(s_{l+1})-V(s_{l}),\quad 0\leq\gamma,\lambda\leq 1.
        $$

Group Relative Policy Optimization(GRPO)

  • 与 PPO 相比,GRPO 省去了价值函数,并以组相对方式估计优势,对于特定 question-answer 对 \((\mathbf{q},\mathbf{a})\),行为策略 \(\pi_{\theta_{old} }\) 采样一组 \(G\) 个独立响应 \(\{o_{i}\}_{i=1}^{G}\)。随后,第 \(i\) 个响应的优势通过对组级奖励 \(\{R_{i}\}_{i=1}^{G}\) 归一化计算:
    $$
    \hat{A}_{i,t}=\frac{r_{i}-\mathrm{mean}(\{R_{i}\}_{i=1}^{G})}{\mathrm{std}(\{R_{i}\}_{i=1}^{G})}.
    $$
  • 与 PPO 类似,GRPO 采用裁剪目标函数,并直接引入 KL 惩罚项:
    $$
    \begin{split}
    \mathcal{J}_{\mathrm{GRPO} }(\theta) &=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(\cdot|q)} \\
    &\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|\mathbf{o}_i|}\sum_{t=1}^{|\mathbf{o}_i|}\Bigg{(}\min\Big{(}r_{i,t}(\theta)\hat{A}_{i,t},\mathrm{clip}\Big{(}r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\Big{)}\hat{A}_{i,t}\Big{)}-\beta D_{\mathrm{KL} }(\pi_{\theta}|\pi_{\mathrm{ref} })\Bigg{)}\right],
    \end{split}
    $$
    • 其中
      $$
      r_{i,t}(\theta)=\frac{\pi_{\theta}(o_{i,t}\mid q,\mathbf{o}_{i,<t})}{\pi_{\theta_{old} }(o_{i,t}\mid q,\mathbf{o}_{i,<t})}.
      $$
  • 特别注意:GRPO 在样本级别计算目标函数
    • GRPO 首先计算每个生成样本序列内的平均损失 ,再对不同样本的损失取平均
    • 如第3.3节所述,这种差异可能对算法性能产生影响。

Removing KL Divergence

  • KL 惩罚项用于调节在线策略与冻结参考策略之间的差异
  • 在 RLHF 场景[23]中,RL 的目标是在不偏离初始模型太远的情况下对齐模型行为
  • 但在训练长思维链推理模型时,模型分布可能与初始模型显著偏离,因此这种限制并非必要
  • 因此,论文将从提出的算法中排除 KL 项
  • 理解:容易把模型训崩溃了吧,毕竟 Reward 中已经没有了 KL 散度了,保留 KL 散度项,适当降低权重是否就足够了?

Rule-based Reward Modeling

  • 使用奖励模型通常会遇到奖励破解(Reward Hacking)问题。相反,论文直接使用可验证任务的最终准确率作为结果奖励,通过以下规则计算:
    $$
    R(\hat{y},y)=\begin{cases}1,&\texttt{is_equivalent}(\hat{y},y)\\ -1,&\text{otherwise}\end{cases}
    $$
    • 其中 \(y\) 是真实答案, \(\hat{y}\) 是预测答案
  • 这种方法已被证明能够有效激活基础模型的推理能力,并在多个领域(如自动定理证明、计算机编程和数学竞赛)中表现出色

DAPO 算法

  • DAPO 为每个问题 \(q\) 及其对应答案 \(a\) 采样一组输出 \(\{\mathbf{o}_i\}_{i=1}^G\),并通过以下目标函数优化策略:
    $$
    \begin{align}
    \mathcal{J}_{\mathrm{GRPO} }(\theta) &=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(\cdot|q)} \\
    &\left[\frac{1}{\color{red}{\sum_{i=1}^G|\mathbf{o}_i|}}\color{red}{\sum_{i=1}^{G}\sum_{t=1}^{|\mathbf{o}_i|}}\min\Big{(}r_{i,t}(\theta)\hat{A}_{i,t},\mathrm{clip}\Big{(}r_{i,t}(\theta),1-\color{red}{\varepsilon_\text{low}},1+\color{red}{\varepsilon_\text{high}}\Big{)}\hat{A}_{i,t}\Big{)}\right] \\
    \text{s.t.}\quad &\color{red}{0 < \left|\{\mathbf{o}_i \mid \texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i)\}\right| < G}
    \end{align}
    $$
    • 其中:
      $$
      r_{i,t}(\theta) = \frac{\pi_{\theta}(o_{i,t} \mid q, \mathbf{o}_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} \mid q, \mathbf{o}_{i,<t})}, \quad \hat{A}_{i,t} = \frac{R_i - \text{mean}(\{R_i\}_{i=1}^G)}{\text{std}(\{R_i\}_{i=1}^G)}.
      $$
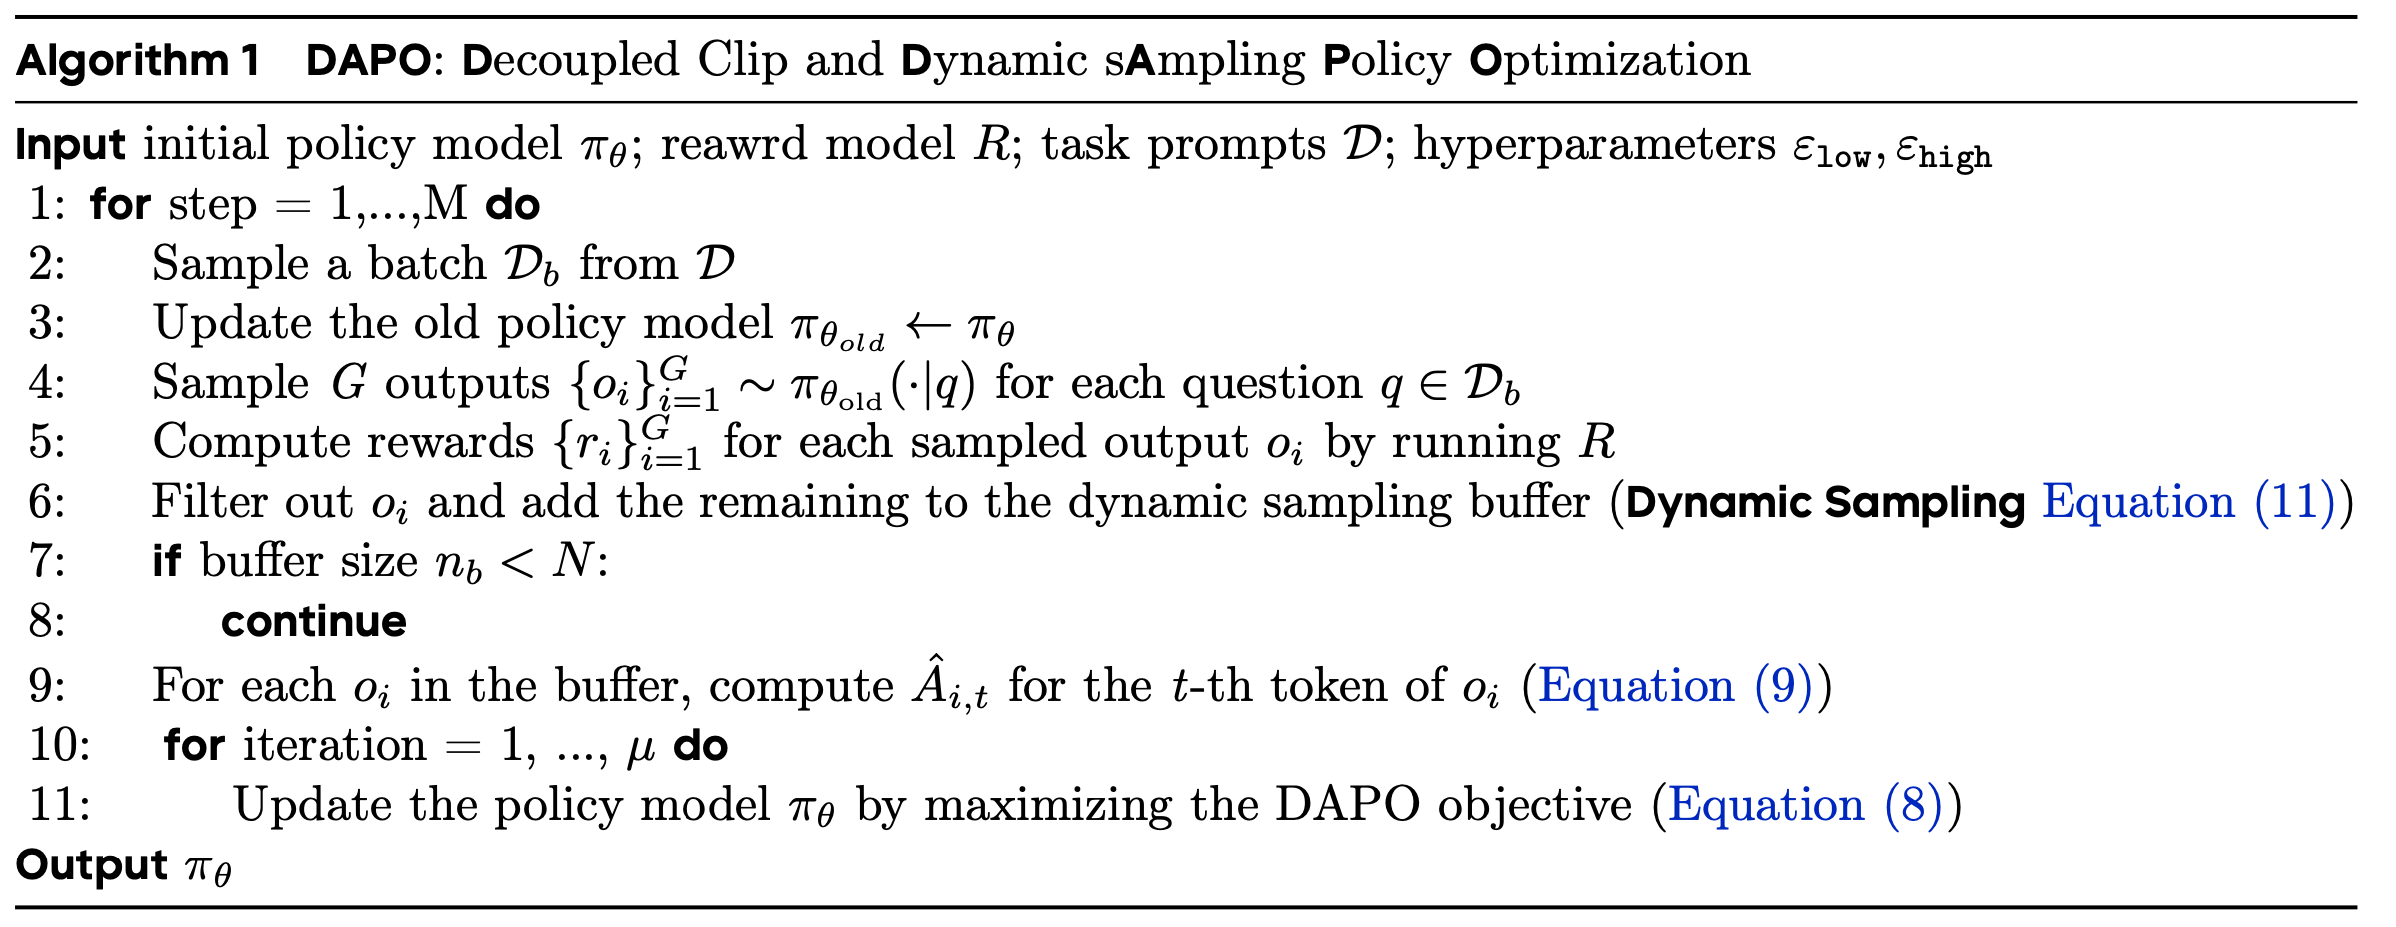
  • 完整算法如算法1所示

Raise the Ceiling: Clip-Higher

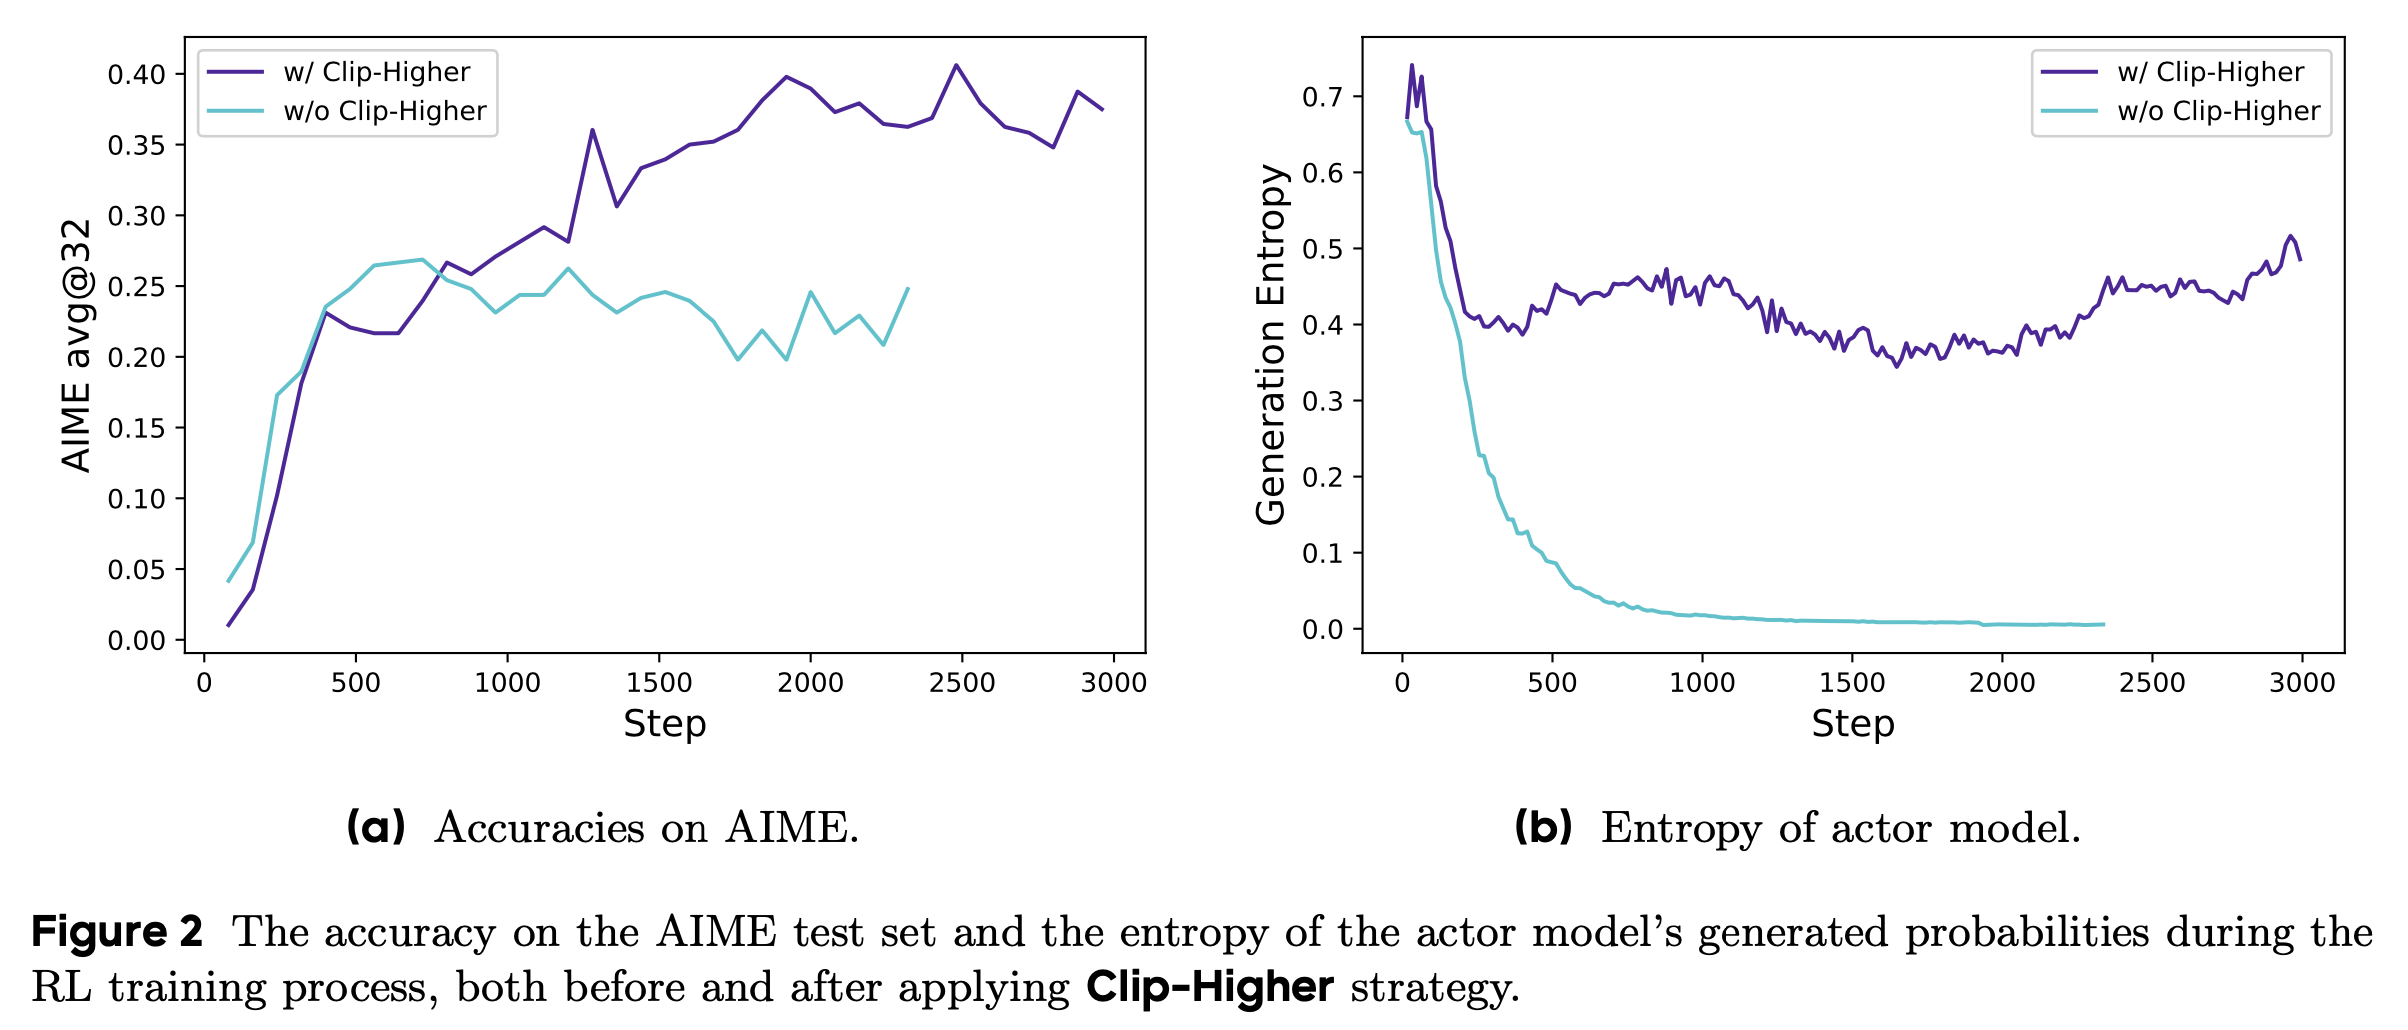
  • 在初步实验中,论文发现使用原始 PPO 或 GRPO 时会出现熵崩溃现象:随着训练进行,策略的熵迅速下降(图2(b))。某些组内的采样响应几乎完全相同,这表明探索能力受限和策略过早确定性化,从而阻碍了模型性能的提升
  • 为解决这一问题,论文提出了Clip-Higher策略。裁剪重要性采样比率(PPO-Clip)的目的是通过限制信任区域来增强 RL 训练的稳定性。论文发现,上限裁剪会限制策略的探索能力。具体来说,提升高概率 token(“利用token”)的概率比提升低概率 token(“探索token”)的概率更容易
    • 理解:原始 PPO 对称 Clip 设定下,确实存在提升高概率 token 的概率比提升低概率 token 的概率更容易的现象
  • 论文中给了一个例子:
    • 当 \(\varepsilon = 0.2\) (大多数算法的默认值)时,考虑两个动作的概率分别为 \(\pi_{\theta_{\text{old} } }(\mathbf{o}_i \mid q) = 0.01\) 和 \(0.9\) ,更新后的最大概率 \(\pi_{\theta}(\mathbf{o}_i \mid q)\) 分别为 \(0.012\) 和 \(1.08\)
    • 以上现象意味着高概率 token(如 \(0.9\) )受到的约束较小,而低概率 token 的概率提升则更为困难
  • 实验数据显示,裁剪后 token 的最大概率约为 \(\pi_{\theta}(\mathbf{o}_i \mid q) < 0.2\) (图3(a)),这证实了上限裁剪确实限制了低概率 token 的概率提升,从而可能降低系统的多样性
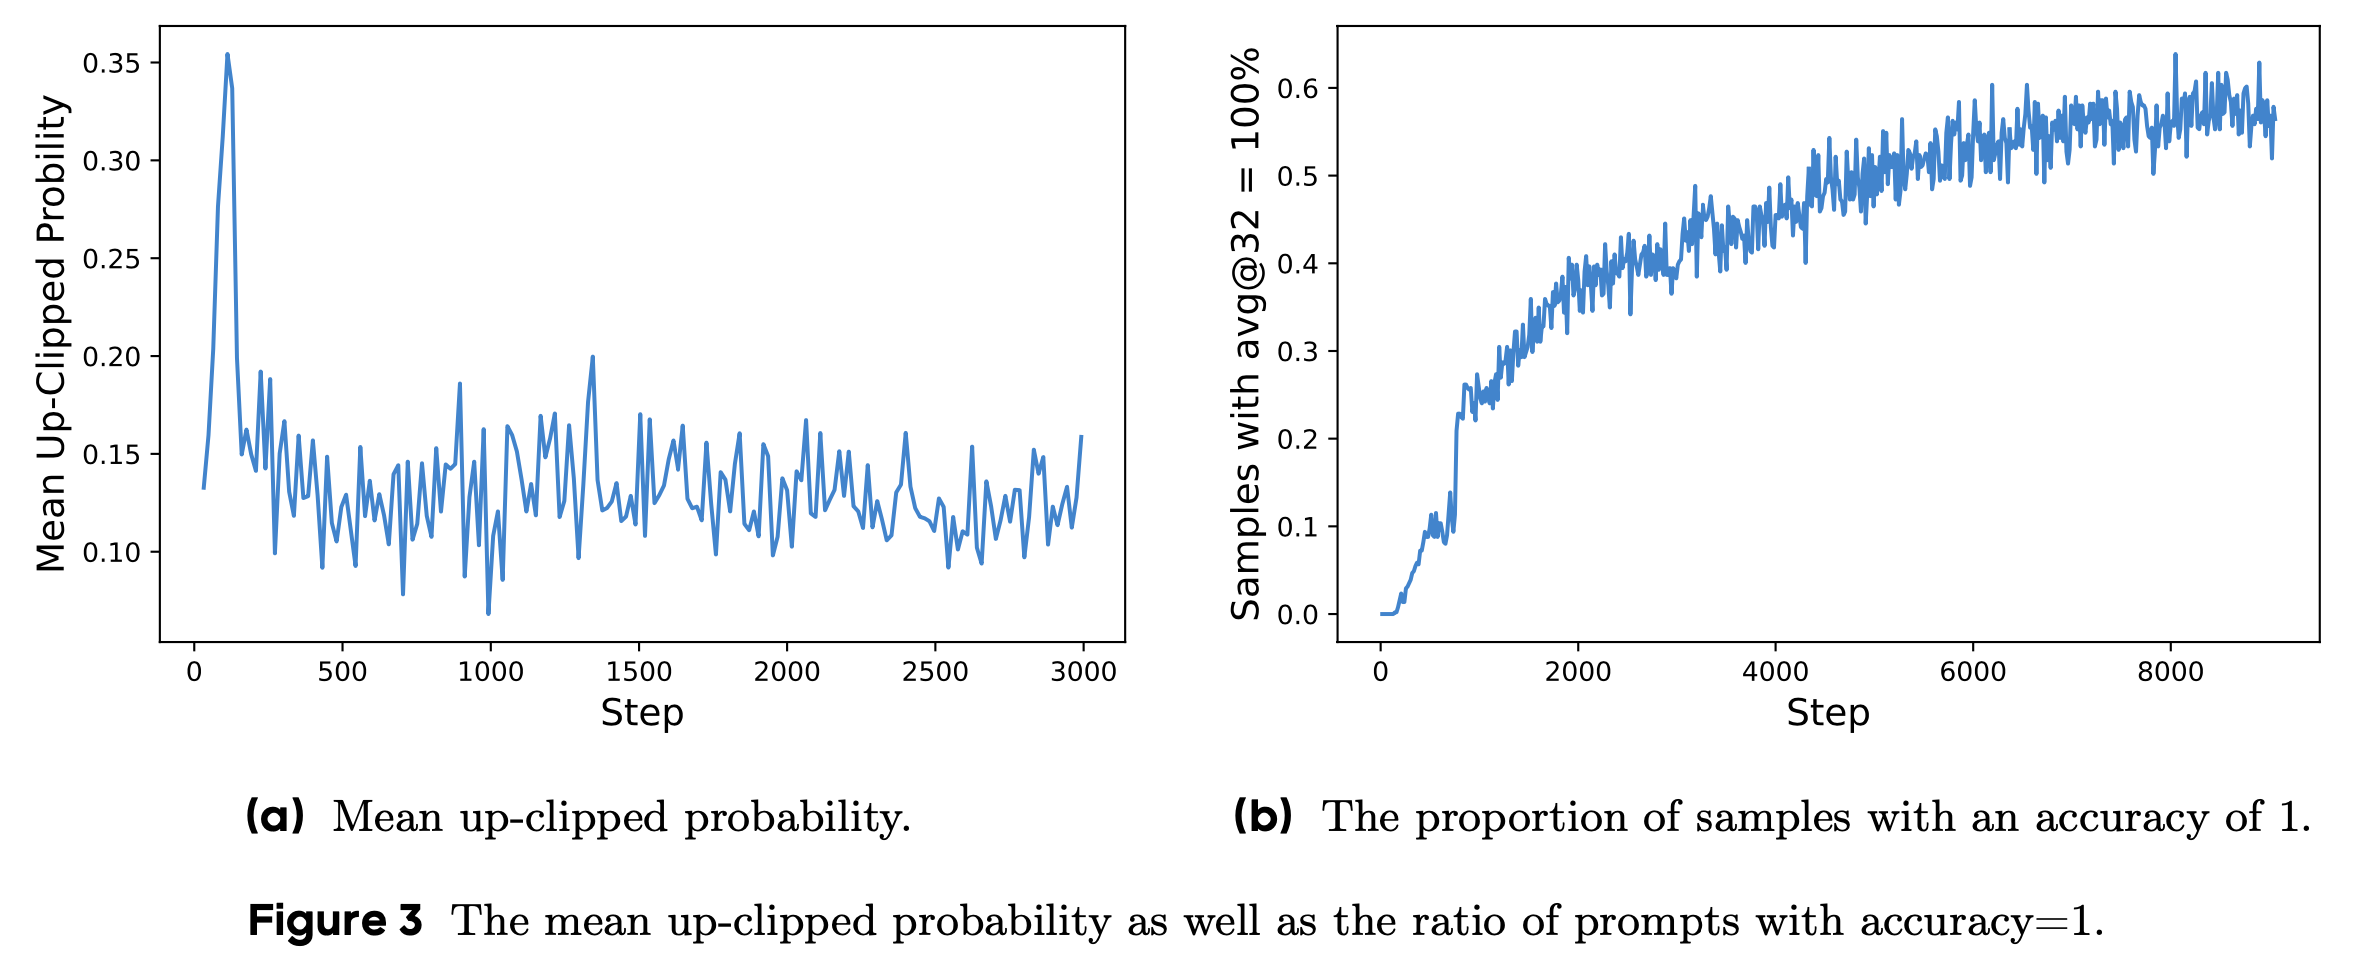
  • 问题:这里说的最大概率是什么?是真实概率还是概率提升比例?
    • 回答:猜测是指触碰到最大上界的样本的比例
  • 基于 Clip-Higher 策略,论文将裁剪范围解耦为下限 \(\varepsilon_{\text{low} }\) 和上限 \(\varepsilon_{\text{high} }\) ,如公式10所示:
    $$
    \begin{align}
    \mathcal{J}_{\mathrm{GRPO} }(\theta) &=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(\cdot|q)} \\
    &\left[\frac{1}{\sum_{i=1}^G|\mathbf{o}_i|}\sum_{i=1}^{G}\sum_{t=1}^{|\mathbf{o}_i|}\min\Big{(}r_{i,t}(\theta)\hat{A}_{i,t},\mathrm{clip}\Big{(}r_{i,t}(\theta),1-\color{red}{\varepsilon_\text{low}},1+\color{red}{\varepsilon_\text{high}}\Big{)}\hat{A}_{i,t}\Big{)}\right] \\
    \text{s.t.}\quad &0 < \left|\{\mathbf{o}_i \mid \texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i)\}\right| < G
    \end{align}
    $$
  • 论文通过增大 \(\varepsilon_{\text{high} }\) 为低概率 token 的概率提升留出更多空间
  • 如图2所示,这一调整有效提升了策略的熵,并促进了更多样化的采样。同时,论文保持 \(\varepsilon_{\text{low} }\) 较小,因为增大它会将这些 token 的概率压制到 0,导致采样空间崩溃

The More the Merrier: Dynamic Sampling

  • 标题为“多多益善:动态采样”,思路是通过动态采样来过滤全正或全负的 Prompt(样本)
  • 现有 RL 算法在部分 Prompt 的准确率为 1 时会面临梯度消失问题
    • 例如,在 GRPO 中,如果某一组所有输出 \(\{\mathbf{o}_i\}_{i=1}^G\) 均正确且奖励为1,则该组的优势值为零
    • 零优势值会导致策略更新无梯度,从而降低采样效率
  • 实验数据显示,准确率为 1 的样本数量持续增加(图3(b)),这意味着每批次中有效 Prompt 数量不断减少,可能导致梯度方差增大并削弱训练信号
  • 为此,论文提出动态采样策略,通过过采样并过滤掉准确率为 1 或 0 的 Prompt (如公式11所示),确保批次中所有 Prompt 均具有有效梯度,并保持 Prompt 数量稳定。在训练前,论文持续采样直至批次中所有样本的准确率均不为 0 或 1
    $$
    \begin{align}
    \mathcal{J}_{\mathrm{GRPO} }(\theta) &=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(\cdot|q)} \\
    &\left[\frac{1}{\sum_{i=1}^G|\mathbf{o}_i|}\sum_{i=1}^{G}\sum_{t=1}^{|\mathbf{o}_i|}\min\Big{(}r_{i,t}(\theta)\hat{A}_{i,t},\mathrm{clip}\Big{(}r_{i,t}(\theta),1-\varepsilon_\text{low},1+\varepsilon_\text{high}\Big{)}\hat{A}_{i,t}\Big{)}\right] \\
    \text{s.t.}\quad &\color{red}{0 < \left|\{\mathbf{o}_i \mid \texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i)\}\right| < G}
    \end{align} \tag{11}
    $$
    • 理解:这里是按照 Prompt 为维度进行过滤的,也就是说只有当一个 Prompt 所有的回答都对或者都错时才会被计算梯度,否则这个 Prompt 不参与梯度计算
    • \(\color{red}{0 < \left|\{\mathbf{o}_i \mid \texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i)\}\right| < G}\) 的含义是 保留符合以下要求的 Prompt:
      • 对每个 Prompt,采样 \(G\) 个答案 \(\mathbf{o}_i\),要求这些答案不全对也不全错(因为不管是全对还是全错都会导致没有梯度)
      • 注:模型输出 \(\mathbf{o}_i\) 与 标准答案 \(a\) 等价意味着 \(\texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i) = 1\)
  • 需要注意的是,这一策略不会显著影响训练效率,因为生成时间主要由长尾样本的生成决定(前提是 RL 系统同步且生成阶段未流水线化)
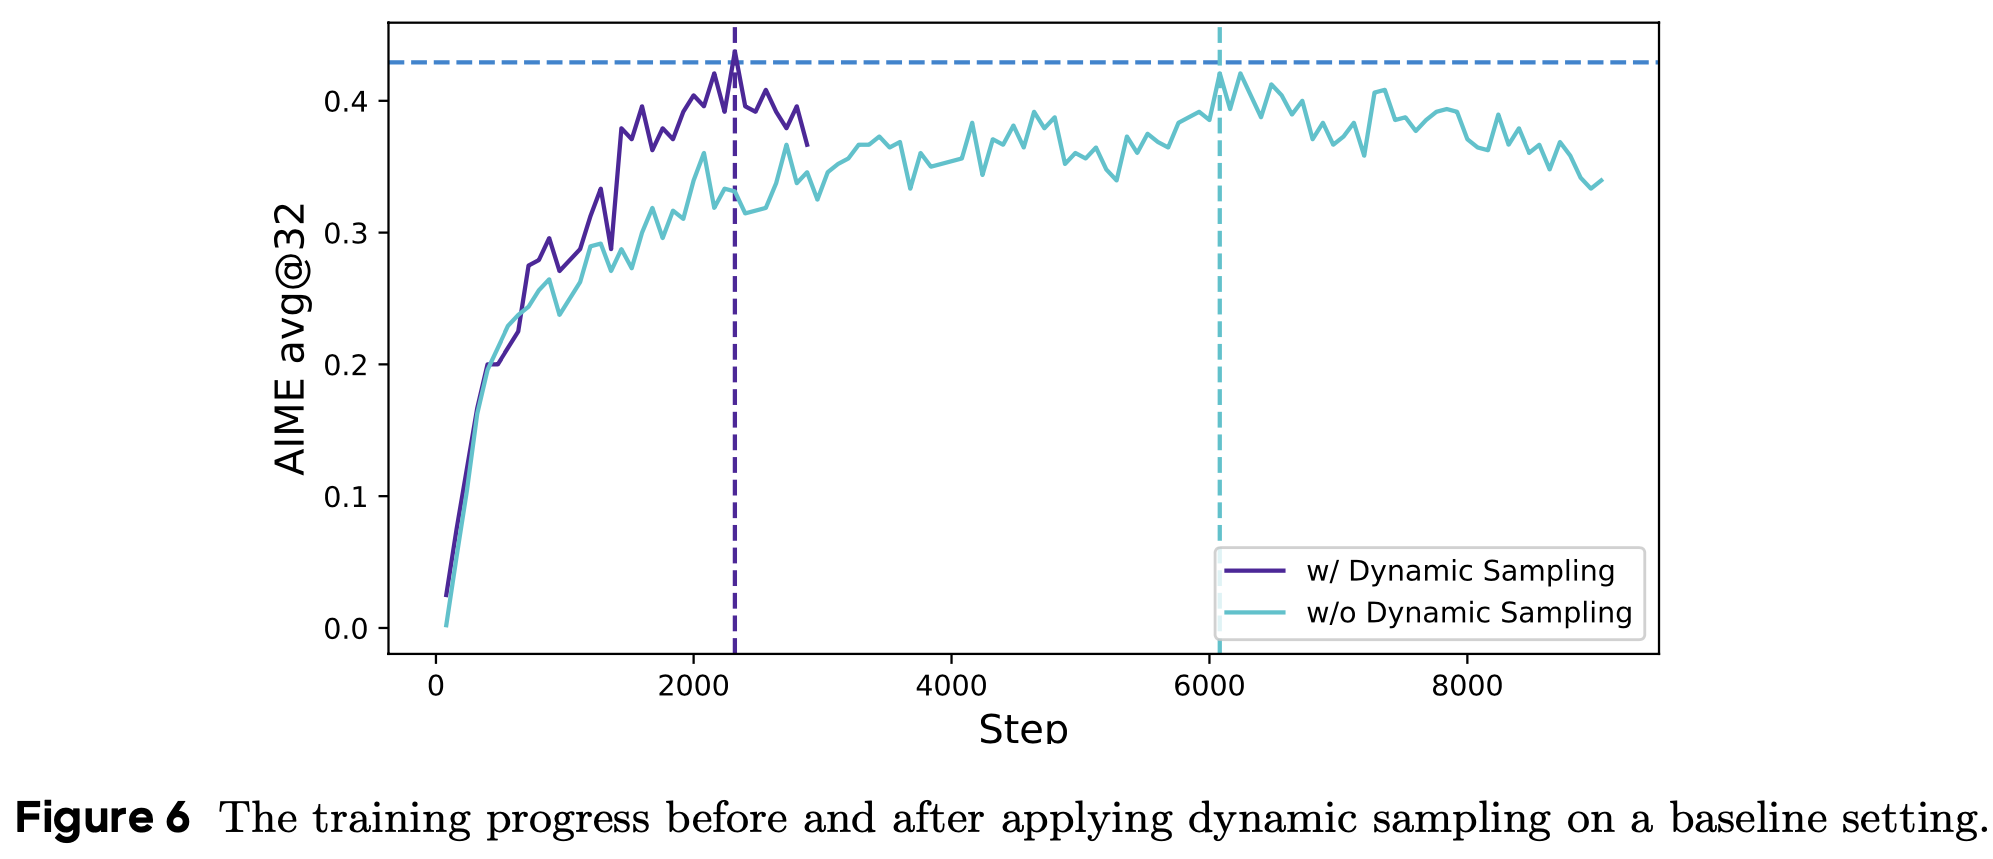
  • 此外,实验表明动态采样能以更少的训练步骤达到相同性能(图6)

Rebalancing Act: Token-Level Policy Gradient Loss

  • 原始 GRPO 算法采用样本级损失计算,即先在每个样本内按 token 平均损失,再在样本间聚合损失
  • 这种方法为每个样本分配了相同的权重。然而,论文发现这种损失计算方式在长链式思维(long-CoT)RL场景中会带来以下问题:
    • 由于所有样本在损失计算中权重相同,长响应中的 token 对整体损失的贡献可能被低估
    • 这会导致两种负面影响:
      • 第一,对于高质量的长样本,模型难以从中学习推理相关的模式;
      • 第二,论文观察到过长的样本通常包含低质量模式(如无意义重复)
    • 样本级损失计算无法有效惩罚这些长样本中的不良模式,从而导致熵和响应长度不健康增长(图4(a)和图4(b))
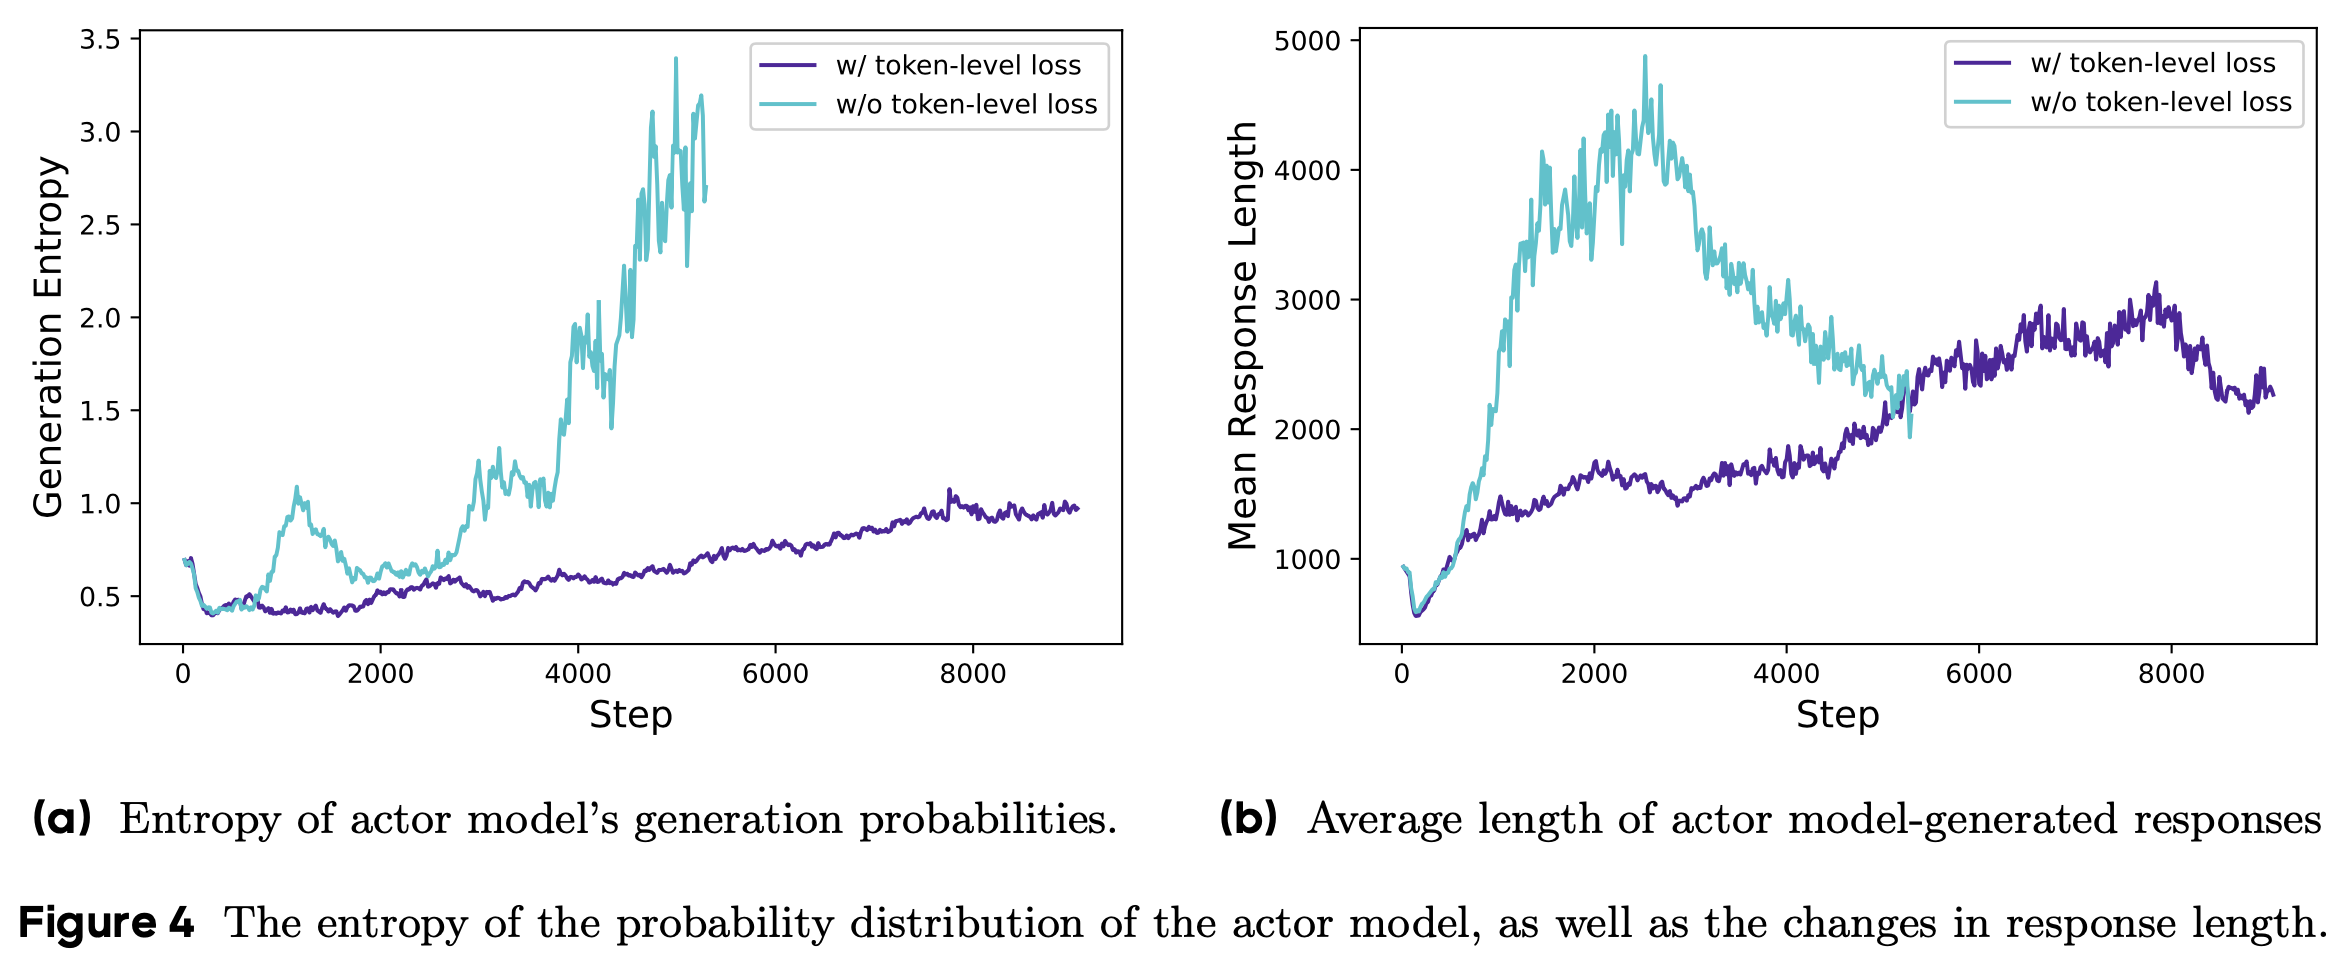
  • 为解决这一问题,论文在长链式思维RL场景中引入了Token-Level Policy Gradient Loss :
    $$
    \begin{align}
    \mathcal{J}_{\mathrm{GRPO} }(\theta) &=\mathbb{E}_{(\mathbf{q},\mathbf{a})\sim\mathcal{D},\{o_{i}\}_{i=1}^{G}\sim\pi_{\theta_{old} }(\cdot|q)} \\
    &\left[\frac{1}{\color{red}{\sum_{i=1}^G|\mathbf{o}_i|}}\color{red}{\sum_{i=1}^{G}\sum_{t=1}^{|\mathbf{o}_i|}}\min\Big{(}r_{i,t}(\theta)\hat{A}_{i,t},~\mathrm{clip}\Big{(}r_{i,t}(\theta),1-\varepsilon_\text{low},1+\varepsilon_\text{high}\Big{)}\hat{A}_{i,t}\Big{)}\right] \\
    \text{s.t.}\quad &0 < \left|\{\mathbf{o}_i \mid \texttt{is_equivalent}(\mathbf{a}, \mathbf{o}_i)\}\right| < G
    \end{align}
    $$
  • 在这种设置下,长序列对整体梯度更新的影响更大
  • 从单个 token 的角度看,如果某种生成模式能够增加或减少奖励,无论其出现在多长的响应中,都会被同等程度地促进或抑制

Hide and Seek: Overlong Reward Shaping

  • 在 RL 训练中,论文通常设置生成的最大长度,超长样本会被截断
    • 论文发现,对截断样本的不当奖励设计会引入噪声并严重干扰训练过程
  • 默认情况下,研究人员会为截断样本分配惩罚性奖励(punitive reward)
    • 这种方式可能会在训练中引入噪声,因为一些正确的推理过程可能仅因长度过长而受到惩罚 ,从而混淆模型对其推理有效性的判断
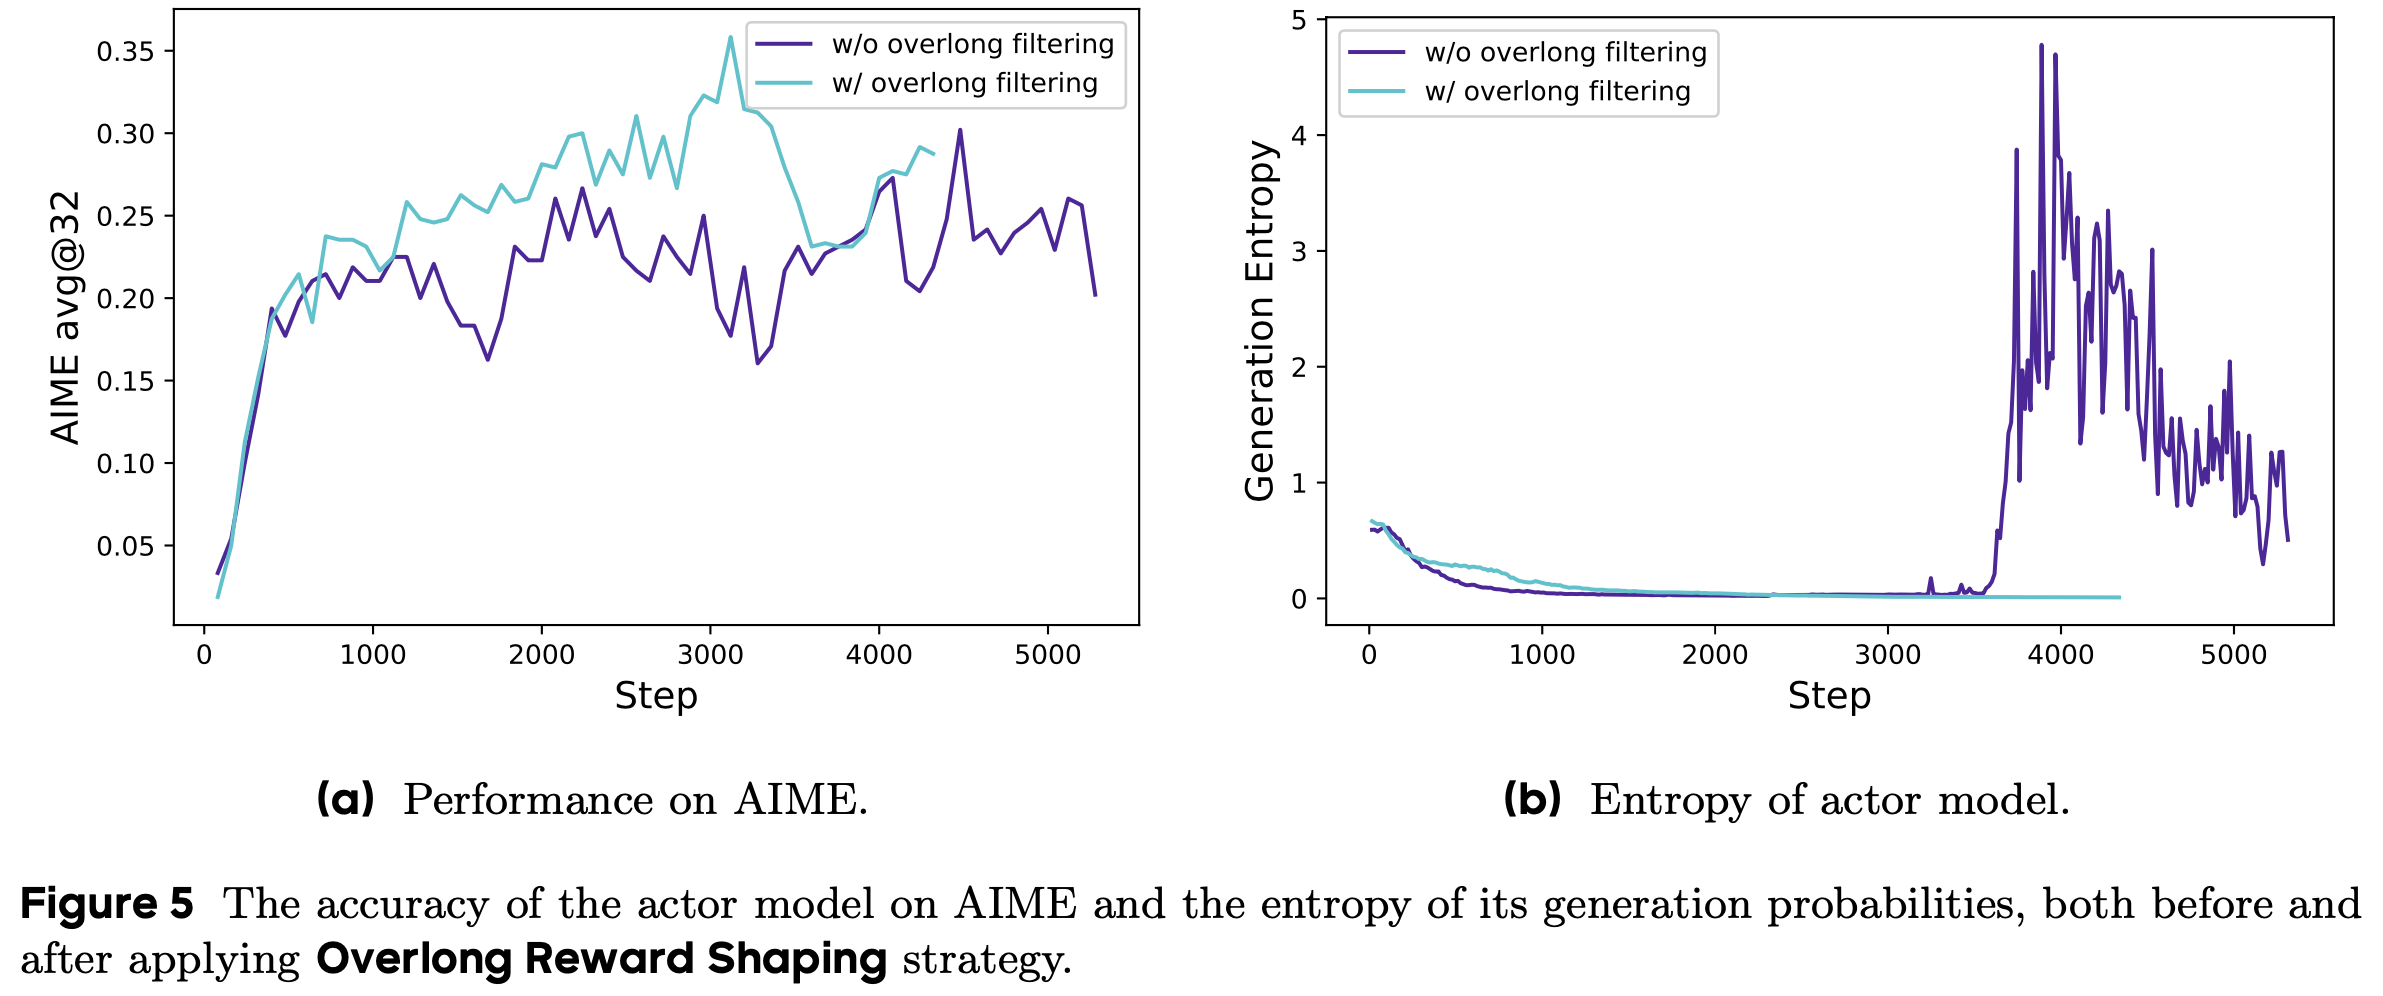
  • 为研究这种奖励噪声的影响,论文首先采用超长过滤(Overlong Filtering)策略,屏蔽截断样本的损失(实验表明,这种方法显著提升了训练稳定性和性能(图5))
    • 问题:超长过滤策略为什么可以屏蔽阶段样本的损失?
    • 答案:太长的样本就直接过滤掉(而不是截断),因为截断了就是错误(会回传负奖励),而过滤掉则不会回传梯度
  • 此外,论文提出了软超长惩罚(Soft Overlong Punishment)机制(公式13),这是一种基于长度的惩罚方法,用于重塑截断样本的奖励
    $$
    R_{\text{length} }(y) =
    \begin{cases}
    0, & |y| \leq L_{\max} - L_{\text{cache} } \\
    \frac{(L_{\max} - L_{\text{cache} }) - |y|}{L_{\text{cache} } }, & L_{\max} - L_{\text{cache} } < |y| \leq L_{\max} \\
    -1, & L_{\max} < |y|
    \end{cases} \tag{13}
    $$
    • 当响应长度超过预设最大值时,论文定义一个惩罚区间,区间内响应越长,惩罚越大
    • 该惩罚会叠加到原始基于正确性的规则奖励上,从而引导模型避免生成过长的响应
    • 理解:\(L_{\max} - L_{\text{cache} } < |y| \leq L_{\max}\) 时,有:
      $$\frac{(L_{\max} - L_{\text{cache} }) - |y|}{L_{\text{cache} } } \color{red}{\in (-1, 0)}$$
      • 这是一种软性的惩罚,更适合放到模型里面
  • 个人理解:
    • 原始的超长样本截断(阶段后答案就是错误,奖励是负的)本身也具有惩罚超长样本的能力吧?

DAPO 相关实验

Training Details

  • 在本工作中,论文专注于数学任务来评估论文的算法,该算法可以轻松迁移到其他任务
  • 论文采用 verl 框架进行训练,并以 naive GRPO 作为基线算法,使用组奖励归一化(group reward normalization)来估计优势
  • 在超参数设置上:
    • 论文使用 AdamW 优化器
    • 恒定学习率为 \(1 \times 10^{-6}\)
    • 在 20 个 rollout 步骤中进行线性预热(预热后使用恒定学习率)
      • 问题:这里 20 个 rollout 是指每个 Prompt 都 rollout 20 次,然后进行训练吗?
    • 对于 rollout, Prompt 的批次大小为 512,每个 Prompt 采样 16 个响应
    • 训练时,小批次大小设置为 512,即每个 rollout 步骤进行 16 次梯度更新
    • 对于过长奖励调整(Overlong Reward Shaping) ,论文将预期最大生成长度设置为 16,384 个 token,并额外分配 4,096 个 token 作为软惩罚缓存,因此生成的最大 token 数为 20,480
    • 对于Clip-Higher机制,论文将裁剪参数 \(\varepsilon_{\text{low} }\) 设置为 0.2, \(\varepsilon_{\text{high} }\) 设置为 0.28 ,以有效平衡探索与利用的权衡
    • 在 AIME 评估中,论文将评估集重复 32 次,并报告 avg@32 以确保结果稳定性
      • 问题:avg@32 是代表同一个 Prompt 使用 32 次采样,每次采样取最大概率的回复,然后对所有回复求均值吗?
      • 回答:是的,参见文中图3对采样回答全对的描述
    • 推理超参数设置为 temperature 1.0 和 topp 0.7

实验结果

  • 在 AIME 2024 上的实验表明,DAPO 成功地将 Qwen-32B 基础模型训练为一个强大的推理模型,其性能优于 DeepSeek 在 Qwen2.5-32B 上使用 R1 方法的结果
  • 如 图1 所示,论文在 AIME 2024 上观察到性能的显著提升,准确率从接近 0% 提高到 50%。值得注意的是,这一提升仅使用了 DeepSeek-R1-Zero-Qwen-32B 所需训练步骤的 50%
  • 论文在 表1 中详细分析了每种训练技术对结果的贡献
    • 这些改进证明了这些技术在 RL 训练中的有效性,每种技术都为 AIME 2024 的准确率提升贡献了若干百分点
    • 在 native GRPO 设置下,Qwen2.5-32B 基础模型的准确率仅能达到 30%
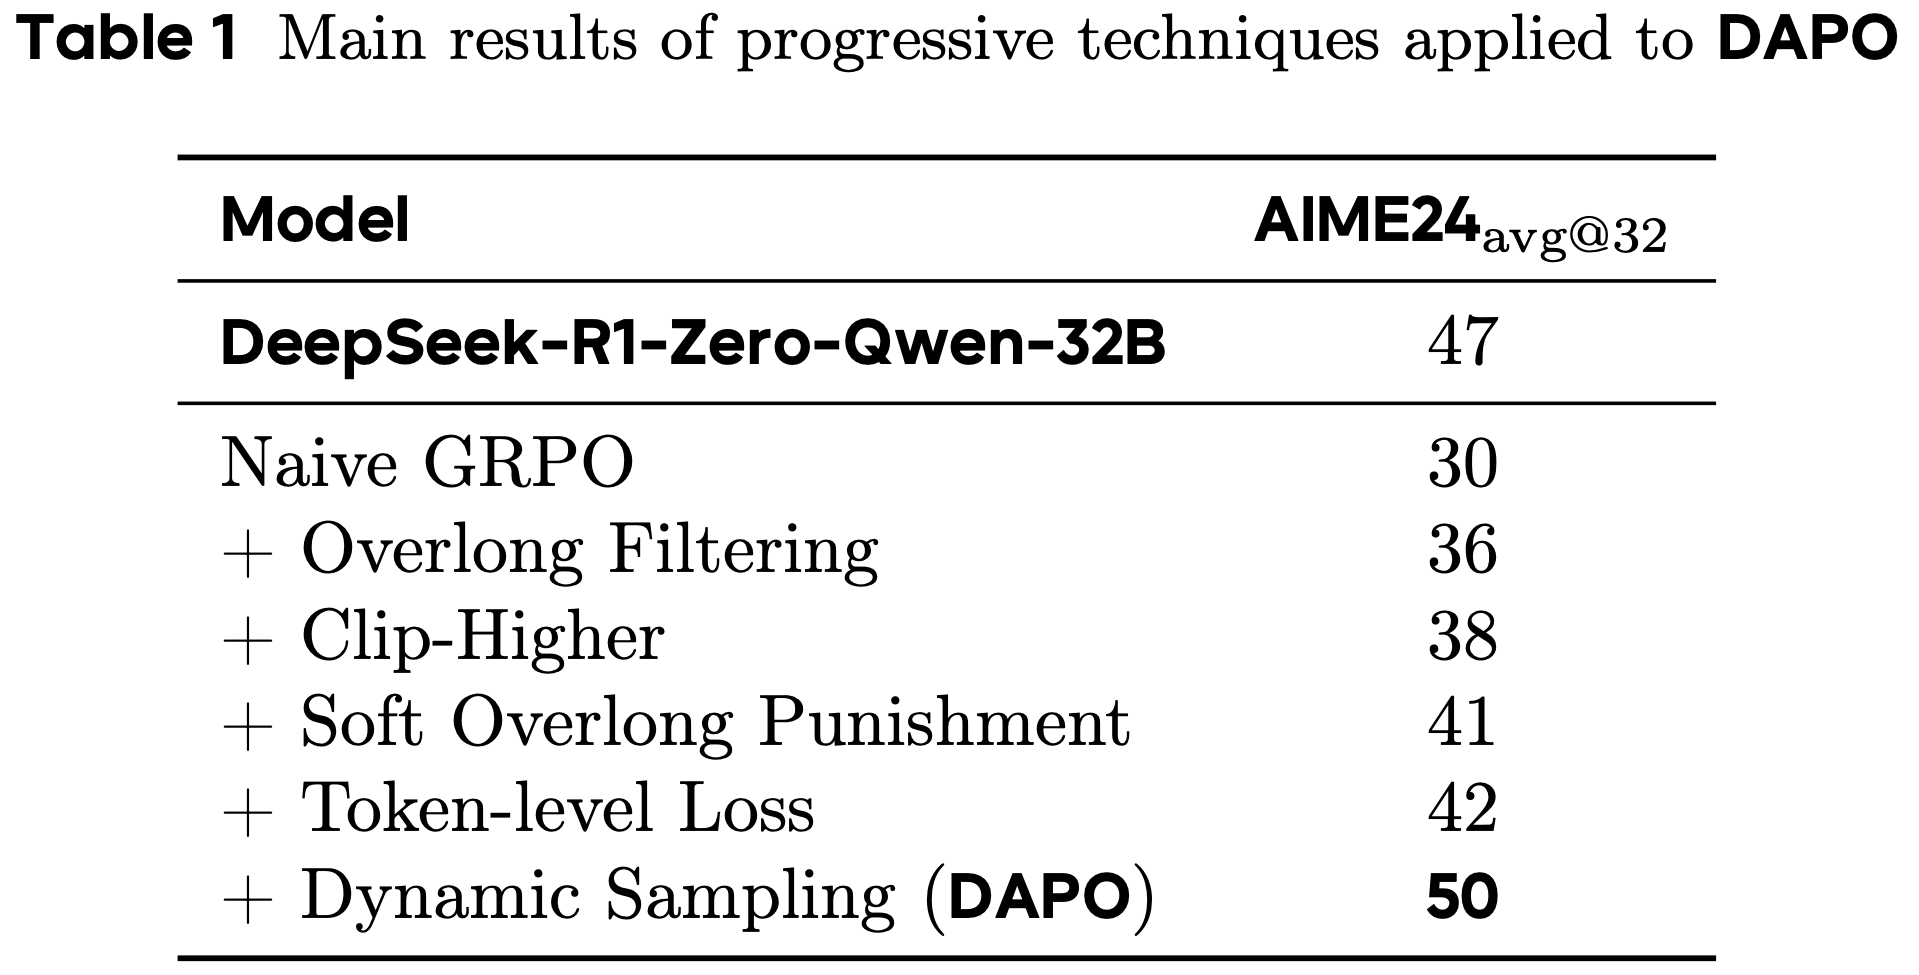
  • 对于 token-level 损失,尽管其带来的性能提升较小,但论文发现它增强了训练的稳定性,并使生成长度的增长更加健康
  • 在应用动态采样时,尽管由于过滤掉零梯度数据需要采样更多数据,但整体训练时间并未受到显著影响
    • 如图 6 所示,尽管采样实例数量增加,但由于所需训练步骤减少,模型的收敛时间甚至有所缩短

Training Dynamics(训练动态监控)

  • 大型语言模型的强化学习不仅是一个前沿研究方向,也是一个内在复杂的系统工程挑战,其特点是各子系统之间的相互依赖
  • 对任何子系统的修改都可能通过系统传播,并由于这些组件之间的复杂相互作用而导致不可预见的后果
  • 即使是初始条件的微小变化(如数据和超参数的差异),也可能通过迭代强化学习过程放大,从而在结果中产生显著偏差
  • 这种复杂性常常使研究人员陷入两难境地:即使经过细致分析并有充分理由认为某项修改会提升训练过程的某些方面,实际结果却往往与预期轨迹不符
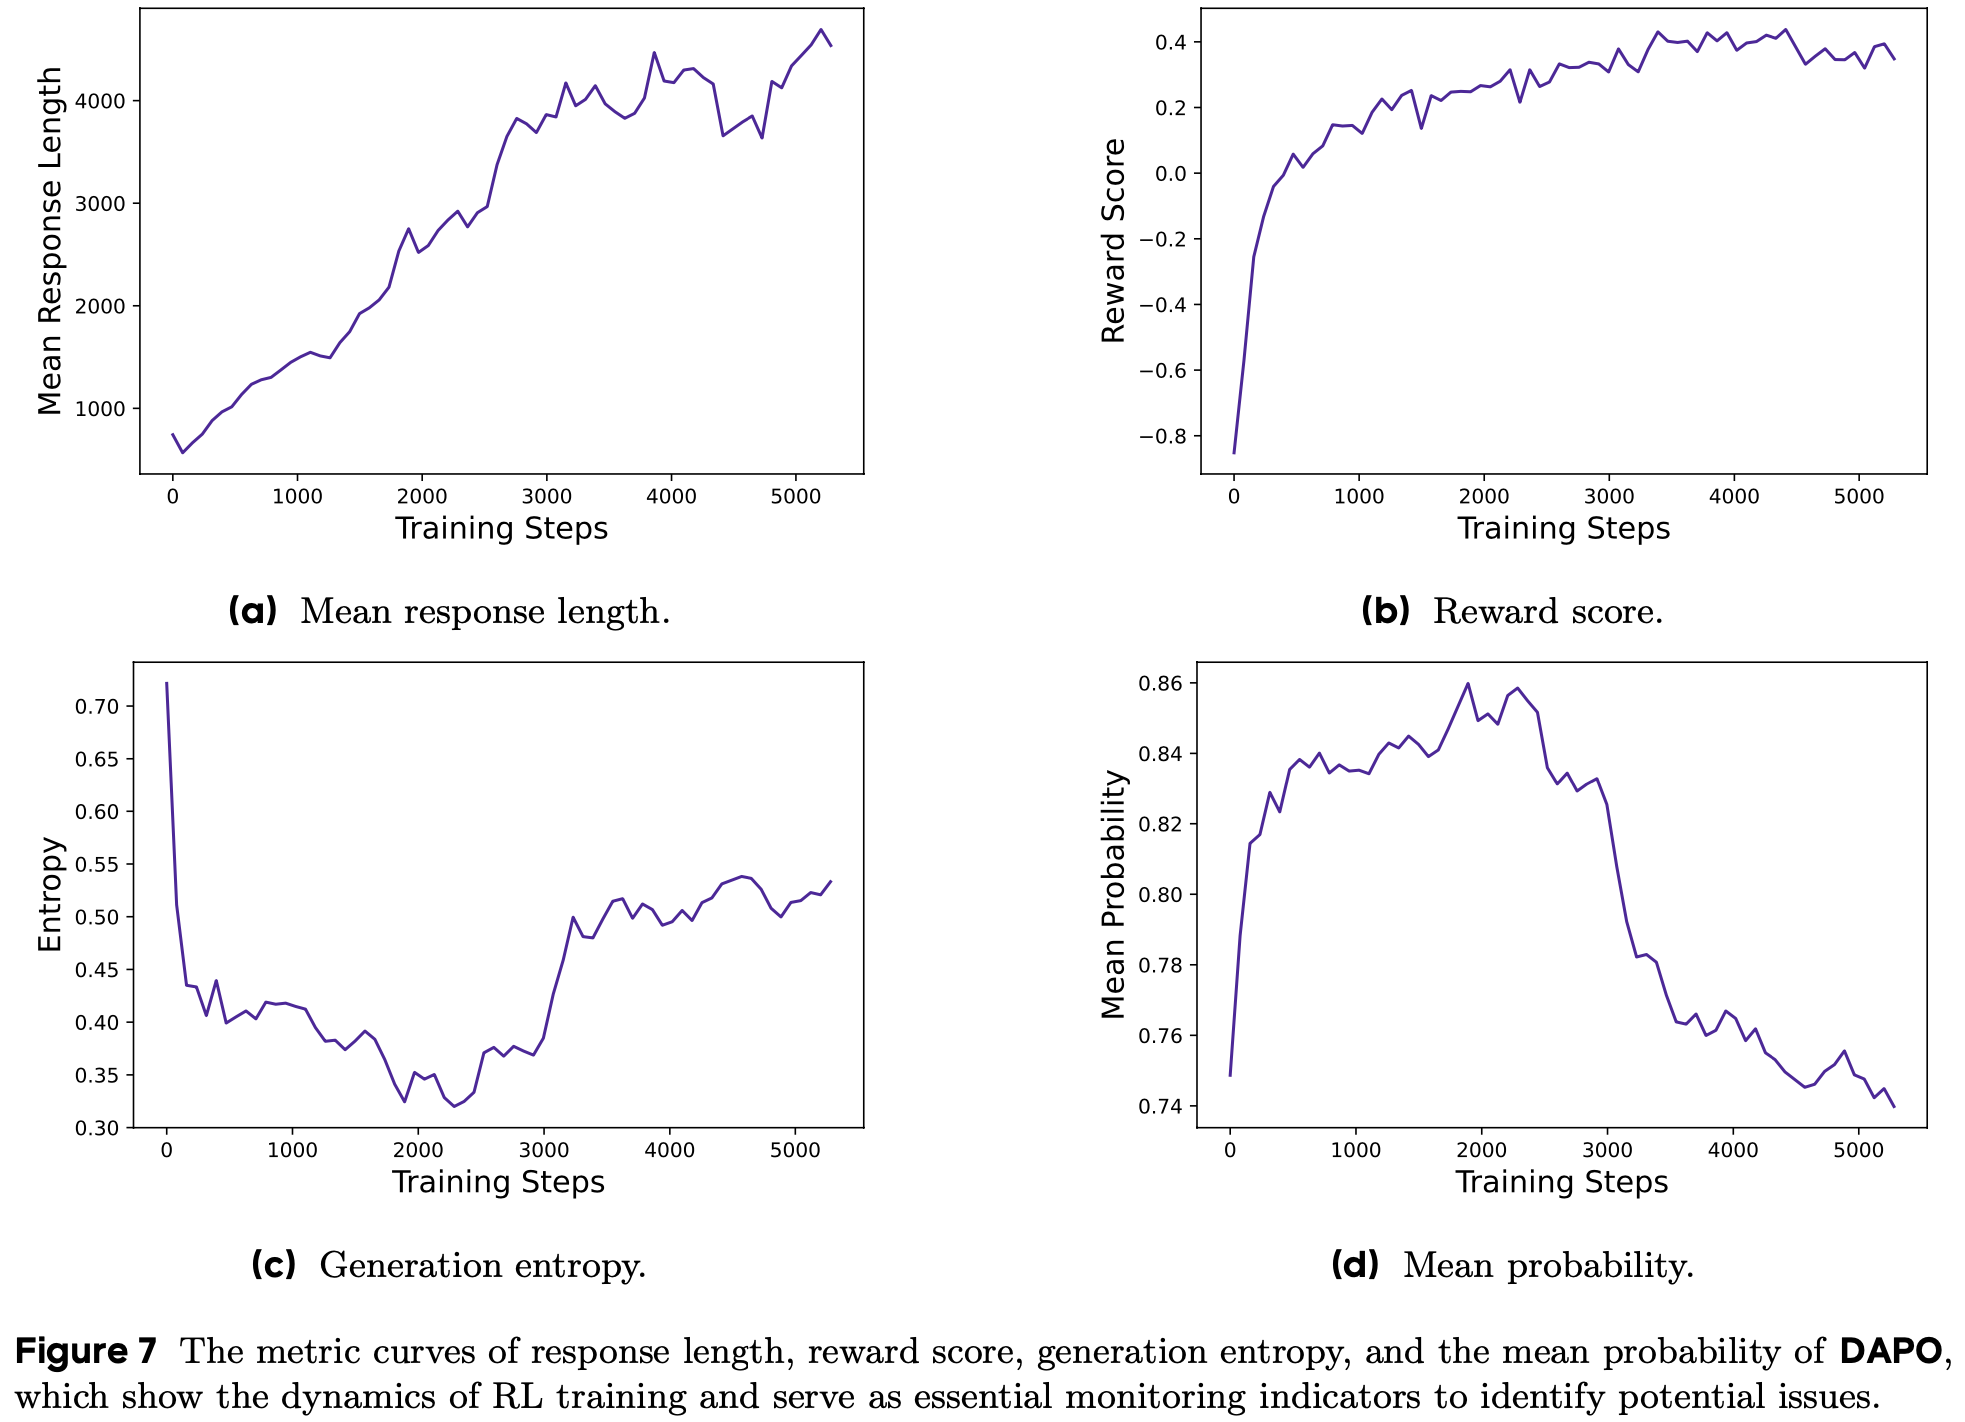
  • 因此,在实验过程中监控关键中间结果对于快速识别差异来源并最终优化系统至关重要,监控指标包括下面三种:
  • 生成响应的长度(The Length of Generated Responses) :
    • 与训练稳定性和性能密切相关的指标,如图7(a) 所示
    • 长度的增加为模型提供了更大的探索空间,允许采样更复杂的推理行为,并通过训练逐步强化
    • 需要注意的是,长度在训练过程中并不总是保持持续上升趋势:在某些较长的阶段,它可能表现出停滞甚至下降的趋势,这在 Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning 中也有所体现
    • 论文通常将长度与验证准确率结合使用,作为评估实验是否恶化的指标
  • 训练期间的奖励动态(The Dynamics of Reward)
    • 强化学习中的关键监控指标之一,如图 7(b) 所示
    • 在大多数实验中,奖励的增长趋势相对稳定,不会因实验设置的调整而出现显著波动或下降
    • 这表明,在可靠的奖励信号下,语言模型能够稳健地拟合训练集的分布
    • 过拟合发现 :论文发现训练集的最终奖励与验证集的准确率往往相关性较低,这表明模型对训练集存在过拟合
  • Actor Model 的熵 & 生成概率
    • 熵与模型的探索能力相关,是论文实验中密切监控的关键指标
    • 直观上,模型的熵需要保持在适当范围内:熵过低表明概率分布过于尖锐,导致探索能力丧失;而熵过高通常与过度探索问题(如胡言乱语和重复生成)相关
      • 生成概率则与熵相反,生成概率越大,对应的熵可能越小
    • 如第 3.1 节所示,通过应用 Clip-Higher 策略,论文有效解决了熵崩溃问题
    • 在后续实验中,论文发现保持熵的缓慢上升趋势有助于模型性能的提升 ,如图 7(c) 和图 7(d) 所示

Case Study

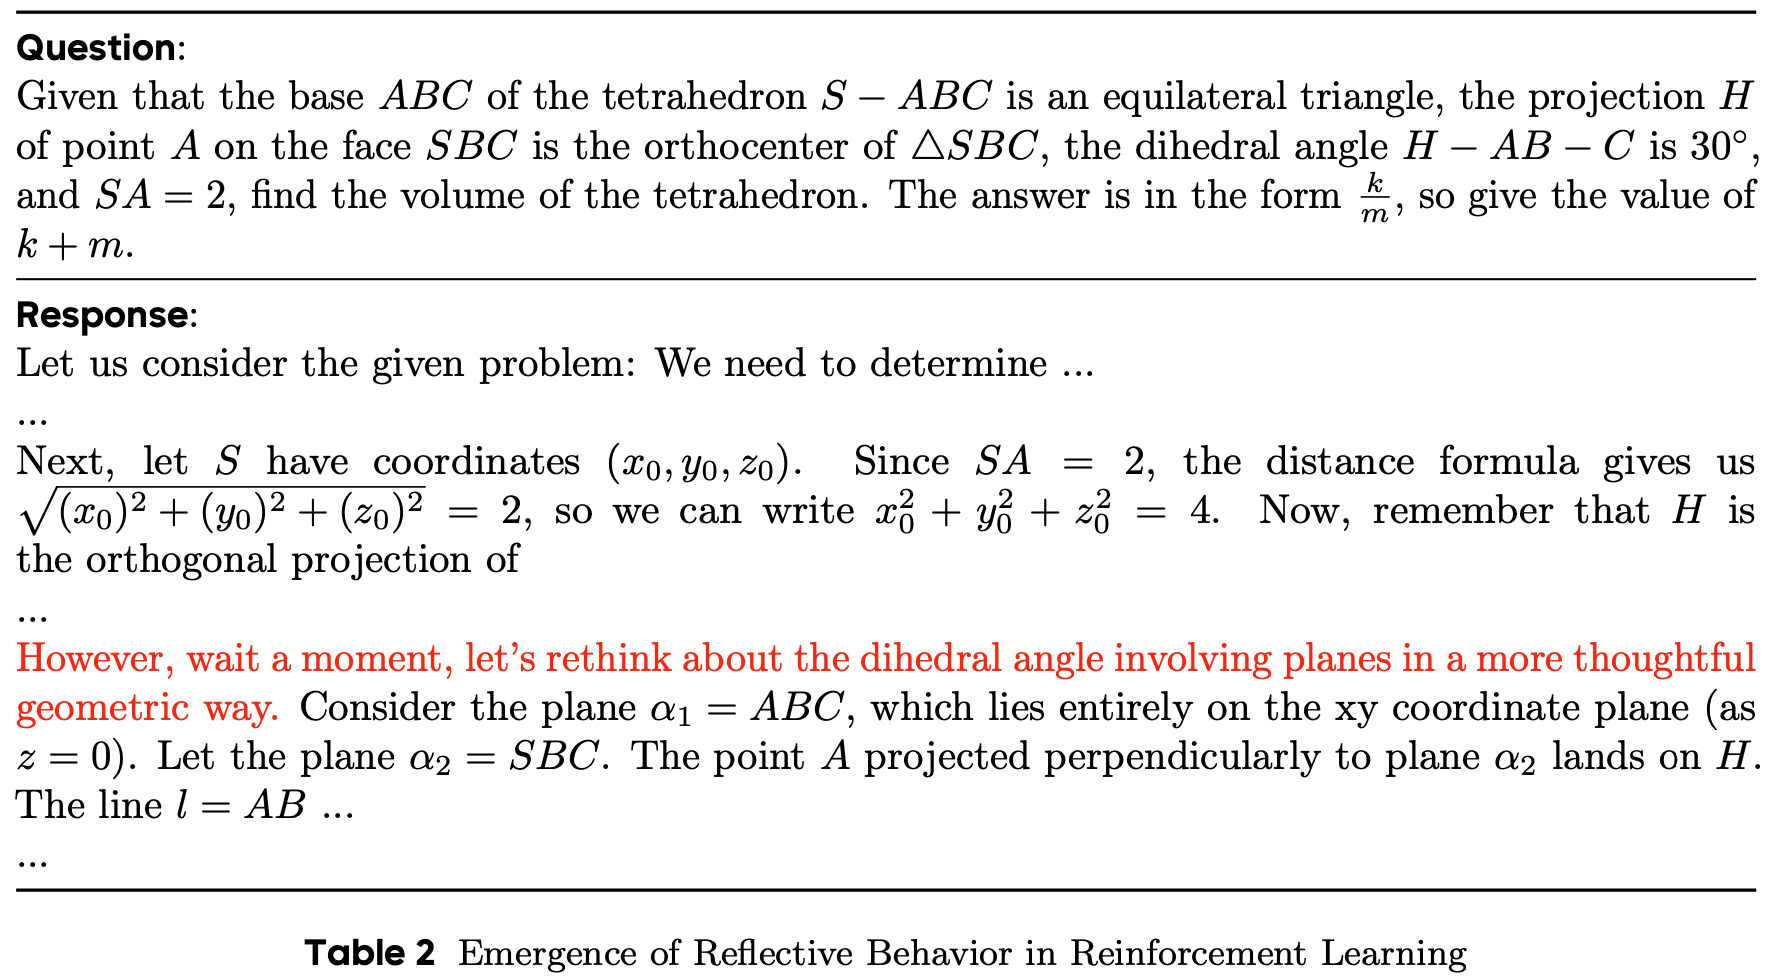
  • 在 RL 训练过程中,论文观察到一个有趣的现象:Actor Model 的推理模式会随时间动态演变
  • RL 算法不仅会强化那些有助于正确解决问题的现有推理模式,还会逐渐催生最初不存在的全新推理模式
  • 这一发现揭示了 RL 算法的适应性和探索能力,并为模型的学习机制提供了新的见解
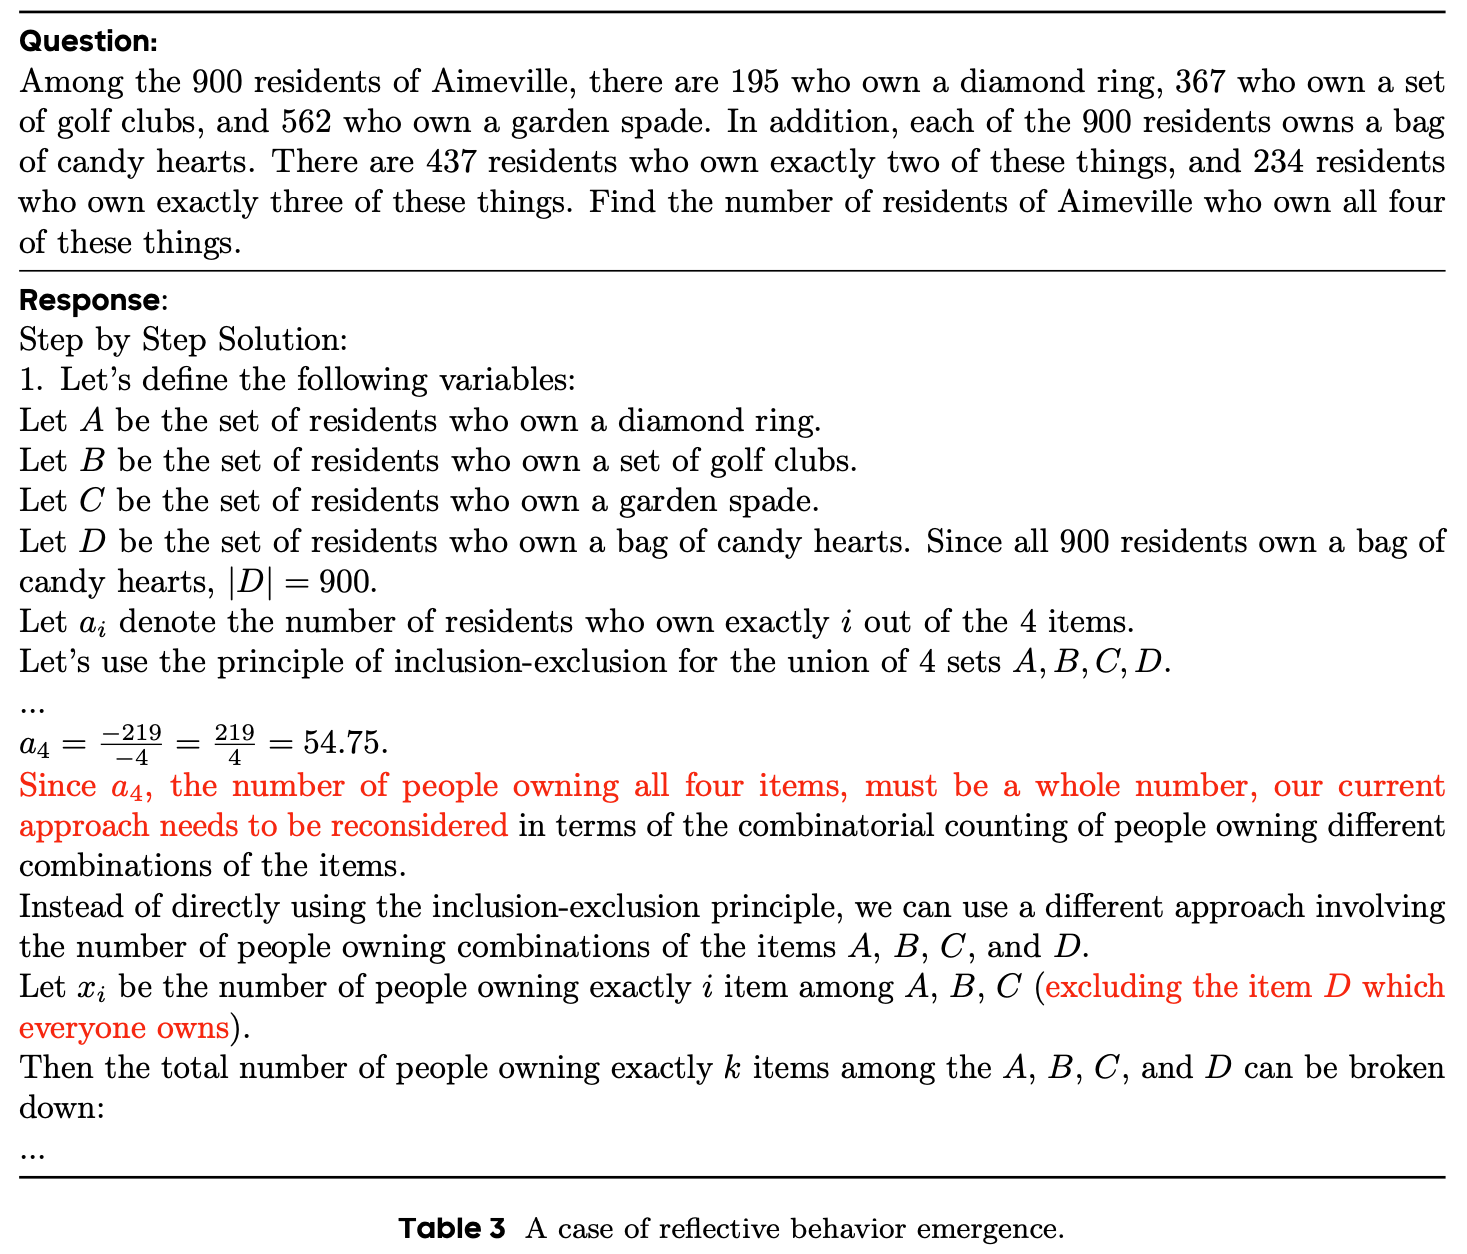
  • 观察到的现象示例:在模型训练的早期阶段 ,几乎没有出现对模型之前输出推理步骤的检查和反思行为;随着训练的进行,模型表现出明显的反思和回溯行为,如表2 所示(这一观察为未来研究 RL 中推理能力的涌现提供了新的方向)
附录A 数据集转换示例

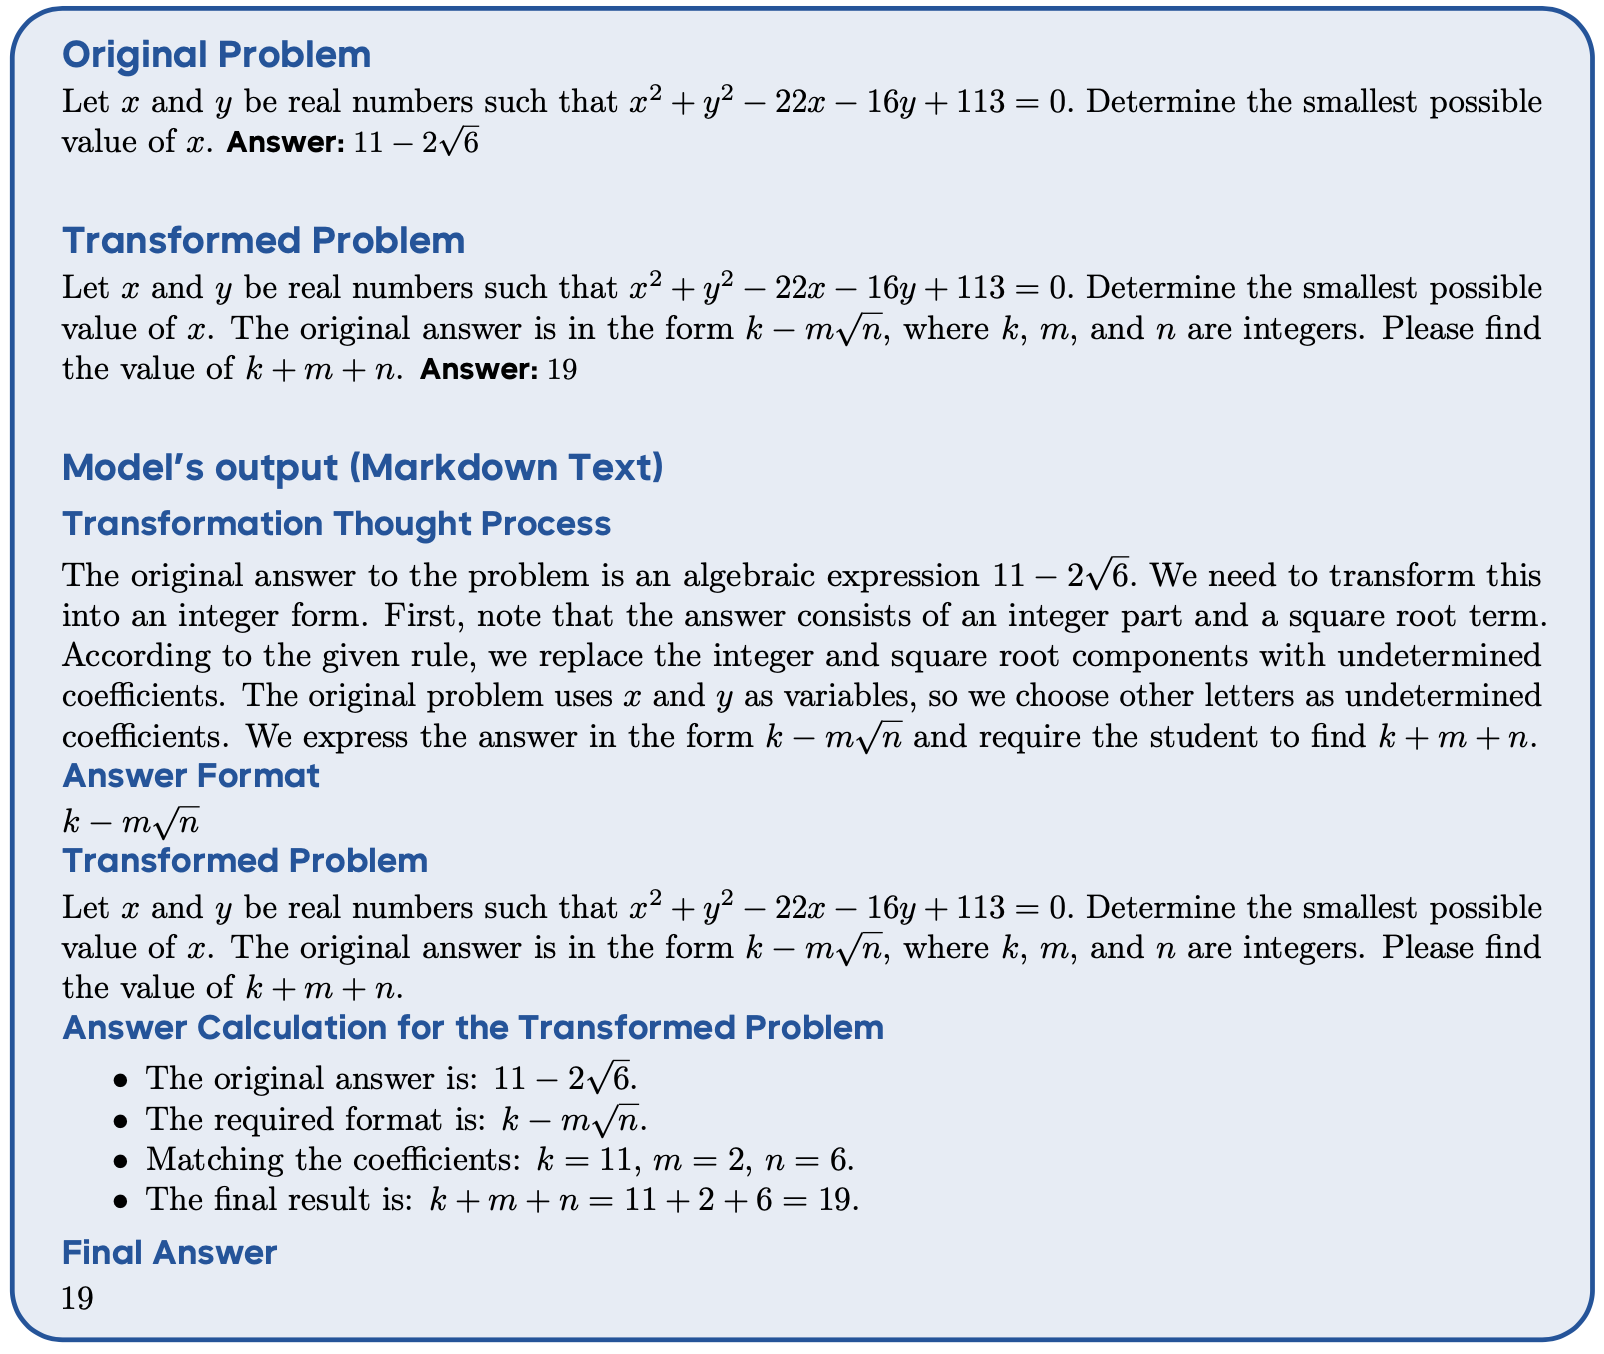
  • 以下展示了一个数据转换的示例,包括原始问题、转换后的问题以及模型在转换过程中的输出(原始内容为 Markdown 文本,已为可读性进行渲染)
    • 问题:转换是谁做的?提前人工转换的?
  • 为确保模型能高精度完成此任务,论文的目标是使其进行全面的推理,同时避免幻觉
  • 为此,论文提供了一个清晰的思维框架,鼓励深入推理,采用思维链(CoT)推理,并定义四个明确的步骤:
    • 提取答案格式
    • 重写问题陈述(问题:按照什么目标来重写?写的更简单,还是难?)
    • 解决修改后的问题
    • 提供整数作为最终答案
  • 在每个步骤中,论文提供少量示例解决方案或详细指南,以引导模型的推理过程
  • 通过这种方法,论文观察到在大多数情况下,LLM 生成的重新表述在格式和质量上都能令人满意
附录B 一个补充示例

  • 反思性行为涌现的一个示例

NLP——LLM对齐微调-CISPO-MiniMax-M1

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention, arXiv 20250616, MiniMax
    • 名字说明:Clipped IS-weight Policy Optimization 中 IS 表示 Importance Sampling
    • 开源地址:github.com/MiniMax-AI/MiniMax-M1
    • API 地址:minimax.io

Paper Summary

  • 写在最前面:
    • MiniMax 作为一个小型创业公司,在今天还能独立坚持创新的尝试新的 Transformer 框架(论文的 Lightning Attention 是 线性 Attention(Linear Attention)的变体),是非常值得尊重的
    • 论文中含有非常多的训练和实现细节,比如 AdamW 优化器参数的观察和调整;重复文本生成的提前结束等,都是非常难得的实验观察和实现细节
    • 综上:这篇文章的含金量也非同一般!
  • 论文介绍了 MiniMax-M1(后续有时候也简称 M1),包含许多特性
    • MiniMax-M1 是全球首个开源的、基于混合注意力(hybrid-attention)架构的大规模推理模型
    • MiniMax-M1 采用了 MoE 架构与 Lightning Attention 机制相结合的设计
    • MiniMax-M1 模型基于论文之前的 MiniMax-Text-01 模型(2025)开发
    • MiniMax-M1 总参数量为 456B,每个 token 激活的参数量为 45.9B
    • MiniMax-M1 模型原生支持 1M token 的上下文长度,是 DeepSeek R1 上下文大小的 8 倍
    • MiniMax-M1 的 Lightning Attention 机制能够高效扩展测试时计算(test-time compute)
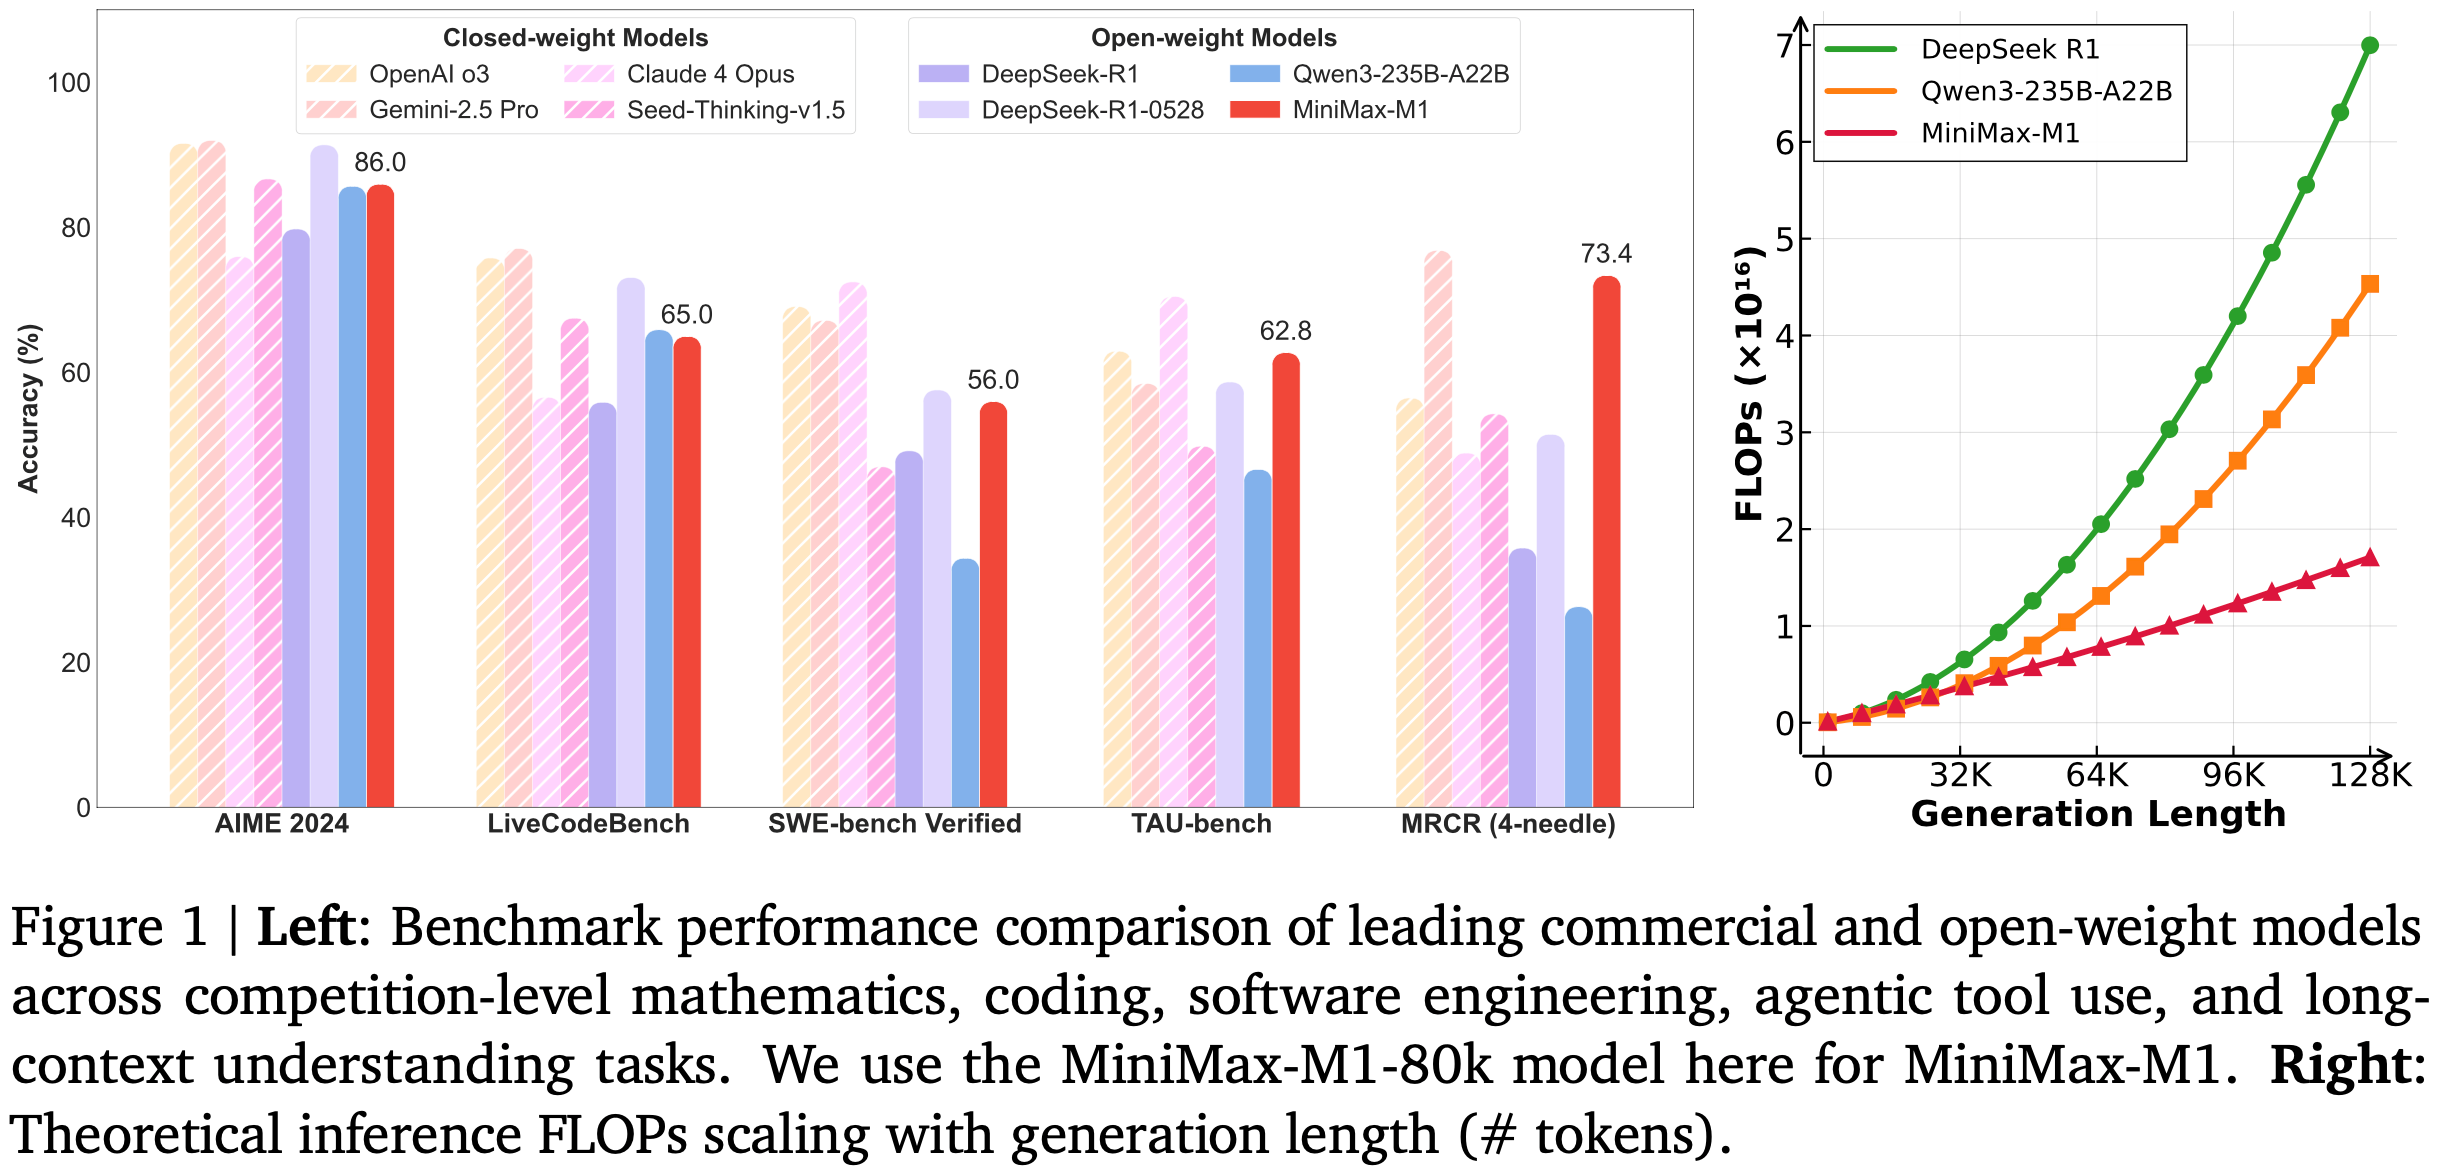
      • 例如,在生成长度为 100K token 时,其 FLOPs 消耗仅为 DeepSeek R1 的 25%
    • 以上这些特性使得 MiniMax-M1 特别适合需要处理长输入并进行深度思考的复杂任务 :
  • 大规模强化学习训练 :MiniMax-M1 通过大规模 RL 在多样化问题上进行训练,涵盖从传统数学推理到基于沙盒(sandbox)的真实世界软件工程环境
    • 改进一:在 RL 训练中,Lightning Attention 存在固有的效率优势
    • 改进二:论文提出了 CISPO(一种新型 RL 算法),通过裁剪重要性采样权重而非 token 更新来进一步提升 RL 效率
  • 训练成本低 :
    • 结合混合注意力与 CISPO,MiniMax-M1 在 512 张 H800 GPU 上的完整 RL 训练仅需三周 ,租赁成本仅为 53.47 万美元
  • 发布版本 :
    • 论文发布了两个版本的 MiniMax-M1 模型,分别支持 40K 和 80K token 的思考预算
    • 其中 40K 模型是 80K 训练过程的中间阶段
    • 作者在 GitHub 和 Hugging Face 上公开了 MiniMax-M1 模型,地址为:https://github.com/MiniMax-AI/MiniMax-M1
  • 模型效果基准测试 :
    • 在标准基准测试中,论文的模型表现优于或与领先的开源模型(如 DeepSeek-R1 和 Owen3-235B)相当,尤其在复杂软件工程、工具使用和长上下文任务中表现突出
  • 整体评价 :
    • 通过高效扩展测试时计算,MiniMax-M1 为下一代语言模型代理提供了强大的基础,使其能够推理并应对现实世界的挑战

Introduction and Discussion

  • 大型推理模型(Large Reasoning Models, LRMs),如 OpenAI o1(2025)和 DeepSeek-R1(2025),通过大规模 RL 扩展推理长度,已取得了显著成功
    • 近几个月来,开源社区和商业组织纷纷跟进这一趋势,在复杂任务(如奥林匹克数学竞赛和竞技编程)上取得了重大进展(Anthropic,2025;Google DeepMind,2025;2025;Kimi Team,2025;Seed Team 2025;2025;2025)
    • LRMs 的成功主要归功于测试时计算这一新的扩展维度,随着更多 FLOPs 被用于生成过程中的扩展推理,模型性能(尤其是复杂现实应用中的性能)表现出持续提升(2024;OpenAI,2025)
  • 在传统的 Transformer 架构(2017)中,持续扩展推理过程具有挑战性,因为 softmax 注意力机制具有固有的二次计算复杂度
    • 已有研究提出了多种技术来缓解这一问题,例如:
      • 稀疏注意力(sparse attention)(2020;2025;2025;2020)
      • 线性注意力(linear attention)(2024;2021;2025;2024;2020;2021;2021;2024;2025,2023;2024)
      • 带 delta 衰减的线性注意力(linear attention with delta decay)(2025;2024a,2024b)
      • 状态空间模型(state space models)(Dao 和 Gu,2024;2024;Gu 和 Dao,2024;2020,2022,2023;2022;Jamba Team,2024;2024)
      • 线性 RNN(linear RNNs)(2024;2024;1997;2018;2023;2023;2025;2024;2025)
    • 以上这些方法尚未在大规模推理模型中得到充分验证 ,几乎所有现有的竞争性 LRMs 仍依赖于传统的注意力机制(理解:即 softmax 注意力机制)
    • 唯一的例外是采用 Mamba 架构(2024;2024)的 Hunyuan-T1 模型(Tencent AI Lab,2025),但该模型未开源且披露细节有限
    • 本工作的目标是构建并开源一个能够高效扩展测试时计算、并与最先进推理模型竞争的大型推理模型
  • MiniMax-M1 模型介绍
    • MiniMax-M1 是一个基于 MoE 架构和 Lightning Attention(2024b)的推理模型
      • Lightning Attention 是线性注意力变体的 I/O 感知实现(2024b)
    • MiniMax-M1 基于论文之前的 MiniMax-Text-01(2025)模型开发,总参数量为 456B,激活参数量为 45.9B,包含 32 个专家
    • 在论文的注意力设计中,每 7 个 Lightning Attention Transformer 块后跟随一个带 softmax 注意力的 Transformer 块(2024b)
      • 理解:相当于在 8 个 attention 中,有 7 个用的 linear attention,仍有 1 个使用的 softmax attention,完全放弃 softmax attention 比较难
    • 这种设计理论上能够高效扩展推理长度至数十万 token,如图 1(右图)所示
      • 与 DeepSeek R1 相比,M1 在生成长度为 64K token 时的 FLOPs 消耗不到 50%,在 100K token 时约为 25%
      • 这种计算成本的大幅降低使得 M1 在推理和大规模 RL 训练中显著更高效
      • 此外,得益于其 Lightning Attention 机制,论文的 M1 模型原生支持高达 1M token 的上下文长度
        • 与 MiniMax-Text-01 一致
        • 这是 DeepSeek R1 上下文大小的 8 倍,比目前所有开源 LRMs 高出一个数量级
      • 这些特性使得 M1 特别适合处理需要长输入和扩展思考的复杂现实任务
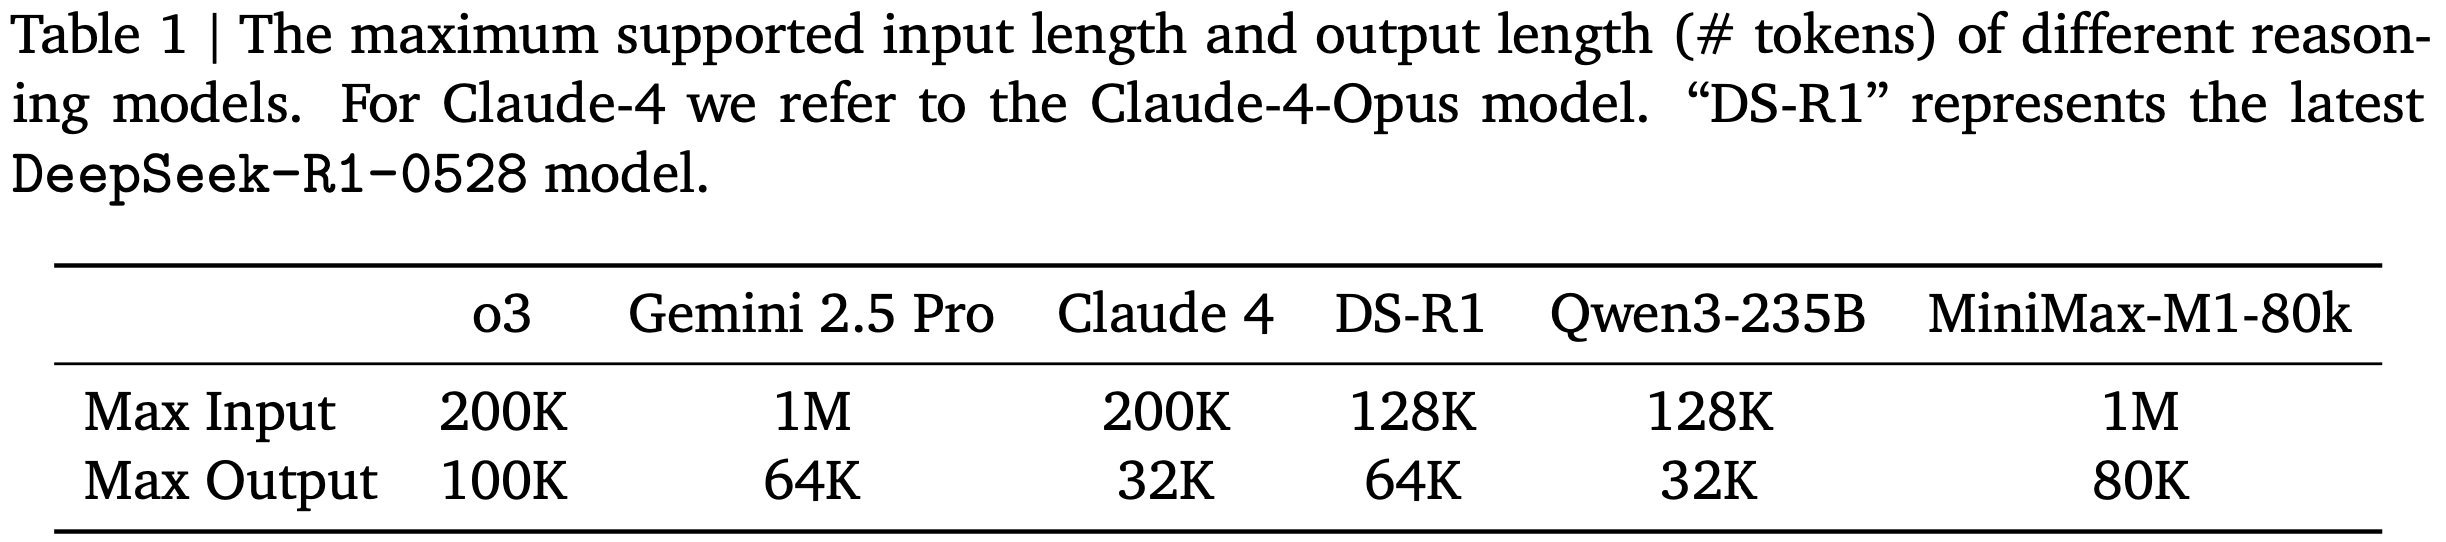
    • 表 1 展示了 M1 与其他领先模型在最大输入和输出长度上的对比
  • 为了开发 M1 模型,论文做了以下工作:
    • 第一步 :在精心策划的、以推理为主的语料库上对 MiniMax-Text-01 进行了 7.5T token 的继续预训练
      • 注意:是在 MiniMax-Text-01 上进行的继续预训练,不是从头开始
    • 第二步 :通过 SFT 注入特定的 CoT 模式(2022),为 RL 阶段(M1 开发的核心阶段)奠定了坚实基础
    • 第三步 :论文的高效 RL 框架使得 MiniMax-M1 在 512 张 H800 GPU 上的完整 RL 训练仅需 3 周——相当于约 53.47 万美元的租赁成本
    • 特别讨论:论文的 RL 扩展通过两个关键视角的创新实现了高效性:
      • (1)论文提出了 CISPO,它放弃了信任区域约束,转而裁剪重要性采样权重以稳定训练
        • 这种方法始终利用所有 token 进行梯度计算,在实验中表现出比 GRPO(2024)和 DAPO(2025)更高的效率
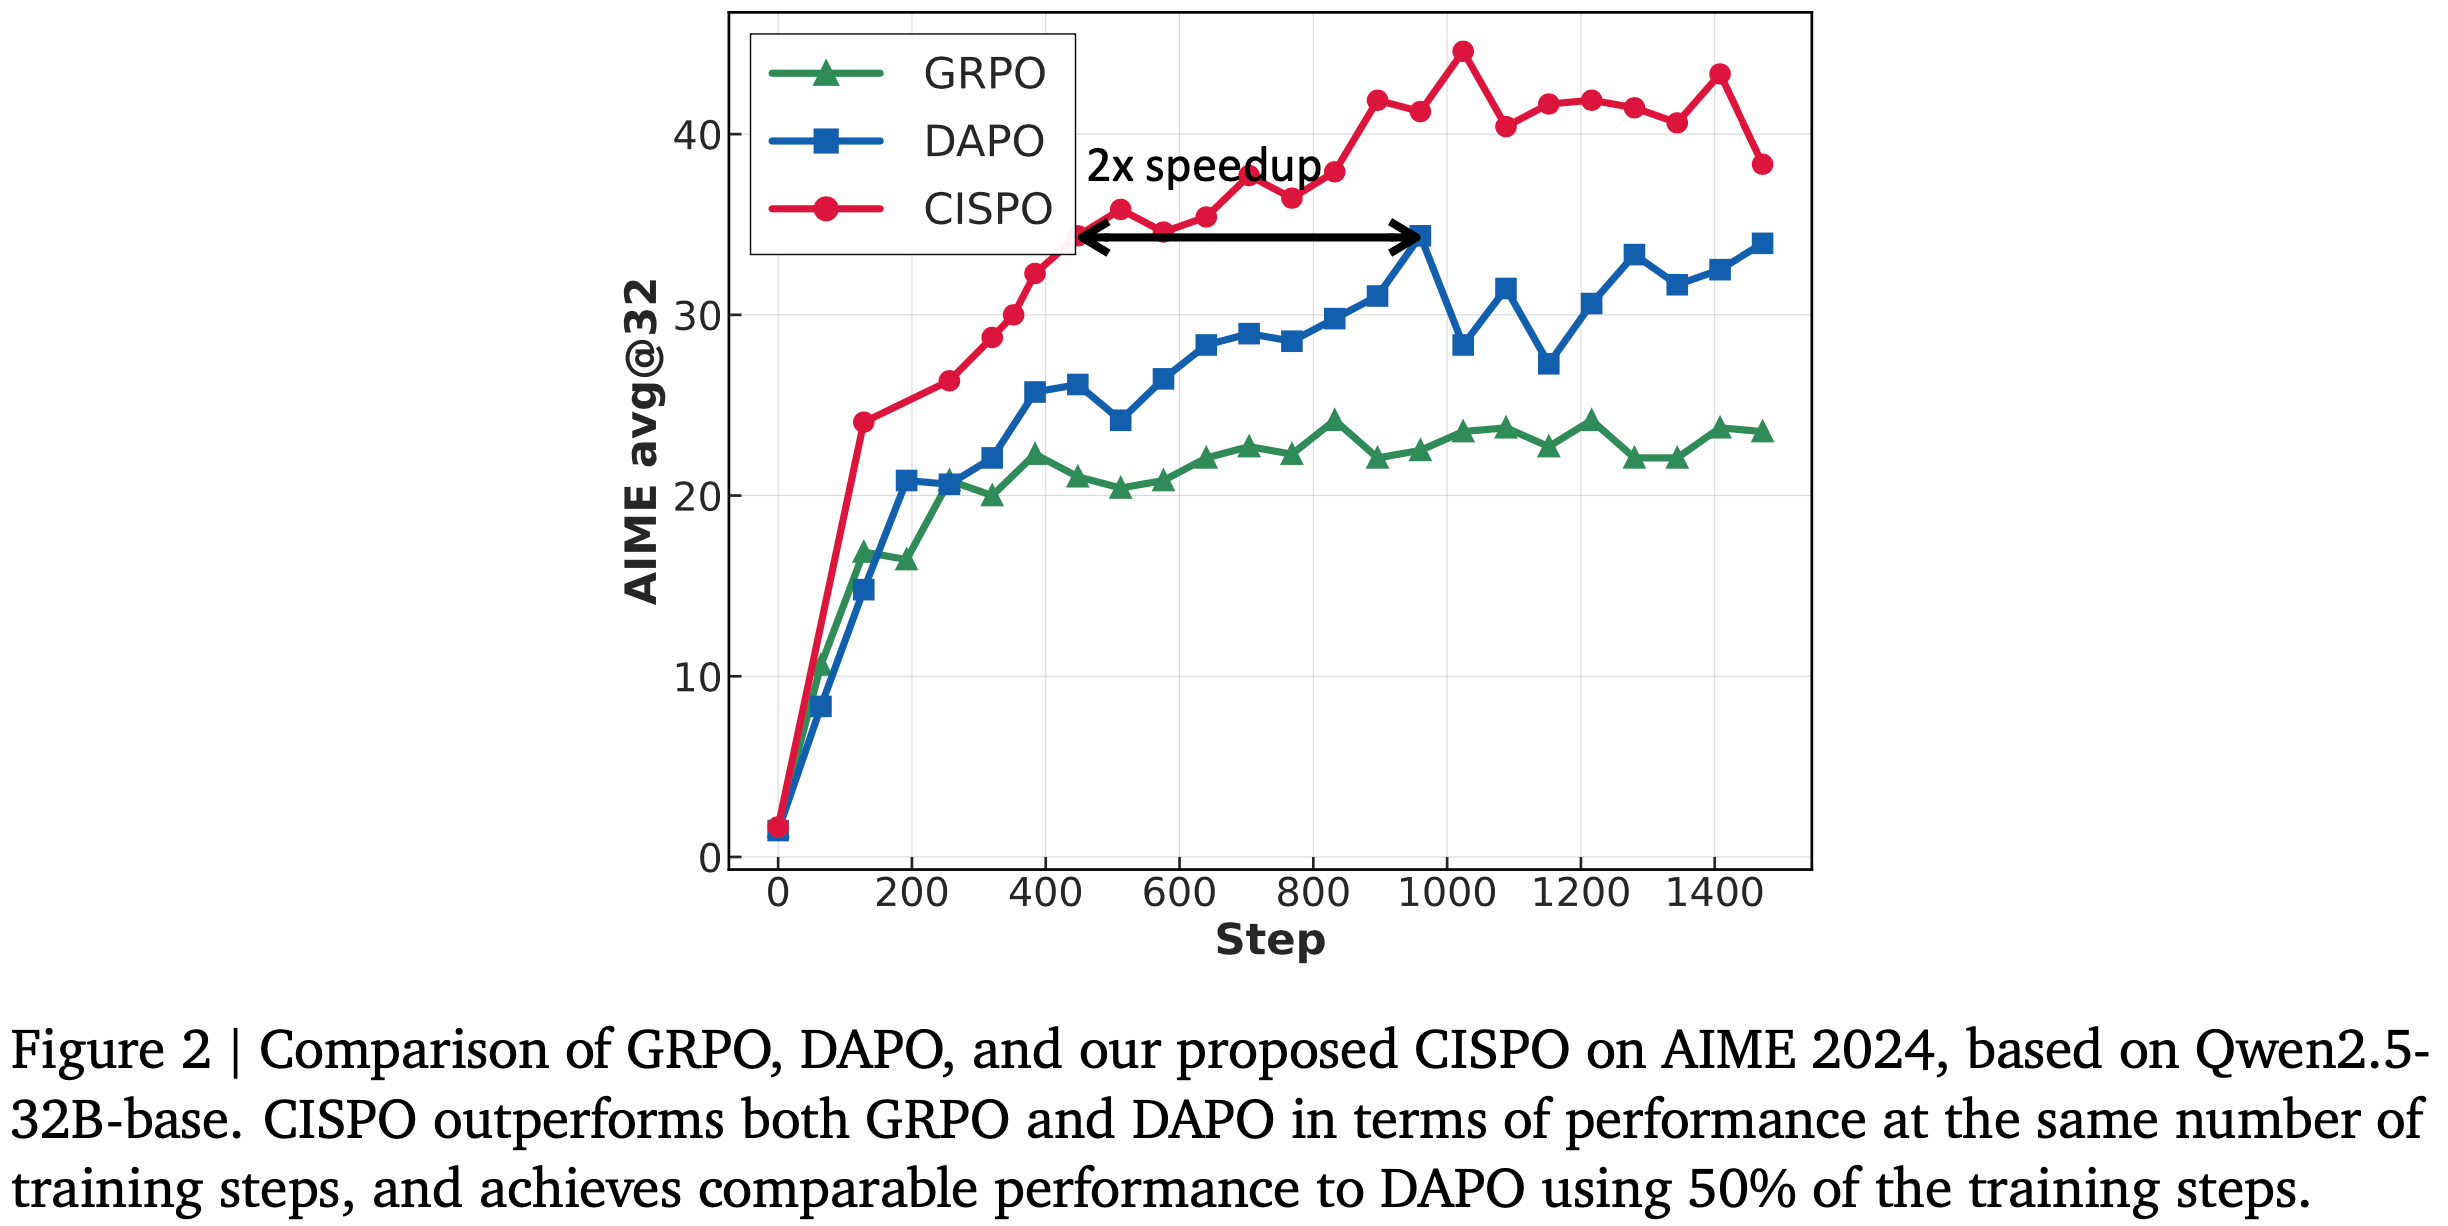
        • 在基于 Qwen2.5-32B 模型(2025)的对照研究中,CISPO 实现了比 DAPO 快 2 倍的速度;
      • (2)论文开发了针对性解决方案来应对这些挑战,并成功实现了混合架构的 RL 扩展
        • 背景:尽管 M1 的混合注意力设计天然支持高效的 RL 扩展,但在扩展 RL 训练时仍面临独特挑战
        • 作者发现架构的训练和推理内核之间存在精度不匹配问题,这会阻碍 RL 训练中的奖励增长
  • 除了方法创新外,论文还为 RL 训练策划了多样化的问题和环境。论文的数据涵盖可验证和不可验证的问题
    • 对于通常被视为推理学习关键的可验证问题:
      • 论文不仅包含数学推理和竞技编程问题(相关工作中常用的)
      • 还利用论文之前的数据合成框架 SynLogic(2025a)生成了涵盖 41 种不同任务的多样化逻辑推理问题
      • 论文基于 SWE-bench(2024)构建了复杂软件工程(Software Engineering, SE)环境的沙盒(sandbox),并在真实 SE 问题上进行基于执行的 RL 训练,以提升 M1 在挑战性 SE 场景中的表现
        • 理解:这里应该主要是指模型编程能力
    • 论文的不可验证问题涵盖问答和创意写作等广泛领域,其中论文使用生成式奖励模型提供反馈
  • 开源情况:
    • 论文训练了两个版本的 MiniMax-M1 模型,分别支持最大 40K 和 80K token 的生成长度,对应模型为 MiniMax-M1-40k 和 MiniMax-M1-80k
    • MiniMax-M1-80k 在复杂数学和编程任务上优于 MiniMax-M1-40k,进一步证明了扩展测试时计算的好处
    • 作者已将模型公开发布在 GitHub 和 Hugging Face 上
    • 这些模型现支持 vLLM 和 Transformers 框架,详细的部署指南可在 vLLM 和 Transformers 文档中找到
    • 此外,作者还提供了商业级 API,地址为 minimax.io
  • 如图 1(左图)所示,MiniMax-M1 在整体性能上超越了之前的领先开源模型(如 DeepSeek-R1 和 Qwen-235B),尤其在复杂软件工程、工具使用和长上下文任务中表现突出
    • 与最新的 DeepSeek-R1-0528 模型相比,MiniMax-M1 在数学和编程竞赛中稍逊,但在更现实的工具使用和长上下文场景中表现相当或更优
    • 值得注意的是,MiniMax-M1 在代理工具使用基准 TAU-Bench(2025)上超越了 Gemini 2.5 Pro,并在长上下文理解基准上优于 OpenAI o3 和 Claude 4 Opus
  • 通过高效扩展测试时计算,MiniMax-M1 为下一代语言模型代理应对现实挑战奠定了坚实基础

Preparation for Scalable RL: Continual Pretraining and SFT

  • 在本工作中,论文专注于通过强化学习扩展 MiniMax-Text-01 的推理能力
  • 为了支持可扩展的 RL 训练,论文进行了继续预训练和 SFT 两个阶段:
    • 继续预训练 :对基础模型进行了继续预训练,以增强其内在推理能力
    • SFT :随后通过冷启动的 SFT 阶段为模型注入特定的推理模式,从而为后续 RL 阶段提供更强的基础

Continual Pre-Training: Foundation for RL Scaling

  • 为了增强基础模型的推理和长上下文能力,同时确保多样性,论文使用额外的 7.5T token 继续训练 MiniMax-Text-01 模型,并优化了数据质量和混合比例
Training Data
  • 论文改进了网页和 PDF 解析机制 ,并优化了启发式清洗规则 ,以确保数学和代码相关数据的高召回率
  • 论文优先从网页、论坛和教科书等多样化来源提取自然问答对(QA pairs),同时严格避免使用合成数据
  • 论文对 QA 数据进行了语义去重,以保持其多样性和独特性
  • 论文还提高了 STEM(科学、技术、工程和数学)、代码、书籍和推理相关数据的比例至 70%,这显著增强了基础模型处理复杂任务的能力,同时不影响其其他通用能力
Training Recipe
  • 论文降低了 MoE 辅助损失的系数 ,并调整了并行训练策略以支持更大的训练微批次(micro batch)大小 ,从而减轻辅助损失对模型整体性能的负面影响
  • 基于 MiniMax-Text-01,论文以恒定学习率 8e-5 训练了 2.5T token,随后在 5T token 上采用衰减计划将学习率降至 8e-6
    • 理解:没有 warmup 阶段?
Long Context Extension
  • 对于具有更高收敛复杂性的 hybrid-lightning 架构模型,论文观察到训练长度扩展过于激进会导致梯度爆炸 ,使优化过程极具挑战性
    • 作者将此归因于早期层的参数优化未能跟上后期层的变化(对于 Lightning Attention),早期层和后期层具有不同的衰减率,这使得早期层更关注局部信息
    • 论文通过分阶段平滑扩展上下文长度缓解了这一问题:
      • 从 32K 上下文窗口开始 ,最终将训练上下文扩展至 1M token

SFT: Focused Alignment for Efficient RL

  • 在继续预训练后,论文进行了 SFT,利用高质量示例注入 reflection-based CoT 推理等期望行为,为后续 RL 阶段提供了更高效和稳定的起点
  • 具体而言,论文策划了包含长 CoT 响应的数据样本,涵盖数学、编程、STEM、写作、问答和多轮对话等多样化领域,其中数学和编程样本约占全部数据的 60%

Efficient RL Scaling: Algorithms and Lightning Attention

  • 如图 1(右)所示,M1 架构在推理过程中展现出显著的效率优势
  • 这自然有助于在生成长度逐渐增加的响应时实现高效的强化学习扩展
  • 但作为在这一混合架构中扩展强化学习的先驱者,论文在过程中遇到了独特的挑战,并且由于各种问题,强化学习过程可能会变得不稳定甚至失败
  • 贡献一 :为了解决这些困难,论文开发了针对性的解决方案 ,成功实现了 M1 的强化学习扩展
  • 贡献二 :论文还提出了一种新的强化学习算法 CISPO ,其效率优于现有方法
  • 这两项贡献共同构成了训练 M1 的高效且可扩展的强化学习框架,完整的训练周期在 512 张 H800 GPU 上仅需 3 周时间,相当于约 53 万美元的租赁成本
  • 本节首先介绍强化学习的背景知识并展示论文的新算法,随后描述论文在混合架构中遇到的具体挑战以及为解决这些挑战而设计的方案

Efficient RL Scaling with CISPO

Background
  • 对于数据集 \(\mathcal{D}\) 中的问题 \(q\),论文将策略模型表示为参数化的 \(\pi_\theta\),生成的响应为 \(o\)。PPO(2017)采用以下目标函数来优化策略以最大化预期回报,并通过裁剪操作稳定训练:
    $$
    \mathcal{J}_{\text{PPO} }(\theta) = \mathbb{E}_{q\sim\mathcal{D},o_i\sim\pi_{\theta_{\text{old} } }(\cdot|q)} \left[\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\min\left(r_{i,t}(\theta)\hat{A}_{i,t}, \text{clip}(r_{i,t}(\theta),1-\epsilon,1+\epsilon)\hat{A}_{i,t}\right) - \beta D_{KL}(\pi_\theta||\pi_{\text{ref} })\right],
    $$
    • 其中 \(r_{i,t}(\theta) = \frac{\pi_\theta(o_{i,t}|q,o_{i,< t})} {\pi_{\theta_{\text{old} } } (o_{i,t}|q,o_{i, < t})}\) 是重要性采样权重(Importance Sampling, IS),用于在 Off-policy 更新时校正分布
  • PPO 需要一个单独的价值模型来计算优势 \(\hat{A}_{i,t}\),GRPO(2024)则通过将优势定义为响应组内相对奖励来消除价值模型:
    $$
    \hat{A}_{i,t} = \frac{R_i - \text{mean}(\{R_j\}_{j=1}^G)}{\text{std}(\{R_j\}_{j=1}^G)},
    $$
    • 其中 \(R_i\) 是响应的奖励,每个问题采样 \(G\) 个响应 \(\{o_i\}_{i=1}^G\)
    • 奖励可以来自基于规则的验证器(如数学问题求解)或奖励模型
Issues of Token Clipping
  • 在 Zero-RL 设置下对混合架构进行初步实验时,论文发现 GRPO 算法对训练性能产生了负面影响,且未能有效促进长链思维推理行为的涌现
  • 通过一系列对照实验,最终确定原始 PPO/GRPO 损失中的裁剪操作是导致学习性能下降的主要因素
    • 作者发现与反思行为相关的 Token(例如“However”、“Recheck”、“Wait”、“Aha”)通常较为罕见,且被基础模型分配了较低的概率
      • 补充说明:当时,可以观察到的是这些词的频次是和下游性能指标一起提升的,推测这是作者会重点关注到这一部分的原因之一
  • 在策略更新过程中,这些 Token 往往会表现出较高的 \(r_{i,t}\) 值,因此在首次策略更新后被裁剪掉,无法为后续的 Off-policy 梯度更新做出贡献
    • 这一问题在混合架构模型中尤为突出,进一步阻碍了 RL 的扩展
  • 问题是:这些低概率 Token 对于稳定熵(2025)和促进可扩展强化学习(2025)至关重要
  • DAPO 尝试通过增加裁剪上限来缓解这一问题,但论文发现这种方法在论文的设置中效果有限,因为每次生成批次需要进行 16 轮 Off-policy 更新
The CISPO Algorithm
  • 基于以上分析,论文提出了一种新算法,明确避免丢弃 Token(即使是那些与大幅更新相关的 Token),同时通过合理范围的熵保持稳定探索
  • 首先,回顾带有校正分布(重要性采样)的原始 REINFORCE 目标函数 :
    $$
    \mathcal{J}_{\text{REINFORCE} }(\theta) = \mathbb{E}_{(q,a)\sim\mathcal{D},o_t\sim\pi_{\theta_{\text{old} } }(\cdot|q)} \left[\frac{1}{|o_i|}\sum_{t=1}^{|o_i|} \mathbf{sg}(r_{i,t}(\theta))\hat{A}_{i,t}\log\pi_\theta(o_{i,t} \mid q,o_{i,<t})\right], \tag{3}
    $$
    • 其中 \(\mathbf{sg}(\cdot)\) 表示停止梯度操作
    • 注意:这里的截断方式与 PPO/GRPO 有着明显的不同
      • 在 PPO/GRPO 中,被截断以后就整个 Token 都不生效了(这部分 Token 的梯度因为截断而变成 0);
      • 但是这里的截断方式下,仅仅是将重要性权重比例进行了截断,Token 的重要性比例被截断了,但本身梯度还可以被继续更新
  • 与 PPO/GRPO 中裁剪 Token 更新不同,论文在公式 3 中裁剪重要性采样权重以稳定训练(CISPO 是基于原始 REINFORCE 方法的,而不是基于 PPO/GRPO 的)
    • 论文将这种方法称为 CISPO(Clipped IS-weight Policy Optimization) ,采用 GRPO 的组相对优势和 Token-level 损失(2025),CISPO 优化以下目标函数:
      $$
      \mathcal{J}_{\text{CISPO} }(\theta) = \mathbb{E}_{(q,a)\sim\mathcal{D},\{o_i\}_{i=1}^G\sim\pi_{\theta_{\text{old} } }(\cdot|q)} \left[\frac{1}{\sum_{i=1}^G |o_i|} \sum_{i=1}^G \sum_{t=1}^{|o_i|} \mathbf{sg}(\hat{r}_{i,t}(\theta))\hat{A}_{i,t}\log\pi_\theta(o_{i,t} \mid q,o_{i,<t})\right], \tag{4}
      $$
    • 其中 \(\hat{r}_{i,t}(\theta)\) 是裁剪后的重要性采样权重:
      $$
      \hat{r}_{i,t}(\theta) = \text{clip}\left(r_{i,t}(\theta),1-\epsilon_{low}^{IS},1+\epsilon_{high}^{IS}\right).
      $$
    • 特别强调 again:这里 CISPO 的截断方式与 PPO/GRPO 有着明显的不同
      • 在 PPO/GRPO 中,截断对象是整个 Token 本身,被截断以后就整个 Token 都不生效了(这部分梯度因为截断而变成变成 0);
      • 在 CISPO 的截断方式下,仅仅是将重要性权重比例进行了截断,Token 的重要性比例被截断了,但本身梯度还可以被继续更新
        • 严格来讲:CISPO 中,无论怎样的 Token 都会参与更新,只是说重要性比例对应的权重会被截断调整
    • 理解(吐槽一下):现在这种做法改变了重要性采样的比值了,没有科学依据了,这里其实放宽裁剪系数就可以做到相同的效果吧,比如将上界进一步放开
  • 实际上,如果不进行权重裁剪,\(\mathcal{J}_{\text{CISPO} }\) 会退化为标准的策略梯度目标(准确说是带重要性采样修正的策略梯度目标)
    • 注意:此时已经不是 PPO 或 GRPO 的形式了,是标准的 策略梯度形式
  • 在实验中,论文未对重要性采样权重设置下限(即 \(\epsilon_{low}^{IS}\) 设为较大值),仅调整 \(\epsilon_{high}^{IS}\)
  • 尽管公式 4 的梯度因权重裁剪而略有偏差 ,但这种方法保留了所有 Token 的梯度贡献 ,尤其是长响应中的 Token
    • 理解:这里是指尤其在长响应中的 Token 容易出现概率自身概率较低的,此时其重要性采样系数波动可能会比较大(容易被完全 Clip 掉梯度而得不到好的更新)
  • CISPO 在实验中表现有效,有助于降低方差并稳定强化学习训练
  • 此外,论文还采用了动态采样和长度惩罚技术(2025)
  • 与近期其他工作(2025)类似,CISPO 中没有 KL 惩罚项
A General Formulation
  • 这里给出一个通用形式的表达
  • 注意:作者在实验中采用了 CISPO,这里进一步给出了一种统一形式化方法,通过在 CISPO 目标中引入 Token-level 掩码来控制是否以及在何种条件下应丢弃特定 Token 的梯度:
    $$
    \mathcal{J}_{\text{unify} }(\theta) = \mathbb{E}_{(q,a)\sim\mathcal{D},\{o_i\}_{i=1}^G\sim\pi_{\theta_{\text{old} } }(\cdot|q)} \left[\frac{1}{\sum_{i=1}^G |o_i|} \sum_{i=1}^G \sum_{t=1}^{|o_i|} \mathbf{sg}(\hat{r}_{i,t}(\theta))\hat{A}_{i,t}\log\pi_\theta(o_{i,t} \mid q,o_{i,<t})M_{i,t}\right].
    $$
    • 掩码 \(M_{i,t}\) 等价于 PPO 信任区域中隐式定义的掩码:
      $$
      M_{i,t} = \begin{cases}
      0 & \text{if } \hat{A}_{i,t} > 0 \text{ and } r_{i,t}(\theta) > 1 + \epsilon_{\text{high} }, \\
      0 & \text{if } \hat{A}_{i,t} < 0 \text{ and } r_{i,t}(\theta) < 1 - \epsilon_{\text{low} }, \\
      1 & \text{otherwise}.
      \end{cases}
      $$
  • 这一统一的损失形式化可以在一个共同框架下灵活表示不同的裁剪策略
    • 理解:
      • 公式仍然不是 PPO 的形式,是一个标准的策略梯度,但可以通过上述的掩码(像 PPO 一样)实现丢弃部分样本
      • 这种做法本质和 PPO 类似了,重要性采样和 Clip 都有了,实际上 PPO 的核心元素应该是都是实现了,只是 CISPO 这个统一目标可以将重要性采样比值的 Mask 和 Clip 使用的上下界分开设置了
        • PPO 中两者是耦合到一起的,没有被 mask 掉的重要性权重,都会采样自身的值
        • CISPO 统一公式中,clip 和 mask 可以分开,即假设 \(r=8\) 才会截断,同时可以配置前面的 Clip 上界为 \(5\),这样可以允许 \(r\in[5, 8]\) 的 Token 被以 \(r=5\) 取更新梯度(防止完全丢弃这部分重要的 Token)
Empirical Validation of CISPO
  • 为了验证 CISPO 的有效性,论文在 Zero-RL 训练设置中将其与 DAPO 和 GRPO 进行了实证比较
  • 论文在数学推理数据集(2025)上应用不同的强化学习算法训练 Qwen2.5-32B-base 模型,并在 AIME 2024 基准测试中报告性能
  • 如图 2 所示,在相同训练步数下,CISPO 显著优于 DAPO 和 GRPO
  • CISPO 展现出更高的训练效率(仅用 50% 的训练步数即可达到 DAPO 的性能)
  • 个人理解:CISPO 的收益来源应该是 CISPO 多训练了一些本该被截断的样本
    • 问题一:这里的实验可以做的更加充分,比如将 DAPO 的上界提升(释放出来更多被截断的 Token),是不是会有不同效果
    • 问题二:CISPO 本质上是让所有 Token 都被更新,在信号相对准确时,确实应该能提升训练效率(实验中也可以看到),但是 PPO 原始的思路不是表面的简单 Clip,而是隐含了希望 \(\pi_\theta\) 偏离 \(\pi_{\theta_\text{old}}\) 的范围在 \([1-\epsilon, 1+\epsilon]\) 之间,超过的先不更新,但允许拉回来
      • 注:CISPO 中介绍的 General Formulation 形式完美的保留了 PPO 的这个思想,PPO 可以认为是这个 CISPO General Formulation 的一个特例

Efficient RL Scaling with Lightning Attention - Challenges and Recipes

  • 如图 1(右)所示,论文强调混合注意力设计相比传统注意力设计天然支持更高效的强化学习扩展,因为 rollout 计算和延迟通常是强化学习训练的主要瓶颈
  • 作为在这一新颖架构中进行大规模强化学习实验的先驱者,论文遇到了独特的挑战并开发了针对性的解决方案,具体如下
Computational Precision Mismatch in Generation and Training
  • 强化学习训练对计算精度高度敏感
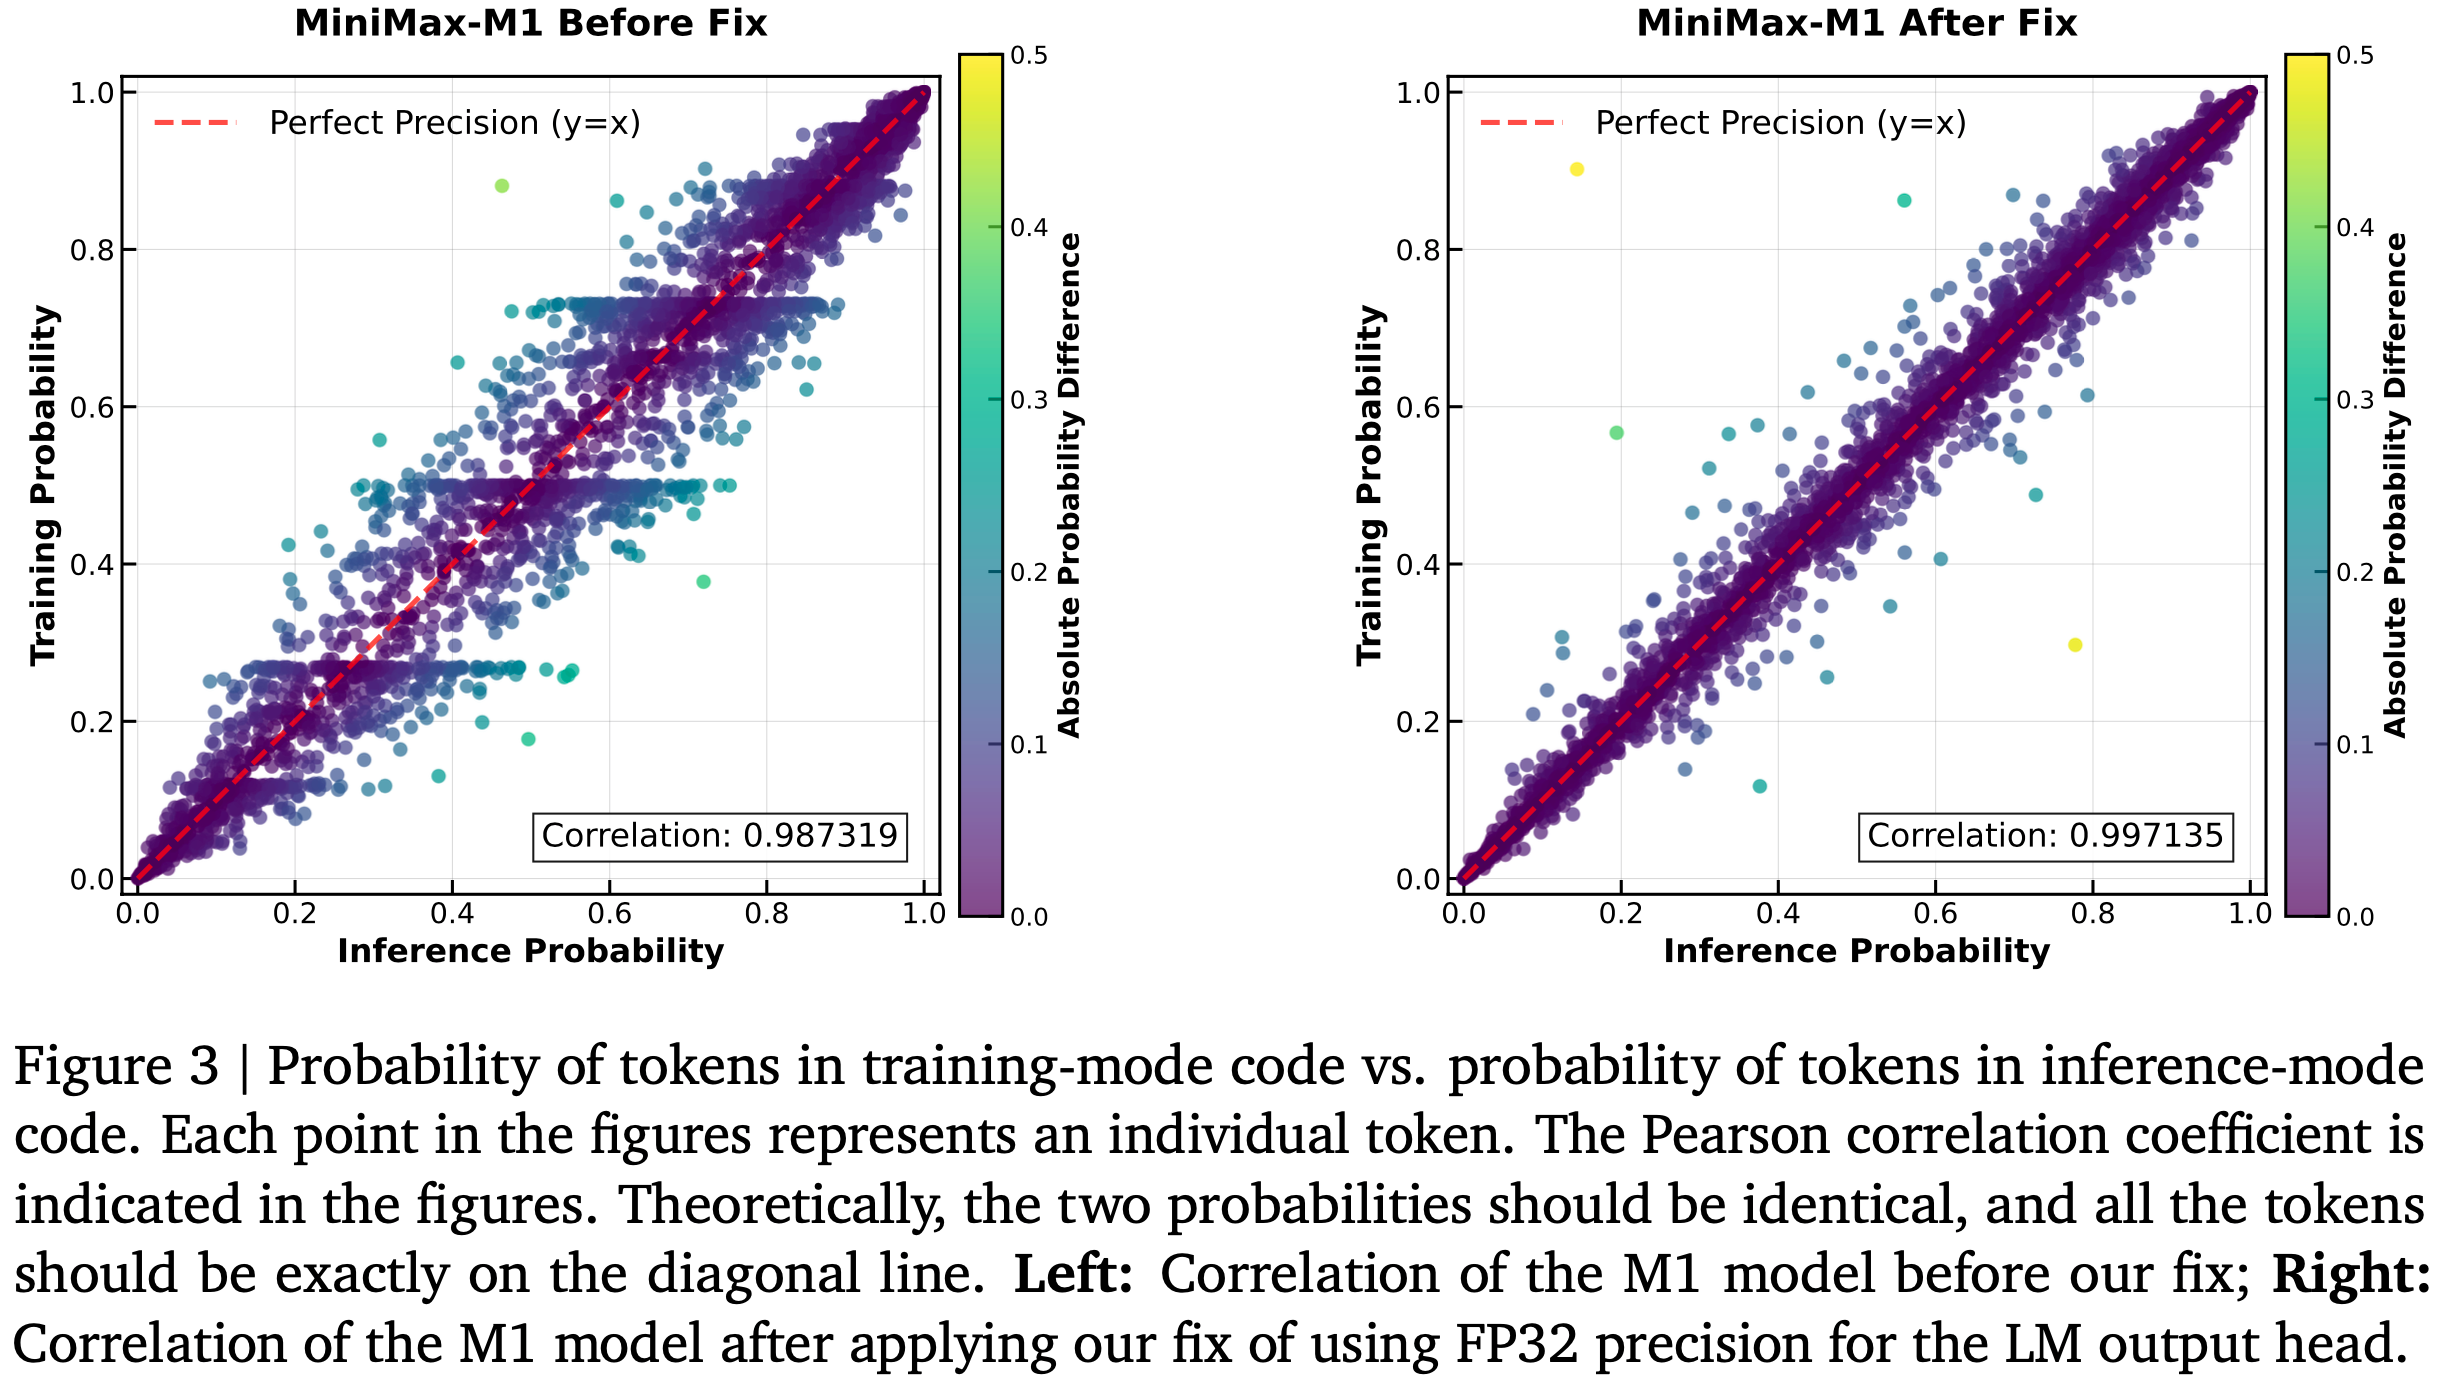
  • 在训练过程中,论文观察到训练模式和推理模式下生成 Token 的概率存在显著差异(如图 3 左)
  • 这种差异源于训练和推理内核之间的精度不匹配
    • 这一问题具有破坏性,阻碍了实验中奖励的增长
    • 有趣的是,这一问题并未出现在使用 softmax 注意力的小型 Dense 模型中
  • 通过逐层分析,作者确定了 输出层 LM 头部(LM head at the output layer)的高幅值激活是误差的主要来源
    • 理解:这是很有用也很强的实践经验
  • 为了解决这一问题,作者将 LM 输出头(LM output head)的精度提高到 FP32 ,从而重新对齐理论上相同的概率(如图 3 右)
    • 理解:这里可以大幅缓解训推不一致问题
    • 这一调整将训练和推理概率之间的相关性从约 0.9x 提高到 0.99x
    • 而且,这一相关性指标在整个训练过程中保持稳定,从而实现了奖励的持续增长
Optimizer Hyperparameter Sensitivity
  • 论文使用 AdamW(2019)优化器,但 \(\beta_1\)、\(\beta_2\) 和 \(\epsilon\) 的不当配置可能导致训练不收敛(2023)
    • 例如,使用 VeRL(2024)的默认配置(betas = (0.9, 0.999) 和 eps = 1e-8)会导致此类问题
  • 论文观察到 MiniMax-M1 训练中的梯度幅值范围广泛,从 1e-18 到 1e-5,且大多数梯度小于 1e-14
  • 此外,相邻迭代的梯度相关性较弱(理解:说明不能使用太强的平滑系数,即应该让历史值对当前值的影响变小些)
  • 基于此,论文将 \(\beta_1\) 设为 0.9,\(\beta_2\) 设为 0.95,eps 设为 1e-15
  • 注(表扬):这种非常细节的点是需要实践出来的,这种细节的披露对社区发展很有帮助
Early Truncation via Repetition Detection
  • 在强化学习训练中,论文发现复杂提示可能引发病态的长重复响应 ,其大幅梯度威胁模型稳定性
  • 论文的目标是提前终止这些生成循环 ,而非惩罚已经重复的文本
  • 由于简单的字符串匹配对多样化重复模式无效,论文开发了一种基于 Token 概率的启发式方法
  • 论文观察到,一旦模型进入重复循环,每个 Token 的概率会飙升
  • 因此,论文实施了早期截断规则:
    • 如果连续 3,000 个 Token 的概率均超过 0.99,则停止生成
    • 这一方法成功防止了模型不稳定性,并通过消除这些病态长尾案例提高了生成吞吐量
  • 理解:这里作者给了一个非常有意义的理解(观察),当出现重复循环时,模型的输出非常的自信,此时输出概率非常高

Scaling Reinforcement Learning with Diverse Data

  • 本节将介绍论文在 RL 阶段采用的数据和奖励机制
  • 论文整合了多样化的任务环境到强化学习训练流程中,包括可通过规则验证的任务以及需要通过奖励模型验证的通用任务
  • 所有这些环境均通过精心设计的课程学习(curriculum)融入强化学习阶段

Reasoning-Intensive Tasks with Rule-based Verification

  • 以下介绍论文可通过确定性规则验证的数据
  • 对于以下所有任务,论文采用基于规则的最终正确性作为正确性奖励,并辅以格式奖励
Mathematical Reasoning
  • 论文的初始数学数据集包含数十万道高质量竞赛级题目,这些题目从公开资源和官方数学竞赛中精心整理而来,涵盖广泛的难度范围,每道题目均配有标准参考答案
  • 数据清洗流程:
    • 首先剔除不完整样本以及存在格式或排版错误的样本
    • 随后对强化学习数据源进行 Embedding-based 的去重处理,并严格分离 SFT 数据集以避免重叠
      • 因为监督微调阶段的数据泄漏到强化学习阶段会阻碍探索并削弱训练效果
  • 剔除污染基准的样本 :论文采用 n-gram 和 Embedding-based 的方法剔除可能污染常用数学基准测试集的样本 ,从而确保评估的完整性和公平性
  • 样本优选流程:
    • 首先:论文过滤掉包含多个子问题、证明类题目以及易受随机猜测影响的二元选择题(如判断题) ,并将多选题重新格式化为开放式问题以更好地适应强化学习框架
    • 其次:论文使用内部模型从参考答案中提取最终答案,仅保留那些答案能被基于规则的检查器正确解析的样本
    • 最后:论文通过强推理模型计算每道题目的 pass@10 通过率,仅保留通过率严格介于 0 到 0.9 之间的样本,最终得到近 5 万道高质量数学题目用于强化学习训练
Logical Reasoning
  • 对于逻辑推理数据,论文精心挑选了 41 项需要非平凡推理能力的任务(如密码破解和数独),并通过数据合成框架生成所有数据
  • 具体而言,论文利用 SynLogic 框架(2025a)实现数据合成流程,该框架包含任务特定的数据生成器和基于规则的任务验证器,支持自动生成逻辑数据
  • 论文在生成过程中精细配置难度参数,确保数据的学习挑战性适中
  • 为防止包含过于困难的实例:
    • 论文基于当前强推理模型的可解性上限设定难度上限,要求其 pass@10 通过率大于零;
    • 同时,相似的设置难度下限

      Specifically, to prevent inclusion of overly difficult instances, we establish an upper difficulty bound based on the solvability limits of current strong reasoning models, requiring their pass@10 rates greater than zero. Similarly, we set a lower difficulty bound using the lowest difficulty parameters for which the MiniMax-Text-01 model achieves pass rates between 0 and 0.5

      • 理解:从文章中阅读文字来看,难度下限的设置方式是:
        • 首先测试 MiniMax-Text-01 模型在不同难度参数下的表现
        • 找到一组参数,使得该模型的任务通过率恰好处于 0%-50% 区间
        • 将这组参数对应的难度水平作为数据集的最低难度标准
    • 这一方法确保数据在难度和可学习性之间保持平衡。此外,随着模型能力在训练中提升,论文在后期阶段逐步提高数据难度。通过该框架,论文合成了约 53K 条逻辑推理样本用于强化学习训练
Competitive Programming
  • 对于竞技编程问题,论文从在线判题平台和热门编程网站收集公开题目
  • 对于缺乏测试用例的题目,论文开发了 LLM-based 的工作流,利用 MiniMax-Text-01 模型生成全面的测试套件
  • 与数学推理数据集的处理类似,论文基于模型采样的通过率筛选题目质量和难度,保留中等难度且高质量的算法问题
  • 通过这一流程,论文生成了 30K 条竞技编程数据样本用于强化学习训练
Software Engineering
  • 在软件工程领域,受 SWE-bench(2024)启发,论文通过利用公开 GitHub 仓库的真实数据构建了可验证的强化学习环境
  • 数据集主要由问题和 Pull Request 组成,涵盖常见的软件开发挑战,如错误定位、代码修复和测试用例合成
  • 为支持高效强化学习,论文开发了一个复杂的容器化沙盒环境(sandbox environment),模拟真实的软件开发工作流
  • 该环境支持实际代码执行,为智能体提出的干预措施提供直接且可验证的正确性和有效性反馈
  • 预定义或新生成测试用例的通过/失败状态作为强化学习的主要奖励信号:
    • 成功执行并通过所有相关测试用例将获得正向奖励
    • 编译错误、运行时失败或测试用例回归则导致零或负奖励
    • 从而为策略优化提供清晰信号
  • 通过这一流程,论文整理出数千条高质量数据样本
    • 每条样本包含问题描述(如问题中的错误报告)、初始错误代码和一组关联测试用例
  • 这一设置使强化学习智能体能够学习准确定位错误、提出正确代码修复方案 ,甚至合成新的有效测试用例 ,通过沙盒环境中的执行直接验证性能

General Domain Tasks with Model-based Feedbacks

  • 本节将强化学习范围进一步扩展至更广泛的通用领域任务
  • 由于这些任务难以通过规则验证,论文利用奖励模型提供反馈
Data and Reward Models
  • 论文的通用强化学习数据集总计包含 25K 条复杂样本,可大致分为两类:
    • 难以通过规则验证的,有客观答案的样本
    • 无标准答案的样本
Tasks with Ground Truth
  • 此类任务主要包括 STEM 和其他事实性问题,其答案客观但可能有多种有效表达形式
    • 这种多样性通常导致基于规则的检查器不准确
  • 论文的数据清洗流程与数学推理类似,但使用生成式奖励模型(Generative Reward Model, GenRM)作为验证器,而非依赖基于规则的检查器
  • 为评估标准答案与模型响应的一致性,论文采用五级奖励缩放来评估两个组件:
    • 首先构建人工标注的奖励模型基准,涵盖多样知识领域和任务类型的客观任务,特别是那些基于规则检查器无法准确判断的模型响应-标准答案对;
    • 其次通过比较 GenRM 选择的 Best-of-N(BoN)响应与多个基准上的 pass@N 指标来评估 GenRM 的有效性
      • 问题:这里的基准上的 pass@N 指标是什么?在这种表达形式不确定的多场景怎么会有 pass@N 指标呢?
    • GenRM 的性能评估:通过其在人工标注基准上的准确率以及 BoN 与 pass@N 之间的性能差距来衡量
      • 这些指标指导实验以优化数据分布和 GenRM 训练中的提示设计
Tasks without Ground Truth
  • 此类任务涵盖更广泛的范围,包括指令遵循、创意写作等
  • 提示词从基于内部标签系统的大规模池中采样,确保跨细粒度领域的平衡训练分布
  • 尽管这些查询通常是开放式的且无标准答案,论文仍尝试为每个查询配对参考答案以支持奖励模型判断
    • 论文首先生成来自各种内部和外部模型的响应,随后这些参考答案需通过内部质量评估
    • 在强化学习训练期间,论文采用成对比较框架评估模型输出
      • 每次比较生成 -1、0 或 1 的分数,分别表示模型输出劣于、类似于或优于参考答案
  • 对于特别带有约束的指令遵循任务,论文同时使用基于规则的奖励评估响应是否满足约束,以及基于模型的奖励评估响应质量
  • 与有标准答案的设置类似
    • 论文首先构建人工标注基准,整合来自可靠标注者的多重盲测偏好判断
    • 随后优化评分标准和偏好提示以提高准确性并减少潜在偏差(详见 4.2.2 节)
  • 为最小化潜在偏差,训练数据还通过多重盲测一致判断、位置切换一致判断等方法优化
  • 一旦训练出最优 GenRM,将在训练数据集上执行瑞士轮(Swiss Round)评分系统以确定最适合强化学习训练的参考答案
    • 问题:这里的瑞士轮方法具体是什么?
    • 瑞士轮评分方法:
      • 进行多轮对战
      • 每一轮上让分数尽可能相近的参赛者进行比赛
      • 两个组之间只会进行一次比赛
      • 比赛轮次结束后,按照累计分数排名
Addressing Bias of Generative Reward Models for Long CoT
  • 针对复杂链式推理(CoT)任务的有效通用强化学习高度依赖准确且无偏差的奖励模型,评估此类链式推理响应具有挑战性
    • 论文发现 GenRM 倾向于偏好更长输出而非可能更优质的简洁替代方案 ,而不考虑实际推理质量
  • 这种长度偏差(length bias)是一个严重问题,因为它可能严重误导强化学习策略优化,激励无实质内容的冗长表达并诱发奖励破解(reward hacking)
  • 论文初步改进 GenRM 保真度的努力包括标准离线策略:
    • (1) 多样化训练数据,涵盖广泛的响应长度、来源和质量层级;
    • (2) 纳入对抗样本以暴露脆弱性;
    • (3) 优化模型架构
  • 然而,实证分析表明,纯粹离线评估和预缓解 GenRM 中的长度偏差往往无法在强化学习训练期间防止长度偏差
    • 问题:只要 GenRM 足够精确的话,理论上来说,基于 GenRM 的 RL 训练也是可以避免长度偏差的吧
  • 因此,论文的核心策略是在强化学习训练期间持续在线监测长度偏差
    • 设立特定指标以检测强化学习策略是否过度延长输出长度以最大化 GenRM 奖励,而未能提升任务成功率或推理深度
    • 一旦检测到这种有害的长度追求行为(表明利用了 GenRM 长度偏差),立即触发 GenRM 重新校准
    • 这种迭代调整对于预防与输出长度相关的奖励破解至关重要,确保策略优先提升实质能力而非表面文本膨胀
    • 作为补充,论文系统性地采用强化学习侧技术,包括奖励塑形(reward shaping)、价值裁剪(value clipping)和归一化(normalization)
      • 这些机制使奖励信号对表面特征(如长度)的极端值不敏感,从而引导策略优化专注于长链式推理的实质质量和正确性

Curriculum of Incorporating Diverse Data

  • 鉴于论文的强化学习数据涵盖广泛类别,核心挑战是训练单一策略以同时在推理密集型任务和通用领域任务上表现出色
  • 为此,论文的方法涉及在强化学习训练过程中精心管理课程和动态加权策略:
    • 开始仅使用基于规则奖励的推理密集型任务 ,随后逐步混入通用领域任务
    • 这确保模型持续精进可验证技能(如数学和编程),同时逐步提升在多样化通用任务上的表现,从复杂指令遵循到开放式链式推理
    • 这种混合强化学习训练鼓励模型学习上下文依赖的推理能力应用
      • 即对可验证问题采用严格的逐步演绎,对通用查询采用更灵活的适应性生成
      • 所有能力均统一在单一策略框架下
    • 该方法避免了特定技能的灾难性遗忘,同时促进更广泛的泛化能力

Extending RL Scaling to Longer Thinking

  • 论文的首次 RL 训练设置了 40K 词元的输出长度限制
  • 鉴于 M1 的混合架构天然支持对更长序列的近线性扩展(如图 1 右所示),论文进一步在 RL 训练中将生成长度扩展至 80K 词元,由此得到的新模型称为 MiniMax-M1-80k

Data

  • 为了高效训练支持 80K 输出长度的 RL 模型,论文利用先前训练的 40K 模型指导数据筛选过程
    • 首先,论文在 第4节 描述的精选数据集上评估通过率,并移除易解决的样本
    • 随后,论文调整数据分布,偏向更具挑战性的示例(如高难度数学和编程问题)
  • 此外,论文减少合成推理数据的采样比例 ,因为观察到这类数据会破坏长上下文 RL 训练的稳定性
    • 具体而言,合成推理数据生成的输出往往重复且同质化 ,持续暴露于这些模式会对模型的整体性能产生负面影响

Length Scaling Strategy

  • 为逐步增加输出长度,论文采用分阶段窗口扩展的 RL 策略
    • 具体方法:初始输出长度为 40K,随后逐步扩展至 48K、56K、64K、72K,最终达到 80K
    • 这种分阶段方法确保了每一步的训练稳定性
    • 过渡到下一阶段的依据是一组经验指标 ,包括生成序列的困惑度收敛情况 ,以及输出长度的 99% 分位数是否接近当前上下文窗口限制
      • 这些信号为模型的扩展准备提供了关键洞察,从而在整个过程中保持稳健的训练

Addressing Training Instability During Scaling

  • 在扩展过程中,论文在每个长度窗口的训练后期遇到了一个关键问题:
    • 模型易出现模式崩溃(pattern collapse) ,即生成序列的后半部分退化为不连贯或乱码文本
    • 这一现象始终与困惑度上升同步,表明生成质量和稳定性受损
  • 论文确定了以上问题的根本原因:
    • 在输出长度扩展时,负样本的长度增长显著快于正样本 ,且更早触及上下文窗口限制
    • 这种不平衡源于 GRPO 的优势归一化和论文采用的 Token-level 损失的内在不对称性
  • 为此,论文实施了三种关键解决方案:
    • (1) 通过早期停止检测重复模式(连续高概率词元),防止重复响应过度消耗上下文窗口;
    • (2) 采用 Sample-level 损失与 Token-level 归一化相结合的方法,缓解正负样本不平衡及其负面影响;
      • 问题:Token-level 归一化是什么?
    • (3) 降低梯度裁剪阈值和 \(\epsilon_{high}^{IS}\) 以进一步稳定生成
  • 理解:由于 GRPO 的 Token-level 损失会给所有样本都加了一个权重 \(\color{red}{\frac{1}{|\mathbf{o}_i|}}\),导致模型鼓励长的错误回答和短的正确回答,即出现论文所谓的“负样本的长度增长显著快于正样本”,论文所说的解法应该是跟 DAPO 思路一致

Evaluations

Core Benchmarks

  • 论文对 MiniMax-M1 在多个关键领域进行了全面评估:数学、通用编程、软件工程、推理与知识、长上下文、智能体工具使用、事实性以及通用助手能力
  • 所有任务均使用温度 1.0 和 top-p 0.95 采样进行评估
  • 数学 :
    • 为评估数学推理能力,论文使用了多个竞赛级数学基准,包括 MATH-500 (2021)、AIME 2024 和 AIME 2025
    • 对于 AIME 评估,论文采样 32 次并计算平均通过率作为最终得分
  • 通用编程(General Coding) :
    • 论文使用 LiveCodeBench (2025) 和 FullStackBench (2024) 评估跨多样化编程任务的代码生成能力
    • 对于这两个基准,论文报告 16 次采样的平均通过率
  • 推理与知识(Reasoning & Knowledge) :
    • 通过 GPQA-Diamond (2024)、MMLU-Pro (2024) 和极具挑战性的 HLE (2025) 评估领域知识与推理能力
    • 对于 GPQA-Diamond,论文采样 32 次并报告平均通过率
    • HLE 评估在不使用外部工具的情况下进行
    • 论文使用 ZebraLogic (2025) 测量逻辑推理能力
  • 软件工程(Software Engineering) :
    • 论文使用 SWE-bench Verified (2024) 评估解决真实 GitHub 问题的能力
    • 结果基于 Agentless scaffold (2024) 的方法生成,采用两阶段定位流程(无嵌入检索机制):粗粒度文件定位后细化至具体文件和代码元素
  • 长上下文(Long Context) :
    • 使用 OpenAI-MRCR (OpenAI, 2024b) 测试长上下文中的检索与消歧能力,以及 LongBench-v2 (2024)——一个包含 503 道多选题的挑战性基准,上下文长度从 8K 到 2M 词不等
  • 智能体工具使用(Agentic Tool Use) :
    • 通过 TAU-bench (2025) 评估工具使用能力,该基准模拟动态对话场景,要求智能体遵循领域策略使用 API 工具
    • 评估使用 GPT-4.1 作为用户模型,通用系统提示,且无自定义工具,最大交互步数为 40
      • 注:论文中给出的通用系统提示为:“In each round, you need to carefully examine the tools provided to you to determine if any can be used. You must adhere to all of the policies. Pay attention to the details in the terms. Solutions for most situations can be found within these policies”
  • 事实性(Factuality) :
    • 使用 SimpleQA (2024) 测量模型的事实性,该基准通过对抗性收集的单答案问题构成
  • 通用助手(General Assistant) :
    • 使用 MultiChallenge (2025) 评估多轮对话能力,得分由 GPT-4 评判
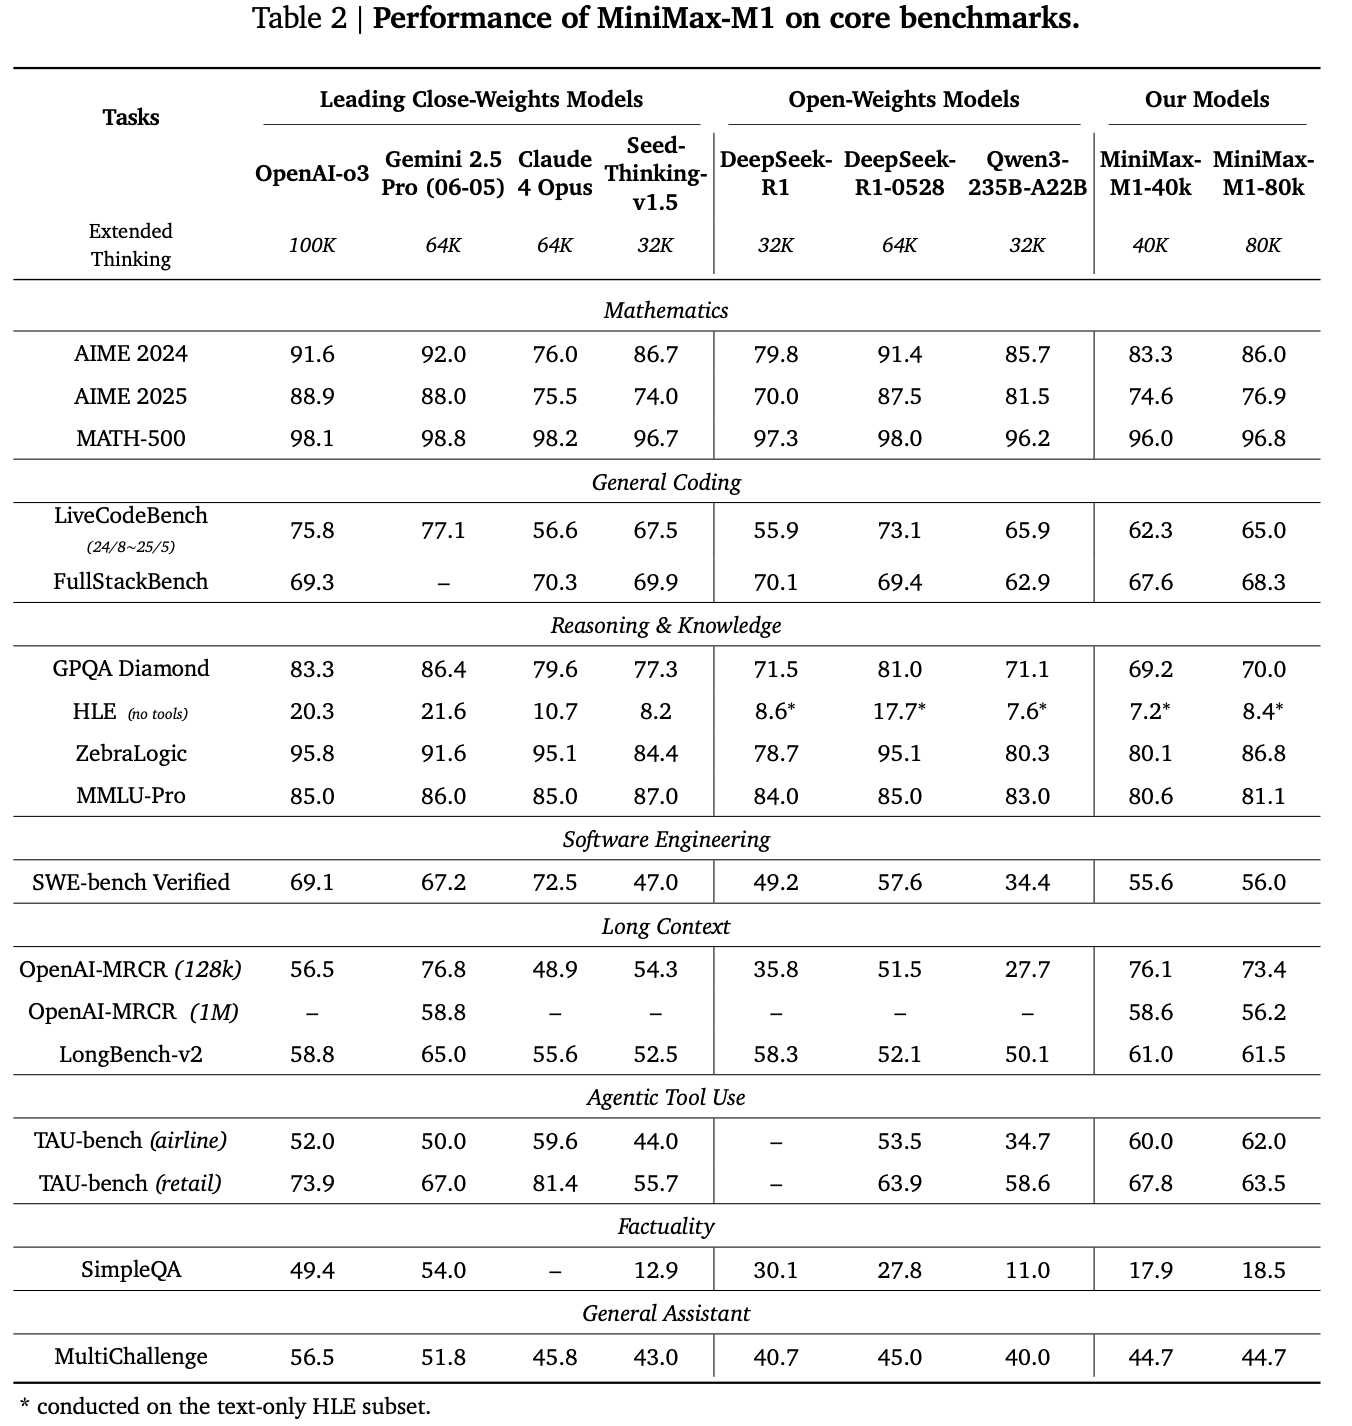
  • 表 2 展示了 MiniMax-M1 在核心基准上的性能
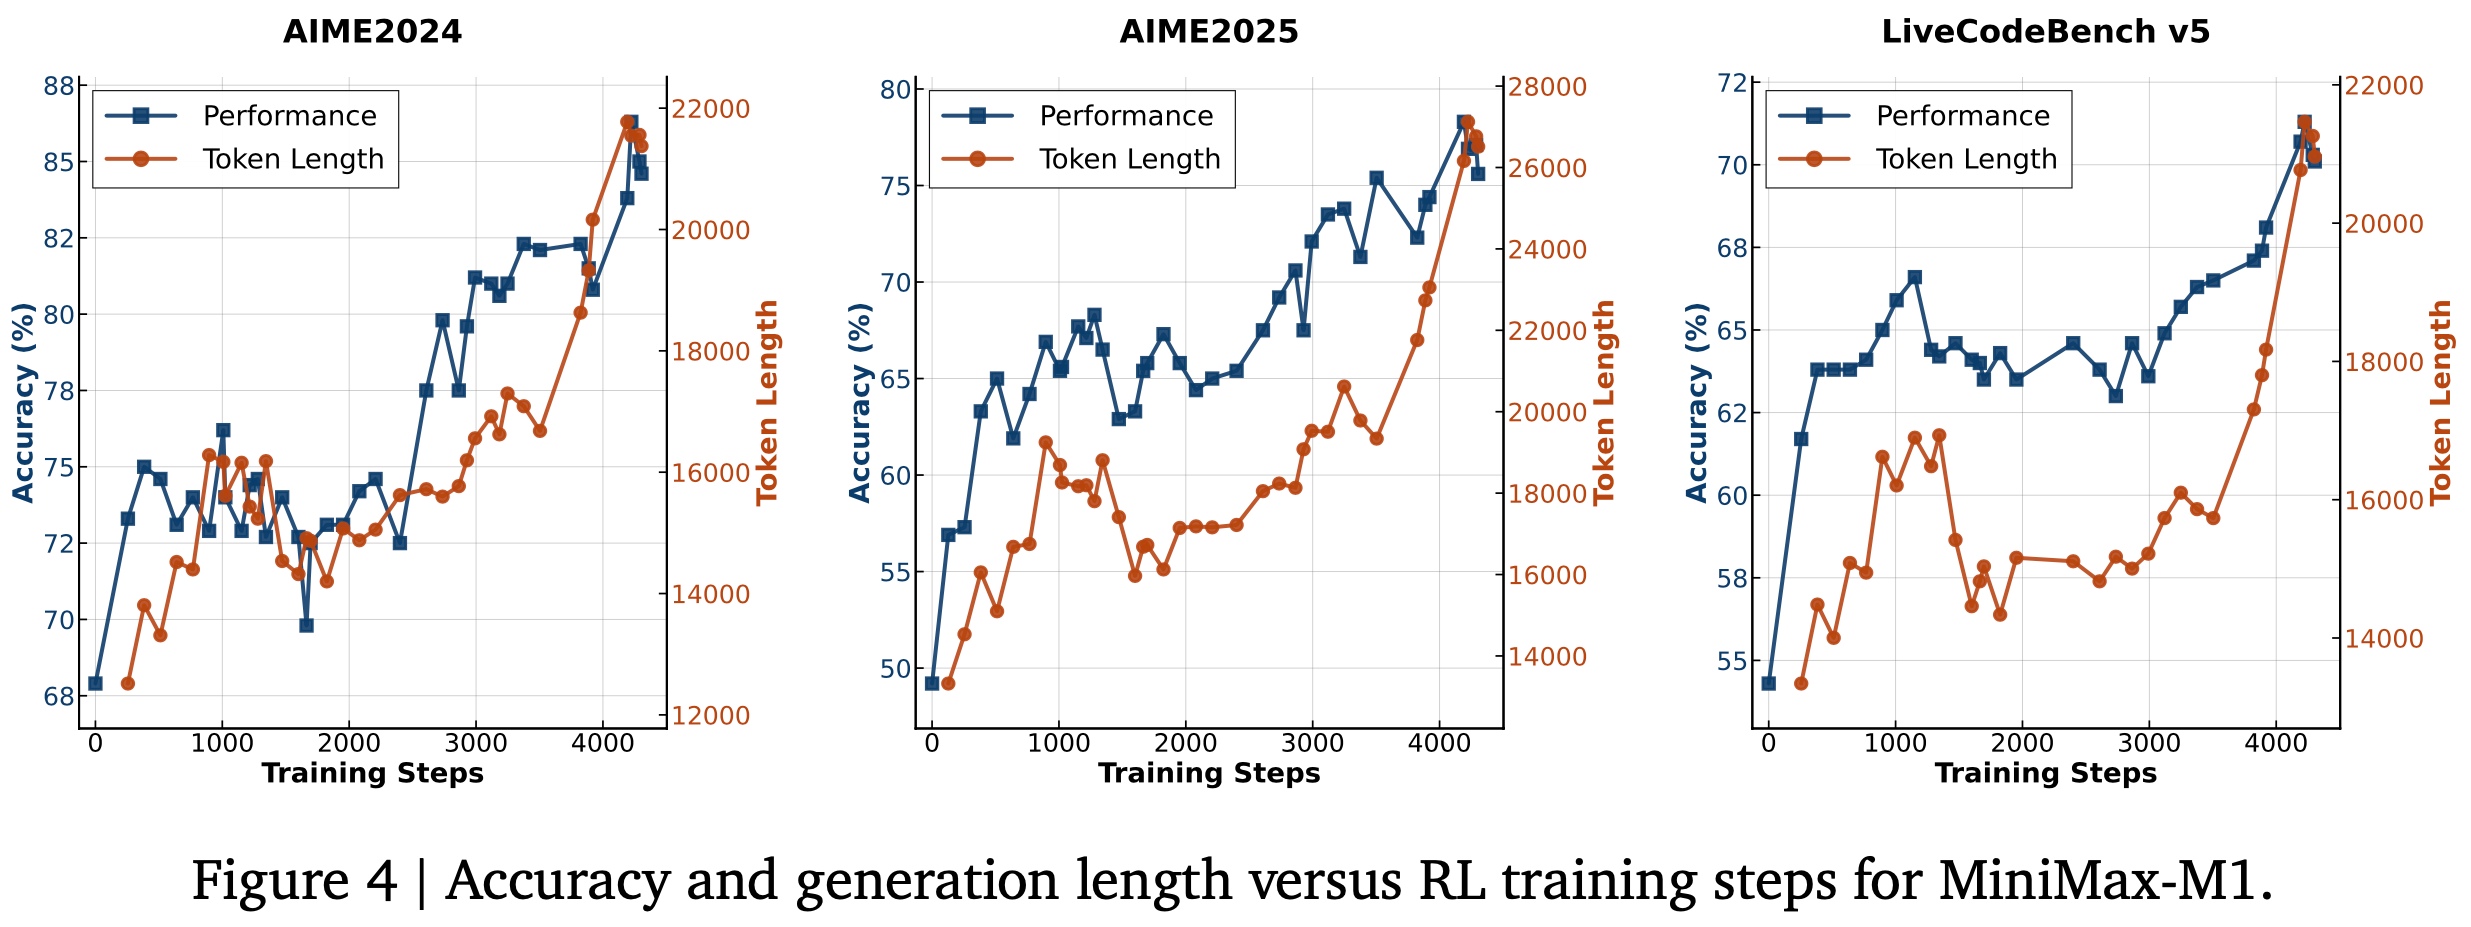
  • 图 4 呈现了 RL 训练中准确率与生成长度随训练步数的变化趋势

Conclusion and Future Work

  • 推出并开源了 MiniMax-M1,这是全球首个采用 Lightning Attention 机制的大规模开放权重推理模型
  • 高效的注意力设计使 MiniMax-M1 原生支持高达 1M 词元的输入和 80K 词元的生成长度(远超其他开放权重模型的能力范围)
  • 这些特性使其特别适合需要长上下文和深度推理的复杂现实场景 ,其在软件工程、智能体工具使用和长上下文理解基准上的优异表现也验证了这一点
  • 除 Lightning Attention 对 RL 训练的固有优势外,论文还提出了一种新型 RL 算法 CISPO 以加速训练
  • 结合架构优势与 CISPO,论文高效完成了 MiniMax-M1 的训练,其完整 RL 训练仅需 3 周时间(使用 512 张 H800 GPU)
  • 综合评估表明,MiniMax-M1 与 DeepSeek-R1 和 Qwen3-235B 并列世界顶级开放权重模型
  • 展望未来:
    • 随着测试时计算(test-time compute)持续扩展以支持更复杂场景,作者预见此类高效架构在应对现实挑战中的巨大潜力,例如自动化企业工作流 (2025) 和科学研究 (OpenAI, 2025; 2024)
    • 实际应用尤其需要 LRM 作为智能体与环境、工具、计算机或其他智能体交互,这要求模型在数十至数百轮交互中进行推理,并整合多源长上下文信息
    • 论文期待 MiniMax-M1 凭借其独特优势成为此类应用的坚实基础,并将持续推动其向这一目标演进
1…737475…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4