Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

ML——GBDT-梯度提升树-概念性总结

GBDT(GradientBoostingDecisionTree), 梯度提升树
*GBDT泛指所有梯度提升树,包括XGBoost(XGBoost是GBDT的变种),平时为了进行区分,GBDT特指“Greedy Function Approximation:A Gradient Boosting Machine”(GBDT论文原文)提出的算法,只利用了一阶导数信息(XGBoost利用了二阶导数信息)
梯度的数学定义:函数上升最快的方向

参考论文:Greedy Function Approximation: A Gradient Boosting Machine
一篇很详细的论文阅读笔记:GBM Paper Reading

引用一个常见的通俗例子:GBDT的思想可以用一个通俗的例子解释,假如有个人30岁,我们首先用20岁去拟合,发现损失有10岁,这时我们用6岁去拟合剩下的损失,发现差距还有4岁,第三轮我们用3岁拟合剩下的差距,差距就只有一岁了(残差作为下一轮拟合的数据的理解)。如果我们的迭代轮数还没有完,可以继续迭代下面,每一轮迭代,拟合的岁数误差都会减小,最终预测时使用他们的结果


五种简称

  • 各种简称,都是同一种算法:
    • GBDT(Gradient Boosting Decision Tree)
    • MART(Multiple Additive Regression Tree)
    • GBT(Gradient Boosting Tree)
    • GTB(Gradient Tree Boosting)
    • GBRT(Gradient Boosting Regression Tree)

模型原理

核心

  • 使用CART作为基础模型(GDBT只能使用CART,不能使用其他树C4.5和ID3等), 后来作者提出也可以使用逻辑回归模型
  • 每棵树学习的是前一棵树的残差(预测值与真实值的差)[这里是当损失函数是均方误差(平方损失, square loss)时可直接使用残差,其他类似的学习算法中若]
  • 残差 = 真实值 - 预测值

如何理解GBDT中的梯度G?

  • G表示Gradient,表示梯度,在GBDT中梯度是指损失函数关于每一个迭代中模型的梯度

与AdaBoost不同

  • AdaBoost是通过利用前一轮弱学习器的误差率来更新训练集的权重

    • 增大分类错误的样本权重,从而使得样本更加关注上一步中分类错误的样本
  • GBDT是通过学习上一轮学习器的残差来实现对真实结果的不断逼近

    • 上一步中预测越接近真实结果的样本,残差越接近0,下一轮中对该样本的关注度越低
    • 上一步中预测越不接近真实结果的样本,残差越大,下一轮中对该样本的关注度越高
  • GBDT的弱学习器只能使用CART回归树,只能用回归树这一点与AdaBoost和RF均不同

    • 因为我们的目标是拟合上一若学习器的残差
    • 而残差往往是数值,不是类别,所以只能使用回归树CART

GBDT分类

二分类
  • GBDT实现二分类时可以每轮迭代直接用一个模型去学残差
  • 此时类别可编码为一个一维向量,取值0或1
多分类
  • GBDT实现多分类时每轮使用一个模型不够了,因为三个模型时使用1,2,3编码显然是不科学的,类别之间不应该有这种数值大小关系
  • 此时三分类模型的类别可编码为一个三维向量,每一维的取值为0或1
  • 在每一轮迭代时,为每个类训练一个CART树,每棵CART树是相互独立的
  • 然后每个模型每轮分别学习当前特征的残差
  • 每个模型都会用到所有的样本
    • 比如一个标记为标记为类别2的样本(x, y=2)
    • 编码为(x, [0,1,0])
    • 对于CART1和CART3(类别1和类别3的CART树)来说,该样本对应输入为(x, y=0)
    • 对于CART2(类别2CART树)来说,该样本对应输入为(x, y=1)
  • 可以理解为把一个三分类问题转化成了3个二分类问题解决了
  • 最后预测时
    • 给定一个未标记样本
    • 每个类对应的模型(每个类的模型个数是该类上模型的迭代次数)都对应给出该类的打分
    • 最后选择分数最高的一个类为最终分类即可

GDBT + LR

  • 为什么在广告CTR预估中, GDBT+LR能够提升效果?
    • 和LR对比: 线性模型
    • 和GBDT对比:

GBDT和神经网络的优劣

深度神经网络

  • 通过不同层级和类型的网络可以对时空信息建模
  • 适合图像, 声音, 文字等带有时序特质的数据

GBDT

  • 基于树模型的GBDT则能很好地处理表格数据
  • 模型的可解释性
  • 输入数据的不变性(几乎不用格式化数据)
  • 更易于调参等特质更适合数值型数据

ML——GBDT-梯度提升树-推导过程

本文介绍梯度提升树(族)的推导过程,包括传统的GBDT,XGBoost等


参数空间的优化

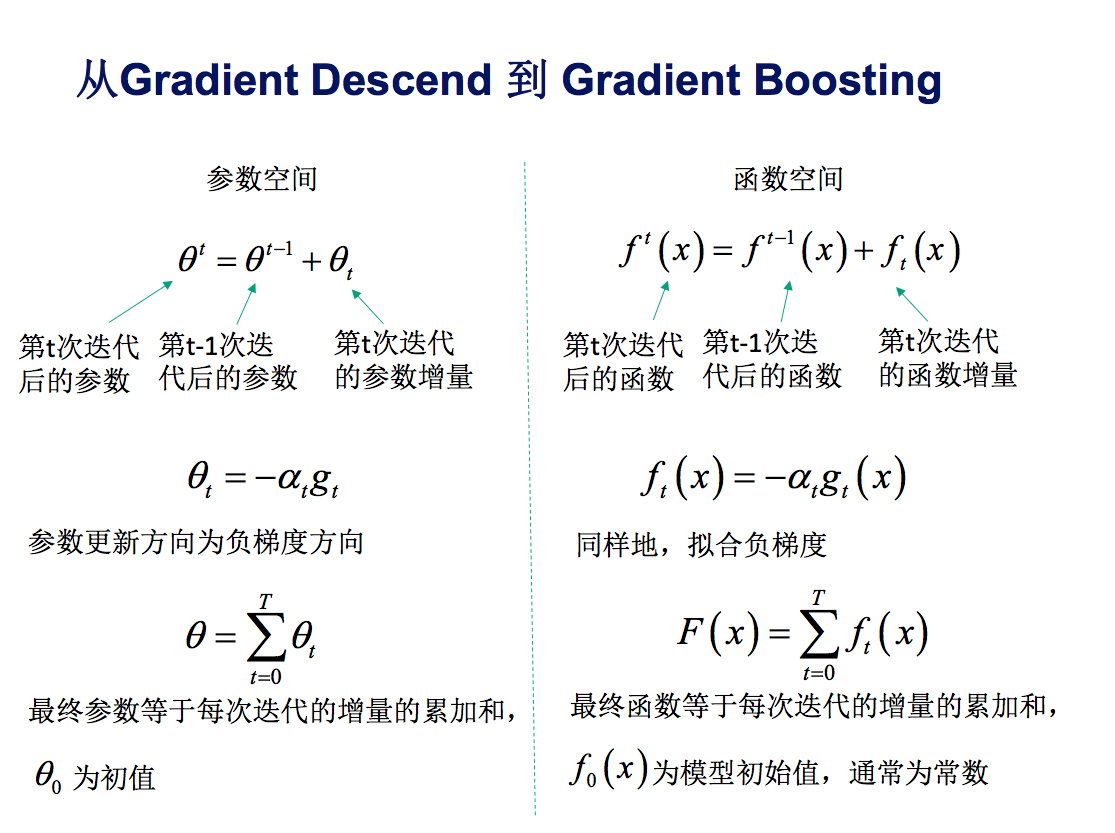
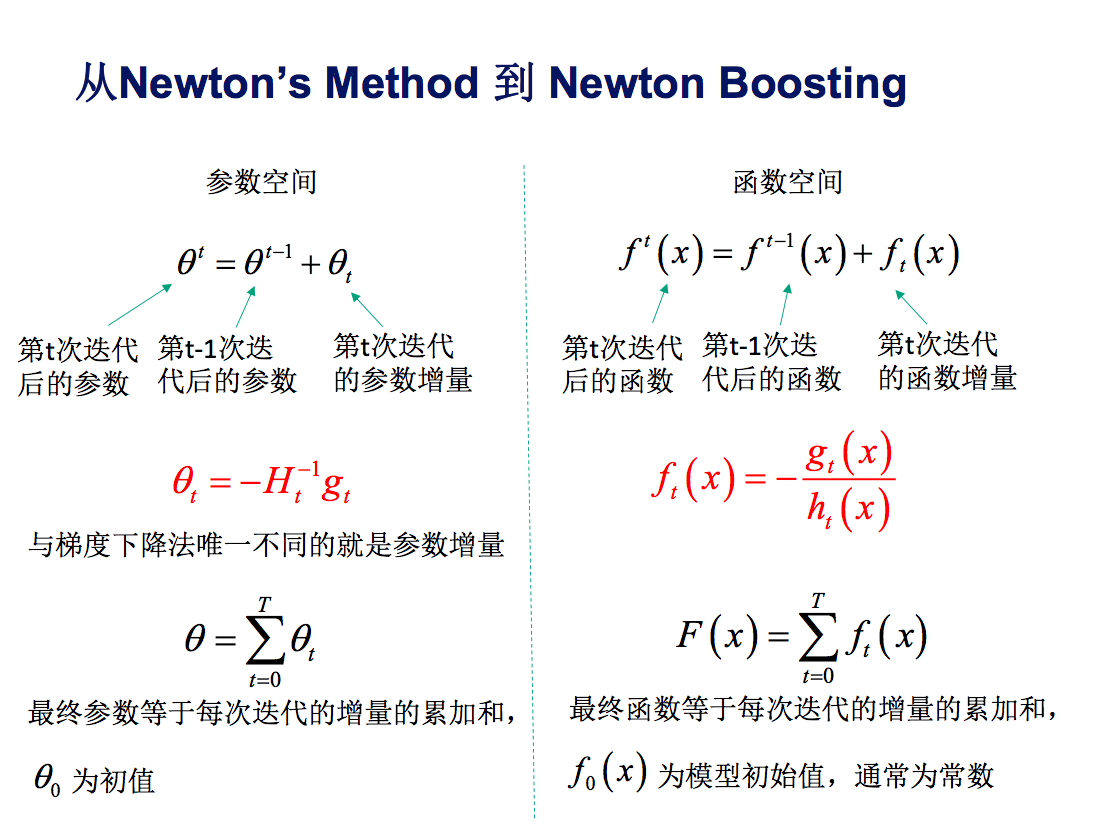
  • 参数空间中我们使用梯度下降法(一阶导数)和牛顿迭代法(二阶导数)来优化
  • 关于无约束参数优化方法参考无约束参数优化方法

从参数空间优化到函数空间的优化

  • 函数空间中我们使用GBDT(一阶导数)和XGBoost(二阶导数)来优化
  • 函数空间的优化完全类比参数空间的优化

Boosting是一种加法模型

加法模型:additive training
$$
\begin{align}
F(x) = \sum_{t=0}^{T}f_{t}(x)
\end{align}
$$

  • 上式中 \(f_{t}(x)\) 为基分类器, 我们通常采用回归树[Friedman 1999] 和逻辑回归
    [Friedman 2000]
  • 树模型的优缺点可以参考ML——DT-决策树

GBDT算法原理

这里只原论文中的Gradient Boosting Tree算法
Friedman于论文”GreedyFunctionApproximation…”中最早 出GBDT

模型 \(F\) 的加法定义:

$$
\begin{align}
F(x) &= \sum_{t=0}^{T}\alpha_{t} h_{t}(x;w_{t}) \\
&= \sum_{t=0}^{T} f_{t}(x;w_{t})
\end{align}
$$

  • 其中, \(x\) 为输入样本, \(h_{t}\) 为分类回归树, \(w_{t}\) 是树 \(h_{t}\) 的参数, \(\alpha_{t}\) 是树 \(h_{t}\) 的权重

损失函数的定义

$$
\begin{align}
F^{\star} = \mathop{\arg\max}_{F}\sum_{i=1}^{N}L(y_{i}, F(x_{i};w))
\end{align}
$$

  • 其中, \(N\) 为样本数量,所有样本的损失总和为总的损失函数
  • 最小化损失函数即可得到最优模型

最优模型的求解

  • 直接列举所有可能的树——NP难问题
  • 所以GBDT算法使用贪心法, 迭代求局部最优解
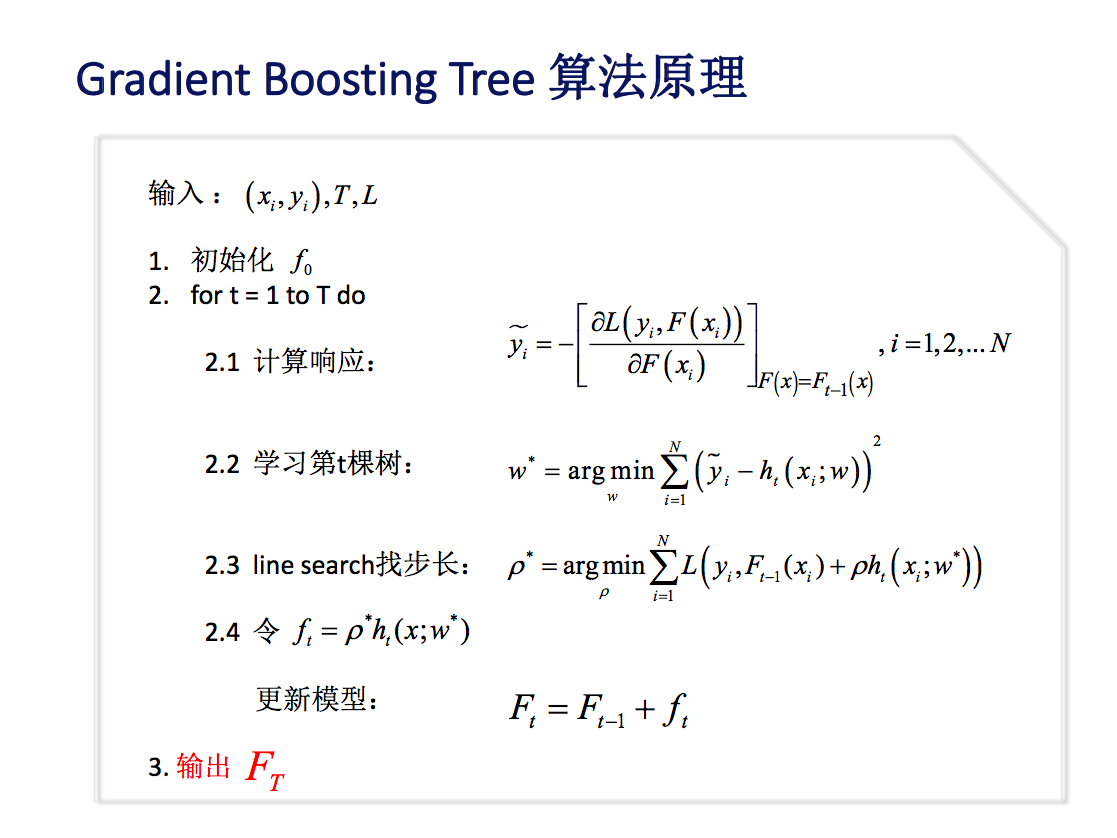
  • 详细的Gradient Boosting Tree迭代过程如下
  • 上面的推导中
    • 2.1中: \(\tilde{y}_{i}\) 是当前的损失函数 \(L(y_{i}, F(x_{i}))\) 关于当前函数 \(F(x)\) (模型)在 \(F(x)=F_{t-1}(x)\) 处的负梯度(每个样本都有一个负梯度),这个梯度也是GBDT名字中梯度的由来
      • 这个损失函数在使用不同回归方法时时定义各不相同
      • 原始论文中提到两个损失函数定义,根据损失函数的不同,对应的归回方法不同: 最小二乘归回或者最小绝对误差回归
    • 2.2中: \(w^{\star}\) 是指能够拟合当前负梯度的树 \(h_{t}(x;w^{\star})\) 的最佳参数,这里我们认为最佳参数就是最小二乘的最佳参数,实际上这个地方可以使用其他测拟合标准(这个标准是拟合当前负梯度的拟合标准,与后面的损失函数 \(L(y, F(x;w))\) 无关),只是这里最小二乘是最简单也是最自然的选择
      • 原始论文中这里使用的基函数是 \(\beta h(x;w)\),其中 \(\beta\) 是当前基函数 \(h(x;w)\) 的权重,这里我认为直接使用 \(h(x;w)\) 作为基函数即可,权重 \(\beta\) 会自动被基函数学到的(可能原始论文中 \(h(x;w)\) 指的是简单的基函数,是不含权重学习功能的)
      • 但是需要注意的是,如果我们使用的基分类器是逻辑回归,那么这里每个基分类器的结果都是在[0-1]之间的数,是需要前面的 \(\beta\) 的
      • 这里我们推导的时候假定了基分类器是回归树,所以不需要使用 \(\beta\)
    • 2.3中:由于 \(w^{\star}\) 只能保证当前树 \(h_{t}(x;w^{\star})\) 是能拟合负梯度的,不能保证把当前这棵树添加到模型中时模型的损失函数是最小的,所以我们加了一个步长参数 \(\rho\),用来表示得到当前树的最优权重
      • 损失函数是平方损失函数时,这里的参数为 \(\rho\) 就是1,无需计算
    • 2.4中:将当前树的最优树(包括权重)一起加入到模型中

不同损失函数和基函数对应不同的算法

上述式子中推导用到的基函数为树模型,实际使用中也可以使用逻辑回归模型[Friedman 2000]等基函数
本小节将介绍不同损失函数或者基函数带来的不同算法

  • 注意:包括Adaboost和GBDT在内Boosting框架中,基函数(基分类器)都不能使用线性模型
    • 理解: Boosting框架本质上是一个加法模型,是对多个基函数的线性组合,得到更优的分类器,可以证明线性模型的线性组合还是线性模型,如果Boosting框架中使用线性模型,那么我们最终得到的分类器也是线性模型,这就局限了我们的整体模型的表达能力
最小二乘回归(损失函数)

Least-Squares Regression

损失函数定义
  • 此时损失函数定义为
    $$
    \begin{align}
    L(y,F(x)) = \frac{1}{2}(y-F(x))^{2}
    \end{align}
    $$
进一步理解推导过程
  • 2.1中 \(\tilde{y}_{i}=y_{i}-F_{t-1}(x_{i})\),这里直接对损失函数求导即可的到
    $$
    \begin{align}
    \tilde{y_{i}} &= -\left [\frac{\partial L(y,F(x_{i}))}{\partial F(x_{i})}\right ]_{F(x) = F_{t-1}(x)} \\
    &= -\left [\frac{\partial L(y,F_{t-1}(x_{i}))}{\partial F_{t-1}(x_{i})}\right ] \\
    &= -\left [\frac{\partial \frac{1}{2}(y_{i}-F_{t-1}(x_{i}))^{2}}{\partial F_{t-1}(x_{i})}\right ] \\
    &= 2 \cdot -\frac{1}{2}(y_{i}-F_{t-1}(x_{i})) \cdot -1 \\
    &= y_{i}-F_{t-1}(x_{i})
    \end{align}
    $$
  • 2.2中正常拟合(使用线性回归和CART回归树均可)
  • 2.3中基函数的权重 \(\rho^{\star}\) 是常数1,推导如下
    $$
    \begin{align}
    L(y,F_{t}(x)) &= \sum_{i=1}^{N}L(y_{i}, F_{t}(x_{i})) \\
    &= \frac{1}{2}\sum_{i=1}^{N}((y_{i}-F_{t}(x_{i}))^{2}) \\
    &= \frac{1}{2}\sum_{i=1}^{N}((y_{i}-F_{t-1}(x_{i}) - h_{t}(x_{i};w))^{2}) \\
    &= \frac{1}{2}\sum_{i=1}^{N}((\tilde{y}_{i}-h_{t}(x_{i};w))^{2}) \\
    \end{align}
    $$
  • 显然,这个式子和2.2中拟合目标完全相同(只差着2倍常数权重),所以2.2中得到的最优基函数 \(h_{t}(x;w^{\star})\) 就是2.3中使得模型损失函数 \(L(y,F_{t}(x))\) 最小的最优基函数,无需添加任何的权重系数
最小绝对偏差回归(损失函数)

Least Absolute Deviation Regression, LAD

损失函数定义
  • 此时损失函数定义为
    $$
    \begin{align}
    L(y,F(x)) = |y-F(x)|
    \end{align}
    $$
进一步理解推导过程
  • 2.1中 \(\tilde{y}_{i}=sign(y_{i}-F_{t-1}(x_{i}))\)
    • 绝对值的导数就是1或者-1,当
      $$y_{i}-F_{t-1}(x_{i}) > 0$$
    • 对损失函数求导得到-1,负梯度为1
    • 同理得到,当
      $$y_{i}-F_{t-1}(x_{i}) > 0$$
    • 对损失函数求导得到1,负梯度为-1
    • 总结得到负梯度为
      $$\tilde{y}_{i}=sign(y_{i}-F_{t-1}(x_{i}))$$
  • 2.2中正常拟合(使用线性回归和CART回归树均可)
  • 2.3中基函数的权重 \(\rho^{\star}\) 不再是常数,推导如下
  • 待更新*
    $$
    \begin{align}
    待更新
    \end{align}
    $$
回归树(基函数)

Regression Trees

  • 传统GBDT中原始论文使用树回归 ,论文见Firedman 1999,后来作者提出可以使用逻辑回归 ,论文见Friedman 2000
  • 回归树和逻辑回归的优缺点比较
    • 树模型优点 :
      • 可解释性强
      • 可处理混合类型特征(混合类型特征指的是数值型和类别型均可处理)
      • 具有伸缩不变性(无需特征归一化: 神经网络和逻辑回归都需要,逻辑回归中是为了保证随机梯度下降的方向正确,速度快)
      • 可自然的处理缺失值, C4.5树处理缺失值默认使用的方法是先用未缺失样本计算信息增益确定分裂结点,然后将缺失值的每个样本按照权重(当前叶子节点未缺失样本数量 / 未缺失样本总数)分配到各个结点
      • 对异常点鲁棒(不用去除异常点,LR不具有这个优点)
      • 有特征选择的作用
      • 可扩展性强,容易并行(并行是最好的,用来解释为什么XGBoost等都用树模型)
    • 树模型缺点 :
      • 缺乏平滑性(回归预测时输出值只能输出若干种数值,而不是连续的数值,所以不平滑[不平滑即离散])
      • 不适合处理高维稀疏数据(当数据量太少时,非常容易过拟合,树的深度太深,从而模型变得太复杂)

传统GDBT与XGBoost的比较

  • 参考博客: ML——XGBoost-vs-传统GBDT
1…309310311…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4