Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

DL——为什么Dropout能防止过拟合

  • 参考博客: https://blog.csdn.net/dQCFKyQDXYm3F8rB0/article/details/81976571

关于Dropout

  • 用途是防止过拟合,关于过拟合的讲解可参考
    • DL——深度学习中降低过拟合的方法
    • ML——模型的方差与偏差(机器学习中的正则化与过拟合)
  • 基本思路:
    • 训练时:随机失活部分神经元
    • 推理时:激活全部神经元

定义

  • dropout是指在深度学习网络的训练过程中,对于神经网络单元,按照一定的概率将其暂时从网络中丢弃。注意是暂时 ,对于随机梯度下降来说,由于是随机丢弃,故而每一个mini-batch都在训练不同的网络。(因为每一轮被丢弃的神经元不同)

应用

  • 在CNN中防止过拟合的效果明显
  • 一般选择0.5比较好,因为0.5的时候Dropout随机生成的网络结果最多,但是实际使用中一般需要调节甚至变化
    • 亲测: 在使用VGG16模型迁移学习来分类Dogs2Cats数据集时,先使用0.5,然后再使用0.2略优于一直使用0.5的情况

Why能防止过拟合?

  • 虽然Dropout在实际应用中的确能防止过拟合,但是关于Dropout防止过拟合的原理,大家众说纷纭
  • 下面介绍两个主流的观点

组合派观点

集成学习方法论
  • 传统神经网络的缺点: 费时 , 容易过拟合
  • 过拟合是很多机器学习的通病
  • 一种修改模型的过拟合解决思路是: 采用Ensemble方法的Bagging方法(平均多个模型的结果,从而能够减少模型的方差,同时减轻过拟合)或者Boosting方法(减小模型的偏差,同时能减轻过拟合?[待更新]),即训练多个模型做组合
  • 但是解决了过拟合后, 费时就成为一个大问题,不仅训练起来费时,测试起来多个模型也很费时
  • Dropout能同时解决以上问题:
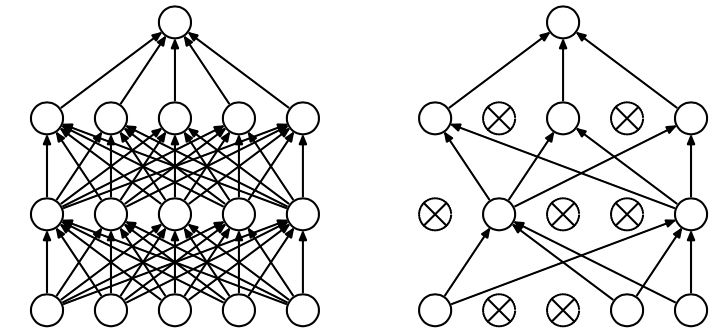
    • Dropout的示意图如下: 左图是原图结构,右图是加入Dropout层的
    • 从图上可以看出,有了Dropout,训练的模型就可以看成是多个模型的组合,最终预测时丢弃Dropout即可的到所有模型的组合,从而实现类似于Ensemble方法的Bagging方法,实现了多个模型的组合
动机论
  • 虽然直观上看dropout是ensemble在分类性能上的一个近似,然而实际中,dropout毕竟还是在一个神经网络上进行的,只训练出了一套模型参数。那么他到底是因何而有效呢?

  • 首先分析一个小故事

在自然界中,在中大型动物中,一般是有性繁殖,有性繁殖是指后代的基因从父母两方各继承一半。但是从直观上看,似乎无性繁殖更加合理,因为无性繁殖可以保留大段大段的优秀基因。而有性繁殖则将基因随机拆了又拆,破坏了大段基因的联合适应性。但是自然选择中毕竟没有选择无性繁殖,而选择了有性繁殖,须知物竞天择,适者生存。我们先做一个假设,那就是基因的力量在于混合的能力而非单个基因的能力。不管是有性繁殖还是无性繁殖都得遵循这个假设。为了证明有性繁殖的强大,我们先看一个概率学小知识

  • 基本思想: 有性繁殖的方式不仅仅可以将优秀的基因传下来,还可以降低基因之间的联合适应性,使得复杂的大段大段基因联合适应性变成比较小的一个一个小段基因的联合适应性

  • dropout也能达到同样的效果,它强迫一个神经单元,和随机挑选出来的其他神经单元共同工作,达到好的效果。消除减弱了神经元节点间的联合适应性,增强了泛化能力

噪声派观点

  • 对于每一个dropout后的网络,进行训练时,相当于做了Data Augmentation ,因为,总可以找到一个样本,使得在原始的网络上也能达到dropout单元后的效果。 比如,对于某一层,dropout一些单元后,形成的结果是(1.5,0,2.5,0,1,2,0),其中0是被drop的单元,那么总能找到一个样本(新样本),使得结果也是如此。这样,每一次dropout其实都相当于增加了样本
噪声派观点总结
  • 将dropout映射回得样本训练一个完整的网络,可以达到dropout的效果
  • dropout由固定值变为一个区间,可以提高效果
  • 将dropout后的表示映射回输入空间时,并不能找到一个样本 x 使得所有层都能满足dropout的结果,但可以为每一层都找到一个样本,这样,对于每一个dropout,都可以找到一组样本可以模拟结果

Dropout其他需要注意的点

  • 数据量小的时候,dropout效果不好,数据量大了,dropout效果好
  • dropout的缺点就在于训练时间是没有dropout网络的2-3倍

Dropout训练和预测阶段输出分布一致性保证

  • 保持分布一致的必要性 :Dropout操作会改变神经元输出分布,在 Dropout 的训练和预测阶段保证输出均值一致,能使得模型在训练和预测时具有相同的统计特性,从而提高模型的泛化能力
  • 方式 :通过调整训练和预测阶段的神经元输出比例,可以保证确保两者输出分布的一致性实现方式
  • 方法一:训练阶段缩放(Inverted Dropout)
    • 训练阶段:以概率 \(p\) 失活部分神经元,同时对被激活的所有神经元,对输出均乘以 \(\frac{1}{1-p}\)
    • 预测阶段:在预测阶段,不进行神经元的随机丢弃,而是直接使用训练好的模型进行推理。此时,由于在训练阶段已经对神经元的输出进行了缩放,所以在预测阶段不需要额外的操作,模型的输出均值就会与训练阶段保持一致
  • 方法二:预测阶段缩放(Vanilla Dropout)
    • 训练阶段:以概率 \(p\) 失活部分神经元,不调整输出
    • 预测阶段:激活所有神经元,且对被激活的所有神经元,对输出均乘以 \(1-p\)
  • 注:常规的Dropout实现均保证了训练和推理阶段分布一致,测试代码如下:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    import torch
    import torch.nn as nn

    x = torch.randn(8)
    dropout = nn.Dropout(p=0.5)

    dropout.train()
    train_output = dropout(x)
    print("训练阶段输出:", train_output)

    dropout.eval()
    test_output = dropout(x)
    print("预测阶段输出:", test_output)

    # 训练阶段输出: tensor([ 0.0000, -1.0198, -1.4742, -0.0408, 1.8699, 0.0000, -0.0000, -0.0000])
    # 预测阶段输出: tensor([ 0.1318, -0.5099, -0.7371, -0.0204, 0.9350, 0.9006, -0.2567, -0.7391])

DL——学习率和梯度方向的思考


为什么可以冻结参数或使用不同的学习率?

  • 改变学习率的两种方式,冻结参数(学习率为 0)或对不同参数使用不同的学习率
  • 前置结论:
    • 承认问题:冻结参数或使用不同的学习率,确实改变了参数更新的整体方向
    • 一般不称为梯度有偏:但在深度学习和最优化理论中,这通常不被称为“梯度有偏(Biased Gradient)”(因为“有偏”通常指代在随机梯度下降 SGD 中,小批量梯度的期望不等于全量梯度,即 \(\mathbb{E}[\hat{g}] \neq \nabla L\))
    • 数学理解:这种操作在数学上被理解为投影梯度下降(Projected Gradient Descent) 、块坐标下降(Block Coordinate Descent) 或预条件(Preconditioning)
  • 三个核心问题:
    • 导致梯度有偏吗?
      • 从数学上看,方向确实变了(几何上确实改变了方向),但我们一般不称这种特意修改学习率为梯度有偏,相当于把梯度投影到了一个子空间,或者对空间进行了仿射变换
    • 为什么可以这么更新?
      • 因为只要未冻结的参数有梯度,或者学习率大于0,新的更新方向与原负梯度方向的内积依然大于0,数学上依然保证损失函数会下降
    • 为什么要这么做?
      • 首先:原始的全量梯度方向虽然是当前点下降最快的方向,但它可能会破坏预训练权重、导致震荡或引发过拟合
      • 通过冻结或调整学习率来人为引导优化路径,使其符合对任务的先验知识(如迁移学习),从而可能让神经网络学的又快又稳

数学视角理解梯度方向

  • 假设模型参数可以分为两部分
    $$\theta = [\theta_1, \theta_2]^T$$
  • 损失函数为
    $$ L(\theta_1, \theta_2)$$
  • 全量梯度(最陡下降方向)为:
    $$
    g = \nabla_{\theta} L = \begin{bmatrix} \nabla_{\theta_1} L \\ \nabla_{\theta_2} L \end{bmatrix}
    $$

冻结部分参数 = 子空间投影(块坐标下降)

  • 如果冻结了 \(\theta_1\),只更新 \(\theta_2\),实际更新方向变成了:
    $$
    \Delta \theta = - \eta \begin{bmatrix} 0 \\ \nabla_{\theta_2} L \end{bmatrix}
    $$
  • 这相当于在原始梯度上乘了一个投影矩阵 \(P\):
    $$
    \Delta \theta = - \eta P g, \quad \text{其中} \quad P = \begin{bmatrix} 0 & 0 \\ 0 & I \end{bmatrix}
    $$
  • 在最优化理论中,只要更新方向 \(d\) 与负梯度方向 \(-g\) 的夹角小于 90 度(即内积大于 0),这个方向就是一个下降方向(Descent Direction) ,就能保证损失函数下降
  • 我们计算一下投影梯度与原梯度的内积:
    $$
    \langle P g, g \rangle = g^T P g = |\nabla_{\theta_2} L|^2 \ge 0
    $$
    • 只要 \(\theta_2\) 的梯度不为 0,这个内积就严格大于 0
    • 注意:因为 投影矩阵 \(P\) 中,关于 \(\theta_1\) 的位置(上半部分)都是0,下半部分都是 1(单位矩阵),所以有下面的式子成立:
      $$ g^T P g = |\nabla_{\theta_2} L|^2 $$
  • 因此,虽然方向改变了,但它依然保证了损失函数在 \(\theta_2\) 的子空间内是下降的
  • 这在数学上被称为“块坐标下降法(Block Coordinate Descent)”

不同参数不同学习率 = 预条件(Preconditioning)

  • 如果给 \(\theta_1\) 设定学习率 \(\eta_1\),给 \(\theta_2\) 设定学习率 \(\eta_2\),更新公式为:
    $$
    \Delta \theta = - \begin{bmatrix} \eta_1 I & 0 \\ 0 & \eta_2 I \end{bmatrix} \begin{bmatrix} \nabla_{\theta_1} L \\ \nabla_{\theta_2} L \end{bmatrix} = - H g
    $$
    • 这里的 \(H\) 是一个对角矩阵
  • 只要 \(H\) 是一个正定矩阵(即所有的学习率 \(\eta_i > 0\)),那么:
    $$
    \langle H g, g \rangle = g^T H g = \eta_1 |\nabla_{\theta_1} L|^2 + \eta_2 |\nabla_{\theta_2} L|^2 > 0
    $$
    • 这同样保证了更新方向是一个有效的下降方向
  • 事实上,改变梯度的方向往往是作者梦寐以求的
    • 标准的梯度方向(最陡下降)在损失函数等高线呈椭圆(病态条件,Ill-conditioned)时,会导致严重的“Z字形”震荡
    • 牛顿法(乘以海森矩阵的逆 \(\nabla^2 L^{-1}\))或 Adam 优化器(除以历史梯度的均方根),本质上都是在改变梯度的方向 ,使其指向真正的极小值点
    • 不同层使用不同学习率,就是一种手动且粗糙的预条件操作

从功能上理解改变学习率的含义

  • 除了数学上的合理性,在深度学习的实际应用中,故意 改变梯度方向(冻结或分层学习率),也有物理上的原因

避免灾难性遗忘(Catastrophic Forgetting)与保护特征提取器

  • 核心理由:防止已经训练的不错的参数被其他随机参数影响(一般来说刚开始训练时,传回来的误差梯度会非常大且混乱)
  • 在迁移学习或 Fine-tuning 中,\(\theta_1\) 通常是预训练模型的骨干(Backbone),\(\theta_2\) 是新加的分类头(Head)
    • \(\theta_1\) 已经在一个巨大的数据集上学到了非常好的通用特征表示
    • \(\theta_2\) 是随机初始化的
  • 如果一开始就全参数更新,\(\theta_2\) 传回来的误差梯度会非常大且混乱,这个“全量梯度”会直接破坏 \(\theta_1\) 已经学好的脆弱的特征空间
    • 需要 把 \(\theta_1\) 的梯度强行变为 0(冻结),或者给一个极小的学习率
  • 于是,此时我们并不想要全局的最陡下降,只想要局部(分类头)的下降

深度神经网络的“过参数化”特性

  • 核心理由:参数太多时,适当缩小搜索空间反而是一种正则化,能防止过拟合
  • 深度学习模型通常是严重过参数化的(参数量远大于数据量)
  • 损失函数的极小值不是一个点,而是一个巨大的、平坦的低维流形(Manifold)
  • 意味着,不需要在全维度的参数空间中寻找最优解
    • 只需要在某一个子空间(未冻结的参数空间)中移动,就能找到一个使得训练误差降为 0 的解
    • 冻结部分参数相当于给模型施加了一种强正则化(Regularization) ,缩小了搜索空间,反而能防止模型在小数据集上过拟合

梯度的尺度差异(Lipschitz 平滑度不同)

  • 核心理由:不同层、不同参数可能量级不同(梯度范数可能差异巨大),相同的学习率可能导致一些层已经梯度爆炸,但一些层还在梯度消失
  • 在深层网络中,不同层的梯度方差和曲率(Curvature)差异巨大
  • 例如,底层(靠近输入)的梯度可能很小且平缓,而顶层(靠近输出)的梯度可能很大且陡峭
  • 如果使用统一的学习率(即保持原始梯度方向),可能会导致顶层梯度爆炸,而底层梯度消失
  • 给不同层分配不同的学习率,相当于在不同维度上拉伸/压缩了空间,使得优化过程在各个维度上更加均衡
1…240241242…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4