Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

DL——NNLM

神经网络语言模型(Nerual Network Language Model, NNLM)

参考论文: A Neural Probabilistic Language Model
参考博客: 神经网路语言模型(NNLM)的理解


概率模型

  • 传统的 \(n\) 元语言模型:
    $$(p(w_{t}|w_{t-(n-1)},…,w_{t-1}))$$
  • 一般来说可以通过前 \(n-1\) 个词将预测第 \(n\) 个词的概率分布

NNLM模型原理

  • NNLM 模型直接通过一个神经网络结构对 \(n\) 元条件概率进行评估

模型结构

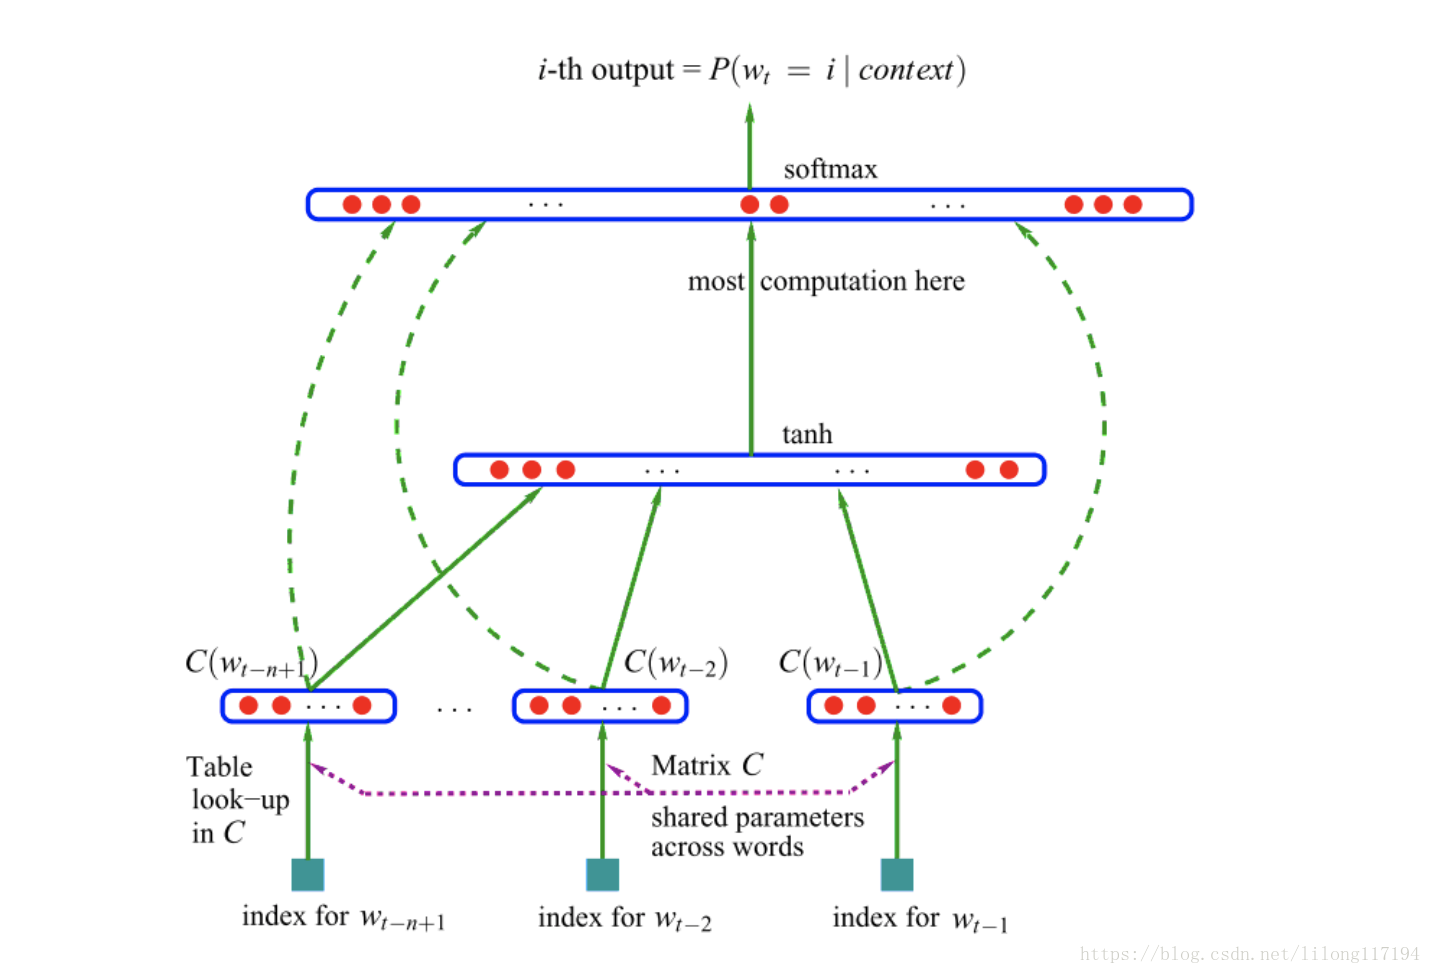
  • NNLM 网络结构图如下:

数据集预处理

  • 对于给定的预料库,我们需要生成训练数据集(大量训练样本的集合),单个样本如下是长度为n的序列 \((w_{1},…,w_{n})\),其中 \((w_{1},…,w_{n-1})\) 对应训练样本特征值,训练样本标记为 \(w_{n}\),通常可以用One-Hot编码(一个维度为|V|的向量)

模型分析

模型分析主要介绍前向传播过程

输入与输出
  • 将构造的数据集作为训练样本集
  • 其中每个样本输入为 \((w_{1},…,w_{n-1})\),输出为一个向量(维度为 |V|),向量代表词的分布,该分布应该与词 \(w_{n}\) 的 One-Hot 编码(也是一个 |V| 维向量)尽量匹配,输出误差就是这两个向量的差异大小(不同损失函数均通过将上述两个向量作为输入,输出一个标量等(也可能 \(n\) 为向量,此时按照不同维度分别计算,或者是其他的值)从而实现当前样本损失的计算
模型结构分析
  • \(x=(C_{j|w_{j}=w_{1}};…;C_{j|w_{j}=w_{n-1}})\)

    • \(x\) 为输入向量, \(x\in R^{(n-1)m}\),\(x\) 是词序列 \((w_{1},…,w_{n-1})\) 对应的拼接向量,其中每个词都会先被矩阵C映射成一个m维的向量,将 \((n-1)\) 维的向量拼接起来就得到了 \(x\)
  • \(y=b+Wx+Utanh(d+Hx)\)

    • \(y\) 为输出向量, \(y\in R^{|V|}\), \(y_{i}\) 表示 \(w_{i}\) 是第 \(n\) 个单词的概率

      模型参数分析
  • C:映射矩阵 \(C\in R^{|V|\times m}\),其中矩阵的第 \(j\) 行 \(C_{j}\) 是词 \(w_{j}\) 对应的特征向量, \(m\) 为特征向量的维度

  • H:输入层到隐含层的权重矩阵 \(H\in R^{(n-1)m\times h}\),其中 \(h\) 为隐含层神经元的数量

  • W:输入层到输出层的权重矩阵 \(W\in R^{(n-1)m\times |V|}\), \(W\) 是可选参数,对应模型结构图中的绿色虚线,如果输入层输出层不直接相连,则直接令 \(W=0\) 即可

  • U:隐含层到输出层的权重矩阵 \(U\in R^{h\times |V|}\)

  • b:输出层的偏执参数

  • d:隐含层的偏执参数

模型训练

损失函数
  • 似然函数:\(L(\theta)=\prod_{t=1}^{T} p(w_{t-(n-1)},…,w_{t-1},w_{t}|\theta)+R(\theta)\)
    • T 为训练集 D 中的样本总数,即 \(T=|D|\)
    • \(R(\theta)\) 是正则项
  • 对数似然函数:\(L(\theta)=\sum_{t=1}^{T}\log(p(w_{t-(n-1)},…,w_{t-1},w_{t})|\theta) + R(\theta)\),其中T为训练集 D 中的样本总数,即 \(T=|D|\)
  • 我们选择优化对数似然函数,原因如下:
    • 似然函数连乘操作造成浮点数溢出,乘积越来越小(概率值都在[0,1]之间)
    • 似然函数连乘操作耗时大于对数似然函数的连加操作
    • 取对数的操作可以同时把函数中其他的指数项(比如出现在正则项 \(R(\theta)\) 中)中的处理成连加,减少运算量
    • 对数似然函数的单调性与似然函数相同,最大化对数似然函数等价于最大化似然函数(最重要的一点)
训练目标
  • 最大化对数似然函数(等价于最大化似然函数)
参数迭代
  • 使用梯度上升法,每轮迭代时朝着正梯度方向移动
    • \(\theta=\theta+\lambda\frac{\partial L(\theta)}{\partial\theta}\)
    • \(\lambda\) 为步长

总结

  • NNLM 模型使用了低维连续的词向量对上文进行表示,这解决了词袋模型带来的数据稀疏、语义鸿沟等问题
  • 相比传统模型,NNLM 是一种更好的n元语言模型(NNLM的 \(n\) 元不是由神经元决定,而是在根据语料库生成训练数据时单个训练样本中包含的词数,也就是窗口大小)
    • n元模型指的是跟军前 \(n-1\) 个词预测第 \(n\) 个词的语言模型,而不是根据前 \(n\) 个词生成第 \(n+1\) 个词的模型
  • 根据相似的上下文语境,NNLM 模型可以预测出相似的目标词,而传统模型无法做到这一点

DL——Softmax求导

关键词:Softmax梯度,Softmax求导


softmax函数定义

  • 对于输入向量 \( x = [x_1, x_2, \dots, x_n] \),softmax函数将其映射为概率分布:
    $$
    \sigma(x)_i = \frac{e^{x_i} }{\sum_{j=1}^n e^{x_j} }
    $$
    • 其中 \( \sigma(x)_i \) 表示第 \( i \) 个元素的输出,满足 \( \sum_{i=1}^n \sigma(x)_i = 1 \)

求导推导(分情况讨论)

  • 设 \( s_i = \sigma(x)_i \),目标是计算 \( \frac{\partial s_i}{\partial x_j} \),分两种情况

情况1:\( i = j \)(自变量对自身求导)

  • 展开表达式:
    $$
    s_i = \frac{e^{x_i} }{\sum_{k=1}^n e^{x_k} } = \frac{e^{x_i} }{S}, \quad \text{Where } S = \sum_{k=1}^n e^{x_k}
    $$
  • 利用商数法则求导:
    $$
    \frac{\partial s_i}{\partial x_i} = \frac{e^{x_i} \cdot S - e^{x_i} \cdot e^{x_i} }{S^2} = \frac{e^{x_i}(S - e^{x_i})}{S^2} = \frac{e^{x_i} }{S} \cdot \frac{S - e^{x_i} }{S} = s_i(1 - s_i)
    $$

情况2:\( i \neq j \)(自变量对其他元素求导)

  • 此时 \( x_j \) 出现在分母 \( S \) 中,分子与 \( x_j \) 无关:
    $$
    \frac{\partial s_i}{\partial x_j} = \frac{0 \cdot S - e^{x_i} \cdot e^{x_j} }{S^2} = -\frac{e^{x_i} e^{x_j} }{S^2} = -\frac{e^{x_i} }{S} \cdot \frac{e^{x_j} }{S} = -s_i s_j
    $$

矩阵形式(向量求导)

  • 若输入为向量 \( \mathbf{x} \),输出为向量 \( \mathbf{s} = \sigma(\mathbf{x}) \),则其雅可比矩阵为:
    $$
    \frac{\partial \mathbf{s} }{\partial \mathbf{x}^T} = \left[ \frac{\partial s_i}{\partial x_j} \right] = \mathbf{S} - \mathbf{s s}^T
    $$
    • \( \mathbf{S} \) 是对角矩阵,对角线元素为 \( s_i \);
    • \( \mathbf{s s}^T \) 是外积矩阵
  • 对角矩阵 \(\mathbf{S}\) :
    $$
    \mathbf{S} = \begin{bmatrix}
    s_1 & 0 & \cdots & 0 \\
    0 & s_2 & \cdots & 0 \\
    \vdots & \vdots & \ddots & \vdots \\
    0 & 0 & \cdots & s_n
    \end{bmatrix}
    $$
  • 外积矩阵 \(\mathbf{s s}^T\) :
    $$
    \mathbf{s s}^T =
    \begin{bmatrix}
    s_1 \\
    s_2 \\
    \vdots \\
    s_n
    \end{bmatrix}
    \begin{bmatrix}
    s_1 & s_2 & \cdots & s_n
    \end{bmatrix} =
    \begin{bmatrix}
    s_1 s_1 & s_1 s_2 & \cdots & s_1 s_n \\
    s_2 s_1 & s_2 s_2 & \cdots & s_2 s_n \\
    \vdots & \vdots & \ddots & \vdots \\
    s_n s_1 & s_n s_2 & \cdots & s_n s_n
    \end{bmatrix}
    $$
  • 最终梯度形式 :
    $$
    \frac{\partial \mathbf{s} }{\partial \mathbf{x}^T} = \mathbf{S} - \mathbf{s s}^T = \begin{bmatrix}
    s_1 & 0 & \cdots & 0 \\
    0 & s_2 & \cdots & 0 \\
    \vdots & \vdots & \ddots & \vdots \\
    0 & 0 & \cdots & s_n
    \end{bmatrix} -
    \begin{bmatrix}
    s_1 s_1 & s_1 s_2 & \cdots & s_1 s_n \\
    s_2 s_1 & s_2 s_2 & \cdots & s_2 s_n \\
    \vdots & \vdots & \ddots & \vdots \\
    s_n s_1 & s_n s_2 & \cdots & s_n s_n
    \end{bmatrix}
    $$

一些总结

  • softmax 函数的矩阵形式导数可表示为 对角矩阵与外积矩阵的差
    • 核心结论:“对角线元素为 \(s_i-s_i s_i\),非对角线元素为 \(-s_i s_j\)”的规律
  • 越接近 one-hot 的预估,其梯度越接近于 0
1…239240241…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4