文本介绍DDPM(Denoising Diffusion Probabilistic Models)的理论介绍
- 参考链接:
- 原始论文:Denoising Diffusion Probabilistic Models, NeurIPS 2020
- What are Diffusion Models?:Lilian Weng的博客
- 54、Probabilistic Diffusion Model概率扩散模型理论与完整PyTorch代码详细解读
- 视频中有部分小bug,评论区已修复
- 一文解决你关于扩散模型ddpm的所有疑惑,回答了很多疑惑
推导过程
这部分推导参考自由浅入深了解Diffusion Model - ewrfcas的文章 - 知乎和What are Diffusion Models?
Diffusion前向过程
前向过程的整体描述
- 给定真实图片 \(x_0 \sim q(x_0)\),Diffusion前向过程通过 \(T\) 次对其添加高斯噪声,得到 \(x_T\),第 \(t\) 次加噪后得到的样本为 \(x_t\)
- 加噪过程是增加一个服从高斯分布的误差,每一步中高斯分布方差的超参数是提前设定的 \(\{\beta_t \in (0,1)\}_{t=1}^T\)
- 前向过程由于每个时刻 \(t\) 只与 \(t-1\) 时刻有关,所以也可以看做马尔可夫过程
$$
\begin{align}
q(x_t|x_{t-1}) = \mathcal{N}(x_t; \sqrt{1-\beta_t}x_{t-1}, \beta_t\boldsymbol{I}) \\
q(x_{1:T}|x_0) = \prod_{t=1}^T q(x_t|x_{t-1}) \\
\end{align}
$$ - 实际实现中 \(\{\beta_t \in (0,1)\}_{t=1}^T\) 中的元素是递增的,即 \(\beta_1 < \beta_2 < \cdots < \beta_T\),DDPM实验时设置了 \(T=1000\),且 \(\beta_t\) 是 \([0.0001, 0.02]\) 之间的线性的固定值,即 \(\beta_1 = 0.0001 \ \text{to} \ \beta_T = 0.02\)
- 加噪过程中,随着加噪时间步骤 \(t\) 的增加, \(x_t\) 越来越接近纯随机噪声,且 \(T \rightarrow \infty\) 时, \(x_T\) 完全是噪声
可以用 \(x_0\) 和方差 \(\beta\) 来表示 \(x_t\)
- 即 \(\forall t, \ x_t = f(x_0, \{\beta_i\}_{i=1}^t)\) \(x_t\)
- 引入新变量 \(\alpha_t = 1- \beta_t\),且 \(\bar{\alpha}_t = \prod_{i=1}^t\alpha_i\) (理解: \(\alpha_t\) 和 \(\bar{\alpha}_t\) 都随着扩散时间步逐步变小)
- 将 \(x_t\) 进行展开可得得到用 \(x_0\) 和方差 \(\beta\) 来表示 \(x_t\):
$$
\begin{align}
\mathbf{x}_t
&= \sqrt{\alpha_t}\mathbf{x}_{t-1} + \sqrt{1 - \alpha_t}\mathbf{\epsilon}_{t-1} \quad \quad \quad \quad \quad \quad \quad \quad \text{ ;where } \mathbf{\epsilon}_{t-1}, \mathbf{\epsilon}_{t-2}, \dots \sim \mathcal{N}(\mathbf{0}, \boldsymbol{I}) \\
&= \sqrt{\alpha_t}(\sqrt{\alpha_{t-1}}\mathbf{x}_{t-2} + \sqrt{1 - \alpha_{t-1}}\mathbf{\epsilon}_{t-2}) + \sqrt{1 - \alpha_t}\mathbf{\epsilon}_{t-1} \\
&= \sqrt{\alpha_t \alpha_{t-1}}\mathbf{x}_{t-2} + (\sqrt{\alpha_t(1 - \alpha_{t-1})}\mathbf{\epsilon}_{t-2} + \sqrt{1 - \alpha_t}\mathbf{\epsilon}_{t-1}) \\
&= \sqrt{\alpha_t \alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{1 - \alpha_t \alpha_{t-1}} \bar{\mathbf{\epsilon}}_{t-2} \quad \quad \quad \quad \text{ ;where } \bar{\mathbf{\epsilon}}_{t-2} \text{ merges two Gaussians (*).} \\
&\quad \vdots \\
&= \sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\mathbf{\epsilon} \\
q(\mathbf{x}_t \vert \mathbf{x}_0) &= \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t)\boldsymbol{I})
\end{align}
$$- 推导中两个高斯分布的合并使用使用到: \(\mathcal{N}(\mu_1,\sigma_1^2\boldsymbol{I}) + \mathcal{N}(\mu_2,\sigma_2^2\boldsymbol{I}) \sim \mathcal{N}\Big((\mu_1+\mu_2),(\sigma_1^2+\sigma_2^2)\boldsymbol{I}\Big)\)
- 显然,当 \(T \rightarrow \infty\) 时, \(x_T\) 完全是噪声,因为 \(\sqrt{\bar{\alpha}_T} \rightarrow 0,\ \sqrt{1-\bar{\alpha}_T} \rightarrow 1\)
- Merge后的噪声 \(\epsilon\) 也是高斯噪声,且服从标准正态分布 \(\epsilon \sim \mathcal{N}(0,\boldsymbol{I})\)
- 同时,也可以用 \(x_t\) 和方差 \(\beta\) 来表示 \(x_0\):
$$ x_0 = \frac{1}{\sqrt{\bar{\alpha}_t}}(x_t - \sqrt{1-\bar{\alpha}_t}\epsilon) $$
- 问题:为什么前向过程的需要使用 \(\sqrt{1-\beta_t}x_{t-1}\) 来表示均值?
- 回答:因为这样可以使得 \(x_T\) 的均值中不含有原始样本 \(x_0\) 的信息,也就是说,这样使得 \(x_T\) 接近噪声
- 补充问题:使用其他小于0的数 \(k_t\) 替代 \(\sqrt{1-\beta_t}\) 吗?答案是可以的,但是使用 \(\sqrt{1-\beta_t}\) 是为了满足 \((\sqrt{1-\beta_t})^2+\beta_t = 1\) 这样的形式,方便后续的推导,如果不使用这样的形式,推导起来会更复杂些,详情见苏神的博客生成扩散模型漫谈(一):DDPM = 拆楼 + 建楼
Diffusion逆向过程
符号定义 :为了与其他文章常用习惯保持一致,论文在前向过程中使用 \(q(x_t|x_0)\),逆向过程中 \(q(x_0|x_t)\),需要按照区分前后下标大小来区分前向过程和后向过程
逆向过程的目标 :逆向过程是前向过程的相反过程,其目标是从随机噪声 \(x_T \sim \mathcal{N}(0, \boldsymbol{I})\) 中一步步恢复得到原始样本 \(x_0\)
- 思考 :如果能够得到 \(q(x_{t-1}|x_t)\),则可以一步步恢复出来原始样本 \(x_0\)
- 注:可以证明,如果 \(q(x_t|x_{t-1})\) 是高斯分布且方差 \(\beta_t\) 足够小,那么 \(q(x_{t-1}|x_t)\) 也还是一个高斯分布【TODO: On the theory of stochastic processes, with particular reference to applications.?】
逆向过程的拟合 :我们使用 \(p_\theta(x_{t-1}|x_t)\) 来拟合逆向分布,由于 \(p_\theta(x_{t-1}|x_t)\) 是高斯分布,所以可以拆解成建模均值 \(\mu_\theta(x_t, t)\) 和方差 \(\Sigma_\theta(x_t, t)\) 即可
$$
\begin{align}
p_\theta(\mathbf{x}_{0:T}) &= q(\mathbf{x}_T) \prod^T_{t=1} p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) \\
p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) &= \mathcal{N}(\mathbf{x}_{t-1}; \mathbf{\mu}_\theta(\mathbf{x}_t, t), \mathbf{\Sigma}_\theta(\mathbf{x}_t, t))
\end{align}
$$难题 :实际上,我们是无法直接得到 \(q(x_{t-1}|x_t)\) 的(理解:不知道 \(x_0\) 的情况下,噪声并不知道要朝着什么方向去生成 \(x_0\) )
如果 \(x_0\) 已知,结合 \(x_t \sim q(x_t|x_0) = \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t)\boldsymbol{I})\),则可以通过贝叶斯公式求得 \(q(x_{t-1}|x_t,x_0)\):
$$q(x_{t-1}|x_t,x_0) = \mathcal{N}(x_{t-1};\tilde{\mu}(x_t, x_0), \tilde{\beta}_t\boldsymbol{I})$$- \(\tilde{\mu}(x_t,x_0)\) 是均值,是 \(x_t,x_0\) 的函数,而 \(\tilde{\beta}_t\) 是方差,与 \(x_t,x_0\) 无关,仅与时间片有关
目标是均值和方差 :至此,我们的目标是求得 \(\tilde{\mu}(x_t, x_0)\) 和 \(\tilde{\beta}_t\),为了这个目标,我们首先将 \(q(x_{t-1}|x_t,x_0)\) 展开:
$$
\begin{aligned}
q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)
&= \frac{q(x_{t-1},x_t,x_0)}{q(x_t, x_0)} \\
&= \frac{q(x_t|x_{t-1},x_0) \cdot q(x_{t-1},x_0)}{q(x_t, x_0)} \\
&= q(x_t|x_{t-1},x_0) \frac{q(x_{t-1}|x_0) \cdot q(x_0)}{q(x_t| x_0) \cdot q(x_0)} \\
&= q(\mathbf{x}_t \vert \mathbf{x}_{t-1}, \mathbf{x}_0) \frac{ q(\mathbf{x}_{t-1} \vert \mathbf{x}_0) }{ q(\mathbf{x}_t \vert \mathbf{x}_0) } \\
&= q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) \frac{ q(\mathbf{x}_{t-1} \vert \mathbf{x}_0) }{ q(\mathbf{x}_t \vert \mathbf{x}_0) } \quad \quad \quad \quad \text{;马尔可夫性}\\
&\propto \exp \Big(-\frac{1}{2} \big(\frac{(\mathbf{x}_t - \sqrt{\alpha_t} \mathbf{x}_{t-1})^2}{\beta_t} + \frac{(\mathbf{x}_{t-1} - \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0)^2}{1-\bar{\alpha}_{t-1}} - \frac{(\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0)^2}{1-\bar{\alpha}_t} \big) \Big) \\
&= \exp \Big(-\frac{1}{2} \big(\frac{\mathbf{x}_t^2 - 2\sqrt{\alpha_t} \mathbf{x}_t \color{blue}{\mathbf{x}_{t-1}} \color{black}{+ \alpha_t} \color{red}{\mathbf{x}_{t-1}^2} }{\beta_t} + \frac{ \color{red}{\mathbf{x}_{t-1}^2} \color{black}{- 2 \sqrt{\bar{\alpha}_{t-1}} \mathbf{x}_0} \color{blue}{\mathbf{x}_{t-1}} \color{black}{+ \bar{\alpha}_{t-1} \mathbf{x}_0^2} }{1-\bar{\alpha}_{t-1}} - \frac{(\mathbf{x}_t - \sqrt{\bar{\alpha}_t} \mathbf{x}_0)^2}{1-\bar{\alpha}_t} \big) \Big) \\
&= \exp\Big( -\frac{1}{2} \big( \color{red}{(\frac{\alpha_t}{\beta_t} + \frac{1}{1 - \bar{\alpha}_{t-1}})} \mathbf{x}_{t-1}^2 - \color{blue}{(\frac{2\sqrt{\alpha_t}}{\beta_t} \mathbf{x}_t + \frac{2\sqrt{\bar{\alpha}_{t-1}}}{1 - \bar{\alpha}_{t-1}} \mathbf{x}_0)} \mathbf{x}_{t-1} \color{black} + C(\mathbf{x}_t, \mathbf{x}_0) \big) \Big)
\end{aligned}
$$- 其中 \(C(\mathbf{x}_t, \mathbf{x}_0)\) 是与 \(x_{t-1}\) 无关的常数,在指数上,可以变成乘法,所以能忽略
转换为高斯分布 ,上面的结果本质是在用等式表达一个高斯分布来,回顾高斯分布的概率密度函数的指数部分是 \(\exp\Big( -\frac{(x-\mu)^2}{2\sigma^2} \Big) = \exp\Big( -\frac{1}{2}(\frac{1}{\sigma^2}x^2 - \frac{2\mu}{\sigma^2}x + \frac{\mu^2}{\sigma^2})\Big) \),上面的推导结果可以进一步得到 \(\tilde{\mu}(x_t, x_0)\) 和 \(\tilde{\beta}_t\):
- 方差的推导:
$$
\begin{aligned}
\frac{1}{\sigma^2} &= \frac{1}{\tilde{\beta}_t} = (\frac{\alpha_t}{\beta_t} + \frac{1}{1 - \bar{\alpha}_{t-1}}) \\
\color{red}{\tilde{\beta}_t} &= 1/(\frac{\alpha_t}{\beta_t} + \frac{1}{1 - \bar{\alpha}_{t-1}})
= 1/(\frac{\alpha_t - \bar{\alpha}_t + \beta_t}{\beta_t(1 - \bar{\alpha}_{t-1})})
= \color{red}{\frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t} \cdot \beta_t} ;
\end{aligned}
$$ - 均值的推导:
$$
\begin{aligned}
\frac{2\mu}{\sigma^2} &= \frac{2\tilde{\mu}(x_t,x_0)}{\tilde{\beta}_t} = \frac{2\sqrt{\alpha_t}} {\beta_t} \mathbf{x}_t + \frac{2\sqrt{\bar{\alpha}_{t-1}}}{1 - \bar{\alpha}_{t-1}} \\
\color{red}{\tilde{\boldsymbol{\mu}} (\mathbf{x}_t, \mathbf{x}_0)} &= (\frac{\sqrt{\alpha_t}}{\beta_t} \mathbf{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1} }}{1 - \bar{\alpha}_{t-1}} \mathbf{x}_0)/(\frac{\alpha_t}{\beta_t} + \frac{1}{1 - \bar{\alpha}_{t-1}}) \\
&= (\frac{\sqrt{\alpha_t}}{\beta_t} \mathbf{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1} }}{1 - \bar{\alpha}_{t-1}} \mathbf{x}_0) \color{red}{\frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t} \cdot \beta_t} \\
&= \color{red}{\frac{\sqrt{\alpha_t}(1 - \bar{\alpha}_{t-1})}{1 - \bar{\alpha}_t} \mathbf{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1 - \bar{\alpha}_t} \mathbf{x}_0} \\
\end{aligned}
$$
- 方差的推导:
去掉结果中的\(\boldsymbol{x_0}\),结合用 \(x_t\) 和方差 \(\beta\) 来表示 \(x_0\) 的公式 : \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_t}}(x_t - \sqrt{1-\bar{\alpha}_t}\epsilon) \) ,我们可以进一步可以将 \(\tilde{\mu}(x_t,x_0)\) 中的 \(x_0\) 替换为 \(x_t\),得到 \( \tilde{\mu}(x_t,x_0) = \tilde{\mu}(x_t)\):
$$
\begin{aligned}
\color{red}{\tilde{\boldsymbol{\mu}}(x_t)}
&= \frac{\sqrt{\alpha_t}(1 - \bar{\alpha}_{t-1})}{1 - \bar{\alpha}_t} \mathbf{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1 - \bar{\alpha}_t} \frac{1}{\sqrt{\bar{\alpha}_t}}(\mathbf{x}_t - \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}) \\
&= \color{red}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon} \Big)}
\end{aligned}
$$- 其中 \(\epsilon\) 是使用深度学习预测得到的混合噪声,表示 \(x_0 \rightarrow x_t\) 过程中添加的 \(t\) 个噪声的Merge结果(仍然是一个高斯噪声且服从标准正太分布),可以表示为 \(\epsilon_\theta(x_t, t)\)
最终得到逆向推导结果 :我们已经求得了 \(\tilde{\mu}(x_t, x_0) = \tilde{\mu}(x_t)\) 和 \(\tilde{\beta}_t\),即可根据下面的方式采样:
$$q(x_{t-1}|x_t,x_0) = \mathcal{N}(x_{t-1};\tilde{\mu}(x_t, x_0), \tilde{\beta}_t\boldsymbol{I})$$- 将 \(x_0\) 替换为 \(x_t\) 后得到:
$$q(x_{t-1}|x_t,x_0) = q(x_{t-1}|x_t) = \mathcal{N}(x_{t-1};\tilde{\mu}(x_t), \tilde{\beta}_t\boldsymbol{I})$$ - 进一步地带入详细表征形式有(其中 \(z_t \sim N(0,\boldsymbol{I})\)):
$$
\begin{align}
x_{t-1} &= \tilde{\mu}(x_t) + \sqrt{\tilde{\beta}_t} z_t \\
\color{red}{x_{t-1}} &= \color{red}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(x_t, t) \Big)} + \color{blue}{\sqrt{\frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t} \cdot \beta_t}} \cdot z_t
\end{align}
$$
- 将 \(x_0\) 替换为 \(x_t\) 后得到:
对推导结果进行简化 :采样(生成)过程可以总结为如下的流程(下面的流程表示已知 \(x_t\) 和时间步 \(t\) 时采样 \(x_{t-1}\) 的步骤):
- 计算均值 \(\tilde{\boldsymbol{\mu}}(x_t, t)\):将 \(x_t\) 和时间步 \(t\) 输入神经网络预测 \(x_0 \rightarrow x_t\) 过程中添加的 \(t\) 个噪声的Merge结果 \(\epsilon_\theta(x_t, t)\),接着将 \(\epsilon_\theta(x_t, t)\) 带入 \(\tilde{\boldsymbol{\mu}}(x_t) = \color{red}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(x_t, t) \Big)}\) 得到均值
- 计算方差 \(\boldsymbol{\Sigma}_\theta(x_t,t)\):在DDPM中,使用固定值作为方差 \(\boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t) = \sigma^2_t \boldsymbol{I}\),此时所有 \(\mathbf{x}_t\) 中所有维度的变量共享同一个方差 ,同时在实践中,使用 \(\color{blue}{\sigma_t^2 = \tilde{\beta}_t = \frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t} \cdot \beta_t \approx \beta_t} \),即简单实现下可以取 \(\boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t) = \beta_t \boldsymbol{I}\)
- 其他有些文章会使用可学习的神经网络表示 \(\Sigma_\theta(x_t, t)\),此时不同维度的变量方差可能不同,但是一般仍然假设不同维度变量独立 ,即始终保持 \(\Sigma_\theta(x_t, t)\) 是对角矩阵,比如[GLIDE: Towards Photorealistic Image Generation and Editing with Text-Guided Diffusion Models]和[Improved Denoising Diffusion Probabilistic Models, ICML 2021]等
- 采样 \(x_{t-1} \sim \mathcal{N}(\tilde{\boldsymbol{\mu}}(x_t, t), \Sigma_\theta(x_t,t))\)
一些符号说明 :在数学中,常用 \(\sigma\) 表示标准差、 \(\Sigma\) 表示方差或协方差矩阵(多变量情况下,如果变量间独立,则有 \(\Sigma\) 矩阵上每个元素是 \(\sigma_i^2\) ),Diffusion相关的文章也沿用了这种表示。同时,由于特定的设定在Diffusion中, \(\beta\) 常常等于方差,所以常常也会用 \(\beta\) 直接表达方差含义
Diffusion模型训练目标函数推导
- 之前已经知道了,我们Diffusion模型的目标是通过训练学习 \(\mu_\theta(x_t,t)\) 和 \(\Sigma_\theta(x_t,t)\),这个模型训练时的目标是在已知数据集中数据出现的概率最大(极大似然法),即优化在分布 \(x_0 \sim q(x_0)\) 下 \(p_\theta(x_0)\) 的交叉熵:
$$ L(\theta) = \mathbb{E}_{x_0 \sim q(x_0)}[-\log p_\theta(x_0)] = \mathbb{E}_{q(x_0)}[-\log p_\theta(x_0)] $$ - 其中(下面的推导使用了Jenson不等式):
$$
\begin{aligned}
- \log p_\theta(\mathbf{x}_0)
&\leq - \log p_\theta(\mathbf{x}_0) + D_\text{KL}(q(\mathbf{x}_{1:T}\vert\mathbf{x}_0) | p_\theta(\mathbf{x}_{1:T}\vert\mathbf{x}_0) ) \\
&= -\log p_\theta(\mathbf{x}_0) + \mathbb{E}_{\mathbf{x}_{1:T}\sim q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \Big[ \log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T}) / p_\theta(\mathbf{x}_0)} \Big] \\
&= -\log p_\theta(\mathbf{x}_0) + \mathbb{E}_{\mathbf{x}_{1:T}\sim q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \Big[ \log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} + \log p_\theta(\mathbf{x}_0) \Big] \\
&= \mathbb{E}_{\mathbf{x}_{1:T}\sim q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \Big[ \log \frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} \Big] \\
\text{Let }L_\text{VLB}
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ \log \frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} \Big] \geq - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} [\log p_\theta(\mathbf{x}_0)]
\end{aligned}
$$ - 交叉熵损失函数(下面的推导使用到了重积分中的Fubini定理和Jenson不等式)
$$
\begin{aligned}
L_\text{CE}
&= - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} \Big[\log p_\theta(\mathbf{x}_0) \Big]\\
&= - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} \Big[\log \Big( \int p_\theta(\mathbf{x}_{0:T}) d\mathbf{x}_{1:T} \Big)\Big] \\
&= - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} \Big[\log \Big( \int q(\mathbf{x}_{1:T} \vert \mathbf{x}_0) \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_{0})} d\mathbf{x}_{1:T} \Big)\Big] \\
&= - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} \Big[\log \Big( \mathbb{E}_{\mathbf{x}_{1:T} \sim q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)} \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_{0})} \Big)\Big] \\
&\leq - \mathbb{E}_{x_0 \sim q(\mathbf{x}_0)} \Big[\mathbb{E}_{\mathbf{x}_{1:T} \sim q(\mathbf{x}_{1:T} \vert \mathbf{x}_0)}\Big[ \log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_{0})}\Big]\Big] \\
&= - \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[\log \frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T} \vert \mathbf{x}_{0})} \Big]\\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})}\Big[\log \frac{q(\mathbf{x}_{1:T} \vert \mathbf{x}_{0})}{p_\theta(\mathbf{x}_{0:T})} \Big] = L_\text{VLB}
\end{aligned}
$$ - 进一步推导:
$$
\begin{aligned}
L_\text{VLB}
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ \log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ \log\frac{\prod_{t=1}^T q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{ p_\theta(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t) } \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=1}^T \log \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \log\frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \Big( \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)}\cdot \frac{q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1}\vert\mathbf{x}_0)} \Big) + \log \frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \sum_{t=2}^T \log \frac{q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} + \log\frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \log\frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)} + \log \frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} \Big[ \log\frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_T)} + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \Big] \\
&= \mathbb{E}_{\mathbf{x}_{0:T} \sim q(\mathbf{x}_{0:T})} [\underbrace{D_\text{KL}(q(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_T))}_{L_T} + \sum_{t=2}^T \underbrace{D_\text{KL}(q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t))}_{L_{t-1}} \underbrace{- \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)}_{L_0} ]
\end{aligned}
$$ - 我们可以进一步将上面的表达式简化写为下面的形式:
$$
\begin{aligned}
L_\text{VLB} &= L_T + L_{T-1} + \dots + L_0 \\
\text{where } L_T &= D_\text{KL}(q(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_T)) \\
L_t &= D_\text{KL}(q(\mathbf{x}_t \vert \mathbf{x}_{t+1}, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_t \vert\mathbf{x}_{t+1})) \text{ for }1 \leq t \leq T-1 \\
L_0 &= - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)
\end{aligned}
$$- \(L_T\):由于前向过程 \(q(x_T|x_0)\) 没有可学习参数,且 \(x_T\) 是纯粹的高斯噪声,所以优化参数 \(\theta\) 时 \(L_T\) 可以当做常数忽略
- \(L_0\): \(\mathcal{N}(\mathbf{x}_0; \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1), \boldsymbol{\Sigma}_\theta(\mathbf{x}_1, 1))\) , \(L_0\) 是扩散模型训练过程中变分下界的一部分,定义为 \(-\log p_{\theta}(x_0 | x_1)\) ,与反向过程的最后一项有关。实际上,虽然 \( L_0 \) 确实与模型参数 \( \theta \) 有关,但在论文的推导和训练过程中,作者通过离散解码器的设计和简化训练目标,将 \( L_0 \) 视为一个相对不重要的常数项。这种做法简化了训练过程,并且实验结果表明,这种简化并不会显著影响模型的生成质量。更多讨论见附录
- \(L_t\): \(L_t\) 可以看做是两个高斯分布的KL散度, \(q(x_{t-1}|x_t,x_0) = \mathcal{N}(x_{t-1};\tilde{\mathbf{\mu}}(x_t,x_0),\tilde{\beta}_t\boldsymbol{I})\) 和 \(p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) = \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t))\),其中 \(\tilde{\boldsymbol{\mu}}(x_t,t) = \frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big)\)
- 参照 \(\tilde{\boldsymbol{\mu}}(x_t,t) = \frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big)\) 的定义,可以将 \(\mu_\theta(x_t,t)\) 定义为如下形式(也就是说,只需要学习噪声 \(\epsilon_\theta(x_t, t)\) 即可):
$$
\begin{aligned}
\boldsymbol{\mu}_\theta(\mathbf{x}_t, t) &= \color{red}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \Big)} \\
\text{Thus }\mathbf{x}_{t-1} &= \mathcal{N}(\mathbf{x}_{t-1}; \frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \Big), \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t))
\end{aligned}
$$ - 使得KL散度最小,可以直接使得两者的均值和方差尽可能相等,其中均值目标可以进一步优化为(DDPM中方差直接使用固定值)
$$\begin{aligned}
L_t
&= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{1}{2 | \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t) |^2_2} | \color{blue}{\tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0)} - \color{green}{\boldsymbol{\mu}_\theta(\mathbf{x}_t, t)} |^2 \Big] \\
&= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{1}{2 |\boldsymbol{\Sigma}_\theta |^2_2} | \color{blue}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big)} - \color{green}{\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t) \Big)} |^2 \Big] \\
&= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{ (1 - \alpha_t)^2 }{2 \alpha_t (1 - \bar{\alpha}_t) | \boldsymbol{\Sigma}_\theta |^2_2} |\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)|^2 \Big] \\
&= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{ (1 - \alpha_t)^2 }{2 \alpha_t (1 - \bar{\alpha}_t) | \boldsymbol{\Sigma}_\theta |^2_2} |\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t)|^2 \Big]
\end{aligned}
$$
- 参照 \(\tilde{\boldsymbol{\mu}}(x_t,t) = \frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big)\) 的定义,可以将 \(\mu_\theta(x_t,t)\) 定义为如下形式(也就是说,只需要学习噪声 \(\epsilon_\theta(x_t, t)\) 即可):
- 最终训练时的目标函数可以表示为:
$$
\begin{aligned}
L_t^\text{simple}
&= \mathbb{E}_{t \sim [1, T], \mathbf{x}_0, \boldsymbol{\epsilon}_t} \Big[|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)|^2 \Big] \\
&= \mathbb{E}_{t \sim [1, T], \mathbf{x}_0, \boldsymbol{\epsilon}_t} \Big[|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t)|^2 \Big]
\end{aligned}
$$ - 如果考虑 \(L_T\) 和 \(L_0\),则有:
$$ L_\text{simple} = L_t^\text{simple} + C $$
训练和推理
- 训练和推理伪代码:
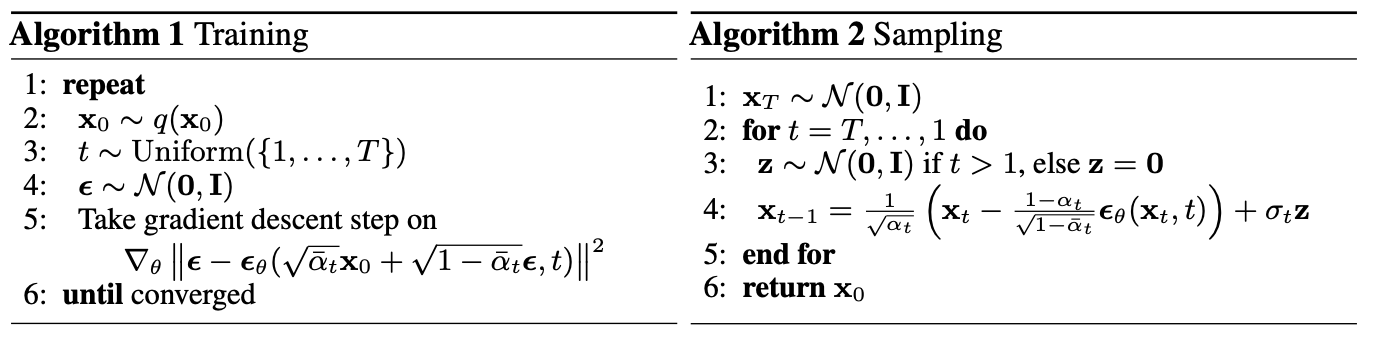
- 训练过程:
- 从数据集中挑选出一个样本 \(x_0 \sim q(x_0)\)
- 均匀采样,随机选择一个扩散时间步 \(t \sim \text{Uniform}(\{ 1,\cdots,T \})\) (扩散时间步的总长度是提前设置的)
- 从标准正态分布采样误差 \(\epsilon \sim \mathcal{N}(0, \boldsymbol{I})\),注意这里的误差跟样本 \(x_0\) 维度相同
- 使用梯度下降训练Diffusion的误差模型 \(\epsilon_\theta(x_t,t)\): \(L(\theta) = \mathbb{E}_{t,x_0,\epsilon}[|\epsilon - \epsilon_\theta(\sqrt{\bar{\alpha}}x_0+\sqrt{1-\bar{\alpha}}\epsilon, t)|]^2 \)
- 采样过程:
- 从标准正态分布采样加噪后的样本 \(x_T\): \(x_T \sim \mathcal{N}(0, \boldsymbol{I})\),注:可以这样采样的原因是实际上加噪后的样本可以看做是已经变成了随机值了
- 逆向过程包含 \(T\) 步, \(t = T,\cdots,1\):
- 如果 \(t > 0\),则采样 \(z \sim \mathcal{N}(0, \boldsymbol{I})\),否则 \(z = 0\)
- 恢复 \(x_{t-1}\): \(x_{t-1} = \frac{1}{\sqrt{\alpha_t}}\Big( x_t - \frac{1-\alpha_t}{\sqrt{1-\bar{\alpha}_t}}\epsilon_\theta(x_t, t) \Big) + \sigma_t z\)
- 其中 \(\epsilon_\theta(x_t, t)\) 的含义是在预测从 \(x_0 \rightarrow x_t\) 的过程中加入的 \(t\) 个混合噪声, \(\sigma_t\) 是方差,DDPM中直接取近似值 \(\sigma_t = \beta_t\)
- \(z\) 是为了添加生成图片的随机性加入的,与 \(\epsilon_\theta(x_t, t)\) 没有任何关系,如果在每一步中保持 \(z=0\),对于相同的噪声 \(x_T\),生成的图片 \(x_0\) 将是固定的,且图片质量往往不好
一些问题和思考
为什么学习的是 Merge噪声 \(\epsilon_{\theta}(x_t, t)\)
- 训练时预估的 \(\epsilon_{\theta}(x_t, t)\) 的含义是什么?学到的是从 \(x_0\) 到 \(x_t\) 加的噪声,还是从 \(x_{t-1}\) 到 \(x_t\) 加的噪声?
- 回答:是从 \(x_0\) 到 \(x_t\) 加的噪声,本质是多个噪声Merge以后得结果(还是高斯噪声),因为从训练流程的公式就可以看出, \(\epsilon_{\theta}(x_t, t)\) 中的 \(x_t=\sqrt{\bar{\alpha}_{t}}x_0 + \sqrt{1-\bar{\alpha}_{t}}\epsilon\),其中 \(\epsilon\) 就是从 \(x_0\) 到 \(x_t\) 加的噪声,而损失函数的目标就是让 \(\epsilon_{\theta}\rightarrow\epsilon\)
- 在推理时,既然 \(\epsilon_{\theta}(x_t, t)\) 是从 \(x_0\) 到 \(x_t\) 加的累计噪声,为什么可以使用 \(\epsilon_{\theta}(x_t, t)\) 来完成从 \(x_{t}\) 到 \(x_{t-1}\) 的过程?
- 回答:因为这里从 \(x_{t}\) 到 \(x_{t-1}\) 的本质也是分两步的,第一步是从 \(x_{t}\) 到 \(x_{0}\) (由 \(x_t=\sqrt{\bar{\alpha}_{t}}x_0 + \sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta}\) 反推即可得到 \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\),注意这里得到的 \(x_0\) 可能质量不太好,不能直接作为最终结果);第二步是已知从 \(x_{t}\) 和 \(x_{0}\) 后,可以得到 \(x_{t-1}\) 的分布 \(q(x_{t-1}|x_t,x_0)\),进一步对分布进行采样,就能得到一个 \(x_{t-1}\) 的实例。两步合并以后就是DDPM的采样伪代码中的公式
为什么不能一步到位得到 \(x_0\)?
- 补充一步到位的公式 :\(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\)
- 回答1(训练损失函数视角):可以,但效果不好。从训练的损失函数看,这样做可以,但是效果不一定好(实践来看效果不好,效果不好的原因是一步到位难度较高?),此时相当于简单的把Diffusion模型作为一个单步去噪器了,甚至不需要采样过程
- 回答2(一种直观理解):为什么效果不好? :模型直接学习 \(q(x_0|x_t)\) 是困难的,即误差 \(\epsilon_\theta(x_t,t)\) 虽然可以用于直接恢复 \(x_0\),但是不太精确(相当于是“粗略预估”),为了得到较好的 \(x_0\),在预估误差 \(\epsilon_\theta(x_t,t)\) 后,我们需要进行“修正”,所以,逐步采样的过程就是逐步“粗略预估”,逐步“修正”的过程(“预估”+“修正”的视角来自生成扩散模型漫谈(十):统一扩散模型(理论篇))
- 更进一步的理解:可以将多步采样看做是一个ensemble的过程,可以提升效果
- 回答3(一种理论视角的讨论,待商榷):不可以。在整个推导过程中,我们有 \(q(x_t|x_0) = \mathcal{N}(x_t;\sqrt{\bar{\alpha}_{t}}x_0, (1-\bar{\alpha}_{t})\boldsymbol{I})\) (这里是通过高斯过程的叠加实现的,整个过程遵循马尔可夫过程),所以才有公式 \(x_t=\sqrt{\bar{\alpha}_{t}}x_0 + \sqrt{1-\bar{\alpha}_{t}}\epsilon\),这不代表我们可以通过 \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\) 来得到 \(x_0\),因为此时的 \(x_0\) 是无法一步导出的(即 \(q(x_0|x_t)\) 是未知的,未知的原因是不遵循马尔可夫过程,训练时使用的损失函数是在满足马尔可夫过程假设的情况下推导出来的,推理时也不能违背该假设),必须遵循马尔可夫过程(即 \(q(x_{t-1}|x_t)\) )
- \(q(x_t|x_0)\) 已知但是 \(q(x_0|x_t)\) 未知的原因是因为采样是不可逆的
- 既然 \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\) 不准确(不遵循马尔可夫过程),为什么按照 \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\) 的到的 \(x_0\) 可以作为中间变量来帮助生成 \(x_{t-1}\) 呢?公式推导带入的时候使用了这个式子,本质上也说明推导过程不遵循马尔可夫过程了吧?(一种理解是中间使用的 \(x_0 = \frac{1}{\sqrt{\bar{\alpha}_{t}}}(x_t-\sqrt{1-\bar{\alpha}_{t}}\epsilon_{\theta})\) 本质是 \(x_0\) 的一个不精确近似,使用这个来作为条件引导生成可行【引导需要的准确度不高】,但是直接用来作为最终的 \(x_0\) 则效果不太行)
DDPM可以不加入噪声吗?
- 实践1 :不可以,图片生成质量会特别差
- 实践2 :不加入噪声,没有随机性,生成图片的多样性受损
- 理解1 :可以类比LLM采样不能使用纯贪心策略(argmax),因为这样可能生成的是重复的无意义文本,噪音反而能一定程度跳开重复
- 理解2 :类似于随机梯度下降(SGD)中的噪声帮助跳出局部最优解,扩散模型的噪声让生成过程有机会“绕开”累积的预测偏差
- 理解3 :扩散模型的生成是一个多步迭代过程,如果每一步仅依赖预测的均值(不加噪声),前一步的误差会逐步累积,最终偏离真实数据分布。通过加入噪声,模型能够在后续步骤中修正误差,提升生成稳定性
- 理解4 :扩散模型的推导基于随机微分方程(SDE)或变分推断。在反向过程中,噪声项的引入是数学推导的自然结果。例如,在基于分数的生成模型(Score-Based Models)中,采样过程需要引入朗之万动力学(Langevin Dynamics)的随机性,对应扩散模型中的噪声添加
- 其他参考:一个视频看懂DDIM凭什么加速采样|扩散模型相关【这个观点无法解释DDIM为什么可以直接生成,DDIM(DDIM生成时不加入噪声)生成1000步效果也不会太差】
为什么模型不直接拟合 \(x_t\rightarrow x_{t-1}\) 的噪音?
- DDPM现状 :目前DDPM训练时模拟拟合的是从 \(x_0\) 到 \(x_t\) 加的噪声,本质是多个噪声Merge以后得结果(还是高斯噪声)
- 原因(效率视角) :如果直接一步步采样,会导致没张图片都要采样T次(T一般很大)才能训练,训练效率较低,都2023年了,我不允许你还不懂DDPM! - Defa Zhu的文章 - 知乎 中是这个观点
- 原因(理论视角) :因为逆向过程实际上是 \(q(x_{t-1}|x_t,x_0)\),而 \(q(x_{t-1}|x_t)\) 是在近似拟合 \(q(x_{t-1}|x_t,x_0)\),噪音应该是与 \(x_0\) 相关的,只是在推导过程中用 \(x_t\) 和 Merge噪声 把 \(x_0\) 替换了
- 特别注意: \(q(x_{t-1}|x_t)\) 本身可以被预估误差,但是本质上是无法直接求解的(一个采样的逆过程,没有梯度,也无法求解),只有 \(q(x_{t-1}|x_t,x_0)\) 可以求解
- 如果不考虑效率,直接拟合 \(x_t\rightarrow x_{t-1}\) 的噪音是否可行呢?
- 直观感觉是可行的,但是预估结构可能无法保障,此时相当于假设了 \(q(x_{t-1}|x_t)\) 是一个高斯分布,是否还能继续在采样过程中加入随机有待实践考证
- 参考:为什么DDPM反向去噪时不直接用q(x_t|x_{t-1})从x_t反推回x_{t-1}? - gpenai的回答 - 知乎 是一个知乎回答,不一定准确,但可以参考看一下
附录:为什么\(L_0\)可以舍弃?
- 结论:不论是否丢弃 \(L_0\),最终求出来的损失函数形式是一样的,都是 MSE 的形式;
- 一方面:通过其他推导方式(生成扩散模型漫谈(一):DDPM = 拆楼 + 建楼或 DDPM 推导视频),可以做到不丢弃任何项得到相同的最终结果
- 另一方面:最小化 \(\mathcal{N}(\mathbf{x}_0; \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1), \boldsymbol{\Sigma}_\theta(\mathbf{x}_1, 1))\) 等价于最小化 \(\vert x_0 - \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1)\vert^2\),进一步推导后可得 \(t=1\) 时刻的最终形式和以上化简后的最优目标函数其实是相同的
- 在论文中,损失函数的变分下界(VLB)被分解为多个项,其中 \( L_0 \) 是最后一项,表示在给定 \(\mathbf{x}_1\) 的情况下,模型对原始数据 \( \mathbf{x}_0 \) 的重建误差。具体来说,\( L_0 \) 的形式如下:
$$
L_0 = -\log p_{\theta}(\mathbf{x}_0 | \mathbf{x}_1)
$$- 进一步可表达为:\(\mathcal{N}(\mathbf{x}_0; \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1), \boldsymbol{\Sigma}_\theta(\mathbf{x}_1, 1))\)
- 在论文的推导中,有一些误区
- 问题一 :作者提到 \( L_0 \) 可以被视为常数,这实际上是一种简化,不是严谨的表达,因为 \( L_0 \) 显然与模型参数 \( \theta \) 有关,直接说是化简不合适
- 问题二(问题一的扩展):虽然 \( L_0 \) 确实与模型参数 \( \theta \) 有关,但在论文的推导和训练过程中,作者认为自己通过离散解码器的设计和简化训练目标,将 \( L_0 \) 视为一个相对不重要的常数项,这种做法简化了训练过程,并且实验结果表明,这种简化并不会显著影响模型的生成质量
- 实际上作者使用的损失函数已经是最优的了,且训练会采样到 \(t=1\) 的样本,所以不存在丢弃或者简化的操作
- 问题三 :作者声称自己丢弃了 \(p_\theta(x_0|x_1)\) 的损失学习,如果真的是丢弃,是否会导致采样到最后一步的时候模型不知道应该如何从 \(x_1\) 生成 \(x_0\)?实验证明是不会的(从理论上来看也不会,因为作者其实没丢弃 \(p_\theta(x_0|x_1)\) 的损失学习),具体原因是:
- 从目标函数看:简化后的训练的目标函数为:
$$
L_\text{simple} = \mathbb{E}_{t \sim [1, T], \mathbf{x}_0, \boldsymbol{\epsilon}_t} \Big[|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t)|^2 \Big]
$$- 当训练时遇到 \(t=1\) 时(训练采样时 \(t\in \{1,2,\cdots,T\}\),所以可以遇到这种样本),这里这个损失函数的目标是建模误差就是 \(\epsilon_\theta(x_1, 1)\),即已知 \(x_1\) 时,自然可以恢复 \(x_0\)
- 考虑到最小化 \(\mathcal{N}(\mathbf{x}_0; \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1), \boldsymbol{\Sigma}_\theta(\mathbf{x}_1, 1))\) 等价于让 \(\vert x_0 - \boldsymbol{\mu}_\theta(\mathbf{x}_1, 1)\vert^2\) 最小化,进一步推导后得到 \(t=1\) 时刻的最终形式和以上化简后的最优目标函数其实是相同的(这在苏神的博客 生成扩散模型漫谈(一):DDPM = 拆楼 + 建楼 中给出了证明)
- 从目标函数看:简化后的训练的目标函数为:
- 苏神的博客中,从另一个视角推导(不一定很严谨),得到了简化的目标函数,详情参考:生成扩散模型漫谈(一):DDPM = 拆楼 + 建楼,这说明 \(L_0\) 的简化是合理的
- DDPM 推导视频 也提供了另一种推导方式,在不丢弃任何一项的情况下,最终目标函数是一样的