多层感知机(Multi-Layer Perception, MLP)及其BP(Back Propagation)算法,本文记录一些有趣的图
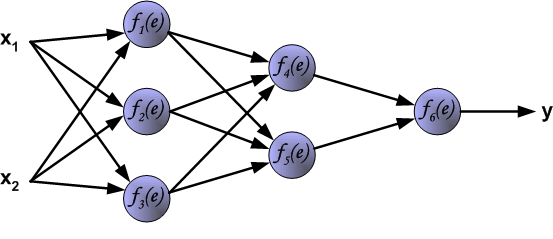
多层感知机
- 图示如下
BP算法
推导
以一维输出(二分类)为例
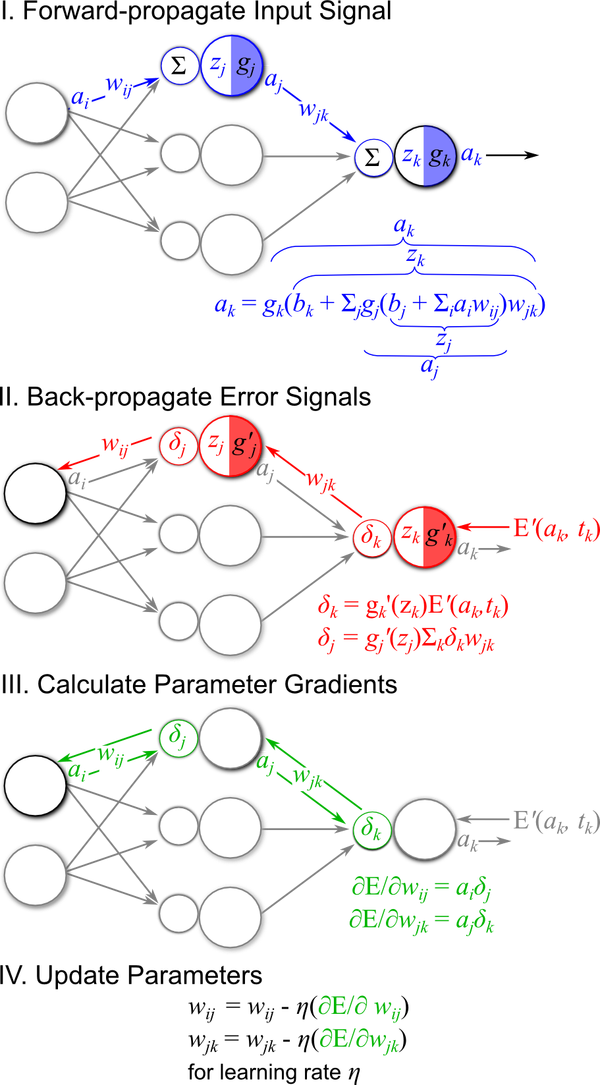
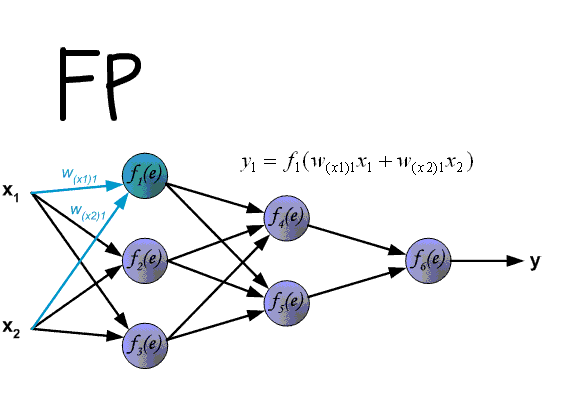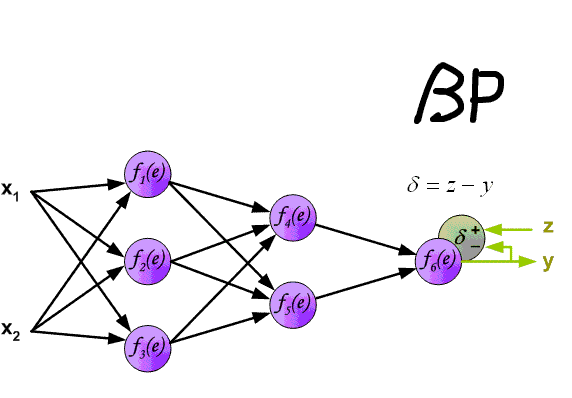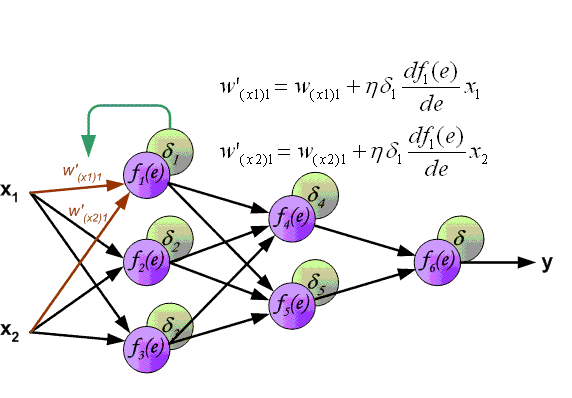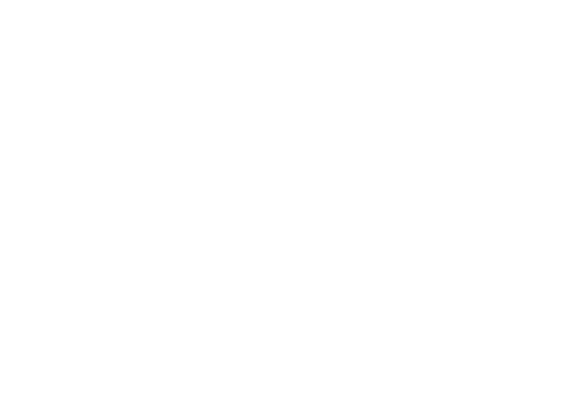
详细流程
- 动图
References
References:
相关参数: Weight decay(权重衰减)
添加L2或L1正则化, 详情可参考: ML——模型的方差与偏差
参考文档:
L1正则化:
L2正则化:
weight_decay, 默认为0PyTorch中的weight_decay参数说明
weight_decay (float, optional): weight decay (L2 penalty) (default: 0)
我之前的实现代码:
1 | # zero the parameter gradients |
# L1 regularization后面是添加的L1 正则化就整体而言,对比加入正则化和未加入正则化的模型,训练输出的loss和Accuracy信息,我们可以发现,加入正则化后,loss下降的速度会变慢,准确率Accuracy的上升速度会变慢,并且未加入正则化模型的loss和Accuracy的浮动比较大(或者方差比较大),而加入正则化的模型训练loss和Accuracy,表现的比较平滑。并且随着正则化的权重lambda越大,表现的更加平滑。这其实就是正则化的对模型的惩罚作用,通过正则化可以使得模型表现的更加平滑,即通过正则化可以有效解决模型过拟合的问题
Soft Weight Sharing
(auxiliary classifiers)