Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM模型存储形式


整体说明

  • 当前主流的大模型存储格式可以按 “训练框架原生格式 -> 通用交换格式 -> 高效推理格式” 这条演进路线来理解
  • TLDR:“训练阶段用 .pth/.ckpt/.bin,跨框架交换用 ONNX,线上部署优先 Safetensors,如果对体积和 CPU 推理速度极端敏感就转 GGUF”

模型格式归纳

  • 训练框架原生格式
    • .pth / .pt:PyTorch 的 pickle 序列化结果,既可以是 state_dict,也可以是完整模型(含结构+权重)通用、易用,但体积大、加载慢,且存在反序列化安全风险
    • .ckpt:PyTorch Lightning 在 .pth 基础上扩展出的 Checkpoint 格式,额外保存优化器状态、epoch、超参等,用于断点续训
    • .bin:TensorFlow 早期常用的纯权重二进制文件,没有统一元数据,需配合 config.json 使用;在 Hugging Face 生态中仍大量出现
  • 通用交换格式
    • ONNX(.onnx):微软+Facebook 推出的开放标准,旨在跨框架(PyTorch/TF/ Paddle 等)部署;支持图优化、量化,但大模型时文件体积依旧可观
    • HDF5 / .h5:Keras/TensorFlow 传统格式,层次化存储网络结构和权重;对超大规模模型支持有限,已逐渐被 TF Checkpoint 或 SavedModel 取代
  • 高效推理格式
    • Safetensors(.safetensors):Hugging Face 推出的安全张量格式,只存权重、无代码、支持 zero-copy 与懒加载,加载速度 >pickle,且杜绝反序列化漏洞,已成为 HF Hub 的默认推荐
    • GGUF(GPT-Generated Unified Format):由 llama.cpp 作者 Georgi Gerganov 设计,用于取代旧版 GGML二进制紧凑、自带量化方案(Q2_K/Q4_0 等)、内存映射快速加载、元数据自包含,无需额外文件即可部署;Gemma、Qwen、Llama-3 等均官方提供 GGUF 版本
    • GGML(已弃用):早期 llama.cpp 使用的二进制格式,无版本控制、扩展困难,已全部迁移到 GGUF
  • 训练/数据级格式(辅助)
    • TFRecord / RecordIO:TensorFlow 训练数据管道常用,顺序、可压缩、高吞吐
    • Parquet / Arrow / LMDB:离线特征或中间结果列式存储,便于大规模并行读取

大模型常用框架相关的格式整体说明

  • 本文描述大模型的存储的形式和 转到 Hugging Face 的方式
  • Megatron / DeepSpeed / FSDP 都把 “一张完整的权重图” 切成很多片,文件名、目录结构、张量 key 名均与 HF 不一致;
  • 想进 HF 生态,必须 “合并分片 + 重命名 key + 生成 config.json”;
  • 合并脚本一般都已有各框架的官方提供,一般按照官方提供脚本转换即可

Hugging Face 原生格式

  • Hugging Face 上的开源模型通常以 “模型仓库(model repository)” 的形式托管,下载到本地后是一个目录,里面包含若干标准文件
  • 使用 Hugging Face 的接口加载模型时,该接口会大致进行以下流程:
    • 加载配置:读取 config.json 文件,用于构建模型的基本结构
    • 加载权重:读取模型权重文件(如 model.safetensors)中的参数值会被加载到定义好的模型结构中
    • 分词器初始化(处理输入):分词器文件(如 tokenizer.json, vocab.json)负责将原始文本转换为模型能够理解的 token ID 序列
    • 其他步骤:如果是文本生成任务,generation_config.json 会提供默认的生成参数
  • 推理最少三件套 :config.json + 权重文件 + 分词器文件
  • 微调再补 :tokenizer_config.json、special_tokens_map.json、generation_config.json 及优化器 checkpoint
  • 大模型 :使用 .safetensors 分片和 *.index.json 索引,断点续传更方便

必存在文件(推理/微调都少不了)

  • config.json
    • 主要包含模型超参与架构描述:隐藏层大小(hidden_size)、注意力头数(num_attention_heads)、层数(num_hidden_layers)、激活函数(hidden_act)等
    • 不同模型的内容不完全相同(是各家模型厂商自己自定义的),这个文件是会被当做超参数传递到模型的初始化文件中的
    • 还包含模型的 参数类型 (比如 "torch_dtype": "bfloat16") 作为加载时的统一转换类型
      • 注:同一个模型的不同参数可以存储为不同类型,这里的 "torch_dtype" 字段仅仅指定加载时的参数
  • 权重主文件(可以是 .bin, .h5, safetensors 等类型的文件,也可能是 gguf 等量化格式的文件)
    • pytorch_model.bin(PyTorch)
      • 分片(shard)文件 比如pytorch_model-00001-of-00008.bin 到 pytorch_model-00008-of-00008.bin,会伴随一个 pytorch_model.bin.index.json 索引文件来记录这些分片信息
    • tf_model.h5(TensorFlow)
    • flax_model.msgpack(Flax/JAX,不常见)
    • model.safetensors(新版统一二进制格式,零拷贝、更安全)
      • Hugging Face 推荐的安全格式 ,不包含可执行代码 ,避免了传统 PyTorch 格式因使用 pickle 序列化而可能存在的安全风险(如恶意代码执行)
      • 通常加载更快且更节省内存
      • 分片(shard)文件 比如model-00001-of-00008.safetensors 到 model-00008-of-00008.safetensors,会伴随一个 model.safetensors.index.json 索引文件来记录这些分片信息
    • gguf(量化后的 GGUF 格式)
      • CPU 或个人设备上进行本地推理 ,首选能提供更好的体验
      • 一般会按照不同的量化格式提供多个 gguf 文件,如 q4_k_m.gguf 等来说明量化形式
    • 注:加载过程中,根据不同的模型权重类型,Hugging Face 框架会使用不同的加载函数加载
  • tokenizer.json
    • 分词器核心配置:预处理器状态、编解码规则、特殊 token 映射
    • 词表内容一般也会在这格文件中,以 vocab 为 Key 存在,所以 tokenizer.json 一般会有几十 MB 大小
  • 补充:model.safetensors.index.json 索引文件示例,包含模型的每一层权重到权重分片的映射
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    {
    "metadata": {
    "total_size": 144575840256
    },
    "weight_map": {
    "lm_head.weight": "model-00082-of-00082.safetensors",
    "transformer.h.0.attn.c_attn.bias": "model-00002-of-00082.safetensors",
    "transformer.h.0.attn.c_attn.weight": "model-00002-of-00082.safetensors",
    "transformer.h.0.attn.c_proj.weight": "model-00002-of-00082.safetensors",
    "..."
    }
    }

常见文件(大部分仓库可见)

  • 分词器相关文件:
    • tokenizer.json:分词器的完整定义,包括编码规则和词汇表映射(前面已经介绍过)
    • tokenizer_config.json:分词器的附加配置,如特殊标记(如[CLS]、[SEP]、[PAD])、填充方式、截断策略等
      • 部分模型会将聊天模版也放到这个文件中的 chat_template 字段(Qwen,Deepseek 等),部分模型则将聊天模板放到外面的 chat_template.jinja 文件(这样虽然不便于管理,但可读性会更高)
    • vocab.txt, vocab.json:模型的词汇表,存储 token 到 ID 的映射关
      • 注:目前许多模型已经不需要这个文件,因为该文件会以 "vocab" 字段的形式放到 tokenizer.json 中
    • merges.txt:适用于 BPE 等分词算法,定义了 token 的合并规则
      • 注:目前许多模型已经不需要这个文件,因为该文件会以 "merges" 字段的形式放到 tokenizer.json 中
    • special_tokens_map.json:统一声明 [PAD]、[CLS]、[SEP]、<|im_start|> 等特殊 token 的 ID 与字符串映射
      • 注:目前许多模型已经不需要这个文件,因为该文件会以 "additional_special_tokens" 字段的形式放到 tokenizer_config.json
    • added_tokens.json :用户或微调阶段追加的新 token
      • 注:目前许多模型已经不需要这个文件,因为该文件会以 "added_tokens" 字段的形式放到 tokenizer.json 中
  • generation_config.json : 文本生成默认策略:max_new_tokens、do_sample、temperature、top_p 等
  • .gitattributes : 用于配合 Git-LFS 把大文件托管到 LFS
    • gitattributes 是 Git 中用于定义特定文件(或文件类型)在 Git 操作中的处理规则的配置文件
    • 核心作用是 “为不同文件定制 Git 行为” ,告诉 Git:对于不同类型的文件,应该如何执行换行符转换、合并策略、文件属性标记、diff 对比方式等操作,从而在团队协作或跨平台开发中保持文件处理的一致性

附录:关于 generation_config.json 文件的使用

  • 在使用 Hugging Face 的 transformers 库加载模型时,会自动读取模型文件路径下的 generation_config.json 文件(如果存在的话)

  • generation_config.json 是用于存储模型生成相关配置的文件,包含了如最大生成长度(max_length)、采样温度(temperature)、top-k 采样等与文本生成任务相关的参数

  • 当使用 from_pretrained() 方法加载模型时,库会自动检查并加载该文件中的配置,这些配置会被存储在模型的 generation_config 属性中。例如:

    1
    2
    3
    4
    5
    6
    7
    from transformers import AutoModelForCausalLM, AutoTokenizer

    model = AutoModelForCausalLM.from_pretrained("model_path")
    tokenizer = AutoTokenizer.from_pretrained("model_path")

    # 查看加载的生成配置
    print(model.generation_config)
  • 如果模型路径中存在 generation_config.json,上述代码会自动加载其中的配置;如果该文件不存在,transformers 会使用默认的生成配置

  • 也可以通过 GenerationConfig 类手动加载或修改这些配置,并在生成文本时传入:

    1
    2
    3
    4
    5
    6
    7
    8
    from transformers import GenerationConfig

    # 手动加载生成配置
    gen_config = GenerationConfig.from_pretrained("model_path")
    # 修改配置
    gen_config.max_length = 100
    # 生成文本时使用
    outputs = model.generate(**inputs, generation_config=gen_config)

其他可选/场景文件

  • training_args.bin : 由 transformers.Trainer 自动保存,包含学习率、warmup step、batch_size 等训练超参
  • optimizer.bin / scheduler.bin : 断点续训时保存的优化器状态和 LR scheduler 状态
  • quantization/ 目录 : 低比特量化权重,如 F8_E4M3、INT4、GGML 等
  • README.md / LICENSE / *.md : 模型卡片、许可证、使用示例、局限性与伦理声明
  • preprocessor_config.json : 多模态模型(如 LLaVA、BLIP-2)中,图像预处理超参
  • adapter_config.json / adapter_model.bin : PEFT/LoRA 微调产生的轻量 adapter,仅含可训练增量参数
  • tokenizer.model 文件是 SentencePiece 分词器的核心文件,通常以二进制格式存储,包含分词规则、词汇表和预处理逻

关于 .bin 格式 和 .safetensors 格式的说明

  • .bin 是 Hugging Face 最早、最通用的格式(PyTorch 的格式),任何支持 from_pretrained() 的库都能直接加载

  • 如果同时包含一个同名的 .safetensors 和 .bin,HF 会优先用 .safetensors(更快、更安全)

  • 将 .bin 格式升级为 .safetensors 格式的接口如下:

    1
    2
    import safetensors
    safetensors.torch.save_file(state_dict, "model.safetensors")
  • 特别说明:.bin 和 .safetensors 中会包含权重文件的参数类型(fp16, fp32, bf16 等)

    • 而且,.bin 和 .safetensors 文件会为每个不同的参数张量存储各自的参数,所以理论上这些参数类型可以不用
    • 在加载模型时,会先按照权重文件中的真实类型读取,并转换成 config.json 中指定的文件格式(比如 "torch_dtype": "bfloat16" 指定 bf16 格式),存放到内存中

Megatron-LM 框架文件格式

  • 分片数量与分片参数(TP=N1、PP=N2、DP=N3)有关,下面是磁盘目录示例:

    1
    2
    3
    4
    5
    6
    7
    8
    iter_0001000/
    ├── model_optim_rng.pt # 传统同步格式(老版本)
    ├── __0_0.distcp # 新异步格式(v0.7+),每个文件只含本 rank 的分片
    ├── ...
    ├── __1_0.distcp
    ├── common.pt # 公共张量(embedding、lm_head 等)
    ├── metadata.json # 并行拓扑
    └── latest_checkpointed_iteration.txt
  • 注:部分 Megatron-LM 存储形式中, iter_0001000 下存储的是多个类似 mp_rank_xx_xx_cp_xx_dp_xx 目录的结构,每个结构存储部分模型参数

    • 这是 Megatron-LM 原生 checkpoint 的分布式存储结构

    • 命名规则:

      1
      mp_rank_{tensor_parallel_rank}_{checkpoint_partition}_{data_parallel_rank}
    • 含义:

      • mp_rank_xx_xx :Tensor Model Parallel rank(张量并行+流水线并行的分片编号)
      • cp_xx :Context parallel rank(上下文并行分片编号)
      • dp_xx :Data parallel rank(数据并行的副本编号)
    • 每个目录里可能包含:

      • distrib_optim.pt
        • 分布式优化器(比如 ZeRO)的状态分片,包含梯度累积缓冲、参数分片等,用于 resume 训练使用,若确定不再需要继续训练,则可以删除该文件
      • model_optim_rng.pt
        • 保存随机数生成器状态(Python random、NumPy RNG、PyTorch CPU/CUDA RNG、Megatron并行RNG),用于恢复训练时保证随机性一致
        • 注:部分架构中,模型权重也存储在这个文件里面
  • Megatron 格式与 HF 不兼容;需要合并+重命名,下面是官方给出的转换脚本(同步格式)

    1
    2
    3
    4
    5
    6
    python tools/checkpoint_converter.py \
    --model-type GPT \
    --load-dir iter_0001000 \
    --save-dir hf_format \
    --target-tensor-parallel-size 1 \
    --target-pipeline-parallel-size 1
  • HF 的一般格式现在是类似下面的形式

    1
    2
    3
    4
    5
    6
    7
    hf_format/
    ├── model_00001-of-00010.safetensors # 文件权重
    ├── model_xxx...
    ├── model.safetensors.index.json # 分片成多个文件时用于索引
    ├── tokenizer.json
    ├── tokenizer_config.json
    └── config.json # 由脚本自动生成

DeepSpeed 框架文件格式

  • ZeRO-3 会对参数进行分片,分片数量参数有关,磁盘目录(16 GPU)

    1
    2
    3
    4
    5
    6
    7
    global_step1000/
    ├── bf16_zero_pp_rank_00_mp_rank_00_optim_states.pt # 优化器状态
    ├── bf16_zero_pp_rank_01_mp_rank_00_optim_states.pt
    ├── ...
    ├── zero_pp_rank_00_mp_rank_00_model_states.pt # 权重分片
    ├── zero_pp_rank_01_mp_rank_00_model_states.pt
    └── ...
  • DeepSpeed 与 HF 不兼容;需要合并(DeepSpeed 自带工具)

    1
    python zero_to_fp32.py global_step1000 ds_model.pth
  • 进一步精简权重文件(仅保留权重)并转 HF 的代码:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    import torch
    from transformers import AutoConfig, AutoModelForCausalLM

    state_dict = torch.load('ds_model.pth', map_location='cpu')
    torch.save(state_dict, 'pytorch_model.bin') # 仅权重

    config = AutoConfig.from_pretrained('meta-llama/Llama-2-7b-hf')
    model = AutoModelForCausalLM.from_config(config)
    model.load_state_dict(state_dict)
    model.save_pretrained('hf_from_ds')

PyTorch FSDP 框架文件格式

  • 磁盘目录(8 GPU)

    1
    2
    3
    4
    5
    checkpoint-1000/
    ├── __0_0.distcp # 每个 rank 的分片
    ├── ...
    ├── __7_0.distcp # 每个 rank 的分片
    └── .metadata # FSDP 元数据
  • PyTorch FSDP 与 HF 不兼容;需要合并,官方合并脚本(PyTorch 大于 2.2)

    1
    2
    3
    python -m torch.distributed.checkpoint.format_utils dcp_to_torch_save \
    checkpoint-1000 \
    fsdp_model.pth
  • 再转成 HF Safetensors(更快、安全)

    1
    2
    3
    4
    5
    from safetensors.torch import save_file
    import torch

    state_dict = torch.load('fsdp_model.pth')
    save_file(state_dict, 'model.safetensors')

附录:在不加载模型的情况下查看 safetensors 文件参数类型

  • 使用 transformers 库加载模型后查看参数,参数可能会被自动转换(依据不同模型实现有所不同,部分模型参数加载后是 float32)
    • 注意:即使 config.json 中显示是 "torch_dtype": "bfloat16",在 from_pretrain 函数不显示指定参数类型的情况下,也会出现自动转换为 float32 的情况
  • 显示指定参数类型加载后,输出与指定类型一致,但是看不到原始的参数类型了
  • 下面介绍两种方法,可以直接查看某个 safetensors 文件的参数类型

方式一:命令行查看

  • 使用 hexdump 命令可以抽取部分文件查看其 dtype 信息

    1
    hexdump -C -n 4096 model_00001-of-00010.safetensors | grep -A 20 '"dtype"'
  • 这条命令的作用是查看 safetensors 模型文件的十六进制内容,并筛选出包含 “dtype” 的行及其后 20 行,以便分析模型数据类型相关信息。下面是详细解释:

    • hexdump:用于以十六进制和 ASCII 形式显示文件内容的工具
    • -C:以规范的十六进制+ASCII 格式显示,左侧为十六进制值,右侧为对应的可打印字符
    • -n 4096:仅显示文件的前 4096 个字节(4KB)
    • grep -A 20:在文本中搜索匹配模式,除了显示匹配的行外,还显示该行之后的 20 行内容(A 即 After 的缩写)
  • 执行命令后会看到类似的输出:

    1
    ..."dtype":"BF16"...

方式二:python 查看

  • 安装 safetensors 包

  • 执行下面的代码:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    from safetensors.torch import load_file

    # 加载 .safetensors 文件
    weight_file = "~/model/Qwen2.5-7B-Instruct/model-00001-of-00004.safetensors"

    state_dict = load_file(weight_file, device="cpu")

    # 查看存储类型
    for name, param in list(state_dict.items())[:5]:
    print(f"参数 {name} 在硬盘上的存储类型: {param.dtype}")
  • 输出如下:

    1
    2
    3
    4
    5
    参数 model.embed_tokens.weight 在硬盘上的存储类型: torch.bfloat16
    参数 model.layers.0.input_layernorm.weight 在硬盘上的存储类型: torch.bfloat16
    参数 model.layers.0.mlp.down_proj.weight 在硬盘上的存储类型: torch.bfloat16
    参数 model.layers.0.mlp.gate_proj.weight 在硬盘上的存储类型: torch.bfloat16
    参数 model.layers.0.mlp.up_proj.weight 在硬盘上的存储类型: torch.bfloat16
  • bfloat16 与 Qwen2.5-7B-Instruct 的 config.json 类型能对齐


附录:ckpt 中添加自定义模型类

  • 在模型 ckpt 目录(hf 文件目录)下,可以存放 *.py 文件,用于定义自定义的模型结构
  • 这些 *.py 文件会被 transformers 库加载,故而可以在 config.json 中指定使用
  • 注意:megatron 训练一般不会使用 config.json 中指定的类,而是根据各种超参加载的
  • transformers 库 AutoModelForCausalLM.from_pretrained -> AutoConfig.from_pretrained 加载模型的方式有两种:
    • 第一种:config.json 包含 model_type 参数的
      • 此时要求模型类提前备注册过
    • 第二种:config.json 不包含 model_type 参数的
      • 此时可以按照自定义的类进行初始化(定义在 *.py 中,放到 ckpt 路径下即可)
      • 执行 AutoModelForCausalLM.from_pretrained 函数时添加 trust_remote_code=True 参数,否则无法加载模型文件

附录:llama.cpp 部署 GU 模型

  • 部署教程(很简单)

    1
    2
    3
    4
    5
    6
    7
    8
    # 安装 llama.cpp
    brew install llama.cpp

    # 下载 GGUF 格式的模型文件
    hf download Qwen/Qwen3-0.6B-GGUF Qwen3-0.6B-Q8_0.gguf --local-dir ~/models/qwen3-0.6b

    # 启动服务
    llama-server -m ~/models/qwen3-0.6b/Qwen3-0.6B-Q8_0.gguf --port 8010 --ctx-size 8192 --jinja
  • 关于 llama-server 启动的服务

    • 如果还在当前窗口
      • 直接使用 CTRL + C 即可结束
    • 如果已经切换窗口,需要找到进程号并 kill
      1
      2
      3
      4
      5
      # 查找进程号
      pgrep -fl llama-server

      # 关闭进程
      kill [PID]

RL——DecoupledPPO

  • 参考链接:
    • 原始论文:(Decoupled PPO, Decoupled Policy Objectives)Batch size-invariance for policy optimization, 20220924, OpenAI
    • 后来补充:后续很多文章或者博客一般都会称这篇文章为 Decoupled PPO 或 Decoupled Policy Objectives

整体总结

  • 在 RL 的策略优化算法中(如 PPO),算法的稳定性和可靠性通常依赖于对策略更新幅度的控制(通过 Trust Region 或 Surrogate Objective)
  • 传统理论认为,限制更新幅度是为了“不让当前策略偏离用于采集经验的策略(即 Behavior Policy,行为策略)太远”
  • 作者的核心观点:
    • 这种传统解释存在细微缺陷
    • 真正重要的并非“行为策略”本身,而是控制策略更新的 速度 (即近似 Natural Policy Gradient)
    • 论文的 Insight:
      • 在 PPO 中,“旧策略”承担了两个相互独立的职责(行为策略和近端策略),但一直被混为一谈
      • 通过 解耦(Decoupling) 这两个职责,不仅提升了算法对陈旧数据的利用效率,还实现了 RL 算法中极为实用的“批次大小不变性(Batch size-invariance)”
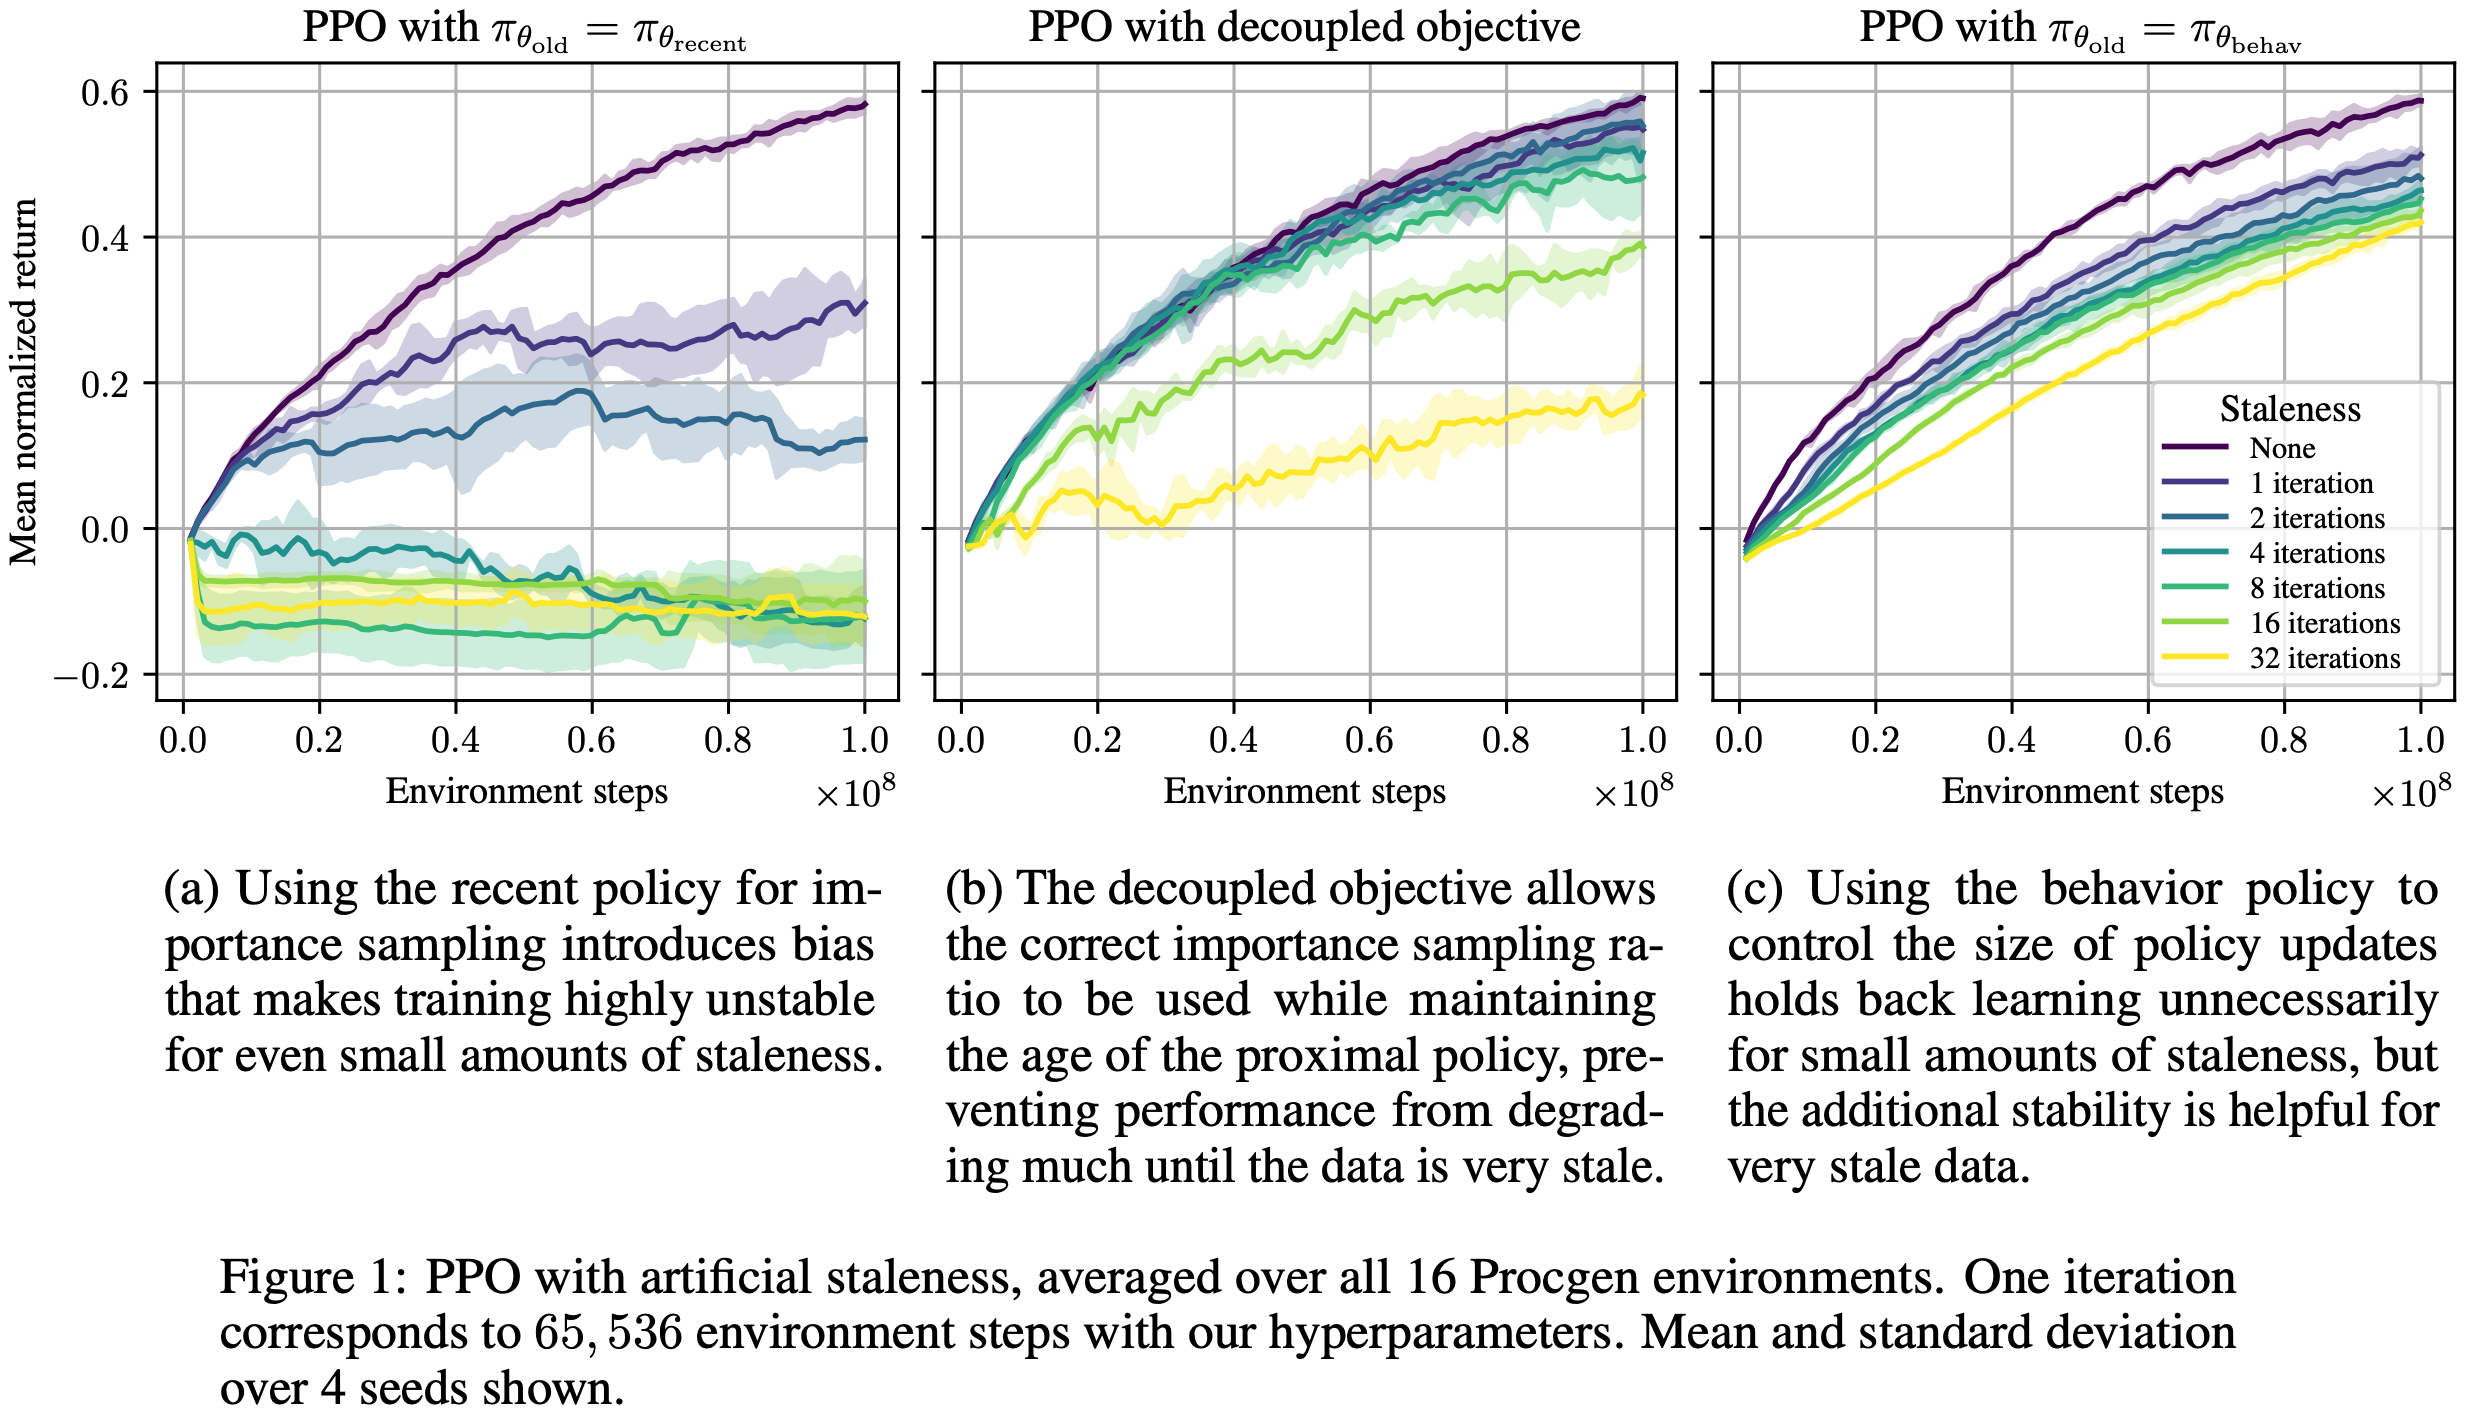
  • 不同方法的对比如下:
    • 图 a:使用当前策略作为旧策略,效果最差,微弱的 off-policy 都会造成极大的性能损耗
      • 理解:丢失了 off-policy 的的修正,梯度是有偏的
    • 图 b:使用 decoupled policy objective 策略
      • 理解:在较小的 陈旧性 下,几乎无损
    • 图 c:使用行为策略作为旧策略,在小陈旧性时性能不如 Decoupled
      • 理解:在较小的 陈旧性 下,就开始有损,效果不如 图 b 使用 decoupled policy objective 策略的情况
      • 异常现象:在很大的陈旧性下,图 c 的效果反而更好
        • 个人理解:
          • 可能是因为极端陈旧性下,分开策略会导致当前策略还从未被采样过就被用于作为 Proximal 策略,这会导致模型更新比较极端(激进)
            • 这也不符合 Trust Region 方法的思路(Trust Region 方法要求策略贴近行为策略来更新,不能离开行为策略太远)
            • 论文中会用 Natural Policy Gradient 方法来解释 PPO,Natural Policy Gradient 方法下,靠近行为策略并不重要 ,重要的是不要移动得太快(即靠近某个“近期策略”)
          • 但是 图 c 的这种使用行为策略作为旧策略的方式相当于更保守的策略,让模型更新的更慢一些(KL 散度限制在行为策略上)
            • 论文中也提到,这种方法更贴近与 Trust Region 方法

PPO 中“旧策略”的双重角色

  • 在标准的 PPO 中,参数为 \(\theta_{\text{old} }\) 的旧策略被用于两个目的:
    • 1)行为策略(Behavior Policy, \(\color{blue}{\pi_{\theta_{\text{behav} } }}\)) :
      • 用于与环境交互采样。在 Importance Sampling 中,必须使用该策略来保证梯度估计的无偏性
    • 2)近端策略(Proximal Policy, \(\color{red}{\pi_{\theta_{\text{prox} } }}\)) :
      • 作为一个“锚点”,通过 KL 散度惩罚或 Clipping 机制将当前策略拉向该策略,从而控制更新幅度
  • 作者的 Insight
    • 近端策略不一定非要是行为策略
    • 只要近端策略足够“新”(Recent),它能起到控制更新速度的作用,而不必关心它是否被用于采样

Decoupled Policy Objectives 方法

Decoupled KL Penalized Objective

  • 原始 KL 惩罚目标为(其中 \(\hat{A}_t\) 是优势函数估计器):
    $$
    L^{\text{KLPN} }(\theta) := \hat{\mathbb{E} }_{t}\left[\frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\theta_{\text{old} } }(a_t \mid s_t)}\hat{A}_t - \beta \text{KL}\left[\pi_{\theta_{\text{old} } }(\cdot \mid s_t), \pi_{\theta}(\cdot \mid s_t)\right]\right]
    $$
  • 将其解耦为:
    $$
    L_{\text{decoupled} }^{\text{KLPN} }(\theta) := \hat{\mathbb{E} }_{t}\left[\frac{\pi_{\theta}(a_t \mid s_t)}{\color{blue}{\pi_{\theta_{\text{behav} } }}(a_t \mid s_t)}\hat{A}_t - \beta \text{KL}\left[\color{red}{\pi_{\theta_{\text{prox} } }}(\cdot \mid s_t), \pi_{\theta}(\cdot \mid s_t)\right]\right]
    $$
    • 第一个分式的分母必须使用 \(\color{blue}{\pi_{\theta_{\text{behav} } }}\)(用于 Importance Sampling 纠偏)
    • KL 散度项则使用独立的 \(\color{red}{\pi_{\theta_{\text{prox} } }}\)

Decoupled Clipped Objective

  • 标准的 Clipped 目标为:
    $$
    \begin{align}
    L^{\text{CLIP} }(\theta) &:= \hat{\mathbb{E} }_{t}\left[\min \left(r_t(\theta)\hat{A}_t, \text{clip}\left(r_t(\theta), 1 - \epsilon, 1 + \epsilon\right)\hat{A}_t\right)\right] \\
    r_t(\theta) &= \frac{\pi_{\theta} }{\pi_{\theta_{\text{old} } } }
    \end{align}
    $$
  • 为了解耦,重新改写目标,令 Behavior 和 Prox 分离
  • 令 \(r_t(\theta) = \frac{\pi_{\theta} }{\color{red}{\pi_{\theta_{\text{prox} } }} }\),则解耦后的 Clipped 目标为:
    $$
    \begin{align}
    L_{\text{decoupled} }^{\text{CLIP} }(\theta) &:= \hat{\mathbb{E} }_{t}\left[\frac{\color{red}{\pi_{\theta_{\text{prox} } }} }{\color{blue}{\pi_{\theta_{\text{behav} } }} }\min \left(r_t(\theta)\hat{A}_t, \text{clip}\left(r_t(\theta), 1 - \epsilon, 1 + \epsilon\right)\hat{A}_t\right)\right] \\
    r_t(\theta) &= \frac{\pi_{\theta} }{\color{red}{\pi_{\theta_{\text{prox} } }} }
    \end{align}
    $$
    • 这里的前置系数 \(\frac{\color{red}{\pi_{\theta_{\text{prox} } }} }{\color{blue}{\pi_{\theta_{\text{behav} } }} }\) 是为了补偿因替换策略引起的概率分布偏移,确保 Importance Sampling 仍针对 Behavior Policy 进行

实现批次大小不变性的具体方案:PPO-EWMA 和 PPG-EWMA

批次大小不变性(Batch size-invariance)的概念

  • 原始论文中定义:
    • 如果改变 Batch size 后,可以通过调整其他超参数来大致恢复原始的训练行为(以处理的样本总数作为横轴),则该算法具有批次大小不变性
      • 例如:Batch size 翻倍,则训练步数减半,使得训练行为大致不变
    • 问题:原始的 PPO 为什么不满足 Batch size-invariance?
      • 主要是因为没有固定 Proximal 策略的情况下,批次变化后 PPO 的 Proximal 一直在变化,是无法通过调整其他超参数做到批次大小不变性的,详情见本文附录部分
  • 在 RL 中,存在两种 Batch size:
    • Optimization batch size :每次梯度更新使用的环境步数
      • 这个相当于一次梯度更新的样本数
    • Iteration batch size :每次采样与优化交替之间的环境步数
      • 这个相当于 Rollout 的样本数
  • 为了让整个 PPO 具备不变性,两者必须同时按相同比例变化(即改变数据并行度)

核心工程组件:PPO-EWMA(指数加权移动平均)

  • 为了解决“近端策略”需要是“近期策略”但存储所有历史副本代价过高的问题,论文引入了 EWMA(Exponentially-Weighted Moving Average)
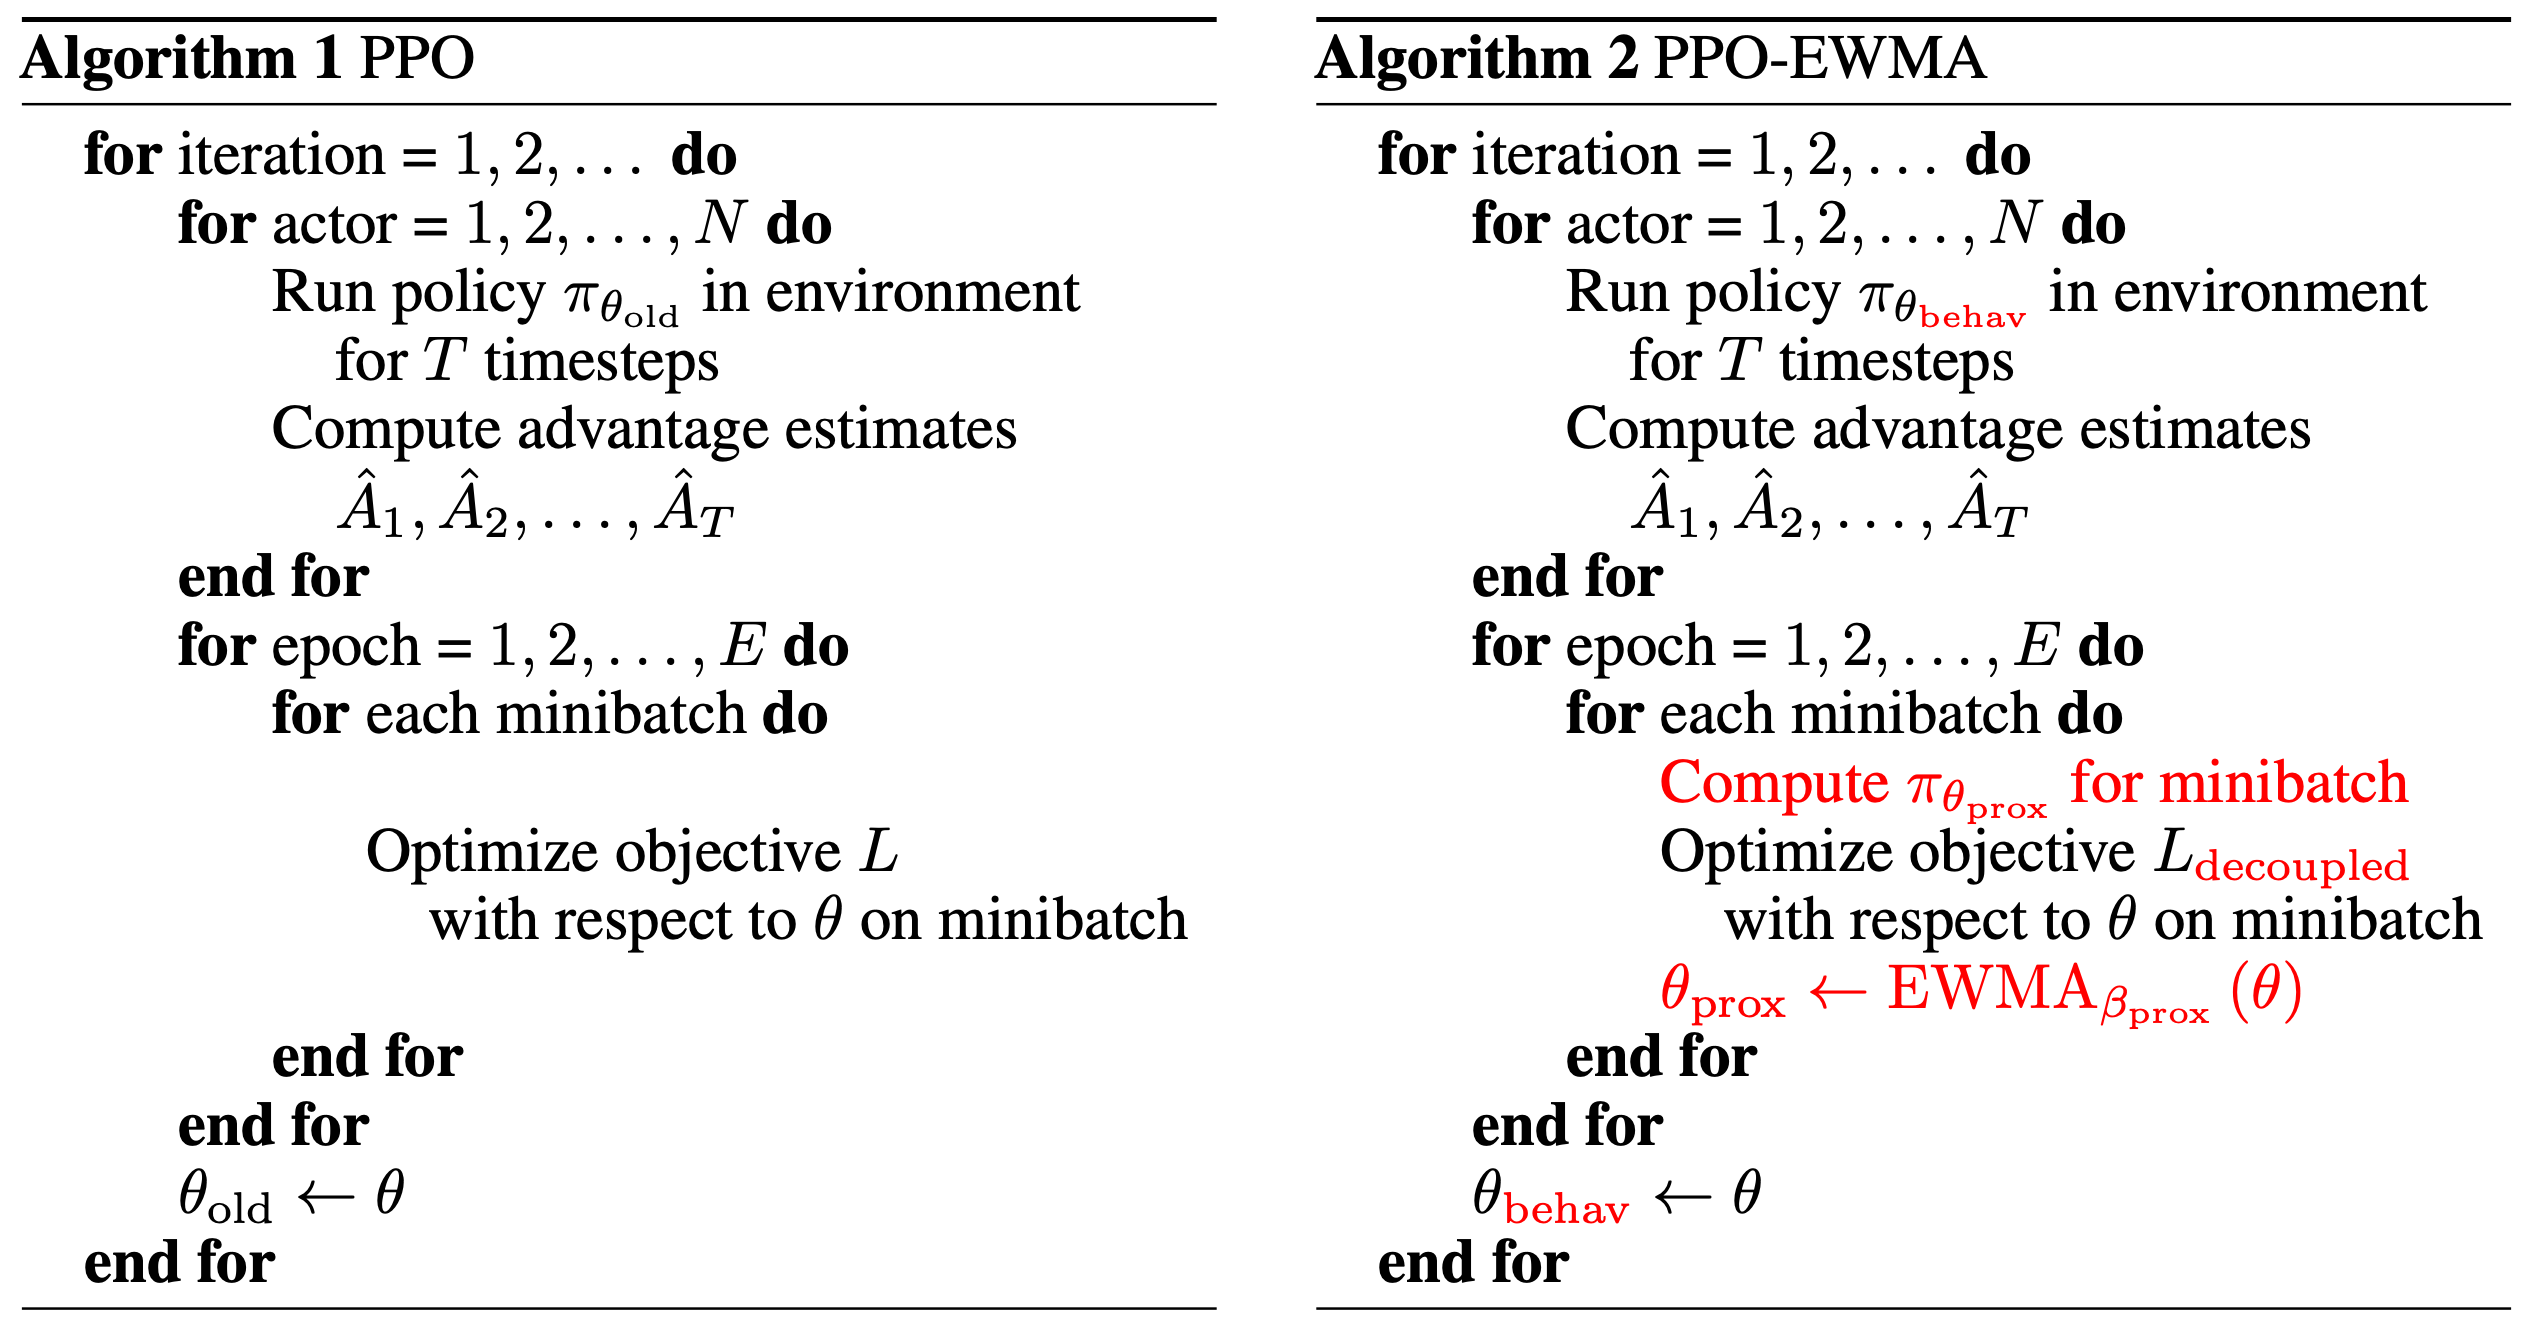
  • PPO-EWMA 方法流程 :
    • 1)初始化策略网络参数 \(\theta\),近端策略参数 \(\theta_{\text{prox} }\)
    • 2)在每次梯度更新后,不直接将 \(\theta_{\text{prox} }\) 赋值为 \(\theta\),而是执行软更新:
      $$
      \theta_{\text{prox} } \gets \text{EWMA}_{\beta_{\text{prox} } }(\theta)
      $$
      • 具体计算方式为维护权重 \(w\),每次更新时:
        $$
        \begin{align}
        w_{\text{new} } &\gets 1 + \beta_{\text{prox} } w \\
        \theta_{\text{prox} } &\gets \frac{1}{w_{\text{new} } } \theta + \beta_{\text{prox} } \frac{w}{w_{\text{new} } } \theta_{\text{prox} } \\
        w &\gets w_{\text{new} }
        \end{align}
        $$
    • 3)将更新后的 \(\theta_{\text{prox} }\) 作为解耦目标中的近端策略使用
  • 设计思路 :EWMA 的质心(Center of Mass,\(\text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1\))代表了近端策略的平均 “Age”(以梯度步数计)
    • 通过调整 \(\beta_{\text{prox} }\),可以在不保存旧模型的情况下,精确控制该 Age
实现完全 Batch size-invariance 的超参数调整规则
  • 当优化 Batch size 和迭代 Batch size 同时除以常数 \(c\)(即并行度减少,Batch size 变小)时,为了维持训练动态不变,需要执行以下四步调整法(按重要性排序):
    • 1)调整优化器步长(最重要) :
      • 论文使用 Adam 优化器
      • 由于 Adam 除以了梯度 Root Mean Square 的估计值,其有效学习率自动缩放
      • 因此,为了补偿 Batch size 缩小 \(c\) 倍,Adam 的 Step size \(\alpha\) 需除以 \(\sqrt{c}\)(对应 SGD 则是除以 \(c\))
        • 理解:Batch size 越小,学习率应该越小,详细推导见附录
      • 论文通过附录 C 的公式推导(\(\text{Denominator} \propto 1/\sqrt{n}\))证明了这一点
    • 2)调整 EWMA 质心(保持近端策略 Age ) :
      • 调整 \(\beta_{\text{prox} }\),使得 \(\text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1\) 乘以 \(c\)
      • 以环境步数衡量的近端策略 “Age” 保持不变
    • 3)调整优势归一化(Advantage Normalization) :
      • 如果使用了优势归一化,需要将用于估计优势均值和方差的迭代次数乘以 \(c\)(即使用更长的 EWMA 估计期),以防止小 Batch size 下估计方差过大
        • 优势归一化的实现一般是滑动窗口或滑动平均
          • 对应滑动窗口时,这里的意思就是把滑动窗口加大 c 倍
    • 4)调整 PPG 特定参数 :
      • 对于 PPG(Phasic Policy Gradient),需将每个阶段(Phase)的策略迭代次数 \(N_{\pi}\) 乘以 \(c\),以保持阶段 Batch size 恒定
  • 最终的 PPO-EWMA 算法:

实验

实验一:Artificial Staleness 实验

  • 目的 :通过 人工陈旧性 实验验证解耦近端策略的有效性
  • 方法 :将采集的数据延迟固定的迭代次数后再用于训练
  • 结果 :
    • 若使用原始 PPO 目标(无论选择最近策略还是行为策略作为旧策略),极小的陈旧性都会导致性能剧烈下降(图 1)
    • 使用解耦目标(\(\pi_{\text{behav} }\) 用于采样率,\(\pi_{\text{prox} }\) 采用近期策略)后,算法对陈旧性表现出惊人的鲁棒性,直到陈旧性达到约 8 次迭代(500W 环境步)才出现明显退化
  • 结论:明确证明了解耦可以安全地利用陈旧数据

实验二:批次大小不变性验证(核心实验)

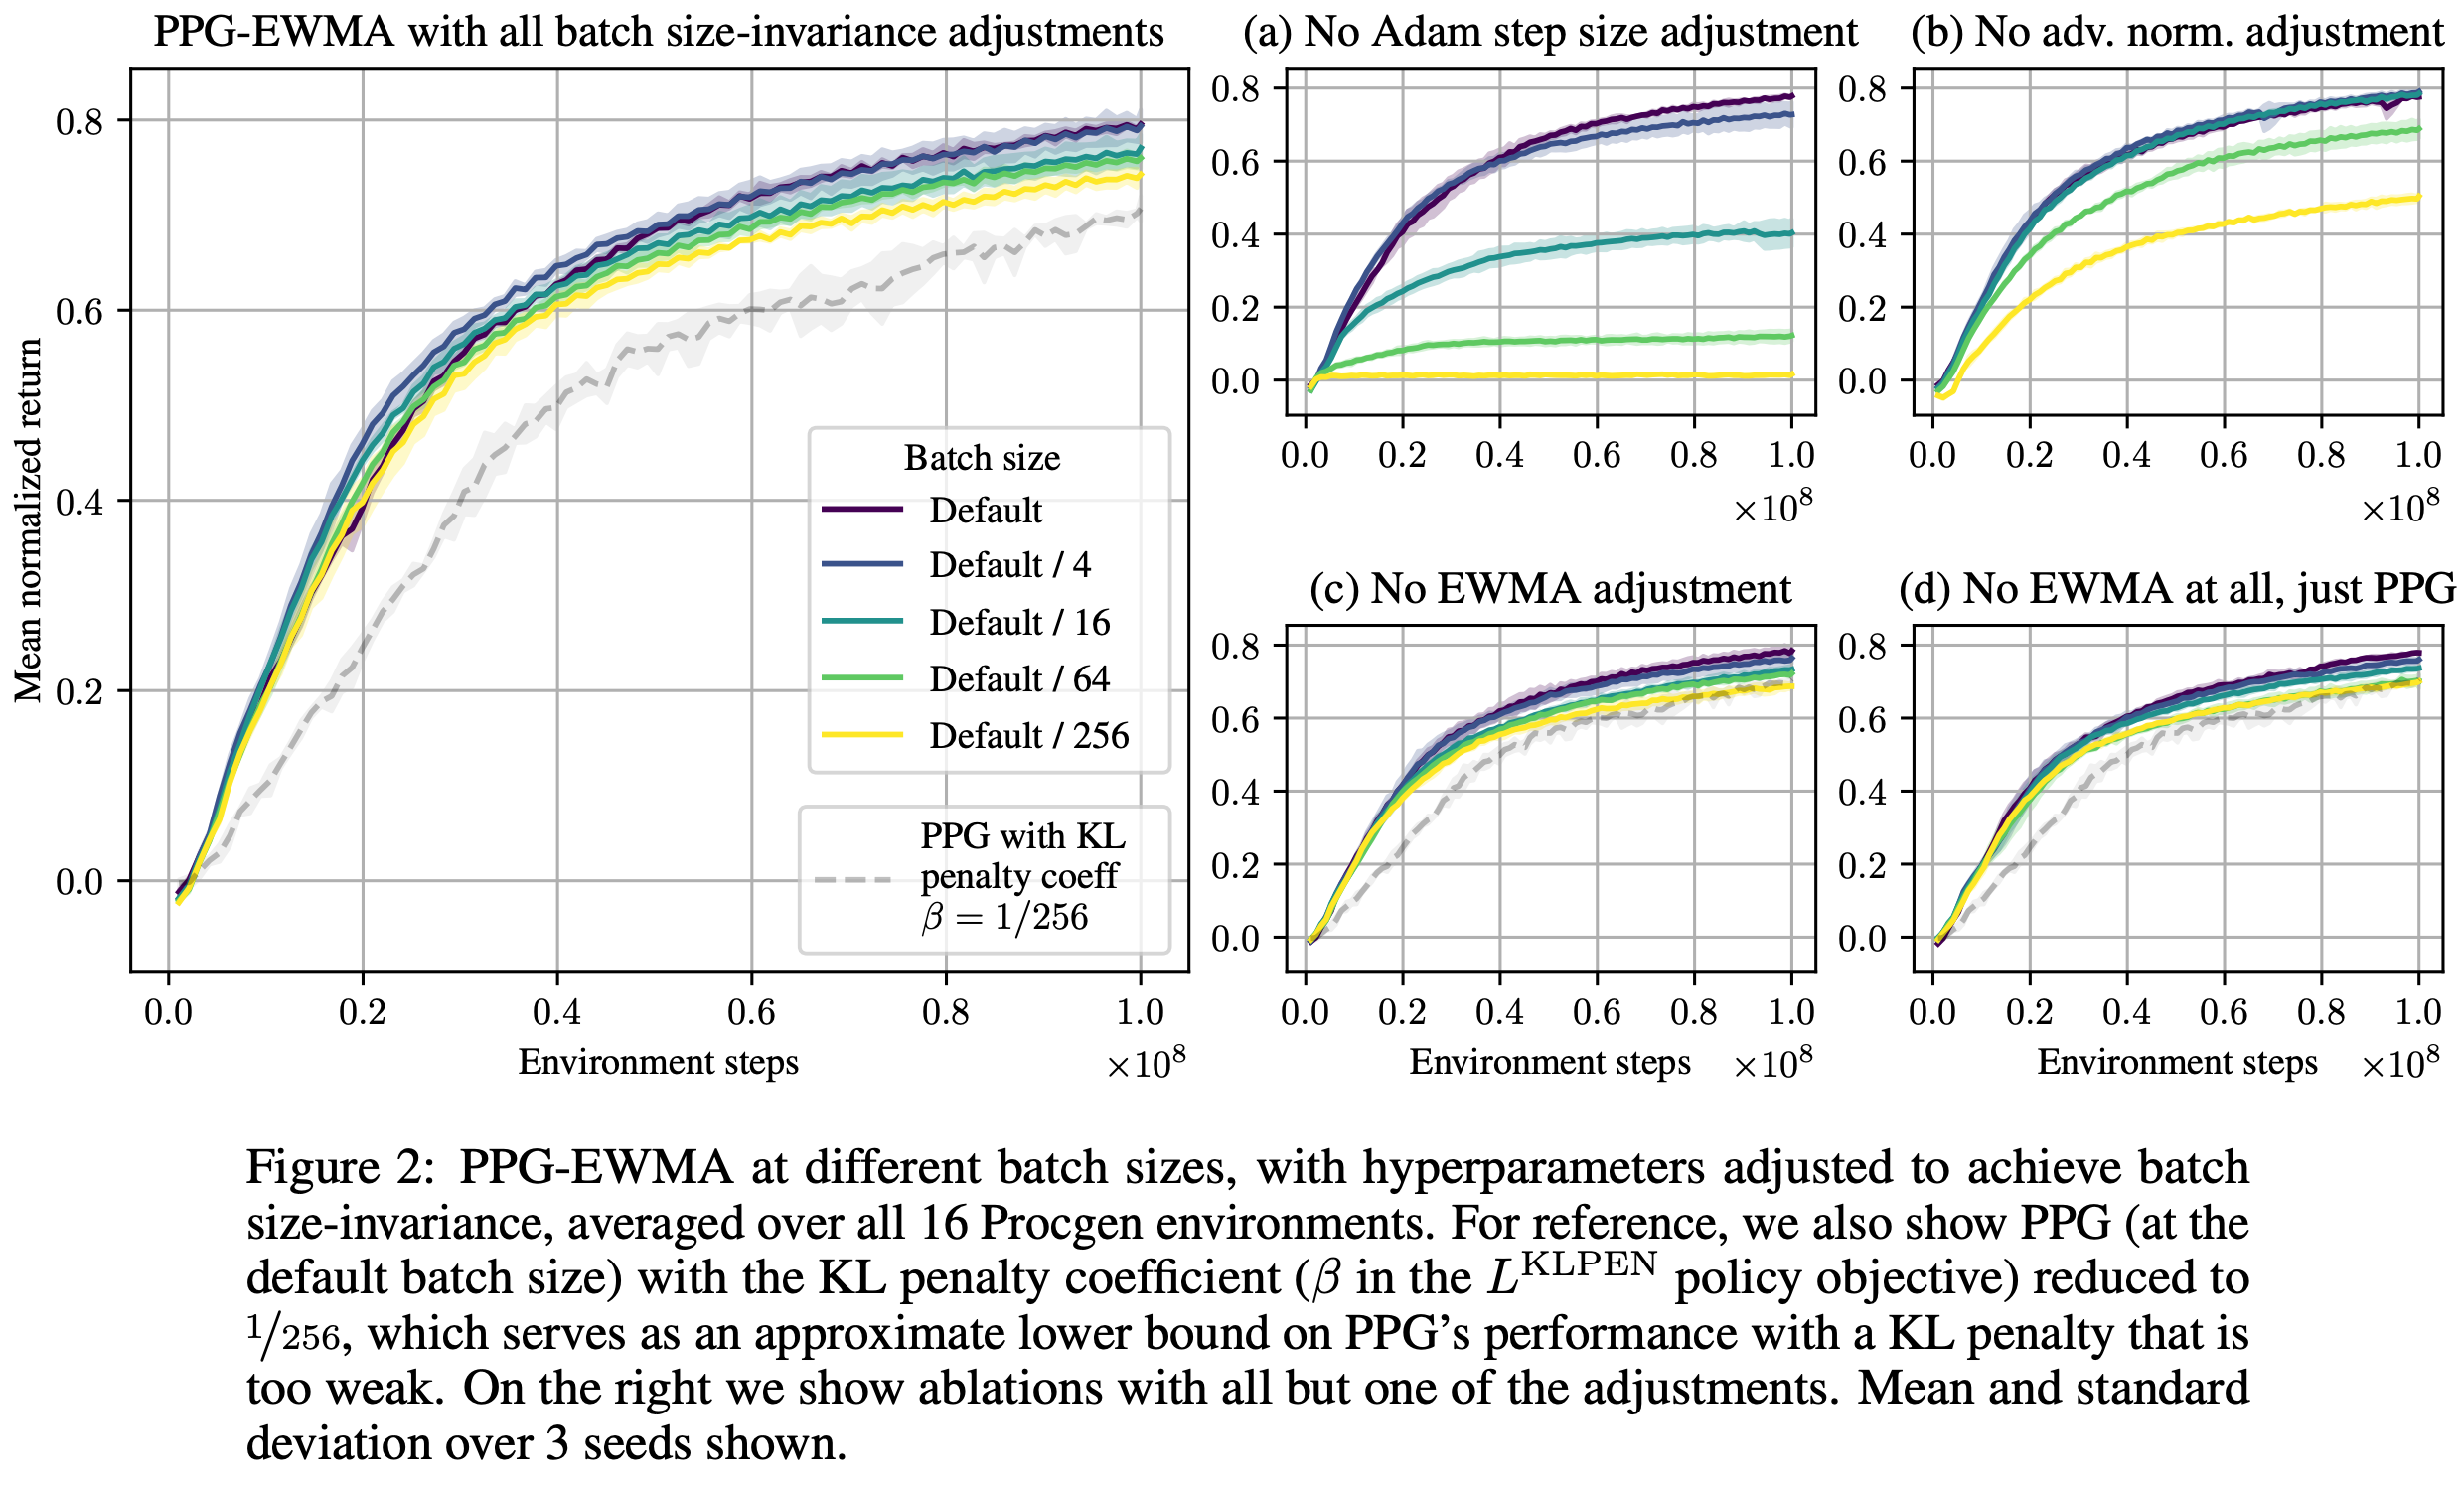
  • 设置 :将并行环境数从默认的 256 个逐步减少到 1 个(Batch size 缩小 256 倍),并应用上述四步调整法
  • 结果(图 2 & 图 3):
    • 实现了高度的批次大小不变性
    • 最大 Batch size 与最小 Batch size 之间的最终归一化回报差异仅为 0.052
    • 除去单个异常环境(Heist),差异缩小至 0.019
  • 消融实验重要性排名(附录 E 表 5):
    • 1)Adam Step size 调整(最致命) :没有它,小 Batch size 训练极度不稳定(Z-score > 6.8)
    • 2)优势归一化调整 :在大 Batch size 下不重要,但在极小 Batch size 下至关重要(尤其当优势标准差估计振荡超过 10 倍时)
    • 3)EWMA 调整 :在所有规模下都有轻微影响(因为 PPG 对 KL 惩罚本身较鲁棒)

实验三:EWMA 的直接收益对比

  • 对比 :PPO vs PPO-EWMA,PPG vs PPG-EWMA
  • 结果(图 4):
    • EWMA 带来的提升虽小但在所有 16 个 Procgen 环境中异常一致且稳定(在最后 8 个未用于调参的环境上全部优于基线)
    • 作者推测收益来源于 EWMA 降低了近端策略的方差(进一步证据见附录 G)
  • 代价是增加 30%(PPO)或 2.3%(PPG)的计算开销(主要是额外的 Forward Pass),但不包括环境交互成本

补充:论文的其他观点

PPO 应被视为 Natural Policy Gradient 方法

  • 传统观点认为 PPO 近似 Trust Region(信任域)
    • Trust Region 要求策略靠近行为策略
  • 但本论文的实验表明,靠近行为策略并不重要 ,重要的是不要移动得太快(即靠近某个“近期策略”)
  • 论文提出将 PPO 重新解释为 Natural Policy Gradient 方法
    • 其核心是在“策略改变量”固定的情况下,最大化性能提升效率
  • 个人不同观点:从 超大陈旧性下 靠近行为策略更重要来看(图 1c vs 图 1b),我认为 PPO 还是更贴近 Trust Region 方法

针对小 Batch size 场景的实战建议

  • 当计算资源受限(必须使用极小 Batch size)且无法预先在大 Batch size 上调参时,论文给出以下建议:
    • 1)优先精调学习率(Adam Step size) ,并遵循 \(\sqrt{c}\) 缩放法则
    • 2)优先将 Policy Epochs 设为 1(尤其在迭代 Batch size 很小时,多轮 Epoch 只是重复拟合相同数据,收益低)
    • 3)监控 Clipping 比例 :
      • 若被截断的比例远小于 1%,应增大迭代 Batch size 或使用高 \(\beta_{\text{prox} }\) 的 PPO-EWMA
      • 若远大于 10%(单 Epoch)或 20%(多 Epoch),则学习率过高
    • 4)监控优势标准差估计 :若振荡超过 10 倍,应使用更多迭代数据进行归一化

Adam 超参数调整

  • Adam 的 \(\beta_1, \beta_2\) 调整 :
    • 理论上 Batch size 缩小时需将 \(\beta\) 提升至 \(1/c\) 次幂,但实验证明在大多数环境中该调整影响不大(Heist 环境的异常表现无法通过调整 \(\beta\) 解决)
  • KL 惩罚与 EWMA 质心的等效性(附录 G):原始论文通过热力图证明,将 EWMA 质心(\(\text{COM}_{\text{prox} }\))减半与将 KL 惩罚系数 \(\beta\) 加倍的效果基本等价(局部范围内),这验证了控制近端策略 “Age” 就是控制更新力度的核心直觉

附录:学习率与 Batch Size 的关系(SGD 和 Adam 下)

  • 详细推导见原始论文原文
  • 核心:调整优化器步长的理论依据来源于 SGD 与 Adam 在应对梯度噪声时的根本性数学差异
    • 核心思路是不允许梯度方差提升太多
  • 符号设定:
    • \(n\):当前的 Batch size
    • \(c\):Batch size 缩小的倍数(即新 Batch size 为 \(n/c\))
    • \(g\):当前 Mini-batch 计算出的梯度向量
    • \(\mu = \mathbb{E}[g]\):梯度的真实期望(信号)
    • \(\sigma^2 = \text{Var}(g)\):梯度的方差(噪声)
    • \(\alpha\):学习率

SGD 的线性调整(除以 \(c\))

  • 推导逻辑(基于 SDE 离散化) :
    • SGD 的更新规则为:
      $$
      \theta_{t+1} = \theta_t - \alpha \cdot g
      $$
    • 其中
      $$ g = \frac{1}{n} \sum_{i=1}^n \nabla L(\theta; x_i)$$
    • 根据中心极限定理,Mini-batch 梯度的方差 与 Batch size 成反比:
      $$
      \text{Var}(g) \propto \frac{1}{n}
      $$
    • 当 Batch size 缩小 \(c\) 倍(变为 \(n/c\))时,梯度的方差会放大 \(c\) 倍
      • 为了保持单位样本处理量下的参数更新轨迹一致(即随机微分方程 SDE 的扩散项系数不变),学习率 \(\alpha\) 必须相应缩小 \(c\) 倍,以抵消方差放大带来的随机游走增量
  • 结论公式 :
    $$
    \alpha_{\text{new} } = \frac{\alpha_{\text{old} } }{c}
    $$
  • 直观理解 :数据少了,梯度噪声大了,步长必须线性地缩小,否则参数会在噪声中随机游走甚至发散

Adam 的平方根调整(除以 \(\sqrt{c}\))(附录 C 核心)

  • Adam 与 SGD 不同,它 除以其梯度的 Root Mean Square 滑动估计
    • 注:所以 Adam 是平方根法则(\(\sqrt{c}\))而非线性法则(\(c\))
  • 第一步:写出 Adam 的有效更新量
    • 忽略偏差修正和动量(\(m_t\))的影响,Adam 的单步有效更新量近似为:
      $$
      \Delta \theta \approx \alpha \cdot \frac{g}{\sqrt{v_t} + \epsilon}
      $$
      • 其中 \(v_t\) 是梯度平方 \(\mathbb{E}[g^2]\) 的指数移动平均(EWMA)
    • 在大多数情况下,\(\epsilon\) 极小可以忽略,因此有效更新量约为:
      $$
      \Delta \theta \approx \alpha \cdot \frac{g}{\sqrt{\mathbb{E}[g^2]} }
      $$
  • 第二步:将 \(\mathbb{E}[g^2]\) 分解为信号与噪声
    • 根据方差定义(\(\text{Var}(g) = \mathbb{E}[g^2] - \mathbb{E}[g]^2\)),有:
      $$
      \mathbb{E}[g^2] = \mu^2 + \sigma^2
      $$
    • 引入 McCandlish 等人(2018)定义的梯度噪声尺度(Gradient Noise Scale) \(B\),其逐分量定义为信号与噪声的比值:
      $$
      B := \frac{\sigma^2}{\mu^2}
      $$
      • 由于方差与 Batch size 成反比(\(\sigma^2 \propto 1/n\)),而信号 \(\mu^2\) 与 Batch size 无关,因此:
        $$
        \mathbb{E}[g^2] = \mu^2 \left(1 + \frac{B}{n}\right)
        $$
  • 第三步:应用“小 Batch size”假设(核心条件)
    • 论文的批次大小不变性实验要求 Batch size 足够小 ,即 \(n \ll B\)(远小于临界 Batch size),此时:
      $$
      \frac{B}{n} \gg 1
      $$
    • 因此信号项 \(\mu^2\) 被淹没,可以忽略 \(1\),得到:
      $$
      \mathbb{E}[g^2] \approx \mu^2 \cdot \frac{B}{n} \propto \frac{1}{n}
      $$
  • 第四步:将近似结果代入 Adam 更新量
    • 开平方得:
      $$
      \sqrt{\mathbb{E}[g^2]} \propto \frac{1}{\sqrt{n} }
      $$
    • 将其代回 Adam 的有效更新公式:
      $$
      \Delta \theta \approx \alpha \cdot \frac{g}{1 / \sqrt{n} } = \alpha \cdot \sqrt{n} \cdot g
      $$
  • 第五步:推导步长缩放公式
    • 假设原 Batch size 为 \(n\),步长为 \(\alpha_{\text{old} }\)
    • 现在 Batch size 缩小 \(c\) 倍变为 \(n/c\)
    • 新的有效更新量为:
      $$
      \Delta \theta_{\text{new} } \approx \alpha_{\text{new} } \cdot \sqrt{\frac{n}{c} } \cdot g
      $$
    • 为了保持与原更新量 \(\Delta \theta_{\text{old} } \approx \alpha_{\text{old} } \cdot \sqrt{n} \cdot g\) 一致,必须令:
      $$
      \alpha_{\text{new} } \cdot \sqrt{\frac{n}{c} } = \alpha_{\text{old} } \cdot \sqrt{n}
      $$
    • 约去 \(\sqrt{n}\),得到 Adam 的最终调整法则:
      $$
      \boxed{\alpha_{\text{new} } = \frac{\alpha_{\text{old} } }{\sqrt{c} } }
      $$

解释:SGD 和 Adam 为什么会有这种差异?

  • SGD :梯度没有自适应分母
    • 噪声放大 \(c\) 倍,步长必须缩小 \(c\) 倍来压制噪声
  • Adam :其分母(Root Mean Square)在小 Batch 时会自动感知并反映噪声的增大
    • 当 Batch size 变小,噪声增大,\(\mathbb{E}[g^2]\) 变大,分母自动变大,已经替我们除以了 \(\sqrt{c}\)
    • 所以只需要在步长 \(\alpha\) 上额外再除以 \(\sqrt{c}\),两者合力(自动的 \(\sqrt{c}\) + 手动的 \(\sqrt{c}\))就等效于 SGD 所需的总体除以 \(c\) 的效果

补充说明: 原论文附录 C 的实验验证

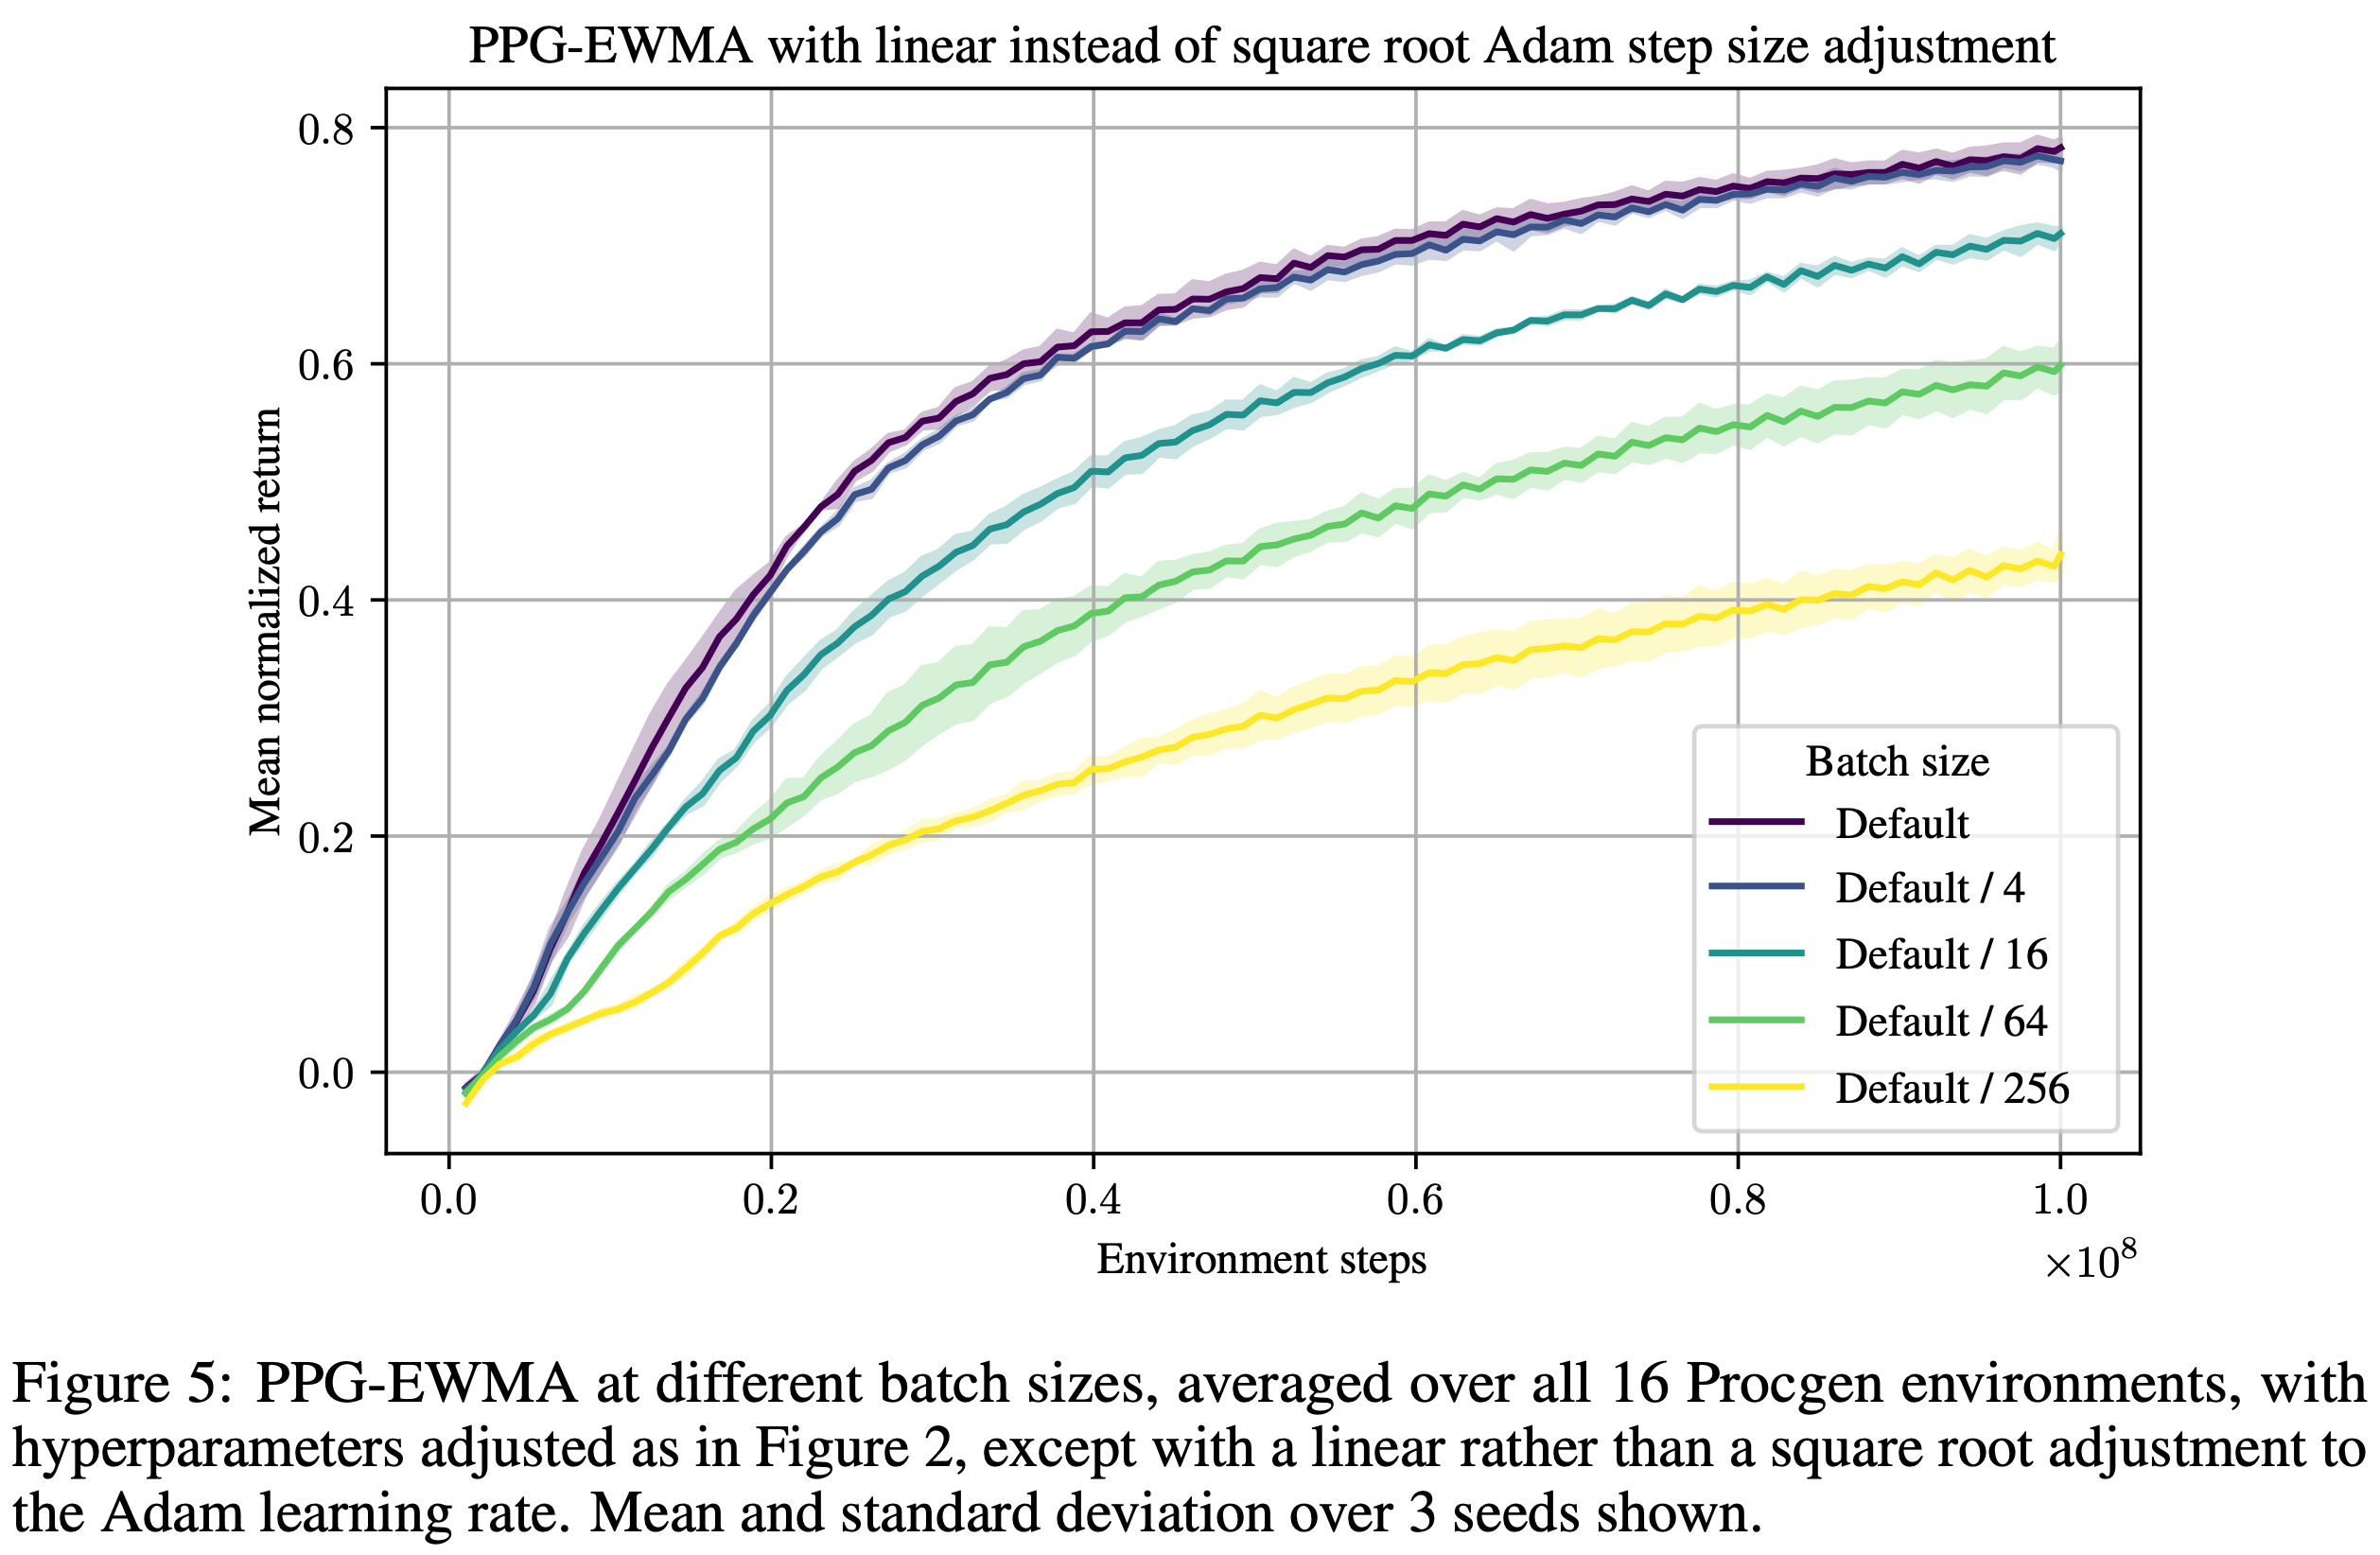
  • 论文在附录 C 中专门做了一个消融实验(图 5 vs 图 2):
    • 如果按照错误的线性法则(除以 \(c\))调整 Adam 的 Step size(图 5),在小 Batch size(Default / 256)下,训练极其不稳定且性能远低于图 2
  • 只有使用正确的平方根法则(除以 \(\sqrt{c}\)) ,Adam 才能在小 Batch size 下维持稳定的训练动态
  • 理解:学习率太小,导致学习慢(但是实际上,继续训练下去应该是会到最高点位置的

补充说明:Adam 的 \(\epsilon\) 参数的影响

  • 如果 Adam 的 \(\epsilon\) 参数设得非常大 ,使得 \(\epsilon \gg \sqrt{v_t}\),那么 Adam 会退化为带 Momentum 的 SGD
    • 调整法则会从平方根法则过渡 到线性法则
  • 但在标准的深度强化学习设置中(\(\epsilon = 10^{-8}\) 或 \(10^{-5}\)),\(\epsilon\) 几乎可以忽略,因此平方根法则(\(\sqrt{c}\))是严格且最优的选择

附录:为什么原始 PPO 无法实现 Batch size-invariance ?

原始 PPO 无法实现 批次大小不变性 的根本原因 是它将“行为策略”和“近端策略” 强行耦合在同一个网络参数 \(\theta_{\text{old} }\) 上

第一步:明确 PPO 涉及的两类 Batch size

  • Optimization batch size :每次梯度更新时使用的样本数量
    • 这部分由 SGD/Adam 控制,原始 PPO 本身是可以做到这一层不变性的 (因为 Adam 有 \(\sqrt{c}\) 缩放法则)
  • Iteration batch size :
    • 每次更新开始前,Rollout 收集的数据数(即每次采集多少数据后才做一次更新)
  • 基本结论:原始 PPO 无法保证 Batch size-invariance 的根源在于 “Iteration batch size” 的变化 无法被其他超参数恢复

耦合导致的“近端策略年龄”失控(核心推导)

  • 在原始 PPO 的目标函数中(无论是 Clip 版本还是 KL 惩罚版本),\(\theta_{\text{old} }\) 只有一个,它同时负责两件事:
    • 1)重要性采样(Importance Sampling) :作为分母,必须是采集数据的 Behavior Policy
    • 2)近端约束(Clipping / KL Penalty) :作为锚点,用来拉住当前策略
  • 将 Iteration batch size 乘以或除以某个常数 \(c\) 时(例如并行环境数减少,每次采集的数据变少了),会发生以下连锁反应:
    • 采样频率改变 :Batch size 变小,意味着 Agent 与环境交互更少的步数就会触发一次梯度更新(一次可能连续更新多步)
    • 策略更新频率变快 :在固定的环境步数内,参数 \(\theta\) 被更新的次数变多了
    • \(\theta_{\text{old} }\) 的 “Age” 剧烈变化 :
      • 在原始 PPO 中,每次 Rollout + 多次 梯度 Step 更新后,\(\theta_{\text{old} }\) 都会被立刻替换为最新的 \(\theta\)
        • 注意是仅在 Rollout + 多次梯度更新后,消耗完当前数据后
      • 如果迭代 Batch size 很小(除以 \(c\)),一次 Rollout 更新的次数会比较少,\(\theta_{\text{old} }\) 就会变得 “很年轻”
        • Rollout 一次,更新次数很少,off-policy 程度很小
      • 如果迭代 Batch size 很大(乘以 \(c\)),一次 Rollout 梯度更新的次数会比较多,\(\theta_{\text{old} }\) 就会变得“很陈旧”
        • Rollout 一次,更新次数太多,off-policy 程度变大

为什么单纯调整学习率(LR)无法补偿?

  • 问题:既然更新频率变了,那调整学习率(Adam Step size)不就行了吗?
  • 答案是 不行 因为学习率控制的是 “参数在参数空间中移动的距离” ,而 Clipping 范围(\(\epsilon\)) 和 KL 惩罚系数(\(\beta\)) 控制的是 “概率比(\(\pi_\theta / \pi_{\text{old} }\))允许偏离 1 的程度”
  • 当 \(\theta_{\text{old} }\) 的“年龄”改变时,\(\theta_{\text{old} }\) 本身的质量(是好是坏)以及它与当前 \(\theta\) 的内在距离发生了结构性改变:
    • 如果 Batch size 变小,\(\theta_{\text{old} }\) 更新极快,近端锚点跟得太紧 ,导致 Clipping 几乎不起作用(惩罚太弱),策略变化过快,容易崩塌
    • 如果 Batch size 变大,\(\theta_{\text{old} }\) 极为陈旧,近端锚点拖得太远 ,导致 Clipping 过度生效(惩罚太强),策略几乎无法学习
  • 由于 \(\theta_{\text{old} }\) 同时是行为策略,不能单独调整它的更新频率
    • 学习率只能改变“走多快”,但无法改变“锚点本身的陈旧程度”
    • LR 控制更新幅度,无法调整参考方向(\(\theta_{\text{old} }\))

补充:数学视角的直观解释(基于论文第 4 节)

  • 论文用 EWMA 的质心(Center of Mass, COM) 来量化近端策略的“年龄”:
    $$
    \text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1
    $$
  • 在原始 PPO 中,近端策略就是行为策略本身,它的“年龄”严格等于 “采集数据所花费的环境步数” ,即严格等于迭代 Batch size
    • 即:当前策略 \(\theta\) 现在正试图将自己拉向 “质心 步前的自己”(而 质心是一个基本固定的数字(通过加权平均实现))
  • 当迭代 Batch size 改变 \(c\) 倍时,COM 自动改变 \(c\) 倍
  • 而 PPO 的 Clip 参数 \(\epsilon\) 和 KL 系数 \(\beta\) 是固定的绝对数值 ,它们不会随着 Batch size 的变化而自动缩放
  • 同样的 \(\epsilon=0.2\),在大 Batch size 下可能意味着“限制极严”,在小 Batch size 下却可能意味着 “几乎没有限制”
  • 为什么 PPO-EWMA 能实现不变性?
    • PPO-EWMA 强行将“近端策略”与“行为策略”剥离:
      • 行为策略 :依然使用采集数据的 \(\theta_{\text{behav} }\)(只用于 Importance Sampling,无偏估计)
      • 近端策略 :使用独立的 EWMA 网络 \(\theta_{\text{prox} }\)
    • 当迭代 Batch size 改变时,通过调整 EWMA 的衰减率 \(\beta_{\text{prox} }\),使得 \(\theta_{\text{prox} }\) 的质心(COM)在“环境步数”维度上保持恒定
    • 无论采集 256 步还是 1 步就做更新,近端锚点的“物理年龄”始终不变,Clipping/KL 惩罚的力度也就始终不变

关于 PPO-EWMA 中质心的理解

  • “质心(Center of Mass, COM)” 可以想象成一个 “滑动平均窗口的加权年龄”

数学定义与公式拆解(附录 G)

  • 在 PPO-EWMA 中,近端策略网络参数 \(\theta_{\text{prox} }\) 并非等于某一步的旧参数,而是对所有历史参数 \(\theta_0, \theta_1, \dots, \theta_t\) 做指数加权移动平均(EWMA):
    $$
    \theta_{\text{prox} } = \frac{\theta_t + \beta_{\text{prox} } \theta_{t-1} + \beta_{\text{prox} }^2 \theta_{t-2} + \dots + \beta_{\text{prox} }^t \theta_0}{1 + \beta_{\text{prox} } + \beta_{\text{prox} }^2 + \dots + \beta_{\text{prox} }^t}
    $$
    • \(\beta_{\text{prox} }\)(论文默认 0.889)是衰减率,越靠近当前时刻(\(t\))的权重越大,越旧的权重呈指数级衰减
  • 质心的定义公式为:
    $$
    \text{COM}_{\text{prox} } := \lim_{t \to \infty} \frac{0 \cdot 1 + 1 \cdot \beta_{\text{prox} } + 2 \cdot \beta_{\text{prox} }^2 + \dots + t \cdot \beta_{\text{prox} }^t}{1 + \beta_{\text{prox} } + \beta_{\text{prox} }^2 + \dots + \beta_{\text{prox} }^t} = \frac{1}{1 - \beta_{\text{prox} } } - 1
    $$

质心的物理意义

  • 质心代表的是:EWMA 窗口中所有历史参数“平均滞后了多少梯度步”
    • 如果 \(\beta_{\text{prox} } = 0.889\),则 平均滞后 8 步:
      $$ \text{COM} = \frac{1}{1 - 0.889} - 1 \approx 9 - 1 = 8 $$
      • 虽然 EWMA 包含了从 0 到 \(t\) 的所有历史参数,但加权平均后 ,\(\theta_{\text{prox} }\) 的“年龄”大约相当于 8 个梯度步之前的参数
      • 换句话说,当前策略 \(\theta\) 现在正试图将自己拉向“8 步前的自己”
    • 理解:类似滑动平均的那个权重参数的功能

为什么用“质心”而不是直接用“\(\beta\)”?

  • 因为 \(\beta\)(衰减率)是一个抽象且非线性的数值,不直观
  • 而 质心(COM) 的单位是 “梯度步数” ,具有明确的物理意义
  • 当 \(\theta\) 在参数空间中沿直线路径移动时,当前参数与近端参数的差值 \(\theta - \theta_{\text{prox} }\) 与质心(COM)近似成正比
    • 质心越大,\(\theta_{\text{prox} }\) 离 \(\theta\) 越远
    • 质心越小,\(\theta_{\text{prox} }\) 离 \(\theta\) 越近

质心在“批量大小不变性”中的核心作用(原论文第 4 节)

  • 问题 :当把迭代 Batch size(每次采集的数据量)缩小 \(c\) 倍时,在相同的环境步数内,执行的梯度更新次数会变多 \(c\) 倍
  • 后果 :如果质心(COM)不动(仍为 8 步),那么质心对应的 真实环境步数 就从原来的 \(8 \times \text{ 旧 Batch Size}\) 变成了 \(8 \times \text{ 新 Batch Size}\)
    • 质心越长,近端策略越老,PPO 比值差异越大
  • 解决方案 :为了维持 “以环境步数衡量的近端策略年龄” 不变,你需要 将质心乘以 \(c\) (即拉长质心的梯度步数)
  • 公式调整 :
    • 当 Batch size 除以 \(c\) 时,必须调整 \(\beta_{\text{prox} }\),使得:
      $$
      \text{COM}_{\text{new} } = \text{COM}_{\text{old} } \times c
      $$
    • 例如原来 COM=8(步),Batch size 缩小了 256 倍(\(c=256\)),必须把 COM 调整为 \(8 \times 256 = 2048\)(步)
      • 这意味着 EWMA 现在要平均过去 2048 步的参数,才能在 环境时间维度 上对应于原来 8 步的跨度

质心与 KL 惩罚系数的“等效互换性”

  • 论文在附录 G 中通过热力图(图 18)证明了一个非常优雅的结论:
    • 在局部范围内,将质心(COM)减半,与将 KL 惩罚系数(\(\beta\))加倍,效果是完全等价的。
  • 直观上看:两者都在控制离开当前参考策略的幅度
    • KL 散度的梯度 \(\nabla_\theta \text{KL}[\pi_{\theta_{\text{prox} } }, \pi_\theta]\) 在局部近似为 \((\theta - \theta_{\text{prox} })\) 的线性函数
    • 而 \(\theta - \theta_{\text{prox} } \propto \text{COM}\)

质心调整为什么不能无限拉长?

  • 问题:既然质心越长,近端策略越老,那为了稳定,直接把 COM 设为无限大(\(\beta \to 1\))不就好了吗?
  • 答案是 不行 ,质心只能在局部范围内等效互换
    • 当把 COM 连续减半(对应连续加倍 KL 系数)时,性能会逐渐退化
  • 理解:
    • 信噪比降低 :当 \(k\)(滞后步数)增大时,\(\theta_t - \theta_{t-k}\) 的信号-噪声比会降低
      • 用极度陈旧的锚点来做约束,会引入过时的梯度干扰,最终无法通过单纯增大 KL 系数来弥补
      • 理解:很早前的策略可能是随机策略,约束到这个锚点是不健康的(相当于添加了很多噪声)
    • 即使很早以前的策略不是随机策略,也只是适配当时数据分布的策略,不适配当前数据
1…132133134…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4