- 参考链接:
- 原始论文:(Decoupled PPO, Decoupled Policy Objectives)Batch size-invariance for policy optimization, 20220924, OpenAI
- 后来补充:后续很多文章或者博客一般都会称这篇文章为 Decoupled PPO 或 Decoupled Policy Objectives
整体总结
- 在 RL 的策略优化算法中(如 PPO),算法的稳定性和可靠性通常依赖于对策略更新幅度的控制(通过 Trust Region 或 Surrogate Objective)
- 传统理论认为,限制更新幅度是为了“不让当前策略偏离用于采集经验的策略(即 Behavior Policy,行为策略)太远”
- 作者的核心观点:
- 这种传统解释存在细微缺陷
- 真正重要的并非“行为策略”本身,而是控制策略更新的 速度 (即近似 Natural Policy Gradient)
- 论文的 Insight:
- 在 PPO 中,“旧策略”承担了两个相互独立的职责(行为策略和近端策略),但一直被混为一谈
- 通过 解耦(Decoupling) 这两个职责,不仅提升了算法对陈旧数据的利用效率,还实现了 RL 算法中极为实用的“批次大小不变性(Batch size-invariance)”
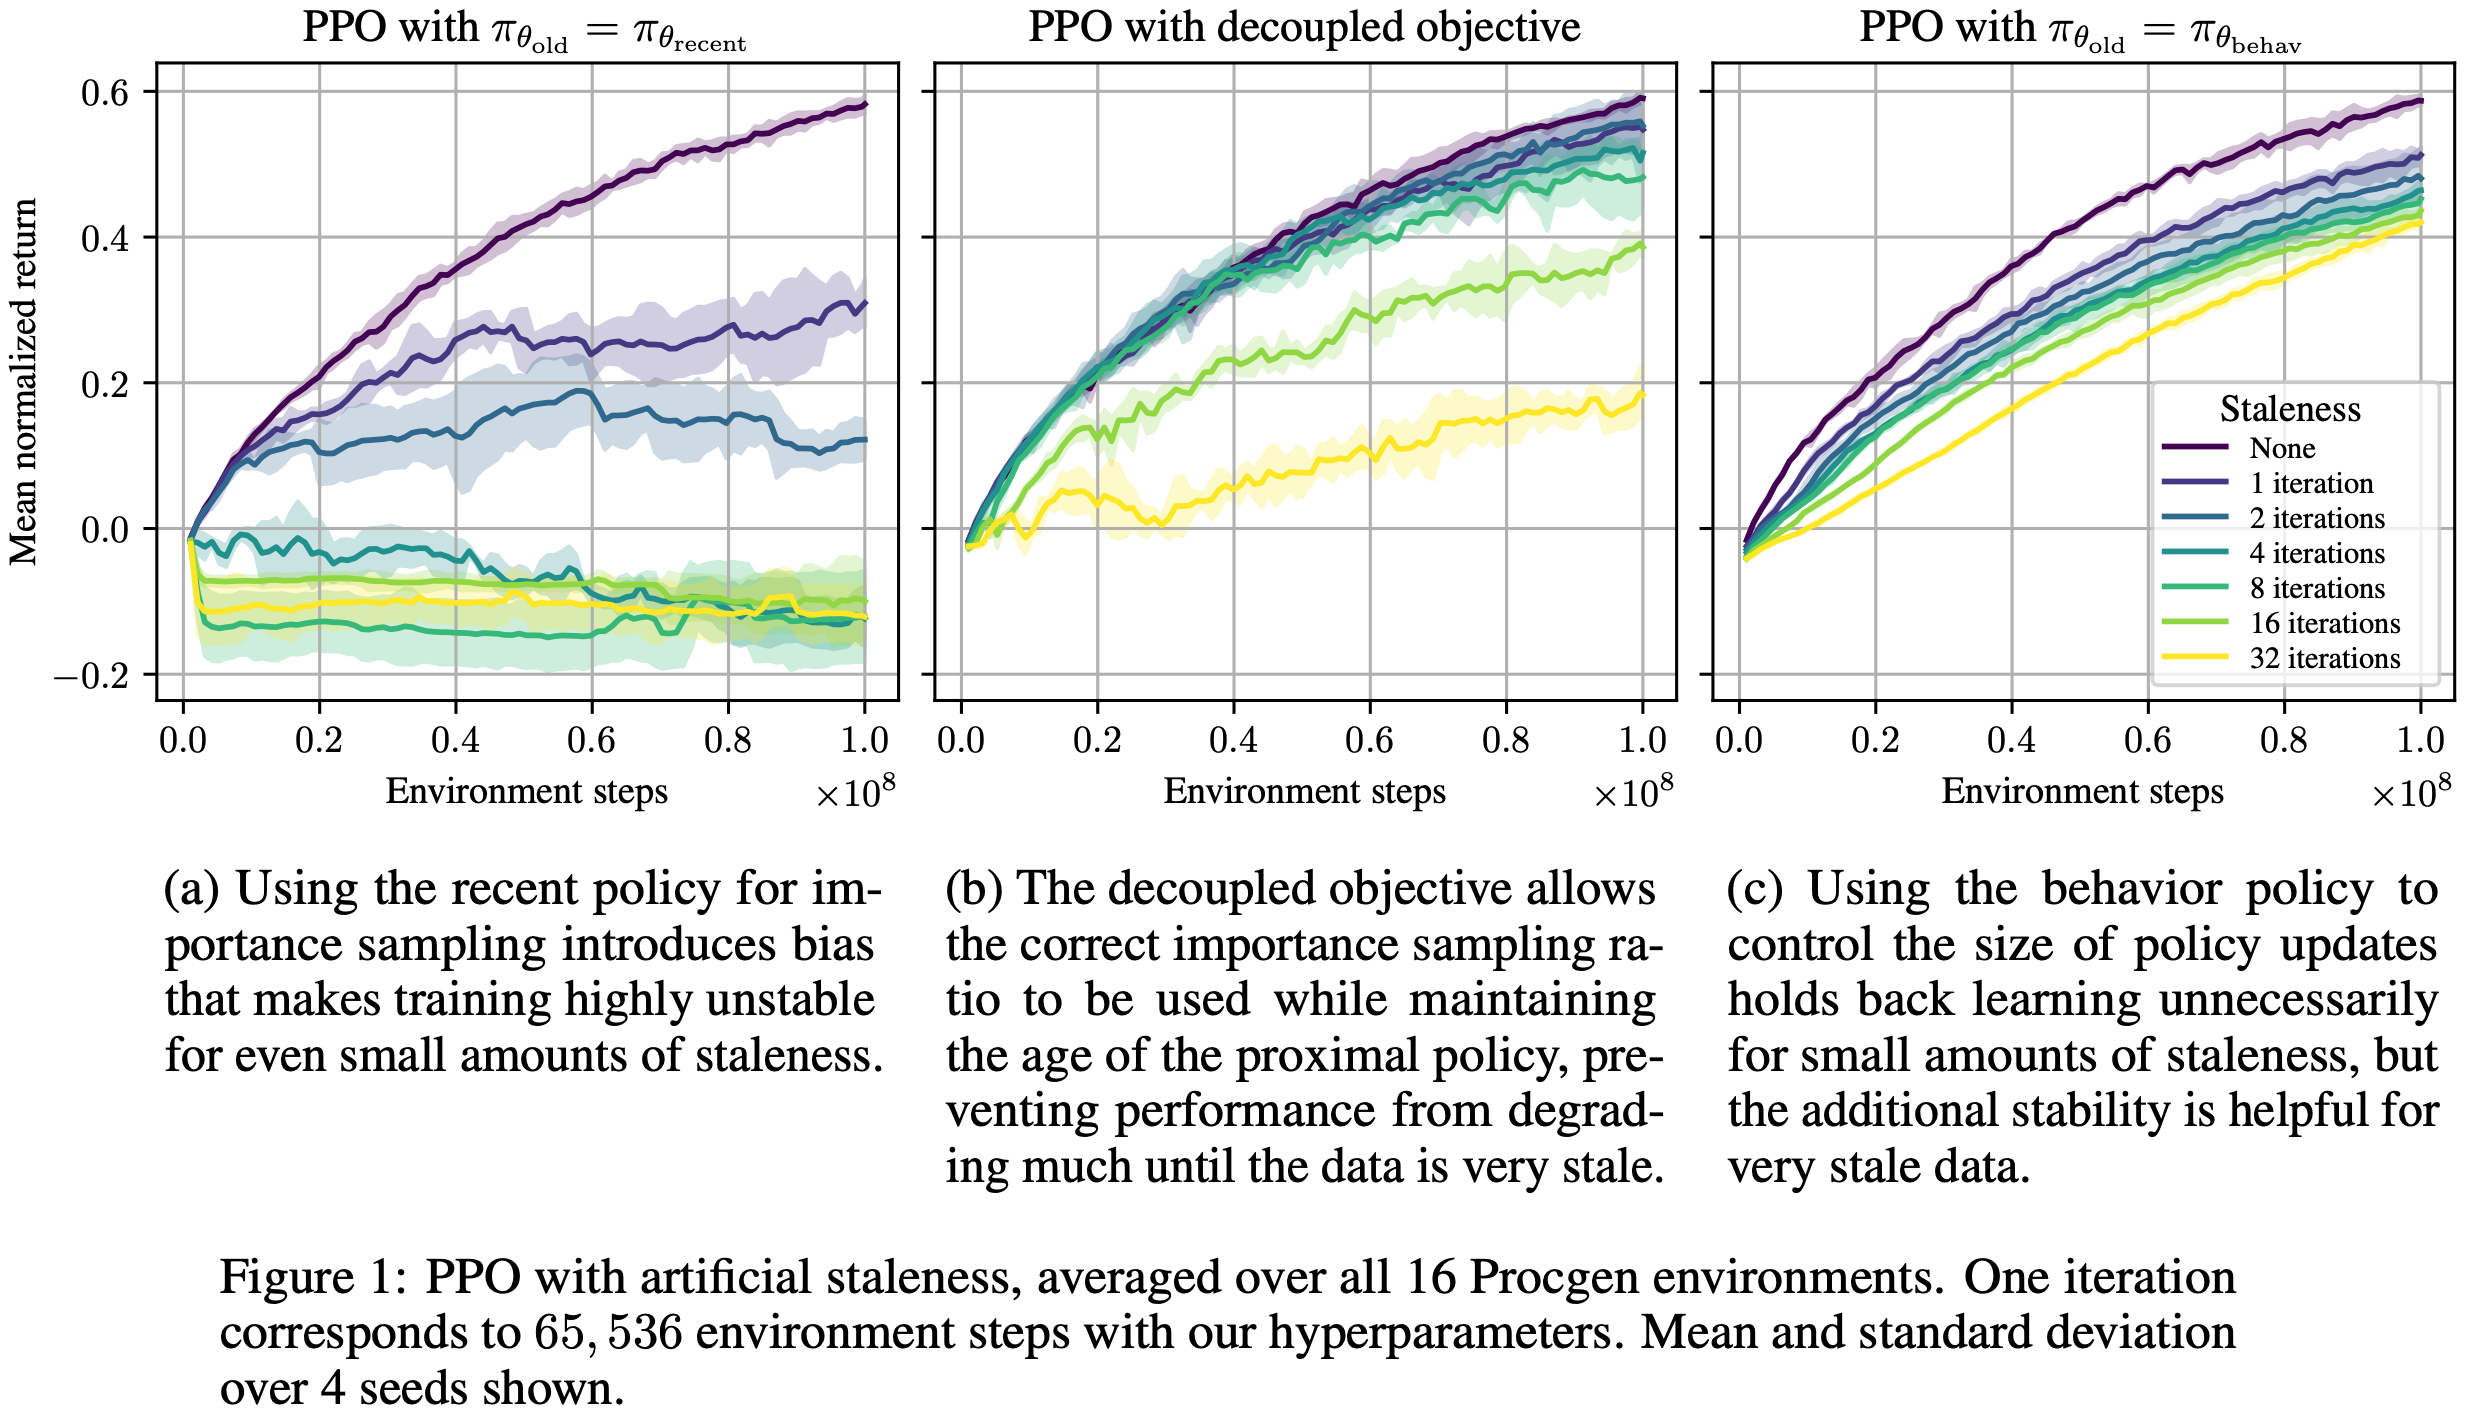
- 不同方法的对比如下:
- 图 a:使用当前策略作为旧策略,效果最差,微弱的 off-policy 都会造成极大的性能损耗
- 理解:丢失了 off-policy 的的修正,梯度是有偏的
- 图 b:使用 decoupled policy objective 策略
- 理解:在较小的 陈旧性 下,几乎无损
- 图 c:使用行为策略作为旧策略,在小陈旧性时性能不如 Decoupled
- 理解:在较小的 陈旧性 下,就开始有损,效果不如 图 b 使用 decoupled policy objective 策略的情况
- 异常现象:在很大的陈旧性下,图 c 的效果反而更好
- 个人理解:
- 可能是因为极端陈旧性下,分开策略会导致当前策略还从未被采样过就被用于作为 Proximal 策略,这会导致模型更新比较极端(激进)
- 这也不符合 Trust Region 方法的思路(Trust Region 方法要求策略贴近行为策略来更新,不能离开行为策略太远)
- 论文中会用 Natural Policy Gradient 方法来解释 PPO,Natural Policy Gradient 方法下,靠近行为策略并不重要 ,重要的是不要移动得太快(即靠近某个“近期策略”)
- 但是 图 c 的这种使用行为策略作为旧策略的方式相当于更保守的策略,让模型更新的更慢一些(KL 散度限制在行为策略上)
- 论文中也提到,这种方法更贴近与 Trust Region 方法
- 论文中也提到,这种方法更贴近与 Trust Region 方法
- 可能是因为极端陈旧性下,分开策略会导致当前策略还从未被采样过就被用于作为 Proximal 策略,这会导致模型更新比较极端(激进)
- 个人理解:
- 图 a:使用当前策略作为旧策略,效果最差,微弱的 off-policy 都会造成极大的性能损耗
PPO 中“旧策略”的双重角色
- 在标准的 PPO 中,参数为 \(\theta_{\text{old} }\) 的旧策略被用于两个目的:
- 1)行为策略(Behavior Policy, \(\color{blue}{\pi_{\theta_{\text{behav} } }}\)) :
- 用于与环境交互采样。在 Importance Sampling 中,必须使用该策略来保证梯度估计的无偏性
- 2)近端策略(Proximal Policy, \(\color{red}{\pi_{\theta_{\text{prox} } }}\)) :
- 作为一个“锚点”,通过 KL 散度惩罚或 Clipping 机制将当前策略拉向该策略,从而控制更新幅度
- 1)行为策略(Behavior Policy, \(\color{blue}{\pi_{\theta_{\text{behav} } }}\)) :
- 作者的 Insight
- 近端策略不一定非要是行为策略
- 只要近端策略足够“新”(Recent),它能起到控制更新速度的作用,而不必关心它是否被用于采样
Decoupled Policy Objectives 方法
Decoupled KL Penalized Objective
- 原始 KL 惩罚目标为(其中 \(\hat{A}_t\) 是优势函数估计器):
$$
L^{\text{KLPN} }(\theta) := \hat{\mathbb{E} }_{t}\left[\frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\theta_{\text{old} } }(a_t \mid s_t)}\hat{A}_t - \beta \text{KL}\left[\pi_{\theta_{\text{old} } }(\cdot \mid s_t), \pi_{\theta}(\cdot \mid s_t)\right]\right]
$$ - 将其解耦为:
$$
L_{\text{decoupled} }^{\text{KLPN} }(\theta) := \hat{\mathbb{E} }_{t}\left[\frac{\pi_{\theta}(a_t \mid s_t)}{\color{blue}{\pi_{\theta_{\text{behav} } }}(a_t \mid s_t)}\hat{A}_t - \beta \text{KL}\left[\color{red}{\pi_{\theta_{\text{prox} } }}(\cdot \mid s_t), \pi_{\theta}(\cdot \mid s_t)\right]\right]
$$- 第一个分式的分母必须使用 \(\color{blue}{\pi_{\theta_{\text{behav} } }}\)(用于 Importance Sampling 纠偏)
- KL 散度项则使用独立的 \(\color{red}{\pi_{\theta_{\text{prox} } }}\)
Decoupled Clipped Objective
- 标准的 Clipped 目标为:
$$
\begin{align}
L^{\text{CLIP} }(\theta) &:= \hat{\mathbb{E} }_{t}\left[\min \left(r_t(\theta)\hat{A}_t, \text{clip}\left(r_t(\theta), 1 - \epsilon, 1 + \epsilon\right)\hat{A}_t\right)\right] \\
r_t(\theta) &= \frac{\pi_{\theta} }{\pi_{\theta_{\text{old} } } }
\end{align}
$$ - 为了解耦,重新改写目标,令 Behavior 和 Prox 分离
- 令 \(r_t(\theta) = \frac{\pi_{\theta} }{\color{red}{\pi_{\theta_{\text{prox} } }} }\),则解耦后的 Clipped 目标为:
$$
\begin{align}
L_{\text{decoupled} }^{\text{CLIP} }(\theta) &:= \hat{\mathbb{E} }_{t}\left[\frac{\color{red}{\pi_{\theta_{\text{prox} } }} }{\color{blue}{\pi_{\theta_{\text{behav} } }} }\min \left(r_t(\theta)\hat{A}_t, \text{clip}\left(r_t(\theta), 1 - \epsilon, 1 + \epsilon\right)\hat{A}_t\right)\right] \\
r_t(\theta) &= \frac{\pi_{\theta} }{\color{red}{\pi_{\theta_{\text{prox} } }} }
\end{align}
$$- 这里的前置系数 \(\frac{\color{red}{\pi_{\theta_{\text{prox} } }} }{\color{blue}{\pi_{\theta_{\text{behav} } }} }\) 是为了补偿因替换策略引起的概率分布偏移,确保 Importance Sampling 仍针对 Behavior Policy 进行
实现批次大小不变性的具体方案:PPO-EWMA 和 PPG-EWMA
批次大小不变性(Batch size-invariance)的概念
- 原始论文中定义:
- 如果改变 Batch size 后,可以通过调整其他超参数来大致恢复原始的训练行为(以处理的样本总数作为横轴),则该算法具有批次大小不变性
- 例如:Batch size 翻倍,则训练步数减半,使得训练行为大致不变
- 问题:原始的 PPO 为什么不满足 Batch size-invariance?
- 主要是因为没有固定 Proximal 策略的情况下,批次变化后 PPO 的 Proximal 一直在变化,是无法通过调整其他超参数做到批次大小不变性的,详情见本文附录部分
- 如果改变 Batch size 后,可以通过调整其他超参数来大致恢复原始的训练行为(以处理的样本总数作为横轴),则该算法具有批次大小不变性
- 在 RL 中,存在两种 Batch size:
- Optimization batch size :每次梯度更新使用的环境步数
- 这个相当于一次梯度更新的样本数
- Iteration batch size :每次采样与优化交替之间的环境步数
- 这个相当于 Rollout 的样本数
- Optimization batch size :每次梯度更新使用的环境步数
- 为了让整个 PPO 具备不变性,两者必须同时按相同比例变化(即改变数据并行度)
核心工程组件:PPO-EWMA(指数加权移动平均)
- 为了解决“近端策略”需要是“近期策略”但存储所有历史副本代价过高的问题,论文引入了 EWMA(Exponentially-Weighted Moving Average)
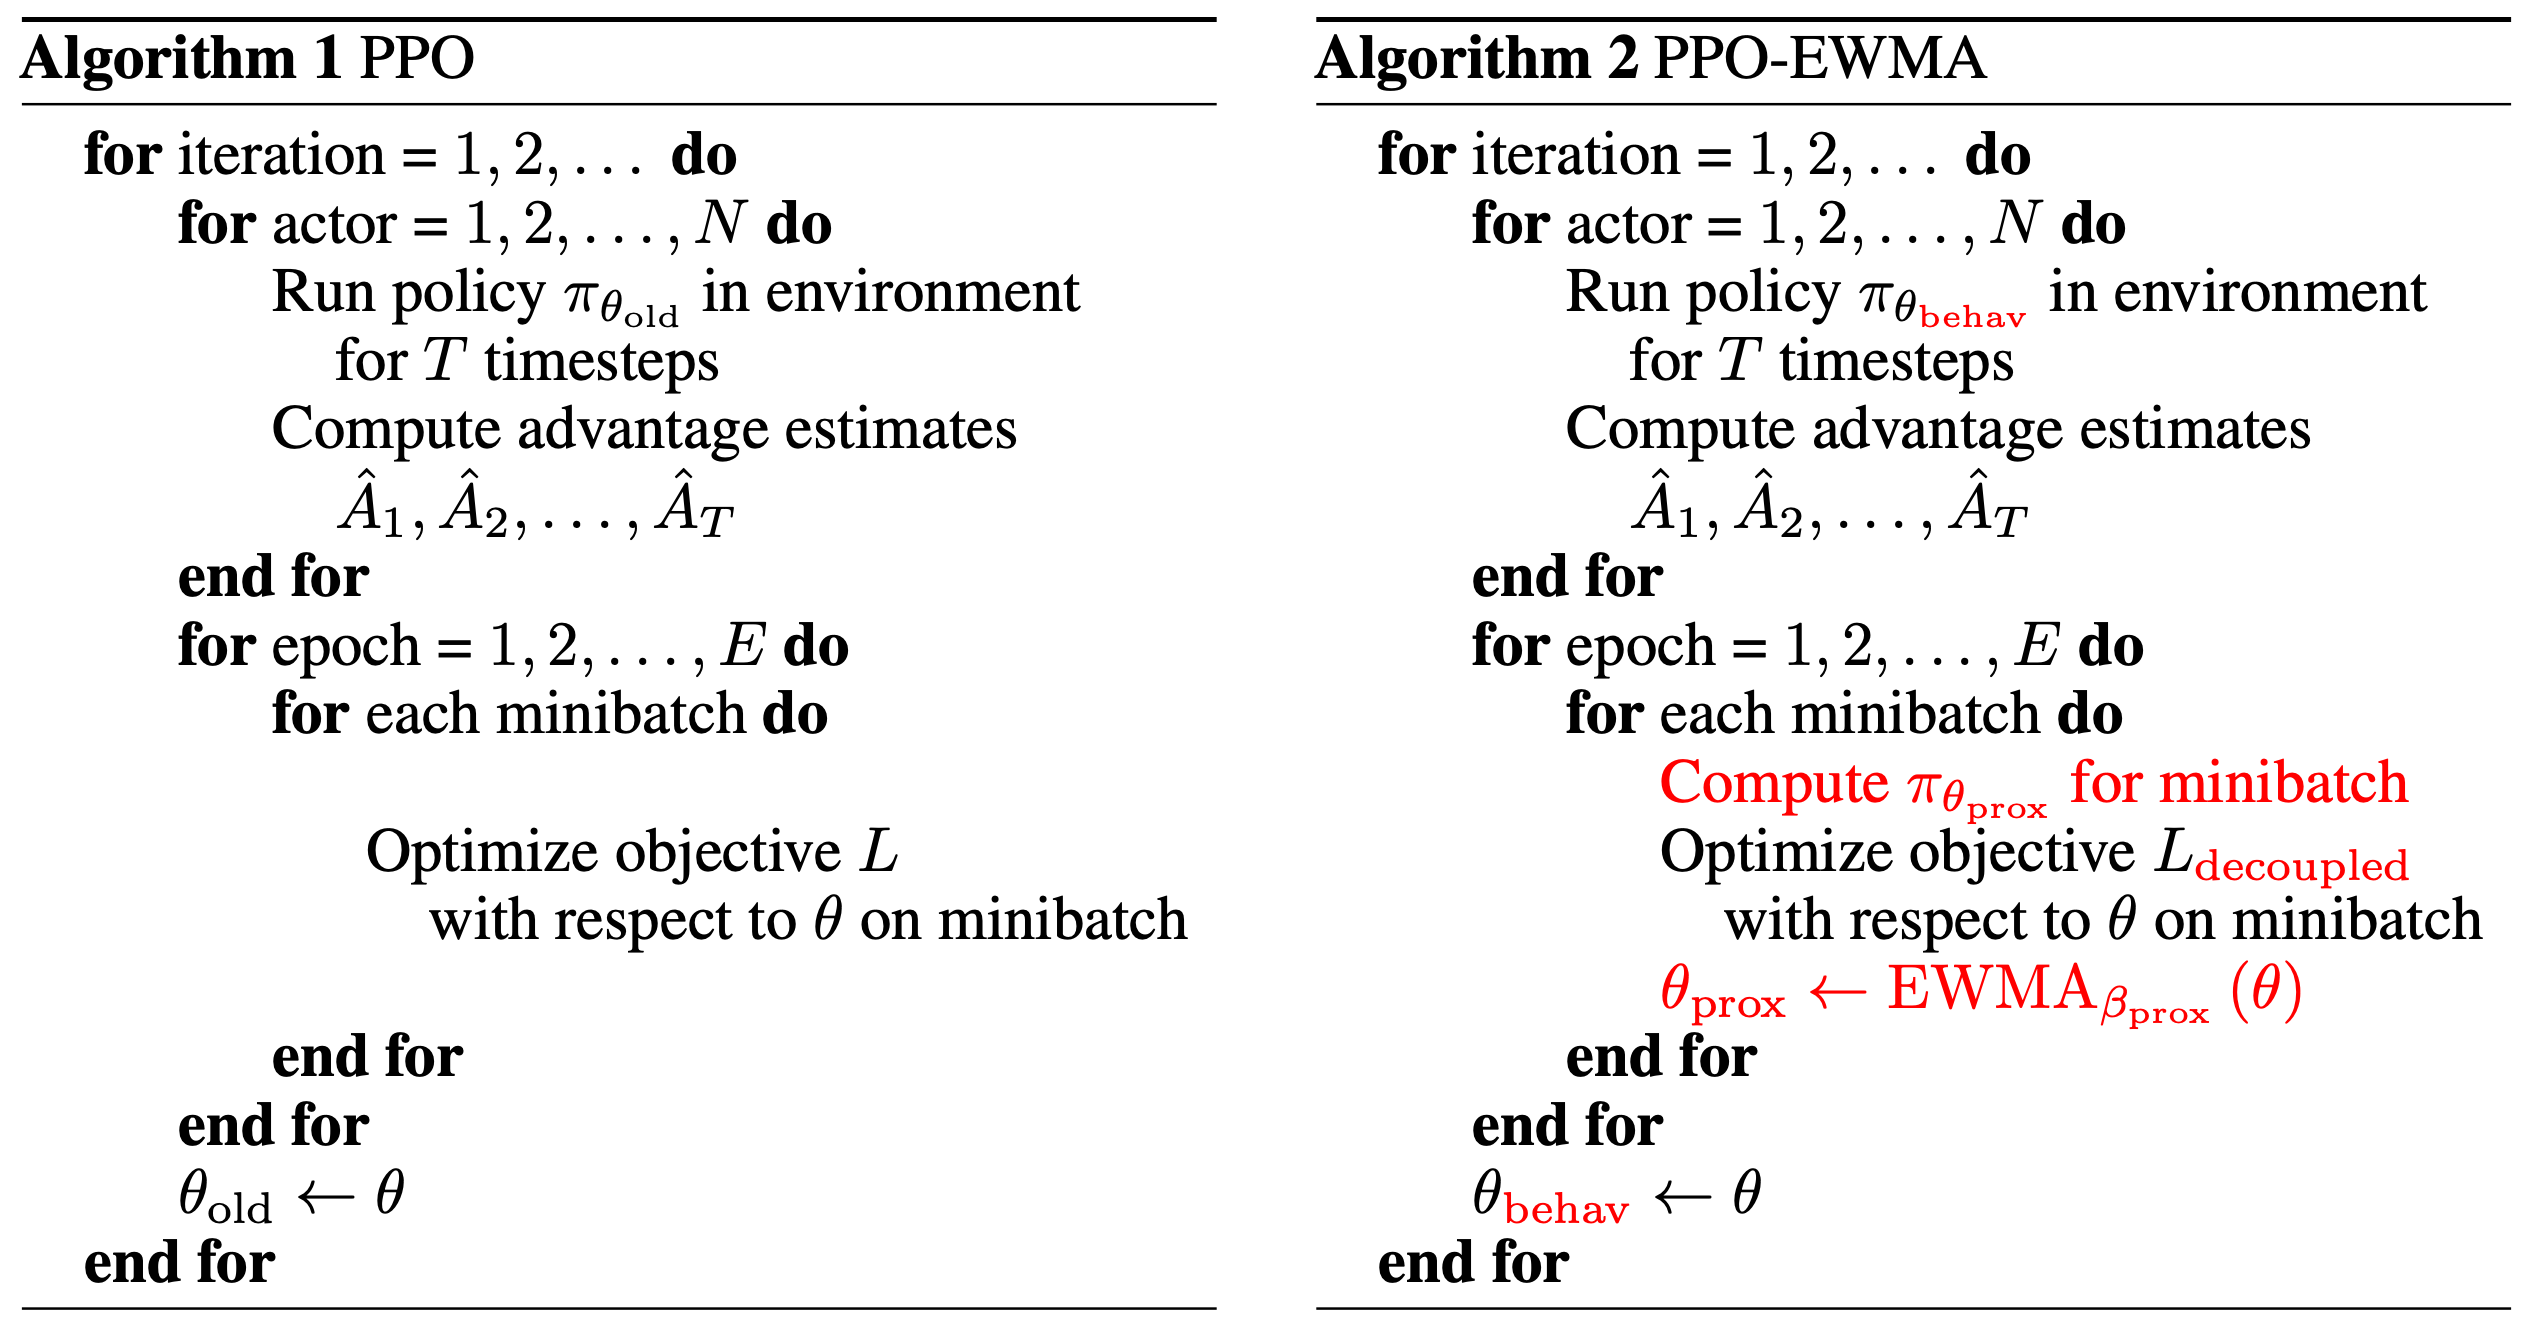
- PPO-EWMA 方法流程 :
- 1)初始化策略网络参数 \(\theta\),近端策略参数 \(\theta_{\text{prox} }\)
- 2)在每次梯度更新后,不直接将 \(\theta_{\text{prox} }\) 赋值为 \(\theta\),而是执行软更新:
$$
\theta_{\text{prox} } \gets \text{EWMA}_{\beta_{\text{prox} } }(\theta)
$$- 具体计算方式为维护权重 \(w\),每次更新时:
$$
\begin{align}
w_{\text{new} } &\gets 1 + \beta_{\text{prox} } w \\
\theta_{\text{prox} } &\gets \frac{1}{w_{\text{new} } } \theta + \beta_{\text{prox} } \frac{w}{w_{\text{new} } } \theta_{\text{prox} } \\
w &\gets w_{\text{new} }
\end{align}
$$
- 具体计算方式为维护权重 \(w\),每次更新时:
- 3)将更新后的 \(\theta_{\text{prox} }\) 作为解耦目标中的近端策略使用
- 设计思路 :EWMA 的质心(Center of Mass,\(\text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1\))代表了近端策略的平均 “Age”(以梯度步数计)
- 通过调整 \(\beta_{\text{prox} }\),可以在不保存旧模型的情况下,精确控制该 Age
实现完全 Batch size-invariance 的超参数调整规则
- 当优化 Batch size 和迭代 Batch size 同时除以常数 \(c\)(即并行度减少,Batch size 变小)时,为了维持训练动态不变,需要执行以下四步调整法(按重要性排序):
- 1)调整优化器步长(最重要) :
- 论文使用 Adam 优化器
- 由于 Adam 除以了梯度 Root Mean Square 的估计值,其有效学习率自动缩放
- 因此,为了补偿 Batch size 缩小 \(c\) 倍,Adam 的 Step size \(\alpha\) 需除以 \(\sqrt{c}\)(对应 SGD 则是除以 \(c\))
- 理解:Batch size 越小,学习率应该越小,详细推导见附录
- 论文通过附录 C 的公式推导(\(\text{Denominator} \propto 1/\sqrt{n}\))证明了这一点
- 2)调整 EWMA 质心(保持近端策略 Age ) :
- 调整 \(\beta_{\text{prox} }\),使得 \(\text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1\) 乘以 \(c\)
- 以环境步数衡量的近端策略 “Age” 保持不变
- 3)调整优势归一化(Advantage Normalization) :
- 如果使用了优势归一化,需要将用于估计优势均值和方差的迭代次数乘以 \(c\)(即使用更长的 EWMA 估计期),以防止小 Batch size 下估计方差过大
- 优势归一化的实现一般是滑动窗口或滑动平均
- 对应滑动窗口时,这里的意思就是把滑动窗口加大 c 倍
- 优势归一化的实现一般是滑动窗口或滑动平均
- 如果使用了优势归一化,需要将用于估计优势均值和方差的迭代次数乘以 \(c\)(即使用更长的 EWMA 估计期),以防止小 Batch size 下估计方差过大
- 4)调整 PPG 特定参数 :
- 对于 PPG(Phasic Policy Gradient),需将每个阶段(Phase)的策略迭代次数 \(N_{\pi}\) 乘以 \(c\),以保持阶段 Batch size 恒定
- 1)调整优化器步长(最重要) :
- 最终的 PPO-EWMA 算法:
实验
实验一:Artificial Staleness 实验
- 目的 :通过 人工陈旧性 实验验证解耦近端策略的有效性
- 方法 :将采集的数据延迟固定的迭代次数后再用于训练
- 结果 :
- 若使用原始 PPO 目标(无论选择最近策略还是行为策略作为旧策略),极小的陈旧性都会导致性能剧烈下降(图 1)
- 使用解耦目标(\(\pi_{\text{behav} }\) 用于采样率,\(\pi_{\text{prox} }\) 采用近期策略)后,算法对陈旧性表现出惊人的鲁棒性,直到陈旧性达到约 8 次迭代(500W 环境步)才出现明显退化
- 结论:明确证明了解耦可以安全地利用陈旧数据
实验二:批次大小不变性验证(核心实验)
- 设置 :将并行环境数从默认的 256 个逐步减少到 1 个(Batch size 缩小 256 倍),并应用上述四步调整法
- 结果(图 2 & 图 3):
- 实现了高度的批次大小不变性
- 最大 Batch size 与最小 Batch size 之间的最终归一化回报差异仅为 0.052
- 除去单个异常环境(Heist),差异缩小至 0.019
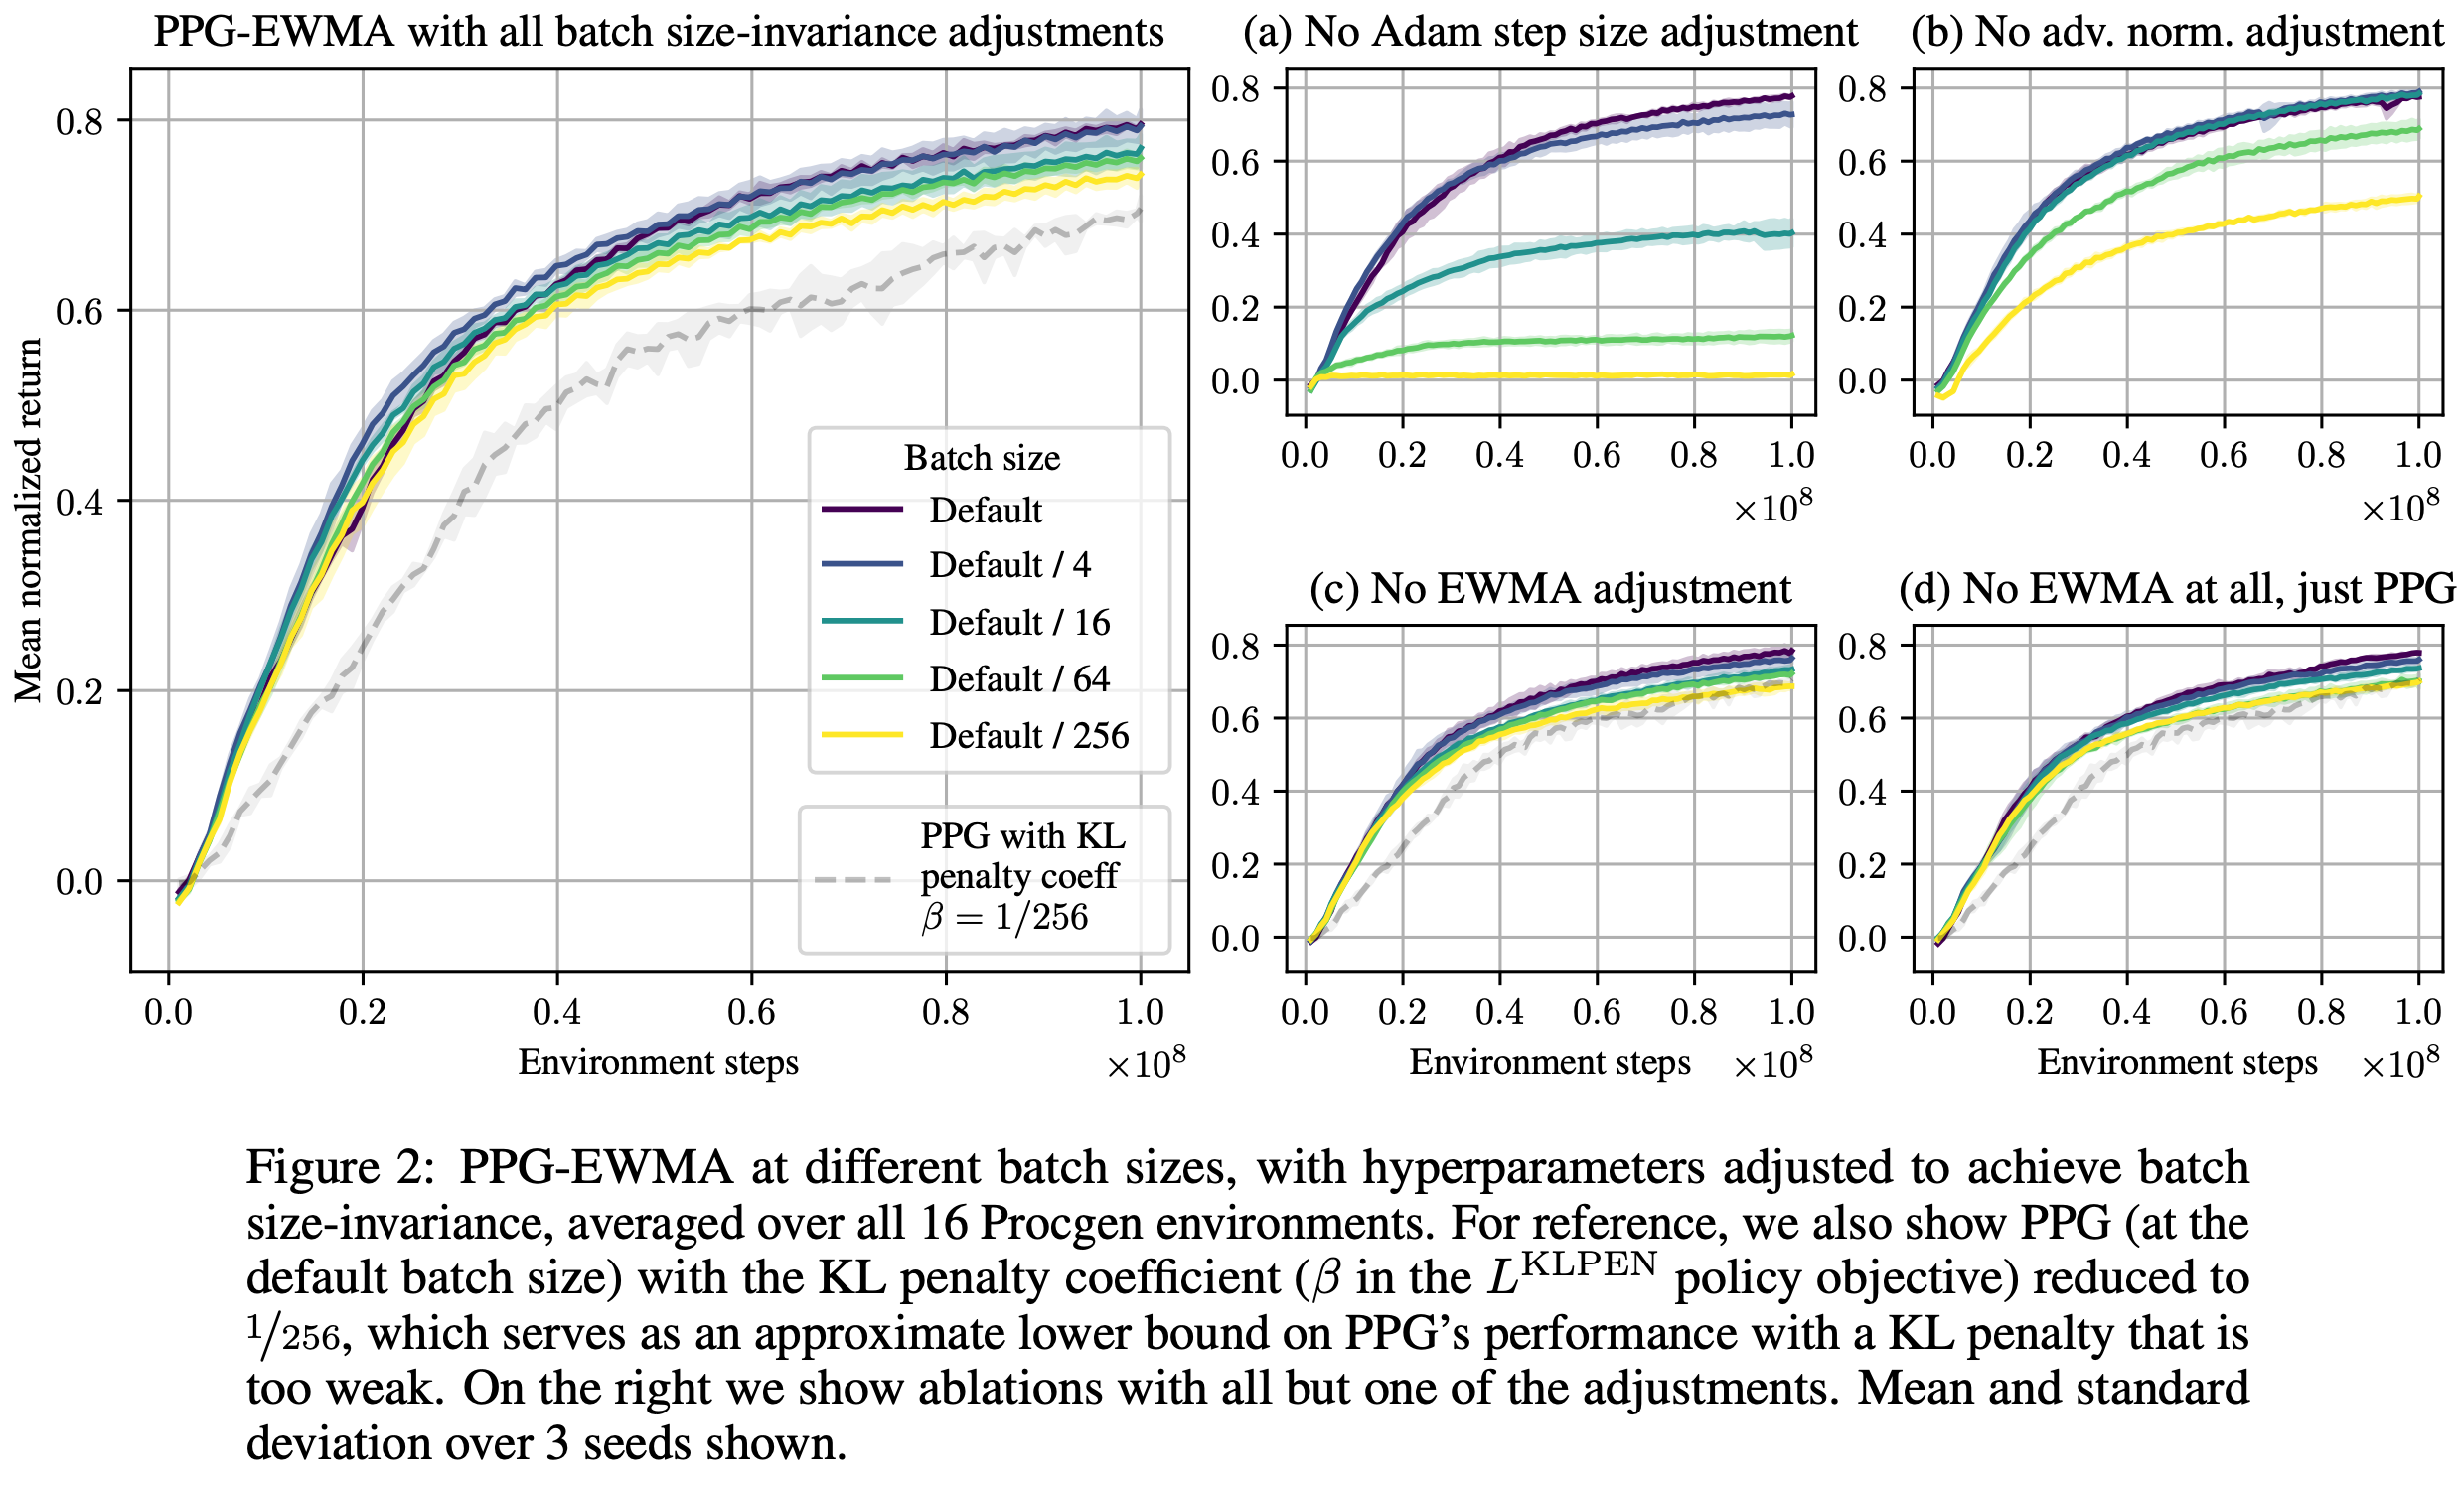
- 消融实验重要性排名(附录 E 表 5):
- 1)Adam Step size 调整(最致命) :没有它,小 Batch size 训练极度不稳定(Z-score > 6.8)
- 2)优势归一化调整 :在大 Batch size 下不重要,但在极小 Batch size 下至关重要(尤其当优势标准差估计振荡超过 10 倍时)
- 3)EWMA 调整 :在所有规模下都有轻微影响(因为 PPG 对 KL 惩罚本身较鲁棒)
实验三:EWMA 的直接收益对比
- 对比 :PPO vs PPO-EWMA,PPG vs PPG-EWMA
- 结果(图 4):
- EWMA 带来的提升虽小但在所有 16 个 Procgen 环境中异常一致且稳定(在最后 8 个未用于调参的环境上全部优于基线)
- 作者推测收益来源于 EWMA 降低了近端策略的方差(进一步证据见附录 G)
- 代价是增加 30%(PPO)或 2.3%(PPG)的计算开销(主要是额外的 Forward Pass),但不包括环境交互成本
补充:论文的其他观点
PPO 应被视为 Natural Policy Gradient 方法
- 传统观点认为 PPO 近似 Trust Region(信任域)
- Trust Region 要求策略靠近行为策略
- 但本论文的实验表明,靠近行为策略并不重要 ,重要的是不要移动得太快(即靠近某个“近期策略”)
- 论文提出将 PPO 重新解释为 Natural Policy Gradient 方法
- 其核心是在“策略改变量”固定的情况下,最大化性能提升效率
- 个人不同观点:从 超大陈旧性下 靠近行为策略更重要来看(图 1c vs 图 1b),我认为 PPO 还是更贴近 Trust Region 方法
针对小 Batch size 场景的实战建议
- 当计算资源受限(必须使用极小 Batch size)且无法预先在大 Batch size 上调参时,论文给出以下建议:
- 1)优先精调学习率(Adam Step size) ,并遵循 \(\sqrt{c}\) 缩放法则
- 2)优先将 Policy Epochs 设为 1(尤其在迭代 Batch size 很小时,多轮 Epoch 只是重复拟合相同数据,收益低)
- 3)监控 Clipping 比例 :
- 若被截断的比例远小于 1%,应增大迭代 Batch size 或使用高 \(\beta_{\text{prox} }\) 的 PPO-EWMA
- 若远大于 10%(单 Epoch)或 20%(多 Epoch),则学习率过高
- 4)监控优势标准差估计 :若振荡超过 10 倍,应使用更多迭代数据进行归一化
Adam 超参数调整
- Adam 的 \(\beta_1, \beta_2\) 调整 :
- 理论上 Batch size 缩小时需将 \(\beta\) 提升至 \(1/c\) 次幂,但实验证明在大多数环境中该调整影响不大(Heist 环境的异常表现无法通过调整 \(\beta\) 解决)
- KL 惩罚与 EWMA 质心的等效性(附录 G):原始论文通过热力图证明,将 EWMA 质心(\(\text{COM}_{\text{prox} }\))减半与将 KL 惩罚系数 \(\beta\) 加倍的效果基本等价(局部范围内),这验证了控制近端策略 “Age” 就是控制更新力度的核心直觉
附录:学习率与 Batch Size 的关系(SGD 和 Adam 下)
- 详细推导见原始论文原文
- 核心:调整优化器步长的理论依据来源于 SGD 与 Adam 在应对梯度噪声时的根本性数学差异
- 核心思路是不允许梯度方差提升太多
- 符号设定:
- \(n\):当前的 Batch size
- \(c\):Batch size 缩小的倍数(即新 Batch size 为 \(n/c\))
- \(g\):当前 Mini-batch 计算出的梯度向量
- \(\mu = \mathbb{E}[g]\):梯度的真实期望(信号)
- \(\sigma^2 = \text{Var}(g)\):梯度的方差(噪声)
- \(\alpha\):学习率
SGD 的线性调整(除以 \(c\))
- 推导逻辑(基于 SDE 离散化) :
- SGD 的更新规则为:
$$
\theta_{t+1} = \theta_t - \alpha \cdot g
$$ - 其中
$$ g = \frac{1}{n} \sum_{i=1}^n \nabla L(\theta; x_i)$$ - 根据中心极限定理,Mini-batch 梯度的方差 与 Batch size 成反比:
$$
\text{Var}(g) \propto \frac{1}{n}
$$ - 当 Batch size 缩小 \(c\) 倍(变为 \(n/c\))时,梯度的方差会放大 \(c\) 倍
- 为了保持单位样本处理量下的参数更新轨迹一致(即随机微分方程 SDE 的扩散项系数不变),学习率 \(\alpha\) 必须相应缩小 \(c\) 倍,以抵消方差放大带来的随机游走增量
- SGD 的更新规则为:
- 结论公式 :
$$
\alpha_{\text{new} } = \frac{\alpha_{\text{old} } }{c}
$$ - 直观理解 :数据少了,梯度噪声大了,步长必须线性地缩小,否则参数会在噪声中随机游走甚至发散
Adam 的平方根调整(除以 \(\sqrt{c}\))(附录 C 核心)
- Adam 与 SGD 不同,它 除以其梯度的 Root Mean Square 滑动估计
- 注:所以 Adam 是平方根法则(\(\sqrt{c}\))而非线性法则(\(c\))
- 第一步:写出 Adam 的有效更新量
- 忽略偏差修正和动量(\(m_t\))的影响,Adam 的单步有效更新量近似为:
$$
\Delta \theta \approx \alpha \cdot \frac{g}{\sqrt{v_t} + \epsilon}
$$- 其中 \(v_t\) 是梯度平方 \(\mathbb{E}[g^2]\) 的指数移动平均(EWMA)
- 在大多数情况下,\(\epsilon\) 极小可以忽略,因此有效更新量约为:
$$
\Delta \theta \approx \alpha \cdot \frac{g}{\sqrt{\mathbb{E}[g^2]} }
$$
- 忽略偏差修正和动量(\(m_t\))的影响,Adam 的单步有效更新量近似为:
- 第二步:将 \(\mathbb{E}[g^2]\) 分解为信号与噪声
- 根据方差定义(\(\text{Var}(g) = \mathbb{E}[g^2] - \mathbb{E}[g]^2\)),有:
$$
\mathbb{E}[g^2] = \mu^2 + \sigma^2
$$ - 引入 McCandlish 等人(2018)定义的梯度噪声尺度(Gradient Noise Scale) \(B\),其逐分量定义为信号与噪声的比值:
$$
B := \frac{\sigma^2}{\mu^2}
$$- 由于方差与 Batch size 成反比(\(\sigma^2 \propto 1/n\)),而信号 \(\mu^2\) 与 Batch size 无关,因此:
$$
\mathbb{E}[g^2] = \mu^2 \left(1 + \frac{B}{n}\right)
$$
- 由于方差与 Batch size 成反比(\(\sigma^2 \propto 1/n\)),而信号 \(\mu^2\) 与 Batch size 无关,因此:
- 根据方差定义(\(\text{Var}(g) = \mathbb{E}[g^2] - \mathbb{E}[g]^2\)),有:
- 第三步:应用“小 Batch size”假设(核心条件)
- 论文的批次大小不变性实验要求 Batch size 足够小 ,即 \(n \ll B\)(远小于临界 Batch size),此时:
$$
\frac{B}{n} \gg 1
$$ - 因此信号项 \(\mu^2\) 被淹没,可以忽略 \(1\),得到:
$$
\mathbb{E}[g^2] \approx \mu^2 \cdot \frac{B}{n} \propto \frac{1}{n}
$$
- 论文的批次大小不变性实验要求 Batch size 足够小 ,即 \(n \ll B\)(远小于临界 Batch size),此时:
- 第四步:将近似结果代入 Adam 更新量
- 开平方得:
$$
\sqrt{\mathbb{E}[g^2]} \propto \frac{1}{\sqrt{n} }
$$ - 将其代回 Adam 的有效更新公式:
$$
\Delta \theta \approx \alpha \cdot \frac{g}{1 / \sqrt{n} } = \alpha \cdot \sqrt{n} \cdot g
$$
- 开平方得:
- 第五步:推导步长缩放公式
- 假设原 Batch size 为 \(n\),步长为 \(\alpha_{\text{old} }\)
- 现在 Batch size 缩小 \(c\) 倍变为 \(n/c\)
- 新的有效更新量为:
$$
\Delta \theta_{\text{new} } \approx \alpha_{\text{new} } \cdot \sqrt{\frac{n}{c} } \cdot g
$$ - 为了保持与原更新量 \(\Delta \theta_{\text{old} } \approx \alpha_{\text{old} } \cdot \sqrt{n} \cdot g\) 一致,必须令:
$$
\alpha_{\text{new} } \cdot \sqrt{\frac{n}{c} } = \alpha_{\text{old} } \cdot \sqrt{n}
$$ - 约去 \(\sqrt{n}\),得到 Adam 的最终调整法则:
$$
\boxed{\alpha_{\text{new} } = \frac{\alpha_{\text{old} } }{\sqrt{c} } }
$$
解释:SGD 和 Adam 为什么会有这种差异?
- SGD :梯度没有自适应分母
- 噪声放大 \(c\) 倍,步长必须缩小 \(c\) 倍来压制噪声
- Adam :其分母(Root Mean Square)在小 Batch 时会自动感知并反映噪声的增大
- 当 Batch size 变小,噪声增大,\(\mathbb{E}[g^2]\) 变大,分母自动变大,已经替我们除以了 \(\sqrt{c}\)
- 所以只需要在步长 \(\alpha\) 上额外再除以 \(\sqrt{c}\),两者合力(自动的 \(\sqrt{c}\) + 手动的 \(\sqrt{c}\))就等效于 SGD 所需的总体除以 \(c\) 的效果
补充说明: 原论文附录 C 的实验验证
- 论文在附录 C 中专门做了一个消融实验(图 5 vs 图 2):
- 如果按照错误的线性法则(除以 \(c\))调整 Adam 的 Step size(图 5),在小 Batch size(Default / 256)下,训练极其不稳定且性能远低于图 2
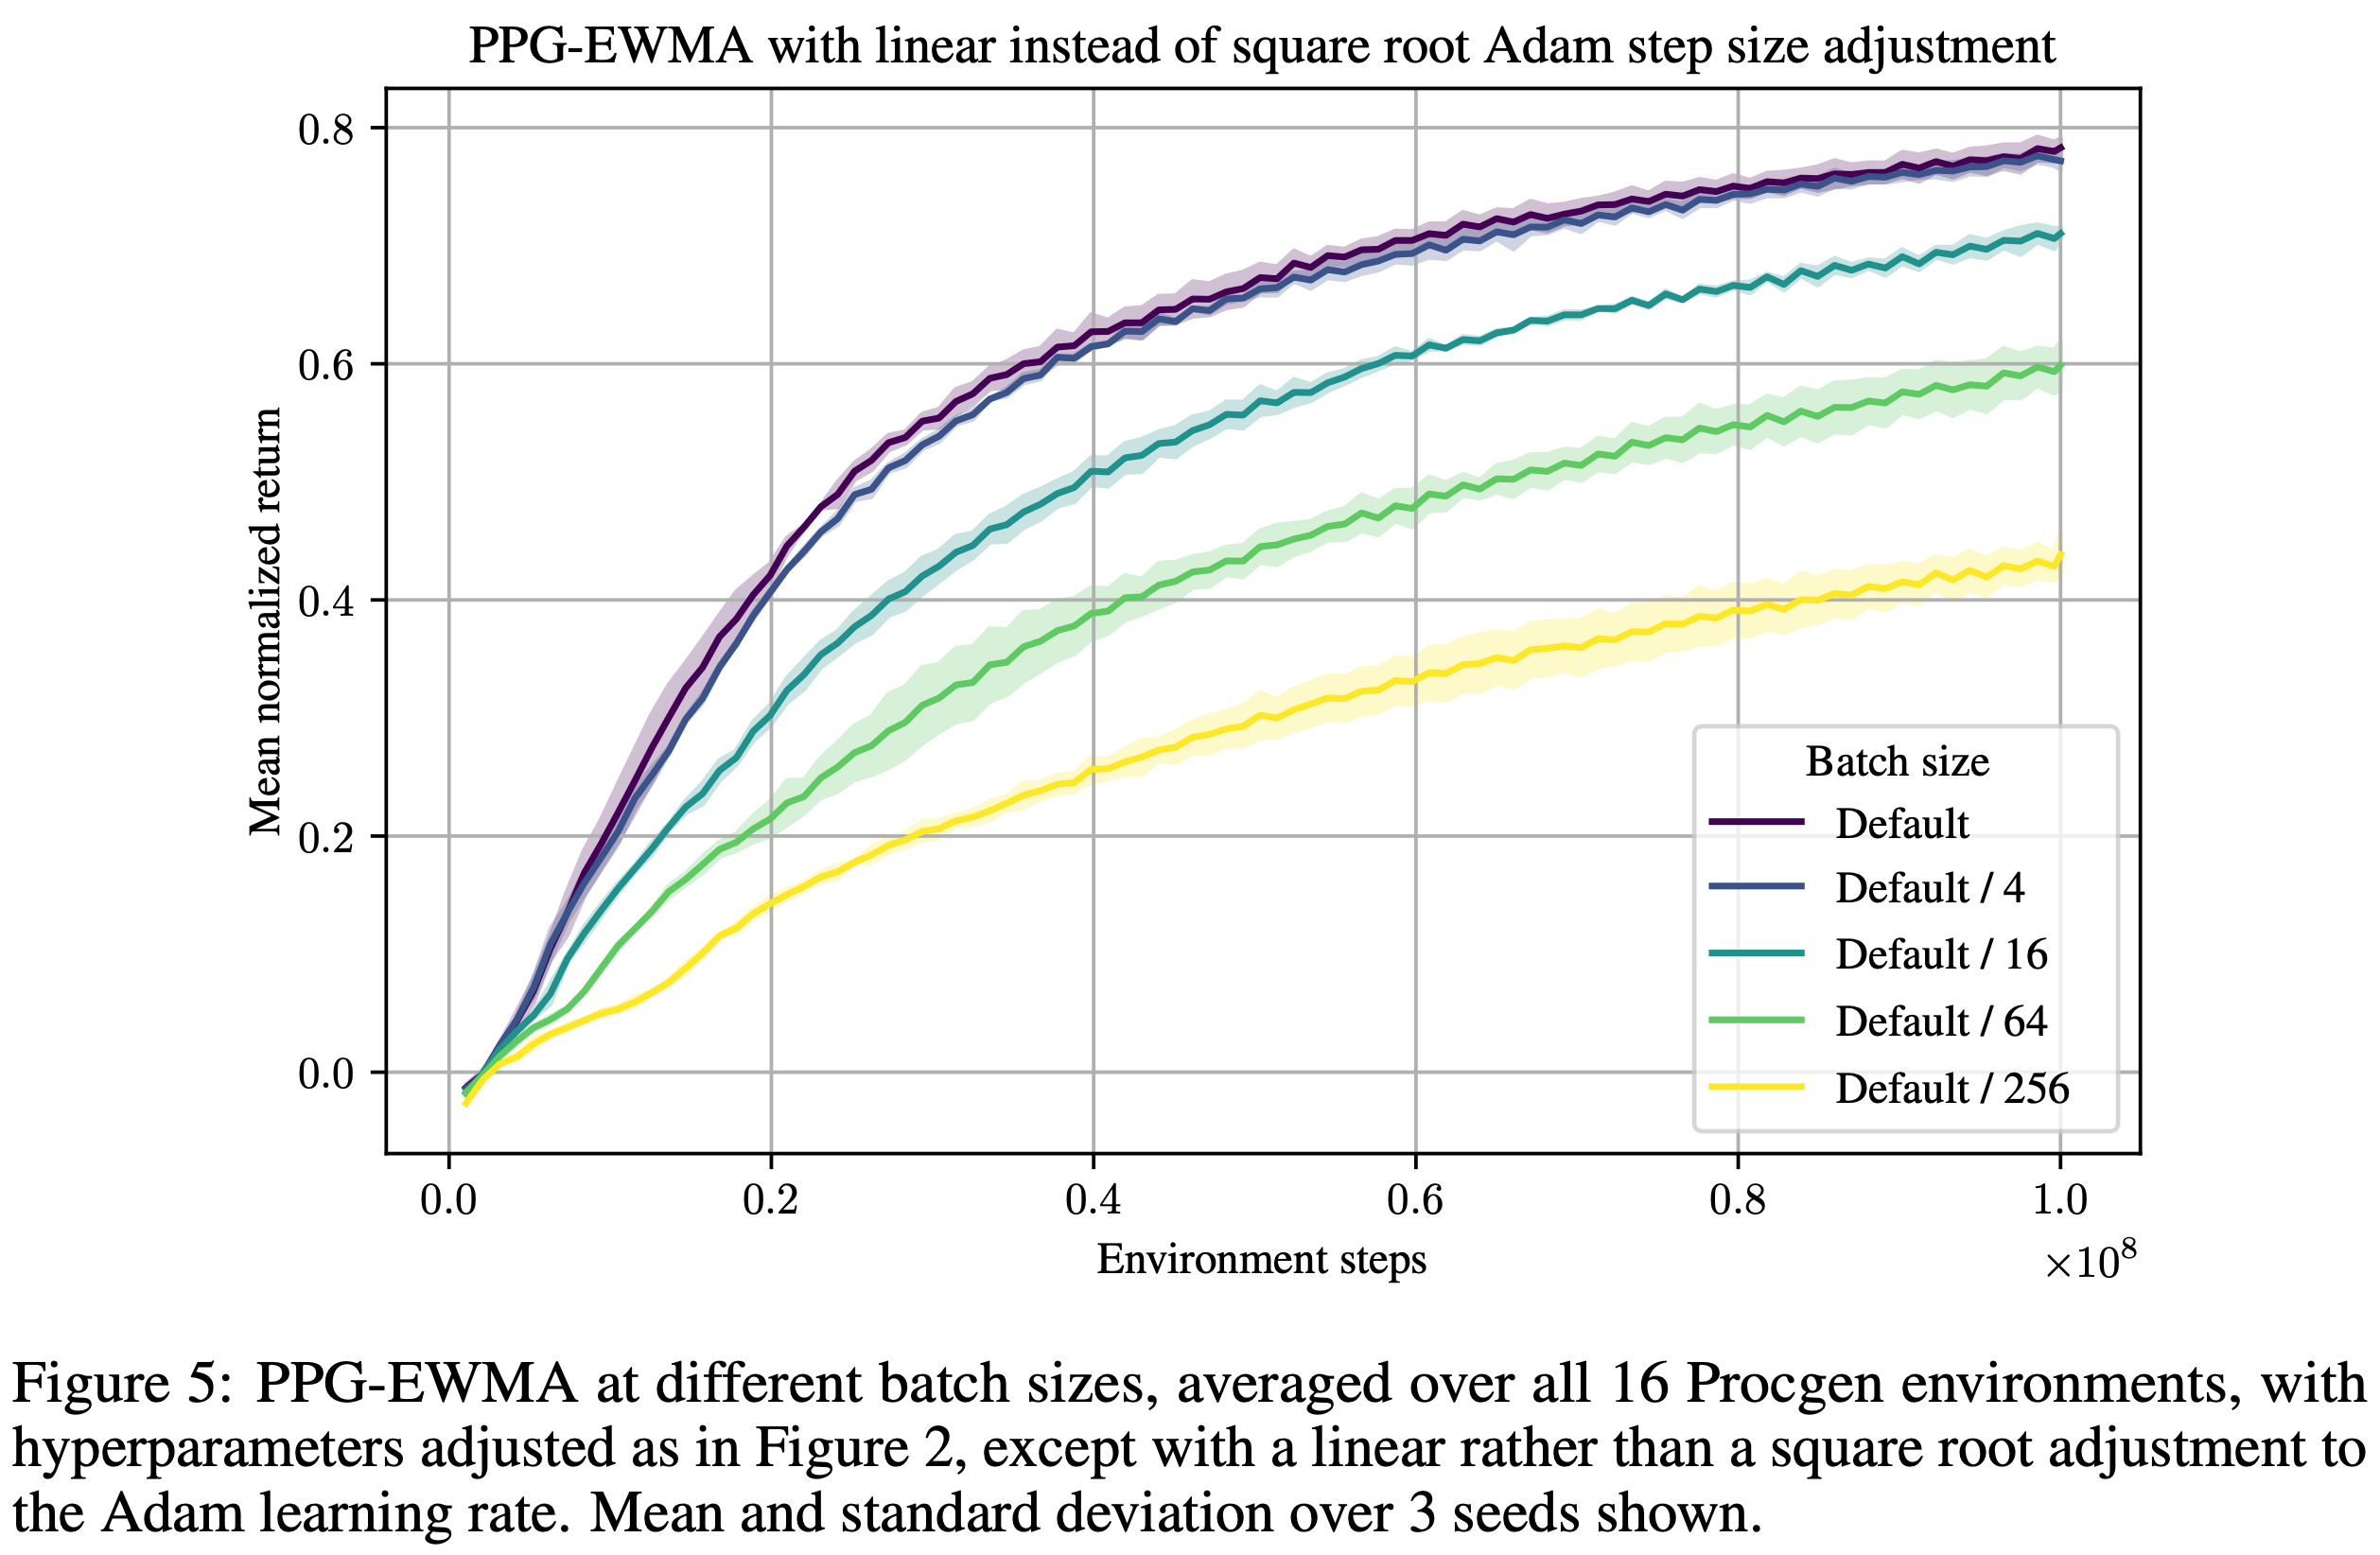
- 如果按照错误的线性法则(除以 \(c\))调整 Adam 的 Step size(图 5),在小 Batch size(Default / 256)下,训练极其不稳定且性能远低于图 2
- 只有使用正确的平方根法则(除以 \(\sqrt{c}\)) ,Adam 才能在小 Batch size 下维持稳定的训练动态
- 理解:学习率太小,导致学习慢(但是实际上,继续训练下去应该是会到最高点位置的
补充说明:Adam 的 \(\epsilon\) 参数的影响
- 如果 Adam 的 \(\epsilon\) 参数设得非常大 ,使得 \(\epsilon \gg \sqrt{v_t}\),那么 Adam 会退化为带 Momentum 的 SGD
- 调整法则会从平方根法则过渡 到线性法则
- 但在标准的深度强化学习设置中(\(\epsilon = 10^{-8}\) 或 \(10^{-5}\)),\(\epsilon\) 几乎可以忽略,因此平方根法则(\(\sqrt{c}\))是严格且最优的选择
附录:为什么原始 PPO 无法实现 Batch size-invariance ?
原始 PPO 无法实现 批次大小不变性 的根本原因 是它将“行为策略”和“近端策略” 强行耦合在同一个网络参数 \(\theta_{\text{old} }\) 上
第一步:明确 PPO 涉及的两类 Batch size
- Optimization batch size :每次梯度更新时使用的样本数量
- 这部分由 SGD/Adam 控制,原始 PPO 本身是可以做到这一层不变性的 (因为 Adam 有 \(\sqrt{c}\) 缩放法则)
- Iteration batch size :
- 每次更新开始前,Rollout 收集的数据数(即每次采集多少数据后才做一次更新)
- 基本结论:原始 PPO 无法保证 Batch size-invariance 的根源在于 “Iteration batch size” 的变化 无法被其他超参数恢复
耦合导致的“近端策略年龄”失控(核心推导)
- 在原始 PPO 的目标函数中(无论是 Clip 版本还是 KL 惩罚版本),\(\theta_{\text{old} }\) 只有一个,它同时负责两件事:
- 1)重要性采样(Importance Sampling) :作为分母,必须是采集数据的 Behavior Policy
- 2)近端约束(Clipping / KL Penalty) :作为锚点,用来拉住当前策略
- 将 Iteration batch size 乘以或除以某个常数 \(c\) 时(例如并行环境数减少,每次采集的数据变少了),会发生以下连锁反应:
- 采样频率改变 :Batch size 变小,意味着 Agent 与环境交互更少的步数就会触发一次梯度更新(一次可能连续更新多步)
- 策略更新频率变快 :在固定的环境步数内,参数 \(\theta\) 被更新的次数变多了
- \(\theta_{\text{old} }\) 的 “Age” 剧烈变化 :
- 在原始 PPO 中,每次 Rollout + 多次 梯度 Step 更新后,\(\theta_{\text{old} }\) 都会被立刻替换为最新的 \(\theta\)
- 注意是仅在 Rollout + 多次梯度更新后,消耗完当前数据后
- 如果迭代 Batch size 很小(除以 \(c\)),一次 Rollout 更新的次数会比较少,\(\theta_{\text{old} }\) 就会变得 “很年轻”
- Rollout 一次,更新次数很少,off-policy 程度很小
- 如果迭代 Batch size 很大(乘以 \(c\)),一次 Rollout 梯度更新的次数会比较多,\(\theta_{\text{old} }\) 就会变得“很陈旧”
- Rollout 一次,更新次数太多,off-policy 程度变大
- 在原始 PPO 中,每次 Rollout + 多次 梯度 Step 更新后,\(\theta_{\text{old} }\) 都会被立刻替换为最新的 \(\theta\)
为什么单纯调整学习率(LR)无法补偿?
- 问题:既然更新频率变了,那调整学习率(Adam Step size)不就行了吗?
- 答案是 不行 因为学习率控制的是 “参数在参数空间中移动的距离” ,而 Clipping 范围(\(\epsilon\)) 和 KL 惩罚系数(\(\beta\)) 控制的是 “概率比(\(\pi_\theta / \pi_{\text{old} }\))允许偏离 1 的程度”
- 当 \(\theta_{\text{old} }\) 的“年龄”改变时,\(\theta_{\text{old} }\) 本身的质量(是好是坏)以及它与当前 \(\theta\) 的内在距离发生了结构性改变:
- 如果 Batch size 变小,\(\theta_{\text{old} }\) 更新极快,近端锚点跟得太紧 ,导致 Clipping 几乎不起作用(惩罚太弱),策略变化过快,容易崩塌
- 如果 Batch size 变大,\(\theta_{\text{old} }\) 极为陈旧,近端锚点拖得太远 ,导致 Clipping 过度生效(惩罚太强),策略几乎无法学习
- 由于 \(\theta_{\text{old} }\) 同时是行为策略,不能单独调整它的更新频率
- 学习率只能改变“走多快”,但无法改变“锚点本身的陈旧程度”
- LR 控制更新幅度,无法调整参考方向(\(\theta_{\text{old} }\))
补充:数学视角的直观解释(基于论文第 4 节)
- 论文用 EWMA 的质心(Center of Mass, COM) 来量化近端策略的“年龄”:
$$
\text{COM} = \frac{1}{1 - \beta_{\text{prox} } } - 1
$$ - 在原始 PPO 中,近端策略就是行为策略本身,它的“年龄”严格等于 “采集数据所花费的环境步数” ,即严格等于迭代 Batch size
- 即:当前策略 \(\theta\) 现在正试图将自己拉向 “质心 步前的自己”(而 质心是一个基本固定的数字(通过加权平均实现))
- 当迭代 Batch size 改变 \(c\) 倍时,COM 自动改变 \(c\) 倍
- 而 PPO 的 Clip 参数 \(\epsilon\) 和 KL 系数 \(\beta\) 是固定的绝对数值 ,它们不会随着 Batch size 的变化而自动缩放
- 同样的 \(\epsilon=0.2\),在大 Batch size 下可能意味着“限制极严”,在小 Batch size 下却可能意味着 “几乎没有限制”
- 为什么 PPO-EWMA 能实现不变性?
- PPO-EWMA 强行将“近端策略”与“行为策略”剥离:
- 行为策略 :依然使用采集数据的 \(\theta_{\text{behav} }\)(只用于 Importance Sampling,无偏估计)
- 近端策略 :使用独立的 EWMA 网络 \(\theta_{\text{prox} }\)
- 当迭代 Batch size 改变时,通过调整 EWMA 的衰减率 \(\beta_{\text{prox} }\),使得 \(\theta_{\text{prox} }\) 的质心(COM)在“环境步数”维度上保持恒定
- 无论采集 256 步还是 1 步就做更新,近端锚点的“物理年龄”始终不变,Clipping/KL 惩罚的力度也就始终不变
- PPO-EWMA 强行将“近端策略”与“行为策略”剥离:
关于 PPO-EWMA 中质心的理解
- “质心(Center of Mass, COM)” 可以想象成一个 “滑动平均窗口的加权年龄”
数学定义与公式拆解(附录 G)
- 在 PPO-EWMA 中,近端策略网络参数 \(\theta_{\text{prox} }\) 并非等于某一步的旧参数,而是对所有历史参数 \(\theta_0, \theta_1, \dots, \theta_t\) 做指数加权移动平均(EWMA):
$$
\theta_{\text{prox} } = \frac{\theta_t + \beta_{\text{prox} } \theta_{t-1} + \beta_{\text{prox} }^2 \theta_{t-2} + \dots + \beta_{\text{prox} }^t \theta_0}{1 + \beta_{\text{prox} } + \beta_{\text{prox} }^2 + \dots + \beta_{\text{prox} }^t}
$$- \(\beta_{\text{prox} }\)(论文默认 0.889)是衰减率,越靠近当前时刻(\(t\))的权重越大,越旧的权重呈指数级衰减
- 质心的定义公式为:
$$
\text{COM}_{\text{prox} } := \lim_{t \to \infty} \frac{0 \cdot 1 + 1 \cdot \beta_{\text{prox} } + 2 \cdot \beta_{\text{prox} }^2 + \dots + t \cdot \beta_{\text{prox} }^t}{1 + \beta_{\text{prox} } + \beta_{\text{prox} }^2 + \dots + \beta_{\text{prox} }^t} = \frac{1}{1 - \beta_{\text{prox} } } - 1
$$
质心的物理意义
- 质心代表的是:EWMA 窗口中所有历史参数“平均滞后了多少梯度步”
- 如果 \(\beta_{\text{prox} } = 0.889\),则 平均滞后 8 步:
$$ \text{COM} = \frac{1}{1 - 0.889} - 1 \approx 9 - 1 = 8 $$- 虽然 EWMA 包含了从 0 到 \(t\) 的所有历史参数,但加权平均后 ,\(\theta_{\text{prox} }\) 的“年龄”大约相当于 8 个梯度步之前的参数
- 换句话说,当前策略 \(\theta\) 现在正试图将自己拉向“8 步前的自己”
- 理解:类似滑动平均的那个权重参数的功能
- 如果 \(\beta_{\text{prox} } = 0.889\),则 平均滞后 8 步:
为什么用“质心”而不是直接用“\(\beta\)”?
- 因为 \(\beta\)(衰减率)是一个抽象且非线性的数值,不直观
- 而 质心(COM) 的单位是 “梯度步数” ,具有明确的物理意义
- 当 \(\theta\) 在参数空间中沿直线路径移动时,当前参数与近端参数的差值 \(\theta - \theta_{\text{prox} }\) 与质心(COM)近似成正比
- 质心越大,\(\theta_{\text{prox} }\) 离 \(\theta\) 越远
- 质心越小,\(\theta_{\text{prox} }\) 离 \(\theta\) 越近
质心在“批量大小不变性”中的核心作用(原论文第 4 节)
- 问题 :当把迭代 Batch size(每次采集的数据量)缩小 \(c\) 倍时,在相同的环境步数内,执行的梯度更新次数会变多 \(c\) 倍
- 后果 :如果质心(COM)不动(仍为 8 步),那么质心对应的 真实环境步数 就从原来的 \(8 \times \text{ 旧 Batch Size}\) 变成了 \(8 \times \text{ 新 Batch Size}\)
- 质心越长,近端策略越老,PPO 比值差异越大
- 解决方案 :为了维持 “以环境步数衡量的近端策略年龄” 不变,你需要 将质心乘以 \(c\) (即拉长质心的梯度步数)
- 公式调整 :
- 当 Batch size 除以 \(c\) 时,必须调整 \(\beta_{\text{prox} }\),使得:
$$
\text{COM}_{\text{new} } = \text{COM}_{\text{old} } \times c
$$ - 例如原来 COM=8(步),Batch size 缩小了 256 倍(\(c=256\)),必须把 COM 调整为 \(8 \times 256 = 2048\)(步)
- 这意味着 EWMA 现在要平均过去 2048 步的参数,才能在 环境时间维度 上对应于原来 8 步的跨度
- 当 Batch size 除以 \(c\) 时,必须调整 \(\beta_{\text{prox} }\),使得:
质心与 KL 惩罚系数的“等效互换性”
- 论文在附录 G 中通过热力图(图 18)证明了一个非常优雅的结论:
- 在局部范围内,将质心(COM)减半,与将 KL 惩罚系数(\(\beta\))加倍,效果是完全等价的。
- 直观上看:两者都在控制离开当前参考策略的幅度
- KL 散度的梯度 \(\nabla_\theta \text{KL}[\pi_{\theta_{\text{prox} } }, \pi_\theta]\) 在局部近似为 \((\theta - \theta_{\text{prox} })\) 的线性函数
- 而 \(\theta - \theta_{\text{prox} } \propto \text{COM}\)
质心调整为什么不能无限拉长?
- 问题:既然质心越长,近端策略越老,那为了稳定,直接把 COM 设为无限大(\(\beta \to 1\))不就好了吗?
- 答案是 不行 ,质心只能在局部范围内等效互换
- 当把 COM 连续减半(对应连续加倍 KL 系数)时,性能会逐渐退化
- 理解:
- 信噪比降低 :当 \(k\)(滞后步数)增大时,\(\theta_t - \theta_{t-k}\) 的信号-噪声比会降低
- 用极度陈旧的锚点来做约束,会引入过时的梯度干扰,最终无法通过单纯增大 KL 系数来弥补
- 理解:很早前的策略可能是随机策略,约束到这个锚点是不健康的(相当于添加了很多噪声)
- 即使很早以前的策略不是随机策略,也只是适配当时数据分布的策略,不适配当前数据
- 信噪比降低 :当 \(k\)(滞后步数)增大时,\(\theta_t - \theta_{t-k}\) 的信号-噪声比会降低