Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

CA——智能出价与激励兼容

以下思考仅为笔者与其他同事讨论时的一些想法,仅供参考


Background

  • 问题提出 :拍卖机制的激励兼容是指机制能否让商家说真话时从系统获得最大收益,但在智能出价时,还支持激励兼容吗?
  • 激励兼容(IC)的简单定义 :讲真话是利益相关者在这个机制下的最优选择,IC的详细定义看下面

Answer

  • 从计费方式上看 :由于系统为了保ROI会计费到满足商家出价ROI,本质上算是ROI上的一价计费 ,从这里直观上看不能算是激励兼容了
  • 从更广泛的视角看 :
    • 激励兼容有个等价表达是,同时满足以下两个条件:
      • 第一,分配规则:随着出价提升,分配到的资源是单调不减
      • 第二,计费规则:净胜者需要支付的数额等于将使他赢得拍卖的最小值
    • 在oCPC中(假设商家投放期间固定目标ROI),可以算是激励兼容的,但是比较弱:
      • 分配规则 :流量可以看做是连续的,所以流量随着商家出价是单调递增的,分配规则满足激励兼容
      • 计费规则 :由于流量是随着出价单调递增的, 所以实际上,商家计费对应的流量就是他拿到这些流量的最小计费
      • 边际效益递减 :但是,从商家视角考虑,随着出价增多,边际效益递减(流量会越来越贵),再增加支付成本拿到的流量并不多,所以其实容易出现计费高了,但是流量涨幅不多(甚至相当于没涨),从这个角度来讲,好像上述两条激励兼容的满足又有点弱

oCPX是否激励兼容的其他思考(非严格证明,准确性有待商榷)

  • 如果把智能出价下的系统分成两层
    • 第一层:对每个投放周期内,商家出价,给出指定目标(目标在每个投放周期内固定),比如ROI约束下最大化点击的产品,商家出价则是目标ROI值
    • 第二层:对每个请求,智能出价在商家约束和目标下,智能体给出满足商家约束且能最大化商家效果的单次出价
  • 在第一层中,激励兼容可以理解为:每个投放周期内,商家都会说真话,选择一个自己能接受且能最大化自己效果的目标值,比这个目标值小或大都不符合商家利益
    • 此时每个投放周期内,对一个商家来说,系统都在进行一次拍卖,是对一个投放周期内整体流量进行打包拍卖,商家出一次价即可购买一定量的效果,这种拍卖不是0-1拍卖,不是简单的拍卖成功或拍卖失败,而是给出一个连续的出价目标,对应一个连续成本和一个连续的收益,成本和收益之间一般是正相关关系
  • 在第二层中,激励兼容可以理解为:每个请求下,智能体给出的出价都是达成商家目标所能给出的最优出价,即能让自己收益最大化的最优出价
    • 当然,此时商家出价不再仅仅与这次拍卖相关,而是与整个投放周期内的成本和效果相关

智能出价下的计费方式讨论

  • 存在外部平台竞争的情况 :在存在外部其他流量平台竞争且商家预算有限的情况下,商家更多会考虑其他平台投放成本和当前平台投放的边际收益,实际上无论如何商家都不会说真话,此时一价计费反而让商家成本更准确
  • 没有其他流量平台竞争时 :流量平台垄断(没有其他流量平台时),如果一价计费,商家会不断下探,此时需要二价计费防止商家下探
  • 一价计费的其他优点 :面对oCPX这种形式时,一价计费更容易保成本,可以先上一价计费,然后长期观察商家是否降价/调价来判断激励兼容性是否受到影响

附录:激励兼容相关定义

  • 激励兼容(IC) :讲真话是利益相关者在这个机制下的最优选择
    • IC是一种信息激励机制,通过协调委托、代理双方的利益,使被激励方主动公布自己的真实信息,由不诚实转变为诚实 ,达到组织中各成员目标的一致
    • 贝叶斯激励兼容(BIC)、占优策略激励兼容(DSIC)都是激励兼容(IC)的不同表现形式
  • 贝叶斯激励兼容(BIC) :如果其他参与者说真话(如实报告自己的类型),那么每个参与者说真话是最优策略 ,这里的最优策略即使得自己期望效用最大化的策略
  • 占优策略激励兼容(DSIC) :论其他参与者如何行动 ,每个参与者说真话都是一个占优策略 ,即无论其他人采取什么策略,该参与者选择真实策略都能获得最优结果,至少不会比其他策略更差
    • 例如VCG(二价拍卖)就是一种DSIC机制,在这种拍卖中,买家即使知道其他买家的报价,报出自己的真实价值仍然是将自身效用最大化的策略
  • BIC与IC、DSIC的关系 :BIC和DSIC都是IC的子类
    • DSIC是性质更强的一类拍卖机制,而BIC是更广的一类,一个DSIC机制一定也是一个BIC机制,但反过来不一定成立
    • DSIC要求无论其他参与者的策略如何,真实披露都是最优策略 ,这是一个很强的条件;而BIC只要求在给定参与者对其他参与者策略分布的信念下,真实披露是最优的 ,相对条件更宽松一些
NLP——LLM-Attention优化之MLA

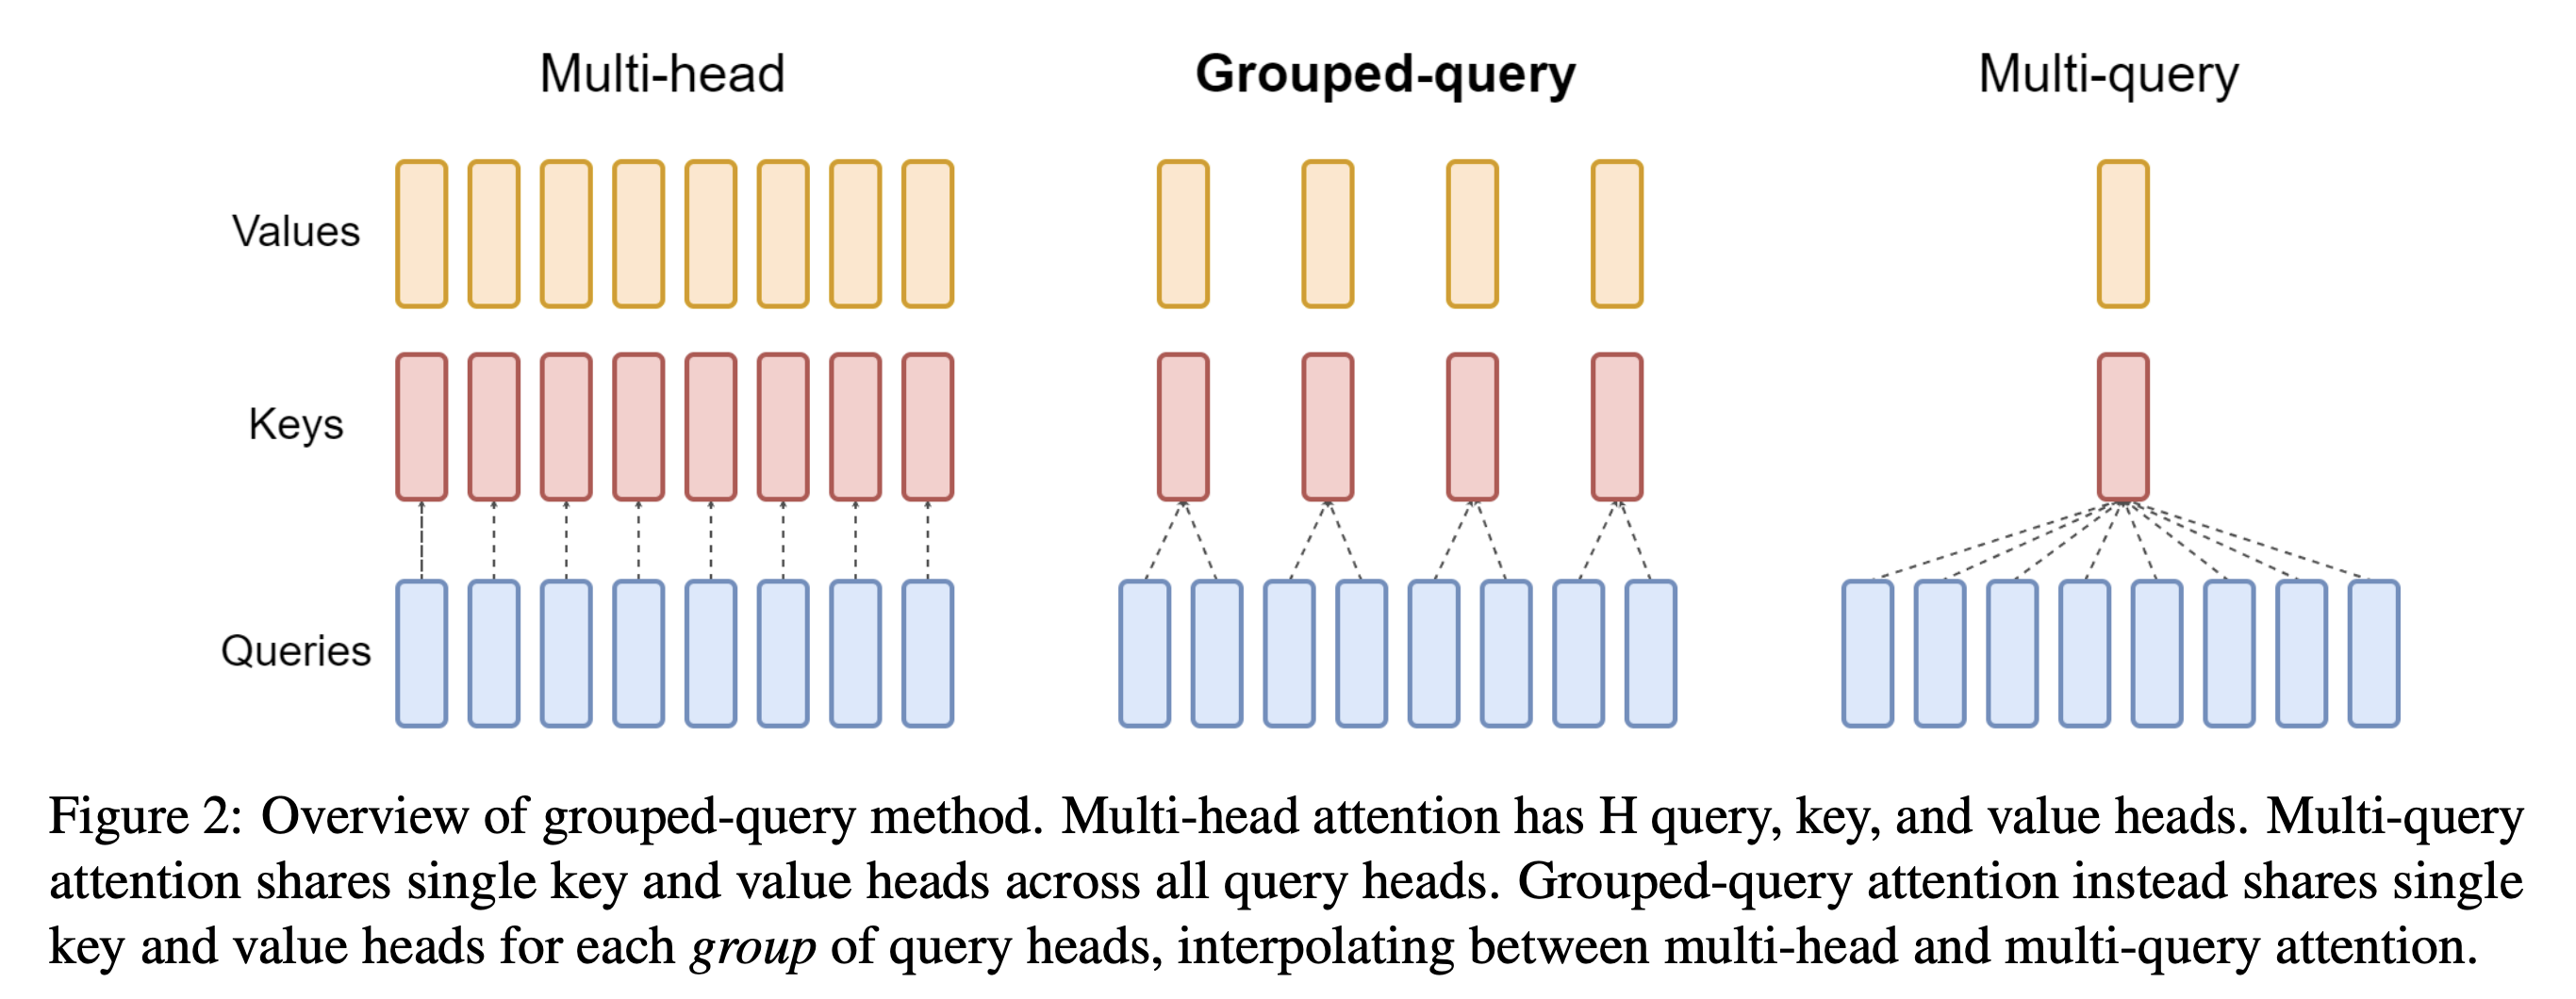
本文主要介绍LLM-Attention优化方法中的MHA、MQA、GQA到MLA的发展历程

  • 参考链接:
    • MLA原始论文:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
    • GQA原始论文:GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
    • 来自苏神的参考链接:缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA
    • 讲的较为清晰的原创博客:deepseek技术解读(1)-彻底理解MLA(Multi-Head Latent Attention) - 姜富春的文章 - 知乎

MHA/MQA/GQA/MLA对比和讨论

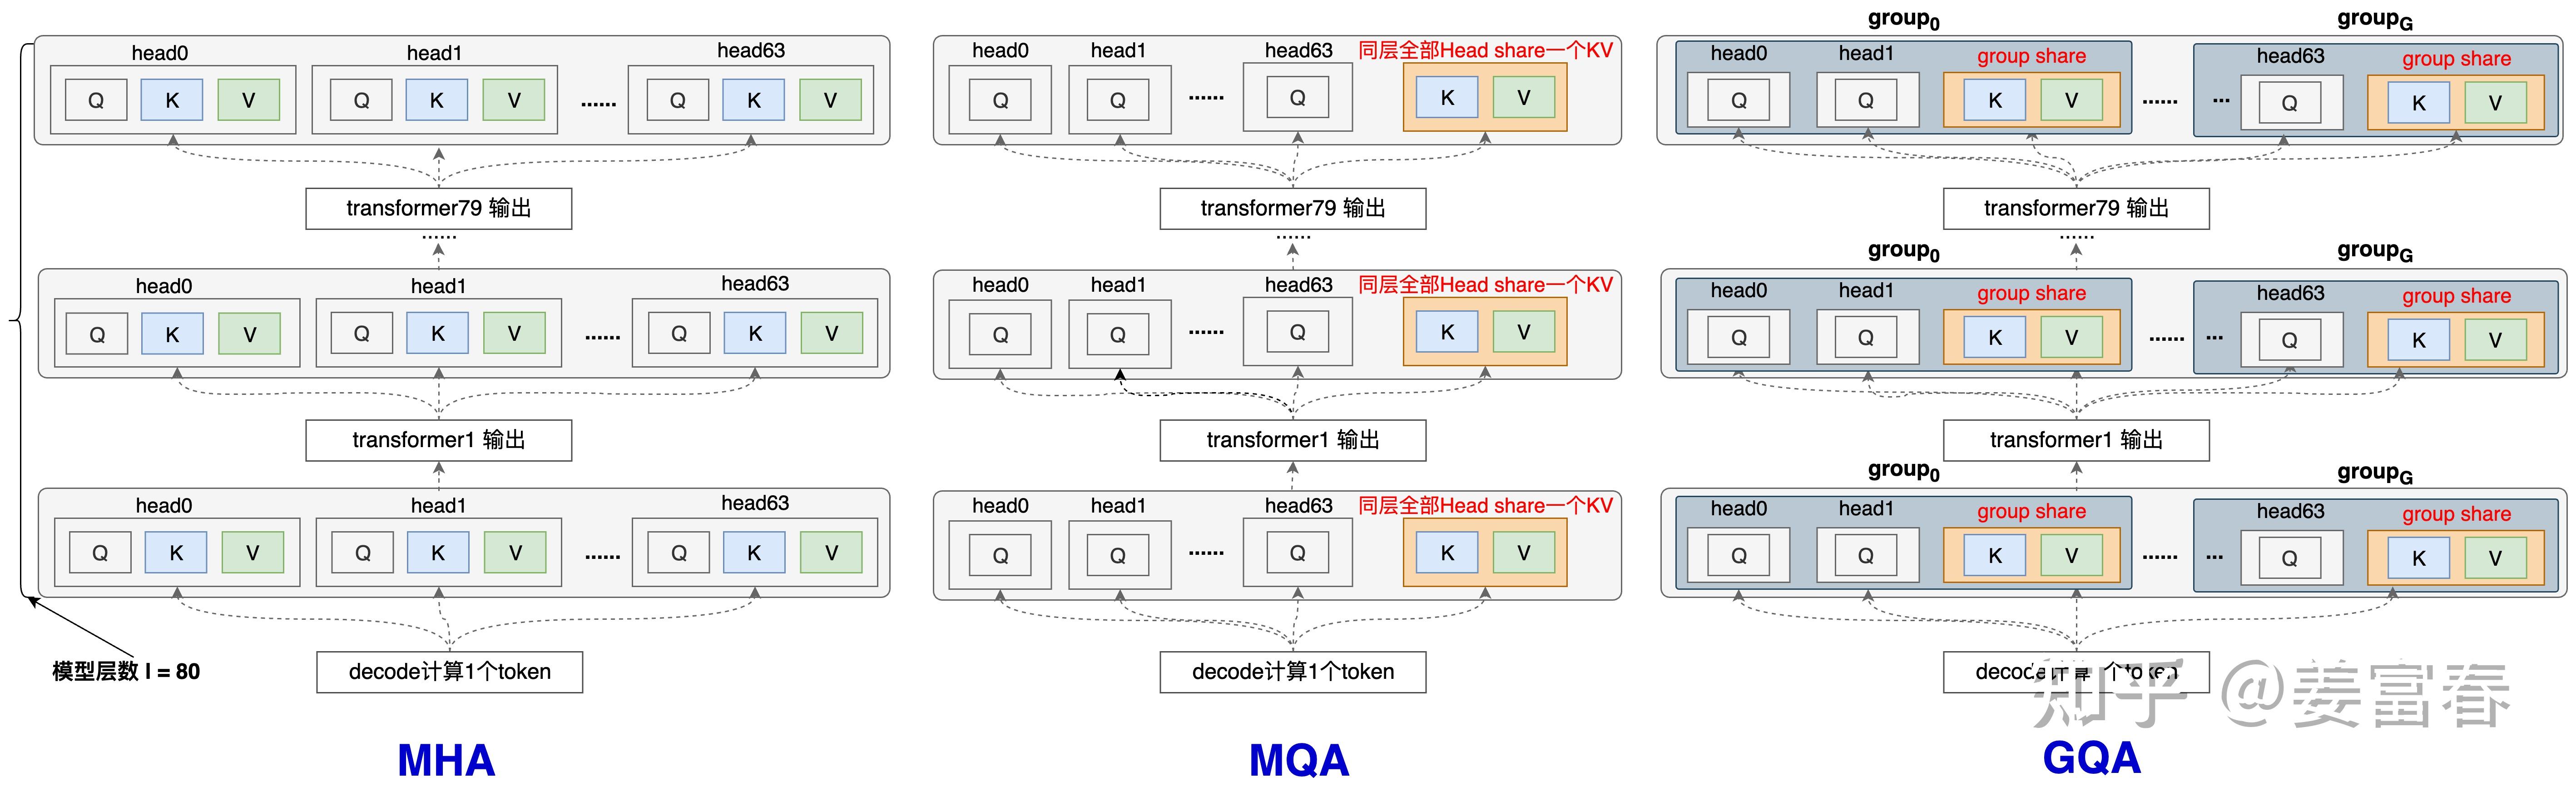
  • MHA/MQA/GQA Overview(from GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints )
  • KV-Cache示意图 (from deepseek技术解读(1)-彻底理解MLA(Multi-Head Latent Attention) - 姜富春的文章 - 知乎)
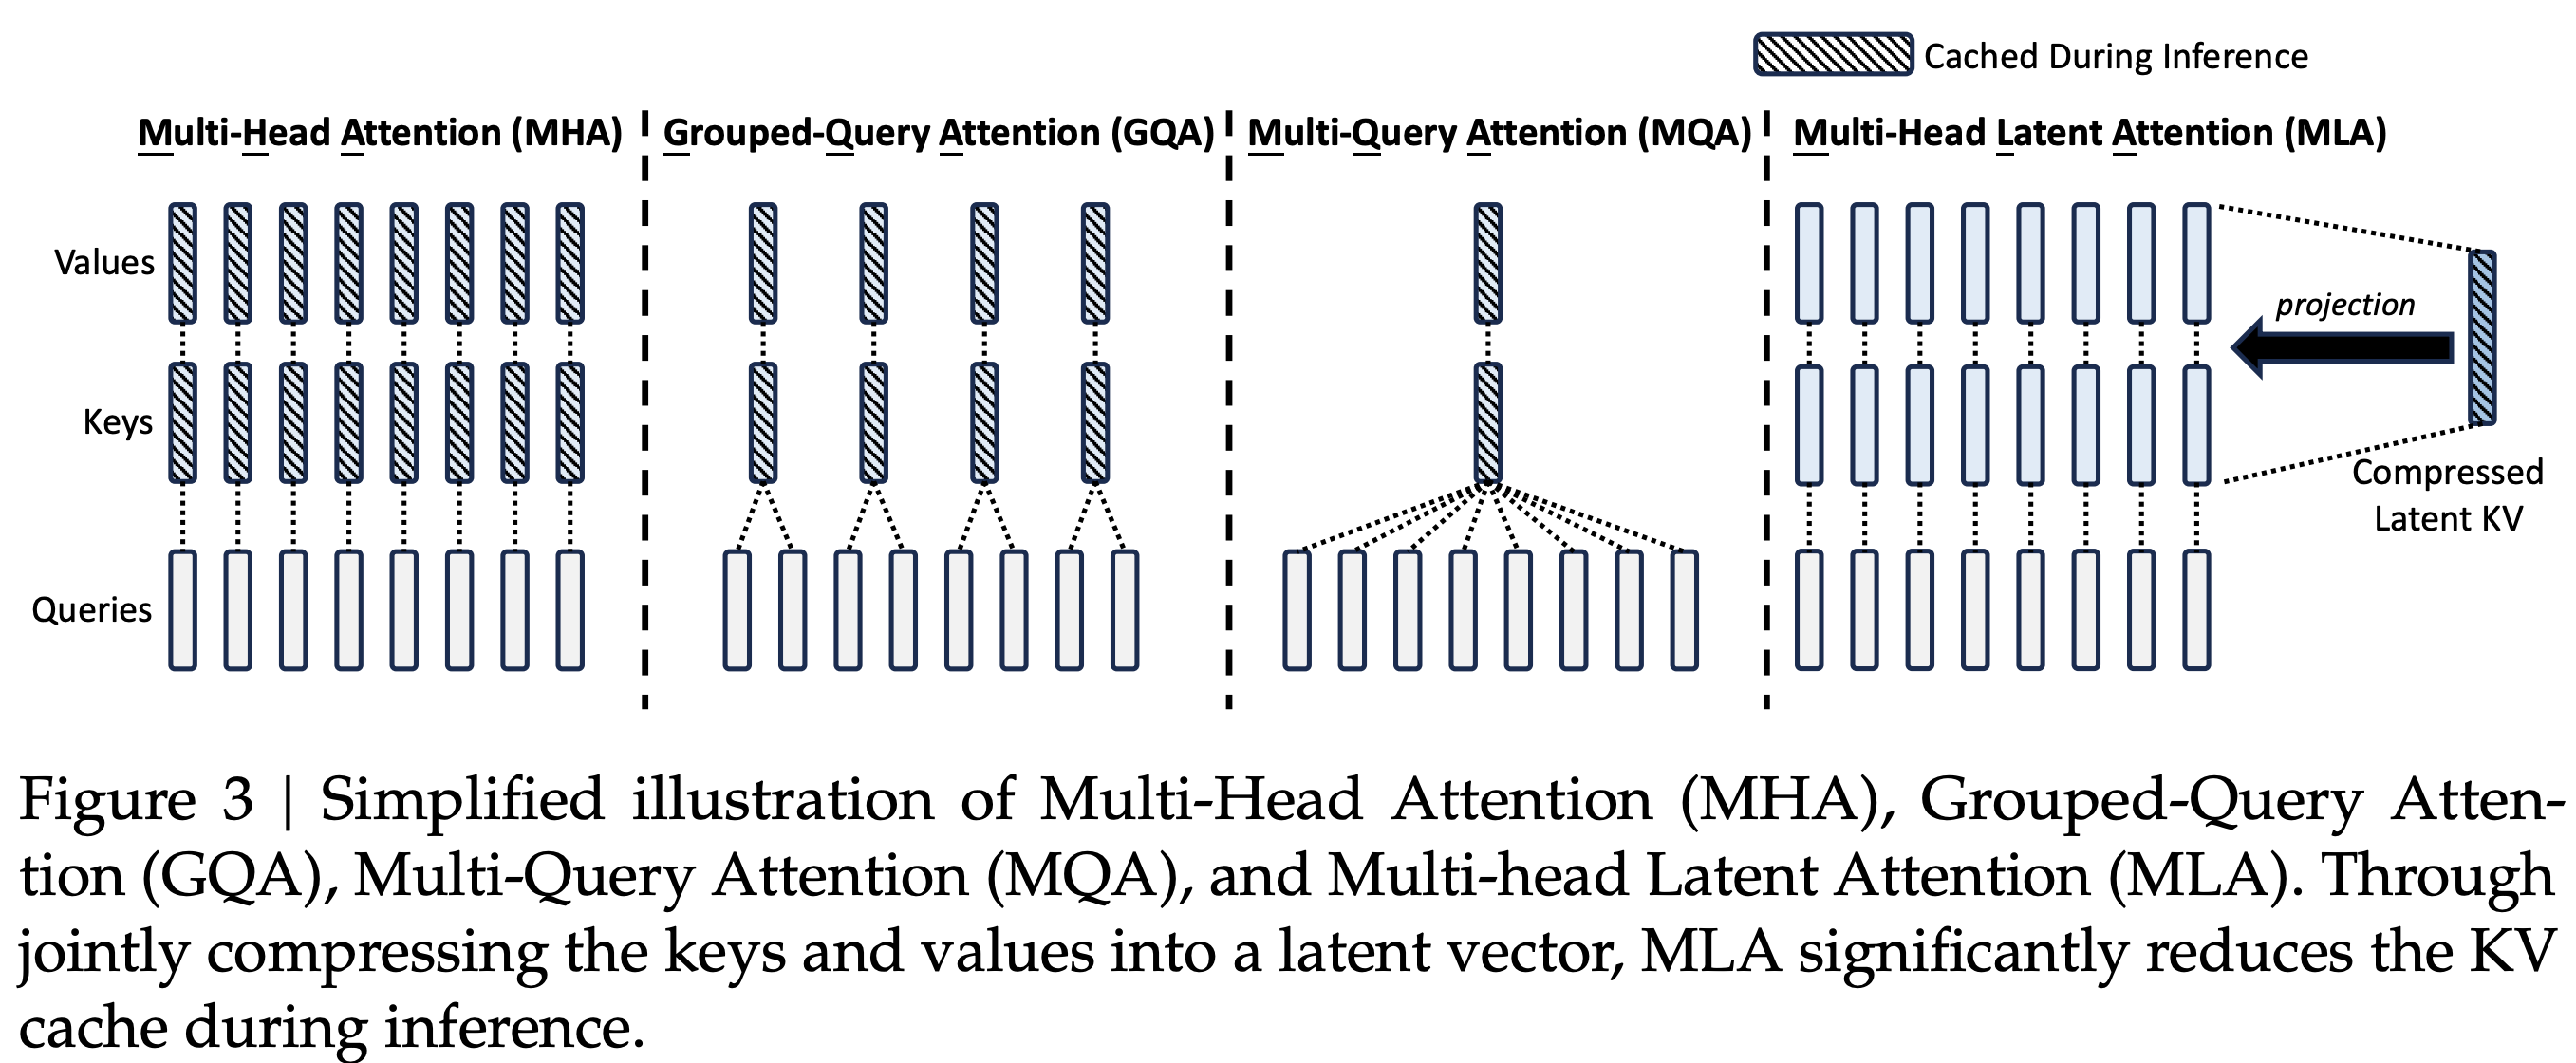
  • MHA/MQA/GQA/MLA Overview(from DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model )
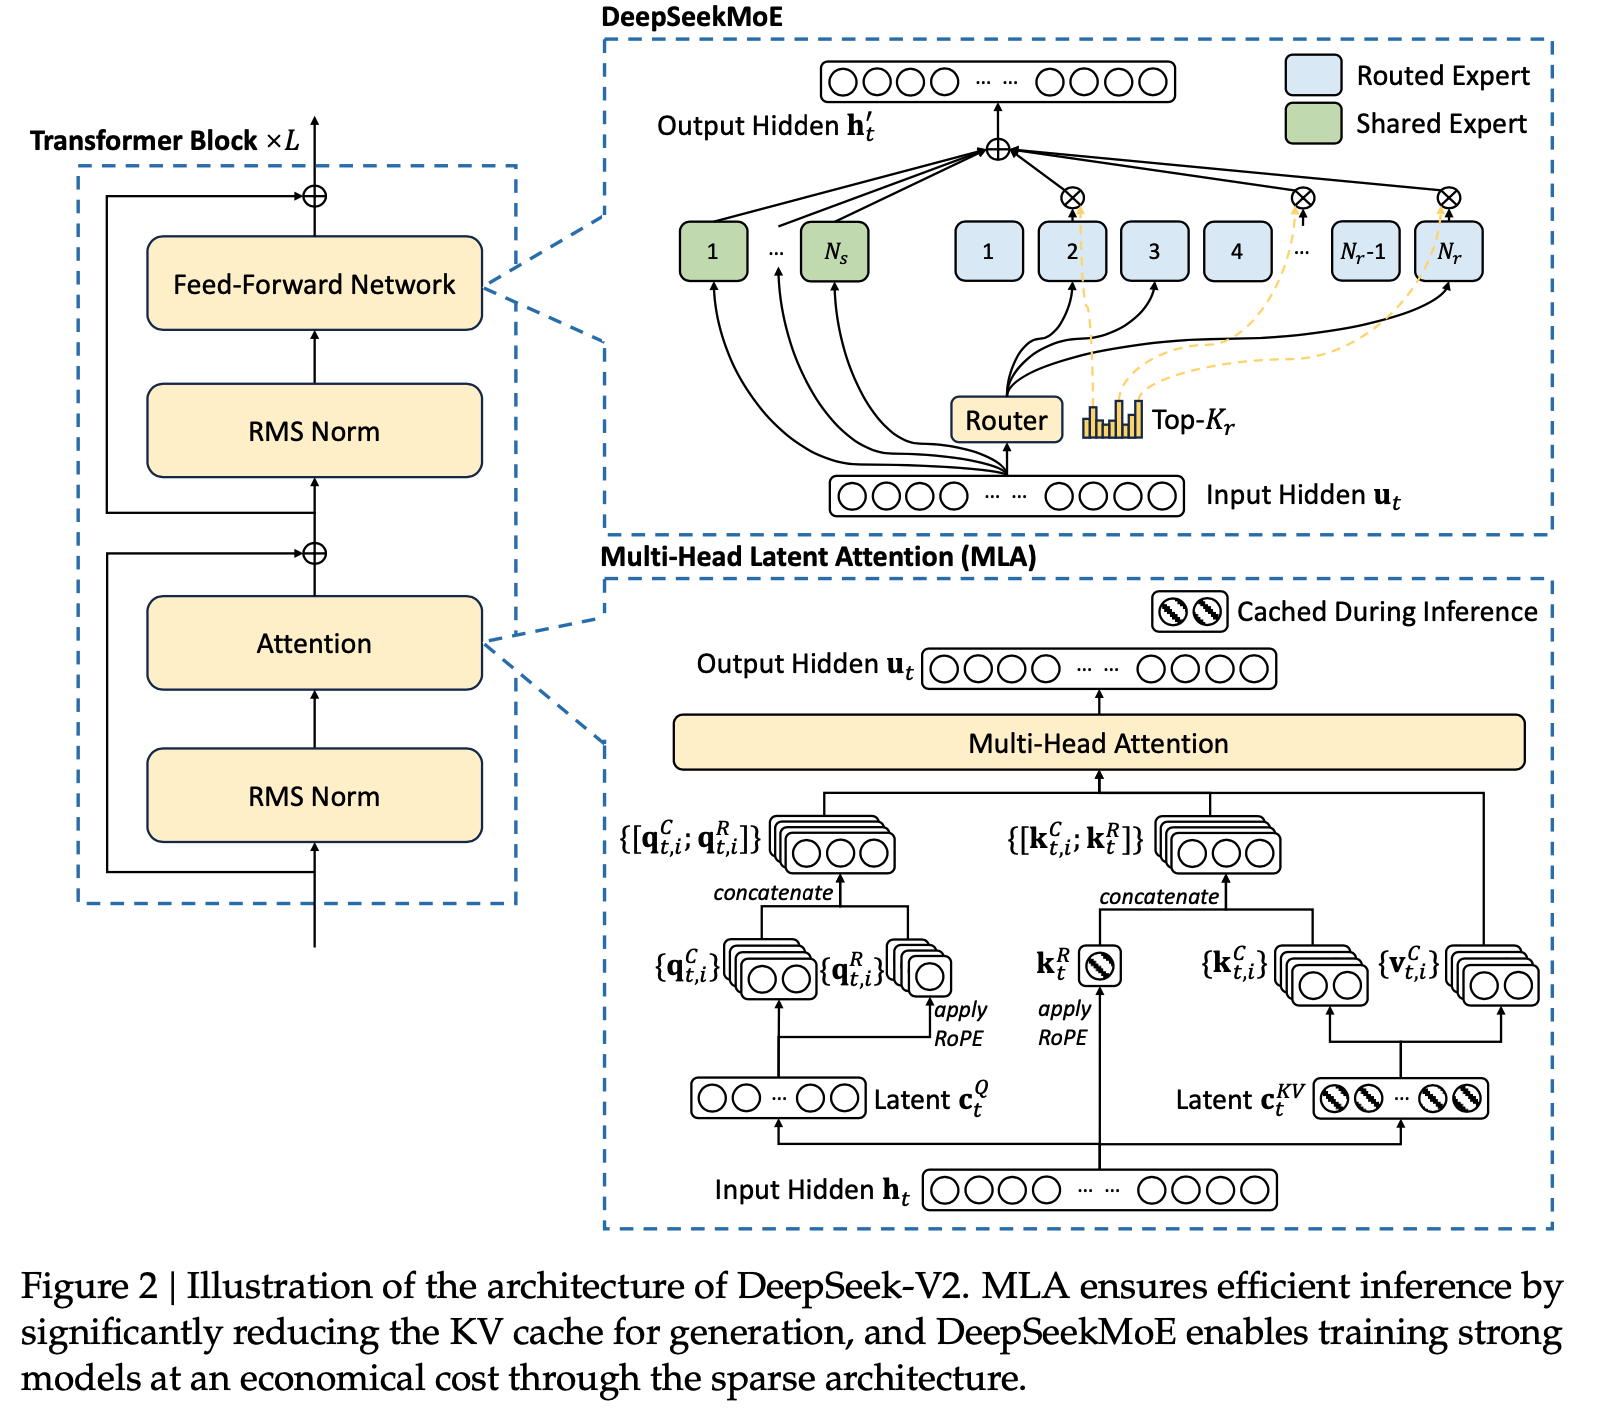
  • 原始论文中,MLA的示意图 * 核心,MLA 将 Q 和 K 拆开成 引入 RoPE 和 不引入 RoPE(NoPE)两部分,两者的 q 和 k 分别做 concat,本质是 qk 相乘以后做加法
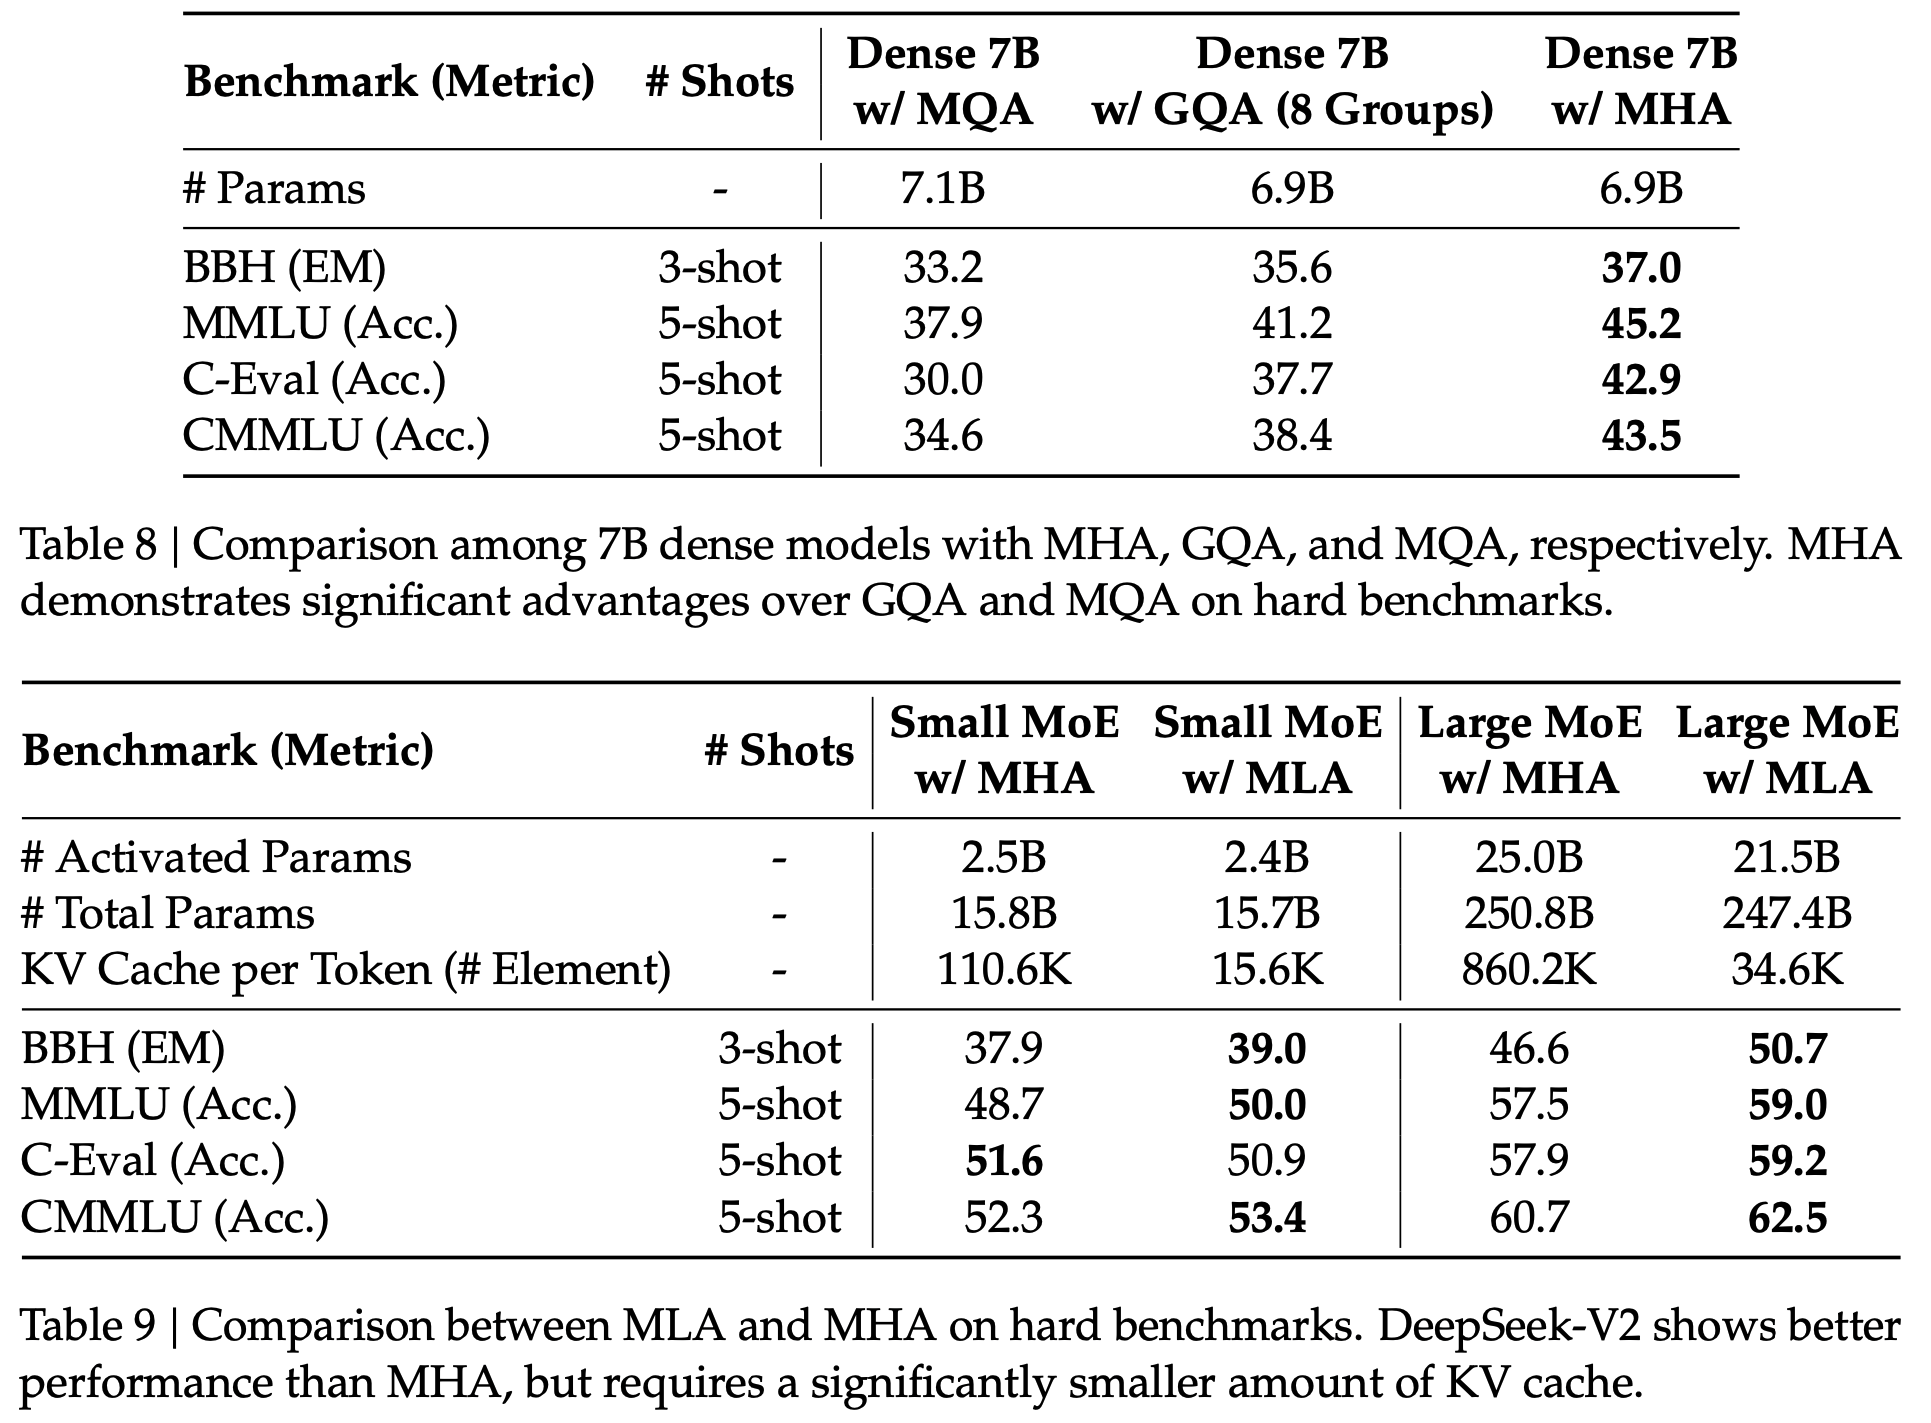
  • MHA/MQA/GQA 效果对比
  • 从上图中可以看出,整体效果为:MLA > MHA > GQA > MQA
    • 问题:为什么目前在很多模型中,GQA 仍然是常客?

带RoPE的普通MHA

  • 公式(from 缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA):
    $$
    \begin{align}
    \boldsymbol{o}_t &= \left[\boldsymbol{o}_t^{(1)}, \boldsymbol{o}_t^{(2)}, \cdots, \boldsymbol{o}_t^{(h)}\right] \\
    \boldsymbol{o}_t^{(s)} &= Attention\left(\boldsymbol{q}_t^{(s)}, \boldsymbol{k}_{\leq t}^{(s)} ,\boldsymbol{v}_{\leq t}^{(s)}\right)\triangleq\frac{\sum_{i\leq t}\exp\left(\boldsymbol{q}_t^{(s)} \boldsymbol{k}_i^{(s)}{}^{\top}\right)\boldsymbol{v}_i^{(s)}}{\sum_{i\leq t}\exp\left(\boldsymbol{q}_t^{(s)} \boldsymbol{k}_i^{(s)}{}^{\top}\right)} \\
    \boldsymbol{q}_i^{(s)} &= \boldsymbol{x}_i\boldsymbol{W}_q^{(s)}\color{red}{\boldsymbol{\mathcal{R}}_i}\in\mathbb{R}^{d_k},\quad \boldsymbol{W}_q^{(s)}\in\mathbb{R}^{d\times d_k}\\
    \boldsymbol{k}_i^{(s)} &= \boldsymbol{x}_i\boldsymbol{W}_k^{(s)}\color{red}{\boldsymbol{\mathcal{R}}_i}\in\mathbb{R}^{d_k},\quad \boldsymbol{W}_k^{(s)}\in\mathbb{R}^{d\times d_k} \\
    \boldsymbol{v}_i^{(s)} &= \boldsymbol{x}_i\boldsymbol{W}_v^{(s)}\in\mathbb{R}^{d_v},\quad \boldsymbol{W}_v^{(s)}\in\mathbb{R}^{d\times d_v}
    \end{align}
    $$

带RoPE的MLA

  • 核心思想是通过将K,V降维再升维的方式,既保证了每个head有不同的K,V,又能显著降低缓存量,巧妙的减少KV-Cache存储量(仅存储降维后的中间值即可),最早由DeepSeek提出
  • 此外,在训练时,将Q值也进行了降维再升维(具体优势是什么?)
  • MLA公式(from 缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA):
    $$
    \begin{align}
    \boldsymbol{o}_t &= \left[\boldsymbol{o}_t^{(1)}, \boldsymbol{o}_t^{(2)}, \cdots, \boldsymbol{o}_t^{(h)}\right] \\
    \boldsymbol{o}_t^{(s)} &= Attention\left(\boldsymbol{q}_t^{(s)}, \boldsymbol{k}_{\leq t}^{(s)} ,\boldsymbol{v}_{\leq t}^{(s)}\right)\triangleq\frac{\sum_{i\leq t}\exp\left(\boldsymbol{q}_t^{(s)} \boldsymbol{k}_i^{(s)}{}^{\top}\right)\boldsymbol{v}_i^{(s)}}{\sum_{i\leq t}\exp\left(\boldsymbol{q}_t^{(s)} \boldsymbol{k}_i^{(s)}{}^{\top}\right)} \\
    \boldsymbol{q}_i^{(s)} &= \left[\boldsymbol{c}_i’\boldsymbol{W}_{qc}^{(s)}, \boldsymbol{c}_i’\boldsymbol{W}_{qr}^{(s)}\color{red}{\boldsymbol{\mathcal{R}}_i}\right]\in\mathbb{R}^{d_k + d_r},\quad \boldsymbol{W}_{qc}^{(s)}\in\mathbb{R}^{d_c’\times d_k},\boldsymbol{W}_{qr}^{(s)}\in\mathbb{R}^{d_c’\times d_r}\\
    \boldsymbol{k}_i^{(s)} &= \left[\boldsymbol{c}_i\boldsymbol{W}_{kc}^{(s)}, \boldsymbol{x}_i\boldsymbol{W}_{kr}^{\color{lightgray}{\smash{\not{(s)}}}}\color{red}{\boldsymbol{\mathcal{R}}_i}\right]\in\mathbb{R}^{d_k+d_r},\quad \boldsymbol{W}_{kc}^{(s)}\in\mathbb{R}^{d_c\times d_k}, \boldsymbol{W}_{kr}^{\color{lightgray}{\smash{\not{(s)}}}}\in\mathbb{R}^{d\times d_r} \\
    \boldsymbol{v}_i^{(s)} &= \boldsymbol{c}_i\boldsymbol{W}_v^{(s)}\in\mathbb{R}^{d_v},\quad \boldsymbol{W}_v^{(s)}\in\mathbb{R}^{d_c\times d_v} \\
    \boldsymbol{c}_i’ &= \boldsymbol{x}_i \boldsymbol{W}_c’\in\mathbb{R}^{d_c’},\quad \boldsymbol{W}_c’\in\mathbb{R}^{d\times d_c’} \\
    \boldsymbol{c}_i &= \boldsymbol{x}_i \boldsymbol{W}_c\in\mathbb{R}^{d_c},\quad \boldsymbol{W}_c\in\mathbb{R}^{d\times d_c} \\
    \end{align}
    $$
  • 为了引入 RoPE,在中间向量中拼接了 RoPE 降维后的向量,该向量维度较小

原始论文中 MLA 完整公式

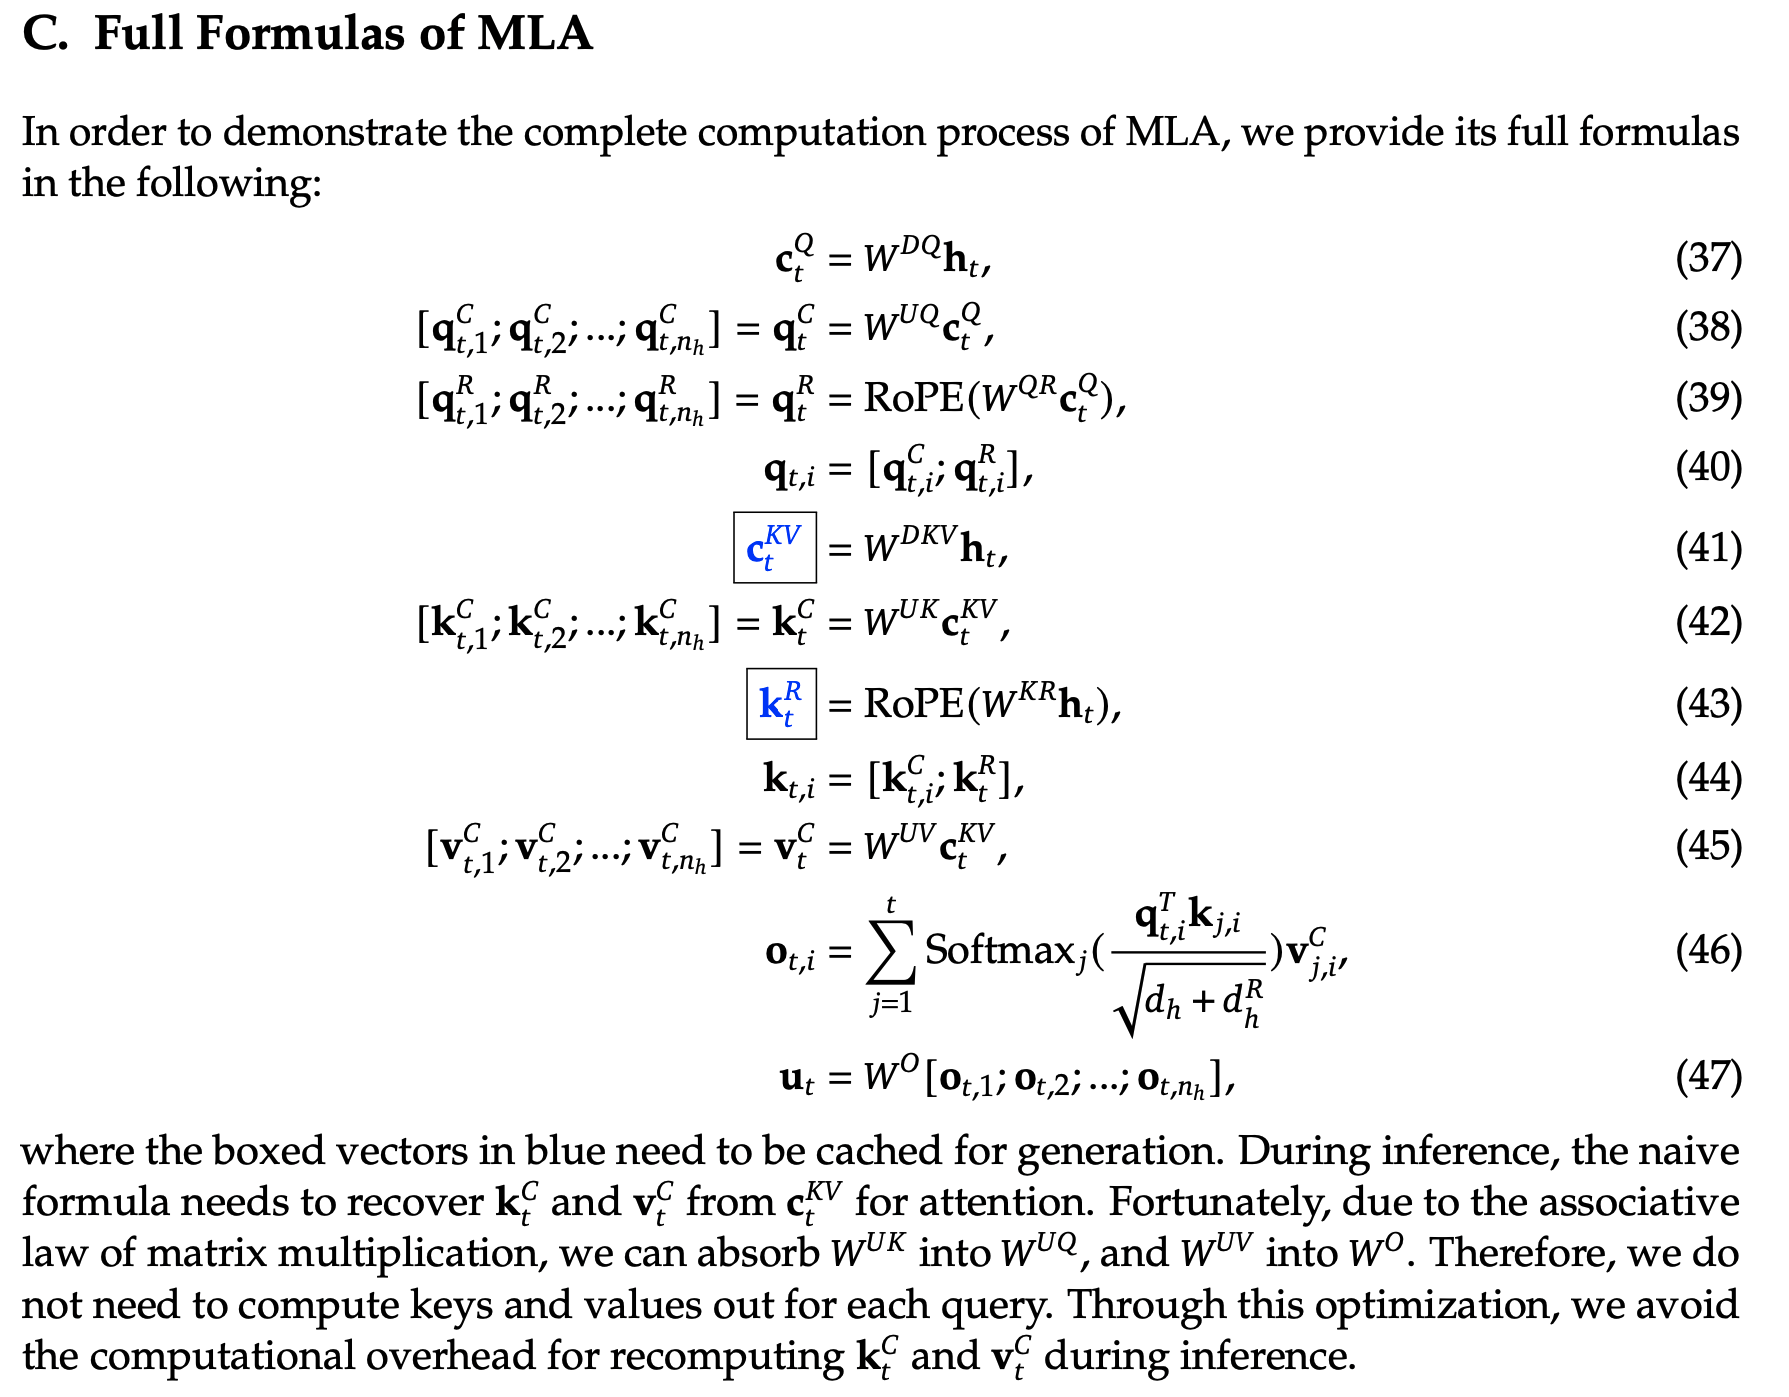
  • MLA 完整公式如下:
  • MLA 的 Q 和 K 分为 RoPE 和 非 RoPE 两部分
    • 表达在 隐向量上则是 从 concat
    • 表达在最终的乘积结果上泽变成 sum
    • 两种表达本质是一样的(对 qk 分别做 concat 和对 qk 乘积做加法结果等价),详情见:DeepSeek-v2 MLA 原理讲解-哔哩哔哩
1…125126127…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4