Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

RL——DDPO

本文介绍DDPO(Denoising Diffusion Policy Optimization, DDPO)方法

  • 参考链接:
    • 原始论文:TRAINING DIFFUSION MODELS WITH REINFORCEMENT LEARNING, UC Berkeley & MIT, 2024
    • 论文解读:论文阅读:Training Diffusion Models with Reinforcement Learning
    • 源码:github.com/kvablack/ddpo-pytorch/

基本思路

  • 目标:解决 Diffusion 图片生成时无法捕捉“人类审美”反馈的问题,也可以用于多模态对齐
    • 个人理解也可以用于生成最大化某个指标的图片,比如最大化“CTR”的图片?
  • 基本思路:将 Diffusion 的每一个生成步骤视为 MDP 过程,从而通过 RL 来引导生成过程
  • MDP 建模思路: \(\epsilon_\theta(x_t, c, t)\) 作为策略网络,其他MDP的详细信息定义如下
    • \(s_t \triangleq (c, t, x_t)\)
    • \(a_t \triangleq x_{t-1}\)
    • \(\pi(a_t|s_t) \triangleq p_\theta(x_{t-1}|x_t, c)\),这里实际上可以写为 \(p_\theta(x_{t-1}|x_t, c, t)\) 更准确
    • \(P(s_{t+1}|s_t, a_t) \triangleq (\delta_c, \delta_{t-1}, \delta_{x_{t-1}}) \),这里 \(\delta_y\) 是狄拉克 \(\delta\) 分布函数(e Dirac delta distributin),表示在指定值时概率无穷大,其他位置概率为0的概率分布
      • 问题:这里概率本质应该是一个标量数字,不能用三维数字来表达吧?文章这里应该是想表达联合概率分布的含义
    • \(\rho_0(s_0) = \triangleq (p(c), \delta_T, \mathcal{N}(0,\mathbf(I)))\),表示初始状态出现的概率,这里也是联合概率分布
    • \(R(s_t, a_t) = \triangleq
      \begin{cases}
      r(x_0, c)& \text{if}\ t = 0\\
      0& \text{otherwise}
      \end{cases}\),表示仅在最后时刻有reward,其他时刻没有reward反馈
RL——Diffusion-QL

本文介绍Diffusion-QL(Diffusion Q-Learning)方法

  • 参考链接:
    • 原始论文:DIFFUSION POLICIES AS AN EXPRESSIVE POLICY CLASS FOR OFFLINE REINFORCEMENT LEARNING, Twitter, 2023

基本思路

  • 目标:解决 Offline RL 的问题
  • 基本思想:通过Diffusion模型 \(\epsilon_\theta(a^i,s_t,i)\) 来建模策略,具体地通过反向过程的多次采样得到当前状态 \(s_t\) 下的最优的动作 \(a_{t}^0\),其中 \(i\) 表示Diffusion采样时间步
  • 学习策略时,使用Diffusion模型的模仿能力保证决策的动作不要偏离原始数据集太多(利用DDPM损失函数来学习);同时使用普通强化学习思路找到使得Q值最大的动作

Diffusion-QL方法

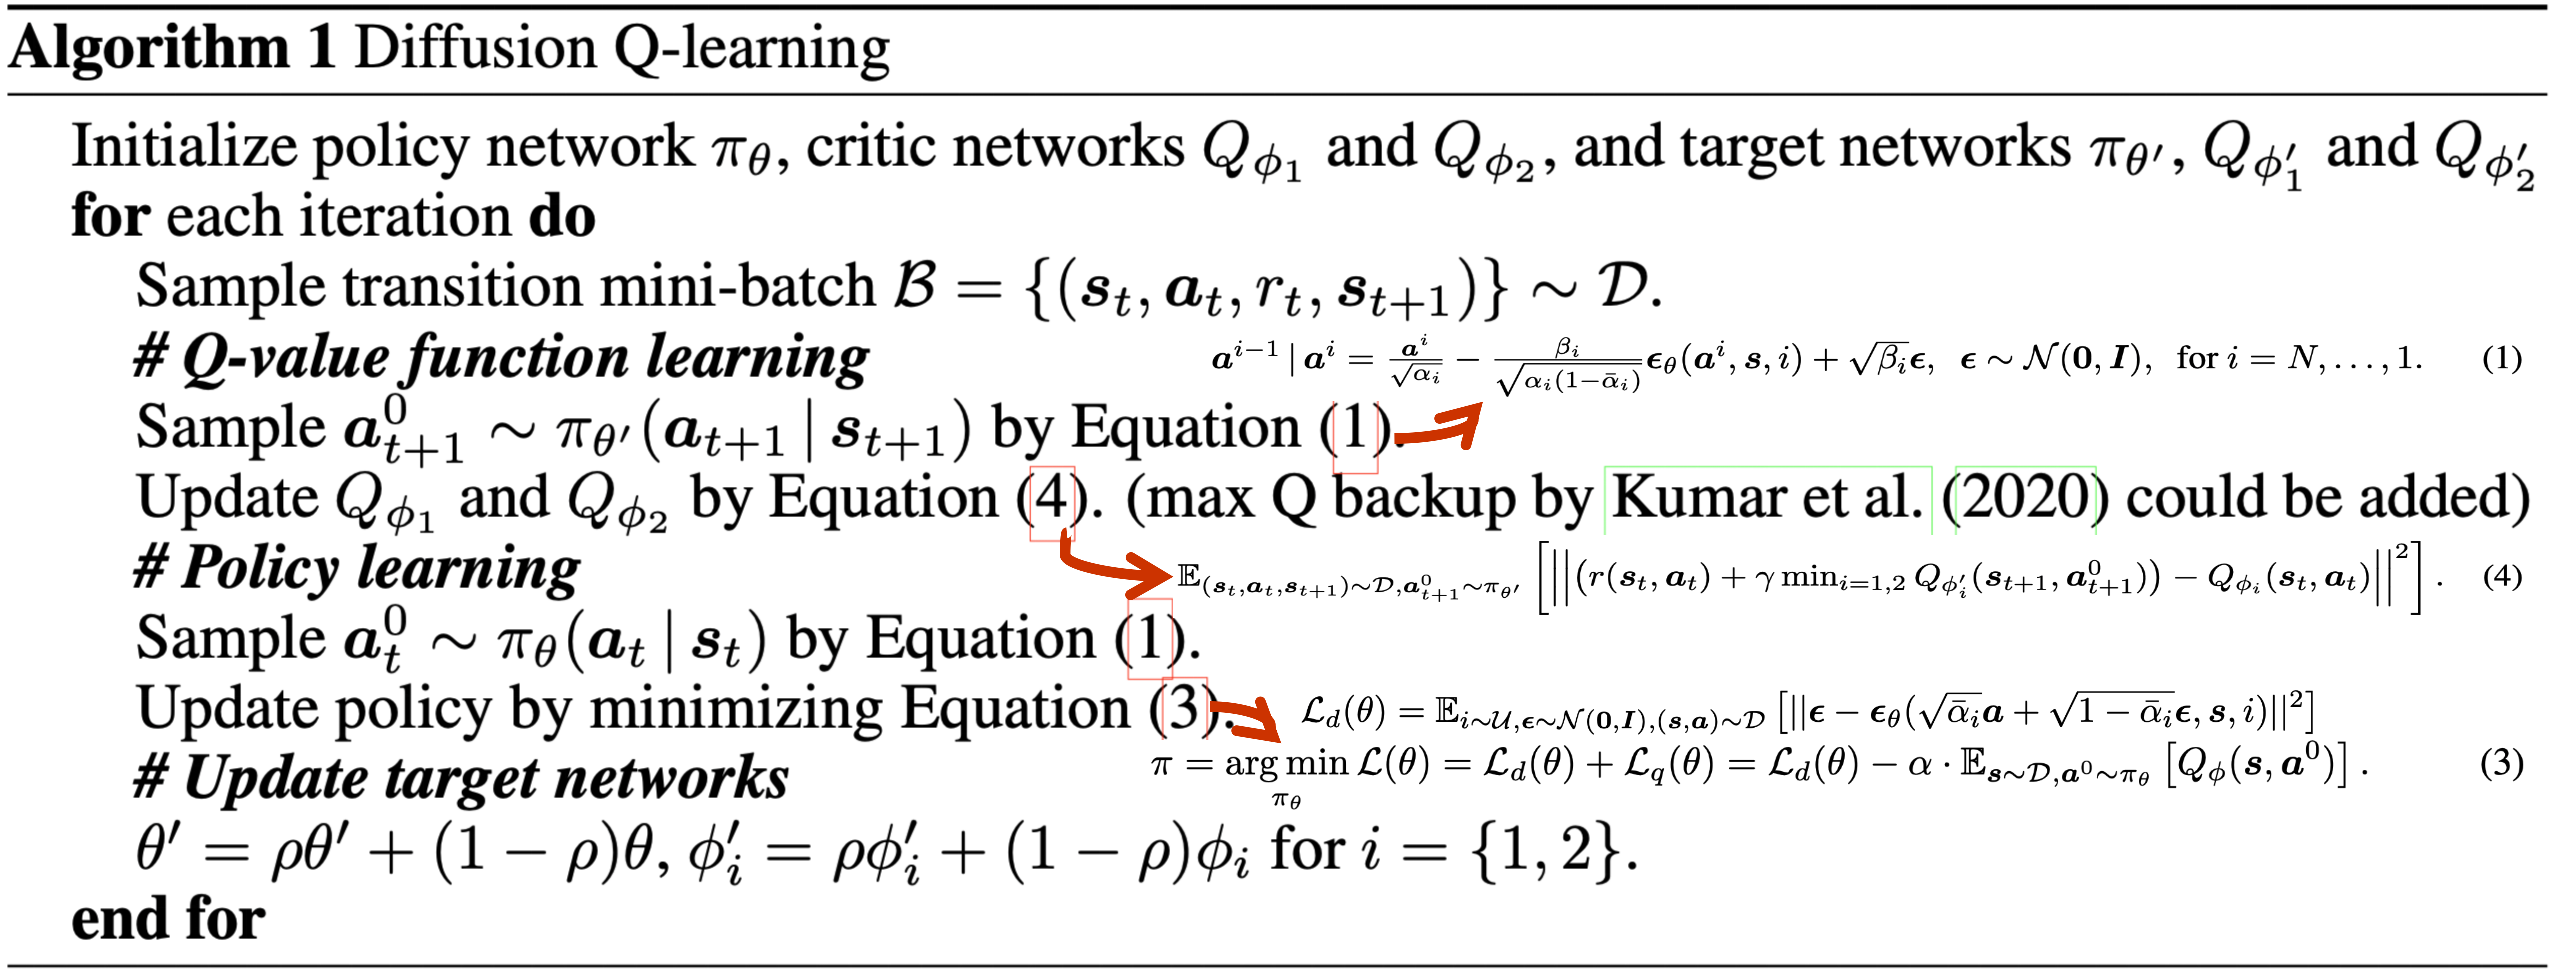
  • 伪代码:
  • 训练Q值时,就是普通的贝尔曼算子对应的损失函数,其中下个状态的最优动作通过Diffusion模型 \(\epsilon_\theta(a^i,s_t,i)\) 来采样得到
  • 训练策略网络(即Diffusion模型 \(\epsilon_\theta(a^i,s_t,i)\) )时包含两部分损失:
    • 最大化Q网络:通过Diffusion模型 \(\epsilon_\theta(a^i,s_t,i)\) 来采样得到动作 \(a_{t}^0\),该动作包含了 \(\theta\) 的梯度信息,将该动作\(a_{t}^0\) 填充到Q网络中即可通过梯度更新 \(\theta\) 的参数(类似DDPG的方式)
    • 最小化DDPM的损失函数,保证生成的动作分布符合原始状态动作对 \((s,a)\)

一些补充

  • 为什么需要使用Diffusion的损失函数?
    • Online RL中,理论上找到使得Q值最大的动作就可以了
    • Offline RL中,加入DDPM的损失函数之后有一种拟合原始数据策略的含义,保证生成的动作不会偏离原始数据集太多,有助于缓解Offline RL的OOD问题
1…107108109…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4