注:本文包含 AI 辅助创作
- 参考链接:
Paper Summary
- 整体说明:
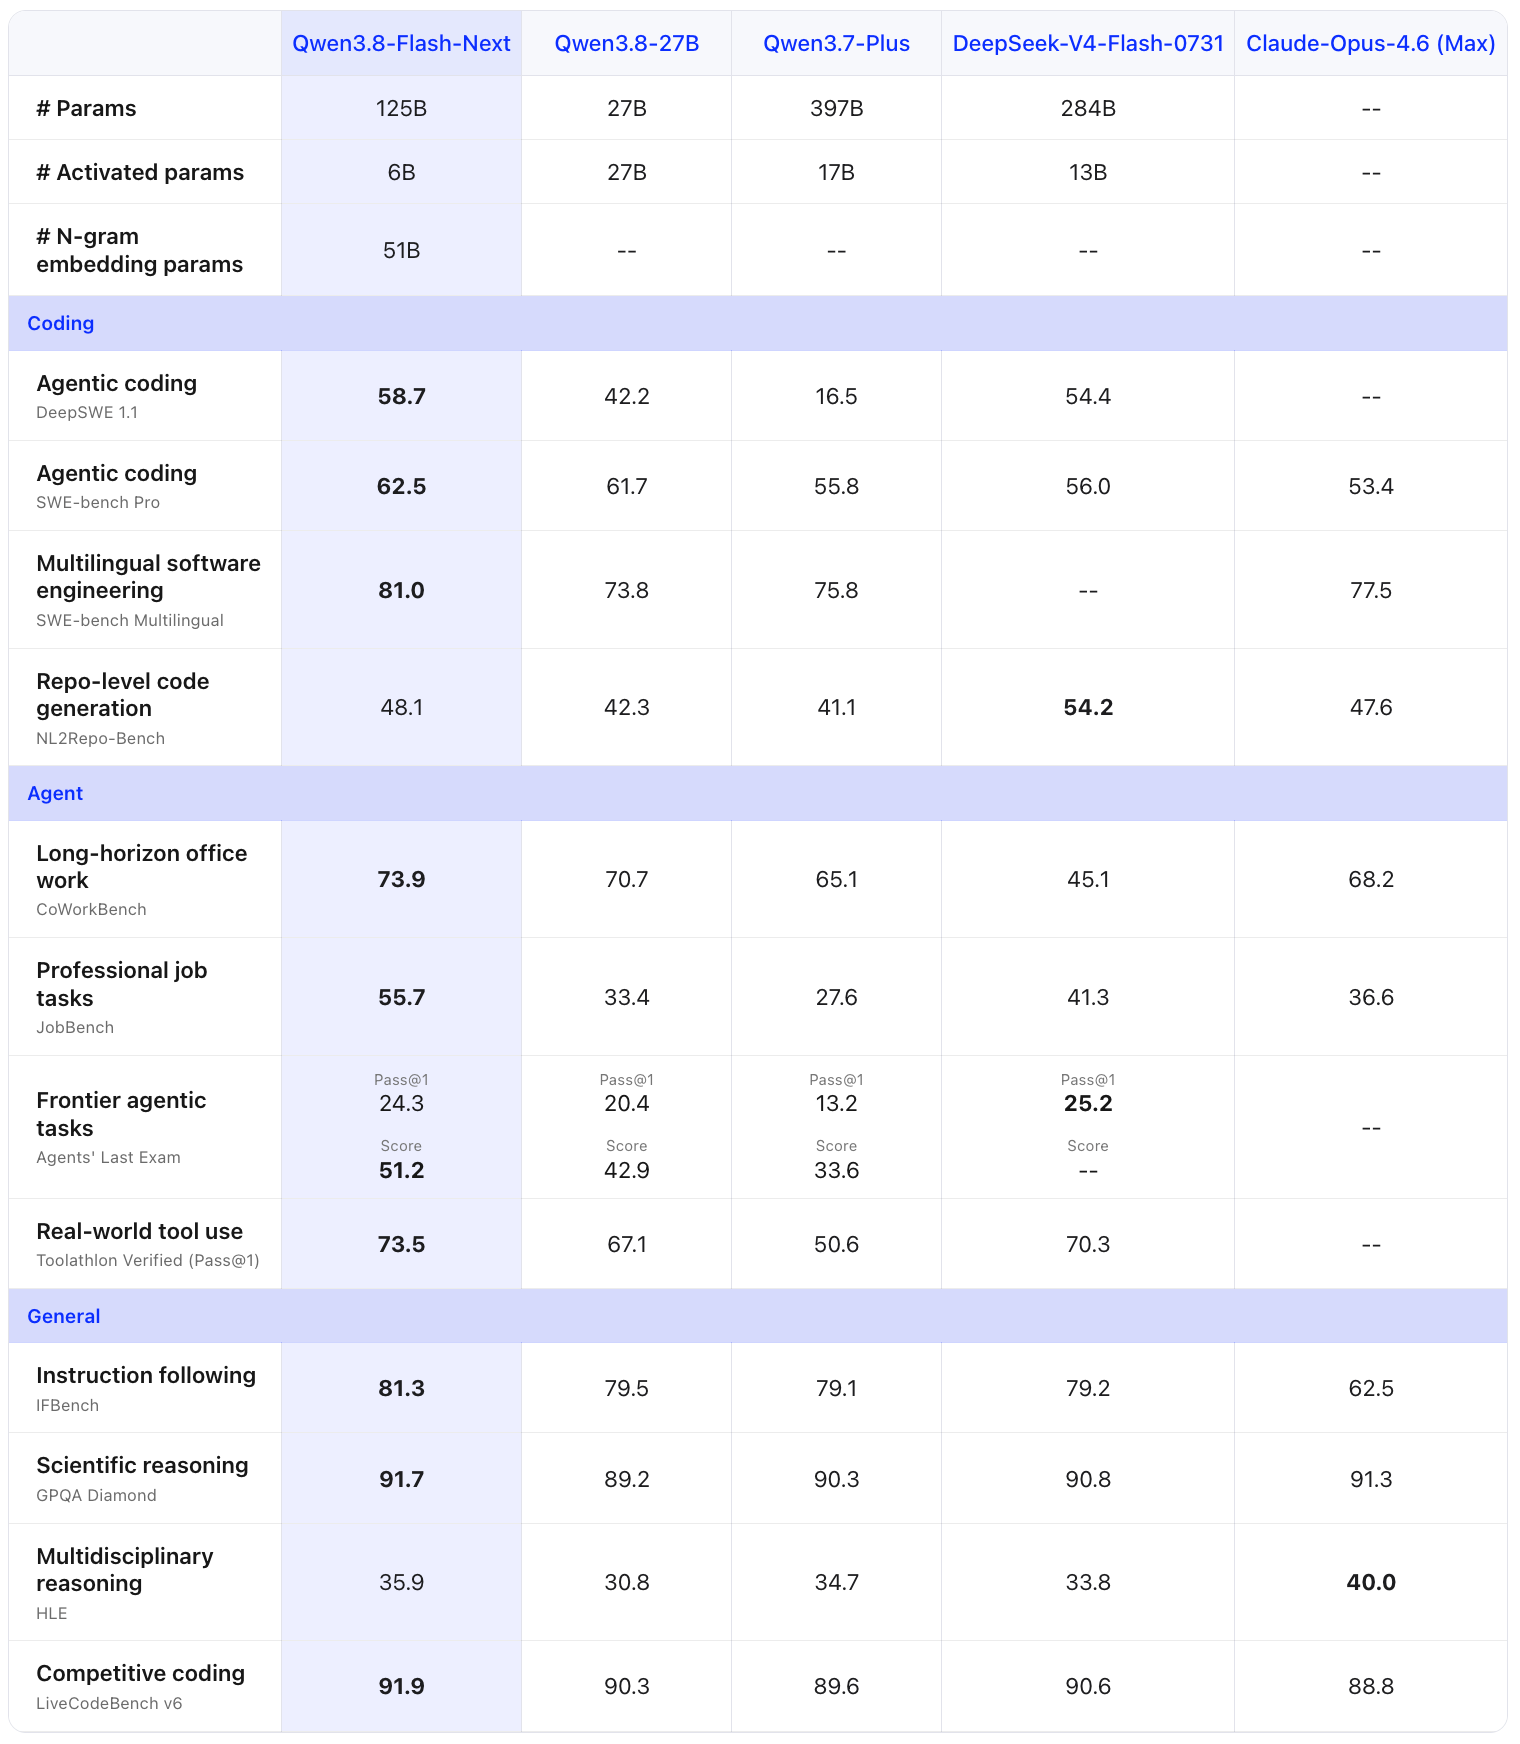
- 纸面参数:125B-A6B
- N-gram 嵌入表参数量 :51B,这部分参数存储在 Host 内存中,不驻留加速器
- 理解:真实总参数量是 176B = 125B + 51B,因为 51B 的 N-gram Embedding 参数是放到 Host 里面,使用时被直接检索(Lookup)的,所以没有写到纸面参数里面
- 一次前向传播实际从 Host 搬运到 GPU 的数据量远远小于 51B
- 论文中还使用了多种工程手段提升检索效率,降低延迟
- 核心:在约 1/9 的训练 FLOPs 下,达到上一代 397B-A17B 旗舰模型的质量水平
- 8 个基准领先于 397B-A17B 前代模型
- 6 个基准落后,但差距不超过 2.6 个百分点
- 仅使用约 1/3 的激活参数和 1/3 的训练 Token
- 训练 FLOPs 约为前代的 1/9
- Qwen3.8-Flash-Next 的全规模训练顺利进行 :
- 无 Loss Spike
- 无 梯度范数异常波动
- 不依赖 qk-clip 或 SwiGLU-clip 等显式 Clipping 方法
模型架构详解
Token Mixing:GDN 混合架构
设计思路
- 传统 Full Attention 存在两个核心问题:
- 1)Token Mixing 成本 随序列长度呈 \(O(n^2)\) 增长
- 2)KV Cache 在自回归生成时线性增长
- 滑动窗口注意力(SWA)虽然降低了计算和缓存消耗,但窗口外的信息只能通过深度间接传播,造成了局部处理效率与持久内容记忆之间的张力
Gated DeltaNet 核心机制
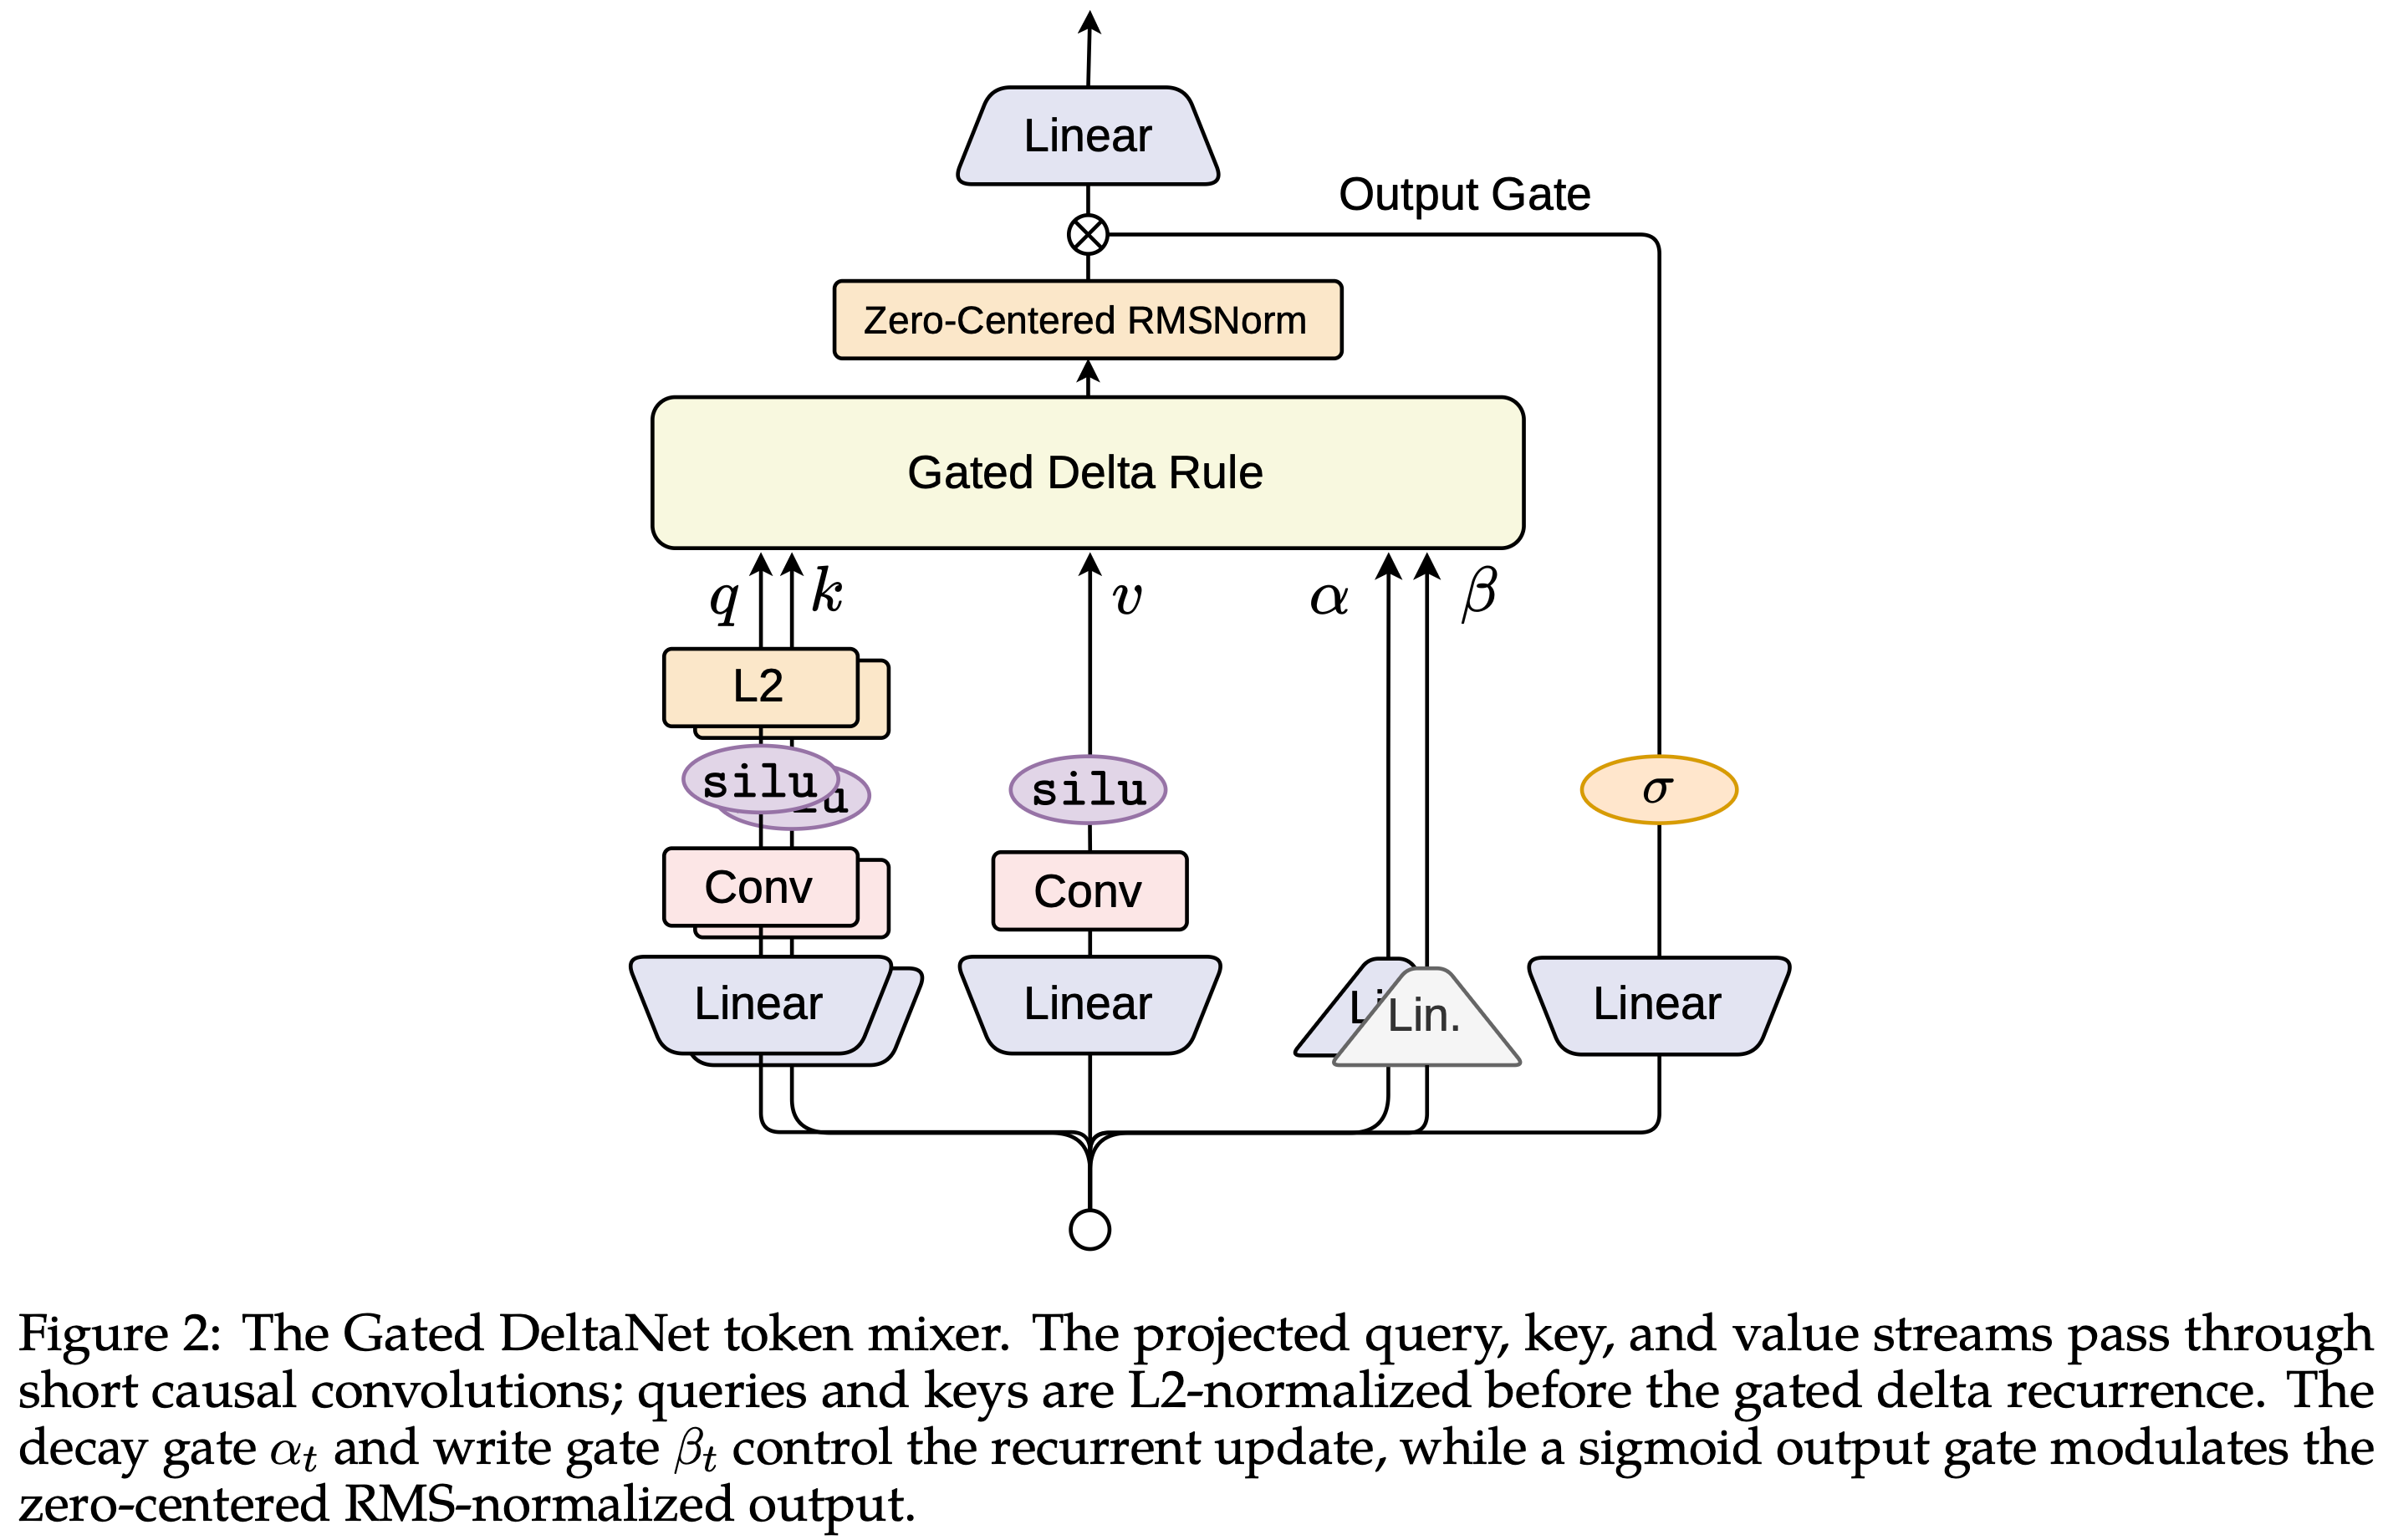
- GDN 将前缀压缩为固定大小的循环状态 ,按内容更新
- GDN 的核心是门控 Delta 规则 :
- 对于每个 Head,设 \(\pmb{q}_t, \pmb{k}_t \in \mathbb{R}^{d_k}\) 和 \(\pmb{v}_t \in \mathbb{R}^{d_v}\),GDN 维护状态 \(\pmb{S}_t \in \mathbb{R}^{d_k \times d_v}\),其更新规则为:
$$
\begin{array}{rl}
& \tilde{S}_{t-1} = \alpha_t S_{t-1}, \\
& e_t = v_t - \tilde{S}_{t-1}^{\top} k_t, \\
& S_t = \tilde{S}_{t-1} + \beta_t k_t e_t^{\top}, \\
& y_t = S_t^{\top} q_t
\end{array}
$$ - 等价形式为:
$$
S_t = \alpha_t (I - \beta_t k_t k_t^{\top}) S_{t-1} + \beta_t k_t v_t^{\top}
$$
- 对于每个 Head,设 \(\pmb{q}_t, \pmb{k}_t \in \mathbb{R}^{d_k}\) 和 \(\pmb{v}_t \in \mathbb{R}^{d_v}\),GDN 维护状态 \(\pmb{S}_t \in \mathbb{R}^{d_k \times d_v}\),其更新规则为:
- 两个门控的互补作用 :
- \(\alpha_t\)(衰减门) :全局控制现有状态的生存周期,\(\alpha_t \in (0,1)\)
- \(\beta_t\)(写入门) :估计与 \(k_t\) 关联的已有值,只写入残差误差,\(\beta_t \in (0,1)\)
- 这种定向擦除-写入机制避免了纯加性线性注意力的无界外积累积
GDN 参数化细节
- 给定归一化残差流输入 \(\pmb{x}_t \in \mathbb{R}^d\):
- 内容特征计算(带短卷积):
$$
\begin{array}{rl}
& q_t = \text{L2Norm}(\text{SiLU}(\text{ShortConv}(\pmb{W}_q \pmb{x}_t))), \\
& k_t = \text{L2Norm}(\text{SiLU}(\text{ShortConv}(\pmb{W}_k \pmb{x}_t))), \\
& v_t = \text{SiLU}(\text{ShortConv}(\pmb{W}_v \pmb{x}_t))
\end{array}
$$ - 门控参数化 :
$$
\begin{array}{rl}
& \beta_t = \sigma(W_\beta x_t), \\
& \alpha_t = \exp[-\exp(A)\text{softplus}(W_\alpha x_t + b_\alpha)]
\end{array}
$$ - 输出门控(使用 Sigmoid 而非 SiLU):
$$
\pmb{o}_t = \pmb{W}_o[\sigma(\pmb{W}_z \pmb{x}_t) \odot \text{RMSNorm}(\pmb{y}_t)]
$$ - 关键设计决策:
- L2 归一化限制 \(q/k\) 幅值,稳定秩一 Delta 更新
- 短卷积提供显式局部归纳偏置
- Zero-Centered RMSNorm 约束 RMSNorm 权重增长
- Sigmoid 输出门 优于 SiLU,与 GDN 和 Attention 组件中的观察一致
混合架构配置
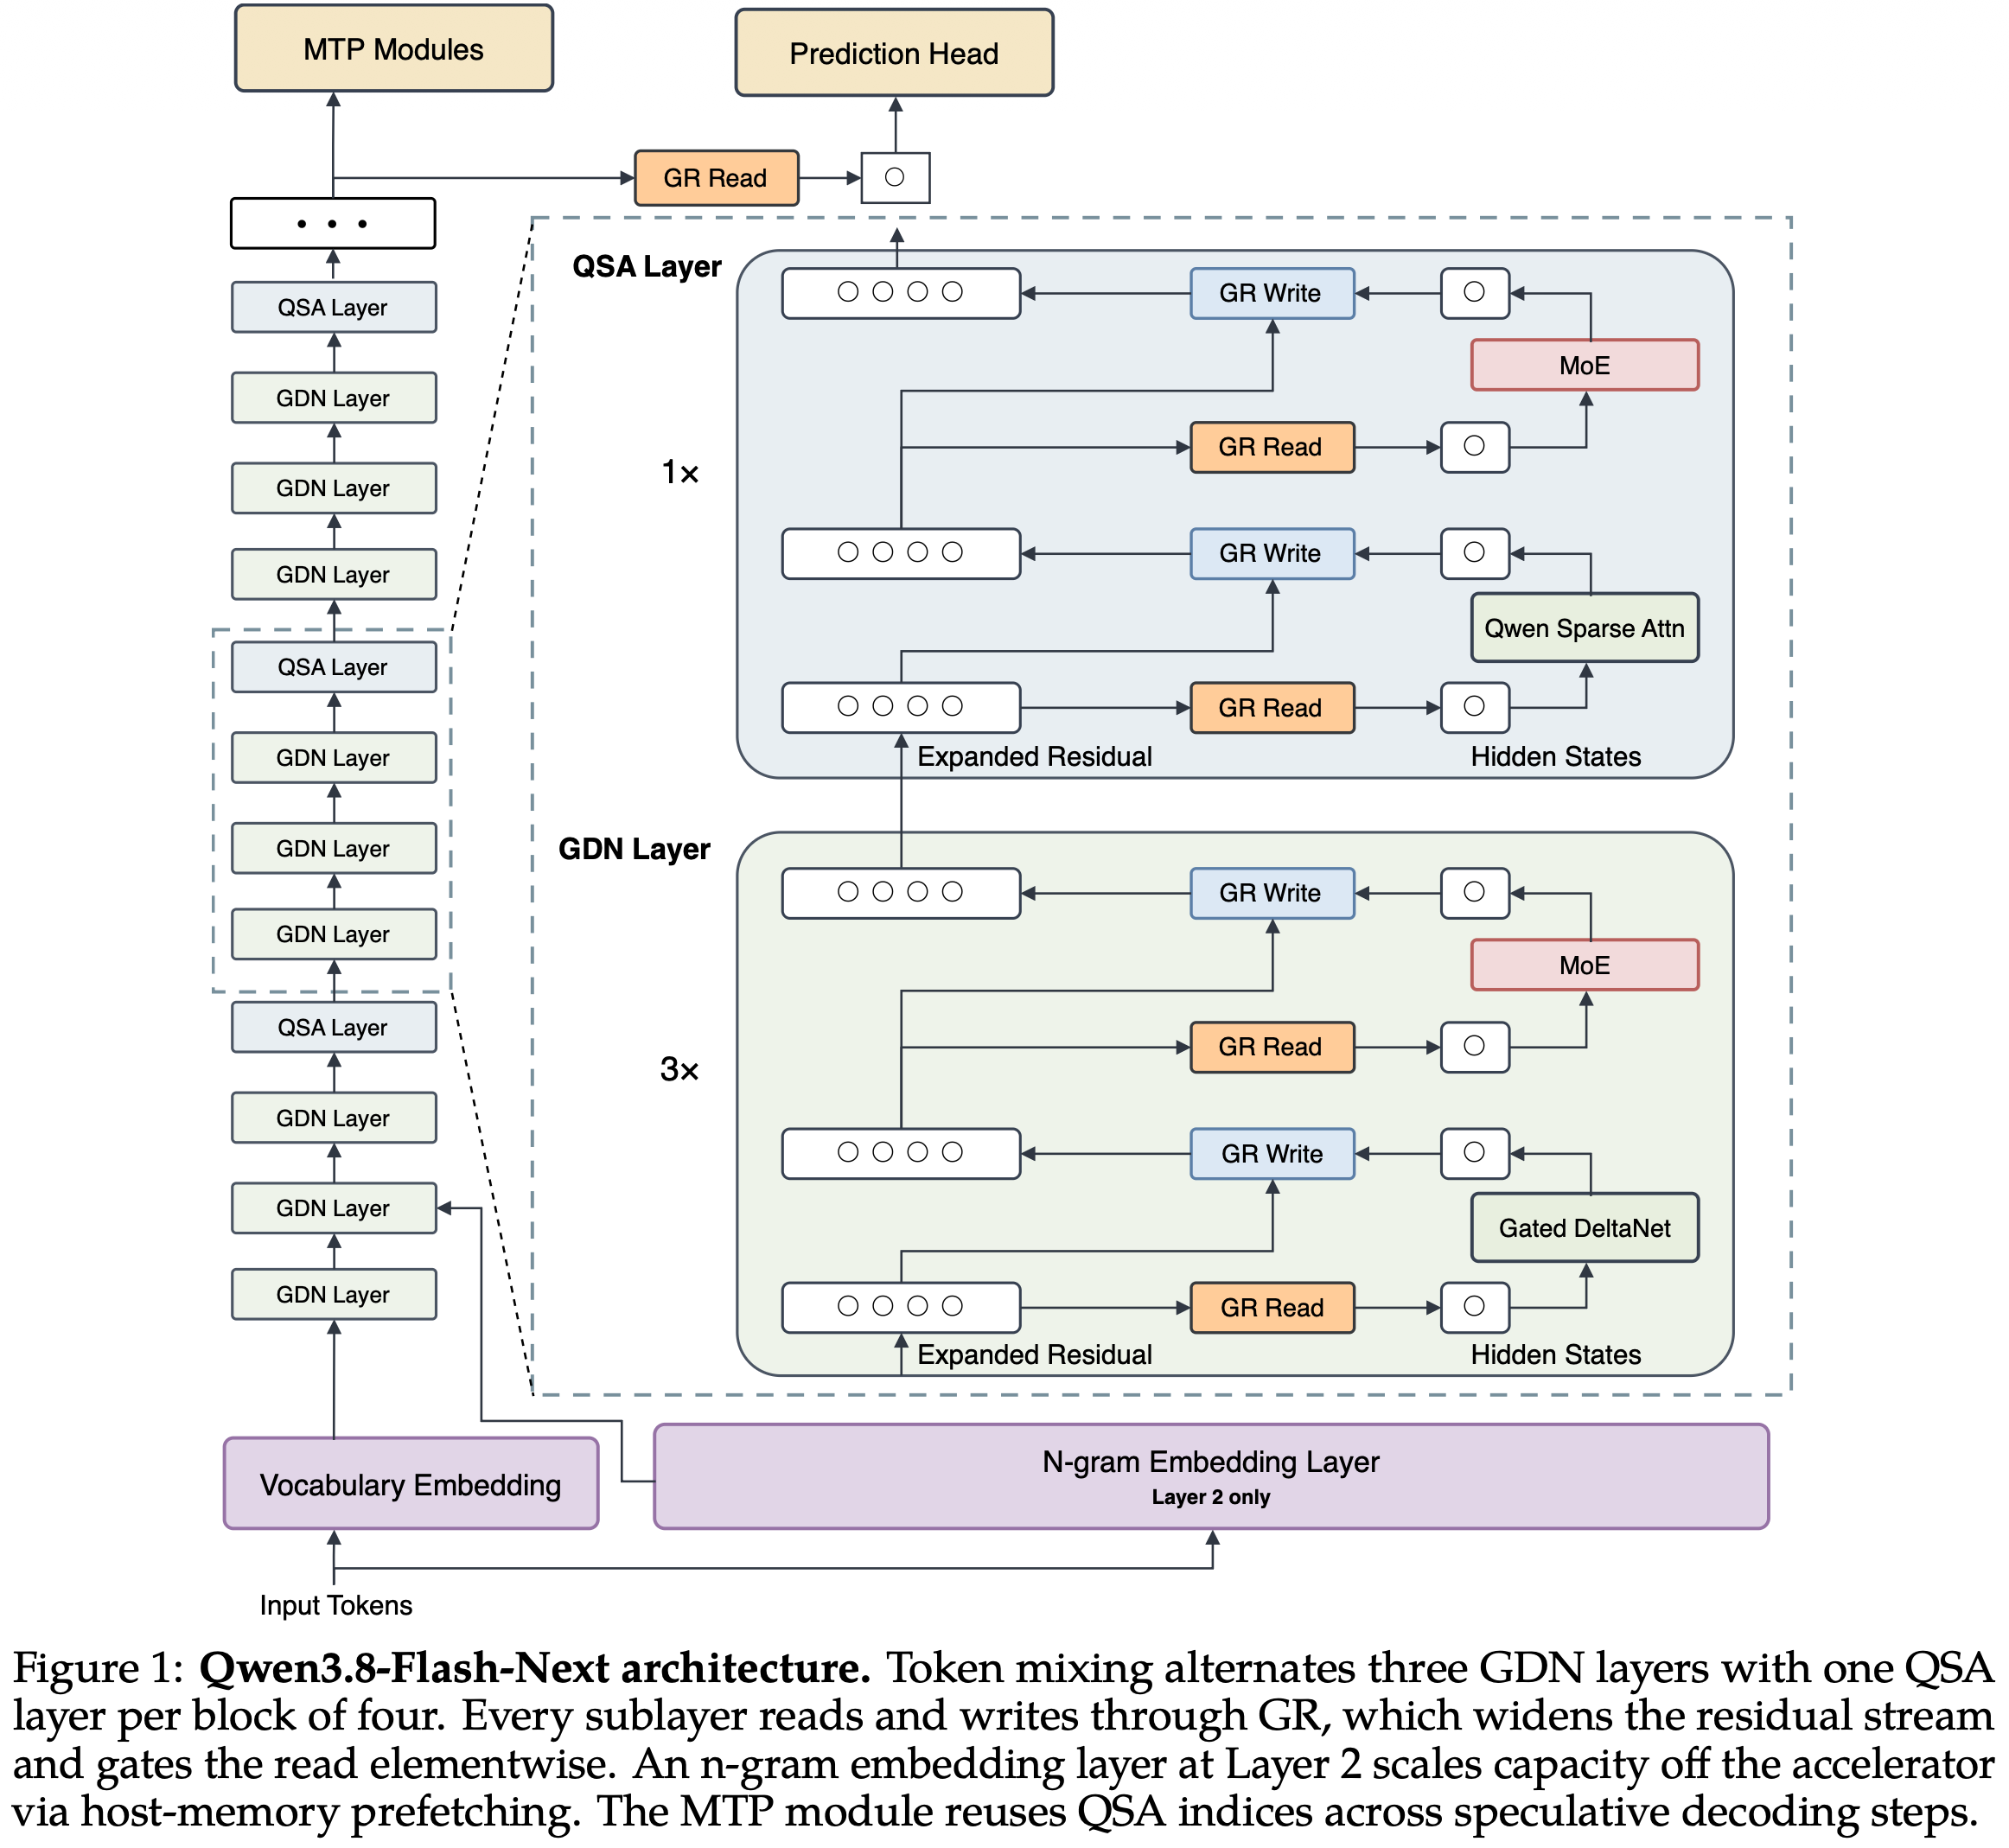
- 每 4 层中放置 1 个 Full-Attention 层(保留 RoPE)
- 其余 3 层使用 GDN
- RoPE 与 NoPE 变体在预训练时差异不大,但 NoPE 在后训练后表现出更高的无限生成率 ,更容易无法终止
- PS:架构消融结果
- Full Attention:49.87
- SWA Hybrid:51.15
- GDN Hybrid:53.81
- GDN Hybrid 在 9 个基准中 8 个优于 Full Attention,7 个优于 SWA Hybrid
内核效率
FlashQLA :基于 TileLang 的融合线性注意力内核库
* Forward 速度提升:\(2-3\times\)(相比 FLA Triton 内核)
* Backward 速度提升:约 \(2\times\)
Token Mixing:Qwen Sparse Attention(QSA)
设计思路
- DSA(2025a)使用轻量级 Indexer 生成 Token 级稀疏掩码实现推理加速,但其 Indexer 的 \(O(n^2)\) 开销在长序列下仍然显著
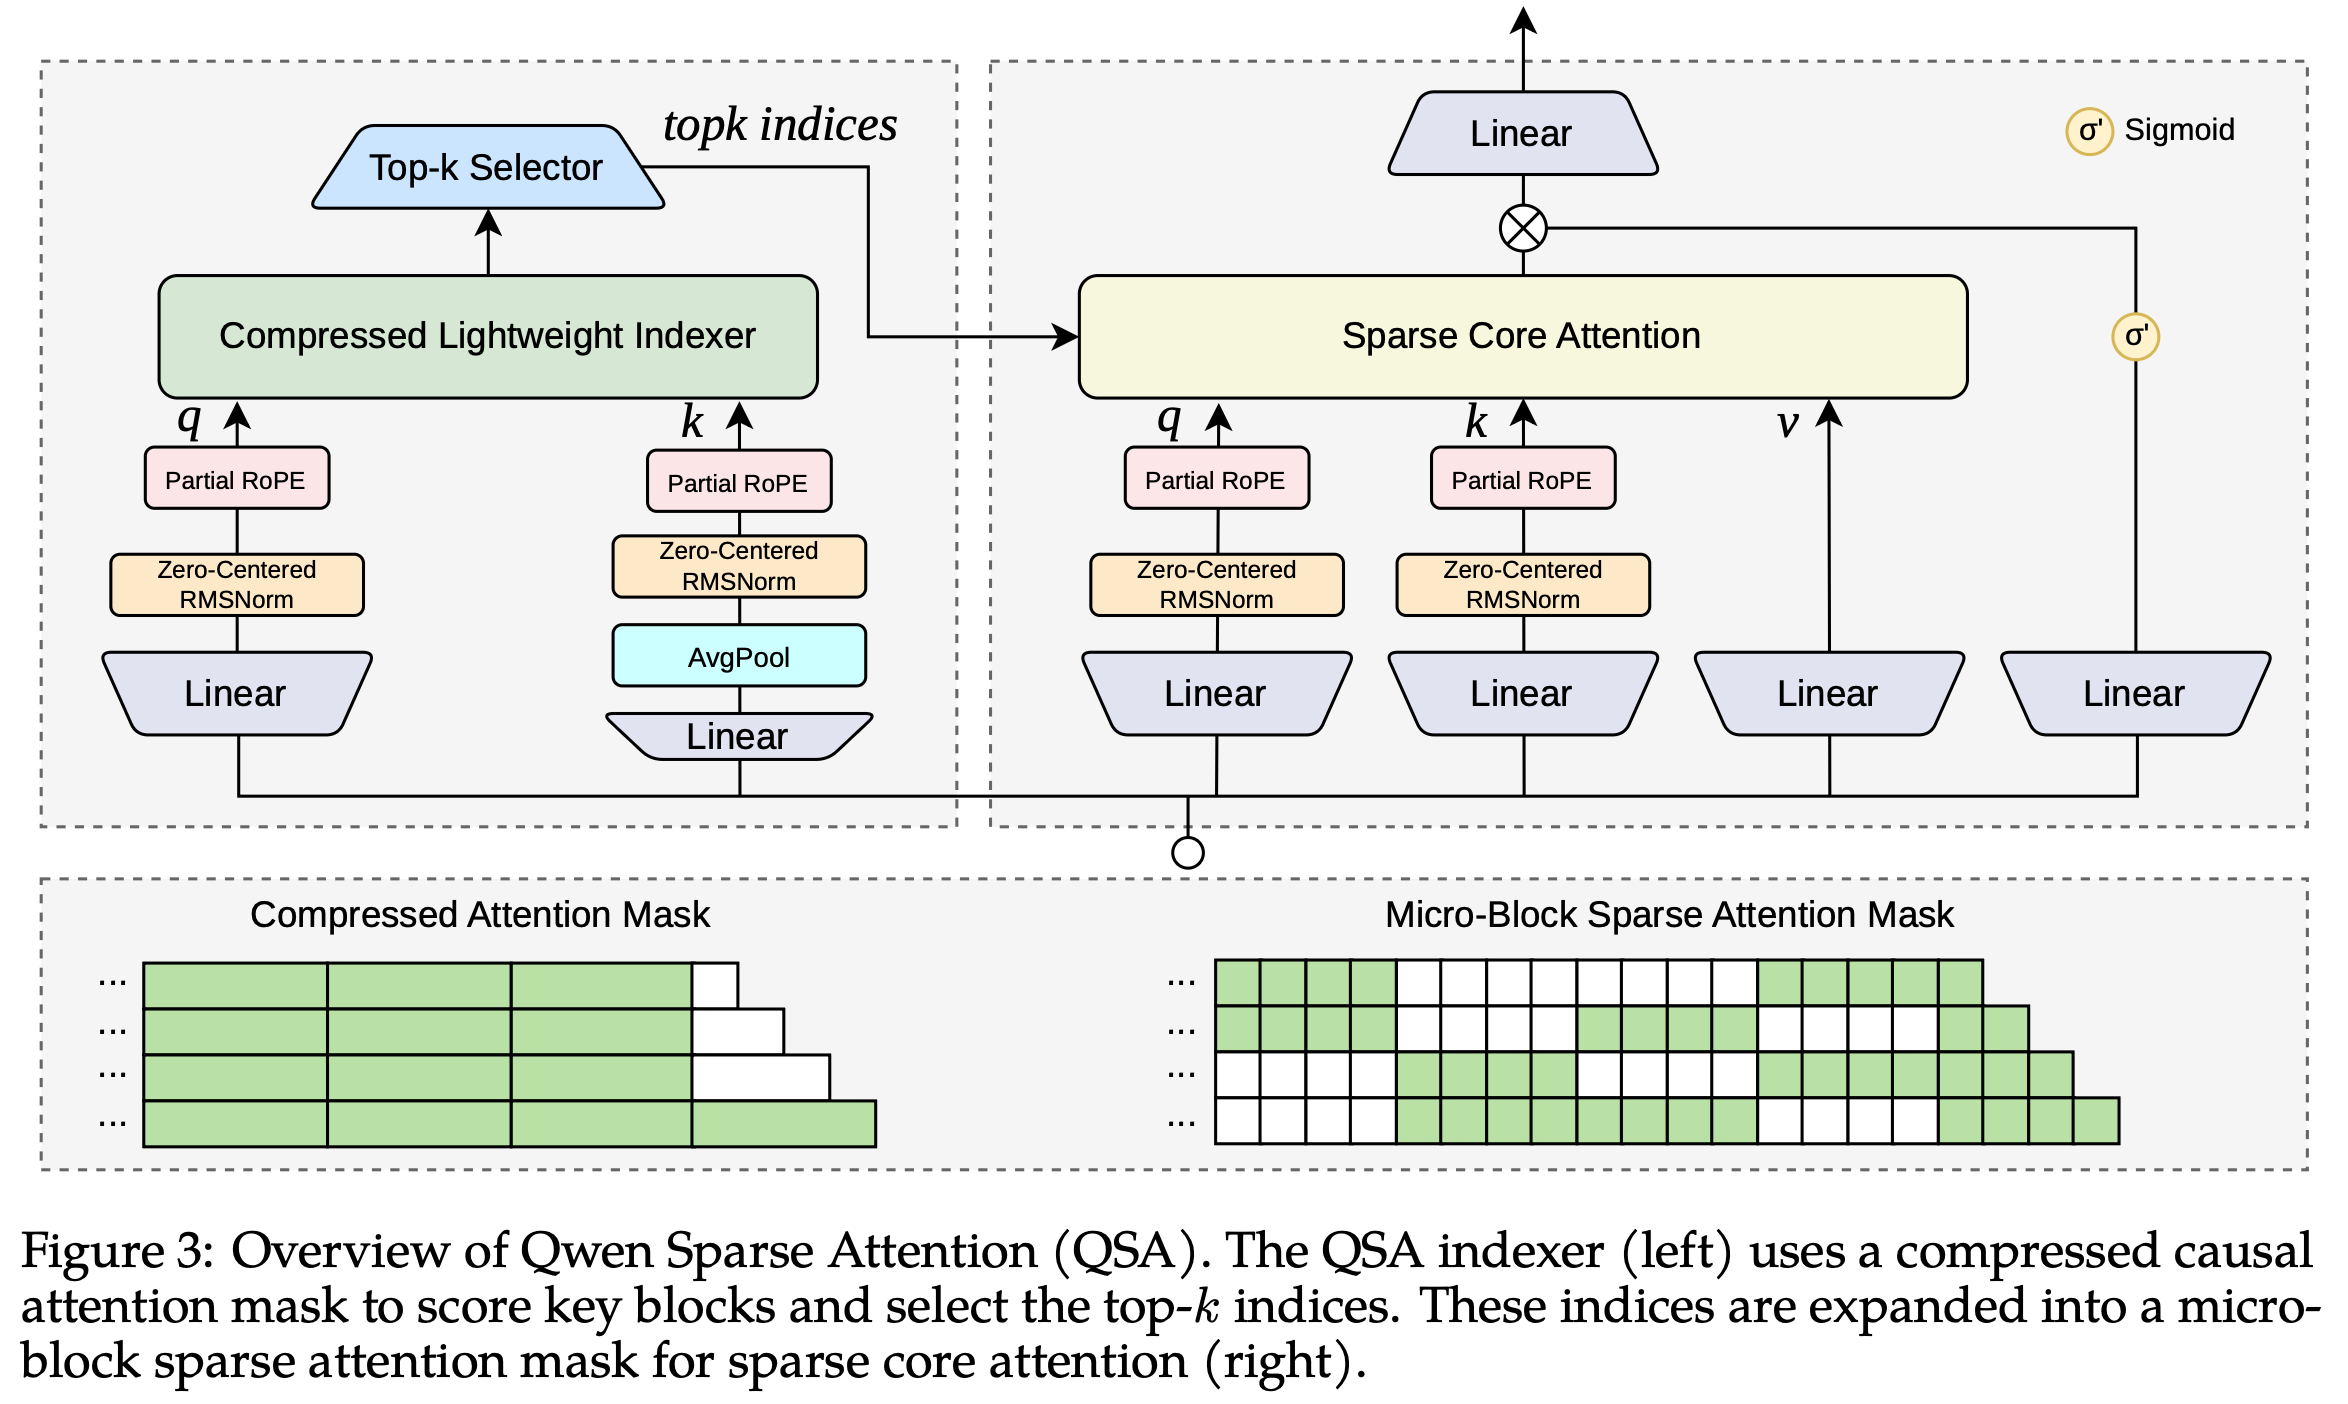
- QSA 的核心思想 :将序列压缩为微块表示 ,估计其重要性,选择最相关的上下文进行注意力计算,将 Indexer 复杂度从 \(O(n^2)\) 降至 \(O(n^2/r)\)
压缩轻量级 Indexer
- 给定输入隐状态 \(\mathbf{x}_i\),Indexer 采用 MQA 结构(H 个 Query Head,1 个共享 Key Head):
- 独立轻量级投影 :
$$
\hat{\mathbf{q} }_i^h = \text{RMSNorm}(\mathbf{W}_Q^h \mathbf{x}_i), \quad \mathbf{k}_i = \mathbf{W}_K \mathbf{x}_i
$$ - Key 压缩(非重叠块,块大小 \(r\),起始位置 \(p_b = b \cdot r\)):
$$
\hat{\mathbf{k} }_b = \text{RMSNorm}\left(\text{AvgPool}(\mathbf{k}_{p_b : p_b + r - 1})\right), \quad 0 \leq b < \left\lfloor \frac{n}{r} \right\rfloor
$$ - Partial RoPE :应用于每个 Indexer Head 的 128 维中的 64 维,与 Core Attention 的旋转维度匹配
- Key 压缩在位置编码之前执行 ,避免平均不同旋转相位的 Token 表示
$$
\mathbf{q}_i^h = \text{PRoPE}(\hat{\mathbf{q} }_i^h, i), \quad \hat{\mathbf{k} }_b = \text{PRoPE}(\hat{\mathbf{k} }_b, p_b)
$$
- Key 压缩在位置编码之前执行 ,避免平均不同旋转相位的 Token 表示
- 块级重要性评分(Block-Causal,ReLU 激活):
$$
I_{ib} = \begin{cases}
\sum_{h=1}^{H} \text{ReLU}(\langle \mathbf{q}_i^h, \hat{\mathbf{k} }_b \rangle), & p_b + r - 1 \leq i, \\
-\infty, & \text{otherwise}
\end{cases}
$$ - Top-K 块选择(Token 预算 \(K\),块预算 \(K_B = \lceil K/r \rceil\)):
$$
B_i = \text{TopK}_{K_B}(\{I_{ib}\}_b), \quad K_B = \left\lceil \frac{K}{r} \right\rceil
$$ - 最终 Token 集合(扩展选中的块 + 最后一个不完整块的尾部 Token):
$$
\mathcal{S}_i = \text{Expand}(B_i) \cup \left\{ r\left\lfloor \frac{i+1}{r} \right\rfloor, \ldots, i \right\}
$$
- 独立轻量级投影 :
QSA 两阶段训练流程
Stage 1:Dense Distillation
- 将 Full-Sequence Attention 分布蒸馏到 Indexer:
- 通过对所有 Teacher Head 的 Softmax Attention 分布求和并 L1 归一化,得到 Token 级教师分布 \(\mathbf{a}_i \in \mathbb{R}^n\)
- 使用 Max Pooling 对齐到块级(保留显著 Token 级信号):
$$
\hat{a}_{ib} = \text{MaxPool}(\mathbf{a}_{i, p_b : p_b + r - 1}), \quad \hat{\mathbf{a} }_i = \frac{\hat{\mathbf{a} }_i}{|\hat{\mathbf{a} }_i|_1}
$$ - KL 散度损失:
$$
\mathcal{L}_{\text{KL} } = \frac{1}{N} \sum_i D_{\text{KL} }(\hat{\mathbf{a} }_{i,:} | \text{Softmax}(\mathbf{I}_{i,:}))
$$ - 仅训练 Indexer 1000 步,学习率 \(1 \times 10^{-3}\),每步 8 条 256K 序列(约 20 亿 Token)
Stage 2:稀疏训练
- 整个 Backbone 在 Indexer 指导下训练,适应稀疏注意力模式
- KL 损失仅计算 Top-\(K_B\) 块,教师概率重新归一化:
$$
\mathcal{L}_{\text{KL} } = \frac{1}{N} \sum_i D_{\text{KL} }(\hat{\mathbf{a} }_{i, B_i} | \text{Softmax}(\mathbf{I}_{i, B_i}))
$$ - Backbone + Indexer 联合训练 8000 步,学习率 \(2.5 \times 10^{-5}\),每步 96 条 256K 序列(约 2000 亿 Token)
QSA 配置与效果
- 配置 :
- Token 预算 \(K = 2048\)
- 压缩比 \(r = 4\)
- 4 个 Query Head,1 个 Shared Key Head
- 所有 Full-Attention 层(Backbone + MTP)替换为 QSA
- 效果 :
- LM Loss 与 Full Attention 高度一致,差异约 \(10^{-4}\)
- 短上下文任务上匹配或超越 Full Attention(平均分 75.9 → 76.8)
- 长上下文检索:RULER 在 512K+ 上 90.08 → 93.00;MRCR 在 512K 上 30.66 → 40.53,1M 上 20.71 → 26.44
- MTP 平均接受长度无明显变化(4.06 → 4.07)
架构消融
- 压缩比消融 :
- QSA 在相对 Indexer 延迟 0.25 时匹配 Full Attention 基线
- IndexShare(跨层共享 Index)在 0.5 时仍低于基线 → 混合架构中跨层相似性低,层内压缩更优
- Indexer Head 数量 :
- 密集初始化后直接应用稀疏注意力的性能有明显下降
- 短暂联合训练使 Backbone 适应稀疏模式并恢复到 Full Attention 水平
- 最终采用 4 个 Query Head(平衡速度和精度)
效率分析
- 内核级 Prefill 速度:在 1M 上下文下 7.6× 加速
- 内核级 Decode 速度:在 1M 上下文下 4.9× 加速
- Indexer 延迟降低:与压缩比成比例
- 从 64K 上下文开始产生加速,随序列增长加速更显著
残差网络:Gated Residual(GR)
设计思路 & 思路
- 问题 :Pre-Norm 结构中,每个 Block 读取相同的流,早期写入的特征必须与之后所有写入竞争
- 改进思路:
- 1)使每层的读/写更具表达性(Highway Networks)
- 2)拓宽流本身(Alternating Updates、Hyper-Connections)
拓宽残差流
- 残差状态 \(\pmb{R}^{(\ell)} \in \mathbb{R}^{n_r \times d}\)(\(n_r\) 个分支,\(d\) 为隐藏维度):
- 读取 (加权和):
$$
\pmb{x}^{(\ell)} = \sum_{i=1}^{n_r} h_i \pmb{R}_i^{(\ell)}
$$ - 写入 (轮询单分支):
$$
\pmb{R}_i^{(\ell+1)} = \pmb{R}_i^{(\ell)} + \mathbf{1}[i = \ell \boldsymbol n_r] \pmb{y}^{(\ell)}
$$ - 仅拓宽(静态)即可将 25B-A3B MoE 的训练 Loss 降低约 0.01
Hyper-Connections 泛化
- 三个可学习算子:Read 算子 \(H_{\text{mix} }\)、Write 算子 \(H_{\text{combine} }\)、Mixing 算子 \(H_{\text{res} }\):
$$
\begin{array}{l}
\pmb{x}^{(\ell)} = \pmb{H}_{\text{mix} }^\top \pmb{R}^{(\ell)}, \\
\pmb{y}^{(\ell)} = \pmb{\mathcal{F} }^{(\ell)}(\text{Norm}(\pmb{x}^{(\ell)})), \\
\pmb{R}^{(\ell+1)} = \pmb{H}_{\text{res} } \pmb{R}^{(\ell)} + \pmb{H}_{\text{combine} } \pmb{y}^{(\ell)\top}
\end{array}
$$ - 其中 \(H_{\text{mix} }, H_{\text{combine} } \in \mathbb{R}^{n_r}\),\(H_{\text{res} } \in \mathbb{R}^{n_r \times n_r}\)
- 每个算子 = 静态项 + 数据依赖项 :
$$
\begin{array}{r}
H_{\text{mix} } = H_{\text{mix} }^{\text{s} } + \lambda_m \odot \phi(\overline{R} W_m), \\
H_{\text{combine} } = H_{\text{combine} }^{\text{s} } + \lambda_c \odot \phi(\overline{R} W_c), \\
H_{\text{res} } = H_{\text{res} }^{\text{s} } + \lambda_r \odot \phi(\overline{R} W_r)
\end{array}
$$
设计消融的关键发现
- 1)有界正门控 :Sigmoid 门优于 Tanh(与 mHC 一致)
- 2)数据依赖 :使 \(H_{\text{mix} }\) 和 \(H_{\text{combine} }\) 数据依赖仅降低 Loss 0.002,但 Benchmark 提升 1.98 点 → Loss 与下游精度不同步
- 3)Read 粒度 > Write 粒度 :细化 \(H_{\text{mix} }\) 有帮助,细化 \(H_{\text{combine} }\) 几乎无收益
- 4)读取所有分支 > 仅使用最后分支或 Pooling;每个分支独立归一化(Group RMSNorm)带来进一步提升
- 5)\(H_{\text{res} }\) 贡献小 :Read/Write 足够表达时,\(n_r \times n_r\) Mixing 算子无明显提升
Gated Residual 具体设计
- 独立分支归一化(每个分支有自己的增益 \(\gamma_i \in \mathbb{R}^d\)):
$$
\hat{R}_i = \text{RMSNorm}(R_i; \gamma_i), \quad i = 1, \ldots, n_r
$$ - 读取(元素级门控,瓶颈秩 \(r = d/8\)):
$$
\begin{align}
G &= \text{unvec}\left(\sigma\left(W_u \text{SiLU}\left(\frac{1}{n_r} W_d \text{vec}(\hat{R})\right)\right)\right) \in \mathbb{R}^{n_r \times d} \\
x *= \frac{1}{n_r} \sum_{i=1}^{n_r} G_i \odot \hat{R}_i
\end{align}
$$- 其中 vec 将分支堆叠为长度 \(n_r d\) 的向量,unvec 为其逆操作
- \(W_d \in \mathbb{R}^{r \times n_r d}\),\(W_u \in \mathbb{R}^{n_r d \times r}\)
- 写入(每个分支一个数据依赖标量):
$$
\begin{align}
s &= 2\sigma\left(\frac{1}{n_r} W_u \text{vec}(\hat{R})\right) \in \mathbb{R}^{n_r} \\
R_i’ &= R_i + s_i \pmb{y}
\end{align}
$$ - 配置 :\(n_r = 4\) 个分支,每个 Layer 的 Attention Block 和 MLP Block 各有独立的 GR 模块
Gated Residual 与 HC/mHC/VWN 的对比
- HC/mHC:Read/Write 为 Per-Branch 标量,容量放在 \(H_{\text{res} }\)
- VWN:拓宽 Token Embedding,分割为多个窄段
- GR :表达力放在 Read(元素级门控),完全去掉 \(H_{\text{res} }\) → 减少内存流量
分支使用分析
- 分解方法 :
- 分支 \(c\) 在 Block \(v\) 之前的状态:
$$
R_c^{(v)} = R_c^{(0)} + \sum_{u<v} s_c^{(u)} y^{(u)}
$$
- 分支 \(c\) 在 Block \(v\) 之前的状态:
- Block \(u\) 对 Block \(v\) 输入的贡献:
$$
\pmb{a}_{u \to v} = \frac{1}{n_r} \sum_{c=1}^{n_r} G_c^{(v)} \odot \gamma_c \odot \frac{s_c^{(u)} y^{(u)} }{\text{rms}(R_c^{(v)})}
$$ - 归一化贡献:
$$
\pi_{uv} = \frac{|\pmb{a}_{uv}|}{\sum_{u’<v} |\pmb{a}_{u’}|}
$$ - 关键发现(\(\Delta_{uv} = \pi_{uv}^{\text{GR} } - \pi_{uv}^{\text{ref} } \geq 0.05\) 的路径):
- 1 个分支承载长程路径(典型跨度 10.9 层)
- 3 个分支保持局部(典型跨度 3.4-3.9 层)
- 长程路径主要流向 Softmax Attention 层(Global Attention 作为整合长期历史信息的关键枢纽)
- 示例:Layer 0 GDN → Layer 15 Attention:份额 0.020 → 0.138
- 整体:相邻层路径集体增益 0.96;长程路径增益 0.91;中程路径损失 3.21
Gated Residual 与 Attention Residual 的对比
- Gated Residual 与 Attention Residual 的对比
Residual 设计 Loss Loss + GN Pre-norm 1.789 1.787 Block AttnRes, S=4 1.773 1.768 Block AttnRes, S=2 1.770 1.766 Full AttnRes 1.762 1.758 GR (nr=4) — 1.762 - Full AttnRes 与 GR 持平(1.762)
- GatedNorm(GN)在所有设置下降低 Loss 0.002-0.005
- 当输入更复杂时,Gate 帮助更大
推理效率优化
- 尝试 1:稀疏写入
- 每个 Block 只读取门控值最高的 2 个分支
- 预训练 Loss 和 Benchmark 几乎不受影响
- 但后训练后质量明显下降 → 未采用
- 尝试 2:FP8 存储
- GR 门控、门控注意力和 GDN 都约束写入流的幅值
- 残差值保持在窄范围,适合低精度格式
- 存储分支为 FP8 将残差状态的字节数减半,几乎无质量损失
- 融合 Kernel :Read(公式 30-32)和 Write(公式 33-34)各融合为单个 Kernel,Group RMSNorm 折叠到 Read 中
N-gram 嵌入层
设计思路
- 嵌入记忆提供互补维度的容量扩展
- N-gram 嵌入通过局部上下文(而非 Token 身份)条件化记忆检索
- 确定性寻址支持 Host 内存卸载和异步预取
- 以可忽略的额外 Per-Token FLOPs 扩展参数量
- 注:实验统一使用 300 Tokens per Active Parameter(TPP)
放置消融
- 核心 Insight(固定参数预算):
- 无单一深度支配:浅层(Layer 1-2)表现强劲,中层(Layer 10、15)和深层(Layer 25)仍有竞争力
- 单层足够 ,多层分布无一致收益
- Layer 2 + Layer 25 的边际 Loss 降低不转化为下游性能提升
- 在 Full Attention 和 GDN 下相对性能相似 → 对 Attention 机制不敏感
- 最终选择:Layer 2(Host 内存预取可与 Layer 1 计算重叠)
词汇量消融(点赞:TR 给的信息真细致啊!)
- 固定总参数预算下 (增加 N-gram 槽位,减少专家数量):
Vocab Scale Loss 观察 None (0%) 1.202 基线 5× (10%) 1.200 略有下降 10× (25%) 1.197 最优 30× (50%) 1.201 上升 - Loss 非单调变化,10× 最优(与先前工作一致);但 Benchmark 无明确改善 → N-gram Embedding 与 MoE Expert 角色不同
- 理解:5x 表示的应该是 N-gram 数量增加 5 倍,后面的 10% 应该是其占总参数量的比例?
- 单独扩展 N-gram 词汇量 (增加总参数):
Vocab Scale Loss 观察 None 1.585 基线 20× 1.553 下降 50× 1.541 下降 100× 1.534 下降 200× 1.526 持续下降 - Loss 单调下降 ,但下游性能不遵循同一趋势
- 中文基准(C-Eval、CMMLU)随 N-gram 词汇量持续改善
- 尝试了 Token 归一化、非均匀分配、频率分区等策略,无一致收益
优化策略
优化器:Muon
Muon 核心机制
- Muon 通过对动量应用 Newton-Schulz 迭代进行正交化来计算矩阵参数的更新方向
- 本文核心配置:
- Nesterov 加速动量:\(\mu = 0.95\)
- 缩放因子:\(\gamma(A,B) = 0.2\sqrt{\max(A,B)}\)(参数形状 \(A \times B\),使更新 RMS 与矩阵形状无关)
- NS 迭代步数:8 步(更准确的正交化,减少梯度范数尖峰)
- 采用 Polar Express 的逐歩系数调度(给定步数预算下的极小极大最优)
- Frobenius 归一化的数值稳定性常数:\(10^{-14}\)
哪些参数使用 Muon
- 使用 Muon 的参数(真正作为线性映射的二维权重):
- Attention 的 \(q/k/v\) 投影和输出投影
- GDN 的输入/输出投影
- Routed Expert 和 Shared Expert 的 fc1/fc2
- N-gram 嵌入层的 Key/Value 投影
- 使用 AdamW 的参数:
- 输入 Embedding 和 Output Head
- MoE Router(Muon 加剧早期波动;每个输出维度对应一个 Expert 分数,维度间独立,无可共享线性结构供正交化利用)
- GR 的两个低秩投影(非常细长的形状)
- GDN 的 Decay 和 Beta 投影(每个 Head 一个标量 → 向量,正交化无意义)
- 注意力的 Output Gate 和 GDN 的 z 投影(AdamW 与 Muon 相当或略优)
- GDN 的 Decay 和 Beta 投影
- N-gram 嵌入表 :使用 Adam,禁用 Weight Decay
分裂融合参数
- 在 Megatron-LM 中,以下矩阵存储为融合矩阵,但语义上是独立线性算子的拼接:
- Attention 的 \(qkv\) 投影
- SwiGLU 的 fc1
- GDN 的输入投影
- 正交化融合矩阵的两个错误 :
- 1)混合不相关子块间的奇异方向
- 2)\(\gamma(A,B)\) 基于拼接形状而非真实算子形状
- 解决方案 :
- 正交化前分裂融合梯度
- 每个子矩阵独立运行 NS
- 收集回原始布局再应用更新
- 分裂粒度 :
- \(qkv\) 和 GDN 输入投影:Per-Head 粒度(改善 Loss 和 Benchmark)
- fc1:分裂为 Gate 和 Up 两半(Loss 基本不变,Benchmark 略微改善)
工程实现:Canzona 框架
两个核心挑战及解决
挑战 1:分布式下的 NS 迭代
- TP 下:无 Rank 拥有完整权重矩阵
- DP 下:短边为立方成本,Megatron 的等元素分区导致严重 Straggler
挑战 1 解决方案 :
- \(\alpha\)-Balanced 静态分区器 :将整个参数(Tensor 内无切割)重新分配给 DP Rank,均衡估计的 NS FLOPs
- 异步 Micro-Group Pipeline :通过融合 All-to-All 跨 TP Rank 重构每个 Muon 矩阵
- 每个 Owner 运行数学上等价于单设备 Muon 的 Step
- 保留 ZeRO-1 的 Bucket 几何,维持 Megatron 的 Reduce-Scatter/Backward 重叠
挑战 2:分裂后的 Kernel 启动开销**
8 一层贡献约 100 个子矩阵
8 Optimizer Step 变成一长串非常小的 Kernel,受启动开销而非算术限制挑战 2 解决方案 :将整个 Step 捕获到 CUDA Graph 中消除开销
超参数缩放定律
核心理念
- 架构和优化器变化使最优超参数偏移:
- 新架构 + Muon 训练更稳定 → 更大 Batch Size 和学习率成为可能
- 学习率衰减随模型规模增长而更慢
Batch Size 验证(20 层 10.8B-A0.89B MoE,4T Token)
- 验证情况:
Batch Size Final Loss 观察 12.6M(旧配方) 1.5774 基线 25.2M(新预测) 1.5702 最优 37.7M(1.5×) 1.5707 轻微退化 - 理解:12.6M 大约是 128K 的 packing 后样本,一次 Step 大约 1024 个左右
- 新预测优于旧配方:\(7.2 \times 10^{-3}\)
- 低于预测值 Loss 急剧上升 ,高于预测值趋于平稳
- 预测接近最优,足够大实现性能增益而不过度
Batch Size Warmup 不再必要
- Warmup 方案 :从 6.3M 逐步增加到 25.2M(524B Token 处达到目标),实验结果如下:
- 两种变体(保持峰值 LR、降低早期 LR)均无改善
- 比 Constant-Batch 基线差 \(2.5 \times 10^{-4}\) 和 \(3.5 \times 10^{-4}\)
- Warmup 需要 多 18.8% 的 Optimizer Step
- 所有运行稳定(Loss 不超过局部中位数 0.1;p99.9 梯度范数 0.088-0.190,低于 0.5 阈值)
- 机制分析 :
- Warmup 阶段:小 Batch Size 带来更高梯度噪声,Loss 高于 Constant-Batch
- Batch Size 达到目标后:因早期更多 Optimizer Step 可能有短暂优势
- 随着学习率衰减和模型收敛,Step 计数优势被中和
- Constant-Batch 最终超越 Warmup
- 结论 :不采用 Batch Size Warmup
学习率验证(48 层 156B-A7B MoE,419B Token)
- 配置对比 :
- 新预测最优:\(B = 8.4M, \eta = 1.76 \times 10^{-3}\)
- \(\eta / \sqrt{2}\) 和 \(\eta \times \sqrt{2}\)
- \(B \times 1.25\) 及其匹配 \(\eta\)
- Qwen3.5 旧配方
- Loss 结果 :
- 旧配方比预测最优高 \(7.8 \times 10^{-3}\)
- 预测最优附近的 4 个设置在 \(7 \times 10^{-4}\) 内(接近噪声水平)
- 最优位于平坦碗底(LR 方向至少 \(\sqrt{2}\) 因子,Batch Size +25%)
- Benchmark 结果(Tab. 10):
- 预测最优获得最高平均精度
- 增大 Batch Size 或 LR 只有边际、统计上不显著的下降
- 旧配方明显落后
- 训练稳定性 :
- 所有配置中 Gradient Clipping 在 Warmup 后从未触发
- 预测最优:最大 Pre-Clip 梯度范数仅为阈值的 **28%**(旧配方 51%)
- Loss 曲线极其平滑 ,无任何 Spike
- 进一步提高预测 LR 仍然完全稳定
训练稳定性压力测试
测试设计 & 结果
- 核心思想 :将学习率保持为最优值的倍数(绕过标准 Decay 调度),在中等规模下复现大规模不稳定性
- 设置 :
- 28 层 MoE
- \(2\times\) 和 \(4\times\) 最优学习率
- 恒定学习率
- Gradient-Norm Clipping 阈值:0.5
- 评估指标 :
- 1)Loss Spike:超过 201 步滚动中位数 >0.1 的步数
- 2)Pre-Clip 梯度范数的 \(p_{99.9}\) 和阈值跨越次数
- 3)Per-Block 最大激活值
- 压力测试结果
配置 2× 最优 LR 4× 最优 LR AdamW 基线 4.3 spikes/10k 步 183 spikes/10k 步,213/19,932 步触发 Clipping Muon 0.2 spikes/10k 步 无 Clipping 阈值跨越 Muon + GR 0.2 spikes/10k 步 零 Loss Spike - 结论 :新架构 + 优化器组合在同等压力下显著更稳定
Gate 的角色分析
- 关键观察(Fig. 11):
- \(2\times\) 最优 LR:Muon 的中位数梯度范数和最大激活值高于 AdamW,但 Loss Spike 少得多
- 添加 GR 同时减少梯度范数 Spike 的频率和幅度 ,以及激活异常值幅度
- 单变量实验(28 层,\(3\times\) 最优 LR,AdamW,切换 GatedNorm):
- Gate 启用:Spike 率 32.0 → 3.2 per 10k 步;阈值跨越 256 → 20
- 无 Gate 基线的 LR 阶梯:激活异常值几乎与 LR 成比例增长,Spike 率增长快得多
- 最高 LR 下启用 Gate:异常值水平低于最低 LR 的基线
- 机制解释 :
- 高 LR 训练需要缩放机制
- 无显式 Gate:网络通过增长激活异常值实现缩放 → 脆弱
- 乘法 Gate 直接提供必要的缩放 → 稳定
生产运行验证
- 对比(前 276B Token,相同数据顺序、LR 调度、优化器):
- 1)Qwen3.5 结构 + Muon
- 2)结构 + GR
- 3)完整 Qwen3.8-Flash-Next
- Loss(Fig. 13a):
- 添加 GR:276B Token 处 Loss 降低 0.026
- 完整 Flash-Next:额外降低 0.032
- 总增益:0.058
- 梯度范数(Fig. 13b):
- Muon 单独:中位数范数约 2×,\(p_{99.9}\) 为门控运行的 4.2×(0.097/0.298 vs 0.053/0.071 和 0.043/0.066)
- Muon 单独:唯一跨越 Clipping 阈值的运行
- 门控运行标准差低 4.3-4.7×
- 将残差读取和 LM Head 前最终归一化融合为门控读取操作进一步降低梯度范数
- 激活值(Fig. 13c):
- 添加 GR 显著降低整个网络的残差最大值(所有探测深度一致)
- 允许稳定训练,无需 qk-clip 和 SwiGLU-clip 等显式激活控制