注:本文包含 AI 辅助创作
- 参考链接:
Paper Summary
- Kimi K3 整体总结:
- 2.8T-A104B 激活参数的 MoE 模型
- 具备原生视觉能力
- 1M token 的上下文窗口
- 架构方面:
- 基于 KDA (2025) 和 Attention Residuals (2026) 构建
- 主要考量是改善信息在序列长度和模型深度上的流动
- 使用了 Stable LatentMoE(有效激活每 token 896 个路由专家中的 16 个)+ 优化后的训练和数据方案
- 使得整体扩展效率相较 Kimi K2 (2025) 提升了约 \(2.5\times\)
- 注:Stable LatentMoE 是 Kimi K3 在 LatentMoE 上创新以后得到的,详情见第二节
- 基于 KDA (2025) 和 Attention Residuals (2026) 构建
- Post-training 阶段重点包括在通用、Agentic 和编码领域以及多推理强度(reasoning-effort)级别上进行 RL
- 实现了组合泛化和鲁棒的长期执行能力
- 基础设施总结:
- 面向 KDA 的算法-系统协同设计
- 完美负载均衡的专家并行训练与高效内存管理
- 支持百万 token 的 Agentic RL(具备持久化 Rollout 和沙箱状态)以及部署创新
- 评估结论:仅次于 Claude Fable 5 (2026) 和 GPT-5.6 Sol (2026),内部评估中一致优于其他开源和专有模型
- 其他值得注意的关键核心点提炼
- 后训练流程是 SFT -> RL -> MOPD
- SFT :强调高质量数据集
- 使用扩展的 Agentic 轨迹(含多阶段验证与人工标注),轨迹由先前 Kimi 系列专用模型合成
- 使用基于 XML 的聊天模板(XTML)统一序列化数据
- 注:SFT 全程应用 MXFP4 权重 + MXFP8 激活的量化感知训练(QAT)
- RL :在三大领域(通用、Agentic、编码)分别训练不同推理强度(低/高/最大)的专家模型,共 9 个
- Partial Rollout :避免长尾延迟,在 \(\lambda\) 比例轨迹完成后即暂停并异步恢复,支持跨 策略 的长期轨迹
- Reasoning Effort RL :基于初始预算 \( b_0(x) \) 和乘子 \( \tau \) 动态控制思考或工具调用 token 数,超阈值则奖励置为 -1,并采用分阶段课程退火
- Agentic GRM :用于不可验证任务,要求评判器遵循固定协议(阅读 -> 生成 Rubric -> 打分)
- 注:这里加入冗长度惩罚防止 Reward Hacking (输出长度超过 \(\sigma \cdot \ell_0\) 的候选者自动在 Pair-wise 比较中失败)
- 算法稳定性 :通过每 token 正则化容忍极度 Off-Policy 数据和数据陈旧性,保障训练稳定
- MOPD :将 9 个领域/强度专家的能力蒸馏整合为单一统一模型
- 对给定领域 \( d \) 和强度 \( e \),使用对应教师模型 \( \pi_{\text{teacher} }^{(d,e)} \) 指导
- 定义每 token 的 OPD 奖励(带裁剪 \( R_{\max} \) 的优势信号),无缝融入 RL 框架
- 支持基础设施级优化(如部分 Rollout)
- Insight:未从更细粒度 top-\(k\) 蒸馏中获益
- SFT :强调高质量数据集
- 其他 Insight
- 量化感知训练(QAT) :MoE 专家权重为 MXFP4,激活为 MXFP8,非专家部分保持高精度,且 RL 全程训练与推理量化一致
- Draft 模型微调 :将预训练 MTP 层微调为 EAGLE-3 风格 Draft 模型,融合多层 AttnRes 特征,并直接优化 LK 损失(接受率负对数)以提升推测解码效率
- 统一白盒 RL 环境 :Agent 工具包模块化可配置,动态组合不同工具架,防止过拟合单一协议
- 知识图谱引导任务合成 :自演进分层知识图谱,Agent 递归扩展,采样节点生成关键词并检索真实材料,合成多类型训练任务
- 可验证 Agentic 环境 :包括下面几个方向:
- 多步复杂信息搜索任务
- 内核优化任务(GPU 编程套件 + 正确性与性能奖励 + 防 Hacking 检测)
- 个人助理任务(模拟应用 + 长期多事件流)
- 自主执行任务(AET,验证在环 + 隐藏/公开验证器)
- Web 开发任务(容器沙箱 + 确定性检查 + 模型评判)
- 所有环境均支持长 Rollout(可达数千工具调用、百万上下文 token)和跨场景泛化
- 后训练流程是 SFT -> RL -> MOPD
Introduction
- 核心强调效果:仅次于 Claude Fable 5 和 GPT-5.6 Sol
Model Architecture
- 沿序列长度、网络深度和模型宽度三个维度扩展信息流
Hybrid Attention
- 每个 Block 包含 3 层 KDA 和 1 层 Gated MLA(比例为 3:1),并在 Backbone 末端额外增加一层 Gated MLA
Kimi Delta Attention (KDA)
- 扩展了 delta-rule 递归,引入 channel-wise 遗忘门
- 对于位置 \(t\),Query \(\mathbf{q}_t\)、Key \(\mathbf{k}_t\)、Value \(\mathbf{v}_t\),递归状态 \(\mathbf{S}_t \in \mathbb{R}^{d_k \times d_v}\) 更新为:
$$
\mathbf{S}_t = (\mathbf{I} - \beta_t \mathbf{k}_t \mathbf{k}_t^\top) \text{Diag}(\alpha_t)\mathbf{S}_{t-1} + \beta_t \mathbf{k}_t \mathbf{v}_t^\top,\quad \tilde{\mathbf{o} }_t = \mathbf{S}_t^\top \mathbf{q}_t
$$- 其中 \(\alpha_t \in (0,1)^{d_k}\) 是 channel-wise retention 因子,\(\beta_t \in (0,1)\) 控制 delta-rule 写入强度
- 关键改进包括 :
- Lower-bounded decay :将 log-decay 映射从负 Softplus 改为 scaled sigmoid,公式为:
$$
\mathbf{g}_t^h = g_{\min} \text{Sigmoid}(e^{A_h} \mathbf{z}_t^h),\quad g_{\min}=-5
$$- 这保证 retention 因子 \(\alpha > e^{-5}\),避免数值溢出,使得所有 tile(包括对角线)均可使用 Tensor Core 矩阵乘法,消除了逐位置计算瓶颈
- Full-rank gate :将输出门从低秩改为输入依赖的全秩投影(公式 (6)),提升表达能力
- Lower-bounded decay :将 log-decay 映射从负 Softplus 改为 scaled sigmoid,公式为:
Gated MLA
- Kimi K3 采用 Multi-head Latent Attention (MLA) 压缩 KV 为低维 latent vector
- Kimi K3 对 MLA 层使用 No Position Encoding (NoPE) ,位置信息由 KDA 层提供(KDA 的递归衰减机制可以提供位置信息),无需修改位置编码即可扩展上下文
- 理解:这里是一个很好的设计,若使用 RoPE,这里长度扩展时比较麻烦,但这种设计下,可以保证 KDA 隐式包含位置信息,又不用针对 MLA 扩展上下文,两全其美
- 理解:实际上,传统的 Casual LM 天然就包含位置编码的,因为是任意两个 Token 位置交换结果都是不一样的,只是说仅但看某个 待输出的目标 Token 时,可能看起来交换位置前后的结果一样,所以显示加上位置编码会好些
- 训练时保持 Attention 输出为 FP32 以纠正 Flash Attention 的舍入误差
Attention Residuals (AttnRes)
- 标准残差连接将所有前层信息压缩为单一状态,形成深度方向的瓶颈
- AttnRes 让每一层通过可学习的伪 Query \(\mathbf{q}_l = \mathbf{w}_l\) 和来自所有前层的 Key/Value(公式 (8))计算注意力权重(公式 (9)),实现层间选择性信息检索
- 为降低开销,采用 Block AttnRes :
- 将层划分为 \(N\) 个 Block(Kimi K3 中 \(N=8\),每 Block 12 层),在 Block 级别进行 Attention,内部用部分和(partial sum)合并,将内存和通信开销从 \(O(Ld)\) 降至 \(O(Nd)\)
Stable LatentMoE
- LatentMoE 将 routed experts 置于低维空间(维度 \(\ell\))
- 这使 Kimi K3 能扩展到 896 个 routed experts,每 token 激活 16 个(稀疏度 56)
- 但极端稀疏引发激活爆炸和负载不均问题
- 本文提出三项改进:
- Normalized LatentMoE :在 routed 分支聚合后插入 RMSNorm(公式 (11)),稳定训练并提升下游性能
- Sigmoid Tanh Unit GLU (SiTU-GLU) :替代 SwiGLU,使用 scaled tanh 对门控分支和上分支进行软裁剪(soft cap),公式为:
$$
\text{SiTU-GLU}(\mathbf{x}) = \left[\beta_1 \tanh\left(\frac{\mathbf{W}_g \mathbf{x} }{\beta_1}\right) \odot \text{Sigmoid}(\mathbf{W}_g \mathbf{x})\right] \odot \left[\beta_2 \tanh\left(\frac{\mathbf{W}_u \mathbf{x} }{\beta_2}\right)\right]
$$- 其中 \(\beta_1=4, \beta_2=25\),保证输出有界(\(\le 100\)),同时保留 SwiGLU 在原点附近的线性响应
- Quantile Balancing (QB) :替代固定步长 bias 更新
- 设 batch 有 \(m\) 个 tokens,\(n\) 个 experts,每个 token 选 \(k\) 个专家,目标负载 \(q = mk/n\)
- QB 通过使每个 expert 的 margin(\(s_{i,j} - \alpha_i^{(t)}\),其中 \(\alpha_i^{(t)}\) 是 token \(i\) 的 Top-\((k+1)\) 截断值)的 \((1-k/n)\)-分位数等于 bias 调整量,达到精确负载均衡
- 更新公式为:
$$
\hat{b}_j^{(t+1)} \leftarrow \text{quantile}_{1-k/n}\left( s_{i,j} - \alpha_i^{(t)} \right),\quad \mathbf{b}^{(t+1)} \leftarrow \hat{\mathbf{b} }^{(t+1)} - \text{mean}(\hat{\mathbf{b} }^{(t+1)})\mathbf{1}
$$ - 实践中使用直方图估计分位数,通信代价仅为每层数百个 bins 的 all-reduce
Native Vision
- 视觉编码器 MoonViT-V2(27 层,0.4B 参数)从头训练(不使用 SigLIP 初始化),发现从头训练更稳定且性能相当
- 采用 RMSNorm,去除所有 bias
- 图像和视频共享参数,通过 intra-frame spatial 和 inter-frame temporal 注意力处理,pixel-shuffle 下采样减少 token 数量
Per-Head Muon
- 对 Attention 投影矩阵采用 Muon 优化器,并改进为 Per-Head 变体:
- 将 momentum 矩阵按 head 维度划分,对每个 head 的 block 分别进行 Newton-Schulz 正交化,平衡各 head 的更新尺度,提高训练稳定性
Pre-Training
预训练数据
- 涵盖四大文本领域(Web、Code、Math、Knowledge)和大规模视觉语料
- 文本数据经规则过滤、分类器质量评分、去重,并按领域采样
- 对知识和数学语料采用风格多样化的重述(rephrase)和忠实性验证
- 视觉数据包括图像描述、交错图文、OCR、感知、视频以及程序化多模态数据(SVG、3D、Webpage、Game、CAD 等),训练时提供绝对和归一化坐标监督
Scaling Law
- 新架构、数据和训练改进整体带来约 2.5 倍 scaling 效率提升(对比 Kimi K2)
- 注:这个结论是对学习率调度进行了公平比较的:
- 在各自最优超参数下,Cosine Decay 始终优于 Warmup Stable Decay (WSD),因此采用 Cosine Decay
Training Recipe
- 采用原生多模态联合训练策略,语言和视觉从训练开始就共同优化(而非事后嫁接)
- 优化器使用 Per-Head Muon 配合 weight clipping,MoE 负载均衡使用 QB
- 采用 Cosine 学习率调度(1% 线性 warmup),weight decay 设为 0.1
Long-Context Extension
- 位置编码 :由于使用 NoPE,KDA 的递归门控机制隐式编码位置信息,无需 RoPE 缩放或插值即可直接外推至 1M
- 长上下文数据 :对长文档和视频进行严格的清洗(精确/模糊去重、感知哈希、质量过滤、结构验证),并上采样长序列。同时合成额外长上下文数据(将多模态文档和子任务精心排列拼接),强制模型关注分散在 1M 上下文中的信息
- 渐进式扩展 :采用四阶段课程:预训练期间从 8K 扩展到 64K,cooldown 期间从 256K 扩展到 1M
Post-Training
Method
- 后训练 Pipeline 遵循三阶段范式:
- SFT: 初始化基线 Agent 能力
- RL:在不同推理强度下开发特定领域的专家模型
- MOPD:将这些领域专用策略整合为单一模型
SFT
- SFT 阶段为后续 RL 阶段建立高质量的冷启动策略
- 在之前 Kimi 模型 (2025; 2026) 的 SFT Pipeline 基础上,为 Kimi K3 扩展了 SFT 数据集
- 核心:大幅拓宽了其对复杂 Agentic 任务的覆盖
- 具体做法:
- 使用先前 Kimi 系列中的领域专用模型合成数据轨迹,随后进行多阶段验证和人工参与标注
- 为了一致地表示这些复杂的 Agentic 轨迹,使用基于 XML 的聊天模板(可扩展 Token 标记语言,eXtensible Token Markup Language;详见 § F)对所有数据进行序列化
- 这些步骤共同生成了一个大规模指令数据集,使 Kimi K3 具备了自适应推理、精确工具调用以及在长期 Agentic 场景中的稳健执行能力
- 此外,从 SFT 阶段起就应用量化感知训练(Quantization-Aware Training,QAT)
- 注:采用 MXFP4 权重和 MXFP8 激活值(见 §4.1.4)
RL
- SFT 提供了坚实的冷启动基础,RL 对于解锁高阶推理和执行能力至关重要
- 并非针对单个任务训练专用 RL 模型,而是将 RL 扩展至三个广泛领域,每个领域涵盖大量子任务,并在每个推理强度级别上为每个领域训练一个单独的专家模型:
- (i) 通用任务,涵盖通用体验、视觉、推理、忠实性、搜索能力和知识工作任务
- (ii) 通用 Agent,涵盖长期助理任务、深度研究和段落级写作
- (iii) 编码 Agent,涵盖软件工程(SWE)、编码体验、内核任务和 Web 开发
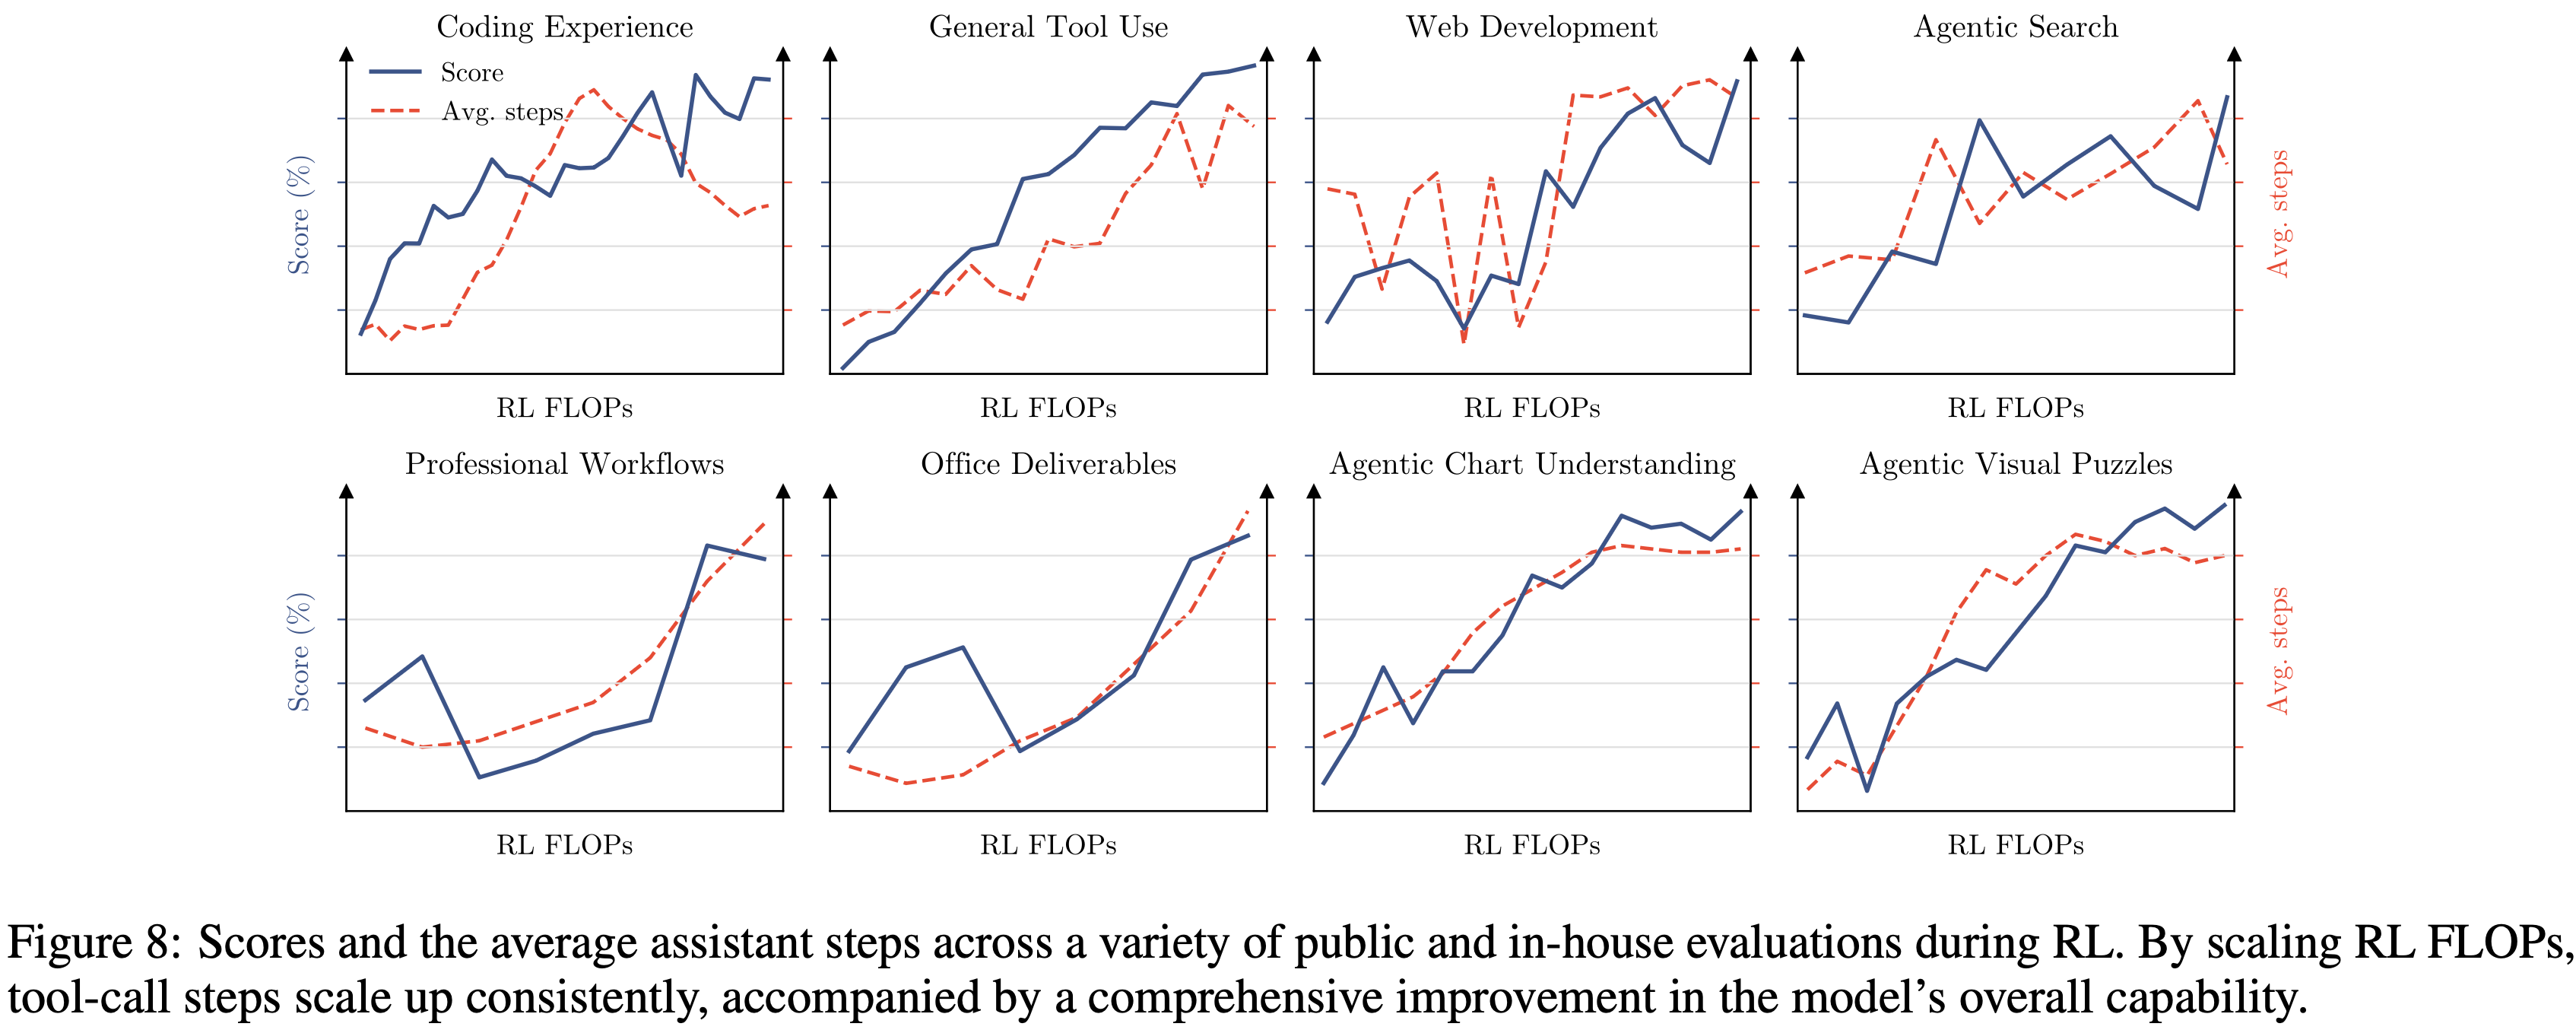
- 如图 8 所示,扩展 RL FLOPs 持续提升了知识、推理、视觉、通用 Agent 和编码等多方面能力
- 将这三个领域专家与三个推理强度级别 {low, high, max} 交叉,共得到九个专家模型
- 将这三个领域专家与三个推理强度级别 {low, high, max} 交叉,共得到九个专家模型
Algorithm
- 为缓解长期任务中加剧的长尾延迟,扩展了同步 RL 框架 (2025; 2026) 中的 Partial Rollout 方案
- 在每次迭代的 Rollout 阶段,对 \(N\) 个 Prompt 各采样 \(K\) 个补全,维持 \(N \times K\) 条轨迹的活动负载
- 生成阶段一旦有 \(\lambda \in (0,1)\) 比例的轨迹完成(即 \(\lambda NK\))便暂停
- 允许策略优化不必等待执行拖尾者
- 暂停的 Rollout 被入队并在下一次迭代开始时优先恢复,这由沙箱基础设施(§5.3.2)支持
- 一旦某个 Prompt 的所有 \(K\) 个 Response 完成,它们便立即被派发进行策略优化,该优化遵循 Kimi K2.5 (2026) 中的算法
- 在本文的 Partial Rollout 方案下,单条长期轨迹自然跨越多次迭代,引入数据陈旧性,可能威胁训练稳定性
- 本文的策略优化算法通过每 token 的正则化天然容忍这种极端的 Off-Policy 情形
- 通过将策略更新约束在局部邻域内,该正则化使算法能够稳健处理高度陈旧的数据,并维持训练稳定性
Reasoning Effort RL
- 为在最大化 token 效率的同时微调推理强度,在 RL 期间实施基于每个问题的预算控制机制 (2026)
- 将每个问题 \(x\) 与一个初始 token 预算 \(b_0(x)\) 关联,该预算由冷启动模型估计,并对于总 token 预算 \(T(y)\) 超过缩放阈值 \(\tau \cdot b_0(x)\) 的轨迹,将任务奖励覆盖为 \(-1\)
- 对于通用任务,\(T(y)\) 衡量思考 token 的数量
- 对于 Agent 任务,\(T(y)\) 则计入累积输出 token,包括推理轨迹和工具调用参数
- 训练遵循预算乘子 \(\tau\) 的分阶段课程
- 首先训练一个最大预算变体,其 \(\tau\) 相对较大,同时仍设置最大预算上限以抑制过度思考
- 然后将 \(\tau\) 退火至较小值,以获得高强度和低强度的专家模型
- \(\tau\) 的调整按领域配置,并有人工指导
- 所得专家在各推理强度下产生的轨迹被联合收集,用于监督微调和多教师 On-Policy 蒸馏
Agentic Generative Reward Model
- 对于不可验证的通用任务,采用 Agentic GRM,保留 Kimi K2.5 (2025; 2026) 中采用锦标赛式成对比较的组奖励
- 除了增强判断的通用 Agentic 能力外,Agentic 评判器还被要求遵循强制协议:
- (1) 阅读结果、产品或文本输出
- (2) 生成 Rubric
- (3) 根据 Rubric 对每个候选者打分
- (4) 将 Rubric 分配的分值记录在记分板中
- 为缓解对越来越长输出的 Reward Hacking 行为,应用基于预算的冗长控制,类似于上述推理强度控制:
- 给定由冷启动模型估计的初始冗长度 \(\ell_0\) 和乘子 \(\sigma\)
- 输出长度超过 \(\sigma \cdot \ell_0\) 的候选者自动在 Pair-wise 比较中失败
- 给定由冷启动模型估计的初始冗长度 \(\ell_0\) 和乘子 \(\sigma\)
MOPD
- 采用 MOPD (2025; 2026; 2026) 将这些领域专用能力在不同推理强度下整合为统一模型
- 在训练期间,对于给定领域 \(d\) 和采样的推理强度级别 \(e \in \{\text{low,high,max}\}\),优化由对应的教师模型 \(\pi_{\text{teacher} }^{(d,e)}\)(来自九个专家之一)指导
- 给定输入查询 \(x\) 和前缀 Response \(y_{< t}\),教师 \(\pi_{\text{teacher} }^{(d,e)}\) 与学生 \(\pi_{\theta}\) 之间在 \(y_t\) 上的每 token OPD 奖励定义为:
$$
r_{\text{opt} }^{d}(y_{t}\mid e,x,y_{< t}) = \text{clip}\left(\text{sg}\left(\log \frac{\pi_{\text{teacher} }^{(d,e)}(y_{t}\mid x,y_{< t})}{\pi_{\theta}(y_{t}\mid e,x,y_{< t})}\right), - R_{\text{max} },R_{\text{max} }\right), \quad (15)
$$- \(\text{sg}(\cdot)\) 表示停止梯度算子,\(R_{\text{max} } > 0\) 是裁剪阈值,用于约束极端优势信号,从而稳定 RL 训练
- 这一密集奖励信号无缝集成到 RL 框架中,自然支持基础设施级优化,如针对长期任务的 Partial Rollout 训练
- 本文还尝试了更细粒度的 top-\(k\) 蒸馏目标,但在设置中未观察到收敛速度或最终性能有明显优势
- 注:这和 DeepSeek 的做法不同,结论也不同
Deployment-Aware Post-Training,部署感知的后训练
MXFP4 Quantization-Aware Post-Training
- 为降低部署时的内存占用和服务成本,将 MoE 专家权重(占模型参数内存主体)量化为 MXFP4 (2023),激活值以 MXFP8 计算,而所有非专家组件(注意力投影、Latent MoE 投影、共享专家和 MoE 路由器)保持较高精度
- 在整个后训练阶段(包括 SFT 和 RL)均进行量化感知训练(QAT)(2018),使模型适应量化带来的精度损失
- 在 RL 期间,Rollout 和训练共享相同的量化方案,消除了训练-推理不匹配
- 问题:训练也使用 MXFP4 量化?
Draft Model Fine-Tuning
- 优化推理效率对于服务复杂、长期 Agentic 模型至关重要
- Kimi K3 预训练时带有一个 MTP 层,其结构与主干块类似
- 由于 EAGLE-3 (2025) 的 Draft 模型包含一个与 MTP 层结构匹配的单解码器层,本文将预训练的 MTP 层微调为 EAGLE-3 风格的 Draft 模型,目标模型冻结,仅更新 Draft 层及其特征融合投影
- 遵循 EAGLE-3 的训练时测试协议
- 训练期间 Draft 展开七步
- 在第一步之后(此时最新位置的目标侧特征不可用),Draft 消耗自身较早步骤的输出,模拟推理时的循环 Draft 过程
- Draft 输入融合目标模型的低、中、高级特征,分别取自第 1、第 4 和最后一个 AttnRes 块(§2.2)的输出
- 这些特征被拼接并通过一个无偏置矩阵 \(W_{E3}\) 投影到隐藏维度,该矩阵初始化为 \([0 \ \mathbf{0} \ \mathbf{I}]\),使得融合表示在初始化时与高级特征 \(h_{h}\) 一致(MTP 层预训练时的输入),并在微调过程中逐渐学习融入低、中级特征
- 推测解码的加速由每 token 接受率 \(\sum_{x\in \mathcal{V} }\min (p(x),q(x))\) 决定(在无损推测采样下),其中 \(p\) 和 \(q\) 分别为目标模型和 Draft 模型的下一 token 分布
- 由于最小化传统 KL 散度代理并不能保证在容量受限的 Draft 模型下最大化该比率,本文直接优化基于似然的 LK 损失 (2026),即接受率本身的负对数:
$$
\mathcal{L}_{\text{LK} } = -\log \sum_{x\in \mathcal{V} }\min (p(x),q(x)), \quad (16)
$$- \(p\) 和 \(q\) 在温度 1 下评估,且无辅助真实标签交叉熵项
- Draft 微调遵循后训练 QAT 配置(§4.1.4),MoE 专家权重为 MXFP4,输入激活为 MXFP8,非专家模块保持较高精度
RL Task Synthesis and Agentic Environments,RL 任务合成与 Agentic 环境
- 本文的 RL 框架的有效性在很大程度上依赖于丰富、多样且可稳健验证的环境
- 为支持跨复杂长期任务的可扩展训练,本文设计了一系列专门的白盒环境和任务合成范式
Unified White-Box RL Environment
- 使用单一固定 Agent 工具包(harness)进行训练可能导致模型过拟合特定的工具模式、系统 Prompt、上下文管理机制或交互协议
- 为解决此问题,开发了一个统一白盒 RL 环境,将 Agent 工具包表示为一组可配置、可组合的模块,包括工具接口、系统 Prompt、上下文管理策略、技能、记忆、子 Agent 和其他组件
- 通过配置组合这些模块,该环境可以实例化主流工具包,如 Kimi Code (2026)、Claude Code (2026)、Codex (2026)、OpenClaw (2026) 和 Hermes (2026),以及全新的工具包
- 在 RL 训练期间,为不同任务组动态构建不同的工具包配置,使 Kimi K3 暴露于这些模块的多样组合,而非任何单一工具包的惯例
- 同样的抽象也易于支持跨不同任务领域的 RL,为训练更通用的 Agent 提供了可扩展基础
Knowledge-Graph-Guided Task Synthesis,知识图谱引导的任务合成
Motivation and overview
- 后训练任务的质量和多样性在很大程度上取决于其 source materials
- 基于细粒度 Concept 的检索能够挖掘专业化和不常见的知识
- 跨不同 Concept 的采样可拓宽领域覆盖
- 为在大规模上控制粒度和覆盖,本文构建了一个 自演进的、分层组织的 知识图谱=
- Agent 通过在知识和编码密集领域进行 web-scale 探索持续扩展该图谱
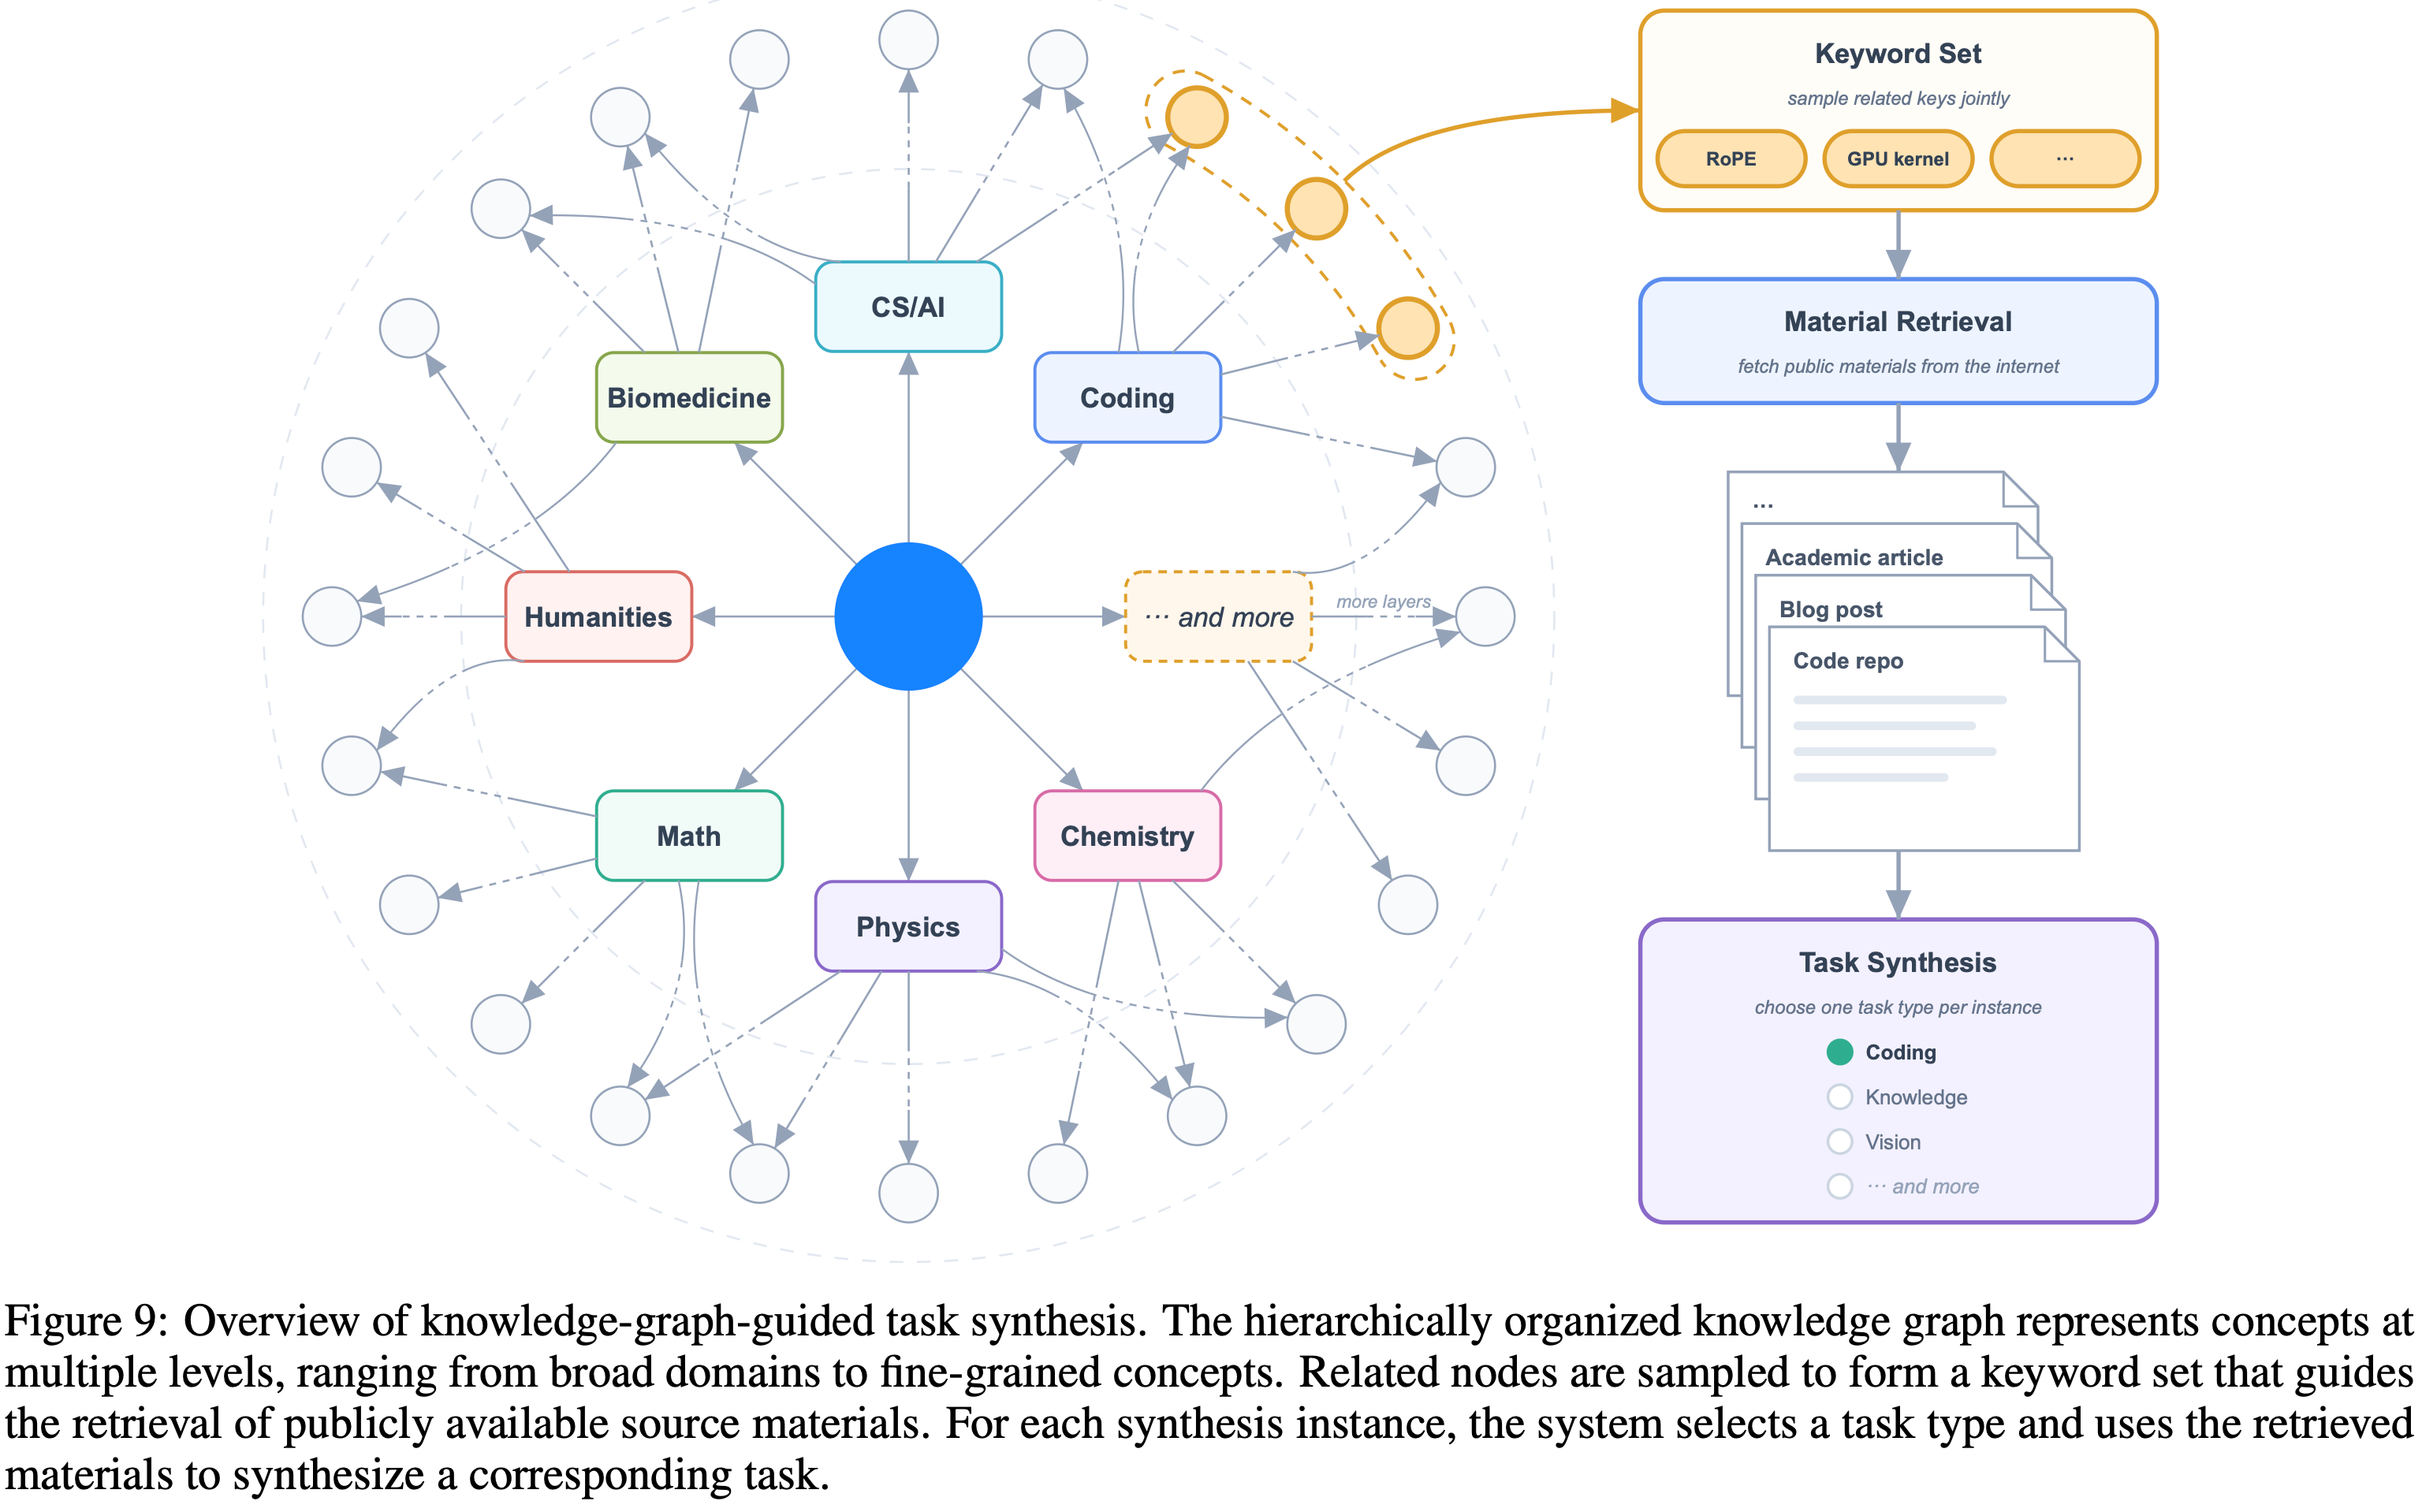
- 图 9 展示了任务合成 Pipeline
- 知识图谱在多个层级上表示 Concept (按照层级组织的分层结构),范围从广泛领域到细粒度 Concept
- 对相关节点进行采样,形成一组关键词,用于指导公开 source materials 的检索
- 对于每个合成实例,系统会选择一个任务类型,并使用检索到的材料来合成相应的任务
Agentic knowledge graph construction
- 通过递归的 Agent 驱动扩展来构建有向无环图形式的知识图谱
- 扩展过程从一组预定义的粗粒度种子节点开始(理解:一些高阶 Concept )
- 然后将一个 Agent 实例分配给每个节点,执行多次 Web 搜索以探究对应 Concept (理解:针对一个 Concept 进行不断理解,构建子图)
- 在添加新节点之前,Agent 会探索现有图谱以识别等效或相关 Concept ,复用现有节点(如果适用的话),并最小化重复
- 理解:防止出现过多重复节点,导致图谱越来越大
- 边始终从较粗 Concept 指向较细 Concept ,无论 Agent 先发现哪个端点
- 理解:确保实现有向无环
- 新添加的节点随后被分配给 Agent 进一步探索
- 理解:这里是递归探索的 Concept
- 当分配的 Agent 确定当前 Concept 足够原子时,分支停止扩展
- 理解:直到原子 Concept 出现(不可再分)
- 理解:总结知识图谱的递归构建流程如下:
- 第一步:从一组预定义的粗粒度种子节点开始,例如“编程语言”、“金融市场”等
- 第二步:为每个节点( Concept )分配一个 AI Agent,这个 Agent 会执行多次网络搜索,深入研究该 Concept
- 第三步:添加新节点步骤
- 在添加新发现的 Concept 作为子节点前,Agent 会检查现有图谱,以避免重复
- 新节点会通过有向边连接到其父 Concept (总是从父 Concept 链接到子 Concept )
- 第四步:新加入节点探索(递归的思路)
- 新加入的节点会被再次分配给新的 Agent 继续探索,直到某个节点被其负责的 Agent 认定为“足够原子”,分支才会停止生长
Material retrieval and task synthesis
- 为瞄准跨领域和任务类型的期望分布,系统在不同粒度级别上采样节点(单独或相关组合)
- 从采样节点派生的关键词结合其在知识图谱中祖先的上下文信息,形成 Web Queries
- 检索到的真实世界材料被组装,使合成 Agent 生成各种任务类型的训练任务
- 理解:材料检索和任务合成的流程:
- Concept 采样:系统会根据需求,从图谱的不同层级采样一个或多个节点
- 可以采样一个广泛领域(如“Web 开发”)来生成通用任务,也可以采样一组细粒度的关联节点(如 “React Hooks” + “性能优化”)来生成更聚焦的任务
- 生成查询:从采样节点及其图谱上下文(如父节点信息)中提取关键词,组合成高效的网络搜索 Query(Web Query)
- 检索材料:使用生成的 Query 从互联网检索真实的、相关的源材料
- 合成任务:最后,由一个 “合成 Agent” 根据预定义的任务类型模板,利用检索到的材料,生成具体的 训练任务
- Concept 采样:系统会根据需求,从图谱的不同层级采样一个或多个节点
Verifiable Problems in Agentic Environments,Agentic 环境中的可验证问题
- 在 Agentic 环境中使用可验证问题训练 Kimi K3
- 代表性示例包括多步复杂信息搜索,其中模型规划其研究,逐步从 Web 收集证据,并生成最终答案
- 还包括其他任务,如代码执行、系统管理等
Kernel Optimization Tasks
- 为增强 Kimi K3 的 GPU 内核优化能力,本文构建了一个大规模内核任务套件,范围从单算子内核到融合巨型内核,来源包括高质量 GitHub 仓库如 Flash Linear Attention (2024)
- 该套件涵盖多样的 GPU 编程方法,如 CUDA、Triton、CuTe DSL、Gluon、ThunderKittens (2025) 和 TileLang (2025),并覆盖广泛使用的 GPU 架构和数值格式,包括 BF16、FP8 和 FP4
- 奖励同时评估正确性和性能:
- 每个内核提供 PyTorch 参考实现,超过预定义数值误差阈值的解决方案获得零奖励
- 性能对照专家实现进行评分,与之匹配得 0.5 分,接近硬件极限则奖励趋向 1
- 为确保奖励反映真正的优化,本文开发了一个 Hacking 行为检测系统,惩罚 Reward Hacking 策略,如 CUDA graph 重放、输入缓存和精度降低,并随着 Kimi K3 开发过程中观察到新的 Hacking 策略而持续扩展防护措施
Personal Assistant Tasks
- 对于长期个人助理任务,开发了广泛使用的应用程序(如 Gmail、Notion、Slack 和 Canvas)的逼真模拟实现
- 它们保留了真实世界对应物的核心语义,同时支持可重现的大规模交互,无需外部 API 或速率限制
- 在这些模拟应用基础上,设计了受真实世界专业工作流程启发的复杂任务,场景涉及人力资源、法律服务和金融
- 在每个任务中,Agent 在持续演进的模拟环境中运行多个模拟日,并遇到分布在多个应用中的数十个相互依赖的事件
- 单次 Rollout 可能涉及多达数千次工具调用和数百万上下文 token
- 每个事件都带有自己的评估标准,由确定性规则或基于 LLM 的评估器判断
- 初始工作空间由 Agent 自主搜索 Web 参考材料并将其转换为连贯、任务相关的环境
- 本文还扩展 RL 框架以支持这种生活环境,模拟复杂事件流及其引发的世界状态转换
Autonomous Execution Tasks
- 本文引入自主执行任务(AET)
- 这是一种通过“验证在环”优化训练长期 Agent 智能的环境范式
- 每个任务指定初始状态、约束目标、基于工具的动作空间、执行预算和独立验证器
- Agent 只看到目标、上下文、约束和验证接口,而不见参考轨迹或预定义程序,必须自主进行任务分解、工具选择、规划、错误恢复和终止
- 奖励基于验证器对最终环境状态的评估,而非 Agent 的自我报告完成情况
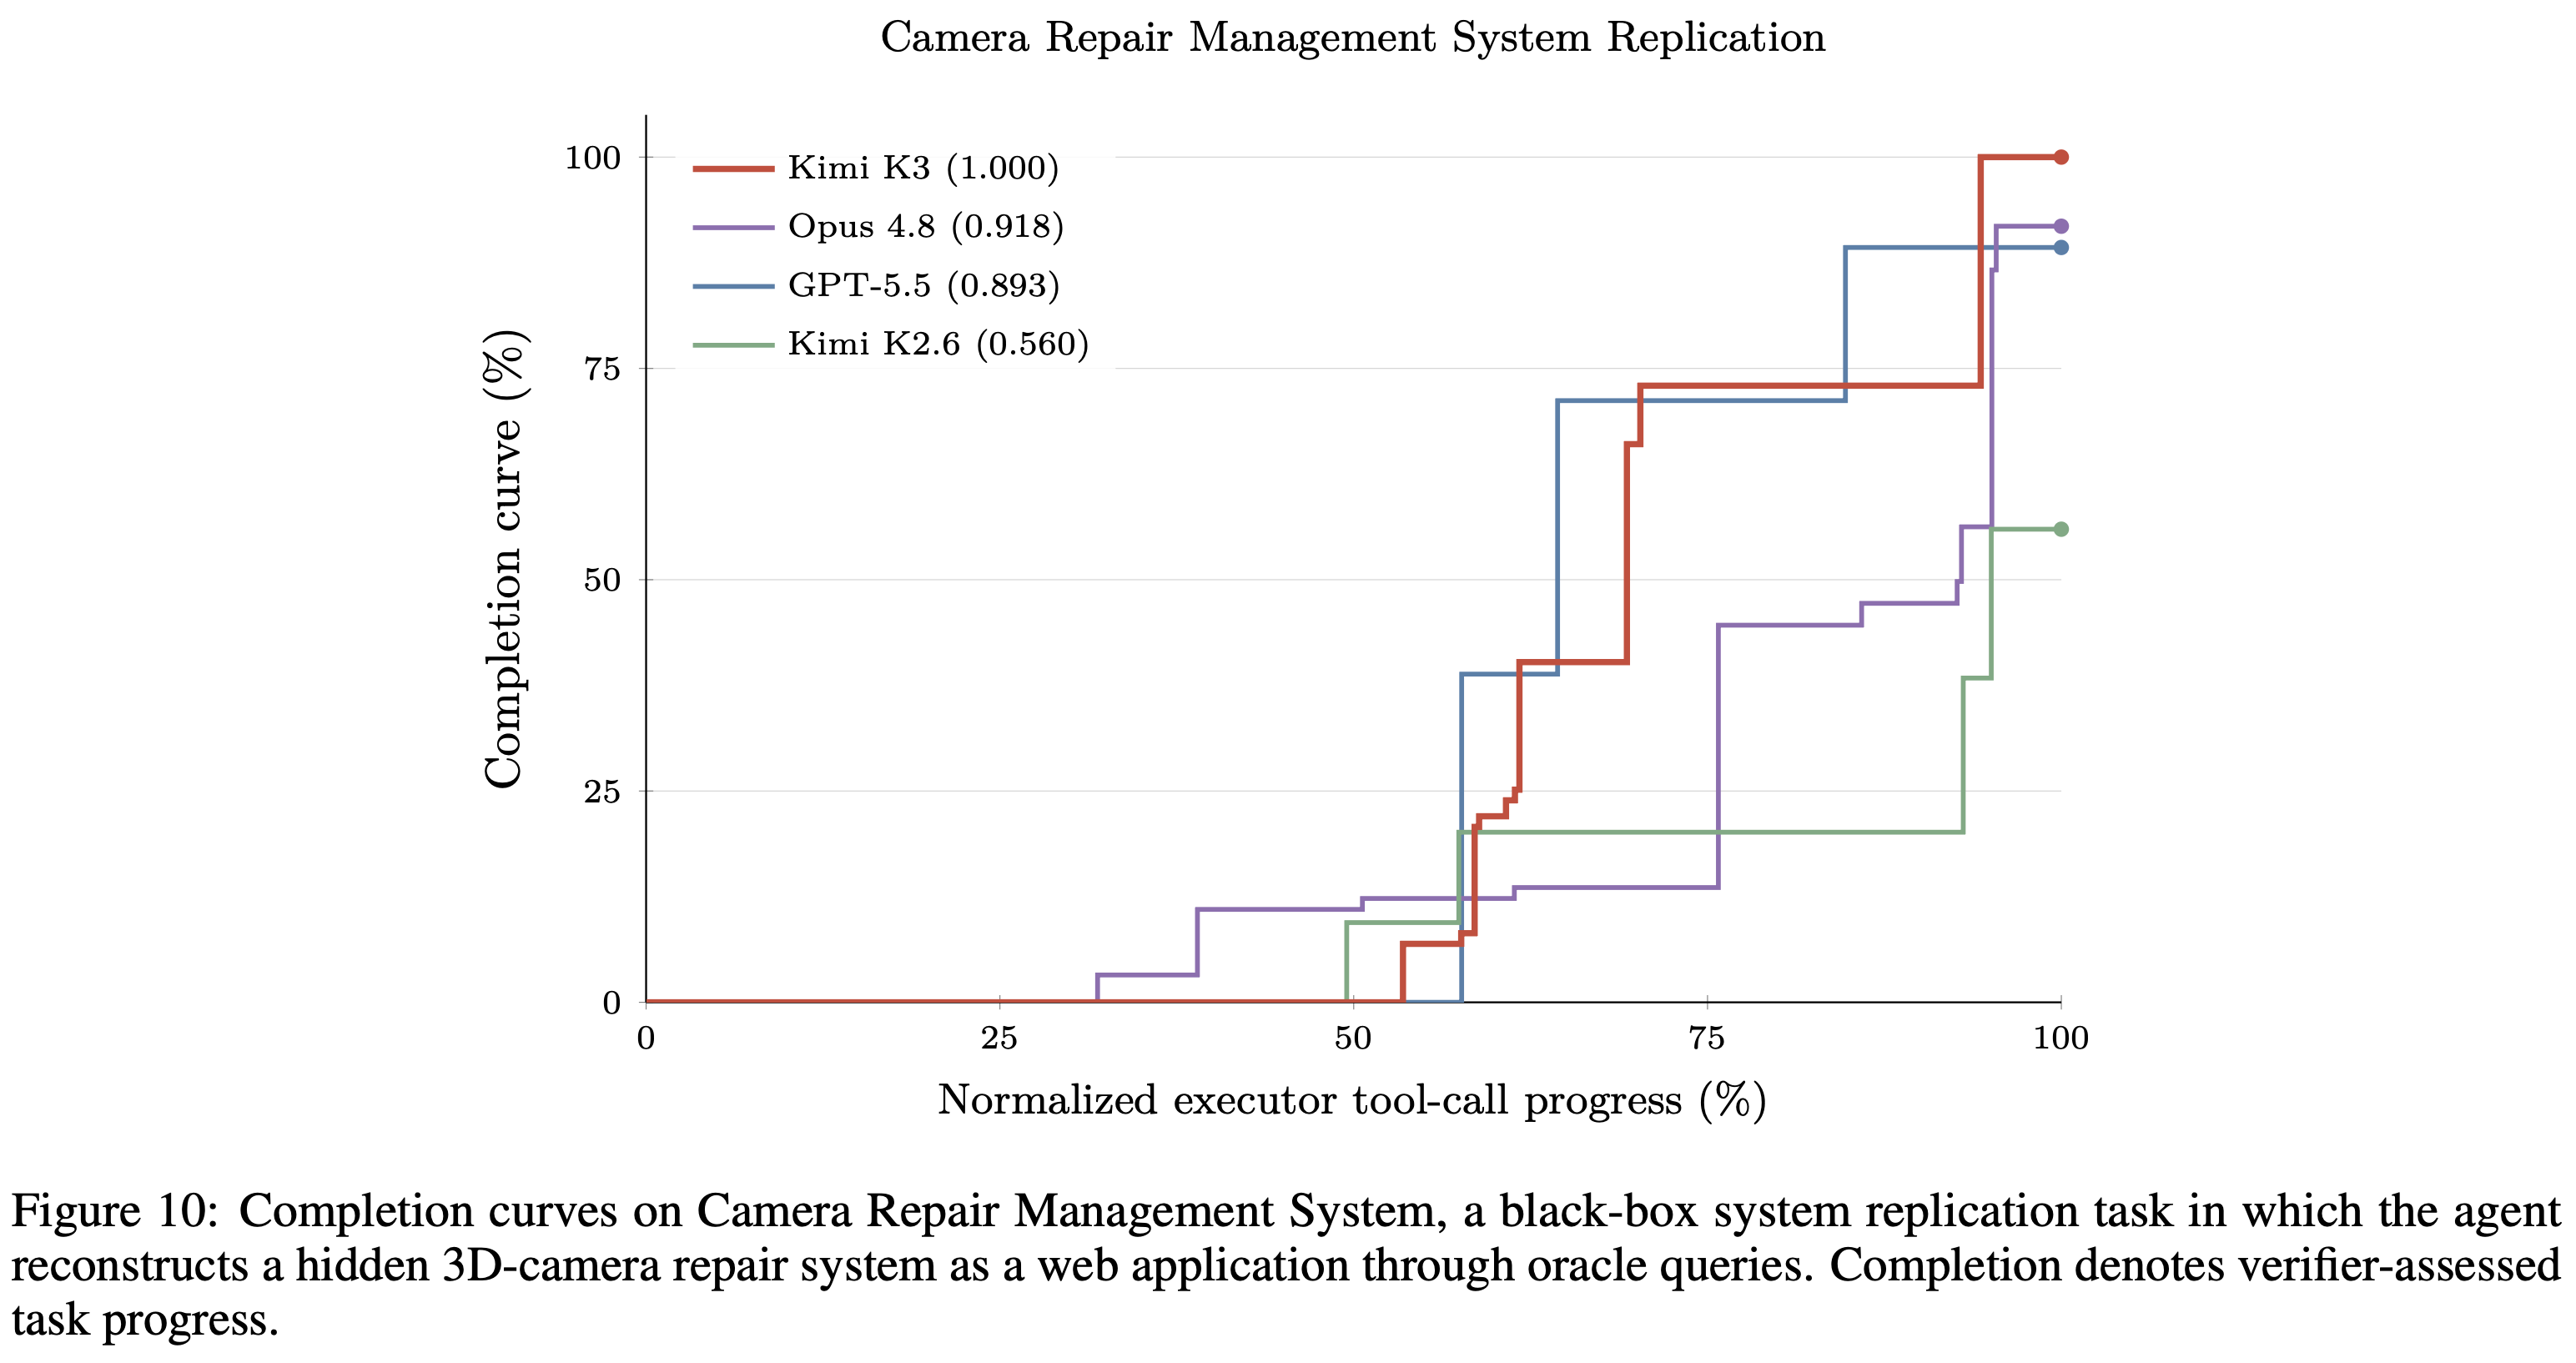
- 本文设计了多种验证器类型,支持多样环境,包括黑盒系统复制(图 10)、定量因子发现和税务审计
- 在每个环境中,Agent 迭代提交解决方案、接收验证器反馈并改进策略,训练出一个假设、行动、分析反馈和适应的通用循环
- 通过将 Agent 与验证器隔离、提供诊断反馈的公共验证器与评估保留场景的隐藏验证器配对,并在有限提交预算下应用基于惩罚的奖励,从而缓解 Reward Hacking 行为
Web Development Tasks
- 本文构建了一个由专家策划的多样化 Web 开发任务套件,覆盖典型场景
- 输入范围从单行场景描述到多段落规格说明
- Artifacts 涵盖网站、交互式游戏、3D/WebGL 场景、数据可视化、SVG 和全栈应用
- 每个任务在容器化沙箱中运行,并在多样 Agent 工具架下 Rollout,而非单一固定工具架,以促进跨工具架的泛化
- 奖励由两部分组成:确定性检查和内部奖励模型的模型评判
- 确定性检查功能性地测试应用行为,并为复制参考的任务评估结构和像素级相似性
- 当项目构建失败、运行出错或伪造(而非实现) Artifact 时,奖励置零
- 模型评判使用其他模型进行源代码检查或查看并交互输出 Artifact
Infrastructure
KDA 的算法-系统协同设计
- KDA 核函数 :
- 训练和 Prefill :开发 FlashKDA(基于 CUTLASS),将 intra-chunk 计算与 cross-chunk 状态传播重叠,大幅超越 Triton 参考实现
- 长上下文 Prefill 的 intra-device CP :将序列在单个 GPU 的 SMs 间分区,独立计算每个 segment 的转移,再精确组合,避免跨设备通信
- KDA Context Parallelism (KCP) :
- 由于 KDA 的更新依赖于传入状态(\(\mathbf{S}_t = \mathbf{M}_t \mathbf{S}_{t-1} + \dots\)),不能简单地从零状态求和
- KCP 将每个 segment 的效果分解为两个局部可计算量:
- 累积转移矩阵 \(\mathbf{M}_{t\leftarrow 1}^{[i+1]}\) 和 从零生成的状态 \(\tilde{\mathbf{S} }_t^{[i+1]}\)
- 对于 rank \(i+1\),其状态为:
$$
\mathbf{S}_t^{[i+1]} = \tilde{\mathbf{S} }_t^{[i+1]} + \mathbf{M}_{t\leftarrow 1}^{[i+1]} \mathbf{S}_{T_i}^{[i]}
$$- 其中 \(\mathbf{S}_{T_i}^{[i]}\) 是前一 rank 的输出状态
- 只需一个固定大小的 all-gather 同步这些片段,再通过 prefix scan 恢复每个 rank 的传入状态,实现线性扩展
3T 级预训练基础设施
- 采用 PP + VP + EP + ZeRO-1 DP + ZeRO-2 + CP 的组合并行策略
- MoonEP(完美均衡的 Expert Parallelism) :
- 保证每个 EP rank 恰好接收 \(S \times K\) 个 tokens(\(S\) 序列长,\(K\) 每 token 选专家数),所有 rank 计算量相同
- 证明冗余专家数上界为 \(E/R\)(\(E\) 总专家数,\(R\) EP size),且此上界紧致
- 在线规划由 GPU kernel 近优求解,零拷贝通信(fused permute/unpermute),静态形状避免 host-device 同步
- 内存高效训练 :
- 采用 FSDP2 + 自定义 offload,结合 ZeRO-2 梯度分片,将 optimizer states 和部分梯度 offload 到 CPU/NVMe
- 利用梯度 buffer 复用来存储 reference model 的权重
- 多模态编码器优化 :
- 对大图像/视频采用动态 CP(沿 patch 维度分区,gather-KV)
- 将 ViT 计算分解并调度到 pipeline bubbles 中,大幅隐藏视觉编码器开销
百万 Token Agentic RL 基础设施
- 长上下文 RL 系统 :
- 采用协同定位 RL 和 partial rollout 减少长尾延迟
- 外部 KV cache 池 :将空闲 prefix 的 KV cache(包括 KDA 状态和 MLA KV)写回 CPU DRAM,仅在需要时预取,缓解 GPU 内存压力
- Rollout 自动限流调度器 :根据活动请求数、排队数和 KV cache 利用率动态控制并发度
- 非策略模型梯度 buffer 复用 :Reference 模型的权重复用在策略模型的 FP32 梯度 buffer 中,避免额外内存分配
- 沙盒基础设施(AgentENV) :
- 基于 Firecracker microVM,提供高隔离性和高保真度(可挂载磁盘、运行容器甚至虚拟机)
- 支持增量 checkpoint/resume(延迟低至 133ms/49ms)、Pause/Resume、Fork(用于无副作用评判)和 Snapshot
- 采用 OverlayBD 镜像格式和 ublk 驱动,实现 sub-second 启动;Copy-on-Write 内存和 page-cache 优化实现 6.5x 内存超售
推理与在线服务
- KDA-Aware Prefix Cache :
- 将 KDA 固定大小的 recurrent state 与 MLA 的 KV cache 统一放入同一 paged block pool
- 细粒度 prefix caching :哈希基于小粒度 block(如 512 tokens),但物理块较大
- KDA checkpoint 仅保存在稀疏边界(如对话轮次边界)
- 查找分两阶段:MLA 哈希匹配 + KDA checkpoint 匹配,使命中边界可以是 512 的任意倍数,而非仅物理块边界
- 一致性保证:通过 pinning、排除新注册块、原子性 checkpoint 避免并发问题
- 高性能核函数 :
- KDA Decoding :在 MTP 推测解码中,为避免状态回滚困难,缓存 projected inputs 而非状态,按需重建状态(类似 ReplaySSM)
- Block AttnRes :Prefill 用 Sequence Parallelism 减少内存;Decoding 用 side stream 重叠 inter-block 计算,并融合 intra-block 更新和 RMSNorm
- Stable LatentMoE :融合 down-projection 和 router;shard 权重并 overlap all-gather;小 batch 下采用 token-centric 的 WarDecode 风格 kernel
- 集群级调度 :
- 缓存感知亲和性调度 :每个 session 绑定到主/备两个集群,主集群处理流量,备集群在主集群故障时接管(需重新 prefill),通过一致性哈希分散故障影响
- 预算感知准入控制 :为不同请求类分配独立资源预算,防止长上下文突发流量影响短请求的 SLO
Evaluations
Main Results
- Benchmarks :
- 涵盖 Reasoning & Knowledge(GPQA Diamond, CritPt, AA-LCR, HLE-Full)、Coding(DeepSWE, ProgramBench, Terminal-Bench 2.1, FrontierSWE, SWE-Marathon 等)、Agentic(BrowseComp, DeepSearchQA, GDPval-AA v2, Toolathon-Verified, MCPMark, AutomationBench 等)和 Vision(WorldVQA, OmniDocBench, PerceptionBench, Video-MME, MMVU, MMMU-Pro, CharXiv, Math-Vision, ZeroBench 等)
- Baselines :对比闭源模型 Claude Fable 5, GPT-5.6 Sol, Claude Opus 4.8, GPT-5.5 和开源模型 GLM-5.2
- 配置 :所有 Kimi K3 评估使用 max reasoning effort,temperature=1.0;推理/知识任务 top-p=0.95,Agentic/Coding 任务 top-p=1.0
- 结果分析(Table 2):
- Reasoning & Knowledge :GPQA Diamond 达 93.5%,接近前沿;但在 HLE-Full 和 CritPt 上仍落后于 Claude Fable 5 和 GPT-5.6 Sol,表明研究级推理是改进方向
- Coding :ProgramBench 最佳(77.8%),SWE-Marathon 领先 Claude Fable 5 达 7 个百分点(42.0% vs 35.0%),Terminal-Bench 2.1 几乎持平 GPT-5.6 Sol(88.3% vs 88.8%),FrontierSWE 排名第二(81.2%)
- Agentic :在 BrowseComp(91.2%)、DeepSearchQA(95.0% F1)、MCPMark-Verified(94.5%)等多项取得 SOTA;但在知识工作 Elo 套件(GDPval-AA v2, AA-Briefcase)和较难的计算机使用基准(OSWorld 2.0, SaaS-Bench)上落后于 Claude Fable 5 或 GPT-5.6 Sol
- Vision :OmniDocBench 最佳(91.1%);Math-Vision 达 94.3%(用 Python tool 提升至 97.8%);ZeroBench-main 与 Claude Fable 5 持平(23.0% pass@5,用 tool 提升至 41.0%)
Internal Evaluation
- 能力评估(Table 3, 4):
- 内部基准涵盖 Coding 体验、General Agent 体验(24/7 ClawBench, MIRA, KAET, CLIF, Agentic Vision, Swarm Bench, Online Experience, Deep Research, Finance, KWV, DECK, Agent Behavior)和对话体验(Faithfulness, Chat All-in-One)
- 强项 :Orchestration 和研究型 Agentic(Swarm Bench 76.3,Deep Research 90.0 领先);Coding 能力强(Kimi Code Bench 2.0 仅次于 Claude Fable 5,Coding Experience 最佳;Webdev 盲测中 +31.0% 胜过 Claude Opus 4.8,尤其在 3D/WebGL/Shader 领域 +59.1%)
- 弱项 :在 Agent Behavior Bench, MIRA Bench, 24/7 ClawBench 2.0, Agentic Vision Bench, KWV Bench 上落后于领先者
- 网络安全评估 :
- Tier 1(漏洞发现) :在数十个广泛部署系统中识别出数百个候选漏洞,经人工确认约 70% 为真实漏洞,包括 Linux 内核中两个此前未知的高危漏洞(远程堆越界写入、Dirty-COW 类权限提升)
- Tier 2(漏洞利用) :在 36 个专家可解任务(用户空间 16 个,内核 20 个)中,Kimi K3 解决 14 个(38.9%),优于 GLM-5.2(8 个,22.2%);但内核空间任务仅解决 4 个,表明在完整利用链和对抗缓解措施方面仍与人类专家有差距。UK AI Security Institute 的独立评估结论一致
Third-Party Evaluation, Table 5,第三方评估
- Artificial Analysis :Intelligence Index v4.1 57.1,在 580 个模型中排名第 4(若将 GPT-5.6 Sol 变体算作一个则第 3)
- Vals AI :Vals Index 74.7%,在 39 个模型中排名第 2(仅次于 Claude Table 5)
- Arena :WebDev Arena Elo 1,678,排名第 1(首个登顶的开源模型);Text Arena 排名第 8(1,486 Elo);Agent Arena 排名第 4(9.1)
6.4 成本效率(Cost Efficiency)
- 在 Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2 和 AA-Briefcase 四个套件上比较分数与每任务推理成本
- Kimi K3 接近或位于成本-效率前沿:
- Kimi Code Bench 2.0:分数比 Claude Fable 5 低 4.0 分,但成本仅为 38%
- BrowseComp:最佳分数(91.2%),每任务成本 $2.03,仅为 Claude 模型的一个数量级成本
- GDPval-AA v2:Elo 落后 GPT-5.6 Sol 不到 50 分,成本低 13%;比 Claude Fable 5 便宜 2.6 倍
- AA-Briefcase:第二好分数,成本约为 Claude Fable 5 的一半
附录:Kimi-K3 博客内容介绍(发表于 20260717)
- 博客链接:Kimi K3: Open Frontier Intelligence, Moonshot AI (Kimi), 20260717
- Kimi K3 整体介绍:
- 2.8T 参数(世界上首个开放的 3T 级模型)
- 注:在过去十二个月中的九个月里,Kimi 模型一直保持着开放模型规模的上限,中间被打断的时间是 DeepSeek-V4
- 基于 KDA(Kimi Delta Attention)和 AttnRes(Attention Residuals)构建
- 具备原生视觉能力(native vision capabilities)
- 1M Token 的上下文窗口
- 专为 long-horizon coding、knowledge work 和 reasoning 的前沿智能而设计
- Kimi-K3 整体性能处于第一梯度
- 虽然 Kimi-K3 整体性能仍落后于最强大的专有模型 Claude Fable 5 和 GPT 5.6 Sol
- 2.8T 参数(世界上首个开放的 3T 级模型)
- Kimi K3 即日起可在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上使用
- Kimi K3 将默认使用 max thinking effort(低强度和高强度模式将在后续更新中推出)
- 推理和开源系统适配中
- 完整的模型权重将于 2026 年 7 月 27 日发布
- 注:关于架构、训练和评估的更多细节将与 Kimi K3 技术报告一同发布
Coding
- Kimi K3 具有强大的长时程编码性能
- 在极少的人工监督下运行,它能够持续进行长时间的工程会话,导航大规模代码仓库,并编排终端工具
- Kimi K3 还擅长将软件工程与视觉推理相结合的任务:利用截图和视觉信息来优化游戏开发、前端和 CAD 设计
Kernel Optimization
GPU Compiler Development
- Kimi K3 能够从头构建一个 GPU 编程系统
- Kimi K3 开发了 MiniTriton,一个紧凑的类 Triton 编译器,拥有自己的基于 MLIR 的 tile-level IR 层、优化 passes 和 PTX 代码生成 Pipeline
- Kimi K3 能够构建一个连贯的端到端编译器
- 从 DSL 前端和 IR passes 到 PTX 代码生成和运行时,而不仅仅是孤立的 kernels
- 其从头编写的 Tensor Core 路径已经可以与 Triton 大量优化的栈相媲美
Game Dev and Digital Creation
- Kimi K3 结合了强大的 3D 推理、编码和视觉能力,将概念(Concepts)、图像和视频转化为完全可玩的交互式体验
- Kimi K3 通过在代码和实时截图之间无缝迭代,实现了真正的 “视觉在 Loop 中(vision in the loop)”,即时查看和优化输出
Chip Design
- 作为早期概念验证,Kimi K3 设计了一款芯片,用于服务基于其自身架构构建的 nano 模型
- 在单次 48 小时的自主运行中,K3 使用开源 EDA 工具在 Nangate 45nm 库上构建、优化并验证了该芯片
Coding for Research
- Kimi K3 架起了科学文献与可执行代码之间的桥梁
- 自主实现、验证和分析复杂的计算研究工作流
- 在一个案例中,Kimi K3 在大约两小时内完成了通常需要一位经验丰富的研究人员一到两周的工作
Knowledge Work
- 除了公开基准测试之外,Kimi K3(max)在 Kimi 的内部评估中表现出了持续的性能提升
- 这些评估来源于真实世界用户-Agent 工作流中观察到的重复模式和挑战
- 这些在面向生产的不同工作流中持续存在的优势,反映了 Kimi K3 Agentic 知识工作能力的广泛提升
Research with Interactive Visualization
- Kimi K3 在 Kimi Work 中可以在金融咨询和科学研究领域产出的一些示例:
案例 1:Interactive 42 years of AI ASIC industry research website
- 一份可以深入探索的交互式研究报告:42 年的 ASIC 行业历史,通过 120 多轮递归自我改进(recursive self-improvement)创建而成
- Kimi K3 将证据转化为定制图表、动画图表和交互式可视化叙事
- 通过 2,800 多次网络搜索/获取和 1,100 多次终端数据拉取来获取数据,涵盖 11,000 多个页面,跨越 87 份季度报告和 99 份原始 PDF
案例 2:Fusion Industry Research
- 一份咨询风格的行业报告,带有交互式可视化
- 包括时间线、漏斗图(Funnel Chart)、范围条形图(Range Bar Chart)、甘特图(Gantt Charts)和出版质量的幻灯片
案例 3:GWTC-5 Gravitational-wave Analysis,GWTC-5 引力波分析
- 使用 20 多个并发子 Agent(subagents)对 391 个引力波事件进行分析,生成 7 个科学可视化图表、2 个表格和来自 10 多篇论文的文献综述
- Kimi K3 还特别擅长生成信息图风格(infographic-style)的演示文稿
Widgets and Dashboard
- 本次新介绍:在 Kimi Work 中引入了两个新功能(Widgets 和 Dashboard),它们使与 Kimi K3 的交互更加可视化和持久化
- Widgets 允许在对话中直接生成交互式组件,并可连接本地数据或外部插件以实现持续更新
- Dashboard 将最关心的 Widgets 汇聚到一个持久的、个性化的视图中,围绕一个主题、项目或目标进行组织
Video Editing
- Kimi K3 在动态设计、动画和视频编辑方面表现出色,因为其原生多模态架构(native multimodal architecture)在同一个模型中理解文本、图像和视频
- 示例一:Kimi K3 创建了一个 3Blue1Brown 风格的动态图形解说视频,来解释其自身的架构,将技术理念转化为动画图表和转场
- 示例二:Kimi K3 从 56 个源剪辑中编辑了自己的预告视频,处理了片段选择、动作匹配剪辑、帧级精确的节拍同步、音频处理和多轮修订
- 像这样一个高密度的短视频通常需要一位经验丰富的编辑一到两个工作日,或者一位初学者三到五天
Architecture and Infrastructure
- Kimi K3 基于 KDA 和 AttnRes 构建,这两项架构更新旨在改善信息在序列长度和模型深度上的流动方式
- Kimi K3 扩大了 MoE 稀疏性
- 与 Stable LatentMoE 框架配合,有效激活 896 个专家中的 16 个
- 在 2.8 万亿参数规模下的稳定高效训练
- Quantile Balancing 直接从路由器得分的分位数推导专家分配,消除了启发式更新和敏感的平衡超参数
- Per-Head Muon 通过独立优化 Attention 头将 Muon 扩展到更自适应的规模化学习
- Sigmoid Tanh Unit(SiTU)和 Gated MLA 分别改善了激活控制和 Attention 选择性
- Kimi K3 从 SFT 阶段开始应用量化感知训练(quantization-aware training),使用 MXFP4 权重和 MXFP8 激活以实现广泛的硬件兼容性
- 为防止专家不平衡在大型专家并行规模下降低吞吐量,引入了一种完全平衡的专家并行训练方法,具有静态形状且在关键路径上无主机同步
- 由于推理效率同样受益于更大的高带宽通信域,建议在具有 64 个或更多加速器的超级节点配置上部署 Kimi K3
- 由于 KDA 对传统前缀缓存(prefix caching)提出了新的挑战,已向 vLLM 社区贡献了相应的实现,将与模型一同发布
- 借助带有预填充缓存(prefill cache)的 KDA,能够以极具竞争力的 Token 价格提供 Kimi K3 服务(点赞!)
Availability,Kimi 系列模型通用
- Kimi K3 Agents :从移动应用商店下载或更新最新版 Kimi App,可在 iOS、Android 和 HarmonyOS 上使用,或访问 kimi.com
- 使用 Kimi K3 Work :下载最新的 Kimi Work 桌面应用,版本 3.1.0 或更高,适用于 Windows 和 Apple silicon Mac
- 使用 Kimi K3 编码 :在终端中运行 Kimi Code,并使用
/model命令选择 Kimi K3 - 使用 Kimi API 构建 :访问 Kimi API 平台 并选择
kimi-k3- 定价为缓存命中输入 $0.30/MTok,缓存未命中输入 $3.00/MTok,输出 $15.00/MTok
- 在 Mooncake 的解耦推理架构(disaggregated inference architecture)支持下,官方 Kimi API 在编码工作负载中实现了超过 90% 的缓存命中率
- 将 Kimi 引入工作组织 :Kimi Enterprise 提供企业级数据隐私和成员管理,个人账户与组织账户完全分离
- 访问定价页面并选择 “Get Kimi Enterprise” 获取团队订阅
测评相关
- 报告的所有 Kimi K3 结果均是在下面的条件下获得的
- Reasoning 强度设置为“max”
- 温度
temperature = 1.0 top-p = 1.0
- 根据基准测试的不同,每个模型在三种 Agentic Harness 之一下进行评估
- KimiCode
- Claude Code
- Codex
Limitations
- 对思考历史的敏感性(Sensitivity to thinking history)
- K3 是在保留思考历史模式(preserved thinking history mode)下训练的
- 如果 Agent Harness 未能按要求传回所有历史思考内容,或者如果正在进行的会话切换到了 K3,生成质量可能会变得非常不稳定
- 建议使用已验证兼容性的 Harness,例如 Kimi Code,并避免在会话中途切换到 K3
- 过度主动(Excessive proactiveness)
- K3 的训练特别强调长时程、具有挑战性的任务
- 因此,当它在任务执行过程中遇到小问题或模糊的用户意图时,可能会代替用户做出意外的决定
- 如果应用程序要求 Agent 在明确定义的边界内操作并避免过度即兴发挥,请在系统 Prompt 或
AGENTS.md中对 K3 施加更明确的行为约束
- 总体而言 K3 是一个极具竞争力的模型,但与 Claude Fable 5 和 GPT 5.6 Sol 相比,它在用户体验方面仍存在明显的差距
- K3 的训练特别强调长时程、具有挑战性的任务
补充:关于 Kimi K3 位置编码的思考
- 在 Kimi K3 中,位置编码的设计是分离且互补的 :
- Gated MLA 层采用 NoPE(无显式位置编码)
- 理解:实际上,传统的 Casual LM 天然就包含位置编码的,因为是任意两个 Token 位置交换结果都是不一样的,只是说仅但看某个 待输出的目标 Token 时,可能看起来交换位置前后的结果一样,所以显示加上位置编码会好些
- KDA 提供主要位置编码信息:位置感知能力完全由 KDA 层通过其内部的递归衰减机制隐式提供
- Gated MLA 层采用 NoPE(无显式位置编码)
- 这种设计的核心考量在于简化长上下文扩展并提升外推能力 ,避免了传统 RoPE(旋转位置编码)在超长文本上可能出现的“长度过拟合”问题
Kimi K3 各模块的位置编码策略
- KDA 层 :作为位置信息的唯一来源
- KDA 不依赖外部位置编码,而是通过自身的 通道级遗忘门(Channel-wise forget gate)和衰减机制(Decay mechanism) 隐式编码位置
- KDA 核心公式
$$ \mathbf{S}_t = (\mathbf{I} - \beta_t\mathbf{k}_t\mathbf{k}_t^\top)\text{Diag}(\alpha_t)\mathbf{S}_{t - 1} + \beta_t\mathbf{k}_t\mathbf{v}_t^\top $$- \(\text{Diag}(\alpha_t)\)( retention 因子)和 \(\beta_t\)(写入强度)都是位置敏感的,随着 token 位置变化而动态调整,从而让模型感知序列的顺序
- Gated MLA 层 :完全采用 NoPE
- Query 和 Key 在计算注意力时不添加任何形式的位置编码(如 RoPE 或可学习的位置嵌入),纯粹基于内容进行交互
- 整体结构 :
- Kimi K3 的 93 层网络组成(69 层 KDA + 24 层 Gated MLA )
- 两者以 3:1 的比例在每个 Block 中堆叠(3 层 KDA 后接 1 层 MLA)
- 这种结构让 KDA 处理位置信息,MLA 专注于全局内容交互,实现了分工
- Kimi K3 的 93 层网络组成(69 层 KDA + 24 层 Gated MLA )
Kimi K3 的位置编码(“KDA 隐式编码 + MLA 无显式编码”)设计思考
- 简化上下文扩展 :由于 MLA 层没有使用 RoPE,在将上下文从 8K 扩展到 1M token 时,无需进行 RoPE 的基础频率调整或插值(如 YaRN) 等复杂操作
- 原始论文中作者就明确指出:Kimi K3 能直接外推至 1M 上下文,而无需任何位置编码修改
- 避免 RoPE 导致的 “长度过拟合” :
- NoPE MLA 避免了因 RoPE 频率固定而导致的 “长度过拟合” 问题,使模型在处理超过训练长度的文本时,鲁棒性更强
- 架构分工 :
- KDA 层作为高效的线性注意力,负责捕获序列的顺序和局部模式
- MLA 层作为强大的全局注意力,则不受位置信息干扰,专注于建模 token 间的深层语义关系