注:本文包含 AI 辅助创作
- 参考链接:
- 技术报告原始论文:(ROLL Technical Report)Reinforcement Learning Optimization for Large-Scale Learning: An Efficient and User-Friendly Scaling Library, ROLL Team, 20250606
- ROLL 开源地址:github.com/alibaba/ROLL
- ROLL 中文文档:(面向大规模学习的强化学习优化框架)Reinforcement Learning Optimization for Large-scale Learning
- 副标题:阿里巴巴开源的强化学习库,专为大语言模型优化。支持分布式训练、多任务学习与智能体交互,让 AI 模型训练更简单、更高效
- ROLL 英文文档:ROLL: Reinforcement Learning Optimization for Large-Scale Learning
- ROLL 团队 Blog:wwxfromtju.github.io/roll_team.
Paper Summary
- ROLL 是阿里巴巴淘天未来生活实验室出品的 LLM RL 训练框架
- ROLL 基于 Ray构建,并集成了现有的 LLM 优化系统,包括 vLLM、SGLang、DeepSpeed 和 Megatron
- 背景:当前 RL 框架需要协调管理多个模型和多阶段流水线,在效率、可扩展性和易用性方面带来了挑战
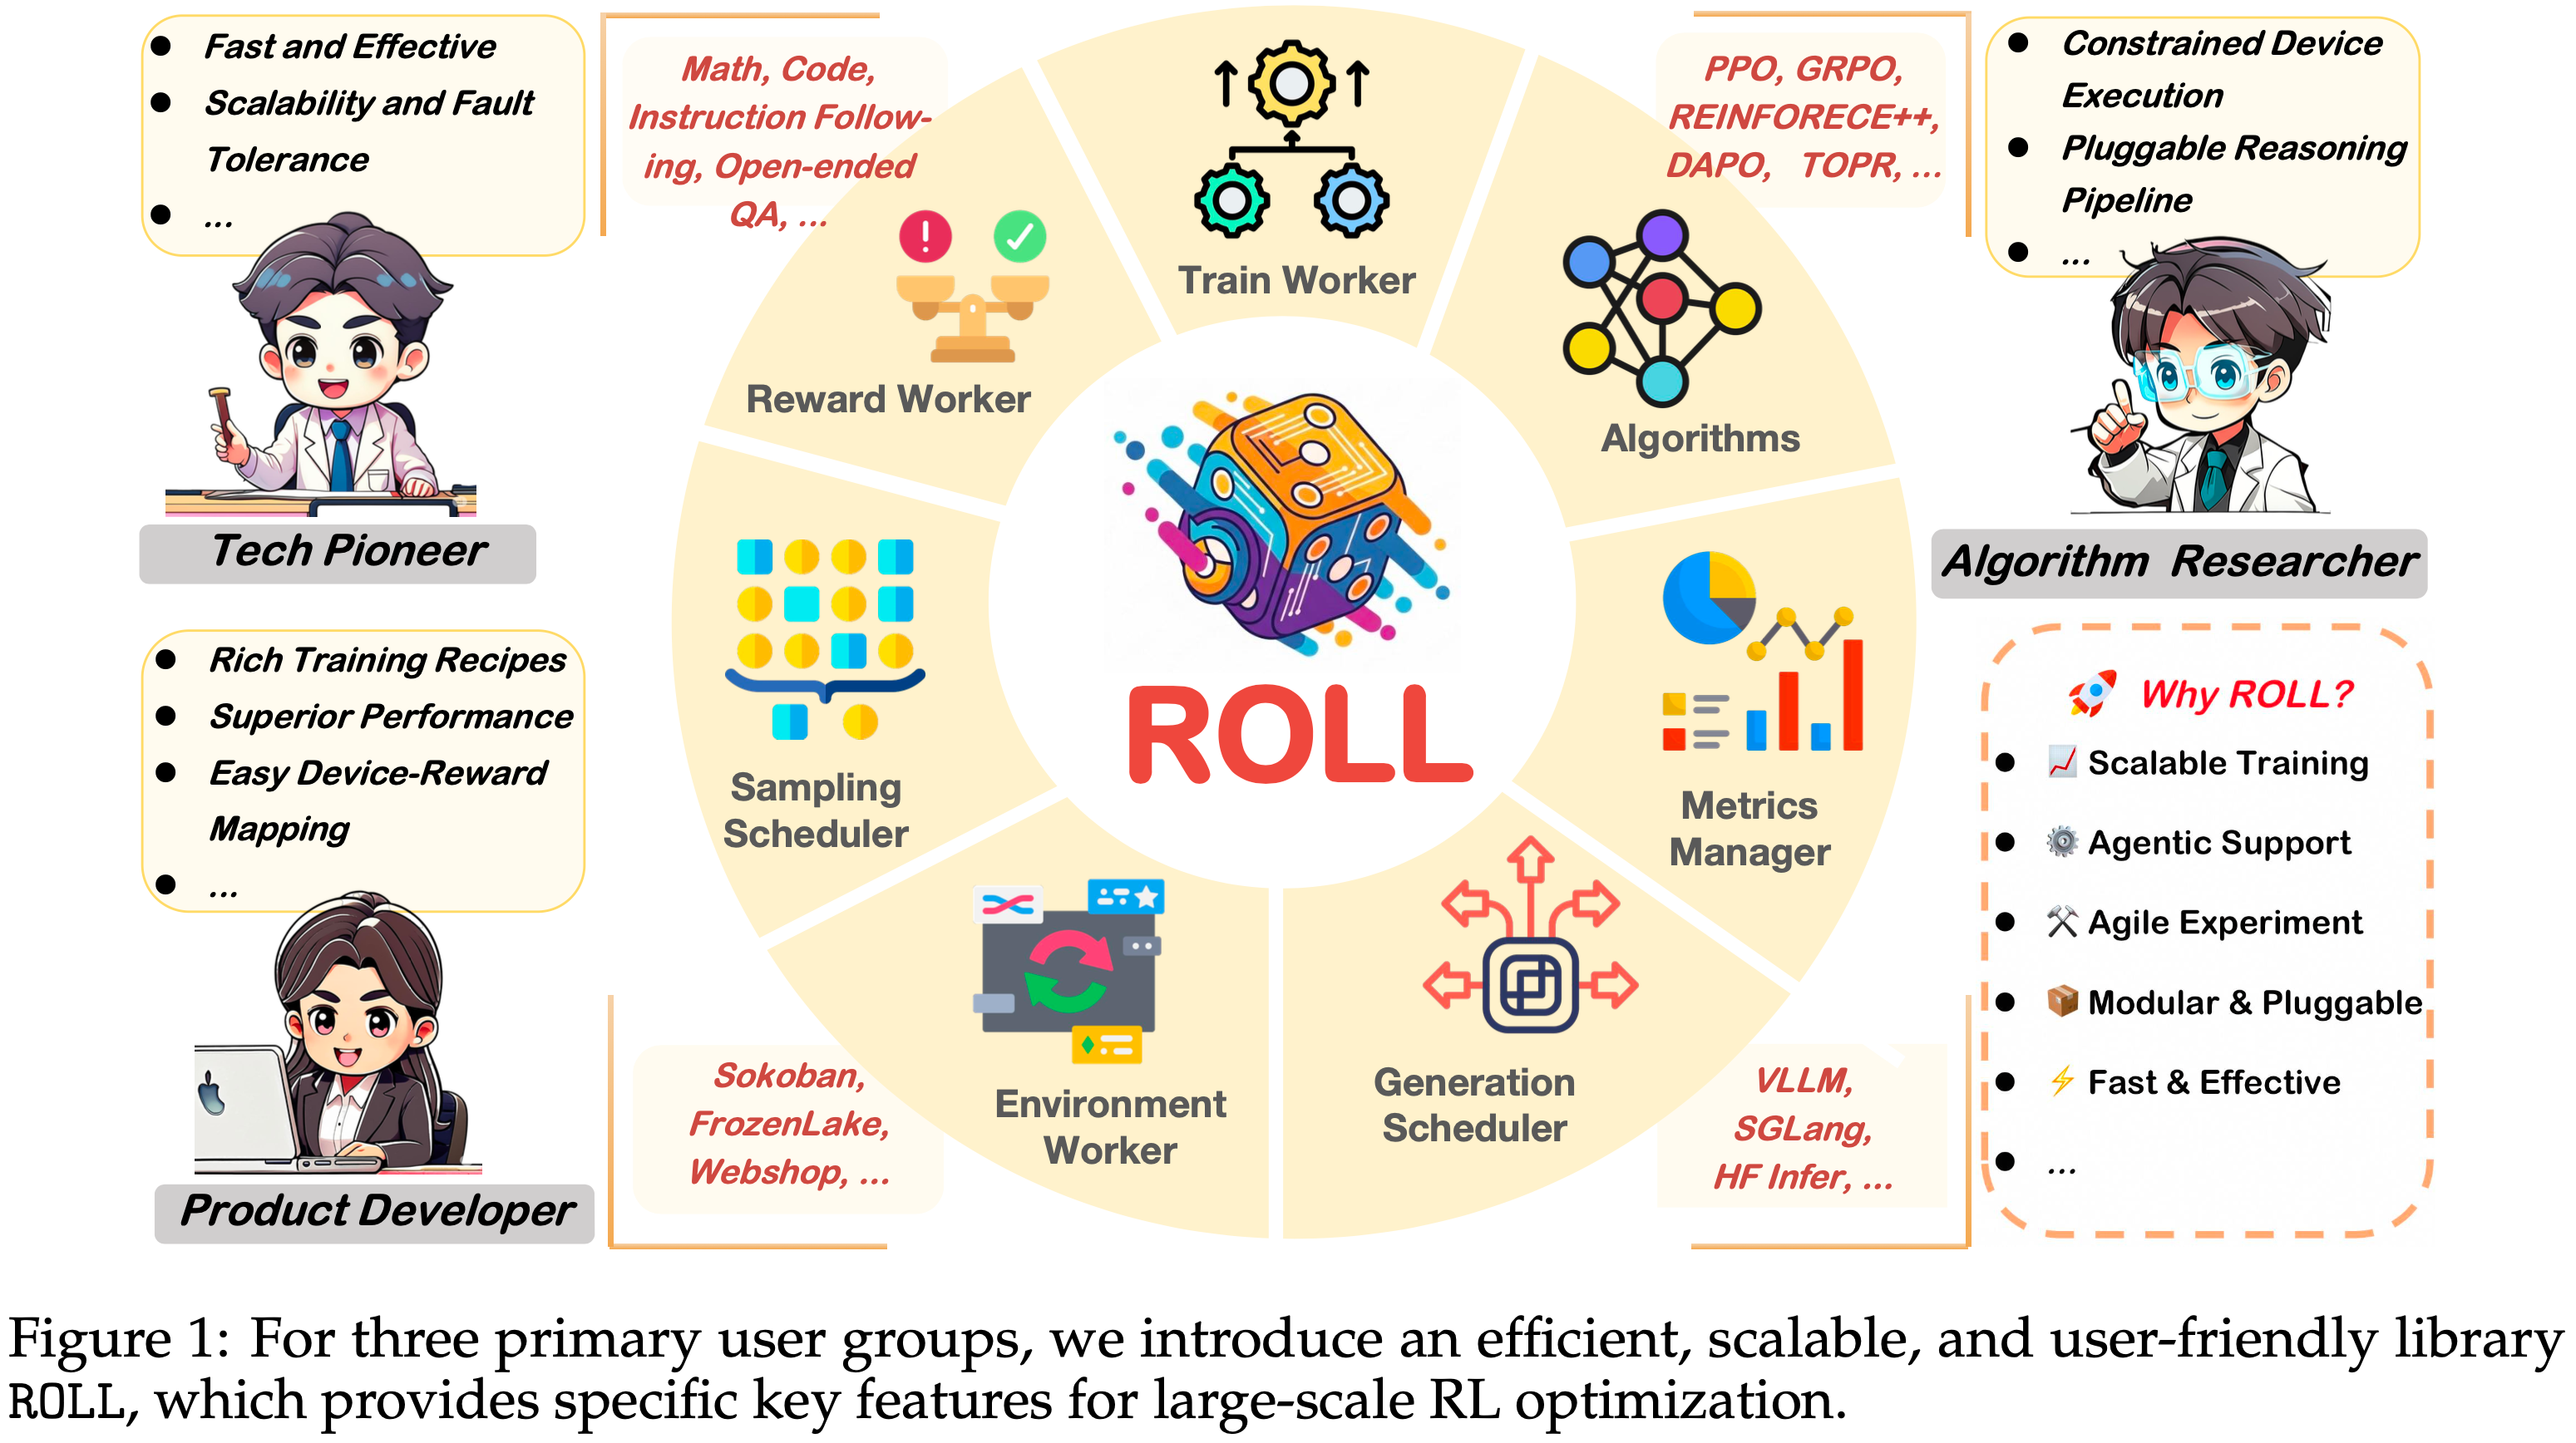
- ROLL 的野心很大,好像可同时面向三类主要用户群体:
- 追求成本效益高、容错性强的大规模训练的 Tech Pioneers
- ROLL 支持在具有异构硬件的大规模 GPU 集群中进行快速、成本效益高、可扩展且容错的 RL 训练
- 需要对训练工作流进行灵活控制的开发者
- ROLL 提供灵活且细粒度的控制,可将输入样本路由到适当的 Agent 环境、Reward Worker 和设备,以最小的工程投入实现强劲性能
- 寻求快速实验的研究人员
- ROLL 便于在资源受限的 GPU 设置上进行高效训练,并通过设计良好的 RL 训练流水线抽象实现对新思路的敏捷实验
- 追求成本效益高、容错性强的大规模训练的 Tech Pioneers
- ROLL 基于以下关键模块构建,以有效服务这些用户群体:
- (1) 单控制器架构与 Parallel Worker 结合,简化训练 Pipeline 开发
- (2) Parallel Strategy 和 Data Transfer 模块实现高效且可扩展的训练
- (3) Rollout Scheduler 在 Rollout 生成阶段对每个样本的生命周期进行细粒度管理
- (4) Environment Worker 和 Reward Worker 分别支持对 Agentic RL 算法和奖励设计进行快速灵活的实验
- (5) AutoDeviceMapping 允许用户在不同阶段灵活地为不同模型分配资源
- 本文使用 ROLL 在内部训练了一个总参数量超过 200B 的 MoE 模型,成功扩展至数千块 GPU 并持续运行约两周无中断,证明了其可扩展性和容错性
Introduction and Discussion
- 现有 LLM 的 RL 优化算法包含以下几种范式:
- RLHF
- RLVR
- Agentic RL(具有多轮 Agentic 交互的 RL)
- 标准的 RL 中
- 训练工作流涉及多达四个不同的 LLM(2022;2022):Actor、Critic、Ref 和 Reward 模型
- 每次训练迭代包含三个阶段
- 生成阶段(Generation):Actor 根据一批输入 Prompt 生成 Response
- 在 Agentic RL 设置中,Actor 还可能与环境进行多轮交互
- 推理阶段(Inference):Critic、Ref 和 Reward 模型对生成的 Response 执行前向传播,以计算监督信号或奖励估计
- 最近的 RL 工作通过减少此阶段的 LLM 数量甚至移除该阶段对其进行了简化(2023;2025a;2024)
- 训练阶段(Training):Actor 和 Critic 模型利用推理阶段获得的奖励信号更新参数
- 在某些 RL 算法(2025;2024;2023b)中,Critic 模型保持非激活状态
- 生成阶段(Generation):Actor 根据一批输入 Prompt 生成 Response
- 已有训练框架的大部分引入了包括单控制器(2024)、共置(2024)和分离式架构(2025)在内的几种经典系统设计方法,以加速 LLM 的 RL 训练
- ROLL 的主要特点:
- ROLL 基于提出的单控制器架构,并引入了定义良好的 Parallel Worker 抽象,以实现灵活且模块化的 RL 训练流水线,从而便于新思路的实验
- ROLL 引入了优化的 Parallel Strategy 和 Data Transfer,以实现在资源受限设备上的执行,以及快速、可扩展和容错的训练
- ROLL 提供了 Rollout Scheduler,以支持在生成阶段对每个 Prompt 样本进行细粒度的生命周期管理,简化了 Response 生成、环境交互和奖励计算之间执行流的编排
- ROLL 专门设立了 Environment Worker 和 Reward Worker,以提供高效且可扩展的 Agentic 环境交互和奖励计算
- ROLL 实现了 Resource Pool 并利用 AutoDeviceMapping 来实现高效的工作器放置和优化的资源分配
Background
RL for LLMs
- PPO 及其变体的训练流水线通常由几个关键组件组成:
- 生成 Response 的 Actor 模型
- 估计值函数的 Critic
- 用于防止过度偏离初始行为的 Ref 模型
- 评估 Response 质量的 Reward 模型
- 用于 LLM 的 RL 优化中的每次迭代包含如下生成、推理和训练阶段:
- 生成阶段(Generation Stage):Actor 模型与环境交互,为一批 Prompt 生成 Response
- 生成过程涉及 Prefill 阶段、解码阶段和环境交互阶段
- Prefill 阶段是一个计算密集型的 GPU 任务,它处理 Prompt 以计算其 KV 缓存
- 解码阶段是一个内存密集型的 GPU 任务,自回归地生成 Token,直到满足终止条件
- 环境交互阶段涉及执行复杂环境并促进这些环境与 Actor 模型之间的交互,利用大量的 CPU 资源
- 数学和代码推理等单轮任务,Actor 模型通常涉及无状态的环境交互,并且仅包含 Prefill 和解码阶段
- 多轮任务(如工具使用)中,Actor 模型与环境进行多轮交互,使得环境交互阶段成为显著的性能瓶颈
- 在生成阶段,Rollout 样本包含在 Prefill、解码和环境交互期间产生的 Token,并用于后续的推理和训练阶段
- 在此阶段生成大量的 Response 以加速收敛,但代价是大量的计算开销
- 生成过程涉及 Prefill 阶段、解码阶段和环境交互阶段
- 推理阶段(Inference Stage):
- 第一步:Actor 模型生成的每个序列通过参考模型、Critic 模型和奖励模型的单次前向传播进行评估
- 参考模型提供 KL 惩罚以防止过度的策略偏离
- Critic 模型估计用于优势计算的值分数
- 奖励模型分配质量分数
- 第二步:将这些输出组合起来计算最终训练目标
- 该目标通常包括策略损失、值损失和 KL 惩罚项
- 上述过程仅涉及 Prefill 阶段,这一般是一个计算密集型过程
- 一个例外情况是奖励计算:基于 LLM 的奖励计算可视为 Prefill 阶段,并在 GPU 上运行
- 可验证奖励的计算,包括基于规则的数学验证和沙盒验证,类似于环境交互阶段 ,通常需要大量 CPU 资源来快速获取奖励目标
- 第一步:Actor 模型生成的每个序列通过参考模型、Critic 模型和奖励模型的单次前向传播进行评估
- 训练阶段(Training Stage):
- Actor 和 Critic 模型使用生成阶段产生的样本和推理阶段的奖励信号进行更新
- 更新后的参数在后续迭代中为生成阶段进行同步
- 与生成和推理阶段相比,训练阶段通常消耗大量 GPU 内存,并需要各种 LLM 并行化策略来实现高效执行
- 生成阶段(Generation Stage):Actor 模型与环境交互,为一批 Prompt 生成 Response
System Optimization for RL-enhanced LLMs
- Training
- LLM 训练可以通过 5D 并行性加速,包括数据并行(Data Parallelism, DP)(2020;2023)、张量并行(Tensor Parallelism, TP)(2019)、流水线并行(Pipeline Parallelism, PP)(2019)、上下文并行(Context Parallelism, CP)(2021)和专家并行(Expert Parallelism, EP)(2022)
- 此外,通过使用梯度检查点(2016)和卸载(2021)可以显著减少 GPU 内存消耗
- 现有的 LLM 训练系统,如 DeepSpeed(Microsoft,2021)和 Megatron(2019),都支持 DP、TP、PP 和 EP
- 这些系统通常为 LLM 训练优化计算和内存
- Inference and Generation
- 与训练阶段相比,推理和生成阶段通常具有不同的计算模式和内存访问模式
- LLM 推理和生成可以通过诸如连续批处理、内存高效的注意力机制和优化的 KV 缓存管理之类的方法来加速
- LLM 服务系统,如 vLLM(2023)和 SGLang(SGLang Team,2025),提供高效的推理和生成引擎
- 这些系统采用各种技术,如 PagedAttention 和前缀缓存,以实现高吞吐量和低延迟
- 此外,许多 LLM 服务优化工作优化了注意力计算(2023a;2025b)和 KV 缓存使用(2024b;2024;2025)
- RL Optimizations
- 用于 LLM 的 RL 训练具有独特的计算特性,包括生成、推理和训练,并且涉及不同大小的 LLM
- Actor 模型执行生成和训练阶段,Critic 模型执行训练和推理阶段,Ref 模型执行推理阶段,Reward 模型执行推理阶段
- 因此可以为不同阶段的不同模型定制不同的并行策略,以最大化整体性能
- NeMo(2025)和 OpenRLHF(2024)将 GPU 集群划分为多个分区,并将其分配给不同阶段
- 在每个阶段,它们使用优化的并行化策略运行 LLM
- 为了提高资源利用率,Verl(2024)、RLHFuse(2024)、Real(2024)和 PUZZLE(2024)将不同阶段的 LLM 共置于同一资源池中
- StreamRL(2025)提出将训练和生成阶段分离,并以流水线方式异步运行生成和训练阶段
- 由于推理集群的高内存带宽优势,Rollout 生成可以得到加速
- 用于 LLM 的 RL 训练具有独特的计算特性,包括生成、推理和训练,并且涉及不同大小的 LLM
RL Algorithms
- RLHF:
- 在 ChatGPT 发布后,许多 RLHF 方法(2022;2017)被提出以使 LLM 与人类偏好和价值观对齐,这通常包括三个阶段:监督微调、奖励模型训练和策略优化
- 但这些 RLHF 方法需要大量人类标注样本来训练奖励模型,阻碍了其广泛采用
- RLVR
- 特点:可验证的奖励
- 这些推理任务的准确性通常由最终答案是否正确来决定
- 这种方法源于这样一个事实:可靠地评估中间步骤仍然很困难,尤其是当这些步骤缺乏带标注的真实值时
- 在数学任务中采用基于规则的策略来评估解决方案
- 在编码任务中使用沙盒来判断生成的代码是否成功通过所有测试用例
- 在某些情况下,难以获得答案的正确性,因此采用了 LLM-as-a-Judge(2024),即使用 LLM 来识别生成答案的正确性
- 其他:最近,动态采样(2025)策略已被广泛用于根据难度筛选样本并提高推理性能
- Agentic RL(RL with Multi-turn Agentic Interaction):
- 与 单轮设置(LLM 仅执行一次 Response 生成而无持续的环境交互)不同,Agentic RL (多轮 RL)面向更真实的 Agent 场景(2024b;2025)
- 基于 LLM 的 Agent 需要执行一系列动作来完成某些任务,例如管理终端(2024a)、遍历基于 Web 的界面(2024a)
- 环境的慢速执行、从动作中获得奖励反馈的困难,以及环境与 LLM 之间复杂的交互,共同对在多轮 Agentic 交互场景中采用用于 LLM 的 RL 优化构成了重大挑战
Key Features in ROLL
- ROLL 提供了若干关键功能来支持高效执行和用户友好的 RL 开发
- 本节还详细阐述 Agentic RL 训练 Pipeline 的规范
Tech Pioneer
- 技术先驱在 LLM 社区中寻求领先地位,他们拥有大规模 GPU 集群以促进 LLM 的可扩展 RL 训练
- ROLL 的优势体现在三个方面,以吸引这类用户群体
- 快速且成本效益高(Fast and Cost Effective):ROLL 可以利用高性能硬件资源来加速 RL 训练,并在大型 GPU 集群中实现可观的训练成本和时间缩减
- 可扩展性和容错性(Scalability and Fault Tolerance):ROLL 支持广泛的 LLM 训练和服务优化技术,能够在数千块 GPU 上对 200B 参数模型进行约两周不间断的可扩展训练
- 还具备高效的检查点和恢复机制,允许以最小的工程投入重启训练任务
- 灵活的硬件使用(Flexible Hardware Usage):ROLL 支持在各种硬件类型上运行 RL 训练
- 用户可以在共置或分离式架构之间进行选择,并配置同步或异步执行模式,以充分利用不同硬件架构的优势
Product Developer
- 产品开发者拥有足够的 GPU 来对其内部 LLM 进行 RL 训练,他们专注于配置任务和奖励,以增强 LLM 的人类对齐、推理能力、工具使用和业务指标
- 建议产品开发者选择 ROLL,原因如下
- 多样且可扩展的奖励/环境(Diverse and Extensible Rewards/Environments):ROLL 实现了一套 Reward Worker 和 Environment Worker
- 产品开发者可以基于现有的实现轻松定制自己的奖励和环境
- 组合式样本-奖励路由(Compositional Sample-Reward Route):ROLL 提供了一个用户友好的接口来控制不同任务的 Prompt 采样比例,并将每个样本动态路由到相应的 Reward Worker(例如,数学验证器、沙盒环境和 LLM-as-a-Judge)
- 由于生产级 LLM 通常涵盖多种能力,此功能使开发者能够跨领域和任务的混合体优化模型性能
- 简易设备-奖励映射(Easy Device-Reward Mapping):ROLL 开发了设备-奖励映射接口,以便轻松配置 Reward Worker 的设备映射
- 此功能在多任务 RL 训练中将奖励计算与其他计算工作负载隔离开来,防止干扰和性能瓶颈
- 丰富的训练配方(Rich Training Recipes):ROLL 提供了各种 RL 算法、LLM、任务和数据集,以减少开发新训练功能所需的工程投入
- 卓越性能(Superior Performance):ROLL 包含一组调整好的训练配置,在许多任务上都能达到令人满意的性能,减轻了繁重的超参数搜索负担
- 多样且可扩展的奖励/环境(Diverse and Extensible Rewards/Environments):ROLL 实现了一套 Reward Worker 和 Environment Worker
Algorithm Researcher
- 大多数算法研究人员只能访问有限数量的 GPU,他们需要对用于 LLM 的 RL 训练的每个组件进行灵活、细粒度的控制,以便有效地实验新思路
- ROLL 非常适合此目的,提供以下关键功能
- 受限设备执行(Constrained Device Execution):ROLL 通过一系列内存优化技术(包括单 GPU 设置)在受限的 GPU 资源上实现高效训练
- 这使得算法研究人员能够进行多次试错实验,并获得及时的反馈,而无需大量高端 GPU
- 可插拔推理 Pipeline (Pluggable Reasoning Pipeline):ROLL 以适当的粒度抽象了 RL 训练 Pipeline 的每个阶段,从而支持对新思路的敏捷实验
- 研究人员可以灵活地编排各个阶段的执行,促进各种 RL 算法的实现和定制
- 透明实验(Transparent Experimentation):ROLL 提供透明的日志记录和监控能力,便于跟踪和分析每个实验
- 公平学术基准(Fair Academic Baselines):ROLL 提供经典的算法、模型和任务,以便在标准基准上进行公平的基线比较
- 受限设备执行(Constrained Device Execution):ROLL 通过一系列内存优化技术(包括单 GPU 设置)在受限的 GPU 资源上实现高效训练
Specifications for Agentic RL, Agentic RL 的规范
- Agentic RL 的兴起要求对基于 Agent 的、使用 LLM 的 RL 训练提供高效支持
- 为此,本文为 ROLL 配备了以下功能,以实现可扩展的 Agentic RL 训练
- 可扩展的多轮 Agent-环境交互(Scalable Multi-Turn Agent-Environment Interaction):
- 受 RAGEN(2025)启发,ROLL 支持 Agent 与环境之间的多轮交互,可扩展至长时程任务
- 样本级可扩展环境(Sample-wise Scalable Environments):
- ROLL 灵活地执行环境扩展以匹配输入样本的规模,从而实现高吞吐量的 Rollout
- 异步并行化 Agent-环境交互(Asynchronous Parallelized Agent-Environment Interaction):
- ROLL 通过样本级环境管理异步执行环境执行和 Actor 生成,并通过环境扩展实现并行化环境执行,减少 GPU 空闲时间并最大化资源利用率
- 可扩展的多轮 Agent-环境交互(Scalable Multi-Turn Agent-Environment Interaction):
Framework Design
System Architecture and Modules
- Architecture
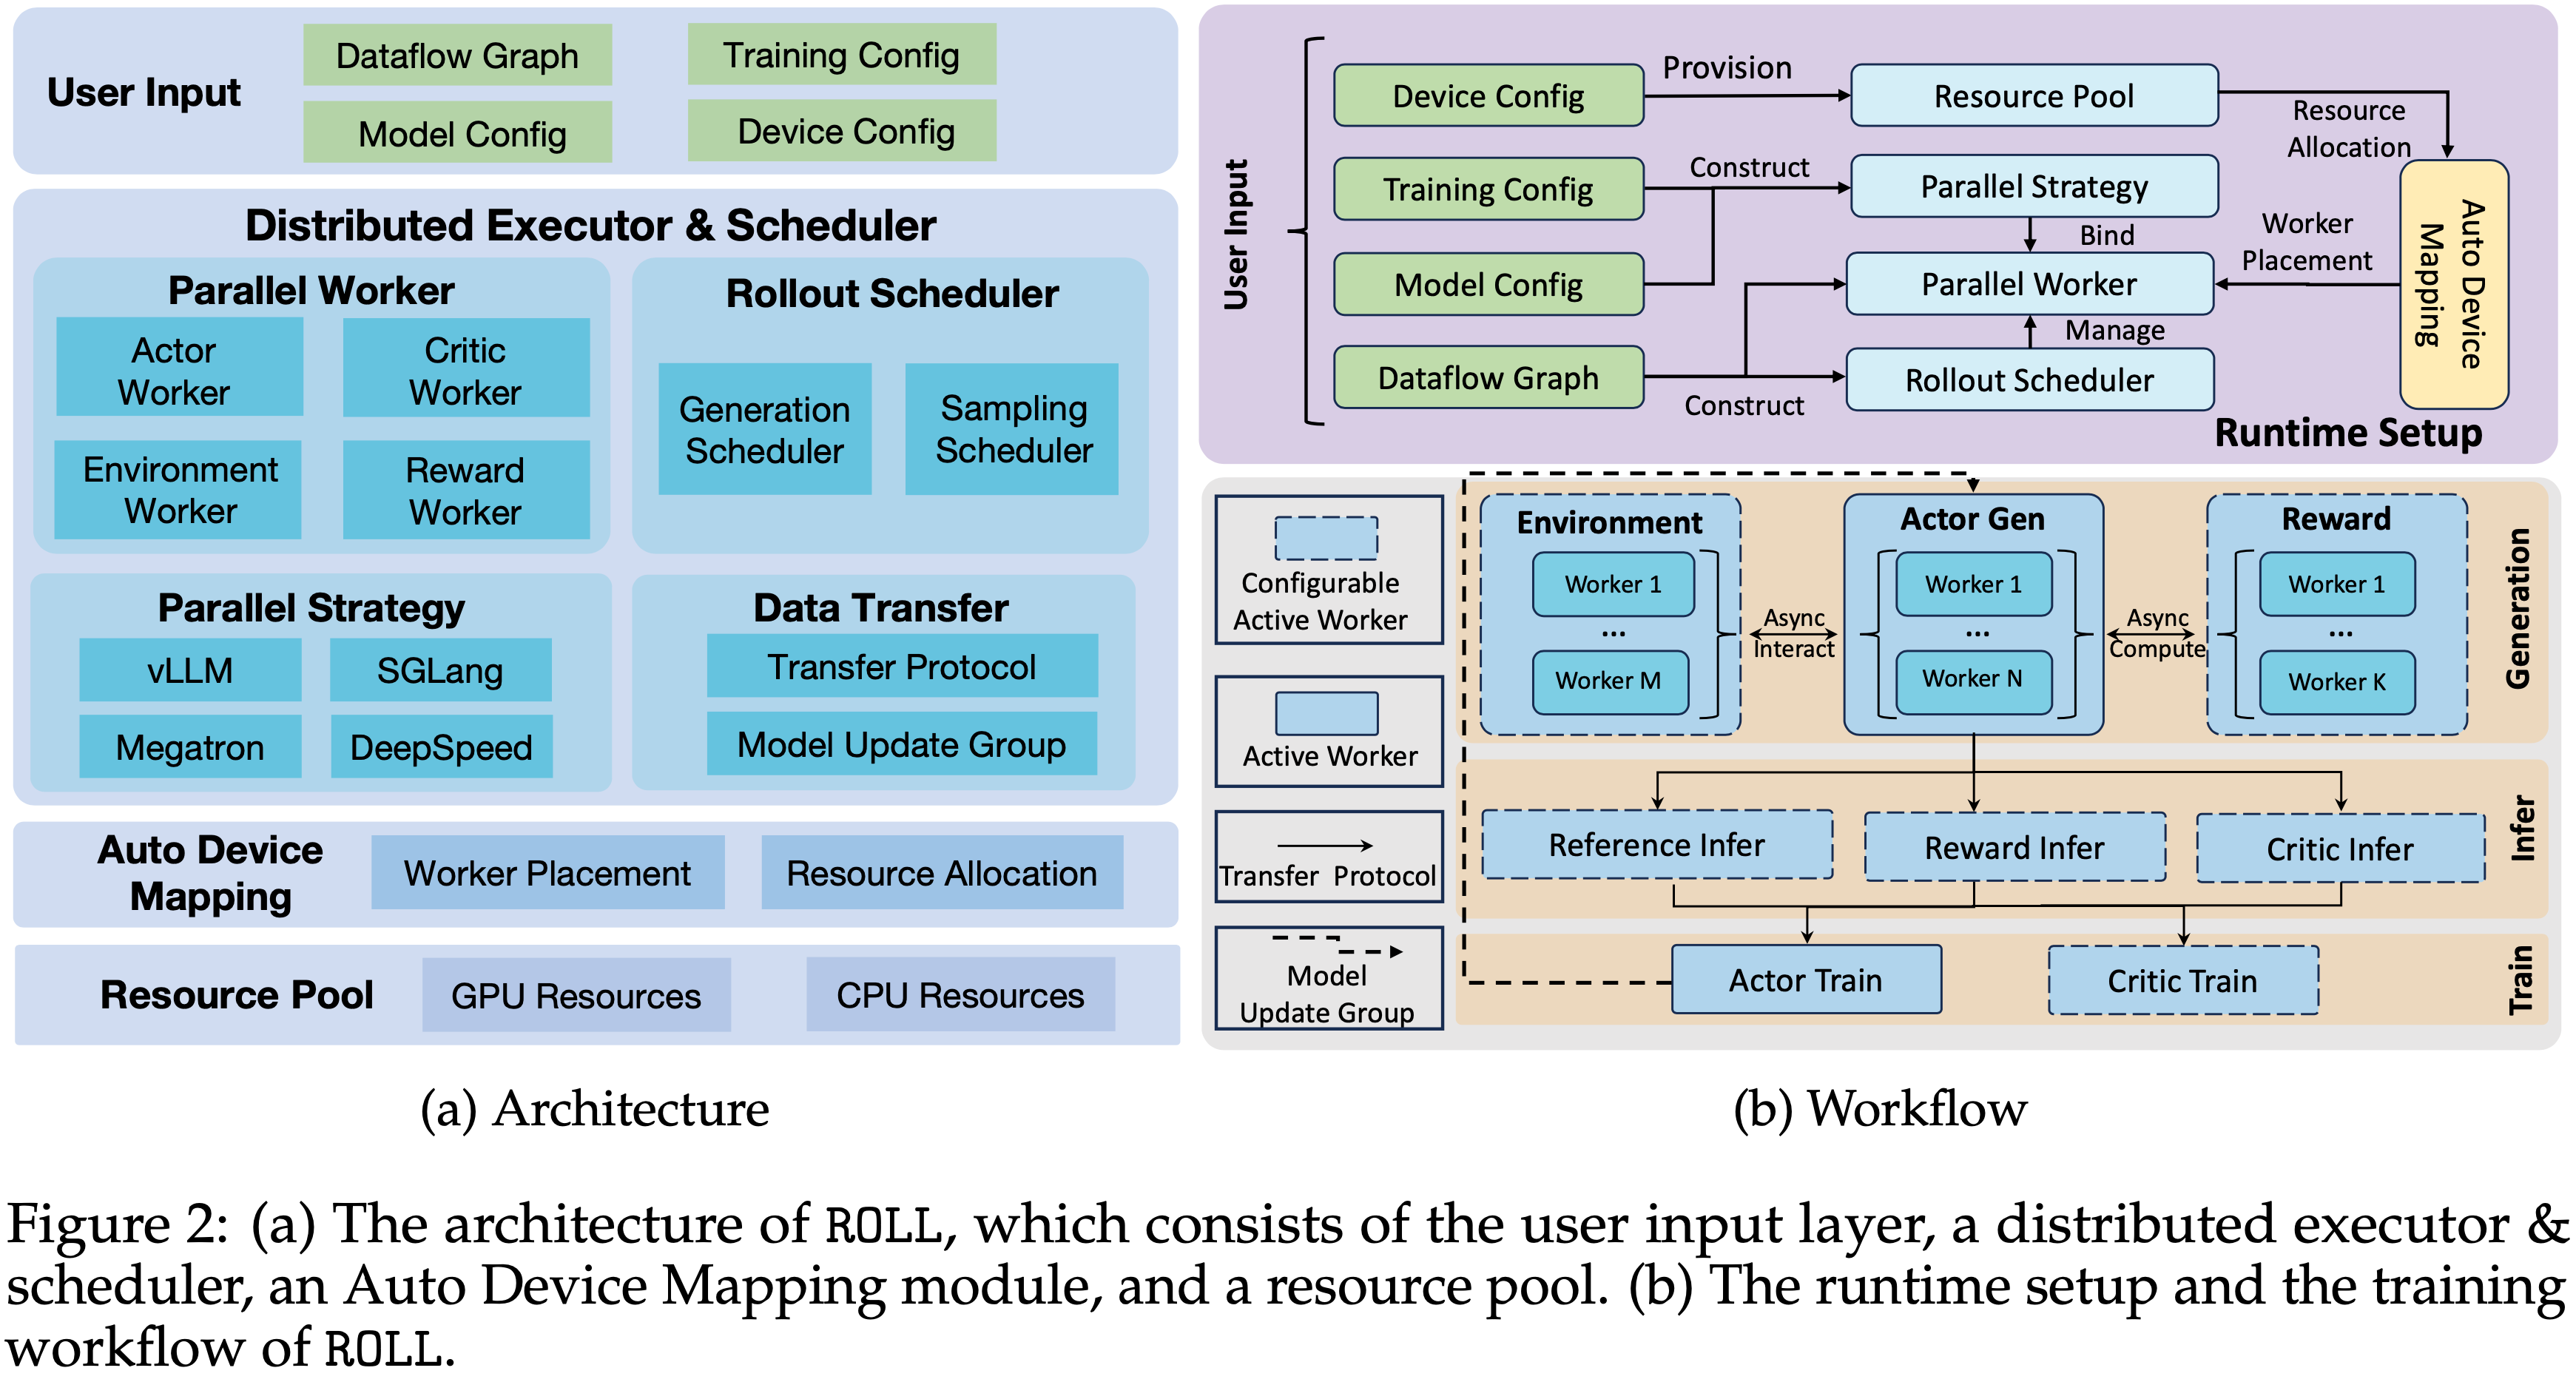
- 图 2a 展示了 ROLL 的架构
- ROLL 将用户定义的 RL 数据流图及其相关配置作为输入
- 基于该输入,Distributed Executor and Scheduler 编排 Workers 和 Schedulers
- AutoDeviceMapping 模块管理已配置资源池 (Resource Pool) 中的资源,并将 Workers 和 Schedulers 高效地绑定到其分配的资源上
- Parallel Worker
- Parallel Worker 是资源集合(即 Ray 中的 PlacementGroup)的拥有者,ROLL 使用 Cluster 来表示一组在 RL 训练中共享相同角色(例如,Actor 训练、Critic 推理)的 Parallel Workers,以简化对这些 Workers 的集体管理
- ROLL 提供了多种类型的 Parallel Workers
- Actor Worker 可以被实例化为 Actor 或 Ref
- Critic Worker 实现 Critic 的功能
- Reward Worker 处理 Reward 组件,提供多种奖励计算方法
- 包括基于规则的验证 (rule-based verification) (2025)、沙箱执行 (sandbox execution) (2024) 和 LLM-as-a-Judge (2024)
- Environment Worker 支持各种类型的环境与 LLM 之间的多轮交互
- Parallel Strategy
- ROLL 中的 RL 训练包括训练、推理和生成阶段
- ROLL 集成了 MegatronCore 和 DeepSpeed 来加速 LLM 训练,支持先进的 5D 并行策略,包括 DP、PP、TP、CP 和 EP
- 得益于 DeepSpeed (2022),ROLL 还支持 ZeRO2、ZeRO3 和 ZeRO-offload (2021)
- ROLL 提供梯度检查点 (gradient checkpointing) (2016) 和卸载 (offloading) 策略,以显著减少 GPU 内存消耗,从而在资源受限的设备上实现高效执行
- 对于推理和生成阶段,ROLL 集成了 vLLM (2023) 和 SGLang (2025),为 ROLL 配备 TP、EP 和 PP 以加速推理和生成阶段
- Rollout Scheduler
- Rollout Scheduler 允许用户在生成阶段,以单个样本 (sample) 而非批次 (batch) 的粒度来调度每个请求的生命周期
- 理解:好处是便于进行异步 RL
- Rollout Scheduler 可以根据当前资源可用性和响应生成的进度,动态地添加和中止请求
- Rollout Scheduler 允许用户在生成阶段,以单个样本 (sample) 而非批次 (batch) 的粒度来调度每个请求的生命周期
- Data Transfer
- Transfer Protocol 首次由 HybridFlow (2024) 引入,ROLL 复用该协议以在不同阶段之间重新分片 (reshard) 输入和输出数据
- ROLL 实现了 ModelUpdateGroup,以支持在训练阶段和生成/推理阶段之间,即使在同址 (collocated) 训练场景下,也能通过 NCCL 通信后端实现快速的参数同步
- 自动设备映射 (AutoDeviceMapping) 与资源池 (Resource Pool)
- AutoDeviceMapping 模块编排 Resource Pool 中的一组 CPU 和 GPU 资源,并将其绑定到 Workers 和 Scheduler
System Workflow
- 图 2b 描绘了工作流,包括运行时设置 (Runtime Setup)(顶部)和训练迭代 (Training Iteration)(底部)
- Runtime Setup
- ROLL 根据提供的设备配置,配置一个包含 GPU 和 CPU 资源的 Resource Pool
- 在 RL 数据流的指导下,ROLL 创建一个 Rollout Scheduler 和多个 Parallel Workers
- Rollout Scheduler 在生成阶段监督每个 Prompt 样本请求的生命周期
- 基于训练和模型配置,ROLL 实例化 Parallel Strategy,以决定每个 Parallel Worker 的并行化策略和执行后端
- 一旦 Parallel Workers 建立,ROLL 遵循用户指定的设备映射配置,并采用 AutoDeviceMapping 从 Resource Pool 中为各个 Parallel Workers 分配资源
- Training Iteration ,训练迭代
- 在生成阶段,一批样本首先被送入 Rollout Scheduler 以生成响应
- 在生成阶段,Actor 模型可以与 Environment Worker 交互,以在 Agentic RL 任务中执行多轮环境交互
- ROLL 还在生成阶段调用 Reward Worker 来计算奖励信号,从而支持先进的采样技术(例如,动态采样 (dynamic sampling) (2025))以提高采样效率
- 问题:这里是推理阶段后才知道奖励情况吧?
- 理解:这里应该是说 RLVR 是在这里完成的,推理阶段是 Reward Model 的前向推理
- 问题:这里是推理阶段后才知道奖励情况吧?
- 在推理阶段涉及 Critic、Reward 和 Ref 模型的前向传播
- Transfer Protocol 对生成阶段的响应进行分片,并将其送入每个激活的 Parallel Worker
- 注:Critic、Reward 和 Ref 模型的前向传播 的 前提是它们在 RL 数据流图中被激活,部分算法中会根据需要丢弃部分角色
- 在训练阶段,Critic 和 Actor 模型使用准备好的奖励信号更新其参数
- 注:Actor 模型还会在下一个训练迭代中,通过 ModelUpdateGroup 与生成阶段同步模型参数
- 在生成阶段,一批样本首先被送入 Rollout Scheduler 以生成响应
How to Underpin Key Features,如何支撑关键特性
- 本节解释 ROLL 中的系统模块如何支持第 3 节中讨论的关键特性
- Single-Controller Pipeline
- 遵循 HybridFlow (2024) 的混合编程模型,在单个控制器内实现 RLHF、RLVR 和 Agentic RL 的训练流水线,从而简化 RL 训练工作流的开发和管理
- RL 流水线的 Worker 抽象 (Worker Abstraction for RL Pipeline)
- Parallel Worker 和 Rollout Scheduler 的抽象使用户能够通过遵循 ROLL 提供的训练工作流示例,以最少的工程工作量定义和实验新的流水线
- 特别地,Actor Worker、Critic Worker、Reward Worker 和 Environment Worker 封装了 RL 训练中的不同角色
- 这种定义良好的抽象使用户能够专注于开发和定制单个组件,而无需修改整个代码库
- Optimized LLM Execution
- ROLL 充分利用现有 LLM 执行引擎的高级特性,包括 DeepSpeed、Megatron、vLLM 和 SGLang,以促进在大规模 GPU 集群和资源受限设备环境中的 RL 优化
- 用户定义的设备映射 (User-defined Device Mapping)
- 已有框架:
- OpenRLHF (2024) 和 NeMo (2025),在不同训练阶段强制使用独占资源
- 近期研究工作 (2024; 2024) 支持将不同阶段的 LLM 部署在同一设备组内
- 在 ROLL 中,AutoDeviceMapping 模块支持灵活的、用户定义的设备映射,允许单个设备被来自不同阶段的多个 LLM 共享
- 这使用户能够将分配给 Actor 模型生成阶段的部分 GPU 重新分配给其训练阶段,从而提高整体资源利用率
- 此能力源于两个关键功能
- 第一:ROLL 构建在 Ray 之上,这允许将每个设备绑定到特定的 Worker,同时也允许多个 Worker 共享同一设备
- 第二:ModelUpdateGroup 促进了不同阶段之间的模型同步
- 如前所述,在 RL 训练中共享相同 LLM 角色的一组 Parallel Workers 可以被组织成一个 Cluster
- 在 Actor_Train Cluster 和 Actor_Infer Cluster 之间同步模型参数时,训练阶段的每个 Worker 就会将其模型参数以分块 (bucketed chunks) 的形式广播给生成阶段对应的 Worker,从而提高传输速度
- 这种设计避免了强制同址训练和推理进程 ,因此与先前的 RL 系统 (2025; 2024; 2024; 2024) 相比,支持更灵活的、用户定义的设备映射
- 已有框架:
- 样本级 Rollout 生命周期控制 (Sample-level Rollout Lifecycle Control)
- 大多数 RL 系统 (2025; 2024; 2024; 2024) 在生成阶段处理一批 Prompt 样本以提高吞吐量
- 但生成阶段的长尾问题 (2024) 导致不同 Worker 之间的资源利用不均衡
- 为解决此问题,Rollout Scheduler 在生成阶段以每个 Prompt 样本的粒度提供请求 Rollout 生命周期控制
- ROLL 提供的动态采样优化是样本级 Rollout 生命周期控制的成功应用
- 动态采样是指对 Prompt 进行过采样,并过滤掉那些准确率为 1 或 0 的样本,仅保留那些能提供有效梯度的样本的策略
- 样本级 Rollout 生命周期控制可以在三个关键方面显著加速动态采样
- (1) 异步奖励计算 (Async Reward Computation):ROLL 消除了生成阶段和奖励计算阶段之间的同步屏障,在完成样本的响应生成后立即启动奖励计算,而不是等待批次中的所有 Prompt 完成响应生成
- (2) 添加请求 (Add request):ROLL 持续监控 Worker 的完成状态,并根据实时需求动态分发新的 Prompt 样本,从而提高资源利用率
- (3) 中止请求 (Abort Request):一旦产生有效梯度的 Prompt 数量达到目标阈值,ROLL 可以主动终止其他正在进行的响应生成任务,减少不必要的生成开销
- 大多数 RL 系统 (2025; 2024; 2024; 2024) 在生成阶段处理一批 Prompt 样本以提高吞吐量
- 奖励和环境的样本级管理 (Sample-Wise Management of Rewards and Environments)
- 图 2b 中训练工作流的生成阶段描述了异步奖励计算和异步环境交互
- ROLL 可以根据作业负载按规模生成多个 Reward Workers 和 Environment Workers,并将它们分布在资源池中,以防止性能瓶颈
- 样本级 Rollout 生命周期控制允许用户灵活地将每个样本路由到相应的 Reward Worker 和 Environment Worker
- 奖励计算:
- ROLL 利用 Ray 支持异步奖励计算
- 在 RL 训练期间,可以激活多种类型的 Reward Workers,包括基于规则的验证、沙箱执行和 LLM-as-a-Judge
- 这些 Workers 在运行时根据当前作业负载动态执行奖励计算,而样本级 Rollout 控制允许按需灵活组合地将样本路由到适当的 Reward Worker
- 得益于 AutoDeviceMapping,每个 Reward Worker 都被分配到用户指定的设备,从而简化了将奖励模块分配到硬件资源的过程
- 环境交互:
- 与 Reward Worker 类似,ROLL 分配足够的资源来部署可扩展的 Environment Workers,并促进 Actor 模型与环境之间的大规模高效交互
- ROLL 支持并行的环境交互,提高了环境吞吐量并减少了等待响应造成的延迟
- 样本级 Rollout 生命周期控制允许 Actor 在不等待 Environment Workers 响应的情况下处理其他样本
- 在这种场景下,ROLL 可以异步启动新的 Prompt 样本进行生成,从而防止资源利用不足
- 这种机制被称为异步环境交互
- 鉴于这些 Environment Workers 可能是 CPU 密集型的,ROLL 谨慎地将它们分布在可用的资源池中,以最大程度地减少对其他工作负载以及 Workers 之间的干扰
Experiments
RLVR Pipeline
- Data Collection
- ROLL 在 RLVR 流水线上的实验数据系统地来源于三个领域的已有来源:
- (1) Math 领域:DeepMath-103K (2025),从中根据难度按比例抽样了 5,000 个样本
- (2) Code 领域:KodCode (2025),首先过滤掉低质量数据,然后根据难度均匀抽样了 2,000 条记录
- (3) General 领域:Multi-subject-RLVR (2025)、Nemotron-CrossThink (2025) 和 RLVR-IFeval (2024),有意识地移除了低质量数据
- ROLL 在 RLVR 流水线上的实验数据系统地来源于三个领域的已有来源:
- Training Setting
- 对两个 LLM 进行了实验:Qwen2.5-7B-base 和 Qwen3-30B-A3B-base
- 对于策略优化,使用 PPO loss,其中 advantage value 使用 REINFORCE returns 而非基于 GAE 的估计 (2015) 进行计算
- 问题:为什么不使用 GAE 呢?
- 各领域的采样比例设置为数学 \(40%\)、代码 \(30%\)、通用推理 \(30%\)
- 本文结合了基于规则的验证、代码的沙箱执行,以及通用推理的基于规则验证和 LLM as a judge
- 更详细的训练配置可以在以下文件中找到
- Performance
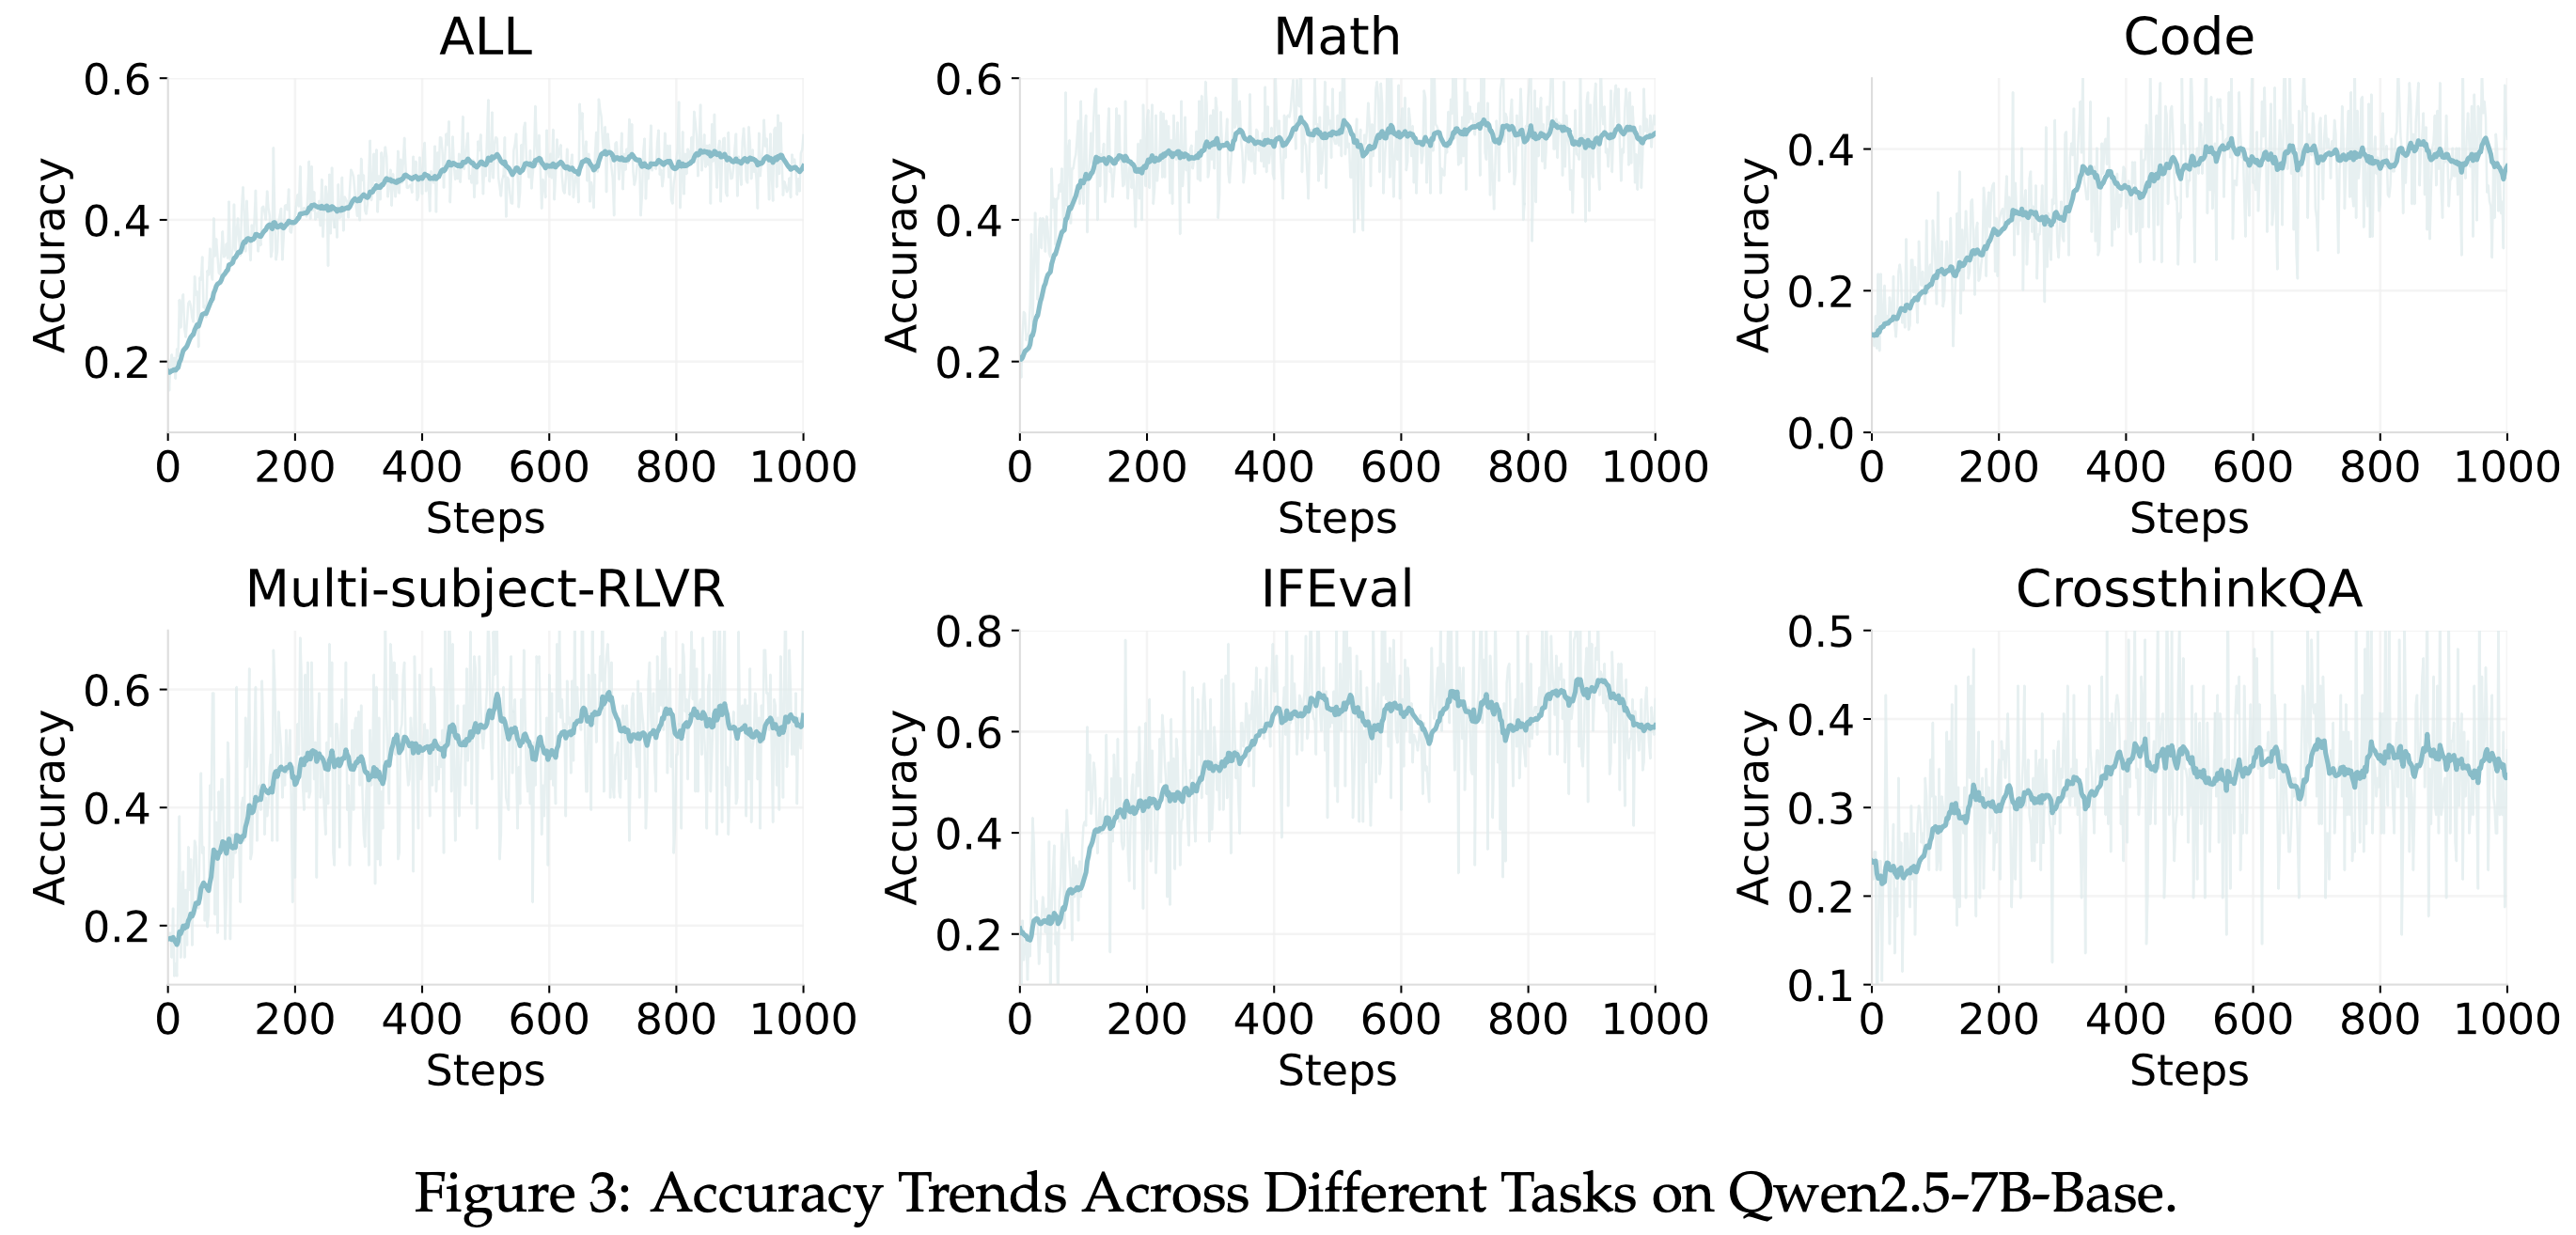
- 如图 3 所示,Qwen2.5-7B-Base 模型的平均准确率从 0.18 上升到 0.52,实现了 \(2.89 \times\) 的提升
- 任务层面的分析显示,数学推理(从 0.20 到 0.53)和代码生成(从 0.13 到 0.41)均有显著提升,突显了 ROLL 在特定任务中的正确性和有效性
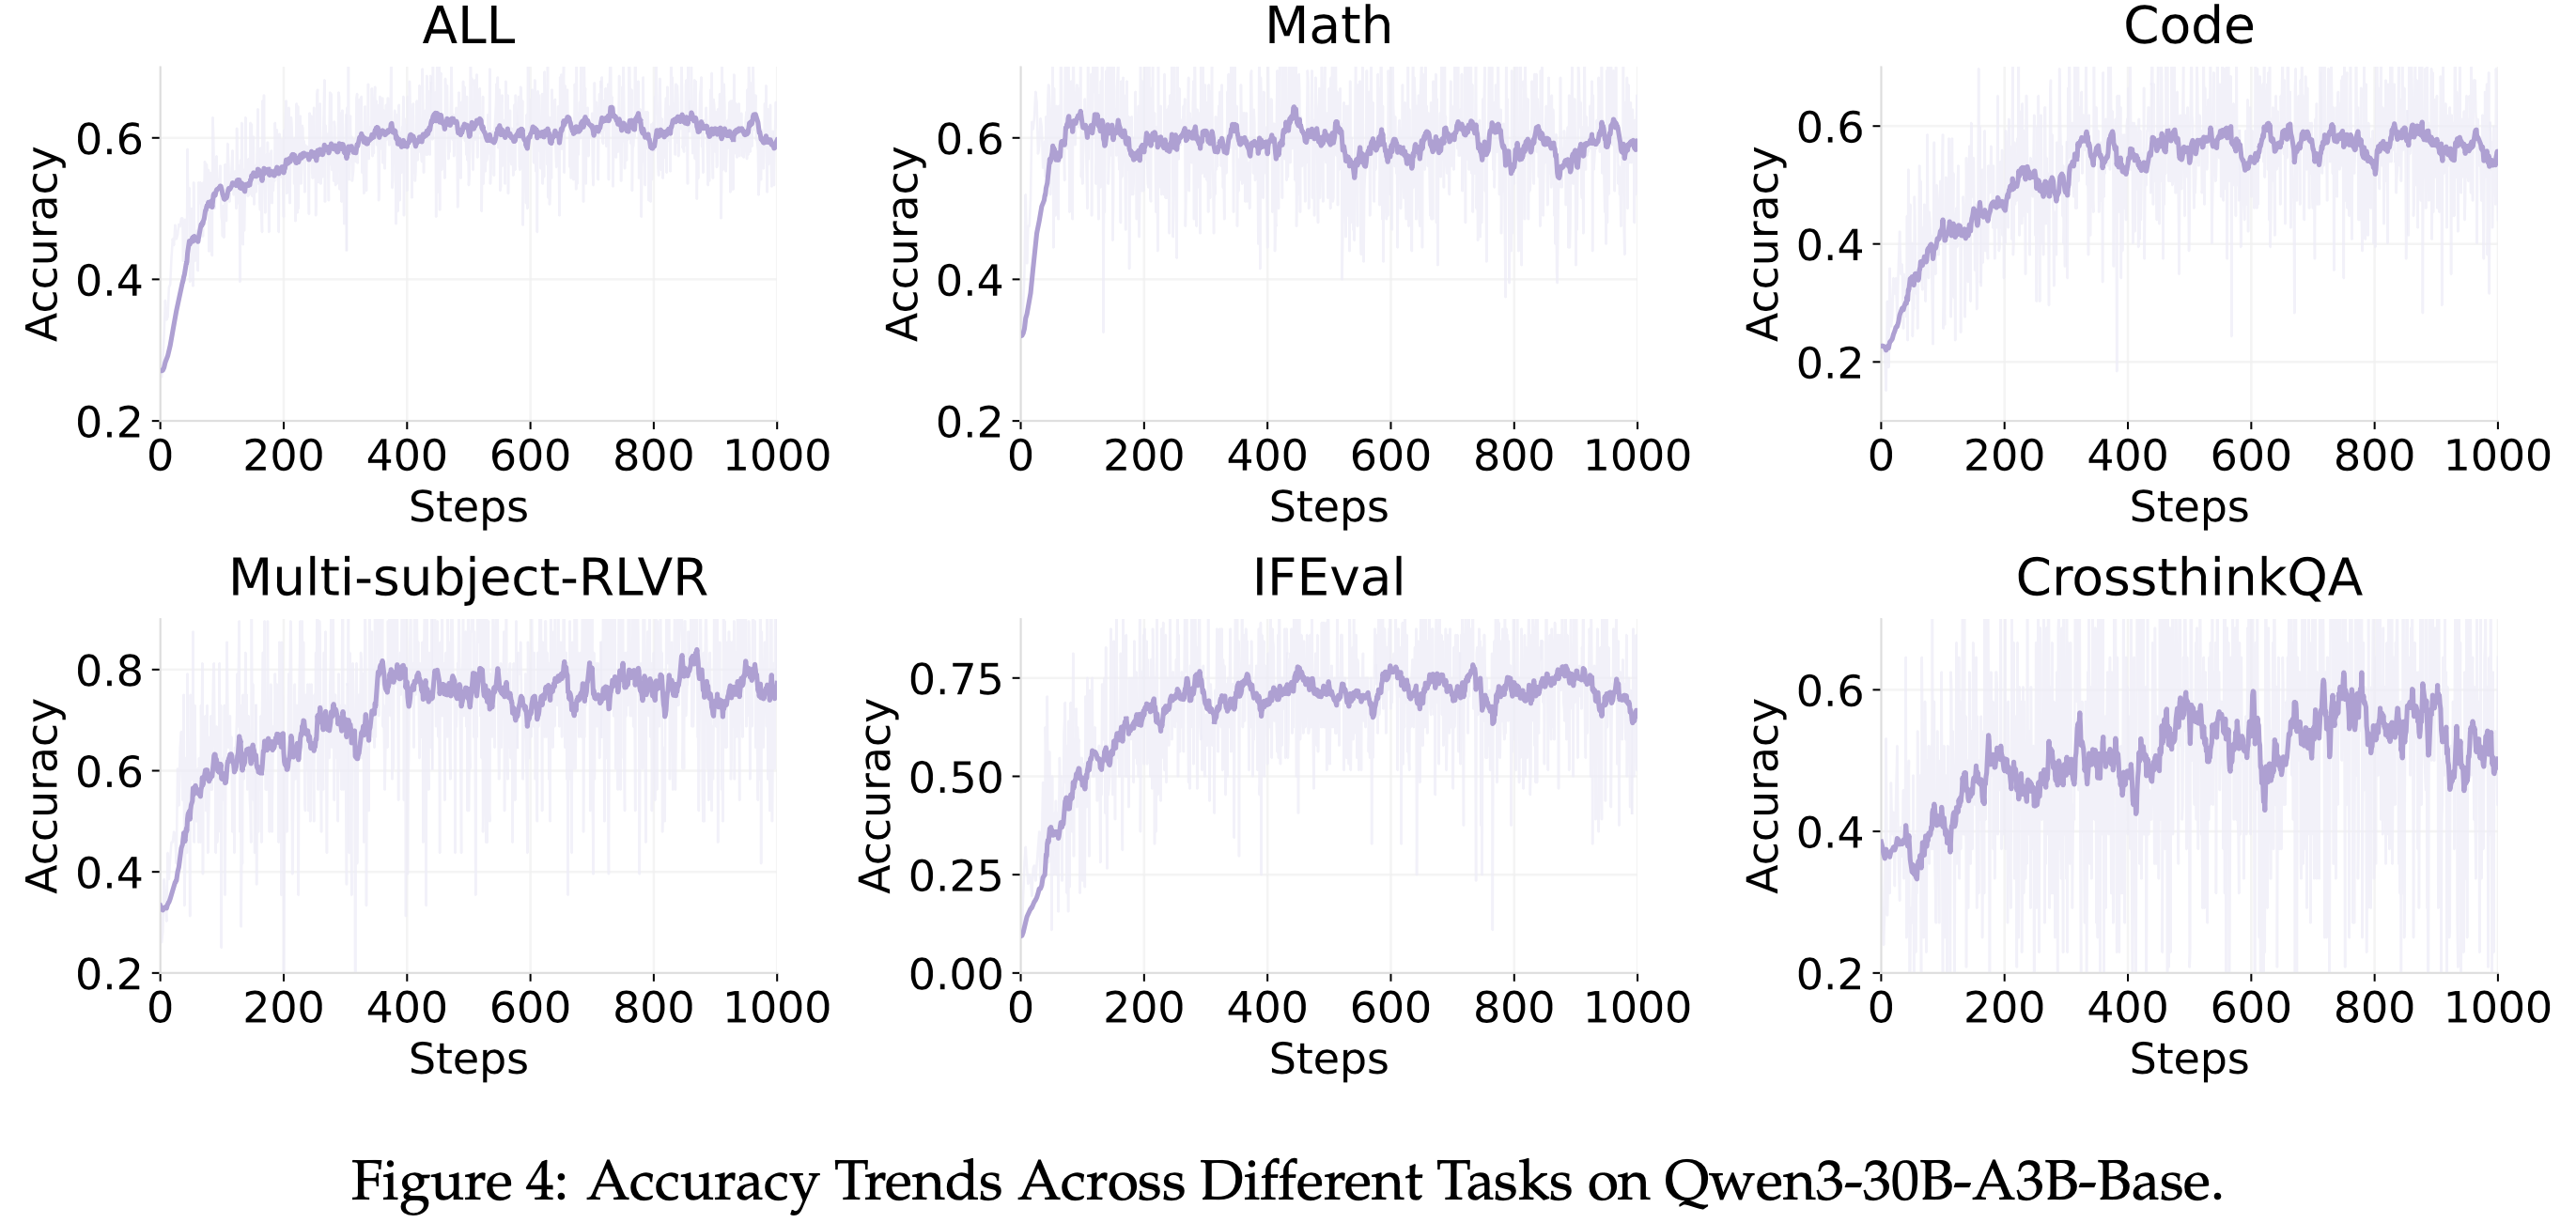
- 图 4 展示了 Qwen3-30B-A3B-Base 在不同任务上的准确率,从 0.27 提升至 0.62,增长了 \(2.30 \times\)
- 尽管采用 MoE 架构的 Qwen3-30B-A3B-Base 模型在训练过程中相比 Qwen2.5-7B-Base 模型表现出更大的准确率波动,但它仍然呈现出明显的上升趋势,并最终取得了更优的性能
- 总体而言,两个模型在整个训练过程中均表现出稳定且持续的准确率提升,且未出现模型崩溃,这表明了 ROLL 的稳健性和实用性
- 如图 3 所示,Qwen2.5-7B-Base 模型的平均准确率从 0.18 上升到 0.52,实现了 \(2.89 \times\) 的提升
Agentic Pipeline
- 在三种不同的环境中进行了广泛的实验,以严格评估 Agentic Pipeline 的能力和适应性
Sokoban
- Environment Configuration
- Sokoban 环境是一个经典的益智游戏,Agent 需要在网格内将箱子推到目标位置
- 本文配置了三种变体:
- (1) SimpleSokoban,一个 \(6 \times 6\) 网格,带有一个箱子
- (2) LargerSokoban,一个 \(8 \times 8\) 网格,带有两个箱子
- (3) SokobanDifferentGridVocab,使用不同的符号的一个 \(6 \times 6\) 网格
- 允许的动作是方向移动(上、下、左、右)
- Training Setting
- 在 Sokoban 环境中使用 Qwen2.5-0.5B-Instruct 模型作为基础模型进行训练
- 训练任务分布在 8 个 GPU 上,Rollout 批次大小为 1024
- 对于策略优化,使用 PPO loss,其中优势值使用 REINFORCE returns 而非基于 GAE 的估计进行计算,并采用 10.0 的优势裁剪 (advantage clipping) 和 20 的奖励裁剪 (reward clipping) 以保持训练稳定性
- 应用了权重为 -0.001 的格式惩罚 (format penalty),以鼓励正确格式化的动作输出
- 更详细的训练配置可以在这里找到:
- Performance
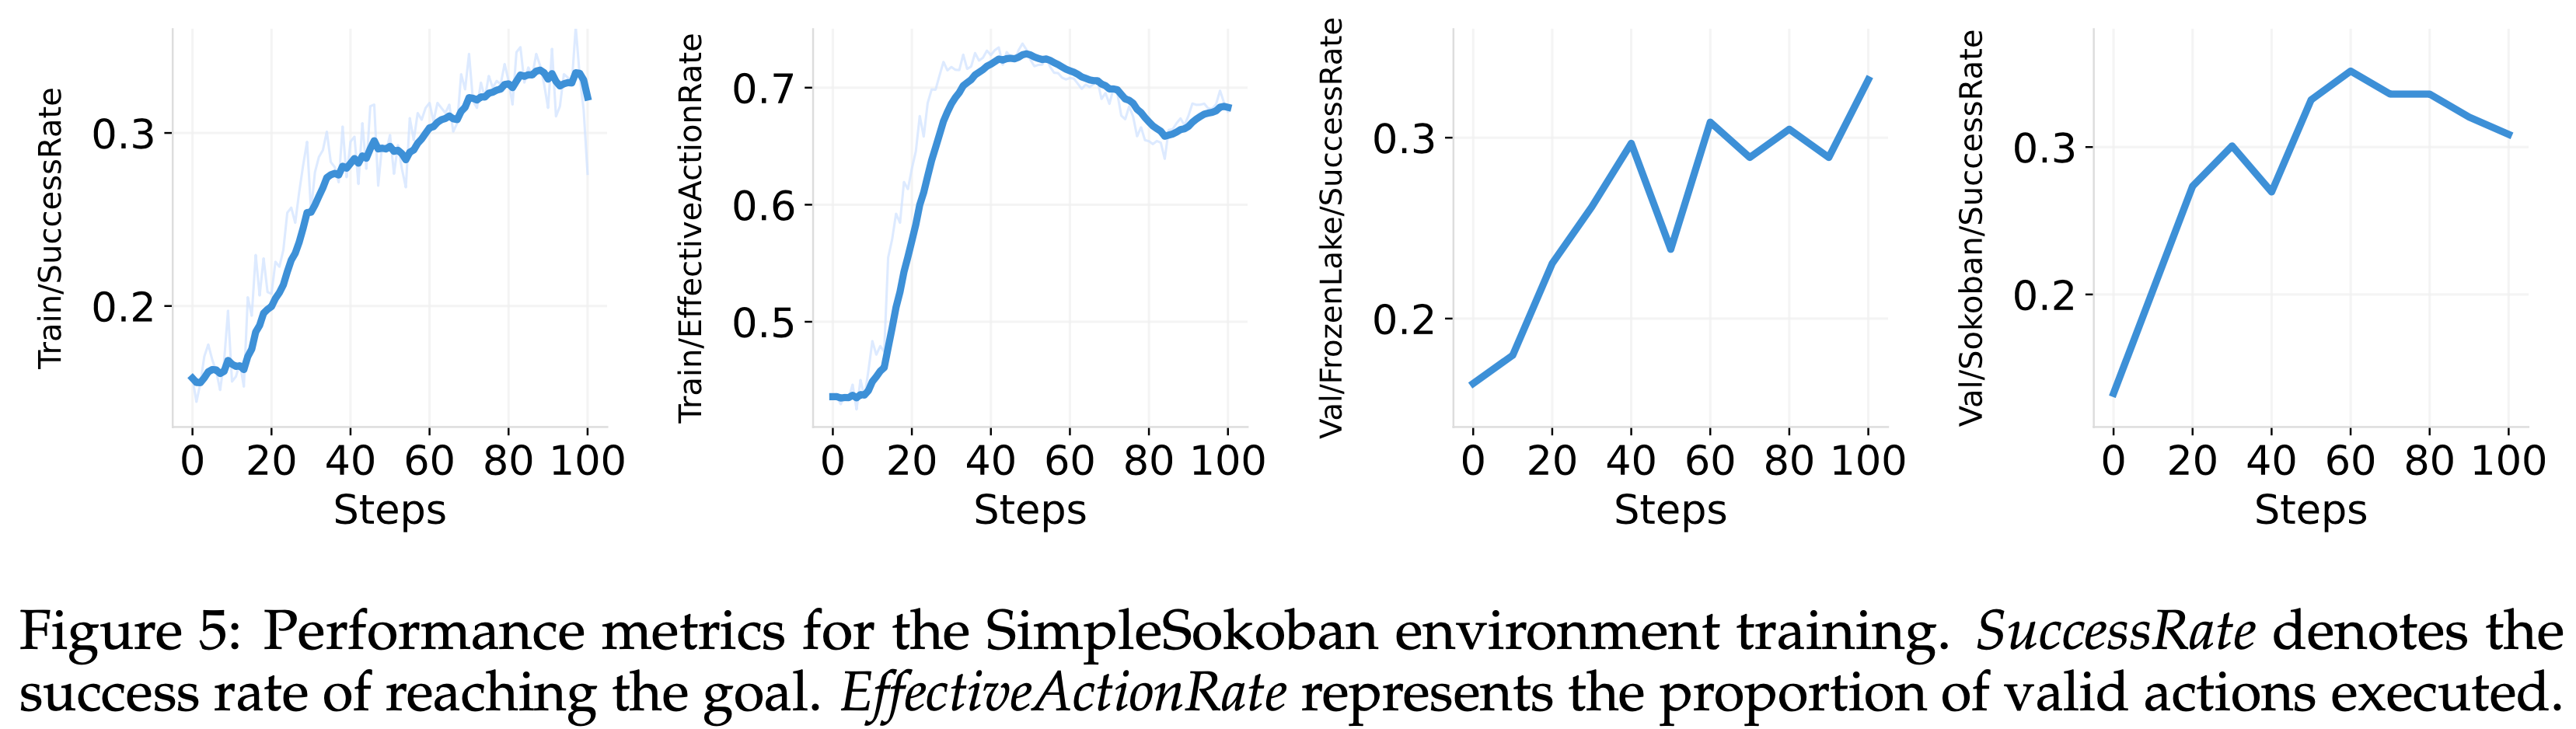
- 图 5 展示了在 SimpleSokoban 环境中的训练结果
- 模型获得了显著的性能提升
- 训练中的成功率从 \(16.8%\) 增加到 \(26.0%\)
- 验证环境的成功率从 \(13.3%\) 上升到 \(35.2%\),有效动作的比例从 \(43.6%\) 增长到 \(73.4%\),表明 Agent 能力稳步提高
- 而且,这些提升很好地泛化到了 FrozenLake 环境,证明了本文 RL 训练框架的鲁棒性
FrozenLake
- Environment Configuration
- FrozenLake 环境要求 Agent 在冰冻表面上从起点导航到目标位置,同时避开洞
- 可选的滑冰机制通过引入意外移动引入了随机性,从而挑战 Agent 对不确定性的适应能力
- Training Setting
- 为保持一致性,使用与 Sokoban 环境中相同的 Qwen2.5-0.5B-Instruct 模型和训练配置
- 可参阅代码仓库以获取详细的训练配置
- Performance
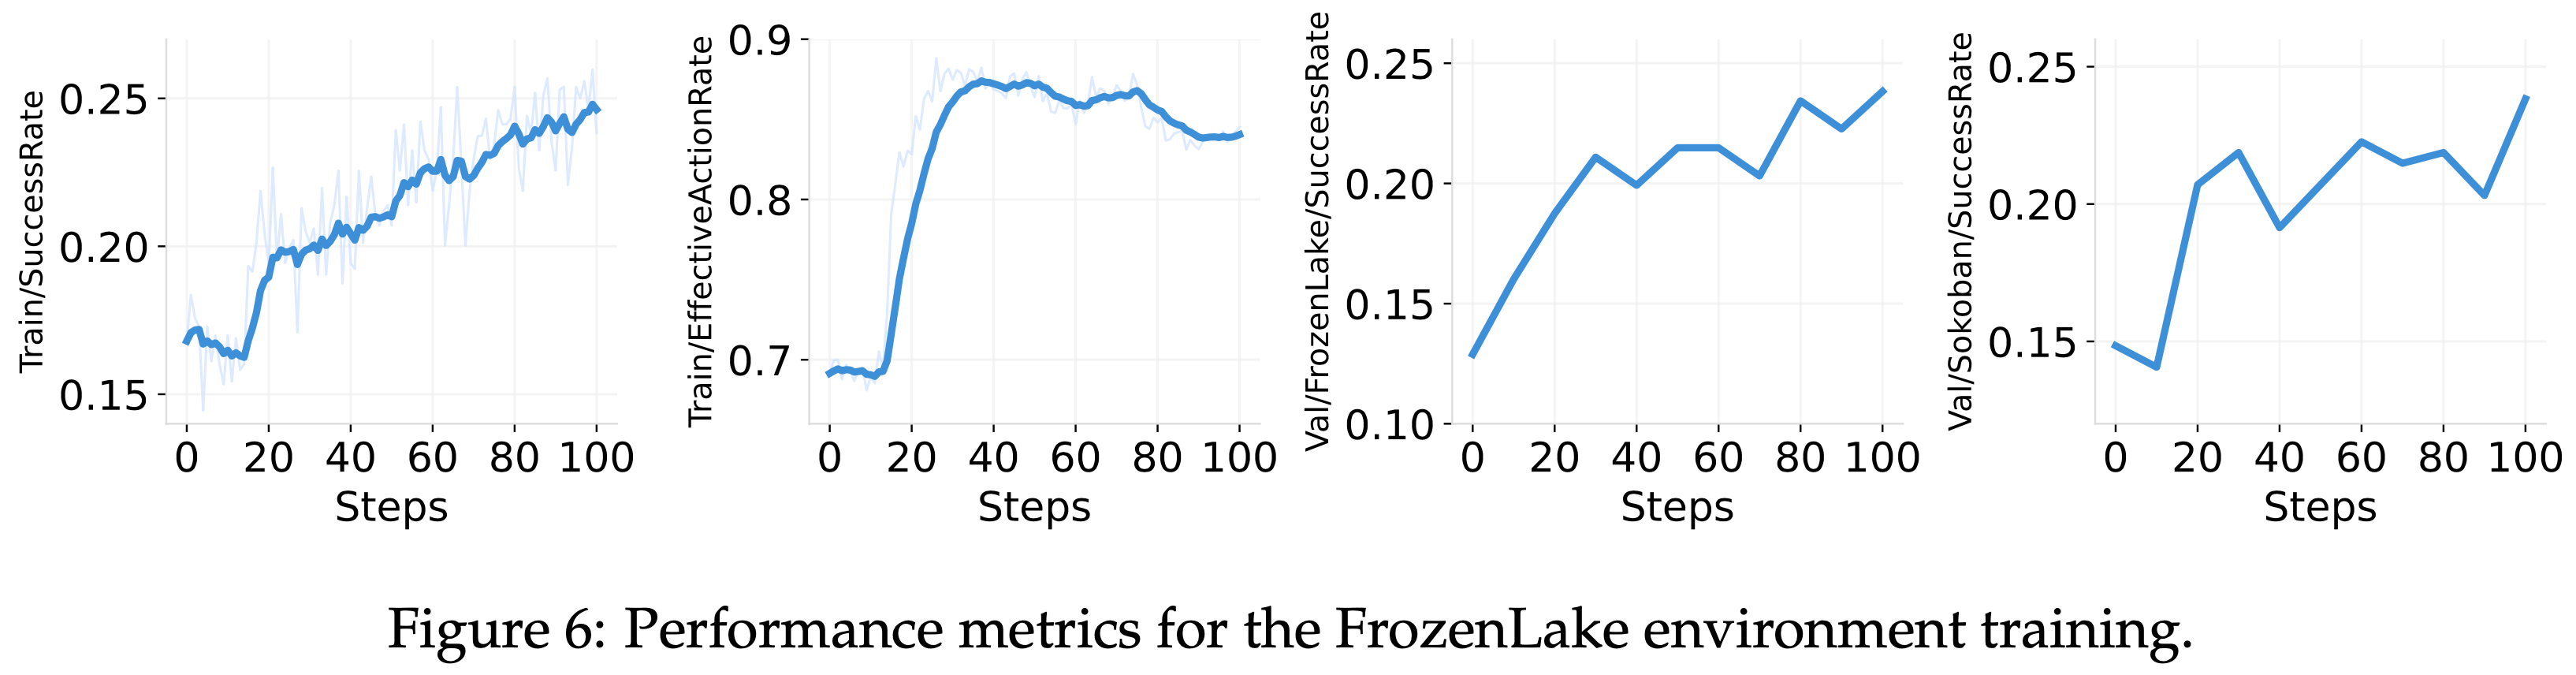
- 图 6 展示了在 FrozenLake 环境中的训练结果
- 模型表现出稳定的性能提升
- 训练中的成功率从 \(16.8%\) 增加到峰值 \(26.0%\),提升了 \(55%\)
- 有效动作的比例从 \(69.1%\) 上升到峰值 \(88.8%\),表明训练期间动作质量有所提高
- 在验证集上,成功率也呈现出相应的模式,从训练开始时的 \(12.9%\) 上升到最大值 \(23.8%\)
- 同时,该模型还表现出跨环境迁移学习能力,尽管仅在 FrozenLake 上训练,但在 SimpleSokoban 验证集上的成功率达到了 \(23.8%\)
WebShop
- Environment Configuration
- WebShop 环境模拟了一个在线购物任务,Agent 需要根据自然语言指令找到特定产品
- Agent 执行迭代动作,包括关键词搜索、选择产品链接、检查产品详情(例如,描述、特性、尺寸、颜色)以及做出购买决定
- 动作因网页上下文而异,每条轨迹限制为 50 步,突显了所需决策制定和指令遵循能力的复杂性
- Training Setting
- 在 WebShop 环境中使用 Qwen-2.5-7B-Instruct 模型进行训练,以支持长交互和丰富的上下文
- 序列长度设置为 8192 个 Token
- 保留了 REINFORCE 算法,并使用相同的裁剪参数进行优势估计
- 将格式惩罚增加到 -0.05,以鼓励格式良好的响应
- 更详细的训练配置可以在这里找到
- Performance
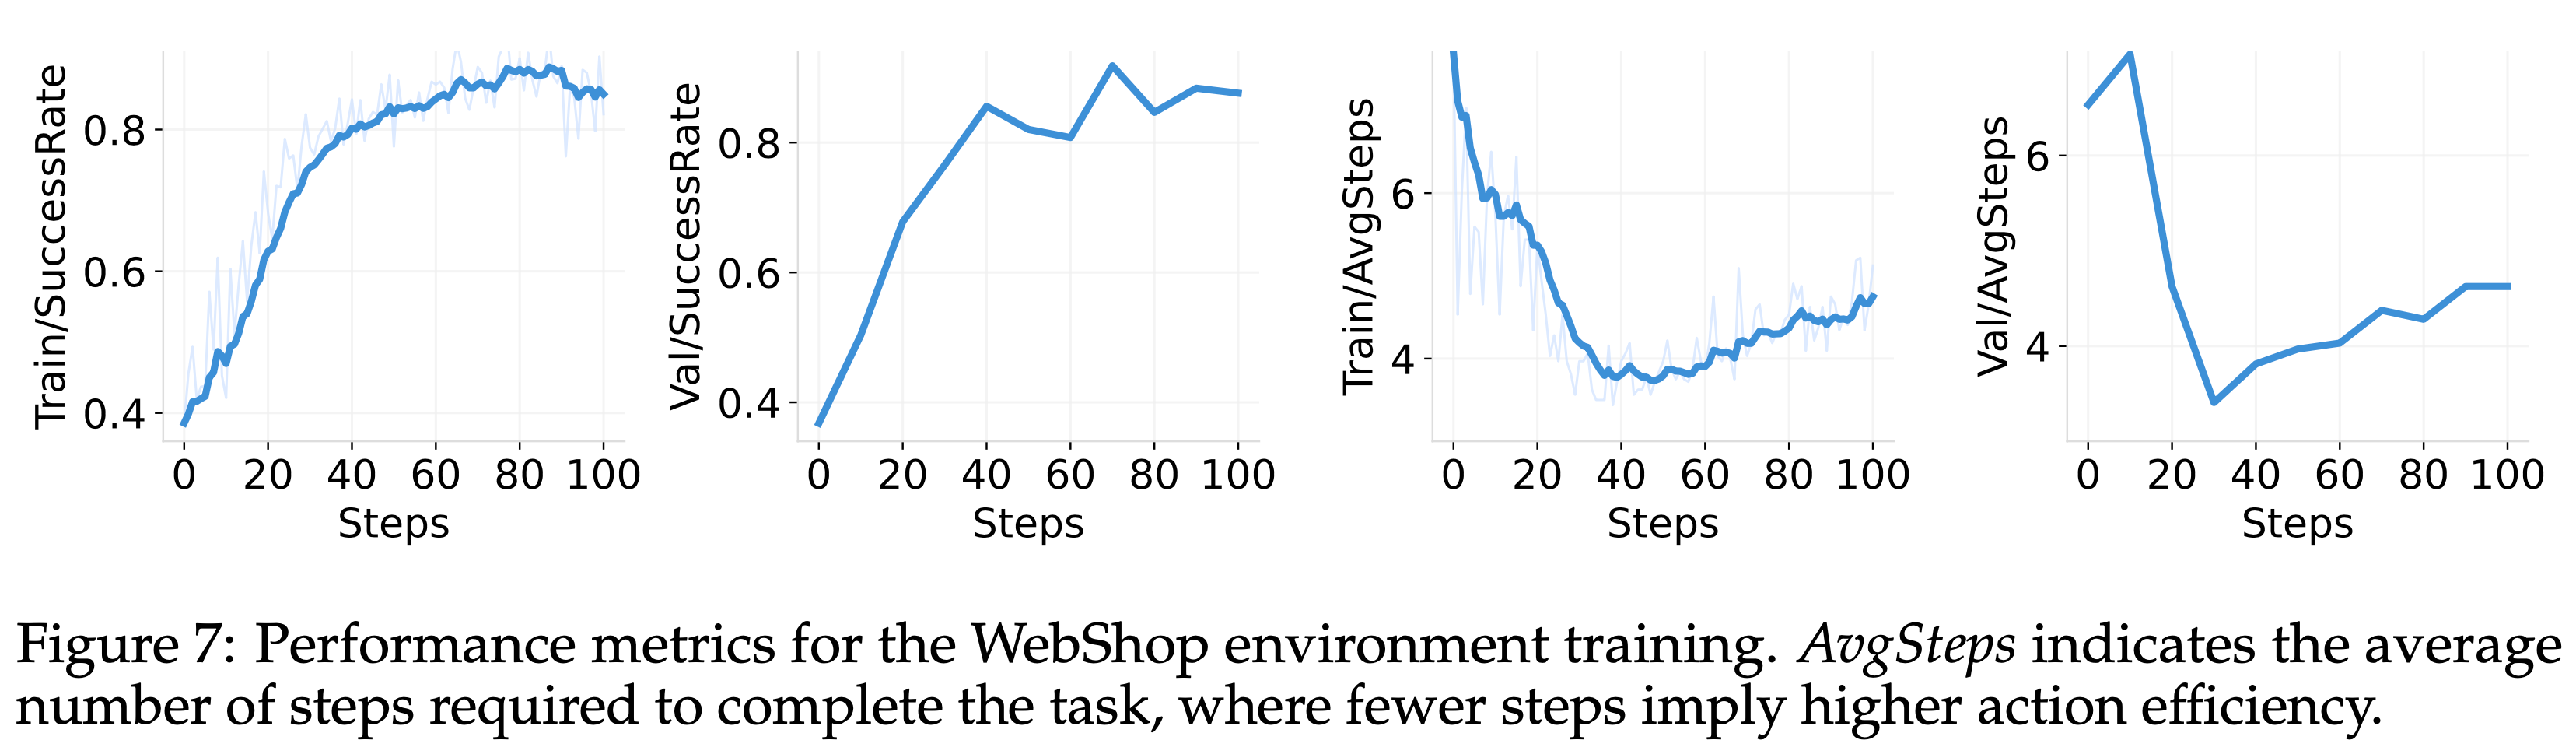
- 图 7 显示任务成功率显著提高
- 在训练和验证环境中均从 \(37%\) 增加到超过 \(85%\)
- 每个 Episode 的平均动作数从超过 7 个减少到大约 4 个,表明 LLM 学会了更有效地完成任务
- In Summary,LLM 可以有效地具备任务能力和操作效率,以应对现实世界的环境
- 图 7 显示任务成功率显著提高