注:本文包含 AI 辅助创作
- 参考链接:
- 原始论文:(ROLL-Part2-ROLL-Flash)Part II: ROLL Flash – Accelerating RLVR and Agentic Training with Asynchrony, 20251013, ROLL
- 其他参考:
- ROLL 发表的第一篇:(ROLL-Part1-RL4LLM-Reasoning, Lite PPO)Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning, 20250811-20251027, ROLL
- 技术报告原始论文:(ROLL Technical Report)Reinforcement Learning Optimization for Large-Scale Learning: An Efficient and User-Friendly Scaling Library, ROLL Team, 20250606
- ROLL 开源地址:github.com/alibaba/ROLL
- ROLL 中文文档:(面向大规模学习的强化学习优化框架)Reinforcement Learning Optimization for Large-scale Learning
- 副标题:阿里巴巴开源的强化学习库,专为大语言模型优化。支持分布式训练、多任务学习与智能体交互,让 AI 模型训练更简单、更高效
- ROLL 英文文档:ROLL: Reinforcement Learning Optimization for Large-Scale Learning
- ROLL 团队 Blog:wwxfromtju.github.io/roll_team.
Paper Summary
- 整体说明:
- 给出了较为清晰的一些推导,理论上给出了异步 RL 训练的好处
- 本文叫做 ROLL Flash 框架,本质上是以原生方式扩展了 ROLL 对异步的支持
- ROLL Flash 基于两个核心设计原则:
- 细粒度并行
- Rollout-训练解耦(rollout-train decoupling)
- 在这些原则的指导下:
- ROLL Flash 提供了灵活的编程接口
- 实现了完全异步的训练架构
- 支持高效的 Rollout 机制
- 包括队列调度(queue scheduling)和环境级异步执行(environment-level asynchronous execution)
- ROLL Flash 加速效果:
- 在 RLVR 任务上,ROLL Flash 使用与同步基线相同的 GPU 预算实现了高达 \(2.24\times\) 的加速
- 在 Agentic 任务上实现了 \(2.72\times\) 的加速
- 本文还实现了多种流行的 Off-Policy 算法,验证了异步训练能够达到与同步训练相当的性能
- 如图 1 所示展示了同步方法和本文的异步方法:
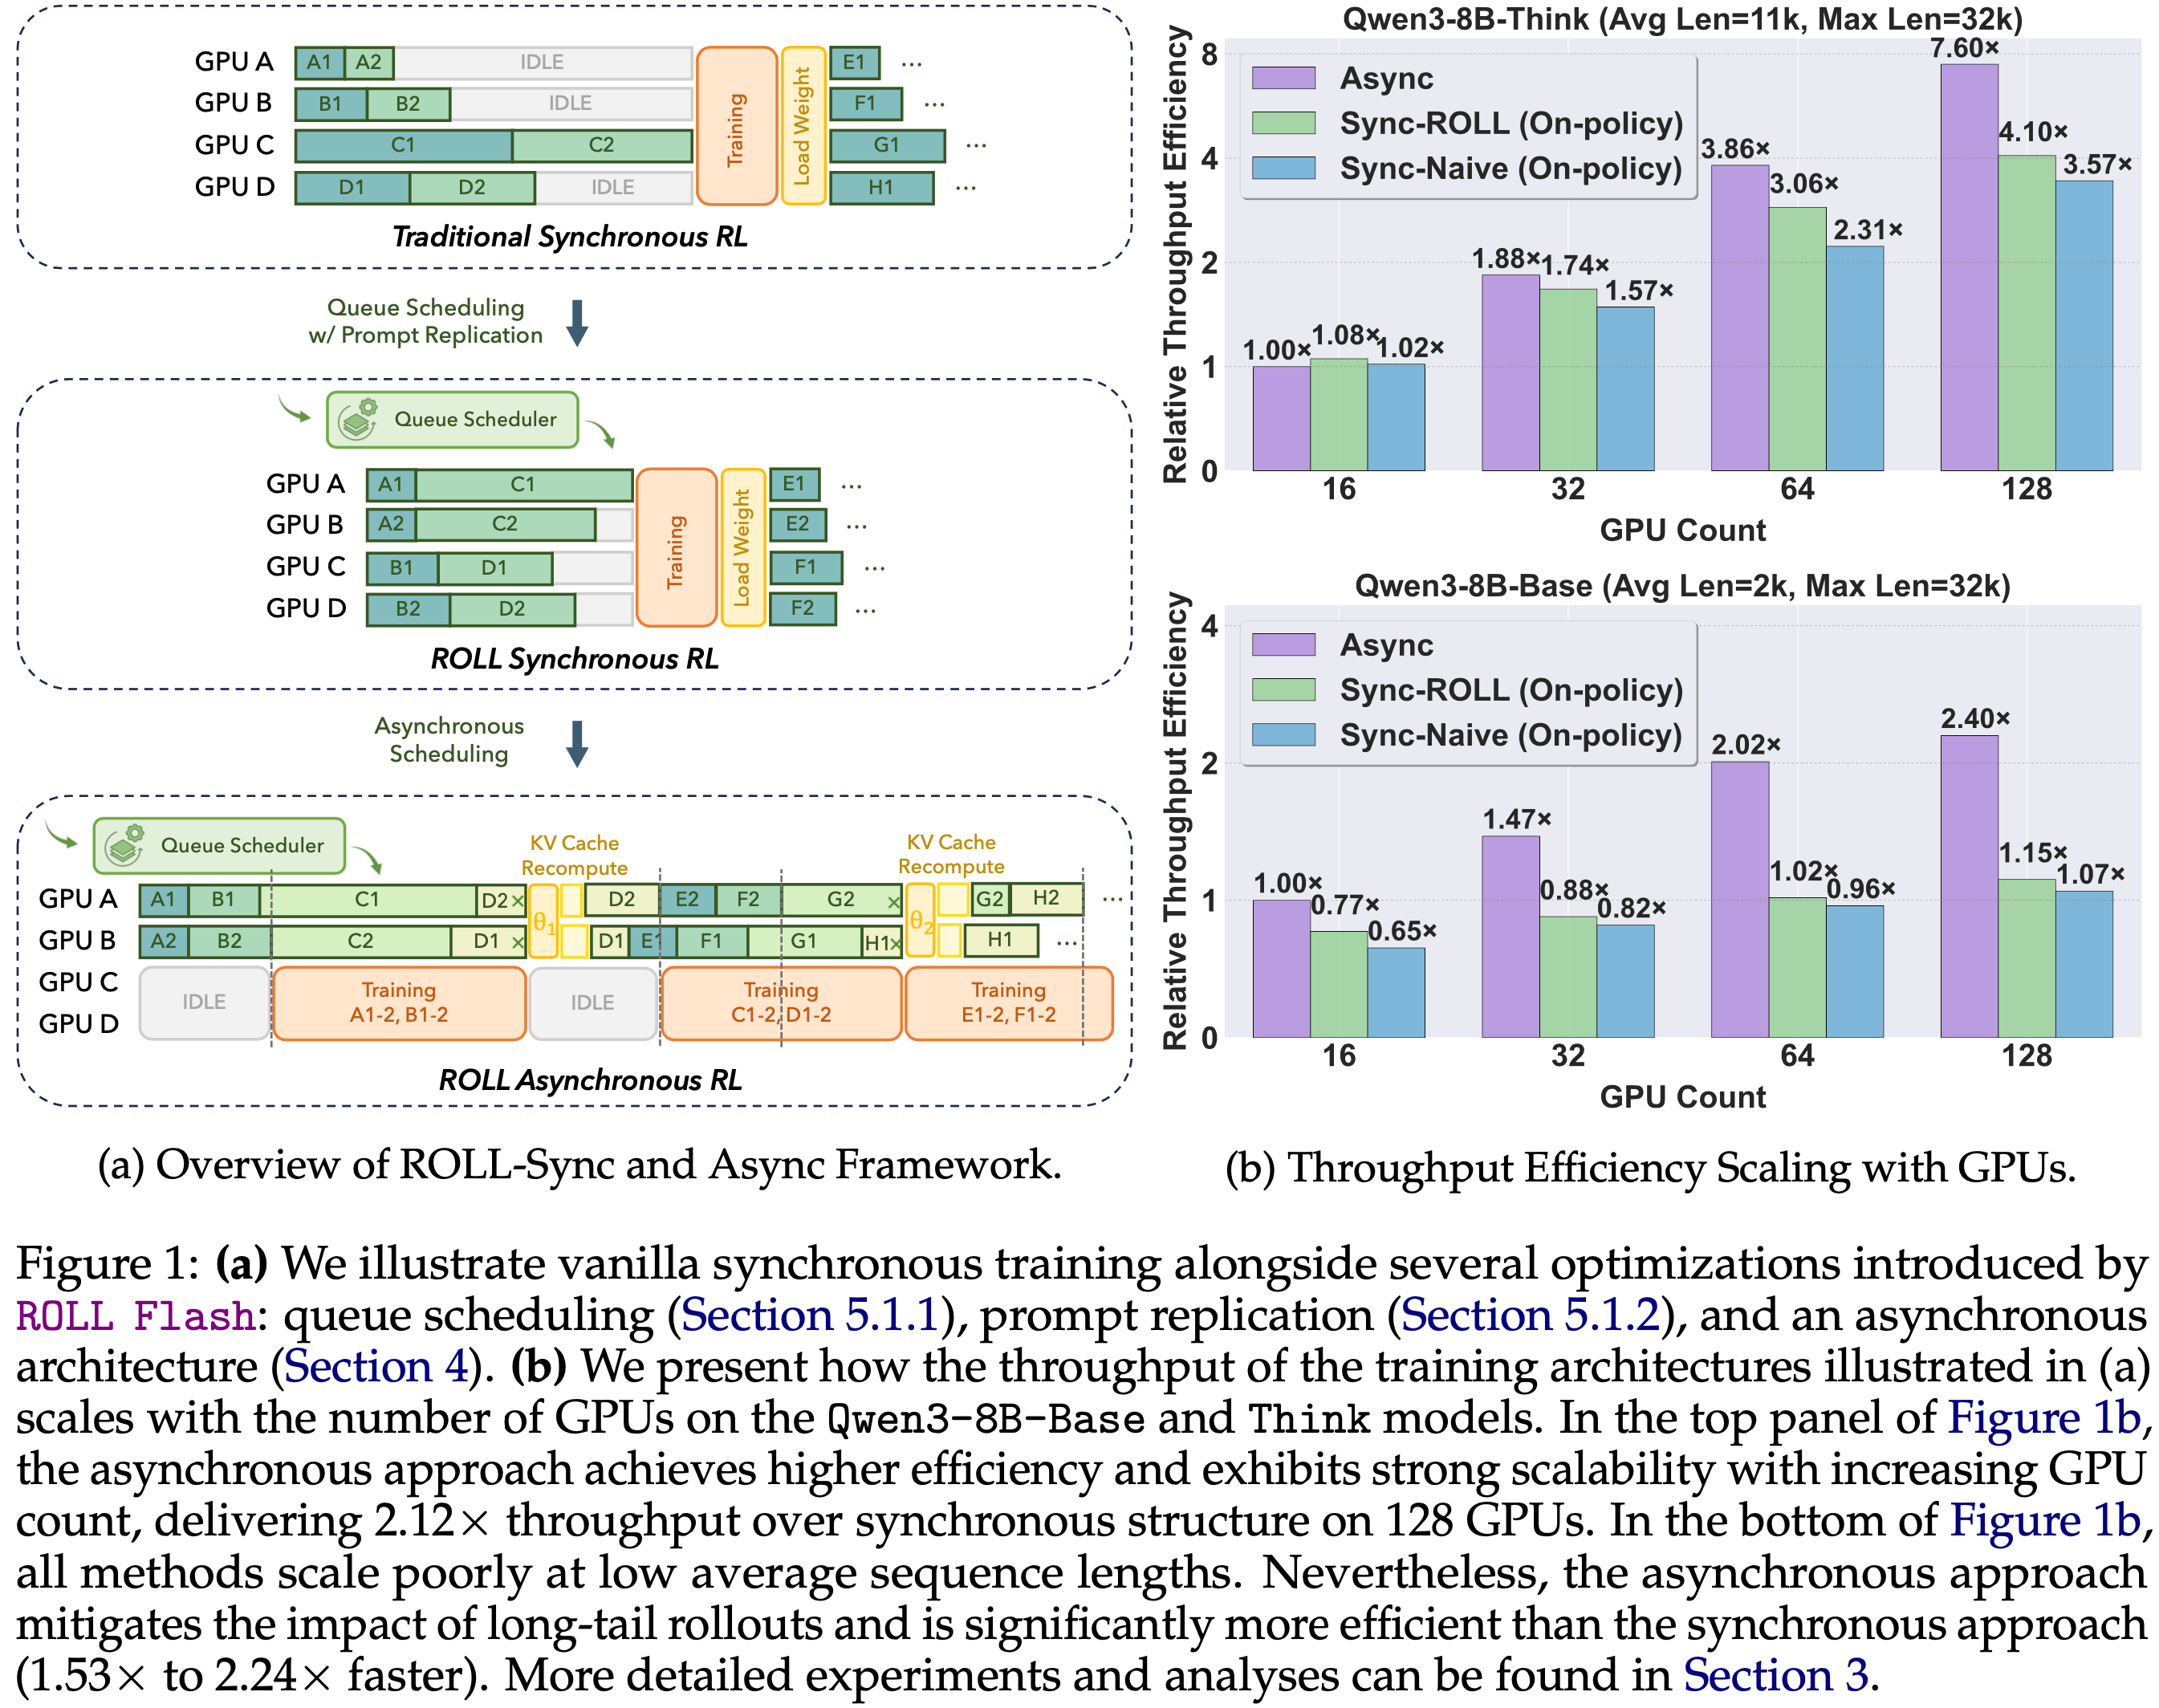
- 图 1 解读:
- (a) 普通的同步训练以及 ROLL Flash 引入的几种优化:队列调度、Prompt 复制和异步架构
- 理解:队列调度下能部分缓解某些 Prompt 的 Response 过长导致的超长尾,部分提效;异步架构下是效率最高的
- (b) 图 (a) 中所示的训练架构在 Qwen3-8B-Base 和 Think 模型上的吞吐量随 GPU 数量扩展的情况
- 在图 1b 的上方图中(Qwen3-8B-Think),异步方法在 128 个 GPU 上实现了更高的效率并表现出强大的可扩展性,吞吐量是同步结构的 \(2.12\times\)
- 在图 1b 的下方图中(Qwen3-8B-Base),所有方法在低平均序列长度下可扩展性均较差
- 但异步方法缓解了长尾 Rollout 的影响,效率显著高于同步方法(快 \(1.53\times\) 到 \(2.24\times\))
- 理解:因为 Base 模型下队列偏短,所以大家的长度都有限,此时提升 GPU 卡数带来的效率提升非常有限
- 理解:Relative Throughput Efficiency 是只相对效率,比如卡数为 16 卡时,如果刚好提升 16 倍,则 Relative Throughput Efficiency = 1.0,如果涨幅跟不上卡数,则小于 1.0
- 问题:单卡为什么效率(MFU)低?甚至低于多卡的 MFU?
- 解码过程主要受内存带宽限制 ,因此 扩展到更多 GPU 并不会提高解码速度
- 在单卡上运行这个模型时,由于显存装不下完整的 KV Cache 和大量并行请求,系统不得不采用极小的 Batch Size(甚至 Batch Size=1)进行串行生成
- 这导致 GPU 计算单元严重 “浪费”(MFU 极低),吞吐量极低
- (a) 普通的同步训练以及 ROLL Flash 引入的几种优化:队列调度、Prompt 复制和异步架构
Introduction and Discussion
- RL 后训练工作流由 Rollout 和训练两个阶段组成,这两个阶段循环执行以迭代优化 LLM
- 在 Rollout 阶段,Actor LLM 生成一批 Response,并为每个 Response 分配奖励信号,直到 Rollout 终止
- 在 Agentic RL 任务中,Actor 还会与环境交互,生成动作和反馈序列以合成 Response
- 在训练阶段,Actor 根据生成的 Response 及其对应的奖励更新模型权重
- 在 Rollout 阶段,Actor LLM 生成一批 Response,并为每个 Response 分配奖励信号,直到 Rollout 终止
- 已有 RL 后训练 框架的问题:
- 严重的资源气泡问题,尤其是在 Rollout 阶段,该阶段占总训练时间的 \(70%\) 以上(2025;2025)
- 不同 Prompt 的 Response 长度差异很大,呈现长尾分布
- 最长的 Response 可能超过中位长度 \(20\times\) 以上(2025)
- 常见的做法是在 Response 生成、环境交互和奖励评估之间强制执行同步 Barrier(Synchronization Barrier),此时长尾 Response 会导致 GPU 大量空闲时间,造成明显的资源浪费
- 资源可扩展性较差
- 在 Rollout 阶段,LLM 生成需要执行数千次自回归解码步骤才能生成每个完整的 Response
- 解码过程主要受内存带宽限制 ,因此 扩展到更多 GPU 并不会提高解码速度
- 解码成本是端到端训练时间的主要组成部分,增加 GPU 并不能显著减少端到端训练时间
- RL 后训练流水线还在 Rollout 和训练阶段之间施加了 Synchronization Barrier ,即训练阶段只能在 Rollout 完成后才开始
- 增加 GPU 可以缩短训练计算时间,但只能略微缓解长尾 Rollout 的开销
- 通过资源扩展所能获得的加速效果有限,整体资源可扩展性仍然较差
- 在 Rollout 阶段,LLM 生成需要执行数千次自回归解码步骤才能生成每个完整的 Response
- 已有异步框架
- AREaL(2025)提出了一个可扩展的 RL 后训练框架,放宽了 Rollout 和训练之间的 Synchronization Barrier
- Rollout 可以持续进行而不会阻塞,增加 GPU 可以扩展并行化 LLM 生成的 Prompt 数量
- 许多同期工作(2025;2025;2025)也启用了异步训练以提高训练吞吐量
- 但异步训练引入的 Off-Policy 漂移可能会降低模型精度,因此需要专门的 Off-Policy 算法(2022;2016;2018;2025;2025)来保持精度
- 得益于系统和算法的联合进步,异步 RL 后训练可以在不牺牲模型性能的情况下提高 Rollout 吞吐量和资源可扩展性
- AREaL(2025)提出了一个可扩展的 RL 后训练框架,放宽了 Rollout 和训练之间的 Synchronization Barrier
- 严重的资源气泡问题,尤其是在 Rollout 阶段,该阶段占总训练时间的 \(70%\) 以上(2025;2025)
- ROLL Flash 通过异步执行增强了 ROLL,提高了 RL 后训练的资源利用率和可扩展性
- ROLL Flash 满足两个关键设计原则
- 第一,细粒度并行(fine-grained parallelism)在 Rollout 阶段提供样本级生命周期控制,使 LLM 生成、环境交互和奖励计算能够重叠执行,从而减少空闲时间并提高 GPU 利用率
- 利用这一能力,实现了 Prompt 复制(prompt replication)和冗余环境 Rollout(redundant environment rollout),并提供了详细的实证分析验证其有效性
- 第二,Rollout-训练解耦(rollout-train decoupling)将 Rollout 和训练阶段置于独立的资源上并行执行
- Rollout 阶段不需要等待训练完成,训练可以使用在陈旧策略下生成的 Response 来优化 LLM
- 这种解耦是异步训练的基石,能够实现灵活控制并增强资源可扩展性
- 为实现这些原则,ROLL Flash 引入了 LLMProxy、EnvManager、SampleBuffer 和 AsyncController
- 这些系统组件共同促进了异步训练架构的实现,并通过队列调度、Prompt 复制、环境级异步 Rollout 和冗余环境 Rollout 实现了细粒度并行
- 第一,细粒度并行(fine-grained parallelism)在 Rollout 阶段提供样本级生命周期控制,使 LLM 生成、环境交互和奖励计算能够重叠执行,从而减少空闲时间并提高 GPU 利用率
- 为了确保异步 RL 后训练中的训练稳定性,ROLL Flash 引入了异步比率(asynchronous ratio),它限制了当前策略与发起样本生成的策略版本之间的策略版本差距
- 这种按样本的新鲜度约束防止了陈旧的 Rollout 损害训练性能,同时实现了高资源利用率
- 本文还从理论上证明了异步训练本质上比同步训练更高效
- 异步训练遵循生产者-消费者模型,其中 Rollout 阶段通过持续的 Response 生成保持饱和状态,不会因训练阶段而停滞
- 这有效地缓解了长尾 Rollout 造成的资源浪费
- 实际上,训练和 Rollout 的资源分配是粗粒度的,这为异步训练的实证研究提供了动机
- 异步训练遵循生产者-消费者模型,其中 Rollout 阶段通过持续的 Response 生成保持饱和状态,不会因训练阶段而停滞
- 实验关键维度:资源可扩展性、资源利用率、异步比率和训练稳定性
- 如图 1 所示,本文方法在 Qwen3-Base 和 Think 模型(2025)上均比同步训练取得了显著的加速,并且随着 GPU 资源扩展,加速效果持续增长
- ROLL Flash 在可扩展性和利用率方面都表现出强大的优势,在数百个 GPU 规模下吞吐量最高可达 \(2.24 \times\)
- 其他 Insight:
- 较小的异步比率通常足以实现接近最大加速,同时保持样本新鲜度
- 现有的 Off-Policy 算法(2024;2022;2016;2025;2025)可以有效补偿陈旧样本带来的潜在性能下降,最终性能与同步训练相当
- Agentic 场景中异步 Rollout 策略的收益:
- 在 ALFWorld 上实现了 \(2.72 \times\) 的加速
- 在 SWE 上实现了 \(1.81 \times\) 的加速
- 本文贡献总结:
- 1)ROLL Flash Structure :支持细粒度并行和 Rollout-训练解耦的系统设计
- 支持异步训练,提升异步生成效率
- 强大资源可扩展性和高利用率
- 2)Async-Sync Analysis :提供对异步训练何时表现优异的理论和实验
- 3)RLVR & Agentic Acceleration :实验消融:
- ROLL-Flash 在 RLVR 任务中实现了高达 \(2.24\times\) 的加速
- 在 Agentic 任务中实现了高达 \(2.72\times\) 的加速
- 1)ROLL Flash Structure :支持细粒度并行和 Rollout-训练解耦的系统设计
- 图 2: 增加资源时,ROLL Flash 训练加速是高于线性的
Background and Preliminaries
Synchronous RL Post-Training
- RL 后训练包括三个阶段:Rollout、奖励计算和训练
- 本文使用 Agentic 任务来说明工作流
- 在 Rollout 期间,Agent LLM 与环境进行多轮交互,产生状态和动作的元组,形成一条轨迹
- 然后,奖励 Worker 为每条轨迹分配一个分数
- 最后,LLM 使用这些轨迹和奖励更新其权重
- 同步训练要求每个训练步骤中模型权重严格同步,从而在 Rollout 阶段和训练阶段之间产生 Barrier ,导致大量的资源气泡和利用率不足
- 两个代表性的例子是 PPO 和 GRPO
PPO
- PPO(2017)通过优化一个裁剪的替代目标函数来增强稳定性,该目标函数限制了更新后的策略 \(\pi_{\theta}\) 在每个更新步骤中与旧策略 \(\pi_{\theta_{\text{old} } }\) 的偏离程度
- PPO 目标函数定义为:
$$\begin{array}{rl} & {\mathcal{J}_{\text{PPO} }(\theta) = \mathbb{E}_{[q\sim P(Q),o\sim \pi_{\theta_{\text{old} } }(O|q)]} }\ & {\qquad \frac{1}{|o|}\sum_{t = 1}^{|o|}\min \left(\frac{\pi_{\theta}(o_t|q,o_{< t})}{\pi_{\theta_{\text{old} } }(o_t|q,o_{< t})} A_t,\text{clip}\left(\frac{\pi_{\theta}(o_t|q,o_{< t})}{\pi_{\theta_{\text{old} } }(o_t|q,o_{< t})},1 - \epsilon ,1 + \epsilon\right)A_t\right),} \end{array} \tag {1}$$- \(q\) 表示采样的问题,\(o\) 是生成的序列,\(o_{t}\) 表示 \(o\) 中的第 \(t\) 个 Token
GRPO
- PPO 在各种任务中表现稳健,但它对 Critic 的依赖揭示了在语言生成中的局限性:
- 在稀疏奖励的长序列下优势估计变得不稳定,不可靠的价值估计可能加剧策略在次优 Landscape 中的收敛
- Critic 需要额外计算开销
- GRPO 是一种无需 Critic 的替代方案,通过为每个 Prompt 采样多个 Response 并归一化其奖励来构建优势信号
- 给定一个 Prompt \(q\) 和 \(G\) 个输出序列及其奖励 \(\{r_i\}_{i = 1}^G\),GRPO 将第 \(i\) 个序列第 \(t\) 个 Token 的归一化优势定义为:
$$\hat{A}_{i,t} = \frac{r_i - \text{mean}(\{r_i\}_{i = 1}^G)}{\text{std}(\{r_i\}_{i = 1}^G)}. \tag {2}$$ - GRPO 通过组统计量(均值和标准差)对奖励进行标准化,使得即使奖励稀疏或相似,也能通过相对排序产生有意义的学习信号
- 理论上,它作为一种奖励塑造(reward shaping),强调组内差异以保持梯度可区分性(2020)
- GRPO 在损失中显式地添加 KL 散度作为正则项
- GRPO 目标函数为
$$\begin{align} \mathcal{J}_{\text{GRPO} }(\theta) &= \mathbb{E}_{q\sim P(Q),\{o_i\}_{i = 1}^G\sim \pi_{\theta_{\text{old} } }(O|q)} \\ &\frac{1}{G}\sum_{i = 1}^{G}\frac{1}{|\alpha_i|}\sum_{t = 1}^{|\alpha_i|}\Big\{\min \Big(r_{i,t}(\theta)\hat{A}_{i,t},\text{clip}(r_{i,t}(\theta),1 - \epsilon ,1 + \epsilon)\hat{A}_{i,t}\Big) - \beta D_{\text{KL} }[\pi_{\theta}\parallel \pi_{\text{ref} }]\Big\}
\end{align} \tag {3}$$- 其中 \(r_{i,t}(\theta) = \frac{\pi_{\theta}(o_{i,t}|q,\theta_{i,t})}{\pi_{\theta_{\text{old} } }(o_{i,t}|q,\theta_{i,t})}\)
- \(\beta\) 是正则化权重
- \(D_{\text{KL} }\) 表示当前策略与参考策略之间的 KL 散度
Asynchronous LLM Post-Training
- 如先前 RL 后训练框架(2025;2025)所观察到的,Rollout 阶段通常占总训练时间的 \(70%\) 以上,长尾 Rollout 会引发大量资源空闲和利用率不足
- 而且,扩展 GPU 并不能缓解这些长尾 Rollout,只能带来边际的计算收益
- 异步训练作为一种有前景的技术出现,以缓解这一问题并提高资源利用率和可扩展性(2016;2025;2025)
- 异步训练将 Rollout 和训练阶段解耦,并在独立的资源上并行运行,消除了严格的 Synchronization Barrier
- 训练阶段可以使用 Rollout 阶段使用陈旧模型权重生成的 Response,而 Rollout 阶段则同时持续生成新的 Response,无需等待模型更新
- 虽然异步训练可以提高计算效率,但它引入了策略陈旧性,可能会降低模型精度(2025),使用专用 Off-Policy 算法支持是必要的
- Response 是从旧分布 \(\pi_{\text{old} }\) 中采样的,该分布通常与当前策略 \(\pi_{\theta}\) 不同
- 当在这种异步设置中应用同步训练算法(例如 PPO)时,旧策略与当前策略之间的分歧可能引发策略崩溃(2023)并使梯度产生偏差,导致训练不稳定和严重的性能下降
- 为了恢复精度,采用 Off-Policy 训练算法来稳定训练动态
- 主流的 Off-Policy RL 后训练算法通常分为两类:
- (1)梯度截断(gradient truncation),即对重要性采样(IS)比率位于信任域之外的 Token 截断梯度
- 例如 Decoupled PPO(2022)
- 理解:这里说的截断就是常规的 PPO 阶段,只是 Decoupled PPO 是特别使用到 Off-policy 场景的(传统 PPO 也可以用到 Off-policy 场景),实际上 (Decoupled PPO)Batch size-invariance for policy optimization, NeurIPS 2022, OpenAI 中并未提出任何针对 \(\frac{\pi_\text{prox}}{\pi_\text{behav}}\) 的 Clip,仅仅是有针对 \(\frac{\pi_\theta}{\pi_\text{prox}}\)
- (2)重要性采样优化(importance-sampling optimization),即保留所有样本的梯度,但裁剪重要性采样权重以稳定训练
- 例如截断 IS(Truncated IS)(2016;2018)、CISPO(2025)和 TOPR(2025)
- (1)梯度截断(gradient truncation),即对重要性采样(IS)比率位于信任域之外的 Token 截断梯度
- Notation
- 在以下公式中,\(R(\tau)\) 表示与轨迹 \(\tau\) 关联的学习信号,在实践中也可以是优势估计 \(A(\tau)\)
- 本文用 \(\mathbf{sg}(\cdot)\) 表示停止梯度算子(梯度不通过该项反向传播),用 \(\mathbf{1}_{\{\cdot \} }\) 表示指示函数
- 缩写 \((x)_b^a\) 表示 \(\text{clip}(x,b,a)\),即 \(x\) 被限制在下界 \(b\) 和上界 \(a\) 之间
- Loss Objective for Off-policy Algorithms
- Decoupled PPO 引入了一个近端策略 \(\pi_{\text{prox} }\) 来更好地调节策略更新
- TIS 和 TOPR 都采用截断阈值 \(c\) 来从上方限制重要性采样比率,以减轻方差和不稳定性
- PPO 和 CISPO 将比率限制在 1 附近的对称或非对称区间内,由 \(\epsilon_{\text{low} }^{\text{IS} }\) 和 \(\epsilon_{\text{high} }^{\text{IS} }\) 控制
- TOPR 将轨迹划分为两个集合:\(T^{+}\)(高回报/正确)和 \(T^{- }\)(低回报/错误),仅对 \(T^{- }\) 应用截断,以保留良好轨迹的学习信号,同时抑制较差轨迹中的噪声
- ROLL Flash 已集成了上述 Off-Policy 算法,以促进异步训练的性能
Performance-Preserving Asynchronous Acceleration
Theoretical Analysis
- ROLL Flash 采用了两种设计:
- (1)具有 Prompt 复制的队列调度(Queue Scheduling with Prompt Replication)
- 其中 Response 被单独调度,并在任何空闲 Worker 上立即执行
- (2)在异步模式(Async)中,相同总数的 GPU 被划分为训练和推理两部分
- 异步比率 \(\alpha\) 表示 Rollout 策略允许落后于当前训练模型的模型更新次数,它直接决定了生成数据池的大小
- (1)具有 Prompt 复制的队列调度(Queue Scheduling with Prompt Replication)
Proposition 1: Generation Time Bound
- 命题 1:生成时间界限
- 设有 \(K\) 个 Worker 以队列调度方式执行(一旦 Worker 完成,新任务立即分配)
- 假设需要生成 \(Q\) 个样本,每个样本的生成时间位于 \([0,L_{\text{gen} }]\) 内,均值为 \(\mu_{\text{gen} }\),则总完成时间满足:
$$T_{\text{completion} }\leq \frac{Q}{K} h_{\text{gen} } + L_{\text{gen} }. \tag {4}$$ - 因此,每个样本的平均完成时间受限于:
$$\frac{T_{\text{completion} } }{Q}\leq \frac{h_{\text{gen} } }{K} +\frac{L_{\text{gen} } }{Q}. \tag {5}$$ - 在同步设置中 \((Q = N)\),每个样本的平均完成时间满足:
$$\overline{T}_{\text{sync} }\leq \frac{\mu_{\text{gen} } }{K} +\frac{L_{\text{gen} } }{N}. \tag {6}$$ - 在异步设置中 \((Q = (\alpha +1)N\),其中 \(\alpha\) 表示异步比率(详见第 4.3 节)):
$$\overline{T}_{\text{async} }\leq \frac{h_{\text{gen} } }{K} +\frac{L_{\text{gen} } }{(\alpha + 1)N}. \tag {7}$$- 当 \(\alpha \to \infty\) 时,每个样本的完成时间收敛于 \(\mu_{\text{gen} } / K\)
- 当 \(K = N\) 时,异步相对于同步所能达到的最大理论加速至多为
$$ \frac{L_{\text{gen} } + \mu_{\text{gen} }}{\mu_{\text{gen} }}$$
Proposition 2: End-to-End Efficiency with Resource Partitioning
- 命题 2:资源划分下的端到端效率
- 考虑一个具有 \(K\) 个 Worker 的系统,资源分配策略如下:
- 同步:所有 \(K\) 个 Worker 生成 \(N\) 个样本,然后顺序进行训练
- 异步:Worker 被划分为两个不相交的池,由参数 \(\beta \in (0,1)\) 控制
- \((1 - \beta)K\) 个 Worker 分配给持续样本生成
- \(\beta K\) 个 Worker 用于并行训练
- 设 \(\mu_{\text{gen} }\) 表示平均样本生成时间(最大值为 \(L_{\text{gen} }\)),\(\mu_{\text{train} }\) 表示每个样本的平均训练时间,定义 \(\bar{E}\) 为训练期间每个生成样本的复用次数
- 1)同步(顺序流水线)的端到端完成时间为:
$$T_{\text{sync} }\leq \frac{N}{K}\mu_{\text{gen} } + L_{\text{gen} } + E\frac{N}{K}\mu_{\text{train} } = \frac{N}{K} (\mu_{\text{gen} } + E\mu_{\text{train} }) + L_{\text{gen} }. \tag {8}$$ - 2)异步(并行、资源隔离流水线)的端到端完成时间为:
$$T_{\text{async} }\leq \max \left(\frac{N}{(1 - \beta)K}\mu_{\text{gen} } + \frac{L_{\text{gen} } }{(\alpha + 1)(1 - \beta)},\frac{EN}{\beta K}\mu_{\text{train} }\right). \tag {9}$$
- 1)同步(顺序流水线)的端到端完成时间为:
- 使 \(T_{\text{async} }\) 上界最小化的最优 Worker 分配比率 \(\beta^{*}\) 为
$$\beta^{*} = \frac{EN\mu_{\text{train} } }{N\mu_{\text{gen} } + \frac{KL_{\text{gen} } }{\alpha + 1} + EN\mu_{\text{train} } }. \tag {10}$$ - 在这个最优 \(\beta^{*}\) 下,两个组成部分达到平衡,得到的上界为:
$$T_{\text{async} }\leq \frac{N}{K} (\mu_{\text{gen} } + E\mu_{\text{train} }) + \frac{L_{\text{gen} } }{\alpha + 1}. \tag {11}$$ - 异步设置产生了更紧的理论界限,并且当 \(\alpha >0\) 时严格优于同步设置
- 当 \(\alpha \rightarrow \infty\) 时,异步相对于同步的最大理论加速收敛于
$$ 1 + \frac{KL_{\text{gen} } }{N(\mu_{\text{gen} } + E\mu_{\text{train} })} $$
Experimental Validation
- 异步训练的详细实证分析揭示了四个关键要点:资源可扩展性、资源利用率、异步比率和训练稳定性
Experimental Setup
- 除非另有说明,本节中的所有实验均使用 Qwen3-8B-Base 或 Think 模型(2025)
- 序列长度为 32k,256 个 Rollout
- 每个小批量 32 个 Prompt 的组大小
- 在 DAPO-Math-18K(2025)数据集上进行(其他细节见附录 A)
- 在以下实验中,通过变化几个关键参数进行了详细的消融研究,包括:
- (1)基础模型的选择:Qwen3-8B-Base(平均长度 2k)或 Qwen3-8B-Think(平均长度 11k)
- (2)GPU 数量,范围从 16 到 128
- (3)Rollout 批量大小,从 32 到 512 变化
- (4)训练和推理之间不同的 GPU 分配比例
- 在图 1b 中,评估的范式包括:
- (1)异步(Async):ROLL 的异步架构,异步比率为 2
- (2)Sync-ROLL(On-policy):一种增强了 ROLL 特定优化(包括队列调度和 Prompt 复制)的同步架构
- (3)Sync-Naive(On-policy):标准的同步强化学习设置
- 默认的训练与推理 GPU 比率为 1:1
Takeaway 1: Async Architecture Achieves Superior Throughput Scalability
- 异步架构实现优越的吞吐量可扩展性
- 增加 GPU 资源使同步(Sync)更容易受到长尾样本的影响
- 异步(Async)则表现出更好的扩展行为并实现更高的资源利用率
- 图 1b 展示了不同训练范式在 GPU 数量扩展时的吞吐量效率
- 在 Qwen3-8B-Think 模型下,异步方法实现了近乎线性的吞吐量扩展——在 \(8 \times\) GPU 下达到了惊人的 \(7.6 \times\) 加速,是传统同步(Sync-Naive)基线的 \(2.13 \times\)
- 在 Qwen3-8B-Base 模型下,平均生成长度显著缩短,系统不再受计算限制
- 因此,所有架构的资源利用率都大幅下降
- 同步方法(Sync-Naive 和 Sync-ROLL)的吞吐量趋于平缓,异步架构继续有效扩展,在 128 个 GPU 上实现了比 Sync-Naive 高 \(2.24 \times\) 的吞吐量
- 这种行为的原因在于,增加 GPU 数量会减少每 GPU 的工作负载(即每设备的 Rollout 数量),从而放大了长尾效应的影响
- 在 Base 设置中,Response 长度具有高方差,这个问题进一步加剧
- 传统的同步训练在这种条件下遭受严重的效率下降,而 Sync-ROLL 变体通过 ROLL 特定的优化(例如队列调度和 Prompt 复制)部分缓解了该问题
- 异步架构通过解耦生成和训练从根本上消除了拖后腿者的瓶颈
- 这些结果得出了一个明确的结论:在资源丰富的场景或具有明显长尾生成延迟的情况下,异步架构能够实现显著更高效的资源利用,应作为首选
Takeaway 2: Async Accelerates Training in Almost All Cases
- 异步在几乎所有情况下都能加速训练
- 异步有效地缓解了由长尾生成延迟引起的训练停滞,当训练和推理资源的分配良好平衡时,可带来显著的加速
- 异步的核心加速优势源于消除了由长尾生成延迟引起的资源浪费和空闲等待
- 在理想情况下,消费速率(训练)应与生产速率(生成)大致匹配,异步比率用于吸收尾部延迟并防止训练停滞
- 一个关键的 design 决策是在训练和推理之间最优地分配资源以最大化整体效率
- 图 3:在不同 Rollout 批量大小和训练-推理资源比率下,异步和同步的效率比较
- (a) 在固定的 GPU 资源预算下,通过调整训练和推理之间的分配比率可以实现最优效率
- (b) 显示了异步和 ROLL-Sync 的效率扩展曲线
- 异步在几乎所有情况下都表现出明显的优势
- 个人补充观察结论:随着 Rollout Batch Size 增大,异步的边际收益递减,原因应该是因为 Rollout Batch Size 很大时,超长样本本身不少
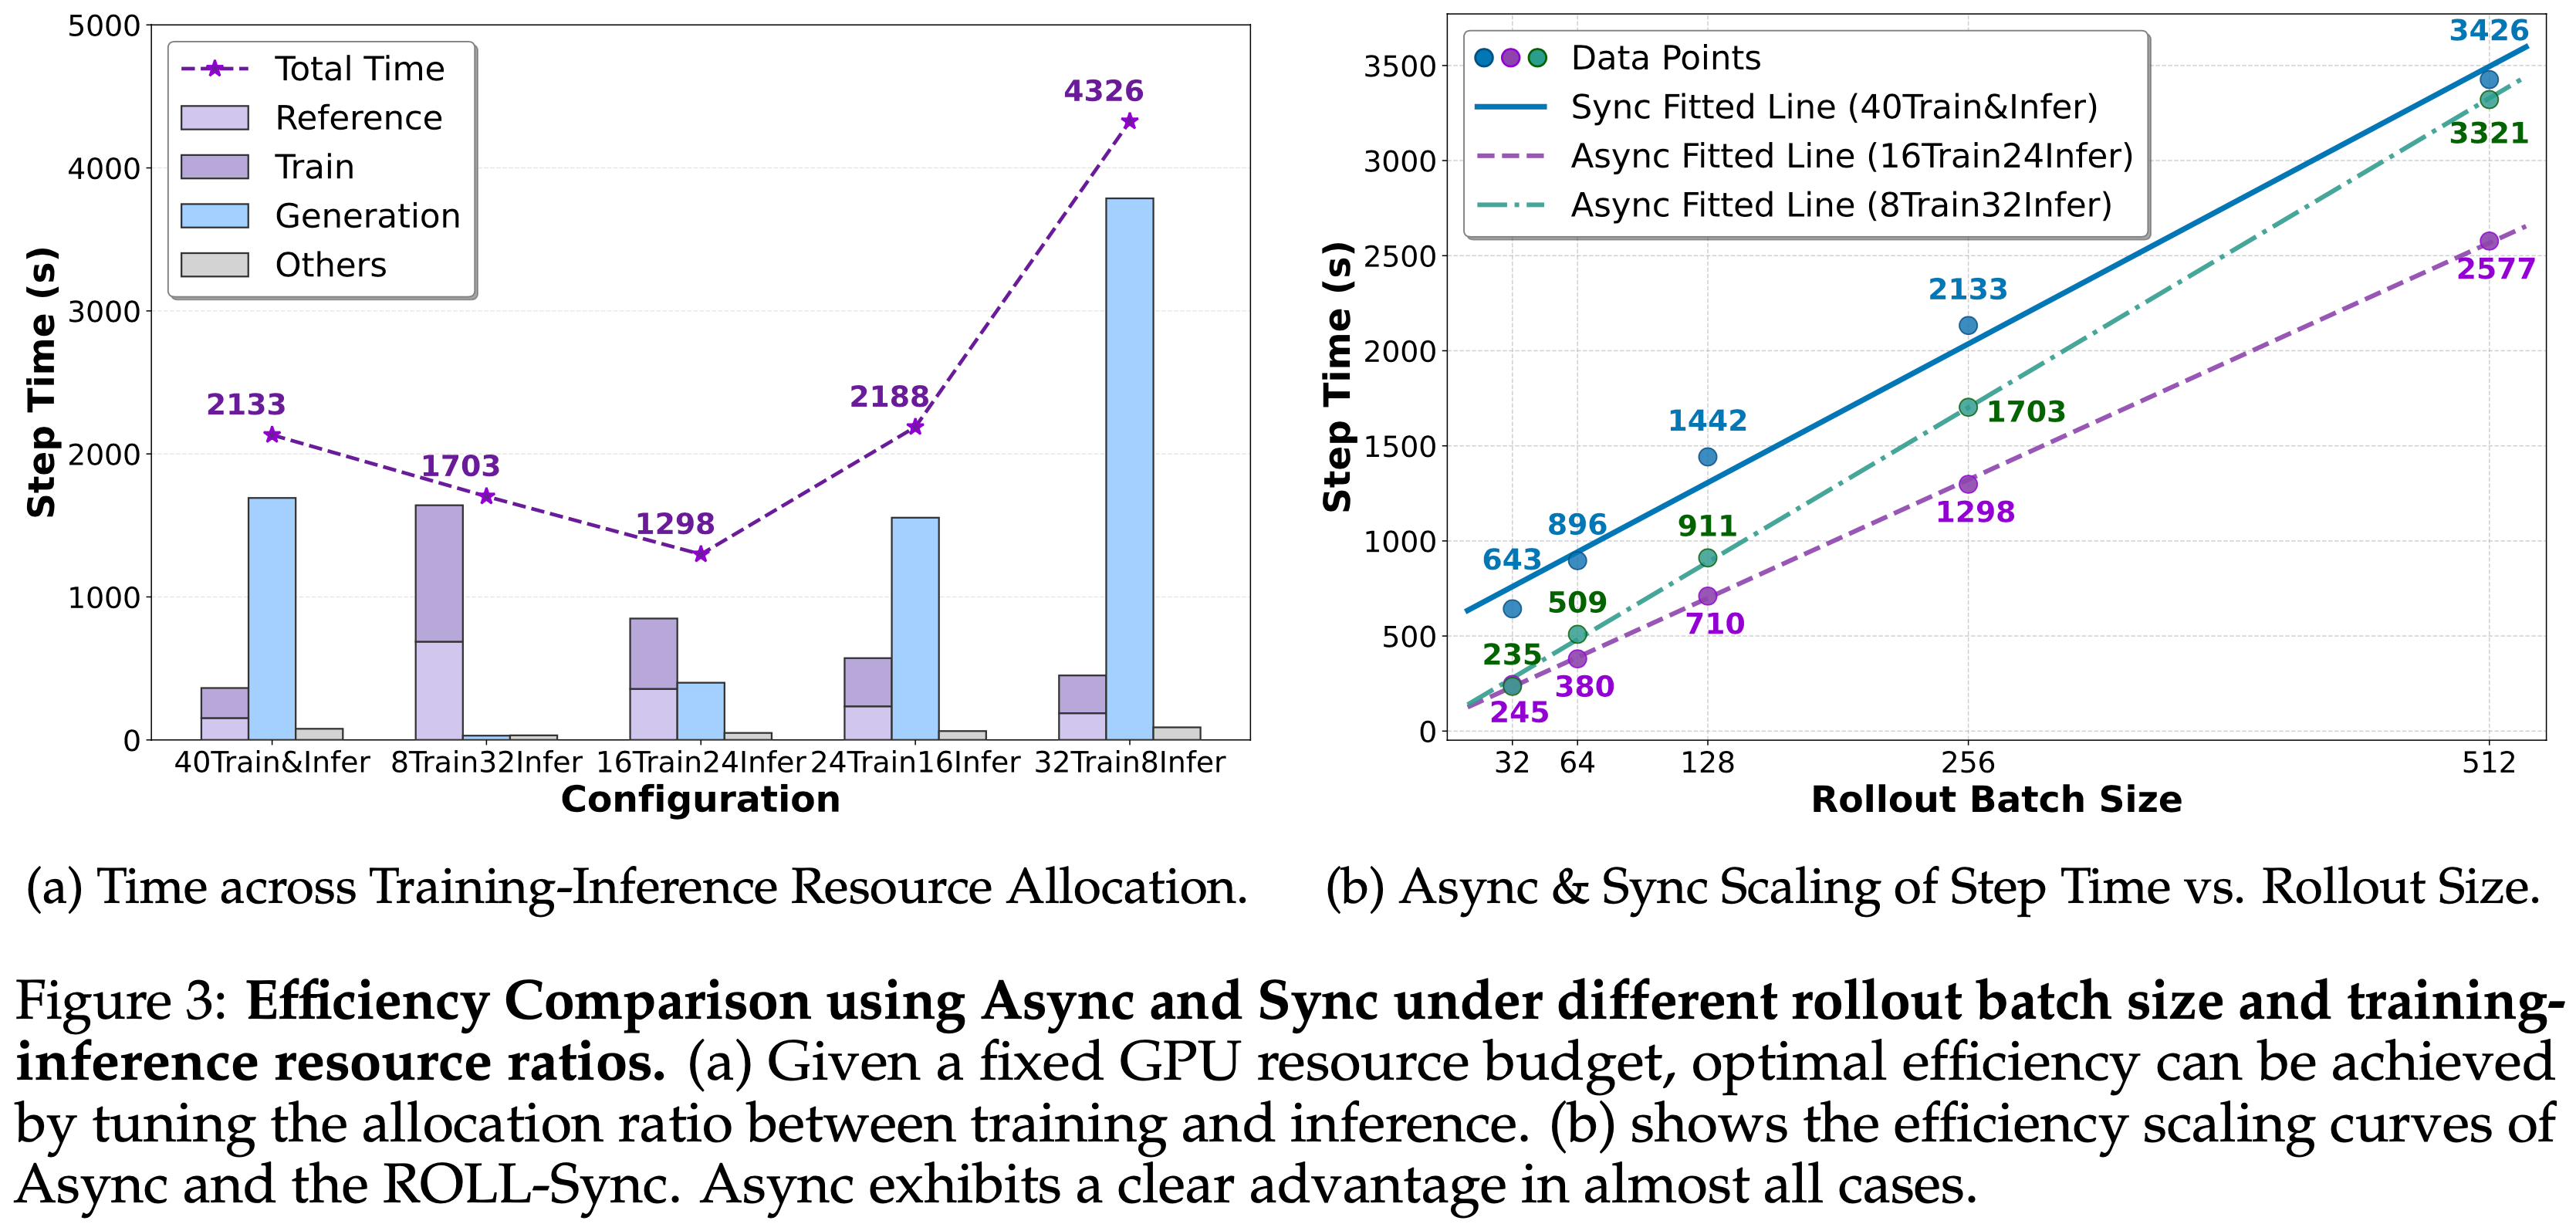
- 图 3a 展示了在不同训练-推理资源分配下的效率提升
- 一个调优良好的异步配置(16 个 GPU 用于训练,24 个 GPU 用于推理)实现了比基线近 \(2 \times\) 的加速
Notably, to support various off-policy methods and evaluation metrics, our training phase includes not only parameter updates but also inference passes over both the initial and proximal reference models.
- ROLL-Sync 花费大量时间等待样本生成
- 32Infer 设置下,虽然训练永远不需要等待数据生成,但计算资源在生成期间被过度利用不足
- 24Infer 配置实现了最佳的整体性能
- Insight:适当等待新生成的样本不仅避免了浪费,而且通过使用更新鲜的数据有助于稳定训练
- 一个调优良好的异步配置(16 个 GPU 用于训练,24 个 GPU 用于推理)实现了比基线近 \(2 \times\) 的加速
- 图 3b 显示了同步和异步在每个步骤的训练时间随 Rollout 批量大小的变化
- 对于固定数量的样本,训练时间大致随样本数量线性扩展,并伴有固定的常数开销,如模型加载和卸载
- 如公式 5 所预测,生成时间受平均延迟和尾部延迟的相互作用支配,观察到的步骤时间确实表现出近线性扩展
- 每条曲线的斜率反映了处理额外样本的边际成本
- 图 3b 中的 Rollout 大小已经对应于现实中的 On-Policy 或 Off-Policy 训练场景
- 如图 1 进一步证实的,异步比同步在 GPU 数量增加时扩展更有利
- 结论:异步几乎在所有实际场景中都能加速训练
Takeaway 3: Async Ratio Can Be Small Enough.
- Async Ratio 可以很小:
- 在典型配置中,将异步比率设置为 2 可获得 最高的吞吐量 ,有效平衡了学习效率和 Off-Policy 学习程度
- 在异步架构中,异步比率是一个关键的超参数
- 如果设置过低,样本生成可能落后于训练,导致长尾样本成为瓶颈,限制整体吞吐量
- 如果设置过高,训练样本变得过于陈旧,由于过时的策略采样,会损害训练稳定性和有效性
- 本文的目标是确定最大化吞吐量的最优异步比率,本文在标准配置下进行评估:
- Qwen3-8B-Think,序列长度 32K,Rollout 批量大小 256
- 最优异步比率取决于生成吞吐量
- 在 32Train8Infer 设置中,异步比率为 1 比完全同步基线提升了 \(25%\) 的吞吐量
- 这是该设置下可实现的最大值
- 在 24Train16Infer 配置中,异步比率为 1 提供了 \(28%\) 的加速,比率为 2 则释放了全部收益,带来了 \(64%\) 的吞吐量提升
- 进一步增加异步比率不会带来额外改进,因为它不再缓解长尾瓶颈
- 在 32Train8Infer 设置中,异步比率为 1 比完全同步基线提升了 \(25%\) 的吞吐量
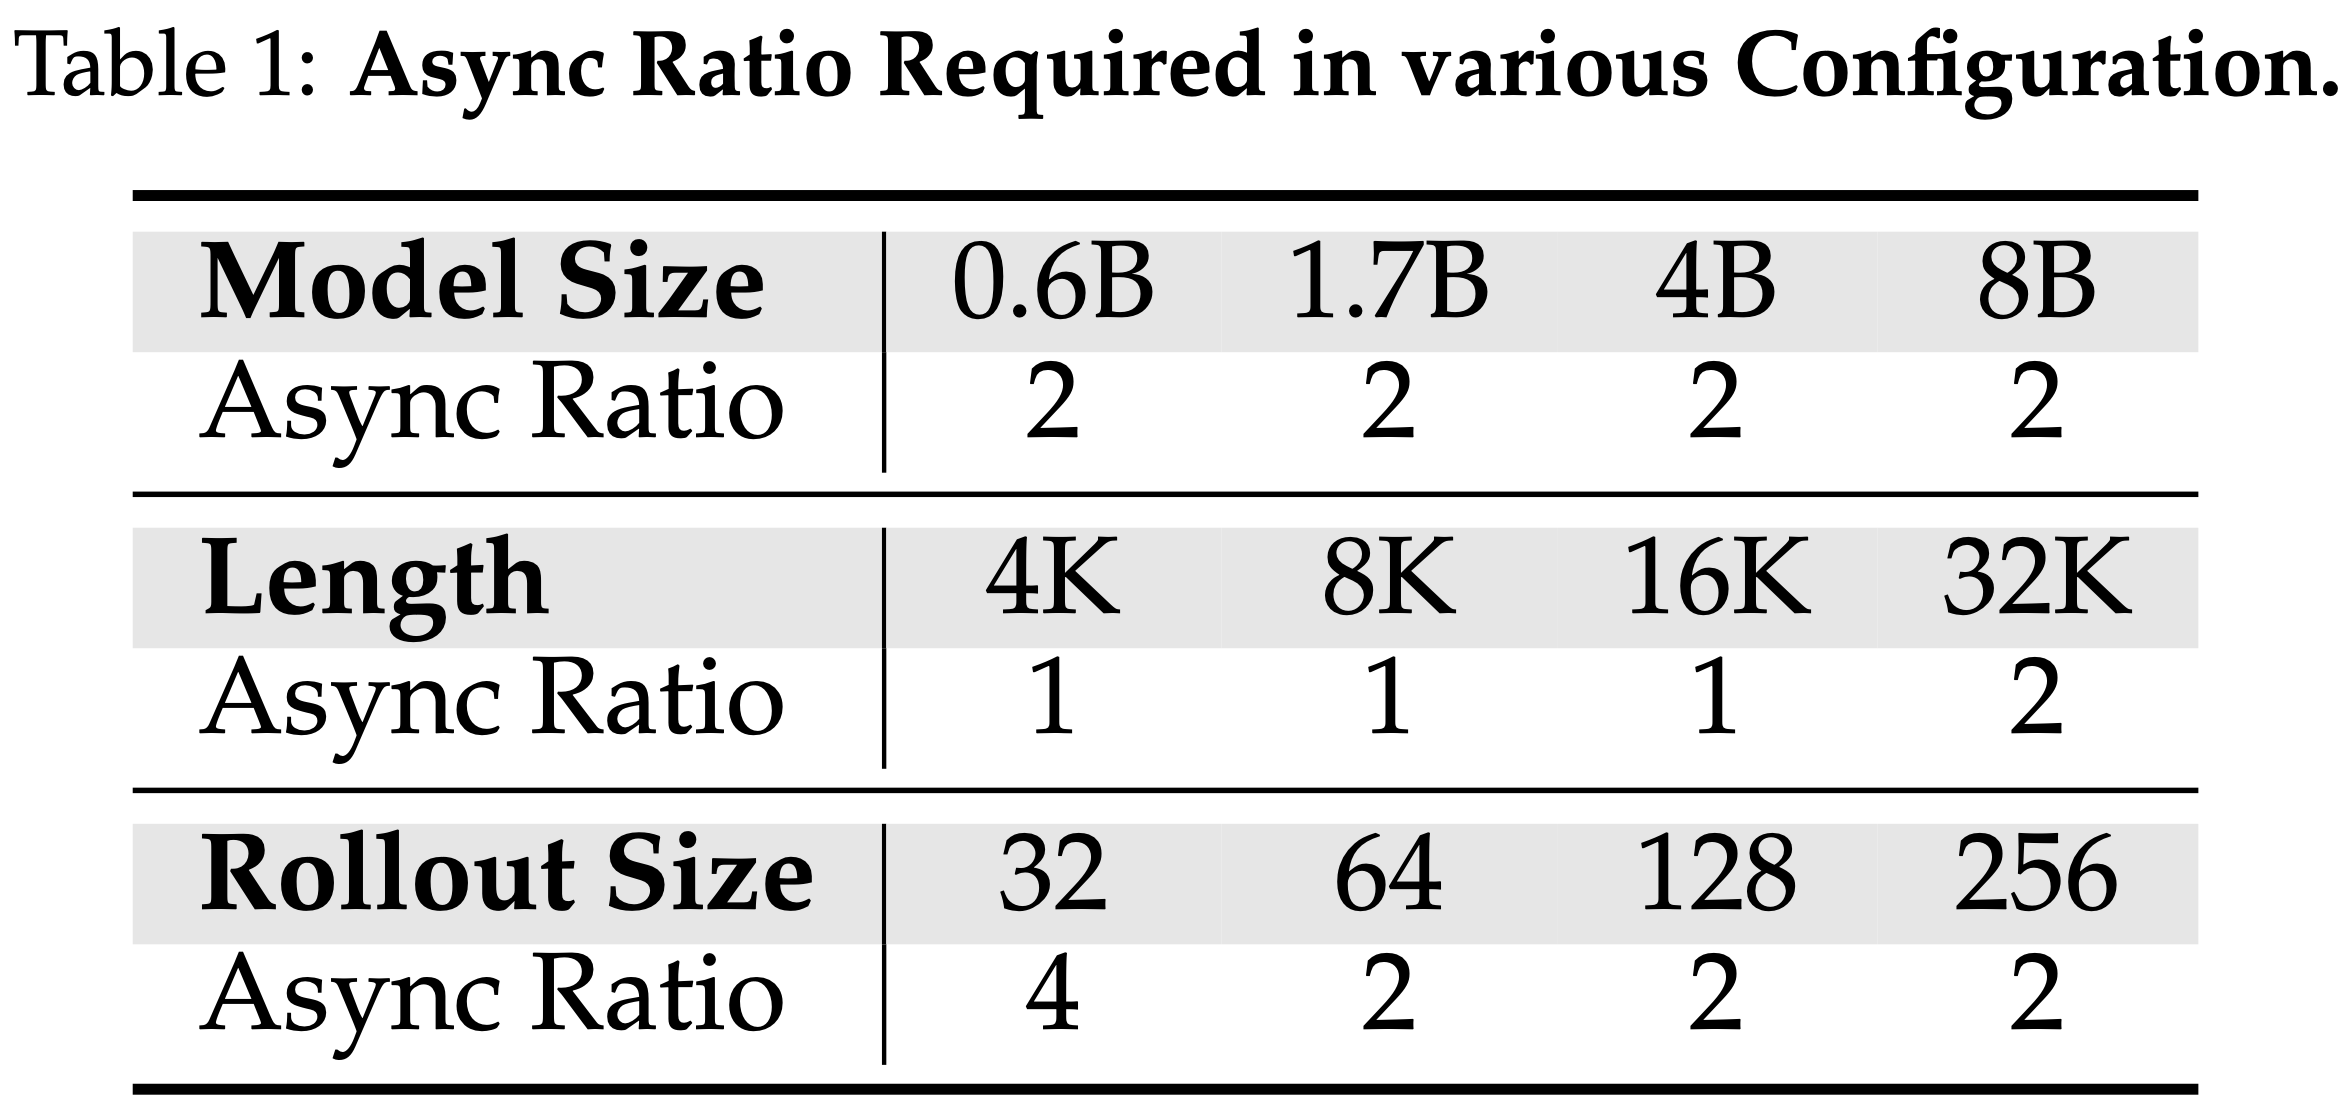
- 基于图 3 中的最高吞吐量配置(24Train16Infer),进行了消融研究,分析各个组件如何影响最优异步比率
- 如表 1 总结,最优异步比率对模型大小基本不敏感,随序列长度单调增加,随 Rollout 批量大小单调减少
- 对于大多数实际场景,低至 2 的值就足够了
- 而且:我们可以从异步框架中获得显著的加速,而不会产生严重的 Off-Policy 惩罚
Takeaway 4: Async Training Can Be Stable and Nearly Performance-Lossless
- 异步训练可以稳定且几乎无损性能
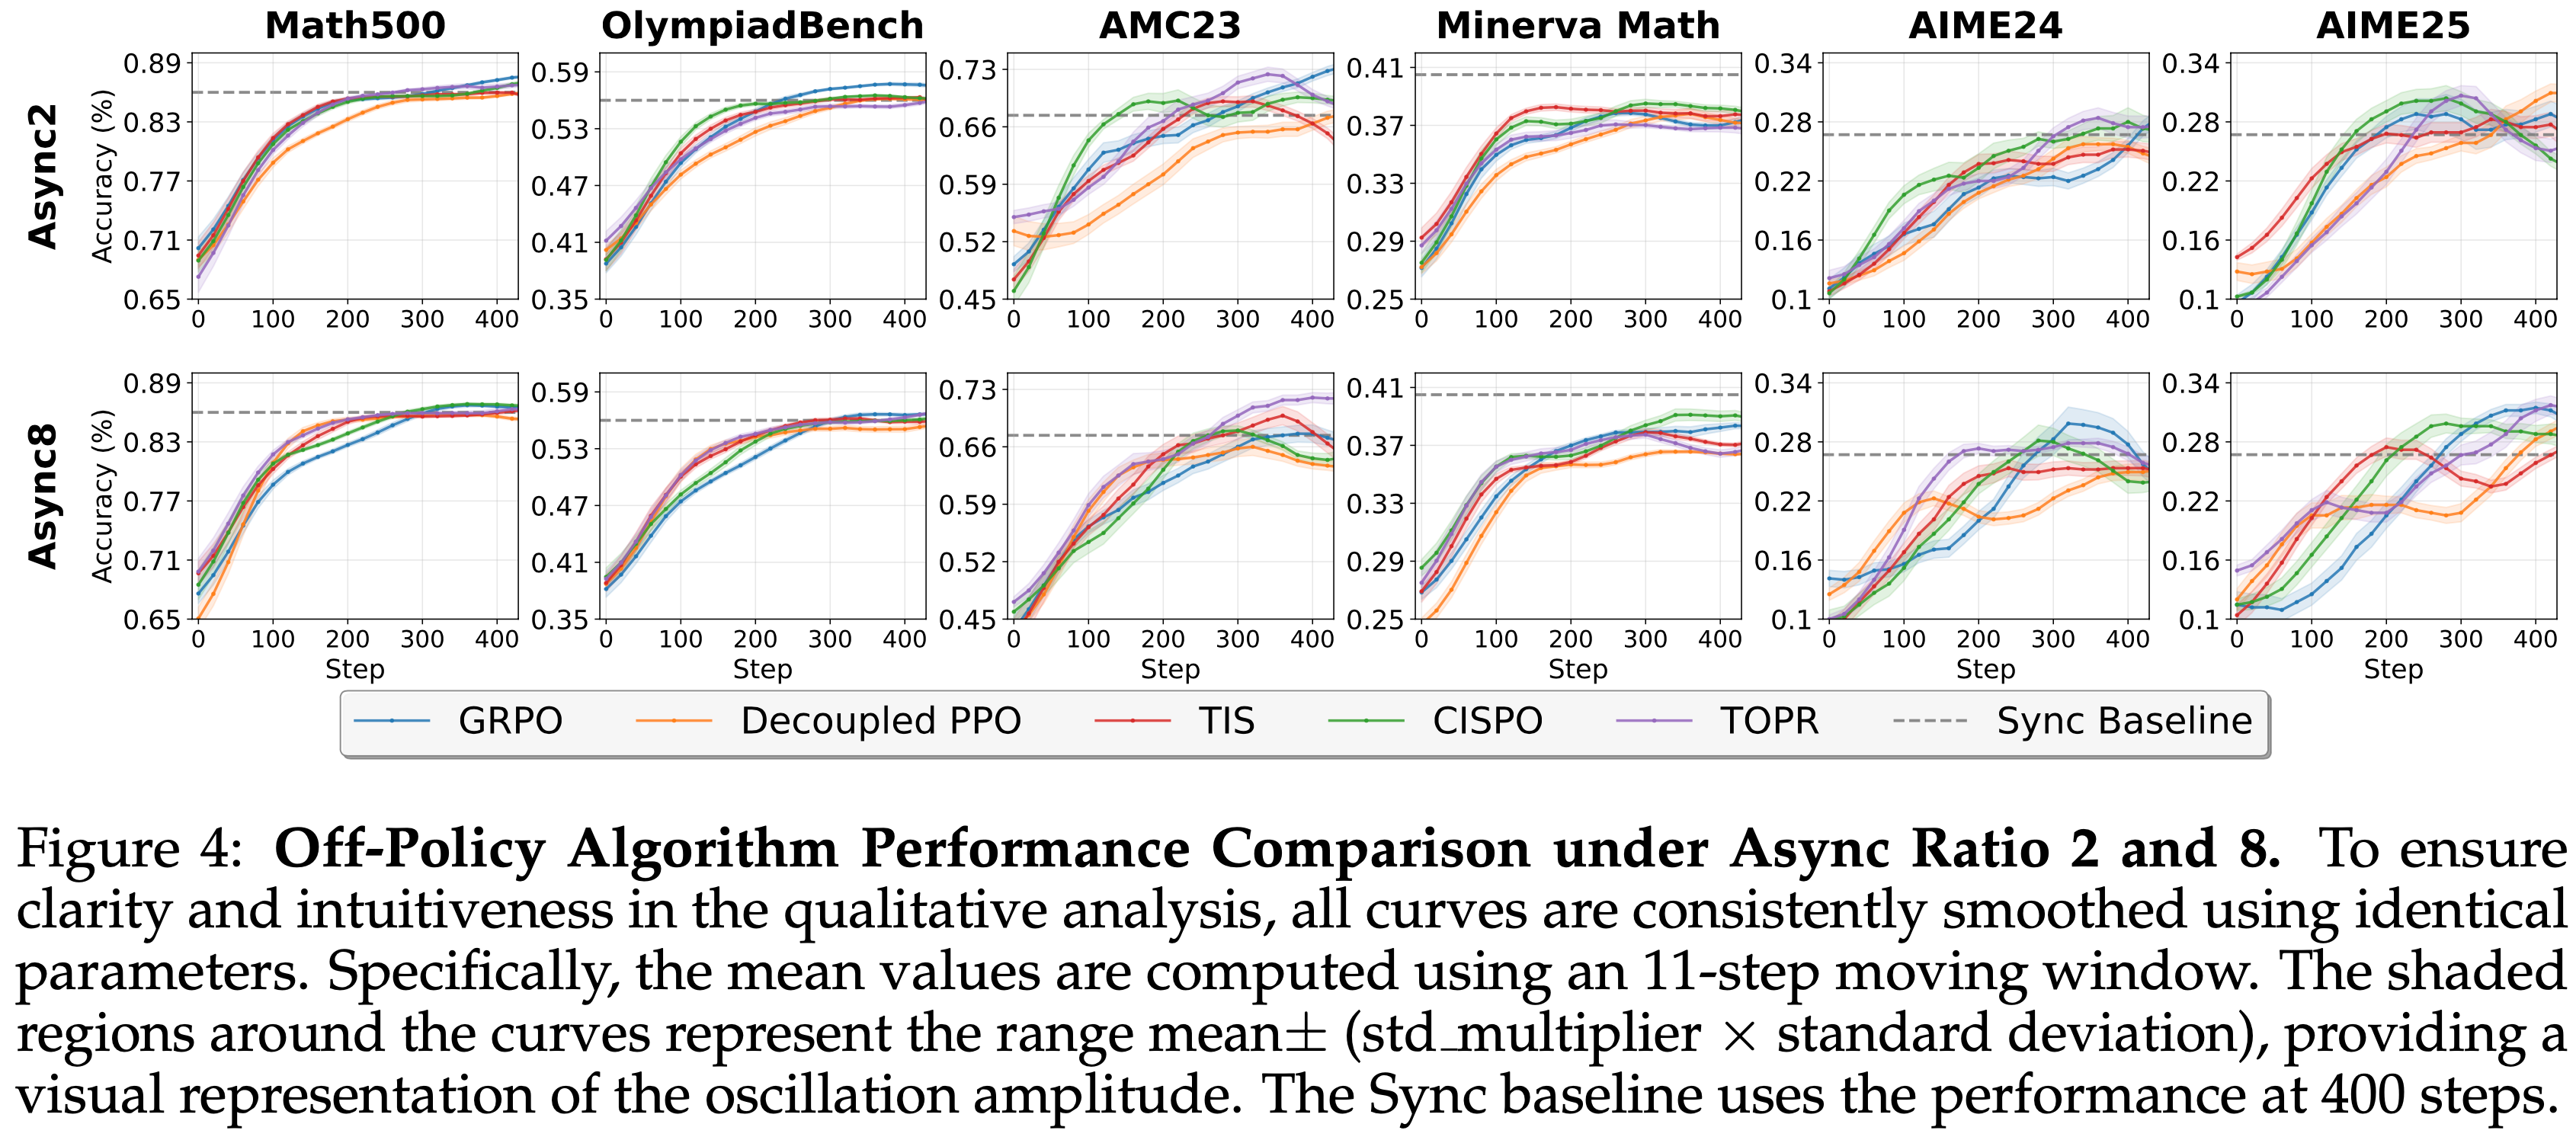
- 在异步比率为 2 和 8 的设置下,各种 Off-Policy 方法以及广泛使用的 GRPO 算法都能持续提供与同步训练相当的性能提升
- 虽然较小的异步比率在均衡工作负载下已经足够(要点 3),但一个关键问题仍然存在:
- 增加异步比率是否会损害稳定性或最终性能?
- 本文在 Qwen3-8B-Base 上使用标准的 GRPO 风格训练,采用较小的 Rollout 批量大小 32,在受控设置下评估不同异步比率下的流行 Off-Policy 算法
- 如图 4 所示,所有方法在各项基准测试中均实现了相当的 Pass@1 准确率,差异很小
- 异步变体在 Math500 和 OlympiadBench 上略优于同步基线,而在 Minerva Math 上略微落后
- 注:仅使用普通的 GRPO 就能产生强劲的性能
- 在重要性采样后简单裁剪目标 Response 区域外的 Token 已经提供了一个稳健的基线
- 注:还引入了加权 TOPR(Weighted TOPR),通过灵活平衡正负样本来提高稳定性,从而在各种训练场景中增强稳定性
- 对 图 4 的理解:
- 整体看:Async Ratio = 2 时,普遍优于 Async Ratio = 8 时,但是部分指标和方法上有不同,应该是波动导致
- 在部分指标上,比如 Minerva Math 上,异步训练的效果始终到不了同步效果
- 不管是 Async Ratio = 2/8,标准的 GRPO 就已经有不错的效果(理解:这是因为 GRPO 本身的 PPO IS 就是适配了 Off-policy 的)
- 问题:图 4 没有给出同步训练在各个 Step 下的结果,直接给了一个最终的结果(同步训练的最终 Step 未明确),不太严谨
- In Summary,异步训练能够可靠地实现有竞争力的性能,无需依赖特定算法的技巧或大量工程调优,证明了高吞吐量和训练保真度可以共存
Framework Design
Design Principles
- 引入了 ROLL Flash 的基础是两大设计原则:
- Rollout-训练解耦 (rollout-train decoupling)
- 细粒度并行 (fine-grained parallelism)
Rollout-Train Decoupling
- 启用异步训练需要管理陈旧性以防止显著的精度损失,并在 Rollout 和训练之间分配资源以最大化效率
- 为了提供灵活的控制,本文采用了一种 Rollout-训练解耦架构:
- 两个阶段的执行工作线程 (execution workers) 被放置在用户指定的资源上,并作为流水线运行
- 其核心在于,用户可以配置 Rollout 模型更新策略,从阻塞的同步更新过渡到非阻塞的异步更新
- 一旦更新变为非阻塞,Rollout 和训练阶段即可并行进行,从而最大化资源利用率和端到端吞吐量
- 用户还可以调整异步的频率(例如,异步比率)以减轻精度损失
Fine-grained Parallelism
- 本文启用了细粒度并行,以在 Rollout 阶段内执行 LLM 生成、环境交互和奖励计算
- 细粒度并行不是以完整批次 的方式进行这些阶段,而是在样本级别进行操作
- 这允许用户控制每个样本的生命周期,决定特定样本的每个阶段在何时何地执行
- 这使得 Rollout 流水线成为可能:一个样本的 LLM 生成可以与另一个样本的环境交互以及第三个样本的奖励计算重叠进行
- 细粒度并行通过 Prompt 复制 (prompt replication) 将 LLM 生成工作负载均匀地分布到各个 GPU 上,防止长尾 Rollout 集中在少数设备上并放大其不利影响
- 理解:这里的一个 Prompt 对应多个 Response,而 Prompt 往往决定了输出长度,所以需要打乱
- 注:本文中的样本粒度是 Response 或 Rollout 维度,不是 Prompt 维度
- 理解:这里的一个 Prompt 对应多个 Response,而 Prompt 往往决定了输出长度,所以需要打乱
Asynchronous Execution Workflow
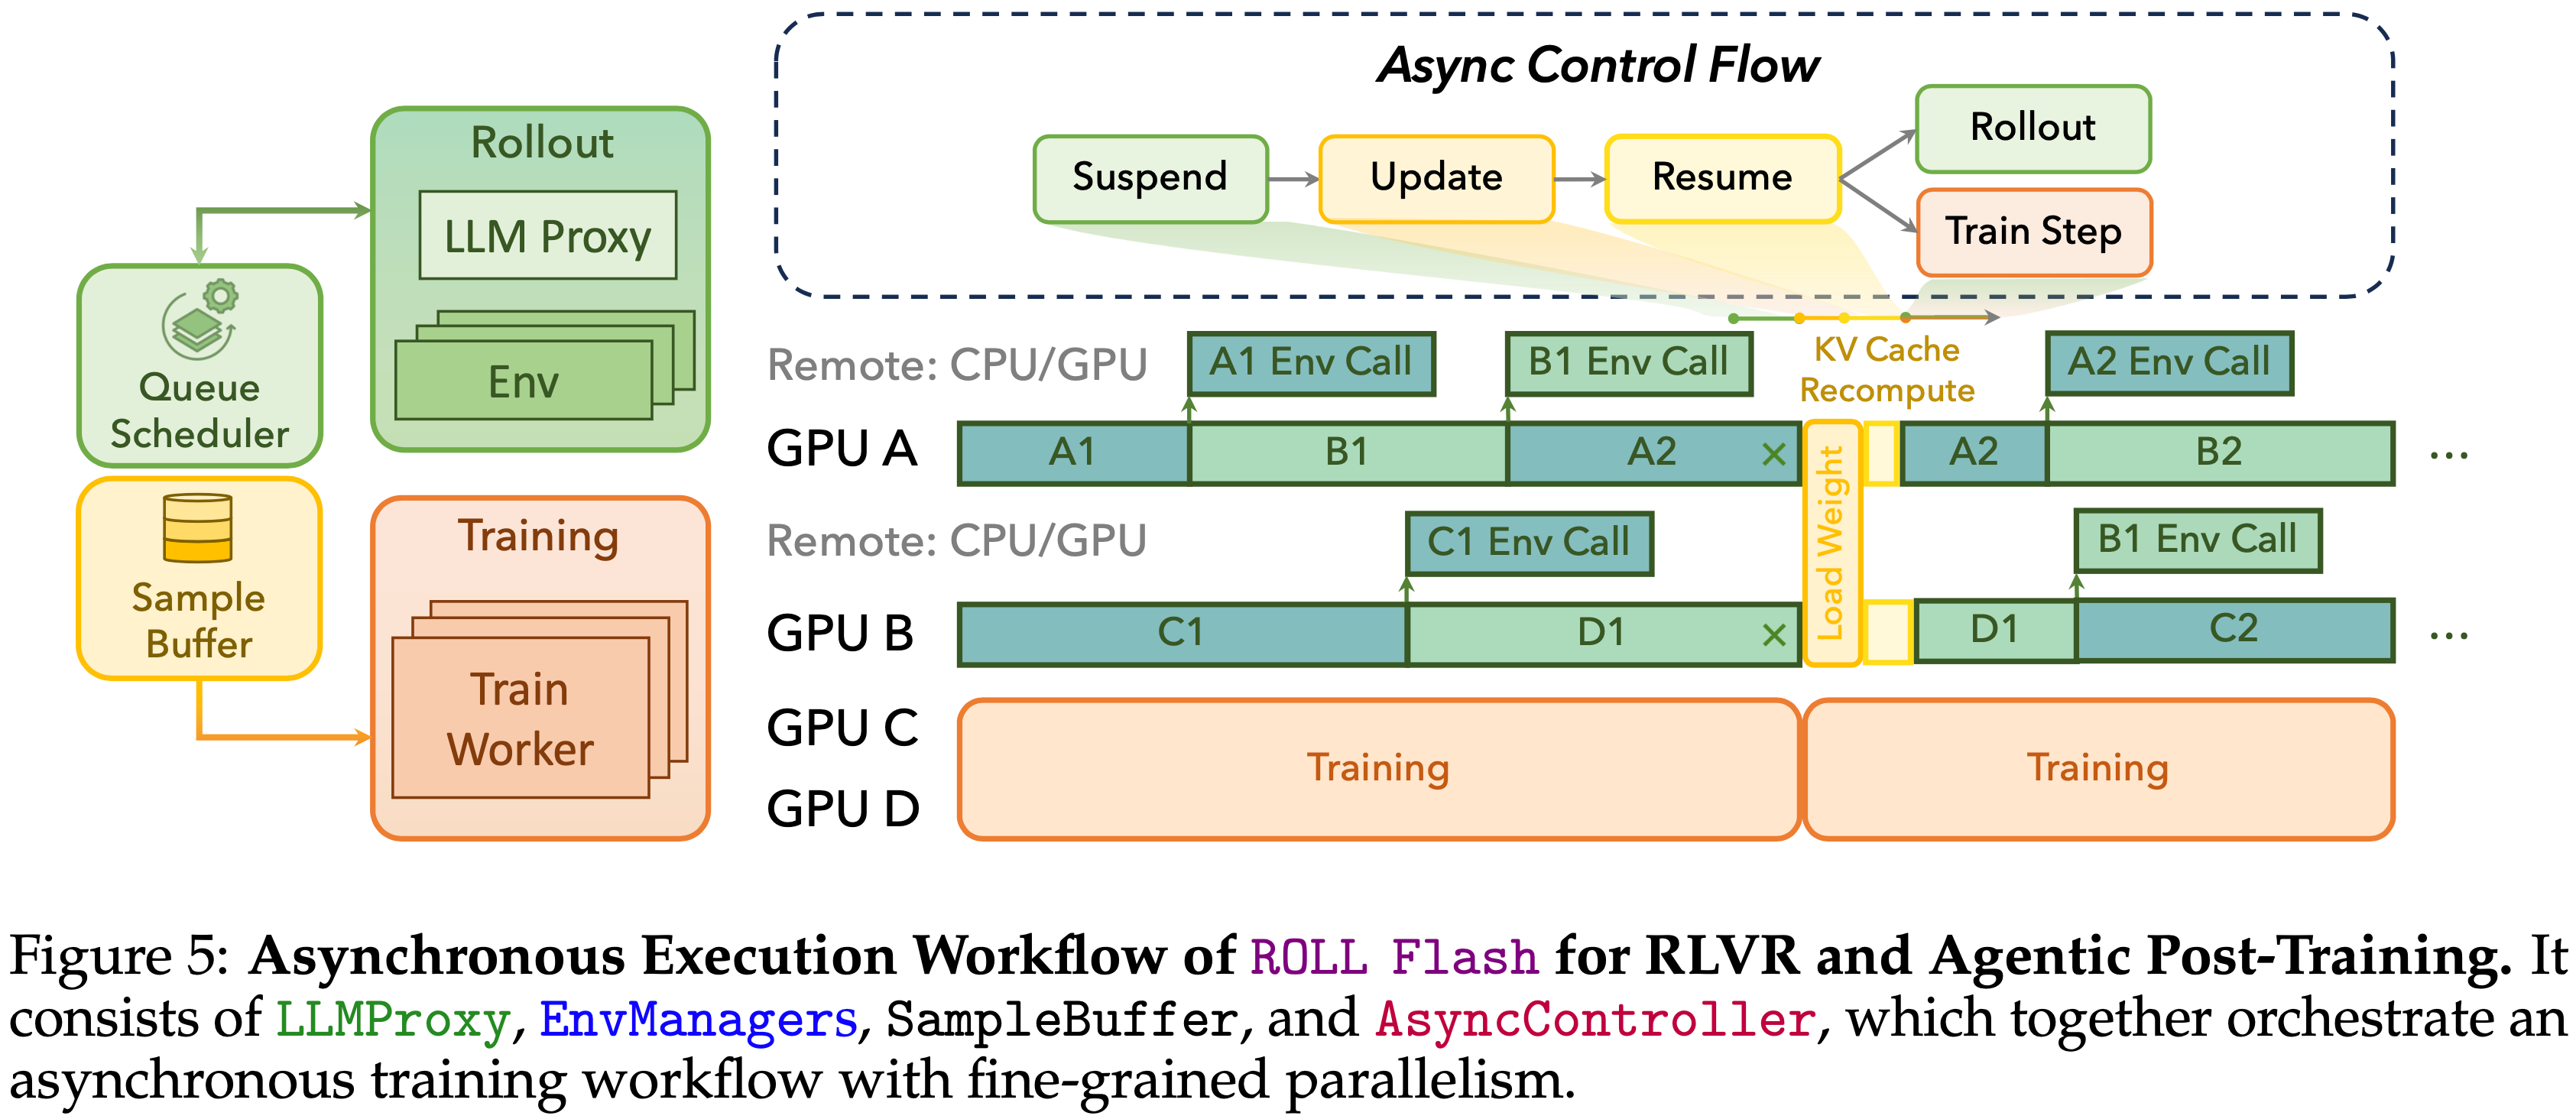
- 图 5 展示了 ROLL Flash 用于 RLVR 和 Agentic 后训练的异步执行工作流
- 该异步工作流以 Rollout 阶段为核心
- 在阶段内部,细粒度并行最大化 LLM 生成、环境和奖励之间的重叠
- 在阶段之间,Rollout-训练解耦架构并行化 Rollout 和训练的执行
- 本文为了清晰期间使用 Agentic RL 训练工作流来描述该系统
- ROLL Flash 由 LLMProxy、EnvManagers、SampleBuffer 和 AsyncController 组成
- 该异步工作流以 Rollout 阶段为核心
LLMProxy
- 为了编排 LLM 推理,ROLL Flash 引入了 LLMProxy
- LLMProxy 充当内部后端工作线程 (backend workers) 集群的编排器 (orchestrator),并由多个 EnvManager 共享
- 每个工作线程围绕一个命令驱动的事件循环 (command-driven event loop) 构建,该循环管理一个推理引擎(例如,vLLM)
- 该循环旨在最大化 GPU 利用率并实现完全异步
- 它持续且非阻塞地运行,提供三项核心服务:
- (1)逐步推理 (Step-wise Inference) :在每次迭代中,它通过对一批请求执行单次解码或预填充步骤来推进引擎,从而充分利用 GPU 资源
- (2)后处理 (Post-Processing) :每当引擎完成一个请求,它会立即触发一个注册的回调函数,该函数对输出进行后处理并将结果返回给发起客户端(例如,EnvManager)
- (3)处理命令 (Process Commands) :该循环持续处理从 proxy 分派的命令,包括
- ADD(将新请求加入队列)
- ABORT(中断正在运行的请求,并将其回收至 SampleBuffer 以供后续重新计算和生成)
EnvManager
- EnvManager 是基本的执行工作线程,支持细粒度的并行 Rollout
- 每个 EnvManager 通过 Reset 其环境来启动一个循环,然后进入一个独立的事件循环,该循环在其 BaseEnv 和共享的 LLMProxy 之间进行协调
- 在此循环中,EnvManager 从 LLMProxy 接收响应作为动作 (action),通过 step 将其应用于 BaseEnv,处理得到的观察结果 (observation),并重复此过程直到满足终止条件
- 通过这种细粒度的 Rollout,ROLL Flash 将 LLM 解码与数千个环境的执行重叠
- 当轨迹完成时,EnvManager 立即触发奖励计算,该计算与正在进行的 Rollout 并行进行
- 通过解耦样本级和环境级的执行,该设计实现了跨组件的样本级执行,达到了高度的并行性并最大化了吞吐量
AsyncController
- ROLL Flash 通过 AsyncController 和共享的 SampleBuffer 运行异步训练流水线
- 一组 EnvManager 进程充当独立的生产者:它们生成轨迹并将其加入 SampleBuffer 队列
- 在每次训练步骤中,AsyncController 执行 Rollout 阶段和训练阶段之间的权重同步,分为三个阶段:
- Step 1:AsyncController 发出 suspend 以暂停轨迹收集
- 注:suspend 会暂停 Rollout 过程,但这是一个极其短暂、细粒度的“暂停”,而不是一个长时间的“停止”
- 从图 1 看,这里的 suspend 应该是立即终止生成,下一个 Token 就是新的模型参数生成的了,所以同一个 Response 可能有多个 Policy 的结果
- Step 2:执行
model_update(通过获取并将最新权重广播到所有 LLM 服务工作线程) - Step 3:发送 resume 以便 EnvManager 继续使用更新后的模型收集轨迹
- 在实践中,模型更新的开销仅占总训练时间的一小部分,不会阻碍 Rollout 的进行
- Step 1:AsyncController 发出 suspend 以暂停轨迹收集
- 在每次训练迭代期间,AsyncController 向 SampleBuffer 发出阻塞式
get_batch调用以获取一个小批量的轨迹,然后对检索到的数据执行train_step - 在异步模式下,训练阶段与 Rollout 阶段重叠,EnvManager 和 LLM 服务工作线程继续并行收集下一批数据
- ROLL Flash 也可以轻松切换回同步模式:在
get_batch之后立即调用 suspend 会暂停轨迹收集,确保所有后续轨迹都使用最新的模型权重生成 - 通过这种异步设计,用户无需实现复杂的并发控制或定制的通信方案
- 可选的 Barrier 可以放置在 LLMProxy、EnvManager 和 AsyncController 中,以支持不同的训练模式(例如,异步训练、批量 Rollout)
- 在缺少这些 Barrier 的情况下,流水线保持完全异步,允许训练过程持续充分利用可用资源
- 基于这些组件,我们可以配置一个异步比率 (asynchronous ratio) 来控制异步的程度,从而在性能和训练效率之间取得平衡
Asynchronous Ratio
- 图 1a 和图 5 中 展示了作者的 Rollout-训练解耦架构
- 在 SampleBuffer 中,响应生成可能会被中断,并在更新策略 LLM 下恢复执行
- 因此,响应样本是由多个策略 LLM 版本生成的
- 注:这里一个 Response 来源于多个不同策略修正靠下面的方法实现的:
- 第一步:逐 token 保留真实生成时的 logprob,存为 infer_logprobs(混合策略)
- 第二步:通用的 train-infer correction:用 exp(old_log_probs - infer_logprobs) 算 IS 权重 + 过滤 ratio 离群 token,把 partial 的混合策略偏差当作”推理≠训练”的 mismatch 一并吸收。
- 注:这里一个 Response 来源于多个不同策略修正靠下面的方法实现的:
- 由陈旧策略产生的样本可能会引入高方差,破坏训练稳定性
- 因此,响应样本是由多个策略 LLM 版本生成的
- AREaL (2025) 通过控制批次内 样本的平均新鲜度(average sample freshness) 来缓解这一问题
- AREaL 中是 优先从数据缓冲区中选择较旧的轨迹组成训练批次
- 理解:这里的 average sample freshness 是一个 Batch 内所有样本的平均 Freshness,Freshness 越大,Staleness 越小,样本越新
- 对于单个 Response,其 staleness 的是生成当前 Response 的最早 Policy 版本决定的(
curr_version - first_version)
- 对于单个 Response,其 staleness 的是生成当前 Response 的最早 Policy 版本决定的(
- ROLL Flash 引入了异步比率 \(\alpha\) 来规范每个样本的新鲜度
- 异步比率 \(\alpha\) 针对每个样本定义为当前策略版本号与发起该样本生成的策略版本号之间允许的最大差距
- 如果策略网络已前进到版本 \(n\),则 SampleBuffer 中的任何样本都必须由不早于 \((n - \alpha)\) 的策略版本发起
- SampleBuffer 的大小上限为 \((1 + \alpha) \times\) batchsize 个样本,并且没有样本被浪费,因为永远不会生成违反新鲜度约束的样本
- \(\alpha\) 可以是非负整数或实数
- 理解:\(\alpha\) 控制了 SampleBuffer 的数量
- 如果训练 Step 太快,比如一次生成还未完成已经进行了多次更新,这是不可能的,因为每次更新参数都要消耗 B 个 Prompt/样本
- 注意:\(\alpha\) 能够控制最小新鲜度的前提是(即 \(\alpha = \max(\text{staleness})\)):
- 前提1:
get_batch总是获取最旧的数据(即先进先出队列),否则可能出现部分数据一直未被抽取到训练而最终过期的情况- 论文中没有明确提到,但开源框架实现中使用的是类似
self.finished_prompts.popleft()的函数,这是个先进先出队列的实现 - 注:AREaL 论文中是 明确提到优先从数据缓冲区中选择较旧的轨迹组成训练批次
- 论文中没有明确提到,但开源框架实现中使用的是类似
- 前提2:每次训练后都必须同步参数到 Rollout 引擎中,若参数更新后没有被同步到 Rollout 引擎,则可能会有无限大的 Staleness
- 原论文中有 每次训练步骤中,AsyncController 执行 Rollout 阶段和训练阶段之间的权重同步
- 同步时,会发出 suspend 以暂停轨迹收集,所以这里保证了每一轮更新后的参数都被同步到 Rollout Engine 上
- 理解:注意,这里不能跨任何步数,必须是每一步都同步,否则就可能导致 \(\alpha\) 不能严格对应最大 staleness
- 原论文中有 每次训练步骤中,AsyncController 执行 Rollout 阶段和训练阶段之间的权重同步
- 前提1:
- 理解:永远没有样本被浪费情况下,超长样本的处理逻辑:
- 情况1:对于一个样本,如果多次训练后都还没生成完,它会阻塞其他新样本进入 Rollout
- 情况2:及时识别到已经过期,直接丢弃(作者认为这时候不算是浪费)
- 通过排查代码,使用的是情况 2,
ReplayBuffer.gc()函数会根据当前的 Step 和self.async_generation_ratio(对应 \(\alpha\)) 换算当前能留下的样本,超过 staleness 的 Prompt 会被 drop,其他在源码中看到相关的发现如下:- 这里超过的依据是起始 Step(
start_step),不是平均值啥的(其实这样才对) - Drop 掉的 Prompt 会被回收(合理)
- 这里 drop 是 Prompt 维度的,同一个 Prompt 的所有 Rollout 共享一个
sampling_start_step,sampling_start_step是 Prompt 维度的导致了一个 Prompt 需要丢弃时是同时丢弃所有 Rollout 的- 实际操作中,
sampling_start_step可能不严格,因为获取sampling_start_step的时间和真实开始时间可能会有 Diff
- 实际操作中,
- 这里超过的依据是起始 Step(
- 在 SampleBuffer 中,响应生成可能会被中断,并在更新策略 LLM 下恢复执行
Detailed Design in RLVR and Agentic Pipeline
RLVR Pipeline
Queue Scheduling
- 在传统的 RL 后训练 Pipeline 中,Rollout 是严格同步和批处理的:
- 一组 Prompt 作为一个批次进行处理,LLM 必须完成为所有 Prompt 的生成,之后才能开始任何奖励计算或过滤
- 这造成了落后者瓶颈 (straggler bottleneck),因为最长的序列决定了批次的完成时间,导致显著的 GPU 利用率不足、高 Rollout 延迟和大量开销
- ROLL Flash 专注于细粒度并行,并采用队列调度 (Queue Scheduling) 来解决这些限制
- 每个 Prompt 被视为一个独立的 Rollout 任务,并加入队列进行动态调度
- 一旦生成一个响应,它会被立即分发给奖励工作线程进行评估,而无需等待批次中的其余部分完成
- 奖励计算与正在进行的生成重叠,消除了流水线气泡并减少了 GPU 空闲时间
- 此设计带来两个关键优势:
- (1)通过在不同长度的响应上持续保持计算资源繁忙,显著提高了 GPU 利用率
- (2)在具有冗余 Prompt 的动态过滤场景中,它加速了高质量样本的收集,从而提高了整体训练吞吐量
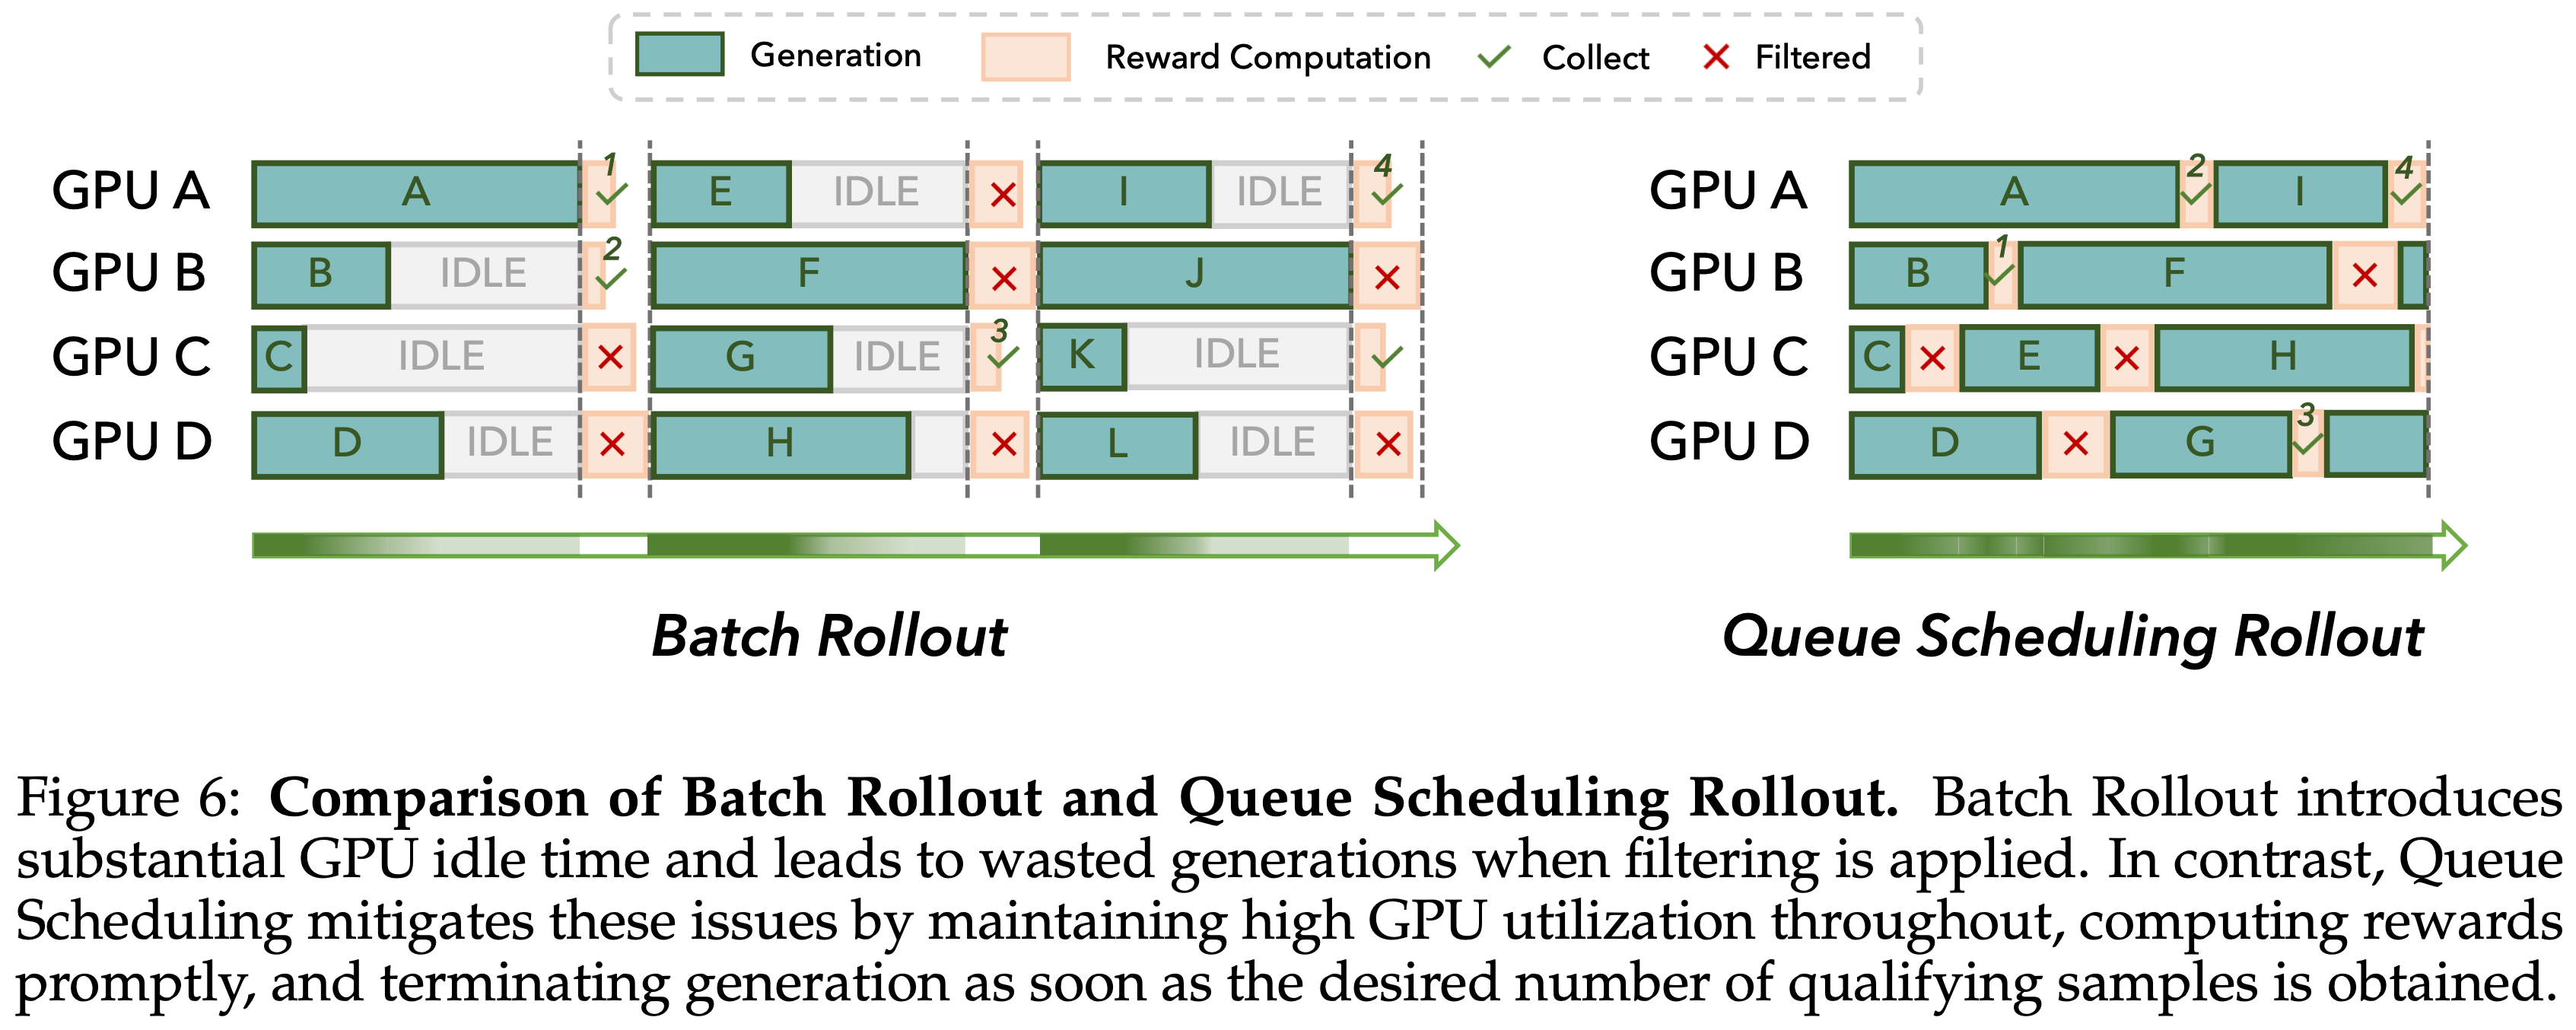
- 图 6 清晰地展示了队列调度 Rollout 所带来的优势
- 批量 Rollout 和队列调度 Rollout 的比较
- 批量 Rollout 引入了大量的 GPU 空闲时间,并在应用过滤时导致生成浪费
- 队列调度通过在整个过程中保持高 GPU 利用率、及时计算奖励,并在获得所需数量的合格样本后立即终止生成,从而缓解了这些问题
Experimental Evaluation
- 本文在动态过滤条件下实证评估了队列调度的有效性
- 在同步基线中,奖励计算推迟到整个批次生成完成后进行
- 在本文设置中,为每个 Prompt 生成 \(k = 8\) 个响应,允许最多 16 个额外的并发 Prompt ,并过滤掉组内方差为零的样本
- 比较了队列调度(有和没有冗余生成)与基线在不同批量大小下的表现
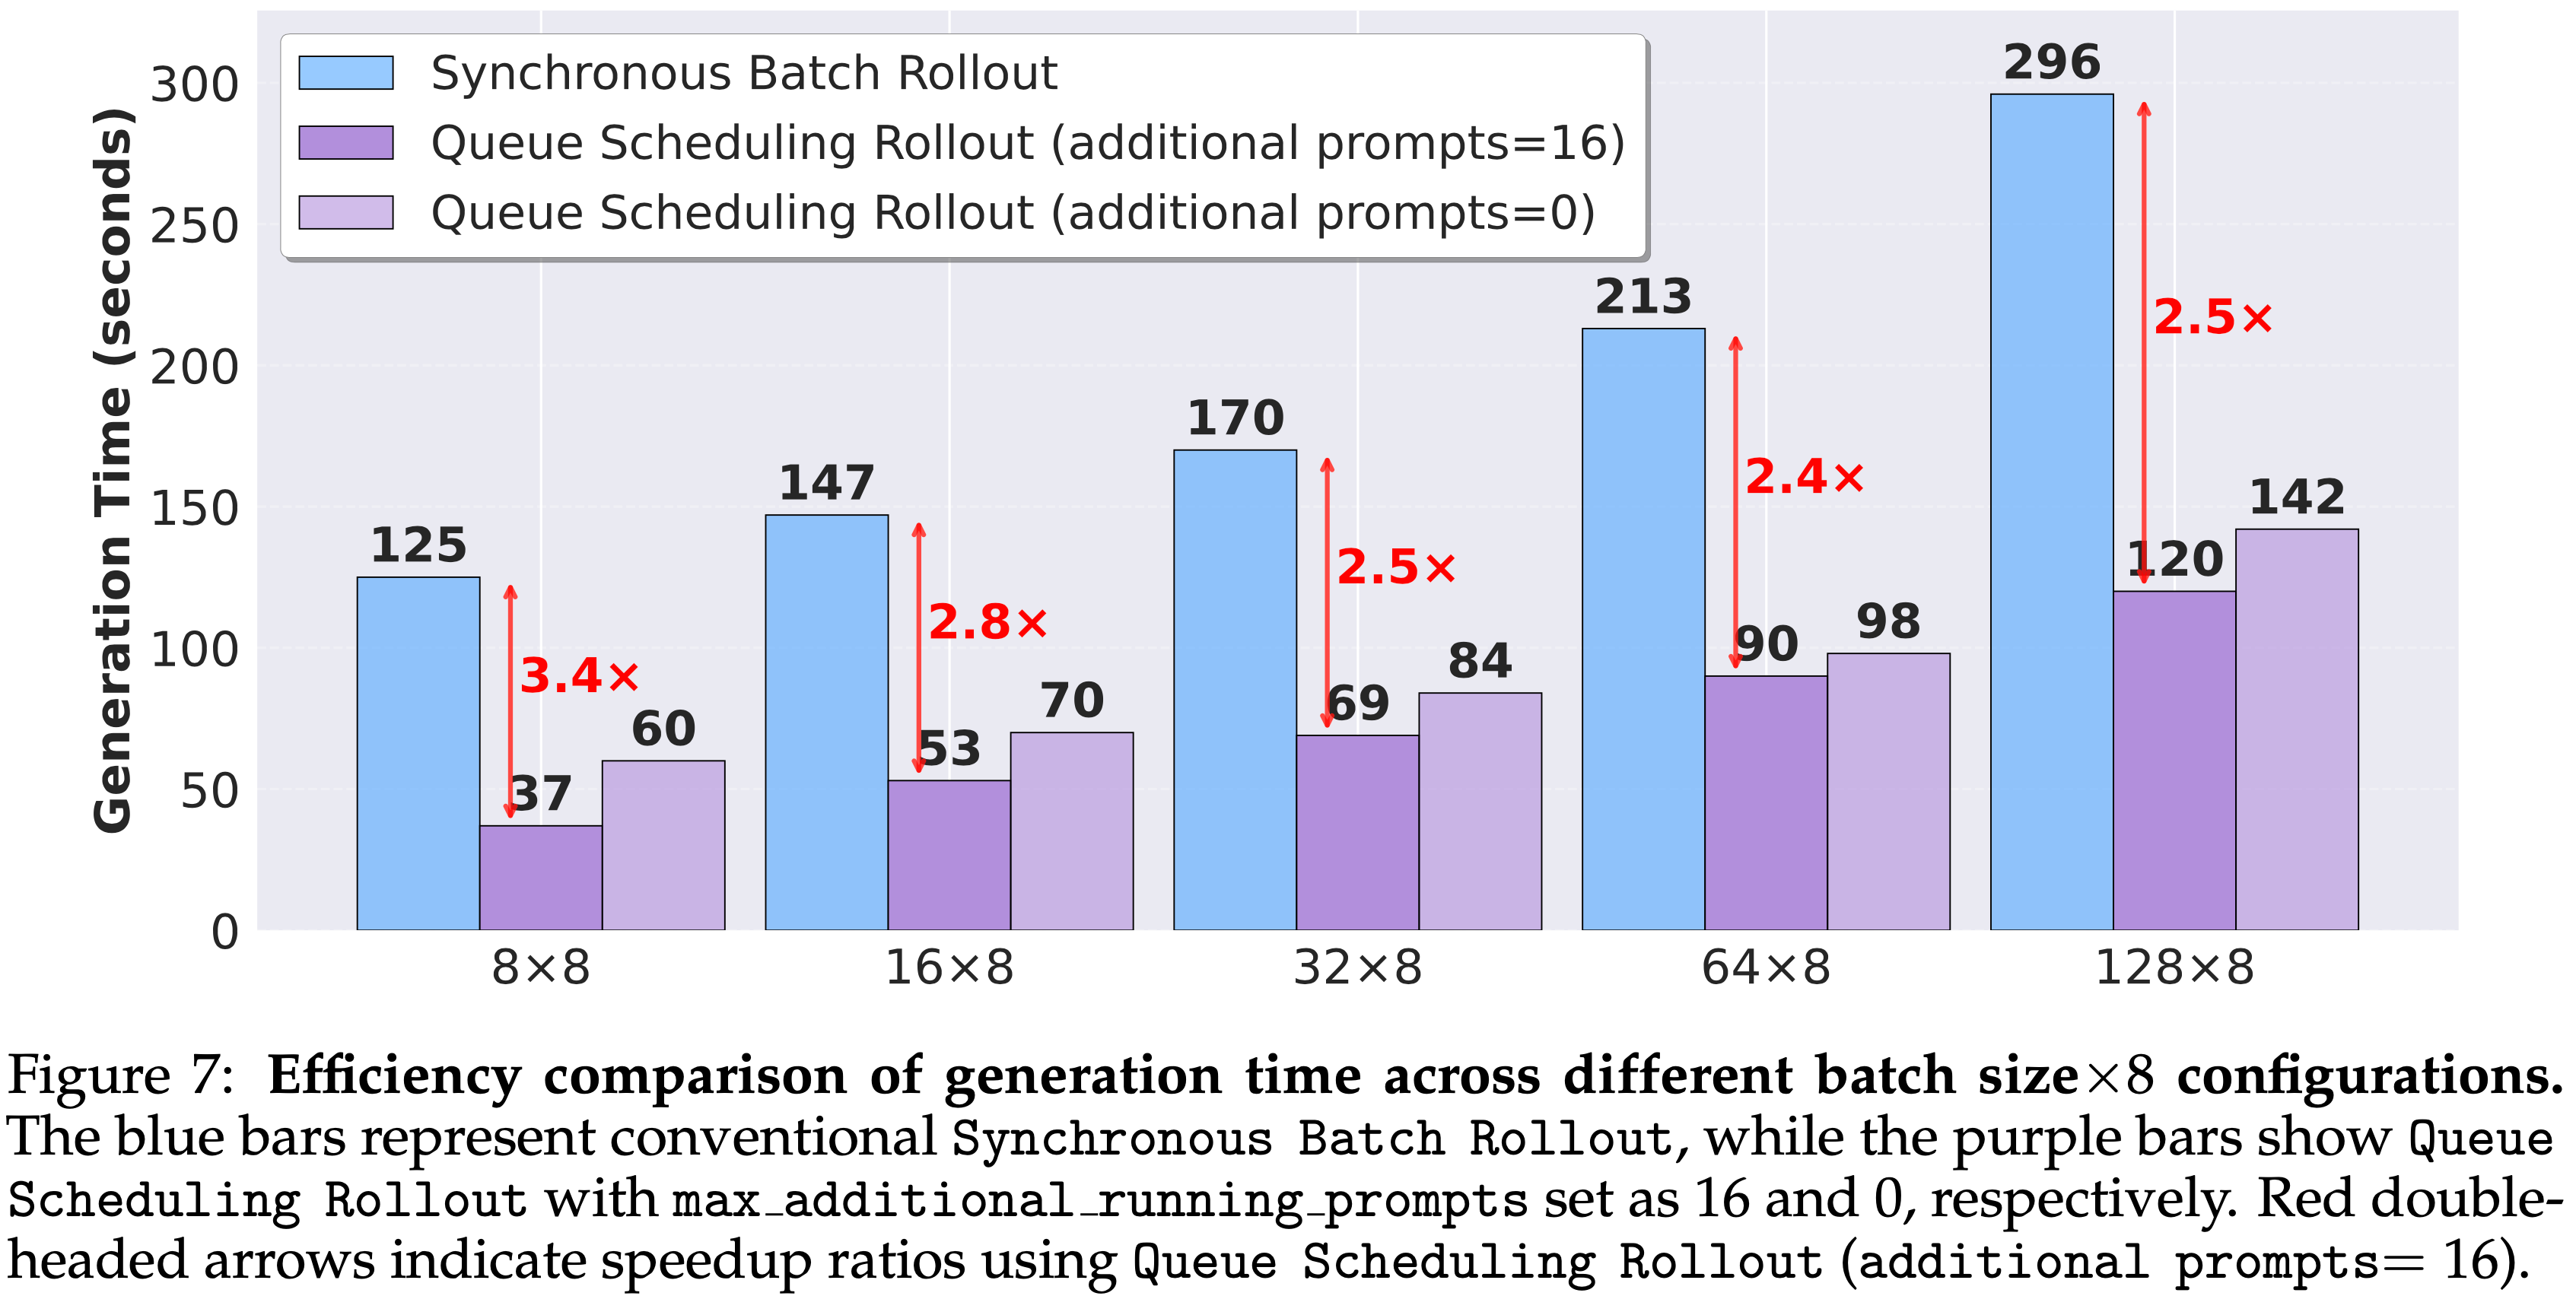
- 如图 7 所示,队列调度减少了平均每步生成时间
- 在有 16 个冗余 Prompt 和 \(8 \times 8\) 配置(8 个 Prompt,每个 8 个响应)下,平均每步生成时间从 125 秒降至 37 秒(3.4 倍加速)
- 对于更大的批量大小也观察到类似的收益,并且该收益随着冗余度和过滤强度的增加而增长
- 这些结果证实,队列调度有效地提高了 Rollout 流水线的效率,尤其是在动态过滤场景中
- 红色双箭头表示使用队列调度 Rollout(additional prompts \(= 16\))的加速比
Prompt Replication
- ROLL Flash 实现了 Prompt 复制 (Prompt Replication) 以进一步提高 Rollout 效率
- 该机制缓解了多候选解码中固有的同步瓶颈
- RL 训练 通常设置
num_return_sequences\(>\) 1 以在 Rollout 期间为单个 Prompt 生成多个响应 (2024)- 这强制单个工作线程同步解码所有 \(n\) 个响应
- ROLL Flash 通过标志
is_num_return_sequences_expand将每个 Prompt 扩展为 \(n\) 个独立的 Rollout 任务,每个任务生成单个响应- 这种解耦允许来自同一 Prompt 的候选者运行在不同的 GPU 上并被独立调度,从而减少了由异构响应长度引起的流水线气泡
- 如图 1a 所示,复制 Prompt C 并将其候选响应(C1 和 C2)调度在不同的 GPU 上有效地减少了这些气泡
- 问题:锁定在同一块 GPU,目的是复用 prompt 前缀的 KV-cache 吧
- 推测: “消除木桶效应(长尾阻塞)”的优先级远高于“优化单卡 Prefill 计算”
- 注:源码中似乎没实现 Prompt Replication 的功能
- 源码中,
is_num_return_sequences_expand=True不会把同一 prompt 的 response 分到不同 GPU - 它把采样拆成 N 个独立 request(从而每个能独立续写),但路由按 uid=prompt_id 走,id_to_dp_rank 把整组锁在同一块 GPU 上复用了 prefix cache
- 源码中,
Experimental Evaluation
- 本文量化了 Prompt 复制在不同 batch_size 和
num_return_sequences配置下的影响 - 首先,固定
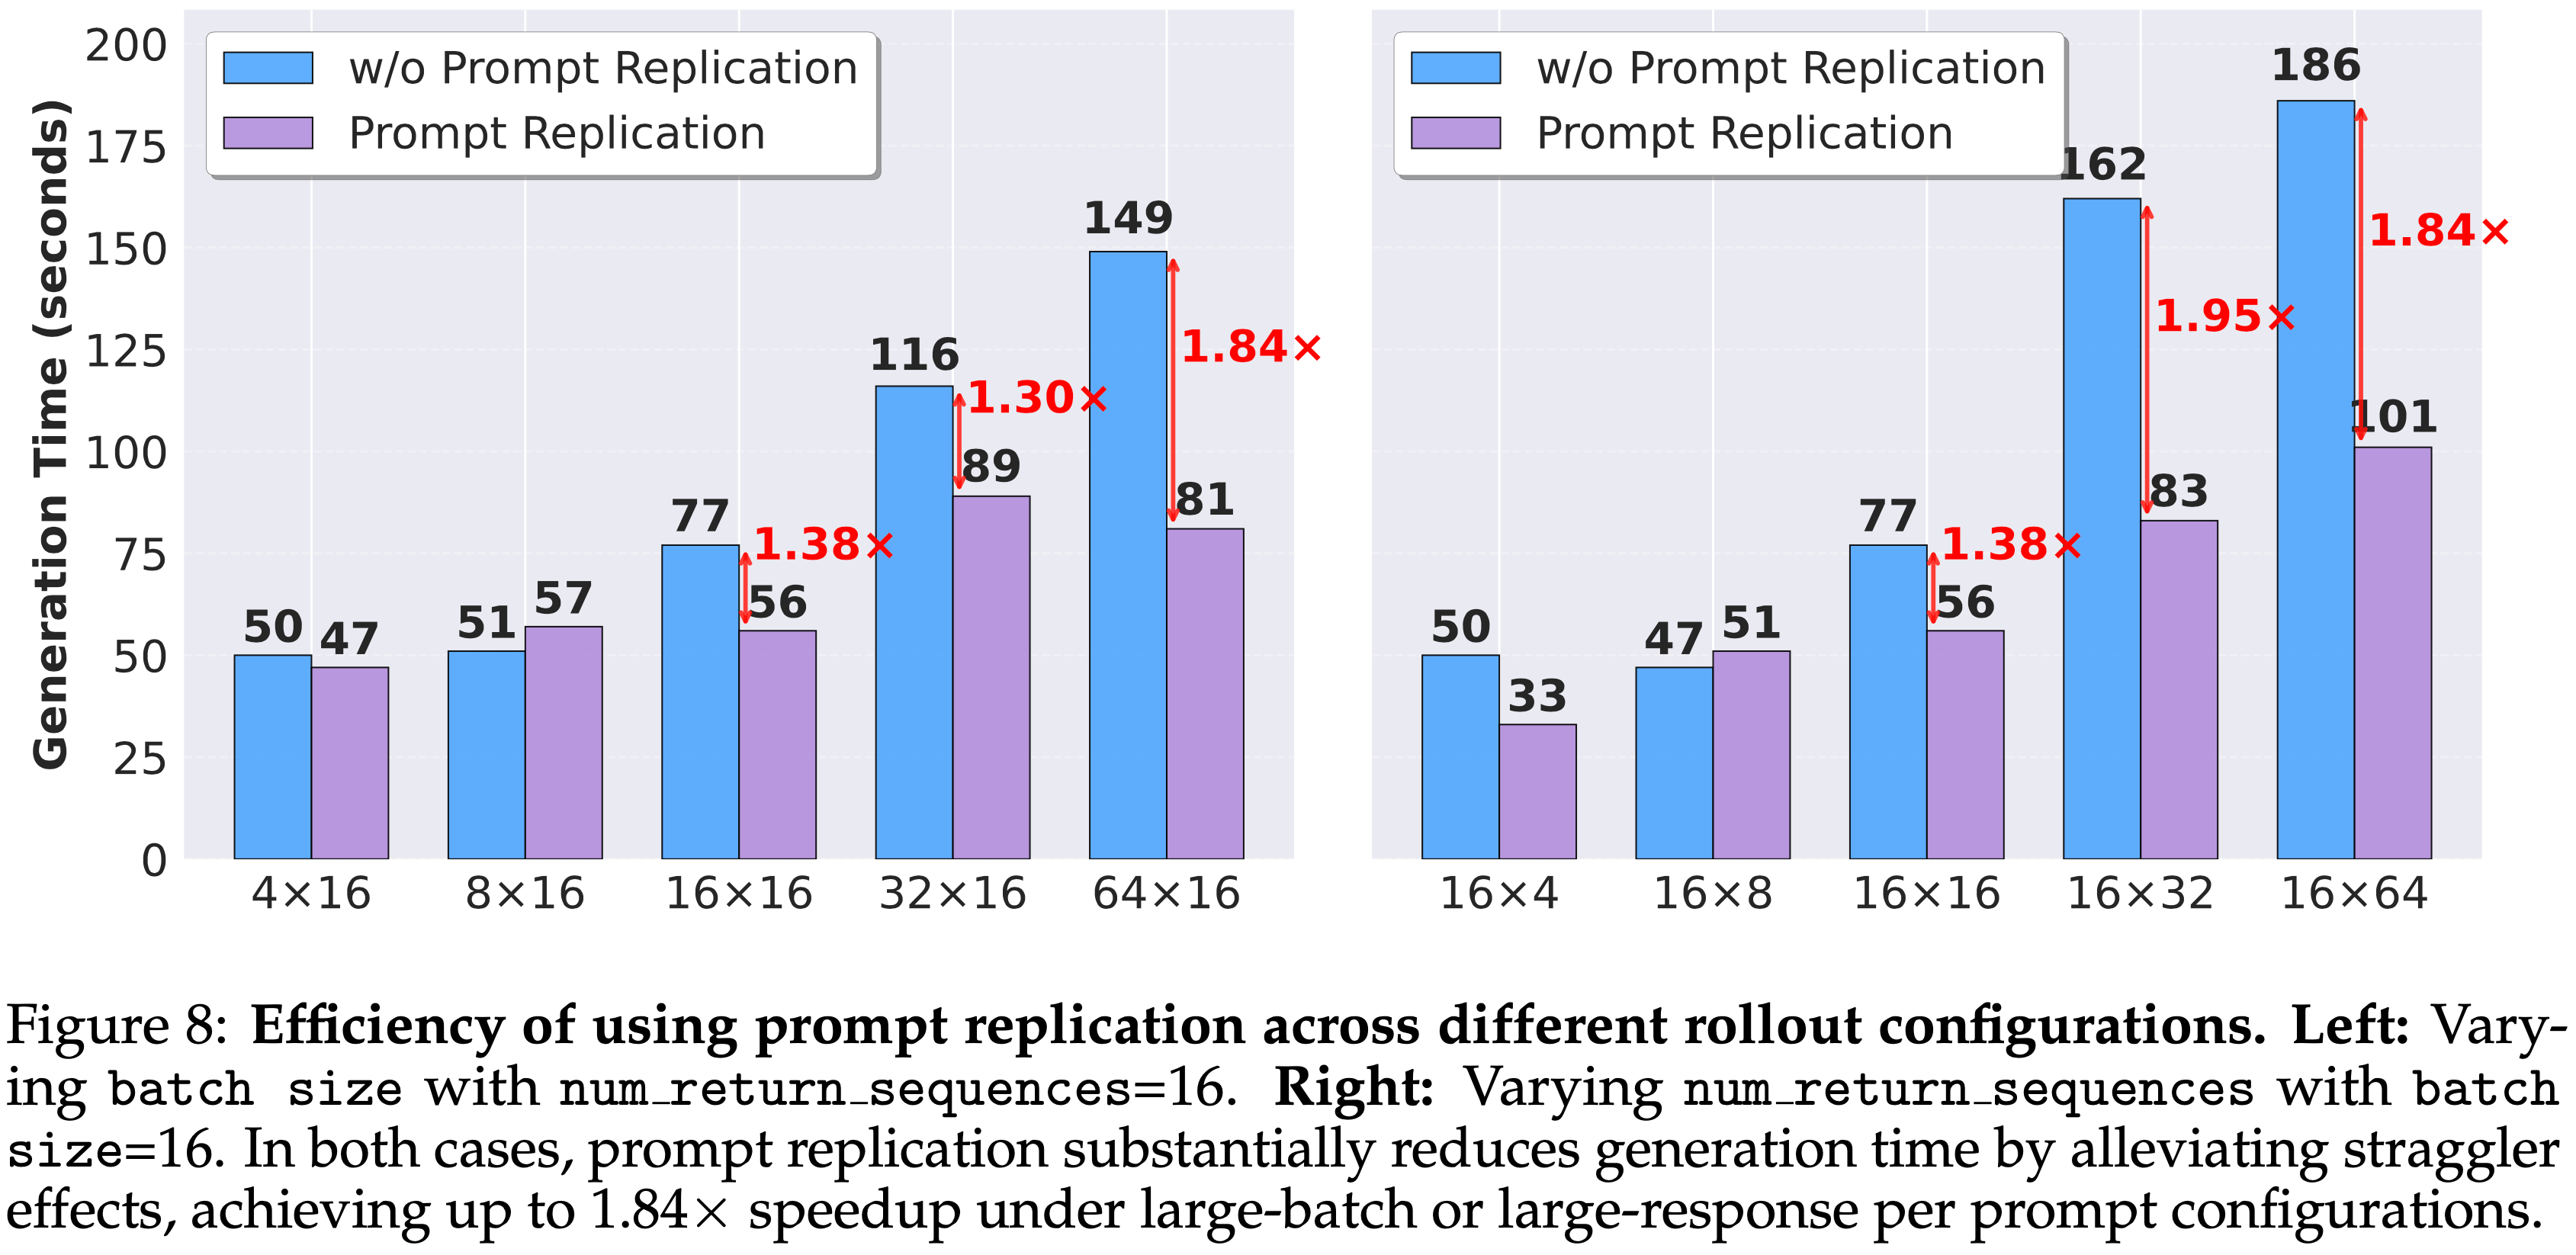
num_return_sequences为 16,并将 batch_size 从 4 扩展到 64- 如图 8 所示,Prompt 复制在小批量大小时收益有限,但在中等规模以上通过减轻长尾落后者和减少平均步长时间提供了显著的改进
- 在 \(32\times 16\) 时,延迟从 116 秒降至 89 秒(\(1.30\times\) 加速)
- 在 \(64\times 16\) 时,延迟从 149 秒降至 81 秒(\(1.84\times\) 加速)
- 如图 8 所示,Prompt 复制在小批量大小时收益有限,但在中等规模以上通过减轻长尾落后者和减少平均步长时间提供了显著的改进
- 其次,固定 batch_size 为 16,并将
num_return_sequences从 4 增加到 64- 随着候选者数量的增长,Prompt 复制持续提升效率
- 在 \(16\times 32\) 时,步长时间从 162 秒降至 83 秒(\(1.95\times\) 加速),在 \(16\times 64\) 时,仍然实现了 \(1.84\times\) 的加速
- 图 8: 在不同 Rollout 配置下使用 Prompt 复制的效率
- 左图:批量大小变化,
num_return_sequences\(= 16\) - 右图:
num_return_sequences变化,batch size \(= 16\) - 在两种情况下,Prompt 复制通过减轻落后者效应显著减少了生成时间,在大批量或每个 Prompt 大响应数的配置下实现了高达 \(1.84\times\) 的加速
- 左图:批量大小变化,
- In Summary ,这些结果证实了 Prompt 复制能够实现细粒度的 Rollout 内并行,有效地带来显著的效率提升
Agentic Pipeline
- 在 Agentic 流水线中,单个轨迹涉及与复杂外部环境(如 SWE (2023)、ALFWorld (2020) 和 ShopSimulator (2025a))的多轮交互,这些环境的执行延迟变化很大且故障常见
- 尽管大多数 Rollout 在几秒钟内完成,但有些会因环境初始化和网络延迟而延长至几分钟
- 这种显著的长尾延迟严重影响了训练效率,并催生了两个关键设计:
- 环境级异步 Rollout (environment-level asynchronous rollout)
- 冗余环境 Rollout (redundant environment rollout)
Environment-Level Asynchronous Rollout
- 为了减少环境交互期间的 GPU 空闲,本文设计了一种环境级异步 Rollout
- 将每个轨迹分解为一系列细粒度的、环境级的交互单元
- 一旦一个轨迹开始与环境交互以接收反馈,SampleBuffer 中待处理的轨迹会立即被分发给可用的 LLM 服务工作线程,以继续生成响应(即动作)
Experimental Evaluation
- 本文首先进行受控模拟,其中环境延迟从具有均值 \((\mu)\) 和标准差 \((\sigma)\) 的高斯分布中采样
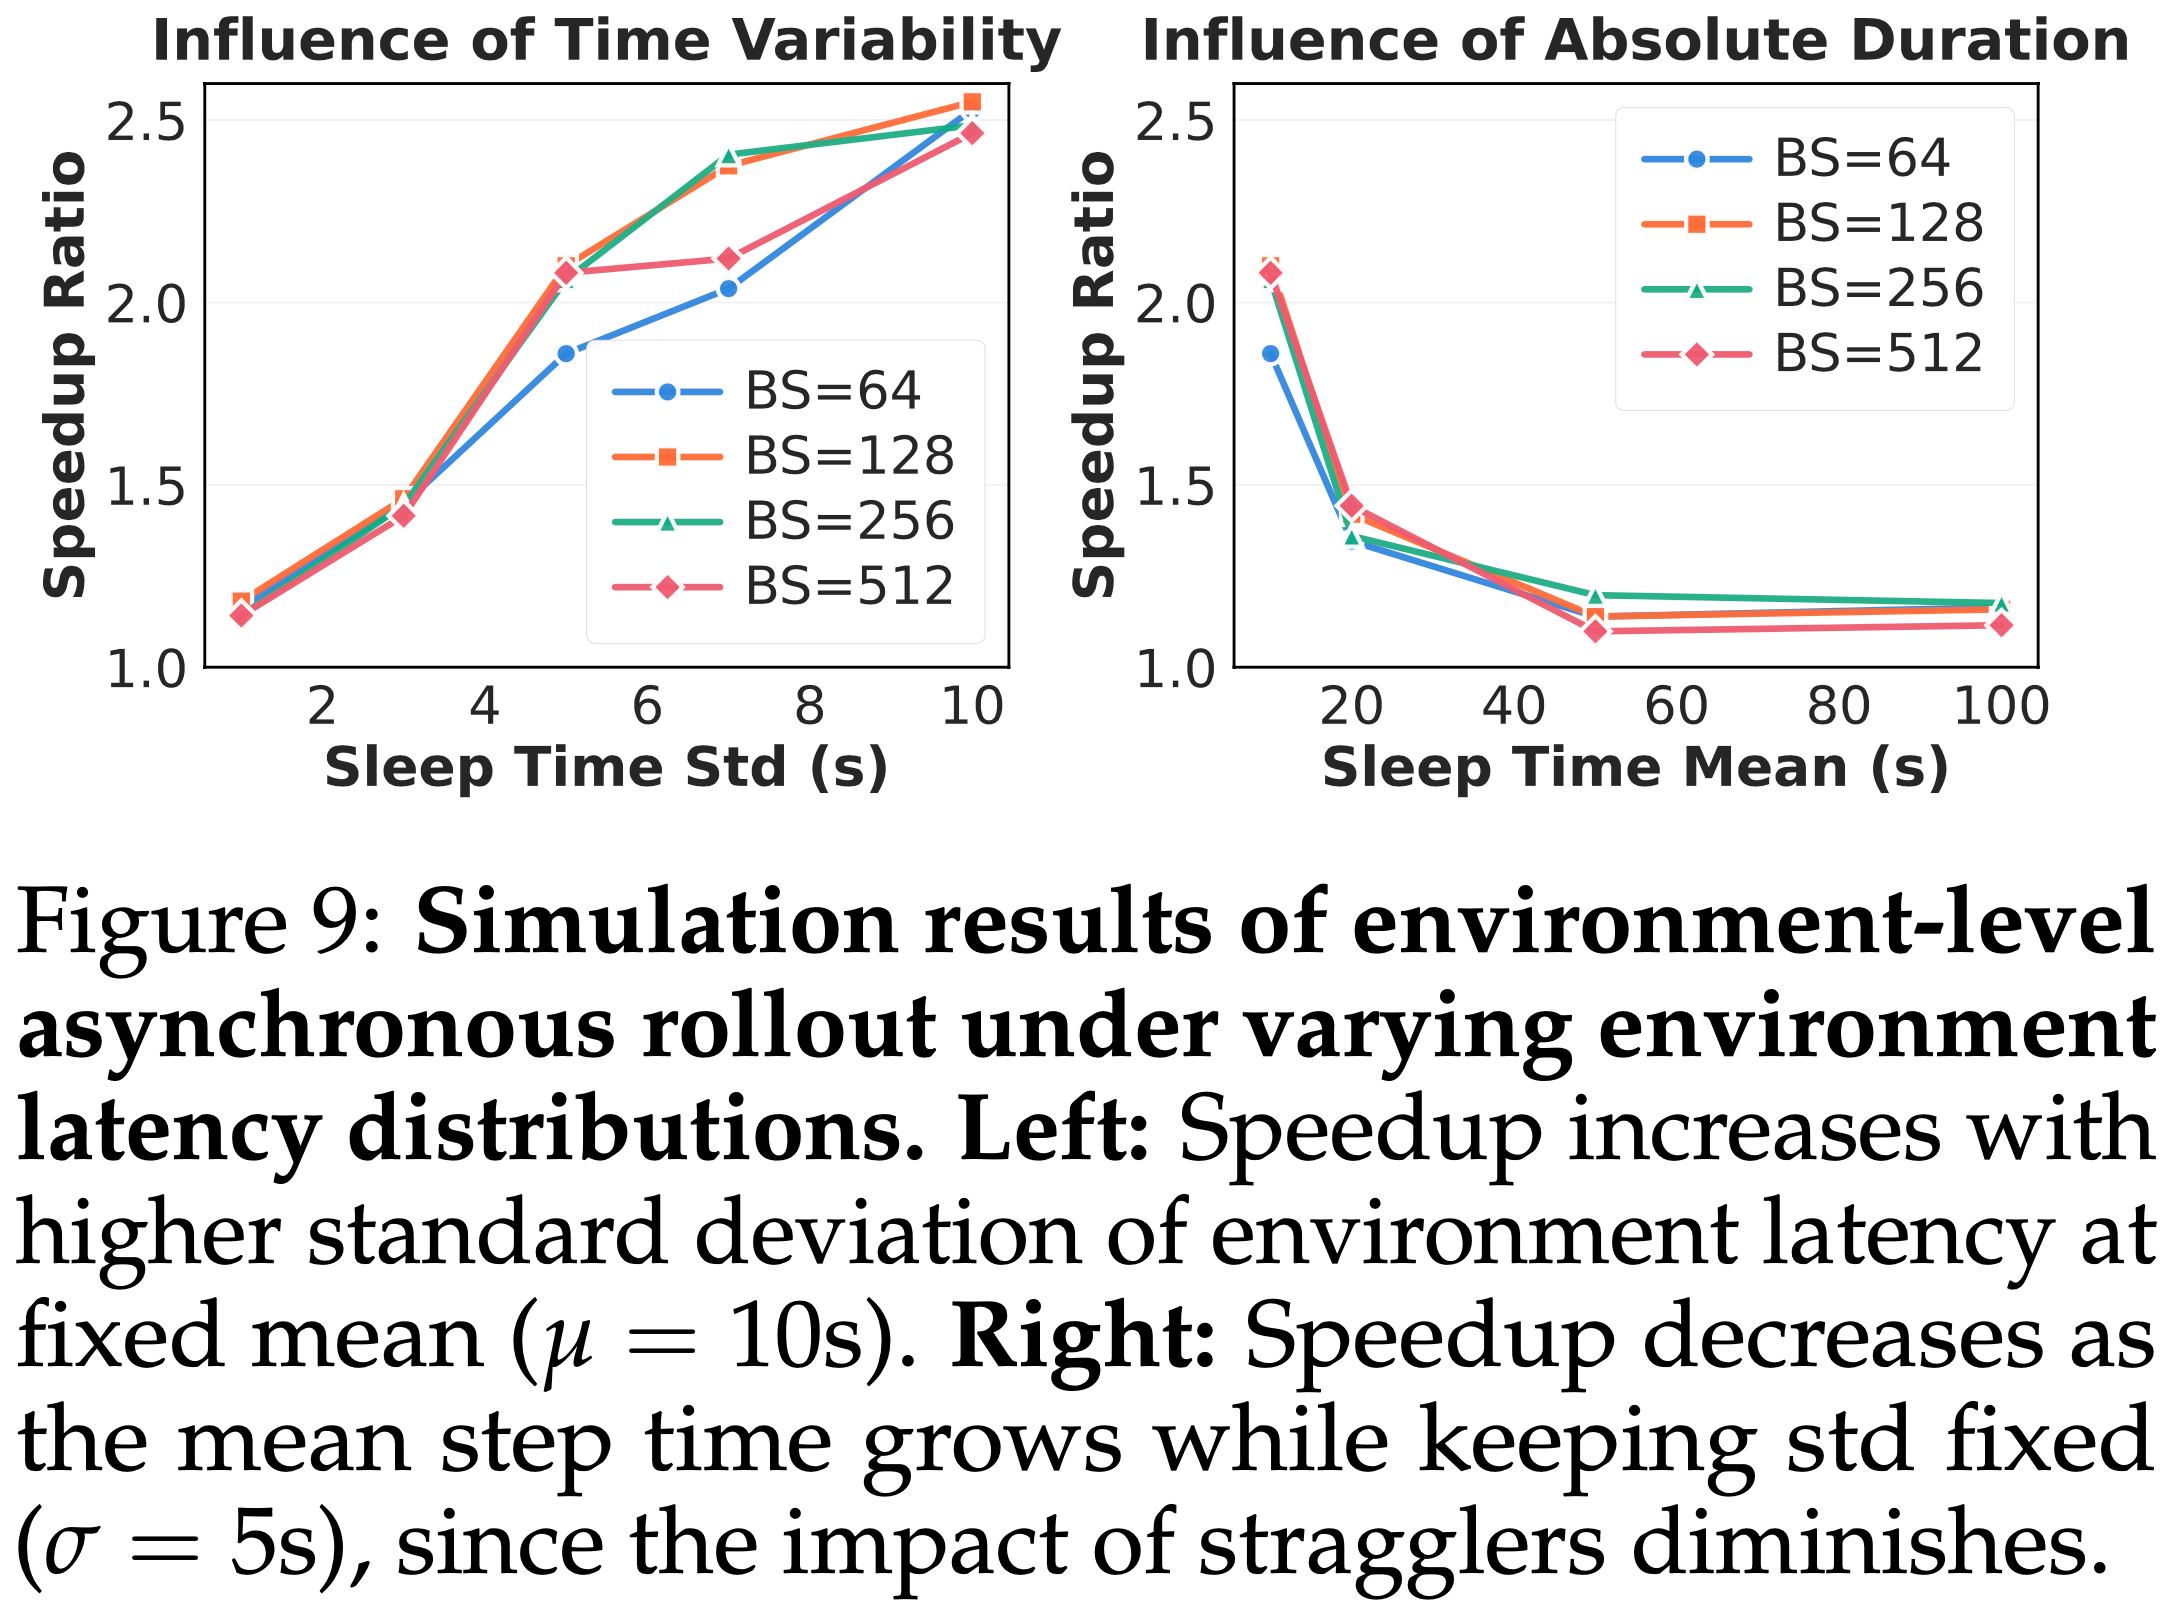
- 如图 9 所示,一个明显的趋势是:方差越大,加速比越大
- 当延迟接近均匀分布时,例如 \((10,1)\),收益有限,在批量大小为 512 时仅为 \(1.16 \times\)
- 随着方差增加,收益变得显著
- 在 \((10,10)\) 的情况下,批量大小为 512 时,平均步长时间从 892 秒降至 362 秒,提升了 \(2.46 \times\)
- 对于 \((10,7)\) 也观察到类似的结果,加速比达到 \(2.12 \times\),对于 \((50,5)\),加速比为 \(1.20 \times\)
- 这些结果表明,异步调度缩短了整体步长时间并保持了高吞吐量,且收益随着环境延迟方差的增加而增长
- 图 9: 在不同环境延迟分布下环境级异步 Rollout 的模拟结果
- 左图:在固定均值 \((\mu = 10s)\) 时,加速比随环境延迟标准差的增加而增加
- 右图:在固定标准差 \((\sigma = 5s)\) 时,加速比随平均步长时间的增加而减小,因为落后者 (stragglers) 的影响减弱了
- 本文在真实环境中进一步验证了这一机制
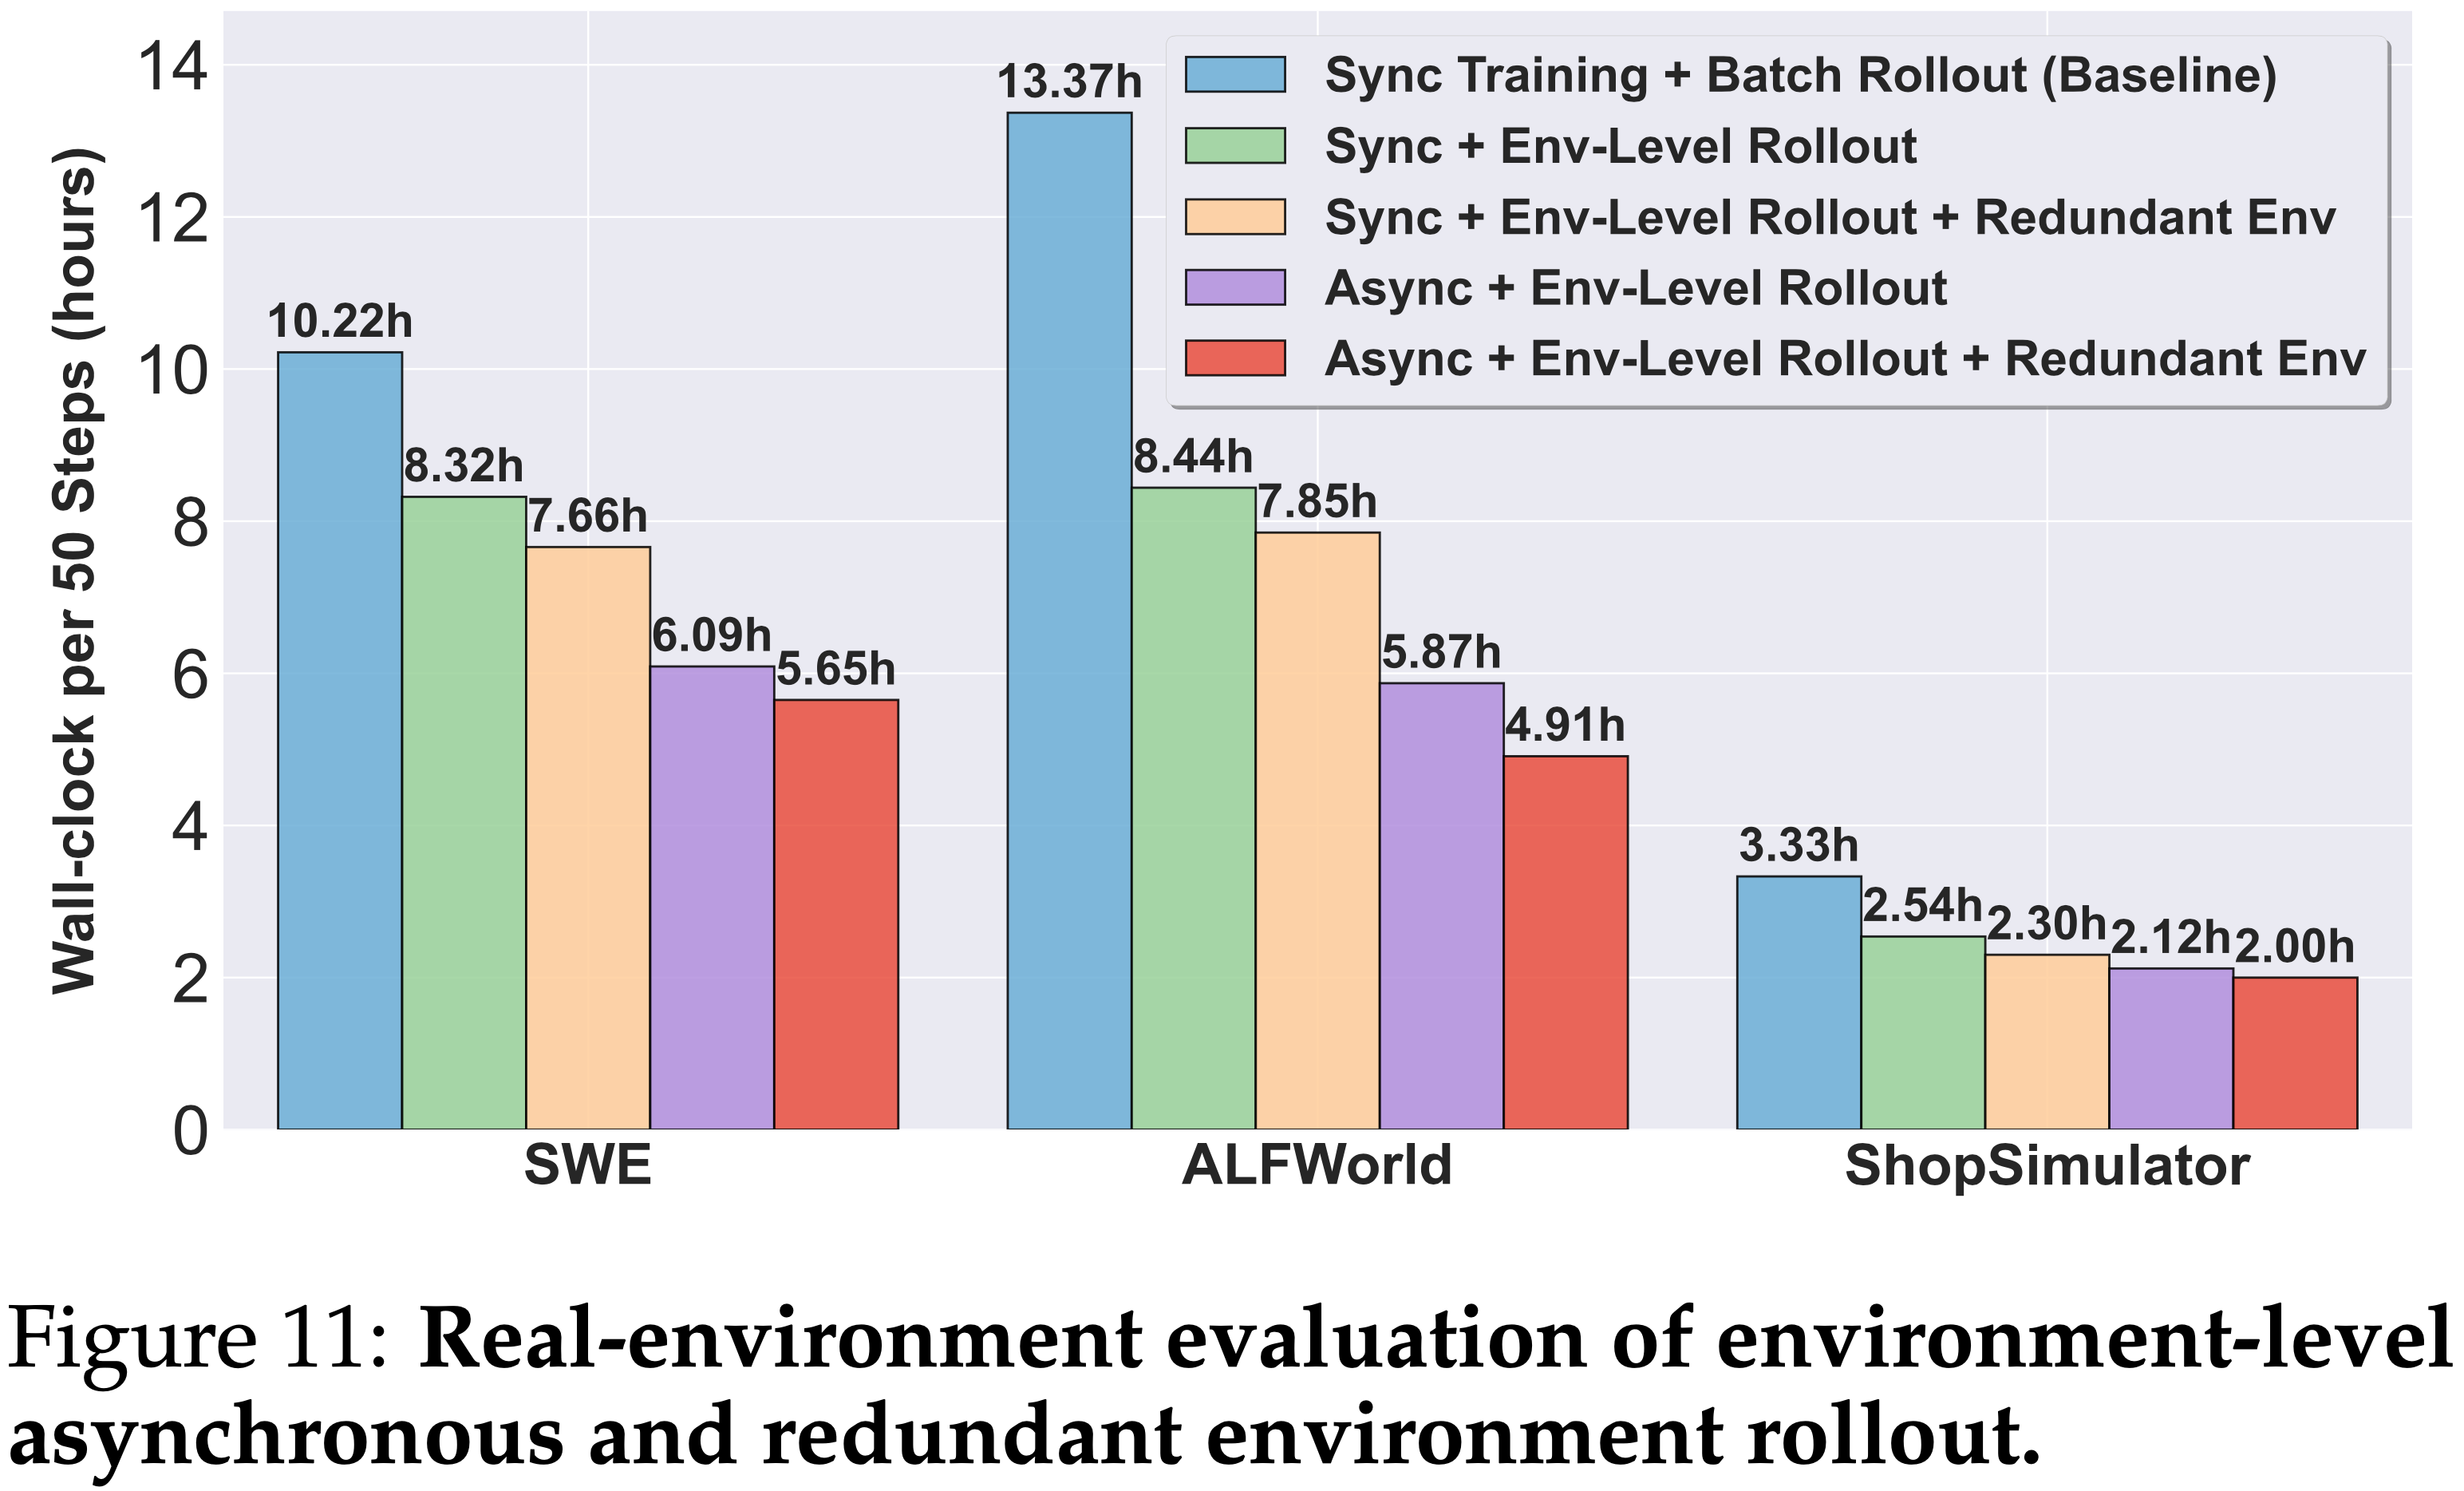
- 如图 11(环境级异步和冗余环境 Rollout 的真实环境评估)所示,即使在同步 (Sync) 训练中,环境级异步 Rollout 也能:
- 将 SWE 上的端到端训练时间从 10.22 小时减少到 8.32 小时(\(1.23\times\))
- 在 ALFWorld 上从 13.37 小时减少到 8.44 小时(\(1.58\times\))
- 如图 11(环境级异步和冗余环境 Rollout 的真实环境评估)所示,即使在同步 (Sync) 训练中,环境级异步 Rollout 也能:
- 这些结果证实,环境级异步 Rollout 在模拟之外始终有效,并在实践中带来了令人满意的收益
- 注:详细的实验配置见附录 A
Redundant Environment Rollout,冗余环境 Rollout
- 本文引入了冗余环境 Rollout (Redundant Environment Rollout) 以减轻环境不稳定性对 Agentic RL 训练效率的负面影响
- 该机制提供两个可调控制项:
- (1)增加 num_env_groups 以生成更多的并发环境组
- (2)增加 group_size 以在每个组内生成更多的候选轨迹
- 由于 ROLL Flash 在收集到预定义数量的轨迹后会终止 Rollout,增加 num_env_groups 和 group_size 有助于防止慢故障 (fail-slow) 和停故障 (fail-stop) 环境成为系统瓶颈
- 理解:这里多出来的轨迹(冗余)是“不增加 Prompt 数量,仅增加每个 Prompt 的采样数(即 Response 副本数)”,因为每个 Prompt 到数量就可以训练
- 经验观察:增加 num_env_groups 在应对慢故障和停故障行为方面比增加 group_size 更有效
Experimental Evaluation
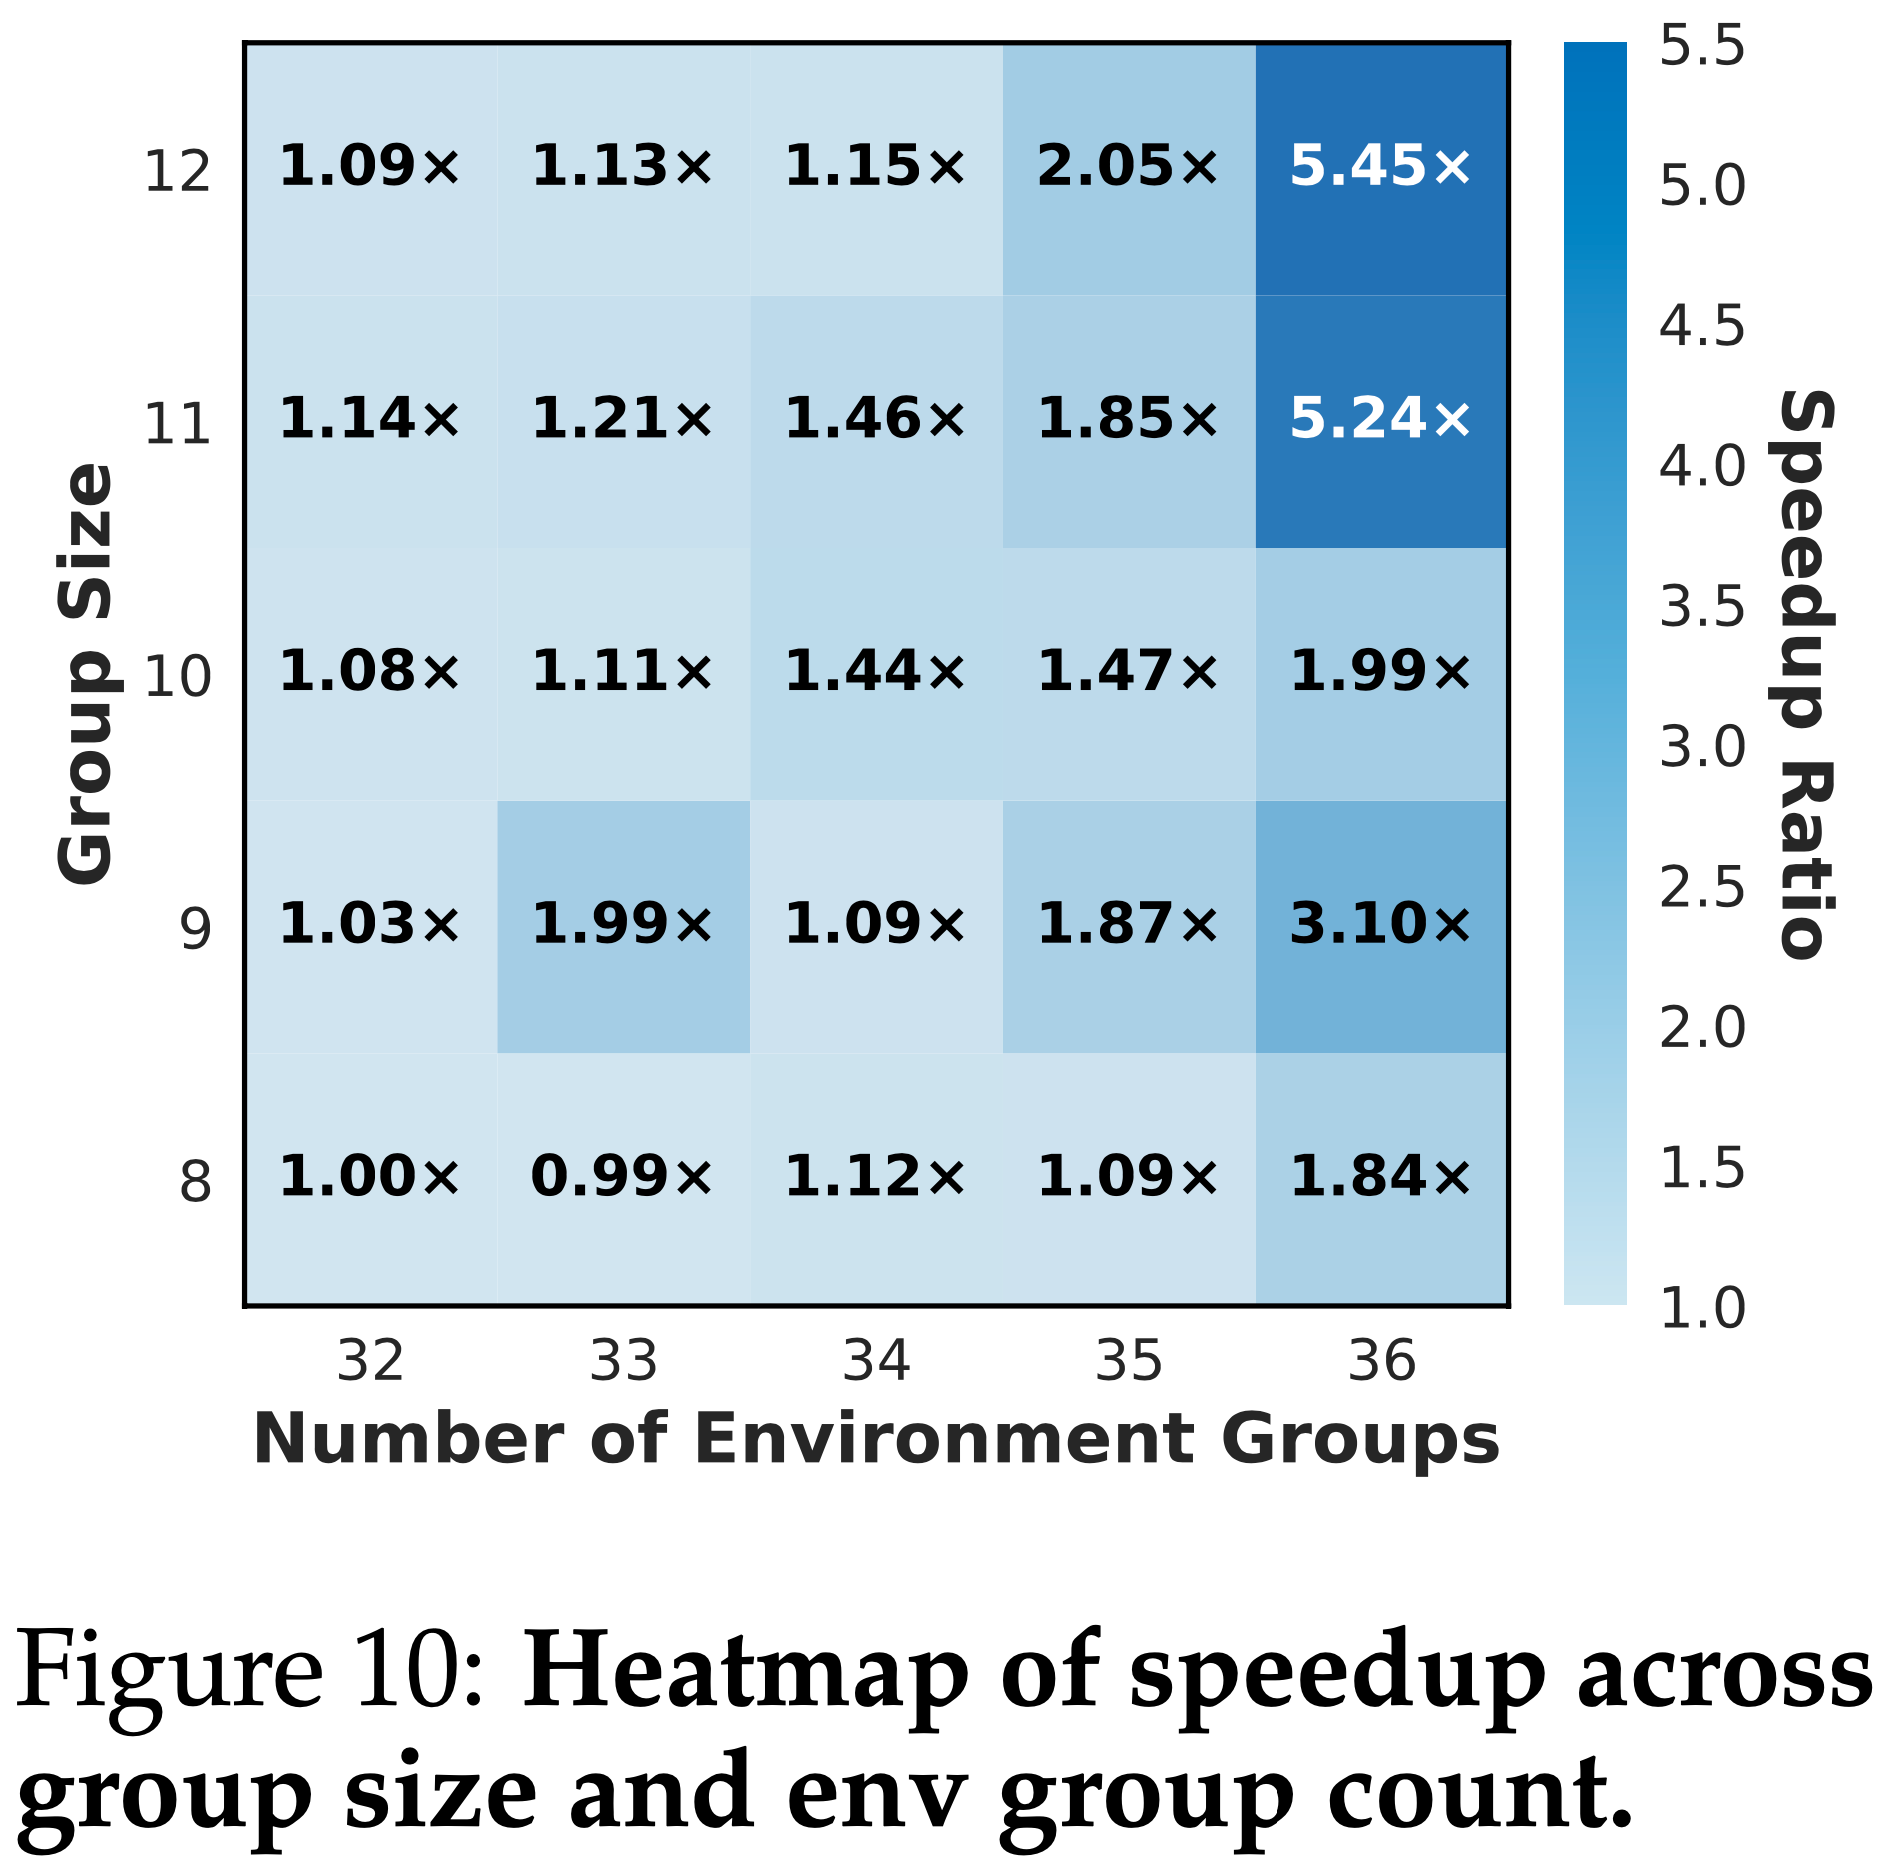
- 本文通过固定总 Rollout 批量大小为 256,并改变 num_env_groups 和 group_size 来模拟不同配置,其中环境延迟由具有不同均值 \(\mu = 10\) 和标准差 \(\sigma = 5\) 的高斯分布建模
- 图 10 中的结果显示,增加组数 (groups) 始终比增大组大小 (group size) 更有效
- 例如,从 \(32 \times 8\)(基线)扩展到 \(36 \times 12\) 将步长时间从 243 秒减少到 45 秒,实现了 \(5.45 \times\) 的加速
- 对于 \(36 \times 11\)(\(5.24 \times\))和 \(36 \times 9\)(\(3.10 \times\))也观察到类似的改进
- 热图可视化突出显示了更高的组数 (group counts) 能带来更稳定的步长时间和对延迟方差更好的鲁棒性
- 本文还在真实环境中验证了此设计
- 如图 11 所示,冗余环境 Rollout 在同步和异步 Rollout 的基础上都带来了额外的收益
- 在 SWE 上:
- 同步 Rollout 下的训练时间从 8.32 小时减少到 7.66 小时(\(- 7.9%\))
- 异步 Rollout 下从 6.09 小时减少到 5.65 小时(\(- 7.2%\))
- 在 ALFWorld 上,相应的减少分别是从 8.44 小时到 7.85 小时(\(- 7.0%\))和从 5.87 小时到 4.91 小时(\(- 16.4%\))
- 在 SWE 上:
- 如图 11 所示,冗余环境 Rollout 在同步和异步 Rollout 的基础上都带来了额外的收益
- 这些结果表明,在真实的 Agentic 环境中实现了 7%-16% 的吞吐量提升
- 这两种技术共同构成了一种有效的设计,能在随机和易出错条件下维持训练效率
附录 A:Training Details
A.1 RLVR Pipeline
Datasets
- 使用 DAPO-MATH-18K (2025) 作为训练数据集
- 在评估时,使用 MATH-500、OLYMPIADBENCH、MINERVA MATH、AMC 2023、AIME 2024 和 AIME 2025
Implementation Details
async_generation_ratio控制异步程度:- 0 表示同步(Sync)模式,任何正整数或小数值则表示异步比率
在异步模式下,生成和训练的 GPU 分配分别通过
actor_infer和actor_train设置优势估计使用 group-normalized rewards 进行计算,并通过
pg_variant选择应用于各种 off-policy 算法使用 SGLANG (2024) v0.4.6 和 vLLM (2023) v0.8.4 作为生成后端,并使用 Megatron (2019) 进行分布式训练
具体配置:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
seed: 42
pg_variant: ppo # can be decoupled_ppo, topr, tis, cispo
gamma: 1.0 # discount factor
lambd: 1.0 # GAE lambda
pretrain: Qwen/Qwen3-8B-Base
rollout_batch_size: 256 # prompt count
num_return_sequences_in_group: 16 # group size per prompt
ppo_epochs: 1 # per sample usage
prompt_length: 2048
response_length: 30720
generate_opt_level: 0 # whether to use Queue Scheduling
is_num_return_sequences_expand: false # whether to use Prompt Replication
async_generation_ratio: 0 # 0 represnets Sync, > 0 represnet Async
# use GRPO
adv_estimator: "reinforce"
reward_norm: group
actor_train:
data_args:
template: qwen2_5
file_name:
- data/train_data_math_dapo_18k.jsonl # use DAPO dataset
training_args:
learning_rate: 1.0e-6
weight_decay: 0
per_device_train_batch_size: 1
gradient_accumulation_steps: 256 # control on-policy or 4 minibatchs update
warmup_steps: 20
# Use Train Speed Up
use_remove_padding: true
use_dynamic_batching_in_train: true
device_mapping: list(range(0,16))
actor_infer:
generating_args:
max_new_tokens: ${response_length}
top_p: 1
top_k: 1000000
num_beams: 1
temperature: 1
num_return_sequences: ${num_return_sequences_in_group}
device_mapping: list(range(0,16)) # can be different from train in Async Setting
...在实践中,强制设置
temperature = 1和top-p = 1以获得原始的、未修改的 logits(这遵循了与 AReaL (2025) 相同的实践)- 这是必要的,因为推理引擎必须产生原始的 token 概率
- 任何对采样参数的修改都会改变输出分布,并使作者无法恢复真实的 logits
- 论文提到这会导致一个问题:虽然这确保了保真度,但也限制了采样超参数的灵活性
- 注:这个限制可以通过未来的架构接口支持来解决
由于推理引擎(如 vLLM 或 SGLang)和训练引擎(如 Megatron)之间存在固有的差异,采用截断重要性采样(truncated importance sampling, IS)来稳定训练,将重要性权重限制在阈值 \(C\) 内,例如 \(C = 5\)
$$\min \left(\frac{\pi_{\text{megatron} }(a\mid\theta)}{\pi_{\text{vllm} }(a\mid\theta)},C\right) \tag {12}$$这个问题在同步(Sync)架构中也会出现,使用与 VeRL (2025) 中相同的 off-policy 校正来解决它
A.2 Agentic Pipeline
Datasets
- 使用 R2E-Gym-Lite (2025) 作为 SWE 领域的训练数据集
- 使用 ALFWorld-Train (2020) 和 ShopSimulator-SingleTurn (2025a) 作为 ALFWorld 和 ShopSimulator 的训练数据集
- 在评估阶段,采用 SWE-Bench-Verified (2023)、ALFWorld 和 ShopSimulator-SingleTurn 作为测试基准,以确保在不同任务领域中进行全面且一致的评估
Implementation Details
- 异步比率和生成后端采用与 RLVR 流水线相同的实现细节
- 除了这些共享组件之外,还引入了冗余环境(Redundant Env)实验配置
- 在默认模式下,
train_env_manager满足关系group_size × num_env_groups = rollout_batch_size - 在冗余环境(Redundant Env)模式下,该条件被放宽为
group_size × num_env_groups > rollout_batch_size
- 在默认模式下,
- 在所有三个场景中
- 默认配置将
train_env_manager设置为group_size = 16和num_env_groups = 8,将val_env_manager设置为group_size = 1和num_env_groups = 128 - 在冗余环境(Redundant Env)模式下,设置调整为
train_env_manager: group_size = 17, num_env_groups = 9,以及val_env_manager: group_size = 1, num_env_groups = 144
- 默认配置将
- 具体配置:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
pretrain: Qwen/Qwen3-8B # Qwen/Qwen3-14B for SWE, Qwen/Qwen3-8B for others
async_generation_ratio: 1 # 0 represnets Sync, > 0 represnet Async
rollout_batch_size: 128 # env count for train
sequence_length: 32768 # max sequence length
train_env_manager:
num_env_groups: 8 # can be different from train in Redundant Env
group_size: 16 # can be different from train in Redundant Env
val_env_manager:
num_env_groups: 128 # > ${val_batch_size} for Redundant Env
group_size: 1
actor_train:
device_mapping: list(range(0,32))
actor_infer:
device_mapping: list(range(32,64))
# Env Special Parameters
custom_envs:
SWEEnv:
max_steps: 50
max_new_tokens: 8192
AlfworldEnv:
max_steps: 30
max_new_tokens: 4096
ShopSimulator:
max_steps: 30
max_new_tokens: 2048
...