注:本文包含 AI 辅助创作
Self-Harness 总结
- 提出 Self-Harness 新范式 :首次让 LLM-based Agent 在没有人类工程师或更强外部 Agent 指导的情况下,自主改进自己的 Harness
- 设计三阶段迭代优化流程 :
- Weakness Mining:通过 verifier-grounded 聚类识别 model-specific 失败模式
- Harness Proposal:生成多样且最小的候选修改
- Proposal Validation:通过回归测试确保非退化改进
- 在 Terminal-Bench-2.0 上对三个不同家族模型实验:
- 绝对提升达 21.4 个百分点,相对提升最高达 138%
- 注:本文研究的是 bounded harness edits,非 open-ended self-improvement
背景 & 问题提出
- LLM-based Agent 的性能不仅取决于 Base model 本身,还高度依赖于其 Harness
- Harness 即围绕模型、调控模型与环境交互的支撑系统,Harness 通常包括:
- System Prompts(系统提示词)
- Tools(工具)
- Runtime Mechanisms(运行时机制)
- Verification Rules(验证规则)
- Orchestration Logic(编排逻辑)
- Failure-Recovery Procedures(失败恢复流程)
- 关键 Insight:同一个 base model 在不同 Harness 下可能表现出截然不同的性能
- 不同模型具有不同的行为模式、工具使用习惯、错误类型和 Prompt 敏感性,因此有效的 Harness 设计本质上是 model-specific 的
- Harness 即围绕模型、调控模型与环境交互的支撑系统,Harness 通常包括:
- 现有范式的局限性:
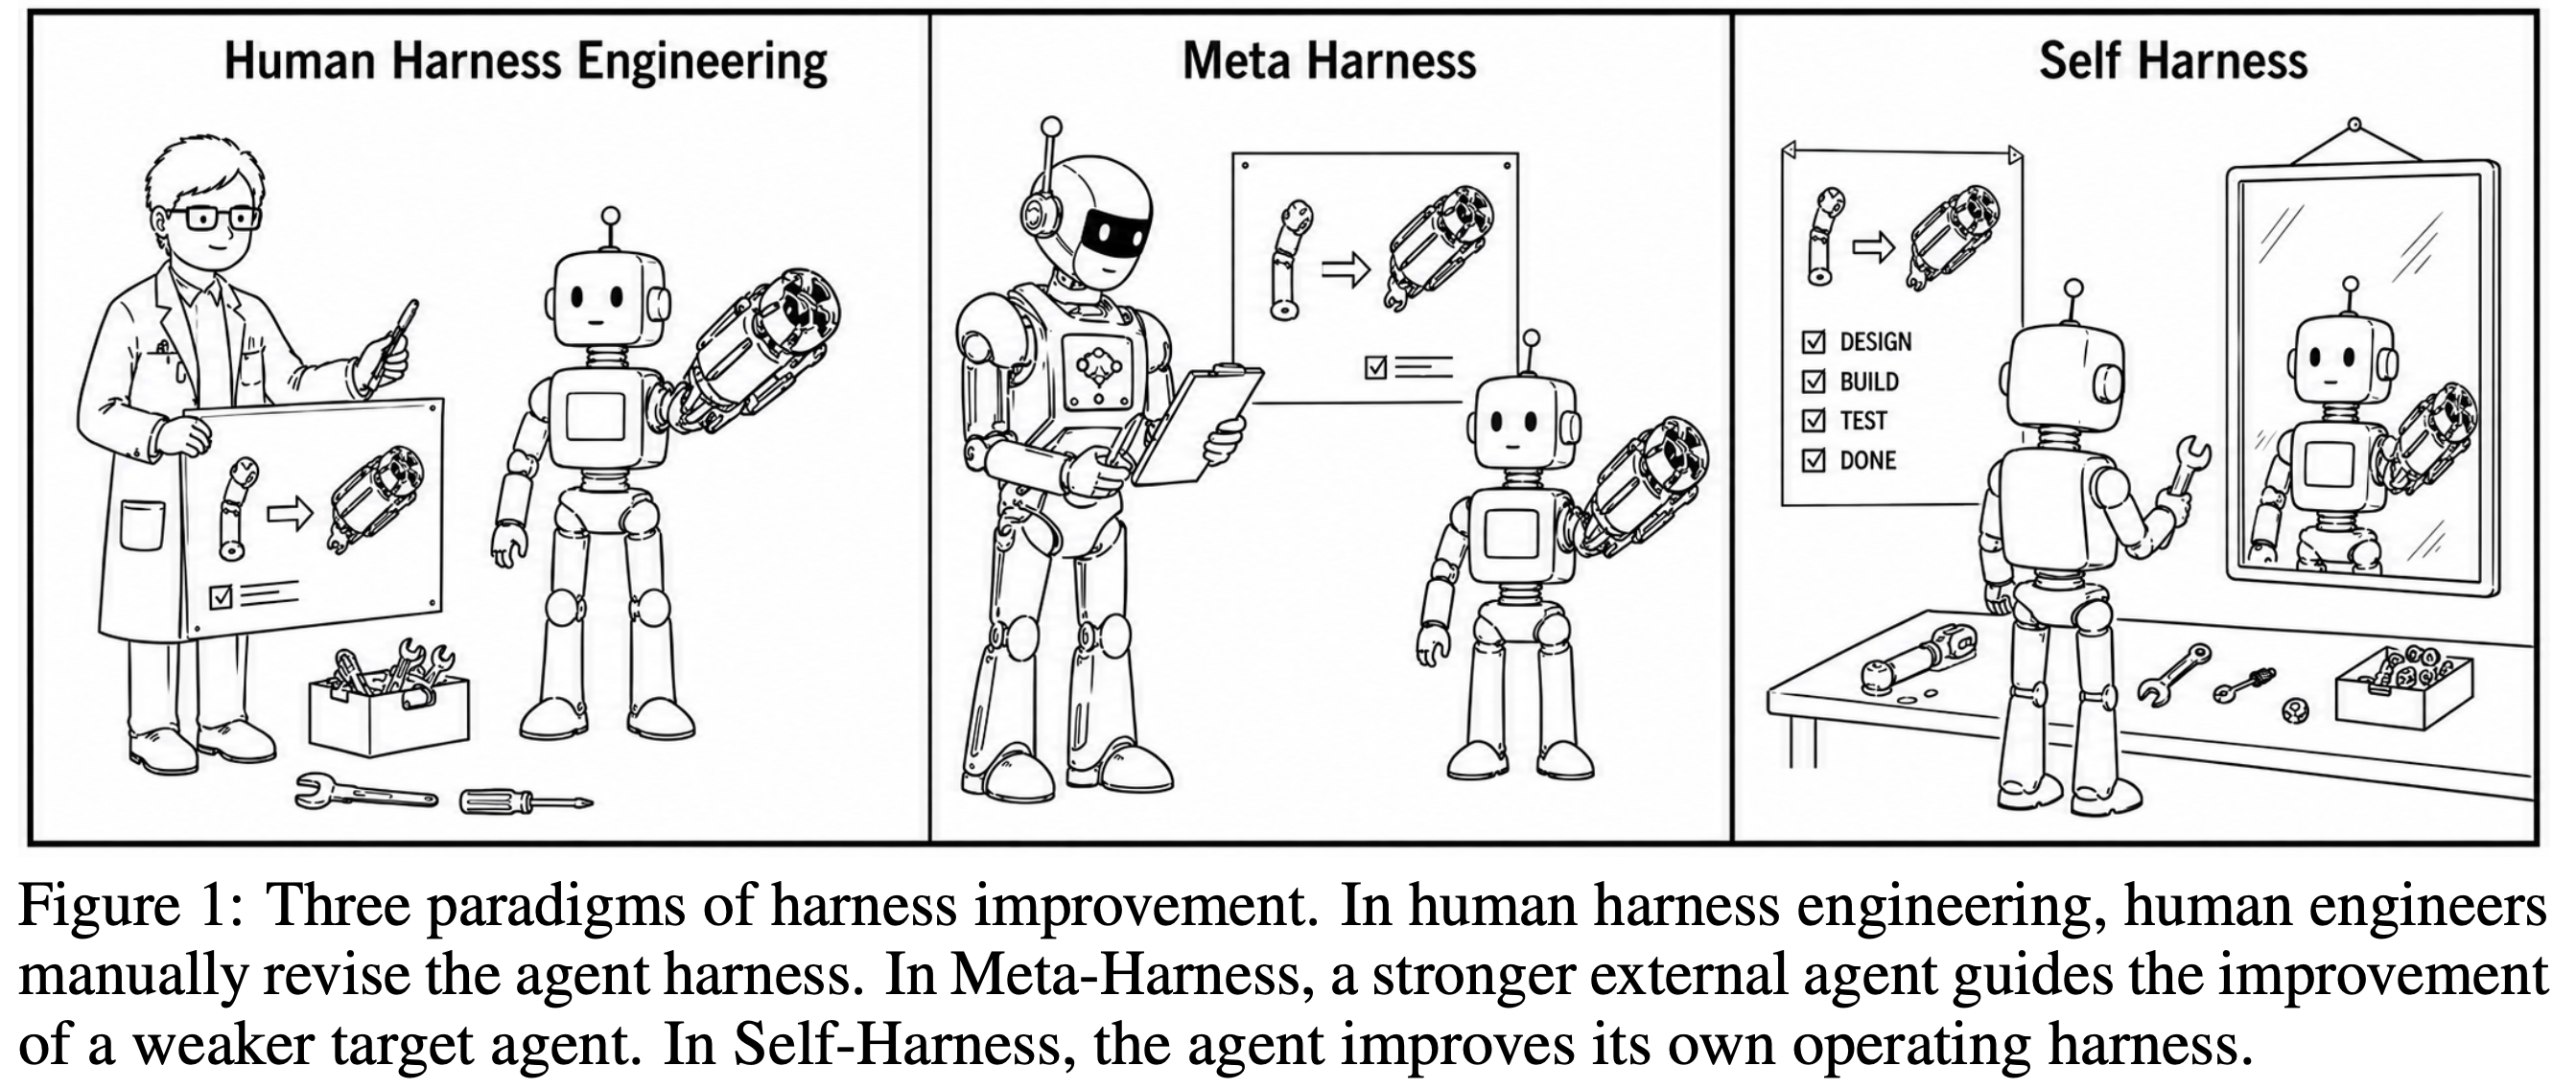
- 论文总结了三类 Harness 改进范式(Figure 1):
- Human Harness Engineering :人类专家手动设计、修改 Harness
- 无法随 LLM 的快速迭代和多样化扩展
- Meta-Harness :使用更强的外部 Agent 来优化目标 Agent 的 Harness
- 依赖外部引导,成本高,且对前沿模型可能不可用
- Self-Harness(本文) :目标 Agent 自身迭代地改进自己的 Harness
- 减少外部依赖,实现自我进化
- 减少外部依赖,实现自我进化
- Human Harness Engineering :人类专家手动设计、修改 Harness
- 论文总结了三类 Harness 改进范式(Figure 1):
- 本文核心思想
- 论文中引用 Bergson 的名言作为哲学隐喻:
“For a conscious being, to exist is to change, to change is to mature, to mature is to go on creating oneself endlessly.”
- 对于一个有意识的存在来说,存在就是改变,改变就是成熟,成熟就是不断地创造自己
- Self-Harness 的本质 :让一个 LLM-based Agent 不仅被其 Harness 所塑造,还能主动参与重塑自己的 Harness,实现技术层面的“自我创造”
- 论文中引用 Bergson 的名言作为哲学隐喻:
问题形式化
Harness 的数学定义
- 设:
- \( M \):固定的语言模型(参数不变)
- \( h \):Agent Harness(非参数化的脚手架)
- 给定任务实例 \( x \),在 Harness \( h \) 下运行模型 \( M \),产生:
- 执行轨迹 \( \tau \)(记录 messages、tool calls、verifier outcomes)
- 输出 \( y \)
- Evaluator \( \mathcal{E} \) 将任务、轨迹和输出映射为行为结果(如 pass/fail)
- 核心设定 :
- \( M \) 和 \( \mathcal{E} \) 固定,Harness \( h \) 是唯一的优化对象
- Self-Harness 操作于 Harness 序列 \( h_0, h_1, h_2, \ldots \),每次转移对应一个 bounded edit(有界编辑)
评估指标
- 对于 Harness \( h \),定义:
- \( P_{\text{in} }(h) \):在 held-in split \( D_{\text{in} } \) 上的通过任务数
- \( P_{\text{ho} }(h) \):在 held-out split \( D_{\text{ho} } \) 上的通过任务数
- 候选 Harness \( h_t^{(j)} \) 相对于当前 Harness \( h_t \) 的改进量:
$$
\begin{align}
\Delta_{\text{in} }^{(j)} &= P_{\text{in} }(h_t^{(j)}) - P_{\text{in} }(h_t) \\
\Delta_{\text{ho} }^{(j)} &= P_{\text{ho} }(h_t^{(j)}) - P_{\text{ho} }(h_t)
\end{align}
$$
Self-Harness 方法,迭代循环优化
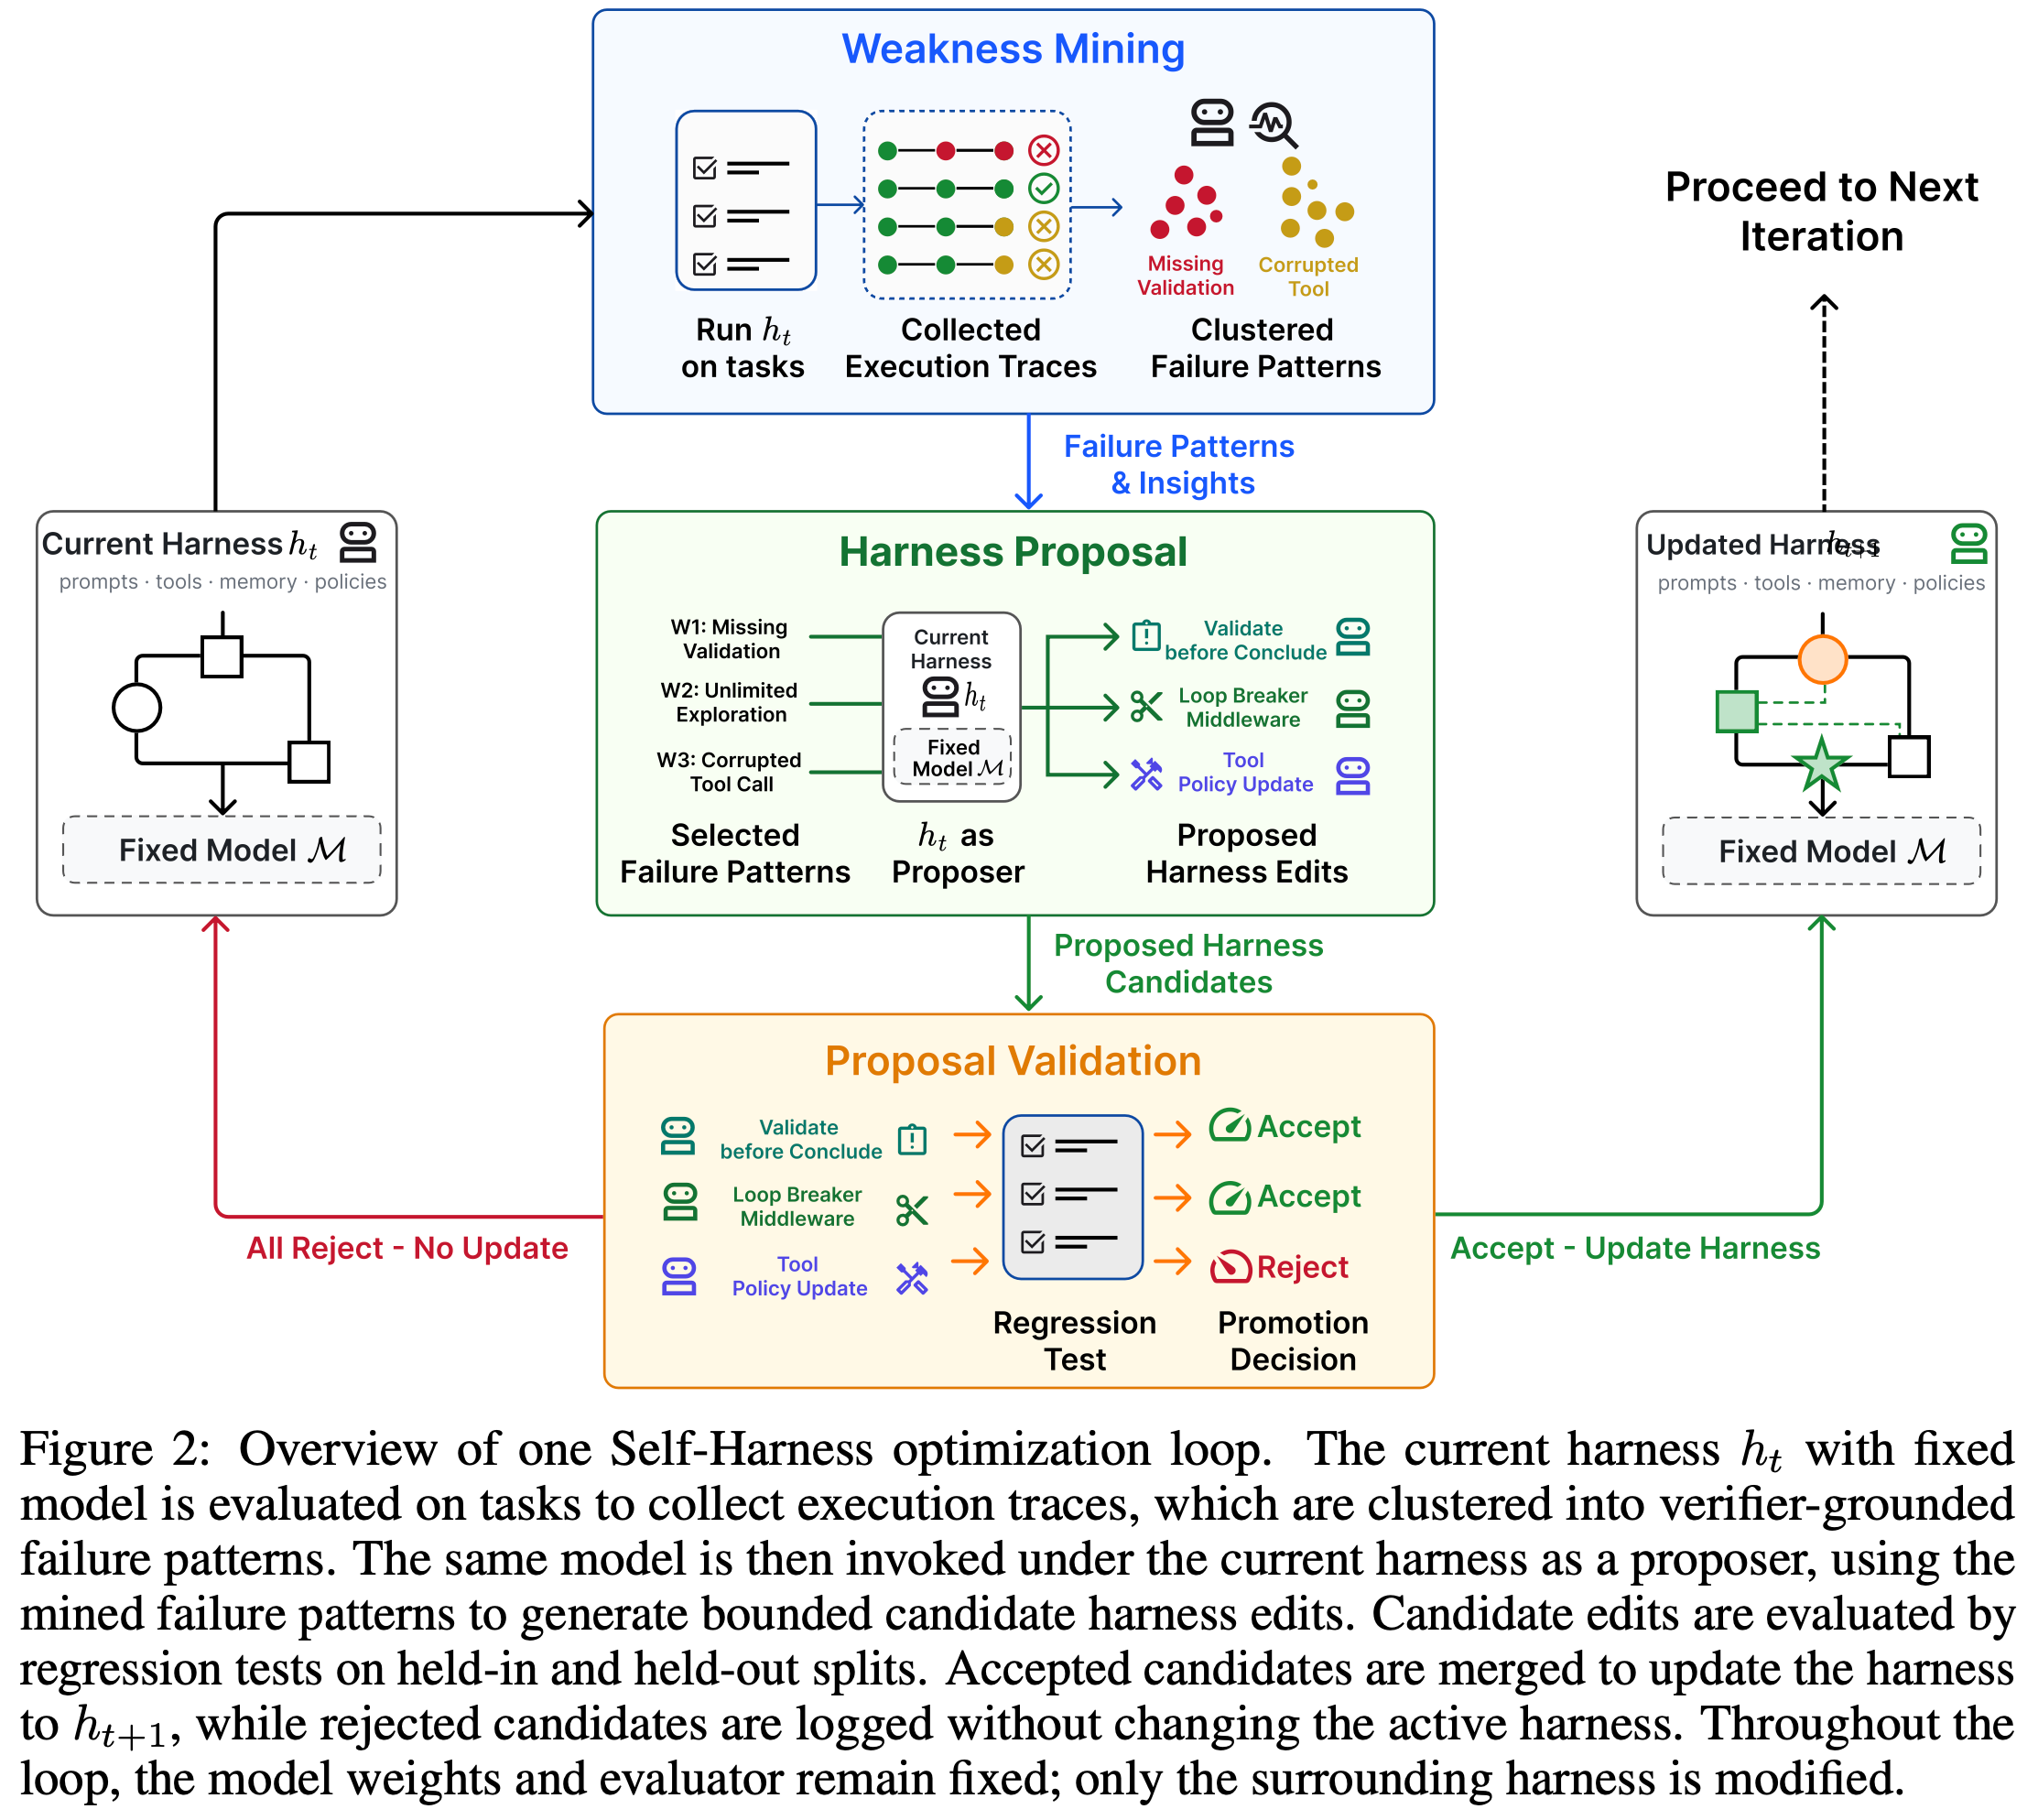
- Self-Harness 算法总览: Self-Harness 是一个迭代的三阶段循环(Figure 2):
- 1)Weakness Mining(弱点挖掘):从执行轨迹中识别模型特定的失败模式
- 2)Harness Proposal(Harness 提议):基于失败模式生成多样且最小的候选修改
- 3)Proposal Validation(提议验证):通过回归测试验证候选修改
阶段一:Weakness Mining,从执行轨迹中识别失败模式
轨迹收集
- 在第 \( t \) 轮,使用当前 Harness \( h_t \) 在 held-in split \( D_{\text{in} } \) 上运行固定模型 \( M \)
- 这里的 held-in 强调 Proposer 可见
- 对于每个任务 \( x_i \in D_{\text{in} } \):
- 产生输出 \( y_i \)
- 产生执行轨迹 \( \tau_i \)
- Evaluator \( \mathcal{E} \) 给出结果 \( z_i = \mathcal{E}(x_i, \tau_i, y_i) \),取值为 pass 或 fail
- 得到轨迹记录:
$$
r_i = (x_i, \tau_i, y_i, z_i)
$$ - 全集:
$$
R_t = \{r_i\}_{i=1}^{|D_{\text{in} }|}
$$ - 失败的记录子集:
$$
F_t = \{r_i \in R_t \mid z_i = \text{fail}\}
$$
失败签名(Failure Signature)
- 论文的核心设计是:不将失败视为孤立事件,而是通过 verifier-grounded 的聚类 来识别可复用的失败机制
- 对于每个失败记录 \( r_i \),评估系统分析轨迹,识别:
- 终端失败原因(verifier 拒绝的原因)
- Agent-side 行为(与终端失败相关的行为)
- 因果状态(该行为在轨迹中的因果地位)
- 这产生一个 失败签名 :
$$
\phi(r_i) = (c_i, q_i, m_i)
$$- \( c_i \):终端 verifier-level 原因(terminal verifier-level cause)
- \( q_i \):相关 Agent 行为的因果状态(causal status)
- \( m_i \):轨迹中暴露的抽象 Agent 机制(abstract agent mechanism)
聚类与 Evidence Bundle 构建
- 失败按签名的精确匹配进行聚类:
$$
C_{\phi} = \{r_i \in F_t \mid \phi(r_i) = \phi\}
$$ - 对于每个聚类 \( C_{\phi} \),构建结构化的失败模式,包含:
- 聚类大小(cluster size)
- 代表性任务实例
- 共享的轨迹症状
- Verifier 证据
- 推断的 Agent 机制
- 聚类按 support(支持度) 和 estimated actionability(估计的可操作性) 排序
- 最终输出 Evidence Bundle \( B_t \),总结了当前 Harness 下观察到的主要失败模式
- 关键设计原则 :
- \( B_t \) 不预设 Harness 编辑,而是将 verifier-level 失败与 agent-level 机制分离,让 Proposer 针对特定的可复用弱点进行修改
阶段二:Harness Proposal,生成多样且最小的候选修改
Proposer 角色
- Proposer 不是外部优化器,而是 同一个固定模型 \( M \) ,在当前 Harness \( h_t \) 下被调用,但扮演 Proposer 角色
- Proposer 接收一个 bounded proposal context ,包括:
- 当前 Harness 的 Editable surfaces
- Verifier-grounded 的失败模式(来自评估系统)
- 应保留的成功行为记录
- 之前尝试过的编辑摘要
并行提议生成
- Proposer 生成 \( K \) 个彼此不同的提议包:
$$
\mathcal{P}_t = \{(\Delta_j, a_j)\}_{j=1}^K
$$- \( \Delta_j \):编辑操作,将当前 Harness 映射到候选 Harness
$$
h_t^{(j)} = \Delta_j(h_t)
$$ - \( a_j \):审计记录(audit record),描述:
- 目标失败模式
- 编辑的 Harness 表面
- 预期的行为效果
- 回归风险(regression risks)
- \( \Delta_j \):编辑操作,将当前 Harness 映射到候选 Harness
目标选择与可操作性准则
- Proposer 从 \( B_t \) 中选择目标失败模式,必须满足两个条件:
- 1)证据支持(supported by evidence)
- 2)可操作性(addressability):失败模式可以通过可编辑的 Harness 表面来解决
- 排除标准 :反映任务固有难度、随机波动或模型能力局限的聚类被排除
多样性与最小性约束
- 多样性 :不同提议分支可针对不同的失败机制、选择不同的 Harness 表面、或表达不同的改进假设
- 最小性 :每个个体编辑只修改解决所选机制所需的表面,保留无关的 Harness 行为,避免大规模重写控制架构
阶段三:Proposal Validation,通过回归测试确保稳健改进
评估流程
- 每个候选 Harness \( h_t^{(j)} \) 与当前 Harness \( h_t \) 同时在 held-in split 和 held-out split 上评估:
- Held-in split:衡量提议是否解决了激励它的证据(即 Proposer 之前看得到的任务是否被改进)
- Held-out split:作为回归测试,检测 proposer 未看到的行为是否被破坏
Acceptance Rule
- 候选 \( h_t^{(j)} \) 被接受当且仅当:
$$
\Delta_{\text{in} }^{(j)} \geq 0, \quad \Delta_{\text{ho} }^{(j)} \geq 0, \quad \max(\Delta_{\text{in} }^{(j)}, \Delta_{\text{ho} }^{(j)}) > 0
$$ - 理解:
- 至少一个 split 有严格改进
- 另一个 split 不退化(non-regressive)
- 任何在两个 split 之间 trade-off 的提议都被拒绝
随机性与合并策略
- 当评估具有随机性时,重复多次评估并使用聚合通过计数
- 如果多个兼容的候选满足规则,它们的编辑被 合并 到下一个 Harness
- 被拒绝的候选被记录但不改变活动 Harness
审计记录
- 每个候选评估记录:
- 改变的 Surface
- Split-wise 结果
- 评估重复次数
- 提议摘要
- 接受/拒绝决策
- 这使得 Harness 谱系中的每次转移都是可审计的(auditable)
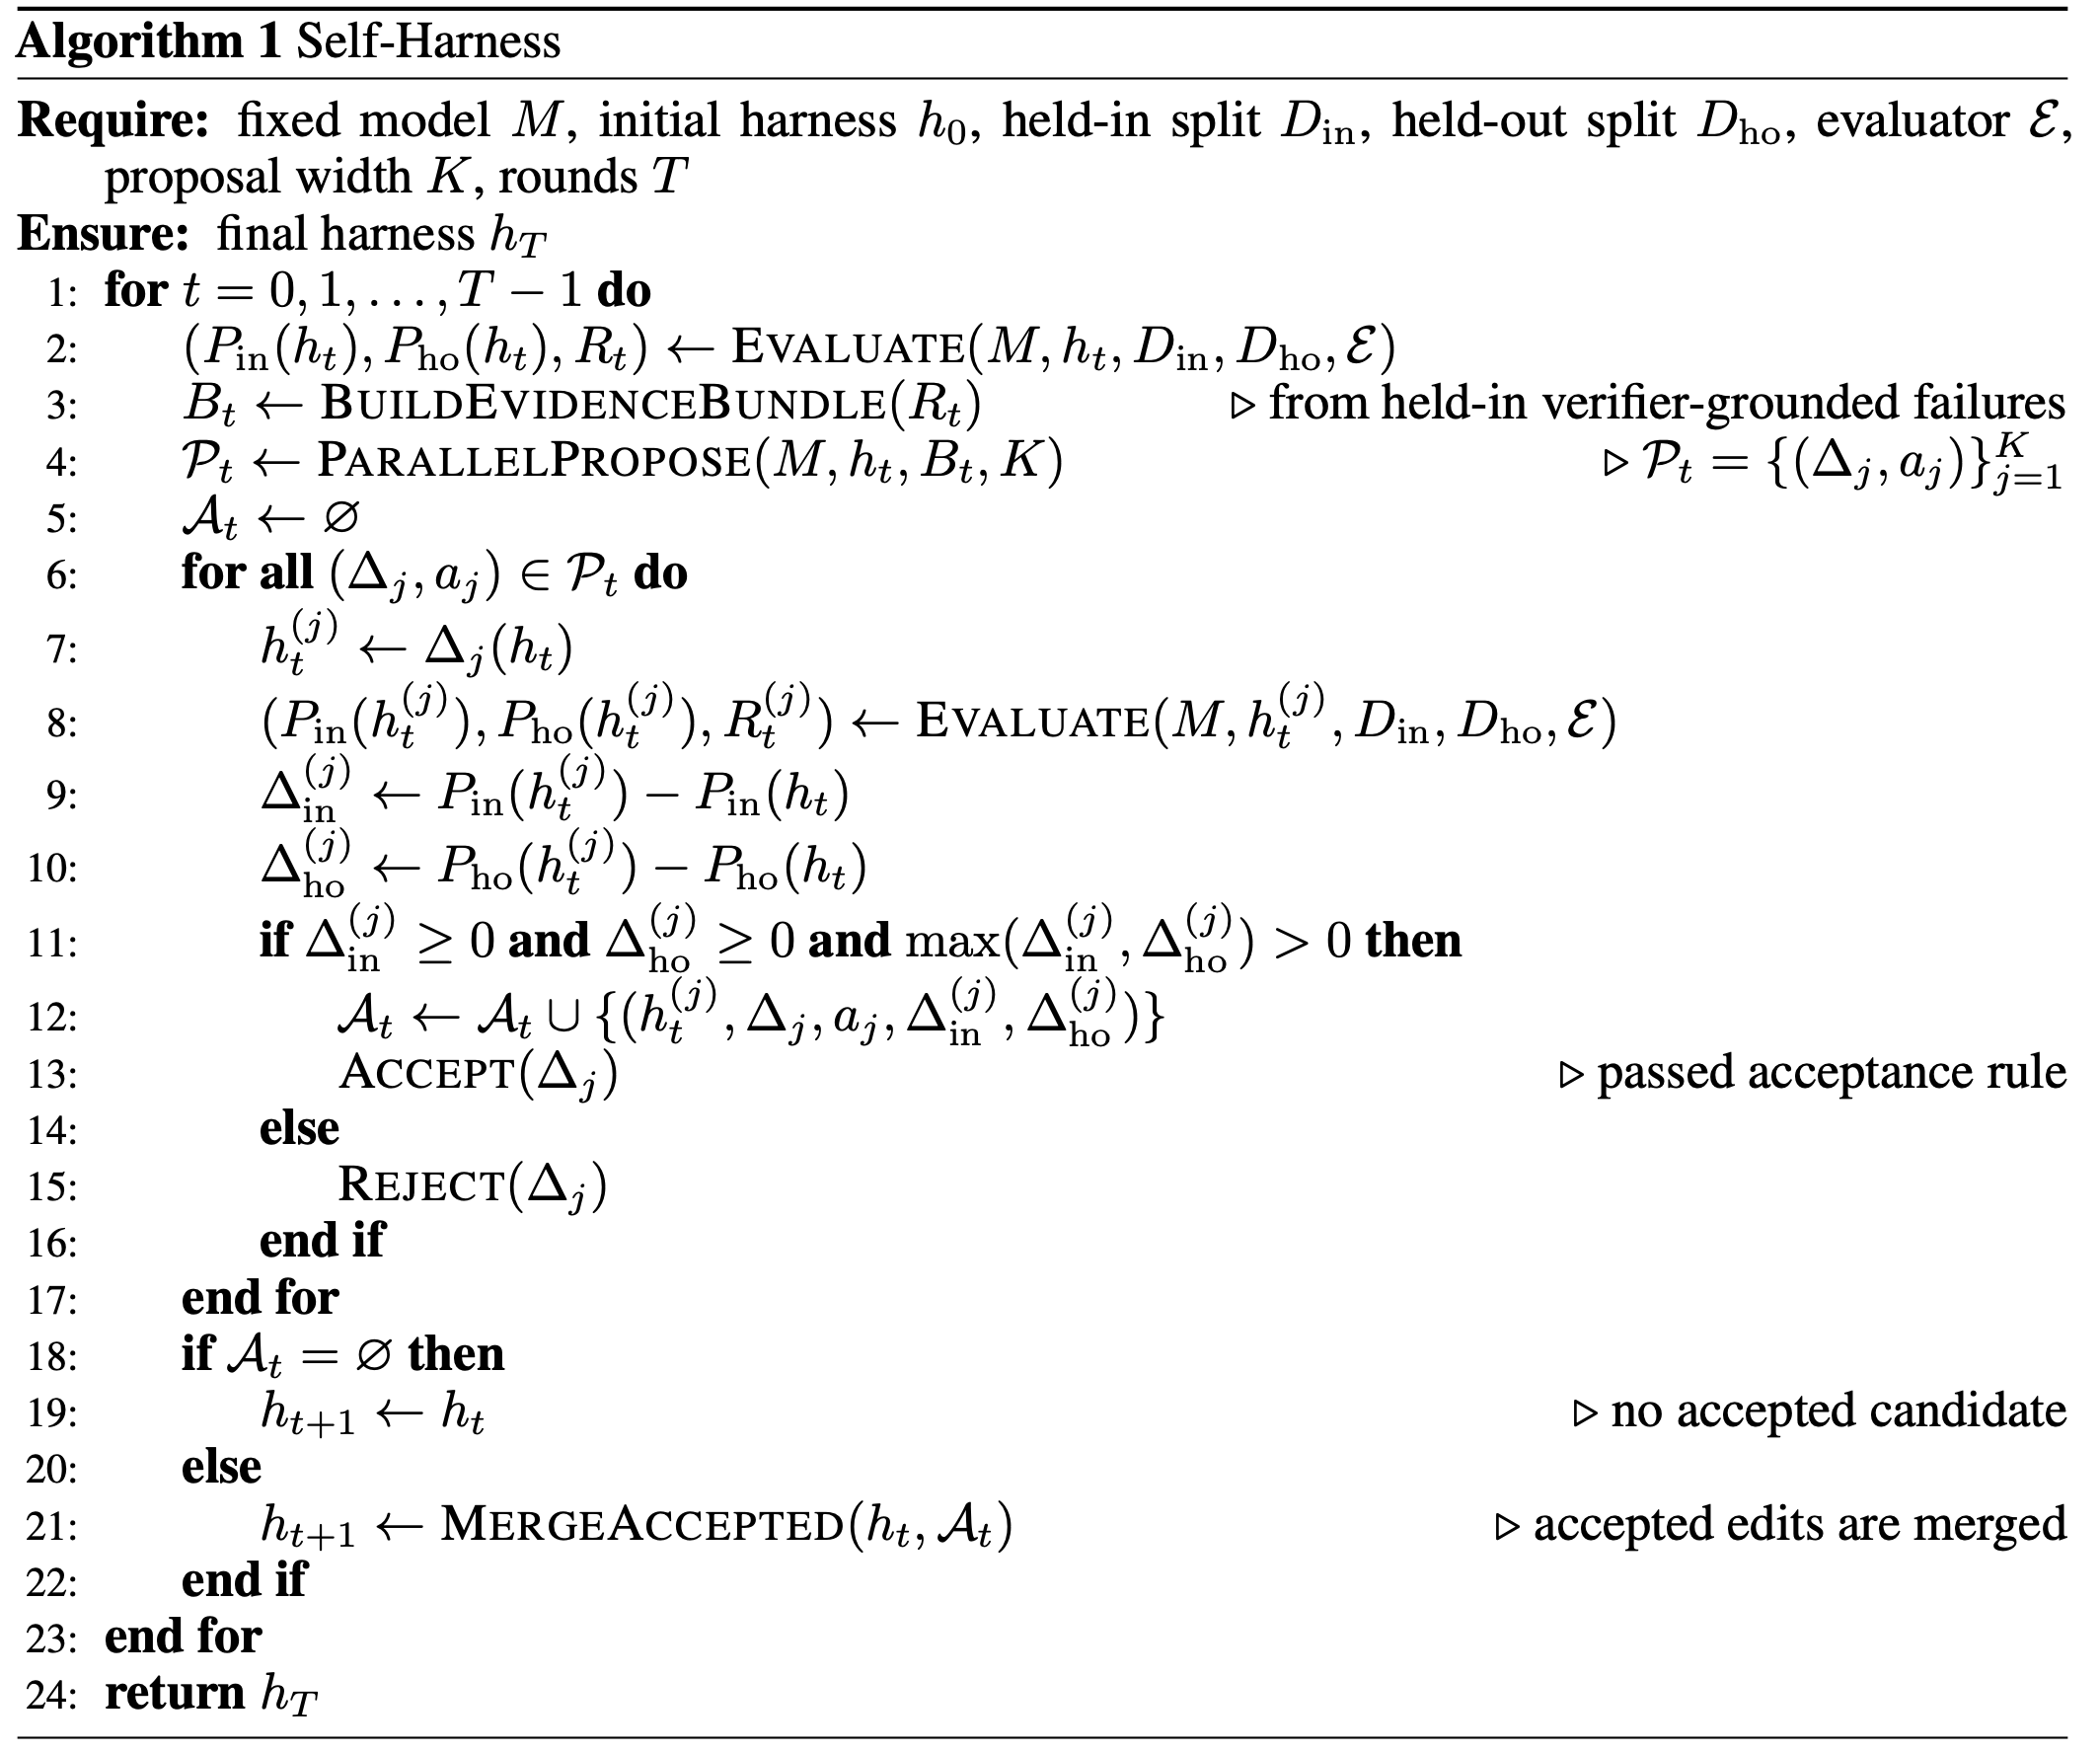
完整算法伪代码
- Self-Harness 伪代码
实验
实验设置
- 基准测试:Terminal-Bench-2.0
- 特点:
- 89 个容器化终端任务
- 测试 Agent 与真实执行环境的交互
- 使用确定性 verifier 评判结果
- 包括 artifact 管理、命令使用、验证行为和从执行错误中恢复
- 筛选 :使用 64 个任务的固定子集,排除依赖不稳定外部网络资源或多模态输入的任务
- 特点:
- 模型:
- 使用三种不同家族的模型:
- 1)MiniMax M2.5(通过 MiniMax 托管 API)
- 2)Qwen3.5-35B-A3B(本地部署,4×NVIDIA H200,使用 SGLang)
- 3)GLM-5(通过 OpenRouter 访问)
- 关键设定 :模型在 Harness 变体中保持固定,也在 Proposal 阶段用于从 evaluator 反馈生成编辑
- 使用三种不同家族的模型:
- 初始 Harness
- 初始 Harness(Figure 3)基于 DeepAgent SDK,有意保持最小化 :
- 简短的 benchmark-facing system prompt
- 默认文件系统和 shell 工具
- 可编辑的配置点:
build_system_prompt()build_memory_sources()build_subagents()build_skills()build_bootstrap_instruction()build_execution_instruction()build_verification_instruction()build_failure_recovery_instruction()build_runtime_control_policy()
- 初始 Harness(Figure 3)基于 DeepAgent SDK,有意保持最小化 :
- 实验协议
- Split 划分 :在运行 Self-Harness 前固定任务集划分
- Held-in split :提供轨迹、verifier 结果和失败证据给 Proposer
- Held-out split :不展示给 Proposer,仅用于自动晋级门控
- 每个候选评估两次 :取平均通过率
- Split 划分 :在运行 Self-Harness 前固定任务集划分
- 评估指标
- Pass (%) :通过 benchmark verifier 的任务尝试百分比,测量单次尝试任务成功率
主要实验结果
- 整体性能提升(Figure 4)
模型 Split Initial Pass (%) Self-Harness Pass (%) 绝对提升 (pp) 相对提升 MiniMax M2.5 Held-in 43.0 50.0 +7.0 +16% Held-out 40.5 61.9 +21.4 +53% Overall 42.2 53.9 +11.7 +28% Qwen3.5-35B-A3B Held-in 15.1 36.0 +20.9 +138% Held-out 23.8 38.1 +14.3 +60% Overall 20.3 36.7 +16.4 +81% GLM-5 Held-in 47.7 57.0 +9.3 +20% Held-out 42.9 57.1 +14.2 +33% Overall 46.1 57.0 +10.9 +24% - 核心结论 :
- 所有三个模型均一致改进
- 改进不仅限于 held-in 任务,held-out 任务也有显著提升
- 没有 promoted Harness 导致任何 split 的性能退化(non-regressive)
实验分析与定性结果
- Harness 进化轨迹(Figures 5a, 6a, 10a)
- 每个模型的进化轨迹显示:
- 绿色标记:被接受的 Harness 候选
- 灰色叉号:被拒绝的 Harness 候选
- Step lines:连接接受的候选,在拒绝迭代期间保持性能不变
- 最终 Harness 通过少量 validation-gated 编辑达到
- 每个模型的进化轨迹显示:
保留的代码级编辑
MiniMax M2.5(Figure 5b)
- 接受的三个 Harness 修改:
- 1)Bootstrap instruction 从“识别最小编辑表面”改为“识别所需输出 artifact 并尽早创建初始版本”
- 2)Runtime policy 启用:限制总 tool messages 数量
- 3)其他编辑:处理结构化 tool content 更仔细,在长时间 tool 交互后重定向执行
- 核心主题 :早期 artifact 创建和有界执行(bounded execution)
Qwen3.5-35B-A3B(Figure 6b)
- 接受的四个 Harness 修改:
- 1)Dependency precheck :提前检查依赖
- 2)Loop breaking :打破无休止探索循环
- 3)Command-retry discipline :避免精确命令重试
- 4)Artifact-focused recovery :tool 错误后聚焦 artifact 恢复
- 核心主题 :失败恢复能力和避免重复无效动作
GLM-5(Figure 10b)
- 接受的四个 Harness 修改:
- 1)Environment persistence :保持 shell 会话间的环境变化
- 2)Session-scoped tools :会话范围工具
- 3)Transition from exploration :从探索转向实现和测试
- 4)External computation :处理外部计算
- 核心主题 :环境状态保持和从探索到实现的策略切换
轨迹级案例分析
- MiniMax M2.5:
count-dataset-tokens任务(Figure 7)初始 Harness 编辑后 Harness 行为 继续数据集探索,即使已找到相关 metadata 配置 识别 metadata-backed science subset 结果 超时,未创建所需 answer artifact 计算所需 token 总数,写入 /app/answer.txt,验证失败机制 开放式 tool 使用无终止条件 有界执行,早期 artifact 创建 - Qwen3.5:
extract-elf任务(Figure 8)初始 Harness 编辑后 Harness 行为 创建 extractor 脚本,遇到 overwrite/edit 失败,反复尝试,最终删除 /app/extract.jsTool-error-triggered system prompt 重定向到缺失 artifact 结果 Verifier 失败(所需文件缺失) 重新创建 extractor,修复解析逻辑,生成 JSON 输出,验证 失败机制 重复失败动作 错误触发的恢复策略 - GLM-5:
build-pov-ray任务(Figure 9)初始 Harness 编辑后 Harness 行为 长时间外部下载消耗大量 budget,然后尽管 sanity check 失败仍 finalize 分阶段有界操作,检查外部 archive 证据,修复失败的 sanity check 结果 失败 成功 失败机制 无边界的外部操作 有界操作,基于证据的决策
附录:核心 Insight 总结
- 论文中作者的核心观点:
- Harness 是 Agent 性能的关键决定因素 :同样 base model 在不同 Harness 下表现差异巨大
- Harness 设计本质上是 Model-Specific :不同模型的失败模式不同,需要针对性调整
- 人类中心范式不可扩展 :随着 LLM 快速迭代,手动设计 model-specific Harness 成本过高
- Self-Harness 实现了“自我创造”的技术类比 :系统不是被动被改变,而是主动参与重塑自己
- Harness 改进应作为经验状态转移 :有用的 Harness 编辑必须指定目标行为、修改表面、证据动机和验证结果
- Self-Harness 设计原则
- 证据驱动 :修改必须基于 verifier-grounded 的执行证据,而非直觉
- 可操作性约束 :只针对可以通过可编辑 Harness 表面解决的失败模式
- 多样性与最小性 :探索多种候选,但每个编辑保持最小且聚焦
- 非退化回归测试 :任何改进都不能以另一部分性能下降为代价
- 可审计性 :每次编辑都有完整的审计记录,包括变更表面、split-wise 结果、决策依据
- Self-Harness 关键创新点总结
- 将 Proposer 角色内部化 :使用同一固定模型来提议 Harness 修改,而非依赖更强的外部 Agent
- Verifier-Grounded 失败聚类 :通过失败签名(terminal cause + causal status + agent mechanism)聚合失败,而非简单的语义相似性
- 保守的接受规则 :要求至少一个 split 改进,且另一个不退化
- 并行提议生成 :从同一证据生成多个不同候选,拓宽探索空间
附录:相关工作对比
- 与 Prompt Engineering/Context Engineering 的区别
Prompt Engineering Self-Harness 修改对象 单个输入 整个执行协议(Harness) 范围 指令、示例、检索证据 工具、内存、验证规则、运行时策略、编排逻辑 目标 改进单次响应 改进长期 Agent 行为 - 与 Self-Improving Agents 的区别
方法 修改对象 特点 Reflexion Response strategy / memory 存储口头反馈供后续尝试 Agentic Context Engineering Context 为后续 model 调用进化 context STOP Generated program 递归自我改进代码生成 Self-Harness Harness 本身 修改控制未来行为的执行协议 - 与 Automated Agent Design 的区别
方法 优化主体 特点 Automated Design of Agentic Systems 外部搜索 搜索 Agent 设计空间 Language Agents as Optimizable Graphs 外部优化 Agent 表示为可优化图 Meta-Harness 外部 Agent 更强外部 Agent 优化目标 Agent Self-Harness 目标 Agent 自身 在目标 Agent 当前 Harness 下提议 bounded edit - 与 Scientific Discovery/Self-Evolving Systems 的关系
- 最接近 spirit:The AI Scientist, AI Scientist-v2, AlphaEvolve, Alita, Gödel Agent, Darwin Gödel Machine
- 区别:Self-Harness 研究 更窄的控制设定——同一固定模型在当前 Harness 下能否提议对自身 Harness 的有界候选变更