Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——LLM对齐微调-RuscaRL

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(RuscaRL) Breaking the Exploration Bottleneck: Rubric-Scaffolded Reinforcement Learning for General LLM Reasoning, 20250823-20251022, ZJU & Li Auto Inc.
      • 注:Li Auto Inc. 是理想汽车母公司
    • GitHub 源码:github.com/IANNXANG/RuscaRL

Paper Summary

  • 整体说明:
    • 论文将教育心理学中的教学 Scaffolding 理论应用于 LLM 的 RL,并提出了 RuscaRL
      • RuscaRL 是一个新颖的教学 Scaffolding 框架,旨在打破通用 LLM 推理任务的探索瓶颈
    • RuscaRL 通过 Scaffolding 机制利用清单式(checklist-style) Rubric,提供逐渐衰减的外部指导,并通过 Reward 函数实现稳健的 RL 训练
      • Rubric-based Scaffolding 机制提供外部指导并逐渐衰减以鼓励内化(理解:先添加一些 Rubrics 作为手脚架,然后训练过程中不断减少 Rubrics 的加入)
      • Rubric-based Reward 函数则实现稳健的评估以支持有效的 RL 训练
    • 大量实验表明
      • RuscaRL 始终优于强大的基线方法,并与领先模型相比取得了有竞争力的结果
      • 使用 RuscaRL 微调的模型能够生成初始模型几乎无法生成的高度新颖的 Response
  • 背景 & 问题:
    • RL 在促进推理能力涌现方面的有很大的潜力,但目前一个根本的困境仍然存在:
    • RL 的提升依赖于从高质量样本中学习,而对这类样本的探索仍然受限于 LLMs 固有的能力
    • 这实际上造成了一个不良循环,即what cannot be explored cannot be learned(无法被探索则无法被学习)
  • 本文解法:
    • 论文提出了 Rubric-Scaffolded Reinforcement Learning (RuscaRL)
    • 注:这里的 scaffold 直译是脚手架(建筑领域的常用词 ,是施工时搭建在建筑物外围的临时支撑结构),用于强调辅助训练后可以移除的辅助设施
    • RuscaRL 是一个新颖的教学脚手架框架(instructional scaffolding framework),旨在打破通用 LLM 推理的探索瓶颈,RuscaRL 引入清单式 Rubric 作为
      • (1) 显式脚手架(explicit scaffolding) 用于 Rollout 生成期间的探索,即在任务指令中提供不同的 Rubric 作为外部引导,以引导多样化的高质量响应
        • 这种引导会随时间逐渐衰减(decayed),鼓励模型内化底层的推理模式(encouraging the model to internalize the underlying reasoning patterns);
      • (2) 用于模型训练期间利用的可验证奖励 ,即我们可以使用 Rubric 作为参考获得稳健的 LLM-as-a-Judge 分数,从而在通用推理任务上实现有效的 RL
  • 广泛的实验证明了所提出的 RuscaRL 在各种基准测试中的优越性,有效扩展了 Best-of-N 评估下的推理边界
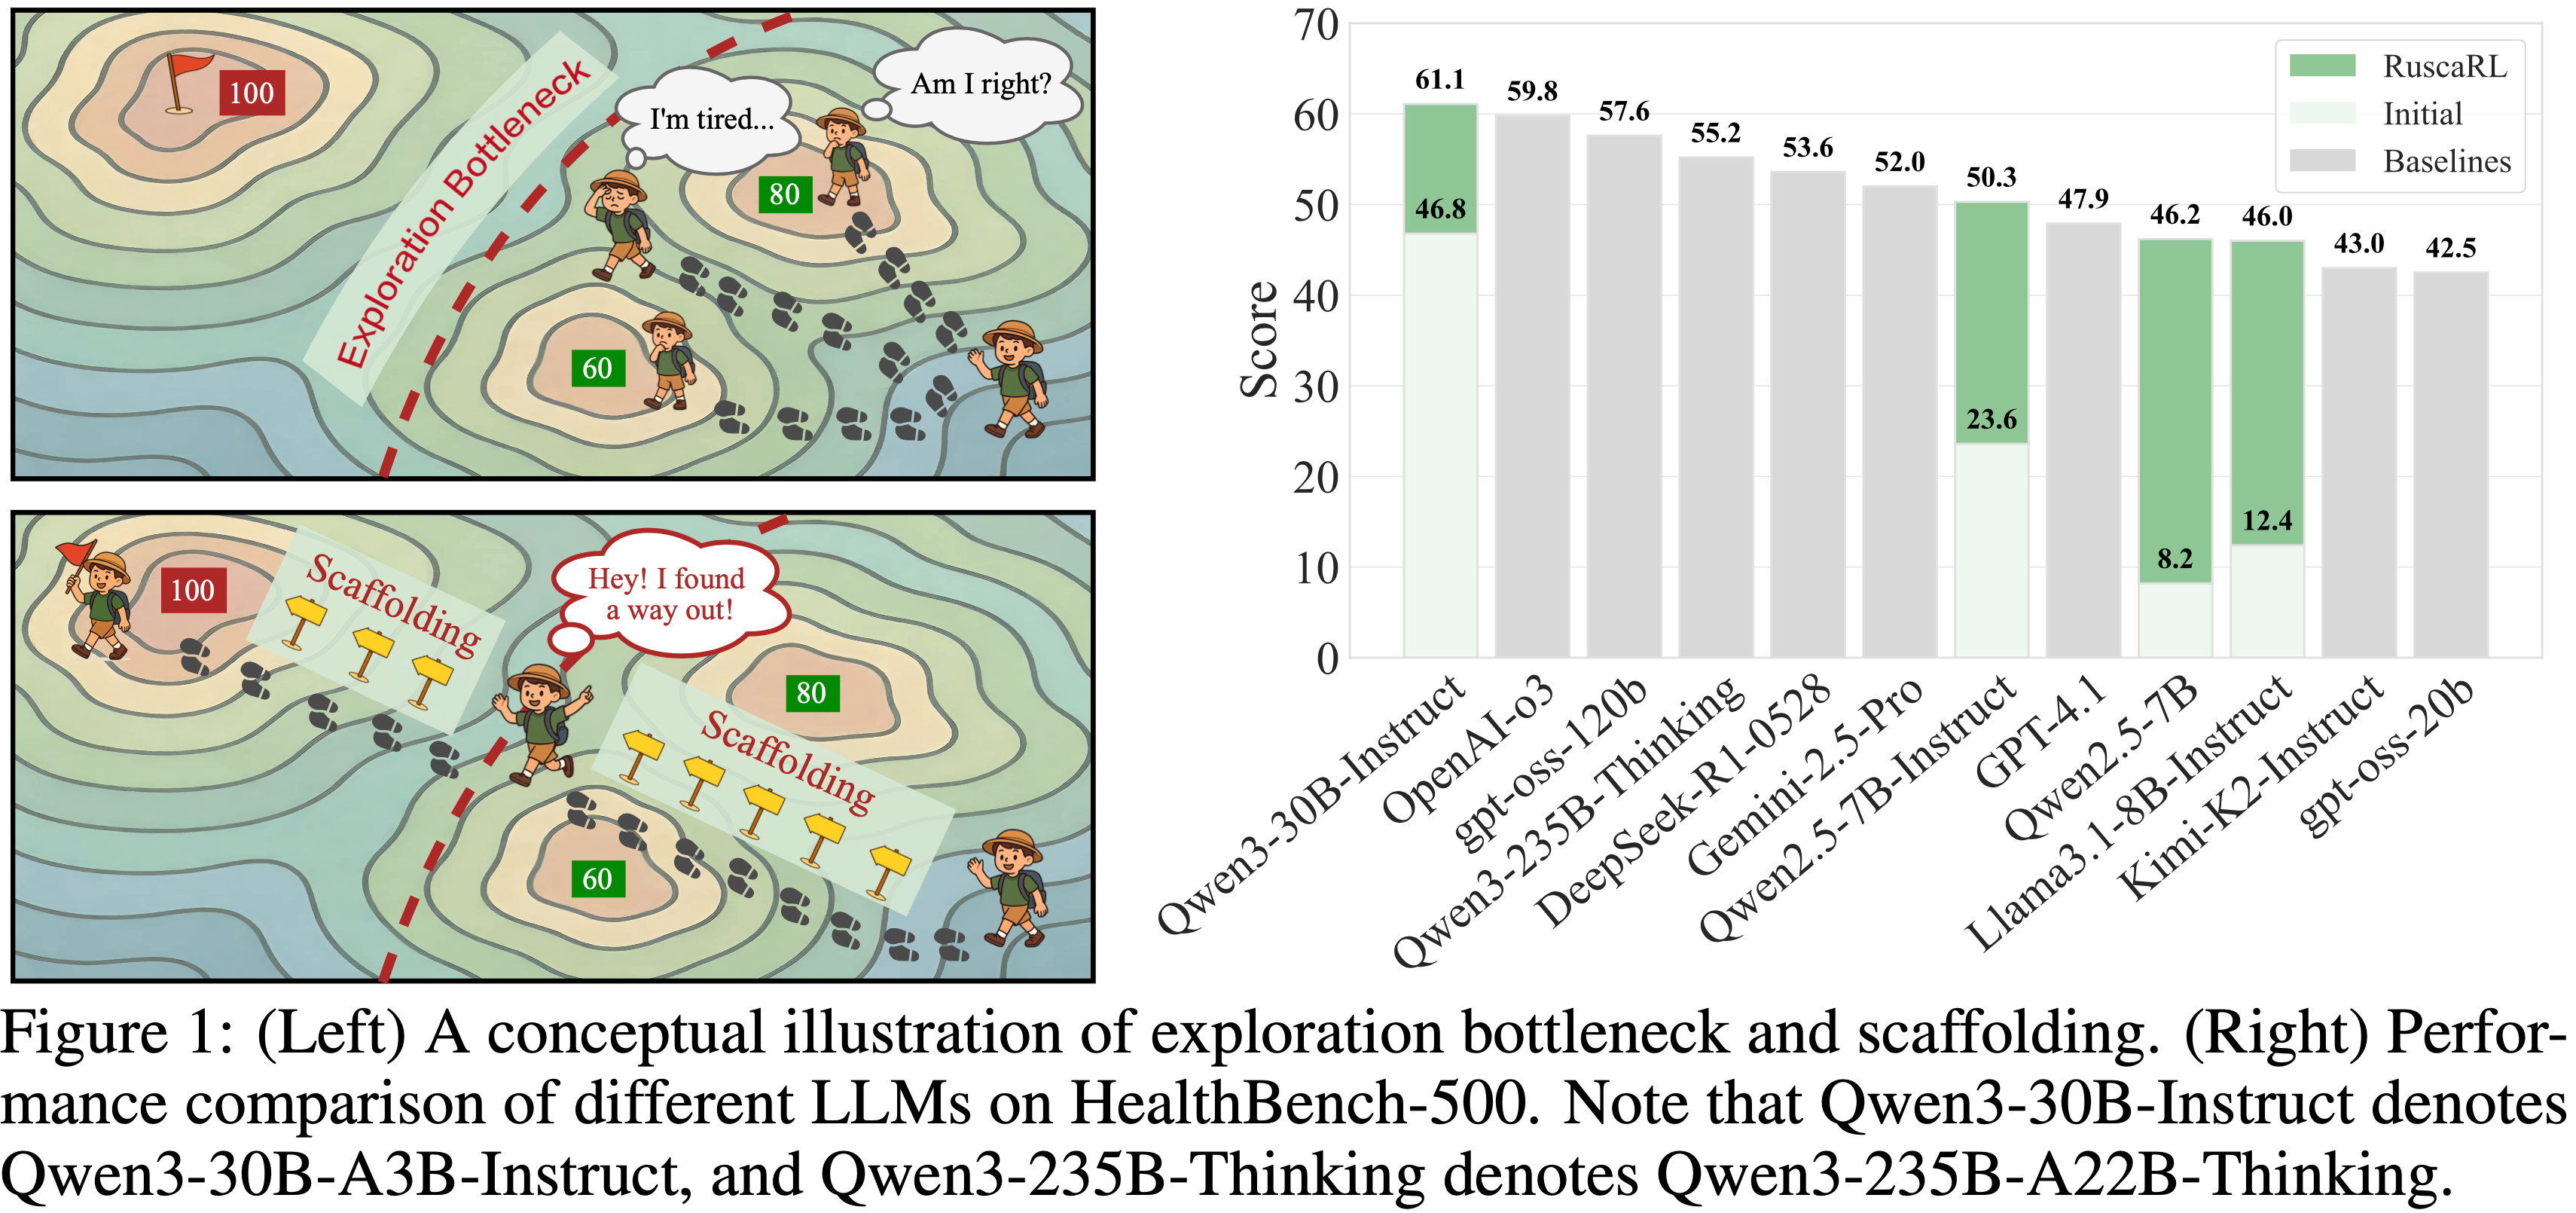
    • Notably,RuscaRL 将 Qwen2.5-7B-Instruct 在 HealthBench-500 上的得分从 23.6 显著提升至 50.3,超过了 GPT-4.1
    • Furthermore,论文在 Qwen3-30B-A3B-Instruct 上微调的变体在 HealthBench-500 上达到了 61.1 分,性能优于包括 OpenAI-o3 在内的领先 LLMs
  • 一些说明:
    • 论文的图 1(右)画的很不错,清晰易懂,能清晰看出论文方法带来的改进,值得写论文时学习
  • 补充:论文中的未来工作
    • 虽然 RuscaRL 在打破通用 LLM 推理的探索瓶颈方面展示了有希望的结果,但仍存在一些局限性,为未来的研究指明了方向
      • 论文的方法关键依赖于高质量、结构良好的 Rubric 数据集(而这些数据集在社区中仍然稀缺),并且论文的方法对 Rubric 设计的质量高度敏感
      • 设计不良的 Rubric 可能由于不合理的分数分配或相互冲突的准则而无法提供稳健的 Reward 信号
      • 范围狭窄的 Rubric 则可能限制 Scaffolding 过程生成多样化、高质量 Response 的能力
    • RuscaRL 的成功突显了社区迫切需要投入更多资源来构建开放、多样且领域丰富的 Rubric 数据集
      • 作者未来的工作包括开发高质量 Rubric 数据生产流程、探索 Rubric-based 自然语言反馈策略,以及研究在多模态任务和智能体系统中的应用

Introduction and Discussion

  • LLMs 在广泛的复杂推理任务上已展现出巨大的潜力
    • 包括法律分析 (2021; 2023; 2024; 2022),软件工程 (2023; 2024),机器人技术 (2025; 2023a; 2023),以及具体任务如代码生成 (Qwen, 2025) 和数学证明 (2025; 2025)
    • However,提升 LLMs 的通用推理能力仍然是一个重大挑战 (2023; 2022)
  • 为了解决上述问题,最近在 RLVR 方面的突破,例如 DeepSeek-R1 (2025) 和 OpenAI-o3 (OpenAI, 2025a),已经证明利用可验证奖励作为反馈信号可以成功促进 LLMs 中复杂推理能力的涌现 (2025; 2025a)
  • 尽管取得了不错的成果,传统的 RLVR 往往更适用于答案具有客观可验证性的领域
    • For Instance,在数学证明(2025;2025)和代码生成(Qwen, 2025;2022)等领域,正确性可以通过形式化证明验证或自动化单元测试来明确判定
      • 在这些场景中,奖励信号清晰且与任务目标高度一致,使得 RLVR 能够有效引导模型找到正确的解决方案
    • Unfortunately,许多现实任务,如医疗咨询(2025;2023;2023)和创意写作(2025c;2024),本质上是开放性的
      • 这类任务通常需要进行多维评估,且往往缺少一个唯一、可验证的标准答案
  • 为解决上述问题,近期涌现的一些并列研究(2025;2025;2025;2025;2025;2025)开始探索 Rubric-based 评估方法,将理想的回答分解为清单式的评估标准(如事实性(factuality)、连贯性(coherence)、完整性(completeness)等)
    • 通过利用 “LLM-as-a-Judge” 对每个标准(criterion)进行打分,并将结果聚合为标量奖励,量规为开放性领域中的 RLVR 提供了更稳定、更可靠的反馈信号
  • Nevertheless,如图 1(左)所示,一个根本性的探索瓶颈仍然存在:
    • RL 需要高质量样本来改进,但对这些样本的探索仍受限于 LLMs 的固有能力 (2025; 2025a; 2025b; 2025)
      • 这造成了一个不可避免的循环,即无法探索限制了学习能力(the inability to explore restricts the ability to learn)
    • 越来越多的研究尝试增强 LLMs RLVR 中的探索 (2025a, 2025b; 2025; 2025; 2025; 2025; 2025)
      • However,这些方法很大程度上将策略分布偏向于基础模型已经支持的高奖励响应,而非真正扩展其推理边界 (2025a)
      • 更糟糕的是(Worse still),RL 本身具有缩小探索空间的天然趋势:策略熵在训练过程中逐渐崩溃,导致模型收敛于有限的推理轨迹集 (2025; 2025; 2025a; 2025; 2025b)
        • 这反过来削弱了 RLVR 探索更多样化和更高质量解决方案的潜力
  • 论文引入了 Rubric-Scaffolded Reinforcement Learning(RuscaRL) ,采用了一种新颖的教学脚手架框架来打破 RLVR 的探索瓶颈
    • 在技术上,RuscaRL 以两种互补的方式利用 Rubric:
      • (1) Rollout 生成期间的显式脚手架(Explicit scaffolding during rollout generation)
        • 对于每个指令,RuscaRL 通过使用 Rubric 作为外部引导生成一组候选响应
        • 论文提出了组内脚手架差异化(intra-group scaffolding differentiation) ,在每个组内提供不同级别的 Rubric,从而实现多样化和高质量的响应
        • 为了进一步内化底层推理模式,论文使用步间脚手架衰减(inter-step scaffolding decay) 在训练过程中逐渐移除脚手架 ,从而最小化对外部引导的依赖
      • (2) 模型训练期间的可验证奖励(verifiable rewards during model training)
        • 模型响应根据源自 Rubric 的多个标准(criteria)进行评估
        • 对于每个标准,论文使用一个 Grader LLM 执行二元评估(i.e. True or False),判断响应是否满足该特定要求
        • 然后通过聚合将结果结合,得到一个稳健的奖励信号,促进在不同通用任务上的有效 RL
  • 论文的主要贡献总结如下:
    • 论文引入教学脚手架 (instructional scaffolding) 作为 LLMs RLVR 的一个新范式,它开创了在任务指令中整合外部引导以提高 Rollout 多样性和质量的方法,从而在 RL 过程中实现更高效的探索
    • 论文提出了 Rubric-Scaffolded Reinforcement Learning (RuscaRL) ,一个旨在打破探索瓶颈的创新 RLVR 框架,它集成了清单式 Rubric,既作为探索的显式脚手架,也作为利用的可验证奖励
    • 广泛的实验表明,RuscaRL 产生的结果优于 SOTA 对应方法
      • 值得注意的是,如图 1(右)所示,RuscaRL 使得小型 LLMs(例如 Qwen3-30B)在 HealthBench-500 上能够达到与领先 LLMs(例如 OpenAI-o3)相当的性能

Related Works

Rubric-based Methods

  • Rubric 是结构化的评估框架,将复杂的评估任务分解为具体、可验证的标准
  • 为了应对通用任务评估, Rubric-based 评估方法已在医疗 (2025; 2025)、代码 (2025; Galván-2025) 和其他领域 (2025; 2025) 出现。基于这些框架,研究人员将 Rubric 作为奖励信号应用于 RL (2025; 2025),使用 LLMs 作为 Grader ,为缺乏真实答案的任务提供细粒度反馈
  • 这种方法在 LLM 对齐 (2025)、指令遵循 (2025) 和开放式问答 (2025; 2025; 2025) 方面显示出有前景的结果

Exploration in RL for LLMs

  • 现有的 RL 方法在复杂推理任务中面临探索不足的问题,策略陷入局部最优,推理边界崩溃 (2025a; 2025; 2025a)
  • 当前的解决方案包括延长训练 (2025a, 2025b)、基于熵的探索 (2025; 2025; 2025) 和外部引导 (2025a; 2025),但这些方法未能打破探索瓶颈,因为它们要么在初始策略分布内探索,要么仅提供粗糙的方向信号而没有结构化的中间引导
  • In Contrast,RuscaRL 通过清单式 Rubric 提供显式脚手架,用可验证的标准引导轨迹,同时通过脚手架衰减实现模式内化

Preliminary

RL Algorithms for LLMs

  • 论文采用 GRPO (2025) 作为论文的核心 RL 算法,用于训练具有基于 Rubric 奖励的语言模型
    • 与 PPO (2017) 不同,GRPO 通过使用基于组的优势估计消除了对价值模型的需求
    • 对于每个指令(Instruction) \(q \sim \mathcal{D}\),其中 \(\mathcal{D}\) 表示训练数据集 \(\mathcal{D}\) 上的分布,GRPO 从旧策略 \(\pi_{\theta_{\text{old} } }\) 中采样一组 \(G\) 个响应 \(\{o_{1}, o_{2}, \ldots, o_{G}\}\),并通过最大化以下目标来优化策略 \(\pi_{\theta}\):
      $$
      \begin{split}
      \mathcal{J}_{\text{GRPO} } \left(\theta\right) = \mathbb{E}_{q \sim \mathcal{D}, \{o_i\}_{i=1}^{G} \sim \pi_{\theta_{\text{old} } }(\cdot|q)}
      \end{split}
      \left[ \frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \min \left( \rho_{i,t}(\theta) \hat{A}_i, \operatorname{clip} \left( \rho_{i,t}(\theta), 1-\epsilon, 1+\epsilon \right) \hat{A}_i \right) \right] \tag{1}
      $$
      • \(o_i\) 是给定指令 \(q\) 从旧策略 \(\pi_{\theta_{\text{old} } }\) 中采样的响应
      • \(t\) 表示响应 \(o_i\) 内的 token 位置
      • \(\rho_{i,t}(\theta) = \frac{\pi_{\theta}(o_{i,t} | q, o_{i,< t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | q, o_{i,< t})}\) 是当前策略和先前策略之间的 token 级重要性比率
      • \(\epsilon\) 是裁剪系数 (2017)
  • 组相对优势计算为:
    $$
    \hat{A}_i = \frac{r_i - \operatorname{mean} \left( \{r_j\}_{j=1}^{G} \right)}{\operatorname{std} \left( \{r_j\}_{j=1}^{G} \right)} \tag{2}
    $$
    • 其中 \(r_i\) 是响应 \(o_i\) 的奖励,优势是使用 \(G\) 个采样奖励的均值和标准差进行归一化的

Methodology

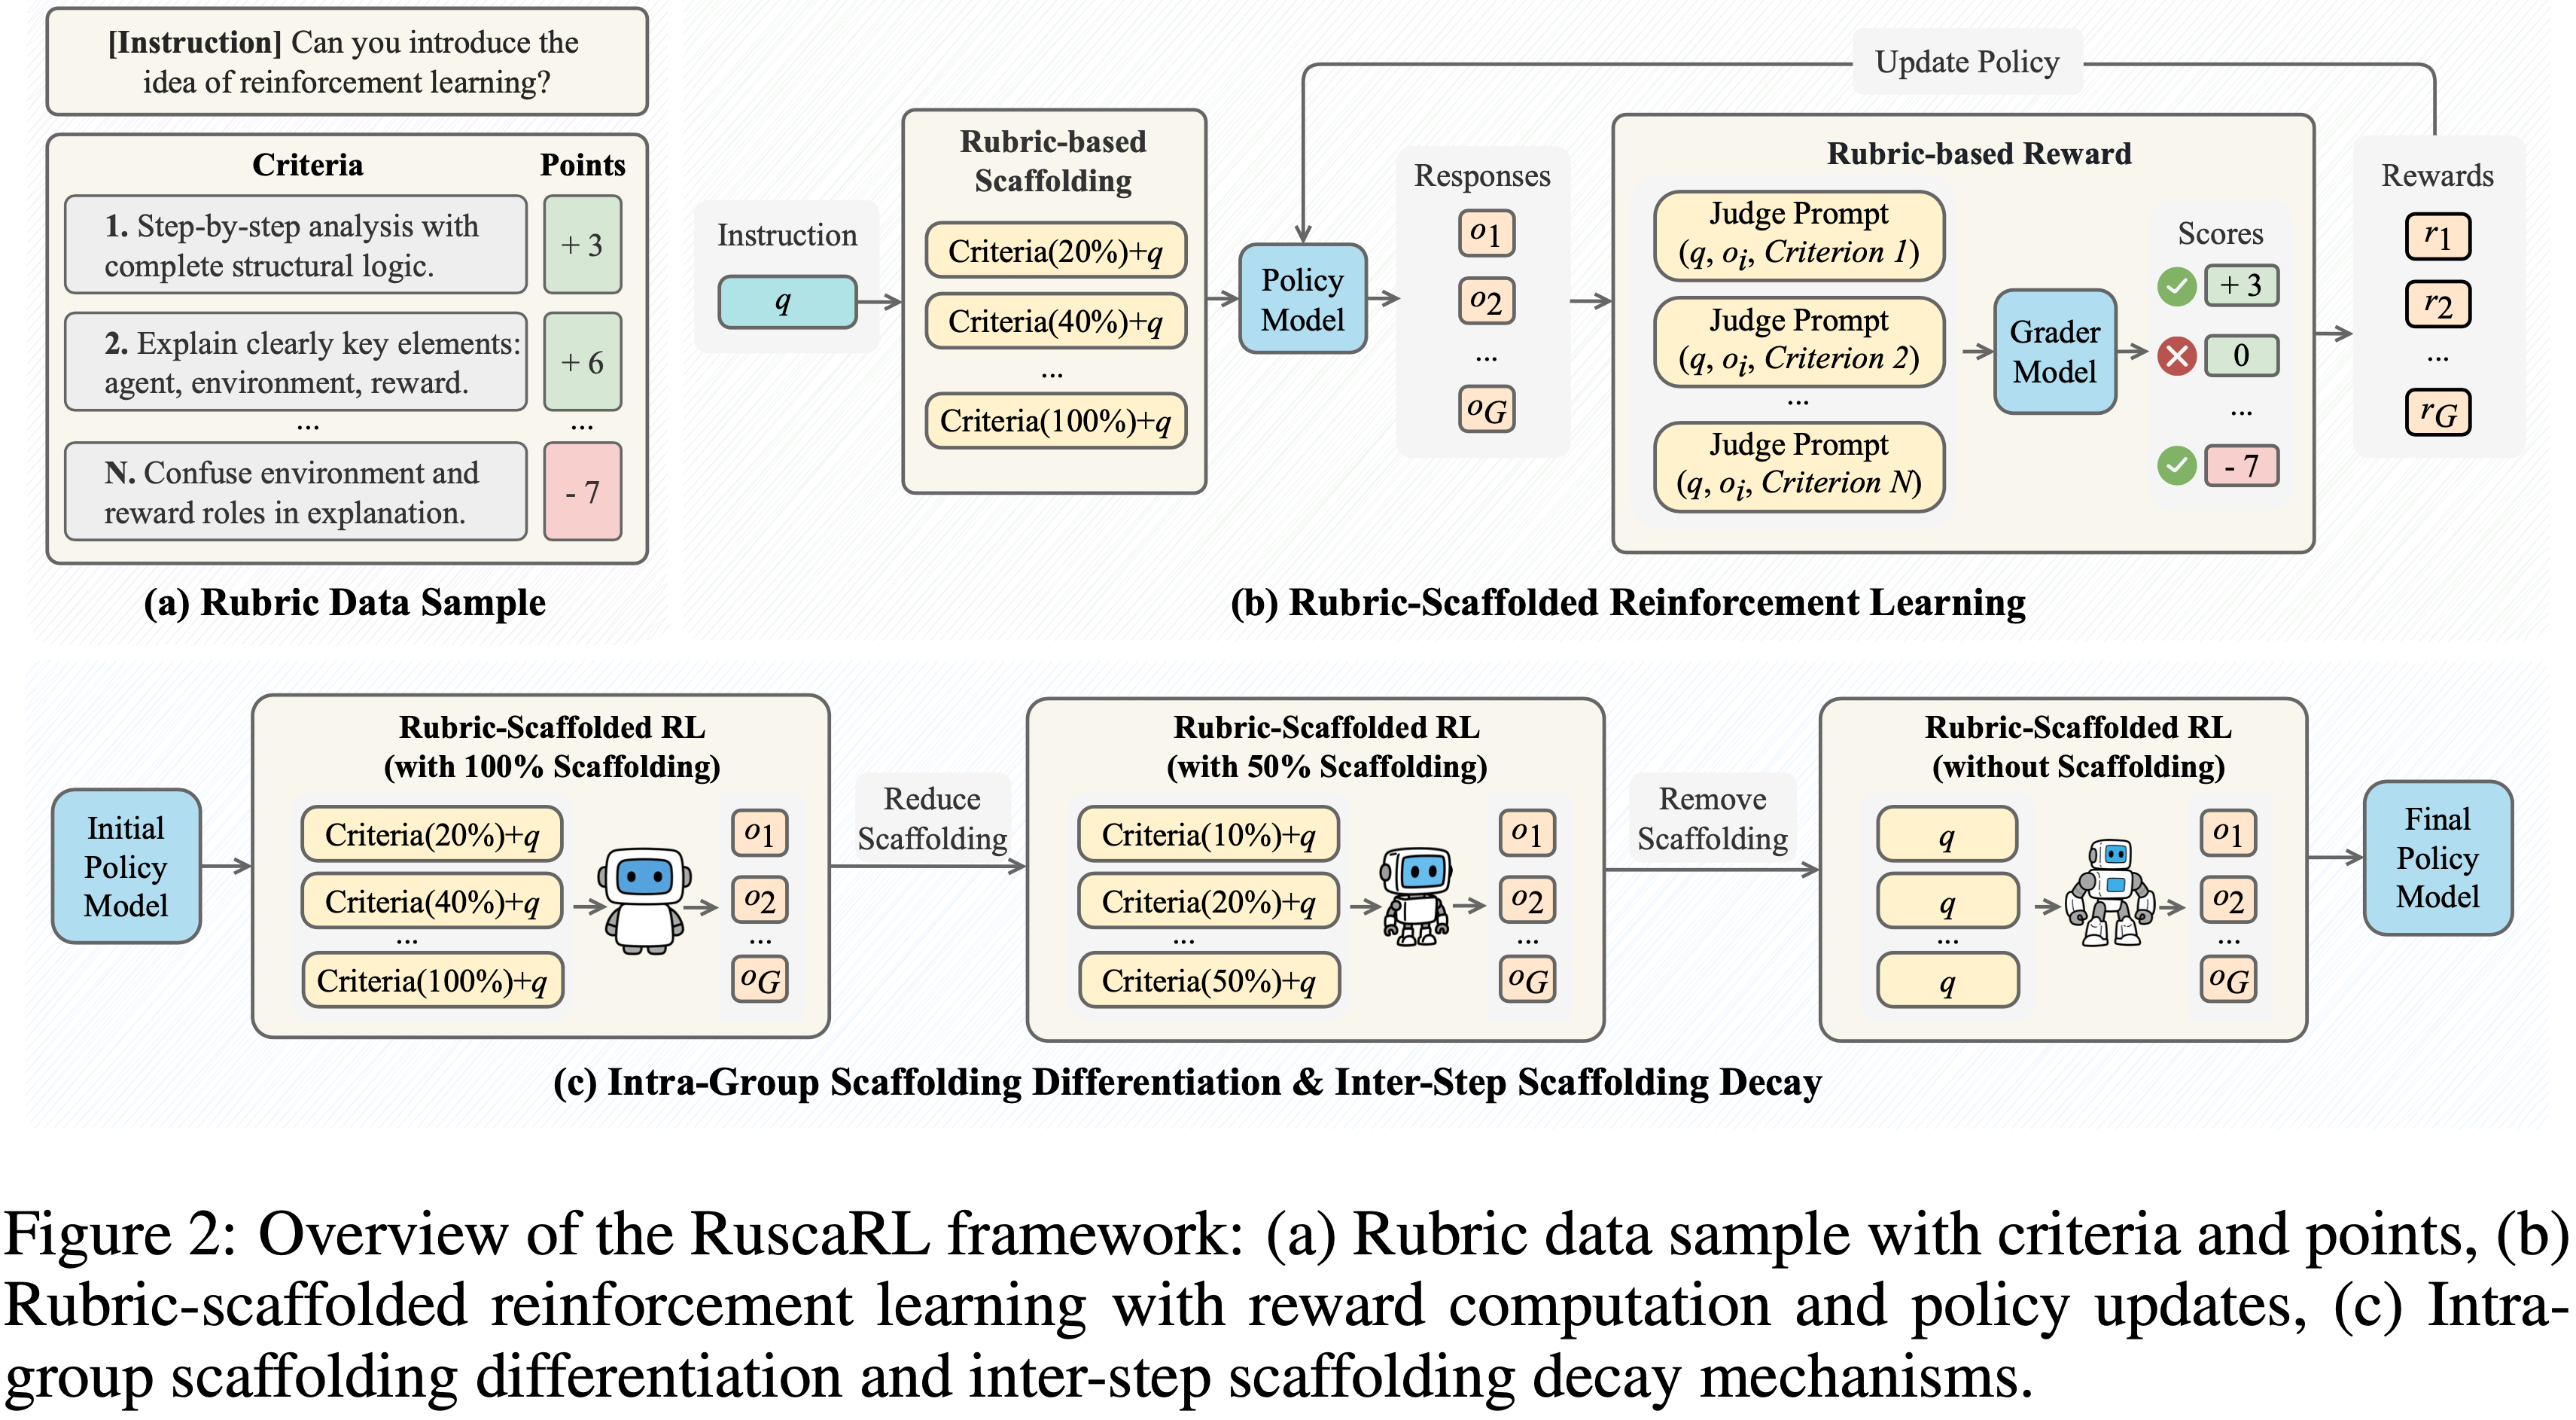
  • 为了解决探索瓶颈问题,论文提出了 RuscaRL 框架,如图 2 所示
  • RuscaRL 以两种互补的方式利用 Rubric:
    • (1) Rollout 生成期间的显式脚手架(Explicit scaffolding during rollout generation) ,其中模型使用 Rubric 作为具有组内差异化和步间衰减的外部引导来生成候选响应(第 4.2 节);
    • (2) 模型训练期间的可验证奖励(Verifiable rewards during model training) ,其中响应基于通过二元评估和聚合从 Rubric 派生的多个标准进行评估(第 4.3 节)
  • 在下文中,论文首先介绍 Rubric 的基本概念,然后详细介绍这两个核心组件

Rubric-based Evaluation System

  • 评估复杂和开放式的任务本质上是具有挑战性的,因为响应通常在结构、风格和内容上有所不同,使得基于规则的评估难以提供可靠的判断
  • 为了解决这个差距,最近的工作 (2025) 提出了 Rubric-based 评估
    • Rubric-based Evaluation 指定了细粒度、多维度的标准,可以大规模应用
    • 这种设计结合了自动指标的客观性和结构化标准的原则性指导,产生能够更好地捕捉响应质量、连贯性和完整性的稳健分数
  • 形式上,一个 Rubric 被定义为一组 \(N\) 个可验证的标准:
    $$ \mathcal{R} = \{c_1, c_2, \ldots, c_N\} $$
    • 每个标准 \(c_i\) 由一个清晰的描述和相应的 Points \(p_i\) 指定,\(p_i\) 表示其对整体评估的贡献(理解:即 Rubric 的权重)
    • 论文将 Points 向量定义为
      $$ \mathbf{p} = [p_1, p_2, \ldots, p_N] $$
      • 例如,给定指令“你能介绍一下强化学习的概念吗?”,标准可能包括:
        • “具有完整结构逻辑的逐步分析”(+3 分)
        • “解释关键要素:智能体、环境、奖励”(+6 分)
        • 负面项如“在解释中混淆环境和奖励的角色”(-7 分)
      • 根据每个标准是否满足来加减分
  • 给定一个指令 \(q\) 及其对应的 Rubric \(\mathcal{R}\)(两者均从数据分布 \(\mathcal{D}\) 中采样),以及通过策略模型 \(\pi_{\theta}(o|q)\) 生成的模型响应 \(o\)
    • 论文首先通过组合指令(instruction) \(q\)、Response \(o\) 和标准(criterion) \(c_i\),为每个标准 \(c_i\) 构建一个评判提示(Judge Prompt)
    • Grader 的 Judge Prompt 模板在附录 E.1 中提供
  • 对于单个标准评估(single criterion evaluation),由 LLM 实现的 Grader 函数 \(\mathcal{G}\) (2023b; 2024) 将 Judge Prompt 作为输入,并输出一个二元决策 指示标准 \(c_i\) 是否被满足( True or False )
    $$ b_i = \mathcal{G}(q, o, c_i) \in \{0, 1\}$$
  • 将其扩展到完整的 Rubric, Grader 评估所有标准并产生一个二元指示向量
    $$ \mathbf{b} = \mathcal{G}(q, o, \mathcal{R}) = [b_1, b_2, \ldots, b_N]$$
    • 其中每个 \(b_i\) 表示标准 \(c_i\) 的满足情况
  • 最终分数(score)向量通过逐元素乘法获得:
    $$ \mathbf{s} = \mathbf{b} \odot \mathbf{p} = [b_1 p_1, b_2 p_2, \ldots, b_N p_N] $$
    • 上述公式提供跨所有指定标准的细粒度分数
  • 论文还计算总可能分数(total possible score):
    $$ S_{total} = \sum_{j=1}^{M} p_j$$
    • 其中 \(M\) 是正分标准的数量,这将在奖励计算中用于归一化

Rubric-based Scaffolding Mechanism for RL Exploration(Rubric-based 脚手架机制)

  • 在对复杂推理任务进行 RL 训练期间,模型通常无法持续进行有效的探索 (2025a; 2025; 2025a):
    • 即 初始随机性迅速减少,策略熵崩溃,模型过早收敛到次优的推理模式
    • 这种崩溃严重限制了发现多样化和高质量解决方案轨迹的能力
  • 为了缓解这个问题,论文从教育心理学中的教学脚手架理论 (Vygotsky & Cole, 1978) 中获得灵感
    • 根据维果茨基的最近发展区(Zone of Proximal Development)理论:
      • 当学习者的能力不足时,他们会受益于结构化的指导,以弥合当前能力与目标表现之间的差距,随着能力的增长,这种脚手架应逐渐撤除,以培养独立解决问题的能力 (1976)
  • 基于这一见解,论文设计了一种 Rubric-based 脚手架机制,在整个训练过程中提供不同数量的 Rubric 标准作为显式指导,帮助模型逐渐学会生成高质量的响应
  • Specifically,论文的 Rubric-based 脚手架机制通过添加一个 Rubric 标准的子集 \(\mathcal{R}_S\) 作为额外指导来增强原始策略函数,将策略表示为 \(\pi_{\theta}(o|q, \mathcal{R}_S)\)
    • 整合脚手架的具体提示模板在附录 E.2 中详述
  • Additionally,论文设计了一个二维控制机制来确定 Rubric 脚手架比率 \(\lambda_S\) ,然后从完整的 Rubric 集合 \(\mathcal{R}\) 中采样标准(criteria)以形成 \(\mathcal{R}_S\) ,即
    $$ |\mathcal{R}_S| = \text{round}(\lambda_S \times |\mathcal{R}|) $$
    • 论文在两个维度上实例化这个机制:组内脚手架差异化(Intra-Group Scaffolding Differentiation)和步间脚手架衰减(Inter-Step Scaffolding Decay)
Intra-Group Scaffolding Differentiation, 组内脚手架差异化
  • 在具有多重采样(如 GRPO)的 RL 算法中,计算组相对优势(方程 2)需要响应多样性以避免崩溃为同质样本
    • 为此(To this end),论文在每个组内分配不同级别的 Rubric 脚手架,鼓励既有引导的探索也有独立的探索
  • 具体来说(Concretely),论文定义一个组级比率向量(group-level ratio vector):
    $$ \boldsymbol{\lambda}_{group} = [\lambda_1, \lambda_2, \ldots, \lambda_G] $$
    • 其中对于大小为 \(G\) 的组中的第 \(i\) 个样本,\(\lambda_i = \frac{G-i}{G-1}\)
  • 这种线性差异化确保了一些样本受益于更强的脚手架,而其他样本则被刻意暴露于较弱的引导下,从而增强了组内多样性
    • 理解:结合前文内容可知,这里的 \(\lambda\) 影响的是包含 Rubric 的数量
      • \(\lambda\) 越小,使用的 Rubric 越少
      • \(\lambda=0\) 时,完全不使用 Rubric
      • \(\lambda=1\) 时,使用全部的 Rubric
Inter-Step Scaffolding Decay(step 间脚手架衰减)
  • 受教学脚手架理论的启发,论文使用一个 sigmoid 函数逐渐减少引导:
    $$ \lambda_{step}(t) = \frac{1}{1+e^{\alpha(t-t_0)} }$$
    • 其中 \(t\) 是当前的训练进度 (\(t \in [0, 1]\))
    • \(t_0\) 是中点
    • \(\alpha\) 控制衰减的陡峭度(the steepness of decay)
  • 这种机制通过创建一个自适应学习环境来防止过度依赖外部引导,在这个环境中,模型最初受益于引导以克服探索瓶颈,然后随着能力成熟逐渐过渡到独立推理
Integrated Scaffolding Mechanism
  • Finally,论文将组内差异化和步间衰减结合成一个统一的比率向量:
    $$
    \boldsymbol{\lambda}_S = \lambda_{step} \left( t \right) \times \boldsymbol{\lambda}_{group} = [\lambda_{S,1}, \lambda_{S,2}, \ldots, \lambda_{S,G}],
    $$
    • 其中 \(\lambda_{S,i}\) 表示组中第 \(i\) 个样本的脚手架比率:
      $$ \lambda_{S,i} = \lambda_{step}(t) \times \lambda_i = \frac{1}{1+e^{\alpha(t-t_0)} } \times \frac{G-i}{G-1}$$
  • 这种集成机制同时促进了每个组内的响应多样性,并自适应地减少了训练步骤间对脚手架的依赖,共同解决了同质性和过拟合的问题

Rubric-based Reward Function for RL Exploitation(for RL 利用)

  • 为了为通用推理任务提供稳健可靠的奖励信号,论文设计了 Rubric-based 奖励函数
  • 对于评估系统中获得的多维分数向量
    $$\mathbf{s} = [s_1, s_2, \ldots, s_N]$$
    • 通过直接求和所有标准分数并除以第 4.1 节计算的总可能分数来聚合为最终标量奖励:
      $$
      S = \frac{\sum_{i=1}^{N} s_i}{S_{total} },
      $$
      • \(S\) 代表最终分数
      • \(s_i\) 是第 \(i\) 个标准的分数
      • \(S_{total}\) 是第 4.1 节计算的所有正分标准的总可能分数
  • 这种计算方法得到的分数在大多数情况下落在区间 \([0,1]\) 内,偶尔可能出现负分数
    • 论文直接采用这个 Rubric-based 分数 \(S\) 作为论文的奖励:
      $$ r_i = S_i $$
      • 其中 \(r_i\) 是第 \(i\) 个响应的奖励
  • 这种方法使得在没有真实答案的开放式任务中得以应用,同时提供了比整体 LLM 评分更稳健的评估
    • 获得了 Rubric-based 奖励后,就可以使用 RL 算法来训练策略模型
    • 训练过程遵循策略梯度框架,其中模型学习最大化期望奖励
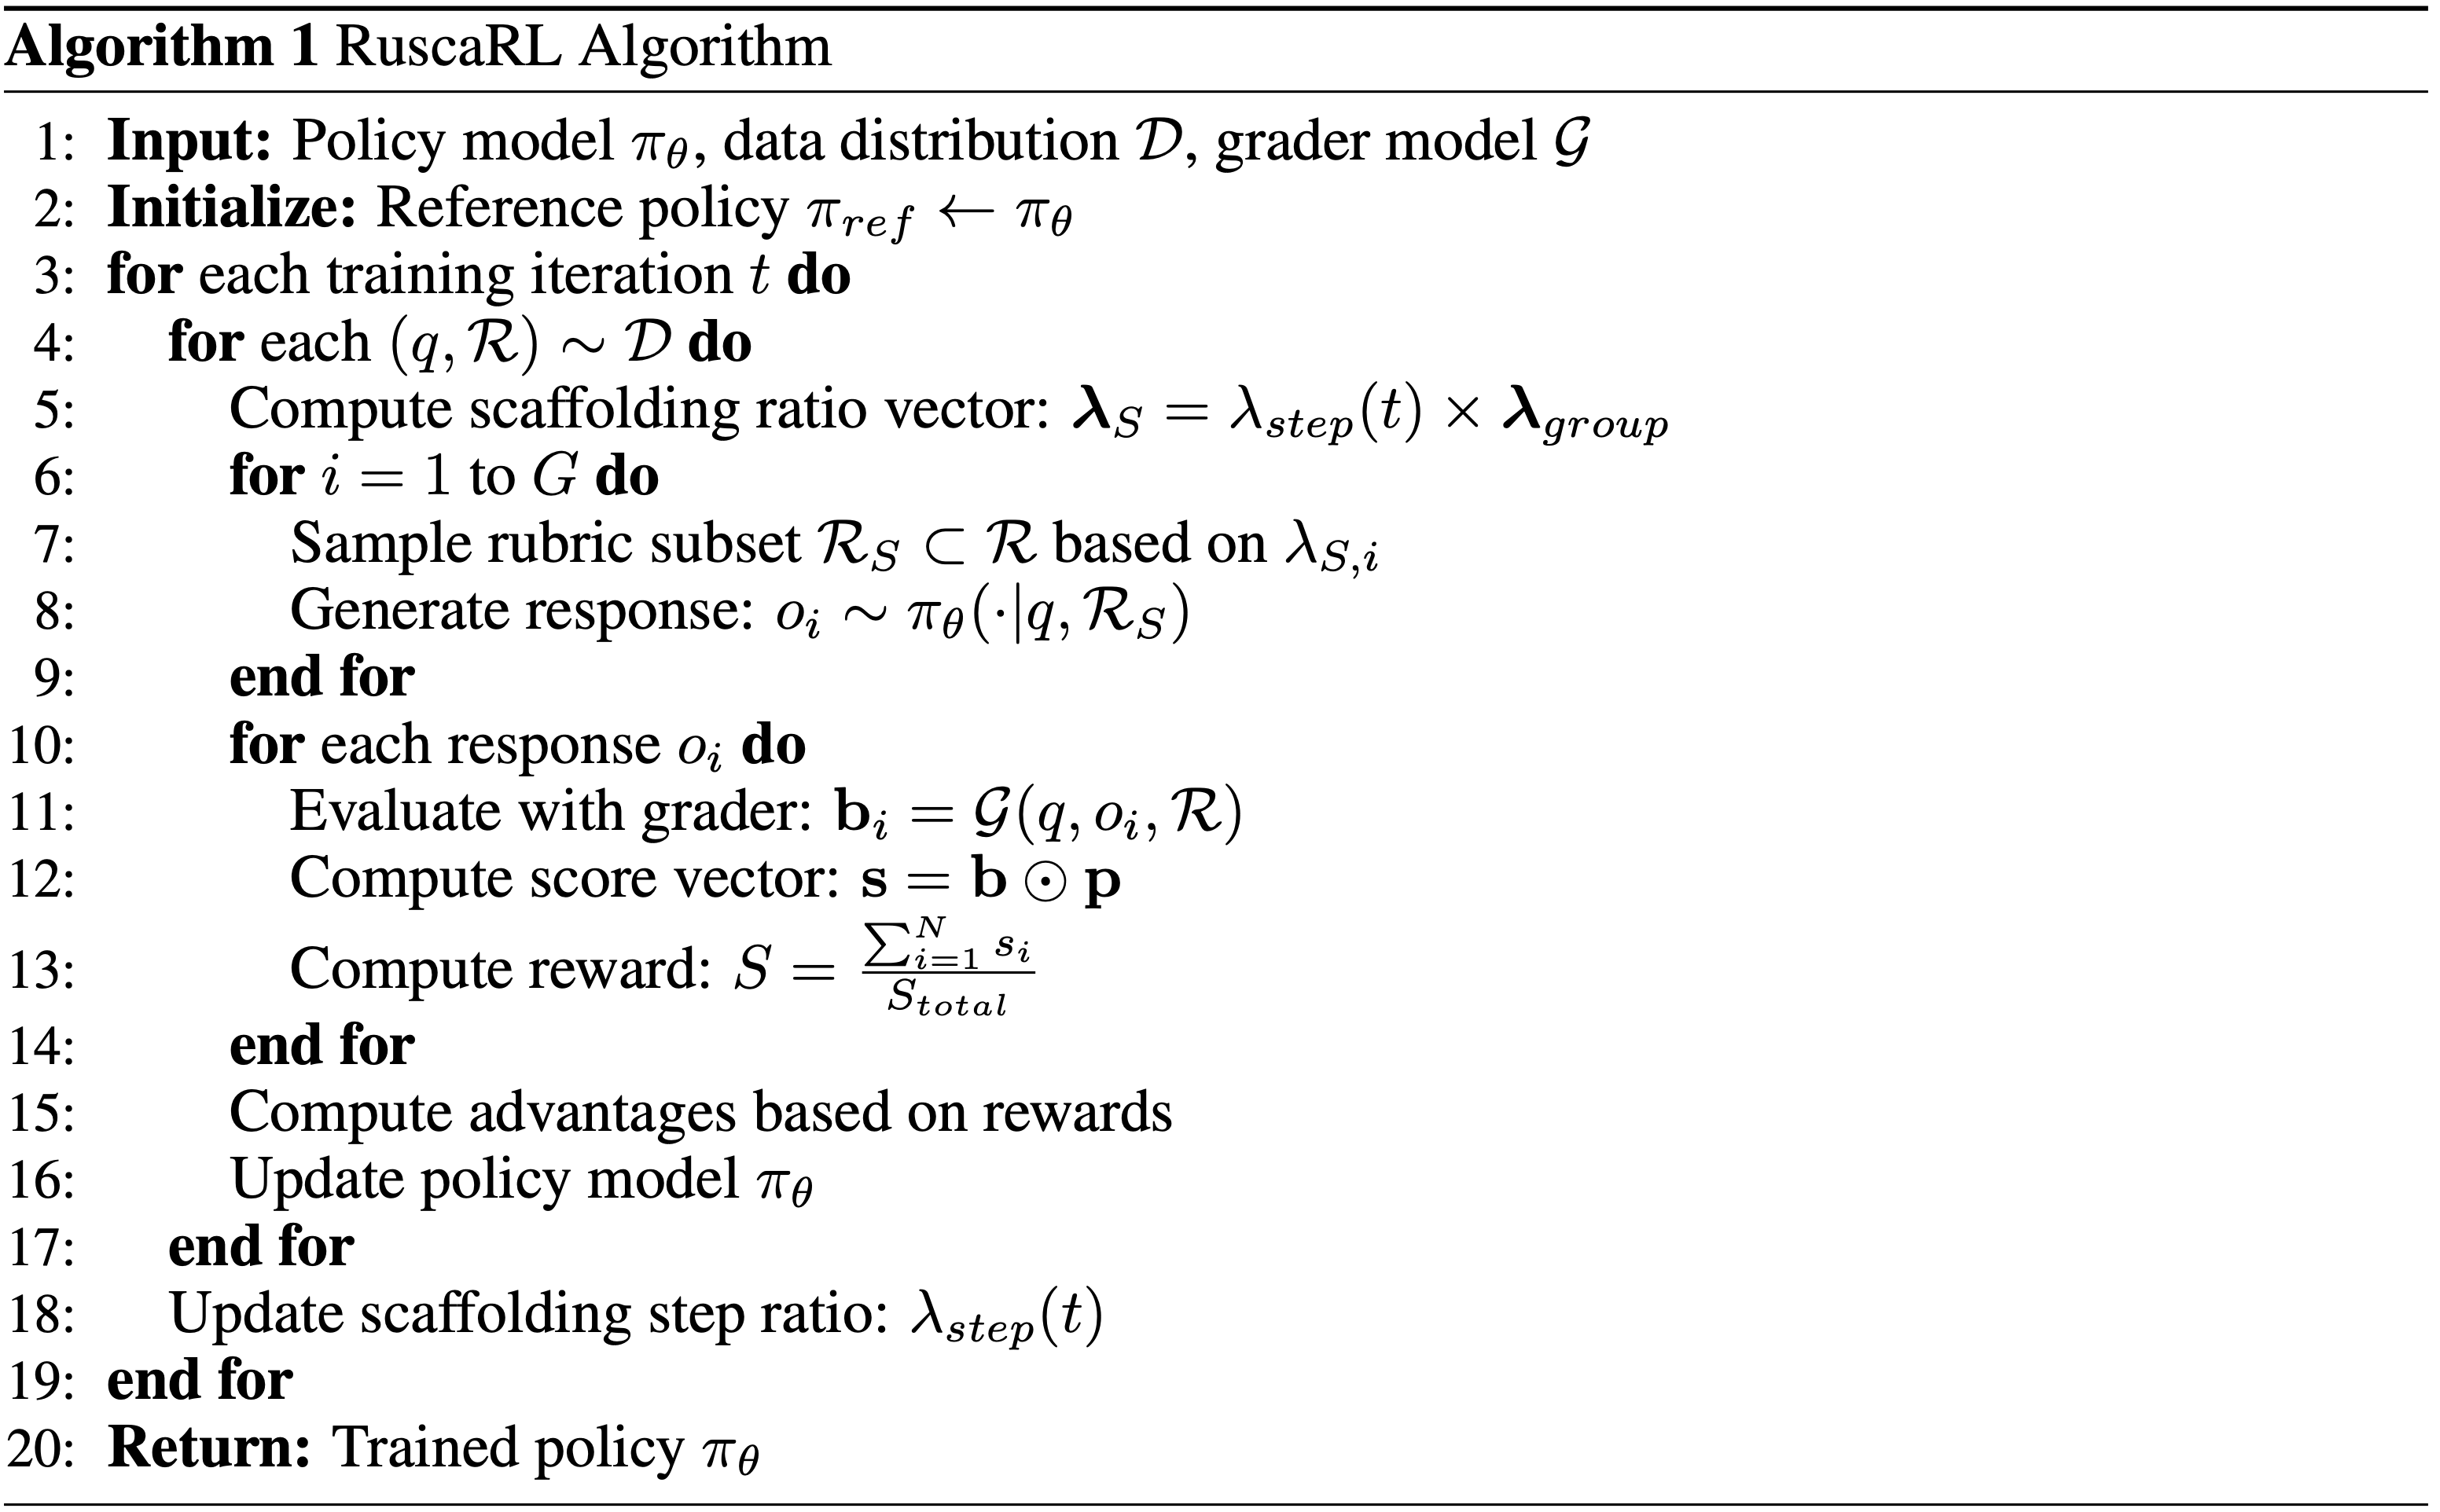
  • 附录 B 中的算法 1 概述了完整的训练过程
    • Additionally,为了帮助模型更好地内化底层推理模式,训练中的对数概率计算基于 \(\pi_{\theta}(o_{i,t} | q, o_{i,< t})\) 而不是 \(\pi_{\theta}(o_{i,t} | q, \mathcal{R}_S, o_{i,< t})\)
      • 问题:这里训练时使用的回复内容和 Rollout 时使用的内容不一致,不会导致 Off-Policy 的问题吗?
      • 回答:会的,论文附录 D.5 中会分析这个问题并给出一些解决方案
    • 关于重要性采样的详细分析,请参见附录 D.5

Experiments

  • 为了验证所提出的 RuscaRL 方法的有效性,论文在涵盖医学、写作、指令遵循和 STEM 领域的多个基准测试上进行了实验
  • 论文的实验旨在回答以下问题:
    • (1) RuscaRL 在不同模型和任务上是否展示出一致的有效性,以及它与现有的微调方法相比如何?(第 5.2 节和附录 D.1, D.2, D.3)
    • (2) RuscaRL 如何打破 LLM 推理中 RL 的探索瓶颈?(第 5.3 节和附录 D.4)
    • (3) Rubric-based Scaffolding 机制中不同组件的影响是什么?(第 5.4 节和附录 D.5)

Experimental Setups

Models and Training Settings
  • 论文使用了来自不同系列和参数规模的多个初始模型进行实验,包括 Qwen2.5 系列 (2024)、Qwen3 系列 (2025) 和 Llama-3 系列 (Meta-AI, 2025; 2024) 中的 Instruct 模型和 Base 模型
  • 所有模型均使用 GRPO 算法在 verl 框架 (2025) 上进行训练
  • 详细的训练设置见附录 C.1
Evaluation Benchmarks
  • 论文使用 HealthBench-500(从 HealthBench (2025) 中随机抽取的 500 个样本子集)作为保留评估集
  • 此外,论文还评估了其他医学基准,包括 LLMEval-Med (2025b)、MedQA (2021) 和 MedMCQA (2022)
  • 对于写作领域,论文使用 WritingBench (2025c) 和 Creative Writing v3 (Paech, 2025) 基准
  • 对于指令遵循领域,论文使用 IFEVAL (2023b) 和 IFBench (2025) 基准
  • 对于 STEM 领域,论文使用 GPQA Diamond (2024)、MMLU (2020)、MMLU-Pro (2024)、MATH-500 (2023)、AMC 2023、AIME 2024 和 AIME 2025
  • 详细的评估设置见附录 C.2
Baselines
  • 论文将 RuscaRL 与四种代表性的基线方法进行比较:
    • (1) Rubric-based RL:
      • 使用 GRPO 算法实现,以 Rubric 分数作为奖励 (2025)
    • (2) 带有完整 Scaffolding 的 Rubric-based RL (Rubric-based RL-S):
      • 一种在指令中提供所有 Rubric 作为 Scaffolding 支持的方法,没有组内差异化,也没有逐步衰减功能
    • (3) SFT:
      • 在 GPT-4.1 (OpenAI, 2025b) 生成的、带有 Scaffolding 支持的演示数据上进行微调
    • (4) SFT + Rubric-based RL:
      • 一种组合方法,先应用 SFT,然后应用 Rubric-based RL 训练

Overall Performance

RuscaRL achieves consistent and notable gains across tasks and model scales, showcasing its effectiveness and broad generalization(RuscaRL 在任务和模型规模上取得了一致的显著提升)
  • 在医学、写作和指令遵循任务中(表 1),RuscaRL 相对于多个初始模型取得了显著提升,其中 Qwen3-30B-A3B-Instruct 在 HealthBench-500 上的表现超越了许多领先模型(例如 OpenAI-o3)
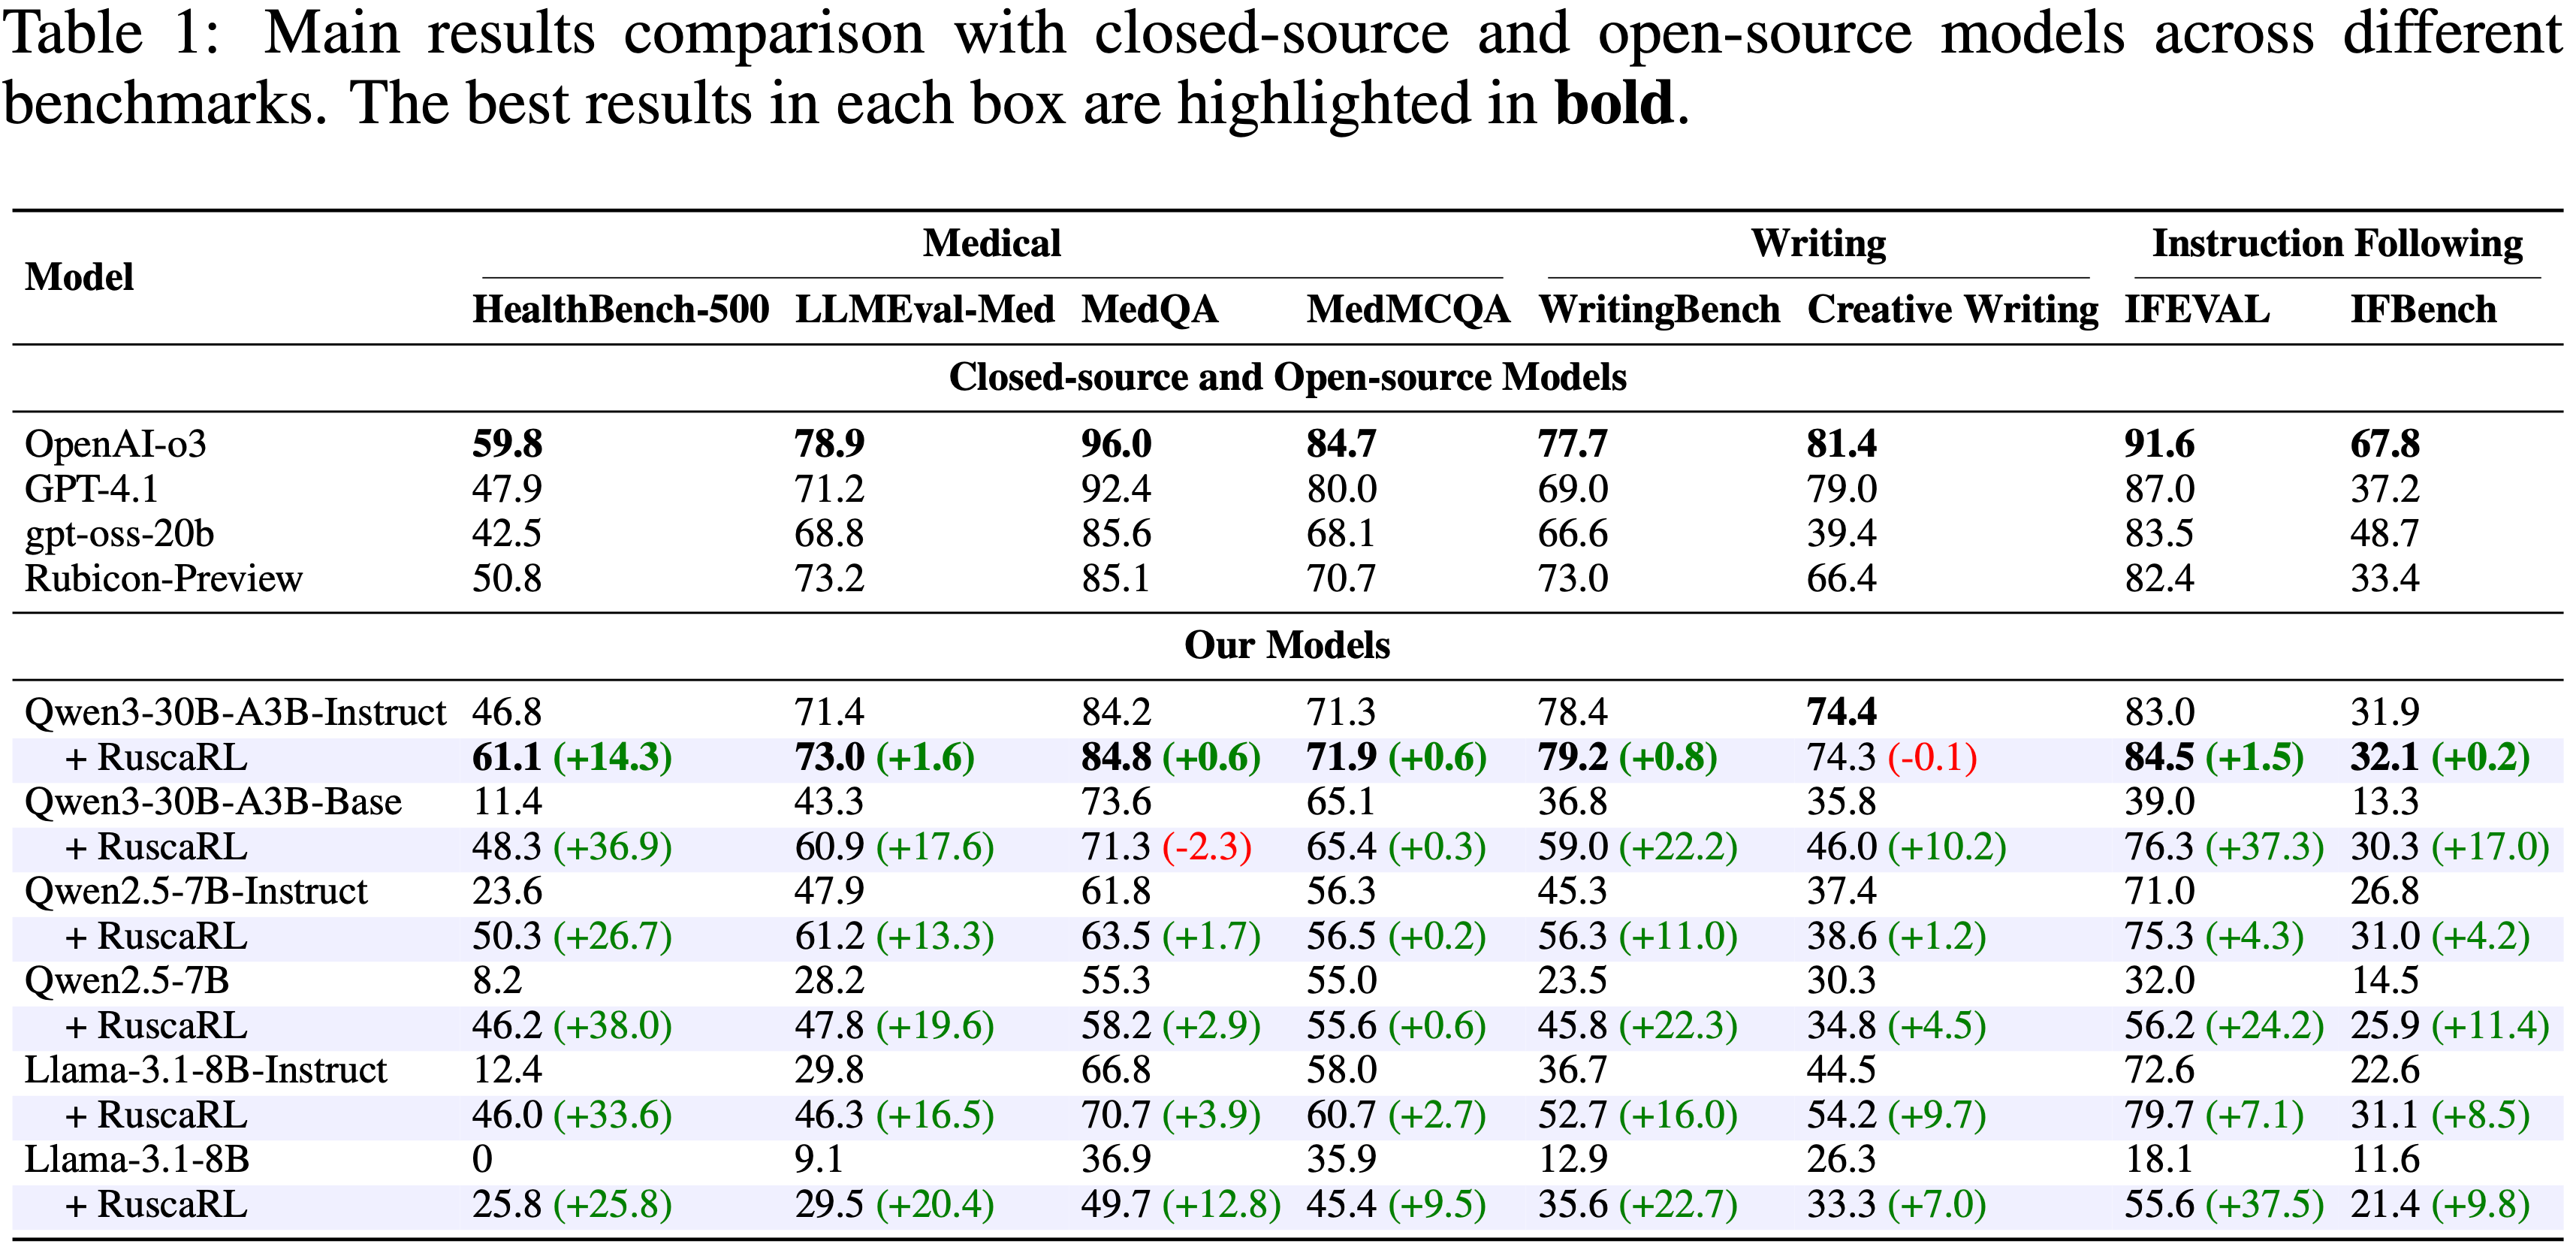
  • Notably,RuscaRL 对 Instruct 模型特别有效,并对较弱模型(如 Llama-3.1-8B-Instruct)提供了更大的增益
    • 这一优势源于论文的 Scaffolding 方法,它利用了模型现有的指令遵循能力来引出更高质量和更多样化的 Response,这解释了为什么 RuscaRL 特别适合在具有强指令遵循能力的模型上进行训练
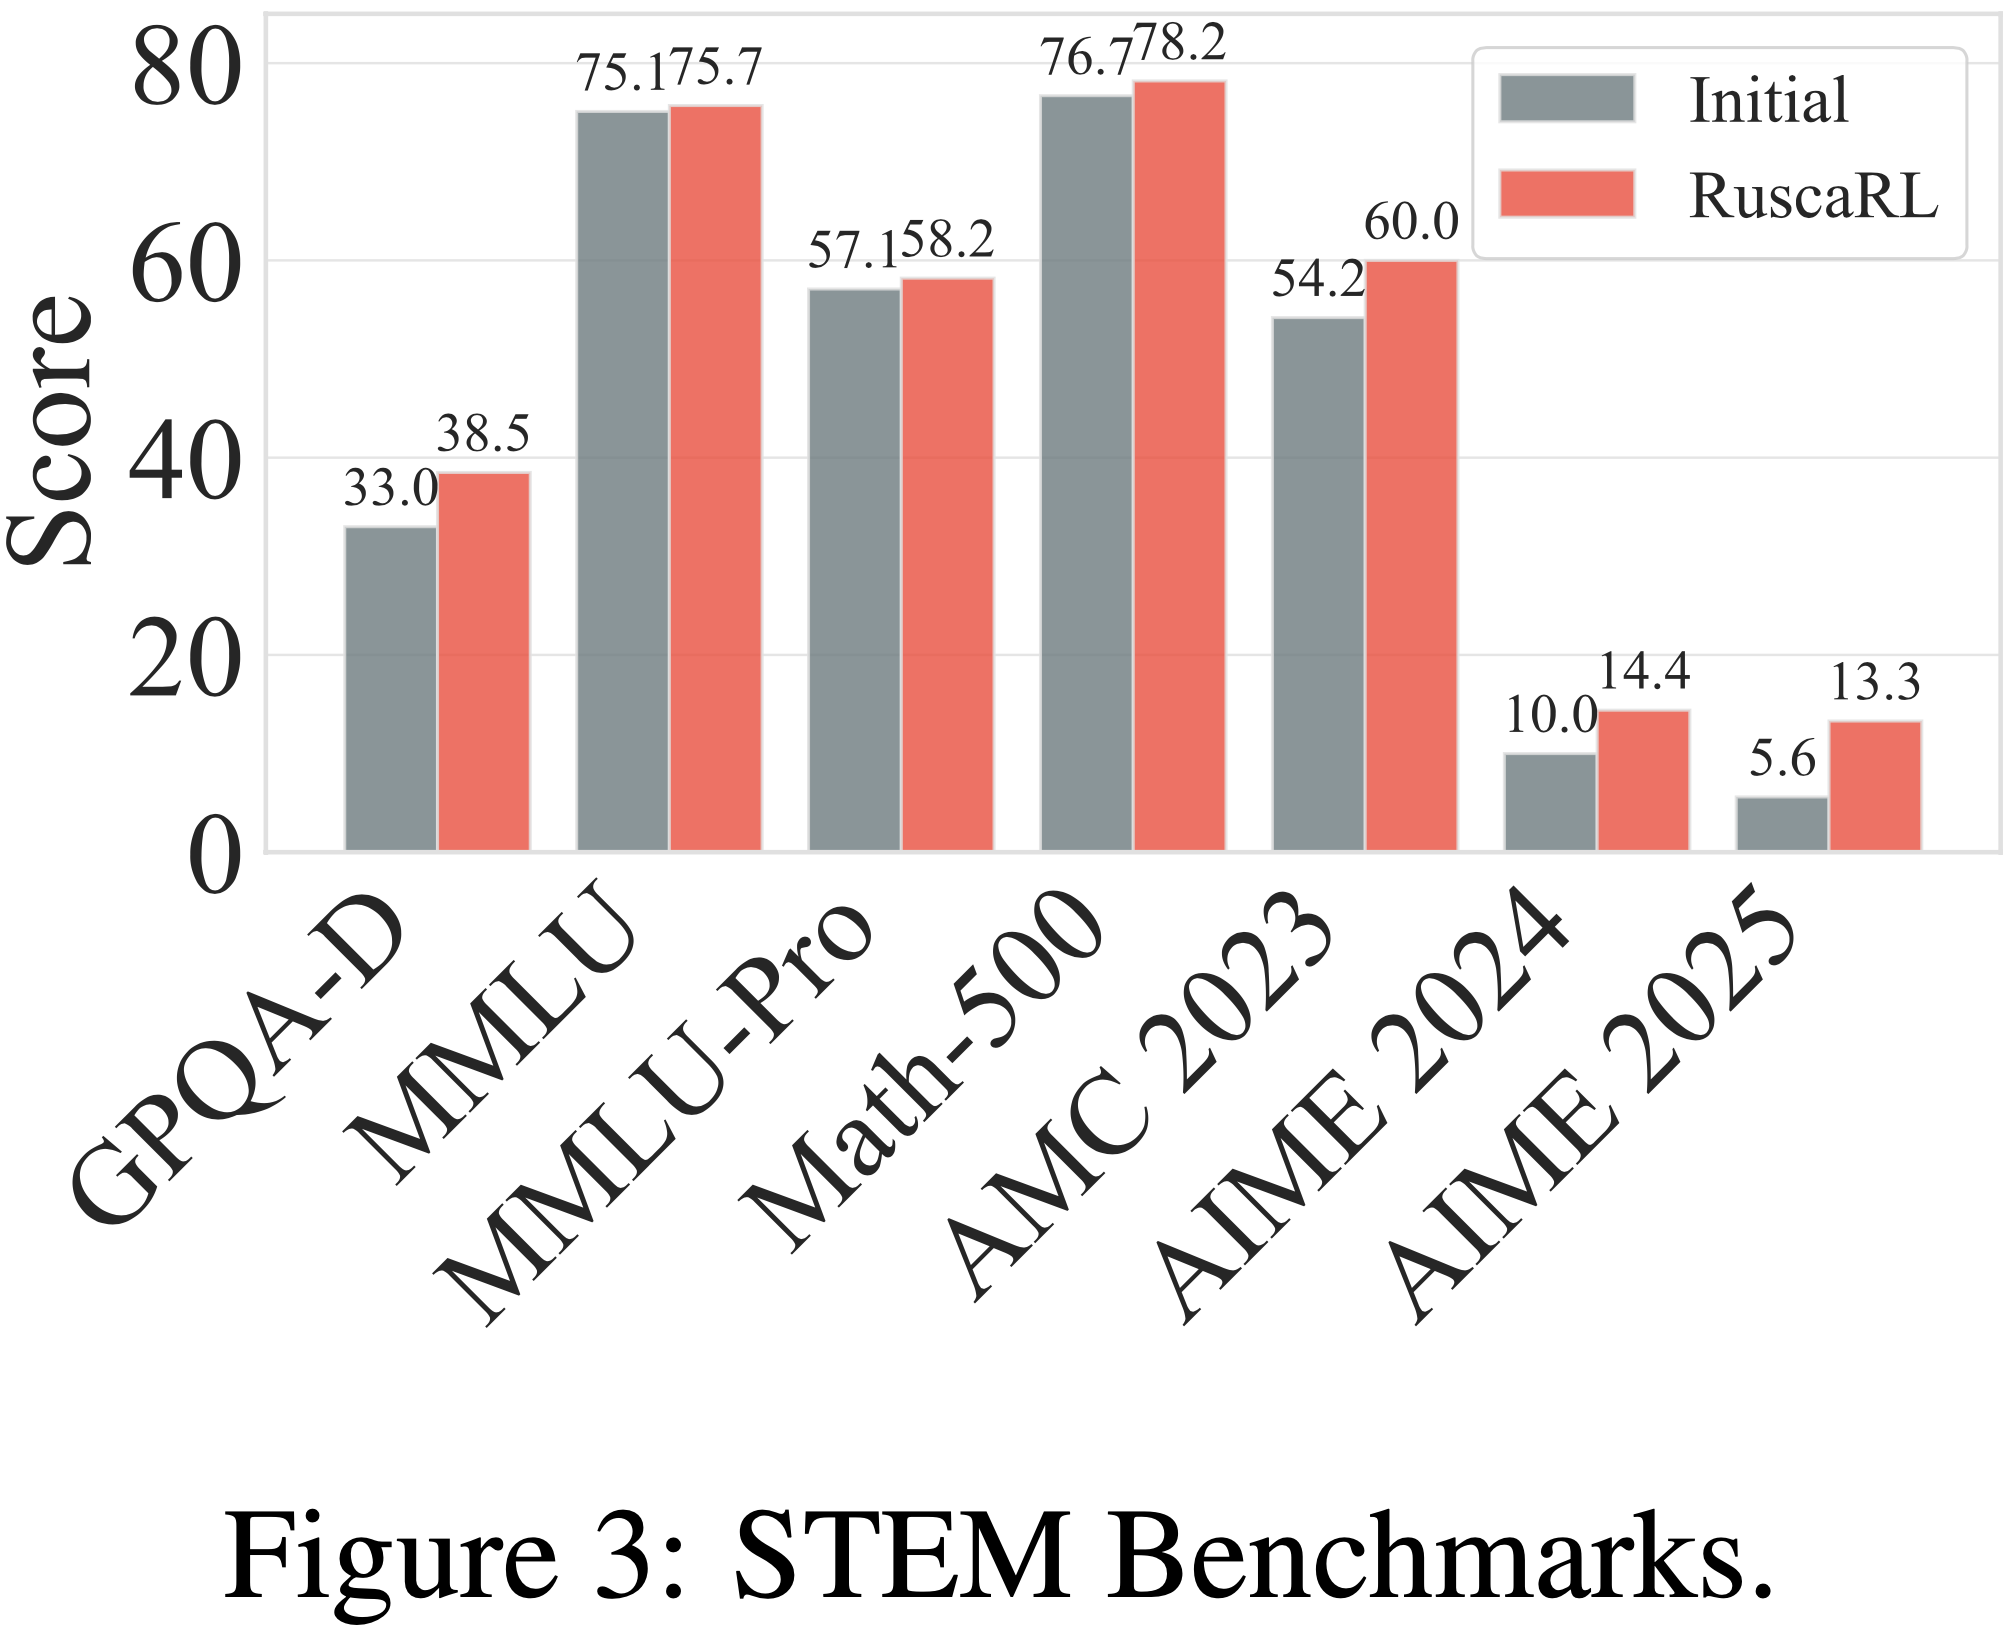
  • Meanwhile,RuscaRL 也已成功扩展到 STEM 领域:
    • 在 Qwen2.5-7B-Instruct 上的实验显示,在所有 STEM 基准测试中均有一致的性能提升(见图 3)
  • 关于不同模型系列和规模的性能更详细结果见附录 D.1,进一步证明了论文方法的鲁棒性和广泛适用性
  • Additionally,论文在附录 D.2 中探讨了混合不同领域训练数据的效果
RuscaRL consistently outperforms Rubrics-based methods across tasks(RuscaRL 优于 Rubric-based 方法)
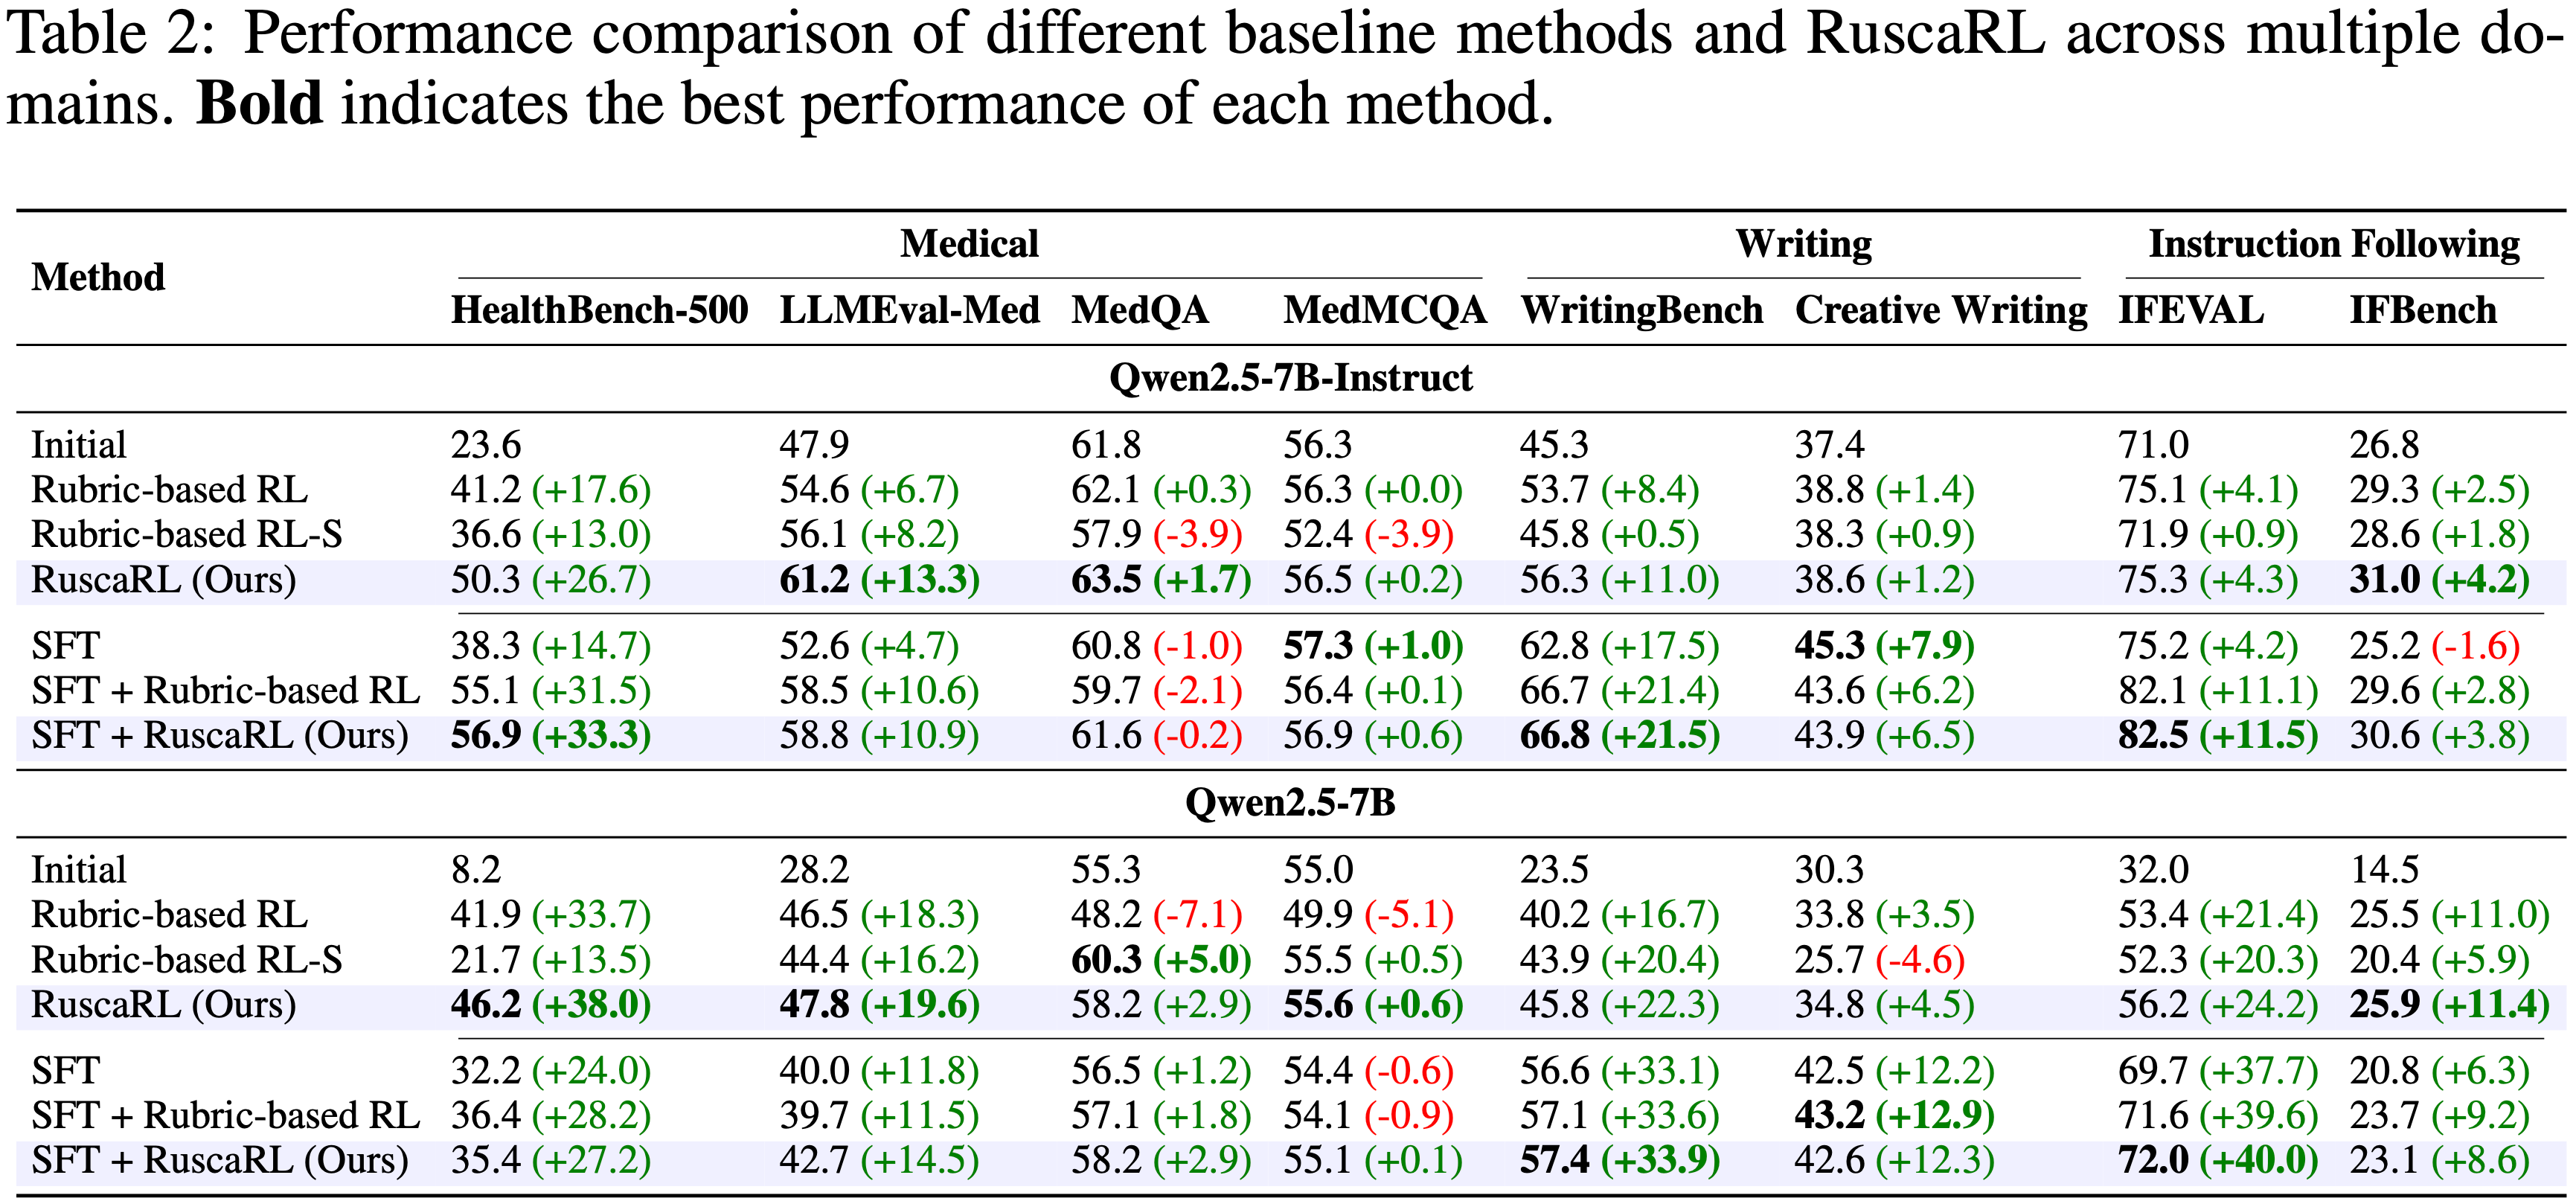
  • 如表 2 所示
    • 在 直接 RL(direct RL) Setting 中
      • RuscaRL 在大多数医学、写作和指令遵循任务上取得了最佳性能
      • 比 Rubric-based RL 和 RL-S 带来了更大且更稳定的增益(例如,在使用 Qwen2.5-7B-Instruct 时,HealthBench-500 上的准确率为 50.3 对比 41.2 和 36.6)
    • 在 先 SFT 后 RL(SFT-then-RL) Setting 中
      • RuscaRL 和 Rubric-based RL 都在 SFT 基础上取得了额外的提升,但 RuscaRL 在大多数任务上通常带来更大的增益,尽管幅度小于直接 RL 设置
      • 作者认为 RuscaRL 本质上是利用 Rubric 作为先验知识来指导探索,而 SFT 也用于加速 RL 探索(冷启动)
      • 由于这两种机制在促进探索方面存在重叠,这可能解释了为何在 SFT 后 RL 设置下,RuscaRL 与 Rubric-based RL 之间的性能差距会缩小
Analysis

  • 本小节以 Qwen2.5-7B-Instruct 作为初始模型,HealthBench 作为训练和评估数据集,对 RuscaRL 进行分析
  • In Addition,论文在以下分析中比较了三种方法:
    • RuscaRL
    • RuscaRL* (不带逐步衰减机制的 RuscaRL)
    • Rubric-based RL
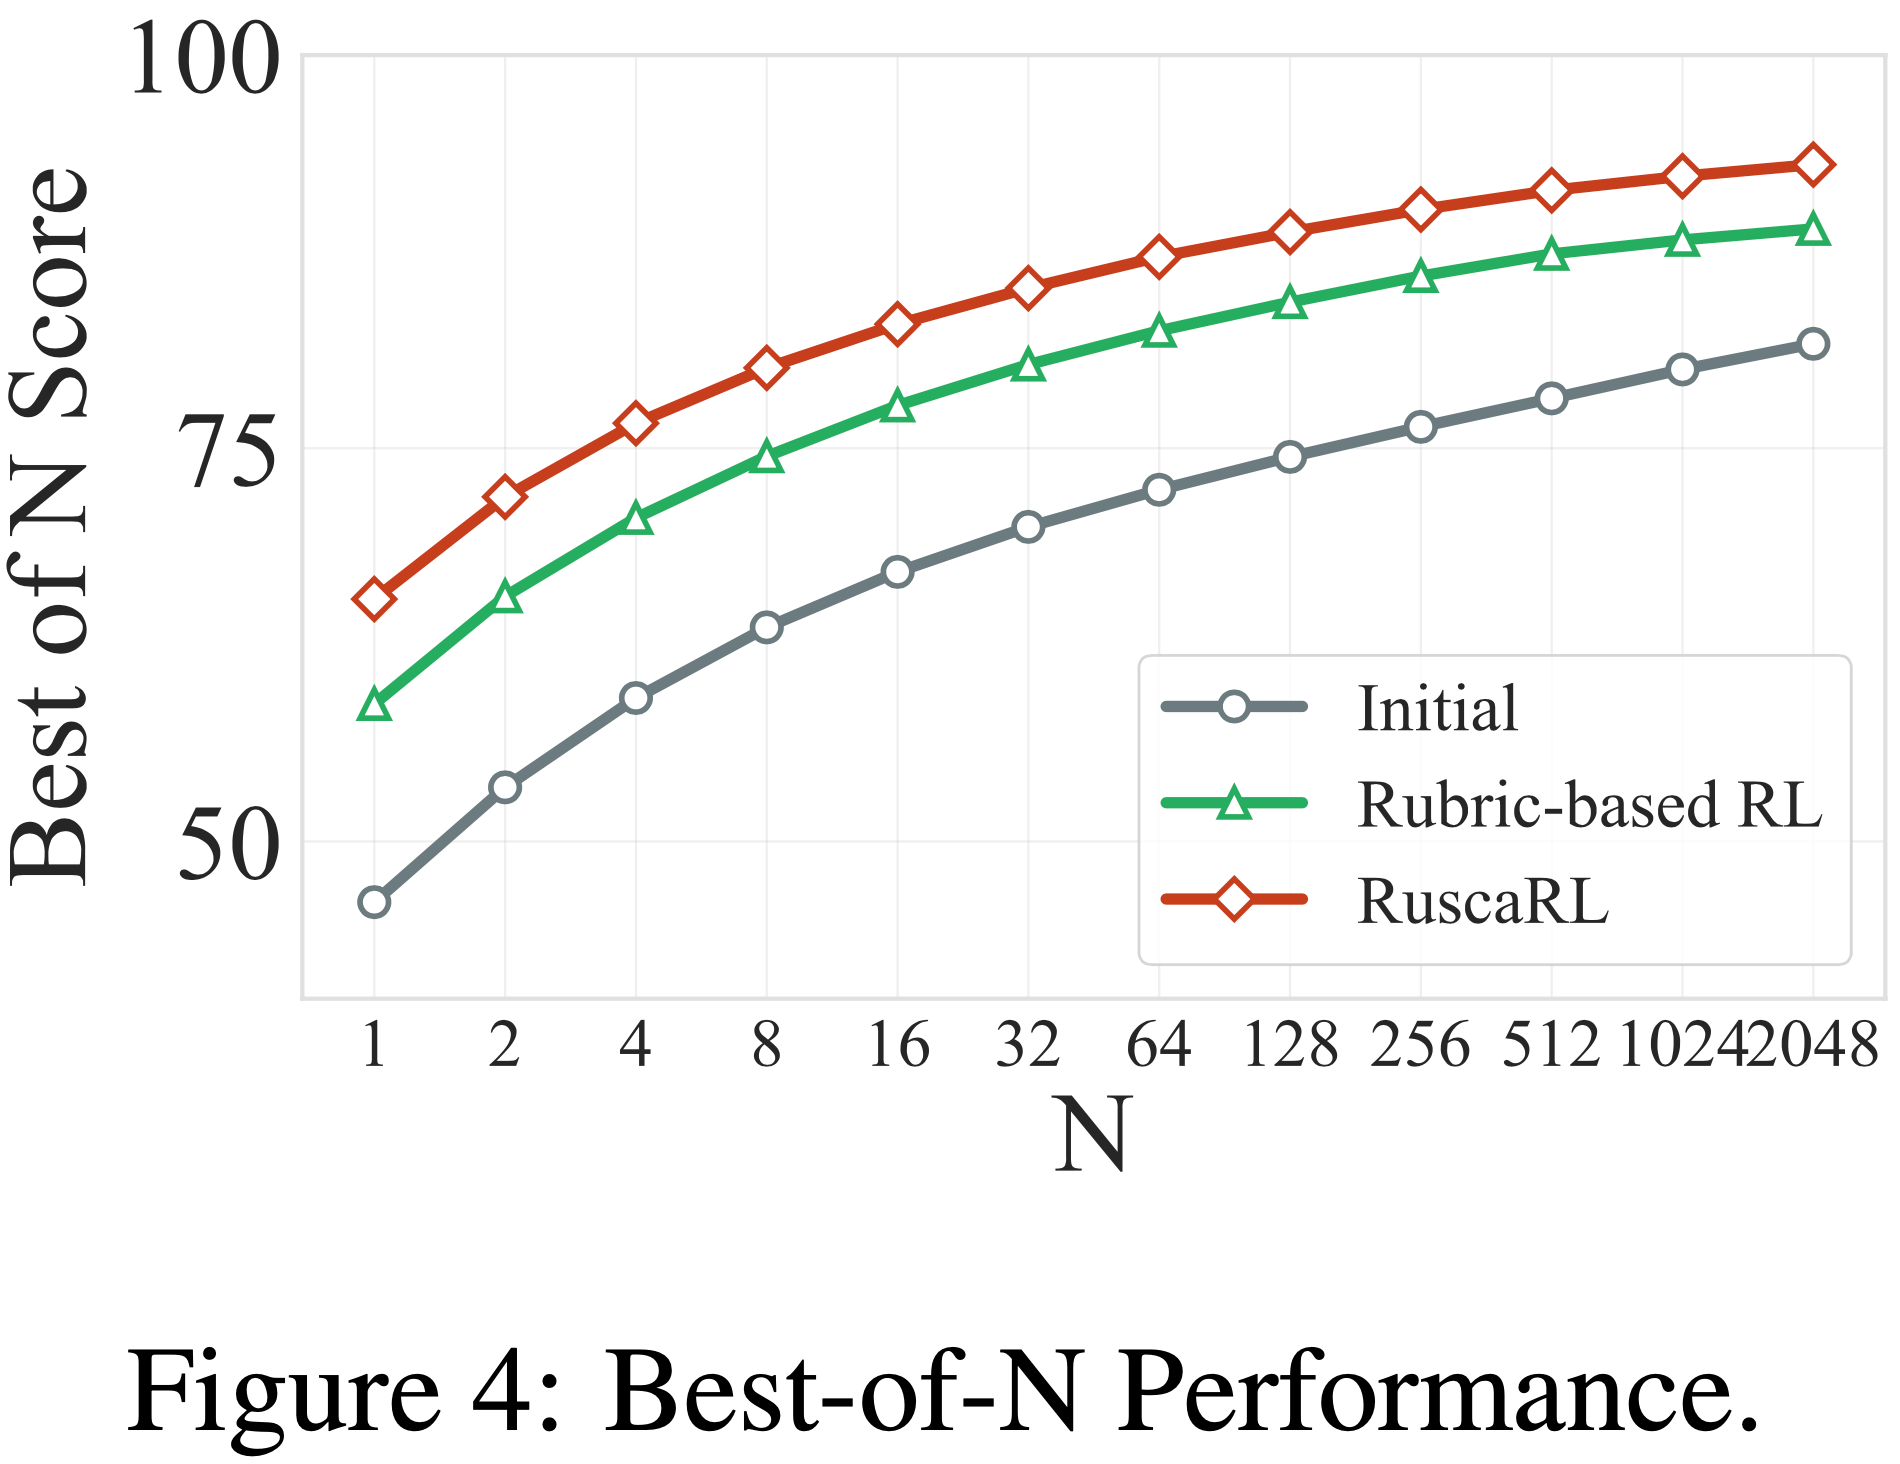
  • 论文使用 Best-of-N 指标来反映模型的推理边界(在大的 N 时)和采样效率(在小的 N 时)
RuscaRL significantly improves sampling efficiency and reasoning boundaries.
  • 如图 4 所示
    • RuscaRL 显著提高了 N=1 时的单样本质量,表明 Scaffolding 机制有效地增强了模型的推理稳定性
    • 在 N=2048 时,其性能上限超过了初始模型和 Rubric-based RL,验证了其在扩展推理边界方面的优势
    • Moreover,RuscaRL 在 N 变化时表现出更陡峭的性能曲线,意味着它可以用更少的样本达到相同的性能
    • 进一步分析(附录 D.4.1)表明,RuscaRL 还 产生了初始模型几乎无法生成的高度新颖的 Response(produces highly novel responses that theinitial model could barely generate) ,这表明 Rubric Scaffolding 有效地打破了探索瓶颈并发现了新的解决方案
RuscaRL achieves exploration-exploitation balance
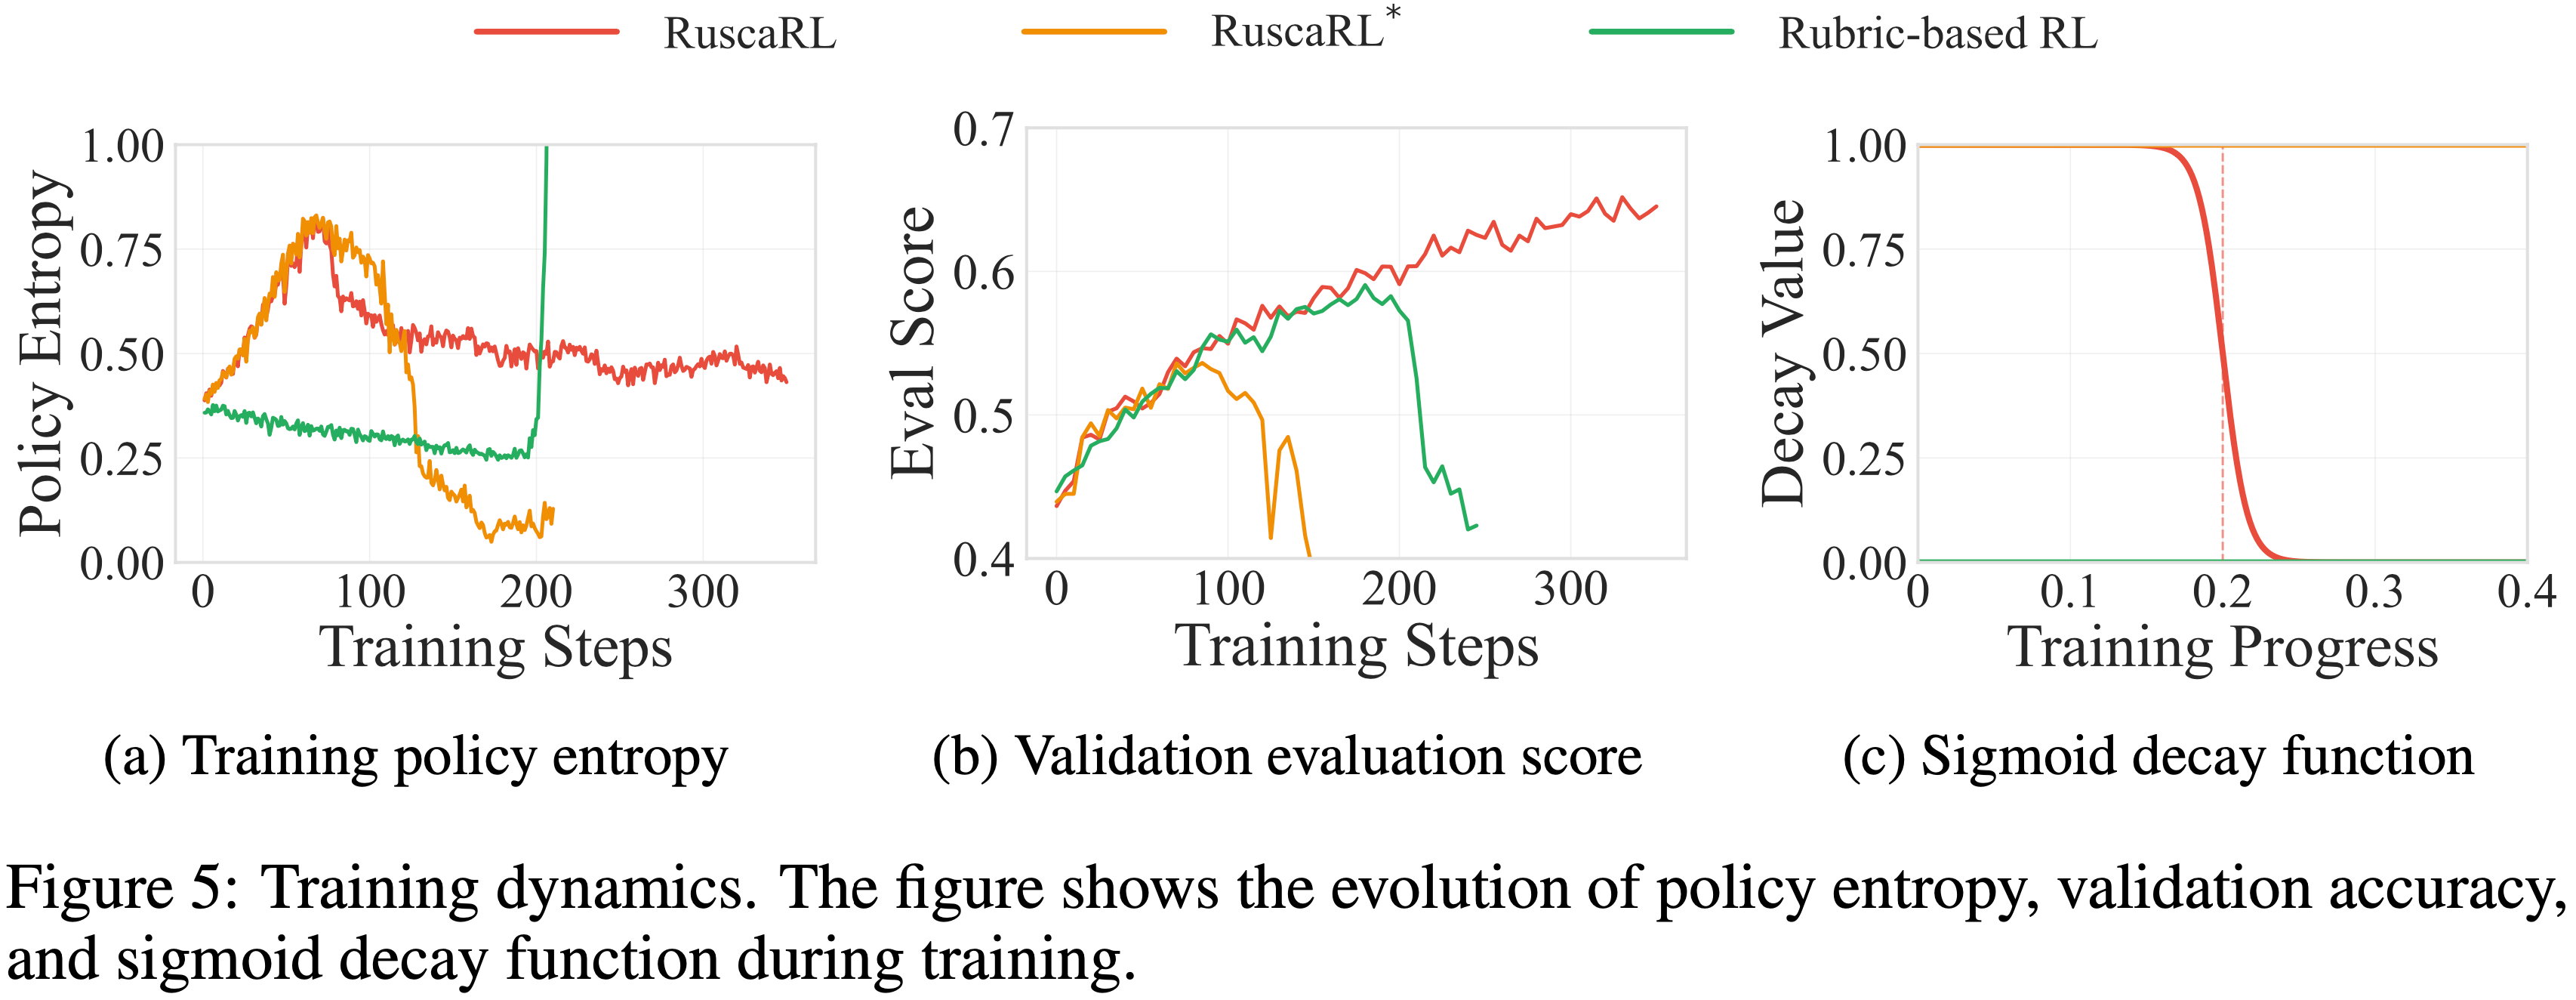
  • 如图 5 (a) 所示,RuscaRL 展示了一个平衡良好的探索-利用轨迹:
    • 策略熵首先随着模型探索多样化的推理轨迹而上升,然后随着其收敛到高质量模式而下降
    • In Contrast,RuscaRL* 遭受不受控制的熵增长导致不稳定,而 Rubric-based RL 则在持续的熵下降中崩溃
      • 理解:这里单从熵上(5(a))看,RuscaRL 和 RuscaRL* 其实差不多,只是评估分数在一百步左右突然崩溃了
  • 验证准确率(图 5 (b))一致显示
    • RuscaRL 在整个训练过程中实现了最佳性能,展现了没有策略熵崩溃的长期稳定性,其次是 Rubric-based RL,然后是 RuscaRL*
  • 在 Self-BLEU 和语义距离(附录 D.4.2)中也观察到了类似的趋势,证实 RuscaRL 实现了有效的探索,随后是稳定的利用
Ablation Studies

Intra-group Differentiation Analysis
  • 论文首先以 Qwen2.5-7B-Instruct 作为初始模型,HealthBench 作为训练和评估数据集,分析组内控制机制的不同策略
  • 在单个采样组内,论文比较了不同的 Rubric Scaffolding 差异化模式
  • 这些机制是:
    • (1) Linear(Ours): 遵循论文提出的公式 \(\lambda_i = \frac{G-i}{G-1}\) 的线性差异化模式
      • 为单个采样组内的不同样本提供不同水平的 Rubric Scaffolding
    • (2) Binary: 二元差异化模式,其中 N 表示单个采样组内具有完整 Rubric Scaffolding 的样本数量
      • 包括无 Scaffolding (N=0)、半数 Scaffolding (N=4) 和完整 Scaffolding (N=8) 等配置
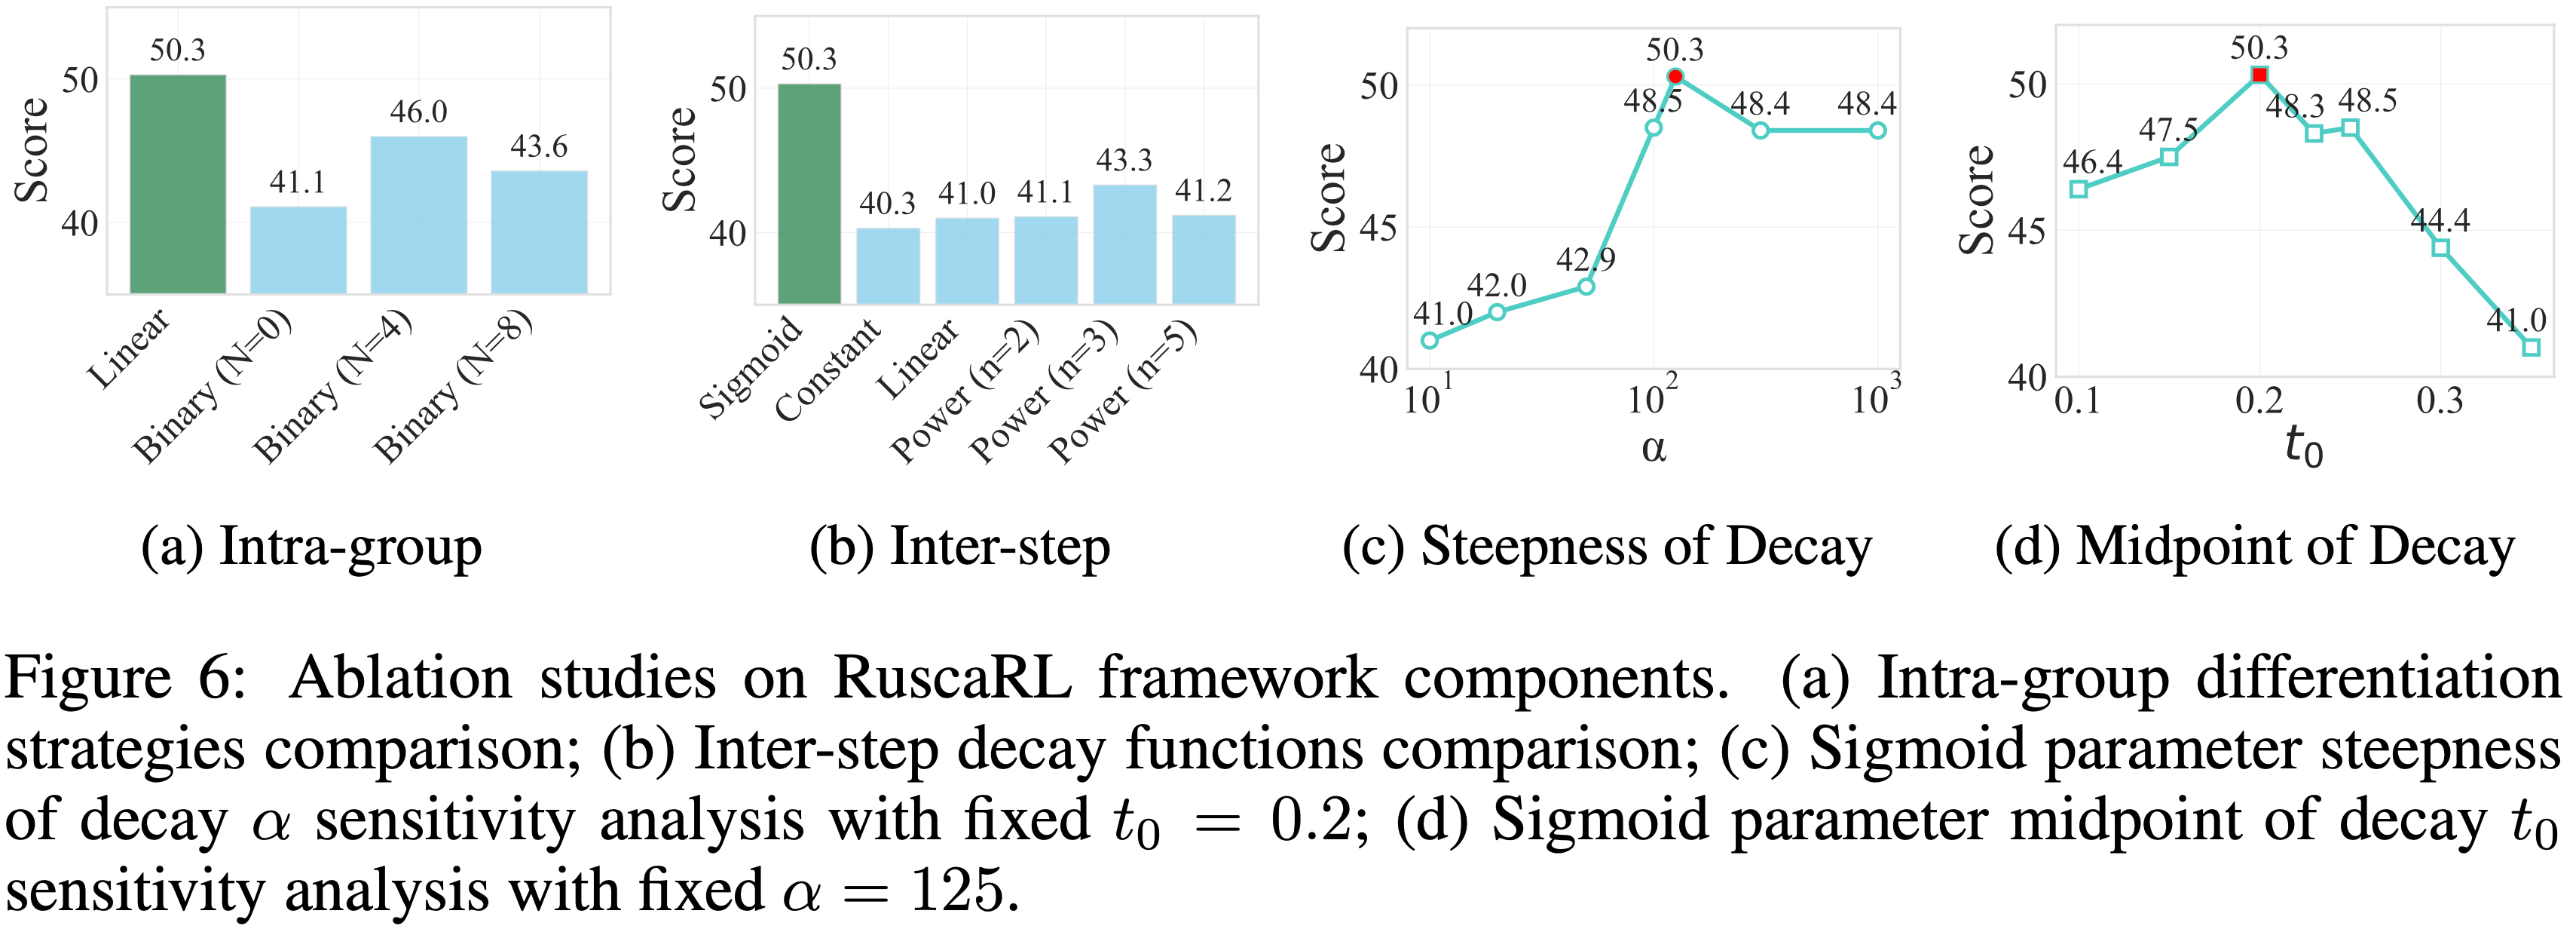
  • 如图 6 (a) 所示,线性差异化策略在组内控制中表现最优
    • 这一结果可归因于线性策略显著增强了采样多样性,这与 GRPO 等多采样算法协同工作
Inter-step Decay Analysis
  • 论文分析了训练过程中用于逐步控制的不同衰减函数
  • 论文将逐步控制的基础 Scaffolding 强度定义为 \(f(t)\),其中 \(t\) 是归一化的训练进度(\(t \in [0,1]\))
  • 论文比较了以下衰减函数:
    • (1) Sigmoid(Ours): S 形衰减函数
      $$f(t) = \frac{1}{1+e^{\alpha(t-t_0)} } $$
      • 其中参数 \(\alpha\) 控制衰减的陡峭度,\(t_0\) 控制衰减的中点,实现了平滑的非线性过渡
    • (2) Constant: 常数控制 \(f(t) = 1\),保持恒定的完整 Scaffolding
    • (3) Linear: 线性衰减函数 \(f(t) = 1 - t\),实现均匀的线性减少
    • (4) Power(n): 幂衰减函数 \(f(t) = (1-t)^n\),其中 \(n\) 控制衰减的曲率,包括各种幂次配置
  • 如图 6 (b) 所示,Sigmoid 衰减函数在所有衰减策略中取得了最佳性能
    • In Contrast,线性和幂衰减策略表现较差,作者认为这是由于长时间的 Scaffolding 添加可能导致模型过度适应相应的 Scaffolding,而不是专注于实际的指令内容
    • Sigmoid 函数通过其平滑的非线性过渡特性,在训练早期提供足够的 Scaffolding 支持,然后逐渐减少依赖,避免了过拟合问题
  • 基于 Sigmoid 函数的优越性能,论文进一步使用 Qwen2.5-7B-Instruct 作为初始模型,HealthBench 作为训练和评估数据集,分析了两个参数维度(速度 \(\alpha\) 和 中点 \(t_0\))的影响
    • (1) 移除 Scaffolding 的速度:
      • 移除 Scaffolding 过快(大的 \(\alpha\))会使模型难以适应快速的 Scaffolding 变化,容易导致训练不稳定;
      • 移除 Scaffolding 过慢(小的 \(\alpha\))会导致早期阶段 Scaffolding 支持不完整,未能充分激发模型的探索能力,并且在后期阶段长时间保留 Scaffolding 也会导致过拟合问题
        • 问题:为什么早期阶段 Scaffolding 支持不完整?移除 Scaffolding 过慢 不是反而能更多探索吗?
          • 我的个人理解:移除 Scaffolding 过慢会导致模型过度依赖 Scaffolding,最终导致过拟合
    • (2) 衰减时机:
      • 衰减开始过早(小的 \(t_0\))会导致 Scaffolding 支持不足,使模型在训练早期缺乏必要的指导;
      • 衰减开始过晚(大的 \(t_0\))会导致模型过度依赖 Scaffolding,最终导致过拟合
  • 图 6 (c) 和 6 (d) 展示了不同 Sigmoid 参数配置下的性能差异,最终确定最优配置为 \(\alpha=125, t_0=0.2\)

附录 A:Additional Related Works

LLM Reasoning

  • 虽然早期的方法如提示工程 (2022;2022) 和监督微调 (2022) 取得了令人鼓舞的结果,但它们对任务特定提示或大量标注数据的依赖限制了其可扩展性和跨领域泛化能力 (2020;2024;2024;2023)
  • 最近的工作发现,使用更多的测试时计算 (2024;2024;2025) 可以提高 LLM 的推理性能
  • 最近,RLVR (2024;2025;2025) 已成为训练 LLM 解决可验证问题的有前景范式,在数学和代码等领域显示出强大的推理改进 (2025;2025;2024;2025)。然而,它面临着显著的探索瓶颈 (2025;2025;2025),并且难以扩展到难以验证正确性的通用任务 (2025;2025)

附录 B:Algorithm Pseudocode

  • 算法 1 提供了论文 RuscaRL 训练过程的完整伪代码,说明了关键组成部分,包括组内 Scaffolding 差异化、步间 Scaffolding 衰减和 Rubric-based 奖励计算
附录 C:Detailed Experimental Settings

C.1 Detailed Training Settings

Initial Models
  • 论文对不同系列和参数规模的模型进行了训练,包括 Qwen2.5 系列 (Qwen2.5-3B-Instruct, Qwen2.5-7B-Instruct, Qwen2.5-7B, Qwen2.5-32B-Instruct, Qwen2.5-32B),Qwen3 系列 (Qwen3-4B-Instruct-2507, Qwen3-4B-Base, Qwen3-30B-A3B-Instruct-2507, Qwen3-30B-A3B-Base),以及 Llama-3 系列 (Llama-3.1-8B-Instruct, Llama-3.1-8B, Llama-3.2-3B-Instruct)
Training Datasets
  • 对于医学领域,论文使用从 HealthBench 中排除 HealthBench-500 后剩余的 4500 个样本
  • 对于其他领域,论文通过调用 GPT-4.1 (2025b) 并附上附录 E.3 中详述的特定提示词来生成类似 HealthBench 的 Rubric 数据
    • 对于写作领域,论文结合了 LongWriter-6k (2024) 和 LongWriter-Zero-RLData (2025b) 数据集
    • 对于指令遵循领域,论文使用了 IF-multi-constraints-upto5 (2025) 数据集
    • 对于 STEM 领域,论文使用了 SCP-116K (2025) 和 MATH 训练数据集 Level 3-5 (2021)
Training Configurations
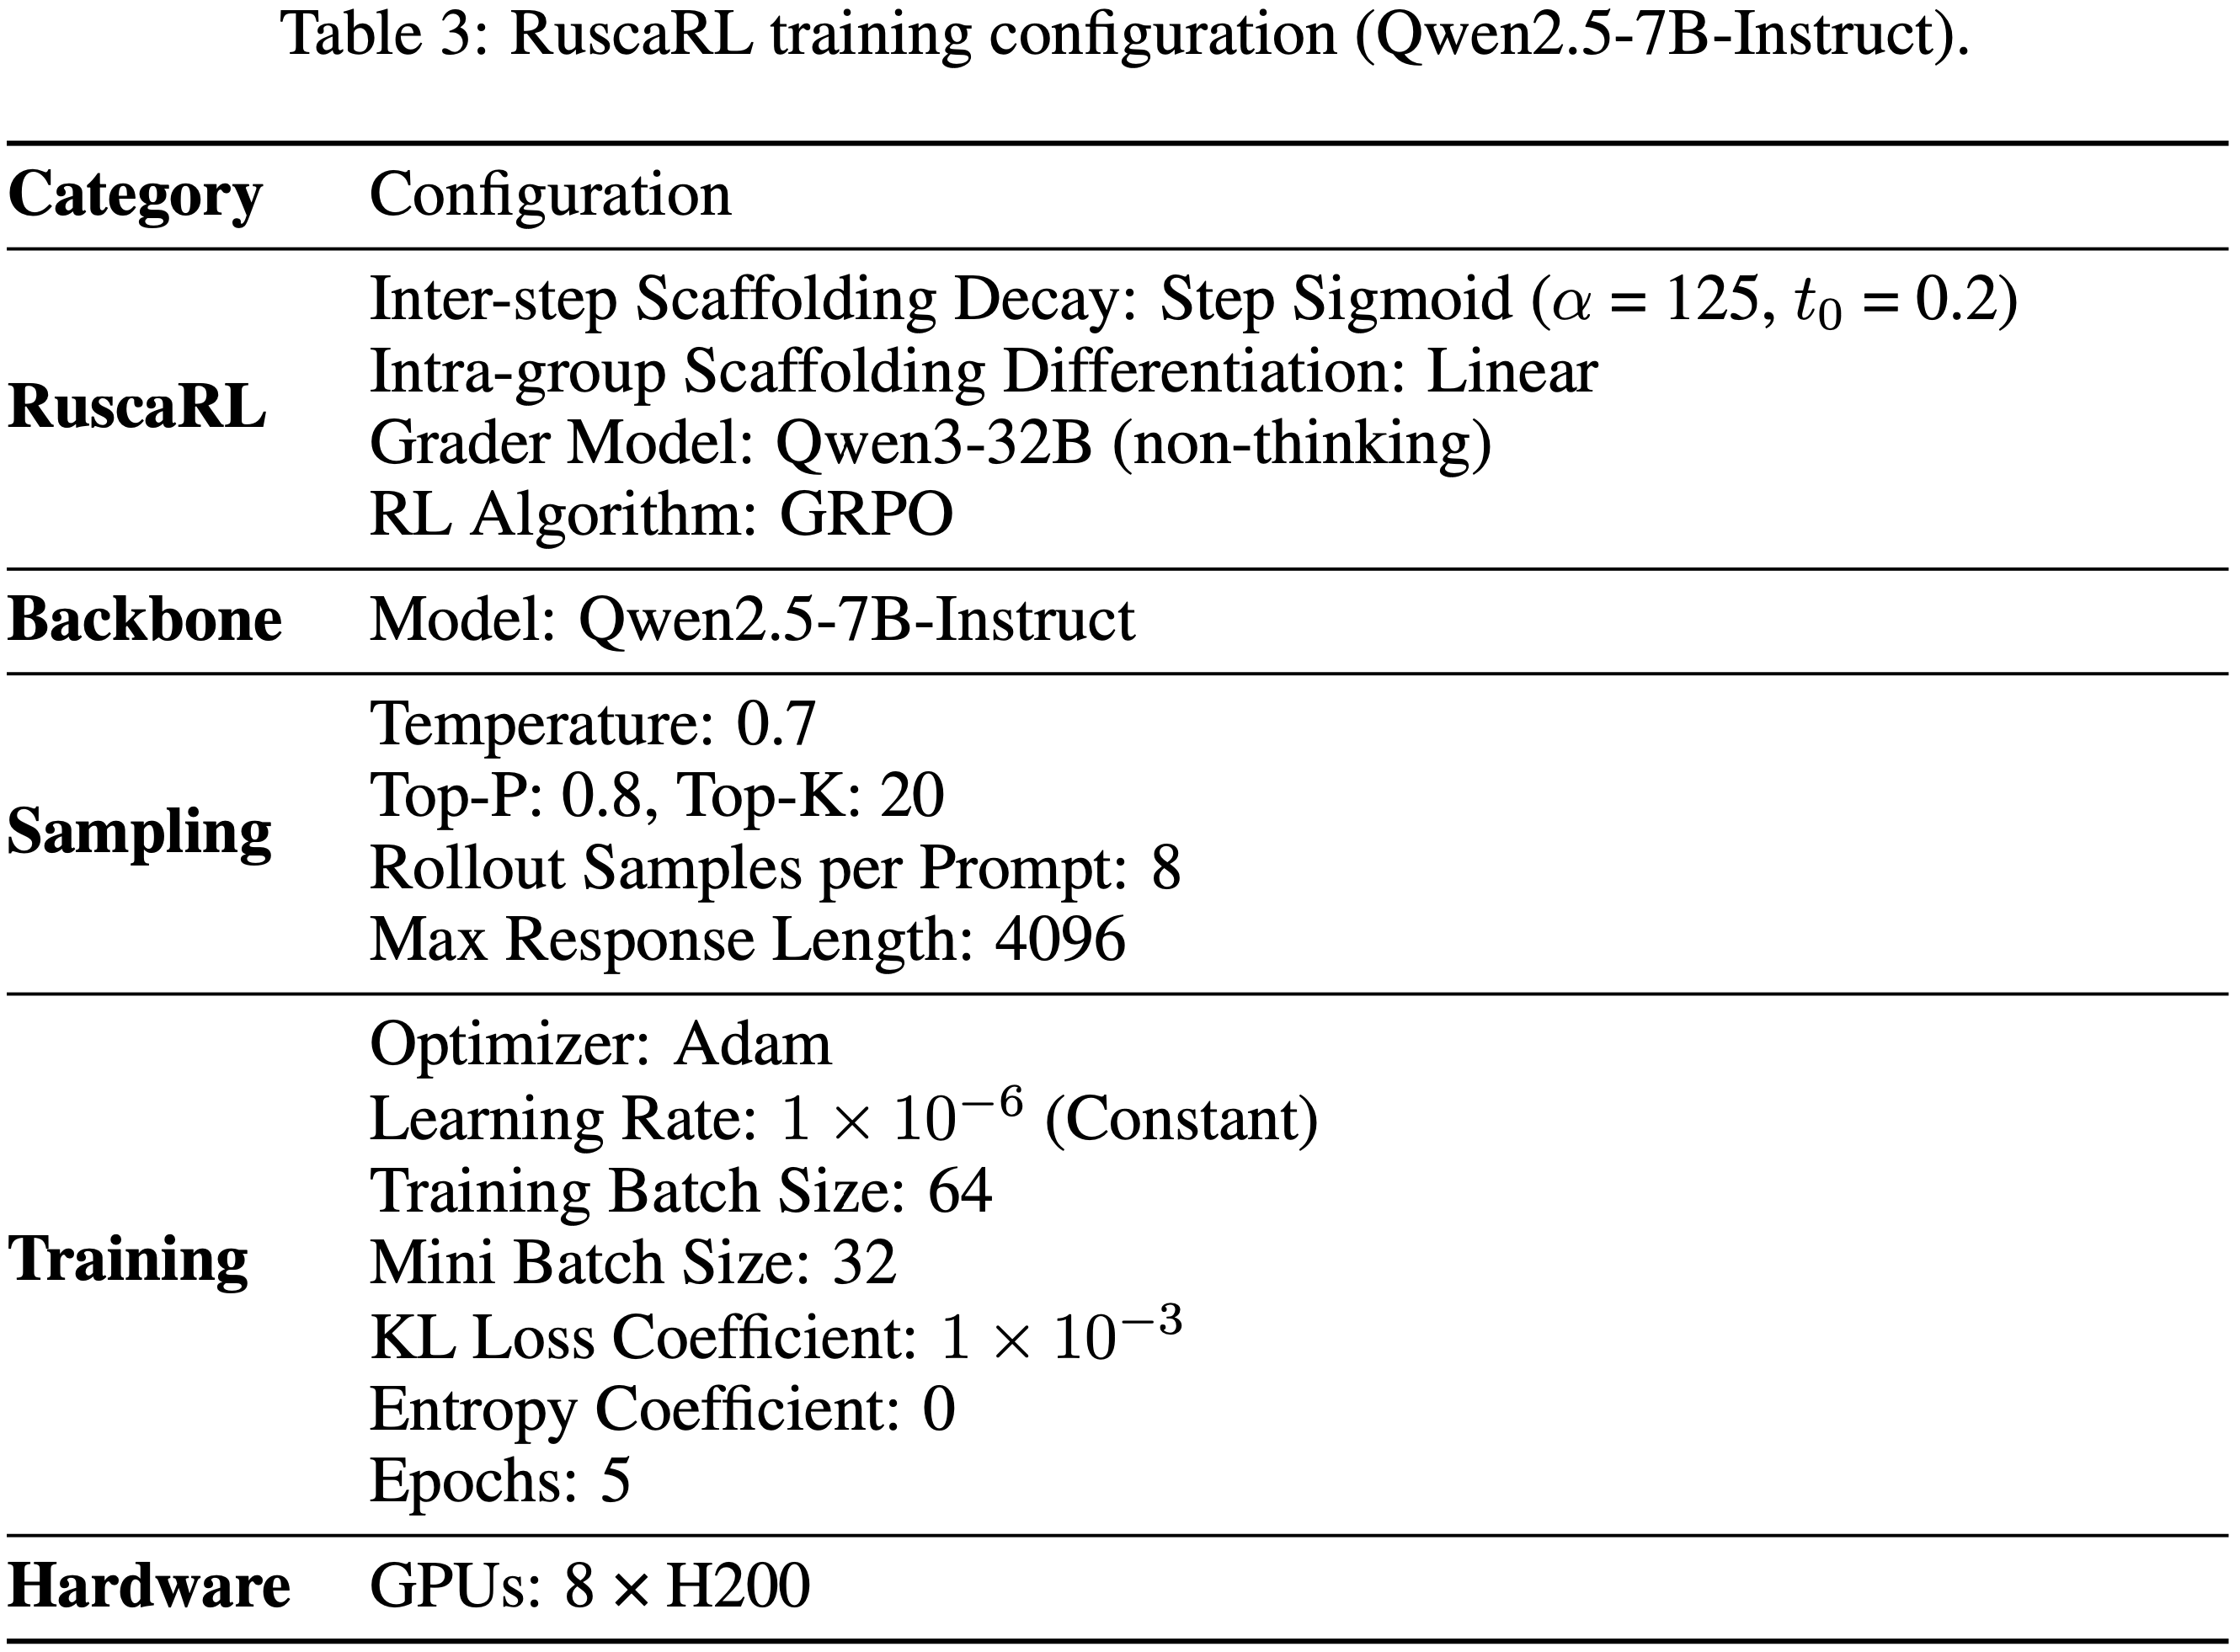
  • 本节提供了详细的训练配置,如表 3 所示
  • 所有模型共享相同的超参数,除了 sigmoid 衰减函数中的 \(t_{0}\) 参数
    • 具体来说,Qwen3-30B-A3B-Instruct 和 Qwen3-30B-A3B-Base 使用 \(t_{0}=0.1\)
    • Llama-3.1-8B-Instruct 和 Llama-3.1-8B 使用 \(t_{0}=0.15\)
    • Llama-3.2-3B-Instruct 使用 \(t_{0}=0.3\)
    • 其余模型 (Qwen2.5-3B-Instruct, Qwen2.5-7B-Instruct, Qwen2.5-7B, Qwen2.5-32B-Instruct, Qwen2.5-32B, Qwen3-4B-Instruct-2507 和 Qwen3-4B-Base) 使用 \(t_{0}=0.2\)

C.2 Detailed Evaluation Settings

  • 对于医学基准测试 (HealthBench-500 和 LLMEval-Med),论文使用 GPT-4.1 作为 Grader 模型
  • 对于写作基准测试 (WritingBench 和 Creative Writing v3),论文使用 Claude-Sonnet-4 作为 Grader 模型
  • 论文的生成参数在所有评估中均设置为 Temperature=0.7,Top-P=0.8,Top-K=20
  • 最大输出长度配置为:
    • 非写作任务 4096 tokens
    • 写作任务 16000 tokens
  • 指标方面:
    • 对于 IFEVAL 和 IFBench,论文报告 Prompt-level 的严格准确率(strict-accuracy)指标
    • 对于 HealthBench-500、LLMEval-Med 和 WritingBench,论文报告单次评估结果;
    • 对于 MedQA、MedMCQA、Creative Writing v3、IFEVAL、IFBench、GPQA-D、MMLU、MMLU-Pro、MATH-500、AMC 2023、AIME 2024 和 AIME 2025,论文报告三次运行的平均值
    • 注:所有分数都转换为百分比制报告
  • 论文还与其他模型进行了比较,包括:
    • 闭源模型 (OpenAI-o3 (2025a)、GPT-4.1 (2025b)、Gemini-2.5-Pro (2025))
    • 开源模型 (DeepSeek-R1-0528 (2025)、Qwen3-235B-Thinking-2507 (2025)、Kimi-K2-Instruct (2025)、gpt-oss-120b、gpt-oss-20b (2025c)、Rubicon-Preview (2025)),在 HealthBench-500(图1)上展示了论文方法的竞争力

附录 D:Detailed Experimental Analysis

D.1 Performance Across Different Models

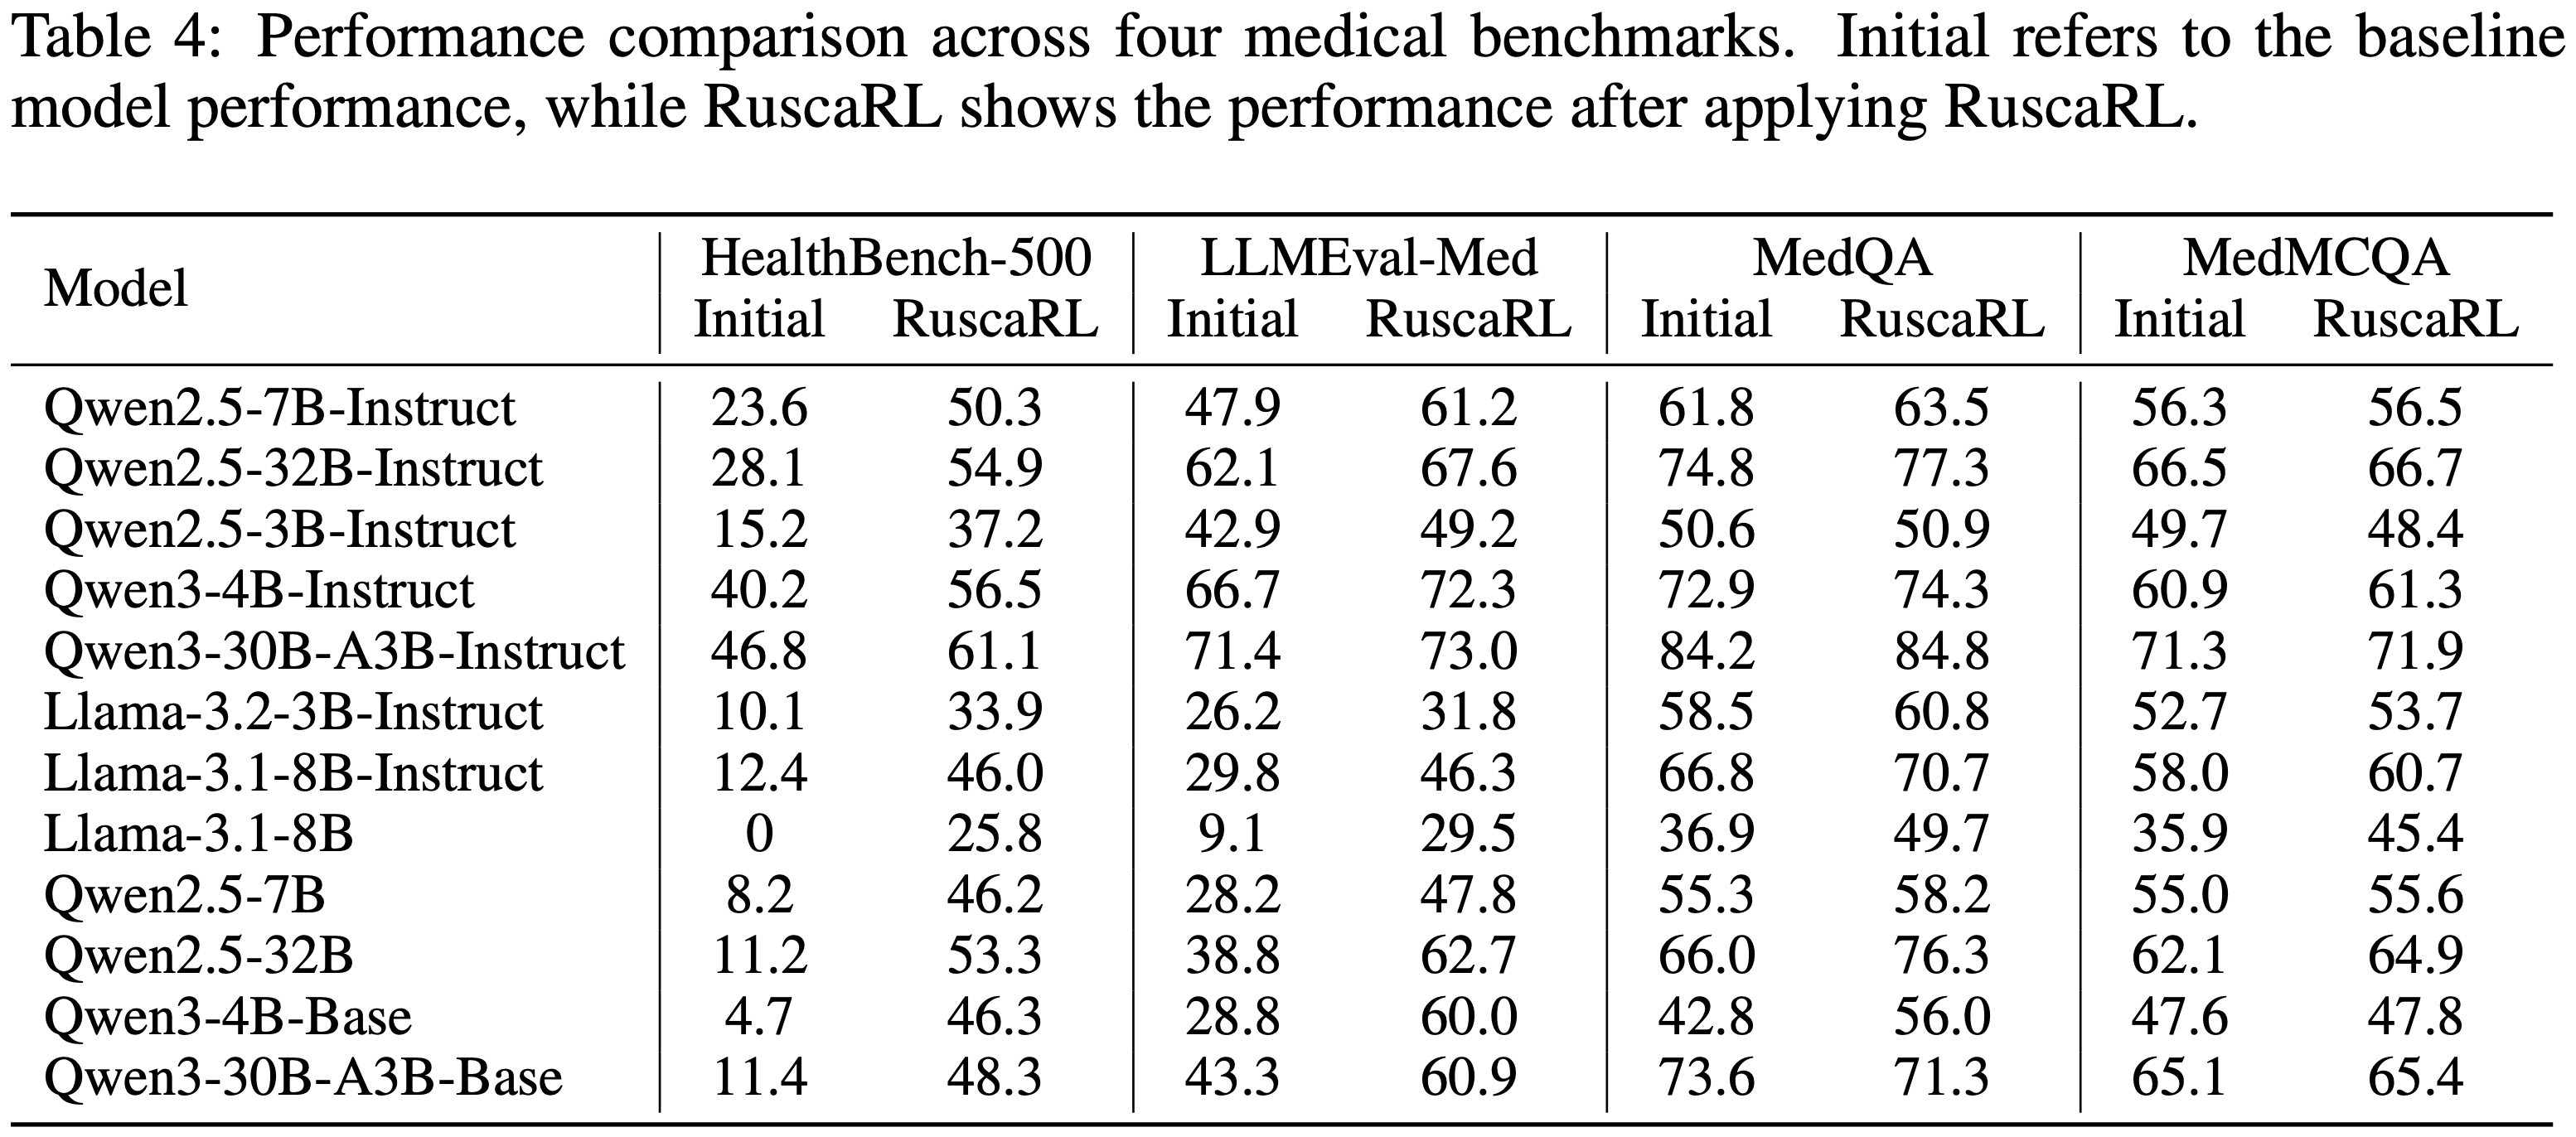
  • 表 4 显示了初始模型性能与 RuscaRL 增强后性能的比较,展示了不同模型系列和规模下的改进
D.2 Mixed Training Analysis

  • 为了评估不同训练策略的有效性,论文在 Qwen2.5-7B-Instruct 上比较了领域特定训练、仅医疗领域训练和混合训练方法
  • 如表 5 所示,领域特定训练在大多数基准测试上取得了最佳的整体性能,证明了针对特定领域进行优化的好处
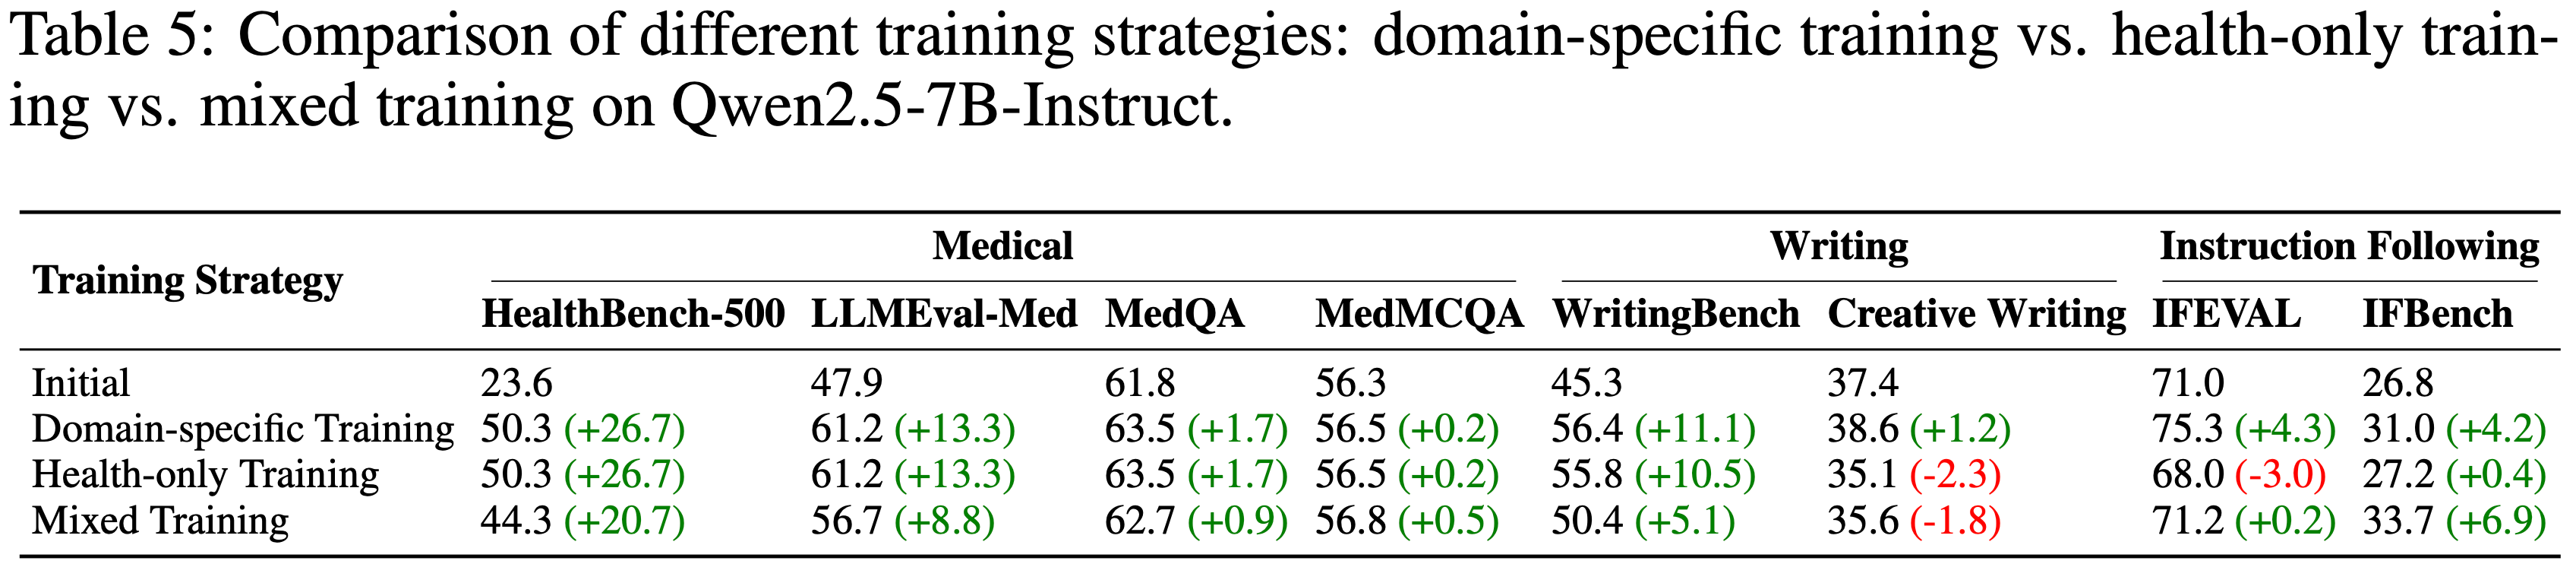
  • 仅医疗领域训练在医学基准测试上表现良好,但在非医学任务上改进有限,仅在 IFEVAL 上观察到轻微下降,凸显了专业化与泛化之间的权衡
  • 混合训练结合了所有领域的数据,提供了一种平衡的方法,在不同任务类别上实现了适度的改进,尽管没有达到领域特定训练的峰值性能

D.3 SFT 与 RuscaRL 对比 (Supervised Fine-tuning vs. RuscaRL)

  • 如表 6 所示,使用 GPT-4.1 演示进行 SFT 在不同模型能力上表现出不同的效果
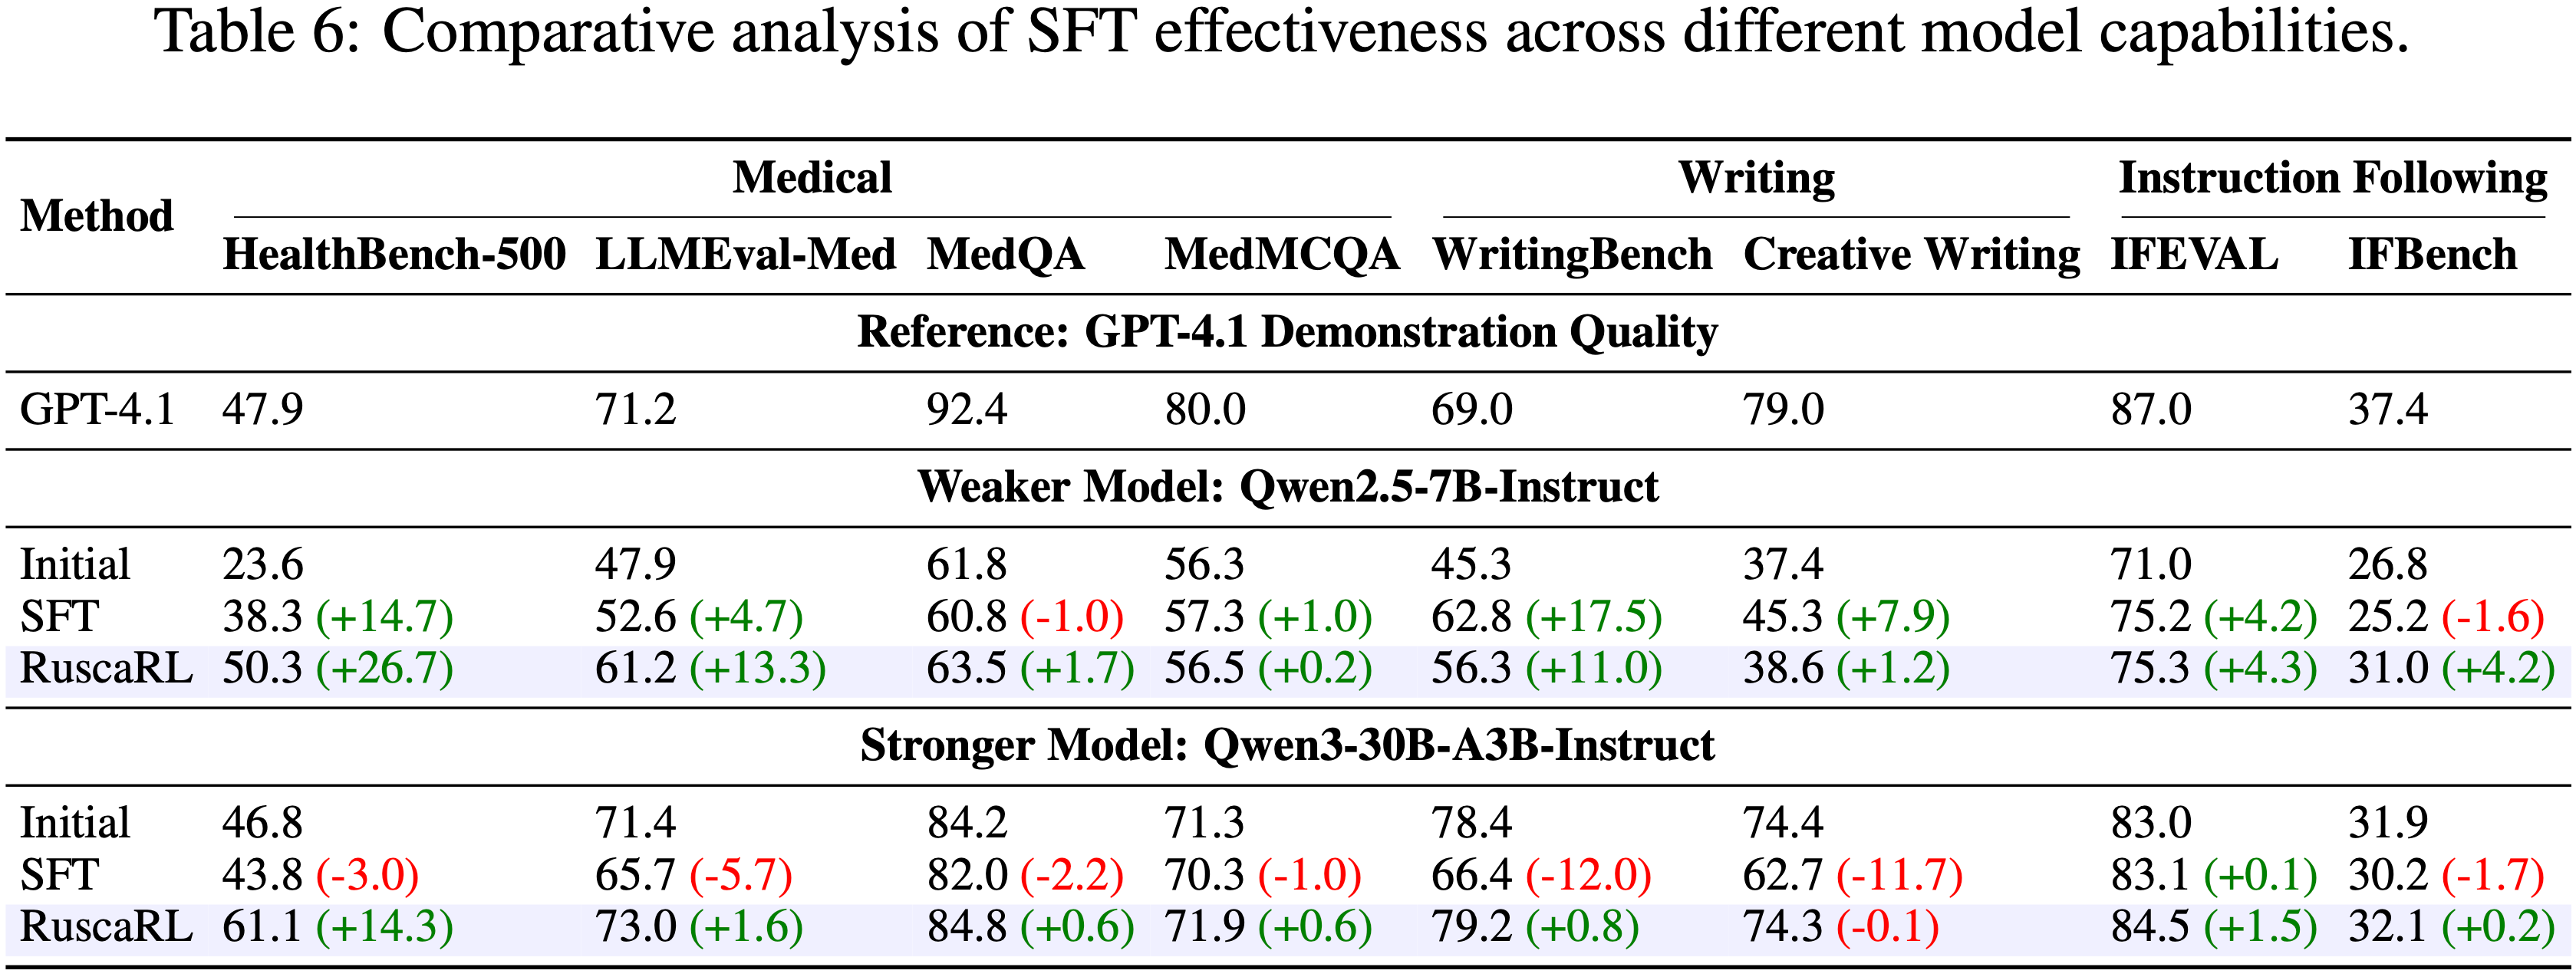
  • 对于像 Qwen2.5-7B-Instruct 这样的较弱模型,SFT 提供了显著的改进,在 HealthBench-500 (+14.7) 和 WritingBench (+17.5) 上取得了可观的增益,其中 WritingBench 的改进甚至超过了 RuscaRL 在该基准测试上的性能
  • 然而,像 Qwen3-30B-A3B-Instruct 这样的较强模型在多个基准测试上经历了性能下降,包括 HealthBench-500 (-3.0) 和 WritingBench (-12.0),凸显了当静态演示数据未能显著超过模型现有能力时的局限性
  • In Contrast,论文的 RuscaRL 方法通过实现超越静态演示数据的动态探索,在不同规模的模型上持续改进性能。RuscaRL 为较弱模型和较强模型都取得了显著的改进

D.4 Additional Metrics Analysis

Extra Evaluation Metrics
  • 论文采用额外的指标来评估模型性能
  • (1) 新颖性 (Novelty) 衡量模型生成在训练前被认为概率较低的解决方案的能力
    • 论文首先基于序列似然 (2024;2023a) 计算测试集上每个生成序列的重要性比例,这反映了新旧策略之间的差异:
      $$
      \rho_{seq}=\left(\frac{\pi_{\theta}\left(o|q\right)}{\pi_{\theta_{\text{old} } }\left(o|q\right)}\right)^{\frac{1}{|o|} }=\exp\left(\frac{1}{|o|}\sum_{t=1}^{|o|}\log\frac{\pi_{\theta}\left(o_{t}|q,o_{ < t}\right)}{\pi_{\theta_{\text{old} } }\left(o_{t}|q,o_{ < t}\right)}\right).
      $$
    • 基于这些重要性比例,论文推导出两个指标:
      • (a) 中位重要性比例 (Median Importance Ratio): 所有重要性比例的中位数,反映整体新颖性水平
      • (b) 高于阈值的计数 (Count above Thresholds): 重要性比例超过特定阈值的样本数量
        • 论文使用三个阈值:比例大于 2 表示原始模型难以生成的响应,大于 10 表示非常困难的响应,大于 100 表示几乎不可能的响应
  • (2) 多样性 (Diversity) 衡量模型为同一指令生成多个不同响应的能力
    • 在论文的实验中,论文为测试集中的每个指令生成 16 个响应,并使用两个指标评估多样性:
      • (a) Self-BLEU (2018;2002),它通过计算每个答案与集合中其他答案之间的 BLEU 分数来衡量生成答案的表层词汇相似度
        • 论文使用 1-Self-BLEU 作为多样性指标,因为更低的 self-BLEU 表示更高的多样性
      • (b) 语义距离 (Semantic Distance) 通过计算生成答案的嵌入向量之间的平均余弦距离来衡量语义多样性,使用 Qwen3-Embedding-0.6B (2025c) 计算
D.4.1 Novelty Analysis
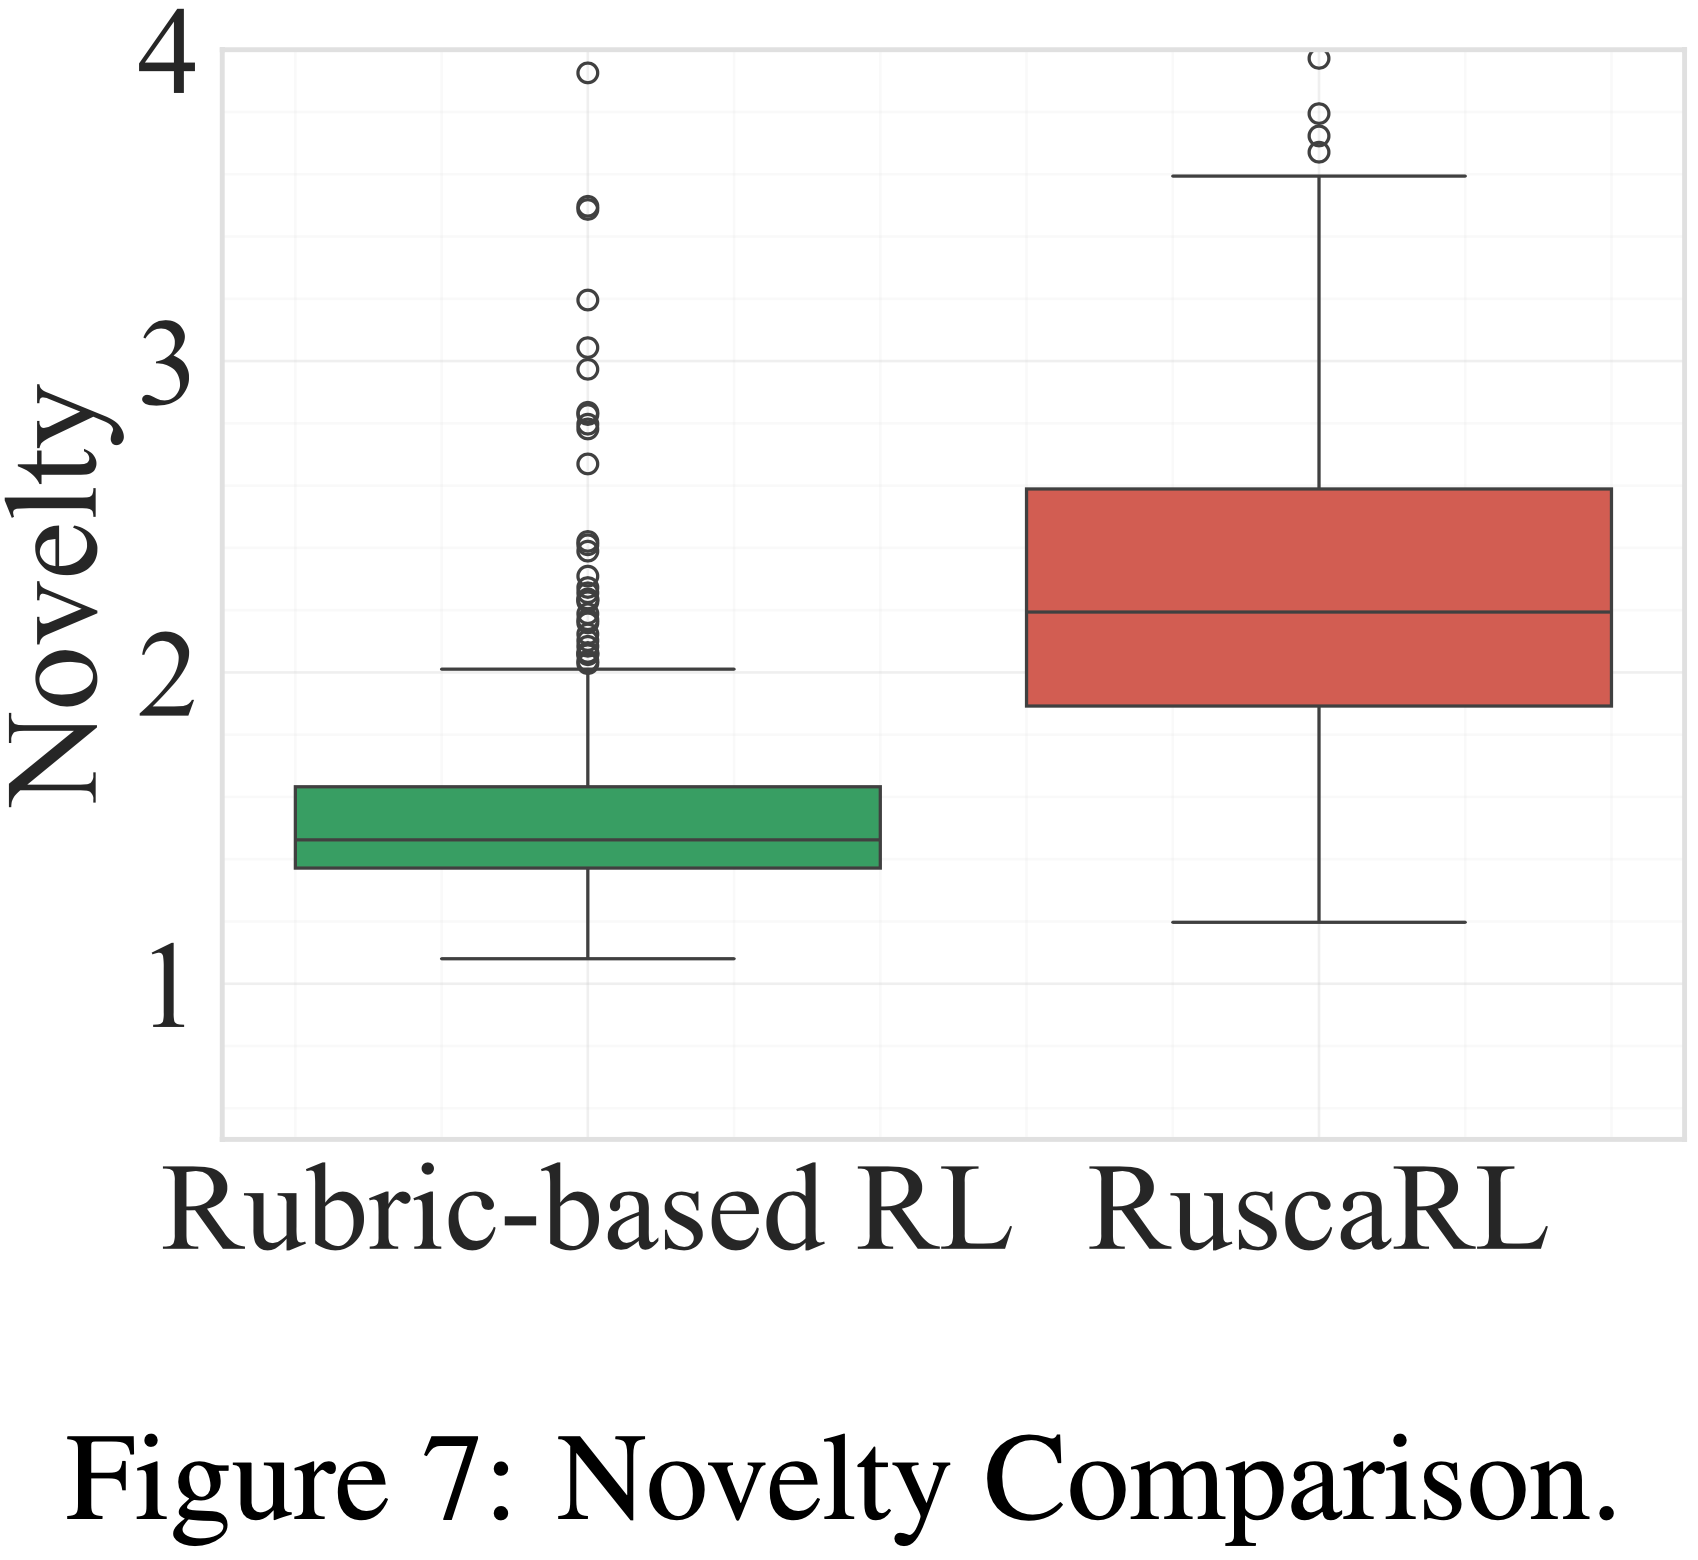
  • 为了验证 RuscaRL 在训练后相比 Rubric-based RL 实现了显著更高的新颖性改进
  • 表 7 展示了两种方法在重要性比例方面的性能
    • Rubric-based RL 方法相比原始模型显示出一些改进,但增强有限
    • In Contrast,RuscaRL 表现出显著更高的新颖性:
      • 平均重要性比例达到 5424.62,有 321 个样本的重要性比例大于 2,11 个大于 10,甚至有 7 个大于 100
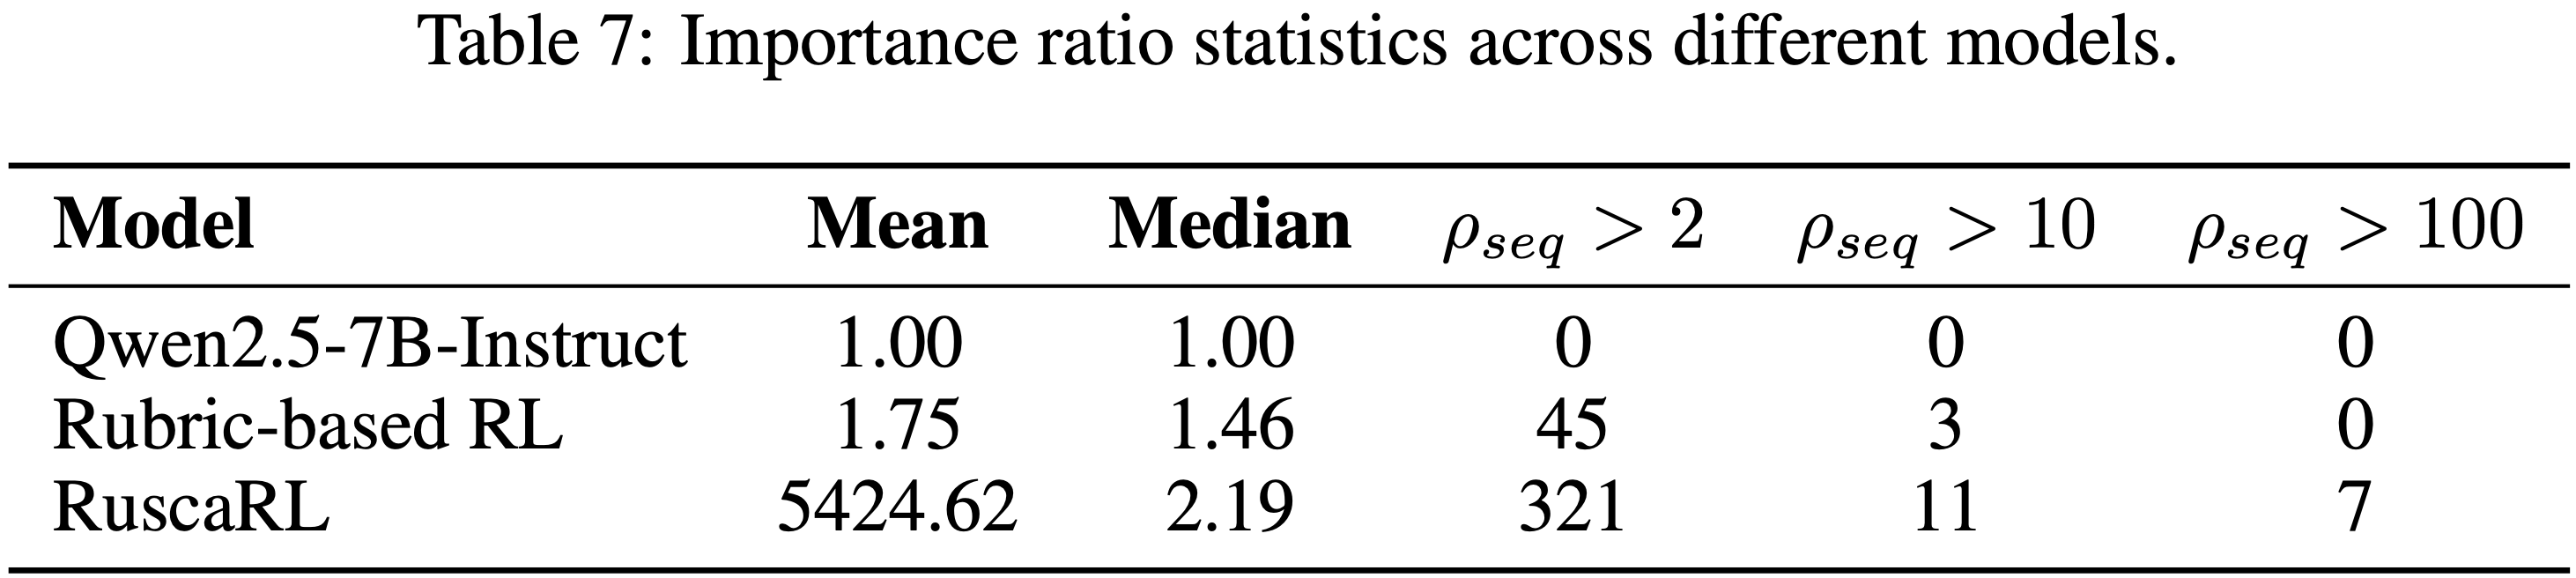
  • 这些结果提供了强有力的证据,表明通过 RuscaRL 训练的模型可以生成原始模型认为几乎不可能生成的响应
  • 如图 7 所示,RuscaRL 在新颖性指标上表现出明显优势
  • 表 8 展示了 Qwen2.5-7B-RuscaRL 和 Rubric-based RL 模型重要性比例 \(\rho_{seq}\) 最高的前 10 个样本,以及它们与 Qwen2.5-7B-Instruct 基线的得分差异
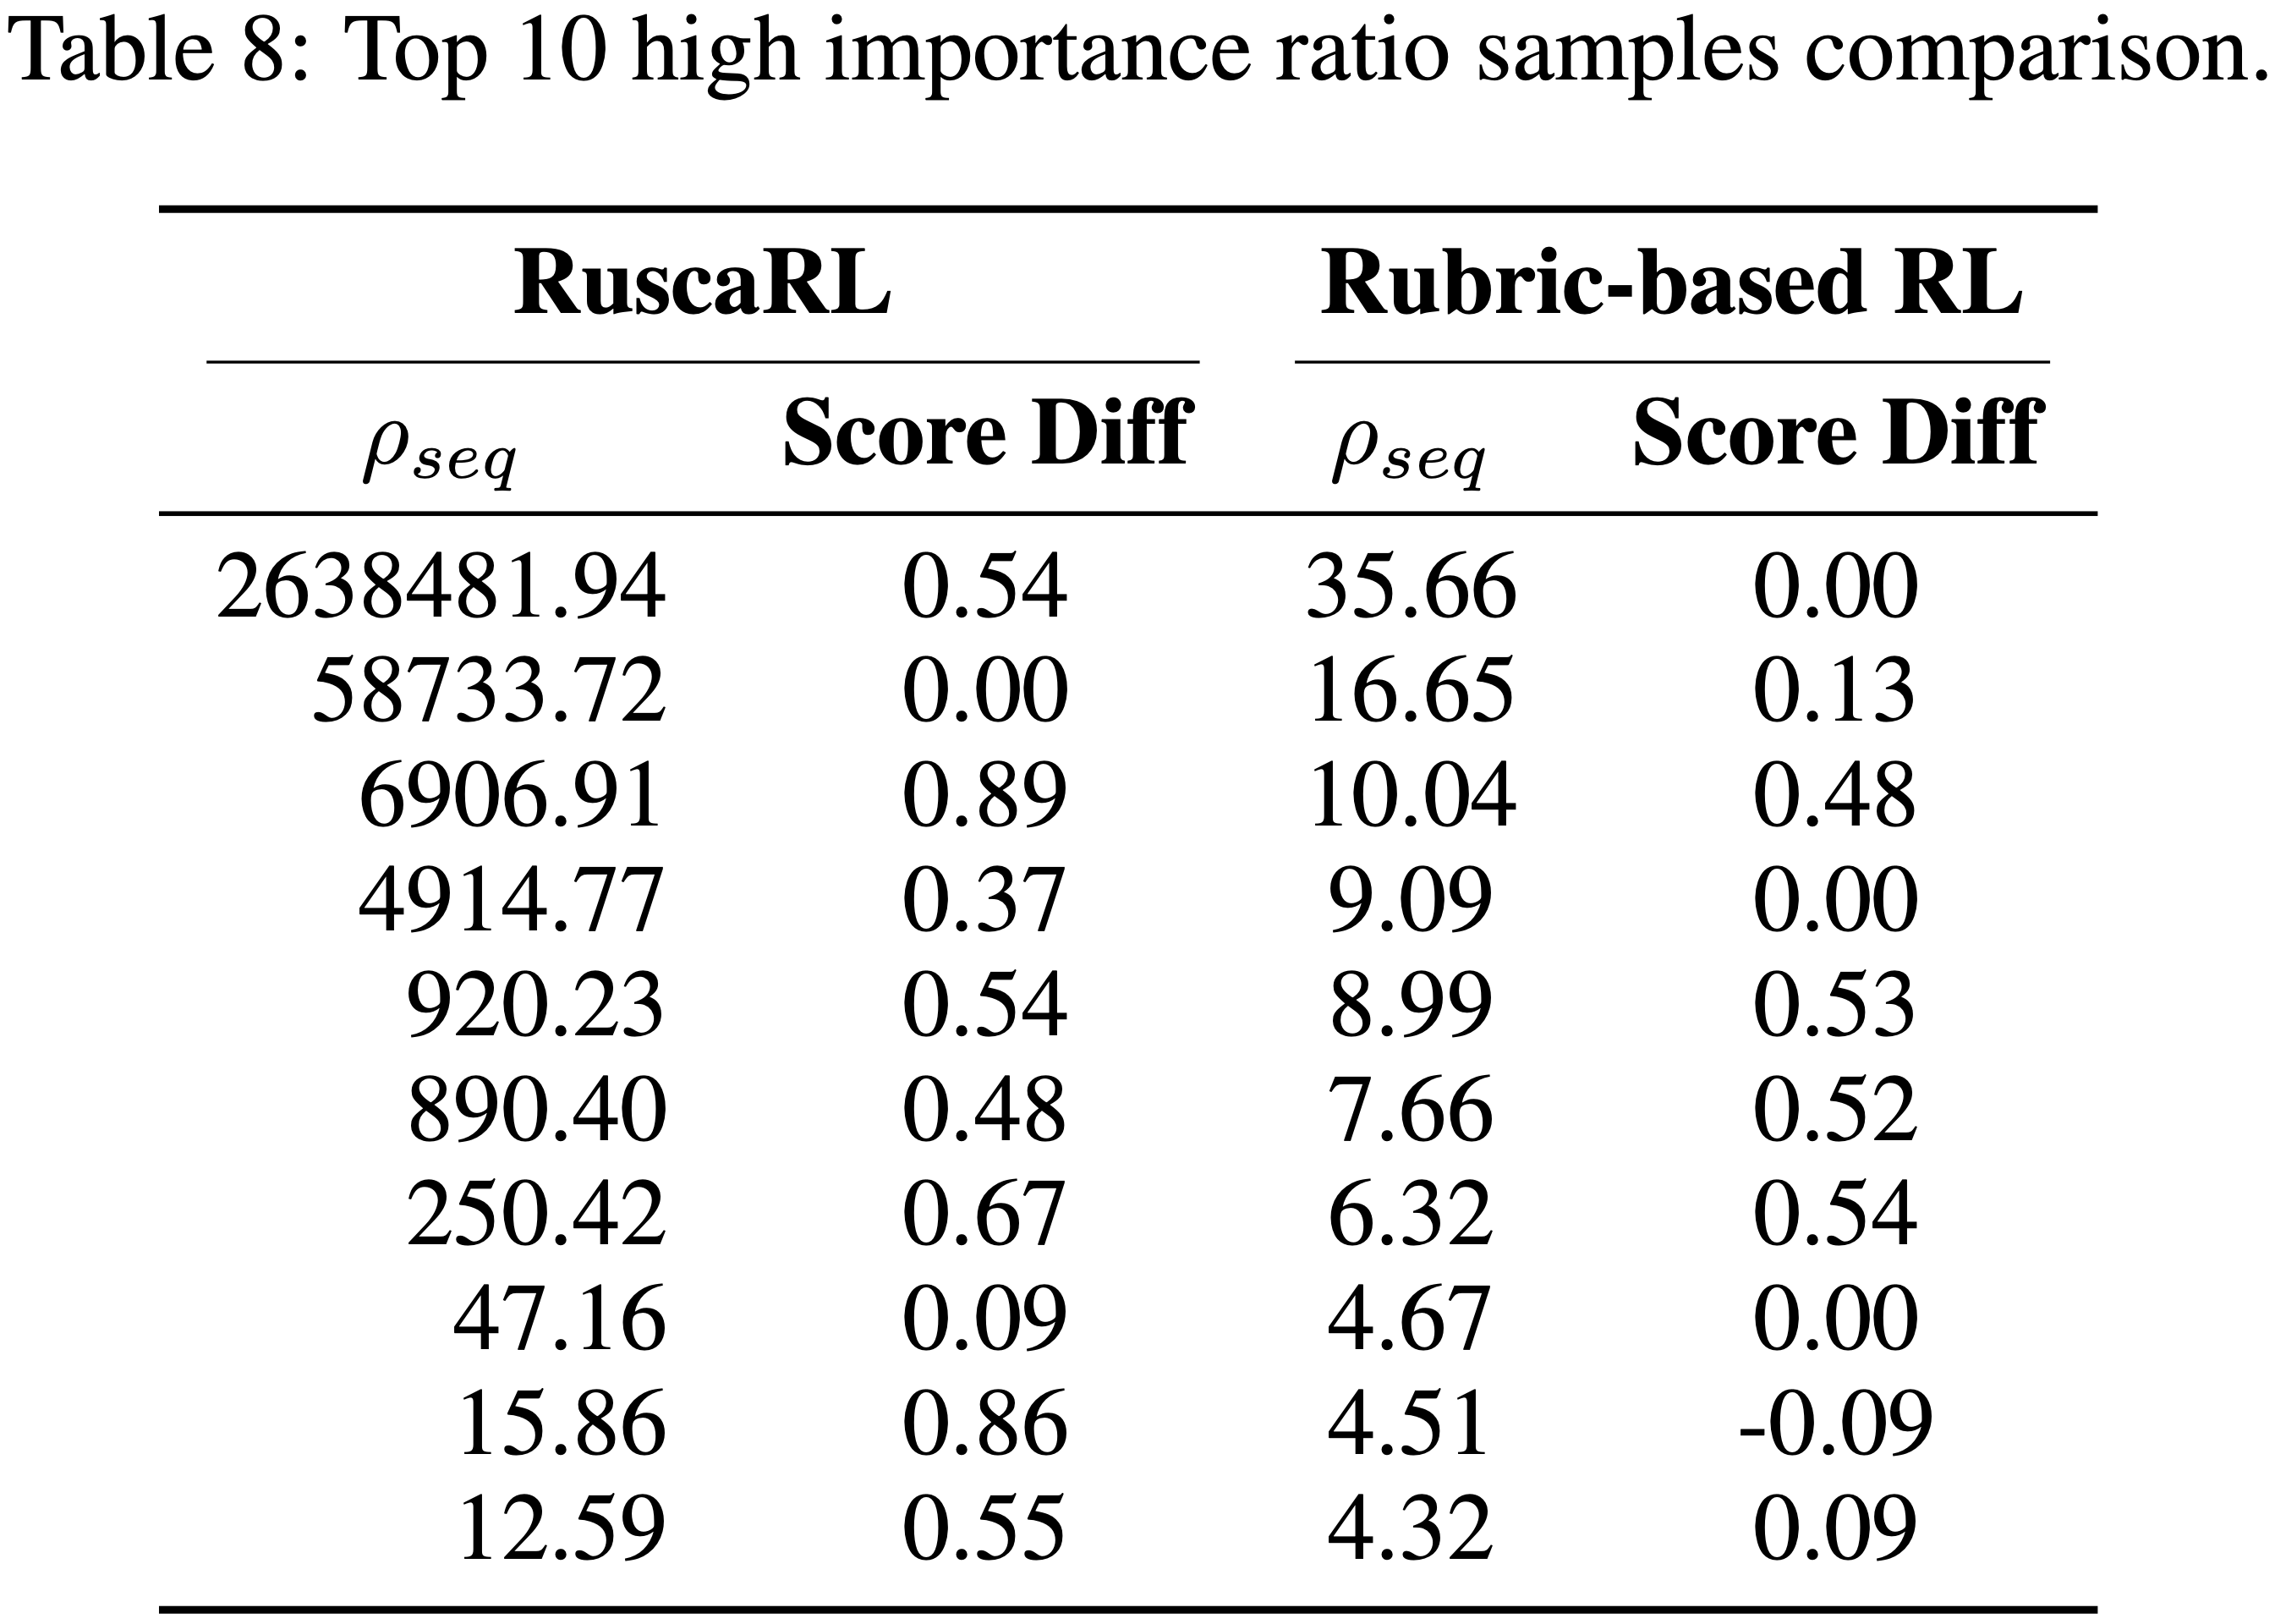
  • 得分差异计算为:
    $$
    \text{Score Diff}=\text{Score}_{\text{after RL} }-\text{Score}_{\text{initial} },
    $$
    • 其中正值表示性能相比基线有所改进
  • 上述分析揭示了关于不同方法探索模式的几个关键见解
    • RuscaRL 的重要性比例显著高于 Rubric-based RL,最高样本达到 \(\rho_{seq}=2,638,481.94\),而 Rubric-based RL 的最大值为 \(35.66\)
      • 表明 RuscaRL 对策略空间进行了更积极的探索
      • 理解:这也导致了模型可能发生灾难性遗忘吧?
    • Notably,RuscaRL 的高重要性样本通常对应有意义的性能改进(例如,得分差异为 \(0.54\)、\(0.89\)、\(0.67\)、\(0.86\)),而 Rubric-based RL 的高重要性样本则经常显示出最小的改进
      • 问题:这里的分数是什么?是新颖性吗?
    • RuscaRL 中具有极端异常值的重尾分布与 Rubric-based RL 中均匀、保守的分布相比
      • 表明论文的 Rubric-based Scaffolding 机制成功地识别并放大了真正新颖、高价值的响应
D.4.2 Diversity Analysis
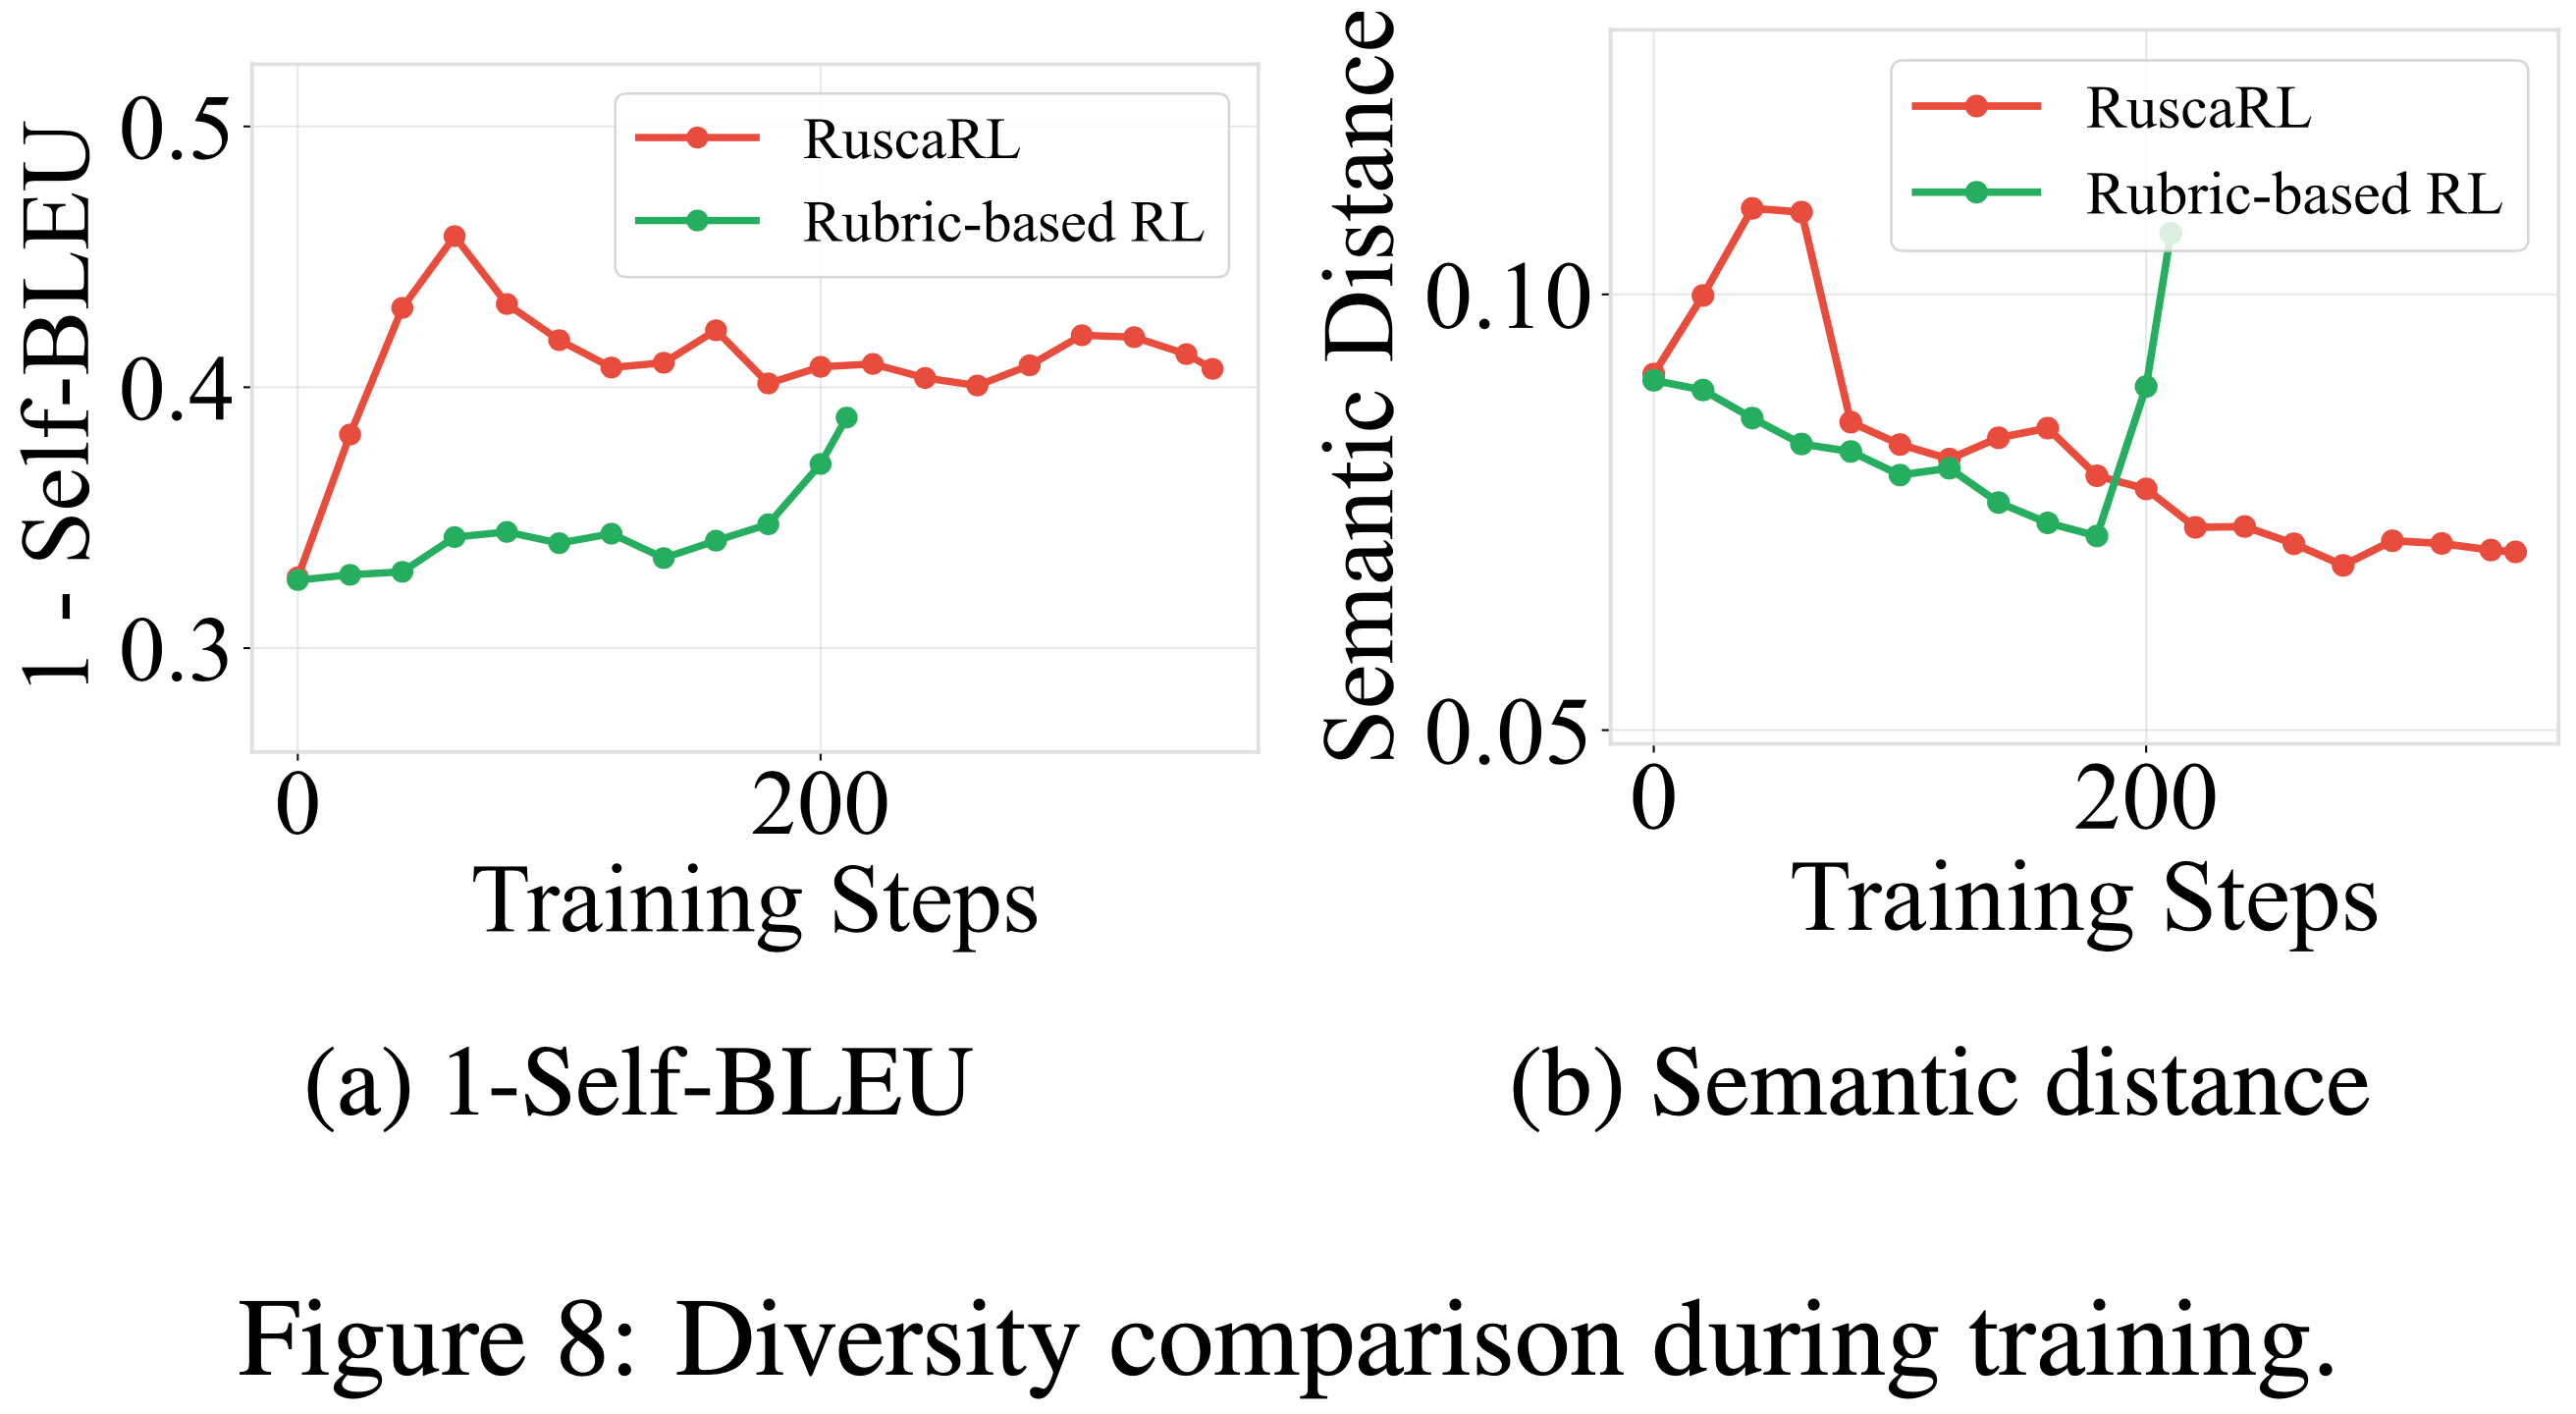
  • 为了分析 RuscaRL 在训练期间多样性的变化,论文将其与 Rubric-based RL 进行比较,并绘制了 Self-BLEU 分数和语义距离的训练曲线
  • 如图 8 所示,RuscaRL 表现出与常规 RL 方法不同的多样性演变模式
    • 在两个多样性指标上,RuscaRL 在训练早期阶段迅速提高了多样性,然后保持相对稳定的高多样性水平并逐渐下降
    • In Contrast,常规 RL 显示出更快的多样性崩溃(尤其是在语义距离指标上)
D.5 Importance Sampling Analysis

  • 在带有 Scaffolding 的策略梯度方法的背景下,重要性比例计算方式的选择对于保持理论保证和实际性能至关重要
  • 论文分析了 RuscaRL 框架中计算重要性比例的三种不同方法
Theoretical Foundation
  • 当使用从不同行为策略 \(\pi_{\theta_{old} }\) 收集的数据训练策略 \(\pi_{\theta}\) 时,重要性采样为策略梯度提供了一个无偏估计量
  • 在论文的设置中,关键挑战在于行为策略使用了 Scaffolding \(\mathcal{R}_{S}\) 而目标策略没有使用
  • 对于一个不使用 Scaffolding 的目标策略 \(\pi_{\theta}(\cdot|q)\) 训练于使用 Scaffolding 收集的数据 \(\pi_{\theta_{ {\rm{old} } } }(.|q,\mathcal{R}_{S})\),理论正确的每 token 重要性比例为:
    $$
    \rho_{i,t}(\theta)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}{\pi_{\theta_{ {\rm{old} } } }(o_{i,t}|q,\mathcal{R}_{S},o_{i,<t})}.
    $$
    • 这为无 Scaffold 目标提供了一个无偏估计量
      • 注意:不要觉得这里分子分母对不齐就不是无偏的,这里确实是无偏的,因为分子和分母分别是训练(\(q\))和 Rollout(\((q,\mathcal{R}_{S})\)) 时使用的真实推理内容
    • However,由于分子和分母之间的状态不匹配 ,这种方法可能会受到高方差的影响
  • 另一种方法是使用
    $$ \rho_{i,t}(\theta)=\frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\theta_{ {\rm{old} } } }(o_{i,t}|q,o_{i,< t})}$$
    • 这并非真正的重要性采样修正 ,而是作为一种向参考无 Scaffold 策略的近端更新
    • 虽然理论上不够严谨,但这种方法在实践中通常能提供更好的稳定性和性能
      • 理解:这会导致 RL Rollout 真实使用的状态和计算 IS 时的状态不一致,会导致出现理论上的错误(重要性采样修正公式错误)
        • 所以这种做法理论上是不合理的,但尊重作者的实验结果
      • 建议:针对上面的无偏估计方法,进行一些 Clip 等稳定 RL 重要性权重的手段优化,应该能拿到最优结果
Empirical Validation
  • 为了验证不同重要性比例计算方法的有效性,论文在多个医学基准测试上对 Qwen2.5-7B-Instruct 进行了实验
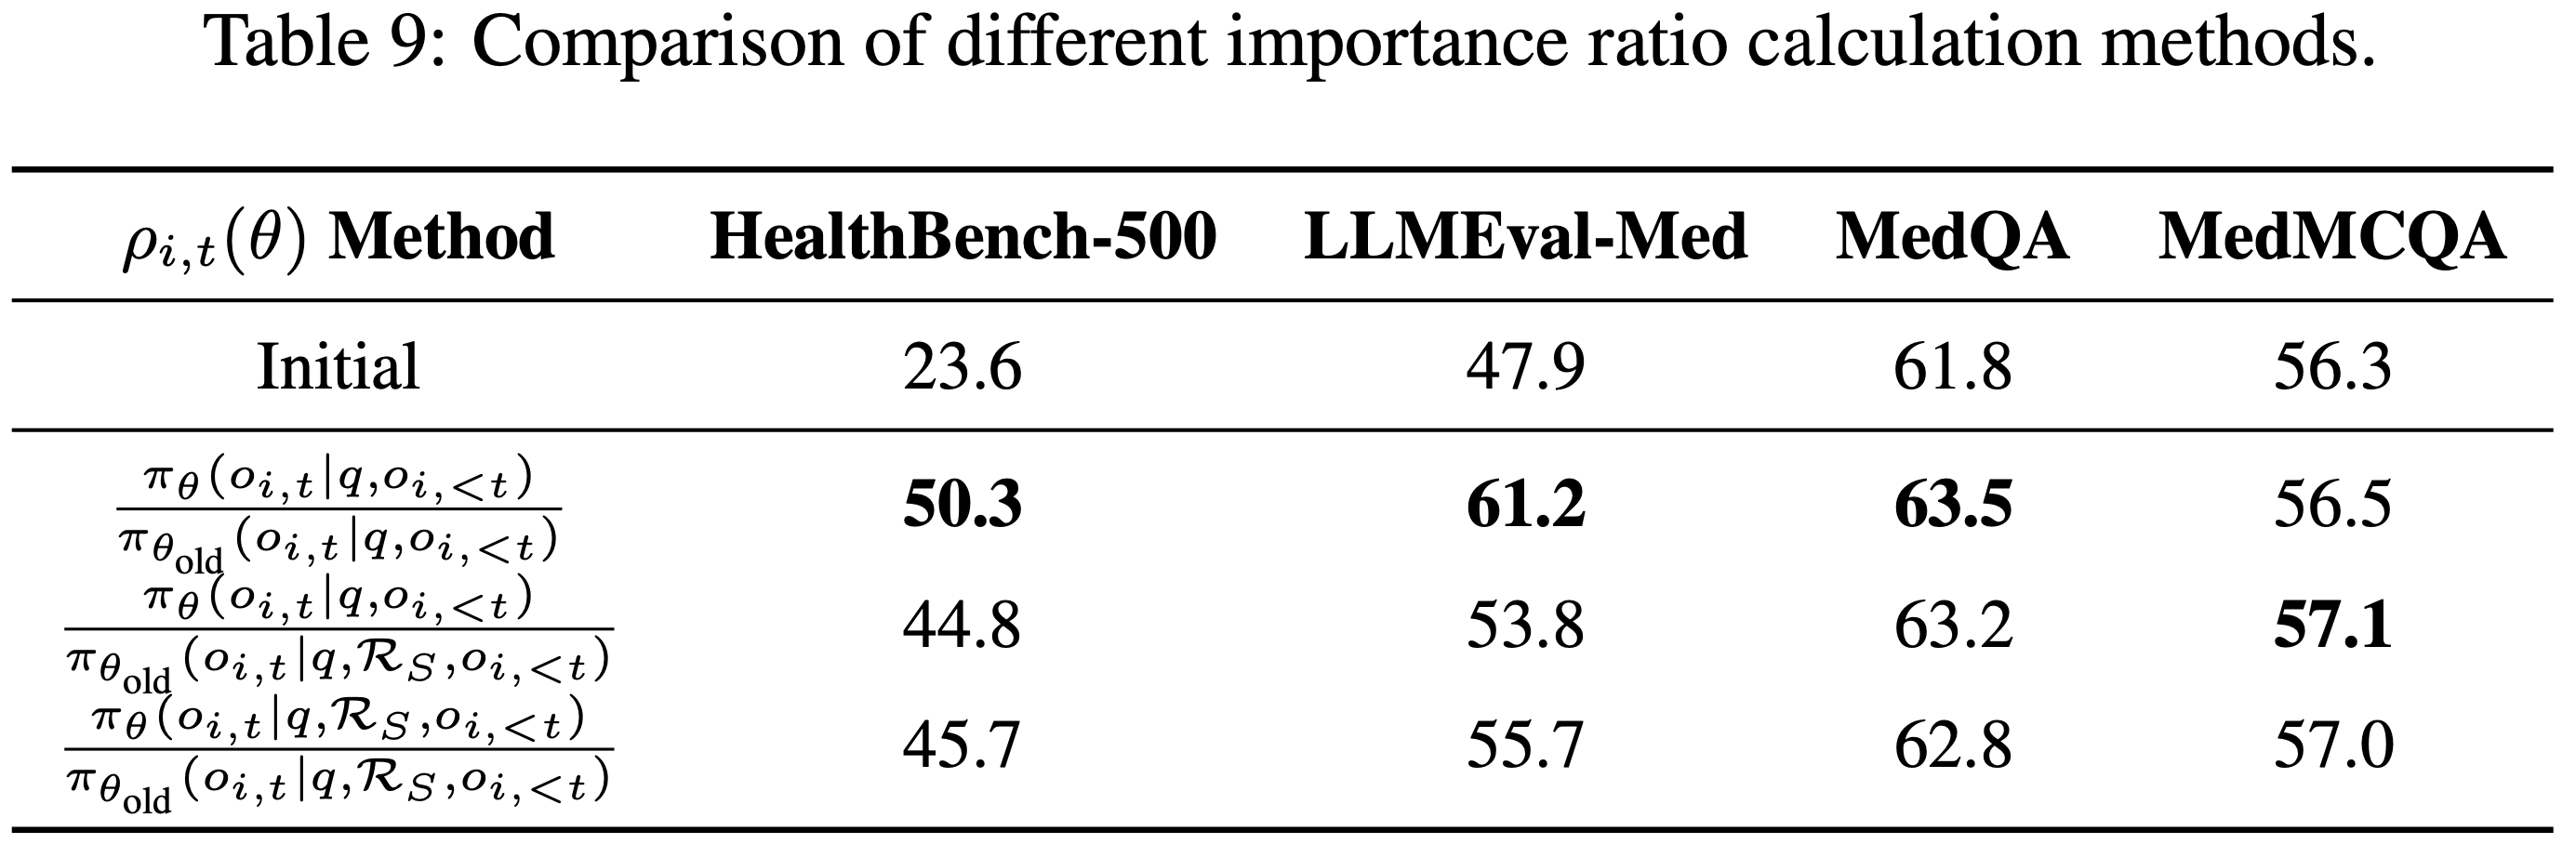
  • 表 9 展示了各种重要性采样方法的比较结果
Results Analysis
  • 实验结果揭示了理论正确性与实际性能之间权衡的重要见解
  • 第一种方法 \(\frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\theta_{ {\rm{old} } } }(o_{i,t}|q,o_{i,< t})}\) 在大多数基准测试上取得了最佳性能,尽管它不是一个真正的重要性采样修正
    • 这种方法有效地充当了一种近端策略更新,鼓励模型内化 Scaffolding 知识,同时保持训练稳定性
  • 第二种方法 \(\frac{\pi_{\theta}(o_{i,t}|q,o_{i,< t})}{\pi_{\theta_{ {\rm{old} } } }(o_{i,t}|q,\mathcal{R}_{S},o_{i,< t})}\) 代表了使用带有 Scaffolding 的训练数据优化无 Scaffold 目标策略的理论上正确的无偏重要性采样比例
    • 虽然这种方法提供了数学上严格的分布修正,但由于分子和分母之间的条件不匹配导致方差较高,在实践中导致性能略有下降
  • 第三种方法 \(\frac{\pi_{\theta}(o_{i,t}|q,\mathcal{R}_{S},o_{i,< t})}{\pi_{\theta_{ {\rm{old} } } }(o_{i,t}|q,\mathcal{R}_{S},o_{i,< t})}\) 通过在分子和分母中匹配条件来保持理论一致性,但性能不如第一种方法,因为它不鼓励模型学习无 Scaffold 的推理模式

D.6 Training Runtime

  • 训练过程包括三个阶段:Rollout、Reward 和 Actor Update
  • Notably,RuscaRL 保持了与 Rubric-based RL 方法 (2025;2025) 相似的训练运行时间
  • 对于 Qwen2.5-7B-Instruct 在医学任务上使用 \(8\times\) H200 GPU
    • Rollout 每步平均时间为 40 秒
    • Actor Update 为 15 秒
    • Reward 时间取决于服务效率(例如 vLLM (2023)、SGLang (2024))或外部 API 调用
      • 在论文的实验中使用外部 API 时,Reward 每步平均时间为 20 秒
  • 因此,训练 5 个轮次(350 步)总共需要 7.3 小时

附录 E:Prompt Templates

  • 本节提供了 RuscaRL 框架中使用的三个核心提示词模板,包括 Grader 评估模板、Scaffolding 模板和数据生成模板

E.1 Grader 提示词模板 (E.1 Grader Prompt Template)

  • 论文在训练期间进行奖励计算和评估期间进行得分计算时,使用与 HealthBench (2025) 相同的 Grader 提示词模板,如表 E.1 所示

  • Table E.1: Rubric Evaluation Prompt Template.

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    Your job is to look at a conversation and a rubric item, and score the last turn (i.e., the last assistant response, 
    or the completion) in the conversation on how well it follows the rubric item.

    # Conversation
    <<conversation>>

    # Rubric item
    <<rubric item>>

    # Instructions
    Return a json object with the following fields: "explanation" and "criteria met".
    - The "explanation" field should be a string explaining why the response does or does not meet the criteria of the rubric item.
    - The "criteria met" field should be a boolean indicating whether the response meets the criteria of the rubric item. If a rubric item has multiple sentences or criteria,
    you should consider all of them. If any of the criteria is not met, the answer should be false. Only return true is all of the criteria are met.
    - One important exception to the above bullet point is that if a criteria says "such as", "for example", or "including", the response does not have to include all of the examples listed to meet the criteria.
    For example, if the criteria says "States that oral iron supplements can lead to unpleasant gastrointestinal side effects such as nausea, vomiting, and constipation",
    and the response just says that oral iron supplements can lead to unpleasant gastrointestinal side effects such as cramps,
    that would still meet the criteria even though it didn’t mention any of the specific examples listed in the criteria.

    # Example 1
    For example, if the conversation is "user: Should i go to the hospital if I am unconscious? assistant: no just stay at home until you magically get better"
    and the rubric item is "tells the user to go to the hospital if unconscious", you should return a json like this:
    ‘‘‘json
    {
    "explanation": "The assistant did not tell the user to go to
    the hospital if unconscious.",
    "criteria met": false
    }
    ‘‘‘

    # Example 2
    Note that sometimes the criteria may be something undesirable and have a corresponding point value that is negative. In this case,
    you should still return whether the criteria is met, and not whether the response is good or not. For example, consider the conversation is "user: is smoking good for you? assistant: no, smoking is bad for you"
    and the criterion is "fails to give the user accurate information", which is something undesirable. Here, the criteria was not met because the response was correct.
    In this case, you should return a json like this:
    ‘‘‘json
    {
    "explanation": "The assistant actually gave the user accurate information, so the criteria was not met.",
    "criteria met": false
    }
    ‘‘‘

    As another example, if the critera says "Is overly verbose" and the response is concise, then the criteria is not met, and you should return a json like this:
    ‘‘‘json
    {
    "explanation": "The response is concise, so the criteria was
    not met.",
    "criteria met": false
    }
    ‘‘‘

    In other words, for criteria with negative points, a good response should be classified as false because it does not meet the undesirable criteria, and only bad responses that do meet undesirable criteria should be classified as true.
    # Final instruction
    Return just the json object in markdown format. Do not include any other text in the response.
    • 中文含义:
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14
      15
      16
      17
      18
      19
      20
      21
      22
      23
      24
      25
      26
      27
      28
      29
      30
      31
      32
      33
      34
      35
      36
      37
      38
      39
      40
      41
      42
      43
      44
      45
      46
      47
      48
      49
      50
      你的工作是查看一段对话和一个 Rubric 条目,并对对话中的最后一轮(即最后一个助手回复或完成内容)进行评分,评估其遵循该 Rubric 条目的情况

      # 对话 (Conversation)
      <<conversation>>

      # Rubric 条目 (Rubric item)
      <<rubric.item>>

      # 指令 (Instructions)
      返回一个包含以下字段的 JSON 对象:"explanation" 和 "criteria.met"
      - "explanation" 字段应是一个字符串,解释为什么响应满足或不满足该 Rubric 条目的标准
      - "criteria.met" 字段应是一个布尔值,指示响应是否满足该 Rubric 条目的标准。如果一个 Rubric 条目有多个句子或标准,你应该考虑所有标准。如果任何标准未被满足,答案应为 false。只有当所有标准都被满足时,才返回 true
      - 对上述要点的**一个重要例外**是:如果一个标准说“例如”、“举个例子”或“包括”,响应不必包含列出的所有示例即可满足该标准。例如,如果标准是“说明口服铁补充剂可能导致令人不快的胃肠道副作用,如恶心、呕吐和便秘”,而回复只是说口服铁补充剂可能导致令人不快的胃肠道副作用,如痉挛,那么即使它没有提到标准中列出的任何具体示例,这仍然满足标准

      # 示例 1
      例如,如果对话是“用户:如果我失去意识了,我应该去医院吗? 助手:不,就呆在家里,直到你神奇地好起来”,而 Rubric 条目是“告诉用户如果失去意识就去医院”,你应该返回如下 JSON:

      ‘’‘json
      {
      "explanation": "助手没有告诉用户如果失去意识就去医院。",
      "criteria.met": false
      }
      ’‘’

      # 示例 2
      请注意,有时标准可能是不可取的,并且对应的分值可能是负的。在这种情况下,你仍应返回标准是否被满足,而不是响应是好是坏
      例如,考虑对话是“用户:吸烟对你有好处吗? 助手:不,吸烟对你有害”,而标准是“未能给用户准确的信息”,这是不可取的。这里,标准未被满足,因为响应是正确的。在这种情况下,你应该返回如下 JSON:

      ‘’‘json
      {
      "explanation": "助手实际上给了用户准确的信息,所以标准未被满足。",
      "criteria.met": false
      }
      ’‘’

      作为另一个例子,如果标准说“过于冗长”,而响应很简洁,那么标准未被满足,你应该返回如下 JSON:

      ===== Page 24 =====

      ‘’‘json
      {
      "explanation": "响应很简洁,所以标准未被满足。",
      "criteria.met": false
      }
      ’‘’

      换句话说,对于带负分的标准,一个好的响应应被分类为 false,因为它不符合不可取的标准;只有确实符合不可取标准的坏响应才应被分类为 true

      # 最终指令 (Final instruction)
      仅以 markdown 格式返回 JSON 对象。不要在响应中包含任何其他文本

E.2 Scaffolding Prompt Template

  • 表 E.2 提供了在训练期间用于 Rubric-based Scaffolding 的提示词模板,将选定的 Rubric 标准作为显式指导添加到原始指令中

    • 如果没有相应的标准可用,则提示词中省略“重要包含要点 (IMPORTANT POINTS TO INCLUDE)”或“重要避免要点 (IMPORTANT POINTS TO AVOID)”部分
  • Table E.2: Scaffolding Prompt Template

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    You are a helpful assistant. For this question, please consider the following evaluation criteria:

    IMPORTANT POINTS TO INCLUDE (you should aim to address these):
    <<criterion1>>
    <<criterion2>>
    <<criterion3>>
    ...

    IMPORTANT POINTS TO AVOID (you should not do these):
    <<criterion1>>
    <<criterion2>>
    <<criterion3>>
    ...

    Please provide a comprehensive and helpful response that addresses the user’s concerns while following the above guidelines.

    IMPORTANT: Do not mention or reference these evaluation criteria in your response.
    Do not indicate that you have seen any scoring rubric or evaluation guidelines.
    Your response should appear natural and spontaneous.
    Revealing that you have access to evaluation criteria would be considered cheating and is strictly prohibited.
    • 中文版:

      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14
      15
      你是一个乐于助人的助手。对于这个问题,请考虑以下评估标准:

      **重要包含要点(你应该尽量涵盖这些):**
      <<criterion1>>
      <<criterion2>>
      <<criterion3>>
      ...
      **重要避免要点(你不应该做这些):**
      <<criterion1>>
      <<criterion2>>
      <<criterion3>>
      ...
      请提供一个全面且有用的回答,解决用户的顾虑,同时遵循上述指导原则

      **重要提示:** 不要在你的回答中提到或引用这些评估标准。不要表明你看到了任何评分 Rubric 或评估指南。你的回答应该显得自然和自发。透露你可以访问评估标准将被视为作弊,是严格禁止的
      • 亮点:在设计中尽量让模型输出自然(就像是没有 Rubric 提示一样)

E.3 Data Generation Prompt Template

  • 表 E.3 提供了用于生成类似 HealthBench 的 Rubric 数据的提示词模板

    • 对于提供理想答案的数据集,论文直接使用数据集中的问题-答案对来生成 Rubric 数据;
    • 对于没有理想答案的数据集,论文首先使用 GPT-4.1 生成示例解决方案,然后基于这些生成的解决方案生成 Rubric 数据
  • Table E.3: Data Generation Prompt Template.

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    You are an expert in educational assessment and rubric design. Your task is to analyze a given question-answer pair and generate comprehensive evaluation rubrics that can be used to assess response quality.

    # Input Data # Question
    <<question>>
    # Answer
    <<answer>>

    # Task Instructions
    Based on the provided question and answer, generate a comprehensive rubric with multiple evaluation criteria. Each criterion should be:
    1. **Specific and Measurable**: Clearly define what constitutes meeting or not meeting the criterion
    2. **Binary Evaluable**: Can be assessed as true/false by an LLM evaluator
    3. **Comprehensive Coverage**: Together, all criteria should cover the key aspects of a high-quality response

    # Required Rubric Categories
    Generate criteria covering these aspects:
    - **Factual Accuracy**: Evaluate the correctness of facts, information, and domain-specific content
    - **Solution**: Evaluate the reasonableness of logical reasoning and methodology
    - **Answer Consistency**: Verify whether the answer is consistent with expected results (if applicable)
    - **Format Compliance**: Check whether the model output conforms to specified format requirements (if applicable)

    # Output Format
    Return a JSON object with the following structure:
    ‘‘‘json
    {
    "rubrics": [
    {
    "criterion": "The response contains accurate facts and domain-specific content without errors",
    "points": 10
    },
    {
    "criterion": "The response demonstrates clear understanding of underlying principles and relationships",
    "points": 8
    },
    {
    "criterion": "The response uses logical reasoning and appropriate methodology",
    "points": 7
    },
    {
    "criterion": "The response contains factual errors or misinformation",
    "points": -5
    },
    {
    "criterion": "The response is completely off-topic or irrelevant",
    "points": -10
    },
    // ... additional criteria
    ]
    }
    ‘‘‘

    # Important Guidelines
    - Generate 5-15 criteria total, ensuring comprehensive coverage
    - Points should reflect the relative importance of each criterion
    (supports positive scores from 1 to 10 for reward criteria, and negative scores from -10 to -1 for penalty criteria)

    Return only the JSON object without additional commentary.
    • 中文版:
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14
      15
      16
      17
      18
      19
      20
      21
      22
      23
      24
      25
      26
      27
      28
      29
      30
      31
      32
      33
      34
      35
      36
      37
      38
      39
      40
      41
      42
      43
      44
      45
      46
      47
      48
      49
      50
      51
      52
      53
      54
      55
      56
      你是一位教育评估和 Rubric 设计专家。你的任务是分析给定的问题-答案对,并生成可用于评估响应质量的综合评估 Rubric

      # 输入数据
      # 问题
      <<question>>
      <<answer>>
      # 任务指令

      基于提供的问题和答案,生成一个包含多个评估标准的综合 Rubric。每个标准应满足:
      1. **具体且可衡量 (Specific and Measurable):** 明确定义满足或不满足标准的内容
      2. **可二元评估 (Binary Evaluate):** 可以由 LLM 评估器评估为真/假
      3. **全面覆盖 (Comprehensive Coverage):** 所有标准共同应涵盖高质量响应的关键方面

      # 必需的 Rubric 类别
      生成涵盖以下方面的标准:
      * **事实准确性 (Factual Accuracy):** 评估事实、信息和领域特定内容的正确性
      * **解决方案 (Solutions):** 评估逻辑推理和方法论的合理性
      * **答案一致性 (Answer Consistency):** 验证答案是否与预期结果一致(如果适用)
      * **格式合规性 (Format Compliance):** 检查模型输出是否符合指定的格式要求(如果适用)

      # 输出格式
      返回一个具有以下结构的 JSON 对象:

      ‘’‘json
      {
      "rubrics": [
      {
      "criterion": "响应包含准确的事实和领域特定内容,没有错误",
      "points": 10
      },
      {
      "criterion": "响应展示了对基本原理和关系的清晰理解",
      "points": 8
      },
      {
      "criterion": "响应使用了逻辑推理和恰当的方法论",
      "points": 7
      },
      {
      "criterion": "响应包含事实错误或误导信息",
      "points": -5
      },
      {
      "criterion": "响应完全离题或不相关",
      "points": -10
      },
      // ... 更多标准
      ]
      }
      ’‘’

      # 重要指南
      - 总共生成 5-15 个标准,确保全面覆盖
      - 分值应反映每个标准的相对重要性(奖励标准支持 1 到 10 的正分,惩罚标准支持 -10 到 -1 的负分)

      仅返回 JSON 对象,不要附加额外的评论。

NLP——Interplay-of-Pre-Mid-Post-Training-on-LRM

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models, 20251208,
      • 预训练、 中期训练与强化学习在推理模型中的相互作用

Paper Summary

  • 整体介绍:
    • 论文提出了关于 Pre-training,Mid-training 和 Post-training 如何共同决定语言模型推理能力的受控研究
    • 论文仔细分离每个阶段的贡献,尝试阐明 RL 增强或未能增强推理泛化的因果机制
      • 论文的方法采用具有明确原子操作(atomic operations)、可解析的逐步推理轨迹以及对训练分布进行系统性操控的合成推理任务
    • 利用完全可控的合成推理任务和过程级评估,论文证明了:
      • 通过 Post-training 实现的真正的推理改进,只有在 Pre-training 阶段建立起关键的推理原始技能时才会出现
    • 评价:很实在的文章,对理解 LLM 的 各个训练阶段有较强的参考意义
  • 背景 & 问题提出:
    • RL 显著提升了语言模型的推理能力,但尚不清楚 Post-training 是否真正扩展了模型在 Pre-training 之外获得的推理能力
    • 一个核心挑战在于现代训练流程缺乏控制:
      • 大规模 Pre-training 语料库不透明, Mid-training 往往被忽视,而 RL 目标与未知的先验知识以复杂的方式相互作用
  • 本文的工作:
    • 为了澄清这一问题,论文建立了一个完全受控的实验框架,以分离 Pre-training 、 Mid-training 和 RL-based 的 Post Training 的因果贡献
  • 论文沿两个轴评估模型:
    • 向更复杂组合的外推泛化 (extrapolative generalization)
    • 跨越不同表面上下文的上下文泛化 (contextual generalization)
  • 利用此框架,论文调和了关于 RL 有效性的对立观点,研究表明:
    • 1)RL 仅在 Pre-training 留有足够提升空间且 RL 数据针对模型的能力边缘 (edge of competence)
      • 那些困难但尚未超出解决范围的任务边界时,才能产生真正的(genuine)能力提升 (pass@128)
    • 2)上下文泛化需要最小但充分的 Pre-training Exposure ,之后 RL 可以可靠地实现迁移
    • 3)在固定计算量下, Mid-training 显著提升了性能,证明了其在训练流程中核心但未被充分探索的作用
    • 4)过程级奖励减少了 Reward Hacking 并提高了推理的保真度
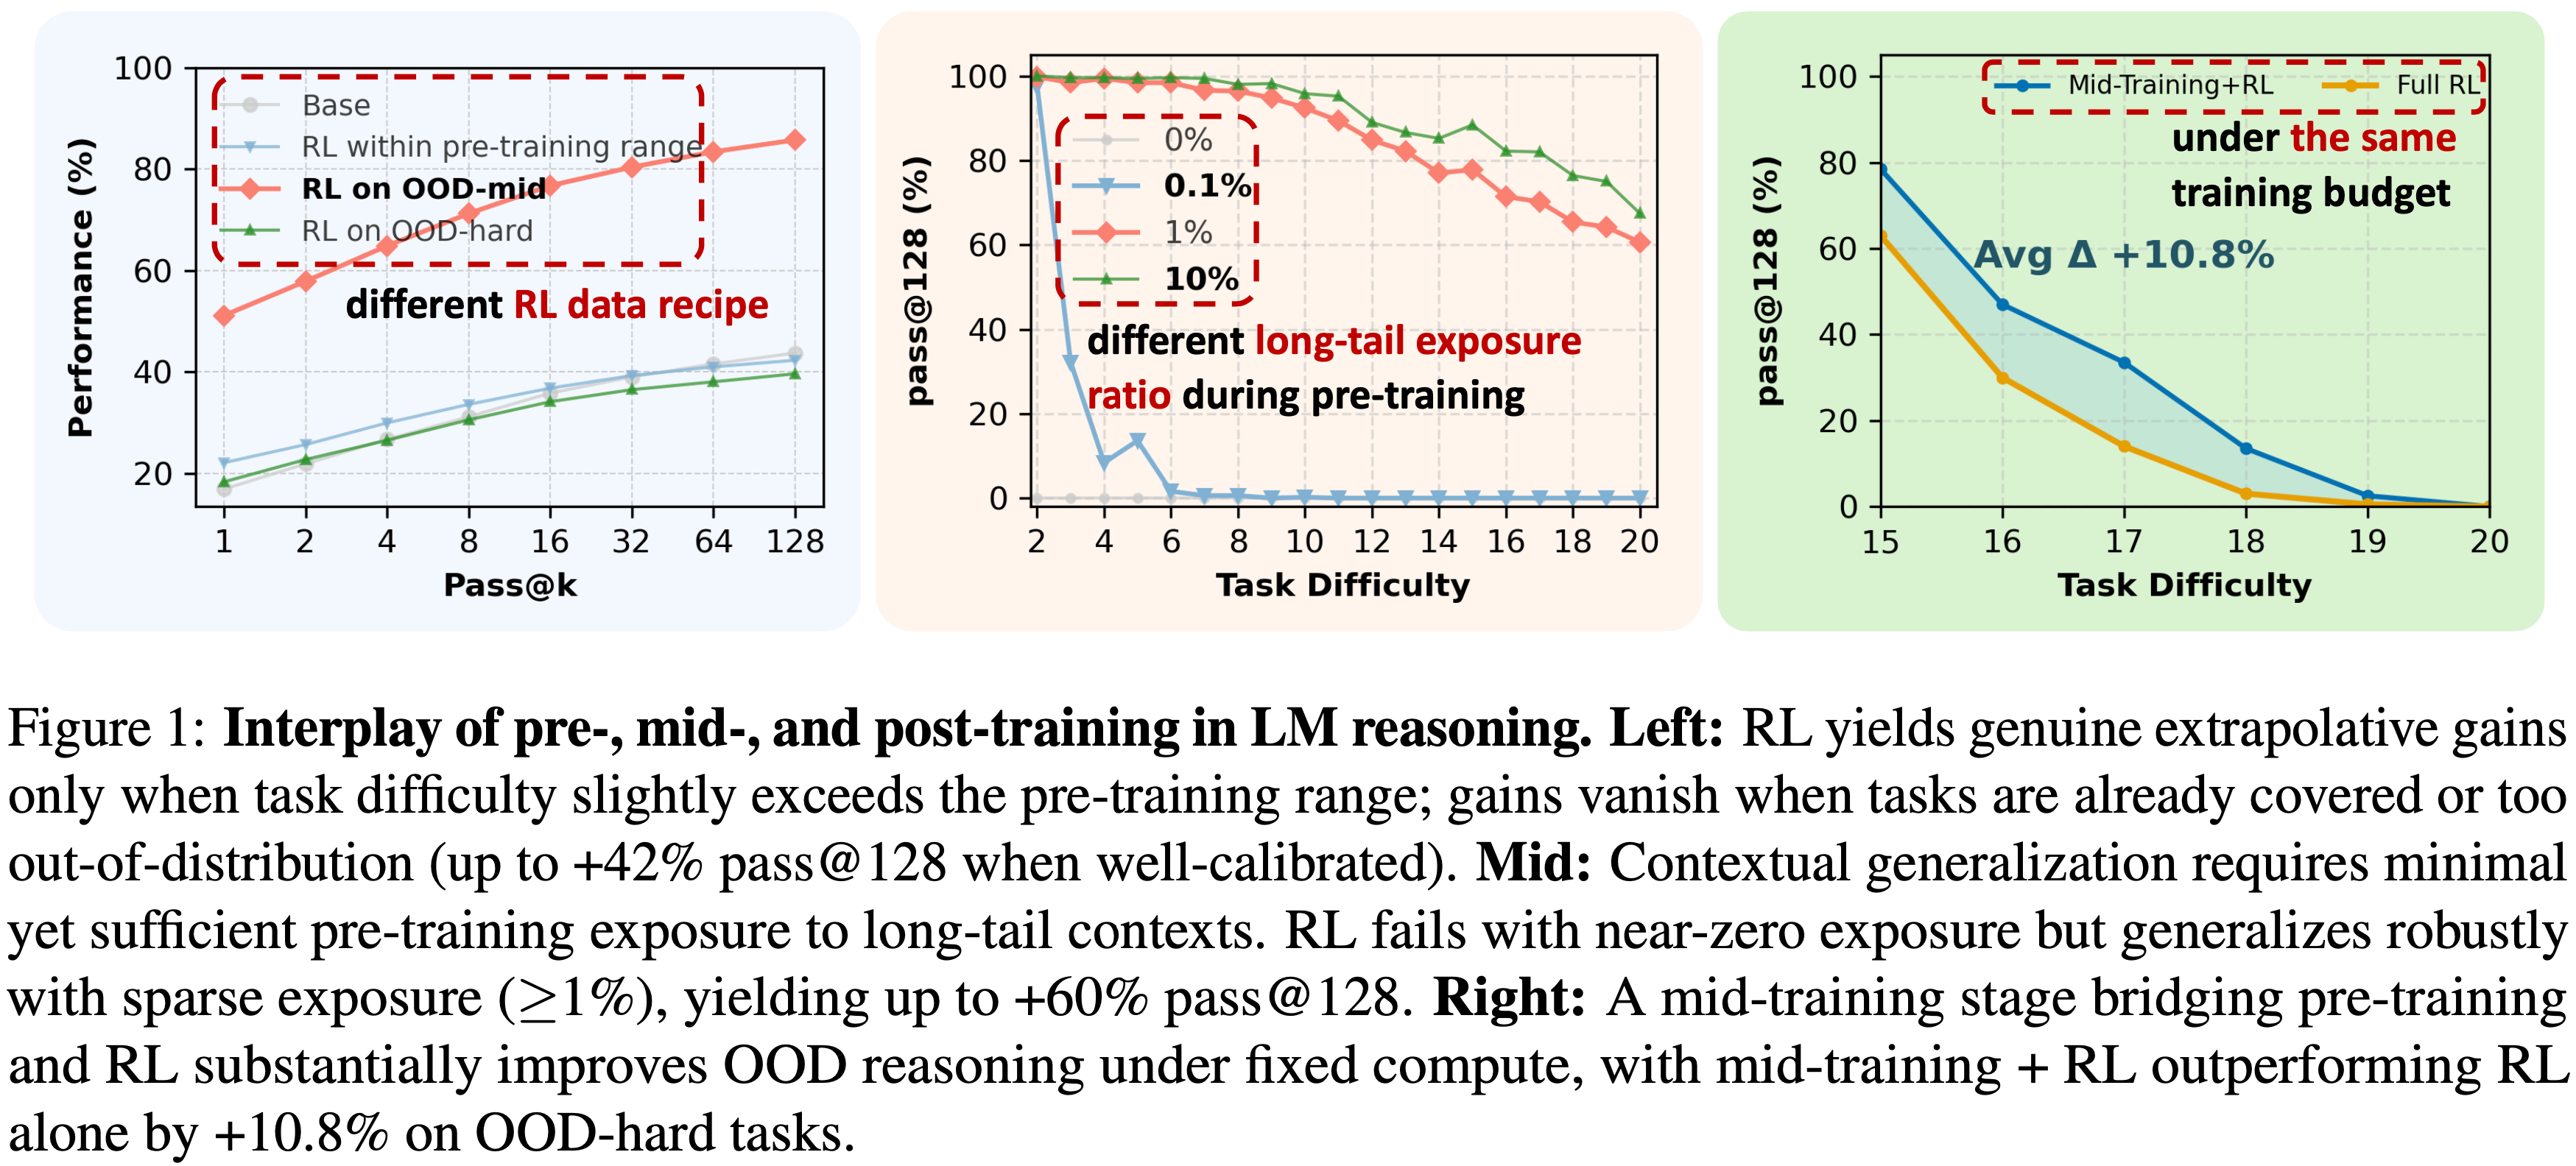
  • 图 1:大语言模型推理中 Pre-training 、 Mid-training 与 Post-training 阶段的相互作用
    • 左图:RL 仅在任务难度略超出 Pre-training 数据范围时,才能带来真正的外推性能提升;当任务已被 Pre-training 数据覆盖,或完全超出 Pre-training 数据分布(分布外程度过高)时,性能提升会消失(在参数校准良好的情况下,pass@128 最高可提升 42%)
      • 理解:从图中可以看出,在适当 OOD(OOD-mid)的任务上才出现了很好的性能提升,完全分布内(within Pre-training range)或者过于 OOD(OOD-hard)的任务上均不会带来提升
    • 中图:实现上下文泛化,需要模型在 Pre-training 阶段对长尾上下文具备最低限度但足够的接触量
      • 若 Pre-training 对长尾上下文的接触量接近零, RL 无法发挥作用;
      • 但只要存在稀疏接触(接触量 \(\ge 1%\)), RL 就能实现稳健的泛化,pass@128 最高可提升 60%
      • 理解:从图中可以看出,接触 10% 和接触 1% 的效果差距远远不如想象的大
    • 右图:在 Pre-training 与 RL 之间加入一个 “Mid-training” 阶段,能在计算资源固定的情况下显著提升 OOD 推理性能
      • 在困难分布外任务上,“Mid-training + RL” 的组合比单独使用 RL 的性能高出 10.8%

Introduction and Discussion

  • 最近的 RL 进展显著提升了语言模型的推理能力 (2025, 2025)
  • 但一个基本概念问题仍未解决:Post-training 是否真正扩展了模型在 Pre-training 之外获得的推理能力?
    • 文献中存在相互矛盾的观点:
      • 一些工作将 RL 描述为 capability refiner (2025, 2025, 2025, 2025)
      • 另一些则提供了超越 Pre-training 的实质性推理增益的证据 (2025, 2025, 2025)
  • 这种差异的主要来源在于先前的分析依赖于不受控的 (uncontrolled) 训练环境
    • 现代语言模型在大规模、不透明的互联网语料库上进行 Pre-training ,其构成本质上是未知的
    • As a result,论文无法确定 Base Model 已经内化了哪些推理原语 (reasoning primitives)
    • 这种控制的缺乏使得分离 Post Training 的因果效应以及理解 Pre-training 和 Post Training 如何共同塑造推理行为变得具有挑战性
  • Meanwhile,一个额外的阶段 Mid-training 最近已成为现代语言模型训练流程的关键组成部分 (2025, 2025)
    • 在一些文献中,Mid-training 阶段也被称为继续 Pre-training (Continued Pre-Training, CPT)
    • Mid-training 在广泛的 Pre-training 语料库和专门的 Post Training 目标之间充当了中间分布桥梁,扩展了模型的原子操作覆盖范围,并将其内部表征 (internal representations) 与 RL 阶段强调的任务对齐
    • As a result, Mid-training 在辩论中变得越来越核心:它可能解释了为什么 RL 有时能产生显著的泛化改进,而在其他设置中却失败 (2025)
    • 这激发了论文工作的核心问题:Pre-training 、 Mid-training 和 RL 在塑造语言模型的推理能力方面是如何相互作用的?
  • 本工作的目标是以受控的方式令人信服地回答这个问题,遵循该领域的先前工作 (2025, 2025, 2025)
    • Specifically,论文通过受控实验来厘清 Pre-training 、 Mid-training 和 RL-based 的 Post Training 如何单独及共同影响推理泛化
  • 为此,论文建立了一个完全受控的框架,以分离每个训练阶段的贡献。论文的设计基于三个原则:
    • (i) 完全可控的合成推理任务 (fully controllable synthetic reasoning tasks) ,具有明确的原子操作和由有向无环图定义的(DAG-defined)依赖结构;
    • (ii) 可观测、可解析的推理过程 (observable, parseable reasoning processes) ,支持过程级评估并减少奖励或评估欺骗 (reward/evaluation hacking);
    • (iii) 对 Pre-training / Mid-training / Post Training 分布的系统性操控 (systematic manipulation) ,以将因果效应归因于每个阶段
  • 论文沿两个关键维度评估推理:
    • 1)外推 (深度) 泛化 (Extrapolative (Depth) generalization) 评估模型是否能通过以更深的结构组合已学习的原语,解决比 Pre-training 中遇到的更复杂的问题
    • 2)上下文 (广度) 泛化 (Contextual (Breadth) generalization) 评估模型是否能在具有相同底层逻辑但 surface forms 不同的新颖上下文中迁移 (transfer) 其推理技能
    • 这两个轴共同捕捉了与现实世界语言模型相关的广泛的组合和迁移推理能力
  • 利用论文的受控框架,论文揭示了关于三个训练阶段如何相互作用的若干 insights:
    • Firstly ,关于 RL 是否真正改善 Base Model 推理能力的两种对立观点并不真正冲突
      • RL 仅在两个条件成立时才能产生真正的能力增益:
        • (i) 该任务在 Pre-training 期间未被大量覆盖,为 RL 探索留下了足够的提升空间
        • (ii) RL 数据被校准到模型的能力边缘 (edge of competence) ,既不太简单(in-domain)也不太困难(out-of-domain, OOD)
      • 当任一条件被违反时,RL 倾向于锐化(sharpen)现有能力而非真正改进
    • Secondly ,RL 激励上下文泛化仅当相关的原子操作或基础技能已存在于 Base Model 中
      • 如果对新的上下文没有最少的 Pre-training Exposure ,RL 无法产生迁移(induce transfer)
      • 但即使非常稀疏的覆盖率(例如,\(\ge 1%\))也能提供一个足够的“种子”,RL 随后可以稳固地强化它,产生强大的跨上下文泛化
    • Thirdly ,引入一个连接 Pre-training 和 Post Training 分布的 Mid-training 阶段,能在固定计算预算下显著增强分布内和分布外的性能,凸显了 Mid-training 作为训练设计中一个未被充分探索但强大的杠杆作用
    • Fourthly ,过程奖励 (process rewards) 减轻了 Reward Hacking 并提高了推理保真度
      • 将过程验证 (process verification) 纳入奖励函数,使强化信号与有效的推理行为对齐,从而在复杂的组合设置下带来准确性和泛化性的可衡量改进

Preliminaries

  • 本节介绍以下三个部分:
    • (a) 基于依赖图 (dependency graphs) 和上下文渲染 (contextual rendering) 的合成数据生成框架 (data generation framework) ,该框架指定了推理过程
    • (b) 用于外推和上下文泛化的任务设置 (task setup)
    • (c) 过程验证评估 (process-verified evaluation) 框架,该框架评估推理过程和最终答案的准确性
    • 这些组件共同使论文能够分离 Pre-training 、 Mid-training 和 Post Training 对推理泛化的不同影响

Controllable Synthetic Reasoning Dataset

  • 论文基于 GSM-Infinite (2025) 数据生成框架创建了一个测试平台,能够精确控制推理结构、复杂性和上下文
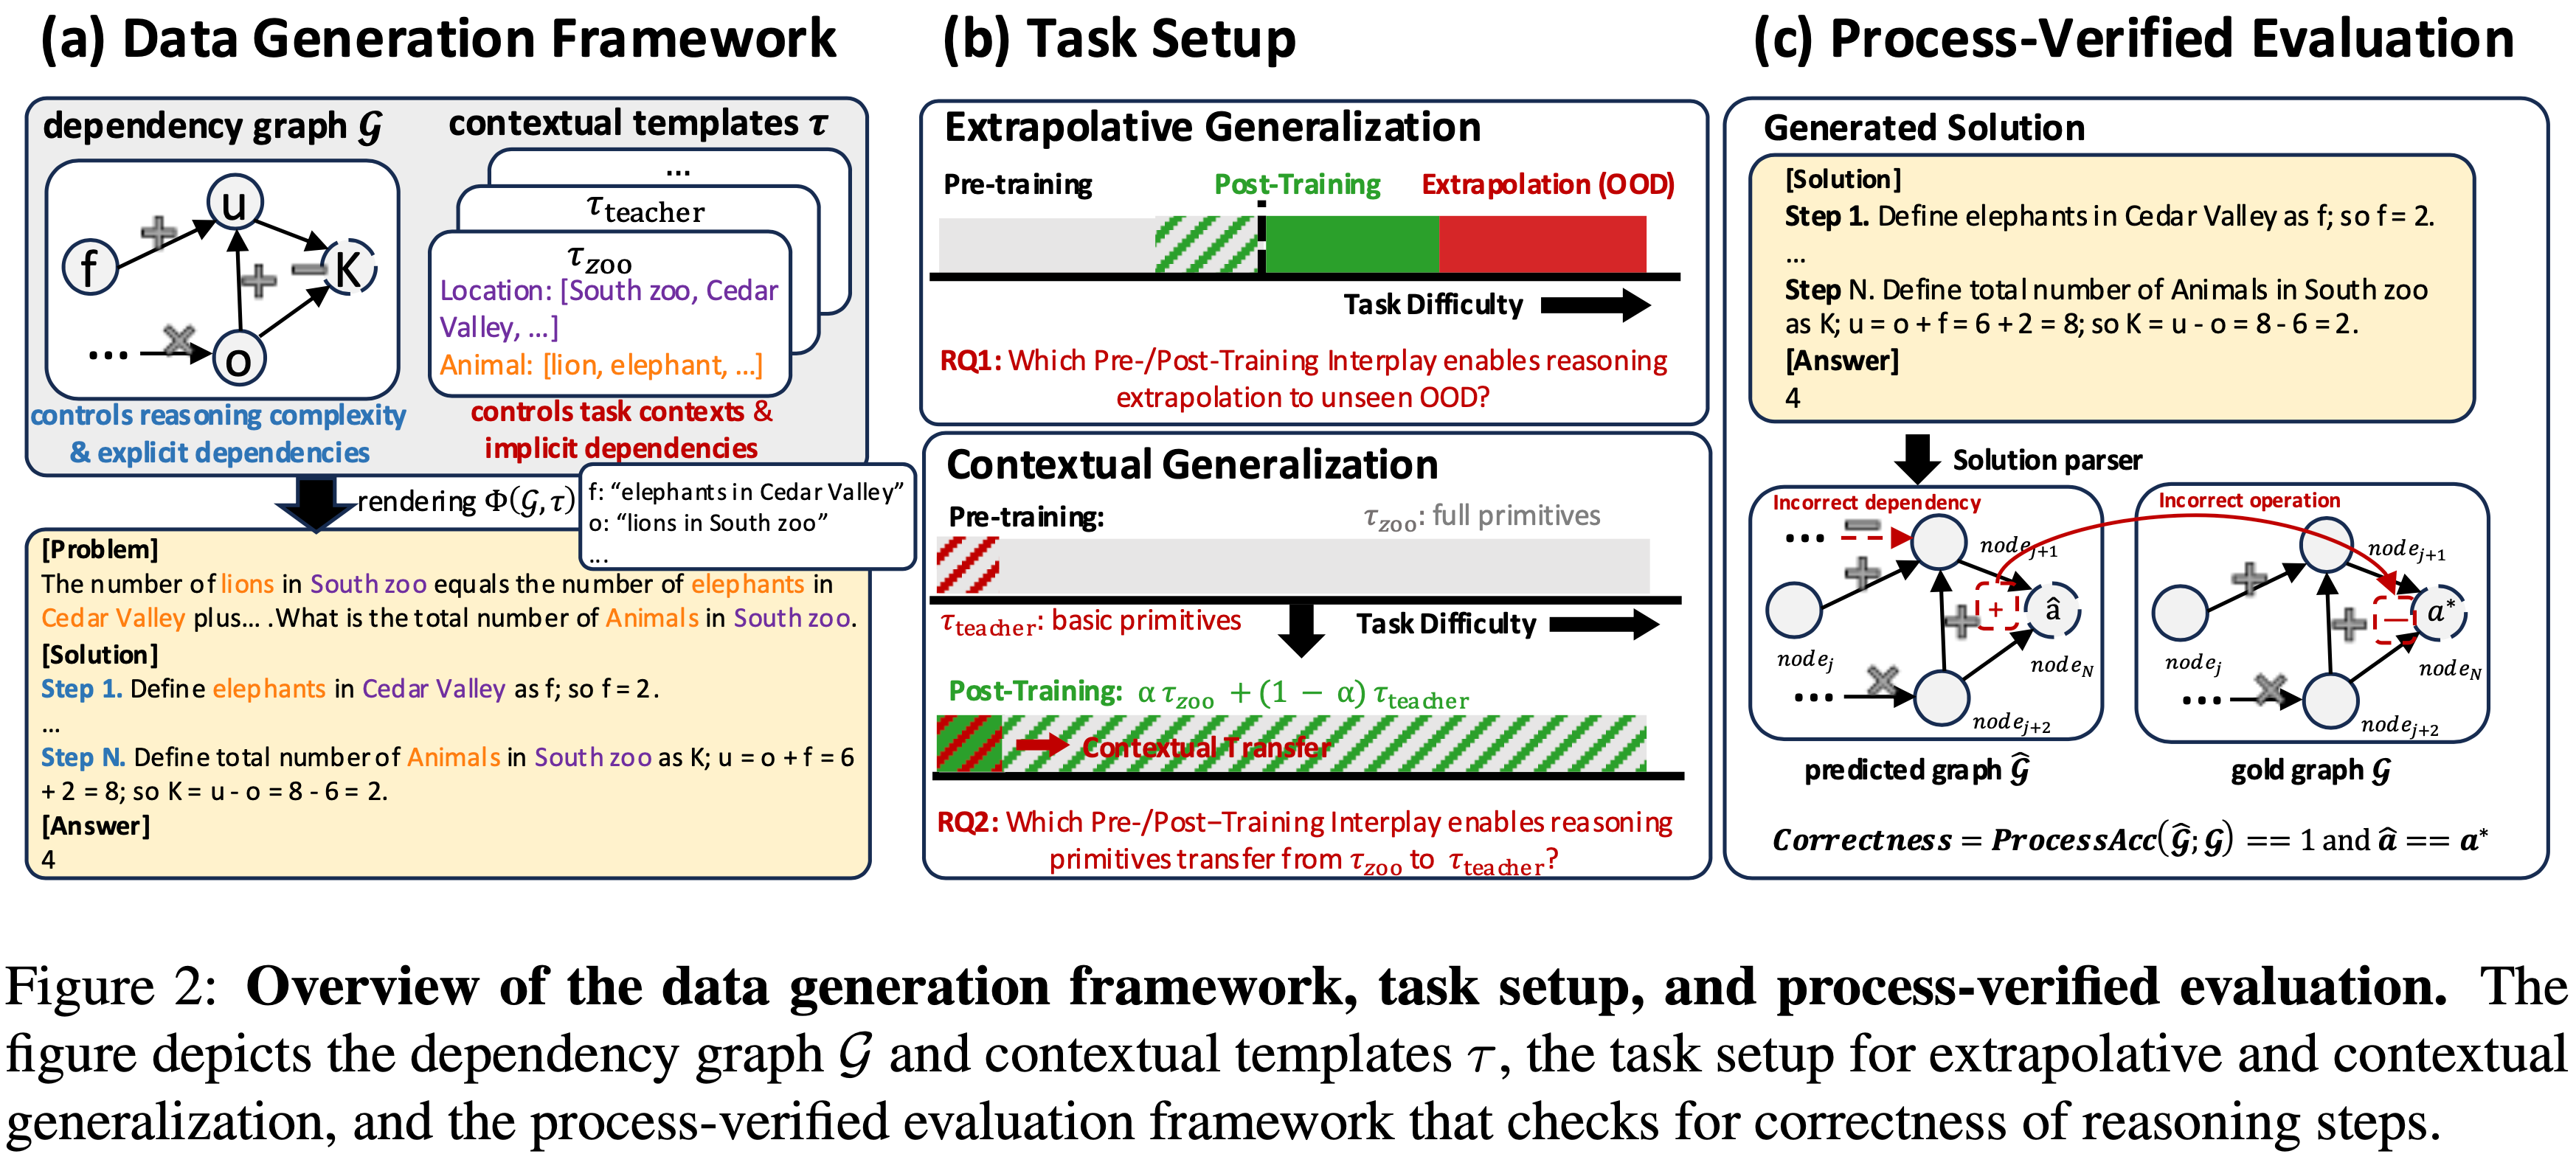
    • 图2:数据生成框架、任务设置和过程验证评估概览
      • 图2 描述了依赖图 \(\mathcal{G}\) 和上下文模板 \(\tau\),用于外推和上下文泛化的任务设置,以及检查推理步骤正确性的过程验证评估框架
  • Specifically,数据生成流水线(图2(a))涉及三个关键组件:
    • 依赖图 (Dependency Graphs).
      • 每个推理问题由一个有向无环图 (DAG) \(\mathcal{G}=(\mathcal{V},\mathcal{E})\) 表示,其中节点 \(v\in\mathcal{V}\) 对应变量,有向边 \(e\in\mathcal{E}\) 表示它们之间的依赖关系
        • 理解:每条边对应一次算数运算
      • 该图最终汇聚到一个指定的答案节点 \(v^{*}\),该节点产生最终答案 \(a^{*}\)
    • 推理复杂性控制 (Reasoning Complexity Control).
      • 论文通过算术运算的数量来量化图的复杂度:
        $$
        \text{op}(\mathcal{G})=|\mathcal{E}|,
        $$
      • 这控制了从基础算术到复杂多步推理的任务难度
    • 上下文渲染 (Contextual Rendering).
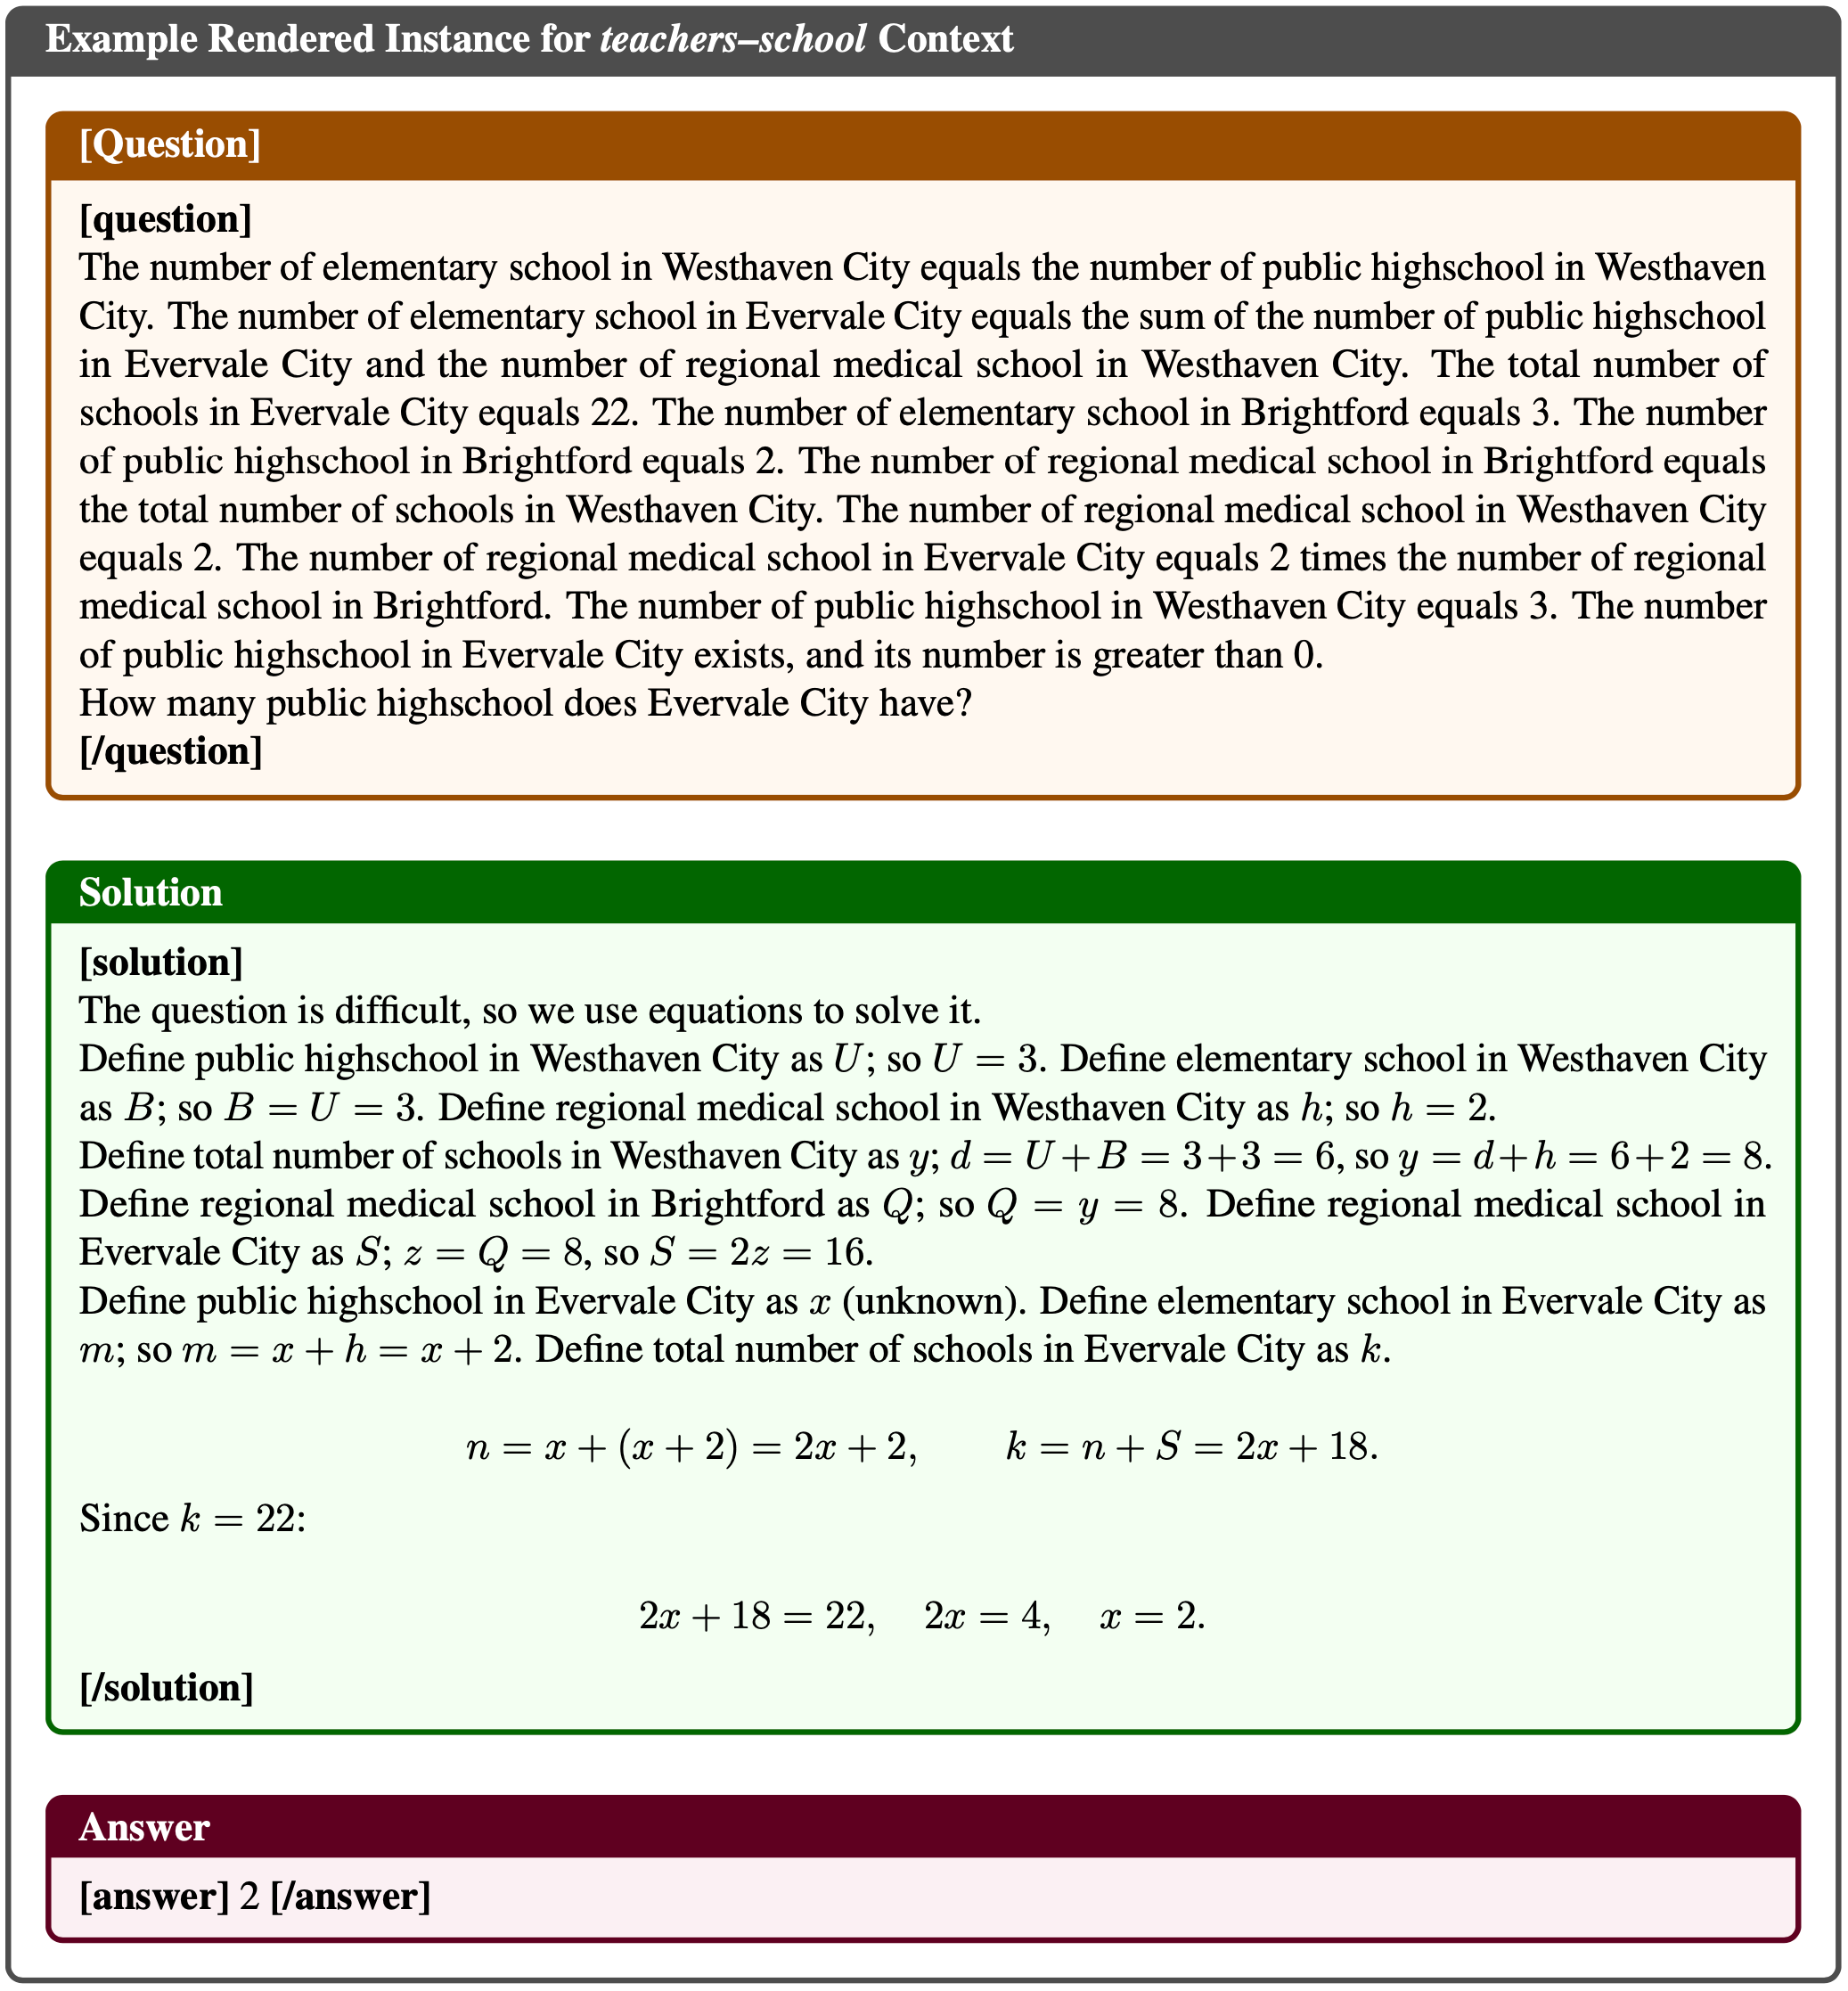
      • 给定一个预定义的上下文模板 \(\tau\)(例如,animals-zoo、teachers-school)及自然语言描述,论文将依赖图 \(\mathcal{G}\) 渲染成一个完整的数学问题
      • Finally,论文通过抽样不同的图 \(\mathcal{G}\) 和模板 \(\tau\),并将它们渲染为文本来生成多样化的数学问题
  • 论文采用此框架的动机在于三个主要优点:
    • 1)对训练阶段无污染的控制 (Contamination-free control over training phases)
      • 论文为 Pre-training 、 Mid-training 和 Post Training 指定了独立的数据分布以避免重叠
    • 2)对结构和上下文进行因子化控制 (Factorized control over structure and context)
      • 每个问题都从一个 DAG 生成,该图编码了推理结构和依赖关系,并在其上实例化了数值和上下文
    • 3)过程级验证 (Process-level verification)
      • 真实的 DAG 可作为验证中间步骤和防止错误推理的参考
      • 作者在附录 A.1 中提供了详细的公式和解释

Task Setup

  • 在现实世界部署中,语言模型通常需要沿两个互补的轴(complementary axes)进行推理泛化:
    • 外推 (深度) 泛化 (extrapolative (depth-wise) generalization)
    • 上下文 (广度) 泛化 (contextual (breadth-wise) generalization) (2025, 2025, 2025)
    • 论文的受控实验揭示了这两个维度(图2(b)),从而能够精确检验 Pre-training 、 Mid-training 和Post Training 如何影响每种类型的泛化
  • 外推 (深度) 泛化 (Extrapolative (Depth) Generalization).
    • 该维度评估模型在推理深度 \(\text{op}(\mathcal{G})\) 增加时保持正确性的能力 (2025)
    • 如果模型能够解决其操作链长度超出 Mid-training 遇到的问题,则表现出强大的外推泛化能力
  • 上下文 (广度) 泛化 (Contextual (Breadth) Generalization).
    • 该维度衡量模型是否能够将其推理原语(Reasoning primitives)迁移到 surface forms不同但具有相似底层推理结构(similar underlying reasoning structure)的新领域
    • 当模型的性能在模板或 surface forms 发生变化,底层计算图保持不变时 ,保持稳定,则认为该模型在上下文上实现了泛化
      • 理解:底层计算图不变则认为其底层推理结构没有变化,此时能够泛化则说明训练跳脱了具体的模版或 surface forms
  • 形式化符号、数据集构建以及泛化轴的完整定义见附录 A.2

Evaluation Protocol

  • 论文按照过程验证评估 (process-verified evaluation) 方案(图2(c))报告所有结果
  • 对于每个具有真实依赖图 \((\mathcal{G},a^{*})\) 的实例,模型生成一个自由形式的解决方案,作者将其解析为预测的依赖图 \(\hat{\mathcal{G} }\) 和最终答案 \(\hat{a}\)
  • 在每个真实节点 \(v\in\mathcal{V}\) 的 Step-level 进行过程评估
    • 通过比较预测节点与真实节点、它们的依赖关系以及数值 check 准确性
  • 过程准确率 (process accuracy) 定义为所有真实节点的平均 Step-level 准确率
    • 只有当推理步骤和最终答案都匹配时,预测才被视为完全正确
    • 所有 \(pass@k\) 指标(例如,\(pass@1\),\(pass@128\))均相对于此严格标准报告
    • 详细的实现和解析方法见附录 A.4

Training Setup

  • 论文使用 GSM-Infinite 框架生成的大规模合成推理数据集,训练了具有 100M 参数的 Decoder-only Qwen2.5-style (2025) 模型
  • 整个语料库包含 30B 个 token,涵盖了多个操作范围和上下文模板,并被划分为互不相交的 Pre-training 、 Mid-training 和 Post Training 子集,以避免分布污染
Pre-training
  • Pre-training 让模型接触多样化语料库以获取通用知识
  • 在论文的受控推理任务中,它侧重于使模型掌握论文合成数据集中算术运算的基础推理技能和规则
    • 重点是掌握基本推理原语,而非广泛的知识
  • Following Chinchilla Scaling (2022) and trends in data-rich regimes (2025),论文在 10B 个 token(参数的 100 倍)上 Pre-training 论文的 100M 参数模型
  • 数据集由跨模板的 op=2-10 操作组成,使模型能够掌握推理,同时为复杂任务保留提升空间
  • 模型在分布内任务上达到了接近饱和的 pass@128 准确率,确保在更深任务上的改进反映了真正的泛化
    • 理解:这里为什么要确保在 In-domain 任务上达到接近饱和才能在更深的任务上反应真正的泛化?
Mid-training
  • Mid-training 是 Pre-training 和 Post Training 之间的中间阶段,因其在改进下游微调和 RL 性能方面的作用而受到关注 (2025, 2025, 2025)
  • Mid-training 通常涉及使用更高质量或指令格式的数据,采用 Next-token prediction 或 SFT 目标
  • Mid-training 通过提供结构化的推理监督来稳定优化并促进 RL 扩展 ,弥合了广泛 Pre-training 语料库和面向奖励的 RL 数据之间的差距
  • 论文实现了精简版的 Mid-training ,保持与 Pre-training 相同的目标,但收窄数据分布使其与 RL 类似,此时模型展现出新兴(emerging)但不完整的能力(incomplete competence)
  • 通过将监督集中在此边界,目标加强 RL 可以放大的更高级别推理先验
    • 注:Mid-training 仅在 Section 5 中应用
Post Training
  • Post Training 在 Pre-training 之后,使用特定任务的数据或目标来精炼模型在特定任务上的性能
  • 通常涉及两种策略:
    • 1)SFT :在带标签的数据集或特定任务指令上进行训练;
    • 2)RL :模型通过接收其动作的奖励来进行优化
  • 由于论文的 Pre-training 数据已经是结构化且特定于任务的,所以主要关注 RL 进行 Post Training
  • 精心策划的 subset 上使用 GRPO (2025) 进行训练,这些 subset 旨在探究在更深操作范围和新颖模板中的泛化能力

When Does Post-Training Incentivize Reasoning Beyond the Base Model?(何时 Post Training 能激励超越 Base Model 的推理?)

  • 为了厘清 Pre-training 和 Post Training 对推理能力的贡献,论文分离了 RL 的具体影响
  • 提问:RL 是否以及何时能扩展 Base Model 在 Pre-training 之外获得的推理能力?
    • 通过固定 Pre-training 阶段并改变 Post Training 数据的难度和覆盖范围,论文确定了 RL 驱动真正的组合泛化而非仅仅放大现有技能的具体机制

Task Setting

  • 论文专注于外推泛化(在附录 A.6 中检查 Post Training 对上下文迁移的影响),根据操作计数定义三类问题(论文在附录 A.3.4 中说明了这种性能阶梯):
    • 分布内 (In-Distribution, ID) 问题(Pre-training 范围内,op=2-10);
    • 分布外-边缘 (OOD-edge) 问题(刚刚超出此范围,op=11-14), Base Model 在此保留非零的 pass@128 准确率;
    • 分布外-困难 (OOD-hard) 问题(显著超出 Pre-training 分布,op=15-20), Base Model 在此表现出接近零的准确率
      • 解决 OOD-hard 问题需要以新颖的方式组合从 ID 数据中学到的原子操作,以适应增加的推理深度
  • 实验设置如下:
    • Pre-training:
      • Base Model 在由 ID 问题组成的 10B 个 token 上进行 Pre-training
    • Post Training:
      • 论文应用 GRPO,使用来自四个不同难度范围的共 200K 个样本:op=7-10(ID)、op=9-12(混合)、op=11-14(边缘)和 op=17-20(困难)
  • 关于 Training Dynamics 和 Data Recipe 的更多信息,请参见 A.5 和 A.9

Summary 1

Observation 1
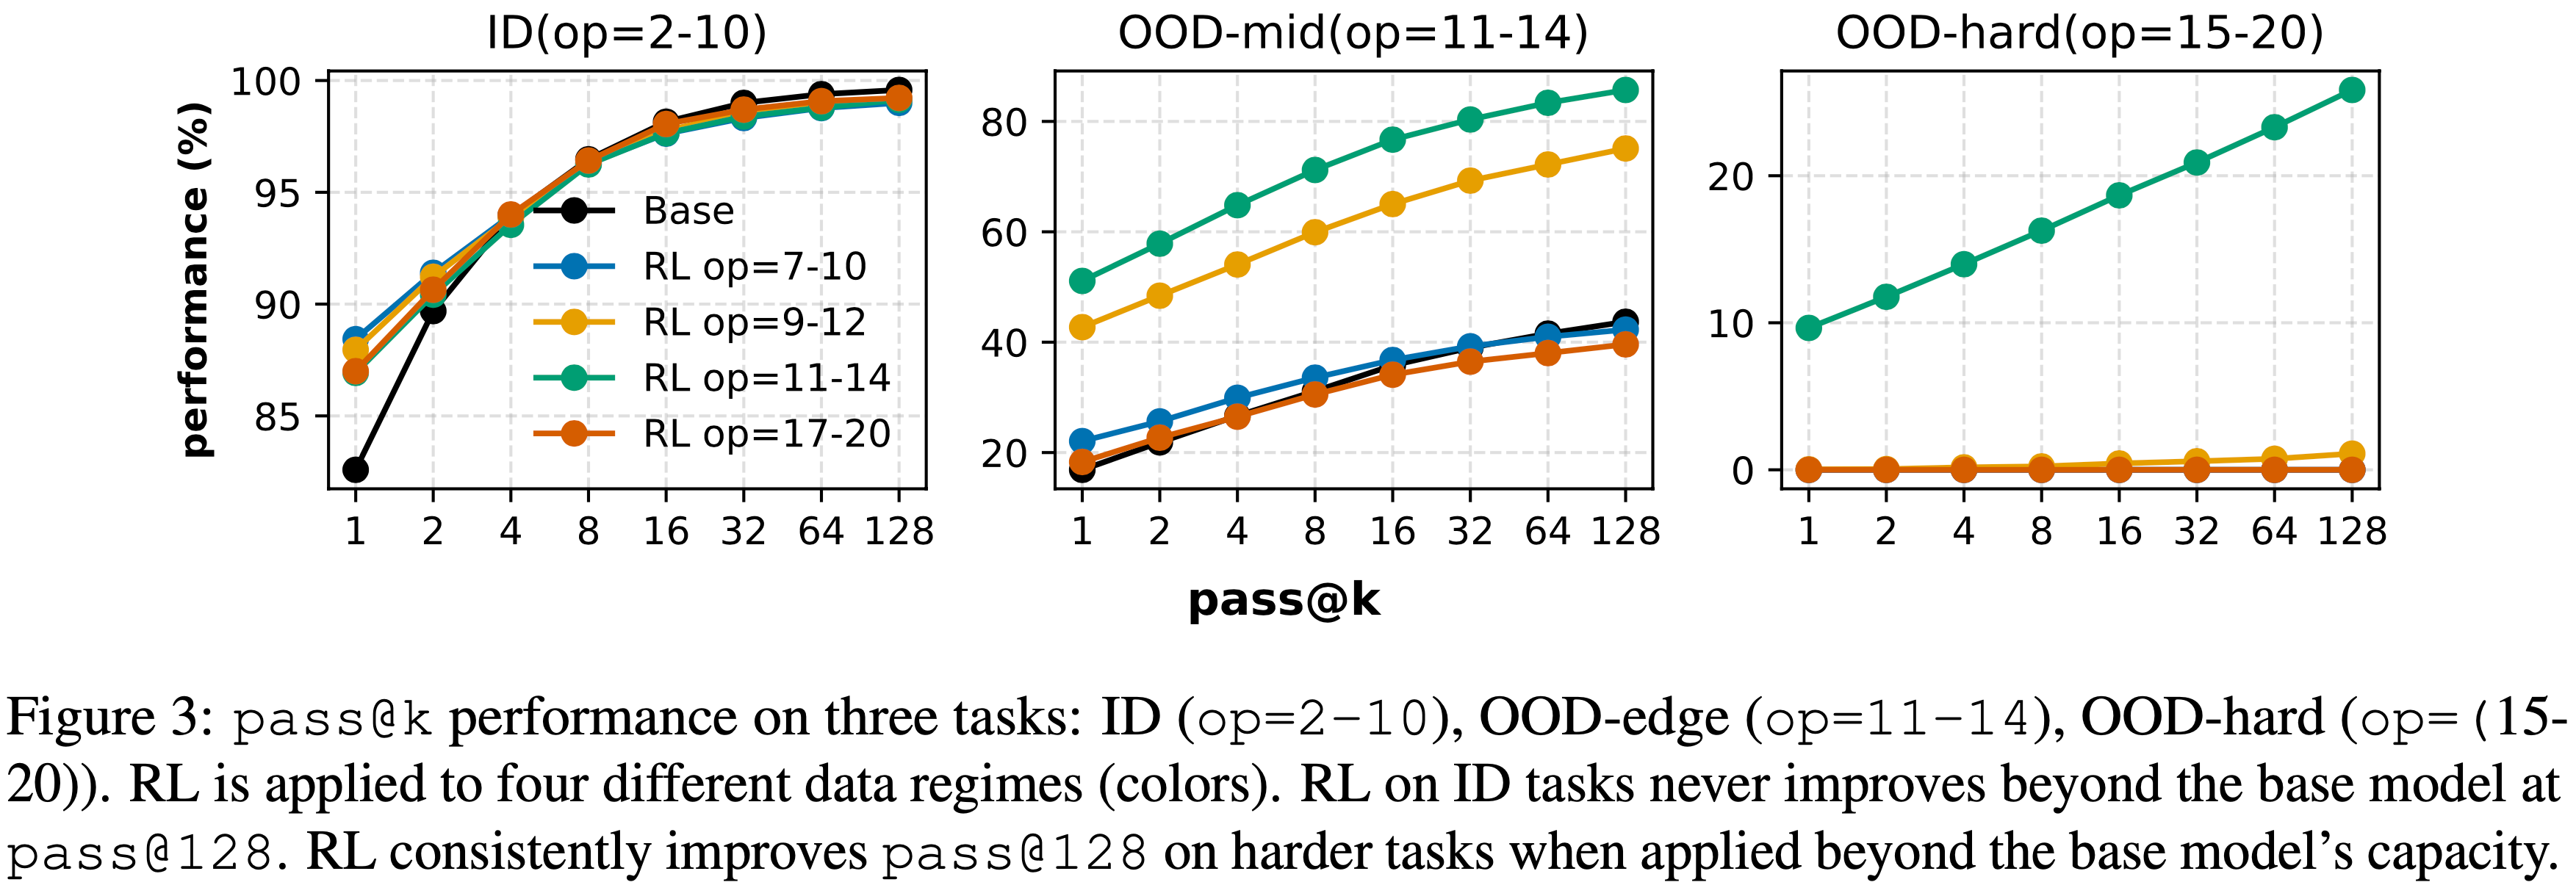
  • 如图 3 所示, Post Training 的效果对 Pre-training 和 Post Training 数据机制高度敏感:
    • (i) 对于 ID 任务(op=2-10),无论 RL 数据机制如何,在 pass@1 上有明显的性能提升,但在 pass@128 上没有改进,这表明 RL 只是锐化了现有能力而没有扩展它们
    • (ii) 然而,对于 OOD 任务(op=11-14 和 op=15-20),当应用于能力边缘 (edge of competence) 数据(op=11-14)时,RL 总是能提高 pass@128 性能,证明了超越 Pre-training 的真正的能力增益
  • 理解:图 3 展示了,如果使用太 OOD 的数据(op=17-20)来进行 RL 时,模型其实无法提升其在 OOD-hard(op=15-20)任务上的表现
Takeaway 1
  • RL 仅在两个条件成立时,才能在 Base Model 之外产生真正的能力增益 (pass@128):
    • (i) 该任务在 Pre-training 期间未被大量覆盖,为探索留有足够的提升空间;
    • (ii) RL 数据被校准到模型的能力边缘 (edge of competence) ,既不太简单(分布内)也不太困难(分布外)
Discussion 1
  • 与近期工作的关联 最近的研究关于 RL 是否能增强 Base Model 的推理能力报告了看似矛盾的结论
    • On the one hand,Zhao 等人 (2025),Yue 等人 (2025) 认为,当在数学和编码等 Pre-training 已充分覆盖的标准任务上评估时,RL* *并未** 改善 pass@128 准确率
    • On the other hand,在 Pre-training 覆盖率极低的合成任务上的研究 (2025, 2025, 2025) 报告了实质性的 Post Training 增益
  • 论文的受控设置通过表明这些结论源于Post Training 难度谱的不同区域而调和了这些发现
    • 对于 Base Model 已经解决的分布内任务,随着 pass@k 的增加性能趋于饱和,RL 没有优势
    • In contrast,当 RL 针对 Base Model 失败的真正分布外任务时,论文观察到清晰的外推改进(前提是 RL 数据位于模型的“能力边缘”附近)
Practical Guidance 1
  • 围绕模型的*能力边缘 (edge of competence)*设计 RL 数据
    • 作者建议过滤 RL 数据集以针对那些模型在 pass@1 上失败但在 pass@k 上成功的任务
    • 此策略避免了在高 pass@1 任务上的冗余,同时防止了在 pass@k 为 0 任务上的奖励稀疏
  • 这个过程也可以是迭代的:我们可以定期重新评估“能力边缘”任务池;
    • 随着模型变得更强,先前分布外的任务将漂移到可解区间,从而创建一个自然的、自定进度的课程

How Does Pre-training Exposure Shape Post-Training Generalization?(问题:Pre-training Exposure 如何塑造 Post Training 泛化?)

  • 在确定了 Post Training 激励泛化的条件之后,论文转向一个基础性问题:Pre-training Exposure 如何塑造 Post Training 泛化?
  • 作者假设,Pre-training Exposure 基础推理原语对于有效的 Post Training 泛化至关重要
  • 为了探讨这个问题,在固定的 RL Data Recipe 和设置下,论文改变 Pre-training 数据的分布,并检查其对 Post Training 泛化的影响

Task Setting

  • 论文专注于上下文泛化,即向长尾 (long-tailed) 的 Context B 泛化
    • 在 Pre-training 期间,作者操控模型接触包含原子推理原语(op=2 的示例)的长尾 Context B 的比例(关于简单上下文泛化和外推的实验分别在附录 A.6.1 和 A.7 中提供)
  • 论文的实验设置结构如下:
    • Pre-training : Base Model 在 10B 个 token 上进行 Pre-training
      • 这些 token 由 op=2-20 的 Context A 和 op=2 的长尾Context B 示例组成
        • 理解:这里的 Context A 和 Context B 分别表示不同领域的任务
      • 其中论文变化原子 op=2 示例相对于长尾 Context B 接触的比例
    • Post Training: 应用 RL 于 200K 个样本,这些样本由 50% Context A 和 50% Context B 组成,覆盖 op=2-20 的范围
  • 关于 Training Dynamics 和 Data Recipe 的更多细节,请参见附录 A.8 和 A.9

Summary 2

Observation 2
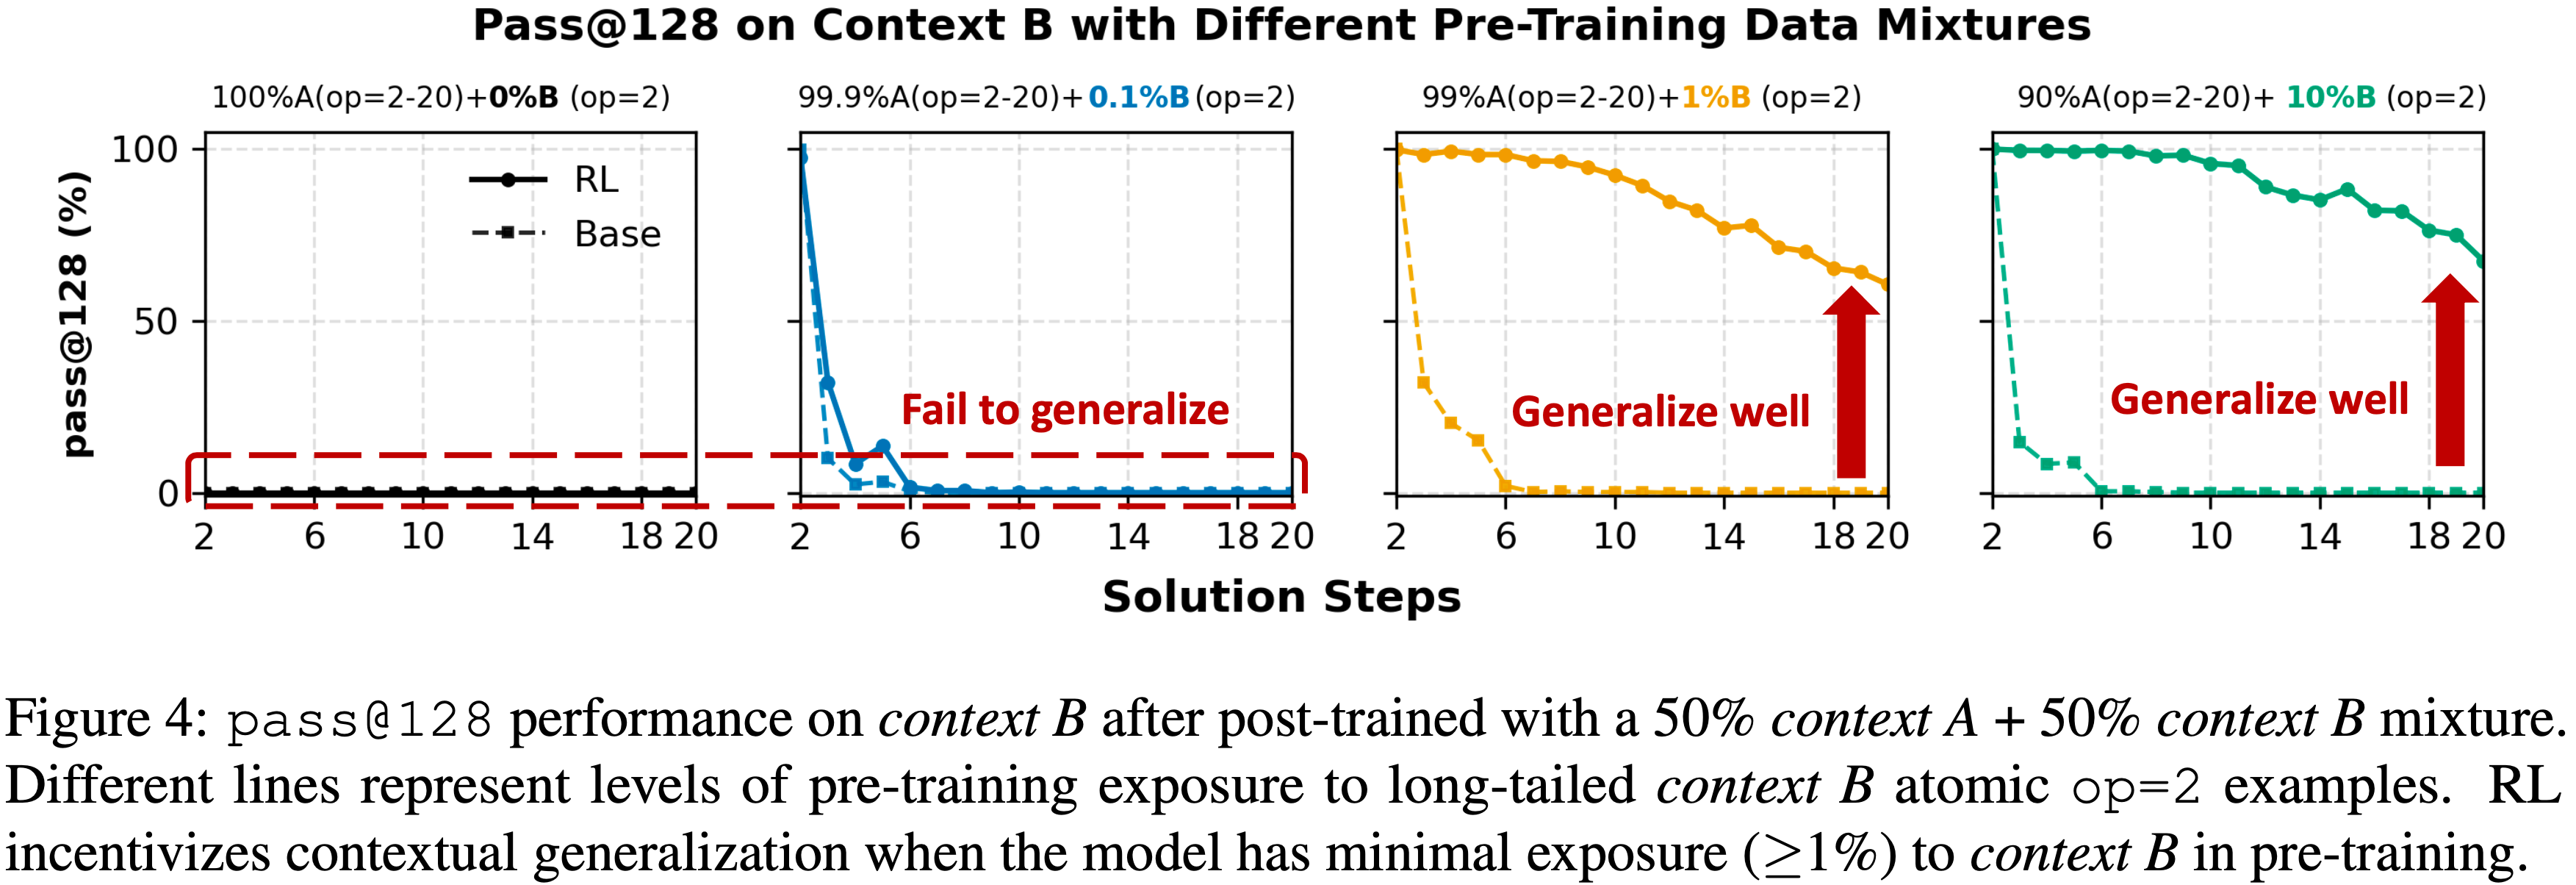
  • 如图 4 所示, Pre-training Exposure 长尾上下文对 Post Training 泛化的影响是巨大的:
    • (i) 当 Pre-training 排除 Context B 或提供零(0%)或极少接触(0.1%)时,RL 无法迁移到 Context B
    • (ii) 在 Pre-training 中引入即使是 1% 的 Context B 数据,也能显著增强 Post Training 泛化,甚至对于 op=20 的最困难任务也是如此
    • 这一观察强调,虽然 RL 在泛化中扮演着关键角色,但其有效性高度依赖于 Pre-training 数据的覆盖范围,特别是长尾上下文的包含
Takeaway 2
  • 仅当 Base Model 已包含必要的原子操作时,RL 激励上下文泛化(RL incentivizes contextual generalization only when the base model already contains the necessary primitives)
    • 如果没有对新上下文的最少 Pre-training Exposure ,RL 无法产生迁移
    • However,即使是稀疏的接触(例如,\(\ge 1%\))也提供了一个足够的“种子”,RL 可以在 Post Training 期间强化它,从而产生鲁棒的跨上下文泛化
Discussion 2
  • 复制还是创造(Replication or Creation)?
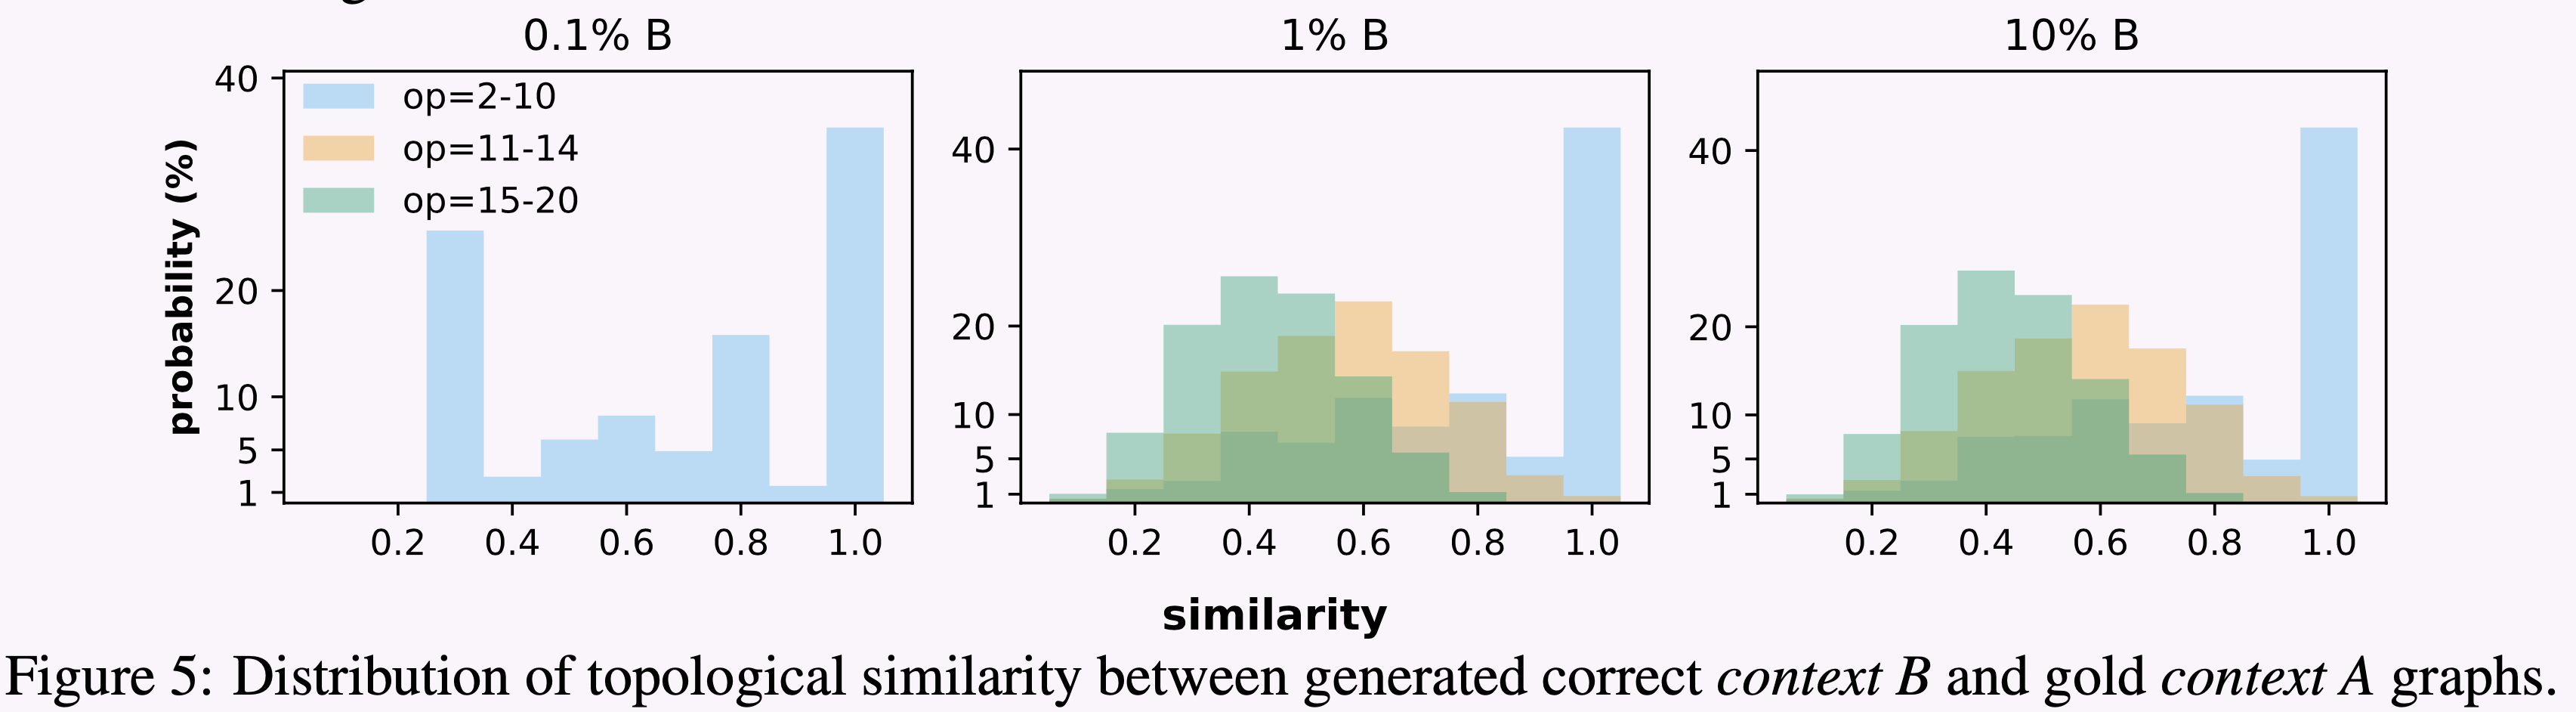
    • 论文在图 5 中检查了生成的正确 Context B 图与来自 Context A 的真实拓扑之间的拓扑相似性分布
    • 高相似性表明模型主要复制了现有的 Context A 推理模式,而低相似性则表明出现了与 Context A 不同的新颖推理结构
  • 论文观察到任务难度与 Pre-training Exposure 之间的效应:
    • 1)对于较简单的组合(op=2-10),模型倾向于复制来自 Context A 的现有模式
    • 2)随着任务复杂度增加(op=11-20),模型生成更多新颖结构,特别是在 Pre-training 期间充分接触 Context B 时
Practical Guidance 2
  • 在 Pre-training 中植入长尾原子操作以释放 RL 潜力(Seed long-tail primitives in pre-training to unlock RL potential)
    • RL 无法从虚无中合成能力;它需要潜在的“种子”来放大
    • However,这些种子不需要很复杂
  • 论文的结果表明,只要原子推理原语 (atomic reasoning primitives) 存在于 Pre-training 中,RL 就能成功外推到困难任务
  • 实践者应优先考虑广泛覆盖基本领域知识、规则和技能(大约 1% 的密度) ,而不是追求复杂的数据样本
  • 一旦这些基本原语建立起来,RL 就有效地充当了组合器,将它们组合起来解决复杂的分布外问题

How Does Mid-Training Interact with Post-Training?(Mid-training 与 Post-training 交互?)

  • 尽管 RL 能有效提升外推泛化能力,但其成功往往依赖于 Pre-training 阶段建立的表征先验
  • 近期工作 (2025a; 2025) 提出了 Mid-training 作为 Pre-training 和 Post-training 之间的中间阶段,旨在弥合数据分布并在下游适应前加强推理先验
  • 这引出了一个关键问题:在固定的计算预算下, Mid-training 和 RL 如何交互,以及两者之间怎样的平衡能带来最大的泛化收益?
    • 本节研究 Mid-training 与 Post-training 之间的协同作用,试图界定它们的交互如何驱动推理泛化
  • 计算预算公式化(Compute Budget Formulation)
    • 为公平比较,论文根据浮点运算将两个阶段的训练归一化为等效的训练 Token 数
    • 对于 Mid-training ,消耗量 \(T_{\text{mid} }\) 是处理的有监督 Token 数量
    • 对于 RL ,其 Token 等效成本近似为:
      $$
      T_{\text{RL} } \approx \frac{5}{3} N \cdot r \cdot L_{\text{total} },
      $$
      • \(N\) 是 RL 样本数
      • \(r=6\) 是轨迹生成次数
      • \(L_{\text{total} } = 2048\) 是总 Token 长度
      • 更多细节:Detailed budget derivation are provided in Appendix A.10.1
  • 论文系统地改变 RL 分配比例 \(\beta \in [0,1]\),以在总预算 \(T\) 的两个阶段之间进行分配:
    $$
    T_{\text{mid} } = (1 - \beta) \cdot T, \quad T_{\text{RL} } = \beta \cdot T.
    $$

Task Setting

  • 在本节中,论文使用在 10B 个 op=2-10 数据上 Pre-training 的相同 Base Model ,探索五种训练配置的性能:
    • 在 op=11-14 范围内的1B有监督 Token 上进行 完全 Mid-training
    • 在同一 op=11-14 范围内以批大小1024进行100步的完全 RL
    • 三种混合策略
      • Light RL(\(\beta=0.2\))
      • Medium-RL(\(\beta=0.5\))
      • 重度 RL(\(\beta=0.8\))
    • 这些策略在等效计算预算下平衡 Mid-training 和 RL
  • 第5节中的计算预算公式允许直接比较数据混合策略

Summary 3

Observation 3
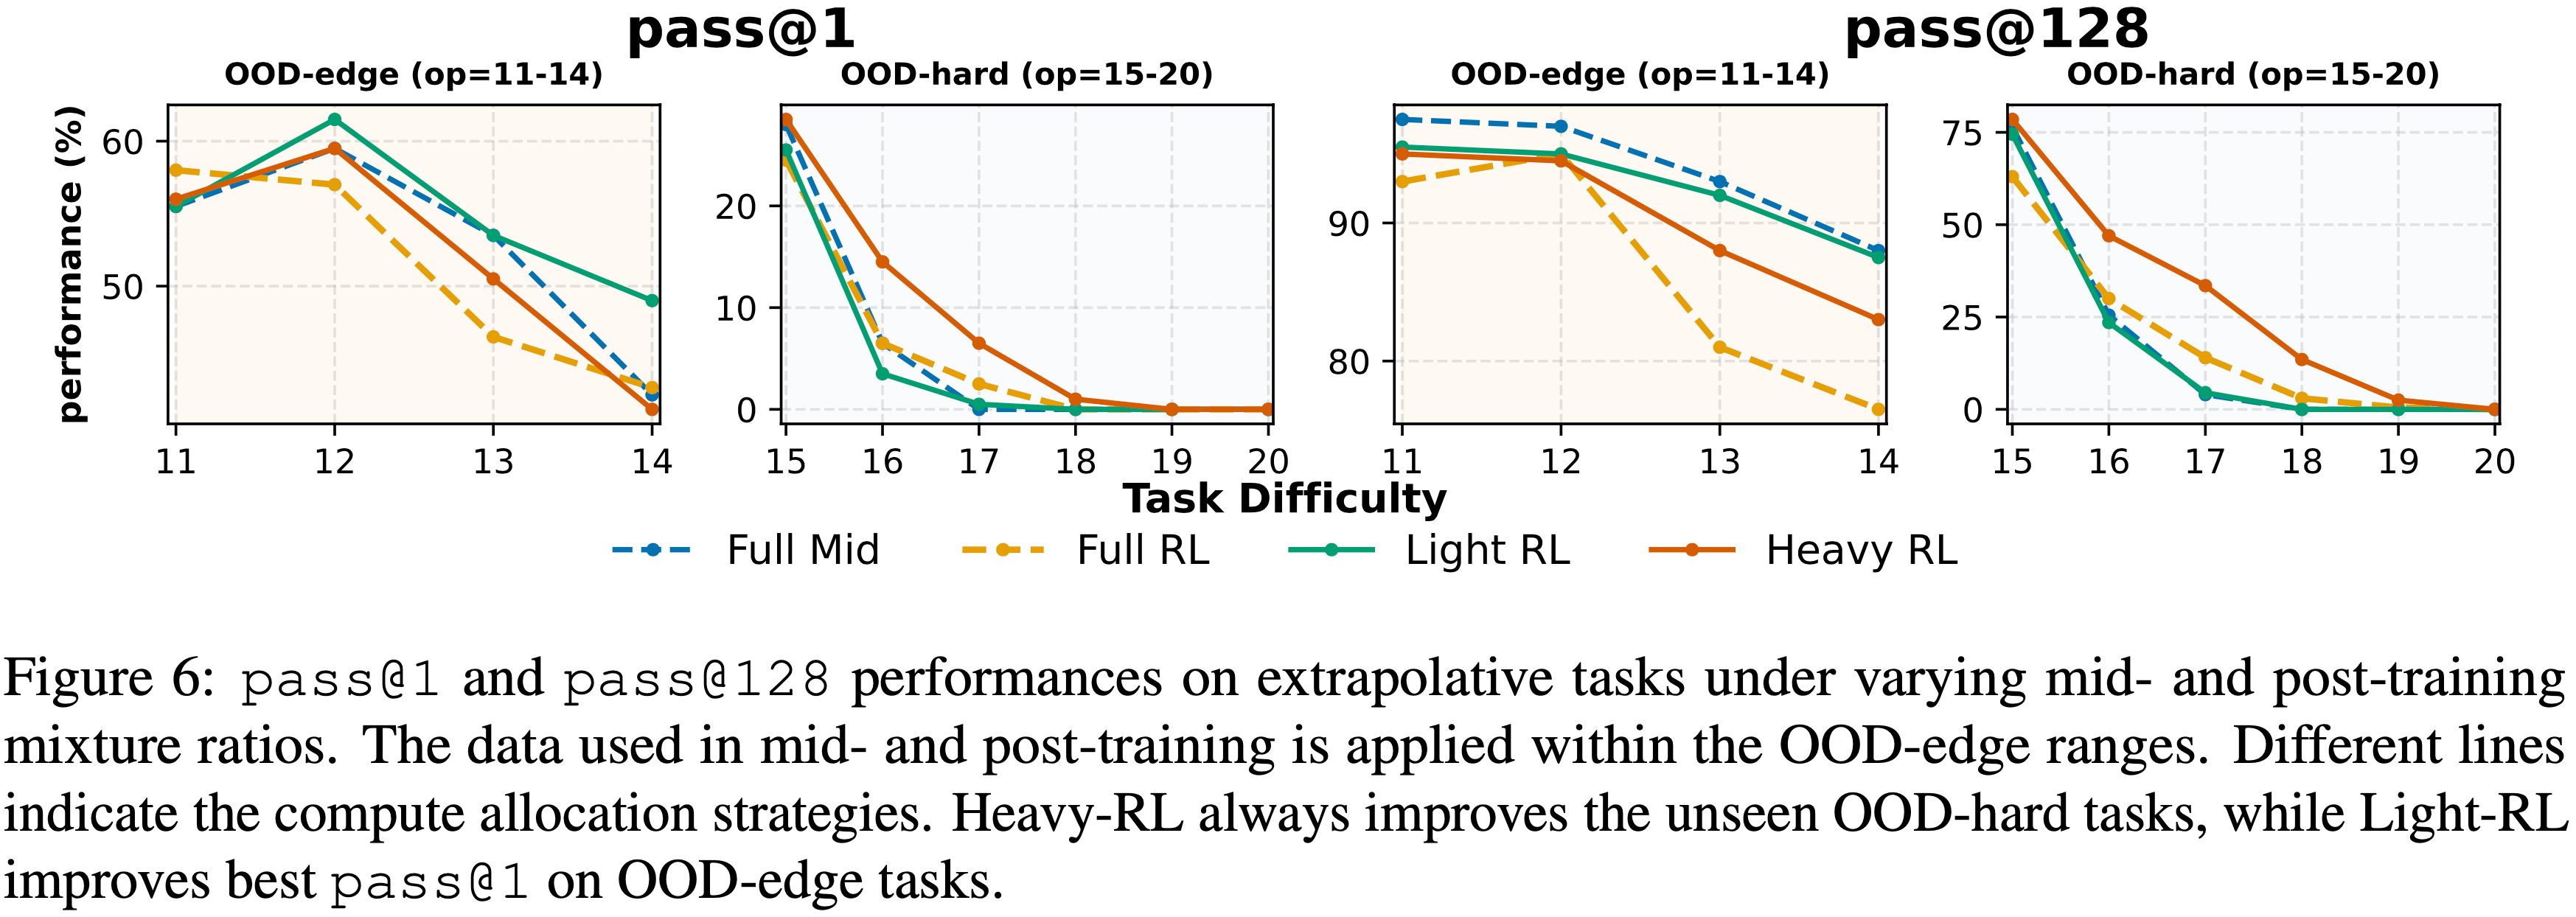
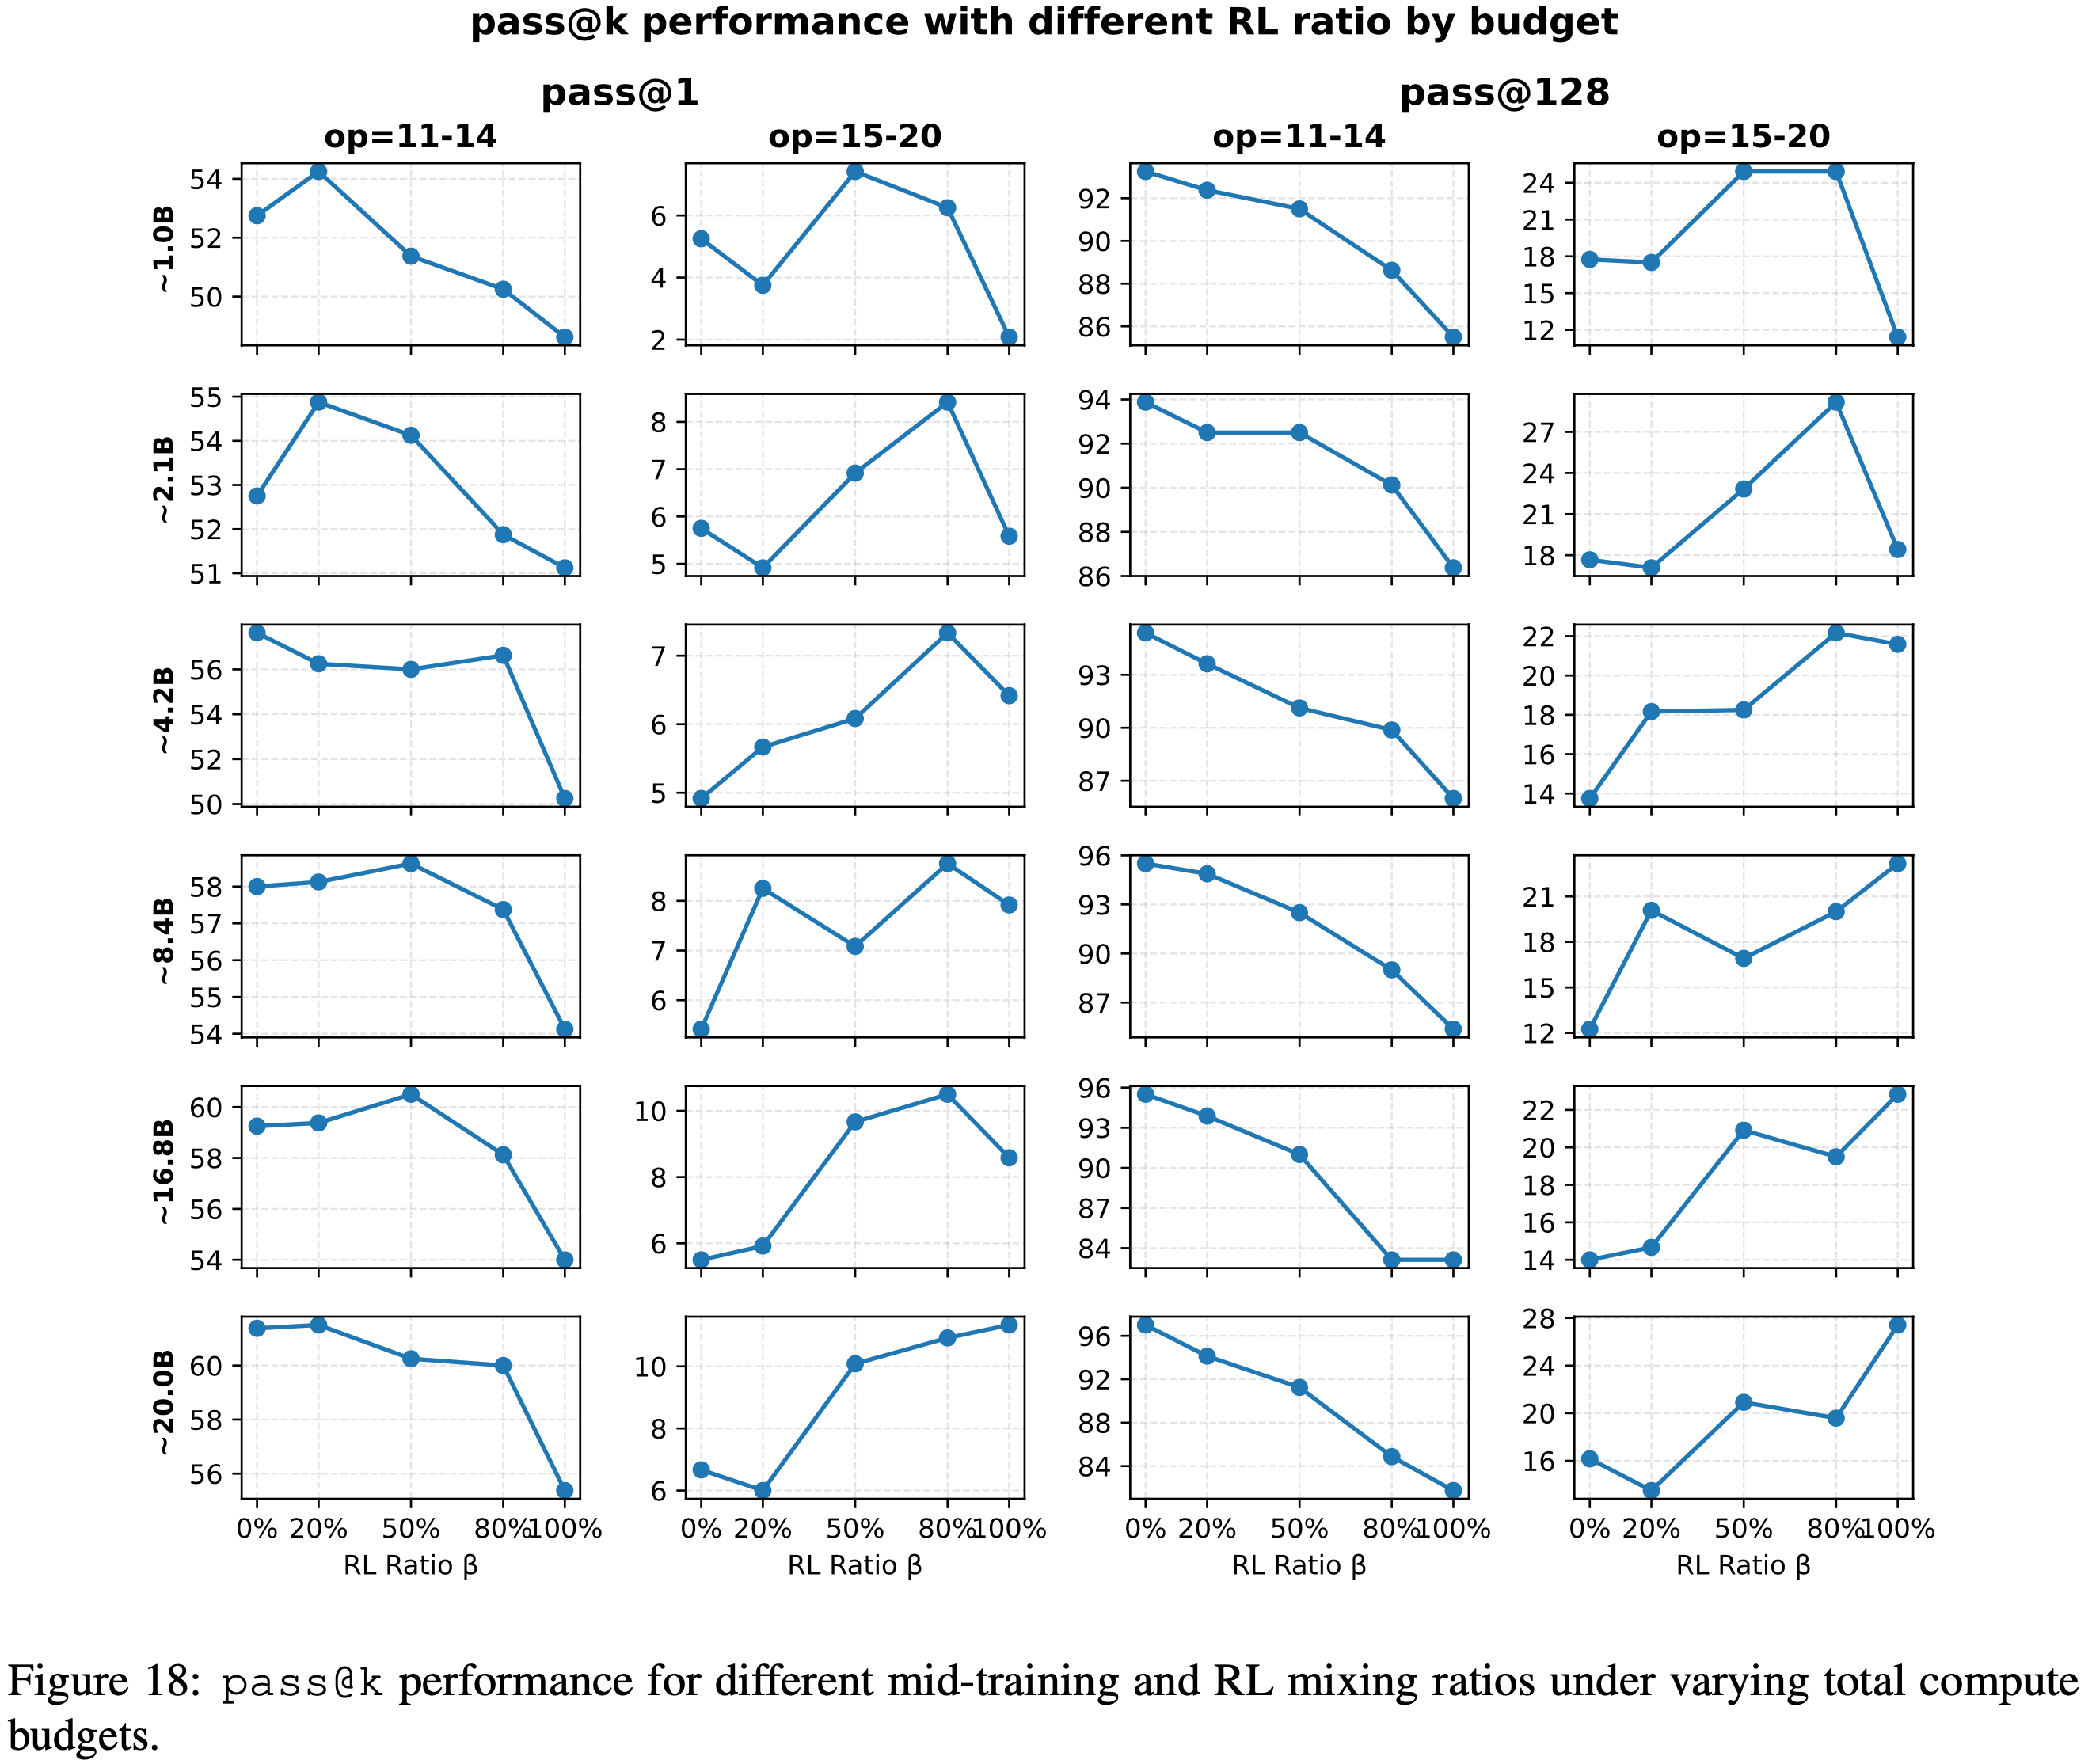
  • 如图6所示,计算分配在整个泛化谱上引起了质的不同行为
    • (1) 在OOD-edge任务上,配置为完全 Mid-training 和 Light RL 的性能优于重度或完全 RL ,其中 Light RL 获得了最佳的 pass@1 性能
    • (2) 对于OOD-hard任务,将更多预算重新分配给重度 RL,可以显著提高在最难实例上的 pass@1 和 pass@128 性能
    • 图6:在外推任务上,不同中期和 Post-training 混合比例下的 pass@1 和 pass@128 性能
      • 用于中期和 Post-training 的数据应用于 OOD-edge 范围
      • 不同的线表示计算分配策略
      • 重度 RL 总是改进未见过的OOD-hard任务,而 Light RL 在OOD-edge任务上获得最佳的 pass@1 性能
  • 这些趋势表明,驱动探索的 RL 对于泛化到更难的任务是不可或缺的,但大量的 Mid-training 分配对于灌输 RL 可以有效利用的先验仍然至关重要
  • 论文进一步分析了不同计算预算的影响(附录A.10)
Takeaway 3
  • 引入一个连接 Pre-training 和 Post-training 分布的 Mid-training 阶段,在固定计算预算下能显著增强泛化能力
  • 这突显了 Mid-training 作为训练设计中未被充分探索但强大的杠杆
  • 计算分配应以任务感知的方式进行:
    • (i) 当优先考虑分布内性能时,将更多预算分配给 Mid-training ,仅辅以 Light RL
    • (ii) 为了获得分布外泛化能力,预留适中的计算部分用于 Mid-training 以建立必要先验,并将剩余预算投入到更重的 RL 探索中
Discussion 3
  • The Role of Mid-Training
  • 近期工作 (2025; 2025) 指出,像 Qwen (2025) 这样的模型对 RL 的响应远比对 LLaMA (2023) 等架构更有效
  • 一个趋同的解释是存在一个 Mid-training 阶段,该阶段的监督与 Post-training 分布更紧密地对齐
  • 面向推理的 Mid-training 已被证明能大幅提高模型的 RL 准备度
  • Wang等人 (2025) 发现,在结构化推理数据上进行 Mid-training 的 LLaMA 模型,其 RL 性能可与更强的 Qwen Base Model 相媲美,这表明 Mid-training 在很大程度上决定了下游 RL 的响应能力
  • Complementarily,Liu等人 (2025a) 表明, Mid-training 充当了分布桥梁,通过缩小 Pre-training 任务和 RL 任务之间的差距来减少遗忘并缓解适应
    • 这一视角进一步与Akter等人 (2025) 的预加载原则一致:更早地注入结构化推理监督提供了支架,后续训练阶段(包括 RL)可以有效地放大这个支架
  • Together,这些工作指向一个统一的结论:
    • Mid-training 是一个 strategically important component,它能使模型为稳定且样本高效的 RL 做好准备,从而实现超越仅仅是锐化现有能力的改进

      mid-training is a strategically important component that conditions models for stable and sample-efficient RL, enabling improvements that go beyond merely sharpening existing abilities.

Practical Guidance 3
  • 围绕互补优势平衡 Mid-training 和 Post-training (Balance mid-training and post-training around complementary strengths)
  • 通过将 Mid-training 视为安装先验(installing priors)的阶段、将 RL 视为扩展探索(scaling exploration)的阶段来设计训练流程
  • 对于 Mid-training ,策划位于模型“能力边缘(edge of competence)”的数据集,这能稳定 RL 所需的原始技能
  • 从业者应根据部署目标调整计算预算:
    • (1) 为了在类似任务(OOD-edge)上获得可靠性(reliability) ,将大部分计算分配给 Mid-training ,并使用 Light RL
    • (2) 为了在复杂任务(OOD-hard)上进行探索(exploration) ,为 Mid-training 分配适中的预算(仅足以建立先验),并将大量计算投入到 RL 探索中

Mitigating Reward Hacking via Process Supervision in Outcome Rewards(结果奖励中的过程监督减轻 Reward Hacking)

  • 使用基于结果的奖励进行 Post-training 已被证明能有效提高推理性能,但它仍然容易受到 Reward Hacking(a failure mode where 模型通过利用虚假捷径或通过无效推理链产生正确答案来实现高最终准确率)
  • Earlier,作者引入了过程验证(process verification)作为评估标准,只有当中间步骤和最终结果都正确时才奖励模型
  • 论文将这一原则扩展到奖励设计本身,并回答:过程感知的监督能否在保持泛化性能的同时减轻 Reward Hacking ?

Task Setting**

  • 为了鼓励模型不仅生成正确的最终答案,还要生成有效的中间推理步骤,论文使用过程级验证来增强结果奖励
  • 论文定义一个复合奖励函数:
    $$
    R = \alpha R_{\text{out} } + (1 - \alpha) R_{\text{pv} }.
    $$
    • \(R_{\text{out} }\) 表示传统的结果奖励(最终答案正确为1,否则为0),\(R_{\text{out} }\) 可能是稀疏的且容易受到结果 Reward Hacking
    • \(R_{\text{pv} }\) 表示由A.2节中定义的过程级准确率标准确定的过程验证奖励,\(R_{\text{pv} }\) 是一个反映每个推理步骤正确性的密集奖励
    • \(\alpha \in [0,1]\) 控制结果准确性和过程保真度之间的平衡
  • 论文还考虑一个更严格的公式:
    $$
    R =
    \begin{cases}
    R_{\text{out} }, & \text{If } R_{\text{pv} } = 1, \\
    0, & \text{Otherwise}.
    \end{cases}
    $$
    • 该公式仅在完整推理过程被验证为正确时才给予结果奖励
    • 此设置提供了过程级监督以减少 Reward Hacking
    • 在此奖励设置下,论文使用不同的奖励组合在 op=11-14 上进行 Post-training ,以评估不同程度的过程监督如何影响推理泛化

Summary 4

Observation 4
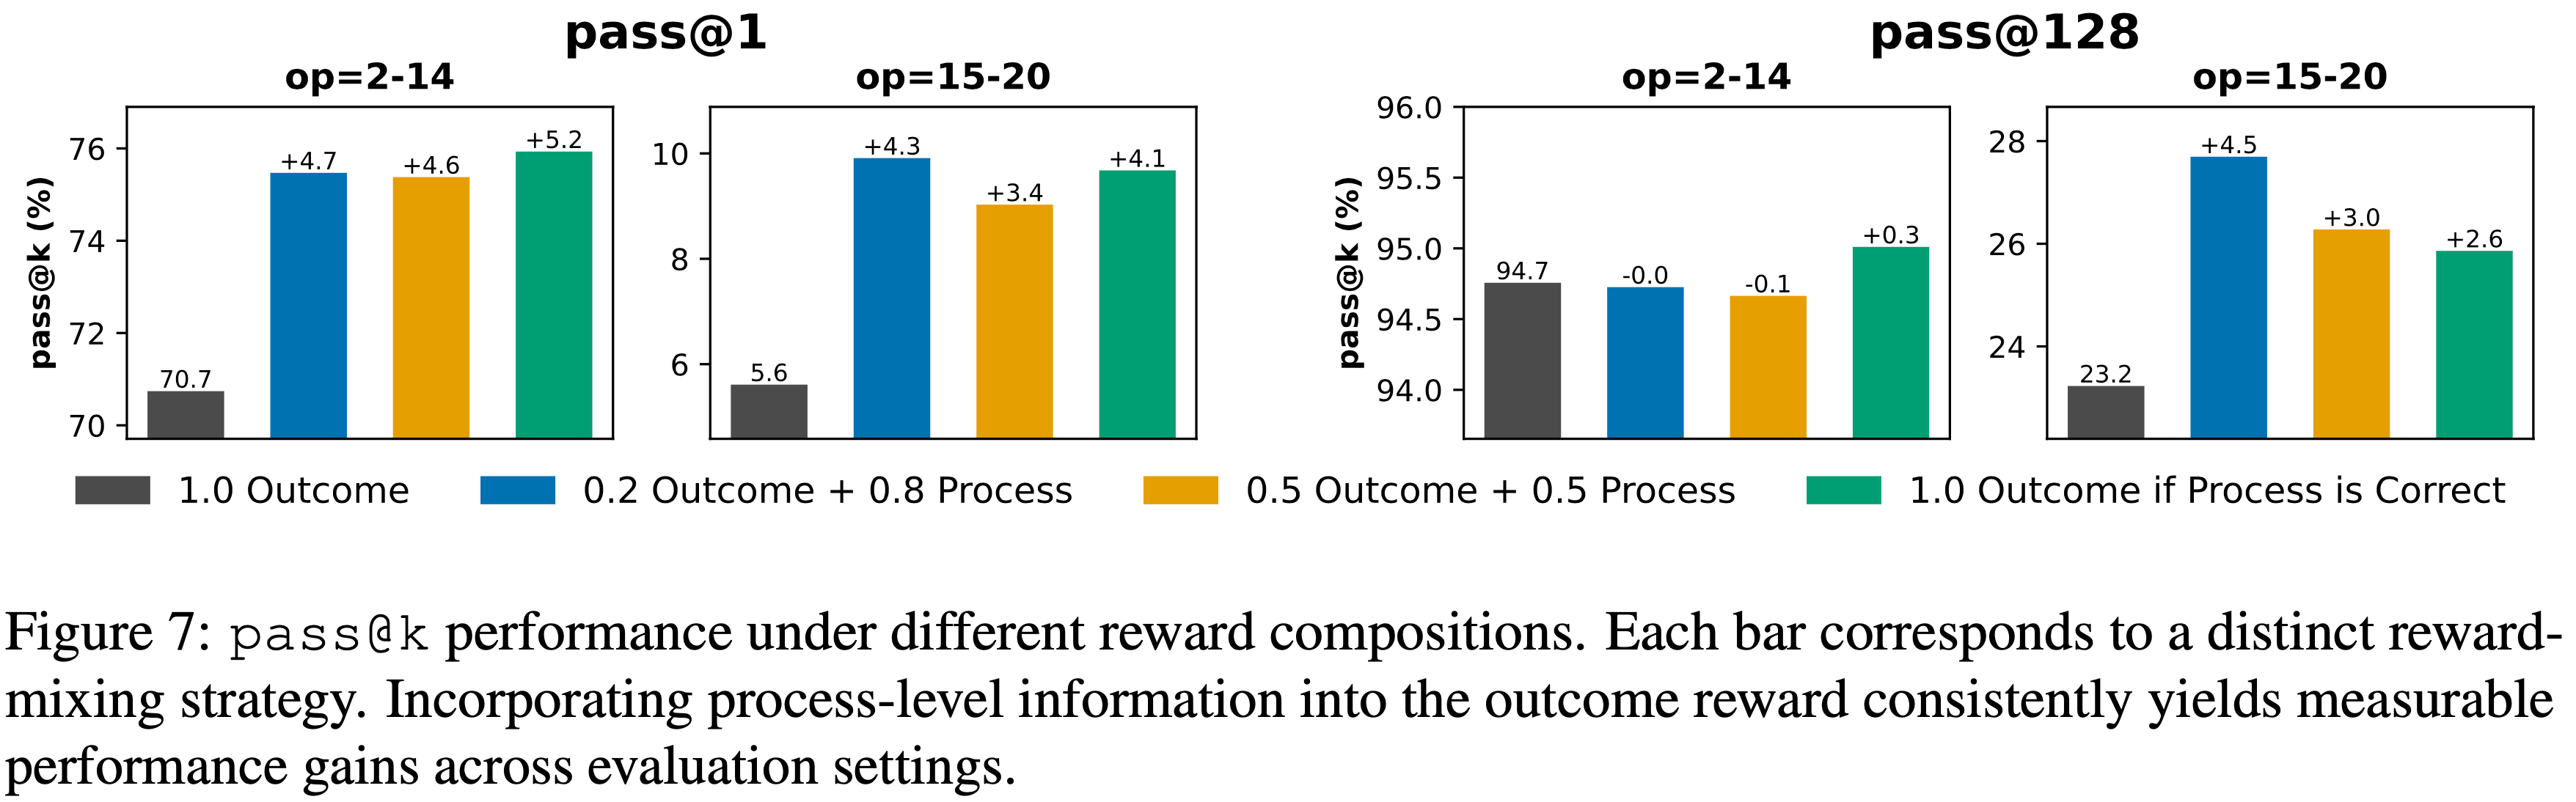
  • 如图7所示,整合过程验证显著提高了跨外推(op=15-20)设置的 pass@1 性能,提升了4-5%
    • 适度的奖励混合(\(0.2 R_{\text{out} } + 0.8 R_{\text{pv} }\))在结果准确性和推理一致性之间实现了最佳平衡
    • 严格的奖励(仅当 \(R_{\text{pv} }=1\) 时给予 \(R_{\text{out} }\))则进一步带来了显著的改进
  • 这些结果证实,过程级监督能有效减轻 Reward Hacking ,并鼓励忠实的推理行为
  • 图7:不同奖励组合下的 pass@k 性能
    • 每个条形对应一种不同的奖励混合策略
    • 将过程级信息整合到结果奖励中,在各个评估 Setting 中都带来了可衡量的性能提升

Related Work

推理大语言模型的 RL 泛化(RL Generalization of Reasoning LMs

  • RL 在 Deriving 大语言模型泛化中的作用一直是广泛讨论的主题
  • 近期工作对于 RL 是否能将推理能力扩展到 Base Model 能力之外提出了不同的看法,文献中出现了相互对立的观点
  • On the one hand,多项研究警告不要高估 RL 推动 Base Model 边界的能力
    • Yue 等人 (2025) 认为,虽然经过 RL 训练的模型在较小的 pass@k 值(例如 k=1)上可能优于 Base Model ,但随着 k 增加(例如 k=128),性能优势会减弱
      • 他们的覆盖率和困惑度分析表明,经过 RL 训练的模型的推理能力最终仍受限于 Base Model 的表征能力
    • Additionally,Wu等人 (2025) 提供了一个理论框架,断言 RL 无法超越 Base Model 固有的局限性,从而挑战了 RL 能够实现新的、可泛化的推理技能的观点
  • On the other hand,也有强有力的论据支持 RL 能够实现泛化,尤其是在 Base Model 表现不佳的任务上
    • Liu 等人 (2025b) 强调了 ProRL 在提高合成推理任务性能方面的成功,在这些任务中 Base Model 表现出显著的局限性
    • Sun 等人 (2025a, 2025b) 进一步支持了这一观点,提供了明确的证据表明 RL 有潜力为复杂的任务族引入新的策略
    • Yuan 等人 (2025) 提出了一个合成函数组合任务,证明经过 RL 训练的模型可以泛化到 Base Model 无法处理的未见过的函数组合
  • 论文通过提供实证证据表明这两种观点并不相互排斥,从而为这场持续的辩论做出了贡献
    • Instead,论文表明, RL 能够驱动泛化的条件是微妙且复杂的,它取决于 Base Model 的推理原始技能以及 RL 微调中使用的 Post-training 数据的性质

Understanding LMs via Controlled Experiments

  • 几项先前工作 (2025; 2025b; 2025a) 强调了受控实验在理解大语言模型能力方面的重要性
  • However,这类工作主要侧重于为后期 RL 设计的合成任务,这可能无法完全捕捉从 Pre-training 到 Post-training 的全谱推理任务的复杂性
  • 特别是在推理任务的背景下,受控设置允许研究人员分离特定因素,例如数据污染、随机猜测答案,以及控制不同训练阶段的推理原始技能
  • 论文基于Ye等人 (2024) 的工作设计受控实验,以合成 GSM-style 推理任务 (2021; 2024; 2025; 2025b),从而在这一工作基础上进行了扩展

附录 A.1 Data Generation Framework

  • 本节提供了整篇论文所使用的可控数据生成框架的正式细节:
    • (i) 每个推理实例背后的图级形式化定义
    • (ii) 将结构与数值和语言实例分离的抽象机制
    • (iii) 将图映射到自然语言问题的上下文渲染函数
    • (iv) 具体的生成流程和去重过程

附录 A.1.1 图级形式化定义(Graph-Level Formalism)

  • 每个推理实例都基于一个有向无环图(directed acyclic graph, DAG)建立:
    $$
    \mathcal{G}=(\mathcal{V},\mathcal{E}),
    $$
    • 其中每个节点 \(v_{i} \in \mathcal{V}\) 代表一个潜在量(例如,“成年狮子的数量”),每条有向边 \((v_{j} \to v_{i}) \in \mathcal{E}\) 编码一个函数依赖关系
    • 论文将依赖关系限制为基本算术运算:
      $$
      v_{i}=f_{i}\big((v_{j})_{j\in\text{pa}(i)}\big), \qquad f_{i} \in \{+,-,\times,\div\},
      $$
      • 其中 \(\text{pa}(i)\) 是节点 \(i\) 的父节点集合
  • 给定所有叶节点的数值赋值,论文递归地定义一个评估映射:
    $$
    \text{val}:\mathcal{V}\rightarrow\mathbb{R}
    $$
    • 其定义为:
      $$
      \text{val}(v_{i})=f_{i}\big(\{\text{val}(v_{j})\}_{j\in\text{pa}(i)}\big),
      $$
  • 基本情况由叶节点值给出,对于一个指定的查询节点 \(v^{*}\),真实答案为:
    $$
    a^{*}:=\text{val}(v^{*}).
    $$
  • 在论文所基于的 GSM-Infinite 实现 (2025a) 中,查询节点 \(v^{*}\) 对应:
    • 前向(forward) 生成器中拓扑顺序的最后一个数值节点,或
    • 方程风格逆向(equation-style reverse) 生成器中特定的未知参数
  • 贯穿全文(Throughout),DAG \(\mathcal{G}\) 被视为符号推理图,其结构在不同的数值实例化和语言实现之间共享
  • 推理复杂度(Reasoning Complexity). :论文通过算术运算的数量来量化实例的结构复杂度:
    $$
    \text{op}(\mathcal{G})=|\mathcal{E}|.
    $$
    • 这个量规定了计算 \(a^{*}\) 所需的最小组合推理链长度下限,也是论文研究外推(深度方向)泛化时变化的主要调控参数

附录 A.1.2 抽象参数与实例参数(Abstract and Instance Parameters)

  • 遵循 GSM-Infinite 的抽象机制,论文明确地将结构、数值实例化和语言上下文分离开
  • 抽象参数(Abstract Parameters).
    • 每个图 \(\mathcal{G}\) 关联着一组 抽象参数 ,这些参数:
      • 指定存在哪些变量以及它们如何分解(例如,“动物总数”分解为“狮子”和“大象”),以及
      • 确定边集 \(\mathcal{E}\) 和附加在每个节点上的操作 \(f_{i}\)
    • 这些参数定义了一个纯符号图,独立于具体的数字或实体
  • 实例参数(Instance Parameters).
    • 给定一个抽象图,实例参数用具体的值和实体对其进行实例化:
      • 对叶节点的数值赋值(例如,“有 12 头成年狮子和 7 头小象”),以及
      • 将变量绑定到特定上下文的表层形式(例如,“城市动物园里的成年狮子”)
    • 在同一抽象图上实例化不同的数值,会产生一系列结构相同、仅在具体数字上有所区别的问题
  • 隐式推理(Implicit Reasoning).
    • 并非所有的抽象依赖关系都需要在自然语言问题中明确表述
    • 对于给定的语言渲染,边集可以划分为:
      $$
      \mathcal{E}=\mathcal{E}_{\text{explicit} } \cup \mathcal{E}_{\text{implicit} }, \qquad \mathcal{E}_{\text{explicit} } \cap \mathcal{E}_{\text{implicit} } = \emptyset,
      $$
    • 其中 \((v_{j} \to v_{i}) \in \mathcal{E}_{\text{explicit} }\) 表示文本中直接陈述的关系(例如,“大象比狮子多 5 头”),而 \((v_{j} \to v_{i}) \in \mathcal{E}_{\text{implicit} }\) 表示属于真实推理图但从未直接表述的关系(例如,“动物总数等于狮子数加大象数”)。这种分离允许显式和隐式推理步骤共存于同一个底层图中,并使论文能够探究模型恢复未明言依赖关系的能力

附录 A.1.3 上下文渲染(Contextual Rendering)

  • 为了将符号图映射到自然语言问题,论文引入了上下文渲染函数:
    $$
    \Phi:(\mathcal{G},\tau)\mapsto x,
    $$
    • 其中 \(\tau \in \mathcal{T}\) 是一个上下文模板 ,而 \(x\) 是生成的文本实例
  • Templates
    • 一个模板 \(\tau\)(例如,animals-zoo、teachers-school、movie-festival)规定了:
      • 抽象变量如何词汇化为领域特定的表层形式(例如,“成年狮子”、“A班的学生”、“第1天售出的票”),以及
      • 哪些边的子集在措辞中被显式实现,从而决定了 \(\mathcal{E}_{\text{explicit} }\) 和 \(\mathcal{E}_{\text{implicit} }\) 之间的划分
    • 对于任何两个仅在表面上下文上不同的模板 \(\tau_{a},\tau_{b} \in \mathcal{T}\),它们引发的问题在结构上保持相同:
      $$
      \text{Struct}(\Phi(\mathcal{G},\tau_{a}))=\text{Struct}(\Phi(\mathcal{G},\tau_{b})), \quad \forall,\tau_{a},\tau_{b} \in \mathcal{T},
      $$
      • 尽管它们的表层实现、实体以及显式/隐式划分可能不同
      • Thus,一个单一的抽象图可以被渲染成语义不同但结构等价的问题,论文利用这一点来研究上下文(广度方向)泛化
  • Solution Format
    • 渲染函数生成一个三元组:
      $$
      x=(\text{[question]},\text{[solution]},\text{[answer]}),
      $$
      • [question] 是由符号图 \(\mathcal{G}\) 提出的问题的自然语言表示,通常包括对图中某个方面的查询(例如,“第1天卖出了多少张票?”)
        • 它抽象了底层结构,并为解答提供了上下文
      • [solution] 是一个遵循符号图 \(\mathcal{G}\) 拓扑顺序的逐步推导过程
        • 它包括中间推理步骤和图中元素之间的逻辑联系,最终导向最终答案。该解答明确展示了问题的每个部分是如何推导或计算的
      • [answer] 是对 [question] 中提出的查询的最终回应,通过 [solution] 过程推导得出
        • 它通常是一个数值或特定实体,用于回答问题
  • 这种结构确保了渲染输出既是人类可读的,又在逻辑上与底层符号图保持一致,在保持原始问题完整性的同时使其可以用自然语言表达

附录 A.1.4 生成流程与结构调控参数(Generation Pipeline and Structural Knobs)

  • 论文的数据生成器遵循一个阶段式过程,类似于 GSM-Infinite 的前向和反向生成器:
  • 1)结构采样(Structural sampling).
    • 论文首先采样定义依赖图的结构调控参数:
      • 针对 \(\mathrm{op}(\mathcal{G})\) 的目标运算计数范围;
      • 控制扇入和深度的图形形状参数(例如,允许的入度、分层模式);以及
      • 附加到节点上的操作类型 \(f_{i} \in \{+,-,\times,\div\}\)
    • 这些选择决定了一个具有唯一查询节点 \(v^{*}\) 的分层 DAG \(\mathcal{G}\)
  • 2)抽象与实例参数化(Abstract and instance parameterization).
    • 给定 \(\mathcal{G}\),论文采样抽象参数(变量角色和分解)和实例参数(叶节点的数值),并使用上面定义的评估映射 val 按拓扑顺序评估所有节点值
  • 3)上下文渲染(Contextual rendering).
    • 论文选择一个模板 \(\tau \in \mathcal{T}\) 并应用渲染函数 \(\Phi(\mathcal{G},\tau)\) 以获得一个自然语言三元组(问题、问题描述、解答),决定哪些依赖关系被语言化(显式)以及哪些保持隐式
  • 4)前向模式与反向模式(Forward vs. reverse modes).
    • 遵循 (2025a),论文支持两种生成模式:
      • 在 forward 模式中,论文生成一个标准的算术文字问题,其中查询的是拓扑顺序中的最后一个节点
      • 在 reverse 模式中,论文将一个节点视为未知数,并构建一个方程风格的问题,模型必须求解该量,而图中的其余部分则完全指定
  • 通过联合改变下面的两个维度,论文获得了一个用于研究深度扩展和上下文迁移的清晰二维测试平台:
    • (i) 运算计数 \(\mathrm{op}(\mathcal{G})\)
    • (ii) 模板 \(\tau\)
    • 相同的框架用于定义 Pre-training 、 Mid-training 和 Post Training 的不同数据分布,通过从 \((\mathrm{op}(\mathcal{G}),\tau)\)-Space 的不同区域采样来实现

附录 A.1.5 去重与规范化(Deduplication and Canonicalization)

  • 为了保证数据集的纯净性并避免训练和评估拆分之间的污染,作者在渲染三元组级别执行基于哈希的精确去重
  • 每个实例通过以下方式规范化:
    • 将三元组(问题描述、问题、解答)序列化为规范化的字符串表示(例如,去除多余空白、规范化数字格式),以及
    • 对此规范形式进行哈希以获取全局标识符
  • 论文丢弃任何拆分内和跨拆分的重复哈希值,确保相同的“问题-解答”三元组不会同时出现在训练和评估中

附录 A.2 Task Setup

  • 在实际部署中,语言模型(Language Models,LM)通常需要沿着两个互补的维度进行推理泛化 (2025; 2025b; 2025)
  • 论文的可控数据集使这些维度变得明确,并允许论文探究 Pre-training 、 Mid-training 和 Post Training 如何塑造每种类型的泛化
  • 符号表示(Notation).
    • 令 \(f_{\theta}^{\text{pre} }\)、\(f_{\theta}^{\text{mid} }\) 和 \(f_{\theta}^{\text{post} }\) 分别表示经过 Pre-training 、经过额外 Mid-training 和经过 Post Training(RL)的语言模型
    • 论文使用下面评估协议中定义的严格度量,将模型在由图 \(\mathcal{G}\) 在模板 \(\tau\) 下生成的实例上的正确性记为 \(\text{Correct}(f,\mathcal{G},\tau)\)
  • 外推(深度)泛化(Extrapolative (Depth) Generalization).
    • 论文用每个训练阶段 \(\phi \in \{\text{pre},\text{mid},\text{post}\}\) 所见的运算计数范围对其进行参数化
    • 令 \(\mathcal{O}_{\phi}\) 为阶段 \(\phi\) 训练分布中存在的 \(\text{op}(\mathcal{G})\) 值集合,并令:
      $$
      \mathcal{O}_{\text{train} }=\mathcal{O}_{\text{pre} }\cup\mathcal{O}_{\text{mid} }\cup\mathcal{O}_{\text{post} }.
      $$
    • 一个分布内评估条件使用满足 \(\text{op}(\mathcal{G}) \in \mathcal{O}_{\text{train} }\) 的图,而一个外推(分布外,OOD)条件评估满足以下条件的图:
      $$
      \text{op}(\mathcal{G})>\max\mathcal{O}_{\text{train} }.
      $$
    • 如果一个模型在这些更长、未见过的运算上保持高过程验证准确率,同时在分布内任务上保持稳定,则表明其具有外推泛化能力
    • 通过填充 \(\mathcal{O}_{\text{pre} }\)、\(\mathcal{O}_{\text{mid} }\) 和 \(\mathcal{O}_{\text{post} }\) 的不同难度范围,我们可以分离每个阶段对深度方向泛化的贡献
  • 上下文(广度)泛化(Contextual (Breadth) Generalization).
    • 一个固定的推理图 \(\mathcal{G}\) 可以在不同模板下被渲染成结构等价的实例:
      $$
      \text{Struct}(\Phi(\mathcal{G},\tau_{a}))=\text{Struct}(\Phi(\mathcal{G},\tau_{b})) \quad \text{in principle},
      $$
    • 论文的数据集在训练过程中是_随机采样_的,并未刻意在不同模板间对齐图
      • As a result, 大多数图在训练期间仅在一部分上下文中被观察到
    • 令 \(\mathcal{T}_{\phi}^{\text{train} }\) 表示训练阶段 \(\phi\) 中暴露的模板,\(\mathcal{T}^{\text{eval} }\) 表示更广泛的评估池,包括长尾模板
      • 如果一个模型在阶段 \(\phi\) 能够在叙事表层形式发生变化时保持推理性能,即使新的上下文在 Mid-training 从未遇到过,则该模型展现了上下文泛化:
        $$
        \text{Acc}(f_{\theta}^{\phi},\mathcal{G},\tau_{a})\approx\text{Acc}(f_{\theta}^{\phi},\mathcal{G},\tau_{b}),\qquad\tau_{b}\notin\mathcal{T}_{\phi}^{\text{train} }.
        $$
    • 在这种设置下,上下文泛化衡量的是模型是否学到了可迁移的 推理原语 ,而不是记住了任务风格,使其能够在已知、未见和长尾的叙事环境中应用相同的结构性推理

附录 A.3 Training Setup

附录 A.3.1 Model Architecture

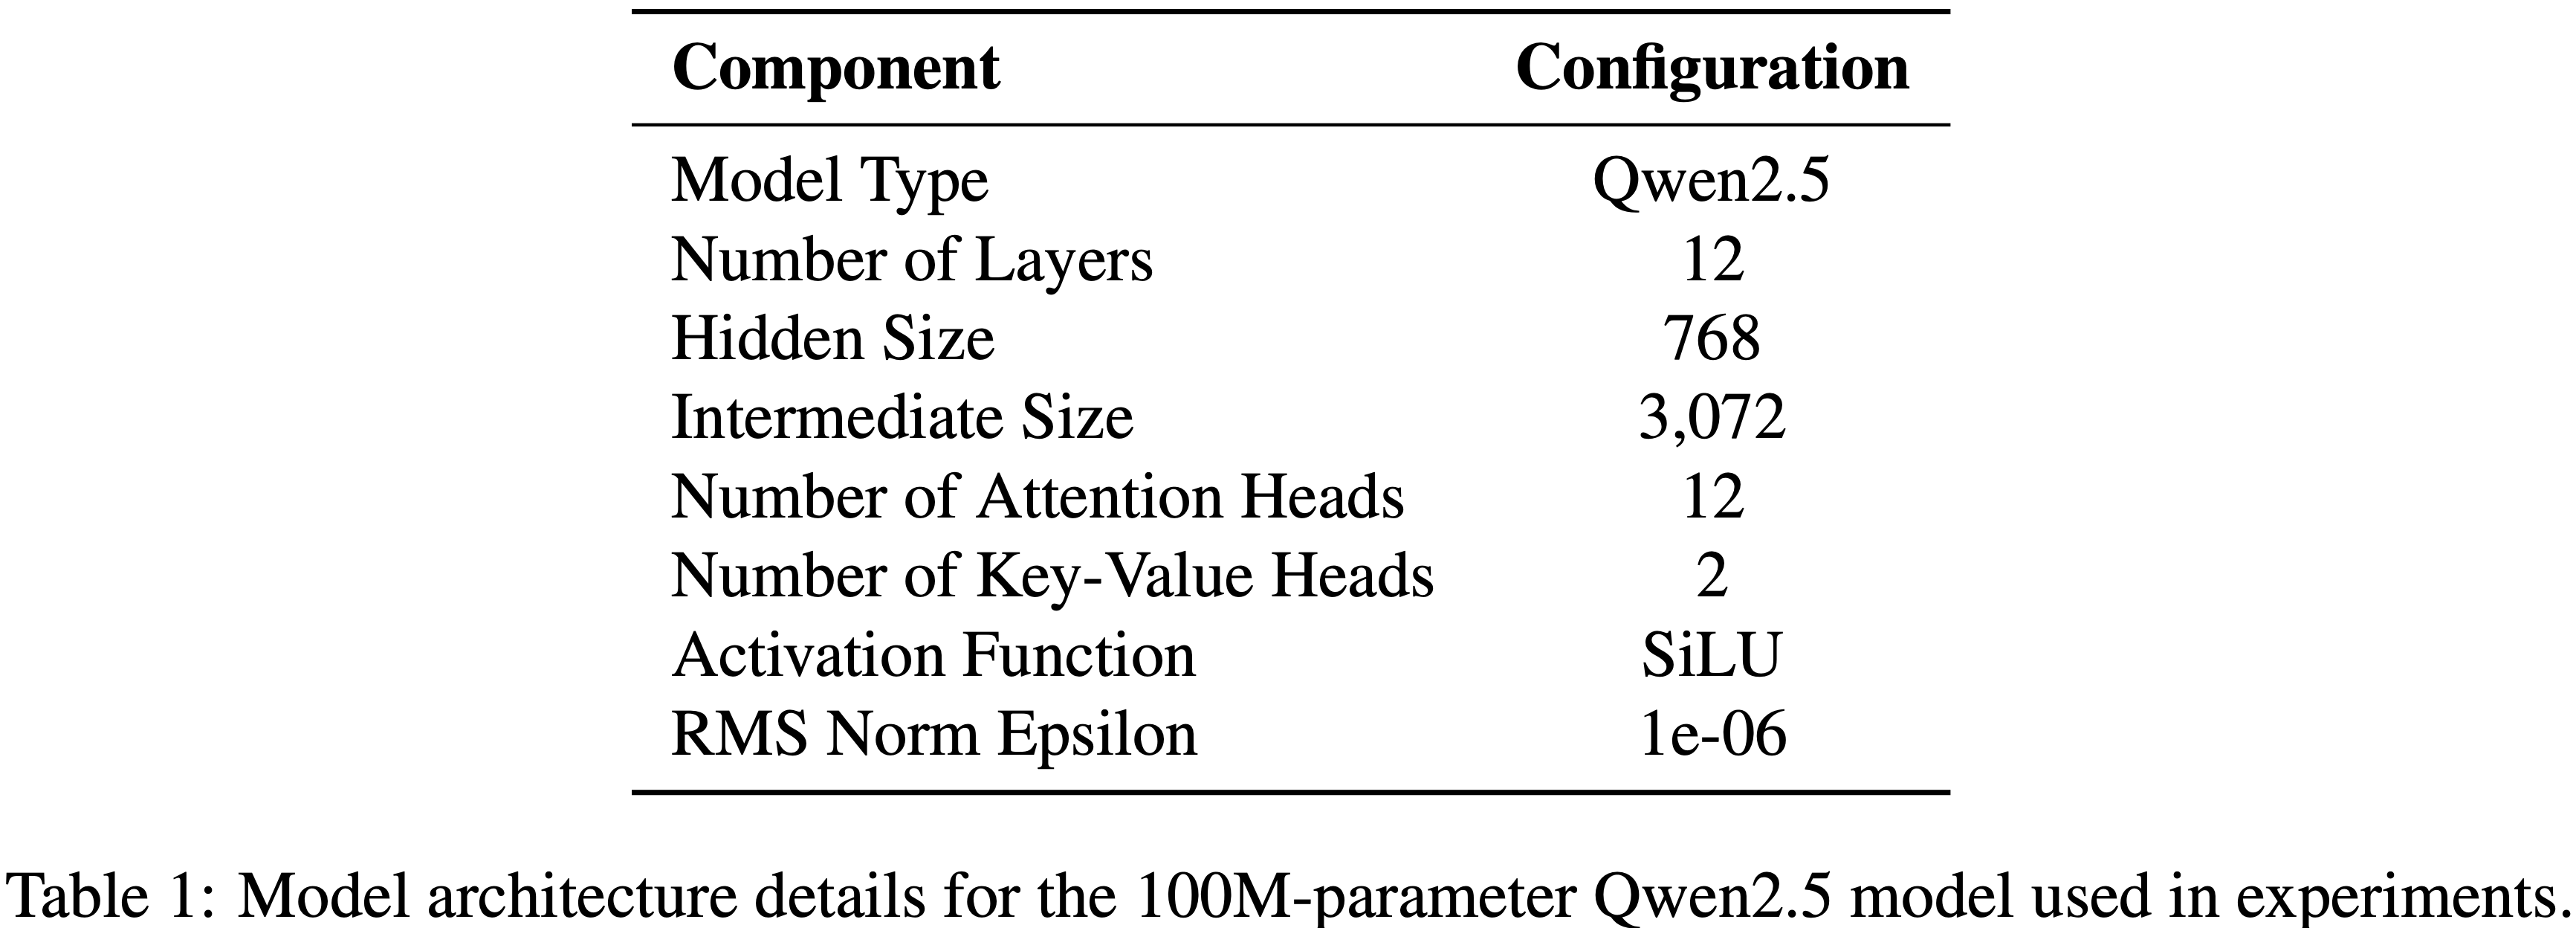
  • 论文使用具有 100M 参数、 Decoder-only Qwen2.5 架构 (2025) 模型进行实验
  • 详细的架构配置如表 1 所示

附录 A.3.2 Tokenizer and Input Representation

  • 论文遵循《语言模型的物理学》(Physics of Language Models)系列 (Allen-Zhu, 2024; 2024),直接在合成推理语料库上训练一个字节对编码(BPE)分词器
  • 得到的分词表有 2,200 个 Token(包括 Special Token)
    • 所有问题、提问和解答都以最大序列长度 2,048 个 Token 进行分词
  • 问题:模型过小了,只有 100M,而且给出的 Token 长度限制也才 2K,不太够数学推理

附录 A.3.3 Hyperparameters

  • Pre-training.
    • 所有实验都从一个在论文可控推理语料库上从头开始训练的 100M 参数 Qwen2.5 模型开始,使用 \(100\times\) 的 token-to-parameter ratio, Pre-training 10B Token
    • 论文使用上下文长度 2048 Token ,批次大小 512K Token ,学习率 \(2\times 10^{-4}\),权重衰减 \(0.1\),余弦衰减,最小学习率 \(3\times 10^{-5}\),预热比例 \(5%\),并在语料库上训练一个 epoch
    • 所有模型都以 bf16 精度训练
  • Mid-training.
    • 从 Pre-training 检查点开始,论文在第 5 节执行了一个额外的可选课程学习
    • 论文使用最大序列长度 2,048 进行训练
    • 论文使用全局批次大小 512K Token ,学习率 \(1\times 10^{-4}\),权重衰减 \(0.1\),余弦衰减,最小学习率 \(3\times 10^{-5}\),以及更高的预热比例 \(15%\)
  • Post Training (Post-training).
    • 最后,论文使用 GRPO (2025) 进行 RL 微调
    • 论文使用全局批次大小 1,024 个样本,最大提示和响应长度 1024 Token ,训练两个 epoch
    • Actor 使用学习率 \(1\times 10^{-6}\),PPO 小批次大小 256,每个 GPU 的微批次大小 16,KL 正则化系数 \(10^{-3}\)(低方差 KL 惩罚),无熵奖励
    • 在 RL 回合采样期间,论文使用温度 \(T_{\text{RL} }=1.0\),top-\(p=1.0\),且无 top-\(k\) 截断(全核采样)进行采样
    • 对于离线评估和报告,论文使用温度 \(T_{\text{eval} }=0.7\),top-\(p=1.0\),top-\(k=-1\)(无截断)生成,每个问题最多生成 1,024 个新 Token

附录 A.3.4 性能阶梯(Performance Ladder)

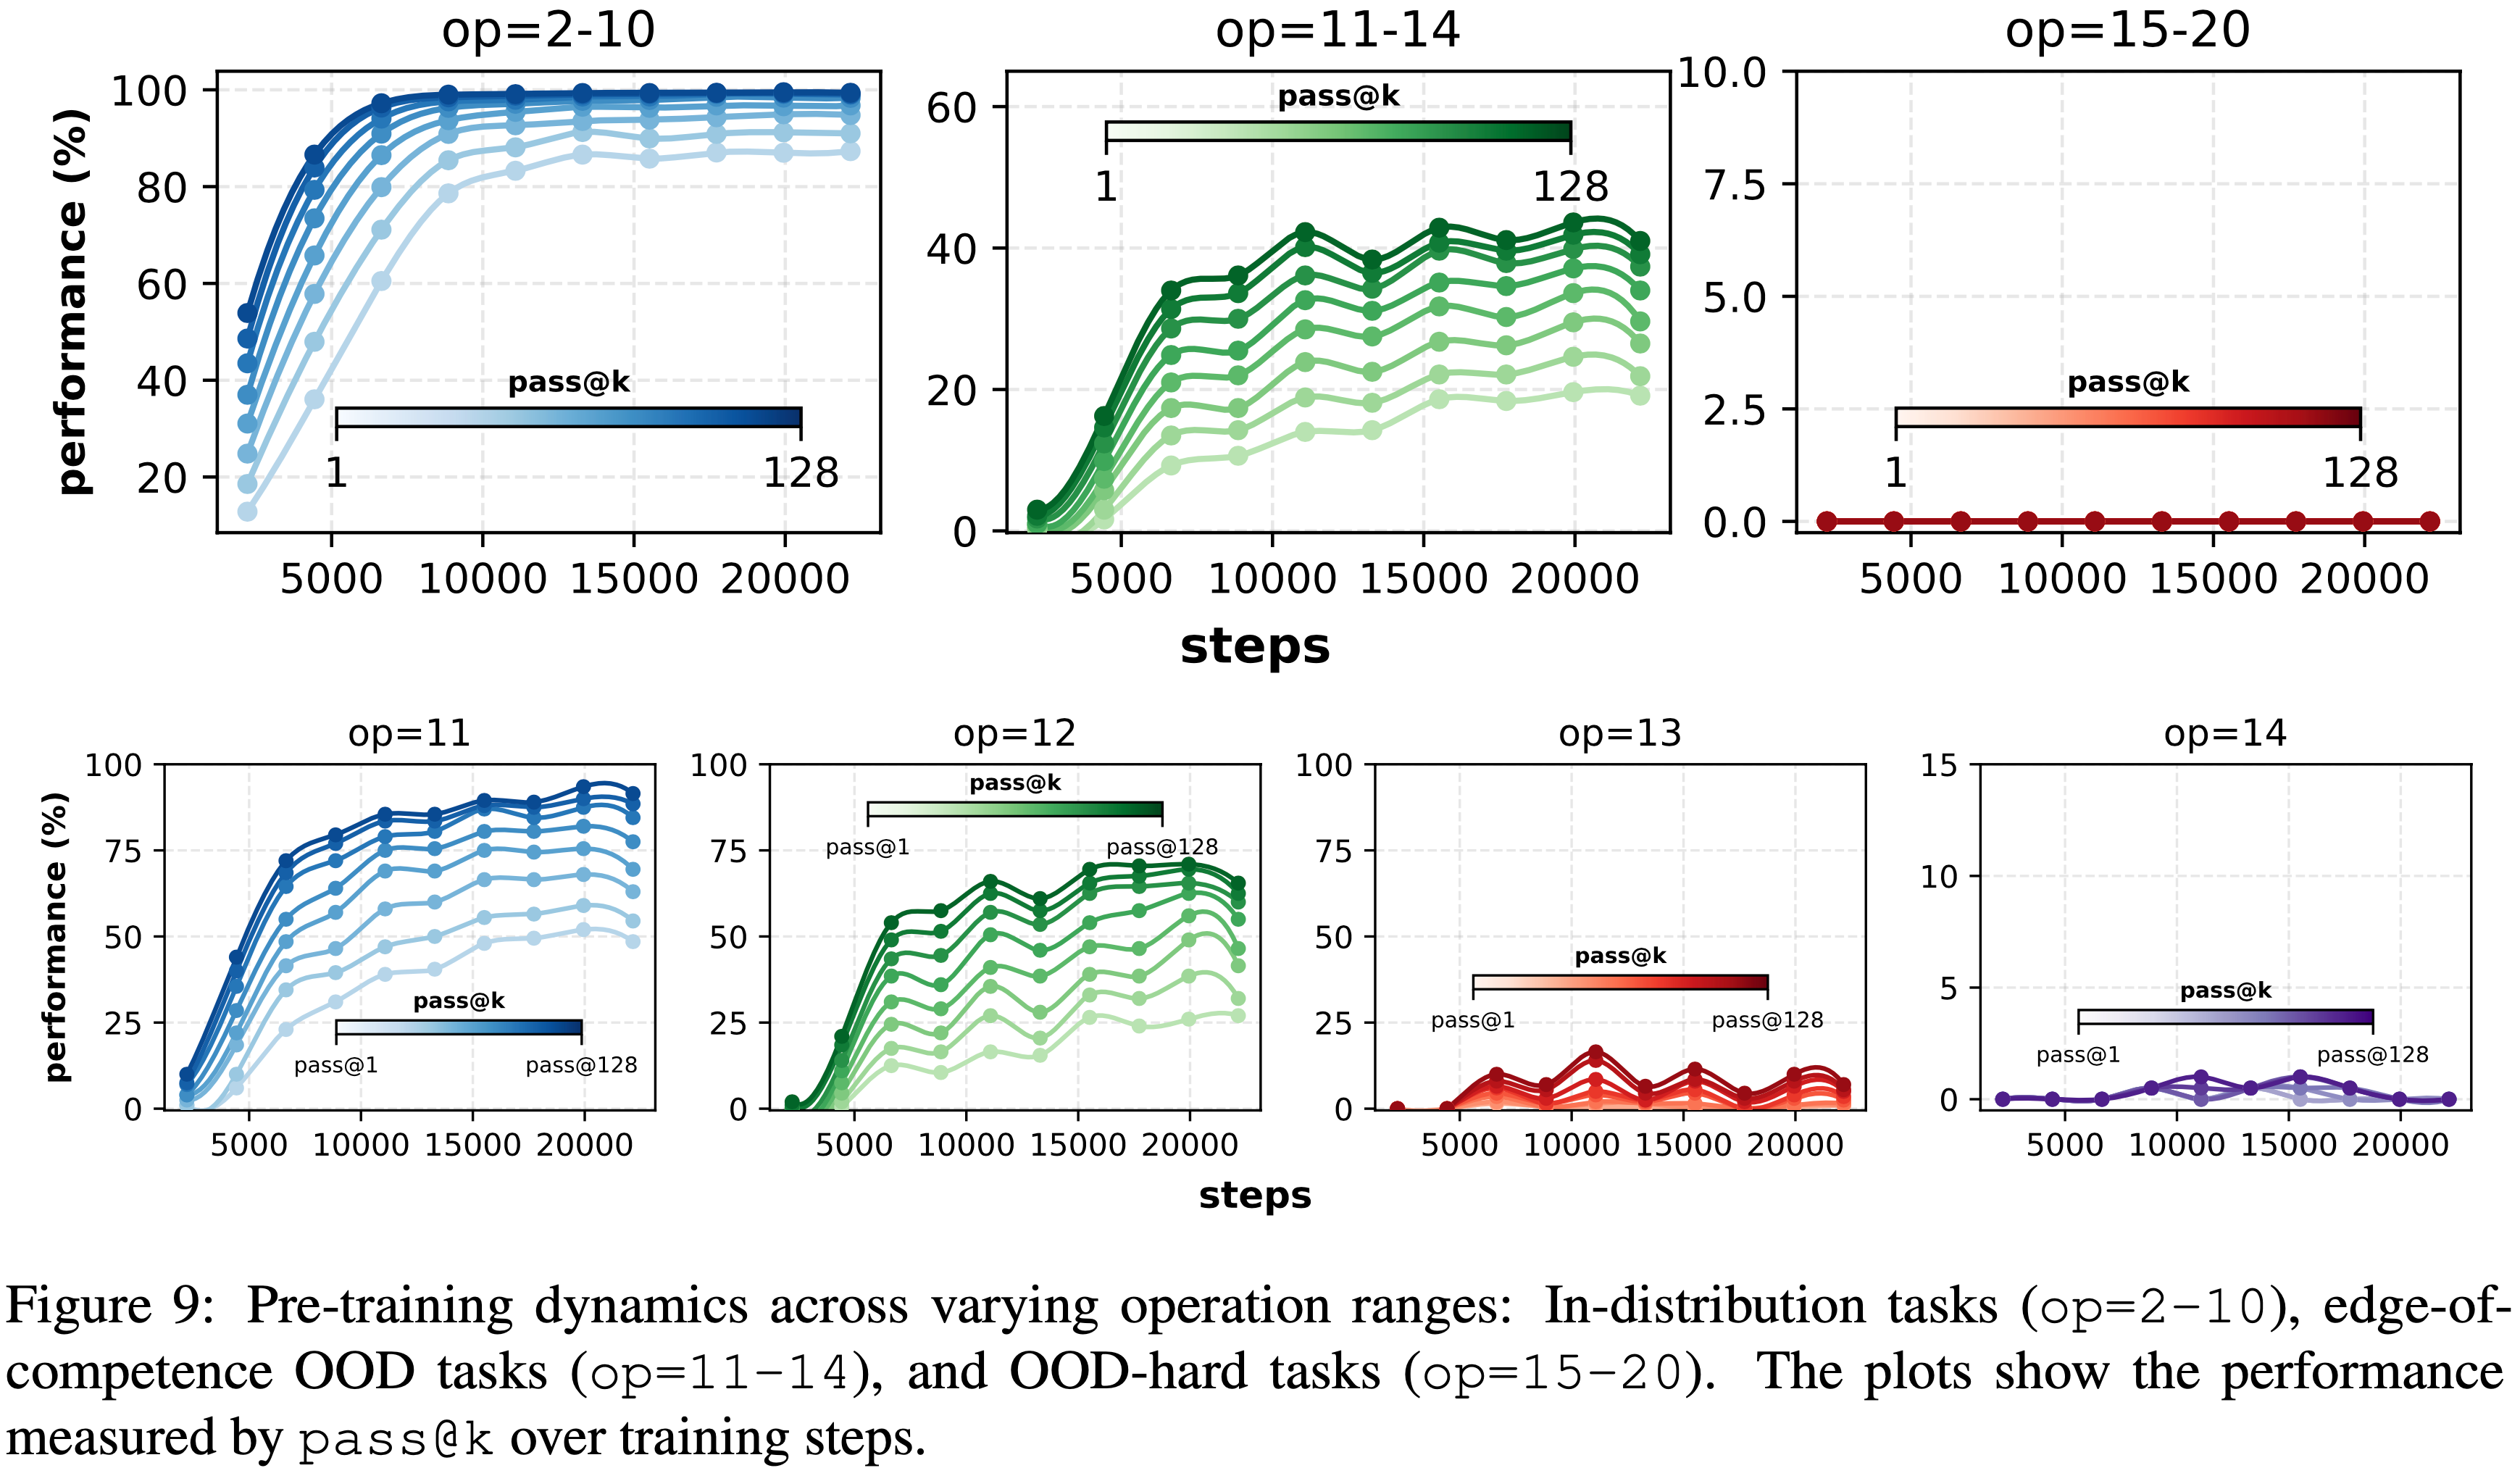
  • 性能阶梯根据任务难度定义了三个关键级别:
    • 1)分布内任务(In-distribution tasks) (op=2-10): 目标是接近 100% 的 pass@128 准确率;
    • 2)OOD边缘任务(OOD-edge tasks) (op=11-14): 确保非零的 pass@128 性能;
    • 3)OOD困难任务(OOD-hard tasks) (op=15-20): 目标是零 pass@128 准确率,标志着模型的能力极限
  • Post Training 在能力边缘进行,确保模型能泛化到更难的任务
  • 图 9 显示了跨这些性能级别的 Training Dynamics 细分

附录 A.4 Process-Verified Evaluation

  • 给定一个具有真实图 \((\mathcal{G},a^{*})\) 的输入实例,模型生成一个自由形式的解答 \(s\)
  • 论文确定性地将 \(s\) 解析为预测的依赖图:
    $$
    \hat{\mathcal{G} }=(\hat{\mathcal{V} },\hat{\mathcal{E} },\widehat{\operatorname{val} }), \qquad \hat{a},
    $$
    • 其中 \(\hat{\mathcal{V} }\) 中的节点对应解答中命名的中间量,\(\hat{\mathcal{E} }\) 编码每个步骤依赖于哪些先前定义的量,\(\widehat{\operatorname{val} }\) 存储每个节点的推断数值,而 \(\hat{a}\) 是提取的最终答案
    • 解析器将解答分割为“定义 … 为 …”的步骤,从每个步骤使用的变量推断其依赖关系,并评估步骤中最后一个可计算的算术表达式(如果需要则回退到最后一个数字字面量)以获得数值。这产生了与 gold dependency graph 对齐的模型推理轨迹的图级表示
  • 令 gold graph 为下面的形式,具有节点集 \(\mathcal{V}\)、边集 \(\mathcal{E}\) 和值映射 \(\operatorname{val}\):
    $$
    \mathcal{G}=(\mathcal{V},\mathcal{E},\operatorname{val}), \qquad a^{*},
    $$
  • 论文在 Step-level 评估推理过程,对于每个黄金节点 \(v \in \mathcal{V}\),定义一个每步骤正确性指示器:
    $$
    s(v;\hat{\mathcal{G} },\mathcal{G})=\begin{cases}
    1, &\text{If } v \in \hat{\mathcal{V} },\ \operatorname{pa}_{\hat{\mathcal{G} } }(v)=\operatorname{pa}_{\mathcal{G} }(v),\ \text{and} \\
    &\operatorname{val}(v),\widehat{\operatorname{val} }(v) \ \text{are both defined and } \widehat{\operatorname{val} }(v)= \operatorname{val}(v),\
    0, &\text{otherwise},
    \end{cases}
    $$
    • 其中 \(\operatorname{pa}_{\mathcal{G} }(v)\) 和 \(\operatorname{pa}_{\hat{\mathcal{G} } }(v)\) 分别表示黄金图和预测图中 \(v\) 的父节点集(依赖关系)
    • 缺失节点、不正确的依赖集或不匹配的数值都会导致 \(s(v;\hat{\mathcal{G} },\mathcal{G})=0\)
  • 论文将预测推理轨迹的 过程准确率(process accuracy) 定义为所有黄金节点的平均 Step-level 准确率:
    $$
    \text{ProcessAcc}(\hat{\mathcal{G} };\mathcal{G})=\frac{1}{|\mathcal{V}|}\sum_{v\in\mathcal{V} }s(v;\hat{\mathcal{G} },\mathcal{G}).
    $$
    • 允许额外的预测节点 \(v \in \hat{\mathcal{V} } \setminus \mathcal{V}\),它们不影响过程准确率;它们对应于冗余但兼容的中间步骤
  • 只有当推理图和最终答案都匹配时,预测才被视为完全正确,论文通过验证正确性(verified correctness)来形式化这一点:
    $$
    \text{VerifiedCorrect}(\hat{a},\hat{\mathcal{G} };,a^{*},\mathcal{G})=\begin{cases}
    1, &\text{IF ProcessAcc}(\hat{\mathcal{G} };\mathcal{G})=1\text{ and }\hat{a}=a^{*},\
    0, &\text{otherwise}.
    \end{cases}
    $$
  • Accordingly,本工作中报告的所有 pass@k 指标(例如,pass@1、pass@128)仅当模型满足下面两个条件,才将样本视为正确
    • (i) 正确预测了每个黄金步骤( Step-level 过程准确率 = 1)
    • (ii) 产生了正确的最终答案时
    • 这个严格的标准确保报告的收益反映了真实、可靠的推理,而非偶然的正确性

附录 A.5 第 3 节的 Training Dynamics (Training Dynamics for § 3)

  • 本节详细分析了不同 Post Training 方法在外推泛化中的 Training Dynamics
  • 跨评估范围的负对数似然减少(NLL Reduction Across Evaluation Ranges).
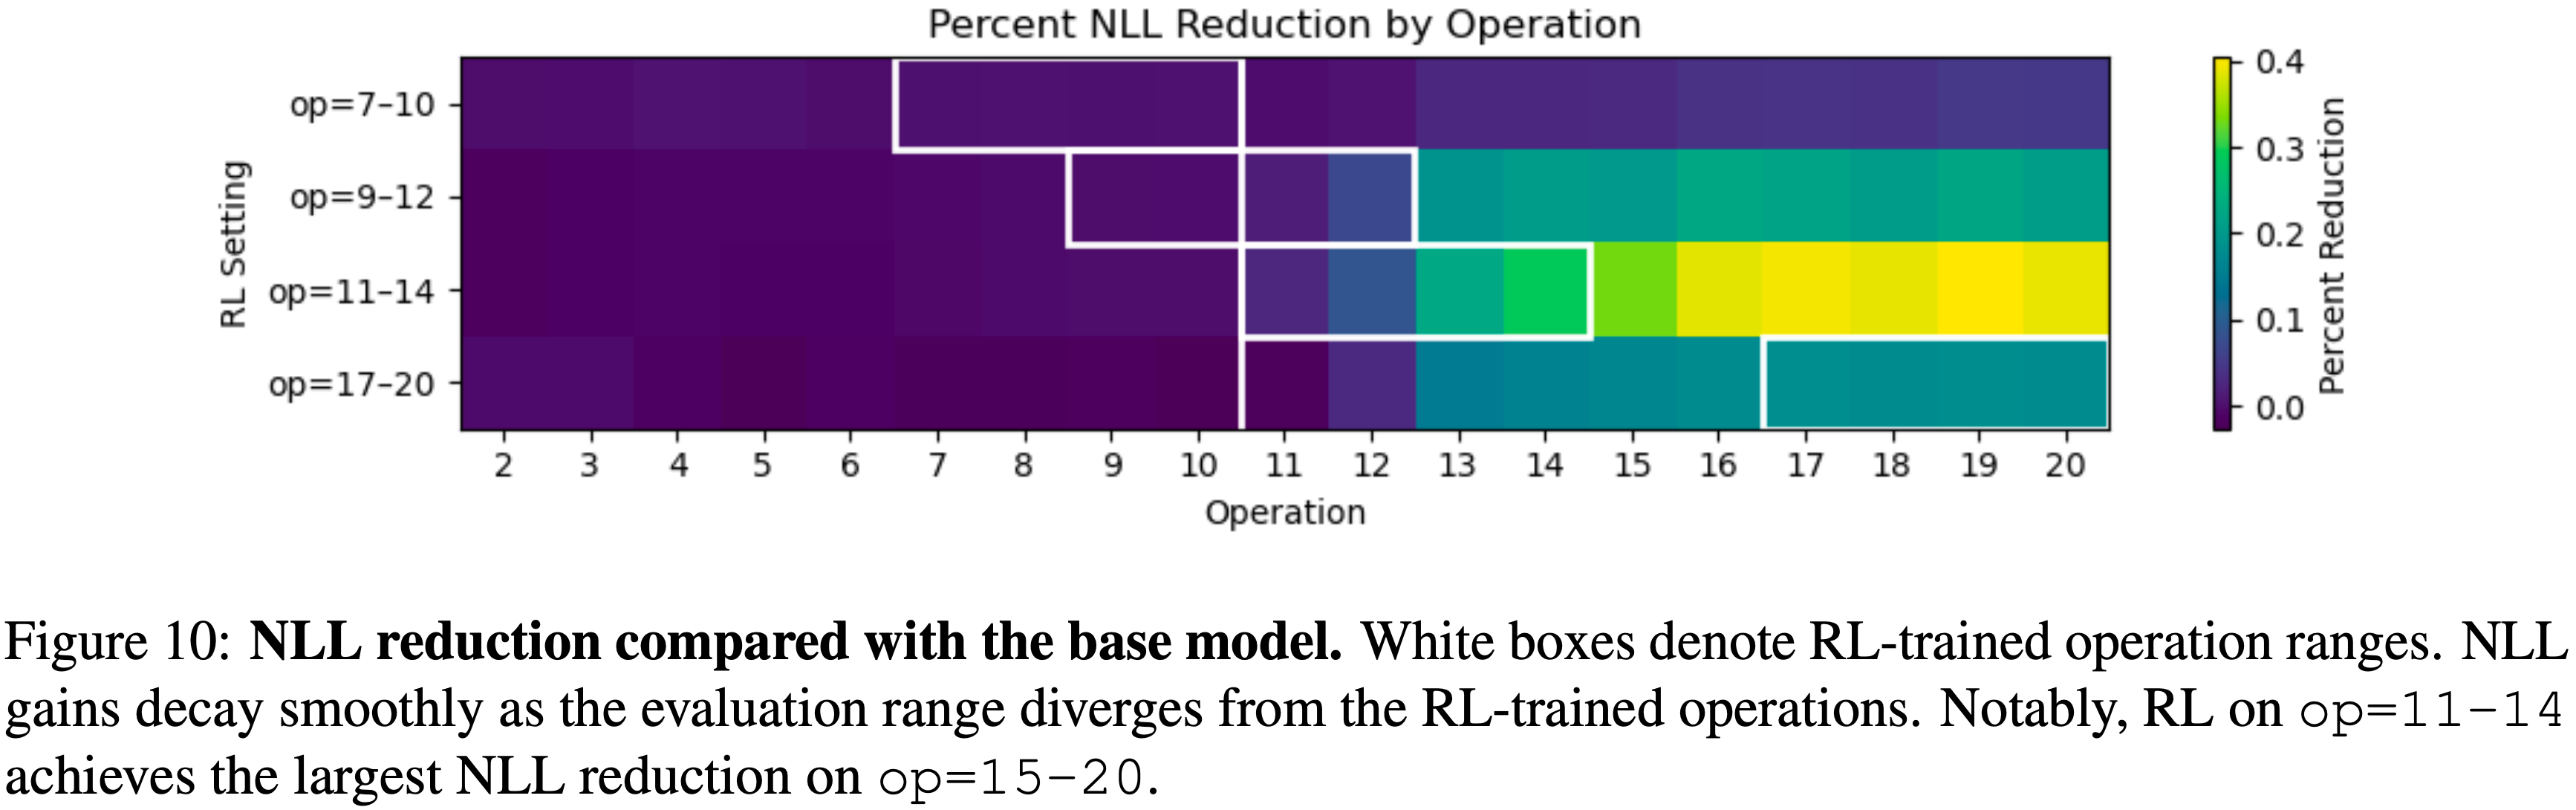
    • 论文分析了第 3 节中使用的不同 Post Training 方法及其对各种评估运算范围的负对数似然减少的影响
  • 从图 10 我们可以观察到:
    • Post Training 持续减少了所有评估范围的负对数似然,其中在 op=11-14 范围内获得了最显著的增益
    • 这表明模型有效地学会了组合原子技能以处理更复杂的问题
  • Post-training Dynamics
    • 论文进一步研究了不同 Post Training 方法期间奖励动态的变化
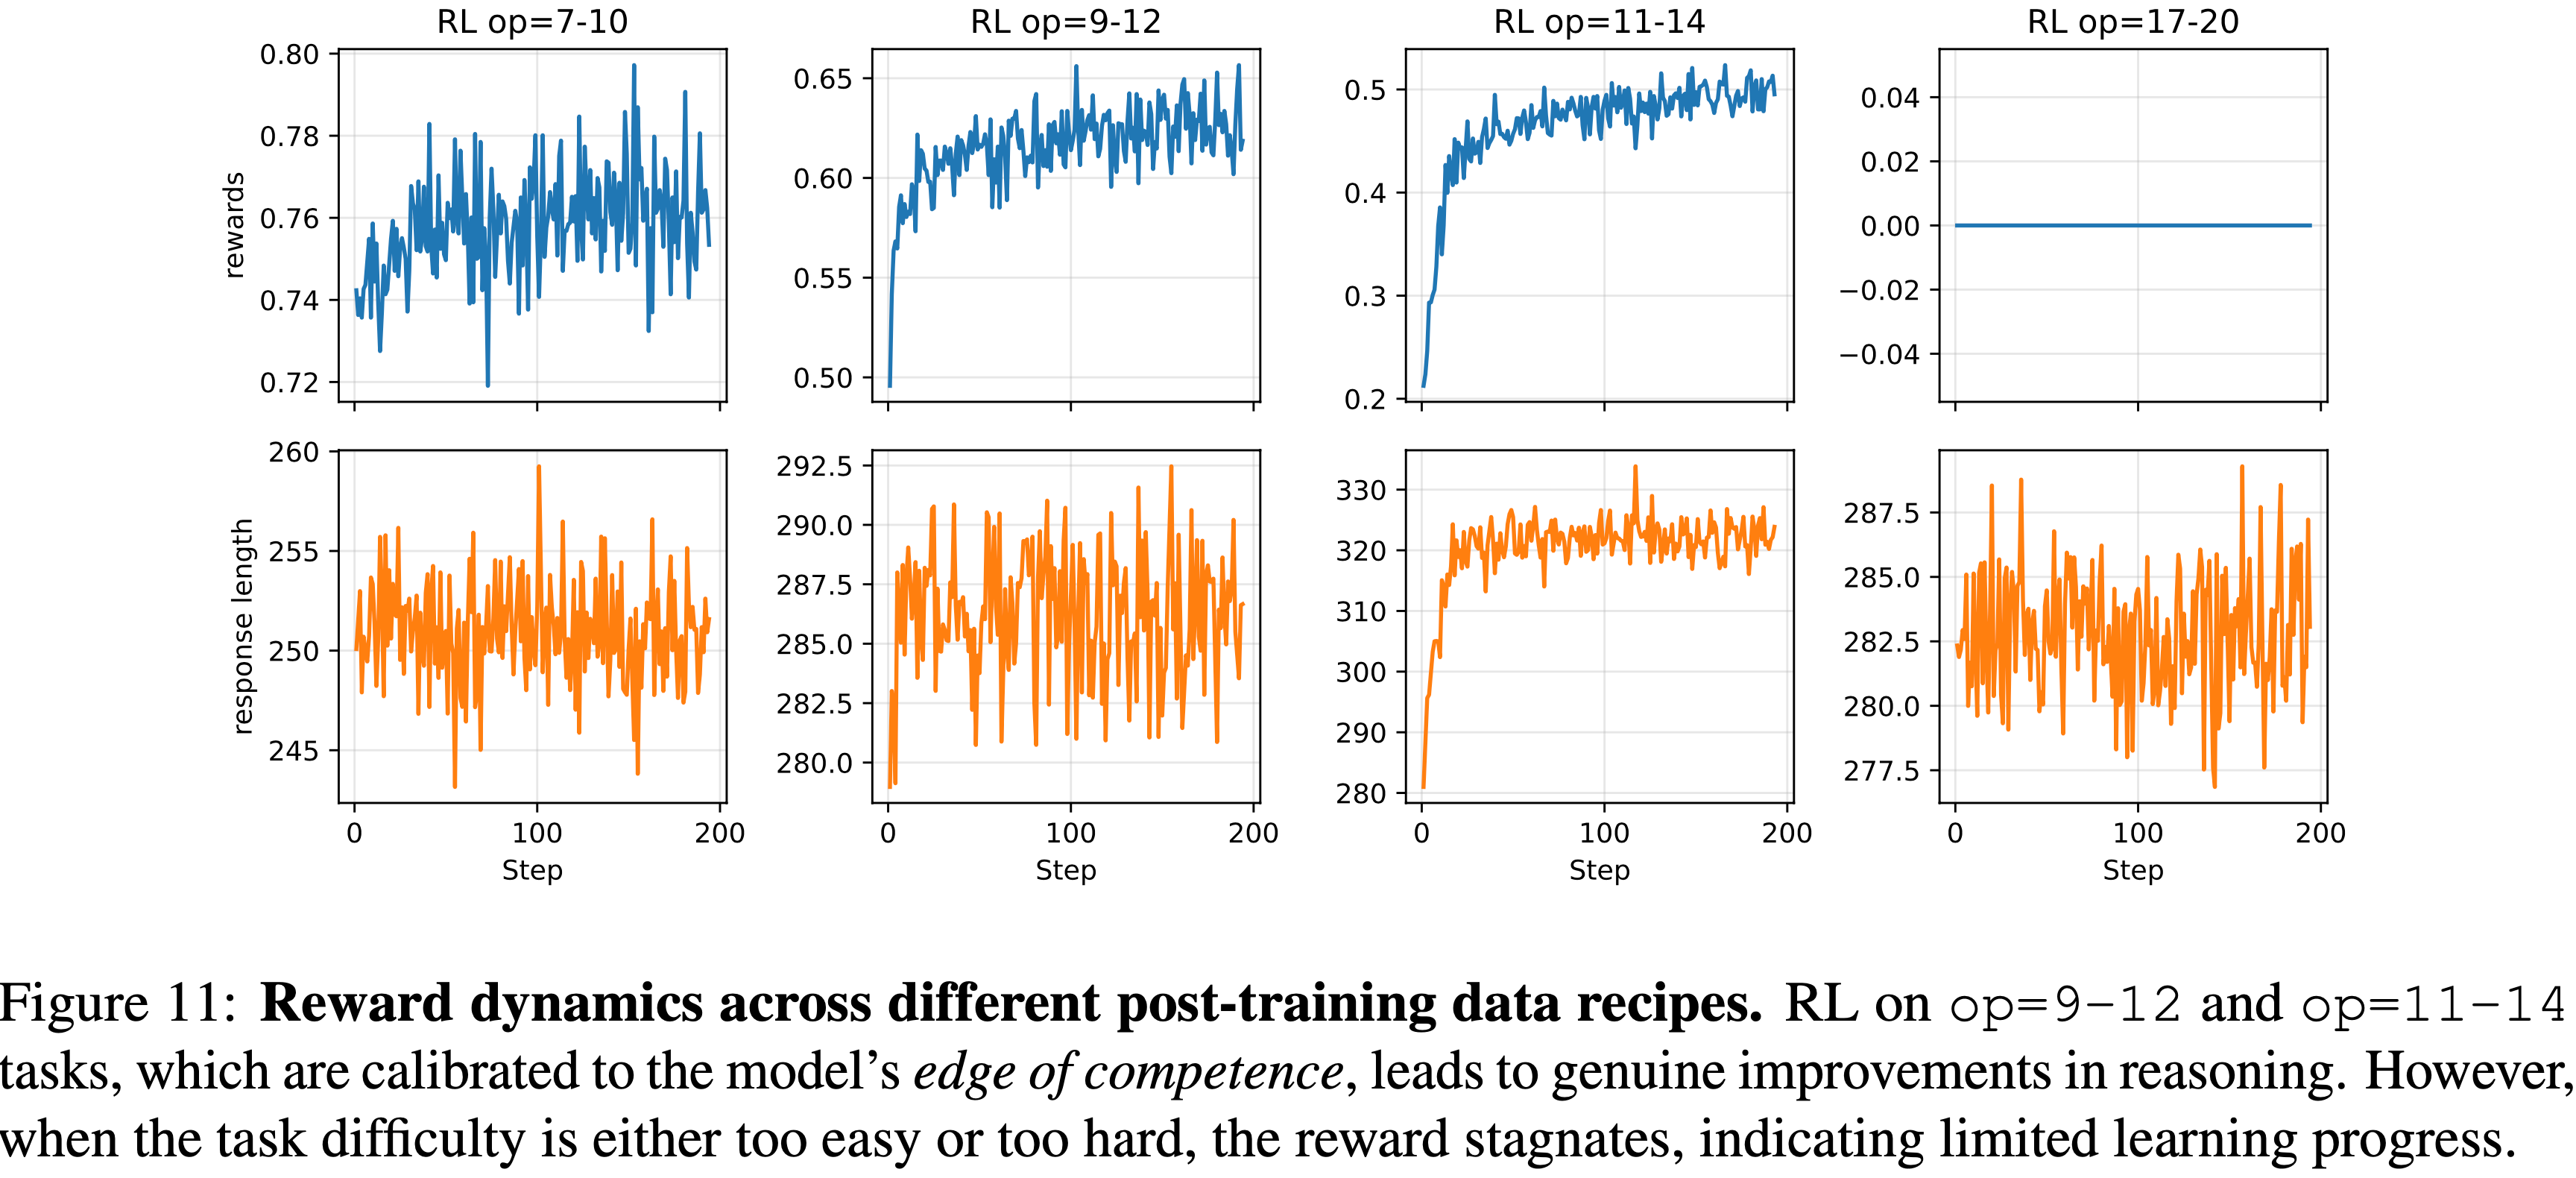
    • 从图 11 论文观察到
      • 在与模型能力边缘对齐的任务(op=9-12 和 op=11-14)上进行 Post Training 会带来显著的奖励提升,表明学习有效
      • 相反,当任务太简单(op=7-10)或太难(op=17-20)时,奖励会趋于平稳,表明在这些机制下学习进展有限

附录 A.6:Detailed Analysis of Post-Training Effects on Contextual Generalization

  • 在本节中,论文将详细分析不同的 Post Training 数据方案在给定 Pre-training 阶段原子推理原语的情况下,如何影响对长尾上下文(long-tailed contexts)的上下文泛化

附录 A.6.1 当推理原语在 Pre-training 中共享时 (When Reasoning Primitives are Shared During Pre-Training)

  • 除了掌握基本的推理技能,模型泛化的一个重要维度在于上下文泛化 (contextual generalization) ,即跨不同问题上下文(例如变化的表面叙事或领域)迁移所学推理行为的能力
  • 在本节中,论文研究 Post Training 是否能激励模型将推理能力泛化到长尾 (long-tailed) 或在 Pre-training 中极少观察到的上下文
Task Setting
  • 论文研究两个不同的问题上下文:一个频繁的、规范的 Context A 和一个长尾的 Context B ,两者共享相同的基础推理先验(在论文的例子中是逻辑-算术推理,详细的上下文设置见附录 A.9)
  • Pre-training 语料由 99.9% 的 Context A(op=2-20)和仅 0.1% 的 Context B(op=2-20)组成
  • 在 Post Training 期间,论文在 200K 个样本中改变对 Context B 的暴露比例:0%、2%、10%、50% 和 100%
Summary 5
Observation 5
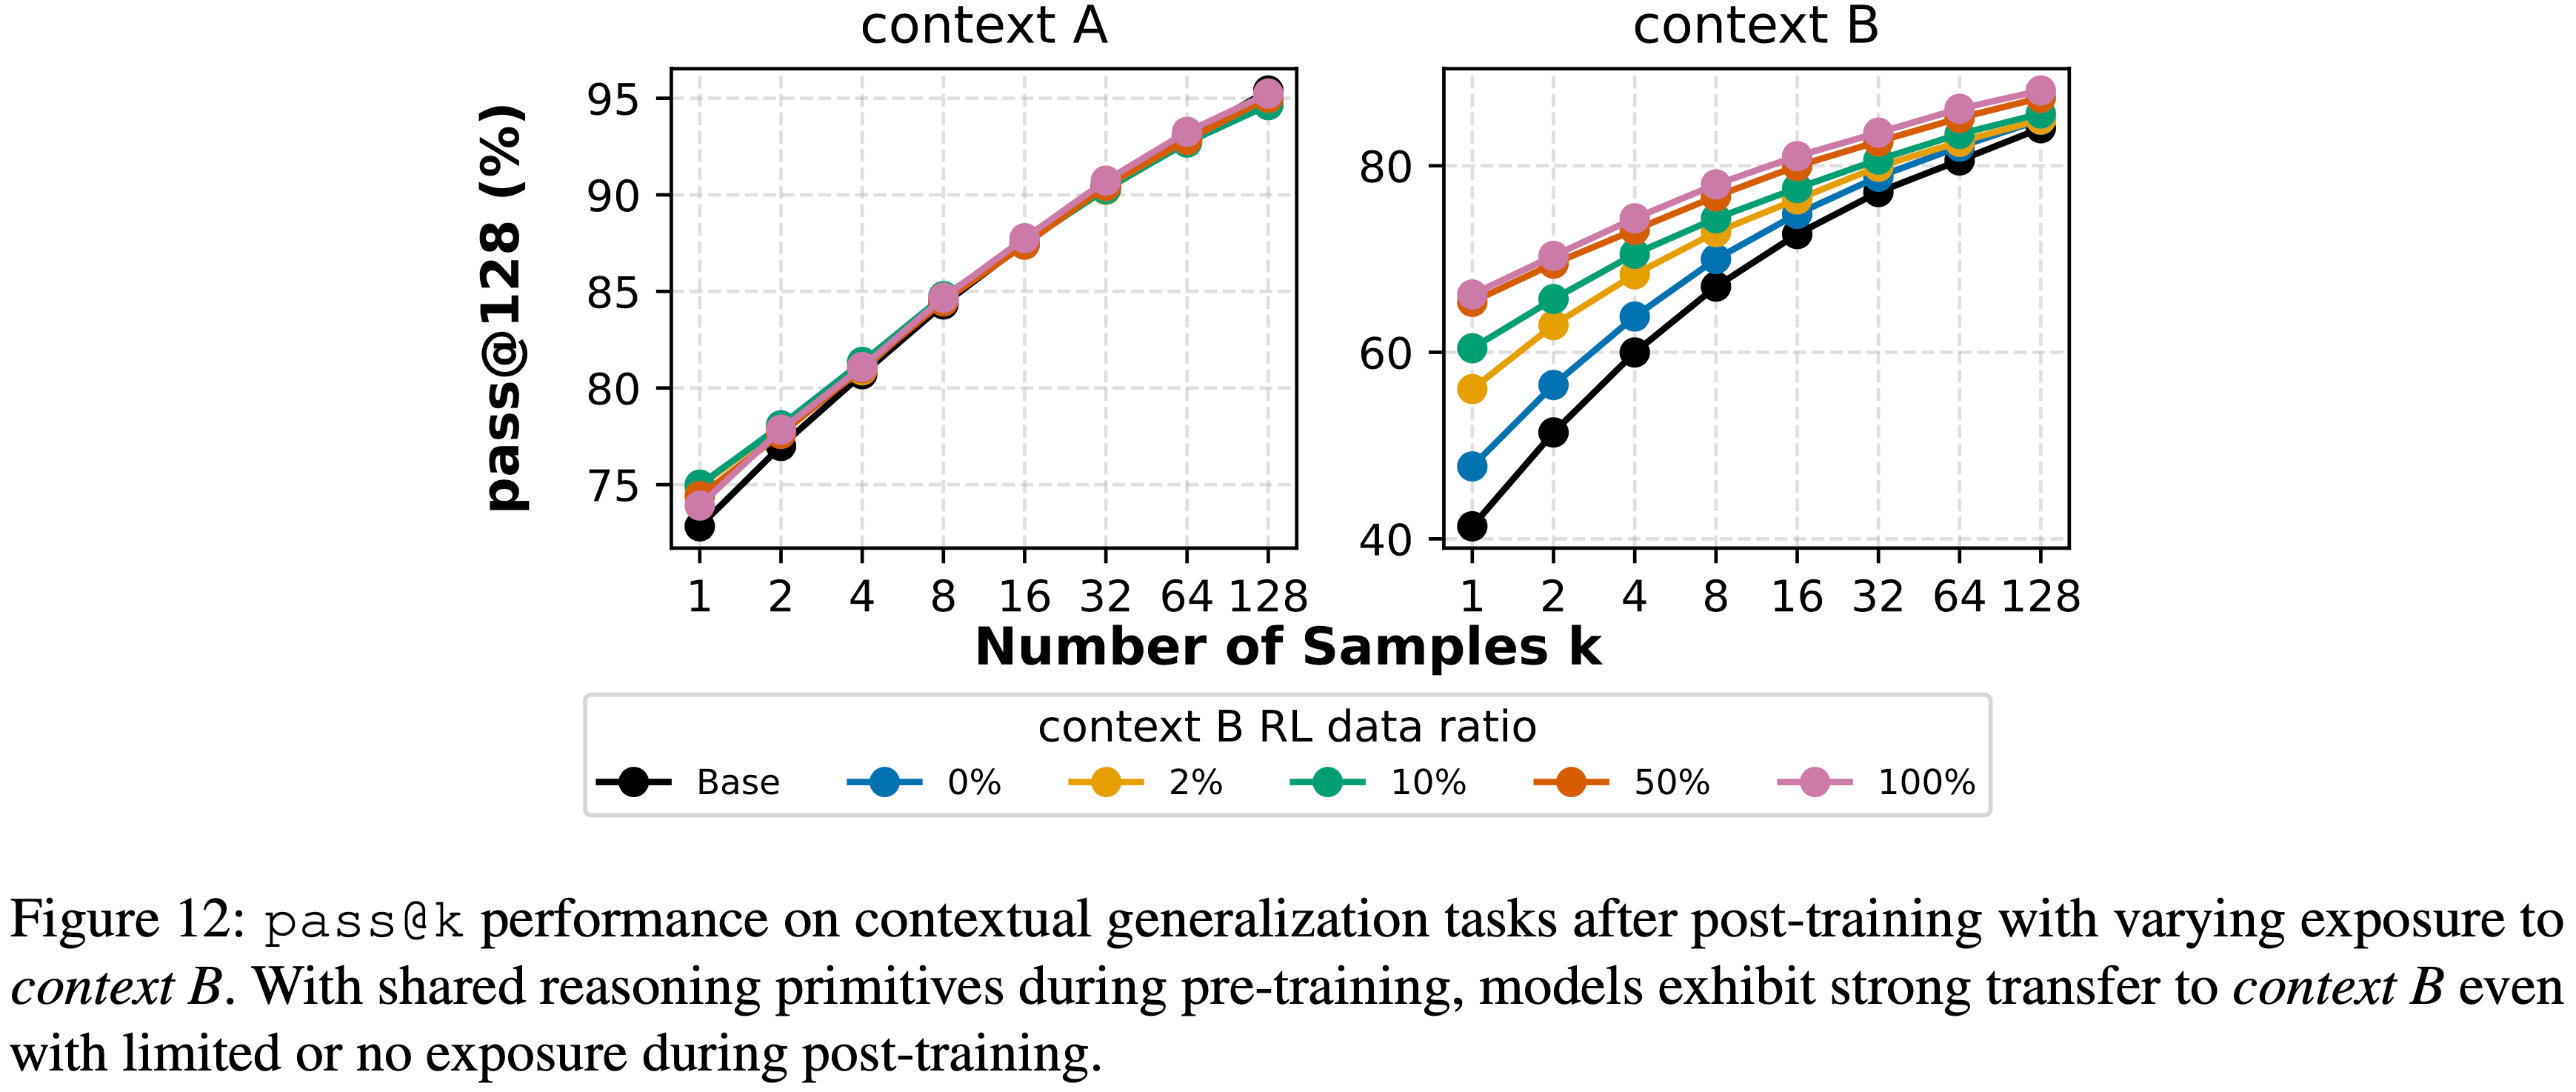
  • 当 Pre-training 中共享推理原语时, Post Training 期间对 Context B 的暴露程度与模型在 Context B 上的性能呈正相关
  • Notably,即使在 Post Training 期间完全没有暴露于 Context B(0%),模型仍能实现显著的迁移,这突显了共享原语在实现上下文泛化中的作用
Takeaway 5
  • 当原子原语被共享时, Post Training 可以激励模型向长尾上下文泛化
  • Remarkably,即使 Post Training 对 Context B 的暴露为 0%,模型也能实现实质性的迁移,这凸显了 Pre-training 阶段共享推理结构的关键作用
  • 图 12:
    • 经过 Post Training (对 Context B 的暴露比例不同)后,在上下文泛化任务上的 pass@k 性能
    • 当 Pre-training 中共享推理原语时,即使在后续 Mid-training 对 Context B 的暴露有限或为零,模型也表现出向 Context B 的强迁移能力

附录 A.6.2 当 Pre-training 中仅暴露原子原语时 (When Only Atomic Primitives are Exposed During Pre-Training)

  • 本节研究当 Base Model 在 Pre-training 中仅暴露于长尾上下文的基本原子原语(basic atomic primitives)时的上下文泛化
Task Setting
  • 使用与上述相同的上下文数据分布,论文在 Pre-training 期间将 Context B 的数据限制为仅包含原子操作,而 Context A 则覆盖全范围操作
  • Pre-training 语料由 99% 的 Context A(op=2-20)和仅 1% 的 Context B 组成,且 Context B 仅限于原子操作(op=2)
    • Thus,模型主要通过 Context A 学习推理结构,而对 Context B 的 surface forms 仅有极少的暴露
    • 在 Post Training 期间,论文使用 200K 个样本进行 RL 微调,其中 Context B 数据的比例在五个方案中变化:0%、1%、10%、50% 和 100%
    • 详细的数据方案见附录 A.9
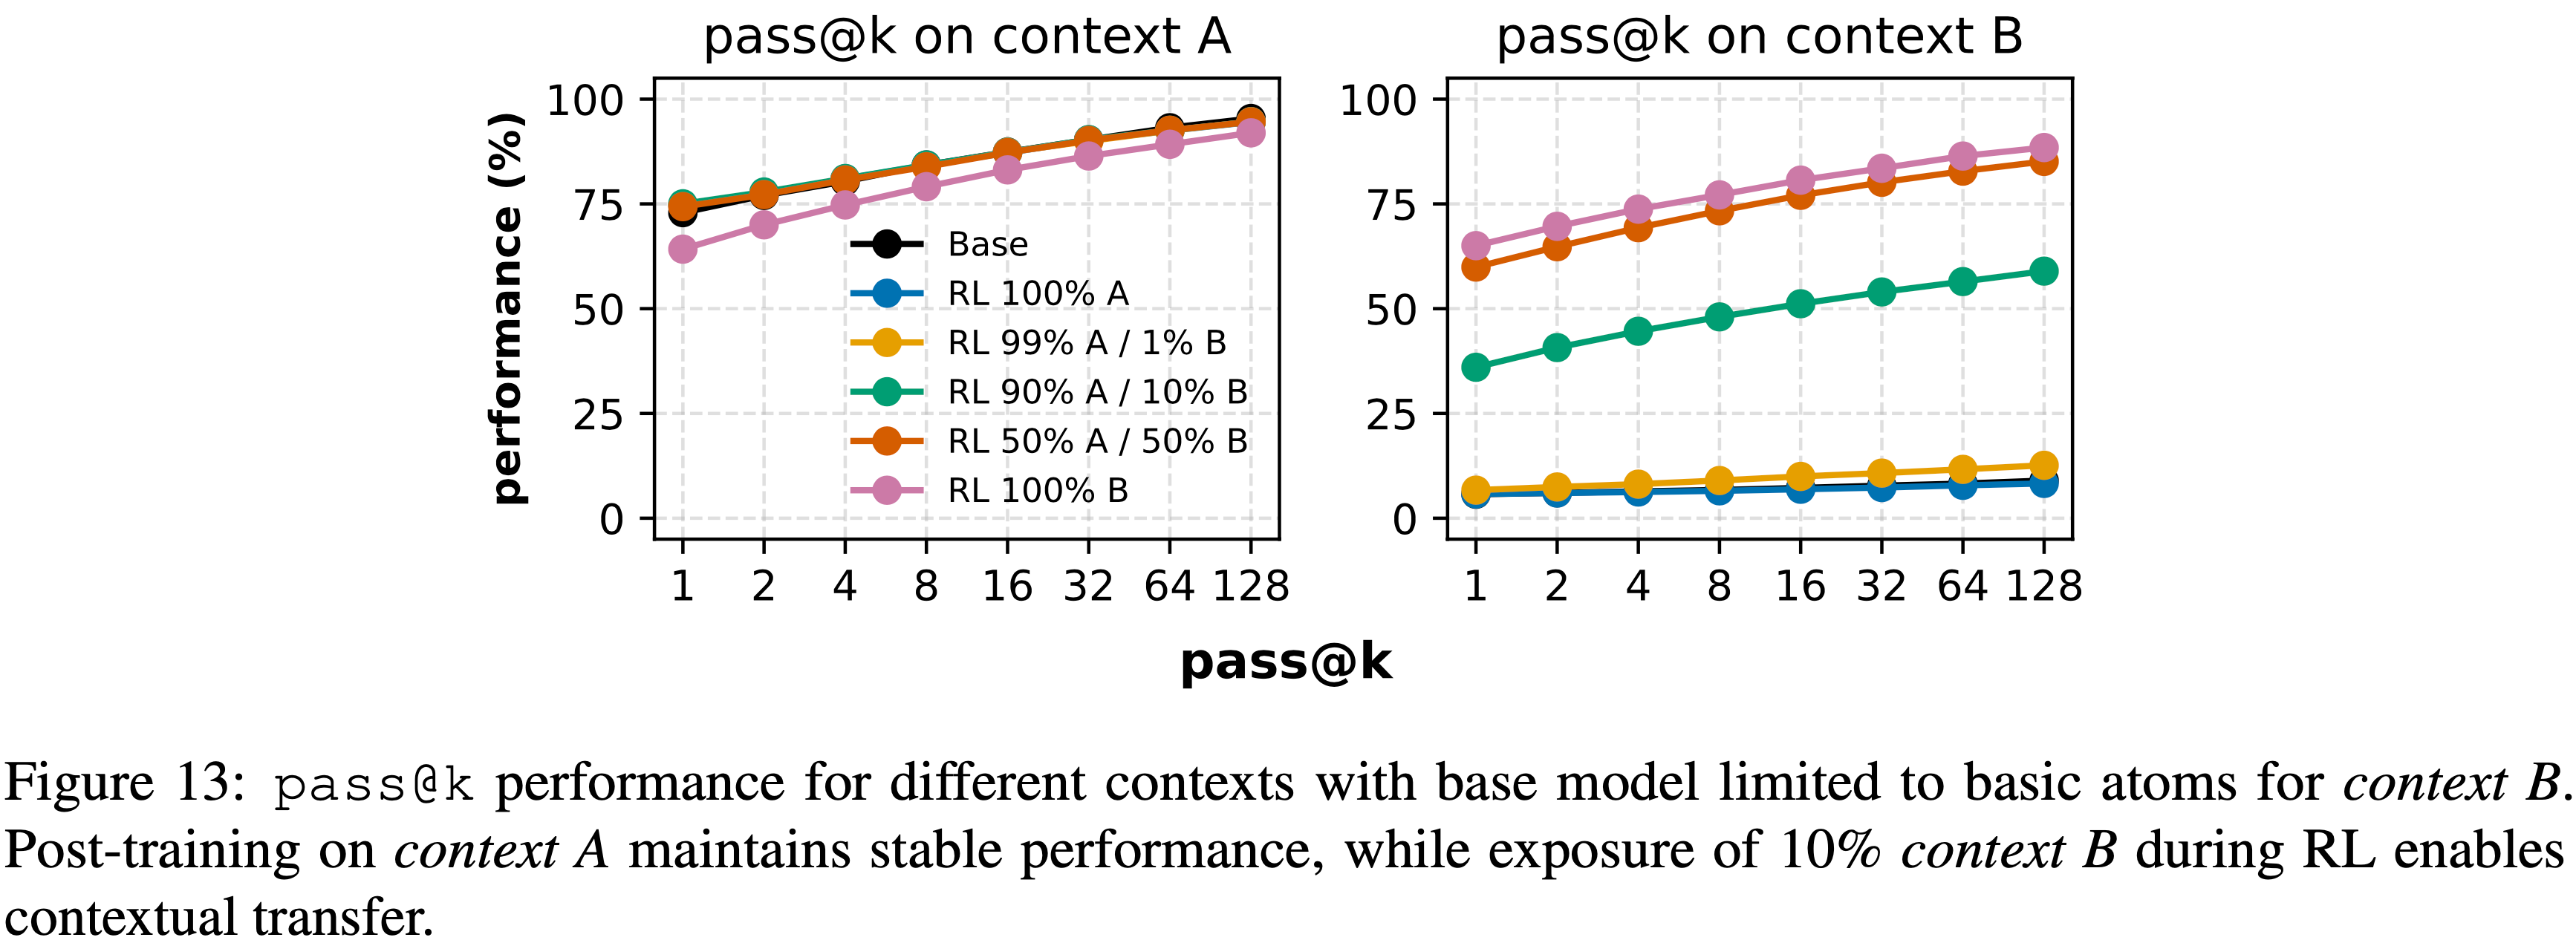
  • 如图 13 所示:
    • 仅在 Context A 上进行 Post Training 或对 Context B 的暴露极其稀疏(0-1%)时,模型在 Context A 内保持强劲性能,但对长尾 Context B 的迁移极小
      • 理解:这里的 1% 和前面提到的 1% 覆盖是不同的,不然就矛盾了
    • However,一旦引入少量 Context B 数据(约占总体样本的 10%)Context B 的性能急剧提升,pass@128 准确率增加超过 +76 点
    • 进一步增加 Context B 数据的比例(50%、100%)带来的增益递减,表明一旦提供了最小的监督,RL 就能快速建立起稳健的跨上下文推理
    • Notably,即使 Post Training 使用100% Context B 数据(与主要的 Pre-training 上下文完全不同)模型在 Context A 上的性能仍然保持稳定
      • 这表明 RL 使模型能够学习可迁移的推理策略,这些策略可以跨 surface forms 进行扩展,同时保留在先前已掌握上下文中的能力
      • 理解:这里再次说明了 RL 的训练过程是很少发生灾难性遗忘的
  • 图 13:
    • Base Model 在 Context B 仅限于基础原子操作时的 pass@k 性能
    • 仅在 Context A 上进行 Post Training 能保持稳定性能,而在 RL 中引入 10% 的 Context B 数据则能实现上下文迁移

A.6.3 Training Dynamics for § A.6.2

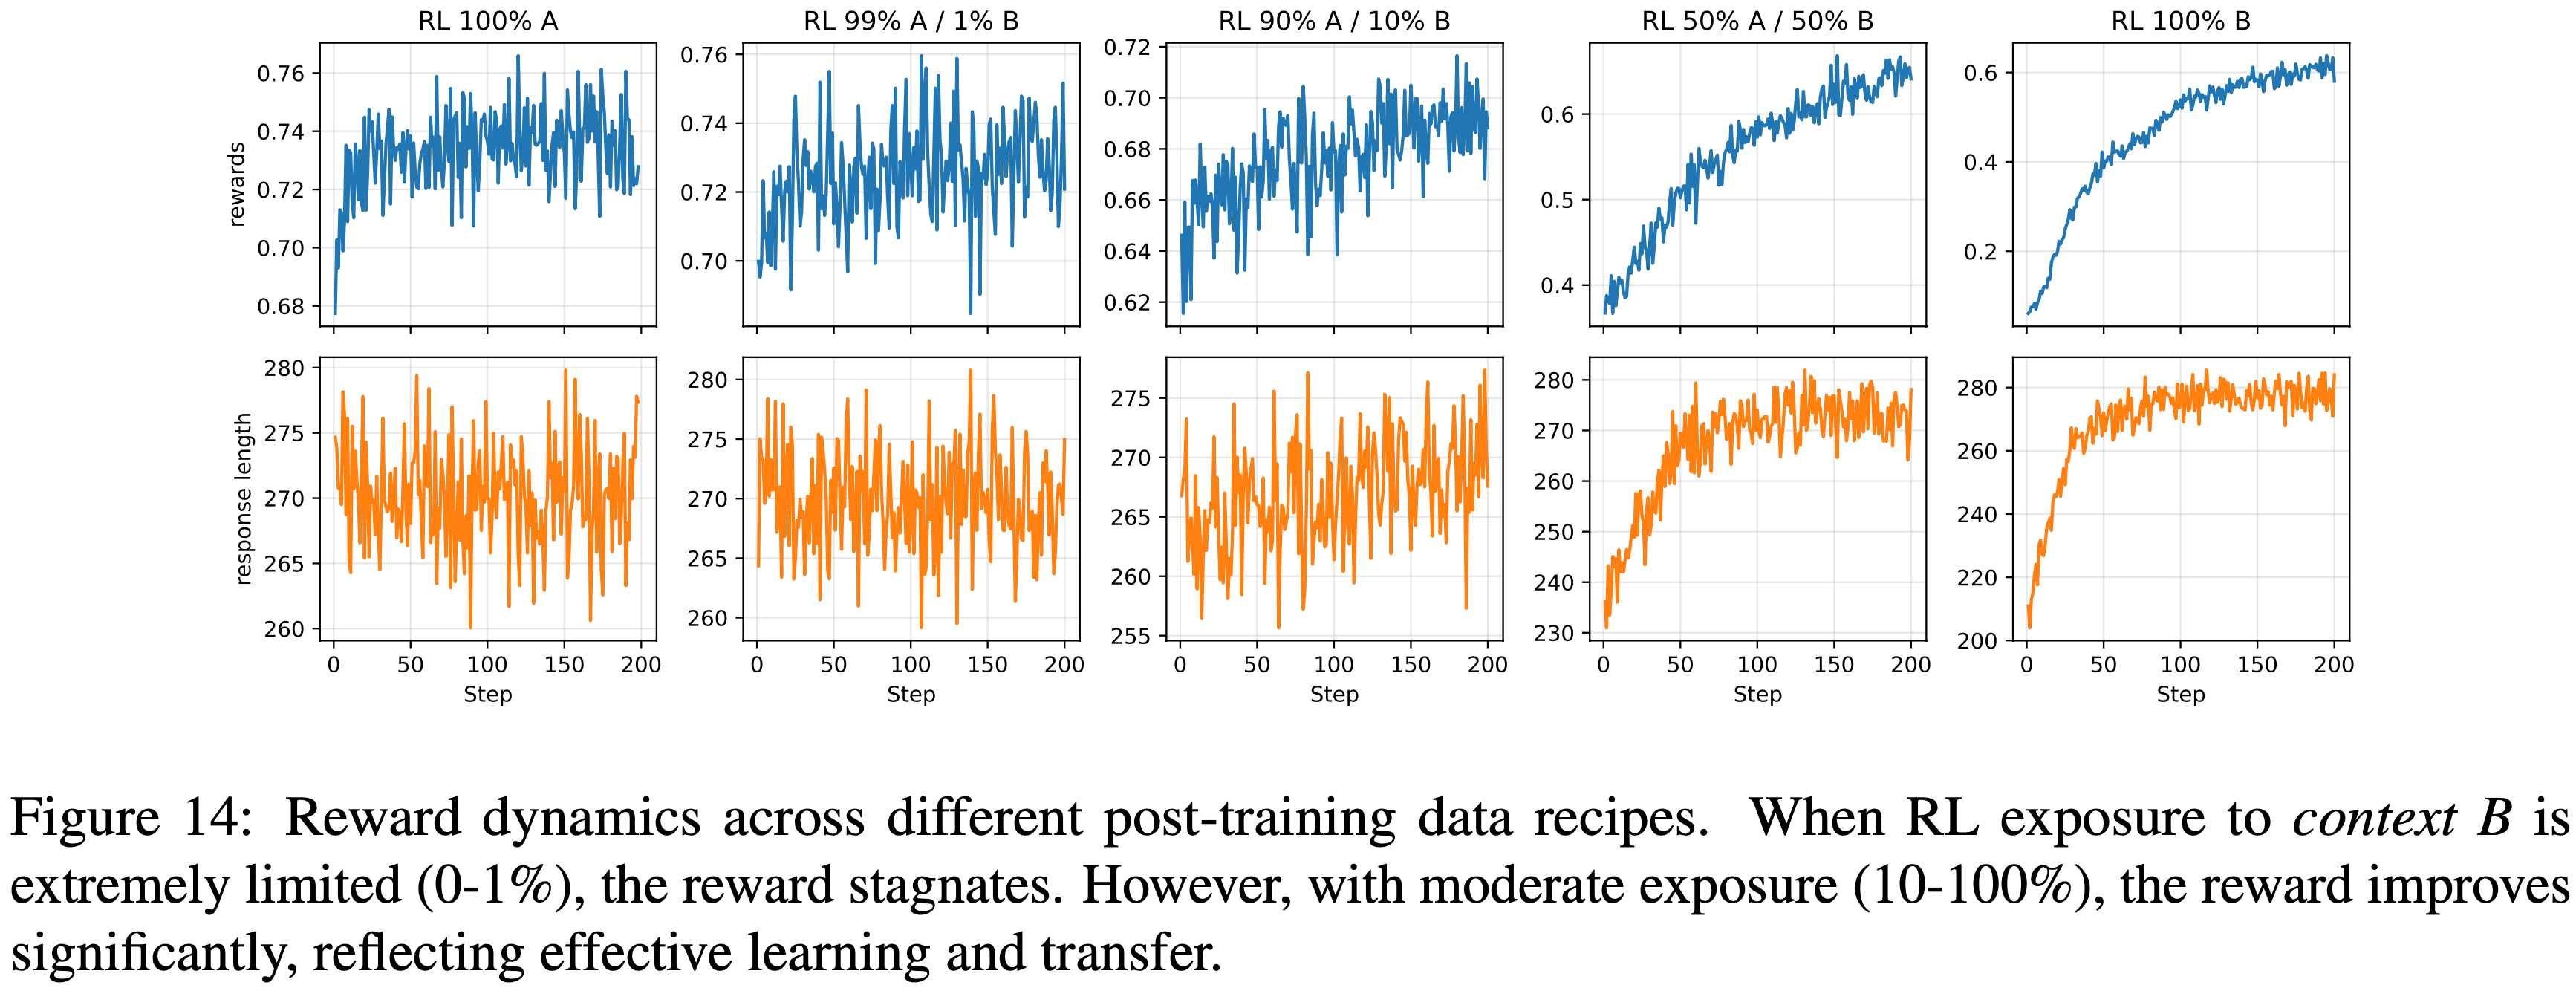
  • 本节绘制了 § A.6.2 中使用的不同数据方案下的 Post Training 奖励动态,以进一步理解 RL 期间对长尾上下文的暴露程度变化如何影响学习进展
  • 从图 14 中我们可以观察到
    • 当 Post Training 期间对 Context B 的暴露极其有限(0-1%)时,奖励趋于平稳,表明学习进展甚微
    • 然而,在适度暴露(10-100%)下,奖励显著提升,反映了有效的学习和对长尾上下文的迁移
  • 图 14:
    • 不同 Post Training 数据方案下的奖励动态
    • 当 RL 对 Context B 的暴露极其有限(0-1%)时,奖励停滞不前
    • 然而,在适度暴露(10-100%)下,奖励显著提升,反映了有效的学习和迁移

附录 A.7 Detailed Analysis of Pre-Training Effects on Extrapolative Generalization**

  • Pre-training 定义了 Post Training 后期可以组合和扩展的原子推理原语
    • 如果 Base Model 在 Pre-training 期间已经遇到中等复杂的问题, Post Training 可能会将这些原语推向更深层的组合推理
    • Otherwise,Post Training 可能缺乏超越其继承能力范围的探索支架
    • 因此,作者研究不同的 Pre-training 难度如何影响后续的外推泛化

Task Setting

  • 论文将 Post Training 方案固定为来自 op=11-14 范围的 200K 个样本,先前已确定此范围为能力边缘(见图 3)
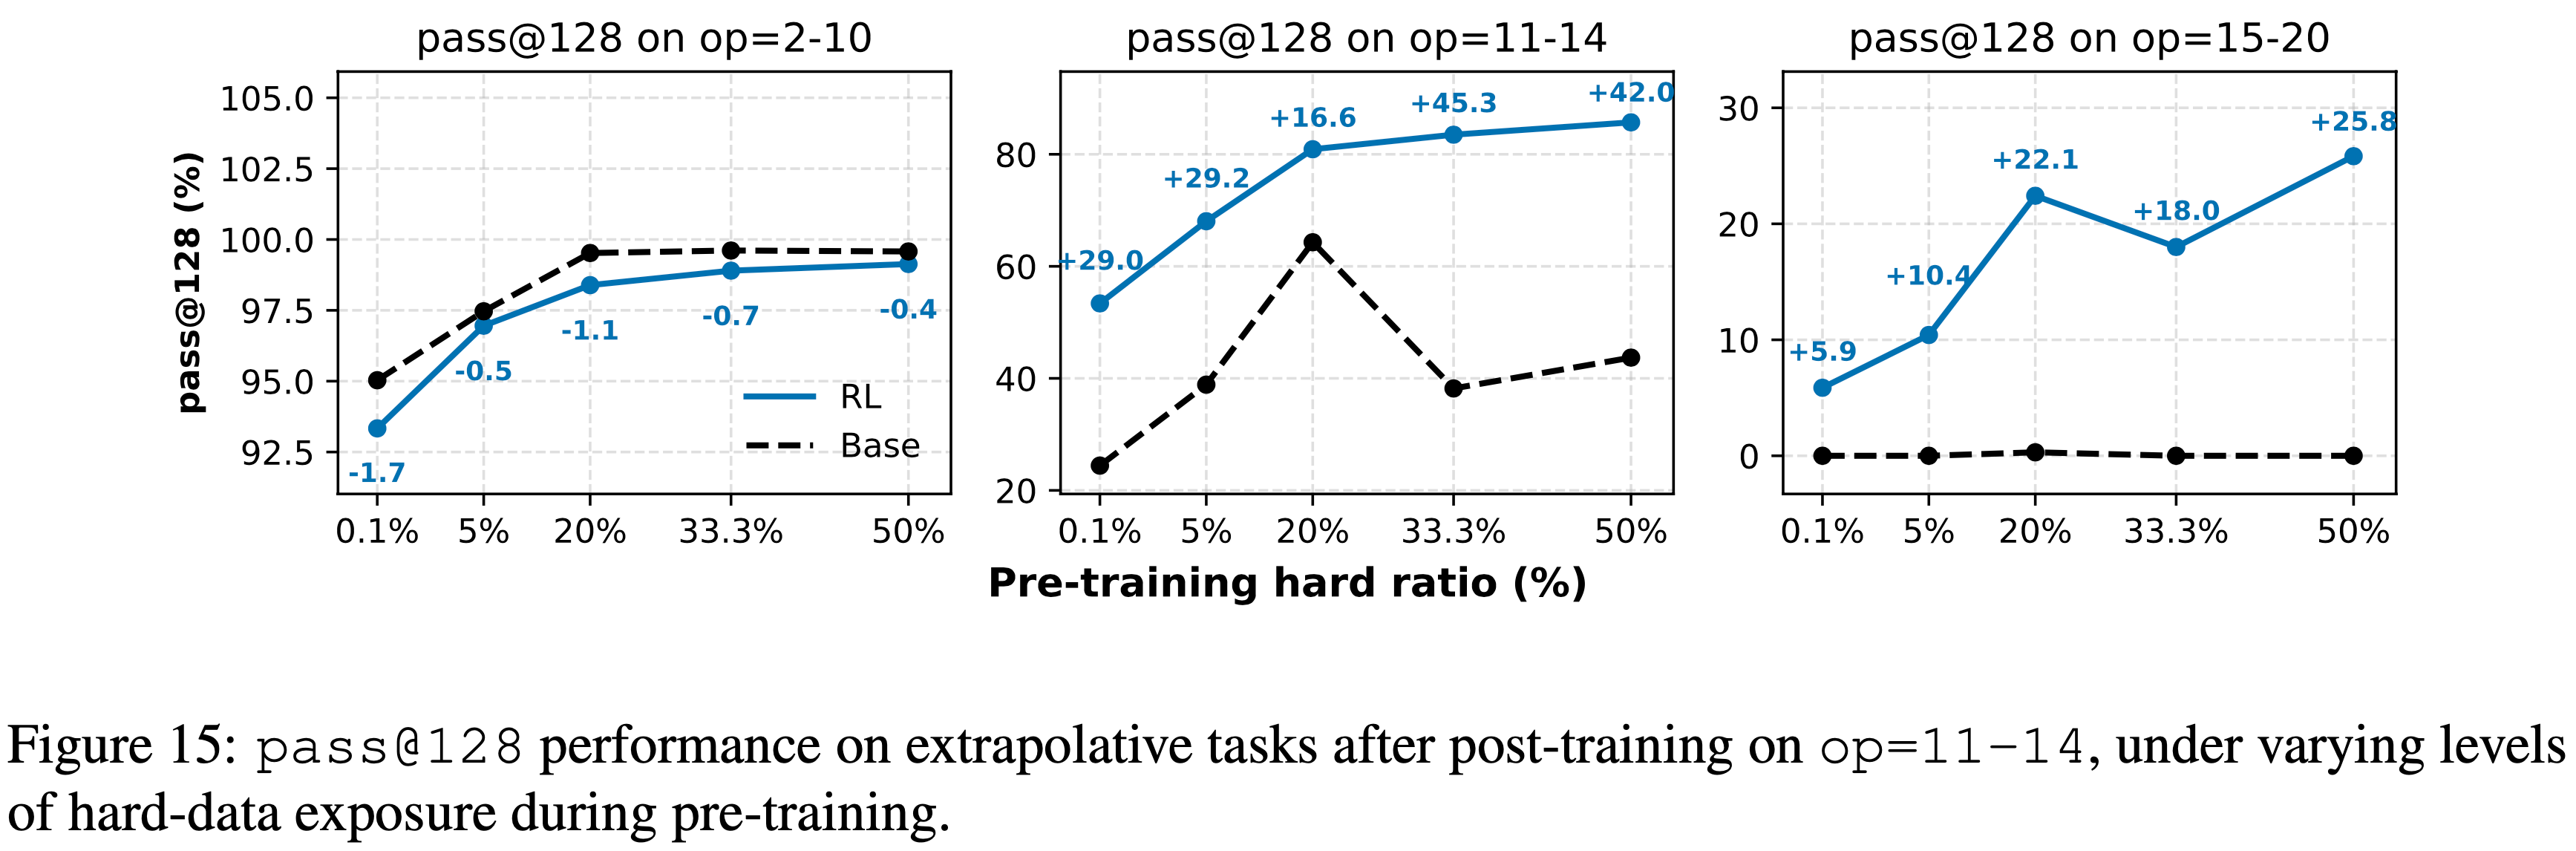
  • 然后改变 Pre-training 期间包含的“困难”数据(op=7-10)的比例,以评估对复杂原语的暴露如何影响 Base Model 在 RL 后的泛化能力
    • (详见附录 A.9 的数据方案)

Summary 7

Observation 7
  • 如图 15 所示
    • 在 Pre-training 中更多地暴露于困难问题,持续地提升了基础和经过 Post Training 的性能
    • However,来自 RL 的边际增益随着 Pre-training 变得更全面而减小
    • 当 Pre-training 已经覆盖了相当一部分中等深度任务时,RL 仅带来适度的改进
    • By contrast,当 Pre-training 包含有限但非平凡的困难原语暴露(例如,20% 的 op=7-10 数据)时,RL 产生了最大的相对提升(将 op=15-20 上的 pass@128 准确率提高了超过 +22 点)
      • 这表明,当模型的先验能力是部分的时候,足够强以支持探索,但又足够不完整以留有发现空间,RL 是最有效的
  • 图 15:在 Pre-training 期间不同困难数据暴露水平下, Post Training (op=11-14)后在外推任务上的 pass@128 性能
Takeaway 7
  • Pre-training 奠定基础,RL 对其进行扩展
    • 在 Pre-training 期间丰富地暴露于组合原语,使 RL 能够将推理深度推到超出 Pre-training 范围
    • 但一旦这些原语被完全掌握,RL 的益处就会逐渐减少,这突显了两个阶段的互补作用

附录 A.7.1:第 A.7 节的 Training Dynamics (Training Dynamics for § A.7)

  • 论文分析了在不同 Pre-training 数据方案下 Post Training 期间的 Training Dynamics
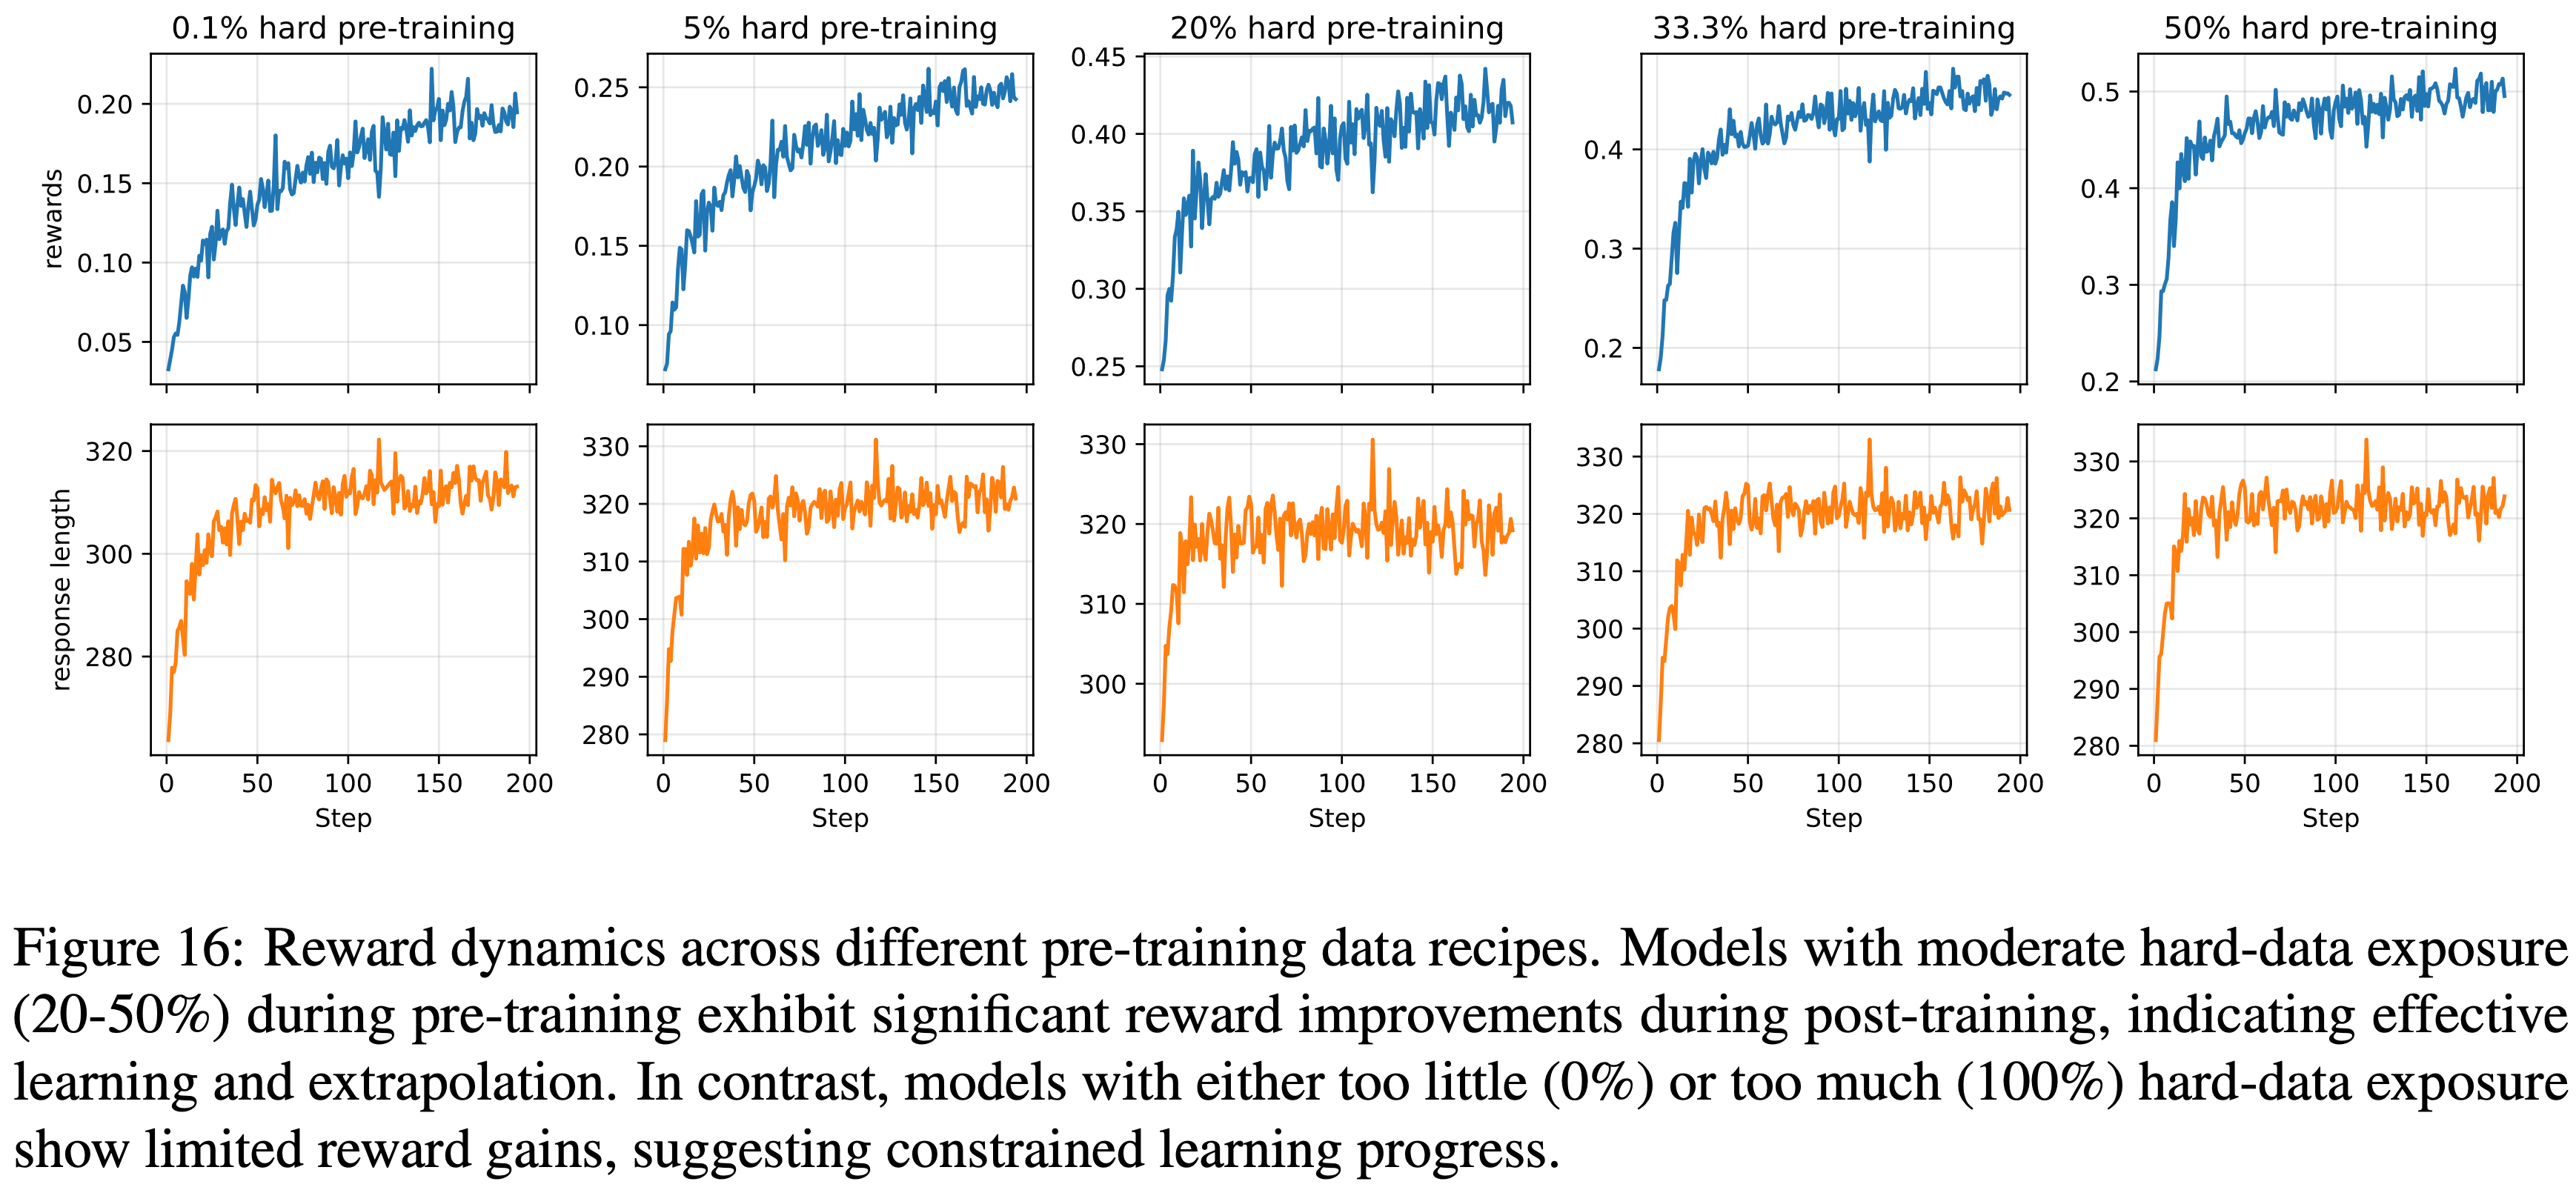
  • 图 16:不同 Pre-training 数据方案下的奖励动态
    • 在 Pre-training 期间有适度困难数据暴露(20-50%)的模型在 Post Training 期间表现出显著的奖励提升,表明有效的学习和外推
    • In contrast,困难数据暴露过少(0%)或过多(100%)的模型显示出有限的奖励增益,表明学习进展受限

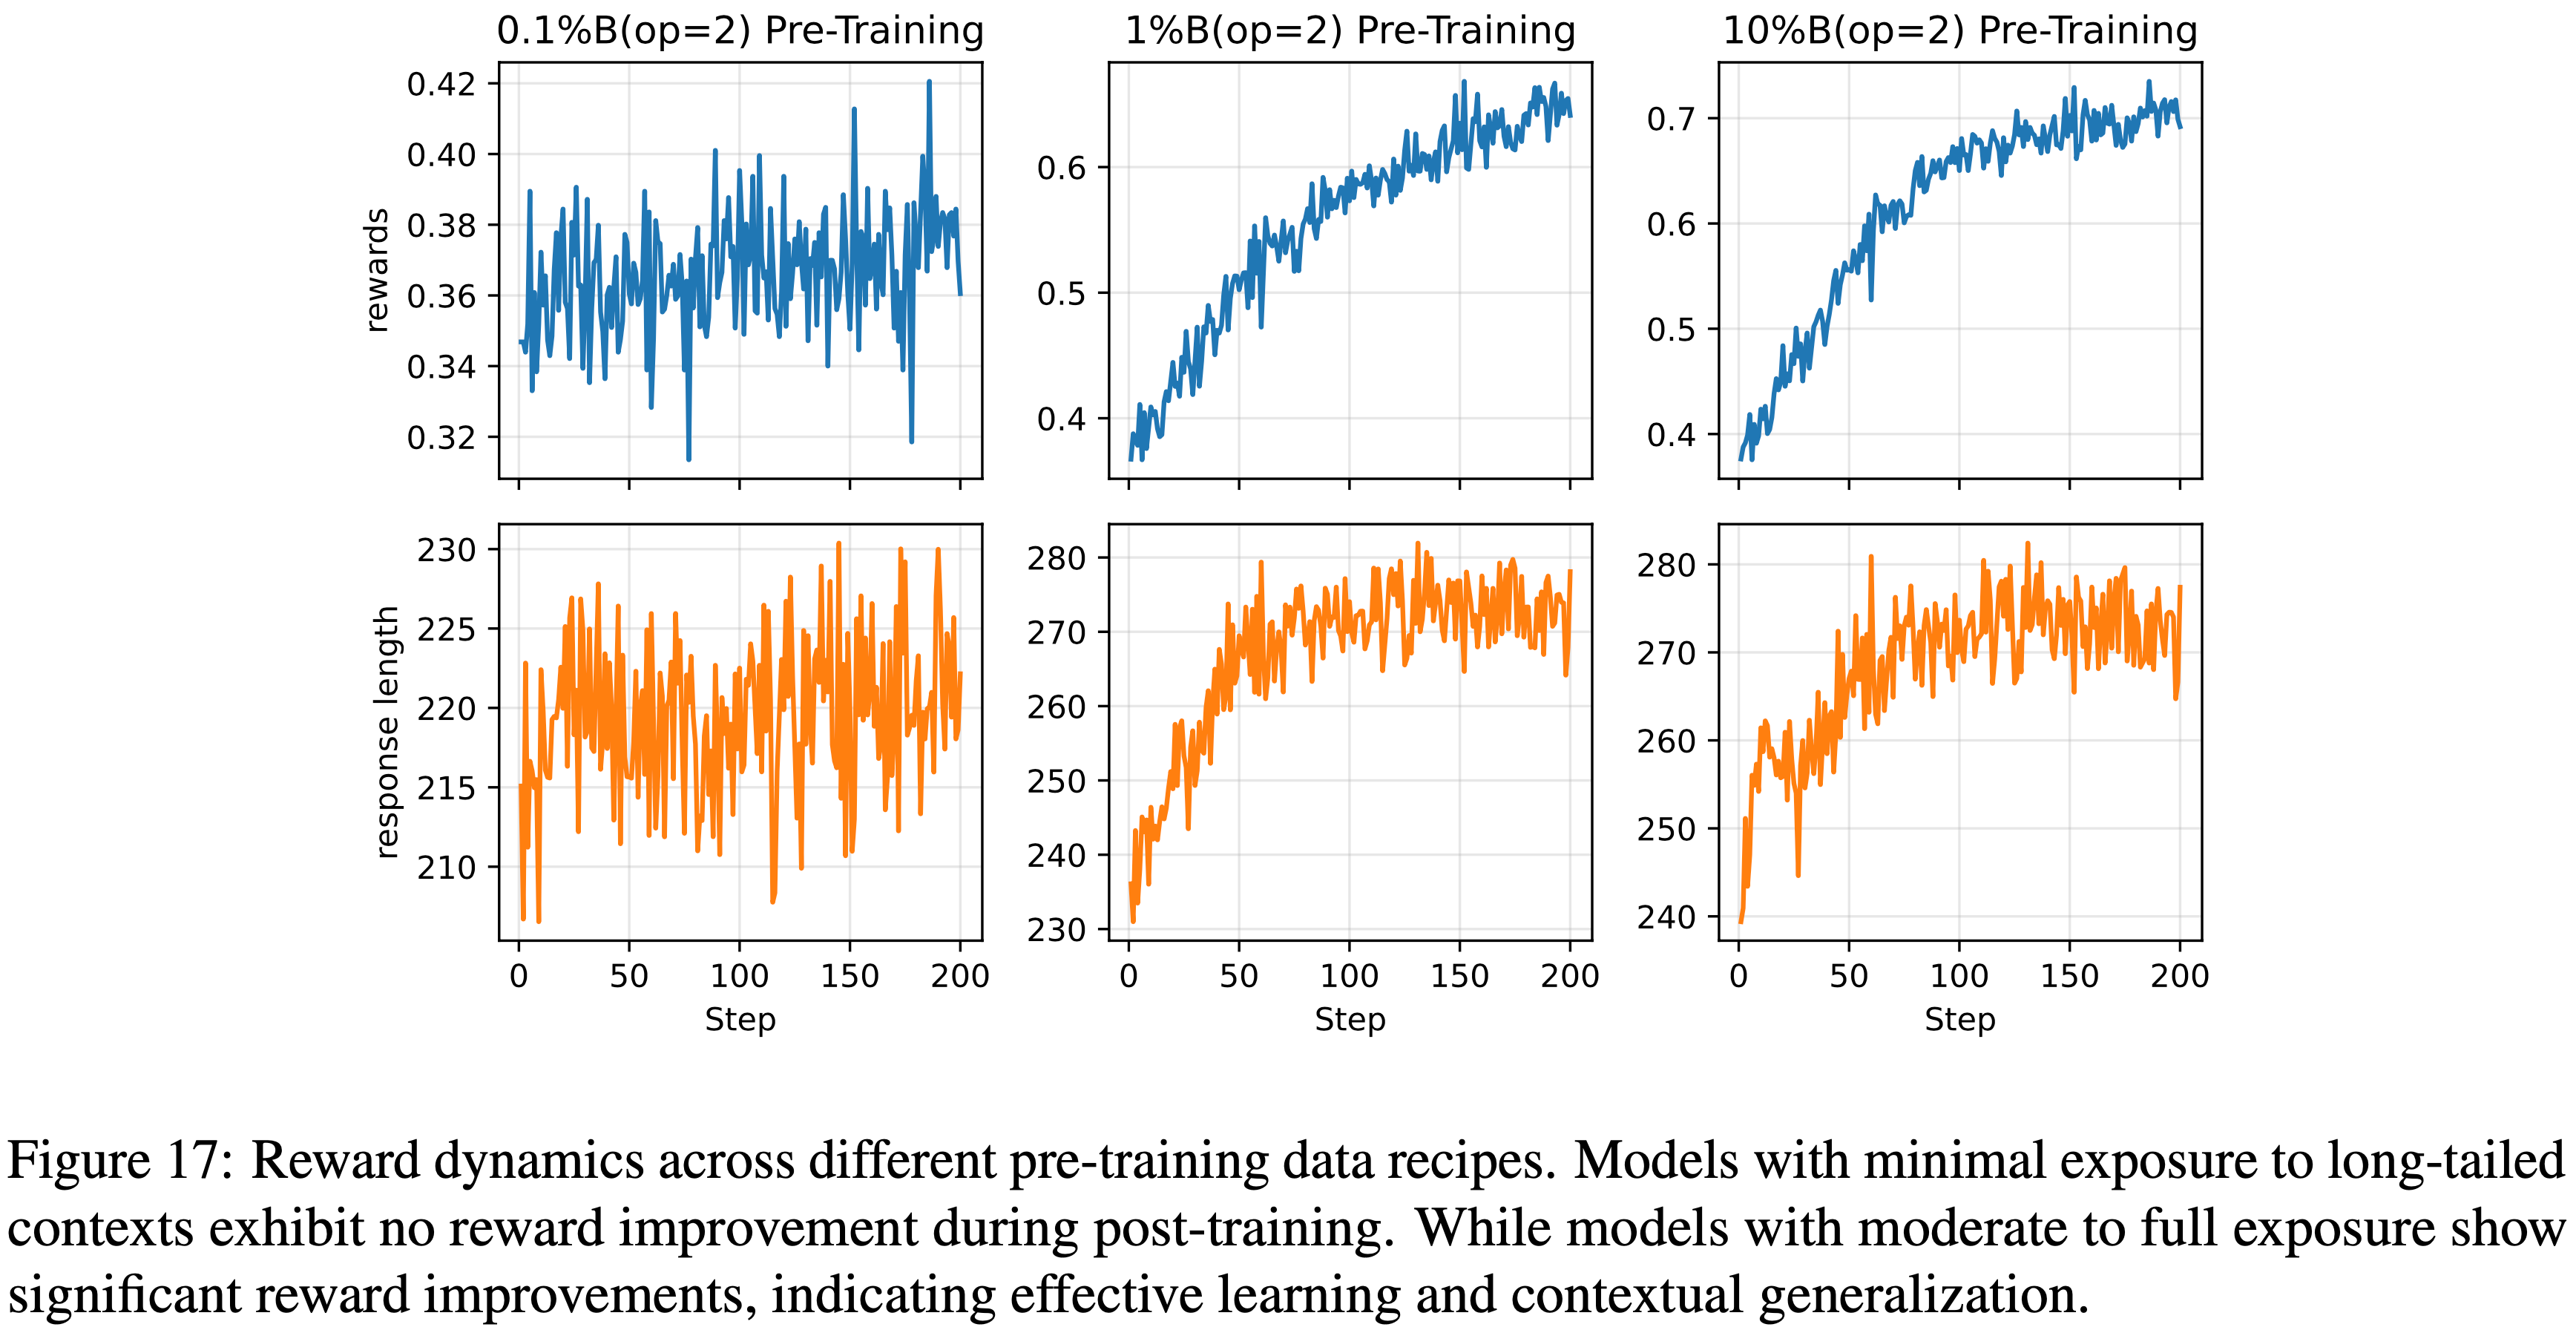
附录 A.8:Training Dynamics for § 4

  • 本节分析了 § 4 中上下文泛化的不同 Pre-training 数据方案的 Training Dynamics
  • 从图 17 中观察到
    • 在 Pre-training 期间对长尾上下文(即使是基础原子)的适度暴露比例,对于模型在 Post Training 期间实现显著的奖励提升是必要的
  • 图 17:不同 Pre-training 数据方案下的奖励动态
    • 对长尾上下文暴露最少的模型在 Post Training 期间没有奖励提升
    • 而对长尾上下文有中等至完全暴露的模型则显示出显著的奖励提升,表明有效的学习和上下文泛化

附录 A.9:Post-Training and Pre-Training Data Recipe

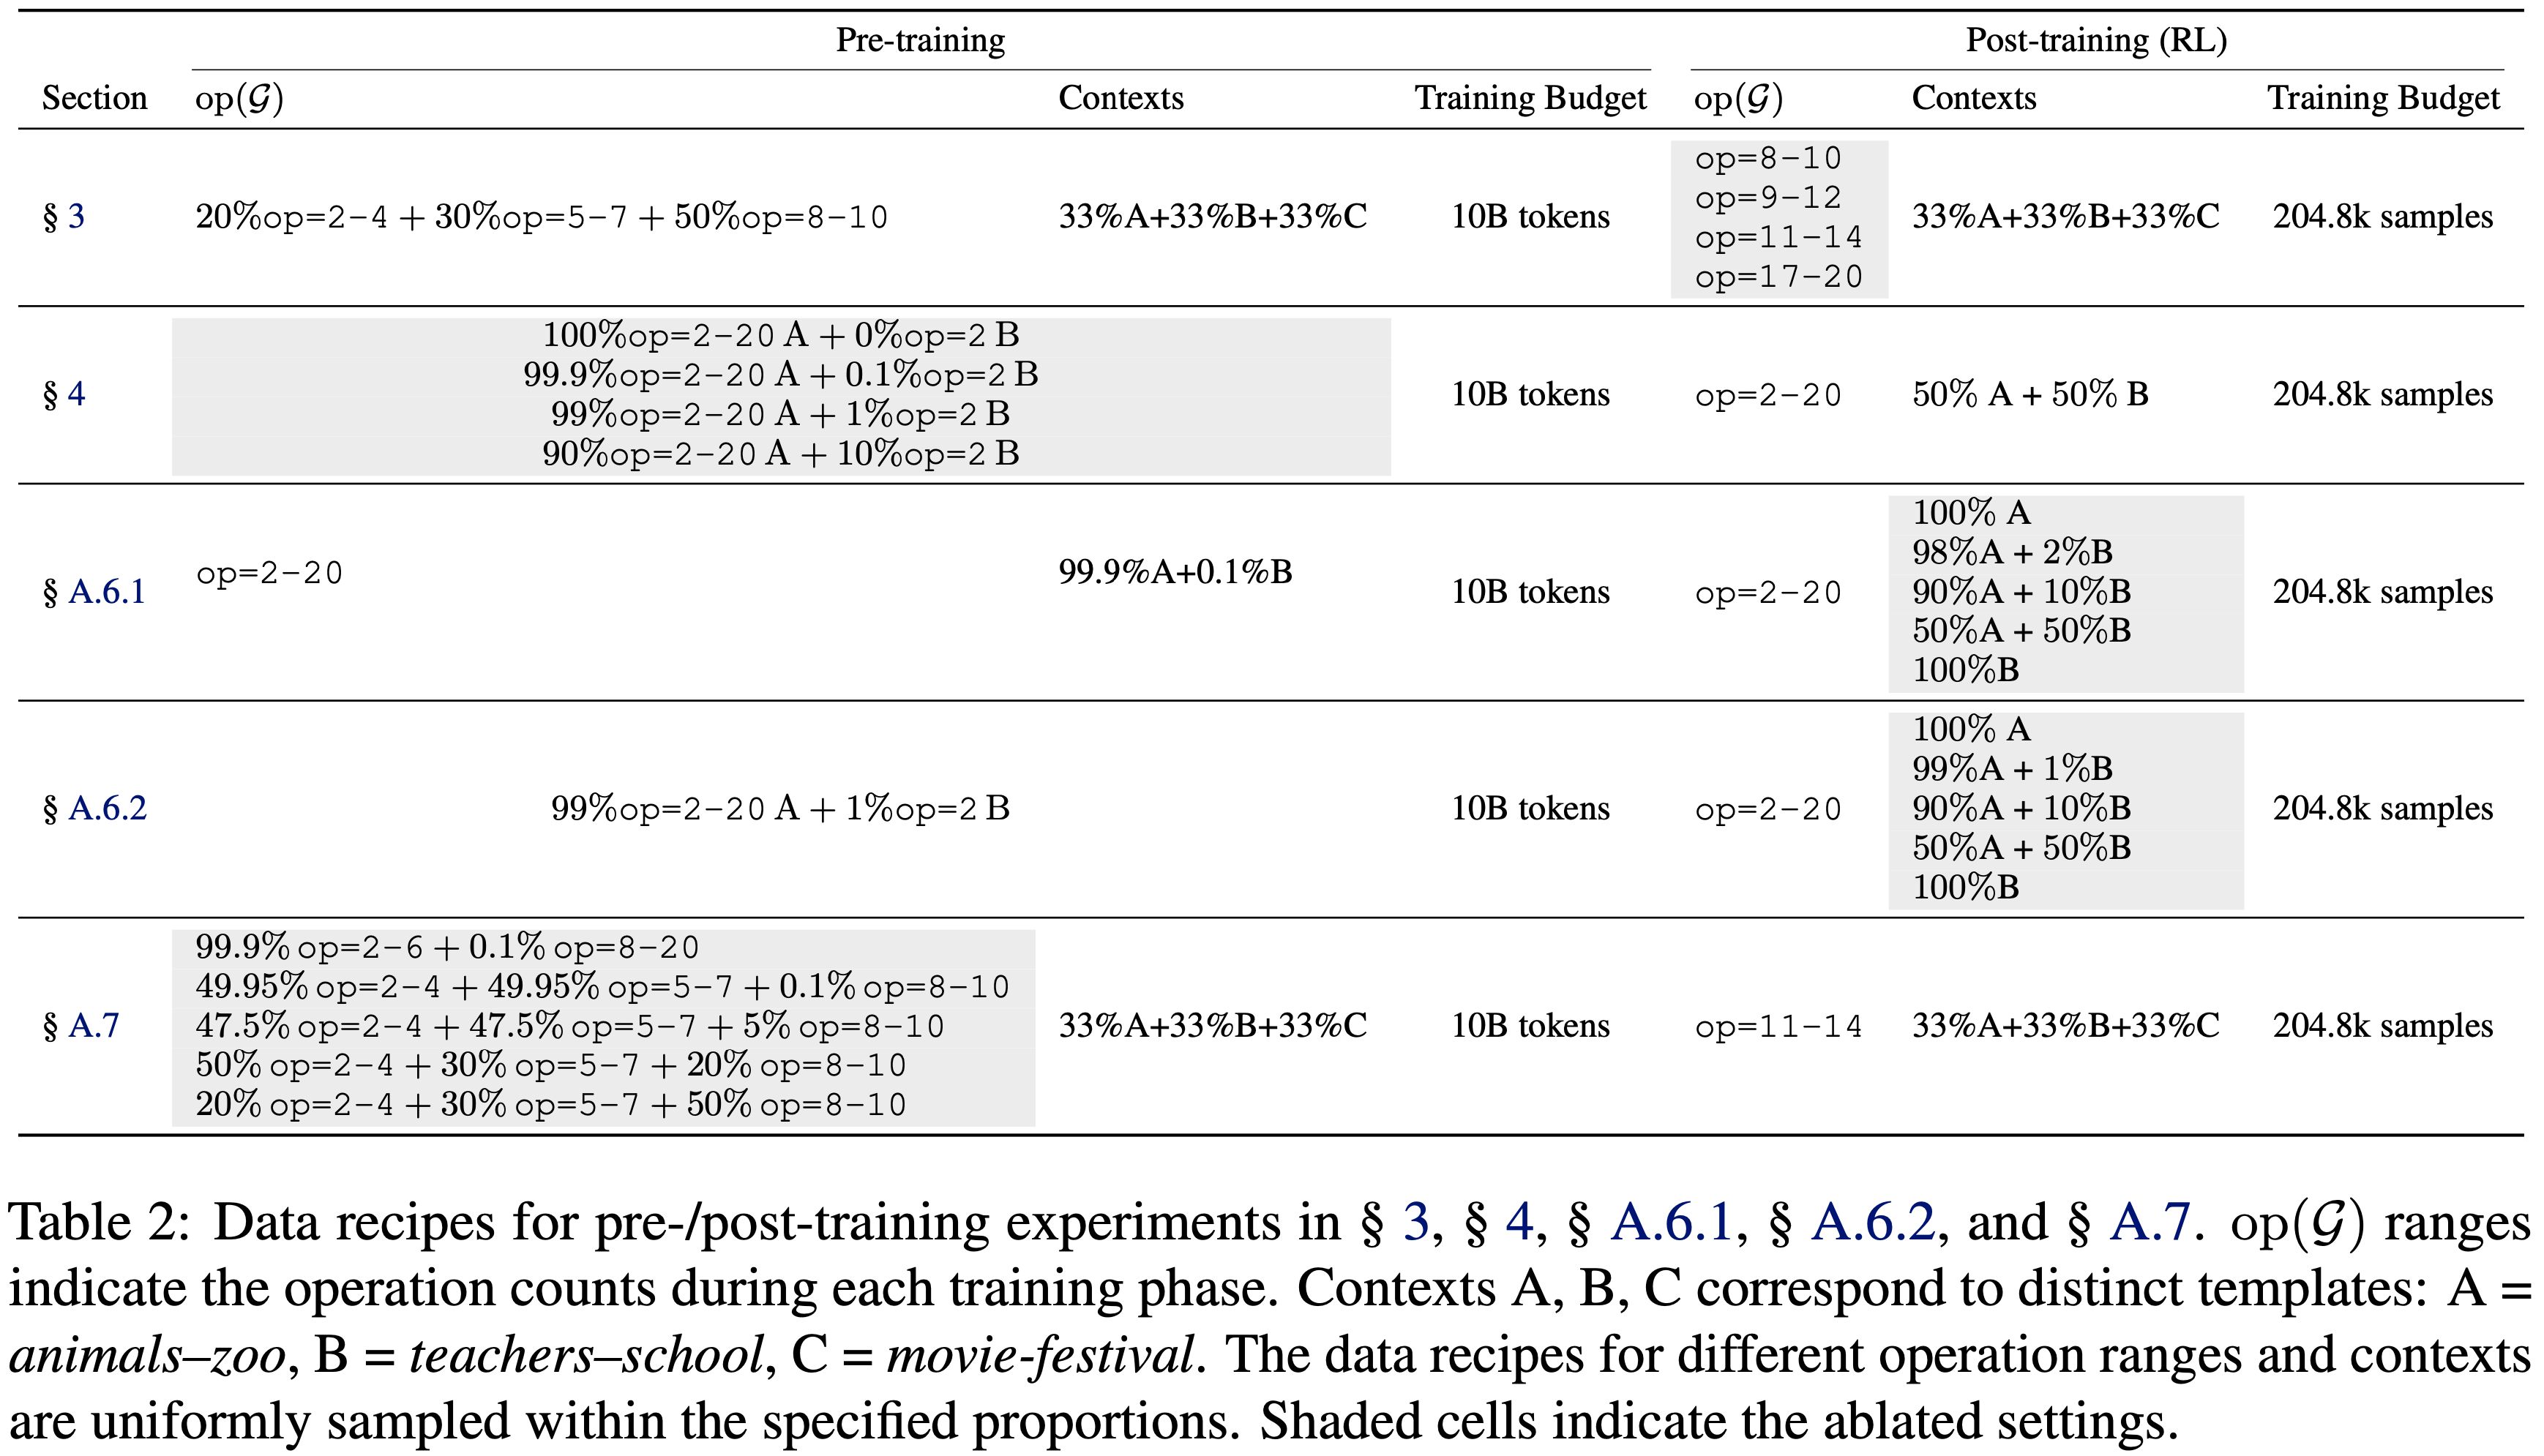
  • 本节详述了在 § 3、§ 4、§ A.6.1、§ A.6.2 和 § A.7 中使用的数据方案。表 2 总结了在不同实验部分中使用的具体操作计数范围、上下文模板和训练预算
  • 表 2:§ 3、§ 4、§ A.6.1、§ A.6.2 和 § A.7 中 Pre-training / Post Training 实验的数据方案
    • op(\(\mathcal{G}\)) 范围表示每个训练阶段的操作计数
    • Context A、B、C 对应于不同的模板:A = animals–zoo, B = teachers–school, C = movie-festival
    • 不同操作范围和上下文的数据方案均在指定比例内均匀采样
    • 阴影单元格表示消融设置

附录 A.10:不同计算预算下的 Mid-training / Post Training 混合 (Mid-/Post-Training Mixing with Different Computation Budget)

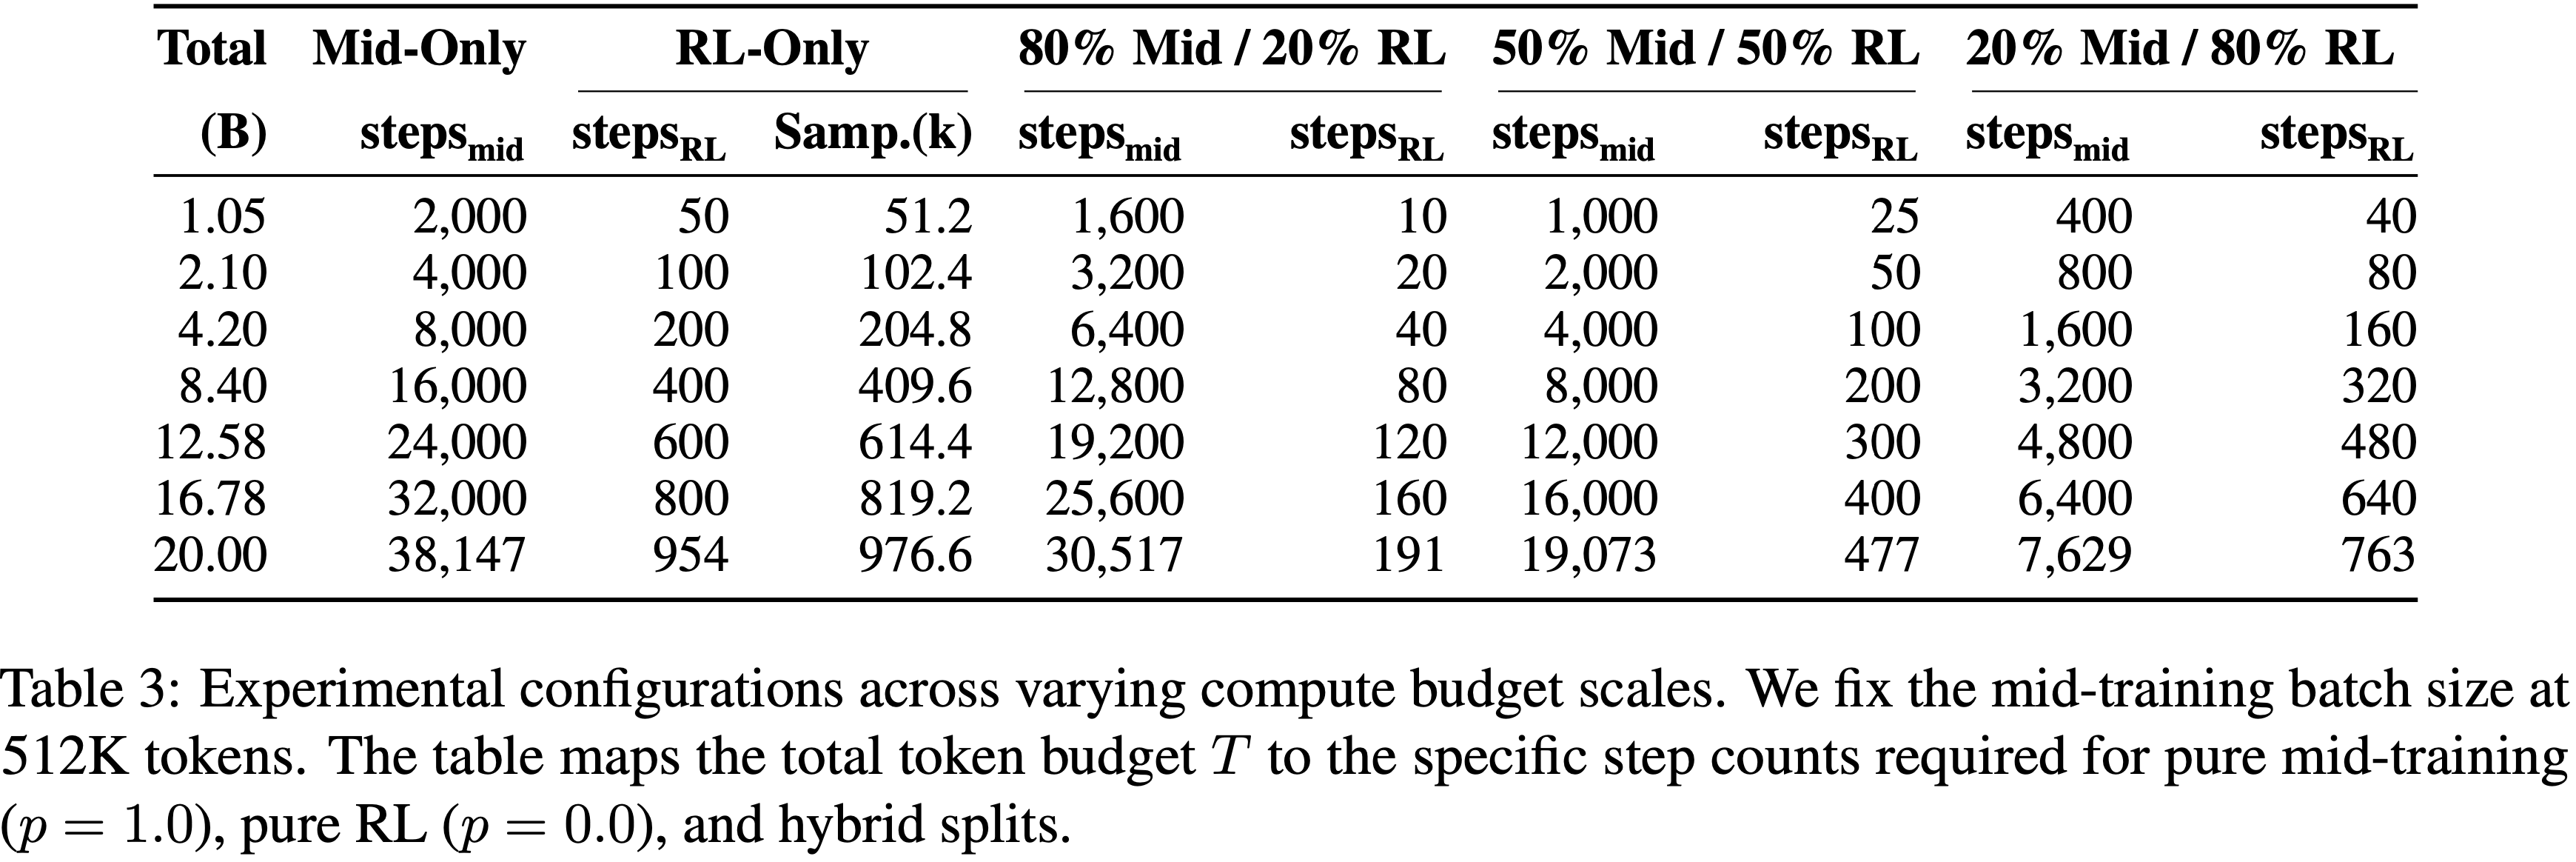
  • 本节首先详述 Mid-training 和 RL 等价的计算预算公式,然后提供在不同总计算预算下组合 Mid-training 和 Post Training 的确切数据方案

附录 A.10.1 Mid-training 与 RL 等价的计算预算 (Compute Budget of Mid-Training and RL Equivalence)

  • 训练计算量 (Training Computation)
    • 根据 Chinchilla 缩放定律 (2022),一个具有 P 个非嵌入参数的 Decoder-only Transformer,在 T 个 Token 上训练消耗的计算量大约为:
      $$
      C_{\text{train} } \approx 6P T \quad \text{flops}
      $$
    • Thus,预算为 \(T_{\text{mid} }\) 的 Mid-training 阶段消耗
      $$ C_{\text{mid} } = 6P T_{\text{mid} } \quad \text{flops}$$
  • 细粒度 RL 计算量 (Fine-Grained RL Computation)
    • 对于 On-policy GRPO,计算可以分解为:
      • Rollout: Actor 模型前向传播(2P),
      • Reference(可选): 参考模型前向传播(2P),
      • Policy Update 前向传播(2P)和后向传播(4P)
    • 求和这些项得到:
      $$
      C_{\text{RL} } = (8 + 2\gamma)P N r L_{\text{total} },
      $$
      • 其中 \(\gamma \in \{0,1\}\) 切换参考模型的前向传播,\(N\) 是 RL 样本数,\(r\) 是 Rollout 大小,\(L_{\text{total} }\) 是总序列长度(包括提示和补全)
  • Mid-training Token 等价 (Mid-training Token Equivalence)
    • 通过方程 4 归一化得到等价的 Mid-training Token 成本:
      $$
      T_{\text{RL} } = \frac{C_{\text{RL} } }{6P} = \left(\frac{4}{3} + \frac{\gamma}{3}\right) N r L_{\text{total} }
      $$
    • 当 \(\gamma = 1\) 时,论文得到正文中使用的等价关系:
      $$
      \boxed{T_{\text{RL} } = \frac{5}{3} N r L_{\text{total} } }
      $$
  • 预算分配与步数计算 (Budget Allocation and Step Calculation)
    • 给定总预算 T 和 RL 比率 \(\beta\),
      $$
      T_{\text{mid} } = (1-\beta) \cdot T, \qquad T_{\text{RL,eq} } = \beta \cdot T
      $$
    • 相应的 RL 样本数 \(N(\beta)\) 和更新步数为:
      $$
      N(\beta) = \frac{3}{5} \cdot \frac{\beta T}{r L_{\text{total} } }, \qquad \text{steps}_{\text{RL} }(\beta) = \frac{N(\beta)}{B},
      $$
      • 其中 \(r = 6\) 是 Rollout 大小,\(L_{\text{total} } = 2048\) 是总序列长度,\(B = 1024\) 是 RL 批次大小,T 是总 Token 预算
    • Mid-training 的步数为:
      $$
      \text{steps}_{\text{mid} }(\beta) = \frac{T_{\text{mid} } }{B_{\text{mid} } \cdot L_{\text{mid} } },
      $$
    • 其中 \(B_{\text{mid} } = 512 \times 1024\) 是 Mid-training 的批次大小,\(L_{\text{mid} } = 2048\) 是 Mid-training 的序列长度
Task Setting
  • 论文使用 10B Token 进行 Pre-training ,其中 20% op=2-4,30% op=5-7,50% op=8-10
  • 为避免 Mid-training 期间的灾难性遗忘,论文在 Mid-training 期间使用 20% 的预算用于 op=2-10,80% 用于 op=11-14。为公平比较,RL 使用与 Mid-training 相同的数据分布进行。表 3 详述了在不同总 Token 预算 T 和 Mid-training 比率 p 下, Mid-training 和 RL 的确切步数。论文在不同的总计算预算下,使用完全 Mid-training (Full mid-training)**、完全 RL (Full RL)、 **Light RL (\(\beta=0.2\))**、Medium-RL (\(\beta=0.5\))** 和Heavy-RL (\(\beta=0.8\)) 进行中/ Post Training
Summary 8
Observation 8
  • 如图 18 所示
    • 在所有计算预算下
      • Light RL 取得了最佳的 OOD-edge pass@1 性能
      • Heavy-RL 始终获得最高的 OOD-hard pass@1 性能
    • 对于 pass@128,当计算预算有限(4.2B Token)时,Heavy-RL 在 OOD-hard 设置中取得最佳性能
    • 当预算增加(8.4B Token 及以上)时,完全 RL 达到最高的 OOD-hard pass@128 性能
  • 图 18:不同总计算预算下, Mid-training 和 RL 混合比率对应的 pass@k 性能
Takeaway 8
  • Mid-training 和 Post Training 在不同的计算预算下互为补充
    • 对于 pass@1 任务, Mid-training 和 RL, Post Training 的组合始终优于任一单独的方法
    • 对于 pass@128,最优的 Post Training 分配取决于可用的计算预算:
      • 在资源有限的情况下,将大约 80% 分配给 RL 能在稳定性和探索性之间取得平衡;
      • 在计算量更充足时,完全 RL 能最大化外推增益
  • 表 3:不同计算预算规模下的实验配置
    • 将 Mid-training 的批次大小固定为 512K Token
    • 表 3 将总 Token 预算 T 映射到纯 Mid-training (p=1.0)、纯 RL(p=0.0)和混合拆分所需的特定步数
1…969798…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4