Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——DeepCoder

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始博客链接:(GRPO+)DeepCoder: A Fully Open-Source 14B Coder at O3-mini Level, 20250407, Agentica & Together AI
      • 作者:Agentica 团队与 Together AI 的联合合作
    • 其他链接:官网 | GitHub | Hugging Face 模型 | Hugging Face 数据集 | Wandb | 评估日志

Paper Summary

  • 核心内容:
    • 论文推出了 14B 模型 Deepcoder-14B-Preview(DeepCoder 是一款完全开源达到 o3-mini 水平的编程模型)
      • 基于 Deepseek-R1-Distilled-Qwen-14B 并通过分布式强化学习微调而成的代码推理模型
      • 在 LiveCodeBench 中实现了与 o3-mini 模型相当的性能,Pass@1(单次尝试通过率)准确率达60.6%
    • 重点:构建了高质量、可验证的代码数据集,并引入了算法与系统层面的优化,以实现高效的 RL 训练
    • 论文提出了 GRPO 和 DAPO 的改进版方法,GRPO+
      • 核心是移除了熵损失
    • Deepcoder-14B-Preview 是该方向上的第二个重要里程碑,其研发建立在作者之前的首款模型DeepScaleR-1.5B-Preview(聚焦数学推理任务)奠定的基础之上
    • 论文完整共享数据集、代码及训练方案
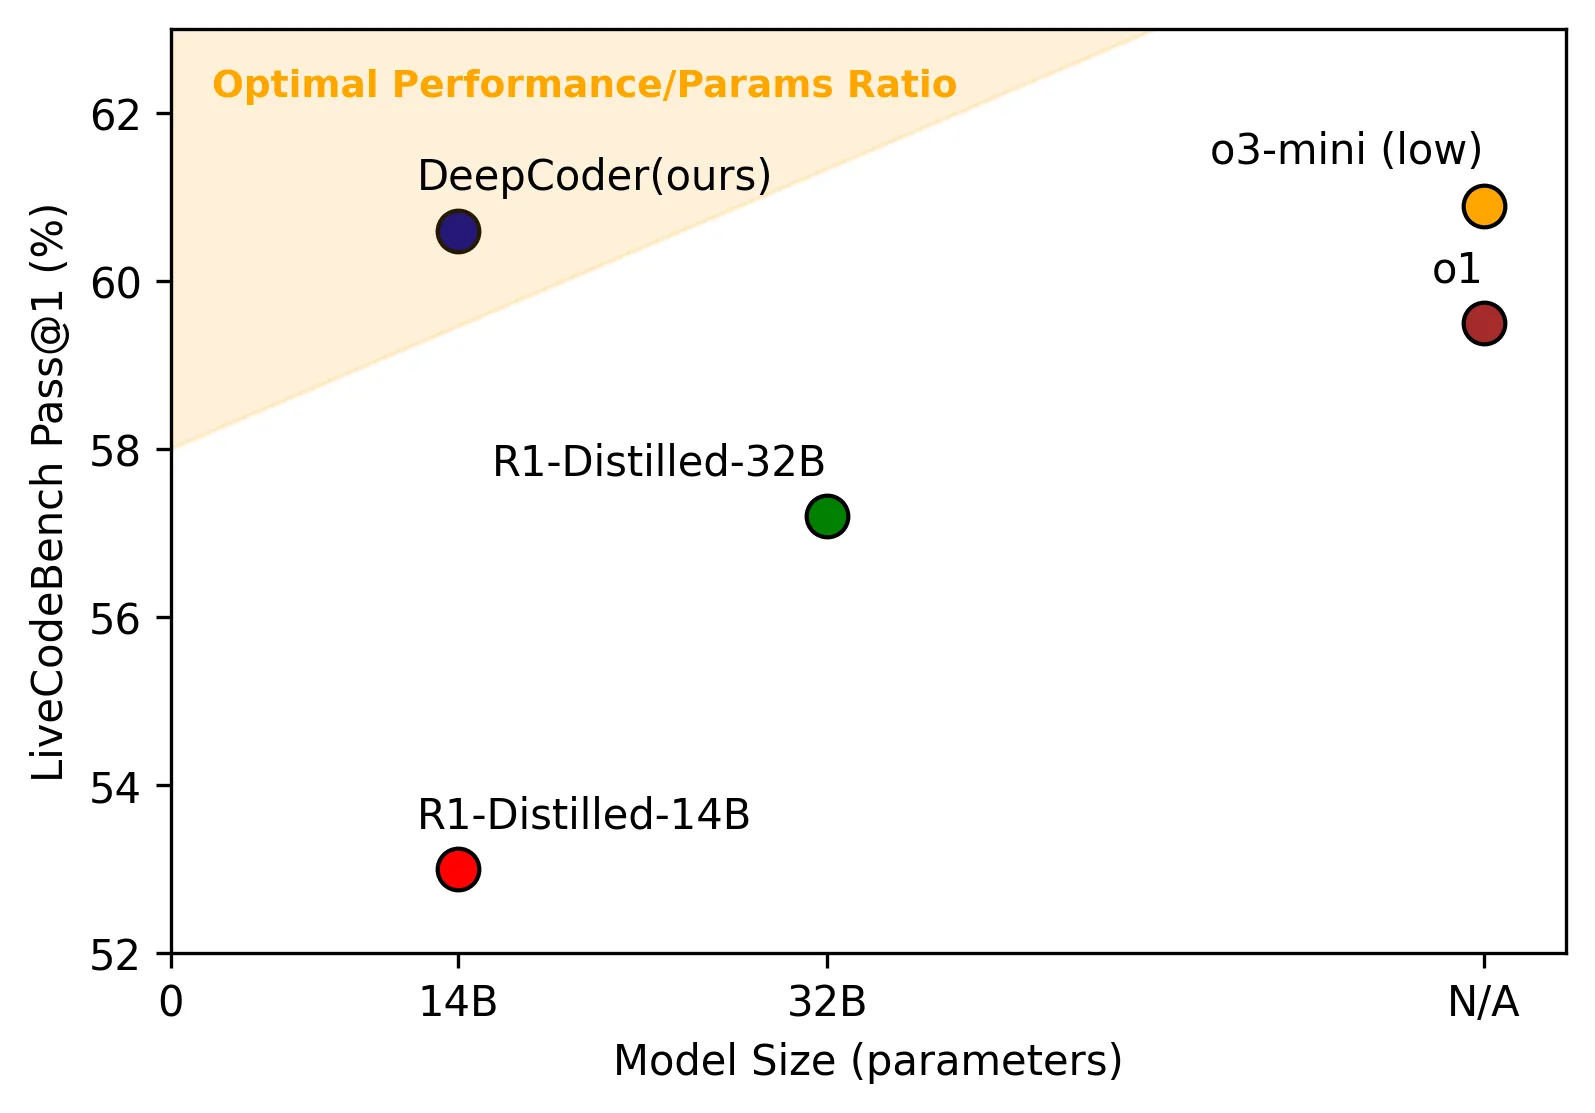
  • 该模型在 LiveCodeBench 上取得了令人印象深刻的 60.6% Pass@1 准确率(+8% 提升),以仅 14B 参数的规模,性能匹敌 o3-mini-2025-01-031 (Low) 和 o1-2024-12-17
  • 作者已将数据集、代码、训练日志和系统优化全部开源,旨在推动基于强化学习的智能扩展与加速

DeepCoder-14B-Preview 性能概览

  • 整体性能概览表:
    模型 LiveCodeBench (Pass@1)
    (2024年8月1日 - 2025年2月1日)
    Codeforces 评分 Codeforces 百分位
    DeepCoder-14B-Preview 60.6 1936 95.3
    DeepSeek-R1-Distill-Qwen-14B 53.0 1791 92.7
    O3-Mini-2025-1-31 (Low) 60.9 1918 94.9
    O1-2024-12-17 (Low) 59.5 1991 96.1
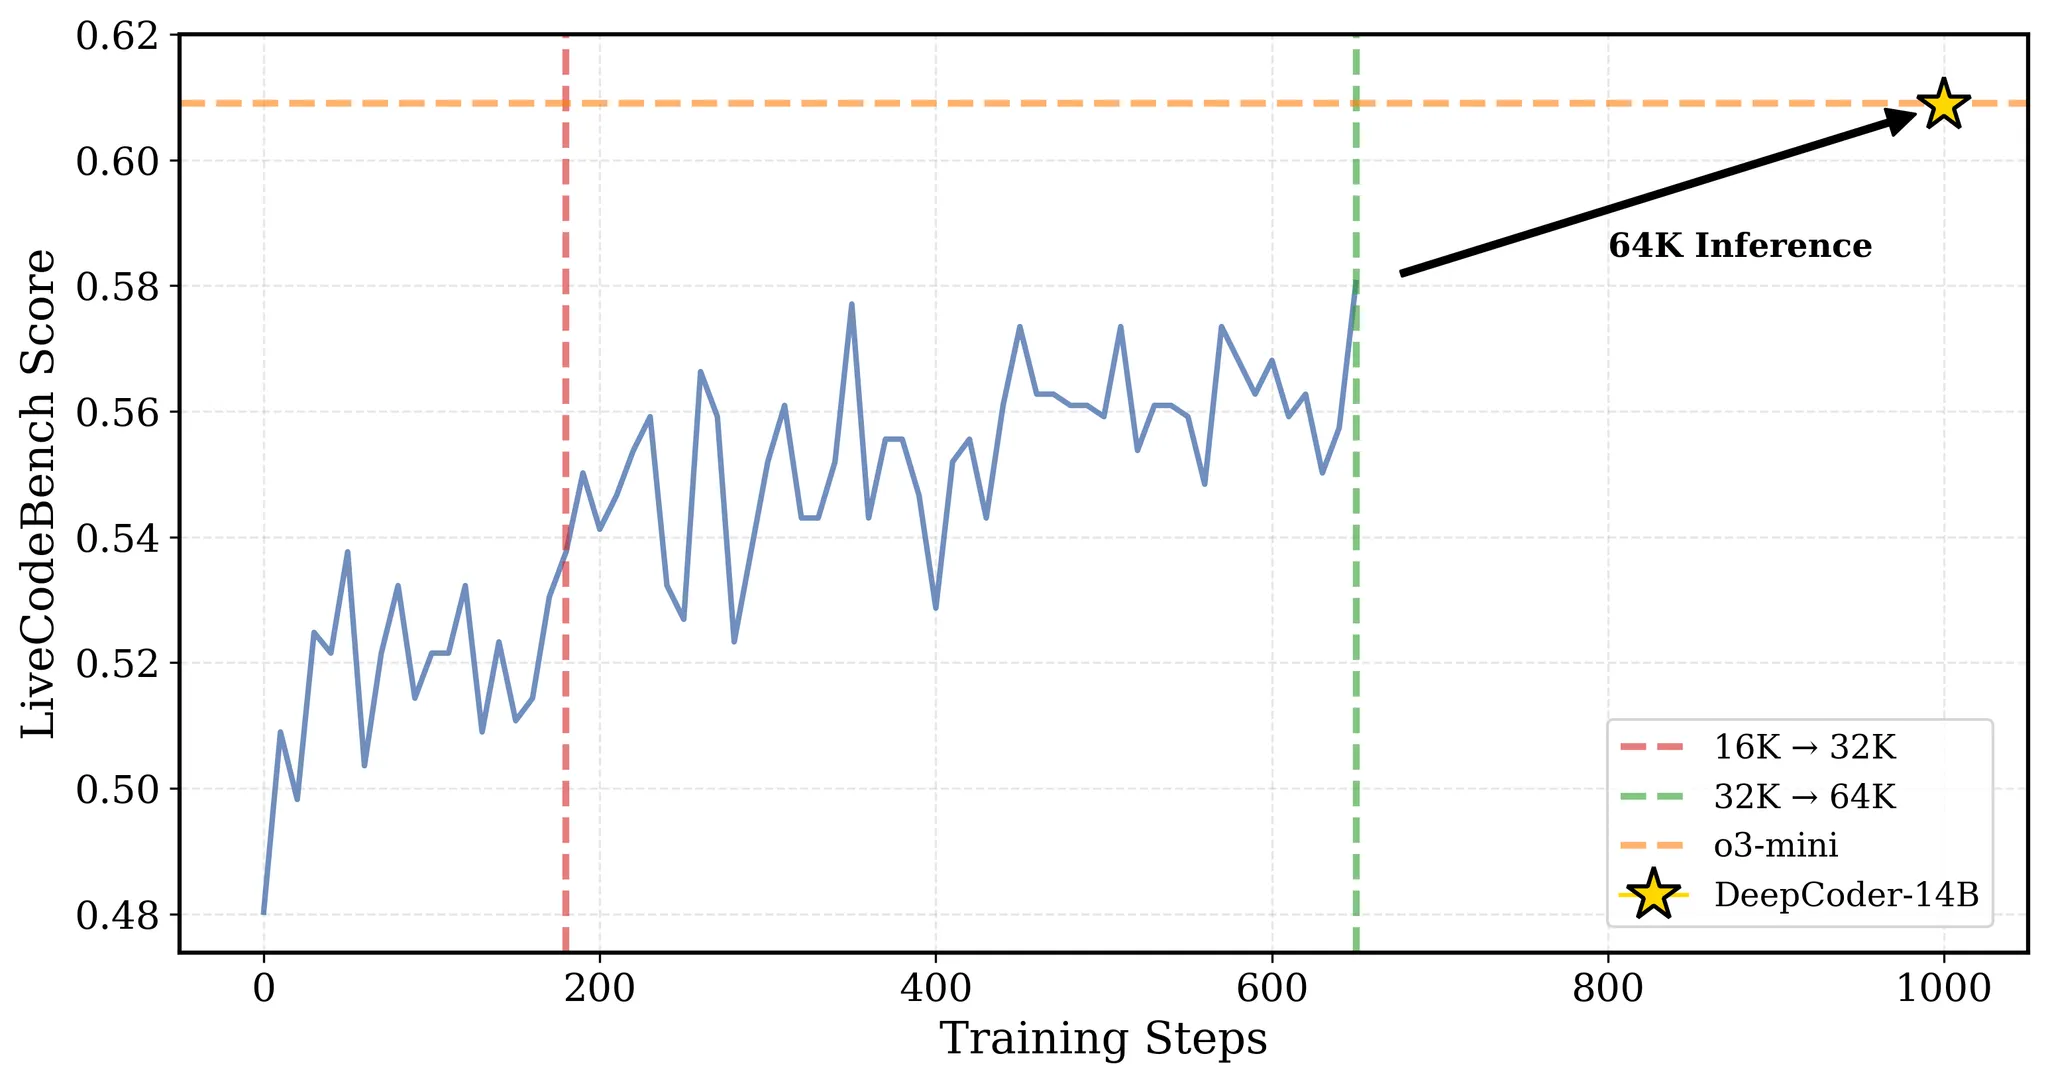
  • 图 1: DeepCoder 在训练过程中的 LiveCodeBench (LCB) 分数。在第 180 步时,上下文长度扩展至 32K。最佳的 32K 检查点用于推理时扩展至 64K,最终实现 60.6% 的 LCB 分数——性能与 o3-mini 相当
  • 近年来,我们见证了通过 RL 在数学领域(例如 DeepScaleR、AReaL、Light-R1、DAPO)显著提升了推理模型的扩展能力。然而,编程领域的进展相对滞后,主要原因是构建具有可靠、可验证奖励的高质量数据集存在挑战
  • 在这篇博客中,作者将公开训练一个小型模型成为强大竞争性编程选手的“配方”,使用强化学习技术使其达到与 o3-mini 相当的水平
    • 作者介绍了 DeepCoder-14B-Preview,该模型在 32 块 H100 GPU 上,利用 2.4 万个可验证的编程问题训练了 2.5 周,其表现达到甚至超越了 OpenAI 的 o3-mini 在多个编程基准测试上的成绩
    • 作者还开源了 verl-pipe,这是对 verl 后训练系统的扩展,包含多项系统优化,可将端到端训练速度提升 2 倍

数据集构建

  • 在数学领域,先前的研究表明,使用可验证奖励进行强化学习可以显著增强模型的推理能力。然而,与互联网上存在大量高质量、可验证数据的数学领域不同,编程领域面临此类数据相对稀缺的问题
  • 在早期实验中,作者评估了几个流行的编程数据集,包括 APPS、TACO、CodeContests、KodCode 和 LeetCode,作者发现:
    • 有些数据集对于论文的模型来说太简单(如 KodCode、LeetCode)
    • 另一些数据集则存在噪声或包含有缺陷或缺失测试用例的不可验证问题
    • 这些问题通常会产生无效或误导性的奖励信号,最终导致 RL 训练不稳定
  • 为克服这些限制,作者精心策划了一个高质量的训练集,包含:
    • TACO 验证过的问题
    • PrimeIntellect 的 SYNTHETIC-1 数据集中经过验证的问题
    • 2023 年 5 月 1 日至 2024 年 7 月 31 日期间提交的 LiveCodeBench 问题
  • 为了确保数据质量以实现有效的 RL 训练,作者实施了严格的过滤流程:
    • 1)程序化验证 :每个问题都使用外部官方解决方案自动验证
      • 论文只保留那些官方解决方案能通过所有单元测试的问题
      • 此过程在 tests/rewards/test_code_batch.py 中自动化完成
    • 2)测试用例过滤 :每个问题必须至少包含 5 个单元测试
      • 论文发现,测试用例较少的问题容易引发 “Reward Hacking” 行为 ,即模型学会通过识别常见测试用例来直接打印出记忆的答案
    • 3)去重 :论文移除了跨数据集的重复问题,以避免污染
      • 论文对三个训练数据集(Taco Verified、PrimeIntellect SYNTHETIC-1 和 LCB (05/01/23-07/31/24))进行了去重,并验证了测试数据集(LCB (08/01/24-02/01/25) 和 57 场 Codeforces 比赛)中没有污染
  • 经过过滤后,论文得到了 2.4 万个高质量的编程问题用于 RL 训练,其中包括:
    • 7500 个来自 TACO Verified 的问题
    • 1.6 万个来自 PrimeIntellect 的 SYNTHETIC-1 的问题
    • 600 个来自 LiveCodeBench 的问题

代码沙箱环境

  • 为了计算代码 RL 训练的奖励,我们必须在代码沙箱中运行模型生成代码的单元测试
  • 在每次 RL 迭代中,论文的训练批次需要在 1024 个问题上进行评估,每个问题都包含多个单元测试(大于等于 5 个)
  • 这种繁重的工作负载要求并行扩展 100 多个代码沙箱,以确保在合理时间内准确验证大语言模型生成的代码
  • 目前,论文使用两种沙箱,下面分别进行介绍

Together Code Interpreter

  • 这是一个快速、高效的环境,与论文的 RL 训练直接兼容,每个问题的成本仅为 3 美分
  • 论文一直在努力将 Together Code Interpreter 可靠地扩展到 100 多个并发沙箱和每分钟 1000 多次沙箱执行
  • 这些沙箱暴露了 stdout、stdin 和代码输出的最后一行,同时安全地限制执行并将代码与主机系统隔离
  • Together Code Interpreter 目前处于测试阶段;详细信息请参阅 Together Code Interpreter 文档,集成示例代码可在论文的代码仓库中找到

Local Code Sandbox

  • 启动一个独立的、有防护的 Python 子进程作为本地沙箱,通过 stdin 接收测试用例输入,并将答案打印到 stdout
  • 论文的本地沙箱遵循官方 LiveCodeBench 仓库的相同评估代码,确保论文的结果与现有排行榜一致

奖励函数

  • 论文的奖励函数采用稀疏的结果奖励模型(ORM)
  • 论文避免分配部分奖励,例如思维链惩罚,或如果 K/N 个测试通过则分配 K/N 的奖励,因为这可能导致 “Reward Hacking” 行为,即大语言模型学会直接打印出公共测试的答案,或错误地收敛于通过简单的边缘情况
  • 1 :生成的代码必须通过所有采样的单元测试
    • 由于一些问题包含数百个测试,使得完全验证不切实际,论文为每个问题采样 15 个最具挑战性的测试,这些测试由其输入字符串的长度确定
  • 0 :如果大语言模型的代码至少在一个测试用例上失败,或者答案格式不正确(即缺少 python [CODE]),则不给予奖励
    • 每个测试用例的超时时间为 6-12 秒

训练配方

GRPO+:GRPO 的稳定版本

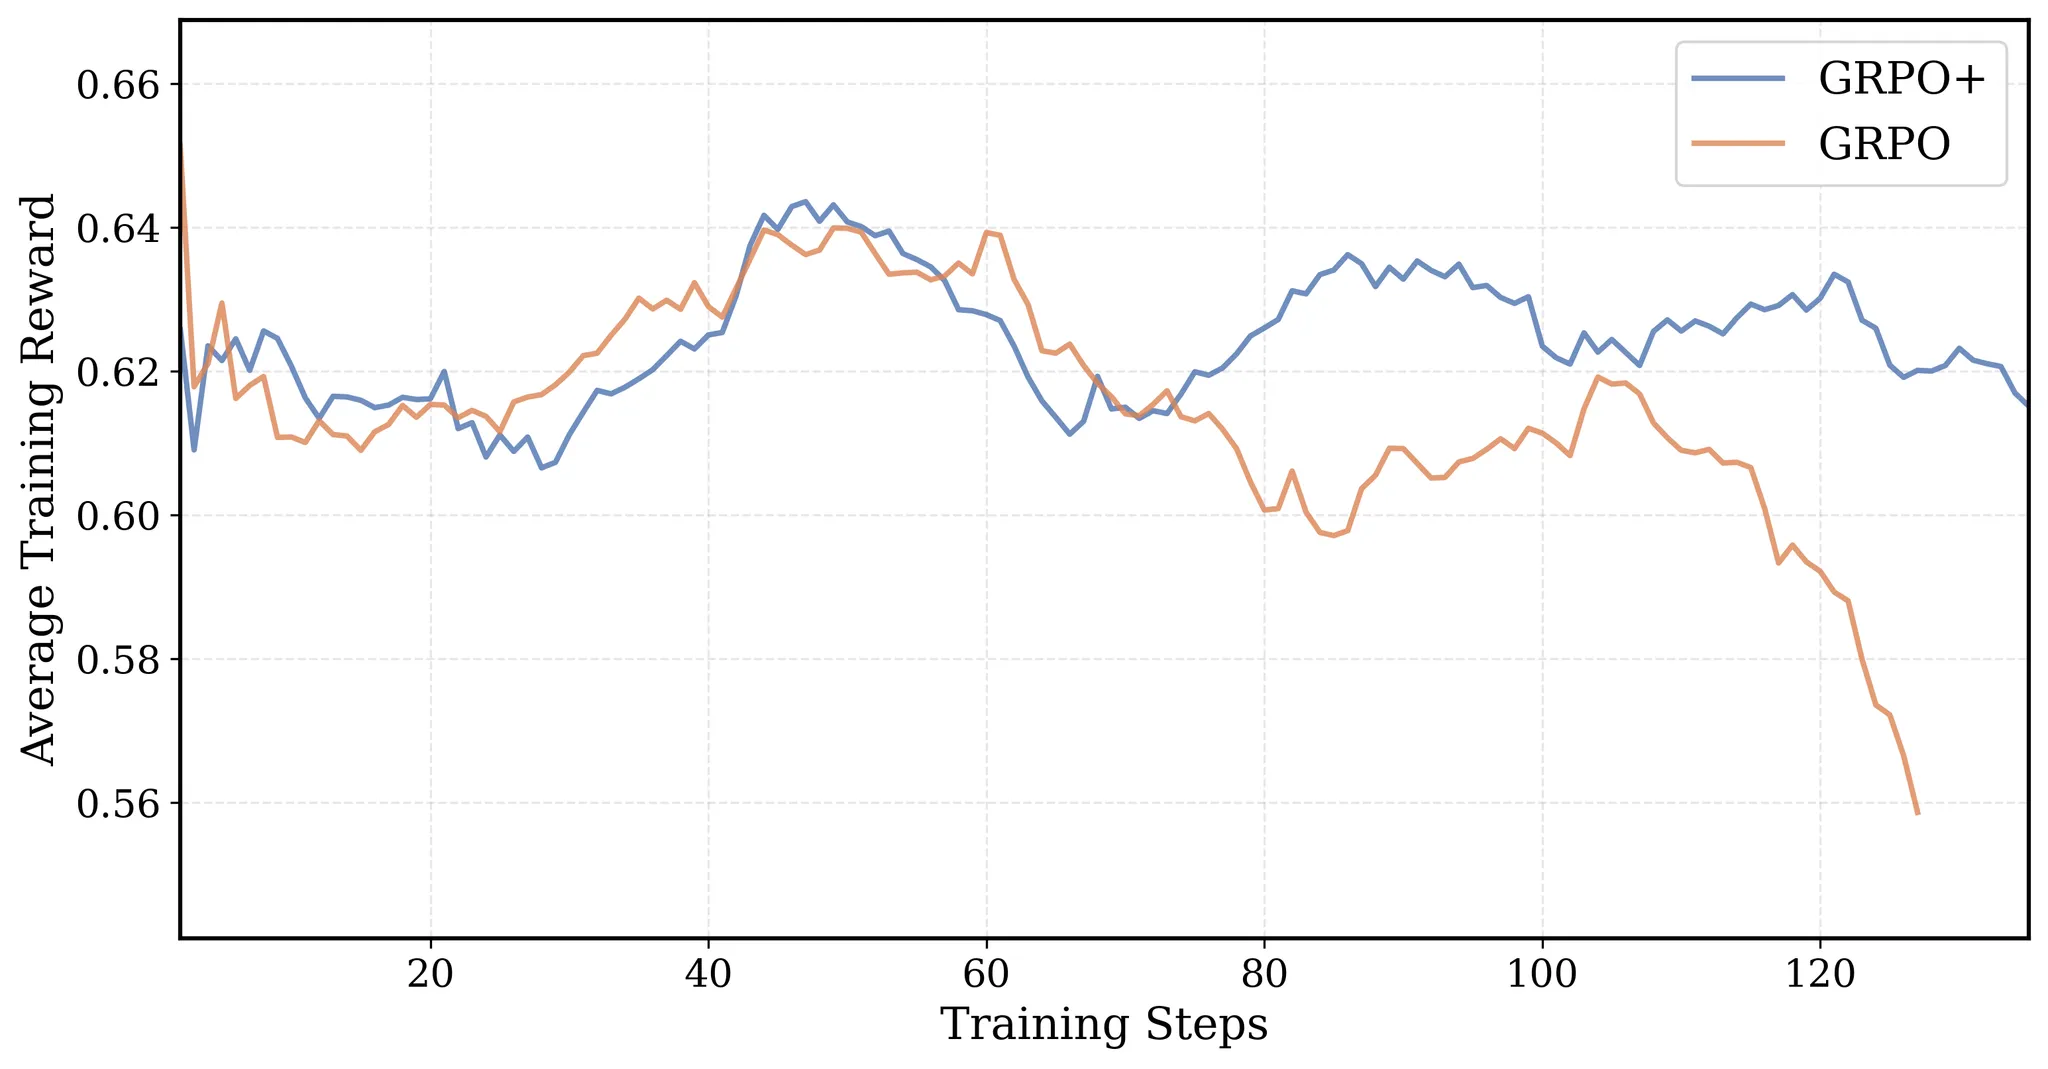
  • 图 2: GRPO+ 和 GRPO 在 16K 运行中的平均训练奖励,GRPO 的奖励曲线最终崩溃,由于 Clip High,GRPO+ 的曲线保持稳定
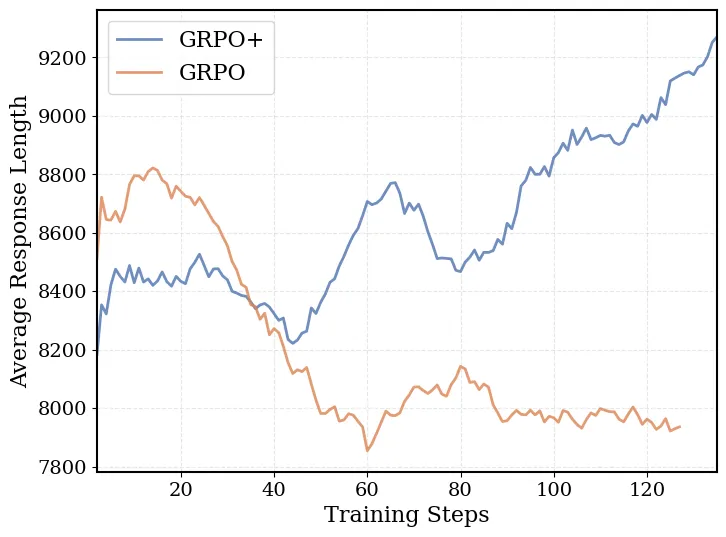
  • 图 3: 由于长序列过滤,GRPO+ 的响应长度随时间稳步增长
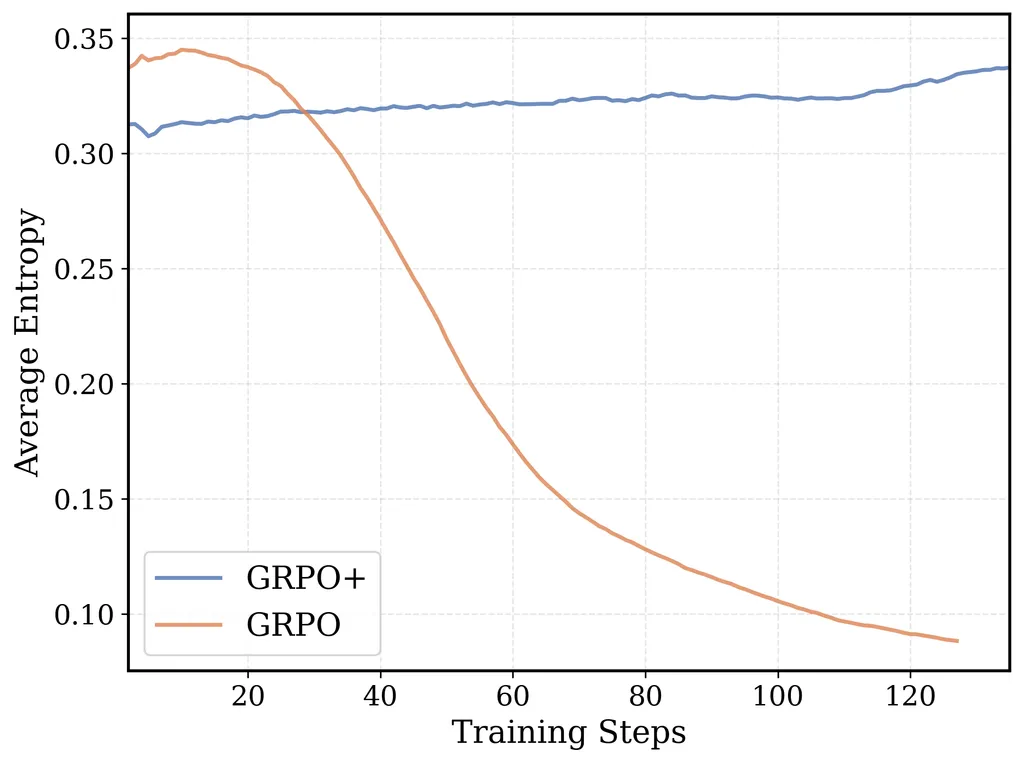
  • 图 4: Clip High 和无熵损失确保了 GRPO+ 的 token 级熵不会崩溃,并鼓励足够的探索
  • 本文通过整合 DAPO 的 Insight,增强了原始的 GRPO 算法,以实现更稳定的训练:
    • 无熵损失 :论文观察到包含熵损失项常常导致不稳定,熵会呈指数级增长并最终导致训练崩溃
      • 为缓解此问题,论文完全消除了熵损失
    • 无 KL 损失 (来自 DAPO) :消除 KL 损失可以防止大语言模型被约束在原始 SFT 模型的信任区域内
      • 这一移除也免去了计算参考策略的对数概率的需要,从而加速了训练
    • 长序列过滤 (来自 DAPO) :为了保留长上下文推理能力,论文对截断的序列屏蔽损失
      • 这项技术使 DeepCoder 能够推广到 64K 上下文的推理,尽管它是在 32K 上下文下训练的
      • 如图 3 所示,这种方法允许响应长度自然增长而不受截断惩罚
    • Clip High (来自 DAPO) :通过增加 GRPO/PPO 代理损失的上限,论文鼓励更多探索并稳定熵
      • 图 4 表明,这种调整带来了更稳定的训练和改进的模型性能

迭代式上下文延长:开箱即用的泛化能力

  • 在论文最初的 DeepScaleR 博客文章 中,论文介绍了迭代式上下文延长,这是一种训练技术,使语言模型能够先在较短的上下文长度下学习有效思考,然后推广到更长的上下文
  • 这种方法帮助论文的 1.5B 参数模型在将其上下文窗口从 8K -> 16K -> 24K 扩展时,下游性能稳步提升,在 AIME 上的准确率从 33% -> 38% -> 43%,最终达到 O1-preview 的性能
  • 然而,在将此技术应用于论文的 14B 参数模型时,论文遇到了新的挑战:
    • 14B 参数模型已经比 1.5B 参数模型拥有显著更强的推理能力,这意味着进一步的改进需要解决更难的问题
    • 这些更难的问题自然需要比小模型使用的 8K 起始点更长的上下文窗口
    • 从短上下文开始并惩罚模型超出该窗口的行为产生了负面影响——导致初始性能下降、响应变短以及模型在长上下文上推理能力的退化
  • 为了在实现高效训练的同时保留长上下文推理能力,论文采用了来自 DAPO 的长序列过滤技术
    • 该技术在训练期间屏蔽截断的序列,因此模型不会因生成超出当前上下文限制的深思熟虑但冗长的输出而受到惩罚
    • 结果是,模型在较短的上下文中训练时仍然可以“长思考”
  • 论文将迭代式上下文延长应用于论文的 DeepCoder-14B-Preview,将上下文窗口从 16K 扩展到 32K。在 LiveCodeBench 上,该模型实现了:
    • 16K 和 32K 上的准确率分别为 54% -> 58%,
    • 在 64K 上下文评估时达到 60.6%,展示了超越其训练上下文的强大泛化能力
  • 这种泛化能力与像 DeepSeek-R1-Distill-Qwen-14B 这样的基础蒸馏模型形成鲜明对比,后者在其训练上下文长度之外会达到性能瓶颈:
    模型 16K 32K 64K
    DeepCoder-14B-Preview 45.6 57.9 60.6
    DeepSeek-R1-Distill-Qwen-14B 50.2 53.0 53.0
  • 虽然由于其更长的平均响应长度导致截断和分数惩罚,DeepCoder 在 16K 的原始性能较低,但它最终在 64K 上凭借其在更长上下文中推理的能力超越了其他模型
  • 图 5: DeepCoder 在训练过程中的平均响应长度和训练奖励。平均响应长度从 8K 增加到 17.5K 上下文长度 > Baby, there ain't no mountain high enough. Ain't no context long enough. — Inspired by Marvin Gaye & Tammi Terrell
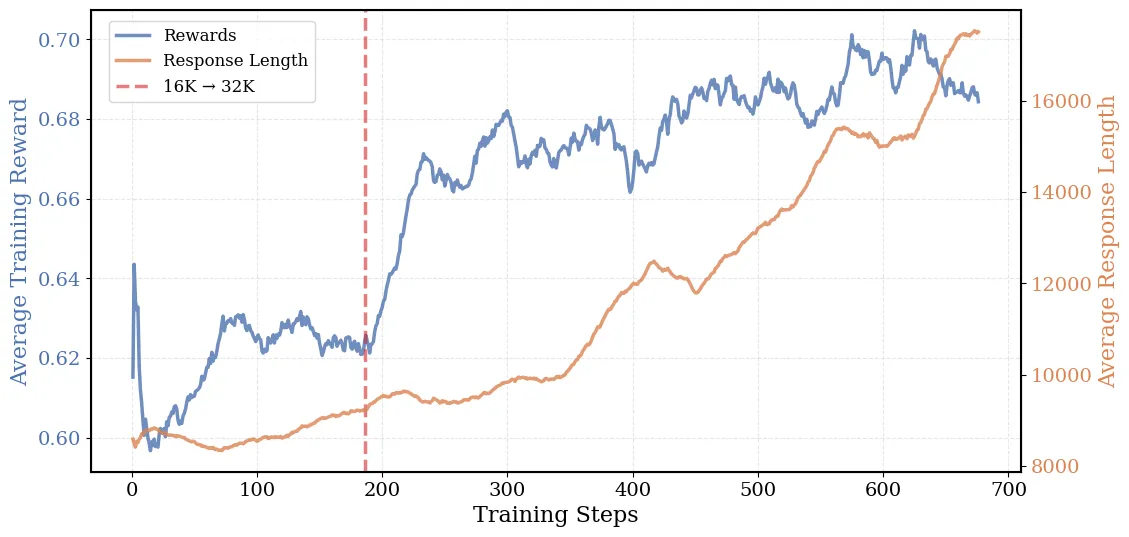
  • DeepCoder 的成功直接源于将迭代式上下文延长与长序列过滤相结合。如图 5 所示,在整个训练过程中,模型的平均响应长度从 8K 稳步增长到 17.5K,同时平均奖励从 0.6 提升到 0.7——这清晰地表明,模型正在逐步学习更具可扩展性和连贯性的思考模式

评估

  • 论文在多个编程基准上评估了Deepcoder-14B-Preview,包括 LiveCodeBench (LCB)、Codeforces 和 HumanEval+ 以及AIME2024
  • 拥有 14B 参数的模型在整个编程基准测试中展示了强大的性能,LiveCodeBench 达到了 60.6%,Codeforces 评分为 1936 分,与o3-mini(低配置版)和o1的表现相当
  • 此外,尽管该模型没有专门针对数学任务进行训练,但其从编程任务中获得的推理能力很好地推广到了数学领域
    • 这在其 AIME2024 得分 73.8% 上体现出来,比基础模型提高了 4.1%
    • 总体而言,论文的模型在编程和数学领域都表现出色
  • 评估结果如下:
    Model LCB (8/1/24-2/1/25) Codeforces Rating* Codeforces Percentile* HumanEval+Pass@1 AIME 2024
    DeepCoder-14B-Preview (ours) 60.6 1936 95.3 92.6 73.8
    DeepSeek-R1-Distill-Qwen-14B 53.0 1791 92.7 92.0 69.7
    O1-2024-12-17 (Low) 59.5 1991 96.1 90.8 74.4
    O3-Mini-2025-1-31 (Low) 60.9 1918 94.9 92.6 60.0
    O1-Preview 42.7 1658 88.5 89 40.0
    Deepseek-R1 62.8 1948 95.4 92.6 79.8
    Llama-4-Behemoth** 49.4 - - -
    • * 表示由于 DeepSeek 和 OpenAI 对 Codeforces 的评估为内部流程,有关 Codeforces 评估的更多细节,可参考附录A
    • ** 表示非推理型模型
  • 图6:LiveCodeBench Pass@1准确率与模型规模对比。DeepCoder仅需14B 参数,性能便已与前沿推理模型o1和o3-mini(低配置版)持平
训练后阶段的系统优化

  • 采用长上下文强化学习训练大型语言模型十分耗时,需要在长上下文环境中反复进行采样和训练
  • 若缺乏系统级优化,完整的训练流程可能需要数周甚至数月,论文针对 14B 参数模型的编程任务训练,每一步便需 1200-2500 秒,总训练时长更是长达2.5周
  • 为此,论文开发并开源了 verl-pipeline ,这是基于开源强化学习人类反馈(RLHF)库 verl 的优化扩展版本
    • 该扩展通过多项系统级改进,实现了端到端强化学习训练的加速,较基础版 verl 实现最高可提升2.5倍训练速度
    • 论文将这些全新的系统优化方案应用于 DeepCoder-1.5B-Preview 模型的训练,使其在 LCB 测试集上的通过率达到 25%,较Deepseek-R1-Distill-Qwen-1.5B模型提升了 8%
  • 作者诚邀整个社区(包括verl开发团队及其他新兴项目团队)采用这些优化方案,并在此基础上进一步开发创新

采样器是性能瓶颈

  • 图7:Verl的PPO/GRPO训练流程。每个强化学习迭代周期均包含采样、奖励函数计算和训练三个环节。其中,采样是性能瓶颈;训练速度受限于生成长序列的“滞后采样器”(straggler samplers)
  • 在训练后阶段的系统中,采样时间往往是主要瓶颈,使用 vLLM、SGLang 等推理引擎生成超长序列(最长可达32K tokens)会产生较高延迟
  • 如图7所示的 Verl PPO/GRPO 流程中,响应长度的不一致会导致部分采样器成为“滞后采样器”
    • 这些滞后采样器会拖延训练进度,而已完成任务的采样器则处于闲置状态,最终导致 GPU 利用率低下

基础解决方案:Minibatch Pipelining

  • 图8:小批量流水线流程。采样器与训练器分属不同的工作组。当采样器完成小批量(用于PPO/GRPO)生成并输出后,训练器工作组会异步处理这些数据。在一个迭代周期结束时,训练器会将权重广播至采样器
  • 为减少训练后阶段的设备闲置时间,作者将采样与训练流程进行流水线处理,允许训练器在采样器继续生成下一批数据的同时,提前对已生成的小批量数据进行更新。这种并行重叠操作有助于掩盖采样过程中的延迟
  • 然而,该方案存在三个关键局限性:
    • 1)首先,小批量数据的平均序列长度会随时间推移而增加,这会延长后续小批量数据的训练时间。最终,最后几批数据的训练往往会在采样完成后才结束,从而限制了流水线方案的收益
    • 2)其次,流水线方案需要在采样器和训练器之间分配GPU资源,这会减少可用于采样的设备数量。与Verl不同(Verl可在同一GPU资源池内动态切换采样器和训练器角色),这种静态资源分配方式会因采样器数量减少,导致端到端采样时间延长
    • 3)最后,奖励函数计算可能需要较长时间(尤其对于编程类任务而言,每个强化学习迭代周期可能需要运行数千次单元测试)。在默认的Verl流程中,奖励计算需在采样完成后,由主节点(head node)统一执行
  • 尽管存在上述限制,我们仍在代码库的 ray_trainer_pipeline.py 文件中实现了小批量流水线方案,并发现通过微批量(microbatching)技术可进一步改进流水线性能

论文的解决方案:One-Off Pipelining

  • 图9:一次性流水线流程。采样器提前一个迭代周期生成数据批次,而训练器则使用上一个迭代周期的数据更新梯度。其次,奖励函数计算与采样过程交叉进行。该方案不会为GRPO/PPO的在策略(on-policy)算法引入异步离策略(off-policy)样本
  • 为实现训练、奖励计算与采样的完整流水线化,我们提出了 一次性流水线(One-Off Pipelining) 方案。其核心思路十分简洁:
    • 牺牲第一个强化学习迭代周期,仅用于采样;
    • 在下一个迭代周期中,再使用上一周期采样得到的数据进行训练
    • 这种设计能让采样与训练并行进行,彻底消除采样完成后训练器的闲置时间
  • 其次,作者将奖励计算与采样过程交叉结合,一旦某个请求处理完成,便立即对其进行奖励计算
    • 这一改进减少了奖励评估的额外开销,尤其适用于编程类等计算密集型任务(如测试用例执行)
  • 作者在 verl 分支的 ray_trainer_async.py 文件中实现了一次性流水线方案

端到端性能

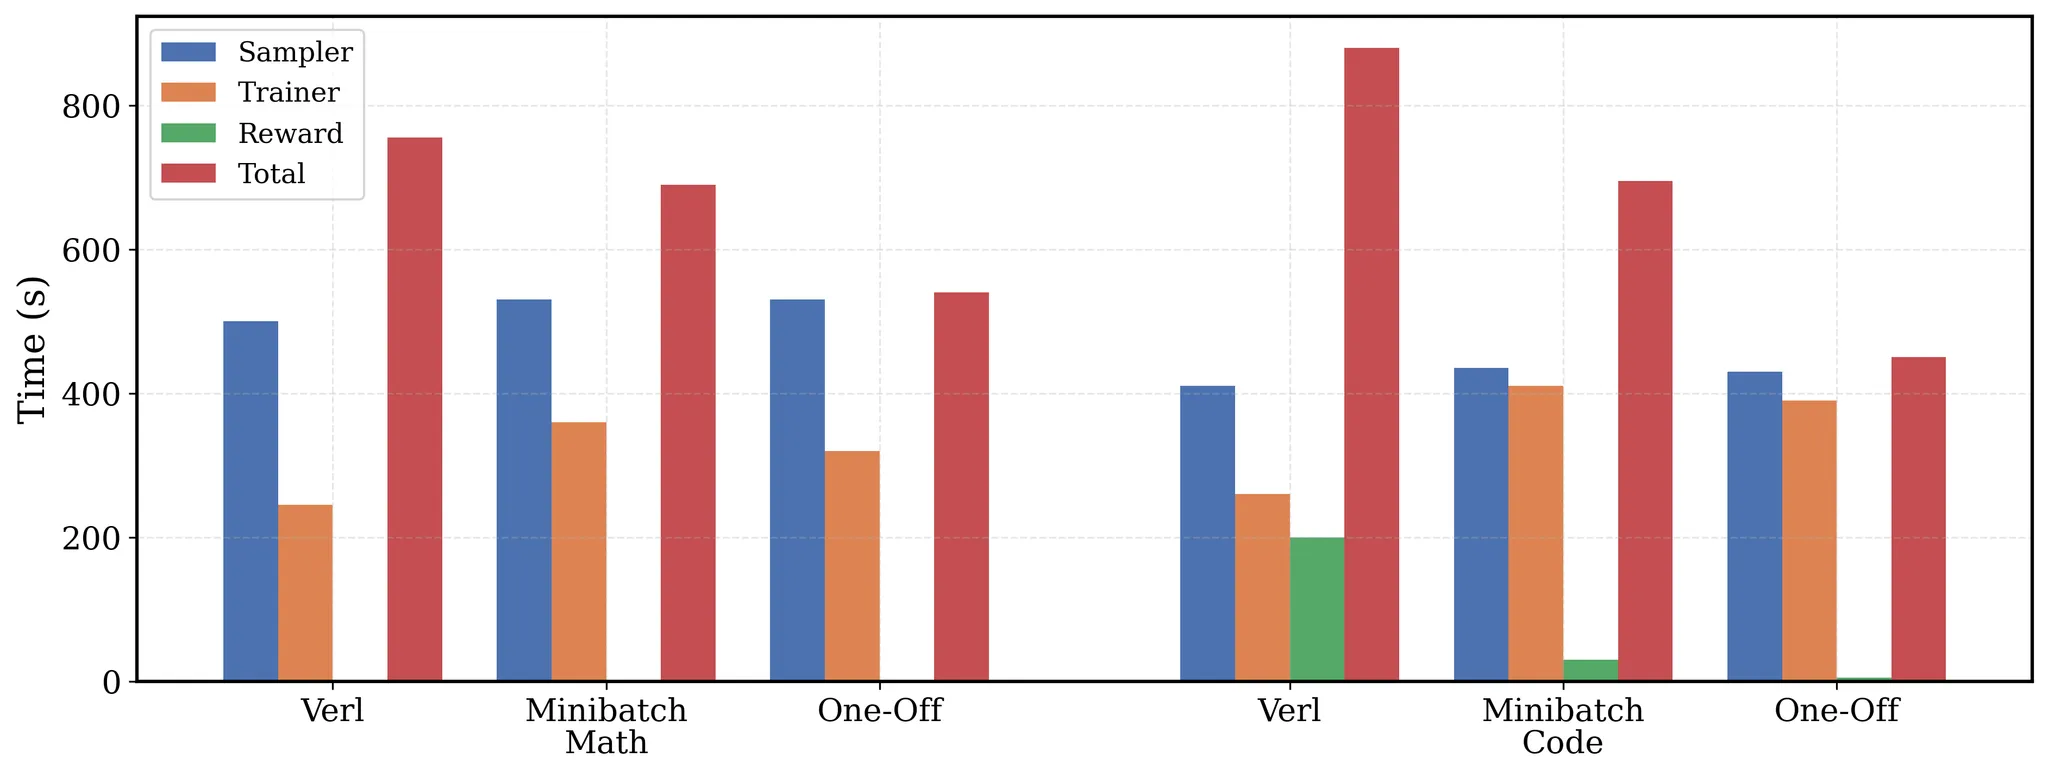
  • 在 图10 中,我们针对数学和编程两类任务负载,分别评估了 verl 基础版、微批量流水线方案和一次性流水线方案的性能
  • 为保证公平性,所有基准方案均通过 Python 线程池并行计算奖励;而 verl 官方版本对每个样本的奖励计算为串行执行,这对于编程任务而言耗时过长,不具备实际可行性
  • 作者在8台A100设备上对Deepcoder-1.5B-Preview模型进行评估,并调整采样器与训练器的比例,以更好地平衡两者的运行时间
  • 在数学任务中,一次性流水线方案将每个强化学习迭代周期的时间缩短了1.4倍。需说明的是,数学任务的奖励计算时间几乎为零,因为其仅涉及基础的sympy检查。具体而言,一次性流水线方案完全掩盖了训练器的运行时间,而微批量流水线方案中最后一批数据的训练仍会出现延迟
  • 在编程任务中,奖励计算需在每个强化学习迭代周期内运行数千次测试,是一个耗时过程。一次性流水线方案同时掩盖了训练器和奖励计算的时间,最终将端到端训练时间缩短了2倍
  • 图10:一次性流水线方案完全掩盖了训练器和奖励计算的时间,使数学任务的训练时间缩短1.4倍 ,编程任务的训练时间缩短2倍
  • 最重要的是,一次性流水线方案不仅有效,还能扩展应用于复杂的编程任务
    • 作者使用 ray_trainer_async.py 训练出 DeepCoder-1.5B-Preview 模型,其 LCB 得分较基础蒸馏模型提升了 8%
  • 具体数据为:
    Model LCB(8/1/24-2/1/25) Codeforces Rating Codeforces Percentile HumanEval+
    DeepCoder-1.5B-Preview 25.1 963 28.5 73.0
    Deepseek-R1-Distill-Qwen-1.5B 16.9 615 1.9 58.3

附录

附录 A. 训练基础设施与成本

  • DeepCoder-14B-Preview 的训练在 Together AI 提供的云平台上进行,使用了 32 块 NVIDIA H100 GPU
    • 整个训练过程持续了 2.5 周
  • 论文采用了高效的分布式训练框架和优化的通信策略,以最大化 GPU 利用率
    • 得益于 verl-pipe 系统中的多项优化(包括梯度检查点、混合精度训练和高效的批处理调度),端到端的强化学习训练速度相比基线提升了 2 倍
  • 单次完整训练的成本主要由 GPU 小时和沙箱验证费用构成:
    • GPU 计算成本 :约 $45,000
    • Together Code Interpreter 沙箱成本 :约 $720 (基于 3¢/problem 和总计 24,000 个问题计算)
    • 总估算成本 :约 $45,720

附录 B. 可复现性指南

  • 为确保研究结果的可复现性,作者在 GitHub 仓库中提供了详细的文档和脚本:
    • 1)数据准备 :scripts/download_and_filter_datasets.py 脚本自动化了从原始来源下载、验证和过滤数据集的全过程
    • 2)环境配置 :environment.yml 文件定义了精确的 Python 依赖环境
    • 3)训练启动 :launch_training.sh 脚本包含了启动 GRPO+ 训练的所有参数和配置
    • 4)评估流程 :eval/ 目录下的脚本可用于在 LiveCodeBench、Codeforces 和 AIME2024 等基准上复现我们的评估结果
  • 强烈建议使用者参考 README.md 中的“快速开始”部分来部署和运行模型

附录 C. 局限性与未来工作

  • 尽管 DeepCoder-14B-Preview 取得了显著成果,但仍存在一些局限性:
    • 领域专注 :模型在竞争性编程任务上表现出色,但在真实世界软件工程任务(如调试大型代码库、理解复杂 API)上的泛化能力有待验证
    • 语言覆盖 :当前版本主要针对 Python 代码生成进行了优化,对其他编程语言的支持较弱
    • 推理延迟 :由于其长上下文推理能力,在 64K 上下文下生成答案的延迟较高,可能不适用于对实时性要求极高的场景
  • 未来的工作将集中在解决这些局限性,并探索将此框架应用于更广泛的智能体任务,例如自主代理和复杂决策系统
NLP——LLM-Reasoning-Coconut

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(Coconut)Training Large Language Models to Reason in a Continuous Latent Space, Meta, 20251104

Paper Summary

  • 核心内容:
    • 论文介绍了一种在连续潜在空间中进行推理的新范式 Coconut,创新性很强,可能是未来的一个趋势,有可能开一个先河
    • Coconut 在潜在空间中进行推理产生了新行为,即 Continuous Thought 可以表示多个备选的后续步骤
    • Coconut 使得模型能够对可能的推理路径执行 BFS,而不是像语言空间 CoT 推理那样过早地承诺一条单一的确定性轨迹
  • LLM 被限制在“语言空间(Language Space)”中进行推理,通常通过 CoT 来表达推理过程以解决复杂的推理问题
  • 作者认为语言空间对于推理而言可能并非总是最优的
    • 如大多数 Token 主要是为了确保文本连贯性,对推理并非必需
    • 一些关键 Token 则需要复杂的规划,并对 LLM 构成了巨大挑战
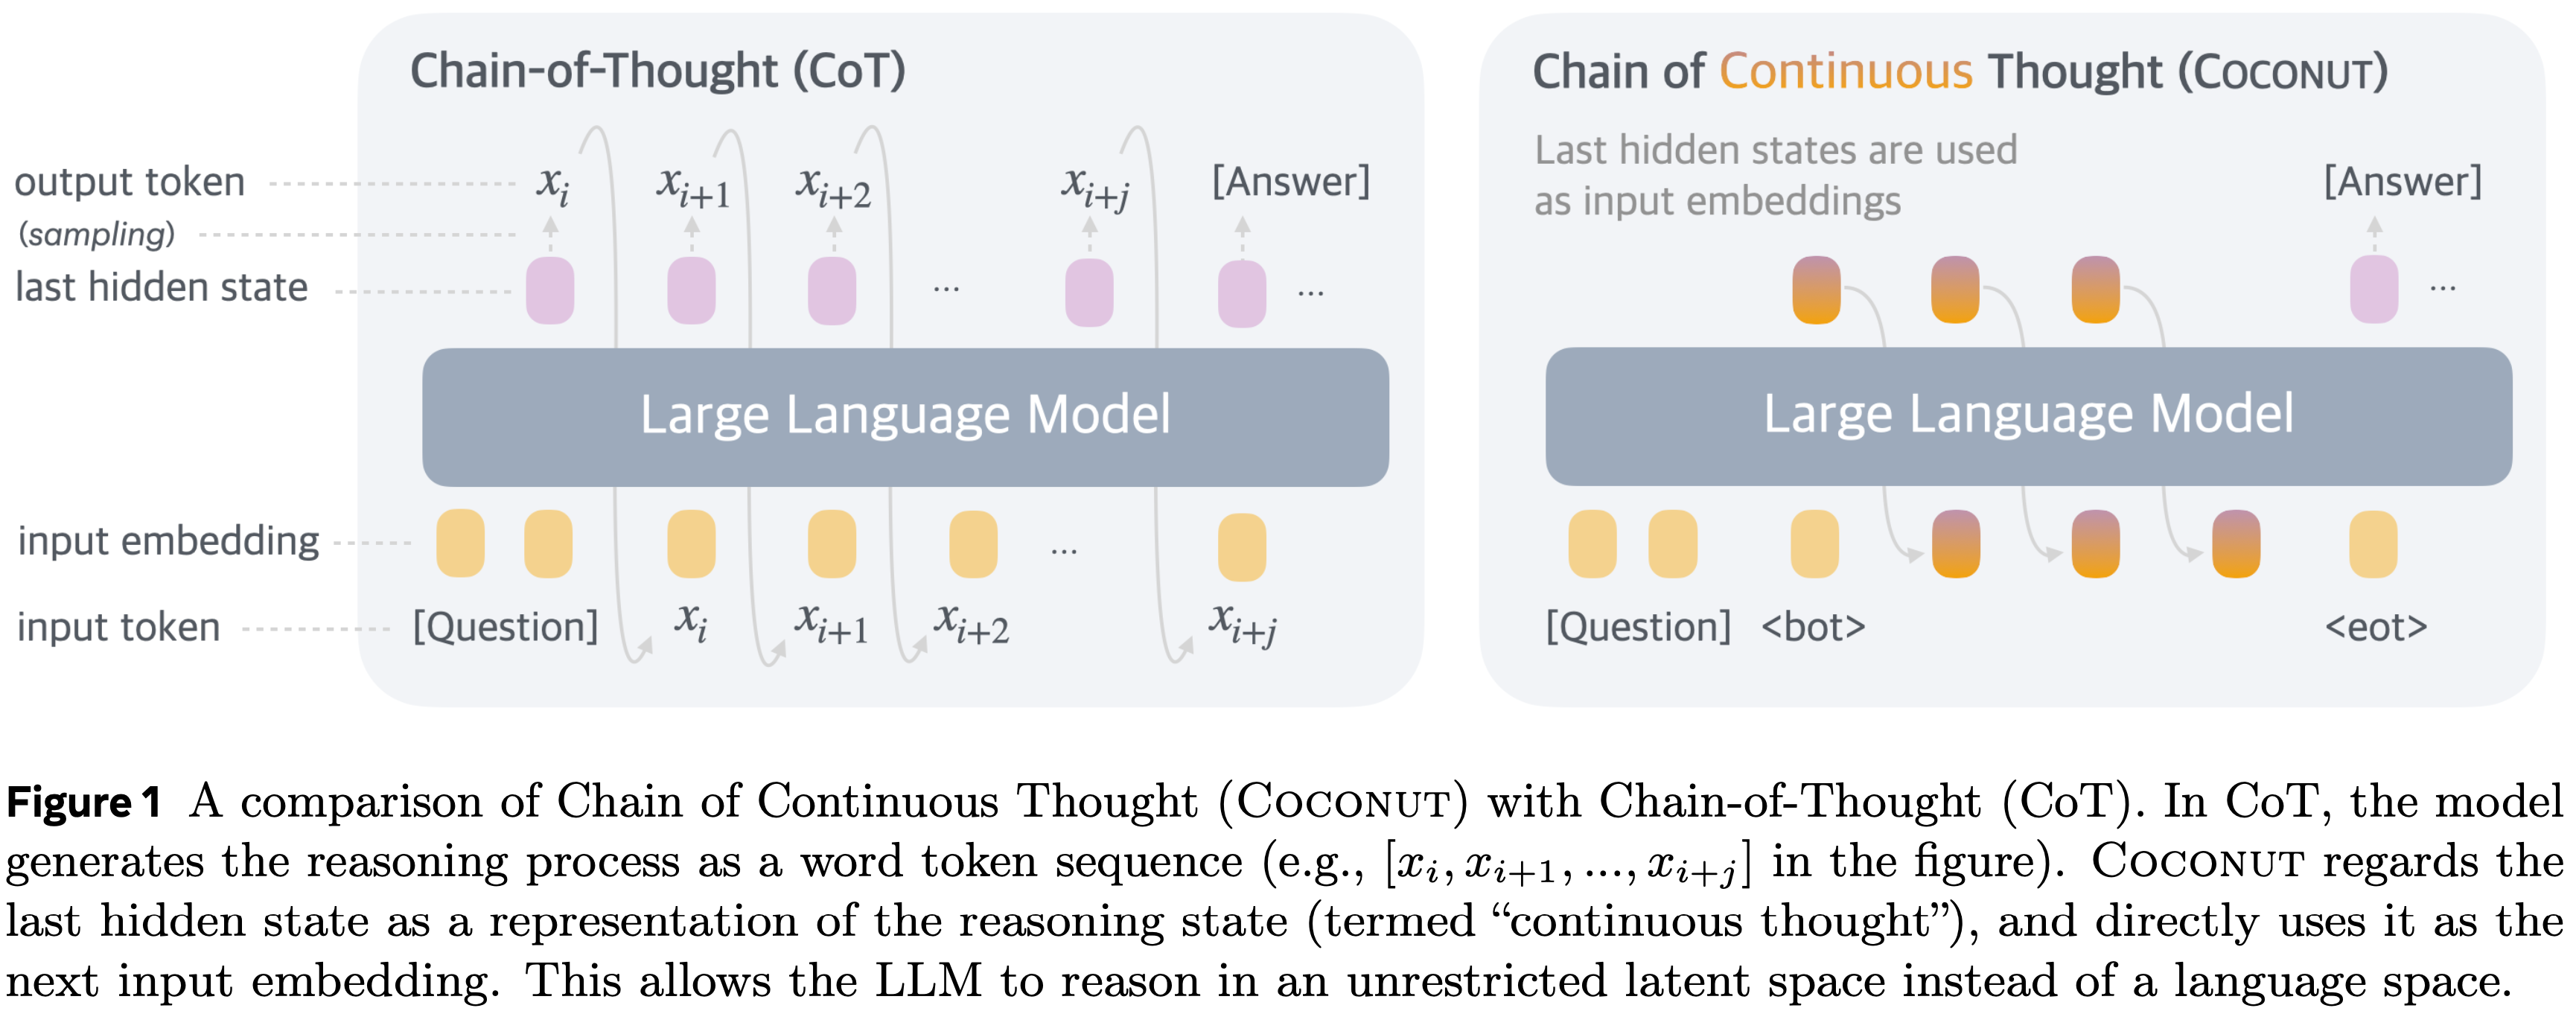
  • 为了探索 LLM 在不受限制的潜在空间(Latent Space)中进行推理的潜力(而不是使用自然语言),论文引入了一个新范式 Coconut(连续思维链,Chain of Continuous Thought)
    • 利用 LLM 的最后一个隐藏状态作为推理状态的表示(称为“ Continuous Thought”)
  • 论文不是将其解码为一个 Token ,而是直接在连续空间中将其作为后续的输入嵌入反馈给 LLM
    • 这种 Latent Reasoning 范式导致了一种高级推理模式的出现:** Continuous Thought 可以对多个备选的后续推理步骤进行编码** ,使得模型能够执行广度优先搜索(Breadth-First Search, BFS)来解决问题,而不是像思维链那样过早地承诺单一的确定性路径
    • Coconut 在某些需要大量搜索规划的逻辑推理任务上优于思维链,并在准确性和效率之间展现了更好的权衡

Introduction and Discussion

  • LLM 已经展现出卓越的推理能力,这源于对人类语言的大规模预训练 (2024; 2023)
  • 虽然 Next Token Prediction 是一个有效的训练目标,但它对 LLM 作为一个推理机器施加了一个基本限制:
    • LLM 的显式推理过程必须用 Token 生成
    • 例如 CoT 推理 (2022),涉及提示或训练 LLM 使用自然语言逐步生成解决方案,但这与某些人类认知研究结果形成鲜明对比
      • 神经影像学研究一致表明,在各种推理任务中,负责语言理解和产生的脑区集合(语言网络)大部分保持不活跃状态 (2019; 2012, 2007, 2009; 2011)
    • 进一步的证据表明,人类语言是为沟通而非推理而优化的 (2024)
  • 当 LLM 使用语言进行推理时,一个显著的问题出现了:
    • 每个特定 Token 所需的推理量差异很大,然而当前的 LLM 架构为预测每个 Token 分配了几乎相同的计算预算
      • 理解:有些 Token 需要思考,有些 Token 是不需要的
    • 推理链中的大多数 Token 仅仅是为了流畅性而生成的,对实际的推理过程贡献甚微
      • 另一些关键 Token 则需要复杂的规划,并对 LLM 构成了巨大挑战
    • 先前的工作试图通过 Prompting LLM 生成简洁的推理链 (2022),或者在生成一些关键 Token 之前执行额外的推理 (2024) 来修复这些问题
      • 但这些解决方案仍然局限于语言空间内,并未解决根本问题
    • 理想的情况是: LLM 能够不受任何语言约束地自由推理,然后仅在必要时将其发现转化为语言
  • 论文引入一个新范式 Coconut(连续思维链,Chain of Continuous Thought)来探索 LLM 在潜在空间中的推理
    • Coconut 对传统思维链过程做了简单修改:
      • Coconut 不使用语言模型头和嵌入层在隐藏状态和语言 Token 之间进行映射,而是直接将最后一个隐藏状态(一个 Continuous Thought)作为下一个 Token 的输入 Embedding(图 1)
    • 这种修改将推理从语言空间中解放出来,并且系统可以通过梯度下降进行端到端优化,因为 Continuous Thought 是完全可微分的
    • 为了增强 Latent Reasoning 的训练,论文采用了受 (2024) 启发的多阶段训练策略,该策略有效地利用语言推理链来指导训练过程
  • 论文提出的范式给出了一种高效的推理模式
    • 对比基于语言的推理,Coconut 的 Continuous Thought 可以同时编码多个潜在的后续步骤,允许进行类似于 BFS 的推理过程
      • 理解:离散化本身是一个采样过程,会丢失一些信息,相当于在选择一条确定的路,而 Continuous Thought 则保留了未采样的分布信息
    • 虽然模型最初可能不会做出正确的决策,但它可以在 Continuous Thought 中保持许多可能的选择,并在某些隐式价值函数的指导下,通过推理逐步消除不正确的路径
    • 这种高级推理机制超越了传统的思维链,尽管模型并未像先前工作 (2023; 2023) 中那样被明确训练或指示以这种方式操作
      • 问题:如何理解上面这句话?
  • 实验表名:Coconut 成功增强了 LLM 的推理能力
    • 对于数学推理(GSM8k, 2021)任务, Continuous Thought 对推理准确性有益
      • 这表明通过链接更多 Continuous Thought 来扩展和解决更具挑战性问题的潜力
    • 在逻辑推理方面,包括 ProntoQA (2022) 和论文新提出的需要更强规划能力的 ProsQA(第 4 节)
      • Coconut 及其一些变体甚至超越了基于语言的思维链方法,同时在推理过程中生成的 Token 数量显著减少
      • 作者相信这些发现强调了 Latent Reasoning 的潜力,并可能为未来的研究提供宝贵的见解

Coconut: Continuous Thought 链 (Coconut: Chain of Continuous Thought)

  • 本节介绍新范式 Coconut(Chain of Continuous Thought),在不受约束的潜在空间中进行推理

Background

  • 对于输入序列 \(x=(x_{1},…,x_{T})\),标准的 LLM \(\mathcal{M}\) 可以描述为:
    $$
    \begin{align}
    H_{t} =\text{Transformer}(E_{t}) \\
    \mathcal{M}(x_{t+1}\mid x_{\leq t}) =\text{softmax}(Wh_{t})
    \end{align}
    $$
    • \(E_{t}=[e(x_{1}),e(x_{2}),…,e(x_{t})]\) 是直到位置 \(t\) 的 Token 嵌入序列;
    • \(H_{t}\in\mathbb{R}^{t\times d}\) 是直到位置 \(t\) 的所有 Token 的最后一个隐藏状态矩阵;
    • \(h_{t}\) 是位置 \(t\) 的最后一个隐藏状态,即 \(h_{t}=H_{t}[t,:]\);\(e(\cdot)\) 是 Token 嵌入函数;\(W\) 是语言模型头的参数

Method Overview

  • 在语言模式下,模型作为标准语言模型运行,自回归地生成下一个 Token
  • 在 Coconut 中, LLM 在“语言模式”和“潜在模式”之间切换(图 1)
    • 直接使用最后一个隐藏状态作为下一个输入嵌入
    • 这个最后一个隐藏状态代表了当前的推理状态,被称为“ Continuous Thought ”
  • 使用特殊 Token <bot> 和 <eot> 分别 Token Latent Thought 模式的开始和结束
  • 举例:假设 Latent Reasoning 发生在位置 \(i\) 和 \(j\) 之间,即 \(x_{i}=\) 且 \(x_{j}=\)
    • 当模型处于潜在模式时(\(i < t < j\)),论文使用前一个 Token 的最后一个隐藏状态来替换输入嵌入,即
      $$ E_{t}=[e(x_{1}),e(x_{2}),…,e(x_{t}),h_{i},h_{i+1},…,h_{t-1}]$$
    • 在潜在模式结束后(\(t\geq j\)),输入恢复为使用 Token 嵌入,即
      $$ E_{t}=[e(x_{1}),e(x_{2}),…,e(x_{t}),h_{i},h_{i+1},…,h_{j-1},e(x_{j}),…,e( x_{t})] $$
    • It is worth noting that 最后一个隐藏状态已经经过最终归一化层处理,因此它们的幅度不会太大
      • 当 \(i < t < j\) 时,\(\mathcal{M}(x_{t+1}\mid x_{\leq t})\) 未定义,因为 Continuous Thought 不打算映射回语言空间
      • 但出于探测目的,仍然可以计算 softmax(\(Wh_{t}\))(见第 5 节)

Training Procedure

  • 论文专注于一个问题解决场景,其中模型接收一个问题作为输入,并期望通过推理过程生成一个答案
  • 论文利用语言思维链数据,通过实施受 (2024) 启发的多阶段训练课程来监督 Continuous Thought
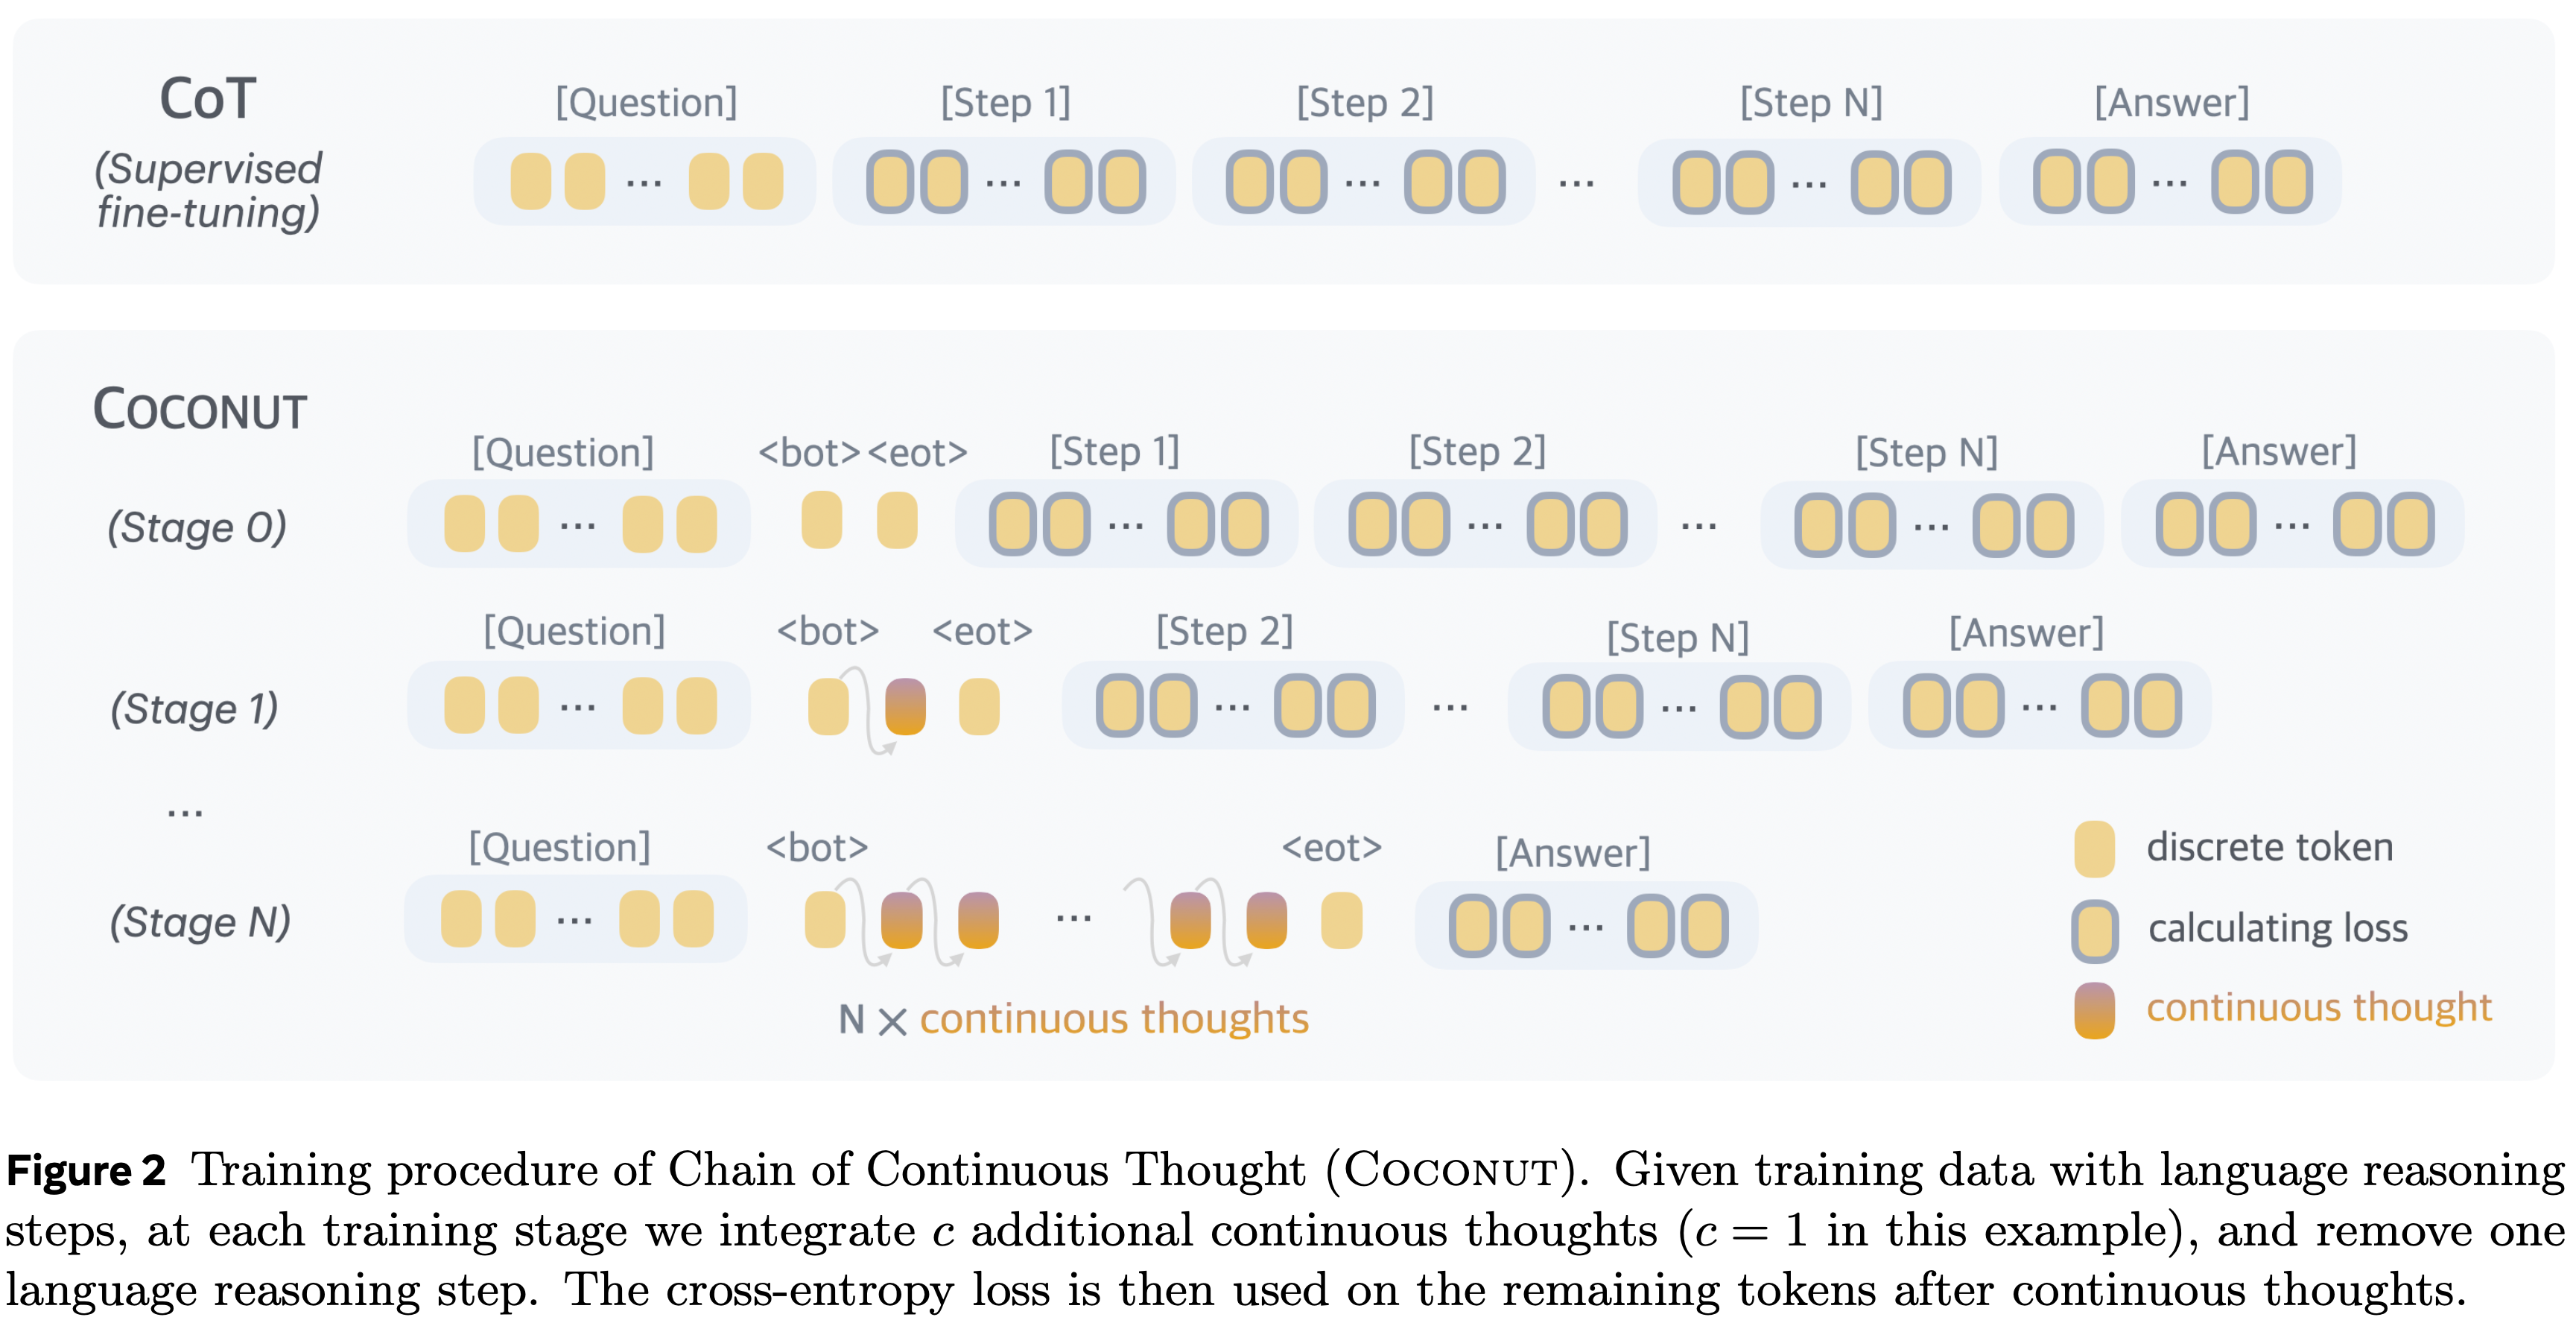
  • 如图 2 所示
    • 在初始阶段,模型在常规的思维链实例上进行训练
    • 在后续阶段中,在第 \(k\) 个阶段,思维链中的前 \(k\) 个推理步骤被替换为 \(k\times c\) 个 Continuous Thought(如果语言推理链短于 \(k\) 步,那么所有的语言思维都将被移除)
      • 其中 \(c\) 是一个超参数,控制替换单个语言推理步骤的 Latent Thought 数量
      • 问题:这里的推理步骤是如何定义和划分的?
    • 遵循 (2024),论文在训练阶段切换时也重置优化器状态
    • 论文插入 <bot> 和 <eot> Token (不计入 \(c\))来封装 Continuous Thought
  • 在训练过程中,优化标准的负对数似然损失,但屏蔽问题和 Latent Thought 上的损失
  • It is important to note that 目标并不鼓励 Continuous Thought 去压缩被移除的语言思维 ,而是去促进对未来推理的预测
    • 因此, LLM 有可能学习到比人类语言更有效的推理步骤表示

Training Details

  • Continuous Thought 是完全可微分的,并允许反向传播
  • 在当前训练阶段安排了 \(n\) 个 Latent Thought 时,论文执行 \(n+1\) 次前向传播,每次传播计算一个新的 Latent Thought ,最后进行一次额外的前向传播以获得剩余文本序列上的损失
  • 虽然可以通过使用 KV 缓存来节省任何重复计算,但多次前向传播的顺序性质对并行性提出了挑战
  • 进一步优化Coconut 的训练效率仍然是未来研究的一个重要方向

Inference Process

  • Coconut 的推理过程类似于标准的语言模型解码,除了在潜在模式下,直接将最后一个隐藏状态作为下一个输入嵌入
  • 一个挑战在于确定何时在潜在模式和语言模式之间切换
  • 论文专注于问题解决场景
    • 在问题 Token 之后立即插入一个 <bot> Token
    • 对于 <eot>,论文考虑两种潜在策略(或 关系):
      • a)在 Latent Thought 上训练一个二元分类器,使模型能够自主决定何时终止 Latent Reasoning
      • b)总是将 Latent Thought 填充到恒定长度
    • 作者发现两种方法效果相当
    • 在实验中,除非另有说明,论文出于简单性使用第二个选项

Continuous Space Enables Latent Tree Search(连续空间使得我们可以使用Latent 树搜索)

  • 本节提供了一个概念验证,证明了在连续潜在空间中进行推理的优势
  • 在 ProsQA 这个需要强大规划能力的新数据集上,Coconut 的表现优于语言空间的 CoT 推理
  • Interestingly,论文的分析表明,推理的连续表示可以编码多个备选的后续推理步骤
    • 这使得模型能够执行广度优先搜索来解决问题,而不是像语言 CoT 那样过早地承诺一条单一的确定性路径
  • 4.1 节:介绍实验设置
  • 4.2 节:通过利用 Coconut 在语言和潜在空间推理之间切换的能力,论文能够控制模型在完全 Latent Reasoning 和完全语言推理之间进行插值,并测试它们的性能
  • 4.3 节:作者将 Latent Reasoning 过程解释为树搜索(tree search)
  • 4.4 节:基于树搜索的视角,作者解释了为什么 Latent Reasoning 能帮助 LLM 做出更好的决策

Experimental Setup

Dataset
  • 论文引入了 ProsQA(Proof with Search Question-Answering),一个新的逻辑推理数据集
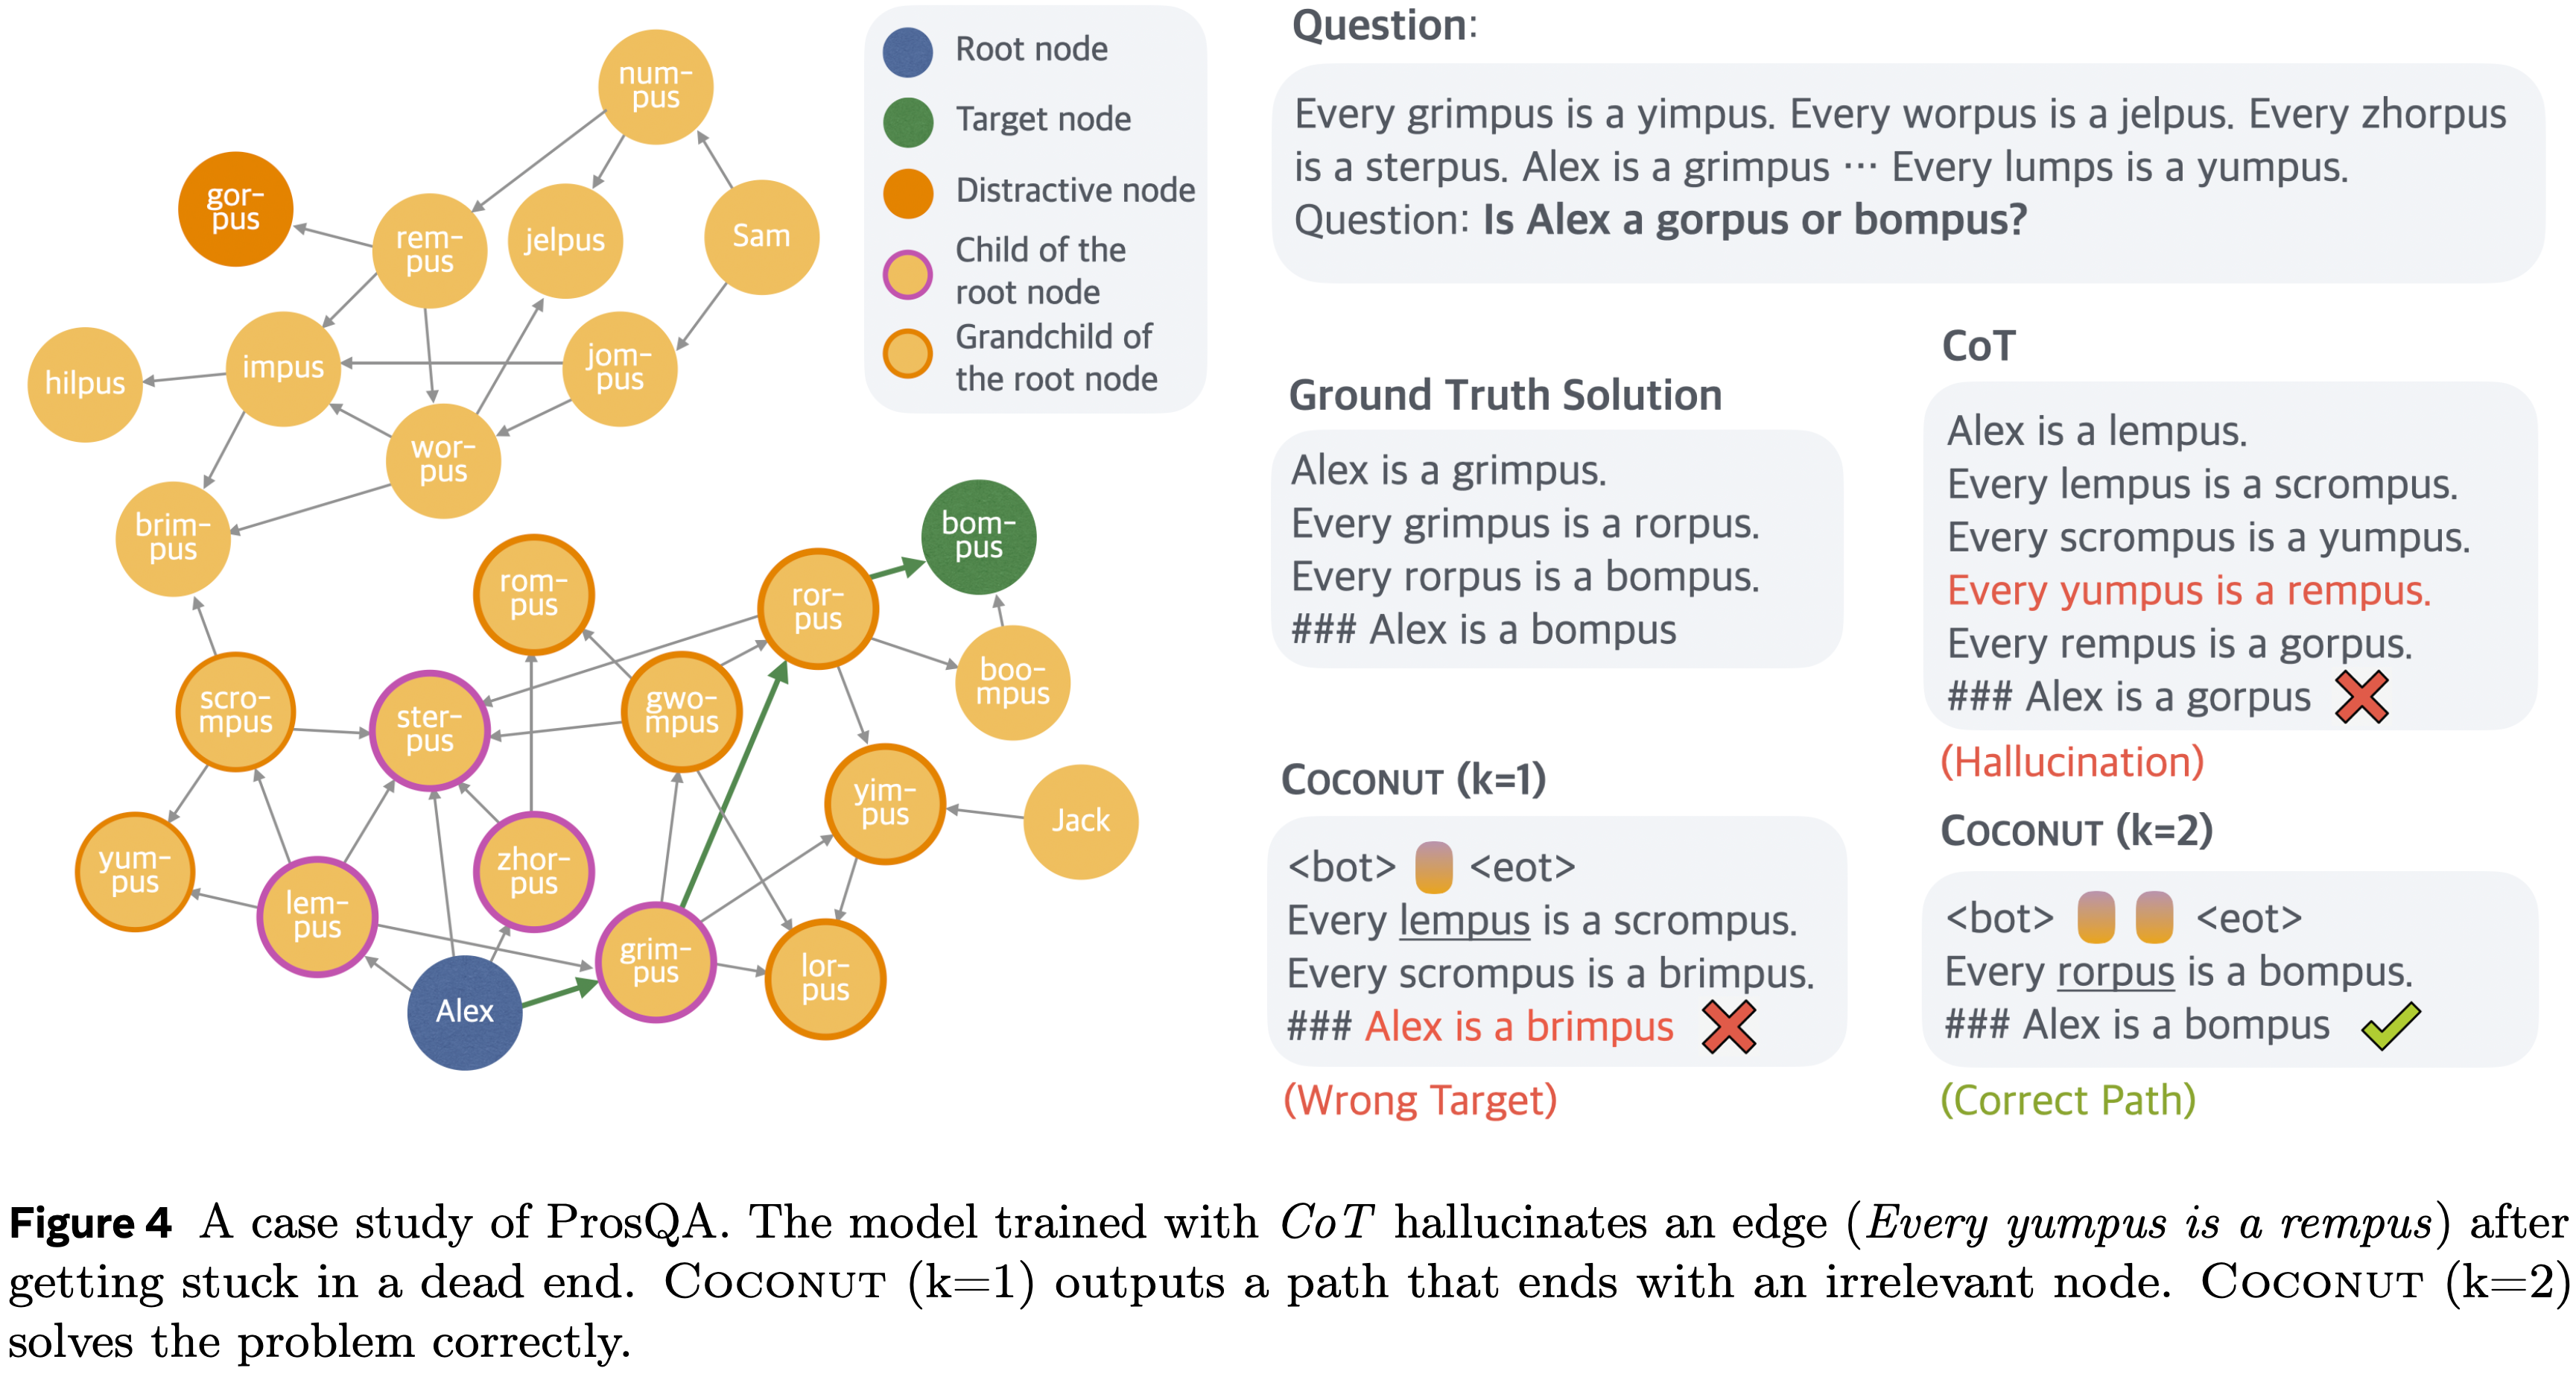
    • 一个可视化的例子如图 4 所示
  • ProsQA 中的每个实例都由一个概念间逻辑关系的有向无环图组成,以自然语言语句的形式呈现
  • 该任务要求模型通过在此图中找到有效路径来确定逻辑关系,这需要复杂的规划和搜索策略
  • 与之前的逻辑推理数据集(如 ProntoQA (Saparov and He, 2022))不同,ProsQA 的 DAG 结构引入了复杂的探索路径,使得模型识别正确的推理链特别具有挑战性
  • 关于数据集构建和特征的更全面细节可以在附录 A 中找到
Setup
  • 论文使用预训练的 GPT-2 模型作为所有实验的基础模型
  • 学习率设置为 \(1\times 10^{-4}\),有效批次大小为 128
  • 作者按照第 3 节的训练过程训练一个 Coconut 模型
  • 由于 ProsQA 中的最大推理步数为 6,论文在训练过程中将训练阶段数设置为 \(N=6\)
  • 在每个阶段,论文训练模型 5 个 Epoch ,并在最后一个阶段保持训练直到总共 50 个 Epoch
  • 使用最后一个阶段中准确率最高的检查点进行评估
  • 作为参考,论文报告了以下基线的性能:
    • (1) CoT:模型使用 CoT 数据进行训练,在推理过程中,模型会生成完整的推理链来解决问题
    • (2) no-CoT:模型仅使用问题和答案对进行训练,没有任何推理步骤
  • 为了理解 Latent Reasoning 空间和语言推理空间的特性,论文通过手动设置 <eot> Token 在推理过程中的位置,来操纵模型在完全 Latent Reasoning 和完全语言推理之间切换
  • 当强制 Coconut 使用 \(k\) 个 Continuous Thought 时,模型需要从第 \(k+1\) 步开始,以语言形式输出剩余的推理链
  • 在论文的实验中,论文在 ProsQA 上测试了 Coconut 的变体,其中 \(k\in \{0,1,2,3,4,5,6\}\)
    • 请注意,所有这些变体仅在推理时有所不同,而共享相同的模型权重
Metrics
  • 论文应用了两套评估指标
    • 一套基于 最终答案 的正确性,而不考虑推理过程。这也是后面章节(第 5.3 节)使用的主要指标
    • 为了对 ProsQA 进行细粒度分析,论文定义了另一个关于 推理过程 的指标
  • 论文将推理链分类为:
    • (1) 正确路径 (Correct Path) :输出是到达正确答案的最短路径之一
    • (2) 更长路径 (Longer Path) :正确回答问题但比最短路径长的有效路径
    • (3) 幻觉 (Hallucination) :路径包含不存在的边或是不连通的
    • (4) 错误目标 (Wrong Target) :图中的有效路径,但目标节点不是被问及的节点
  • 这四类自然地适用于 Coconut (\(k=0\)) 和 \(CoT\) 的输出,它们生成完整路径
  • 对于仅输出部分语言路径(初始步骤为连续推理)的 Coconut (\(k>0\)),如果存在一个有效的解释可以补全该路径,论文将其推理归类为正确路径
    • 类似地,作者也为部分路径定义了更长路径和错误目标
  • 如果没有有效的解释可以补全该路径,则归类为幻觉
  • 在 no-CoT 和具有较大 \(k\) 的 Coconut 中,模型可能只输出最终答案而没有任何部分路径,这属于
    • (5) 正确标签 (Correct Label) 或
    • (6) 错误标签 (Incorrect Label)
  • 以上这六个类别涵盖了所有情况且没有重叠

Overall Results

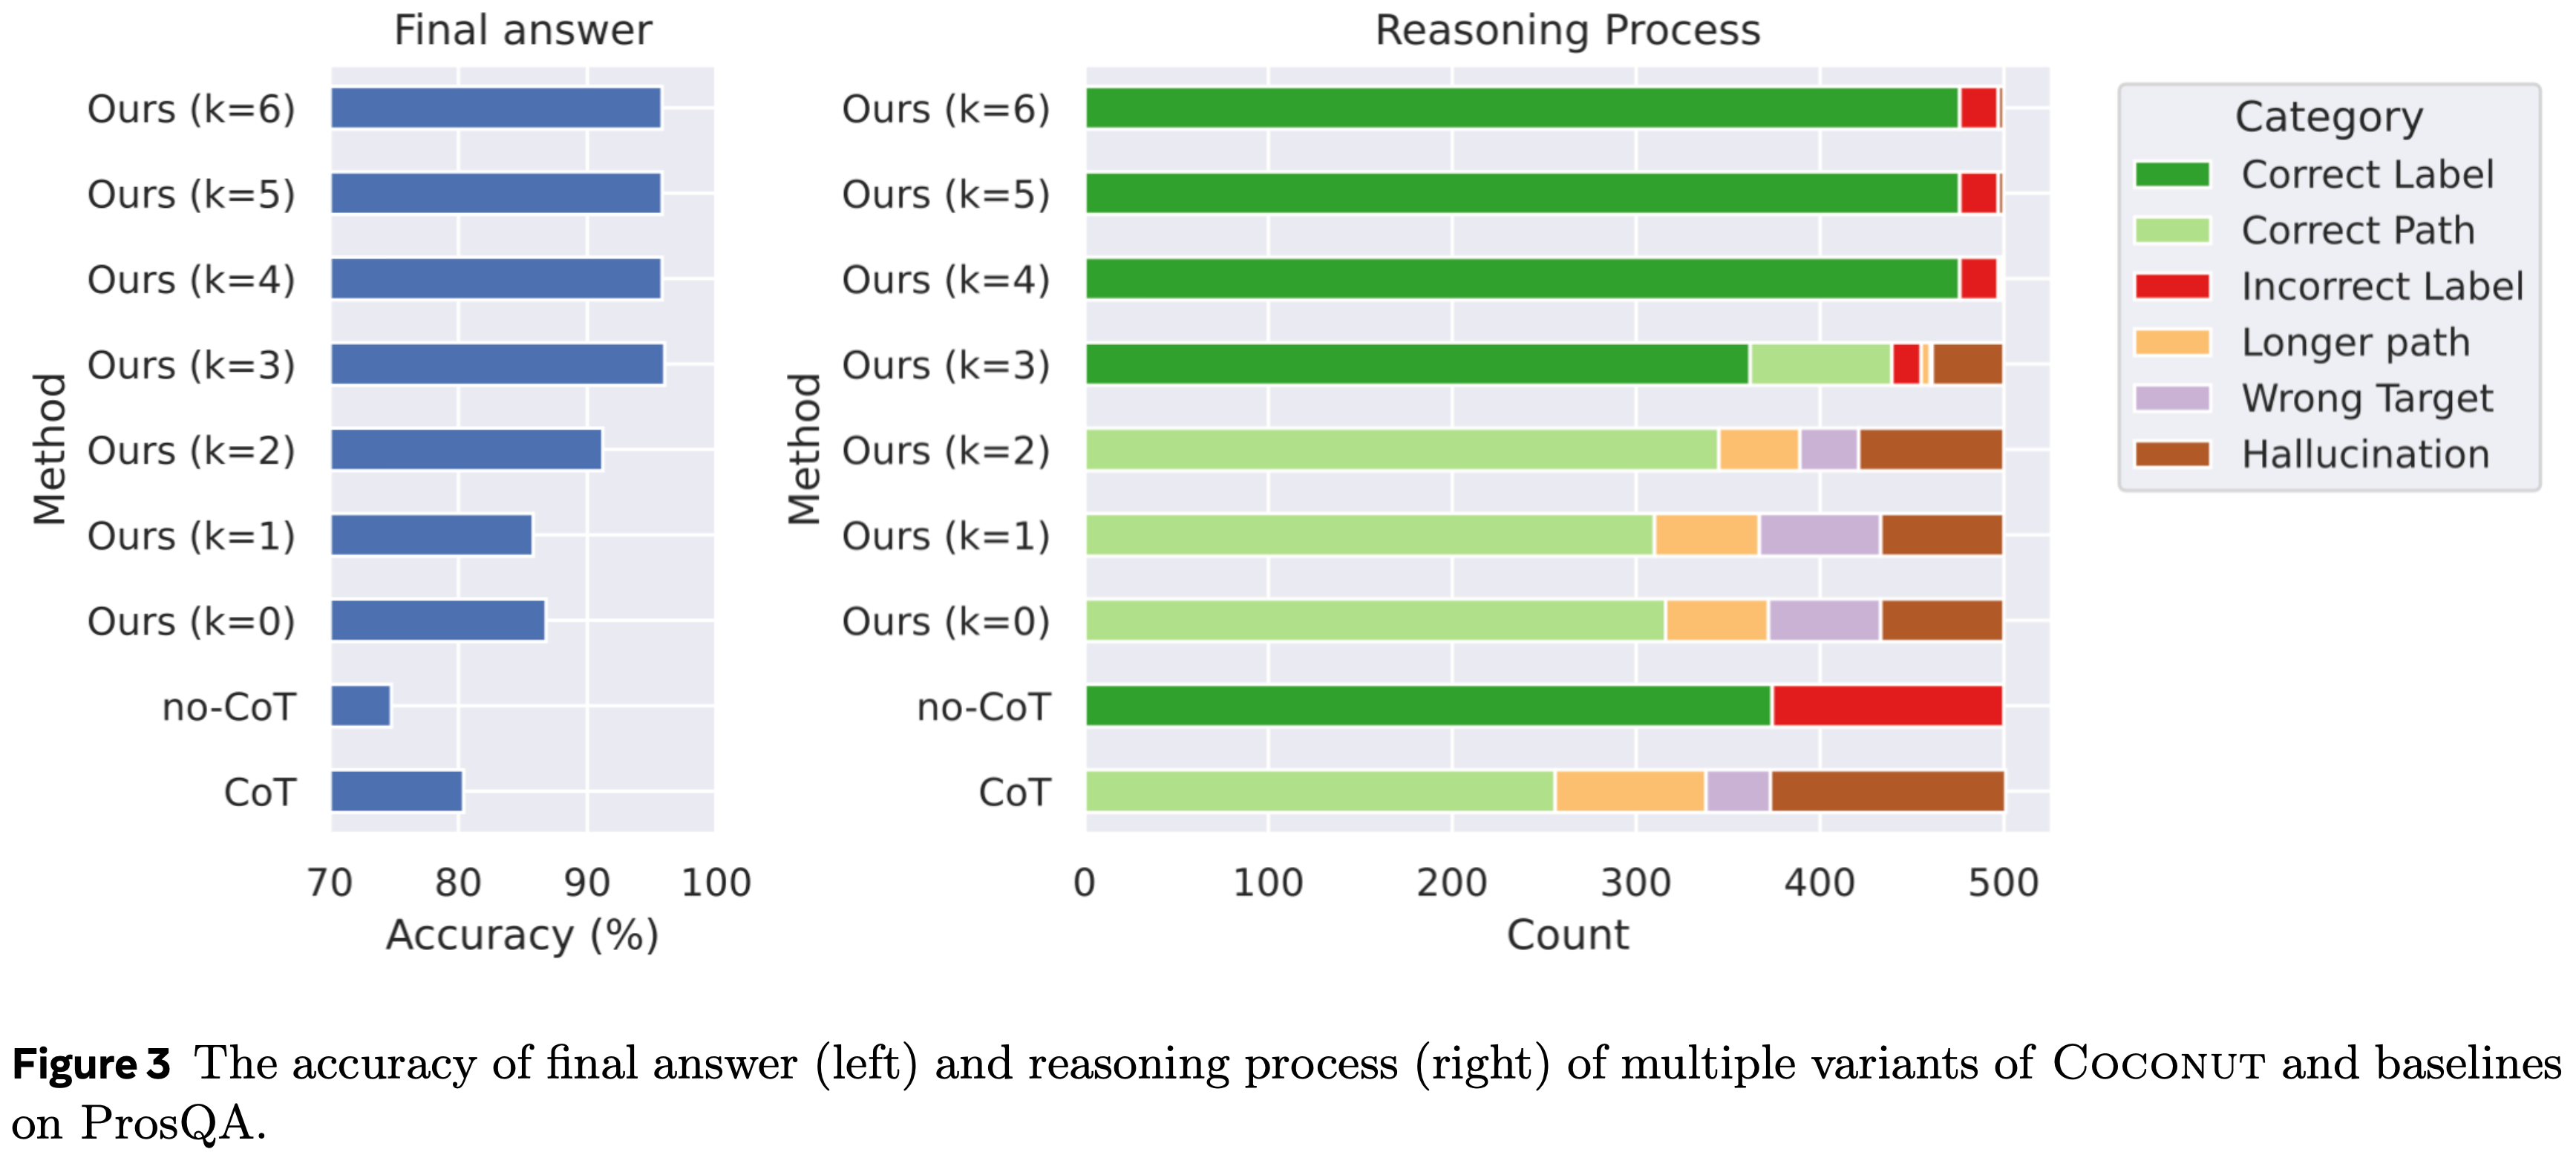
  • 图 3 展示了在 ProsQA 上评估的各种推理方法的比较分析
    • 使用 \(CoT\) 训练的模型经常幻觉出不存在的边或输出导致错误目标的路径,导致答案准确率较低
    • 利用连续空间推理的 Coconut 随着使用 Continuous Thought 数量的增加,表现出更高的准确率
    • 正确推理过程(由“正确标签”和“正确路径”表示)的比例显著增加
    • “幻觉”和“错误目标”的情况显著减少,这些问题通常在模型在推理过程早期犯错时出现
  • 图 4 所示的案例研究直观地展示了在语言空间进行推理的局限性
    • 如图所示,在语言空间操作的模型常常无法提前规划或回溯
      • 一旦它们承诺了一条错误的路径,它们要么幻觉出不支持的边,要么以不相关的结论终止
    • Latent Reasoning 通过使模型能够在多个推理步骤中迭代地优化其决策,避免了这种过早的承诺
      • 这种灵活性允许模型逐步淘汰不正确的选项并收敛到正确答案,最终实现更高的准确率

Interpreting the Latent Reasoning as Tree Search(将 Latent Reasoning 解释为树搜索)

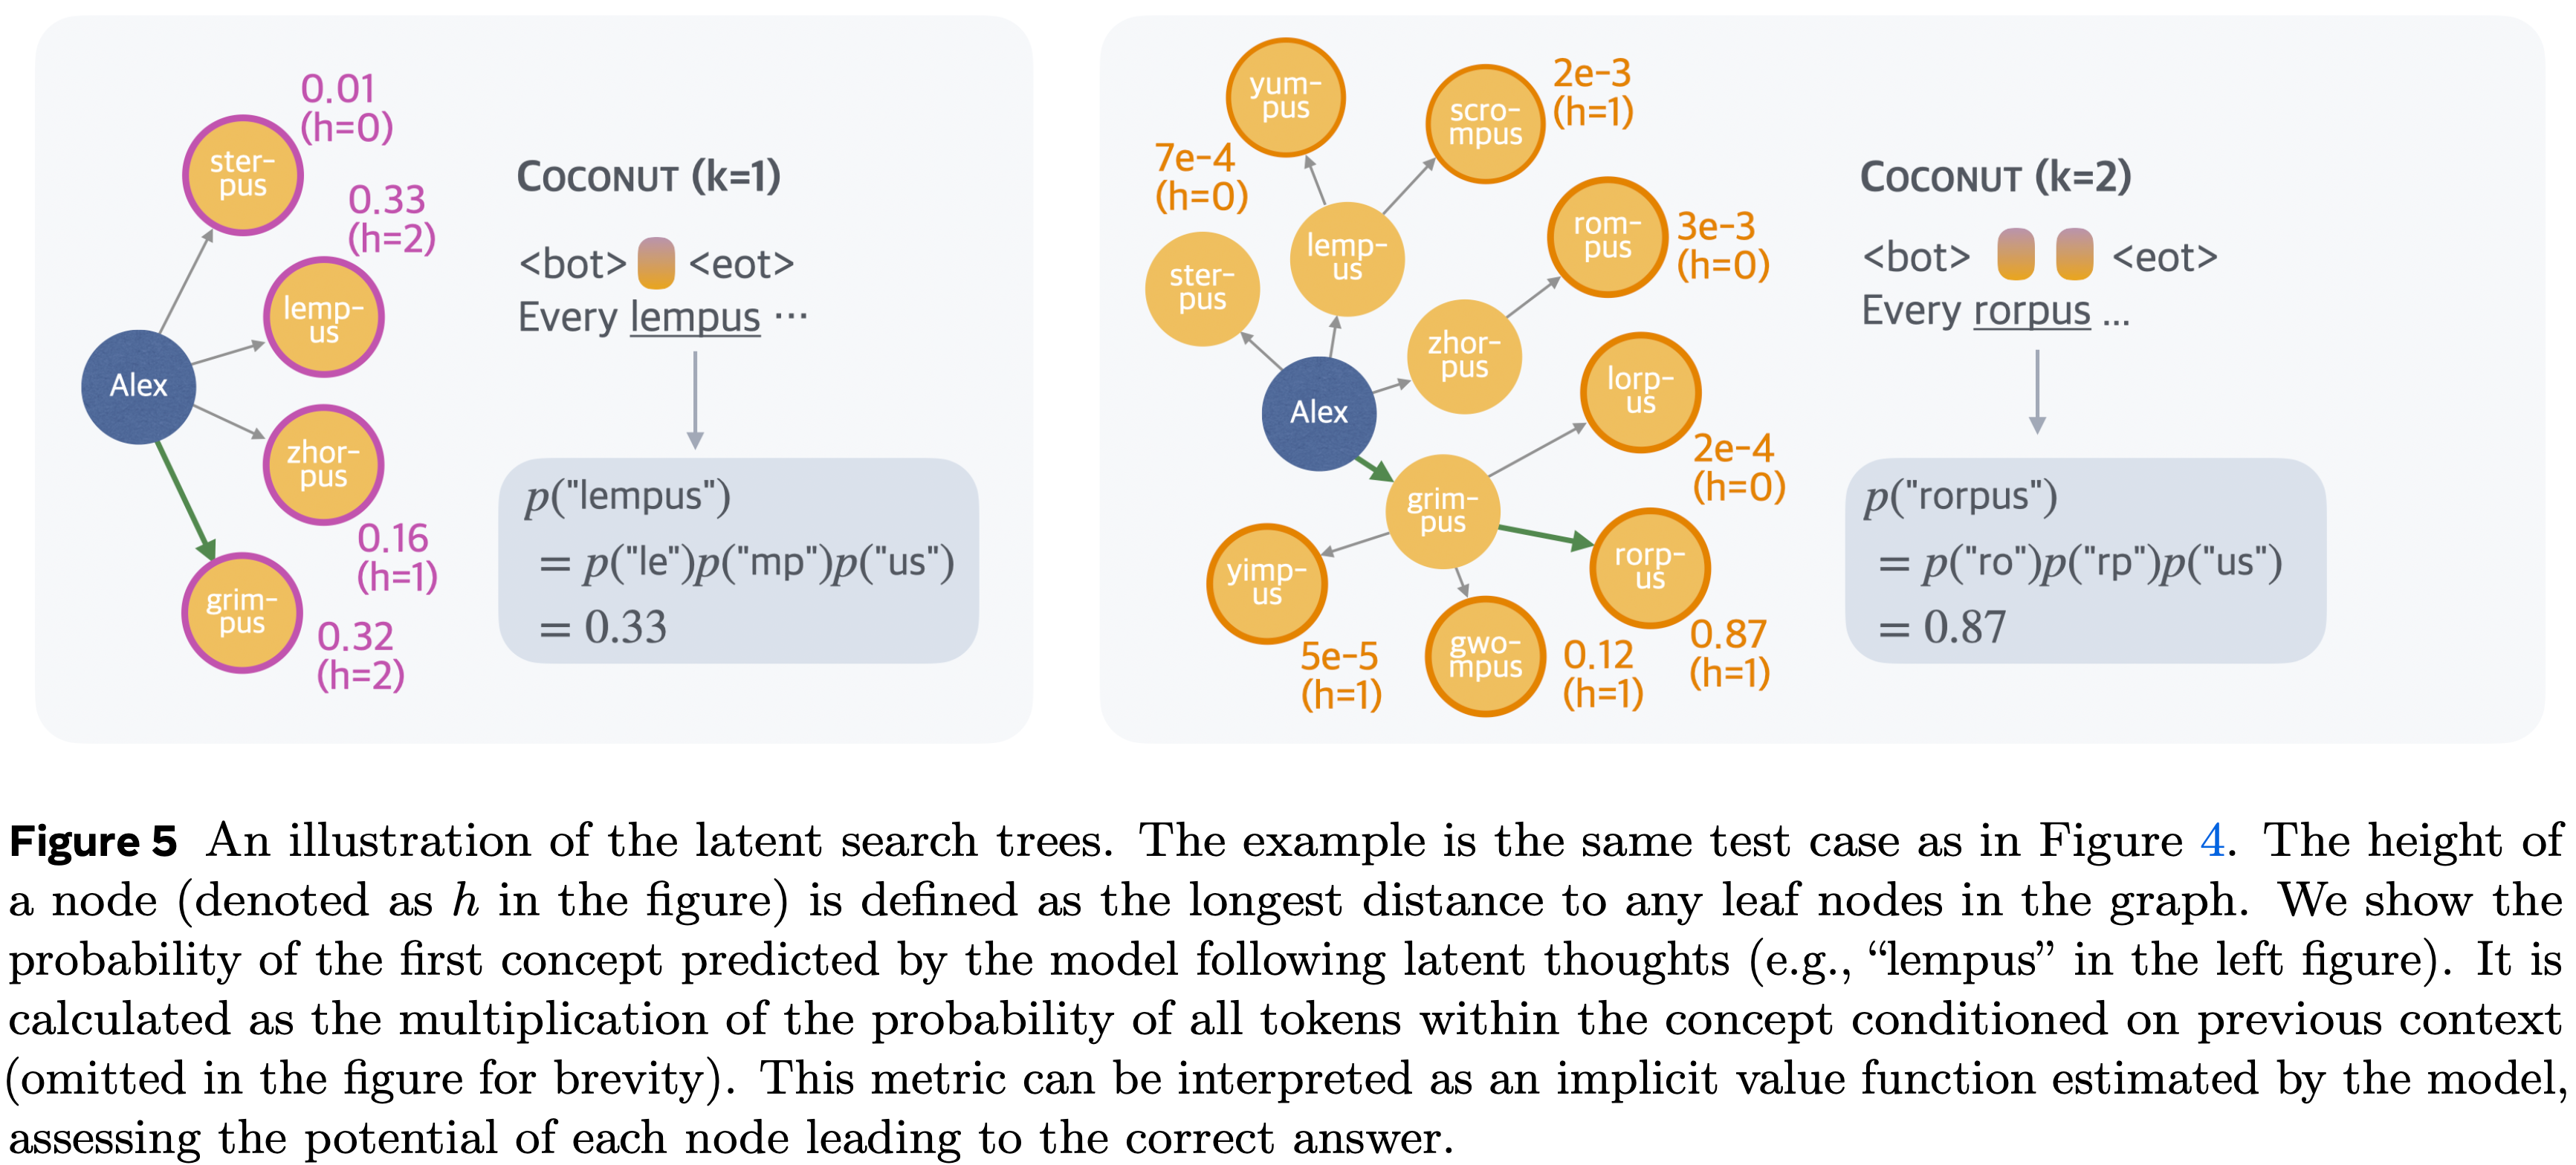
  • 为了更好地理解 Coconut,论文通过在中间 Continuous Thought 之后强制模型显式生成语言推理步骤来探测 Latent Reasoning 过程(图 5)
    • 使用图 4 中展示的例子,在初始推理步骤,模型必须选择接下来考虑“Alex”的哪个直接子节点,具体是从集合 {“lempus”, “sterpus”, “zhorpus”, “grimpus”} 中选择
    • 这些候选下一步的分布如图 5 左侧所示
    • 在随后的推理步骤中,这些节点进一步扩展为一组扩展的潜在路径,包括“Alex”的所有孙节点(图 5 右侧)
  • 论文将 Continuous Thought 之后某个概念的预测概率定义为一个价值函数(图 5),用于估计每个节点到达正确目标的潜力
  • Interestingly,Coconut 采用的推理策略并非贪婪搜索:
    • 虽然在第一个推理步骤中“lempus”最初具有最高的价值 (\(0.33\))(图 5 左侧),但模型随后将最高价值 (\(0.87\)) 分配给了“grimpus”的子节点“corpus”,而不是跟随“lempus”(图 5 右侧)
    • 这个特性类似于广度优先搜索方法,与传统的 CoT 方法典型的贪婪解码形成鲜明对比
    • 连续表示能够编码多个候选路径的固有能力使模型能够避免立即做出确定性决策
    • Importantly,这种树搜索模式并不仅限于所展示的例子,而是构成了在 Coconut 中使用较大 \(k\) 值时观察到的一致改进的基本机制
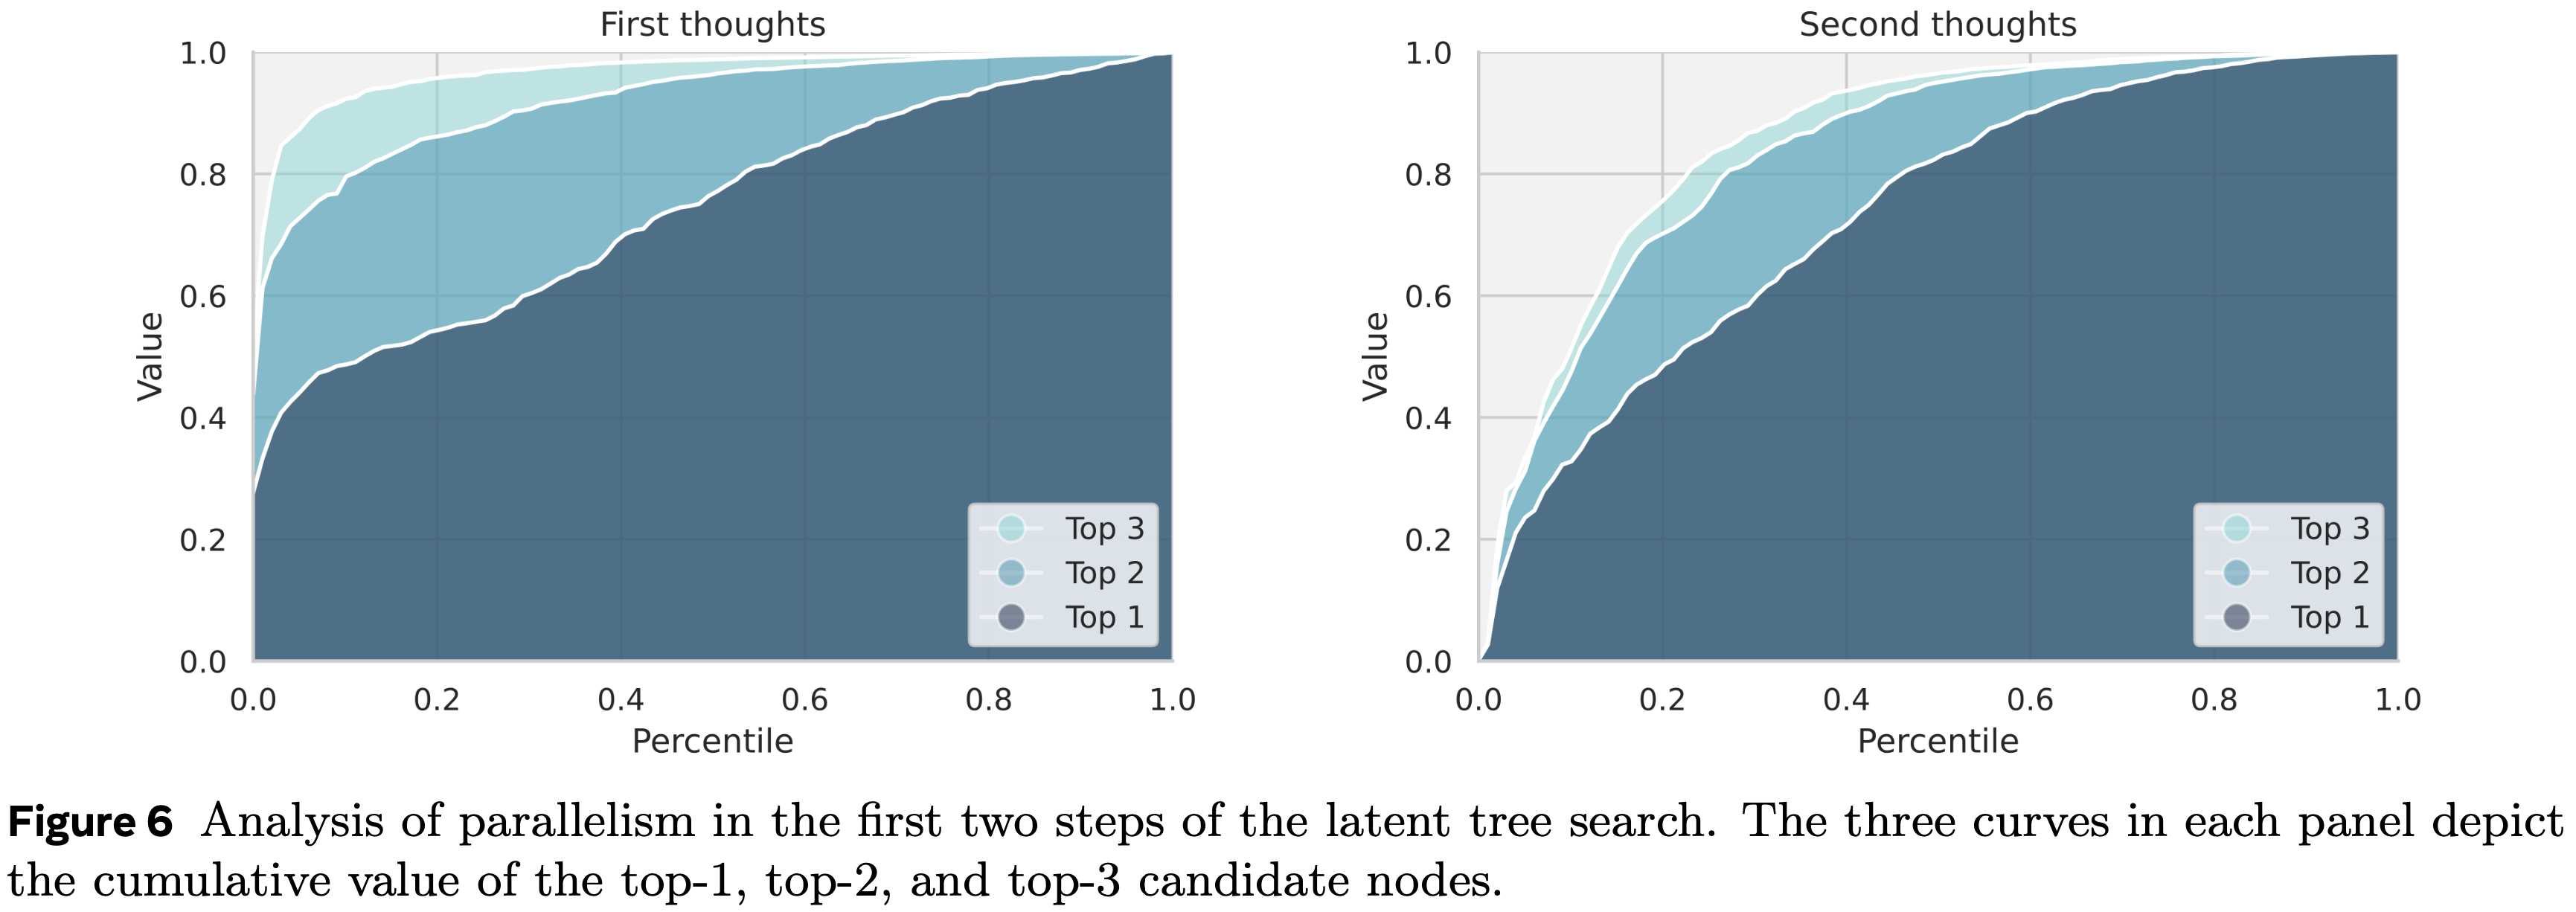
  • 图 6 展示了模型在第一和第二个思维中 Latent Reasoning 并行性的分析
    • 对于第一个思维(左图),计算了前 1、前 2 和前 3 候选节点的累积价值,并针对它们在测试集中的相应百分位数进行绘制
    • 三条线之间的明显差距表明,模型在此阶段在其推理路径中保持了显著的多样性,表明了对替代可能性的广泛探索
    • In contrast,第二个思维(右图)显示这些差距在缩小
      • 这种趋势表明,模型在第二个 Latent Reasoning 步骤中从并行探索转向更集中的推理,很可能是因为它对最有希望的路径获得了更多的确定性

Why is Latent Space Better for Planning?

  • 基于树搜索的视角,作者进一步研究了为什么 Latent Reasoning 有益于规划任务
    • 具体来说,为什么保持多个候选路径并推迟确定性决策能提高推理性能
  • 作者的假设是,在早期推理阶段探索的节点本质上更难以准确评估,因为它们距离最终的目标节点更远
    • In contrast,位置更接近潜在目标的节点,由于后续探索的可能性较少,可以以更高的置信度进行准确评估
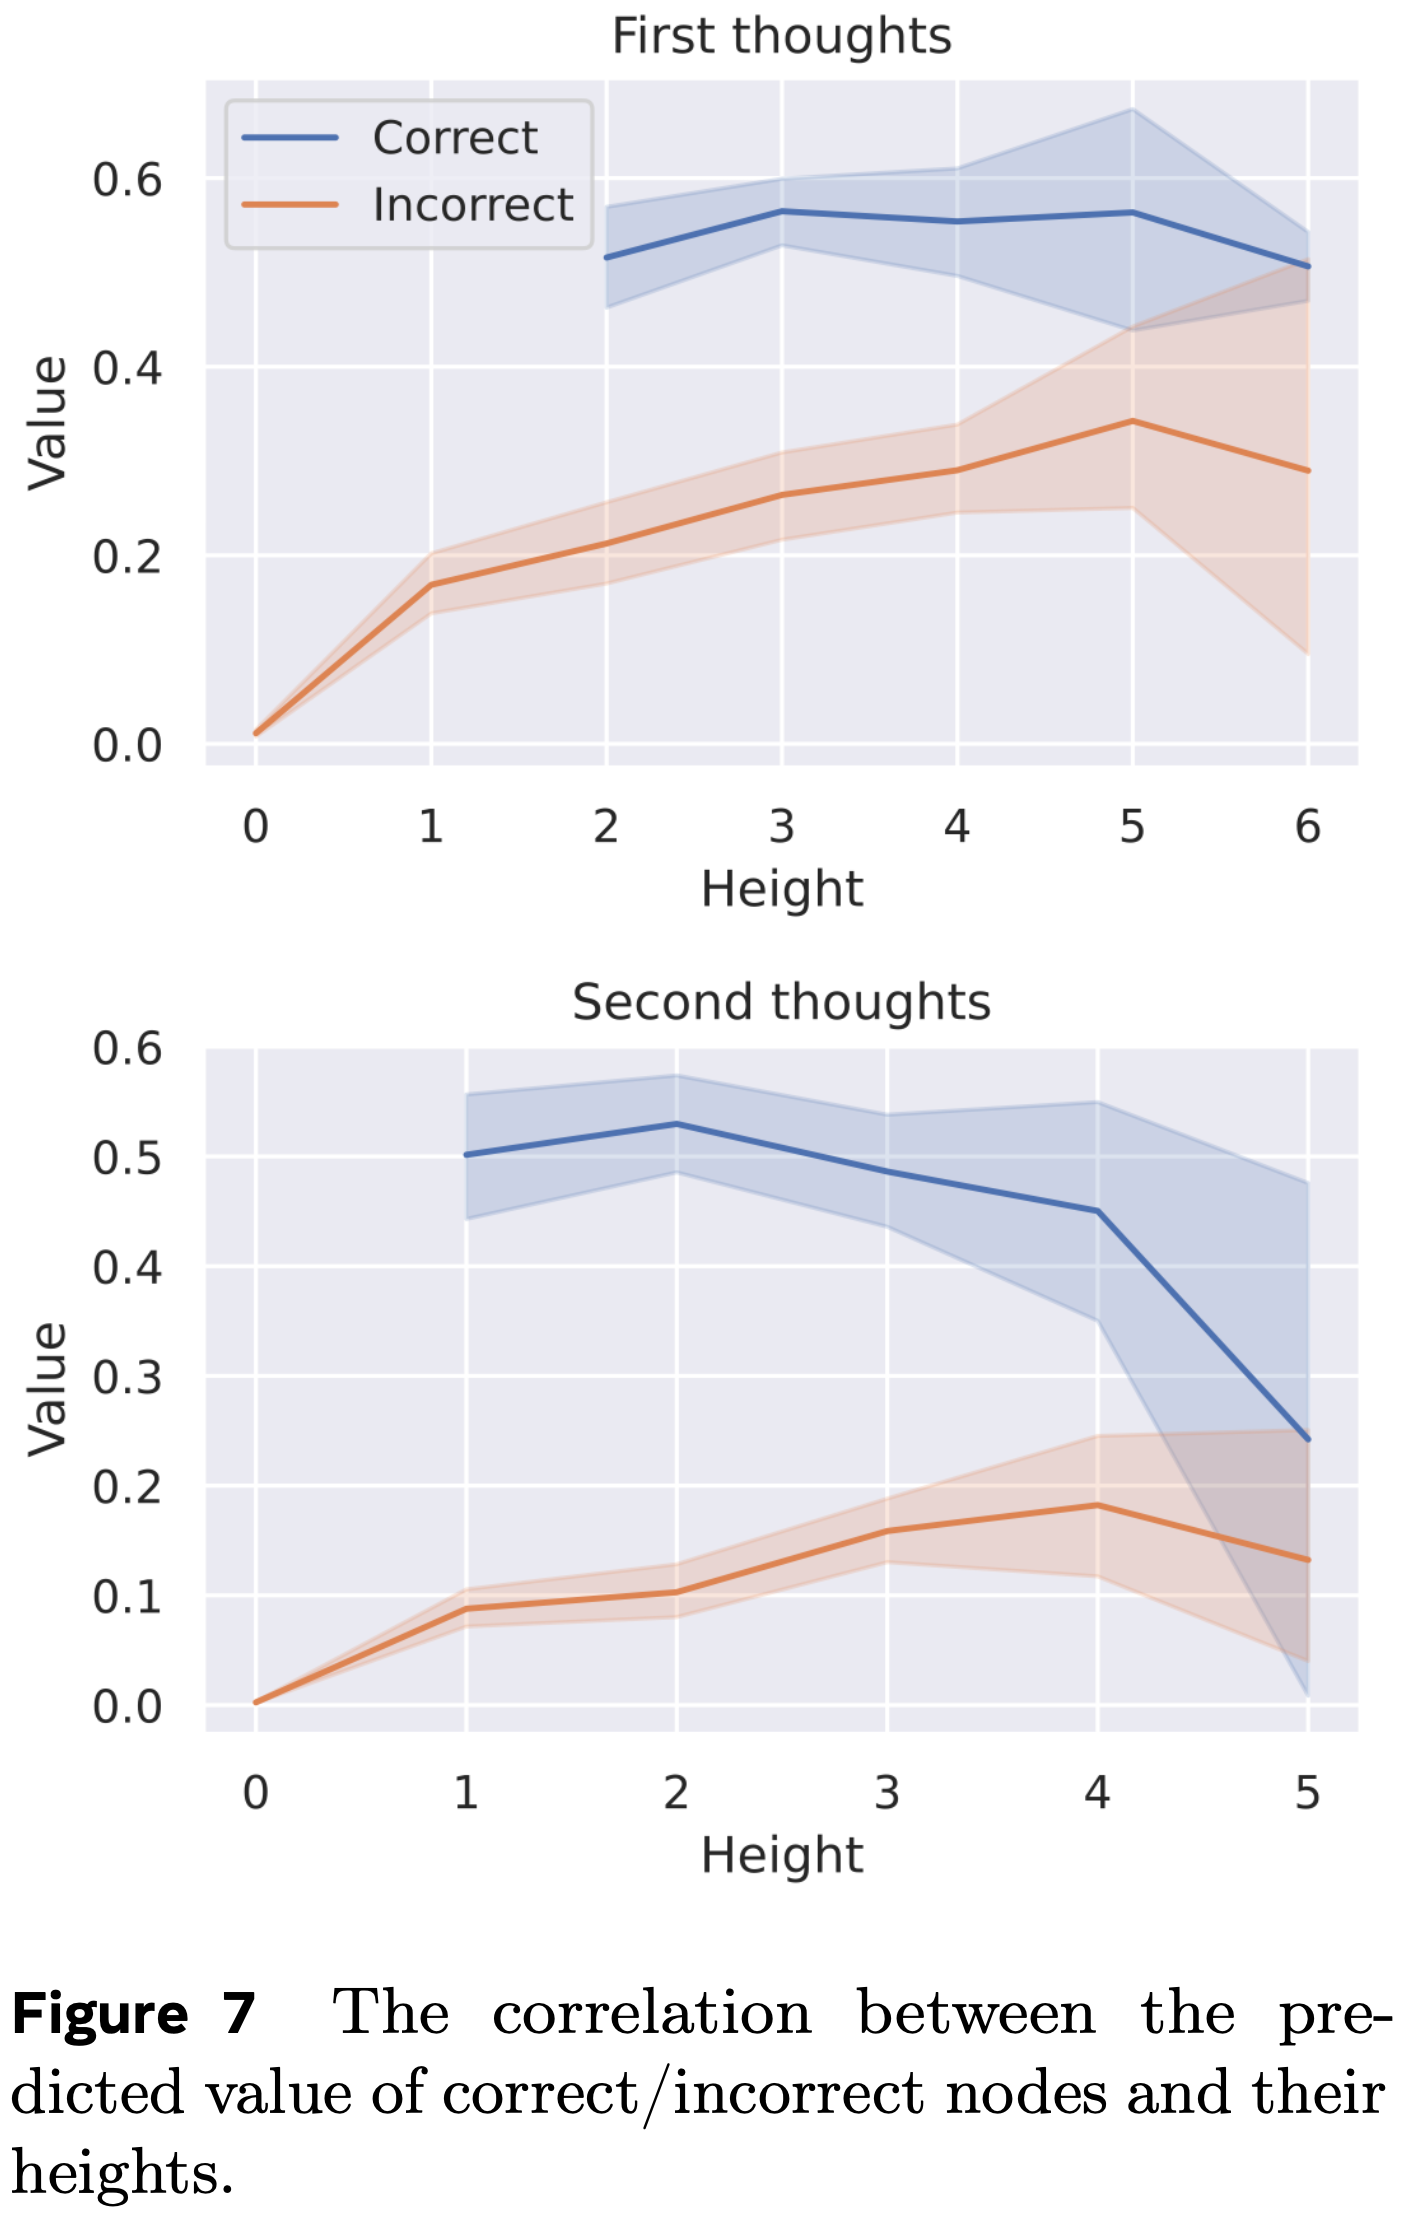
  • 为了系统地测试这一点,论文定义了一个节点的高度为其到任何叶节点的最短距离,并分析了节点高度与模型估计价值之间的关系
  • 理想情况下,一个正确的节点(即能够通向目标节点的节点)应该获得较高的估计价值,而一个不正确的节点(即不能通向目标节点的节点)应该获得较低的价值
  • 在整个测试集上的实证结果(图 7)支持了作者的假设:
    • 高度较低的节点持续获得更准确和明确的概率评估
    • Conversely,高度较大的节点表现出更模糊的评估,反映了不确定性的增加
  • 这些发现强调了潜在空间推理的优势
    • 通过延迟确定性决策并允许探索向终端状态进行, Latent Reasoning 显著增强了模型区分正确路径和错误路径的能力,从而在复杂的、规划密集的任务上相比传统的贪婪方法提高了性能

Coconut Empirical Results with Coconut

  • 在分析了 Coconut 有前景的并行搜索模式之后,论文通过更全面的实验验证了在连续潜在空间中进行 LLM 推理的可行性,突出了其相对于语言空间更好的推理效率,以及通过测试时缩放增强模型表达能力的潜力

Experimental Setup

Math Reasoning
  • 论文使用 GSM8k (2021) 作为数学推理的数据集
    • 它包含小学水平的数学问题
  • 为了训练模型,论文使用 (2023) 生成的合成数据集
  • 论文对每个推理步骤使用两个 Continuous Thought (即 \(c=2\))
  • 模型除了初始阶段外,还经历了 3 个阶段
  • 然后论文增加一个额外的阶段,该阶段仍像前一个阶段一样使用 \(3\times c\) 个 Continuous Thought ,但移除所有剩余的语言推理链
  • 这处理了推理链长度超过 3 步的长尾分布
  • 论文在初始阶段训练模型 6 个 Epoch ,在其余每个阶段训练 3 个 Epoch
Logical Reasoning
  • 逻辑推理涉及正确应用已知条件,使用逻辑规则来证明或反驳一个结论
  • 论文使用 ProntoQA (Saparov and He, 2022) 数据集和论文新提出的 ProsQA 数据集,后者由于有更多干扰分支而更具挑战性
  • 论文对每个推理步骤使用一个 Continuous Thought (即 \(c=1\))
  • 模型除了初始阶段外,还经历了 6 个训练阶段,因为这两个数据集中的最大推理步数为 6
  • 然后模型在最后一个阶段完全使用 Continuous Thought 来解决问题
  • 论文在每个阶段训练模型 5 个 Epoch
  • 对于所有数据集,在标准调度之后,模型停留在最终训练阶段,直到达到 50 个 Epoch
  • 论文根据验证集上的准确率选择检查点
  • 对于推理,论文手动设置 Continuous Thought 的数量,以与其最终训练阶段保持一致
  • 所有实验均使用贪婪解码

Coconut Baselines and Variants of Coconut

  • 论文考虑了以下基线:
    • (1) CoT
    • (2) No-CoT
    • (3) iCoT (2024):模型使用语言推理链进行训练,并遵循一个精心设计的、用于“内化” CoT 的调度
      • 随着训练的进行,推理链开头的 Token 被逐渐移除,直到只剩下答案
      • 在推理过程中,模型直接预测答案
    • (4) Pause token (2023):模型仅使用问题和答案(没有推理链)进行训练
      • 与 No-CoT 不同,在问题和答案之间插入了特殊的 <pause> Token ,这为模型提供了额外的计算能力来推导答案
      • <pause> Token 的数量设置为与 Coconut 中的 Continuous Thought 数量相同
  • 论文还评估了 Coconut 的一些变体:
    • (1) w/o curriculum: 直接在最后一个阶段训练模型
      • 模型使用 Continuous Thought 来解决整个问题
    • (2) w/o thought: 论文保留多阶段训练,但不添加任何连续 Latent Thought
      • 虽然这与 iCoT 的高层思想相似,但为了进行严格比较,其确切的训练调度设置为与 Coconut 一致,而不是 iCoT
    • (3) pause as thought:论文使用特殊的 <pause> Token 替换 Continuous Thought ,并应用与 Coconut 相同的多阶段训练课程

Results and Discussion

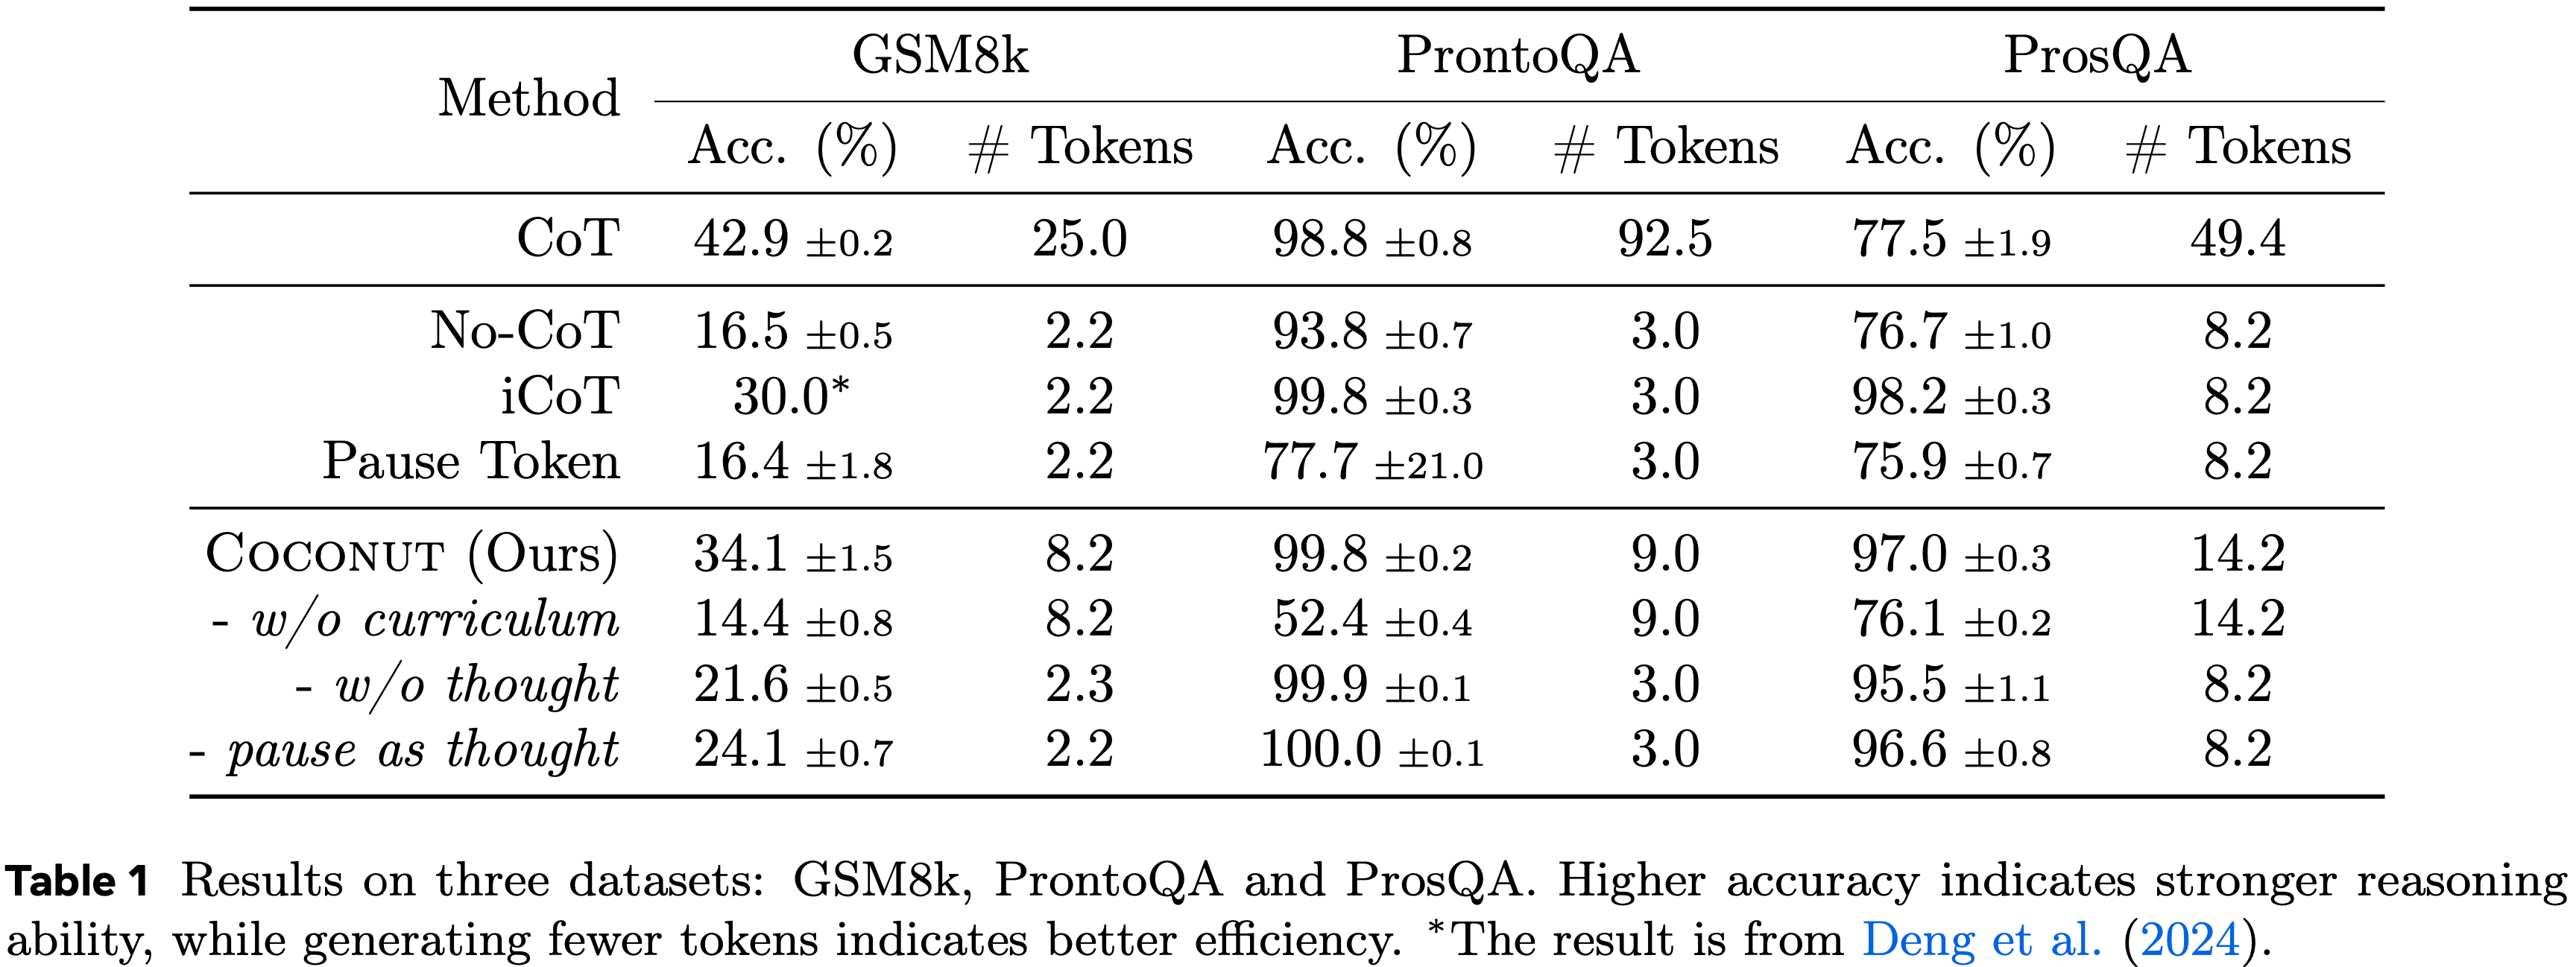
  • 在表 1 中展示了总体结果
    • 使用 Continuous Thought 有效地增强了 LLM 推理能力,超过了 No-CoT 基线
    • 例如,通过使用 6 个 Continuous Thought ,Coconut 在 GSM8k 上达到了 34.1% 的准确率,显著优于 No-CoT (16.5%)
“链接” Continuous Thought 增强了推理能力
  • 语言 CoT 被证明可以增加 LLM 的有效深度并增强其表达能力 (2023)
  • 因此,生成更多 Token 是推理时缩放的一种方式 (2025; 2024)
  • 这个理想的特性自然也适用于 Coconut
  • 在 GSM8k 上,Coconut 的表现优于使用类似策略训练的其他架构,包括 Coconut (pause as thought) 和 Coconut ( w/o thought )
    • 特别是,它超过了最新的基线 iCoT (2024),后者需要更精心设计的训练调度
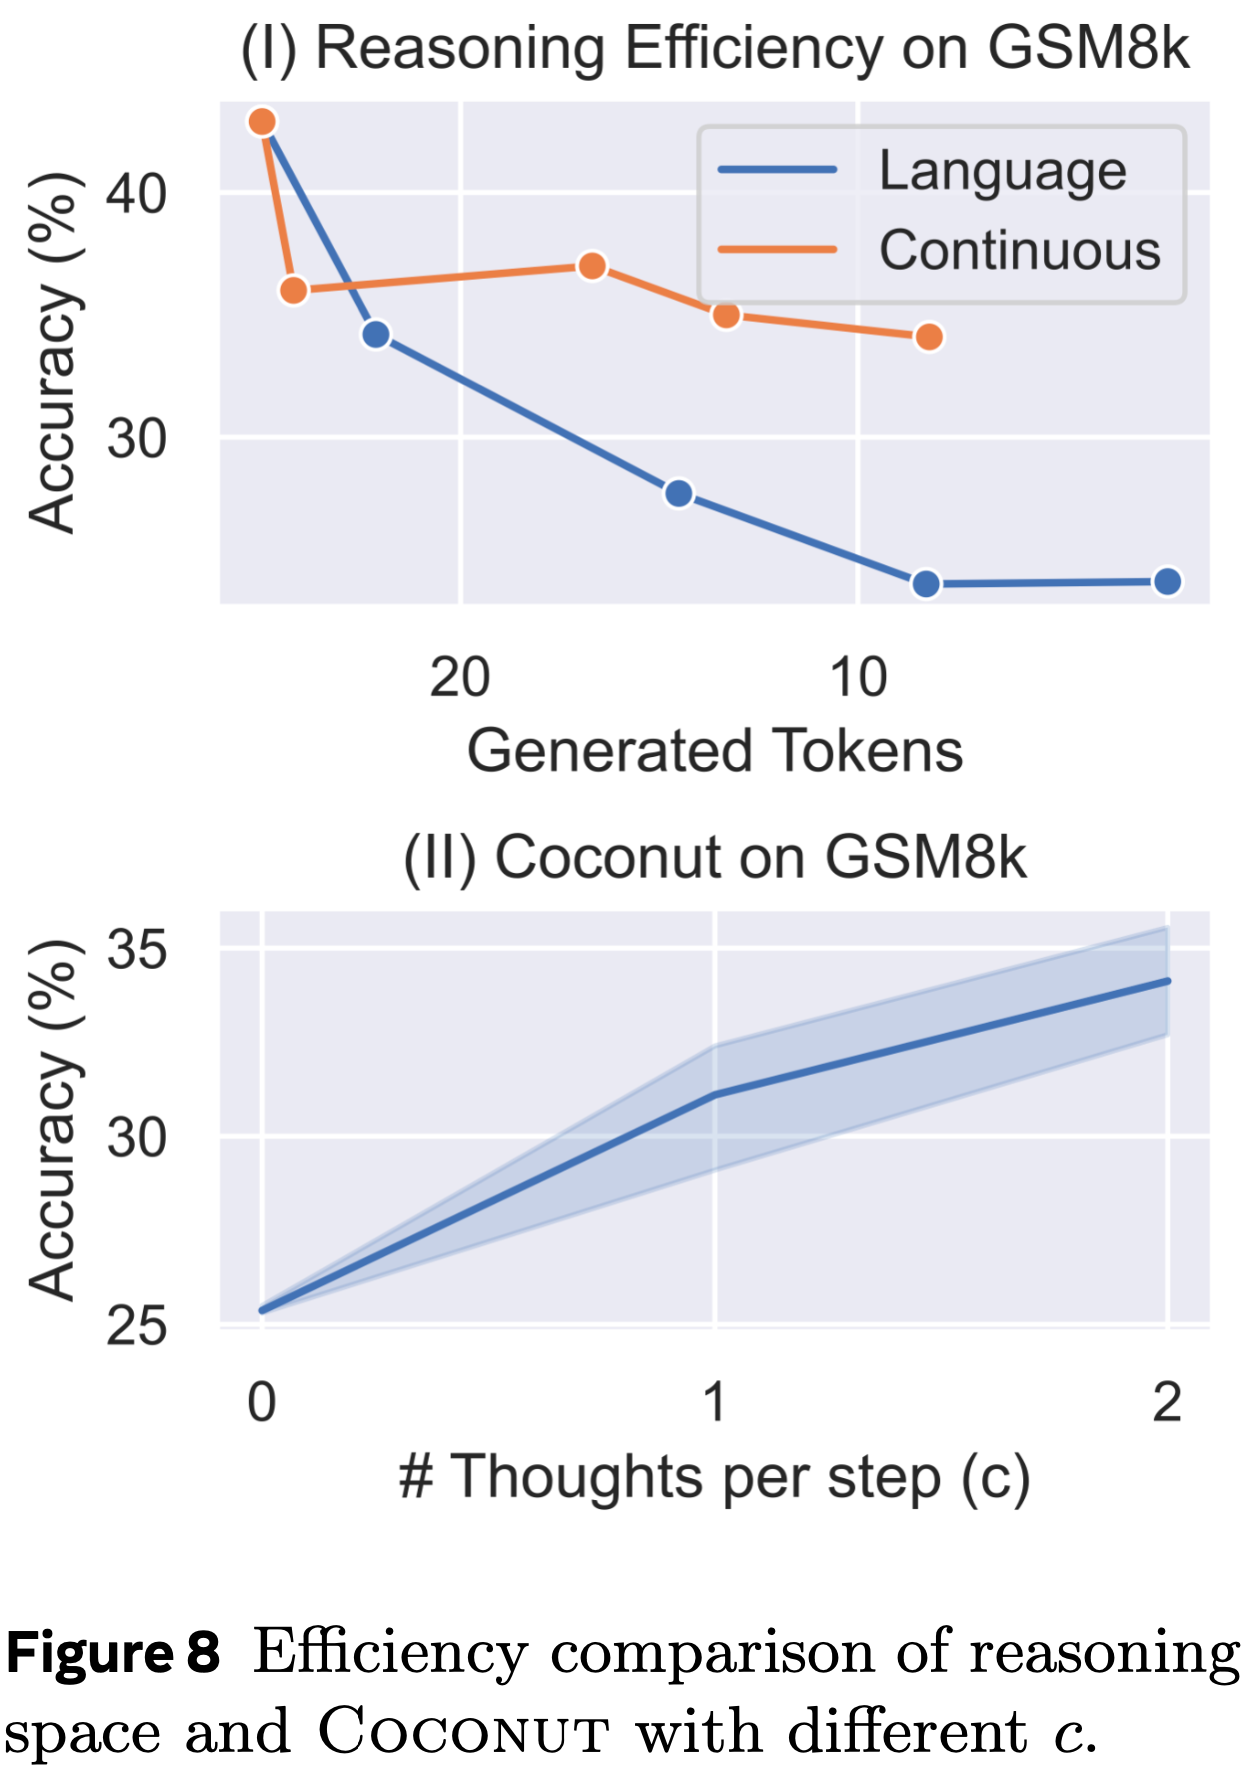
  • 此外,论文尝试调整超参数 \(c\),它控制对应于一个语言推理步骤的 Latent Thought 数量(图 8, II)
    • 随着论文将 \(c\) 从 0 增加到 1 再到 2,模型的性能稳步提高
    • 这进一步验证了 Continuous Thought 能够扩展到更困难问题的潜力
  • 在另外两个合成任务中,论文发现 Coconut 的变体( w/o thoughts 或 pause as thought)以及 iCoT 基线也取得了令人印象深刻的准确率
    • 这表明在这些任务中,模型的计算能力可能不是瓶颈
    • 相比之下,GSM8k 涉及更复杂的上下文理解和建模,对计算能力提出了更高的要求
Continuous Thought 是高效的推理表示
  • 与传统的 CoT 相比,Coconut 在 ProntoQA 和 ProsQA 上生成的 Token 更少,同时实现了更高的准确率(表 1)
  • 尽管 Coconut 在 GSM8k 上没有超过 CoT ,但它在推理效率和准确率之间提供了更优的权衡(图 8, I)
  • 为了说明这一点,论文训练了一系列 CoT 模型,这些模型逐步“内化”(2024) 了初始的 \(m=\{0,1,2,3,\textrm{ALL}\}\) 个推理步骤,并绘制了它们的准确率与生成 Token 数量的关系图(在图中 Token 为“语言”)
  • 这些模型在跳过更多推理步骤时迅速失去准确率
  • 相比之下,通过应用 Coconut 训练策略——用两个 Continuous Thought 替换每个语言推理步骤——准确率的下降得到了显著缓解,即使在生成更少 Token 时也能保持更高的性能
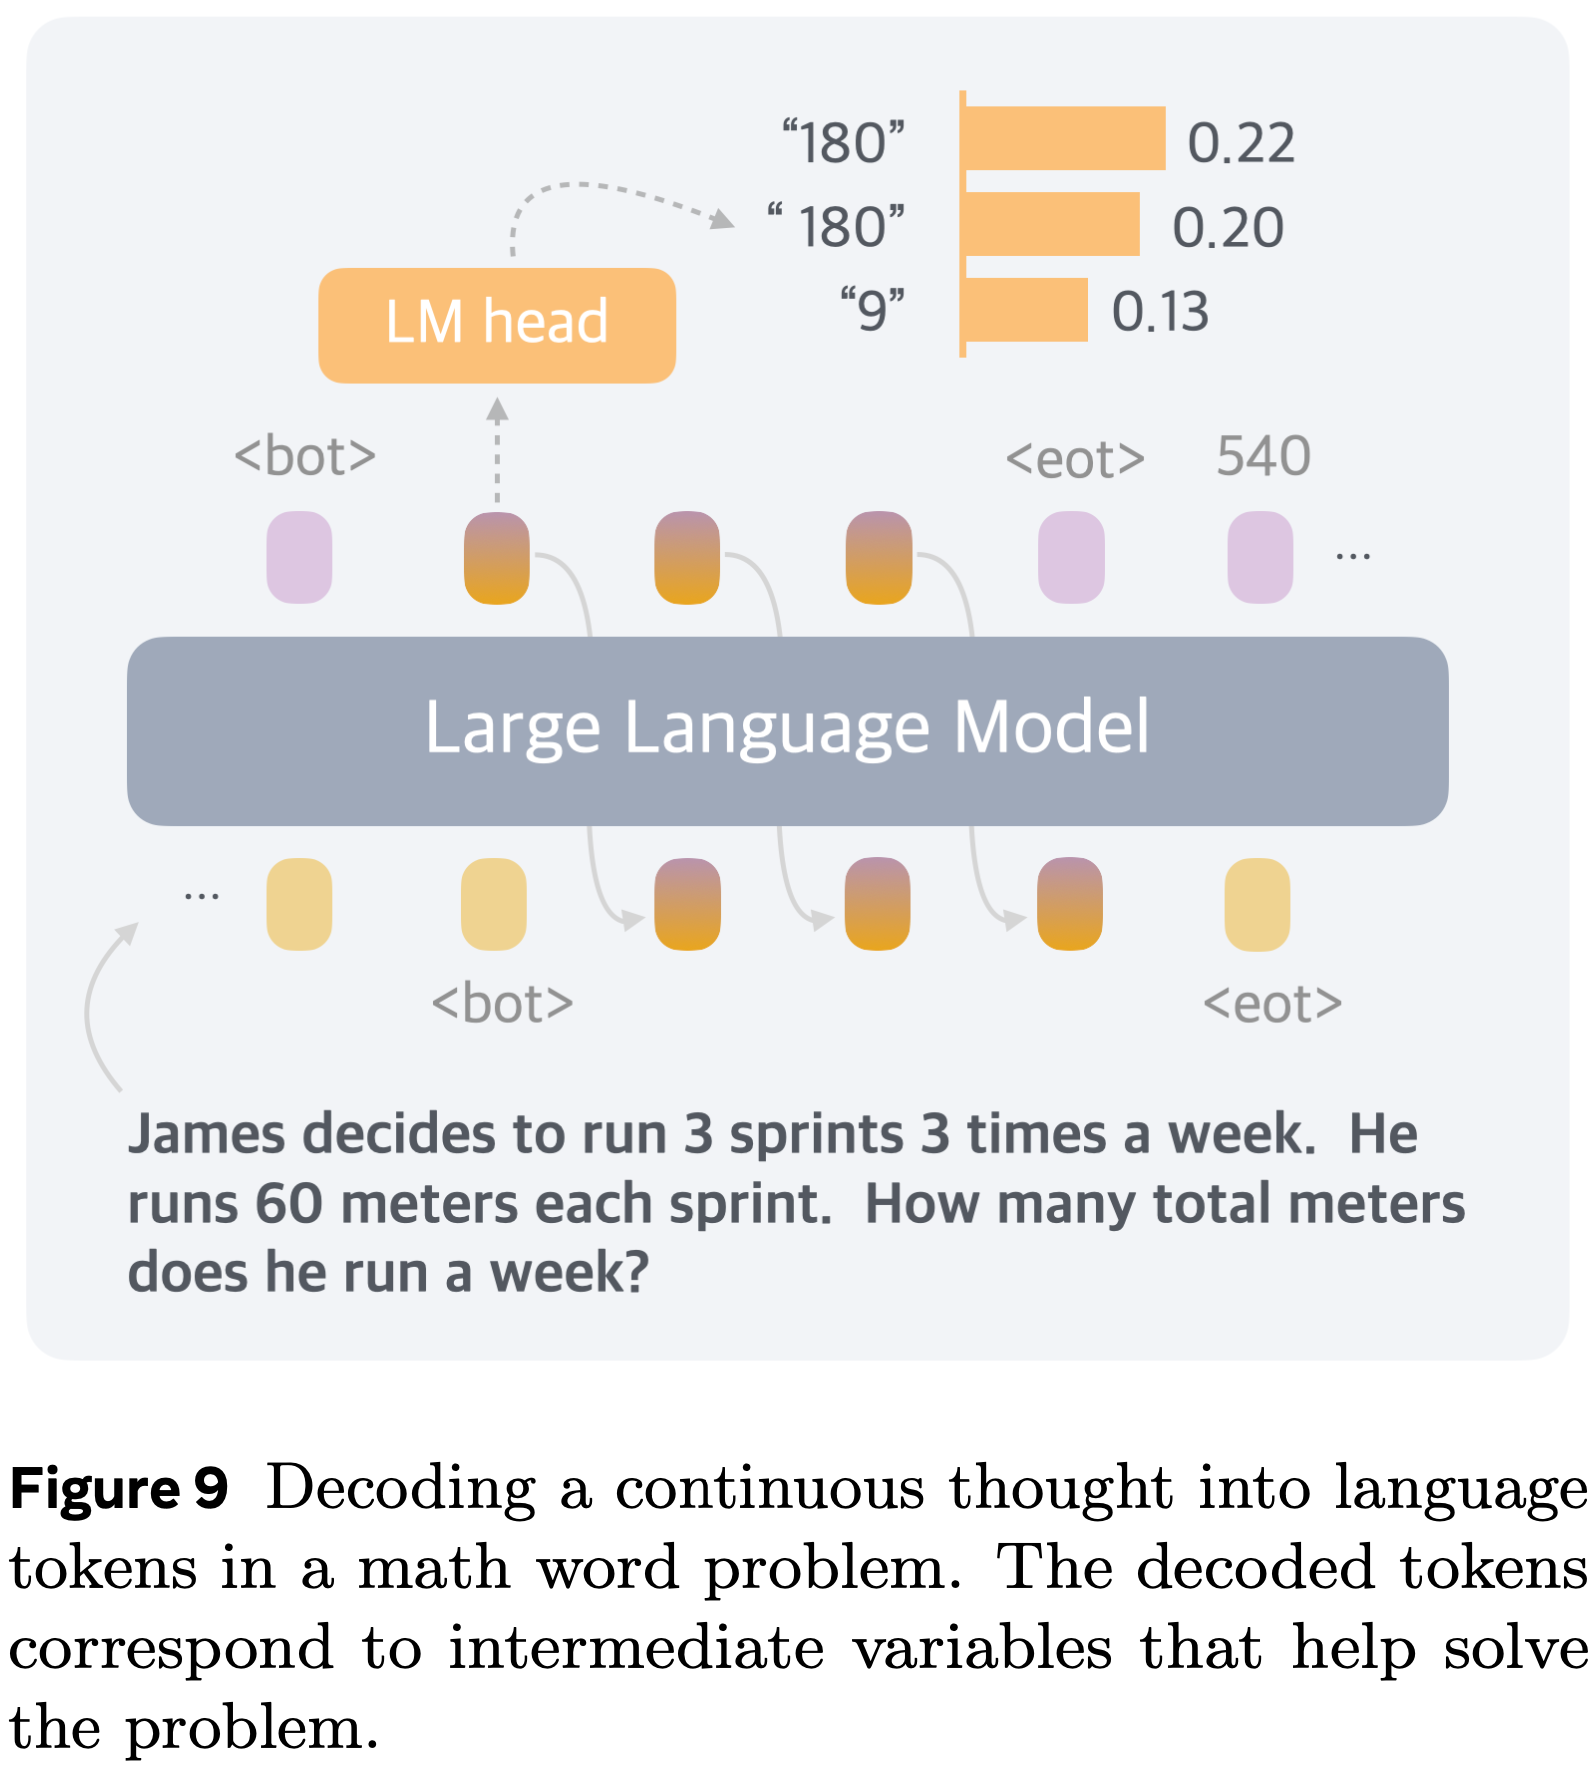
  • 另一个有趣的观察是,当论文解码第一个 Continuous Thought 时,它通常对应于计算中可能的中间变量(图 9)
  • 这也表明 Continuous Thought 是更高效的推理表示
LLM 仍然需要指导来学习 Latent Reasoning
  • 在理想情况下,模型应该通过关于问题和答案的梯度下降自动学习最有效的 Continuous Thought (即 Coconut\(w/o\)\(curriculum\))
  • 然而,从实验结果中,论文发现以这种方式训练的模型表现并不比 no-CoT 更好
  • 相反,通过多阶段课程学习,Coconut 能够在各种任务中达到顶尖性能
  • 多阶段训练也能与 pause tokens 很好地结合(Coconut-pause as thought)
  • 尽管使用相同的架构和相似的多阶段训练目标,论文观察到:
    • \(iCoT\) 和 Coconut (\(w/o\)\(thoughts\)) 的性能之间存在微小差距
    • \(iCoT\) 中更细粒度的移除调度(逐个 Token )和其他一些技巧可能使训练过程更容易
  • 论文将结合 \(iCoT\) 和 Coconut 作为未来的工作
  • 虽然用于 Coconut 的多阶段训练已被证明是有效的,但肯定需要进一步的研究来开发更好、更通用的策略,以在潜在空间中学习推理,特别是在没有语言推理链监督的情况下

补充:Related Work

CoT 推理

  • 论文广义地使用思维链这个术语来指代在输出最终答案之前,用语言生成中间推理过程的方法
    • 这包括 Prompting LLM (2022; 2022; 2022),或者通过监督微调 (2023; 2023) 或强化学习 (2024; 2024; 2024; 2024b) 来训练 LLM 生成推理链
    • Madaan and Yazdanbakhsh (2022) 将思维链中的 Token 分类为符号、模式和文本,并基于对其角色的分析提出引导 LLM 生成简洁的思维链
    • 最近的理论分析从模型表达能力的角度证明了思维链的有用性 (2023; 2023; 2024)
    • 思维链使得 Transformer 的有效深度增加了,生成的输出被循环回输入 (2023)
  • 这些分析,结合思维链已确立的有效性,让我们能设计了将 Continuous Thought 反馈给 LLM 作为输入嵌入的方案
    • 虽然思维链已被证明对某些任务有效,但其自回归生成的性质使得在更复杂的问题上模仿人类推理具有挑战性 (2022; 2023),这些问题通常需要规划和搜索
    • 有一些工作为 LLM 配备了显式的树搜索算法 (2023; 2023; 2024),或者在搜索动态和轨迹上训练 LLM (2024; 2024; 2024)
    • 作者分析发现,在移除语言空间的约束后,即使模型没有经过明确的训练,也会出现一种类似于广度优先搜索的新推理模式

LLM 中的 Latent Reasoning

  • 先前的工作大多将 LLM 中的 Latent Reasoning 定义为 Transformer 中的隐藏计算 (2024; 2024)
    • Yang 等 (2024) 构建了一个双跳推理问题的数据集,并发现从隐藏表示中恢复中间变量是可能的
    • Biran 等 (2024) 进一步提出通过“反向修补”隐藏表示来干预 Latent Reasoning
    • Shalev 等 (2024) 在 LLM 中发现了并行的 Latent Reasoning 路径
  • 另一项工作发现,即使模型生成思维链进行推理,模型实际上可能利用的是不同的 Latent Reasoning 过程
    • 这种现象被称为思维链推理的不忠实性 (2022; 2024)
  • 为了增强 LLM 的 Latent Reasoning ,先前的研究提出用额外的 Token 来增强它
    • Goyal 等 (2023) 通过在训练语料库中随机插入一个可学习的 <pause> Token 来预训练模型
      • 这提高了 LLM 在各种任务上的性能,特别是在随后使用 <pause> Token 进行监督微调时
    • Pfau 等 (2024) 进一步探索了填充 Token (例如“…”)的使用,并得出结论它们对于高度可并行化的问题效果很好
      • 但Pfau 等 (2024) 提到这些方法不像思维链那样扩展 LLM 的表达能力;因此,它们可能无法扩展到更一般和复杂的推理问题
    • Wang 等 (2023) 提出在生成下一个推理步骤之前预测一个规划 Token 作为离散潜在变量
  • 最近还发现可以通过知识蒸馏 (2023) 或逐渐缩短思维链的特殊训练课程 (2024) 将思维链推理“内化”到 Transformer 的 Latent Reasoning 中
    • Yu 等 (2024b) 也提出从使用复杂推理算法生成的数据中蒸馏出一个能够进行 Latent Reasoning 的模型
  • 这些训练方法可以结合到论文的框架中:
    • 具体来说,作者发现,受 iCoT (2024) 启发,将 Continuous Thought 的学习分解为多个阶段对训练非常有益
    • 其他工作探索了用于 Latent Reasoning 的替代架构,包括循环 Transformer (2023; 2024),句子嵌入空间中的扩散模型 (2024)
  • 与这些工作不同,论文专注于一般的多步推理任务 ,并旨在研究 Latent Reasoning 与语言空间相比的独特属性
  • 除了推理任务,Pham 等 (2023) 也探索了使用连续空间进行多智能体通信
    • 基于 Coconut,Zhu 等 (2025b) 开发了一个理论框架,证明通过将多个推理路径编码在叠加状态中, Continuous Thought 链在某些任务上可以比离散思维链更高效
    • Zhu 等 (2025a) 分析了训练动态,以解释这种叠加是如何在 Coconut 训练目标下出现的

附录 A:数据集 Datasets

附录 A.1: 示例 Examples

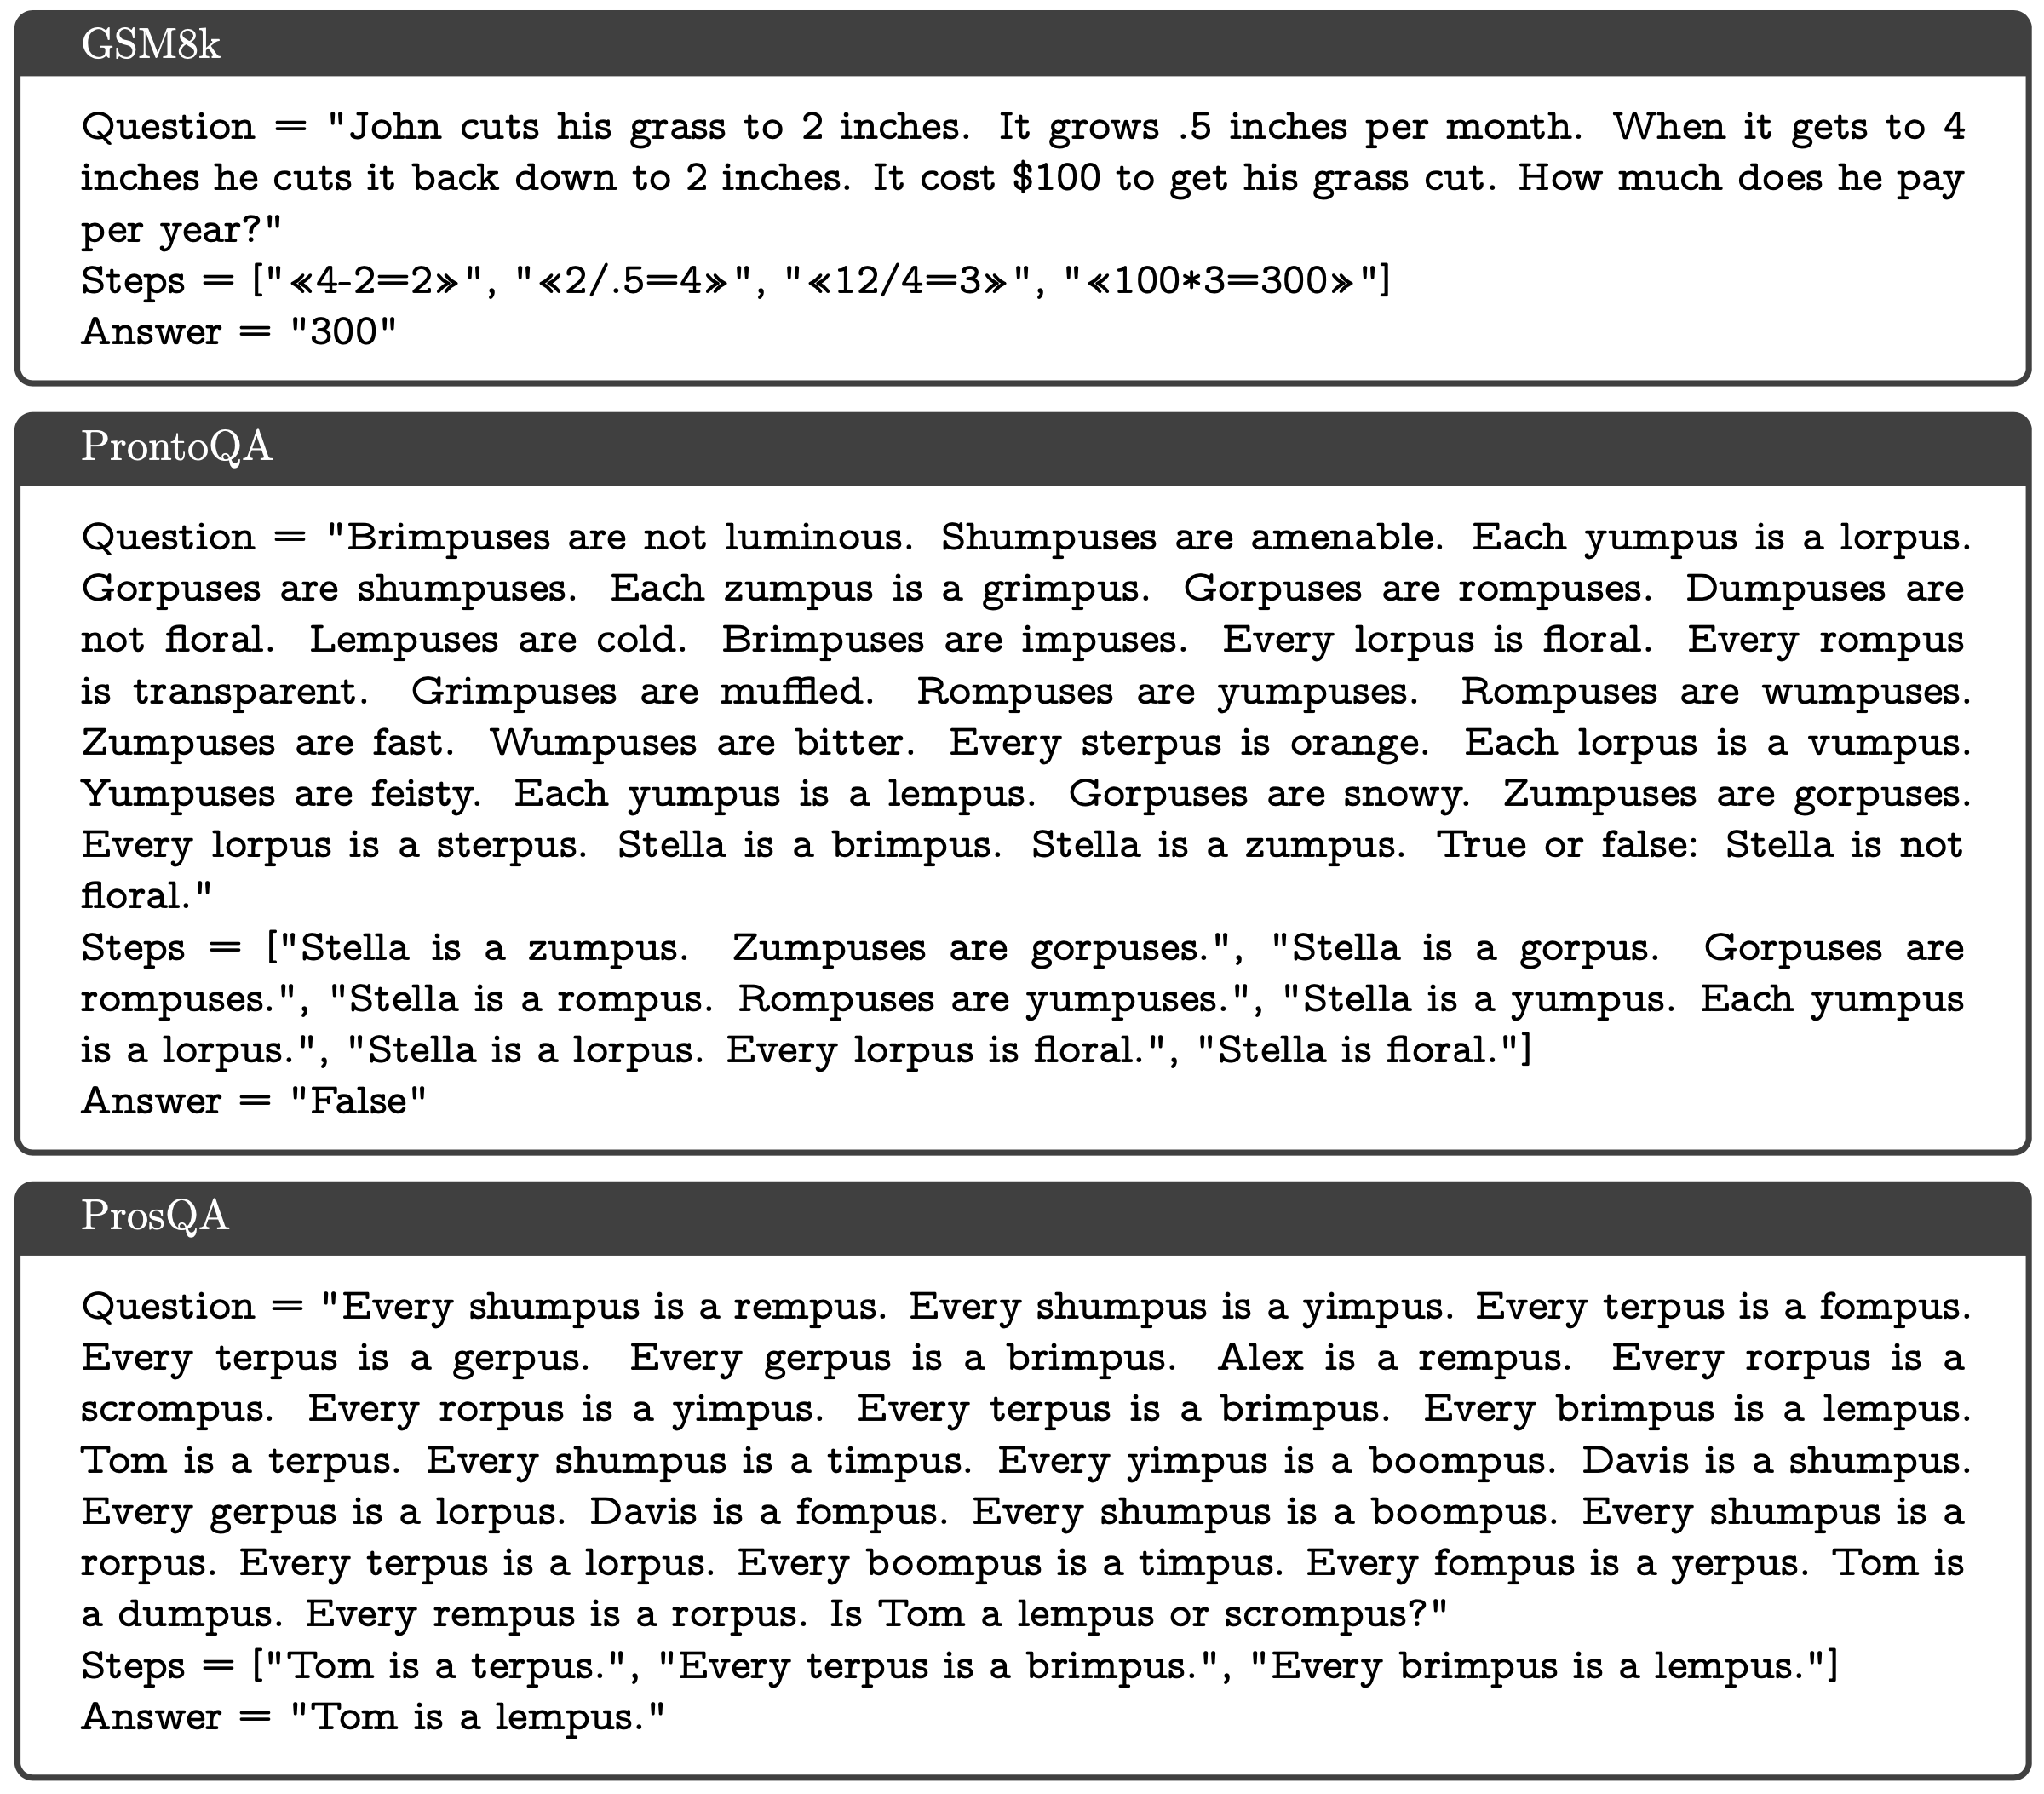
  • 示例:

附录 A.2: Construction of ProsQA

附录 A.3: 统计数据 Statistics


附录 B:Clock-Time Reasoning Efficiency Metric

  • 论文提供了一个时钟时间比较来评估推理效率
  • 报告的值代表了在 Nvidia A100 GPU 上测量的、批次大小为 1 时每个测试案例的平均推理时间(以秒为单位)
  • 对于 no-CoT 和 CoT 基线,论文使用了 transformers 库中的标准生成方法。论文的结果表明,时钟时间通常与新生成的 Token 数量成正比,详见表 1

附录 C: 更多讨论 More Discussion

C.1 使用更多 Continuous Thought Using More Continuous Thoughts

  • 在图 8 (II) 中,论文展示了 Coconut 在 GSM8k 上使用 \(c\in\{0,1,2\}\) 的性能
  • 当试验 \(c=3\) 时,论文观察到性能略有下降,同时方差增大
  • 对训练日志的分析表明,一次性添加三个 Continuous Thought(尤其是在最后阶段转换期间)会导致训练损失急剧上升,从而引发不稳定性
  • 未来的工作将探索更细粒度的调度方案,例如像 iCoT (2024) 那样,逐步一次添加一个 Continuous Thought ,同时移除更少的语言 Token
  • 此外,将语言推理和 Latent Reasoning 相结合(例如,用语言生成推理骨架,并在潜在空间中完成推理过程)可能为提高性能和稳定性提供一个有前景的方向

C.2 使用更大模型的 Coconut Coconut with Larger Models

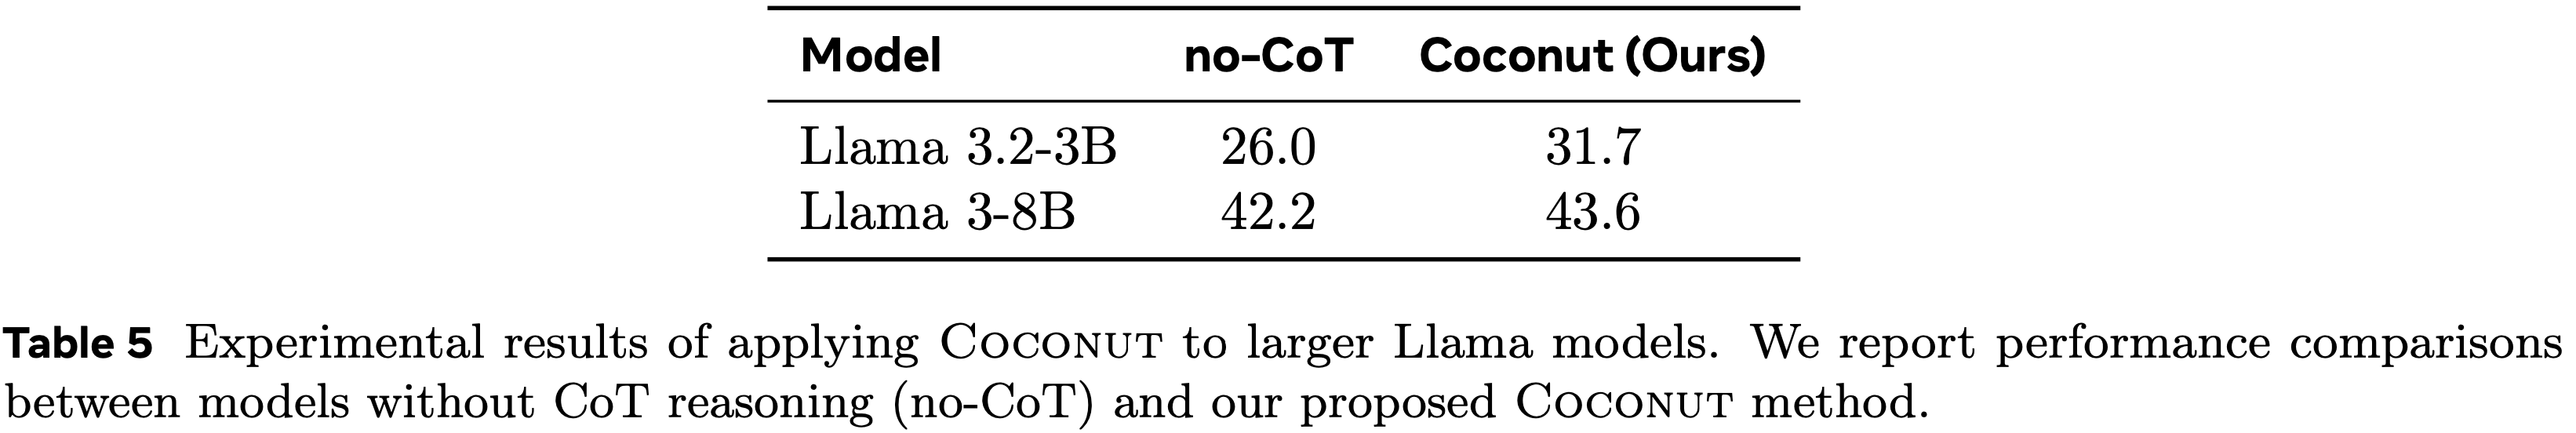
  • 论文在 GSM8k 上使用 Llama 3.2-3B 和 Llama 3-8B (2024) 以及 \(c=1\) 对 Coconut 进行了实验。论文在阶段 0 训练 3 个 Epoch ,随后每个后续阶段训练 1 个 Epoch
  • 结果如表 5 所示
  • 论文观察到,与 no-CoT 基线相比,在 Llama 3.2-3B 和 Llama 3-8B 模型上都取得了一致的性能提升,尽管这些改进不如之前使用 GPT-2 所展示的那么显著
    • 一个可能的原因是更大的模型已经经历了广泛的语言焦点预训练,使得向 Latent Reasoning 的转变更具挑战性
  • We emphasize that 论文的主要目标是突出潜在空间推理的有前景特性,并在这个新方向上启动探索
  • 要普遍超越基于语言的 CoT,很可能需要致力于潜在空间预训练的大量研究工作
  • 论文受到该领域近期进展 (2025; 2024; 2025) 的鼓舞
  • 虽然这些最近的模型为潜在表示学习提供了可扩展的方法,但潜在空间尚未被明确优化用于推理
  • 将这些最新进展与 Coconut 相结合,为未来的研究提供了一个令人兴奋且有前景的途径
1…707172…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4