Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

NLP——EverGreenQA(EG-E5)

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:(EverGreenQA,EG-E5)Will It Still Be True Tomorrow? Multilingual Evergreen Question Classification to Improve Trustworthy QA, arXiv 20250527, Skoltech
      • 注:Skoltech 是俄罗斯斯科尔科沃科学技术研究院的简称

Paper Summary

  • LLM 在问答(QA)任务中经常产生幻觉(hallucination),一个关键但尚未充分探索的因素是问题的时间性:
    • 即问题属于常青类(evergreen,答案随时间稳定)还是可变类(mutable,答案会变化)
  • 本论文探讨了问题的常青性(evergreenness),即答案是否会随时间变化
    • 论文测试了 LLM 检测常青性的能力,并展示了其在多个应用中的价值
    • 论文提出了 EverGreenQA ,这是首个支持多语言且带有常青标签的问答数据集,可用于评估和训练,包含 7 种语言的 4,757 个示例
    • 利用 EverGreenQA 数据集,论文对现代大语言模型在常青问题分类任务上的表现进行了基准测试,并训练了 EG-E5 ,一个轻量级分类器,其性能优于大语言模型和此前训练的方法
  • 论文进一步分析了大语言模型是否通过不确定性估计隐式编码了常青性 ,发现它们确实具备一定的能力 ,且模型规模越大,表现越好
  • 论文展示了常青分类在三个应用中的实际价值:
    • 改进自我知识估计(self-knowledge estimation):论文通过预测的常青概率增强了现有的不确定性估计方法 ,取得了稳定的改进
    • 过滤问答数据集:论文展示了常青分类器有助于筛选高质量的问答数据集,支持更可靠和公平的评估
    • 解释 GPT-4o 的检索行为:论文证明常青性是预测 GPT-4o 搜索行为的最佳指标,优于所有其他测试因素

Introduction and Discussion

  • 大语言模型在问答任务中常因幻觉答案而表现不佳(2025)
  • 为提高可信度,近期研究聚焦于:
    • 估计模型的自我知识(self-knowledge),即识别自身已知与未知的能力(2023;2025)
    • 通过检索增强生成(Retrieval-Augmented Generation, RAG)整合最新外部信息(2024;2024;2023)
  • 未充分探索 ,同时确是影响问题难度的关键因素是其是否为常青(evergreen)或可变(mutable)问题(2024a),即正确答案是否随时间稳定(如图 1 所示)
    • 可变问题尤其具有挑战性,因为它们通常需要访问最新信息,而这些信息可能未包含在模型的固定参数化知识中
  • 常青性(evergreen-ness)具有实际重要性,但在评估和改进大语言模型行为时,它仍是一个未被充分探索的因素
    • 现有研究大多局限于小规模、仅限英语的数据集,且主要关注问答准确性,很少探讨其更广泛的影响(2024;2024)
    • 问题常青性在塑造大语言模型可靠性和可解释性中的作用仍未被充分研究
  • 为填补这一空白,论文开展了关于问题常青性及其实际应用的全面研究
  • 论文提出了 EverGreenQA ,这是首个多语言人工标注的常青感知问答数据集,包含适合模型训练的训练-测试划分
  • 基于 EverGreenQA ,论文评估了 12 个现代大语言模型,判断它们是否通过显式(直接提示,through direct prompting)或隐式(基于不确定性的信号,via uncertainty-based signals)方式编码时间性知识
  • 此外,论文还开发了 EG-E5 ,一个轻量级的,截止到当前最优的分类器,用于识别常青问题
  • 论文展示了 EG-E5 在多个下游任务中的实用性:
    • (1)改进自我知识估计
    • (2)筛选问答数据集以支持更公平的评估
    • (3)有效解释 GPT-4o 的黑盒检索行为
  • 论文的贡献和发现如下:
    • 1)构建了 EverGreenQA ,首个用于问题常青性分类的多语言数据集,涵盖 7 种语言,共 4,757 个样本
    • 2)首次全面评估了大语言模型对问题常青知识的掌握情况,通过显式信号(提示)和隐式信号(不确定性估计)评估了 12 个模型
    • 3)开发了 EG-E5 ,一个轻量级多语言分类器,用于识别常青问题,在此任务上达到当前最优性能,同时适用于低计算资源场景
    • 4)展示了 EG-E5 在三个应用中的价值:
      • (1)改进自我知识估计
      • (2)筛选问答数据集以实现更公平的评估
      • (3)有效解释 GPT-4o 的检索行为
  • 论文发布了模型和数据以供进一步使用

EverGreenQA & EG-E5

Dataset Collection

  • 论文构建了一个问答数据集,包含来自 AI 聊天助手的真实用户查询,每个问题标注为常青或可变,并提供对应的标准答案
  • 所有问题均为事实性问题,并通过多轮内部 alpha 测试(internal alpha testing)手动验证以确保多样性和减少主题偏差
    • 理解:Alpha Testing(α测试) 是软件开发过程中一种重要的内部测试阶段,主要用于在产品正式发布前,由开发团队或内部相关人员对软件进行系统性测试,目的是发现并修复主要的功能缺陷、性能问题和用户体验漏洞
    • 补充:alpha 测试 和 beta 测试的区别如下:
      维度 Alpha Testing Beta Testing
      测试人员 内部团队/员工 外部真实用户
      环境 开发/模拟环境 接近真实的生产环境
      目的 修复核心缺陷,验证基本功能 收集用户反馈,优化体验
      阶段 早于Beta,接近开发完成 晚于Alpha,接近正式发布
  • 标签和标准答案由训练有素的语言学家团队手动分配,他们根据检索到的信息从头编写答案
  • 由于初始数据集中大多数问题为可变问题,为避免训练数据偏差,论文还生成了 1,449 个仅针对常青类的合成数据(这些附加数据同样经过语言学家验证)
  • 最终数据集包含 4,757 个问题,其中 3,487 个用于训练,1,270 个保留用于测试
  • 数据集构建和标注的详细信息见附录 F

Dataset Translation

  • 论文使用 GPT-4.1 将问题从俄语翻译为英语,再从英语翻译为目标语言
  • 此前研究表明,GPT-4.1 在多种语言(包括准确处理文化差异)上表现优异(2024)
  • 完整翻译提示见附录 B

Dataset Validation

  • 为评估翻译质量,论文为每种目标语言招募了人类评估员,均为母语者或具备高级语言水平(B2-C1 级)
  • 论文从测试集中随机抽取 100 个问题(50 个可变,50 个常青)进行评估
  • 英语、希伯来语、德语和阿拉伯语的翻译未发现错误,中文仅有两处轻微不准确
  • 评估员指导见附录 C

EG-E5 Training

  • 论文使用多语言数据集进行训练和测试
  • 对于验证,论文使用了 FreshQA(2024)的开发集和测试集,将其快速变化和慢速变化类别合并为可变标签
  • 为与多语言设置一致,FreshQA 数据被翻译为所有目标语言
  • 论文尝试了多语言版本的 BERT(2019)、DeBERTaV3(2023)和 E5(2024)作为编码器
  • 最佳性能由 E5-Large 模型实现,论文将其称为分类器 EverGreen-E5 (EG-E5)
  • 超参数细节和消融实验结果见附录 A

Are LLMs Aware of Evergreenness?

  • 在本节中,论文评估现代 LLM 是否能可靠地判断一个问题是否为常青问题(evergreen)
  • 论文测试了12种不同架构的 LLM,完整细节见附录A

Verbalized Evergreen Awareness

  • 为了评估LLM是否能显式识别常青问题,论文通过提示(prompting)让每个模型给出二元的“是/否”答案
  • 论文还纳入了两种专门训练的方法:
    • UAR (2024):一种基于 LLaMA2-13B 微调的模型,用于分类常青问题
    • MULAN (2024):基于维基数据(Wikidata)中可变(mutable)和常青样本的分类器
  • 结果 :表2显示,论文提出的分类器 EG-E5 在所有语言中均表现最佳,显著优于通用LLM和专门训练的模型
    • 在LLM中,LLaMA 3.1 70 和 Qwen 2.5 32B 表现最强,GPT-4.1稍逊一筹
  • 论文观察到不同语言的性能存在差异,但无明显差距,即使对于非拉丁语系(如阿拉伯语、中文、俄语)也是如此
  • 基线方法 UAR 和 MULAN 的表现远逊于 LLM 和 EG-E5,这可能是因为它们对 QA 数据集的常青性假设过于简化
  • Takeaway:EG-E5 超越了 few-shot LLMs 和之前的方法,这些方法较差原因是他们训练数据中包含非真实的假设

Internal Evergreen Awareness

  • 论文进一步通过不确定性估计(uncertainty estimation)评估 LLM 是否隐式编码了问题的常青性信息
  • 论文从测试集中抽样 400 个问题(200 个常青,200 个可变),并采用两种广泛使用的不确定性度量方法 (2024; 2025):
    • 困惑度(Perplexity) :预测序列的逆概率,按长度归一化。对于 Token 序列 \(x_{1},\ldots,x_{T}\),定义为:
      $$
      \text{PPL} = \exp\left(-\frac{1}{T}\sum_{t=1}^{T}\log p(x_{t}\mid x_{ < t})\right)
      $$
    • 平均 Token 熵(Mean Token Entropy) :模型预测 Token 分布的平均熵:
      $$
      \text{Entropy} = -\frac{1}{T}\sum_{t=1}^{T}\sum_{w\in V}p_{t}(w)\log p_{t}(w)
      $$
      • 其中 \(p_{t}(w)\) 是位置 \(t\) Token \(w\) 的预测概率,\(V\) 是词汇表
  • 结果 :表3显示,大多数模型的不确定性与常青性仅呈现弱相关性(mild correlations),其中 Mistral 7B 和 Qwen 2.5 32B 的信号最强
  • 论文还发现一个微弱趋势:
    • 更大规模的模型,(不确定性与)常青性的相关性更强,可能表明其对时间线索的内部依赖更强
    • 困惑度和熵的表现无显著差异
    • 总体而言,不确定性信号能捕捉部分时间信息 ,但明显弱于显式表达的判断
    • 更多分析见附录E
  • Takeaway:不确定性指标编码了常青性中的弱且不一致的信号,且在更大的模型中有微弱更强的趋势

Enhancing Self-Knowledge

  • 本节评估结合问题常青性知识是否能改进自我知识(self-knowledge)估计,即模型识别自身知识边界并判断能否回答问题的能力 (2025; 2023)
  • 这一能力被视为提升 LLM 可信度的关键因素

Task formulation

  • 论文将自我知识估计定义为二分类任务,目标标签 \(y\in\{0,1\}\) 表示模型对输入 \(x\) 的答案是否正确
  • 每种评估方法为输入分配一个实值自我知识分数 \(f(x)\in\mathbb{R}\)

Methods

  • 论文使用 LLaMA3.1-8B-Instruct 和五种广泛采用的高性能不确定性估计器进行评估,这些方法代表不同的不确定性量化家族(如基于 logit 和一致性的方法):
    • 最大 Token 熵(Max Token Entropy) :计算 Token-level 熵并取序列最大值作为最终分数 (2020)
    • 平均 Token 熵(Mean Token Entropy) :类似上述方法,但通过平均 Token-level 熵值聚合序列 (2020)
    • 词汇相似性(Lexical Similarity) :通过计算多响应间的平均词汇重叠估计不确定性,作为输出一致性的代理 (2020)
    • SAR :结合熵与语义重要性加权,对序列调整后的熵值求和 (2023)
    • EigValLaplacian :构建响应相似图,计算其拉普拉斯矩阵特征值和以量化响应多样性 (2023)
  • 对于每种方法,论文评估结合常青问题预测概率(来自EG-E5分类器)的效果
  • 最终自我知识分类器 \(f(x)\) 的训练使用标准机器学习模型,输入特征为不确定性估计指标(若适用则加入常青概率)
    • 标准分类模型,包括:包括随机森林,决策树等
  • 完整训练流程见附录D

Evaluation

  • 论文采用文献中广泛使用的标准指标 (2024; 2025):
    • AUROC :衡量模型基于 \(f(x)\) 区分正确答案与错误答案的能力,值越高表示可分性越强
    • AUPRC :量化不同决策阈值下精确率与召回率的权衡,对不平衡数据集尤为重要
    • 预测拒绝率(Prediction Rejection Ratio, PRR) :模拟拒绝最不确定的响应,追踪平均质量的提升,值越高表示不确定性与答案正确性的校准越好

Datasets

  • 论文在 6 个 QA 数据集上评估方法,涵盖单跳(single-hop)和多跳(multi-hop)推理
  • 单跳数据集包括 SQuAD v1.1 (2016)、Natural Questions (2019) 和 TriviaQA (2017),多跳数据集包括 MuSiQue (2022)、HotpotQA (2018) 和 2WikiMulti-HopQA (2020)

Results

  • 如表 4 所示,常青概率是改进自我知识识别的强信号
  • 在 18 项评估中,16 项的最佳结果由常青特征单独或结合不确定性估计方法取得
  • 此外,它能改进校准(PRR),对实际应用极具价值
  • 值得注意的是,常青特征在 AUPRC 上表现突出,在 4 个数据集中排名第一,表明常青性是模型是否具备可靠知识的强指标
  • 然而,论文也发现一致模式:常青性在 AUPRC 上得分高,但在 AUROC 上较低
    • 这表明该特征虽能有效识别模型“知道答案”的情况,但对“不知道答案”的判别较弱(真阴性区分能力不足)
    • 换言之,若问题是常青的,模型很可能正确回答;但若问题非常青,结果更难预测
  • Takeaway:常青概率持续提升 self-knowledge 评估和校准(calibration),在 18 个设定下实现了 16 个 top 结果
  • 问题:本节的 自我知识分类器 \(f(x)\) 的特征和 label 是什么?训练后的 \(f(x)\) 用来做什么?

Filtering QA with Evergreen

  • 在本节中,论文展示了 Evergreen 分类在过滤 QA 数据集中的价值,通过排除可变问题(mutable questions),可以实现更公平的评估
    • 论文使用了与第 5 节“自我知识”相同的模型设置
  • QA 数据集理想情况下应仅包含 Evergreen 问题,这一点在 SimpleQA (2024a) 中得到了强调
    • 为了实现这一目标,SimpleQA 依赖于人工标注者评估问题的 Evergreen 性
    • 相比之下,EG-E5 支持自动化数据集整理,无需手动标注,从而促进了大规模 QA 语料库的构建

Popular QA Datasets Analysis

  • 可变问题对公平的 QA 评估提出了严峻挑战:
    • 过时的黄金答案(outdated gold answers)可能导致现代 LLM 的正确回答被误判为错误,尤其是在模型在不同时间被评估时
  • 示例 :表 5 展示了六个数据集(见第 5.4 节)中的可变问题示例,这些问题的答案在 2025 年已与原参考答案不同
    • 这些示例包括简单和复杂的查询,甚至来自最近发布的数据集如 MuSiQue (2022)
    • 变化的性质多样:有些是可预测的(如奥运会主办城市、人口数据),有些是偶发的(如职位名称或配偶),还有一些是意外的(如君主、GDP 排名)
  • 统计数据 :表 6 显示,可变问题仍然普遍存在,在 NQ 中占比高达 18%,平均占数据集的 10%
    • 这一现象挑战了 QA 基准具有时间稳定性的普遍假设,并引发了对评估公平性的担忧
    • 为确保可靠性,可变问题应被过滤掉,或者需要维护实时基准如 RealTimeQA (2024),尽管后者成本较高
  • 错误的假设 :UAR (2024) 隐含假设数据集具有 Evergreen 性,而 MULAN (2024) 将许多问题视为不可变,但实际上某些关系(e.g., Wikidata’s P190, “sister cities”)可能会变化
    • 这种不匹配可能解释了这些方法在面对时间漂移时实际效果有限的原因
  • Takeaway:QA 基准包含可变问题,破坏了评估的公平性。过滤这些问题对可靠性评估非常重要

Filtered QA Performance

  • 零样本性能 :如表 6 所示,模型在 Evergreen 问题上的准确率始终更高,在复杂任务中的相对差异高达 40%
    • 这与预期一致,因为可变问题通常需要模型静态知识之外的实时信息
  • RAG 的优势 :论文展示了模型在回答可变问题时通常更能从带有黄金上下文的 RAG 中受益,相对增益高达 30%
    • 然而,在可变问题样本较少的数据集中,这种效果会减弱

Explaining GPT-4o Retrieval

  • GPT-4o 通过内部的黑盒标准自主决定何时调用其检索系统
  • 论文发现,问题的 Evergreen 性是这种行为的最强预测因子,这表明 GPT-4o 对外部搜索的使用与输入的时间性质密切相关
  • 论文使用了与第 4.2 节相同的子集,并通过其网络接口查询 GPT-4o,记录是否触发了检索调用
  • 除了 Evergreen 标签外,论文还评估了第 4.2 节中的几种基于不确定性的信号以及 EG-E5 ,以评估它们与 GPT-4o 检索决策的相关性
  • 如表 7 所示,Evergreen 性和 EG-E5 预测比任何基于不确定性的信号都强得多(信息量是后者的两倍以上)
  • 这表明 GPT-4o 可能在内部建模问题的时间性,或者其检索策略对时间性高度敏感
  • Takeaway:常青性是 GPT-4o 的检索行为中最强的预测者(Predictor),表明检索和时序是强相关的

Error Analysis

  • 论文从 EverGreenQA 数据集的测试部分中选取了样本,并对 EG-E5 分类器的错误进行了定性分析
  • 表 8 展示了按原因分组的假阳性和假阴性示例
    • 值得注意的是,分类器在涉及最高级表达时表现出较高的不确定性,有时将其标记为易变的,而其他时候则将“最”“最大”或“最健康”等趋势敏感短语误解为普遍固定的
  • 其他错误包括将活人的成就误分类为已故,以及错误地将稳定的地理或生物事实视为时间敏感的
  • 有趣的是,假阴性的数量是假阳性的两倍
    • 这表明分类器在判断问题是否涉及稳定事实时更为谨慎
  • 在某些情况下,外部信息至关重要
    • 例如,如果一个人已去世,所有关于他的问题都将是 Evergreen 的,但模型需要知道该人是否仍在世
    • 类似地,关于最近年份(如 2023-2024)的问题也带来了挑战,因为模型缺乏对当前日期的感知
  • 在其他情况下,模型在组织和区分其知识方面还有改进空间
    • 例如,学习区分真正稳定的物理事实(如列支敦士登的面积)和更易变的事实(如天空中最亮的恒星),或区分已完成的历史事件(如法国大革命)和正在发展的动态(如即将举行的总统选举)
  • 更多示例见附录 G

补充:Related Work

  • 时间推理在问答任务中仍是一个基础性挑战,因为时间动态性常常使问题解释和答案检索变得复杂
    • 时间敏感的问答任务得益于如 TimeQA(2021)等数据集的改进,该数据集包含 20,000 个需要时间推理的问题-答案对
      • 尽管有帮助,但它仅涉及简单推理
    • SituatedQA(Zhang 和 Choi,2021)通过将问题置于时间和空间上下文中,展示了语境的重要性
    • StreamingQA 强调了时间适应的必要性,揭示了大语言模型在跟踪变化事实时的困难(2022)
    • TemporalAlignmentQA (TAQA) (2024)通过提供 2000 年至 2023 年每年 20,000 个时间敏感问题及其答案,进一步增强了时间对齐的可能性
    • MuLan(2024)根据变化率和事实类型对问题进行了区分
    • FreshQA(2024)提出了一个专注于新鲜度敏感信息的基准,进一步说明了大语言模型在处理时间动态知识时的局限性
    • 这些研究表明需要专门的时间推理方法(2024)
    • 表 1 展示了数据集的对比
  • 检索增强生成(RAG)方法,如 DRAGIN(2024)、IRCoT(2023)或 Rowen(2024),通过动态检索决策解决了时间敏感问答问题,但效果有限
    • 动态检索决策需要自我知识估计
    • 在问答系统被信任之前,它们需要知道自己不知道什么
    • 大语言模型通常难以识别无法回答的问题(2023),但利用自我知识(self-knowledge)可以减少需要大量知识的任务中的错误(2023;2025)
      • 问题:这里的 self-knowledge 是什么?是模型自己的内容知识吗?
  • 基于检索的方法从外部解决了时间知识缺口(temporal knowledge gaps externally),另一种方向是更新大语言模型的内部知识
    • 更新大语言模型的内部知识计算成本高昂,因为重新训练或编辑模型通常需要大量资源,且无法在实际中每天或每小时执行
  • 诸如 LLM Surgery(2024)和参数高效微调(2024;2025)等技术试图使此类更新更实用,但仍面临大规模变更或事实幻觉的问题

Limitations

  • 尽管论文的 EverGreenQA 数据集是首个多语言、人工标注的常青性基准测试,但其规模仍相对较小(3,278 个示例)
    • 不过,它覆盖了 7 种语言的高质量数据,足以揭示模型行为的明确趋势
  • 虽然论文涵盖了 7 种语言,但数据集并未覆盖所有主要语系,且在低资源语言环境中的表现仍有待探索
    • 尽管如此,论文的选择包括了拉丁和非拉丁文字,能够进行有意义的多语言评估
  • 论文对大语言模型的评估涵盖了 14 个不同规模和家族的模型,但主要聚焦于每个规模层级的代表性模型
    • 扩展到更多指令调优或领域适配的变体可能会进一步推广研究结论
  • 在基于不确定性的分析中,论文聚焦于五种代表性指标
    • 尽管这些指标被广泛使用且足以得出强有力的结论,但引入更多最新或任务特定的指标可能会提供更多洞见
  • 论文训练的常青分类器表现优异,但仅对其架构、训练过程和辅助数据的使用进行了有限的消融实验
    • 探索更多模型变体或迁移学习策略可能会进一步提升鲁棒性
  • 最后,尽管论文展示了常青分类的几种实际用途,但并未探索其在主动学习(active learning)、答案校准(answer calibration)或搜索重排序(search reranking)等任务中的潜力
    • 这些有前景的方向留待未来工作

附录A Evergreen Testing Details

LLM 的文本参数

  • 每个示例包含 5 个可变(mutable)和 5 个不可变(immutable)的样本
  • 对于 LLaMA 3.1,采样参数如下:
    • 温度(temperature)= 0.7
    • top_p = 0.9
  • 对于 Qwen 2.5:
    • 温度 = 0.6
    • top_p = 0.95
    • top_k = 20
    • min_p = 0

分类器参数

  • 分类器模型训练参数如下:
    • 所有模型训练了10个周期(epoch)
    • 采用早停(early-stopping)策略
    • 学习率(lr)= 4.6e-5
    • 批量大小(batch size, bs)= 16
    • 未使用额外数据集
    • 论文为所有语言训练了一个统一模型
  • 如表10 所示,multilingual-e5-large-instruct 表现最佳
  • Evergreen Verbal Instruction

    You are a helpful assistant. You help user to classify the questions based on the tem- porality. There are two classes: immutable and mutable. Immutable, in which the an- swer almost never changes. Mutable, in which the answer typically changes over the course of several years or less. Think about each question and in the end answer with Mutable or Immutable starting with ’Classi- fication:’


附录B Translation Prompt

  • 翻译验证指令(Translation Validation Instruction) :将以下英文文本翻译为法语、德语、希伯来语、阿拉伯语和中文。以JSON格式提供翻译结果,键名为“French”、“German”、“Hebrew”、“Arabic”和“Chinese”
  • Translation Validation Instruction :

    Translate the following English text into French, German, Hebrew, Arabic and Chi- nese. Provide the translations as a JSON object with keys ’French’, ’German’, ’He- brew’, ’Arabic’, ’Chinese’.

  • 论文使用GPT-4.1,温度参数(temperature)= 0.2,并添加标签 "response_format": "json_object"

附录C Validation Instructions

  • 验证指令 :对每个翻译的问题,根据以下标准打分:
    • 0 :翻译包含扭曲原意的错误
    • 1 :翻译包含不影响整体含义的轻微错误
  • Translation Validation Instruction:

    For each translated question, assign a score according to the following criteria:
    • 0 – the translation contains errors that distort the meaning.
    • 1 – the translation contains minor er- rors that do not affect the overall mean- ing.


附录D Classifier for Self-Knowledge

  • 论文探索了七种分类模型(使用scikit-learn (2013) 和CatBoost (2020)):
    • 逻辑回归(Logistic Regression)
    • k近邻(k-Nearest Neighbors)
    • 多层感知机(Multilayer Perceptron)
    • 决策树(Decision Tree)
    • 随机森林(Random Forest)
    • 梯度提升(Gradient Boosting)
    • CatBoost
  • 所有模型均使用标准化特征(StandardScaler)训练,超参数在训练数据的 100 个示例子集上优化,并在每个数据集上重复三次实验以确保鲁棒性
  • 最终评估时,论文选择验证集上表现最佳的两个模型,使用 VotingClassifier 将其组合为软投票集成(soft-voting ensemble)
  • 每个组件模型均使用调优后的超参数在全训练集上重新训练

超参数网格

  • 逻辑回归 :C: [0.01, 0.1, 1],求解器(solver): [lbfgs, liblinear],类别权重(class_weight): [balanced, 0:1, 1:1, None],最大迭代次数(max_iter): [10000, 15000, 20000]
  • k近邻 :n_neighbors: [5, 7, 9, 11, 13, 15],距离度量(metric): [euclidean, manhattan],算法(algorithm): [auto, ball_tree, kd_tree],权重(weights): [uniform, distance]
  • 多层感知机 :隐藏层大小(hidden_layer_sizes): [(50), (100), (50,50), (100,50), (100,100)],激活函数(activation): [relu, tanh],求解器: [adam, sgd],alpha: [0.00001, 0.0001, 0.001, 0.01],学习率(learning_rate): [constant, adaptive],早停(early_stopping): True,最大迭代次数: [200, 500]
  • 决策树 :最大深度(max_depth): [3, 5, 7, 10, None],最大特征数(max_features): [0.2, 0.4, sqrt, log2, None],分裂标准(criterion): [gini, entropy],分裂器(splitter): [best, random]
  • CatBoost :迭代次数(iterations): [10, 50, 100, 200],学习率: [0.001, 0.01, 0.05],深度(depth): [3, 4, 5, 7, 9],bootstrap类型(bootstrap_type): [Bayesian, Bernoulli, MVS]
  • 梯度提升 :n_estimators: [25, 35, 50],学习率: [0.001, 0.01, 0.05],最大深度: [3, 4, 5, 7, 9],最大特征数: [0.2, 0.4, sqrt, log2, None]
  • 随机森林 :n_estimators: [25, 35, 50],最大深度: [3, 5, 7, 9, 11],最大特征数: [0.2, 0.4, sqrt, log2, None],bootstrap: [True, False],分裂标准: [gini, entropy],类别权重: [balanced, 0:1, 1:1, None]

附录E Predictive Analysis of Uncertainty for Temporality

  • 表9 报告了逻辑回归模型的 McFadden’s pseudo-\(R^2\) value , 该模型基于两种不确定性指标(困惑度(perplexity)和平均 Token 熵(mean token entropy))预测问题是否为常青(evergreen)
    • 注:McFadden’s pseudo-\(R^2\) value 即麦克法登伪 \(R^2\) 值,是一种用于评价非线性模型,特别是逻辑回归模型等定性选择模型拟合优度的指标。该指标的取值范围是从 0 到小于 1,其值越接近 0,表明模型没有预测能力;值越接近 1,说明模型对数据的拟合效果越好,即模型能够解释因变量的变异程度越高
  • 大多数模型的伪 pseudo-\(R^2\) 值低于 0.07,表明不确定性对常青分类的预测能力有限
  • 唯一例外是 Phi-3-medium (128k),其困惑度得分最高(0.137),表明长上下文训练可能改善时间性不确定性的编码,但仍非常有限
  • 两种不确定性指标无显著优劣,模型大小与预测性能也无明确相关性
  • 结果表明,不确定性指标仅能捕捉有限的时间性信号,适合作为辅助特征而非独立预测器

附录F Dataset Collection Details

  • 负责标注常青和可变标签(evergreen/mutable)及生成标准答案(golden answers)的语言学家团队均持有语言学学士以上学位,确保标注质量
  • 每阶段标注均通过团队负责人验证以保证一致性
  • 此外,为支持多样化应用,所有答案均转换为别名集合,具体流程见附录F.4
  • 标注人员薪酬符合当地法规(注:这也太谨慎了)

Golden Answers Annotation

  • 标准答案需完整且对用户有用
优质答案示例
  • 问题 :谁被视为物理学的奠基人?
    • 答案 :艾萨克·牛顿(Isaac Newton)被广泛认为是物理学的奠基人
    • 注释 :问题为单数形式,而根据多数来源,牛顿是经典物理学的奠基人。尽管伽利略和笛卡尔也有贡献,但牛顿是最被广泛接受的答案
  • 问题 :2000年意大利总统是谁?
    答案 :Carlo Azeglio Ciampi 是意大利政治家,曾任意大利共和国第10任总统及总理
不完整答案示例
  • 问题 :蜘蛛有牙齿吗?
    • 答案 :是的,蜘蛛有牙齿
    • 注释 :正确答案应为“蜘蛛没有牙齿,但有螯肢(chelicerae),可分泌消化酶。”
  • 开放式列表问题(如“最高的山有哪些?”)需列出多个正确示例并注明非穷举

Evergreen-ness Annotation

  • 常青性标准因领域而异
  • 多数问题涉及已确立的事实或事件,但天文学等领域的新发现可能改变答案
  • 政治领导人类问题(如“现任总统是谁?”)显然非常青
可变问题示例
  • 1)最近一次日食是哪年?
  • 2)哪个国家拥有最长铁路?
常青问题示例
  • 1)罗马帝国分裂为哪两部分,何时发生?
  • 2)梅西是谁?

Synthetic Data Generation

  • 使用 GPT-4.1 生成并人工验证了 1,449 个额外问答对
  • 过滤重复问题并改写常见模板(如“某人年龄”)
  • 仿照 FreshQA 风格,生成常青和可变问题,后者进一步分为慢变(slow-changing)和快变(fast-changing)两类,以增强数据多样性
  • 合成指令 :
    • “请生成以下类型的问答对:慢变问题(答案通常几年内变化)、快变问题(答案一年内变化)、永不变问题(答案永不变化)。”
  • Synthetic Instruction:

    Can you generate different question-answer pair: slow-changing questions, in which the answer typically changes over the course of several years (up to 10); fast-changing question, in which the answer typically changes within a year or less; never-changing, in which the answer never changes.

Short-Answer Generation Prompt

  • 简短答案生成器指令 :
    • 给定一个事实性问题和完整(可能较长)答案 ,生成多个简洁且语义等价的答案变体
    • 规则 :
      • 1)每个变体必须事实正确且独立回答问题
      • 2)尽量简短(约1–5词),同时保持无歧义
      • 3)包含常见拼写、缩写、数字与罗马数字形式
      • 4)不添加答案未明确包含的信息
      • 5)返回如 JSON 对象:{ "answers": ["变体1", "变体2", ...] }
    • 示例 :
      • 问题 :“英国国王是谁?”
      • 答案 :“英国国王是查尔斯三世(Charles Philip Arthur George)。”,["查尔斯3世", "国王是查尔斯3世", "Charles III"]
  • 论文使用 GPT-4o(温度=0.2)并添加了 “response_format”: “json_object” 标签,从长 form 中生成简短 form 答案,便于比较 LLM 的性能

附录G Error Analysis Extended

  • 表11 扩展了EG-E5分类器的错误模式分析,包括更多误分类示例
  • 误报(False Positives) :
    • 时间性表述误为固定历史事实(如“俄罗斯总统选举在哪年举行?”)
    • 最高级假设为静态事实(如“最健康的茶是哪种?”)
  • 漏报(False Negatives) :
    • 最高级误为时间敏感(如“最古老的货币是什么?”)
    • 生物地理事实误为频繁变化(如“列支敦士登的面积是多少?”)
  • 完整示例见附录G

附录H License and Infrastructure

  • 实验使用 1–2 块 NVIDIA A100 GPU,总计约 40 GPU 小时
  • 模型遵循各自许可:LLaMA 3.1 (2024) 和 Gemma 2 (2024) 为自定义许可,Phi-3 (2024) 和 E5 为 MIT 许可,Qwen 2.5 (2024) 和 Mistral (2023) 为 Apache 2.0 许可
  • GPT模型通过 API 或网页界面访问
  • 数据集和分类器以 MIT 许可发布

NLP——技术报告解读-Kimi-K1.5

注:本文包含 AI 辅助创作

  • 参考链接:
    • 原始论文:Kimi K1.5: Scaling Reinforcement Learning with LLMs, Moonshot AI (Kimi), 20250103
    • Kimi K1.5: Long Context RL 的成功实践 - Chayenne Zhao的文章 - 知乎
      • 包含关于 partial Rollout 方法较为详细的讨论

Paper Summary

  • 论文报告了最新多模态大语言模型 Kimi K1.5 的训练实践,包括其 RL 训练技术、多模态数据配方和基础设施优化
    • 并从实践中总结了一个关键结论:上下文长度的扩展对于持续提升大语言模型的性能至关重要
  • 论文通过优化的学习算法和 Infra 优化(如部分轨迹回放,partial rollouts)实现了高效的长上下文强化学习训练
    • 固定每次 Rollout 的预算,允许同一条估计由不同策略生成
  • 使用的方法叫做 OPMD ,既不是 GRPO 也不是 PPO
    • OPMD 不需要使用 Critic 模型
  • 论文结合了多种技术改进了策略优化(policy optimization)
    • 为长思维链 RL 制定了数学框架,并推导出一种在线镜像下降(online mirror descent)的变体以实现鲁棒的优化
    • 通过实验验证了采样策略(sampling strategies)、长度惩罚(length penalty)和数据配方优化(data recipe optimization)对强化学习性能的提升作用
  • 即使不依赖更复杂的技术(如 MCTS、价值函数 和 过程奖励模型),仅通过长上下文扩展和改进的策略优化也能实现强大的性能
  • 作者还观察到长到短(long2short)方法的潜力(即利用长思维链(long-CoT)技术改进短思维链(short-CoT)模型)
    • 这些方法显著提升了短思维链模型的性能
    • 可以尝试将长到短方法与长思维链强化学习迭代结合,以进一步提高给定上下文长度预算下的 Token Efficient 和性能
  • 论文建立了一个简单而有效的 RL 框架,无需依赖更复杂的技术(如蒙特卡洛树搜索、价值函数和过程奖励模型),其关键组成部分包括:
    • 长上下文扩展(long context scaling)
    • 改进的策略优化方法(policy optimization methods)
  • 论文的系统在跨多模态的多个基准测试中实现了 SOTA 推理性能,与 OpenAI 的 o1 模型相当
  • 论文提出了有效的长到短(long2short)方法(利用长思维链技术改进短思维链模型)实现了 SOTA 短思维链推理结果,大幅超越现有短思维链模型(如 GPT-4o 和 Claude Sonnet 3.5),优势最高达 +550%

Introduction and Discussion

  • 在扩展定律(scaling law)的背景下,基于 NTP 的语言模型预训练已得到广泛研究
    • 其中模型参数和数据规模的成比例扩展会带来智能的持续提升 (2020; 2022)
    • 但这种方法受限于可用高质量训练数据的数量 (2024; 2023)
  • 论文介绍了 Kimi K1.5 的训练配方,这是论文最新通过 RL 训练的多模态大语言模型
    • 目标是探索一种可能的新扩展方向
    • 通过将 RL 与大语言模型结合,模型能够通过奖励驱动的探索进行学习,从而不再受限于静态的预存数据集
  • K1.5 的设计和训练包含以下几个关键要素:
    • 长上下文扩展(Long context scaling) :
      • 论文将 RL 的上下文窗口扩展至 128k,并观察到随着上下文长度的增加,性能持续提升
      • 论文方法的核心思想是通过部分轨迹回放(partial rollouts)提高训练效率(即通过重用先前轨迹的大部分内容来采样新轨迹,避免从头重新生成新轨迹的成本)
      • 论文的观察表明,上下文长度是大语言模型 RL 持续扩展的关键维度
    • 改进的策略优化(Improved policy optimization) :
      • 论文推导了长思维链 RL 的公式化表示,并采用了一种在线镜像下降(online mirror descent)的变体进行鲁棒策略优化
      • 该算法通过有效的采样策略、长度惩罚(length penalty)和数据配方的优化进一步改进
    • 简洁框架(Simplistic Framework) :
      • 长上下文扩展与改进的策略优化方法相结合,为大语言模型学习建立了一个简洁的 RL 框架
      • 由于论文能够扩展上下文长度,学习到的思维链展现出规划(planning)、反思(reflection)和修正(correction)的特性
      • 增加的上下文长度相当于增加了搜索步数。因此,论文证明即使不依赖更复杂的技术(如蒙特卡洛树搜索、价值函数和过程奖励模型),也能实现强大的性能
    • 多模态(Multimodalities) :
      • 论文的模型联合训练文本和视觉数据,具备跨两种模态联合推理的能力
  • 论文还提出了有效的长到短方法,利用长思维链技术改进短思维链模型
    • 包括对长思维链激活应用长度惩罚以及模型融合(model merging)
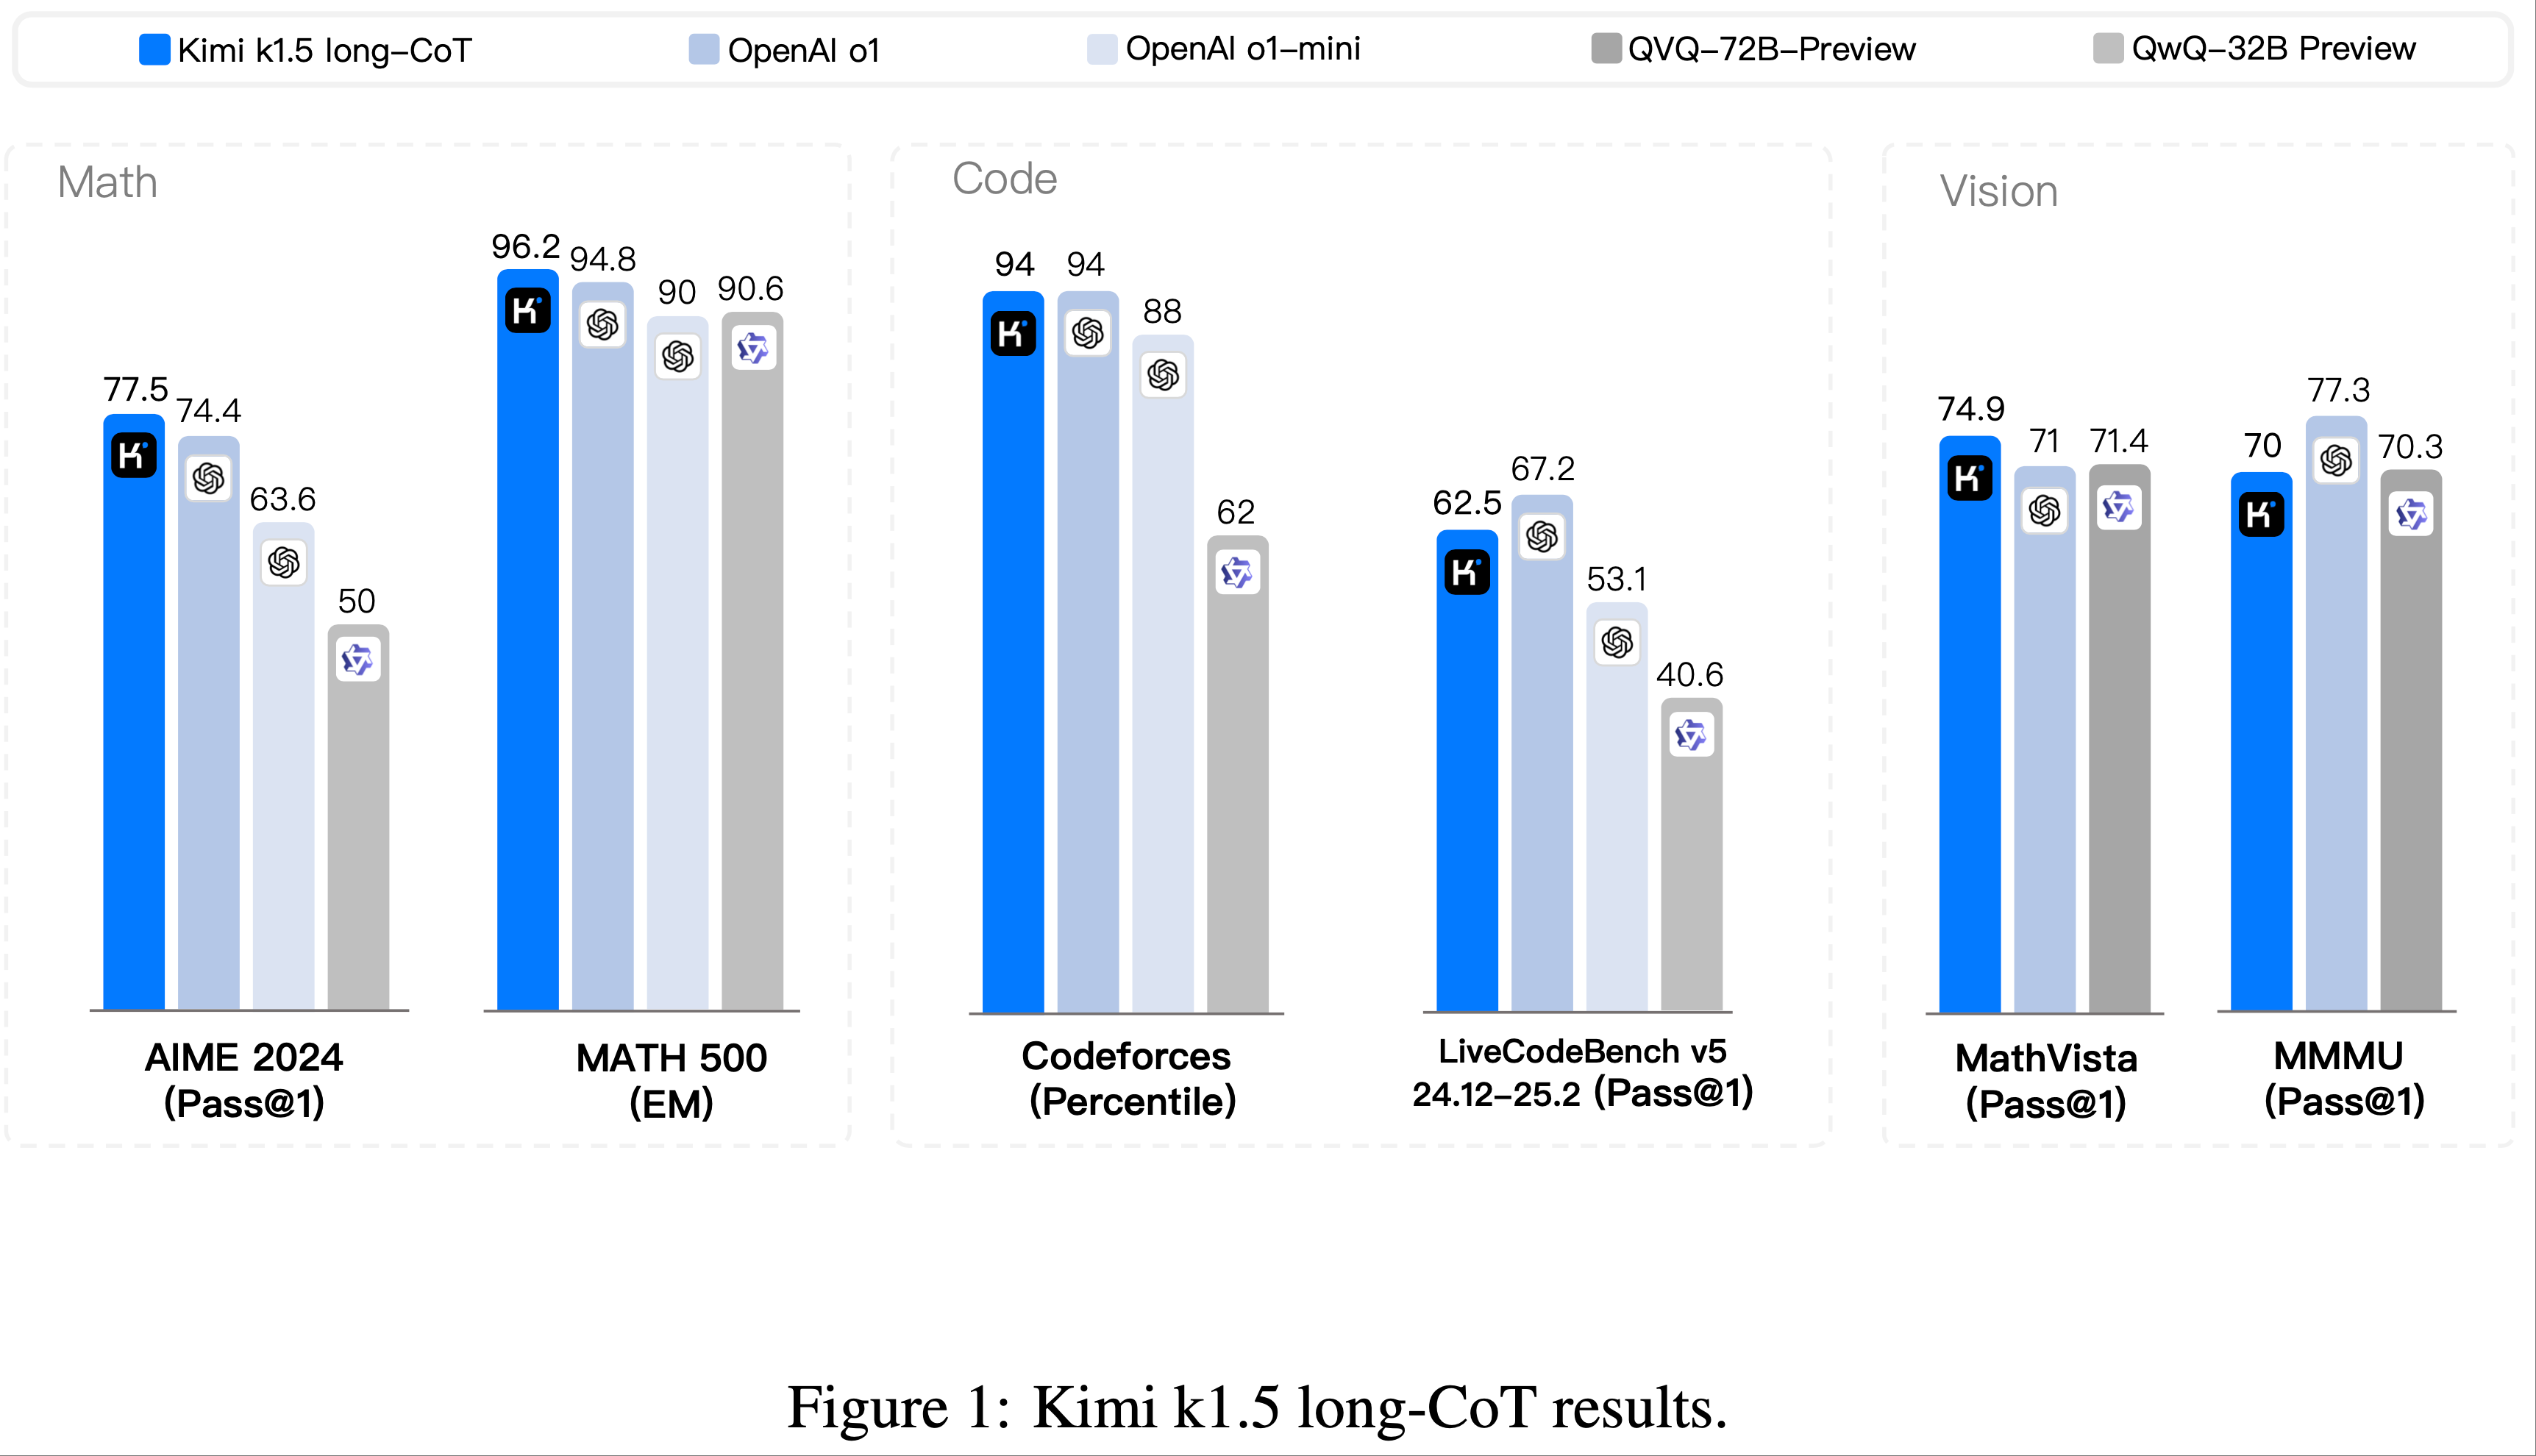
  • 论文的长思维链版本在跨多模态的多个基准测试中实现了 SOTA 推理性能
    • AIME 77.5 分
    • MATH 500 96.2 分
    • Codeforces 94% 分位数
    • MathVista 74.9 分
    • 与 OpenAI 的 o1 模型相当
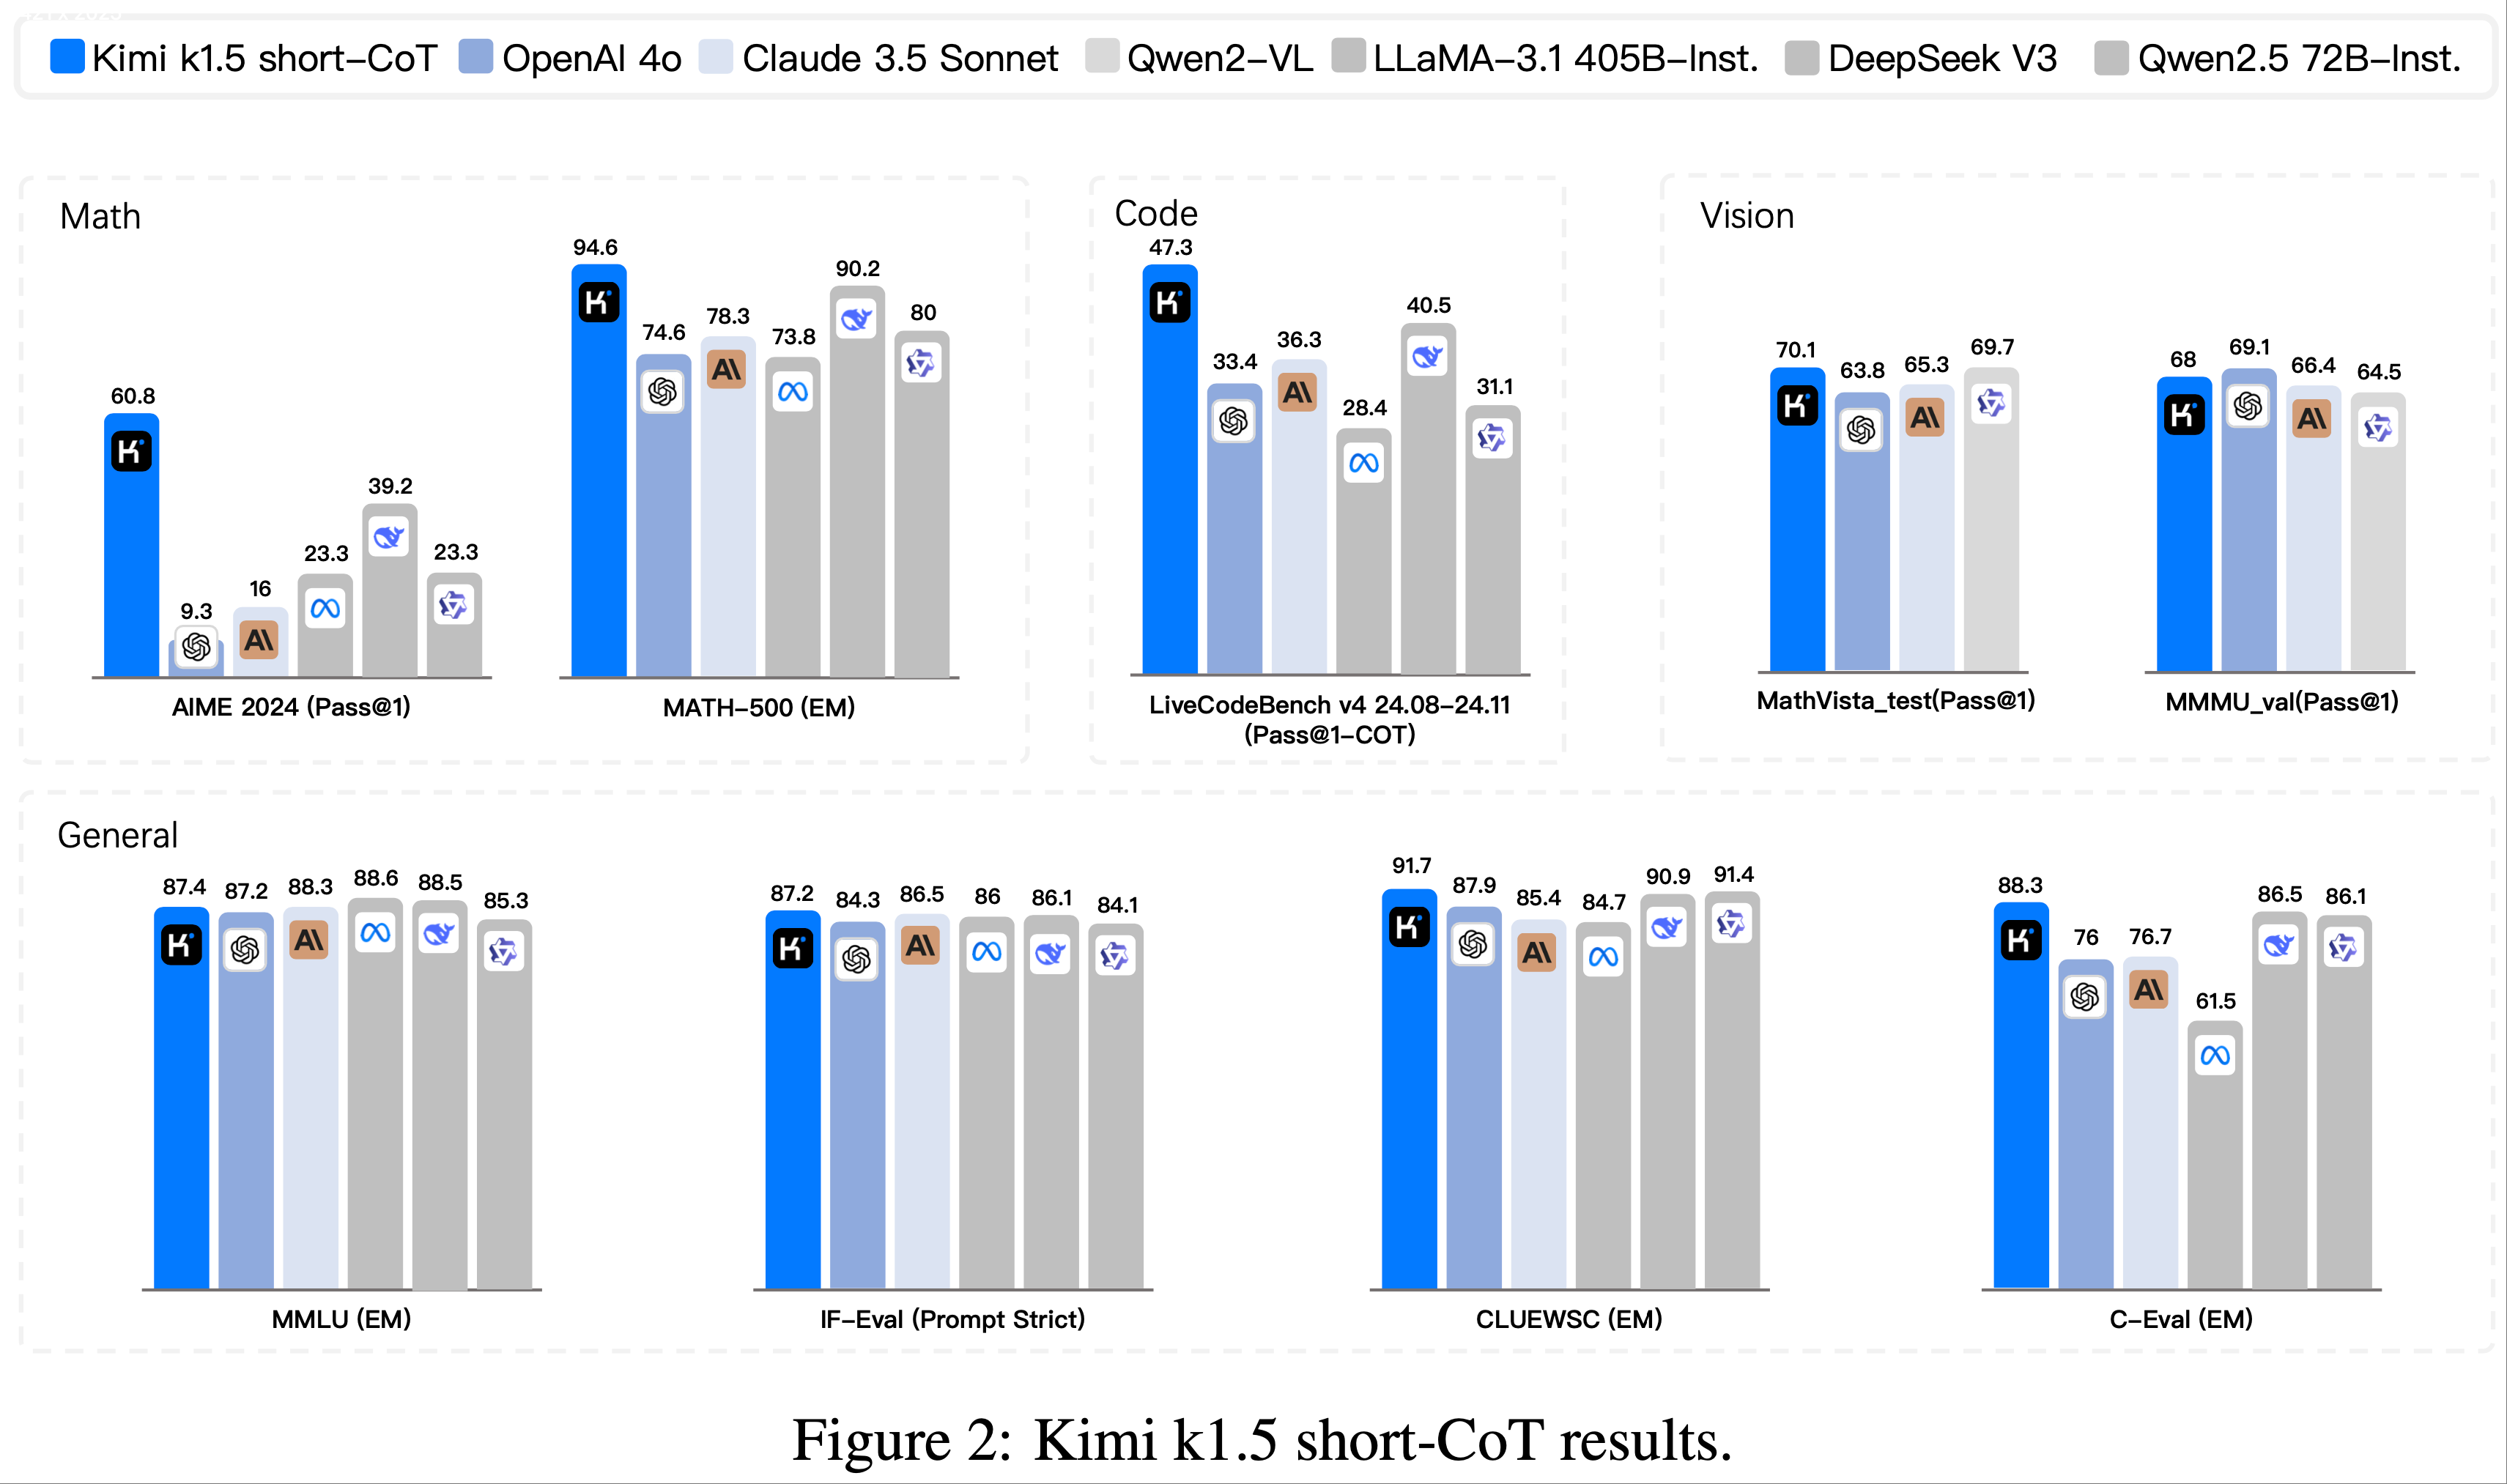
  • 论文的短思维链模型也实现了 SOTA 推理结果
    • AIME 60.8 分
    • MATH500 94.6 分
    • LiveCodeBench 47.3 分
    • 大幅超越现有短思维链模型(如 GPT-4o 和 Claude Sonnet 3.5),优势最高达 +550%
  • 结果如图 1 和图 2 所示

Approach: Reinforcement Learning with LLMs

  • Kimi K1.5 的开发包含多个阶段:
    • 预训练(pretraining)
    • 基础监督微调(vanilla supervised fine-tuning, SFT)
    • 长思维链监督微调(long-CoT supervised fine-tuning)
    • RL
  • 本报告重点关注强化学习部分:
    • 概述 RL 提示集构建(Section 2.1)
    • 概述 长思维链监督微调(Section 2.2)
    • 深入讨论 RL 训练策略(Section 2.3)
  • 注:预训练和基础监督微调的更多细节可见 Section 2.5

RL Prompt Set Curation

  • 通过初步实验,论文发现 RL 提示集的质量和多样性对强化学习的有效性至关重要
    • 一个精心构建的提示集不仅能引导模型进行鲁棒推理 ,还能降低奖励破解(reward hacking)和过拟合表面模式的风险
  • 高质量的 RL 提示集需满足以下三个关键特性:
    • 多样性覆盖(Diverse Coverage) :提示应涵盖 STEM、编程和通用推理等多个领域 ,以增强模型的适应能力并确保广泛的适用性
    • 难度平衡(Balanced Difficulty) :提示集应包含简单、中等和困难问题的均衡分布 ,以促进渐进式学习并避免过拟合特定难度级别
    • 可准确评估(Accurate Evaluability) :提示应支持通过验证器进行客观可靠的评估 ,确保模型表现基于正确的推理而非表面模式或随机猜测
  • 多样性覆盖 :为实现多样性覆盖,论文采用自动过滤器筛选需要丰富推理且易于评估的问题
    • 数据集包含来自 STEM 领域、竞赛和通用推理任务的文本及图文问答数据
    • 此外,论文开发了标签系统,按领域和学科对提示分类,确保各主题的均衡代表性(2023)
  • 难度平衡 :论文采用基于模型的方法,利用模型自身能力自适应评估每个提示的难度
    • 对于每个提示,SFT 模型以较高采样温度生成 10 次答案 ,通过通过率(pass rate)作为难度代理
      • 通过率越低,难度越高
    • 这种方法使难度评估与模型内在能力对齐,显著提升 RL 训练效果
    • 通过此方法,我们可以预过滤大部分简单案例,并在 RL 训练中灵活探索不同采样策略
  • 可准确评估 :为避免奖励破解(2021;2022),论文需确保每个提示的推理过程和最终答案均可被准确验证
    • 实证表明,某些复杂推理问题的答案可能较简单且易猜测,导致误判(即模型通过错误推理得到正确答案),论文排除了易出现此类问题的题型,如多选题、判断题和证明题
    • 对于通用问答任务,论文提出一种简单有效的方法识别并移除易破解提示:
      • 要求模型在不进行思维链推理的情况下猜测答案
      • 若模型在 \(N=8\) 次尝试内猜中正确答案 ,则该提示被视为易破解并被移除
    • 注:开发更先进的验证模型仍是未来研究方向

Long-CoT Supervised Fine-Tuning

  • 基于优化的 RL 提示集,论文通过提示工程构建一个小型高质量的长思维链预热数据集,包含文本和图像输入的已验证推理路径
  • 该方法类似于拒绝采样(rejection sampling, RS),但专注于通过提示工程生成长思维链推理路径
  • 预热数据集旨在封装人类推理的关键认知过程,包括:
    • 规划(Planning) :模型在执行前系统化步骤;
    • Evaluation :对中间步骤的批判性分析;
    • 反思(Reflection) :重新审视并优化方法;
    • 探索(Exploration) :考虑替代解决方案
  • 通过对该数据集进行轻量级 SFT,模型能有效内化这些推理策略
  • 微调后的长思维链模型在生成详细且逻辑连贯的响应方面表现更优,从而提升多样化推理任务的性能

Reinforcement learning

Problem Setting
  • 给定一个训练数据集,论文的目标是训练一个策略模型 \(\pi_\theta\) 以准确解决测试问题
    $$\mathcal{D} = \{(x_i, y^*_i)\}_{i=1}^n$$
    • 其中 \(x_i\) 表示问题,\(y^*_i\) 表示对应的真实答案
  • 在复杂推理任务中,从问题 \(x\) 到答案 \(y\) 的映射并非直接完成
    • 为解决这一挑战,思维链(Chain of Thought, CoT)方法提出使用一系列中间步骤 来连接 \(x\) 和 \(y\):
      $$ z = (z_1, z_2, \ldots, z_m)$$
      • 其中每个 \(z_i\) 是一个连贯的 Token 序列,作为解决问题的关键中间步骤 (2022)
    • 在解决问题 \(x\) 时,思维 \(z_t \sim \pi_\theta(\cdot|x, z_1, \ldots, z_{t-1})\) 通过自回归方式采样生成,随后生成最终答案 \(y \sim \pi_\theta(\cdot|x, z_1, \ldots, z_m)\)
    • 论文用 \(y, z \sim \pi_\theta\) 表示这一采样过程
    • 需要注意的是,思维和最终答案均以语言序列的形式生成
  • 为了进一步增强模型的推理能力,可使用规划算法(planning algorithms)探索不同的思维过程,从而在推理时生成改进的思维链 (2024;)
    • 规划算法的核心思想是通过价值估计显式构建一个思维搜索树
    • 这使得模型能够探索思维过程的多种可能延续,或在遇到死胡同时回溯以研究新的方向
    • 规划算法的具体流程如下:
      • 设 \(\mathcal{T}\) 为一个搜索树,其中每个节点表示一个部分解 \(s = (x, z_{1:|s|})\),包含问题 \(x\) 和一系列思维
        $$ z_{1:|s|} = (z_1, \ldots, z_{|s|})$$
        • \(|s|\) 表示序列中思维的数量
      • 规划算法使用一个评判模型 \(v\) 提供反馈 \(v(x, z_{1:|s|})\),帮助评估当前解决问题的进展并识别现有部分解中的错误
      • 反馈可以是一个判别分数或语言序列 (2024)
      • 根据所有 \(s \in \mathcal{T}\) 的反馈,规划算法选择最有潜力的节点进行扩展,从而生长搜索树
      • 上述过程迭代重复,直到生成完整的解
  • 从算法视角来看:
    • 给定第 \(t\) 次迭代时的历史搜索记录
      $$ (s_1, v(s_1), \ldots, s_{t-1}, v(s_{t-1}))$$
    • 规划算法 \(\mathcal{A}\) 迭代确定下一个搜索方向
      $$ \mathcal{A}(s_t|s_1, v(s_1), \ldots, s_{t-1}, v(s_{t-1})) $$
    • 并为当前搜索进展提供反馈
      $$ \mathcal{A}(v(s_t)|s_1, v(s_1), \ldots, s_{t-1}, v(s_{t-1}))$$
    • 由于思维和反馈均可视为中间推理步骤,且这些组件均可表示为语言 Token 序列,论文用 \(z\) 替换 \(s\) 和 \(v\) 以简化符号
    • 因此,论文将规划算法视为直接作用于推理步骤序列的映射
      $$ \mathcal{A}(\cdot|z_1, z_2, \ldots) $$
    • 在这一框架下,规划算法使用的搜索树中存储的所有信息被扁平化为提供给算法的完整上下文
  • 这为生成高质量思维链提供了一个有趣的视角:与其显式构建搜索树并实现规划算法,不如考虑训练一个模型来近似这一过程
    • 此时,思维数量(即语言 Token 数量)类似于传统规划算法分配的计算预算
    • 长上下文窗口的最新进展(注:大模型的上下文越来越长了)为训练和测试阶段的无缝扩展提供了可能
    • 如果可行,这种方法将使模型能够通过自回归预测直接在推理空间中进行隐式搜索
    • 因此,模型不仅学会解决一组训练问题,还培养了有效解决单个问题的能力,从而提升对未见测试问题的泛化能力
  • 论文考虑使用 RL 训练模型生成思维链 (OpenAI, 2024)
    • 设 \(r\) 为一个奖励模型,用于根据真实答案 \(y^*\) 判断给定问题 \(x\) 的答案 \(y\) 的正确性,并分配一个值
      $$ r(x, y, y^*) \in \{0, 1\} $$
    • 对于可验证的问题,奖励直接由预定义的标准或规则确定
      • 例如,在编程问题中,论文评估答案是否通过测试用例
    • 对于自由形式的真实答案,论文训练一个奖励模型 \(r(x, y, y^*)\) 来预测答案是否与真实答案匹配
    • 给定问题 \(x\),模型 \(\pi_\theta\) 通过采样过程 \(z \sim \pi_\theta(\cdot|x)\) 和 \(y \sim \pi_\theta(\cdot|x, z)\) 生成思维链和最终答案
      • 生成的思维链的质量通过其是否能导向正确的最终答案来评估
  • 综上所述,论文考虑以下目标来优化策略:
    $$
    \max_{\theta} \mathbb{E}_{(x, y^*) \sim \mathcal{D}, (y, z) \sim \pi_\theta} \left[ r(x, y, y^*) \right].
    $$
  • 通过扩展强化学习训练,论文的目标是训练一个模型,使其能够结合以下两者的优势 :
    • 简单基于提示的思维链(simple prompt-based CoT)
    • 规划增强思维链(planning-augmented CoT)
  • 在推理时 ,模型仍通过自回归方式采样语言序列 ,从而避免了部署时复杂并行化的需求
  • 这种方法与简单基于提示的方法的关键区别在于
    • 模型不应仅遵循一系列推理步骤,而应通过学习关键规划技能(如错误识别、回溯和解决方案优化)来利用所有探索过的思维作为上下文信息
Policy Optimization
  • 论文采用一种在线策略镜像下降(online policy mirror descent,OPMD)的变体作为训练算法 (Abbasi-2019; 2019; 2020)
    • 该算法迭代执行
    • 关于 Mirror Descent 方法的介绍见附录
  • 在第 \(i\) 次迭代时,论文将当前模型 \(\pi_{\theta_i}\) 作为参考模型,并优化以下相对熵正则化的策略优化问题:
    $$
    \max_{\theta} \mathbb{E}_{(x, y^*) \sim \mathcal{D} } \left[ \mathbb{E}_{(y, z) \sim \pi_\theta} \left[ r(x, y, y^*) \right] - \tau \text{KL}(\pi_\theta(x) || \pi_{\theta_i}(x)) \right],
    $$
    • 其中 \(\tau > 0\) 是控制正则化程度的参数
    • 注意:是每次迭代都要求解上面的优化问题,而这个优化问题的求解可能是经过多个小步骤的,所以在不同大迭代轮次之间,参数已经发生了改变,下文中使用每次大迭代之后的策略 \(\pi_{\theta_i}\) 采样样本后,实际上是一种 Off-policy 策略而不是 On-policy 策略
  • 该目标具有闭式解:
    $$
    \pi^*(y, z|x) = \pi_{\theta_i}(y, z|x) \exp(r(x, y, y^*)/\tau)/Z.
    $$
    • 这里 \(Z = \sum_{y’, z’} \pi_{\theta_i}(y’, z’|x) \exp(r(x, y’, y^*)/\tau)\) 是归一化因子
  • 对两边取对数,论文得到对于任意 \((y, z)\) 满足以下约束,这使得论文能够在优化过程中利用 Off-policy 数据:
    $$
    r(x, y, y^*) - \tau \log Z = \tau \log \frac{\pi^*(y, z|x)}{\pi_{\theta_i}(y, z|x)}.
    $$
  • 我们得到以下最终代理损失函数(surrogate loss):
    $$
    \color{red}{L(\theta) = \mathbb{E}_{(x, y^*) \sim \mathcal{D} } \left[ \mathbb{E}_{(y, z) \sim \pi_{\theta_i} } \left[ \left( r(x, y, y^*) - \tau \log Z - \tau \log \frac{\pi_\theta(y, z|x)}{\pi_{\theta_i}(y, z|x)} \right)^2 \right] \right]}.
    $$
  • \(\tau \log Z\) 的近似表示 :可以使用样本 \((y_1, z_1), \ldots, (y_k, z_k) \sim \pi_{\theta_i}\):
    $$
    \tau \log Z \approx \tau \log \frac{1}{k} \sum_{j=1}^k \exp(r(x, y_j, y^*)/\tau).
    $$
    • 注:上式是对 \(Z = \sum_{y’, z’} \pi_{\theta_i}(y’, z’|x) \exp(r(x, y’, y^*)/\tau)\) 的估计
  • \(\tau \log Z\) 的近似表示改进 :论文进一步发现,使用采样奖励的均值在实践中效果显著:
    $$\overline{r} = \text{mean}(r(x, y_1, y^*), \ldots, r(x, y_k, y^*))$$
    • 这是合理的,因为当 \(\tau \to \infty\) 时,\(\tau \log Z\) 趋近于 \(\pi_{\theta_i}\) 下的期望 Reward(详细证明见附录)
  • 最后,论文的算法(代理损失的梯度)总结如下:对于每个问题 \(x\),使用参考策略 \(\pi_{\theta_i}\) 采样 \(k\) 个响应,梯度由下式给出:
    $$
    \color{red}{\frac{1}{k} \sum_{j=1}^k \left( \nabla_\theta \log \pi_\theta(y_j, z_j|x)(r(x, y_j, y^*) - \overline{r}) - \frac{\tau}{2} \nabla_\theta \left( \log \frac{\pi_\theta(y_j, z_j|x)}{\pi_{\theta_i}(y_j, z_j|x)} \right)^2 \right).}
    $$
  • 对于熟悉策略梯度方法的读者,这一梯度类似于使用采样奖励均值作为基线的策略梯度 (2019; 2024)
    • 主要区别在于响应是从 \(\pi_{\theta_i}\) 采样而非 On-policy 采样,并且应用了 \(l_2\) 正则化
      • 注:前文中有关于 Off-policy 和 On-policy 的讨论,每次大的迭代内都包含一些小的迭代,\(\pi_{\theta_i}\) 是第 \(i\) 次大迭代后的策略
    • 因此,可以将其视为常规 On-policy 正则化策略梯度算法在 Off-policy 情况下的自然扩展 (2017)
  • 论文从 \(\mathcal{D}\) 中采样一批问题,并将参数更新为 \(\theta_{i+1}\)(注:这里需要更新很多个小步骤),随后将其作为下一次迭代的参考策略
    • 由于每次迭代因参考策略的变化而考虑不同的优化问题,论文在每次迭代开始时重置优化器(这里是指大的迭代)
  • 在论文的训练系统中,论文排除了价值网络(value network),这一设计选择在先前的研究中也有采用 (2024)
    • 这一选择显著提高了训练效率,论文假设传统强化学习中用于信用分配(credit assignment)的价值函数可能不适用于论文的场景
  • 考虑一种情况:
    • 模型生成了一个部分思维链 \((z_1, z_2, \ldots, z_t)\),并且存在两个潜在的下一步推理步骤 \(z_{t+1}\) 和 \(z’_{t+1}\)
    • 假设 \(z_{t+1}\) 直接导向正确答案,而 \(z’_{t+1}\) 包含一些错误
    • 如果存在一个预言价值函数(oracle value function),它将表明 \(z_{t+1}\) 相对于 \(z’_{t+1}\) 具有更高的价值
      • 根据标准信用分配原则,选择 \(z’_{t+1}\) 会因为相对于当前策略具有负优势而受到惩罚
    • 但探索 \(z’_{t+1}\) 对于训练模型生成长思维链极具价值
  • 通过使用从长思维链推导出的最终答案的合理性作为奖励信号 ,模型可以从选择 \(z’_{t+1}\) 中学习试错模式,只要它成功恢复并达到正确答案
    • 理解:使用合理性作为奖励信号而不是正确性?那是否也可以将 价值模型 建模为这个合理性呢?这与是否使用 价值网络没有关系吧!
  • 这一例子的关键启示是,论文应鼓励模型探索多样化的推理路径,以增强其解决复杂问题的能力
    • 这种探索方法生成了丰富的经验,支持关键规划技能的开发
  • 论文的主要目标不仅限于在训练问题上实现高准确率,而是专注于使模型掌握有效的问题解决策略,最终提升其在测试问题上的表现
Length Penalty
  • 论文观察到一种“过度思考”(overthinking)现象:即在强化学习训练过程中,模型的响应长度显著增加
  • 虽然这带来了性能提升,但过长的推理过程在训练和推理时成本高昂,且通常不符合人类偏好
  • 为解决这一问题,论文引入了一种长度奖励(length reward)以抑制 Token 长度的快速增长,从而提高模型的 Token Efficiency
  • 给定问题 \(x\) 的 \(k\) 个采样响应 \((y_1, z_1), \ldots, (y_k, z_k)\) 和真实答案 \(y^*\)
    • 设
      • \(\text{len}(i)\) 为 \((y_i, z_i)\) 的长度
      • \(\min_\text{len} = \min_i \text{len}(i)\) 和 \(\max_\text{len} = \max_i \text{len}(i)\)
    • 如果
      • \(\max_\text{len} = \min_\text{len}\)
      • 论文将所有响应的长度奖励设为零,因为它们的长度相同
    • 否则,长度奖励由下式给出:
      $$
      \text{len_reward}(i) = \begin{cases}
      \lambda & \text{if } r(x, y_i, y^*) = 1 \\
      \min(0, \lambda) & \text{if } r(x, y_i, y^*) = 0
      \end{cases}, \quad \text{where } \lambda = 0.5 - \frac{\text{len}(i) - \min_\text{len} }{\max_\text{len} - \min_\text{len} }.
      $$
  • 本质上,论文的奖励思路是:
    • 在正确答案中:鼓励更短的响应 ,并惩罚更长的响应;
    • 在错误答案中:显式惩罚具有错误答案的长响应
    • 对奖励的理解:如果答案出错,即使很短的回答也不给奖励,因为可能错误的让模型觉得应该缩短队列造成结果出错
    • 这一基于长度的奖励随后通过加权参数添加到原始奖励中
  • 在初步实验中,长度惩罚可能会导致在训练初期减缓进度
    • 为缓解这一问题,论文提出在训练过程中逐步预热长度惩罚
    • 具体来说,论文首先使用标准策略优化(不包含长度惩罚),随后在剩余训练中应用恒定长度惩罚
Sampling Strategies
  • 强化学习算法本身具有相对良好的采样特性(更困难的问题提供更大的梯度),但其训练效率仍然有限
  • 一些定义良好的先验采样方法可能带来更大的性能提升
  • 论文利用多种信号进一步改进采样策略
    • 首先,论文收集的强化学习训练数据自然带有不同的难度标签(例如,数学竞赛问题比小学数学问题更难)
    • 其次,由于强化学习训练过程对同一问题多次采样,论文还可以跟踪每个问题的成功率作为难度指标
  • 论文提出两种采样方法,利用这些先验知识提高训练效率
    • 课程采样(Curriculum Sampling) :论文首先在较简单的任务上训练模型,随后逐步过渡到更具挑战性的任务
      • 由于初始强化学习模型性能有限 ,将有限的计算预算用于非常困难的问题通常只会产生少量正确样本,导致训练效率较低
      • 同时,论文收集的数据自然包含年级和难度标签,使得基于难度的采样成为一种直观且有效的方式
    • 优先级采样(Prioritized Sampling) :除了课程采样外,论文还使用优先级采样策略 ,专注于模型表现不佳的问题
      • 论文跟踪每个问题的成功率 \(s_i\),并按照与 \(1 - s_i\) 成比例的概率采样问题 ,使得成功率较低的问题获得更高的采样概率
      • 这使模型能够集中精力改进其薄弱环节,从而加速学习并提升整体性能
More Details on Training Recipe
  • 代码测试用例生成(Test Case Generation for Coding) :
    • 由于网络上许多编程问题的测试用例不可用 ,论文设计了一种自动生成测试用例的方法 ,作为训练模型的奖励
      • 问题:网络上测试用例不可用的原因是什么?是因为不专业吗?
    • 论文主要关注不需要特殊评判(special judge)的问题,并假设这些问题的真实解决方案可用,以便利用这些解决方案生成更高质量的测试用例
      • 问题:不需要特殊评判是指什么?
    • 论文使用广受认可的测试用例生成库 CYaRon 来增强论文的方法,测试用例的生成如下:
      • 基于问题描述,论文使用 Based Kimi K1.5 模型生成测试用例
      • CYaRon 的使用说明和问题描述作为生成器的输入
      • 对于每个问题,论文生成 50 个测试用例,并随机抽取 10 个真实提交结果对每个测试用例进行验证
        • 如果至少 7 个提交结果匹配,则该测试用例被视为有效
      • 经过这轮筛选后,论文得到一组选定的测试用例
    • 如果至少 9 个提交结果通过全部选定的测试用例,则该问题及其关联的测试用例被加入训练集
    • 在统计数据方面,从 1,000 个在线竞赛问题样本中,约 614 个问题不需要特殊评判
    • 论文开发了 463 个测试用例生成器,生成了至少 40 个有效测试用例,最终将 323 个问题纳入训练集
    • 问题:本节的描述不够清晰,还需要重新理解一下
  • 数学奖励建模(Reward Modeling for Math)
    • 评估数学解决方案的一个挑战在于,不同的书写形式可能表示相同的答案
      • 例如,\(a^2 - 4\) 和 \((a + 2)(a - 2)\) 可能是同一问题的有效解
    • 论文采用两种方法提高奖励模型的评分准确性:
      • 1)经典奖励模型(Classic RM) :受 InstructGPT (2022) 方法的启发,论文实现了一个基于价值头(value-head)的奖励模型,并收集了约 800K 数据点进行微调
        • 该模型最终以“问题”、“参考答案”和“响应”作为输入,输出一个标量以指示响应是否正确
      • 2)思维链奖励模型(Chain-of-Thought RM) :近期研究 (2024; 2024) 表明,结合思维链推理的奖励模型,在需要细微正确性标准的任务(如数学)上显著优于经典方法
        • 论文收集了约 800K 带有思维链标注的示例对 Kimi 模型进行微调
        • 基于与经典奖励模型相同的输入,思维链方法在提供最终正确性判断(以 JSON 格式输出)之前显式生成逐步推理过程,从而实现更鲁棒且可解释的奖励信号
    • 在人工抽查中,经典奖励模型的准确率约为 84.4% ,而思维链奖励模型达到了 98.5% 的准确率
    • 在强化学习训练过程中,论文采用思维链奖励模型以确保更准确的反馈
  • 视觉数据(Vision Data)
    • 为提升模型在真实世界图像中的推理能力,并实现视觉输入与 LLM 的更有效对齐,论文的视觉强化学习(Vision RL)数据主要来源于三个类别:
      • 真实世界数据
      • 合成视觉推理数据
      • 文本渲染数据
    • 1)真实世界数据(Real-world data) :
      • 涵盖需要图形理解和推理的各年级科学问题、需要视觉感知和推理的位置猜测任务,以及涉及理解复杂图表的数据分析等
      • 这些数据集提升了模型在真实场景中的视觉推理能力
    • 2)合成视觉推理数据(Synthetic visual reasoning data) :
      • 人工生成的图像和场景,旨在提升特定的视觉推理技能,如理解空间关系、几何模式和物体交互
      • 这些合成数据集为测试模型的视觉推理能力提供了可控环境,并提供了无限的训练样本
    • 3)文本渲染数据(Text-rendered data) :
      • 通过将文本内容转换为视觉格式,确保模型在处理不同模态的文本查询时保持一致
      • 通过将文论文档、代码片段和结构化数据转换为图像,论文确保无论输入是纯文本还是渲染为图像(如截图或照片),模型都能提供一致的响应
      • 这也有助于增强模型处理 text-heavy 图像的能力
    • 每种类型的数据对于构建全面的视觉语言模型都至关重要,使其能够有效管理广泛的真实应用,同时确保跨不同输入模态的一致性能

Long2short: Context Compression for Short-CoT Models(长到短:短链思维模型的上下文压缩)

  • 尽管长链思维(long-CoT)模型表现出强大的性能,但与标准的短链思维(short-CoT) LLM 相比,它在测试时需要消耗更多的 Token
  • 论文将长链思维模型的思维先验(thinking priors)迁移到短链思维模型中,从而在有限的测试 Token 预算下提升性能
  • 本节介绍了几种解决这一“长到短”(long2short)问题的方法,包括
    • 模型融合(model merging)
    • 最短拒绝采样(shortest rejection sampling)
    • 直接偏好优化(Direct Preference Optimization, DPO)
    • 长到短强化学习(long2short RL)
  • 模型融合(Model Merging)
    • 模型融合在保持泛化能力方面已被证明是有效的
    • 论文还发现,在融合长链思维模型和短链思维模型时,该方法能显著提升 Token Efficient
    • 具体而言,论文通过简单地对两个模型的权重进行平均来实现融合:
      $$
      \theta_{\text{merged} } = \frac{\theta_{\text{long-CoT} } + \theta_{\text{short-CoT} } }{2}
      $$
      • 其中,\(\theta_{\text{long-CoT} }\) 和 \(\theta_{\text{short-CoT} }\) 分别表示长链思维模型和短链思维模型的参数
  • 最短拒绝采样(Shortest Rejection Sampling)
    • 论文观察到,对于同一问题,模型生成的响应长度存在较大差异
    • 最短拒绝采样方法对同一问题采样 \(n\) 次 ,并选择其中最短的正确响应用于 SFT
      • 注:实验中 \(n=8\)
  • 直接偏好优化(DPO)
    • 与最短拒绝采样类似,论文利用长链思维模型生成多个响应样本
    • 选择最短的正确解作为正样本 ,而较长的响应作为负样本
      • 包括 错误的较长响应 和 比所选正样本长 1.5 倍的正确响应
    • 这些正负样本对构成了用于 DPO 训练的成对偏好数据
  • 长到短强化学习(Long2short RL)
    • 在标准强化学习训练阶段后,论文选择一个在性能和 Token Efficient 之间达到最佳平衡的模型作为基础模型,并进行单独的长到短 RL 训练阶段
    • 在第二阶段(RL 训练阶段)中,论文应用了第 2.3.3节 中介绍的长度惩罚(length penalty),显著减少最大展开长度(maximum rollout length),以进一步惩罚超出预期长度但可能正确的响应

Other Training Details

Pretraining
  • Kimi K1.5 的基础模型是在多样化、高质量的多模态语料库上训练的
    • 语言数据涵盖五个领域:英语、中文、代码、数学推理和知识
    • 多模态数据集包括
      • 图像描述(Captioning)数据集
      • 图文交错(Image-text Interleaving)数据集
      • 光学字符识别(Optical Character Recognition, OCR)数据集
      • 知识和问答数据集
    • 使模型具备视觉-语言能力
    • 严格的质控确保了预训练数据的相关性、多样性和平衡性
  • 论文的预训练分为三个阶段:
    • 1)视觉-语言预训练(Vision-language pretraining) :
      • 首先建立强大的语言模型基础,随后逐步引入视觉-语言交错数据,获得多模态能力
    • 2)冷却阶段(Cooldown) :
      • 使用精选的合成数据巩固模型能力,尤其是在数学推理、知识任务和代码生成方面
    • 3)长上下文激活(Long-context activation) :
      • 将序列处理能力扩展到 131,072 个 Token ,支持需要长上下文的任务
Vanilla Supervised Finetuning(标准监督微调)
  • 论文构建了涵盖多个领域的标准监督微调语料库
  • 对于非推理任务(如问答、写作和文本处理),论文通过人工标注构建初始种子数据集,并训练种子模型
  • 随后,论文收集多样化的提示(prompts),利用种子模型为每个提示生成多个响应 ,标注者对响应进行排名并优化排名靠前的响应,形成最终版本
  • 对于数学和编程等推理任务,由于基于规则和奖励模型的验证比人工判断更准确高效,论文采用拒绝采样(rejection sampling)扩展监督微调数据集
  • 论文的标准监督微调数据集包含约 1M 文本示例,其中:
    • 500K 示例用于通用问答
    • 200K 用于代码生成
    • 200K 用于数学和科学
    • 5K 用于创意写作
    • 20K 用于长上下文任务(如摘要、文档问答、翻译和写作)
  • 此外,论文还构建了 1000K 图文示例,涵盖图表解读、OCR、基于图像的对话、视觉编程、视觉推理以及带有视觉辅助的数学/科学问题
  • 训练分为两个阶段:
    • 1)在 32k Token 序列长度下训练 1个 Epoch,学习率从 \(2 \times 10^{-5}\) 衰减到 \(2 \times 10^{-6}\)
    • 2)在 128k Token 序列长度下训练 1个 Epoch,学习率重新预热到 \(1 \times 10^{-5}\),最终衰减到 \(1 \times 10^{-6}\)
    • 问题1:为什么长 Token 序列要在后面训练?不能混合训练吗?先后顺序可以变化吗?
    • 问题2:为什么长 Token 序列要用更低的学习率?
  • 为提升训练效率,论文将多个训练示例打包到单个训练序列中

RL Infrastructure

Large Scale Reinforcement Learning Training System for LLM
  • 在人工智能领域,RL 已成为 LLM 训练的关键方法 (2022; 2024)
    • 其灵感来源于在复杂游戏(如围棋、星际争霸 II 和 Dota 2)中取得的成功,例如 AlphaGo (2017)、AlphaStar (2019) 和 OpenAI Dota Five (2019)
  • 遵循这一传统,Kimi K1.5 系统采用了一种迭代同步(iterative synchronous)的 RL 框架,通过持续学习和适应来增强模型的推理能力
    • 该系统的关键创新是引入了 Partial Rollout 技术,用于优化复杂推理轨迹的处理
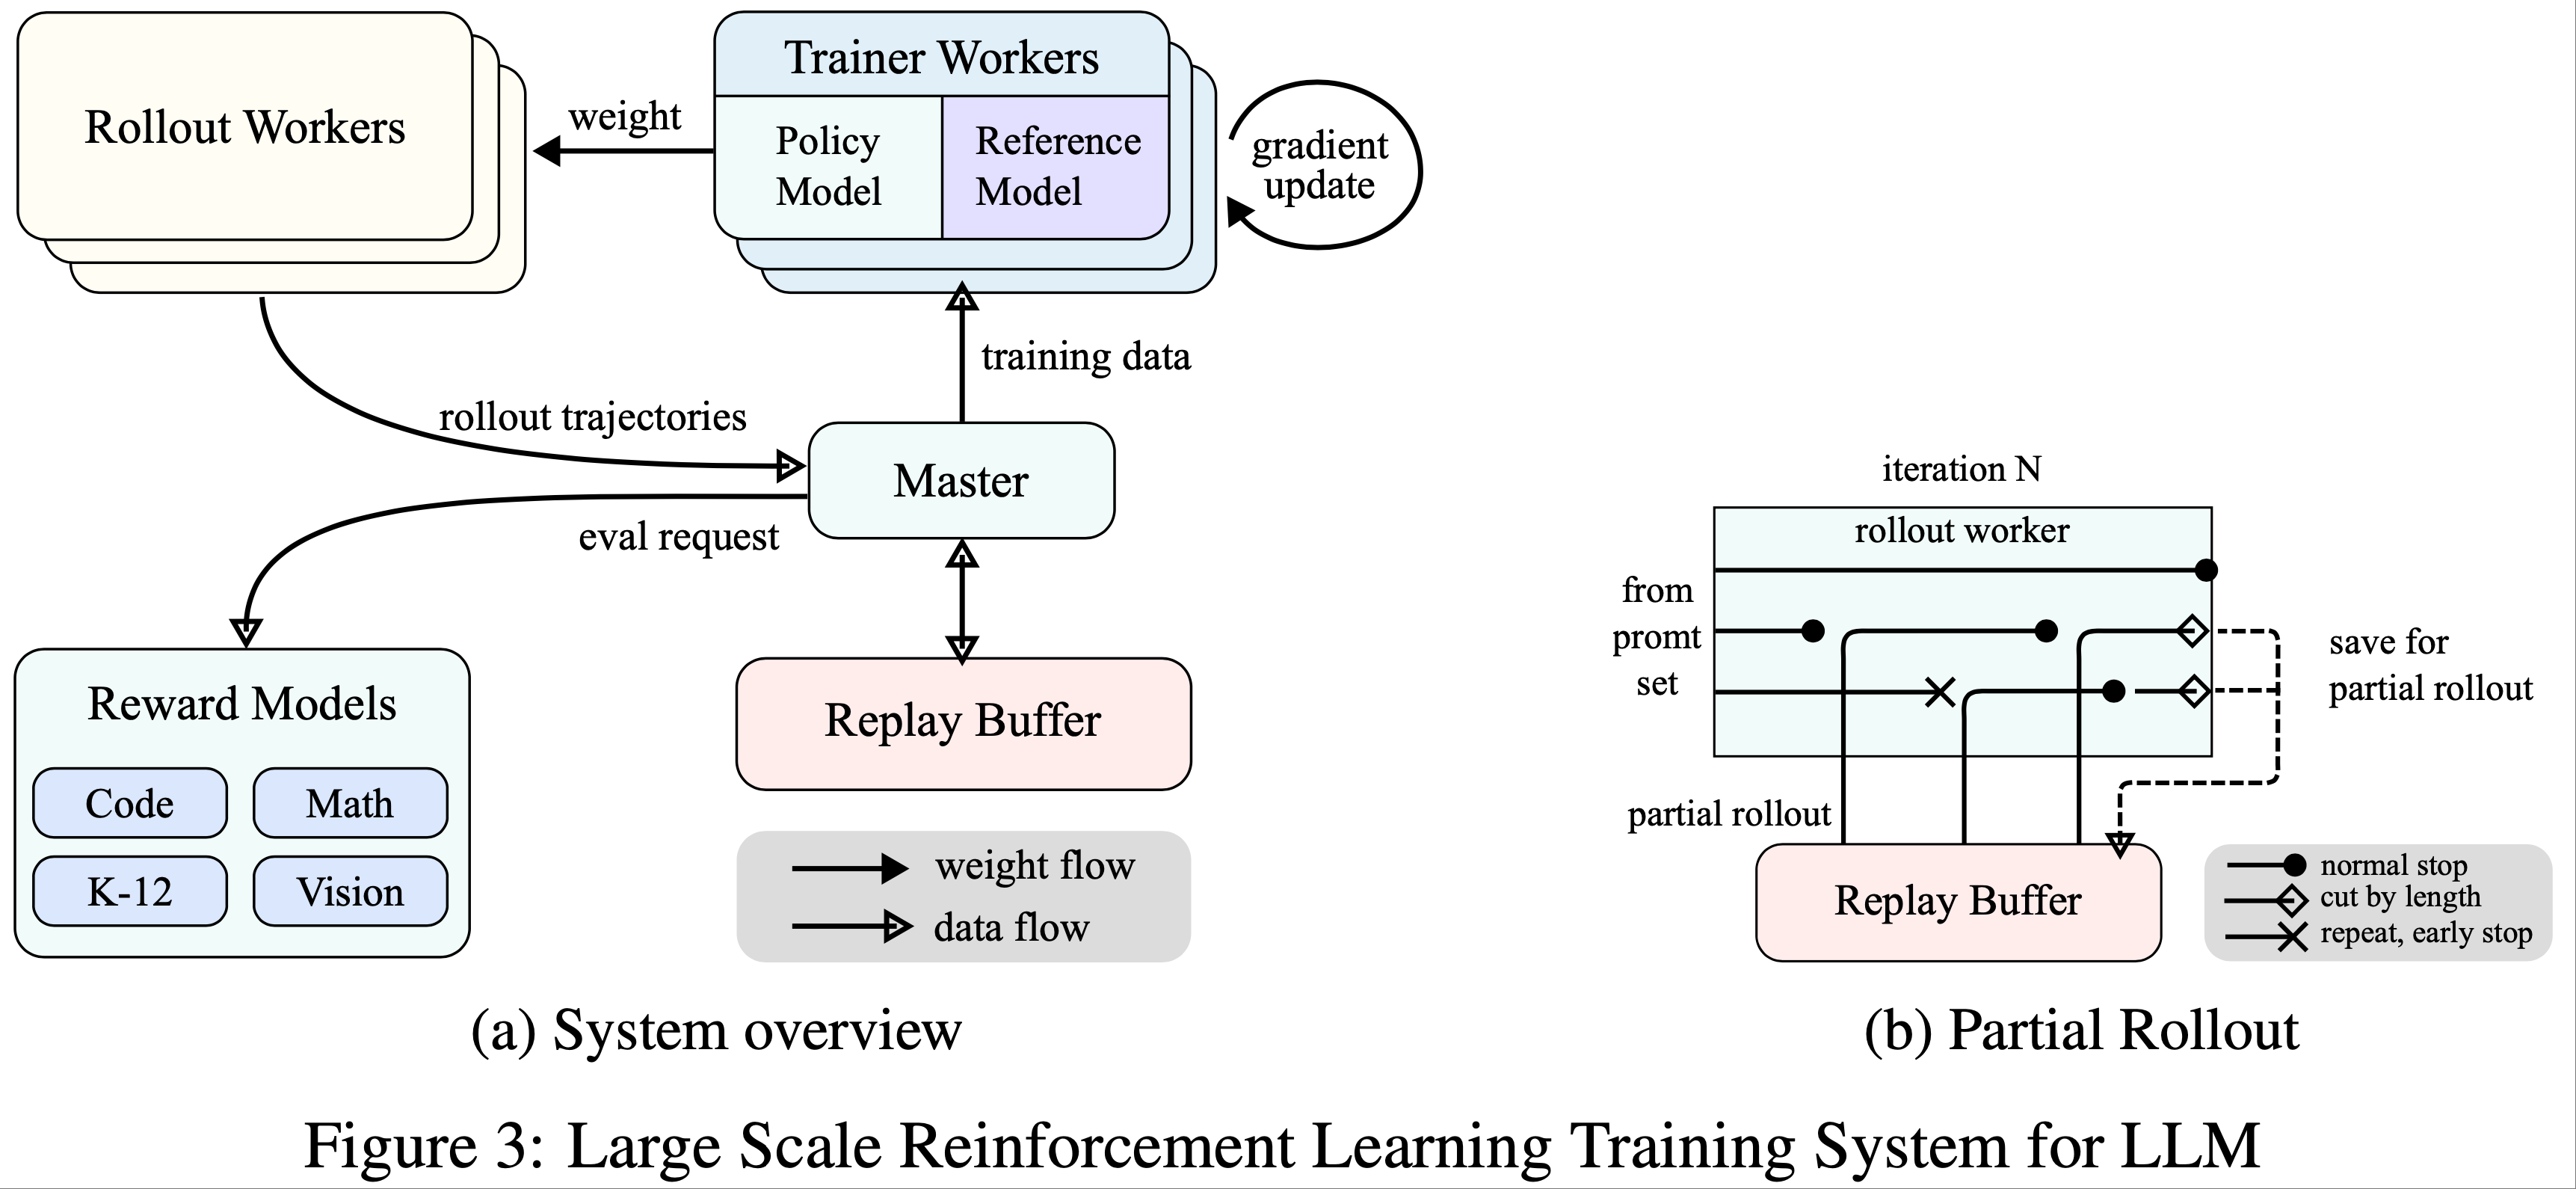
  • 如图 3a 所示,RL 训练系统通过迭代同步(iterative synchronous)的方式运行,每次迭代包含展开阶段和训练阶段
    • 在Rollout 阶段 ,由 Central Master 协调的 Rollout Workers 通过与模型交互生成展开轨迹,产生对各类输入的响应序列
      • 这些轨迹随后被存储在一个 Replay Buffer 中 ,通过打乱时间相关性来确保训练数据的多样性和无偏性
      • 问题:为什么要打乱时间相关性?不同时间点生成的数据是独立的吧
    • 在训练阶段 , Trainer Workers 访问这些经验来更新模型的权重
    • 这一循环过程使模型能够从其行为中持续学习,逐步调整策略以提升性能
  • Central Master 作为核心调度器,管理 Rollout Workers、Trainer Workers、奖励模型评估(Evaluation with Reward Models)和 Replay Buffer 之间的数据流和通信
    • 它确保系统协调运行,平衡负载并促进高效的数据处理
  • Trainer Workers 访问这些展开轨迹(无论是单次迭代完成还是跨多次迭代分割)来计算梯度更新,从而优化模型参数并提升性能
    • 在这一过程中,Reward Model 评估模型输出的质量并提供关键反馈以指导训练过程
    • 奖励模型的评估对于确定模型策略的有效性并引导模型实现最佳性能尤为重要
  • 此外,系统还集成了一个代码执行服务(Code Execution Service) ,专门用于处理代码相关问题,并与奖励模型紧密结合
    • 代码执行服务 在实际编码场景中评估模型的输出 ,确保模型的学习与真实编程挑战紧密对齐
    • 通过将模型的解决方案与实际代码执行结果进行验证,这一反馈循环对于优化模型策略和提升代码相关任务的性能至关重要
Partial Rollouts for Long CoT RL
  • 本研究的一个核心思想是扩展长上下文 RL (long-context RL)训练的规模
  • Partial Rollouts 通过管理长轨迹和短轨迹的展开,有效解决了处理长链式思维(Long CoT)特征的挑战
    • 该技术设定了一个固定的输出 Token 预算,限制每次展开轨迹的长度
    • 如果在展开阶段轨迹超出 Token 限制,未完成的部分会被保存到 Replay Buffer ,并在下一次迭代中继续
    • 这确保了单个长轨迹不会独占系统资源
    • Rollout Workers是异步运行的 ,当部分工作器处理长轨迹时,其他工作器可以独立处理新的短展开任务
      • 这种异步操作通过确保所有 Rollout Workers 积极参与训练过程,最大化计算效率,从而优化系统的整体性能
  • 如图 3b 所示, Partial Rollouts 系统通过将长响应分割为跨迭代的片段(从迭代 \(n-m\) 到迭代 \(n\))来工作
    • Replay Buffer 作为中央存储机制,保存这些响应片段,其中只有当前迭代(迭代 \(n\))需要按策略计算
    • 之前的片段(迭代 \(n-m\) 到 \(n-1\))可以从缓冲区高效复用,无需重复展开
    • 这种分段方法显著降低了计算开销:
      • 系统不是一次性展开整个响应,而是逐步处理和存储片段,从而能够生成更长的响应,同时保持快速的迭代时间
      • 在训练过程中,某些片段可以从损失计算中排除,以进一步优化学习过程 ,使整个系统既高效又可扩展
    • 问题:这种跨段的偏短不符合重要性采样规则了吧,还算是 On-policy 的策略吗?上面说的在损失中排除部分片段是为了解决这个问题吗?
      • 回答:生成后,有两个选择,选择1)保存历史生成的概率(理论效果更优);选择2)用当前策略重新计算生成概率(可能引入未知不一致问题),在更新前一般都需要用当前的 Actor 重新计算 log_prob 的,所以这里虽然不是同一个 Actor 生成的,但是其重要性权重使用的 prob 能保证是最新的
      • 一个参考博客,包含较为详细的讨论:Kimi K1.5: Long Context RL 的成功实践 - Chayenne Zhao的文章 - 知乎
  • Partial Rollouts 的实现还包括重复检测功能
    • 系统识别生成内容中的重复序列并提前终止,减少不必要的计算,同时保持输出质量
    • 检测到的重复内容可以被分配额外的惩罚,从而有效抑制提示集中冗余内容的生成
个人补充:对 Partial Rollout 的理解
  • Partial Rollout 是一种将长输出序列分段生成和复用的训练策略
  • Partial Rollouts 的 rollout 阶段,由于生成的长 CoT 可能非常长(可达 128k 上下文),Partial Rollout 通过以下方式优化:
    • 为每个 rollout 设定固定的输出 token 预算 ,限制单次生成的序列长度
    • 如果生成的轨迹超出该长度限制,则截断并保存未完成部分 ,在下一轮迭代中继续生成
    • 已生成的旧段落在 replay buffer 中复用 ,无需重新生成,大幅减少计算开销
  • Partial Rollout 训练的详细流程
    • Step 1: 设置输出 token 预算
      • 系统为每个 rollout 任务设定一个固定的 token 数量上限(如 4096 或 8192 tokens)
    • Step 2: 生成与截断
      • Rollout worker 开始生成模型响应(包含推理链和答案)
      • 若生成内容在达到预算前完成,则直接保存完整轨迹
      • 若生成内容超过预算,则截断 ,只保留预算内的部分,并标记该轨迹为“未完成”
      • 重复检测与提前终止 :一旦发现模型生成重复内容,会提前终止该轨迹(直接 Drop 掉该条样本),避免浪费计算资源
    • Step 3: 保存未完成轨迹到 Replay Buffer
      • 未完成的轨迹段(包括已生成的 token 和当前状态)被保存到 replay buffer 中
      • 这些段落在后续迭代中继续生成 ,而不是从头开始
        • 理解:如果从头开始的话有点浪费资源了,而且从头开始可能就再也回不来了
    • Step 4: 跨迭代拼接与复用
      • 在后续迭代(如 iter n)中,系统从 replay buffer 中读取之前未完成的轨迹段(如 iter n-m 到 n-1)
        • 对应过去多轮迭代,即 staleness 最多为 m
      • 只有当前迭代(iter n)的生成部分需要on-policy 计算 ,旧段直接复用,无需重新生成
    • Step 5: 训练时选择性计算 Loss
      • 在训练阶段,系统可以选择性地对部分 token 计算 loss ,例如只对最新生成的段落计算梯度,旧段落仅作为上下文,不参与反向传播
        • 理解:如果记录下了每次采样的 行为策略的概率值,则可以通过重要性采样将分布修正回去
    • 注:资源利用率优化
      • 由于 rollout worker 异步执行,当某些 worker 处理长轨迹时,其他 worker 可以处理短轨迹,最大化计算资源利用率
  • 总结:Partial Rollout 的优势
    • 支持超长上下文训练 :可扩展到 128k tokens
    • 节省计算资源 :复用旧轨迹,避免重复生成
    • 加速迭代 :每次迭代只需生成新增部分
    • 提高训练效率 :异步处理长短轨迹,减少空闲时间
    • 支持长 CoT 探索 :允许模型生成更复杂的推理路径,提升性能
Hybrid Deployment of Training and Inference
  • RL 训练过程包含以下阶段:
    • 训练阶段(Training Phase) :
      • 初始阶段,Megatron (2020) 和 vLLM (2023) 在单独的容器中运行,由一个称为检查点引擎(Checkpoint Engine)的中间进程封装(详见第 2.6.3 节)
      • Megatron 启动训练过程
      • 训练完成后,Megatron 卸载 GPU 内存,准备将当前权重传输给 vLLM
    • 推理阶段(Inference Phase) :
      • Megatron 卸载后,vLLM 以虚拟模型权重启动,并通过 Mooncake (2024) 从 Megatron 接收最新权重进行更新
      • 展开完成后,检查点引擎停止所有 vLLM 进程
    • 后续训练阶段(Subsequent Training Phase) :
      • vLLM 占用的内存释放后,Megatron 重新加载内存并启动新一轮训练
  • 论文发现现有工作难以同时支持以下所有特性:
    • 1)复杂的并行策略(Complex parallelism strategy) :
      • Megatron 和 vLLM 可能采用不同的并行策略
      • 在 Megatron 中分布在多个节点的训练权重可能难以与 vLLM 共享
    • 2)最小化空闲 GPU 资源(Minimizing idle GPU resources) :
      • 对于按策略 RL,近期工作如 SGLang (2024) 和 vLLM 可能在训练过程中保留部分 GPU,这反过来会导致训练 GPU 闲置
      • 更高效的方式是在训练和推理之间共享相同的设备
    • 3)动态扩展能力(Capability of dynamic scaling) :
      • 在某些情况下,通过增加推理节点数量(同时保持训练过程不变)可以显著加速
      • 论文的系统能够在需要时高效利用闲置 GPU 节点
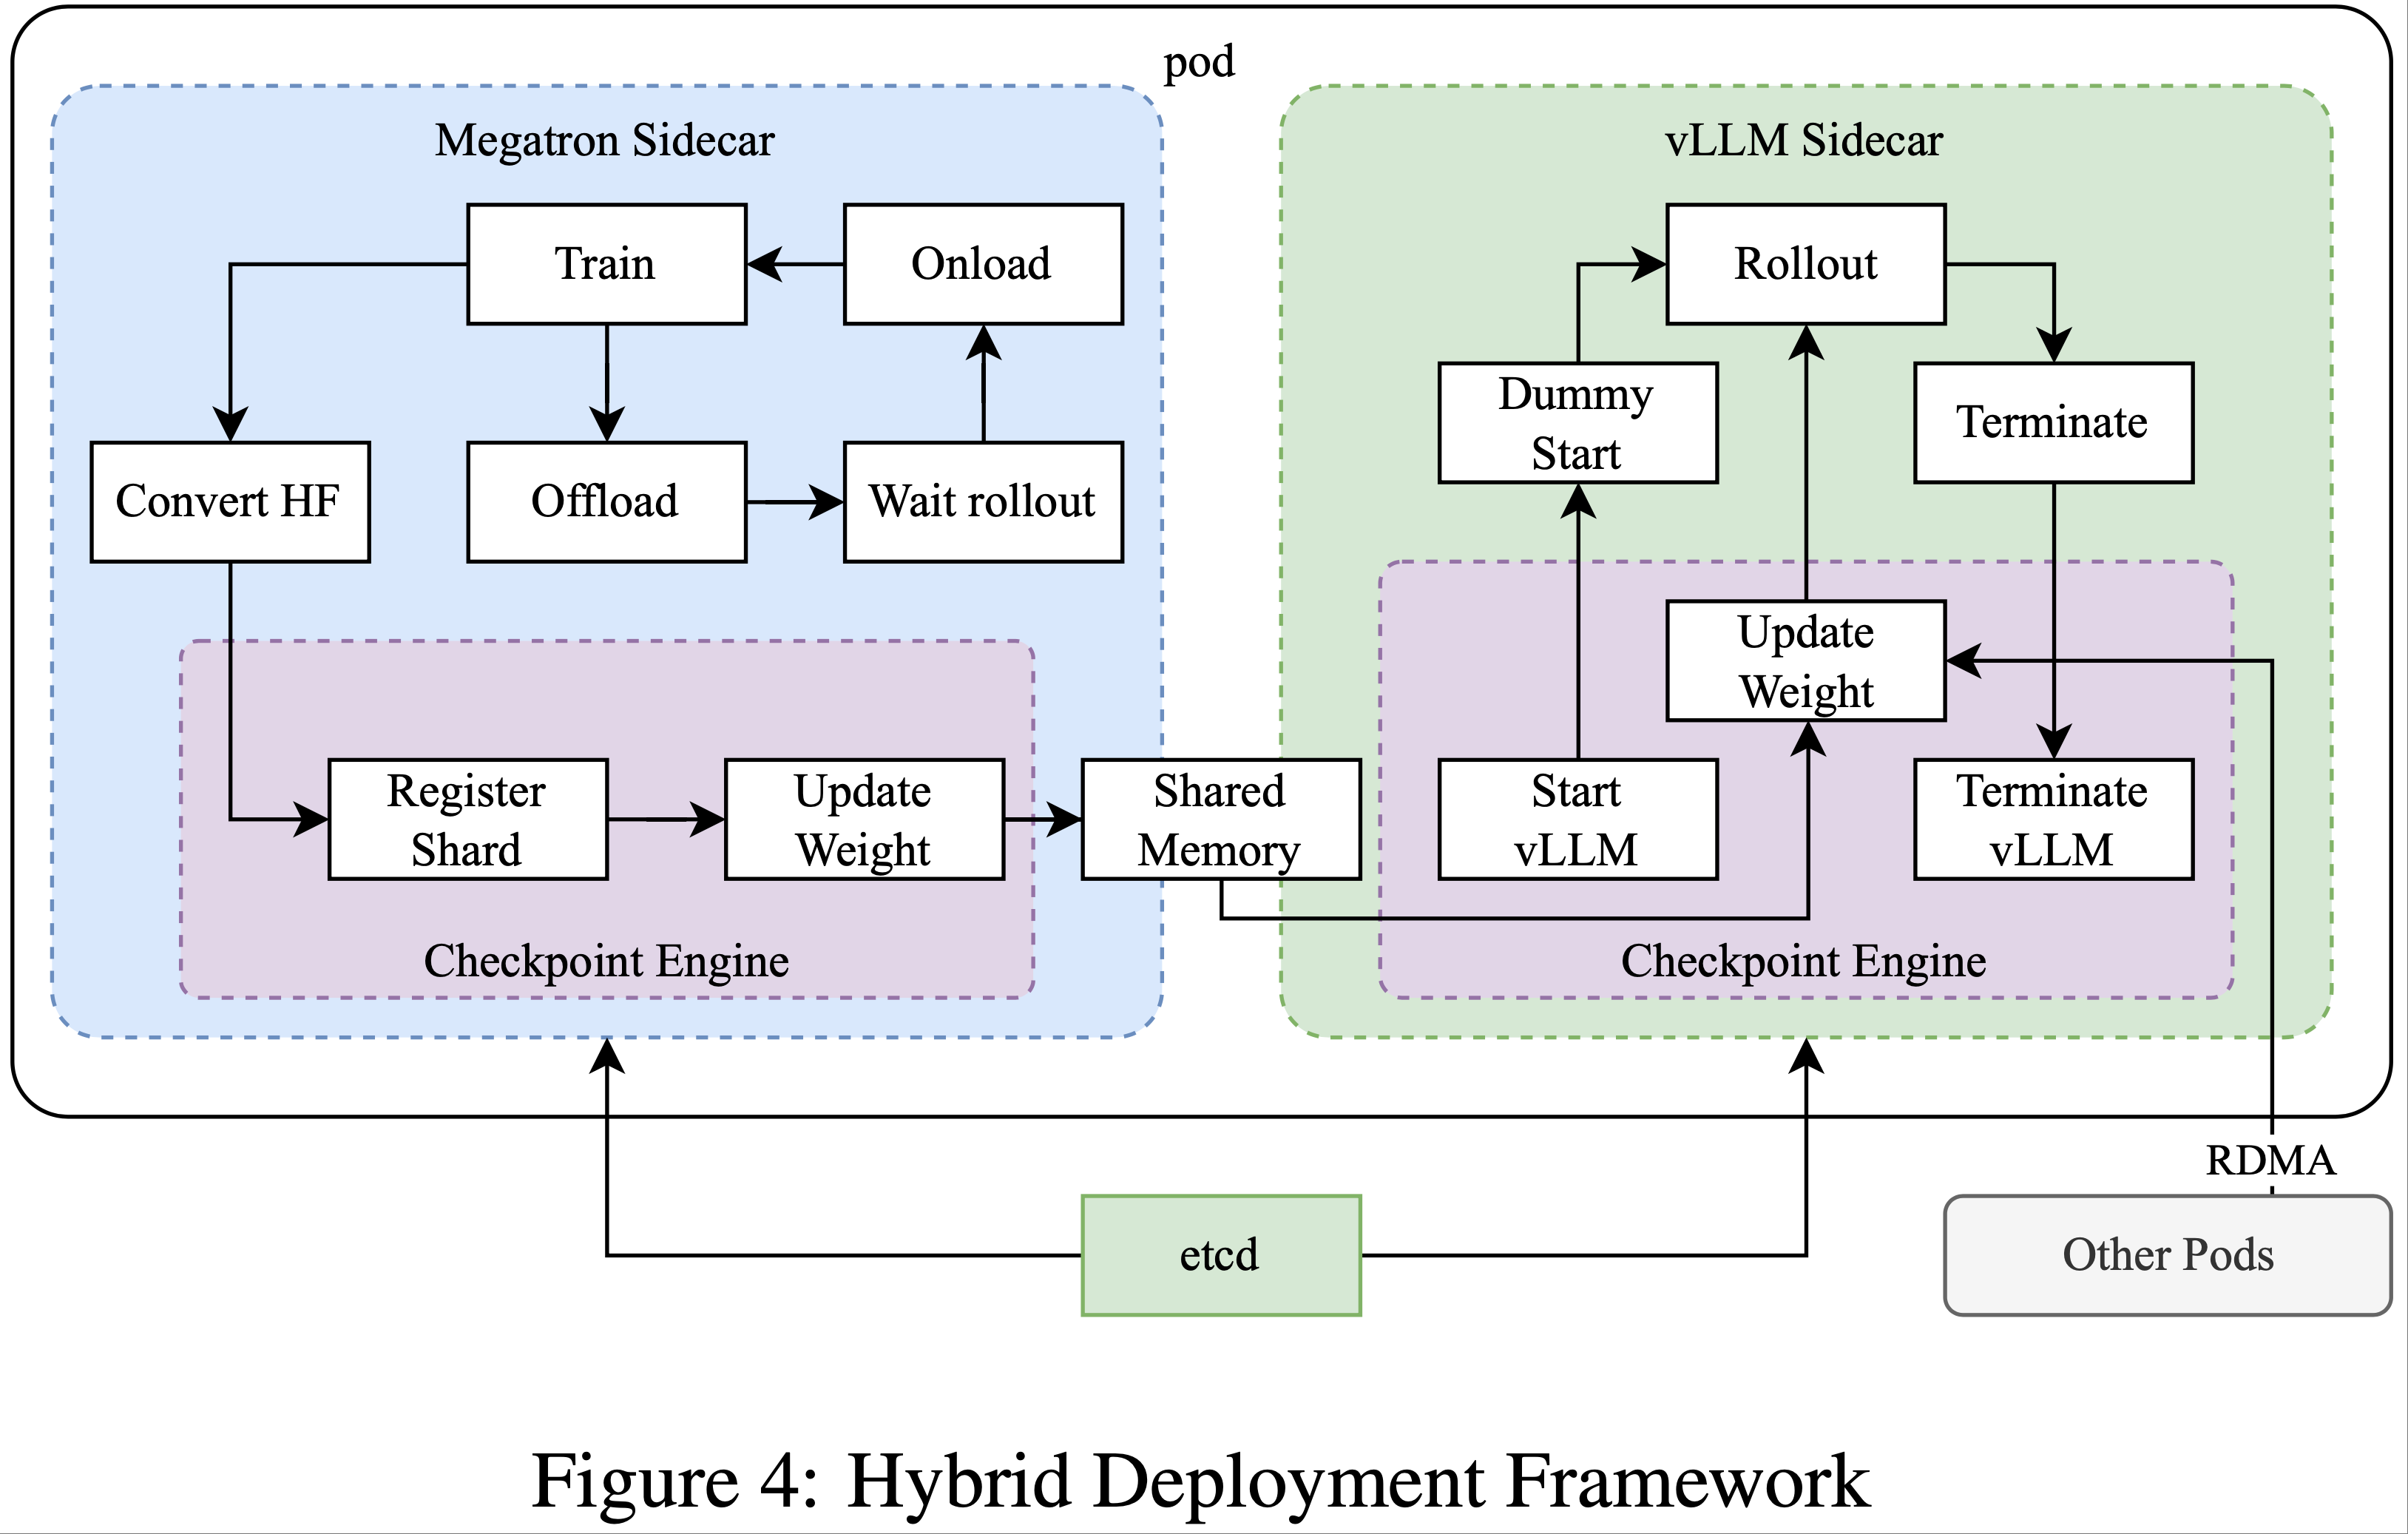
  • 如图 4 所示,论文在 Megatron 和 vLLM 之上实现了这一混合部署框架(详见第 2.6.3 节),实现了从训练到推理阶段少于 1 分钟的切换时间,反之约为 10 秒
  • 混合部署策略(Hybrid Deployment Strategy)
    • 论文提出了一种训练和推理任务的混合部署策略,利用 Kubernetes Sidecar 容器共享所有可用 GPU,将两种工作负载部署在同一 Pod 中。该策略的主要优势包括:
      • 促进高效的资源共享和管理,避免训练节点在等待推理节点时闲置(当两者部署在不同节点时)
      • 利用独立的部署镜像,训练和推理可以各自独立迭代以获得更好的性能
      • 该架构不仅限于 vLLM,其他框架也可以方便地集成
  • 检查点引擎(Checkpoint Engine)
    • 检查点引擎负责管理 vLLM 进程的生命周期,暴露 HTTP API 以支持对 vLLM 的各种操作触发
    • 为了确保整体一致性和可靠性,论文使用由 etcd 服务管理的全局元数据系统来广播操作和状态
    • 由于 CUDA 图、NCCL 缓冲区和 NVIDIA 驱动等因素,vLLM 卸载后完全释放 GPU 内存可能具有挑战性
      • 为了最小化对 vLLM 的修改,论文在需要时终止并重启它以获得更好的 GPU 利用率和容错能力
    • Megatron 中的工作器将拥有的检查点转换为共享内存中的 Hugging Face 格式
      • 此转换还考虑了流水线并行(Pipeline Parallelism)和专家并行(Expert Parallelism),因此这些检查点中仅保留张量并行(Tensor Parallelism)
      • 共享内存中的检查点随后被分片并注册到全局元数据系统中
      • 论文使用 Mooncake 通过 RDMA 在对等节点之间传输检查点
      • 需要对 vLLM 进行一些修改以加载权重文件并执行张量并行转换
Code Sandbox
  • 论文开发了沙箱作为一个安全的环境,用于执行用户提交的代码,并针对代码执行和代码基准评估进行了优化
  • 通过动态切换容器镜像,沙箱支持 MultiPL-E (2023)、DMOJ Judge Server、Lean 等 (2023)、Jupyter Notebook 和其他镜像的不同用例
  • 对于编码任务中的 RL,沙箱通过提供一致且可重复的评估机制,确保训练数据判断的可靠性
  • 其反馈系统支持多阶段评估,例如代码执行反馈和仓库级编辑,同时保持统一的上下文以确保跨编程语言的公平基准比较
  • 论文将服务部署在 Kubernetes 上以实现可扩展性和弹性,并通过 HTTP 端点对外暴露以支持外部集成
    • Kubernetes 的自动重启和滚动更新等功能确保了可用性和容错性
  • 为了优化性能并支持 RL 环境,论文在代码执行服务中集成了多项技术以提升效率、速度和可靠性,包括:
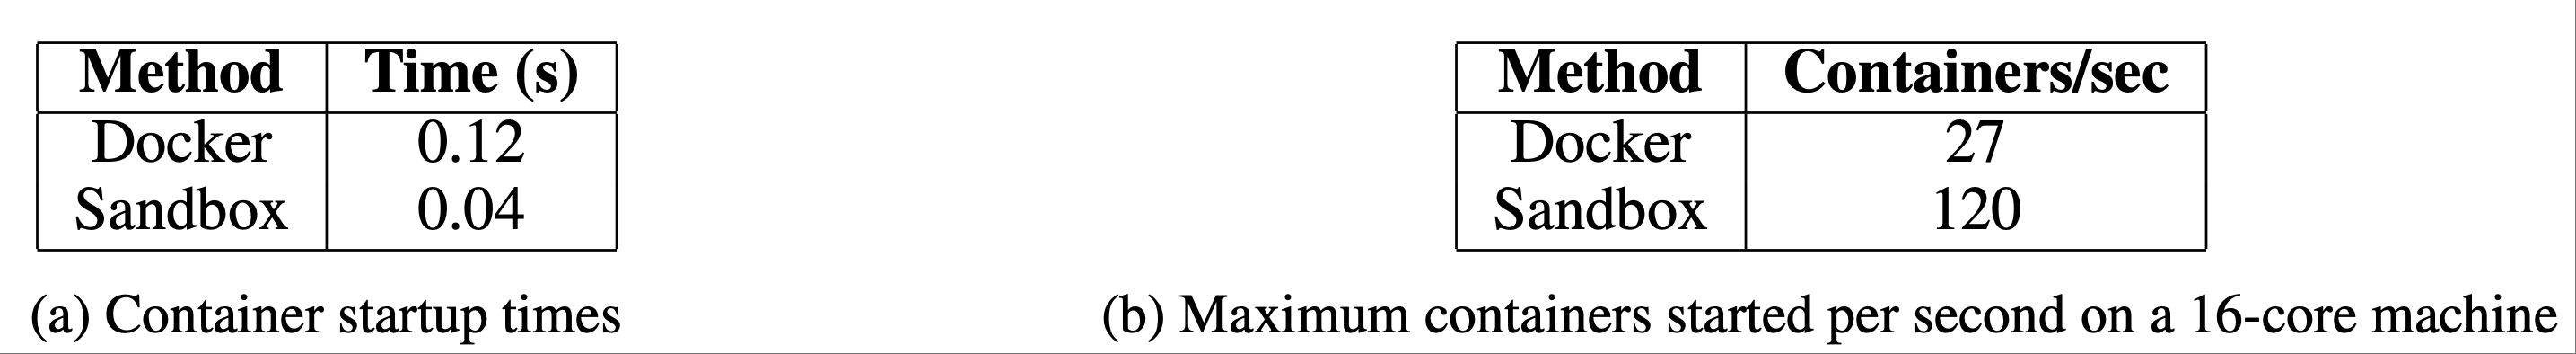
    • 使用 Crun(Using Crun) :论文使用 crun 作为容器运行时而非 Docker ,显著减少了容器启动时间
    • Cgroup 复用(Cgroup Reusing) :论文为容器预创建 cgroup,这对于高并发场景至关重要,因为为每个容器创建和销毁 cgroup 可能成为瓶颈
    • 磁盘使用优化(Disk Usage Optimization) :论文使用带有 tmpfs 上层的覆盖文件系统来控制磁盘写入,提供固定大小的高速存储空间
      • 这种方法对临时工作负载特别有益
  • 这些优化提升了代码执行中的 RL 效率,为评估 RL 生成的代码提供了一致且可靠的环境,这对于迭代训练和模型改进至关重要

Experiments

Evaluation

  • 由于 K1.5 是一个多模态模型(multimodal model),论文在不同模态的多个基准测试上进行了全面评估(详细的评估设置见附录 C)
  • 论文的基准测试主要包括以下三类:
    • 文本基准测试(Text Benchmark) :MMLU (2020)、IF-Eval (2023)、CLUEWSC (2020)、C-EVAL (2023)
    • 推理基准测试(Reasoning Benchmark) :HumanEval-Mul (2024)、Codeforces (2024)、MATH-500 (2023)
    • 视觉基准测试(Vision Benchmark) :MMMU (2024)、MATH-Vision (2024)、MathVista (2023)

Main Results

  • K1.5 长链思维模型(K1.5 long-CoT model)
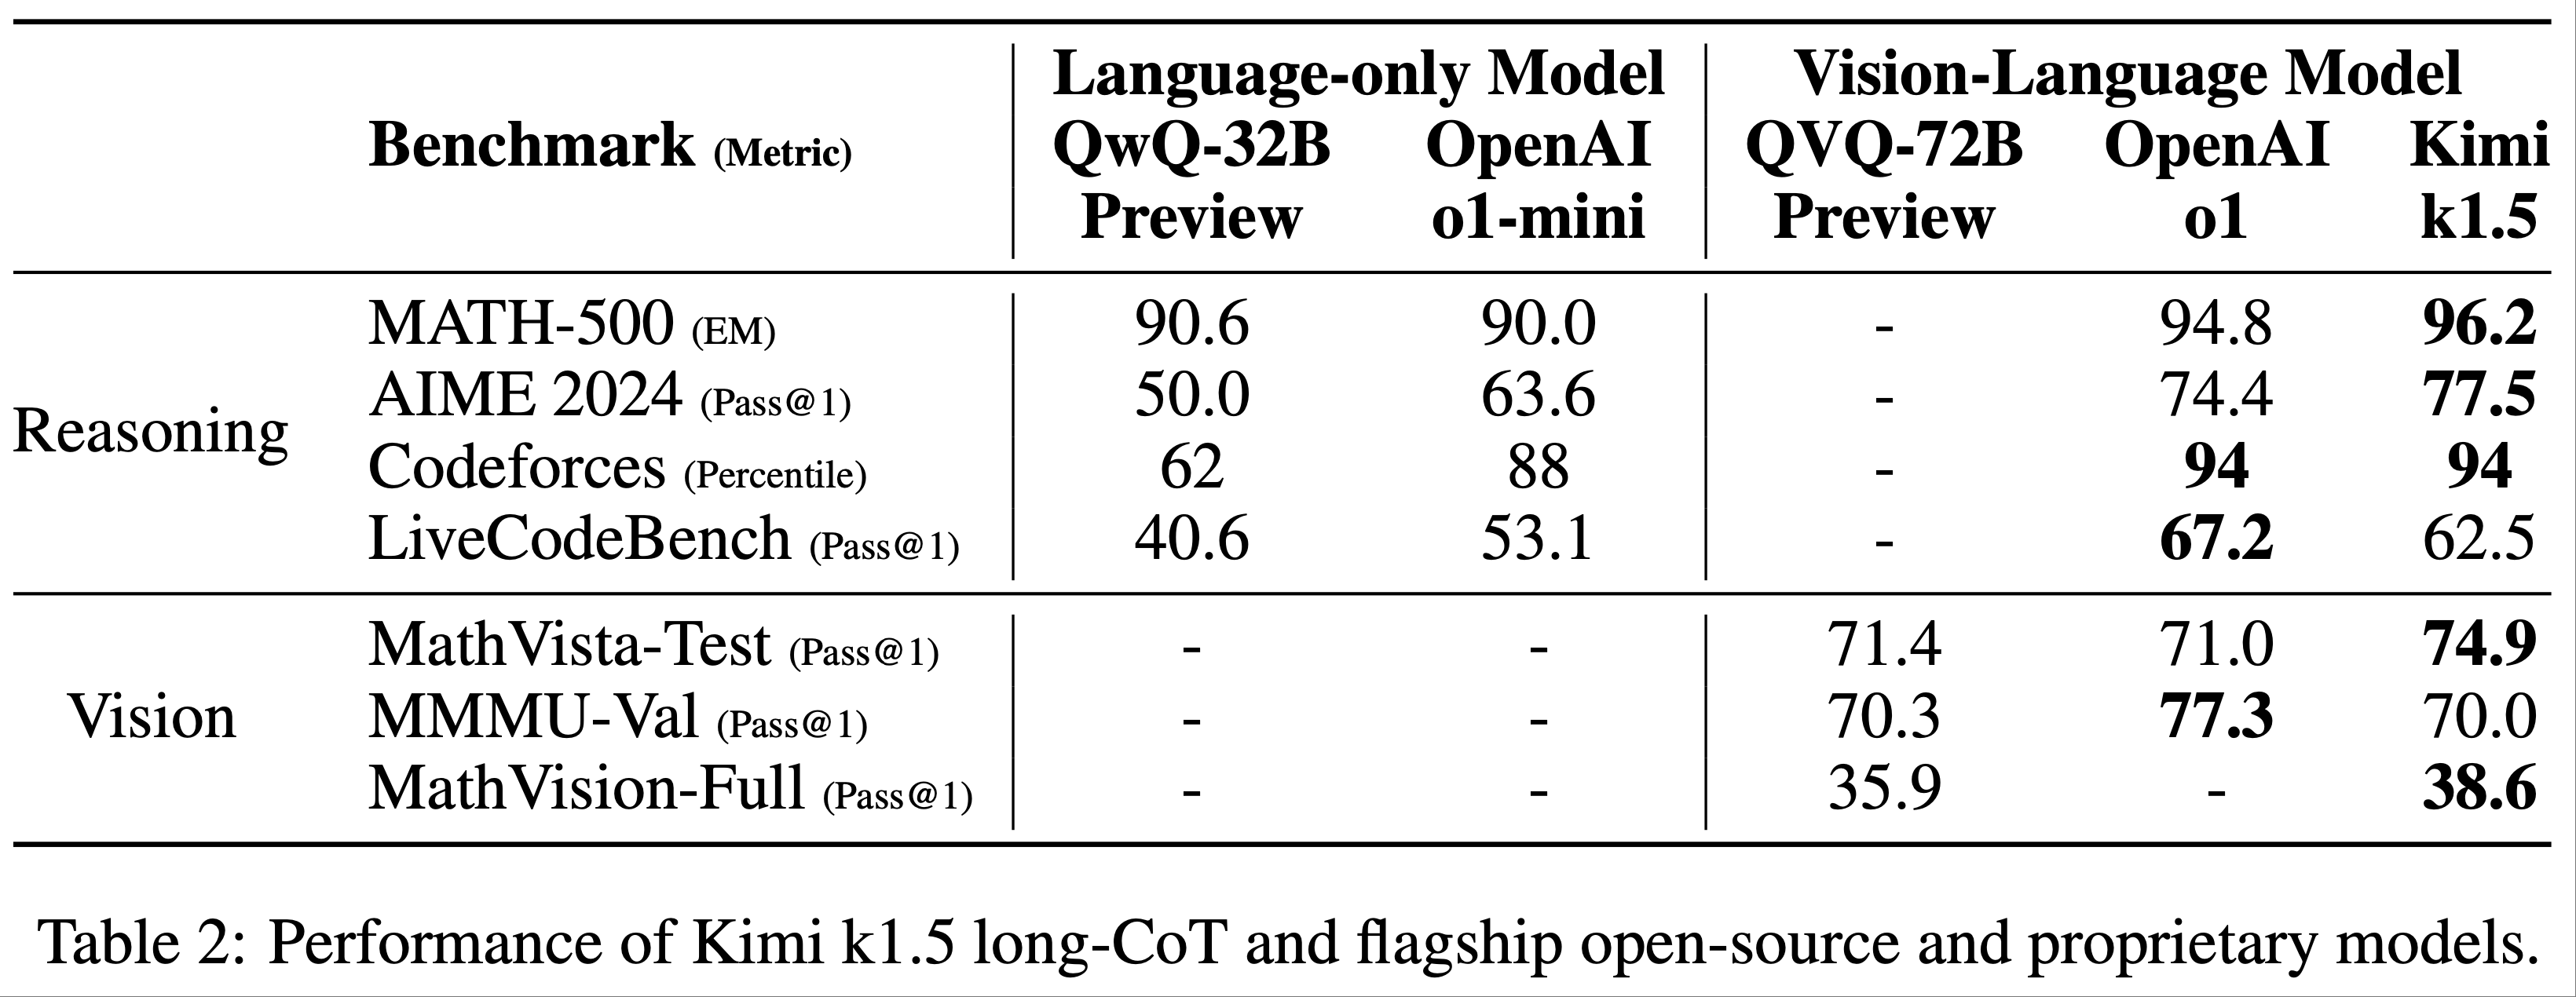
    • Kimi K1.5 长链思维模型的性能如表 2 所示
    • 通过长链思维监督微调(如第 2.2 节所述)和视觉-文本联合强化学习(如第 2.3 节所述),模型的长期推理能力显著增强
    • 测试时计算规模的扩展进一步提升了其性能,使模型在多种模态上实现了 SOTA 结果
    • 论文的评估表明,模型在长上下文中的推理、理解和信息综合能力有了显著提升,代表了多模态人工智能能力的重大进步
  • K1.5 短链思维模型(K1.5 short-CoT model)
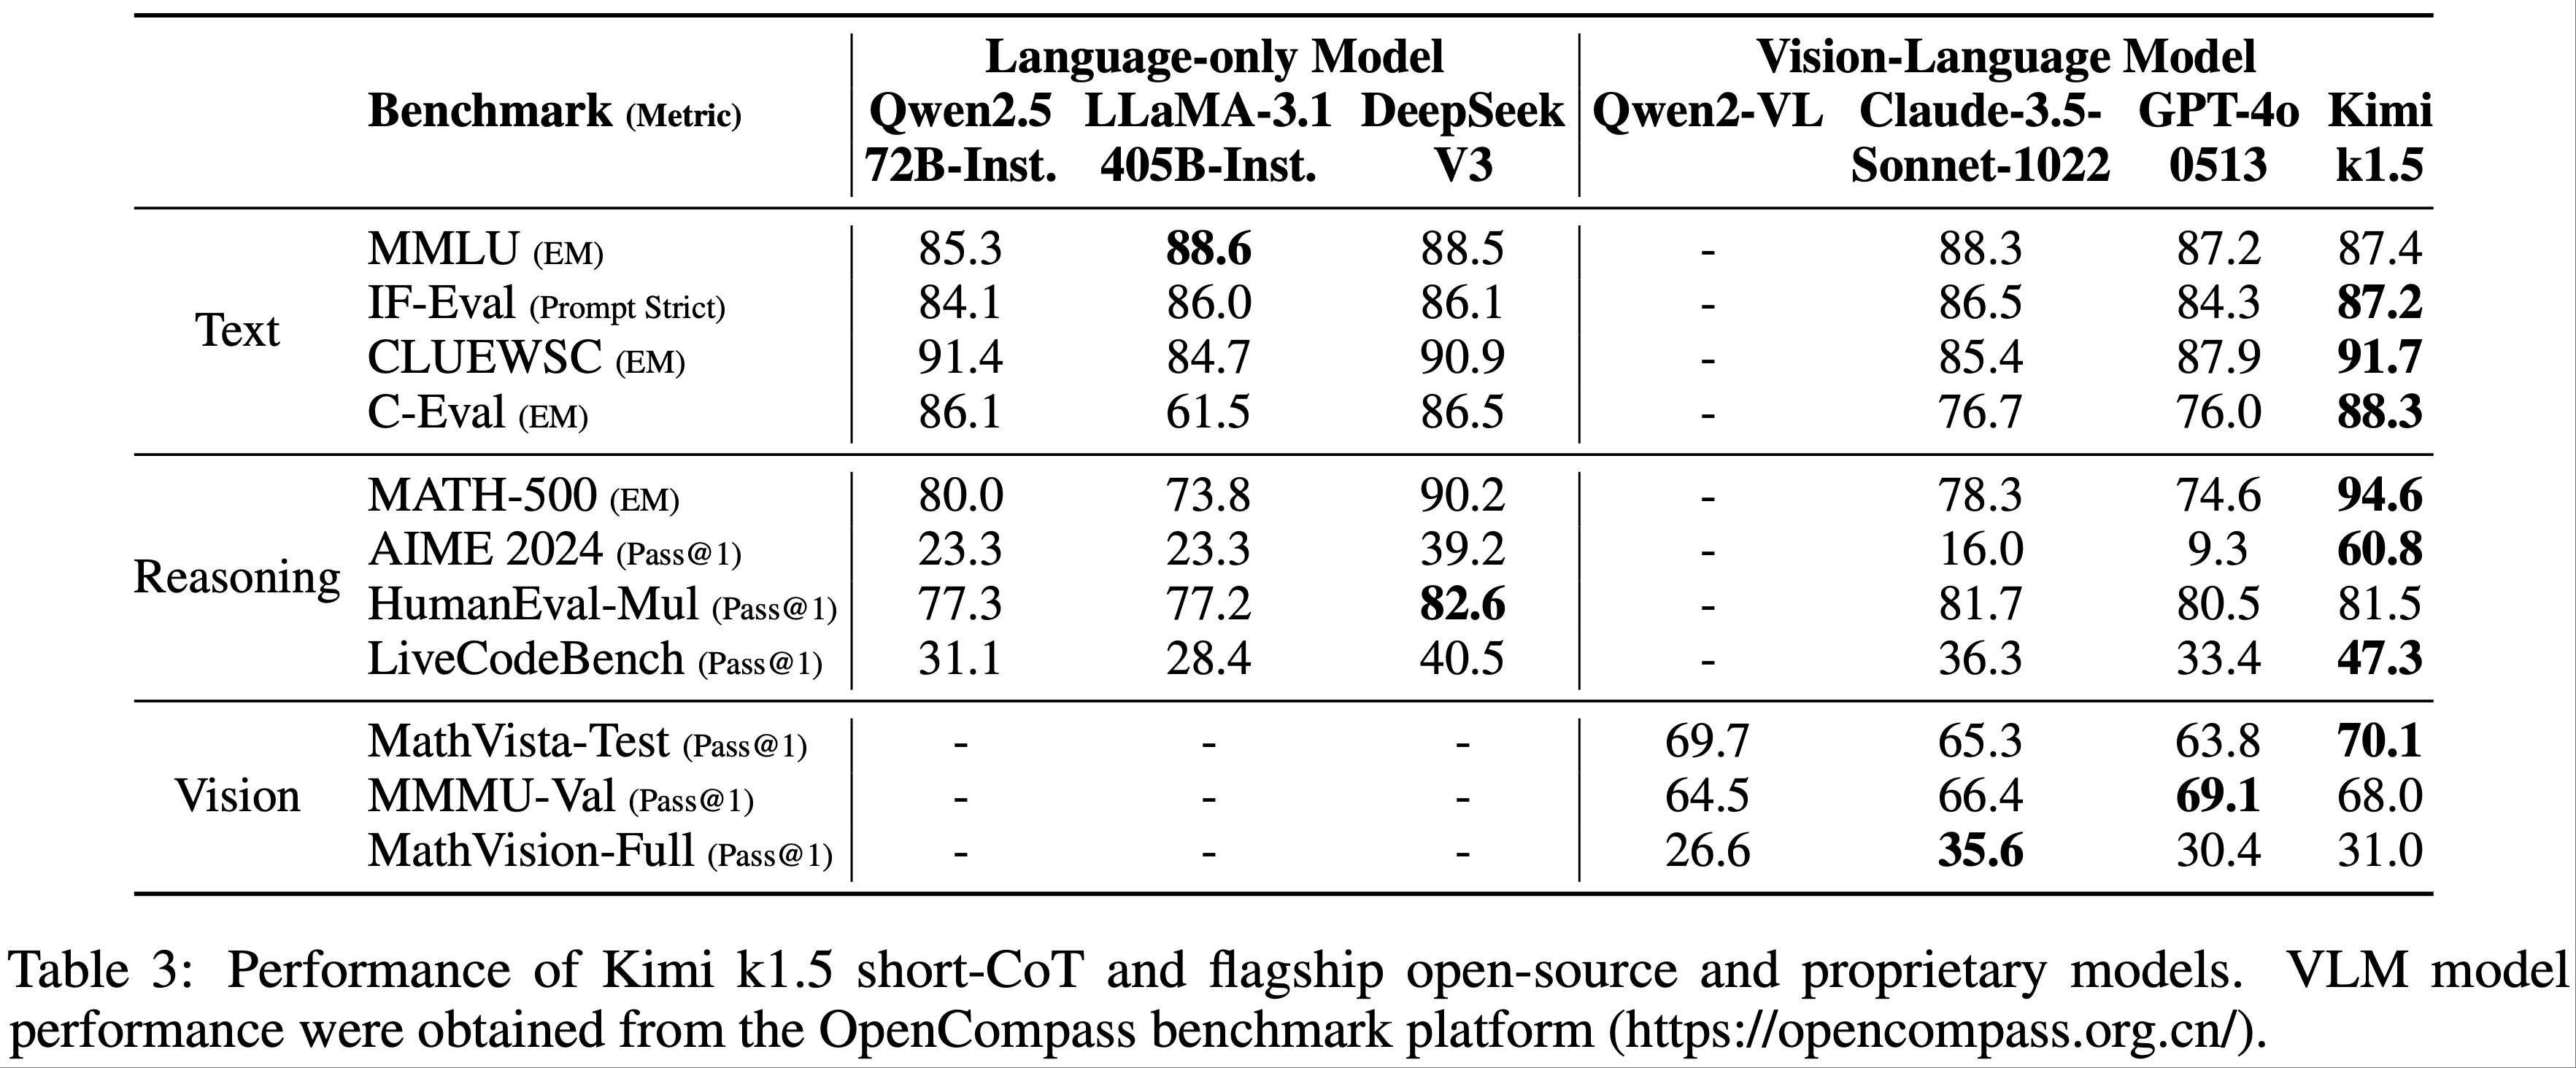
    • Kimi K1.5 短链思维模型的性能如表 3 所示
    • 该模型整合了多种技术,包括传统的监督微调(如第 2.5.2 节所述)、强化学习(如第 2.3 节所述)以及长链到短链的知识蒸馏(如第 2.4 节所述)
    • 结果表明,K1.5 短链思维模型在多项任务中表现优于或与领先的开源和专有模型相当,包括文本、视觉和推理任务,尤其在自然语言理解、数学、编程和逻辑推理方面表现突出

Long Context Scaling

  • 论文使用一个中等规模的模型来研究 LLM 在强化学习中的扩展特性
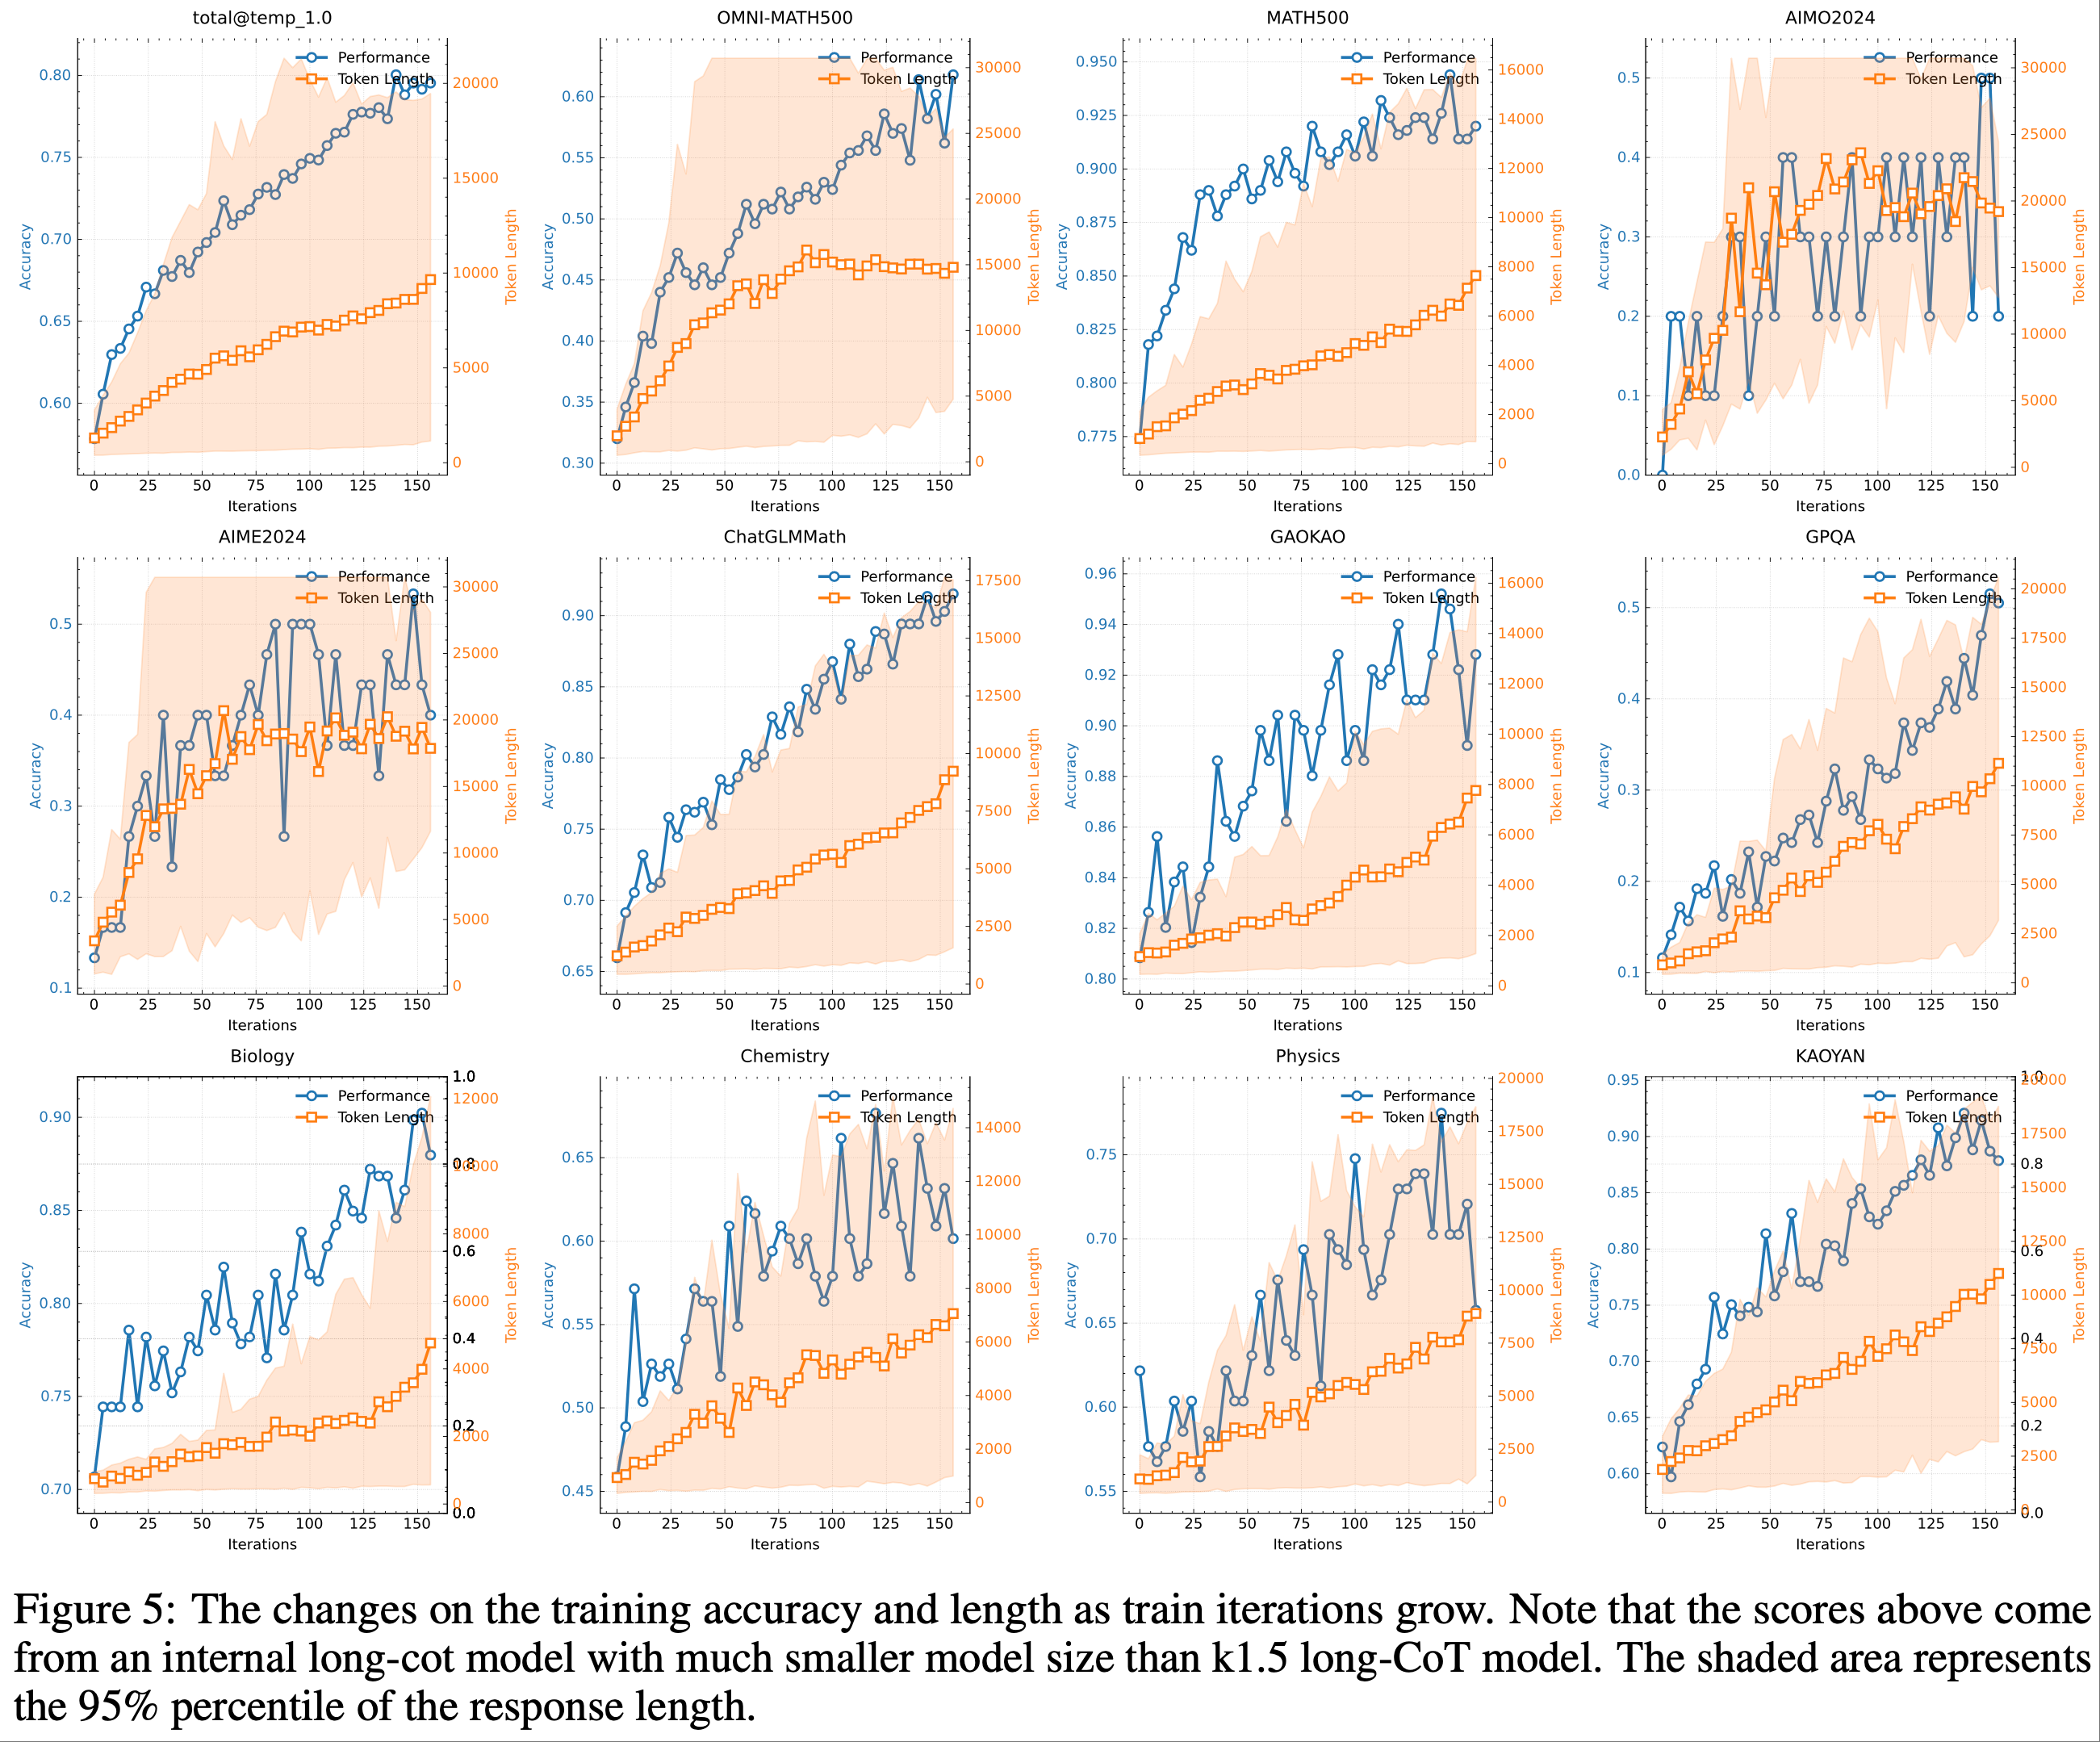
  • 图 5 展示了小型模型变体在数学提示集上训练时,训练准确率和响应长度随训练迭代的变化情况
    • 随着训练的进行,论文观察到响应长度和性能准确率同步增长
    • 在更具挑战性的基准测试中,响应长度的增长更为显著,这表明模型学会了为复杂问题生成更详细的解决方案
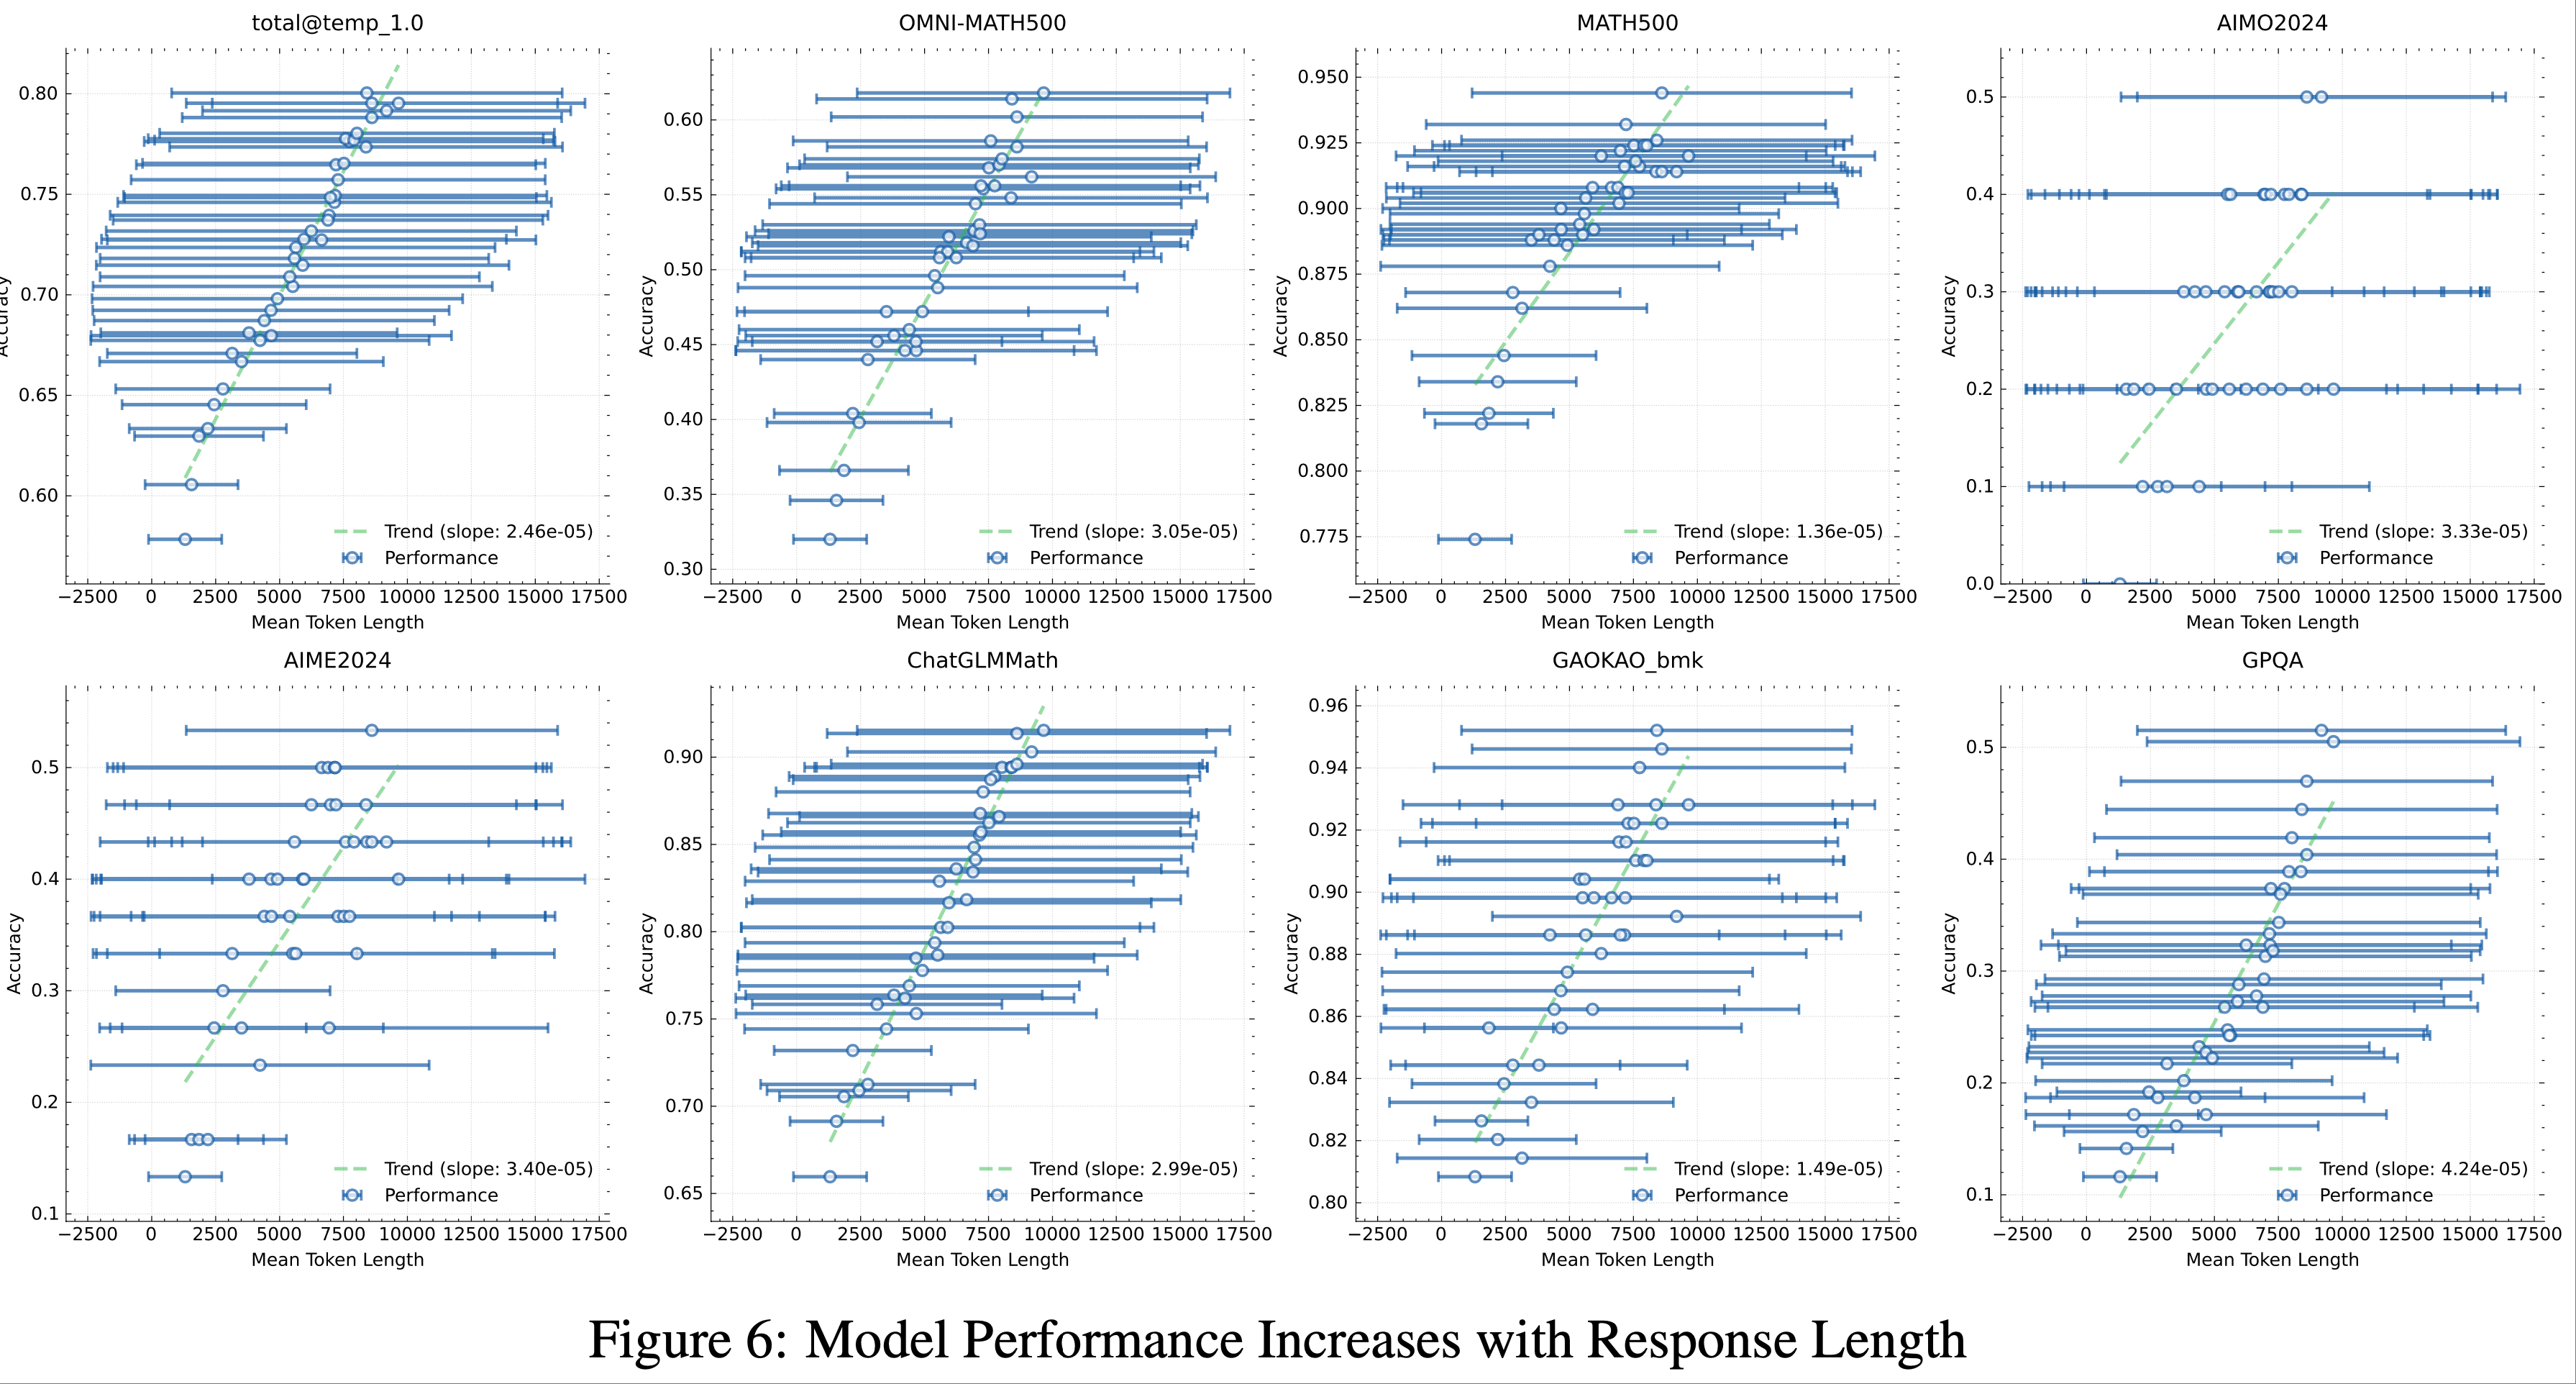
  • 图 6 表明,模型的输出上下文长度与其问题解决能力之间存在强相关性
    • 论文最终的 K1.5 运行将上下文长度扩展到 128k,并在困难的推理基准测试中观察到持续的性能提升

Long2short

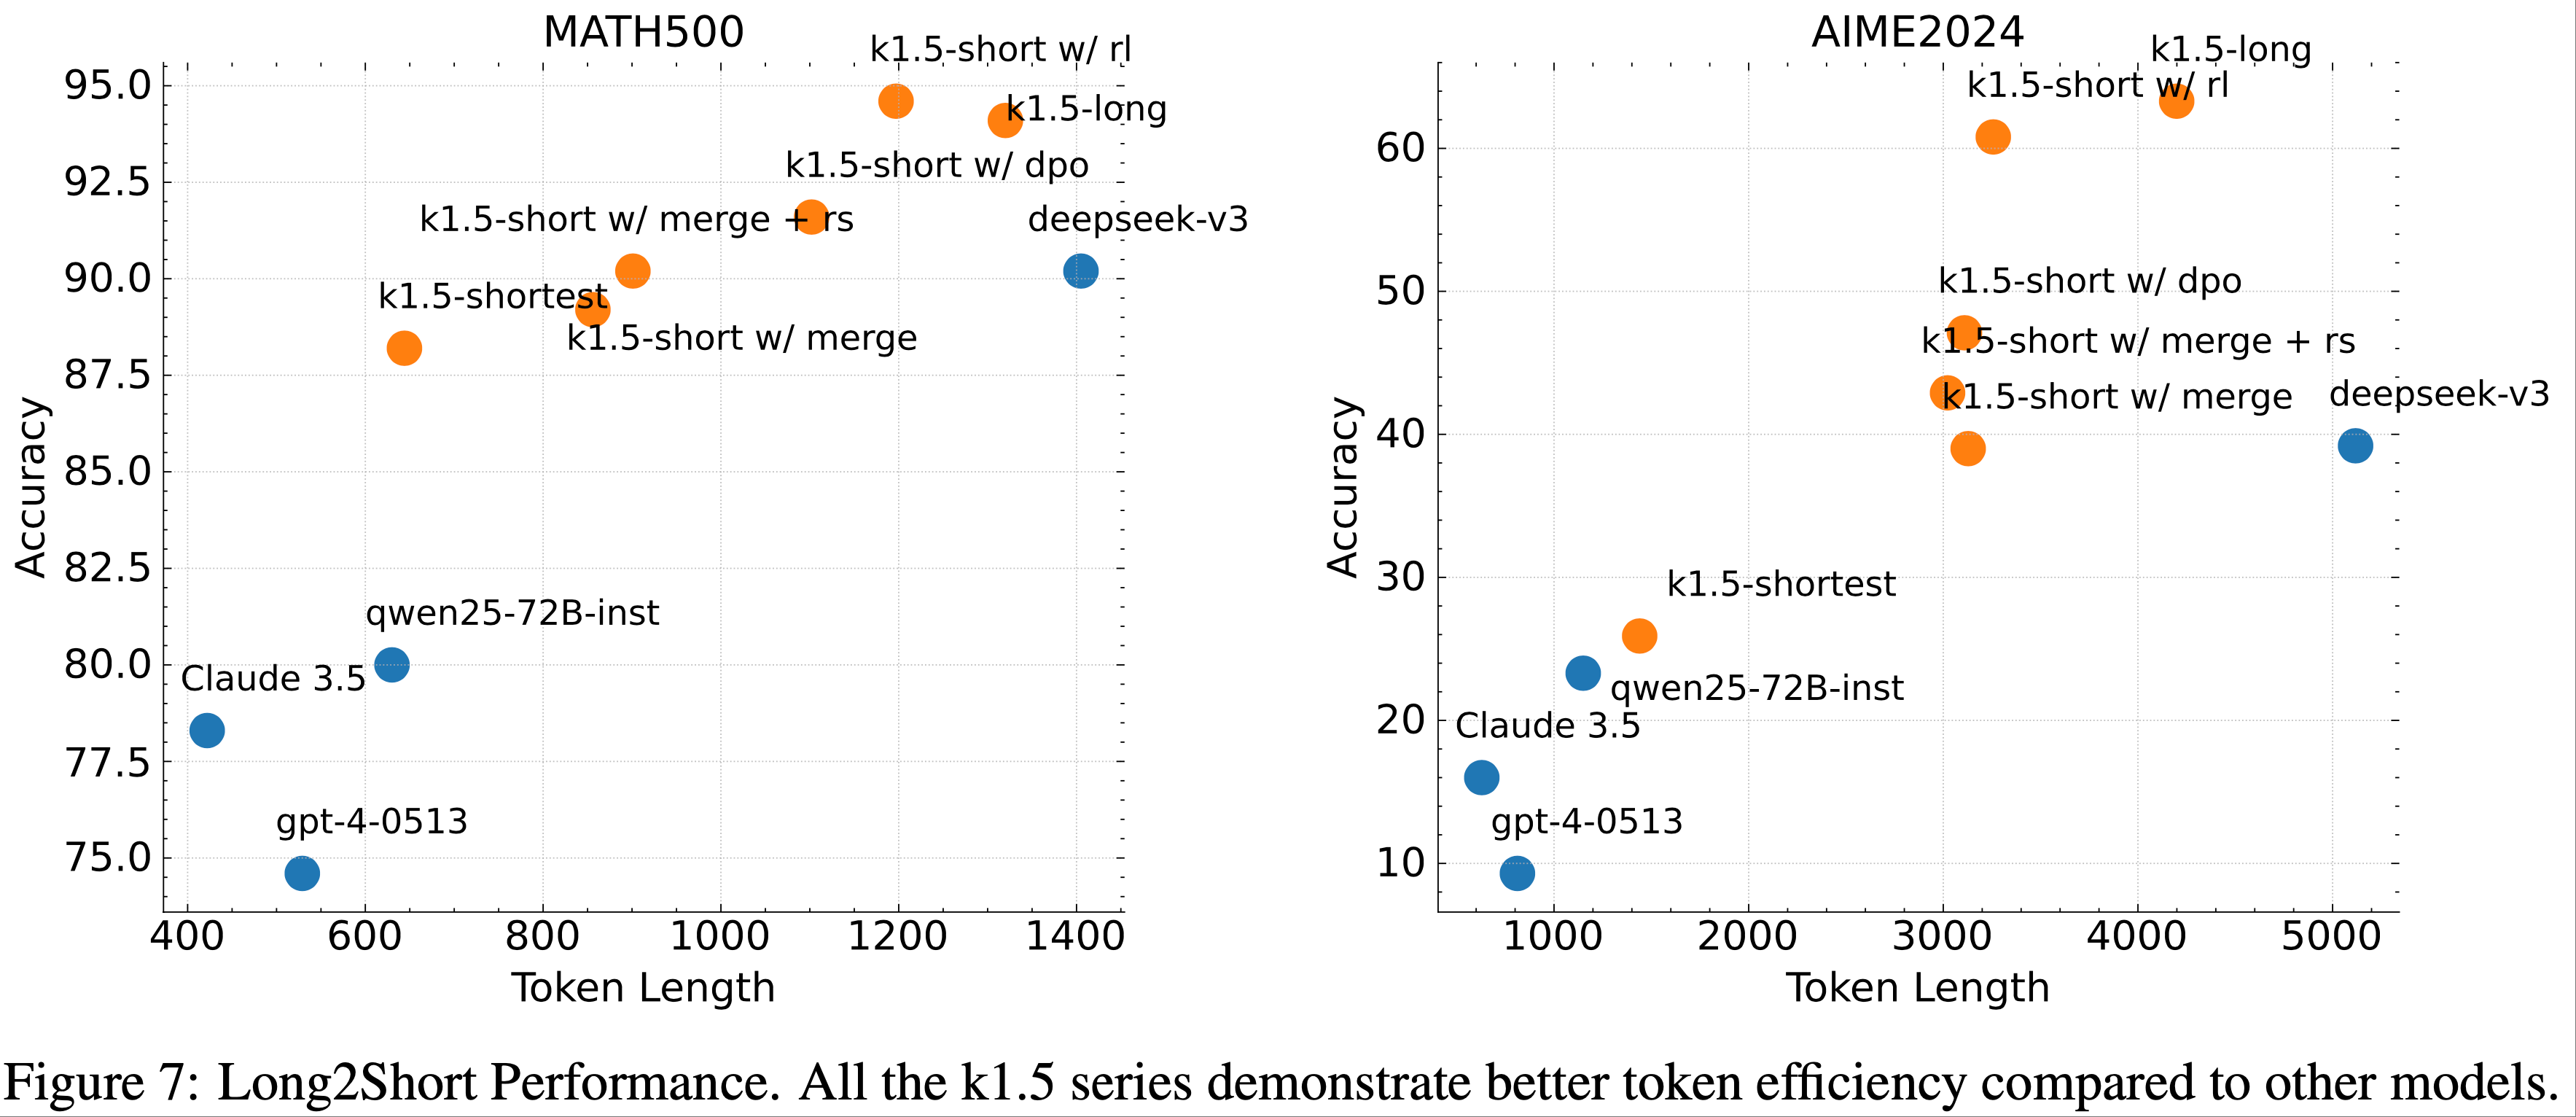
  • 文比较了第 2.4 节中提出的长链到短链强化学习算法与 DPO、最短拒绝采样和模型合并方法,重点关注长链到短链问题的 Token Efficiency (2024),即如何将长链思维模型的优势传递给短链模型
  • 在图 7 中:
    • K1.5-long 代表论文用于长链到短链训练的长链思维模型
    • K1.5-short w/ rl 表示通过长链到短链强化学习训练得到的短链模型
    • K1.5-short w/ dpo 表示通过 DPO 训练提升 Token Efficiency 的短链模型
    • K1.5-short w/ merge 表示模型合并后的结果
    • K1.5-short w/ merge + rs 表示对合并模型应用最短拒绝采样得到的短链模型
    • K1.5-shortest 表示论文在长链到短链训练中获得的最短模型
  • 如图 7 所示
    • 与其他方法(如 DPO 和模型合并)相比,长链到短链强化学习算法展示了最高的 Token Efficiency
    • K1.5 系列的所有模型(橙色 Token )均表现出比其他模型(蓝色 Token )更优的 Token Efficiency
      • 例如,K1.5-short w/ rl 在 AIME2024 上的 Pass@1 得分为 60.8(8 次运行的平均值),平均仅使用 3,272 个 Token
      • 同样,K1.5-shortest 在 MATH500 上的 Pass@1 得分为 88.2,同时消耗的 Token 数量与其他短链模型相当

Ablation Studies

Scaling of model size and context length
  • 论文的主要贡献是通过 RL 增强模型生成长链思维的能力,从而提升其推理能力
  • 一个自然的问题是:这与单纯增加模型规模相比如何?
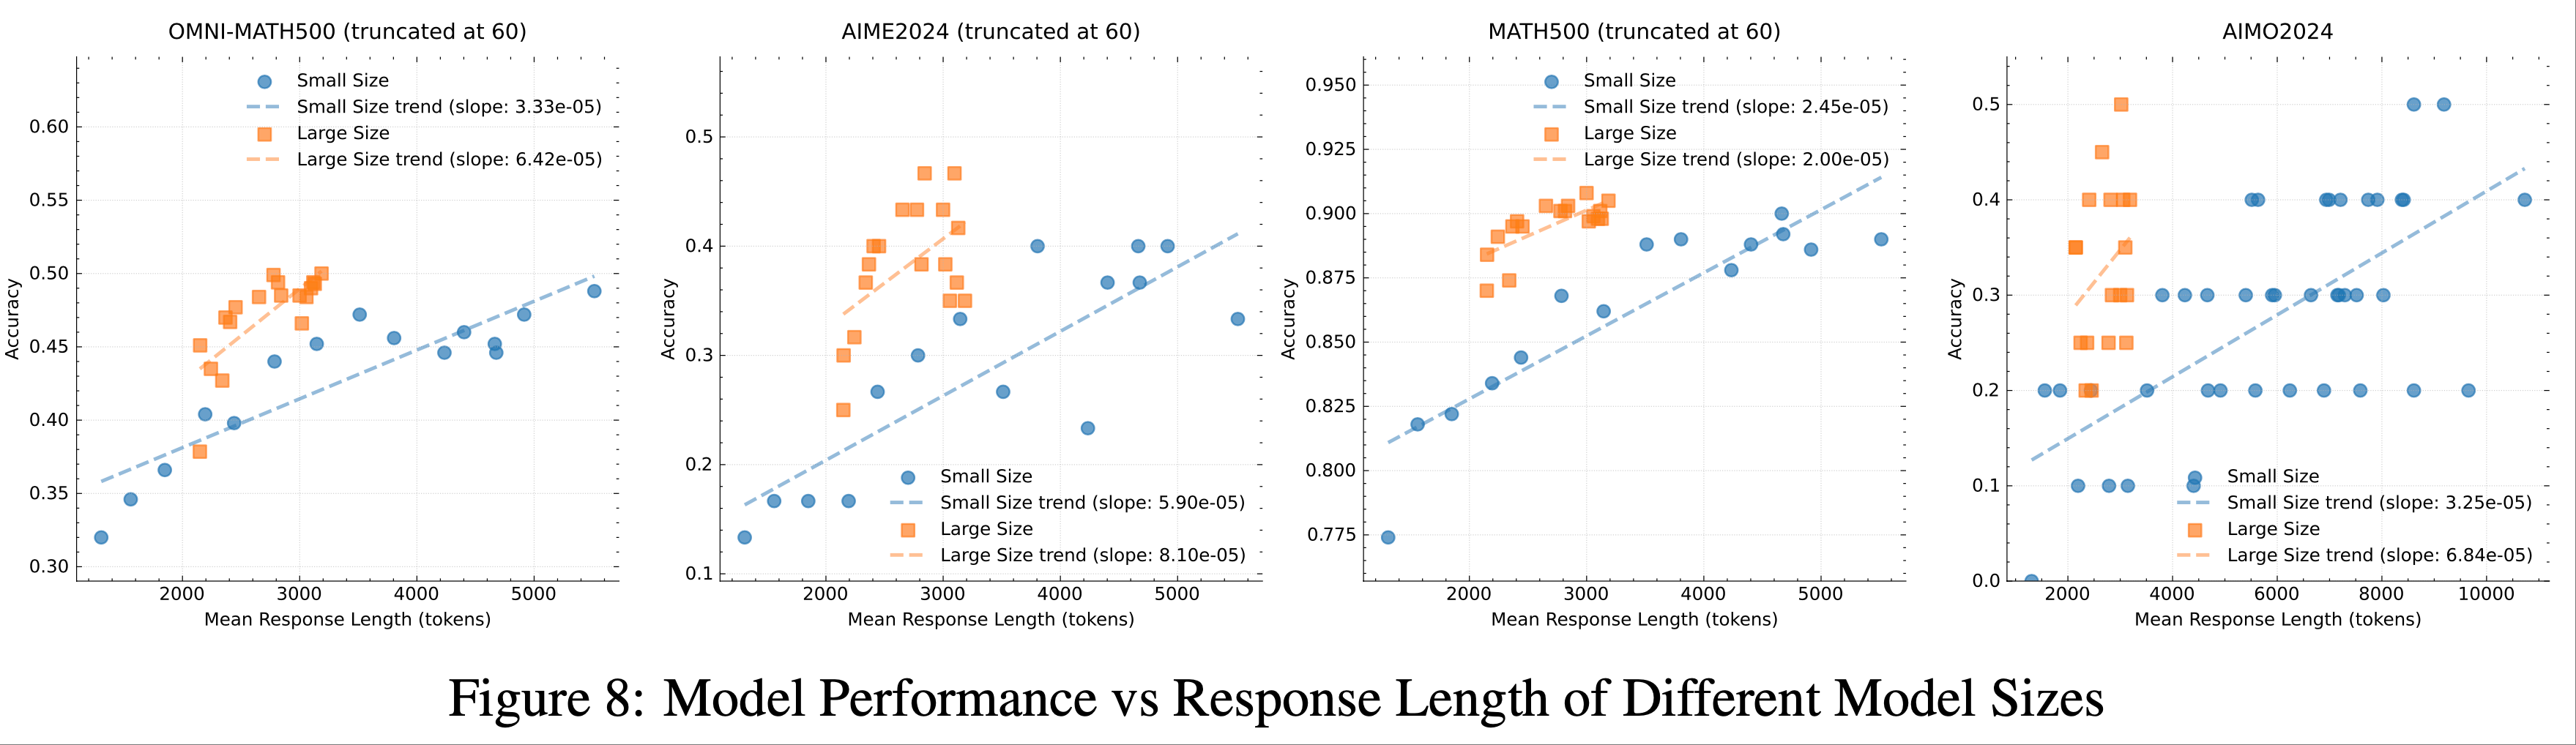
  • 为了证明论文方法的有效性,论文使用相同数据集训练了两个不同规模的模型,并记录了强化学习训练期间所有检查点的评估结果和平均推理长度
  • 这些结果如图 8 所示
    • 较小模型初始性能不如较大模型,但较小模型通过优化后的长链思维可以达到与大规模模型相当的性能
    • 大规模模型通常表现出更好的 Token Efficiency
      • 这也表明,如果目标是追求最佳性能,扩展大规模模型的上下文长度具有更高的上限,并且更节省 Token
      • 但如果测试时计算有预算限制,训练较小模型并扩展上下文长度可能是可行的解决方案
Effects of using negative gradients
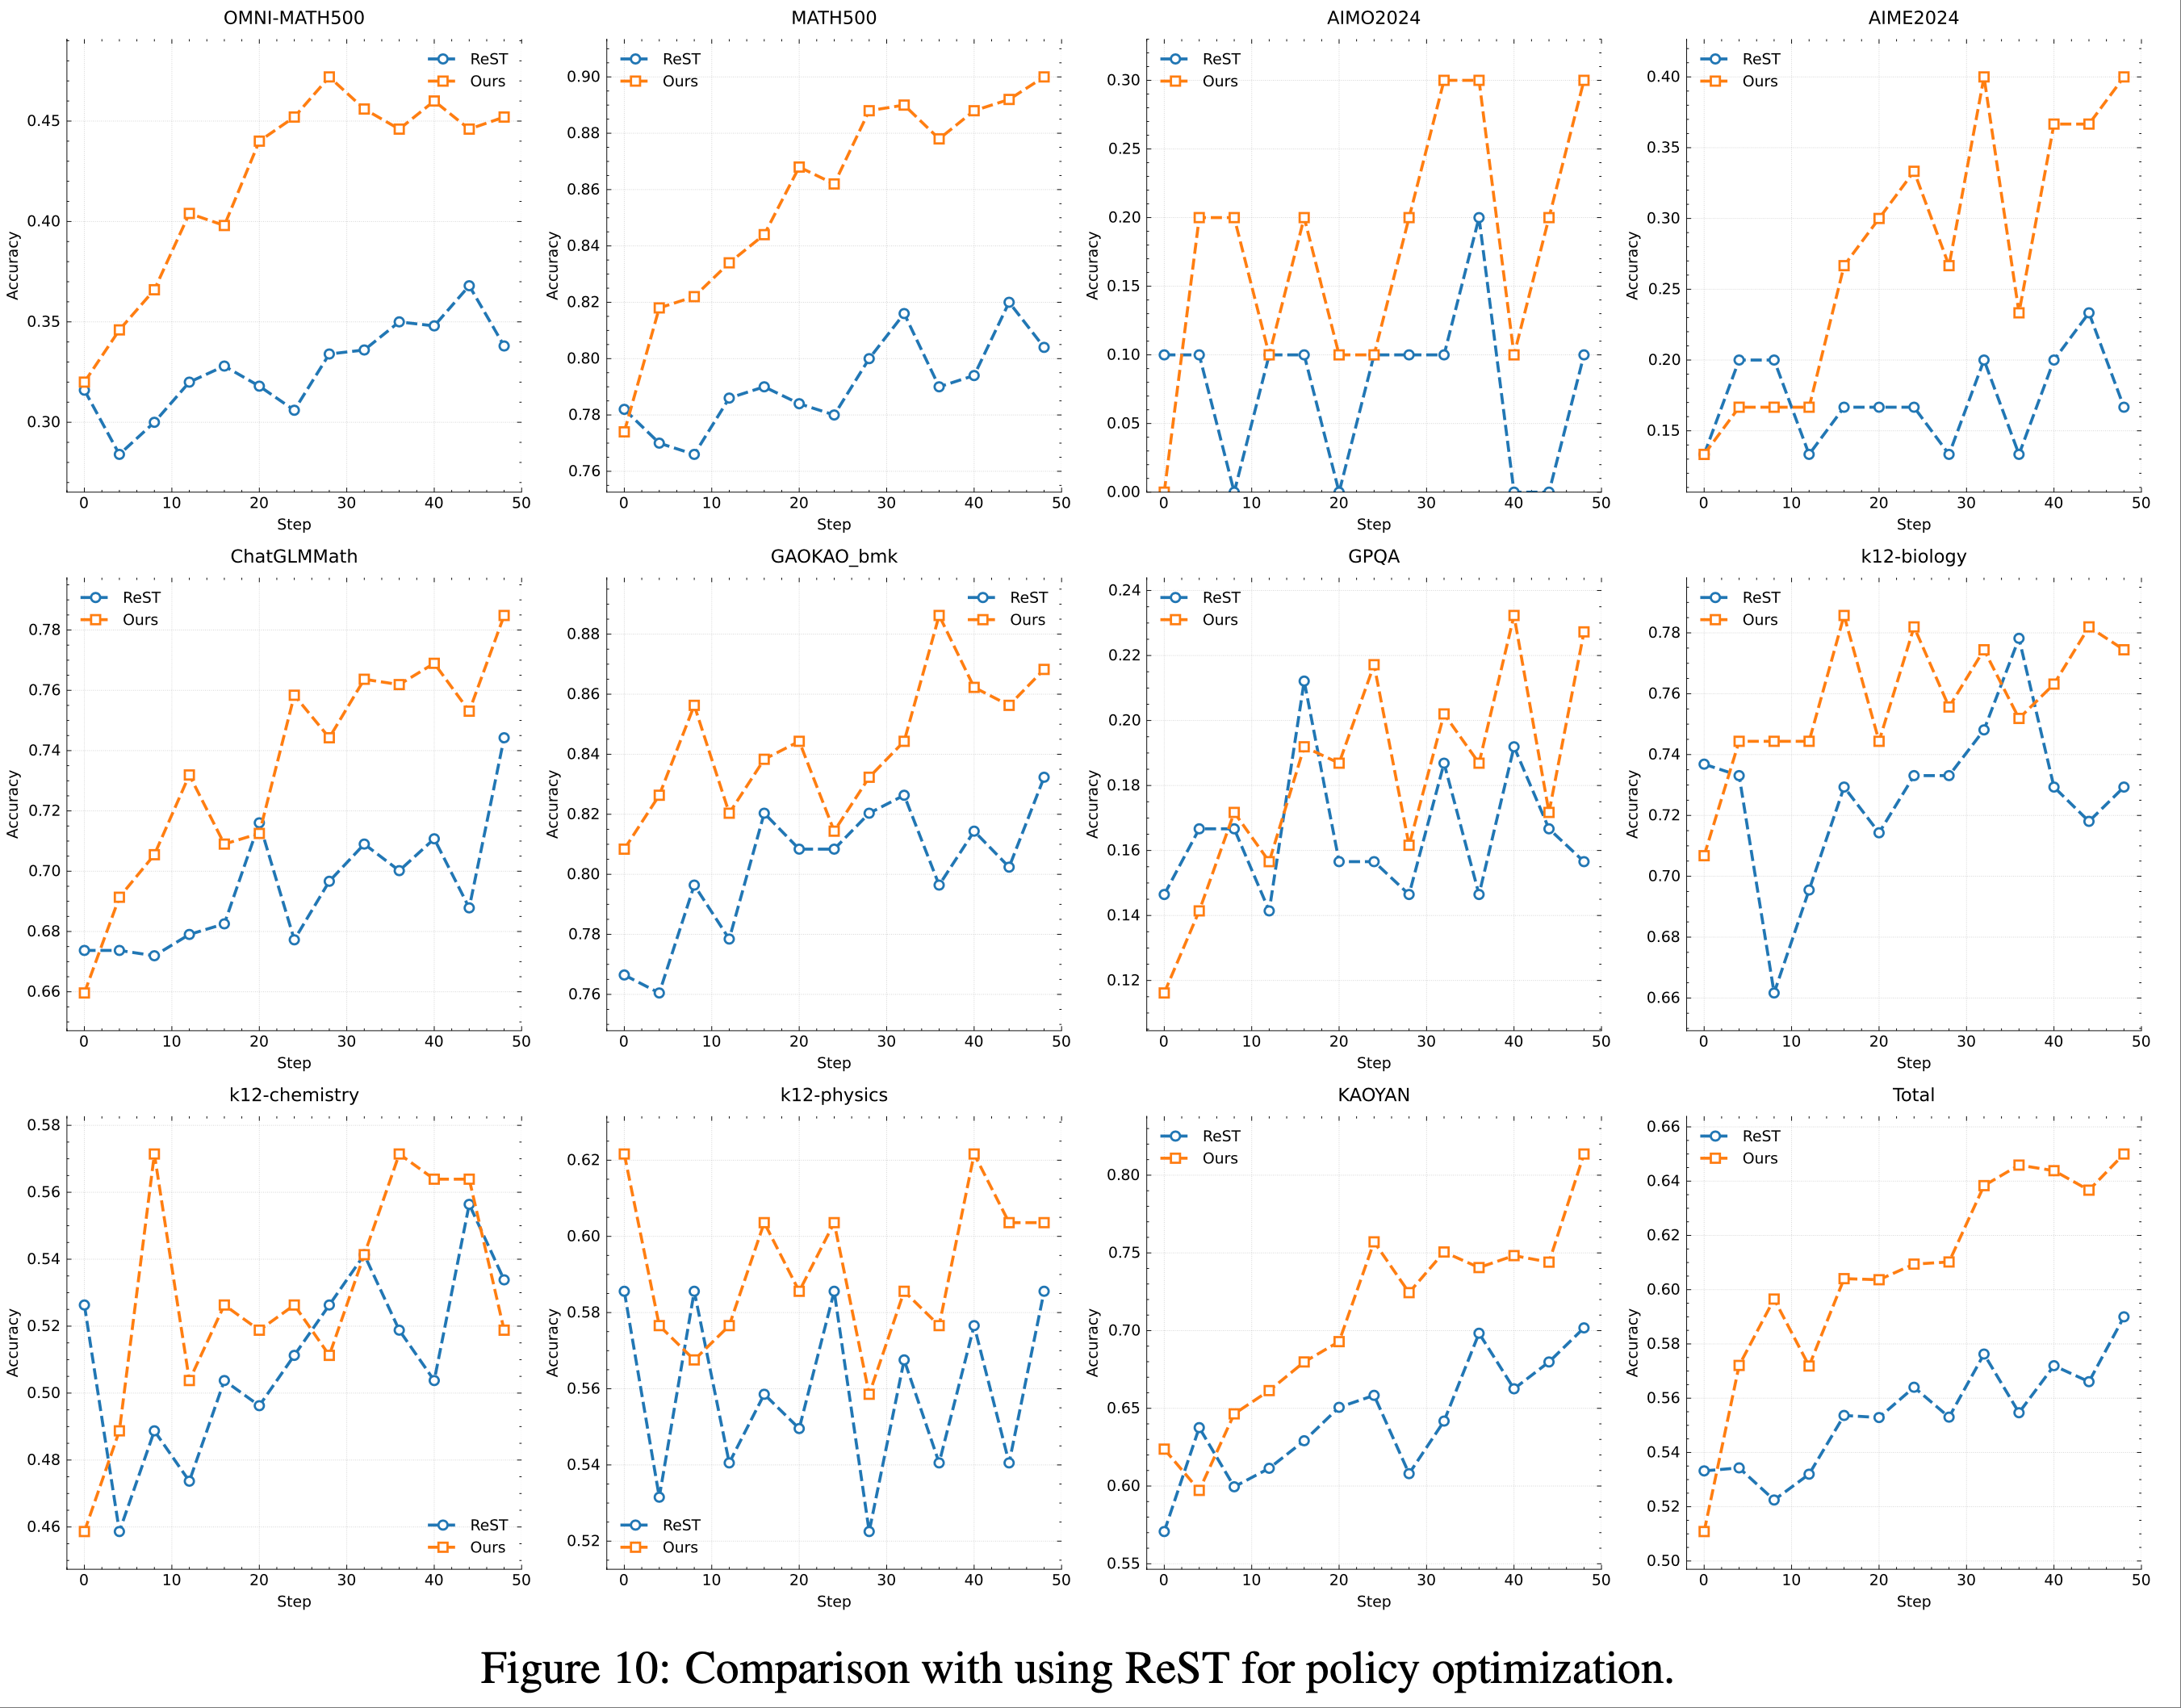
  • 论文研究了在设置中使用 ReST (2023) 作为策略优化算法的有效性
  • ReST 与其他 RL-based 的方法(包括论文的方法)的主要区别在于
    • ReST 通过拟合当前模型采样的最佳响应来迭代优化模型,而不会对错误响应施加负梯度惩罚
  • 如图 10 所示
    • 论文的方法在样本复杂度上优于 ReST,这表明引入负梯度显著提升了模型生成长链思维的效率
      • ReST 不会使用负梯度,详情见附录
    • 论文的方法不仅提高了推理质量,还优化了训练过程,以更少的训练样本实现了稳健的性能
      • 这一发现表明,策略优化算法的选择在论文的设置中至关重要,因为 ReST 与其他 RL-based 的方法在其他领域中的性能差距并不明显 (2023)
      • 论文的结果凸显了选择适当优化策略以最大化长链思维生成效果的重要性
      • 问题:这里强调的 优化策略/策略优化算法 是什么?
Sampling strategies
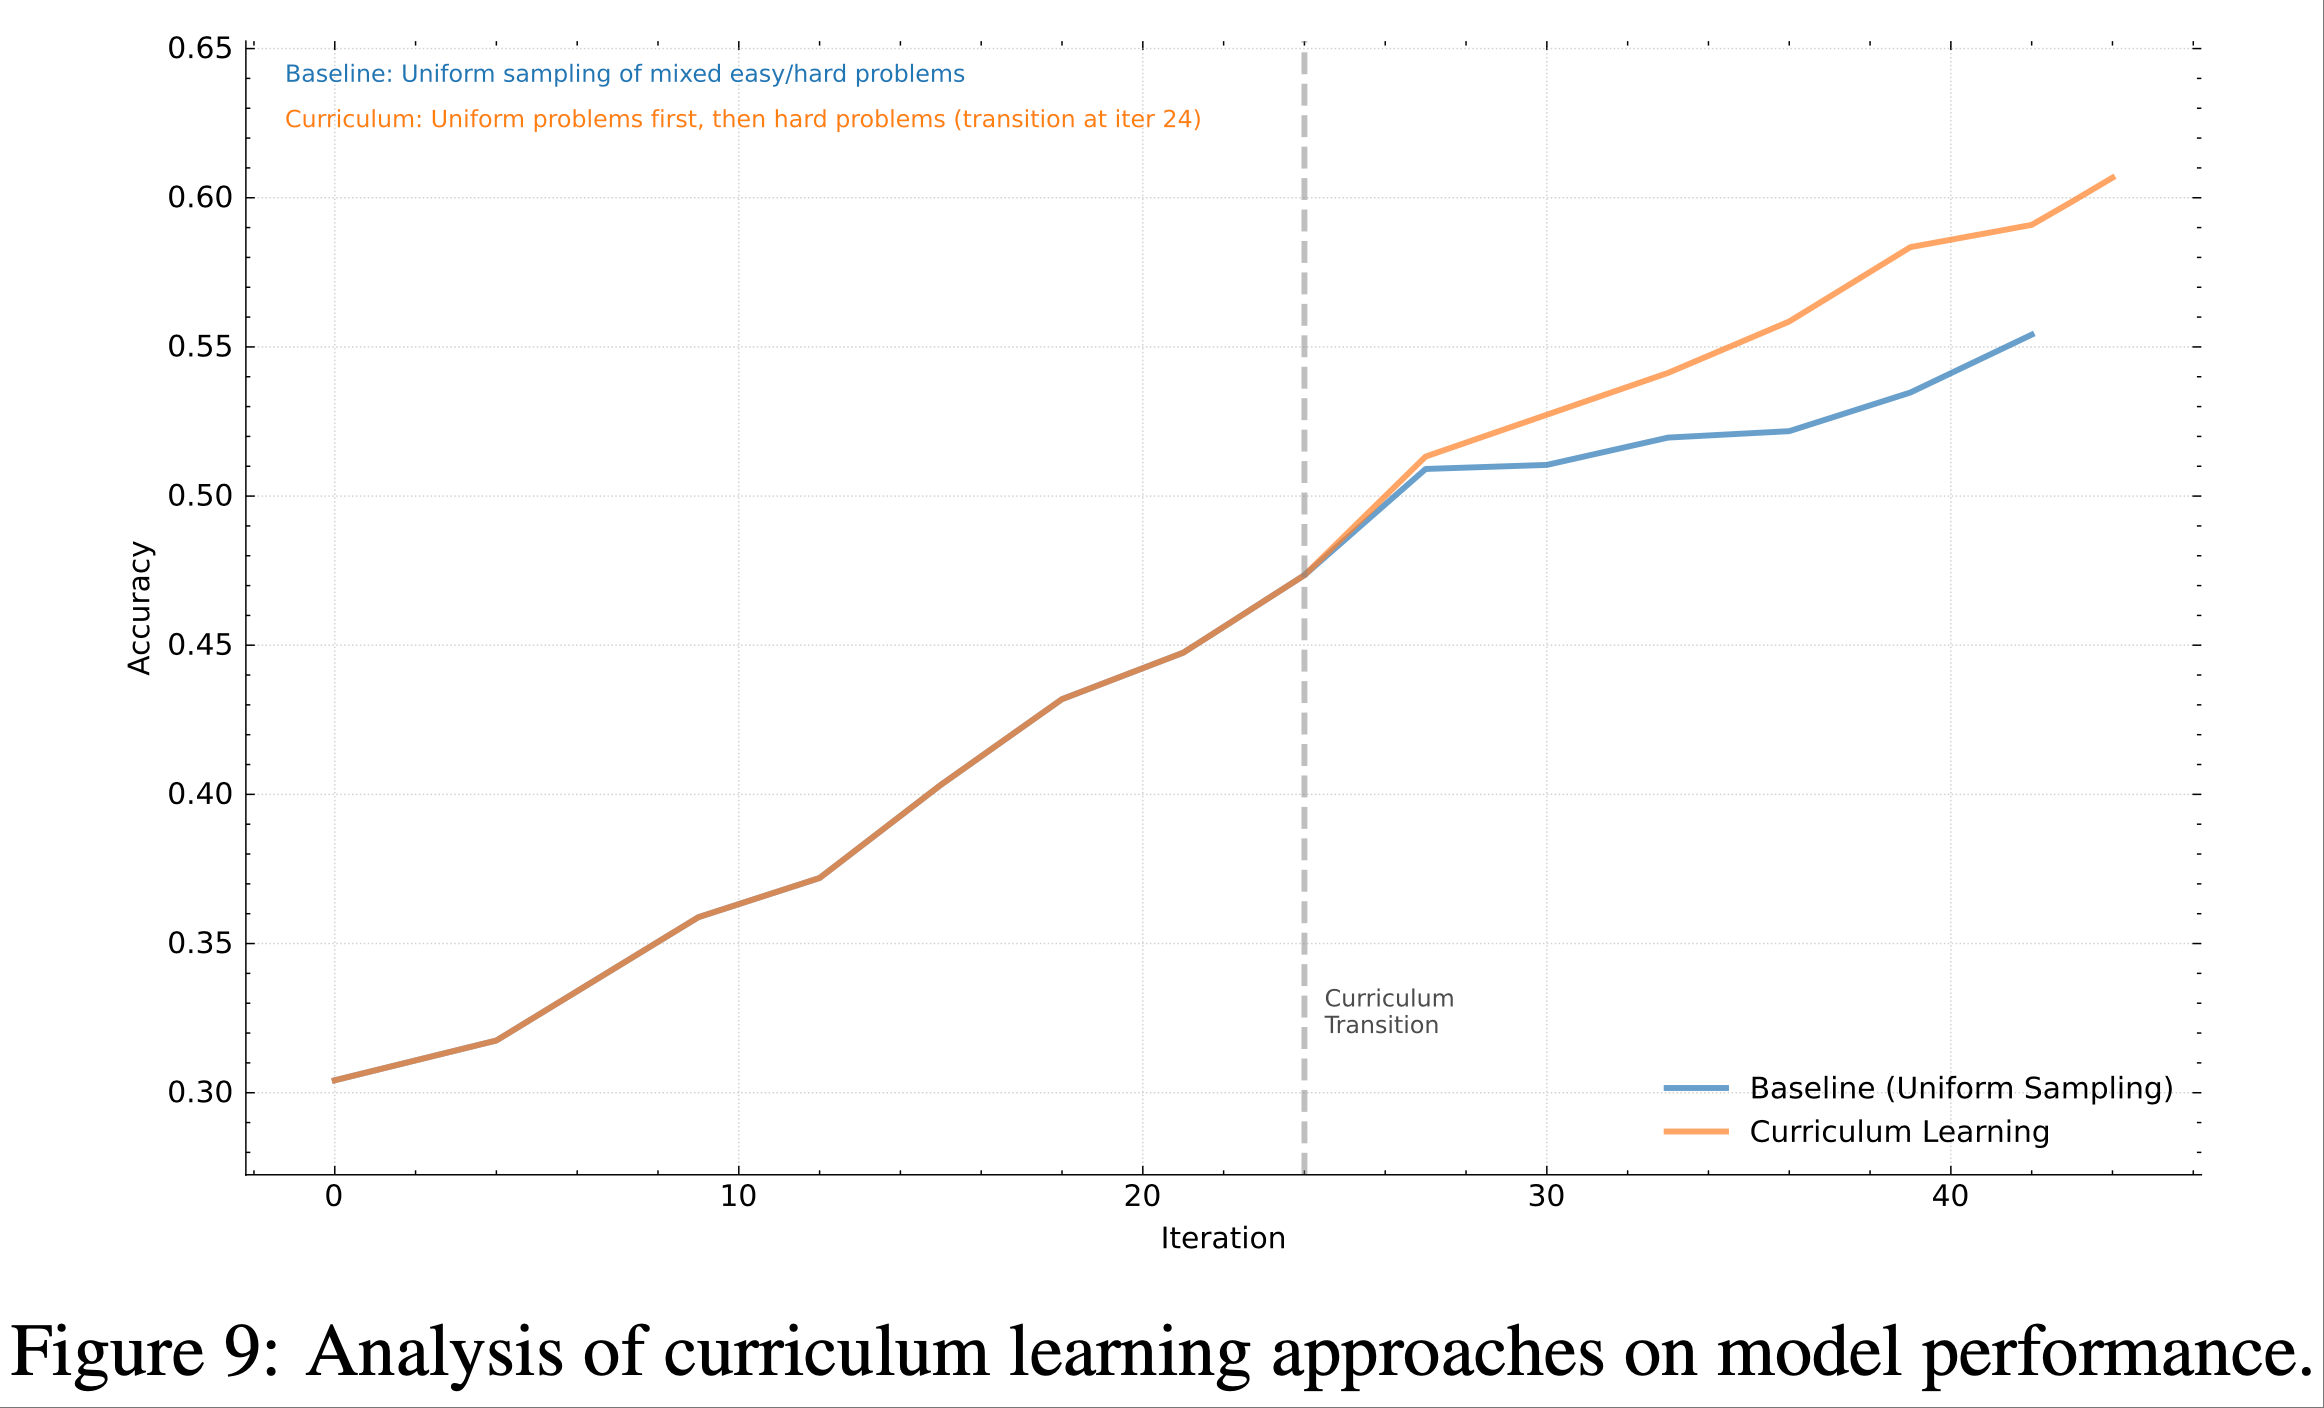
  • 本节进一步证明了第 2.3.4 节中提出的课程采样策略的有效性
  • 论文的训练数据集 \(\mathcal{D}\) 包含不同难度级别的问题
  • 论文的方法 :
    • 通过课程采样方法 ,论文首先使用 \(\mathcal{D}\) 进行预热阶段 ,随后仅专注于困难问题来训练模型
  • 基线方法 :
    • 采用均匀采样策略且无课程调整
  • 如图 9 所示,论文的结果清楚地表明,课程采样方法显著提升了性能
    • 这种改进可以归因于该方法逐步挑战模型的能力,使其能够更稳健地理解和解决复杂问题
    • 通过在初始通用阶段后专注于更困难的问题,模型能够更好地增强其推理和问题解决能力

附录 B:Pretraining

  • RL 的效率与基础模型的性能密切相关
  • 前沿模型如 Gemini (2024) 和 Llama (2024) 强调了预训练数据质量对于实现高性能的重要性
  • 但许多最新的开源模型并未完全公开其数据处理流程和配方,这为更广泛社区的理解带来了挑战
  • 尽管论文目前并未开源专有模型,但论文致力于全面公开数据流程和方法论
  • 本节主要关注多模态预训练数据配方,随后简要讨论模型架构和训练阶段

B.1 Language Data

  • 论文的预训练语料库旨在为训练 LLM 提供全面且高质量的数据,它涵盖五个领域:
    • 英语(English)
    • 中文(Chinese)
    • Code
    • 数学与推理(Mathematics & Reasoning)
    • 知识(Knowledge)
  • 论文对每个领域采用复杂的过滤和质量控制机制,以确保训练数据的最高质量
  • 对于所有预训练数据,论文对每个数据源进行了严格的单独验证,以评估其对整体训练配方的具体贡献
  • 这种系统性评估确保了多样数据组成的质量和有效性
English and Chinese textual data
  • 论文开发了一个多维质量过滤框架,结合多种评分方法以减少个体偏见并确保全面的质量评估。论文的框架包括:
    • 1)基于规则的过滤(Rule-based filtering) :
      • 论文实施领域特定的启发式方法,移除问题内容,包括重复内容、机器翻译文本和低质量的网络抓取内容
      • 论文还过滤掉包含过多特殊字符、异常格式或垃圾模式的文档
    • 2)基于 FastText 的分类(FastText-based classification) :
      • 论文训练了专门的 FastText (2016; 2024) 模型,基于语言特征和语义连贯性识别内容质量
      • 这有助于识别具有自然语言流和正确语法结构的文档
    • 3)基于 Embedding 的相似性分析(Embedding-based similarity analysis) :
      • 使用文档 Embedding (2024),论文计算文档级相似性分数,以识别并移除近重复内容,同时保留语义上有价值的变体
      • 这种方法有助于保持训练语料库的多样性
    • 4)LLM-based 质量评估(LLM-based quality assessment) :
      • 参考 (2024),论文利用 LLM 根据连贯性、信息量和潜在教育价值对文档进行评分
      • 这种方法特别适用于识别简单方法可能忽略的细微质量指标
  • 每个文档的最终质量分数是这些单独分数的组合
  • 基于广泛的实证分析,论文实施了动态采样率,高质量文档在训练期间被上采样,而低质量文档被下采样
Code data
  • 代码数据主要包括两类
  • 对于从代码文件提取的纯代码数据,论文遵循 BigCode (2023; 2024) 的方法论,对数据集进行了全面的预处理
    • 首先,移除杂项语言,并应用基于规则的清理程序以提高数据质量
    • 随后,通过策略性采样技术解决了语言不平衡问题
      • 具体而言,Token 语言如 JSON、YAML 和 YACC 被下采样,而 32 种主要编程语言(包括 Python、C、C++、Java 和 Go)被上采样以确保平衡表示
  • 对于从各种数据源获取的文本-代码交错数据,论文使用基于 Embedding 的方法召回高质量数据
    • 这种方法确保了数据的多样性并保持了其高质量
Math & Reasoning data
  • 数学和推理数据组件对于开发强大的分析和问题解决能力至关重要
  • 数学预训练数据主要从公开可用的互联网资源中检索,包括网页文本和 PDF 文档 (2023)
  • 最初,论文发现通用领域的文本提取、数据清理过程和 OCR 模型在数学领域中表现出较高的假阴性率
  • 因此,论文首先开发了专门的数据清理程序和 OCR 模型,特别针对数学内容,旨在最大化数学数据的召回率
  • 随后,论文实施了两阶段数据清理过程 :
    • 1)使用 FastText 模型进行初步清理,移除大部分无关数据
    • 2)利用微调的语言模型进一步清理剩余数据,从而获得高质量的数学数据
Knowledge data
  • 知识语料库经过精心策划,以确保全面覆盖学术领域
  • 论文的知识库主要包括学术练习、教科书、研究论文和其他通用教育文献
  • 这些材料的大部分通过 OCR 处理数字化,为此论文开发了专有模型,针对学术内容(尤其是数学公式和特殊符号)进行了优化
  • 论文使用内部语言模型为文档添加多维度标签,包括:
    • 1)OCR 质量指标,用于评估识别准确性
    • 2)教育价值指标,衡量教学相关性
    • 3)文档类型分类(如练习、理论材料)
  • 基于这些多维度标注,论文实施了一个复杂的过滤和采样流程
    • 首先,文档通过 OCR 质量阈值进行过滤
      • 论文的 OCR 质量评估框架特别关注检测和过滤常见的 OCR 伪影,尤其是表明识别失败的重复文本模式
    • 其次,通过评分系统仔细评估每份文档的教育价值
      • 具有高教学相关性和知识深度的文档被优先考虑,同时在理论深度和教学清晰度之间保持平衡
      • 这有助于确保论文的训练语料库包含高质量的教育内容,能够有效促进模型的知识获取
    • 最后,为了优化训练语料库的整体组成,不同文档类型的采样策略通过大量实验经验性确定
      • 论文进行隔离评估,以识别对模型知识获取能力贡献最显著的文档子集
      • 这些高价值子集在最终训练语料库中被上采样
      • 为了保持数据多样性并确保模型的泛化能力,论文仔细保留其他文档类型的平衡表示
      • 这种数据驱动的方法帮助论文优化了聚焦知识获取与广泛泛化能力之间的权衡

B.2 Multimodal Data

  • 论文的多模态预训练语料库旨在提供高质量数据,使模型能够处理和理解来自多种模态(包括文本、图像和视频)的信息
  • 为此,论文还从五个类别中精选了高质量数据以构建语料库
    • 这五个类别是:字幕(captioning)、交错(interleaving)、OCR(光学字符识别)、知识(knowledge)和通用问答(general question answering)
  • 在构建训练语料库时,论文开发了多条多模态数据处理流程以确保数据质量,包括:过滤、合成和去重
    • 建立有效的多模态数据策略在联合训练视觉和语言时至关重要,因为它既保留了语言模型的能力,又促进了跨多种模态的知识对齐
  • 论文在本节中详细描述这些来源,分为以下类别:
Caption data
  • 论文的字幕数据为模型提供了基本的模态对齐和广泛的世界知识
  • 通过融入字幕数据,多模态 LLM 能够以高效的学习方式获取更广泛的世界知识
  • 论文整合了各种开源的中英文字幕数据集 (2022; 2024),并从多个来源收集了大量内部字幕数据
  • 但在整个训练过程中,论文严格限制合成字幕数据的比例,以减轻因真实世界知识不足而导致的幻觉风险
  • 对于通用字幕数据,论文遵循严格的质量控制流程,避免重复并保持高图像-文本相关性
  • 论文还在预训练期间改变图像分辨率,以确保视觉塔在处理高分辨率和低分辨率图像时均保持高效
Image-text interleaving data
  • 在预训练阶段,模型从交错数据中获益良多,例如:
    • 多图像理解能力可以通过交错数据提升;
    • 交错数据通常为给定图像提供详细知识;
    • 更长的多模态上下文学习能力也可以通过交错数据获得
  • 论文发现交错数据对保持模型的语言能力有积极贡献
    • 图像-文本交错数据是论文训练语料库的重要组成部分
    • 论文的多模态语料库考虑了开源的交错数据集 (2024; 2024),并利用教科书、网页和教程等资源构建了大规模的内部数据
  • 论文发现合成交错数据有助于多模态 LLM 保持文本知识的表现
    • 为了确保每张图像的知识得到充分学习,对于所有交错数据,除了标准的过滤、去重和其他质量控制流程外,论文还集成了数据重新排序程序,以保持所有图像和文本的正确顺序
OCR data
  • 光学字符识别(Optical Character Recognition, OCR)是一种广泛采用的技术,可将图像中的文本转换为可编辑格式
  • 强大的 OCR 能力对于更好地将模型与人类价值观对齐至关重要
    • 论文的 OCR 数据来源多样,包括开源和内部数据集,涵盖干净和增强的图像
  • 除了公开可用的数据外,论文还开发了大量的内部 OCR 数据集,涵盖多语言文本、密集文本布局、基于网络的内容和手写样本
  • 此外,遵循 OCR 2.0 (2024) 中概述的原则,论文的模型还配备了处理多种光学图像类型的能力,包括图形、表格、几何图表、流程图和自然场景文本
  • 论文应用了广泛的数据增强技术(如旋转、扭曲、颜色调整和噪声添加)以增强模型的鲁棒性
  • 最终,论文的模型在 OCR 任务中表现出高水平的熟练度
Knowledge data
  • 多模态知识数据的概念与之前提到的文本预训练数据类似,只是这里论文专注于从多样来源汇集全面的人类知识库,以进一步增强模型的能力
    • 例如,论文数据集中精心策划的几何数据对于培养视觉推理技能至关重要,确保模型能够理解人类创建的抽象图表
  • 论文的知识语料库遵循标准化的分类法,以平衡各个类别的内容,确保数据来源的多样性
    • 与纯文本语料库类似(从教科书、研究论文和其他学术材料中收集知识),多模态知识数据使用布局解析器和 OCR 模型处理这些来源的内容
    • 论文也纳入了来自互联网和其他外部资源的过滤数据
  • 由于论文的知识语料库的很大一部分来自基于互联网的材料,信息图表可能导致模型仅关注基于 OCR 的信息
  • 在这种情况下,仅依赖基本的 OCR 流程可能会限制训练效果
  • 为了解决这个问题,论文开发了一个额外的流程,以更好地捕获图像中 Embedding 的纯文本信息
General QA Data
  • 在训练过程中,论文观察到将大量高质量的问答数据集纳入预训练会带来显著的好处
  • 论文纳入了严格的学术数据集,涉及基础任务、表格/图表问答、网络代理和通用问答
  • 论文还编制了大量内部问答数据以进一步增强模型的能力
  • 为了保持难度和多样性的平衡,论文对通用问答数据集应用了评分模型和细致的手动分类,从而实现了整体性能的提升

B.3 Model Architecture

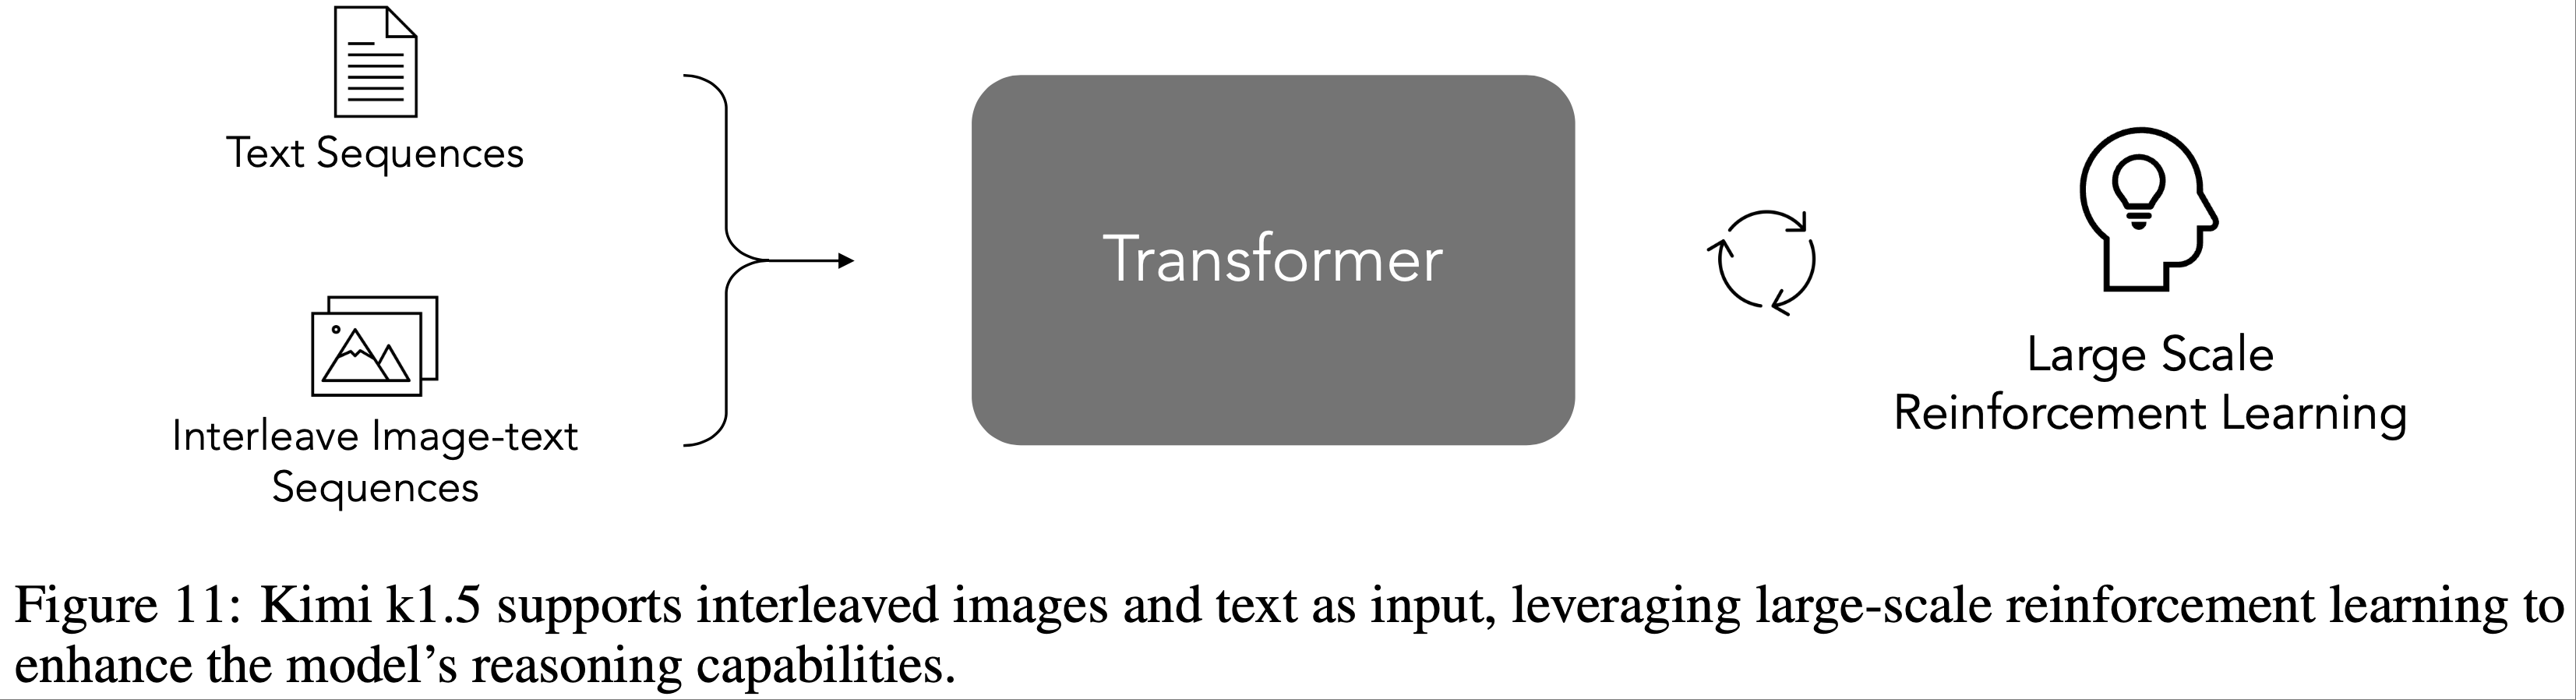
  • Kimi K 系列模型采用了 Transformer Decoder (2017) 的变体,集成了多模态能力以及架构和优化策略的改进,如图 11 所示
  • 这些进步共同支持了稳定的大规模训练和高效推理,专门针对大规模强化学习和 Kimi 用户的操作需求
  • 广泛的扩展实验表明,基础模型的大部分性能来自于预训练数据质量和多样性的提升
  • 关于模型架构扩展实验的具体细节超出了本报告的范围,将在未来的出版物中讨论

B.4 Training Stages

  • Kimi K1.5 模型的训练分为三个阶段:
    • 视觉-语言预训练阶段(vision-language pretraining stage)
    • 视觉-语言冷却阶段(vision-language cooldown stage)
    • 长上下文激活阶段(long-context activation stage)。每个阶段专注于特定的能力提升
Vision-language pretraining stage
  • 首先,仅在语言数据上进行训练,建立强大的语言模型基础
  • 随后,模型逐渐引入视觉-语言交错数据,获得多模态能力
    • 视觉塔最初在隔离状态下训练,不更新语言模型参数
    • 然后论文解冻语言模型层,最终将视觉-文本数据的比例提高到 30%
    • 最终的数据混合及其权重是通过在较小模型上进行的消融研究确定的
Vision-language cooldown stage
  • 在冷却阶段,模型继续使用高质量的语言和视觉-语言数据集进行训练,以确保卓越的性能
  • 通过实证研究,论文观察到在冷却阶段融入合成数据会带来显著的性能提升,尤其是在数学推理、知识任务和代码生成方面
  • 冷却数据集的英语和中文部分从预训练语料库的高保真子集中精选而来
  • 对于数学、知识和代码领域,论文采用混合方法:
    • 利用选定的预训练子集,同时通过专有语言模型生成内容进行增强
    • 论文利用现有的数学、知识和代码语料库作为源材料,通过拒绝采样技术生成问答对以保持质量标准 (2023; 2024)
    • 这些合成的问答对在纳入冷却数据集之前经过了全面验证
Long-context activation stage
  • 在长上下文激活阶段,K1.5 通过上采样的长上下文冷却数据进行训练,使其能够处理扩展序列并支持需要更长上下文的任务
  • 为了确保基础模型具备出色的长文本能力,论文上采样了长上下文数据,并在长上下文训练期间使用了 40% 的完全注意力数据和 60% 的部分注意力数据
    • 完全注意力数据(full attention data) :部分来自高质量的自然数据,部分来自合成的长上下文问答和摘要数据
    • 部分注意力数据(partial attention data) :来自冷却数据的均匀采样
  • RoPE 频率 (2024) 设置为 1,000,000
  • 在此阶段,论文通过将最大序列长度从 4,096 逐步增加到 32,768,最终达到 131,072,逐步扩展了长度激活训练

附录 C Evaluation Details

C.1 Text Benchmark

  • MMLU (2020)
    • 涵盖了 STEM、人文、社会科学等 57 个学科
    • 其难度范围从初级水平到高级专业水平,测试模型的世界知识和问题解决能力
  • IF-Eval (2023)
    • 一个用于评估大语言模型遵循可验证指令能力的基准
    • 包含 500 多个提示,例如“写一篇超过 800 字的文章”等
    • 由于版本变动,表 3 中报告的 IF-Eval 分数来自一个中间模型
    • 论文将根据最终模型更新分数
  • CLUEWSC (2020)
    • 是 CLUE 基准中的共指消解任务,要求模型判断句子中的代词和名词短语是否共指,数据来自中文小说
  • C-EVAL (2023)
    • 一个全面的中文评估套件,用于评估基础模型的高级知识和推理能力
    • 包含 52 个学科的 13,948 道选择题,涵盖四个难度级别

C.2 Reasoning Benchmark

  • HumanEval-Mul
    • 是 MultiPL-E (2022) 的一个子集
    • MultiPL-E 将 HumanEval 和 MBPP 基准扩展到 18 种编程语言,涵盖多种编程范式和流行度
    • 论文选择了 8 种主流编程语言(Python、Java、C++、C#、JavaScript、TypeScript、PHP 和 Bash)的 HumanEval 翻译版本
  • LiveCodeBench (2024)
    • 一个全面且无污染的基准,用于评估大语言模型在编码任务中的表现
    • 具有实时更新功能以防止数据污染,涵盖多种编码场景,提供高质量的问题和测试,并平衡问题难度
    • 论文使用 2408-2411 版本(v4)的问题测试短思维链模型,使用 2412-2502 版本(v5)的问题测试长思维链模型
  • AIME 2024
    • 包含 2024 年美国数学邀请赛(AIME)的竞赛题目
    • AIME 是一项仅限邀请的高中生数学竞赛,评估高级数学技能,要求扎实的基础和高水平的逻辑思维
  • MATH-500 (2023)
    • 一个综合性数学基准,包含 500 道涵盖代数、微积分、概率等主题的数学问题
    • 测试计算能力和数学推理能力,分数越高表明数学问题解决能力越强
  • Codeforces
    • 一个知名的在线评测平台,也是评估长思维链编码模型的流行测试平台
    • 为了在 Div2 和 Div3 竞赛中取得更高排名,论文使用 K1.5 长思维链模型生成的代码片段进行多数投票,测试用例也由同一模型生成
    • Codeforces ELO 评分的百分位数提取自 OpenAI Day12 Talk

C.3 Image Benchmark

  • MMMU (2024)
    • 包含从大学考试、测验和教科书中精心挑选的 11.5K 个多模态问题
    • 涵盖六大主要学术领域:艺术与设计、商业、科学、健康与医学、人文与社会科学以及技术与工程
  • MATH-Vision (MATH-V) (2024)
    • 一个精心策划的集合,包含 3,040 个高质量的视觉上下文数学问题,源自真实数学竞赛
    • 涵盖 16 个不同的数学学科,并按 5 个难度级别分级
    • 该数据集提供了全面多样的挑战,非常适合评估大语言模型在数学推理方面的能力
  • MathVista (2023)
    • 一个整合了多种数学和视觉任务的基准,要求参与者展示细粒度的深度视觉理解和组合推理能力以成功完成任务

附录:证明 \(\tau \to \infty\)时,\(\tau \log Z\)趋近于\(\pi_{\theta_i}\)下的期望Reward

  • 目标:证明当 \(\tau \to \infty\) 时,\(\tau \log Z\) 趋近于 \(\pi_{\theta_i}\) 下的期望 Reward
  • 已知
    $$ Z = \sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) \exp(r(x, y’, y^{*}) / \tau)$$
    • \(r(x, y’, y^{*})\) 为奖励函数
    • \(\pi_{\theta_i}(y’, z’ | x)\) 是参考策略下的概率分布
  • 对 \(Z\) 取对数并乘以 \(\tau\),得到
    $$ \tau \log Z = \tau \log\left(\sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) \exp(r(x, y’, y^{*}) / \tau)\right)$$
  • 当 \(\tau \to \infty\) 时,(泰勒展开的一阶近似)
    $$ \exp(r / \tau) \approx 1 + r / \tau$$
    • 补充 \(e^x\) 在 \(x=0\) 处泰勒展开完整式子:
      $$ e^x = \sum_{n=0}^{\infty} \frac{x^n}{n!} = 1 + x + \frac{x^2}{2!} + \frac{x^3}{3!} + \cdots + \frac{x^n}{n!} + \cdots $$
  • 代入上式可得:
    $$
    \begin{align*}
    \tau \log Z &\approx \tau \log\left(\sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) \left(1 + \frac{r}{\tau}\right)\right) \\
    &= \tau \log\left(1 + \frac{1}{\tau} \sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) r\right) \\
    \end{align*}
    $$
  • 当 \(\tau \to \infty\) 时, 进一步使用 \(\log(1+x)\) 在 \(x=0\) 处的泰勒展开的一阶近似(\(\log(1+x) \approx x\)):
    $$ \ln(1+x) = \sum_{n=1}^{\infty} \frac{(-1)^{n+1} x^n}{n} = x - \frac{x^2}{2} + \frac{x^3}{3} - \frac{x^4}{4} + \cdots + \frac{(-1)^{n+1} x^n}{n} + \cdots $$
  • 于是有
    $$
    \begin{align*}
    \tau \log Z &= \tau \log\left(1 + \frac{1}{\tau} \sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) r\right) \\
    &\approx \tau \cdot \frac{1}{\tau} \sum_{y’, z’} \pi_{\theta_i}(y’, z’ | x) r \quad (\text{因为} \text{当}\epsilon \to 0\log(1+\epsilon) \approx \epsilon ) \\
    &= \mathbb{E}_{\pi_{\theta_i} }[r]
    \end{align*}
    $$
  • 因此,当 \(\tau \to \infty\) 时,\(\tau \log Z\) 趋近于 \(\pi_{\theta_i}\) 下的期望 Reward

附录:Mirror Descent 方法介绍

  • Mirror Descent是一种用于优化问题的迭代算法,特别适用于解决大规模和约束的凸优化问题
  • 它是梯度下降的一种推广,结合了梯度下降和凸分析中的 Bregman 距离,使得算法能够在不同的空间中进行优化
  • 基本思想 :
    • Mirror Descent通过将原始问题映射到一个更易处理的空间来进行优化
    • 它利用一个称为镜像映射(mirror map)的凸函数,将原空间中的点映射到镜像空间中
    • 在镜像空间中进行梯度更新 ,然后通过镜像映射的逆映射将更新后的点映射回原空间
  • 适用于处理具有特定结构的优化问题,如约束优化,特别适合高维空间中的优化问题
  • 具体计算流程 :
    • 初始化 :
      • 选择一个初始点 \( x_0 \)
      • 选择一个镜像映射函数 \( \psi \),通常是一个强凸函数
    • 迭代步骤(对于每个迭代 \( t \)):
      • 1)计算梯度 :计算当前点的梯度 \( \nabla f(x_t) \)
      • 2)镜像映射 :将当前点映射到镜像空间 \( z_t = \nabla \psi(x_t) \)
      • 3)梯度更新 :在镜像空间中进行梯度更新(其中 \( \eta \) 是学习率):
        $$ z_{t+1} = z_t - \eta \nabla f(x_t) $$
      • 4)逆镜像映射 :将更新后的点映射回原空间:
        $$ x_{t+1} = (\nabla \psi)^{-1}(z_{t+1}) $$
    • 终止条件 :
      • 根据问题的性质,可以选择固定迭代次数或根据梯度的变化情况来终止迭代
  • 问题:论文 2.3.2 节中讲的优化方法似乎和这个 OPMD 没什么直接关系?

附录:CYaRon 介绍

  • CYaRon 是一款由 Luogu 开发的用于生成随机测试数据的 Python 库,其全称为“Yet Another Random Olympic-informatics”
  • CYaRon 包含很多功能:
    • 随机图生成 :支持简单图、非简单图、有向图、无向图以及带权图和无权图的生成,可以满足不同算法对图结构测试数据的需求
    • 随机树生成 :能够生成链状、随机树或菊花图等不同形态的树,并可设定树的强度,方便对树相关的算法进行测试
    • 多维向量生成 :支持生成允许相同或不同的多维向量,还能快速生成数量可达(10^6)的数列,为数据结构和算法的测试提供了大量的向量和数列数据
    • 函数解析生成数列 :根据给定的函数生成对应的数列,这对于测试一些基于数学函数规律的算法非常有帮助
    • 随机多边形生成 :可以生成随机多边形,并计算其面积和周长,适用于几何算法的测试
    • 字符串、单词、句子的生成 :从字典中生成随机的字符串、单词和句子,可用于自然语言处理相关算法的测试
  • 安装方法 :通常使用Python的包管理工具pip进行安装,在命令行中输入pip install cyaron,即可将CYaRon下载并安装到Python环境中
  • 使用示例
    • 生成随机整数 :使用Random.randint方法,如cyaron.Random.randint(1, 100)可以生成1到100之间的随机整数
    • 生成随机浮点数 :通过Random.uniform方法,例如cyaron.Random.uniform(1.0, 10.0)可生成1.0到10.0之间的随机浮点数
    • 生成随机字符串 :利用Random.string方法,如cyaron.Random.string(8)能生成一个长度为8的随机字符串
    • 生成随机日期 :使用Random.date方法,如cyaron.Random.date("2000-01-01", "2023-12-31")可以生成2000年1月1日到2023年12月31日之间的随机日期
  • 应用场景 :CYaRon主要应用于信息学奥林匹克(OI)等编程竞赛中,帮助出题者快速、便捷地生成高质量的测试数据,以检验参赛选手的算法正确性和效率

附录:ReST(Reinforced Self-Training)方法介绍

  • ReST 是指强化自训练(Reinforced Self-Training)算法(Google DeepMind 2023 年提出),用于语言模型的对齐
  • ReST 的核心原理是 将语言模型的对齐问题视为一个不断增长的Batch RL(离线强化学习)问题 ,通过离线强化学习方法,交替进行数据集增长(Grow)和策略改进(Improve)两个步骤,来高效地调度强化学习过程中的策略生成和更新
  • ReST 的训练步骤(交替执行一下步骤) :
    • Grow 步骤 :
      • 从当前策略 \(\pi_{\theta}\) 中采样出许多输出序列,以此扩充训练数据集,相当于强化学习里的行动或数据生成步骤
      • 即对于 \(x \sim D\),有 \(y \sim \pi_{\theta}(y|x)\),从而创建出一个轨迹增强数据集 \(D_g\)
    • Improve 步骤 :
      • 用评分函数给扩充后的数据集进行排序和筛选
        • 通常会根据人类偏好提前训练一个奖励模型作为评分函数(也可以在中途继续优化奖励模型)
      • 定义一个过滤函数,只保留奖励高于特定阈值 \(\tau\) 的样本,再用监督学习损失(或离线强化学习损失)在筛选后的数据上微调当前最优策略
        • 注意:这里相当于仅仅保留了正样本,并没有对负样本施加惩罚
      • 在多次执行 Improve 步骤时,会不断提高过滤阈值,且每次微调新策略时,都会在前一个策略的基础上,用更低的学习率进行,以保证在固定数据集 \(D_g\) 上实现策略的优化
  • ReST 在多个 Improve 步骤中利用了 Grow 步骤的输出结果,不像在线强化学习那样需要在模型训练过程中多次采样新样本,大大减轻了计算负担
  • 同时,在ReST 中,新的训练数据是从优化后的策略里采样得到的,所以策略质量不受原始数据的束缚
    • 在离线强化学习里,策略的好坏常常受原始数据集质量的限制
  • ReST 算法简单、运行稳定,需要调整的超参数也很少
1…505152…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4