文本介绍CTR预估模型STAR
- 参考链接:
Background
- 随着业务场景的多样化,单一场景下的CTR预估模型已经不能满足需求,因此出现了针对多场景联合建模的需求。STAR(Star Topology Adaptive Recommender)模型正是为了解决这一问题而设计的
STAR 模型概述
- STAR模型的设计目的是为了同时学习不同业务场景中的共性和差异性。它通过一种星形拓扑结构来实现这一点,这种结构允许模型在共享某些参数的同时,也为每个特定场景保留一些私有参数。这样做不仅能够利用跨场景的信息来提升长尾小场景的学习效果,同时也确保了对各个场景特性的精确捕捉
STAR 的核心组成部分
- 模型结构
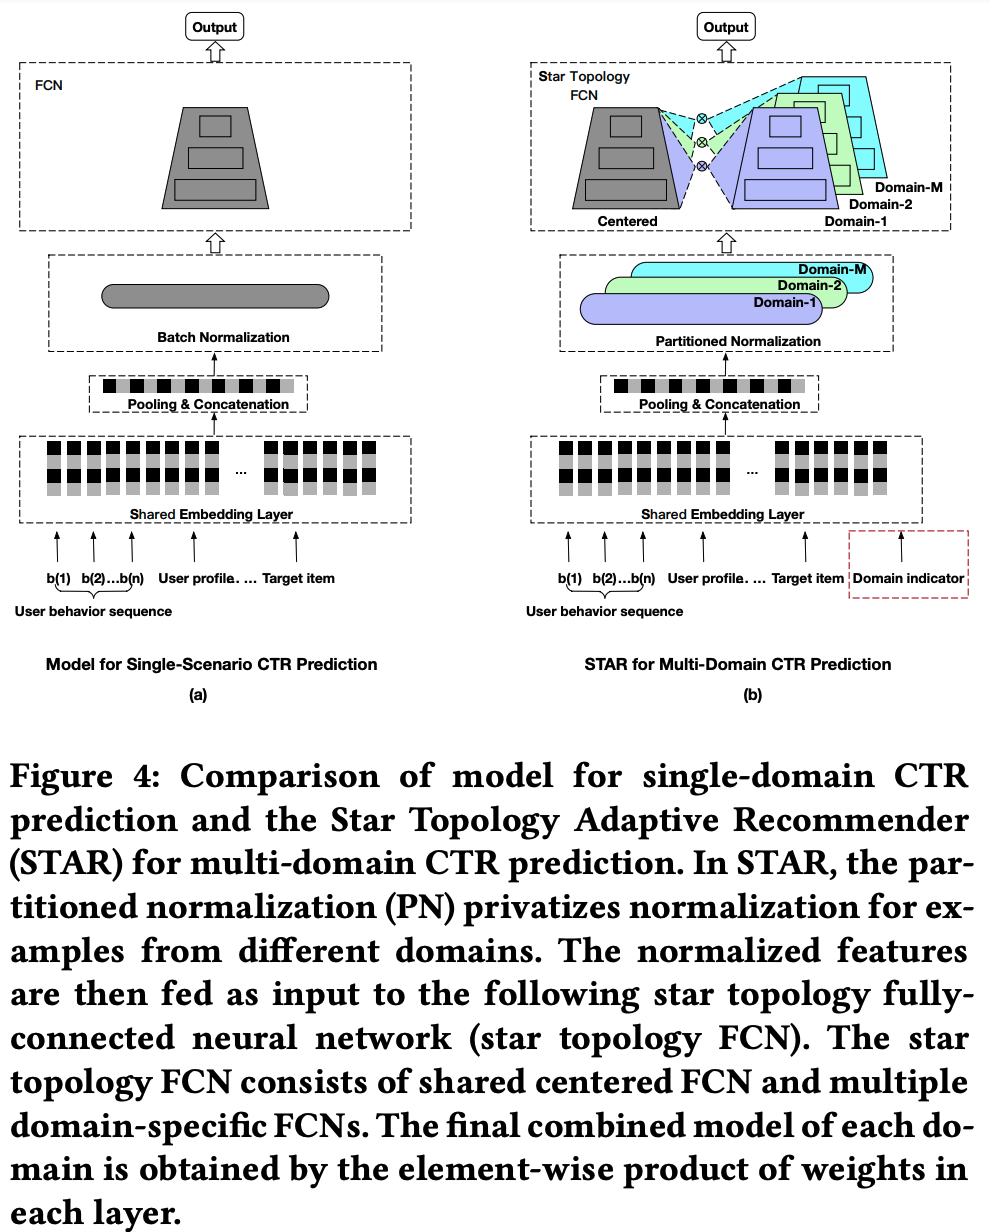
- STAR模型主要包括三个核心部分:
- 星型拓扑全连接网络(STAR Topology Fully-Connected Network) :这是STAR的核心架构,它由两大部分组成——一个所有业务场景共享的中心网络和每个业务场景独有的独立网络。对于每一层FC(Fully Connected),都有一个中心的共享参数和场景特有的私有参数。这些参数通过逐元素乘法(element-wise product)结合在一起,从而为每个场景生成最终的参数。这种方式使得共享参数可以被所有场景的数据更新,以学习到跨场景的共同特征;而场景私有参数则仅由该场景内的数据更新,以捕捉场景特有的特征
- Partitioned Normalization (PN) :在多场景背景下,传统的Batch Normalization (BN)假设所有样本都是独立同分布的,并使用相同的统计量进行归一化处理。然而,在实际应用中,不同场景的数据分布往往存在显著差异,这就要求我们采用不同的归一化策略。为此,STAR引入了Partitioned Normalization,即对不同域(domain)的样本采用不同的归一化统计量,以更好地适应各场景的独特性
- 普通BN的公式为:
$$ \text{BN}(x) = \gamma \left( \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} \right) + \beta $$ - PN的公式为:
$$ \text{PN}_d(x) = (\gamma \cdot \gamma_p) \left( \frac{x - \mu_{p}}{\sqrt{\sigma_{p}^2 + \epsilon}} \right) + (\beta+\beta_p) $$
- 普通BN的公式为:
- 辅助网络 :
- 关于STAR Topology Fully-Connected Network的说明
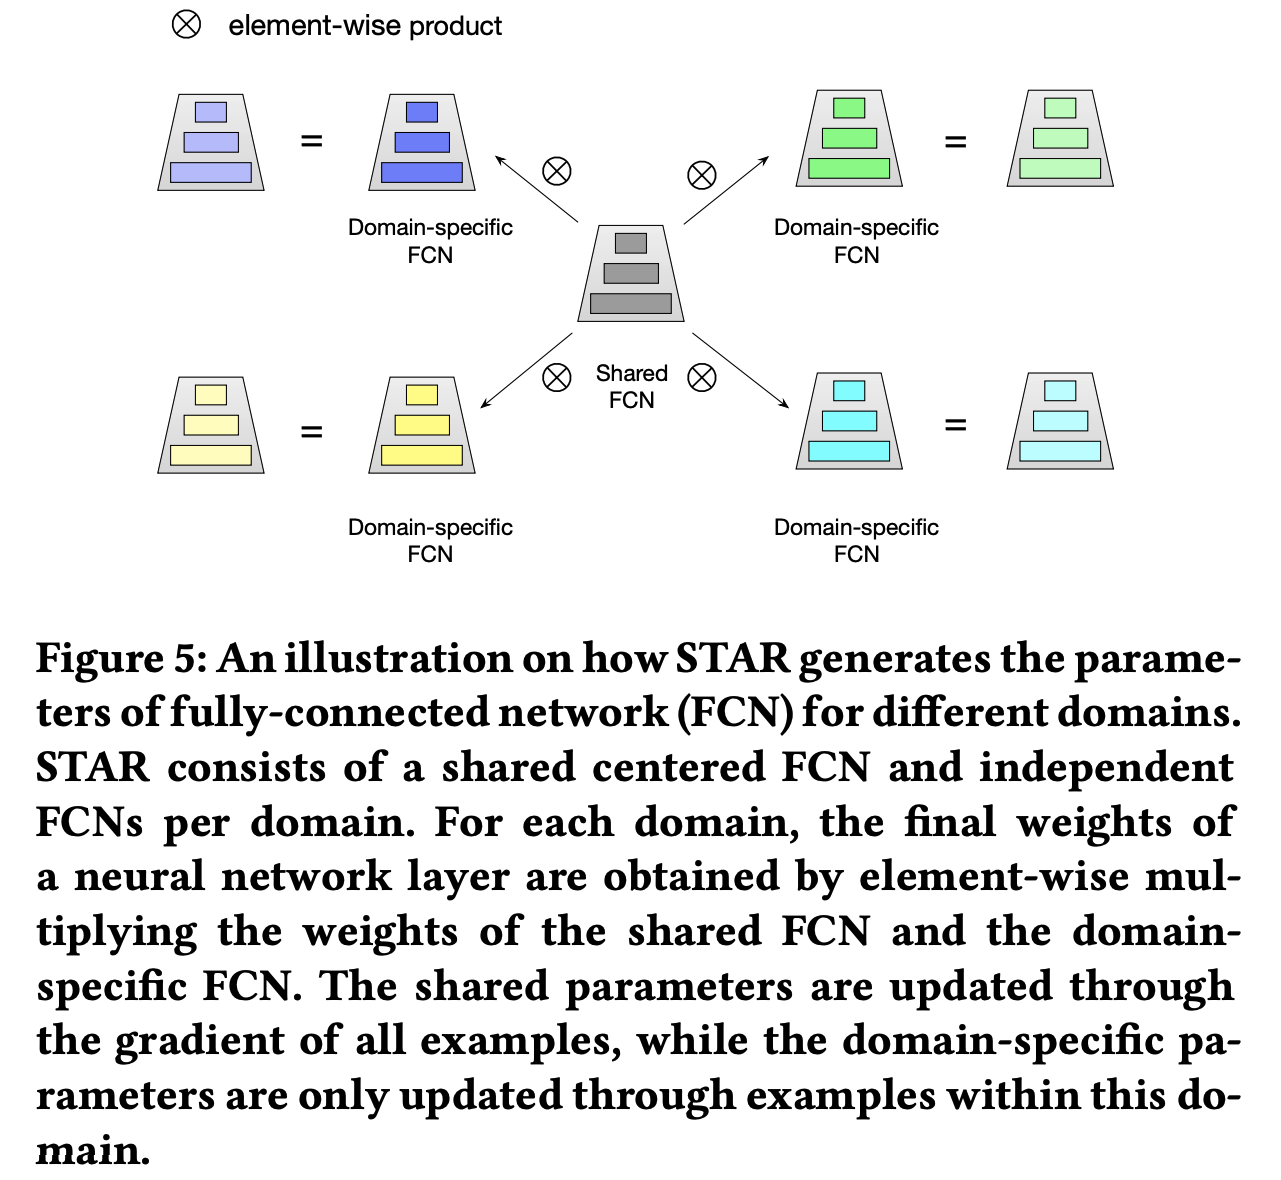 * 每个域的参数都是与通过中心共享参数和私有参数按照按位相乘的到的,其中权重和Bias参数的计算方式不同:
$$
W_{p}^{\star} = W_{p} \otimes W, \quad b_{p}^{\star} = b_{p} + b
$$
* \\(W_{p}^{\star}\\) :这是第 \\(p\\) 个领域的最终权重矩阵,通过将共享的中心网络的权重 \\(W\\) 和特定领域的权重 \\(W_{p}\\) 进行逐元素相乘( \\(\otimes\\) )得到
* \\(b_{p}^{\star}\\) :这是第 \\(p\\) 个领域的最终偏置向量,通过将共享的中心网络的偏置 \\(b\\) 和特定领域的偏置 \\(b_{p}\\) 进行相加得到
* \\(W\\) 和 \\(b\\) :这些是共享的中心网络的权重和偏置,它们从所有领域的数据中学习,捕捉跨领域的共性
* \\(W_{p}\\) 和 \\(b_{p}\\) :这些是特定领域的权重和偏置,它们只从第 \\(p\\) 个领域的数据中学习,捕捉该领域的特性
* 通过这种结合方式,STAR模型能够在共享的共性知识和特定领域的特性之间找到一个平衡,从而更好地适应多领域的CTR预测任务
* 最终输出:
$$
out_{p} = \phi\(\(W_{p}^{\star}\)^{\top} in_{p} + b_{p}^{\star}\)
$$
* \\(out_{p}\\) :这是第 \\(p\\) 个领域的输出,表示该领域的CTR预测结果
* \\(in_{p}\\) :这是第 \\(p\\) 个领域的输入特征向量
* \\(\phi\\) :这是激活函数,用于引入非线性
* \\(\(W_{p}^{\star}\)^{\top} in_{p}\\) :这是将输入特征 \\(in_{p}\\) 与最终权重矩阵 \\(W_{p}^{*}\\) 进行矩阵乘法操作,得到线性变换后的结果
* \\(b_{p}^{\star}\\) :这是最终偏置向量,加到线性变换的结果上
* \\(\phi\(\(W_{p}^{\star}\)^{\top} in_{p} + b_{p}^{\star}\)\\) :这是将线性变换后的结果加上偏置,并通过激活函数 \\(\phi\\) 进行非线性变换,得到最终的输出
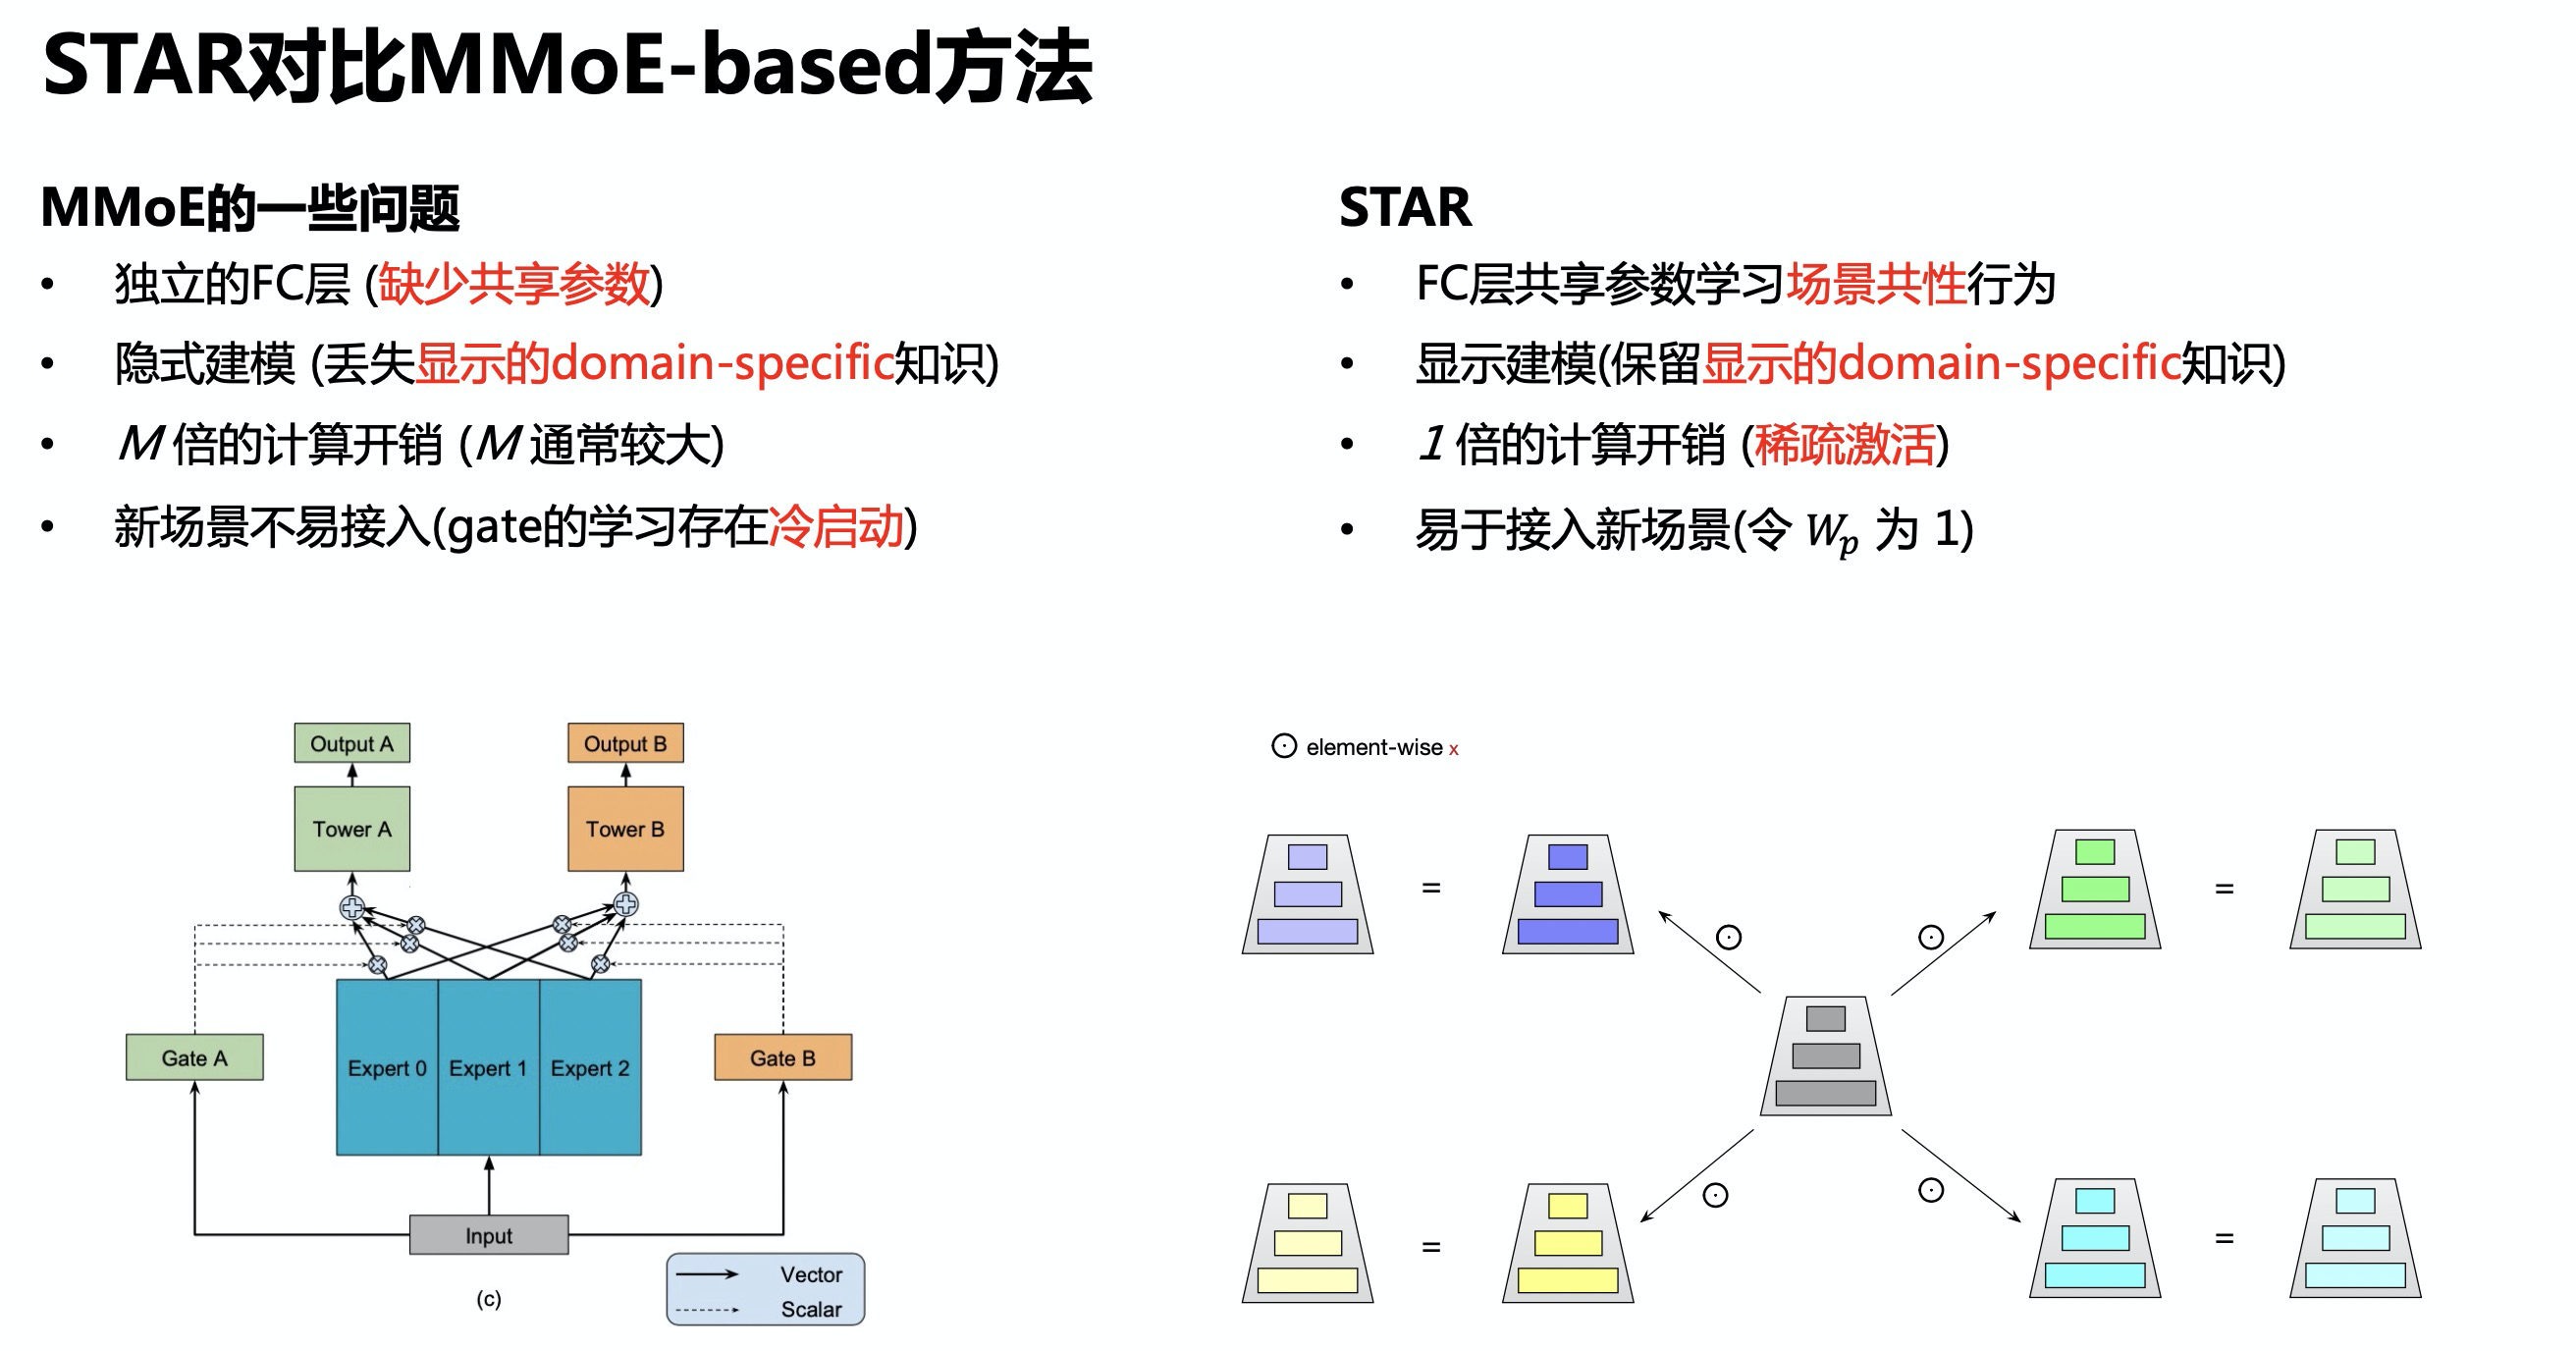
STAR与MMoE对比
- 对比如下,图来自 CIKM 2021 | 多场景下的星型CTR预估模型STAR:
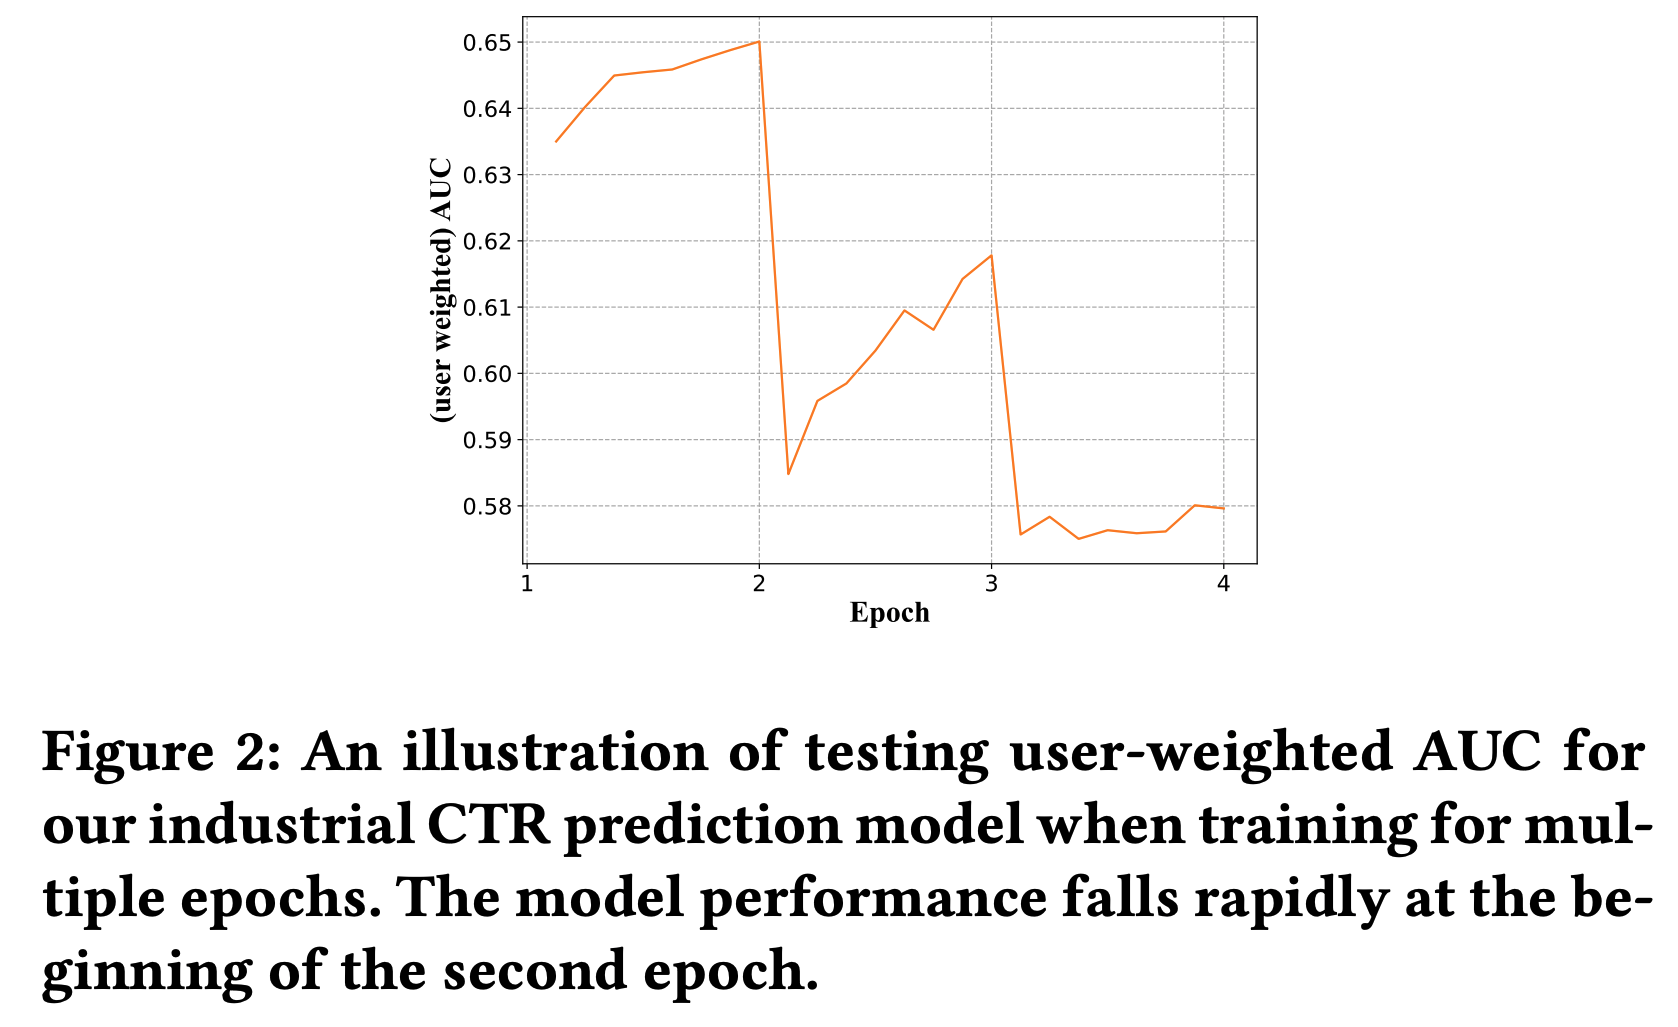
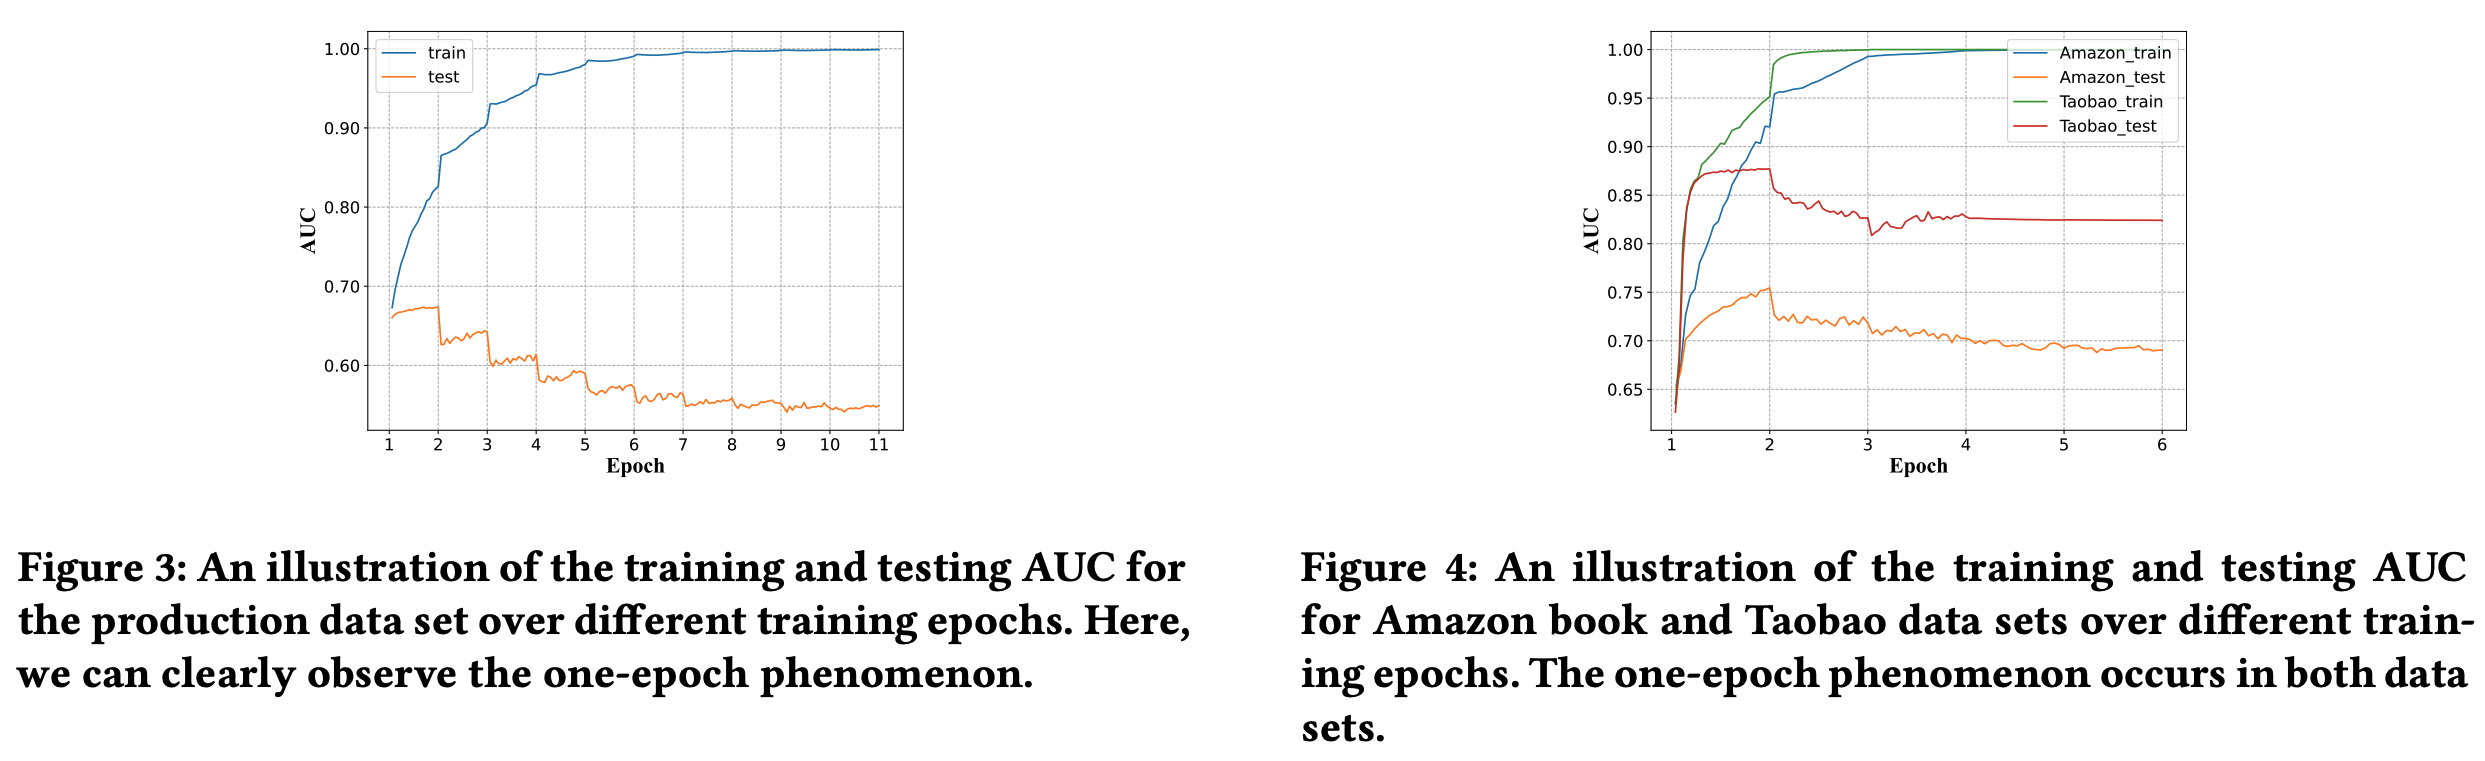
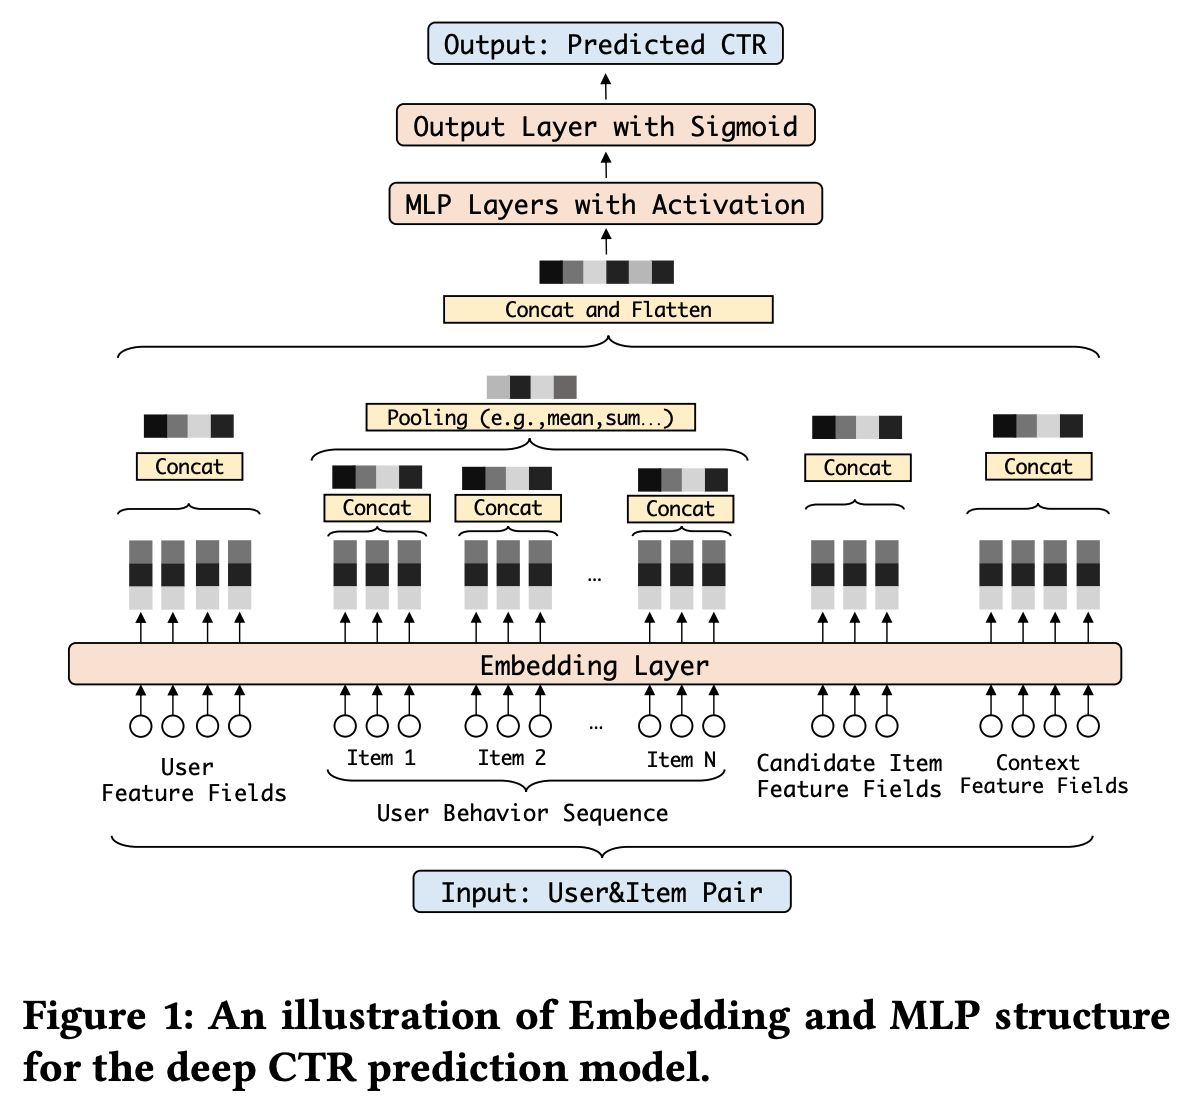
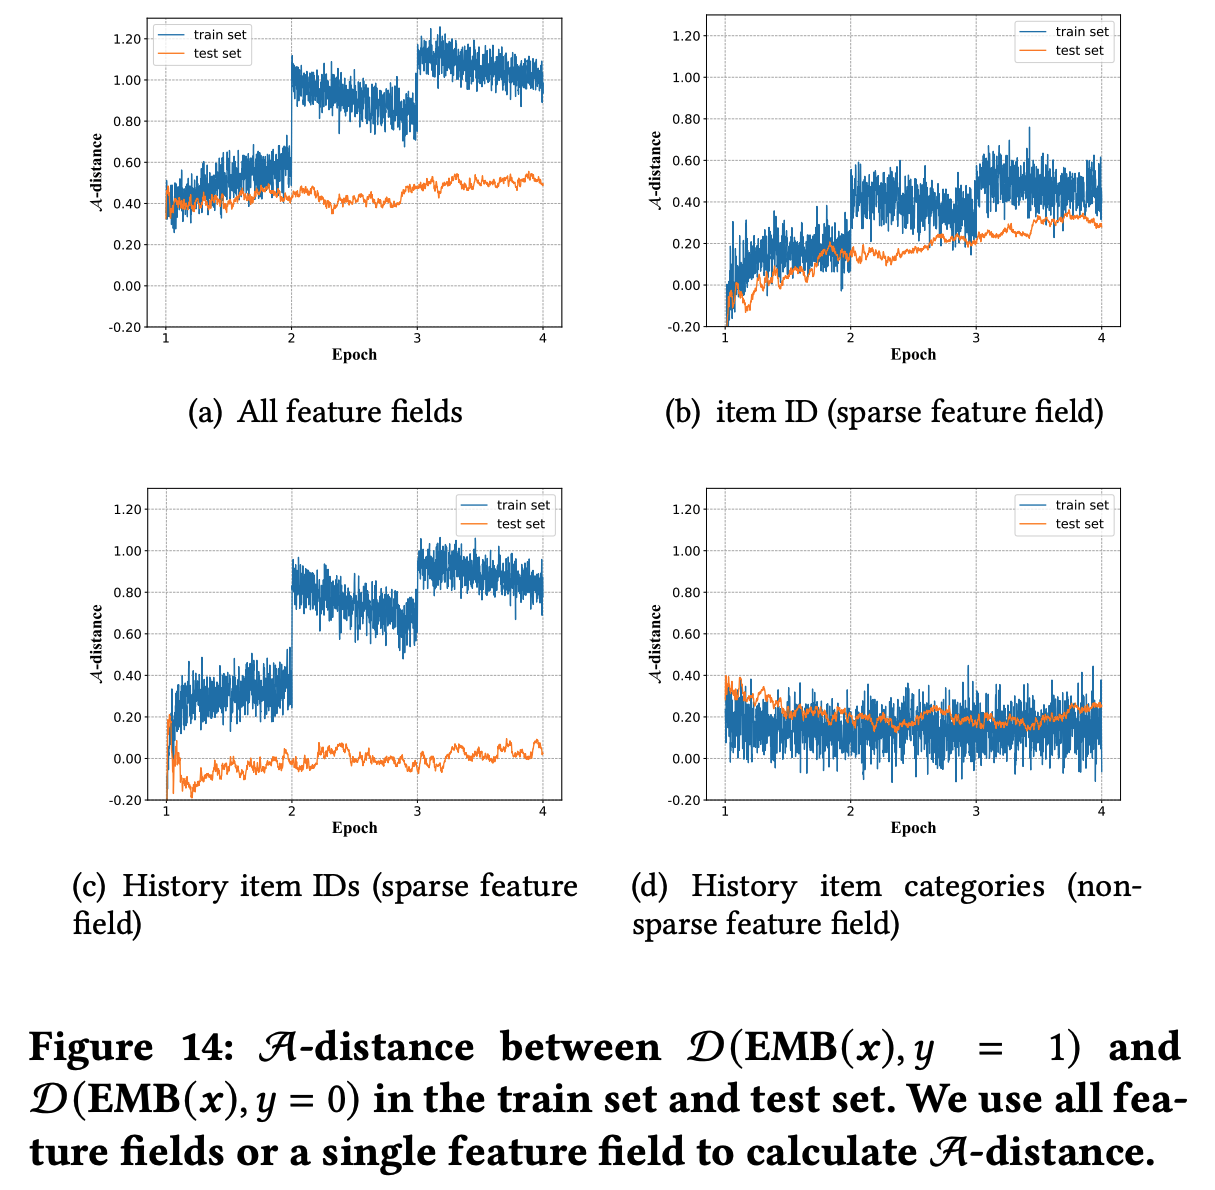
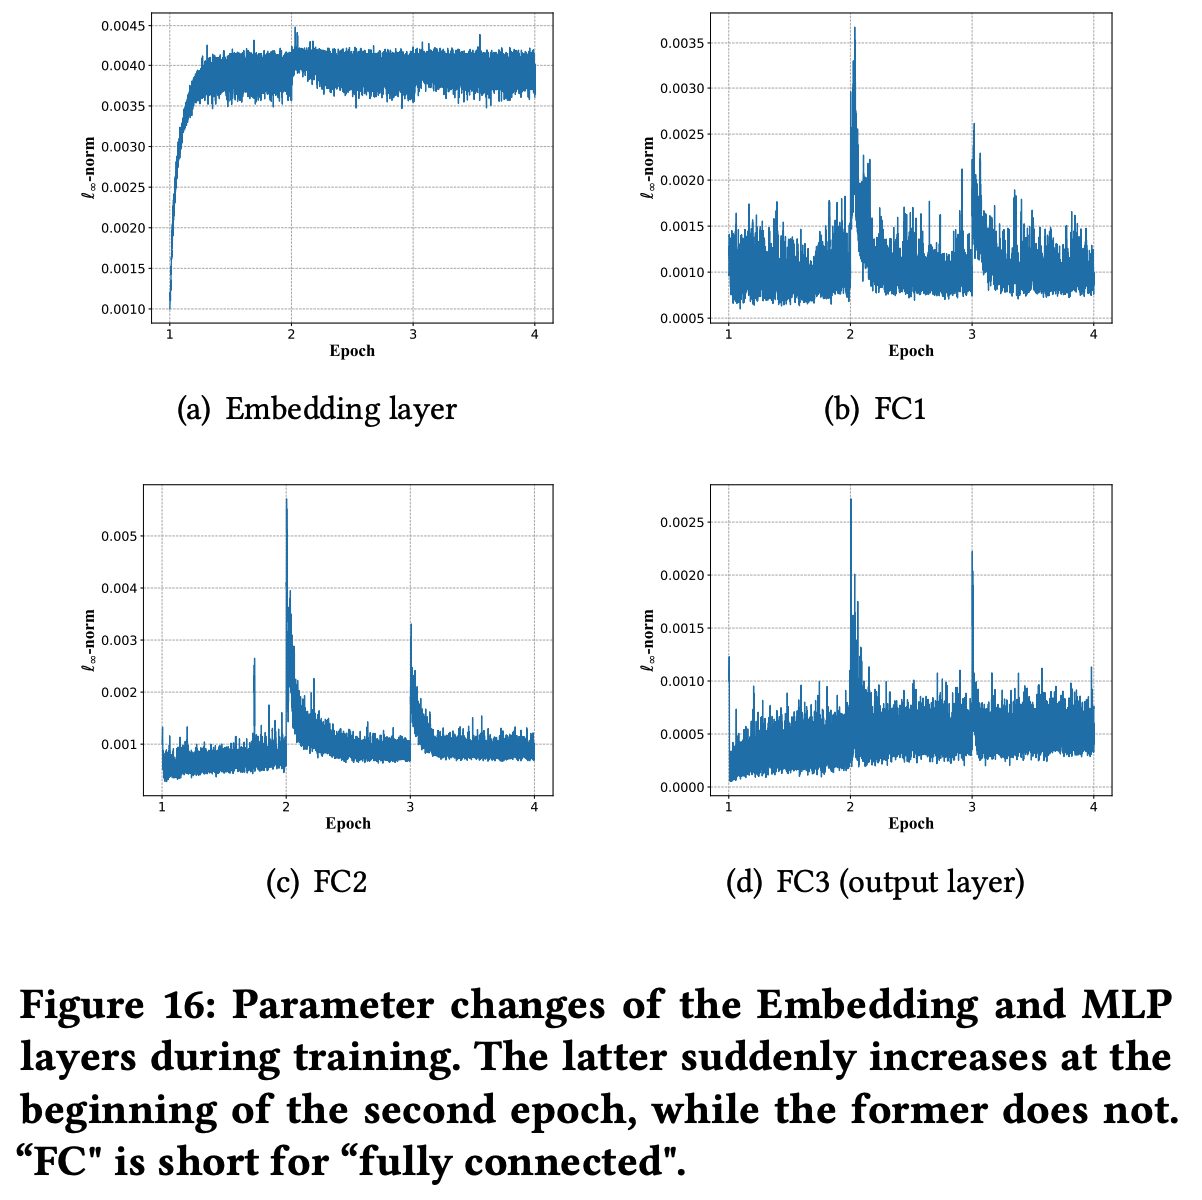
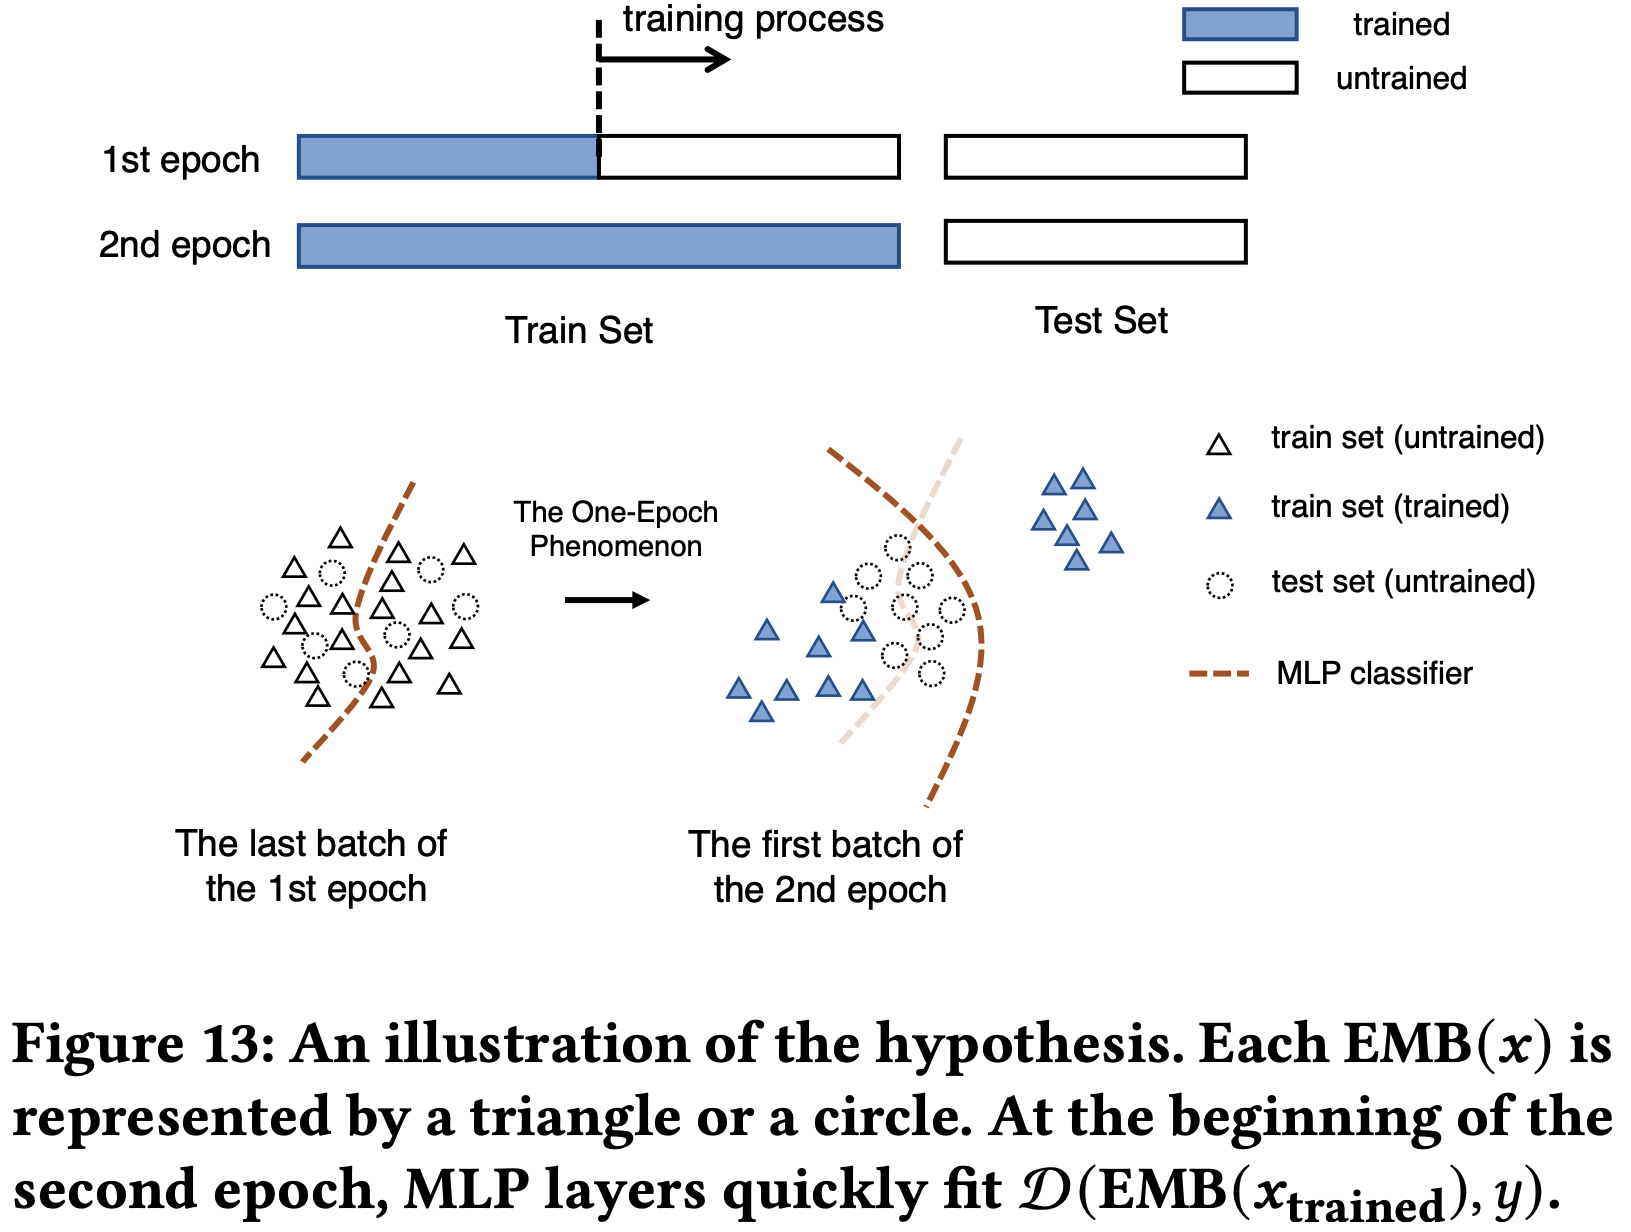
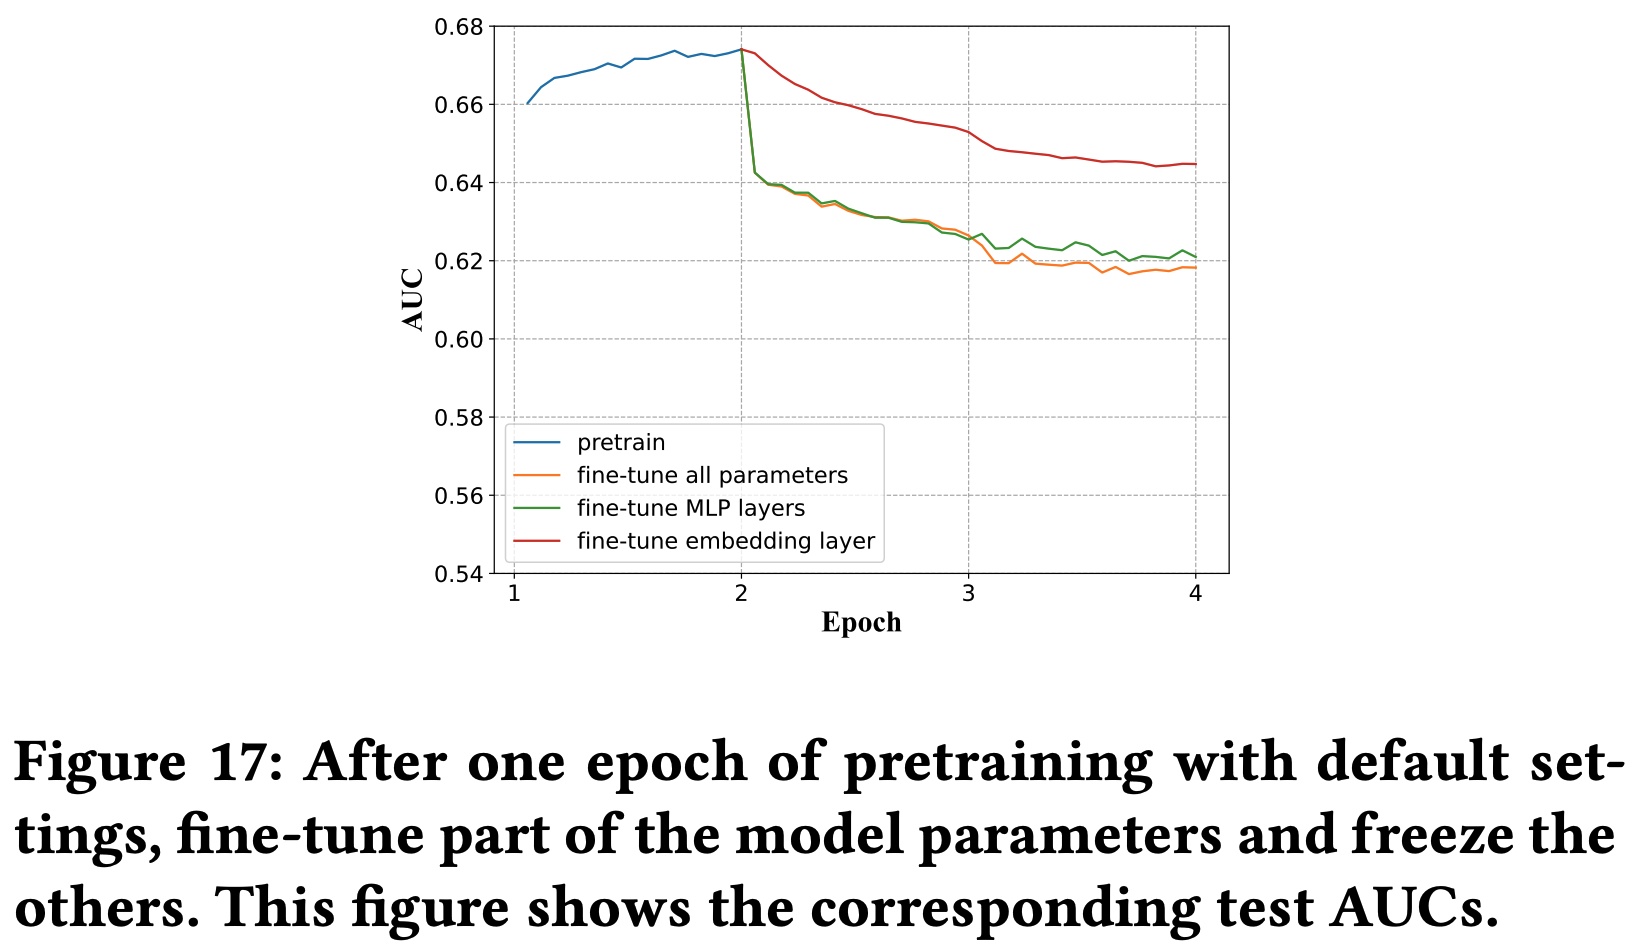
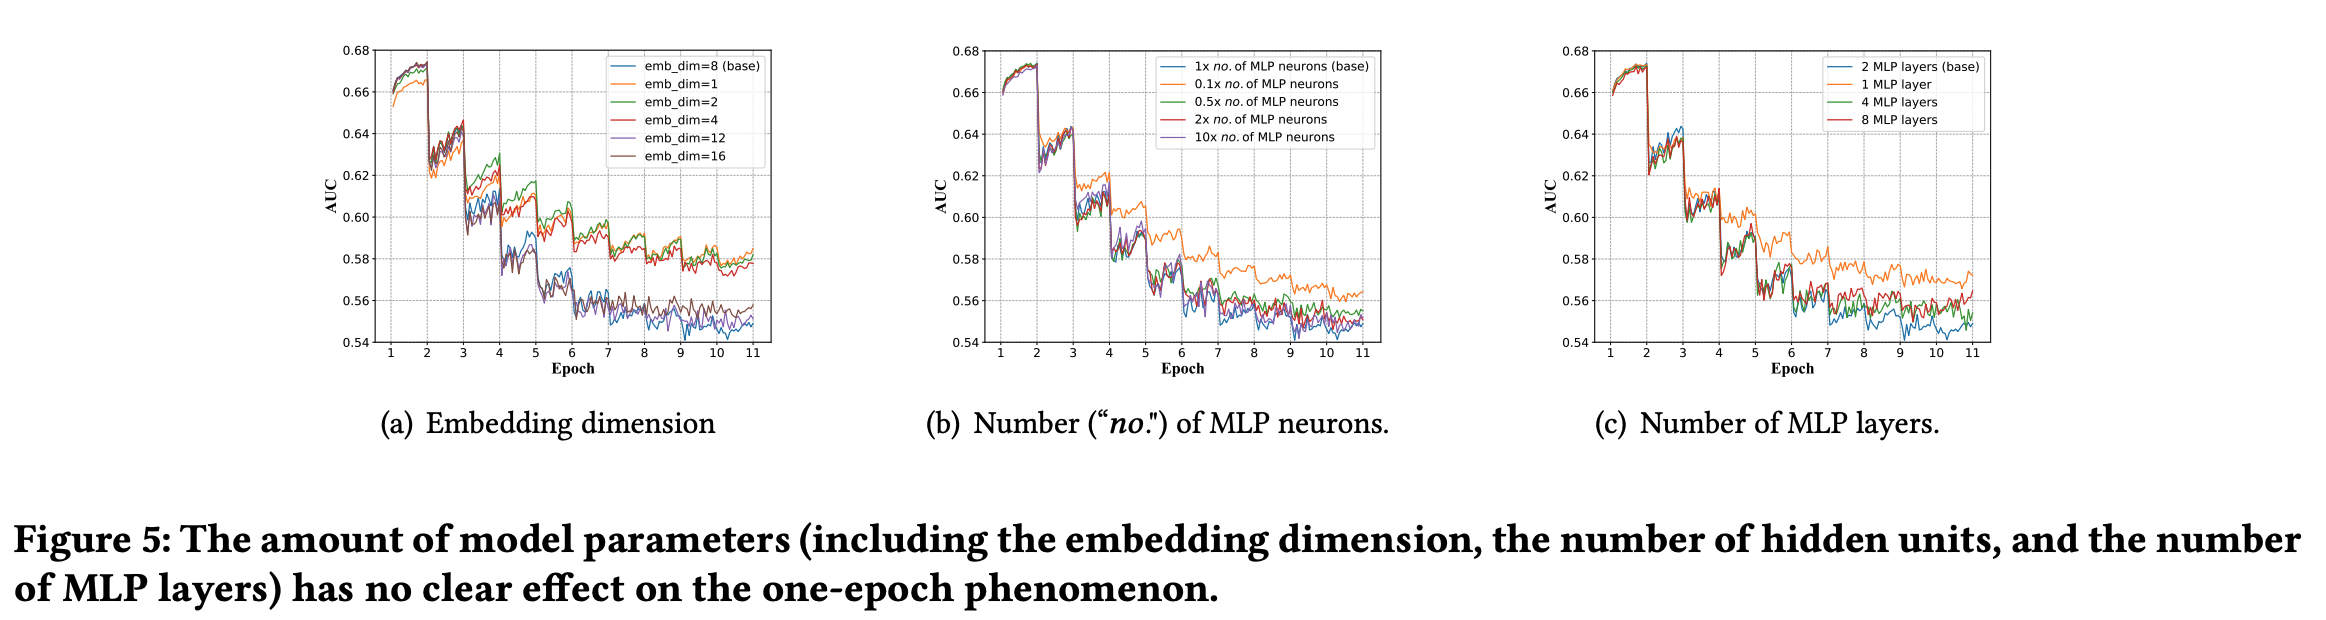
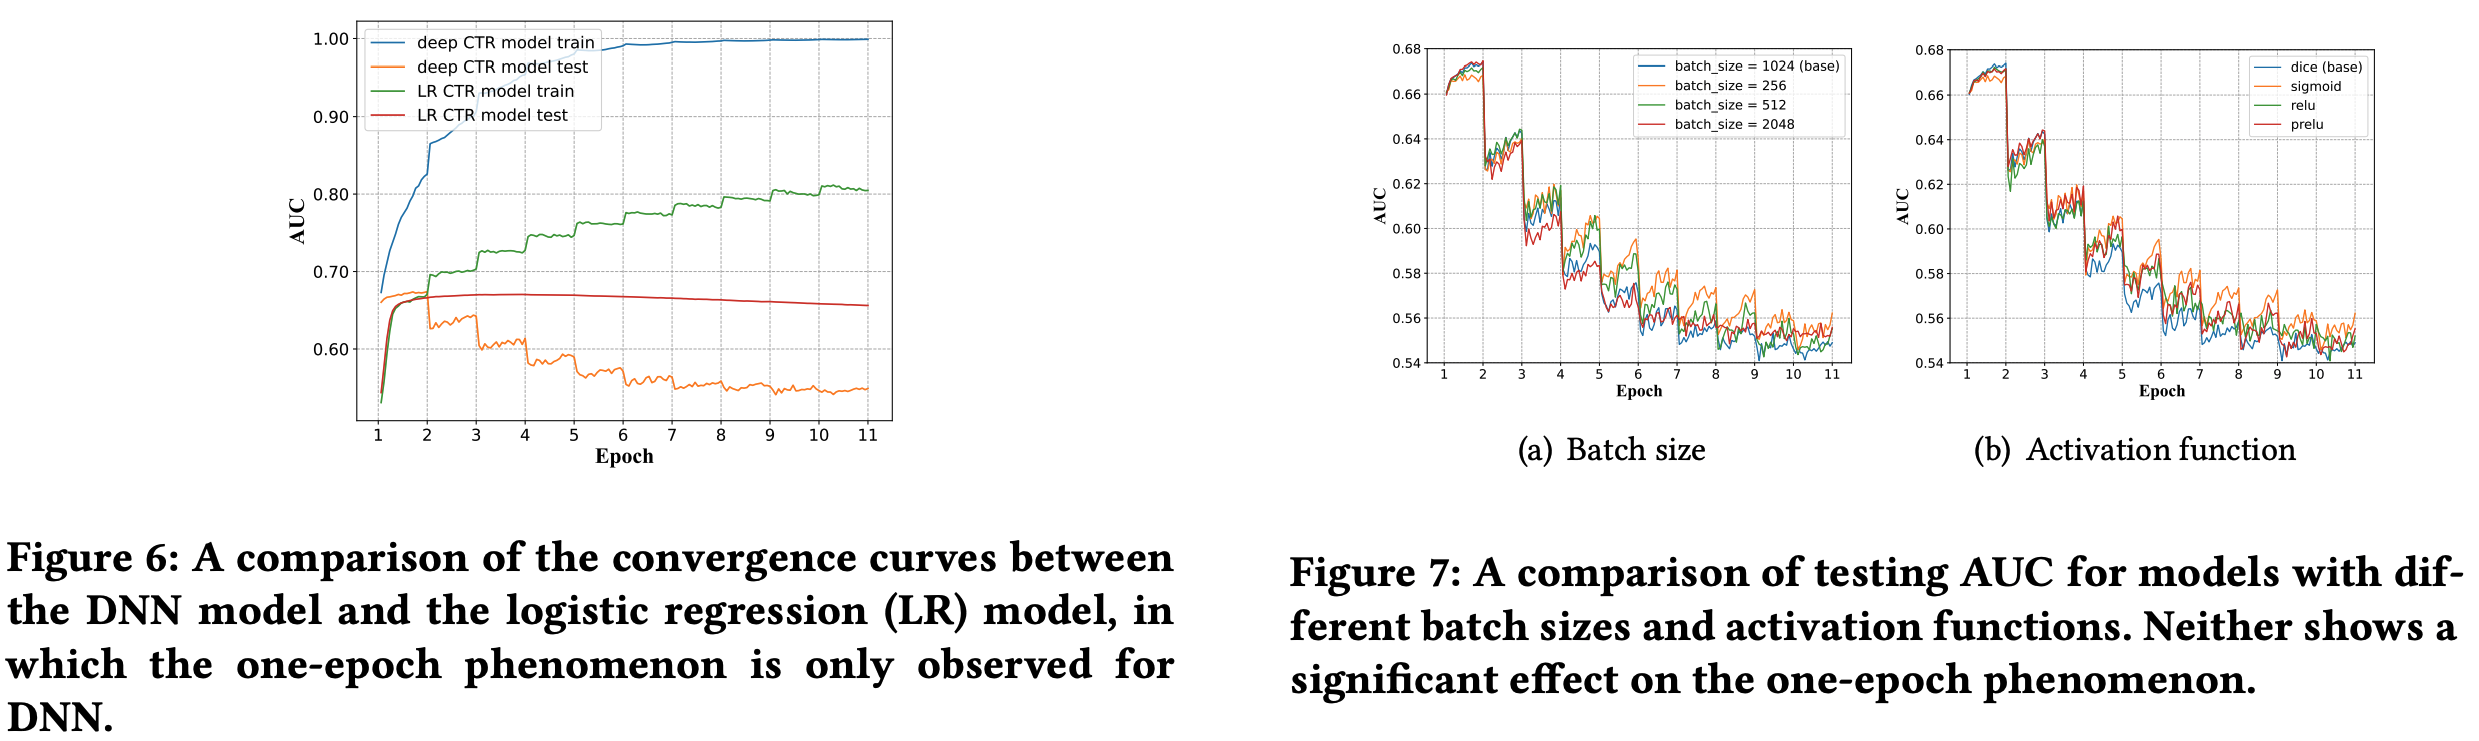
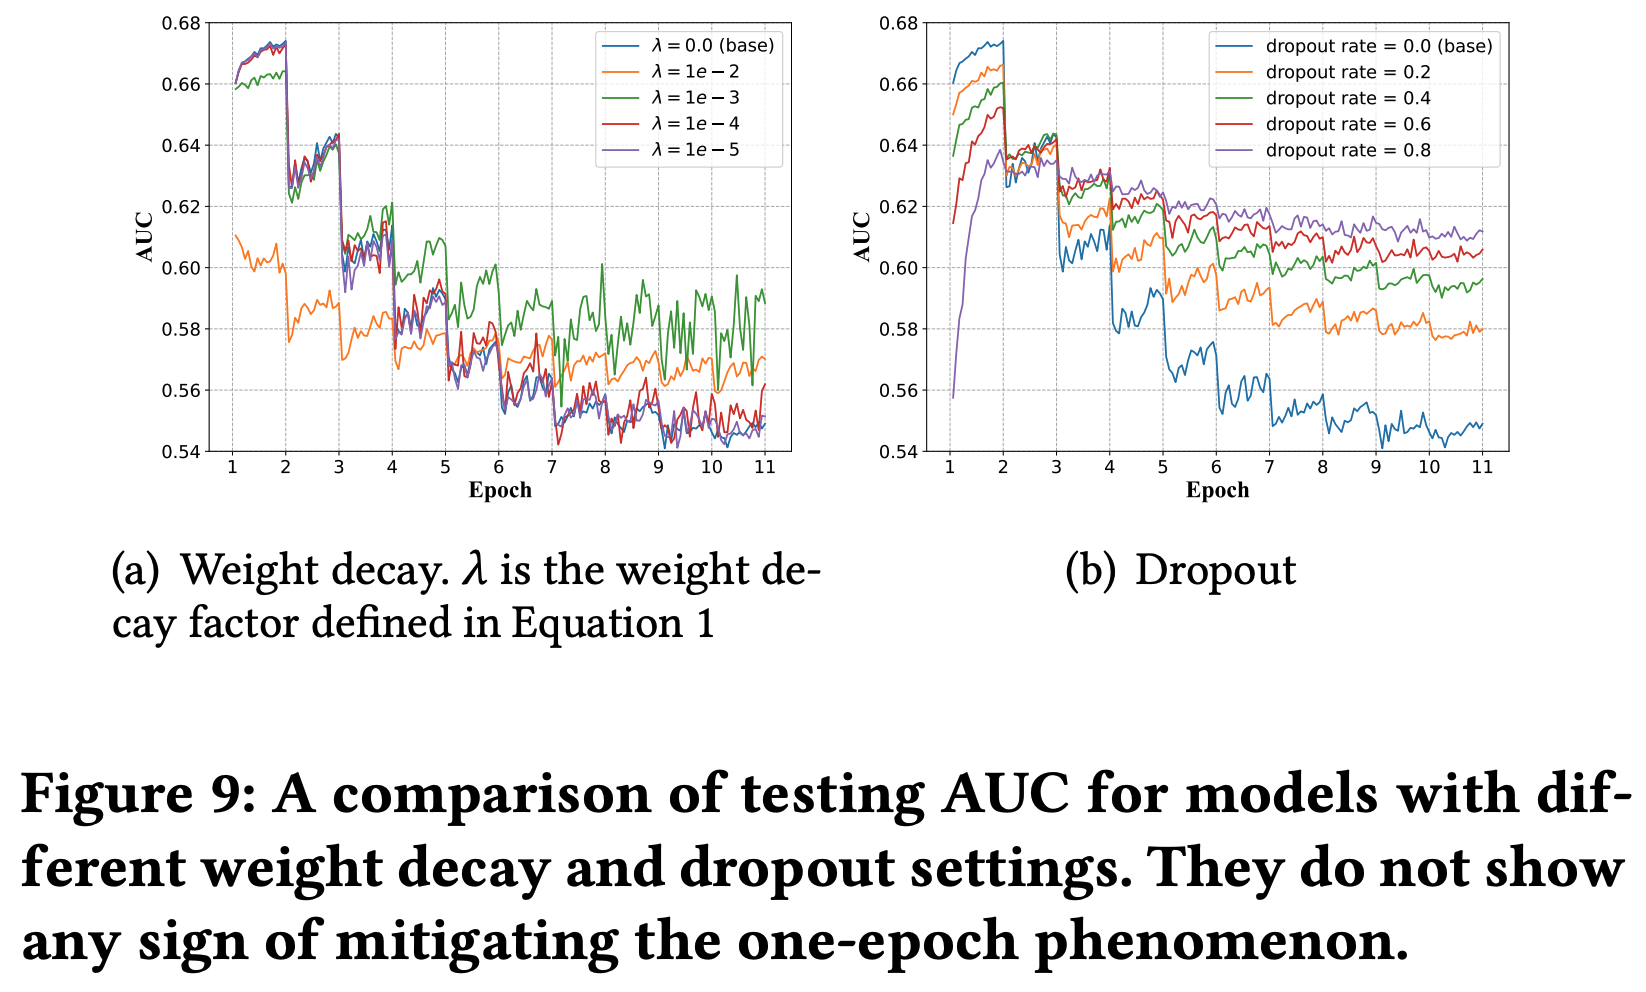
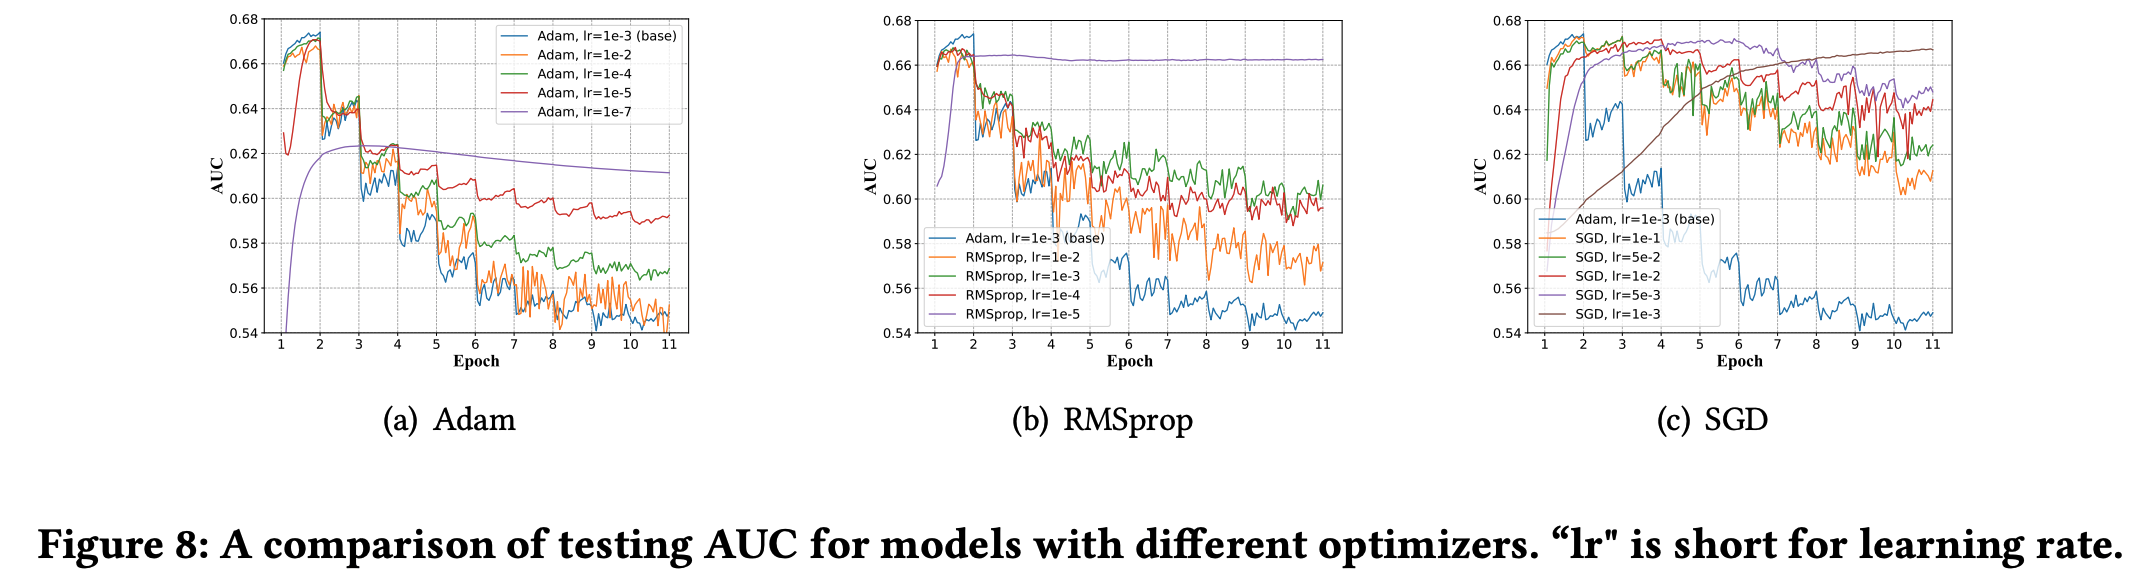
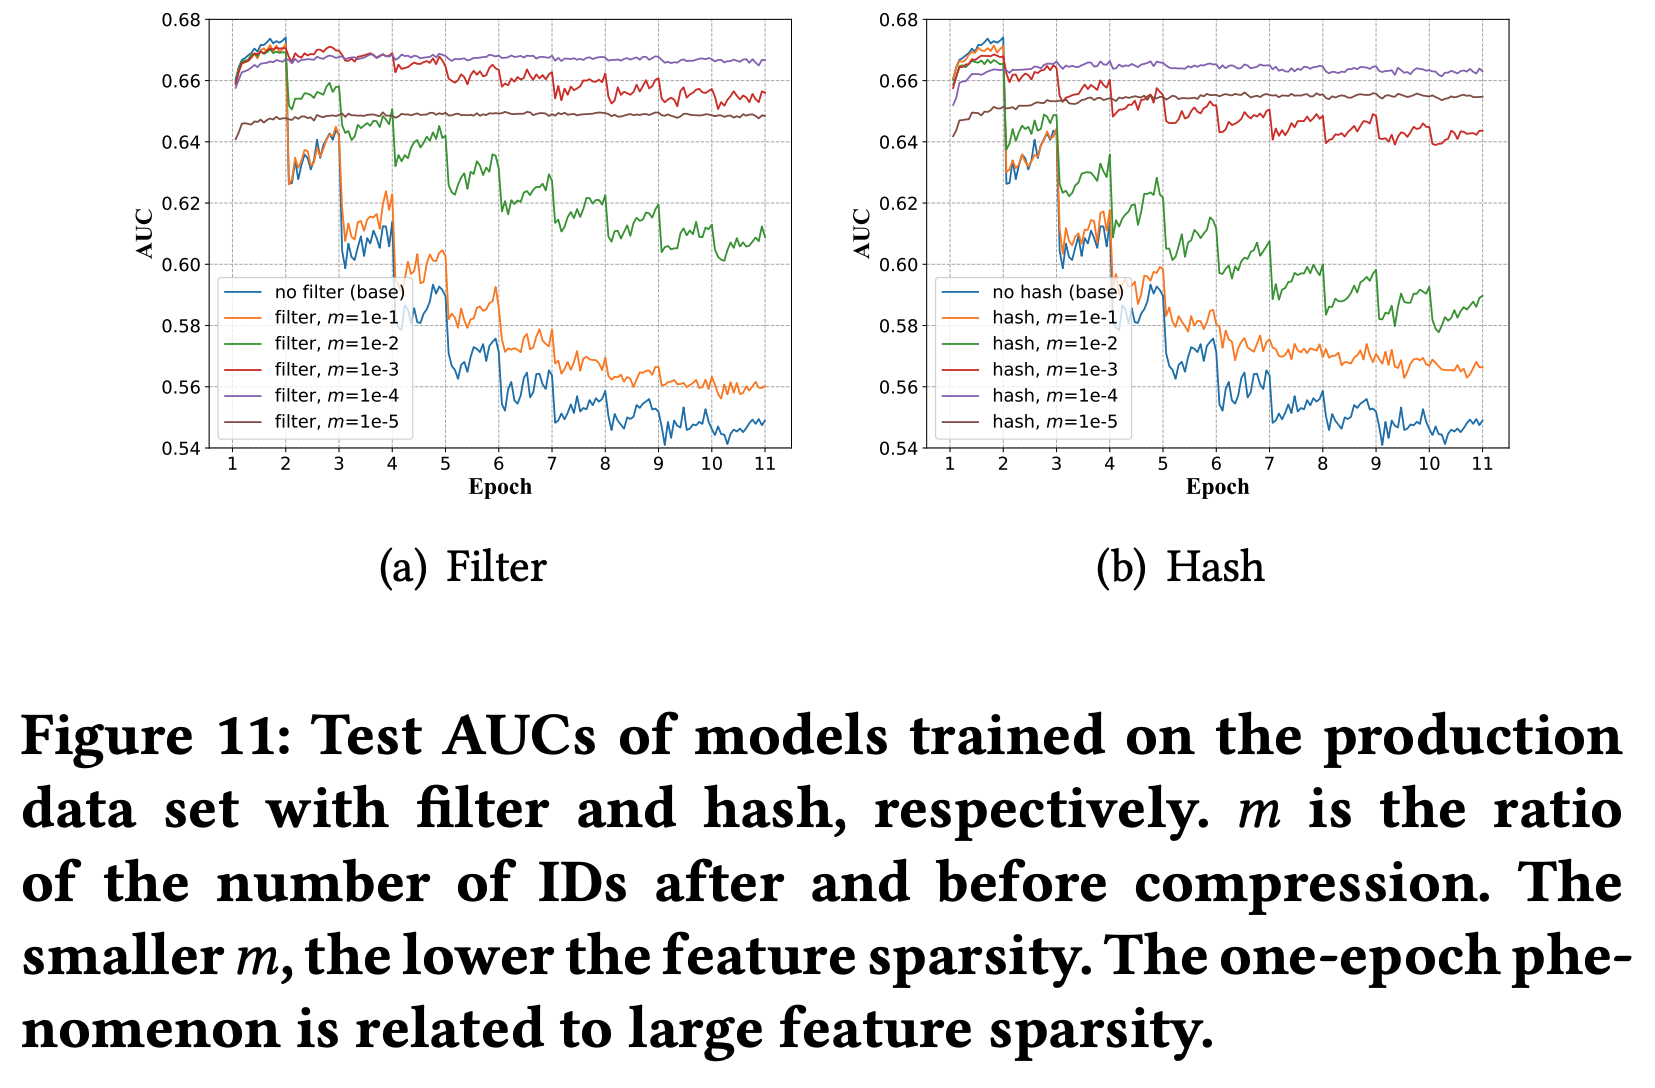
 * 问题:为什么稀疏反而收敛快?甚至一个 epoch 就能收敛
* 回答:文章没有给出详细解释,但个人理解为稀疏和收敛快不一定是严格矛盾的,可能是 Embedding 层参数更容易学习,但从文章给的实验结果看,一个 epoch 后 Embedding 层参数分布确实几乎收敛了