Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

RL——POMDP

本文是对POMDP这个不常见的概念的一些简单介绍,主要内容参考自POMDP讲解

  • 参考链接:POMDP讲解

MDP 和 POMDP

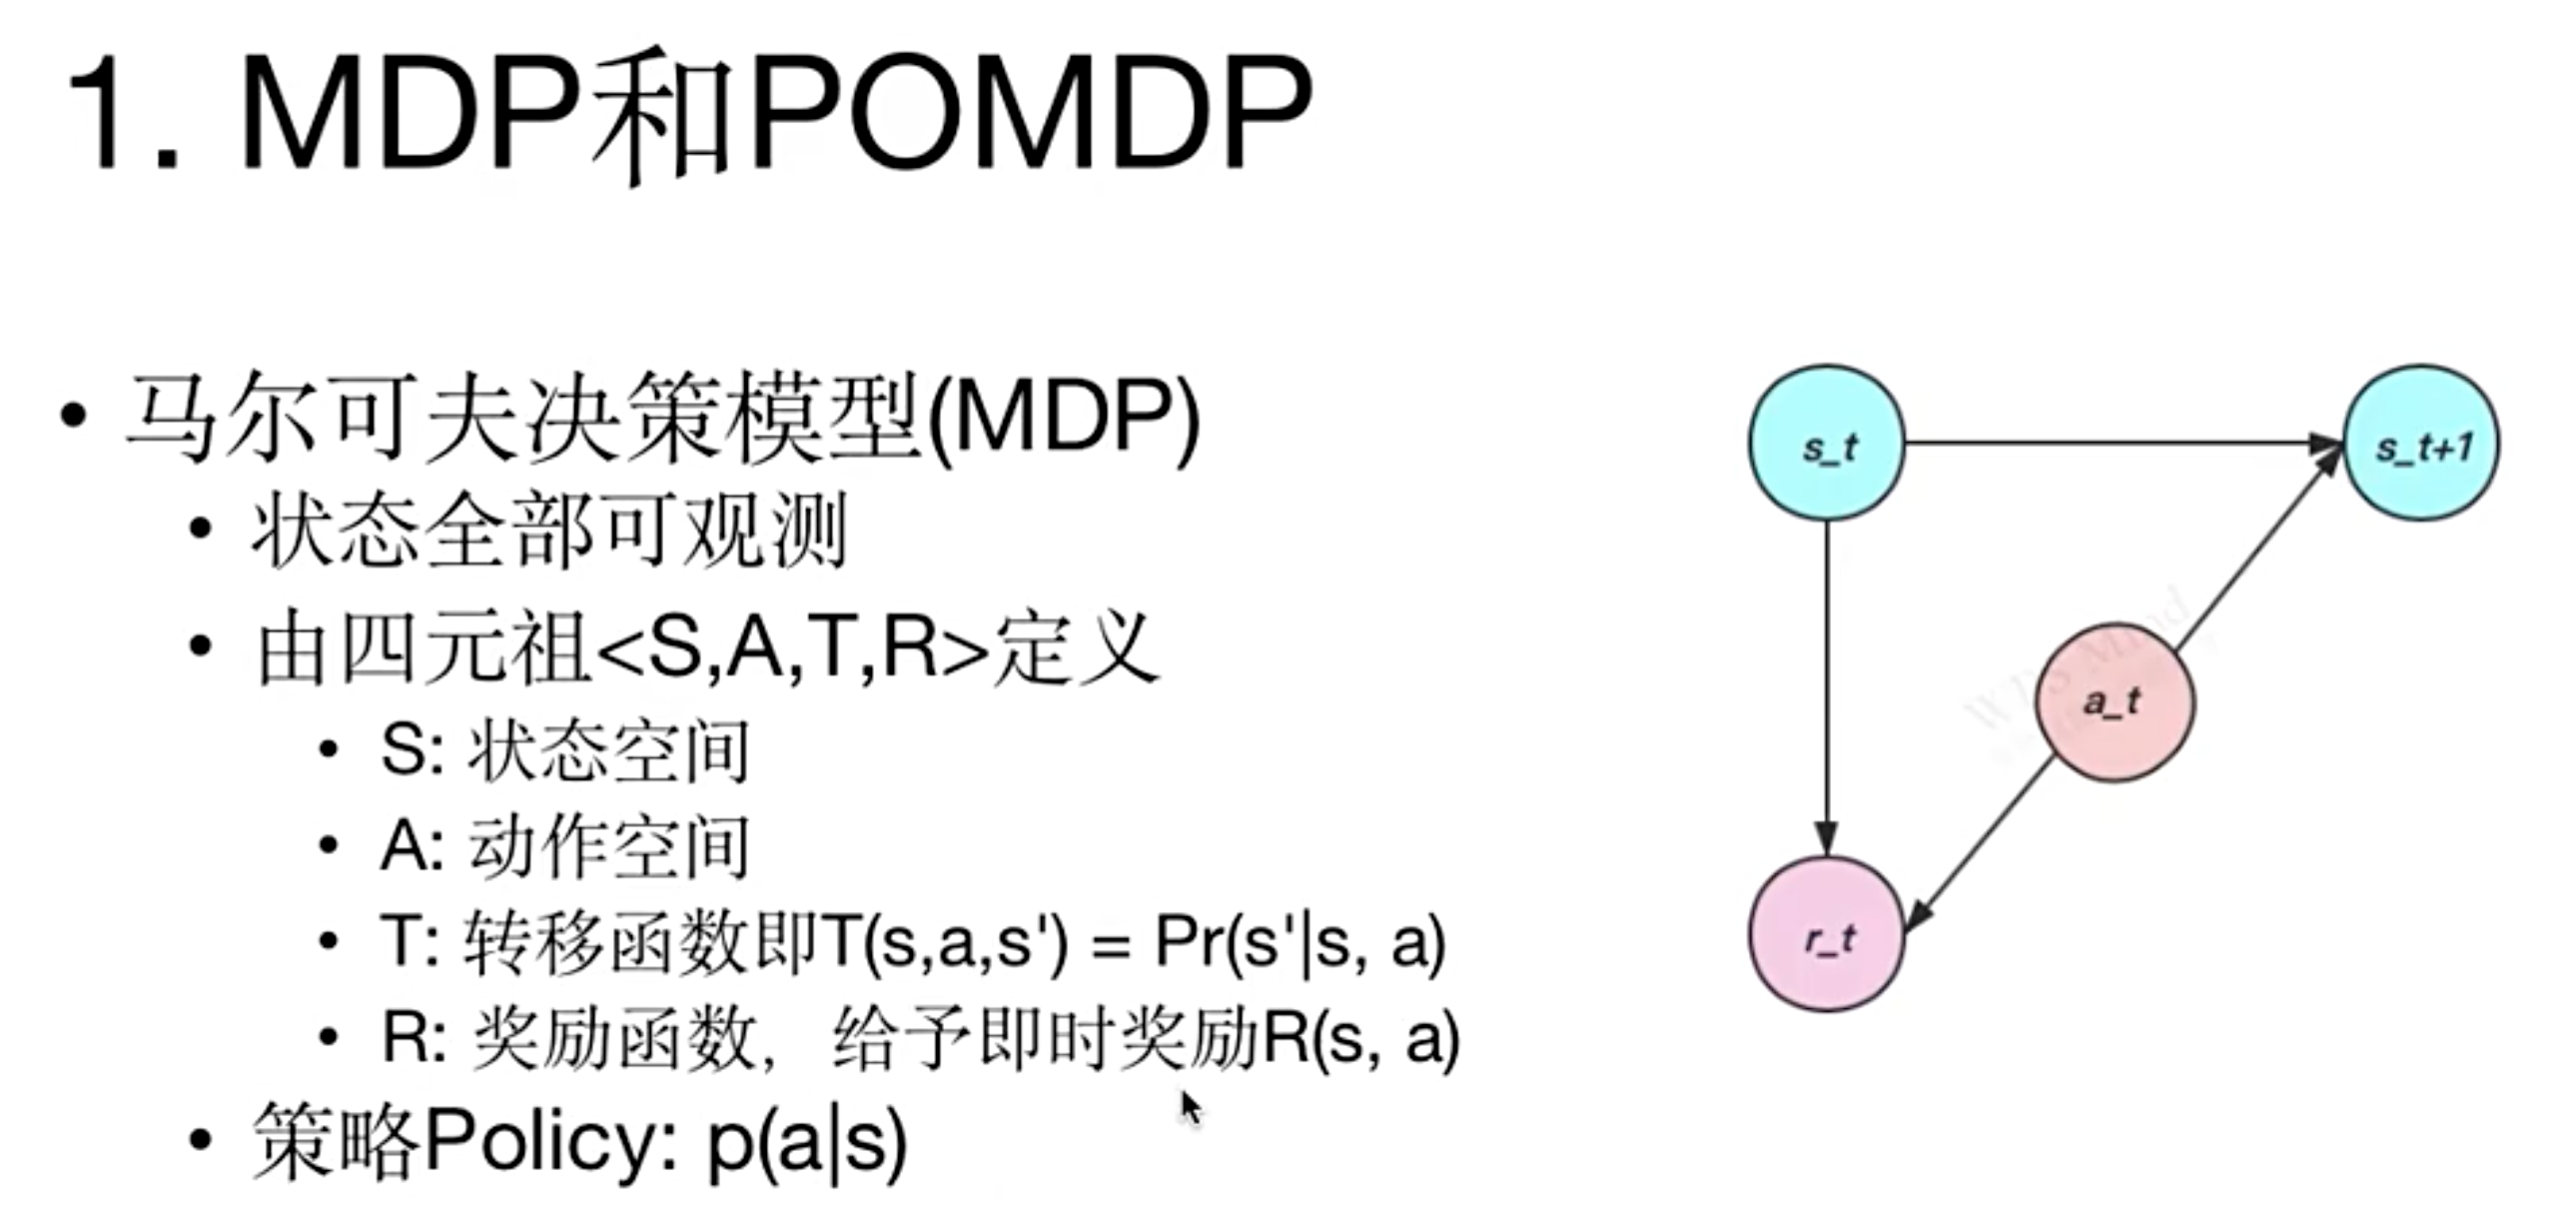
  • 马尔可夫决策模型(MDP)
    • 状态全部可观测
    • 由四元祖 \(\langle S, A, T, R\rangle\) 定义:
      • \(S\):状态空间
      • \(A\):动作空间
      • \(T\):转移函数即 \(T(s, a, s’) = Pr(s’|s, a)\)
      • \(R\):奖励函数,给予即时奖励 \(R(s, a)\)
    • 策略Policy: \(p(a|s)\)
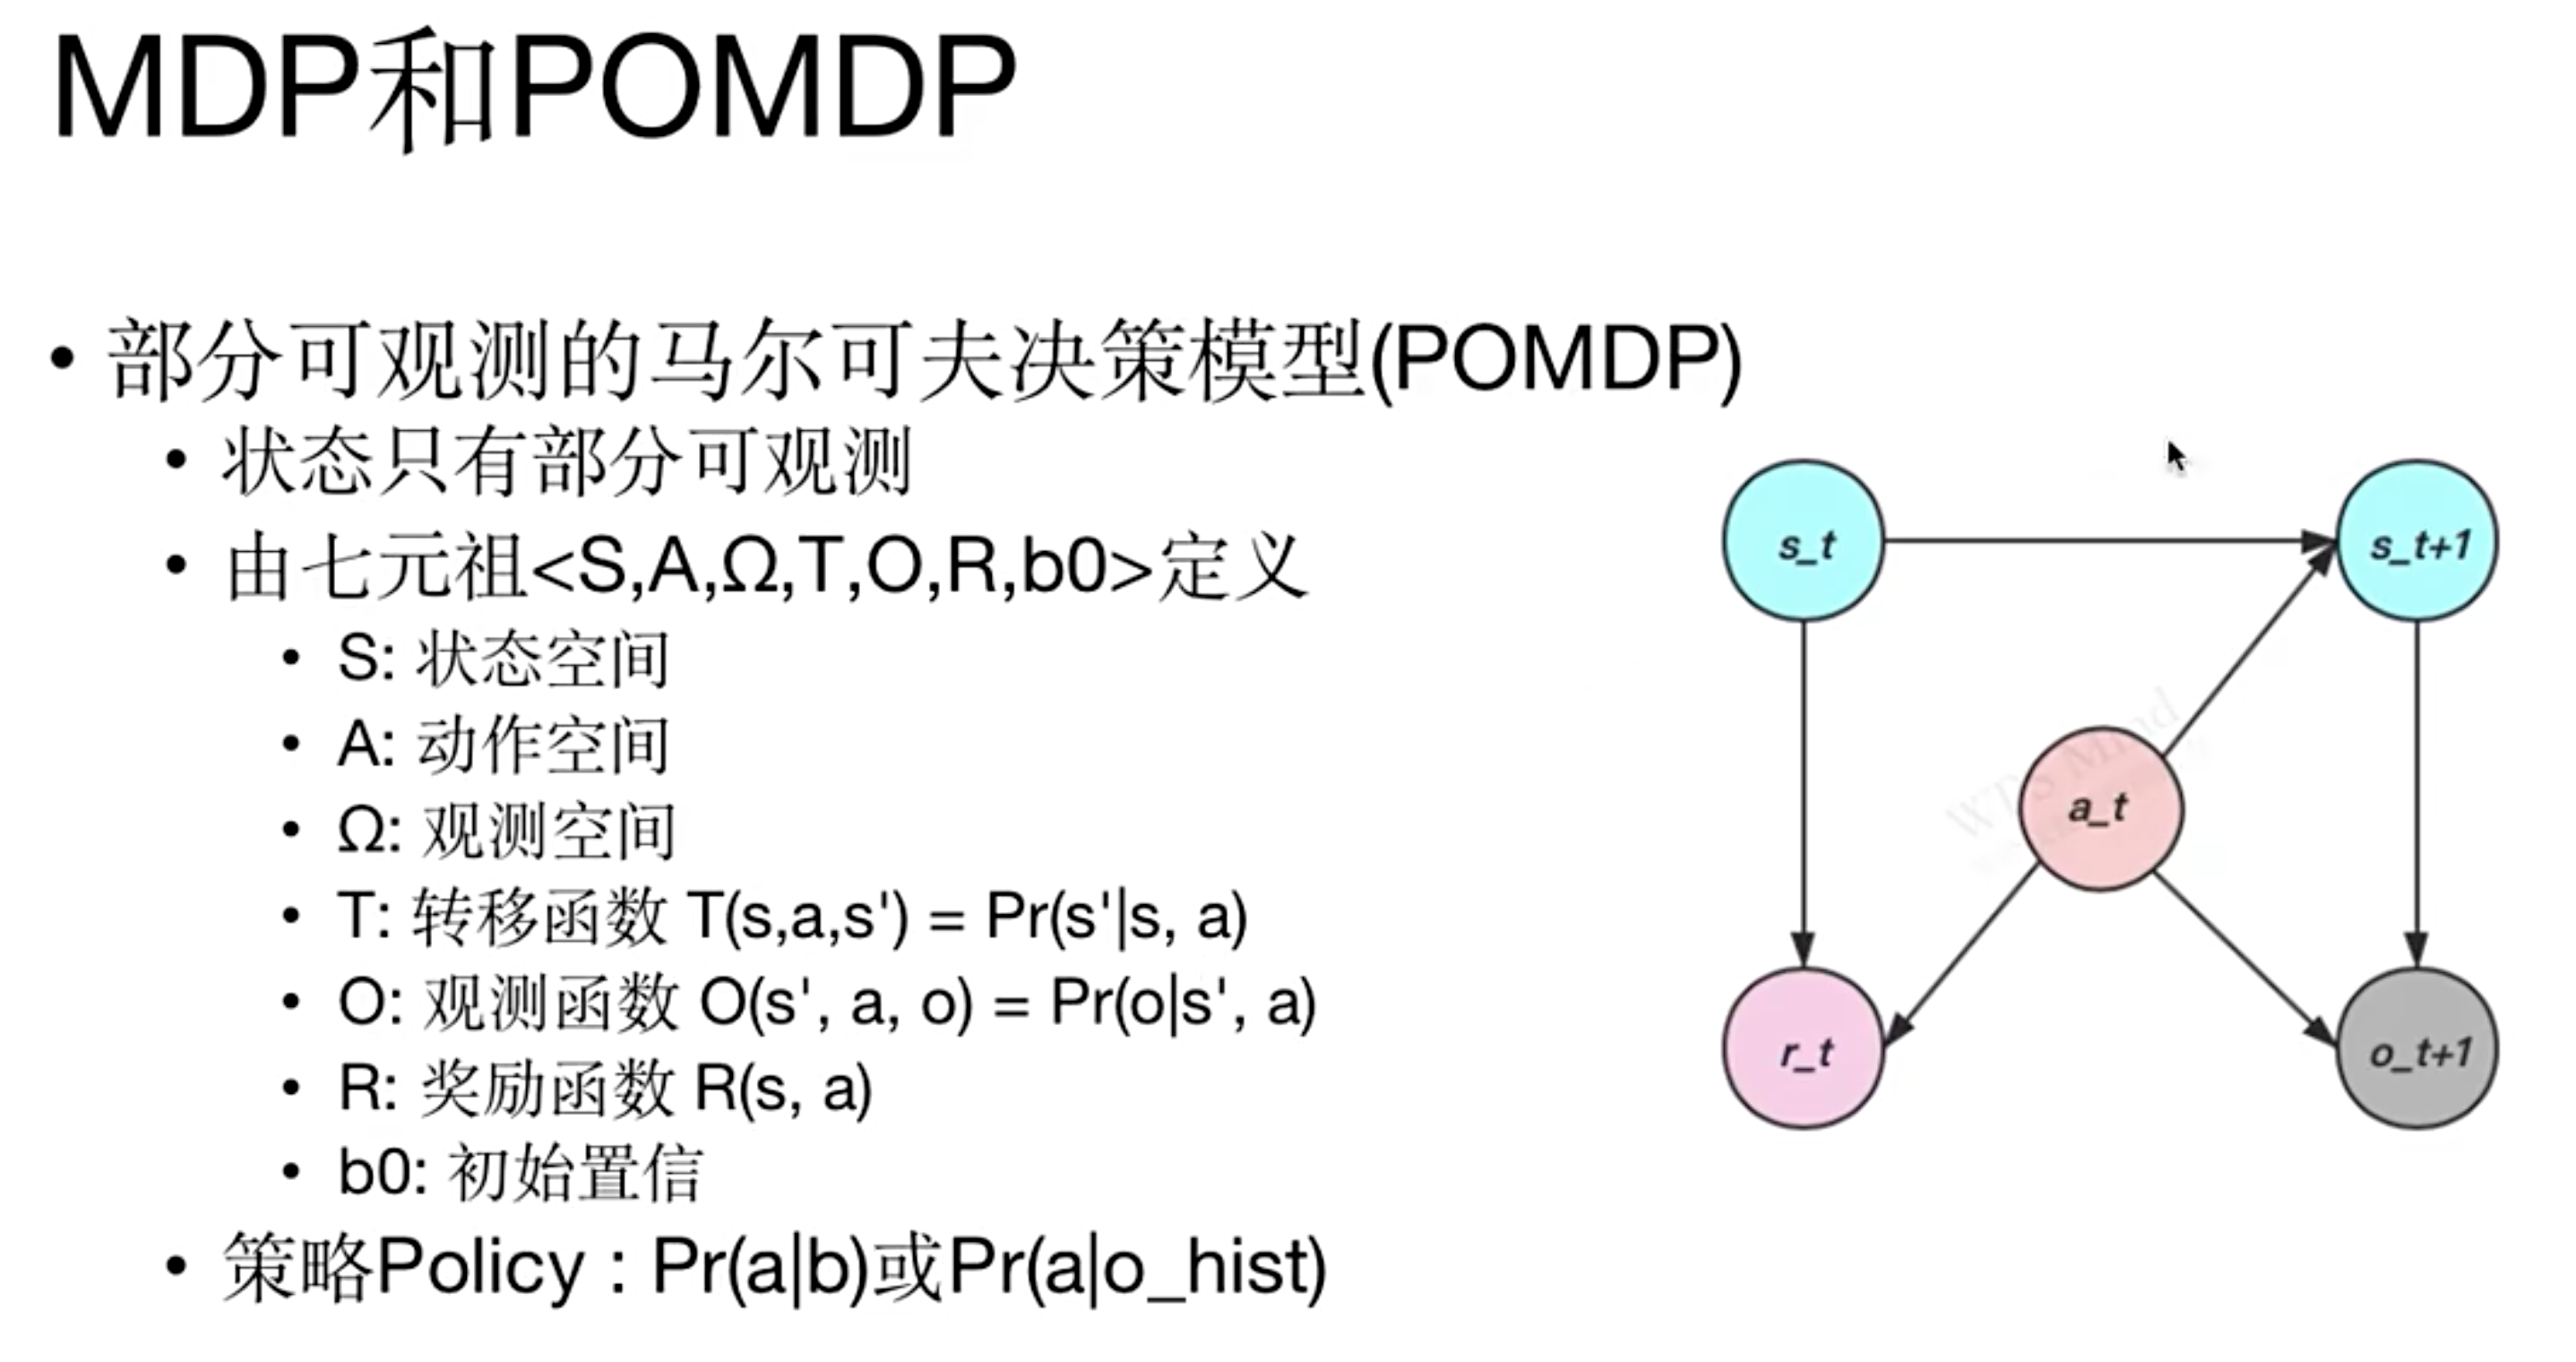
  • 部分可观测的马尔可夫决策模型(POMDP)
    • 状态只有部分可观测
    • 由七元祖 \(\langle S, A, \Omega, T, O, R, b0\rangle\) 定义:
      • \(S\):状态空间
      • \(A\):动作空间
      • \(\Omega\):观测空间
      • \(T\):转移函数 \(T(s, a, s’) = Pr(s’|s, a)\)
      • \(O\):观测函数 \(O(s’, a, o) = Pr(o|s’, a)\)
      • \(R\):奖励函数 \(R(s, a)\)
      • \(b0\):初始置信
    • 策略Policy: \(Pr(a|b)\) 或 \(Pr(a|o_{hist})\) ,其中 \(o_{hist}\) 表示单帧或多帧的历史观测信息(因为观测 \(o\) 是不分更新的,可能已经不满足马尔科夫性了)
  • POMDP 的观测本身是不完整的系统状态信息,可能已经不满足马尔科夫性了,此时可以通过信念状态(Belief State,写作 \(b\))或历史观测序列(写作 \(o_{hist}\))来表示当前状态,从而保证智能体看到的观测是尽量完整的

POMDP 中的置信 Belief

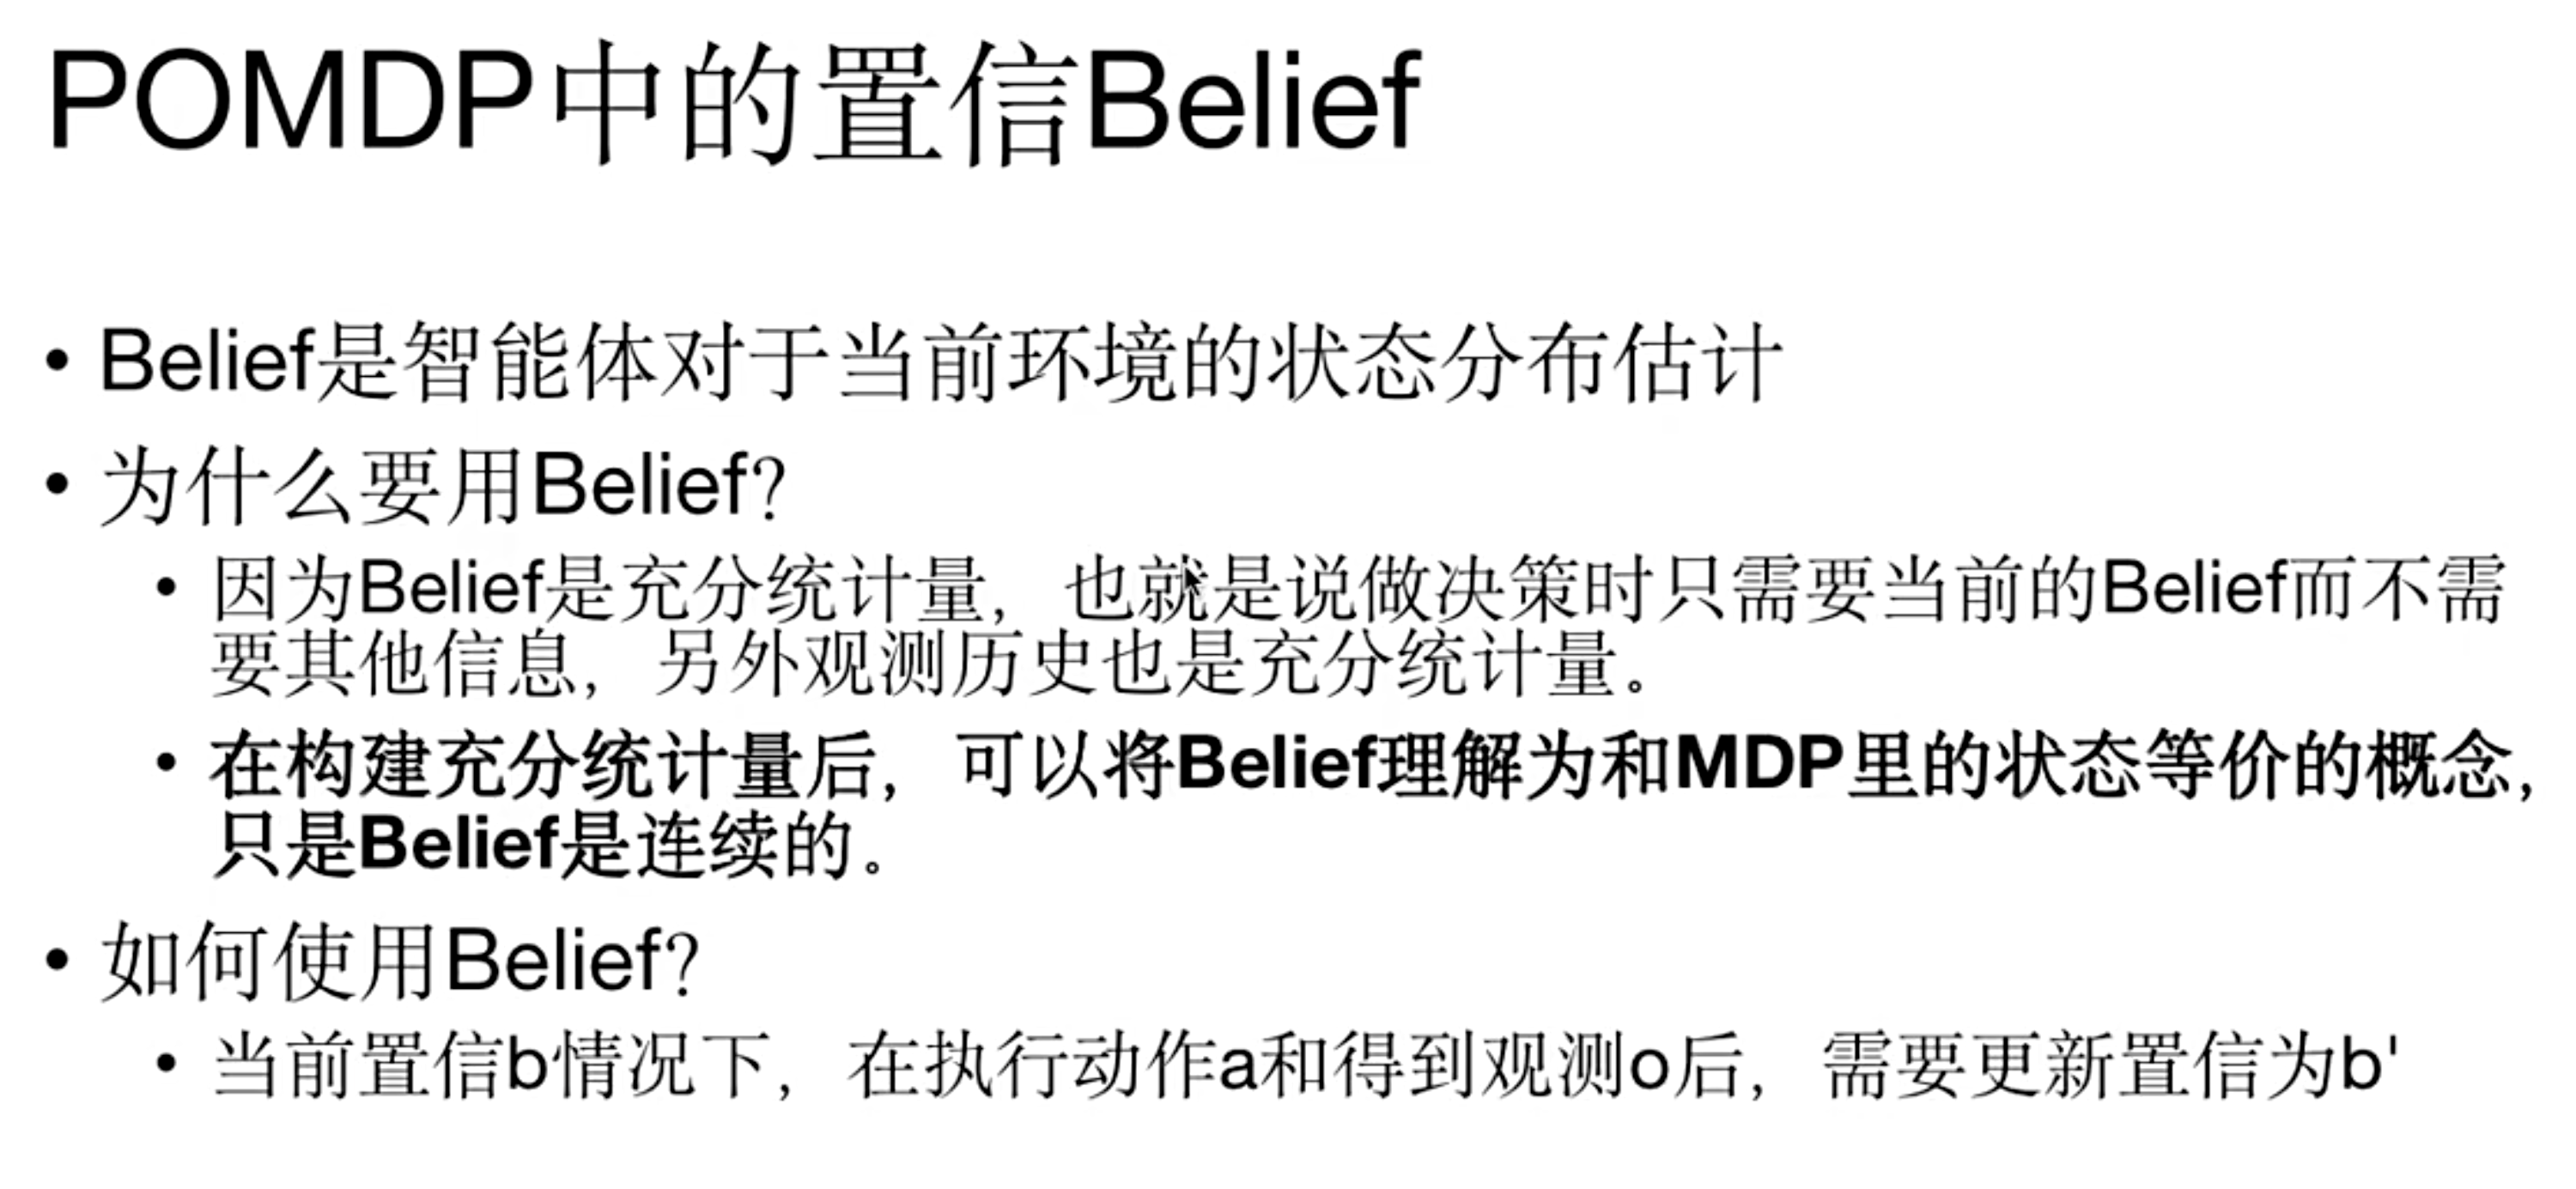
  • Belief 的定义 :Belief是智能体对于当前环境的状态分布估计
  • 使用 Belief 的原因 :因为Belief是充分统计量,也就是说做决策时只需要当前的Belief而不需要其他信息,另外观测历史也是充分统计量。在构建充分统计量后,可以将Belief理解为和MDP里的状态等价的概念,只是Belief是连续的
  • 使用方式 :当前置信 \(b\) 情况下,在执行动作 \(a\) 和得到观测 \(o\) 后,需要更新置信为 \(b’\)
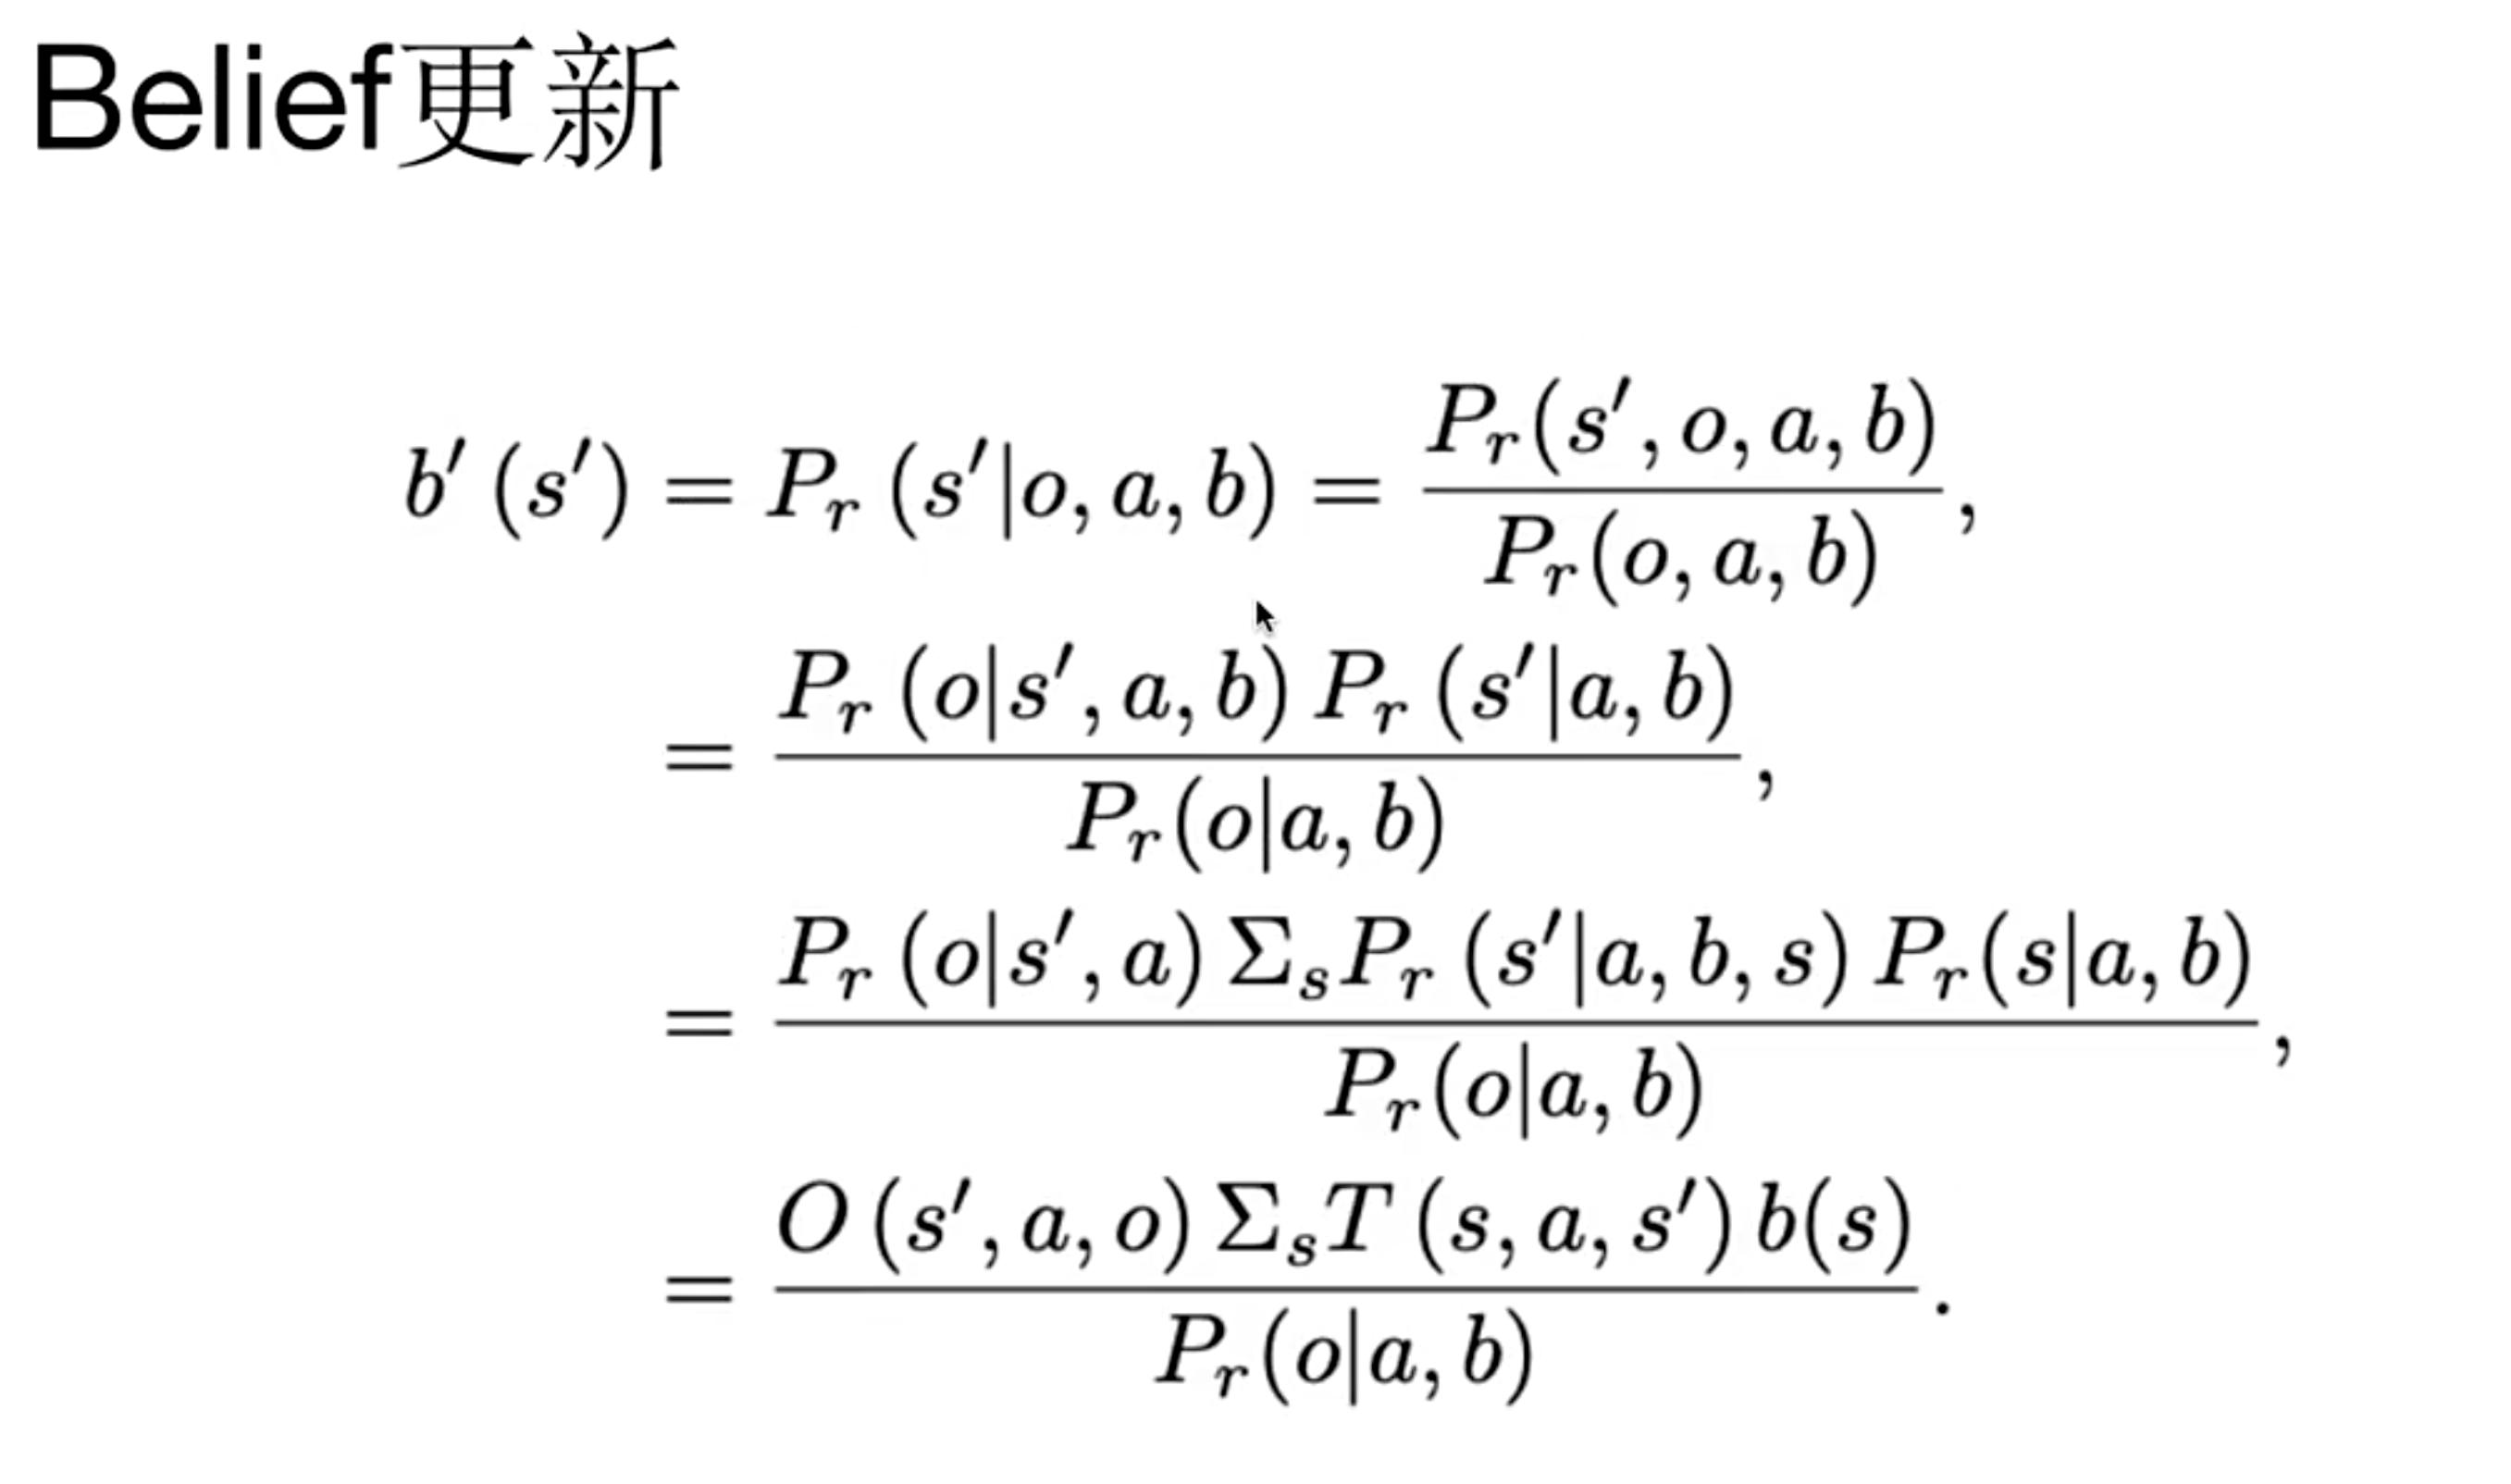
  • Belief 更新公式 :
    $$
    \begin{align}
    b’(s’) &= P_r(s’|o, a, b) = \frac{P_r(s’, o, a, b)}{P_r(o, a, b)}\\
    &= \frac{P_r(o|s’, a, b)P_r(s’|a, b)}{P_r(o|a, b)}\\
    &= \frac{P_r(o|s’, a)\sum_s P_r(s’|a, b, s)P_r(s|a, b)}{P_r(o|a, b)}\\
    &= \frac{O(s’, a, o)\sum_s T(s, a, s’)b(s)}{P_r(o|a, b)}
    \end{align}
    $$

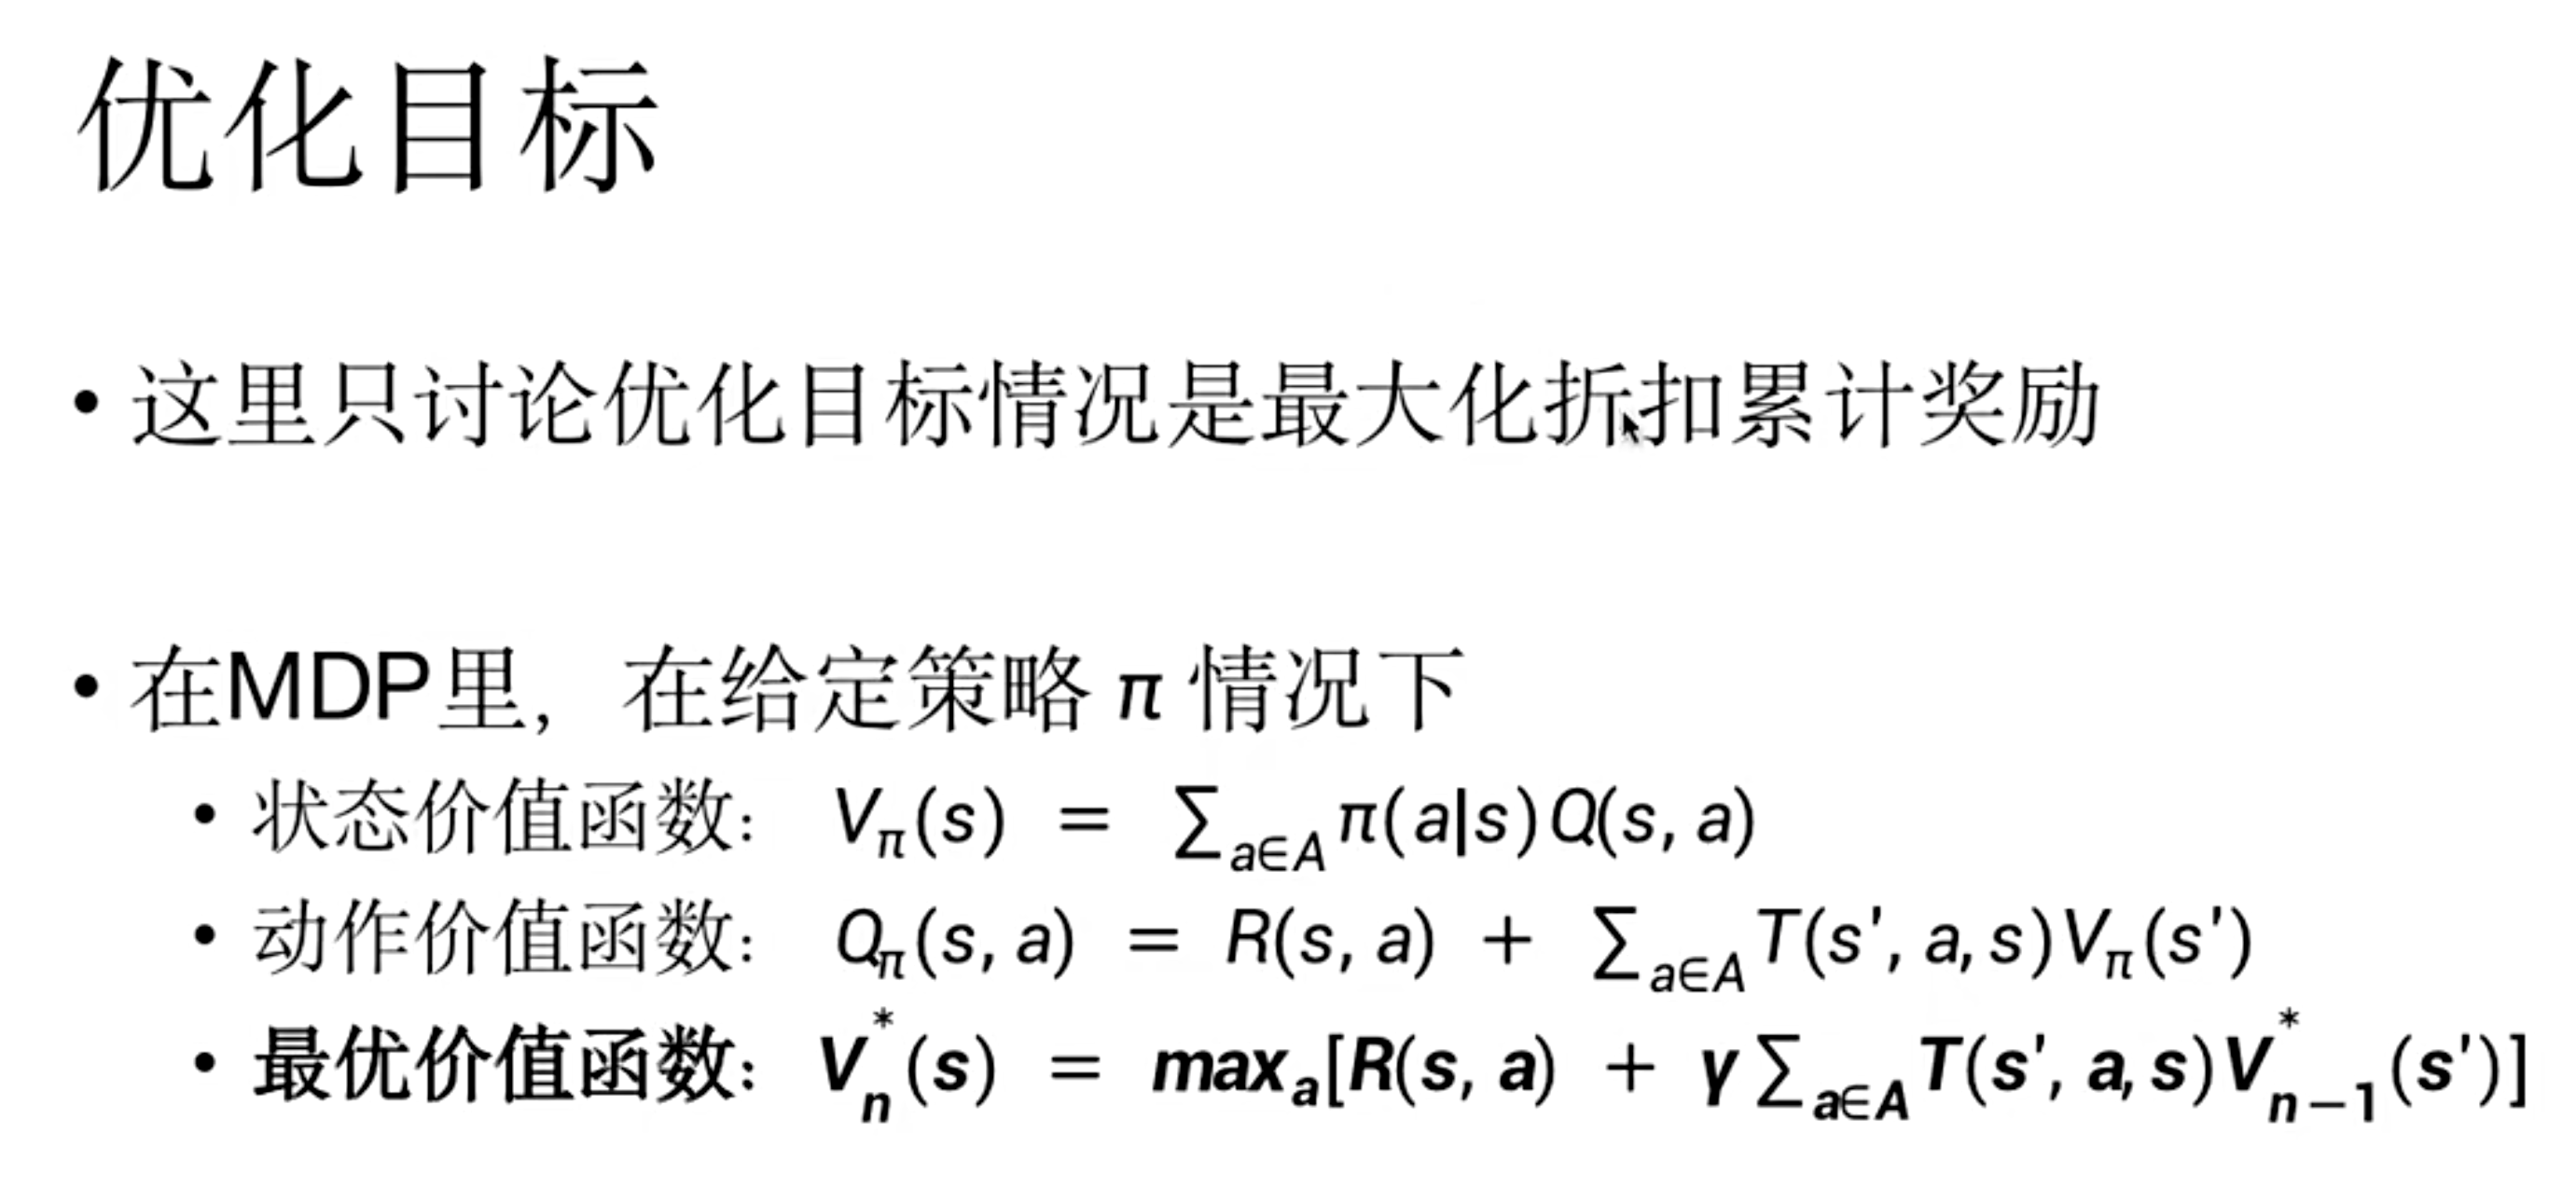
MDP 和 POMDP 的优化目标

  • 在 MDP 里 :在给定策略 \(\pi\) 情况下
    • 状态价值函数: \(V_{\pi}(s) = \sum_{a\in A}\pi(a|s)Q(s, a)\)
    • 动作价值函数: \(Q_{\pi}(s, a) = R(s, a) + \sum_{a\in A}T(s’, a, s)V_{\pi}(s’)\)
    • 最优价值函数: \(V_{n}^{*}(s) = \max_{a}[R(s, a) + \gamma\sum_{a\in A}T(s’, a, s)V_{n - 1}^{*}(s’)]\)
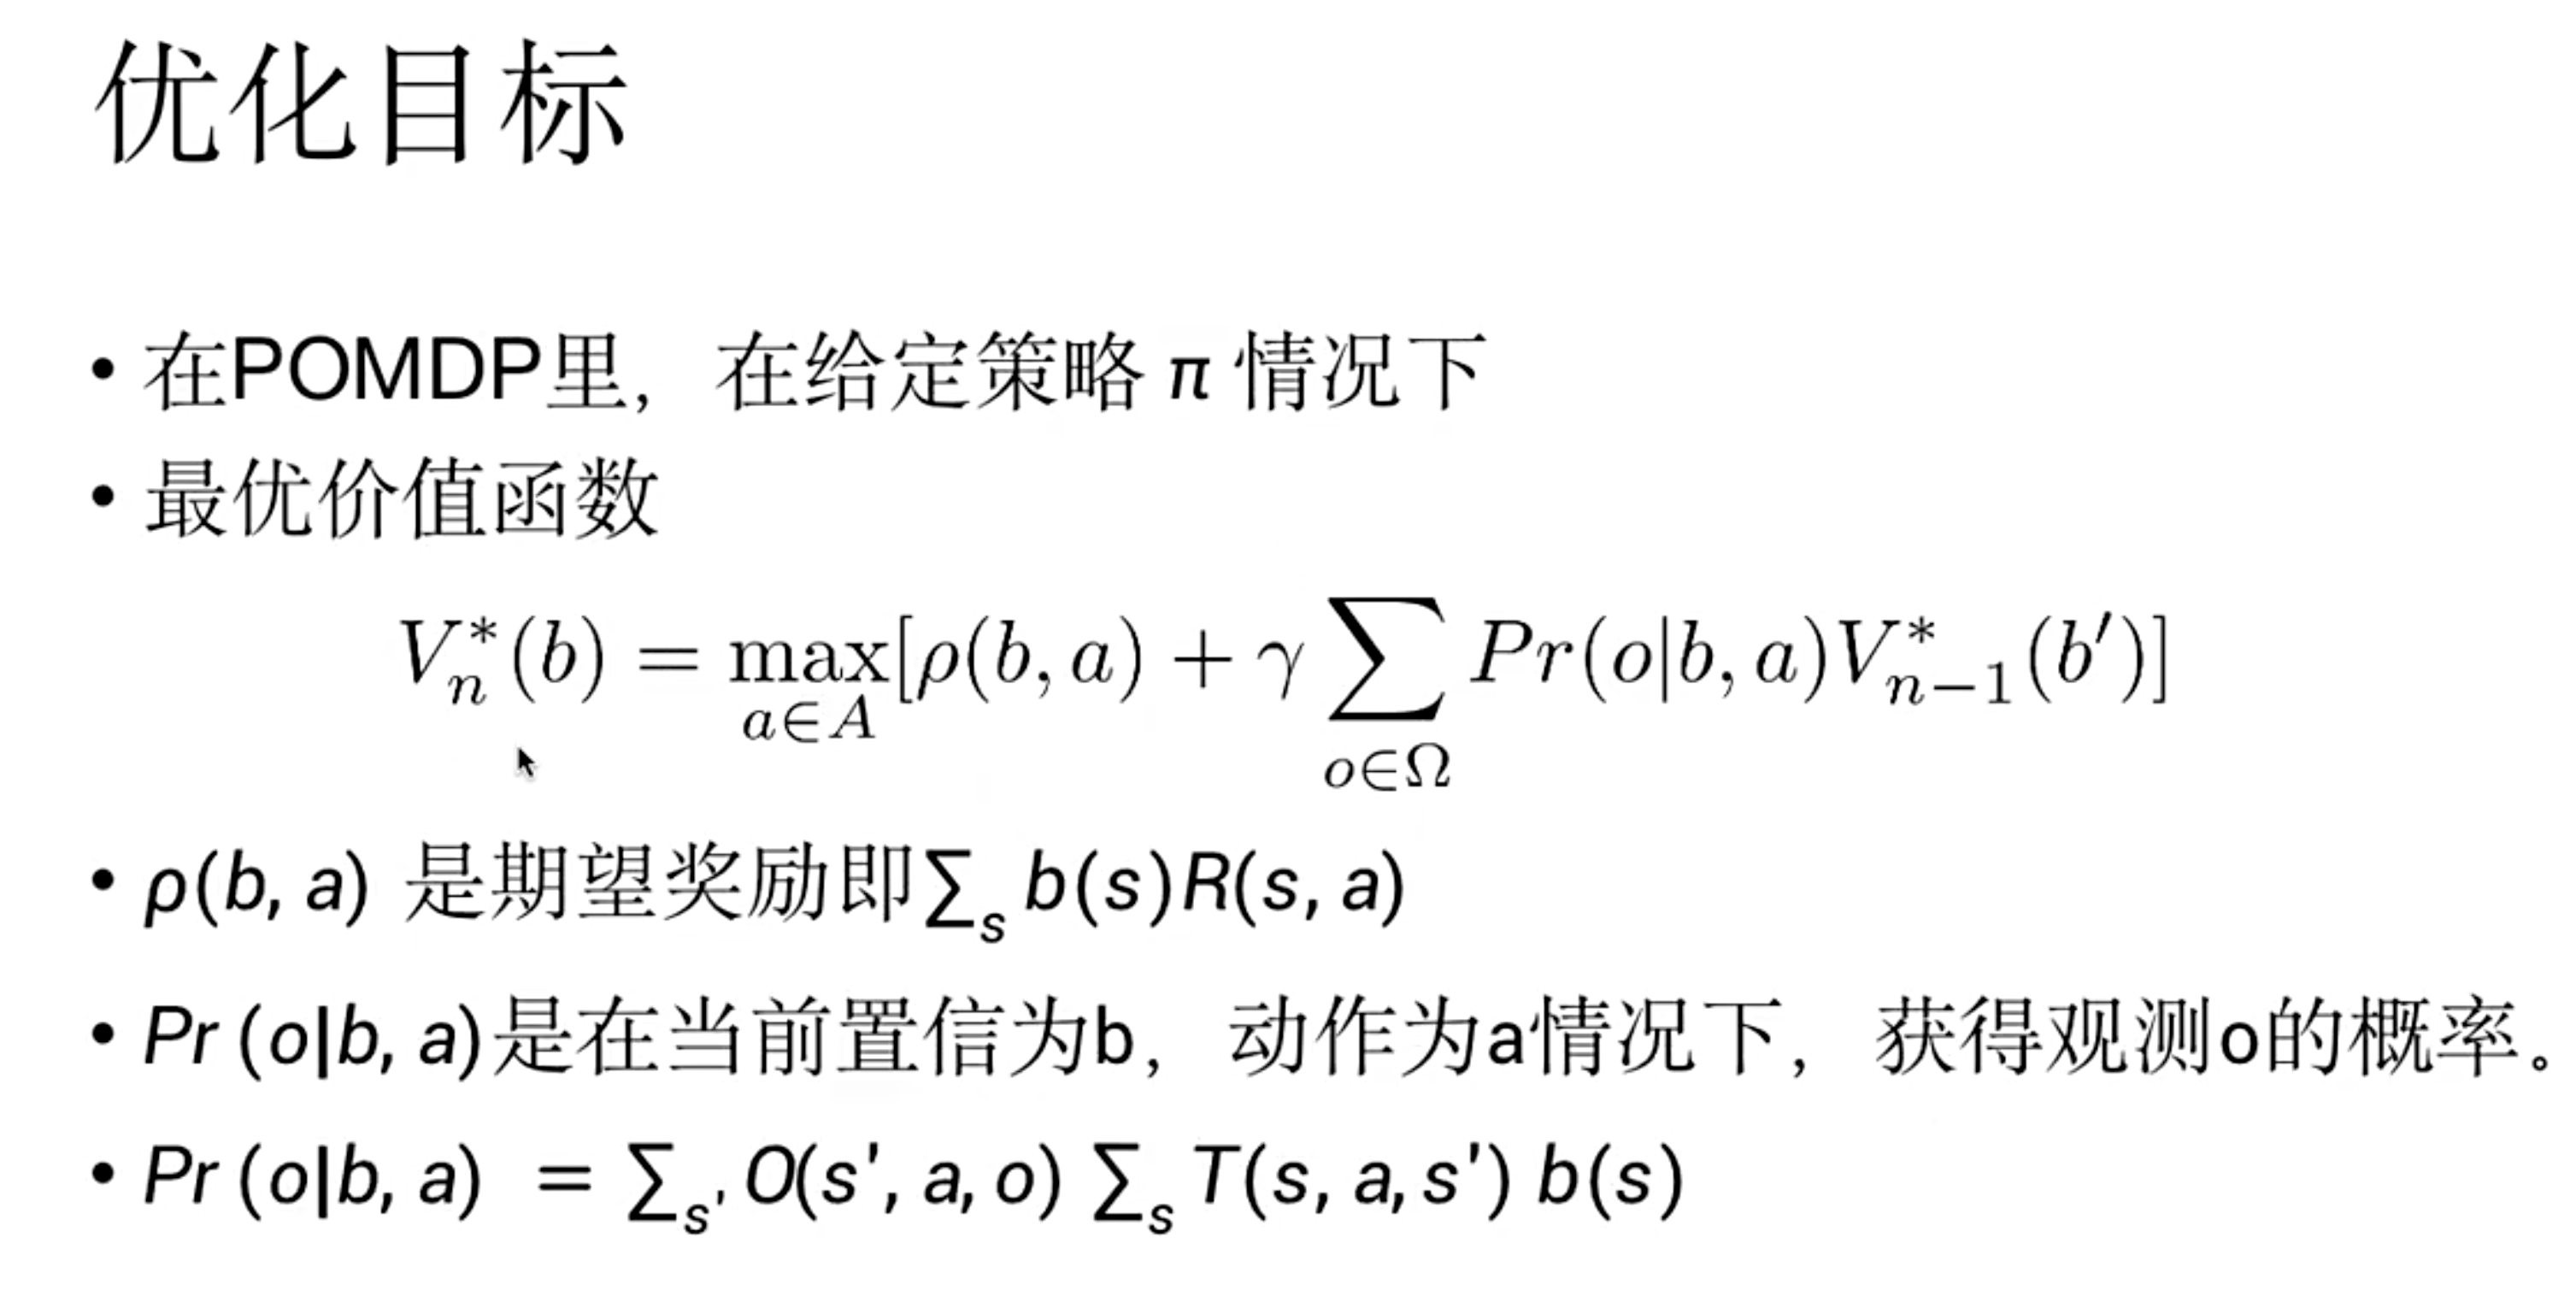
  • 在 POMDP 里 :在给定策略 \(\pi\) 情况下
    • 最优价值函数:
      $$
      V_{n}^{*}(b) = \max_{a\in A}[\rho(b, a) + \gamma\sum_{o\in\Omega}Pr(o|b, a)V_{n - 1}^{*}(b’)]
      $$
    • 其中 \(\rho(b, a)\) 是期望奖励即 \(\sum_{s}b(s)R(s, a)\)
    • \(Pr(o|b, a)\) 是在当前置信为 \(b\) ,动作为 \(a\) 情况下,获得观测 \(o\) 的概率,且 \(Pr(o|b, a) = \sum_{s’}O(s’, a, o)\sum_{s}T(s, a, s’)b(s)\)

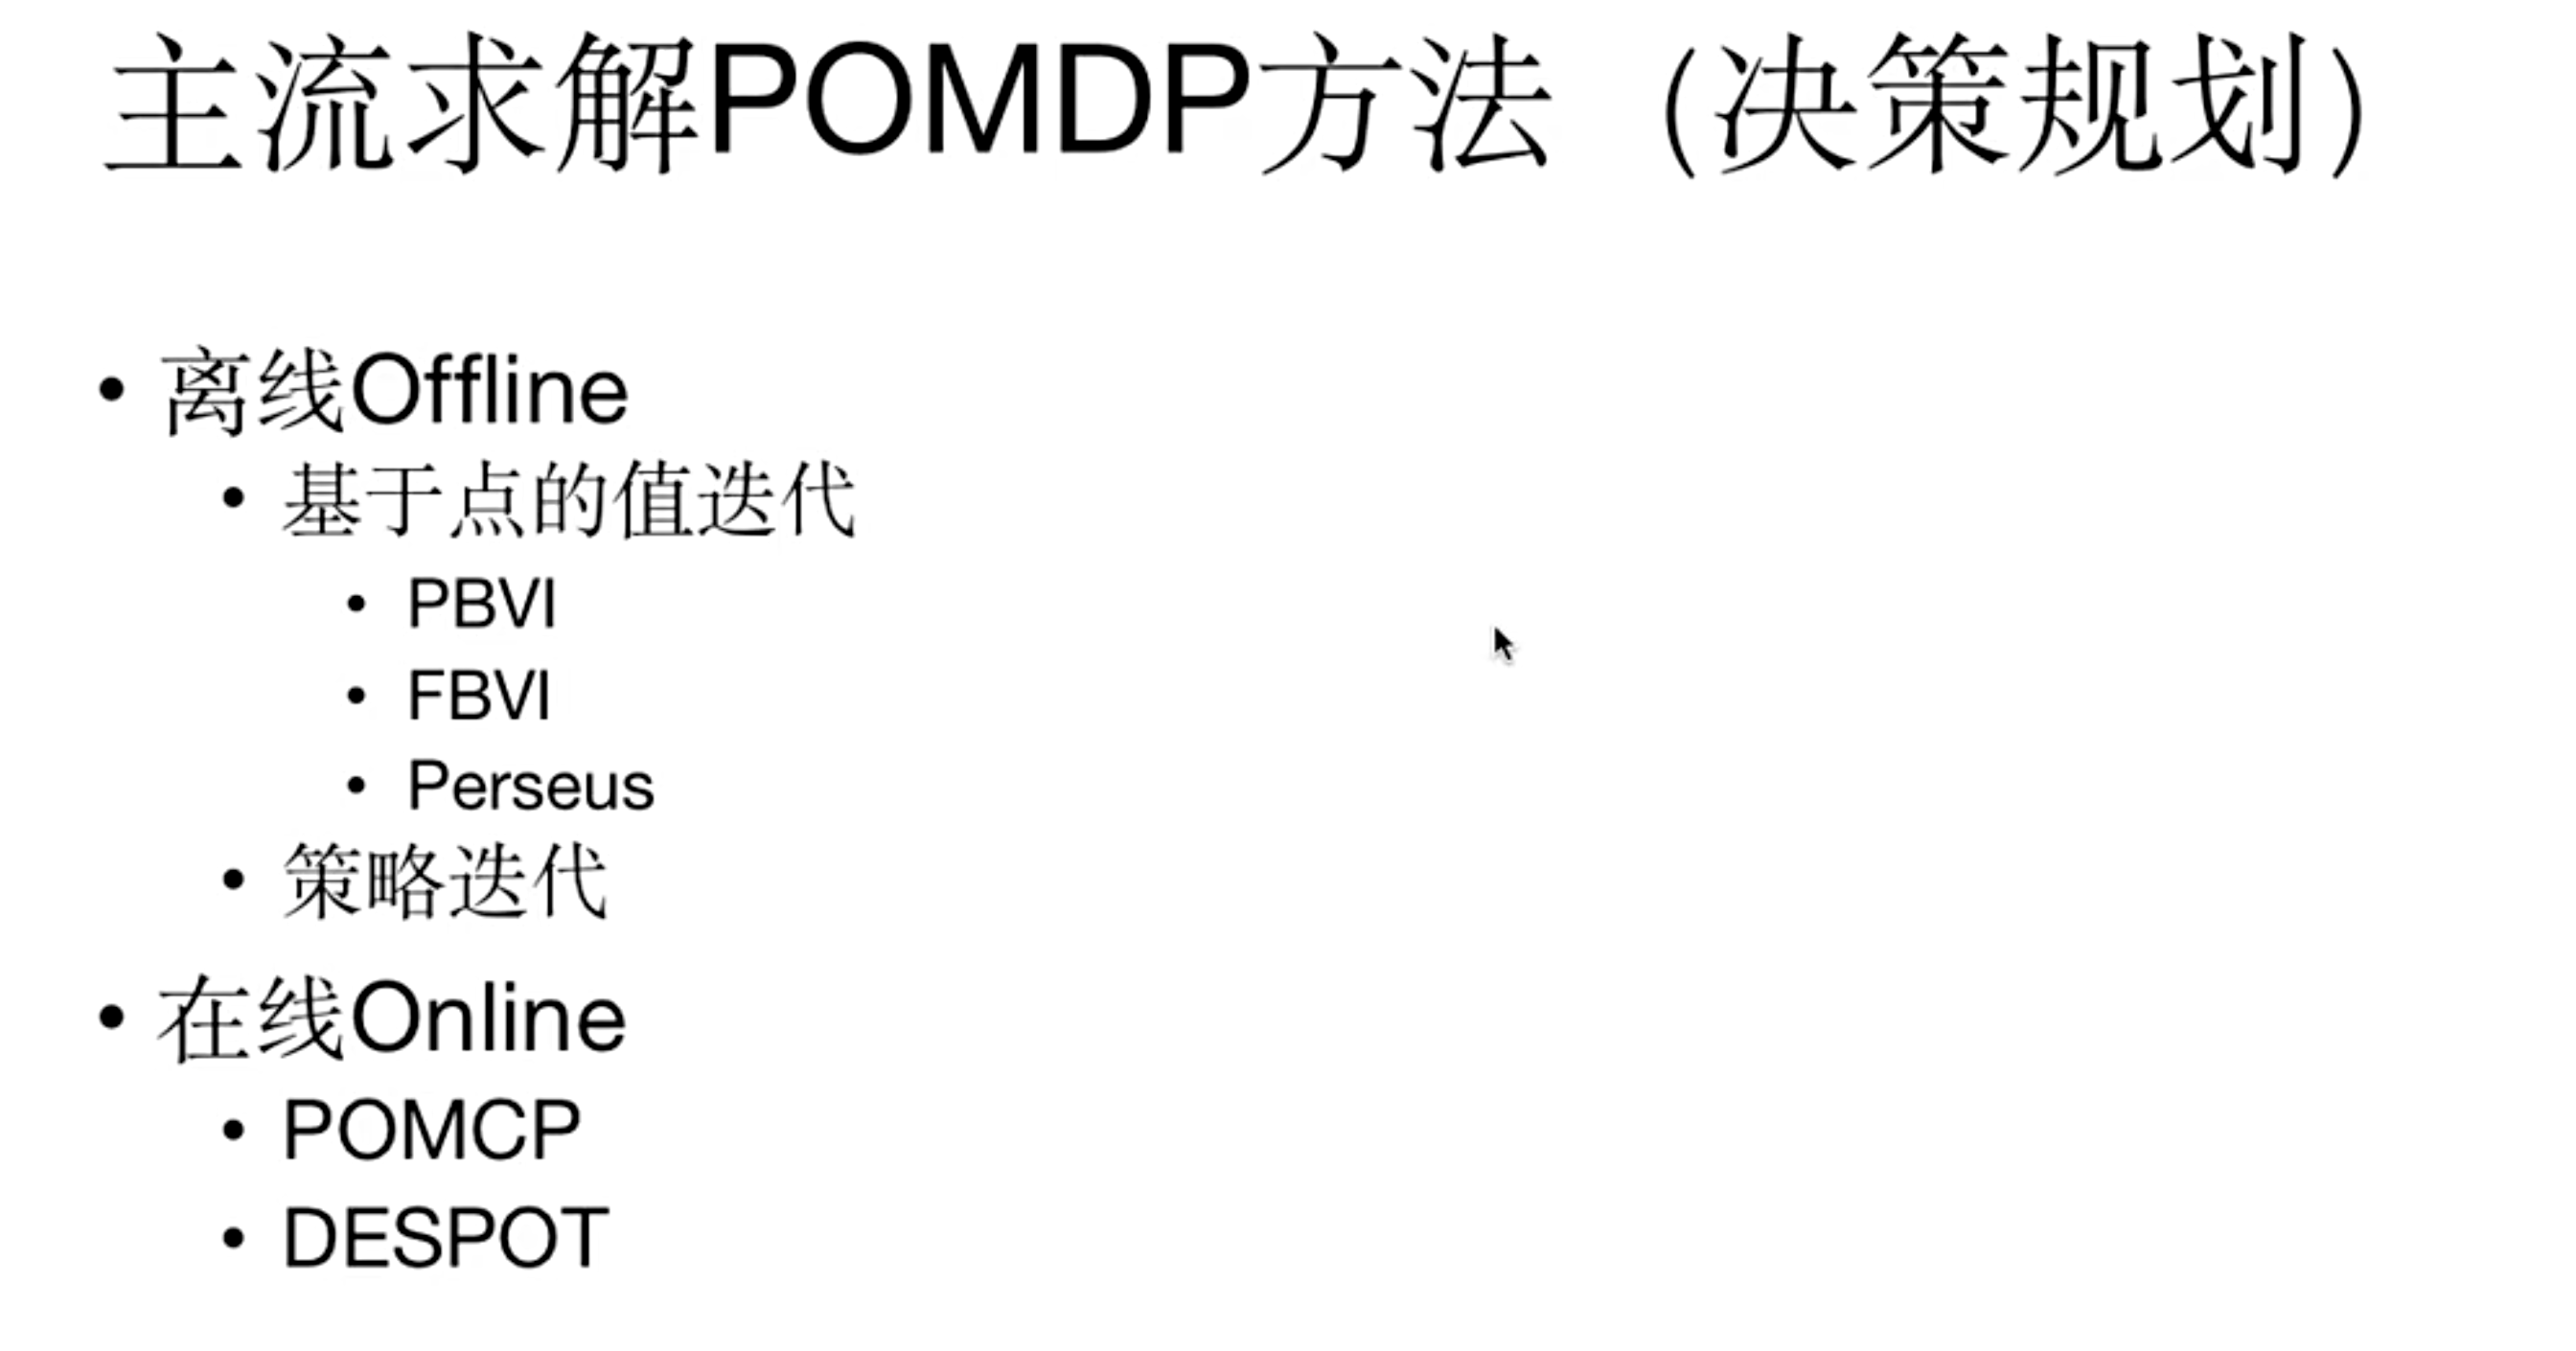
主流求解 POMDP 方法(决策规划)

  • 离线(Offline)
    • 基于点的值迭代 :PBVI、FBVI、Perseus
    • 策略迭代
  • 在线(Online) :POMCP、DESPOT

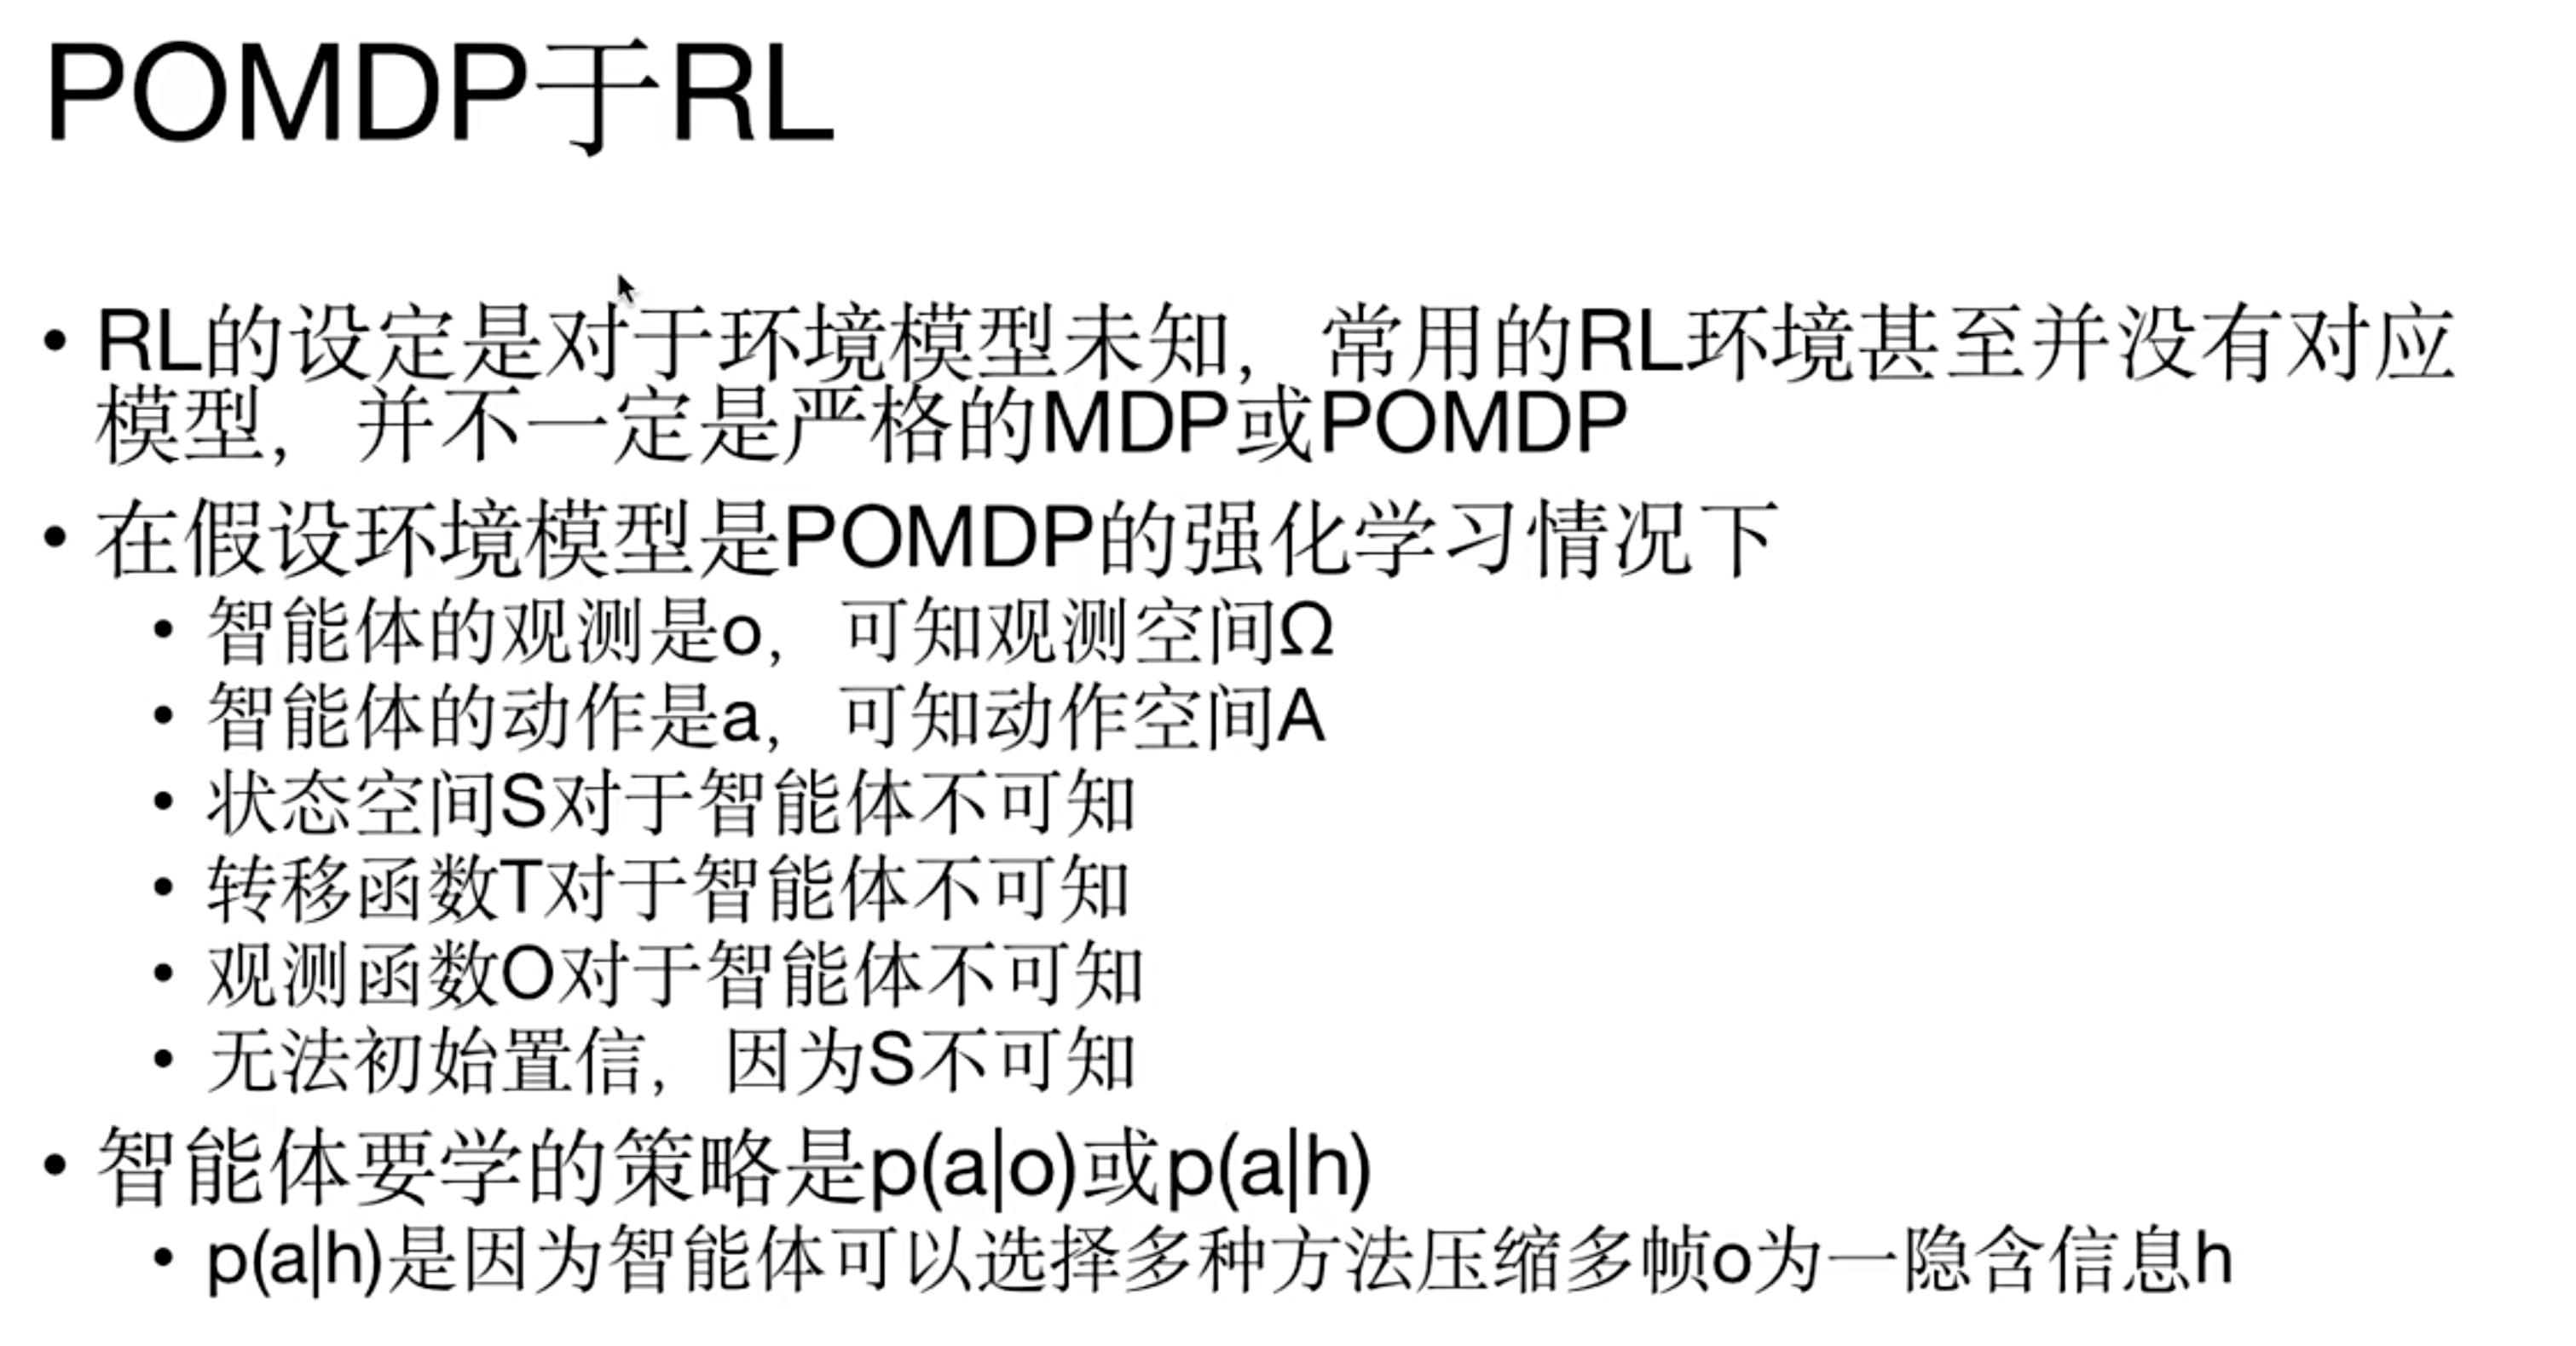
POMDP 于 RL

  • RL的设定是对于环境模型未知,常用的RL环境甚至并没有对应模型,并不一定是严格的MDP或POMDP
  • 在假设环境模型是POMDP的强化学习情况下:
    • 智能体的观测是 \(o\) ,可知观测空间 \(\Omega\)
    • 智能体的动作是 \(a\) ,可知动作空间 \(A\)
    • 状态空间 \(S\) 对于智能体不可知
    • 转移函数 \(T\) 对于智能体不可知
    • 观测函数 \(O\) 对于智能体不可知
    • 无法初始置信,因为 \(S\) 不可知
    • 智能体要学的策略是 \(p(a|o)\) 或 \(p(a|h)\) , \(p(a|h)\) 是因为智能体可以选择多种方法压缩多帧 \(o\) 为一隐含信息 \(h\) 。
  • 传统的RL算法本身并不假设知道状态转移矩阵等,所以其实常见的RL算法可以直接用于求解POMDP,只是如果观测到的信息太少,RL不一定能保证收敛(观测不是环境的完整描述,可能不满足马尔可夫性,基于贝尔曼方程迭代的价值函数可能难以收敛)
  • 比如策略梯度法推导过程中始终考虑的是期望收益,并不要求完整观测到环境,所以策略梯度法理论上适用于解决POMDP问题,但是观测不是环境的完整描述,可能不满足马尔可夫性,使用策略梯度法时最好使用REINFORCE方法,不使用Critic网络

附录:一些 PPT 原始介绍

  • 以下PPT内容来自:POMDP讲解

MDP

  • MDP的介绍
  • 对于确定决策,策略的概率值为1即可

POMDP

  • POMDP的介绍

POMDP 的求解方案

  • POMDP的解决方案介绍

ML——AUC和GAUC

本文介绍AUC和GAUC


参考链接

  • 图解AUC和GAUC-知乎

编程实现

  • AUC计算的3种实现方法
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    62
    63
    64
    65
    66
    67
    68
    69
    70
    71
    72
    73
    74
    75
    # encoding=utf8
    from sklearn.metrics import roc_auc_score

    ## 实现1:O(Nlog(N))
    def calculate_auc1(labels, predictions):
    # 将预测结果和真实标签按照预测结果从大到小的顺序进行排序
    sorted_predictions = [l for _, l in sorted(zip(predictions, labels), reverse=True)]
    print(sorted_predictions)
    # 统计正样本和负样本的数量
    positive_count = sum(labels)
    negative_count = len(labels) - positive_count

    neg_found_count = 0
    pos_gt_neg_count = 0
    # 计算正样本大于负样本的数量之和
    for label in sorted_predictions:
    if label == 1:
    pos_gt_neg_count += negative_count - neg_found_count
    else:
    neg_found_count += 1

    # 计算AUC
    auc = 1.0 * pos_gt_neg_count / (positive_count * negative_count)

    return auc

    ## 实现2:O(N^2)
    def calculate_auc2(labels, predictions):
    pos_indexes = [i for i in range(len(labels)) if labels[i] == 1]
    neg_indexes = [i for i in range(len(labels)) if labels[i] == 0]
    p = len(pos_indexes)
    n = len(neg_indexes)

    pos_gt_neg_count = 0
    for i in pos_indexes:
    for j in neg_indexes:
    if predictions[i] > predictions[j]:
    pos_gt_neg_count += 1
    elif predictions[i] == predictions[j]:
    pos_gt_neg_count += 0.5
    return pos_gt_neg_count/(p*n)

    ## 实现3:O(Nlog(N))
    def calculate_auc3(labels, predictions):
    # 将预测结果和真实标签按照预测结果从小到大的顺序进行排序,注意:排序是从小到大
    sorted_predictions = [[p,l] for p, l in sorted(zip(predictions, labels))]
    print(sorted_predictions)
    # 统计正样本和负样本的数量
    positive_count = sum(labels)
    negative_count = len(labels) - positive_count
    # 统计正样本的序号和,注意:序号从1开始
    positive_count_indexes_sum = sum([i+1 for i in range(len(sorted_predictions)) if sorted_predictions[i][1] == 1])
    return (positive_count_indexes_sum - 0.5*positive_count*(positive_count+1))/(positive_count*negative_count)
    pass

    # 真实标签
    labels = [1, 1, 0, 0, 1, 1]
    # 预测结果
    predictions = [0.2, 0.8, 0.3, 0.4, 0.5, 0.6]

    # 计算AUC
    auc1 = calculate_auc1(labels, predictions)
    print("AUC1:", auc1)

    # 计算AUC
    auc2 = calculate_auc2(labels, predictions)
    print("AUC2:", auc2)

    # 计算AUC
    auc3 = calculate_auc3(labels, predictions)
    print("AUC3:", auc3)

    # 调用官方库计算AUC
    auc = roc_auc_score(labels, predictions)
    print("AUC:", auc)

SQL实现

  • 详情见:深入理解AUC

  • 推导思路:

    • 统计每个正样本大于负样本的概率(排在该正样本后面的负样本数/总的负样本数)
    • 对所有正样本的概率求均值
  • 整体推导流程:
    $$
    \begin{align}
    AUC &= \frac{1}{N_+} \sum_{j=1}^{N_+}\frac{(r_j - j)}{N_-} \\
    &= \frac{\sum_{j=1}^{N_+}r_j - N_+(N_+ + 1)/2}{N_+N_-} \\
    &= \frac{\sum_{j =1}^{N_+} r_j - N_+(N_+ + 1)/2}{N_+ N_-}
    \end{align}
    $$

    • 注意:以上公式是在按照预估值从大到小排序后的基础上计算的,实际应用上述公式时需要先排序
    • 公式符号说明:对于第 \(j\) 个正样本 ,假定其排序定义为 \(r_j\),则在这个正样本之前共有 \((r_j-1)\) 个样本,其中有 \((j - 1)\) 个正样本,\((r_j-j)\) 个负样本,此时该正样本的预估值大于负样本的概率为:\(\frac{(r_j - j)}{N_-}\)
  • SQL实现

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    select
    (ry - 0.5*n1*(n1+1))/n0/n1 as auc
    from(
    select
    sum(if(y=0, 1, 0)) as n0,
    sum(if(y=1, 1, 0)) as n1,
    sum(if(y=1, r, 0)) as ry
    from(
    select y, row_number() over(order by score asc) as r
    from(
    select y, score
    from some.table
    )A
    )B
    )C
  • SQL实现(分场景+pcoc实现)

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    select 
    scene,
    (ry - 0.5*n1*(n1+1))/n0/n1 as auc,
    n1/(n1+n0) as ctr,
    pctr,
    pctr/(n1/(n1+n0)) as pcoc,
    from(
    select
    scene,
    sum(if(y=0, 1, 0)) as n0,
    sum(if(y=1, 1, 0)) as n1,
    sum(if(y=1, r, 0)) as ry,
    avg(score) as pctr
    from(
    select scene, score, y, row_number() over(partition by scene order by score asc) as r
    from(
    select scene, y, score
    from some.table
    )A
    )B
    )C
1…193194195…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4