Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

Math——增广拉格朗日乘子法


整体说明

  • 增广拉格朗日方法(Augmented Lagrangian Method, ALM)是一种用于求解约束优化问题的数值优化算法。它结合了拉格朗日乘子法和罚函数法的优点,能够在保证收敛性的同时避免传统罚函数法中罚参数过大导致的数值不稳定问题

问题描述

  • 考虑一个约束优化问题:
    $$
    \begin{align}
    &\min_{x \in \mathbb{R}^n} , f(x) \\
    \text{s.t.} \quad &g_i(x) = 0, \quad i = 1, \dots, m, \\
    &h_j(x) \leq 0, \quad j = 1, \dots, p.
    \end{align}
    $$
  • 其中:
    • \(f(x)\) 是目标函数;
    • \(g_i(x)\) 是等式约束;
    • \(h_j(x)\) 是不等式约束

增广拉格朗日函数

  • 为了处理上述约束优化问题,引入拉格朗日乘子 \(\lambda \in \mathbb{R}^m\) 和 \(\mu \in \mathbb{R}^p\),并定义增广拉格朗日函数为:
    $$
    L_A(x, \lambda, \mu; \rho) = f(x) + \sum_{i=1}^m \left[ \lambda_i g_i(x) + \frac{\rho}{2} g_i(x)^2 \right] + \sum_{j=1}^p \left[ \mu_j h_j(x) + \frac{\rho}{2} \max(0, h_j(x))^2 \right],
    $$
  • 其中:
    • \(\lambda_i\) 是等式约束 \(g_i(x) = 0\) 的拉格朗日乘子;
    • \(\mu_j\) 是不等式约束 \(h_j(x) \leq 0\) 的拉格朗日乘子;
    • \(\rho > 0\) 是罚参数,用于平衡约束违反的程度

算法步骤

  • 增广拉格朗日方法通过迭代更新变量 \(x\)、拉格朗日乘子 \(\lambda\) 和 \(\mu\),以及罚参数 \(\rho\) 来求解优化问题。具体步骤如下:

初始化

  • 初始化 \(x^{(0)}\),\(\lambda^{(0)}\),\(\mu^{(0)}\),以及初始罚参数 \(\rho^{(0)} > 0\)
  • 设置收敛容差 \(\epsilon > 0\) 和最大迭代次数 \(k_{\text{max}}\)

迭代过程

对于第 \(k\) 次迭代依次执行下面的流程:

  • 优化子问题(更新原始变量) :固定 \(\lambda^{(k)}\)、\(\mu^{(k)}\) 和 \(\rho^{(k)}\),求解以下无约束优化问题:
    $$
    x^{(k+1)} = \arg\min_x L_A(x, \lambda^{(k)}, \mu^{(k)}; \rho^{(k)}).
    $$

  • 更新拉格朗日乘子 :

    • 对于等式约束 :
      $$
      \lambda_i^{(k+1)} = \lambda_i^{(k)} + \rho^{(k)} g_i(x^{(k+1)}), \quad i = 1, \dots, m.
      $$
      • 问题:为什么拉格朗日乘子的更新公式是这样的?理论上,这等价于梯度上升法
      • 直观理解:目标是让 \(g_i(x^{(k+1)}) \rightarrow 0\)?
        • 当 \(g_i(x^{(k+1)}) < 0\) 时,缩小 \(\lambda\),表示可适当放开约束,使得下次优化子问题时 \(g_i(x^{(k+1)})\) 变大?
        • 当 \(g_i(x^{(k+1)}) > 0\) 时,增大 \(\lambda\),表示可适当收紧约束,使得下次优化子问题时 \(g_i(x^{(k+1)})\) 变小?
    • 对于不等式约束 :
      $$
      \mu_j^{(k+1)} = \max\left(0, \mu_j^{(k)} + \rho^{(k)} h_j(x^{(k+1)})\right), \quad j = 1, \dots, p.
      $$
  • 检查收敛条件 :如果满足下面条件,则停止迭代,输出 \(x^{(k+1)}\) 作为解,否则继续迭代
    $$
    |g(x^{(k+1)})|_\infty \leq \epsilon \quad \text{ And } \quad |\max(0, h(x^{(k+1)}))|_\infty \leq \epsilon,
    $$

  • 更新罚参数 :通常选择逐步增大罚参数,例如按下面的方法更新
    $$
    \rho^{(k+1)} = \beta \rho^{(k)},
    $$

    • 其中 \(\beta > 1\) 是一个预设的增长因子

终止条件

  • 当达到最大迭代次数或满足收敛条件时,算法终止

特点与优势

  • 稳定性 :相比于传统罚函数法,增广拉格朗日方法对罚参数 \(\rho\) 的依赖较小,能够避免数值不稳定问题
  • 灵活性 :可以处理等式和不等式约束,适用范围广泛
  • 全局收敛性 :在适当的条件下,增广拉格朗日方法具有全局收敛性

附录:对偶上升法与增广拉格朗日乘子法

  • 对偶上升法(Dual Ascent)和增广拉格朗日乘子法(Augmented Lagrangian Method,ALM)都是用于解决约束优化问题的迭代算法。它们在更新变量的方式上有显著的不同
  • 特别说明 :两者的区别不仅仅是对偶变量更新的公式不同,最小化求解原始变量时,分别在最小化拉格朗日函数和增广拉格朗日函数 ,这里区别也很大
  • 以下对照均已等式约束为例

对偶上升法

  • 对偶上升法是一种基于拉格朗日对偶理论的优化方法。它的基本思想是通过交替更新原始变量和对偶变量来逼近最优解。具体步骤如下:
    • 初始化 :选择初始值 \(x^{(0)}\) 和对偶变量 \(\lambda^{(0)}\)
    • 构建增广拉格朗日函数 :构造带拉格朗日函数 \(L(x, \lambda) = f(x) + \lambda^T h(x) \)
    • 最小化拉格朗日函数 :对于固定的 \(\lambda^{(k)}\),求解无约束优化问题(拉格朗日函数)以找到 \(x^{(k+1)}\)
    • 更新对偶变量 :更新对偶变量 \(\lambda^{(k+1)} = \lambda^{(k)} + \alpha_k \nabla_\lambda L(x^{(k+1)}, \lambda^{(k)})\),其中 \(\alpha_k\) 是步长参数
      • 说明:这是根据梯度上升法来更新参数(使用梯度上升是因为更新对偶变量时,目标是最大化原始拉格朗日函数 \(L(x^{(k+1)}, \lambda^{(k)})\)),其中有\(\nabla_\lambda L(x^{(k+1)}, \lambda^{(k)}) = h(x^{(k+1)})\)
  • 这种方法要求目标函数和约束条件满足一定的凸性条件,并且通常需要较小的步长 \(\alpha_k\) 来保证收敛性

增广拉格朗日乘子法

  • 增广拉格朗日乘子法是在拉格朗日乘子法的基础上添加了一个二次惩罚项 ,从而增强了原问题的凸性和稳定性。其主要特点如下:
    • 初始化 :同样选择初始值 \(x^{(0)}\) 和 \(\lambda^{(0)}\)
    • 构建增广拉格朗日函数 :构造带有惩罚项的拉格朗日函数 \(L_{\rho}(x, \lambda) = f(x) + \lambda^T h(x) + \frac{\rho}{2} |h(x)|^2\),其中 \(\rho > 0\) 是惩罚参数
    • 最小化增广拉格朗日函数 :对于固定的 \(\lambda^{(k)}\) 和 \(\rho\),求解无约束优化问题(增广拉格朗日函数)以找到 \(x^{(k+1)}\)
    • 更新对偶变量 :更新 \(\lambda^{(k+1)} = \lambda^{(k)} + \rho h(x^{(k+1)})\)
      • 说明:这等价于固定学习率为 \(\rho\) 的梯度上升法更新 \(\lambda\),其中有\(\nabla_\lambda L_{\rho}(x^{(k+1)}, \lambda^{(k)}) = h(x^{(k+1)})\)
  • 与对偶上升法相比,增广拉格朗日乘子法不需要特别小的步长(固定为 \(\rho\) 了),并且由于惩罚项的存在,它能够更好地处理非凸问题,并且通常具有更好的数值稳定性和收敛速度

比较总结

  • 收敛性 :增广拉格朗日乘子法通常比对偶上升法有更强的收敛性,特别是在非凸问题上
  • 鲁棒性 :由于加入了惩罚项,增广拉格朗日乘子法通常更稳健,不易受到数值不稳定的影响
  • 计算复杂度 :每一步中,增广拉格朗日乘子法可能需要解决一个更加复杂的优化问题 ,因为它包含了额外的惩罚项
  • 适用场景 :如果问题是严格凸的,对偶上升法可能是足够的;但如果存在非凸性或需要更高的鲁棒性 ,则增广拉格朗日乘子法通常是更好的选择

附录:其他相关方法之拉格朗日乘子法

  • 拉格朗日乘子法一般用于求解一个原始问题的最优形式(最优形式一般包含着拉格朗日乘子),部分时候根据KKT条件可以直接求得最优解

具体示例

  • 拉格朗日乘子法 :通过引入拉格朗日乘子将约束条件与目标函数结合成一个新的函数,即拉格朗日函数。其基本思想是将原约束优化问题转化为无约束的拉格朗日函数的极值问题
    • 对于具有等式约束的优化问题:
      $$
      \begin{align}
      &\min f(x) , \\
      \text{s.t.} \ &h_i(x)=0 , i = 1,2,\cdots,m
      \end{align}
      $$
    • 拉格朗日函数定义为:
      $$ L(x,\lambda)=f(x)+\sum_{i = 1}^{m}\lambda_ih_i(x)$$
    • 通过求解 \(\nabla L = 0\) 来得到原问题的最优解

求解方式

  • 拉格朗日乘子法 :直接对拉格朗日函数求偏导数并令其为零,得到一组方程组,然后求解方程组得到最优解。这种方法在理论上很优美,但在实际求解中,当约束条件较多或问题较为复杂时,求解方程组可能会变得非常困难
RL——强化学习与动态规划

  • 参考文献
    • 【强化学习】个人总结03——动态规划寻找最优策略
    • 手把手教你强化学习 (四)动态规划与策略迭代、值迭代
    • 第四章 动态规划(DP)、蒙特卡罗(MC)、时间差分(TD) - 臭皮匠的文章 - 知乎
    • David Silver强化学习之动态规划寻找最优策略理论与实战(三) - CristianoC的文章 - 知乎

动态规划方法

  • 动态规划(Dynamic Programming, DP) 是一种将复杂问题分解为若干子问题,并通过求解这些子问题来获得原问题解的方法。它适用于满足以下两个性质的问题:
    • 最优子结构(optimal substructure) :原问题可以分解为多个子问题,通过解决这些子问题并将其解组合起来,可以得到原问题的最优解
    • 重叠子问题(overlapping subproblems) :子问题在求解过程中会多次出现,且这些子问题的解可以被存储并重复利用
  • 马尔可夫决策过程 (MDP) 恰好满足动态规划的这两个条件:贝尔曼方程将问题分解为递归结构的子问题,而价值函数能够存储并复用其最优解。因此,我们可以使用动态规划来解决马尔可夫决策过程的核心问题:预测和控制
    • 预测(prediction) :给定一个马尔可夫决策过程 MDP 和一个策略 \(\pi\),或者给定一个马尔可夫奖励过程 MRP,求解基于该策略的价值函数 \(v_\pi\)。(评估给定策略的效果)
    • 控制(control) :给定一个马尔可夫决策过程 MDP,求解最优价值函数 \(v_\∗\) 和最优策略 \(\pi_\∗\)。(即寻找最佳策略)
  • 预测问题和控制问题的主要区别在于,预测问题是在策略已知的情况下求解其价值函数,而控制问题则是在没有给定策略的情况下寻找最优价值函数及其对应的策略。两者之间存在递进关系:在强化学习中,我们通常先解决预测问题,再进一步解决控制问题

同步动态规划(Synchronous Dynamic Programming)

  • 同步动态规划算法中,每一次迭代都更新所有状态的价值
  • 参考链接:策略迭代与值迭代的区别
策略迭代(policy iteration)
  • Step1:初始化所有状态的价值 (\(v(s)\)) 和策略 (\(\pi(s)\))
  • Step2:策略评估(policy evaluation):按照贝尔曼方程迭代,直到收敛(求解当前策略下的不动点)
  • Step3:策略迭代(policy improvement):寻找一个新的策略,在任意状态下都有 \(Q^\pi(s,\pi’(s)) \ge V^\pi(s)\),可以证明此时有 \(V^{\pi’}(s) \ge V^\pi(s)\)
  • 循环Step2和Step3直到收敛
值迭代(value iteration)
  • Step1:初始化所有状态的价值 (\(v(s)\))
  • Step2:迭代找到最优策略(常常隐含直接使用 argmax 作为最优策略决策),直到收敛
  • Step3:最优策略提取
  • 这种方法仅进行价值函数迭代,不考虑策略,最终迭代到最优价值函数后,即可反向求解得到最优的策略

异步动态规划(Asynchronous Dynamic Programming,非重点)

  • 异步动态规划算法中,在每一次迭代时,根据特定规则选择性地更新部分状态的价值(并不更新所有状态的价值)
    • 注:这种方法可以显著节省计算资源,并且只要所有状态能够持续被访问和更新,算法最终仍能收敛到最优解
    • 目标:解决经典DP需遍历全部状态的问题,通过异步更新提高效率
  • 以下是几种常见的异步动态规划方法:
    • 就地动态规划(In-place DP) :直接覆盖旧价值函数,而非保留新旧两份
    • 优先扫描(Prioritized Sweeping) :根据优先级对状态进行排序,优先更新优先级较高的状态的价值(优先更新贝尔曼误差较大的状态)
    • 实时动态规划(Real-time DP) :仅更新当前交互中访问的状态

动态规划的其他说明

  • 动态规划算法的缺点 :采用全宽度(full-width)的回溯机制来更新状态价值,算力需求大且容易导致维度灾难
    • 无论是同步还是异步动态规划,每次回溯更新某个状态的价值时,都需要追溯到该状态的所有可能后续状态,并结合已知的马尔可夫决策过程的状态转换矩阵和奖励来更新该状态的价值
    • 解决方案:可以使用采样回溯方法来近似估计价值,从而减少算力的消耗
  • 动态规划算法是model-based算法,因为需要回溯当前状态的所有后续状态(full-width回溯机制)

Model-free方法辨析

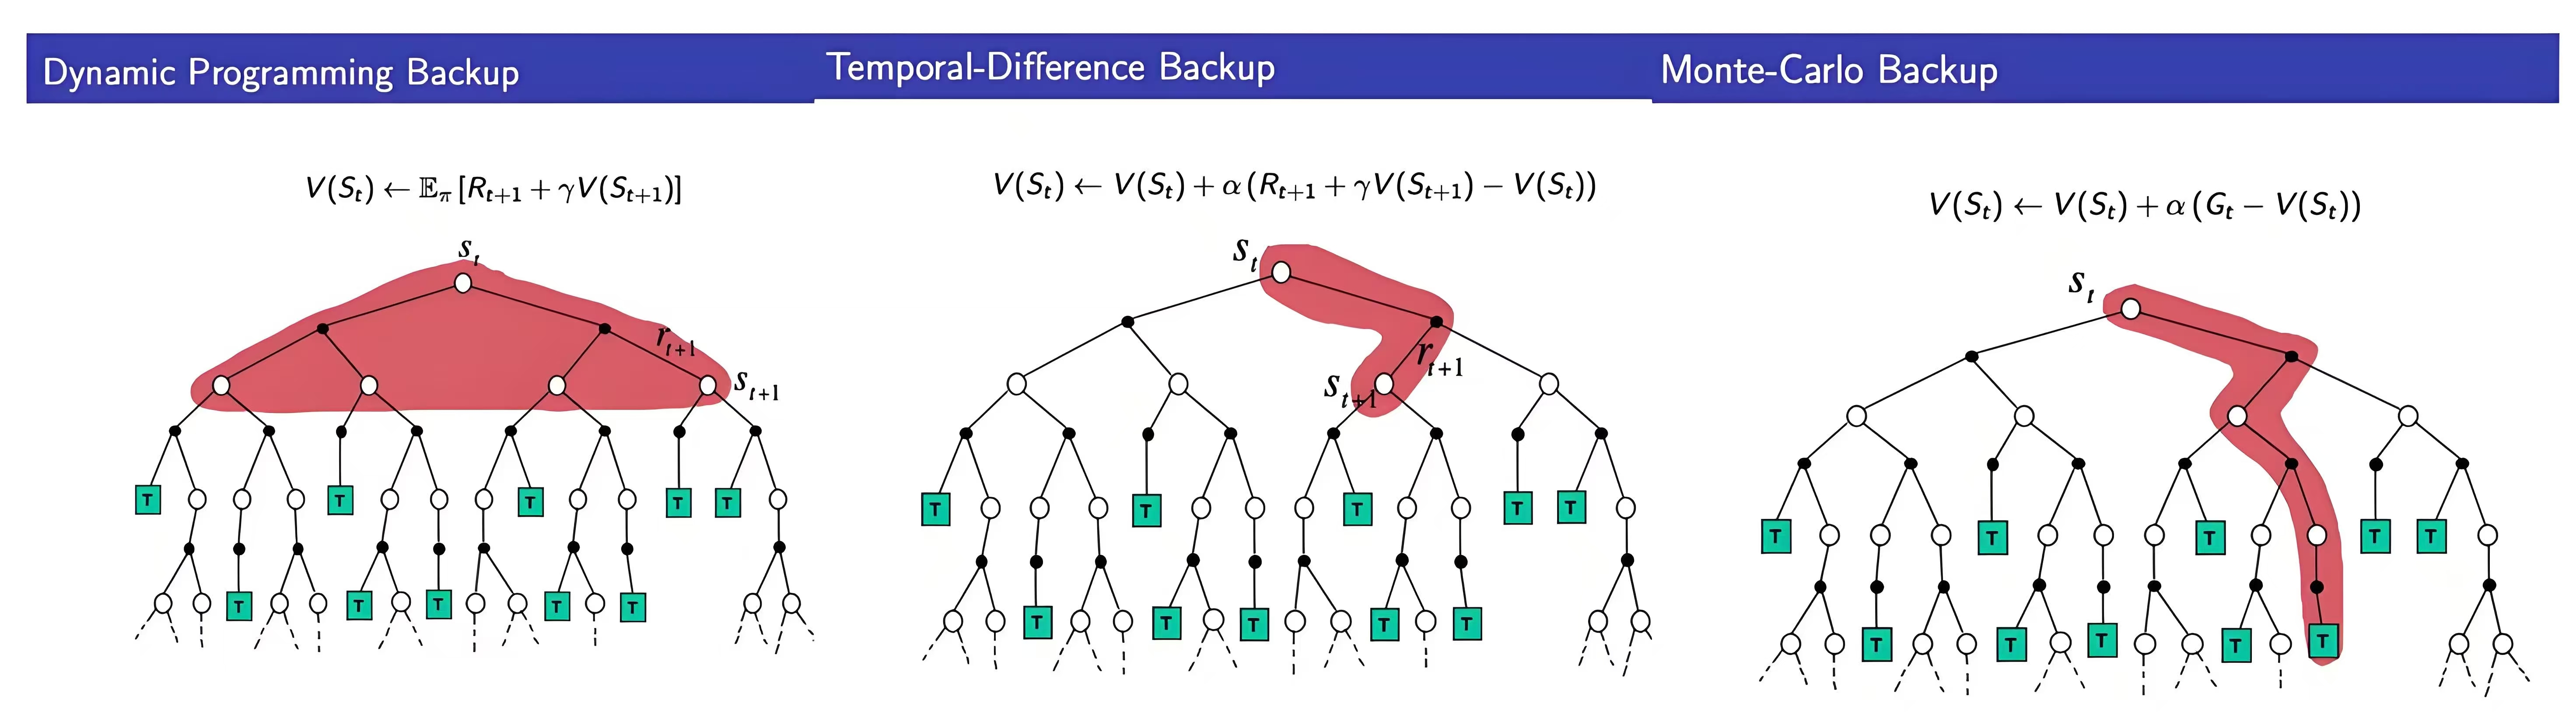
  • Model-free 不知道环境动力学(Dynamics),无法精确计算精确的目标值,所以通常使用 TD 和 MC 这两种方案来近似估计目标值
    • 时序差分(Temporal Difference, TD):Q-learning 和 SARSA 都使用这种方法估计目标值
    • 蒙特卡罗方法(Monte-Carlo,MC):REINFORCE方法就使用了MC方法估计目标值
    • n-step方法是 TD 和 MC 的结合
  • TD 其实同时是结合了 MC 和 DP 的思想,更详细的比较见附录
    • 需要模拟交互序列(和MC方法一样);但不需要积累很多交互数据求均值(不同于 MC)
    • 使用当前回报和下一时刻的价值预估来更新当前时刻的价值(和DP方法一样);不需要知道状态转移矩阵,也不需要full-width回溯(不同于DP方法)
  • Q-learning 和 SARSA 为什么不是DP方法?
    • Q-learning 并不基于模型计算期望(不需要依赖状态转移矩阵),是直接使用贪心策略
    • SARSA 依赖采样,并不是精确计算期望

附录:Planning、Decision、Prediction和Control的区别

  • 在自动化和智能系统中,Planning、Decision、Prediction 和 Control 是四个关键的概念:
    • Planning(规划) :制定未来行动步骤,生成一系列行动步骤或策略
    • Decision(决策) :在当前时刻选择最佳行动,即在已知状态下决策动作
    • Prediction(预测) :推断未来状态或事件,预估环境相关的变化等
    • Control(控制) :实时调节系统行为以实现目标,常常涉及到反馈机制,以应对环境变化
  • 实际例子举例:自动驾驶中,Prediction用于预测其他车辆行为,Decision用于选择最佳驾驶策略,Planning用于规划路径,Control用于执行驾驶操作

附录:MC、TD和DP 详细比较

  • 蒙特卡罗方法(MC) :通过完整回合的采样回报估计值函数,依赖实际经验,无需环境模型
  • 时序差分(TD) :结合MC和DP思想,结合当前奖励和后续状态的价值估计来更新当前状态
  • 动态规划(DP) :基于模型的全宽度回溯更新,利用贝尔曼方程迭代求解值函数,需已知环境动力学

动态规划(DP)

  • 核心思想 :利用贝尔曼方程全宽度回溯更新值函数,需已知状态转移 \( P \) 和奖励函数 \( R \)
  • 策略评估(Policy Evaluation) :
    $$
    V_{k+1}(s) = \sum_a \pi(a|s) \sum_{s’, r} P(s’, r|s, a) \left[ r + \gamma V_k(s’) \right]
    $$
    • 迭代至收敛得到精确值函数
  • 策略改进(Policy Improvement) :
    $$
    \pi’(s) = \arg\max_a \sum_{s’, r} P(s’, r|s, a) \left[ r + \gamma V^\pi(s’) \right]
    $$

蒙特卡罗方法(MC)

  • 核心思想 :用完整回合的回报均值估计值函数,仅适用于回合制任务
  • 值函数更新 :
    $$
    V(S_t) \leftarrow V(S_t) + \alpha \left[ G_t - V(S_t) \right]
    $$
    • 其中 \( G_t = \sum_{k=t}^T \gamma^{k-t} R_{k+1} \) 是实际回报,\( \alpha \) 为学习率,\( T \) 为回合终止时刻

时序差分(TD)

  • 核心思想 :用当前奖励与下一状态估计值(自举)更新值函数,可在线学习
  • TD(0) 更新 :
    $$
    V(S_t) \leftarrow V(S_t) + \alpha \left[ R_{t+1} + \gamma V(S_{t+1}) - V(S_t) \right]
    $$
    • 其中 \( R_{t+1} + \gamma V(S_{t+1}) \) 称为 TD目标 ,\( \delta_t = R_{t+1} + \gamma V(S_{t+1}) - V(S_t) \) 为 TD误差

三者方差偏差比较

  • MC :高方差、无偏估计,需完整回合
  • TD :低方差、有偏估计,可在线学习
  • DP :精确但计算量大,需模型支持。
1…171172173…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4