Hexo

凡事预则立,不预则废


  • Home

  • Tags

  • Archives

  • Navigation

  • Search

RL——Q-learning与DQN收敛性证明


前言

  • 在数学中,函数、泛函、算子都是映射
  • 函数 :是从一个集合的元素映射到另一个集合的元素
  • 泛函 :是从一个函数空间映射到数值空间(如实数或复数集)
  • 算子 :是从一个函数空间映射到另一个函数空间

Q-learning 和 DQN 的收敛性讨论

  • DQN基本原理 :DQN的核心是使用一个深度神经网络来逼近Q-learning的Q函数
  • Q-learning有严格的收敛性证明(贝尔曼最优算子是压缩映射),但DQN没有(DQN虽然也按照贝尔曼最优算子更新,但还增加了一个神经网络近似)
    • 贝尔曼算子和贝尔曼最优算子都是压缩映射;神经网络近似是收敛的,但是贝尔曼最优算子+神经网络近似不一定能保证收敛
  • 本文主要针对Q-learning证明其收敛性,同时附带证明了贝尔曼算子和贝尔曼最优算子都是压缩映射

压缩映射定理(Contraction Mapping Theorem)

  • 压缩映射定理也称为Banach不动点定理

    压缩映射的定义

  • 定义 :设 \((X, d)\) 是一个完备的度量空间(即所有柯西序列都收敛), \(\mathcal{T}: X \to X\) 是一个映射。如果存在一个常数 \(\gamma \in (0, 1)\) ,使得对于所有的 \(x_1, x_2 \in X\) ,都有满足下面的式子,则称 \(\mathcal{T}\) 是一个压缩映射 :
    $$ \color{red}{d}(\mathcal{T}(x_1), \mathcal{T}(x_2)) \leq \color{blue}{\gamma} \color{red}{d}(x_1, x_2) $$
    • 其中 \( d \) 表示度量(metric) ,即度量空间中用于衡量两个点之间距离的函数
  • 直观理解 :
    • 压缩映射会将空间中的点逐渐拉近,使得它们之间的距离不断缩小。由于这种收缩性质,压缩映射在完备度量空间中必然存在一个唯一的不动点
    • \(\mathcal{T}\) 将任意两点之间的距离压缩至少 \(\gamma\) 倍
    • 即构造序列 \({x_n}\) ,其中 \(x_{n + 1} = \mathcal{T}(x_n)\),则随着 \(n \rightarrow \infty\), 序列 \({x_n}\) 会收敛到压缩映射的不动点 \(x^*\)

压缩映射定理(Contraction Mapping Theorem)

  • 不动点(Fixed-Point)定义 :对于一个映射 \(\mathcal{T}: X \to X\) ,如果存在一个点 \(x^* \in X\) ,使得 \(\mathcal{T}(x^*) = x^*\) ,那么 \(x^*\) 就被称为 \(\mathcal{T}\) 的不动点
  • 压缩映射定理(Banach不动点定理) :设 \((X, d)\) 是一个完备的度量空间(即所有柯西序列都收敛),\(\mathcal{T}: X \to X\) 是一个压缩映射。则:
    • \(\mathcal{T}\) 在 \(X\) 中存在唯一的不动点 \(x^*\)(即 \(\mathcal{T}(x^*) = x^*\))
    • 对于任意初始点 \(x_0 \in X\),通过迭代 \(x_{n+1} = \mathcal{T}(x_n)\) 生成的序列 \({x_n}\) 收敛于 \(x^*\)
    • 收敛速度的估计:
      $$
      d(x_n, x^*) \leq \frac{k^n}{1 - k} d(x_0, x_1)
      $$
      • 即,误差以指数速度衰减

压缩映射定理的简单证明

  • 存在性 :从任意 \(x_0\) 出发,构造序列 \(x_{n+1} = \mathcal{T}(x_n)\)。利用压缩性可证明 \({x_n}\) 是柯西序列,由完备性可知其收敛到某点 \(x^*\)。再证明 \(x^*\) 是不动点
  • 唯一性 :假设有两个不动点 \(x^*\) 和 \(y^*\),利用压缩性导出矛盾

贝尔曼算子与压缩映射

  • 贝尔曼方程定义 :在强化学习中,贝尔曼方程用于描述最优值函数(如最优Q函数)的递归关系。对于一个马尔可夫决策过程(MDP),贝尔曼最优性方程可以表示为:
    $$Q^*(s, a)=\mathbb{E}_{s^{\prime}}\left[r(s, a, s^{\prime})+\gamma \max _{a^{\prime}} Q^*(s^{\prime}, a^{\prime})\right]$$
    • \(\gamma\) 是折扣因子, \(Q^*(s, a)\) 是最优Q函数,表示在状态 \(s\) 执行动作 \(a\) 的最优价值
  • 贝尔曼算子与压缩映射 :贝尔曼方程定义了一个从Q函数空间到自身的映射 \(\mathcal{T}\) (函数空间到函数空间的映射也称为算子 ,这里也称为贝尔曼算子),即:
    $$\mathcal{T}Q(s, a)=\mathbb{E}_{s^{\prime}}\left[r(s, a, s^{\prime})+\gamma \max _{a^{\prime}} Q(s^{\prime}, a^{\prime})\right]$$
    • 可以证明,在无穷范数度量下(即度量 \(d\) 为无穷范数(\( \Vert \cdot\Vert_\infty \)))时,有贝尔曼算子 \(\mathcal{T}\) 是一个压缩映射
    • 实际上,在无穷范数度量下,贝尔曼最优算子和贝尔曼算子都是压缩映射 ,详情见附录证明

附录:度量的完整定义

度量的定义

  • 给定一个集合 \( X \),若函数 \( d: X \times X \to \mathbb{R} \) 满足以下性质,则称 \( d \) 为 \( X \) 上的度量:
    • 非负性 :
      $$ d(x, y) \geq 0 \quad \text{且} \quad d(x, y) = 0 \iff x = y. $$
    • 对称性 :
      $$ d(x, y) = d(y, x). $$
    • 三角不等式 :
      $$ d(x, z) \leq d(x, y) + d(y, z). $$
  • 此时,二元组 \( (X, d) \) 称为度量空间
  • 在压缩映射定理中:
    $$ d(\mathcal{T}(x_1), \mathcal{T}(x_2)) \leq \gamma \cdot d(x_1, x_2) \quad (\gamma \in [0, 1)), $$
    • \( d(x_1, x_2) \) 表示两点 \( x_1 \) 和 \( x_2 \) 的原始距离
    • \( d(\mathcal{T}(x_1), \mathcal{T}(x_2)) \) 表示它们经过映射 \(\mathcal{T}\) 后的像之间的距离
    • 不等式表明,\(\mathcal{T}\) 将距离压缩了至少 \( \gamma \) 倍(\( \gamma < 1 \))

附录:贝尔曼算子是压缩映射的证明

  • 证明目标:贝尔曼算子(Bellman Operator)和贝尔曼最优算子(Bellman Optimality Operator)在适当的条件下都是无穷范数(\( \Vert \cdot\Vert_\infty \))下的压缩映射 ,但它们的压缩性质依赖于折扣因子 \( \gamma \in [0, 1) \) 和 MDP 的结构。

贝尔曼算子 \( \mathcal{T}^\pi \)(Policy Evaluation)

  • 对于给定的策略 \( \pi \),贝尔曼算子定义为:
    $$
    (\mathcal{T}^\pi V)(s) = \sum_{a} \pi(a|s) \left( r(s, a) + \gamma \sum_{s’} P(s’|s, a) V(s’) \right)
    $$
  • 对于任意两个值函数 \( V_1, V_2 \),有:
    $$
    \begin{align}
    \Vert \mathcal{T}^\pi V_1 - \mathcal{T}^\pi V_2 \Vert_\infty &= \max_s \left| \sum_{a} \pi(a|s) \gamma \sum_{s’} P(s’|s, a) (V_1(s’) - V_2(s’)) \right| \\
    &\leq \gamma \max_s \sum_{a} \pi(a|s) \sum_{s’} P(s’|s, a) |V_1(s’) - V_2(s’)| \\
    &\leq \gamma \max_s \sum_{a} \pi(a|s) \sum_{s’} P(s’|s, a) \Vert V_1 - V_2 \Vert_\infty \\
    &= \gamma \Vert V_1 - V_2 \Vert_\infty \quad (\text{注: } \sum_{a} \pi(a|s) \sum_{s’} P(s’|s, a) = 1)
    \end{align}
    $$
  • 也就是说,下面的式子成立:
    $$
    \Vert \mathcal{T}^\pi V_1 - \mathcal{T}^\pi V_2 \Vert_\infty \leq \gamma \Vert V_1 - V_2 \Vert_\infty
    $$
  • 至此,我们证得结论:贝尔曼算子 \( \mathcal{T}^\pi \) 是无穷范数下的压缩映射(\( \gamma \)-压缩),压缩因子为 \( \gamma \)

贝尔曼最优算子 \( \mathcal{T}^* \)(Optimal Control)

  • 贝尔曼最优算子定义为:
    $$
    (\mathcal{T}^* V)(s) = \max_{a} \left( r(s, a) + \gamma \sum_{s’} P(s’|s, a) V(s’) \right)
    $$
  • 对于任意两个值函数 \( V_1, V_2 \),设 \( a^*_1 \) 和 \( a^*_2 \) 分别是 \( \mathcal{T}^* V_1 \) 和 \( \mathcal{T}^* V_2 \) 的最优动作:
    $$
    \begin{align}
    \mathcal{T}^* V_1(s) - \mathcal{T}^* V_2(s) &= \left( r(s, a^*_1) + \gamma \sum_{s’} P(s’|s, a^*_1) V_1(s’) \right) - \left( r(s, a^*_2) + \gamma \sum_{s’} P(s’|s, a^*_2) V_2(s’) \right) \\
    &\leq \left( r(s, a^*_1) + \gamma \sum_{s’} P(s’|s, a^*_1) V_1(s’) \right) - \left( r(s, a^*_1) + \gamma \sum_{s’} P(s’|s, a^*_1) V_2(s’) \right) \\
    &= \gamma \sum_{s’} P(s’|s, a^*_1) (V_1(s’) - V_2(s’)) \\
    &\leq \gamma \Vert V_1 - V_2 \Vert_\infty
    \end{align}
    $$
  • 同理可得:
    $$
    \mathcal{T}^* V_2(s) - \mathcal{T}^* V_1(s) \leq \gamma \Vert V_1 - V_2 \Vert_\infty
    $$
  • 进一步将上面两个结论转换为绝对值,也就是说,下面的式子成立::
    $$
    | \mathcal{T}^* V_1(s) - \mathcal{T}^* V_2(s) | \leq \gamma \Vert V_1 - V_2 \Vert_\infty
    $$
  • 对绝对值取最大值,即得到无穷范数:
    $$
    \Vert \mathcal{T}^* V_1 - \mathcal{T}^* V_2 \Vert_\infty \leq \gamma \Vert V_1 - V_2 \Vert_\infty
    $$
  • 至此,我们证得结论:贝尔曼最优算子 \( \mathcal{T}^* \) 是无穷范数下的压缩映射(\( \gamma \)-压缩),压缩因子为 \( \gamma \)

比较两者的不动点

  • 贝尔曼算子 \( \mathcal{T}^\pi \) :用于策略评估(Policy Evaluation) ,计算给定策略 \( \pi \) 的值函数 \( V^\pi \)
    $$ (\mathcal{T}^\pi V)(s) = \mathbb{E}_{a \sim \pi} [ r + \gamma \mathbb{E}_{s’} V(s’) ] $$
    • 收敛到 \( V^\pi \),即 \( \mathcal{T}^\pi V^\pi = V^\pi \),且 \( V^\pi \) 是唯一不动点
  • 贝尔曼最优算子 \( \mathcal{T}^* \) :用于最优控制(Optimal Control) ,计算最优值函数 \( V^* \)
    $$(\mathcal{T}^* V)(s) = \max_a [ r + \gamma \mathbb{E}_{s’} V(s’) ] $$
    • 收敛到 \( V^* \),即 \( \mathcal{T}^* V^* = V^* \),且 \( V^* \) 是唯一不动点

一些补充思考

  • 折扣因子 \( \gamma < 1 \) 是关键,否则压缩性可能不成立(如无折扣问题 \( \gamma = 1 \) 时,可能不收敛)
  • 无穷范数 保证了压缩性,其他范数(如 \( L^2 \))不一定成立
  • 随机策略 vs. 确定性策略 :\( \mathcal{T}^\pi \) 适用于随机策略,而 \( \mathcal{T}^* \) 隐含地使用了确定性策略(取 max)

附录:神经网络近似的本质讨论

  • 神经网络近似本身可以看做是一种算子 \(\mathcal{\Pi}\):
    $$ (\mathcal{\Pi} q)(s,a) = \arg\min_{q’\in\Omega} \frac{1}{2}\Vert q(s,a) - q’(s,a)\Vert^2_2 $$
  • (未经过严格证明)一些讨论中会提到这种算子也是一种压缩映射。(注:即便如此,两个压缩映射(贝尔曼最优算子+神经网络近似)组合以后得映射也无法证明为压缩映射 ,即无法证明DQN的收敛性)
RL——Soft-Q-Learning

  • 参考文献
    • 原始论文:(Soft Q-learning)Reinforcement learning with deep energy-based policies., ICML 2017, UC Berkeley, 与 SAC 同作者
    • Soft Q-learning解读 - 单字卓的文章 - 知乎
    • 读书笔记:Reinforcement Learning with Deep Energy-Based Policies
    • 论文理解【RL经典】—— 【SQL】Reinforcement Learning with Deep Energy-Based Policies:非常详细的证明

回顾常规的强化学习场景

  • 目标定义:
    $$
    \begin{align}
    J(\theta) &= \mathbb{E}_{\tau\sim \pi_\theta}[R(\tau)] \\
    &= \mathbb{E}_{s_0, a_0,\ldots \sim \pi_\theta}\Big[\sum\limits_{t=0}^{\infty}\gamma^t r(s_t, a_t) \Big] \\
    &= \sum_{t=0}^\infty \mathbb{E}_{(s_t,a_t) \sim \rho_{\pi_\theta}} [r(s_t, a_t)]
    \end{align}
    $$
    • 第一行是普通PG方法推导的写法,最贴近本质
    • 第二行是TRPO文章的写法,是第一行的展开形势
    • 第三行这里 \(\sum_{t=0}^T \mathbb{E}_{(s_t,a_t) \sim \rho_{\pi_\theta}} [r(s_t, a_t)]\) 的写法是Soft Q-Learning 论文 和 SAC 论文提出来的,和之前TRPO等文章写法都不同,这里从第二行到第三行的变换可以理解为积分和求和交换顺序的写法,从状态 \(s_0\) 开始, \((s_t,a_t)\) 都是按照策略 \(\pi_\theta\) 执行下去可能遇到的概率分布
  • Q值定义:
    $$
    \begin{align}
    Q^\pi(s_t,a_t) &= \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=0}^\infty\gamma^lr(s_{t+l}, a_{t+l})\Big] \vert_{(s_t,a_t)} \\
    &= r(s_t, a_t) + \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^lr(s_{t+l}, a_{t+l})\Big] \vert_{(s_t,a_t)} \\
    &= r(s_t, a_t) + \sum\limits_{l=1}^\infty \mathbb{E}_{(s_{t+l},a_{t+l}) \sim \rho_\pi}[\gamma^lr(s_{t+l}, a_{t+l})] \vert_{(s_t,a_t)}
    \end{align}
    $$
    • “ \(\vert_{(s_t,a_t)}\) “表示条件概率,一般来说,不引起歧义的情况下,也可以省略” \(\vert_{(s_t,a_t)}\) “
  • V值定义:
    $$
    \begin{align}
    V^\pi(s_t) &= \mathbb{E}_{a_t,s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=0}^\infty\gamma^lr(s_{t+l}, a_{t+l})\Big] \vert_{(s_t,a_t)} \\
    &= \mathbb{E}_{a_t \sim \pi}[Q^\pi(s_t, a_t)]
    \end{align}
    $$

Soft Q-Learning

  • 目标定义
    $$ J(\phi) = \sum_{t=0}^T \mathbb{E}_{(s_t, a_t) \sim \rho_{\pi_\phi}} [r(s_t, a_t) + \alpha \mathcal{H}(\pi_\phi(.\vert s_t))] $$
    • 这里目标中增加的熵就是Soft名字的来源,这里相对标准的强化学习,仅增加了 \(\alpha \mathcal{H}(\pi_\phi(.\vert s_t))\) 为额外目标,后续在不引起歧义的情况下,我们也用 \(\alpha \mathcal{H}(\pi_\phi(s_{t}))\) 来表示,且为了方便,后续推导中常常会视为 \(\alpha=1\),这里可以通过奖励和熵同时乘以 \(\frac{1}{\alpha}\) 来变换得到
  • Soft Q值定义
    $$
    \begin{align}
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^l(r(s_{t+l}, a_{t+l}) +\alpha\mathcal{H}(\pi(s_{t+l})))\Big] \\
    &= r(s_t, a_t) + \sum\limits_{l=1}^\infty \mathbb{E}_{(s_{t+l},a_{t+l}) \sim \rho_\pi}[\gamma^l(r(s_{t+l}, a_{t+l}) + \alpha\mathcal{H}(\pi(s_{t+l})))]
    \end{align}
    $$
    • 对于 \(Q_{\text{soft}}^\pi(s_t, a_t)\) 来说,已经发生的事件是“ \((s_t,a_t)\) ”,此时 \(a_t\) 是确定的动作,对应的熵 \(\mathcal{H}(\pi(s_{t}))=0\)
  • Soft V值定义,同时推导用Soft Q值表示Soft V值
    $$
    \begin{align}
    V_{\text{soft}}^\pi(s_t) &= \mathbb{E}_{a_t,s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=0}^\infty\gamma^l(r(s_{t+l}, a_{t+l}) + \alpha\mathcal{H}(\pi(s_{t+l})))\Big] \\
    &= \mathbb{E}_{a_t \sim \pi}\Big[r(s_t, a_t) + \alpha\mathcal{H}(\pi(s_{t})) + \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^l(r(s_{t+l}, a_{t+l}) +\alpha\mathcal{H}(\pi(s_{t+l})))\Big]\Big] \\
    &= \mathbb{E}_{a_t \sim \pi}\Big[r(s_t, a_t) + \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^l(r(s_{t+l}, a_{t+l}) +\alpha\mathcal{H}(\pi(s_{t+l})))\Big] + \alpha\mathcal{H}(\pi(s_{t}))\Big] \\
    &= \mathbb{E}_{a_t \sim \pi}[Q_{\text{soft}}^\pi(s_t, a_t)] + \alpha\mathcal{H}(\pi(s_{t})) \\
    &= \mathbb{E}_{a_t \sim \pi} [Q_{\text{soft}}^\pi(s_t, a_t)] - \alpha \mathbb{E}_{a_t \sim \pi} [\log \pi(a_t \vert s_t)]\\
    &= \mathbb{E}_{a_t \sim \pi} [Q_{\text{soft}}^\pi(s_t, a_t) - \alpha \log \pi(a_t \vert s_t)]
    \end{align}
    $$
  • 推导用Soft V值表示Soft Q值
    $$
    \begin{aligned}
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^l(r(s_{t+l}, a_{t+l}) +\alpha\mathcal{H}(\pi(s_{t+l})))\Big] \\
    &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=1}^\infty\gamma^{l-1}(r(s_{t+l}, a_{t+l}) +\alpha\mathcal{H}(\pi(s_{t+l})))\Big] \\
    &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1},a_{t+1},\cdots \sim \pi}\Big[\sum\limits_{l=0}^\infty\gamma^l(r(s_{t+1+l}, a_{t+1+l}) +\alpha\mathcal{H}(\pi(s_{t+1+l})))\Big] \\
    &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} \Big[\mathbb{E}_{a_{t+1},s_{t+2},a_{t+2},\cdots \sim \pi}\Big[\sum\limits_{l=0}^\infty\gamma^l(r(s_{t+1+l}, a_{t+1+l}) + \alpha\mathcal{H}(\pi(s_{t+1+l})))\Big]\Big] \\
    &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} [V_{\text{soft}}^\pi(s_{t+1})] \\
    \end{aligned}
    $$

Soft贝尔曼期望方程

  • 通过上面的推导,我们可以得到,Soft贝尔曼期望方程为:
    $$
    \begin{aligned}
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} [V_{\text{soft}}^\pi(s_{t+1})] \\
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} [\mathbb{E}_{a_{t+1} \sim \pi} [Q_{\text{soft}}^\pi(s_{t+1}, a_{t+1}) - \alpha \log \pi(a_{t+1} \vert s_{t+1})]] \\
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s), a_{t+1} \sim \pi} [Q_{\text{soft}}^\pi(s_{t+1}, a_{t+1}) - \alpha \log \pi(a_{t+1} \vert s_{t+1})] \\
    V_{\text{soft}}^\pi(s_t) &= \mathbb{E}_{a_t \sim \pi} [Q_{\text{soft}}^\pi(s_t, a_t) - \alpha \log \pi(a_t \vert s_t)] \\
    V_{\text{soft}}^\pi(s_t) &= \mathbb{E}_{a_t \sim \pi}[Q_{\text{soft}}^\pi(s_t, a_t)] + \alpha\mathcal{H}(\pi(s_{t}))
    \end{aligned}
    $$

Soft贝尔曼最优方程

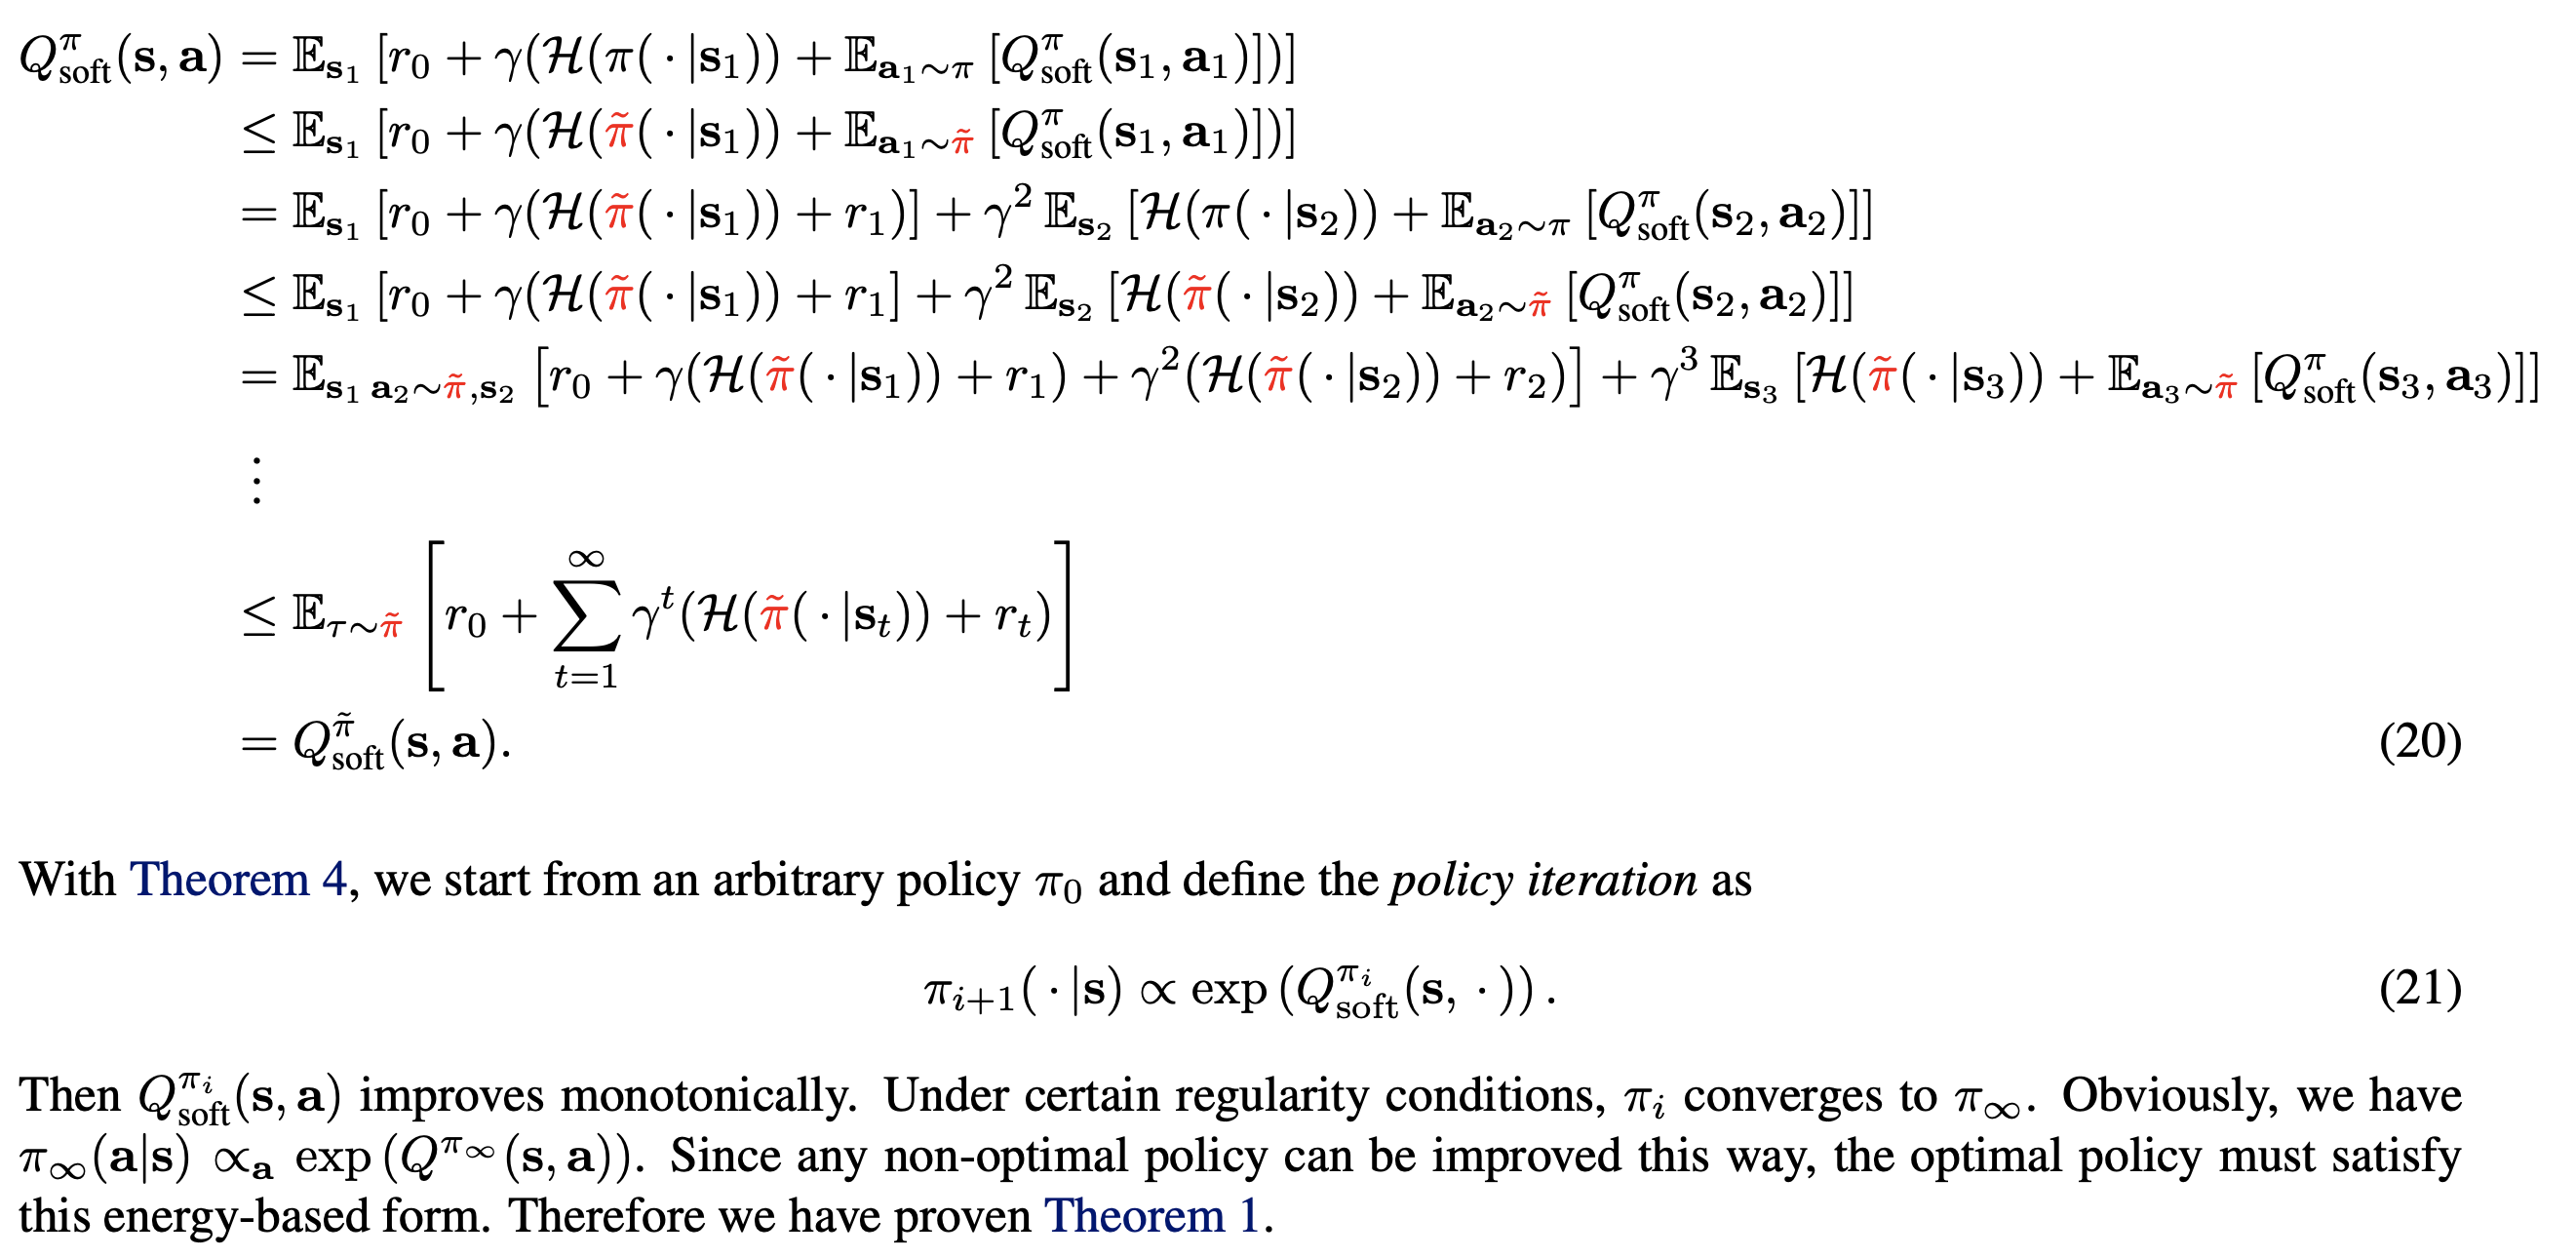
  • 首先证明,在满足如下策略改进的时候(其中 \(\tilde{\pi}\))是新策略, \(\pi\) 是旧策略,
    $$
    \tilde{\pi}(\cdot | s) \propto \exp \left(Q_{\text{soft}}^{\pi}(s, \cdot) \right), \quad \forall s.
    $$
  • 策略的Soft Q值是单调的,即:
    $$
    Q_{\text{soft}}^{\tilde{\pi}}(s, a) \geq Q_{\text{soft}}^{\pi_{\text{old}}}(s, a) ; \forall s, a.
    $$
  • 策略的Soft Q值是单调性的证明如下:
    • 以上式子证明时没有考虑温度系数 \(\alpha\),考虑温度系数 \(\alpha\) 时在所有的熵 \(\mathcal{H}(\pi(\cdot\vert\cdot))\) 时前面都加上 \(\alpha\) 即可
    • 其中使用到以下不等式 :
      $$
      \mathcal{H}(\pi(\cdot\vert s)) + \mathbb{E}_{a\sim \pi}[Q_{\text{soft}}^\pi(s,a)] \le \mathcal{H}(\tilde{\pi}(\cdot\vert s)) + \mathbb{E}_{a\sim \tilde{\pi}}[Q_{\text{soft}}^\pi(s,a)]
      $$
    • 上面的不等式又使用到以下式子(下面的式子如何推出上面的式子待确认TODO):
      $$
      \mathcal{H}(\pi(\cdot\vert s)) + \mathbb{E}_{a\sim \pi}[Q_{\text{soft}}^\pi(s,a)] = - D_{\text{KL}}(\pi(\cdot|s) || \tilde{\pi}(s, \cdot)) + \log \int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da
      $$
      • 以上式子证明过程如下:
        $$
        \begin{align}
        \text{right} &= - \int \pi(\cdot | s) \log \frac{\pi(\cdot | s)}{\tilde{\pi}(\cdot | s)} + \log \int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da \\
        &= - \int \pi(\cdot | s) \log \pi(\cdot | s) + \int \pi(\cdot | s) \log {\tilde{\pi}(\cdot | s)} + \int \pi(\cdot | s) \Big(\log \int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da\Big) \\
        &= - \int \pi(\cdot | s) \log \pi(\cdot | s) + \int \pi(\cdot | s) \log \frac{\exp \left(Q_{\text{soft}}^{\pi}(s, \cdot) \right)}{\int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da} + \int \pi(\cdot | s) \Big(\log \int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da\Big) \\
        &= - \int \pi(\cdot | s) \log \pi(\cdot | s) + \int \pi(\cdot | s) \log \exp \left(Q_{\text{soft}}^{\pi}(s, \cdot) \right) \\
        &= \mathcal{H}(\pi(\cdot\vert s)) + \mathbb{E}_{a\sim \pi}[Q_{\text{soft}}^\pi(s,a)] \\
        &= \text{left}
        \end{align}
        $$
  • 其中,由式子
    $$
    \begin{align}
    \mathcal{H}(\pi(\cdot\vert s)) + \mathbb{E}_{a\sim \pi}[Q_{\text{soft}}^\pi(s,a)] = - D_{\text{KL}}(\pi(\cdot|s) || \tilde{\pi}(s, \cdot)) + \log \int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da \\
    \end{align}
    $$
    • 其中 \(\tilde{\pi}\) 是按照 \(\tilde{\pi}(s) = \frac{\exp \left(Q_{\text{soft}}^{\pi}(s, \cdot) \right)}{\int \exp \left(Q_{\text{soft}}^{\pi}(s, a)\right) da}\) 迭代以后的策略
    • 以上推导没有增加温度系数,默认温度系数为1,实际上,如果增加温度系数,有 \(\tilde{\pi}(s) = \frac{\exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi}(s, \cdot) \right)}{\int \exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi}(s, a)\right) da}\)
    • 问题:如果策略的熵为0或温度系数为0,此时这个最优形式还能降级到 \(\pi^*(s) = \mathop{\arg\max}_a Q(s,a)\) 吗?
      • 当策略的熵为0时,是可以的,此时策略必须是确定性策略,按照上述公式,动作只能取Q值最大的那一个
      • 当温度系数为0时,此时Reward和DQN一致,最优解应该是 \(\pi^*(s) = \mathop{\arg\max}_a Q(s,a)\) 。考虑温度系数的版本 \(\tilde{\pi}(s) = \frac{\exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi}(s, \cdot) \right)}{\int \exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi}(s, a)\right) da}\),当温度系数 \(\alpha\rightarrow 0\) 时,策略近似取Q值最大的动作,等价于DQN
  • 当策略收敛以后,即经过迭代以后 \(\tilde{\pi} = \pi = \pi^*\),此时有 \(D_{\text{KL}}(\pi(\cdot|s) || \tilde{\pi}(s, \cdot)) = 0\) 成立,即
    $$ \mathcal{H}(\pi^*(\cdot\vert s)) + \mathbb{E}_{a\sim \pi^*}[Q_{\text{soft}}^{\pi^*}(s,a)] = \log \int \exp \left(Q_{\text{soft}}^{\pi^*}(s, a)\right) da $$
  • 考虑温度系数后有:
    $$ \alpha\mathcal{H}(\pi^*(\cdot\vert s)) + \mathbb{E}_{a\sim \pi^*}[Q_{\text{soft}}^{\pi^*}(s,a)] = \log \int \exp \left(Q_{\text{soft}}^{\pi^*}(s, a)\right) da $$
  • 两边同时除以 \(\alpha\) 有
    $$ \mathcal{H}(\pi^*(\cdot\vert s)) + \mathbb{E}_{a\sim \pi^*}[\frac{1}{\alpha}Q_{\text{soft}}^{\pi^*}(s,a)] = \log \int \exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi^*}(s, a)\right) da $$
  • 由于
    $$
    V_{\text{soft}}^\pi(s_t) = \mathbb{E}_{a_t \sim \pi}[Q_{\text{soft}}^\pi(s_t, a_t)] + \alpha\mathcal{H}(\pi(s_{t}))
    $$
  • 所以有
    $$
    \frac{1}{\alpha}V_{\text{soft}}^\pi(s_t) = \mathbb{E}_{a_t \sim \pi}[\frac{1}{\alpha} Q_{\text{soft}}^\pi(s_t, a_t)] + \mathcal{H}(\pi(s_{t}))
    $$
  • 最优的策略 \(\pi^*\) 对应的V值 \(V^{\pi^*}(s)\) 为:
    $$ V_{\text{soft}}^{\pi^*}(s_t) = \alpha \log \int \exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi^*}(s, a)\right) da $$

贝尔曼方程总结

  • 贝尔曼方程
    $$
    \begin{align}
    Q^\pi(s_t,a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim p(s_{t+1}|s_t, a_t)}[V^\pi(s_{t+1})] \\
    V^\pi(s_t) &= \mathbb{E}_{a_t \sim \pi}[Q^\pi(s_t, a_t)]
    \end{align}
    $$
  • 贝尔曼最优方程
    $$
    \begin{align}
    Q^{\pi^*}(s_t,a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim p(s_{t+1}|s_t, a_t)}[V^{\pi^*}(s_{t+1})] \\
    V^{\pi^*}(s_t) &= \max_{a_t}[Q^{\pi^*}(s_t, a_t)]
    \end{align}
    $$
  • Soft贝尔曼方程
    $$
    \begin{aligned}
    Q_{\text{soft}}^\pi(s_t, a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} [V_{\text{soft}}^\pi(s_{t+1})] \\
    V_{\text{soft}}^\pi(s_t) &= \mathbb{E}_{a_t \sim \pi} [Q_{\text{soft}}^\pi(s_t, a_t) - \alpha \log \pi(a_t \vert s_t)] \\
    V_{\text{soft}}^\pi(s_t) &= \mathbb{E}_{a_t \sim \pi}[Q_{\text{soft}}^\pi(s_t, a_t)] + \alpha\mathcal{H}(\pi(s_{t}))
    \end{aligned}
    $$
  • Soft贝尔曼最优方程
    $$
    \begin{aligned}
    Q_{\text{soft}}^{\pi^*}(s_t, a_t) &= r(s_t, a_t) + \gamma \mathbb{E}_{s_{t+1} \sim \rho_{\pi}(s)} [V_{\text{soft}}^{\pi^*}(s_{t+1})] \\
    V_{\text{soft}}^{\pi^*}(s_t) &= \alpha \log \int \exp \left(\frac{1}{\alpha}Q_{\text{soft}}^{\pi^*}(s, a)\right) da
    \end{aligned}
    $$
1…154155156…352
San Ye

San Ye

Stay Hungry. Stay Foolish.

704 posts
53 tags
© 2026 San Ye
Powered by Hexo
|
Theme — NexT.Gemini v5.1.4