Hindsight Experience Replay,简称HER,一种用于解决奖励稀疏问题的方法
- 参考链接:
- 原始论文:Hindsight Experience Replay,NIPS 2017,OpenAI
- 论文解读:Hindsight Experience Replay,Kenvnn’s Blog,论文的许多笔记参考自该博客
Background
- 在机器人领域,要想使强化学习训练它完美执行某任务,往往需要设计合理的奖励函数,但是设计这样的奖励函数工程师不仅需要懂得强化学习的领域知识,也需要懂得机器人、运动学等领域的知识。而且,有这些知识也未必能设计出很好的奖励函数供智能体进行学习
- 因此,如果可以从简单的奖励函数(如二分奖励)学习到可完成任务的模型,那就不需要费心设计复杂的奖励函数了
HER 技术思路
- 奖励函数的设计往往需要很强的先验知识,且往往比较难,特别在稀疏奖励和二分奖励场景中
- 系数奖励:完成目标的episode太少或者完成目标的步数太长,导致负奖励的样本数过多
- 二分奖励:完成目标时,奖励为A值,完不成目标时,奖励为B值
- 一句话说:通过在经验池中引入“Hindsight”(事后聪明)来解决稀疏奖励和二分奖励中的问题
- Hindsight的理解:hind表示“后面的”,sight则表示“看见;视力;视野等”,综合起来表示“事后聪明;事后的领悟”。与Foresight表示“先见之明”对比来看,翻译Hindsight为“后见之明”可能更为合适
- 可以用于所有Off-policy方法中
A motivating example
- 一个来自HER论文中的例子:bit-flipping environment
- 状态空间 \(\mathcal{S}=\left \{ 0,1 \right \}^{n}\),维度为n
- 动作空间 \(\mathcal{A}=\left \{ 0,1,\cdots,n-1 \right \}\),动作空间大小也为n
- 规则:对于每个episode,给定目标状态 \(s_{g}\),从任意初始状态 \(s_{0}\) (如 \(n=5,s_{0}=10101\) )每一步从动作空间中选取一个动作 \(a\),翻转 \(s_{0}\) 第 \(a\) 个位置的值,如 \(a=1\Rightarrow s_{1}=11101\),直到回合结束或者翻转后的状态与 \(s_{g}\) 相同
- 奖励函数: \(r_{g}(s,a)=-\left [ s \neq g \right ]\),即达到目标状态则为0,未达到目标状态则为-1。( \(s \neq g \Rightarrow true \doteq 1,s = g \Rightarrow false \doteq 0\) )
- 注:后续将目标状态 \(s_{g}\) 简化为 \(g\)
- 数组长度越长,反馈越稀疏,当 \(n>40\) 时,几乎没有除了-1以外的奖励,标准的强化学习算法很难求解该问题。即使使用一些探索技术也不行,因为这个问题完全不是缺乏探索,而是状态太多,探索不完,导致奖励极其稀疏,算法根本不知道需要优化的目标在哪里
解决方法
reward shaping
- 将reward设计成某些变量的函数,如 \(r_{g}(s,a)=-\left || s-g \right ||^{2}\),将训练的算法逐步引导至奖励函数增大的决策空间
- 该方案在这种场景中可以使用,但是不通用,无法应用到其他更加复杂的现实问题中
任务分解
- 将目标分解成多个粒度更小的,更容易解决的任务,使用类似层次强化学习(Hierarchical reinforcement learning)的方法去解决
- 这个文章中没有提到,一些书籍会提到
HER的做法
HER的主要思想就是:
- 通过修改目标简化问题,从而让奖励变得稠密。具体地,假定序列为 \(s_{0},s_{1},s_{2}, \cdots ,s_{T}\),目标为 \(g\),如果将目标状态 \(g\) 修改为 \(s_{T}\),即 \(g=s_{T}\),那么这样看来智能体就可以获得奖励了
- 利用这个思想对经验池进行扩充即可,可以将稀疏奖励问题给转化成非稀疏奖励,使得奖励变得稠密
HER具体做法:
- 将经验池中的状态 \(s\) 改为 \(s||g\),也就是tf.concat(s,g)
- 训练算法的输入也是 \(s||g\),也就是需要在当前状态后边连结上每个episode的目标状态,每个episode的目标状态可能不同
- HER对经验池进行了扩充,不仅存入实际采样得到的transition/experience, \(\left ( s_{t}||g,a_{t},r_{t},s_{t+1}||g \right )\),也要在回合结束时重新设置目标状态,得到相应的奖励值(在二分奖励问题中,只有在 \(s=g\) 时奖励才需要更改),存入“事后”(当初如果这样就好啦!)的经验 \(\left ( s_{t}||g’,a_{t},r_{t}’,s_{t+1}||g’ \right )\),详见伪代码,这个事后经验究竟存入多少份、多少种,由超参数 \(k\) 控制,下文讲解
- HER更适合解决多目标问题,多目标的意思为,目标点非固定,每个episode的目标状态可以不相同。详见实验部分
HER的几种扩展方式:
- 未来模式——future:在一个序列 \(s_{0},s_{1},s_{2},\cdots,s_{T}\) 中,如果遍历到状态 \(s_{2}\),则在 \(s_{3},\cdots,s_{T}\) 之间随机抽取 \(k\) 个状态作为目标状态 \(g’\),并依此向经验池中存入 \(\left ( s_{2}||g’,a_{2},r_{2}’,s_{3}||g’ \right )\),特点:一个episode的后续部分
- 回合模式——episode:在一个序列 \(s_{0},s_{1},s_{2},…,s_{T}\) 中,如果遍历到状态 \(s_{2}\),则在整个序列中随机抽取 \(k\) 个状态作为目标状态 \(g’\),并依此向经验池中存入 \(\left ( s_{2}||g’,a_{2},r_{2}’,s_{3}||g’ \right )\),特点:一个episode
- 随机模式——random:在一个序列 \(s_{0},s_{1},s_{2},…,s_{T}\) 中,如果遍历到状态 \(s_{2}\),则在多个序列 \(\tau_{0},\tau_{1},\tau_{2},\cdots\) 中随机抽取 \(k\) 个状态作为目标状态 \(g’\),并依此向经验池中存入 \(\left ( s_{2}||g’,a_{2},r_{2}’,s_{3}||g’ \right )\),特点:多个episode
- 最终模式——final:在一个序列 \(s_{0},s_{1},s_{2},\cdots,s_{T}\) 中,如果遍历到状态 \(s_{2}\),则之间令 \(g’=s_{T}\),并向经验池中存入 \(\left ( s_{2}||g’,a_{2},r_{2}’,s_{3}||g’ \right )\),特点:一个episode的最后一个状态,如果设置k,则存入k个相同的经验
- 注:上面的 \(s_{T}\) 不一定是当前episode的最终目标值,因为此时我们拟合的本意已经变成了“任意给定一个起始状态 \(s_0\) 和目标状态 \(s_i\),找到一个动作来实现将动作从 \(s_0\) 变化到 \(s_i\) ”
伪代码及其解析
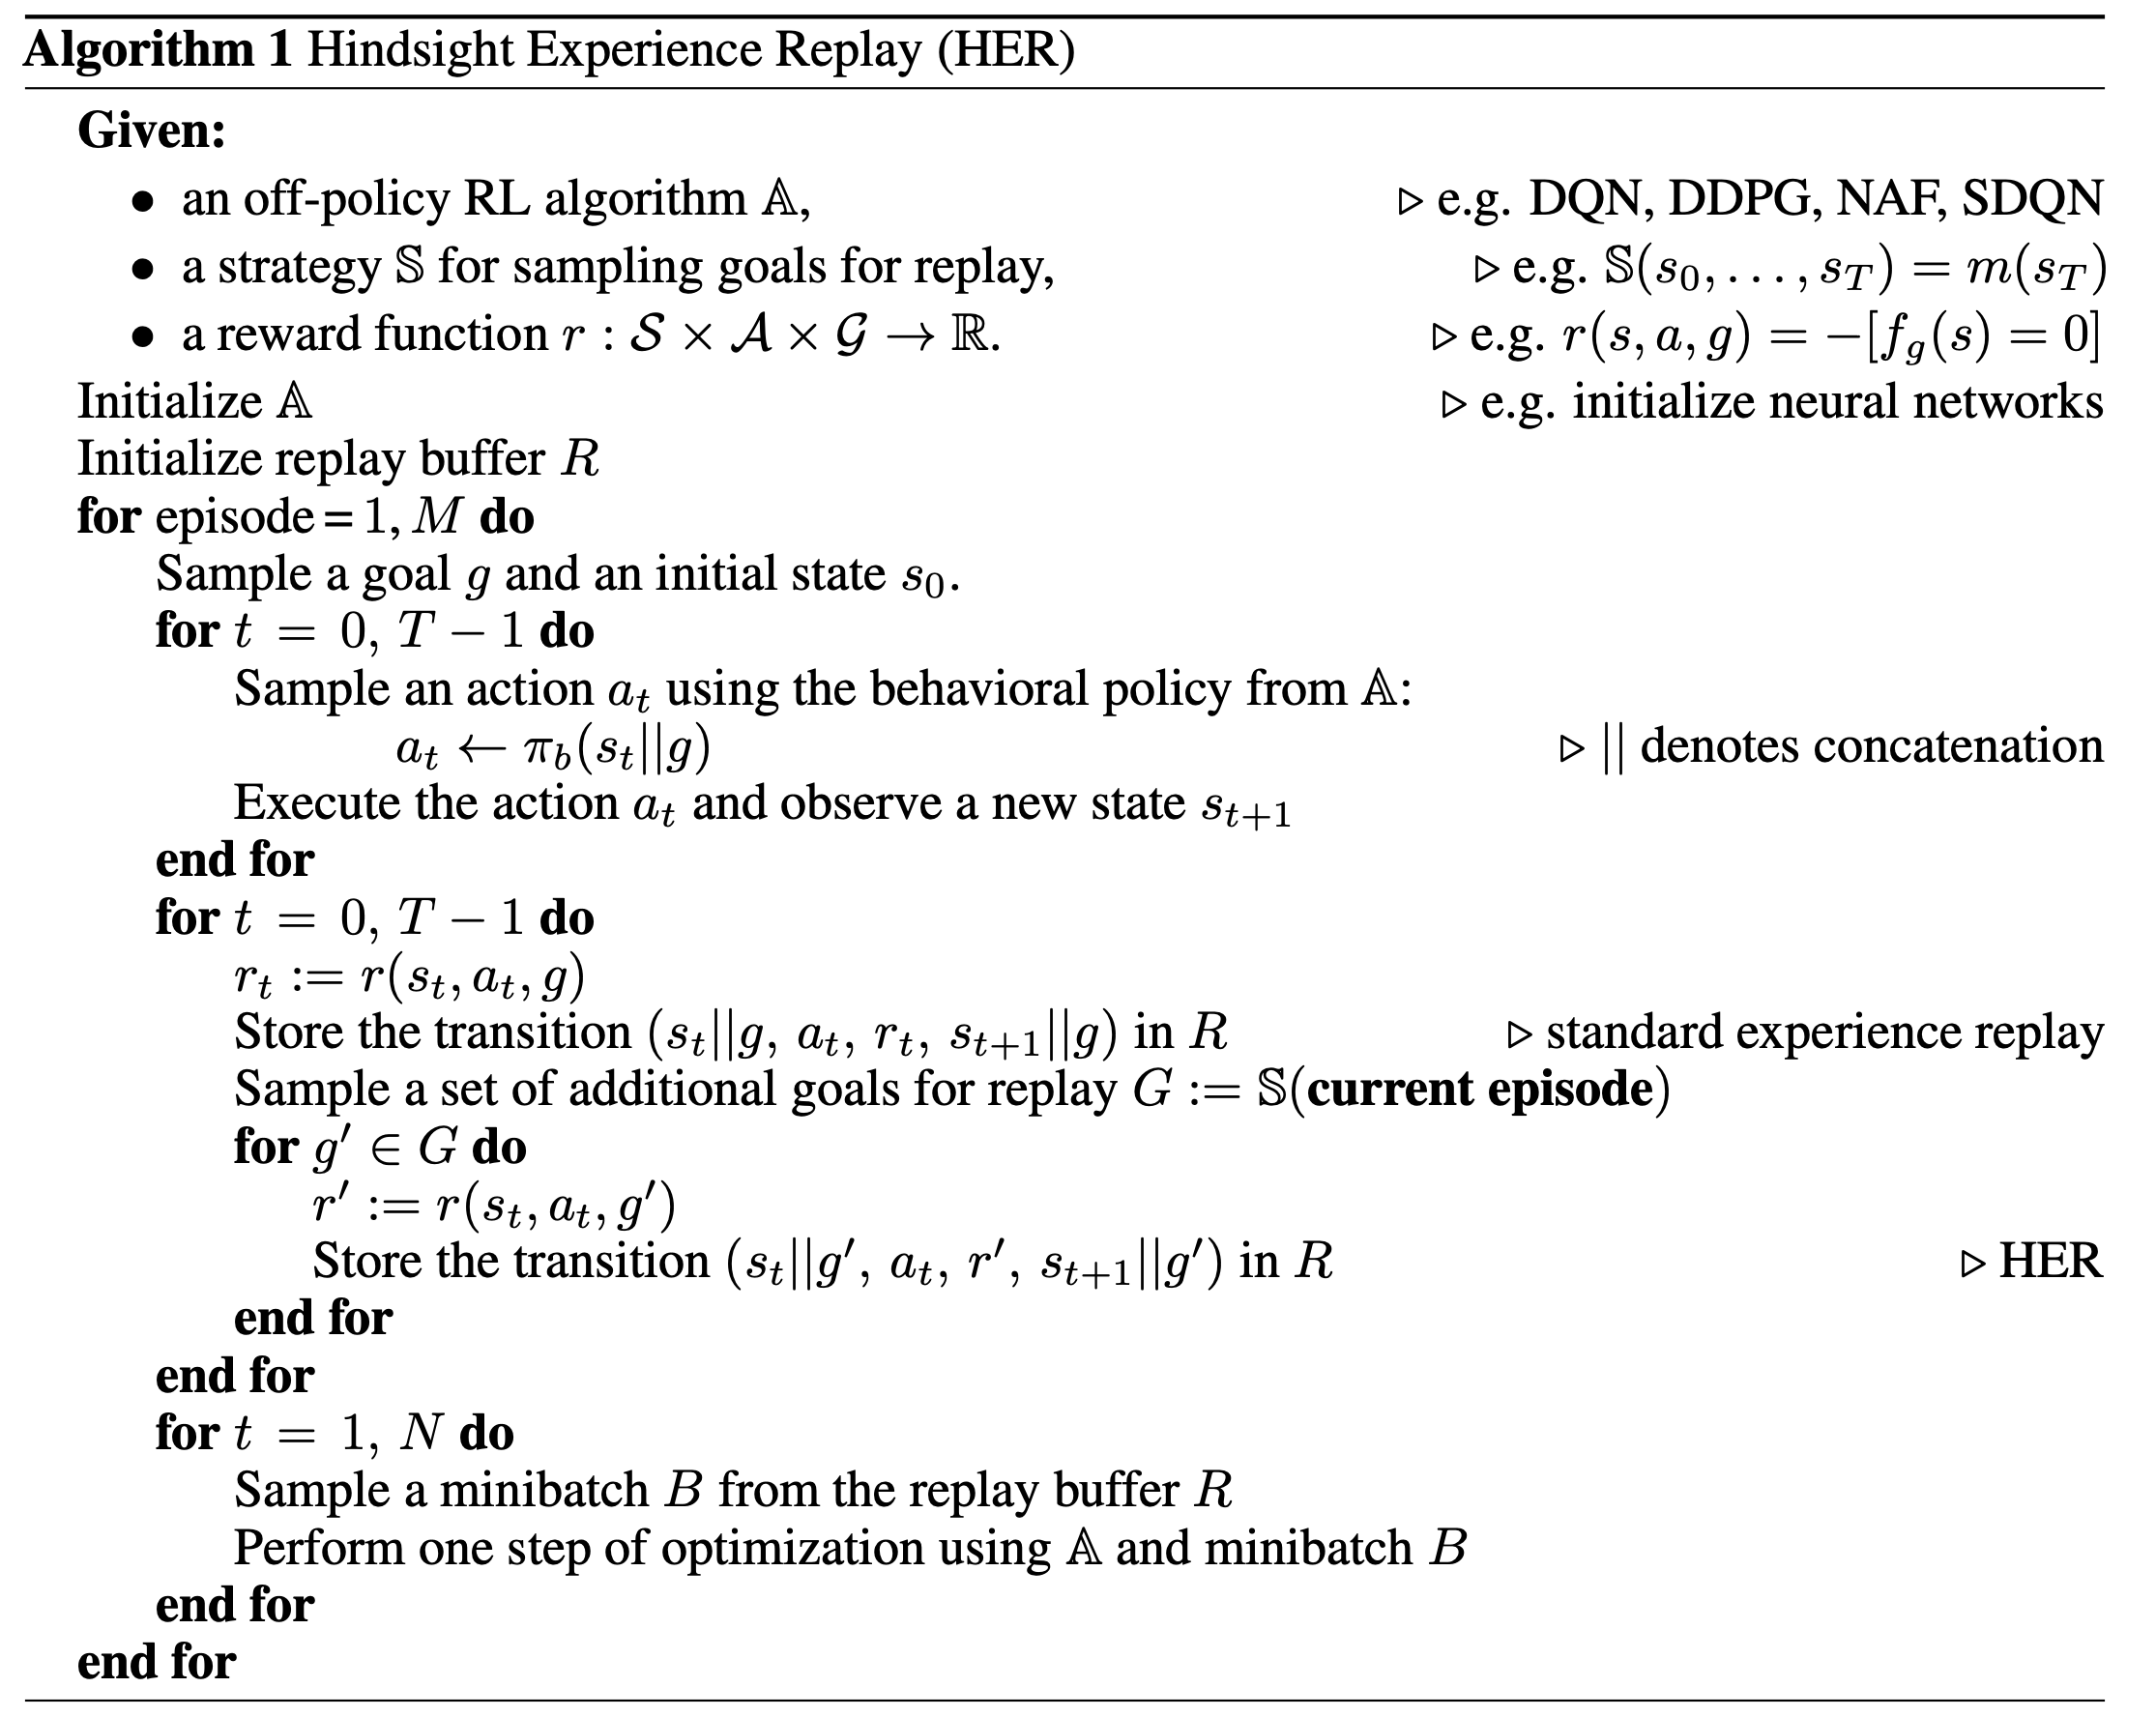
- \(r(s,a,g)\) 表示奖励不仅仅与当前状态和动作有关,还与最终的目标状态有关
- 伪代码中没有提到超参数 \(k\),其实在循环条件 \(\textbf{for} \ g’ \in G \ \textbf{do}\) 中循环执行了 \(k\) 次
- \(||\) 操作为连结操作,简言之,将两个长度为5的向量合并成一个长度为10的向量
- \(G:=\mathbb{S}(\textbf{current episode})\) 即为上文提到的四种扩展模式:future、episode、random、final
- 奖励函数 \(r(s,a,g)=-\left [ f_{g}(s)=0 \right ]\) 即为前文提到的 \(r_{g}(s,a)=-\left [ s \neq g \right ]\),即完成为0,未完成为-1,具体奖励函数可以根据我们的使用环境设计
- \(a_{t} \leftarrow \pi_{b}(s_{t}||g)\) 表示神经网络的输入为当前状态与目标状态的连结
HER的优点
- 可解决稀疏奖励、二分奖励问题
- 可适用于所有的Off-Policy算法
- 提升了数据采样效率
如何选择 HER 的模式?
- 实验结果:
- 效果:future>final>episode>random>no HER
- 稳定性:final(好)=no-HER(差)>future>episode>random
超参数的设置
- \(k\) 值不能太大,太大了会导致数据集中真实样本减少,出现问题
其他理解
- 问题:HER从 \(s_{2}\) 扩展成 \(s_{2}||g’\) 的过程中,相当于增加了MDP的数量(虽然MDP可能变得更短了),是否会导致MDP数量太多,模型难以收敛呢?