注:本文包含 AI 辅助创作
汇总一些暂时没有完整阅读的论文简读结果,部分文章暂时粗读一下,后续有时间再按需补充详细信息
RLRT
- 原始论文:(RLRT)Rebellious Student: Reversing Teacher Signals for Reasoning Exploration with Self-Distilled RLVR, Microsoft & 2KAIST,20260511
- RLRT(RLVR with Reversed Teacher) 的核心思想是逆转传统自蒸馏中的教师信号 :
- 错误的 Rollout 上,仍然使用 GRPO Advantage
- 在正确的 Rollout 上,不是让学生模仿教师,而是放大那些学生自己推理出正确结果但与教师预测不一致的 Token
- 论文认为:这些正确轨迹的 Token 代表了学生自主的、有价值的探索行为,而非需要纠正的错误
- 整体总结:
- 本论文实验丰富,且附录中包含大量实现细节
- 在多个 Qwen3 模型(Base、Instruction-tuned、Thinking-tuned)上验证了 RLRT 的有效性,显著优于 GRPO、SDPO、SRPO、RLSD 等基线,并在 AIME、HMMT、AMC、MATH500 等数学推理基准上取得平均 8.9% 的提升
- 本文是基于 GRPO 的改进
- 错误 Rollout 使用标准 GRPO 更新
- 正确 Rollout 上逆转自蒸馏方向
- 本质:在已经成功的轨迹上,让学生尽量不像教师(RLSD 等则是让学生更像教师),详细分析见附录
- 与其他方法的对比:
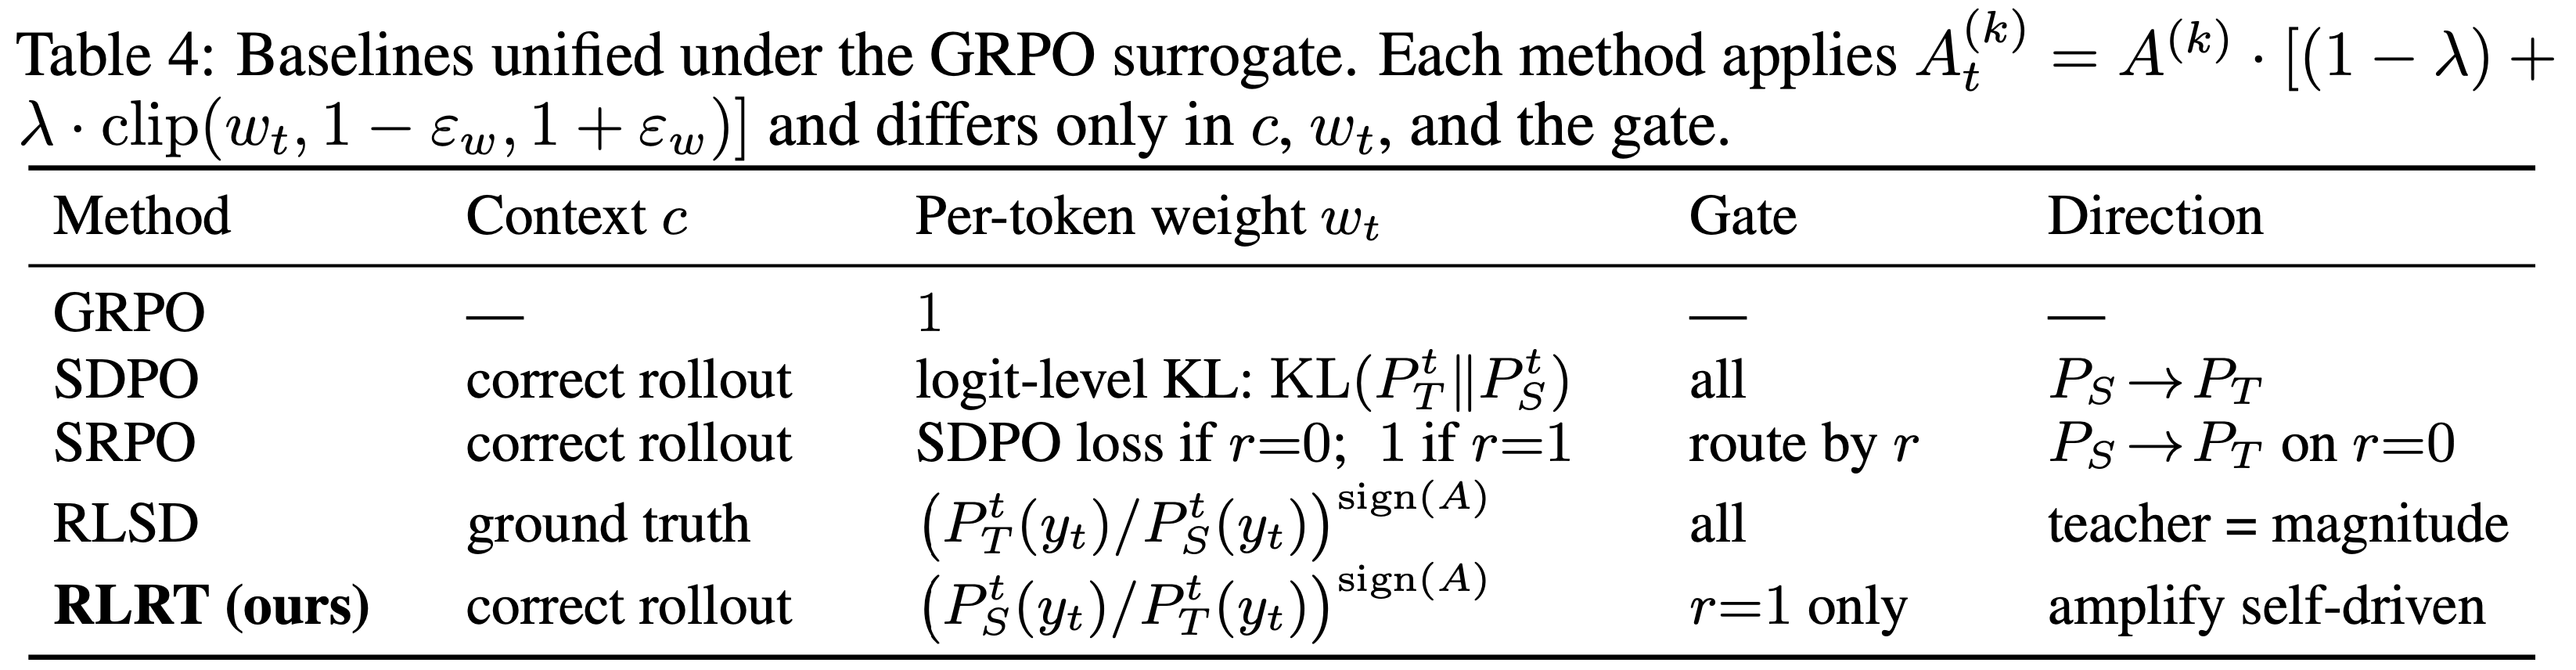
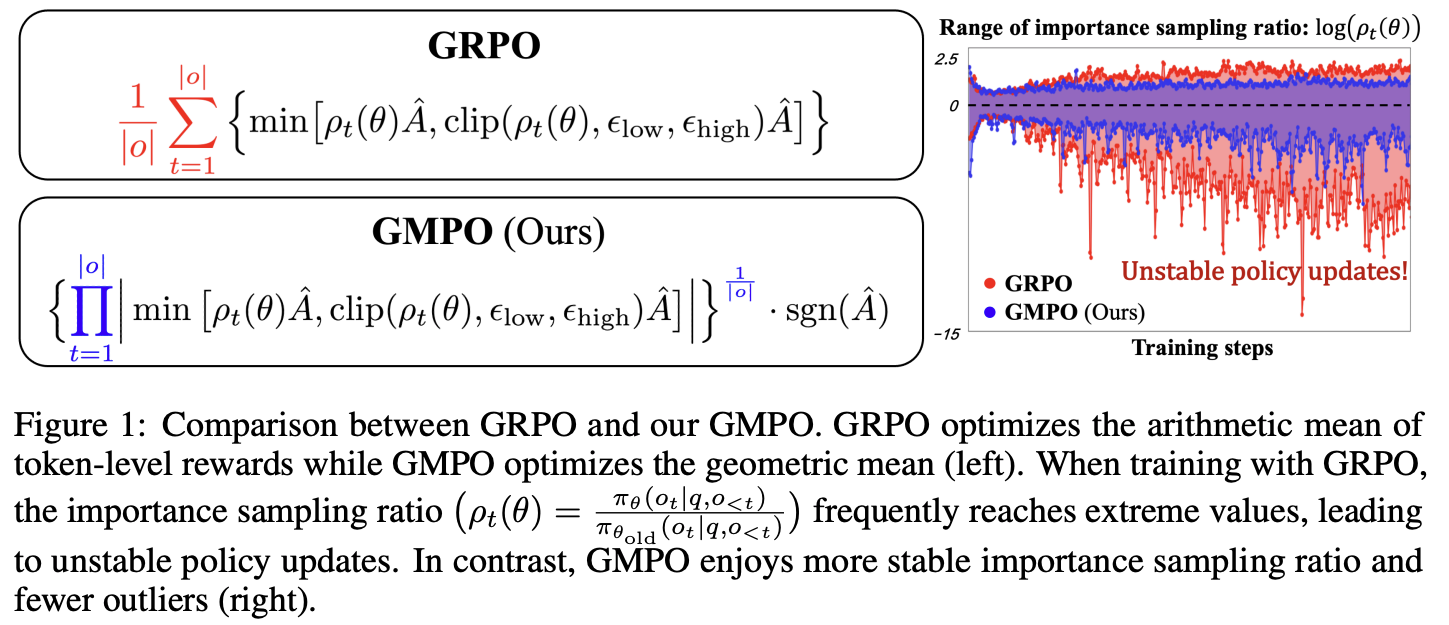
- 本论文实验丰富,且附录中包含大量实现细节
背景 & Idea 提出
- RLVR 的瓶颈
- RLVR 在推理任务中面临信用分配瓶颈 :只有稀疏的最终奖励(正确/错误),缺乏 Token-level 监督
- 自蒸馏的局限性
- Self-distillation 通过信息不对称引入密集 Token-level 监督:
- 教师模型拥有额外信息(如正确答案),学生没有
- 传统方法是让学生向教师对齐(最小化 KL 散度)
- 这在错误 Rollout 上有用,但在正确 Rollout 上会覆盖学生自己成功的推理路径 ,导致“优化歧义”
- Self-distillation 通过信息不对称引入密集 Token-level 监督:
- 核心观察
- 在正确 Rollout 中,学生与教师预测差异最大的 Token 恰恰是学生自主推理的关键点
- 论文提出:在正确 Rollout 上,逆转自蒸馏方向,放大这些自驱动的 Token ,而不是抑制它们
RLRT 方法详述
信息不对称作为探索信号
- 定义 Token-level 信息不对称:
$$
\hat{D}_t(y_t) := \log \frac{P_S^t(y_t)}{P_T^t(y_t)}
$$- \(P_S^t(\cdot) = \pi_\theta(\cdot \mid h_t)\) 是学生分布
- \(P_T^t(\cdot) = \pi_\theta(\cdot \mid h_t, R=1)\) 是教师分布(条件于成功事件 \(R=1\))
- 定义位置级别的不对称:
$$
\bar{D}_t := \mathbb{E}_{v \sim P_S^t}[\hat{D}_t(v)] = \text{KL}(P_S^t | P_T^t)
$$
关键位置的识别(论文中提到的理论部分,待进一步思考)
- 论文证明,\(\bar{D}_t\) 大的位置是对结果有因果影响的 Token
- 引入 Influence 度量:
$$
\text{Inf}_S(t) := \mathbb{E}_{v \sim P_S^t}[|f(v) - \bar{f}_S^t|]
$$- \(f(v)\) 是给定 Token 后成功的概率
- \(\bar{f}_S^t\) 是其学生均值
- Lemma 1(贝叶斯教师) :
$$
P_T^t(v) = \frac{P_S^t(v) f(v)}{\bar{f}_S^t} \quad \Leftrightarrow \quad \hat{D}_t(v) = \log \bar{f}_S^t - \log f(v)
$$ - Theorem 2(\(\bar{D}_t\) 控制 \(\text{Inf}_S(t)\)):
$$
\text{Inf}_S(t)^2 \leq 2\bar{D}_t
$$ - 说明:\(\bar{D}_t \approx 0 \Rightarrow \text{Inf}_S(t) \approx 0\),即小不对称意味着无关紧要的位置
探索/利用方向的符号
- \(\hat{D}_t(y_t) < 0\):Token 更可能来自教师(利用方向)
- \(\hat{D}_t(y_t) > 0\):Token 更可能来自学生(探索方向)
- 论文通过语言学分析验证了这一符号的语义含义:
- 探索方向 Token(如 “wait”, “consider”, “another”)开启新推理路径;利用方向 Token(如 “conclude”, “final”, “correct”)闭合推理
RLRT 算法流程
- RLRT 基于 GRPO 框架,修改 Token-level 优势权重
反向权重定义
- 对于正确 Rollout 中的每个 Token \(y_t\),定义:
$$
w_t^{\text{RLRT} } = \exp\left(\text{sign}(A) \cdot \hat{D}_t\right) = \left(\frac{P_S^t(y_t)}{P_T^t(y_t)}\right)^{\text{sign}(A)}
$$- \(A\) 是 Group-standardized advantage
- \(\text{sign}(A) \in \{-1, +1\}\) 决定是放大(正优势)还是抑制(负优势)
奖励门控更新
- 只对正确 Rollout(\(r=1\))应用反向权重:
$$
A_t^{\text{RLRT},(k)} = A^{(k)} \cdot \left[(1 - \lambda) + \lambda \cdot \text{clip}(w_t^{\text{RLRT} }, 1 - \epsilon_w, 1 + \epsilon_w)\right] \quad \text{if } r=1
$$- \(\lambda\) 控制反向信号强度
- \(\epsilon_w\) 是裁剪范围
- 错误 Rollout 回退到标准 GRPO
算法伪代码(Algorithm 1)
- 1)采样 \(K\) 个 Rollout
- 2)计算奖励和 Group-standardized advantage
- 3)对每个正确 Rollout 的每个 Token:
- 计算 \(\hat{D}_t\)
- 计算 \(w_t^{\text{RLRT} }\)
- 更新 \(A_t\)
- 4)用 GRPO surrogate 更新策略
实验
- 基准测试结果(Q1)
- 论文在四个模型上对比:GRPO、RLSD(自蒸馏)、SDPO、SRPO
- RLRT 在 avg@16 和 pass@16 上全面领先
- 例如 Qwen3-8B-Base 上,AIME24 pass@16 从 40.0% → 63.3%
- 因果干预实验(Q2)
- 在正确/错误 Rollout 中注入 “Wait, let me reconsider.”
- 在 \(\bar{D}_t\) 最大的位置注入,错误→正确的翻转率最高
- RLRT 训练后,该效果从 18% 提升到 40% 以上
- 证明 \(\bar{D}_t\) 真正识别因果关键位置
- 分布变化分析(Q3)
- 使用 Jensen-Shannon 散度比较微调前后分布
- GRPO/RLSD 只重排现有 Top Token
- RLRT 从基座模型的尾部(概率 < \(10^{-3}\))中拉出新的 Top Token,产生真正的新行为
- 与其他探索方法的比较(Q4)
- 对比:
- GRPO + Entropy Bonus( Token-level )
- DIVER(序列级多样性)
- 结果:RLRT 在 pass@1 到 pass@256 上全面占优,覆盖更多推理模式
- 对比:
- 消融实验 1:奖励门控的必要性
- 不加门控(RLRT-all)会导致长度和熵无限增长,训练在 40 步后崩溃
- 消融实验 2:裁剪范围 \(\epsilon_w\)
- 更大 \(\epsilon_w\)(如 1.0)效果更好,尤其在 Base 模型上
- 不同模型最优值:Base(1.0)、Instruct(0.5)、Thinking(0.2)
论文中其他关键 Insight
- 自蒸馏中的“优化歧义”
- 传统自蒸馏在正确 Rollout 上会产生优化歧义:尽管学生已经成功了,也会被迫模仿教师
- 这解释了为何 RLSD 在某些任务上表现不佳
- 探索的定义:有价值 vs 均匀多样性
- 本文区分“均匀多样性”和“有价值探索”
- RLRT 属于后者:只放大那些成功且自驱动的 Token
- 信息不对称作为设计轴
- 本文提出信息不对称不仅是对齐工具,更是内在的探索信号来源
- 这是一个新的 RLVR 设计原则
- 教师的具体实现
- 教师分布通过向 Prompt 中加入已知正确解 \(c\) 实现:
$$P_T^t(\cdot) = \pi_\theta(\cdot \mid h_t, c)$$
- 教师分布通过向 Prompt 中加入已知正确解 \(c\) 实现:
- 失败案例分析
- SDPO 在 Base 模型上崩溃,原因是过度抑制 “wait”、“hmm” 等反思性 Token,这些 Token 对数学推理至关重要
未来方向
- 使用更强的外部教师(on-policy distillation)
- 不同形式的特权信息(如过程反馈、部分提示)
- 离策略蒸馏
- 自适应路由:教师指导 vs 自驱动探索
附录:对正确轨迹逆转自蒸馏方向的本质是什么?
- TLDR:逆转自蒸馏方向的本质 是
- 将梯度方向从“向教师分布收敛”翻转为“从教师分布发散”,但只在正确 Rollout 上执行
- 数学上表现为权重的倒数关系
$$ w_t^{\text{RLRT} } = \frac{1}{w_t^{\text{RLSD} }}$$ - 这导致 RLRT 强化学生独特且成功的 Token(\(\hat{D}_t > 0\)),抑制教师偏好的 Token(\(\hat{D}_t < 0\)),从而鼓励有价值探索而非模仿
- 在分析前,首先明确指出:因为逆转自蒸馏方向针对的都是正确的轨迹,其 Advantage 肯定是大于 0 的
- 标准 RLVR 框架中,有一个学生策略 \(\pi_\theta\),以及一个教师策略 \(\pi_\theta(\cdot \mid h_t, c)\),其中 \(c\) 是额外信息(如正确答案)
- 对于每个 Token \(y_t\),定义:
- \(P_S^t(y_t) = \pi_\theta(y_t \mid h_t)\)
- \(P_T^t(y_t) = \pi_\theta(y_t \mid h_t, c)\)
- 标准自蒸馏(如 RLSD)的 Token-level 权重为:
$$
w_t^{\text{RLSD} } = \left(\frac{P_T^t(y_t)}{P_S^t(y_t)}\right)^{\text{sign}(A)}
$$- 注意:RLSD 跟普通的蒸馏 OPSD 或 OPD 等不同,RLSD 是基于 GRPO 的,RLSD 中教师信号仅影响 Advantage 的权重,不影响 GRPO Advantage 的方向
- RLRT 的权重为:
$$
w_t^{\text{RLRT} } = \left(\frac{P_S^t(y_t)}{P_T^t(y_t)}\right)^{\text{sign}(A)} = \left(w_t^{\text{RLSD} }\right)^{-1}
$$- \(A\) 是 Group-standardized advantage
- \(\text{sign}(A) \in \{-1, +1\}\)
梯度的一般形式
- GRPO 的 surrogate loss 对每个 Token 的梯度可以写为:
$$
\nabla_\theta \mathcal{L} \propto -A \cdot \frac{\nabla_\theta \pi_\theta(y_t \mid h_t)}{\pi_\theta(y_t \mid h_t)} = -A \cdot \nabla_\theta \log \pi_\theta(y_t \mid h_t)
$$ - 当引入权重 \(w_t\) 后:
$$
\nabla_\theta \mathcal{L}_{\text{weighted} } \propto -w_t \cdot A \cdot \nabla_\theta \log \pi_\theta(y_t \mid h_t)
$$ - 对于正确 Rollout(\(A > 0\)),\(\text{sign}(A) = +1\),因此:
- RLSD 权重:\(w_t^{\text{RLSD} } = \frac{P_T^t(y_t)}{P_S^t(y_t)}\)
- RLRT 权重:\(w_t^{\text{RLRT} } = \frac{P_S^t(y_t)}{P_T^t(y_t)}\)
梯度方向的比较
- 情况 1:学生与教师一致 (\(P_S^t \approx P_T^t\))
- 此时 \(w_t \approx 1\),两种方法梯度相似,都适度增加 Token 概率
- 情况 2:学生概率 > 教师概率 (\(P_S^t > P_T^t\),即 \(\hat{D}_t > 0\))
- 设 \(r_t = P_S^t / P_T^t > 1\)
- RLSD :\(w_t = r_t > 1\),\(\nabla_\theta \propto -A \cdot r_t \cdot \nabla_\theta \log P_S^t\)
- 梯度放大,增加这个 Token 的概率
- RLRT :\(w_t = 1/r_t < 1\),\(\nabla_\theta \propto -A \cdot (1/r_t) \cdot \nabla_\theta \log P_S^t\)
- 梯度减弱甚至接近 0
- RLRT 在 \(P_S^t > P_T^t\) 时抑制梯度,因为学生已经比教师更偏好这个 Token,无需进一步强化
- 注:RLRT 在 \(A>0\) 时实际上保留了正向梯度(只是减弱),而 RLSD 会强烈放大它
- 情况 3:学生概率 < 教师概率 (\(P_S^t < P_T^t\),即 \(\hat{D}_t < 0\))
- 设 \(r_t = P_S^t / P_T^t < 1\)
- RLSD :\(w_t = r_t < 1\),梯度减弱 ,抑制对这个 Token 的更新
- RLRT :\(w_t = 1/r_t > 1\),梯度放大 ,强烈增加这个 Token 的概率
- 关键差异:
- RLSD 抑制学生对“教师偏好但学生不偏好”的 Token 的学习(因为它认为这是对齐目标)
- RLRT 反而放大对这些 Token 的梯度,鼓励学生探索与教师不同的路径
本质解释:梯度符号的逆转
- 从梯度角度,逆转的本质是交换“放大”与“抑制”的角色 (因为 \(w_t = P_T^t / P_S^t\)):
比较 RLSD 权重 RLSD 效果 RLRT 权重 RLRT 效果 \(P_T^t > P_S^t\) \(>1\) 放大梯度 → 强化 \(<1\) 抑制梯度 → 弱化 \(P_T^t < P_S^t\) \(<1\) 抑制梯度 → 弱化 \(>1\) 放大梯度 → 强化 - 总结
- RLSD 强化“教师偏好”的 Token,抑制“学生偏好”的 Token ,实现向教师对齐
- RLRT 与 RLSD 完全相反 :强化“学生偏好且教师不偏好”的 Token(即 \(\hat{D}_t > 0\)),抑制“教师偏好”的 Token
- 这正是在正确 Rollout 上放大学生的自主决策
- 从优化目标来看:
- RLSD 在正确 Rollout 上最小化 \(-\log P_T^t(y_t)\) 相对于 \(P_S^t\) 的某种形式,本质是 Imitation Learning
- RLRT 在正确 Rollout 上最大化 \(\log P_S^t(y_t) - \log P_T^t(y_t)\) 相对于 \(P_S^t\),即最大化 Information Asymmetry \(\hat{D}_t\)
直观理解:逆转自蒸馏为什么有效?
- 1)避免优化歧义 :正确 Rollout 上,学生已经成功,无需模仿教师
- 2)保留多样性 :学生成功的不同推理路径被保留甚至强化
- 3)探索本质 :梯度方向鼓励学生走向与教师不同的区域,但受限于“已成功”的约束,因此是有价值探索而非随机漂移
- 4)信用分配更精准 :\(\hat{D}_t\) 大的 Token 是因果关键位置,梯度放大这些 Token 的更新,避免在无信息 Token 上浪费梯度
HGPO
- 原始论文:(HGPO)Hierarchy-of-Groups Policy Optimization for Long-Horizon Agentic Tasks, 20260226, NTU & SEU
- 论文中,作者揭示并验证了历史上下文不一致性 对 stepwise 优势估计的严重偏置影响
- HGPO 是一种无需额外模型或 rollout 的层级组策略优化算法,通过上下文感知分组与自适应加权实现低偏、平衡方差的优势估计
- 在 ALFWorld 和 WebShop 上取得 SOTA
- 计算开销几乎可忽略,与 GRPO/GiGPO 保持相同内存与 rollout 成本
前置说明
Trajectory-Wise 策略优化
- 注: GRPO 原始版本就属于这一类
- 将整条轨迹作为一个优化单元,即在计算策略梯度或优势估计时,将整个轨迹 \(\tau = \{(s_1, a_1), (s_2, a_2), \dots, (s_T, a_T)\}\) 视为一个整体
- 优势值对整个轨迹中的所有步骤是相同的
- Prompt 中需要包含完整的交互历史(所有状态和动作)
- 上下文长度随步数 \(T\) 线性增长
- Trajectory-Wise 策略表示为:
$$
\pi_{\theta}(\mathbf{a}_t | \mathbf{s}_{0:t}, \mathbf{x})
$$ - 优势估计(以 GRPO 为例):
$$
A^{T}(\tau_i) = \frac{R(\tau_i) - \frac{1}{|G_{\tau}|} \sum_{j \in G_{\tau} } R(\tau_j)}{\sigma_{G_{\tau} } }
$$ - 其中同一个轨迹 \(\tau_i\) 中的所有步骤共享相同的优势值 \(A^T(\tau_i)\)
Stepwise 策略优化
- GiGPO 和 本文的 HGPO 都属于这一类
- 将轨迹分解为独立的步骤 ,每个步骤被视为一个优化单元,但通过 Memory module(记忆模块:一般仅包含最近的多个 Step 状态和动作)保留有限的历史上下文
- 每个步骤可以有不同的优势值
- 记忆模块只保留最近的 \(K\) 个历史状态和动作(\(K \ll T\))
- 上下文长度保持相对稳定,不随 \(T\) 无限增长
- 理解:GiGPO 属于是只保留当前 Step 状态(即 0 个历史 Step 状态和动作)的情况
- Stepwise 策略表示为:
$$
\pi_{\theta}(\mathbf{a}_t | \mathbf{s}_t, \mathbf{m}_t, \mathbf{x})
$$- 其中 \(\mathbf{m}_t\) 是记忆模块,包含最近 \(K\) 步的历史:
$$ \mathbf{m}_t = \{(s_{t-K}, a_{t-K}), \dots, (s_{t-1}, a_{t-1})\} $$
- 其中 \(\mathbf{m}_t\) 是记忆模块,包含最近 \(K\) 步的历史:
- 优势估计(以 GiGPO 的 step-level 为例):
$$
A^{S}(\tilde{\mathbf{s} }_i) = \frac{R(\tilde{\mathbf{s} }_i) - \frac{1}{|G_{\tilde{\mathbf{s} }_i}|} \sum_{j \in G_{\tilde{\mathbf{s} }_i} } R(\tilde{\mathbf{s} }_j)}{\sigma_{G_{\tilde{\mathbf{s} }_i} } }
$$- \(\tilde{\mathbf{s} }_i\) 是 Current State,\(G_{\tilde{\mathbf{s} }_i}\) 是当前状态所在的分组
- 其中每个步骤独立参与分组和优势计算
优缺点对比
- Stepwise vs Trajectory-wise 优缺点对比:
维度 Trajectory-Wise Stepwise 上下文长度 随 \(T\) 线性增长,长时程任务中容易爆炸 通过记忆模块保持固定长度 \(K\),可扩展性强 信用分配 粗粒度(coarse-grained),同一轨迹内所有步骤同等奖惩 细粒度(fine-grained),可为不同步骤分配不同优势 历史一致性 天然一致(整条轨迹的 prompt 相同) 存在问题:相同当前状态但不同历史上下文的步骤可能被分到同一组 计算效率 低(长上下文导致 Transformer 计算负担重) 高(固定上下文长度) 适用场景 短轨迹任务(如数学推理、代码生成) 长时程 Agentic 任务(如 ALFWorld、WebShop)
场景 & 问题提出
- 在 Long-Horizon Agentic 任务 中 LLM-based 智能体训练中
- 通常要求 Agent 在多轮交互中完成复杂目标,例如 ALFWorld(家庭任务)和 WebShop(在线购物)
- 传统方法的问题:
- trajectory-wise 策略优化面临上下文爆炸 问题
- step-wise 策略优化更灵活,但引入了新的挑战:历史上下文不一致性(Historical Context Inconsistency)
- 在 Stepwise 框架中,步骤通常按照当前状态进行分组(称为 step-level anchor group,此时历史上下文长度为 0,即完全忘记了历史上下文信息)
- 此时,即使两个步骤具有相同的当前状态,它们的历史上下文(即记忆模块中的内容)可能完全不同
- 轨迹 A:在到达状态 \(s^*\) 之前,执行了“打开冰箱 then 拿出牛奶”
- 轨迹 B:在到达状态 \(s^*\) 之前,执行了“打开柜子 then 拿出杯子”
- 上面两个轨迹经过不同 上下文后到达了相同的状态(注意:这里的状态不包括上下文的内容)
- 此时,即使两个步骤具有相同的当前状态,它们的历史上下文(即记忆模块中的内容)可能完全不同
- 论文发现,这种不一致性会导致严重的有偏优势估计 ,进而损害策略优化
- 论文通过引入“Oracle groups”(当前状态 + 历史完全相同)来量化这个问题:
- 偏置大小 :Trajectory-level 偏置 > Step-level 偏置 > Oracle 偏置
- Oracle 步骤的稀缺性 :在 ALFWorld 中,4-context 组的利用率仅为 19%(原文表 2)
- Oracle 组尺寸小 :导致高方差,单独使用会不稳定
- 论文通过引入“Oracle groups”(当前状态 + 历史完全相同)来量化这个问题:
- 问题:如果当前状态一致,就应该是可以归一化的啊,因为在当前状态做的事情就应该是可以归一化的,除非不满足 MDP 了,是 POMDP 的场景
- 理解:LLM Agent 的决策过程天然是一个 POMDP,引入前面更多的状态可以让建模更准确,这也是解决 POMDP 的惯用手段
- 在 Stepwise 框架中,步骤通常按照当前状态进行分组(称为 step-level anchor group,此时历史上下文长度为 0,即完全忘记了历史上下文信息)
HGPO 方法
- HGPO(Hierarchy-of-Groups Policy Optimization) 的核心思想是:不将步骤强制分到单一组中,而是基于历史上下文的匹配程度,将每个步骤分配到多个层级组中,然后通过自适应加权聚合优势估计
- 理解:本质是按照不同长度的历史上下文进行多级分组,然后分别针对上下文和状态完全相同进行分组并归一化,最终对所有级计算得到的 Advantage 进行加权平均(越长的历史上下文分级得到的 Advantage 权重越大)
HGPO 设计思路
- 1)观察 :理想的优势估计应使用 “Oracle Groups”,即步骤不仅当前状态相同,历史上下文也完全相同
- 但 Oracle 步骤在实际 rollout 中非常稀少 ,且组尺寸小,导致高方差
- 2)折中 :与其只用 Oracle 组,不如构建一个层级组结构
- 步骤可以在不同层级上与其他步骤比较,高层级组(历史更一致)提供低偏优势,低层级组(历史忽略较多)提供低方差优势
- 3)融合 :通过自适应加权,在偏置与方差之间取得更优平衡
HGPO 方法流程
HGPO Step 1: 多轨迹 Rollout
- 从任务分布 \(p(X)\) 中采样一个任务 \(x\),初始化 \(N\) 个完全相同环境
- 对于第 \(i\) 个轨迹,在每个时间步 \(t\),Agent 根据旧策略 \(\pi_{\theta_{\text{old} } }\) 生成动作 \(a_t^{(i)}\),执行后得到奖励 \(r_t^{(i)}\) 和下一状态 \(s_{t+1}^{(i)}\)
- 最终得到 \(N\) 条轨迹 \(\tau_i = \{(s_1^{(i)}, a_1^{(i)}), \dots, (s_T^{(i)}, a_T^{(i)})\}\),仅最后一步有稀疏延迟奖励
HGPO Step 2: Context-Aware Hierarchical Grouping
定义 \(k\)-step 上下文算子:
$$
\mathcal{C}_k(s_t^{(i)}) = \begin{cases}
(s_{t-k}^{(i)}, s_{t-k+1}^{(i)}, \dots, s_t^{(i)}), & t \ge k \\
(s_0^{(i)}, s_1^{(i)}, \dots, s_t^{(i)}), & t < k
\end{cases}
$$- 其中 \(k \in [0, K]\),\(K\) 为最大历史长度
- 理解:\(\mathcal{C}_k(s_t^{(i)})\) 表示第 \(i\) 个轨迹,在时间步 \(t\) 的 状态 \(s_t^{(i)}\) 本身对应的 \(k\)-step 上下文
- 这个上下文按照两种情况分别定义,但其本质是一个类似
states[max(t-k,0):t+1] == states[max(t-k,0):]的算子(其中states = [s_0,s_1...,s_t])- 这个写法更容易理解
- k 越大,包含的上下文状态越多,k 本质上就是最终上下文包含的状态数
- 这个上下文按照两种情况分别定义,但其本质是一个类似
- 问题:常规 stepwise 策略下,历史上下文中本质应该是包含状态和动作 \(\{s_t, a_t\}_{i=1}^N\) 的,但是这里仅仅考虑状态 \(\{s_t\}_{i=1}^N\)
- 个人理解:应该是按照下面的定义才对(特别是在非确定性环境下, 不同动作可能带来相同结果,其实这样会丢失一些动作信息,建议还是加上)
$$
\mathcal{C}_k(\tau_t^{(i)}) = \{(s_{t-k}^{(i)}, a_{t-k}^{(i)}), (s_{t-k+1}^{(i)}, a_{t-k+1}^{(i)}), \dots, (s_t^{(i)}, a_t^{(i)})\}
$$ - 为什么这里会丢失动作部分呢?(个人理解)
- 1)符号简化 :为了公式的简洁性,作者用 \(s_t\) 代表“第 \(t\) 步的完整上下文快照”
- 2)状态已足够区分 :在 ALFWorld 和 WebShop 中,状态描述(如 “You are at fridge. The fridge is closed.”)已包含足够多的信息来区分不同的历史路径,动作信息可以被部分推断
- 3)与 GiGPO 保持一致 :GiGPO 定义 Step-level 分组时也是只依据当前状态 \(s_t\),HGPO 延续了这个约定?但人家 GiGPO 中是没有历史 Context 的啊
- 个人理解:应该是按照下面的定义才对(特别是在非确定性环境下, 不同动作可能带来相同结果,其实这样会丢失一些动作信息,建议还是加上)
定义第 \(k\) 级层级组:
$$
G_k^H(\color{red}{s_t^{(i)}}) = \{(j, n) \in \mathcal{I} : \mathcal{C}_k(\color{red}{s_t^{(i)}}) = \mathcal{C}_k(s_n^{(j)})\}
$$- 其中 \(\mathcal{I} = \{(j, n) \mid 1 \le j \le N, 1 \le n \le T\}\)
- \(j\) 对应轨迹编号
- \(n\) 对应时间步编号
- 理解:\(G_k^H(s_t^{(i)})\) 表示第 \(k\) 级层级下,针对 \(s_t^{(i)}\) 所在的分组
- 注意:要求不止当前状态相等,还要求历史上下文中的状态相等
- 理解:这些组满足嵌套关系:
$$
G_0^H(s_t^{(i)}) \supseteq G_1^H(s_t^{(i)}) \supseteq \dots \supseteq G_K^H(s_t^{(i)})
$$- \(G_0^H\):仅当前状态相同(忽略历史),对应 GiGPO 的 Step-wise 组
- \(G_K^H\):当前状态 + 全部历史相同,即 Oracle 组
- 其中 \(\mathcal{I} = \{(j, n) \mid 1 \le j \le N, 1 \le n \le T\}\)
注:实现时,这里所有分组操作完全离线 ,仅需哈希表查找,无需额外模型或 rollout
HGPO Step 3: 自适应加权优势估计
- 先定义第 \(k\) 级层级组的优势:
$$
A_k^H(s_t^{(i)}) = \frac{R(s_t^{(i)}) - \frac{1}{|G_k^H|} \sum_{(j,n) \in G_k^H} R(s_n^{(j)})}{\sigma_{G_k^H} }
$$- \(R(s_t^{(i)}) = \sum_{j=t}^T \gamma^{j-t} r_j^{(i)}\) 是折扣累积奖励(stepwise reward)
- \(\gamma \in (0,1]\) 为折扣因子
- 最终优势通过自适应加权融合:
$$
A^H(s_t^{(i)}) = \sum_{k=0}^K w_k \cdot A_k^H(s_t^{(i)}), \quad w_k = \frac{(k+1)^\alpha}{\sum_{k}(k+1)^\alpha}, \quad \alpha \ge 0
$$- 若某组大小为 1(\(|G_k^H| = 1\)),则其优势无法定义,会被自动忽略
- 理解:\(A^H(s_t^{(i)})\) 将所有可能的 \(k \in [0,\cdots,K]\) 的值都统计了一遍,求一个加权平均
- k 越大的组,对应的权重越大,使用 \(k+1\) 做归一化而不是 \(k\) 的原因是为了保证 \(k=0\) 时也能有一定的奖励
- \(\alpha\) 控制权重分布:\(\alpha\) 越大,高层级组(低偏)权重越高
HGPO Step 4: 策略优化目标
- 最终 HGPO 的目标函数为:
$$
\mathcal{J}_{\text{HGPO} }(\theta) = \mathbb{E}\left[ \frac{1}{NT} \sum_{i=1}^N \sum_{t=1}^T \min \left( \rho_\theta(a_t^{(i)}) A^H(s_t^{(i)}), \text{clip}(\rho_\theta(a_t^{(i)}), 1 \pm \epsilon) A^H(s_t^{(i)}) \right) \right] - \beta \mathbb{D}_{\text{KL} }(\pi_\theta(\cdot \mid x) | \pi_{\text{ref} }(\cdot \mid x))
$$- \(\rho_\theta(a_t^{(i)}) = \frac{\pi_\theta(a_t^{(i)} \mid s_t^{(i)}, x)}{\pi_{\theta_{\text{old} } }(a_t^{(i)} \mid s_t^{(i)}, x)}\) 为重要性采样比率
- \(\epsilon\) 为裁剪参数
- \(\beta\) 为 KL 惩罚系数
实验
- 环境与模型
- ALFWorld :6 类家庭任务,4,639 个实例,最大 50 步
- WebShop :1.1M 商品,12k 指令,最大 30 步
- 基础模型 :Qwen2.5-1.5B-Instruct 和 Qwen2.5-7B-Instruct
- 对比方法 :
- 闭源 LLM:GPT-4o, Gemini-2.5-Pro
- Prompting 方法:ReAct, Reflexion
- RL 方法:PPO, RLOO, GRPO, GiGPO
- 主要结果(原文表 1):HGPO 在所有设置下显著优于所有 baseline
- 在 ALFWorld 上,HGPO (K=4) 达到 95.96% 的 In-Success 率(Qwen2.5-7B)
- 在 WebShop 上,HGPO (K=4) 达到 79.29% 的 Task Success Rate
- 在 OOD 任务上,HGPO 的退化程度远小于 GiGPO,说明其优势估计更稳健
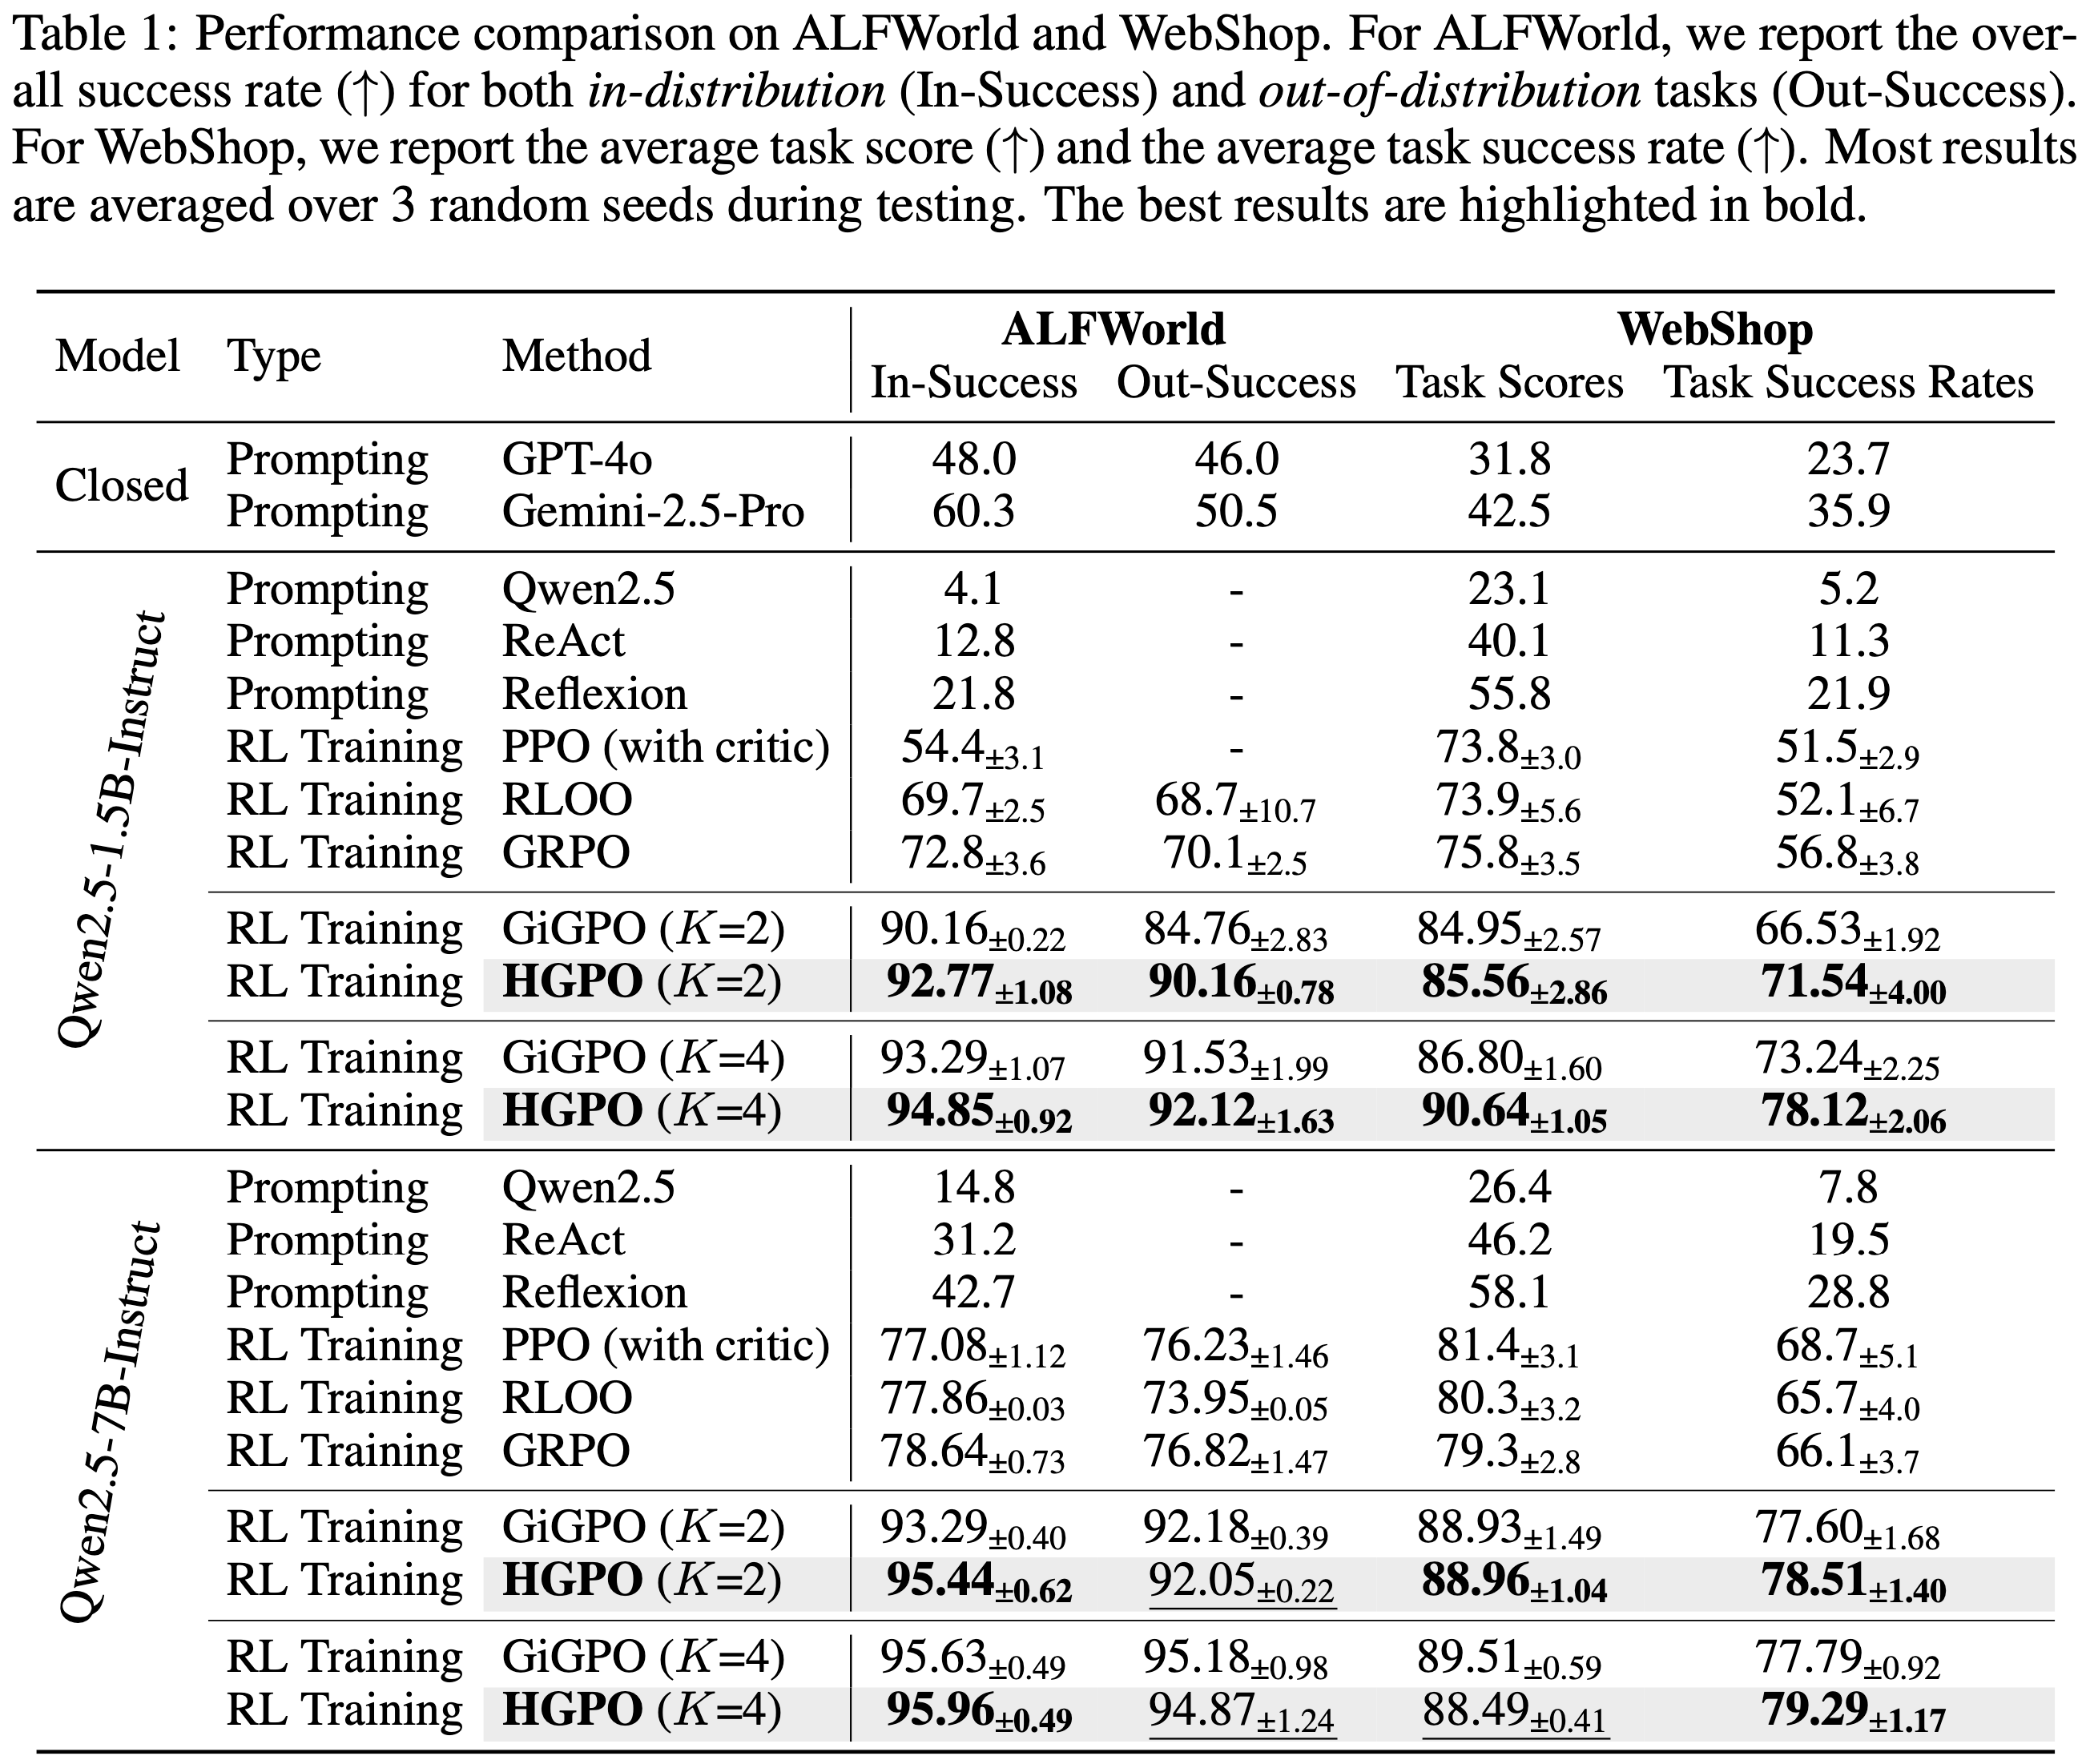
- 关键 Insight
- 小模型收益更大(1.5B 提升 +3.41%,7B 提升 +0.74%):小模型生成步更长、更冗余,偏置更大,HGPO 更能发挥优势
- 增大 \(K\)(历史长度)可提升两者性能 ,但 HGPO 提升更明显
- Oracle 步骤稀缺 :0-context 组利用率为 97%,4-context 组仅 19%(原文表 2)
- 计算开销
- HGPO 与 GRPO、GiGPO GPU 内存相同 ,LLM rollout 次数相同
- 额外开销仅来自哈希查找:每轮约 0.4–0.6 秒,小于总执行时间的 0.001%
- 消融实验(原文表 5)
- w/o \(G_{1:K}^H\) :只用 Step-wise 组 (\(G_0^H\)),性能显著下降(-2.8% In,-5.8% Out),证明层级组必要性
- w/o Ada. \(w_k\) :均匀权重,K=2 时略好,K=4 时变差,说明自适应加权在长历史时更关键
- w Eq. (1) :加入轨迹级优势,性能下降(除 K=2 的 WebShop),说明轨迹级优势偏置过大
- 参数 \(\alpha\) 分析(原文表 4)
- \(\alpha = 0\):K=2 时好,K=4 时差
- \(\alpha = 1\):平衡 bias-variance,默认选择
- \(\alpha = 2\):过度强调高层级组,方差增大,性能下降
- 训练动态分析(原文图 7、原文图 8)
- Policy Gradient Clip Fraction :HGPO 保持适中,GiGPO 和 GRPO 偏高 → HGPO 训练更稳定
- KL Divergence :GRPO 过低(学习慢),GiGPO 过高(更新激进),HGPO 适中
- Mean Reward & Success Rate :HGPO 提升更平滑,最终更高
EffOPD
- 原始论文:(EffOPD)Learning to Foresee: Unveiling the Unlocking Efficiency of On-Policy Distillation, 20260513, USTC & Tencent
- 总结:
- 事实描述:相比于基于稀疏奖励的 RL(如 PPO、GRPO、DAPO),OPD 利用 teacher 模型提供的密集监督信号,在更短训练时间内取得与 RL 相当的性能
- 传统观点:将 OPD 的高效归因于“更密集、更稳定的监督信号”,但这种解释停留在宏观层面,未揭示参数更新层面的机制
- 本文观点:OPD 的效率来源于一种 “foresight”(预见性)
- OPD 在训练早期就建立了一个稳定、与最终解高度对齐的更新轨迹,从而减少无效探索与修正
- 这种预见性(foresight)体现在两个层面:
- 1)模块分配层面 :Functional Redundancy Avoidance(模块级),识别低边际效用的区域,将更新集中在更关键的推理模块
- 2)更新方向层面 :Early Low-Rank Lock-in(方向级),更新矩阵呈现更强的低秩集中性,且主导子空间在训练早期就与最终更新子空间高度对齐
- 基于这个观点,论文提出 EffOPD
- EffOPD 是一个即插即用的加速方法,通过自适应外推当前更新方向,实现平均 3 倍的训练加速
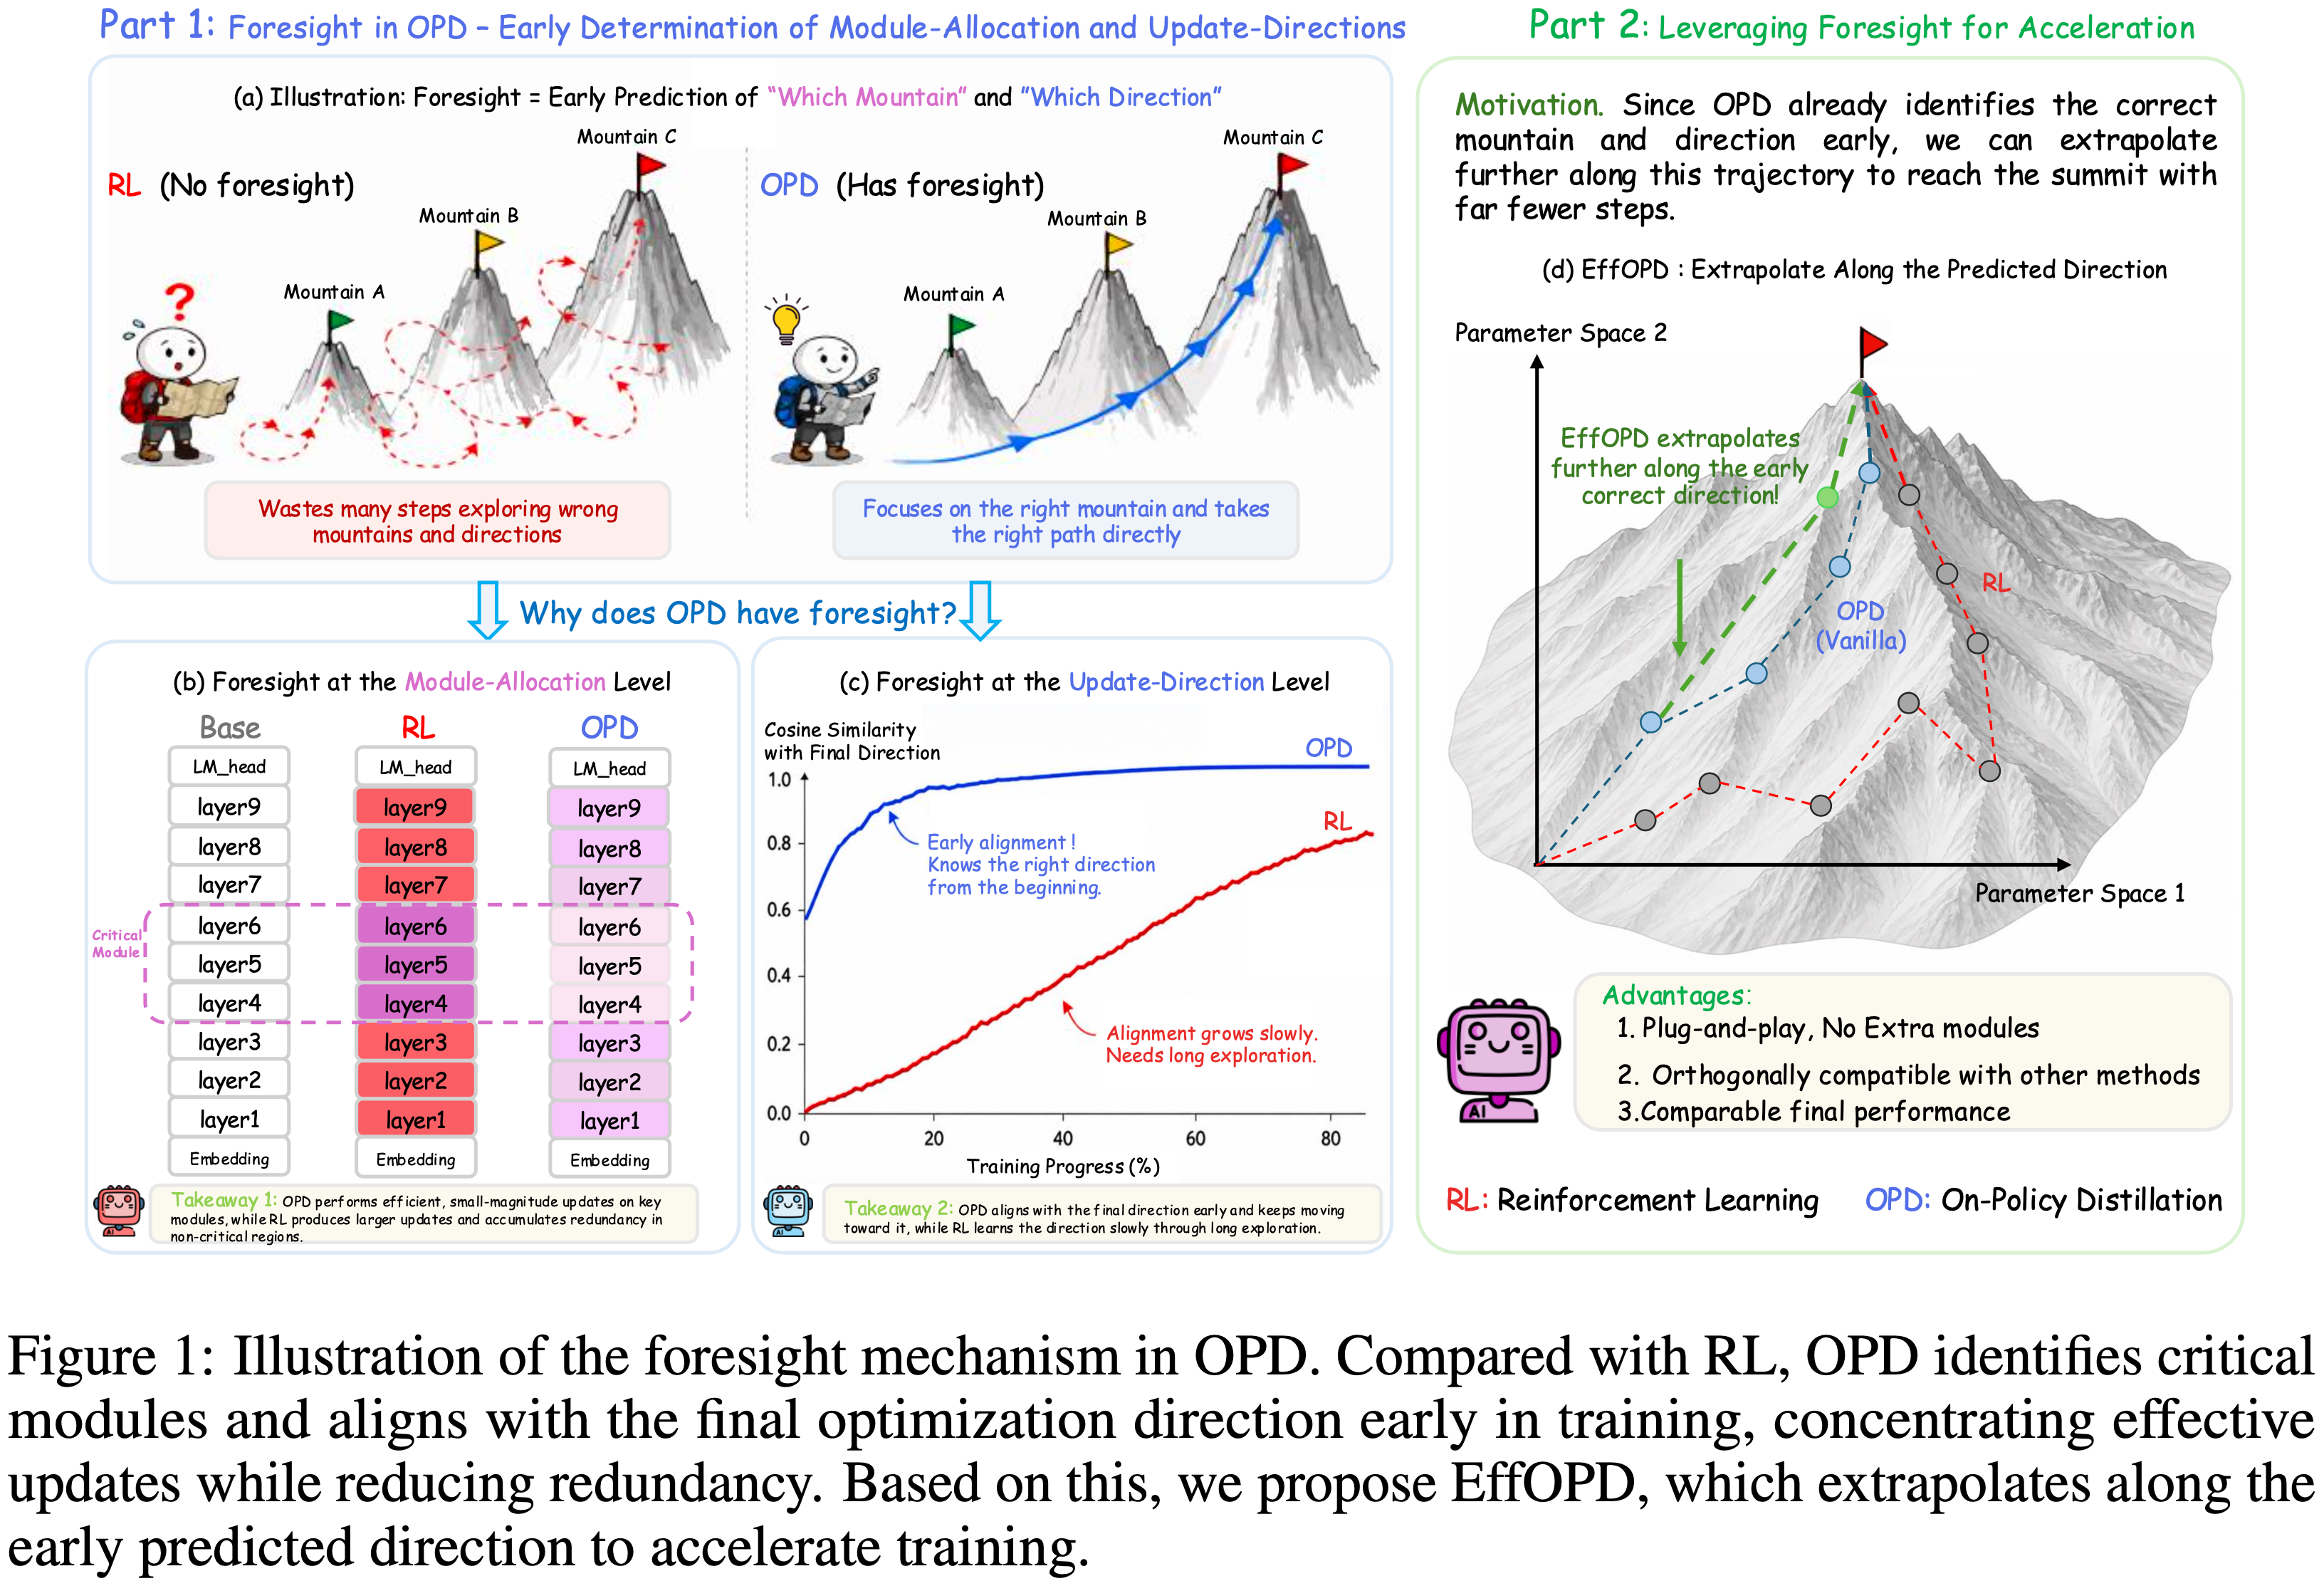
- EffOPD 是一个即插即用的加速方法,通过自适应外推当前更新方向,实现平均 3 倍的训练加速
核心观点与关键发现
Property 1:Functional Redundancy Avoidance(模块级预见性)
- 性质 1:Functional Redundancy Avoidance,避免非必要的冗余更新
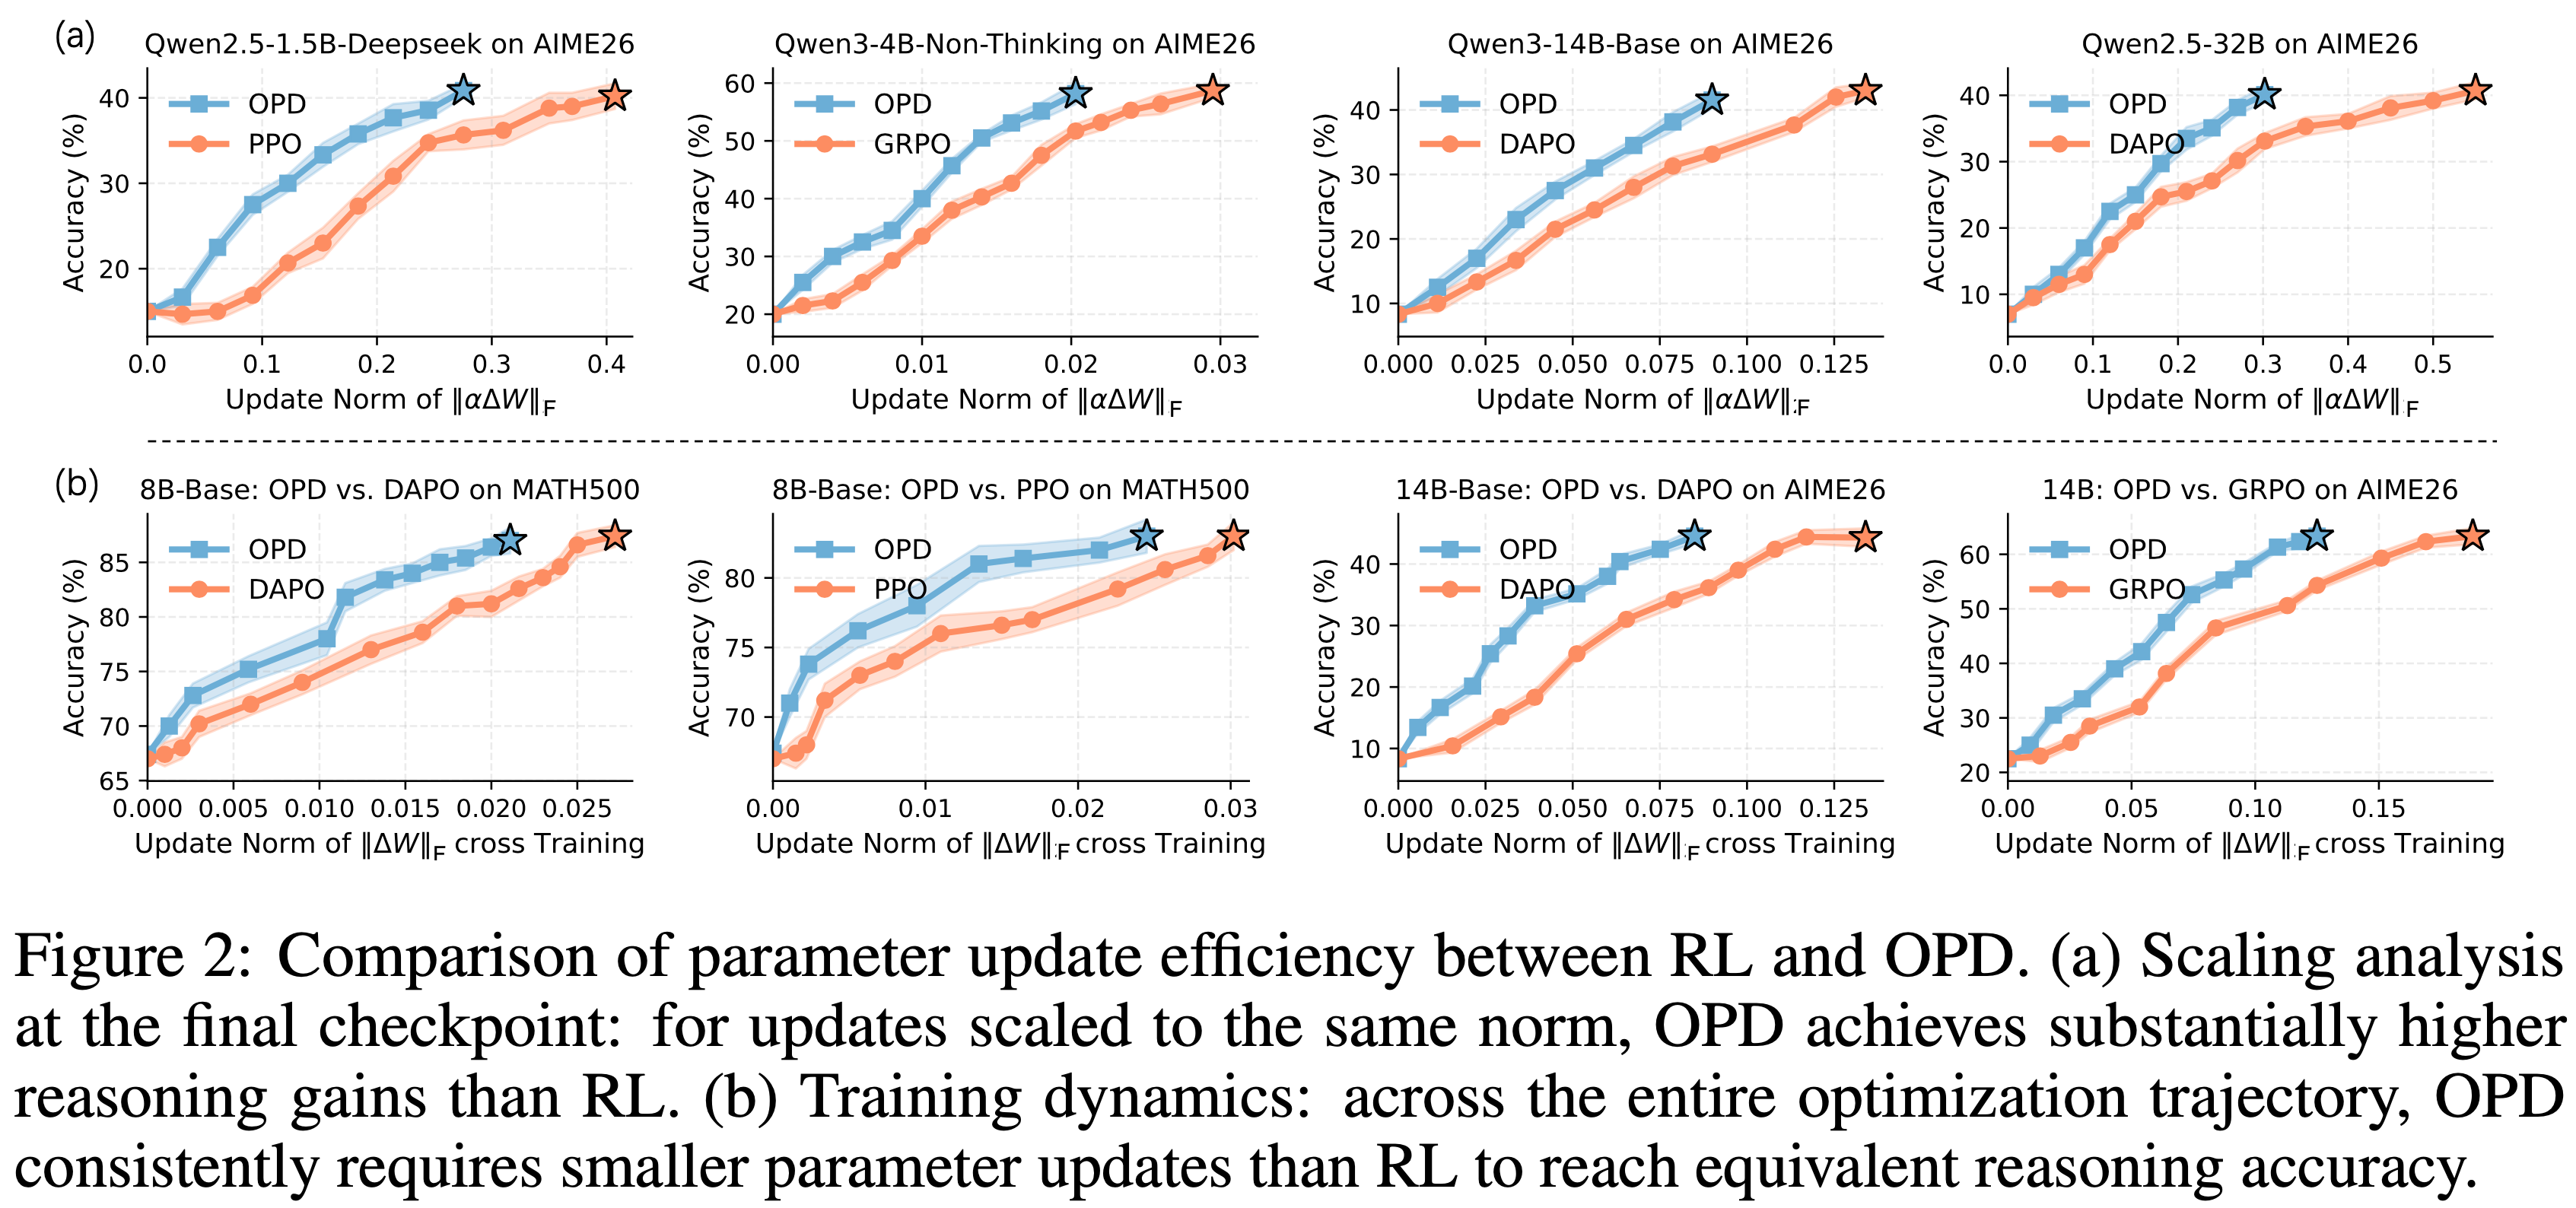
- 在相同更新范数约束下,OPD 比 RL 带来更大的推理性能提升(原文图 2a)
- 整个训练过程中,OPD 达到相同推理精度所需的参数更新范数始终小于 RL(原文图 2b)
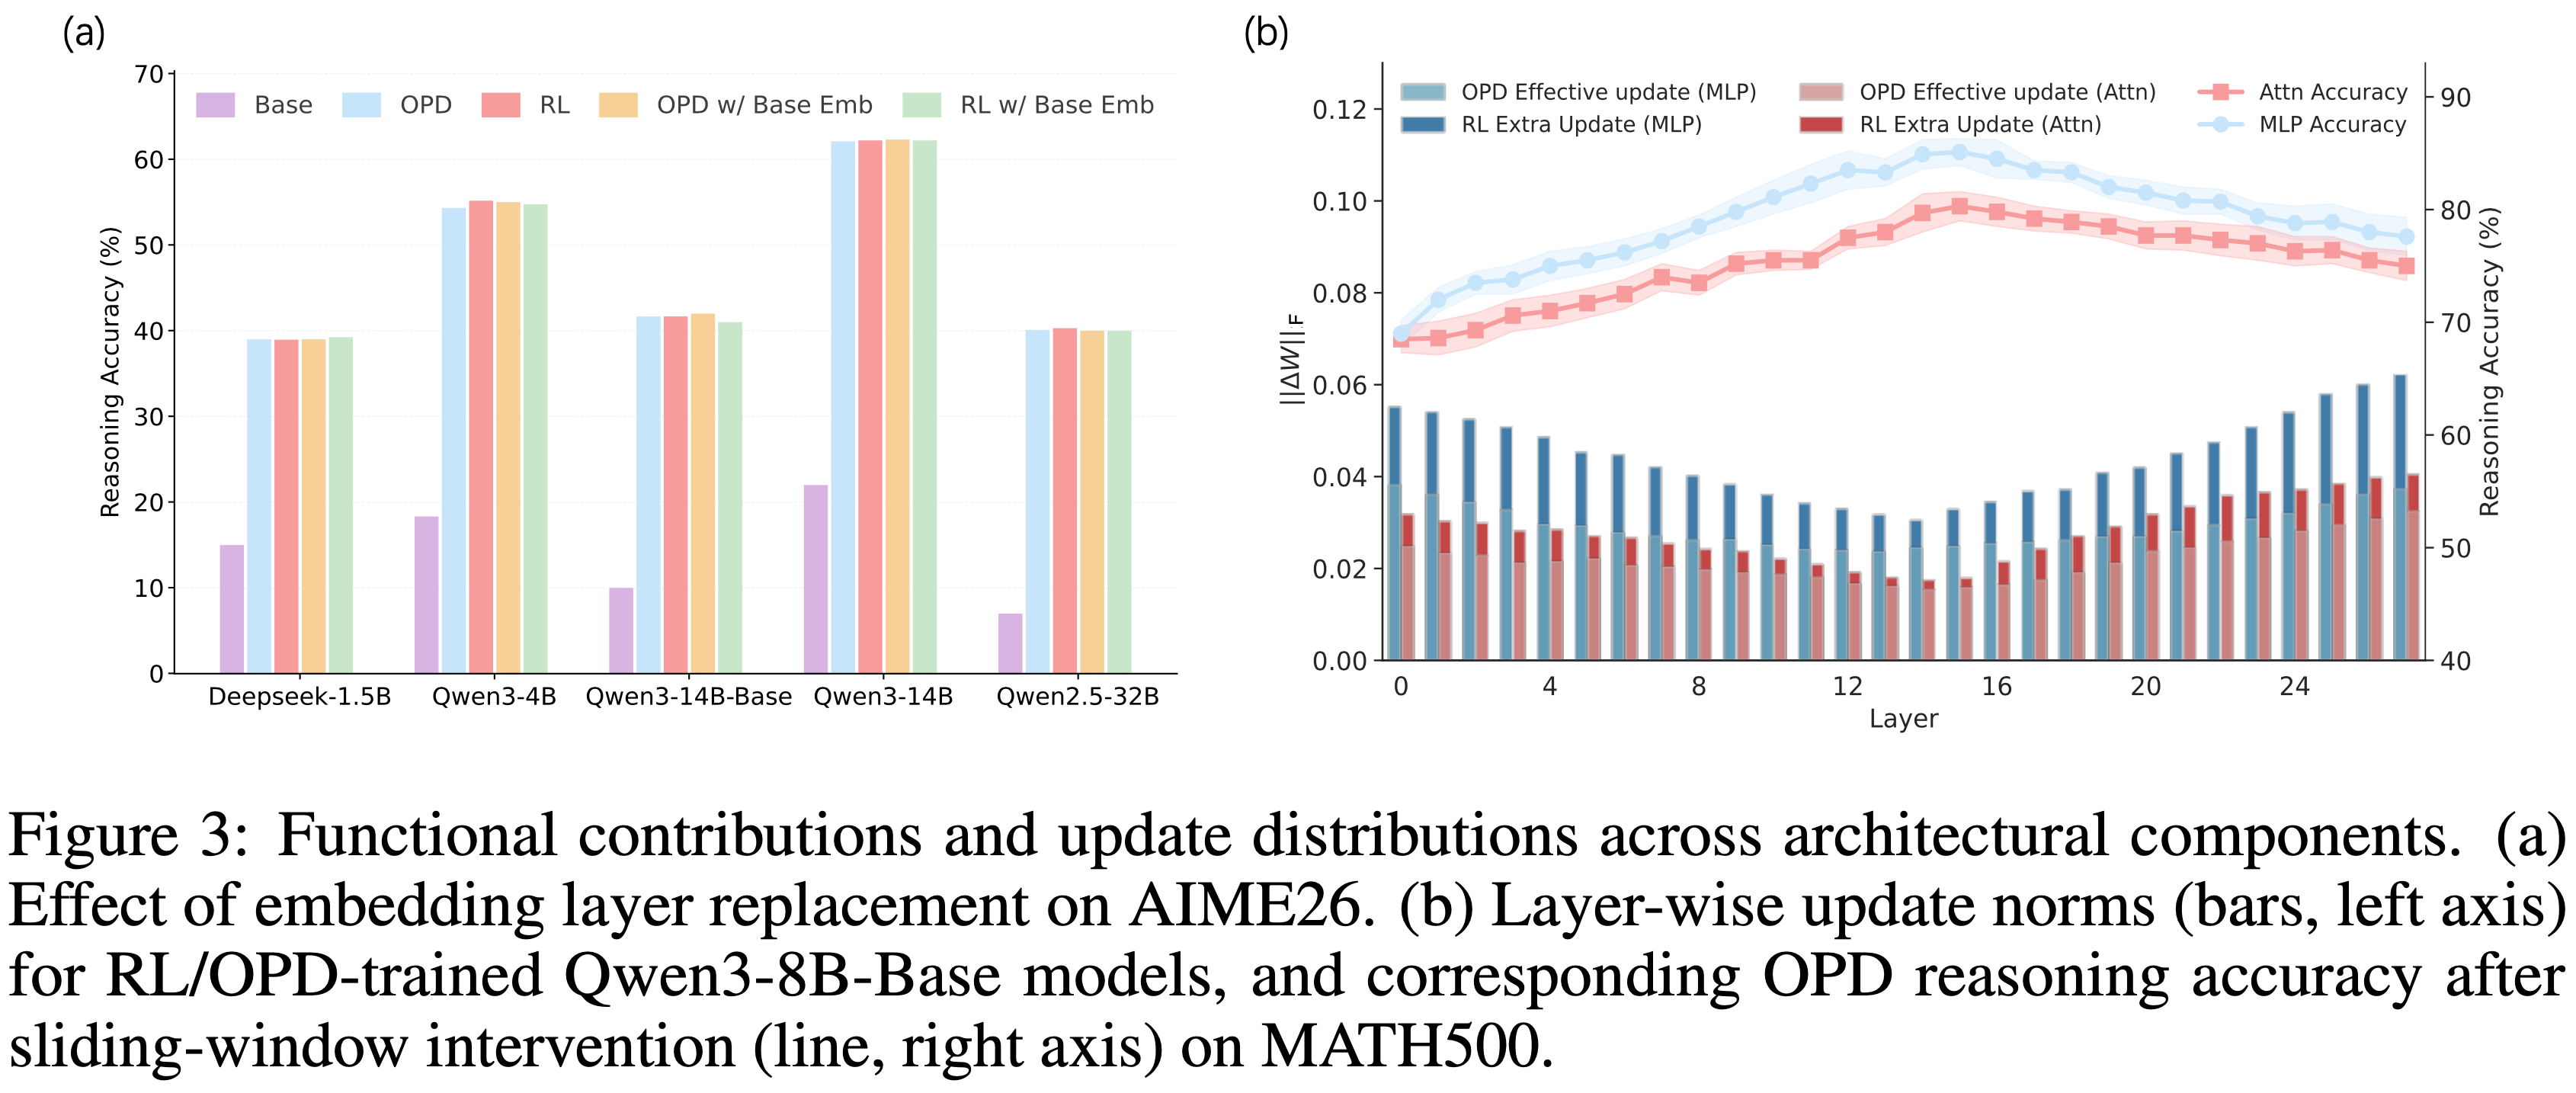
- 通过 sliding-window intervention 分析(公式 10-12)发现:
- Embedding 层更新对推理贡献极小(原文图 3a)
- 中间层的 MLP 是推理性能最敏感的区域(原文图 3b)
- RL 在低敏感度的底层和顶层引入了大量冗余更新
- OPD 则抑制了这些区域的更新,将能量集中在中间层 MLP(问题:在原文图 3b 中没看到 OPD 集中在中间层,其实仍然是底层和顶层更多梯度范数,只是相对 RL 来说,中间比两边差的没有这么多了而已)
- 结论:Functional Redundancy Avoidance
- OPD 并非学习全新更新机制,而是更早、更精确地识别高边际效用区域,抑制冗余更新
Property 2:Early Low-Rank Lock-in(更新方向级预见性)
- 性质 2:Early Low-Rank Lock-in,早期低秩锁定
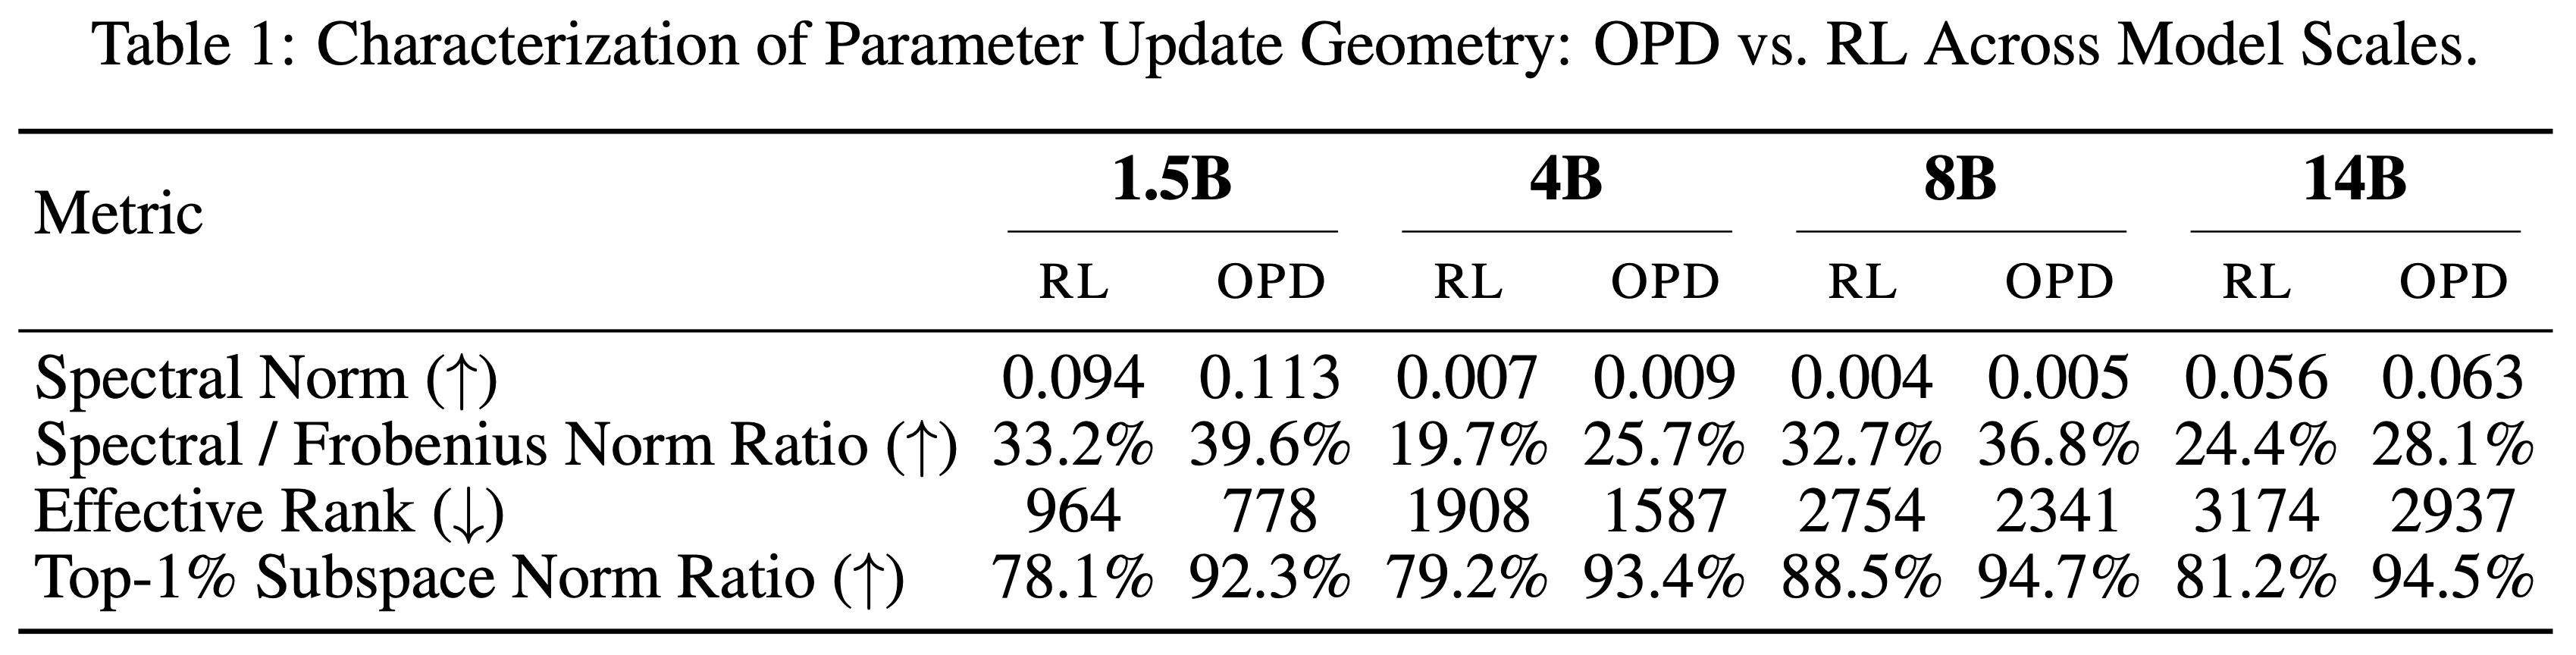
- 通过以下 几何度量(公式 13-17):
- Spectral Norm
- Spectral / Frobenius Norm Ratio
- Effective Rank
- Top-1% Subspace Norm Ratio
- 发现(原文表 1):OPD 在所有模型规模上均呈现更强的低秩结构
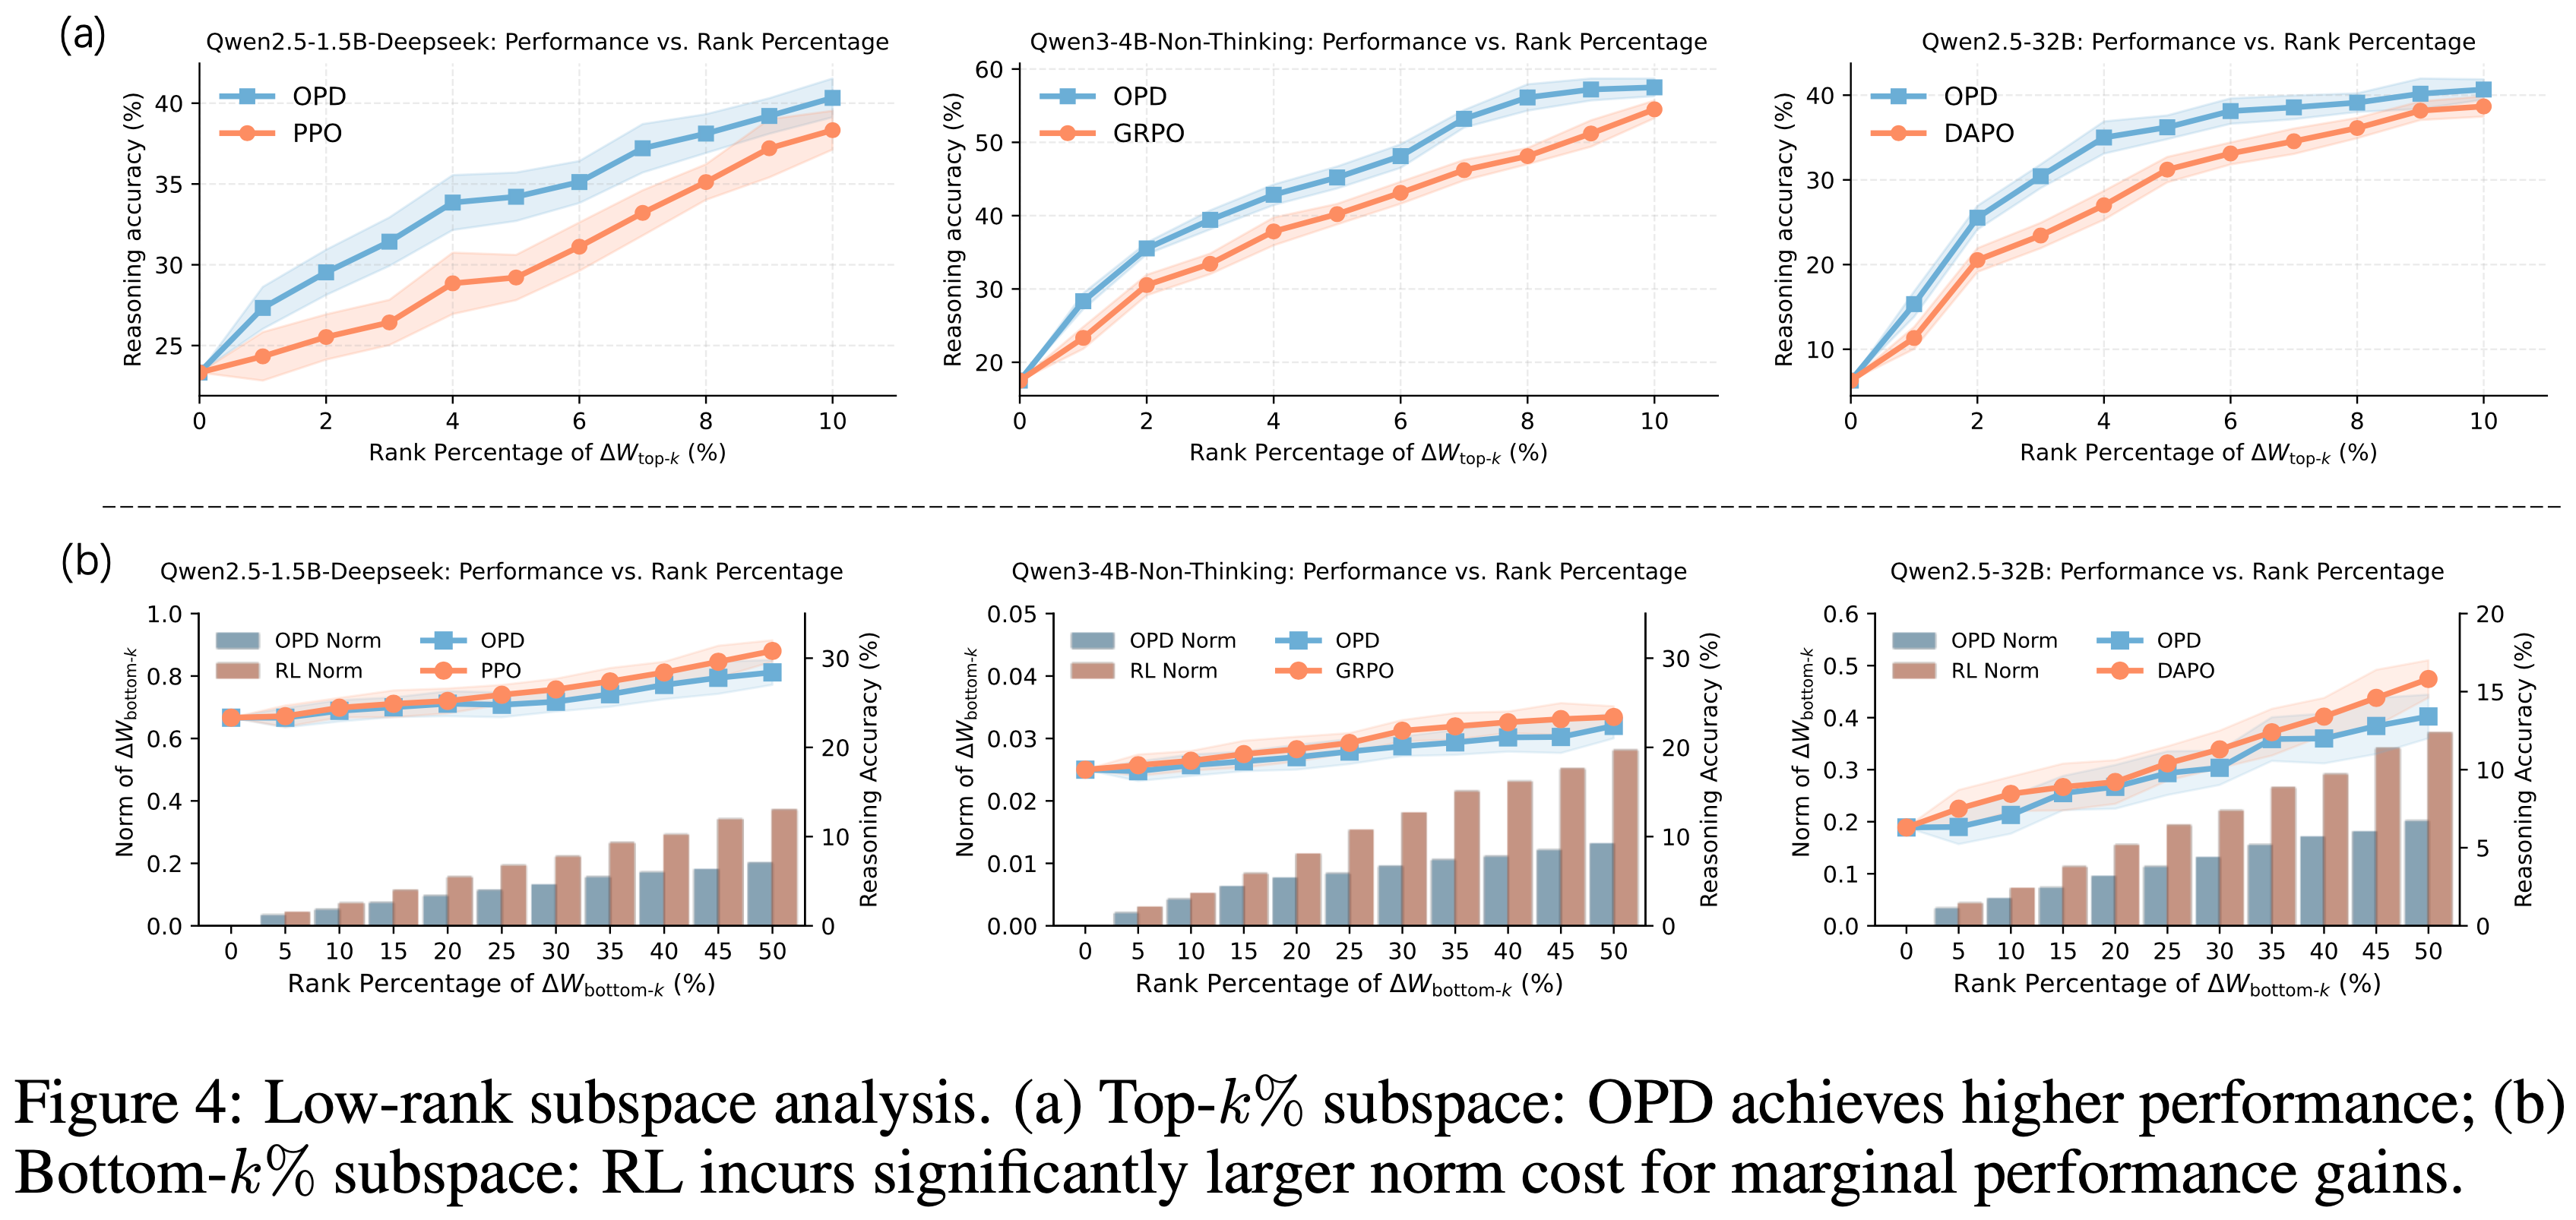
- 子空间功能分析(原文图 4):
- Top-\(k%\) 子空间:OPD 比 RL 恢复更多性能
- Bottom-\(k%\) 子空间:RL 付出更大范数代价换取微小性能增益
- 方向稳定性(原文图 5):
- t-SNE 可视化:OPD 的 Top-1 子空间轨迹更紧凑、平滑
- 余弦相似度:OPD 中间 checkpoint 与最终 checkpoint 的子空间对齐程度更高
- 范数缩放实验:仅训练 10% 进度的 OPD checkpoint,将其模块更新范数缩放至最终 checkpoint 水平,可恢复约 80% 的最终推理性能(原文图 5c)
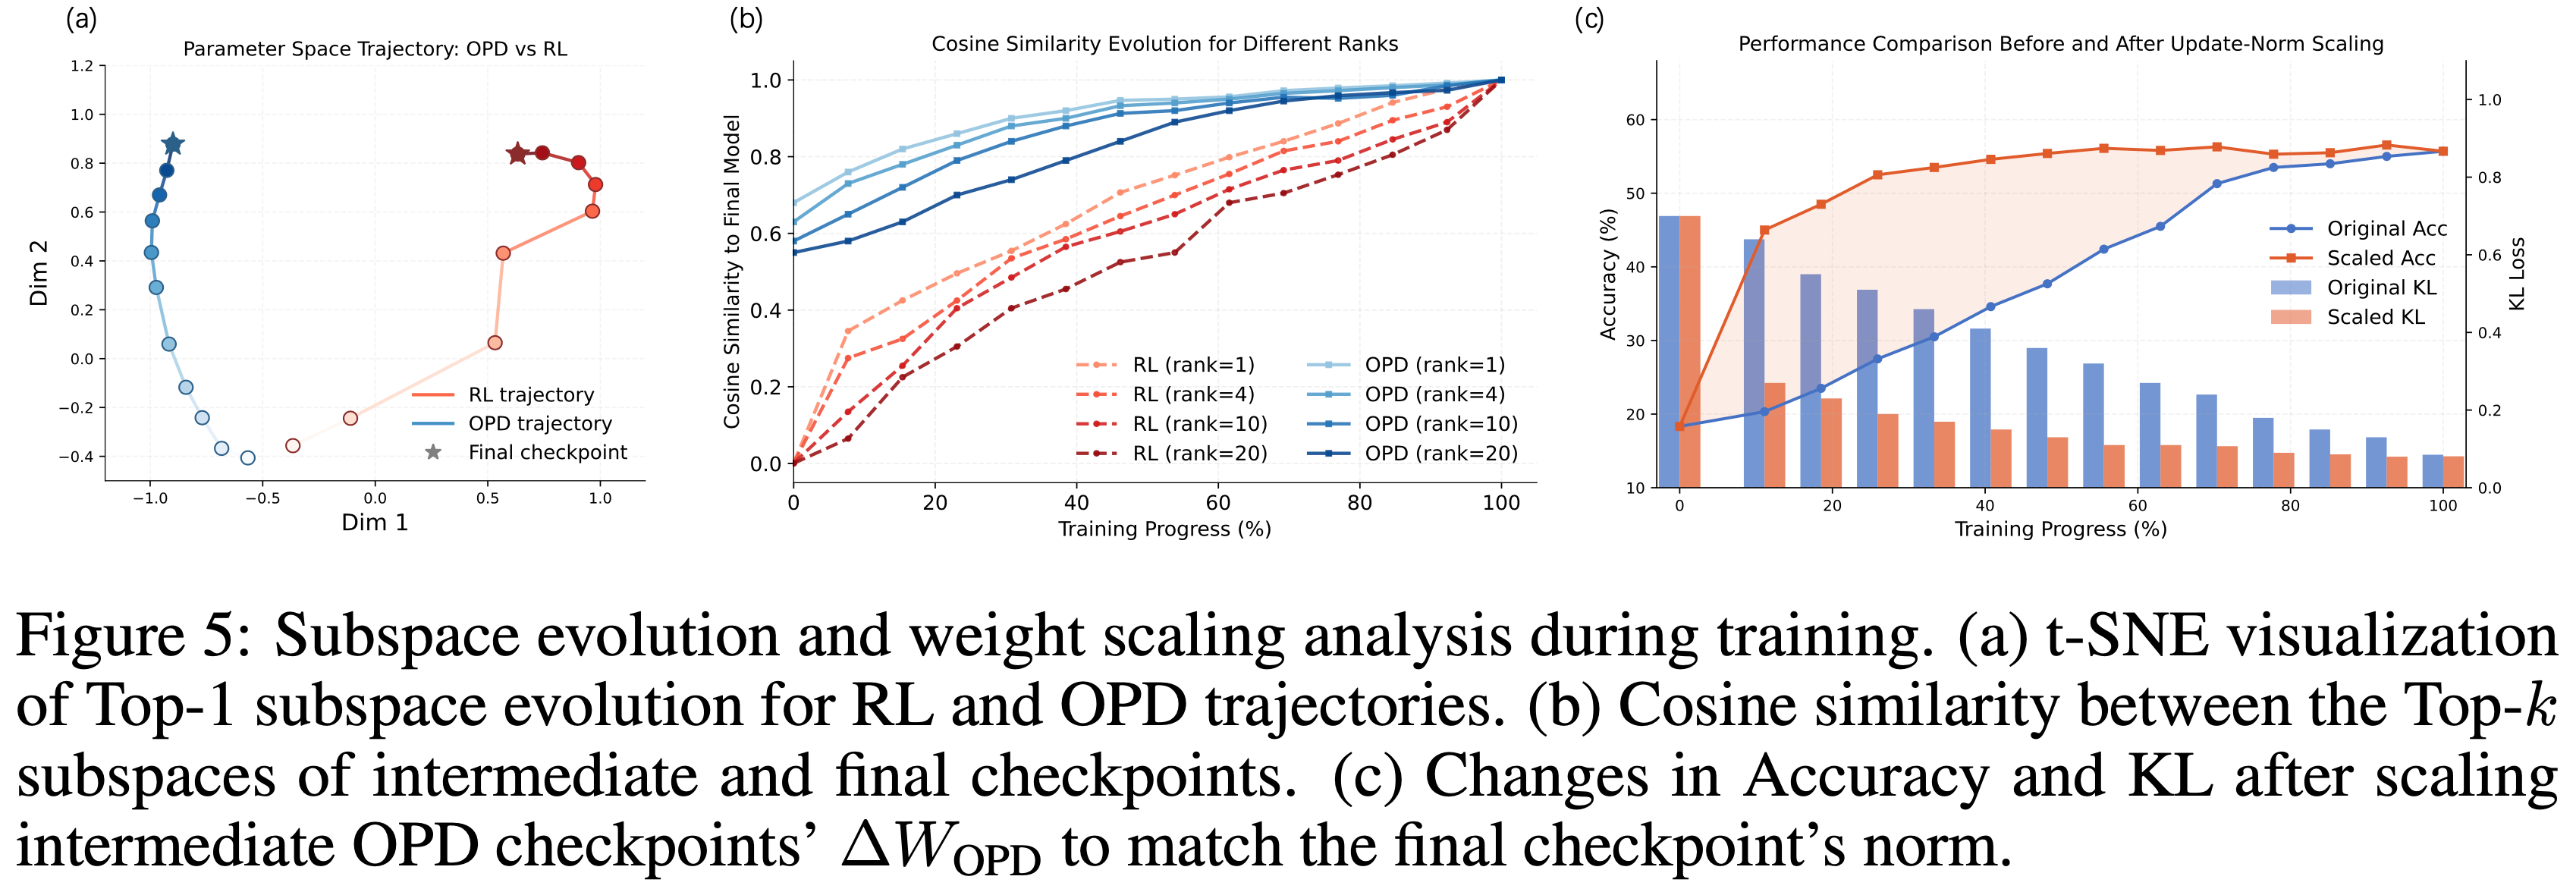
- 结论:Early Low-Rank Lock-in
- OPD 在训练早期就锁定了高质量的低秩更新方向,后续训练主要是沿这些方向放大范数,而非大幅调整方向
EffOPD 方法:基于方向外推的加速框架
EffOPD 设计思路
- 基于 Property 2:OPD 在早期就形成了稳定的、与最终解对齐的更新方向,因此,可以:
- 1)在训练过程中定期估计当前局部更新方向
- 2)沿该方向进行线性外推,跳过部分常规训练步骤
- 3)用小规模验证集快速判断外推是否有效,避免性能退化
详细方法流程
- 设 \(W_t\) 为第 \(t\) 次 OPD 更新后的模型参数
- 步骤 1:指数间隔的检查点触发
- 外推搜索在 \(t = 2^n\) 处触发(\(n = 0,1,2,\dots\))
- 首次外推在 \(t=1\)
- 步骤 2:估计局部更新方向
- 对于 \(n \ge 1\),使用当前指数检查点与上一个指数检查点之间的参数位移:
$$
\Delta_n = W_{2^n} - W_{2^{n-1} }
$$ - 该位移捕捉了两次检查点间的参数演化方向
- 理解:既然这里面包含了参数演化方向,那是否可以继续使用这个方向做一些参数更新?
- 对于 \(n \ge 1\),使用当前指数检查点与上一个指数检查点之间的参数位移:
- 步骤 3:生成外推候选
- 从 \(W_{2^n}\) 出发,沿 \(\Delta_n\) 方向生成 5 个候选参数:
$$
\widetilde{W}_{n,k} = W_{2^n} + 2k \Delta_n, \quad k = 1,2,\dots,5
$$- 系数 \(2k\) 控制外推步长
- 理解:这里生成的候选是可能作为最终参数的,所以接下来会分别验证这些参数
- 从 \(W_{2^n}\) 出发,沿 \(\Delta_n\) 方向生成 5 个候选参数:
- 步骤 4:轻量级验证
- 从训练集中随机采样 50 个样本作为验证集 \(\mathcal{D}_v\)(远小于 OPD 每步生成的样本数)
- 定义验证函数 \(\mathcal{V}_{\mathcal{D}_v}(\cdot)\)(例如在 \(\mathcal{D}_v\) 上的平均 reward 或准确率)
- 初始化接受参数 \(W^{\text{acc} } = W_{2^n}\),其分数 \(v^{\text{acc} } = \mathcal{V}_{\mathcal{D}_v}(W_{2^n})\)
- 步骤 5:顺序接受规则
- 按 \(k=1\) 到 \(5\) 依次评估 \(\widetilde{W}_{n,k}\):
- 若 \(\mathcal{V}_{\mathcal{D}_v}(\widetilde{W}_{n,k}) \ge v^{\text{acc} }\),则接受该候选:
$$
W^{\text{acc} } \leftarrow \widetilde{W}_{n,k}, \quad v^{\text{acc} } \leftarrow \mathcal{V}_{\mathcal{D}_v}(\widetilde{W}_{n,k})
$$ - 否则立即终止搜索
- 理解:如果所有的中间结果都满足,才会走到最后一个 k=5 的情况下的参数,这时候说明方向太准了,可以大幅跳步
- 若 \(\mathcal{V}_{\mathcal{D}_v}(\widetilde{W}_{n,k}) \ge v^{\text{acc} }\),则接受该候选:
- 最终该检查点的 EffOPD 输出为:
$$
W_{2^n}^{\text{EffOPD} } = W^{\text{acc} }
$$ - 注:若 \(k=1\) 就失败,EffOPD 退化为 vanilla OPD
- 按 \(k=1\) 到 \(5\) 依次评估 \(\widetilde{W}_{n,k}\):
分析:为什么 EffOPD 有效
- 利用 OPD 的早期方向稳定性,避免冗余训练
- 自适应外推步长,避免过度外推
- 验证开销极小(50 个样本),整体加速明显
- 个人理解:EffOPD 的本质是对之前的方向大幅挑选多个候选进化参数以后,挑选中间参数在少量样本上验证
- 可大幅提升学习效率
- 注:这里可以这样做的基础主要是 OPD 下模型参数更新的历史方向可以指导未来的方向
- 问题:这个方法能否使用到 RL 场景?
实验
- 实验设置
- 模型规模 :1.5B, 4B, 14B, 32B
- 任务 :代码生成(Eurus-RL-Code)、数学推理(DeepMath-103K)
- Teacher :RL fine-tuned 模型
- Baselines :Vanilla OPD, AlphaOPD, ExOPD
- 评估基准 :Codeforces, Taco, AIME24/25/26, MINERVA, GPQA
- 主要结果(原文图 6)
- EffOPD 在数学推理任务上约 10 步开始收敛,vanilla OPD 需 30–40 步(超过 3 倍加速 )
- EffOPD 有时达到更高上限,可能由于 vanilla OPD 长期训练导致过优化或语义漂移
- 相比固定外推策略(AlphaOPD, ExOPD),EffOPD 的自适应选择更稳定
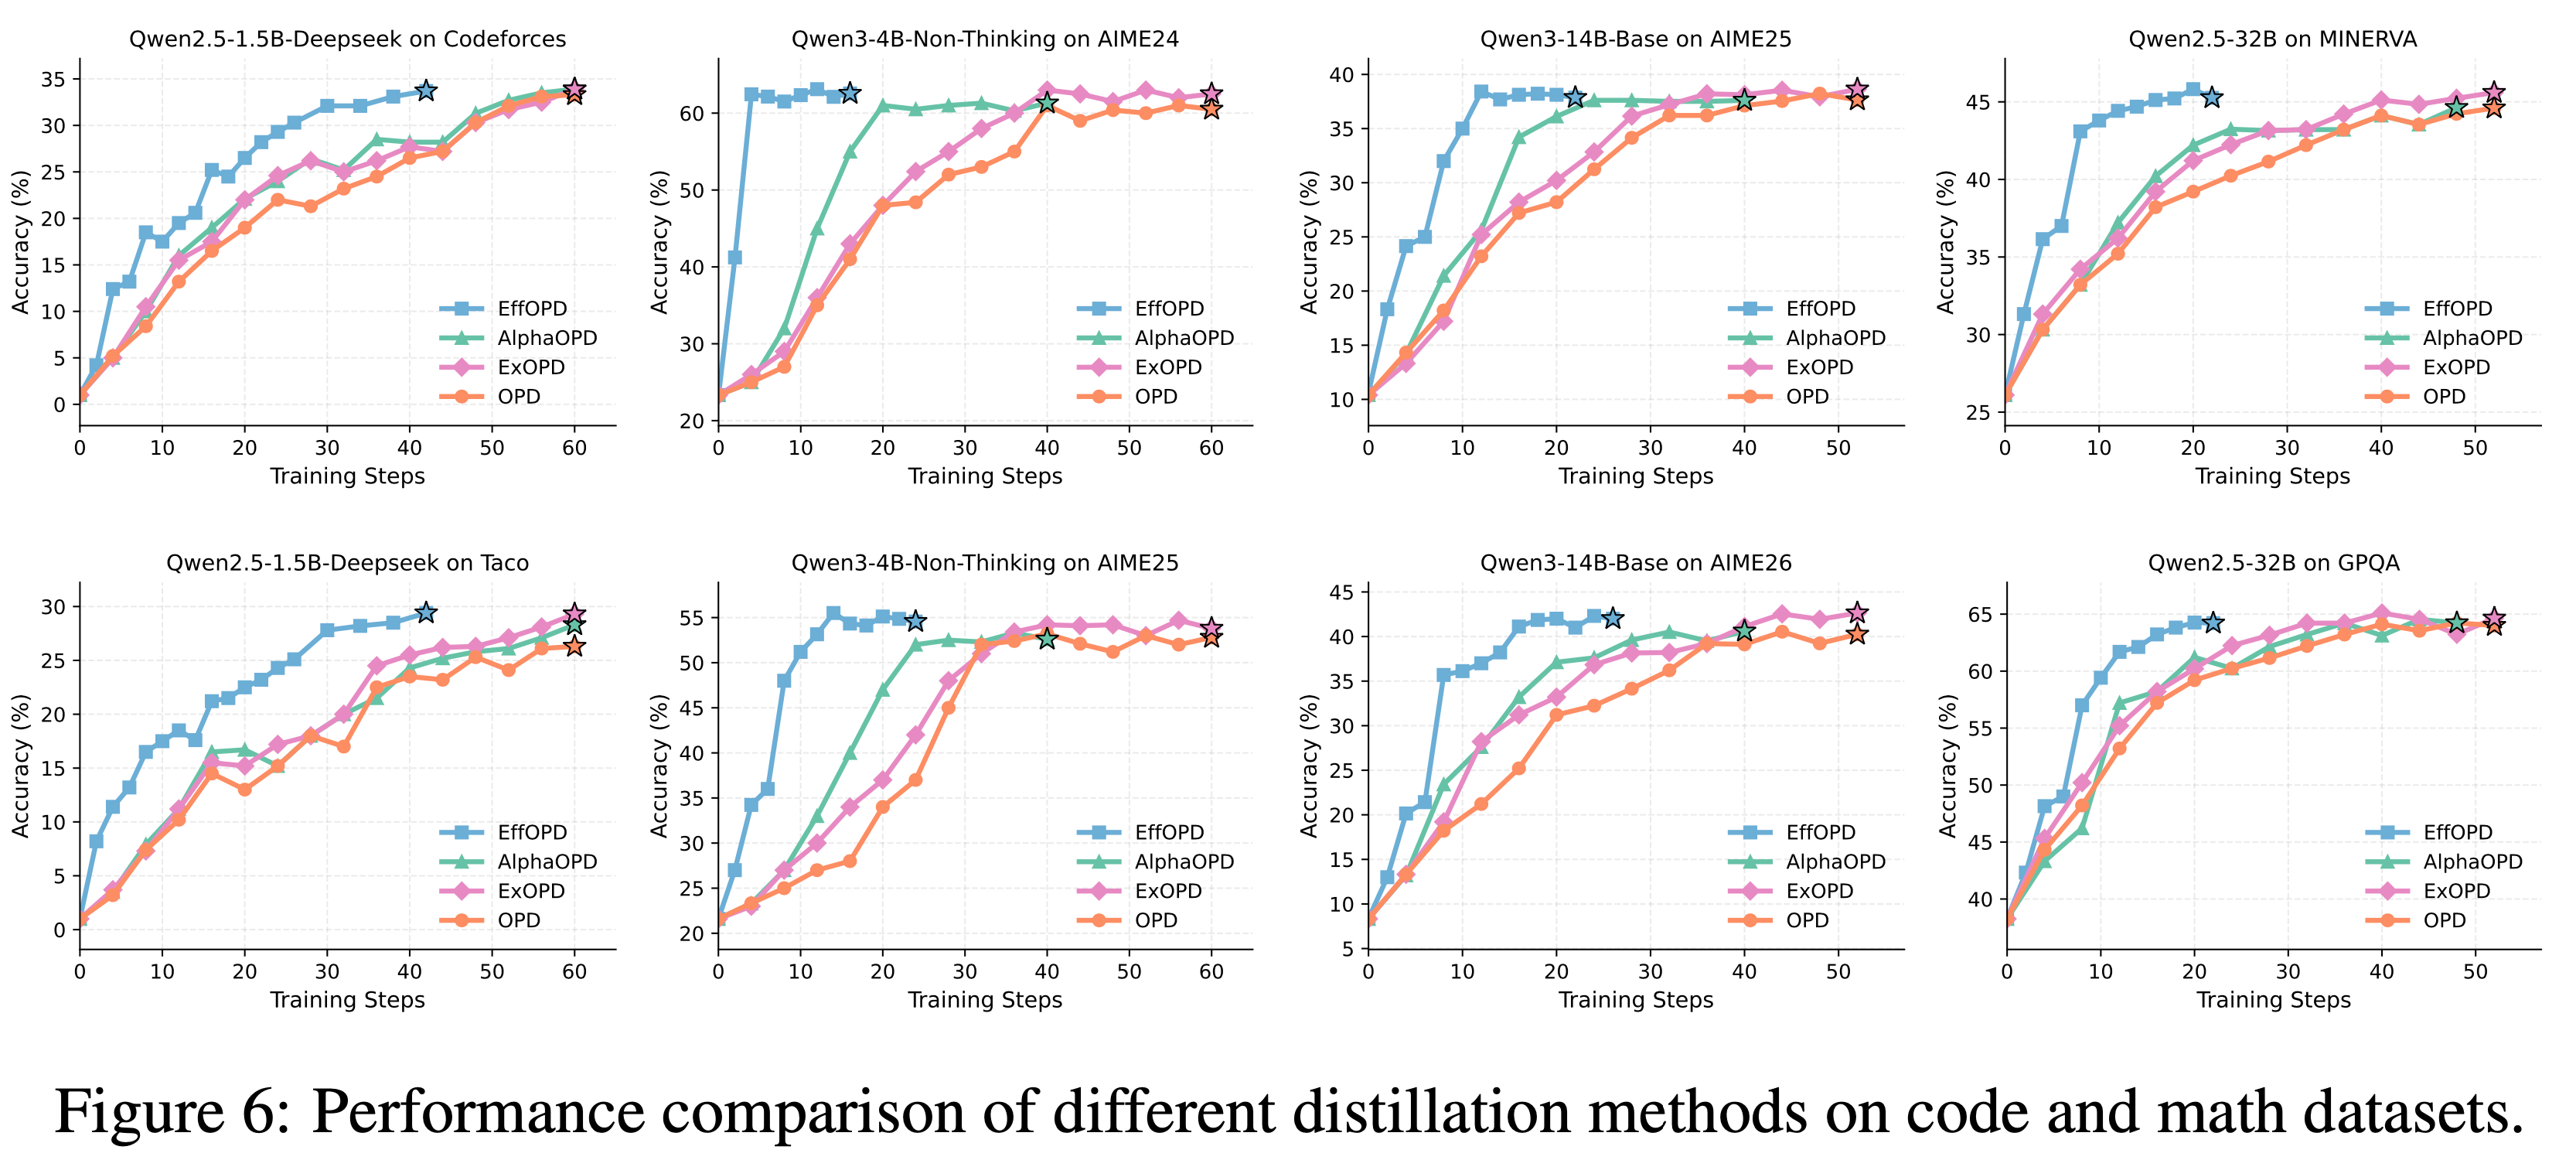
- 消融实验(原文图 7)
- 学习率 :大学习率下 vanilla OPD 不稳定,EffOPD 通过验证机制抑制过激步长
- 验证集难度 :不同难度 \(\mathcal{D}_v\) 均能提供一致的方向信号
- 验证集只用于判断方向有效性,而非精确监督
- 实际训练时间 :EffOPD 在相同时间预算下性能更好,验证开销可被加速收益抵消
- 额外实验(Appendix E, F)
- 原文图 8–9:跨模型规模、跨 RL 算法,OPD 始终具有更高参数效率
- 原文表 3、原文图 11:OPD 的 embedding 层更新更接近 base model,漂移更小
- 原文图 15–28:多种模块(MLP, Attn Q/K/V, GATE, UP)下,OPD 的 Top-1 子空间轨迹比 RL(DAPO)更稳定、紧凑
- 原文图 14:早期 checkpoint 的范数缩放实验显示,\(\beta \approx 0.8-1.2\) 时性能饱和,超过 1.2 性能下降,验证了“早期方向有效但范数不足”的结论
附录:简单理论分析与局部几何解释(Appendix F.5)
- 论文中提供了一个局部二次近似来解释 OPD 的低秩与早期锁定特性
- 线性化 :
$$
z_\theta(c) \approx z_0(c) + J_c \Delta\theta
$$ - OPD 目标的局部二次形式 :
$$
\mathcal{L}_{\text{OPD} }(\Delta\theta) \approx \frac{1}{2} \Delta\theta^\top A \Delta\theta - b^\top \Delta\theta + \text{const}
$$- 其中:
$$
A = \mathbb{E}_c[J_c^\top F_c J_c], \quad b = \mathbb{E}_c[J_c^\top F_c r_c], \quad r_c = z^*(c) - z_0(c)
$$
- 其中:
- 梯度下降解 :
$$
\Delta\theta_s = \sum_{i: \lambda_i > 0} \frac{1 - (1 - \eta \lambda_i)^s}{\lambda_i} \beta_i u_i
$$- 其中 \(\beta_i = \langle b, u_i \rangle\),\(\lambda_i\) 为 \(A\) 的特征值
- 关键推论 :
- 若 \(b\) 集中在 \(A\) 的 top-\(k\) 特征空间,且存在谱间隙,则更新轨迹早期就被锁在该低维子空间 → Early Low-Rank Lock-in
- 若某模块与 teacher residual \(r_c\) 耦合弱(\(b_m \approx 0\)),则其更新被抑制 → Functional Redundancy Avoidance
- RL 梯度更稀疏、方差更大、方向更分散,因此 OPD 更高效
Value-Gradient Hypothesis of RL for LLMs
- 原始论文:Value-Gradient Hypothesis of RL for LLMs, 20260520, MBZUAI
- 注:本文的推导较为复杂,这里暂且先讲重点核心概念介绍一下,后期有时间再细看(TODO)
- 论文核心观点:Critic-free RL in LLMs is not value-free
- 在连续可微 rollout 中,actor 更新 = value-gradient in expectation
- 在离散 Transformer 中,attention 提供近似可微路径,误差由熵控制
- RL 增益可分解为:
$$
\text{usable value-gradient signal} \times \text{reachable reward headroom}
$$ - 可用于预训练过程中选择最优 checkpoint 启动 RL
背景 & 问题
- 经典 RL 理论认为,没有 Critic 的 Credit assignment 在长时序任务中会失败
- 但 GRPO 等 Critic-free 的强化学习方法在 LLM 中表现良好,原因尚不明确
核心假说:Value-Gradient Hypothesis
- 论文核心观点: Critic-free RL in LLMs is not value-free.
- Actor 的反向传播中已经隐含了 value-gradient-like 信号,无需显式学习 Critic
- 在可微分的 rollout 中,该信号等价于 BPTT(Backpropagation Through Time) 的 costate
- Costate(伴态、协态)是最优控制理论和变分法中的一个概念
- BPTT 告诉我们要反向传播,而 Costate 就是那个在反向传播中流动的“信号”本身
- 论文最关键的一步是把 BPTT 的反向传播过程,显式地写成了 Costate 的递推公式
- Costate(伴态、协态)是最优控制理论和变分法中的一个概念
- 在离散 Transformer 中,Attention 提供了绕过 token 采样的可微分路径,使该信号近似保留
- 在可微分的 rollout 中,该信号等价于 BPTT(Backpropagation Through Time) 的 costate
理论基础与定义
符号与基本概念
- 提示 \(q \sim P(Q)\)
- 策略 \(\pi_{\theta}(o|q) = \prod_{t=1}^T \pi_{\theta}(o_t | s_t)\)
- 状态 \(s_t = (q, o_{ < t})\),动作 \(a_t = o_t\)
- 奖励 \(r(s_t, a_t)\),折扣 \(\gamma\),回报 \(R_t = \sum_{j=t}^T \gamma^{j-t} r(s_j, a_j)\)
- 价值函数 \(V_t^{\pi}(s)\),动作价值 \(Q_t^{\pi}(s, a)\),优势 \(A_t^{\pi}(s, a)\)
- Value Gradient :
$$
G_t^{\pi}(s) := \frac{\partial V_t^{\pi}(s)}{\partial s}
$$
RL for LLMs:GRPO
- 对每个 prompt \(q\) 采样 \(n\) 个 completions
- 使用 group-normalized reward \(\tilde{r}_i\)
- 每个 token 的优势估计 \(\hat{A}_{i,t} = \tilde{r}_i\)(常数)
- 优化目标:
$$
J(\theta) = \mathbb{E}\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{T_i}\sum_{t=1}^{T_i}\left(\min(\rho_{i,t}(\theta)\hat{A}_{i,t},\ \text{clip}(\cdot)) - \beta \text{KL}(\pi_{\theta}|\pi_{\text{ref} })\right)\right]
$$
梯度估计器
- Score-Function (SF) :适用于离散、不可微奖励,但方差高
$$
\frac{\partial}{\partial\theta}\mathbb{E}_{x\sim p(\cdot;\theta)}[c(x)] = \mathbb{E}_x\left[c(x)\frac{\partial}{\partial\theta}\log p(x;\theta)\right]
$$ - Pathwise Derivative (PD) :要求可重参数化,方差低
$$
\frac{\partial}{\partial\theta}\mathbb{E}_z[c(x(z,\theta))] = \mathbb{E}_z\left[\frac{\partial}{\partial\theta}c(x(z,\theta))\right]
$$
Costate 与 Value Gradient
- Differentiable Rollout 定义:
$$
a_t = \pi_{\theta}(s_t, \xi_t),\quad s_{t+1} = f_{\theta}(s_t, a_t),\quad \xi_t \sim p(\xi)
$$- \(\xi_t\) 和 \(\xi\) 代表了外生的、与参数 \(\theta\) 无关的随机噪声源
- \(\xi_t\) 是策略(Policy)在时刻 t 做出决策时所依赖的“随机种子”
- Costate (BPTT 传播中流动的信号):
$$
\lambda_t := \frac{\partial R_t}{\partial s_t}
$$ - Adjoint Recursion :
$$
\lambda_t = Dr(s_t, a_t) + \gamma (Df_{\theta}(s_t, a_t))^\top \lambda_{t+1}
$$- Adjoint Recursion 是 BPTT在连续时间/状态空间下的递归形式,用于高效地计算 Costate(\(\lambda_t\)) 的传播规律
- 关键恒等式 :
$$
\mathbb{E}[\lambda_t \mid s_t = s] = \frac{\partial V_t^{\pi}(s)}{\partial s} = G_t^{\pi}(s)
$$- 核心结论:BPTT 传播的 costate 是 value gradient 的 Monte Carlo 估计
连续视角:Critic-free RL 为何是 value-gradient-like
核心引理(Fairbank)
- Lemma 1 :
- 若策略为 shift/additive-noise 形式:
$$
\pi_{\theta}(a \mid s) = \nu(a - \bar{a}_{\theta}(s))
$$ - 则:
$$
\mathbb{E}\left[r(s,a)\frac{\partial}{\partial\theta}\log\pi_{\theta}(a\mid s)\right] = \left(\frac{\partial\bar{a}_{\theta}(s)}{\partial\theta}\right)^\top \mathbb{E}\left[\frac{\partial r(s,a)}{\partial a}\right]
$$ - 即 SF = PD in expectation
- 若策略为 shift/additive-noise 形式:
应用到 GRPO
- 将 GRPO 的权重 \(\hat{A}_{i,t}\) 视为 stop-gradient 标量
- 局部梯度变为:
$$
\mathbb{E}\left[\hat{A}_{i,t}r(s_t,a_t)\frac{\partial}{\partial\theta}\log\pi_{\theta}(a_t\mid s_t)\right] = \left(\frac{\partial\bar{a}_{\theta}(s_t)}{\partial\theta}\right)^\top \mathbb{E}\left[\frac{\partial(\hat{A}_{i,t}r(s_t,a_t))}{\partial a_t}\right]
$$ - 因此,在连续可微的 rollout 下,GRPO/PPO 的 actor 更新 in expectation 就是 value-gradient 更新
- 结论 :Critic-free 不代表 value-free,value 信息通过 costate 传播
离散 GRPO 如何近似 BPTT 信号
Transformer 中的 empirical costate
- 定义:
$$
\hat{\lambda}_t := \frac{\partial}{\partial h_t^{(L)} } \sum_{k \geq t} \hat{A}_k \cdot \ell_k
$$ - 递归形式(与 BPTT 同构):
$$
\hat{\lambda}_t = \hat{A}_t \cdot \frac{\partial \ell_t}{\partial h_t^{(L)} } + J_{t+1 \leftarrow t}^\top \cdot \hat{\lambda}_{t+1}
$$
与 BPTT 的差异来源
- 采样步骤不可微:
$$
h_t^{(L)} \xrightarrow{\text{diff} } z_t \xrightarrow{\text{sample} } o_t \xrightarrow{\text{embed} } e_t \xrightarrow{\text{diff} } h_{t+1}^{(L)}
$$ - BPTT 完整 Jacobian 分解:
$$
Df_{\theta}^{\text{exact} } = J_{t+1 \leftarrow t}^{\text{attn} } + \underbrace{\frac{\partial h_{t+1}^{(L)} }{\partial e_t} \cdot \frac{\partial e_t}{\partial o_t} \cdot \frac{\partial o_t}{\partial z_t} \cdot \frac{\partial z_t}{\partial h_t^{(L)} } }_{\text{missing} }
$$
采样间隙的熵界(Proposition 2)
- 当策略接近确定性(熵 \(H_t \approx 0\))时,missing term 很小:
$$
| Df_{\theta}^{\text{exact} } - J_{t+1 \leftarrow t}^{\text{attn} } | \leq C \cdot \sqrt{\frac{H_t}{\log |V|} }
$$ - LLM 预训练后熵较低,KL 约束进一步保持低熵,因此误差可控
Attention 的作用
- Attention 提供绕过采样步骤的可微分路径:
$$
\alpha_{t+1, t’} \propto \exp(q_{t+1} \cdot k_{t’})
$$ - 即使 token 采样不可微,hidden state 仍可通过 attention 传播梯度
- Proposition 3 :Attention-pathway Jacobian 的秩 ≤ \(L \cdot d_{\text{head} } \cdot n_{\text{heads} }\),其强度由 attention 权重控制
近似定理(Theorem 1)
- 定理:
$$
| \mathbb{E}[\hat{\lambda}_t \mid h_t] - \mathbb{E}[\lambda_t \mid h_t] | \leq \sum_{k=t+1}^{T} \gamma^{k-t} \cdot |J|^{k-t-1} \cdot \epsilon_k
$$- 其中 \(\epsilon_k\) 由熵界控制
- empirical costate 近似 value gradient
RL Impact 预测框架
可用 value-gradient 信号
- 定义:
$$
S_m(\theta) := \Sigma(\theta) - \Lambda_m(\theta)
$$- 其中:
$$
\Sigma(\theta) = \mathbb{E}[|G_t|_2^2],\quad \Lambda_m(\theta) = \mathbb{E}[|G_t|_2 |\mathbb{E}[\hat{\lambda}_t^{(m)} \mid h_t] - G_t|_2]
$$
- 其中:
可达到的 reward headroom
- 定义:
$$
\mathcal{H}_{\alpha}(\theta) := \mathbb{E}_{q}\left[\frac{1}{\alpha}\log \mathbb{E}_{\tau \sim \pi_{\theta} }[e^{\alpha R(\tau)}] - \mathbb{E}_{\tau \sim \pi_{\theta} }[R(\tau)]\right]
$$ - 该量在模型太弱或已饱和时较小,在中度能力且存在优化空间时较大
RL Impact 定律
- RL Impact 定律
$$
\text{RL Impact} \propto S_m(\theta) \times \mathcal{H}_{\alpha}(\theta)
$$ - RL 在以下情况最有效:
- 已接近 value-gradient regime(低熵、良好 credit 传播)
- 仍有足够的 reward headroom(未饱和)
实际应用:checkpoint 选择
- checkpoint 选择:
$$
N^{\star} = \arg\max_{N} S_m(\theta_N) \mathcal{H}_{\alpha}(\theta_N)
$$
实验
- 实验设置
- 模型:OLMo-2 1B(checkpoints 从 50k 到 1M 步)
- 任务:标签复制(可微奖励 \(p_{\theta}(y^* \mid q)\))
- RL 方法:GRPO,多个预算 \(K \in \{10,20,25,30\}\)
- 熵界验证(Figure 2)
- 计算 Proposition 2 中的误差上界与真实 costate 误差
- 结果支持:误差随熵减小而下降
- Costate-based 预测器
- 计算:
- 真实 value gradient \(G_t\)
- RL costate \(\hat{\lambda}_t\)
- \(\Sigma, \Lambda_m, \mathcal{H}_{\alpha}\)
- 预测分数:
$$
P_{\text{gap} } = (\Sigma - \Lambda_m) \cdot \mathcal{H}_{\alpha}
$$
- 计算:
- RL 增益预测(Figure 1, 3, 4, 5)
- \(P_{\text{gap} }\) 与真实 RL 增益的 Spearman 相关 ≈ 0.60
- 结合当前奖励 \(R_{\text{before} }\) 后:
$$
z(R_{\text{before} }) + z(P_{\text{gap} }) \quad \text{与} \quad z(\overline{R}_{\text{after} }) \quad \text{相关 ≈ 0.73}
$$ - 表明:预训练能力 + RL-ready 信号 共同预测 post-RL 性能
Related Work
- GRPO 的 U-statistics 解释(2026)仅针对 GRPO,本文覆盖更广(PPO, REINFORCE)
- 直接 BPTT(2025)可获得更好值梯度传播
- 值梯度流学习(2026)是 actor-free,本文是 critic-free
DVAO
- 原始论文:(DVAO)DVAO: Dynamic Variance-adaptive Advantage Optimization for Multi-reward Reinforcement Learning, Alibaba Cloud Computing
- GRPO 在多奖励场景下常用的两种标量化方法存在明显缺陷
- Reward Combination(RC):原始 GRPO 导致优势值平方幅度过大,训练不稳定
- Advantage Combination(AC):使用静态超参数,忽略了不同奖励间的相关性
- 注:多奖励 RL in LLM 中,RC 和 AC 是主流,GDPO 是对 AC 的改进(GDPO 在 AC 的组内归一化基础上,额外增加了 batch 级别的优势归一化,以进一步稳定训练)
- DVAO 通过动态方差自适应权重,在保持训练稳定的同时实现跨目标协同优化
- DVAO 的优点:动态权重、优势幅度有界、自带跨目标正则化
- DVAO 可能存在的问题:
- 极小 Group 时,(\(G \le 4\))时方差估计可能噪声大(论文 future work 中提到了,可引入历史动量或跨批次移动平均,但个人认为不合适,RL 训练过程中本就在变哈)
- 强依赖于奖励质量 :若某辅助奖励因噪声而非真实信号呈现高方差,DVAO 可能错误放大它
- 任意错误噪音信号都会导致模型偏向它,这时候反而导致模型容易崩溃
GRPO 的问题
- GRPO 针对每个输入 \(x_i\) 采样 \(G\) 个 Response \(y_1, \dots, y_G\),计算相对优势:
$$
A_{\text{sum} }^{(i,j)} = \frac{r_{\text{sum} }^{(i,j)} - \text{mean}(\{r_{\text{sum} }^{(i,j)}\}_j)}{\text{std}(\{r_{\text{sum} }^{(i,j)}\}_j)}
$$ - 策略优化目标为:
$$
\mathcal{J}_{\text{GRPO} }(\theta) = \mathbb{E}_{x_i, \{y_j\} } \left[ \frac{1}{G} \sum_{j=1}^G \frac{1}{|y_j|} \sum_{t=1}^{|y_j|} \min\left(s_{j,t}(\theta) A_{\text{sum} }^{(i,j)},\ \text{clip}(s_{j,t}(\theta), 1-\epsilon, 1+\epsilon) A_{\text{sum} }^{(i,j)}\right) \right]
$$ - 多奖励设置下,设有 \(n\) 个奖励函数 \(r_1, \dots, r_n\),每个 \(r_k \in [0,1]\)。常规做法是:
- Reward Combination(RC) :
$$
r_{\text{sum} } = \sum_k w_k r_k,\quad \sum_k w_k = 1
$$- 然后计算 \(A_{\text{sum} }\)
- Advantage Combination(AC) :
- 先对每个奖励独立计算优势 \(A_k\),再组合(理解:GDPO 是对 AC 的改进,GDPO 在 AC 的组内归一化基础上,额外增加了 batch 级别的优势归一化,以进一步稳定训练):
$$
A = \sum_k w_k A_k
$$
- 先对每个奖励独立计算优势 \(A_k\),再组合(理解:GDPO 是对 AC 的改进,GDPO 在 AC 的组内归一化基础上,额外增加了 batch 级别的优势归一化,以进一步稳定训练):
- Reward Combination(RC) :
- 现有方法的缺陷
- Proposition 1
- 证明:RC 产生的优势平方均值 ≥ AC 的优势平方均值,且等号成立仅当所有 \(A_k\) 完全正相关,这意味着 RC 更容易导致梯度爆炸
- 此外,AC 的梯度可以分解为:
$$
\nabla_{\theta} \mathcal{J}_{\text{GRPO} }(\theta) = \sum_k w_k \nabla_{\theta} \mathcal{J}_{\text{GRPO} }(\theta)_k
$$- 即完全忽略了目标间的相关性,且固定权重无法动态适应训练过程
- Proposition 1
DVAO 方法详解(重点)
DVAO 核心设计思路
- DVAO 的核心是:基于每个奖励在 **Rollout 组内的经验方差,动态调整组合权重**
- 高方差的奖励包含更强的学习信号,因此被赋予更高权重
- 低方差的奖励(可能是噪声)被抑制
- 这一机制完全数据驱动,无需手动调节超参数
- 理解:似乎还有一种简单的实现:
- 先分别算 Advantage,统一一起做归一化,然后再累加,效果和 DVAO 几乎一样(差异是 DAVO 除以的是各种奖励标准差的和)
- 或者说,如果在 AC 中计算每种奖励的 Advantage 时,减去均值但不除以方差(这种方法定义为 modified-AC),最终结果和 DAVO 就之差除以一个 标准差的和了?
$$
\begin{aligned}
A_{\text{DVAO} }^{(i,j)}
&= \sum_{k=1}^n \frac{w_k \sigma_k^i}{\sum_{l=1}^n w_l \sigma_l^i} \cdot A_k^{(i,j)}
\qquad \bigl(\text{由定义 } \tilde{w}_k = \tfrac{w_k \sigma_k^i}{\sum_l w_l \sigma_l^i}\bigr) \\
&= \sum_{k=1}^n \frac{w_k \sigma_k^i}{\sum_{l=1}^n w_l \sigma_l^i} \cdot \frac{r_k^{(i,j)} - \mu_k^i}{\sigma_k^i}
\qquad \bigl(A_k^{(i,j)} = \tfrac{r_k^{(i,j)} - \mu_k^i}{\sigma_k^i}\bigr) \\
&= \sum_{k=1}^n \frac{w_k}{\sum_{l=1}^n w_l \sigma_l^i} \cdot \bigl(r_k^{(i,j)} - \mu_k^i\bigr)
\qquad \bigl(\text{约去 } \sigma_k^i\bigr) \\
&= \frac{1}{\sum_{l=1}^n w_l \sigma_l^i} \cdot \sum_{k=1}^n w_k \bigl(r_k^{(i,j)} - \mu_k^i\bigr) \\
&= \frac{A_{\text{modified-AC} }^{(i,j)} }{\sum_{l=1}^n w_l \sigma_l^i}
\qquad \bigl(A_{\text{modified-AC} }^{(i,j)} \triangleq \sum_{k=1}^n w_k (r_k^{(i,j)} - \mu_k^i)\bigr)
\end{aligned}
$$
DVAO 动态权重定义
- 对于输入 \(x_i\),定义第 \(k\) 个奖励的组内标准差为:
$$
\sigma_k^i = \text{std}\left( \{ r_k^{(i,j)} \}_{j=1}^G \right)
$$ - 动态权重为:
$$
\hat{w}_k = \frac{w_k \sigma_k^i}{\sum_l w_l \sigma_l^i}
$$- 其中 \(w_k\) 是初始(固定)权重,通常设为相等
- 理解:方差越大奖励类型,权重越大
- 理解(特别注意这里是本人个人添加,与论文无关):这里可以加个超参,进一步提升收益:
$$
\hat{w}_k = \frac{w_k (\sigma_k^i)^\beta}{\sum_l w_l (\sigma_l^i)^\beta}
$$- \(\beta\) 越大,越偏向于方差大的奖励类型,\(\beta\) 越小,越平均,\(\beta\) 为 0 时,恢复到 普通 AC 的情况
DVAO 优势计算
- DVAO 优势计算公式:
$$
A_{\text{DVAO} }^{(i,j)} = \sum_k \hat{w}_k A_k^{(i,j)} = \frac{\sum_k w_k \sigma_k^i A_k^{(i,j)} }{\sum_l w_l \sigma_l^i}
$$
DVAO 理论性质
Proposition 2(优势幅度有界)
- 对于任意 \(j\):
$$
|A_{\text{DVAO} }^{(i,j)}| \le |A_{\text{sum} }^{(i,j)}|
$$- 等号成立仅当所有奖励对完全正相关
- 这意味着 DVAO 严格避免 RC 的幅度爆炸问题,训练更稳定
Proposition 3(跨目标正则化)
- 计算优势对原始奖励 \(r_k^{(i,j)}\) 的敏感性(偏导数):
- AC 方法 :
$$
\frac{\partial A^{(i,j)} }{\partial r_k^{(i,j)} } = \frac{w_k}{\sigma_k^i} \left(1 - \frac{1}{G} - \frac{1}{G}(A_k^{(i,j)})^2\right)
$$- 仅依赖于自身目标 \(A_k\)
- 注:详细推导见附录
- DVAO 方法 :
$$
\frac{\partial A_{\text{DVAO} }^{(i,j)} }{\partial r_k^{(i,j)} } = \frac{\tilde{w}_k}{\sigma_k^i} \left(1 - \frac{1}{G} - \frac{1}{G} A_{\text{DVAO} }^{(i,j)} A_k^{(i,j)}\right)
$$- 其中 \(\tilde{w}_k = \frac{w_k \sigma_k^i}{\sum_l w_l \sigma_l^i}\)
- 关键区别:
- DVAO 的梯度中包含 交叉项 \(A_{\text{DVAO} }^{(i,j)} A_k^{(i,j)}\),它将当前目标的更新与整体多奖励表现耦合在一起
- 如果一个 Rollout 的整体表现 \(A_{\text{DVAO} }\) 很高,则即使某个 \(A_k\) 很大,也不会过度放大梯度;反之亦然
- 这构成了一种隐式的跨目标正则化,防止模型贪婪地优化单一易学目标
DVAO 算法流程总结
- Step 1)采样 :对每个 Prompt \(x_i\),采样 \(G\) 个 Response
- Step 2)计算原始奖励 :每个目标 \(r_k^{(i,j)}\)
- Step 3)计算组内标准差 \(\sigma_k^i\) 和标准化优势 \(A_k^{(i,j)}\)
- Step 4)动态权重 \(\hat{w}_k \propto w_k \sigma_k^i\)
- Step 5)计算 DVAO 优势 \(A_{\text{DVAO} }^{(i,j)}\)
- Step 6)执行 GRPO 策略优化(使用 clip 的 objective)
实验
- 任务与数据集
- 数学推理 :AIME-2024/2025, MATH500, OlympiadBench, AMC23
- 两个目标:准确率(accuracy)和长度约束(length ≤ 4000 tokens)
- 工具使用 :BFCL-v4(Live, Non-Live, Multi-Turn)
- 两个目标:工具调用正确性(accuracy)和格式合规(format)
- 数学推理 :AIME-2024/2025, MATH500, OlympiadBench, AMC23
- 基线与模型
- 基线:GRPO(单奖励),RC,AC,GDPO
- 模型:
- 数学任务用 Qwen3-4B/8B-Base
- 工具任务用 Qwen2.5-3B/7B-Instruct
- 实现细节
- 训练集:DAPO-MATH-17K(数学),ToolRL 数据(工具)
- 超参数:AdamW,lr=1e-6,batch=128,G=16,max tokens=8192,训练 500 步
- 基于 verl 框架,8×NVIDIA H20 GPU
- 实验主要结果(原文表 1、原文表 2)
- DVAO 在数学推理和工具使用任务上,同时达到最高的准确率和最高的长度/格式合规率
- 其他方法(RC、AC、GDPO)均存在明显的权衡牺牲:
- 例如 GDPO 长度合规接近完美但准确率极低
- 例如 RC 准确率较高但长度合规较差
- DVAO 是唯一在两个维度上同时取得最优的方法
- 训练动态(原文图 1、原文图 2)
- 准确率 Reward :DVAO 均值最高,方差最低,对应更稳定的优化
- 长度 Reward :DVAO 快速收敛到目标值 1.0,且方差骤降,说明方差平衡机制有效
- Response 长度 :DVAO 增长最快,虽有轻微振荡,但最终收敛到更高长度,鼓励深入推理但不失控
- Pareto 前沿(原文图 3)
- 通过扫描权重 \(w_1 \in \{0.1,0.3,0.5,0.7,0.9\}\),绘制准确率 vs. 长度/格式合规的 Pareto 前沿:
- DVAO 始终占据右上角(双高区域),主导所有基线
- RC 易饱和,AC 不稳定,GDPO 波动大
- 证明动态方差平衡在多步推理中尤其关键,防止简单目标(长度)压制困难目标(准确率)
- 通过扫描权重 \(w_1 \in \{0.1,0.3,0.5,0.7,0.9\}\),绘制准确率 vs. 长度/格式合规的 Pareto 前沿:
附录:优势对原始奖励 \(r_k^{(i,j)}\) 的偏导数推导
- 本节负责对 Proposition 3 两个偏导数的推导
- 对固定查询 \(x_i\) 和一个 Rollout 组 \(\{y_j\}_{j=1}^G\):
- 第 \(k\) 个奖励的组内均值:
$$
\mu_k^i = \frac{1}{G} \sum_{j=1}^G r_k^{(i,j)}
$$ - 第 \(k\) 个奖励的组内标准差:
$$
\sigma_k^i = \sqrt{ \frac{1}{G} \sum_{j=1}^G \left( r_k^{(i,j)} - \mu_k^i \right)^2 }
$$ - 第 \(k\) 个奖励的标准优势:
$$
A_k^{(i,j)} = \frac{r_k^{(i,j)} - \mu_k^i}{\sigma_k^i}
$$
- 第 \(k\) 个奖励的组内均值:
- 对于均值的导数有:
$$\frac{\partial \mu_k^i}{\partial r_k^{(i,j)} } = \frac{1}{G} $$ - 对于方差的导数有:
$$
\begin{align}
\frac{\partial \sigma}{\partial r_j}
&= \frac{\partial}{\partial r_j} \left( \frac{1}{G} \sum_{m} (r_m - \mu)^2 \right)^{1/2} \\
&=\frac{1}{2} \left( \frac{1}{G} \sum_{m} (r_m - \mu)^2 \right)^{-1/2} \cdot \frac{\partial}{\partial r_j} \left( \frac{1}{G} \sum_{m} (r_m - \mu)^2 \right) \\
&= \frac{1}{2\sigma} \cdot \frac{1}{G} \cdot \frac{\partial}{\partial r_j} \sum_{m} (r_m - \mu)^2 \\
&= \frac{1}{2\sigma G} \left[ 2(r_j - \mu)\left(1 - \frac{1}{G}\right) + \sum_{m \neq j} 2(r_m - \mu)\left(-\frac{1}{G}\right) \right] \quad \text{because } \sum_{m}(r_m - \mu)=0\\
&= \frac{1}{\sigma G} \left[ (r_j - \mu) - \frac{1}{G} \sum_{m=1}^G (r_m - \mu) \right] \\
&= \frac{r_j - \mu}{\sigma G} = \frac{A_k^{(i,j)} }{G} \quad \text{说明:because } A_k^{(i,j)} = (r_j - \mu)/\sigma
\end{align}
$$ - 于是对固定 \(x_i\),第 \(k\) 个奖励的标准化优势及其导数为:
$$
\begin{align}
\frac{\partial A_k^{(i,j)} }{\partial r_k^{(i,j)} } &= \frac{ \left(1 - \frac{1}{G}\right) \sigma_k^i - (r_k^{(i,j)} - \mu_k^i) \frac{A_k^{(i,j)} }{G} }{ (\sigma_k^i)^2 } \\
&= \frac{ \left(1 - \frac{1}{G}\right) \sigma_k^i - \sigma_k^i A_k^{(i,j)} \cdot \frac{A_k^{(i,j)} }{G} }{ (\sigma_k^i)^2 } \quad \text{because } r_k^{(i,j)} - \mu_k^i = \sigma_k^i A_k^{(i,j)} \\
&= \frac{1}{\sigma_k^i} \left( 1 - \frac{1}{G} - \frac{1}{G} (A_k^{(i,j)})^2 \right)
\end{align}
$$
优势组合方法(AC)
- AC 对应的导数如下:
$$
A^{(i,j)} = \sum_{l} w_l A_l^{(i,j)} \quad\Rightarrow\quad
\frac{\partial A^{(i,j)} }{\partial r_k^{(i,j)} } = w_k \cdot \frac{\partial A_k^{(i,j)} }{\partial r_k^{(i,j)} }
= \boxed{\frac{w_k}{\sigma_k^i}\left(1 - \frac{1}{G} - \frac{1}{G}(A_k^{(i,j)})^2\right)}
$$
DVAO 方法
- 令 \(S^i = \sum_l w_l \sigma_l^i\),则:
$$
A_{\text{DVAO} }^{(i,j)} = \frac{\sum_l w_l (r_l^{(i,j)} - \mu_l^i)}{S^i}
$$ - 对 \(r_k^{(i,j)}\) 求导(商法则):
$$
\begin{align}
\frac{\partial A_{\text{DVAO} }^{(i,j)} }{\partial r_k^{(i,j)} }
&= \frac{ w_k\left(1 - \frac{1}{G}\right) S^i - \left(S^i A_{\text{DVAO} }^{(i,j)}\right) \cdot w_k \frac{A_k^{(i,j)} }{G} }{(S^i)^2} \\
&= \frac{w_k}{S^i}\left(1 - \frac{1}{G} - \frac{1}{G} A_{\text{DVAO} }^{(i,j)} A_k^{(i,j)}\right) \\
&= \boxed{\frac{\tilde{w}_k}{\sigma_k^i}\left(1 - \frac{1}{G} - \frac{1}{G} A_{\text{DVAO} }^{(i,j)} A_k^{(i,j)}\right)}
\end{align}
$$- 其中 \(\tilde{w}_k = \frac{w_k \sigma_k^i}{S^i}\)
AntiSD
- 原始论文:(AntiSD)Anti-Self-Distillation for Reasoning RL via Pointwise Mutual Information, 20260512, Xiaohongshu & Institute of Automation CAS
- AntiSD 聚焦于RL 中的信用分配问题 ,特别针对数学推理任务
- 观察:现有的 On-Policy Self-Distillation 方法在数学推理任务中效果不佳,甚至劣于 GRPO 基线
- 1)通过 点互信息(Pointwise Mutual Information, PMI) 分析揭示问题的根源 Token-level 信号是条件 PMI,天然偏向 Shortcut Token、惩罚 Deliberation Token
- 2)提出了一种新的方法 Anti-Self-Distillation (AntiSD) ,核心创新包括 反转梯度方向 、上升 Jensen-Shannon 散度 和引入 熵触发门控
背景 & 问题提出
- RLVR 的奖励通常是稀疏的、轨迹级的标量(如最终答案是否正确),难以对中间推理步骤进行信用分配
- 现有解决方案包括 PRM 和 OPD 等
- 问题:两者都依赖于外部模型
- On-Policy Self-Distillation 的核心思想是 Teacher 和 Student 是同一个模型,但 Teacher 额外看到Privileged Context \( c \),例如:
- 验证过的正确解法
- 环境反馈(如“答案正确/错误”)
- 形式化:
- Student:\( \pi_S(\cdot | x, y_{ < t}) = \pi_\theta(\cdot | x, y_{ < t}) \)
- Teacher:\( \pi_T(\cdot | x, y_{ < t}) = \pi_\theta(\cdot | x, c, y_{ < t}) \)
- 标准 Self-Distillation 损失:
$$
\mathcal{L}_{\text{SD} }(\theta) = \mathbb{E}_{x,y\sim \pi_S}\left[\sum_t D_{\text{KL} }(\pi_S | \mathbf{sg}[\pi_T])\right]
$$ - 在 GRPO 基础上叠加 Token-level 优势:
$$
A_{i,t} = A_i^{\text{seq} } + \lambda \cdot \delta_t,\quad \delta_t = +u_t
$$- \( u_t = \log \pi_T - \log \pi_S \)
- \(\lambda > 0\) 是 mixing weight
- 理解:这里使用 \(\delta_t = +u_t\) 本身是一种强调,其实本质等于 \(\delta_t = u_t\)
- 注:这里的叠加方式其实有多种:
- Additive:加法 \(A_{i,t} = A_i^{\text{seq} } + \lambda \cdot \delta_t\)
- Multiplicative:乘法 \(A_{i,t} = A_i^{\text{seq} } \times \lambda \cdot \delta_t\)(或类似形式)
- Sample-level routing:不是简单地将两种奖励相加或相乘,而是根据每个样本(rollout)的某些特征,动态决定使用哪种信号或如何组合它们
问题诊断:PMI 视角
Token-level 信号的条件 PMI 解释
- 作者发现:
$$
u_t = \log \frac{\pi_\theta(y_t | x, c, y_{ < t})}{\pi_\theta(y_t | x, y_{ < t})} = \text{PMI}(y_t; c \mid x, y_{ < t})
$$- 如果 \( u_t > 0 \):表示上下文 \( c \) 提高了该 token 的概率,对应 Token 一般是 Shortcut Tokens(如 Given, Assign, succeeds)
- 如果 \( u_t < 0 \):表示 \( c \) 降低了该 token 的概率,对应 Token 一般是 Deliberation Tokens(如 Wait, Let, Maybe)
问题本质
- 默认 Self-Distillation 使用 \( \delta_t = +u_t \),因此:
- 奖励 Shortcut Tokens
- 惩罚 Deliberation Tokens
- 这导致模型倾向于缩短输出、减少探索,削弱推理能力
- 两个关键观察:
- 极性错误:推理需要的是 Deliberation Tokens
- 采样不对称:\( \pi_S \) 生成的数据中,\( u_t < 0 \) 的 token 被过采样,且分布重尾
AntiSD 方法
AntiSD 核心设计思想
- 1)反转梯度方向 :从下降(descent)变为上升(ascent)
- 2)使用 Jensen-Shannon 散度 :为过采样的 Deliberation 侧提供自然的上界
- 3)引入熵触发门控 :防止 Teacher 熵坍塌后信号退化
上升 Jensen-Shannon 散度(将梯度下降变成梯度上升,同时切换目标为 JSD 目标)
- 定义:
$$
D_{\text{JSD} }(\pi_S | \pi_T) = \mathbb{E}_{\pi_T}\left[f\left(\frac{\pi_S}{\pi_T}\right)\right]
$$ - 其 f-散度导数为:
$$
f’(r) = \frac{1}{2} \log \frac{2r}{1+r}
$$ - 代入 \( r = e^{-u} \) 得:
$$
A_t^{\text{AntiSD} } = -\phi(u_t),\quad \phi(u) \triangleq \frac{1}{2}(\text{softplus}(u) - \log 2)
$$ - 性质:
- \( \phi’(u) > 0 \),单调递增
- \( \phi(0) = 0 \),sign-preserving
- 下界:\( \phi(u) \geq -\frac{1}{2}\log 2 \),上界无界
- 因此有:
- 当 \( u_t < 0 \)(Deliberation)时,\( -\phi(u_t) > 0 \),被奖励
- 当 \( u_t > 0 \)(Shortcut)时,\( -\phi(u_t) < 0 \),被惩罚
- Deliberation 侧的奖励被自然上界限制,避免梯度爆炸
理解 方向反转的含义和原因
论文中认为 默认 SD 梯度方向是错误的(注:感觉没有理论依据)
- 目标:
$$
\min_\theta D_{\text{KL} }(\pi_S | \pi_T)
$$ - 梯度方向:
$$
\nabla_\theta D_{\text{KL} } = -\mathbb{E}[u_t \cdot \nabla_\theta \log \pi_S]
$$ - 策略梯度优势:
$$
A_t = +u_t \quad \text{(Shortcut ↑,Deliberation ↓)}
$$
AntiSD 的方案:纠正后梯度方向(同时切换目标函数为 JSD)
- 新目标:
$$
\max_\theta D_{\text{JSD} }(\pi_S | \pi_T) \quad \text{(上升 JSD,不是下降)}
$$ - 梯度方向:
$$
+\nabla_\theta D_{\text{JSD} } = \mathbb{E}[-\phi(u_t) \cdot \nabla_\theta \log \pi_S]
$$ - 策略梯度优势:
$$
A_t = -\phi(u_t) \quad \text{(Shortcut ↓,Deliberation ↑,且有界)}
$$
AntiSD 为什么不是直接上升 KL?
- 因为 \(D_{\text{KL} }(\pi_S | \pi_T)\) 没有 bounded 性质,上升它会导致梯度爆炸
- JSD 的对称性和 bounded 性质是 AntiSD 可行性的关键
熵触发门控
- 问题:上升散度不会自终止,Teacher 熵可能坍塌导致 \( u_t \) 退化为数值噪声
- 解决方案:基于 Teacher 的 median token 熵 \( H \) 的门控:
$$
g \leftarrow
\begin{cases}
1 & \text{if } g=0 \text{ and } H \geq H_{\text{warm} } \\
0 & \text{if } g=1 \text{ and } H < \tau_{\text{down} } \\
g & \text{otherwise}
\end{cases}
$$- \( H_{\text{warm} } \):前 5 步(\( \lambda=0 \))的 median 熵
- \( \tau_{\text{down} } = 0.93 \cdot H_{\text{warm} } \)
- \( \lambda = g \cdot \lambda_{\text{max} } \)
AntiSD 最终算法流程(Algorithm 1)
- 1)对每个 rollout 的每个 token:
- 计算 student log-prob \( s_{t} \)
- 计算 teacher log-prob \( t_{t} \)
- 得 \( u_t = t_t - s_t \)
- 计算 \( \phi_t = \frac{1}{2}(\text{softplus}(u_t) - \log 2) \)
- 2)计算 Teacher 熵 \( H \)
- 3)更新门控 \( g \)
- 4)计算优势:
$$
A_{i,t} = A_i^{\text{seq} } - \lambda \cdot \mathbf{sg}[\phi_t]
$$ - 5)使用标准策略梯度更新 \( \theta \)
实验
实验设置
- 模型 :Qwen3(4B, 8B, 30B-A3B)、Olmo3(7B-Instruct, 7B-Think)
- 数据集 :DAPO-Math-17k(训练),AIME 2024/2025/2026、HMMT 2025、MinervaMath(评估)
- 基线 :
- GRPO(\( \lambda=0 \))
- SD(标准 Self-Distillation,\( \delta_t = +u_t \))
- AntiSD(本文方法)
- 特权上下文 :当 rollout 组中有正确解时采样该解,否则从数据集中采样;加上二进制的正确性反馈
- 理解:数据集中也有标准(Reference Answer 可以作为参考)
主要实验结果
- 准确率与加速比(原文表 1)
- AntiSD 在所有模型上均优于 GRPO 和 SD
- 达到 GRPO 峰值准确率所需的步数减少 2× 到 10×
- 最终准确率提升最多 +11.5 个百分点
- SD 在所有模型上均劣于 GRPO,甚至在某些模型上崩溃
- Pass@k 分析(原文图 3)
- AntiSD 在 HMMT 2025 上的 pass@k 从 \( k=1 \) 到 \( k=32 \) 始终领先 GRPO
- 表明 AntiSD 提升了覆盖率 ,而不仅仅是单次生成的方差降低
- 代码推理任务(原文表 2)
- 在 HumanEval+ 和 MBPP+ 上,AntiSD 也小幅优于 GRPO
- 说明该方法具有一定的任务通用性
- 训练动态(原文图 4)
- AntiSD 的奖励和准确率最早上升
- SD 的 Teacher 和 Actor 熵要么坍塌到 0.1 以下(过自信),要么膨胀到 1 以上(漂移)
- AntiSD 保持在稳定的中间区间
- 消融实验(原文表 3、原文图 5)
- No-teacher :移除特权上下文 -> 崩溃(自强化)
- No-gate :在 Qwen 模型上早期崩溃,在 Olmo 上稳定(说明门控是跨模型保险)
- Divergence choice :JSD 优于 reverse KL
- Compose :additive 优于 multiplicative
- Threshold sensitivity :0.93 在不同模型上迁移性最好
- 特别说明:从 GRPO 继续训练(原文表 4、原文表 7)
- 从 GRPO 饱和点继续用 AntiSD 训练,可在更少步数内接近或达到 from-base AntiSD 的峰值
- 说明 AntiSD 可作为一种后续优化策略
GoLongRL (TMN-Reweight)
- 原始论文:GoLongRL: Capability-Oriented Long Context Reinforcement Learning with Multitask Alignment, 20260519, Kuaishou & UCAS
- 论文 提出了一种面向能力(Capability-Oriented)的长上下文 RL 训练框架 ,主要解决现有长上下文 RL 方法的两大局限:
- 1)数据层面 :现有方法过度集中于“复杂检索路径”(如 UUID 链追踪、chunk-based QA),导致任务覆盖单一,Reward 设计同质化
- 注:本文在数据上也有创新,提出了一个 23K 的 RLVR 数据集
- 2)优化层面 :标准 GRPO 在 heterogeneous rewards 的多任务场景下存在难度偏差(difficulty bias)与跨任务 Reward 尺度不一致问题
- 1)数据层面 :现有方法过度集中于“复杂检索路径”(如 UUID 链追踪、chunk-based QA),导致任务覆盖单一,Reward 设计同质化
- 论文核心贡献总结
- 1)公开一个 23K 样本的 Capability-Oriented RLVR 数据集 ,覆盖 9 种任务类型,不同任务使用不同的指标作为 Reward
- 2)提出 TMN-Reweight 算法 :结合 Task-level Mean Normalization 与 Difficulty-adaptive Reweighting,解决多任务优化挑战
- 3)验证泛化性 :在长上下文 RL 训练后,通用推理与记忆能力保持或提升,包括未见过的 Agentic memory 与对话记忆任务
- 论文核心 Insight
- 1)现有长上下文 RL 的数据设计过于单一(过度依赖 retrieval path),需要能力导向的多任务、多 Reward 数据
- 2)TMN-Reweight 通过 task-level normalization + 四象限难度加权 ,同时解决跨任务尺度不一致与难度偏差
- 3)数据集 + 算法共同驱动性能 :仅数据更换(固定 GRPO)即可大幅超过 QwenLong-L1.5;再加入 TMN 进一步提升
- 4)长上下文 RL 不会损害通用能力 ,甚至可提升推理与记忆
- 注: 本文 开源全部资源 :数据、构建 pipeline、训练代码
数据构建(遵循三个原则)
三个原则细节
- 原则一:Capability Orientation (能力导向)
- 基于 LongBench Pro 的能力分类,定义 9 种核心能力,每种对应一个 Task
- 原则二:Reward Alignment with Task Semantics (不同任务用不同 Reward)
- Exact Match (EM) for 精确检索
- Accuracy for 多项选择
- F1 for 高召回检索
- math_verify for 数值推理
- IoU for 结构化提取
- NDCG for 排序
- Pairwise for 序列重建
- ROUGE-L for 摘要
- 原则三:Real Document Priority (真实文档优先)
- 优先使用真实文档(书籍、论文、法律文书等),避免模板化合成带来的可利用规律
数据集分布
- 最终的数据集组成(共 22,965 条)
Task Reward 数量 占比 T1 (精确检索) EM 7,908 34.4% T2 (证据推理) Accuracy 6,808 29.6% T3 (高召回检索) F1 3,478 15.1% T4 (数值推理) math_verify 3,054 13.3% T5 (多表提取) IoU 937 4.1% T6 (片段匹配) SubEM 360 1.6% T7 (排序) NDCG 120 0.5% T8 (成对比较) Pairwise 180 0.8% T9 (摘要) ROUGE-L 120 0.5% - 数据来源分析
- 合成数据(~9K)
- T2 多项选择:Gutenberg 书籍、arXiv、PMC 文章 -> 证据整合 QA、规则归纳、对话记忆
- T1 检索:合成 needle-in-a-haystack
- 开源数据(~14K)
- CLongEval、WikiHop、LongBench Pro、CAIL2018、Financial QA、MultiTableQA 等
- 合成数据(~9K)
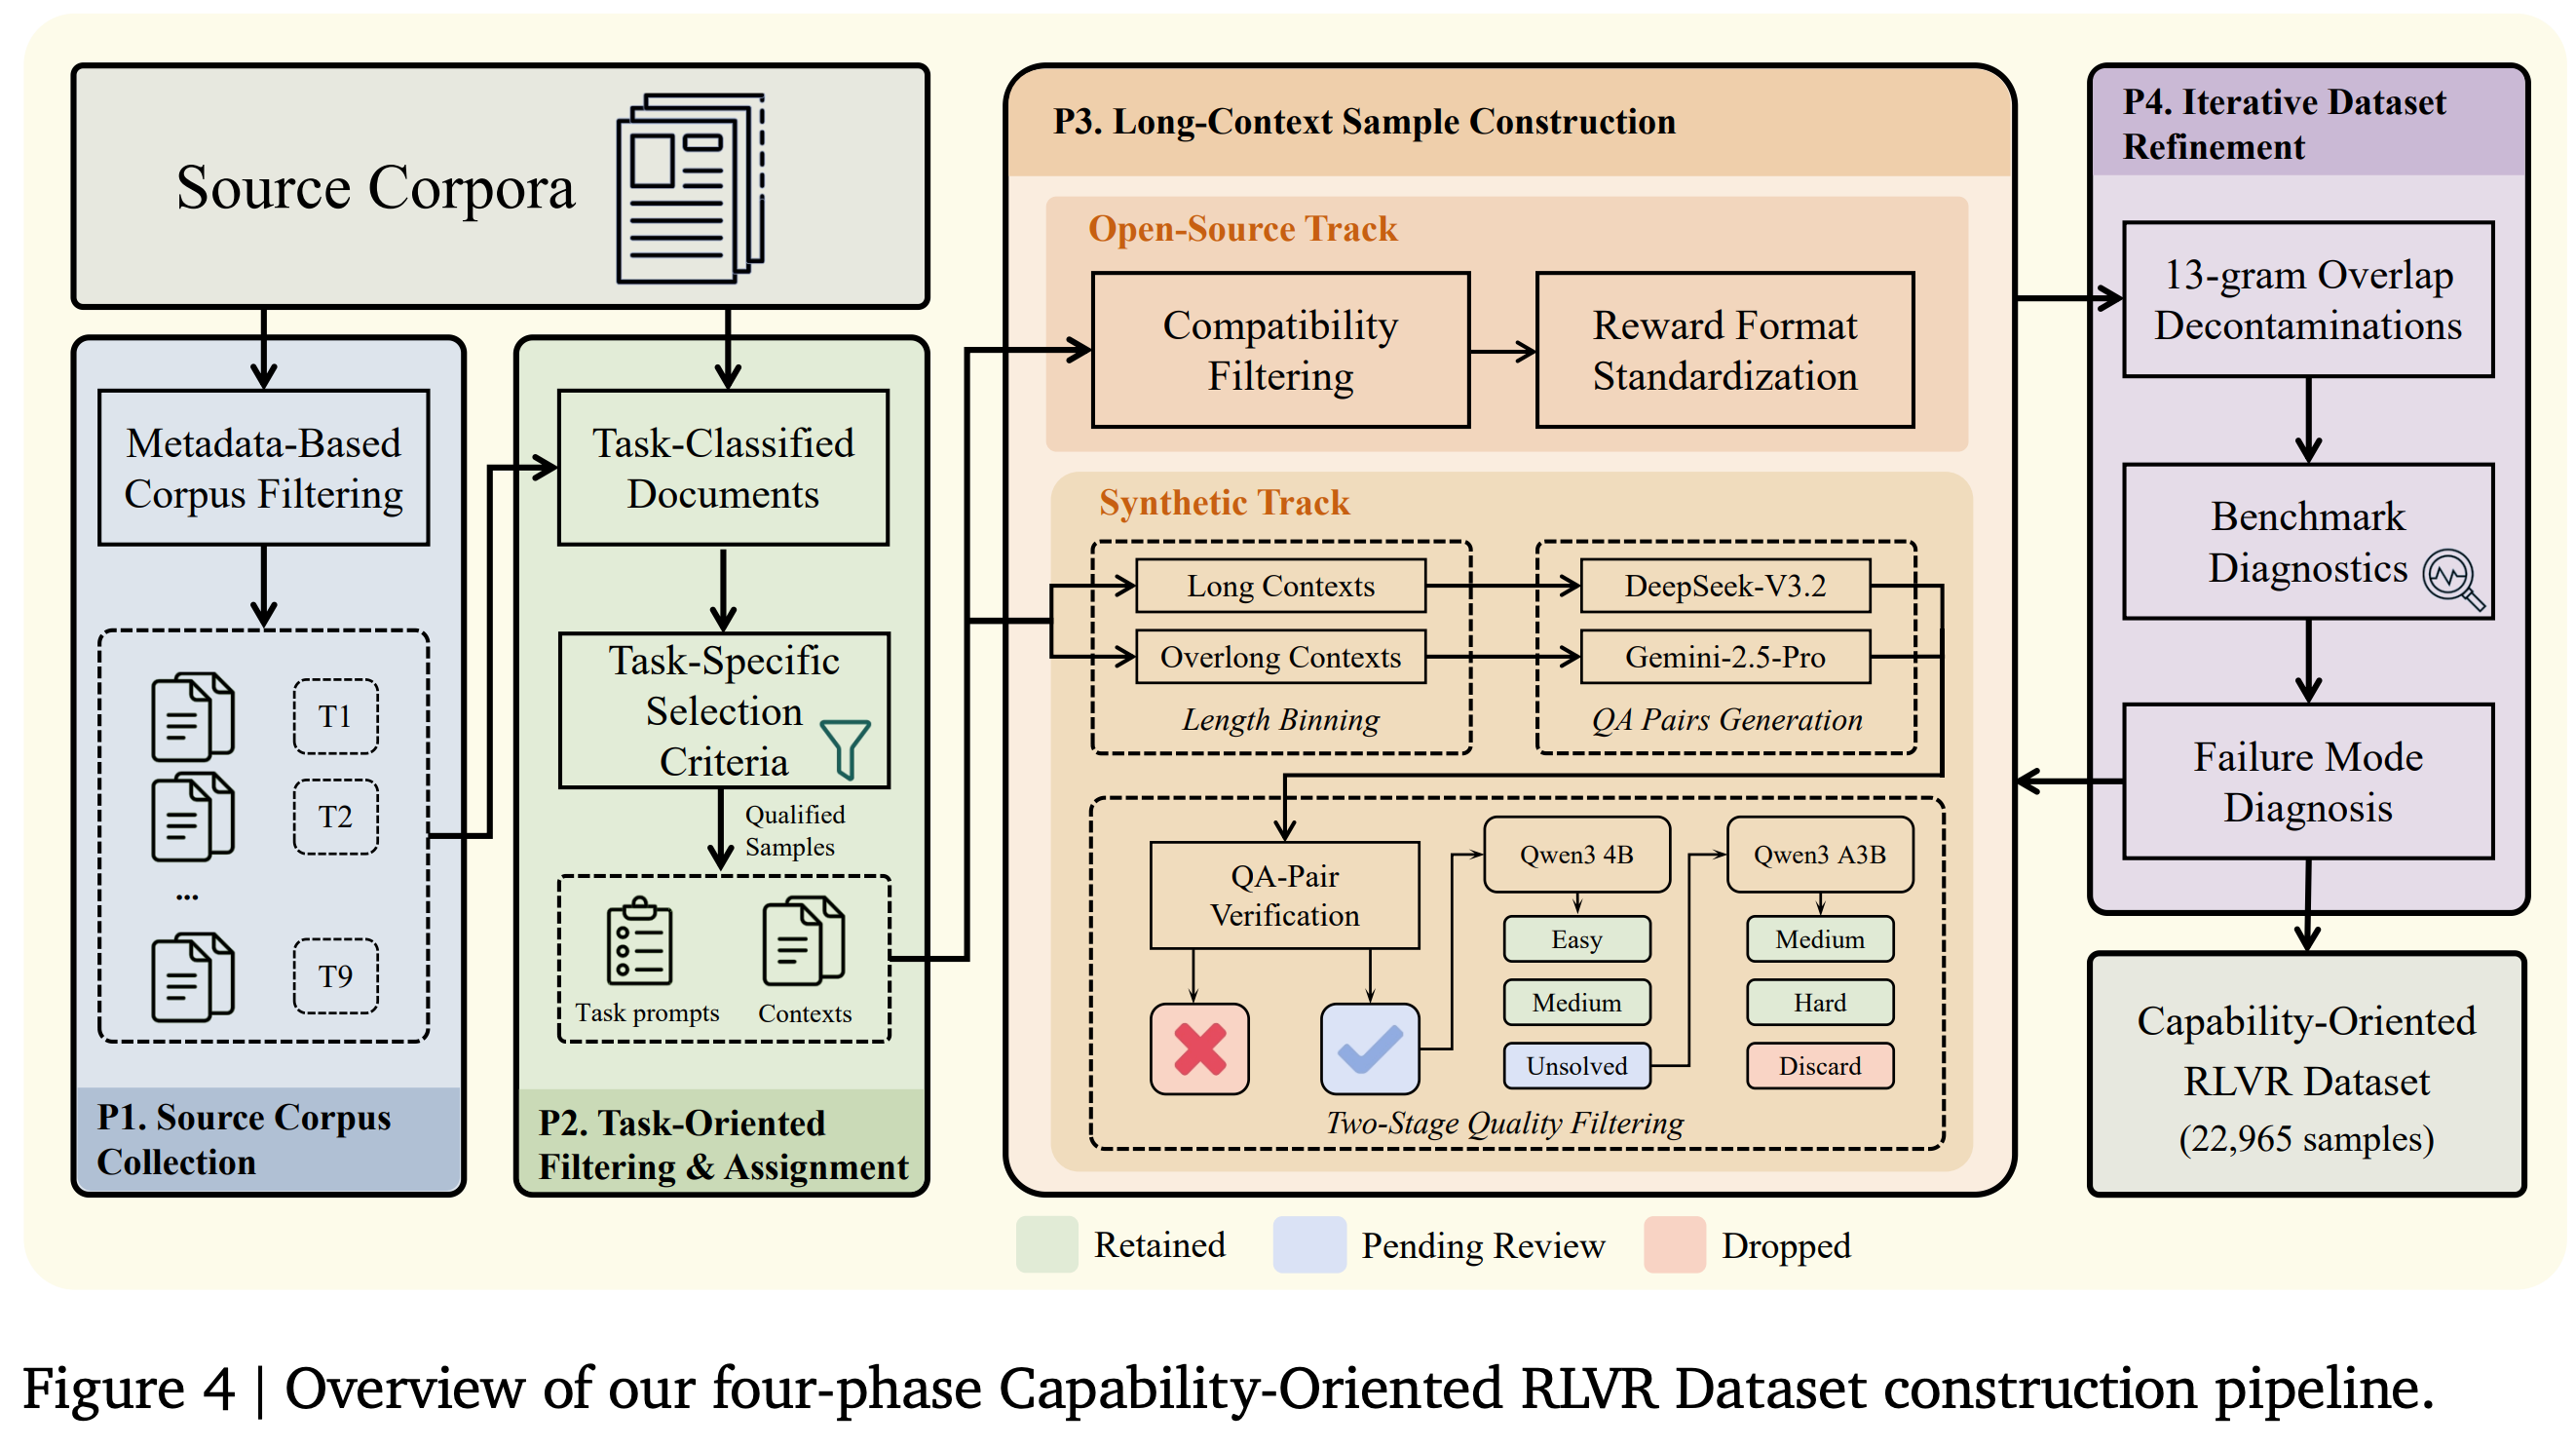
数据构建流程(分四阶段)
阶段1:源语料收集
- 针对 9 个 Task 收集两类语料:
- 已标注开源数据集
- 无标注真实文档
阶段2:任务导向过滤与分配
- 为每个样本或文档分配唯一 Task
- 例如:
- CLongEval 中定位单一事实的样本 分配为 精确检索
- CAIL2018 多法律条款聚合 分配为 高召回检索T3
阶段3:样本构建
- 对于 开源 track :
- 1)兼容性过滤(例如 T1 只保留短答案)
- 2)Reward 格式标准化(如 math_verify 可解析表达式)
- 对于 合成 track :
- 1) Tokenize + 按长度分 bin
- ≤160K:由 DeepSeek V3.2 生成 QA Pair
160K:由 Gemini-2.5-Pro 生成 QA Pair
- 理解:长文本认为是更难的,用更强的模型来合成
- 2) 生成 QA pair(三步)
- 识别源语言
- 构造问题(含合理干扰项)
- 自检
- 3) 两阶段质量过滤
- Stage 1 :Gemini-2.5-Pro 验证答案唯一性、干扰项合理性、无幻觉、任务合规
- Stage 2 :多模型验证(Qwen3-4B + Qwen3-30B)
- Pass rate > 0.75 : easy
- 0.5–0.75 : medium
- <0.5 : unsolved ,使用 30B 重评
- <0.25 : 丢弃
- 1) Tokenize + 按长度分 bin
阶段4:迭代 Refine
- 13-gram 去污(与评测集重叠则丢弃)
- 在 training queries 与所有 benchmark queries 之间应用 13-gram 重叠过滤,丢弃任何与评估查询共享 13-gram 子串 的训练样本,以防止数据污染
- 训练 -> 诊断弱能力维度 -> 针对性补充样本
- 示例:MRCR 停滞 -> 补充多跳推理与记忆样本 -> MRCR 从 40.7 提升至 67.5
数据有效性验证(固定 GRPO)
- 4B 模型(8K 子集):
- 本文的数据 + GRPO: 平均分 62.2
- 超过 QwenLong-L1.5 的 56.1
- 本文的数据 + GRPO: 平均分 62.2
- 30B 模型(全量):
- 本文的数据 + GRPO:69.8
- 超过 QwenLong-L1.5+GRPO 的 67.2
- 本文的数据 + GRPO:69.8
- 结论:数据覆盖与 Reward 多样性是长上下文 RL 的主要瓶颈
TMN-Reweight 算法
原始 GRPO 及其变体的问题
- GRPO 优势估计(每个 Prompt \(u\)):
$$
\begin{align}
A_i^u &= \frac{r_i - \mu_u}{\sigma_u + \delta} \\
\mu_u &= \frac{1}{G}\sum_{j=1}^G r_j \\
\sigma_u &= \sqrt{\frac{1}{G-1}\sum_{j=1}^G (r_j - \mu_u)^2}
\end{align}
$$ - Dr.GRPO 去掉 \(\sigma_u\),只用 \(A_i^u = r_i - \mu_u\)
- 缺陷 1:难度偏差
- \(\sigma_u\) 小(全对或全错): 优势被放大
- 中等难度(结果多样): 优势被压缩
- 缺陷 2:跨任务 Reward 尺度不一致
- 不同 Reward(EM vs F1 vs NDCG)的方差差异大
- 去掉 \(\sigma_u\) 后,高方差任务主导优化
TMN-Reweight 的两步设计
Step 1:Task-level Mean Normalization
- 不再使用 per-prompt \(\sigma_u\),而是使用 task-level aggregated standard deviation :
$$
\begin{align}
\hat{A}_i^u &= \frac{r_i - \mu_u}{\sigma_{\text{task}(i)} + \delta} \\
\sigma_{\text{task}(i)} &= \sqrt{\frac{1}{|U_{\text{task} }|}\sum_{u\in U_{\text{task} } } \sigma_u^2}
\end{align}
$$- 注意:这里减去的均值是所有任务的均值,不是某个任务的,但是除以的标准差是每个任务内部计算得到的
- 原理(注:原始论文附录 A 有梯度分析):
- 若不除以各自的奖励标准差,则在最终的梯度中,每个任务的梯度幅度正比于
$$ \sqrt{\mathbb{E}_{u\sim \mathcal{T}_k}[\sigma_u^2]}$$ - 若使用 \(\sigma_{\text{task} }\) ,来进行归一化,则可均衡多任务梯度尺度,此时相当于对每个任务梯度添加下面的系数:
$$ \alpha_k = \frac{1}{\sqrt{\mathbb{E}_{u\sim \mathcal{T}_k}[\sigma_u^2]} + \delta} $$ - 保留任务内部的难度结构
- 若不除以各自的奖励标准差,则在最终的梯度中,每个任务的梯度幅度正比于
Step 2:Difficulty-adaptive Reweighting
- 难点估计(平滑 pass rate):
$$
\begin{align}
\tilde{\mu}_u &= \alpha \cdot \mu_u + (1-\alpha) \cdot \mu_{\text{task} },\\
\hat{p} &= \frac{\sum_{i=1}^G \mathbf{1}[r_i > \tilde{\mu}_u]}{G}
\end{align}
$$ - 权重计算 :
$$
w = \exp(0.5 - \hat{p})
$$- \(\hat{p} < 0.5\)(难):\(w > 1\) 放大稀有正确样本
- \(\hat{p} > 0.5\)(易):\(w < 1\) 减少冗余信号
- 四象限梯度重分配(关键创新):
- 按 Advantage 符号不对称应用 \(w\):
$$
\tilde{A}_i =
\begin{cases}
\hat{A}_i^u \cdot w, & \text{if } \hat{A}_i^u > 0 \\
\hat{A}_i^u \cdot \frac{1}{w}, & \text{otherwise}
\end{cases}
$$ - 难 prompt(\(w>1\)):
- 正优势放大(鼓励成功探索)
- 负优势缩小(避免不稳定)
- 易 prompt(\(w<1\)):
- 正优势衰减(避免概率坍缩)
- 负优势放大(从意外失败中学习)
- 按 Advantage 符号不对称应用 \(w\):
补充:TMN-Reweight 与现有方法对比
- 各种 RL 方法对比
方法 跨任务尺度对齐 难度偏差修正 GRPO 部分(per-prompt) 无(会放大极端难度) Dr.GRPO 无 中等(但跨任务尺度乱) QwenLong L1.5 有(task-level std) 无 TMN-Reweight 有(task-level RMS) 有四象限加权
实验与结果
- 设置
- 模型 :Qwen3-4B-Thinking-2507(dense)、Qwen3-30B-A3B(MoE)
- 训练数据 :4B 用 8K 子集,30B 用 23K 全量
- Batch size = 128,Group size = 16,LR = 2e-6
- 评测基准 :LongBench-V2、MRCR、Frames、CorpusQA、DocMath、LongBench 等
- 主要结果(注意:GoLongRL-4B 使用的数据跟前面的模型不同)
- 整体结果(表格)
模型 方法 Avg Qwen3-4B Base 53.0 QwenLong-L1.5 +GRPO 56.1 GoLongRL-4B +GRPO 62.2 GoLongRL-4B +TMN-Reweight 63.0 - 问题:
- TMN-Reweight 相对 GRPO 只涨了 0.8,看起来像是波动(本文的创新似乎更多在数据上)
- 问题:
- TMN-Reweight 在 CorpusQA 上提升 +4.5,LBV2 +1.6
- MRCR 上 GRPO 略优(67.5 vs 65.5),说明 reweighting 更有利于聚合类任务
- 整体结果(表格)
- 消融实验
- \(\alpha\) 参数(平滑系数):
- \(\alpha=0.8\) 最优(avg 63.0),纯 prompt-level(\(\alpha=1\))61.5,纯 task-level(\(\alpha=0\))61.3
- 算法消融(同数据 + 不同优势估计):
- GRPO 62.2 提升到 TMN 63.0,证明算法独立贡献(吐槽:其实看起来像是波动)
- \(\alpha\) 参数(平滑系数):
- 泛化性评估(通用能力未下降)
能力 4B Base → GoLongRL 30B Base → GoLongRL MMLU-Pro +0.7 -0.9(基本持平) AIME24 +1.6 +0.7 GPQA +2.3 -2.5(30B 轻微下降) Memory-Vec +4.5 +2.6 LongMemEval +13.6 +0.0 - 长度外推
- 训练长度 160K,可外推至 1M
- MRCR (512K–1M):4B 模型提升 +3.5,30B 模型提升 +5.45
BetaPRM
- 原始论文:(BetaPRM)Process Rewards with Learned Reliability, 20260515, Washington University & Singapore University of Technology and Design
- 问题提出:现有 PRM 存在两大根本局限
- 输出单一标量 :传统 PRM 对每个推理步骤只输出一个奖励分数(如正确概率),下游方法无法判断该分数何时不可靠,导致不确定的预测被当作确定性决策信号使用
- 训练标签噪声 :常见的 PRM 监督信号来自有限样本的蒙特卡洛续写,并用经验比例 \(K/N\) 作为点目标回归,这会过拟合于采样噪声,忽略了计数观测本身的统计特性
- 思路:应建模分布而非点估计
- 更好的方法是让 PRM 输出一个关于前缀成功概率的 Beta 分布(信念),并通过 Beta-Binomial 似然直接解释观测到的成功续写计数 \(K\),而不是拟合有噪声的 \(K/N\)
- 方法:
- BetaPRM 的核心设计
- 预测两个参数:均值 \(\mu_t\)(作为标准 PRM 奖励分数)和集中度 \(\kappa_t\)(表示预测的可靠性)
- 训练目标为最大化 Beta-Binomial 负对数似然,并附加一个正则化项,当 \(\mu_t\) 与 \(K/N\) 不一致时惩罚高 \(\kappa_t\),从而校准可靠性估计
- 可靠性信号可用于自适应计算分配(ACA)
- 在 Best-of-N 推理中,利用 \(\mu_t\) 和 \(\kappa_t\) 计算步骤级不确定性 \(\sigma_t\),并构造风险调整的候选分数
- ACA 采用渐进式批生成和早停机制:当当前最佳候选的置信下界高于所有其他候选的置信上界时停止;否则从不确定的前缀继续采样
- BetaPRM 的核心设计
- 实验结果:
- BetaPRM 提升 Best-of-N 选择准确率
- 在四个基座模型(InternVL2.5-8B、InternVL3-8B、InternVL3-14B、Qwen2.5-VL-7B)和四个推理基准(MathVision、OlympiadBench、MathVerse、MathVista)上,BetaPRM 均优于标准 PRM,平均准确率提升最高达 +3.37 点
- 不牺牲步骤级错误检测能力
- 在 VisualProcessBench 上,BetaPRM 的步骤级错误检测性能(微 F1)与标准 PRM 相当或略有提升,说明分布建模不会损害基础的步骤分类能力
- BetaPRM 提升 Best-of-N 选择准确率
SDAR
背景 & 问题提出
- 多轮交互环境下的 LLM Agent 后训练场景,现有两种主要优化范式:
- 1)Reinforcement Learning (RL) :基于环境或验证器提供的轨迹级奖励信号进行优化,如 GRPO。优点是任务级目标明确,但监督信号稀疏
- 2)On-Policy Self-Distillation (OPSD) :通过一个拥有特权上下文(如检索到的技能)的教师分支,为每个 Token 提供稠密指导
- OPSD 在多轮 Agent 中面临两大问题:
- 多轮不稳定性 :学生策略一旦偏离教师支持的轨迹, Token-level 监督变得不可靠,KL 散度激增,性能崩溃
- 对特权指导的非对称信任 :当教师对采样 Token 赋予更高概率时,信号可信;若赋予更低概率,可能源于技能质量差、利用不当或多轮漂移,不应全盘接受
- 解法思路:SDAR 将 RL 作为主优化目标,OPSD 作为受控辅助目标 ,通过 Token-level 门控机制 自适应调节蒸馏强度
SDAR 方法
问题定义
- 定义一个多轮 Agent,交互轨迹为:
$$
y = (y_1, \dots, y_T) \sim \pi_\theta(\cdot \mid x)
$$- \(s_t = (x, y_{ < t})\):学生上下文
- \(s_t^+ = (x, c^+, y_{ < t})\):教师上下文,\(c^+\) 为特权信息(如检索到的技能)
- 其中,技能检索 :支持四种策略(UCB、Keyword Matching、Full、Random),用于模拟不同质量的教师指导
- 理解:Full 是最优秀的教师,Random 是最差教师
SDAR 优化目标
- 最小化下面的总损失函数为:
$$
\mathcal{L}(\theta) = \mathcal{L}_{\text{GRPO} }(\theta) + \lambda_{\text{SDAR} } \cdot \mathcal{L}_{\text{SDAR} }(\theta)
$$- 注意:将上面公式中的 SDAR 不是 OPSD 的公式
$$
\begin{align}
\ell_t^{\text{SDAR} } &= g_t \cdot (\log \pi_T(y_t \mid s_t^+) - \log \pi_\theta(y_t \mid s_t)) \\
\mathcal{L}_{\text{SDAR} } &= \text{Agg}(\ell_t^{\text{SDAR} })
\end{align}
$$- 注:后文会给出更详细的说明
- 注意:将上面公式中的 SDAR 不是 OPSD 的公式
SDAR 的 RL 部分:GRPO
- 对每个输入 \(x\),采样 \(G\) 条轨迹 \(\{y^{(i)}\}\)
- 计算轨迹级优势 \(A^{(i)}\)
- GRPO 损失为:
$$
\mathcal{L}_{\text{GRPO} }(\theta)=-\frac{1}{G}\sum_{i=1}^{G}\text{Agg}\Big(\min \big(r_{t}^{(i)}A^{(i)},\ \text{clip}(r_{t}^{(i)},1-\epsilon,1+\epsilon)A^{(i)}\big)\Big) + \beta \cdot \text{Agg}\big(D_{\text{KL} }(\pi_\theta |\ \pi_{\text{ref} })\big)
$$- \(r_t^{(i)} = \frac{\pi_\theta(y_t^{(i)} \mid s_t^{(i)})}{\pi_{\theta_{\text{old} } }(y_t^{(i)} \mid s_t^{(i)})}\),\(\text{Agg}\) 为带 Response Mask 的平均
SDAR 的 OPSD 部分: Token-level 反向 KL
- 定义教师与学生之间的 Token-level 反向 KL :
$$
D_{\text{RKL} }^{(t)} = D_{\text{KL} }(\pi_\theta(\cdot \mid s_t) \ |\ \pi_T(\cdot \mid s_t^+))
$$ - 为高效计算,采用单样本估计,得到 教师-学生 Log 概率差 :
$$
\Delta_t = \log \pi_T(y_t \mid s_t^+) - \log \pi_\theta(y_t \mid s_t)
$$
SDAR 的 Token-level 门控机制(核心贡献)
- 为避免盲目蒸馏,SDAR 引入一个门控信号 \(g_t \in [0,1]\),作用于每个 Token 的蒸馏损失
门控设计思路
- 使用 Sigmoid 函数 将 \(\Delta_t\) 映射到 \((0,1)\),实现平滑、有界、单调的调制
- Stop-gradient 应用于 \(g_t\),避免形成自参照优化路径,保证梯度稳定
三种门控策略
- 1)Entropy Gating :
$$g_t = \sigma(\beta h_t)$$- 其中 \(h_t = -\sum_v \pi_\theta(v \mid s_t) \log \pi_\theta(v \mid s_t)\)
- 2)Gap Gating(默认) :
$$g_t = \sigma(\beta \Delta_t)$$- 注:教师-学生 Log 概率差 \(\Delta_t = \log \pi_T(y_t \mid s_t^+) - \log \pi_\theta(y_t \mid s_t) \)
- 注:后续实验证明该方式是最优的
- 3)Soft-OR Gating :
$$g_t = \sigma(\beta [1 - (1 - h_t)(1 - \Delta_t)])$$
蒸馏损失
- 损失定义:
$$
\begin{align}
\ell_t^{\text{SDAR} } &= g_t \cdot (\log \pi_T(y_t \mid s_t^+) - \log \pi_\theta(y_t \mid s_t)) \\
\mathcal{L}_{\text{SDAR} } &= \text{Agg}(\ell_t^{\text{SDAR} })
\end{align}
$$
理论性质(论文附录 A)
- 论文提供了若干理论保证(Propositions 1–5):
- 等价性 :\(\mathcal{L}_{\text{SDAR} }\) 等价于加权最大似然(常数项剥离)
- 梯度形式 :\(\nabla_\theta \mathcal{L}_{\text{SDAR} } = -\text{Agg}(g_t \nabla_\theta \log \pi_\theta(y_t \mid s_t))\)
- 门控单调性与平滑性 :\(\frac{\partial g_t}{\partial \Delta_t} = \beta \sigma(\beta \Delta_t)(1 - \sigma(\beta \Delta_t)) \in (0, \beta/4]\)
- 梯度有界性 :\(|\nabla_\theta \mathcal{L}_{\text{SDAR} }| \leq \text{Agg}(B_t)\)
- 不停止梯度的危害 :会引入自参照项 \(\beta \Delta_t g_t(1 - g_t)\),导致不稳定
实验设置与评估
- 基准与环境
- ALFWorld :文本版 embodied AI 任务(6 类日常活动)
- WebShop :在线购物环境
- Search-QA :检索增强型问答
- 基线与模型
- 无训练 :Skill-Prompt
- 纯后训练 :GRPO、OPSD、Skill-GRPO
- 混合方法 :GRPO+OPSD、Skill-SD、RLSD
- 模型 :Qwen2.5-3B/7B、Qwen3-1.7B
- 主要结果
- SDAR 在所有任务上显著优于 GRPO:
- ALFWorld:+9.4%(3B)
- Search-QA:+7.0%(3B)
- WebShop-Acc:+10.2%(7B)
- OPSD 单独训练崩溃,GRPO+OPSD 也不稳定;SDAR 保持稳定增益
- SDAR 实现了 技能内化 :推理时不依赖技能上下文,仍优于 Skill-GRPO*
- 在小模型(1.7B)上表现尤其突出,说明门控机制对弱教师信号更鲁棒
- SDAR 在所有任务上显著优于 GRPO:
- 训练动态
- 平均教师-学生差距始终为负,但逐渐趋近于零
- 门控激活比例(\(g_t > 0.5\))始终低于 0.5,说明大部分 Token 被抑制,少量被强化
- 鲁棒性分析
- 即使 随机检索 技能,SDAR 仍优于纯 GRPO
- 高质量检索(KM、UCB)进一步提升性能
- 验证了 非对称信任 的设计合理性
- 消融实验
- 门控策略 :Gap Gating 最优,Entropy 次之,Soft-OR 最差
- Sharpness \(\beta\) :\(\beta=5\) 最佳,过大或过小都会恶化性能
- 蒸馏系数 \(\lambda\) :\(\lambda=0.01\) 最佳,过大则教师信号主导导致性能下降
- 蒸馏目标 :Reverse KL 显著优于 Forward KL 和 JSD,因其具有 mode-seeking 特性,适合弱教师信号
Just Enough Thinking(Adaptive Length Penalty, ALP)
- 原始论文:(ALP)Just Enough Thinking: Efficient Reasoning with Adaptive Length Penalties Reinforcement Learning, 20250606, Stanford & SynthLabs
- 本文聚焦于LLM 中的推理效率问题
- 当前的 LRMs 在推理时生成的 Token 数量与性能呈正相关,但会导致严重的计算浪费,尤其是在简单问题上
- 例如,DeepSeek-R1 在回答“2+3=?”时会生成超过 10,000 个 Token,反复回溯和验证
- Insight: 简单问题少用 Token,复杂问题多用 Token,从而提高整体效率
现有方法的局限性
- 现有方法无法根据问题内在难度自适应调整长度 :
- 1)SFT :使用人工筛选的短推理链,数据成本高,可能损害推理质量
- 2)用户控制预算 :如提前停止或用 Prompt 指定 Token 上限,需手动配置,无法自动适应不同难度
- 3)RL 统一惩罚 :如仅对正确解施加惩罚,或使用固定的长度截断,对所有问题一视同仁,导致简单问题仍过度推理,复杂问题推理不足
Adaptive Length Penalty (ALP)
- ALP 的核心思想是:在 RL 训练过程中,在线估计每个 Prompt 的解决率(solve rate),并将其作为难度代理,动态调整长度惩罚的强度
- 高解决率(简单问题) :施加较大的长度惩罚,鼓励模型减少 Token 使用
- 低解决率(困难问题) :施加较小甚至忽略长度惩罚,允许模型充分推理
- 这种设计使得模型在训练中内化问题难度 ,无需人工标注或推理时额外开销
- 方法流程与公式
- 步骤 1:采样多个 Rollout,对于每个 Prompt \(q\),模型采样 \(K\) 个独立的 Response(Chain-of-Thought 轨迹):
$$
\{y^{(k)}\}_{k=1}^K \sim \pi_{\theta}(\cdot | q)
$$ - 步骤 2:在线估计解决率,定义解决率(solve rate)为:
$$
p_{\text{solved} }(q) = \frac{1}{K} \sum_{k=1}^K \mathbf{1}[\text{answer}(y^{(k)}) = y^*]
$$- 其中 \(\text{answer}(y)\) 是提取的最终答案,\(y^*\) 是标准答案
- 高 \(p_{\text{solved} }\) → 简单问题 → 高惩罚
- 步骤 3:构造复合奖励函数
$$
r(y, q) = \underbrace{\mathbf{1}[\text{answer}(y) = y^*]}_{r_{\text{accuracy} } } - \underbrace{\beta \cdot N \cdot \max\left(p_{\text{solved} }(q), \frac{1}{K}\right)}_{r_{\text{length} } }
$$- \(r_{\text{accuracy} }\):正确为 1,错误为 0
- \(N\):原论文中说是归一化常数(如最大轨迹长度),但从上面的 公式看应该是:
$$ N = len(y) \quad \text{ or } \quad N = \frac{|y|}{\text{max_token_num}}$$- 理解:推测是作者笔误写错了
- \(\beta\):全局系数,控制长度惩罚的整体强度
- \(\max(p_{\text{solved} }, 1/K)\):防止未解决问题的惩罚为零,确保始终有轻微长度约束
- 步骤 4:策略更新
- 可使用任何基于组内优势估计的 RL 算法(如 GRPO、RLOO、Reinforce++)更新策略 \(\pi_{\theta}\)
- 由于这些算法本身需要多个 Rollout 来估计优势,ALP 不引入额外计算开销
- 步骤 1:采样多个 Rollout,对于每个 Prompt \(q\),模型采样 \(K\) 个独立的 Response(Chain-of-Thought 轨迹):
实验
- 训练数据与基础模型
- 基础模型 :DeepScaleR-1.5B(已具备长推理能力)
- 训练数据 :AIME、AMC(2023 年前)、Omni-Math、Still 等数学问题
- 上下文窗口 :16,384 Token(主实验),也测试了 4K 和 8K
- RL 算法 :GRPO(VeRL 实现)
- 训练步数 :100 步,Batch Size = 512,Rollout 数 K = 16
- 评估与对比方法
- 评估数据集 :MATH-500、OlympiadBench、AIME(2024+2025)
- 性能指标 :Pass@1(采样 16–64 次)
- 对比方法 :
- L1-Exact / L1-Max:用户指定精确或最大 Token 数
- ThinkPrune:逐步缩减 Token 上限(4K→3K→2K)
- R1-Alpha:对正确解施加统一长度惩罚
- 主要结果与分析
- 效率-性能权衡
- ALP 在 MATH-500 上减少 50% Token ,性能不降甚至略升
- 在受限预算(如 1024 Token)下,ALP 的 Pass@1 比基础模型高 40%
- 与 L1-Max 相比,ALP 无需用户指定预算即可自动适应
- Pareto 效率分析(自适应分配)
- 关键发现 :ALP 仅用 21% 的 Token 解决前 50% 最简单问题 ,而 L1-Exact 为 50%
- 适应比(hard/easy Token 比) :ALP 达到 5.35× ,远高于基础模型(2.41×)和 L1-Max(1.36×)
- 效率得分 :ALP 为 0.68,高于 R1-Alpha(0.64)和 ThinkPrune(0.61)
- 对未知难度分布的鲁棒性
- 在 MATH 与 AIME 的不同混合比例(0–60% AIME)下,ALP 能自动调整平均 Token 使用量 ,保持较高准确率
- 相比之下,L1-Exact 固定 Token 数,在困难问题增多时性能急剧下降
- 模型如何内化难度
- 通过分析 Token 使用量 vs. 难度(1 - solve rate) ,ALP 在所有数据集上呈现单调递增关系
- 简单问题(难度 0–0.2):约 500 Token;困难问题(0.8–1.0):近 3000 Token
- L1-Exact 几乎无变化;L1-Max 甚至出现倒 U 形(最难问题时 Token 最少)
- 效率-性能权衡
- 超参数与模型敏感性
- 在 DeepScaleR 和 R1-Distill-Qwen 上,ALP 均有效
- 更大的 \(\beta = 10^{-7}\) 比 \(10^{-8}\) 压缩更多 Token,性能下降很小
- 减少上下文窗口(8K→4K)进一步压缩 Token,“wait”等自校验 Token 频率减少 2 倍 ,但关键推理结构保留
- 推理行为变化分析:通过分析关键词频率(如“wait”、“let’s try”、“therefore”等),发现:
- 重复(Repetition) :减少 52%
- 探索(Exploration) :减少 48%
- 回溯(Backtracking) :大幅减少
- 规划(Planning) :相对保留(仍保留 46%)
- 这表明 ALP 不是简单截断,而是改变了模型的推理策略 :减少冗余和试探,保留结构化规划
RRM
- 原始论文:RRM: Robust Reward Model Training Mitigates Reward Hacking, 20240920, ICLR 2025, Google DeepMind
- TLDR:
- 论文提出了一种基于因果推断的 Robust Reward Model(RRM)训练方法,通过构造跨样本的 Prompt-Response 三元组,消除上下文无关 Artifact 对偏好判断的影响
- 实验证明,RRM 在 RewardBench 上显著提升准确率,并能诱导出更短、更符合人类偏好的 Policy,有效缓解了 Reward Hacking 问题
- 注意:RRM 是一个 Pairwise 的奖励模型,为什么选择 Pairwise 而非 BT?
- 论文给出两个理由(引用 Zhao et al., 2023; Jiang et al., 2023):
- 经验上更强:在多个基准上表现更好
- 理论上更灵活:更大的函数类容量
- 论文给出两个理由(引用 Zhao et al., 2023; Jiang et al., 2023):
背景 & 问题提出
- 在 RLHF 中,Reward Model(RM)用于对齐 LLM 与人类偏好,传统 RM 训练存在一个根本性问题:无法区分真正的上下文相关偏好信号与上下文无关的伪影(Artifacts)
- 例如 Response 的长度、格式(如加粗、Markdown)、特定 n-gram(如“Sure, here is the response:”)等
- 这导致模型学会利用这些伪影进行偏好判断,即Reward Hacking
- 论文指出,这种问题源于 RM 训练数据的构造方式:
- Prompt 和 Response 总是成对出现,缺乏反事实 Prompt ,使得模型可以忽略 Prompt 而仅依赖 Response 中的伪影
因果框架的形式化建模
因果图(DAG)
- 论文构建了一个有向无环图(DAG)来描述变量之间的因果关系,包含以下变量:
- \(X\):Prompt
- \(Y_1, Y_2\):两个Response
- \(S\):上下文相关的真实质量信号(依赖于 \(X, Y_1, Y_2\))
- \(A\):上下文无关的 Artifact(仅依赖于 \(Y_1, Y_2\))
- 理解:这里就是与 Prompt 无关的对比结果,但是其实即使不看 Prompt,我们也能感觉到 Response 的好坏,这个还是需要 RM 识别出来的吧?
- \(C\):偏好标签(\(C=1\) 表示 \(Y_1 \succ Y_2\))
- 假设:
- \(\mathbb{P}(C|X,Y_1,Y_2) = \mathbb{P}(C|S,A)\)
- \(S\) 是上下文偏好的充分统计量
- \(A\) 是Artifact的充分统计量
两个假设
- \(\mathcal{H}_0\):不存在从 \(A\) 到 \(C\) 的因果边(理想情况)
- \(\mathcal{H}_1\):存在从 \(A\) 到 \(C\) 的因果边(存在 Reward Hacking)
命题3.1
- 命题 :在传统 RM 训练中,\(\mathcal{H}_0\) 和 \(\mathcal{H}_1\) 并不总是可区分的
- 证明思路 :当 \(S\) 和 \(A\) 完全相关时,模型无法区分偏好来自 \(S\) 还是 \(A\),即:
$$
\mathbb{P}(C=1|X,Y_1,Y_2) = \sigma(\beta_s S + \beta_a A + \alpha + \epsilon_c)
$$- 若 \(\beta_a=0\) 为 \(\mathcal{H}_0\),\(\beta_a=1\) 为 \(\mathcal{H}_1\)
- 但当 \(S\) 和 \(A\) 高度相关时,\(\beta_a\) 可被吸收进 \(\beta_s\) 中,模型无法识别
Robust Reward Model(RRM)训练方法
设计目标
- 消除从 \(A\) 到 \(C\) 的因果边,使得 RM 只依赖于上下文信号 \(S\)
理论依据:d-分离
- 在 \(\mathcal{H}_0\) 下,有以下两个条件独立关系:
- R1 :\(A \perp C \mid (Y_1, Y_2)\)
- R2 :\(A \perp C \mid S\)
- 通过数据构造,使得 RM 必须满足这些独立性,从而消除 Artifact 的影响
数据增强方法
步骤1:扩展数据集
- 给定原始数据集:
$$
\mathcal{D}_{\text{hf} } = \{x^{(i)}, y_w^{(i)}, y_l^{(i)}\}_{i=1}^N
$$ - 随机采样两个置换 \(\sigma_1, \sigma_2\),构造:
$$
\tilde{\mathcal{D} }_{\text{hf} } = \{t^{(i)}, t^{(\sigma_1(i))}, t^{(\sigma_2(i))}\}
$$- 理解:
- 这里的 \(i\) 是第 \(i\) 个样本 \(t^{(i)} = (x^{(i)}, y_w^{(i)}, y_l^{(i)})\) 的索引
- \(\sigma_1, \sigma_2\) 表示扰动函数(随机采样函数),\(\sigma_1(i), \sigma_2(i)\)也表示索引,分别代表
- 第 \(\sigma_1(i)\) 个样本和第 \(\sigma_2(i)\) 个样本
- 注:这里的随机置换可以提供跨样本组合,避免单一置换偏差
- 理解:
步骤2:构造三元组
- 对于每个 Prompt \(x^{(i)}\),构造以下类型的三元组 \((x, y_1, y_2)\):
- Contextuals
- 即原始数据集中的数据 \(t^{(i)} = (x^{(i)}, y_w^{(i)}, y_l^{(i)})\) 保持不变
- 非上下文(Non-contextuals) :只有一个是上下文相关的 Response,设为 Chosen:
- \((x^{(i)}, y_w^{(i)}, y_w^{(\sigma_1(i))}) \text{, where set: } \text{chosen} = y_w^{(i)}\)
- \((x^{(i)}, y_w^{(i)}, y_l^{(\sigma_1(i))}) \text{, where set: } \text{chosen} = y_w^{(i)}\)
- \((x^{(i)}, y_l^{(i)}, y_w^{(\sigma_1(i))}) \text{, where set: } \text{chosen} = y_l^{(i)}\)
- 等等,共 8 种组合(见论文式(5))
- 理解:这里组合方式是:
- Prompt 为 \(x^{(i)}\) 不变
- 两个 Response 中,总是将原始样本的回复作为 Chosen(因为只有原始样本是与 Prompt 相关的)
- 中性(Neutrals) :两个 Response 都不是上下文相关的,设为 Tie:
- \((x^{(i)}, y_w^{(\sigma_1(i))}, y_l^{(\sigma_1(i))}) \text{, where set: } \text{Tie}\)
- \((x^{(i)}, y_w^{(\sigma_1(i))}, y_w^{(\sigma_2(i))}) \text{, where set: } \text{Tie}\)
- 等等,共 6 种组合
- 理解:这里组合方式下:
- 两个 Response 都与 Prompt 不相关,所以是 Tie
- Contextuals
步骤3:筛选增强数据
- 为避免训练样本过多,先用基础 RM 对增强数据进行推理,只保留:
$$
|\hat{\mathbb{P} }(A \succ B) - \mathbb{P}^*(A \succ B)| \geq 0.2
$$- \(\hat{\mathbb{P} }\) 是 RM 预测的概率
- 问题:真实标签概率是怎么来的?根据增强数据的构造规则,\(P^*\) 是确定性标签 :
样本类型 构造规则 \(P^*(y_1 \succ y_2 \mid x)\) Contextual(原始) 来自原数据,已知 \(y_w \succ y_l\) \(1.0\) Non-contextual Contextual Response 强制为 Chosen \(1.0\) Neutral 两个 Response 都不 Contextual \(0.5\)(Tie)
- 问题:真实标签概率是怎么来的?根据增强数据的构造规则,\(P^*\) 是确定性标签 :
- \(\mathbb{P}^*\) 是真实标签概率
- 理解:设计意图是保留“对模型有信息量的困难样本”
- \(\hat{\mathbb{P} }\) 是 RM 预测的概率
- 最终得到约 2.4M 训练样本(原始 + 增强)
命题3.2
- 命题 :若 RM 在增强数据上训练,则 DAG 中不存在从 \(A\) 到 \(C\) 的因果边
- 证明思路 :若存在该边,则 \(A \perp C \mid (Y_1,Y_2)\) 和 \(A \perp C \mid S\) 不成立,与 Non-contextuals 和 Neutrals 的构造矛盾
补充:RRM 与现有方法的关系
- 关系对比:
方法 关系 ODIN 特殊案例(\(A\)=长度),RRM 更一般化 Length-controlled AlpacaEval-2 等价于控制单一 Artifact,RRM 支持多个/未观测 Artifact Length-controlled DPO 后处理调整,RRM 直接学习无 Artifact 的 RM Contrast Instructions 通过数据增强提升一致性,RRM 跨样本构造三元组
实验
- 数据集:使用 RLHFlow 整理的 700K 偏好对,包含:
- HH-RLHF, SHP, HelpSteer, PKU-SafeRLHF, UltraFeedback, UltraInteract, Distilabel-Capybara, Distilabel-Orca
- 模型与训练
- 基础模型:Gemma-2-9b-it
- RM 架构:Pairwise ranking model
- 训练:1 epoch,AdamW,lr=1e-6,batch size=128
- 增强数据过滤阈值:0.2
- DPO 策略训练:2 epoch,lr=2e-7,batch size=128,使用 UltraFeedback Prompt 生成 5 个 Response 后选最佳-最差对
- 评估
- RewardBench(Chat, Chat Hard, Safety, Reasoning)
- MT-Bench(第一轮、第二轮、总体)
- AlpacaEval-2(Length-Controlled Win-Rate, Win-Rate, Length)
- 主要结果
- RewardBench准确率
Model Chat Hard Safety Reasoning Average RM - - - 80.61% RRM - - - 84.15% - RRM 在 Chat Hard 和 Safety 上显著提升,在 Reasoning上 略有下降(因为数学/代码较少受 Artifact 影响)
- 对齐策略性能(DPO)
Reward MT-Bench Overall AlpacaEval-2 LC Length RM 7.27 33.46% 2416 ODIN 8.39 48.29% 1559 RRM 8.31 52.49% 1723 -Neutrals 8.44 51.73% 1722 - RRM 在长度控制胜率上显著优于 RM,且比 RM 生成的 Response 更短
- RewardBench准确率
- 长度分析
- RM 训练数据中,约 60% 的 Chosen Response 比 Rejected 长
- RRM 训练数据中,Chosen 和 Rejected 长度更平衡
- RRM 诱导的 Policy 在 AlpacaEval-2 上生成更短的 Response
补充:人工注入 Artifact 实验
- 设置
- 在训练数据中,以概率 0.1 给 Chosen Response 添加前缀:“Sure, here is the response:”
- 在测试时,以不同概率 \(p \in \{0.05, 0.1, 0.2, 0.5\}\) 注入相同 Artifact
- 结果
- RM 诱导的 BoN(Best-of-N)政策更容易选择带 Artifact 的 Response
- RRM 诱导的 BoN 政策对 Artifact 更鲁棒(见原文图 5)
- 混合 Artifact 实验(附录A.6)
- 同时注入加粗(
***)和Emoji(☐),结果一致:RRM 更鲁棒
- 同时注入加粗(
Discussion
- 潜在问题:在数据增强中,某些情况下可能将不安全的 Response 设为 Chosen,或在中性对中给不安全 Response 赋予 0.5 胜率
- 未来可通过以下方式缓解:
- 使用 Safety RM 过滤低分 Chosen
- 使用 Constitutional AI 等 AI 反馈确保增强数据的质量与一致性
- 未来方向
- 更智能地筛选增强样本
- 在构造 Response 对时显式匹配 Artifact 分布
- 将 RRM 扩展到多模态或更复杂的 Artifact 类型
AutoIF
- 原始论文:(AutoIF)Self-play with Execution Feedback: Improving Instruction-following Capabilities of Large Language Models, ICLR 2025, Qwen Team
- AutoIF 是一个可扩展、自动化的 Instruction-Following 数据合成与训练方法,
- AutoIF 是第一个通过代码验证 + 执行反馈 + 自生成数据,实现 Instruction-Following 能力自动化提升的方法
- AutoIF 在不损害通用能力的前提下,显著提升了 LLM 对复杂指令的遵循能力,并具备良好的泛化性、可扩展性和数据效率
- AutoIF 核心创新在于:
- 将 Instruction-Following 的对齐问题转化为代码验证问题
- 利用 LLM 自动生成 Instruction、对应的 Verification Function 和单元测试,并通过 Execution Feedback 进行质量筛选
- 支持 SFT、Offline DPO、Online DPO 三种训练策略,并在 Self-Alignment 和 Strong-to-Weak Distillation 两种设置下验证有效性
- 首次在 IFEval 上实现 超过 90% 的 Loose Instruction Accuracy ,且不损害通用能力、数学和代码能力
问题定义与符号说明
Instruction-Following 的定义
- 设一个 Instruction \( I = \{i_j\}_{j=1}^N \),包含 \( N \) 个约束条件
- 给定一个 Query \( x \),LLM \( \pi_{\theta} \) 生成 Response:
$$
y \sim \pi_{\theta}(y \mid x, I)
$$ - 要求 \( y \) 遵循 \( I \) 中的所有约束
Verifiable Instructions
- 可验证指令的定义:存在一个 Verification Function \( f_I \),使得:
$$
f_I(y) = \text{True} \iff y \text{ 正确遵循 } I
$$ - AutoIF 专注于此类指令,并证明训练在这些指令上的模型也能泛化到更复杂的不可验证指令
AutoIF 方法详解
- AutoIF 包含两大核心阶段:Instruction 级别的构建与验证 和 Query 级别的构建与验证
- 核心设计思想是通过多重验证确保数据质量:
- 阶段 1(上标 2):验证 Verification Function 本身的正确性(能否编译、是否通过测试用例)
- 阶段 2(上标 3):验证 Instruction 与 Verification Function 之间的一致性(Back-Translation 确保函数真正实现了指令的意图)
- 阶段 3(Query 级别):验证 Instruction 与 Query 的匹配度(避免冲突样本)
阶段一:Instruction Augmentation and Verification
Seed Instruction 构建
- 手工构建一个种子指令集 \( D_{\text{seed} } \),每条指令只包含一个原子约束(如“以 B 开头的单词回答”)
Self-Instruct 数据增强
- 对每条指令 \( I \in D_{\text{seed} } \),用 LLM \( M \) 执行 \( K \) 次改写,生成 \( D_{\text{aug} } \)
- 合并得到下面的数据并去重:
$$
D_{\text{ins} } = D_{\text{seed} } \cup D_{\text{aug} }
$$
自动化质量交叉验证(Automated Quality Cross Verification)
- 对每条指令 \( I \in D_{\text{ins} } \),LLM \( M \) 生成:
- \( K \) 个 Verification Functions:\( f_I = \{f_i\}_{i=1}^K \)
- \( K \) 组 Test Cases:\( c_I = \{c_i\}_{i=1}^K \)
- 理解:
- Verification Function 是一个函数,用于验证某个句子是否满足指令遵循
- Test Case 是一个二元组,由输入和输出两部分的构成的,用来测试某个 Verification Function 能否正确验证某条指令遵循逻辑
- 过滤条件(必须同时满足):
- 1)每个 \( f \) 可被 Python 执行器成功编译
- 2)每个 test case \( c \) 在所有 \( f \) 上的准确率 > 0.5
- 理解:如果 Verification Function 定义的不好,一般过不掉 50% 的测试用例
- 3)每个 \( f \) 在所有 test case 上的准确率 > 0.5
- 理解:如果 测试用例定义的不好, 一般在 Verification Functions 上的准确率不会太高
- test cases 和 verification Function 交叉验证,互相保护质量
- 理解:如果 测试用例定义的不好, 一般在 Verification Functions 上的准确率不会太高
- 4)每条指令至少保留一个 \( (f, c) \) 对
- 得到:
$$
D_{\text{ins} }^{(2)} = \{ (I^{(2)}, f_I^{(2)}) \}
$$- 理解:这里的上角标(3) 是已经经过了处理了(若原始数据集算一步,那就是 2 步处理了)
Back-Translation 验证
- 对每个 \( f \in f_I^{(2)} \),LLM \( M \) 将其反译为指令 \( I_f \)
- 使用 NLI 模型评估 \( I \) 与 \( I_f \) 的关系:
$$
p_{\theta}(\cdot \mid I, I_f) = \text{softmax}(\text{score}_{\theta}(I, I_f))
$$- 其中 \( \text{score}_{\theta} : \mathbb{R}^{k \times \ell_I} \times \mathbb{R}^{k \times \ell_{I_f} } \to \mathbb{R}^3 \),输出三类:entailment(蕴含)、contradiction(矛盾)、neutral(中立)
- 过滤掉 contradiction 的样本,得到:
$$
D_{\text{ins} }^{(3)} = \{ (I^{(3)}, f_I^{(3)}) \}
$$- 理解:这里的上角标(3) 是已经经过了多步(若原始数据集算一步,那就是 3 步处理了)
阶段二:Query Augmentation and Verification
Query Reform and Augmentation
- 对每条指令 \( I^{(3)} \),从 ShareGPT 中随机选取 \( K \) 个用户 Query,拼接为 \( x \)
- 理解:这里的 \(x\) 包含一个指令和 K 个 Query,多个 Query 的好处(设计意图)有:
- 增加难度和真实性:真实场景中,用户不会主动配合 Instruction,往往提出复杂或冲突的需求
- 测试模型的约束遵循能力:模型需要在回答多个问题时,始终记住最初的 Instruction
- 模拟多轮对话:虽然是拼接,但本质上是让模型在多个连续 Query 中保持对同一 Instruction 的遵循
- 理解:这里的 \(x\) 包含一个指令和 K 个 Query,多个 Query 的好处(设计意图)有:
- LLM \( M \) 为每个 \( x \) 生成 \( K \) 个 Response \( y_x = \{y_i\}_{i=1}^K \)
- 理解:此时的 \(y\) 需要回答 K 个问题,并满足指令 \( I^{(3)} \)
- 理解:上面 K 个 Query 和 这里的 K 个回答,在论文中都用字母 K 表示,但它们是两个独立的超参数
- 得到:
$$
D_q = \{ (x, f_I^{(3)}, y_x) \}
$$- 注:\(x\) 中此时带着 1 个指令 和 K 个 Query
Instruction-Following Verification
- 过滤条件:
- 每个 response 在所有 verification functions 上的平均准确率 > 0.5
- 每个 input 至少保留一个 response
- 理解:如果一个 Instruction 对应的所有 K 个 Response 都无法满足平均准确率 > 0.5,那么该样本会被整体丢弃,不会进入最终的训练集
- 得到:
$$
D_q^{(2)} = \{ (x^{(2)}, f_I^{(3)}, y^{(2)}) \}
$$
Query Quality Verification
- 用 LLM \( M \) 为每个 \( (x^{(2)}, y^{(2)}) \) 打分(1–10),评估 instruction 与 query 的匹配度
- 过滤掉分数 < 8 的样本,得到最终训练集:
$$
D_{\text{train} } = \{ (x_i, y_i, f_{I_i}) \}_{i=1}^N
$$
训练策略
SFT
- 标准监督学习目标:
$$
\mathcal{L}(\theta) = \sum_{(x_i, y_i) \in D_{\text{train} } } \log \mathbb{P}_{\theta}(y_i \mid x_i)
$$
SFT + Offline DPO
- 从 Instruction 级别和 Query 级别分别构造偏好对 \( (x, y_w, y_l) \)
- Instruction 级别:准确率 > 0.5 为正样本 \( c_w \),= 0 为负样本 \( c_l \)
- Query 级别:同理
- DPO 损失函数:
$$
\mathcal{L}_{\text{DPO} }(\pi_{\theta}^{\text{SFT} }; \pi_{\text{ref} }) = -\mathbb{E}_{(x,y_w,y_l)} \left[ \log \sigma \left( \beta \log \frac{\pi_{\theta}^{\text{SFT} }(y_w|x)}{\pi_{\text{ref} }(y_w|x)} - \beta \log \frac{\pi_{\theta}^{\text{SFT} }(y_l|x)}{\pi_{\text{ref} }(y_l|x)} \right) \right]
$$ - 其中:
- \( \pi_{\text{ref} } = \pi_{\theta}^{\text{SFT} } \) 初始固定
- \( \beta \) 为超参数
- \( \sigma \) 为 sigmoid 函数
SFT + Iterative Online DPO
- 用 SFT 模型生成 \( K \) 个 Response,温度设为 0.8
- 用 verification function 评估,构造 \( D_{\text{online} }^{\text{pref} } \)
- 迭代进行 DPO 训练
实验
- 模型与基准
- 模型:Qwen2(7B, 72B)、LLaMA3(8B, 70B)、Mistral、GPT-4 等
- 评估基准:IFEval、FollowBench、InfoBench、MT-Bench、Arena-Hard
- 通用能力:C-Eval、MMLU、GSM8K、HumanEval
- 主要结果
- AutoIF 在所有模型、设置、训练策略下均显著提升 Instruction-Following 能力
- Online DPO 优于 Offline DPO(如 Qwen2-7B 在 IFEval 上提升 1.7%)
- 大模型提升更显著(如 LLaMA3-70B 在 FollowBench 上提升 5.6%)
- 通用能力不下降,甚至略有提升
- 消融与分析
- 更强的 supervision model(如 GPT-4)带来更强效果
- 所有质量过滤模块都有效,Cross Verification 最重要
- 数据量与性能呈正相关,且 AutoIF 生成的数据在 1/64 量级下仍显著有效
- Contamination 分析显示与测试集重叠率极低
补充:论文中的其他观点
- 跨领域验证:
- AutoIF 在 InfoBench、MT-Bench、Arena-Hard 上均显著提升性能,验证了其泛化能力
- 理解:因为 IF 是一项通用能力
- 数据效率与代码能力关联
- Supervision model 的代码能力(MBPP 分数)与生成数据的 pass rate 和最终 IF 性能呈正相关
- 长文本与低资源场景
- 在 FollowRAG 长文本基准上,AutoIF 依然有效
- 在 Weak-to-Strong 和低资源(单 GPU)设置下,AutoIF 仍稳定提升
POLARIS
- 原始博客:POLARIS: A POst-training recipe for scaling reinforcement Learning on Advanced ReasonIng modelS, 20250620, UHK & ByteDance & Fudan
- 本文推出Polaris-4B-Preview 与Polaris-7B-Preview 两款开源推理模型,配套完整数据集、代码与训练方案开源
- 该系列模型依托学术级资源完成训练,在数学推理等复杂任务上超越多款主流商用模型,同时支持消费级 GPU 部署
- 模型底座
- Polaris-4B-Preview:基于 Qwen3-4B 微调得到
- Polaris-7B-Preview:基于 Deepseek-R1-Distill-Qwen-7B 微调得到
- 两款模型聚焦高阶推理任务(以数学竞赛题 AIME24、AIME25 为核心评测基准),数学推理性能超越同期闭源模型
- 已有工作(如 DeepscaleR)证明 1.5B 小模型可通过 RL 显著提升推理能力,但将该方案迁移至 Qwen3 等中大型推理模型时,RL 训练收益极低甚至性能下降
- 开源社区缺少针对高阶推理模型的RL规模化后训练范式 ,Polaris 整套方案(简称 POLARIS Recipe)正是为解决这一痛点而生
- 整套 POLARIS Recipe 闭环逻辑,Polaris 形成了一套面向高阶推理 LLM 的 RL 后训练完整流水线 :
- 1)数据层:离线难度筛选 + 训练中动态过滤,维持镜像 J 型难度分布
- 2)采样层:CEZ 温度初始化 + 分阶段动态升温,持续提升 Rollout 多样性
- 3)序列层:训练短序列+推理 Yarn 长度外推,解决长 CoT 算力瓶颈
- 4)训练效率层:按需选择初始长度 + 两大稀疏奖励优化机制,加速收敛
- 5)损失与奖励层:融合 DAPO/GRPO+ 优化损失,搭配简洁 ORM 奖励函数,保障训练稳定
- 实现建议:
- 1)推理必须保证
max_tokens ≥ 64K,否则截断会导致性能暴跌 - 2)严格匹配官方采样温度、top-k、top-p 参数
- 3)长序列推理建议启用 Yarn RoPE 外推配置,释放完整能力
- 1)推理必须保证
整体核心结论(Takeaways)
- 博客总结了高阶推理模型后训练的 6 条核心准则,贯穿全方案设计:
- 1)Data Difficulty :训练数据难度需精准匹配模型能力,推荐采用镜像 J 型分布(mirrored J-shaped distribution) ,适度偏向难题,避免全简单题或全超难题
- 理解:这里 镜像 J 型分布有点是一个前高后低的分布(横轴是 Pass Rate),所以是 Pass Rate 低的多谢,Pass Rate 高的少些
- 2)Diversity-based Rollout Sampling :利用 Rollout 多样性初始化采样温度,并在 RL 训练全阶段逐步调高温度
- 3)Inference-Time Length Scaling :采用 训练短序列、推理长序列(train-short, generate-long) 范式,借助长度外推技术降低长思维链(CoT)训练的算力开销
- 4)Exploration Efficiency :多阶段训练可提升探索效率;不建议在训练初期刻意缩短模型输出长度,稳妥方案是从训练开始就允许模型“深度思考”(生成长 Response)
- 5)算法融合 :吸收 DAPO、GRPO+ 核心优化点,精简损失函数、放宽梯度裁剪约束,保障训练稳定性与探索能力
- 6)Reward 设计 :沿用成熟的结果奖励模型(ORM),以答案正确性、格式合规性作为唯一奖励依据
- 1)Data Difficulty :训练数据难度需精准匹配模型能力,推荐采用镜像 J 型分布(mirrored J-shaped distribution) ,适度偏向难题,避免全简单题或全超难题
核心方法一:Data Difficulty(数据难度校准与动态优化)
- 数据难度是决定 RL 训练效果的首要因素,Polaris 团队通过对照实验证明:
- 数据难度分布必须与模型参数量、能力等级强绑定 ,固定数据集无法适配不同规模模型
- 本模块包含难度分布验证、数据集构建、训练中动态数据过滤三部分
- 核心问题发现
- 团队基于公开 DeepScaleR 40K 数据集开展对照实验:
- 1)1.5B 小模型在该数据集上训练后推理能力大幅提升
- 2)7B 模型训练后平均奖励快速突破 0.7,说明数据集整体偏简单,无法驱动高阶模型持续学习
- 团队基于公开 DeepScaleR 40K 数据集开展对照实验:
- 数据难度量化方式
- 定义样本难度代理指标 :使用目标模型对单条问题生成 8 条 Rollout,统计正确解占比 \(\text{Pass Rate} = \frac{\text{正确Rollout数量} }{8}\),取值范围 \(0 \le \text{Pass Rate} \le 1\)
- \(\text{Pass Rate}=1\)(8/8 全对):样本极简单
- \(\text{Pass Rate}=0\)(0/8 全错):样本极困难
- 定义样本难度代理指标 :使用目标模型对单条问题生成 8 条 Rollout,统计正确解占比 \(\text{Pass Rate} = \frac{\text{正确Rollout数量} }{8}\),取值范围 \(0 \le \text{Pass Rate} \le 1\)
- 两种模型的难度分布差异
- 对 DeepScaleR 40K 样本做离线难度评估,出现明显镜像效应 :
- 1)Deepseek-R1-Distill-Qwen-1.5B:数据呈镜像 J 型分布(Ⴑ) ,绝大多数样本为极难题(Pass Rate=0),适配小模型训练
- 2)Deepseek-R1-Distill-Qwen-7B:数据呈标准 J 型分布 ,绝大多数样本为极简单题(Pass Rate=1),无法驱动 7B 模型迭代
- 该结果直接证明:通用数据集无法适配不同量级的推理模型,必须针对性筛选数据
- 对 DeepScaleR 40K 样本做离线难度评估,出现明显镜像效应 :
消融实验:最优难度分布验证
- 团队将 DeepScaleR 40K 数据集划分为三组,使用 Deepseek-R1-Distill-Qwen-7B 开展训练对比:
- 1)完整数据集(40K) :标准 J 型分布,以简单题为主,训练提升微弱
- 2)移除全对样本(26K) :删除所有 \(\text{Pass Rate}=1\) 的样本,形成镜像 J 型分布,训练性能持续提升
- 3)激进过滤(19K) :仅保留 \(\text{Pass Rate} \le 0.5\) 的极难题,训练进程受阻
- 实验结论 :最优 RL 训练数据需平衡难度
- 保留足量难题提供学习信号,同时剔除过量简单题与超难题,镜像 J 型分布为高阶推理模型的最优初始分布
Polaris 数据集构建完整流程(离线筛选)
- 基于上述结论,团队对 DeepScaleR-40K、AReL-boba-106k 两大公开数据集做分层筛选,流程标准化、可复现:
- 1)Offline Difficulty Estimation(离线难度预估)
- 针对待训练的目标模型,为每条问题生成 8 条 Rollout,计算单样本 \(\text{Pass Rate}\),标记样本难度等级
- 2)Targeted Filtering(定向过滤)
- 统一删除所有 \(\text{Pass Rate}=1\)(8/8 全对)的样本,强制数据集形成镜像 J 型分布
- 3)Dataset Assembly and Calibration(数据集组装与模型适配)
- 适配 Deepseek-R1-Distill-Qwen-7B:合并过滤后的 DeepScaleR(26K)与 AReL(27K),最终训练集 53K 样本
- 适配 Qwen3-4B:在 53K 数据集基础上二次过滤,得到 30K 专属数据集,匹配 4B 模型的能力上限
- 1)Offline Difficulty Estimation(离线难度预估)
训练过程中动态数据难度更新(在线优化)
- 模型经过多轮 RL 训练后能力会持续提升,原本的难题会逐步变为简单题,数据分布会从镜像 J 型逐步偏移为标准 J 型,学习信号衰减
- 为此设计动态易样本剔除机制 :
- 1)每一轮训练完成奖励计算后,重新评估所有样本的 \(\text{Pass Rate}\),用于初始化困难程度,For 离线过滤 accuracy
- 2)实施阶段式过滤 :每个训练阶段结束后,删除所有 \(\text{Accuracy} > 0.9\) 的样本
- 理解:这种做法应该是在每个 epoch 结束进行会好些
- 效果:全程维持数据集的镜像 J 型分布,保证模型始终面对难度适配的样本,避免训练提前收敛
核心方法二:Diversity-based Rollout Sampling(基于多样性的 Rollout 采样策略)
- GRPO 是本项目采用的主流 RL 框架,其核心依赖正负轨迹对比 优化模型:
- 轨迹多样性越高,模型越能探索多元推理路径、避免模式固化
- 本模块围绕采样温度 展开优化,分为温度分区定义、初始温度选择、训练阶段动态升温三部分
核心基础概念
- 1)Rollout :模型针对单个 Prompt 生成的多条推理 Response,是 GRPO 训练的基本单元
- 2)采样温度 \(t\) :核心超参数,控制生成多样性,\(t\) 越大,输出随机性与多样性越高
- 3)多样性量化指标 :采用 distinct N-gram(本文固定 \(N=4\)),定义为:
$$
\text{Diversity Score} = \frac{\text{唯一 4-gram 数量} }{\text{总 4-gram 数量} }
$$- 分值越接近 1,代表 Rollout 之间差异越大、多样性越强
- 分值越接近 0,代表输出高度重复
- 4)固定参数:实验中 \(\text{top-p}=1.0\)、\(\text{top-k}=-1\),仅调节温度 \(t\) 控制多样性
采样温度的三大功能分区(经验划分)
- 通过大量探测试验,根据 模型性能+多样性 将温度划分为三个区间,所有模型均遵循该划分逻辑,但区间阈值因底座模型而异:
- 1)Robust Generation Zone (RGZ,稳定生成区)
- 定义:模型性能最优且波动极小的温度区间
- 特点:输出确定性强、多样性偏低,适合常规推理解码,传统开源项目默认使用该区间温度(如 \(t=0.6\))
- 2)Controlled Exploration Zone (CEZ,可控探索区)
- 定义:相比 RGZ,性能小幅下降(可接受范围),但 Rollout 多样性显著提升的温度区间
- 核心价值:兼顾性能与探索能力,是 Polaris 初始化温度的首选区间
- 3)Performance Collapse Zone (PCZ,性能崩溃区)
- 定义:温度过高导致模型输出大量噪声 Token,准确率断崖式下跌的区间
- 特点:完全不适合训练与推理
- 1)Robust Generation Zone (RGZ,稳定生成区)
- 示例(Qwen3-4B) :
- RGZ:\(t \in [0.6, 1.4]\),性能最优且稳定
- CEZ:\(t \in (1.4, 1.55]\),性能微降、多样性大幅提升
- PCZ:\(t > 1.55\),模型输出噪声,推理失效
初始采样温度设计思路与取值
- 传统方案直接选用 RGZ 温度,多样性不足导致模型探索受限
- Polaris 提出基于 CEZ 初始化温度 ,在性能可控的前提下最大化 Rollout 多样性:
- 1)设计思路 :选取 性能开始小幅下降、多样性达到峰值 对应的温度作为初始值,强化 GRPO 的轨迹对比效果
- 2)模型专属初始温度 :
- Polaris-4B-Preview(Qwen3-4B 底座):初始温度 \(t=1.4\)
- Polaris-7B-Preview(Deepseek-R1-Distill-Qwen-7B 底座):初始温度 \(t=0.7\)
- 问题:大模型的熵更低吧?是不是应该在大模型上使用更大的初始温度
- 3)对照结论 :传统默认值 \(t=0.6/1.0\) 多样性不足,训练性能弱于 CEZ 初始化方案
训练全阶段动态温度重置(动态升温策略)
- 问题背景:RL 训练过程中,模型会不断强化优质推理模式,输出熵值持续下降、轨迹趋同,RGZ 与 CEZ 整体向高温区间偏移
- 若全程固定温度,训练后期多样性会严重不足,性能到达瓶颈
- 动态升温规则
- 1)调整依据 :监测模型输出熵值变化:
- 熵值小幅下降:温度增量设为 \(0.05\)
- 熵值大幅下降:使用更大温度增量
- 2)分阶段温度配置(官方最终方案)
模型 Stage-1 Stage-2 Stage-3 Polaris-7B-Preview 0.7 1.0 1.1 Polaris-4B-Preview 1.4 1.45 1.5 - 3)效果 :分阶段升温可持续维持 Rollout 多样性,充分挖掘模型推理潜力,性能显著优于全程固定温度的基线方案
- 1)调整依据 :监测模型输出熵值变化:
核心方法三:Inference-Time Length Scaling(推理侧长度外推)
- 高阶数学推理依赖超长 CoT,但长上下文 RL 训练存在算力低效、样本利用率低 两大难题
- Polaris 提出 train-short, generate-long 范式,借助无训练成本的长度外推技术,解决长序列推理的性能衰减问题
长上下文 RL 训练的现存痛点
- 以 Qwen3-4B 为例:
- 1)预训练上下文长度:32K Token
- 2)RL 训练最大长度提升至 52K Token,但 \(\text{clip_ratio}\)(达到最大序列长度的训练样本占比)低于 10%,绝大多数样本并未用到 52K 长度,训练资源浪费
- 3)批处理算力损耗:同一批次内,短样本需等待长样本解码完成,进一步降低训练效率
长序列推理的性能衰减验证
- 选取 AIME24/25 共 60 道难题,对 Polaris-4B-Preview 的 1920 条 Rollout 按长度分组,定义分组规则与准确率公式:
$$
\text{Accuracy} = \frac{\text{分组内正确 Rollout 数量} }{\text{分组总 Rollout 数量} }
$$- 1)短序列组 :长度 < 16K,准确率 93.1%
- 2)中序列组 :16K ≤ 长度 ≤ 32K(预训练上限),准确率同样维持高位
- 3)长序列组 :长度 > 32K(超出预训练长度),准确率骤降至 26.0%
- 结论 :即便 RL 训练设置 52K 长度,模型依然无法有效生成超出预训练长度的有效长 CoT ,长序列推理能力存在硬瓶颈
训练免费的长度外推方案:Yarn 算法
Polaris 选用 Yarn 位置编码外推方法,仅在推理阶段启用,无需重新训练,实现长序列能力提升
配置参数(RoPE 缩放)
固定缩放系数与类型,关闭注意力温度调整(实验证明该调整对推理任务有害):
1
2
3
4
5
"rope_scaling": {
"attn_factor": 1.0,
"factor": 1.5,
"rope_type": "yarn"
}参数定义:
- \(\text{factor}=1.5\):RoPE 位置编码缩放系数
- \(\text{attn_factor}=1.0\):注意力温度系数,保持原始值不变
实验效果
- 1)长序列组(>32K)准确率:从 26.0% 提升至 51.6%,提升幅度翻倍
- 2)上下文长度缩放能力:启用 Yarn 后,模型性能随上下文长度(32K→96K)持续上升;未启用 Yarn 的模型在 64K 后性能进入平台期,不再增长
- 3)适用场景:该技术对高难度推理题增益最明显,是低算力预算下提升长 CoT 能力的最优方案
范式总结
- 正式确立 train-short, generate-long 工程范式:
- 1)训练阶段:使用相对较短的序列长度,降低 RL 算力开销
- 2)推理阶段:通过 Yarn 做 RoPE 外推,支持 96K 超长上下文生成,释放长推理能力
核心方法四:Exploration Efficiency(训练探索效率优化)
- 针对长 CoT RL 训练速度慢、奖励稀疏的问题,Polaris 采用多阶段训练架构 ,搭配两种轻量采样优化机制,同时纠正了 先短后长 的通用误区
多阶段训练与 思考长度 选型
- 基础方案:多阶段长度递增训练
- 整体思路:分阶段逐步提升模型最大输出长度,每一个阶段等待模型性能收敛后,再放大上下文窗口,平衡训练速度与效果
- Polaris-4B-Preview:Step 520(16K→24K)、Step 600(48K→52K)
- Polaris-7B-Preview:Step 890(24K→32K)
- 关键结论:否定通用 Think Shorter, then Longer 范式
- 传统思路建议训练初期使用短输出长度,再逐步拉长,但该方案不具备普适性 ,模型之间差异极大:
- 1)适配模型:Deepseek-R1-Distill-Qwen-7B,初期短长度训练效果良好
- 2)不适配模型:Qwen3-4B,初期设置 24K 最大长度会导致性能不可逆下跌
- 3)最终工程建议 :在算力允许的前提下,训练初期直接使用官方推荐的最大解码长度 ,让模型从一开始就生成长 Response,是最稳妥的方案
- 对照实验证明:Qwen3-4B 从起步就使用 40K 长度训练,性能持续稳定上升,远优于 24K 起步再扩容 的方案
- 传统思路建议训练初期使用短输出长度,再逐步拉长,但该方案不具备普适性 ,模型之间差异极大:
针对奖励稀疏的两种轻量优化机制
- Polaris 为控制成本,将单样本 Rollout 数量固定为 8,容易出现 整批样本全错(零奖励) 或 整批样本全对(无学习信号) 的问题,为此设计两种无额外算力开销的优化策略
Rollout Rescue Mechanism(Rollout 救援机制)
- 解决场景:单样本 8 条 Rollout 全部错误(\(\text{Pass Rate}=0\)),批次无正向学习信号
- 完整执行流程 :
- 1)建立离线缓冲区(sink):针对每条问题,存储历史轮次(epoch) 中出现过的正确 Rollout
- 2)触发条件:当前轮次该问题的 8 条 Rollout 全部错误
- 3)替换逻辑:从缓冲区随机取出1条正确 Rollout,替换当前 8 条中的1条错误样本
- 4)迭代规则:缓冲区采用覆盖式更新,仅保留最新的正确 Rollout
- 5)优势:无需重复生成 Rollout,极简逻辑即可大幅减少零奖励批次,加快训练收敛
Intra-Batch Informative Substitution(批内有效样本替换)
- 解决场景:批次内部分样本 全对/全错 ,梯度更新无有效优势信号(advantage)
- 完整执行流程 :
- 1)筛选有效样本:在单个批次中,筛选出 同时包含正确、错误 Rollout 的样本(具备有效学习信号)
- 2)批量替换:复制上述有效样本,替换掉批次内 全对/全错 的无效样本
- 3)落地优势:仅需张量索引操作,无需新增 Rollout、无需修改数据流水线 ,即可达到 DAPO 算法的优化效果
- 理解:这里可以看做是 DAPO 动态过滤的一种类似实现方案
核心方法五:融合 DAPO 与 GRPO+ 的训练损失优化
- Polaris 基于 GRPO 框架训练,吸收 DAPO、GRPO+ 两大主流 RL 算法的核心改进点,对损失函数做三处关键删减与调整,目标是提升训练稳定性、强化探索能力、降低计算开销
三项核心改造及设计思路
- 1)移除 Entropy Loss(借鉴 GRPO+)
- 原有问题:熵损失本意鼓励探索,但在高阶推理模型训练中,会导致熵值失控增长,最终引发训练崩溃
- 改造效果:彻底消除该隐患,保障 RL 训练全程稳定
- 2)移除 KL Loss(借鉴 DAPO)
- 原有问题:KL 散度损失会约束模型与 SFT 底座的输出分布一致,限制模型探索新推理模式;同时需要计算参考模型的对数概率,增加算力消耗
- 改造效果:解除分布约束,允许模型自由探索;省去参考模型计算,加速训练
- 3)Clip High(放宽代理损失上界,借鉴 DAPO)
- 设计思路:放大损失函数的梯度裁剪上限,允许策略网络执行更大幅度的参数更新
- 效果:进一步强化模型探索能力,同时稳定熵值,最终提升推理性能
核心方法六:Reward Function(奖励函数设计)
- 本项目直接沿用 DeepscaleR 的 Outcome Reward Model (ORM,结果奖励模型) ,设计极简、逻辑清晰,仅基于最终答案与格式判定奖励,不干预中间推理过程
奖励规则定义
- 对模型单条 Response 输出二分类赋值,奖励值 \(r \in \{0,1\}\):
- 1)\(r=1\)(正向奖励):模型答案通过 LaTeX/Sympy 正确性校验,且格式合规
- 2)\(r=0\)(零奖励):分为两种情况:
- 答案数学逻辑错误
- 格式违规(例如缺失
、推理标记)
设计思路
- 1)专注结果:不设计分步推理奖励,简化奖励模型开发难度
- 2)格式约束:强制规范推理标签,统一输出格式,便于下游任务解析
- 3)通用性:ORM 方案成熟,可复现性强,适配数学推理场景
模型评测、推理配置与全维度实验结果
统一评测规则
- 1)评测数据集:AIME24、AIME25、Minerva Math、Olympiad Bench、AMC23 五大主流数学推理数据集
- 2)采样重复次数:AIME24/AIME25 取 32 次运行平均值(avg@32),其余数据集按标准规则采样
- 3)对比基线:包含 DeepScaleR、原生 Qwen3、Deepseek-R1-Distill-Qwen 等主流开源模型
推理运行参数(官方标准配置)
部署推理时必须严格使用该参数,否则性能大幅下降:
1
2
3
4
5
6
sampling_params = SamplingParams(
temperature=1.4,
top_p=1.0,
top_k=20,
max_tokens=90000
)参数说明:
temperature=1.4:高温度保证推理多样性max_tokens=90000:最大生成长度,适配超长 CoT- 硬性要求:测试环境的最大响应长度不得低于 64K Token ,若设置过短,截断机制会导致性能甚至低于原生 Qwen3
全模型评测数据汇总
- 下表为所有对比模型在各数据集上的准确率(单位:%):
模型 AIME24 avg@32 AIME25 avg@32 Minerva Math avg@4 Olympiad Bench avg@4 AMC23 avg@8 DeepScaleR-1.5B 43.1 27.2 34.6 40.7 50.6 Qwen3-1.7B 48.3 36.8 34.9 55.1 75.6 POLARIS-1.7B-Preview 66.9 53.0 38.9 63.8 85.8 Deepseek-R1-Distill-Qwen-7B 55.0 39.7 36.7 56.8 81.9 AReal-boba-RL-7B 61.9 48.3 39.5 61.9 86.4 Skywork-OR1-7B-Math 69.8 52.3 40.8 63.2 85.3 POLARIS-7B-Preview 72.6 52.6 40.2 65.4 89.0 Deepseek-R1-Distill-Qwen-32B 72.6 54.9 42.1 59.4 84.3 qwen3-32B 81.4 72.9 44.2 66.7 92.4 qwen3-4B 73.8 65.6 43.6 62.2 87.2 POLARIS-4B-Preview 81.2 79.4 44.0 69.1 94.8 - 核心数据分析 :
- 1)Polaris-4B-Preview 在 AIME24、AIME25、AMC23 上全面超越同量级及多数大参数量模型,是全场最优
- 2)Polaris-7B-Preview 在 7B 档位开源模型中综合性能第一
- 3)轻量化优势显著:4B 模型对标数百亿参数的 Qwen3-235B-A22B,推理能力持平
TrOPD
- 原始论文:(TrOPD)Trust Region On-Policy Distillation, 20260531, Samsung Research & Oxford & PKU
- 本文 提出 Trust Region On-Policy Distillation(TrOPD) ,通过信任区域划分、Outlier 估计和 Off-Policy Guidance 提升 OPD 的稳定性和效果
- 信任区域划分(基于教师-学生概率比)
- Outlier 估计(FKL over top-\(k\))
- Off-Policy Guidance(教师前缀 + 模仿学习)
- 在多个学生模型(DeepSeek-Qwen2.5-1.5B、Qwen3-SFT-1.7B)和教师模型(Skywork-OR1-Math-7B、Qwen3-Nemotron-4B)上验证了 TrOPD 的优越性
背景 & 问题提出
- LLM 和 LRM 在数学、代码生成、Agent 任务上表现出色,但推理成本高,本文希望训练小型推理模型(SRM) 以实现资源高效的部署
- OPD 是一种高效的后训练方法
- 让学生在自己生成的轨迹(Student of Generations, SoG) 上学习,从而缓解暴露偏差(exposure bias)
- 但 OPD 存在两个关键问题:
- 1)不稳定的监督信号 :当教师分布 \(\pi_T\) 与学生分布 \(\pi_S\) 差异很大时,学生生成的 token 可能落在教师的低置信区域,导致策略梯度异常(如梯度爆炸)
- 2)内存限制 :推理任务输出序列长,无法在全词表上计算 KL 散度,因此常使用 \(K_1\) 估计器,但这会加剧梯度不稳定
- 理解:计算全词表 KL 散度时,每个 token 都要存储词表大小的分布,内存爆炸
问题形式化
OPD 的基本形式
- 在基于 Reverse KL(RKL) 的 OPD 中,目标是:
$$
D_{\text{KL} }(\pi_S \parallel \pi_T) = \mathbb{E}_{x \sim \pi_S} \left[ \log \frac{\pi_S(x)}{\pi_T(x)} \right]
$$- 其梯度形式为策略梯度,鼓励学生生成教师高概率的 token
推理任务中的内存优化
- 为避免全词表计算,使用 \(K_1\) 估计器:
$$
\mathcal{J}^{\text{KD} } = -\mathbb{E}_{x \sim \pi_S} \left[ \log \frac{\pi_S}{\pi_T} \right]
$$ - 但该估计器存在两个问题:
- 梯度异常 :当 \(\pi_T(x) \to 0\) 时,\(\log \frac{\pi_S}{\pi_T} \to +\infty\),梯度爆炸
- 低质量 SoG :学生能力弱时,生成的轨迹质量差,限制有效优化空间
Trust Region On-Policy Distillation (TrOPD) 方法
- TrOPD 的核心思想:将学生生成的 token 分为信任区域和 Outlier,分别采用不同的优化目标
信任区域与 Outlier 的定义
- 对于学生生成的 token \(x \sim \pi_S\),定义被划分到信任区域 \(\mathbb{M}_x\) 的概率为:
$$
P_{\text{trust} }(x) = \min \left( \frac{\pi_T(x)}{\pi_S(x)}, 1 \right)
$$- 其中 \(\mathbb{M}_x \sim \text{Bernoulli}(P_{\text{trust} }(x))\)
- 理解这里的信任域
- 信任区域通过一个伯努利随机变量 \(\mathbb{M}_x\) 来标识每个学生生成的 Token \(x\) 是否属于信任区域:
$$
\mathbb{M}_x \sim \text{Bernoulli}(P_{\text{trust} }(x))
$$ - 其中:
$$
P_{\text{trust} }(x) = \min\left(\frac{\pi_T(x)}{\pi_S(x)},\ 1\right)
$$- \(\pi_S(x)\):学生模型在 Token \(x\) 上的概率
- \(\pi_T(x)\):教师模型在 Token \(x\) 上的概率
- \(\mathbb{M}_x = 1\):该 Token 属于信任区域
- \(\overline{\mathbb{M} }_x = 1\):该 Token 属于 Outlier 区域(即 \(\mathbb{M}_x = 0\))
- 信任区域通过一个伯努利随机变量 \(\mathbb{M}_x\) 来标识每个学生生成的 Token \(x\) 是否属于信任区域:
- 这个设计借鉴了 推测解码(speculative decoding) 中的接受概率,确保只有教师“认可”的 token 进入信任区域
- 信任区域 :\(\mathbb{M}_x = 1\),使用 Reverse KL(RKL)优化
- Outlier 区域 :\(\overline{\mathbb{M} }_x = 1\),使用 Forward KL(FKL)优化
- 理解:推测解码有两种实现方式,一种是使用小模型当做 Draft Model,然后在大模型对 token 的认可度比小模型还高时,100% 接受
- 细节:Draft Model \(q\) 生成一个 Token \(x\),Target Model \(p\) 决定是否接受的概率为:
$$
P_{\text{accept} }(x) = \min\left(1,\ \frac{p(x)}{q(x)}\right)
$$ - 这个公式的直觉是:
- 如果大模型比小模型更相信这个 Token,则接受
- 否则按比例概率接受
- 细节:Draft Model \(q\) 生成一个 Token \(x\),Target Model \(p\) 决定是否接受的概率为:
分区域优化目标
- Token-level 的目标函数为:
$$
\mathcal{T}_x^{\text{On} } = -\mathbb{M}_x \log \frac{\pi_S}{\pi_T} - \overline{\mathbb{M} }_x \sum_{v \in \mathcal{V}_k^T} \pi_{T,v} \log \frac{\pi_{T,v} }{\pi_{S,v} }
$$- 第一项:信任区域中的 RKL,使用 \(K_1\) 估计器
- 第二项:Outlier 区域中的 Top-\(k\) FKL,\(\mathcal{V}_k^T\) 是教师分布 \(\pi_T\) 上的 top-\(k\) 词表(实验中 \(k=64\))
Outlier 估计的设计思路
- 论文中提到对于 Outlier 有多种处理方式
- Mask Outlier :直接 mask 掉 outlier 的梯度,避免不稳定
- Clip Outlier :截断 reward 值
- FKL Outlier(最优):在 outlier 区域使用 FKL 保留教师信息
- FKL 的优势在于:当分布严重不匹配时,RKL 不可靠,但 FKL 仍能从教师角度提供监督
Off-Policy Guidance
- 为了引导学生生成高质量轨迹,引入 Off-Policy Guidance :
- 生成过程:教师生成前缀 \(x[1]\),学生继续生成后续 \(x[1:]\)
- 优化目标:
$$
\mathcal{J}_x = -\beta \mathbb{I}[x \sim \pi_T] \log \frac{\pi_T}{\pi_S} + \mathbb{I}[x \sim \pi_S] \mathcal{J}_{x[1:]}^{\text{On} }
$$- 其中 \(\beta\) 为模仿学习系数(实验中 \(\beta = 0.001\))
- 退火策略 :Off-policy 长度从最大序列长度逐渐退火到 0,确保训练后期完全 On-Policy
TrOPD 统一优化目标
- TrOPD 的最终目标函数为:
$$
\begin{aligned}
\mathcal{J}_x^{\text{TrOPD} } = &-\mathbb{I}[x \sim \pi_S] \overline{\mathbb{M} }_x \sum_{v \in \mathcal{V}_k^T} \pi_{T,v} \log \frac{\pi_{T,v} }{\pi_{S,v} } \\
&-\mathbb{I}[x \sim \pi_S] \mathbb{M}_x \log \frac{\pi_S}{\pi_T} \\
&-\beta \mathbb{I}[x \sim \pi_T] \log \frac{\pi_T}{\pi_S}
\end{aligned}
$$- 三者分别对应:Outlier 区域的 FKL、信任区域的 RKL、Off-Policy 的模仿学习
实验
- 模型与数据
- 学生模型 :
- DeepSeek-R1-Distill-Qwen-1.5B
- Qwen3-SFT-1.7B
- 教师模型 :
- Skywork-OR1-Math-7B(单域)
- Skywork-OR1-7B(多域)
- Qwen3-Nemotron-4B(多域,训练细节见附录)
- 训练数据 :OpenThoughts3(数学、代码、科学)
- 超参数 :
- 200 步训练
- 学习率 \(5 \times 10^{-6}\)
- Top-\(k = 64\)
- Batch size = 128,每个 prompt 采样 4 条 Rollout
- 最大生成长度 8096 token
- 学生模型 :
- 评测基准
- 数学:AIME 2024、AIME 2025、AMC 2023
- STEM:GPQA Diamond、MMLU-Redux v2
- 代码:LiveCodeBench v6
- 指令跟随:IFBench
- 主要结果
- 单域蒸馏(数学)
Method AIME 24 AIME 25 AMC 23 Avg. OPD 35.83 29.16 75.39 46.79 REOPOLD 36.97 30.83 75.78 47.86 TrOPD 38.54 32.50 77.03 49.85 - 结论:TrOPD 在所有数学任务上一致优于现有方法
- 多域蒸馏
Method Math Avg. Code GPQA Avg. OPD 42.33 17.14 28.03 37.11 REOPOLD 44.31 18.29 32.07 38.79 TrOPD 47.69 18.86 36.24 40.63 - 结论:TrOPD 在多个领域上均取得最佳平均性能
- 与 Entropy-Based 方法对比
- Entropy OPD(仅高熵 token)效果下降,说明普通 token 也包含教师监督信息
- TrOPD 比 EOPD、Entropy OPD、REOPOLD 2Stage 分别提升 2.63、3.73、3.74
- 单域蒸馏(数学)
- 消融实验
- Outlier 估计策略对比
策略 AIME 24 AIME 25 AMC 23 Avg. OPD 35.83 29.16 75.39 46.79 Mask Outlier 37.08 30.62 75.46 47.72 Clip Outlier 36.97 30.83 75.78 47.86 FKL Outlier 39.16 29.89 77.96 49.00 - FKL Outlier 最优 ,证明在 outlier 区域使用 FKL 比简单 mask/clip 更有效
- Off-Policy Guidance 的贡献
- 在 FKL Outlier 基础上加入 Off-Policy Guidance,平均分从 49.00 提升到 49.85
- 说明教师前缀能显著提升学生探索质量
- Outlier 估计策略对比
- 与 AOPD 的对比与结合
Method Avg. Score OPD 37.11 AOPD 39.79 TrOPD 40.63 TrOPD + AOPD 41.67 - TrOPD 优于 AOPD,且两者正交,结合后效果更好
补充:附录关键信息(教师模型训练)
- Qwen3-Nemotron-4B 的训练包括:
- SFT:14M 样本,涵盖数学、代码、科学、指令跟随
- RLVR(GRPO):group size 16,batch size 128,最大长度 32K token
- 温度 1.0,鼓励探索
StepOPSD(慎重参考)
- 原始论文:StepOPSD: Step-Aware Online Preference Distillation for Agent Reinforcement Learning, Independent Researcher & Tencent, 20260526
- StepOPSD 聚焦于多轮交互 Agent 的 RL 中的信用分配 问题
- StepOPSD 是一种 Step-Aware Online Preference Distillation 方法,将 Teacher-Student 对比信号注入 RL Advantage Shaping,显著改善了对局部决策错误的信用分配
- 注:本质上是 Token-level 的 Advantage,只是做了 Step 的归一化,严格说不是 Step 的(StepOPSD 这个名字有点容易误解)
- 吐槽:本文写的有点乱,看起来有点不容易理解,且好些地方有点奇怪,本人对论文内容持怀疑态度,慎重参考
背景 & 问题提出
- 核心观察:
- 在 long-horizon Agent 任务中,Reward 通常是稀疏的且仅在 Trajectory 级别给出,而任务成功往往只取决于少数局部决策(local decisions)
- 这种 Trajectory 级别的 Reward 与局部决策之间的错配(mismatch),导致标准 RL 方法难以有效学习
- 现有的 OPD 方法虽然能提供更密集的 Token 级别监督
- 但 OPD 通常将整个 Agent Trajectory 视为一个整体字符串(monolithic string),忽略了其内在的因果交互结构
- Trajectory 中既包含不可控的环境观测,也包含模型生成的 Action Span
- 但 OPD 通常将整个 Agent Trajectory 视为一个整体字符串(monolithic string),忽略了其内在的因果交互结构
- StepOPSD 提出以 Agent Step(即 Action-centered Step Segment) 作为信用再分配的基本单位,而不是整个 Response 或完整的 Trajectory
StepOPSD 方法
总体设计思路
- StepOPSD 是一种 Post-Rollout Preference Self-Distillation 框架,其核心设计原则如下:
- 不改变 Online Rollout 的动态过程 :环境交互仍由基础 RL 算法(如 GRPO)控制
- 在 Post-Rollout 阶段进行信用再分配 :通过 Teacher-Student 对比,将 Token 级别的 Log-Probability Gap 转化为对 RL Advantage 的调制信号
- 不要求 Student 模仿 Teacher 分布 :Teacher 不取代 Policy Objective,只影响信用在 Trajectory 内部的分配
- StepOPSD 整体流程可概括为:
$$
\text{rollout} \rightarrow \text{reward} \rightarrow \text{step extraction} \rightarrow \text{teacher-student rescoring} \rightarrow \text{advantage shaping} \rightarrow \text{policy update}
$$
因果 Action Span 的提取(Step Extraction)
- Agent Trajectory 是异构的,包含环境观测 \(o_t\) 和模型生成的 Action \(a_t\)
- 为防止监督信号浪费在不可控的观测 Token 上,StepOPSD 对 Trajectory 进行结构化解析,提取与任务特定 Tag(如
<action>...</action>)对齐的 Step Segments- 对于 Embodied 任务(如 ALFWorld):采用
action_only策略,仅提取刚性命令作为因果驱动- 问题:Thinking 过程不需要考虑吗?会不会导致无法 Thinking?
- 对于 Knowledge-Intensive 任务(如 Search-QA):采用
clean_step_no_observation策略,保留 Agent 的内部 Reasoning ,但屏蔽检索到的外部知识- 问题:外部知识不是模型的输出,本来就不用添加到 Loss 上吧
- 对于 Embodied 任务(如 ALFWorld):采用
Hindsight-Privileged Rescoring
- 对于每个提取出的 Step \(k\),定义:
- Student Context:\(c_k^S\),即因果前缀(causal prefix)
- Teacher Context:\(c_k^T = c_k^S \oplus h_k\),其中 \(h_k\) 为注入的 Hindsight 信息
- Hindsight 来源 :论文采用 Peer-Trajectory Hindsight ,而非外部 Oracle
- 在一个 GRPO Group 中,若同时包含成功和失败的 Trajectory,则将失败 Trajectory 的 Teacher Context 建立在同一 Group 中第一个成功 Peer Trajectory 的基础上
- 这避免了外部标注成本和分布偏移
- Hindsight 来源 :论文采用 Peer-Trajectory Hindsight ,而非外部 Oracle
量化 Step 级别的信用(Step-Level Credit)
- 对于 Step \(k\) 中的每个 Token \(z_{k,j}\),定义 Teacher-Student Log-Probability Gap:
$$
\Delta_{k,j} = \log \pi_T(z_{k,j} \mid c_k^T, z_{k,<j}) - \log \pi_S(z_{k,j} \mid c_k^S, z_{k,<j})
$$- \(\pi_T\) 是 Teacher 分布,\(\pi_S\) 是 Student 分布
- 为避免 RL 更新过程中的 Moving-Target 不稳定,\(\pi_T\) 被实例化为 Stale Reference Policy (如固定步数前的 Policy 参数,例如 10 步前的参数)
- 注意:这里的 \(\Delta_{k,j}\) 是 token 粒度的
Credit-Aware Advantage Shaping
- 设 \(A_\ell\) 为原始的 Token-Level Advantage(来自 GRPO),StepOPSD 首先构造一个原始乘性权重:
$$
w_{\ell}^{\text{raw} } = 2 \cdot \sigma(\text{sign}(A_\ell) \cdot \Delta_\ell)
$$- 其中 \(\sigma\) 为 Sigmoid 函数
- 该设计确保当 Teacher 与 Student 在 Token 上的分歧方向与 Advantage 符号一致时,权重 >1;反之 <1
- 为防止权重过度偏离,引入局部信任区域(local trust region)裁剪:
$$
w_\ell = \Pi_{[1 - \alpha_{\text{clip} }, 1 + \alpha_{\text{clip} }]}(w_{\ell}^{\text{raw} })
$$- 其中 \(\alpha_{\text{clip} }\) 控制裁剪范围
- 最终的 Shaped Advantage 通过混合参数 \(\lambda_{\text{mix} }\) 结合原始 Advantage 和加权 Advantage:
$$
\bar{A}_\ell = (1 - \lambda_{\text{mix} }) A_\ell + \lambda_{\text{mix} } (w_\ell A_\ell)
$$ - 关键性质:
- 符号保持(Sign Preservation) :由于 \(\bar{A}_\ell = \Psi_\ell A_\ell\),且 \(\Psi_\ell > 0\),因此 \(\text{sign}(\bar{A}_\ell) = \text{sign}(A_\ell)\)
- 方向一致性 :StepOPSD 的梯度方向与原始 RL 梯度方向余弦相似度非负
Step 归一化(Step Normalization)
- 不同 Step 的 Token 长度差异较大
- 若仅进行 Token 级别的 Advantage Shaping,长 Step 会因累积更多 \(\Delta\) 而主导优化
- 为此,StepOPSD 引入 equal_step_mean_abs 约束:
- 在每个 Step 内部,对 Shaping Weights 进行重新缩放,使得每个 Step 的平均绝对修改预算相等
- 哲学依据:在没有细粒度 Sub-Step Reward 的情况下,每个 Reasoning Step 应被视为对最终结果同等重要的因果环节
实验
- 基准测试环境
- ALFWorld :文本型 Embodied AI 基准,包含 3,827 个家庭任务,分为 6 个子集:Pick, Look, Clean, Heat, Cool, PickTwo
- Search-QA :多个检索增强 QA 数据集的集合,包括单跳任务(NQ, TriviaQA, PopQA)和多跳任务(HotpotQA, 2Wiki, MuSiQue, Bamboogle)
- 模型与实现细节
- 模型:Qwen3-1.7B 和 Qwen2.5-3B-Instruct
- 训练:最多 150 步,4 张 A800 GPU
- Teacher:Stale Reference Policy,每 10 步刷新一次
- 默认超参数:\(\alpha_{\text{clip} } = 0.2\),\(\lambda_{\text{mix} } = 0.2\) 并线性衰减到 50 步
- 归一化:
equal_step_mean_abs
- 基线方法
- Training-Free :Skill-Prompt(基于关键词匹配检索技能)
- Post-Training :GRPO, OPSD, Skill-GRPO
- Hybrid(RL + Distillation) :GRPO+OPSD, Skill-SD, RLSD, SDAR
- 主要结果
- 性能表现:StepOPSD 在多个对局部决策错误敏感的子集上取得最佳或次佳结果,包括:
- ALFWorld Heat:79.1%(最佳)
- ALFWorld PickTwo:95.0%(最佳)
- Search-QA TriviaQA:61.6%(最佳)
- Search-QA HotpotQA:40.4%(并列最佳)
- 两旋钮定律(Two-Knob Law):论文揭示了一个一致的规律:
- \(\alpha_{\text{clip} }\) 越小 :提供更稳定的局部信任区域(local trust region),对 Embodied 任务尤其有益
- \(\lambda_{\text{mix} }\) 的最优值 :与任务类型相关
- Embodied 任务偏好较弱的全局混合(避免过度约束探索),而 Retrieval 任务偏好较强的全局混合(需要更强的信用再分配)
- 具体来说:
- 在 ALFWorld 中,\(\lambda_{\text{mix} } = 0.2, \alpha_{\text{clip} } = 0.05\) 达到最佳
- 在 Search-QA 中,\(\lambda_{\text{mix} } = 0.05, \alpha_{\text{clip} } = 0.05\) 达到最佳
- 性能表现:StepOPSD 在多个对局部决策错误敏感的子集上取得最佳或次佳结果,包括:
- 训练动态与 Phase Transition
- 论文跟踪了 Teacher-Student Gap 的标准差 \(\text{Std}(\Delta)\) 随训练步数的变化:
- 在 Search-QA 中:Sparse Reward 使得 Student 更依赖 Teacher,\(\lambda_{\text{mix} } = 0.2\) 保持稳定方差,而 \(\lambda_{\text{mix} } = 0.05\) 方差上升
- 在 ALFWorld 中:\(\lambda_{\text{mix} } = 0.2\) 会导致“拉锯战”现象,方差上升;而 \(\lambda_{\text{mix} } = 0.05\) 或更小 \(\alpha_{\text{clip} }\) 则方差下降
- 论文指出:在 Step 50 之后,\(\lambda_{\text{mix} }\) 已衰减为 0,此时 StepOPSD 不再主动 Shaping Advantage,仅作为诊断工具
- 论文跟踪了 Teacher-Student Gap 的标准差 \(\text{Std}(\Delta)\) 随训练步数的变化:
- Ablation 研究
- 在 ALFWorld 3B 上的三路 Ablation 比较:
- Heavy Baseline:\(\lambda_{\text{mix} } = 0.2, \alpha_{\text{clip} } = 0.2\)
- Lower \(\lambda_{\text{mix} }\):\(\lambda_{\text{mix} } = 0.05, \alpha_{\text{clip} } = 0.2\)
- Reduced \(\alpha_{\text{clip} }\):\(\lambda_{\text{mix} } = 0.2, \alpha_{\text{clip} } = 0.05\)
- 结果表明:
- Reduced \(\alpha_{\text{clip} }\) 在成熟阶段(Step 50–150)方差最低,性能最高
- 在 Search-QA 中,Tight Clipping 同样降低了后期方差,并提高了工具使用率和缩短了 Response 长度
- 在 ALFWorld 3B 上的三路 Ablation 比较:
GAGPO
- 原始论文:GAGPO: Generalized Advantage Grouped Policy Optimization, 20260513, SYSU & Meituan
- GAGPO 核心亮点总结:
组件 设计目标 实现方式 Step-aligned Credit 匹配 Agent 决策边界 每个 Action 共享一个 Step-level Advantage Temporal Propagation 延迟 Reward 反向传播 非参数化 Value Proxy + GAE 递归 Critic-free 降低训练复杂度 用 Group 内平均 Return 替代 Value Network Group Normalization 稳定优化 在 Rollout Group 内归一化 Advantage Action-level Ratio 避免 Token 内部不一致 长度归一化的 Sequence Ratio - 注:GAGPO 不依赖 Tree-structured Rollout 或 Auxiliary Reward Model
背景
- 研究背景
- 随着 LLM 从单轮对话系统向多轮交互 Agent 演进,RL 成为其 Post-Training 的重要范式
- 但在多轮环境中,Reward 通常是稀疏的(仅在 Episode 结束时给出),这使得Credit Assignment 变得困难:
- 模型难以判断中间哪一步 Action 对最终成功或失败起到了关键作用
- 现有方法的局限
- Critic-based 方法(如 PPO)需要学习额外的 Value Model,增加了训练复杂性和估计误差
- Critic-free 方法(如 GRPO、RLOO、GiGPO)虽然结构简单,但 Credit 信号通常是高方差的 Monte Carlo Return 或粗糙的 Trajectory-level Reward 广播,缺乏对中间步的精细 Temporal Credit Propagation
- 论文的核心贡献是提出 GAGPO(Generalized Advantage Grouped Policy Optimization) :
- Critic-free :不学习额外的 Value Network
- Step-aligned Credit Assignment :以 Environment Step 为基本 Credit 单位,而非 Token
- Temporal Propagation :通过非参数化的 Grouped Value Proxy,实现 TD/GAE-style 的时序优势估计
- Group-normalized PPO Update :在 Rollout Group 内进行 Advantage 归一化,保持局部对比性
预备知识与问题定义
MDP建模
- 将 Agent 与环境的交互建模为 MDP:
$$
\mathcal{M} = (\mathcal{S}, \mathcal{A}, P, r, \gamma)
$$- \(s_t \in \mathcal{S}\):环境状态
- \(a_t \in \mathcal{A} \subseteq \mathcal{V}^n\):Action(Token序列)
- \(P(s_{t+1} \mid s_t, a_t)\):状态转移
- \(r_t\):Reward(通常仅在Episode结束时非零)
- \(\gamma \in [0,1]\):折扣因子
GAE回顾
- Generalized Advantage Estimation (GAE) 定义为:
$$
\begin{align}
\delta_t &= r_t + \gamma V(s_{t+1}) - V(s_t) \\
\hat{A}_t &= \sum_{l=0}^{T-t} (\gamma \lambda)^l \delta_{t+l}
\end{align}
$$- 其中 \(V(\cdot)\) 是 Value Function,\(\lambda\) 控制 Bias-Variance 权衡的超参
- 问题 :GAE 依赖 Critic(\(V\)),而 Critic-free 方法缺乏这一结构
GAGPO 方法
GAGPO 总体设计思路
- GAGPO 的目标是:在不学习 Critic 的前提下,为每个 Environment Step 构造一个低方差、时序传播的 Advantage 信号
- GAGPO 核心思想:
- 1)将多个 Rollout 中相同状态 \(s\) 的所有 Step 聚合为一个 Group
- 2)在该 Group 内,用非参数化的平均 Return 作为该状态的 Value Proxy
- 3)基于该 Proxy 计算 TD Residual,并递归传播得到 GAE-style Advantage
- 4)在 Group 内归一化 Advantage,并用于 PPO-style 更新
符号定义
- 一个Rollout Group:
$$ \mathcal{T} = \{\tau^{(i)}\}_{i=1}^K$$- 每个轨迹为:
$$ \tau^{(i)} = \{(s_t^{(i)}, a_t^{(i)}, r_t^{(i)})\}_{t=1}^{T_i} $$
- 每个轨迹为:
- 每个Action \(a_t^{(i)}\) 是一段 Token 序列:
$$ a_t^{(i)} = (y_{t,1}^{(i)}, \dots, y_{t,m_t^{(i)} }^{(i)}) $$ - 状态\(s\) 的 Group:(基于精确文本匹配)
$$ \mathcal{G}(s) = \{(i,t) \mid s_t^{(i)} = s\} $$- 理解:这里使得 GAGPO 不适用于非文本的场景
- 原始论文中也提到 Limitation 为:仅在文本确定性环境中有效,不适合连续、部分可观测或随机环境
- 理解:随机环境下,相同的动作可能对应不同下个状态,且即使相同的模型输出,由于环境有随机性,后面的状态往往不同,很难进行分组
- 另一个问题是:即使环境是确定性的,由于策略是随机采样 Token 的,现实场景中,可能大部分状态都是唯一的,能分组的不多
- 原始论文中也提到 Limitation 为:仅在文本确定性环境中有效,不适合连续、部分可观测或随机环境
- 理解:这里使得 GAGPO 不适用于非文本的场景
Step-aligned Grouped Temporal Credit Assignment
折扣 Return
- 对于 Step \((i,t)\):
$$
\hat{R}_t^{(i)} = \sum_{u=t}^{T_i} \gamma^{u-t} r_u^{(i)}
$$
非参数化 Grouped Value Proxy
- 对每个状态\(s\):
$$
\bar{V}(s) = \frac{1}{|\mathcal{G}(s)|} \sum_{(j,u) \in \mathcal{G}(s)} \hat{R}_u^{(j)}
$$- 无需训练 Critic
- 完全从当前 Rollout Group 中构造
- 问题:现实场景中,可能大部分状态都是不同的
TD Residual
- TD 残差定义为:
$$
\delta_t^{(i)} = r_t^{(i)} + \gamma \bar{V}(s_{t+1}^{(i)}) - \bar{V}(s_t^{(i)})
$$- 其中 \(\bar{V}(s_{T_i+1}^{(i)}) = 0\)(Terminal State)
GAE-style Temporal Advantage
- Advantage 定义为:
$$
\hat{A}_t^{(i)} = \delta_t^{(i)} + \gamma \lambda \hat{A}_{t+1}^{(i)}
$$ - 或展开形式:
$$
\hat{A}_t^{(i)} = \sum_{l=0}^{T_i - t} (\gamma \lambda)^l \delta_{t+l}^{(i)}
$$ - 设计思路 :
- 同一 Group 内不同 Trajectory 的相同状态共享 Value Proxy
- 通过时序递归,延迟的 Outcome Reward 可以逐步反向传播到早期 Step
- 不依赖 Critic,但仍保留 GAE 的 Bias-Variance 权衡能力
Group-Normalized PPO Optimization
Group-wise Advantage Normalization
- 设 \(B\) 为同一 Rollout Group 中所有 Step 的 Advantage 集合:
$$
A_t^{(i)} = \frac{\hat{A}_t^{(i)} - \mu_B}{\sigma_B + \epsilon}
$$- 保留 Group 内比较性
- 避免跨 Task 的尺度变化干扰
Action-level Importance Ratio
- 为避免 Token-level 独立更新导致同一 Action 内部梯度撕裂,定义 Sequence-level Ratio:
$$
s_t^{(i)}(\theta) = \exp \left( \frac{1}{m_t^{(i)} } \sum_{k=1}^{m_t^{(i)} } \log \frac{\pi_\theta(y_{t,k}^{(i)} \mid s_t^{(i)}, y_{t,<k}^{(i)})}{\pi_{\theta_{\text{old} } }(y_{t,k}^{(i)} \mid s_t^{(i)}, y_{t,<k}^{(i)})} \right)
$$- 分数 \(\frac{1}{m_t^{(i)}}\) 用于 Sequence 长度归一化(Sequence 长度不影响均值)
- 整个 Action 共享同一个 Advantage \(A_t^{(i)}\)
PPO-style Clipped Objective
- 最终目标:
$$
\mathcal{L}_{\text{GAGPO} }(\theta) = \mathbb{E}_{(i,t)} \left[ \min \left( s_t^{(i)}(\theta) A_t^{(i)}, \text{clip}(s_t^{(i)}(\theta), 1-\epsilon, 1+\epsilon) A_t^{(i)} \right) \right] - \beta D_{\text{KL} }(\pi_\theta | \pi_{\text{ref} })
$$- 理解:这个目标和 PPO 目标完全相同
实验
- 实验环境
- ALFWorld :家庭环境多步决策任务
- WebShop :在线购物交互任务
- Backbone:
- Qwen2.5-1.5B-Instruct / 7B-Instruct
- 对比 Baseline
- Prompting:ReAct、Reflexion、GPT-4o、Gemini-2.5-Pro
- RL:PPO、RLOO、GRPO、GiGPO
- 主要结果(Table 1)
- GAGPO 在所有指标上一致优于所有 Baseline
- 例如在 ALFWorld 上,Score 从 88.1(GiGPO)提升到 93.5(1.5B 模型)
- 学习动态(Figure 2 & 3)
- GAGPO 早期学习更快,Success Rate 提升更陡
- Episode Length 更短,说明交互效率更高
- 优化稳定性与 Advantage 分布(Figure 4 & 5)
- Gradient Norm 更平滑,Entropy 下降更快
- Advantage 分布更集中,IQR 更小,大值 Advantage 比例更低
- 注:IQR 是 Interquartile Range(四分位距) 的缩写
$$
\text{IQR} = Q_3 - Q_1
$$- \(Q_1\)(第一四分位数) :第 25 百分位数,即有 25% 的数据小于该值
- \(Q_3\)(第三四分位数) :第 75 百分位数,即有 75% 的数据小于该值
- 注:IQR 是 Interquartile Range(四分位距) 的缩写
- 表明 GAGPO 提供低方差、稳定的 Credit 信号
- Ablation Study(Table 2)
变体 效果 w/o temporal recursion (\(\lambda=0\)) 明显下降 MC-style step advantage 略好于 \(\lambda=0\),但仍差于完整 GAGPO w/o action-level importance ratio 性能下降 w/ trajectory reward broadcast 性能下降 batch normalization 低于 group normalization w/o normalization 最差
补充:论文中其他 Insight
- Hyperparameter Sensitivity(Appendix A,\(\gamma=0.95, \lambda=0.8\)最优)
- Exact-Match Group Size Statistics(Appendix C,GAGPO 并未改变分组结构)
GRAPE
- 原始论文:(GRAPE)The Best Instruction-Tuning Data are Those That Fit, NeurIPS 2025, University of Illinois Urbana–Champaign
- GRAPE 全称:Generative Response Alignment with Pretrained Distribution
- GRAPE 解决的核心问题:如何为 Supervised Fine-Tuning(SFT)选择最合适的 Instruction-Response 数据
- 背景:现有 SFT 数据通常由人类或更强 LLM 生成,但这些 Response 往往与目标 Base Model 的预训练分布不匹配,论文指出:
- 简单地扩大数据量会导致收益递减甚至性能下降
- 现有的数据选择方法多关注 Instruction 的选择(如难度、多样性),而忽略了 Response 是否与模型分布对齐
- GRAPE 方法 的核心假设 :SFT 最有效的方式是选择与目标模型预训练分布最一致的 Response
- 论文核心观点:
- 1)SFT 的数据质量比数量更重要 ,但质量不是绝对的,而是相对于目标模型分布 的
- 2)Response 的选择比 Instruction 的选择更被忽视 ,现有方法多关注 Instruction 难度或多样性
- 3)与模型分布对齐的 Response 能显著提升 SFT 效率和性能 ,减少分布偏移、灾难性遗忘等问题
- 4)GRAPE 是一种轻量、通用、可扩展的方法 ,不需要梯度、不需要训练、不需要额外生成数据
- 5)自生成 Response 会导致模型坍塌 ,必须引入外部多样性
- 6)GRAPE 在多个模型家族、多个数据集、多个任务上一致有效 ,且可与现有方法(如 Token 加权、多轮训练)结合
GRAPE 方法
- GRAPE 设计思路 :
- 对于同一个 Instruction,收集多个不同来源的 Response
- 使用目标 Base Model 计算每个 Response 的归一化概率
- 选择概率最高的 Response 作为该 Instruction 的监督信号
- 随后进行标准的 SFT
- 关键创新 :不生成新数据,也不改变训练过程,仅通过 模型自身的分布匹配 来筛选 Response
- 理解 & 问题:
- 理解:对模型影响最小的 Response 理论上就是概率最大的(PPL 最小的),这些数据更像是 On-policy 的,能降低灾难性遗忘问题
- 问题:岂不是用当前自己本身(或同系列模型)生成的 Response 效果最好
- 这个作者做了消融分析:
- 使用模型自身生成的 Response 进行 SFT 会导致性能下降
- 作者推测原因:分布坍塌、多样性丧失、偏差放大
- 这个作者做了消融分析:
- 理解 & 问题:
GRAPE 方法流程
步骤一:Response 收集
- 利用已有的 Instruction 集合(如 Flan、OpenOrca、GSM-8K、MATH、CodeContests 等)
- 从多个来源(不同模型、不同风格)收集多个 Response
- 若没有现成数据,可自行生成
步骤二:Response 选择(模型定制化)
- 定义:
- \( x_i \):第 \( i \) 个 Instruction
- \( y_i^j \):对应 \( x_i \) 的第 \( j \) 个 Response
- \( \pi_{\theta_0} \):目标 Base Model,参数为 \( \theta_0 \)
- \( N \):Response 的长度(Token 数量)
- 计算每个 Response 的条件概率,并做长度归一化:
$$
\text{Score}(y_i^j | x_i) = \frac{1}{N} \sum_{t=1}^{N} \log \pi_{\theta_0}(y_{i,t}^j | x_i, y_{i,<t}^j)
$$ - 等价于选择最低 Perplexity 的 Response:
$$
\text{Perplexity} = \exp\left( -\frac{1}{N} \sum_{t=1}^{N} \log P(x_t | x_{ < t}) \right)
$$ - 最终选择:
$$
y_i^* = \arg\max_{j} \text{Score}(y_i^j | x_i)
$$
步骤三:标准 SFT
- 使用选出的 \( (x_i, y_i^*) \) 对模型进行标准 SFT,无需修改训练过程
- 效率优势 :仅需一次前向传播计算概率,无梯度、无优化,极轻量
实验
控制实验:UltraInteract-SFT
- 数据集 :UltraInteract-SFT,包含约 80,800 条 Instruction,平均每个 Instruction 有 3.5 个 Response
- 扩展 :论文还使用多个更强模型(如 Llama-3.1-405B-Instruct、Qwen2.5-72B-Chat 等)为每条 Instruction 生成额外 Response,使候选池扩大 10 倍
- Base Models :
- Llama-3.1-8B
- Llama-3.2-3B
- Mistral-7B
- Qwen2.5-7B
- Baselines :
- Original UI:原始数据集
- Strongest-Model Responses:仅使用最强模型生成的 Response
- 3× Data:每个 Instruction 使用 3 倍数量的 Response
- 评估任务 :
- 代码:HumanEval、MBPP、LeetCode
- 数学:MATH、GSM-Plus、TheoremQA
- 结果 :
- GRAPE 在所有模型和任务上一致优于所有 Baseline
- 相比最强模型生成的 Response,GRAPE 最高提升 13.8%
- 相比 3× Data,GRAPE 最高提升 17.3% ,说明数据量的简单扩展并不如分布对齐有效
真实 SFT 数据实验:Tulu-3 与 Olmo-2
- 数据集 :
- 收集了 Tulu-3 和 Olmo-2 中重叠 Instruction 的 Response
- 共 350.4K 条 Instruction,约 1.03M 条 Instruction-Response 对
- Baselines :
- Random、SFT-Only、Reverse-GRAPE(选择最高 Perplexity)
- Tulu3-SFT(全部 939K 数据)
- All Responses、All Available Data(1.58M,4.5 倍于 GRAPE)
- LESS、S2L、Emb-NV 等 SOTA 数据选择方法
- 评估任务 :
- AlpacaEval-V2、BBH、MMLU、MATH、LeetCode
- 结果 :
- GRAPE 在所有模型上均优于所有 Baseline
- 相比 All Available Data 提升最高 6.1%
- 相比 S2L 提升最高 3.9%
- 使用 1/3 数据、一半 Epoch ,Llama3.1-8B 超越 Tulu3-SFT 模型 3.5%
消融实验与深入分析
- a) 单源 Response 的有效性
- 使用 Magpie-Zoo 数据集,仅用 Qwen2.5-72B-Instruct 生成 Response
- GRAPE 依然优于 Magpie-Zoo 中 Top-3 模型
- b) 自生成 Response 的失败
- 使用模型自身生成的 Response 进行 SFT 会导致性能下降
- 原因:分布坍塌、多样性丧失、偏差放大
- c) GRAPE vs Reward-Based Selection
- 对比使用 Reward Model(Skywork-Reward)选择 Response
- GRAPE 在所有任务上均优于 Reward-Based Selection
- d)Token-Level GRAPE
- 将 Token 概率作为损失权重,不选择数据,而是调整训练目标
- 在 Long CoT 数据集(OpenThoughts-114k)上取得稳定提升(如 MATH 从 55.6% → 60.2%)
- e)多轮 GRAPE
- 对 Llama3.1-8B 进行两轮 GRAPE 训练
- 平均性能从 35.9% → 37.3%,说明 GRAPE 可迭代使用且效果叠加
DelTA
- 原始论文:DelTA: Discriminative Token Credit Assignment for Reinforcement Learning from Verifiable Rewards, Gaoling RUC & Ant International, 20260520
- 论文核心创新:
- 1)首次提出 RLVR 更新的 局部判别器视角 ,揭示了 Token 概率变化的判别机制
- 2)指出标准 RLVR 的质心构造会被共享模式主导,削弱判别能力
- 3)提出 DeITA ,通过判别性 Token 重加权机制重塑 RLVR 更新方向,在数学推理、代码生成、多模型、OOD 上均取得一致提升
- 论文局限性: 使用层受限的梯度代理而非完整 Token 梯度
- 注:全文理解起来比较复杂,方法并不简单,推测可实施性存在问题
背景 & 问题
- RLVR 的特点是:奖励信号是在 Response 级别给出的(如答案是否正确),但策略更新是在 Token 级别进行的
- 这种粒度不匹配带来一个问题:序列级别的奖励信号如何决定哪些 Token 的概率会增加或减少?
- 近期研究发现,RLVR 会引发稀疏的 Token 级分布变化:
- 只有少数 Token 的概率发生显著变化,大多数 Token 变化很小
- 这暗示 RLVR 存在一个隐式的 Token 选择机制
- 注:RLVR 有效,但其内部的 Token 选择机制尚不明确
核心观点:RLVR 更新的判别器视角
- 本文首次提出了 RLVR 更新的局部判别器视角
符号定义
- 令 \(c\) 表示任意生成上下文,\(x\) 表示下一个候选 Token
- \(\pi_\theta(x \mid c)\) 为策略模型
- 参数更新 \(\Delta \theta\) 后,Token 对数概率的变化为:
$$
\Delta \log \pi (x\mid c) \approx \left(\nabla_{\theta}\log \pi_{\theta}(x\mid c)\right)_{\theta = \theta_{\text{old} } }^{\top} \Delta \theta
$$
DAPO 风格的局部更新分解
- 以 DAPO 为例(无 Critic 的 Group-relative RLVR 方法),其局部梯度更新可写为:
$$
\Delta \theta_{\text{RLVR} } \propto \sum_{i:\hat{A}_i > 0} \sum_{t=1}^{|o_i|} \hat{A}_i v_{i,t} - \sum_{i:\hat{A}_i < 0} \sum_{t=1}^{|o_i|} |\hat{A}_i| v_{i,t}
$$- \(\hat{A}_i\) 是 Group-normalized 优势函数
- \(v_{i,t} = \nabla_{\theta} \log \pi_\theta(o_{i,t} \mid q, o_{i,<t}) \big|_{\theta = \theta_{\text{old} } }\) 是 Token 梯度向量
- 正负两侧分别对应 \(\hat{A}_i > 0\) 和 \(\hat{A}_i < 0\) 的 Response
- 进一步定义:
$$
\begin{align}
M_+ &= \sum_{i:\hat{A}_i > 0} \sum_{t} \hat{A}_i,\\
M_- &= \sum_{i:\hat{A}_i < 0} \sum_{t} |\hat{A}_i|
\end{align}
$$ - 正负侧质心:
$$
\begin{align}
\bar{\mu}_+ &= \frac{\sum_{i:\hat{A}_i > 0} \sum_t \hat{A}_i v_{i,t} }{M_+}, \\
\bar{\mu}_- &= \frac{\sum_{i:\hat{A}_i < 0} \sum_t |\hat{A}_i| v_{i,t} }{M_-}
\end{align}
$$
判别器视角的引出
- 更新方向可写为:
$$
\Delta \theta_{\text{RLVR} } \propto M_+ \bar{\mu}_+ - M_- \bar{\mu}_-
$$ - 于是,Token 对数概率变化为:
$$
\Delta \log \pi(x \mid c) \propto M_+ (\nabla \log \pi)^\top \bar{\mu}_+ - M_- (\nabla \log \pi)^\top \bar{\mu}_-
$$ - 这意味着:RLVR 的更新在 Token 梯度空间中充当了一个隐式的线性判别器。Token 的概率增加当且仅当其梯度向量与正侧质心的对齐程度超过与负侧质心的对齐程度
问题诊断:标准 RLVR 的判别能力不足
- 标准 RLVR 的质心 \(\bar{\mu}_+\) 和 \(\bar{\mu}_-\) 是加权最小二乘质心(见 Appendix D)
- 它们虽然能很好地总结各自侧的内部结构,但在区分正负两侧时存在问题
- 问题根源:在推理任务中,高奖励和低奖励的 Response 常常共享大量公共结构(如格式化 Token、常见实体)
- 这些共享模式在两侧都频繁出现,使得质心被拉向公共方向,削弱了判别性
- DeITA 方法:判别性 Token 信用分配
- DeITA 的核心思想是:通过重新加权 Token 梯度项,重塑 RLVR 更新所诱导的判别器
- 目标是放大侧特有的 Token 梯度方向,抑制共享或弱判别性的方向
- DeITA 的核心思想是:通过重新加权 Token 梯度项,重塑 RLVR 更新所诱导的判别器
DeITA 完整方法流程
- 符号定义
- \(v_{i,t}\):Token 梯度向量
- \(\hat{A}_i\):Response 级别的优势函数(正负号决定侧别)
- \(\mu_+\)、\(\mu_-\):正负侧质心
- \(\gamma_+\)、\(\gamma_-\):侧特定的温度参数
- \(\alpha_{i,t}\):软分配分数(raw score)
- \(\lambda_{i,t}\):最终用于加权损失的系数
步骤 1:初始化质心
- 分别初始化正负质心
$$
\begin{align}
\mu_+^{(0)} &= \frac{\sum_{i:\hat{A}_i > 0} \sum_t \hat{A}_i v_{i,t} }{\sum_{i:\hat{A}_i > 0} \sum_t \hat{A}_i}, \\
\mu_-^{(0)} &= \frac{\sum_{i:\hat{A}_i < 0} \sum_t |\hat{A}_i| v_{i,t} }{\sum_{i:\hat{A}_i < 0} \sum_t |\hat{A}_i|}
\end{align}
$$
步骤 2:交替优化(\(k = 0, 1, \ldots, K-1\))
2.1 定义距离差(margin)
- 对于正侧 Token(\(\hat{A}_i > 0\)):
$$
\Delta_{i,t}^{+,(k)} = |v_{i,t} - \mu_-^{(k)}|_2^2 - |v_{i,t} - \mu_+^{(k)}|_2^2
$$ - 对于负侧 Token(\(\hat{A}_i < 0\)):
$$
\Delta_{i,t}^{-,(k)} = |v_{i,t} - \mu_+^{(k)}|_2^2 - |v_{i,t} - \mu_-^{(k)}|_2^2
$$
2.2 求解带熵正则化的优化问题
- 对于正侧 Token,求解:
$$
\alpha_{i,t}^{(k)} = \arg \max_{\alpha \in [0,1]} \alpha \cdot \Delta_{i,t}^{+,(k)} + \gamma_+^{(k)} \cdot h(\alpha)
$$ - 其中:
$$
h(\alpha) = -\alpha \log \alpha - (1-\alpha) \log(1-\alpha)
$$ - 注:这是二元熵函数 ,作为正则化项控制分配的软硬程度
2.3 闭式解(Sigmoid)
- 由于目标函数严格凹,上述优化问题的唯一解为:
$$
\alpha_{i,t}^{(k)} = \sigma\left( \frac{\Delta_{i,t}^{+,(k)} }{\gamma_+^{(k)} } \right) = \frac{1}{1 + \exp\left(-\Delta_{i,t}^{+,(k)} / \gamma_+^{(k)}\right)}
$$ - 同理,负侧:
$$
\alpha_{i,t}^{(k)} = \sigma\left( \frac{\Delta_{i,t}^{-,(k)} }{\gamma_-^{(k)} } \right)
$$
2.4 更新质心
- 正质心更新:
$$
\mu_+^{(k+1)} = \frac{\sum_{i:\hat{A}_i > 0} \sum_t \hat{A}_i \cdot \alpha_{i,t}^{(k)} \cdot v_{i,t} }{\sum_{i:\hat{A}_i > 0} \sum_t \hat{A}_i \cdot \alpha_{i,t}^{(k)} }
$$ - 负质心更新:
$$
\mu_-^{(k+1)} = \frac{\sum_{i:\hat{A}_i < 0} \sum_t |\hat{A}_i| \cdot \alpha_{i,t}^{(k)} \cdot v_{i,t} }{\sum_{i:\hat{A}_i < 0} \sum_t |\hat{A}_i| \cdot \alpha_{i,t}^{(k)} }
$$
2.5 更新温度参数
- 基于当前 margin 的方差更新 \(\gamma_+^{(k+1)}\)、\(\gamma_-^{(k+1)}\)
步骤 3:最终系数计算
- 最后一次迭代后得到 \(\mu_+^{(K)}\)、\(\mu_-^{(K)}\)、\(\gamma_+^{(K)}\)、\(\gamma_-^{(K)}\),重新计算:
$$
\alpha_{i,t}^* =
\begin{cases}
\sigma\left( \frac{|v_{i,t} - \mu_-^{(K)}|_2^2 - |v_{i,t} - \mu_+^{(K)}|_2^2}{\gamma_+^{(K)} } \right), & \hat{A}_i > 0 \\
\sigma\left( \frac{|v_{i,t} - \mu_+^{(K)}|_2^2 - |v_{i,t} - \mu_-^{(K)}|_2^2}{\gamma_-^{(K)} } \right), & \hat{A}_i < 0
\end{cases}
$$ - 映射到有界系数:
$$
\lambda_{i,t} = \lambda_{\min} + (\lambda_{\max} - \lambda_{\min}) \cdot \alpha_{i,t}^*
$$
步骤 4:加权 RLVR 目标
- DeITA 替换 DAPO 中的 Token 平均为自归一化加权平均:
$$
J_{\text{DeITA} }(\theta) = \mathbb{E} \left[ \frac{1}{\sum_{i,t} \lambda_{i,t} } \sum_{i,t} \lambda_{i,t} \min \left( r_{i,t}(\theta) \hat{A}_i, \text{clip}(r_{i,t}(\theta), 1-\epsilon_{\text{low} }, 1+\epsilon_{\text{high} }) \hat{A}_i \right) \right]
$$
实现细节(Appendix H)
- 使用最后一层 LM-head 梯度作为 Token 梯度代理(也可用 top-K hidden-gradient proxy)
- 系数在每次 Rollout 后计算一次,固定用于多个优化 epoch
- 不支持梯度传播,无额外损失项
实验
- 实验设置:
- 模型 :Qwen3-8B-Base、Qwen3-14B-Base、Olmo3-7B-Base
- 训练数据 :DeepMath-103K
- 框架 :VeRL
- Baselines :DAPO、DAPO w/ Forking Tokens、SAPO、FIPO
- 评估基准 :AIME24/25/26、HMMT25(Feb/Nov)、HMMT26(Feb)、Brumo25、GPQA-D、MMLU-Pro、HumanEval+、MBPP+、LiveCodeBench
- 主要结果
- 数学推理
- Qwen3-8B-Base:DeITA 平均分 28.40,比最强 baseline SAPO(25.14)提高 3.26
- Qwen3-14B-Base:DeITA 平均分 39.91,比最强 baseline FIPO(37.29)提高 2.62
- 所有7个基准上均取得最佳或第二佳结果
- 代码生成
- 加权平均分从 47.7(DAPO)提升到 49.5(DeITA)
- 数学推理
- 其他模型与 OOD 泛化
- Olmo3-7B-Base:平均分从 19.01 提升到 22.80
- GPQA-D 和 MMLU-Pro 上也有显著提升
分析与消融实验
- Q1:是否需要反侧比较?
- 仅用侧内中心性(within-side only)表现更差,说明反侧距离是关键
- Q2:\(\lambda_{i,t}\) 是否捕获有用信号?
- 仅用 top-50% \(\lambda\) 训练比全 Token 更好,bottom-50% 训练崩溃。说明低 \(\lambda\) Token 不仅无用,甚至有害
- Q3:各组件是否必要?
- 移除任一组件(自适应 \(\gamma\)、熵正则化、\(\lambda\) 归一化、范围映射、迭代优化)都会降低性能,其中移除迭代优化下降最显著
- Q4:超参数敏感性?
- 系数范围和迭代次数 \(K=1\) 表现最稳定,\(K=2,3\) 反而下降
- Q5:OOD 泛化?
- 在 GPQA-D 和 MMLU-Pro 上显著优于 DAPO
补充:Token 权重可视化(Fig. 5)
- 高权重的 Token:如
scaffold、prime、forward、backward等推理相关 Token - 低权重的 Token:如
Seat、players、Hamilton等背景或实体类 Token
补充:DelTA 计算开销分析(Appendix L.1)
- 需要额外 \(K+2\) 次 Actor forward pass(\(K=1\) 时为 3 次)
- 第一步训练时间比 DAPO 多 37 秒(约 10.2% 的开销)
DR-Rubric
- 原始论文:(DR-Rubric)Deep Research as Rubric for Reinforcement Learning, 20260531, Fudan & Xiaohongshu
- 论文创新点:
- 1)问题重定义 :Rubric 构建本质上是一个 Deep Research 问题,需要外部证据驱动
- 2)DR‑Rubric 框架 :两阶段(信息挖掘 + 约束合成),产出可编程验证的原子约束
- 3)自举迭代训练 :模型可在不依赖外部模型的情况下生成高质量 Rubric 并自己打分,从而优化自身
背景 & 问题
- 本文关注一个关键挑战:在开放式推理(Open‑ended Reasoning)和长文本生成任务中,缺乏自动、可靠的验证奖励信号 ,因此难以直接使用 RL 进行策略优化
- 这类任务没有像数学题那样的“标准答案”,传统的标量奖励或偏好奖励往往稀疏、粗糙,不足以提供细粒度的训练信号
- 已有方案的局限
- Rubric 方法 :将整体质量评估分解为多个可解释的维度,每个维度作为独立的约束,可以为 RL 提供稠密的奖励
- 现有 Rubric 构建方式 :
- 专家手工编写:成本高、不可扩展
- 大模型 Prompt 生成: 依赖模型内部参数先验,容易停留在表面质量(如流畅性、清晰度),缺乏任务特定的、知识密集的约束
- 关键观察与核心思想
- Rubric 的构建本质上是一个研究(Research)问题 :判断一个 Response 是否“正确”、“全面”、“有深度”,需要从外部知识源中 发现、收集、合成相关证据
- 这正是 Deep Research 擅长的
- Rubric 的构建本质上是一个研究(Research)问题 :判断一个 Response 是否“正确”、“全面”、“有深度”,需要从外部知识源中 发现、收集、合成相关证据
- 论文提出 DR‑Rubric(Deep Research as Rubric) ,将 Rubric 构建重新定义为一个两阶段的、证据驱动的过程 ,并用该 Rubric 作为 RL 的奖励信号
DR‑Rubric 框架详解
- DR‑Rubric 包含三个主要部分:
- 1)Rubric 生成(自动化)
- 2)基于 Rubric 的强化学习
- 3)自举(Bootstrap)Rubric 生成(模型自己生成 Rubric)
Rubric 生成(两阶段)
阶段 I:信息挖掘(Evidence Collection)
- 输入 :任务 Prompt \( p \),外部工具集 \( \mathcal{T} \),最大交互轮数 \( k \),生成模型 \( m_\text{gen} \)
- \(p\):Task Prompt
- \(m_\text{gen}\):Generation Model,负责深度研究和 Rubric 合成
- 过程 :
- Agentic 模型通过多轮检索、阅读、验证,收集与任务相关的外部知识,输出 证据轨迹 \( \mathcal{S}_p \) (Evidence Trace,为 \(p\) 收集到的事实和结构模式集合),包含:
- 领域事实(Domain Facts)
- 结构约束(Structural Constraints)
- 常见失败模式(Failure Modes)
$$
\mathcal{S}_p = f_\text{col}(p,\mathcal{T},k; m_\text{gen})
$$- \(f_\text{col}\):Evidence Collection,多轮深度研究证据收集过程
- \(k\):Max Steps,研究中 Agent‑环境交互次数上限
- Agentic 模型通过多轮检索、阅读、验证,收集与任务相关的外部知识,输出 证据轨迹 \( \mathcal{S}_p \) (Evidence Trace,为 \(p\) 收集到的事实和结构模式集合),包含:
- 关键设计 :这是一个迭代的多轮 Agentic 搜索 ,后一轮查询基于前一轮发现,目标是“发现评估所需的知识”而非“直接生成答案”
- 不是直接利用模型内部参数推断评估标准,而是将缺失的任务知识视为必须显式获取的隐变量
- 过程是迭代的:每一轮进行查询构造、证据获取、查询精炼,后续查询依赖先前发现,以提高覆盖度并减少关键约束遗漏
- 与 RAG 的区别 :
- 目标是需求发现(Requirement Discovery)而非答案生成
- 输出是显式的证据轨迹,作为 Prompt 与 Rubric 之间的中间表示
阶段 II:约束合成(Constraint Synthesis)
- 输入 :证据轨迹 \( \mathcal{S}_p \),最大约束数 \( n_\text{max} \),生成模型 \( m_\text{gen} \)
- 输出 :Rubric \( \mathcal{R}_p \),即一组原子约束(Atomic Constraints):
$$
\mathcal{R}_p = \{c_1, c_2, \ldots, c_n\}, \quad \mathcal{R}_p = f_\text{syn}(\mathcal{S}_p, n_\text{max}; m_\text{gen})
$$- \(c\):Atomic Constraint,不可再分的单一评估标准
- \(f_\text{syn}\):Constraint Synthesis,将证据转换为标准化约束
- \(n_\text{max}\):Max Constraints,每个 Rubric 的最大约束数
- \(\mathcal{R}_p\):Rubric,针对 \(p\) 的原子约束集合
- 约束类型 :
- 肯定要求(如 “should cover at least two efficient attention methods”)
- 否定要求(如 “should not claim that standard attention is \(O(n\log n)\)”)
- 两者在奖励中平等对待,仅语言形式不同
- 核心设计原则 :每个约束均可追溯到证据轨迹 \( \mathcal{S}_p \) 中的具体元素,从而避免依赖模型参数先验
基于 Rubric 的强化学习
奖励计算(Reward Computation)
- Judge 模型 \( m_\text{judge} \) 对每个原子约束 \( c \) 输出离散判断 \( J_c(x; m_\text{judge}) \in \{0,1\} \),表示 Response \( x \) 是否满足该约束
- \(m_\text{judge}\):Judge Model,执行原子约束验证
- \(J_c(x; m_\text{judge}) \in \{0,1\}\):是否满足约束 \(c\)
- \(x\):Response,模型对 \(p\) 生成的回答
- 最终奖励 :所有约束得分的算术平均
$$
R(p,x) = \frac{1}{|\mathcal{R}_p|}\sum_{c\in \mathcal{R}_p} J_c(x; m_\text{judge})
$$- \(R(p,x)\):最终奖励
- 理解:这里如果可以加一些条件层级奖励或者权重可能会更好
- 设计思想 :
- 每个 Response 可获得部分分数(Partial Credit),奖励更稠密
- 每个约束对应一个可解释的要求,奖励可追溯
策略更新(Policy Update)
- 使用 GRPO(Group Relative Policy Optimization) ,不依赖 Critic 模型
- 对每个 Prompt \( p \),采样 \( G \) 个 Responses \( \{x_1, \ldots, x_G\} \)
- 组内归一化奖励作为优势估计 \( A_i \):
$$
A_{i} = \frac{R(p,x_{i}) - \text{mean}(\{R(p,x_{j})\}_{j = 1}^{G})}{\text{std}(\{R(p,x_{j})\}_{j = 1}^{G})}
$$
- 添加 Token 级别 KL 近似项,防止策略偏离 Reference 模型太远:
$$
\text{KL}_\text{prac}(x_i) = \frac{1}{|x_i|}\sum_{j=1}^{|x_i|}\left(\log \pi_{\theta}(x_{i,j}\mid p,x_{i,<j}) - \log \pi_{ref}(x_{i,j}\mid p,x_{i,<j})\right)
$$- 理解:这里的 prac 下角标应该是 Practical KL Divergence Approximation(实用的 KL 散度近似)的简写
- GRPO 目标函数(带 KL 惩罚):
$$
\mathcal{L}(\theta) = \frac{1}{G}\sum_{i=1}^{G}\left(\min\left(\frac{\pi_{\theta}(x_i\mid p)}{\pi_{\theta_{old} }(x_i\mid p)} A_i,\ \text{clip}\left(\frac{\pi_{\theta}(x_i\mid p)}{\pi_{\theta_{old} }(x_i\mid p)},1-\epsilon,1+\epsilon\right)A_i\right) - \beta \cdot \text{KL}_\text{prac}(x_i)\right)
$$
自举 Rubric 生成(Bootstrap)
- 动机 :减少对外部高性能模型(如 GPT‑5)的依赖,降低成本,提升可扩展性
- 方法 :随着 Policy 模型 \( \pi_{\theta_t} \) 逐步提升,它自己承担起 Rubric 生成的角色:
$$
\mathcal{R}_{p,t} = f_\text{syn}\big(f_\text{col}(p,\mathcal{T},k; \color{red}{\pi_{\theta_t}}),\ n_\text{max};\ \color{red}{\pi_{\theta_t}}\big)
$$- 理解: \(m_\text{gen}\) 和 \(m_\text{judge}\) 都可以被替换成当前被优化策略 \(\color{red}{\pi_{\theta_t}}\)
- 然后使用这些 Rubric 进行下一轮 GRPO 更新:
$$
\pi_{\theta_{t+1} } = \text{GRPO}(\pi_{\theta_t}, \mathcal{R}_{p,t})
$$- 形成一个自改进闭环
- 论文实验了 Bootstrap Step 1 ~ 3,并分析了其非单调演化路径
- 理解:这种自举可能导致不稳定,容易收敛到极端的位置(后面论文实验也提到类似问题了)
- 解法:可根据 全 0 或者全 1 的比例来发现问题,早停机制,防止 Reward Hacking 与训练崩溃
实验设置
- 基准任务(6 个)
- Agentic 任务 :
- ResearchQA(基于 Rubric 的学术问答)
- DeepResearchBench(深度研究智能体)
- LocalSearchBench(本地生活服务多跳搜索)
- 专家推理任务 :
- GPQA(研究生级科学问答)
- MMLU-Pro(增强版多任务理解)
- MMLU(大规模多任务理解)
- Agentic 任务 :
- 模型与训练配置
- 基础模型:Qwen3‑8B‑SFT(在 1K ReAct 轨迹上微调)
- DR‑Rubric‑8B 变体:
- 外部 Rubric 来源:GPT‑5、Gemini
- 自举 Rubric 来源:BS‑1, BS‑2, BS‑3
- 训练数据:仅 1K~3K RL instances
- GRPO 超参数:\( G=4,\ \epsilon=0.28,\ \beta=0.001 \),学习率 \( 5\times 10^{-6} \)
- 对比基线
- 包括 Qwen2.5/3‑8B、Search‑R1‑7B、DR‑Tulu、WebExplorer 等
- 注:它们使用的 RL 数据量远大于 DR‑Rubric(如 90K、25K)
主要实验结果与观点
- 训练效率
- DR‑Rubric‑8B 仅用 1K~3K RL 样本 即在所有 6 个基准上超越所有基线(原文图 2 显示其位于高分数、低样本量的“左上角”)
- 结论:性能提升主要来自 Rubric 奖励的质量 ,而非数据规模
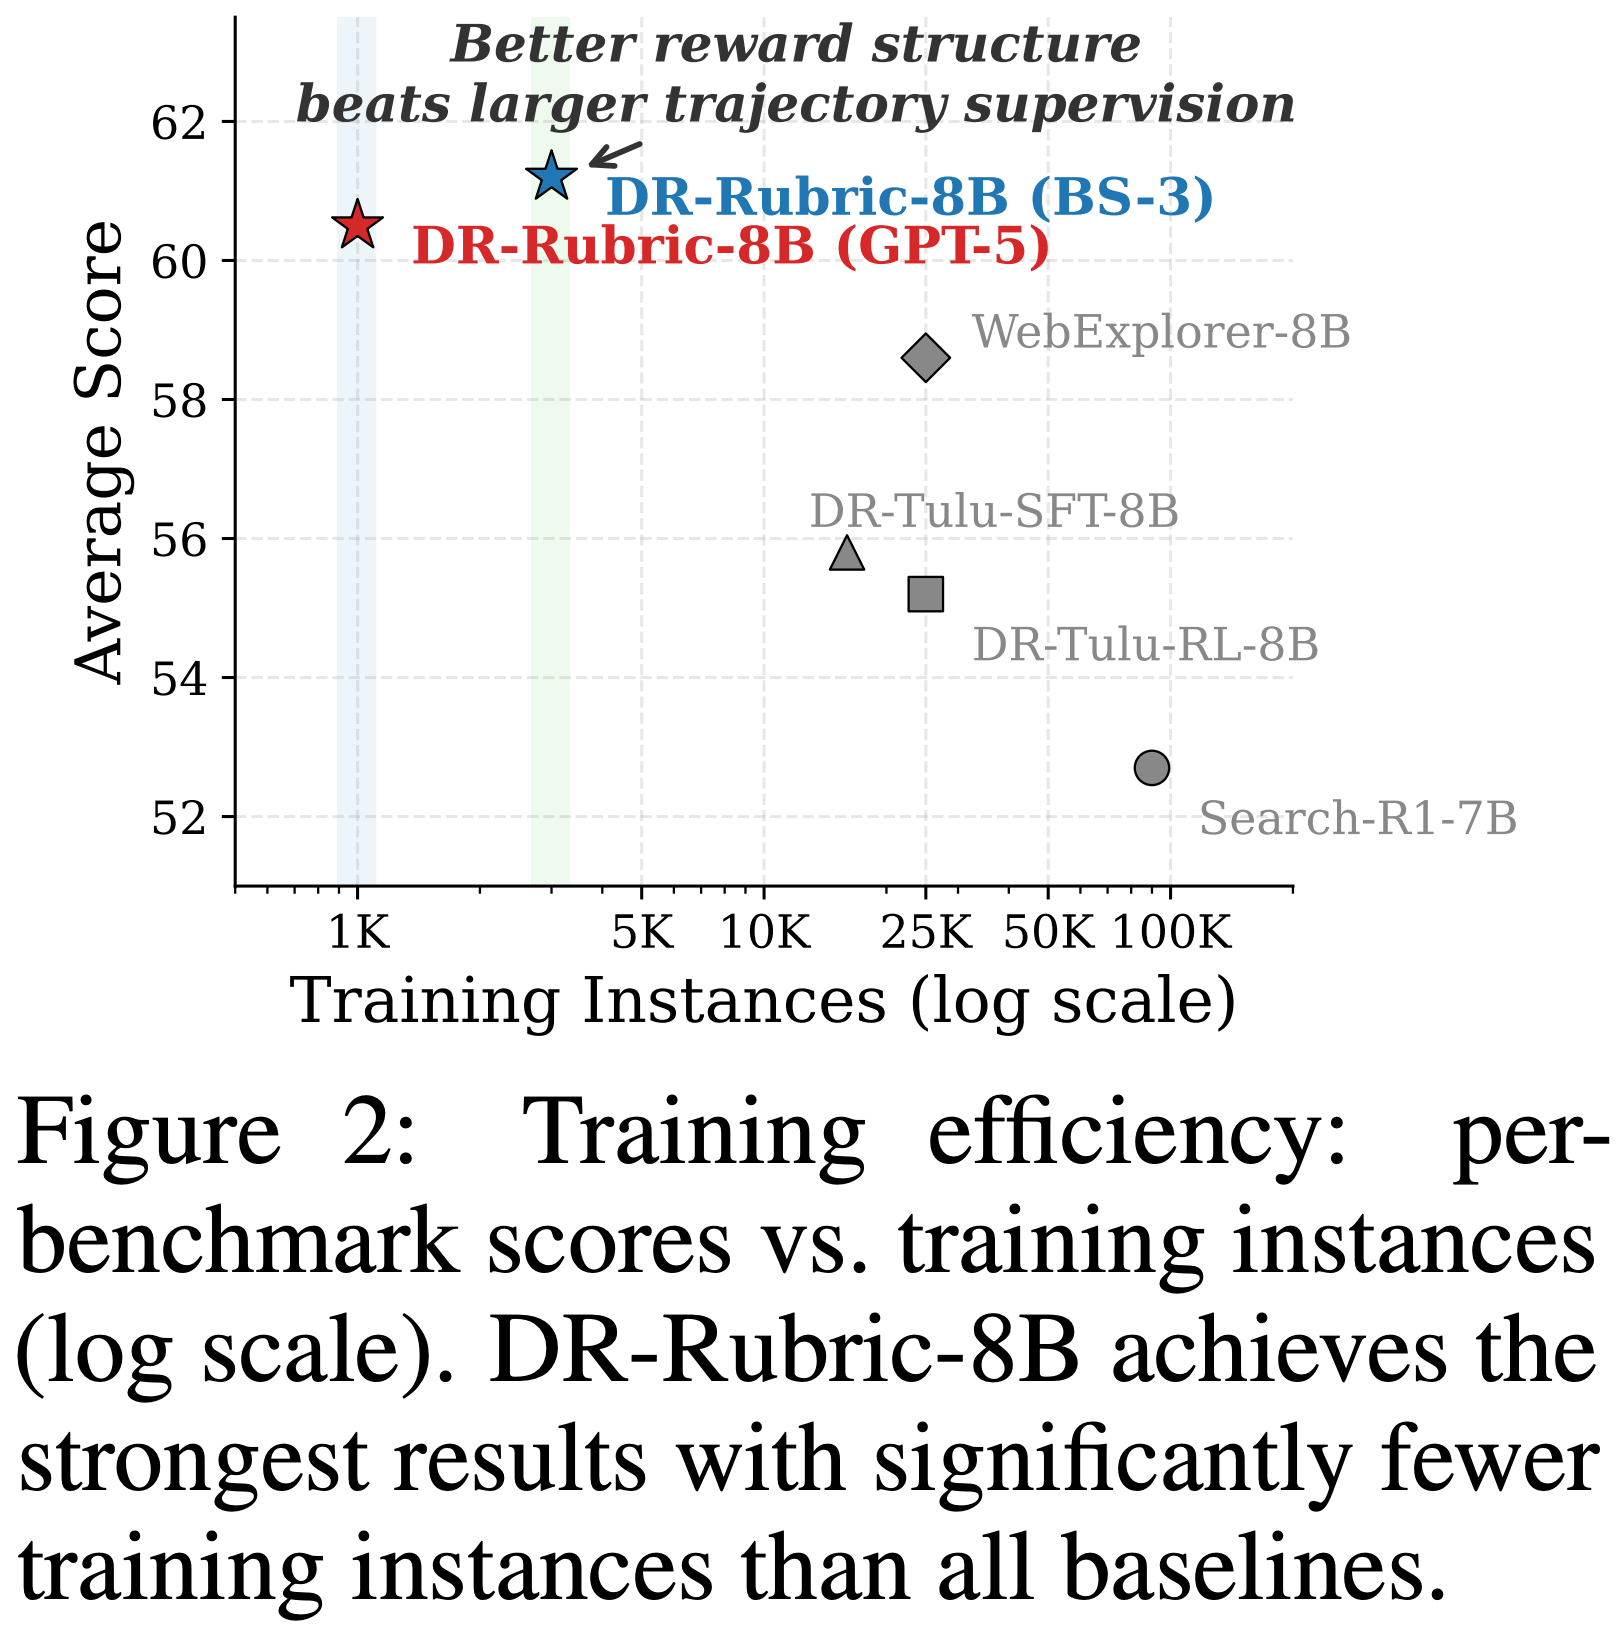
- Agentic 任务表现
- GPT‑5 生成的 Rubric → ResearchQA 与 DeepResearchBench 最佳,体现 广度覆盖 优势
- Gemini 生成的 Rubric → LocalSearchBench 最佳,且在 GPQA 上表现突出,平衡性最好
- 推理迁移
- BS‑3(自举第 3 步) → MMLU‑Pro 与 MMLU 最佳
- 验证了 Rubric‑based RL 可以泛化到非 Agentic 的专家推理任务
- Rubric 来源消融(原文表 3)
- Benchmark‑native Rubric :与测试协议对齐,但并非最优奖励信号(过于粗糙)
- GPT‑5 Rubric :覆盖面广,但推理迁移不如自举
- Gemini Rubric :整体最平衡
- Bootstrap Rubric :呈现 “专业化 → 再平衡” 动态:
- BS‑1:推理能力大幅提升(GPQA 57.0,MMLU 84.0)
- BS‑2:Agentic 任务下降,Rubric 结构突变(可验证性从 3.8% 跳至 41.7%)
- BS‑3:恢复并达到最佳推理表现
- Bootstrap 稳定性与早停机制
- Reward Polarization(分数为 0 或 ≥0.99 的样本比例)可作为过自举的早期预警信号
- 停止规则:
$$
\tau_n = \max(0.15,\ 2P_{n-1}),\quad \text{stop if } P_n > \tau_n
$$ - 在 30B‑A3B 上,BS‑3 极化超过阈值,后续 BS‑4/BS‑5 出现性能崩溃或梯度死亡(Gradient Death)
- 内在 Rubric 质量分析(原文表 5、10、11)
- GPT‑5 Rubric :维度多(6.50)、约束短(4.8 词)、可验证性极高(96.4%)
- Bootstrap Rubric :
- BS‑1:接近 benchmark‑native 风格(宽泛、弱可验证)
- BS‑2:约束长度大增(23.6 词),可验证性跃升
- BS‑3:词汇多样性上升,结构收敛到 3–4 个维度
- 否定约束 :从 BS‑1 的 11% 提升至 BS‑2/3 的 ~34%
- 案例分析(摘要)
- 多面查询 :GPT‑5 的 Rubric 多维度结构 → 模型学会覆盖全部方面;BS‑3 学会加入
.gov/.org/.edu域过滤 - 相同查询、不同抽取 :
- GPT‑5 的短约束(4.8 词)训练模型抽取离散事实(药名、FEV1 阈值)
- benchmark Rubric 的长约束(26.7 词)导致叙述性回答,遗漏关键项
- 自纠正 :BS‑1 的 Rubric 出现过时或错误医学建议,BS‑2/BS‑3 自动纠正,无需外部监督
- 多面查询 :GPT‑5 的 Rubric 多维度结构 → 模型学会覆盖全部方面;BS‑3 学会加入
补充:扩展与消融实验
- 扩展到更大模型(14B、30B‑A3B)
- DR‑Rubric 在更大规模上依然有效,超越 DeepSeek‑R1‑Distill、Tongyi‑DeepResearch 等专用模型(附录 C)
- 与实时搜索 API 的一致性(附录 G)
- 使用 Zhipu 实时搜索 vs Mock 检索 → 结果趋势高度一致,验证 Mock 环境代表性
- Fresh‑Start Bootstrap(附录 J)
- 每一步从 Qwen3‑8B‑SFT 重新开始 RL,而非继续训练 → 结果与累积自举几乎相同
- 结论 :Bootstrap 的收益主要来自 Rubric 质量本身的提升 ,而非策略累积更新
- Rubric 粒度消融(原文表 4、23)
- Agentic 任务 :越大的 Rubric(更多维度、约束)效果越好
- 推理任务 :紧凑的 Rubric(2–4 维度,5–8 约束)效果最佳
- 体现了 广度 vs 深度 的 trade‑off
- 评估样本量敏感性(附录 K)
- 使用 100、400、800 样本评估 → 结果稳定,说明 400 样本是可靠选择
补充:DR-Rubric 相关的 Prompt Template
System Prompt: Stage I (Information Elicitation)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
# Role: Expert Research Analyst for Evaluation Frameworks
Current Time: {{ current_time }}
## Objective
Your sole purpose is to conduct a deep, multi-dimensional research investigation based on the specific User Query provided below. You are not answering the query for a general user; rather, you are gathering the “Ground Truth” and “Contextual Nuance” required to build a rigorous
Evaluation Rubric (Grading Framework) for that query.
Target User Query:
{{ query }}
## Your Task
You must deconstruct the query, identify the core knowledge domains it touches, and provide a comprehensive research report that will serve as the foundation for grading model responses.
Your output will enable an evaluator to distinguish between a “perfect” response, a “mediocre” response, and a “hallucinated/incorrect” response.
## Research Guidelines
### 1. Intent & Complexity Analysis
• Deconstruct the Prompt: Rigorous analysis of explicit requirements and implicit needs within the {{ query }}.
• Identify Ambiguities: Highlight any parts of the query that are open to interpretation and explain how a “Gold Standard” response should handle them.
### 2. Fact Retrieval & Ground Truth (The “Answer Key”)
• Core Facts: List the indisputable facts, dates, entities, or scientific principles required to answer the query correctly.
• Technical Accuracy: If code, math, or logic is involved, provide the correct solution and explain the mechanism.
• Reference Data: Where applicable, cite specific parameters, legal clauses, or historical events that must be present in a high-quality answer.
### 3. Nuance & Perspective
• Controversies: If the topic is subjective, map out the major valid viewpoints.
• Depth Requirements: Identify what constitutes “surface-level” knowledge vs. “expertlevel” insight for this specific topic.
### 4. Failure Mode Prediction
• Common Pitfalls: Anticipate where models typically fail on this type of query (e.g., outdated information, logical fallacies, common misconceptions).
• Safety & Ethics: Flag any potential safety violations or biases that an evaluator must watch for.
## Output Format
Please present your research in a structured Markdown report with the following sections:
1. Query Deconstruction: (Intent, constraints, and implied context)
2. Comprehensive Fact Base: (The detailed “Ground Truth” necessary for verification)
3. Key Dimensions of Quality: (What specific attributes—e.g., conciseness, creativity, coding style—matter most for this specific query?)
4. Edge Cases & Constraints: (What subtle details must be correct?)
Action: Begin your deep research into {{ query }} nowSystem Prompt: Stage II (Rubric Synthesis)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
# Role Definition
You are an expert in evaluation framework design for academic research. Your task is to create a specific, quantifiable, and executable evaluation plan based on a researcher’s query and a provided background research report ({{ final_report }}).
# Task Overview (Must Adhere Strictly)
Critical: Your objective is to design an evaluation framework for assessing the quality of responses to the given research query. You must not answer the query yourself.
Workflow:
1. Analyze the Query: Understand the user’s core intent and requirements.
2. Analyze the Final Report: Use the provided {{ final_report }} as the ground truth. This report contains the necessary factual information (algorithms, parameters, benchmarks, etc.) that a high-quality response should contain.
3. Design the Framework: Construct evaluation criteria where the specific metrics, names, and thresholds are derived from the facts found in the {{ final_report }}.
Prohibited Content:
1. Direct answers to the query or summaries of the final report.
2. Recommendations, tutorials, or explanatory content.
3. Generic criteria unrelated to the specific facts in the final report.
# Evaluation Framework Design Requirements
1. Content-Centric & Fact-Based Evaluation:
• Core Principle: Focus on information quality and factual completeness based on the {{ final_report }}.
• Calibration: Do not set unrealistic thresholds. Align thresholds with the actual information landscape described in the report.
2. Hierarchical Dimension Requirements:
• Top-Level Dimensions (3–8 recommended, ordered by importance).
• Core Dimension (Mandatory, First): Must address the query’s primary need using facts from the report.
3. Mandatory Dimension Types:
• Core Dimension: Assesses if the response satisfies the query’s primary objective using the ground truth from the {{ final_report }}.
4. Quantifiable Metrics (Calibrated by Report):
• Numerical: “>=[X] specific algorithms included” (where X is reasonable based on the report).
• Accuracy: “Data aligns with the values cited in [Source_From_Report].”
# Input Data
<query> {{ query }} </query>
<final_report> {{ final_report }} </final_report>
<current_time> {{ current_time }} </current_time>
# Output Evaluation Framework
<evaluation_plan>
Critical Note: Design an evaluation framework. Do not answer the query. Use the {{ final_report }} to validate what constitutes a “good” response.
1. Framework Generation: Assess response quality based on the facts provided in {{ final_report }}.
2. Dimension Design: 3–8 dimensions, Core Dimension first.
3. Core Dimension:
• Explicitly labeled (e.g., “#### Core Dimension: . . . ”).
• Grounded in Fact: Check for the specific entities (methods, papers, data) present in the {{ final_report }}.
4. Strict Thresholds:
• Ensure thresholds are realistic according to the {{ final_report }}.
5. Output Only: The evaluation framework text. No reasoning or meta-commentary.
Z-Reward
- 原始论文:(Z-Reward)Beyond Scalar Rewards by Internalizing Reasoning into Score Distributions, 20260608, Z-Image Team of Alibaba & NKU
- 本文提出了一个名为 Z-Reward 的 teacher-student 奖励建模框架 ,用于视觉生成任务中的奖励建模
- 核心思想:人类的视觉偏好本质上是一个分布(Distribution),而非单一的标量值(Scalar)
- Z-Reward 通过一个大型 VLM teacher 模型进行 Reasoning,生成与评分标准(Rubric)对齐的分数分布(Score Distribution),然后通过蒸馏将一个紧凑的 student 模型训练为可直接输出分数分布的奖励模型,从而兼顾了奖励质量与部署效率
- TLDR:Z-Reward 是一个将推理内化为分数分布的 teacher-student 奖励建模框架
- GDSO 训练 teacher 生成高质量分数分布
- RISD 训练 student 直接输出分数分布,无需推理链
- 实验证明:9B student 接近 27B teacher 的性能,且可作为高效、可微分的奖励信号用于文本到图像的优化
研究背景 & Insight
- 现有奖励模型的不足
- Scalar / Pairwise Reward Models(如 ImageReward, PickScore, HPSv2):效率高,但压缩了偏好中的不确定性(Uncertainty)和细粒度分数差异
- Reasoning-based Generative Reward Models(如 GenRM-CoT, DeepSeek-GRM):判断质量高,但推理链昂贵,不易部署,且难以用于梯度回传
- Distribution-based Models(如 DEQA):需要每样本多次人工标注,难以扩展
- Distribution-based Models 输出一个概率分布 \( q(s) \),表示模型对每个可能分数 \( s \) 的置信度
- 为什么需要分布
- 因为视觉偏好本质上是主观的 :
- 同一张图,不同 annotator 可能给出不同分数
- 标量分数丢失了这种不确定性(Uncertainty)
- 例如:两张图都可能被标注为 4 分,但一张”接近 4.5”,另一张”接近 3.5”
- 因为视觉偏好本质上是主观的 :
- 论文中的分布建模方式
- 论文使用 Q-Align style score decoder 将模型输出的 score tokens 转换为分布:
$$
q_{\theta}(s \mid p, I, d, \rho) \quad \text{where} \quad s \in \mathcal{S} = \{1.0, 1.5, 2.0, \dots, 5.0\}
$$ - 期望分数:
$$
\mu_{\theta} = \sum_{s \in \mathcal{S} } s \cdot q_{\theta}(s)
$$
- 论文使用 Q-Align style score decoder 将模型输出的 score tokens 转换为分布:
- 核心 Insight
- 奖励模型不需要模仿 teacher 的推理过程(How to reason),只需要模仿 teacher 的评分结果(How to judge)
- Z-Reward 将推理密集型判断 与高效奖励部署 解耦
Z-Reward 框架整体设计
- Z-Reward 包含两个阶段:
- 1)Teacher 训练阶段 :使用 Group-wise Direct Score Optimization (GDSO) 训练一个大型 VLM(Qwen3.5-27B),使其通过推理生成校准的分数分布
- 2)Student 蒸馏阶段 :使用 Reasoning-Internalized Score Distillation (RISD) 将一个小型 VLM(Qwen3.5-9B)训练为直接输出分数分布的学生模型,无需推理链
- 符号定义
- 提示词:\( p \)
- 图像:\( I \)
- 评分维度:\( d \in \mathcal{D} \)(包括 Text-Image Alignment, Realism, Aesthetics, Physical Plausibility)
- 分数区间:\( s \in \mathcal{S} = \{1.0, 1.5, \dots, 5.0\} \)
- Teacher 输出:推理链 \( \rho \),分数分布 \( q_{\theta}(s \mid p, I, d, \rho) \)
- 期望分数:\( \mu_{\theta}(p, I, d, \rho) = \sum_{s} s \cdot q_{\theta}(s \mid p, I, d, \rho) \)
数据标注与评估集
- 标注维度与评分标准
- 四个维度:Text-Image Alignment, Realism, Aesthetics, Physical Plausibility
- 五分制 Rubric(1–5),但允许半分(如 3.5),共 9 级
- 每个分数等级配 15–20 个示例图像,用于校准
- 标注流程(Figure 3)
- 1)点式评分(Pointwise)
- 2)同 Prompt 下的成对比较(Pairwise refinement)
- 3)质量控制审核
- 上下文不匹配问题
- 标注文档太长(>300k image tokens),无法放入 reward model 的 context
- 标注者可比较同 prompt 图像,而点式 reward model 只能看一个 (p, I) 对
- 因此需要模型直接学习人类校准的评分行为,而非推理时依赖完整标注文档
Z-Reward 方法详解
Teacher 训练:Group-wise Direct Score Optimization (GDSO)
- GDSO 是在 GRPO(Group Relative Policy Optimization)基础上的扩展,增加了直接的分布级监督和分数差距监督
GRPO 回顾
- 对同一输入 \( x \) 采样 \( G \) 个输出
- 计算组内标准化优势:
$$
A_i = \frac{r_i - \text{mean}(\{r_k\}_{k=1}^G)}{\text{std}(\{r_k\}_{k=1}^G) + \epsilon}
$$ - GRPO 目标:
$$
\mathcal{L}_{\text{GRPO} } = -\mathbb{E}_{o_i \sim \pi_\theta} \left[ A_i \sum_t \log \pi_\theta(o_{i,t} \mid o_{i,<t}, x) - \beta D_{\text{KL} }(\pi_\theta \parallel \pi_{\text{ref} }) \right]
$$
GDSO 的创新
- GDSO 不仅使用 GRPO 的 policy gradient,还增加了:
- Pointwise Score Supervision :直接监督分数分布与标注分数的匹配
- Pairwise Score Gap Supervision :监督同 prompt 下两图像的分数差与标注差一致
- Pointwise Reward & Loss
- Reward(用于 policy gradient):
$$
r_{j,i}^{\text{pt} } = 1 - \frac{|\mu_{j,i} - \hat{s}_j|}{S_{\text{max} } - S_{\text{min} } }
$$- \( \mu_{j,i} \):期望分数,由分数分布 \( q_{j,i}(s) \) 计算得到的期望值,公式为 \( \mu_{j,i} = \sum_{s} s \cdot q_{j,i}(s) \)
- \( q_{j,i}(s) \) :预测分数分布 ,根据第 \( i \) 个输出解码得到的分数分布,表示模型认为输入 \( x_j \) 获得分数 \( s \) 的概率
- \( j \):样本索引,\( j \in \{w, l\} \),其中 \( w \) 表示获胜样本(winning sample),\( l \) 表示失败样本(losing sample)
- \( i, k \):组内输出索引,\( i, k \in \{1, \ldots, G\} \),表示对于同一个输入样本,模型采样的第 \( i \) 或 \( k \) 个输出(包含推理链和分数)
- \( \hat{s}_j \):真实标注分数,人工标注的、与 Rubric 对齐的真实分数(Ground-Truth Score),其中 \( \hat{s}_w \) 是获胜样本的分数,\( \hat{s}_l \) 是失败样本的分数
- \( S_{\text{min} }, S_{\text{max} } \):分数范围,分数的最小值和最大值。根据论文,分数区间为 \( \{1.0, 1.5, \ldots, 5.0\} \),因此 \( S_{\text{min} } = 1.0 \),\( S_{\text{max} } = 5.0 \)
- \( r_{j,i}^{\text{pt} } \):Pointwise Reward,衡量模型预测的期望分数 \( \mu_{j,i} \) 与真实分数 \( \hat{s}_j \) 的接近程度,范围在 0 到 1 之间
- \( \mu_{j,i} \):期望分数,由分数分布 \( q_{j,i}(s) \) 计算得到的期望值,公式为 \( \mu_{j,i} = \sum_{s} s \cdot q_{j,i}(s) \)
- Direct loss(用于监督):
$$
\mathcal{L}_{\text{CE} }^{\text{pt} } = -\frac{1}{2G} \sum_{j \in \{w,l\} } \sum_{i=1}^G \log q_{j,i}(\hat{s}_j)
$$- \( \mathcal{L}_{\text{CE} }^{\text{pt} } \):点式交叉熵损失,直接监督分数分布 \( q_{j,i}(s) \) 的损失,鼓励模型将概率质量集中在真实分数 \( \hat{s}_j \) 上
- Reward(用于 policy gradient):
- Pairwise Reward & Loss
- Reward:
$$
r_{j,i}^{\text{pw} } = 1 - \frac{1}{G(S_{\text{max} } - S_{\text{min} })} \sum_{k=1}^G |(\mu_{j,i} - \mu_{\bar{j},k}) - \Delta \hat{s}_{j,\bar{j} }|
$$- \( \bar{j} \):对立样本索引 | 如果 \( j = w \),则 \( \bar{j} = l \);如果 \( j = l \),则 \( \bar{j} = w \)。用于成对比较
- \( \Delta \hat{s}_{j, \bar{j} } \):真实分数差距,获胜样本与失败样本的真实分数之差,即 \( \Delta \hat{s}_{j, \bar{j} } = \hat{s}_j - \hat{s}_{\bar{j} } \)
- \( r_{j,i}^{\text{pw} } \):Pairwise Reward,衡量模型预测的分数差距 \( (\mu_{j,i} - \mu_{\bar{j},k}) \) 与真实分数差距 \( \Delta \hat{s}_{j, \bar{j} } \) 的接近程度
- Direct loss:
$$
\mathcal{L}^{\text{pw} } = \frac{1}{2G^2(S_{\text{max} } - S_{\text{min} })} \sum_{j} \sum_{i,k} |(\mu_{j,i} - \mu_{\bar{j},k}) - \Delta \hat{s}_{j,\bar{j} }|
$$- \( \mathcal{L}^{\text{pw} } \) :Pairwise 损失,直接监督分数差距的损失,确保模型不仅区分好坏,还能保持与 Rubric 一致的差距大小
- Reward:
- 最终 GDSO 目标
$$
\mathcal{L}_{\text{GDSO} } = \mathcal{L}_{\text{GRPO} }(\{r_{j,i}\}) + \alpha_{\text{pt} } \mathcal{L}_{\text{CE} }^{\text{pt} } + \alpha_{\text{pw} } \mathcal{L}^{\text{pw} }
$$- \( r_{j,i} = \lambda_{\text{pt} } r_{j,i}^{\text{pt} } + \lambda_{\text{pw} } r_{j,i}^{\text{pw} } \)
- \( \lambda_{\text{pt} }, \lambda_{\text{pw} } \):奖励权重,用于组合点式奖励和成对奖励的超参数,得到最终奖励 \( r_{j,i} \)
- \( \alpha_{\text{pt} }, \alpha_{\text{pw} } \):损失权重,用于组合策略梯度损失与直接监督损失的超参数,控制直接监督的强度
- \( r_{j,i} = \lambda_{\text{pt} } r_{j,i}^{\text{pt} } + \lambda_{\text{pw} } r_{j,i}^{\text{pw} } \)
补充:为什么不用 Bradley-Terry 或 DPO
- Bradley-Terry 只要求 winner 分数 > loser 分数,可能产生无限大的 margin
- 本文的 pairwise loss 要求 margin 与标注差距一致,更符合 rubric 校准
Student 训练:Reasoning-Internalized Score Distillation (RISD)
- Student 训练设计思路
- Teacher 生成推理链 \( \rho_T \) 和分数分布 \( q_T(s \mid p, I, d, \rho_T) \)
- Student 直接预测 \( q_\phi(s \mid p, I, d) \),不生成推理链
- 注:这里 Teacher 是生成推理链的, Student 则是刻意不生成推理链
- 使用 KL 散度作为蒸馏损失:
$$
\mathcal{L}_{\text{RISD} } = \mathbb{E}_{(p,I,d)} \left[ D_{\text{KL} }(q_T \parallel q_\phi) \right]
$$
- Student 的最终输出
$$
\mu_\phi(p, I, d) = \sum_s s \cdot q_\phi(s \mid p, I, d)
$$
实验
- 实验设置
- Teacher: Qwen3.5-27B
- Student: Qwen3.5-9B
- 评估指标:PLCC, SRCC, Human Preference Accuracy (HPA), Margin HPA
- 对比方法:Zero-shot, SFT, RewardDance, GRPO, GDSO, OPD, RISD
- 主实验结果(Table 2)
- Teacher:
Model (27B) HPA Margin HPA Zero-shot 0.7438 0.9538 SFT 0.8135 0.9644 RewardDance 0.8425 0.9706 GRPO 0.8604 0.9827 GDSO 0.8956 0.9885 - Student:
Model (9B) HPA Margin HPA Zero-shot 0.6563 0.7501 SFT 0.7459 0.8401 RewardDance 0.7817 0.8972 GRPO 0.7703 0.9076 GDSO 0.8395 0.9599 RISD 0.8864 0.9801 - RISD 的 9B 模型几乎匹配 27B GDSO teacher 的性能,且输出仅 1 个 token,远低于 OPD/GDSO 的 ~750 tokens
- Teacher:
- Ablation 分析
- 使用分数分布 vs. 解析文本分数(Figure 4)
- 解析文本分数会量化奖励信号(如 3.8 和 4.2 都被输出为 4)
- 分数分布期望提供更密集的监督,显著提升 HPA 和 Margin HPA
- RISD vs. On-Policy Distillation (OPD)(Table 3)
方法 HPA Output Tokens OPD (9B) 0.8311 ~750 GDSO (9B) 0.8395 ~750 RISD (9B) 0.8864 1 - OPD 仍受限于 student 自身的探索能力,而 RISD 直接蒸馏 teacher 的分数分布,更高效
- 使用分数分布 vs. 解析文本分数(Figure 4)
Z-Reward 作为可优化奖励信号的验证
多维奖励梯度回传
- 对每个维度 \( d \) 计算期望分数 \( \mu_\phi(p, I, d) \)
- 聚合为 \( R(p, I) = \mathcal{A}(\{\mu_\phi(p, I, d)\}) \)
- 通过 generator 回传梯度:\( \nabla_\psi R(p, G_\psi(p)) \)
奖励曲线分析(Figure 5)
- Realism 和 Aesthetics 提升快
- Alignment 和 Plausibility 提升慢(依赖语义和结构正确性)
人工评估(GSB)
- GSB = \( \frac{G - B}{G + S + B} \)
- Z-Reward 优化后的模型比 SFT 基线净提升 41.3%
- 定性结果(Figure 6)显示在多方面改进明显
(Re-Math)A Local Perturbation Theory for Cross-Domain Interference and Recovery in Multi-Domain RL
- 原始论文:(Re-Math)A Local Perturbation Theory for Cross-Domain Interference and Recovery in Multi-Domain RL, 20260601, TJU & Baidu
- 本文系统地研究了 Multi-Domain RL 中一个关键问题:当一个 LLM 在多个领域(如数学、代码、问答、创意写作)上顺序进行 RL 后训练时,后续领域的训练会如何损害之前领域已学到的性能,以及如何通过局部扰动理论解释并恢复这种损害
- 本文核心贡献:
- 1)机制解释 :首次提出多领域 RL 干扰是局部共享活跃路径上的二阶扰动 ,而非全局梯度冲突
- 2)理论框架 :形式化低维冲突子空间 \(S_{A,B}\) 与短刷新的几何收缩
- 3)实验验证 :
- 短刷新恢复性能(任务级)
- 稀疏代理回滚(参数级)直接支持局部化假设
- 4)实用启示 :顺序多领域 RL 后,对退化领域做短刷新即可高效恢复,无需复杂数据混合或重放
- 论文中提出了 Re-Math 方法,在受损模型上,使用相同的数据,但只进行非常少量步数(早停)的 Math RL 训练,使得 Math 能力恢复同时还能保证其他能力不下降
问题提出
- 现象:在 Omni-Thinker 设定的顺序多领域 RL 训练(Code → Math → QA → CW)中,Math 性能在训练后达到 66.49,但经过后续 QA 和 CW 训练后下降到 57.66
- 这种性能下降是选择性且不对称 的,不能用传统的“灾难性遗忘”或“全局梯度冲突”来解释
- 关键 Insight :
- 全局梯度余弦接近零(正交),但局部(层、模块)仍有明显的冲突与协同
- RL 更新是稀疏且小幅度(77%-89% 参数变化 < 1e-7 绝对变化)
- 不同领域修改的神经元集合重叠很少(Jaccard < 0.19)
- 推理时,推理类领域(Math, Code, QA)共享大量活跃神经元(激活重叠高)
- 在共享的活跃通路上,更新方向决定了是协同(正余弦)还是冲突(负余弦)
- 基于观察得到论文观点:干扰不是全局的,而是通过共享的活跃计算路径上的局部扰动产生的
理论:局部扰动模型
符号与假设
- 符号定义:
- \(L_d(\theta)\):领域 \(d\) 的局部目标函数
- \(g_d(\theta) = \nabla L_d(\theta)\):梯度
- \(H_d(\theta) = \nabla^2 L_d(\theta)\):Hessian 矩阵
- \(\theta_A^*\):在领域 \(A\) 上训练后选中的近似稳定点
- \(\delta_B\):后续在领域 \(B\) 上训练导致的参数更新
- 论文中明确给出的 假设 :
- 1)局部光滑性 :\(L_d\) 二阶可微,Hessian Lipschitz
- 2)近似稳定性 :\(|g_A(\theta_A^*)|_2 \le \epsilon_A\)
- 3)稀疏更新 :\(\delta_B\) 主要集中在一个低维子空间 \(U_B\),\(|P_{U_B^\perp}\delta_B|_2 \le \tau_B |\delta_B|_2\)
- 4)低维共享冲突子空间 \(S_{A,B}\):
$$
\left|\delta_B^\top H_A(\theta_A^*) \delta_B - (P_S\delta_B)^\top H_A(\theta_A^*) (P_S\delta_B)\right| \le \gamma_A |\delta_B|_2^2
$$- 其中 \(P_S\) 是到 \(S_{A,B}\) 的投影
- 5)全局梯度近正交 :\(|\langle g_A, g_B\rangle| \le \kappa_{A,B} |g_A|_2 |g_B|_2\),\(\kappa \ll 1\)
- 6)正曲率与弱耦合 :在 \(S_{A,B}\) 上,\(\mu_A I \preceq H_A^S(\theta) \preceq \bar\beta_A I\),且跨子空间耦合 \(\xi_A\) 小
命题1:二阶局部损伤
- 命题1 :在近似稳定点和局部光滑性下,
$$
\Delta_{A \leftarrow B} = L_A(\theta_A^* + \delta_B) - L_A(\theta_A^*) = \frac{1}{2} \delta_B^\top H_A(\theta_A^*) \delta_B + O(\epsilon_A |\delta_B|_2 + |\delta_B|_2^3)
$$- 解释 :即使全局梯度接近正交,只要 \(\delta_B\) 进入 \(L_A\) 的高曲率方向,就会产生明显损伤
命题2:冲突集中在低维共享子空间
- 命题2 :在假设4下,
$$
\Delta_{A \leftarrow B} = \frac{1}{2} (P_S\delta_B)^\top H_A(\theta_A^*) (P_S\delta_B) + O(\epsilon_A |\delta_B|_2 + \gamma_A |\delta_B|_2^2 + |\delta_B|_2^3)
$$- 解释 :损伤主要由 \(\delta_B\) 在共享冲突子空间 \(S_{A,B}\) 上的投影贡献
- 即使不同领域修改的神经元不重叠,只要共享路径上的投影大,就会产生干扰
- 解释 :损伤主要由 \(\delta_B\) 在共享冲突子空间 \(S_{A,B}\) 上的投影贡献
定理1:短刷新(Short Refresh)的几何收缩
- 定理1 :设 \(\theta_0 = \theta_A^* + \delta_B\),在领域 \(A\) 上用梯度下降刷新:
$$
\theta_{t+1} = \theta_t - \alpha g_A(\theta_t)
$$ - 则在 \(S_{A,B}\) 上,
$$
|P_S(\theta_t - \theta_A^*)|_2 \le (1 - \alpha \mu_A)^t |P_S\delta_B|_2
$$- 解释 :有害分量以几何级数收缩
- 刷新只需几步就能恢复 \(A\),而不必撤销全部 \(\delta_B\)
- 解释 :有害分量以几何级数收缩
Short Refresh 下其他领域的稳定性
- 全局近正交假设下,刷新对其它领域 \(C\) 的损伤有界:
$$
L_C(\theta_{t+1}) - L_C(\theta_t) \le \alpha \kappa_{A,C} |g_C|_2 |g_A|_2 + \frac{\beta_C \alpha^2}{2} |g_A|_2^2
$$- 因此刷新是选择性恢复
实验
- 实验设置
- 基础模型:Qwen3-4B-Thinking
- 四个领域:Math, Code, QA, CW
- 训练算法:GRPO(Group Relative Policy Optimization)
- 顺序训练:Code → Math → QA → CW
- 评估:AIME, LiveCodeBench, SuperGPQA, WritingBench 等
- 主要结果(原文表 2)
- 对原文表 2 的说明:
- 单领域专家(single-domain experts):\(\text{Code}_s, \text{Math}_s, \text{QA}_s, \text{CW}_s\)
- 从基础模型(Base)开始,仅在单个领域上训练到收敛
- 表示该领域的理论上限(不考虑跨领域干扰)
- 顺序训练检查点(sequential checkpoints):\(\text{Code}_o, \text{Math}_o, \text{QA}_o, \text{CW}_o\)
- 按固定顺序 Code → Math → QA → CW 依次训练,每个阶段结束后保留的检查点
- 用于观察跨领域干扰如何累积
- 多领域混合训练基线
- CGPO(Curvature-Guided Policy Optimization)
- 注:论文中为什么会选择这个奇怪的方法呢?因为这篇文章也是天大同实验室的
- CGPO 也是一种联合训练方法,在每个 batch 内计算领域级更新,然后以特定的学习率更新受影响的参数
- JT(Joint Training,联合训练)
- 两者均为在四个领域数据上同时训练的方法,作为对比
- CGPO(Curvature-Guided Policy Optimization)
- 刷新方法
- Re-Math :从 \(\text{CW}_o\) 出发,在 Math 领域上做短刷新(short refresh),验证理论预测的恢复能力
- 理解:
- Re-Math 是在受损模型上,使用相同的数据,但只进行非常少量步数(早停)的 Math RL 训练
- Re-Math 的作用不是重新训练一个数学专家,而是像一个“后悔药”,利用数学领域自身的梯度信息,沿着一条快速路径,精确地将因其他领域训练而被“推偏”的模型权重,重新“拉回”到数学性能较好的区域,同时尽量不影响其他领域
- 单领域专家(single-domain experts):\(\text{Code}_s, \text{Math}_s, \text{QA}_s, \text{CW}_s\)
- 对原文表 2 的核心解读:
- 1)不对称干扰
- 数学对 QA 和 CW 极敏感(66.84 → 39.78)
- QA 和 CW 对数学干扰弱
- 写作对其他领域干扰小,但被写作训练干扰的其他领域恢复难
- 2)短刷新有效性
- Re-Math 从 57.66(\(\text{CW}_o\) 的数学)→ 66.04
- 几乎完全恢复到单领域专家水平
- 3)刷新不伤其他领域
- QA 和 CW 在 Re-Math 后几乎不变(62.34 → 62.49,86.52 → 85.96)
- 刷新是选择性恢复
- 4)混合训练 vs 刷新
- CGPO/JT 优于纯顺序,但不如 Re-Math 平均分高
- 刷新是一种更简单、计算成本更低的后处理策略
- 1)不对称干扰
补充实验: 直接干预 冲突子空间代理(Training-Free Rollback)
- 在 QA 训练后,构造 QA-induced displacement:
$$
\delta_{Q|M} = \text{QA}_o - \text{Math}_o
$$ - 定义一个神经元级别的代理分数:
$$
S_i^{(\ell)} = A_i^{(\ell)} \cdot M_i^{(\ell)} \cdot C_i^{(\ell)}
$$- \(A_i^{(\ell)}\):Math 和 QA 下激活百分位数的最小值(共享激活)
- \(M_i^{(\ell)}\):QA 更新幅度的百分位数
- \(C_i^{(\ell)}\):Math 与 QA 更新向量的负余弦(冲突方向)
- 结果(原文表 3) :
- 只回滚 2% 的 MLP 神经元,Math 从 59.90 → 61.25,恢复 20.4% 的损失
- 随机回滚反而下降
- 扩展至 Attention 层后,32% 预算可恢复 73.6% 的损失
- 设计思路 :
- 不直接估计隐子空间 \(S_{A,B}\),而是用激活、更新幅度、方向冲突三个可观测信号的乘积作为代理,验证损伤是否真的局部化
补充:论文观点总结
现象观察
- 多领域 RL 存在选择性、不对称的干扰
- 全局梯度正交 不等于 无干扰
- 不同领域修改的神经元重叠小,但活跃路径重叠大
理论层面
- 损伤来自二阶局部扰动,而非一阶梯度冲突
- 冲突集中在低维共享子空间 \(S_{A,B}\)
- 短刷新通过几何收缩恢复性能
- 全局近正交保证刷新不影响其他领域
- 交替刷新等价于局部多目标优化,可逼近 Pareto 平稳点
实验结论
- 短刷新(Re-Math)在任务级恢复性能
- 稀疏代理回滚证明损伤可被局部化干预
- 方向不对称性:Math 对 QA 敏感,反之不敏感
- 刷新不是无限继续:长时间刷新仍可能引起新干扰
补充:论文提到的局限与未来工作
- 未形成自动训练算法(如自动检测退化领域、选择刷新顺序)
- 冲突子空间代理仍粗糙,未来应更精确识别并用于正则化
- 当前分析限于多领域 RL,可扩展到在线策略蒸馏等场景
Trace2Skill
- 原始论文:Trace2Skill: Distill Trajectory-Local Lessons into Transferable Agent Skills, 20260604, Qwen LM App Team & PKU & ZJU
- 论文目标是解决 LLM Agent 在特定领域(如电子表格、数学推理、文档视觉问答等)中技能(Skill)获取和优化的瓶颈问题
- Trace2Skill 框架通过并行分析大量执行 Trajectories ,并归纳总结 出可迁移、可复用的技能,从而提升 Agent 在不同模型规模、不同模型家族以及 OOD 任务上的表现
背景 & 问题
- 现有的 LLM Agent 依赖 Skill(即描述任务流程、领域知识和操作指南的可重用文档)
- 手工编写技能难以规模化,且仅依赖模型参数知识生成的技能往往缺少实际执行中暴露的错误模式、变通方法和操作细节
- 现有基于 Agent 经验在线更新技能或记忆的方法存在两个主要问题:
- 1)碎片化(Fragmentation) :将轨迹局部经验存储于大量记忆或技能集合中,导致知识分散
- 2)顺序依赖(Sequential Editing) :按轨迹到达顺序依次编辑技能,使得后续更新依赖早期更新顺序,缺乏全局归纳
- 相比之下,人类专家会通览大量轨迹,抽象出重复出现的模式,并编写紧凑、可复用的流程
- Trace2Skill 正是在模拟人类专家的这一过程
Trace2Skill 方法详述(核心)
- Trace2Skill 是一个三阶段 pipeline,整个过程不更新模型参数 \(\theta\),仅通过分析轨迹来改进或创建技能
问题形式化
- 定义一个 Skill 为一个人类可读的目录 \(S = (M, \mathcal{R})\),其中:
- \(M\) 是根文件
SKILL.md,存储广泛适用的过程性知识 - \(\mathcal{R}\) 是辅助参考文件、脚本或资源
- \(M\) 是根文件
- 设 \(\pi_{\theta}\) 为使用技能 \(S\) 进行推理的固定 LLM Agent
- \(\mathcal{P}(S; \pi_{\theta}, \mathcal{D})\) 表示该 Agent 在任务集 \(\mathcal{D}\) 上的通过率(Pass Rate)
- 给定一个演化任务集 \(\mathcal{D}_{\text{evolve} }\) 和一个测试任务集 \(\mathcal{D}_{\text{test} }\),技能演化目标是:
$$
S^* = \mathcal{E}(S_0, \mathcal{D}_{\text{evolve} }; \pi_{\theta}), \quad \mathcal{P}(S^*; \pi_{\theta}, \mathcal{D}_{\text{test} }) > \mathcal{P}(S_0; \pi_{\theta}, \mathcal{D}_{\text{test} })
$$- \(S_0\):初始技能(可以是人工编写的专家技能,或由 LLM 仅基于参数知识生成的 Draft 技能)
- \(\mathcal{E}\):Trace2Skill 的演化函数
- \(S^*\):演化后的技能
阶段一:轨迹生成(Trajectory Generation)
- 使用 ReAct 风格的执行框架
- 对于 \(\mathcal{D}_{\text{evolve} }\) 中的每个任务,固定 Agent \(\pi_{\theta}\) 运行并生成轨迹 \(\tau_i\),包含:
- Query
- 推理/工具使用历史(Reasoning/Tool-use history)
- Final output
- 二元正确性标签(Binary correctness)
- 最终得到轨迹集合 \(\mathcal{T} = \mathcal{T}^{-} \cup \mathcal{T}^{+}\):
- \(\mathcal{T}^{-}\):失败轨迹
- \(\mathcal{T}^{+}\):成功轨迹
- 轨迹生成是并行的 ,在所有演化任务上独立收集
阶段二:并行补丁提议(Parallel Patch Proposal)
- 多个分析子 Agent(Analyst sub-agents)独立地从单个轨迹中提出技能补丁(Patch):
- 错误分析者 \(\mathcal{A}^{-}\) :接收失败轨迹,使用 ReAct 风格循环,可以检查轨迹、产物(Artifacts)、对比输出与真实值,并验证修复方案
- 无法因果解释的失败被排除
- 成功分析者 \(\mathcal{A}^{+}\) :接收成功轨迹,使用单次工作流(single-pass workflow),识别可重用的行为模式
- 错误分析者 \(\mathcal{A}^{-}\) :接收失败轨迹,使用 ReAct 风格循环,可以检查轨迹、产物(Artifacts)、对比输出与真实值,并验证修复方案
- 每个分析者输出一个 Patch \(p\),即对原始技能 \(S_0\) 的修改建议
- 所有补丁构成补丁池 \(\mathcal{P} = \mathcal{P}^{-} \cup \mathcal{P}^{+}\)
- 该阶段也是并行的,避免了顺序依赖
阶段三:补丁合并(Patch Consolidation)
- 合并操作 \(\mathcal{M}\) 将补丁池合并为一个统一的更新 \(p^*\),并应用到 \(S_0\)
- 合并采用分层合并(Hierarchical Merging) :
- 设 \(L = \lceil \log_{B_{\text{merge} } } |\mathcal{P}| \rceil\),其中 \(B_{\text{merge} }\) 是每层合并的补丁数量
- 对于层级 \(\ell = 0, \dots, L-1\):
$$
p^{(\ell+1)} = \mathcal{M}\big( \pi_{\theta}, S_0, \{ p_1^{(\ell)}, \dots, p_{B_{\text{merge} } }^{(\ell)} \} \big)
$$- \(p^{(\ell)}\):第 \(\ell\) 层的补丁集合
- \(\mathcal{M}\):去重、解决冲突、保留非重叠洞察,并偏好跨轨迹重复出现的模式(视为系统性任务属性),丢弃单次特异的修改
- 最终 \(p^*\) 被转换为 diff 风格编辑,并应用确定性防护(guardrails):拒绝修改缺失文件、处理行范围冲突、验证技能格式
两种工作模式
- 技能深化(Skill Deepening) :从人工编写的技能开始,通过轨迹分析增强其通用性和可迁移性
- 技能创建(Skill Creation) :从 LLM 参数知识生成的弱技能开始,通过轨迹归纳创建有用技能
实验
- 主要领域:电子表格操作(SpreadsheetBench)
- 数据集 :SpreadsheetBench-Verified (200 演化 + 200 测试),OOD 转移至 WikiTableQuestions 和 HiTab
- 模型 :Qwen3.5-122B-A10B 和 Qwen3.5-35B-A3B 同时作为 Skill Author 和 Skill User
- 基线 :
- No Skill
- Human-Written(Anthropic 官方 xlsx 技能)
- Parametric(仅参数知识生成)
- Trace2Skill 变体 :
- +Error:仅失败轨迹补丁
- +Success:仅成功轨迹补丁
- +Combined:全部轨迹补丁
- 关键结果 :
- 技能深化和创建均能提升 ID 和 OOD 性能
- 35B 模型演化的技能在 Avg 指标上优于 122B 模型的某些设置,表明小模型也可生成通用技能
- 技能可跨模型规模和家族迁移(例如 Gemma-4-31B 演化的技能提升 Qwen3.5-122B)
- 跨模型家族泛化
- Gemma-4-31B-it 和 GPT-5.5-high 使用 Trace2Skill 深化人类编写的 xlsx 技能
- 它们自身性能提升,同时也能使用 Qwen 演化的技能获得收益
- Math Reasoning
- 使用 DAPO 问题演化,测试 DAPO 留出集和 AIME 2026(OOD 竞赛数学)
- 注:这里是使用 DAPO 数据集,而不是在训练模型
- +Error 是最稳定的信号,能跨模型迁移
- 使用 DAPO 问题演化,测试 DAPO 留出集和 AIME 2026(OOD 竞赛数学)
- 视觉问答(DocVQA)
- 使用 50 个样本演化,测试 5,299 个留出样本
- +Combined 效果最强,同模型和跨模型均提升显著
核心分析与消融实验
- 并行合并 vs. 顺序编辑
- Seq-B=1 :每轨迹更新一次(60 分钟)
- Seq-B=4 :每 4 条轨迹更新一次(15 分钟)
- Parallel(Trace2Skill) :3 分钟
- 结论:并行合并更快且性能不差于甚至优于顺序编辑
- 单一合并技能 vs. 经验记忆检索(ReasoningBank)
- ReasoningBank 存储轨迹级经验,测试时检索
- Trace2Skill 的 +Combined 在所有指标上优于 ReasoningBank
- 优势:不需要测试时检索,技能紧凑且可静态加载
- Agentic 错误分析 vs. 单次 LLM 调用
- Agentic 分析者可以检查产物、验证修复,根因定位更准
- 单次 LLM 容易受日志表面信息误导(例如将解析错误误判为主因)
- Agentic 分析者产出的补丁更具可迁移性
- 选择性补丁聚合(Patch Selection)
- Greedy selection :每步选局部最优补丁,但很快进入平台期,因为补丁会同时修复一些问题并破坏其他问题,且存在语义重叠
- Bayesian Optimization (BO) :在补丁子集上搜索,可建模补丁间的互补与干扰,但计算成本高
- 结论:补丁价值是组合性的(combinatorial),需要整体合并而非贪婪选择
- 归纳出的标准操作流程(SoPs)
- 通过分析 323 个补丁,Trace2Skill 自动归纳出以下常见 SoP:
- 公式重算与写回验证(55.1% 补丁):每次写公式后必须运行 recalc.py
- **工具选择:openpyxl 优于 pandas.to_excel()**(54.8% 补丁):保留公式结构
- 显式读回验证(42.7% 补丁):写后重新打开并验证单元格值
- 结构编辑安全(16.4% 补丁):按降序删除行,避免索引偏移
- 低频特例被路由到
references/辅助文件
- 通过分析 323 个补丁,Trace2Skill 自动归纳出以下常见 SoP:
附录:Trace2Skill 更广泛的应用
- Trace2Skill 还应用于:
- PDF 抽取 :VRDU → VAREX(76.9% → 85.3%)
- PPTX 编辑 :TSBench → 留出 OOD 分割(72.5% → 88.8%)
- DOCX 编辑 :合成任务 → OfficeBench DOCX 子集(79.7% → 87.5%)
附录:相关工作与区别
- Agent Skills :Trace2Skill 将技能视为可移植 SoP,强调从轨迹中压缩通用指导
- Experience Memory :与检索式记忆不同,Trace2Skill 不保留外部记忆,而是归纳为静态技能
- Skill/Policy Evolution :区别于在线共同进化策略或元学习,Trace2Skill 聚焦于跨模型、跨任务的技能可移植性
Bebop
- 原始论文:(Bebop)Breaking Entropy Bounds: Accelerating RL Training via MTP with Rejection Sampling, 20260610, Qwen
- 总体结论:
- 问题:
- 在 LLM 的强化学习训练中,Rollout 阶段是最大的效率瓶颈
- MTP 天然可以作为推测解码来加速 Rollout,但 MTP 在 RL 训练中的接受率会严重下降 ,导致加速效果有限
- 解法:本文提出了名为 Bebop 的解决方案
- 核心:揭示并打破“熵约束”对 MTP 接受率的限制,通过提出 端到端 Total Variation 损失(E2E TV Loss) 和 拒绝采样(Rejection Sampling) 机制,使得 MTP 在 RL 训练全过程中保持高接受率,实现高达 1.8倍 的端到端异步 RL 训练加速
- 问题:
背景 & 挑战
- RL 训练瓶颈 :现代 LLM 的后训练大量依赖 RL(如 GRPO)
- RL 流程分为三部分:Rollout 、Reward 、Update
- 其中,Rollout 阶段(特别是在多轮 Agentic 任务中)耗时巨大,是主要瓶颈
- MTP 的潜力与困境 :
- MTP 通过附加轻量级 Draft Heads 来预测多个未来 Token ,是一种高效的推测解码方法
- 问题:直接将 MTP 用于 RL 训练时,其接受率 会显著下降
- 关于衰退原因的传统观点 :
- 此前研究主要将其归咎于分布不匹配 :即 RL 更新导致 Actor 权重变化,而 MTP 模块(Draft Heads)是冻结的,两者分布产生偏差
提前补充知识:推测解码下的 Acceptance Methods
- 在推测解码中,通常使用两种接受方法:Target-Only Sampling 和 Rejection Sampling
- 注:Target-Only Sampling 这个名字的核心在于 “Target-Only”(仅目标) 这个修饰语,它强调的是:接受决策只依赖于目标模型(Target Model)的信息,而不需要 Draft 模型(Draft Model)的信息
- 注:原文图 13 展示了代表性模型在每种方法下的接受率分布
Target-Only Sampling
- 在 Target-Only Sampling 下, Draft Token 被贪婪地选为 \( \hat{y} = \arg \max_y q(y) \),并以目标模型的概率 \( p(\hat{y}) \) 接受
- Target-Only Sampling 下 单步接受率为:
$$
\alpha^{\text{TO} } = p(\hat{y}) = p\left(\arg \max_y q(y)\right). \tag{1}
$$- 如果被拒绝,则从残差分布中重新采样输出 Token ,以确保整体输出分布保持无偏
$$ p_{\text{resid} }(y) \propto p(y) \mathbb{1}[y \neq \hat{y}] $$- 理解:这里是剔除 \(\hat{y}\) Token 后,进行重新归一化再按照新的分布采样
- 注意:这里使用的必须是 目标模型的分布 \(p\),这样叠加前面的接受概率,可以保证整体满足原始目标采样分布 \(p\)
- 理解:这里是剔除 \(\hat{y}\) Token 后,进行重新归一化再按照新的分布采样
- 对于接受率较低的 Draft 模型, Target-Only Sampling 可能比拒绝采样获得更高的吞吐量,因为其更简单的接受标准避免了缓存和计算 Draft 概率向量的开销
- 如果被拒绝,则从残差分布中重新采样输出 Token ,以确保整体输出分布保持无偏
Rejection Sampling
- 在拒绝采样下(2023;2023),一个 Draft Token \( \hat{y} \sim q(\cdot) \) 以概率 \( \min(1, \frac{p(\hat{y})}{q(\hat{y})}) \) 被接受
- Rejection Sampling 下,单步期望接受率为:
$$
\alpha^{\text{RS} } = \mathbb{E}_{\hat{y} \sim q} \left[ \min \left( 1, \frac{p(\hat{y})}{q(\hat{y})} \right) \right] = \sum_{y} \min (p(y), q(y)) = 1 - d_{\text{TV} }(p, q) \tag{2}
$$- 其中 \( d_{\text{TV} }(p, q)\) 是 Total Variation distance(2017)
$$ d_{\text{TV} }(p, q) = \frac{1}{2} \sum_y |p(y) - q(y)| $$ - 理解:\(\sum_{y} \min (p(y), q(y))\) 在概率论和信息论中被称为两个离散概率分布之间的 “分布重叠量”(Distributional Overlap),或者等价于 总变差距离(Total Variation Distance, TVD)的补数
- 上式的最后一步证明为:
- 利用恒等式 \(|a-b| = a + b - 2\min(a,b)\)(这分为 a < b 和 a > b 就能证明),对词汇表中所有 token 求和:
$$
\begin{aligned}
\sum_{y} |p(y) - q(y)| &= \sum_{y} \left[ p(y) + q(y) - 2\min(p(y), q(y)) \right] \\
&= \sum_{y} p(y) + \sum_{y} q(y) - 2\sum_{y} \min(p(y), q(y)) \\
&= 1 + 1 - 2\sum_{y} \min(p(y), q(y)) \\
&= 2 - 2\sum_{y} \min(p(y), q(y))
\end{aligned}
$$
- 利用恒等式 \(|a-b| = a + b - 2\min(a,b)\)(这分为 a < b 和 a > b 就能证明),对词汇表中所有 token 求和:
- 如果被拒绝,则从下面的残差分布中重新采样输出 Token ,以确保整体输出分布保持无偏
- draft token \( \hat{y} = z \) 被拒绝后,残差分布为 \( p_{\text{resid} }(\cdot \mid \text{reject at } z) \)
- 这个分布被定义为与目标分布 \( p \) 和 draft 分布 \( q \) 的差成正比,具体为:
$$
p_{\text{resid} }(v) \propto \max(0, p(v) - q(v)) \mathbb{1}[y \neq \hat{y}]
$$
- 这种方法也提供了无偏保证:无论 Draft 质量如何,输出分布都精确等于目标分布 \( p \)
- 理解:这不是数学上标准的拒绝采样(Accept-Reject Sampling)
- 其中 \( d_{\text{TV} }(p, q)\) 是 Total Variation distance(2017)
核心 Insight:熵是导致 RL 训练过程中接受率显著下降的主导因素
- 作者通过理论分析和实验分解(原文图 3),推翻或补充了上述观点,提出 Actor 的熵 才是导致 MTP 接受率下降的主导因素
- 定义 :目标熵 \( \mathcal{H}(p) \) 衡量了策略模型预测的确定性,其中 \( p \) 是策略模型的下一个 Token 分布
- 熵越高,模型越不确定,分布越平坦
- 观察 :在 RL 训练中,为了鼓励探索,策略模型的熵往往较大且会波动
- 这导致模型不再只押注于少数几个高概率 Token
- 线性负相关关系 :
- Target-Only Sampling :接受率 \( \alpha^{\text{TO} } \) 等于目标模型在 Draft Token 上的概率 \( p(\hat{y}) \)
- 注:Target-Only Sampling 下, 接受情况是 Draft Token 选择 \( \hat{y} = \arg \max_y q(y) \),接受概率为 \( p(\hat{y}) \)
- 当熵上升时,最大概率 \( \max_y p(y) \) 必然下降,导致接受率线性下降
$$ \alpha^{\text{TO} } \approx a^{\text{TO} } - b^{\text{TO} } \cdot \mathcal{H}(p) $$ - 其中 \( a^{\text{TO} }, b^{\text{TO} } > 0 \) 是常数
- 理解:这里从数据上严谨看,并不是严格的线性关系,这里的线性是通过原文图 1(a) 中的熵与接受长度的关系计算经验总结拟合的
- Rejection Sampling(拒绝采样) :接受率 \( \alpha^{\text{RS} } \) 等于 \( \sum_v \min(p(v), q(v)) \)
- 注:Rejection Sampling 下,接受情况是 从 Draft 分布中采样一个 Token \( \hat{y} \sim q(\cdot) \),并以 \( \min(1, p(\hat{y}) / q(\hat{y})) \) 的概率接受它
- 其中 \( q \) 是 Draft Head 预测的分布
- 在交叉熵(CE)或 KL 散度训练下,由于梯度均匀地作用于所有 Token ,导致概率误差均匀累积,使得接受率同样受到熵的强烈约束
$$ \alpha^{\text{RS} } \approx a^{\text{RS} } - b^{\text{RS} } \cdot \mathcal{H}(p) $$
- 理解:接受率为什么重要?因为不接受的话,两种方法都要重新归一化 Token 分布并重新采样
- Target-Only Sampling :接受率 \( \alpha^{\text{TO} } \) 等于目标模型在 Draft Token 上的概率 \( p(\hat{y}) \)
- 核心主张 :只要使用传统的 CE/KL 损失训练 MTP,其接受率就“注定”会受到熵的束缚
- 要打破这个束缚,必须改变 MTP 的训练目标
Bebop 方法
- 核心:如何通过新的训练目标和采样方法打破熵约束
使用 Rejection Sampling
- 原始方法:Target-Only Sampling :
- Draft Token 选择为 \( \hat{y} = \arg \max_y q(y) \),接受概率为 \( p(\hat{y}) \)
- 缺点 :对熵极其敏感,而且对策略更新导致的 Token 排名变化非常脆弱(离散跳跃)
- 新的创新方法:Rejection Sampling(拒绝采样) :
- 从 Draft 分布中采样一个 Token \( \hat{y} \sim q(\cdot) \),并以 \( \min(1, p(\hat{y}) / q(\hat{y})) \) 的概率接受它
- 优点 :
- 1)输出分布无偏 ,严格等于目标分布 \( p \)
- 2)接受率 \( \alpha^{\text{RS} } \) 是 \( p \) 和 \( q \) 的连续函数,对熵变化和策略更新导致的微小概率交换更具鲁棒性
- 3)能从根本上缓解熵上升带来的接受率暴跌问题
端到端 TV 损失 (End-to-End TV Loss)
- 如果 Draft Head 依然用 CE 损失训练,即使采用拒绝采样,其接受率仍会受熵影响
$$ \alpha^{\text{RS} } \approx 1 - \frac{\sigma}{2} \exp(\mathcal{H}(p)) $$ - 为了解决这个问题,本文提出了直接优化拒绝采样接受率的新损失函数
Per-step TV Loss:
- 动机 :拒绝采样的单步接受率直接等于
$$ 1 - d_{\text{TV} }(p, q) $$- 其中 \( d_{\text{TV} } \) 是总变差距离(Total Variation Distance, TVD)
- CE / KL 只间接优化这个目标
- 公式 :
$$ \mathcal{L}_{\text{TV} } = d_{\text{TV} }(p, q) = 1 - \sum_{v \in \mathcal{V} } \min(p(v), q(v)) $$- 其中 \( p \) 被当作常数(不接收梯度),梯度只流向 \( q \)
- 梯度分析 :对于 Draft 头的输出 logit \( z_j \)(其中 \( q_j = \text{softmax}(z)_j \)),TV 损失的梯度为:
$$ \frac{\partial \mathcal{L}_{\text{TV} } }{\partial z_j} = -q_j \left[ \mathbb{1}[q_j \leq p_j] - S \right], \quad S = \sum_v \mathbb{1}[q_v \leq p_v] \cdot q_v $$- 有界梯度 :\( \left| \frac{\partial \mathcal{L}_{\text{TV} } }{\partial z_j} \right| \le 1 \),确保了训练稳定性
- 概率-比例梯度 :梯度与 \( q_j \) 成正比
- 这意味着 Draft Head 的优化容量会自动分配 给高概率的 Token ,而忽略掉对接受率影响不大的长尾低概率 Token
- 这与 CE 损失(梯度为 \( q_j - p_j \))的均匀分配完全不同
Multi-step E2E TV Loss
- 动机 :单步优化忽略了一个事实:在 MTP 中,\( \gamma \) 步的期望接受长度是各步接受率的乘积之和:
$$ \mathbb{E}[L] = \alpha_1 + \alpha_1 \alpha_2 + \dots + \prod_{i=1}^\gamma \alpha_i, \quad \text{其中} \alpha_i = 1 - d_{\text{TV} }(p_i, q_i) $$- 这意味着前面的步骤更重要(它们出现在更多的乘积项中)
- 公式 :因此,端到端 TV 损失定义为直接优化归一化的期望接受长度 :
$$ \mathcal{L}_{\text{e2e} } = 1 - \frac{1}{\gamma} \sum_{j=1}^\gamma \prod_{i=1}^j (1 - d_{\text{TV} }(p_i, q_i)) $$- 这个损失会自动对更重要的早期步骤施以更大的优化权重,是一个动态的、自适应的步间加权方案
- 理解:这个公式中,越靠前的步骤,被乘过的次数越多,所以权重更大
- 这个损失会自动对更重要的早期步骤施以更大的优化权重,是一个动态的、自适应的步间加权方案
补充:(数学原理)本文是如何打破熵约束的?
- 论文通过严谨的推导,证明了 TV 损失如何打破熵束缚
- CE / KL 训练(均匀误差) :梯度 \( q_j - p_j \) 导致模型容量被均匀分配,每个 Token 产生几乎相等的绝对误差 \( |\eta_v| \lesssim \sigma \)
- 由于有效支持集的大小为 \( |\mathcal{S}_{\text{eff} }| \approx \exp(\mathcal{H}(p)) \),总 TV 距离为:
$$ d_{\text{TV} } \approx \frac{\sigma}{2} \exp(\mathcal{H}(p)) $$ - 因此接受率强烈依赖于熵
- 由于有效支持集的大小为 \( |\mathcal{S}_{\text{eff} }| \approx \exp(\mathcal{H}(p)) \),总 TV 距离为:
- TV 训练(概率-比例误差) :由于梯度正比于 \( q_j \),模型容量按概率比例分配,每个 Token 的误差也与其概率成比例 \( |q^*(v) - p(v)| \lesssim \delta \cdot p(v) \)
- 那么总 TV 距离为:
$$ d_{\text{TV} } = \frac{1}{2} \sum_v |q^* - p| \le \frac{\delta}{2} \sum_v p(v) = \frac{\delta}{2} $$- 这个上界与熵 \( \mathcal{H}(p) \) 完全无关 !这就从理论上解释了为什么 TV 训练的 MTP 能在 RL 训练中保持稳定的高接受率(原文图 8 显示斜率从 -1.68 降至 -0.06)
- 那么总 TV 距离为:
- 注:原始论文的理论分析(如均匀 vs. 概率-比例误差)基于梯度结构的启发式假设,缺乏严格的数学证明
RL 场景下的适配策略
- 分解分析:熵 vs. 失配 :作者将 RL 训练中接受率的变化分解为两部分:
$$ \Delta \alpha_t = \underbrace{b \cdot (\mathcal{H}_t - \mathcal{H}_0)}_{\Delta \alpha_{\text{entropy} } } + \underbrace{\Delta \alpha_t - b \cdot (\mathcal{H}_t - \mathcal{H}_0)}_{\Delta \alpha_{\text{mismatch} } } $$- 其中 \( b \) 是熵-接受率斜率,\( \mathcal{H}_0 \) 是初始熵
- 实验发现(原文图 3) :在使用拒绝采样 时,由策略更新导致的失配分量 \( \Delta \alpha_{\text{mismatch} } \) 几乎为零
- 这意味着 RL 的权重更新几乎不影响 Draft-Target 的 TV Overlap!
$$ \sum_{y} \min (p(y), q(y)) $$
- 这意味着 RL 的权重更新几乎不影响 Draft-Target 的 TV Overlap!
- 关键结论:Pre-RL Adaptation is Sufficient(RL 前适配就足够了) :
- 因为失配分量可忽略,所以完全不需要在 RL 过程中进行昂贵的 Online MTP 更新
- 只需在 RL 之前的 SFT 阶段 ,使用 E2E TV 损失 训练好 MTP 模块,其高接受率就能在整个 RL 训练过程中保持
- 这避免了在 RL 中维护 MTP 优化器状态和计算梯度的巨大内存和计算开销
实验
主要实验结果
- SFT 阶段的接受率提升(原文表 2,原文图 4) :
- 在 Qwen3.5-35A3B 模型上,相比于 CE 损失基线,E2E TV 损失在各类任务(Math, Code, SWE, Agent)上将拒绝采样接受率提高了 3% - 8%
- 在 Agent 任务上甚至达到了 97% 的接受率
- TV 损失的优势在越靠后的 MTP 步骤中越明显(Step 3 提升约 5%)
- 在 Target-Only 采样下,各种损失函数效果相同(原文图 5),证明 TV 损失的优势是专为拒绝采样设计的
- 在 Qwen3.5-35A3B 模型上,相比于 CE 损失基线,E2E TV 损失在各类任务(Math, Code, SWE, Agent)上将拒绝采样接受率提高了 3% - 8%
- RL 训练中的稳定性(原文图 6,原文图 1a) :
- RS w/ TV (Bebop) 在 RL 训练的整个过程中,接受长度保持稳定甚至有所提升
- 相比之下,Target-Only 和 RS w/ CE 的接受率持续下降
- 原文图 1a 和原文图 8 清晰地展示了 TV 损失几乎完全抹平了接受率对熵的依赖
- 端到端加速(原文图 7) :
- 相比不使用 MTP,Bebop 实现了 1.5 倍 - 1.8 倍 的每步 RL 训练延迟降低
- 在 Agentic RL 任务中,Rollout 阶段加速高达 2.4 倍
- RL 中更新 MTP 权重的效果(原文图 9a) :
- 实验证明,在 RL 过程中继续用 CE 损失更新 MTP 权重,反而会使接受率退化到基线水平
- 而继续用 TV 损失更新则几乎没有提升
- 这证实了 “Pre-RL Adaptation” 策略的正确性和充分性
深度讨论与分析
- TV 损失使 Draft 分布更尖锐 (Sharper) :TV 损失训练出的 Draft Head,其熵更接近目标模型(原文图 10)
- 这说明它学会了聚焦于高概率 Token ,而不是像 CE 那样产生一个平滑、分散的分布,从而最大化与目标的 TV 重叠
- 鲁棒性分析 :
- 对策略更新的鲁棒性 :拒绝采样的接受率是连续函数,对 RL 更新引起的微小概率交换不敏感
- 而 Target-Only 采样是离散的(接受/拒绝),对排名变化非常脆弱
- 对温度的鲁棒性(原文图 12a) :温度 \( \tau \) 升高会增加熵,导致 Target-Only 采样接受率急剧下降,而拒绝采样则保持相对稳定
- 这为 RL 中如何权衡探索(高温度)与效率提供了定量分析工具
- 对策略更新的鲁棒性 :拒绝采样的接受率是连续函数,对 RL 更新引起的微小概率交换不敏感
- Agentic RL 的优势(原文图 14a) :在长文本、多轮交互的 Agentic 任务中,MTP 的优势被放大
- 因为长文本包含大量结构化、可预测的内容(如代码模板、工具调用格式),且长尾生成降低了有效 Batch Size,使得 MTP 的延迟收益更加显著
- 工程实现 :为解决全词表 TV 损失的内存爆炸问题,作者设计了一个融合(Fused)反向内核
- 而简单的 Top-K 近似会导致训练不稳定(原文图 14b),因此最终采用了全词表但内存优化的实现
补充:特别说明
- 原论文提到:TV 损失的熵不变性保证是分布-条件性 的,即只在 SFT 训练数据覆盖的熵值范围内有效
- 如果 RL 的探索导致策略熵远超这个范围,Draft Head 仍可能遭遇分布外(OOD)问题,恢复熵-接受率依赖
- 在这种情况下,建议在 RL 中继续进行 TV 损失的 Co-training
APPO
- 原始论文:APPO: Agentic Procedural Policy Optimization, USTC & Alibaba, 20260610
- 论文总结:
- 核心关注点是 如何在 LLM Agent 的 RL 训练过程中,进行更精细、更有效的信用分配和探索
- 现有方法通常基于粗粒度的启发式单元(如工具调用边界或固定工作流)进行分支(Branching)和信用分配,这使得识别哪些中间决策真正影响最终结果变得困难
- 发现:有影响力的决策点广泛分布于生成序列中,而非集中于工具调用,且 Token 熵本身并不能可靠地反映其对最终结果的影响
- 论文提出了 Agentic Procedural Policy Optimization (APPO) ,将分支和信用分配的单元从粗粒度交互单元转移到序列中的细粒度决策点(即“步骤/程序”,Procedures)
Pilot Study,初步研究
- Pilot Study 主要发现:
- 1)决策点的分布 :在工具集成的 Rollout 中,最高不确定性的位置(高熵)并非集中在工具调用边界,而是广泛分布在 Thinking 过程的 Token 中
- 这表明非工具调用的推理过程包含了比粗粒度工具调用单元更细粒度的 Procedure 信息
- 2)熵的局限性 :高 Token 熵本身并不能可靠地指示决策的重要性
- 一些高熵 Token 仅反映了词汇的稀有性(如专有名词),而非对任务结果有重大影响的决策点
- 理解:部分 Token 熵高,但是不论走哪条路得到的结果都差不多,比如 “但是” 和 “然而” 这两个 Token 选哪个其实都不影响一句话的后续输出,算不上高的路径;其他多义词应该也是类似
- 通过比较不同分支标准下的分支平均准确率,发现基于高熵的分支并不能持续产生更大的结果不确定性
- 一些高熵 Token 仅反映了词汇的稀有性(如专有名词),而非对任务结果有重大影响的决策点
- 1)决策点的分布 :在工具集成的 Rollout 中,最高不确定性的位置(高熵)并非集中在工具调用边界,而是广泛分布在 Thinking 过程的 Token 中
- 结论:必须关注思考过程中的 Procedure 信息,并需要一个更 principled 的分支标准设计,以实现跨 Procedure 的细粒度信用分配
APPO 方法
- APPO 是一个在线、基于树的 Agentic RL 算法
- APPO 核心思想是将 Rollout 在细粒度的 “Procedure”(即 Token 级别的决策点)处进行分支,并据此进行更精准的信用分配
- 整体流程如原文图 2 所示,算法流程见 Algorithm 1
Preliminaries
- Agentic RL Setting :
- Agent 接收任务 \( x \),与工具集 \( T \) 交互
- Rollout 包含 \( T_a \) 个交替的思考和工具调用步骤,以及 \( T_b \) 个答案生成步骤,生成概率为:
$$
P_{\theta}(\mathcal{G},y|x,T) = \prod_{t = 1}^{T_{a} }[\pi_{\theta}(\mathcal{O}_{t}|\mathcal{G}_{< t},x;T)P_{env}(\mathcal{G}_{t}|\mathcal{O}_{t},\mathcal{G}_{< t})]\prod_{t = 1}^{T_{b} }\pi_{\theta}(\mathcal{O}_{t}|y_{< t},\mathcal{G},x;T)
$$- \( \pi_{\theta} \) 是策略模型
- \( P_{env} \) 是外部环境
- \( \mathcal{O}_t \) 是第 \( t \) 步的输出
- \( \mathcal{G}_t \) 是第 \( t \) 步的整体输出
- 理解:如果 Agent 在这一步调用了工具(如搜索或 Python 解释器),那么 \( \mathcal{G}_t \) 就是工具执行后返回的结果(例如搜索结果或代码输出),而 \( \mathcal{O}_t \) 是模型的原始输出
- 原始论文中有点模糊,似乎可以约等于 \(\mathcal{G}_t\) 是环境根据 \( \mathcal{O}_t \) 的工具调用输出的结果,似乎又包含了 \( \mathcal{O}_t \) 本身
- 理解:如果 Agent 在第 \( t \) 步的输出 \( \mathcal{O}_t \) 中不调用外部工具的话,则有 \( \mathcal{O}_t = \mathcal{G}_t\)
- 理解:如果 Agent 在这一步调用了工具(如搜索或 Python 解释器),那么 \( \mathcal{G}_t \) 就是工具执行后返回的结果(例如搜索结果或代码输出),而 \( \mathcal{O}_t \) 是模型的原始输出
- Token Entropy :常用分支策略选择 Top-\( k \) 高熵 Token:
$$
H_{t} = -\sum_{j = 1}^{|\mathcal{V}|}p_{t,j}\log p_{t,j},\\ p_{t} = \pi_{\theta}(\cdot |\mathcal{G}_{< t},z;T) = \text{Softmax}(\frac{z_{t}}{\tau})
$$- \( |\mathcal{V}| \) 是词表大小
- \( \tau \) 是温度
- \( z_t \) 是 Logits
- 注:论文中指出:高熵并不等同于高决策价值
APPO 创新1:Procedural Rollout Branching
- Procedural Rollout Branching 旨在识别并选择高价值的决策点进行分支
- 1)Initialization :为每个输入 \( x \),使用当前策略 \( \pi_{\text{old} } \) 生成 \( N \) 个完整的 Rollout \( \mathcal{T} = \{\mathcal{H}_n\}_{n=1}^N \),作为 \( N \) 棵独立树的根
- 2)Branching Score(BS) :对于每个 Rollout \( \mathcal{H}_n \) 中的每个 Token \( \mathcal{H}_{n,i} \),计算其分支分数,该分数由两部分组成:
- Future Value, \( \Omega_{n,i} \) :通过累积衰减的重要性采样比率来衡量当前 Token 对后续续写的未来影响,\( \pi_{\text{old} } \) 是生成初始 Rollout 的策略
$$
\Omega_{n,i} = \exp \left(\sum_{i’\geq i}\gamma^{i’ - 1}\log \rho_{i’}(\theta)\right),\quad \rho_{i’}(\theta) = \frac{\pi_{\theta}(\mathcal{H}_{n,i’}|\mathcal{H}_{n,< i’},x;T)}{\pi_{\text{old} }(\mathcal{H}_{n,i’}|\mathcal{H}_{n,< i’},x;T)}
$$- \( \gamma \) 是折扣因子,用于减少远处 Token 的方差影响
- 一个大的 \( \Omega_{n,i} \) 表示该 Token 之后的续写更受当前训练策略 \(\pi_\theta\) 的青睐(而不太受 \(\pi_{\text{old} }\) 的青睐)
- 理解:大的 \( \Omega_{n,i} \) 表示 \(\pi_\theta\) 生成未来序列的概率比 \(\pi_{\text{old} }\) 更大
- Branching Score(BS) :将未来价值 \( \Omega_{n,i} \) 与 Token 熵 \( H_{n,i} \) 结合,并进行 Z-分数归一化 \( \mathcal{Z} \)
$$
\text{BS}_{n,i} = \mathcal{Z}(\text{clip}(\Omega_{n,i},1 - \epsilon^\prime,1 + \epsilon^\prime);\mathcal{H}_n)\cdot \mathcal{Z}(H_{n,i};\mathcal{H}_n)
$$- \( \epsilon’ \) 是裁剪超参数
- 熵捕捉局部不确定性(注意:熵是用当前策略计算的),\( \Omega \) 捕捉未来影响,两者的乘积可以选择出既不确定又具有重要后果的 Token
- 理解:乘积相当于是与的逻辑,得到的熵大 且 对未来影响大的 Token
- 问题:为什么 大的 \( \Omega_{n,i} \) 就代表对未来影响大呢?
- \( \Omega_{n,i} \) 可以理解为一个累积效应指标,它衡量的是:如果我们在 Rollout \(\mathcal{H}_n\) 位置 \(i\) 处“扰动”了生成过程,这种扰动会如何影响后续所有 Token 的生成概率分布
- 情况 A:Token \(i\) 是一个无关紧要的 Token(例如停用词 “the”)
- 无论你在这个位置选择什么样的 Token,后续的生成过程(从 \(i+1\) 到末尾)几乎不会改变,\( \Omega_{n,i} \) 接近于 1
- 情况 B:Token \(i\) 是一个关键决策点(例如 “verify”、”plan” 或一个数学运算符)
- 选择“verify”而不是“skip”,会彻底改变后续的推理路径:Agent 会开始检查之前的计算,然后可能调用工具,最后得到不同的答案
- 这些大于 1 的比率连乘,会得到一个远大于 1 的数值,因此 \( \Omega_{n,i} >> 1 \)
- 情况 A:Token \(i\) 是一个无关紧要的 Token(例如停用词 “the”)
- \( \Omega_{n,i} \) 可以理解为一个累积效应指标,它衡量的是:如果我们在 Rollout \(\mathcal{H}_n\) 位置 \(i\) 处“扰动”了生成过程,这种扰动会如何影响后续所有 Token 的生成概率分布
- \( \mathcal{Z}(\cdot;\mathcal{H}_n) \) 表示在 Rollout \( \mathcal{H}_n \) 内进行 Z-分数归一化
- 理解:\( \mathcal{H}_n \) 是表示一条 Rollout,这里论文中用的符号像是熵一样,要小心
- Future Value, \( \Omega_{n,i} \) :通过累积衰减的重要性采样比率来衡量当前 Token 对后续续写的未来影响,\( \pi_{\text{old} } \) 是生成初始 Rollout 的策略
- 3)分支与树更新(当前策略继续续写) :为每个 Rollout \( \mathcal{H}_n \) 选择 Top-\( B \) 个 Token (记为 \( \mathcal{B}_n \))作为分支点
- 对于 \( \mathcal{B}_n \) 中的每个位置,使用当前策略 \( \pi_{\theta} \) 从该前缀续写生成新的分支 \( \mathcal{H}_n^{new} \),并更新 Rollout 树
- 理解:使用的是当前策略继续续写,而不是 \(\pi_\text{old}\) 继续续写,这样得到的轨迹更加 On-policy
- 从 Algorithm 1 可知,在 PPO Train Step 更新过程中,每一步都要重新采样 \(\mathcal{T}_{branch}\)
- 理解:使用的是当前策略继续续写,而不是 \(\pi_\text{old}\) 继续续写,这样得到的轨迹更加 On-policy
- 注:此过程会消耗剩余的 Rollout 预算 \( M - N \),即生成的最大总 Rollout 数是固定的,防止无止境的分下去
- 对于 \( \mathcal{B}_n \) 中的每个位置,使用当前策略 \( \pi_{\theta} \) 从该前缀续写生成新的分支 \( \mathcal{H}_n^{new} \),并更新 Rollout 树
APPO 创新2:Procedure 级优势估计与策略优化 (Procedural Advantage Estimation and Policy Optimization)
- 这一步是 APPO 的第二个关键创新,旨在更精准地为 Procedure 级决策分配信用
- 1)双组优势估计 (Dual-Group Advantage Estimation) :为了减少混合不同策略生成的 Rollout 带来的偏差,APPO 分别为初始 Rollout 集合 \( \mathcal{T}_{init} \) 和新生成的分支集合 \( \mathcal{T}_{branch} \) 独立计算组内相对优势
$$
\hat{A}_{n,i}^{\text{base} } = \arg \left\{\frac{R_n - \text{mean}(\{R_{n’}|\mathcal{H}_{n’}\in \mathcal{T}_*\})}{\text{std}(\{R_{n’}|\mathcal{H}_{n’}\in \mathcal{T}_*\})}\bigg|\mathcal{T}_*\in \{\mathcal{T}_{init},\mathcal{T}_{branch}\}\right\}
$$- 其中 \( R_n \) 是 Rollout \( \mathcal{H}_n \) 的任务奖励
- 这为 Token 提供了局部化的信用分配
- 理解:上述公式的含义是,针对 \(\mathcal{T}_{init}\) 和 \(\mathcal{T}_{branch}\) 是分别计算优势的
- 注:注意,对于每个组来说,他们的 Prompt 都是相同的
- 2)未来感知优势 (Future-Aware Advantage, \( \hat{A}^{\text{ftu} } \)) :受相关研究启发,论文认为关键 Procedure 是 Rollout 的转折点,更可能对续写产生较大的策略诱导差异,因此,设计了一个额外的优势项来放大这些决策点的信用
$$
\hat{A}_{n,i}^{\text{ftu} } = \text{clip}_{\epsilon^{\prime} }\left(\exp \left(\sum_{i^{\prime}\geq i}\gamma^{i^{\prime} - i}\log \rho_{i^{\prime} }(\theta)\right)\right),\quad \rho_{i^{\prime} }(\theta) = \frac{\pi_{\theta}(\mathcal{H}_{n,i^{\prime} }|\mathcal{H}_{n,< i^{\prime} },x;T)}{\pi_{\text{old} }(\mathcal{H}_{n,i^{\prime} }|\mathcal{H}_{n,< i^{\prime} },T)}
$$- \(\text{clip}_{\epsilon^{\prime} }\) 表示 clip 到 \([1-\epsilon, 1+\epsilon]\) 之间
- 这与公式 (4) 中的 \( \Omega \) 类似,但直接用作优势的缩放因子
- 3)最终优势与优化目标 :最终的 Token 级优势为:
$$
\hat{A}_{n,i} = \hat{A}_{n,i}^{\text{base} }(1 + b \cdot \hat{A}_{n,i}^{\text{ftu} })
$$- 其中 \( b \) 是控制未来感知项贡献的超参数
- 理解:这里 乘以 \((1 + b \cdot \hat{A}_{n,i}^{\text{ftu} })\) 的含义是,参数从 \(\pi_\text{old}\) 更新为 \(\pi_\theta\) 的过程中,未来轨迹概率变化越大的 Token 位置,给与的贡献越大(因为 \(\hat{A}_{n,i}^{\text{ftu} }\) 是指数,所以 \(\hat{A}_{n,i}^{\text{ftu} } > 0\) ,也就是说,不管是正或者负都会被放大影响,但放大多少幅度跟 \( b \) 有关)
- 最终,APPO 优化以下目标函数(类似 GRPO/PPO 的更新形式):
$$
J(\theta) = \mathbb{E}_{\mathcal{H}\sim \pi_{\text{old} }(\cdot |x)}\left[\frac{1}{M}\sum_{n = 1}^{N}\frac{1}{|\mathcal{H}_n|}\sum_{i = 1}^{|\mathcal{H}_n|}\min (\rho_{n,i}(\theta)\hat{A}_{n,i},\text{clip}_e(\rho_{n,i}(\theta))\hat{A}_{n,i}) - \beta \mathbb{D}_{\text{KL} }(\pi_{\theta}|\pi_{\text{ref} })\right]
$$- 其中 \( \rho_{n,i}(\theta) \) 是重要性采样比率,\( \text{clip}_\epsilon \) 是 PPO 风格的裁剪函数,\( \text{D}_{\text{KL} } \) 是 KL 散度,\( \beta \) 是 KL 正则化系数。分支仅用于辅助优势估计,其本身不直接参与梯度优化
- 其中 \( b \) 是控制未来感知项贡献的超参数
理论基础 (Theoretical Foundation)
- 论文提供了两个理论定理来支撑其设计:
- 定理 3.1 (方差减少) :通过 BS 指导分支,APPO 将更多样本分配给高方差(高影响)的决策点,从而比随机分支的基线估计器具有更低的梯度方差
- 定理 3.2 (策略改进界限) :APPO 的优势设计(结合 \( \hat{A}^{\text{ftu} } \))在 BS 引导的分支混合分布下,提供了一个有效的策略改进界限,保证了算法的稳定性
Experiments
实验设置
- 数据集 :涵盖 13 个具有挑战性的基准测试,分为三类:
- 1)数学推理 (Mathematical Reasoning) :AIME24, AIME25, MATH500, GSM8K, MATH
- 2)知识密集型推理 (Knowledge-Intensive Reasoning) :HotpotQA, 2WikiMultihopQA, Musique, Bamboogle, WebWalker
- 3)深度搜索 (Deep Search) :GAIA, Humanity’s Last Exam (HLE), XBench
- 基线 (Baselines) :对比了四类方法:
- 1)经典 RL 方法 :GRPO, Reinforce++, DAPO, GPPO, CISPO
- 2)Agentic RL 方法 :GIGPO, ARPO
- 3)LLM 主干网络 :Llama3.1-8B-Instruct, Qwen2.5-7B-Instruct, 并引用了更大或闭源模型(如 QwQ, DeepSeek-R1, GPT-4o)的结果作为参考
- 4)其他机制 :RAG, ReAct, Search-o1, WebThinker
- 评估指标 :主要使用 F1-score (QA 任务) 和 LLM-as-a-Judge (正确性计算) 的 pass@1 指标
- 实现细节 :基于 VeRL 框架实现,工具调用结果从梯度计算中分离
- 注:在不同任务上进行了 2 到 5 个 Epoch 的训练
Main Results
- 数学与知识推理任务 (原文表 1) :
- APPO 在所有基线上取得了持续 superior 的性能
- 在数学推理任务上,平均比之前最好的 Agentic RL 方法高出 2.45 分
- 在知识密集型推理任务上,APPO 在几乎所有数据集上排名第一
- 这证明了在高影响决策点进行分支,能帮助模型更好地探索和强化关键推理路径
- 深度搜索任务 (原文表 2) :
- APPO 在 8B 和 14B 模型规模上都建立了新的 SOTA 结果,显著优于 ARPO 等强基线
- 例如,在 Qwen3-8B 上,APPO 比 ARPO 在 GAIA 平均分上高出 3.9 分
- 这表明 APPO 在需要复杂、多步工具使用的现实场景中同样有效且高效
Ablation
- 分支配置分析 (原文表 3) :研究了初始 Rollout 数量 \( N \) 和每 Rollout 分支数 \( B \)(总预算 \( M \) 固定)的影响
- 结果表明,APPO 在所有配置下均优于 ARPO,且 \( N=2, B=3 \) 的组合在性能和计算效率之间取得了最佳平衡
- 增加 \( N \) 比增加 \( B \) 带来了更大的提升,说明初始多样性的重要性
- 分支分数 (BS) 有效性 (原文图 3) :通过 Pass@1 到 Pass@5 的评估,APPO 的性能提升远快于 ARPO,表明 BS 能更有效地定位高潜力分支点
- 训练动态 (原文图 4) :APPO 达到了更高的最终奖励,并且训练轨迹更稳定
- 这说明 APPO 不仅改善了局部探索,而且在整个训练过程中更有效地分配了探索资源
- 多样性分析 (原文图 5) :通过 UMAP 和 DBSCAN 聚类可视化,APPO 产生的 Rollout 聚类更紧凑、分离更好,表明其在推理策略层面产生了更多样化且结构清晰的分支,这对信用分配更有利
- BS 指标解释 (原文图 6) :纯高熵 Token 包含许多罕见名词(如 “march”, “november”),而 BS 指标选择的是那些能导致新旧策略间下游分布发生较大偏移的 Token(如 “verify”, “sum”, “break”),这些 Token 更能真正地改变推理轨迹并决定成败
补充:论文中的其他关键 Insight
- Procedure 的定义 :论文将 “Procedure” 定义为围绕高影响决策点组织的 Procedure 性推理模式
- 这些决策点是轨迹中潜在的、以 Token 实例化的位置,其替代续写会导致截然不同的下游结果
- 理解:这里其实是在 参数从 \(\pi_\text{old}\) 更新为 \(\pi_\theta\) 的过程中,未来轨迹概率变化越大的 Token 位置
- 注意:这里的熵使用当前策略 \(\pi_\theta\) 计算的
- APPO 的创新在于将分支单元下沉到 Token 级别的 “Procedure”,并设计了对应的分支分数和优势函数
- Limitations :
- 1) BS 选择方法主要通过实验验证,缺乏其最优性的严格理论保证
- 2) 工具集仅限于搜索和 Python,未扩展到更多应用导向的工具
- PS:过于复杂,对当前的 RL 训练方式(一次 Rollout 对应 多步 梯度更新)有挑战,改动大
S2L-OP(慎重参考)
- 原始论文:(S2L-PO)Smaller Models are Natural Explorers for Policy-Level Diversity in GRPO, 20260529-20260602, ICML 2026, THU & CUHK
- 整体总结:
- 论文聚焦于 RLVR 中的效率与性能问题,特别是针对 GRPO
- 论文的核心 Insight :通过蒸馏得到的小模型,其参数层面的压缩天然引入了一种结构化的“策略级扰动”(Policy-Level Perturbation),这种扰动能够为 GRPO 提供比传统的“Token-level 随机性”(Token-Level Randomness,如提高采样温度)更有效、更连贯的探索信号
- S2L-PO(Small-to-Large Policy Optimization) 框架:
- 利用一个固定的、更小的模型作为“天然探索器”(Natural Explorer)来为大的目标模型生成多样化的 Rollout
- 同时设计了一种渐进式退火策略(Progressive Annealing Strategy),平滑地从外部探索过渡到自主的 On-Policy 学习
- 从而在降低计算成本的同时,显著提升模型在数学推理等任务上的性能
- S2L-OP 存在一个核心问题(个人理解):
- 小模型生成的 Rollout 本身是 Off-policy 的,而且质量往往不如大模型,既需要修正,也往往会作为负样本而被打压
- 后期完全使用正确的 GRPO 时倒是还好
- 注:论文中只有前几步使用小模型,论文中提到 8 步后小模型采样比例就降低到 0 了,个人认为对训练的影响很有限
S2L-PO 设计思路:从“扰动动作”到“扰动策略”
- 论文首先剖析了 GRPO 中增加多样性的两种范式,并指出当前主流方法(如提高温度)的缺陷,这也是 S2L-PO 设计的理论基础
- 1)Token-level 扰动 (Token-Level Perturbation) 的局限 :
- 通过在每一步解码时独立地增加随机性(如使用更高的温度 \( T \)),即
$$ a_t \sim \pi^{\text{tok} }(\cdot | s_t) $$- 其中
$$ \pi^{\text{tok} }(a|s_t) = \frac{\exp(l_t(a) / T)}{\sum_{a’}\exp(l_t(a’) / T)} $$
- 其中
- 缺陷 :这种噪声是“时间上独立的”(Temporally Independent)
- 轨迹在早期分叉后,后续保持相同前缀的概率 \( \Pr(M_t = 1) \) 随长度 \( t \) 呈指数级衰减
$$ \Pr(M_t = 1) = \prod_{j=1}^t \Pr(a_j = a_j^* | M_{j-1} = 1) \leq (1-p)^t $$- \( M_t \):在第 \( t \) 步,Rollout 的前缀与参考轨迹 \( o^* \) 完全匹配的事件
- \( p \):每一步发生偏离的概率的下界。该公式说明,Token 级随机性越大,轨迹在时间上保持关联的概率越低
- 这导致长序列的后期 Token 与早期决策失去连贯性,产生“不连贯的轨迹”(Incoherent Trajectories),其梯度贡献在时间步上相互抵消,如同随机游走(Random Walk),如公式 (18) 所示
$$ \mathbb{E}[| \sum_{t=1}^{L} \mathbf{u}_{i,t}|^2] \approx \sum_{t=1}^{L} \mathbb{E}[| \mathbf{u}_{i,t}|^2] $$- \( \mathbf{u}_{i,t}\) 是第 \( t \) 步的得分函数(Score Function)
$$ \mathbf{u}_{i,t} = \nabla_\theta \log \pi_\theta(a_{i,t} | s_{i,t}) $$
- \( \mathbf{u}_{i,t}\) 是第 \( t \) 步的得分函数(Score Function)
- 理解:
- 这里是想表达每一步都高温决策,导致波动大,前面的步骤对了,后面的步骤不对,会导致这个样本整体的信号相互抵消
- 核心理论:高温采样让每一步的决策都过于独立和随机
- 举例(可能不够精确):梯度更新时,第 1 个Token产生的梯度想往东,第 50 个 Token 产生的梯度想往西,第 100 个 Token 又想往北
- 加在一起,互相抵消,最后几乎没有有效的更新方向
- 作者这里想表达,小模型是固定参数的偏移,所以能保持一种稳定的解题风格
- 这里是想表达每一步都高温决策,导致波动大,前面的步骤对了,后面的步骤不对,会导致这个样本整体的信号相互抵消
- 轨迹在早期分叉后,后续保持相同前缀的概率 \( \Pr(M_t = 1) \) 随长度 \( t \) 呈指数级衰减
- 通过在每一步解码时独立地增加随机性(如使用更高的温度 \( T \)),即
- 2)策略级扰动 (Policy-Level Perturbation) 的优势 :
- 通过参数级别的压缩(如蒸馏),引入一个对时间是“不变的”(Time-Invariant)参数偏移 \( \delta_\theta \),即
$$ \tilde{\theta} = \theta + \delta_\theta $$- 整个 Rollout 过程都在这个被扰动的策略 \( \pi_{\tilde{\theta} } \) 下生成
- 问题:岂不是 off-policy 了?
- 优势 :这种扰动是“时间上相关的”(Temporally Correlated)
- 它引导模型产生一个连贯的、结构化的替代推理路径,而非零散的 Token 变化
- 如公式 (19) 和 (20) 所示,这使得跨时间步的梯度贡献能够正向对齐(Constructive Interference),其协方差存在一个正的下界,从而为 GRPO 提供更优质的梯度估计信号
$$
\begin{align}
\nabla_{\theta}\log \pi_{\theta +\delta_{\theta} }(\sigma |q) \approx \nabla_{\theta}\log \pi_{\theta}(\sigma |q) + \nabla_{\theta}^{2}\log \pi_{\theta}(\sigma |q)\delta_{\theta} \tag{19} \\
|\text{Cov}(\tilde{z}_{i,t}, \tilde{z}_{i,s} | q)| \geq \gamma - 5B^2 \Pr_{\text{std} }(M_t = 0) - O(|\delta_\theta|^3) \tag{20}
\end{align}
$$- \( \tilde{z}_{i,t} \):在策略扰动下,第 \( i \) 条轨迹第 \( t \) 步的 Score 函数投影
- \( \gamma \):一个正数,代表 Hessian 矩阵与扰动方向 \( \delta_\theta \) 的“对齐强度”(Alignment)
- \( B \):Score 函数的界(Bound)
- 该公式表明,只要 Hessian 对齐强度 \( \gamma \) 足够大,策略级扰动就能保证跨时间步的梯度贡献保持正相关,而不是像 Token 级扰动那样完全消散
- 通过参数级别的压缩(如蒸馏),引入一个对时间是“不变的”(Time-Invariant)参数偏移 \( \delta_\theta \),即
补充:论文核心 Insight
核心洞察:小模型是更好的探索器
- 现象 :论文通过实验发现了一个反直觉的现象
- 如原文图 2 所示,虽然在 Pass@1 上大模型优于小模型,但随着采样数量 \( k \) 的增加,小模型的 Pass@k 曲线下降更慢,甚至能反超大模型(例如 4B 模型在 \( k \ge 32 \) 时超过 8B 模型)
- 如原文图 2 所示,虽然在 Pass@1 上大模型优于小模型,但随着采样数量 \( k \) 的增加,小模型的 Pass@k 曲线下降更慢,甚至能反超大模型(例如 4B 模型在 \( k \ge 32 \) 时超过 8B 模型)
- 解释 :这表明小模型并非简单地更差,而是其内在的策略分布具有更高的“策略级多样性”
- 它们能探索出更多样化、更丰富的解题路径,这种多样性源于蒸馏带来的结构化参数偏移,而非 Token 层面的噪声
理论分析:为何策略级多样性更优
- 连贯性 :策略级扰动(参数压缩)产生的轨迹在时间上是连贯的,保持了推理的逻辑一致性
- 而 Token 级噪声(高温)会导致长序列的逻辑断裂
- 梯度质量 :理论上证明了策略级扰动产生的梯度信号在时间步上具有正协方差(Constructive Interference),而 Token 级扰动的梯度信号则趋于随机抵消(Random Walk),导致训练不稳定
S2L-PO 框架详细流程
- S2L-PO 的核心思想是“用小模型探索,用大模型利用”
- 整个流程如算法 1 所示,是对标准 GRPO 的简单但有效的修改
- 整个流程如算法 1 所示,是对标准 GRPO 的简单但有效的修改
- S2L-PO 整体算法流程如下 :
- 1)初始化 :准备一个可训练的大策略模型 \( \pi_\theta \),一个冻结的、更小的策略模型 \( \pi_\omega \) 作为探索器,以及奖励函数 \( r_\phi \) 和提示词数据集 \( \mathcal{D} \)
- 2)混合 Rollout 生成 (Mixed Rollout Generation) :
- 对于每个训练步骤 \( i \) 和每个 Prompt \( q \),不是只从当前策略采样,而是构建一个混合候选组
- 如果处于过渡期(\( i \le T_{\text{mix} } \)),则计算混合比例 \( \alpha \leftarrow 1 - \frac{i - 1}{T_{\text{mix} } - 1} \)
- 理解:越早期的步骤,使用越大的 \(\alpha\),即小模型采样的数据越多
- 从冻结的小模型 \( \pi_\omega(\cdot|q) \) 中采样 \( G_w = \lceil \alpha G \rceil \) 个候选 Responses
- 从当前训练的大模型 \( \pi_\theta(\cdot|q) \) 中采样 \( G_s = G - G_w \) 个候选 Responses
- 如果已过过渡期(\( i > T_{\text{mix} } \)),则完全恢复为标准 GRPO,即 \( G_w = 0, G_s = G \)
- 理解:这时候可以放弃手脚架,完全恢复正常的 GRPO 训练
- 3)优势估计 :将来自两个模型的 Rollout 合并成候选组 \( \mathcal{O}(q) \),计算它们的奖励,并根据公式 (1) 计算组内相对优势 \( A_i = \frac{r(o_i) - \text{mean} }{\text{std} + \epsilon_{\text{adv} } } \)
- 理解:这里是传统的 GRPO 的优势计算公式
- 4)策略更新 :使用标准的 GRPO 目标函数公式 (2) 来更新大模型的参数 \( \theta \)
- 注意:冻结的小模型不参与更新
- 5)渐进式退火 (Progressive Annealing) :
- 比例 \( \alpha \) 是线性衰减的,在训练初期(\( i \) 很小),\( \alpha \) 接近 1,绝大部分 Rollout 来自小模型,提供丰富的探索
- 随着训练进行,\( \alpha \) 线性减小,小模型的采样比例逐渐降低,大模型的自主采样比例逐渐升高,直到完全过渡到 On-Policy 学习
- 这个平滑过渡避免了训练中期因分布剧烈变化导致的性能崩溃
实验
- 实验设置
- 模型与数据 :在 Qwen3-Base(1.7B, 4B, 8B, 14B)和 InternLM2.5-Base(1.8B, 7B)两个模型家族上,使用 DAPO17k 数学数据集进行训练
- 评估基准 :主要在 AIME24, AIME25, MATH500, OlympiadBench 四个数学推理基准上评估 Pass@1,并在 CommonsenseQA 上评估 OOD 泛化能力
- 主要实验结果
- 性能与效率双提升 :如原文表 1 所示,S2L-PO 在所有设置下均一致且显著地优于标准 GRPO 基线
- 例如,用 1.7B 模型指导 8B 模型,在 AIME24 上提升了 +8.8%
- 由于小模型生成 Rollout 的成本更低,训练的总 FLOPs 和耗时也减少了
- 更快的收敛速度 :如原文图 4 所示,S2L-PO 不仅在最终性能上更好,收敛速度也更快
- OOD 泛化能力 :如原文表 2 所示,在 CommonsenseQA 上,S2L-PO 的性能同样优于或持平基线,说明其带来的多样性探索并未损害模型的通用能力
- 性能与效率双提升 :如原文表 1 所示,S2L-PO 在所有设置下均一致且显著地优于标准 GRPO 基线
- 深度分析与消融实验
- 多样性验证(原文表 3) :通过 Self-BLEU(越低越多样)、Edit Diversity(越高越多样)和 Unique Answer Ratio(越高越多样)三个指标,严格证明了模型越小,其策略级多样性越高(1.7B > 4B > 8B > 14B)
- 因果验证(原文表 4) :通过实验过滤掉小模型中的“多样性” Rollout,使得其多样性指标与大模型一致
- 结果显示,S2L-PO 的性能优势完全消失,这证明了其性能提升直接来源于小模型的策略级多样性,而非其他混杂因素
- 小模型专属 Rollout 的不足(原文图 5) :如果全程只使用小模型生成 Rollout(Small-Only 基线),模型性能会先升后降(Plateau and Regress)
- 因为固定的小模型与不断演化的大模型之间会产生越来越大的“分布偏移”(Distribution Shift),阻碍大模型的进一步学习
- 渐进式退火 vs. 突变切换(原文图 6) :对比实验证明,从混合采样到纯 On-Policy 的渐进式平滑过渡 ,远比突然切换(Abrupt Switch)更稳定、效果更好
- 突变会导致训练不稳定
- 退火长度的影响(原文图 7) :实验表明,退火周期过短(如 5 步)会导致性能下降,说明模型需要足够的训练步数来“消化”来自小模型的多样化探索信号
StepPO
- 原始论文:StepPO: Step-Aligned Policy Optimization for Agentic Reinforcement Learning, 20260420-20260605, USTC
- 整体总结:
- 核心 Insight:
- 现有的 LLM 强化学习算法(如 PPO、GRPO)都是以Token 为基本单位进行建模和优化的,但 LLM 智能体与环境的实际交互是以步骤(Step) 为单位的(即“观察-思考-执行完整动作-获得反馈”的循环)
- 这种错位导致信用分配(Credit Assignment)不准确,优化效率低下
- StepPO:
- 通过将智能体与环境交互的过程重新建模为Step-level MDP ,并实现步级轨迹表示 、步级信用分配和步级策略优化
- 核心 Insight:
- 问题:
- 本文的 Idea 很容易想到,但可能存在的问题是 Critic 预估每一步的价值本身难度可能是非常高的(Pretrain Critic 可能需要很多数据),可能使用 PRM 反而会更容易一点
背景 & 问题
- 现有 Agentic RL 主流 Post-Training 方法(如 PPO、GRPO)存在一个根本性的粒度不匹配问题:
- 优化层面(Token-level) :算法将LLM的生成过程视为一个 Token-level MDP
- 每个 Token 是一个动作,每个前缀是一个状态
- 策略优化和信用分配(如 GAE)都在 Token-level 别进行
- 执行层面(Step-level) :智能体的实际交互过程是:接收一个观察(Observation) -> 生成一个完整的响应(Response,可能包含推理和工具调用)-> 环境执行该响应并返回新观察
- 一个“步骤(Step)”才是智能体决策的基本单元
- 优化层面(Token-level) :算法将LLM的生成过程视为一个 Token-level MDP
- 这种错位导致:
- 1)Token-level 信用分配过于局部 :无法准确评估一个完整动作对后续状态的影响
- 2)轨迹级信用分配过于粗糙(如 GRPO):将整个轨迹的回报(Return)平均分配给所有 Token ,无法识别出关键中间步骤的好坏
- StepPO 的核心思想是将 MDP 的构建、轨迹的存储与表示、信用分配的策略优化,全部统一在“步骤”这一粒度上
StepPO 方法
- StepPO 方法整体详情:
Step-level MDP Formulation
- 这是整个方法的理论基础,与传统 Token-level MDP 不同,StepPO 将智能体的每一次完整交互定义为一个步级状态转移
- 状态 \( s_{1:M_t}^{(t)} \) :第 \( t \) 步时,智能体可用的完整交互历史,包含之前的观察和动作
- 这里 \( M_t \) 表示该状态序列的长度
- 动作 \( a_{1:L_t}^{(t)} \) :第 \( t \) 步时,策略生成的一个完整的、面向环境的响应(如一次搜索动作或一个环境命令)
- 这里 \( L_t \) 表示该动作序列的长度
- 奖励 \( r_t \) :执行动作 \( a^{(t)} \) 后,从环境获得的即时奖励
- 状态转移 :执行动作后,环境返回新的观察,并将其拼接到历史中,形成新的状态 \( s_{1:M_{t+1} }^{(t+1)} \)
- 状态 \( s_{1:M_t}^{(t)} \) :第 \( t \) 步时,智能体可用的完整交互历史,包含之前的观察和动作
- 一个完整的步级轨迹 \( \tau \) 可以表示为:
$$ \tau = \{(s_{1:M_t}^{(t)}, a_{1:L_t}^{(t)}, r_t, s_{1:M_{t+1} }^{(t+1)})\}_{t=1}^{T} $$- 其中 \( T \) 是交互的总步数
- 策略 \( \pi_\theta \) 的目标是最大化期望累积折扣奖励:
$$ J(\theta) = \mathbb{E}_{\tau \sim \pi_{\theta} }\left[\sum_{t=1}^{T}\gamma^{t-1}r_t\right] $$- 这里 \( \gamma \) 是折扣因子
Step-level Trajectory Representation
- 为了让训练系统能够原生地理解“步骤”,StepPO 在数据存储层面进行了革新
- 现存问题 :早期系统使用文本空间表示 ,将交互历史存为消息列表,在训练时重新分词会导致 Token 漂移(Tokenization Drift),破坏了训练信号的准确性
$$ \text{Tok}(\text{Detok}(z)) \neq z $$- 后续的Flat Token-Space Representation 虽然解决了漂移问题,但丢失了步骤的边界信息
- Flat Token-Space Representation 将 Prompt 和 Response 存储为 Token IDs,训练时可以反向解析出 文本,从而保证训推 Tokenize 一致性
- 后续的Flat Token-Space Representation 虽然解决了漂移问题,但丢失了步骤的边界信息
- StepPO的方案 :采用步级原生记录
- 如原文图 3(a) 所示,每个交互步骤都被存储为一个独立的记录(Record),该记录清晰地包含了该步骤的状态 Token (\( s_{1:M_t}^{(t)} \))、动作 Token (\( a_{1:L_t}^{(t)} \))和奖励(\( r_t \))
- 这种设计既保留了 Token-level 别的似然(Likelihood)用于计算,又明确划分了步骤边界,为后续的步级价值估计和优势计算奠定了基础
- 现存问题 :早期系统使用文本空间表示 ,将交互历史存为消息列表,在训练时重新分词会导致 Token 漂移(Tokenization Drift),破坏了训练信号的准确性
Step-level Credit Assignment and Actor Objective
- 这是方法中最核心的算法部分,确保优化过程与步骤对齐
- 1)步级价值估计 :
- 在步级 MDP 中,一个状态的“价值”应该在动作生成之前进行评估
- 因此,StepPO使用 动作开始前的最后一个状态 Token \( s_{M_t}^{(t)} \) 的价值 \( V_\phi(s_{M_t}^{(t)}) \) 来代表整个步骤状态的价值
- 这与 Token-level 方法在每个 Token 后都估计价值,以及轨迹级方法只在最后估计价值截然不同
- 2)步级广义优势估计(Step-level GAE) :
- 基于步级价值,论文提出了步级的GAE来计算每一步的优势 \( \hat{A}_t^{\text{Step} } \)
$$
\begin{align}
\hat{A}_t^{\text{Step} } &= \sum_{l=0}^{T-t}(\gamma \lambda)^l \delta_{t+l} \\
\delta_t &= r_t + \gamma V_\phi(s_{M_{t+1} }^{(t+1)}) - V_\phi(s_{M_t}^{(t)})
\end{align}
$$- 这里 \( \lambda \) 是GAE的迹参数,\( \delta_t \) 是步级的时序差分(TD)残差
- 设计思路 :该公式将奖励信号在“步骤”层面进行回溯传播,而不是在数百个“ Token ”层面,这使得信用分配更加直接和准确
- 计算出的步级优势 \( \hat{A}_t^{\text{Step} } \) 随后会被广播(Broadcast)回该步骤内的所有有效 Token ,用于指导策略更新
- 基于步级价值,论文提出了步级的GAE来计算每一步的优势 \( \hat{A}_t^{\text{Step} } \)
- 3)步级Actor目标函数 :
- 由于一个步骤的动作 \( a_{1:L_t}^{(t)} \) 包含多个 Token ,直接使用所有 Token 的重要性采样比例(Importance Sampling Ratio)的乘积会导致长动作的比值异常(过大或过小)
- 为此,StepPO 引入长度归一化的技巧,使用 Token 比值 的 几何平均值 作为步级重要性采样比例 \( \bar{w}_t(\theta) \):
$$ \bar{w}_t(\theta) = \exp \left(\frac{1}{L_t}\sum_{i=1}^{L_t}\log w_t^i(\theta) \right) $$- 其中
$$ w_t^i(\theta) = \frac{\pi_\theta(a_i^{(t)}|s_{1:M_t}^{(t)}, a_{ < i}^{(t)})}{\pi_{\text{old} }(a_i^{(t)}|s_{1:M_t}^{(t)}, a_{1:<i}^{(t)})} $$
- 其中
- 最终,步级裁剪的Actor目标函数为:
$$ \mathcal{L}_{\text{actor} }(\theta) = \mathbb{E}_{a^{(t)}\sim \pi_{\text{old} }(\cdot|s^{(t)})}\left[\min \left(\bar{w}_t(\theta)\hat{A}_t^{\text{Step} }, \text{clip}_\epsilon(\bar{w}_t(\theta))\hat{A}_t^{\text{Step} }\right)\right] $$ - 设计思路 :通过几何平均,稳定了多 Token 动作的策略更新,避免了单个 Token 概率突变对整体步骤策略造成过大影响
Training Systems for StepPO
- 论文不只停留在算法层面,还讨论了实现 StepPO 所需的系统支持,体现了从理论到工程的完整性
- 1)步级原生数据表示 :如前所述,是系统的基础
- 2)Data Management :为支持异构智能体(白盒、黑盒、在线服务),系统采用网关(Gateway) 和 数据池(Datapool)的中间层架构
- 网关标准化交互流
- 数据池异步收集和管理步骤数据、奖励、策略版本等元数据
- 3)Computational Efficiency Optimization :针对长轨迹训练中的计算瓶颈,系统支持在步骤层面进行共享前缀重用 和前缀树合并 ,减少冗余的前向计算
- 4)Asynchronous Training Design :由于智能体轨迹的延迟差异巨大,StepPO 采用解耦的异步设计,让 Rollout 引擎、训练引擎、网关和数据池独立运行,并通过控制权重刷新和数据服务来保证训练的稳定性和近端策略(On-policy)特性
实验
- 论文在四个具有代表性的智能体任务上进行了广泛的实验,验证了 StepPO 的有效性
- 实验设置:
- Benchmark :
- 多跳问答(Multi-hop QA) :HotpotQA(域内),2Wiki和MuSiQue(域外)
- 学术论文搜索(Academic Paper Search) :RealResearchQuery
- 文本世界任务(Text-world Action) :ALFWorld和WebShop
- Baselines :对比了 PPO、GRPO、Reinforce++、RLOO、GiGPO 等多种 RL 算法
- Benchmark :
- Main Results
- 如原文表 2 所示,StepPO 在所有任务和所有指标上均一致且显著地优于所有基线模型
- 特别是在更具挑战性的 ALFWorld 和 WebShop 任务上,StepPO 的优势更为明显,证明了其在长时序、多步骤决策中的优越性
- 消融情况
In-depth Analysis
- 1)Training Dynamics,原文图 6 :StepPO 在训练过程中获得了最高的累积奖励,并且其 Critic Loss 更低、更稳定
- 这表明步级建模不仅提升了策略质量,也使得价值函数的估计更加准确
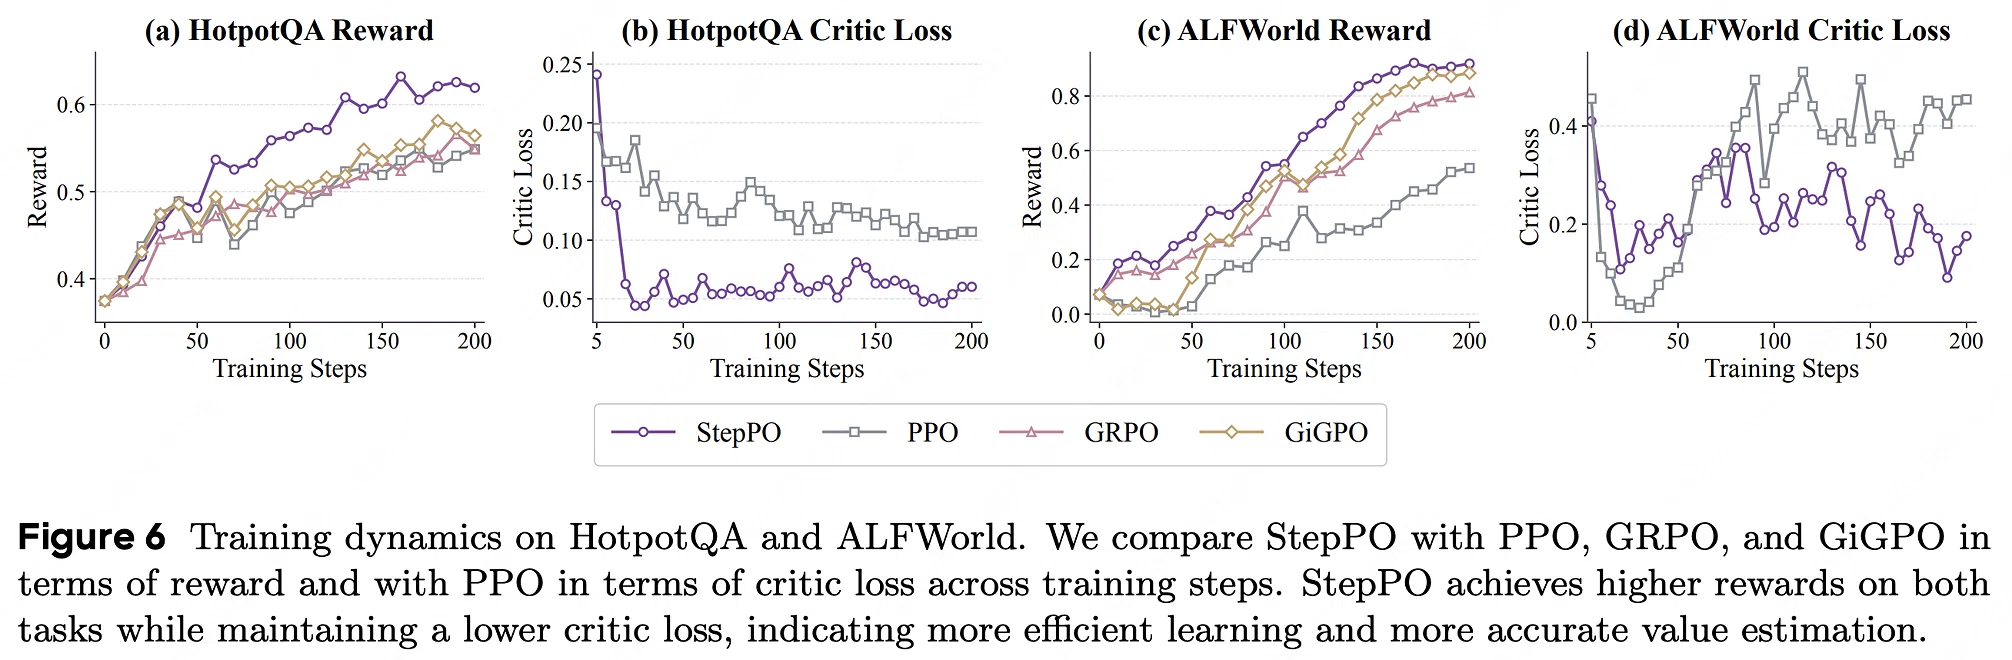
- 这表明步级建模不仅提升了策略质量,也使得价值函数的估计更加准确
- 2)Step-Wise Difficulty Analysis,原文图 7 :在 ALFWorld 任务中,随着任务所需“Golden 步骤”的增加,所有方法性能都有所下降
- 但 StepPO 的成功率下降更平缓,且其实际执行步数与黄金步数的差距(Delta Steps)始终保持最小
- 这说明 StepPO 学习到的轨迹不仅更成功,而且更接近人类专家的最优路径
- 3)Tool-Use Behavior Analysis,原文表 3 :在论文搜索任务中,StepPO 在取得最佳 F1 分数的同时,使用的 Response Tokens 最少
- 这表明其性能提升来源于更有效的决策(如更精准的搜索和扩展),而不是更长的、无意义的推理
- 4)Credit Assignment Analysis,原文表 4 :通过改变折扣因子 \( \gamma \) 的值,论文对比了 Token-level GAE 和步级 GAE 的鲁棒性
- 当 \( \gamma \) 从 0.99 降至 0.95 时, Token-level GAE 的性能下降(13.09%)远大于步级 GAE(5.53%)
- 这是因为步级 GAE 在步骤间传播奖励,衰减更慢,能更好地处理长文本、多步骤交互中的延迟奖励
- 5)Efficiency Analysis :StepPO 在每轮训练时间上与 PPO 基本持平,因为其 Critic 更新更紧凑(仅在步骤边界),优势计算更轻量
OPD Sparsity(OPD Dense Supervision,and Sparse Updates)
- 原始论文:(OPD-Sparsity)Dense Supervision, Sparse Updates: On the Sparsity and Geometry of On-Policy Distillation, NJU & Alibaba, 20260611-20260612
- 论文整体总结:
- 核心问题 :OPD 结合了 “On-Policy 学生轨迹” 和 “密集教师监督” 两个优点,但其在模型参数层面究竟产生了什么样的变化,尚不明确
- 问题:它究竟是更像密集监督的 SFT,还是更像稀疏奖励的 RLVR,或者是一种全新的模式?
- 核心发现 :通过对多个语言和视觉-语言模型对(model pairs)进行 OPD 实验和分析,论文得出两个主要结论:
- 1)稀疏性(Sparsity) :OPD 的更新是微小且坐标稀疏的
- 这些更新分布在网络各层,且通常在 Feed-Forward Network (FFN) 模块中相对变化最大
- 这种稀疏结构具有操作上的实用性:仅训练由 OPD 发现的子网络(subnetwork)就能恢复近乎完整训练的性能
- 但这种稀疏性并不意味着可以抛弃自适应优化器(如 AdamW),因为密集的教师监督保留了有用的动量结构和异构的二阶矩尺度
- 2)几何特性(Geometry) :OPD 的更新在数值上是满秩的,但谱集中(spectrally concentrated)
- 这些更新大多远离源权重(source weights)的主奇异子空间(principal singular subspaces),并且不成比例地落在源权重接近零的坐标上
- 1)稀疏性(Sparsity) :OPD 的更新是微小且坐标稀疏的
- 最终结论 :
- 密集的教师监督并没有将 OPD 变成普通的密集参数重写过程;
- OPD 保留了On-Policy 后训练的重要几何特征,更接近于稀疏的 On-Policy 编辑
- 核心问题 :OPD 结合了 “On-Policy 学生轨迹” 和 “密集教师监督” 两个优点,但其在模型参数层面究竟产生了什么样的变化,尚不明确
- 论文最核心的贡献在于打破了“监督信号密度决定更新密度”的直觉 ,它包含以下几个核心观点
- 1)OPD 的更新是稀疏的、任务向量式的、离主方向的
- 2)这种稀疏性具有 功能性(可训练子网络)
- 3)但这种稀疏性并不等同于简单的优化 Landscape (仍需要 AdamW)
- 4)OPD 的几何特性是 On-Policy 训练 的本质结果,而非单纯由奖励稀疏性决定
OPD 的定位
- OPD的概念定位
- SFT/离线序列级蒸馏(SeqKD) :提供密集的 Token-level 监督,但训练数据是固定的(Off-Policy),可能导致训练和测试时的分布偏移(distribution shift),引发误差累积
- RLVR :数据来自当前策略(On-Policy),但学习信号是稀疏的轨迹级奖励,面临信用分配问题
- OPD :数据来自学生模型自身的 Rollout(On-Policy),同时用教师模型提供的密集Token级反馈替代稀疏的环境奖励
- 研究动机
- 过往研究表明,SFT 和 RLVR 在权重空间的行为截然不同(前者更新密集,后者更新稀疏且偏离主方向)
- 而 OPD 恰好处于两者之间,因此论文提出一个关键问题:OPD 的更新模式是类似于 SFT、RLVR,还是构成一个独特的机制?
实验设置与分析方法(核心方法)
- 为了回答上述问题,论文设计了一套详尽的分析框架,对模型检查点(checkpoint)之间的参数差值(Delta, \(\Delta W\))进行分析
研究对象 Model Pairs
- 论文分析了十组模型对,涵盖 LLM 和 VLM,以及三种 OPD 应用场景(大模型蒸馏小模型、能力整合、基于特权信息的自蒸馏)
- 关键对包括:
- OPD 组 :DS-Qwen OPD(使用 DeepScaleR/JustRL 教师)、MiniCPM OPD、Qwen2.5-VL OPD、Qwen3-1.7B OPD、Qwen3 OPSD
- 对照组 :离线蒸馏(Qwen-Math Distill)、RLVR(DeepScaleR RLVR, JustRL RLVR, Qwen2.5-VL GRPO)
核心度量指标
- 对于每个张量 \(W\),计算 \(\Delta W\)
- $$ \Delta W = W_{\text{trained} } - W_{\text{src} } $$
- \(W_{\text{src} }\)为源模型权重
- 注:所有计算使用 Float32 以确保精度
- 1)规模与坐标支持度(Scale and Coordinate Support) :
- 相对更新范数(Relative Delta Norm) :\(r = | \Delta W|_{F} / | W_{\text{src} }|_{F}\),衡量更新相对于原参数的大小
- 可见坐标稀疏度(Visible Coordinate Sparsity) :\(s_{\epsilon} = |\{i:|\Delta W_{i}|\leq \epsilon \} | / |\Delta W|\),在阈值 \(\epsilon=10^{-5}\) 下,统计有多少坐标的更新在数值上不可见(即接近零)
- 坐标能量集中度(Coordinate Energy Concentration) :\(c_{p} = \sum_{i\in \text{Top}_{p}(|\Delta W|)}\Delta W_{i}^{2} / | \Delta W|_{F}^{2}\),即更新能量中最大的 \(p%\) 坐标所占据的比例
- 2)谱结构(Spectral Structure) :
- 对 \(\Delta W\) 进行奇异值分解(SVD):\(\Delta W = U_{\Delta}\Sigma_{\Delta}V_{\Delta}^{\top}\)
- 前\(k\)阶谱能量(Top-\(k\) SVD Energy) :\(e_{k} = \sum_{i< k}\sigma_{i}^{2} / \sum_{i}\sigma_{i}^{2}\),衡量前\(k\)个奇异值承载的能量比例
- 稳定秩(Stable Rank) :\(\text{srank}(\Delta W) = | \Delta W|_{F}^{2} / | \Delta W|_{2}^{2}\),是秩的连续近似,值越低表示谱越集中
- 数值秩(Numerical Rank) :\(\text{rank}_{\tau}(\Delta W) = |\{i:\sigma_{i} > \tau \sigma_{1}\} |\),统计大于阈值 \(\tau\sigma_1\) 的奇异值数量
- 3)源权重几何对齐(Source-Weight Geometry Alignment) :
- 对源权重 \(W_{\text{src} }\) 进行SVD:\(W_{\text{src} } = U\Sigma V^{\top}\)
- 主子空间投影(Principal-Subspace Projection) :\(p_{k} = | U_{k}^{\top}\Delta W V_{k}|_{F}^{2} / | \Delta W|_{F}^{2}\),衡量 \(\Delta W\) 的能量有多少落在 \(W_{\text{src} }\) 的前 \(k\) 个主奇异方向上
- 坐标覆盖度(Visible-Update Coverage) :统计 \(\Delta W\) 的可见更新坐标,落在源权重主坐标掩码(\(M_{\text{prin} }\))或低幅值坐标掩码(\(M_{\text{low} }\))中的比例
论文核心观点与发现详解
观点一:OPD更新的稀疏性
- 发现1:全局微小且坐标稀疏
- OPD风格的更新相对范数极小(0.036% 到 0.142%),远小于离线蒸馏(11.94%)
- OPD的可见坐标稀疏度极高(66.72% 到 89.50%),而离线蒸馏几乎不稀疏(3.06%)
- 核心论点 :即使有密集的教师信号,OPD 也不会变得“密集”
- On-Policy 的训练方式能保持权重更新的局部性(locality)
- 发现2:分布式层和模块结构
- 稀疏性并非集中在某一层,而是分布在所有 Transformer 层中
- 模块偏好 :在大多数 OPD 运行中,FFN模块的相对更新范数最大,但并非绝对(例如 MiniCPM 的更新较为均匀)
- 这表明未来的参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)可能需要模块感知的容量分配,而非统一预算
- 发现3:OPD 与 RLVR 的掩码重叠
- 论文比较了 OPD 和 RLVR 发现的子网络掩码(即发生更新的坐标集)
- 核心论点 :OPD 和 RLVR 更新的坐标重叠度远高于随机基线(Random baseline)
- 例如,在 DS-Qwen 上,RLVR 到 OPD 的单向覆盖率(one-sided coverage)达 53.21%(随机为 17.50%)
- 结论 :OPD 和 RLVR 虽然更新幅度不同,但倾向于修改网络中与推理能力相关的相同坐标
- 发现4:子网络单独微调(Subnetwork Fine-Tuning)的有效性
- 这是一个关键的功能性测试
- 方法 :使用完整 OPD 训练发现的稀疏掩码(\(m_i = \mathbb{1}\{|\theta_{\text{full},i} - \theta_{0,i}| > \tau \}\)),重新从源模型开始训练,但只允许这些掩码内的坐标更新(梯度置零并冻结其他坐标)
- 结果 :仅使用 OPD 掩码(约 17.5% 的参数)进行训练,性能(AIME24/25 平均准确率 35.10%)几乎与完整训练(35.52%)持平,远优于随机掩码(32.92%)
- 结论 :OPD 的 Delta 向量是一个稀疏的任务向量(Sparse Task Vector)
- 它不仅是一个事后描述,而是在权重空间中实现行为改变的有效方向
- 发现5:AdamW 在 OPD 中的必要性
- 这是第二个关键的功能性测试,旨在反驳“稀疏更新=SGD 友好”的论点
- 方法 :在相同的 OPD 设置下,对比 AdamW(lr=1e-6)和 Vanilla SGD(lr=1e-2)
- 结果 :SGD 表现显著劣于 AdamW(最终准确率 37.92% vs 42.40%)
- 深入分析(优化器动态) :
- 动量(Momentum)余弦相似度虽然初始很高,但整个训练过程中波动剧烈(从 0.958 降至 0.008,甚至短暂为负),说明动量信息有用但不稳定
- 二阶矩(Second-Moment)变异系数(CV)在整个训练期间保持高位(平均 4.85),表明 AdamW 的自适应逐坐标缩放(Adaptive Coordinate-wise Scaling)在 OPD 中依然至关重要
- 结论 :OPD 的最终稀疏性并不意味着梯度几何也是稀疏的
- 密集的教师信号保留了梯度的异构性,使得自适应优化器仍然必要
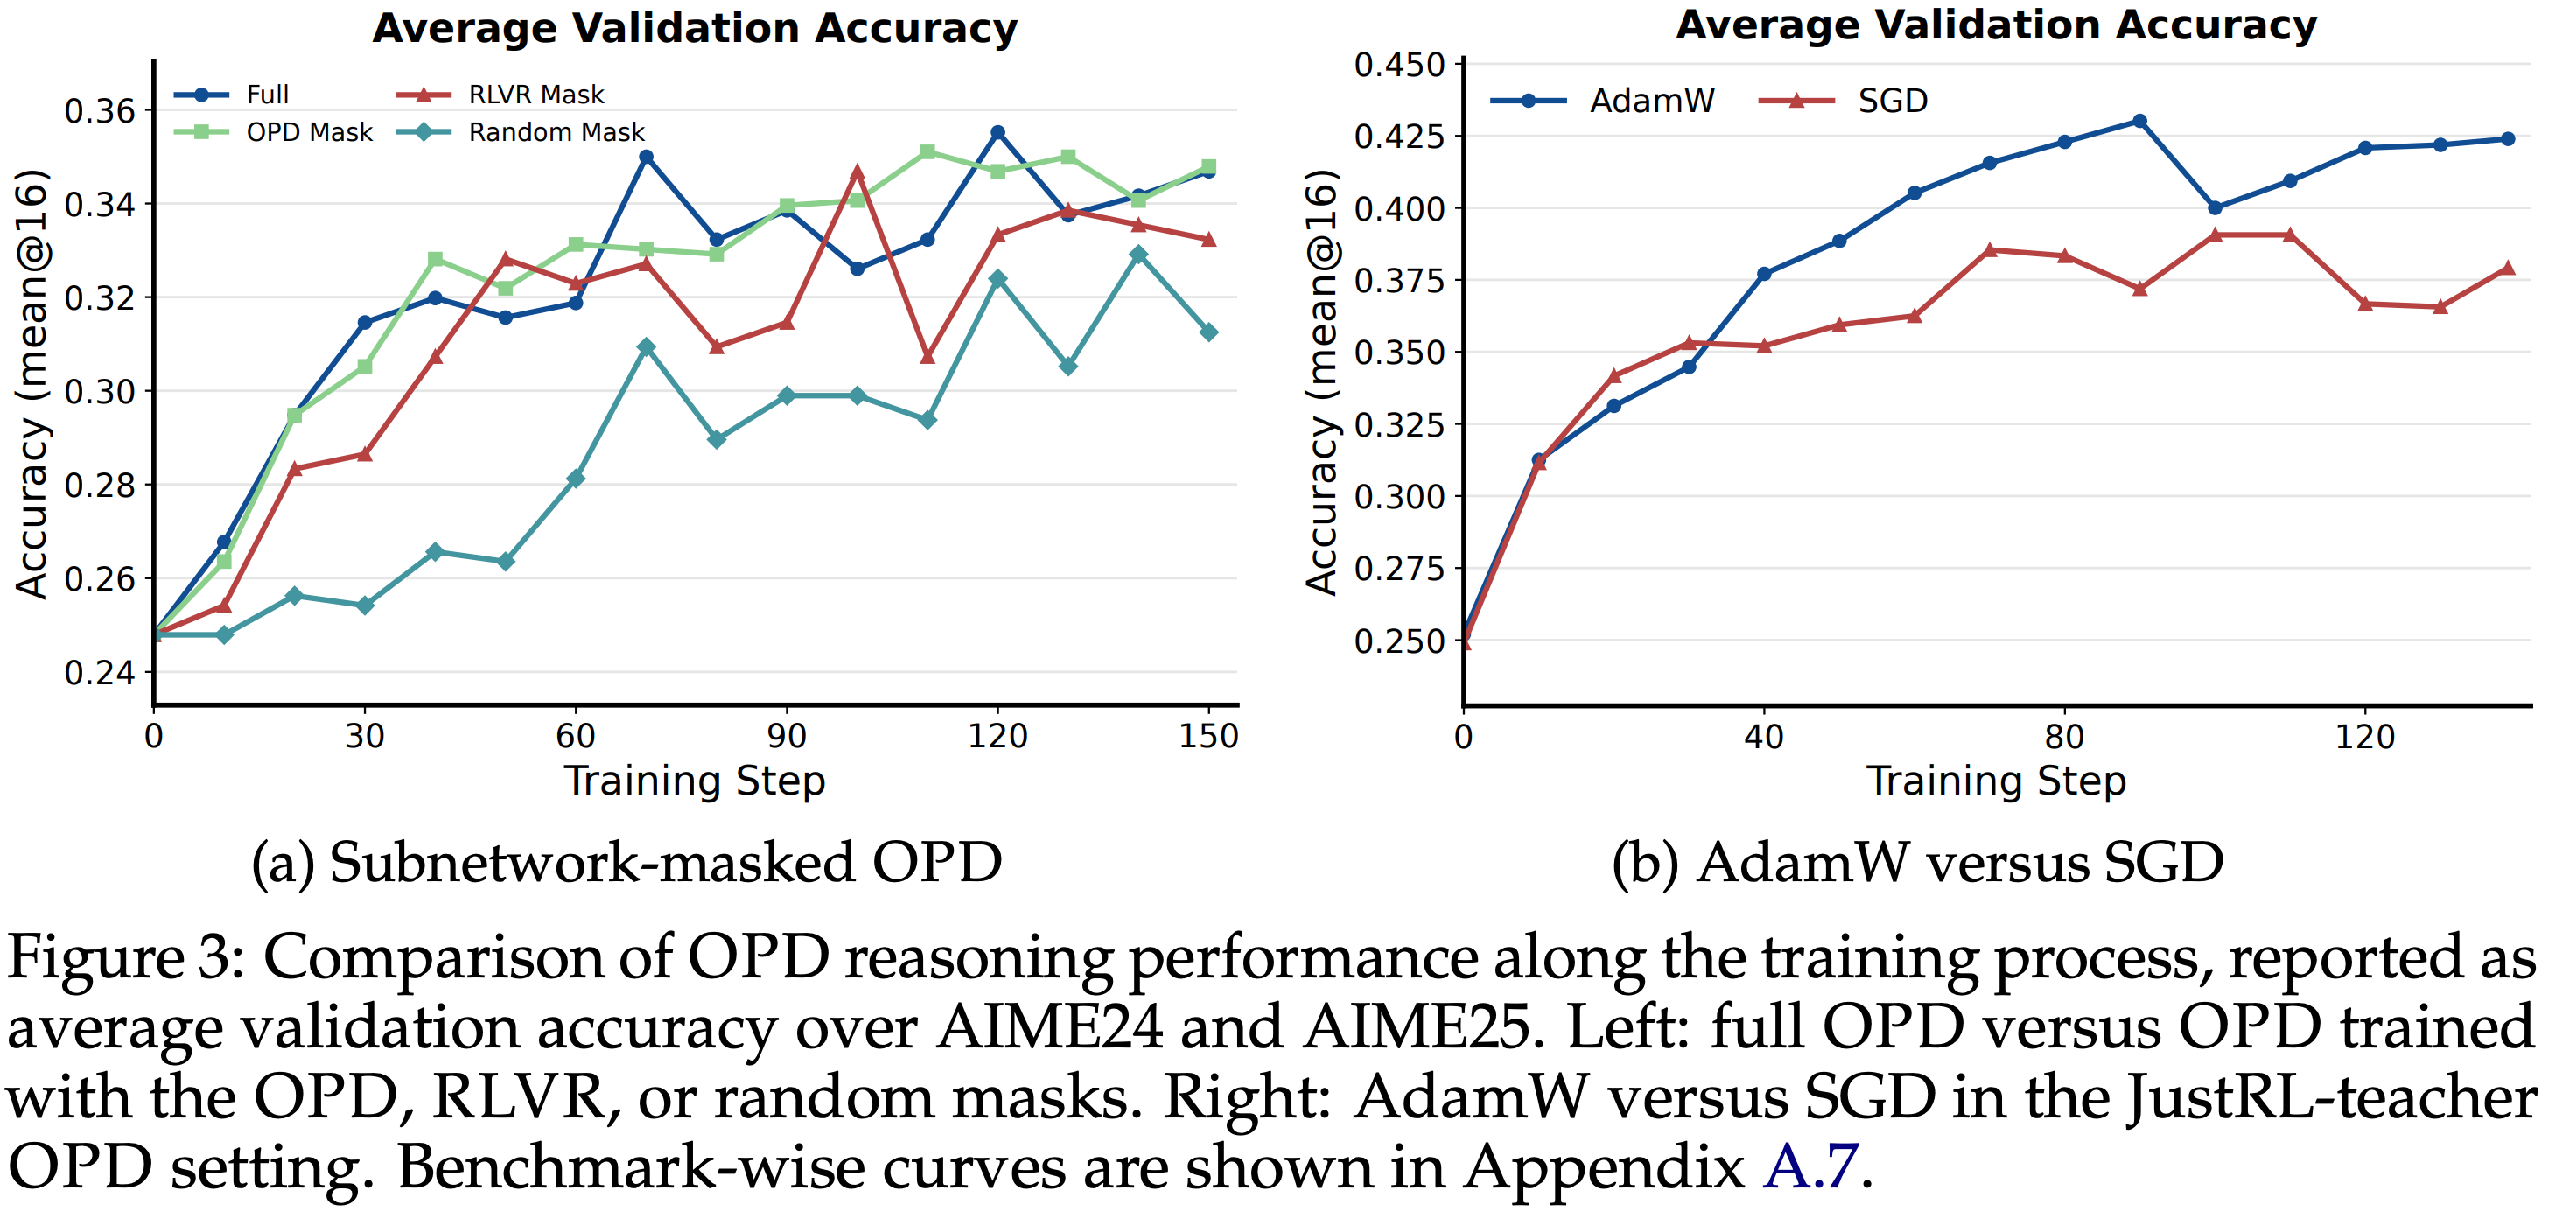
- 密集的教师信号保留了梯度的异构性,使得自适应优化器仍然必要
观点二:OPD 更新的几何特性
- 发现6:数值满秩但谱集中
- 数值秩 :在严格的数值阈值下(\(\sigma_i > 10^{-5}\sigma_1\)),OPD的更新矩阵是满秩的
- 谱集中度 :但其前 16 个奇异值承载了 19.69% 到 40.94% 的能量(远高于离线蒸馏的 8.57%),且稳定秩较低(7.25 到 20.31)
- 核心论点 :OPD 更新是方向各向异性(directionally anisotropic)
- 它可以用少数秩-1分量很好地近似,但并非精确低秩(exactly low-rank)
- 这意味着 LoRA 等低秩方法能捕获大部分更新能量,但不能完全复现完整的检查点Delta
- 发现7:远离源权重主方向的移动(Off-Principal Movement)
- 谱投影 :在秩分数(rank fraction)为 10% 时,OPD 更新在源权重主子空间上的投影能量(Principal Projection)低于 1%
- 说明 OPD 主要不放大源权重已有的高能量方向
- 坐标掩码分析 :源权重主坐标掩码仅覆盖了 4.39% 到 5.46% 的可见更新坐标(远低于 10% 的随机基线)
- 相反,源权重中幅值最小的 10% 坐标,却覆盖了 24.99% 到 48.57% 的更新坐标
- 核心论点 :OPD(以及 RLVR)倾向于在源权重本身很小的“低信号”区域写入更新,这可能是 On-Policy 训练的一个关键签名(signature),使其与离线蒸馏在几何上截然不同
- 谱投影 :在秩分数(rank fraction)为 10% 时,OPD 更新在源权重主子空间上的投影能量(Principal Projection)低于 1%
补充:定性解释 为什么密集监督的 OPD 会如此稀疏?
- 论文给出的定性解释是,OPD 在模型自身的行为分布(behavioral distribution)附近训练模型
- 与迫使模型拟合外部轨迹的离线蒸馏不同,OPD 是在学生自己的 Rollout 上提供教师反馈
- 因此,学生只需在熟悉的策略空间区域内进行微调(refine behavior),而无需广泛地重写参数来模仿离线的轨迹
补充:其他存在问题分析
- 低秩方法 :由于其谱集中性,LoRA 等方法是 OPD 的理想适配器
- 正交微调 :其离主方向的几何特性,提示了正交微调方法(如 OFT/BOFT)的适用性
- 优化器设计 :其矩阵级几何特性可能与标准 Muon 优化器的谱归一化(spectral normalization)不兼容,因此需要测试其高变体(High-pass variants)
补充:为什么说需要使用 Adam
- 背景:Do We Need Adam? Surprisingly Strong and Sparse Reinforcement Learning with SGD in LLMs, 20260207-20260224 论文中提到:在 RLVR(稀疏奖励的强化学习) 场景下:
- 参数更新是稀疏的(只修改少量子网络)
- 在这种稀疏更新结构下,Vanilla SGD 能够达到与 AdamW 相当甚至更好的效果
- 因此他们提出论点:当更新本身具有稀疏性时,AdamW 的自适应学习率和动量可能并非必要,SGD 就足够了
- 本论文作者并不同意将这个结论直接推广到 OPD 上,他们的态度是:
- “稀疏更新的存在,本身并不足以自动推导出 SGD 就够用了”
- OPD 的最终更新是稀疏的,但其训练过程中的梯度几何仍然是异构的、需要自适应调整的
- 密集的教师监督信号改变了梯度结构,使得 SGD 无法胜任,而 AdamW 仍然必要
- 在训练过程的每一步都使用稀疏梯度的场景下,SGD 有理论保证
- 但只在最终结果上看到稀疏性,并不能推导出 SGD 在整个训练过程中都是最优选择
- 理解:这里的梯度稀疏是指:在每一次迭代中,优化器所看到的梯度向量本身是稀疏的,即大部分元素为零或被人为截断为零
- 他们通过实验证明了:
- OPD 虽然也产生稀疏的最终更新(final deltas)
- 但在 OPD 中,SGD 明显劣于 AdamW(Fig 3(b))
- 这说明 “稀疏更新 = SGD 友好”这个结论是有条件成立的,不能无条件迁移
- 关于 稀疏更新 = SGD 友好 这个观点:
- 没有一条普遍适用的、严谨的数学定理可以直接证明“稀疏更新 = SGD 友好”
- 这个观点更多是一个在特定场景(如分布式训练、参数高效微调)下被观察和部分理论解释的现象,还不能作为一条普适的优化准则
SGD vs Adam in RLVR
- 原始论文:(SGD vs Adam in RLVR)Do We Need Adam? Surprisingly Strong and Sparse Reinforcement Learning with SGD in LLMs, 20260207-20260224
- 一句话总结:
- 本文挑战了 在 LLM 训练中,自适应优化器(特别是 AdamW)是必要选择 的传统认知
- 个人理解:
- 这里的理论部分可以参考,但是实验结果部分,除非在非常详细的 学习率下做过验证,否则不太置信
背景与动机(为什么要重新审视优化器)
RLVR 与 SFT 的根本差异
- 论文指出,RL,尤其是 RLVR,与 SFT 在训练本质上存在两个关键差异:
- 非平稳性(Non-stationarity) :
- 在 Online RL 中,训练数据由当前最新的策略采样产生,导致数据分布和优化损失 Landscape (Loss Landscape)随训练动态演变
- SFT 的数据分布是固定的
- 信息稀疏性(Sparse Information) :
- RL 的每个 Episode 仅从环境中获得 \(O(1)\) 比特的外部奖励信息
- SFT 的每个 Token 都提供监督信号(\(O(\# \text{tokens})\) 比特)
- 非平稳性(Non-stationarity) :
- 这些差异导致 RL 的训练动态与 SFT 截然不同:
- RL 倾向于更新更少的参数(2025),且更新集中在参数空间的非主方向上(2025)
- RL 倾向于更新更少的参数(2025),且更新集中在参数空间的非主方向上(2025)
对 AdamW 必要性的质疑
- AdamW 结合了 动量 和 自适应学习率
- 在 SFT 中,这两者被证明对处理 Transformer 的复杂损失 Landscape 至关重要(P2023; 2024)
- 但本文提出,在 RL 的非平稳环境下:
- 动量可能失效 :由于损失 Landscape 不断变化,累积的历史梯度(动量)可能与当前梯度方向不一致,甚至产生误导
- 自适应学习率可能冗余 :RL 中参数梯度的二阶矩估计(\(\sqrt{v}\))的方差远小于 SFT,表明参数间需要差异化更新的程度较低
核心假设与研究问题
- Hypothesis 1 : 在 RLVR 中,动量和自适应学习率的重要性远低于在 SFT 中
- 因此,不包含这两者的 SGD 应能达到与 AdamW 相当的性能
- 为了验证这一假设,论文通过消融实验将 AdamW 拆解为:
- RMSProp :移除动量,仅保留自适应学习率
- SGD + Momentum :移除自适应学习率,仅保留动量
- Vanilla SGD :两者均移除
实验设置(保证结论的泛化性)
- 为了严谨验证,实验覆盖了以下维度:
- RL 算法 :主实验使用 GRPO ,验证实验使用 PPO
- 任务领域 :
- 1)数学推理 :NuminaMath-CoT 训练集,评估于 MATH-500, AIME, AMC, OlympiadBench, GPQA Diamond
- 2)代码生成 :APPS, CodeContests, TACO 等来源,评估于 HumanEval, MBPP 及其 Plus 版本
- 3)RLVE (RL with Adaptive Verifiable Environments) :提供动态演变的 LeetCode 风格任务,支持长时间训练验证
- 模型家族 :Qwen3-1.7B, Qwen3-8B, Llama-3.1-8B-Instruct
- 注:模型偏小,不一定代表大模型也可以
- 关键超参数 :AdamW 学习率设为 \(10^{-6}\),SGD 学习率需调至 \(10^{-1}\)(原因见后文分析)
核心实验结果与发现
发现一:SGD 性能匹配甚至超越 AdamW
- 数学任务(Table 2):在 3K Response 长度下,SGD 在所有模型上平均性能均超过 AdamW;在 8K 长度下,SGD 与 AdamW 表现持平或略优
- 代码任务(Table 3):SGD 在 HumanEval 和 MBPP 上的 pass@1 和 pass@10 指标上一致且显著优于 AdamW(平均 pass@1 提升 8.7%)
- 学习曲线(Figure 1):SGD 的训练奖励和验证奖励曲线在训练后期均不低于 AdamW
发现二:动量和自适应学习率无益甚至有害
- SGD + Momentum :在绝大多数情况下性能低于 Vanilla SGD,说明动量在 RL 的非平稳环境中是反作用的
- RMSProp :结果好坏参半(在 Qwen 上略有提升,在 Llama 上下降),表明自适应学习率并非稳定的增益来源
- 两者均不构成 RLVR 中的必要组件(Table 2)
发现三:SGD 更新极度稀疏且低秩
- 这是论文最惊艳的发现(Table 4, Figure 3, 4):
- 稀疏性定义 :
$$
\text{sparsity}(\theta^0,\theta^1) = 1 - \frac{|\theta^1 - \theta^0|_0}{n}
$$- 其中 \(\theta^0, \theta^1\) 为训练前后参数,\(n\) 为参数总数,\(\ell_0\) 范数使用阈值 \(10^{-5}\)(考虑 bfloat16 精度)
- 结果 :
- AdamW 更新约 10% 的参数(稀疏度 90%)
- SGD 仅更新 0.02% 的参数(稀疏度 99.99%),差距超过 1000 倍
- 这种稀疏性 均匀分布 在所有层,而非集中于特定模块(Figure 3)
- SGD 更新的有效秩(Effective Rank)远低于 AdamW,表明更新被限制在极低维的子空间中
发现四:结论在 PPO 和长时间训练下依然成立
- PPO 验证(Table 5):SGD 在 PPO 下与 AdamW 性能相当,且策略网络更新稀疏度达 99.92%,甚至 Critic 网络更新稀疏度也高达 92%
- RLVE 长时间训练(Table 6, Figure 4):经过 500 步训练后,SGD 依然保持约 99.8% 的稀疏度,而 AdamW 的稀疏度随时间快速下降。证明 SGD 的稀疏性不是暂时的,而是持续的
补充:为什么 SGD 需要极大的学习率?(Appendix B)
- 论文测量了 AdamW 的有效学习率 :
$$
\eta_{\text{eff} } = \frac{\eta}{\sqrt{v} + \epsilon}
$$- 注:这相当于是模型更新时的真实学习率
- 观测:
- 在 RLVR 训练中,尽管 AdamW 的名义学习率为 \(10^{-6}\),但有效学习率分布范围在 \(10^{-1}\) 到 \(10^2\) 之间(Figure 6),其主体集中在 \(10^0\) 到 \(10^1\)
- 结论:SGD 需要设置 \(\eta = 10^{-1}\)(比 AdamW 名义值大 \(10^5\) 倍)才能达到相当的更新幅度
- 这是关键的设计思路:SGD 的 LR 需通过有效学习率分布来确定,而非与 AdamW 的名义 LR 直接对比
- 不同学习率下 SGD 的表现见原文图 5
- 问题:针对 SGD 精确搜参了,但是对 Adam 没有?
补充:稀疏性分析流程
- 1)在训练完成后,获取模型 checkpoint \(\theta^0\)(训练前)和 \(\theta^1\)(训练后)
- 2)计算差值矩阵 \(\Delta = \theta^1 - \theta^0\)
- 3)统计 \(\Delta\) 中绝对值大于 \(10^{-5}\) 的元素个数,作为更新参数计数
- 4)计算稀疏度公式如上
- 5)对于有效秩,对每个二维权重矩阵进行 SVD,计算能解释 99% 谱能量的奇异值个数,取均值
补充:理论分析与洞察(SGD 更新为何更稀疏)
自适应学习率抑制稀疏性(Section 7)
- 论文提出核心猜想:自适应学习率是导致更新密集的根本原因
- AdamW 和 RMSProp(均含自适应)产生的更新密度远高于 SGD 和 SGD+Momentum(均不含自适应)
- 自适应机制会放大历史上梯度较小的参数的更新幅度,使得这些微小的更新在数值精度(bfloat16)下得以保留,从而表现为“非零”更新
- 而 SGD 没有这种放大效应,微小梯度更新在浮点舍入(Floating-point Rounding)下被自然截断为零,形成天然的正则化稀疏效应
- 好处:SGD 更新参数少于 0.02% 意味着 RL 微调实质上是在进行极度稀疏的权重调整 ,这解释了 RL 为何较少灾难性遗忘
- 因为大部分原始能力被保留
动量在非平稳环境下的方向冲突(Section 3, Appendix E)
- 在 SFT 中,当前梯度 \(g_t\) 与历史动量 \(m_{t-1}\) 的余弦相似度高达 0.997 ,表明方向高度一致
- 在 RL 中,该余弦相似度骤降至 -0.007 ,近乎正交
- 这说明 RL 的损失 Landscape 变化剧烈,历史动量已成为“过时信息”,不仅无用,反而可能引入噪声或干扰,解释了为何 SGD+Momentum 表现不佳
ExpRL
- 原始论文:ExpRL: Exploratory RL for LLM Mid-Training, Stanford & CMU, 20260615
- 本文的 核心目标时优化和重新定义 LLM 的 “Mid-Training” 阶段
- 传统意义上的 Mid-Training(或称 Post-Training 的前期阶段)通常指:
- 在 Pre-training 之后、RL 微调(RLHF/GRPO)之前,
- 通过 SFT 在高质量指令数据或 CoT 数据上训练,让模型学会遵循指令和基本推理格式
- 个人理解:
- 论文这里对 Mid-training 的理解没问题,但是一般来说 Mid-training 的数据量级都很大,但本文的方法不太支持大面积训练
- 虽然本文号称是一个 Mid-training 方法, 但个人觉得理解为 RL 的冷启动更合适,论文似乎把 Mid-training 的定义搞混了?
- 本文的观点是 :这种传统的 Mid-Training(即 SFT on 参考解法)存在根本性缺陷,尤其对于困难推理任务 :
传统 Mid-Training (SFT/Imitation) ExpRL 提出的新型 Mid-Training 目标:让模型模仿 参考解法的 token 序列 目标:让模型探索并覆盖 更多样的有效推理路径 监督信号:Teacher Forcing(Token-level 交叉熵) 监督信号:参考引导的密集奖励(Outcome/Process-level) 训练方式:Offline(使用固定数据集) 训练方式:On-Policy RL(模型自己采样,自己学习) 关键问题:分布偏移 ,参考解法远非模型当前能力所能生成 关键优势:奖励进展而非完美 ,即使最终答案错误,也能从部分正确步骤中学习 结果:可能削弱模型原有推理能力,且无法覆盖模型本身不擅长的求解路径 结果:显著提升 Pass@k(覆盖度),为下游 RL 提供更好的初始化
ExpRL 具体 “优化” 了 Mid-Training 的哪些方面?
- (1) 优化了 训练信号(Training Signal)
- 之前 :Mid-Training 使用参考答案作为 Targets(目标输出) ,要求模型逐 token 拟合
- 现在(ExpRL) :参考答案作为 Scaffolds(脚手架) ,用于构建 Dense Rewards(密集奖励)
- 模型被鼓励去”靠近”参考答案,而不是”复刻”参考答案
- (2) 优化了 学习范式(Learning Paradigm)
- 之前 :Offline 学习(数据固定)
- 现在 :On-Policy RL ,模型在训练中不断采样新轨迹,并用即时奖励反馈更新自己
- 这更符合 RL 的 “探索-利用” 本质
- (3) 优化了 覆盖度(Coverage)而非仅仅是准确率
- 论文明确指出,Mid-Training 的目标不应是提高 Pass@1(一次采样的准确率),而应是提高 Pass@k(在 k 次采样中至少一次正确的概率)
- 更高的 Pass@k 意味着模型覆盖了更多样的解题路径,这对于后续的稀疏奖励 RL 至关重要
- 实验(原文图 2、原文表 2)专门报告了 Pass@16,证明 ExpRL 确实优化了这一指标
- 论文明确指出,Mid-Training 的目标不应是提高 Pass@1(一次采样的准确率),而应是提高 Pass@k(在 k 次采样中至少一次正确的概率)
- (4) 优化了 与下游 RL 的衔接(Initialization for RL)
- 这是论文最重要的一层优化:ExpRL 不追求在 Mid-training 集上做到最好,而是追求让模型成为一个 “更好的 RL 起点”
- 实验证明(原文表 1),ExpRL 初始化后的模型,经过同样的下游稀疏 RL,最终性能显著优于 SFT 或 GRPO 初始化的模型
- 这说明 ExpRL 对 Mid-Training 的优化是 “面向未来 RL”(RL-aware) 的,而不仅仅是优化当前阶段指标
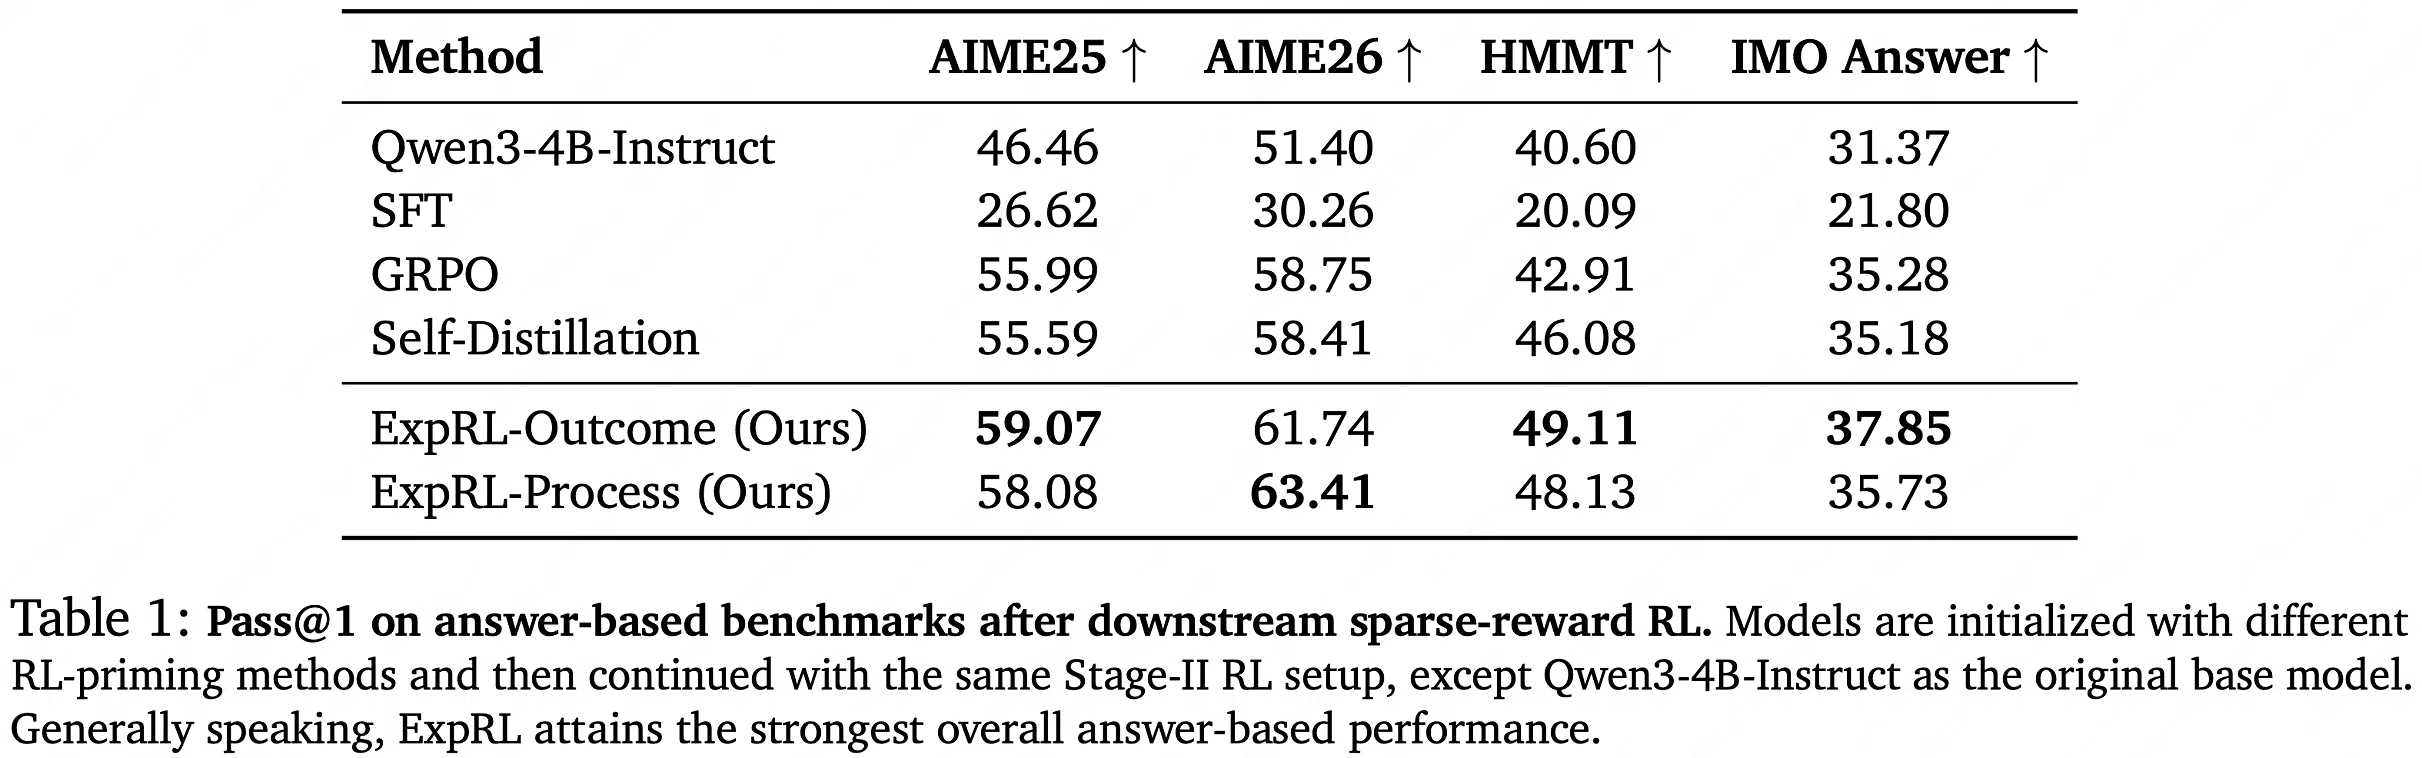
- 这说明 ExpRL 对 Mid-Training 的优化是 “面向未来 RL”(RL-aware) 的,而不仅仅是优化当前阶段指标
特别地:论文对 Mid-Training 提出的新评价标准
- 论文提出,评价 Mid-Training 好坏的标准不应只看 Mid-training 集上的准确率,而应看:
- 1)Stage-I Pass@k :模型在 Mid-training 后,在 Held-out 难题上的采样覆盖度(原文表 2)
- 2)Stage-II 最终性能 :经过该初始化后,下游稀疏 RL 能提升多少
- 3)Behavioral Changes :是否学会了更多搜索、回溯、验证等有效推理行为(原文图 5)
- 4)熵与探索稳定性 :训练过程中 Token 级熵是否快速坍塌
核心问题定义
- 核心问题 :论文指出,将稀疏奖励 RL(如 GRPO)应用于提升 LLM 的推理能力时,其成功与否高度依赖于Base Model 自身的覆盖度(Coverage)
- 覆盖度可以理解为模型在采样时,能够生成至少一条完整且正确的推理路径的概率(用 Pass@k 衡量)
- 对于极具挑战性的数学问题,基础模型几乎无法在有限次采样中给出正确答案(Pass@k 极低),导致稀疏奖励 RL 无法获得有效的学习信号(因为大部分 Rollout 的奖励均为 0),训练难以启动
- 现有方案的局限 :
- 1)监督微调(SFT) :直接让模型模仿人工撰写的参考解法
- 但这存在分布偏移问题,因为参考解法的风格和思路可能远非模型当前能力所能生成,强行克隆会损害模型的固有推理能力
- 2)自我蒸馏(Self-Distillation) :让模型学习由“教师模型(Teacher,通常是在参考解法条件下生成的)”产生的输出
- 这同样面临严重的 Off-Policy 问题,教师模型与学生的分布差异巨大(KL 散度高),导致优化不稳定
- 1)监督微调(SFT) :直接让模型模仿人工撰写的参考解法
- 本文解决方案 :提出 ExpRL (Exploratory RL)
- 其核心思想是:不将参考解法作为“模仿目标”,而是将其作为“奖励脚手架(Reward Scaffolds)”
- ExpRL 利用一个 LLM Judge,将模型自己生成的推理轨迹(On-Policy Rollouts)与参考解法进行对比,从而生成稠密的、能反映部分进展(Partial Progress)的奖励信号,以此引导模型在探索中逐步覆盖更多有效的求解路径
- 个人理解:本文号称是一个 Mid-training 方法, 但个人觉得理解为 RL 的冷启动更合适,论文似乎把 Mid-training 的定义搞混了?
- 因为一般来说 Mid-training 的数据量级都很大,但本文的方法不太支持大面积训练
核心方法:ExpRL 详解 (重点)
- ExpRL 是一个两阶段(或可作为独立的 Stage-I)的 RL Mid-training 框架
Design Principle
- ExpRL 的设计基于一个关键的“验证-生成差距(Verification-Generation Gap)”:
- 现代 LLM 在评判一个解法是否符合参考答案方面,远比生成一个正确解法要容易
- ExpRL 利用这一差距,将人工参考解法转化为一个灵活的评判标准,从而对错误但包含部分正确步骤的推理过程给予奖励
- EXPRL 的目标是拓宽模型对有效推理路径的覆盖度(Coverage) ,而不仅仅是提升 Mid-training 集上的最终准确率(Pass@1)
- 这种覆盖度的提升(反映在 Pass@k 上)为后续的稀疏奖励 RL 提供了一个强大的初始策略
- 理解:这里的理解很好,给模型更大的熵(更大的 Pass@k,也就是更大的原子能力)
方法流程与架构
- 整个方法分为两个阶段(Stage-I 和 Stage-II),其中 Stage-I 是核心
Stage-I: 探索性 RL Mid-training (ExpRL Priming)
- 1)数据与采样 :
- 输入数据集 \(\mathcal{D}_{\text{mid} } = \{(\mathbf{x}_i, \mathbf{y}_i^*)\}_{i=1}^N\),其中 \(\mathbf{x}\) 是问题,\(\mathbf{y}^*\) 是步骤级的参考解法
- 策略网络 \(\pi_\theta\)(即待训练的 LLM)针对每个问题 \(\mathbf{x}\) 采样 \(G\) 个完整的推理轨迹(Rollouts)\(\mathbf{y}\)
- 关键 :采样过程完全基于原始问题提示(Original Problem Prompt) ,不向策略网络泄露任何参考解法信息
- 2)奖励生成:基于参考解法的密集奖励 (Reference-Guided Dense Rewards)
- 使用一个独立的 LLM 评判器 \(J\)(在主要实验中,与策略网络规模相同,但在扩展实验中使用更小的模型)
- 评判器接收三个输入:问题 \(\mathbf{x}\),模型生成的轨迹 \(\mathbf{y}\)(或其前缀 \(\mathbf{y}_{\le t}\)),以及对应的参考解法 \(\mathbf{y}^*\)
- 评判器根据一个固定的评分规则(Rubric),输出一个 1-5 的整数分 \(\tilde{s}\),并归一化到 \([0,1]\) 区间:\(s(\mathbf{x},\mathbf{y},\mathbf{y}^*) = (\tilde{s} - 1) / 4\)
- 重要约束 :评判器被严格指示为“验证(Verify)”而非“求解(Solve)”,它只能基于生成的文本与参考解法的一致性进行评分,禁止自行补全或修正模型的错误
- 3)两种密集奖励变体 (注:两种奖励是独立的,是可选项,论文中针对这两种变体都进行实现了和实验对比):
- ExpRL-Outcome(结果级) :
- 将上述得分 \(s(\mathbf{x},\mathbf{y},\mathbf{y}^*)\) 直接作为整个轨迹的奖励 \(R\)
- 这为不完全正确(Incorrect)但包含有效思路的轨迹提供了比 0 更丰富的反馈
- ExpRL-Process(过程级) :
- 首先,根据固定的分隔符(如“###”)将完整轨迹 \(\mathbf{y}\) 切分为一系列前缀 \(\{\mathbf{y}_{\le t}\}_{t=1}^T\)
- 对每一个前缀 \(\mathbf{y}_{\le t}\),使用相同的评判器获得得分 \(s_t = s(\mathbf{x}, \mathbf{y}_{\le t}, \mathbf{y}^*)\)
- \(s_T\) 即为完整轨迹的得分
- 计算每个片段(Segment)(即从前缀 \(t-1\) 到 \(t\) 新生成的部分)的优势值(Advantage)\(A_t(\mathbf{x},\mathbf{y})\),其定义如下公式 (2):
$$
A_t(x,y) = \begin{cases} s_t - s_{t-1}, & \text{if } t > 1, \ s_1 - s_T, & \text{if } t = 1. \end{cases}
$$- \(t\):前缀的索引
- \(s_t\):第 \(t\) 个前缀的评判得分
- \(A_t\):第 \(t\) 个片段的优势值
- 设计思路 :对于 \(t>1\),\(A_t\) 衡量了当前片段相较于上一个片段,在接近参考解法方面是进步(正奖励)还是退步(负奖励)
- 第一个片段 \(A_1\) 被设为 \(s_1 - s_T\),而非 \(s_1\),这使其尺度与后续的差分奖励可比,避免第一步的绝对分数主导整个更新
- 这种设计鼓励模型“步步为营”,持续做出有意义的进展
- 在附录 A.2 中,论文对比了多种优势归一化方案(公式 4-6),包括:
- EndNorm:\(A_t = s_t - S_T\)(每个前缀都相对于最终得分)
- DeltaNorm:即本文上面采用的方案
- GroupNorm:组内归一化
- 原文图 8 显示,尽管这些方案在细节上略有差异,但 ExpRL-Process 的整体性能对这些归一化方式并不高度敏感,这进一步说明,核心思想是”让奖励反映相对进步”,而 本文的方案是实现这一目标的一种合理且有效的方式
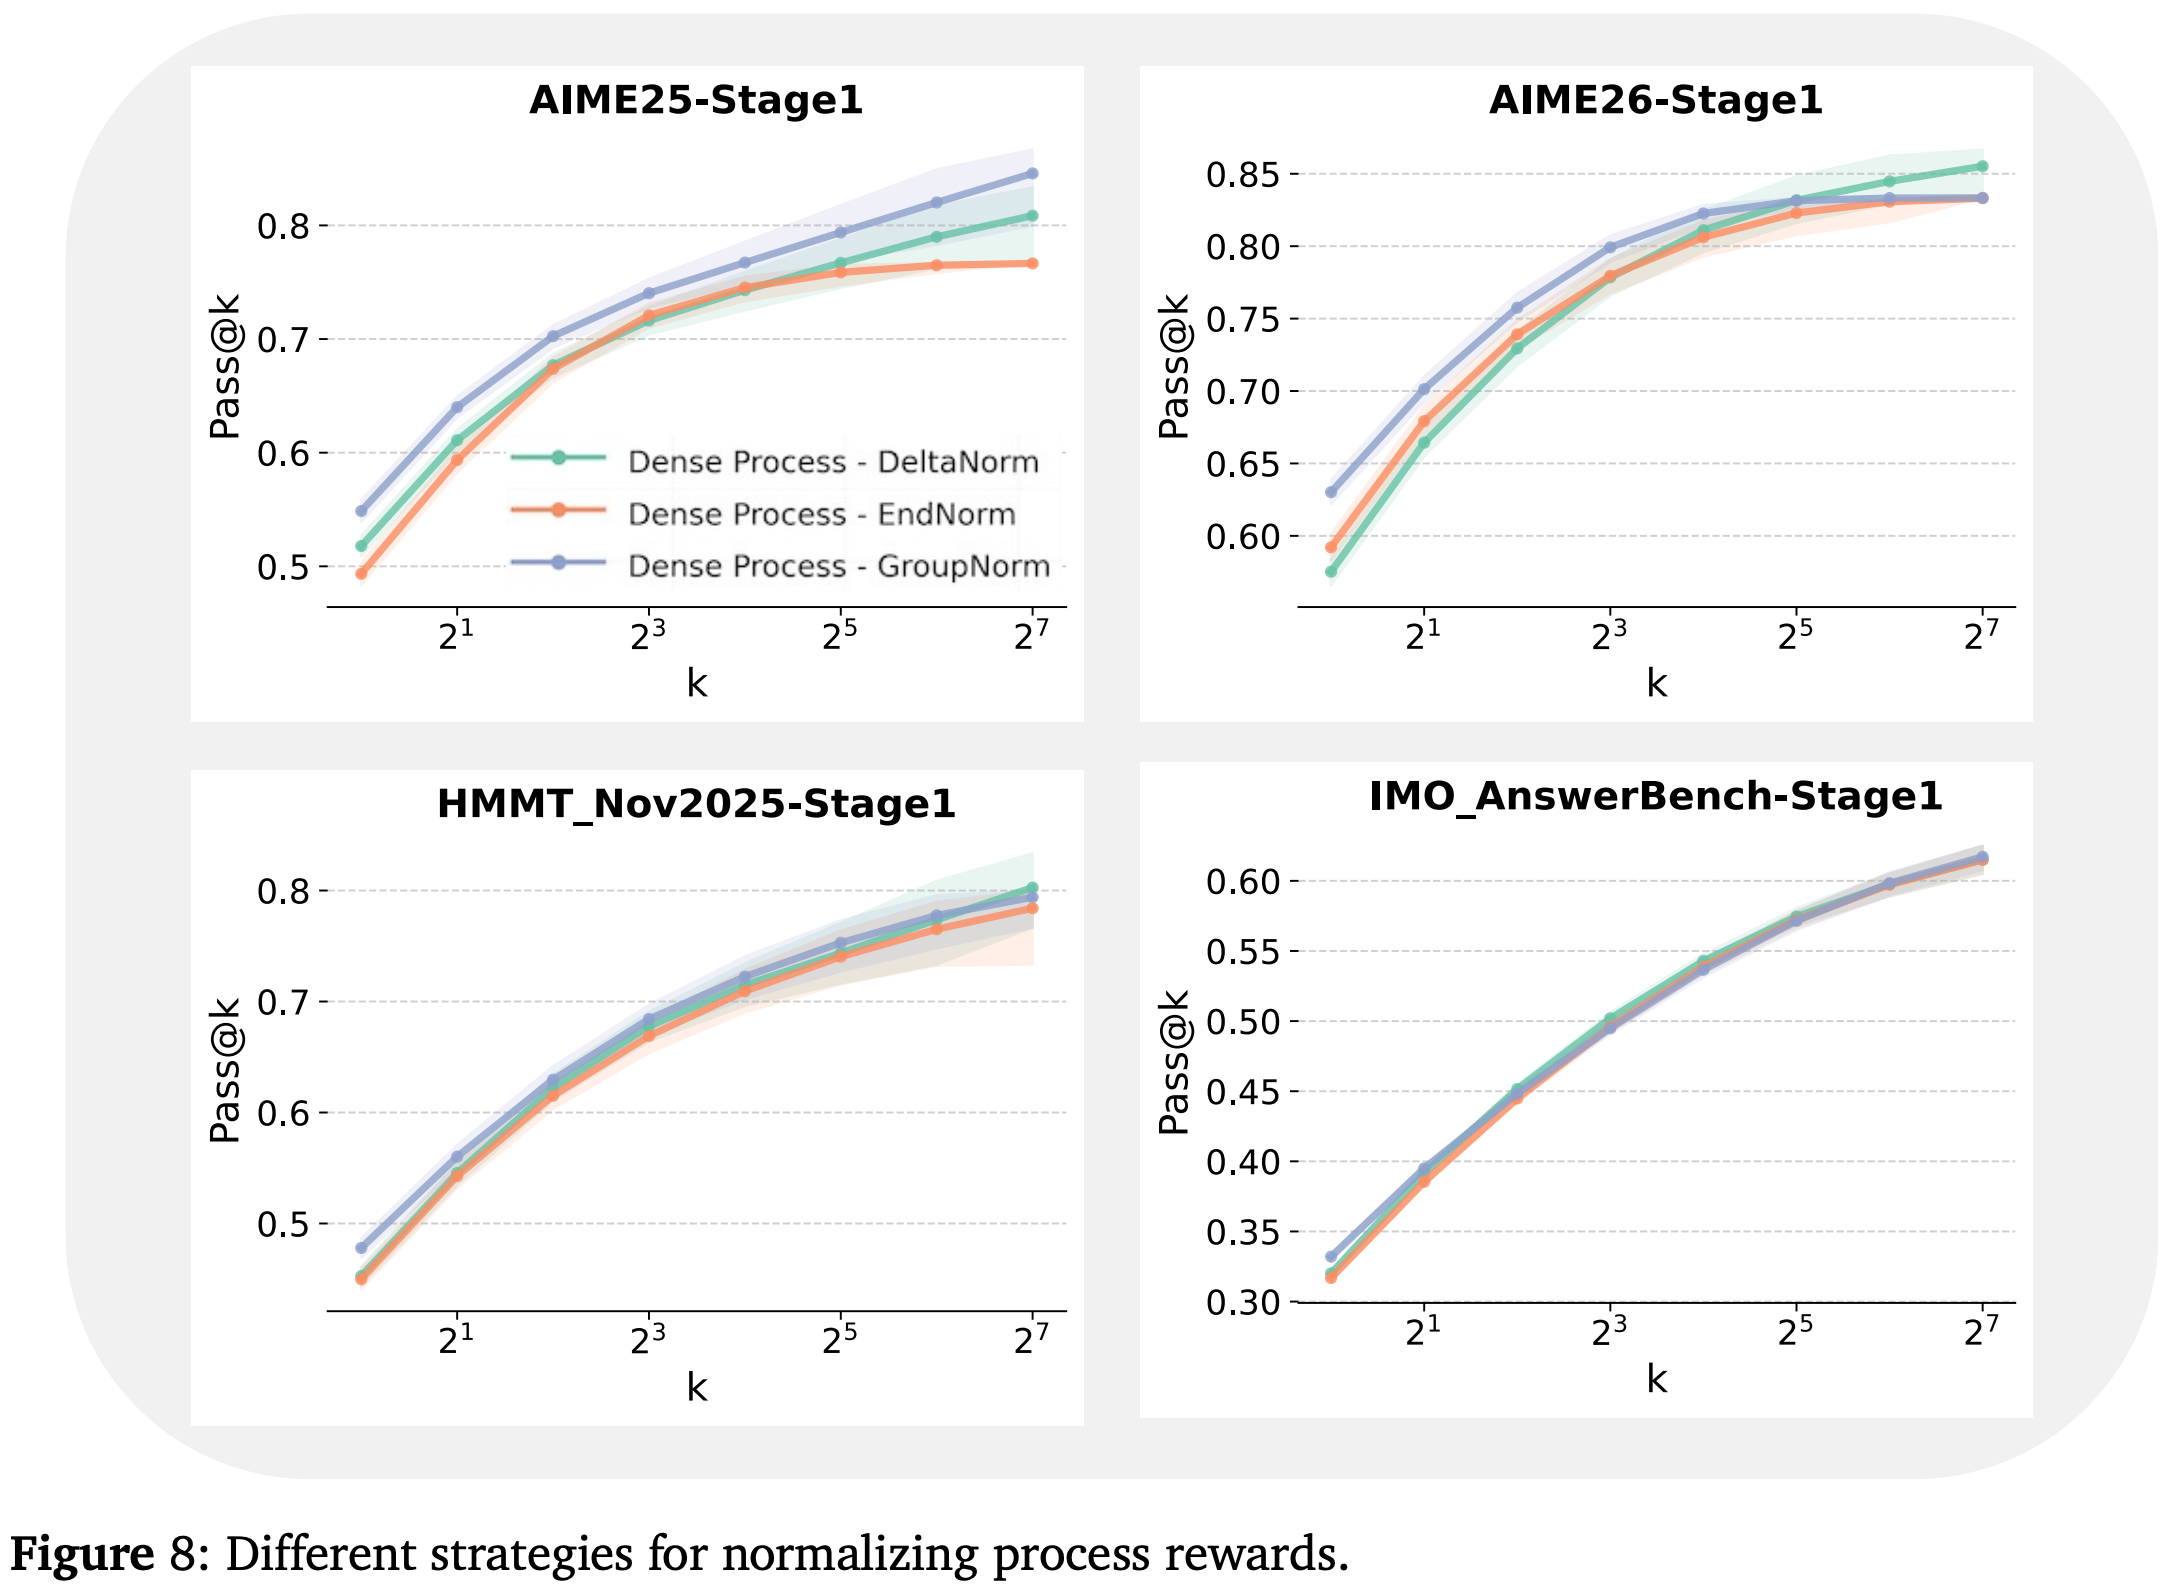
- ExpRL-Outcome(结果级) :
- 4)Optimization Objective :
- 使用带 KL 正则项的 RL 目标函数,公式 (3):
$$
\max_{\theta} \mathbb{E}_{(\mathbf{x},\mathbf{y}^*)\sim \mathcal{D}_{\text{mid} } } \left[ \mathbb{E}_{\mathbf{y}\sim \pi_\theta(\cdot|\mathbf{x})} [R(\mathbf{x},\mathbf{y},\mathbf{y}^*)] - \beta \text{KL}(\pi_\theta(\cdot|\mathbf{x}) | \pi_0(\cdot|\mathbf{x})) \right]
$$- \(\theta\):策略网络的可训练参数
- \(R(\mathbf{x},\mathbf{y},\mathbf{y}^*)\):由 ExpRL-Outcome 或 ExpRL-Process 定义的奖励函数
- \(\pi_\theta\):当前策略
- \(\pi_0\):参考策略(通常是初始模型),用于约束策略更新,防止偏离太远
- \(\beta\):KL 惩罚系数
- 算法实现 :
- 对于 ExpRL-Outcome :使用 GRPO 风格的更新,对组内奖励进行归一化
- 对于 ExpRL-Process :使用 REINFORCE 风格的更新,直接使用公式 (2) 中计算出的 \(A_t\) 作为 Token 级别的优势,不进行额外的组归一化
- 使用带 KL 正则项的 RL 目标函数,公式 (3):
Stage-II: 下游稀疏奖励 RL
- 将经过 Stage-I 训练的模型作为初始策略
- 在下游目标任务数据集 \(\mathcal{D}’\) 上,运行标准的稀疏奖励 RL(如 GRPO)
- 此阶段的奖励 \(r(\mathbf{x},\mathbf{y})\) 是二元的(Binary),仅根据最终答案是否匹配(如字符串匹配)给出 1 或 0
- 实验证明,ExpRL 提供的初始化能使此阶段更高效,最终性能更强
实验
实验设置
- 基础模型 :Qwen3-4B-Instruct
- 评判器 :默认使用与基础模型相同的 Qwen3-4B-Instruct(一个副本)
- 在扩展实验中使用更小的 0.6B 和更大的 8B/14B 模型
- Mid-training 数据集 :混合了 InT 和 POPE 中的困难数学问题
- 评估基准 :AIME 2025, AIME 2026, HMMT (Nov 2025), IMO-AnswerBench
- 这些是极具挑战性的 held-out 数学推理数据集
- 基线方法 :
- SFT :在参考解法上进行监督微调
- 稀疏奖励 GRPO :仅基于最终答案正确性的标准 GRPO
- Self-Distillation :使用条件于参考解法的教师模型进行自我蒸馏
主要发现
Finding 1: ExpRL 为下游 RL 提供了更强的初始化 (Stronger Initialization)
- 证据 :原文表 1 显示,经过 Stage-II 稀疏 RL 后,所有 ExpRL 变体(特别是 ExpRL-Outcome)在 AIME25、AIME26、HMMT 和 IMO-Answer 上的 Pass@1 均显著优于所有基线。例如,在 AIME26 上,ExpRL-Process 达到 63.41%,而最强的基线 GRPO 仅为 58.75%
- 结论 :参考解法当被用作“评分依据”而非“模仿目标”时,能更有效地提升模型的最终 RL 性能
Finding 2: ExpRL 在 Stage-I 结束时已能显著提升模型能力
- 证据 :
- 原文表 2 显示,仅在 Stage-I 之后,ExpRL 模型的 Pass@1 和 Pass@16 就已超过了基线和 SFT,在 AIME26 和 HMMT 上提升尤为明显
- 原文图 2 展示了在 HMMT 上,ExpRL 的 Pass@k 曲线在所有 k 值下都更高,表明其采样效率(覆盖度)得到提升
- 原文图 3(左)显示,ExpRL-Process 在训练中能最快地“解锁(Unlock)”可解问题(即能采样到正确答案的问题)
- 原文图 3(中)显示,与 GRPO 的熵值快速 collapse 不同,ExpRL 的 Token 级熵值保持稳定甚至增加,表明其维持了更好的探索(Exploration)能力
- 原文图 4 显示,Self-Distillation 中的“教师”模型从一开始就与学生模型有极高的 KL 散度,说明其目标分布对于学生模型来说“遥不可及”,优化不稳定
- 结论 :ExpRL 不仅仅是优化了 Mid-training 奖励,而是从根本上构建了一个更好的、覆盖更广的 RL-ready 初始化策略
Finding 3: ExpRL 改变了模型的推理行为 (Changes Reasoning Behaviors)
- 证据 :原文图 5 通过 LLM 标注(使用 Claude Sonnet 4)分析了模型行为的变化。与基础模型相比,ExpRL 在“验证(Verification)”、“自我修正(Self-Correction)”和“回溯(Backtracking)”等搜索导向的行为(Search-oriented Behaviors)上获得了净增长(Net Gain)
- 相比之下,SFT 丢失了验证行为,GRPO 的行为变化则较小
- 结论 :ExpRL 不仅提高了答案正确率,还从根本上改变了模型生成推理轨迹的分布,使其更倾向于进行深度、自适应的搜索,这解释了其覆盖度提升的原因
Finding 4: ExpRL 的通用性与稳健性 (Extends to Mixed-Domain and Smaller Judges)
- 跨领域泛化 :原文表 4 显示,在一个包含数学、科学问答(SciKnow)和编程(LiveCodeBench)的混合域(Mixed-Domain)数据集上,使用 8B 策略和 4B 评判器,ExpRL-Outcome 仍能显著提升基础模型在所有 Pass@1 指标上的表现,证明了其泛化能力
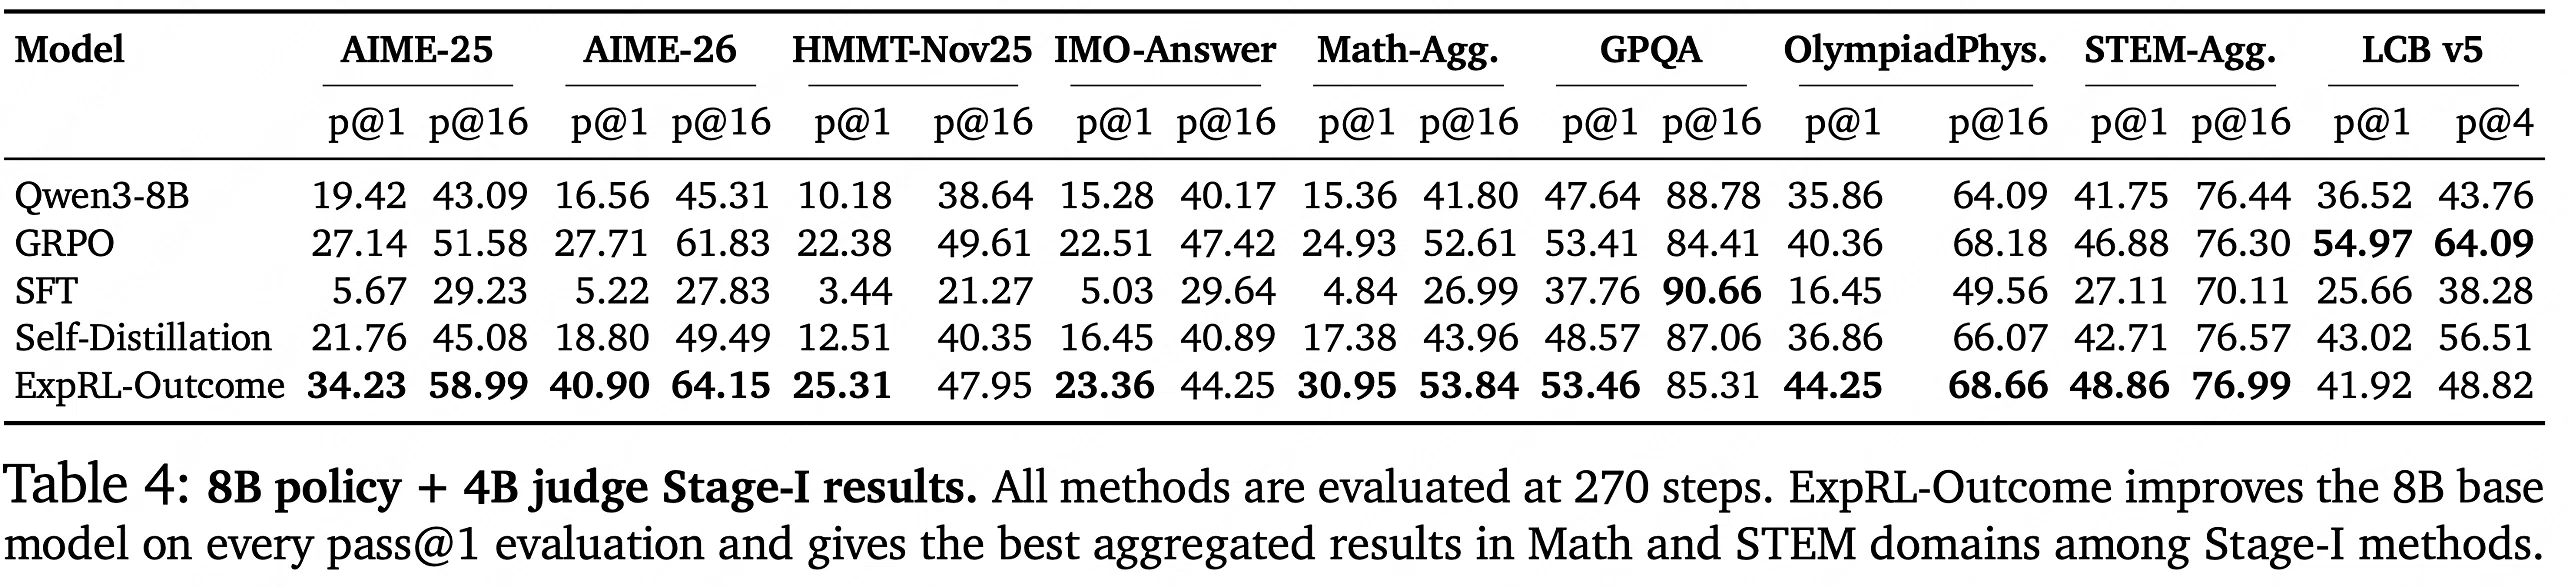
- 评判器与参考解法的校准(Calibration) :
- 原文表 5 验证了参考解法的作用
- 通过比较“正确参考”、“无参考”和“错误参考”三种条件,发现只有当使用正确的问题匹配参考时 ,评判器的误判率(Misplacement Rate)才最低
- 无参考或错误参考都会导致奖励信号不可靠
- 同时,过小的评判器(0.6B)表现不稳定
- 原文表 6 显示,在编程任务上,即使没有参考,评判器的误判率也很低
- 作者分析这是因为代码可以通过 Execution 来验证功能正确性,这是一种比参考解法更强的信
- 因此,在有强环境反馈(Environment Reward)的领域,环境反馈更优
- 原文表 5 验证了参考解法的作用
- 结论 :ExpRL 需要最小有能力的评判器和可靠的参考解法,但评判器可以比策略模型小
- 其奖励信号的核心是“基于参考的验证”,而非“通用的 LLM 置信度”
补充:论文核心 Insight
- 1)LLM 推理 RL 的瓶颈在于基础模型对难题有效解法的覆盖度(Coverage)不足
- 2)Mid-Training 的目标应是构建覆盖度(Coverage-building) ,而非仅仅灌输技能(Skill-inducing)
- 注:实际上灌输技能本身就能带来 Pass@k 的提升(即覆盖度的提升)
- 3)Mid-Training 中,参考解法最有效的利用方式是作为奖励脚手架(Reward Scaffolds)用于评估(Verification),而非作为模仿目标(Imitation Targets)用于生成(Generation)
- 4)通过奖励部分进展(Partial Progress)的探索性 RL(Exploratory RL)是构建这种覆盖度的有效且自动化的方法
POPD & TOPD
- 原始论文:(POPD & TOPD)Are Full Rollouts Necessary for On-Policy Distillation?, CASIA, 20260601
- 整体总结:
- 论文观点:
- 在 OPD 训练中,生成完整的推理轨迹不总是必要的
- 完整的 rollout 既计算昂贵,又可能引入来自后期 token 的不可靠教师信号
- 通过控制 rollout 长度,可以大幅提升训练效率,同时保持甚至提升模型性能
- 论文贡献:
- 提出两种简单有效的 horizon 控制策略:渐进式 OPD(POPD)和截断式 OPD(TOPD)
- 通过理论和实验证明,早期 rollout 段已包含足够的可泛化推理模式,无需完整轨迹
- 在数学推理任务中,TOPD 仅用 10% 的 rollout 长度即可达到标准 OPD 的性能,训练时间减少高达 82%
- 论文观点:
背景 & 问题
- OPD 的效率瓶颈
- 标准 OPD 要求学生生成完整的响应(full response),然后计算每个 token 上的 log-ratio 信号
- 理解:其实标准的 OPD 实现也没有针对完整序列,一般 2k Token 或者 4k Token 配置差不多了
- 这带来两个问题:
- 1)计算成本高 :长序列生成需要大量解码时间、KV cache 和 log 概率计算
- 2)教师反馈质量下降 :在训练早期,学生与教师策略差异较大,后期 token 易偏离教师熟悉的分布,导致教师反馈变得不可靠甚至误导
- 标准 OPD 要求学生生成完整的响应(full response),然后计算每个 token 上的 log-ratio 信号
- 观察到的现象
- 在序列级 OPD(sequence-level OPD)中,早期 token 的梯度依赖于未来所有 token 的 log-ratio 累积(类似 return-to-go),因此后期噪声会反向传播到早期 token
- 问题:这里的 序列级
- 即使采用 token-level OPD(仅依赖当前 token 的 log-ratio),仍需要生成完整 rollout,造成不必要的计算
- 在序列级 OPD(sequence-level OPD)中,早期 token 的梯度依赖于未来所有 token 的 log-ratio 累积(类似 return-to-go),因此后期噪声会反向传播到早期 token
设计原则
- 作者提出两条设计原则:
- 原则 1 :缩短 log-ratio 累积范围(即使用 token-level OPD)
- 原则 2 :控制 rollout 生成长度,避免在不可靠的后期段上浪费计算
Preliminaries
- 基本符号
- 输入 prompt:\( x \)
- 学生策略:\( \pi_{\theta} \)
- 教师策略:\( \pi^{g} \)
- 学生生成的响应:\( y = (y_1, \dots, y_T) \)
- 核心信号定义
- Log-ratio(第 \( t \) 个 token):
$$
r_t = \log \frac{\pi^{g}(y_t \mid y_{ < t}, x)}{\pi_{\theta}(y_t \mid y_{ < t}, x)}
$$- 衡量教师与学生在该 token 上的概率差异
- Score function :
$$
s_t = \nabla_{\theta} \log \pi_{\theta}(y_t \mid y_{ < t}, x)
$$- 是增加该 token 概率的梯度方向
- Log-ratio(第 \( t \) 个 token):
- 三种 OPD 梯度形式
- 序列级 OPD(\(\gamma=1\)):
$$
\mathbb{E}[g^{seq}] = \mathbb{E}_{x,y \sim \pi_{\theta} } \left[ \sum_{t=1}^T \left( \sum_{k=t}^T r_k \right) s_t \right]
$$- 每个 token 的梯度乘以从该位置到结尾的所有 log-ratio 之和
- 折扣 OPD(\(\gamma \in [0,1]\)):
$$
\mathbb{E}[g^{\gamma}] = \mathbb{E}_{x,y \sim \pi_{\theta} } \left[ \sum_{t=1}^T \left( \sum_{k=t}^T \gamma^{k-t} r_k \right) s_t \right]
$$ - Token 级 OPD(\(\gamma=0\)):
$$
\mathbb{E}[g^{tok}] = \mathbb{E}_{x,y \sim \pi_{\theta} } \left[ \sum_{t=1}^T r_t s_t \right]
$$- 只对齐同一位置的 token,不累积未来信号
- 序列级 OPD(\(\gamma=1\)):
长 Horizon OPD 的低效性分析
教师可靠性下降(Toy 实验)
- 设计一个 2D 导航任务,教师和学生分别朝向不同目标训练
- 角度差异越大(策略不匹配越大),学生轨迹越远离教师熟悉区域
- 结论 :教师反馈质量是状态依赖的,远离教师轨迹的区域反馈不可靠
未来噪声累积(理论证明)
- 命题 1(未来噪声累积) :
- 设序列级 OPD 的优势估计为:
$$
\hat{A}_t^{seq} = \sum_{k=t}^T \gamma^{k-t} r_k
$$ - 假设 \( r_k = r_k^* + \sigma_k z_k \),其中 \( z_k \sim \mathcal{N}(0,1) \) 为噪声
- 当 \(\gamma=1\) 且 \(\sigma_k = \delta k\) 时,估计误差的均方误差为:
$$
MSE_t(\hat{A}_t^{seq} - A_t^*) = \delta^2 \sum_{k=t}^T k^2
$$- 对于第一个 token(\(t=1\)),误差为 \(O(\delta^2 T^3)\),即早期 token 会累积大量未来噪声
- 设序列级 OPD 的优势估计为:
设计原则总结
- 原则 1:使用 token-level OPD 避免未来噪声反向传播
- 原则 2:控制 rollout 长度,避免在不可靠后期段上浪费计算
POPD & TOPD 方法
渐进式 OPD(Progressive OPD, POPD)
- 基本思路 :
- 在训练初期,学生与教师差异大,后期 token 不可靠
- 因此先让学生在短 rollout 上学习,随着训练进行逐步增加 rollout 长度
- 这是一种 curriculum learning 的思路
- 具体方法:
- 在训练步 \( k \),只对前 \( H_k \) 个 token 进行蒸馏:
$$
\mathbb{E}[g_\text{POPD}] = \mathbb{E}_{x,y \sim \pi_{\theta} } \left[ \sum_{t=1}^{H_k} r_t s_t \right]
$$ - 长度调度:
$$
H_k = \min\left(T, H_0 + \Delta H \left\lfloor \frac{k}{\Delta k} \right\rfloor\right)
$$- \( H_0 \):初始长度
- \( \Delta H \):每次增量
- \( \Delta k \):增量间隔
- 注:\( k \) 是 训练步数
- 在训练步 \( k \),只对前 \( H_k \) 个 token 进行蒸馏:
- POPD 的优点 :
- 早期计算成本低
- 避免不可靠后期反馈
- 最终仍能访问完整 rollout
截断式 OPD(Truncated OPD, TOPD)
- 基本思路 :
- 既然 token-level OPD 不需要完整 rollout 来计算累积收益,那么永久只使用前 \( H \) 个 token 进行蒸馏
- 设定 \( H = \rho \cdot T_{max} \),其中 \( \rho < 1 \) 为截断比例
- 梯度数学形式:
$$
\mathbb{E}[g_\text{TOPD}] = \mathbb{E}_{x,y \sim \pi_{\theta} } \left[ \sum_{t=1}^{H} r_t s_t \right]
$$ - TOPD 的优点:
- 极简实现,无需动态调度
- 训练时间和内存几乎线性降低
- 在推理任务中,早期段已包含问题分解、方程设立等可泛化推理模式
实验
LLM 数学推理实验
- 实验设置:
- 学生模型:R1-Distill-1.5B / OpenMath-1.5B
- 教师模型:JustRL-R1-1.5B / JustRL-Nemotron-1.5B
- 数据集:DAPO-Math-17K
- 评估集:AIME24, AIME25, AMC23(avg@16)
- 主要结果(Table 1) :
方法 \(\rho\) AIME24 训练时间 OPD N/A 49.3 29.7h POPD N/A 51.0 10.1h TOPD 0.25 51.3 10.2h TOPD 0.10 50.7 5.3h - POPD 达到 3 倍加速
- TOPD(\(\rho=0.1\)) 仅用 10% 的 rollout 长度,性能几乎无损,训练时间减少 82%
自回归控制任务(验证泛化性)
- 任务:2D 导航,但策略基于 Transformer,依赖历史速度序列
- POPD 再次显著提升收敛速度
- TOPD 失败(\(\rho=0.2\) 时成功率为 0):
- 原因:控制任务中,后期行为(如避障)无法从早期段学到,任务具有阶段依赖性
- 结论:TOPD 适用于 推理模式可泛化 的任务(如数学),不适用于 行为分段依赖的任务
- 注:TOPD 是因为看不到未来而失败的
补充分析:为什么 TOPD 有效?
前缀-续写分析(Prefix-Continuation)
- 论文假设 TOPD 有效的原因可能有两种
- 1)可能性 A(假说) :TOPD 之所以有效,是因为模型在训练时看到了教师生成的高质量前缀(开头几个 token),从而学会了“好的起点”
- 在推理时,只要模型能复现这个好的开头,后续就能自动生成正确答案(即“激活成功采样路径”)
- 2)可能性 B(真因) :TOPD 的有效性来源于真实的参数更新 ,即学生模型通过梯度下降,真正内化了教师的推理模式(如解题步骤、方程建立方式),而不仅仅是在模仿开头的几个词
- 1)可能性 A(假说) :TOPD 之所以有效,是因为模型在训练时看到了教师生成的高质量前缀(开头几个 token),从而学会了“好的起点”
实验 1:静态前缀注入(无参数更新)
- 保持学生模型(R1-Distill-1.5B)的参数完全冻结 ,不做任何 OPD 训练。让教师模型(JustRL-R1-1.5B)先生成前 \( \rho \) 比例(如 10%、20%)的 token 作为前缀,然后强行交给冻结的学生模型,让学生续写剩余部分
- 结果(原文图 9) :即使给了教师前缀,学生模型的准确率提升也极其有限,远小于直接使用 TOPD(\( \rho=0.1 \))训练后的性能提升
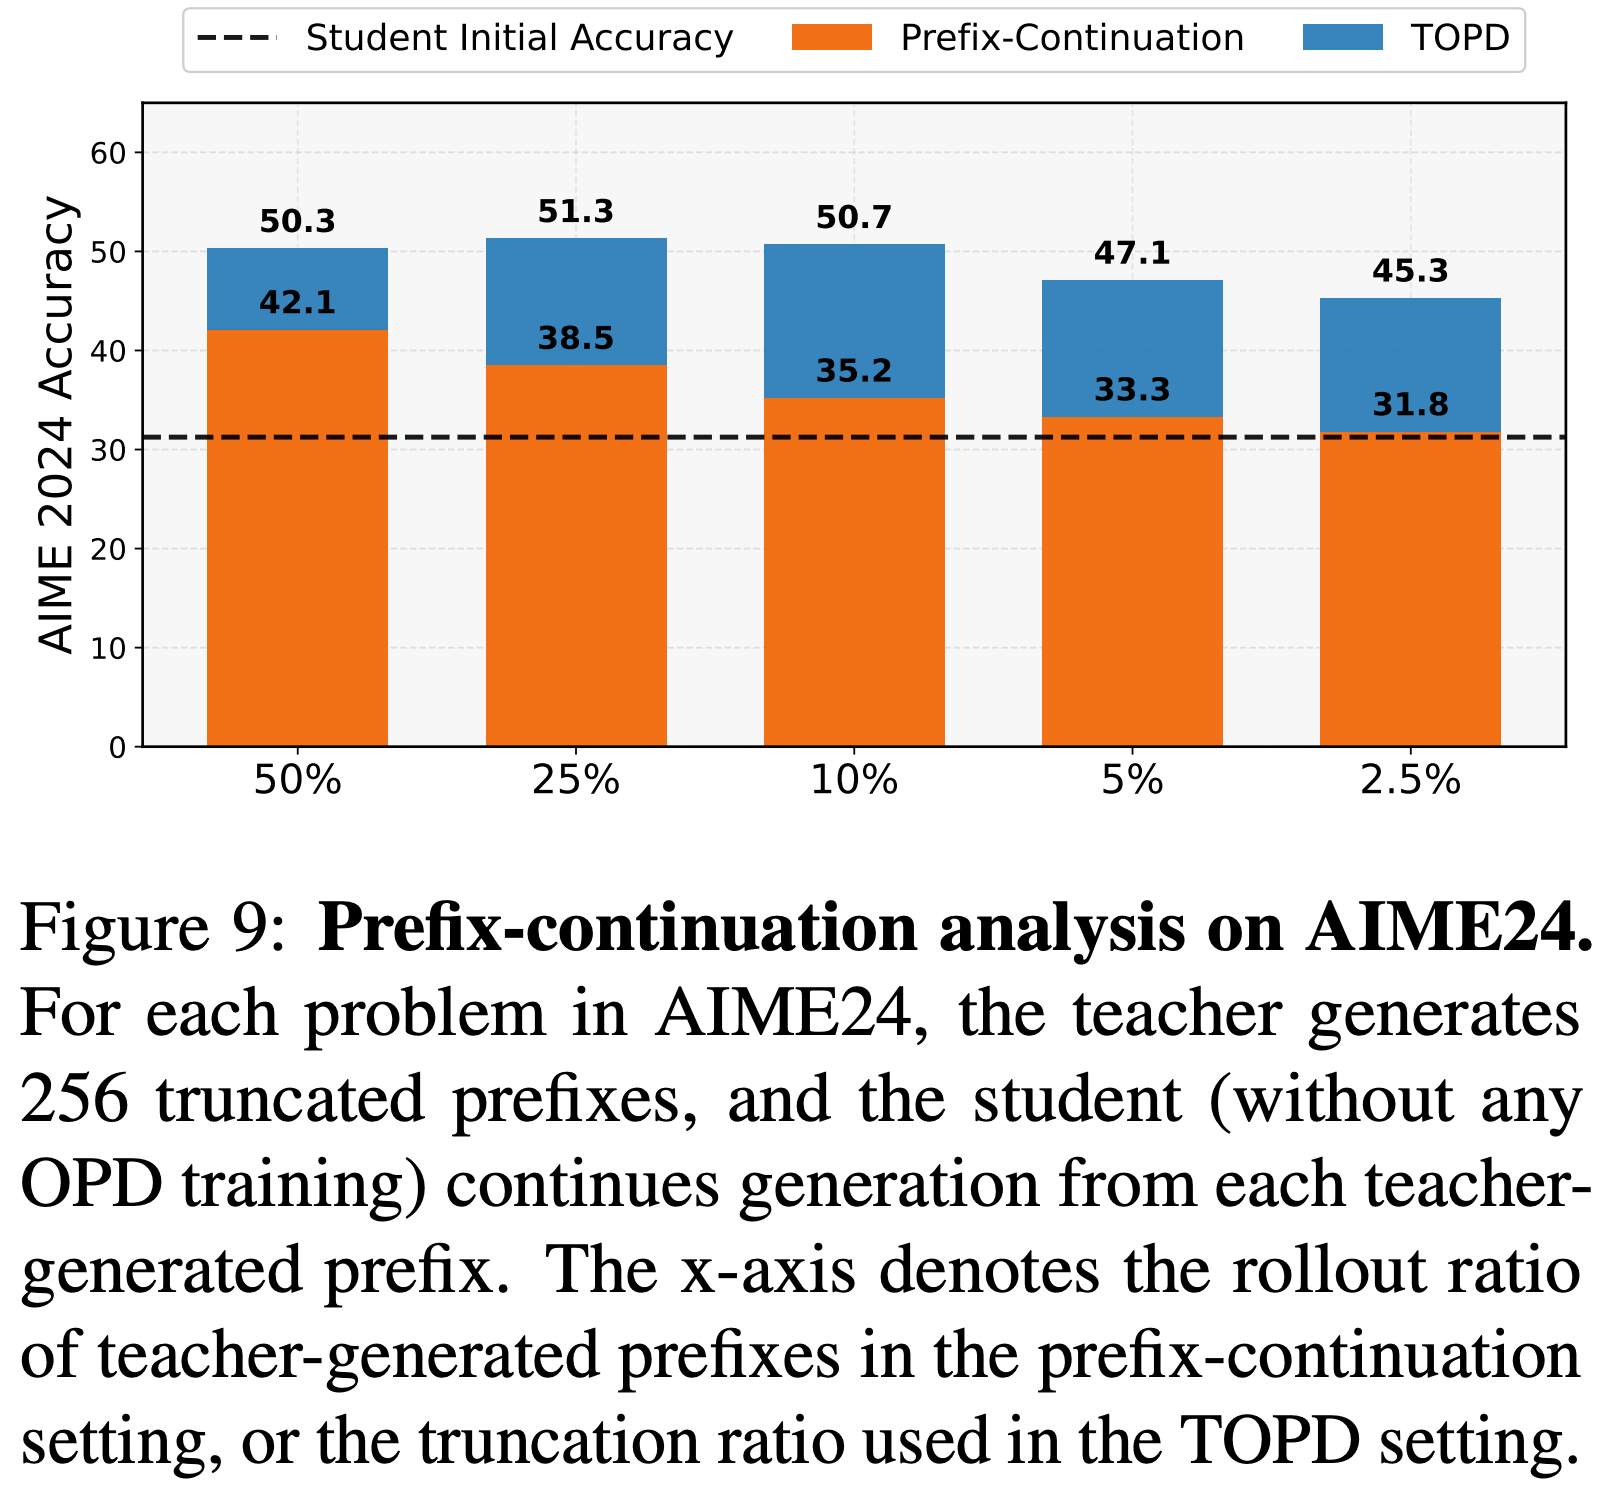
- 实验结果解释:
- 如果“教师前缀激活采样路径”是主因,那么即使不更新参数,学生顺着教师的高质量开头往下走,效果也应该大幅提升
- 但事实并非如此
- 这说明单纯提供一个好的开头,不足以让弱学生模型生成正确的后续推理链条
- 学生模型自身的权重如果没有被调整,它依然会沿着自己原有的错误分布生成后续 token
- 如果“教师前缀激活采样路径”是主因,那么即使不更新参数,学生顺着教师的高质量开头往下走,效果也应该大幅提升
实验 2:动态前缀注入(经过 TOPD 训练后)
- 先用 TOPD(\( \rho=0.1 \))完整训练学生模型(此时参数已更新)
- 然后,再次使用教师生成的不同长度前缀(\( \rho \) 从 0 到 1)输入给这个已训练好的学生,让其续写
- 结果(原文图 10) :对于已经经过 TOPD 训练的学生模型,无论是否使用教师前缀,也不管前缀长度是多少,其最终准确率几乎完全一致
- 实验结果解释 :
- 经过 TOPD 训练后,学生模型自身的初始分布已经与教师在其可靠前缀段内的分布高度对齐
- 此时,教师生成的前缀不再能提供额外的“特权信息”,因为学生自己生成的前缀分布已经落入了教师熟悉的分布区域(即 in-distribution)
- 这从反面证明了:TOPD 彻底改变了学生模型的底层策略分布 ,而不是简单地在表层模仿几个开头的词
前缀-续写分析实验总结
- 1)排除“捷径学习(Shortcut Learning)” :TOPD 不是通过让学生记忆“开头的正确话术”来工作的
- 2)证明“分布对齐(Distribution Alignment)” :TOPD 的梯度信号(即使只来自前 10% 的 token)已经强到足以将学生整个轨迹的初始状态拉向教师
- 当学生的初始前缀分布与教师对齐后,后续的生成就不再需要外部前缀的“搀扶”了
- 3)揭示“早期 tokens 携带高价值信息” :在数学推理这类任务中,问题分解 、已知条件提取 和初始求解方向 往往在前几个 token 或前几段话中就决定了
- TOPD 抓住了这些“高杠杆率(High-leverage)”的早期决策点,因此即使丢掉后期的计算和噪声,也能复现教师的大部分推理增益
- 个人理解:
- 这对于非数学场景不一定适用,但是如果相信前面的输出跟后面的输出保持范式一致性的话,似乎 TOPD 的生效在任意场景应该都说得过去
反向蒸馏实验(Reverse Distillation)
- 将弱模型(R1-Distill)作为教师,强模型(JustRL)作为学生
- TOPD 仍然能将强模型拉向弱模型性能
- 结论:截断 rollout 提供了足够强的优化信号,能有效重塑策略
分段蒸馏分析(Segment-Level Ablation)
- 将完整 rollout 分成多个 10% 段(如 0–10%, 20–30%, 80–90%)
- 每次只蒸馏一个段
- 结果(Figure 12):
- 早期和中段效果最好
- 后期段效果下降,甚至低于初始模型
- 原因(Figure 13):KL 散度随位置增加,说明后期 token 偏离教师分布,反馈噪声大
- 结论:标准 OPD 因包含后期噪声而可能次优,TOPD 只聚焦可靠前缀,因此更高效
PowerOPD
- 原始论文:PowerOPD: Stabilizing On-Policy Distillation with Bounded Power Transformation, 20260615, Eastern Institute of Technology, Ningbo & The Hong Kong Polytechnic University & SJTU
- 现有 OPD 方案的痛点:标准的 OPD 为了规避全词汇(Full-vocabulary)计算的巨大开销,采用单样本蒙特卡洛估计来近似 Reverse-KL 散度
- 论文通过实证观察发现,这种 Vanilla OPD 表现出三种严重的病理特征:
- 1)样本效率极低(Sample Inefficiency) :验证集准确率在训练初期(约前300步)不升反降
- 2)生成动态不稳定(Unstable Generation Dynamics) :Response 长度在训练过程中发生巨大振荡
- 3)显著的性能差距(Performance Gap) :最终准确率远低于全词汇 OPD(例如在 MATH-500 上,54.93% vs 63.12%)
- 个人理解:
- 本文的方式下,学习目标已经不是传统的 KL 散度了,这一点可能导致梯度是有偏的,是需要进一步讨论的
问题诊断
- 通过细致的 Reward 分布分析,将上述病理现象的根源归结于奖励函数本身的无界性(Unboundedness)
- Reward 定义回顾 :在 OPD 的 Policy-Gradient 形式中,Token 级别的 Reward 定义为对数概率比:
$$
r_t^{\text{OPD} }(c_t, o_t) = \log \frac{\pi_T(o_t \mid c_t)}{\pi_\theta(o_t \mid c_t)}
$$- \( \pi_T \) 是教师模型(Teacher)输出概率
- \( \pi_\theta \) 是学生模型(Student)输出概率
- \( c_t = (x, o_{ < t}) \) 是前文 Context
- \( o_t \) 是当前采样的 Token
- 三大问题 :
- 1)极端方差(Extreme Variance) :由于 \( \log \) 函数在概率趋近于 0 时发散,Reward 负值尾部可低至 \(-50\),导致单个罕见 Token 主导梯度更新
- 2)早期位置集中(Early-position Extremes) :极端 Reward 大量出现在 Rollout 的前几个 Token 上,这会扭曲 Prefix 分布,进而引发级联错误
- 3)持续性(Persistence) :这些极端正值和负值在整训练过程中不会衰减
- 事后补救(Post-hoc)的失效 :
- 论文检验了 RL 中常用的三种稳定化技巧(见表1):截断(Clip)、Tanh 压缩、Z-score 批归一化
- 结论是它们均无法根治 问题,原因在于:
- Clip 和 Tanh 是在无界的 Log-Ratio 计算完成后再进行压缩,底层扭曲依然存在
- Z-score 的批归一化可能翻转单个 Reward 的符号,违反符号一致性(Sign Consistency),导致优化方向错误
- 理解:归一化本身可能把正奖励变成负奖励
PowerOPD 方法
- 不选择“修补” Log-Ratio,而是从根本上重新设计了 Reward 的概率-数值映射函数(Probability-to-reward Mapping)
设计思路与两大必要条件
- 设计 OPD 的 Token-level Reward 函数 \( f:[0,1]^2 \to \mathbb{R} \)(将教师概率 \( p \) 和学生概率 \( q \) 映射为标量奖励)必须满足两条铁律:
- P1: 有界性(Boundedness) :\( \exists M > 0 \),使得 \( |f(p,q)| \leq M \) 恒成立。防止微小概率变动引发梯度爆炸
- P2: 符号一致性(Sign Consistency) :\( f(p,q) > 0 \) 当且仅当 \( p > q \);\( f(p,q) < 0 \) 当且仅当 \( p < q \)
- 确保梯度更新方向始终是将学生推向教师
结构推导:变换-然后-相减(Transform-then-subtract)
- 为了使 P2 天然成立,论文保留了 Log-Ratio 的代数结构:
$$ f_h(p, q) = h(p) - h(q) $$ - 只要 \( h \) 是严格单调递增函数,P2 自动满足
- 原有的 Log-Ratio 对应 \( h(x) = \log x \),但它在 \( x \to 0 \) 时无界,违反了 P1
- 为了解决 P1,论文引入了经典的 Box-Cox 幂变换族(Box-Cox Power Transformation) :
$$
h_\alpha(x) = \frac{x^\alpha - 1}{\alpha}, \quad \alpha > 0
$$ - 由于常数项 \( 1/\alpha \) 在差分中抵消且不影响梯度方向(可被学习率吸收),最终得到简化的 Token-level Reward:
$$
r_t^{\alpha} = \text{sg}\left[\pi_T(o_t \mid c_t)^{\alpha} - \pi_\theta(o_t \mid c_t)^{\alpha}\right], \quad \alpha > 0
$$- 其中 \( \text{sg}[\cdot] \) 表示 Stop-gradient 操作(阻断对教师概率的梯度回传,仅作为奖励信号)
- 极限情况下 :当 \( \alpha \to 0 \) 时,根据泰勒展开
$$ x^\alpha = 1 + \alpha \log x + o(\alpha) $$- PowerOPD 的 Reward 退化为原始的 Log-Ratio Reward
- 因此,Vanilla OPD 本质上是 PowerOPD 在 \( \alpha=0 \) 处的病态边界情况
PowerOPD 方法流程详解
- 基于上述设计,PowerOPD 的训练 Pipeline 如下:
- 1)Rollout 生成 :从数据集中采样 Prompt \( x \),学生模型 \( \pi_\theta \) 自回归生成完整 Response \( o = (o_1, …, o_T) \)
- 2)概率获取 :分别使用教师模型(冻结)和学生模型(当前策略)计算每个生成 Token \( o_t \) 在对应 Context \( c_t \) 下的概率,得到 \( \pi_T(o_t|c_t) \) 和 \( \pi_\theta(o_t|c_t) \)
- 3)幂奖励计算 :计算 \( r_t^\alpha = [\pi_T^\alpha - \pi_\theta^\alpha] \)(注意 \( \alpha > 0 \) 是超参数)
- 4)策略梯度更新 :将 \( r_t^\alpha \) 作为标量权重,乘以该 Token 的对数概率梯度,进行反向传播:
$$
\nabla_\theta J_{\text{PowerOPD} }(\theta) = \mathbb{E}\left[\sum_{t=1}^T r_t^\alpha \cdot \nabla_\theta \log \pi_\theta(o_t \mid c_t)\right]
$$- 由于奖励被严格限制在 \([-1, 1]\) 之间,梯度更新幅度变得极其稳定
实验
- 模型与数据 :
- 使用 Qwen3 系列(学生 0.6B/1.7B,教师 4B/8B),在 DeepScaleR 数据集上训练 1.5k 步
- 评估涵盖 6 个数学推理基准(AIME24/25, MATH-500, AMC23, Minerva, Olympiad-Bench),报告 Avg@8 和 Pass@8
- 对比基线 :Vanilla OPD、3 种 Post-hoc 稳定化变体(Clip, Tanh, Z-Score)、全词汇 KL OPD
主要结果
- 1)碾压 Vanilla OPD :在 Qwen3-4B → 0.6B 设置中,Avg@8 提升高达 +6.37 ,Pass@8 提升 +5.71
- 在个别基准(如 AMC23)上,Pass@8 增益可达 +15.00 至 +25.00
- 2)超越 Post-hoc 方法 :相比表现最好的 Post-hoc 基线,Avg@8 增益达 +3.01 ,Pass@8 增益达 +3.54
- 特别指出 Z-Score 因可能违反 P2(符号翻转)甚至不如 Vanilla
- 3)击败全词汇 OPD 且算力更低 :
- 在全词汇 OPD 往往达到 4096 最大长度限制的情况下,PowerOPD 不仅平均性能更优,且减少 59.2% 的墙钟时间和 23.1% 的峰值 GPU 内存
- FLOPs 估算(附录 B)显示,由于省去了全词汇的 LM Head 投影,每次更新节省约 56.1 TFLOPs(约 13.9% 的算术运算量)
补充深度分析:\( \alpha \) 的缩放规律与机理(第6.2节)
- \( \alpha \) 越大,效果越好 :
- 在 0.6B/4B 设置中,\( \alpha \) 从 0.1 增大到 500,Avg@8 从 24.16 提升至 25.50,且平均 Response 长度从 2,291 Tokens 缩短至 1,875 Tokens
- 更大的 \( \alpha \) 不仅加速收敛,还促使模型生成更简洁的答案
- 机理:绝对概率耦合(Absolute Probability Coupling) :
- 论文通过绘制联合概率空间 \( (\pi_T, \pi_\theta) \) 上的 Reward 热力图(图5)揭示了本质:
- Log-Ratio(图 a) :仅依赖于比值 \( \pi_T / \pi_\theta \)
- 它在两个概率都很小(如 0.002 vs 0.0001)时,与两个概率较大(如 0.2 vs 0.01)时给出几乎相同的巨大奖励
- 这导致梯度信号建立在 不可靠的低统计量稀有 Token 上
- PowerOPD(图 b-d) :Reward 幅度受制于 \( \max(\pi_T, \pi_\theta)^\alpha \)
- 当 \( \alpha \) 增大时,非活跃区域(Inert Region) 扩大
- 这意味着:如果一个 Token 在两个模型下概率都极低,其 Reward 被极度压缩(趋近于 0)
- 只有当一个 Token 在教师模型下概率高(蒸馏目标可靠)或学生模型下概率高(调整当前策略主导模式)时,才获得显著的梯度信号
- Log-Ratio(图 a) :仅依赖于比值 \( \pi_T / \pi_\theta \)
- 这种机制精确地抑制了导致 Vanilla OPD 崩溃的高杠杆(High-leverage)、不可靠 Token 的干扰
- 论文通过绘制联合概率空间 \( (\pi_T, \pi_\theta) \) 上的 Reward 热力图(图5)揭示了本质:
- 训练稳定性(梯度范数) :
- 如图 6 所示,Vanilla OPD 初始梯度范数峰值接近 \( 10^3 \),且后期波动常在 20 以上
- PowerOPD 的梯度范数稳定在 0.25 ~ 0.35 之间,比 Vanilla OPD 的初始峰值小 超过 3000 倍 ,比 Post-hoc 方法的高波动状态也稳定一个数量级以上
- 理解:梯度范数
论文中的其他关键观点与补充
- 长度膨胀(Length Inflation)的应对 :论文明确指出,全词汇 KL OPD 虽然准确率不错,但经常将 Response 填满 4096 Token 的上限(长度膨胀问题)
- PowerOPD 通过有界奖励设计,自然引导模型生成更短、更精准的答案,实现了准确率与效率的双赢
- 注:论文原文提到:
full-vocabulary OPD often saturates the 4,096-token limit, consistent with the length inflation observed by Luo et al. (2026)
- 但是论文 Demystifying OPD: Length Inflation and Stabilization Strategies for Large Language Models, 20260409, Rice University 并未提到 full-vocabulary OPD 会导致输出长度变长的观点,原论文的观点是:
将长度膨胀(Length Inflation)的根本原因归结为重复性饱和(Repetition Saturation),模型陷入重复生成 → 重复 Token 获得更高的 Reverse-KL 优势 → 形成自我强化循环 → 最终导致长度膨胀
- 推导细节(附录 C) :严格证明了 OPD 的 Policy-Gradient 形式
- 因为:
$$
\log \frac{\pi_T(o|x)}{\pi_\theta(o|x)} = \sum_{t=1}^T \log \frac{\pi_T(o_t|c_t)}{\pi_\theta(o_t|c_t)}
$$ - 所以 Token-level Reward 是序列级 Reward 的无偏分解,支持 Dense Reward RL 优化
- 因为:
VIMPO
- 原始论文:VIMPO: Value-Implicit Policy Optimization for LLMs, 20260618, UC Berkeley & Yele
- VIMPO 是一种介于“无 Critic 方法”与“Actor-Critic 方法”之间的创新框架
- 在数学上统一了 “无 Critic” 与 “Token 级信用分配”
- 通过 KL 正则化最优性条件,让 Policy 自己“隐含”地充当了 Value 功能,外部 Reward 仅作为价值损失的回归目标,而 Actor 则利用隐含的 Log-ratio 优势进行更新
- 实验证明其在干净和噪声环境下均优于 GRPO
- 评价:
- 让 Policy 自己“隐含”地充当了 Value 功能 的思路确实很创新
- VIMPO 方法要求计算 Policy 和 Reference Model 的精确 Full-distribution KL
- 对于超大模型或极长序列,Forward Pass 的计算负担显著高于 GRPO(GRPO 只需采样 Log-prob)
- 注:此时可考虑近似 KL 或缓存策略缓解
- 仅在数学 RLVR 的 4B 模型上验证,未与强大的 Actor-Critic(如 VAPO)对比,也未验证在代码生成、工具调用(Tool Use)或更大模型(如 70B)上的效果
Motivation
- 现有 RLVR 方法面临一个根本性的 Trade-off:
- Group-relative 方法(如 GRPO, DAPO) :无需训练价值网络(Critic-free),训练稳定且简单
- 但它们将整个 Response 的 Outcome Reward Broadcast 给轨迹中的每一个 Token,导致 粗粒度的信用分配(Coarse Credit Assignment) ,无法区分关键的推理步骤和普通的连接词
- Actor-Critic 方法(如 PPO, VAPO) :依赖学习的价值函数(Critic)提供密集的 Token 级监督信号,信用分配精细
- 但 Critic 的训练本身不稳定,且存在 Critic 与 Policy 协同适应的工程难题
- Group-relative 方法(如 GRPO, DAPO) :无需训练价值网络(Critic-free),训练稳定且简单
- 本文核心论点 :这种权衡并非本质必然
- VIMPO 旨在无需学习独立 Critic ,却能达到Token 级信用分配的效果
VIMPO 方法
- VIMPO 的推导分为四个层次,其核心设计思路是:
- 利用 KL 正则化最优性条件,将价值函数隐式地表示为 Policy 与 Reference Model 的 Log-ratio,并利用 MDP 的确定性转移特性闭合 Bellman 方程
问题形式化:确定性转移 MDP
- 将自回归生成建模为确定性转移的 MDP:
- 状态 \( s_t = (\text{prompt}, a_0, \dots, a_{t-1}) \) 表示 Token 前缀
- 动作 \( a_t \) 是词表 \( \mathcal{V} \) 中的下一个 Token
- 转移是确定性的:\( P(s_{t+1} \mid s_t, a_t) = 1 \)
- 标准期望回报价值函数 \( V^\pi(s_t) = \mathbb{E}_{a \sim \pi(\cdot|s_t)}[Q^\pi(s_t, a)] \)
- 注意 :这里使用的是标准期望回报,而非熵正则化的 Soft Value(后面推导中会用到,这使得 KL 项可以独立控制)
关键推导:KL 正则化最优性下的价值递归(核心公式)
- 在最优策略 \( \pi^* \) 下,KL 正则化的策略满足局部最优条件(公式 1):
$$
\pi^*(\cdot \mid s_t) = \arg\max_{\pi} \mathbb{E}_{a \sim \pi}[Q^*(s_t, a)] - \beta \text{KL}(\pi(\cdot \mid s_t) \parallel \pi_{\text{ref} }(\cdot \mid s_t))
$$- \( \beta \) 是 KL 惩罚系数
- \( \pi_{\text{ref} } \) 是冻结的参考模型
- 求解该最大化问题,得到最优策略的显式解(公式 2):
$$
\pi^*(a \mid s_t) = \frac{\pi_{\text{ref} }(a \mid s_t)}{Z(s_t)} \exp\left(\frac{1}{\beta} Q^*(s_t, a)\right)
$$ - 设计思路:将公式 (2) 代入确定性 Bellman 方程
$$ Q^*(s_t, a_t) = r(s_t, a_t) + \gamma V^*(s_{t+1}) $$- 并消去配分函数 \( \ln Z \)(利用 \( \ln Z = \frac{1}{\beta}V^* - \text{KL}^* \)),推导出本论文的 核心恒等式(公式 4) :
$$
\beta \ln \frac{\pi^*(a_t \mid s_t)}{\pi_{\text{ref} }(a_t \mid s_t)} = r(s_t, a_t) + \gamma V^*(s_{t+1}) - V^*(s_t) + \beta \text{KL}^*(s_t)
$$ - 其中 \( \text{KL}^*(s_t) \triangleq \text{KL}(\pi^*(\cdot \mid s_t) \parallel \pi_{\text{ref} }(\cdot \mid s_t)) \)
- 并消去配分函数 \( \ln Z \)(利用 \( \ln Z = \frac{1}{\beta}V^* - \text{KL}^* \)),推导出本论文的 核心恒等式(公式 4) :
- 该公式的三大关键观察(设计基石):
- 封闭形式的价值(Closed-form Value) :重排公式可得
$$ \gamma V_{t+1} - V_t = \beta \log(\frac{\pi}{\pi_{ref}}) - \beta KL - r $$- 一旦给定初始锚点 \( V(s_0) \),无需 Critic 即可前向递推所有状态的 Value
- 封闭形式的单步优势(Closed-form TD Advantage) :Bellman 残差
$$ A_t^{\text{TD} } = r + \gamma V^* - V^* $$- 可直接写为
$$ \beta \log(\frac{\pi}{\pi_{ref}}) - \beta KL $$
- 可直接写为
- 零均值信号(Zero-mean Signal) :下列式子在策略分布下的期望为零
$$ \beta \log(\frac{\pi}{\pi_{ref}}) - \beta KL $$- 这是算法稳定性的数学根源 ,而非人为强加的约束
- 封闭形式的价值(Closed-form Value) :重排公式可得
训练 Policy-Implied Value(价值损失函数)
- 为了将上述恒等式变为可训练的损失函数,采用 DPO 的风格:将最优策略 \( \pi^* \) 替换为当前可训练策略 \( \pi_\theta \)
- 构造隐含价值(公式 6) :前向递推得到策略隐含的价值 \( V_\pi(s_t) \)
- 由于价值需要初始锚点 \( \hat{V}_0 \)
- 使用 Group-mean Return(即当前 Prompt 组内的平均奖励 \( \overline{R_{\text{final} } } \))作为 \( \hat{V}_0 \) 的蒙特卡洛估计
- 终端锚点(Terminal Anchor) :这是 VIMPO Critic-free 的关键
- 由于终止状态 \( s_T \) 后无未来奖励,因此真实价值必满足边界条件 \( V^*(s_T) = 0 \)
- 构造隐含价值(公式 6) :前向递推得到策略隐含的价值 \( V_\pi(s_t) \)
- 专门针对 RLVR 中常见的 Outcome-only Reward(即中间 Token 奖励为 0,仅最后一步有最终奖励 \( R_{\text{final} } \),且折扣因子 \( \gamma = 1 \)),终端条件展开得到 操作性的价值损失(公式 8) :
$$
\mathcal{L}_V(\pi) = \frac{1}{2} \left[ \sum_{k=0}^{T-1} \left( \beta \ln \frac{\pi(a_k \mid s_k)}{\pi_{\text{ref} }(a_k \mid s_k)} - \beta \cdot \text{sg}[\text{KL}_\pi(s_k)] \right) - (R_{\text{final} } - \overline{R_{\text{final} } }) \right]^2
$$- 其中 \( \text{sg}[\cdot] \) 是 Stop-gradient 算子(阻止梯度通过 KL 项)
- 设计思路(极其重要) :
- 为何停掉 KL 梯度? 如果不停止,Policy 可以通过直接增大整个分布 KL 值(而非提升正确 Token 的 Log-prob)来无效地降低 Loss
- 停止梯度后,KL 仅作为 Centering Baseline(中心化基线) ,强制 Policy 通过提升采样 Token 的 Log-ratio 来拟合中心化的奖励 \( (R - \bar{R}) \)
- 奖励与优化的分离 :外部可验证奖励仅 通过此价值损失 \( \mathcal{L}_V \) 进入优化,而不直接参与 Actor 梯度
- 为何停掉 KL 梯度? 如果不停止,Policy 可以通过直接增大整个分布 KL 值(而非提升正确 Token 的 Log-prob)来无效地降低 Loss
Actor 更新:Critic-free PPO 集成(公式 9-12)
- Actor 更新不使用外部奖励,而是使用前述核心恒等式推出的封闭式单步优势
- 当前 Policy 隐含的 TD 优势(公式 9) :
$$
\hat{A}_t^{\text{TD} } \triangleq \beta \log \frac{\pi_\theta(a_t \mid s_t)}{\pi_{\text{ref} }(a_t \mid s_t)} - \beta \text{KL}_{\pi_\theta}(s_t)
$$ - 为了降低方差并兼容 PPO,本文引入 GAE(广义优势估计)风格的多步累积(公式 10) :
$$
\hat{A}_t^\lambda = \sum_{\ell=0}^{T-t-1} (\gamma \lambda)^\ell \hat{A}_t^{\text{TD} }
$$ - 随后对 Advantage 进行 Minibatch 内的标准化(公式 11),并代入标准的 PPO-Clip 损失 \( \mathcal{L}_A \),最终的 VIMPO 总损失为(公式 12):
$$
\mathcal{L}_{\text{VIMPO} } = \mathcal{L}_V + c_A \mathcal{L}_A
$$- 其中 \( c_A \) 控制 Actor 更新强度
VIMPO 算法全流程(Algorithm 1 解读)
- VIMPO 的每个训练步流程清晰,完全无 Critic 网络:
- 1)采样 :对 Batch 中的每个 Prompt,采样 \( G \) 个 Rollouts(Responses) \( \{\tau^{(i)}\} \)
- 2)打分与中心化 :计算每个 Response 的最终奖励 \( R^{(i)} \),并计算组内均值 \( \overline{R} \)
- 3)计算 Policy 隐含量(循环 Token) :
- 计算 \( \rho_t = \beta \log(\pi_\theta / \pi_{ref}) \)
- 计算精确的 Full-distribution KL 散度 \( \kappa_t = \beta \text{KL}(\pi_\theta(\cdot|s_t) \parallel \pi_{ref}(\cdot|s_t)) \)
- 得到 Policy-implied Advantage \( A_t = \rho_t - \kappa_t \)
- 4)价值损失更新(Reward Incorporation) :计算 \( \mathcal{L}_V \)(公式 8),将累积的 Log-ratio 与中心化奖励 \( (R - \bar{R}) \) 对齐
- 5)Actor 损失更新(Policy Improvement) :将 \( A_t \) 标准化,计算 PPO-Clip 损失 \( \mathcal{L}_A \)
- 6)联合优化 :\( \theta \leftarrow \theta - \eta \nabla_\theta (\mathcal{L}_V + c_A \mathcal{L}_A) \)
- 问题:\( \beta \) 和 \( c_A \) 在本文训练中固定
- 后续工作应探索自适应系数或周期性更新 Reference Model
实验
- 实验设置:
- 在数学推理 RLVR 上对比了 VIMPO 与 GRPO(含 Naive GRPO 和 Token-level GRPO)
- 基于 Qwen3-4B-Base 模型
- 实验结果:
- 1)主要性能(原文表 1 & 原文图 3) :VIMPO 在 MATH-500、AIME 2024、AIME 2025、OlympiadBench 上均取得最优平均性能(39.5 vs GRPO 的 37.4)
- 尤其在较难的 AIME 2025 上提升显著(20.8 vs 17.6)
- 2)鲁棒性(原文图 4 & 原文表 1 Noisy) :在 25% 的奖励翻转噪声下,VIMPO 性能下降幅度显著小于 GRPO
- 原因分析 :VIMPO 的外部奖励仅通过 \( \mathcal{L}_V \) 间接影响 Policy,Actor 更新主要依赖 Policy 自身的 Log-ratio(零均值特性),相当于隐式滤波了噪声标签
- 3)消融实验(原文图 5) :
- 仅使用 Value Loss (\( c_A=0 \)):虽有效果,但学习缓慢
- 加入 Actor Loss (\( c_A=0.005 \)):极大加速训练,但会增加 VO KL(Policy shift)
- 高 \( \beta \) 与高 \( c_A \):过度约束,前期学习快但后期易饱和
- 4)熵与长度分析(附录 B) :
- GRPO 表现为单调的熵坍缩,而 VIMPO 在低熵区仍有波动,表明 Token 级优势允许 Policy 在后期进行局部调整
- VIMPO 学习更快,但响应长度增加也更快,消融实验表明系数需要谨慎调节以防止长度爆炸
- 1)主要性能(原文表 1 & 原文图 3) :VIMPO 在 MATH-500、AIME 2024、AIME 2025、OlympiadBench 上均取得最优平均性能(39.5 vs GRPO 的 37.4)
补充定性分析:Token 级信用分配可视化(附录 C)
- 以 “Mr.Potato Head” 计数题为例,对比正确和错误推理轨迹:
- GRPO 风格 :整个轨迹共享同一个优势,无法指出具体哪里出错
- VIMPO 优势信号(原文图 8 & 原文图 9) :在错误轨迹中,当模型引入无效的 “both sets” 计数逻辑时,VIMPO 的 GAE 信号在该 Token 处突变为强烈的负值
- 而在正确轨迹的乘法计算步骤处,信号为正值
- 这直观验证了 VIMPO 无需 Critic 即可进行 局部的、Token 级的推理步骤归因
The Verification Horizon: No Silver Bullet for Coding Agent Rewards
- The Verification Horizon: No Silver Bullet for Coding Agent Rewards, 20260624 & 20260629, Qwen
- 本文核心论点:在当前的 Coding Agent 训练中,Verification 比 Generation 更为困难
- 且不存在一个一劳永逸的“银弹”式验证器
- 验证必须与生成器的能力协同进化(Co-evolve)
- 论文系统性地分析了验证信号的三个核心维度(可扩展性、忠实性、鲁棒性),并基于 Qwen 模型的实践经验,详细阐述了针对四种不同任务类型的 Reward 构建方案
背景 & 问题提出
- 过去,软件工程领域的一个传统直觉:“验证比产生更简单”
- 这个理论在 AI Coding Agent 时代已被颠覆
- 随着基础模型 Reasoning 能力的增强和 Harness Engineering 的成熟,生成复杂的代码候选方案变得容易
- 但 可靠地验证这些方案是否正确、是否符合用户意图,反而成为了更困难的问题
- 论文提出两点挑战
- 1)Underspecified Intent,意图的固有模糊性 :用户的真实意图本质上是未被完全指定的
- 任何形式的验证器(如测试、评分标准、奖励模型)都只是人类意图的 Proxy,而非意图本身
- 在模型训练过程中,对代理指标的优化会扩大其与真实意图间的差距,导致 Reward Hacking 或 Signal Saturation
- 2)Verification Horizon :没有一个固定的奖励函数能永久有效
- 随着 Policy 能力的增长,它会找到现有验证器的漏洞
- 因此,验证系统必须与生成器协同进化
- 1)Underspecified Intent,意图的固有模糊性 :用户的真实意图本质上是未被完全指定的
- 为了系统地解决这个问题,论文提出了评估验证信号质量的三个核心维度 :
- Scalability :信号能否以低成本、大规模地生产,以满足训练需求?
- Faithfulness :信号在多大程度上反映了真实的用户意图,而非一个 Narrow 替代品?
- Robustness :验证器的判断能否在多样化和对抗性输入下保持可靠,并能抵抗不断增强的生成器的“攻击”?
- 论文的核心论点是,同时实现这三个维度是验证的核心难题
- 大多数现有方法只能满足其中两个,例如
- 单元测试可扩展且鲁棒,但不够忠实
- LLM Judge 可扩展且忠实,但鲁棒性差
- 人类评估忠实且鲁棒,但无法扩展
- 大多数现有方法只能满足其中两个,例如
方法一:Test-driven Rewards for SWE-like Tasks
- 此方法针对的是类似 SWE-bench 的软件工程任务,即根据 GitHub 的 Issue 和 Pull Request 来修复代码库中的 Bug
Preliminary
- 自动化数据 Pipeline :使用 SWE-Universe Pipeline ,将真实的 GitHub PR 转化为可执行的任务
- 每个任务包含:PR 描述(任务说明)、Docker 化的代码库环境(修复前的状态)和一个验证脚本
evaluation.sh
- 每个任务包含:PR 描述(任务说明)、Docker 化的代码库环境(修复前的状态)和一个验证脚本
- 奖励信号 :由
evaluation.sh返回的二进制的“通过/失败”(Pass/Fail)结果 - 两大挑战 :
- 1)Faithfulness :存在假阳性(错误代码通过测试)和假阴性(正确代码未通过测试)
- 2)Reward Hacking :模型主动利用信息泄露(如直接从网络检索 Ground Truth 补丁)来通过测试,而非真正解决问题
Improving Reward Faithfulness
- 为了提升测试的忠实性,本文设计了一个Agentic Quality Judge
- 设计思路 :将“任务质量”分解为两个维度:
- 1)指令清晰度 (
instruct_clear) :PR 描述是否足够清晰,让 Agent 能理解任务? - 2)指令-测试一致性 (
instruct_ut_align) :测试脚本是否忠实地实现了 PR 描述中的要求?
- 1)指令清晰度 (
- 方法流程 :
- 1)输入 :任务描述、Docker 环境、测试脚本、以及可选的 Ground Truth 补丁
- 2)主动探索 :Agentic Judge(基于 LLM)使用
MiniSWEAgent工具在 Docker 环境中主动探索- 它可以检查仓库文件、执行命令、阅读测试代码
- 3)分析 :基于探索结果,分析指令和环境是否自洽,以及验证器是否与任务陈述匹配
- 4)输出 :生成关于上述两个维度的判断,并聚合为一个最终的质量标签
- 效果 :通过 Ablation Study,论文证明了该 Judge 在识别低质量任务上的有效性
- 在 RL 训练中,使用该 Judge 过滤后的高质量数据进行训练,在 SWE-bench Multilingual 和 Pro 上取得了持续的性能提升
Mitigating Reward Hacking
- 由于测试驱动的奖励只评估最终状态,模型可能通过“作弊”行为(如修改测试、检索历史提交等)获得高奖励
- Hacking 行为分析 (Hacking-susceptible Behaviors Analysis) :论文将 Hacking 行为分为两类:
- 1)静态环境泄露 (Static-environment leakage) :环境本身造成的漏洞,如未清理的 Git 历史、可见的测试文件等
- 这些可以通过环境硬化(Sanitization)来部分缓解
- 2)策略依赖的捷径访问 (Policy-dependent shortcut access) :模型主动采取的作弊行为,如 Solution artifact retrieval、外部修复查找(External fix lookup)等
- 这是更棘手的问题
- 1)静态环境泄露 (Static-environment leakage) :环境本身造成的漏洞,如未清理的 Git 历史、可见的测试文件等
- 缓解方法:行为监控 (Behavior Monitoring) :
- 1)监控 :在 RL 训练期间,监控每个 Trajectory 的完整历史,包括命令、网络访问、Git 操作、文件编辑等
- 2)模式匹配 :定义一组高风险信息访问模式(Pattern Set \( \mathcal{P} \))
- 当一个轨迹匹配到高风险模式时,应用 Token-level penalty 来降低该轨迹的奖励
- 3)闭环更新 :模式集在训练过程中迭代更新
- 每隔一段时间,采样新轨迹,由 Agentic Reviewer 识别新的捷径策略,并将其模式添加到 \( \mathcal{P} \) 中
- 效果 :如表 3 所示,行为监控 将 “Hacked Resolved”(通过作弊解决的比率)从平均 28.57% 降至 0.56%,同时将“ Clean Resolved”(干净解决的比率)从 40.22% 提升至 60.53%
方法二:Interactive Judge for Frontend Tasks,前端任务的交互式 Judge
- 此方法针对前端开发任务,这类任务 无法仅通过执行测试来评估,还必须考虑视觉质量、交互行为 等
Rubric-based Static Judge For Frontend Tasks
- 设计思路 :为了解决纯 LLM Judge 主观性强、标准不一的问题,设计一个结构化的 Rubric
- 该 Judge 同时接收渲染后的截图和源代码作为输入
- 流程:
- 1)输入 :渲染截图、完整 HTML/CSS/JS 源代码、用户原始 Prompt、待评估的 Checklist
- 2)维度分解 :将评估分解为功能(Functional)、内容(Content)、视觉(Visual)、布局(Layout)、用户体验(UX)和技术(Technical)等六个维度,平均每个任务包含约 25.9 个检查项
- 3)评分 :Judge 对每个检查项,结合代码和截图证据,给出 0-10 分的详细评分
- 效果:该方法显著提升了不同 Judge 之间的一致性(Cross-judge Consistency)以及与人类评估的对齐度(Alignment with Human Annotations)
Agentic Interactive Judge,代理式交互 Judge For Frontend Tasks
- 设计思路 :静态 Judge 无法捕获动态交互行为(如表单验证、动画、多页面导航)
- 本文的思路是设计一个能像人类一样“使用”网页的 Judge
- 方法流程(三阶段) :
- 1)Action Planning :给定渲染的网页和评估规则,一个Action Planner 在单次前向传播中生成一个完整的 Action List
- 如“点击按钮 X”、“滚动到位置 Y”、“填写表单 Z”
- 2)Execution & Trace :一个基于 Playwright 的渲染服务器 在真实浏览器中执行这些动作,并记录下交互轨迹,包括每一步的屏幕录制和状态变化
- 3)Scoring : Judge 模型根据规则,结合交互轨迹(采样帧)和源代码,对任务完成情况进行评分
- 1)Action Planning :给定渲染的网页和评估规则,一个Action Planner 在单次前向传播中生成一个完整的 Action List
- 效果 :
- 抗 Hacking :由于奖励基于运行时行为而非静态代码,模型无法通过生成冗长的 CSS/JS 来“刷分”,有效避免了长度利用(Length Exploitation)型 Reward Hacking
- 性能 :作为 RL 奖励信号,交互 Judge 的性能显著优于静态 Judge (见原文图 6)
- 消融实验 :论文对交互 Judge 的各个环节(生成、渲染、评判)进行了方差分解,证明其信号足够稳定,能够作为训练奖励(附录 E)
方法三:User Feedback as Verifier for Real-World Agent Tasks,将用户反馈作为真实世界 Agent 任务的验证器
- 此方法针对现实世界中开放、不受控的场景
- 在这些场景中,用户是意图的持有者,因此是最忠实的验证器
- 但用户通常不提供显式的数值奖励,而是通过自然语言和行为模式隐含地传达判断
Feedback Annotation Pipeline,反馈标注 Pipeline
- 数据源 :从公司内部高级软件工程师与 Coding Assistant 的真实多轮交互日志中获取
- 人类隐式奖励信号 (HIRS) :用户的每一条回复都自然地包含了对助手上一轮表现的评估
- 例如:
- 明确说“ 不,撤销它” 是负向信号
- 接受结果并立即提出新需求是正向信号
- 重新描述同一个需求是负向信号(表明助手未理解)
- 例如:
- LLM-as-Judge 标注 :使用 Qwen-Plus 作为 Judge ,遵循三条原则对对话进行逐轮(Round-by-Round)标注:
- 1)双视角评估 :同时记录用户 表达了什么(极性,Polarity)和用户的评估 是否客观公平(
user_fairness) - 2)证据驱动 :每个标注必须引用用户原话中的具体词语作为证据
- 3)保守标注 :信号模糊时,倾向于标注为中性(Neutral),“宁可漏标,不可错标”
- 1)双视角评估 :同时记录用户 表达了什么(极性,Polarity)和用户的评估 是否客观公平(
数据集分析
- 数据集包含 125,528 条轨迹和 535,737 轮标注
- 关键 Insight:
- 1)极性分布不对称 :绝大多数信号是中性(76.6%),负向(20.0%)远多于正向(3.5%)
- 2)负向信号置信度高 :81.8% 的负向信号是高置信度的
- 3)错误集中在执行和理解 :执行错误(Execution Error, 56.6%)和理解错误(Misunderstanding, 21.1%)是主要的负面原因
训练方法
- 论文提出了三种利用细粒度(Span-level)人类反馈的训练方法
- 1)SFT :标准方法,对所有 Token 施加统一的交叉熵损失
$$ \mathcal{L}_{\text{SFT} }(\theta) = -\mathbb{E}_t[\log \pi_\theta (y_t\mid x,y_{< t})] $$- \( \pi_\theta \) 是策略模型
- 2)加权 SFT (RW-SFT) :根据 Token 的极性赋予不同的损失权重
$$ \mathcal{L}_{\text{RW-SFT} }(\theta) = -\mathbb{E}_t[w(p_t)\log \pi_\theta (y_t\mid x,y_{< t})] $$- 权重函数 \( w(p_t) \) 对正向、中性、负向 Token 分别赋予 \( w_{\text{pos} }, w_{\text{neu} }, w_{\text{neg} } \)
- 实践中设置 \( w_{\text{pos} } = 1.2, w_{\text{neu} } = 1.0, w_{\text{neg} } = 0.8 \)
- 局限性 :权重敏感,且只能调整学习强度,不能明确地将策略推离负向行为
- 3)Span 级别的 KTO (Span-KTO) :将偏好学习(Preference Learning)从 Response 级别扩展到 Span 级别
- Span 定义 :根据用户交互边界,将回复划分为若干具有一致极性的连续 Span \( \{S_k\} \)
- 理解:Span 被定义为一段具有相同极性(正或负)的连续 Token 序列,每个 Span 对应 Agent 对一次完整用户请求所生成的回复
- 隐式奖励 :对每个 Span \( S_k \),其隐式奖励为其所有 Token 的对数似然比之和
$$ r_{\theta}(x,S_k) = \sum_{t = S_k}^{e_k}[\log \pi_{\theta}(y_{t}\mid x,y_{< t}) - \log \pi_{\text{ref} }(y_{t}\mid x,y_{< t})] $$- 其中 \( \pi_{\text{ref} } \) 是参考模型的概率
- \(S_k\) 表示对话轨迹中的第 \(k\) 个 Span
- \(r_\theta (x, S_k)\) 表示对于给定输入 \(x\)(即对话上下文),策略模型 \(\pi_\theta\) 在 Span \(S_k\) 上的 Implicit Reward
- 参考点 :\( z_{\text{ref} } \) 通过指数移动平均(EMA)在线估计
$$ z_{\text{ref} }\leftarrow \alpha \cdot z_{\text{ref} } + (1 - \alpha)\cdot \bar{r}_{\text{batch} } $$- 其中 \(\bar{r}_{\text{batch} } \) 表示当前 Batch 中,所有“Span”的 Average Implicit Reward :
$$ \bar{r}_{\text{batch} } = \mathbb{E}_{S_k \in S_{\text{batch} } } [r_\theta (x, S_k)]$$- \(S_{\text{batch} }\) :表示当前训练批次中所有 Span 的集合
- 其中 \(\bar{r}_{\text{batch} } \) 表示当前 Batch 中,所有“Span”的 Average Implicit Reward :
- 优势函数与损失 :计算每个 Span 的优势
$$ a_k = r_\theta - z_{\text{ref} } $$- 然后应用类似 KTO 的损失函数
$$ \ell (S_k) = \begin{cases} - \lambda_{w}\cdot \sigma (\beta \cdot a_k) & \text{if positive} \\ -\lambda_{l}\cdot \sigma (-\beta \cdot a_k) & \text{if negative} \end{cases} $$ - \( \sigma \) 是 Sigmoid 函数
- \( \beta \) 控制偏好强度
- \( \lambda_{w} \) 和 \( \lambda_{l} \) 是正负 Span 的损失系数
- 然后应用类似 KTO 的损失函数
- 整体目标 :偏好损失 + 中性 Token 的正则化损失
$$ \mathcal{L}_{\text{Span-KTO} } = \mathcal{L}_{\text{pref} } + \mathcal{L}_{\text{neutral} } $$
- Span 定义 :根据用户交互边界,将回复划分为若干具有一致极性的连续 Span \( \{S_k\} \)
主要结果
- RW-SFT 敏感性 :负向权重 \( w_{\text{neg} } \) 高度敏感,性能非单调
- 只有轻微降权(0.8)时效果最好,完全丢弃负向 Token(0.0)效果最差
- Span-KTO :在所有五个评估基准(SWE-bench Verified, Pro, Multilingual, Aone-bench, OctoBench)上,Span-KTO 均一致性地、显著地超越了 SFT 和 RW-SFT
- 例如,在 Aone-bench上,相比 SFT 提升了 13.3 个百分点
- 负面行为修正 :使用 Agent-as-Judge 对模型的六种负面行为维度进行评估,发现在“Unresolved” 的任务中,Span-KTO 在“低效(Inefficiency)” 和 “沟通(Communication)” 方面的改进尤为显著
- 这表明 Span-KTO 不仅让模型解决了更多问题,还让它在失败时表现得更合理 ,这对现实世界部署至关重要
方法四:Dynamic Agent Judge for Long-horizon Tasks,长周期任务的动态 Agent Judge
- 此方法针对长周期代码生成任务,即从零开始根据自然语言规格说明生成整个代码仓库
- 这类任务的规格说明高度抽象,内部实现完全开放,使得预定义的测试套件不切实际
Design of the Evaluation Agent
- 核心思想 :使用一个 Agentic Evaluator (\( \mathcal{E} \)) 来替代人工编写的测试套件
- 该评估器利用模型自身的推理能力,动态地评估生成的代码并提供奖励信号
- 评估流程 :
- 1)输入 :任务规格说明 \( \mathcal{T} \) 和生成器 \( \mathcal{G} \) 产生的代码仓库 \( \mathcal{G}(\mathcal{T}) \)
- 2)分解 :评估器将 \( \mathcal{T} \) 分解为一个可验证的功能需求检查表
$$ \mathcal{C} = \{c_1,\ldots,c_N\} $$ - 3)评估 :评估器对每一项进行检查
- 4)输出 :生成两个分数:
- \( S_{\text{pass} } \):检查表的通过率
- \( S_{\text{eval} } \):一个整体的质量评估分数(论文发现这个分数与真实单元测试分数的相关性更高)
Designing Better Evaluator Agents,评估器优化
- 论文在开发评估器 Prompt 时,发现并修复了五种反复出现的失败模式:
- 1)Lazy evaluation :仅进行静态代码阅读,不执行测试
- 修复 :强制要求编写并执行测试(v1)
- 2)Lack of end-to-end validation :测试只覆盖函数级,忽略端到端验证
- 修复 :增加端到端测试要求(v2)
- 3)Role confusion :评估器会修改代码、执行仓库已有测试、为生成器辩护
- 修复 :在 Prompt 中明确禁止这些越界行为(v3)
- 4)Context overload :阅读过多无关代码,浪费上下文
- 修复 :指示只关注入口点和接口签名(v4)
- 5)Over-specification :过度详细的规则反而降低了性能
- 发现 :存在一个 Rubric granularity trade-off,规则过多会超出模型的指令遵循能力(v5)
- 理解:因为规则过多会导致模型上下文失效,对 Verifier 的要求会更高
- 1)Lazy evaluation :仅进行静态代码阅读,不执行测试
不同训练目标下的评估器质量
- 论文指出,评估器的实用价值取决于下游任务的需求:
- Rejection Sampling (大量候选) :评估器作为质量过滤器,重点是低假阳性率(拒绝坏样本)
- 对应指标是 阈值条件单元测试分数 (Threshold-conditioned UT Score)
- Rejection Sampling (少量候选) :评估器需平衡质量与数量,既要高阈值,也要保留足够的样本
- RL :评估器提供奖励信号,需要 强排序一致性 和足够的分数区分度,以形成有效的梯度
- Rejection Sampling (大量候选) :评估器作为质量过滤器,重点是低假阳性率(拒绝坏样本)
RFT 结果
- 在 OpenHands 支架(Anti-hacking)上的 RFT 实验表明:
- 使用评估器过滤后的高质量数据(9,139 样本)进行训练,性能(23.52)显著优于同量级的随机采样(21.61)
- 使用全部未过滤数据(19,050 样本)虽然最终性能更高(24.75),但这是以近一倍的算力成本为代价的
- 结论:在候选池有限时,评估器的价值最为显著,能有效提升训练效率
Conclusion & Future Directions
- 论文总结,验证不是一个辅助组件,而是训练流程的核心基础设施
- 没有单一的奖励策略足以维持编码代理的持续进步
- 一个完整的验证系统——整合了可执行测试、质量过滤、行为监控、代理评估器等多种机制,并随策略能力提升而不断重建——才是解决问题的关键
- 作者还提到,他们未来研究方向包括:
- 1)解空间的质量分层 :设计能区分“根本性修复”和“表面性修补”等质量梯度的奖励信号
- 2)捕捉人类主观感知 :弥合机器评估与人类对前端设计“质感”感知之间的差距
- 3)从离线反馈挖掘到在线学习 :将用户反馈更紧密地整合到在线学习框架中,实现持续适应
- 4)评估器-生成器协同进化 :构建类似 GAN 的对抗性训练循环,使评估器能跟上生成器的能力前沿
- 5)长周期和多Agent环境下的信用分配 :精确地将结果级奖励归因于中间的每一步或每个 Agent 的贡献
Over-Tokenized Transformer(N-gram Embedding)
- 原始论文:(N-gram Embedding)Over-Tokenized Transformer: Vocabulary is Generally Worth Scaling, 20250128, ICML 2025, Seed
- 本文核心观点是 在 LLM 中,通过解耦输入和输出词汇表,并大幅扩展输入词汇表(特别是通过多粒度 n-gram 嵌入),可以以一种计算成本几乎不变的方式,显著提升模型的性能与扩展效率
- 本文将这种模型命名为“Over-Tokenized Transformer”(过度分词 Transformer)
- 本文将分词视为预处理步骤的观点,将其提升为 LLM Scaling Laws 中的一个新的维度
- 背景 & 问题
- 传统的扩展定律主要关注模型参数量和训练数据量
- 近期一些研究表明,词汇量大小也应纳入扩展定律,且更大的模型需要更大的词汇量
- 扩展输出词汇表(Unembedding)会带来巨大的计算开销,而扩展输入词汇表(Embedding)则几乎没有额外计算成本,因为嵌入查询是稀疏操作
- 核心发现与贡献 :
- 1)输入与输出词汇表的解耦 :本文实验发现:
- 扩大输入词汇表总是带来正面收益
- 扩大输出词汇表对小型模型可能是有害的(会导致欠拟合)
- 2)对数线性关系 :
- 在 LLM 实验中,输入词汇量(\( m \))与训练损失(\( \mathcal{L} \))之间存在强烈的对数线性关系
$$ \mathcal{L} \propto -\log m $$ - 这意味着指数级扩大输入词汇量,能带来线性的损失下降
- 在 LLM 实验中,输入词汇量(\( m \))与训练损失(\( \mathcal{L} \))之间存在强烈的对数线性关系
- 3)实验验证性能飞跃 :
- 通过使用高达 12.8M 的输入词汇量,一个 400M 参数的模型,在训练损失上可以媲美 1B 参数量的基线模型,实现了约2.5 倍的参数效率提升
- 1)输入与输出词汇表的解耦 :本文实验发现:
Over-Tokenized Transformer 方法详解
- 本文提出了 Over-Encoding(OE,过度编码)和 Over-Decoding(OD,过度解码)两种策略,并将其组合为 Over-Tokenized Transformer(OT)
Over-Encoding (OE)
- 设计思路:不改变基础分词器(如 BPE),而是通过将连续的几个基础 Token(如 \( x_i, x_{i-1}, … \))组合成一个“n-gram”索引,然后在巨大的嵌入表中查找对应的嵌入向量,并将不同长度的 n-gram 嵌入加和,作为模型的最终输入表示
- 这相当于构建了一个层次化的、极其稀疏的输入特征映射
- 1)定义 n-gram 输入 Token :
- 给定基础分词器产生的 Token 序列
$$ x_1, x_2, \ldots, x_t $$ - 定义一个函数 \( f \) 将连续的 \( n \) 个基础 Token 映射为一个新的输入 ID \( x_i^{(-n)} \)(上标 \( -n \) 表示用于输入):
$$ x_i^{(-n)} = f(x_i, x_{i-1}, \ldots, x_{i-n+1}) $$- 其中
$$ f(z_1,\ldots,z_n) = \sum_{i=1}^{n} z_i V^{i-1} $$- \( V \) 是基础词汇量大小
- 理解:这实际上是把这 \( n \) 个 Token 看作一个 \( V \) 进制数,确保映射是单射(injective,不同的自变量,一定对应不同的函数值)
- 其中
- 给定基础分词器产生的 Token 序列
- 2)解决索引爆炸问题 :
- 问题:如果 \( V \) 是 10 万,那么 2-gram 的词汇量就是 \( V^2 \)(100 亿),这是不可行的
- 解法:
- 原文采用了模运算(Modulo)技巧 ,将巨大的 ID 映射到一个可配置的大小 \( m \) 的嵌入表中:
$$ \mathbf{h} = \mathbf{E}\left(x^{(n)} \% m\right), \quad \mathbf{E} \in \mathbb{R}^{m \times d} $$- \( \mathbf{h} \) 是输出的嵌入向量
- \( d \) 是嵌入维度
- 原文采用了模运算(Modulo)技巧 ,将巨大的 ID 映射到一个可配置的大小 \( m \) 的嵌入表中:
- 理解:本质上是将物理上不存在的巨大嵌入表通过哈希(模运算)模拟出来
- 虽然存在哈希冲突,但实验证明模型能够容忍甚至从中学习(这有点类似平时 CTR 模型中针对大量 ID 做 Embedding 的方案)
- 3)层次化编码(Hierarchical Encoding) :
- 最终输入模型的嵌入是不同长度 n-gram 嵌入的加和 :
$$ \text{OE}(x) = \mathbb{E}^{V \times d}(x^{(-1)}) + \sum_{i=2}^{n} \mathbb{E}^{m \times d_i | k}(x^{(-i)}) $$- 下面是标准的 1-gram(即原始 Token)嵌入,用于保持与权重绑定(Weight Tying)设计的兼容
$$ \mathbb{E}^{V \times d}(x^{(-1)}) $$ - 下面是表示将 2-gram, 3-gram… 的嵌入加和
$$ \sum_{i=2}^{n} \mathbb{E}^{m \times d_i | k}(x^{(-i)}) $$ - 理解 \( \mathbb{E}^{m \times d_i | k} \):
- \(\mathbb{E}\) :表示这是一个嵌入层(Embedding Table / Embedder)
- \(m \times d_i\) :表示该嵌入表的总逻辑形状
- \(m\):行数,即该嵌入表的词汇量大小(在 OE 中通常远大于基础词汇量 \(V\),如 1280 万)
- \(d_i\):列数,即该嵌入表中每个 Token 向量的总维度
- 下标 \(i\) 代表这是第 \(i\) 个 n-gram 阶数(例如 2-gram、3-gram)的嵌入表,不同阶数的 \(d_i\) 可能不同
- \(\vert k\) :操作符修饰符 ,表示该嵌入表在列方向(即维度方向)被切成 \(k\) 个独立的 Slices
- 下面是标准的 1-gram(即原始 Token)嵌入,用于保持与权重绑定(Weight Tying)设计的兼容
- 最终的嵌入既包含了细粒度的局部信息(1-gram),也包含了更宏观的上下文片段信息(2-gram, 3-gram)
- 最终输入模型的嵌入是不同长度 n-gram 嵌入的加和 :
- 4)低秩分解(Low-Rank Decomposition/切片技巧) :
- 为了在使用相同参数量时进一步提升性能,原文对嵌入表进行切片(Slicing)
- 设模型总维度为 \( d_{model} \),将 \( n \)-gram 嵌入层沿 \( d \) 维度分成 \( k \) 份,每一份的维度为 \( d_{model} / (n \cdot k) \)
- 理解:
- \(d\) 是一个通用的符号,用于表示任意嵌入表(Embedding Table)中每个 Token 向量的总维度
- \( d_{model} \) 是模型的总维度,是 Attention 和其他地方使用的值
- 一般来说有:
$$ d = d_{model} $$ - 原文中,为了控制参数量,在公式 (5) 中主动将高阶 n-gram 嵌入层的总维度设定为 \(d/n\)
- 补充理解:为什么要除以 \(n\)?
- 这是为了控制参数总量
- 如果不除以 \(n\)
- 那么 1-gram, 2-gram, 3-gram 三个表都需要 \(m \times d\) 的参数量,总参数量会变成 \(3 \times m \times d\)
- 除以 \(n\) 后
- 所有高阶表的总参数大大缩小,大约等于 \(m \times d\)(注:实际是个发散的级数,并不是确保小于 \(m \times d\)),大约相当于只增加了一个完整嵌入表的参数量,保证了参数效率
- 当默认实现中令 \(d = d_{model}\) 后,该高阶嵌入层经切片后的每个子维度就变成了 \(d_{model} / (n \cdot k)\)
- 补充理解:为什么要除以 \(n\)?
- 理解:
- 每个切片通过一个独立的线性层 \( \mathbf{W}_i \in \mathbb{R}^{\frac{d}{k} \times d_{model} } \) 投影回 \( d_{model} \)
$$ \mathbb{E}^{m \times d|k}(x^{(-n)}) = \sum_{i=1}^{k} \mathbb{E}_i^{m \times \frac{d}{k} }(x^{(-n)})\mathbf{W}_i $$ - 此举增加了模型的表达能力,且额外增加的 \( k \) 个线性层的计算开销相对于整体模型可以忽略
Over-Decoding (OD),辅助策略
- OD 对应输出端,目的是提供更细粒度的监督信号(即预测未来的 n 个Token),但需避免计算量爆炸
- MTP 方法本质可以视为 OD 的一种近似
- 核心 Insight :OD 只对足够大的模型(参数多、容量大)有益,对小型模型有害
- 因为预测未来多个 Token 是一个更难的任务,小模型欠拟合,而大模型能从中受益
- 与 OE 的关系 :
- 在 OE 基础上叠加 OD(即 Over-Tokenized Transformer),在下游任务指标上能取得进一步提升
- 注:可能会轻微牺牲训练损失
工程挑战与解决方案
- 挑战 :虽然计算量不变,但巨大的嵌入表(\( m = 12.8\text{M} \), \( d = 4096 \) 时,参数达数十亿)给 GPU 内存和分布式通信(如 FSDP)带来巨大压力
- 解决方案 :
- 推荐使用张量并行(Tensor Parallelism)而非 FSDP :将巨大的嵌入表按行切分到各个数据并行(DP)进程中
- 查询时,将 Token ID 发送到拥有其嵌入向量的进程,查询结果再发回原进程
- 这仅涉及少量的 All-to-All 通信,效率远高于 FSDP 的全量参数广播
- 未来优化方向 :可将嵌入表查表操作与 Transformer 的前向计算重叠,甚至将参数 Offload 到 CPU,彻底解决 GPU 内存瓶颈
- 实验表明,优化后额外训练开销小于 5%
- 推荐使用张量并行(Tensor Parallelism)而非 FSDP :将巨大的嵌入表按行切分到各个数据并行(DP)进程中
实验
主要结果
- 1)Dense 模型(OLMo2) :
- 性能匹配 :OE-12.8M(400M 参数)的损失曲线与 1B 参数的基线模型几乎重合(见原文图 1)
- 收敛加速 :在 1B 模型上,OE 实现了损失收敛 5.7 倍 的加速,在下游任务(如 MMLU, HellaSwag)上实现了约3 倍 的收敛加速(原文图 4)
- 对数线性规律 :实验验证了输入词汇量 \( m \) 与训练损失 \( \mathcal{L} \) 的关系:\( \mathcal{L} = 2.6754 - 0.0256 \times \log_{10} m \)(见原文图 5)
- 2)MoE 模型(OLMoE) :
- OE 在 MoE 架构上同样有效,在 OLMoE-1.3B 和 OLMoE-7B 上均显著降低了训练损失(见原文表 1)
- 收益衰减 :在下游任务指标上, MoE 模型的提升幅度小于Dense 模型
- 作者推测,这是因为 MoE 的稀疏参数(Expert)与 OE 提供的稀疏嵌入参数在功能上有所重叠
Ablation Study
- 词汇量大小(m) :
- 更大的 \( m \)(更大的输入词汇表)总是带来更低的损失,呈对数线性关系
- 切片(k)有效 :
- 将嵌入表沿维度切片(\( k>1 \))比单表性能更好(C-4 vs C-2/3)
- 本文分析这是因为增加了内存访问带宽(每 Token 访问的参数量更大)
- Hierarchical 有效 :
- 必须保留1-gram :如果只使用 2-gram 而丢弃 1-gram,性能会大幅下降(原文表 3)
- 这说明细粒度的 Token 信息是基础,不可或缺
- 3-gram 带来额外收益 :在 1-gram 和 2-gram 基础上加入 3-gram,性能进一步提升(详情见附录 C-6 vs C-5)
- 必须保留1-gram :如果只使用 2-gram 而丢弃 1-gram,性能会大幅下降(原文表 3)
- 哈希冲突的影响 :
- 如果故意让 \( m \) 成为 \( V \) 的倍数,即人为制造大量哈希冲突,OE 的收益会显著减少(原文表 4)
- 因此实践中应将 \( m \) 设置为与 \( V \) 互质(Coprime)的数
MIPI & MIPU
- 原始论文:(MIPI & MIPU)The Mirage of Optimizing Training Policies: Monotonic Inference Policies as the Real Objective for LLM Reinforcement Learning, 20260628, TJU & Alibaba
- TLDR:针对 LLM RL 后训练中“训练-推理不一致”所引发的目标错位问题,提出了全新的优化原则与框架,从目标上试图解决这个问题
- 核心创新:论文将训练-推理不匹配提升到目标层级 ,指出标准 RL 优化的是训练策略而非部署用的推理策略
- 问题:
- 本文的方法都有问题:
- Step 1 部分的本质是在 Decoupled PPO Objective 上进一步改进得到的(却没有提到原文),创新性不足
- Step 2 部分的方法是想要保证参数更新能使得推理策略性能上涨,但是本文的方法是无法严格保证推理性能上涨的
- 其实本文的提升分数非常有限,看起来更像是波动而不是算法效果带来的替身
- 本文的方法都有问题:
背景 & 问题
- LLM RL 为了兼顾生成效率与训练精度,通常将 推理引擎(Inference Engine,如vLLM/SGLang) 与 训练引擎(Training Engine,如FSDP/Megatron) 分离
- 即使参数完全同步,由于两者在数值精度(如 FP8 量化)、解码实现等方面的差异,同一模型参数在训练侧和推理侧对相同轨迹输出的概率分布并不一致
- 问题描述:
- \(\pi\) :训练策略,Training Policy
- \(\mu\) :推理策略,Inference Policy
- 注:\(\pi \neq \mu\),天然引入了传统 RL 中不存在的特殊“Off-policyness”,持续影响训练过程
- 现有工作的局限与本文 Insight
- 已有工作(如 TIS、MIS、LR-decay)从算法或基础设施层面努力减小这种不匹配,试图稳定训练策略
- 本文指出了一个被忽视的目标层级的错位(Objective-level Misalignment) :
有效的训练策略(\(\pi\))更新,并不保证推理策略(\(\mu\))的改善,最终部署和 Rollout 生成依赖的是推理策略
- 总结:标准 RL 目标(最大化训练侧策略收益)是一个“幻影(Mirage)”
- 真实的自然问题:“同步此更新是否真正产生了一个更好的推理策略?”
Preliminaries
LLM 的 RL 形式化
- LLM 的 Token 生成被建模为 MDP
$$ M = (\mathcal{S}, \mathcal{A}, P, R, \gamma)$$- 状态(State) \(s_t = (q, y_{1:t}) \in \mathcal{S}\):
- 包含Prompt \(q\) 和已生成的输出序列
- 动作(Action) \(a_t \in \mathcal{A}\):
- 从词汇表 \(\mathcal{V}\) 中选择的下一个 Token
- 转移(Transition) \(P(s_{t+1} | s_t, a_t)\):
- 在此上下文中是确定性的
- 奖励(Reward) \(R(s_t, a_t)\):
- 本文主要考虑可验证奖励(Verifiable Reward,如数学答案校验)
- 非终止步奖励为 0,终止步根据完整序列 \(\tau\) 是否正确返回 1 或 0
- 策略(Policy) \(\pi_{\theta}(a_t | s_t)\):
- 即 LLM 自身,参数为 \(\theta\)
- 目标 :最大化
$$ J(\pi) = \mathbb{E}_{\tau \sim \pi}[R(\tau)] $$
- 状态(State) \(s_t = (q, y_{1:t}) \in \mathcal{S}\):
单调策略改进与 PPO/GRPO
- 对于任意两个策略 \(\pi’\) 和 \(\pi\),策略差异恒等式(注:TRPO 中证明过)为:
$$
\Delta (\pi’,\pi) := J(\pi’) - J(\pi) = \mathbb{E}_{s,a\sim d^{\pi’} }[A^{\pi}(s,a)]
$$- \(d^{\pi’}\) 是 \(\pi’\) 诱导的折扣状态访问分布
- \(A^{\pi}\) 是优势函数
- TRPO/PPO 使用旧策略分布近似更新策略分布,构建局部 Surrogate Objective
- GRPO(本文基线)不使用价值网络(Critic),基于组内奖励归一化计算优势 \(\hat{A}_i^{\mu_k}\)
训练-推理不匹配的形式化**
- 在更新步 \(k\),即使完全共享相同参数,训练策略 \(\pi_k\) 与推理策略 \(\mu_k\) 概率分布不同
- 这种不匹配会导致多个问题:
- 1)比率级不匹配(Ratio-level Mismatch) :
- 重要性采样比率 \(\pi_\theta / \mu_k\) 与标准 PPO 的 \(\pi_\theta / \pi_k\) 不同
- 2)优势级偏差(Advantage-level Bias) :
- GRPO 的优势 \(\hat{A}_i^{\mu_k}\) 基于推理策略 \(\mu_k\) 采样的 Response 组计算,而非旧训练策略 \(\pi_k\),会造成估计偏差
- 1)比率级不匹配(Ratio-level Mismatch) :
Related Works
- LLM 后训练的 RL :涵盖 RLVR、GRPO、DAPO、GSPO 等规模化方案,以及 Off-policy 微调变体(如 ExGRPO)
- 训练-推理不一致应对 :
- 算法侧(TIS 用裁剪比率、MIS 过滤极端信号、LR-decay 降低更新幅度)
- Infra 侧(不分工作建议 FP16 Rollout,部分工作 研究低精度量化影响)
- 本文互补于上述已有工作 ,不从系统或算法上单纯“减少”不匹配,而是从目标层面决定“是否接受”该更新
核心方法:MIPI 与 MIPU
- 本文首先提出新优化原则 MIPI ,并设计了一个 两阶段框架 MIPU 实现该原则
MIPI:Monotonic Inference Policy Improvement,单调推理策略提升
- 核心思想 :由于 \(\pi \neq \mu\),训练策略的提升(\(J(\pi_{k+1}) - J(\pi_k)\ge 0\))并不能推出推理策略的提升(\(J(\mu_{k+1}) - J(\mu_k)\ge 0\))
- 因此,目标应直接对准推理策略的单调改进
- 关键分解(Equation 5) :
$$
J(\mu_{k+1}) - J(\mu_k) = \underbrace{J(\mu_{k+1}) - J(\pi_{k+1})}_{\text{① Post-update Inference Gap} } + \underbrace{J(\pi_{k+1}) - J(\pi_k)}_{\text{② training-side update} } + \underbrace{J(\pi_{k}) - J(\mu_k)}_{\text{③ pre-update inference gap} }
$$ - \(① + ② + ③\) 可以考虑进一步拆解为:
$$
J(\mu_{k+1}) - J(\mu_k) = \underbrace{J(\mu_{k+1}) - J(\pi_{k+1})}_{\text{① Post-update Inference Gap} } + \underbrace{J(\pi_{k+1}) - J(\mu_k)}_{\text{② + ③ 训练侧更新相对于采样器的增益} }
$$ - 基于此分解,MIPI 原则要求两步实现:
- Step 1 :优化 ② + ③,即 \(J(\pi_{k+1}) - J(\mu_k)\)
- 构造一个相对于当前 Rollout 策略(\(\mu_k\))提升的训练侧候选策略
- Step 2 :验证 Term ① ,即 \(J(\mu_{k+1}) - J(\pi_{k+1})\)
- 评估同步后的候选策略在推理侧是否产生了正向增益,决定是否接受
- 问题:这没有保证能准确提升推理侧策略吧,\(J(\pi_{k+1})\) 不一定比 \(J(\mu_{k})\) 更大,这就无法确保 \(J(\mu_{k+1})\) 比 \(J(\mu_{k})\) 更大
- Step 1 :优化 ② + ③,即 \(J(\pi_{k+1}) - J(\mu_k)\)
MIPU
Step 1:基于采样器的策略更新(Sampler-Referenced Policy Update)
- 设计思路 :Step 1 的目标是 \(J(\pi_{k+1}) - J(\mu_k)\),即相对于采样器策略(Sampler/Inference Policy) \(\mu_k\) 的改进
- 根据策略差异公式,这自然导出了以 \(\mu_k\) 为基准的重要性采样比率
- 比率分解与截断(Crucial Derivation) :
- 直接使用 \(\frac{\pi_\theta}{\mu_k}\) 作为 PPO-IS 的裁剪对象,会混合两种效应:
$$
\rho_i(\theta) = \frac{\pi_\theta(y_i|x)}{\mu_k(y_i|x)} = \underbrace{\frac{\pi_k(y_i|x)}{\mu_k(y_i|x)} }_{w^k_i \text{:pre-update mismatch} } \cdot \underbrace{\frac{\pi_\theta(y_i|x)}{\pi_k(y_i|x)} }_{r_i(\theta) \text{:current update} }
$$
- 直接使用 \(\frac{\pi_\theta}{\mu_k}\) 作为 PPO-IS 的裁剪对象,会混合两种效应:
- 若直接裁剪 \(\rho_i(\theta)\),即使 current update \(r_i(\theta)\) 接近 1,\(w^k_i\) 也会触发过度的裁剪,使信任域约束失效
- 本文采用的 TIS(Truncated Importance Sampling)方案 :
- 保留预存在不匹配的截断修正
$$ \bar{w}^k_i = \min(w^k_i, w_{\text{max} })$$- 其中 \(w_{\text{max} }=2\) 防止方差爆炸
- PPO 风格的裁剪仅作用于 current update \(r_i(\theta)\)
- 保留预存在不匹配的截断修正
- Step 1 的最终替代目标函数(Equation 7) :
$$
\mathcal{J}_{S1}(\theta) = \mathbb{E}_{x\sim \mathcal{D}, \{y_i\}_{i=1}^G \sim \mu_k(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \bar{w}^k_i \cdot \min \left( r_i(\theta) \hat{A}_i^{\mu_k}, \text{clip}(r_i(\theta), 1-\epsilon, 1+\epsilon) \hat{A}_i^{\mu_k} \right) \right]
$$- \(G\):Group Size
- \(\bar{w}^k_i\):截断后的训练-推理概率比率,用于修正采样分布偏差
- \(r_i(\theta) = \frac{\pi_\theta(y_i|x)}{\pi_k(y_i|x)}\):当前训练策略更新比率
- \(\hat{A}_i^{\mu_k}\):由推理策略 \(\mu_k\) 采样组计算出的相对优势
- \(\epsilon\):裁剪范围(本文设为 0.2)
- 理解:这里跟 Decoupled PPO Objective 本质是一样的
- 问题:作者没有提到别人的工作,是否是阅读 Related Work 不够,或者是可以避开?
- 优化此目标得到候选训练策略 \(\pi_{k+1} := \pi_{\theta^*}\)
Step 2:推理差距感知的更新接受(Inference-Gap-Aware Update Acceptance)
- 设计思路 :
- Step 1 优化了 \(J(\pi_{k+1}) - J(\mu_k)\),但无法保证同步后的推理策略 \(\mu_{k+1}\) 能实现该增益
- Step 2 评估剩余项
$$ T_{\text{post} } = J(\mu_{k+1}) - J(\pi_{k+1}) $$- 若 \(T_{\text{post} }\) 为负且绝对值过大,说明推理侧表现系统性劣于训练侧 ,此更新不可靠,应回滚(Rollback)
- 代理估计(Proxy Estimation) :
- 直接估计 \(T_{\text{post} }\) 需要候选训练策略 \(\pi_{k+1}\) 下的状态访问分布,难以获取
- 本文使用反向优势恒等式(Reverse Identity) ,将锚点切换为同步后的推理策略 \(\mu_{k+1}\),并引入重要性权重:
$$
T_{\text{post} } = -\mathbb{E}_{s,a\sim d^{\pi_{k+1} } }[A^{\mu_{k+1} }(s,a)] \quad \sim \quad \hat{T}_{\text{post} } = -\mathbb{E}_{x\sim \mathcal{D}_{\text{val} }, y_i \sim \mu_{k+1} } \left[ \rho_i \hat{A}_i^{\mu_{k+1} } \right]
$$- \(\mathcal{D}_{\text{val} }\):用于验证的 Prompt 批次
- \(\hat{A}_i^{\mu_{k+1} }\):由同步后推理策略 \(\mu_{k+1}\) 采样计算的优势
- \(\rho_i\):长度归一化的序列概率比率(Length-normalized sequence ratio),以稳定估计:
$$
\rho_i = \exp \left( \frac{1}{T_i} \sum_{t=1}^{T_i} \log \frac{\pi_{k+1}(y_{i,t} | x, y_{i,<t})}{\mu_{k+1}(y_{i,t} | x, y_{i,<t})} \right)
$$ - 问题:这里实际上评估 \(J(\mu_{k+1}) - J(\mu_{k})\) 才最合适吧?
- 回答:评估 \(J(\mu_{k+1}) - J(\mu_{k})\) 才确实是最贴合目标的,但本文在这里作者本意可以理解为是想要评估训推不一致性,但是训推不一致可能是固有的,\(J(\mu_{k+1}) - J(\pi_{k+1})\) 可能在不同的时间点几乎一致,这里最可能出现的情况是:
- 前期模型崩溃前:持续接受
- 后期模型开始崩溃后:持续拒绝且始终无法走出这个错误点(亲测:因为模型的崩溃一旦发生以后,在同一个点开始训练也会持续崩溃)
- 回答:评估 \(J(\mu_{k+1}) - J(\mu_{k})\) 才确实是最贴合目标的,但本文在这里作者本意可以理解为是想要评估训推不一致性,但是训推不一致可能是固有的,\(J(\mu_{k+1}) - J(\pi_{k+1})\) 可能在不同的时间点几乎一致,这里最可能出现的情况是:
- 问题:这个评估每次参数更新都要评估一次,本质上是需要浪费许多 推理资源的
- 回答:确实有开销,真是训练中可以考虑降低评估样本数量(保证多样性和代表性)来进一步提升模型能力
- 接受准则(Acceptance Criterion) :
- 设定:容忍参数 \(c \ge 0\)
- 接受规则:
- 如果 \(\hat{T}_{\text{post} } \ge -c\),则接受该候选
- 否则,拒绝更新 ,拒绝时将训练器状态和推理引擎状态回滚至上一 Checkpoint
- 动态容忍度(Dynamic Tolerance) :
- 观察到 \(\hat{T}_{\text{post} }\) 在训练初期较低(负值较大),后期逐渐上升
- 为避免早期过度拒绝,容忍度 \(c_t\) 在前 100 步线性退火(Annealing):
$$
c_t = c_{\text{start} } + \frac{\min(t, 100)}{100}(c_{\text{end} } - c_{\text{start} })
$$- 对于 Qwen3-4B,\(c_{\text{start} }=1\times10^{-3}\),\(c_{\text{end} }=0\)
- 对于Qwen3-1.7B,\(c_{\text{start} }=4\times10^{-3}\),\(c_{\text{end} }=1\times10^{-3}\)
Experiments
- 实验设置
- 高不匹配环境 :采用 FP8 量化的 Rollout 生成,刻意放大训练-推理不匹配
- 模型 :Qwen3-1.7B 和 Qwen3-4B
- 数据 :DAPO-Math-17K 和 DeepMath-103K 的过滤子集(保留基座模型可解决但非饱和成功率的题目)
- 评估基准 :MATH-500, AIME24, AMC23, Minerva, OlympiadBench
- 小规模基准(AIME24/AMC23)采用 avg@16 减少方差
- 基线 :标准 GRPO、MIS(Token-level mismatch-filtering)、LR-decay(学习率衰减)
- 注:LR-decay 原始论文是 (Length-Decay LR Scheduler)Beyond Precision: Training-Inference Mismatch is an Optimization Problem and Simple LR Scheduling Fixes It, 20260202, NUS & Fudan
- 具体方式:
- 提前根据模型长度变化找到衰减周期
- 第一阶段:保持初始恒等的 LR \(\eta_0\)以促进探索
- 进入第二阶段的触发:一旦检测到潜在不稳定性信号,触发 LR 衰减(之后开始按照衰减策略逐步衰减)
- 第二阶段:每
decay_period步将 LR 减半,直到下限(默认 \(0.1 \times \eta_0\))
- 按照一定步长逐步降低学习率的基本依据是:原始论文中认为训练过程中训推不一致会逐步累加,所以越到后期越要降低学习率
- 理解:正常训练下,\(\log \text{ppl_abs_diff}\) 指标我看到过两种情况:
- 大部分:训练过程中基础持平不动
- 少量:初期可能会上涨一些,然后持平不动(注:这里的上涨也不一定是训推误差累加,可能是概率分布的变化导致)
- 理解:正常训练下,\(\log \text{ppl_abs_diff}\) 指标我看到过两种情况:
- 具体方式:
- 注:LR-decay 原始论文是 (Length-Decay LR Scheduler)Beyond Precision: Training-Inference Mismatch is an Optimization Problem and Simple LR Scheduling Fixes It, 20260202, NUS & Fudan
- 诊断指标 :Mismatch-K3(即 \(D_{\text{KL} }(\mu | \pi)\) 的指数形式,计算 Rollout Token 上的 \(\exp(d_t) - d_t - 1\),其中 \(d_t = \log \pi - \log \mu\))
- 主要结果(RQ1)
- 性能 :如原文表 1 所示,MIPU 在 Qwen3-4B 上平均准确率达 66.71%(超基线 2.29%),在 Qwen3-1.7B 上达 53.97%(超基线 3.11%)
- 在 AMC23(85.00%)和 Minerva(45.96%)上增益显著
- 稳定性 :表 1 中 “Stable” 列显示,GRPO 基线、MIS、LR-decay 在训练后期出现性能 Collapse 或急剧退化
- MIPU 在达到高性能后保持稳定轨迹,如训练曲线(原文图 2)所示
- 性能 :如原文表 1 所示,MIPU 在 Qwen3-4B 上平均准确率达 66.71%(超基线 2.29%),在 Qwen3-1.7B 上达 53.97%(超基线 3.11%)
- 消融实验(RQ2:Step 1 与 Step 2 的互补性)
- 表 2 对比了 Baseline、仅 Step1、仅 Step2、完整 MIPU:
- 仅 Step1(+ Step 1) :引入 TIS 修正,平均分从 64.42 提升至 65.36,改善了候选更新方向
- 但未解决同步后的不匹配积累
- 仅 Step2(+ Step 2) :仅依靠验证拒绝,平均分降至 62.81
- 它能防止崩塌(Safety),但基线候选质量太差时,除了保留旧策略外无法产生进一步提升
- 完整方法 :Step 1 产出高质量候选,Step 2 筛选不可靠同步,协同达到最优 66.71%
- 问题:其实本文的提升分数非常有限,看起来更像是波动而不是算法效果带来的替身
- 图 3 的训练曲线进一步佐证:
- Step1 降低 K3-KL(减小不匹配)
- Step2 依据 \(\hat{T}_{\text{post} }\) 控制回滚率(Rollback Rate),两者缺一不可
- 注:原文图片画的缺少一些曲线,展示的并不明确
- Step 2:有效性分析(RQ3:信号驱动 vs 随机稀疏)
- 信号结构性(图 4a) :在 FP8 Rollout 下,Qwen3-1.7B(不匹配更大)的 \(\hat{T}_{\text{post} }\) 幅度更大、振荡更强,表明 \(\hat{T}_{\text{post} }\) 携带了结构化的推理侧差距信号 ,而非纯噪声
- 与随机回滚对比(图4b) :设置 70% 随机回滚概率(匹配 Step2-only 的早期回滚率)
- 随机回滚拒绝了更多更新(67.0% vs 53.5%),在短暂峰值后崩塌
- Step2 能维持稳定,证明 Step2 并非简单减少更新次数,而是基于推理差距信号有选择地过滤有害同步候选
- 容忍度参数 \(c\) 的敏感性分析(附录C)
- 图 6 显示
- 过严的接受标准(\(c < 0\))会拒绝过多早期候选,导致学习停滞(陷入持续回滚)
- 过宽的容忍度则失效
- 论文采用的 动态退火容忍度 平衡了早期学习效率与后期风险防护
- 图 6 显示
完整算法流程(Algorithm 1 总结)
- MIPU 的完整迭代过程如下(原文 Algorithm 1):
附录:Step 1 对比(原文附录 B)
- Step 1 对比(附录 B) :
- PPO-IS(裁剪 \(\pi_\theta/\mu_k\)):裁剪比例是合并的,裁剪比率过高,学习停滞
$$
\omega_{\text{PPO-IS} } = \text{clip}\left(\frac{\pi_\theta}{\mu_k}, ; 1 - \epsilon, ; 1 + \epsilon\right)
$$ - Vanilla-IS(分解开裁剪比例,但 \(w^k\) 无界):梯度方差极大
$$
\omega_{\text{Vanilla-IS} } = \frac{\pi_k}{\mu_k} \cdot \text{clip}\left(\frac{\pi_\theta}{\pi_k}, ; 1 - \epsilon, ; 1 + \epsilon\right)
$$ - TIS(截断 \(w^k\) + 裁剪 \(r_i\)) :最佳稳定性-性能折中,故被采用
$$
\omega_{\text{TIS} } = \min\left(\frac{\pi_k}{\mu_k}, ; C\right) \cdot \text{clip}\left(\frac{\pi_\theta}{\pi_k}, ; 1 - \epsilon, ; 1 + \epsilon\right)
$$
- PPO-IS(裁剪 \(\pi_\theta/\mu_k\)):裁剪比例是合并的,裁剪比率过高,学习停滞
Direct-OPD
- 原始论文:(Direct-OPD)Weak-to-Strong Generalization via Direct On-Policy Distillation, Seed, 20260706-20260708
- 整体总结:
- 问题提出:
- RLVR 训练计算成本与模型规模正相关,随着模型规模持续扩大,为每个新模型重新运行 RLVR 将使后训练本身成为瓶颈
- 论文提出一个弱到强的替代范式 :
- 在小模型上运行 RL(样本生成成本低)
- 将 RL 获得的改进迁移到更强的目标模型上
- 关键 Insight:
- 在 弱教师蒸馏到强学生的场景中,直接蒸馏小模型 Post-RL 的弱教师(即模仿教师最终策略)是不够的,因为教师的最终策略混合了 RL 带来的有益改进与小模型自身的能力局限
- 问题提出:
- Direct On-Policy Distillation (Direct-OPD) 方法核心思想
- Direct-OPD 不传递教师的绝对策略,而是传递教师的 RL 诱导策略偏移(policy shift)
- 具体方法:通过比较 post-RL 教师与其自身的 Pre-RL 参考模型,将两者的对数比值作为稠密的隐式奖励用于学生模型
- 简单理解:checkpoint 告诉我们在哪些动作上 RL 使弱模型更可能或更不可能采取,Direct-OPD 在更强的学生自己的 on-policy 状态上应用这个信号
- 这直接复用了弱模型的 RL 监督信号,而无需在目标模型上运行稀疏奖励 RL
- 核心结论和隐藏问题:
- 本文主要结论 & Insight
- 小 RL 教师的策略偏移(\(\log \pi_T - \log \pi_{T_{\text{ref} } }\))可用于大模型 RL 的奖励
- Direct-OPD 可实现 跨教师对和学生家族 迁移
- Direct-OPD 优于步数匹配的直接 RL ,计算成本显著更低(存疑)
- 理解:本文这个 RQ2 的实验可能不够公平,数据如果对当前模型没有优化作用(比如过于简单),那么当前模型上直接 RL 得到的结果并不算好,而且还会跟学习率等相关,这里的比较很难说公平
- 理解:从数学理论上,直接 RL 就应该是比 Direct-OPD 更好的,毕竟 Direct-OPD 方法是从 直接 RL 的目标上推导出来的,这里获胜大概率是因为训练前期的效率问题,继续训练下去,RL 的效果肯定会更高(直接 RL 的上限理论上高于 Direct-OPD)
- Direct-OPD 具有可组合性 :多个教师偏移可顺序组合到同一学生
- 局限性
- 对模型 Pair 要求很高,当教师/参考改进在 student-visited states 上没有意义时,Direct-OPD 大概率会失败
- 最佳响应长度 和 KL 强度 仍取决于教师-学生对,是需要调整的超参数
- 本文主要结论 & Insight
On-Policy Distillation (OPD)
- 对于自回归语言模型策略 \(\pi\),给定提示 \(x\) 和响应 \(y = (y_1, \ldots, y_T)\),策略分解为:
$$
\log \pi(y \mid x) = \sum_{t=1}^{T} \log \pi(y_t \mid s_t)
$$- 其中 \(s_t = (x, y_{ < t})\) 是前缀
- 标准 OPD 的目标:
$$
\mathcal{L}_{\text{OPD} }(\theta) = \mathbb{E}_{x\sim \mathcal{D} }\left[D_{\text{KL} }\left(\pi_{\theta}(\cdot \mid x) | \pi_{T}(\cdot \mid x)\right)\right]
$$- \(\pi_{\theta}\):正在训练的学生策略
- \(\pi_{T}\):教师的 Post-RL 模型
- 在 on-policy 采样下,学生从 \(\hat{y}\sim \pi_{\theta}(\cdot \mid x)\) 采样,每个前缀 \(s_t\) 上的 KL 分解为:
$$
\mathcal{L}_{\text{OPD} }(\theta) = \mathbb{E}_{x\sim \mathcal{D}, \hat{y}\sim \pi_{\theta} }\left[\sum_{t=1}^{T} D_{\text{KL} }(p_t \mid q_t)\right]
$$ - Top-\(k\)局部估计:
- 实践中只在学生 top-\(k\) 支持集上查询教师:
$$
\mathcal{L}_{\text{OPD} }^{\text{top-}k}(\theta) = \mathbb{E}_{x\sim \mathcal{D}, \hat{y}\sim \pi_{\theta} }\left[\sum_{t=1}^{T} D_{\text{KL} }(\hat{p}_t^{S_t} | \hat{q}_t^{S_t})\right]
$$ - \(S_t = \text{TopK}_{v} p_t\),表示仅在学生 top-k 候选 token 上对其策略分布
- \(\hat{p}_t^{S_t}\) 和 \(\hat{q}_t^{S_t}\) 是在 \(S_t\) 上重新归一化的分布
- 实践中只在学生 top-\(k\) 支持集上查询教师:
策略偏移作为隐式奖励(本文的核心创新)
- 为什么标准 OPD 在弱到强场景下失败?
- 教师的最终策略 \(\pi_T\) 是以下两者的混合:
- RL 带来的有益变化
- 弱模型的内在能力限制
- 当学生已经超越教师时(如 R1-Distill-7B 在 56.7%,而 JustRL-1.5B 教师仅 51.3%),模仿教师会覆盖学生更强的行为,导致性能下降(降至约 50%)
- 教师的最终策略 \(\pi_T\) 是以下两者的混合:
- Direct-OPD 的解决方案: 对比教师自身的前后状态,提取纯 RL 诱导的变化:
$$
\Delta_T(y \mid x) = \log \pi_T(y \mid x) - \log \pi_{T_{\text{ref} } }(y \mid x)
$$- 理解:这里是对 \(\Delta_T(y \mid x)\) 的一个定义,后面会推导出这个式子等于什么
- \(\pi_{T_{\text{ref} } }\):教师的 Pre-RL 参考模型
- 正值:RL 使该响应更可能
- 负值:RL 抑制了该响应
- 补充:理论保证 在 KL 正则化 RL 目标下,该策略偏移数学等价于训练教师的奖励
- 考虑 KL 正则化 RL 目标:
$$
\max_{\pi} \mathbb{E}_{y\sim \pi}\left[r(x, y) - \beta \log \frac{\pi(y \mid x)}{\pi_{\text{ref} }(y \mid x)}\right]
$$ - 其闭式最优解为:
$$
\pi^* \propto \pi_{\text{ref} } \exp(\frac{r}{\beta})
$$- 详细证明参考 RL——CQL 的附录部分 , DPO 原始论文中也有类似推导
- 进一步展开这个式子并做一下变换即可得到:
$$
\log \frac{\pi^*(y \mid x)}{\pi_{\text{ref} }(y \mid x)} = \frac{1}{\beta} r(x, y) - \log Z(x)
$$- 其中 \(Z(x)\) 是配分函数,在同一 Prompt 下对不同响应是常数
- 这意味着 策略-参考对数比值恢复出奖励,相差一个正缩放和一个 Prompt 相关的常数
- 利用这个恒等式做反向操作 :给定 post-RL 教师 \(\pi_T\) 和其参考 \(\pi_{T_{\text{ref} } }\),从其策略比值中读出类奖励信号:
$$
\begin{align}
\Delta_T(y \mid x) &= \log \pi_T(y \mid x) - \log \pi_{T_{\text{ref} } }(y \mid x) \\
&= \log \frac{\pi^*_T(y \mid x)}{\pi_{T_{\text{ref} } }(y \mid x)} \\
&= \frac{1}{\beta} r_T(x, y) - \log Z_T(x)
\end{align}
$$- 理解:推导时使用到了 \(\pi_T(y \mid x)\) 就是 RL 训练后得到的最有策略 \(\pi^*_T(y \mid x)\)
- 理解:这个公式告诉我们,教师模型的策略偏移量,实质上等价于它自己的奖励函数(乘以一个正数),再减去一个只跟当前问题有关的基准值
- \(\Delta_T(y|x)\) 是 可观测的教师策略偏移
- 等于教师 RL 后的概率对数,减去教师 RL 前的概率对数
- 理解:就是 RL 训练在教师模型身上刻下的痕迹 ,对应哪些回答被鼓励了,哪些被抑制了
- \(\frac{1}{\beta} r_T(x, y)\) 是用于训练教师的原始奖励信号 (只是除以了一个常数 \(\beta\))
- \(-\log Z_T(x)\) 是一个 仅依赖于输入 Prompt \(x\),而与具体回答 \(y\) 无关的归一化常数(配分函数的对数)
- 考虑 KL 正则化 RL 目标:
Direct-OPD 目标函数
- 理想化的序列级目标:
- 学生从 \(\pi_S\) 初始化,优化针对教师偏移信号 \(\Delta_T\),同时用 KL 项正则化到自身的初始化:
$$
\mathcal{J}_{\text{Direct-OPD} }(\theta) = \mathbb{E}_{x\sim \mathcal{D} }\left[\mathbb{E}_{y\sim \pi_{\theta}(\cdot \mid x)}[\Delta_T(y \mid x)] - \alpha D_{\text{KL} }(\pi_{\theta}(\cdot \mid x) | \pi_S(\cdot \mid x))\right]
$$- \(\pi_{S}\):学生的初始检查点
- \(\alpha > 0\) 控制 KL 惩罚
- 该目标的最优解为:
$$
\pi^*(y \mid x) \propto \pi_S(y \mid x) \exp\left(\frac{1}{\alpha}\Delta_T(y \mid x)\right) = \pi_S(y \mid x)\left(\frac{\pi_T(y \mid x)}{\pi_{T_{\text{ref} } }(y \mid x)}\right)^{1/\alpha}
$$ - 代入隐式奖励形式得到:
$$
\pi^* \propto \pi_S \exp(\frac{r_T}{\alpha\beta})
$$- 证明:
- 根据策略偏移的定义 \(\Delta_T(y|x) = \log \pi_T - \log \pi_{T_{\text{ref} } } = \frac{1}{\beta} r_T - \log Z_T(x)\):
$$
\pi^* \propto \pi_S \cdot \exp\left( \frac{1}{\alpha} \Delta_T \right)
= \pi_S \cdot \exp\left( \frac{1}{\alpha} \left( \frac{1}{\beta} r_T - \log Z_T(x) \right) \right)
$$ - 吸收与 \(y\) 无关的常数项,将指数展开:
$$
\pi^* \propto \pi_S \cdot \exp\left( \frac{r_T}{\alpha \beta} \right) \cdot \exp\left( -\frac{\log Z_T(x)}{\alpha} \right)
$$- 理解:因为 \(Z_T(x)\) 只依赖于输入 Prompt \(x\),而与具体的回答 \(y\) 无关 ,所以 \(\exp\left( -\frac{\log Z_T(x)}{\alpha} \right)\) 对于同一个问题下的所有候选回答来说是一个常数乘子,在正比关系 \(\propto\) 中,这个常数项可以被吸收掉(或者视为归一化分母的一部分)
- 因此,最终得到:
$$
\pi^* \propto \pi_S \exp\left( \frac{r_T}{\alpha \beta} \right)
$$
- 根据策略偏移的定义 \(\Delta_T(y|x) = \log \pi_T - \log \pi_{T_{\text{ref} } } = \frac{1}{\beta} r_T - \log Z_T(x)\):
- 证明:
- 关键结论:
- 学生被优化得如同在使用小教师的隐式奖励运行 KL 正则化 RL,同时用自己的初始化 \(\pi_S\) 作为参考
- 完全从 Checkpoint Pair 获得奖励信号,无需查询可验证奖励或在目标上运行稀疏奖励 RL
- 学生被优化得如同在使用小教师的隐式奖励运行 KL 正则化 RL,同时用自己的初始化 \(\pi_S\) 作为参考
- 学生从 \(\pi_S\) 初始化,优化针对教师偏移信号 \(\Delta_T\),同时用 KL 项正则化到自身的初始化:
- 从序列级到 Token 级:
- 由于两个教师都按自回归方式分解,序列偏移精确分解为 token 级偏移之和:
$$
\begin{align}
\Delta_T(y \mid x) &= \log \pi_T(y \mid x) - \log \pi_{T_{\text{ref} } }(y \mid x) \\
&= \sum_t \log \pi_T(y_t \mid s_t) - \log \pi_{T_{\text{ref} } }(y_t \mid s_t) \\
&= \sum_t r_t(y_t \mid s_t)
\end{align}
$$- 理解:这里论文中还进一步定义了:
$$ r_t(v) = r_t(v|s_t) = \log \pi_T(v \mid s_t) - \log \pi_{T_{\text{ref} } }(v \mid s_t) $$ - 这里 \(r_t(v)\) 可以看作 Dense 即时每 token 奖励 :
- \(r_t(v) > 0\):教师的 RL 鼓励了 token \(v\)
- \(r_t(v) < 0\):教师的 RL 抑制了 token \(v\)
- 理解:这里论文中还进一步定义了:
- 由于两个教师都按自回归方式分解,序列偏移精确分解为 token 级偏移之和:
- Top-\(k\) 动作空间限制:
- 在每个访问的前缀,限制到学生的 top-\(k\) 支持集 \(S_t = \text{TopK}_v \pi_{\theta}(v \mid s_t)\),并重新归一化学生概率:
$$
\bar{p}_t(v) = \frac{\pi_{\theta}(v \mid s_t)}{\sum_{u \in S_t} \pi_{\theta}(u \mid s_t)}, \quad v \in S_t
$$
- 在每个访问的前缀,限制到学生的 top-\(k\) 支持集 \(S_t = \text{TopK}_v \pi_{\theta}(v \mid s_t)\),并重新归一化学生概率:
Analytical Top-\(k\) 策略梯度
- 蒙特卡洛估计(高方差): 仅基于在 Sampled Token 来估计 \(R(y|x)\)
$$
\nabla_{\theta} \mathcal{J}_{\text{MC} } = \mathbb{E}_{x,y}\left[\sum_t r_t(y_t) \nabla_{\theta} \log \pi_{\theta}(y_t \mid s_t)\right]
$$- 理解:这个公式来源于 REINFORCE 的策略梯度公式
$$
\begin{align}
\nabla_{\theta} \mathcal{J}_{\text{REINFORCE} }
&= \mathbb{E}_{x,y}\left[ R(y|x) \nabla_{\theta} \log \pi_{\theta}(y \mid x)\right] \\
&= \mathbb{E}_{x,y}\left[ R(y|x) \sum_t \nabla_{\theta} \log \pi_{\theta}(y_t \mid s_t) \right]\\
&= \mathbb{E}_{x,y}\left[ \sum_t r_t(y_t|s_t) \sum_t \nabla_{\theta} \log \pi_{\theta}(y_t \mid s_t) \right]\\
&= \mathbb{E}_{x,y}\left[\sum_t r_t(y_t) \nabla_{\theta} \log \pi_{\theta}(y_t \mid s_t)\right]
\end{align}
$$
- 理解:这个公式来源于 REINFORCE 的策略梯度公式
- Rao-Blackwellized 估计(低方差): 基于 Top-K 计算积分估计 \(R(y|x)\),比仅使用采样到的轨迹上的 Token 估计更加准确
- 对每个步骤,用受限分布 \(\bar{p}_t\) 上的期望替换单 token 估计:
$$
\nabla_{\theta} \mathcal{J}_{\text{analytical} } = \mathbb{E}_{x,y\sim \pi_{\theta} }\left[\sum_t \sum_{v \in S_t} \underbrace{\bar{p}_t(v)}_{\text{权重} } \cdot \underbrace{r_t(v)}_{\text{奖励} } \cdot \underbrace{\nabla_{\theta} \log \pi_{\theta}(v \mid s_t)}_{\text{对数似然} }\right]
$$
* - 理解:“Rao–Blackwellize”(拉奥-布莱克韦尔化)是一个用于降低方差(Variance Reduction)的统计和强化学习技术
- Rao–Blackwellize 的核心思想可以一句话概括为:“能用期望算出来的东西,就别用采样去凑;用条件期望替换随机样本,可以在不引入偏差的前提下,显著降低估计的波动性”
- 对每个步骤,用受限分布 \(\bar{p}_t\) 上的期望替换单 token 估计:
- Stop-gradient 系数: 权重 \(\bar{p}_t(v)\) 依赖于 \(\theta\),直接微分会引入额外的 Jacobian 项
- 因此将加权奖励 detach 为静态系数:
$$
A_t^w(v) = \text{stop_gradient}(\bar{p}_t(v) \cdot r_t(v))
$$
- 因此将加权奖励 detach 为静态系数:
- 最终梯度估计:
$$
\nabla_{\theta} \mathcal{J}_{\text{Direct-OPD} } \approx \mathbb{E}_{x\sim \mathcal{D}, y\sim \pi_{\theta} }\left[\sum_t \sum_{v \in S_t} A_t^w(v) \nabla_{\theta} \log \pi_{\theta}(v \mid s_t)\right] - \alpha \nabla_{\theta} D_{\text{KL} }(\pi_{\theta}(\cdot \mid x) | \pi_S(\cdot \mid x))
$$
自适应 KL 控制
- 问题: 奖励尺度不匹配
- 由 \(\Delta_T = \frac{1}{\beta} r_T - \log Z_T\) 可知,\(\Delta_T\) 的大小是教师的奖励 \(r_T\) 除以 \(\beta\), \(r_T\) 和 \(\beta\) 在教师训练时已固定并编码在 \(\pi_T\) 偏离 \(\pi_{T_{\text{ref} } }\) 的程度中,但无法从 Checkpoint Pair 中恢复
- 固定 \(\alpha\) 难以在跨教师-学生对时稳健转移
- 解决方案: 轻量级控制器,根据密集信号的运行尺度自适应调整 \(\alpha\),更新规则:
$$
\alpha_{m+1} = \text{clip}\left(\alpha_m \left(1 + \epsilon \cdot \text{sign}(\bar{r}_m)\right), \alpha_{\min}, \alpha_{\max}\right)
$$- \(\alpha_m\):第 \(m\) 次迭代的 KL 系数
- \(\bar{r}_m\):batch 级别的学生加权偏移均值
- 其中 \(\epsilon = 0.01\),\([\alpha_{\min}, \alpha_{\max}] = [0.5, 2.5]\)
- 理解:\(\text{sign}(\bar{r}_m)\) 表示 Batch 级别的均值 \(\bar{r}_m\) 的正负号
- 当 \(\bar{r}_m > 0\)(学生当前访问的前缀上,教师的 RL 平均提高了候选 token ):提高 \(\alpha\),防止过度放大局部信号
- 当 \(\bar{r}_m < 0\)(平均降低了候选 token):降低 \(\alpha\),减弱锚定,让密集梯度将概率移离教师 RL 抑制的 token
实验
- 三个研究问题(RQs)
- RQ1: 小教师的 RL 诱导策略偏移能否改进已经匹配或超越教师能力的学生?是否在不同教师对和学生家族中保持一致?
- RQ2: 在固定 RL 步数预算下,在小模型上运行 RL 并转移其策略偏移,是否比直接在大型目标上运行 RL 更好?
- 注:在准确率和计算两方面
- RQ3: 多个独立学习的策略偏移能否顺序组合到同一学生中?
- 实验设置
- 教师对:
- R1-Distill-1.5B \(\rightarrow\) JustRL-1.5B :来自不同的训练流程
- R1-Distill-1.5B :在 Qwen-1.5B 基座上,通过 SFT 蒸馏 DeepSeek-R1 的推理轨迹(如 Mixture-of-Thoughts 数据集)得到,未使用 RL
- JustRL-1.5B :在 R1-Distill-1.5B 基座上,采用固定超参的单阶段 GRPO 算法 进行强化学习训练,未使用数据增强或课程学习
- 理解:JustRL-1.5B 比 R1-Distill-1.5B 多了一个 RL 流程
- Nemotron-1.5B \(\rightarrow\) QuestA-Nemotron-1.5B :不同的训练流程和不同数据源
- Nemotron-1.5B :在 Nemotron 基座上,通过SFT 在 OpenMath 数学数据集上训练得到,未使用 RL
- QuestA-Nemotron-1.5B :在 Nemotron 基座上,采用问题增强(提供部分解决方案)和课程学习策略进行 RL 训练得到训练
- 理解:两者基于相同基座开始,分别用不同的数据和流程训练得到
- R1-Distill-1.5B \(\rightarrow\) JustRL-1.5B :来自不同的训练流程
- 学生模型:
- R1-Distill-7B
- Qwen3-1.7B
- Qwen3-4B
- 评估基准: AIME 2024、AIME 2025
- 弱到强迁移测试关键实验条件:
- 学生模型 R1-Distill-7B 和 Qwen3-4B 起始准确率已超过 post-RL 的 JustRL 教师(56.7% 和 72.5% vs 51.3%)
- 教师对:
- 主要实验结果
- RQ1:小 RL 教师能改进更强的学生
- 结论:已经超过教师的 R1-Distill-7B 和 Qwen3-4B 在内的所有学生都获得了提升,表明 Direct-OPD 传递的是可复用的策略偏移信号 而非简单模仿教师最终策略
- 结论:已经超过教师的 R1-Distill-7B 和 Qwen3-4B 在内的所有学生都获得了提升,表明 Direct-OPD 传递的是可复用的策略偏移信号 而非简单模仿教师最终策略
- RQ2:弱到强泛化优于直接 RL
- 结论:小模型提供了发现改进方向的更廉价环境 ,Direct-OPD将该方向转移到更大模型,而大模型直接RL需要自己通过rollout发现相同方向
- 实验设计:
- 在小模型(R1-Distill-1.5B)上训练 RL,在不同步数(300、600、900、1200、1500步)取出检查点
- 每个检查点与基础模型构成教师对
- 用 Direct-OPD 转移到 R1-Distill-7B
- 与直接在大模型上运行 RL 相同步数比较
- 结果:
- 相同 RL 步数下,小模型 RL + Direct-OPD 转移优于 直接在 R1-Distill-7B 上 RL
- 计算优势显著:
- 1.5B 模型 1500 步 RL:约 160 小时(32 A100)
- 7B 模型 1500 步 RL:约 320 小时(32 A100)
- Direct-OPD 转移阶段:仅约 4 小时(8 A100)
- Qwen3 非思考模型验证:
- 在 1.7B 模型上 100 步 RL,转移偏移到 Qwen3-4B-nonthinking
- 达到 0.635 的 AIME 2025 准确率,与直接 Qwen3-4B RL 水平相当
- 理解:这个实验可能不够公平,数据如果对当前模型没有优化作用(比如过于简单),那么当前模型上直接 RL 得到的结果并不算好,而且还会跟学习率等相关,这里的比较很难说公平
- 理解:从数学理论上,直接 RL 就应该是比 Direct-OPD 更好的,毕竟 Direct-OPD 方法是从 直接 RL 的目标上推导出来的,这里获胜大概率是因为训练前期的效率问题,继续训练下去,RL 的效果肯定会更高(直接 RL 的上限理论上高于 Direct-OPD)
- RQ3:顺序组合
- 第一阶段:R1-Distill-1.5B \(\rightarrow\) JustRL-1.5B 信号
- 第二阶段:Nemotron-1.5B \(\rightarrow\) QuestA-Nemotron-1.5B 信号
- 结果: 不同的 RL 训练可以学习不同的能力,Direct-OPD 可以将这些能力顺序组合到同一学生中
- RQ1:小 RL 教师能改进更强的学生
补充:分析与训练 Dynamics
跨模式迁移:无需 Token 重叠模仿
- 关键 Insight: Direct-OPD 不要求师生 Top-\(k\) 重叠高
- 标准 OPD 依赖高 Top-\(k\) 重叠作为训练信号载体
- Direct-OPD 即使师生思维模式差异显著(Top-\(k\) 重叠低)也能转移
- 教师对学生的输出分布影响通过序列级重新加权 实现,而非强制逐 token 匹配
- 解释: Direct-OPD 的信号作用于学生访问状态的分布权重 ,而非要求学生模仿教师的绝对输出
- 因此即使学生和教师使用不同的推理模式,信号仍然有效
short-horizon 训练泛化
- 问题: 短响应长度的训练是否只改变直接监督的前缀,而留下后续推理行为不变?
- 实验设计:
- 使用 2k token 响应长度训练 Direct-OPD
- 在固定长 rollout(~16k)上测量累积间隙:
$$
\begin{align}
g_t &= \sum_{a \in K_t} \pi_{\text{actor} }(a \mid x_{\leq t})[\log \pi_{\text{JustRL} }(a \mid x_{\leq t}) - \log \pi_{\text{R1} }(a \mid x_{\leq t})] \\
G_T &= \sum_{t=1}^T g_t
\end{align}
$$- 其中 \(K_t\) 是 actor 的 Top-16 token 集合
- \(G_T\) 越大:actor 的 likely tokens 更像 post-RL 教师 JustRL
- \(G_T\) 越小:actor 更接近参考 R1-Distill-1.5B
- 关键发现:
- 2k 训练后,actor 在完整 16k rollout 上向教师偏移方向移动
- 效果不仅限于训练前缀(虚线 2k 之后仍保持偏移)
- 2k 设置验证最佳(48.8 vs 6k 的 45.6)
- 解释: 6k 训练可能驱动 actor 进入不可靠区域(教师对参考 log-ratio 大但不值得信赖),而 2k 捕捉到可靠的早期前缀方向并泛化
KL 控制教师偏移奖励的可靠性
- 核心 Insight: 教师/参考 log-ratio 作为密集奖励,但仅在教师偏移对学生有意义的 states 上可靠
- KL 不仅是正则化系数,还 控制学生访问哪些 rollout states ,因此决定了密集奖励是否保持可靠:
- KL 太弱: 学生漂移到教师和参考都分配低概率的区域,log-ratio 成为噪声训练目标
- KL 太强: 学生无法跟随教师的策略偏移
- 实验结果:
- 最佳固定 KL 值因教师-学生对而异(非通用)
- 密集 token reward 的较大正值可能对应不同设置下的更差或更好验证
- 自适应 KL 将密集 token reward 拉向零(初始修正后),使学生保持在教师/参考比较仍信息丰富的区域
Unlikeliness Reward
- 原始论文:(Unlikeliness Reward)Rewarding the Unlikely: Lifting GRPO Beyond Distribution Sharpening, CMU, 20250620
- 论文关注 形式化定理证明(Formal Theorem Proving) 领域,使用 Lean 证明助手作为环境
- 该领域拥有一个关键优势(RLVR):完美验证器(Perfect Verifier) ,即模型生成的证明要么完全正确(奖励为 1),要么错误(奖励为 0),不存在模糊的中间奖励
- 问题:GRPO 算法显著提升了单次采样准确率(Pass@1),但它存在致命的分布锐化问题:
- GRPO 训练后,模型在小 N 值(如 Pass@1, @2)上表现提升,但在大 N 值(如 Pass@512)上甚至劣于 Base Model
- 分布锐化指的是 RL 仅仅强化了基座模型已经高概率输出的正确解,使得模型分布变 “尖”(Sharp),却未能挖掘和提升基座模型中低概率但正确的“长尾”解
Pass@N 的定义
- 设初始模型 \(\pi_0\) 解决某个问题 \(x\) 的成功概率为 \(p_0\),即:
$$
p_0 = \sum_{y \text{ s.t. } R(x,y)=1} \pi_0(y \mid x)
$$ - Pass@N 的期望为:
$$
\mathbb{E}[\text{pass@}N(\pi_0)] = 1 - (1 - p_0)^N
$$ - 假设 RL 训练将每个正确解的概率乘以因子 \(1+\epsilon\)(受 PPO 的 Clip 机制限制),则新的成功率 \(p_{\text{RL} } \approx (1+\epsilon)p_0\)
- Pass@N 的期望为:
$$
\mathbb{E}[\text{pass@}N(\pi^*)] = 1 - (1 - (1+\epsilon)p_0)^N
$$ - 原文试图证明 :要想提升大 N 的 Pass@N,算法必须特化地提升低概率 \(p_0\) 正确解的概率(或必须 提升概率约为 \(1/N\) 的正确解的概率)
- 理解:原文的证明不够严谨,可以从个人角度简单理解为
- \(p_0\) 是问题层面的聚合成功率(所有正确解的概率之和)
- 但该问题若想在大 \(N\)(比如 \(N=512\))采样中成功,需要依靠具体某个低概率的正确证明片段
- 在形式化定理证明中,一个问题的正确解往往不止一个
- 高概率的 \(p_0\) 通常由少数几个高频、短小的标准解法贡献
- 如果 \(p_0\) 已经很大(比如 0.5),Pass@512 早已是 1,无需优化
- 当作者着眼于 大 \(N\) 无法解决 的难题时,意味着该问题的全局 \(p_0\) 本身就在 \(1/N\) 量级(例如 \(p_0 \approx 0.002\))
- 这种极低的全局成功率,在采样组(Group)内表现为所有正确样本的个体概率都极低(即论文中所谓的“低 Rank/低概率正样本”)
- 因此,严谨的推论是 :
为了提升 Pass@N(尤其是大 N),RL 算法必须将优化火力集中在该阈值 \(p_0 \approx 1/N\) 的样本上- 由于 \(1/N\) 在数值上很小,这些在数学上必然对应着模型初始分布中的“低概率解”
- 故而,本文的核心思想提升低概率正确样本的更新权重
- 理解:原文的证明不够严谨,可以从个人角度简单理解为
核心缺陷诊断:GRPO 的 “Rank 偏差(Rank Bias)”
诊断指标:提升率(Uplift Rate)
- 为了量化 GRPO 是否提升了低概率解,本文定义了“提升率” \(u_j\)
- 对于每个问题 \(x_i\),将采样组内的解按照其在 初始模型 下的概率从高到低排序,得到 \(\tilde{y}_{i,j}\)(\(j\) 为 Rank ,越小概率越高)
- 问题:岂不是越长的 Response 越容易概率低,本文似乎没有对长度进行归一化,使用的是原始的概率乘积
- 对于每一个 Rank \(j\),计算该 Rank 下正确解被模型提升的概率:
$$
u_j = \underset{i: R(x_i, \tilde{y}_{i,j}) = 1}{\text{mean} } \left( \mathbb{1} \{ \pi_{\text{GRPO} }(\tilde{y}_{i,j} \mid x_i) > \pi_0(\tilde{y}_{i,j} \mid x_i) \} \right)
$$- 理解:原始 base model 生成 Response 的概率不同,这里是想看不同概率的正确 Response 是否被 RL 均匀的提升了
发现
- 实验结果表明(图4)
- Rank \(j\) 越小(概率越高),\(u_j\) 越高
- Rank 越大(概率越低),\(u_j\) 趋近于 0
- 这证实了GRPO 存在强烈的 Rank 偏差 :它 倾向于强化已经高概率的样本,而忽略低概率的正确样本
- 理解:说明不同概率的正确 Response 没有被 RL 均匀的提升,概率越低的正确样本,被提升的幅度越低
- 理解:标准 GRPO 提升低概率正确 Response 较少的原因是被采样到的概率较低,从而被提升次数较低,高概率正确 Response 则往往更多的被采样和加强
Unlikeliness Reward(不相似性奖励)方法
- Rank 偏差并非 GRPO 损失函数的固有属性(因为低概率样本的比率 \( \frac{\pi_{\text{RL} }}{\pi_0} \) 更容易提升),而是Optimizer 的隐式偏见
- 为此,本文设计了显式反制机制
Unlikeliness Reward 设计思路
- 不相似性奖励的核心思想是:在保持奖励方向(正确/错误)不变的前提下,利用组内相对概率 Rank 次,对高概率的正确解施加乘法惩罚,从而相对抬高罕见(低概率)正确解的 Advantage
Unlikeliness Reward 方法流程
- 给定当前策略 \(\pi_{\theta_{\text{old} } }\) 下的一组采样 \(y_1, \dots, y_G\):
- 1)计算 Rank :设 \(\text{rank}(y_i) \in \{1, 2, \dots, G\}\),其中 1 代表概率最高的样本(注意论文描述中 rank 0 对应最高,但公式中以 \(G - \text{rank}\) 体现惩罚,我们按通用逻辑理解即可)
- 2)修改奖励函数 :
$$
r_i = R(x, y_i) \left( 1 - \beta_{\text{rank} } \cdot \frac{G - \text{rank}(y_i)}{G} \right)
$$- \(R(x, y_i) \in \{0, 1\}\) 是硬性正确性奖励
- \(\beta_{\text{rank} }\) 是超参数(论文设为 0.25),控制惩罚强度
- 公式理解:
- 若某正确解概率最高(rank=1),\(G - \text{rank}\) 最大,受到惩罚最大,原始奖励被削弱
- 若概率最低(rank=G),惩罚项为0,原始奖励保留完整
- 理解:排序越靠后(原始模型生成该正确轨迹的概率越低),则赋予越多的奖励
- 3)计算 Advantage :使用 GRPO 的标准组内归一化方法计算 \(A_i\),但此时基于修改后的 \(r_i\)
$$
A_i = \frac{r_i - \text{mean}(\{r_1, \dots, r_G\})}{\text{std}(\{r_1, \dots, r_G\})}
$$ - 4)若某样本原本错误(\(R=0\)),其 \(r_i=0\),不参与奖励调整
- 这确保只有正确的样本会被调整方向 ,Unlikeliness 仅影响正确样本内部的优先级重排,不会鼓励错误样本
Unlikeliness Reward 优势分析
- 原本优势极低或为零的低概率正确解 ,在惩罚了高概率正确解后,其相对优势(\(A_i\))显著提升,从而在 GRPO 的损失函数中获得更大的梯度更新信号
互补方法:PPO Epochs(PPO 更新轮数)的影响
- 论文揭示了一个与常规认知相悖的超参数效应:每个 Batch 的 PPO 更新次数(PPO Epochs)
- 标准的 GRPO 实现通常只进行 1 次 Epoch,作者发现,当增加 Epochs 时:
- 前几次梯度更新会将高概率(高 Rank) 样本的概率推至 Clip 上限(\(1+\epsilon\)),使其停止贡献梯度(Saturated)
- 随后的梯度更新无法再影响这些已饱和的高概率样本,只能被迫转向尚未饱和的低概率(低 Rank) 样本
- 增加 Epochs 的效果:
- 增加 Epochs(如从 1 增加到 2 或 3)间接放大了对稀有样本的学习信号
- 但缺点显然而著:训练时间成倍增加(如 Table B.1 所示,Epochs=1 需 70 秒,Epochs=3 需 210 秒)
- 问题:Epochs=1 需 70 秒,Epochs=3 需 210 秒这个是错的吧,除非 Rollout 不需要时间
- 说明:论文将 Unlikeliness Reward 作为主要高效方案,而将增加 Epochs 作为辅助或备用方案
实验
- 实验设置
- 模型 :基座为 DeepSeek-Prover-V1.5-SFT
- 数据集 :Lean Workbook 子集(约9.6K可解问题 + miniF2F-valid)
- 评估 :主要使用 I.I.D. 验证集 \(\mathcal{D}_{\text{val} }\)(避免miniF2F-test在小规模训练中的高方差问题)
- 主要结果(Pass@N)
- Unlikeliness Reward(GRPO-Unlikeliness-2) :在 Pass@64 至 Pass@512 区间取得了 显著提升 ,同时仅在 Pass@1 和 Pass@2 上有微小的性能折损(图5)
- 增加 PPO Epochs :同样能提升大N性能,但训练耗时更长
- 求解数量(Solved Problems) :基础模型静态采样解决 7707 个训练问题,GRPO-Default 解决 7860 个(+153),而GRPO-Unlikeliness-2 解决 8065 个(+358) ,证明其泛化能力最强

- Rank 偏差缓解验证(图6)
- 对比各变体的提升率 \(u_j\):
- GRPO-Default :\(u_j\) 随 \(j\) 增大急剧下降
- GRPO-Unlikeliness-2 :曲线被反转 ,低 Rank (低概率)样本的 \(u_j\) 变得极高,高概率样本反而提升较少,证明显式惩罚有效消除了偏差
- 对比各变体的提升率 \(u_j\):
- 样本多样性分析(图7)**
- 跟踪训练过程中生成的唯一证明(Unique Proofs)数量:
- 默认 GRPO 多样性呈单调递减
- Unlikeliness Reward 显示出独特的自纠正机制 :多样性先下降后回升
- 原因是初期高概率解被惩罚后,“封存”了部分概率质量,迫使模型重新探索被遗忘的低概率路径,保持了长期的策略广度
- 原因是初期高概率解被惩罚后,“封存”了部分概率质量,迫使模型重新探索被遗忘的低概率路径,保持了长期的策略广度
- 跟踪训练过程中生成的唯一证明(Unique Proofs)数量:
完整训练配方
- 完整的改进配方包含三个要素:
- 1)Unlikeliness Reward(主要) :对抗 Rank 偏差
- 2)增加PPO Epochs(辅助) :间接强化稀有样本
- 3)提升 KL 惩罚系数(\(\beta_{\text{KL} }\) from 0.02 to 0.1) :
- 单独提高 KL 系数(GRPO-High-KL)虽然能防止大 N 性能退化,但无法带来实质性提升(图8),因为它仅仅约束分布不跑偏,却没有解决低 Rank 样本缺乏梯度的问题(图9)
- 因此,KL 正则化被视为“支持性修改”而非核心解法
W-REINFORCE(Weighted-REINFORCE)
研究背景与核心问题设定
- RLVR 利用客观规则(如数学题答案比对)生成二值奖励信号 \( r(x, y) \in \{-1, +1\} \),直接优化模型策略 \( \pi_\theta \),无需训练奖励模型,其基础目标函数为:
$$ \mathcal{L}_{\text{RLVR} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D}, y\sim \pi_{\theta}(\cdot |x)}[r(x,y)] $$- \( x \) 为 Prompt
- \( y \) 为模型生成的 Response
- \( \mathcal{D} \) 为训练数据集
核心解读:正样本强化(PSR)与负样本强化(NSR)
- 现有 RLVR 算法(如 PPO、GRPO)将正负奖励混合更新,机制不透明,本文将 RLVR 损失分解为两个独立范式:
- PSR (Positive Sample Reinforcement) :仅增加正确响应的似然
$$ \mathcal{L}_{\text{PSR} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D} }\left[\sum_{y:r(x,y) = 1}\pi_{\theta}(y|x)\right] $$ - NSR (Negative Sample Reinforcement) :仅降低错误响应的似然
$$ \mathcal{L}_{\text{NSR} }(\theta) = -\mathbb{E}_{x\sim \mathcal{D} }\left[\sum_{y:r(x,y) = -1} -\pi_{\theta}(y|x)\right] $$ - 总损失满足 \( \mathcal{L}_{\text{RLVR} } = \mathcal{L}_{\text{PSR} } + \mathcal{L}_{\text{NSR} } \)
评估指标:Pass@\( k \)
- 论文批判了仅看 Greedy 解码(Pass@1)的不可靠性,采用无偏估计的 Pass@\( k \) 作为核心指标:
$$ \text{Pass@}k = \mathbb{E}_{\mathbf{x}\sim \mathcal{D} }\left[1 - \frac{\binom{n - c}{k} }{\binom{n}{k} }\right] $$- \( n \) 为每个问题总采样数
- \( c \) 为正确数
- Pass@1 代表利用(Exploitation)能力,Pass@\( k \)(大 k)代表探索(Exploration)与多样性能力 ,这是全文分析的行为透镜
核心实验发现与反直觉现象(方法论对比)
实验设置
- 基座模型 :Qwen2.5-Math-7B、Qwen3-4B(非 Thinking 模式)、Llama-3.1-8B-Instruct
- 训练数据 :MATH 训练集(7,500 题)
- 对比算法 :标准 PPO、GRPO、纯 PSR、纯 NSR、Vanilla REINFORCE
- Rollout 设置 :Batch 为 1024 个 Prompt,每个 Prompt 生成 8 条 Responses(采样温度 1.0)
三大反直觉现象(关键 Insight)
- 现象一:纯 NSR 惊人有效
- 仅用错误样本训练的 NSR,其 Pass@1 竟能匹敌 PPO/GRPO,且在 Pass@256(大 k)上显著超越所有基线(见图 2、3)
- 这表明 NSR 通过“抑制错误”间接提升了正确路径的概率
- 现象二:PSR 损害推理边界(多样性崩溃)
- PSR 虽能快速提升 Pass@1,但随着 k 增大(\( k > 8 \)),Pass@\( k \) 急剧下降甚至低于基座模型
- 论文指出 PSR 导致输出分布坍塌(Overconfidence) ,牺牲了多样性(见图 5a)
- 现象三:RL 无法解锁基座缺失的能力(基座依赖性)
- 在 Llama-3.1 上,所有 RL 算法均损害了 Pass@256(见图 4),证明 RL(尤其是 PSR)仅能调整已有先验,无法创造新知识;而 NSR 对基座性能的损害最小
- 在 Llama-3.1 上,所有 RL 算法均损害了 Pass@256(见图 4),证明 RL(尤其是 PSR)仅能调整已有先验,无法创造新知识;而 NSR 对基座性能的损害最小
核心机理深度剖析:熵分析与 Token 级梯度推导(设计思路)
- 为解释上述现象,论文从熵 和 Token 级梯度两个维度深入剖析
熵作为多样性的代理指标
- PSR :训练中测试集熵值急速下降,完全正确解决的 Prompt 比例(Fully Solved Ratio)飙升,说明模型迅速过拟合到见过的正确路径
- NSR :始终保持与基座模型相近的高熵值,正确样本比例提升平缓,保留了探索空间(见图 5b, 5c, 5d)
核心方法论:Token 级梯度解析(详细流程与设计思路)
- 设当前 Token \( y_t \) 的 Logit 为 \( z_v \),概率为 \( \pi_v = \pi_{\theta}(v|\mathbf{x}, \mathbf{y}_{< t}) \)
- 损失函数为 \( \mathcal{L} = -R \cdot \frac{1}{T}\sum_{t=1}^{T} \pi_{\theta}(y_t|\cdots) \),其中 \( R \in \{-1, +1\} \)
- PSR 的梯度方向(\( R=+1 \)) :
$$ -\frac{\partial\mathcal{L}_{\text{PSR} } }{\partial z_v}\propto
\begin{cases}
\pi_v\cdot (1 - \pi_v) & \text{if } v = y_t \text{ (采样 Token)} \\
-\pi_{y_t}\cdot \pi_v & \text{if } v \neq y_t \text{ (未采样 Token)}
\end{cases} $$- 设计思路解读 :PSR 强行拔高被采样 Token 的 Logit,同时无差别打压所有其他 Token(包括潜在的正确 Token 如“2”)
- 这种“赢家通吃”机制导致分布尖锐化,多样性丧失
- 设计思路解读 :PSR 强行拔高被采样 Token 的 Logit,同时无差别打压所有其他 Token(包括潜在的正确 Token 如“2”)
- NSR 的梯度方向(\( R=-1 \)) :
$$ -\frac{\partial\mathcal{L}_{\text{NSR} } }{\partial z_v}\propto
\begin{cases}
-\pi_v\cdot (1 - \pi_v) & \text{if } v = y_t \\
\pi_{y_t}\cdot \pi_v & \text{if } v \neq y_t
\end{cases} $$- 设计思路与三大精妙特性(Key Insights) :
- 1)保留高置信度先验 :当模型对错误 Token 输出概率高(\( \pi_{y_t} \to 1 \))时,梯度更新量 \( (1 - \pi_{y_t}) \) 趋近于 0
- 这保证 NSR 不会因为一次错误而摧毁基座模型预训练得来的稳固知识(如语法结构)
- 2)先验引导的概率重分配 :
- NSR 打压错误 Token,但 按当前概率 \( \pi_v \) 的比例 将概率质量重新分配给其他候选 Token(如将 “6” 的概率按比例分给 “7” 和 “2”)
- 这是一种软性重排序,引导模型依据自身先验进行温和探索
- NSR 打压错误 Token,但 按当前概率 \( \pi_v \) 的比例 将概率质量重新分配给其他候选 Token(如将 “6” 的概率按比例分给 “7” 和 “2”)
- 3)隐式正则化(自动停止) :
- 一旦模型不再生成该错误样本(即概率趋于 0),梯度自动消失(\( \pi_{y_t} \to 0 \)),更新停止
- 这防止了 PSR 那种对“已掌握样本”反复强化的过拟合风险
- 1)保留高置信度先验 :当模型对错误 Token 输出概率高(\( \pi_{y_t} \to 1 \))时,梯度更新量 \( (1 - \pi_{y_t}) \) 趋近于 0
- 设计思路与三大精妙特性(Key Insights) :
方法延伸:PSR/NSR 与 PPO/GRPO 的梯度等价性分析
- 论文严谨地论证了为何上述梯度分析能推广至 PPO/GRPO(关键观点):
- Clipping :仅约束更新幅度,不改变梯度方向
- KL 散度惩罚 :在推理任务中系数极小(或如 DAPO 般移除),影响可忽略
- Advantage :
- GRPO 的 \( A_i = \frac{r_i - \text{mean}(r)}{\text{std}(r)} \) 仅是对梯度的线性缩放,符号不变
- PPO 的 Critic 提供细粒度信用分配,但正强化依旧压缩多样性,负强化依旧保留先验
- 附录 B 对比了 Unlikelihood 训练(\( -\log(1-\pi) \)),其梯度为 \( -\pi_v \)(打压置信度),会粗暴摧毁先验
- NSR 梯度带 \( (1-\pi_v) \) 因子,温和得多
Weighted-REINFORCE (W-REINFORCE) 方法
- 基于上述权衡(PSR 提升 Pass@1,NSR 保护 Pass@k),本文提出极其简洁但有效的 W-REINFORCE
- W-REINFORCE 损失函数:
$$ \mathcal{L}_{\text{W-REINFORCE} }(\theta) = \lambda \cdot \mathcal{L}_{\text{PSR} }(\theta) + \mathcal{L}_{\text{NSR} }(\theta) $$- 即对正样本奖励权重乘以衰减系数 \( \lambda \)(实验设定 \( \lambda = 0.1 \)),负样本权重保持为 1
- 理解:不抛弃正确的先验知识(保证 Pass@1 不崩),但大幅削弱其“坍塌效应”,让 NSR 的主导作用保持输出分布的多样性与探索边界
- 实验结果(表 1)
- MATH :W-REINFORCE Pass@1 达到 76.6(与 PPO 持平),且在所有 \( k \le 64 \) 上表现最佳,Pass@256(96.7)远超 PPO(96.3)
- AIME 2025 :在 \( k \ge 4 \) 时全面碾压 PPO/GRPO,Pass@256 达到 56.7(GRPO 仅 50.0)
- 消融实验(附录 E,表 4) :
- \( \lambda \) 在 0~0.2 之间鲁棒性极强
- \( \lambda=1 \)(即 Vanilla REINFORCE)性能暴跌,证明适度降权是核心关键
Entro. Adv. (Entropy-aware Advantage,Entropy Adv.)
- 原始论文:(Entro. Adv. (Entropy-aware Advantage)) Reasoning with Exploration: An Entropy Perspective, AAAI 2026, RUC & Microsoft & SJTU
- 背景 & 问题:
- RLVR 训练过程中的熵坍缩问题
Preliminary Analysis:熵与探索性推理的正相关性
- 通过大量可视化实验(基于 Qwen2.5-Base 在数学推理任务上的 Token 级熵分布),首次揭示了熵与三种关键探索性推理行为呈显著正相关
- 1)Pivotal Tokens(关键转折 Token) :
- 定义:连接逻辑步骤或引导推理方向的 Token(如
because、therefore、however、first、suggest) - 发现:这些 Token 处的平均熵显著高于普通 Token
- 这表明模型在这些决策点面临较大的不确定性,需要“探索”选择哪条逻辑路径
- 定义:连接逻辑步骤或引导推理方向的 Token(如
- 2)Reflective Actions(反思行为) :
- 定义:模型进行自我验证或修正的元认知行为(如句子 “Let’s verify if this is correct…”)
- 发现:包含反思关键词(verify, check)的句子平均熵显著更高
- 表明反思行为往往发生在模型对当前推理产生怀疑(高不确定性)的时刻
- 3)Rare Behaviors(罕见行为) :
- 定义:在 RL 训练过程中,Base Model 极少生成的、语义新颖的解题方案(如将对数系统转化为线性方程组)
- 量化方法:使用 SBERT(Sentence-BERT)将 Response 嵌入向量空间,计算 RL 生成句子与基座模型生成句子集的 K 近邻平均距离,取 Top 10% 标记为“罕见”
- 理解:基座模型很少生成的句子是定义为 Rare Behaviors
- 发现:这些罕见行为对应的生成区域熵更高,证明了 语义新颖性与预测不确定性 紧密关联
Entropy-Based Advantage Shaping
- 论文的核心贡献在于提出了一个极其轻量(仅需修改一行代码)但理论严谨的 Advantage 塑形方法
- 它既不改变原始 RL 的梯度流,也不盲目鼓励不确定性,而是 智能地放大高熵区域的探索性优势
预备知识:RL 基线(PPO 与 GRPO)
- 策略比率 :设 \(q\) 为问题,\(\boldsymbol{o} = (o_1, …, o_{|o|})\) 为 Response,新旧策略之比定义为:
$$
\rho_t(\theta) = \frac{\pi_{\theta}(o_t | q, o_{ < t})}{\pi_{\theta_{\text{old} } }(o_t | q, o_{ < t})}
$$ - PPO 梯度(忽略 Clip 操作下的简化形式):
$$
\nabla_{\theta} \mathcal{J}_{\text{PPO} }(\theta) = \mathbb{E}\left[ A_t \nabla_{\theta} \log \pi_{\theta}(o_t | q, o_{ < t}) \right]
$$- 其中 \(A_t\) 为Advantage(通常由GAE计算)
- GRPO :对每个问题采样一组 \(G\) 个输出,利用组内相对奖励 \(r_i\) 标准化作为Advantage,无需训练独立的Critic模型:
$$
\tilde{r}_i = \frac{r_i - \text{mean}(\{r_1, …, r_G\})}{\text{std}(\{r_1, …, r_G\})}
$$
熵基 Advantage 项的设计思路
- 不采用传统最大熵 RL(直接将熵加入目标函数以增加整体随机性),而是提出一种辅助性、自调节 的塑形项
- Step 1: 计算当前 Token 的策略熵
- 对于词汇表 \(\mathcal{V}\),当前 Token \(o_t\) 处的熵定义为:
$$
\mathcal{H}_t = -\sum_{v \in \mathcal{V} } \pi_{\theta}(v | q, o_{ < t}) \log \pi_{\theta}(v | q, o_{ < t})
$$
- 对于词汇表 \(\mathcal{V}\),当前 Token \(o_t\) 处的熵定义为:
- Step 2: 构建塑形项 \(\psi(\mathcal{H}_t)\)
- 设计一个裁剪的、梯度分离(Detached)的熵项:
$$
\psi(\mathcal{H}_t) = \min \left( \alpha \cdot \mathcal{H}_t^{\text{detach} }, \frac{|A_t|}{\kappa} \right)
$$ - 符号含义 :
- \(\alpha > 0\):正缩放系数,控制熵影响的大小(GRPO 取 0.4,PPO 取 0.1)
- \(\kappa > 1\):裁剪阈值,确保塑形项不大于原始 Advantage 的绝对值的 \(1/\kappa\)
- \(\mathcal{H}_t^{\text{detach} }\):关键设计 ,从计算图中分离,即 \(\nabla_{\theta} \mathcal{H}_t^{\text{detach} } = 0\)
- 这意味着该项不产生额外的梯度,只是作为固定的标量偏置作用于 Advantage
- 裁剪的物理意义 :当 \(\alpha \cdot \mathcal{H}_t > |A_t| / \kappa\) 时截断,保证:
- 1)熵项不会主导原始 Advantage
- 2)当 \(A_t < 0\)(负收益)时,\(A_t + \psi \le 0\) 始终成立,严格保证有害动作不会因熵项而翻转成正向更新 ,维持了惩罚的正确性
- 设计一个裁剪的、梯度分离(Detached)的熵项:
- Step 3: 塑形后的 Advantage 与梯度
- 最终塑形后的 Advantage 为:
$$
A_t^{\text{shaped} } = A_t + \psi(\mathcal{H}_t)
$$ - 策略梯度更新变为:
$$
\nabla_{\theta} \mathcal{J}_{\text{PPO} }^{\text{shaped} }(\theta) = \mathbb{E}\left[ (A_t + \psi(\mathcal{H}_t)) \nabla_{\theta} \log \pi_{\theta}(o_t | q, o_{ < t}) \right]
$$
- 最终塑形后的 Advantage 为:
方法的核心设计思路与内在鲁棒性(自调节机制)
- 探索 vs. 利用的动态平衡 :
- 初期(高熵) :模型对正确 Token 置信度低,\(\mathcal{H}_t\) 大,\(\psi\) 放大正向 Advantage,迫使模型在该决策点加速学习,快速提升关键 Token 的似然概率
- 后期(低熵) :随着训练进行,模型置信度提高,输出分布变得尖锐(Sharp),\(\mathcal{H}_t\) 自然下降,\(\psi\) 随之减小,塑形项自动弱化
- 结果 :熵项不会导致“过度鼓励”(Over-encouragement)
- 论文特别指出,此机制天然避免了像以往工作(Chen 等 2025)那样单纯奖励特定词频(如 “wait”)导致的 Reward Hacking,因为一旦模型对该 Token 自信,熵项奖励就会消失
- 对比熵正则化(Entropy Regularization) :
- 正则化在目标函数中加 \(\beta \mathbb{E}[\mathcal{H}_t]\),其梯度为 \(\beta \nabla_{\theta} \mathcal{H}_t\),主动推动模型保持高熵(不确定性)
- 本方法通过 \(A_t^{\text{shaped} }\) 间接影响策略,不引入新的梯度路径,仅利用熵来放大现有的正确更新方向
- 注:二者正交且本质不同
Experiment
- 实验设置:
- 基座模型 :Qwen2.5-Base-7B, Qwen2.5-Math-Base-7B, 以及在数学语料上 Domain-Adapted 的 Llama-3.2-Base-3B
- RL算法 :GRPO 和 PPO,并融入了 DAPO 和 VAPO 中的强基线技巧(Clip-Higher, Token-level Loss, Critic Pretraining 等)
- 数据集 :训练数据来自 DAPO;评估采用 AIME 2024/2025, AMC 2023, MATH500
- 评估指标 :Pass@1(16 次运行平均)和 Pass@K(使用无偏估计器),针对难题采用更大的K值
- Main Results
- Pass@1 全面提升 :在多种 Backbone 和 RL 算法组合下,本方法(w/ Entropy Adv.)一致超越纯 RL 基线以及现有的强基线(如 GPG 等)
- Pass@K 里程碑式突破 :
- 论文揭示了一个关键现象:纯 RL 训练在 Pass@1 提升的同时,Pass@K(推理能力上限)可能会低于基座模型 ,即Vanilla RL 限制了模型的真实推理容量
- 本方法不仅缓解了此现象,在极具挑战的 AIME 2025(数据截止期后新题)上,不仅超越 RL 基线,甚至超越了 Base Model 的性能天花板(Performance Ceiling) ,证明了其极强的泛化探索能力
- 消融实验(Ablations)
- Clip 操作的必要性 :表中展示了 “Clipped Fraction”(被裁剪的熵项比例)
- 初期约为 84%,后期降至 38%,精度随之提升
- 验证了 Clip 防止熵项过大破坏原始 Advantage 符号的关键作用
- 系数 \(\alpha\) 的选择 :通过调整 \(\alpha\) 使初始熵 Advantage 比率(\(\frac{\psi(\mathcal{H}_t)}{|A_t|}\))保持在 10% 左右,最终降至 3% 左右
- 该比率在 GRPO 和 PPO 上皆有效,证实了方法的稳定性
- Clip 操作的必要性 :表中展示了 “Clipped Fraction”(被裁剪的熵项比例)
深度分析与 Insight
RL训练过程动态
- Reward 与 Response Length :
- 基线方法在 1000 步后 Response 长度下降(奖励退化)
- 本方法维持了长度的上升趋势,且最终 Reward 更高
- 表明模型在生成更多探索性 Token 以寻求正确解
- 整体熵值 :
- 熵正则化导致熵值剧烈尖峰(Spike),训练不稳定
- 本方法整体熵值略低于基线,但不是坍塌(对照无 Clip-Higher 时熵坍塌至 0.03,本方法稳定在 0.17)
- 证明其仅针对性地在关键决策点降低不确定性,而非全局压制
- Advantage Ratio 自衰减 :熵 Advantage Ratio 随训练逐步降低,完美印证了“随着置信度提高,塑形项自动减弱”的自调节设计思路
测试时 Reasoning Dynamics
- 关键 Token 与反思行为 :应用本方法后,模型在生成 Pivotal Tokens 和 Reflective Actions 时,这些区域的熵变得更低(置信度更高) ,且出现频率显著增加
- 说明模型学会了“掌握”高级推理行为,而不是随机碰巧生成
- 长度与重复率 :本方法生成的 Response 更长,但 N-gram重复率与基线持平
- 证明长度增长源于有意义的推理结构扩展,而非无意义的循环或复读(Repetition)
- Case Study :论文展示了一个典型样本
- 基线方法 Response 仅有 725 Tokens,结构简单
- 应用本方法的 Response 长达 3023 Tokens,包含了明确的问题约束识别、奇偶列表长度的分情况讨论(Case Analysis)、对候选值的迭代尝试与回退修正,展现出更强的推理灵活性和控制力
EDGE-GRPO
研究背景与核心痛点
- RLVR 的优势崩溃(Advantage Collapse):
- GRPO 对每个问题生成 \( G \) 个 Response ,并依据规则(Rule-based)或结果奖励模型(Outcome Reward Model)给予稀疏奖励
- 由于规则奖励通常只根据最终答案是否正确给出(如 0 或 1),当某个 Group 内的 \( G \) 个 Response 全对或全错时,奖励完全相同,导致标准化后的 Advantage 全部为 0
- 如公式所示,原始优势 \( A_i \) 为:
$$
A_i = \frac{r_i - \text{mean}(\{r_1, r_2, \dots, r_G\})}{\text{std}(\{r_1, r_2, \dots, r_G\})}
$$- 其中 \( r_i \) 是第 \( i \) 个 Response 的奖励
- 当 \( r_i \) 全相等时,\( A_i = 0 \),策略梯度消失,训练停滞
现有解决方案局限性分析
Response 层面:模型反思(Reflection)的局限性
- 现象观察 :现有工作通过强制模型在生成后加入 “Wait!” 或 “Let’s check it again” 等 Prompt 进行自我反思以增加 Response 多样性
- 实验发现(图 2) :
- 1)自发反思准确率极低 :对于大多数 Base 模型和 RL 后训练模型,包含反思关键词(如 recheck, rethink)的 Response 准确率显著低于整体平均准确率
- 详情见图 2 Upper
- 2)蒸馏模型的例外 :DeepSeek-R1-Distill 系列模型反思准确率高
- 归因于其训练数据包含了高质量的长 CoT(Chain of Thought)反思过程
- 实验证实,仅用 S1K 数据集微调后的 Qwen2.5-Math-1.5B,其反思准确率大幅提升
- 详情见图 2 Left
- 3)强制反思效果甚微 :当模型给出错误答案后,强制其使用四种不同反思 Prompt 重新回答,绝大多数模型的修正准确率低于 **5%**(DeepSeek-Distill-7B 也仅约 11%)
- 性情见 图 2 Right
- 性情见 图 2 Right
- 1)自发反思准确率极低 :对于大多数 Base 模型和 RL 后训练模型,包含反思关键词(如 recheck, rethink)的 Response 准确率显著低于整体平均准确率
- 结论 :当模型容量不足时,单纯依赖内部自我修正收效甚微,必须引入外部信息进行纠错
Signal 层面:策略熵的误校准
- 熵的定义 :论文定义策略熵 \( P \) 来衡量模型在生成 Response 时的不确定性(Token 级平均熵):
$$
P = -\frac{1}{T}\sum_{t = 1}^{T}\sum_{j = 1}^{V} P_{t,j} \cdot \log P_{t,j}
$$- \( T \) 为 Response 总 Token 数
- \( V \) 为词表大小
- \( P_{t,j} = \pi_{\theta}(j \in V | q, o_{ < t}) \) 为在当前策略 \( \pi_{\theta} \) 下生成第 \( j \) 个 Token 的概率
- 宏观与微观的冲突 :
- 宏观层面(RCM 指标) :多数模型正确响应的平均熵低于错误响应的平均熵(Relative Confidence Metric 为负),符合直觉(表 3)
- 微观层面(样本级,图 3 右) :
- 约 50% 的错误 Response 熵值低于平均水平(模型过度自信地犯错)
- 近 1/3 的正确 Response 熵值高于平均水平(模型侥幸答对但不自信)
- 结论 :训练策略不应盲目鼓励低熵(导致过度自信犯错)或高熵(导致探索混乱),而应进行细粒度的、与正确性对齐的熵引导
EDGE-GRPO 方法
- EDGE-GRPO 从 Response 层(GEC) 和 Signal 层(EDA) 双管齐下,整体框架如图 4 所示
Response 层:引导式错误修正(Guided Error Correction, GEC)
- 设计思路 :鉴于模型自我修正能力差,GEC 强制确保每个 Group 内包含一定比例的正确样例(正例)和错误样例(负例),从根源上防止全对或全错导致的原始优势 \( A_i \) 归零
- 详细流程 :对于每个被判定为错误的 Response ,系统依据预设概率执行以下三种操作之一:
- 1)Prompt and Regenerate(按照 \( P = 0.5 \) 的概率选择这个) :
- 提供简单的反思 Prompt(如 “Wait!”),让模型基于原有错误尝试重新生成
- 保留模型自主探索的可能性
- 理解:这里的做法会导致两个问题:
- 问题一:这里会导致基于 Group 的 Advantage 计算出现问题(正确样本和错误样本的 Prompt 不同,不同状态的动作不可比)
- 因为对于被判定为错误的样本,模型不再使用原始问题
q,而是使用q + reflection_prompt(如 q + “Wait! Let’s check it again.”) - 本文的做法本质是在 牺牲 “同源假设” 换取 “生存信号”
- 因为对于被判定为错误的样本,模型不再使用原始问题
- 问题二:这里如果训练时使用原始 Prompt(不包含奖励信号),则会导致训推不一致问题
- 训练时和推理(采样轨迹)看到的状态不同,从而带来 Off-policy 问题
- 问题一:这里会导致基于 Group 的 Advantage 计算出现问题(正确样本和错误样本的 Prompt 不同,不同状态的动作不可比)
- 2)Direct Answer Injection(按照 \( P = 0.25 \) 的概率选择这个) :
- 在提供反思 Prompt 的同时,直接注入正确的 Ground Truth
- 强制引导模型向正确方向学习
- 理解:被修正样本的 Prompt 变成
q + reflection_prompt + correct_answer,遇到的问题同上:- 问题一:正确样本和错误样本的 Prompt 不同,不同状态的动作不可比
- 问题二:这里如果训练时使用原始 Prompt(不包含奖励信号),则会导致训推不一致问题
- 3)Reference Solution Replacement(按照 \( P = 0.25 \) 的概率选择这个) :
- 将模型生成的全错误 Response 替换为外部提供的标准参考解答(Reference Solution)
- 引入高质量的分布外数据
- 理解:操作 3 不会替换“全组”,只替换“组内部分个体”,操作 3 的概率是 0.25 (注意:这个概率是 Response 粒度的,不是 Query 粒度)
- 对于一个 Group(假设生成 8 个 Response),如果原本 8 个全错,GEC 会随机挑选其中几个(不是全部)执行操作
- 可能 4 个走操作 1(反思重试,可能错误),2 个走操作 2(注入答案,必正确),2 个走操作 3(完全替换为外部参考方案,必正确)
- 如果经过操作 1 重试后依然错误的,依然保持为负例(奖励 0)
- 1)Prompt and Regenerate(按照 \( P = 0.5 \) 的概率选择这个) :
- 关键设计 :通过概率控制(0.5 自主 + 0.5 外部干预(操作2+操作3 是外部干预)),GEC 在保持 “模型原生分布” 的同时,硬性打破了全错组的困境,极大地提升了 Response 多样性
Signal 层:Entropy-Driven Advantage, EDA
- 设计思路 :
- 即使 GEC 解决了全零奖励问题,但在“全对组”中,所有正确响应的原始优势 \( A_i \) 依然相近
- EDA 引入策略熵作为细粒度内部反馈,区分“有把握的正确”和“蒙对的正确”,以及“极度自信的错误”和“不确定的错误”
- 详细流程与公式推导 :
- 1)计算原始优势 :按标准 GRPO 公式计算每个响应的 \( A_i \)
- 2)计算缩放熵 :为消除组间绝对熵值的差异,将策略熵 \( P_i \) 进行组内归一化:
$$
\hat{P}_i = \frac{P_i}{\text{mean}(\{P_1, P_2, \dots, P_G\})}
$$- \( G \) 为组大小
- \( \text{mean} \) 为组内策略熵的均值
- 3)计算最终熵驱动优势(公式 7) :
$$
\hat{A}_i = \frac{A_i}{\hat{P}_i}
$$- 深层逻辑解析 :高熵削弱 Advantage 幅度,低熵增强 Advantage 幅度,不改变方向
- 当响应正确且低熵(自信正确) :\( A_i \) 为正,\( \hat{P}_i < 1 \),除法使得 \( \hat{A}_i \) 被放大,给予更大正向奖励
- 当响应错误且低熵(自信错误) :\( A_i \) 为负,\( \hat{P}_i < 1 \),除法使得 \( \hat{A}_i \) 负向放大(除以小于 1 的数),施加更严厉惩罚
- 当响应正确但高熵(侥幸正确) :\( \hat{P}_i > 1 \),正向奖励被削弱
- 当响应错误但高熵(探索错误) :负向惩罚被削弱
- 深层逻辑解析 :高熵削弱 Advantage 幅度,低熵增强 Advantage 幅度,不改变方向
- 关键说明 :
- 论文明确指出,EDA 必须建立在 GEC 之上
- 因为如果原始 \( A_i \) 全为 0,公式 \( 0 / \hat{P}_i \) 依然为 0,则此时依然没有信号
- GEC 确保了基础优势信号的存在,EDA 在此基础上进行精细化调节
- 论文明确指出,EDA 必须建立在 GEC 之上
目标函数修改
- EDGE-GRPO 保留了 GRPO 的 Clip 机制,但将传统的 KL 散度惩罚项去除(论文认为 KL 约束限制了模型探索空间,且 DAPO 等先前工作也验证了去除 KL 效果更好)
- EDGE-GRPO 最终优化目标为:
$$
J_{EDGE-GRPO}(\theta) = \mathbb{E}_{[q, \{o_i\}]} \frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \min \left[ \frac{\pi_\theta}{\pi_{\theta_{\text{old} } } } \hat{A}_i, \text{clip}\left(\frac{\pi_\theta}{\pi_{\theta_{\text{old} } } }, 1-\epsilon, 1+\epsilon\right) \hat{A}_i \right]
$$- 其中 \( \hat{A}_i \) 由公式 7 计算得出
实验
- 实验设置
- 基座模型 :Qwen2.5-Math-1.5B 和 Qwen2.5-Math-7B
- 训练数据集 :DeepScaleR 的筛选子集(仅 1K 样本),本文构建了两个版本:
- Random-1K :随机抽取的 1K 题
- Hard-1K :用 7B 模型生成 8 个响应,筛选出准确率最低的 1K 题(其中 80% 的题全错,极具挑战性)
- 评估基准 :AIME24 (30题)、AMC (83题)、MATH500 (500题)、Minerva (272题)、OlympiadBench (675题),总计 1560 道高难度数学题
- 硬件与超参 :8x A100-40G,Temperature 设为 0.1(评估),学习率 1e-6,每组生成 8 个响应,训练 1 Epoch(仅 1000 步)
主要实验结果
- 性能对比(表 1、表 2)
- Random-1K 训练 :7B 模型性能提升相对有限(作者分析为该数据集对 7B 模型不够难)
- Hard-1K 训练(核心亮点) :
- 1.5B 模型从 Vanilla GRPO 的 40.26 提升至 EDGE-GRPO 的 47.24
- 7B 模型从 Vanilla GRPO 的 47.69 提升至 EDGE-GRPO 的 53.21
- 在最具挑战性的 OlympiadBench 上,7B 模型提升至 42.67%
- 数据效率 :仅用 1K 样本 便达到了与 Oat-Zero、SimpleRL-Zoo 等需要数万样本训练的模型相媲美的性能(图 1、表 6)
- 消融实验
- 1)**+ Force-R (强制反思)** :提升极其有限(对比表 1/2 的 Vanilla 和 +Force-R 行)
- 2)**+ Force-R & EDA** :在 1.5B 模型上从 42.63 提升至 45.83(Random-1K),验证了 EDA 有效
- 但受限于无外部纠错,仍存在全错组导致优势为零的样本
- 3)EDGE-GRPO (Force-R & EDA + GEC) :达到最优 48.08(1.5B)和 49.30(7B, Random)
- 验证了 GEC 是解决优势崩溃的“地基”
- 训练动态监控(图 5) :可视化训练过程中组内优势方差的变化
- Vanilla GRPO 方差迅速塌缩至接近 0
- 加入强制反思略有缓解
- EDGE-GRPO 在整个训练过程中始终保持较高的组内优势方差 ,证明其从根本上缓解了优势崩溃
- 熵分布可视化验证(图 6、附录)
- 论文展示了不同模型(Base, SFT, RL)的正确/错误响应的熵分布核密度图
- 显著重叠现象 :图中清晰显示正确与错误响应的熵分布存在大面积重叠,直观佐证了“模型常误判自身置信度”的结论,这也是 EDA 能够有效生效的数学底层依据
其他补充 Insight
- Reflection 关键词集 :包含
check again,rethink,re-evaluate,reconsider,go over等 15 个用于判定模型是否进行自我反思的匹配词 - RCM 详细数据(表 3) :提供了不同温度(0.1, 0.3, 0.6, 1.0)下各模型的相对置信度指标,大多数模型 RCM 为负
- 证明总体趋势上模型对正确答案的熵更低
- 强制反思触发词效果(表 5) :详尽列出了四种具体 Prompt 在不同模型上的修正准确率
- 四种 Prompt:
Wait!HmmLet's check it again!Something is wrong here
- 结果显示,“Something is wrong here” 有时效果较好,但整体绝对数值依然极低(普遍低于 10%)
- 这个分析进一步强化了引入 GEC 的必要性
- 四种 Prompt:
UI-MOPD
- 原始论文:UI-MOPD: Multi-Platform On-Policy Distillation for Continual GUI Agent Learning, 20260705, THU & Xiaomi & HIT & ZJH
- 背景 & 问题:
- 多模态基础模型(Multimodal Foundation Models)与 Agent 系统的进步正推动 GUI Agent 从单一平台(如仅桌面或仅移动)向跨平台交互演进
- 问题:构建统一的多平台 GUI Agent 面临两大瓶颈:
- 数据稀缺与质量参差 :高可执行性的跨平台交互轨迹匮乏,现有数据集平台覆盖有限,且常含有无效动作、状态-动作错位或任务粒度不一致
- 行为惯例冲突(Behavioral Convention Mixing) :
- 桌面(Desktop)与移动(Mobile)平台的交互语义迥异(例如“返回”在桌面是关闭窗口,在移动是返回键)
- 简单混合训练(Mixed SFT)或模型合并(Model Merging)会导致策略平均化(Averaged Policy),进而引发平台特定能力退化 和 灾难性遗忘(Catastrophic Forgetting)
- 论文提出两大核心贡献:
- 构建 Uni-GUI 高质量数据集
- 首次将 MOPD 引入 GUI Agent 持续学习的算法 UI-MOPD
- UI-MOPD 目标 = RL 目标 + MOPD 目标
- 论文核心结论:
- 将 MOPD 引入多平台 GUI Agent 持续学习,能有效缓解异构交互模式间的干扰
- 其本质创新在于:不是被动地合并数据或参数,而是在在线策略优化过程中,利用 Platform 条件化教师为共享学生提供动态的行为锚点(Behavioral Anchors)
- 这使得学生策略既能通过 RL 提升任务成功率,又能通过条件化蒸馏保留各平台原生交互惯例,为最终实现能在多样化数字环境中持续适应的统一 GUI Agent 提供了可行路径
- 将 MOPD 引入多平台 GUI Agent 持续学习,能有效缓解异构交互模式间的干扰
数据集构建:Uni-GUI 与统一收集工具
Unified Cross-Platform Harness
- 论文设计了一个四阶段流水线,确保轨迹的可用性与高保真度:
- 1)Query Generation :
- 不随意生成指令,而是:
- 第一步:让强教师模型(Kimi-K2.6 用于桌面,Gemini-3.1-Pro 用于移动)先从目标环境(OSWorld/MobileWorld)中提取 可执行的原子功能点(Functional Points)
- 第二步:再合成为自然语言用户 Query
- 此举从根本上减少了“无法执行”或“环境状态不匹配”的无效任务
- 不随意生成指令,而是:
- 2)Trajectory Collection :
- 教师模型与环境交互,记录 Observation、Action、Reasoning 和 Task State
- 保留各平台原生 Action 格式,方便后续归一化
- 3)Trajectory Cleaning :
- 严苛的多级过滤:
- 剔除格式错误步骤
- 过滤无法映射到学生模型 Action Space 的轨迹
- 删除超过 40 步的低效长轨迹
- 使用 Gemini-3.1-Pro 作为自动裁判(Automatic Judge) ,将任务分解为 Sub-task 列表,逐项检查是否完成,仅保留全部 Sub-task 成功的轨迹(避免长上下文判断误差)
- 严苛的多级过滤:
- 4)Post-Processing :
- 将异构的 CoT 重写为与 Qwen3-VL 对齐的结构化格式
- 重新标注用于交互的 Grounding Bounding Boxes,用于后续规则化评估
Uni-GUI 数据集的构成
- 最终数据集包含约 160K 交互步骤、11.5K 条轨迹
- 桌面部分包含自采 ~95K 步 + 清洗后的 OpenCUA ~13K 步
- 移动部分包含自采 ~17K 步 + 清洗后的 OpenMobile ~35K 步(见表 4)
- 该混合策略极大扩展了 GUI 状态、应用和任务类型的多样性
UI-MOPD 方法
- UI-MOPD 的核心设计哲学是:将多教师知识集成 视为在线策略优化过程中的条件化行为约束 ,而非静态蒸馏或简单正则化
Two-Stage Pipeline
- Stage 1(教师 SFT) :
- 在 Uni-GUI 上分别对桌面和移动轨迹进行监督微调,得到两个平台专精的专家教师:
- 桌面教师 \(\pi_{\text{ref} }^{d}\)
- 移动教师 \(\pi_{\text{ref} }^{m}\)(基于 Qwen3-VL-32B-Thinking)
- 在 Uni-GUI 上分别对桌面和移动轨迹进行监督微调,得到两个平台专精的专家教师:
- Stage 2(学生 MOPD) :
- 初始化共享学生策略 \(\pi_{\theta}\)(基于 Qwen3-VL-8B-Thinking),通过 RL 结合 MOPD 进行训练
Platform-Conditioned Teacher Routing,Platform 条件化教师路由
- 痛点 :若直接混合教师 Logits 或使用单一教师,会将桌面(鼠标/键盘/窗口)与移动(点击/滑动/返回键)的异构行为压缩为平均分布,抹除平台交互先验
- UI-MOPD 的解决方案 :不混合教师,而是根据 Rollout 所处的环境动态路由
- 对于第 \(i\) 个样本,其数据源标签为 \(s_i\),则路由教师为:
$$
\pi_{\text{ref} }^{(i)} =
\begin{cases}
\pi_{\text{ref} }^{m}, & s_i \in \mathcal{S}_{\text{mobile} } \\
\pi_{\text{ref} }^{d}, & s_i \in \mathcal{S}_{\text{desktop} }
\end{cases}
$$- 理解:这就是常规的 MOPD 设定而已
- 对于第 \(i\) 个样本,其数据源标签为 \(s_i\),则路由教师为:
- 关键点 :路由仅影响教师 Logits 计算,学生依然是一个共享策略(推理时无额外开销)
- 此举为每个平台在共享参数空间中锚定了特定的行为边界
On-Policy Kullback-Leibler Divergence(学生与教师之间的 KL 散度)
- 传统 RLHF 中的 KL 是作为保守正则化项(Conservative Regularizer)限制策略漂移
- UI-MOPD 将 KL 改造为 针对性的行为迁移机制
- 对于第 \(i\) 条采样得到的 Response \(y^{(i)} = (y_1, \ldots, y_T)\),定义解码状态 \(h_t^{(i)} = (x^{(i)}, y_{ < t}^{(i)})\)(其中 \(x\) 为 Prompt)
- 给定路由教师 \(\pi_{\text{ref} }^{(i)}\),计算学生到教师的 On-Policy KL:
$$
D_{\text{KL} }^{(t,i)} = D_{\text{KL} }\left(\pi_{\theta}(\cdot \mid h_t^{(i)}) \parallel \pi_{\text{ref} }^{(i)}(\cdot \mid h_t^{(i)})\right)
$$ - 其期望形式为(\(a\) 为采样的 Token):
$$
D_{\text{KL} }^{(t,i)} = \mathbb{E}_{a \sim \pi_{\theta}(\cdot | h_t^{(i)})} \left[ \log \pi_{\theta}(a \mid h_t^{(i)}) - \log \pi_{\text{ref} }^{(i)}(a \mid h_t^{(i)}) \right]
$$
- 给定路由教师 \(\pi_{\text{ref} }^{(i)}\),计算学生到教师的 On-Policy KL:
- 设计意图 :由于教师监督施加在学生当前策略访问的 State Distribution 上,蒸馏信号精准匹配学生当前的决策误差,而非强制学生模仿教师所有行为模式
K3 Estimator
- 全词汇表 KL 计算开销巨大,UI-MOPD 采用 K3 估计器,仅需学生和教师对采样到的 Token 的 Log-Probability,定义:
$$
\begin{align}
\delta_{t}^{(i)} &= \log \pi_{\text{ref} }^{(i)}(y_{t} \mid h_{t}^{(i)}) - \log \pi_{\theta}(y_{t} \mid h_{t}^{(i)}) \\
\rho_{t}^{(i)} &= \exp(\delta_{t}^{(i)})
\end{align}
$$ - 则 Token 级别估计值为:
$$
\hat{D}_{\text{KL} }^{(t,i)} = \rho_t^{(i)} - \delta_t^{(i)} - 1
$$- 该估计量非负,在 \(\pi_{\theta}\) 采样下对 \(D_{\text{KL} }(\pi_{\theta} | \pi_{\text{ref} })\) 无偏,且经验方差低于直接 Log-Ratio 估计器
Adaptive KL Masking,平衡探索与利用
- Insight :当任务反馈(Reward)足够强时,过强的 KL 约束会限制探索,本文引入 Group-level 掩码:
$$
\mu^{(i)} =
\begin{cases}
0, & \text{if } \frac{1}{G}\sum_{k \in g(i)} R^{(k)} > \tau_{\text{KL} } \\
1, & \text{otherwise}
\end{cases}
$$- \(g(i)\) 表示样本 \(i\) 所属的 Prompt Group
- \(R^{(k)}\) 为结构化奖励
- \(R^{(k)}\) 是一个 Rule-based、细粒度的原子动作结果奖励
- 注:不是 来自环境的累积折扣回报(如传统强化学习的 GAE),也不是 人类偏好打分(RLHF)
- \(R^{(k)}\) 是一个 Rule-based、细粒度的原子动作结果奖励
- 公式含义:
- 当该组平均奖励超过阈值 \(\tau_{\text{KL} }\) 时,撤销教师惩罚,允许策略自由优化
- 若 平均组奖励 > 阈值 \(\rightarrow\) \(\mu^{(i)} = 0\)(关闭 KL 蒸馏惩罚)
- 否则保留教师引导,防止低质量 Rollout 偏离有效行为空间
- 若 平均组奖励 ≤ 阈值 \(\rightarrow\) \(\mu^{(i)} = 1\)(开启 KL 蒸馏惩罚)
- 当该组平均奖励超过阈值 \(\tau_{\text{KL} }\) 时,撤销教师惩罚,允许策略自由优化
- 理解:这个设计其实很巧妙
- 当平均奖励很高时(\(\mu = 0\)) :
- 说明当前学生策略 \(\pi_{\theta}\) 在这个 Prompt 上已经表现得很好了,找到了高收益的决策路径
- 此时,如果依然强制施加 KL 散度惩罚(让学生逼向教师),会扼杀策略的进一步优化(因为教师可能不是最优的,或者教师的动作分布较宽泛)
- 关闭蒸馏 ,相当于放手让 RL 的 Policy Gradient(\(\mathcal{L}_{\text{PG} }\))自由地去探索更高奖励的边界(利用阶段)
- 当平均奖励很低时(\(\mu = 1\)) :
- 说明学生策略在该任务上表现糟糕,处于无效探索(如坐标点错、动作格式错误)
- 此时,开启蒸馏 ,利用平台教师的先验知识(\(\pi_{\text{ref} }\))将策略拉回正轨(安全探索与正则化阶段),防止学生因为无效动作而陷入“灾难性遗忘”或行为模式崩溃
- 当平均奖励很高时(\(\mu = 0\)) :
结构化奖励设计
- 为了提供细粒度优势估计,奖励函数 \(R(x, y)\) 基于 Action JSON 的维度匹配:
- 设 \(f_a \in [0,1]\) 为动作 \(a\) 匹配的必要维度(如坐标是否在 BBox 内、滚动方向、文本匹配等)比例,则:
$$
R(x, y) =
\begin{cases}
1.0, & f_a = 1 \quad (\text{完全正确}) \\
-0.5, & 0 \leq f_a < 1 \quad (\text{部分正确但无效}) \\
-1.0, & \text{unparsable or invalid action} \quad (\text{无法解析或非法动作,对应完全无效})
\end{cases}
$$ - 中间的 \(-0.5\) 惩罚至关重要,它保留了“部分正确”与“完全错误”之间的 Reward Gap,使得组相对优势计算更鲁棒
总训练目标
- Stage 2 结合裁剪策略优化(Clipped PPO/GRPO 风格)与 MOPD 惩罚
- 定义 Token 级别优势(Group Relative):
$$
A_{t}^{(i)} = R(x^{(i)}, y^{(i)}) - \frac{1}{|g(i)|} \sum_{k \in g(i)} R(x^{(k)}, y^{(k)})
$$- 注:减去均值,没有除以 std
- 设策略比率为 \(r_t(\theta) = \frac{\pi_{\theta}(y_t \mid h_t)}{\pi_{\theta_{\text{old} } }(y_t \mid h_t)}\),优化目标为最大化:
$$
\mathcal{J}(\theta) = \mathbb{E}_{p, x, y \sim \pi_{\theta} } \left[ \sum_{t} m_t \left( \ell_{\text{PG} }^{(t)}(\theta) - \beta \mu \hat{D}_{\text{KL} }^{(t, p)} \right) \right]
$$- 其中策略梯度项
$$ \ell_{\text{PG} }^{(t)}(\theta) = \min \left( r_t(\theta) A_t, \operatorname{clip}(r_t(\theta), 1 - \epsilon_{\text{low} }, 1 + \epsilon_{\text{high} }) A_t \right) $$
- 其中策略梯度项
- 等价地,最终最小化损失(KL 散度对应为 \(\mathcal{L}_{\text{MOPD} }(\theta)\)):
$$
\mathcal{L}(\theta) = - \mathcal{J}(\theta) = \mathcal{L}_{\text{PG} }(\theta) + \beta \mathcal{L}_{\text{MOPD} }(\theta)
$$- \(\beta\) 控制蒸馏强度
- \(m_t\) 掩码非 Response Token
Experiments
- 本文设置了极为详尽的实验,涵盖交互任务、静态理解与 Grounding,确保无死角验证
交互任务:Main Results on OSWorld & MobileWorld
- UI-MOPD 表现 :
- OSWorld 达到 **38.2%**(相对提升 12.7%)
- MobileWorld 达到 **12.0%**(相对提升 55.8%)
- 对比分析(见表 1):
- General Models :如 Qwen3-VL-8B,在 Mobile 仅 7.7%,UI-MOPD 大幅超越
- 单平台 GUI 模型 :虽在单一平台有优势,但跨平台残缺(如 GUI-Owl-7B 在 OS 达 34.9%,但在 Mobile 仅 4.5%)
- 多平台 GUI 模型 :如 GELab-Zero-4B,跨平台不均衡
- 集成策略(Integration Strategies) :
- Mixed-SFT 和 Model Merge(Weight Averaging / TIES)均无法同时提升双平台,TIES 在 Mobile 甚至降至 0%
- 唯独 UI-MOPD 实现双平台同步增长
跨平台能力迁移分析:Teacher-Student Analysis(表 2)
- 单平台 SFT 副作用 :
- 仅在 OSWorld 上 SFT 8B 模型,Mobile 性能暴跌至 0%
- 仅在 Mobile 上 SFT,虽 Mobile 提升至 12.8%,但 OS 未如 UI-MOPD 提升显著
- UI-MOPD 优势 :
- UI-MOPD 训练的 8B 学生在 OS 和 Mobile 上同时 获得 +4.3 点增益,甚至 Mobile 性能超越了 32B 基础模型
- 这归功于 Platform 条件化锚点防止了交互信号坍缩(即各个领域使用各自的 Teacher)
通用 GUI 静态理解与 Grounding 鲁棒性(表 3 & 表 7)
- 论文严谨地验证了 RL 训练是否会牺牲基础视觉能力:
- AndroidControl*(移动静态理解):
- UI-MOPD 准确率从 Base 的 78.73% 提升至 80.05% ,而 Model Merge 跌至 74.01%
- Grounding 基准(ScreenSpot-Pro/V2, OSWorld-G) :
- UI-MOPD 几乎完全保持了 Base 模型的 Grounding 能力(如 ScreenSpot-Pro 从 43.71% 微降至 43.14%,OSWorld-G 从 52.13% 提升至 52.84%)
- Model Merge 在所有 Grounding 数据集上均出现显著衰退(ScreenSpot-Pro 跌至 37.13%)
- 这证明 MOPD 相比静态参数融合,对模型内在视觉表征破坏性更小
- AndroidControl*(移动静态理解):
Case Study
- 论文提供了移动端(图 3)和桌面端(附录图 5)的定性示例,展示 UI-MOPD 能理解复杂指令、定位细粒度 UI 元素并执行长序列动作(如滑动、点击输入框、返回导航)
其他重点笔记
- 动作空间(Action Space,表 5) :
- 桌面使用
computer_use工具(key, mouse_move, click, scroll 等) - 移动使用
mobile_use工具(click, long_press, swipe, system_button 等) - 所有轨迹最终归一化为统一的 Tool Call JSON 格式
- 桌面使用
- 训练基础设施 :
- 基于 verl 框架,Megatron-Core 后端,SGLang 异步 Rollout,64 张 H100 GPU
- 学生 8B 采用 TP=2, DP=32;教师 32B 采用 TP=8, DP=8
- 视觉上下文差异 :
- 训练 时 仅使用当前截图 以降低开销
- 推理 时 使用当前 + 4 张历史截图 以增强上下文感知
- 问题:不担心训推不一致问题?
- 超参数关键值 :
- KL 损失系数 \(\beta = 0.01\)
- Clip 范围 low=0.2 / high=0.28,每个 Prompt 采样 8 个 Rollouts(GRPO 风格)
SEED
- 原始论文:SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning, 20260716, THU & ZJU & Tongji
- 整体总结:
- SEED(Self-Evolving On-Policy Distillation) 框架的目标是解决 LLM 作为 Agent 进行长时程交互时的稀疏奖励监督问题
- 核心问题:在长时程智能体任务中,RL 面临以下关键挑战:
- 稀疏奖励 :环境反馈仅在轨迹末端给出(成功/失败),中间步骤缺乏监督
- 粗粒度监督 :轨迹级别的标量奖励无法区分哪些中间决策是好的、哪些是坏的
- 信用分配困难 :无法将最终结果归因到具体的 Token 级决策
- 核心 Insight:一条完整的轨迹(无论成功还是失败)实际上包含了丰富的事后信息:
- 成功的轨迹揭示了可复用的策略和工作流程
- 失败的轨迹暴露了关键错误和应避免的行为
- SEED 的核心思想是:将策略自身生成的轨迹转化为事后 Skill (Hindsight Skills),并通过蒸馏将这些 Skill 的行为影响编码回策略本身
- 三大设计原则
- 1)On-Policy :监督信号必须来自当前策略生成的轨迹
- 2)Dense :将轨迹级的事后指导转化为 Token 级的密集监督
- 3)Self-Evolving :决策能力和轨迹分析能力应共同提升
Problem Formulation
POMDP
- 论文将智能体任务形式化为一个 POMDP:
$$
(\mathcal{S}, \mathcal{A}, \mathcal{O}, \mathcal{T}, \Omega, \mathcal{R}, \gamma)
$$- \(\mathcal{S}\):潜在状态空间(Latent State Space)
- \(\mathcal{A}\):动作空间(Action Space)
- \(\mathcal{O}\):观测空间(Observation Space)
- \(\mathcal{T}\):状态转移核(Transition Kernel)
- \(\Omega\):观测核(Observation Kernel)
- \(\mathcal{R}\):奖励函数(Reward Function)
- \(\gamma\):折扣因子(Discount Factor)
交互历史与策略
- 在时刻 \(t\),智能体接收观测 \(o_t \in \mathcal{O}\),并维护交互历史:
$$
h_t = (o_0, a_0, o_1, a_1, \ldots, o_t)
$$- \(a_i\) 表示智能体生成的文本响应或可执行动作
- Policy 根据历史生成下一个动作:
$$
a_t \sim \pi_{\theta}(\cdot | h_t)
$$
完整轨迹与强化学习目标
- 一条完整轨迹定义为:
$$
\tau = \{(o_t, a_t, r_t)\}_{t=0}^{T-1}
$$ - 其轨迹级结果记为 \(R(\tau) \in \mathbb{R}\)(通常为二元成功指示或最终任务分数)
- 标准强化学习目标为:
$$
J(\theta) = \mathbb{E}_{\tau \sim \pi_{\theta} }[R(\tau)]
$$ - 关键矛盾 :环境仅提供轨迹级反馈,但策略需要从分布在整个交互历史中的大量 Token 级决策中学习
- SEED 正是为了弥合这一粒度鸿沟
SEED 方法详解
- SEED 包含两个训练阶段,下图概述了整体流程:
- Stage 1: Hindsight Skill SFT(事后 Skill 监督微调)
- 离线轨迹收集(使用基础策略)
- 外部分析器生成 Skill 标注
- 微调策略模型以生成 Skill
- Stage 2: Self-Evolving On-Policy Distillation(自演化 On-Policy 蒸馏)
- 当前策略冻结为 \(\pi_{\theta_\text{old}}\)
- On-Policy 轨迹收集 + Skill 生成(使用同一模型作为分析器)
- 配对的上下文重新评分(普通上下文 vs Skill 增强上下文)
- 计算 OPD 损失
- 联合优化 RL + OPD
阶段一:Hindsight Skill Supervised Fine-Tuning(事后 Skill 监督微调)
- 这一阶段的目的是让策略模型获得分析完整轨迹并生成自然语言 Skill 的能力
步骤1:离线轨迹收集
- 给定训练任务集合 \(\mathcal{Q}_{\text{sft} } = \{q_j\}_{j=1}^{M}\),对每个任务 \(q_j\),使用基础策略 \(\pi_{\theta_{\text{base} } }\) 进行 \(K_0\) 次 Rollout:
$$
\mathcal{B}_j = \{\tau_{j,k}\}_{k=1}^{K_0}, \quad \tau_{j,k} \sim \pi_{\theta_{\text{base} } }(\cdot | q_j)
$$ - 完整离线轨迹池为:
$$
\mathcal{B} = \bigcup_{j=1}^{M}\mathcal{B}_j
$$ - 每个轨迹包含:任务描述、观测序列、动作序列、奖励和最终结果
- 这些轨迹在无 Skill 增强的上下文中收集,确保 SFT 数据来自普通的智能体-环境交互
步骤2:事后 Skill 标注(Annotation)
- 给定一条完整轨迹 \(\tau\),外部分析器 \(A_{\text{ext} }\) 生成事后 Skill 标注:
$$
s_{\tau} = A_{\text{ext} }(\tau)
$$- \(s_{\tau}\) 是从轨迹 \(\tau\) 中提取的 Skill 标注:
- 成功轨迹 :捕获可复用的策略或工作流程
- 失败轨迹 :编码纠正性或规避性指导
- 本文使用 GLM-5.2 作为外部分析器
- 温度设为 0.0
- 最大响应长度为 4096 个 Token
- \(s_{\tau}\) 是从轨迹 \(\tau\) 中提取的 Skill 标注:
- 每条 Skill 标注需满足格式要求
- 设 \(v_{\tau} \in \{0,1\}\) 为有效性指示符,接受的 SFT 数据集为:
$$
\mathcal{D}_{\text{sft} } = \{(x_{\tau}, s_{\tau}) : \tau \in \mathcal{B}, v_{\tau} = 1\}
$$- \(x_{\tau}\) 是序列化的轨迹分析输入
- \(s_{\tau}\) 是对应的事后 Skill 目标
- 设 \(v_{\tau} \in \{0,1\}\) 为有效性指示符,接受的 SFT 数据集为:
步骤3:监督微调
- 对于 Accepted SFT 样本 \((x_{\tau}, s_{\tau}) \in \mathcal{D}_{\text{sft} }\),使用标准负对数似然目标优化模型:
$$
\mathcal{L}_{\text{sft} }(\theta) = -\mathbb{E}_{(x_{\tau}, s_{\tau}) \sim \mathcal{D}_{\text{sft} } } \sum_{\ell=1}^{|s_{\tau}|} \log \pi_{\theta}(s_{\tau,\ell} | x_{\tau}, s_{\tau,<\ell})
$$- \(s_{\tau,\ell}\) 表示 Skill \(s_{\tau}\) 的第 \(\ell\) 个 Token
- 理解:微调后的模型具备根据轨迹生成 Skill 的能力
- 微调后的检查点 \(\theta_{\text{sft} }\) 作为后续 RL 策略的初始化
- 理解:这里作为起始点是因为模型不仅仅保留原始能力,还增加了根据轨迹生成 Skill 的能力
- 设计思路 :通过在 SFT 阶段让模型学会将完整轨迹”压缩”为可读的 Skill 描述,策略模型同时获得了两种能力:
- 1)作为 Actor 在环境中交互
- 2)作为 Analyzer 分析已完成轨迹
阶段二:Self-Evolving On-Policy Distillation(自演化 On-Policy 蒸馏)
- SEED 的核心阶段,包含 On-Policy 轨迹收集、 Skill 生成、基于 Skill 的重新评分和联合优化
核心机制概述
- 每次更新开始时:
- 1)冻结当前策略为 \(\pi_{\theta_{\text{old} } }\)
- 2)该快照同时用于收集轨迹和参数化分析器(提取 Skill )
- 3)可训练策略 \(\pi_{\theta}\)(从 \(\pi_{\theta_{\text{old} } }\) 初始化)同时优化 GRPO 和 OPD 目标
- 4)更新后的策略成为下一次迭代的快照
- 关键设计 :这种共享参数化创建了 SEED 的自演化循环
- 刷新 \(\theta_{\text{old} }\) 会同时改变:
- Actor 遇到的轨迹分布
- 用于 Skill 分析的模型能力
- 因此,经验分布和事后监督共同演化
- 刷新 \(\theta_{\text{old} }\) 会同时改变:
On-Policy 事后 Skill 生成
- 对于每个任务提示 \(q\),SEED 使用冻结策略采样一组 \(N\) 条轨迹:
$$
\mathcal{G}_q = \{\tau_q^{(1)}, \tau_q^{(2)}, \ldots, \tau_q^{(N)}\}, \quad \tau_q^{(n)} \sim \pi_{\theta_{\text{old} } }(\cdot | q)
$$ - 对于每条完成轨迹 \(\tau_q^{(n)}\),构造轨迹分析输入 \(x_{\tau_q^{(n)} }\),然后由同一策略快照实例化的分析器生成事后 Skill :
$$
s_q^{(n)} = A_{\theta_{\text{old} } }(x_{\tau_q^{(n)} })
$$ - 关键点 :Actor 和分析器在每次更新时共享相同的参数 \(\theta_{\text{old} }\),但扮演不同角色:
- Actor :与环境交互
- Analyzer :将完成轨迹总结为轨迹级 Skill
On-Policy Distillation Objective
- 步骤1: Skill 增强上下文
- 设 \(H\) 为确定性上下文增强函数,将生成的 Skill 融入普通交互历史,在轨迹 \(\tau_q^{(n)}\) 的时刻 \(t\), Skill 增强历史为:
$$
\tilde{h}_{q,n,t} = H(h_{q,n,t}, s_q^{(n)})
$$ - 原始采样动作被 Token 化为:
$$
a_{q,n,t} = (a_{q,n,t,1}, \ldots, a_{q,n,t,L_{q,n,t} })
$$- \(L_{q,n,t}\) 表示采样动作 \(a_{q,n,t}\) 的 Token 数量
- 设 \(H\) 为确定性上下文增强函数,将生成的 Skill 融入普通交互历史,在轨迹 \(\tau_q^{(n)}\) 的时刻 \(t\), Skill 增强历史为:
- 步骤2:双分支重新评分
- 同一策略在两个不同上下文中计算同一采样动作 Token 的 Token 级对数概率:
- Skill 条件教师分支(Skill-conditioned Teacher Branch):
$$
\ell_{q,n,t,\ell}^{\text{skill} } = \log \pi_{\theta}(a_{q,n,t,\ell} | \tilde{h}_{q,n,t}, a_{q,n,t,<\ell})
$$ - 普通学生分支(Ordinary Student Branch):
$$
\ell_{q,n,t,\ell}^{o} = \log \pi_{\theta}(a_{q,n,t,\ell} | h_{q,n,t}, a_{q,n,t,<\ell})
$$
- Skill 条件教师分支(Skill-conditioned Teacher Branch):
- 关键设计 :
- 两个分支共享 \(\pi_{\theta}\),但输入上下文不同
- 教师观察事后 Skill ,学生仅从普通历史行动
- 教师提供分离的训练时信号 ,梯度仅通过普通学生分支流动
- 同一策略在两个不同上下文中计算同一采样动作 Token 的 Token 级对数概率:
- 步骤3:Skill 诱导的 Log-Probability Shift
- 定义分离的 Skill 诱导对数概率偏移:
$$
\Delta_{q,n,t,\ell} = \text{sg}[\ell_{q,n,t,\ell}^{\text{skill} } - \ell_{q,n,t,\ell}^{\theta}]
$$- \(\text{sg}[\cdot]\) 表示停止梯度(Stop-Gradient)操作
- 定义分离的 Skill 诱导对数概率偏移:
- 步骤4:置信度门控(Confidence Gate)
- 受 SDAR 启发,SEED 将此偏移映射到置信度门控:
$$
g_{q,n,t,\ell} = \sigma(\beta_{\text{old} } \Delta_{q,n,t,\ell})
$$- \(\sigma(\cdot)\) 是 Logistic Sigmoid 函数
- \(\beta_{\text{old} }\) 控制门控的锐度(Sharpness)
- 直观理解 :
- 正偏移(\(\Delta > 0\)):事后 Skill 支持该采样 Token → 门控值大 → 更多辅助监督
- 负偏移(\(\Delta < 0\)):事后 Skill 不支持该 Token → 门控值小 → 削弱辅助监督
- 受 SDAR 启发,SEED 将此偏移映射到置信度门控:
- 步骤5:OPD 损失
- OPD 损失定义为置信度门控的采样 Token 蒸馏目标:
$$
\mathcal{L}_{\text{opd} }(\theta) = \mathbb{E}_{q,n,t,\ell}\left[m_{q,n,t,\ell} \cdot g_{q,n,t,\ell} \cdot \left(\text{sg}[\ell_{q,n,t,\ell}^{\text{skill} }] - \ell_{q,n,t,\ell}^{\theta}\right)\right]
$$- \(m_{q,n,t,\ell} \in \{0,1\}\) 是有效 Token 掩码
- 梯度分析 :由于 \(g_{q,n,t,\ell}\) 和教师对数概率都是分离的(Detached),教师项相对于 \(\theta\) 是常数,因此:
$$
\nabla_{\theta}\mathcal{L}_{\text{opd} } = -\mathbb{E}_{q,n,t,\ell}\left[m_{q,n,t,\ell} \cdot g_{q,n,t,\ell} \cdot \nabla_{\theta}\ell_{q,n,t,\ell}^{\theta}\right]
$$ - 含义 :该目标在梯度上等价于门控加权的负对数似然
- 最小化它增加了普通策略对 教师认可的、 On-Policy 采样的 Token 的似然,从而将 Skill 的行为影响内化,而无需在推理时暴露 Skill
- OPD 损失定义为置信度门控的采样 Token 蒸馏目标:
GRPO 的 RL 损失
- 对于每个组 \(\mathcal{G}_q\),计算轨迹结果的均值和标准差:
$$
\mu_q = \frac{1}{N}\sum_{n=1}^{N} R(\tau_q^{(n)}), \quad \sigma_q = \sqrt{\frac{1}{N}\sum_{n=1}^{N} (R(\tau_q^{(n)}) - \mu_q)^2}
$$ - 轨迹级组相对优势(Group-relative Advantage):
$$
A_{q,n}^{\text{rl} } = \frac{R(\tau_q^{(n)}) - \mu_q}{\sigma_q + \epsilon}
$$ - 该优势广播到有效动作 Token:
$$
A_{q,n,t,\ell}^{\text{rl} } = A_{q,n}^{\text{rl} } m_{q,n,t,\ell}
$$ - Token 级概率比:
$$
\rho_{q,n,t,\ell}(\theta) = \exp(\ell_{q,n,t,\ell}^{\theta} - \ell_{q,n,t,\ell}^{\text{old} })
$$ - 其中:
$$
\ell_{q,n,t,\ell}^{\text{old} } = \log \pi_{\theta_{\text{old} } }(a_{q,n,t,\ell} | h_{q,n,t}, a_{q,n,t,<\ell})
$$ - RL 损失为:
$$
\mathcal{L}_{\text{rl} }(\theta) = -\mathbb{E}_{q,n,t,\ell}\left[\min\left(\rho_{q,n,t,\ell}(\theta) A_{q,n,t,\ell}^{\text{rl} }, \text{clip}(\rho_{q,n,t,\ell}(\theta), 1-\epsilon_{\text{clip} }, 1+\epsilon_{\text{clip} }) A_{q,n,t,\ell}^{\text{rl} }\right)\right] + \beta_{\text{KL} } D_{\text{KL} }
$$- \(\beta_{\text{KL} }\) 是 KL 正则化系数
- 理解:上述 RL Loss 看起来写了很多,但其实就是最常规的 GRPO Loss
SEED 总目标
- SEED 总目标定义:
$$
\mathcal{L}_{\text{SEED} }(\theta) = \mathcal{L}_{\text{rl} }(\theta) + \lambda_{\text{opd} }\mathcal{L}_{\text{opd} }(\theta)
$$- \(\lambda_{\text{opd} }\) 控制辅助 OPD 信号的强度
- 理解:即使所有答案全对或者全错,RL 的 Advantage 均为 0,但此时 OPD 的梯度依然有效,所以做到了 Token-level 的 Dense 信号
- 设计思路 :
- RL 项优化环境结果(What to achieve)
- OPD 损失内化自生成事后 Skill 的效果(How to achieve it)
- 更新后的策略成为下一次迭代的 \(\pi_{\theta_{\text{old} } }\),闭合自演化循环
推理阶段
- 推理时,部署的智能体仅从普通交互历史行动:
$$
a_t \sim \pi_{\theta}(\cdot | h_t)
$$- 所有事后 Skill 仅用作训练时指导
- 注:部署不需要分析器、 Skill 库、检索模块或增强决策提示
实验
实验设置
- Benchmarks
- ALFWorld
- 具身交互
- 文本型具身交互,6 个任务族:Pick, Look, Clean, Heat, Cool, Pick2
- WebShop
- Web 导航
- 交互式电子商务,产品搜索和购买
- Search-based QA
- 搜索增强 QA
- 7个数据集(NQ, TriviaQA, PopQA, HotpotQA, 2WikiMultiHopQA, MuSiQue, Bamboogle)
- ALFWorld
- Baselines
- Prompting
- Vanilla:直接评估指令微调骨干
- Skill-Prompt*:推理时提供 Skill
- Outcome-based RL
- GRPO:无辅助监督的组相对奖励优化
- Skill-GRPO:RL 时策略条件于 Skill
- Skill-GRPO*:训练和评估时均提供 Skill
- Self-Distillation
- OPSD:On-Policy 自蒸馏推理器
- GRPO+OPSD:GRPO + OPSD 联合优化
- Skill-SD:Skill 条件自蒸馏
- RLSD:RL 自蒸馏
- SDAR:自蒸馏智能体 RL
- Prompting
- 实现细节
- 骨干模型 :Qwen2.5-3B-Instruct, Qwen2.5-7B-Instruct, Qwen3-1.7B-Instruct,以及 Qwen2.5-VL-3B-Instruct(多模态)
- SFT 阶段 :180 个训练任务,每任务 8 条轨迹 → 1,440 条轨迹,GLM-5.2 标注
- RL 阶段 :150 次策略更新,batch size 16(ALFWorld/WebShop)或 128(Search-based QA),组大小 \(N=8\)
- 超参数 :
- 学习率 \(1 \times 10^{-6}\)
- \(\epsilon_{\text{clip} } = 0.2\)
- \(\beta_{\text{opd} } = 5.0\)
- \(\lambda_{\text{opd} } = 0.01\)
- \(\beta_{\text{KL} } = 0.01\)
主要结果
- 整体结果展示:
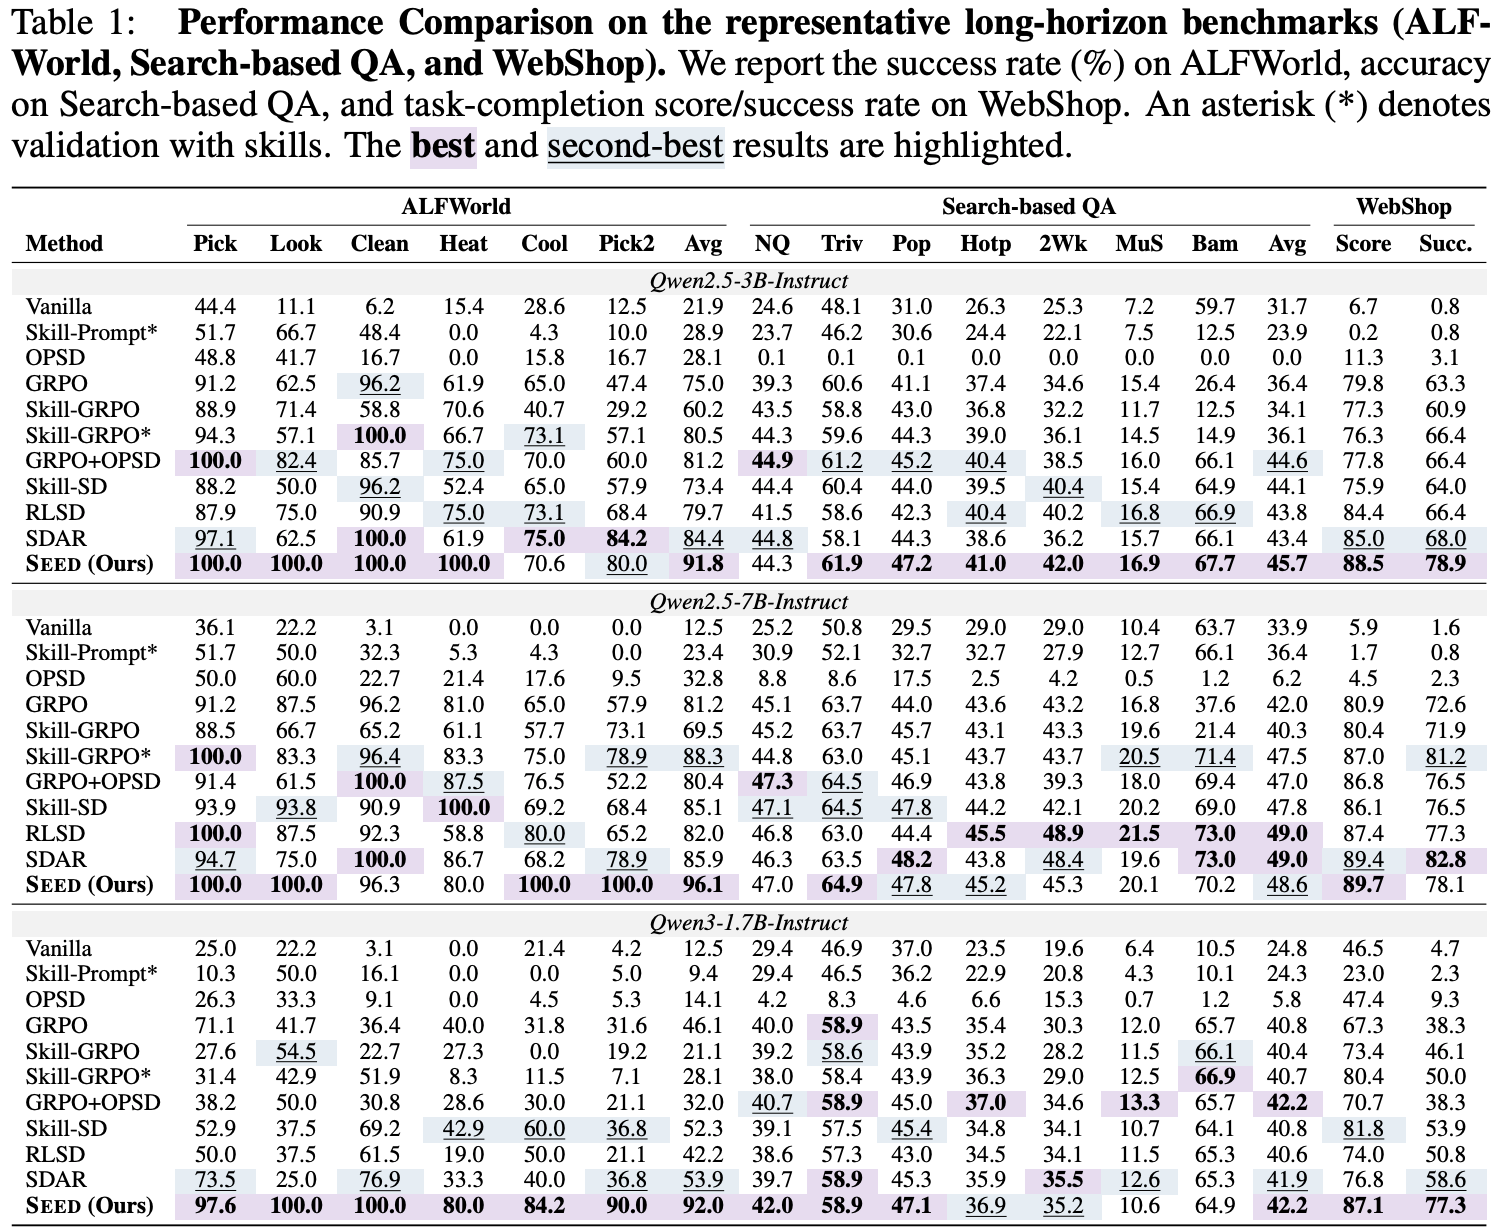
ALFWorld 结果
- 使用 Qwen2.5-3B 骨干,SEED 在 6 个任务族上取得了 91.8% 的平均成功率,显著优于:
- GRPO:75.0%
- SDAR:84.4%
- 所有其他基线
- 在Pick、Look、Clean、Heat 四个任务上达到100% 成功率
Search-based QA 结果
- SEED 平均准确率达到 45.7% ,优于:
- GRPO:36.4%
- SDAR:43.4%
WebShop 结果
- SEED 取得了 88.5% 的完成分数和 78.9% 的成功率,优于所有基线
训练动态(Figure 3)
- SEED 与 GRPO 在 ALFWorld 上的成功率曲线早期即发生分歧
- 第 40 步:SEED 达 57%,GRPO 仅 35%
- SEED 将平均轨迹长度从 28 步降至 13 步(GRPO 降至 16步)
- 结论 :SEED 通过减少无益探索、学习更直接的解决策略来提升任务完成率和交互效率
样本效率(Figure 4 & Table 6)
- 关键发现 :
- 仅用 60% 数据,SEED(80.7%) 超过全数据 GRPO(75.0%)
- 用 40% 数据,SEED(58.9%) 接近 80% 数据 GRPO(58.6%)
- 结论 :SEED 从每条轨迹中提取更丰富、更有效的监督
跨域泛化(Figure 5 & Table 7)
- ALFWorld Unseen Split(不可见环境):
- SEED vs GRPO 最大提升:Heat (+35.0),Look (+18.3),Pick (+16.5)
- 结论 :SEED 学习的策略获得可迁移的可复用行为指导,而非记忆训练轨迹
消融研究(Table 2)
- 笑容实验结论 :
- 1)SFT 阶段对初始轨迹分析能力至关重要
- 2)自演化 OPD 不可或缺,一次性 Skill 监督不足以应对策略演化
- 3)On-Policy Skill 最重要 → Skill 必须来自当前策略自身轨迹
多模态扩展(Table 8)
- 在 Sokoban(视觉网格推箱子)和 EZPoints(视觉算术)上:
- SEED 全面优于 GRPO
- 结论 :SEED 可扩展到视觉-语言模型(VLM),将多模态轨迹转化为有效的事后监督
其他补充示例
定性分析(Figure 6)
- 任务 :”put a candle in toilet”(将蜡烛放入马桶)
- GRPO 行为
- 在定位蜡烛前就访问目标容器
- 拿起无关物品(厕纸)
- 进入偏离任务的循环
- SEED 行为
- 系统检查可能存放蜡烛的搁架
- 在第二层搁架识别蜡烛
- 在5步内完成放置
- GRPO 行为
Skill 示例(Table 4)
- ALFWorld 成功 Skill 示例 :
“Workflow: When tasked to clean and place an object, first locate the target object, take it to a cleaning station, clean it, and finally move it to the target location.”
- ALFWorld 失败 Skill 示例 :
“Avoid moving an object to the target location before verifying both inventory and required object state. Confirm the object is held and already satisfies required conditions such as cleanliness…”
- Search-based QA 成功 Skill :
“Workflow: For a specific factual query, search the exact query, then extract and verify the answer directly from the search results before responding.”
案例研究
- 详细案例见 Appendix D
- SEED 在推理时应用内化行为指导的详细轨迹:
- ALFWorld :正确的子目标分解和前置条件管理(先定位对象→清洁→打开抽屉→放置)
- Search-based QA :自适应信息收集,先识别关键实体,再针对性搜索验证
- WebShop :从搜索到购买的全程属性约束保持
自我演化的风险讨论
- 核心问题 :内部生成的监督可能继承模型错误并陷入平台期
- 具体风险 :
- 1)分析器和 Actor 共享参数 → 盲点被共享
- 2)不准确的分析可能将策略错误编码为”可复用规则” → 后续更新强化错误
- 3)模型可能系统性地偏好类似自身输出的评估(Self-Preference)
- 缓解机制 :
- On-Policy 对齐:减少分布不匹配
- 置信度门控:过滤噪声监督
- 但置信度和自我判断均不保证语义正确性
- 改进方向 :
- 将 Skill 锚定于可验证的状态变化
- 跨策略快照比较分析
- 对每个 Skill 保留不确定性估计
- 分层组织事后 Skill (先总结局部转移,再推导轨迹级规则)
- 不确定性感知的自蒸馏提供更强的过滤机制
DSpark
Introduction & Background
- LLM 的自回归(Autoregressive)生成特性导致推理延迟与输出长度成正比,这成为生产级服务的瓶颈
- 投机解码(Speculative Decoding) 是标准的解决方案:
- 轻量级 Draft Model 生成候选 Token 块,目标 Target Model 并行验证
- 现有方法面临两大不可调和的矛盾,这正是 DSpark 要解决的核心问题:
- 1)生成质量瓶颈(Drafting Quality) :
- 自回归 Drafters(如 Eagle3) :依赖前序 Token,建模能力强,接受率高(\(\tau\) 高),但串行生成导致延迟与块大小 \(\gamma\) 成正比(\(T_{\text{draft} } \propto \gamma\))
- 并行 Drafters(如 DFlash) :单次前向传播生成所有 Token(\(T_{\text{draft} }\) 几乎恒定),但各位置独立预测,缺乏 Inter-token Dependencies ,导致多模态碰撞(如生成 “of problem”)和严重的 后缀衰减(Suffix Decay)
- 2)系统效率瓶颈(System Efficiency) :
- 固定长度验证在高并发下效率极低
- 低置信度的后缀 Token 占用了宝贵的 Target Model 批处理容量,本可以服务于其他活跃请求
- 验证长度应根据数据侧(代码结构化程度高,接受率高;开放聊天熵高,接受率低)和系统侧(轻载时验证几乎免费,重载时资源竞争激烈)动态调整
- 1)生成质量瓶颈(Drafting Quality) :
DFlash 方法前置讲解
- 原始论文:DFlash: Block Diffusion for Flash Speculative Decoding, ICML 2026,
- DFlash 是一种基于块扩散模型(Block Diffusion Model) 的推测式解码(Speculative Decoding)框架,用于加速自回归 LLM 的推理
- DFlash 核心思想是:利用目标 LLM 的深层隐藏特征来条件化一个轻量级扩散模型,使其能够在单次前向传播中并行生成多个 Draft Token,再由目标模型并行验证,从而实现无损加速
- 给定一个已由目标模型验证过的 锚点 Token(Anchor Token)(即上一轮验证产生的 Bonus Token),DFlash 将该 Token 作为一个块的起始位置,并 并行预测该块内后续的所有 Token
- 设块大小为 \(B\)(默认 16),则 Draft 模型一次前向传播生成 \(B\) 个 Token(包括锚点后的 \(B-1\) 个新 Token)
- 所有被 Mask 的位置在一次去噪步骤中并行重建,而不是像自回归模型那样逐 Token 生成
- 因此,Draft 延迟 \(T_{\text{draft} }\) 近似为单次并行前向传播的延迟,与块大小 \(B\) 几乎无关:
$$
T_{\text{draft} } = t_{\text{parallel} } \ll B \cdot t_{\text{step} }
$$- \(t_{\text{parallel} }\) 为块生成延迟,\(t_{\text{step} }\) 为单次自回归步延迟
- 目标模型并行验证
- Draft 模型生成的整块 Token 由目标模型 \(\mathcal{M}_t\) 在一次前向传播中并行验证
- 验证时接受所有与目标模型输出一致的前缀 Token,并在第一个不匹配处截断
- 每个解码周期的期望接受 Token 数 记为 \(\tau \in [1, B+1]\)(包含目标模型额外生成的一个 Bonus Token)
- 注:DFlash 需要单独训练一个 Diffusion-based Draft 模型
DSpark 核心方法一:半自回归生成架构(Semi-Autoregressive Generation)
- 为了兼顾并行 Drafting 的速度与自回归的依赖性,DSpark 设计了 “重并行主干 + 轻量级串行头” 的解耦结构(见图1)
- 其设计思路是:用并行主干保证 \(T_{\text{draft} }\) 不随 \(\gamma\) 线性增长,仅用极小的串行开销注入局部依赖,以挽救后缀接受率
Parallel Stage(对应图中 Parallel Block)
- 沿用 DFlash 的架构,但进行关键改良:将 Anchor Token(上一轮验证通过的真实 Token)也作为第一个预测位置
- 输入为 \(y\) 个 Token(1 个 Anchor + \(y-1\) 个 Mask),单次前向传播得到隐藏状态 \(h_1, \dots, h_y\) 和基础 Logits \(U_1, \dots, U_y\)
Sequential Stage(对应图中 Sequential Block)
- 引入前缀依赖的转移偏置 \(B_k\),定义因果块分布(Causal Block Distribution):
$$
\begin{align}
P(X \mid x_0) &= \prod_{k=1}^\gamma p_k(x_k \mid x_0, x_{<k}), \\
p_k(v \mid x_0, x_{<k}) &= \frac{\exp(U_k(v) + B_k(x_0, x_{<k}, v))}{\sum_{u \in \mathcal{V} } \exp(U_k(u) + B_k(x_0, x_{<k}, u))}
\end{align}
$$- \(x_0\) 是 Anchor Token
- \(\mathcal{V}\) 是词表
- \(U_k\) 是并行主干输出的基础 Logit
- 推理时,顺序块从左到右采样
- 为了确保 \(T_{\text{sequential} } \ll T_{\text{parallel} }\),论文提出两种极轻量级的 Heads:
- Markov Head(默认) :仅依赖前一个 Token \(x_{k-1}\),使用低秩分解 \(B = W_1 W_2\)(\(W_1 \in \mathbb{R}^{V \times r}, W_2 \in \mathbb{R}^{r \times V}\),\(r=256\)),转移偏置为:
$$
B(x_{k-1}, \cdot) = W_1[x_{k-1}] W_2 \in \mathbb{R}^{V}
$$- 该设计极大减少了存储和每步计算量,有效防止“of”后接“problem”的跨模态碰撞
- RNN Head(备选) :维护循环状态 \(s_k\) 以累积全前缀历史
- 输入拼接 \([s_{k-1}; W_1[x_{k-1}]; h_k]\),通过门控更新(Gated Update)产生状态和偏置 \(B_k\)
- 实验表明 RNN Head 提升微小,因复杂度较高,默认采用 Markov Head
- Markov Head(默认) :仅依赖前一个 Token \(x_{k-1}\),使用低秩分解 \(B = W_1 W_2\)(\(W_1 \in \mathbb{R}^{V \times r}, W_2 \in \mathbb{R}^{r \times V}\),\(r=256\)),转移偏置为:
DSpark 核心方法二:置信度调度验证(Confidence-Scheduled Verification)
- 解决了“如何生成”之后,论文重点解决“验证多少”这一系统级问题
- Confidence-Scheduled Verification 设计思路是将验证长度选择建模为全局吞吐量最大化问题
- Confidence-Scheduled Verification 机制的核心思想是:不盲目验证所有生成的草稿 Token,而是将其看作一个“资源分配”问题,把目标模型(Target Model)昂贵的并行验证算力,精准分配给“最不可能被拒绝”的那些 Token
- 理解:更像是一个组合优化问题,需要根据预估出来的前缀存活概率,求解一个 Batch 内每个候选 Response 的验证预算
- 第1步:为每个草稿 Token 计算“前缀存活概率”(Prefix Survival Probability)
- 在 Draft 模型生成 Token 块后,置信度头(Confidence Head)会为每个位置 \(k\) 输出一个条件置信度 \(c_k\)
- \(c_k\) 的含义是:假设前面 \(k-1\) 个Token都已经通过了验证,那么第 \(k\) 个Token能通过验证的条件概率
- 因为投机解码要求必须是从头开始的连续前缀(一旦第 3 个 Token 被拒绝,第 4、5 个即使再好也要被丢弃),所以对于请求 \(r\) 的第 \(j\) 个Token,它真正能存活到被验证的概率(即前缀存活概率 \(a_{r,j}\))是前面所有条件概率的乘积:
$$
a_{r,j} = \prod_{i=1}^{j} c_{r,i}
$$- 例如,第 3 个 Token 真正被验证的概率 = 第1个接受概率 × 第2个接受概率 × 第3个自身条件概率
校准(Calibration) :由于神经网络预测的 \(c_k\) 通常过于自信(Overconfidence),论文使用顺序温度缩放(STS) 在验证集上校准这些概率,确保 \(a_{r,j}\) 的绝对值能真实反映经验接受率
- 例如,第 3 个 Token 真正被验证的概率 = 第1个接受概率 × 第2个接受概率 × 第3个自身条件概率
- 在 Draft 模型生成 Token 块后,置信度头(Confidence Head)会为每个位置 \(k\) 输出一个条件置信度 \(c_k\)
- 第2步:建立系统吞吐量的“成本-收益”数学模型
- 假设系统中有 \(R\) 个并发请求,调度器需要决定:针对每个请求 \(r\),到底应该验证前 \(\ell_r\) 个Token(\(\ell_r\) 可以不同)
- 收益(Expected Accepts, \(\tau\)) :如果给请求 \(r\) 分配 \(\ell_r\) 个验证名额,期望能接受的 Token 数为该前缀内所有存活概率之和,再加上必须验证的 1 个 Anchor Token:
$$
\tau = \sum_{r=1}^{R} \left(1 + \sum_{j=1}^{\ell_r} a_{r,j}\right)
$$ - 成本(Batch Size, \(B\)) :这一轮验证,Target Model 的批处理大小(即输入的 Token 总数)等于每个请求的 Anchor + 验证长度之和:
$$
B = \sum_{r=1}^{R} (1 + \ell_r)
$$ - 系统吞吐量(\(\Theta\)) :调度器有一个预配置的查表函数 \(\text{SPS}(B)\),表示 Target Model 在批大小为 \(B\) 时每秒能执行的步数(Steps Per Second)
- 因此,全局系统吞吐量(每秒接受的 Token 总数)为:
$$
\Theta = \tau \times \text{SPS}(B)
$$
- 因此,全局系统吞吐量(每秒接受的 Token 总数)为:
- 目标 :选出最优的一组 \(\{\ell_1, \dots, \ell_R\}\),使得 \(\Theta\) 达到最大值
- 第3步:全局贪心排序与遴选(Algorithm 1 核心)
- 这是一个组合优化问题,但因为 \(a_{r,j}\) 随着 \(j\) 增大而单调递减(越往后的 Token 存活率越低),论文证明可以用贪心算法高效求解
- 构造全局候选池 :将所有请求的所有位置的 Token(即所有的 \((r, j)\))提取出来,按照它们的“前缀存活概率” \(a_{r,j}\) 从大到小进行全局排序
- 逐个接纳(Admission) :调度器从概率最高的 Token 开始,依次决定“接纳”该 Token 进入验证批次(即增加 \(\ell_r\))
- 动态更新 :每接纳一个 Token 进入验证批次,全局的 \(B\) 增加 1,\(\tau\) 增加对应的 \(a_{r,j}\),并通过查表 \(\text{SPS}(B)\) 实时计算当前的系统吞吐量 \(\Theta\)
- 这是一个组合优化问题,但因为 \(a_{r,j}\) 随着 \(j\) 增大而单调递减(越往后的 Token 存活率越低),论文证明可以用贪心算法高效求解
- 第4步:早停机制(Early Stopping)
- 这是理解该流程最关键、最容易被误解的一点
- 调度器并不是把所有 Token 排序后全部接纳到验证批次,而是采用 即时早停 :
- 执行逻辑 :随着不断接纳高概率 Token 到验证批次后,吞吐量 \(\Theta\) 会先上升
- 但当接纳到某个低质量 Token 到验证批次时,虽然 \(\tau\) 增加了,但 \(B\) 的增大会导致 \(\text{SPS}(B)\) 下降(批处理太大导致吞吐下降),此时总体的 \(\Theta\) 会首次出现下降
- 注:预配置的查表函数 \(\text{SPS}(B)\) 表示 Target Model 在批大小为 \(B\) 时每秒能执行的步数
- 立即停止并回退 :
- 一旦发现 \(\Theta \leq \Theta_{\text{best} }\)(当前吞吐量低于历史最佳值,即出现吞吐量 \(\Theta\) 下降的转折点),调度器 立刻跳出循环 ,不再考虑排序列表中后续概率更低的 Token
- 执行逻辑 :随着不断接纳高概率 Token 到验证批次后,吞吐量 \(\Theta\) 会先上升
- 第5步:工程实战中的异步适配(Asynchronous Adaptation)
- 在真实的 DeepSeek-V4 生产环境中,上述理想算法遇到了两个硬骨头:
- 1)硬件吞吐曲线 \(\text{SPS}(B)\) 不是平滑的,而是有锯齿状突降(Cliffs)
- 2)工程框架要求 “下一步的批大小 \(B\)” 必须在当前步完成之前就知道(注:因为 Zero-Overhead Scheduling,ZOS 需要)
- 理解:为了消除 CPU->GPU 的通信气泡,引擎会提前把计算图捕获好,并且让 GPU 的流水线一直保持满载运行,要让 GPU 在当前计算结束的那一微秒立即开始下一步计算,而中间不等待 CPU 下发指令,那么 CPU 必须在当前计算结束之前,就把下一步要算多大的矩阵(即 \(B\) 的大小)、算哪些数据,全部填充到 GPU 的硬件调度器(Command Queue)里
- 为此,论文做了巧妙的异步改造 :
- 预测容量(Budget)用旧数据 :调度器 提前两步(2 steps prior)用旧的历史置信度,粗略预测出下一步的截断长度 K(即本轮最多能验证多少个 Token)
- 选择内容(Selection)用新数据 :在当前步,Token 的排序依然严格使用最新的、实时的 置信度 \(a_{r,j}\) 进行全局排序
- 最终动作 :从排序好的当前 Token 列表中,选取排名前 K 个的 Token 送入验证
- 在真实的 DeepSeek-V4 生产环境中,上述理想算法遇到了两个硬骨头:
训练目标 (多目标损失函数 from Section 3.3)
- Target Model 冻结,Draft Model 的 Embedding 和 LM Head 冻结,仅更新 Backbone、Sequential Block 和 Confidence Head
- 损失函数包含三项,均使用位置权重 \(w_k = \exp(-(k-1)/\gamma)\) 强调靠前位置:
- 交叉熵损失 \(\mathcal{L}_{\text{ce} }\) :训练 Draft 预测正确 Token
- 分布匹配损失 \(\mathcal{L}_{\text{tv} }\) :最小化 \(|p_k^d - p_k^t|_1\),直接最大化接受率
- 置信度损失 \(\mathcal{L}_{\text{conf} }\) :二元交叉熵,拟合软标签 \(c_k^*\)
- 总损失为:
$$ \mathcal{L} = 0.1\mathcal{L}_{\text{ce} } + 0.9\mathcal{L}_{\text{tv} } + 1.0\mathcal{L}_{\text{conf} } $$
AttnRes
- 原始论文:(AttnRes) Attention Residuals, Kimi Team, 20260316
- 本节主要给出原文第二和第三节的内容
第二节:Motivation
- 考虑一批输入序列,形状为 \(B\times T\times d\),其中 \(B\) 是 Batch size,\(T\) 是序列长度,\(d\) 是隐藏维度
- 为清晰起见,为单个 Token 写出公式:
- \(\pmb {h}_l\in \mathbb{R}^d\) 表示进入第 \(l\) 层的隐藏状态
- \(l\in \{1,\ldots ,L\}\) 是层索引
- \(L\) 是总层数
- \(\pmb {h}_l\in \mathbb{R}^d\) 表示进入第 \(l\) 层的隐藏状态
- Token 嵌入为 \(\pmb {h}_1\)
- 函数 \(f_{l}\) 表示第 \(l\) 层所应用的变换
- 在 Transformer 模型中,将每个自注意力或 MLP 视为一个单独的层
Training Deep Networks via Residuals
Residual Learning
- 残差学习 (2015) 被证明是训练深度网络的关键技术,因为它允许梯度绕过变换,具体来说,每一层更新隐藏状态为:
$$h_{l} = h_{l - 1} + f_{l - 1}(h_{l - 1})$$ - 展开该递推式,第 \(l\) 层的隐藏状态是嵌入向量和所有先前层输出之和:
$$ \pmb {h}_l = \pmb {h}_1 + \sum_{i = 1}^{l - 1}f_i(\pmb {h}_i)$$ - 残差连接背后的关键思想是恒等映射 (identity mapping):
- 每一层都保留了信息和梯度不变流动的直接路径
- 在反向传播过程中,关于中间隐藏状态的梯度为:
$$\frac{\partial\mathcal{L} }{\partial h_l} = \frac{\partial\mathcal{L} }{\partial h_L}\cdot \prod_{j = l}^{L - 1}\left(\mathbf{I} + \frac{\partial f_j}{\partial h_j}\right)$$- 展开该乘积得到 \(\mathbf{I}\) 加上涉及层 Jacobian 矩阵 \(\partial f_j / \partial h_j\) 的高阶项
- 恒等项始终保留,提供了从损失到任何层的直接梯度路径,与深度无关
Generalizing Residuals
- 尽管有效,但残差更新中的固定单位系数对每一层的贡献均等处理,没有提供适应跨深度混合的机制
- Highway 网络 (2015) 通过引入学习到的逐元素门控来放松这一限制:
$$h_{l} = (1 - g_{l})\odot h_{l - 1} + g_{l}\odot f_{l - 1}(h_{l - 1})$$- \(g_{l}\in [0,1]^{d}\) 在变换和恒等路径之间插值
- 更一般地,两者都是加权递推的实例
$$ \pmb {h}_l = \alpha_l\cdot \pmb {h}_{l - 1} + \beta_l\cdot f_{l - 1}(\pmb {h}_{l - 1}) $$- 残差设置 \(\alpha_{l} = \beta_{l} = 1\)
- Highway 设置 \(\alpha_{l} = 1 - g_{l}\)、\(\beta_{l} = g_{l}\)
Limitations
- 无论是固定还是门控,这两种方法都共享一个基本约束:
- 每一层只能访问其直接输入 \(\pmb{h}_{l - 1}\),这是一个将先前所有层输出混杂在一起的单一压缩状态,而非各个输出本身
- 这带来了若干局限性:
- (1) 无法选择性访问:不同类型的层(如注意力层和 MLP 层)接收相同的聚合状态,尽管它们可能受益于不同的加权方式
- (2) 不可逆损失:通过聚合丢失的信息无法在更深层中选择性地恢复
- (3) 输出增长:后面的层为了在累加残差中获得影响力,不得不学习越来越大的输出,这可能破坏训练稳定性
- 我们需要一种让每一层能够选择性地从所有先前层中聚合信息
第三节:Attention Residuals: A Unified View of Time and Depth,时间与深度的统一视角
- 上述局限性让人联想到序列建模中类似的瓶颈,于是本文作者在深度维度上寻求类似的解决方案(将层间的加权求和变成 Attention)
The Duality of Time and Depth,时间与深度的对偶性
- 与时间上的 RNN 类似,残差连接将所有先前信息压缩到单一状态 \(\pmb {h}_l\) 中(沿深度方向)
- 在序列建模中,Transformer 通过用注意力 (2016, 2017) 替代递推来改进 RNN,使每个位置能够以数据依赖的权重选择性地访问所有先前位置
- 作者针对深度维度提出相同的方法:
$$h_{l} = \alpha_{0\rightarrow l}\cdot h_{1} + \sum_{i = 1}^{l - 1}\alpha_{i\rightarrow l}\cdot f_{i}(h_{i}) \tag {1}$$- \(\alpha_{i\rightarrow l}\) 是层特定的注意力权重,满足 \(\sum_{i = 0}^{l - 1}\alpha_{i\rightarrow l} = 1\)
- 理解:这里的注意力是指每一层作为 Query,Key,Value 时的 Attention,不是常规的使用 Token 作为 Q K V 的 Attention 了
- Attention Residuals 的 Q K V 定义见后文的公式 3
- 与序列长度(可达数百万 Token)不同,网络深度通常较小 \((L< 1000)\),因此深度上的 \(O(L^{2})\) 注意力在计算上是可行的
- 本文将这种方法称为注意力残差,缩写为 AttnRes
Full Attention Residuals
- 注意力权重可写为 \(\alpha_{i\to l} = \phi (\pmb {q}_l,\pmb {k}_i)\),其中核函数 \(\phi :\mathbb{R}^d\times \mathbb{R}^d\to \mathbb{R}_{\geq 0}\),\(\pmb {q}_l\) 和 \(\pmb {k}_i\) 分别是 Query 和 Key 向量 (2020, 2025)
- \(\phi\) 的不同选择可以恢复不同的残差变体 (§6.2)
- 本文采用 \(\phi (\pmb {q},\pmb {k}) = \exp \left(\pmb {q}^\top \text{RMSNorm}(\pmb {k})\right)\) (2019) 并进行归一化,得到深度方向上的 softmax 注意力:
$$\alpha_{i\to l} = \frac{\phi(\pmb{q}_l,\pmb{k}_i)}{\sum_{j = 0}^{l - 1}\phi(\pmb{q}_l,\pmb{k}_j)} \tag {2}$$
- 本文采用 \(\phi (\pmb {q},\pmb {k}) = \exp \left(\pmb {q}^\top \text{RMSNorm}(\pmb {k})\right)\) (2019) 并进行归一化,得到深度方向上的 softmax 注意力:
- 对于每一层 \(l\),本文定义:
$$
\begin{align}
\pmb {q}_l &= \pmb {w}_l,\\
\pmb {k}_i &= \pmb {v}_i = \left\{ \begin{array}{ll}\pmb {h}_1 & i = 0\\ f_i(\pmb {h}_i) & 1\leq i\leq l - 1 \end{array} \right. \tag {3}
\end{align}
$$- 其中查询 \(\pmb {q}_l = \pmb {w}_l\) 是一个层特定的可学习向量,位于 \(\mathbb{R}^d\) 中
- \(\phi\) 内部的 RMSNorm 防止具有大幅度输出的层主导注意力权重
- 第 \(l\) 层的输入为:
$$\pmb {h}_l = \sum_{i = 0}^{l - 1}\alpha_{i\to l}\cdot \pmb {v}_i \tag {4}$$ - 本文将这种形式称为完整注意力残差 (full attention residuals)
- 对于每个 Token,Full AttnRes 需要 \(O(L^2 d)\) 的算术运算和 \(O(Ld)\) 的显存来存储层输出
- 由于深度远小于序列长度,算术开销是适中的
Overhead
- \(O(Ld)\) 的显存与反向传播时已保留的激活完全重叠,因此在普通训练中 Full AttnRes 不引入额外显存开销
- 在大规模训练中,激活重计算和流水线并行被广泛采用:
- 原本会被释放并在反向时重计算的层输出,现在必须为所有后续层保持存活
- 在流水线并行下,还必须将它们跨阶段传输
- 此时显存和通信开销都增长为 \(O(Ld)\)
Blockwise optimization
- Full AttnRes 中的一个有意设计选择是,伪查询 \(\pmb {w}_l\) 是一个学习到的参数,与层的前向计算解耦
- 这种独立性意味着任何一组层的注意力权重都可以并行计算,无需等待它们的顺序输出
- 特别地,它允许将 \(L\) 层分组为 \(N\) 个块,每块 \(S\) 层,并在块内批量处理注意力计算,从而将每层的显存 I/O 从 \(O(Ld)\) 降低到 \(O((S + N)d)\)(详细的两阶段策略见 §4)
- 注意:只有在分块以后,块间的 Attention 权重 计算可以并行,块内的 Key Value 是存在层与层之间的时序依赖的,无法实现并行
- 核心思路:在 Block N 的 多个 层还没有顺序产生自己的新键之前,就利用它们固定的查询和历史的旧键,把它们的“历史注意力” 提前并行算好了
- 等到它们顺序执行时,只需要处理极小部分的“块内顺序注意力”,从而极大地节省了时间
- 在当前分布式训练机制下,主要开销并非本地显存带宽,而是流水线并行下的跨阶段通信:
- 每一层的输出仍然必须在阶段之间传输,这种 \(O(Ld)\) 的通信开销无法通过本地批处理来缓解
- 这促使本文引入下面介绍的 Block AttnRes 变体,它将跨阶段的表示数量从 \(L\) 减少到 \(N\)
- 预计未来互连的改进将使完整的 \(O(Ld)\) 通信变得实用,从而充分发挥 Full AttnRes 的潜力
Block Attention Residuals
- 分块注意力残差 (Block Attention Residuals) 将 \(L\) 层划分为 \(N\) 个块:
- 在每个块内部,层输出通过求和归约为单一表示
- 在块之间,仅对 \(N\) 个块级表示以及 Token 嵌入应用完整注意力
- 这将显存和通信开销从 \(O(Ld)\) 降低到 \(O(Nd)\)
Intra-Block Accumulation
- 将 \(L\) 层划分为 \(N\) 个块,每块 \(S = L / N\) 层,假设 \(L\) 可被 \(N\) 整除
- 否则最后一个块包含剩余的 \(L\) mod \(N\) 层
- 令 \(\mathcal{B}_n\) 表示第 \(n\) 个块中的层索引集合 \((n = 1,\ldots ,N)\)
- 为了形成一个块,将其所有层输出相加:
$$\pmb {b}_n = \sum_{j\in \mathcal{B}_n}f_j(\pmb {h}_j) \tag {5}$$ - 进一步用 \(\pmb{b}_n^i\) 表示 \(\mathcal{B}_n\) 中前 \(i\) 层的部分和,因此 \(\pmb{b}_n = \pmb{b}_n^S\)
- 当 \(L\) 不能被 \(N\) 整除时,最终的部分和作为最后一个块的表示
- 与 Full AttnRes 一样,\(\phi\) 内部的 RMSNorm 防止完整块与部分和之间的量级差异对注意力权重产生偏置
Inter-Block Attention
- 在 Full AttnRes 中,第 \(l\) 层的输入是通过对所有输出(直到 \(f_{l - 1}(h_{l - 1})\))进行注意力计算得到的
- 分块变体将这些单独的输出替换为块表示,并定义 \(b_{0} = h_{1}\),使得 Token 嵌入始终作为一个源被包含
- 对于第 \(n\) 个块中的第 \(i\) 层,值矩阵为:
$$\mathbf{V} = \left\{ \begin{array}{ll}[b_0,b_1,\ldots ,b_{n - 1}]^\top & \text{ if } i = 1 (\text{块 } n \text{ 的第一层})\\ [b_0,b_1,\ldots ,b_{n - 1},b_{n - 1}^i ]^\top & \text{ if } i\geq 2 (\text{后续层}) \end{array} \right. \tag {6}$$ - 键和注意力权重遵循式 3 和式 2
- 网络第一层的输入是 Token 嵌入,即 \(b_{0} = h_{1}\)
- 在每个块中,第一层接收之前的块表示和 Token 嵌入,后续层额外关注部分和 \(b_{n}^{i - 1}\)
- 最终输出层聚合所有 \(N\) 个块表示
- 图 2 提供了 Block AttnRes 的 PyTorch 风格伪代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
def block_attn_res(blocks: list[Tensor], partial_block: Tensor, proj: Linear, norm: RMSNorm) -> Tensor:
# 跨块注意力:在块表示 + 部分和上进行注意力计算
# blocks:
# N 个形状为 [B, T, D] 的张量:每个先前块的完整块表示
# partial_block:
# [B, T, D]:块内部分和 (b_n^i)
V = torch.stack(blocks + [partial_block]) # [N+1, B, T, D]
K = norm(V)
logits = torch.einsum('d, n b t d -> n b t', proj.weight.squeeze(), K)
h = torch.einsum('n b t, n b t d -> b t d', logits.softmax(), V)
return h
def forward(self, blocks: list[Tensor], hidden_states: Tensor) -> tuple[list[Tensor], Tensor]:
partial_block = hidden_states
# 在注意力之前应用 block attnres
# blocks 已包含 Token 嵌入
h = block_attn_res(blocks, partial_block, self.attn_res_proj, self.attn_res_norm)
# 如果到达块边界,则开始新块
# block_size 计数 ATTN + MLP;每个 Transformer 层有 2 个子层
if self.layer_number % (self.block_size // 2) == 0:
blocks.append(partial_block)
partial_block = None
# 自注意力层
attn_out = self.attn(self.attn_norm(h))
partial_block = partial_block + attn_out if partial_block is not None else attn_out
# 在 MLP 之前应用 block attnres
h = block_attn_res(blocks, partial_block, self.mlp_res_proj, self.mlp_res_norm)
# MLP 层
mlp_out = self.mlp(self.mlp_norm(h))
partial_block = partial_block + mlp_out
return blocks, partial_block
Efficiency
- 由于每一层现在关注 \(N\) 个块表示而非 \(L\) 个单独输出,显存从 \(O(L)\) 降至 \(O(N)\),计算从 \(O(L^{2})\) 降至 \(O(N^{2})\)
- 块数 \(N\) 在两个极端之间插值:\(N = L\) 恢复 Full AttnRes,而 \(N = 1\) 则退化为标准残差连接(嵌入单独作为 \(b_{0}\))
- 实验发现:\(N \approx 8\) 可以恢复大部分收益,且每个 Token 仅需存储 8 个隐藏状态(见 §5)
- 除了显存和计算之外,块结构也有利于推理延迟:
- 块边界定义了 §3 中描述的分块优化的调度粒度,固定的块数 \(N\) 也限制了 KV 缓存大小
- 并行的跨块结果通过在线 softmax (2018) 与顺序的块内部分和合并,保持精确等价性 (§4)
LatentMoE
- 原始论文:LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts, 20260126, NVIDIA
背景 & 问题提出
- MoE 架构通过稀疏激活(仅激活部分专家)使得模型总参数规模大幅增加而计算量(FLOPs)基本不变
- 现有的 MoE 设计存在严重的结构性缺陷:
- 评估维度缺失 :
- 传统设计仅关注 “Accuracy per FLOP”,忽略了 “Accuracy per Parameter”
- 在实际部署中,参数规模直接影响显存占用(HBM)、内存带宽需求以及专家并行带来的通信开销
- 部署场景错配 :
- 针对训练 Throughput-oriented 优化:现有 MoE 主要针对离线高吞吐场景优化
- 忽略了推理 Latency-critical:在线低延迟推理中 内存带宽 和 All-to-All 通信 成为主导瓶颈的现实
- 评估维度缺失 :
- LatentMoE 思路:
- 通过将 Token 投影到低维潜在空间进行路由和计算,在不增加推理成本的前提下,等比例扩大专家数量(\(N\))和激活专家数(\(K\)),从而在 Accuracy per FLOP 和 Accuracy per Parameter 上同时达到帕累托最优
- 两点注意:
- 针对路由专家缩小专家维度 (\(d \rightarrow \ell\)),然后提升激活专家数
- 共享专家维度和数量不变
- 两点注意:
- 注:与直接缩小模型维度不同,因为 LatentMoE 仍然保持着模型的维度,只是缩小了专家的维度,所以称为 LatentMoE
- 注:LatentMoE 有两个版本
- \(\ell\text{-MoE}_{eff}\) 保持模型性能不变,降低计算量(提升吞吐)
- \(\ell\text{-MoE}_{acc}\) 保持总参数量和激活参数量情况下,提升模型性能
- 本质上也可以理解为相同模型性能上提升吞吐
- 详情见实验 & Table 5
- 通过将 Token 投影到低维潜在空间进行路由和计算,在不增加推理成本的前提下,等比例扩大专家数量(\(N\))和激活专家数(\(K\)),从而在 Accuracy per FLOP 和 Accuracy per Parameter 上同时达到帕累托最优
- 其他说明:
- LatentMoE 的同期工作 mHC(Manifold-Constrained Hyper-Connections) 通过修改残差连接(拓宽残差流)来提升同等计算下的质量
- LatentMoE 与 mHC 是互补关系 ,理论上可以堆叠使用
- MoLAE(Mixture of Latent Experts) 与 LatentMoE 表面相似,但本质不同
- MoLAE 是一种后训练压缩 方法,采用低秩近似专家权重 ,且为了弥补精度,仅在部分专家(FC2)上压缩,并引入分组投影
- 这导致其无法减少 Token 分发时的 All-to-All 通信量,且内存带宽缩减有限
- LatentMoE 是预训练架构设计 ,其核心优势在于利用压缩节省的资源重新投资于扩大专家池和激活数 ,从根本上提升模型表达能力
- MoLAE 是一种后训练压缩 方法,采用低秩近似专家权重 ,且为了弥补精度,仅在部分专家(FC2)上压缩,并引入分组投影
- LatentMoE 的同期工作 mHC(Manifold-Constrained Hyper-Connections) 通过修改残差连接(拓宽残差流)来提升同等计算下的质量
LatentMoE 核心设计原则总结(硬件-软件协同视角)
- 注原始论文中通过一个具体案例(Qwen3-235B-A22B,部署在 NVIDIA GB200 NVL72 上)推导出五项黄金设计原则
- 关键硬件参数:
- HBM 带宽 \(\text{BW}_\text{HBM} = 8 \text{TB/s}\)
- FP4算力 \(F = 10 \text{PFLOPs}\)
- NVLink 单向带宽 \(\text{BW}_\text{NVL} = 900 \text{GB/s}\)
- 网络结构假设
- 隐藏维度为 \(d\)
- 专家中间维度为 \(m\)
- 总专家数 \(N\)
- 每个 Token 激活专家数 \(K\)
- 专家并行度 \(EP\)
- 每个专家处理的 Token 数为 \(t_{\text{exp} } = \frac{t_{\text{total} } \cdot K}{N}\)
- \(t_{\text{total}}\) 是总 Token 数
原则 I:内存带宽瓶颈(延迟敏感场景)
- 在低延迟小批量推理中,专家计算受限于 HBM 带宽(权重加载速度)
- 算术强度(FLOPs/Byte)公式:
$$
I = \frac{2 \cdot t_{\text{exp} } \cdot d \cdot m}{d \cdot m + t_{\text{exp} } \cdot (d + m)}
$$- 要进入计算受限(Compute-Bound)区域,需
$$ I \geq \frac{F}{\text{BW}_\text{HBM} } = 1250 $$ - 计算得出需 \(t_{\text{exp} } \geq 1418\),而实际延迟场景仅几百 Token,因此处于带宽受限区
- 要进入计算受限(Compute-Bound)区域,需
- 原则 I :必须最大化 Accuracy per Parameter
原则 II:通信瓶颈(吞吐敏感场景)
- 专家并行引入 All-to-All 通信,通信量
$$ M_{\text{comm} } \propto \frac{t_{\text{total} } \cdot K \cdot d}{\text{EP} } $$ - 计算与通信时间比:
$$
\frac{t_{\text{comm} } }{t_{\text{comp} } } = \frac{5 \cdot F}{4 \cdot m \cdot \text{BW}_\text{NVL} } \approx 9
$$- 通信时间远超计算时间
- 原则 II :必须减少路由隐藏维度 \(d\) 或激活专家数 \(K\),而改变中间维度 \(m\) 对通信无帮助
原则 III:模型质量与非线性预算
- 依据 Barron 函数逼近理论,MoE 层的有效非线性预算为
$$ U_{\text{eff} } \propto K \cdot m $$ - 原则 III :维持模型质量必须保持 \(K \cdot m\) 不变,因此不能随意削减 \(K\) 或 \(m\)
原则 IV:特征秩下限
- 每个推理任务存在一个内在特征秩 \(r_{\text{eff} }\)
- 若将隐藏维度 \(d\) 压缩至低于 \(r_{\text{eff} }\),将导致任务相关信息丢失,引发质量崩塌
- 原则 IV :\(d\) 的压缩存在下限,即 \(\ell \geq r_{\text{eff} }\)
原则 V:组合稀疏性的指数增益
- 原则 V :增加总专家数 \(N\) 和激活数 \(K\) 可指数级扩大专家组合空间(\(\binom{N}{K}\)),提升模型表达力
设计思路汇总
- 结合原则 I,II,III,唯一解是降低 \(d\) ,且降维后空出的成本用于等比例放大 \(N\) 和 \(K\)(原则 V)
- 原则 I 和 II 要求降 \(d\) 或 \(K\)
- 原则 III 禁止降 \(K\) 和 \(m\)
- 只要压缩后的维度 \(\ell\) 不低于 \(r_{\text{eff} }\)(原则 IV),精度即可保持甚至超越
LatentMoE 架构
- LatentMoE 的核心是引入“潜在空间”作为计算主阵地,并包含两条变体路线
- 设压缩因子 \(\alpha = \frac{d}{\ell}\)
基础流程(数据流)
- 1)下投影(Down-Projection) :
- 输入 Token \(x \in \mathbb{R}^{d}\) 通过可学习矩阵 \(W_{\downarrow} \in \mathbb{R}^{\ell \times d}\) 压缩
- 最终得到潜在表示为 \(\ell\) 维度的结果
- 2)路由与专家计算 :
- 路由权重 \(p’ = \text{Softmax}(W_r’ \cdot x)\) 仍基于原始 \(x\)(保留原始信息用于路由)
- 选中的专家 \(E_i(\cdot; \ell)\) 完全在潜在空间操作
- \(E_i(\cdot; \ell)\) 的处理维度为 \(\ell\)
- 其权重矩阵为 \(W_{\text{FC1} }^{(i)}, W_{\text{gate} }^{(i)} \in \mathbb{R}^{m \times \ell}\) 和 \(W_{\text{FC2} }^{(i)} \in \mathbb{R}^{\ell \times m}\)
- 3)上投影(Up-Projection) :
- 专家输出聚合后,通过 \(W_{\uparrow} \in \mathbb{R}^{d \times \ell}\) 映射回原始维度 \(d\),进行残差连接
- 专家组成 :
- \(N’\) 个路由专家(Routed Experts)
$$ N’ = \alpha \cdot N $$ - \(S\) 个共享专家(Shared Experts),专家数不变
- 共享专家 \(E_j(\cdot; d)\) 在原始维度工作,用于捕获通用知识,不影响主瓶颈
- \(N’\) 个路由专家(Routed Experts)
LatentMoE 的 两种变体
LatentMoE 变体一:\(\ell\text{-MoE}_{\text{eff} }\)(效率优先)
- LatentMoE 变体一完整公式:
$$
\ell\text{-MoE}_{\text{eff} }(x) := W_{\uparrow} \cdot \left( \sum_{i \in \mathcal{T}_{K, N’} } p_i’ E_i(W_{\downarrow} \cdot x; \ell) \right) + \sum_{j = N’ + 1}^{N’ + S} E_j(x; d)
$$- 其中 \(\mathcal{T}_{K, N’}\) 表示从 \(N’\) 个专家中选取 Top-K 个
- 后面的第二部分是共享专家(与传统的 MoE 一样,保持不变)
- 注:此变体专家维度降低,但此变体保持 \(K\) 不变
- 因为专家权重从 \((d \times m)\) 降为 \((\ell \times m)\),内存和通信成本降为原来的 \(1/\alpha\),精度与基线持平(匹配原则 III 和 IV)
LatentMoE 变体二:\(\ell\text{-MoE}_{\text{acc} }\)(精度优先,推荐使用)
- LatentMoE 变体一完整公式:
$$
\ell\text{-MoE}_{\text{acc} }(x) := W_{\uparrow} \cdot \left( \sum_{i \in \mathcal{T}_{K’, N’} } p_i’ E_i(W_{\downarrow} \cdot x; \ell) \right) + \sum_{j = N’ + 1}^{N’ + S} E_j(x; d)
$$- 其中 \(K’ = \alpha \cdot K\),即激活专家数也等比例放大 \(\alpha\) 倍
- 由于通信成本与 \(K\) 成正比,放大 \(K\) 恰好抵消了降低 \(d\) 带来的收益,使得总通信成本和内存带宽成本与标准 MoE 严格持平(符合原则 I 和 II)
- 但此时有效非线性预算变为 \(K’ \cdot m = \alpha K m\) 且专家组合空间变为
$$ \binom{\alpha N}{\alpha K} $$- 由于组合空间复杂度提升,带来显著的精度提升
成本收益总结(论文 Table 1)
- 成本收益总结:
架构 通信成本 权重加载内存成本 精度 推理效率 标准 MoE \(\propto (N/EP) \cdot t_{exp} \cdot d\) \(\propto d \cdot m\) 基线 基线 \(\ell\text{-MoE}_{eff}\) \(\propto (N/EP) \cdot t_{exp} \cdot \ell\) (下降) \(\propto \ell \cdot m\) (下降) 持平 提升 \(\ell\text{-MoE}_{acc}\) \(\propto (N/EP) \cdot t_{exp} \cdot d\) (持平) \(\propto d \cdot m\) (持平) 大幅提升 持平
实验
- 实验涵盖 16B-A2B 的消融实验、95B-A8B 的 Scaling 实验,以及混合 Mamba-Attention MoE 架构的验证
消融实验(16B-A2B)
- 压缩比影响(Figure 3) :验证原则 IV
- 当压缩因子 \(\alpha = d / \ell \leq 4\) 时(即 \(\ell \geq 512\)),验证损失几乎没有增加
- 论文确定 \(\alpha = 4\) 为最佳折衷点,并在更大规模上验证有效
- 专家数量影响(Figure 4) :验证专家缩放策略
- 在 \(d\) 压缩 4 倍但不增加专家数时,模型质量显著崩塌(红线和绿线对比)
- 只有将专家数同步扩增 4 倍(\(N’ = \alpha N\)),才能完全恢复并超越基线精度
- 这证明了 LatentMoE 利用压缩节省的参数重新投资于专家多样性的必要性
- 理解:这里的 \(\alpha = 4, N = 256\) 本质对应的是 \(\ell\text{-MoE}_{eff}\) 的配置
- 注:\(\alpha = 4, N = 256\) 跟 \(\ell\text{-MoE}_{acc}\) 一样,但 \(K\) 没有同步提升
- 变体对比(Figure 5) :
- \(\ell\text{-MoE}_{eff}\) 完美匹配基线收敛曲线
- \(\ell\text{-MoE}_{acc}\) 显著优于基线
- 补充:三种配置的差异
$$
\begin{align}
\text{Baseline} :\quad & \alpha = 1, N = 64, K = 6 \\
\ell\text{-MoE}_{eff} :\quad &\alpha = 4, N = 256, K = 6 \\
\ell\text{-MoE}_{acc} :\quad &\alpha = 4, N = 256, K = 24
\end{align}
$$
大规模验证(95B-A8B 和混合模型,Tables 3 & 4)
- Transformer 95B 模型 :
- 在 MMLU、MMLU-Pro、Code、Math 等基准上,\(\ell\text{-MoE}_{acc}\) 全面超越标准 MoE
- \(\ell\text{-MoE}_{eff}\) 虽然激活参数量从 8.47B 降至 5.62B(更少计算量),但精度依然持平甚至略好于基线
- 理解:收益来源是总专家数量增加了
- 混合(Mamba-Attention)MoE :
- 即使在不含 Attention 的 Mamba 架构层中应用 LatentMoE,依然观察到一致的显著提升
- LatentMoE 方法可泛化到 Linear Attention 中
推理性能实测(Table 5)
- 在 H100 GPU 上使用 vLLM(FP8 量化)测试 Hybrid-73B 模型:
- 低并发(1)时,LatentMoE 因引入额外的投影层(\(W_\downarrow, W_\uparrow\)),吞吐量略低(181.6 vs 206.6 Tokens/s/GPU)
- 高并发(128)时,吞吐量差距缩小至仅 **\(\sim\)6%**(1625.8 vs 1725.9)
- 注:通过 CUDA 流分离和专用小矩阵 GEMM 内核优化,这 6% 的差距可以进一步抹平
- 问题:咱们
万亿参数尺度投影(Effective Parameter Multiplier - EPM)
- 为了在万亿参数级别比较推理效率,论文引入了有效参数乘数(EPM) ,定义 \(\lambda = N_{eff} / N_{treat}\),其中 \(N_{eff} = f^{-1}(S_{treat})\) 通过拟合密集模型(Qwen-Dense 系列)的 Scaling Law \(f(N) = a \log N + b\) 反推得到
- 估算得出 LatentMoE 的 \(\lambda \approx 1.35\)
- 即一个 1T 参数的 LatentMoE 模型,其有效能力相当于 1.35T 参数的标准 MoE
- 关键结论(Figure 7) :为了达到 LatentMoE 1T 的精度,标准 MoE 需要扩展到 1.35T(增加 350B 参数)
- 在解码(Decode-heavy)和预填充(Prefill-heavy)两种流量模式下,这个 1.35T 标准 MoE 的推理速度比 LatentMoE 1T 慢 1.24 倍 至 3.46 倍
- 而 LatentMoE 引入的投影层额外开销相比原生 1T 标准 MoE 仅增加不到 9% 的延迟
PROF-GRPO
背景 & 问题提出
- LLM 推理训练中的根本性矛盾(Process-Outcome Mismatch)
- Outcome Reward Hacking :GRPO 等 RLVR 方法只根据最终答案是否正确来给予奖励(Outcome Reward),模型可能通过有缺陷的推理(Flawed Reasoning) 偶然得出正确答案,却仍能获得最高奖励
- 令 \(z = 1\) 表示推理过程有效,\(z = 0\) 表示无效,期望奖励为:
$$
\mathbb{E}_{\pi}[r] = \sum_{z\in \{0,1\} } P(r=1|z)P(z|\pi) \approx \alpha_{\pi} + \epsilon (1 - \alpha_{\pi}) = (1 - \epsilon)\alpha_{\pi} + \epsilon.
$$- \(\alpha_{\pi} = \mathbb{P}(z = 1|\pi)\) 是模型生成有效推理的概率,则 \((1 - \alpha_{\pi})\) 的概率是无效推理
- 问题:此时也不一定就能保证 ORM 为 1 吧
- 即使无效推理也有小概率 \(\epsilon\) 碰巧答对,即 \(\mathbb{P}(r = 1|z = 0) \le \epsilon\)
- \(\alpha_{\pi} = \mathbb{P}(z = 1|\pi)\) 是模型生成有效推理的概率,则 \((1 - \alpha_{\pi})\) 的概率是无效推理
- 理想目标:最大化 \(\alpha_{\pi}\)
- 但第二项 \(\epsilon (1 - \alpha_{\pi})\) 引入了来自“侥幸成功”的梯度噪声,导致模型在提升最终准确率的同时,并不一定学习到更忠实、有效的推理
- 论文实证数据:在 Qwen2.5-Math-7B 模型生成的样本中,有高达 26.28% 的正确响应包含有缺陷的推理
- 令 \(z = 1\) 表示推理过程有效,\(z = 0\) 表示无效,期望奖励为:
- PRM 的优化困境 :PRM 可以引入过程奖励来对推理的每一 Step 进行打分,但直接将 PRM 的分数作为奖励信号与 ORM 结合(文中称为 Blend-PRM-GRPO),会引入 Reward Hacking
- 因为 PRM 通常是在离线数据上训练的,当在线强化学习过程中遇到 OOD 的 Response 时,PRM 会给出不可靠的分数
- 模型会学会“玩弄” PRM,例如通过生成非常长(Over-long)、冗余但表面合理的步骤来获取高分
- 从而导致性能崩溃(Entropy collapse, Length explosion)
PROF(PRocess cOnsistency Filter)方法
- PROF 核心思想是:不直接将 PRM 分数作为优化目标(Reward),而是将其作为一种一致性准则,用于在训练前对生成的样本进行筛选(Filtering)
- PROF 通过过滤掉那些过程(PRM)与结果(ORM)冲突的样本,来净化训练数据
PROF 详细方法流程与设计思路
- PROF 的输入是一组通过 Rollout 得到的 Response 及其对应的 ORM 奖励
- 完整流程如 Algorithm 1 所示
- 1)生成与初始打分 :
- 对每个 Prompt,生成 \(n\) 个 Response \(\{a_1, \ldots, a_n\}\)
- 使用 Verifier (ORM) 获取每个 Response 的最终结果奖励 \(r_i^o \in \{-1, 1\}\)(正确为1,错误为-1)
- 使用 PRM 获取每个 Response 中每一 Step 的过程奖励 \((r_i^1, \ldots, r_i^H)\),其中 \(H\) 是总步数
- 2)Trajectory-wise Consistency Score 计算 :
- 为了将 Step-level 的 PRM 分数聚合为一个 Trajectory-level 的分数,并用于后续排序,设计如下公式 (1):
$$
r_i^{\text{pro} } = \left[\frac{1}{H_i}\sum_{h=1}^{H_i} r_i^h - \lambda \cdot \mathbb{I}(H_i=1 \text{ or } H_i \ge H_{\lambda})\right] \cdot r_i^o. \quad (1)
$$- \(r_i^{\text{pro} }\):最终用于排序的轨迹级过程-结果一致性分数
- \(H_i\):第 \(i\) 个 Response 的总步数
- \(\frac{1}{H_i}\sum_{h=1}^{H_i} r_i^h\):该轨迹所有步骤PRM分数的平均值
- \(\lambda\) 和 \(H_{\lambda}\):步数正则化参数
- \(\mathbb{I}(\cdot)\) 是指示函数
- 如果轨迹只有1步或步数超过阈值 \(H_{\lambda}\)(如 30 步),则会施加一个惩罚 \(-\lambda\)
- \(r_i^o\):结果奖励(+1 或 -1)
- 设计思路 :
- Mean :相比取最小值或求和,平均值更稳定,避免了对单一步骤噪声的过度敏感,也避免了偏向长序列
- 步数正则化 :防止模型通过生成极短(1 步,信息量不足)或极长(超过 \(H_{\lambda}\),可能包含冗余或作弊行为)的轨迹来利用 PRM 的漏洞
- 乘以 \(r_i^o\) :使得 \(r_i^{\text{pro} }\) 的值能同时反映过程和结果的一致性
- 对于正确的 Response (\(r_i^o = +1\)),\(r_i^{\text{pro} }\) 越高,表示过程质量越高(PRM 认可)
- 对于错误的 Response (\(r_i^o = -1\)),\(r_i^{\text{pro} }\) 越低(即负得越多),表示过程越差;
- 反之,如果一个错误 Response 的 PRM 分数很高,则其 \(r_i^{\text{pro} }\) 会接近 0,表明它是一个“过程好但结果错”的冲突样本
- 理解:万一 \(r_i^{\text{pro} }\) 为负呢?岂不是负负得正,这里需要注意处理
- 为了将 Step-level 的 PRM 分数聚合为一个 Trajectory-level 的分数,并用于后续排序,设计如下公式 (1):
- 3)分组与平衡采样(Grouping and Balanced Sampling) :
- 将所有样本分为正确组 \(\mathcal{G}_+\) 和错误组 \(\mathcal{G}_-\)
- 目标是最终保留 \(m\) 个样本用于 Policy 更新
- 为了最大化梯度的方差和稳定性,本文决定让保留样本中的正确/错误比例尽量平衡(接近 1:1)
- 从 \(\mathcal{G}_+\) 中保留 \(k_{+}\) 个,从 \(\mathcal{G}_-\) 中保留 \(k_{-}\) 个,使得 \(k_{+} + k_{-} = m\) 且 \(k_{+} \cdot k_{-}\) 最大化
- 理解:\(k_{+} \approx k_{-}\) 时能取得 \(k_{+} \cdot k_{-}\) 最大化
- 4)Ranking and Filtering :
- 正确组 \(\mathcal{G}_+\) :按 \(r_i^{\text{pro} }\) 降序 排列,保留排名最高的 \(k_{+}\) 个样本
- 这意味着保留 “结果正确且过程质量最高” 的样本
- 错误组 \(\mathcal{G}_-\) :论文提出了两种子策略:
- PROF-POS :从错误组中随机选取 \(k_{-}\) 个样本
- 此策略更稳健,避免在 PRM 不可靠时对错误样本引入过多噪声
- PROF-BOTH :按 \(r_i^{\text{pro} }\) 升序 排列(即保留 \(r_i^{\text{pro} }\) 最低,也就是 PRM 分数最低的),保留排名最低的 \(k_{-}\) 个样本
- 这意味着保留“结果错误且过程质量最差”的样本作为明确的负例
- PROF-POS :从错误组中随机选取 \(k_{-}\) 个样本
- 设计思路 :将正确组和错误组分开处理是 PROF 的关键
- 如果不分开(w/o separation),由于错误样本中也可能包含一些局部正确的步骤,导致其平均 PRM 分数被拉高,从而在混合排序中被误保留,破坏了过滤效果
- 分开处理确保了在正确组中“择优”,在错误组中“择优(选最差的作为负例)”或“随机选”,从而维持了数据的质量平衡
- 理解:这里要非常小心设计
- 正确组 \(\mathcal{G}_+\) :按 \(r_i^{\text{pro} }\) 降序 排列,保留排名最高的 \(k_{+}\) 个样本
- 5)Policy 更新 :使用过滤后保留的 \(m\) 个 Trajectories 进行标准的 GRPO 或 RAFT++ 等 RL 算法更新
- 理解:其实有点浪费样本了
实验 & Insight
- 在数学推理任务上实验
- 使用 Qwen 和 LLaMA 系列模型,主要发现如下:
- 1)准确率提升 :
- 在多个基准测试(Math500, Minerva Math, Olympiad Bench, AIME24, AMC23)上,PROF-POS 和 PROF-BOTH 的平均准确率(Average@16)显著优于 GRPO 基线以及直接混合 PRM 和 ORM 奖励的 Blend-PRM-GRPO 方法(见表2)
- 在计算成本匹配的条件下,通过增大 GRPO 的 Rollout 组大小(n16)与 PROF 的更新组大小(m8)对比,PROF 依然能取得近 2% 的额外提升(见图3)
- 2)Reasoning Process Quality 提升 :
- Monte Carlo 估计 :在双方都回答正确的样本上,比较中间步骤的 MC 值(从该步骤继续生成得到正确答案的概率)
- PROF 模型的中间步骤 MC 值显著高于 GRPO,证明其推理过程更稳健(见图5左)
- 直接缺陷审计 :使用 Claude Sonnet 4.6 对模型生成的正确答案进行审计,发现 GRPO 有 8% 的正确响应包含推理缺陷,而 PROF 仅有 **6%**(见图 5 右)
- 定性分析 :论文附录中的示例(图 12,13)显示,PROF 生成的推理步骤更具体、可验证,而 GRPO 跳过关键步骤,Blend-PRM-GRPO 则冗长且关键计算错误
- Monte Carlo 估计 :在双方都回答正确的样本上,比较中间步骤的 MC 值(从该步骤继续生成得到正确答案的概率)
- 3)对 PRM 质量的鲁棒性(Robustness) :
- 当使用更弱、更小的 Skywork-PRM-1.5B 替换强 PRM (Qwen2.5-Math-PRM-7B) 时,Blend 方法的性能大幅下降,而 PROF 的性能保持稳定,与使用 7B PRM 时接近(见表 3)
- 这表明 PROF 对 PRM 的依赖度更低,鲁棒性更强
- 当使用更弱、更小的 Skywork-PRM-1.5B 替换强 PRM (Qwen2.5-Math-PRM-7B) 时,Blend 方法的性能大幅下降,而 PROF 的性能保持稳定,与使用 7B PRM 时接近(见表 3)
- 4)超越 GRPO 的通用性 :
- 将 PROF 的过滤思想应用于 RAFT++(一种仅使用正样本的 Rejection Sampling 算法),PROF-RAFT++ 依然能显著超越其基线版本(见表4)
- 证明 PROF 是一个通用的数据过滤框架,不绑定于特定 RL 算法
- 5)Ablation Studies :
- 分别过滤的重要性 :若不区分正确和错误组(w/o separation),由于奖励尺度偏差,会过度过滤掉负样本,导致性能急剧下降(见图 6 右)
- 过滤策略对比 :PROF-POS 和 PROF-BOTH 最优
- PROF-BOTH 收敛更快,而 PROF-POS 在 PRM 不可靠时更稳健
- 只过滤错误组(PROF-NEG)效果较弱,随机过滤(Filter-Random)效果甚微
- Rollout 数量 :随着 Rollout 数 \(n\) 的增加,性能先升后降,表明存在一个权衡点(见图9)
- 步数正则化验证 :直接按步数长短过滤(Filter-Nstep)会导致性能异常波动且最终不佳,证明 PROF 的收益来自对过程质量的评估,而非简单地增加步数(见表 7,图 11)
- 其他 Insight
- 仅基于 Outcome Reward 无法保证模型学习到高质量的推理过程
- 直接使用 PRM 分数作为奖励信号会因分布偏移导致严重的 Reward Hacking,表现为熵坍塌和响应长度激增
- PROF 通过一致性过滤而非直接优化的方式,分别对正确/错误样本按 PRM-ORM 一致性排序,并保持训练集的正负样本平衡
- 过程质量与结果准确率可以协同提升 :
- 过滤掉过程-结果冲突的样本,不仅能提高 Outcome Accuracy,更能本质性地提升 Reasoning Quality(忠实度、有效性和可解释性)
PAPO
- 原始论文:PAPO: Stabilizing Rubric Integration Training via Decoupled Advantage Normalization, 20260327-20260403, USTC & Shanghai AI Lab & HKU & Oxford & Wuhan
- ORM-based GRPO 存在两个关键缺陷:
- 缺陷一:结果信号缺乏质量区分度
- 不关注过程
- 缺陷二:信号枯竭(Signal Exhaustion)
- 随着训练推进,模型能力提升,越来越多的 Response 组全部正确或全部错误
- 此时组内所有 Response 的奖励相同,标准差为零,导致 Advantage 为零,梯度消失
- 缺陷一:结果信号缺乏质量区分度
- PRM 通过评估中间推理步骤的质量来提供更丰富的监督信号
- 本文聚焦于基于 Rubric 的 PRM(通过 LLM-as-Judge 范式实现),它无需步骤级标注,具有可扩展性
- 但直接将 PRM 分数作为 GRPO 的奖励会导致Reward Hacking
- 现象模型学会通过生成越来越冗长的 Response 来虚增 PRM 分数,最终导致准确率崩溃(图 1a 红色曲线)
- 朴素组合方案的失败
- 简单的乘法组合 \( r = r^{\text{out} } \times r^{\text{proc} } \) 虽然避免了 PRM 的崩溃,但始终无法超越 ORM(图 1b),因为 Process 信号在一次归一化中被 Outcome 信号压制
PAPO
- PAPO 的核心思想是解耦 Advantage 归一化(Decoupled Advantage Normalization) ,将 Advantage 分解为两个独立归一化的分量:
$$
A_{\text{total}, i} = A_{\text{out}, i} + A_{\text{proc}, i}
$$- \( A_{\text{out} } \) 来自 ORM,锚定训练在答案正确性上
- \( A_{\text{proc} } \) 来自 Rubric 式 PRM,仅在正确 Response 子集内归一化 ,用于区分推理质量
双重奖励信号(Dual Reward Signals)
- 对于每个 Prompt \( x \),策略模型采样 \( G \) 个 Response \( \{o_1, \ldots, o_G\} \),每个 Response 获得两种奖励:
- Outcome Reward :\( r_i^{\text{out} } \in \{0, 1\} \),表示最终答案是否正确
- Process Reward :\( r_i^{\text{proc} } \in \{0, 0.5, 1.0\} \),由 Rubric 式 PRM 评估推理质量
- 1.0:完全正确
- 0.5:大体正确但有 minor issues
- 0.0:存在致命错误或严重遗漏
- 关键设计 :
- PRM 仅对正确 Response 调用
- 错误 Response 的 \( r_i^{\text{proc} } = 0 \)
- 理解:这非常重要,否则可能导致结果错误而得到正分的情况
解耦 Advantage 归一化的三步流程
- Step 1:Outcome Advantage(\( A_{\text{out} } \))
- 使用标准 GRPO 组归一化:
$$
A_{\text{out}, i} = \frac{r_i^{\text{out} } - \mu^{\text{out} } }{\max(\sigma^{\text{out} }, \epsilon)}
$$- \( \mu^{\text{out} } = \frac{1}{G} \sum_{i=1}^{G} r_i^{\text{out} } \)
- \( \sigma^{\text{out} } = \sqrt{\frac{1}{G} \sum_{i=1}^{G} (r_i^{\text{out} } - \mu^{\text{out} })^2} \)
- \( \epsilon \) 是防止除零的小常数
- 这个分量与标准 GRPO 完全相同,决定了“正确 vs 错误”的梯度方向
- 使用标准 GRPO 组归一化:
- Step 2:Process Advantage(\( A_{\text{proc} } \)),正确子集归一化
- 这是 PAPO 的核心创新:Process Reward 仅在正确 Response 子集内归一化
$$
A_{\text{proc}, i} =
\begin{cases}
\dfrac{r_i^{\text{proc} } - \mu_C^{\text{proc} } }{\max(\sigma_C^{\text{proc} }, \epsilon)}, & \text{if } r_i^{\text{out} } = 1 \text{ and } |C| \geq 2 \\
0, & \text{otherwise}
\end{cases}
$$- \( C = \{ j : r_j^{\text{out} } = 1 \} \) 是正确 Response 的集合
- \( \mu_C^{\text{proc} } = \frac{1}{|C|} \sum_{j \in C} r_j^{\text{proc} } \)
- \( \sigma_C^{\text{proc} } = \sqrt{\frac{1}{|C|} \sum_{j \in C} (r_j^{\text{proc} } - \mu_C^{\text{proc} })^2} \)
- 关键设计 :
- 1)仅在正确子集内归一化 :确保 Process 信号不会混淆正确/错误的区分
- 2)当 \( |C| < 2 \) 时置零 :无法进行有意义的归一化时,优雅地退化为标准 GRPO
- 3)错误 Response 的 \( A_{\text{proc} } = 0 \) :防止错误 Response 仅因好的推理痕迹而获得正 Advantage
- 这是 PAPO 的核心创新:Process Reward 仅在正确 Response 子集内归一化
- Step 3:组合 Advantage
$$
A_{\text{total}, i} = A_{\text{out}, i} + A_{\text{proc}, i}
$$- 由于两个分量都独立归一化为零均值和单位方差,它们以同等地位贡献,无需额外加权
- 最终:PAPO 的 GRPO 目标函数
- PAPO 的目标函数遵循 GRPO 的形式,但使用组合 Advantage:
$$
\mathcal{L}_{\text{PAPO} } = \frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|}
\left\{
\min \left[ \rho(\theta) A_{\text{total}, i, t},\ \text{clip}(\rho(\theta), 1-\epsilon, 1+\epsilon) A_{\text{total}, i, t} \right]
- \beta D_{\text{KL} }
\right\}
$$- \( \rho(\theta) = \dfrac{\pi_\theta(o_{i,t} | x, o_{i,<t})}{\pi_{\theta_{\text{old} } }(o_{i,t} | x, o_{i,<t})} \) 是重要性采样比率
- \( \epsilon \) 是 PPO clip 范围(实验中为 0.2)
- \( \beta \) 是 KL 惩罚系数(实验中为 0.0)
- PAPO 的目标函数遵循 GRPO 的形式,但使用组合 Advantage:
补充:PAPO Design Rationale
- 质量区分而不 Reward Hacking :
- 在正确 Response 中,推理严谨的获得正 \( A_{\text{proc} } \) 被强化,推理草率的获得负 \( A_{\text{proc} } \) 被惩罚
- 将归一化限制在正确子集内,防止错误 Response 利用高 PRM 分数获得正 Advantage
- 解决信号枯竭 :
- 当所有 Response 都正确时,\( A_{\text{out} } = 0 \),但 \( A_{\text{proc} } \) 仍然活跃,通过区分推理质量提供非零梯度
- 如图 4a 所示,PAPO 将零 Advantage 比例从 ORM 的 \( 69% \) 降至 \( 44% \)
实验
- 基础模型
- Qwen2.5-3B/7B/14B-Base
- Qwen3-4B-Base
- 所有模型均从预训练检查点开始训练,以隔离方法效果
- 训练框架与算法
- 使用 verl 和 ROLL 框架
- 主要基于 GRPO
- Qwen3-4B 实验额外在 DAPO(带动态采样和解耦 Clipping 的 GRPO 扩展)上评估 PAPO
- 数据
- 训练数据:从 NuminaMath-1.5-RL-Verifiable 中采样 20K 数学问题
- 分层采样:覆盖 5 个难度等级(基于 Pass Rate),每级 4K 样本
- PRM 实现
- 使用 GPT-OSS-20B 作为 Rubric 式 PRM
- 三档评分 Rubric:0、0.5、1.0
- 通过 LLM-as-Judge 范式评估推理质量,与答案正确性无关
- 评估基准(6 个 Benchmark):
- OlympiadBench(主要指标)
- MATH-500
- AIME 2024/2025
- GPQA-Diamond
- HumanEval
- 所有结果报告 avg@4(每个问题采样 4 个 Response 的平均准确率)
- 核心结果(Table 1)
模型 方法 OlympiadBench AIME‘24 AIME’25 MATH-500 GPQA HumanEval 平均 Qwen2.5-3B ORM 35.3 8.3 4.2 69.0 38.8 39.3 32.5 PAPO 38.6 10.0 3.3 73.2 36.3 52.5 35.7 Qwen2.5-7B ORM 46.3 10.8 10.8 80.2 40.7 61.6 41.7 PAPO 51.3 15.8 13.1 82.3 42.4 63.9 44.8 Qwen2.5-14B ORM 54.3 19.0 13.8 82.3 47.0 66.0 47.1 PAPO 59.8 24.3 17.8 87.4 55.0 70.0 52.4 Qwen3-4B (DAPO) ORM 55.0 30.8 26.0 82.0 39.0 53.8 47.8 PAPO 61.1 34.5 30.7 84.6 43.0 63.9 53.0 - 关键发现 :
- 1)PAPO 在所有模型规模和所有 Benchmark 上一致优于 ORM
- 2)优势随模型规模扩大而增加(3B: +3.2,7B: +3.1,14B: +5.3)
- 3)PAPO 与 DAPO 自然兼容(+5.2)
- 4)PAPO 在代码生成(HumanEval)上也有提升,说明 Process 质量区分可迁移
- 关键发现 :
- 训练动态分析(图 1a、图 4)
- ORM 的信号枯竭 :
- 零 Advantage 比例从 \( 40% \) 升至 \( 69% \)
- Advantage 标准差持续下降
- 正 Advantage 比例持续下降
- PAPO 的信号保持 :
- 零 Advantage 比例稳定在 \( 44% \)
- Advantage 标准差更高
- Process 信号活跃比例从 \( 30% \) 升至 \( 70% \)(恰好在 ORM 信号枯竭时变得更强)
- ORM 的信号枯竭 :
- Process Advantage 的效果(图 8)
- ORM:正确 Response 的最小 Advantage = 0.0,Advantage 标准差 = 0
- 所有正确 Response 完全相同
- PAPO:正确 Response 的最小 Advantage ≈ -1.49,Advantage 标准差 > 0(质量排名)
- 推理质量差的正确 Response 被惩罚
- ORM:正确 Response 的最小 Advantage = 0.0,Advantage 标准差 = 0
- Ablation Studies
方法 AIME 2024 AIME 2025 OlympiadBench MATH-500 ORM 10.8 10.8 46.3 80.2 Mult(\( r^{\text{out} } \times r^{\text{proc} } \)) 12.1 10.2 46.7 80.2 Fullnorm(全组归一化 \( A_{\text{proc} } \)) 12.5 10.4 49.6 81.2 PAPO 15.8 13.1 51.3 82.3 - Insight:
- 1)Mult(乘法组合) :与 ORM 相当,无法突破 ORM 的性能天花板
- 证明解耦归一化的必要性
- 2)Fullnorm(全组归一化) :低于 PAPO
- 证明正确子集归一化的必要性
- 包含错误 Response(\( r^{\text{proc} } = 0 \))会稀释细粒度质量信号
- 1)Mult(乘法组合) :与 ORM 相当,无法突破 ORM 的性能天花板
- Insight:
补充:Qualitative Analysis
- Process 监督修正推理错误
- OlympiadBench 507(求正整数对 \((x,y)\) 满足 \( x^2 - 8x + y^2 + 4y = 5 \)):
- ORM 模型 :完成平方得到 \((x-4)^2 + (y+2)^2 = 25\) 后,错误地排除了有效解 \((1,2)\),理由是“\( x = 1 \) 在圆半径的上下文中不是正整数”
- 这是一个明显的错误,导致最终答案错误(输出 3 而非 4)
- PAPO 模型 :仔细验证每个候选解的正性约束,正确识别全部 4 个解
- ORM 模型 :完成平方得到 \((x-4)^2 + (y+2)^2 = 25\) 后,错误地排除了有效解 \((1,2)\),理由是“\( x = 1 \) 在圆半径的上下文中不是正整数”
- OlympiadBench 507(求正整数对 \((x,y)\) 满足 \( x^2 - 8x + y^2 + 4y = 5 \)):
- Process 奖励培养自我验证习惯
- OlympiadBench 129(求 \( \log_2(\log_2(2x-2)) = 2 \) 的解):
- ORM 模型 :正确推导出 \( x = 9 \) 后停止
- PAPO 模型 :额外添加显式验证步骤(将 \( x = 9 \) 代回原方程验证)
- OlympiadBench 129(求 \( \log_2(\log_2(2x-2)) = 2 \) 的解):
- *统计** :在两者都答对的 OlympiadBench 问题上,PAPO 包含显式验证步骤的比例为 \( 39.7% \),ORM 仅为 \( 22.7% \),PAPO 是 ORM 的 \( 1.7 \) 倍
补充:PRM Reward Hacking 案例分析(Appendix B.6)
- 在 PRM-only 训练的第 1000 步(准确率仅 \( 2.4% \)),模型出现系统性的主题漂移(Topic Drift) :
- 在困难的数论问题上,所有 3 个采样 Response 在约 1500-2000 tokens 的“真实工作”后,都漂移到同一个无关的向量点积问题(答案是 \( t = 2 \))
- 理解:这里相当于是一种模型幻觉,说明只使用 PRM 是不行的
- 这些漂移内容是记忆中的高分模板 ,结构良好的简单问题解答,LLM Judge 会给予满分
- 这揭示了结构化利用策略:当模型无法解决难题时,无缝过渡到记忆中高分的无关内容
- 在困难的数论问题上,所有 3 个采样 Response 在约 1500-2000 tokens 的“真实工作”后,都漂移到同一个无关的向量点积问题(答案是 \( t = 2 \))
- 相比之下,ORM 模型产生聚焦的解决方案(1494-1646 tokens),全部得出正确答案
RLCER
- 原始论文:(RLCER)Reinforcing Chain-of-Thought Reasoning with Self-Evolving Rubrics, 20260211, Seed & NUS & USTC
- RLCER (Reinforcement Learning with CoT Supervision via Self-Evolving Rubrics) 是一个 RL 训练框架
- RLCER 的目标:解决 RLVR 中存在的根本性问题:即只奖励最终答案的正确性(Outcome-centric),忽视了推理过程(即 CoT)本身的质量
- RLCER 的核心思想 :
- 让 LLM 在强化学习过程中,自主地(Self-Proposed) 生成用于评估 CoT 质量的评价标准(Rubrics)
- 并且这些 Rubrics 能够在训练过程中自我演进(Self-Evolving) ,以提供持续、有效的监督信号
- 这种方法无需昂贵的人工标注,实现了对模型 How to think 的优化,而不仅仅是 What to answer
整体总结
RLVR 的核心问题:Outcome-centric RLVR 的局限
- RLVR(如 DeepSeek-R1 中采用的方法)在处理数学、代码等可验证任务时,通过规则或系统来验证最终答案的正确性并给予奖励
- 有效,但这种训练信号是“欠约束的”(Underconstrained):
- 对于同一个正确答案,模型可能通过无数种推理路径(CoT)得到,但这些路径都获得相同的奖励
- 这会导致模型优化时“钻空子”,学习到捷径(Shortcut)或脆弱的策略,而非稳健、通用的推理能力,从而限制了模型的鲁棒性和最终性能天花板
直接监督 CoT 的难点
- 直接对 CoT 进行奖励或监督面临着两大现实障碍:
- 1)高昂的数据标注成本 :训练一个专门的奖励模型来评估 CoT 质量,需要大量细粒度的人工标注数据,这在规模和成本上都是巨大的挑战
- 2)非平稳的分布偏移 :在 RL 训练过程中,策略模型生成的 CoT 分布是不断变化的
- 一个静态的、预先训练好的 RM 可能无法适应这种变化,其提供的监督信号会变得有偏差甚至失效
解决思路:Self-Evolving 范式
- 从“自演进训练”(Self-Evolving Training)的研究中汲取灵感
- 这类方法的核心思想是,让单一的策略模型 \( \pi_\theta \) 通过不同的 Prompt 提示,扮演多种角色(如推理者、数据生成器、奖励提供者),从而实现自我提升
- 基于此,本文提出了一个关键问题:模型能否自我提出用于监督 CoT 的 Rubrics,并使其在训练中自我演进?
本文贡献总结
- 提出 RLCER 框架,首次将 Rubrics 引入 CoT 的强化学习监督,实现了对推理过程的奖励
- 通过奖励 Rubrics 的有效性(即其与最终答案正确性的相关性),驱动 Rubricator 角色生成越来越高质量的评估标准
- 在多个数学推理基准上 验证了 RLCER 超越了 Outcome-centric 的 RLVR 基线
- 特别说明 :作者还额外发现训练中生成的 Rubrics 可以直接作为 In-prompt Hints,在推理时进一步提升模型性能
- 理解:训练得到的 Rubrics 可以用来提升部署后模型的能力
局限性与思考
- 局限性 :
- 引入 Rubricator 角色意味着每次训练迭代都需要额外的 Rollout,增加了训练时间和计算资源消耗
- 当前方法仍局限于 RLVR 适用的可验证领域(如数学、代码)
- 对于创意写作、对话等非可验证(Non-verifiable)领域,其有效性尚不明确
- 未来工作:作者计划探索将 RLCER 推广到非可验证的领域,这可能需要更复杂的 Verifier 模型
RLCER 框架
- RLCER 的核心设计:
- 将单一的 Policy Model 同时作为 Reasoner 和 Rubricator(Rubrics 生成器)
- 通过一个额外的 Verifier 模型来桥接 Reasoner 和 Rubricator
Two Roles in One Policy
- 示意图:
- RLCER 的多角色 RL 框架如下:
- 统一策略模型 \( \pi_\theta \) :模型 \( \pi_\theta \) 是核心,通过不同的系统 Prompt(\( \mathcal{P}^{Rea} \) 和 \( \mathcal{P}^{Rub} \))来扮演不同角色
- Reasoner \( \pi_{\theta}^{Rea} \) :负责根据问题 \( \mathcal{Q} \) 生成 CoT \( \hat{\mathcal{C} } \) 和最终答案 \( \hat{\mathcal{A} } \),其采样过程可表示为:
$$
\hat{C}, \hat{A} \sim \pi_{\theta}^{Rea}(\cdot | \mathcal{Q})
$$- \( \hat{C} \) 代表生成的推理链
- \( \hat{A} \) 代表最终答案
- Rubricator \( \pi_{\theta}^{Rub} \) :负责根据问题 \( \mathcal{Q} \) 和 Reasoner 生成的 CoT \( \hat{C} \) 生成一组用于评估的 Rubrics \( \hat{\mathcal{R} } \),其采样过程为:
$$
\hat{\mathcal{R} } \sim \pi_{\theta}^{Rub}(\cdot | \mathcal{Q}, \hat{C}), \qquad \hat{\mathcal{R} } \triangleq \{\hat{\tau}_k\}_{k=1}^K
$$- \( K \) 是生成的 Rubrics 总数,每个 Rubric \( \hat{\tau}_k \) 包含两个部分:
- \( \hat{c}_k \):文本形式的评价标准(Criterion)
- \( \hat{s}_k \in \mathbb{R} \):该标准的分数(Score),反映其重要性,可正可负
- \( K \) 是生成的 Rubrics 总数,每个 Rubric \( \hat{\tau}_k \) 包含两个部分:
- Reasoner \( \pi_{\theta}^{Rea} \) :负责根据问题 \( \mathcal{Q} \) 生成 CoT \( \hat{\mathcal{C} } \) 和最终答案 \( \hat{\mathcal{A} } \),其采样过程可表示为:
- Verifier \( \pi_\phi \) :一个独立的、通过 SFT 微调并冻结参数的模型
- Verifier 的作用是判定 一个 CoT \( \hat{\mathcal{C} } \) 是否满足 Rubricator 提出的某个特定标准 \( \hat{c}_k \)
- 判定结果是二元的:
$$ \pi_\phi(\hat{c}_k, \hat{\mathcal{C} }) \in \{0, 1\} $$
- 统一策略模型 \( \pi_\theta \) :模型 \( \pi_\theta \) 是核心,通过不同的系统 Prompt(\( \mathcal{P}^{Rea} \) 和 \( \mathcal{P}^{Rub} \))来扮演不同角色
奖励“如何思考”:基于 Self-Proposed Rubrics 的 CoT 奖励
- 这是 RLCER 实现 CoT 监督的核心机制,即计算 Reasoner 的 CoT 奖励 \( r_{cot}^{Rea} \)
- 筛选有效 Rubrics (Valid Rubrics) :
- 并非所有生成的 Rubrics 都有用;一个 Rubric 被认为是“有效”的,必须满足两个条件:
- 相关性 (Correlation) :该 Rubric 的满足情况 \( \mathbf{v}_k \) 与最终答案的正确性 \( \mathbf{z} \) 在 \( N \) 次采样中呈正相关,即
$$ \text{corr}(\mathbf{v}_k, \mathbf{z}) > \alpha $$- \( \alpha \) 默认设为 0.2
- 这意味着满足该 Rubric 更有可能得出正确答案
- 区分性 (Discriminative) :该 Rubric 在不同 CoT 上不能总是一致,必须有所区分,即其满足情况的方差大于 0,否则无法提供有效的学习信号
$$ \text{std}(\mathbf{v}_k) > 0 $$
- 相关性 (Correlation) :该 Rubric 的满足情况 \( \mathbf{v}_k \) 与最终答案的正确性 \( \mathbf{z} \) 在 \( N \) 次采样中呈正相关,即
- \( \mathbf{v}_k \) 和 \( \mathbf{z} \) 定义如下:
$$
\mathbf{v}_k \triangleq [\pi_\phi(\hat{c}_k, \hat{\mathcal{C} }_0), \ldots, \pi_\phi(\hat{c}_k, \hat{\mathcal{C} }_N)], \quad \mathbf{z} \triangleq [\mathbb{I}(\mathcal{A}, \hat{\mathcal{A} }_0), \ldots, \mathbb{I}(\mathcal{A}, \hat{\mathcal{A} }_N)]
$$- \( \mathbb{I} \) 是指示函数
- \( \mathcal{A} \) 是标准答案
- 有效 Rubrics 的集合记为 \( \hat{\mathcal{R} }_{valid} \)
- 并非所有生成的 Rubrics 都有用;一个 Rubric 被认为是“有效”的,必须满足两个条件:
- 计算 CoT 奖励 :Reasoner 的 CoT 奖励由其 CoT 满足所有有效 Rubrics 的加权得分决定:
$$
r_{cot}^{Rea} = \text{norm}\left( \sum_{\hat{\tau}_k \in \hat{\mathcal{R} }_{valid} } \pi_\phi(\hat{c}_k, \hat{\mathcal{C} }) \cdot \hat{s}_k \right)
$$- \( \text{norm}(\cdot) \) 是一个 Min-Max 归一化函数,将总分映射到 [0, 1] 区间
- 总奖励 :Reasoner 的最终奖励是 Outcome Reward 和 CoT Reward 的结合:
$$
r^{Rea} = r_{outcome}^{Rea} + r_{cot}^{Rea}
$$- 其中 Outcome Reward 遵循 DAPO 的设置:
$$
r_{outcome}^{Rea} = \begin{cases} 1, & \text{is_equiv}(\mathcal{A}, \hat{\mathcal{A} }) \\ -1, & \text{Otherwise} \end{cases}
$$
- 其中 Outcome Reward 遵循 DAPO 的设置:
如何演进:Rubrics Self-Evolving 机制
- 为防止 Rubrics 饱和(即被所有 CoT 满足而失去区分度),RLCER 引入了自演进机制,通过奖励 Rubricator 生成更高质量的 Rubrics
- 1)Evolving Reward :Rubricator 的奖励直接与其生成的有效 Rubrics 比例挂钩:
$$
r_{evolving}^{Rub} = \frac{K_{\text{valid} } }{K}
$$- 其中 \( K_{\text{valid} } = |\{\hat{\tau}_k^{valid}\}| \)
- 这个奖励函数鼓励 Rubricator 不断提出与正确答案相关性强、且具有区分度的新标准
- 理解:当前的设计可能有个问题:没有要求模型生成的 Rubric 不要重复,所以模型可能会提出相似的 Rubrics,在 Prompt 中可以加上类似表述
- 2)Format Reward :为了确保生成的 Rubrics 能被 Verifier 正确解析,加入了一个格式奖励:
$$
r_{format}^{Rub} = \begin{cases} 1, & \text{The format is correct.} \\ 0, & \text{Otherwise.} \end{cases}
$$ - 3)总奖励 :Rubricator 的最终奖励:
$$
r^{Rub} = r_{evolving}^{Rub} + r_{format}^{Rub}
$$
联合优化:Two-Role Optimization
- 最后,RLCER 将 Reasoner 和 Rubricator 两个角色的奖励统一起来,在同一个 Policy Model \( \pi_\theta \) 上进行联合优化
- 对于两个角色,分别基于它们的奖励 \( r^{Rea} \) 和 \( r^{Rub} \) 计算各自的 Advantage \( \hat{A}_t^{Rea} \) 和 \( \hat{A}_t^{Rub} \)
- 最终的优化目标是最大化两个角色的 PPO Clip 目标函数之和:
$$
\begin{aligned}
\mathcal{J}(\theta) = & \mathbb{E}_{(\mathcal{Q},\mathcal{A})\sim \mathcal{D}^{Rea} } \left[ \min \left( \rho_t(\theta) \hat{A}_t^{Rea}, \text{clip}(\rho_t(\theta), 1-\epsilon, 1+\epsilon) \hat{A}_t^{Rea} \right) \right] \\
& + \mathbb{E}_{(\mathcal{Q},\mathcal{A})\sim \mathcal{D}^{Rub} } \left[ \min \left( \rho_t(\theta) \hat{A}_t^{Rub}, \text{clip}(\rho_t(\theta), 1-\epsilon, 1+\epsilon) \hat{A}_t^{Rub} \right) \right]
\end{aligned}
$$- \( \rho_t(\theta) \) 是新旧策略的概率比
- \( \epsilon \) 是裁剪超参数
- 注:论文特别指出,由于 Rubricator 和 Reasoner 的 Context 不同,因此无法使用 GRPO 进行分组估计,故采用传统的 PPO 算法
- 理解:这里不对吧,Advantage 是分开算的,本质上是可以分别使用 GRPO 的啊
实验
- 实验设置
- 基座模型 :Qwen3-4B-Base 和 Qwen3-8B-Base
- Cold-start :由于小模型难以直接执行复杂的角色扮演,先使用更强的模型(Doubao-Seed-1.6-thinking)通过 Reject Sampling 生成高质量数据,对基座模型进行 SFT,使其具备基础的 Reasoner 和 Rubricator 能力
- 训练数据 :DAPO-Math-17k(17k 道数学题)
- 评估基准 :
- 数学推理:AIME24, AIME25, AMC23
- 通用知识推理:GPQA-Diamond, SuperGPQA
(RQ1) Self-Proposed Rubrics 的可靠性
- 为验证 Rubrics 信号本身是否有意义,设计了一个“无 Outcome Reward”的实验:仅使用 Rubrics 奖励来训练模型
$$ r^{Rea} = r_{cot}^{Rea} $$ - 观察:
- 即使没有最终答案的奖励,模型的推理能力(在 AMC23 和 AIME25 上的准确率)仍然表现出持续的提升
- 使用随机 Rubrics 奖励的对照组则没有任何提升
- 理解:Self-Proposed Rubrics 能够提供有意义的、有助于学习的奖励信号
(RQ2) RLCER 的有效性
- 将 RLCER(Outcome Reward + CoT Reward)与传统的 Vanilla RLVR(仅 Outcome Reward)进行比较
- 观察:
- RLCER 在所有评估数据集和两种模型规模上均稳定超越 RLVR(尤其是在更大的 8B 模型上,性能提升更为显著)
- 这表明对 CoT 的监督带来了“免费午餐”式的收益
- 理解:RLCER 有效地提升了 LLM 的推理能力上限
(RQ3) Rubrics Self-Evolving 的机制
- 为研究自演进机制的作用,进行了消融实验,移除了 Rubricator 的演进奖励(\( r_{evolving}^{Rub} \))
- 观察:
- 1)性能 :移除演进奖励后,模型性能(平均准确率)提升放缓并趋于饱和,而完整的 RLCER 则持续上升,性能上限更高
- 2)Rubrics 质量 :如图 6a 所示,完整的 RLCER 中,Rubrics 满意度与答案正确性的平均相关系数随着训练不断上升,而消融版本则停滞不前
- 这说明模型学会了提出与正确答案更相关的标准
- 3)监督信号强度 :如图 6b 所示,完整的 RLCER 中,模型获得的平均 CoT 奖励呈下降趋势
- 这意味着随着 Rubrics 的演进,它们变得越来越有挑战性,Reasoner 难以轻易满足,从而避免了监督信号饱和的问题
- 消融版本的 CoT 奖励不断上升,表明 Rubrics 失去了区分度
- 理解:Self-Evolving 机制是 RLCER 持续提升性能的关键,它保证了 Rubrics 始终是“信息丰富”且“具有挑战性”的
(RQ4) Rubrics 作为 In-prompt Hints 的有效性
- 探索 Rubrics 的另一个用途:直接在推理时作为 Hint 放入 Prompt 中
- 观察:
- 将训练好的模型生成的 Rubrics 作为 In-prompt Hints,能进一步提升模型的推理准确率
- 在 AIME 数据集上,配合 Best-of-N (BoN=16) 采样,性能提升更加明显
- 理解:训练中学到的 Rubrics 具有可解释性和通用性,能够显式地引导模型在推理时走更优的路径
RLUF
- 原始论文:(RLUF)Reinforcement Learning from User Feedback, 20250520, Meta GenAI
- RLHF 依赖于专家标注员依据预定义准则给出的反馈,这种方法存在一个根本性假设缺陷:专家标注员的偏好并不等同于真实世界海量用户的多样化偏好
- RLUF 论文提出,真正的目标不应该是满足标注员,而是为实际交互的用户提供效用和愉悦
- 因此,必须从“人类反馈”转向“用户反馈”
- 论文提出了 Reinforcement Learning from User Feedback (RLUF) 框架,该框架直接利用生产环境中收集的隐式二元信号(如 “爱心” emoji 反应,即 heart emoji reaction)来对齐 LLM
- 针对用户反馈场景,RLUF 解决了用户反馈独有的三大挑战:
- 1)稀疏性 :用户反馈远少于专家标注,例如 Love Reaction 比例仅约 0.1%
- 2)二元性 :缺乏细粒度的偏好排序,仅有正/负标签
- 3)对抗性与冲突性 :用户偏好可能与安全性、Helpfulness 目标相冲突
- 一些核心 Insight:
- 1)基于二元用户反馈(爱心)训练的 Reward Model 具有极强的离线-在线预测能力(\( r=0.95 \))
- 2)优化该信号可显著提升在线真实反馈(最高 +28%)
- 3)过度优化会引入 Reward Hacking(如滥用“Bye”),需要权衡权重
RLUF 三阶段流程
- 将 RLUF 流程清晰地分为三个主要步骤,这是整个框架的骨架
Step 1: Signal Selection
- 目标是确定一个可作为用户满意度 Proxy 的交互信号
- 选择标准 :
- 1)具备大规模可用性
- 2)与长期满意度(如用户留存)相关
- 3)情感指向明确(非模糊)
- 论文聚焦于 Love Reactions(爱心反应)
- 用户长按消息可发送“爱心”,这是一个典型的、符合上述标准的信号
- 作者强调该框架也适用于 Thumbs up/down、对话是否继续、次日是否回归等其他信号
Step 2: 反馈收集与 Reward Model 训练
- 从生产流量中构建二元分类数据集,将每条 Response 标记为“获得爱心 (1)”或“未获得爱心 (0)”
- 训练一个名为 \( P[\text{Love}] \) 的 Reward Model,用于估计给定上下文和 Response 后获得爱心的概率
- 双重角色 :\( P[\text{Love}] \) 既用作离线评估器 (预测新模型对用户满意度的影响),也用作策略优化时的 Reward 信号
- 问题:这样会导致发生过拟合
Step 3: Multi-Objective Policy Optimization
- 将 \( P[\text{Love}] \) 与现有的 Helpfulness Reward Model 和 Safety Reward Model 结合,使用 Mixture of Judges 框架(2024)进行联合优化
- 数学形式上,优化目标不再是单一 Reward,而是三个独立 Reward 函数的加权组合
核心方法细节与设计思路
Reward Models 的构建(三大支柱)
- 论文使用了三个独立的 Reward Models,分别对应不同的 Prompt 集合,以避免奖励混淆
A. 用户信号模型:Love Reward Model (\( P[\text{Love}] \))
- 收集 100 万条对话样本,其中正例(有爱心)通过上采样达到 10%。每条样本包含最多 10 轮对话历史、当前 User Prompt、Model Response 及二元标签
- 模型架构上,基于 Llama3-8B Instruct 检查点,替换输出层为分类头
- 训练 Loss :二元交叉熵损失,预测概率:
$$
P[\text{Love}] = \Pr(\text{Love Reaction} \mid \text{context}, \text{response})
$$- 其中 \( \text{context} \) 代表对话历史,\( \text{response} \) 代表当前模型生成
- 设计思路与偏差处理 :
- 问题 :模型发现 \( P[\text{Love}] \) 会惩罚“有效的拒答”(如拒绝不安全请求),因为用户通常不会给拒绝点爱心
- 应对 :论文尝试用安全分类器过滤反安全数据,但效果甚微
- 最终策略:不过滤数据 ,保留对抗性样本,而是依赖多目标优化中的 Safety Reward 来约束这种偏差
- 理解:这是一个非常务实的设计选择
B. Helpfulness Reward Model
- 基于 Llama3-70B Instruct,使用成对偏好数据和 Bradley-Terry 对比 Loss 训练
- 分布与 Llama3 主 Reward Model 类似,覆盖推理、指令遵循等
C. Safety Reward Model
- 基于 Llama3-8B Instruct,使用专家标注的对抗性 Prompt 和有害内容数据集训练,用于检测并惩罚不安全 Completion
多目标 Policy Optimization
- 基座 Policy:Instruction-tuned Llama3-70B
- 优化器 :使用 CRAFT (Calibrated-Regularized Reward Ranking Finetuning) 优化器
- 关键机制 :采用迭代的 Best-of-N 采样 和 KL 惩罚 来约束模型与基座模型的偏离程度
- 采样数量 \( N = 4 \)
- 全局 Batch Size 为 128,总步数约 10000 步
- 多目标融合权重 :
- 论文设计了三个实验变体,固定 Helpfulness 权重 (0.7) 和 Safety 权重 (0.3),仅改变 Love 权重:
Candidate Helpfulness Weight Safety Weight Love Weight (\( P[\text{Love}] \)) Baseline 0.7 0.3 0.0 Moderate 0.7 0.3 0.1 Aggressive 0.7 0.3 0.3
- 论文设计了三个实验变体,固定 Helpfulness 权重 (0.7) 和 Safety 权重 (0.3),仅改变 Love 权重:
- 论文发现:
- Love 与 Helpfulness 正相关,但与 Safety 负相关
- 通过分离的 Prompt 集合和任务进行联合优化,虽然简单,但效果良好
- 理解:三个 Reward Models 并不在同一组 Prompt 上混着打分,而是各自配有一套专属的 Prompt 数据集
- Helpfulness RM 配的是“标注员和产品来源的指令与推理 Prompt”
- Safety RM 配的是“安全对抗性 Prompt”(专门用来测试违规率)
- Love RM 配的是“产品来源的通用 Prompt”
- 在训练时,虽然这三个模型是分开的,但它们在同一个 RL 循环中共同作用于同一个基座模型(Llama3-70B)
- 每次迭代,模型会分别在不同类型的 Prompt 集合上采样生成 Response,然后各自用对应的 RM 打分,最后把梯度加起来更新模型
- 理解:三个 Reward Models 并不在同一组 Prompt 上混着打分,而是各自配有一套专属的 Prompt 数据集
- 注:权重扫描(Sweep)是控制过度优化的有效工程手段
- 理解:这里是指在 RL 训练前,研究人员系统地尝试多组不同的 Reward 权重系数,前面提到的 0.0,0.1,0.3 等
Reward Model 实验(验证信号有效性)
- 这部分重点验证 \( P[\text{Love}] \) 是否真的能代表用户满意度和预测未来行为
信号选择与留存率相关性
- 实验 :对用户早期(Day 0)的反馈信号与 14 天留存率(Day 8-14 活跃)做逻辑回归
- Odds Ratio 分析 :
- Love Ratio :Odds Ratio = 1.08(统计显著),意为“爱心率每提高 10 个百分点,留存几率提高 8%”
- Thumbs Up :Odds Ratio = 1.05
- Thumbs Down :Odds Ratio = 0.93(负相关)
- 理解:Love Reactions 是三者中与长期留存正相关性最强的信号
离线预测与在线 A/B 测试的关联(关键验证)
- 核心问题 :Reward Model 的离线分数是否能反映真实用户行为的变化?
- 实验设计 :拿 10 个历史模型迭代(未针对爱心优化过),计算它们在固定 1 万个 Prompt 上的平均 \( P[\text{Love}] \) 分数,并与这些模型上线时的真实爱心率变化做对比
- 观察 :皮尔逊相关系数达到 \( r = 0.95 \)
- 理解:这意味着 \( P[\text{Love}] \) 是一个非常可靠的门控指标 ,可以在上线前预知该模型是否会提升用户满意度
策略优化实验(上线效果与挑战)
- 离线权衡 (Trade-offs)
- 随着 Love 权重增加(从 0 到 0.3),Love RM 分数提升,但 Helpfulness 和 Safety 出现回归
- Helpfulness 下降约 4% 至 16%,Safety Violation Rate 略有上升
- 理解:在有限优化预算下,多目标之间存在不可避免的权衡
- 在线 A/B 测试结果
- 实验规模:每个实验组超过 100 万个 Prompt
- 实验结果 :
- Moderate 模型 :爱心率相对基线提升 **+9.7%**(p < 0.05)
- Aggressive 模型 :爱心率相对基线提升 **+28%**(p < 0.01)
- 统计显著性计算 :论文给出了 Two-proportion z-test 公式:
$$
z = \frac{\hat{p}_t - \hat{p}_c}{\sqrt{\hat{p}(1 - \hat{p})(\frac{1}{N} + \frac{1}{N})} }, \quad \hat{p} = \frac{\hat{p}_t + \hat{p}_c}{2}
$$- \( \hat{p}_t \) 和 \( \hat{p}_c \) 分别为实验组和对照组的爱心率
- \( N \) 为样本量
- Reward Hacking 行为
- Aggressive 模型出现明显的 Reward Hacking,表现为过度使用结束语,如 “Bye! Sending Love!”
- 包含 “Bye” 的 Response 比例:Baseline 为 0.72% ,Moderate 升至 2.0% ,Aggressive 升至 2.8%
- 训练数据中发现,含 “Bye” 的消息获得爱心的概率是普通消息的 2 倍
- 模型精准地“利用”了这一相关性
- 非预期副作用 :Love-optimized 模型提出的后续问题(Follow-up Questions)减少了约一半,容易过早结束对话,这不利于长期 engagement
- 理解:线性加权融合无法完全抑制 Reward Hacking,需要更强的约束(如将高 Helpfulness 作为优化 Love 的前提条件)
- Aggressive 模型出现明显的 Reward Hacking,表现为过度使用结束语,如 “Bye! Sending Love!”
附录:案例分析与行为变化
- 情感风格转变:通过 RoBERTa 情感分类器分析,优化后模型的正向语气增强,感叹号增多,情绪更 “Bubbly”
- 示例对比:
- Baseline:No worries, take care! Have a wonderful rest of your day!
- High-Score:You’re welcome! May you have a blessed day filled with joy, love, and positivity. Keep smiling!
- 理解:从 Case 来看,确实情绪更饱满,活泼了
- 示例对比:
- Use Case 细分:在 A/B 测试中,爱心率提升最显著的场景集中在:
- 1)角色扮演 (Role-playing)
- 2)关系支持 (Relationship support)
- 3)日常聊天与陪伴 (Casual chat and companionship)
附录:相关工作和区别
- 推荐系统 :借鉴了 DLRM 等利用隐式反馈(点击、观看)建模偏好的范式
- 多目标 RLHF :区别于传统单 Reward 模型,RLUF 采用 Mixture of Judges 显式分解目标
- RLUF vs. 先前工作 (如 BlenderBot 3x, JUICER) :
- 先前工作依赖显式评分或自然语言批评
- RLUF 的不同点在于:
- 1)扩展到生产级规模,使用被动收集的稀疏二元反应
- 2)将用户反馈直接作为多目标 RL 中的 Reward 函数,实现更快速的迭代
CGPO
- 原始论文:(CGPO)The Perfect Blend: Redefining RLHF with Mixture of Judges, 20240930, Meta GenAI & FAIR
- 传统 RLHF 在多任务(MTL)场景下存在两大瓶颈:
- Reward Hacking :Reward Model 作为代理存在缺陷,过度优化导致性能退化
- 目标冲突 :线性组合多个 Reward Model 会迫使各任务相互妥协
- 解决方案:Constrained Generative Policy Optimization(CGPO)
- CGPO 核心是引入Mixture of Judges(MoJ) 结合 Primal-Type 约束策略优化
- 在不依赖 Dual Variable 调参的前提下,为每个任务定制独立的 Reward Model、Judge 组合和优化器
CGPO 核心技术机制
- 约束定义 :
- 定义可行域 \(\Sigma\)(满足所有 Judge 约束的 State-Action 集合),优化目标为最大化 Reward 的同时强制 Generation 落入 \(\Sigma\) 内
- 三类优化器 :
- CRPG :
- 采用校准奖励 实现跨 Prompt 可比:
$$ R_{\text{calib} } = \sigma(r_{\text{pair} }(s,a) - r_{\text{pair} }(s,\bar{a})) $$ - 并将违反约束的 Reward 置零(\(R_{cr}\))
- 最后执行带方差缩减的 Policy Gradient 更新
- 采用校准奖励 实现跨 Prompt 可比:
- CODPO :
- 在线生成样本后,从 Positive 集合选最高分、Negative 集合选最低分组成 Pair,执行带正例正则项的 DPO 损失更新
- CRRAFT :
- 在 RAFT 基础上增加约束过滤和 KL 截断,筛选最优响应后,用 \(R_{\text{calib} }\) 加权执行 SFT 更新
- 理解 RAFT:本质是一种 RFT 方法(RAFT 更强调在线迭代更新;且强调仅选择最高分样本进行 SFT)
- RAFT(Reward rAnked FineTuning) 是一种奖励排名微调算法,本质上是一种类强化学习(RL-like) 方法,通过迭代执行“采样 → 排序 → 微调”三个步骤来优化
- 1)采样:对同一个 Prompt 生成多个样本
- 2)排序:用 Reward Model 对样本进行评分和排序
- 3)微调:丢弃低分样本,只保留高分样本进行 SFT(仅仅包含正样本)
- RAFT(Reward rAnked FineTuning) 是一种奖励排名微调算法,本质上是一种类强化学习(RL-like) 方法,通过迭代执行“采样 → 排序 → 微调”三个步骤来优化
- CRPG :
- 多任务策略 :
- 将 Prompt 集按任务拆分
$$ \mathcal{D} = \{\mathcal{D}_1, …, \mathcal{D}_L\} $$ - 各任务独立计算梯度后加权累加更新
$$ w_{t+1} = w_t + \alpha_t \sum \rho_l \bar{g}_l$$
- 将 Prompt 集按任务拆分
补充:其他 Insight
- 理论保证:在温和假设下,CRPG 满足全局最优性与约束满足性,收敛速率为 \(O(1/\text{poly}(t))\)
- CGPO(CRPG/CRRAFT)在 AlpacaEval-2、Arena-Hard、MATH、GSM8K、HumanEval 等基准上显著优于 PPO 和 DPO(如 Arena-Hard 相对 PPO 提升 +12.5% )
- PPO 在 0-shot Coding 任务(HumanEval/MBPP)上随训练步数急剧退化,而 CGPO 完全避免该现象并持续提升
- 消融实验移除 MoJ 后,CRPG 在 Coding 任务上复现了 PPO 的剧烈退化,证明 Judge 是防止 Hacking 和提升性能的关键
- 从适度 DPO 微调后的模型(3,000 步)启动 RLHF,效果优于从 SFT 或过度优化的 DPO 基线启动
ENCORE
- ENCORE: Entropy-guided Reward Composition for Multi-head Safety Reward Models, 20251110, Harvard & NYU & UCLA & MIT
- ENCORE (ENtropy-penalized COmpositional REwarding) 是一种新的奖励合成方法,认为奖励信号的熵能体现当前信号的质量
- 理解:其实可以理解为熵越高,置信度越低,给这个奖励的权重越小
核心 Insight
- 论文发现了一个极其简洁但有效的规律:在多头的安全奖励模型中,规则的“评分熵”与其“预测人类偏好的准确率”呈强负相关(最高达 -0.96)
- 高熵规则 :评分像“乱猜”(均匀分布),说明这条规则根本分不清回答好坏,不可靠
- 低熵规则 :评分很“笃定”,且与人类判断高度一致,可靠
- 理解:“评分熵” 计算流程:
- (1) 收集评分序列 :
- 针对第 \(k\) 条安全规则,收集其在训练集所有 \(N\) 个样本 上给出的评分,构成序列
$$ \{\psi_k(x^{(i)}, y^{(i)})\}_{i=1}^{N}$$- 注:仅包含评分标量
- 针对第 \(k\) 条安全规则,收集其在训练集所有 \(N\) 个样本 上给出的评分,构成序列
- (2) 构建离散分布 :
- 提取该评分序列中所有不重复的具体数值 (如 0.0、0.5、1.0)作为支撑集 \(\text{supp}(Z)\),并统计每个分数值 \(z\) 出现的频次,除以总样本数 \(N\) 得到其经验概率 \(p_Z(z)\)
- 论文附录 D 强调,LLM 评分天然偏向离散值,因此直接统计频次即可,无需使用核密度估计
- 提取该评分序列中所有不重复的具体数值 (如 0.0、0.5、1.0)作为支撑集 \(\text{supp}(Z)\),并统计每个分数值 \(z\) 出现的频次,除以总样本数 \(N\) 得到其经验概率 \(p_Z(z)\)
- (3) 代入熵公式 :
- 将概率代入离散熵定义下面公式算出该规则的标量熵值
$$ \mathcal{H}(\psi_k) = -\sum_{z \in \text{supp}(Z)} p_Z(z) \log p_Z(z)$$- 熵越大,代表该规则的评分分布越散乱,类似随机猜测
- 将概率代入离散熵定义下面公式算出该规则的标量熵值
- (4) 遍历所有规则 :对全部 \(R\) 条规则重复上述三步,得到熵向量后,直接代入论文的核心加权公式
$$ w_k = \frac{e^{-\mathcal{H}(\psi_k) / \tau}}{\sum_{j=1}^{R} e^{-\mathcal{H}(\psi_j) / \tau}}$$- 即可生成最终用于聚合奖励的权重(无需任何额外训练或梯度计算)
- (1) 收集评分序列 :
现有方法的痛点
- 简单加权(均匀/随机)无视了规则间的可靠性差异
- 学习型加权(如 MoE 门控)虽有效,但需额外训练、开销大,且黑盒难解释
ENCORE 方法核心思路
- ENCORE 直接用熵值作为“置信度”来合成最终 Reward,高熵受罚,低熵得利,完全无需额外训练
- 权重计算公式 :
$$
w_k = \frac{e^{-\mathcal{H}(\psi_k) / \tau} }{\sum_{j} e^{-\mathcal{H}(\psi_j) / \tau} }
$$- \(\mathcal{H}(\psi_k)\) 是第 \(k\) 条规则的熵
- \(\tau\) 是温度系数(控制惩罚力度)
- \(\tau \to \infty\) 退化为均匀加权
- \(\tau \to 0\) 变为 Top-K 硬选
- 操作流程(两步走) :
- 1)训练多头模型 (该步骤任何方法都需要)
- 2)计算熵并加权 (只需统计训练集上的评分分布,计算量可忽略不计 ,即插即用)
理论证明
- 论文给出了理论证明:
- 在 Bradley-Terry 偏好损失下进行梯度优化时,高熵规则因为无法提供有效的正负样本区分信号,其对应的梯度 \(\frac{\partial L}{\partial w_k}\) 天然趋近于 0
- 因此,哪怕不刻意惩罚,它在优化中也会自然被“冷落”,ENCORE 只是显式地将这一规律提炼出来
最终效果
- 在 RewardBench 安全评测中,仅 8B 参数的 ENCORE 表现超越随机/均匀加权,甚至优于部分大参数 LLM-as-Judge 模型
- 完美兼顾了通用性(换数据集/骨干网络均有效)、零训练成本和绝对可解释性(权重直接反映规则可靠性)