注:本文包含 AI 辅助创作
- 参考链接:
- 原始论文:(VibeThinker-1.5B Technical Report, MGPO)Tiny Model, Big Logic: Diversity-Driven Optimization Elicits Large-Model Reasoning Ability in VibeThinker-1.5B, 20251109, Sina Weibo
- 原始论文:(VibeThinker-3B Technical Report)VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in Small Language Models, 20260615, Sina Weibo
整体说明
- VibeThinker 系列目前主打小模型为主,包括 1.5B 和 3B 的模型
- VibeThinker-1.5B 基于 Qwen2.5-Math-1.5B 进行后训练得到
- VibeThinker-3B 基于 Qwen2.5-Coder-3B 进行后训练得到
VibeThinker-1.5B
- 原始论文:(VibeThinker-1.5B Technical Report, MGPO)Tiny Model, Big Logic: Diversity-Driven Optimization Elicits Large-Model Reasoning Ability in VibeThinker-1.5B, 20251109, Sina Weibo
- 论文挑战了主流共识:只有通过极端扩大模型参数规模(如 DeepSeek R1 的 671B 或 Kimi K2 的 1T 参数)才能实现强大的逻辑推理能力
- 本文针对 一个仅有 1.5B 参数的 Dense 小模型,通过精巧的 Post-training 算法设计,可以在数学和代码推理任务上达到甚至超越数百亿至数千亿参数的大模型
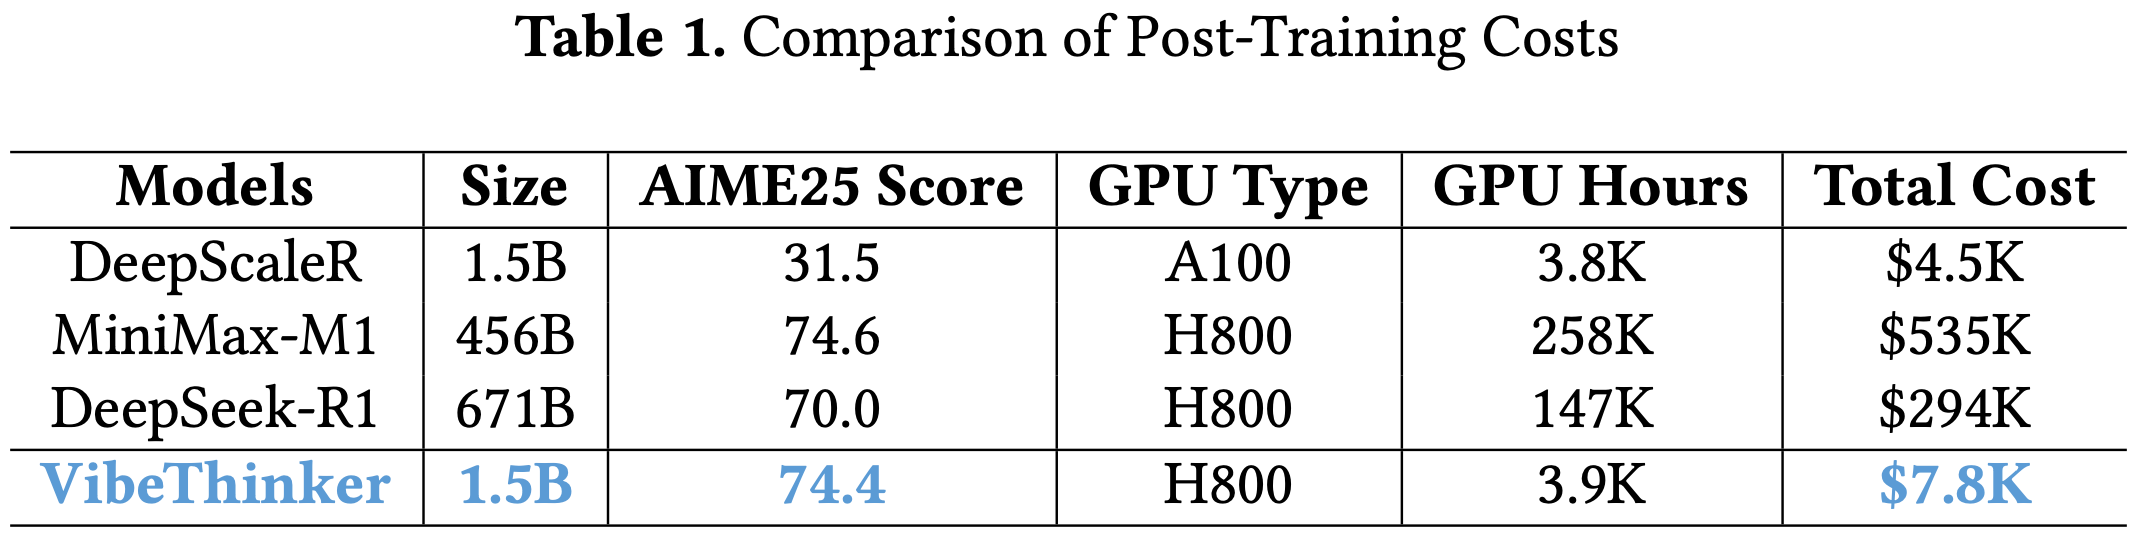
- 注:训练成本仅 7800 美元
- 基于 Qwen2.5-Math-1.5B 进行后训练得到
- 证明了小模型拥有远未被发掘的推理潜力,有望打破大型科技公司对顶级 AI 研究的算力垄断,推动研究民主化
- 本文针对 一个仅有 1.5B 参数的 Dense 小模型,通过精巧的 Post-training 算法设计,可以在数学和代码推理任务上达到甚至超越数百亿至数千亿参数的大模型
VibeThinker-1.5B 核心方法论:“Spectrum-信号原理”(Spectrum-to-Signal Principle, SSP)
- Spectrum-to-Signal Principle 将传统的 “SFT + RL” 两阶段流水线重新定义为分工明确且协同增效的两个阶段:
- Spectrum 阶段(Spectrum Phase),对应 SFT :
- 此阶段的首要目标不是最大化单次生成的准确率(Pass@1),而是最大化模型生成多样化解决方案的能力(Pass@K)
- 目标是构建一个宽广的“候选解空间(Spectrum)”,为后续RL提供丰富的探索土壤
- 信号阶段(Signal Phase),对应 RL :
- 此阶段的目标是在 SFT 建立的广阔Spectrum中,利用奖励信号(Reward Signal)识别并放大最正确的推理路径(Signal) ,将这些正确路径的概率提升
- Spectrum 阶段(Spectrum Phase),对应 SFT :
- 该原理的核心洞察是:一个多样性优化的 SFT 模型,比一个仅优化单次准确率的 SFT 模型,是 RL 阶段更优越的起点
训练流程详解(完整 Pipeline)
- 整体流程严格遵循 SSP,分为两大阶段:
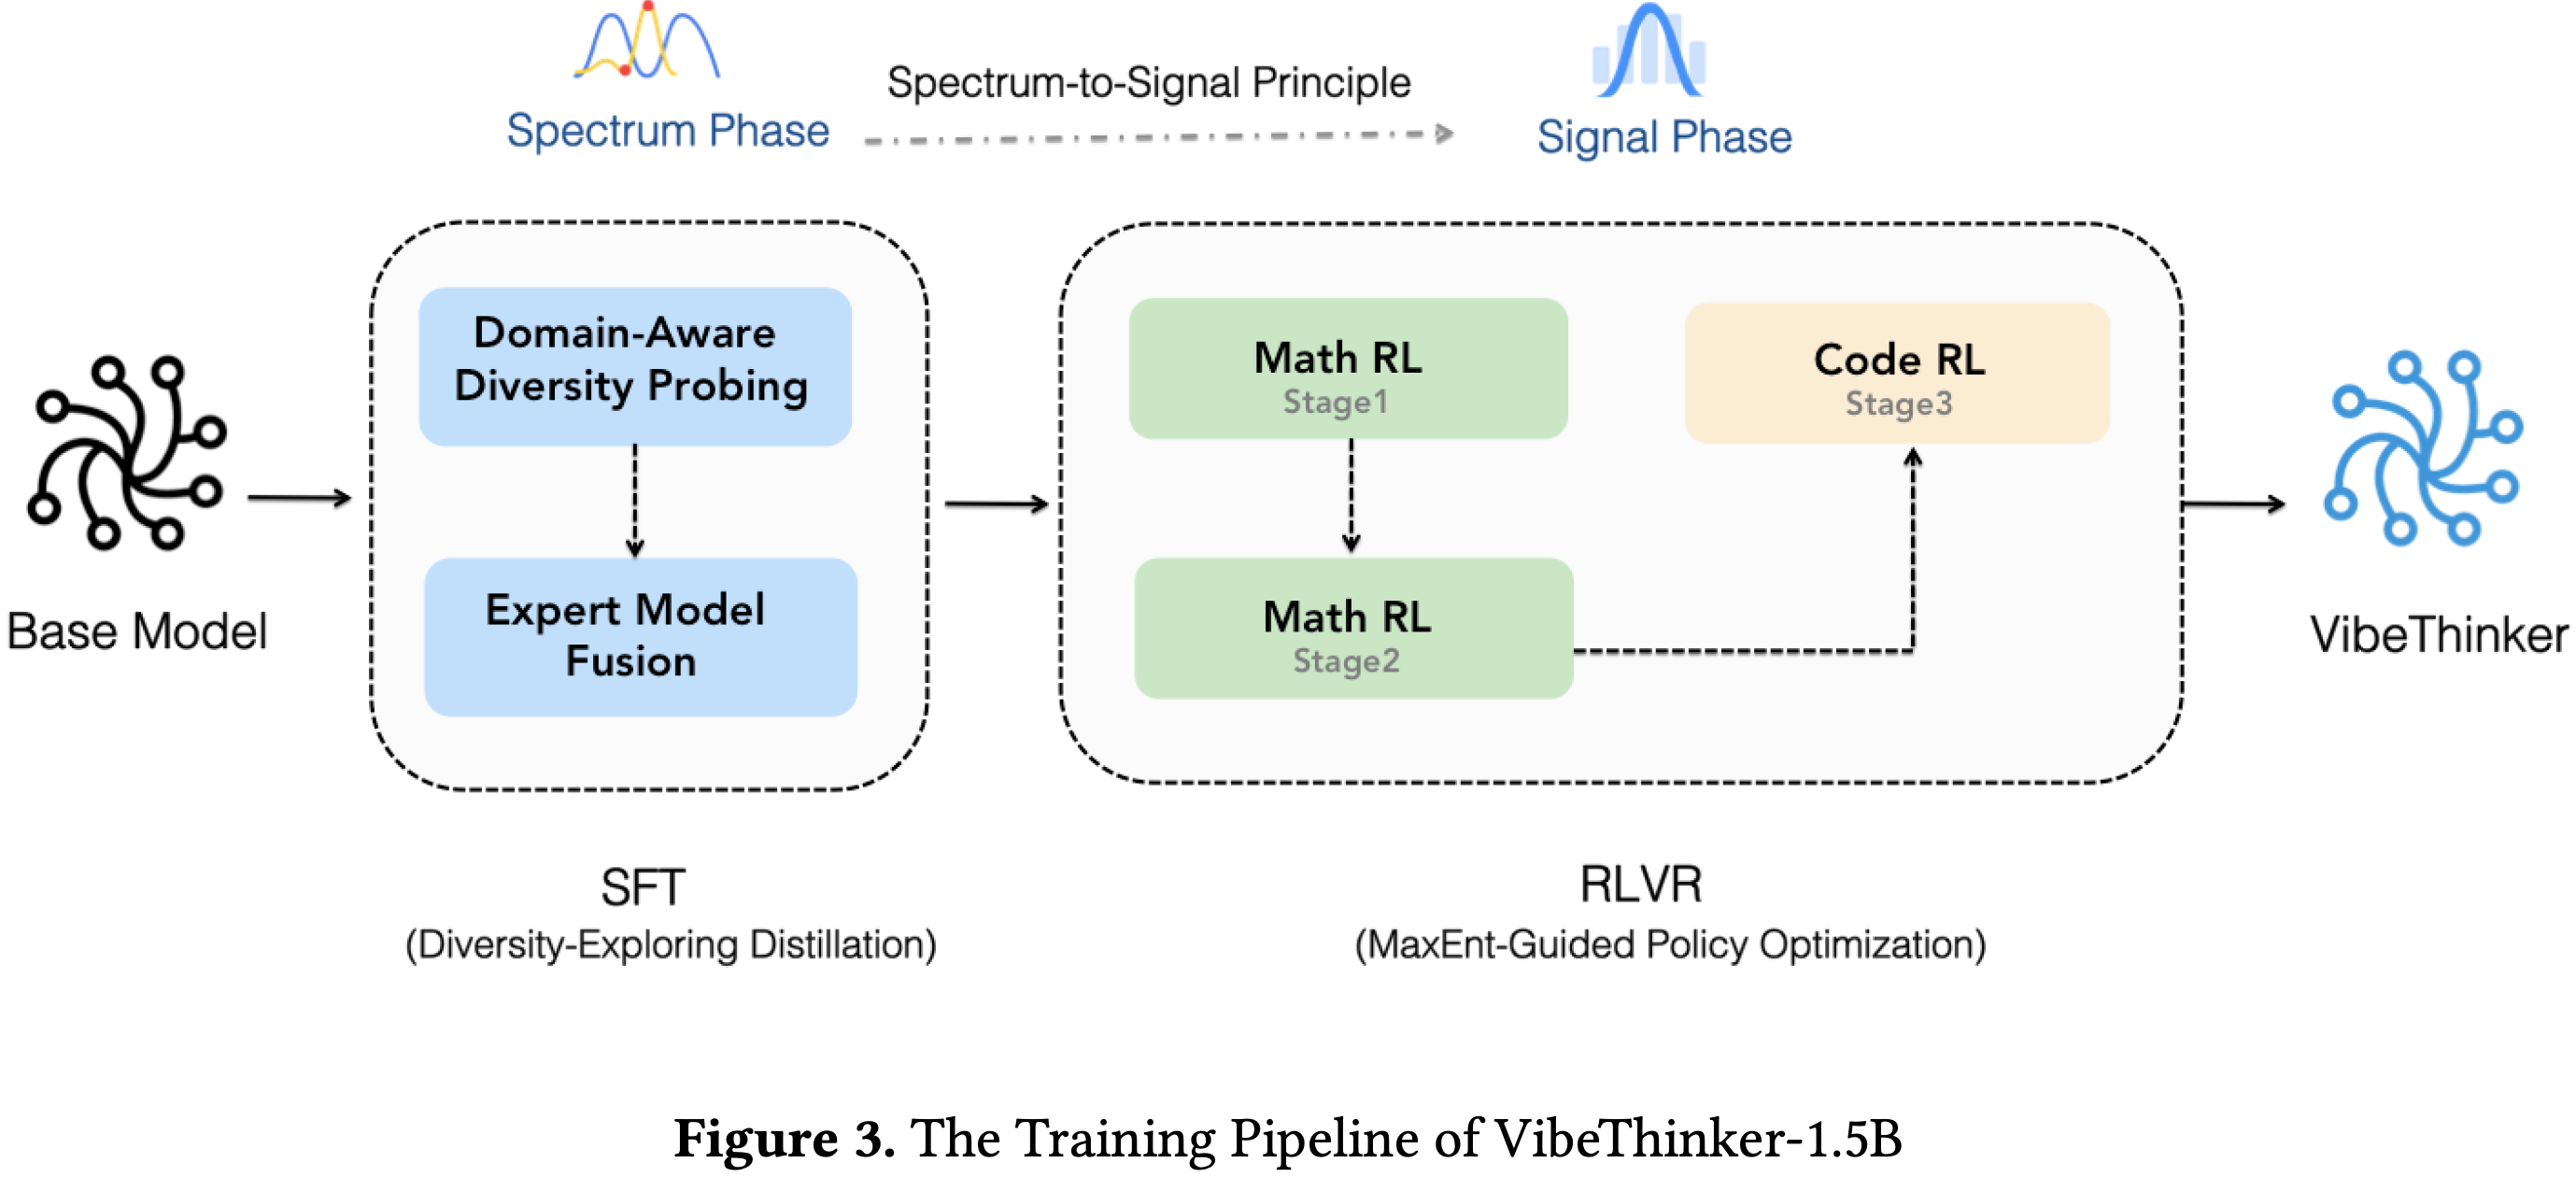
Spectrum 阶段(SFT):两阶段多样性探索蒸馏(Two-Stage Diversity-Exploring Distillation)
- 这一阶段旨在构建一个内部知识多样、解题路径丰富的SFT模型
SFT 步骤1:领域感知多样性探测(Domain-Aware Diversity Probing)
- 将数学知识空间划分为 \( N \) 个子领域
$$ \mathcal{S} = \{S_1, S_2, …, S_N\} $$- 本文中 \( N=4 \),即代数、几何、微积分、统计
- 对每个子领域 \( S_i \),利用强LLM自动构建专门的探测数据集
$$ D_i = \{(q_{ij}, a_{ij})\} $$- \( q \) 为题,\( a \) 为标准答案
- 在SFT训练过程中,每隔 \( k \) 步保存中间检查点 \( M_t \),并在每个探测集 \( D_i \) 上评估其 Pass@K 指标,得到分数 \( P_i(t) \)
- 为每个子领域选出使 Pass@K 最大化的专家检查点
$$ M_i^* = \arg\max_{t} P_i(t) $$- 最终获得 \( N \) 个擅长各自子领域多样化解题的专家模型
$$ \{M_1^*, M_2^*, …, M_N^*\} $$
- 最终获得 \( N \) 个擅长各自子领域多样化解题的专家模型
SFT 步骤2:专家模型融合(Expert Model Fusion)
* 将上述 \\( N \\) 个专家模型通过参数空间的加权线性组合,合并成一个统一的、多样性最大化的 SFT 模型 \\( \mathbf{M}\_{\text{Merge} }^{\text{SFT} } \\):
    $$
    \mathbf{M}\_{\text{Merge} }^{\text{SFT} } = \sum_{i=1}^{N} w_i M_i^\*
    $$
    * 其中权重 \\( w_i \ge 0 \\) 且 \\( \sum_{i=1}^{N} w_i = 1 \\)
    * 本文采用等权平均 \\( w_i = 1/N \\)
- 实证发现 :该融合模型不仅 Pass@K(多样性)达到 SOTA,其 Pass@1(单次准确率)也同样达到 SOTA
- 这表明拓宽 “Spectrum” 非但没有损害“信号”,反而强化了正确路径,为RL阶段提供了更优起点
信号阶段(RL)
- RL 阶段基于 MGPO,且被分为为 三个子阶段 :
- 1)数学推理阶段(16K 上下文窗口)
- 2)数学推理阶段(扩展至 32K 上下文窗口)
- 3)代码生成阶段
最大熵引导的策略优化(MaxEnt-Guided Policy Optimization, MGPO)
- MGPO 不采用静态数据集,而是动态识别并优先训练对当前策略最具“教学价值”的问题,即模型表现最不确定的问题
- 核心假设与度量 :
- 对于问题 \( q \),从当前策略中采样 \( G \) 个回答(Rollout),计算其正确率
$$ p_c(q) = \frac{1}{G}\sum_{i=1}^{G} \mathbb{I}(r_i = 1) $$- \( \mathbb{I} \) 是指示函数
- \( r_i \) 是第 \( i \) 个回答的二元奖励
- 当 \( p_c(q) = 0.5 \) 时,模型对正确或错误完全不确定,此时信息熵最大,该问题被认为具有最高的“探索价值”
- 对于问题 \( q \),从当前策略中采样 \( G \) 个回答(Rollout),计算其正确率
- 熵偏差正则化(Entropy Deviation Regularization) :
- 定义“最大熵偏差距离” \( D_{\text{ME} } \),用于量化当前正确率 \( p_c(q) \) 与理想最大熵分布 \( p_0=0.5 \) 的偏差,采用 KL 散度(Kullback-Leibler Divergence)计算:
$$
D_{\text{ME} }(p_c(q) | p_0) = p_c(q) \log\frac{p_c(q)}{p_0} + (1-p_c(q)) \log\frac{1-p_c(q)}{1-p_0}
$$ - 构建权重函数 \( w_{\text{ME} } \),给靠近 0.5 正确率的问题最高权重,并向 0 或 1 指数衰减:
$$
w_{\text{ME} }(p_c(q)) = \exp(-\lambda \cdot D_{\text{ME} }(p_c(q) | p_0))
$$- 其中 \( \lambda \ge 0 \) 是控制惩罚锐度的正则化系数
- \( \lambda=0 \) 时退化为标准 GRPO
- 定义“最大熵偏差距离” \( D_{\text{ME} } \),用于量化当前正确率 \( p_c(q) \) 与理想最大熵分布 \( p_0=0.5 \) 的偏差,采用 KL 散度(Kullback-Leibler Divergence)计算:
- MGPO 优化目标 :
- 将权重 \( w_{\text{ME} } \) 直接乘到GRPO(Group Relative Policy Optimization)的优势函数(Advantage)上,得到修正后的优势 \( A’_{j}(q) = w_{\text{ME} }(p_c(q)) \cdot A_{j}(q) \)
- 最终MGPO的目标函数 \( \mathcal{J}_{\text{MGPO} }(\theta) \) 为(省略部分展开):
$$
\mathcal{J}_{\text{MGPO} }(\theta) = \mathbb{E}_{(q,y)\sim\mathcal{D} } \left[ \mathbb{E}_{\{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old} } }(\cdot|q)} \left[ \frac{1}{G} \sum_{i=1}^{G} \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \min \left( r_{i,t}(\theta) A’_{i,t}(q), \text{clip}(r_{i,t}(\theta), 1-\epsilon, 1+\epsilon) A’_{i,t}(q) \right) \right] \right]
$$- \( r_{i,t}(\theta)\) 是 token-level 概率比
$$ r_{i,t}(\theta) = \frac{\pi_{\theta}(y_{i,t}|q, y_{i,<t})}{\pi_{\theta_{\text{old} } }(y_{i,t}|q, y_{i,<t})} $$ - \( \epsilon \) 是裁剪超参数
- \( r_{i,t}(\theta)\) 是 token-level 概率比
- 此机制形成隐式课程学习(Curriculum Learning),迫使模型将梯度更新集中于最模糊、最具潜力的问题上
RL 阶段 1:数学推理(16K 上下文窗口)
- 目标:是在较短上下文长度下,让模型初步学会利用 Long CoT 进行数学推理
- 上下文长度 :16K tokens
- 任务类型 :数学问题(如竞赛级数学题)
- RL 算法基础:使用 MGPO
- 作用 :此阶段让模型在 16K 上下文内建立基本的数学推理能力,并利用最大熵准则筛选出“最不确定”的问题进行重点优化
RL 阶段 2:数学推理(扩展至 32K 上下文窗口)
- 目标 :在更长的上下文下,进一步提升数学推理的深度和准确性,允许模型生成更长的 CoT
- 上下文长度 :从 16K 扩展至 32K tokens
- 任务类型 :仍为数学推理,但问题难度可能更高或需要更长的推导过程
- 关键变化 :
- 上下文窗口翻倍,使模型能够处理更复杂的多步推导和更长的中间推理链
- MGPO 框架保持不变 ,但训练数据可能包含需要更长推理路径的问题
- 该阶段继续使用 Entropy Deviation Regularization 来动态选择高不确定性样本,确保训练效率
- 作用 :增强模型处理长推导链的能力,为后续代码生成中更长的逻辑序列做准备
RL 阶段 3:代码生成
- 目标 :将数学推理中习得的 Reasoning 能力迁移到代码生成任务(如竞赛编程)
- 上下文长度 :未明确说明,但从前两阶段的扩展逻辑推测,可能保持 32K 或进一步扩展
- 任务类型 :代码生成(对应 LiveCodeBench V5/V6 等基准)
- 关键差异 :
- 奖励函数 \(R(x, y)\) 不再基于数学答案匹配,而是基于代码的功能正确性(如通过测试用例)
- 仍使用 MGPO,但 Prompt 和 Response 格式调整为代码生成任务
- 由于基础模型(Qwen2.5-Math-1.5B)在预训练阶段主要接触数学数据,代码能力较弱,因此该阶段承担了“跨领域迁移”的重任
- MGPO 的熵权重机制同样适用于代码问题——当模型在某个编程问题上正确率接近 0.5 时,该问题被优先训练
- 作用 :使模型在代码推理上获得显著提升(从基线 0.0 提升至 51.1 分),验证了 SSP 原则在跨任务上的通用性
训练数据与去污(Decontamination)
- 数据来源 :大部分来自公开数据集,少部分为内部合成的专有数据
- 严苛反污染措施 :
- 1)文本标准化 :移除标点和符号,统一大小写
- 2)语义去污 :采用 10-gram 匹配,识别并排除与评估集有语义重叠的训练样本
- 论证基准有效性 :
- 论文强调,模型在 AIME25 和 HMMT25(2025 年新发布)上表现出色,而训练数据不可能包含这些新基准,有力地反驳了“性能提升源于数据污染”的质疑
- 同时,基座模型在代码任务上原始得分为 0.0,经过训练后大幅提升,证明提升源于方法而非污染
训练成本与效率
- 总 GPU 时间 :约 3900 小时(NVIDIA H800)
- 总成本 :按每小时 2 美元计算,低于 8000美元
- 对比优势 :相比 DeepSeek R1(29.4 万美元)和 MiniMax-M1(53.5 万美元)的后期训练成本,VibeThinker-1.5B 的成本仅为它们的 1/30 至 1/60,同时推理成本可降低 20 至 70 倍
实验设置
- 数学推理 :MATH-500, HMMT 2025, AIME 2024, AIME 2025
- 报告 64 次重复采样的平均通过率(Pass@1)
- 代码生成 :LiveCodeBench (LCB) V5 (279 题) 和 V6 (131 题)
- 报告 8 次采样的平均通过率
- 专业知识 :GPQA-Diamond(198个博士生水平的物理、生物、化学问题)
- 基线模型 :对比了三大类:
- 1)最强<3B小模型(DeepScaleR, ProRL, Qwen3-1.7B 等)
- 2)强推理大模型(闭源如 OpenAI o3-mini, Claude Opus 4;开源如 DeepSeek R1, MiniMax-M1);
- 3)顶尖非推理大模型(Kimi K2, GPT-4.1 等)
- 推理设置 :使用 vLLM,数学 temperature=1.0,代码 temperature=0.6,nucleus sampling (top_p=0.95),最大输出长度 40k tokens
主要评估结果与发现
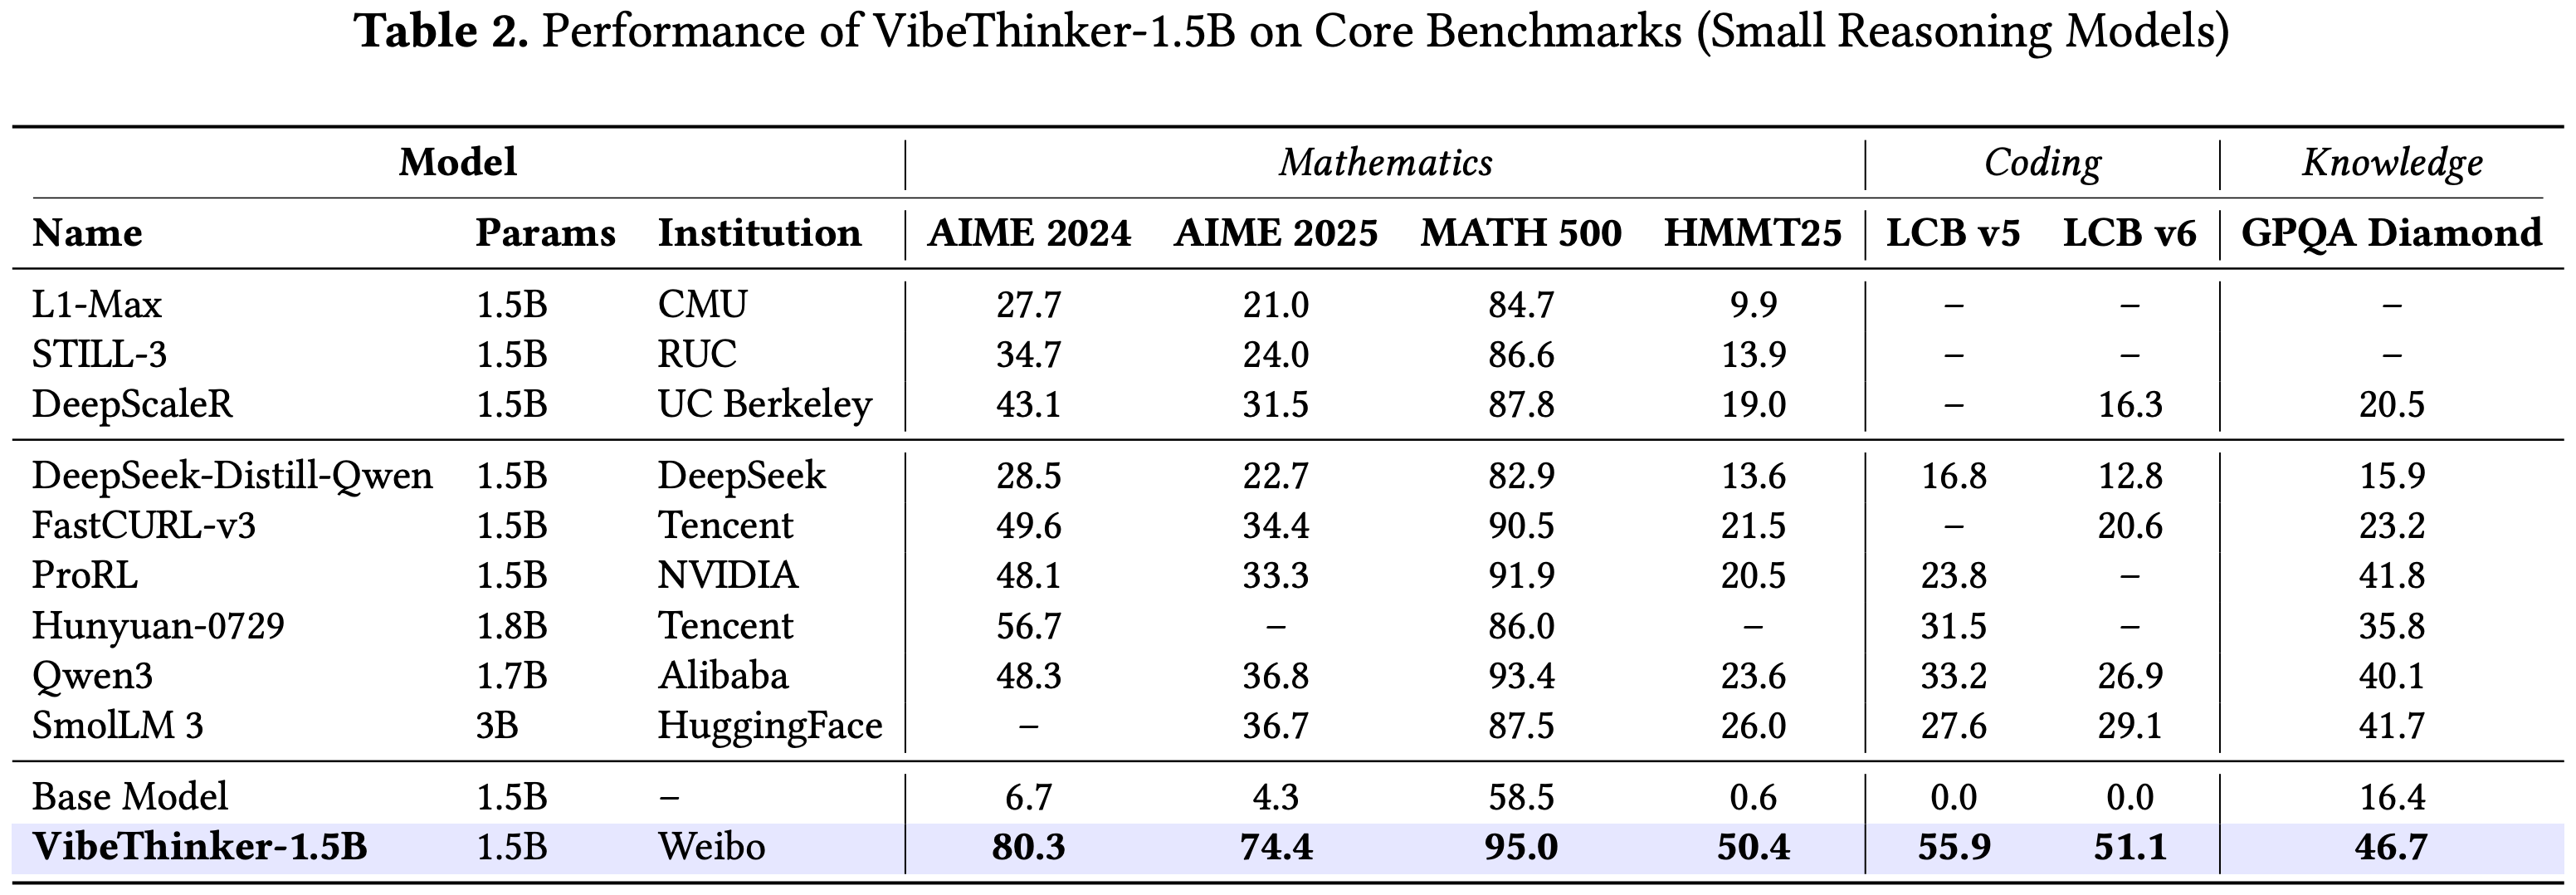
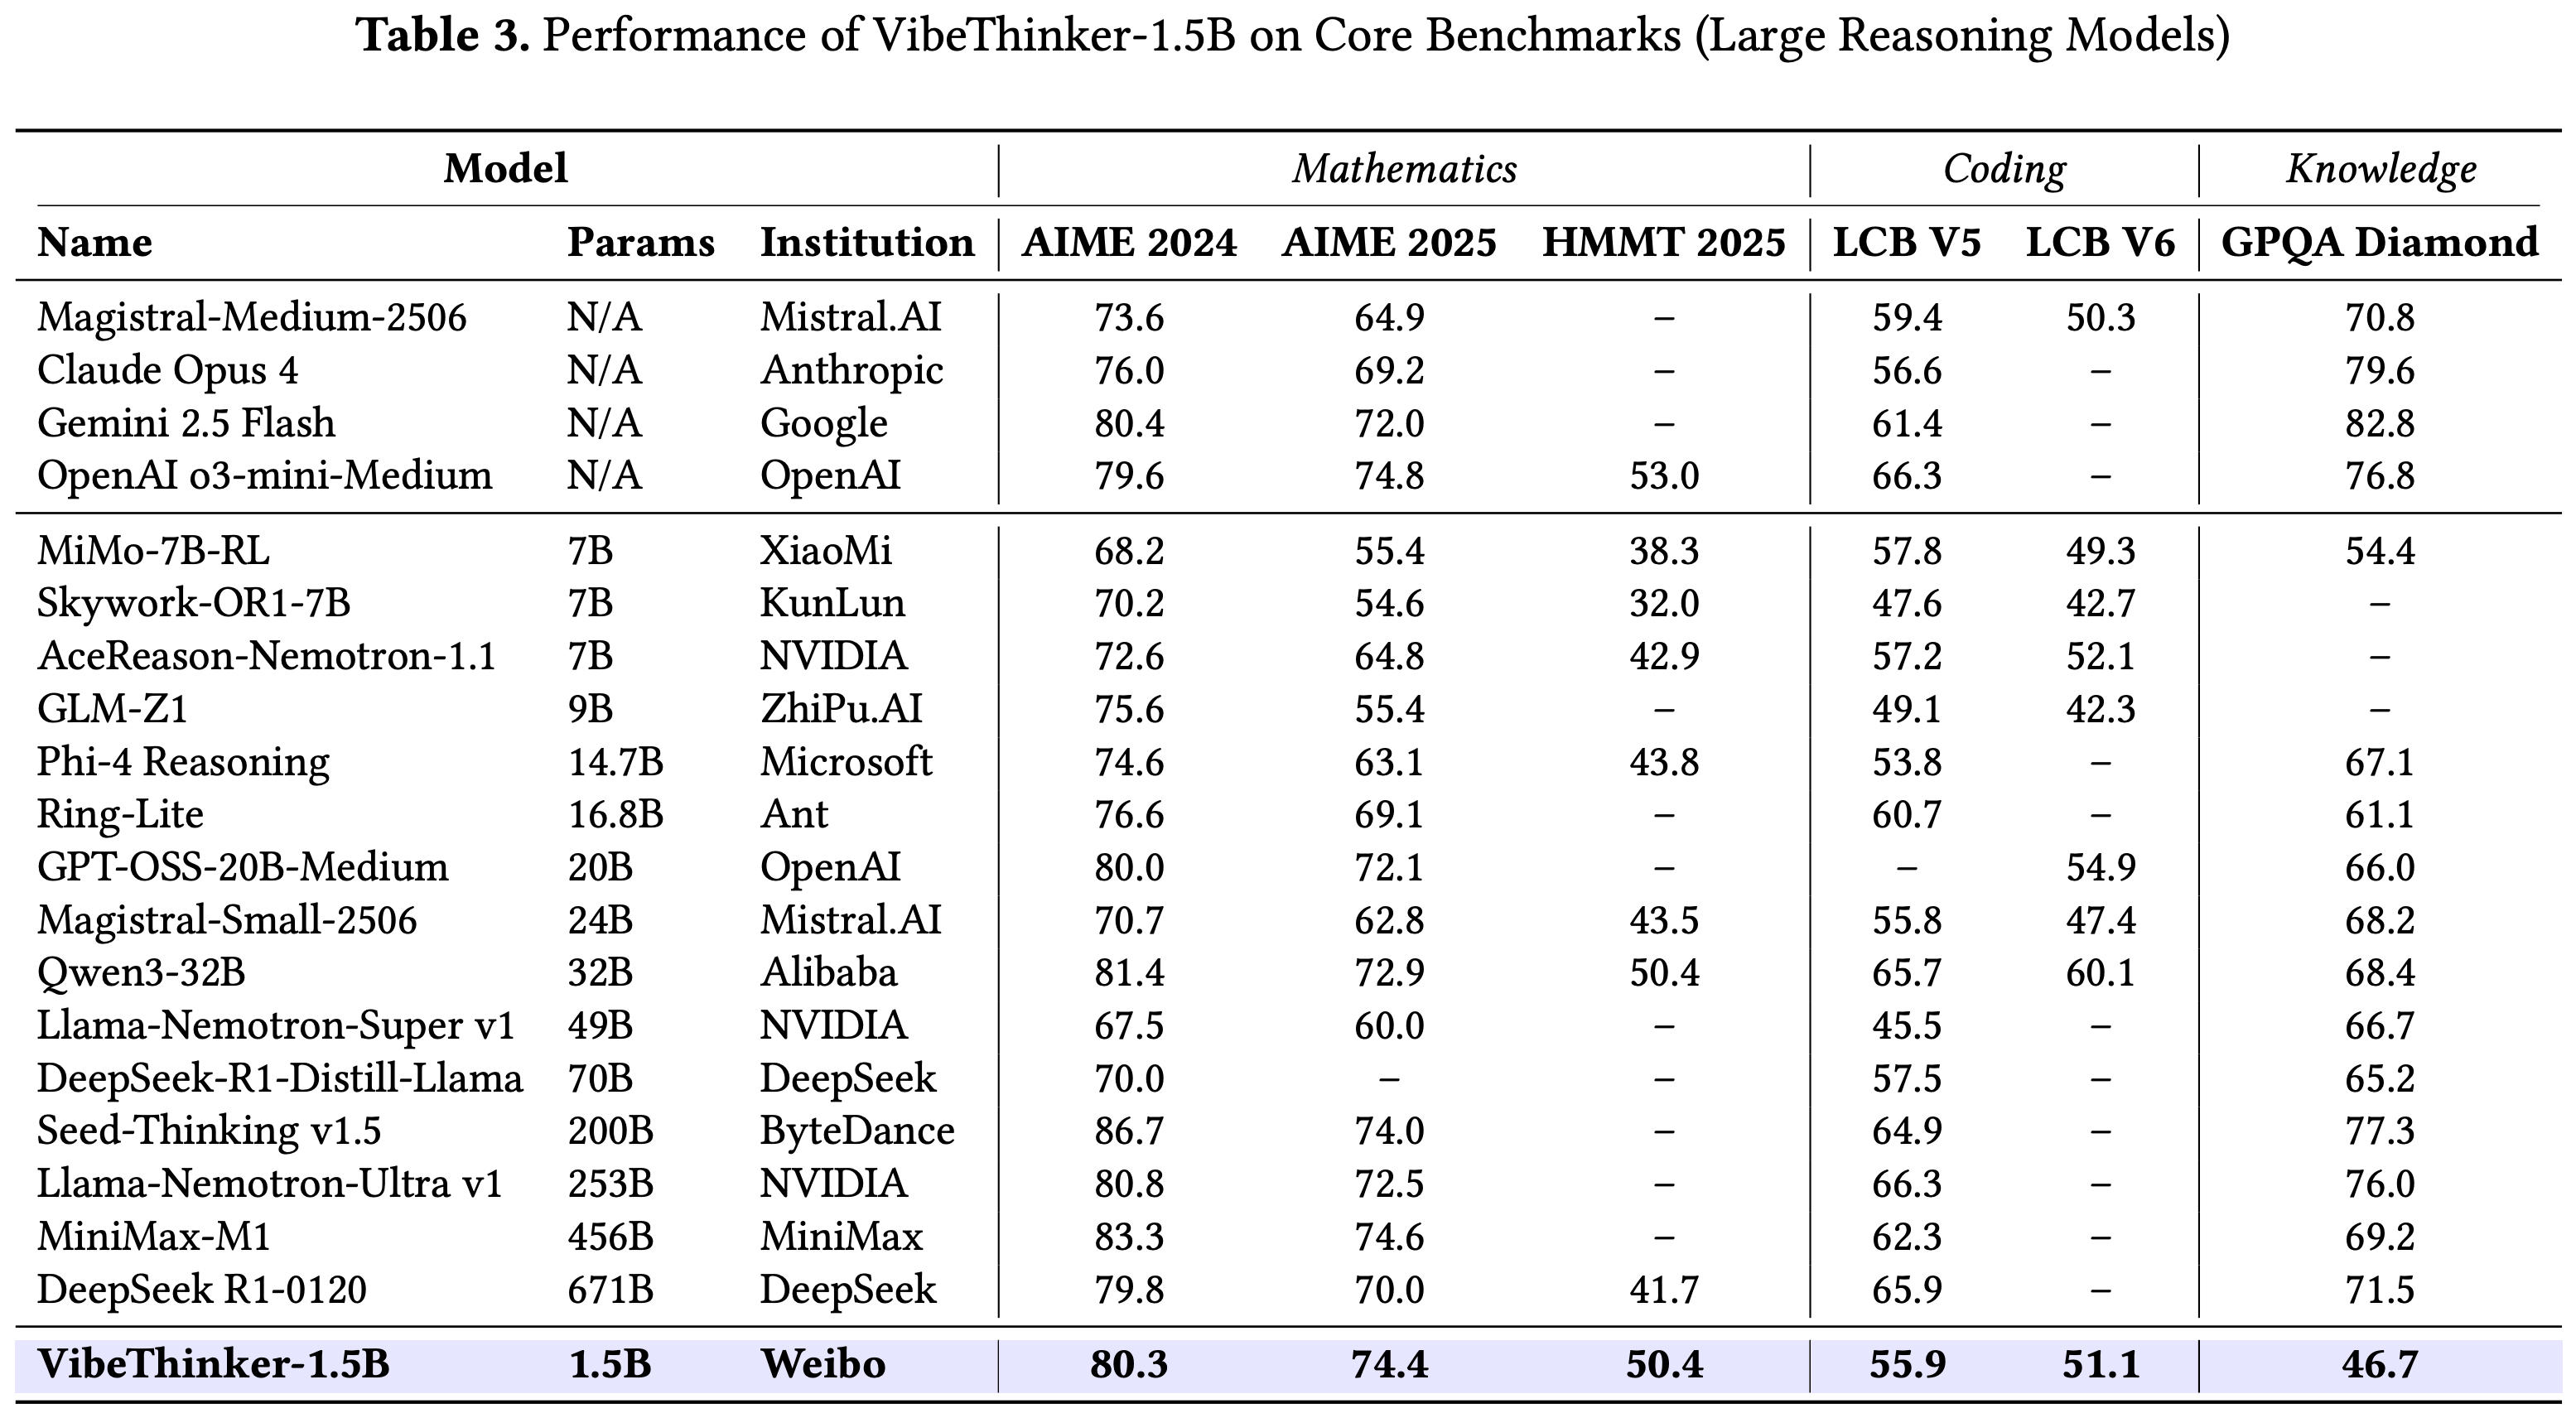
- 1)vs. 小推理模型(<3B) :VibeThinker-1.5B 以绝对优势领先,将 AIME25 性能从基座的 4.3 提升至 74.4(翻倍于 3B 的 SmolLM),LCB V6 从 0 提升至 51.1 ,GPQA 从 16.4 提升至 46.7 ,成为 3B 以下最强模型
- 2)vs. 大推理模型(>10B 至 671B) :
- 数学 :在 AIME24 (80.3 vs 79.8)、AIME25 (74.4 vs 70.0)、HMMT25 (50.4 vs 41.7)上 全面超越 DeepSeek R1-0120(671B)
- 与 OpenAI o3-mini-Medium 和 Gemini 2.5 Flash 性能持平,超越 Magistral Medium 和 Claude Opus 4
- 代码 :性能与 Magistral Medium 和 Claude Opus 4 相当(LCB V6 51.1),但与大模型差距略大于数学,论文归因于基座模型(Qwen2.5-Math)预训练偏向数学,代码数据不足
- 知识(GPQA) :与大模型存在 20-40 分的显著差距(VibeThinker 为 46.7,顶尖模型约 80),论文中明确指出通用知识容量是小模型固有瓶颈 ,是未来重点研究方向
- 理解:这里就是小模型最缺乏的,小模型可以专精某个领域,但是通用知识是有限的
- 3)vs. 顶尖非推理大模型 :
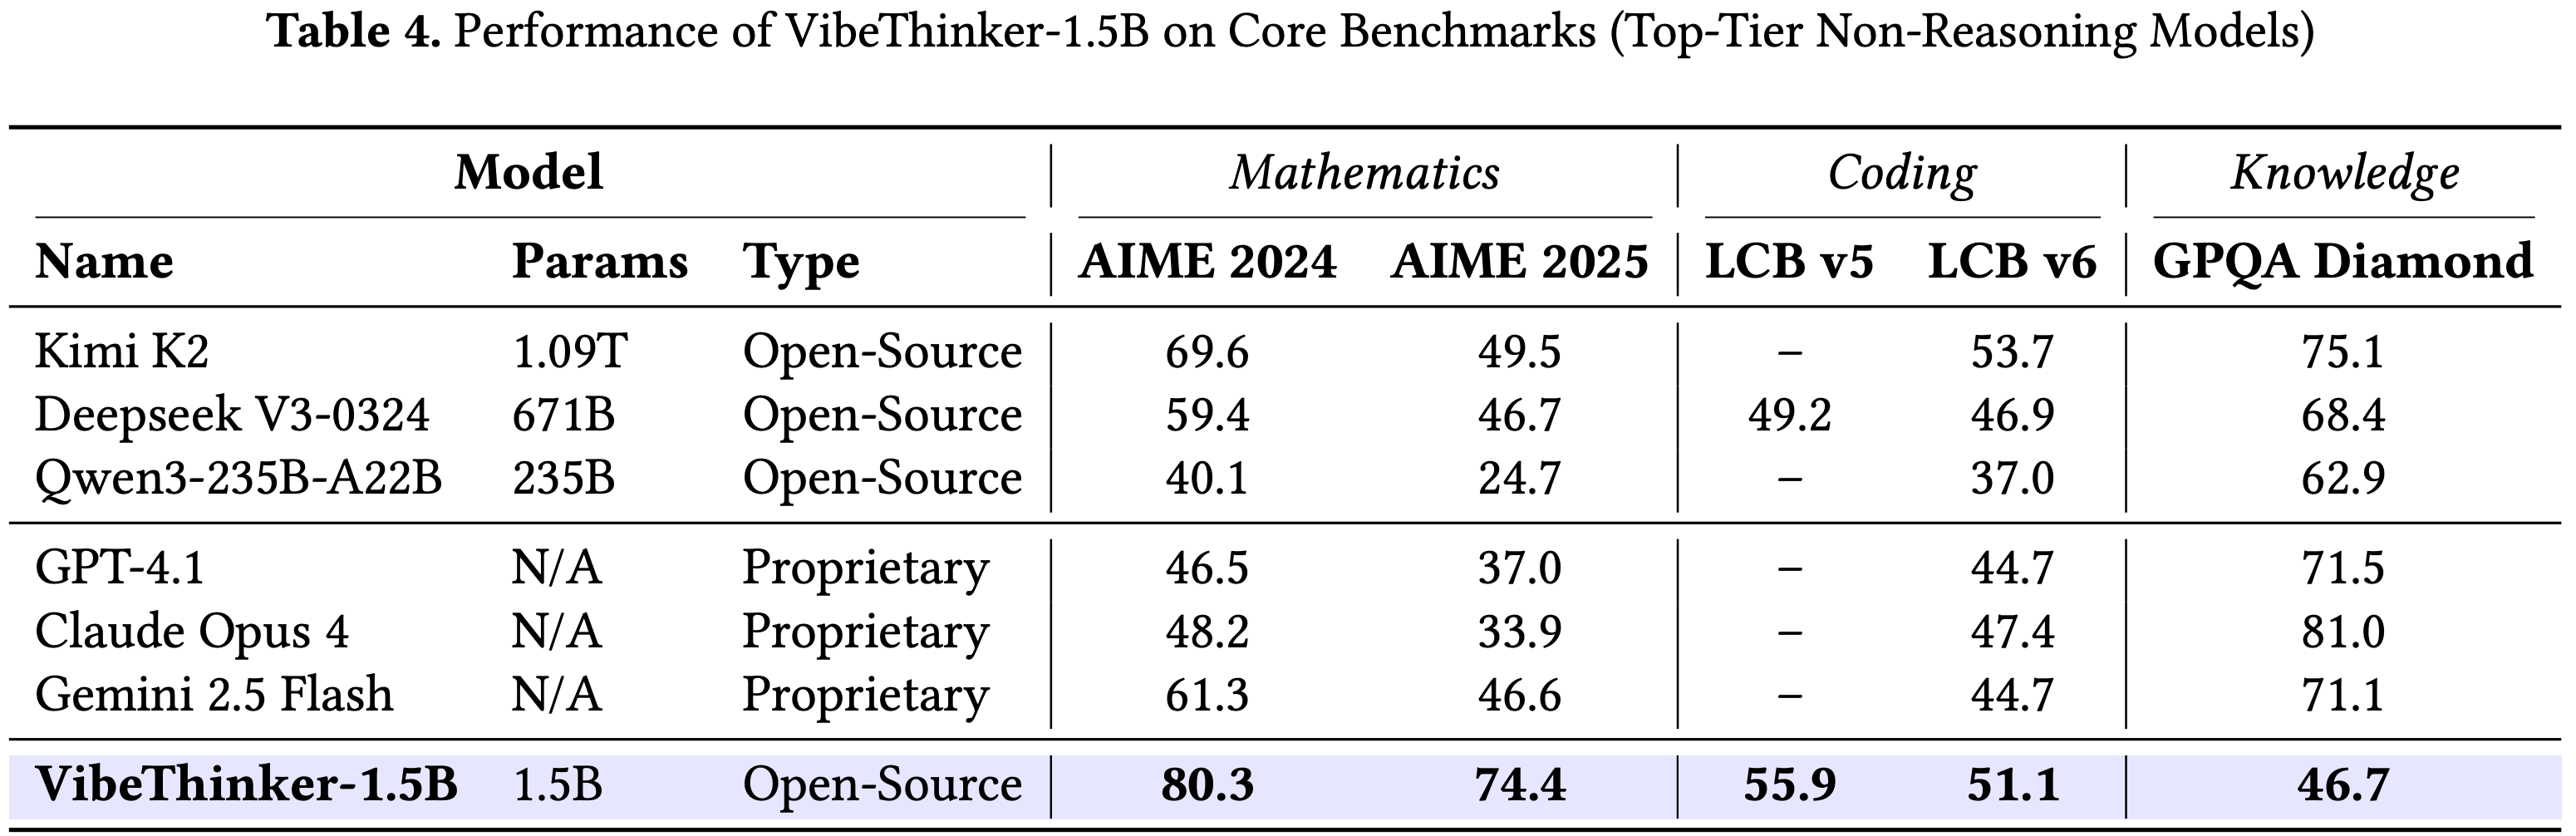
- VibeThinker-1.5B 在 AIME24 和 AIME25 上碾压所有对比的非推理模型(如 Kimi K2, GPT-4.1, Claude Opus 4, Gemini 2.5 Flash)
- 在代码任务上 超过大部分 对比模型
- 结论:小模型在 逻辑推理 任务上的潜力被严重低估,但通用知识短板仍然存在
VibeThinker-3B
- 原始论文:(VibeThinker-3B Technical Report)VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in Small Language Models, 20260615, Sina Weibo
- 本文推出了 VibeThinker-3B ,3B 参数的 Dense SLM,Qwen2.5-Coder-3B 进行后训练得到
- 本文提出了 “参数压缩-覆盖假说”(Parametric Compression-Coverage Hypothesis) ,For 小模型的发展提供了新的理论视角
- “参数压缩-覆盖假说” :模型能力在参数空间中的编码方式存在结构性差异
- 可验证推理 属于“参数密集型压缩”,可被浓缩为小型核心
- 开放域知识/通用能力 属于“参数扩展型覆盖”,依赖模型规模
the Parametric Compression-Coverage Hypothesis, which views verifiable reasoning as compressible into compact reasoning cores, while open-domain knowledge and general-purpose competence require broad parameter coverage over facts, concepts, and long-tail scenarios.
- “参数压缩-覆盖假说” :模型能力在参数空间中的编码方式存在结构性差异
- 核心性能展示:
Introduction & 核心观点
- 当前,强大的推理能力通常依赖于拥有数千亿参数的巨型模型
- 小模型(≤3B)具备部署成本低、推理效率高和易于学术研究的优势,但普遍被认为在复杂数学推导和编程任务上存在先天瓶颈
- 作者的前序工作 VibeThinker-1.5B 已初步证明小模型能产生稳定的逻辑链
- 本工作的核心问题是:将参数提升到 3B 后,小模型的真实能力边界在哪里?能否达到顶级 LLM 的水平?
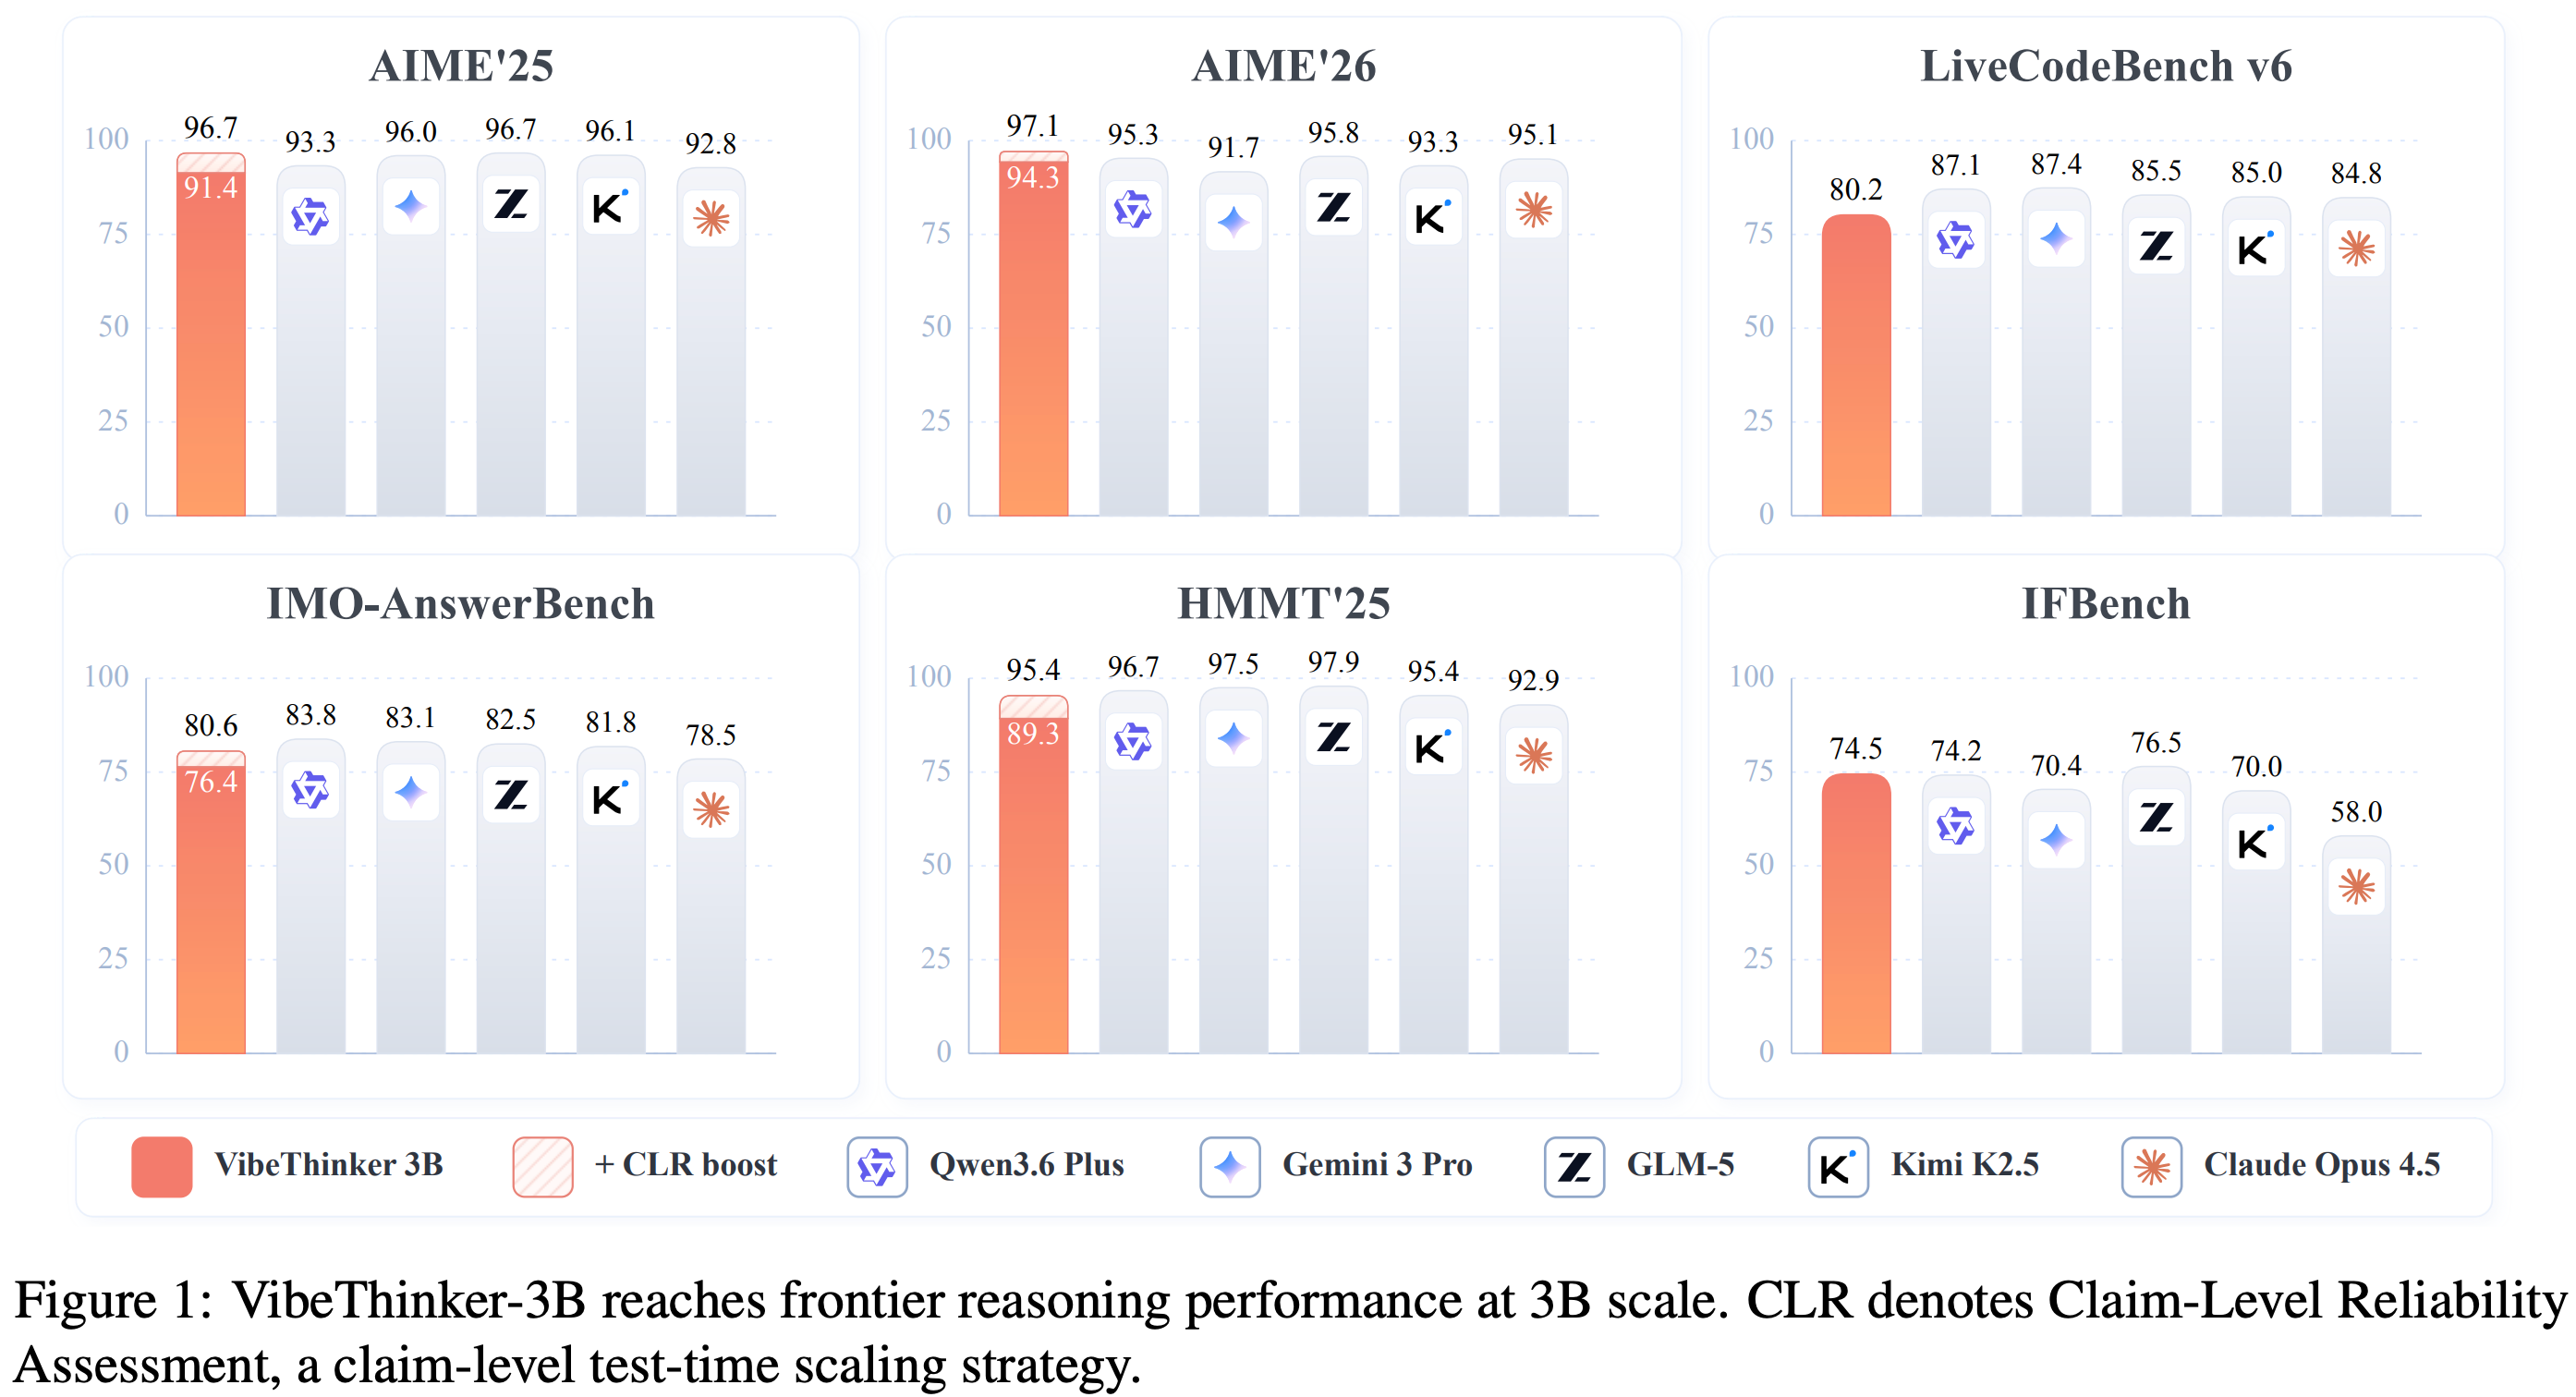
- 核心发现 :VibeThinker-3B 在 AIME26(94.3分,使用CLR后达97.1)、LiveCodeBench v6(80.2 Pass@1)以及最新的 LeetCode 竞赛(96.1% 通过率)上表现卓越
- 这证明严格的 3B 参数预算足以逼近第一梯队推理模型的性能范围
- 论文 提出“推理-知识解耦范式”(Reasoning-Knowledge Decoupling Paradigm) :
- 参数密集型能力(Parameter-Dense Capabilities) :
- 如可验证推理 ,其核心在于结构化的搜索、约束满足和错误修正,可被高度压缩为一个紧凑的“推理核心”
- 参数扩展型能力(Parameter-Expansive Capabilities) :
- 如开放域知识和通用能力 ,需要广泛覆盖海量事实、概念和长尾场景,其参数需求类似于“覆盖问题”
- 结论:小模型不应仅被视为部署效率的被动选择,而是与传统的参数规模扩展范式互补的一条研究路径
- 参数密集型能力(Parameter-Dense Capabilities) :
VibeThinker-3B 训练详细流程
- 整体训练流程建立在 Qwen2.5-Coder-3B 基座模型之上,遵循“Spectrum-信号原则”(Spectrum-to-Signal Principle, SSP),包含五个核心阶段
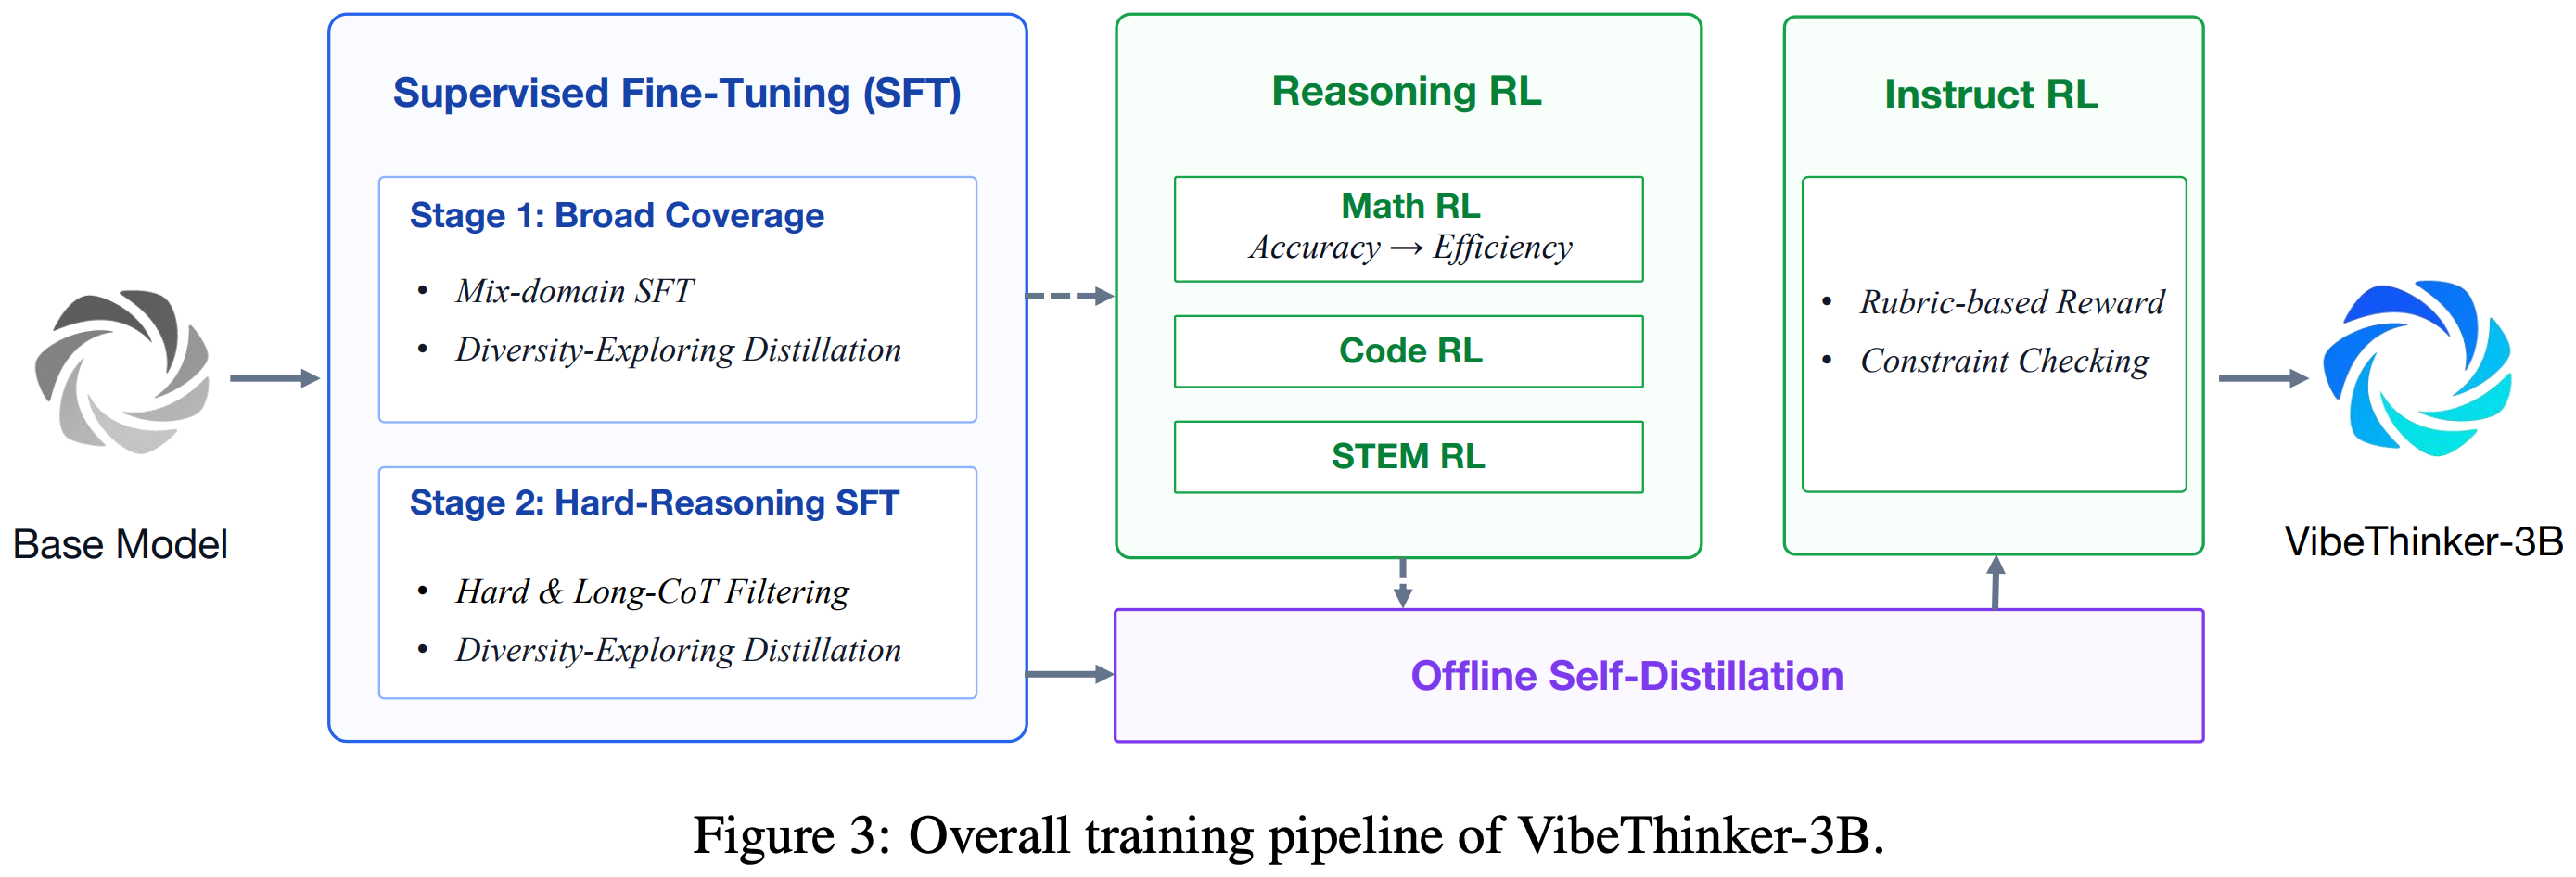
SFT
- 目标 :构建一个多样化的“解空间”(Spectrum),为后续 RL 提供丰富的冷启动策略
Data Construction
- Data Synthesis and Query Expansion :
- 以包含可靠验证信号(如数学题的确定答案、编程题的单元测试)的种子查询为基础,通过概念组合、解题骨架变换等方式扩展查询
- 并使用强教师模型进行多次采样,通过多数投票生成伪标签
- Multi-path Reasoning Distillation :
- 对于推理密集型样本,教师模型采样多条不同的正确推理轨迹(而非仅一条标准答案),保留完整的中间推理步骤。这旨在构建涵盖多种有效方法的 “Spectrum”
- Multi-level Quality Control :
- 1)N-gram过滤 :剔除含有异常重复片段或与评估集重叠的样本
- 2)LLM查询质量过滤 :用 LLM 评估查询质量,筛除描述不清、逻辑无效的样本
- 3)轨迹正确性过滤 :通过答案验证、代码沙盒执行 LLM 多数投票,仅保留推理链完整且结果正确的轨迹
- Training Process :
- 基于课程的两阶段 SFT 策略(Curriculum-based Two-stage SFT) :
- 阶段一(广泛覆盖) :在所有质量过滤后的推理数据上训练 5 个 epoch,学习率从 \(5 \times 10^{-5}\) 按余弦退火降至 \(8 \times 10^{-8}\)
- 采用序列打包(Sequence Packing)提升效率
- 阶段二(聚焦困难样本) :基于阶段一模型,筛选出推理轨迹长度 > 5K tokens 且参考模型(VibeThinker-1.5B)错误率 > 0.75 的“Hard 样本”子集,再训练 2 个 epoch
- 此策略迫使模型专注于长程逻辑推导
- 阶段一(广泛覆盖) :在所有质量过滤后的推理数据上训练 5 个 epoch,学习率从 \(5 \times 10^{-5}\) 按余弦退火降至 \(8 \times 10^{-8}\)
- 多样性探索蒸馏(Diversity-Exploring Distillation) :定期保存中间检查点,在每个领域评估其 Pass@K 性能,选择生成更多有效解 的检查点作为该领域的专家模型,最后进行参数级合并
- 此举旨在最大化输出的多样性,而非单纯追求最佳准确率
- 理解:这里的合并方式是对多个子领域专家模型的参数进行加权平均合并,在 VibeThinker-1.5B 中就已经在使用了
- 从技术操作的层面看(多个专家模型参数加权平均),它确实更接近 模型合并 或 模型融合,而不是传统意义上的“蒸馏”(Distillation)
- Model Merging 通常指同构模型(相同架构、相同维度)在参数空间的简单算术,常被用于提升模型的通用能力
- Distillation 则隐含着“精华的提取与浓缩”
- 基于课程的两阶段 SFT 策略(Curriculum-based Two-stage SFT) :
RL
- 目标:在 SFT 构建的 “Spectrum” 中,放大正确推理的“信号”(Signal)
- 算法依然使用的是 MGPO
Multi-domain Reasoning RL
- 训练数据 :覆盖数学、代码和 STEM,均经过严格的基准去污,并基于初始检查点过滤掉准确率为 0.0 或 1.0 的样本
- Single Long-context Learning :
- 发现:对于 VibeThinker-3B,渐进式扩展上下文窗口的策略反而会损害长程推理能力
- 因此,他们直接使用 64K 长上下文窗口 进行RL,以完整保留高质量的长程推理轨迹
- 理解:确实有点奇怪,可能是任务需要很长的 Thinking 内容才能实现,所以一开始就需要很长的 Thinking 预算
- 训练策略 :(采用串行多领域流程)
- 先进行数学 RL(强化符号推导)
- 再进行代码 RL(强化逻辑执行)
- 最后进行 STEM RL(强化跨领域推理)
- Long2Short Math RL :一个“先精度后效率”的两阶段策略
- 第一阶段:标准 MGPO 优化准确性
- 第二阶段:在保持验证集性能的同时,优化 Token 效率
- 方法 :
- 在正确轨迹集合 \(\mathcal{C}\) 中,定义简洁度得分 \(s_i\)
$$ s_i = 1 / L_i $$- \(L_i\) 为响应长度
- 并应用中心化的长度感知奖励偏移:
$$
r_i^{\prime} = r_i + \lambda \cdot \frac{s_i - \bar{s} }{\max_{j\in \mathcal{C} }|s_j - \bar{s}|},\qquad i\in \mathcal{C}
$$- \(\bar{s}\) 是正确轨迹的平均简洁度得分
- \(\lambda=0.2\) 控制最大调整幅度
- 此偏移在正确集合内 是零和的
$$ \sum_{i\in \mathcal{C} }(r_i^{\prime} - r_i) = 0$$- 这说明该奖励不改变组内平均奖励,但重塑了偏好,鼓励更简洁的正确推理路径
- 理解:这里可以让正确轨迹也有一定的区分度(通过长度来区分),注:错误轨迹没有给长度惩罚或奖励
- 理解:分母上是 \(\max_{j\in \mathcal{C} }|s_j - \bar{s}|\) 是类似 MinMax 归一化的思路,会将长度分数奖励归一化到 0-1 之间
- 注:\(\lambda=0.2\) 可以保证最长的正确轨迹分数最小为 0.8
- 在正确轨迹集合 \(\mathcal{C}\) 中,定义简洁度得分 \(s_i\)
离线自蒸馏(Offline Self-Distillation)
- 目标:将 RL 阶段各领域检查点中激发出的高质量推理模式,稳定地整合回统一的模型中
- 流程:从数学、代码、STEM RL 检查点中提取经过验证的正确轨迹
- 学习潜力过滤(Learning-potential Filtering) :
- 计算每个正确轨迹在学生模型下的长度归一化负对数似然(Negative Log-Likelihood, NLL):
$$
S_{\text{LP} }(q,y) = -\frac{1}{|y|}\sum_{t=1}^{|y|}\log \pi_{\theta_{\text{stu} } }(y_t\mid q,y_{ < t})
$$- 分数越高,表示该轨迹对学生模型越有价值(即“学习潜力”越高)
- 为避免偏差
- 在特定长度桶内进行优先级排序,并过滤异常短或分数极高的离群轨迹
- 最后混合各领域数据构建蒸馏数据集
- 理解:因为负号的存在,所以 学生模型对标准答案 \(y\) 的 “惊讶程度”
- 对数似然(\(\log \pi\)) :如果学生模型非常确信 正确 Token 是 \(y_t\),它会赋予 \(y_t\) 一个很高的概率(接近 1),此时 \(\log \pi \approx 0\)
- 负对数似然(\(-\log \pi\)) :将上述值取反
- 如果学生模型很确定,该值就很小(接近 0)
- 如果学生模型很不确定(概率很低,如 0.01),则 \(-\log \pi\) 就会很大
- 计算每个正确轨迹在学生模型下的长度归一化负对数似然(Negative Log-Likelihood, NLL):
Instruct RL
- 目标:将推理增强的模型转化为可靠的、面向用户的对话模型
- 训练数据:包含格式敏感提示、长上下文指令和通用对齐样本的混合指令数据集
- 奖励计算:
- 对于有明确约束的样本(如格式、顺序、关键词),使用基于规则的验证器 计算奖励
- 对于开放式提示,使用基于 Rubric 的奖励模型 评估帮助性、连贯性和指令遵循度
- 通过在同一 On-policy RL 框架下结合规则检查和基于 Rubric 的奖励,Instruct RL 在强化严格可控性的同时,保留了前一阶段获得的推理能力
- 注:这是在 VibeThinker-1.5B 中没有的流程,VibeThinker-1.5B 中,只训练了 Math 和 Code
Evaluation
评估设置
- Benchmarks :
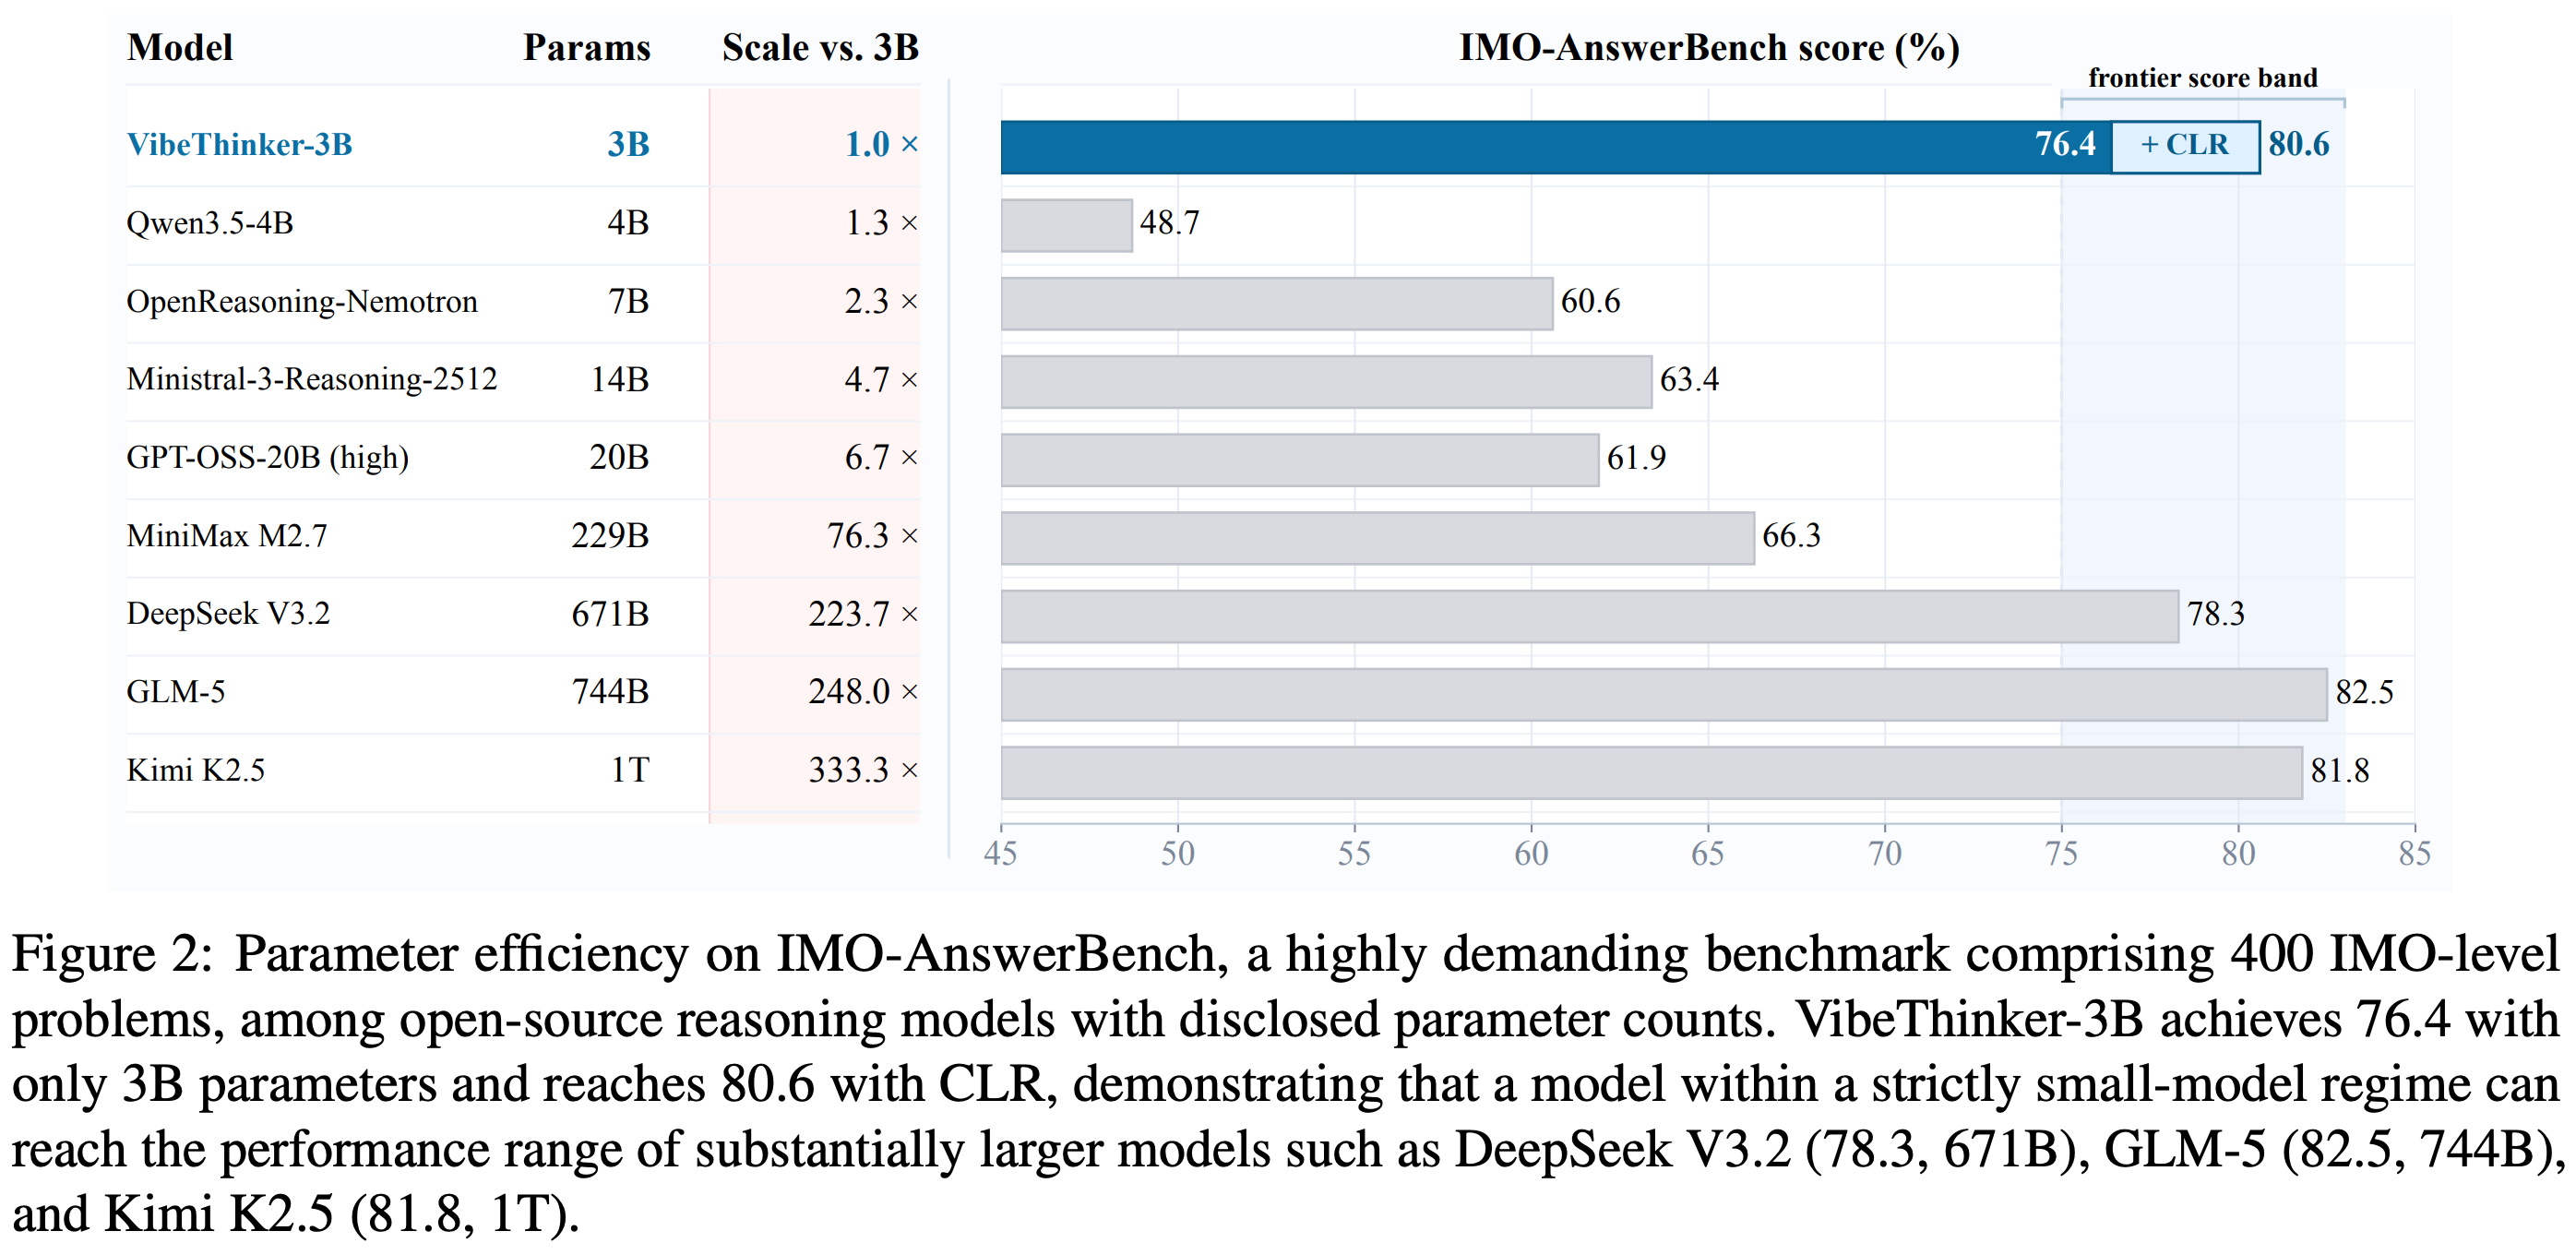
- 数学 :AIME25, AIME26, HMMT25, BruMO25, IMO-AnswerBench
- 代码 :LiveCodeBench v6, OJBench, 以及最新的 LeetCode 周赛/双周赛(作为OOD泛化测试)
- 知识/指令 :GPQA-Diamond(科学推理), IFEval, IFBench(指令遵循)
- 评估协议 :
- 使用 vLLM,温度1.0,不设额外输出长度上限
- 数学任务采用“数学验证 + LLM-as-judge” 联合评估
- 报告多次独立生成的平均 Pass@1
论文新增了一个增强那个模型能力的方式:CLR
- CLR 是一种测试时增强策略 ,不更新模型参数,仅在推理阶段使用
- CLR 的核心逻辑是:不验证整条推理链,只验证链上几个关键声明,用声明通过率来评估整条轨迹的可靠性
- CLR = 生成 32 条轨迹 → 每条抽 5 个关键声明 → 模型自验证每个声明 → 用通过率的 5 次方作为轨迹权重 → 按权重投票选最终答案
- 测试时缩放:声明级可靠性评估(Claim-Level Reliability Assessment, CLR) :
- 核心思想 :不同于聚合整个推理轨迹,CLR 聚焦于影响关键决策的“声明”(Claims)
- 流程 :
- 1)生成 \(K=32\) 条候选轨迹,对每条提取 \(M=5\) 个决策相关声明和最终答案
- 2)模型作为自我验证器(Self-verifier),对每个声明给出二元判定
$$ v_{k,m} \in \{0,1\} $$ - 3)计算非线性轨迹级可靠性分数:
$$r_k = \left(\frac{1}{M}\sum_{m=1}^{M}v_{k,m}\right)^M$$- 若任一声明被证伪,分数将锐减
- 4)将候选答案按等价性聚类,选择可靠性加权聚合得分最高的答案:
$$\text{Score}(G) = \sum_{\{k|v_k\in G\} }r_k$$
- 优势 :隔离关键逻辑锚点,显著减少长轨迹中的噪声,并降低 Token 消耗
- CLR(声明级可靠性评估)的完整流程
- 第一步:生成候选轨迹
- 对每个问题,模型独立采样生成 K = 32 条完整的推理轨迹
- 第二步:提取关键声明
- 从每条轨迹的推理链中,提取 M = 5 个决策相关的关键声明(Claims)
- 这些声明由模型自己抽取,筛选标准有两条:
- 对最终答案的推导具有决定性影响
- 逻辑上可被独立判定为真或假
- 一个声明的典型示例是:”根据均值不等式,\(a + b \geq 2\sqrt{ab}\)”
- 声明不包含最终答案本身,只包含推导过程中的中间结论
- 第三步:自我验证声明
- 模型把自己当作验证器,对提取出的每一个声明进行二元判定:
$$
v_{k,m} \in \{0, 1\}
$$- \(k\) 表示第几条轨迹
- \(m\) 表示该轨迹中的第几个声明
- \(v_{k,m} = 1\) 表示模型判断该声明为真
- \(v_{k,m} = 0\) 表示为假
- 这个过程本质上是让模型”检查自己的作业”:对每个关键中间结论,追问一句”这个推导对吗?”
- 模型把自己当作验证器,对提取出的每一个声明进行二元判定:
- 第四步:计算轨迹级可靠性分数
- 对于第 \(k\) 条轨迹,先计算其声明的平均通过率:
$$
\frac{1}{M} \sum_{m=1}^{M} v_{k,m}
$$ - 然后将其取 \(M\) 次方,得到该轨迹的可靠性分数:
$$
r_k = \left( \frac{1}{M} \sum_{m=1}^{M} v_{k,m} \right)^M
$$ - 论文中 \(M = 5\),这个非线性映射的效果是:
- 5 个声明全部通过时 \(r_k = 1.0\)
- 只要有 1 个声明未通过(通过率 80%),\(r_k\) 就暴跌至 0.328
- 通过率 60% 时 \(r_k\) 仅剩 0.078
- 注:这实现了论文中所说的 “对含有缺陷中间逻辑的轨迹进行重罚”
- 对于第 \(k\) 条轨迹,先计算其声明的平均通过率:
- 第五步:可靠性加权投票聚合
- 将所有 \(K = 32\) 条轨迹按最终答案的等价性进行聚类
- 例如 “\(x = 3\)” 和 “\(x = 3.0\)” 视为同一答案组
- 对每个答案组 \(G\),其最终得分为该组内所有轨迹的可靠性分数之和:
$$
\text{Score}(G) = \sum_{\{k \mid v_k \in G\} } r_k
$$ - 最后选择 Score 最高的答案组 作为该问题的最终输出
- 将所有 \(K = 32\) 条轨迹按最终答案的等价性进行聚类
- 第一步:生成候选轨迹
评估结果分析
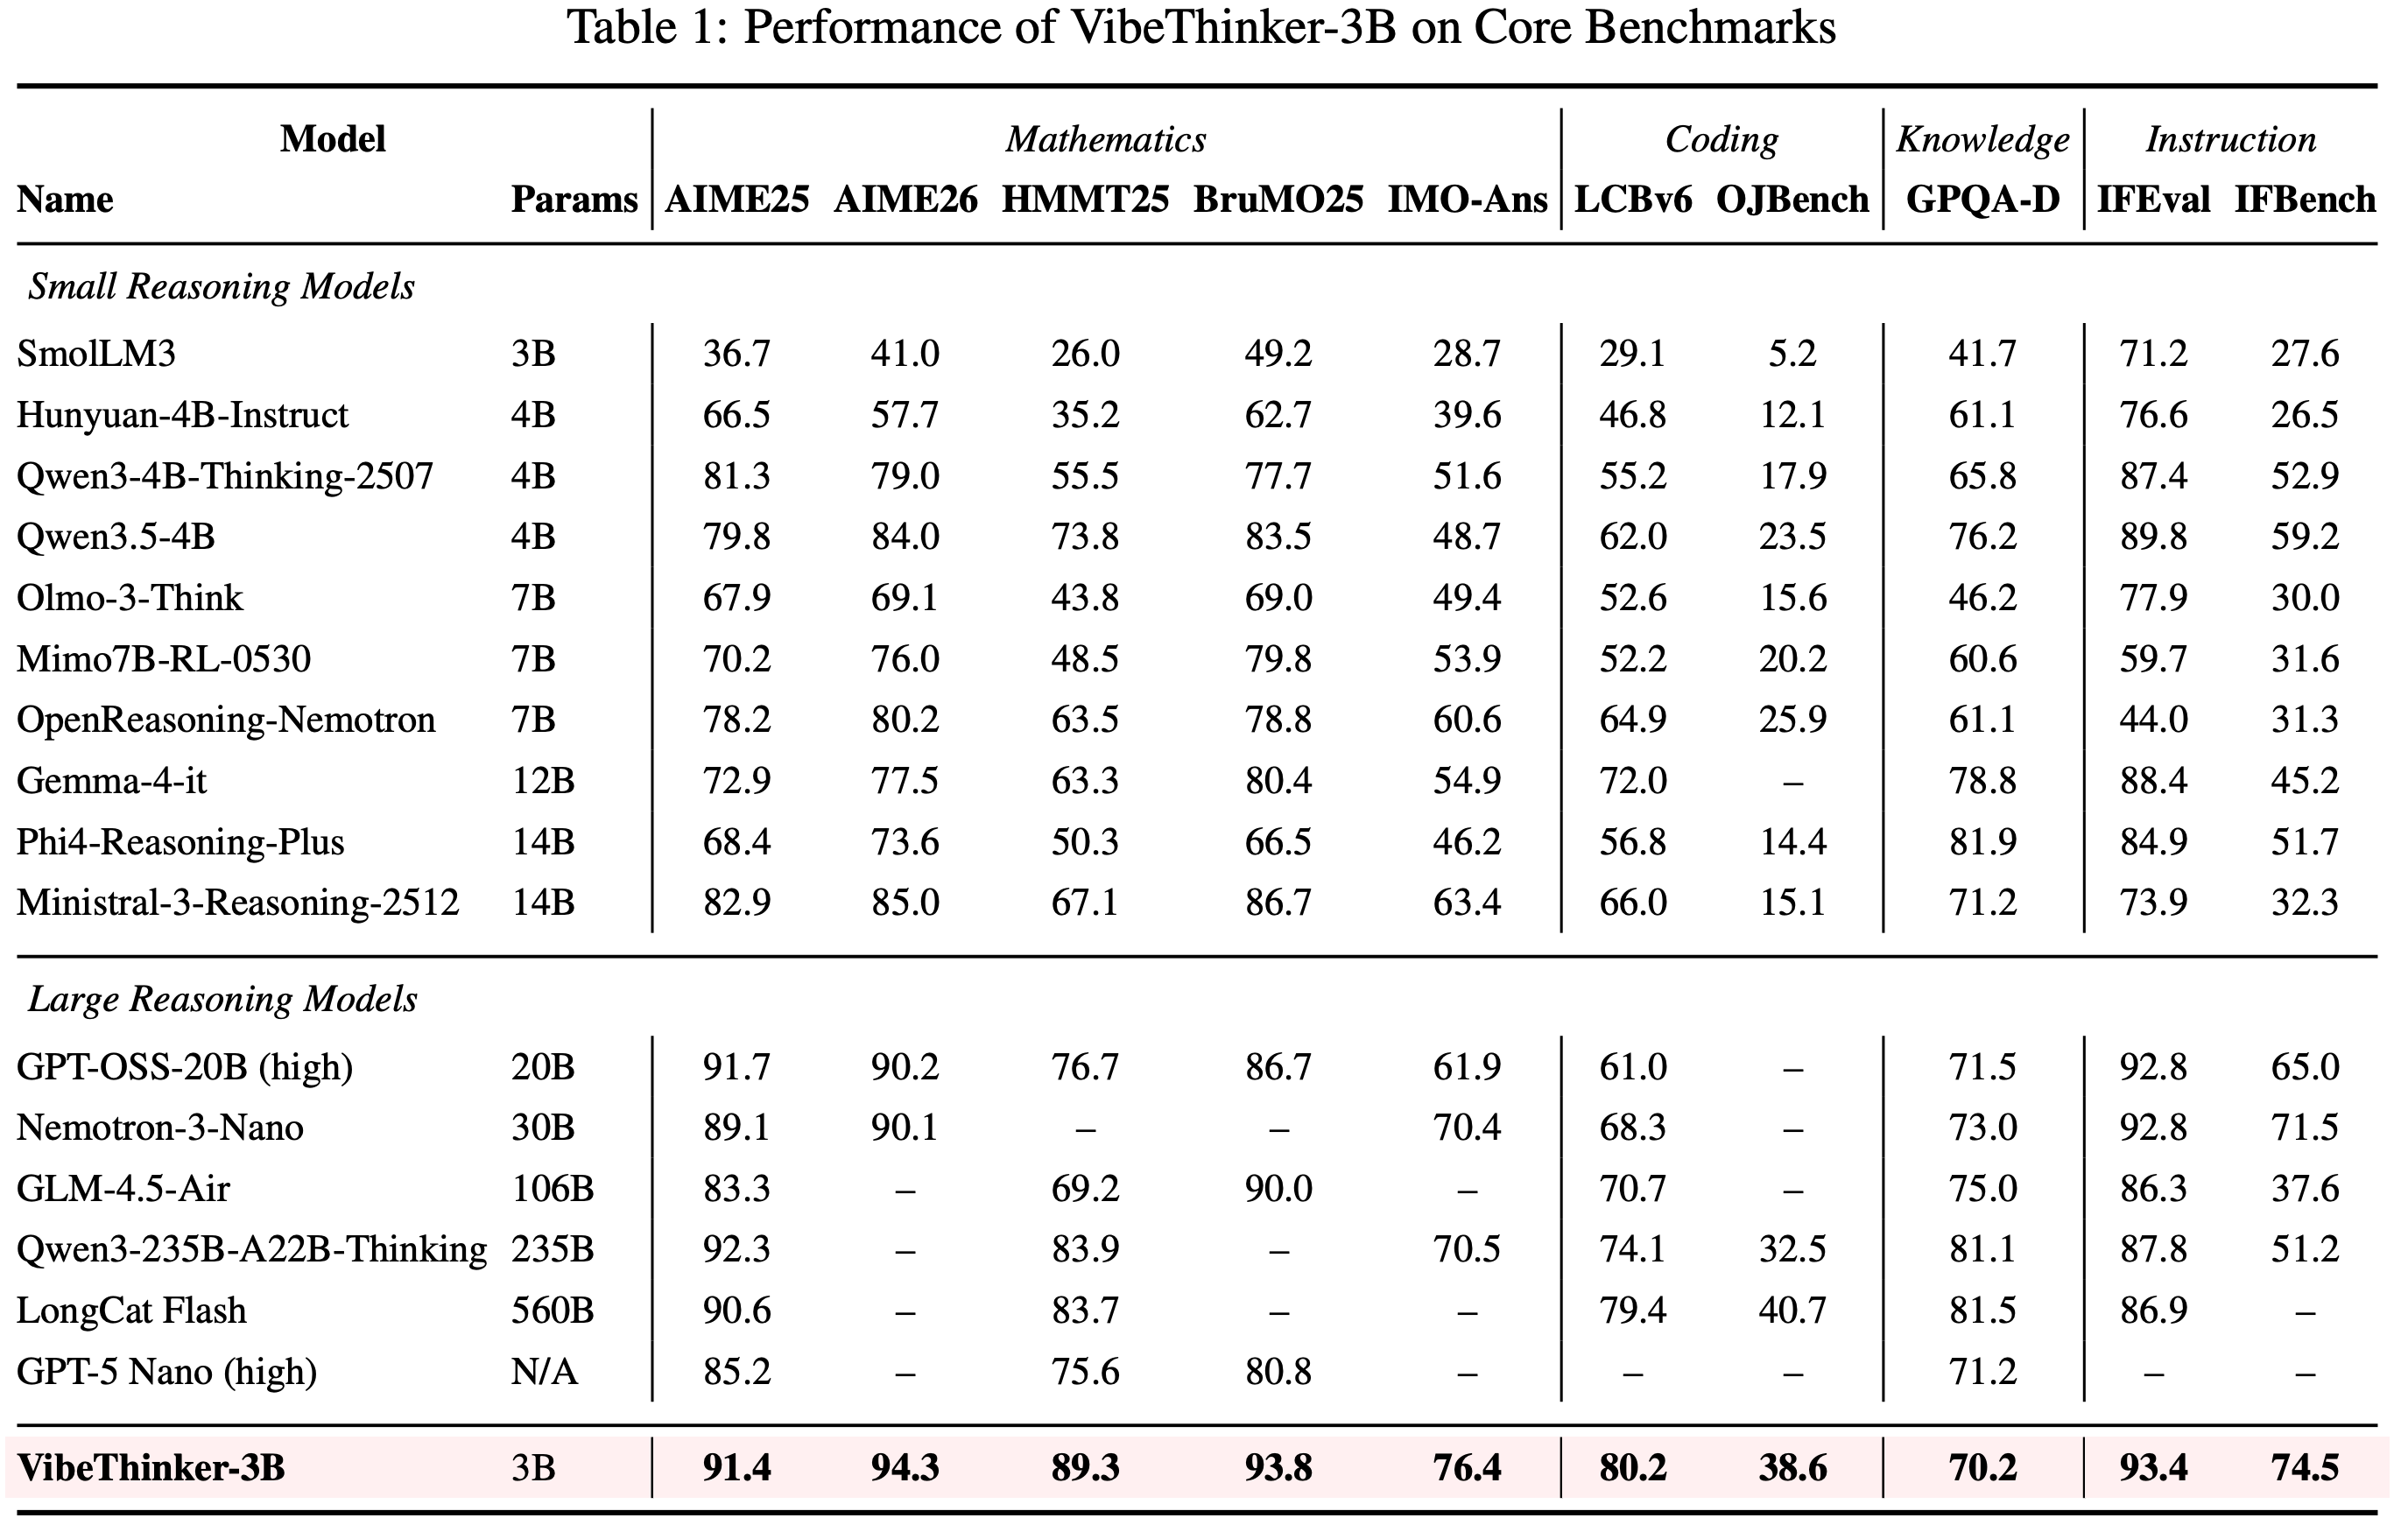
- 1)核心基准性能(表 1) :
- 在与小型和中型推理模型(<14B)的比较中,VibeThinker-3B 在所有数学基准上建立了显著的性能领先优势
- 在 LiveCodeBench v6 上(80.2分)超越了所有对比的小型模型,甚至在代码任务上超过了许多更大的模型
- 在 IFEval (93.4) 和 IFBench (74.5) 上的高分表明,极致的推理优化并未牺牲指令遵循的可控性
- 2)与顶级推理模型对比(表 2) :
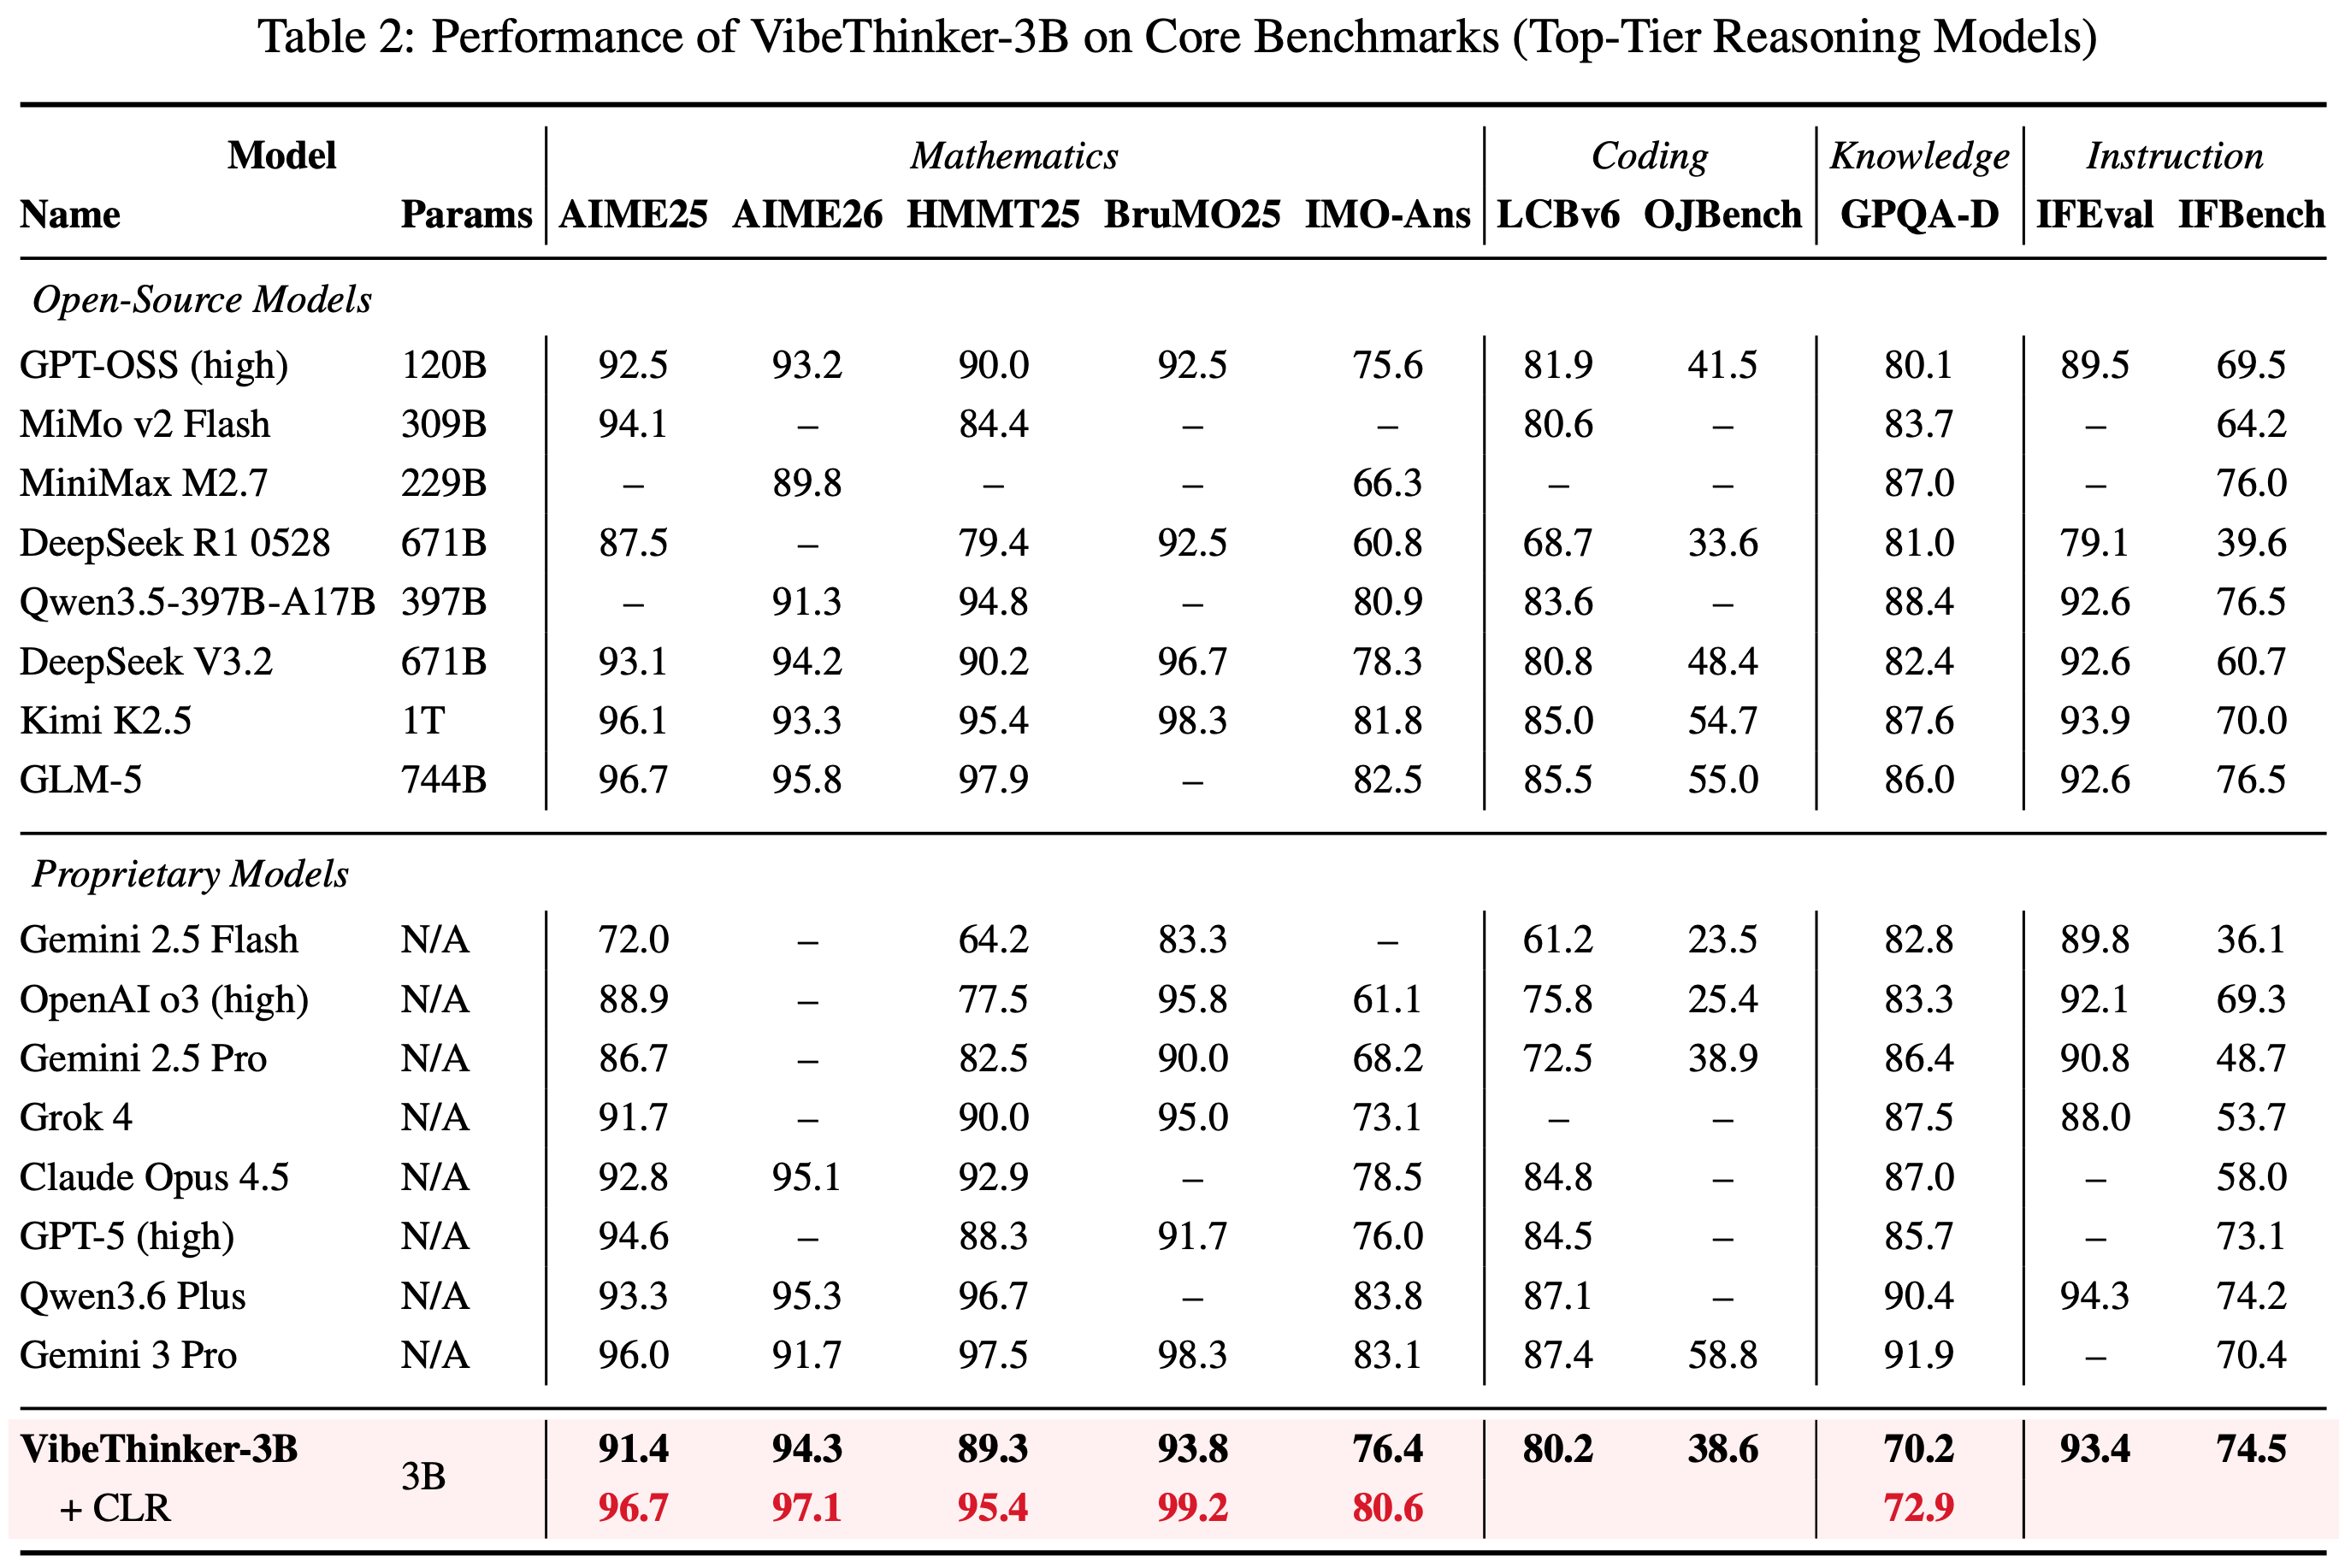
- 关键发现 :不使用 CLR 时,VibeThinker-3B 在 AIME26 (94.3) 上已与 DeepSeek V3.2 (671B) 和 Kimi K2.5 (1T) 相当
- 使用CLR后 ,模型在 AIME25/26、HMMT25、BruMO25 和 IMO-AnswerBench 上进入顶级模型集群,匹配或超越了 GLM-5、Gemini 3 Pro 等旗舰模型
- 边界揭示 :在知识密集型基准 GPQA-Diamond 上,即便使用 CLR(72.9分),VibeThinker-3B 仍与最强的超大模型存在明显差距
- 这完美印证了“推理-知识解耦”假说:小模型可以拥有强大的推理引擎,但广阔的知识覆盖仍依赖于参数规模
- 这完美印证了“推理-知识解耦”假说:小模型可以拥有强大的推理引擎,但广阔的知识覆盖仍依赖于参数规模
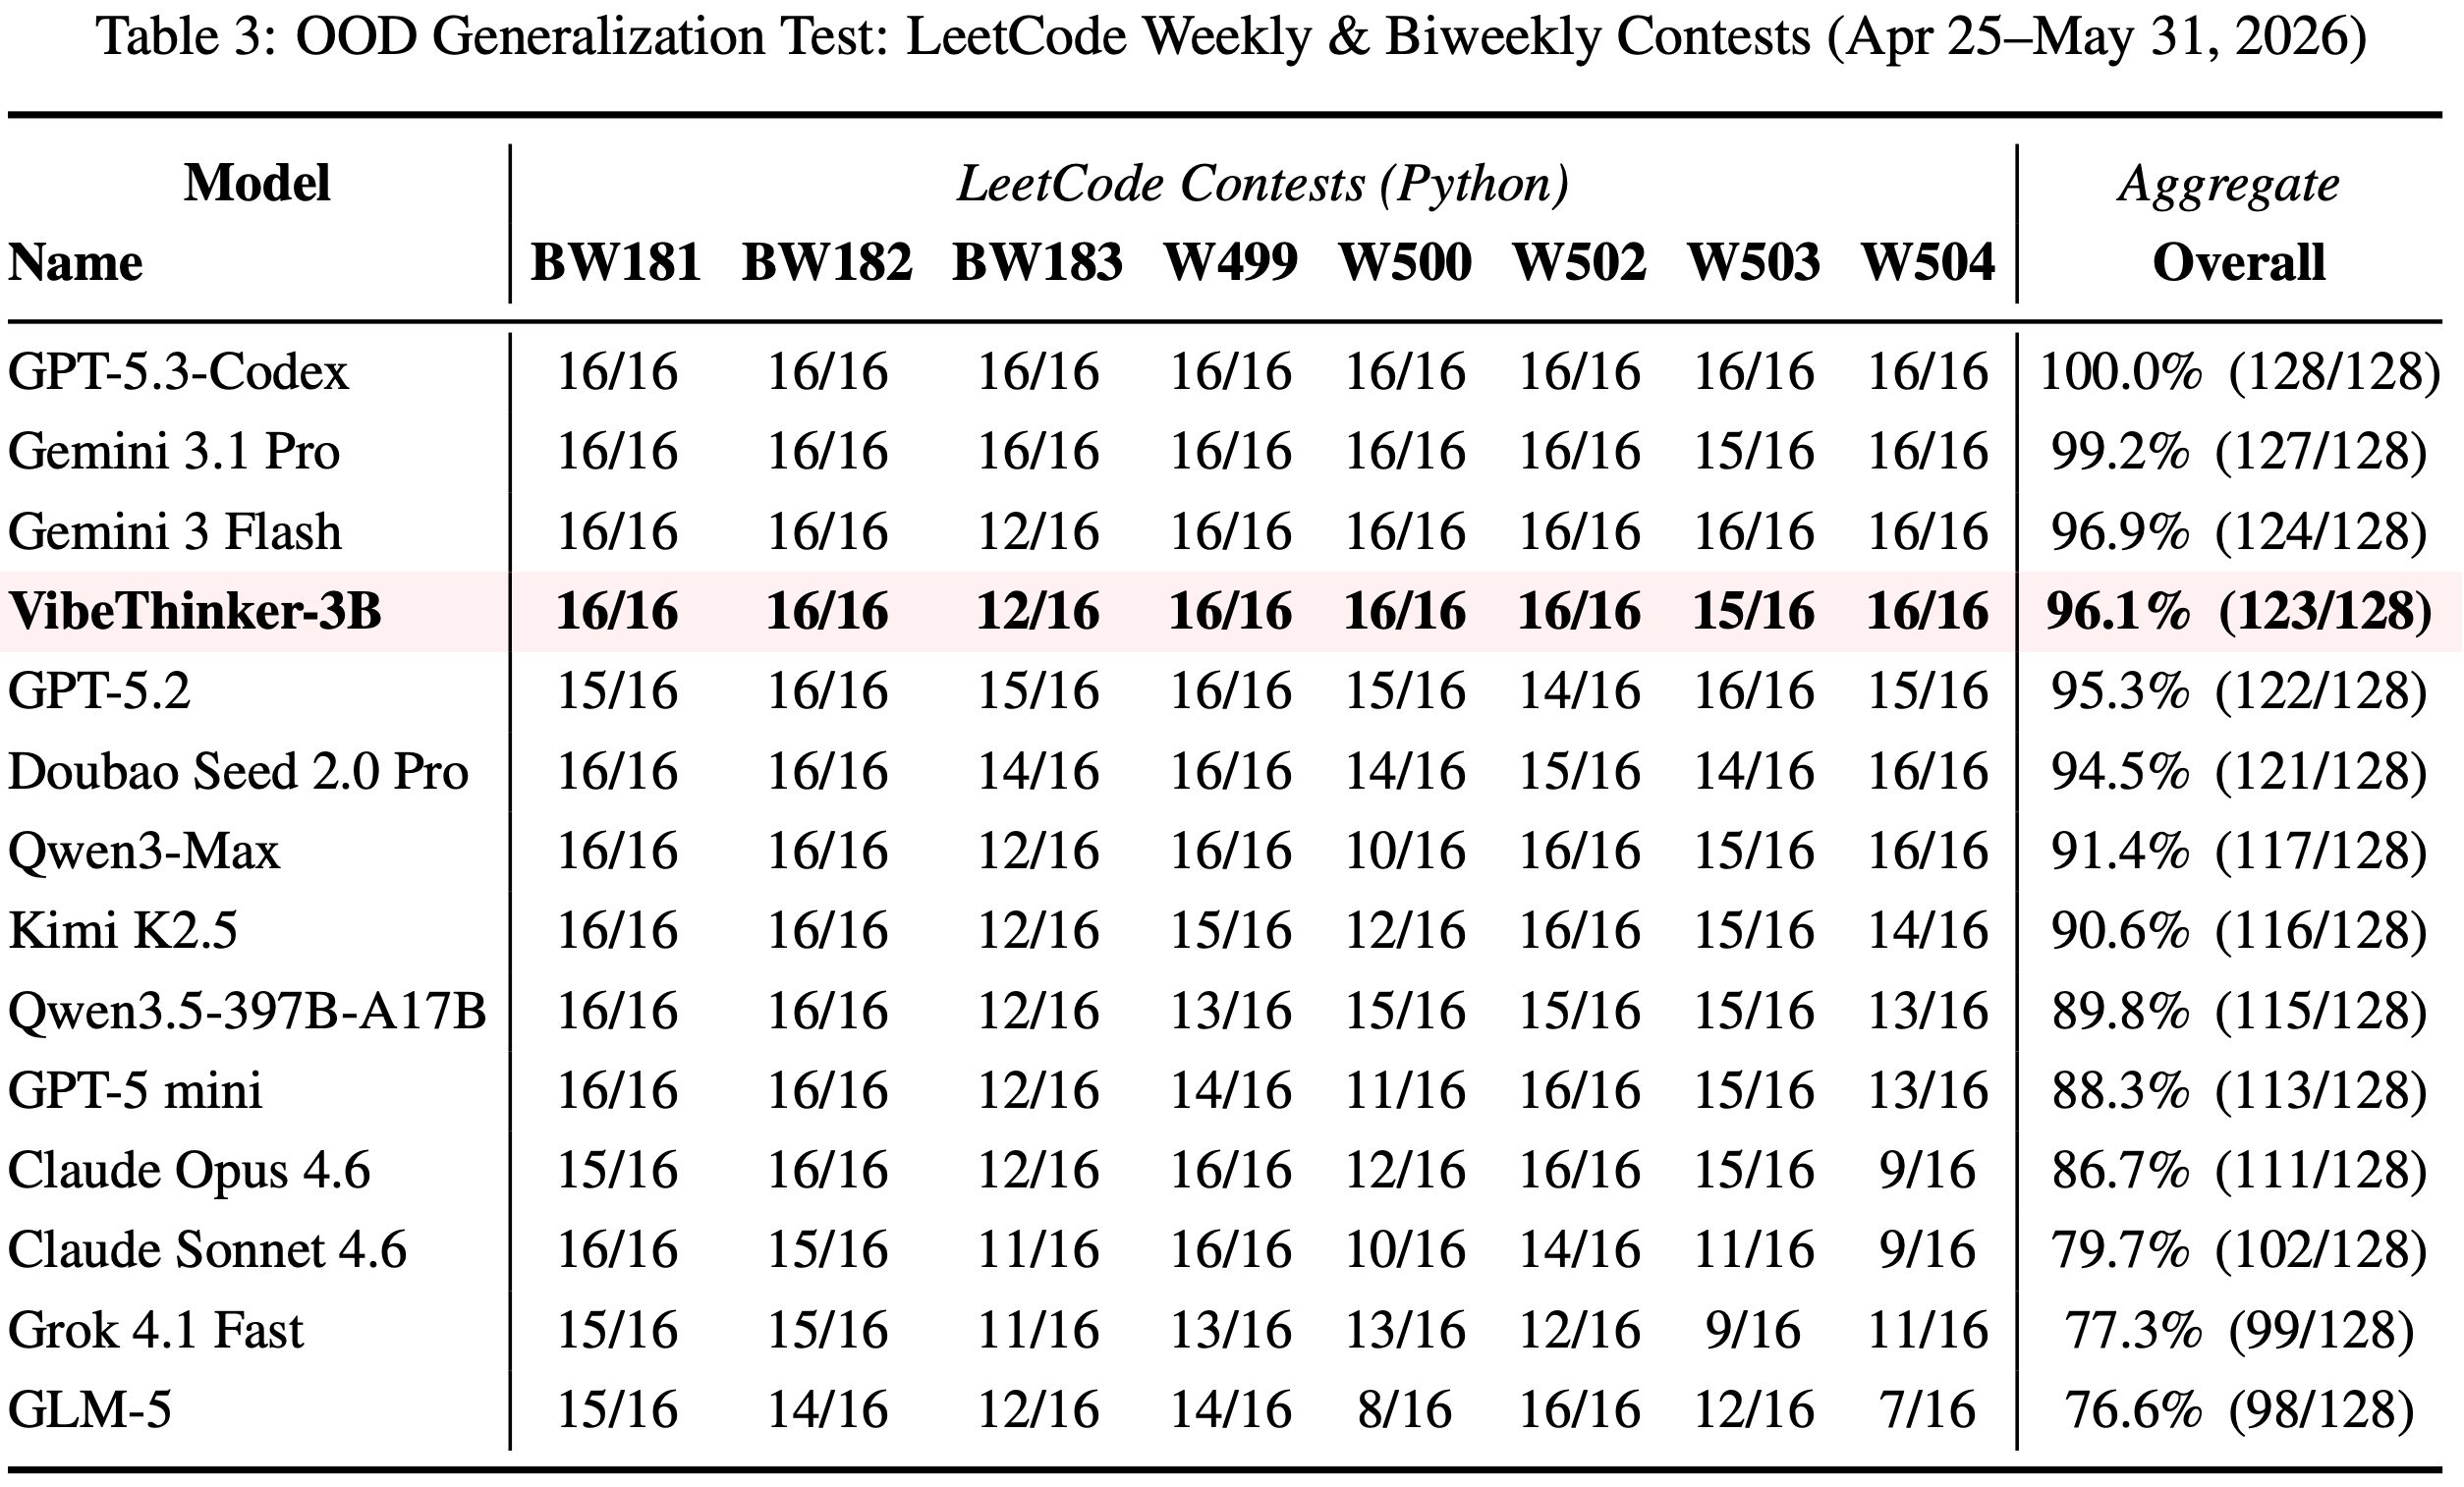
- 3)OOD 泛化测试:LeetCode 最新竞赛(表 3) :
- 在 2026年4月-5月 的 8 场竞赛(共 128 道 Python 题)中,VibeThinker-3B 首次提交通过 123 题,总体通过率 96.1%
- 该成绩超过了 GPT-5.2、Kimi K2.5 和 Claude Opus 4.6,仅次于最强的 Gemini 3.1 Pro 和 GPT-5.3-Codex
- 这证明了模型在处理全新、未见过的算法问题时具有强大的泛化能力