注:本文包含 AI 辅助创作
Paper Summary
- 整体总结:
- 本文将小米之前技术报告中的 MOPD 方法单独拎出来讲了一遍,新东西不多,但是补充了一些实验再次验证了一些认知
- 同源教师效果更好(同一个基座,也是 Student)
- Policy-Gradient 和 Top-k 方法效果相似
- 创新思路:多次迭代 MOPD(在 第一次 MOPD 的基础上进行 RL 和 第二次 MOPD)
- 背景 & 讨论
- LLM 在后训练阶段依赖强化学习来提升特定能力,但将多种能力集成到一个模型中仍然很困难
- Off-Policy Finetune 和 Mix-RL,要么效率低下,要么性能损失
- MOPD (Multi-Teacher On-Policy Distillation) 在策略空间中进行多领域能力整合:
- 学生从自身的 Rollout 中采样,每个 Prompt 被路由到对应的冻结的领域教师,然后教师在每个位置提供密集的、Token 级的对数概率信号
- 消除了 Exposure bias 并提供了密集的优化信号
- 本文实验在 Qwen3-30B-A3B 上,MOPD 优于 Mix-RL、Cascade RL、Off-Policy Finetune 和 Param-Merge 基线
- 领先次优整合方法 5.5 个归一化分数点,同时在每个领域都 Closes 了 91–95% 的学生-教师提升空间
- 在 MiMo-V2-Flash 上,相同的流程在大多数基准上都达到或超过了相应的教师
- 注:MOPD 已部署在工业级前沿模型 MiMo-V2-Flash 的后训练中
- 本文认知:
- Policy-Gradient 和 Top-\(k\) 两种损失形式表现相当
- 同源教师对于稳定优化至关重要
- MOPD Pipeline 支持多轮的学生-教师演化
- 注:MOPD 还支持领域教师的并行、独立开发,消除了多领域后训练中典型的跨领域耦合
- 本文将小米之前技术报告中的 MOPD 方法单独拎出来讲了一遍,新东西不多,但是补充了一些实验再次验证了一些认知
Introduction and Discussion
- LLM RL 的不同的任务领域依赖不同的 RL 流程
- 数学推理现在使用 RLVR (2025; 2024)
- 软件工程使用可在沙盒环境中执行的 Agent 风格 RL (2025; 2025)
- 指令遵循和创意写作使用 Rule-based RL (2022)
- 面向搜索的 Agent 使用 Web 环境 RL (2025; 2022)
- 每个流程都能可靠地提升模型在其目标领域上的能力,但最终想要的是一个在所有领域都能表现良好的单一模型
- 先前解决这一能力集成问题的方法分为四个系列 (表 1)
- (1) Mix-RL (2025) 将来自每个领域的 Prompt 汇集到一个数据集中并运行联合 RL,但跨领域的训练信号会相互干扰,产生跷跷板效应 (see-saw effect) (2020),使得联合模型低于各个领域的教师模型
- (2) Cascade RL (2026) 按顺序训练各个领域,因此早期阶段的能力可能会随着后期阶段的进行而衰减,并且较长的整体运行时间会放大稳定性风险
- (3) Off-Policy Finetune (2025) 训练每个领域的 RL 教师,然后通过 SFT 在学生模型上对其 Rollout 进行微调
- 这种离策略监督引入了经典的 Exposure bias (2016)
- (4) Param-Merge (2023; 2022) 在权重空间中对教师权重进行平均或组合任务向量,但融合后的模型通常不稳定,且无法匹配所有教师的全部能力
- 总结:这些方法在学习效率、可达到的峰值性能和训练稳定性之间进行权衡,没有留下一个令人满意的中间地带
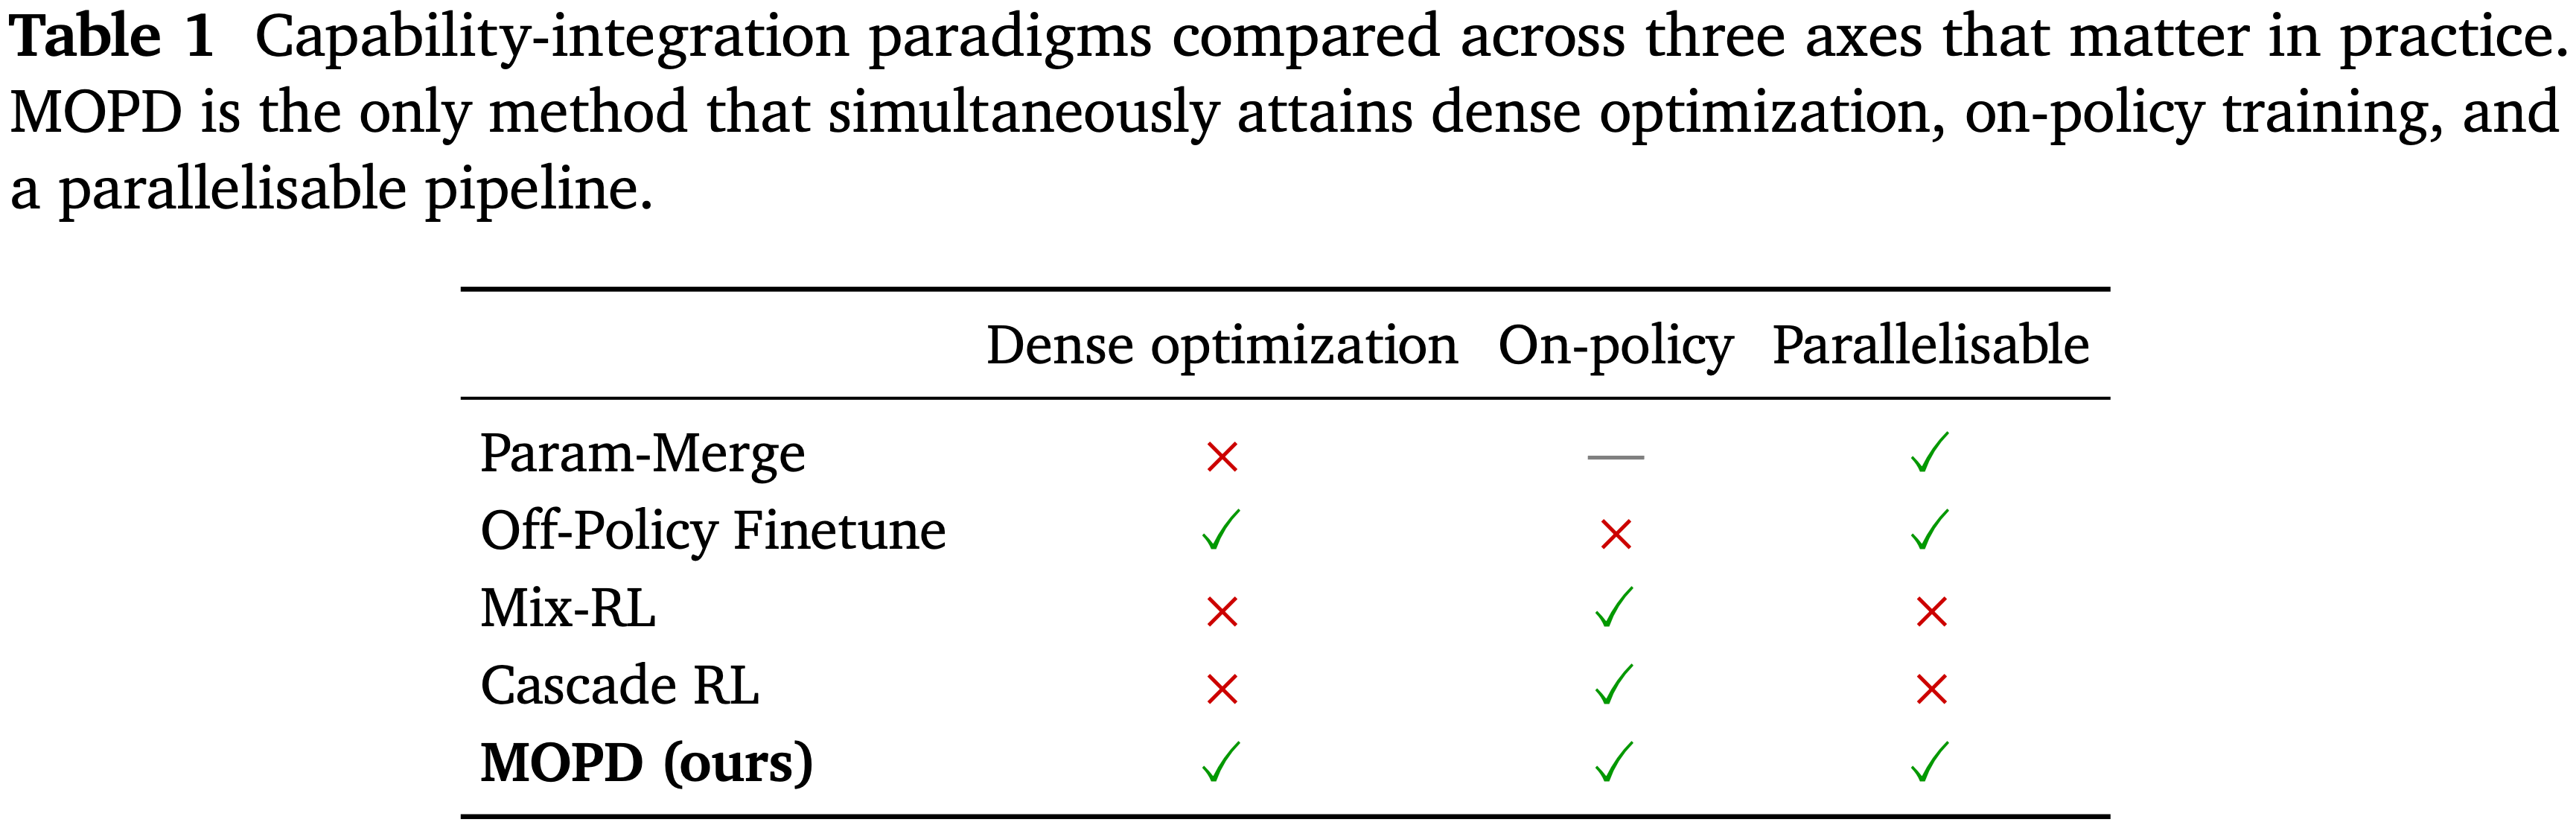
- MODP 在策略空间 (policy space) 而非权重空间或静态数据集空间中执行多教师能力集成
- MOPD 首先在每个领域独立进行专门的 RL,以获得一组强大的领域教师
- 然后,通过 OPD (2024; 2026; 2015) 将这些教师的能力蒸馏到单个学生模型中
- 这种设计有三个结构性的好处:
- (1) 训练信号是密集的,且直接来自每个专门的教师,因此学生继承了每位教师的大部分能力
- (2) 训练完全基于学生自身的 Rollout 分布进行,这从根本上消除了 Exposure bias
- (3) 能力集成是通过每个 Prompt 路由在策略空间中实现的,而不是通过权重空间融合,从而产生明显更稳定的过程
- 本文在两个不同规模和架构的基础模型上实证验证了 MOPD
- 在 Qwen3-30B-A3B (2025) 上
- 在三个领域 (数学、指令遵循和软件工程 (2024; OpenAI, 2024)) 比较了 Mix-RL、Cascade RL、Off-Policy Finetune、Param-Merge 和 MOPD
- MOPD 在标准化分数上领先最强的基线 5.5 分 (0.937 vs. 0.882)
- 在工业级模型 MiMo-V2-Flash (2026) 上,展示了实际有效性
- 本文进一步的分析验证了 top-\(k\) 蒸馏实例化,确认了同源教师 (same-origin teachers) 对于稳定优化至关重要 ,并展示了多轮迭代优化的益处
- 在 Qwen3-30B-A3B (2025) 上
Related Work
Reinforcement learning for LLM
- 在 RLVR 中,PPO 风格 (2017) 和 GRPO 风格 (2024) 的结果奖励优化已成为标准做法
- 这些 RL 流程涵盖了多样的任务领域,包括数学推理 (2025; 2024)、软件工程 (2025; 2025)、指令遵循和创意写作 (2022) 以及搜索 Agent (2025; 2022)
- 每个这样的流程都会产生一个强大的领域专家,将它们整合到一个模型中自然会引出多领域/多任务的问题
- 已有工作主要两条路径:
- Mix-RL (2025),将来自不同领域的样本放入同一个训练批次中 (每个样本仍使用其自身的领域奖励和优势)
- Cascade RL (2026),按顺序训练各个领域
Distillation for LLMs
- 经典蒸馏 (2015; 2016) 在教师补全 (teacher completions) 的固定语料库上最小化前向 KL 散度,因此是 Off-policy 的,所以学生的推理时轨迹可能会偏离训练分布
- On-policy distillation 通过使用教师作为评分信号,在学生自身的 Rollout 上进行训练来解决这个问题,如 MiniLLM (2026) (反向 KL) 和将教师作为奖励的变体 (2024; 2024)
- 但它仅限于单个教师和单个领域
- MOPD 保留了 OPD 的 “学生采样,教师评分” 的模式,并将其扩展到多个、按 Prompt 路由的领域教师,并在生产规模的基础模型上进行了验证
Model merging
- 模型融合在权重空间中融合多个模型检查点,以在无需额外训练的情况下获得组合模型
- Model Soups (2022) 对来自相同初始化的独立微调模型的权重进行平均
- Task arithmetic (2023) 通过在权重空间中加减任务向量来组合能力
- 后续工作通过 TIES-Merging (2023)、DARE (2024) 和 AdaMerging (2024) 缓解了参数冲突
Method
Pipeline
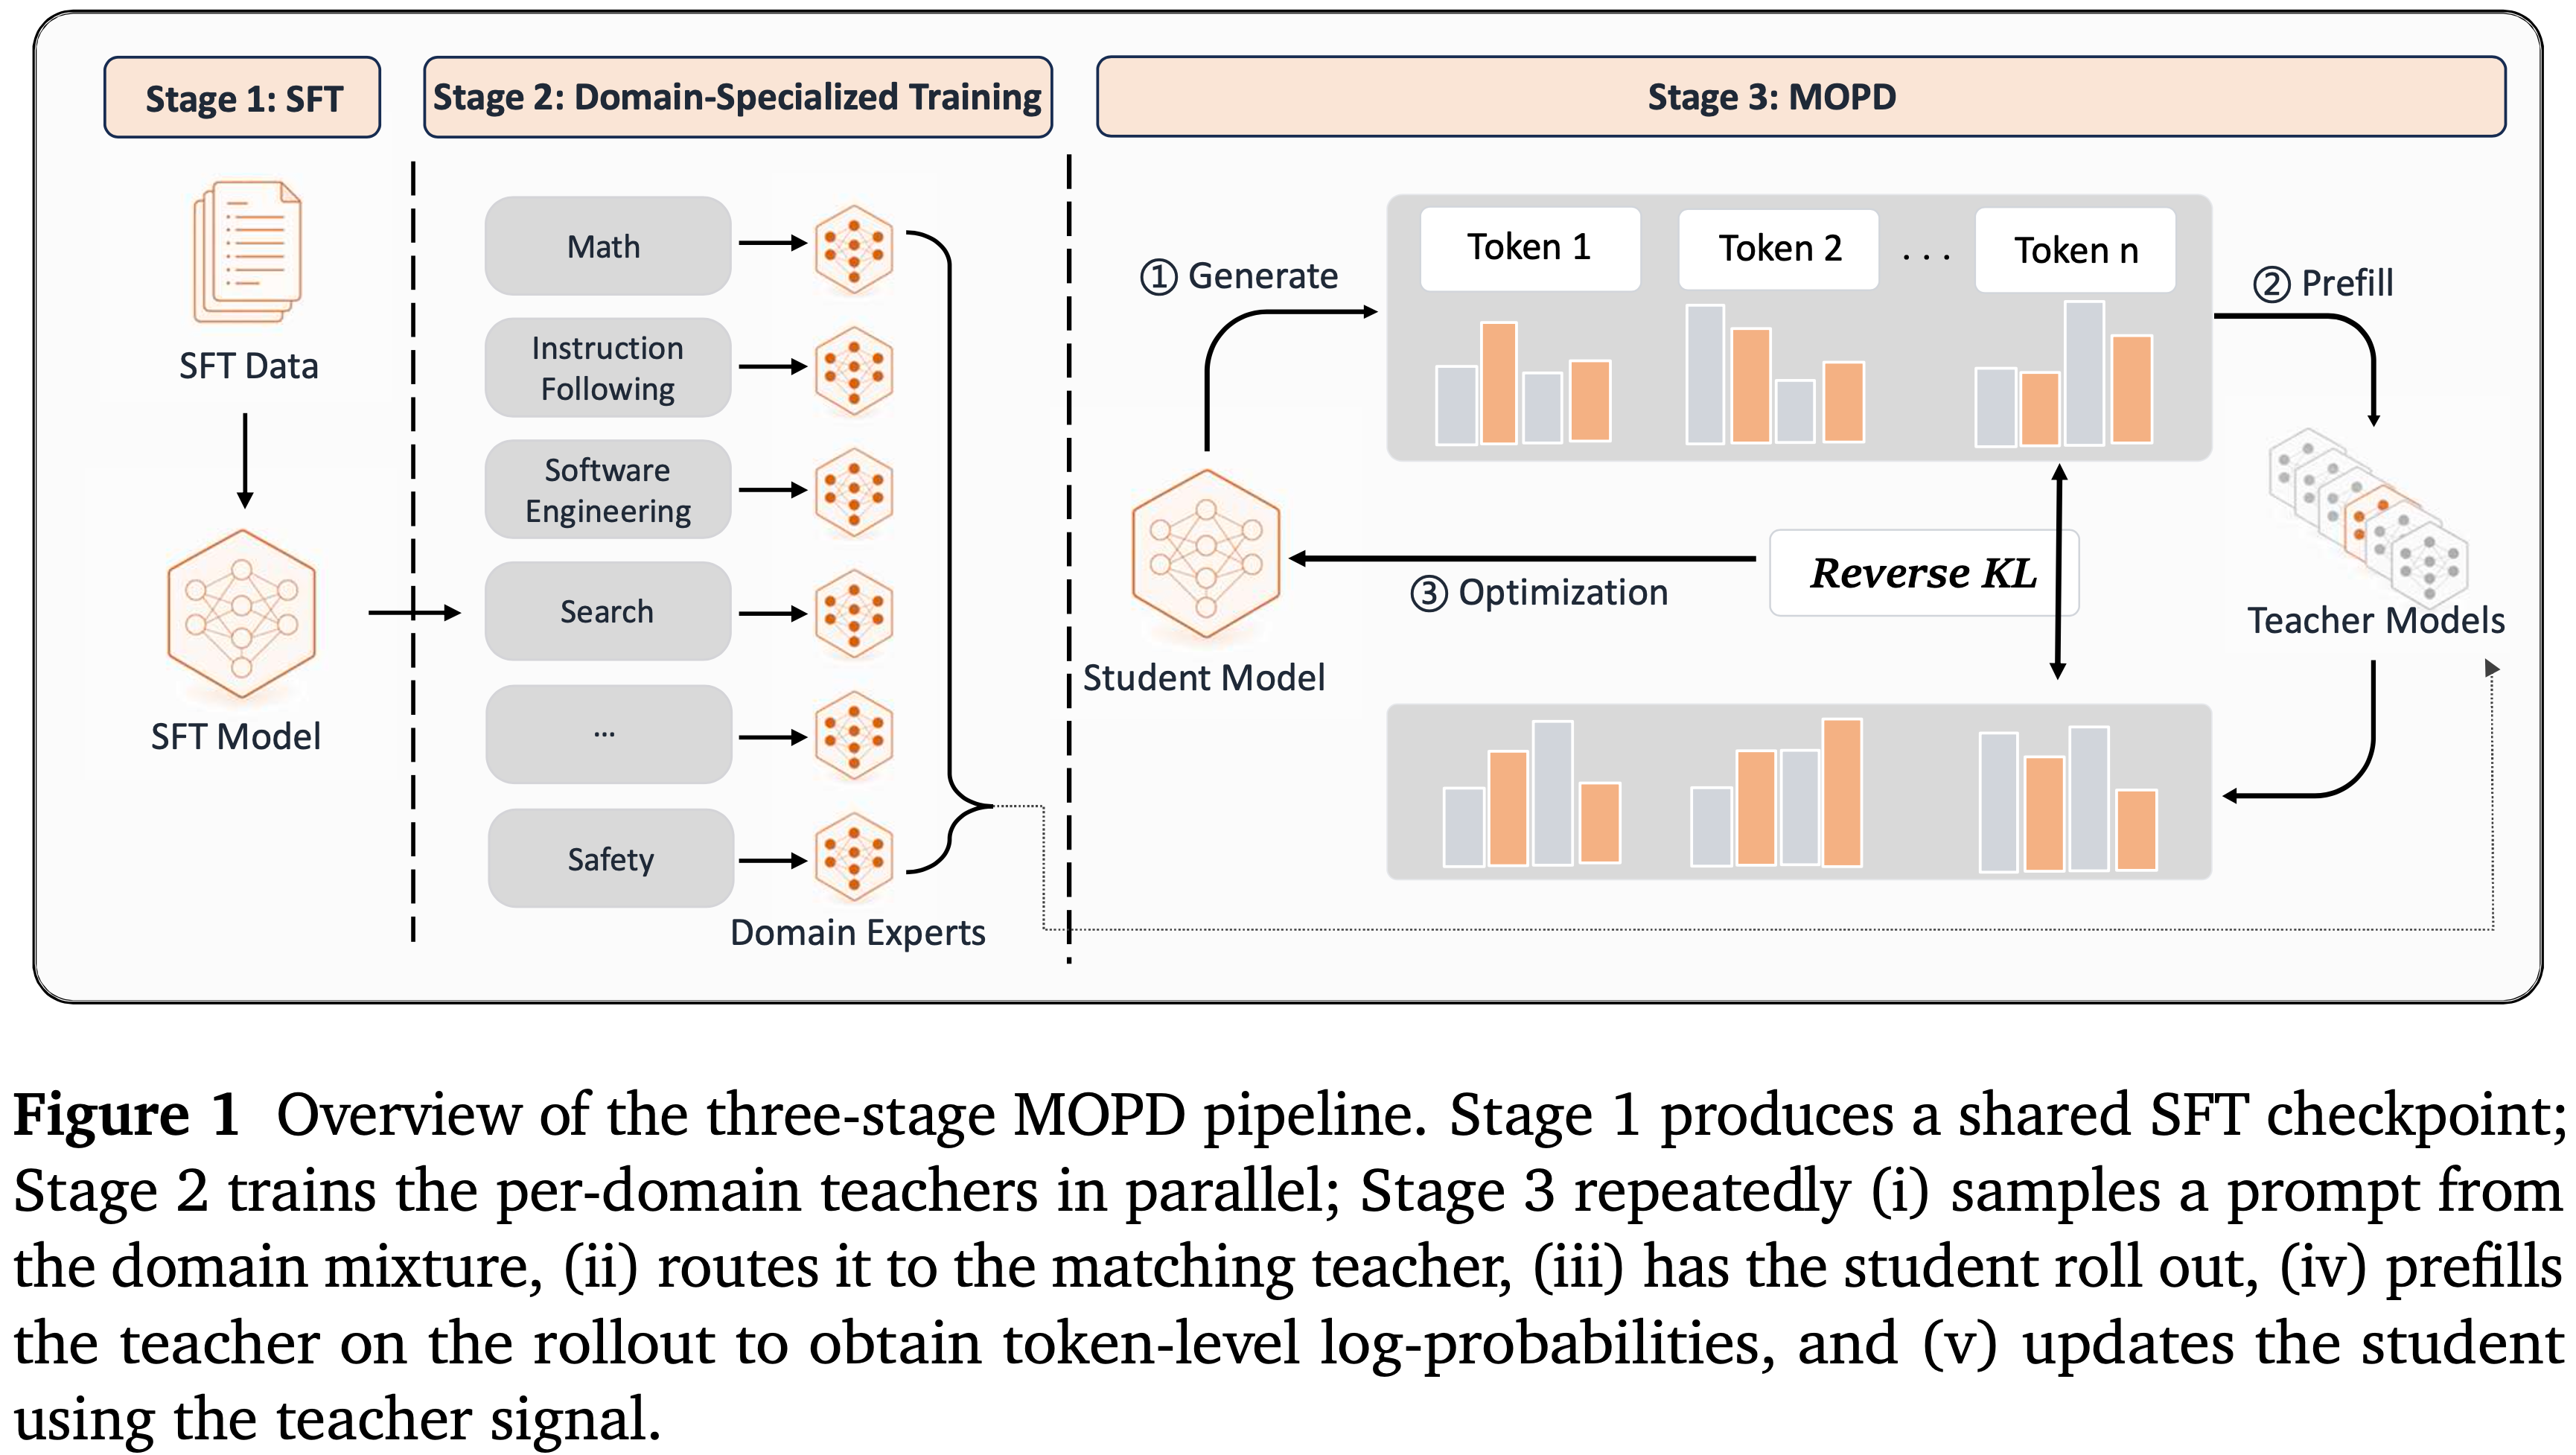
- MOPD 将后训练构建为三个顺序阶段:通用 SFT、领域专用 RL 训练,以及最终的 MOPD 过程,该过程将各个领域的专家融合成一个单一模型 (图 1)
- Stage 1: General SFT
- 首先在涵盖所有基础能力的广泛语料库上微调基础模型,得到一个 SFT 检查点
- 此检查点用作阶段 2 中领域专用 RL 训练的共享初始化,也被用作阶段 3 中 MOPD 学生的初始化
- Stage 2: Domain-specialised RL training
- 在此阶段,对于每个领域 \(d\),从阶段 1 的检查点开始训练一个领域专家 \(\pi_{\phi_d}\)
- 每个专家都使用其领域最自然的 RL 方案进行训练,例如,数学使用 RLVR,软件工程使用可执行沙盒的 Agent RL
- 每个领域的训练是独立的,并且可以完全并行执行
- Stage 3: MOPD
- 学生从阶段 1 的 SFT 检查点初始化,阶段 2 的领域专家 \(\{\pi_{\phi_d}\}\) 被冻结并形成教师组
- 然后在多领域数据集上训练学生,每个优化步骤执行以下操作:
- (1) 从数据集中采样一批 Prompt
- (2) 学生为每个 Prompt 生成一条轨迹,并记录沿该轨迹的每个 Token 的概率分布
- (3) 根据任务的领域,每条轨迹被分派给其对应的领域教师,然后教师对该轨迹进行 Prefill 以获得其每个 Token 的概率分布
- (4) 通过最小化学生与领域教师之间沿轨迹的每个 Token 的反向 KL 散度来更新学生
- 训练结束后,阶段 3 产生一个在所有领域都获得了能力的统一模型
- Stage 1: General SFT
- MOPD 相较于现有能力集成范式具有以下几个结构性优势:
- No exposure bias 学生在自己的 Rollout 上训练,因此训练状态分布与推理状态分布天然匹配
- Dense per-token supervision 教师在轨迹的每个 Token 位置都提供一个概率分布
- 这比标准 RL 中使用的轨迹级别奖励要密集得多,从而降低了方差并提高了样本效率
- Stable integration in policy space 策略空间中的稳定集成(而不是权重空间)
- 通过将每个 Prompt 路由到其匹配的教师来合并能力,而不是通过对教师参数进行平均或任务算术
- 这避免了权重空间融合典型的不稳定性
- Modular and parallel teachers 教师 RL 训练完全并行运行,每位教师都可以使用其自己的超参数配置
- 某位教师 RL 训练中意外失败或超参数调整不会影响其他教师的训练
- Same-origin teacher stability 同源教师稳定性
- 因为每位教师都是通过从初始化学生的同一个 SFT 检查点进行领域专用 RL 训练得到的,所以教师和学生共享一个紧密对齐的策略分布
- 这确保了整个蒸馏过程中初始 KL 散度低且优化平稳稳定
Algorithm
- 在阶段 3,学生针对被分派的教师优化每个 Token 的反向 KL 散度:
$$\mathcal{L}_{\text{rev - KL} } = \mathbb{E}_{x,y\sim \pi_{\theta} }\Big[\frac{1}{|y|}\sum_{t}\sum_{v}\pi_{\theta}(v)\log \frac{\pi_{\theta}(v)}{\pi_{\phi_{d} }(v)}\Big], \tag {1}$$- \(\pi_{\phi_d}\) 是被分派给 Prompt \(x\) 的教师
- \(\pi_{\theta}(v)\) 和 \(\pi_{\phi_d}(v)\) 分别是 \(\pi_{\theta}(v \mid x, y_{< t})\) 和 \(\pi_{\phi_d}(v \mid x, y_{< t})\) 的简写 (下文同样适用此简写)
- 接下来的两个小节给出此目标的两种高效实现
Policy-gradient implementation
- 遵循 MiniLLM (2026),将 MOPD 蒸馏视为一个 RL 过程
- 公式 (1) 的梯度为
$$\nabla_{\theta}\mathcal{L} = -\mathbb{E}_{x,y}\Big[\frac{1}{|y|}\sum_{t}\log \frac{\pi_{\phi_d}(y_t)}{\pi_{\theta}(y_t)}\nabla_{\theta}\log \pi_{\theta}(y_t)\Big], \tag {2}$$- 这正好是策略梯度形式,其中教师-学生对数差充当每个 Token 的优势 (per-token advantage):
$$\hat{A}_{\text{MOPD},t} = \text{sg}\big[\log \pi_{\phi_d}(y_t) - \log \pi_{\theta}(y_t)\big]. \tag {3}$$
- 这正好是策略梯度形式,其中教师-学生对数差充当每个 Token 的优势 (per-token advantage):
- 为了训练稳定性,对优势进行双边截断 (two-side-clip)
$$ \hat{A}_{\text{MOPD},t}^{\text{clip} } = \text{clip}(\hat{A}_{\text{MOPD},t}, - A_{\text{max} }, + A_{\text{max} }) $$ - 得到最终损失
$$\mathcal{L}_{\text{MOPD} }^{\text{PG} }(\theta) = -\mathbb{E}_{x,y}\Big[\frac{1}{|y|}\sum_{t}\hat{A}_{\text{MOPD},t}^{\text{clip} }\log \pi_{\theta}(y_t)\Big]. \tag {4}$$ - 这种形式可以直接放入现有的 PPO/GRPO 训练框架中,唯一的变化是优势计算
Top-\(k\) distillation implementation
- 策略梯度形式仅使用每个 Rollout 位置的单个采样 Token
- 一个方差更低的替代方案是在教师的 top-\(k\) Token 上进行蒸馏 (2024),这利用了更多教师分布的信息,同时保持了实现的简单性
- 令 \(\mathcal{T}_t^{d} = \text{TopK}_k(\pi_{\phi_d}(\cdot \mid x,y_{< t}))\) 为在位置 \(t\) 教师下的 top-\(k\) Token 集合
- 本文使用以下蒸馏损失:
$$\mathcal{L}_{\text{MOPD} }^{\text{TopK} }(\theta) = \mathbb{E}_{x,y}\Big[\frac{1}{|y|}\sum_{t}\sum_{v\in \mathcal{T}_t^{d} }\Big[\pi_{\theta}(v)\log \frac{\pi_{\theta}(v)}{\pi_{\phi_d}(v)} -\pi_{\theta}(v) + \pi_{\phi_d}(v)\Big]\Big], \tag {5}$$- \(\pi_{\theta}(v)\) 和 \(\pi_{\phi_d}(v)\) 都以 \((x,y_{< t})\) 为条件
- 为简洁起见,这里省略了条件
- 在标准的反向 KL 散度之上添加了一个额外的项 \(\pi_{\phi_d}(v) - \pi_{\theta}(v)\)
- 这个附加项用于校正 top-\(k\) 截断引入的偏差,确保在 top-\(k\) Token 上,当 \(\pi_{\theta} = \pi_{\phi_d}\) 时损失达到最小值
- 没有它,朴素的 top-\(k\) 截断反向 KL 散度不具备此性质
- 除了正确性之外,top-\(k\) 形式还减轻了基础设施负担:
- 它将教师的 Prefill 负载保持在足够小的程度,可以像轻量级奖励信号一样传输,这与需要传输每个 Token 的完整词汇表分布的全词汇表蒸馏形成对比
Infrastructure
- 阶段 3 中的额外操作是教师 Prefill:
- 每个学生的 Rollout 都必须通过分派的教师,以获得每个 Token 的对数概率 (或 top-\(k\) logits)
- 一个自然的基线是将教师 Prefill 折叠到 RL 训练循环中,但这会使基础设施复杂化并增加额外的串行延迟
- 观察:教师 Prefill 计算与 RL 中的奖励计算具有相同的性质,因此本文将每个领域教师部署为一个独立的 Prefill 服务,位于 RL 训练器之外
- 运行时的流程如下
- 学生采样器持续生成 Rollout;一旦某个序列的 Rollout 完成,训练器就会向相应的教师服务发送一个异步 Prefill 请求
- 教师服务计算并返回每个 Token 的对数概率
- 因为教师 Prefill 和其他序列的采样在时间上重叠,MOPD 的挂钟时间成本主要由采样决定,而教师的成本基本上隐藏在学生的采样背后
- 在本文的部署中,教师几乎没有带来可测量的挂钟开销
Experiments
- 4.1 - 4.2:将 MOPD 与 Qwen3-30B-A3B 上的四种能力整合范式进行比较
- 4.3:在工业规模的顶尖模型 MiMo-V2-Flash 上对其进行验证
- 4.4:分析
Experimental setup
SFT model
- 初始 checkpoint 是 Qwen3-30B-A3B-Base (2025)
- 为了使其成为 RL 的强起点,在一个覆盖所有目标领域的广泛语料上对其进行了微调
- 所有基线和 MOPD 都从同一个 SFT checkpoint 开始
Tasks and evaluation
- 任务涵盖三个领域:数学 (Math) (在 AIME25 和 AIME26 上评估)、指令遵循 (Instruction Following) (在 IFBench (2025) 和 IFEval (2023) 上评估) 以及软件工程 (Software Engineering) (在 SWE-bench Verified (2024) 上评估)
- 注:训练数据来源和超参数在附录 A 中描述
Baselines
- 比较了五种能力整合范式:
- (i) Mix-RL,在汇集了来自每个领域的 Prompt 的数据集上进行联合 RL
- (ii) Cascade RL,顺序应用各领域 RL,每个阶段都从上一阶段初始化
- (iii) Off-Policy Finetune,在 Stage-2 教师生成的 Rollout 上对学生进行离线 SFT
- (iv) Param-Merge,对 Stage-2 教师进行线性 / 任务算术合并
- (v) MOPD (ours)
Evaluation metric
- 这三个领域的绝对提升空间差异很大,因此原始准确率的平均值会过度加权提升空间更大的领域
- 为了将这些领域放在一个共同的尺度上,报告一个归一化分数
- 令 \(\mathcal{D}\) 表示评估领域的集合
- 对于每个 \(d\in \mathcal{D}\),令 \(s_{d}^{s}\) 为 Stage-1 SFT 学生在那个领域的准确率,\(s_{d}^{t}\) 为对应的 Stage-2 单领域专家 (per-domain specialist) 的准确率
- 对于某个领域准确率为 \(s_{d}\) 的方法,其单领域归一化分数为
$$ \tilde{s}_{d} = (s_{d} - s_{d}^{s}) / (s_{d}^{t} - s_{d}^{s}) $$- 该值在 Stage-1 学生处为 0,在单领域专家教师处为 1
- 本文报告的主要指标是各领域的均匀平均值
$$ \tilde{\tilde{s} } = \frac{1}{|\mathcal{D}|}\sum_{d\in \mathcal{D} }\tilde{s}_{d}$$- 高于 1 的值表示超越了专家教师,低于 0 的值表示相比 Stage-1 学生发生了退化
Main results
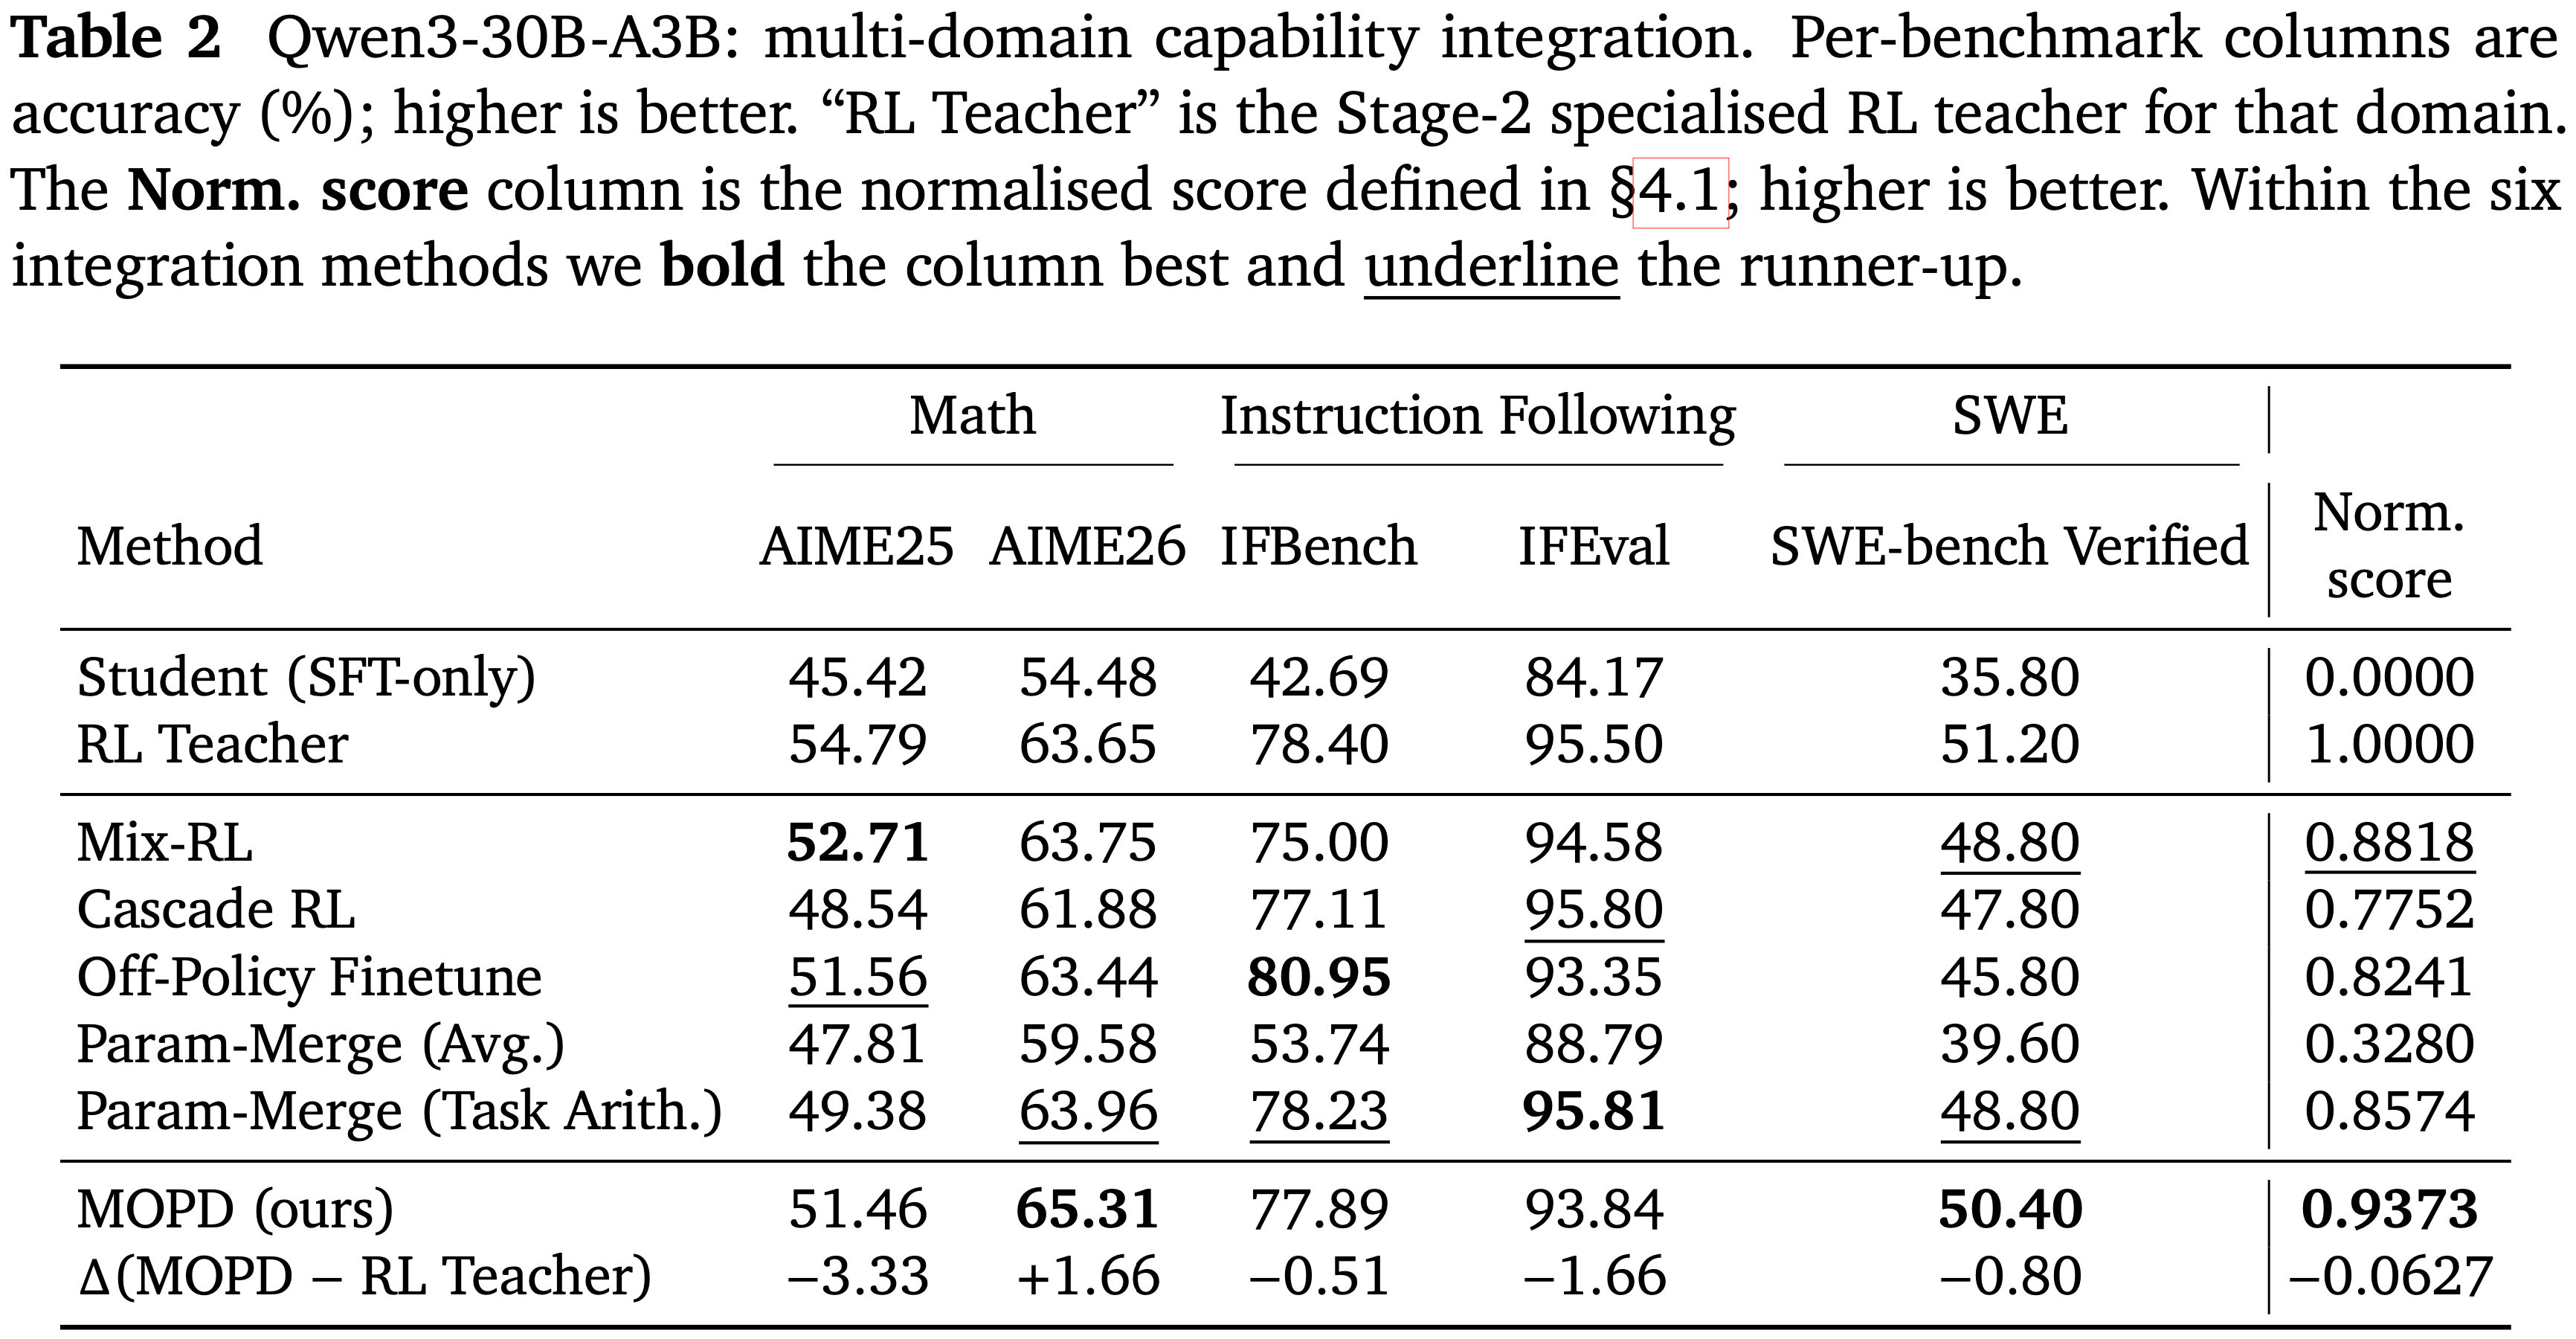
- 表 2 报告了所有三个领域的每个基准准确率和归一化分数
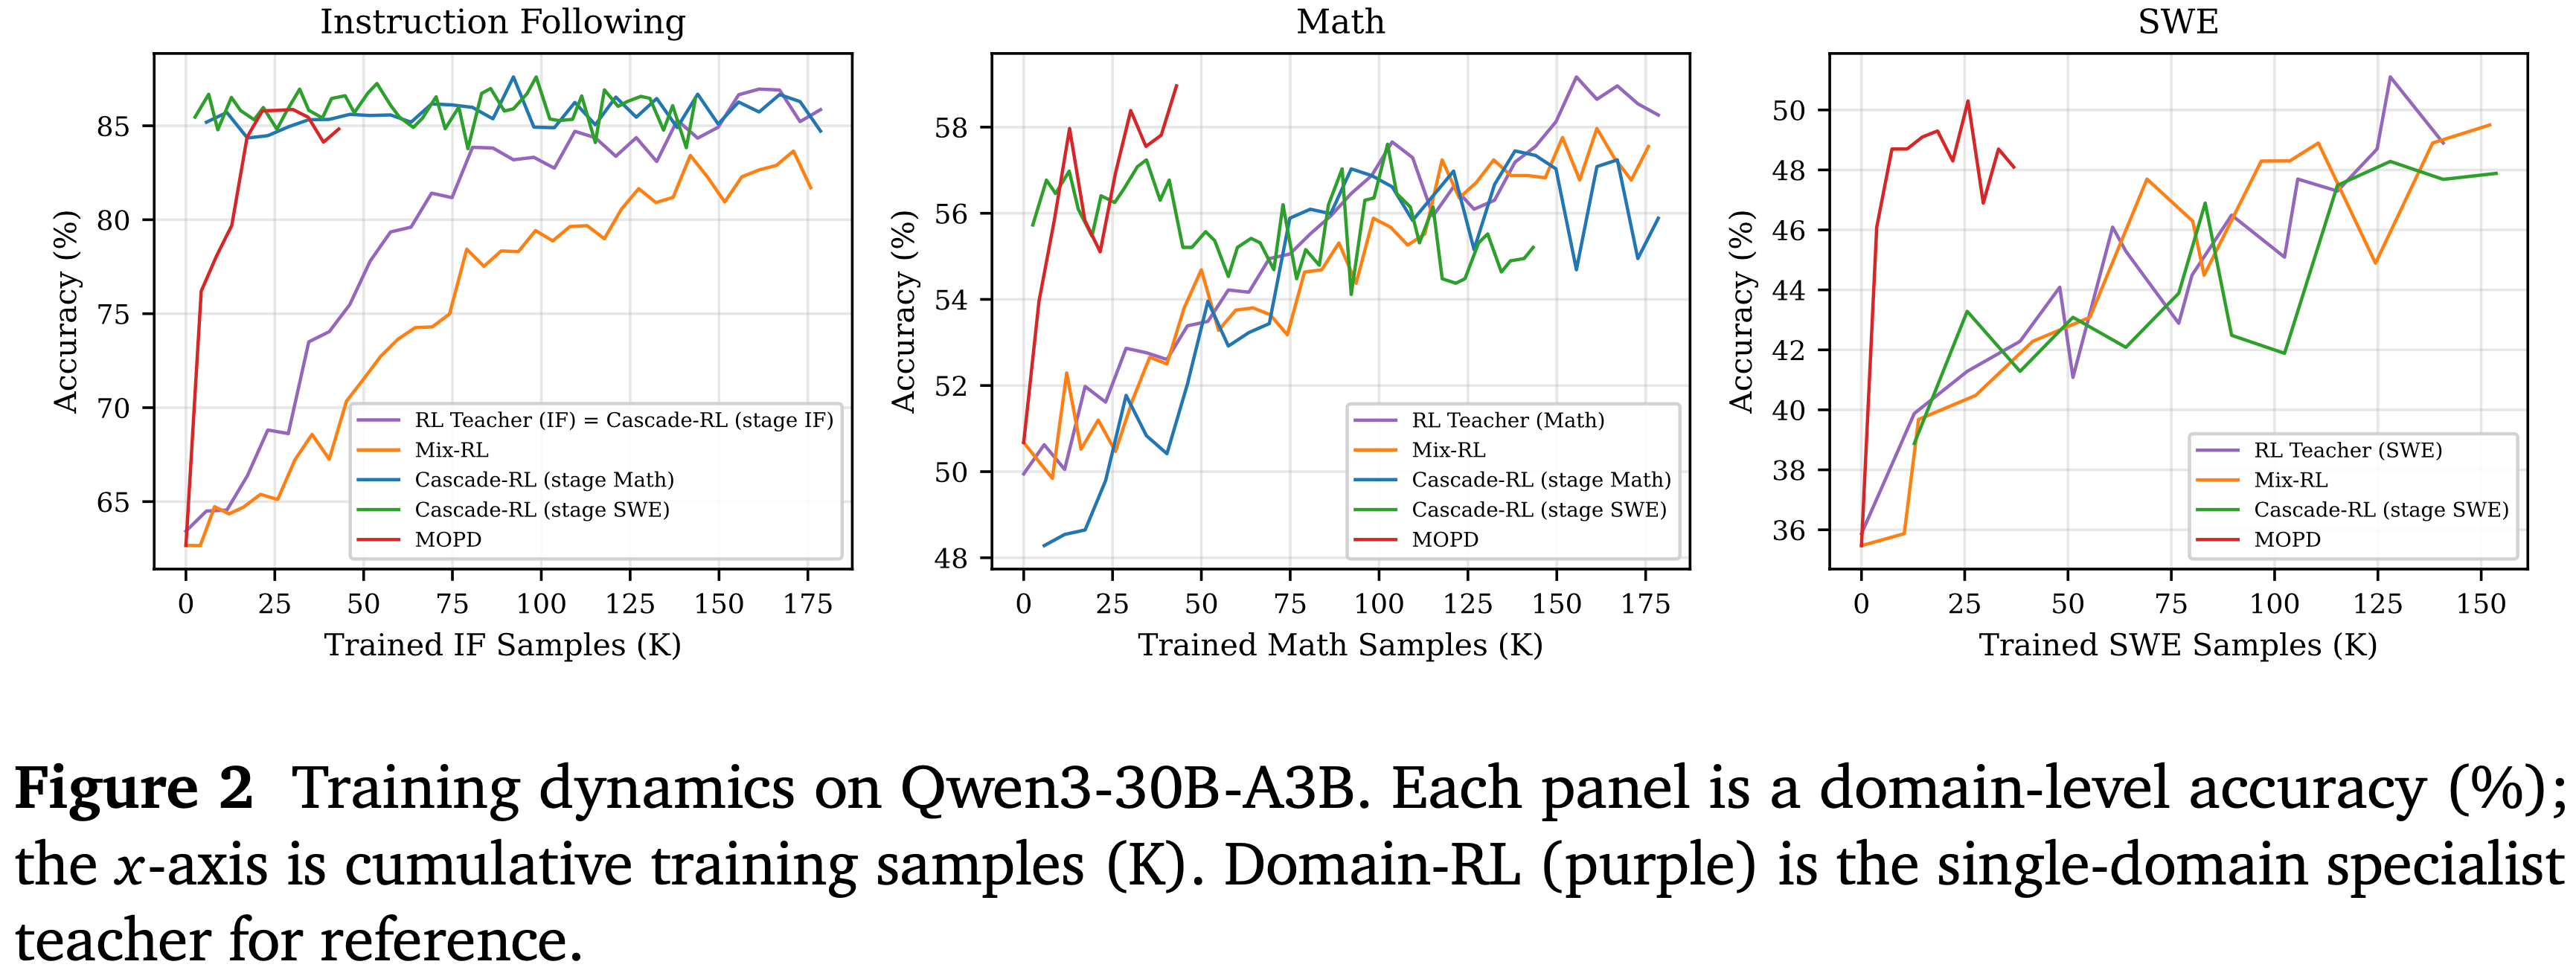
- 图 2 跟踪了领域级别的准确率与单领域训练样本数的关系
- 有以下四点观察
- Mix-RL、Cascade RL 和 Off-Policy Finetune 各自都会留下领域特定的差距,且形态不同
- 这三种方法分别达到了 0.882、0.775 和 0.824 的归一化分数,总体相似,但各自具有不同的单领域弱点
- Cascade RL (按 IF \(\rightarrow\) Math \(\rightarrow\) SWE 的顺序训练) 表现出跨领域干扰:
- 最先训练的 IF 领域 Closes 了 \(98%\) 的提升空间,但 Math (第二阶段) 仅 Closes 了 \(57%\)
- 图 2 进一步显示,Math 准确率在随后的 SWE 阶段出现了下降
- Off-Policy Finetune 在 IF 上超过了教师 (单领域归一化分数为 1.01),但在 SWE 上仅 Closes 了 \(65%\)
- 这表明对教师轨迹的离线模仿在不同任务类型上的迁移效果不均衡
- Mix-RL 是最平衡的基线 (单领域范围 0.064),但总体上仍落后 MOPD 5.5 个点
- MOPD 取得了最高的归一化分数和最均匀的表现
- MOPD 达到了 0.937 的归一化分数,比次优方法 (Mix-RL 的 0.882) 高出 \(+0.055\)
- 其三个单领域归一化分数落在 [0.91, 0.95] 之间,范围仅为 0.044,是所有方法中最小的
- 没有其他方法能如此均匀地 Closes 提升空间:
- Cascade RL 的范围是 0.57-0.98 (跨度 0.41),Off-Policy Finetune 的范围是 0.65-1.01 (跨度 0.36)
- MOPD 达到了 0.937 的归一化分数,比次优方法 (Mix-RL 的 0.882) 高出 \(+0.055\)
- Param-Merge 对合并方式高度敏感
- 线性平均 (linear averaging) 在总体上表现不佳 (归一化分数 0.328)
- 任务算术 (Task Arithmetic) 恢复到了 0.857,但其单领域表现差异很大:
- 在 IF 上超过了教师 (1.00),但在 Math 上仅 Closes 了 \(73%\)
- 结果取决于合并系数和基准,这使得参数合并成为一种不可靠的整合工具
- 理解:
- 线性平均:直接对参数进行平均
- 任务算术:先使用不同任务计算出与原始 Base 模型的差值,然后对差值进行加权平均(或者取 Clip 等),最终将差值加到 Base 模型上
- 任务算术通常会对每个任务向量单独搜索最优缩放系数
- 先进的任务算术(如 TIES-Merging)在加回基座之前,会对任务向量进行修剪(丢弃微小变化)和符号消歧(解决不同任务对同一参数更新方向相反的问题)
- 有些任务算术实现会先用 DARE(随机将部分微小增量置零)处理任务向量,再合并
- 注:在 “等权重合并” 设定下,直接线性平均和任务算术平均的最终参数在数学上是完全等价的,但本文结论差异较大,说明设置上不等价,肯定带着上面的多种方法了
- MOPD 的样本效率明显更高
- 如图 2 所示 (x 轴:消耗的单领域样本数),MOPD 在大约 \(25\text{K}\) 个 IF 样本内和大约 \(30\text{K}\) 个 SWE 样本内就达到了 IF 和 SWE 上的教师水平平台期
- Mix-RL 需要每个领域 150-180K 的完整样本预算才能达到相近水平
- 解释:来自教师的密集 Token 级监督提供了比轨迹级 RL Reward 更强的每样本梯度信号
- 如图 2 所示 (x 轴:消耗的单领域样本数),MOPD 在大约 \(25\text{K}\) 个 IF 样本内和大约 \(30\text{K}\) 个 SWE 样本内就达到了 IF 和 SWE 上的教师水平平台期
Scaling to a 309B-parameter model
- 为了确认 MOPD 能够应用于工业规模的顶尖模型,本文将完整的三阶段流程应用于 MiMo-V2-Flash
- 本文使用了涵盖 Math、Code、IF、SWE 和 Tool Use 的领域教师
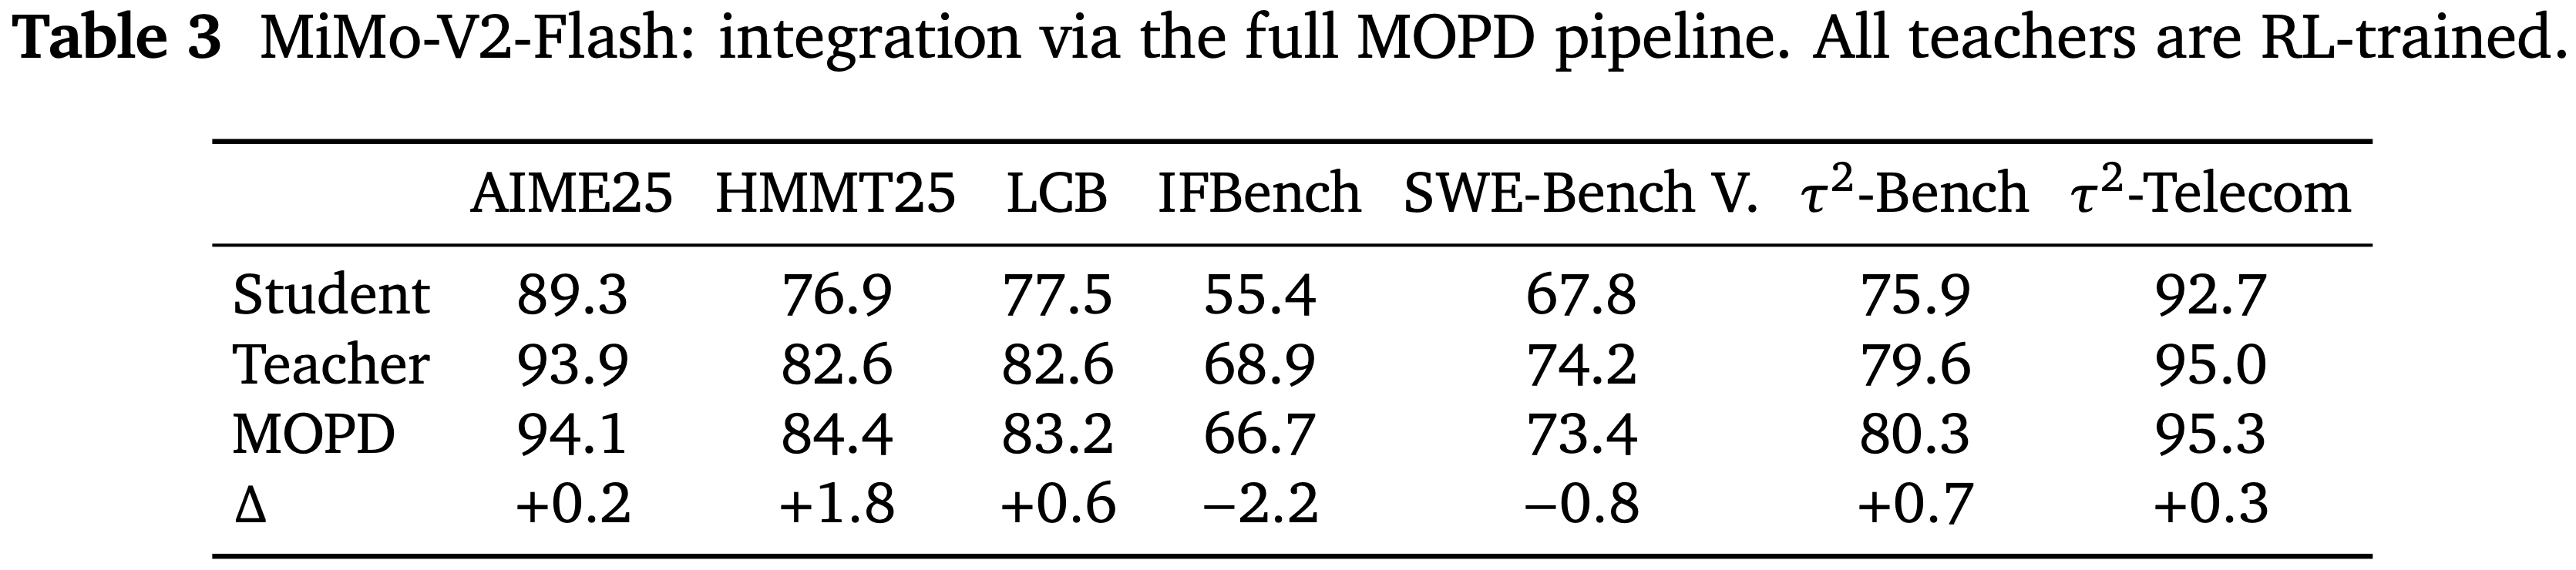
- 表 3 展示了 MiMo-V2-Flash 上的 MOPD 结果
- MOPD 在大多数基准上都达到或超过了对应的教师
- 两个退化情况,IFBench \((- 2.2)\) 和 SWE-Bench Verified \((- 0.8)\),相对于其余基准上的提升来说是适中的
Analysis
Policy-gradient and top-\(k\) distillation perform comparably,表现相当
- 3.2 节介绍了 MOPD 蒸馏损失的两种实现方式:Policy-Gradient 形式 (4) 和 Top-\(k\) 形式 (5)
- 本文在 Qwen3-30B-A3B 上,使用相同的管道 (相同的教师、数据预算和超参数),对两者进行了比较,其中 Top-\(k\) 变体的 \(k = 64\)
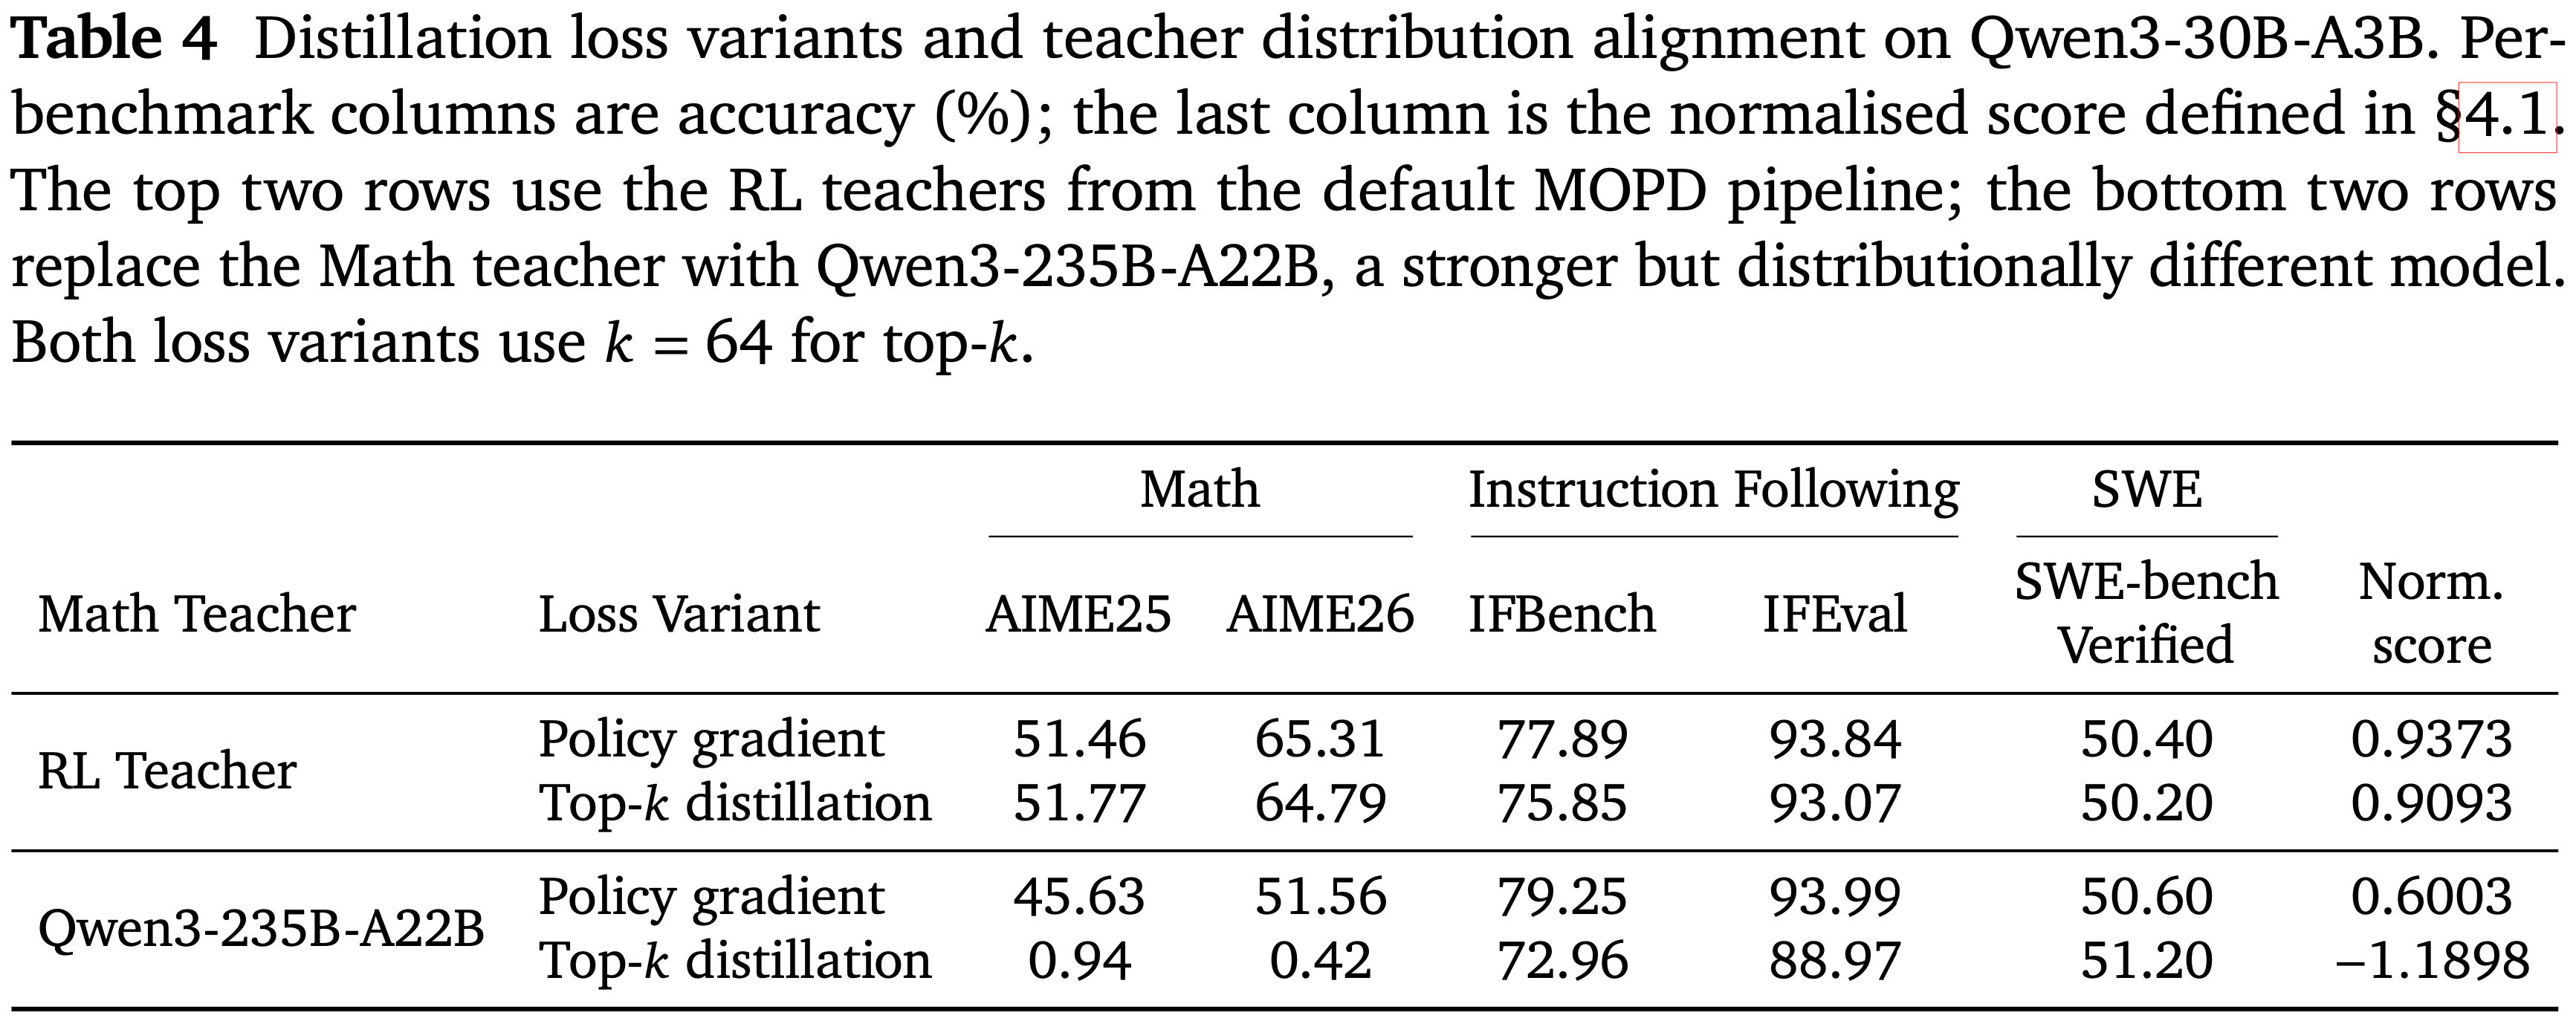
- 表 4 的前两行报告了比较结果
- Top-\(k\) 蒸馏在 Math 上与 PG 形式相当,在 IF 和 SWE 上略差
- 两种形式达到了总体相似的能力,归一化分数分别为 0.909 和 0.937
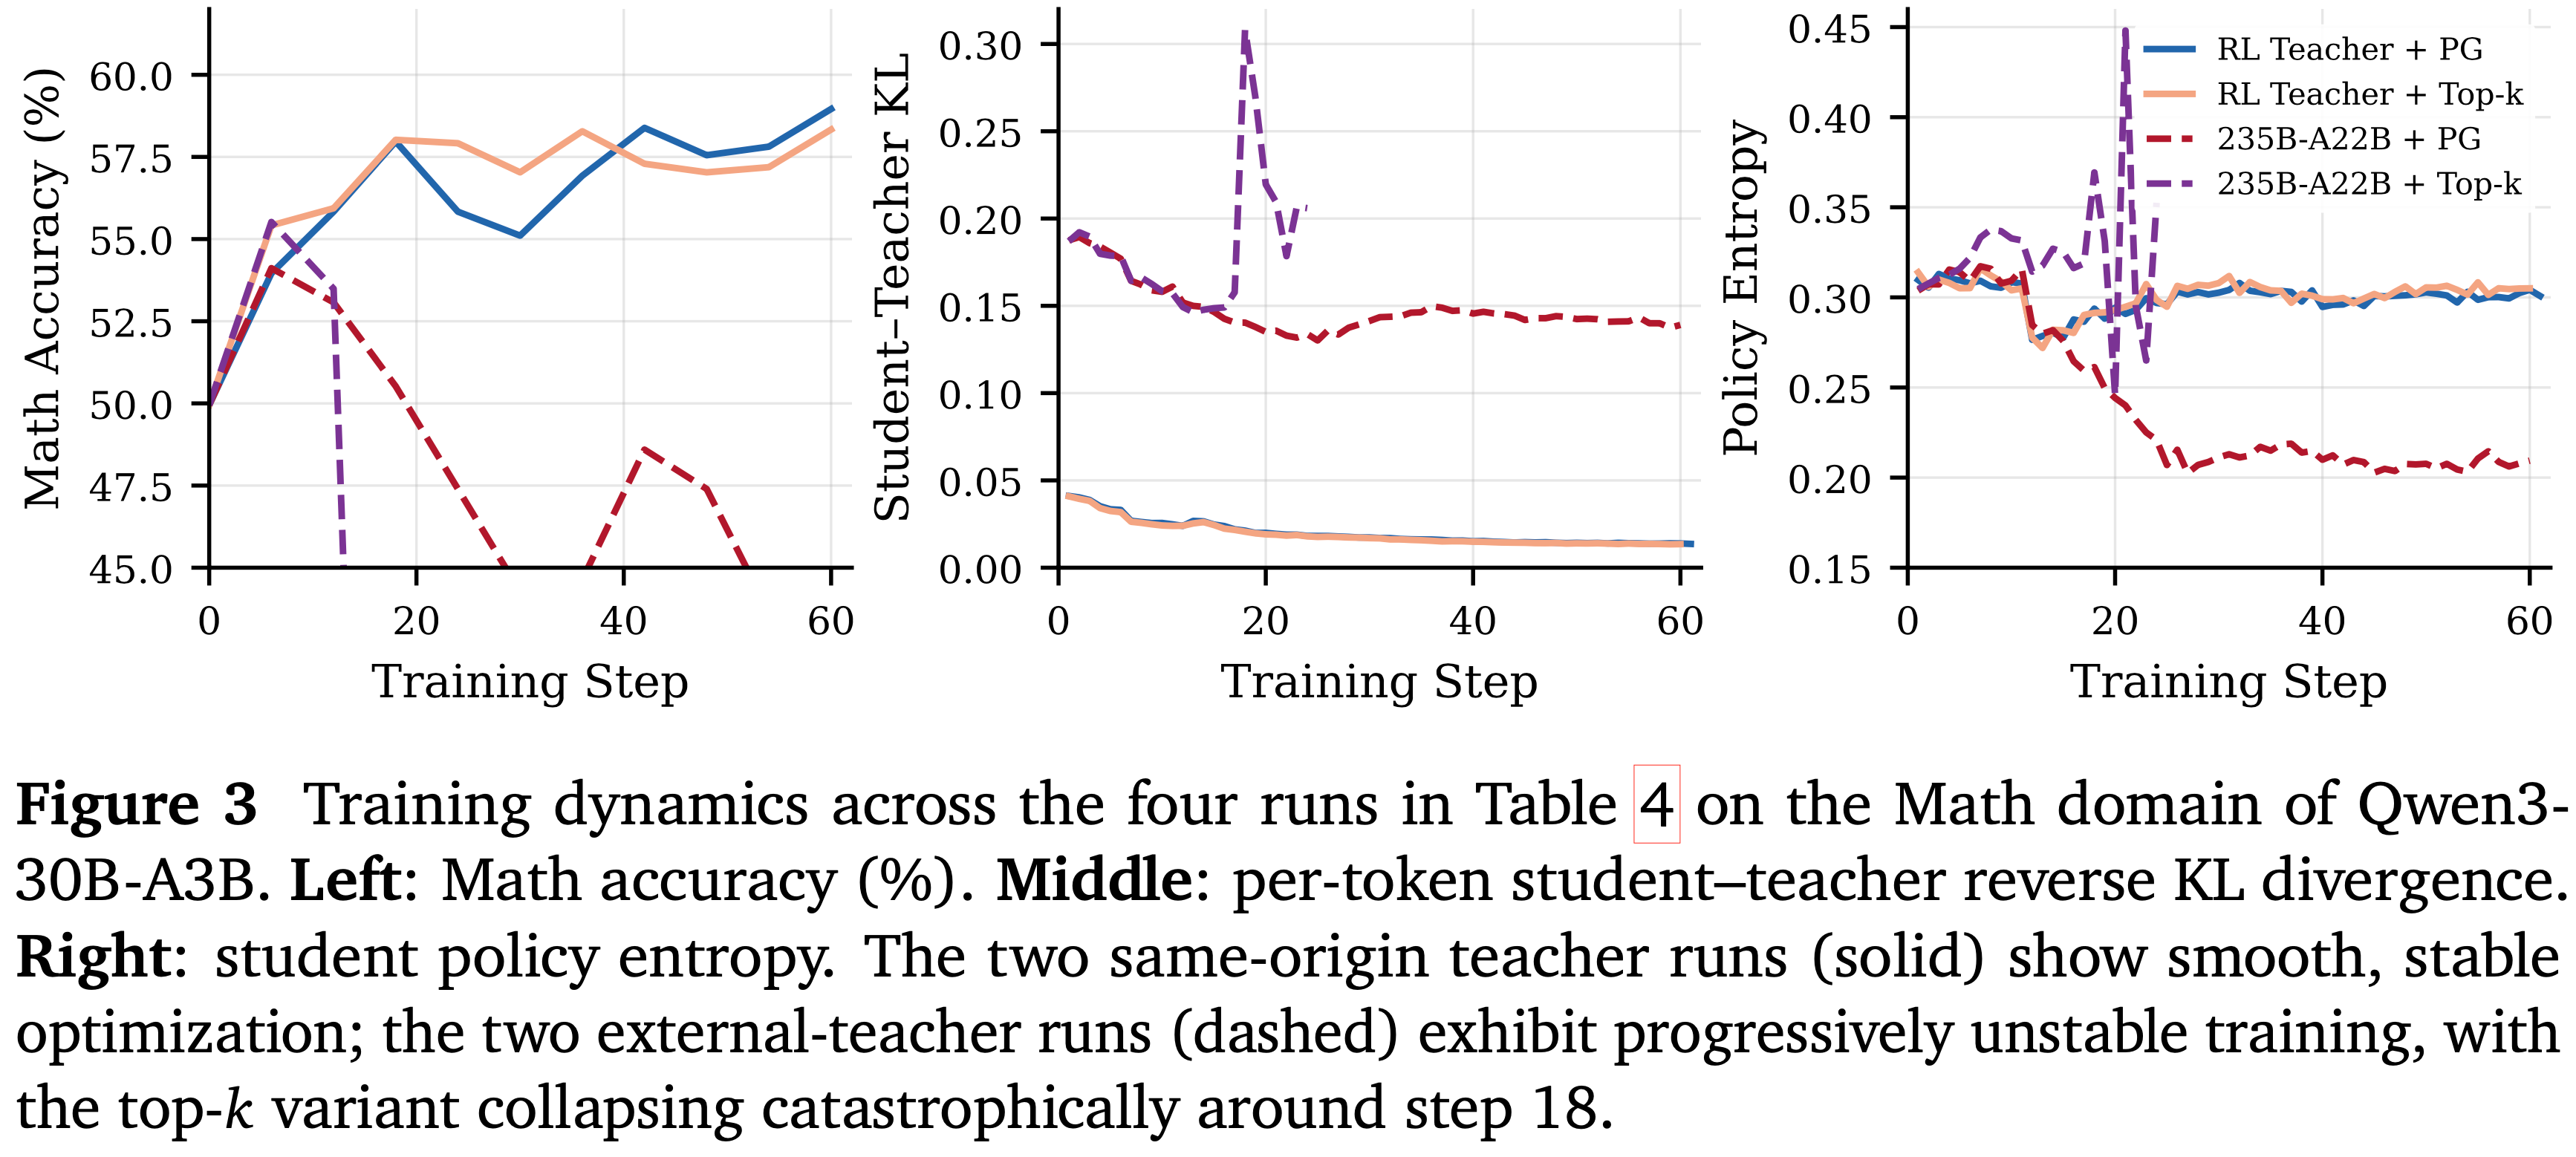
- 图 3 也证实了这一点:在相同来源 (same-origin) 的教师下,两种损失形式产生的训练轨迹几乎重叠:
- 数学准确率平稳上升,每 Token 的反向 KL 散度从已经很低的初始值 \((\(\sim\) 0.04)\) 单调递减,并且策略熵在整个过程中稳定在 0.30 左右
- 当教师和学生的分布紧密相关时,学生的 Rollout 集中在教师的高概率区域,因此两种梯度估计器都能接收到相似的信息信号,并收敛到可比的结果
- 这表明,在相同来源的教师下,Policy-Gradient 形式已经足够稳定
- 引入 Top-\(k\) 并未带来额外的稳定性或方差降低
- 引入 Top-\(k\) 并未带来额外的稳定性或方差降低
Same-origin teachers stabilize distillation,相同来源的教师能稳定蒸馏过程
- MOPD 的领域教师是通过从学生进行 RL 训练获得的
- 这意味着教师和学生共享相似的 Policy 分布
- 最近的研究 (2026; 2026) 讨论了教师-学生 Policy 散度与 On-Policy 蒸馏稳定性之间的关系
- 一个自然的问题是:用更强但分布不同的外部模型替换教师,能否获得更好的结果?
- 为了测试这一点,本文设计了一个对照实验:
- 在 MOPD 的 Math 领域,将原始的 Qwen3-30B-A3B Math RL 教师替换为 Qwen3-235B-A22B(这是一个更大、数学能力更强的模型)
- 所有其他设置 (IF 和 SWE 教师、数据、超参数) 保持不变
- 为了测试这一点,本文设计了一个对照实验:
- 表 4 的底部两行报告了结果:
- 尽管 Qwen3-235B-A22B 的绝对数学能力显著更强,但在两种损失变体下,MOPD 学生的数学表现都出现了下降
- 图 3 揭示了其中的机制
- 初始的每 Token KL 散度大约是同源设置下的 \(5\times\) 高 (约为 \(0.19\) vs. \(0.04\))
- 这定量地证实了巨大的分布差距
- 在 Policy-Gradient 形式下,数学准确率逐渐下降,同时熵从 0.30 收缩到 0.21
- 学生的 Policy 收窄到单一模式,因为它从教师的低概率区域接收到的主要是惩罚性的梯度信号
- 在 Top-\(k\) 形式下,崩溃甚至更为严重:
- 训练在第 18 步左右灾难性地发散,KL 散度和熵都出现剧烈振荡,表明完全失去了优化稳定性
- 初始的每 Token KL 散度大约是同源设置下的 \(5\times\) 高 (约为 \(0.19\) vs. \(0.04\))
- 这些结果强调了 MOPD 使用同源教师至关重要 :紧密的分布对齐确保了整个训练过程的稳定优化,从而产生可靠且一致的收益
Multi-round student-teacher evolution
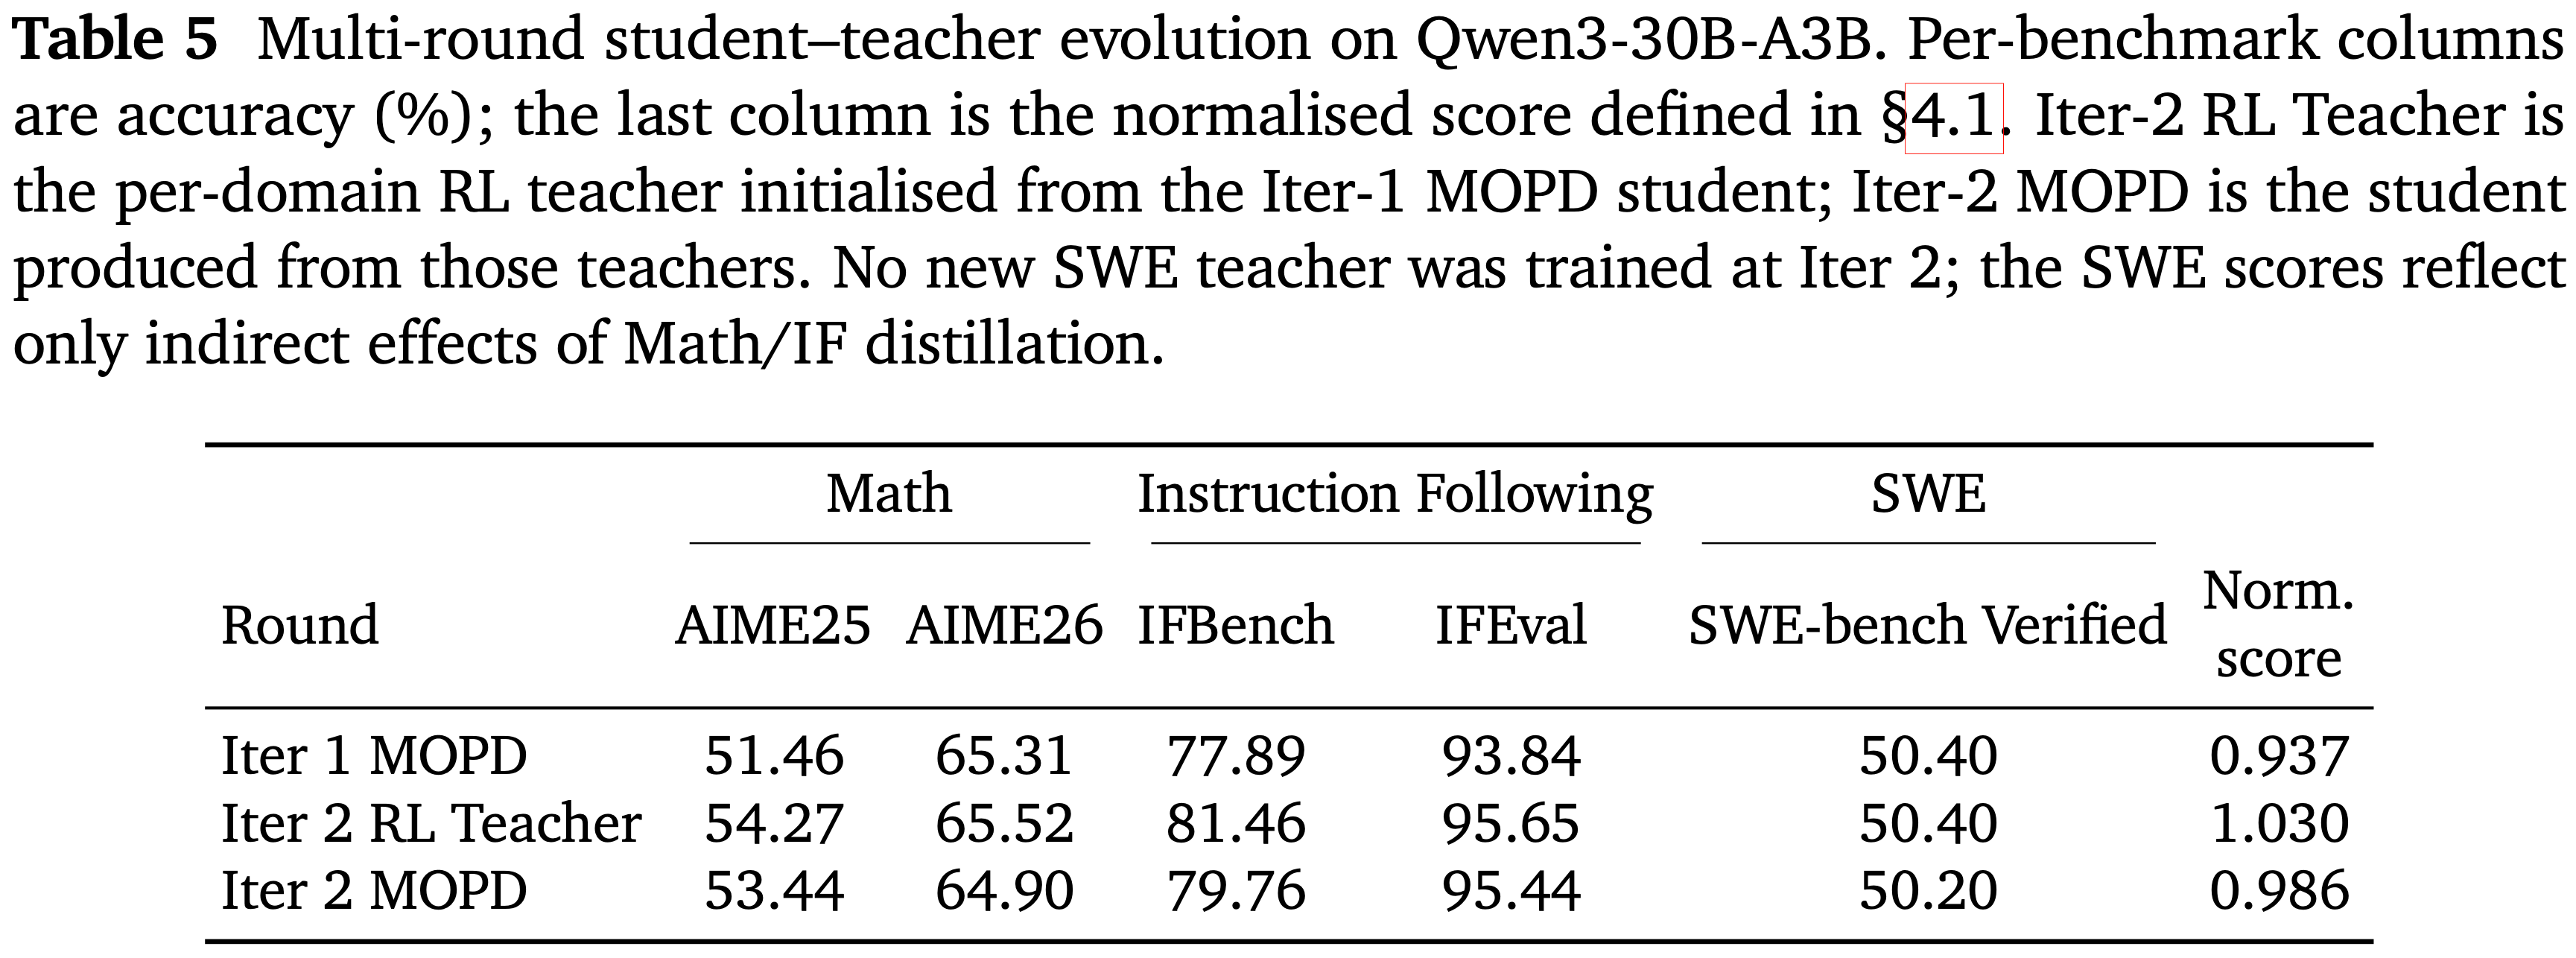
- 单轮 MOPD 在每个领域都 Closes 了学生-教师之间的大部分提升空间,但表 5 显示 Math 和 IF 领域仍有剩余空间
- 建议:将 MOPD 后的模型作为新的学生,并重复该过程:
- 从这个学生重新训练每个领域的教师,然后使用新教师进行另一轮 MOPD 整合
- 本文在 Qwen3-30B-A3B 上验证了一轮这样的后续迭代
- 在第一轮之后,学生成为下一轮单领域 RL 教师的初始化,从而驱动第二轮 MOPD 过程
- 在这一轮中,仅对 Math 和 IF 领域应用 RL 训练和 MOPD 蒸馏 (对于 SWE,既不进行 RL 训练也不进行蒸馏)
- 理解:正因为第二轮没有针对 SWE 做任何动作,所以第二轮 MOPD 后 SWE 的指标几乎不变(微弱降低)
- 观察结果:
- (i) 从 Iter-1 学生初始化下一轮的单领域 RL 确实产生了更强的教师:Iter-2 RL Teacher 达到了 1.030 的归一化分数,比 Iter-1 MOPD 高出 \(+0.093\)
- 这证实了单轮 MOPD 提取之外,单领域的能力提升空间仍然存在
- (ii) 在 Iter-2 RL 教师的指导下,Iter-2 学生在 Math 和 IF 上进一步提高,其归一化分数从 0.937 上升到 0.986 (+0.049),表明 MOPD 管道可以持续吸收来自更强教师的能力
- (i) 从 Iter-1 学生初始化下一轮的单领域 RL 确实产生了更强的教师:Iter-2 RL Teacher 达到了 1.030 的归一化分数,比 Iter-1 MOPD 高出 \(+0.093\)
Discussion
- 除了实证上的收益,MOPD 在结构上解耦了多领域后训练中固有的串行依赖关系,将能力生产 (Stage-2 单领域 RL) 与能力整合 (Stage-3 蒸馏) 分离开来
- 随之而来的是三个工作流程上的好处:
- 并行开发 (Parallel development).
- Stage-2 的教师是相互独立的:每个领域的团队可以并行地迭代其自身的 Reward、沙盒环境和数据管道,没有固定的顺序
- 在计算资源充足的情况下,这直接提高了团队的整体开发效率
- 流程级解耦 (Recipe-level decoupling).
- 每个领域可以自由选择其自身的 RL 流程 (算法、Rollout 过程、Reward 函数、超参数等),而无需担心与其他领域的冲突,也无需担心自身的优化选择会干扰其他领域
- 风险隔离 (Risk isolation).
- RL 训练通常需要迭代调整算法和超参数 (无论是为了提高能力还是仅仅为了解决稳定性问题),而每次这样的调整都强制要求训练重启
- 在联合多领域 RL 下,一次重启会使整个运行回到起点
- 在 MOPD 的并行教师开发下,重启仅局限于受影响的单个领域,其他教师的训练不受干扰继续进行
- RL 训练通常需要迭代调整算法和超参数 (无论是为了提高能力还是仅仅为了解决稳定性问题),而每次这样的调整都强制要求训练重启
- 并行开发 (Parallel development).
附录 A:Training Details
- Qwen3-30B-A3B 实验的训练设置
- 所有实验均使用 Megatron-DeepSpeed 框架实现
Training data
- 考虑了三个领域:Math、Instruction Following 和 Software Engineering
- Math:
- SFT 数据主要来自 Mixture-of-Thoughts 数据集(Hugging Face, 2025)的数学子集
- RL 训练数据从多个开源数据集中收集和过滤,包括 BigMath(2025)和 ORZ(2025)
- 最大序列长度为 32,768
- Instruction Following
- SFT 提示按照 IFBench(2025)介绍的方法构建,并 在 gpt-oss-120b(2025)上进行蒸馏
- RL 训练数据同样按照 IFBench 方案合成
- 最大序列长度
- Software Engineering
- SFT 数据通过开源模型从 R2E-Gym 任务中蒸馏获得
- RL 训练数据使用 R2E-Gym-Lite(2025)
- 最大序列长度为 65,536,交互轮数上限为 50
Hyperparameters
- 对于 RL 训练,使用带有动态采样(Dynamic Sampling)(2025)的 on-policy GRPO(2024)算法:
- 每次 Rollout 生成的数据仅用于一次梯度更新 ,然后被丢弃
- 对于单领域 RL,将学习率设为 \(3 \times 10^{-6}\)
- 对于数学和 IF 训练
- 将 Batch Size(BS)设为 144,每个 Prompt 的 Rollout 数为 \(N = 8\),训练约 175K 条序列
- 对于 SWE,将 BS 设为 80,\(N = 8\),训练约 150K 条序列
- 对于数学和 IF 训练
- Cascade RL:
- 使用与单领域 RL 相同的配置
- 领域训练顺序为
$$ \text{IF} \rightarrow \text{Math} \rightarrow \text{SWE} $$
- 对于 Mix-RL
- 将学习率设为 \(4 \times 10^{-6}\),BS 为 256,\(N = 8\),每个 Batch 的领域比例为
$$ \text{Math} : \text{IF} : \text{SWE} = 0.35 : 0.35 : 0.3 $$ - 对于 MOPD,不使用动态采样,设置 BS 为 2048,\(N = 1\),每个 Batch 的领域比例为
$$ \text{Math} : \text{IF} : \text{SWE} = 0.35 : 0.35 : 0.3 $$
- 将学习率设为 \(4 \times 10^{-6}\),BS 为 256,\(N = 8\),每个 Batch 的领域比例为
- Policy-Gradient 形式的默认 Advantage 截断最大值为 5
- Top-\(k\) 蒸馏形式的默认 \(k\) 值为 64
附录 B:Evaluation Details
- 所有报告结果所使用的评估协议
- 对于两个数学基准 AIME25 和 AIME26
- 对每个问题采样 32 次并报告平均准确率(avg@32),以降低高难度数学评估中因样本量少而产生的方差
- 对于指令遵循,在 IFBench 和 IFEval 上对每个问题评估一次
- 对于软件工程,在 SWE-bench Verified 上对每个任务评估一次
- 所有基准的解码使用温度为 1.0 的采样,不应用 top-\(p\) 或 top-\(k\) 截断