- 参考链接:
Megatron-LM 各种并行简单总结
- 各种并行策略的本质目标不外乎两个:
- 将大批量的数据分发到不同的机器上,实现更高的并行度,缩短训练时间
- 将一个巨大到无法在单个加速器(如 GPU)上训练的模型,高效地拆分到多个加速器上,以解决显存瓶颈并加速训练过程
- Megatron-LM 中七大并行策略核心总结
缩写 全称 拆的对象 核心通信 配置参数 TP Tensor Parallelism(张量并行) 权重矩阵(按列/行切分) AllReduce / ReduceScatter --tensor-model-parallel-size(tensor_model_parallel_size)SP Sequence Parallelism(序列并行) 激活值(按序列维度切分) AllGather / ReduceScatter --sequence-parallel(sequence_parallel)PP Pipeline Parallelism(流水线并行) Transformer 层(按层切分) P2P Send/Recv --pipeline-model-parallel-size(pipeline_model_parallel_size)DP Data Parallelism(数据并行) 训练数据(每卡不同数据) AllReduce(梯度同步) 自动推导,无需显式配置(对应代码变量 data_parallel_size,可通过--data-parallel-size手动覆盖)CP Context Parallelism(上下文并行) 输入序列长度 Ring P2P / AllToAll --context-parallel-size(context_parallel_size)EP Expert Parallelism(专家并行) MoE 专家(不同专家放不同卡) AllToAll(Token 路由) --expert-model-parallel-size(expert_model_parallel_size)ETP Expert Tensor Parallelism(专家张量并行) 专家内部权重(按列/行切分) AllReduce / ReduceScatter --expert-tensor-parallel-size(expert_tensor_parallel_size) - Megatron-LM 并行库的设计哲学:
- TP 与 ETP 解决单层权重放不下的问题(拆 Weight)
- SP 与 CP 解决激活值和长序列放不下的问题(拆 Seq)
- PP 解决层数太多放不下的问题(拆 Layer)
- DP 与 expert_DP 解决数据吞吐量(Batch Size)不够大的问题(拆 Data)
- EP 解决专家数量太多放不下的问题(拆 Expert)
- 所有的通信策略(AllReduce, ReduceScatter, AllGather, AllToAll, P2P)均由底层进程组拓扑驱动,通过严格的数学整除约束,确保了在大规模集群上扩展时,通信开销与计算时间的高度 Overlap
- 一些使用总结:
- PP 的 stage 之间只传激活,不涉参数/梯度集合通信,通信量小,因此可以跨机器,所以分配 rank 时一般是最后考虑的;
- 唯一要注意的是:一定要
micro_batches >= PP_size,否则流水线气泡 > 50%,吞吐腰斩
- 唯一要注意的是:一定要
- TP 是需要通信量最大的,一般限制在同一台机器内部,这样可以提升通信效率,分配 rank 时一般是最优先考虑的,TP 进程组 rank 也一般是连续成对的
- ZeRO-1/2/3 本质仍是 DP,只是梯度/优化器/参数分片;
- ZeRO-3 与 TP 同时开时,同一 TP 组内必须关闭参数分片 ,否则一次 MatMul 要跨 ZeRO 组做 All-Gather,延迟爆炸
- DP 的本质是提升并行度,一般来说,DP 的目标是开启前后保证梯度更新是是一致的,实现时也是朝这个方向实现的,比如 DDP 或 Megatron 中,在聚合梯度时,都是按照 DP 求平均(先 all_reduce SUM,再除以 DP_size)
- DP 的通信量不算太高,也可以跨机器实现
- PP 的 stage 之间只传激活,不涉参数/梯度集合通信,通信量小,因此可以跨机器,所以分配 rank 时一般是最后考虑的;
- 各种并行下,最少需要多少卡?
- 在常见的 PP、TP、CP,SP,EP、ETP 下,GPU 最少卡数的计算公式 是:
min_gpus = PP * lcm(TP * CP, EP * ETP) - 公式取
TP * CP和EP * ETP的最小公倍数 ,是因为 world_size 必须同时被PP * TP * CP(非专家部分,如 Attention 部分)和PP * ETP * EP(专家部分)整除,这是两个独立的整除约束- 当各并行度都是 2 的幂时,其中一个必然能整除另一个,此时一般有些文章会写
lcm(TP * CP, EP * ETP) == max(TP * CP, EP * ETP),所以写成max也成立(有些文章直接用这个)- 注意:但一般情况下必须用
lcm
- 注意:但一般情况下必须用
- 当各并行度都是 2 的幂时,其中一个必然能整除另一个,此时一般有些文章会写
- 在常见的 PP、TP、CP,SP,EP、ETP 下,GPU 最少卡数的计算公式 是:
Megatron-LM 各种并行 与 world_size 的关系
- Megatron-LM 的并行体系与底层的进程组(Process Group)构建逻辑息息相关
- 在
core/parallel_state.py中,总 GPU 数量(world_size)被严格划分为两条独立的路径:- 路径 1: Dense / Attention 路径(含非 MoE 的 MLP) :
$$
\text{world_size} = \text{TP} \times \text{CP} \times \text{DP} \times \text{PP}
$$ - 路径 2:MoE Expert 路径(专门针对专家层) :
$$
\text{world_size} = \text{ETP} \times \text{EP} \times \text{expert_DP} \times \text{PP}
$$
- 路径 1: Dense / Attention 路径(含非 MoE 的 MLP) :
world_size约束:- 在构建 Dense 路径的 Rank 映射时,必须满足
world_size能被 \( \text{TP} \times \text{PP} \times \text{CP} \) 整除- 若不能整除,则会直接抛出
RuntimeError - 整除得到的结果就是 DP
DP并非由用户传入,而是由系统自动推导 得出:
$$
\text{DP} = \frac{\text{world_size} }{\text{TP} \times \text{CP} \times \text{PP} }
$$
- 若不能整除,则会直接抛出
- 同理,在 Expert 路径中,
expert_DP(EDP)自动推导为:
$$
\text{expert_DP} = \frac{\text{world_size} }{\text{ETP} \times \text{EP} \times \text{PP} }
$$
- 在构建 Dense 路径的 Rank 映射时,必须满足
- 注:特别说明,SP 不参与上述乘积运算,因为它不创建独立的进程组,而是复用了 TP 组的内部通信
- 补充:在 Megatron-LM 实现 中, 可以看到 DP 和 EDP 计算的基本规则是:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# megatron/core/parallel_state.py def initialize_model_parallel()
# 注:DP = world_size / (TP * PP * CP)
model_size = tensor_model_parallel_size * pipeline_model_parallel_size * context_parallel_size
if world_size % model_size != 0:
raise RuntimeError(f"world_size ({world_size}) is not divisible by {model_size}")
data_parallel_size: int = world_size // model_size
if expert_tensor_parallel_size is None:
expert_tensor_parallel_size = tensor_model_parallel_size # 如果 EP 没有指定,默认取 EP = TP
expert_tensor_model_pipeline_parallel_size = (
expert_tensor_parallel_size * expert_model_parallel_size * pipeline_model_parallel_size
)
expert_data_parallel_size = world_size // expert_tensor_model_pipeline_parallel_size
if world_size % expert_tensor_model_pipeline_parallel_size != 0:
raise RuntimeError(
f"world_size ({world_size}) is not divisible by expert_tensor_model_pipeline_parallel size ({expert_tensor_model_pipeline_parallel_size})"
)
Megatron-LM 各种并行详细介绍
张量并行(Tensor Parallelism, TP)
- 拆解对象 :权重矩阵的列(Column)与行(Row)
- Tensor Parallelism 一般仅针对 MLP 和 Attention 做张量拆分,在 Attention 和 MLP 之间非两者的部分,每张显卡上都存储了完整的(相同的)激活和参数
- 技术实现 :对于一个标准的线性层 \( Y = XA + b \)(其中 \( X \) 为输入激活,\( A \) 为权重,\( b \) 为偏置):
- 列并行(ColumnParallelLinear) :
- 将 \( A \) 按列切分为 \( [A_1, A_2, …, A_p] \)
- 每张 GPU 计算 \( Y_i = X A_i \)
- 由于输出 \( Y \) 被切分在序列维度上,此过程不需要通信 ,直接进入后续的 GeLU 或 Attention 拆分
- 行并行(RowParallelLinear) :
- 将 \( A \) 按行切分,输入 \( X \) 也必须按列切分(即 \( X = [X_1, X_2, …, X_p] \))
- 每卡计算 \( Y_i = X_i A_i \),随后需要通过 AllReduce 通信将各卡结果相加,得到完整的 \( Y \)
- 核心实现思路:经典配对策略(MLP 与 Attention)
- 对 Attention 或 MLP 层进行张量拆分,在计算 Attention 或 MLP 时,每张卡独立计算自己的部分
- 在 Attention 或 MLP 之前或之后的部分,每张卡上的各种数据/激活是完全一致的
- 通信发生在每次 Attention/MLP 前后,保证 Attention/MLP 前后的输入或激活完全一致
- MLP :第一层 Linear 采用列并行(无通信) \( \to \) GeLU \( \to \) 第二层 Linear 采用行并行(含 AllReduce)
- Self-Attention :QKV 投影采用列并行(无通信) \( \to \) 计算 Attention Score \( \to \) 输出投影(Output Projection)采用行并行(含 AllReduce)
- 这种设计保证了一个 Transformer 层内,TP 通信(AllReduce)只发生一次,极大地降低了通信
- 列并行(ColumnParallelLinear) :
- 补充 Megatron-LM 论文中 Tensor Parallelism 的图片:
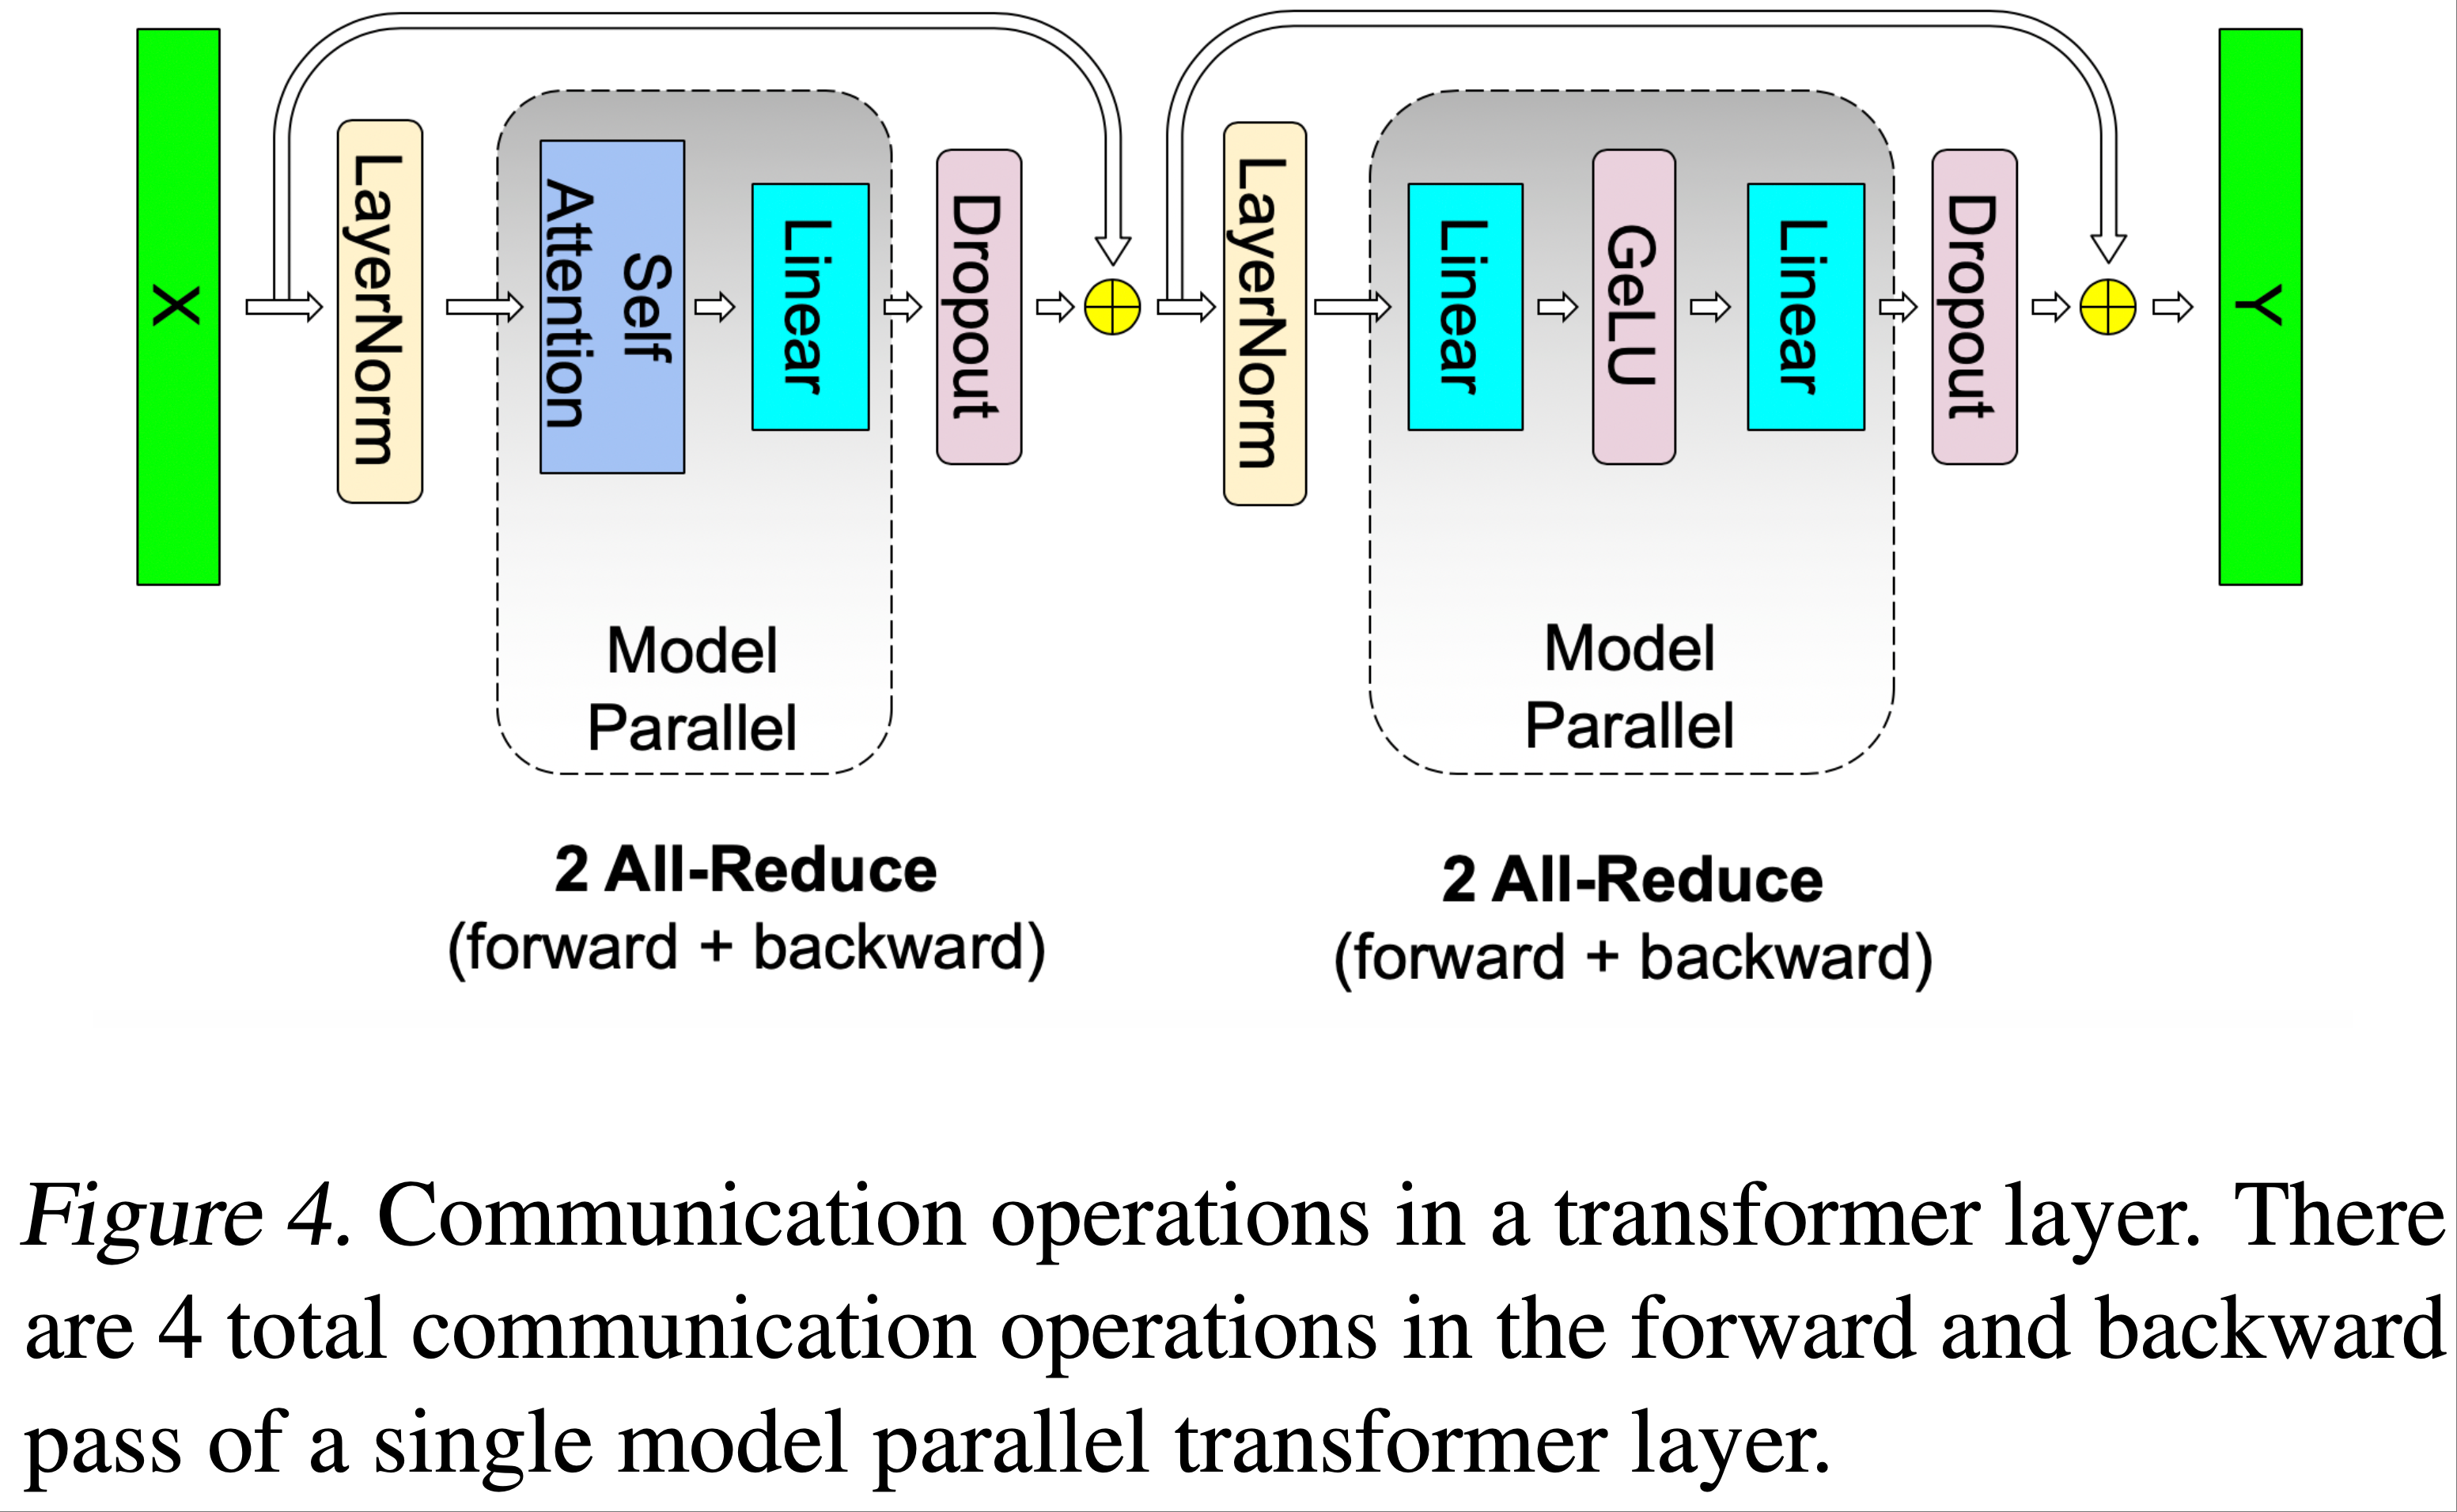
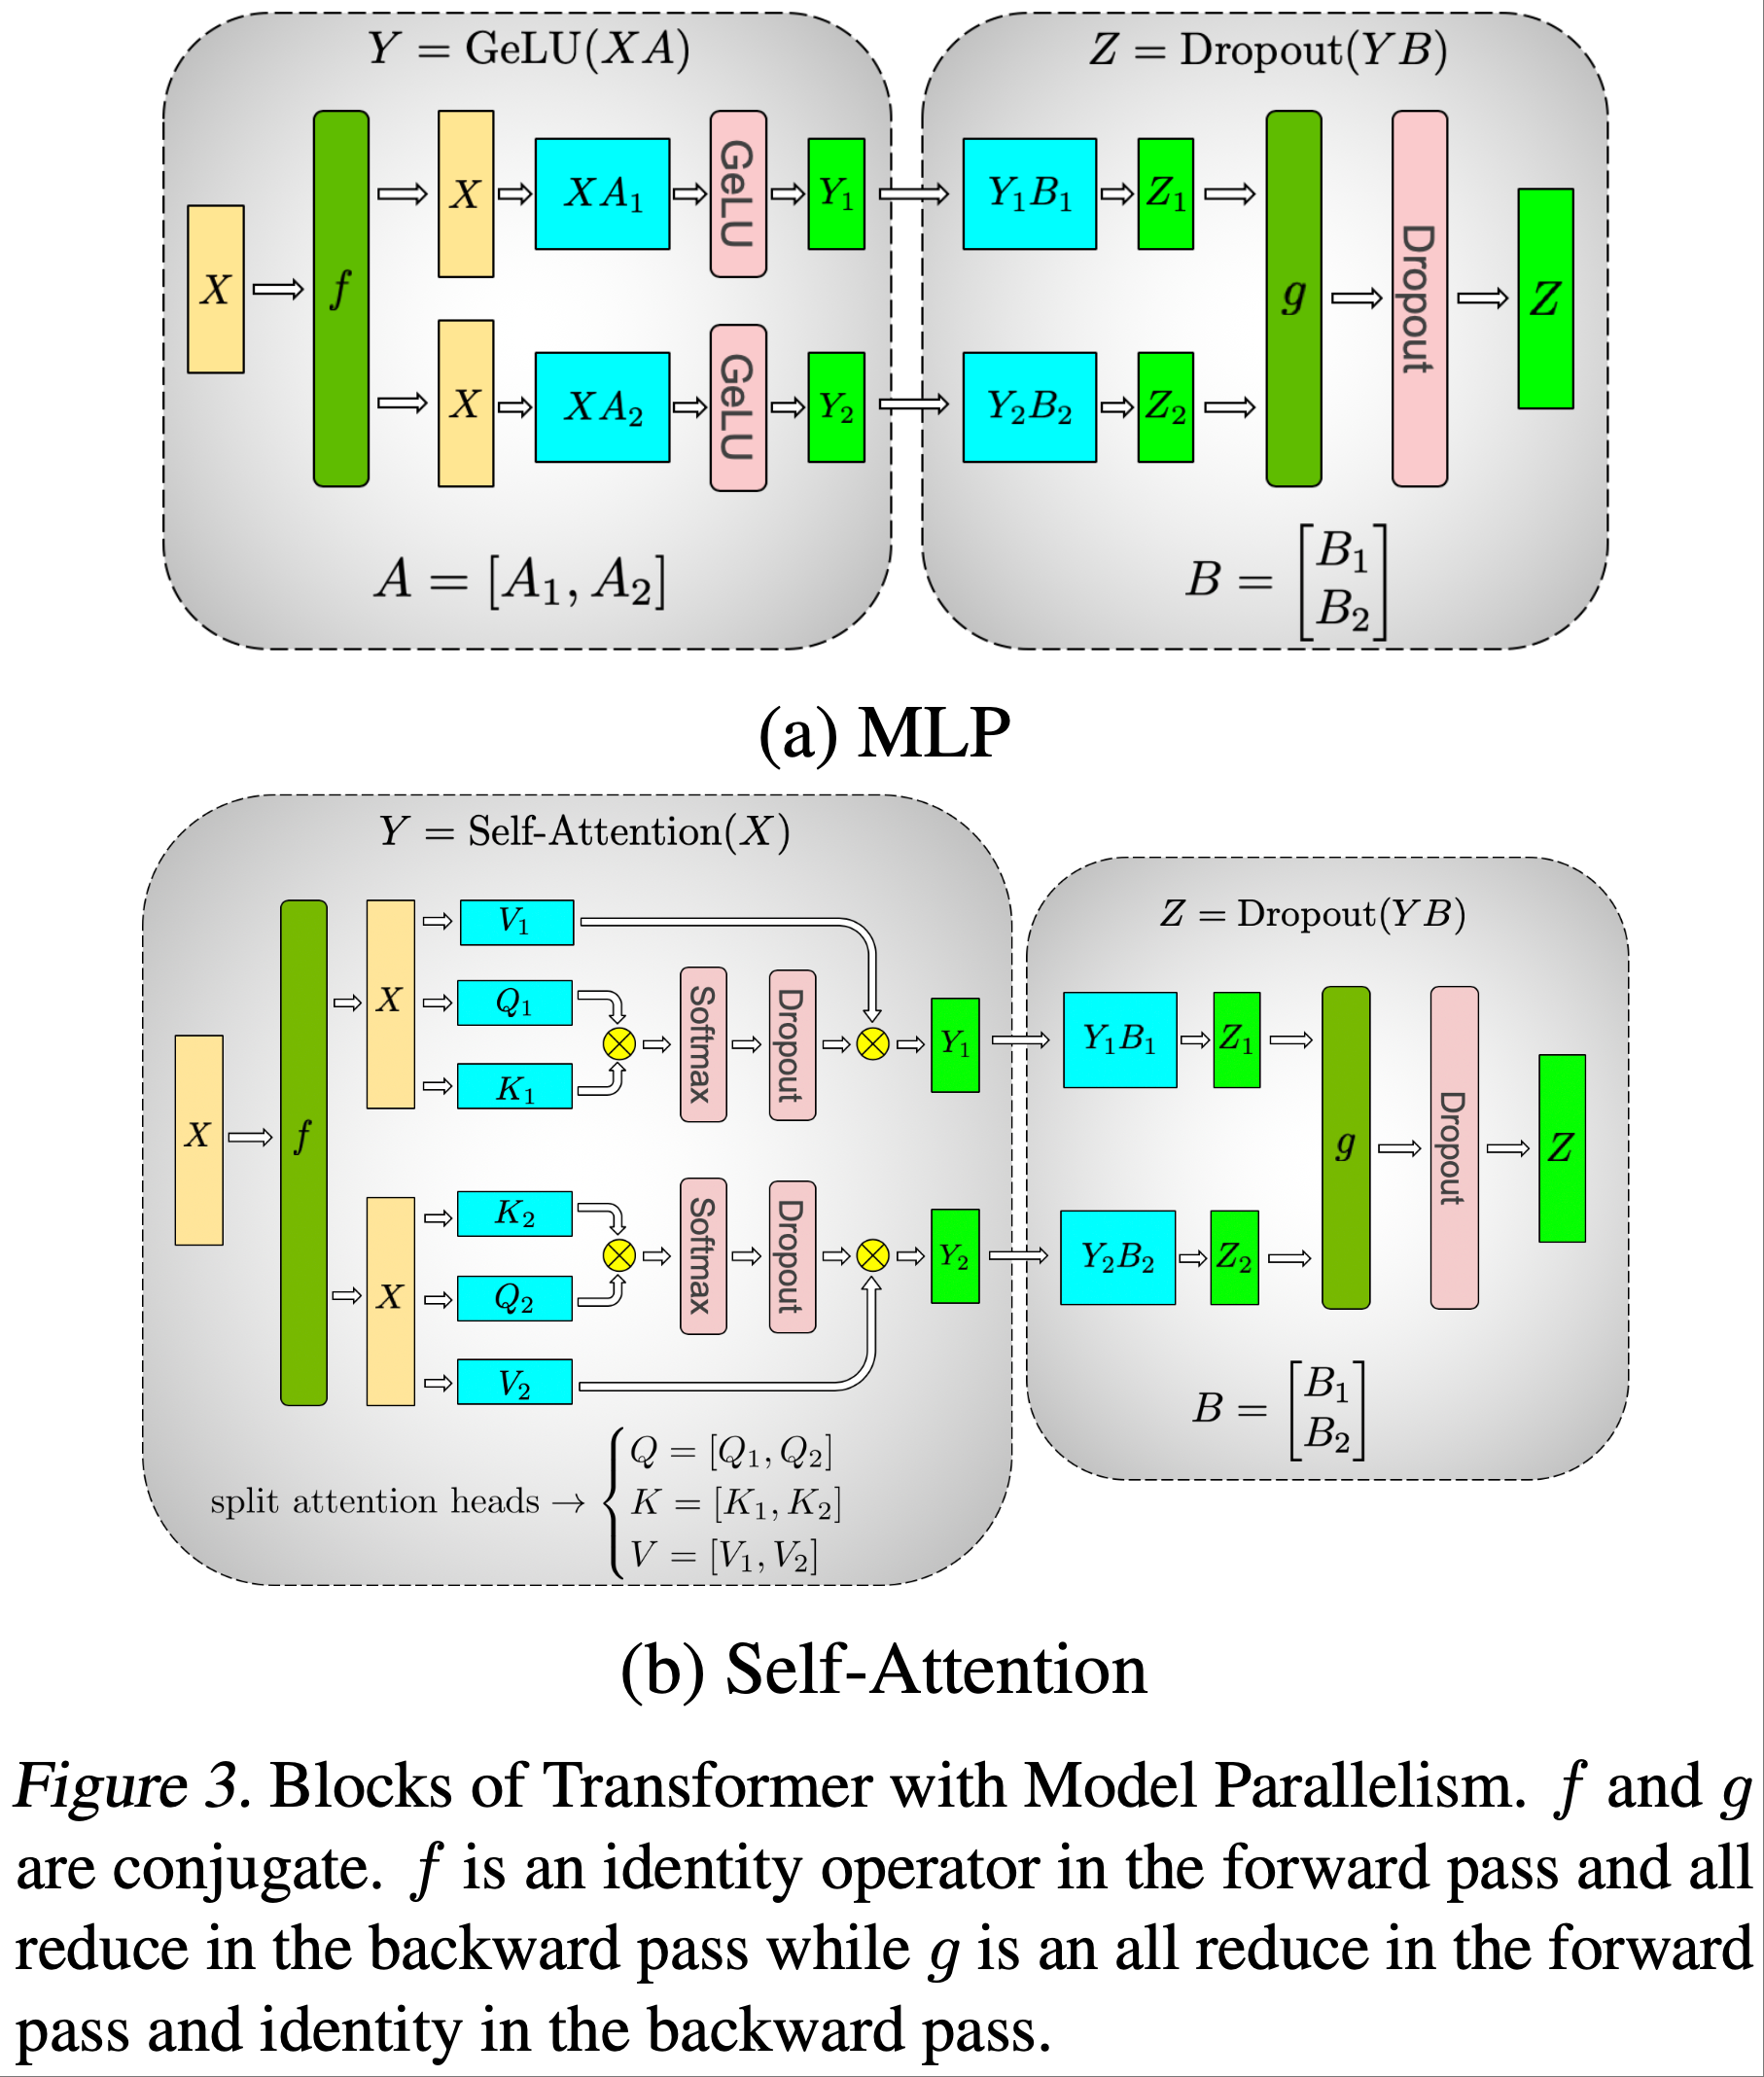
- 具体来说,其交互方式为:
- 可以按照不同方式拆分权重:按照行或列切分权重,分别需要不同的通信逻辑
- 按行切分权重时:Forward 过程需要一次 All-Reduce;Backward 过程需要一次 All-Aather
- 按列切分权重时:Forward 过程需要一次 All-Gather;Backward 过程需要一次 All-Reduce

序列并行(Sequence Parallelism, SP)
- 原始论文:Sequence Parallelism: Long Sequence Training from System Perspective, arXiv 2021, NUS
- 参考链接:
- 解决的核心问题 :纯 TP 模式下,LayerNorm、Dropout 和残差连接(Residual Add)的激活值在每张 GPU 上依然保留完整副本(Shape:
[seq, batch, hidden]),导致显存浪费 - SP 将无法被 TP 切分的算子,沿序列维度(Seq)进行切分
- 设置
sequence_parallel=True后,激活值形状变为
$$ \left[ \frac{\text{seq} }{\text{TP} }, \text{batch}, \text{hidden} \right] $$
- 设置
- 通信重构:SP 没有增加额外通信量 ,只是将原有的 AllReduce 拆解为了两步:
- 1)进入 ColumnParallelLinear 前 :执行 AllGather ,将各卡切分的序列片段拼回完整序列,以满足线性层矩阵乘法的维度要求
- 2)RowParallelLinear 输出后 :执行 ReduceScatter ,将各卡计算结果求和,并重新按序列切分,为下一层的 LayerNorm 做准备
- SP 使得 TP 组内的每张卡只保存 \( 1/\text{TP} \) 的激活值,大幅降低了 Checkpointing(重计算)时的显存压力
- 注:SP 必须在
TP > 1的前提下启用 - Megatron 的 Sequence Parallelism 设计上是结合 Tensor Parallelism 一起使用的(MLP 和 Attention 做 TP,Dropout 和 LayerNorm 做 SP),核心目标是降低单卡激活值
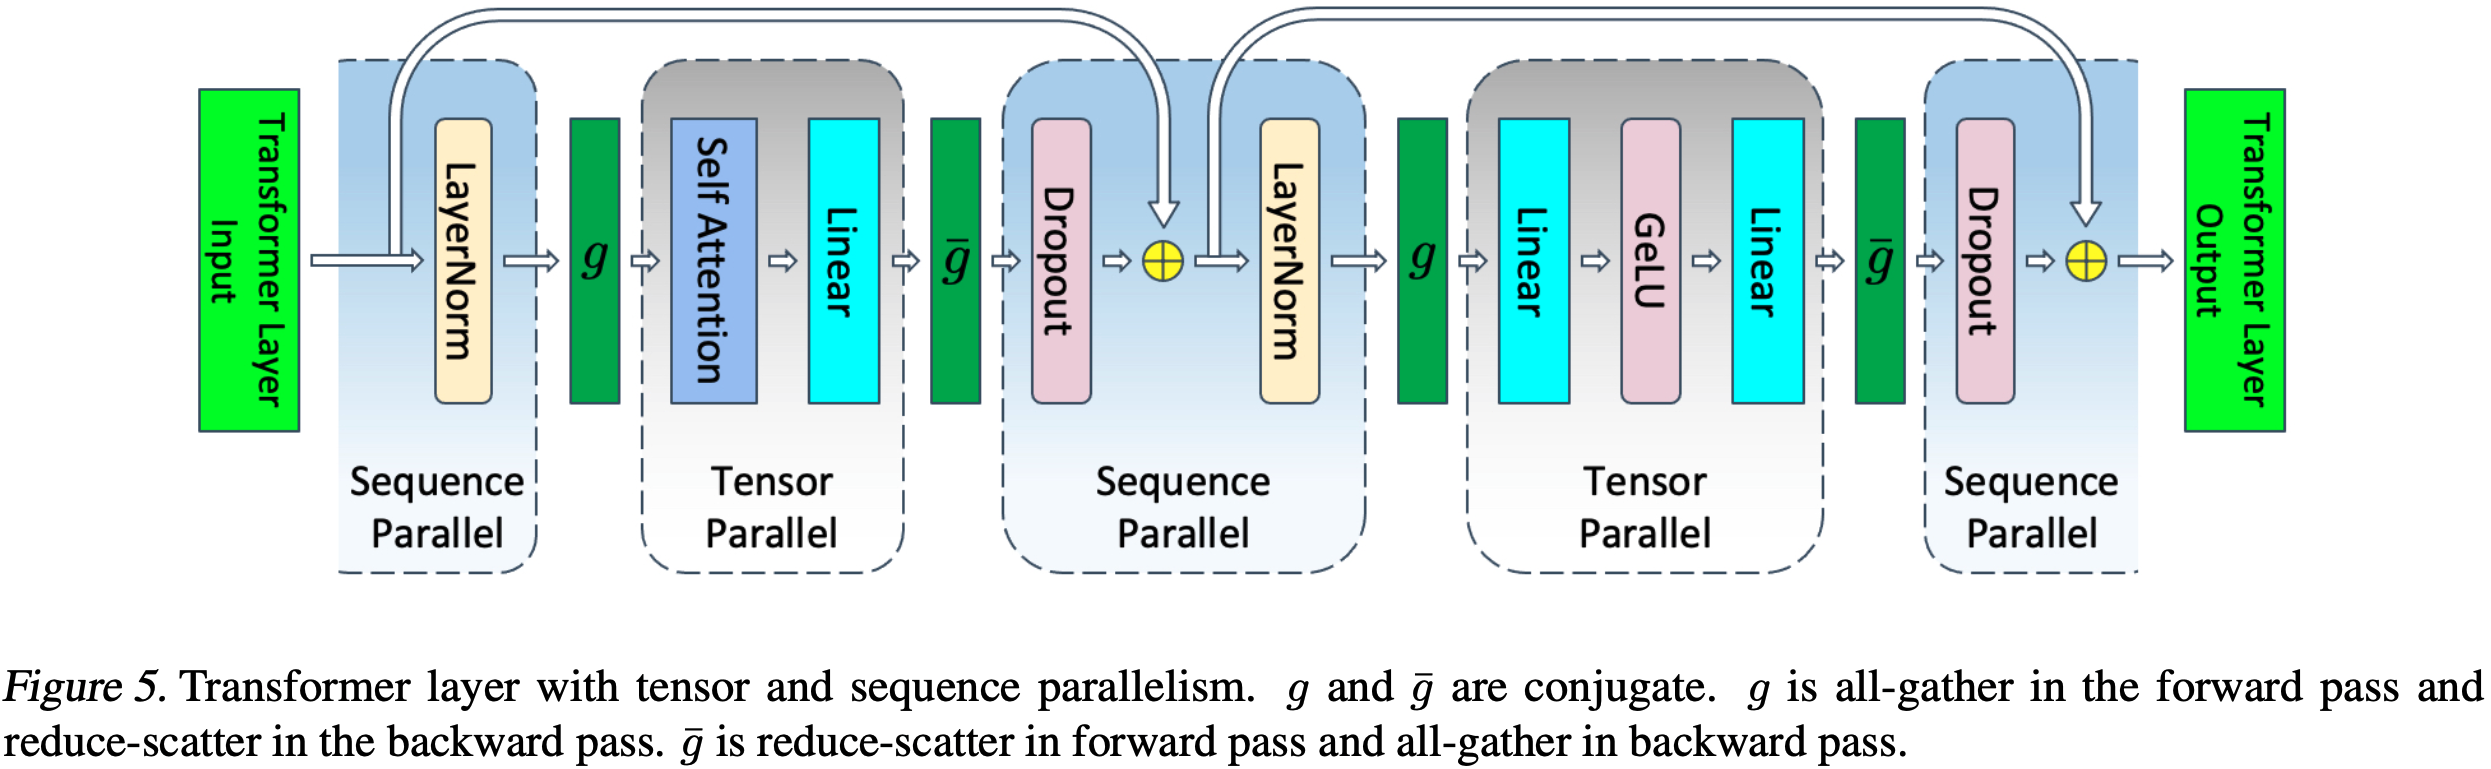
- 其他非 Megatron-LM 的 SP 方式相关技术:
- DeepSpeed-Ulysses 可以对 MLP 和 Attention 也进行 SP,让单张卡只需要维护和计算部分 Attention Head 等结果
- 补充背景:DeepSpeed Zero 1/2/3 的本质都是数据并行(形式上是模型并行),单张卡是需要过完整的 MHA 的,如果不做 Sequence Parallelism,长序列容易导致单卡显存压力过大
- Ring Attention 让每张卡只需要维护自己那部分 Sequence chunk 的 MHA
- DeepSpeed-Ulysses 可以对 MLP 和 Attention 也进行 SP,让单张卡只需要维护和计算部分 Attention Head 等结果
流水线并行(Pipeline Parallelism, PP)
- 拆解对象 :Transformer 的 Layer
- 假设模型有 \( L \) 层,PP Size 为 \( p \),则 Stage 0 承载第 \( 1 \) 至 \( L/p \) 层,Stage 1 承载下一段,依此类推
- PP 的通信原语是点对点(P2P)通信,即
torch.distributed.send和recv,仅相邻 Stage 传递激活(Forward)和梯度(Backward) - 调度策略(1F1B) :
- 为了减少流水线气泡(Bubble),Megatron 采用 1F1B(One Forward One Backward) 策略
- Warmup 阶段 :先向流水线中灌入多个 micro-batch 进行前向传播,直到流水线填满
- 稳态阶段 :每做完一个 micro-batch 的前向,立即调度该 micro-batch 的反向传播,实现前向与反向计算的交叉重叠(Overlap)
- 为了减少流水线气泡(Bubble),Megatron 采用 1F1B(One Forward One Backward) 策略
- 交错式 1F1B(Interleaved 1F1B) :
- 当
virtual_pipeline_model_parallel_size > 1时启用 - 将每个物理 Stage 进一步切分为 \( v \) 个虚拟 Stage
- 气泡比例从原本的 \( \frac{p-1}{m} \)(\( m \) 为 micro-batch 数量)急剧降低至:
$$
\text{Bubble Ratio} = \frac{p-1}{m \cdot v}
$$ - 极大提升了流水线效率,但对设备间通信带宽要求更高(需要更多的 P2P 消息传递)
- 当
数据并行(Data Parallelism, DP)
- 核心机制:每张 GPU 持有完整的模型副本(包含 TP 和 PP 切分后的完整逻辑),输入不同的 micro-batch 数据
- 梯度同步 :在反向传播结束时,跨 DP 组的梯度执行 AllReduce
- Megatron 的 DDP 优化 :
- Megatron 重写了 PyTorch 原生 DDP,实现了桶(Bucket)分级缓冲 :
- 将梯度按大小分桶,每个桶内梯度 Ready 后立即启动 AllReduce,与后续算子的 Backward 计算重叠,掩盖通信延迟
- 分布式优化器(Distributed Optimizer) :
- 当
num_distributed_optimizer_instances > 1时,Megatron 将 DP 组切分 - 这本质上是 ZeRO Stage-1/2 的实现:优化器状态(如 Adam 的一阶矩和二阶矩)被分片存储在不同 GPU 上
- 每张卡只更新自己负责的那部分参数,然后通过 AllGather 收集完整参数,极大降低了单卡显存占用
- 当
上下文并行(Context Parallelism, CP)
- CP 的应用场景:处理超长序列(如数十万 tokens)时,Self-Attention 的 \( O(N^2) \) 复杂度导致单卡无法容纳 KV Cache
- CP 的本质是将输入序列的
seq维度切分到 CP 组内的不同 GPU 上 - 四种通信策略(按复杂程度排序) :
策略模式 通信原语 工作机制 适用条件 p2pP2P Send/Recv(Ring Attention) KV 分块在 CP 组内以环形拓扑逐卡传递,计算与通信完全重叠 默认推荐 ,尤其适用于机内 NVLink 连接 all_gatherAllGather 每卡直接 AllGather 收集所有 KV 完整序列,计算简单但通信量大且无法重叠 调试或头数较少时使用 a2aAllToAll(Ulysses 风格) 将序列维度和注意力头维度互换,每卡负责部分头的全序列 Attention 注意力头数较多时效率极高 a2a+p2pAllToAll + P2P 混合 分层通信:节点内用 AllToAll,节点间用 P2P Ring 跨机分布式长序列训练 - 进程组约束 :CP 拥有独立的进程组,但在默认的 RankGenerator 中,CP 和 EP 不能同时大于 1 (源码中
ep == 1 or cp == 1约束),这是由于两者都涉及复杂的 AllToAll 路由,同时启用会导致进程组映射逻辑冲突
专家并行(Expert Parallelism, EP)
- 专家并行论文:GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, 2020, Google
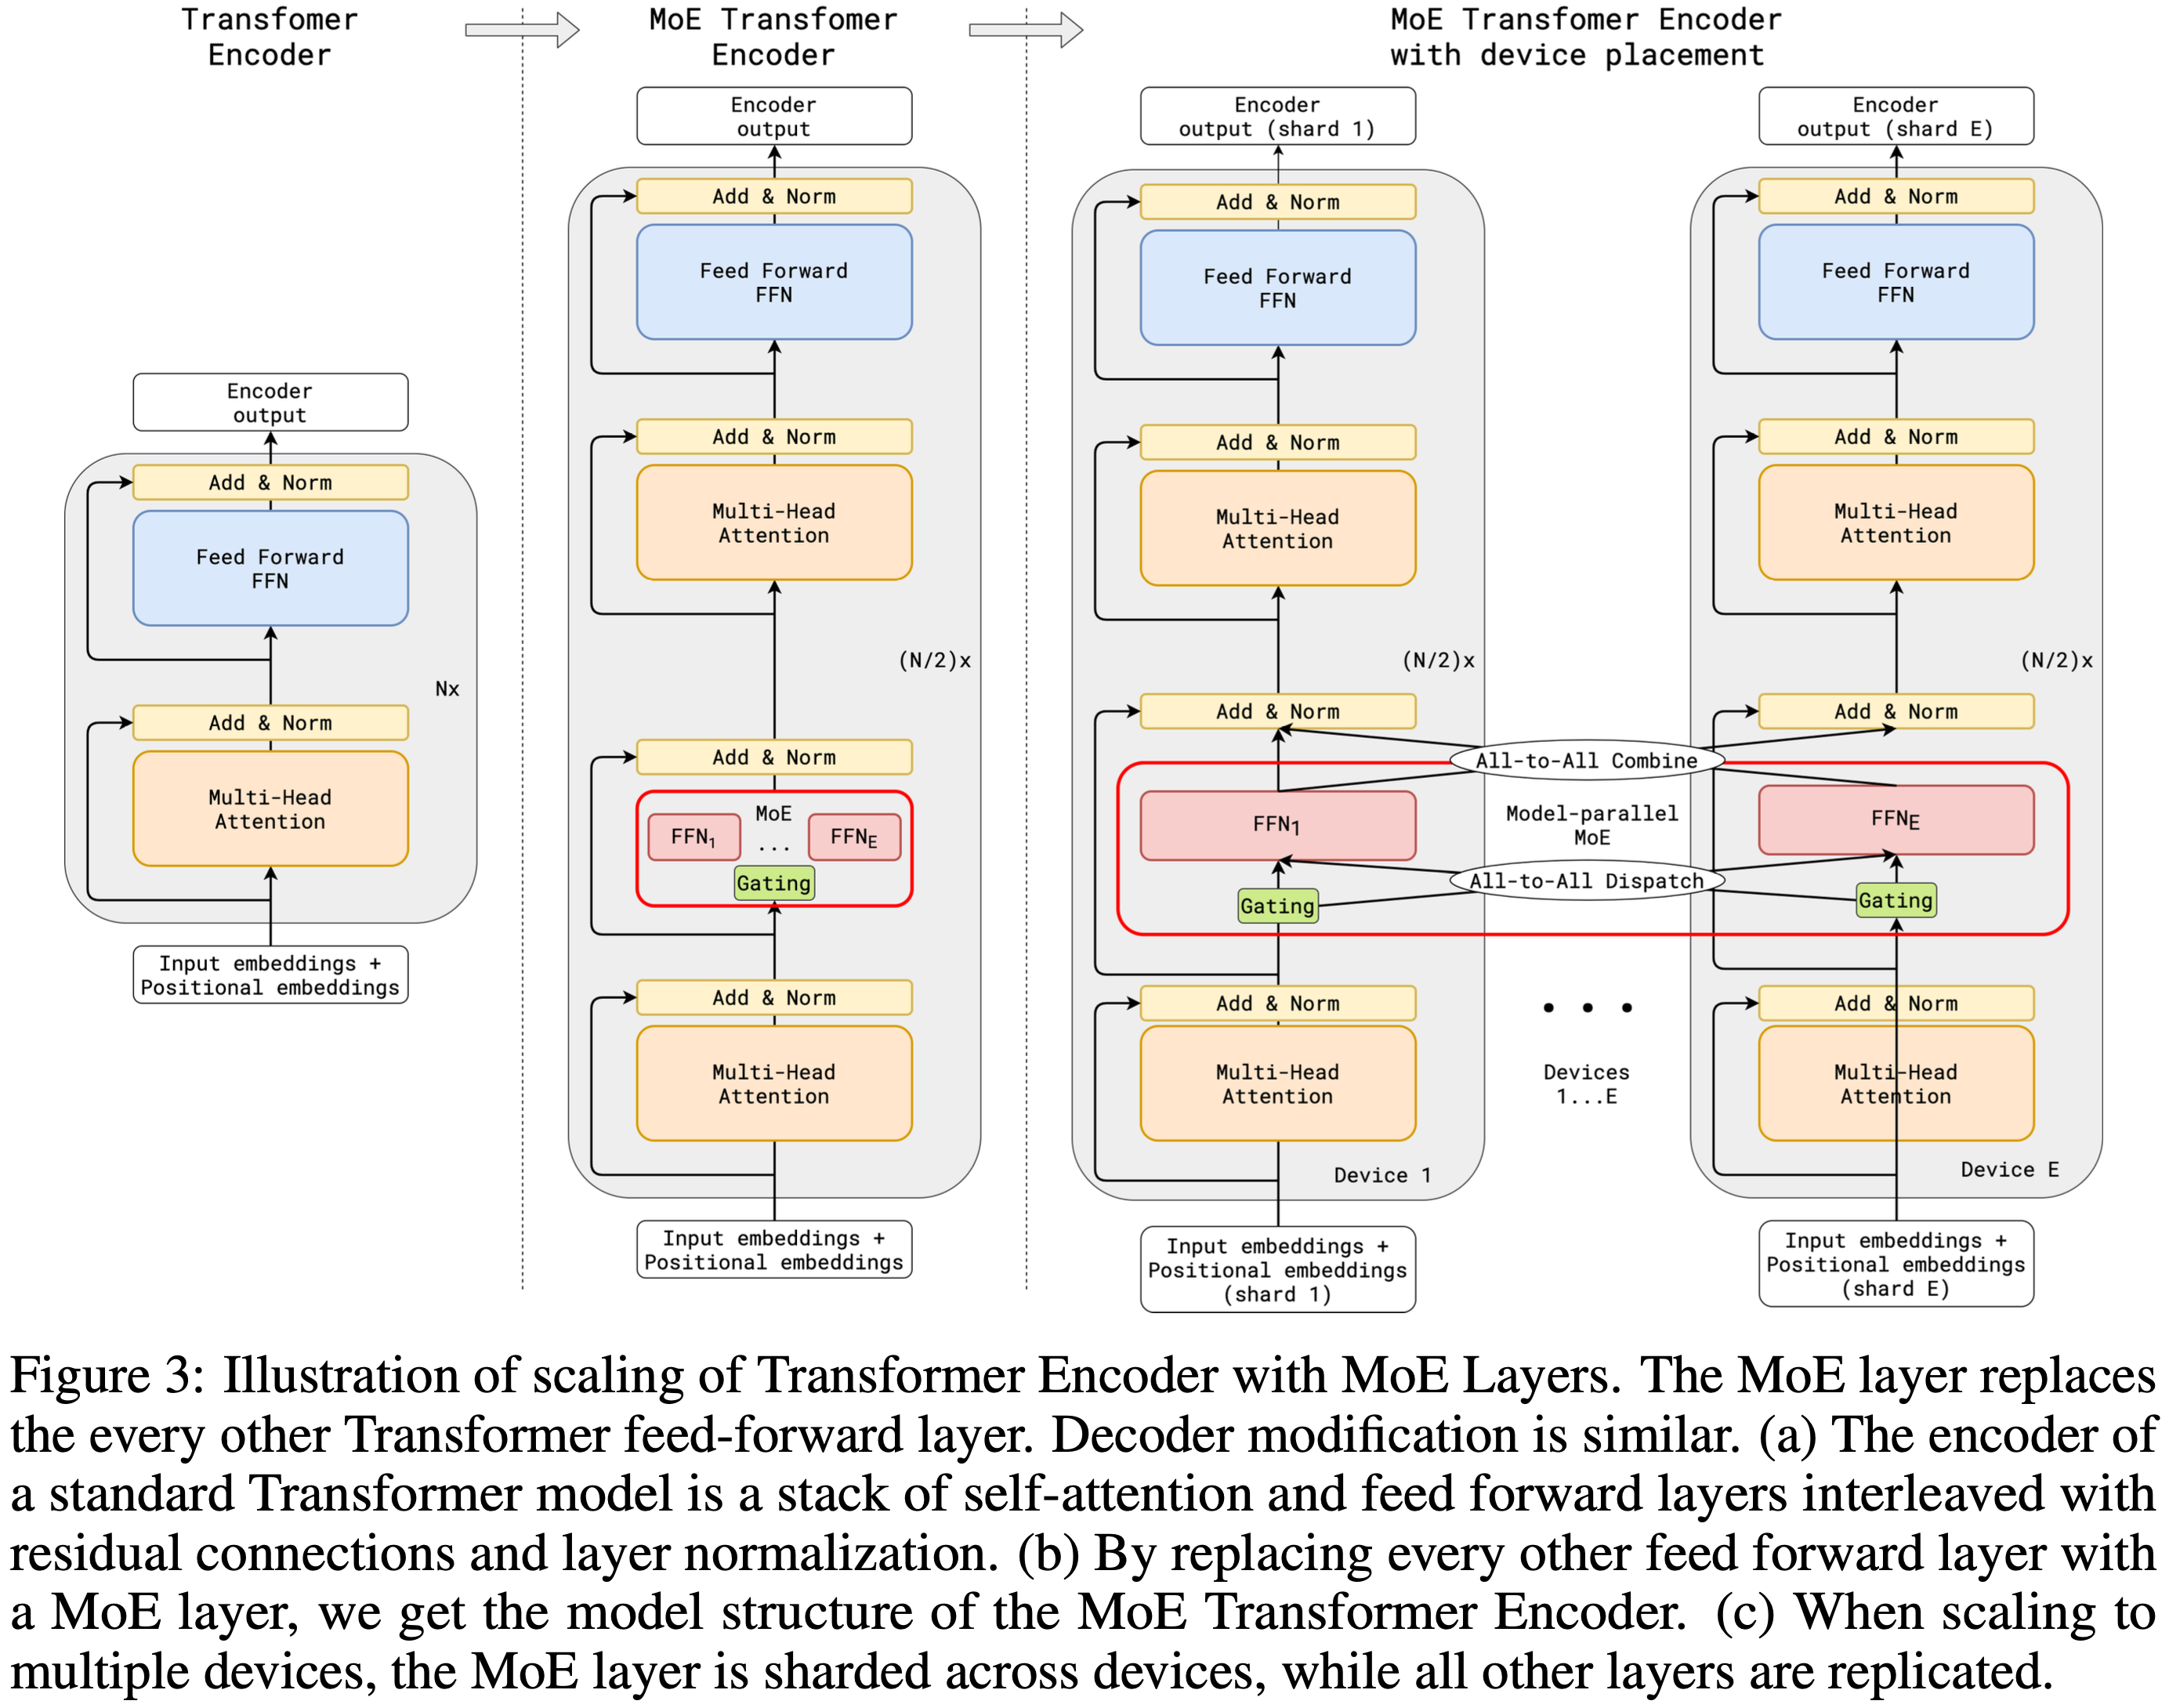
- EP 专为 MoE 设计,思路是将不同的 FFN Expert 放置在不同的 GPU 上
- 每个设备只负责维护分配给它的那一部分专家
- Token 路由与通信(AllToAll) :
- 1)Forward :每张 GPU 上的 Token 通过 Gate 计算路由分数
- 利用 AllToAll 通信,将 Token 发送到其对应的专家所在的 GPU
- 2)Expert Compute :接收端 GPU 上的专家处理这些 Token
- 3)Backward :再次通过 AllToAll 将梯度传回原始 GPU
- 1)Forward :每张 GPU 上的 Token 通过 Gate 计算路由分数
- 三种 Token 分发器(Dispatcher) :
- MoEAllGatherTokenDispatcher :先 AllGather 所有 Token 到每张卡,再本地路由(适合 EP 规模较小时)
- MoEAlltoAllTokenDispatcher :直接使用 AllToAll 分发,通信效率高(主流推荐)
- MoEFlexTokenDispatcher :动态负载均衡的混合策略
- EP 拥有独立的进程组
_EXPERT_MODEL_PARALLEL_GROUP,不依赖于 Dense 层的 TP 组,为灵活的拓扑提供基础
补充:EP 具体详细流程
- EP 的具体流程如下:专家并行 = 专家分布 + 动态路由 + All-to-All 通信 + 本地计算 + 结果还原
- 1)EP 组划分与专家分配 :
- 将不同的专家分配到不同的设备组上,每个设备组称为一个 EP 组,每个 EP 组包含多个机器和显卡
- 例如,假设 MoE 层有 E 个专家,EP=4 那么可以将 E 个专家平均分配给 4 个 EP 组,每个EP组负责一部分专家
- 2)路由决策计算 :
- 输入数据首先经过路由层(Router),计算每个 Token 的路由分数/权重,每个设备本地运行共享的门控网络(通常在所有设备上复制)
- 具体来说,通过公式
Gating_logits = Y @ W_router计算,其中Y是输入张量,W_router是路由层的权重- 如果
W_router在张量并行(TP)组内切分,需要类似 AllGather 或 ReduceScatter 的通信来完成计算或收集结果,最终得到的 Gating_logits
- 如果
- 对 Gating_logits 应用 Top-K 和 Softmax 操作,得到每个 Token 的路由决策,即它应该被发送到哪 K 个专家以及对应的权重
- 3)按照路由决策重排 :
- 对输入的每个 token,门控网络决定其应被路由到哪些专家(Top-K 选择),即包含每个 token 到目标专家索引列表
- 根据门控结果,将发往同一专家的 token 聚合到一个连续的内存块中
- 这一步称为 permutation(重排) ,便于后续高效通信和计算
- 4)All-to-All Dispatch(Token 分发) :
- 使用 All-to-All 通信原语,将 token 从原始设备发送到目标专家所在的设备
- 每个设备只接收它需要处理的 token 子集
- 通信量取决于 batch 大小、专家数量和路由稀疏性
- 5)本地路由与专家计算 :
- 每个设备仅对其本地持有的专家进行前向计算(如 FFN)
- 由于专家数量被切分,内存和计算压力显著降低
- 计算是 并行进行 的,设备间无依赖
- 每张卡对自己筛选出来的 Tokens 应用本卡负责的专家网络进行计算
- 专家网络通常是标准的FFN(如
GeLU(W1 * x) * W2),并且专家网络的权重W1、W2在 TP 组(即 EP 组)内进行张量并行切分
- 专家网络通常是标准的FFN(如
- 6)All-to-All Combine(结果收集)
- 再次使用 All-to-All 通信,将专家计算结果发送回原始设备
- 每个设备根据原始 token 的顺序,恢复输出张量的布局
- 7)输出解码与加权求和
- 将各专家的输出按门控权重加权求和,得到最终的 MoE 层输出
- 输出与残差连接相加,继续进入下一层
专家张量并行(Expert Tensor Parallelism, ETP)
- 问题:为什么 ETP 独立于 TP?
- 在 MoE 模型中,专家 FFN 的隐藏层维度通常远小于 Attention 层的隐藏层维度
- 如果强制将专家层使用与 Attention 层相同的 TP Size(例如 TP=8),会导致每个专家分片极小,产生巨大的通信开销(AllReduce 延迟增加),计算效率严重下降
- ETP 的独立运作机制 :
- ETP 拥有一套完全独立于 Dense 层 TP 的进程组,即
_EXPERT_TENSOR_PARALLEL_GROUP - 用户可设置
expert_tensor_parallel_size,其值默认等于 TP ,但可以单独调低(例如 TP=8,ETP=2)
- ETP 拥有一套完全独立于 Dense 层 TP 的进程组,即
- ETP 引入的专属维度拆分 :
- Expert 层 DP 专用化 :如前文公式所述,Expert 层不使用全局的
DP,而是使用独立的expert_DP - 组合组(ETP+EP+PP) :专家层的前向/反向必须在 ETP、EP 和 PP 的三维组合组(
_EXPERT_TENSOR_MODEL_PIPELINE_PARALLEL_GROUP)内进行通信,确保与 Dense 层的 PP 流水线对齐
- Expert 层 DP 专用化 :如前文公式所述,Expert 层不使用全局的
- 补充:一些关键源码约束 :
world_size必须能被ETP * EP * PP整除- PP 一致性约束 :虽然 ETP 和 TP 可独立,但专家层与 Attention 层的 PP 组必须是同一个(
pp > 1时共享),因为二者处于同一流水线 Stage 顺序中 - CP 不参与 Expert 路径 :在专家 RankGenerator 中,
cp固定置为 1
Megatron-LM 并行下的设备管理:RankGenerator 与进程组顺序(Order)
RankGenerator位于parallel_state.py,它将多维并行逻辑映射到物理 GPU 编号(Rank)上,映射的核心依据是order参数,默认值为"tp-cp-ep-dp-pp"- 设计哲学(通信带宽分层):
- Order 决定了 Rank 在底层硬件(如 NVSwitch、InfiniBand)上的连续性
- 默认顺序将 TP 放在最内层 ,意味着 TP 组的 GPU 编号最连续 ,优先利用机内高带宽的 NVLink
- 将 PP 放在最外层 ,意味着 PP 跨节点的概率最大 ,利用机间相对较低的带宽(如 IB/RoCE)
- 组合进程组的自动生成 :
- 除了基础的 5 个维度(TP、CP、EP、DP、PP),Megatron 还会根据 order 自动生成大量复合进程组(Sub-Grouping),例如:
TP + DP:用于 FP8 训练中的amax参数同步TP + CP:用于 Attention 计算中跨越张量与上下文维度的通信DP + CP:用于数据并行与上下文并行共享梯度同步组(_DATA_PARALLEL_GROUP_WITH_CP)
- 除了基础的 5 个维度(TP、CP、EP、DP、PP),Megatron 还会根据 order 自动生成大量复合进程组(Sub-Grouping),例如:
- 进程组拓扑与组合约束总结(几个最重要的约束推导):
- 1)SP 与 TP 的强绑定 :SP 不是独立维度,
sequence_parallel开关只影响 TP 组内部的通信原语(AllReduce 变为 ReduceScatter + AllGather) - 2)DP 与 expert_DP 可能不等价 :当
ETP != TP或EP != CP(且 CP=1)时,Dense 层的 DP 大小与 Expert 层的 expert_DP 大小会出现分歧- 源码中通过
_DATA_PARALLEL_GROUP(带 CP)和_EXPERT_DATA_PARALLEL_GROUP两个独立的组来隔离它们
- 源码中通过
- 3)VPP(交错流水线)的触发条件 :仅当
PP > 1且用户显式设置了virtual_pipeline_model_parallel_size > 1时生效- 注意,VPP 下同一张卡可能包含多个不连续的模型层段
- 1)SP 与 TP 的强绑定 :SP 不是独立维度,
附录:典型 并行配置方案(基于网上一些建议)
- 参考链接:一文搞懂 Megatron-LM 中的 7 种并行策略:TP / SP / PP / DP / CP / EP / ETP 全解析
模型规模 / 场景 并行组合策略 逻辑依据 ~1B - 7B DP Only(或 TP=2) 模型体量小,单卡可容,避免 TP 带来的通信延迟 ~7B - 20B TP=4 + DP 利用单机 4/8 卡 NVLink 全互联,减少显存碎片 ~20B - 100B TP=4 + PP=4 + DP 跨节点引入 PP,将高延迟的 AllReduce 转为 P2P >100B 长序列 TP=8 + CP=4 + DP + PP 引入 CP 专门应对 Attention 的显存爆炸问题 大规模 MoE TP=4, ETP=2, EP=8, PP=2 专家层使用较小的 ETP 降低通信量,用 EP 分散专家数量
附录:相关源码
- Megatron-LM 中实现的位置:
核心源码路径 对应功能模块 megatron/core/parallel_state.py全局 RankGenerator, get_*_group函数,进程组初始化megatron/core/model_parallel_config.py所有并行参数的配置类定义 megatron/core/tensor_parallel/layers.pyColumnParallelLinear/RowParallelLinear具体实现megatron/core/tensor_parallel/mappings.pygather_from_sequence_parallel/scatter_to_sequence_parallel通信原语megatron/core/pipeline_parallel/schedules.py1F1B 及交错 1F1B 的调度逻辑 megatron/core/transformer/moe/moe_layer.pyMoE 层主逻辑,调用 Token Dispatcher megatron/core/transformer/moe/token_dispatcher.pyAllToAll 路由分发、Token 重排(Permutation)逻辑
附录:数据并行下各种批次关系
micro_batch_size,有时简称mbz,是单个 GPU 在一次前向-反向里真正处理的样本数;gradient_accumulation_steps,有时简称GAS,是同一张 GPU 在做一次参数更新前把 micro_batch 跑几遍并累加梯度- 一般来说:
global_batch_size = DP_size * mini_batch_sizeglobal_batch_size = DP_size * micro_batch_size * grad_accum_stepsmini_batch_size = micro_batch_size * grad_accum_steps
附录:Megatron 中 DP 之间聚合梯度是平均还是累加 ?
和 DDP 中一样,Megatron 中 DP 之间的梯度聚合是分两步的:
- 先调用
all_reduce实现累加 - 然后再调用除法(除以 DP_Size)实现平均
- 先调用
简单代码阅读 github.com/NVIDIA/Megatron-LM/blob/main/megatron/training/training.py:
1
2
3
4
5
6
7
8
9
10
...
torch.distributed.all_reduce(
val,
group=mpu.get_data_parallel_group(with_context_parallel=True)
)
val /= torch.distributed.get_world_size(
group=mpu.get_data_parallel_group(with_context_parallel=True)
)
loss_reduced[key] = val
...特别说明:如果是想做 Token 粒度的平均(每个样本的可学习 Token 数不一致),需要多维护一个 Token 数量的变量并执行一次
all_reduce通信- 当然,为了实现与不做 DP 完全一致的效果,这里其实是应该对 Token 也做聚合,再做除法才行的
补充:DDP 中的 DP 间梯度聚合
- DDP 中在 DP 间累积梯度后,做了平均,具体实现参见 github.com/pytorch/pytorch/blob/main/torch/csrc/distributed/c10d/reducer.cpp
1
2
3
4
5
// 取值与 DP_size 有关(注意: 这里的 size 就是 DDP 中的 world_size,也就是 DP_size)
div_factor_ = process_group_->getSize();
...
// 做除法
bucket_view.div_(div_factor_);
附录:并行下的前向后向过程(尤其 DP 不等于 EDP 时)
- MoE 下的多种并行策略(TP、CP、PP、SP、EP、ETP)混合的训练中,
EDP(专家数据并行度)与DP(普通数据并行度)常常不相等- 问题:batch 是否还对得齐?梯度尺度是否会乱?
- 答案是:
DP != EDP完全正常,它只是同一个“数据汇总度”在 dense 侧和 expert 侧被拆成了不同的因子组合:- Dense 侧 :全部依赖梯度 all-reduce 汇总,组大小
DP×CP - Expert 侧 :部分汇总由 all-to-all + all-gather 在前向/反向中提前完成,剩下的由
EDP组 all-reduce 补足
- Dense 侧 :全部依赖梯度 all-reduce 汇总,组大小
- 只要满足
TP×CP×DP = ETP×EP×EDP,则每个参数最终看到的梯度都覆盖完整的T个 token,且尺度一致- batch 从来不会错位,只是结算路径不同
第一步:数据切分与分组
- 数据进入模型后,按
DP切样本,再按CP切序列,最后通过 SP 沿TP切分 token - 每张卡最终持有一个固定的 token 分片 ,大小为
T / N,其中N = TP × CP × DP = ETP × EP × EDP - 这个划分在整个 step 内不再改变
- 后续所有通信只是“借调算力”,数据归属从未错位
- 各通信组的成员构成示例(以
PP=2, TP=2, CP=2, DP=4, EP=4, ETP=2,world_size=32为例):- 每个 PP stage 有 16 张卡
DP×CP组大小为8(dense 梯度同步)EDP组大小为2(专家梯度同步)EP组大小为4(all-to-all 交换域)
前向过程:数据如何流经 MoE
- 1)Attention 层
- TP 组内 all-gather 拼回完整激活,做分头计算
- CP 组内 ring 式交换 KV(因为序列被切段)
- 输出 reduce-scatter 回 SP 布局
- 2)Router(dense 参数)
- 每卡对自己手上的 token 独立计算路由得分,选出目标专家
- 3)Dispatch:all-to-all(EP 组内)
- 将 token 按“归属专家”重排
- EP 组内共有
EP份 token 分片,交换后每个 rank 收到所有路由到它那批专家的 token
- EP 组内共有
- token 总量守恒,只是换了座位
- 将 token 按“归属专家”重排
- 4)ETP all-gather(若 ETP > 1)
- 专家权重被切成
ETP份,每个 ETP rank 都需要完整的 token 集合,因此在 expert-TP 组内 all-gather,token 在 ETP 维度复制ETP份 - 此时单卡覆盖的 token 数量变为
T / EDP
- 专家权重被切成
- 5)专家 FFN 计算
- 每卡用自己负责的专家权重计算汇入的 token
- 6)Combine:第二次 all-to-all
- 结果按原路送回,每卡重新集齐自己原本那
T/N个 token 的 MoE 输出
- 结果按原路送回,每卡重新集齐自己原本那
- 7)过 PP
- 将激活发送给下一个 stage,重复上述过程直到 loss
- 总结:
- 每张卡从头到尾只“拥有”固定的一批 token
- all-to-all 只是让 token 暂时去专家所在地计算,完成后立即返回
后向过程:梯度如何沿原路返回
- 后向完全沿前向的通信路径逆行:
- loss 逐 PP 回传
- Combine 反向(all-to-all)将梯度搬回专家所在卡
- 各卡用聚集来的 token 计算专家权重梯度
- ETP all-gather 反向(reduce-scatter)聚合专家权重梯度
- Dispatch 反向(all-to-all)将激活梯度搬回原主
- 继续回传过 Attention(TP + CP 通信)
梯度同步:两个不同的域
梯度同步时,dense 参数和专家参数走不同的 all-reduce 域 ,但最终覆盖的 token 总数完全一致 :
参数类型 同步域 组大小 同步前每卡已覆盖 同步后覆盖 Attention / Embedding / Router DP × CPDP × CPT / (DP×CP)T 专家权重(含 bias) EDPEDPT / EDPT 为什么
EDP可以远小于DP×CP?- 因为专家侧有
ETP × EP倍的求和 已经通过 all-to-all 和 all-gather 提前结算了 - 少掉的那几路 all-reduce 不是数据丢失,而是换了一种通信形式提前汇总
- 因为专家侧有
用公式表达汇总度的总账:
1
2
dense 侧汇总度 = TP(attention 内 all-gather)+ (DP × CP)(梯度 all-reduce) = N
expert 侧汇总度 = ETP × EP(all-gather + all-to-all)+ EDP(梯度 all-reduce) = N- 两式都等于
N = TP×CP×DP = ETP×EP×EDP,乘积相等,batch 自然对齐
- 两式都等于
尺度补偿
由于 dense 和 expert 的 all-reduce 组大小不同,直接 average 会导致梯度尺度差异
Megatron 对专家梯度预乘
EDP / (DP×CP),再在 EDP 组内做 average:1
2dense 梯度: 1.0 × 1/(DP×CP) = 1/(DP×CP)
expert 梯度: (EDP/(DP×CP)) × 1/EDP = 1/(DP×CP) ← 完全一致补偿因子仅与
EDP和DP×CP有关 ,与TP/ETP无关,因此无论ETP如何设置,梯度尺度都自动对齐
补充:一个简单示例(无 TP/CP/PP,仅 DP 与 EP)
- 设
TP=CP=PP=ETP=1,world_size=8,EP=4,则DP=8,EDP=2- 8 张卡各持 1 条样本(1000 token)
- MoE 层:EP 组
{0,1,2,3}内 all-to-all,每个 rank 汇集 4000 token(本组全部 token)中路由到自己专家的部分 - 专家 FFN 计算后,再 all-to-all 返回原主
- 梯度同步:
- dense 参数在 8 卡 all-reduce(覆盖 8000 token)
- 专家权重在
EDP=2组 all-reduce,但每卡梯度已含 4000 token,两块副本合起来正好 8000
- 尺度补偿:
EDP/DP = 2/8 = 1/4,预乘后 average 结果与 dense 相同
VeRL 中 Megatron 的并行情况
- 在 VeRL 中,check 配置时有这么一段代码 verl/utils/config.py:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15if config.actor_rollout_ref.actor.strategy == "megatron":
model_parallel_size = (
config.actor_rollout_ref.actor.megatron.tensor_model_parallel_size
* config.actor_rollout_ref.actor.megatron.pipeline_model_parallel_size
)
assert (
n_gpus % (model_parallel_size * config.actor_rollout_ref.actor.megatron.context_parallel_size) == 0
), (
f"n_gpus ({n_gpus}) must be divisible by model_parallel_size ({model_parallel_size}) times "
f"context_parallel_size ({config.actor_rollout_ref.actor.megatron.context_parallel_size})"
)
megatron_dp = n_gpus // (
model_parallel_size * config.actor_rollout_ref.actor.megatron.context_parallel_size
)
minimal_bsz = megatron_dp * config.actor_rollout_ref.actor.ppo_micro_batch_size_per_gpu
TP * PP * CP 是最小单位(除数)
- 在 Megatron 的并行策略中,**
TP * PP * CP共同定义了一个“逻辑模型副本”所占用的 GPU 数量**- 代码中用
n_gpus除以这个乘积,得到的是 Megatron 数据并行度(Megatron DP)
- 代码中用
- 之所以它是“最小不可分割单位”,是因为这三个维度都涉及模型权重或输入数据的物理切分 ,需要占用独立的 GPU 显存和通信组:
- TP(张量并行) :将单层 的权重(如 Attention 的 QKV 矩阵)按列或行切分到不同 GPU
- 这组 GPU 必须同时存在,否则单层无法完成前向计算
- PP(流水线并行) :将模型按层 切分到不同 GPU
- 前一层和后一层的 GPU 必须同时存在,否则流水线断连
- CP(上下文并行) :将输入序列长度 切分到不同 GPU(常见于 Ring Attention 或 Ulysses 风格)
- 处理同一个 Batch 中同一条长序列的 CP 组必须同时存在,否则注意力计算不完整
- TP(张量并行) :将单层 的权重(如 Attention 的 QKV 矩阵)按列或行切分到不同 GPU
- 结论 :这三者的乘积构成了能独立跑通一次完整前向和反向传播的 “最小 GPU 集群”
- GPU 总数必须是它的整数倍,多余的 GPU 才能作为数据并行(DP)副本,用于同时处理不同的微批次(Micro-batch)
minimal_bsz就是基于 DP 副本数乘以单卡微批次大小计算出来的
特殊:VeRL 中的 sp_size 参数
在 VeRL 中,SP 不是开关
- 在 verl 里 SP 指的是 Ulysses Sequence Parallelism(序列并行),它有一个明确的”并行度”概念
sp_size,而不是 0/1 开关 sp_size = 1才表示”不启用序列并行”(等价于关闭)- sp_size > 1
时表示把一个序列沿着 sequence 维度切分到sp_size` 张卡上
- 在 verl 里 SP 指的是 Ulysses Sequence Parallelism(序列并行),它有一个明确的”并行度”概念
sp_size来自配置项ulysses_sequence_parallel_size,默认为 1:1
sp_size = getattr(self, "ulysses_sequence_parallel_size", 1)
sp_size的使用:1
2sp_size = tu.get_non_tensor_data(data=data, key="sp_size", default=1)
max_token_len = max_token_len_per_gpu * sp_sizemax_token_len_per_gpu是单卡显存能容纳的有效 token 数- Ulysses SP 的做法是:把一条长度为 L 的序列沿 sequence 维度切到
sp_size张卡上,每张卡只处理 L / sp_size 长度的子序列 sp_size张卡协同处理同一条完整序列
- Ulysses SP 的做法是:把一条长度为 L 的序列沿 sequence 维度切到
- 所以从”一条序列的视角”看:
- 单卡显存只能容纳
max_token_len_per_gpu个 token - 但因为有
sp_size张卡协同处理这条序列,整条序列的总 token 数最多可以到max_token_len_per_gpu * sp_size - 这正好就是切分 micro-batch 时可以使用的”每条序列 token 上限”
- 单卡显存只能容纳